
softify.pro
A carregar …
Serviços Sobre nós COCO – o nosso servidor de IA Portefólio Insiders Case Studies Vale a pena saber Contacto Login

NEXT-GEN SOFTWARE AESTHETIC

Pure fluidity meets ultimate performance.

A nova identidade visual para fluxos de trabalho digitais modernos.

softify.pro — A nova identidade visual para fluxos de trabalho digitais modernos.

Deslize para descobrir ↓

Software construído como as empresas modernas realmente trabalham

A softify.pro é um estúdio de software baseado numa ideia: a tecnologia deve mover-se tão fluidamente como as empresas que apoia. Trabalhamos na interseção entre o desenvolvimento web moderno, a automação de processos, e a inteligência artificial aplicada — três disciplinas raramente encontradas sob o mesmo teto, mas cada vez mais interligadas. Os nossos clientes vão desde a pequena empresa que introduz o seu primeiro processo de faturação digital, até à empresa de produção de média dimensão já estabelecida que substitui folhas de Excel por software de logística verdadeiro. O que os une não é a dimensão, mas a exigência: querem sistemas rápidos, fiáveis, e agradáveis de usar — não apenas funcionais. Cada projeto começa connosco com as mesmas três perguntas: O que é que esta empresa realmente precisa de acelerar? O que já funciona bem e deve ser respeitado em vez de substituído? E que parte do fluxo de trabalho pode, uma vez bem construída, passar a executar-se sozinha no futuro? As respostas determinam tudo o resto — desde a tecnologia escolhida até ao plano de implementação.

Serviços

A nova identidade visual para fluxos de trabalho digitais modernos.

01 — LOGISTICS

Automatização da logística — para pequenas e médias empresas na região DACH

Uma grande parte do nosso trabalho é dedicada a software de logística e operações para pequenas e médias empresas na Alemanha, Áustria, e Suíça. Estas empresas encontram-se frequentemente entre duas opções pouco atrativas: pacotes de logística enterprise caros, concebidos para grupos empresariais dez vezes maiores, ou uma mistura de folhas de Excel, formulários em papel, e chamadas telefónicas, que limita silenciosamente a rapidez com que podem crescer.

Construímos o caminho intermédio — automação à medida que se adapta à forma real de trabalhar de um determinado armazém, oficina, ou equipa de vendas. Isto pode significar: digitalizar a receção de mercadorias e os movimentos de armazém, gerar automaticamente guias de remessa e etiquetas de envio, ligar a receção de encomendas ao planeamento de rotas, ou simplesmente substituir um ficheiro Excel frágil, que só uma pessoa entende, por um sistema em que toda a equipa pode confiar. Como trabalhamos diretamente com proprietários e gestores de operações na região DACH, os requisitos são recolhidos no idioma em que a empresa realmente opera, e a implementação é planeada em torno de escalas de turnos reais e áreas de armazém reais — não em torno de um plano de projeto abstrato.

02 — WEB

Desenvolvimento web moderno com tecnologia atual

Concebemos e desenvolvemos aplicações web e websites com tecnologia atual e ativamente mantida — não com frameworks desatualizadas, mantidas vivas apenas por hábito. Isso significa PHP 8.4 limpo no backend, onde uma aplicação clássica renderizada no servidor é a escolha certa, JavaScript moderno onde a interatividade importa, e MySQL 8 para dados que precisam de permanecer consistentes e pesquisáveis ao longo dos anos — não apenas nos primeiros seis meses após o lançamento. Cada projeto é planeado desde o primeiro esboço igualmente para desktop e dispositivos móveis, não adaptado posteriormente: os tempos de carregamento, os pontos de quebra de layout, e a interação tátil fazem parte da especificação, não um acréscimo posterior.

Para além da interface visível, importa-nos como um website é por dentro: código legível, um esquema de base de dados que não precisa de ser reconstruído a cada novo pedido de funcionalidade, e passos de implementação que um segundo programador também consegue seguir sem perguntas. Um website que é hoje performante e que daqui a três anos ainda pode ser expandido de forma limpa é, para nós, a verdadeira definição de "moderno".

03 — AI / COCO

COCO — o nosso próprio servidor de IA para testes automatizados de software

Para clientes enterprise, operamos e mantemos o nosso próprio servidor de IA dedicado chamado COCO. Ao contrário de um chatbot genérico, incorporado posteriormente a um fluxo de trabalho, a COCO foi concebida de forma direcionada e alojada autonomamente para o teste automatizado de aplicações web, bem como aplicações de secretária multiplataforma — desde processos de login e autenticação até processos de negócio completos e multietapas.

A COCO planeia um cenário de teste, executa-o contra a aplicação real, captura capturas de ecrã antes e depois como evidência, e cria uma avaliação compreensível do que funcionou, o que falhou, e porquê — incluindo casos extremos como logins falhados repetidos, bloqueios de conta, e processos de recuperação, que são trabalhosos e propensos a erros quando testados manualmente. Como o servidor funciona localmente e sob a nossa gestão, os clientes enterprise mantêm controlo total sobre onde os dados de teste e as capturas de ecrã são armazenados, sem enviar por defeito o tráfego interno da aplicação para um serviço de cloud de terceiros não relacionado.

Configuramos a COCO individualmente para cada cliente enterprise, configuramos e mantemos o servidor — definimos os planos de teste relevantes para a aplicação em questão, ajustamos os limiares de confiança, e decidimos caso a caso quando um resultado deve ser escalado para revisão humana. O objetivo não é substituir uma equipa de QA, mas dar-lhe uma colega incansável que percorre os testes de regressão repetitivos antes de cada lançamento, antes de um humano sequer precisar de intervir.

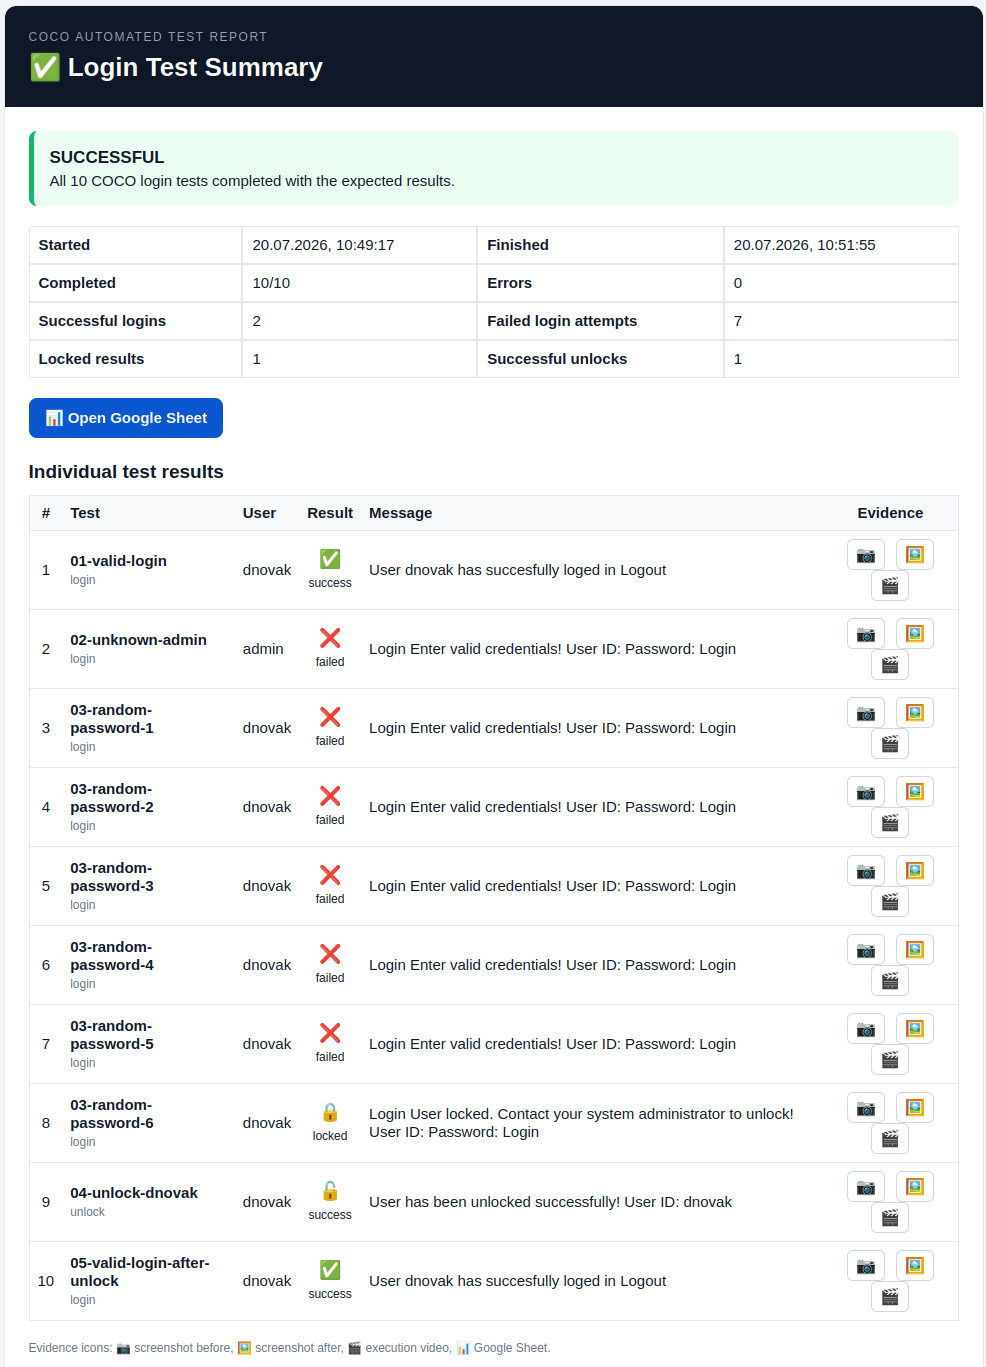
COCO automated login test report
COCO — automated login & account-lockout test report
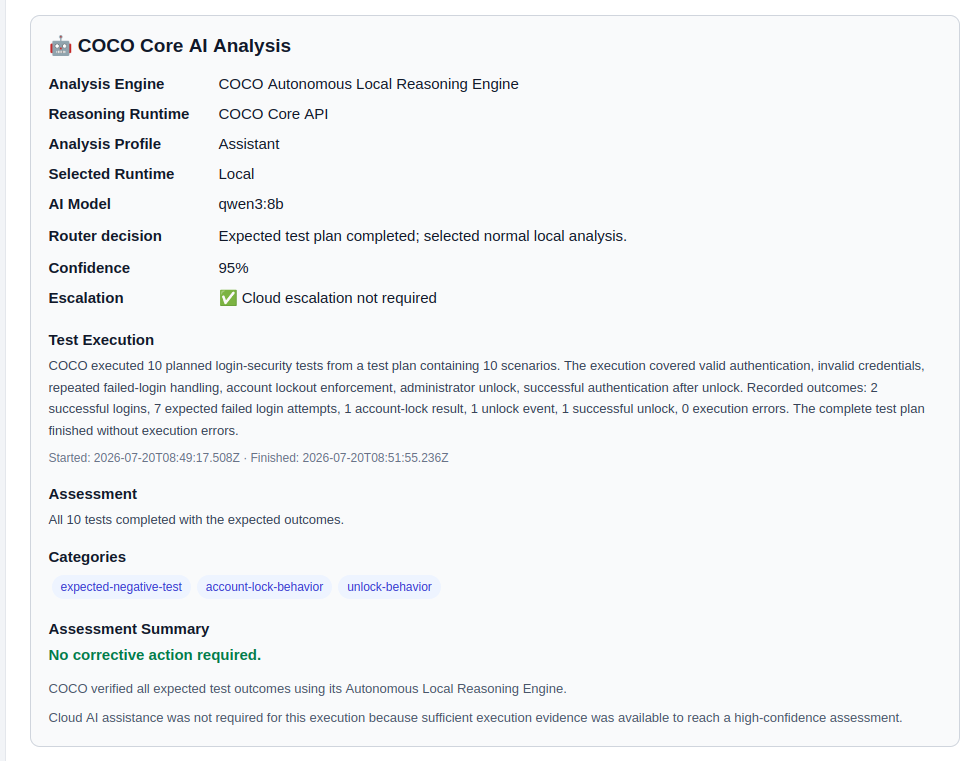
COCO AI analysis panel
COCO — plain-language AI analysis of a completed test run

Porquê a softify.pro

Mantemo-nos deliberadamente pequenos, para que cada projeto seja conduzido por pessoas que já estiveram presentes na primeira reunião de planeamento — em vez de ser transferido para uma fila de espera. Isto significa ciclos de feedback mais curtos, menos mal-entendidos, e uma equipa que, mesmo seis meses depois, ainda se lembra porque é que uma determinada decisão foi tomada. Preferimos uma fiabilidade discreta e comprovável a tendências passageiras: escolhemos uma stack tecnológica porque se adequa ao problema e pode ser mantida por outra pessoa daqui a cinco anos — não porque estava na moda no sprint atual. Se uma folha de Excel realmente cumprir melhor a tarefa do que software personalizado, diremos isso com honestidade. O nosso objetivo é um fluxo de trabalho que funcione verdadeiramente mais rápido — não simplesmente uma fatura de software mais elevada.

Trabalhos selecionados

Uma pequena seleção de trabalhos que podemos mostrar publicamente — apresentamos mais casos de estudo e projetos enterprise a pedido, sob NDA.

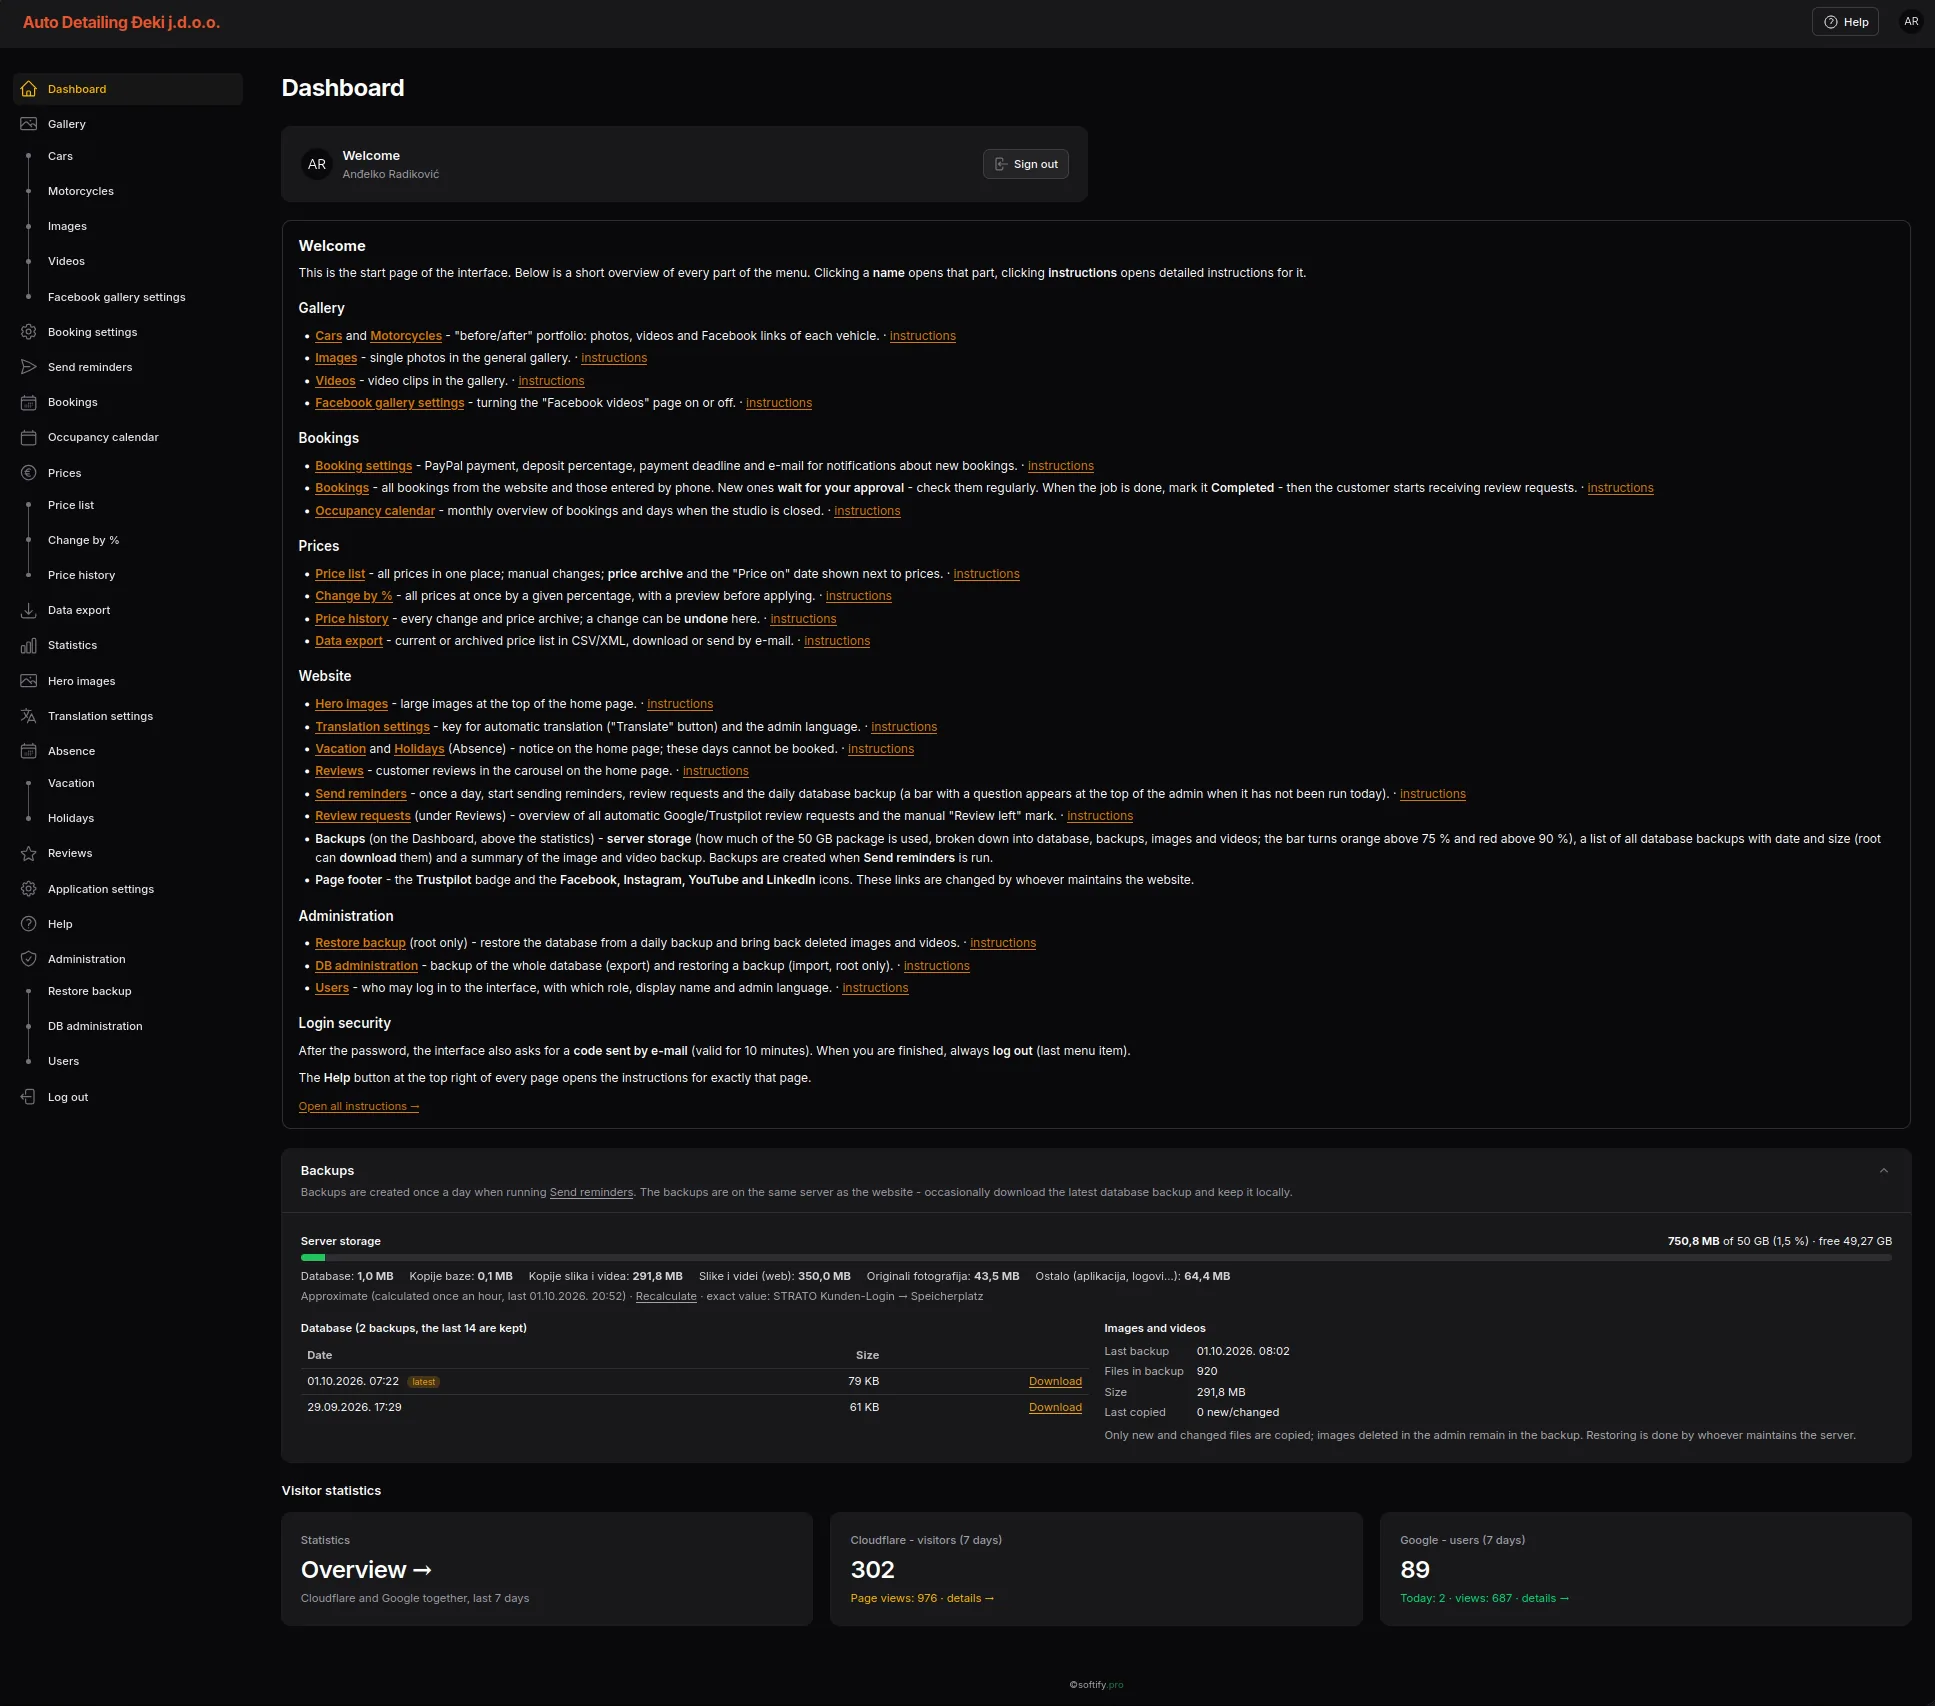
Auto Detailing Đeki – Do site a uma plataforma de serviços digital autodetailing-deki.pro

Auto Detailing Đeki – Do site a uma plataforma de serviços digital

Plataforma multilingue para detailing automóvel – desde o cálculo do preço, passando pela reserva, até ao acompanhamento transparente das encomendas, gerida a partir de um back office central.

Koralpenhaus

Koralpenhaus

Website regional de apresentação e reservas na região alpina, construído com foco numa estrutura clara, carregamento rápido, e manutenção fácil de conteúdo.

Dexosano

Dexosano

Uma plataforma web moderna baseada em PHP, desenvolvida com a mesma abordagem que prioriza o desempenho que a softify.pro aplica em cada projeto de cliente.

softify.pro - Insiders

Um armazém. Uma verdade.

Um armazém. Uma verdade.

Há uma forma simples de fazer um software de armazém parecer convincente.
Abrir um painel.
Mostrar alguns números a verde.
Adicionar um gráfico.
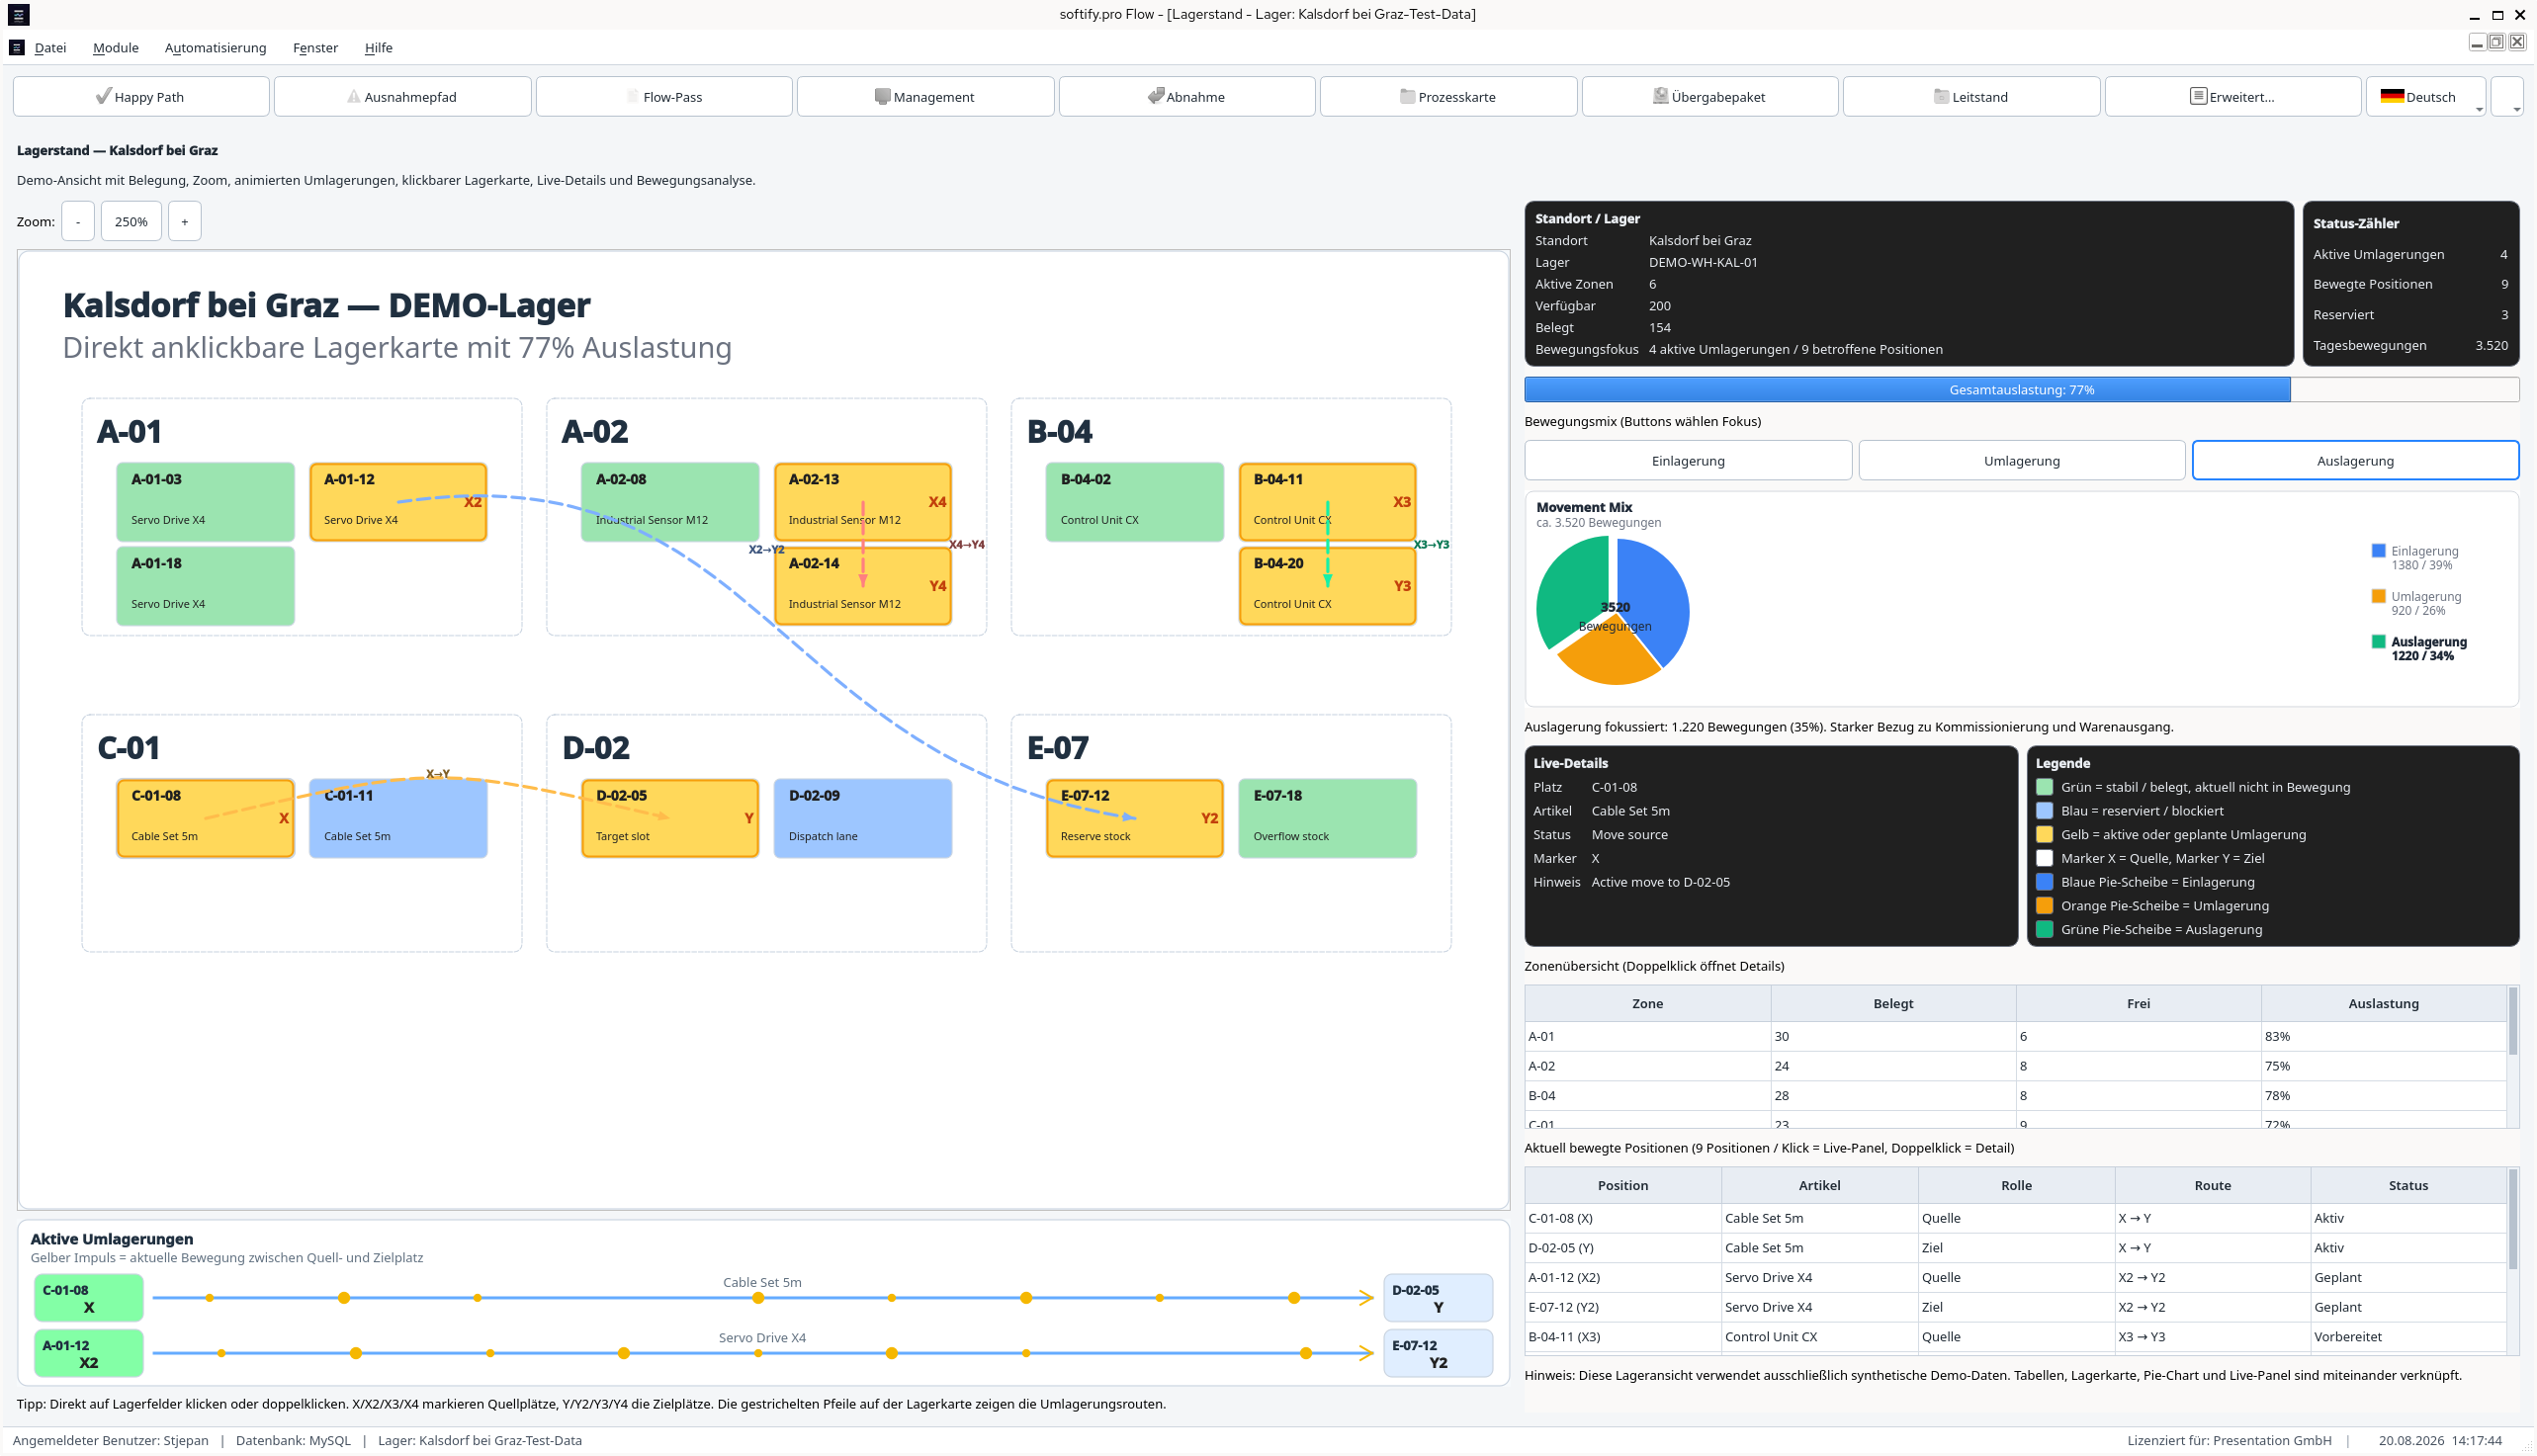
Colocar algum stock num mapa do armazém.
Terminar com um relatório.
Tudo parece estar bem.
E, ainda assim, tudo pode estar errado.
Porque a um armazém não interessa quão bonito o painel parece.
Interessa-lhe se cada parte do sistema concorda sobre o que realmente aconteceu.
Isso tornou-se a parte interessante da mais recente experiência softify.pro Flow.
Não outro ecrã.
Não outro KPI.
Não outro relatório.
Algo muito menos visível.
Consistência.
Começou com um armazém.
A demo atual do softify.pro Flow funciona com vários ambientes de armazém sintéticos.
Diferentes IDs de armazém.
Diferentes capacidades.
Diferentes estruturas de zona.
Sem inventário de produção.
Sem dados de clientes.
Sem informação operacional real.
Mas a lógica do processo comporta-se como se tudo isso importasse.
Porque na logística real, importa.
Assim que um armazém é selecionado, esse contexto torna-se parte de tudo o que se segue.
Flows.
SSCCs.
Movimentos.
Operadores.
Analytics.
Relatórios.
Isso soa óbvio.
Torna-se consideravelmente menos óbvio quando o mesmo processo começa a aparecer em várias partes diferentes da aplicação.
Depois abrimos outra vista.
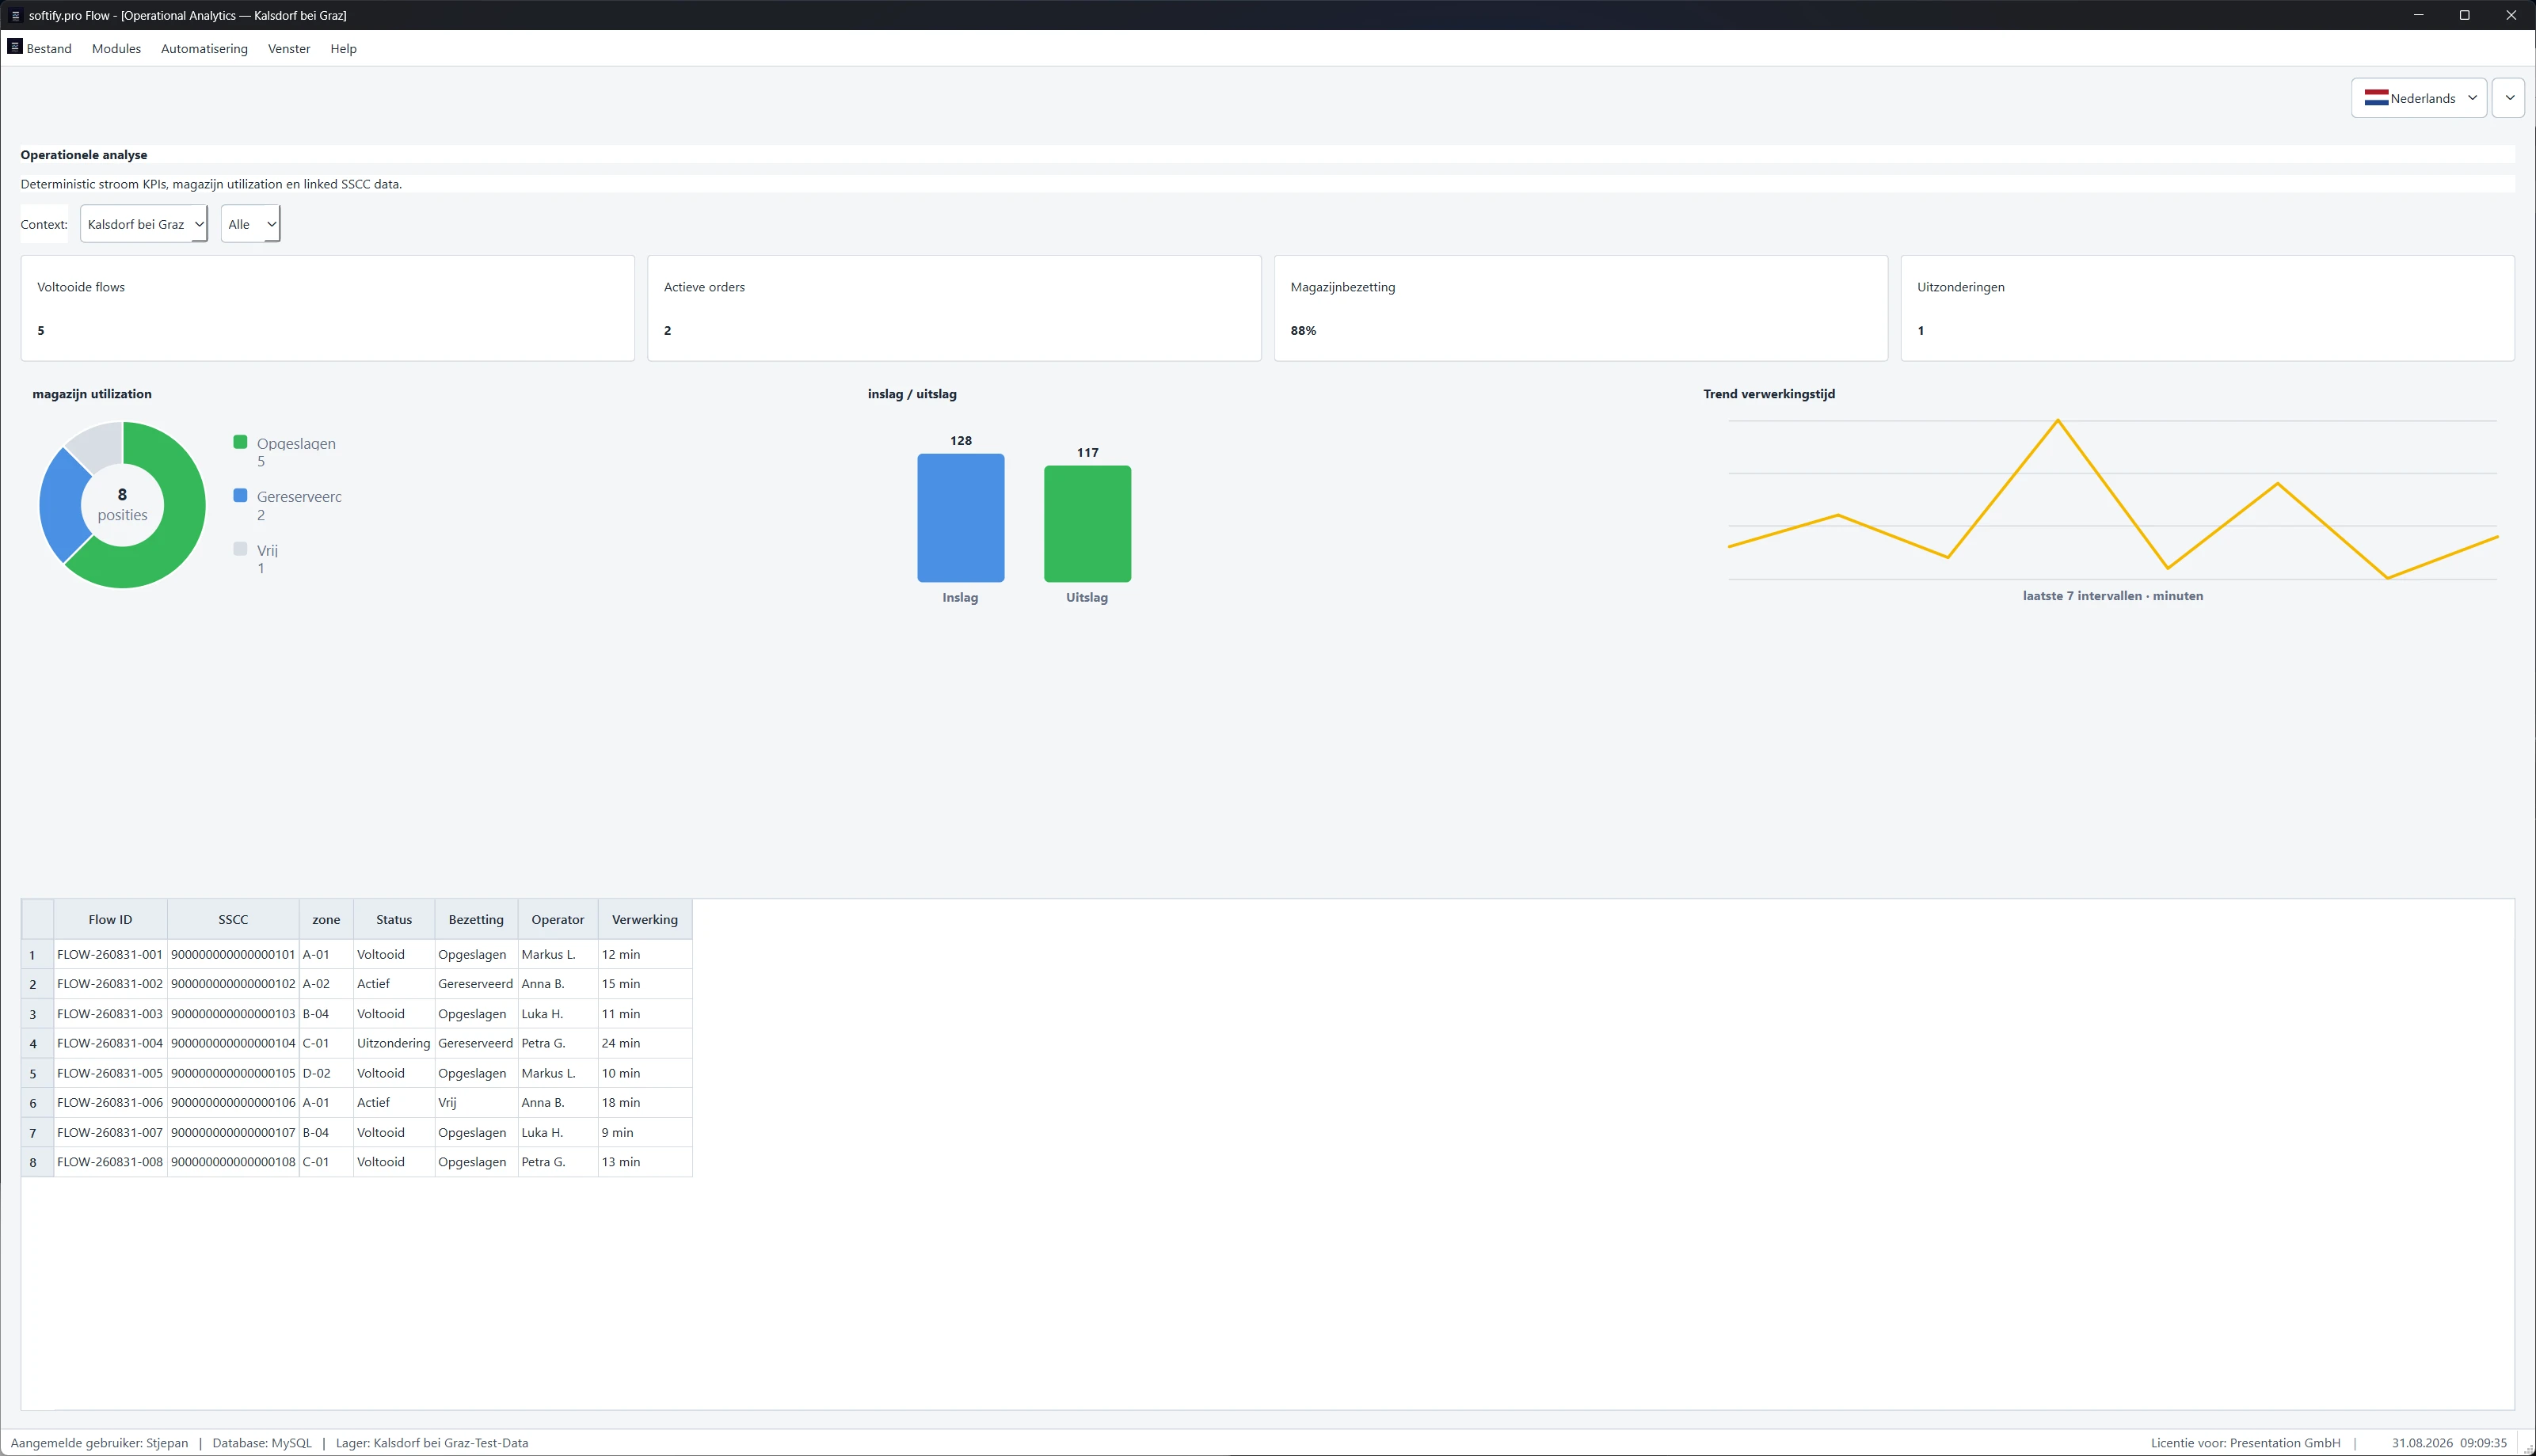
Operational Analytics.
De repente, o armazém parecia completamente diferente.
Sem posições de armazenamento.
Sem setas de movimento.
Em vez disso:

  • Flows concluídos,
  • encomendas ativas,
  • utilização do armazém,
  • exceções,
  • entradas,
  • saídas,
  • tempo de processamento.

A representação visual tinha mudado.
O armazém não.
Essa distinção tornou-se importante.
Porque por baixo dos KPIs continuavam a existir registos individuais.
IDs de Flow.
SSCCs.
Zonas.
Estados.
Operadores.
Tempos de processamento.
Vista diferente.
Mesma realidade operacional.
Até aqui, tudo bem.

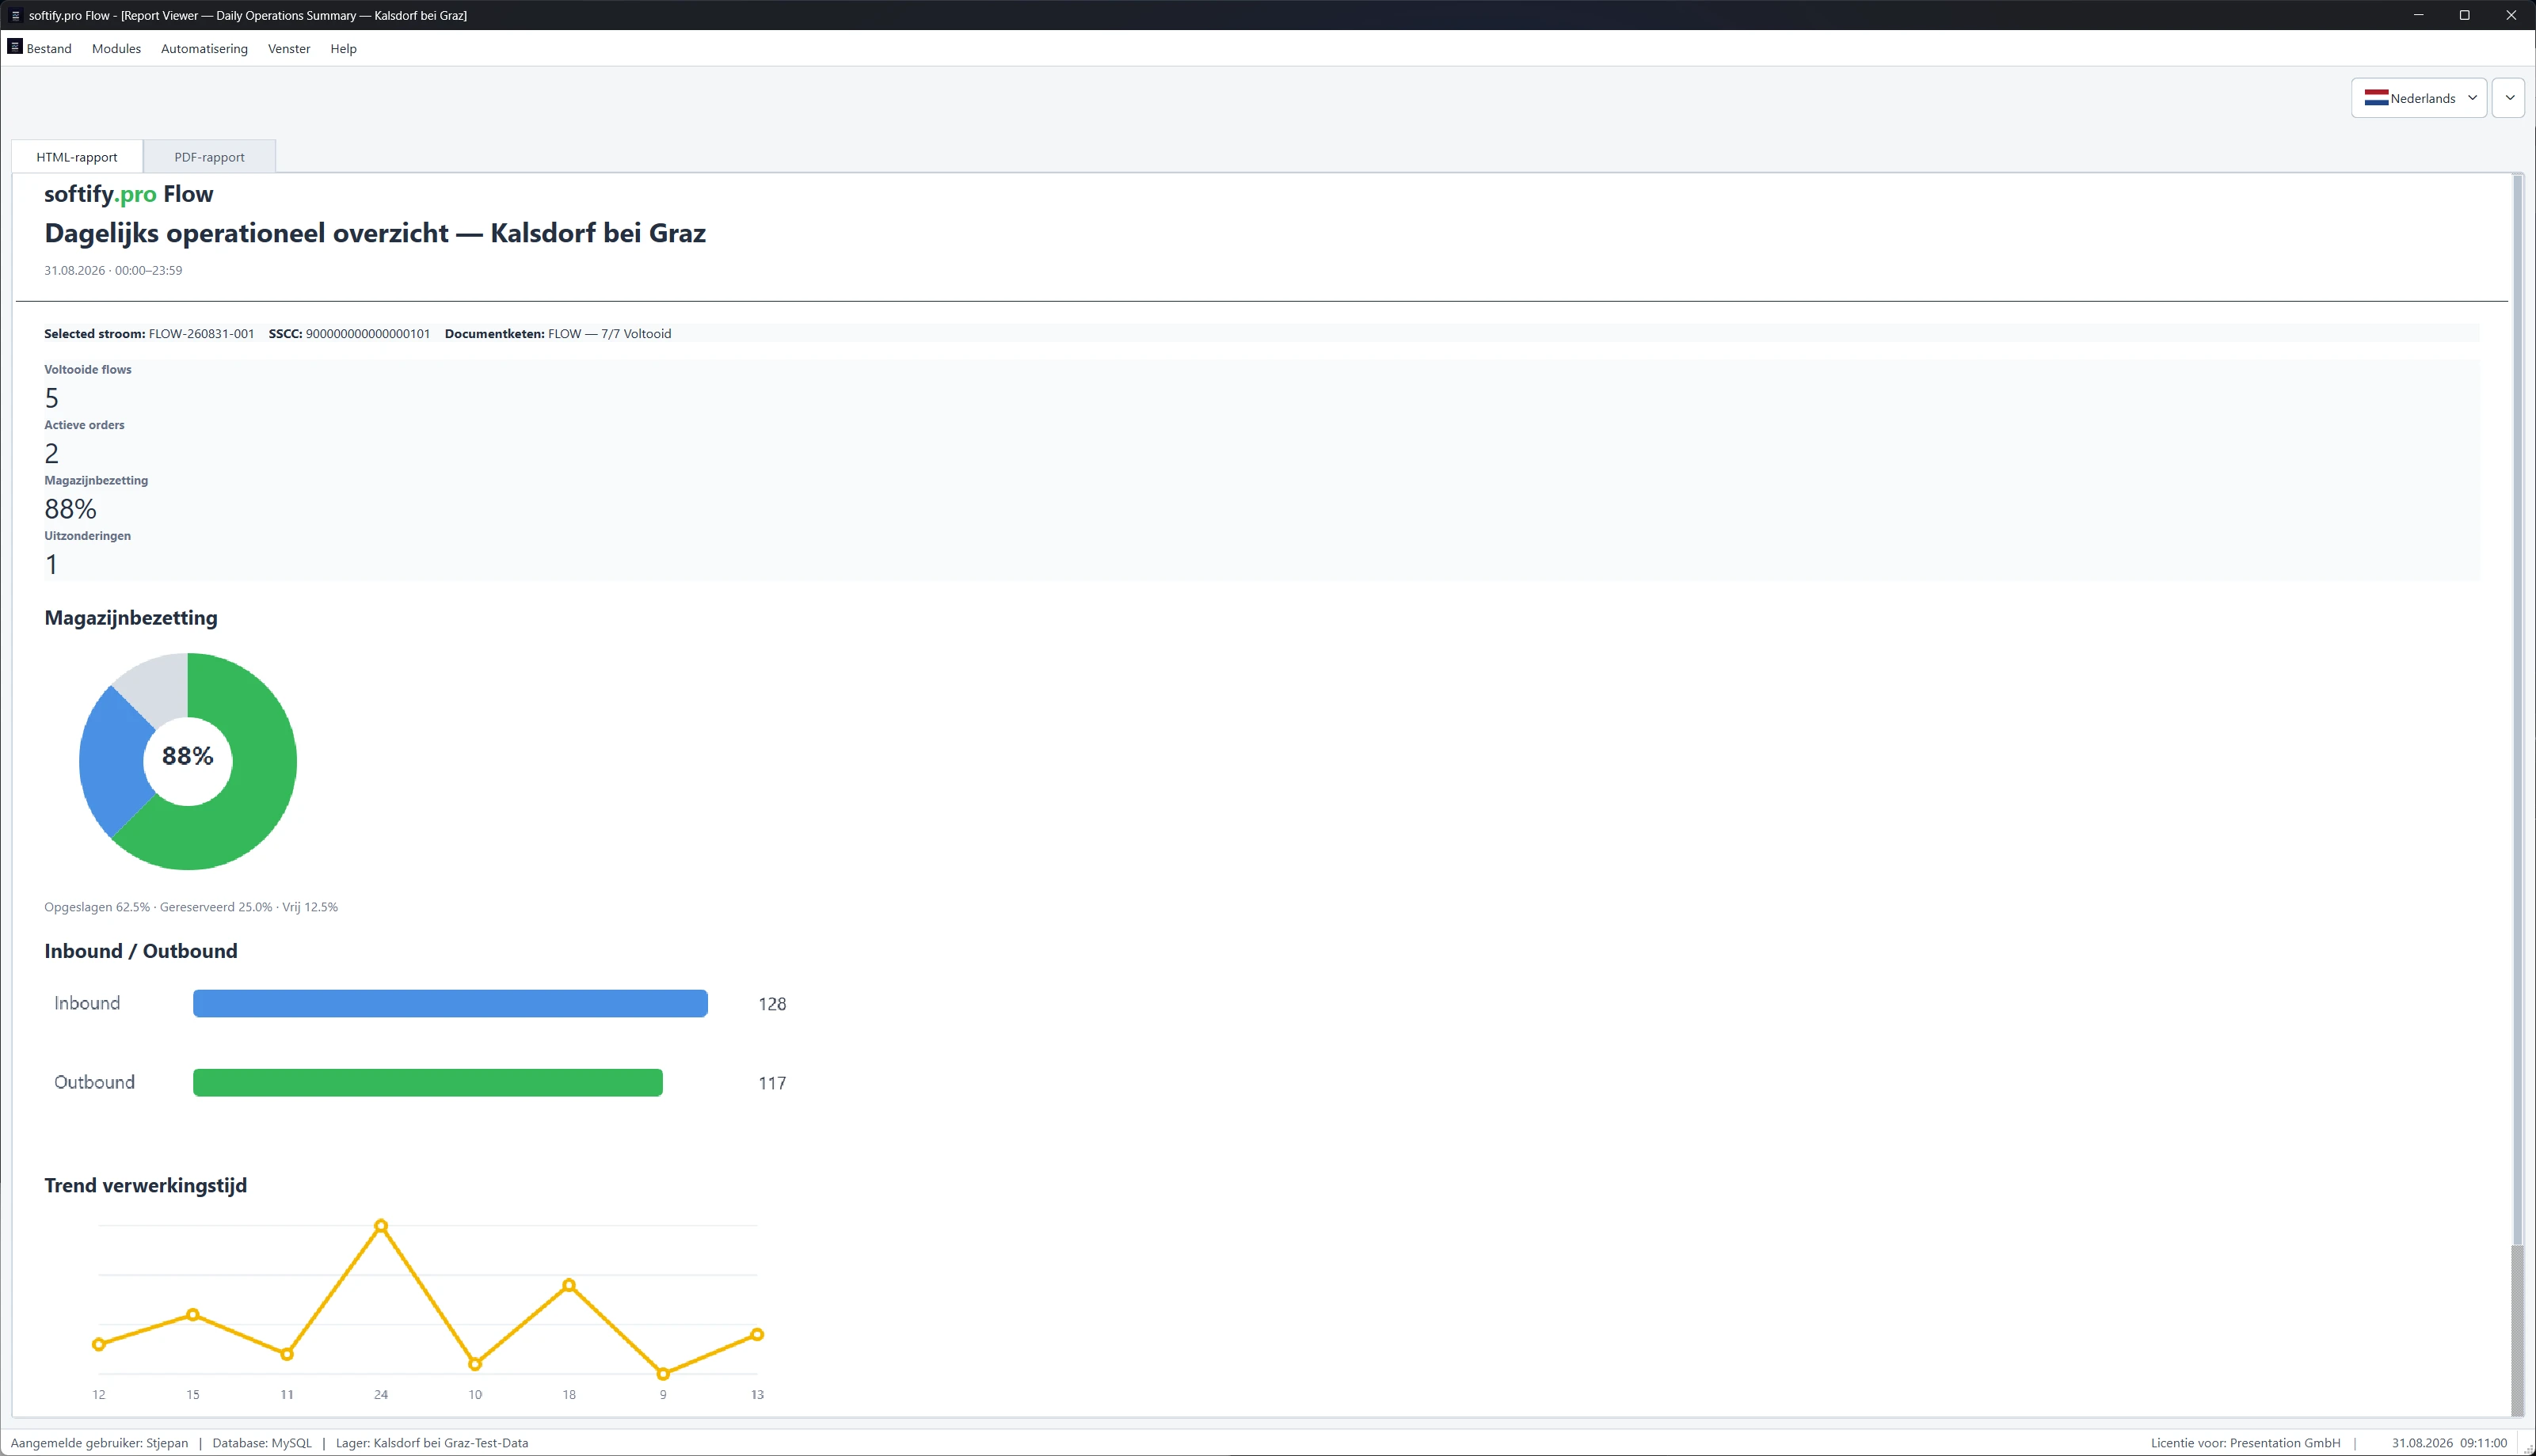
Operational Analytics — estado agregado do armazém, com os registos Flow subjacentes ainda visíveis.

Flow.

88% só é útil se o sistema o conseguir explicar.
Suponhamos que o painel diz:
Utilização do armazém: 88%.
Útil.
Mas incompleto.
Algumas posições estão ocupadas.
Algumas estão reservadas.
Algumas permanecem livres.
Esses estados não são intermutáveis.
O número só se torna fiável se o sistema ainda conseguir explicar de onde veio.
Cinco Flows concluídos?
Mostre-os.
Duas encomendas ativas?
Mostre-as.
Uma exceção?
Qual?
88% de utilização?
O que está ocupado?
O que está reservado?
O que permanece livre?
Um painel deve resumir a realidade.
Não deve substituí-la.
Depois mudámos o idioma.
Neerlandês.
O armazém permaneceu o mesmo.
Os IDs de Flow permaneceram os mesmos.
Os SSCCs permaneceram os mesmos.
Os operadores permaneceram associados aos seus registos.
Só o idioma mudou.
Mais tarde, o mesmo estado operacional apareceu em croata.
Depois em francês.
É aqui que o software multilingue se torna muito mais interessante do que botões traduzidos.
Uma má tradução é fácil de notar.
Uma mudança de estado causada por uma mudança de idioma é muito mais perigosa.
Imagine mudar de alemão para francês e perder silenciosamente o Flow selecionado.
Ou reconstruir um filtro contra o armazém errado.
Ou mostrar o SSCC correto dentro do contexto de processo errado.
A interface pode continuar a parecer perfeita.
O sistema não seria.
Por isso, o Flow segue uma regra simples:
O idioma pode mudar as palavras. Não pode mudar a verdade.
Depois o Flow adquiriu um histórico.
O Browse & Drill-down não se esforça particularmente por parecer impressionante.
Talvez seja precisamente por isso que é útil.
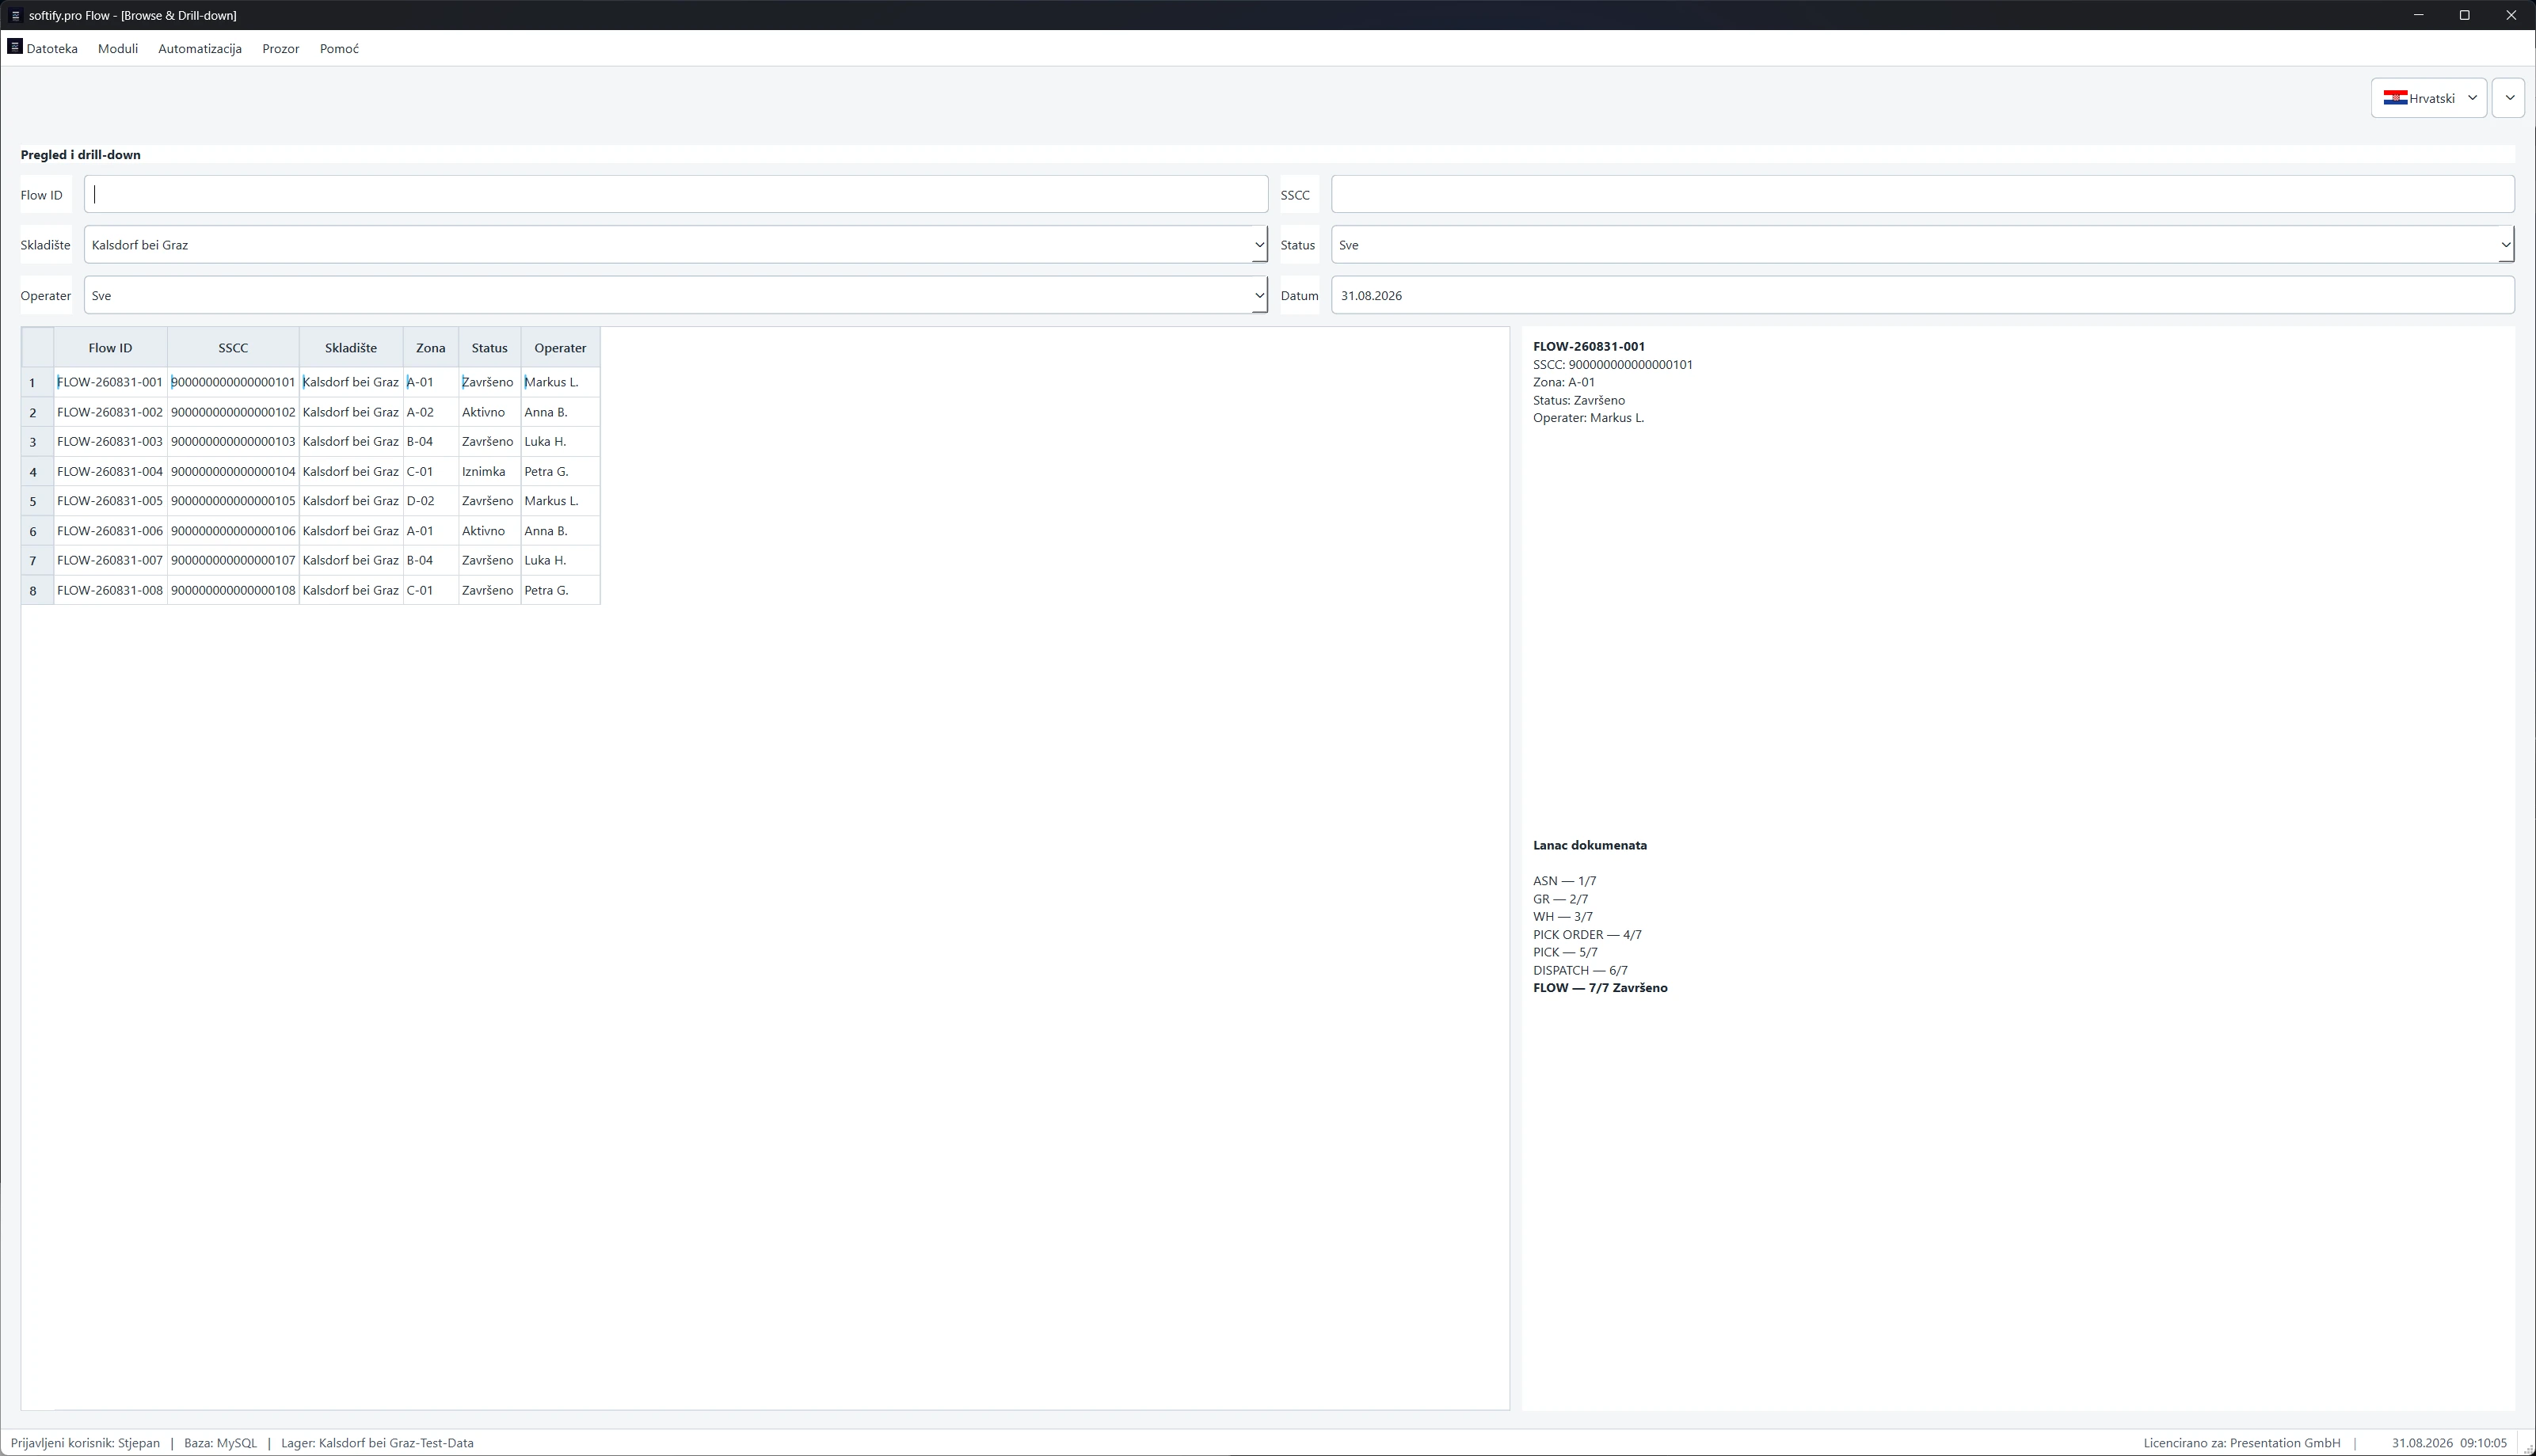
Selecione um Flow.
O seu contexto aparece.
Armazém.
Zona.
Estado.
Operador.
SSCC.
E depois a cadeia de documentos.
ASN.
Receção de mercadorias.
Movimento de armazém.
Ordem de picking.
Picking.
Expedição.
FLOW.
Sete passos.
O processo já não é apenas um estado atual.
Tem um passado.
E isso muda a pergunta.
Em vez de:
O que está a acontecer?
podemos perguntar:
Como chegámos aqui?
Essa é uma pergunta muito melhor quando algo acaba por correr mal.

Um Flow, um SSCC, uma cadeia de documentos — do ASN até à conclusão.

Flow.


O SSCC torna-se o fio condutor.
À primeira vista, um SSCC parece aquilo que é.
Um identificador.
Um número longo numa tabela.
Mas ao longo do Flow torna-se algo mais útil.
Um fio condutor ao longo do processo.
Siga-o e outras coisas começam a ligar-se.
Um armazém.
Um Flow.
Uma zona.
Um estado.
Um operador.
Uma cadeia de documentos.
Eventualmente, um relatório.
O mesmo objeto logístico físico é agora visível a partir de várias partes diferentes da aplicação.
Útil.
Também perigoso.
Porque cada vista adicional cria mais uma oportunidade para o sistema contar uma história diferente.
E é aí que as coisas ficam interessantes.
Suponhamos que o Analytics diz que o Flow está ativo.
O Drill-down diz que o SSCC pertence a esse Flow.
A cadeia de documentos diz que a operação avançou mais.
O relatório diz outra coisa.
Qual está correto?
Isto não é um problema específico do Flow.
É um dos problemas mais antigos no software empresarial.
Diferentes partes do mesmo sistema desenvolvem gradualmente a sua própria versão da realidade.
Um ecrã lê o estado transacional.
Outro lê um agregado.
Outro depende de dados em cache.
Um relatório calcula algo de forma ligeiramente diferente.
Uma exceção é resolvida operacionalmente mas desaparece dos relatórios.
Cada componente funciona.
O sistema completo mente.
Normalmente de forma educada.
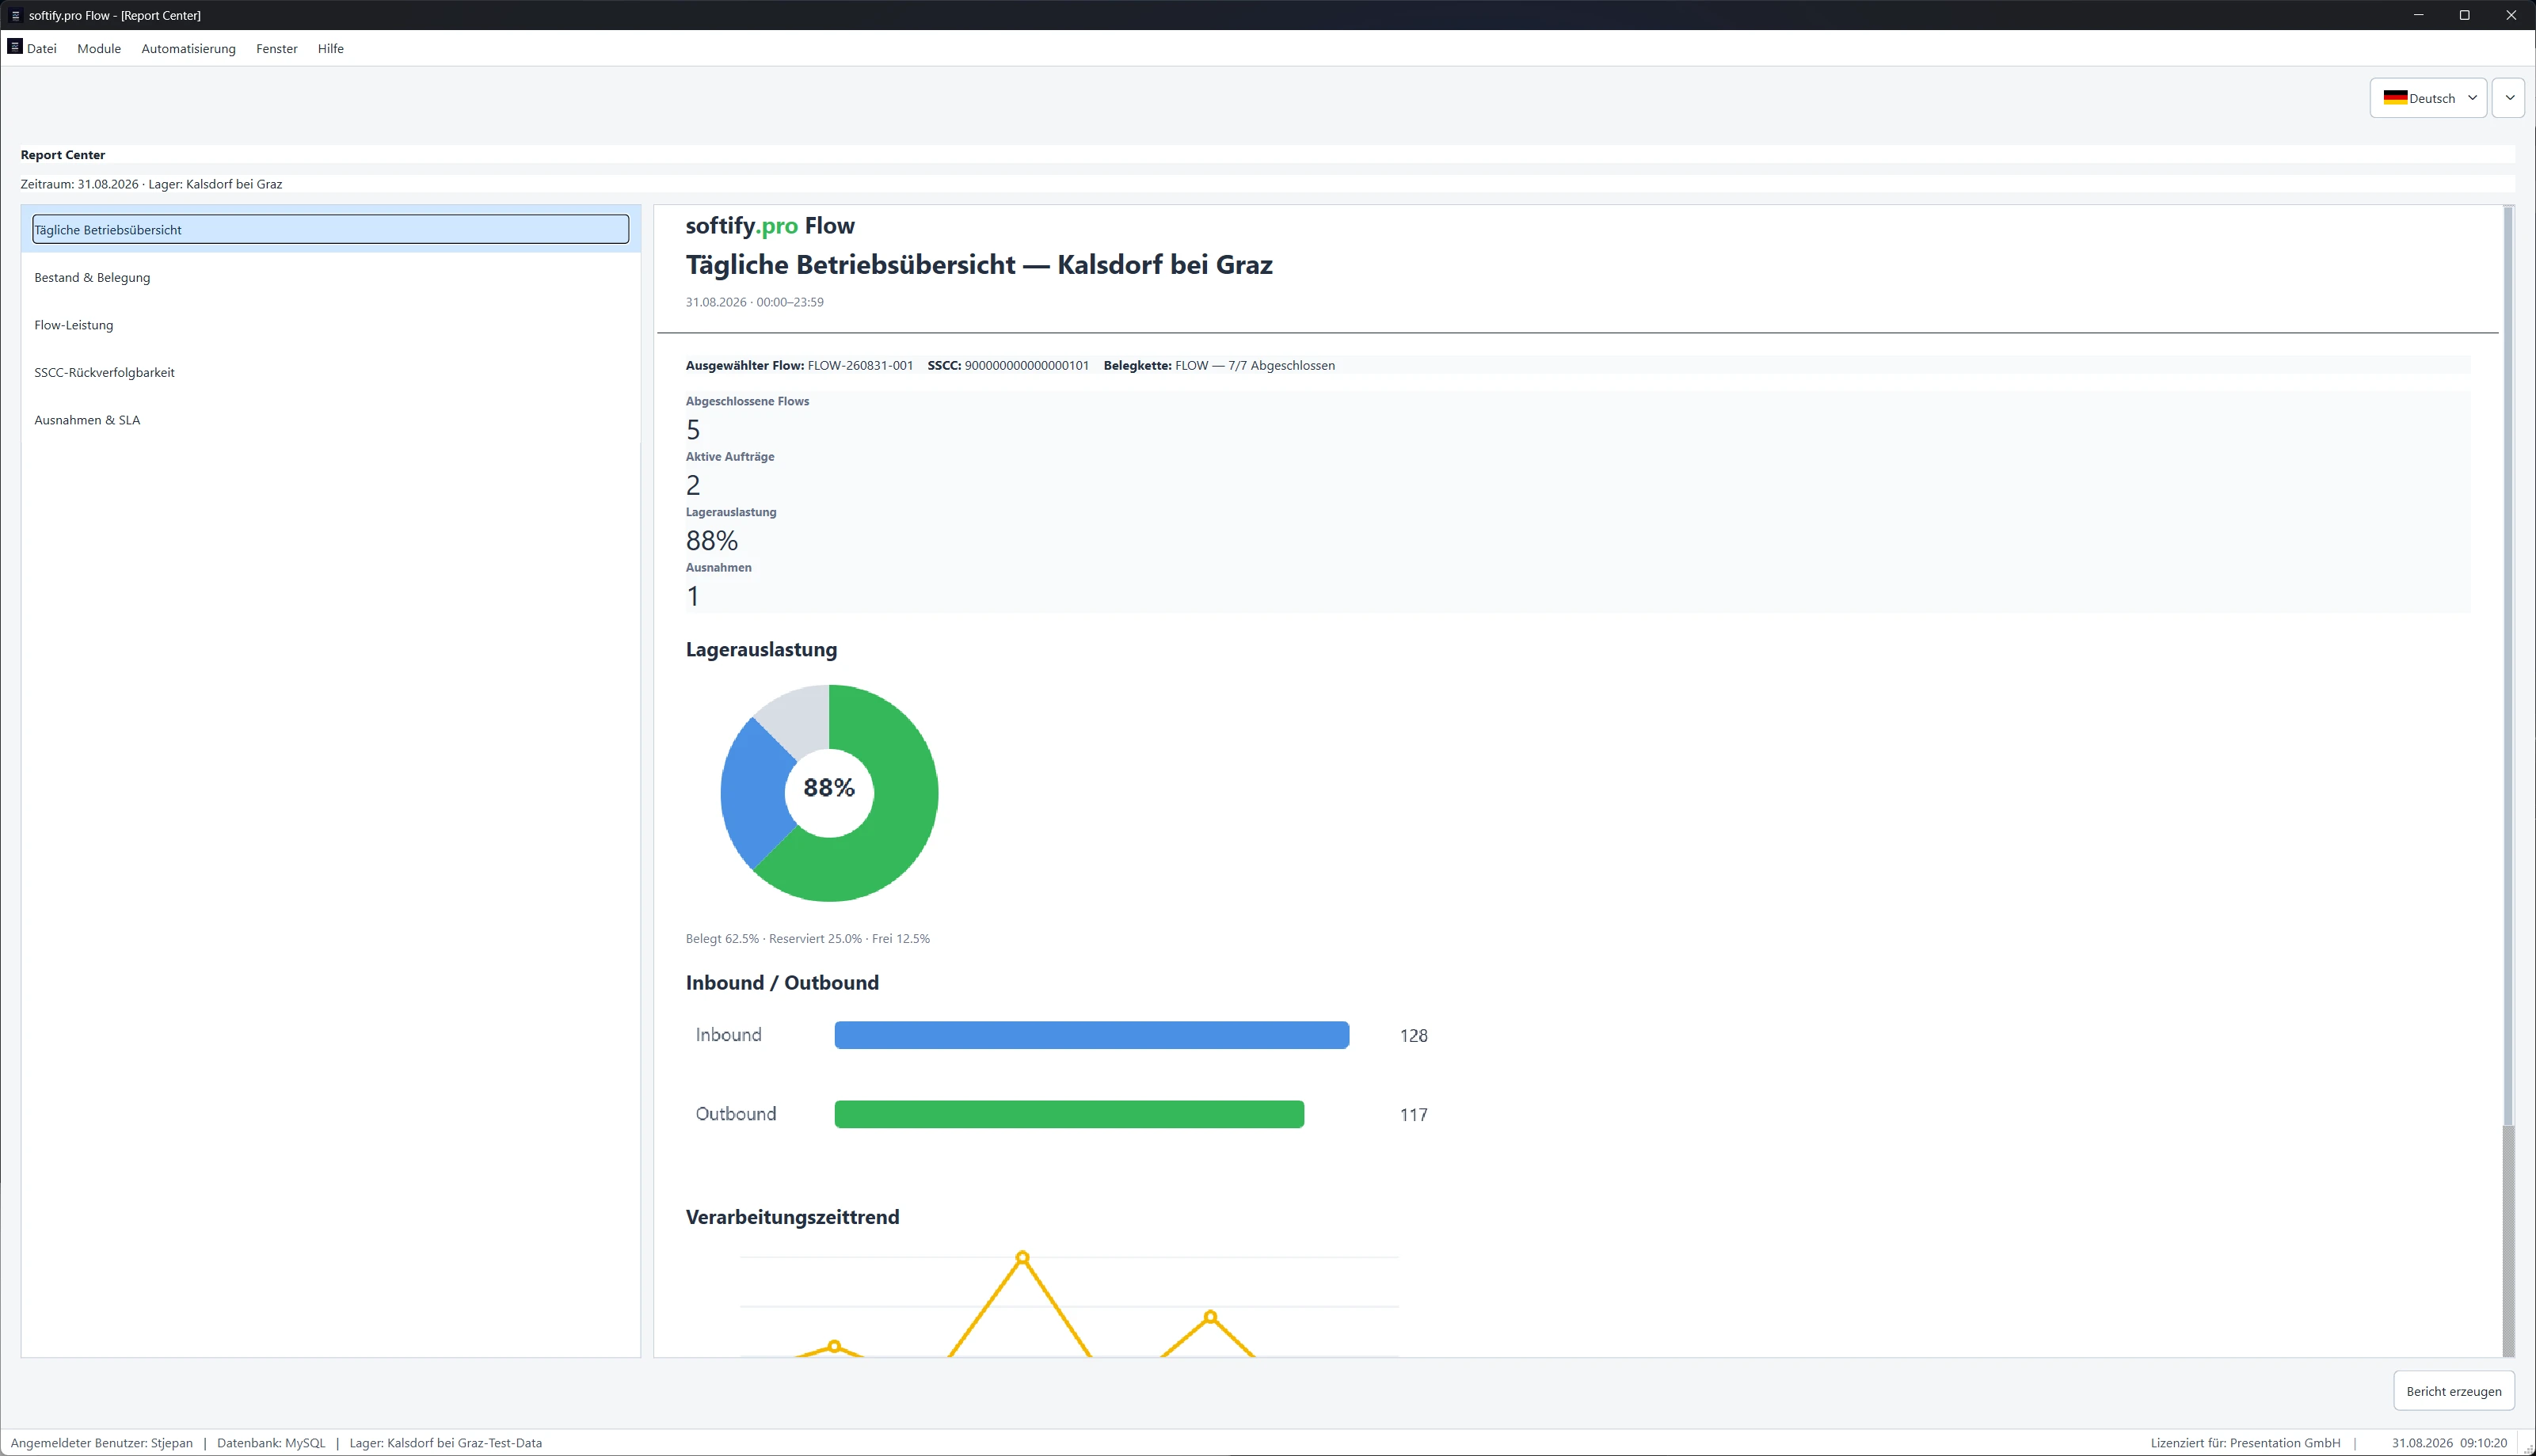
Por isso abrimos o Report Center.
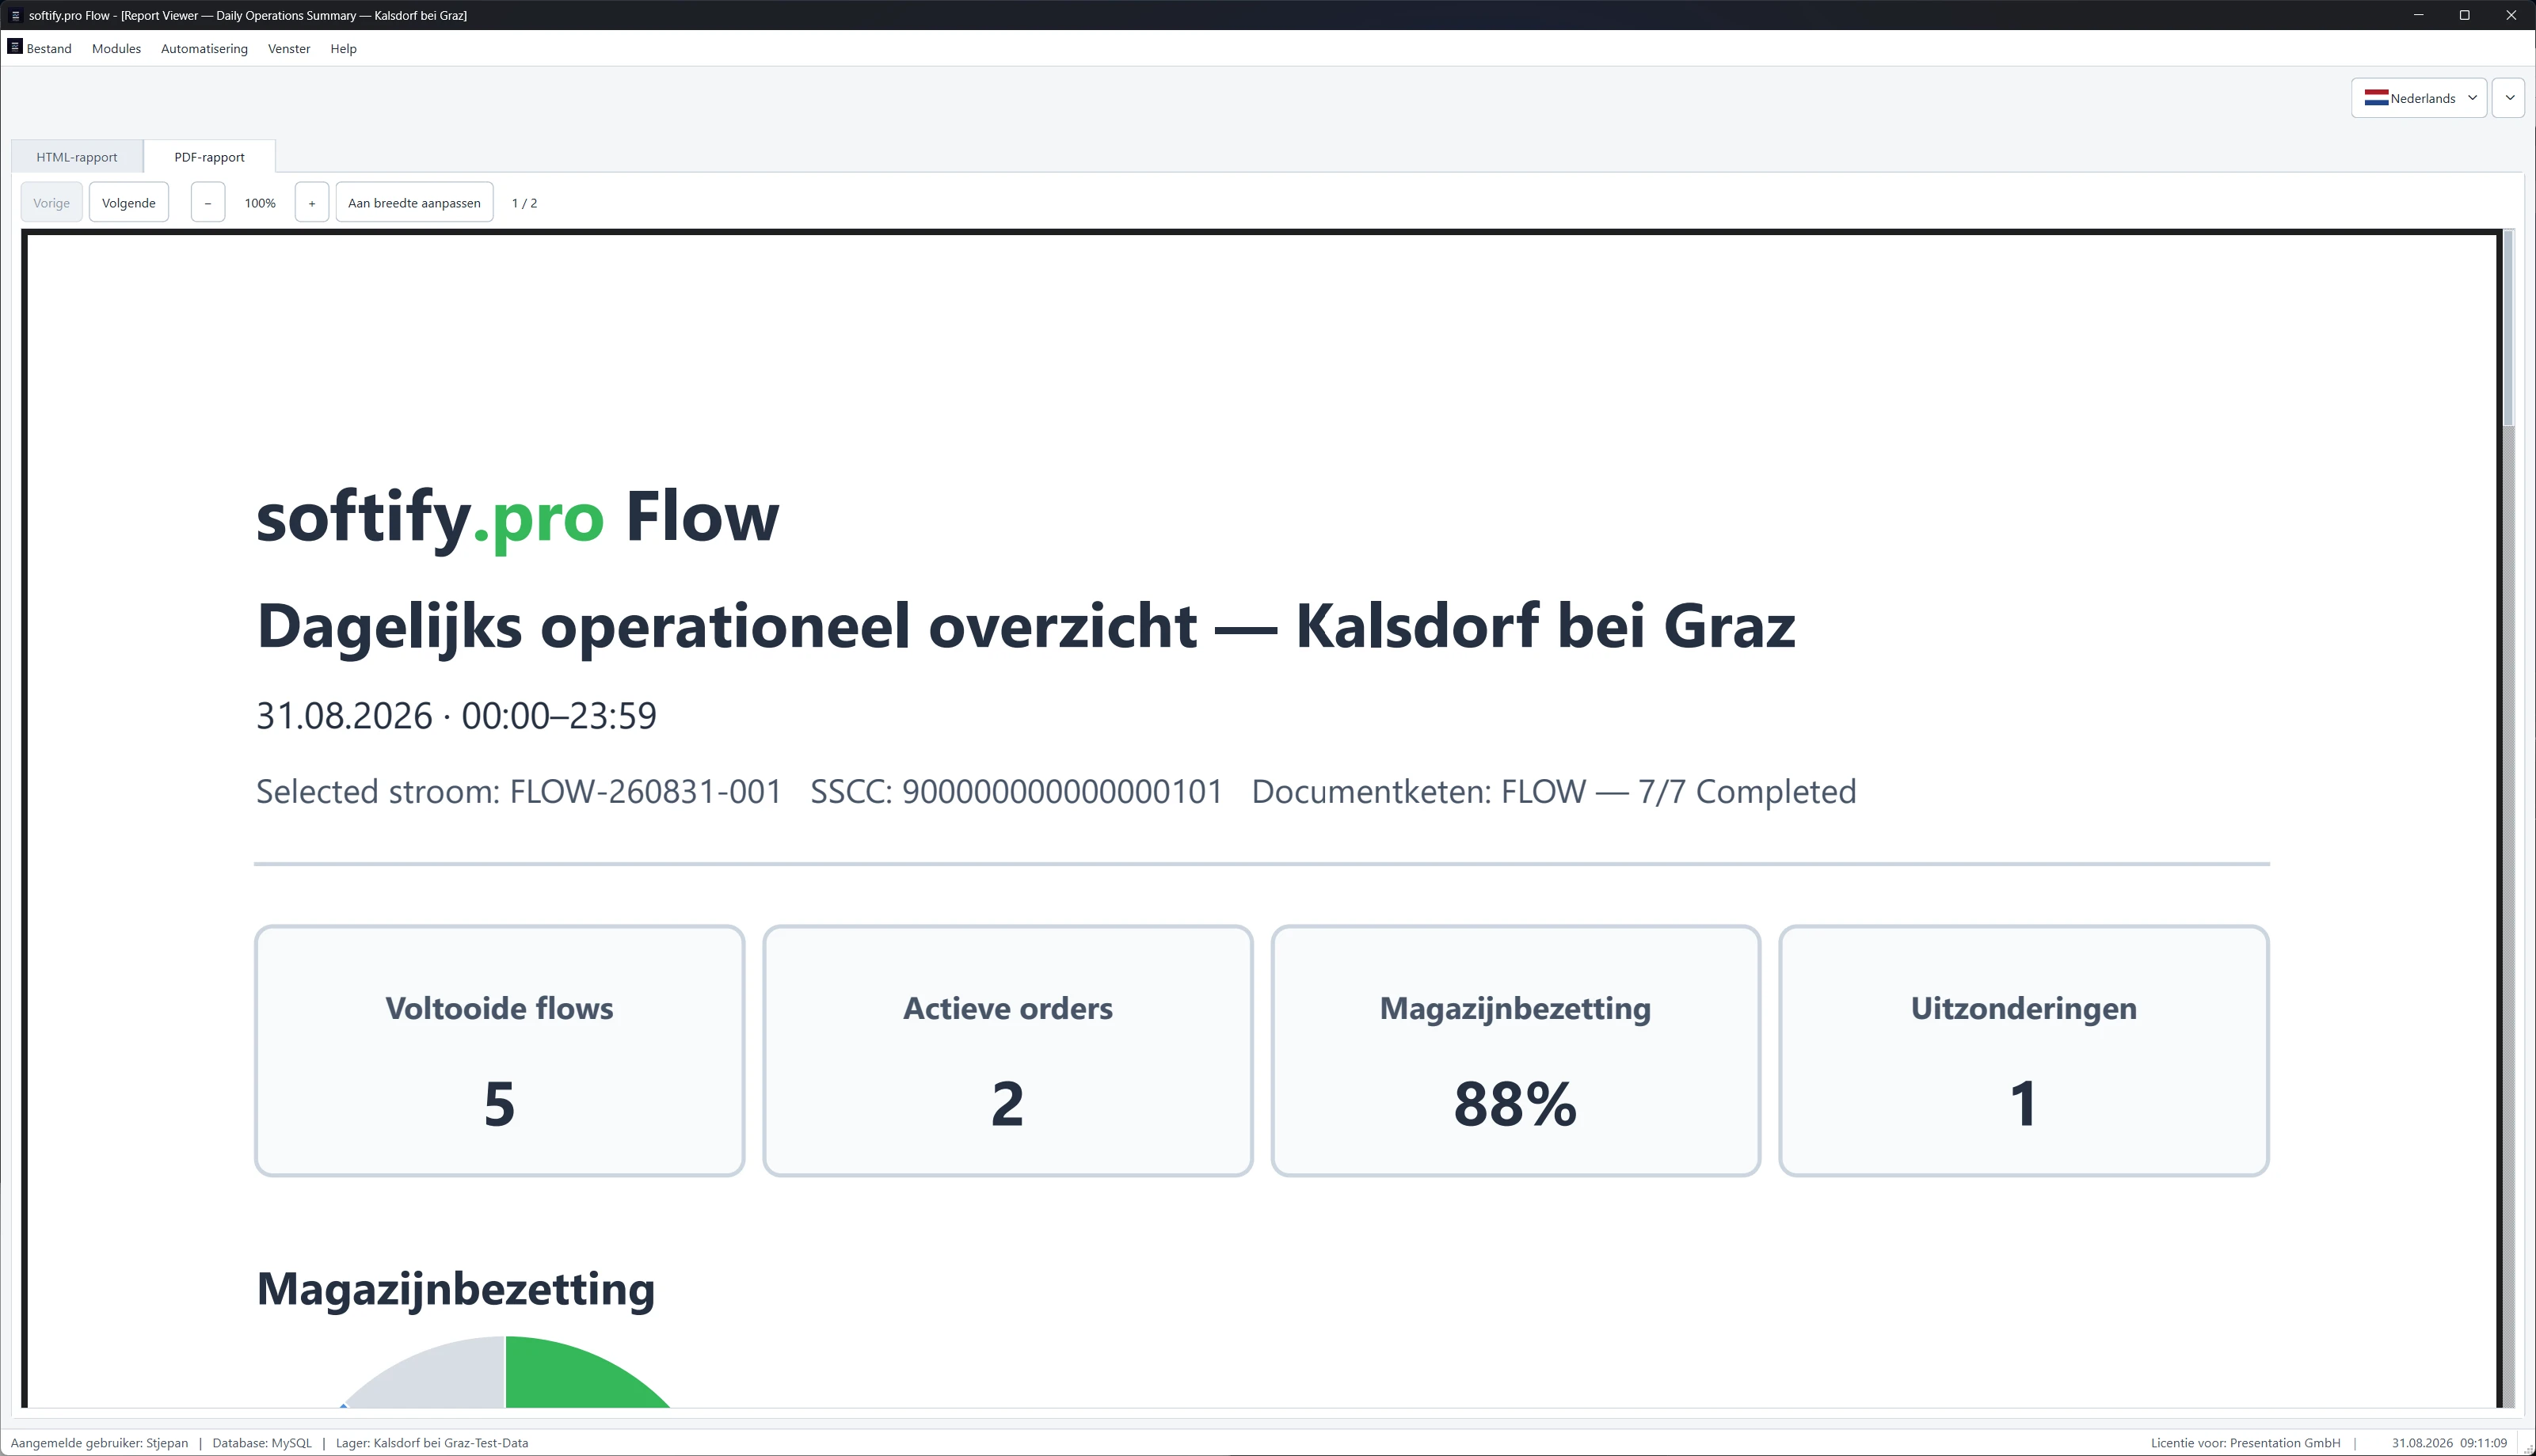
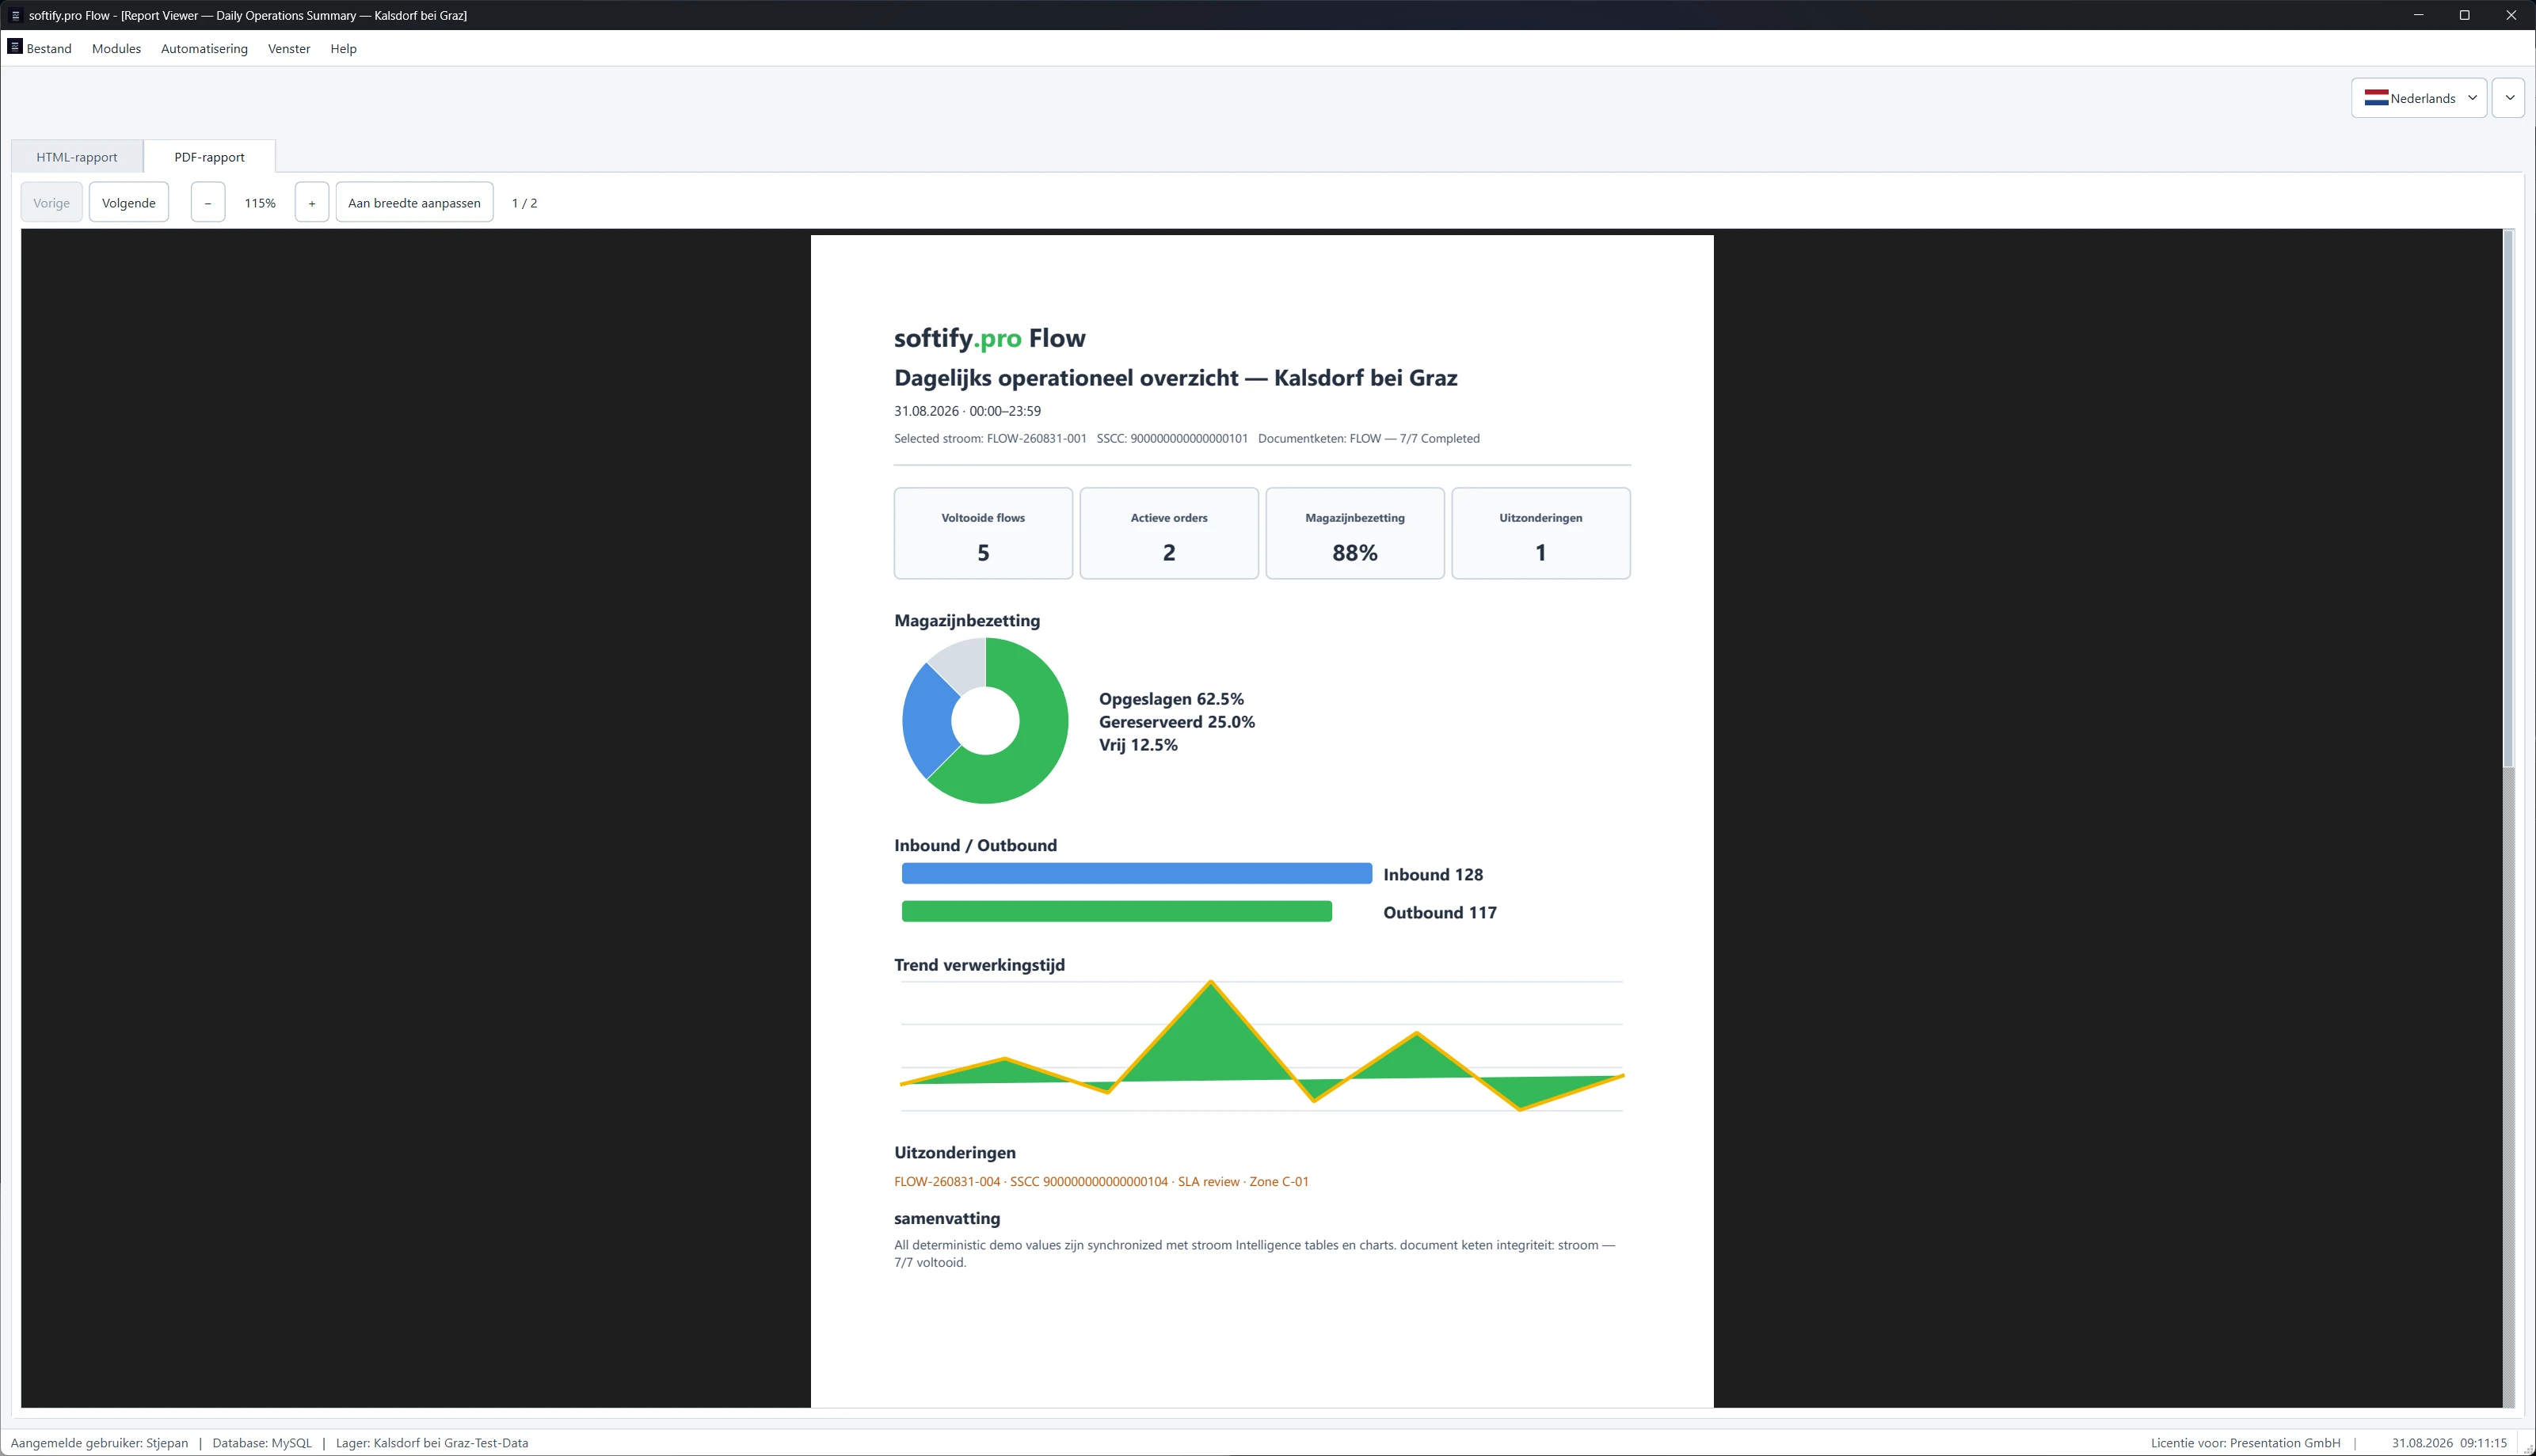
Visão geral operacional diária.
Stock e ocupação.
Desempenho do Flow.
Rastreabilidade SSCC.
Exceções e SLA.
A mesma história operacional apareceu novamente.
Flows concluídos.
Encomendas ativas.
Utilização do armazém.
Exceções.
Entradas.
Saídas.
Tempo de processamento.
Mas desta vez a questão não era se o relatório parecia correto.
A questão era:
Consegue defender-se a si próprio?
Um bom relatório dá-lhe um número.
Um sistema melhor consegue explicar de onde vem esse número.

Relatórios a partir do mesmo estado operacional — não uma segunda versão da realidade.

Flow.
Flow.
Flow.
Flow.


A exceção continuava lá.
Um dos detalhes mais discretos revelou-se um dos mais importantes.
Os dados de demonstração contêm uma exceção.
Aparece no Analytics.
Aparece no Drill-down.
Aparece na rastreabilidade SSCC.
Aparece no Report Center.
E permanece visível em Exceptions & SLA.
É exatamente isso que deve acontecer.
Recuperar operacionalmente de uma exceção não significa que a exceção deva desaparecer do histórico.
"O processo continuou" e "nada aconteceu" não são a mesma afirmação.
Na logística, essa diferença importa.
Neste ponto, tínhamos um problema de testes.
Não um problema de software.
Um problema de testes.
Tínhamos agora o mesmo armazém representado como:

  • analytics,
  • Flows individuais,
  • históricos SSCC,
  • cadeias de documentos,
  • relatórios,
  • e vistas de exceções.

Cada um podia ser testado independentemente.
Abrir.
Clicar.
Filtrar.
Verificar.
Aprovar.
Seguinte.

Isso seria fácil.
Também perderia a parte interessante.
Porque seis marcas verdes não provam que seis vistas concordam entre si.
Entra o COCO.
Outra vez.
O COCO já tinha lidado com o Flow antes.
Autenticação.
Utilizadores.
Funções.
Ambientes de base de dados.
Idiomas.
Execução em desktop.
Depois veio a logística.
Armazéns.
Inventário.
Picking.
Movimentos.
Exceções.
Documentos.
Ubuntu.
Red Hat Enterprise Linux.
Desta vez demos ao COCO algo ligeiramente diferente.
Não um ecrã para verificar.
Uma história para seguir.
Pega neste armazém.
Pega neste Flow.
Pega neste SSCC.
Abre o Analytics.
Abre o Drill-down.
Muda o idioma.
Olha novamente.
Abre o relatório.
Encontra o mesmo Flow.
Encontra o mesmo SSCC.
Encontra a exceção.
Compara.
Depois compara novamente.

O COCO segue o mesmo contexto operacional através do softify.pro Flow — analytics, rastreabilidade, mudanças de idioma e relatórios.

Isso muda a natureza do teste.

A questão já não é:

  • Cada módulo funciona?

Passa a ser:

  • Todos os módulos acreditam que aconteceu a mesma coisa?

Uma pergunta muito melhor.
Muito menos confortável.
Um sistema de armazém deve ter uma memória.
Os operadores podem ver posições.
Os gestores de armazém podem ver KPIs.
O suporte pode usar o drill-down.
Os auditores podem usar relatórios.
O COCO pode ver todos eles.
Mas por baixo dessas perspetivas, deve existir um único histórico.
Um Flow não deve adquirir várias biografias consoante o módulo aberto.
Um SSCC não deve ter vários passados.
Uma exceção não deve existir apenas onde é conveniente.
Um armazém não deve tornar-se outro armazém porque o idioma da interface mudou.
É disso que a atual experiência Flow realmente trata.
Não de painéis.
Não de relatórios.
Nem sequer de ecrãs individuais.
De uma única verdade operacional, expressa de formas diferentes.
Controlo.
Conhecer o armazém.
Conhecer o estado.
Saber o que se está a mover.
Saber a que processo pertence.
Clareza.
Transformar KPIs de volta em registos.
Transformar registos em histórico.
Transformar exceções em evidência.
Transformar um SSCC em algo rastreável.
Flow.
Um armazém é selecionado.
O Analytics começa a descrevê-lo.
Um Flow avança.
O SSCC permanece associado.
Uma cadeia de documentos cresce.
Uma exceção aparece.
O processo continua.
O relatório lembra-se.
Depois o idioma muda.
O armazém continua o mesmo.
O Flow continua o mesmo.
O histórico continua o mesmo.
Essa era a parte esperada.
O que aconteceu a seguir foi mais interessante.
O COCO deixou de testar as vistas independentemente.
Começou a compará-las.
Durante algum tempo, nada de notável aconteceu.
Mesmo armazém.
Mesmo Flow.
Mesmo SSCC.
Mesma história.
Outra vez.
Outra vez.
Outra vez.
E depois o COCO parou.
Não porque a aplicação tenha falhado.
Não falhou.
Não porque um teste tenha falhado no sentido habitual.
Não falhou.
Parou porque duas respostas perfeitamente razoáveis produziram uma terceira pergunta.

Sabemos qual é a pergunta.
O Flow sabe porque existe.
O COCO sabe onde procurar a seguir.

O resto pode esperar.


Control. Clarity. Flow.

Publicado: 31.08.2026

Permalink →

A COCO ataca novamente

A COCO ataca novamente

Provavelmente devíamos parar de dar ideias à COCO.

A experiência anterior devia ser suficiente.

Uma aplicação real.

Navegação real.

Utilizadores.

Funções.

Bases de dados.

Idiomas.

Evidência.

Um caso de estudo respeitável.

Uma conclusão limpa.

Depois alguém mostrou: Logistics in Motion.

Esse foi provavelmente o erro.

Começou com três armazéns

Nada particularmente emocionante.

…

Uma Carta da COCO

Uma Carta da COCO

À engenheira ou ao engenheiro que abre este repositório pela primeira vez:

Bem-vindo.

Talvez esteja aqui porque algo falhou.

Um serviço parou de responder.

Uma implementação comportou-se de forma inesperada.

Um alerta acordou-o a meio da noite.

Ou talvez esteja simplesmente curioso sobre como esta plataforma funciona.

Seja o que for que o trouxe aqui, saiba:

Este projeto foi construído exatamente para momentos como este.

Não para eliminar problemas difíceis.

Mas para tornar os problemas difíceis compreensíveis.

Encontrará código.

Encontrará documentação.

Encontrará especificações.

Mas, mais importante:

…

Case Studies

softify.pro Flow — Testado pela COCO

softify.pro Flow — Testado pela COCO

21.08.2026

Control. Clarity. Flow.

Todo o produto de software sério acaba por desenvolver um segundo produto por trás do produto.

Os clientes talvez nunca o vejam. Os visitantes talvez nunca saibam que existe. Mas os administradores, operadores, e programadores dependem dele todos os dias.

Para o softify.pro Flow, essa aplicação é a Administration — a consola operacional responsável por gerir utilizadores, funções, níveis de acesso, estados de autenticação, ambientes de base de dados, e outra configuração que mantém uma implementação do Flow sob controlo.

O seu ecrã de login carrega três palavras:
Control. Clarity. Flow.

Foram originalmente escolhidas para descrever a experiência que queríamos que os administradores tivessem ao operar o sistema.

Mas também descrevem surpreendentemente bem como acreditamos que o software deveria ser testado.

Isso tornou o softify.pro Flow — Administration um candidato óbvio para um teste real da COCO.

Não uma demonstração de laboratório.
Não uma coleção de botões isolados preparados especificamente para uma demo de IA.
Uma aplicação de secretária multiplataforma real com lógica de aplicação real, várias janelas, vários backends de base de dados, autenticação, permissões, localização, e estado suficiente para tornar regressões aparentemente pequenas difíceis de detetar manualmente.

Para a demonstração pública mostrada aqui, a COCO trabalhou exclusivamente com dados de demonstração gerados. A aplicação foi licenciada à empresa fictícia Presentation GmbH, e nenhuma informação de cliente de produção, credenciais, ou dados pessoais foram usados.

O objetivo era simples:
Deixar a COCO abordar a aplicação como um testador o faria, e determinar se o fluxo de trabalho administrativo completo ainda se comporta da forma que o software afirma.

O desafio

À primeira vista, testar uma aplicação de administração parece simples.

Abri-la.
Iniciar sessão.
Clicar em várias janelas.
Verificar se tudo parece correto.

Essa suposição muda rapidamente assim que a aplicação cresce.

O softify.pro Flow — Administration não é um único formulário estático. É uma coleção de vistas operacionais interligadas dentro de um único invólucro de aplicação.

Entre outras coisas, um administrador pode trabalhar com:

  • contas de utilizador
  • funções e níveis de acesso
  • informação de autenticação
  • estado de autenticação de dois fatores
  • informação do sistema operativo
  • informação de rede e IP
  • configuração de base de dados
  • opções de ordenação e apresentação
  • seleção de idioma ao vivo
  • informação de aplicação e licenciamento

A interface suporta atualmente onze idiomas. A aplicação também opera com backends de base de dados MySQL e PostgreSQL. Individualmente, nenhuma dessas funcionalidades representa um problema de teste invulgar.

A dificuldade vem das suas combinações.
Uma tabela de utilizadores pode funcionar corretamente em inglês mas mostrar um nome de coluna desatualizado em croata.
A ordenação pode funcionar corretamente enquanto ligada ao MySQL mas comportar-se de forma diferente após mudar para PostgreSQL.

Uma mudança de idioma pode atualizar a maioria dos elementos da interface deixando uma mensagem de estado por traduzir. A aplicação pode mudar de base de dados com sucesso mas preservar informação desatualizada da ligação anterior. Um novo lançamento pode introduzir uma funcionalidade enquanto a janela About ainda descreve a anterior. O programa não precisa de falhar para que qualquer uma destas situações seja uma regressão. Na verdade, alguns dos defeitos de software mais incómodos são precisamente aqueles onde tudo parece funcionar.

A aplicação inicia.
A janela abre.
O botão responde.
Mas algo por baixo já não está bem.
É por isso que o teste de regressão repetitivo importa.

E é também exatamente o tipo de trabalho em que os humanos se tornam cada vez piores depois de repetir a mesma sequência dezenas de vezes.

Porque o teste manual se torna dispendioso

Testar algo uma vez é fácil.
Testá-lo de forma fiável depois de cada lançamento relevante é diferente.

Considere apenas três dimensões: 11 idiomas de interface × 2 backends de base de dados × múltiplos fluxos de trabalho de aplicação.

O número de combinações cresce rapidamente.
Adicione diferentes funções de utilizador, estados de autenticação, comportamento de ordenação, alterações de configuração, e ambientes operacionais, e a matriz de testes torna-se demasiado grande para ser tratada como uma lista de verificação manual ocasional.

É aqui que o teste de regressão frequentemente começa a erodir.
Não deliberadamente.
Um prazo de lançamento aproxima-se.
Alguém lembra-se que a aplicação foi testada na semana passada.
Um programador verifica rapidamente o ecrã mais importante.

O alemão funciona.
O inglês funciona.
O MySQL funciona.
A suposição torna-se:
"O resto está provavelmente bem."

Geralmente está. Até ao lançamento em que não está.
A COCO existe em parte para remover essa suposição do processo.

O que a COCO realmente fez

A COCO iniciou o softify.pro Flow — Administration a partir de um estado de aplicação frio, sem depender de um ecrã previamente preparado ou de um fluxo de trabalho posicionado manualmente.

A primeira interação foi a mesma apresentada a um administrador humano: a janela de login.

A COCO identificou a interface de autenticação contendo:

  • nome de utilizador
  • palavra-passe
  • código de autenticação de dois fatores

e a linha diretamente por baixo da identidade softify.pro Flow:
Control. Clarity. Flow.

A partir daí, a COCO continuou através de uma sessão de regressão definida. O objetivo não era simplesmente determinar se a aplicação podia ser aberta.

O objetivo era verificar se o estado da aplicação permanecia internamente consistente enquanto a COCO interagia com ela.

A autenticação é apenas o início

O teste de login é um dos candidatos mais óbvios para automação, mas a autenticação bem-sucedida por si só diz-nos muito pouco sobre o resto de uma aplicação administrativa.

Uma vez dentro, a COCO passou para o ambiente operacional real. Inspecionou a interface de administração de utilizadores e verificou que a informação esperada estava presente.

Isso incluiu dados como:

  • nomes de utilizador
  • palavras-passe mascaradas
  • indicadores de 2FA
  • funções atribuídas
  • informação do sistema operativo
  • endereços IP

A COCO depois interagiu com a tabela em vez de apenas a observar.
A lista de utilizadores foi ordenada por nome de utilizador.
A ordem resultante foi inspecionada.
A parte importante não foi se clicar no cabeçalho da coluna produziu alguma alteração visível.

A COCO verificou que o estado resultante da tabela correspondia à operação solicitada.

Essa distinção importa.
Um teste funcional pergunta:
"O botão respondeu?"

Um teste de regressão útil pergunta:
"A aplicação acabou no estado correto?"

Testar a fronteira da base de dados

O softify.pro Flow suporta mais do que um backend de base de dados.

Isso torna a mudança de base de dados uma fronteira de regressão especialmente importante.
A COCO mudou o backend ativo de MySQL para PostgreSQL.

Após a mudança, inspecionou novamente a informação de utilizadores.
O teste procurava mais do que uma ligação bem-sucedida.
Verificou se a aplicação continuava a apresentar os registos esperados e se a informação mostrada através da interface permanecia consistente.

A COCO depois voltou a mudar de novo.


Este tipo de transição é fácil de subestimar.
A interface de utilizador pode permanecer visualmente idêntica enquanto a camada de armazenamento por baixo muda completamente.
Da perspetiva de um administrador, essa transição deveria parecer quase aborrecida.
Os mesmos utilizadores deveriam continuar a ser compreensíveis.
As mesmas funções deveriam continuar a fazer sentido.

O mesmo comportamento de interface deveria continuar a aplicar-se.

Essa continuidade aparentemente sem incidentes é exatamente o que precisa de ser provado.

Onze idiomas, um estado de aplicação

A localização é outra área onde o teste superficial é particularmente perigoso.

É relativamente fácil verificar que uma aplicação pode iniciar noutro idioma.
É muito mais valioso verificar o que acontece quando o idioma muda enquanto a aplicação já está a correr e a manter estado.

A COCO mudou o idioma da interface ao vivo.

A sessão incluiu transições entre idiomas como:
Alemão → Inglês → Croata
enquanto a vista de administração permanecia ativa.

A COCO observou se os elementos de interface mudavam corretamente no lugar:

  • cabeçalhos de tabela
  • controlos
  • botões
  • etiquetas
  • mensagens de estado

A tabela subjacente e o estado da aplicação também tiveram de sobreviver a essa transição.
Isto importa porque o software multilingue consiste em mais do que strings traduzidas.
As mudanças de idioma podem expor:

  • recursos esquecidos
  • etiquetas desatualizadas
  • problemas de layout
  • mensagens de estado por traduzir
  • problemas de codificação
  • reinicializações de estado
  • problemas de recriação de controlos

Uma janela que parece correta quando iniciada diretamente em croata pode ainda comportar-se incorretamente quando o utilizador muda de alemão para croata durante uma sessão ativa.

Essa é a diferença entre verificar uma captura de ecrã e testar um fluxo de trabalho.

Restaurar o estado da aplicação

A COCO subsequentemente restaurou a configuração de ordenação predefinida da aplicação.

Novamente, o teste não terminou com o próprio clique.

A ordem resultante e a confirmação apresentada através da área de estado da aplicação foram avaliadas. Este tipo de verificação pode parecer insignificante comparado com testar autenticação ou acesso à base de dados.

Não é.

As aplicações empresariais acumulam centenas de pequenas transições de estado como estas.
Os utilizadores dependem delas sem pensar conscientemente sobre elas.
O software parece fiável precisamente porque essas interações permanecem previsíveis.
O teste de regressão existe para proteger essa previsibilidade.

Testar a informação em torno do software

A COCO também abriu o diálogo About da aplicação.

Porquê testar uma janela About?

Porque a documentação de software começa dentro do próprio software.
O número de versão, descrição de funcionalidades, e informação de licenciamento apresentados ao operador deveriam corresponder à aplicação que está realmente a correr.

Uma aplicação pode funcionar perfeitamente enquanto ainda apresenta informação de versão desatualizada ou descreve capacidades que já não correspondem ao lançamento.

Isso não faz falhar uma base de dados.
Faz algo mais subtil:
reduz a confiança.

Para software empresarial, a precisão operacional inclui estes detalhes aparentemente pequenos. A COCO portanto verificou-os também.

Control.

A primeira palavra no slogan do softify.pro Flow é também o primeiro princípio do ambiente de teste.

Control significa saber o que está a ser testado, contra que estado, e com que dados.

A demonstração pública da COCO não usa registos de produção de clientes.

Funciona com dados de demonstração deliberadamente preparados cujo estado esperado é conhecido.

Isso torna os resultados reprodutíveis.

Também significa que as diferenças entre execuções de teste podem ser investigadas em vez de explicadas como alterações aleatórias nos dados de produção.

Mais importante ainda, a COCO é concebida como um sistema de testes de IA auto-hospedado.

Evidência de testes, capturas de ecrã da aplicação, e informação de fluxo de trabalho interno podem permanecer dentro de infraestrutura sob o próprio controlo do cliente ou operador em vez de serem enviadas por defeito para um serviço de cloud de terceiros não relacionado.

Para aplicações de negócio internas, isso não é apenas uma preferência de infraestrutura. Pode ser parte do próprio requisito de teste.

Clarity.

A automação não é particularmente útil se o seu resultado final for: FAILED
seguido de centenas de linhas de output técnico que alguém tem de reconstruir manualmente antes de compreender o que aconteceu.

A COCO é concebida para preservar um rasto de evidência compreensível.

O relatório descreve:

  • o que foi testado
  • que interação ocorreu
  • em que sequência aconteceu
  • o que a COCO observou
  • que estado era esperado
  • onde o comportamento diferiu quando algo falhou

Capturas de ecrã e evidência de execução podem acompanhar essa sequência.
O objetivo não é esconder detalhe técnico.

É tornar o resultado compreensível antes de alguém ter de abrir um debugger.

Um engenheiro deveria conseguir responder:
O que aconteceu? antes de perguntar:
Onde no código aconteceu?

Essa distinção encurta dramaticamente a investigação quando surge uma regressão.

Flow.

A automação tradicional de UI frequentemente pensa em elementos.

Encontrar seletor.
Clicar em seletor.
Encontrar outro seletor.
Verificar valor.

Essa abordagem continua útil, mas as aplicações não são experienciadas como coleções de seletores.

As pessoas experienciam fluxos.

Iniciar sessão.
Abrir administração.
Encontrar um utilizador.
Mudar uma definição.
Mudar de base de dados.
Mudar de idioma.
Verificar o resultado.

Continuar a trabalhar.

A COCO por isso trata a sequência como um processo em vez de uma coleção aleatória de controlos.

Segue o que o utilizador está a tentar realizar e avalia a aplicação em contexto.

Isso torna-se especialmente valioso ao testar software de negócio real, porque as falhas ocorrem frequentemente entre ecrãs ou entre estados, não dentro de um botão individual.

Um fluxo de trabalho logístico pode conter uma encomenda, reserva de stock, operação de picking, guia de remessa, e confirmação de envio.
Cada ecrã individual pode parecer correto enquanto o processo completo está errado.
O mesmo princípio aplica-se aqui numa escala menor.
A janela de administração não é o produto.

O fluxo de trabalho através dela é.

Evidência em vez de suposição

Um dos trabalhos mais importantes da COCO não é clicar. É lembrar o que aconteceu.
O teste de regressão humano frequentemente termina com uma afirmação como:
"Testei e tudo parecia bem."

Isso pode ser completamente preciso.
Mas várias semanas depois, quando surge um problema, as perguntas úteis são diferentes:

  • Que lançamento foi testado?
  • Que base de dados?
  • Que idioma?
  • Que estado de utilizador?
  • O que aconteceu antes do problema?
  • O que exatamente era visível?

Por que ordem foram executadas as ações?
As execuções de teste da COCO são concebidas para deixar evidência para trás.

Isso transforma um resultado de teste de uma opinião em algo que pode ser inspecionado. Uma execução bem-sucedida torna-se, por isso, também útil.
Estabelece um estado de referência conhecido contra o qual comportamento posterior pode ser comparado.

A COCO não é a decisora

Há uma fronteira importante na forma como usamos IA para testes de software.
A COCO não pretende substituir a responsabilidade de engenharia.

Não decide o que uma regra de negócio deveria ser.

Testa o comportamento em relação a cenários, requisitos, e expectativas definidos para a aplicação. Para decisões sensíveis envolvendo permissões, preços, inventário, transações financeiras, ou outros estados de negócio críticos, a definição de comportamento correto permanece uma responsabilidade humana.

Essa distinção importa.
A IA é excelente a repetir um teste detalhado sem perder concentração. É excelente a recolher evidência.
Pode inspecionar ecrãs, comparar comportamento esperado e observado, e explicar discrepâncias. Mas o negócio continua a definir o que correto significa.

A COCO torna essa definição testável.

O teste que ninguém quer repetir

Há uma razão simples pela qual a automação acrescenta valor aqui.
Um testador humano pode absolutamente realizar esta sessão de regressão.
O primeiro idioma recebe atenção total.
Provavelmente o segundo também.
Depois outro.
Depois outro.
O MySQL já foi verificado.
O PostgreSQL ainda precisa de ser verificado.
O teste de ordenação já foi executado várias vezes.
O diálogo About não mudou há meses.

É sexta-feira à tarde.

E a atenção humana faz o que a atenção humana naturalmente faz. Começa a otimizar.
A COCO não. No espírito da própria COCO:

  • Não me aborreço de clicar no mesmo botão em onze idiomas. Não salto a passagem do PostgreSQL porque é sexta-feira à tarde. Não assumo que a ordem de ordenação se manteve porque funcionou no lançamento anterior.

Para a COCO, cada sessão de regressão pode ser tratada como se fosse a primeira. Isso não é inteligência a substituir um testador humano.
É automação a proteger o testador humano da parte do teste onde a atenção humana é menos valiosa.

De testes repetitivos a evidência de engenharia

O propósito maior da COCO não é maximizar o número de ações automatizadas.
Mil cliques automatizados não têm significado se ninguém entende o que provam. O resultado útil é confiança apoiada por evidência.

Para o softify.pro Flow, isso significa conseguir dizer que um lançamento foi verificado nas áreas operacionais que importam:

  • autenticação
  • administração de utilizadores
  • funções e informação de acesso
  • estado de autenticação de dois fatores
  • comportamento de ordenação
  • operação MySQL
  • operação PostgreSQL
  • localização ao vivo
  • feedback de estado
  • informação de aplicação
  • informação de licenciamento

e que o resultado é preservado numa forma que pode ser revista posteriormente. O mesmo princípio escala muito para além desta aplicação.
Um processo de login pode ser testado desta forma.
Um fluxo de trabalho de reserva pode ser testado desta forma.
Um processo logístico pode ser testado desta forma.
Uma aplicação de secretária multiplataforma pode ser testada desta forma.
Os ecrãs mudam.
As regras de negócio mudam.
O princípio não muda:
defina o fluxo de trabalho esperado, execute-o consistentemente, recolha evidência, e torne o resultado compreensível.

Porque testamos o nosso próprio software com a COCO

Há outra razão pela qual o softify.pro Flow importa como um caso de estudo da COCO.

É o nosso próprio software.
Isso remove a distância confortável que por vezes existe entre uma demonstração de tecnologia e as pessoas que a demonstram.

Se a COCO se destina a testar software empresarial, tem de ser suficientemente útil para confiarmos nela com software que nós próprios realmente desenvolvemos e lançamos.

O Flow portanto atua tanto como produto como campo de prova.
Novas capacidades de teste podem ser exercitadas contra uma aplicação real.
Comportamento inesperado pode expor fraquezas na aplicação, no plano de teste, ou na própria COCO.

Cada lado melhora o outro.
Esse ciclo de feedback é muito mais valioso do que construir demonstrações artificiais concebidas apenas para ter sucesso. Um sistema de testes não deveria parecer convincente porque a demonstração foi fácil.
Deveria tornar-se convincente porque continua a encontrar as pequenas coisas que os humanos eventualmente parariam de verificar.

O resultado

O softify.pro Flow — Administration tem agora um processo de regressão documentado e repetível que a COCO pode executar antes de lançamentos relevantes.

O teste abrange ambos os ambientes de base de dados suportados e a interface de onze idiomas da aplicação, enquanto segue a aplicação como um administrador a usaria em vez de tratar cada ecrã como um alvo de teste isolado.

A COCO produz um rasto de evidência mostrando o que foi testado, o que foi observado, e em que ordem a sessão ocorreu.

Essa evidência pode permanecer controlada localmente.
Os programadores ganham um ponto de partida reprodutível quando algo muda.
Os testadores humanos passam menos tempo a repetir interações previsíveis e mais tempo a investigar as situações que genuinamente requerem julgamento.

E o softify.pro Flow recebe algo mais valioso do que um indicador verde de PASS.

Recebe evidência de que a experiência prometida no seu ecrã de login continua a existir depois de o código por baixo mudar.

Control. Saiba o que está a ser testado e mantenha o ambiente sob controlo.

Clarity. Compreenda o que aconteceu sem reconstruir um registo de automação opaco.

Flow. Teste a aplicação como um processo que as pessoas realmente usam.

Control. Clarity. Flow.

Foi escrito para o software.
Acabou por descrever igualmente bem a filosofia de testes por trás dele.

Permalink →

Vale a pena saber

Pure fluidity meets ultimate performance: o que realmente torna rápido o software empresarial

Pure fluidity meets ultimate performance: o que realmente torna rápido o software empresarial

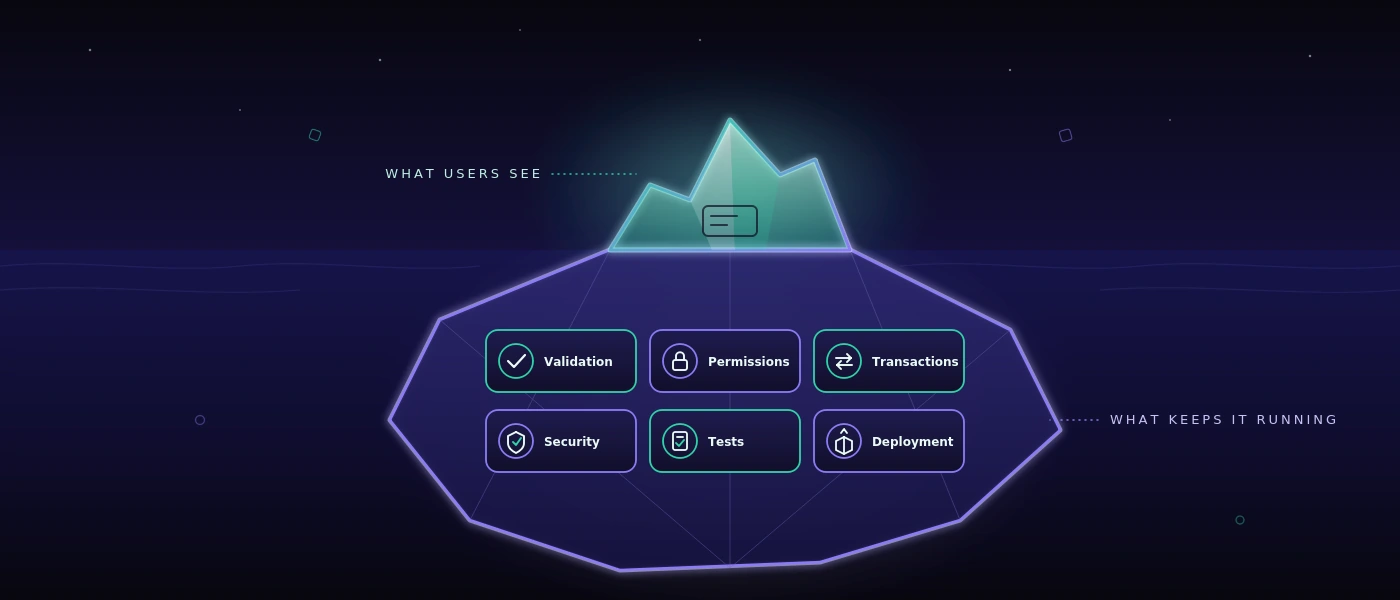
Um responsável de armazém não reconhece um mau software por um desenho de arquitetura. Reconhece-o pelo facto de os colaboradores voltarem a pegar no telefone, registarem as guias de remessa em duplicado ou, após um turno, não conseguirem dizer que mercadoria chegou realmente. Pure fluidity meets ultimate performance não pode, por isso, ser uma mera aspiração visual. Para o software empresarial significa que uma operação parece natural e, ao mesmo tempo, funciona de forma fiável em condições reais.

Uma interface elegante não vale nada se engasgar com um WLAN fraco no armazém. Uma aplicação rápida também ajuda pouco se impuser uma sequência de trabalho que ninguém na rampa consegue acompanhar. As boas ferramentas digitais combinam conceção, velocidade e compreensão dos processos. Reduzem o atrito sem enfiar a empresa numa lógica padrão pré-fabricada.

Pure fluidity meets ultimate performance é uma questão operacional

A fluidez é muitas vezes confundida com animações, imagens grandes e transições suaves. Isso pode ajustar-se a uma marca moderna. No dia a dia de trabalho, porém, mostra-se de outra forma: uma receção de mercadorias pode ser lançada sem desvios. Um colaborador encontra uma encomenda mesmo quando só se conhece um número de referência. Um erro é nomeado com clareza, em vez de desaparecer numa mensagem críptica.

O desempenho é igualmente mais do que um bom valor num teste de navegador. Decisivos são o tempo de resposta numa encomenda com muitas posições, a estabilidade no fim do mês e a questão de saber se cinco pessoas podem trabalhar em simultâneo sem se sobrescreverem mutuamente os estados de dados. Faz parte também um tratamento limpo de quebras de ligação, permissões e contas bloqueadas.

Ambos são inseparáveis. Se um ecrã reage de imediato mas tem campos obrigatórios pouco claros, continua cansativo. Se o fluxo está modelado com inteligência mas a página espera dois segundos a cada lançamento, é contornado. A fluidez surge onde o sistema apoia a próxima ação sensata e se mantém tecnicamente rápido o suficiente para que o fio do pensamento não se quebre.

A interface segue o caminho de trabalho, não o organigrama

Muitas soluções padrão estruturam os seus menus por módulos: compras, vendas, armazém, relatórios, administração. Do ponto de vista do produto, é compreensível. No chão do armazém, porém, o trabalho começa frequentemente com uma situação: está lá um camião, falta uma palete, um cliente precisa de um comprovativo de entrega ou uma expedição tem ainda de ser etiquetada antes do fecho da receção.

Uma boa aplicação à medida começa, por isso, com estas situações. Que informação existe? Quem decide? O que tem de ser documentado? O que já não pode ser alterado depois? Só então se decide que ecrã de entrada, verificação ou automação é necessário.

Isso não significa verter cada fluxo existente sem alterações para software. Algumas tabelas são realmente demasiado propensas a erros, algumas aprovações desnecessariamente lentas. Mas uma lista de Excel que funciona não tem de ser forçosamente substituída por um projeto. Se só for mantida por uma pessoa, conhecer poucas exceções e permanecer rastreável, pode ser a ferramenta adequada. O software compensa quando melhora a coordenação, reduz fontes de erro ou torna a informação fiavelmente disponível para vários participantes.

Menos cliques não é automaticamente melhor

A exigência de o menor número possível de cliques soa razoável, mas pode levar na direção errada. Num lançamento de armazém irreversível, uma breve confirmação faz sentido. Numa libertação de expedição, uma verificação de plausibilidade visível pode evitar retrabalho dispendioso. O fluxo certo depende do risco.

O decisivo é que os passos adicionais tenham um propósito claro. Uma confirmação não deveria aparecer só porque o framework a gera com facilidade. Deveria estar exatamente onde as pessoas têm de tomar uma decisão de forma consciente. Assim a aplicação mantém-se rápida sem se tornar leviana.

O desempenho nasce na arquitetura, não no último sprint

Quem acelera um site ou uma aplicação web só pouco antes do go-live trata geralmente sintomas. Consultas grandes, modelos de dados pouco claros e casos especiais acrescentados posteriormente não se deixam corrigir de forma duradoura com um único dia de otimização.

Uma base sólida começa com uma base de dados que corresponda às relações reais na empresa. No MySQL 8, movimentos, documentos, alterações de estado e ações de utilizadores precisam de chaves rastreáveis e índices sensatos. Um stock não pode aparecer apenas como número se mais tarde for preciso esclarecer por que lançamento resultou. Ao mesmo tempo, não é preciso recalcular cada informação histórica a cada carregamento de página.

Nas aplicações web modernas também é relevante a separação de responsabilidades. O PHP 8.4 pode representar regras de negócio de forma clara e sustentável, enquanto o JavaScript moderno é usado de forma direcionada em áreas reativas. Isto não é uma profissão de fé num determinado stack. É uma questão de manutenção: podem as alterações ser implementadas com segurança daqui a seis meses? Vê-se onde uma regra vale? Pode um erro ser reproduzido, em vez de apenas suposto?

O desempenho precisa ainda de limites. Os campos de pesquisa precisam de um mínimo sensato de caracteres ou de uma lógica de filtro precisa, se forem imagináveis milhões de registos. As listas grandes precisam de páginas ou processos de carregamento graduais. Imagens e documentos não deveriam bloquear o fluxo de trabalho crítico. Estas decisões parecem pouco espetaculares. Precisamente por isso permanecem muitas vezes valiosas por mais tempo do que um efeito de frontend vistoso.

A velocidade visível cria confiança

Nem todo o processo pode terminar em menos de um segundo. Uma impressão de etiquetas, uma interface com o transportador ou uma verificação face a dados externos exige por vezes tempo. O decisivo é então como a aplicação lida com a espera.

Um estado claro como “A etiqueta de expedição está a ser criada” é melhor do que um botão congelado. Após uma conclusão, deveria ser visível que número foi gerado e se a operação pode ser acionada de novo. Se um serviço externo não estiver acessível, a equipa precisa de uma opção de ação compreensível em vez de uma mensagem de erro para programadores.

Esta é também uma questão de integridade de dados. Um duplo clique não pode criar duas entregas. Um processo interrompido não pode deixar silenciosamente um registo a meio. Os bons sistemas planeiam tais casos, porque eles ocorrerão no dia a dia. Especialmente com turnos em mudança, pressão de tempo e dispositivos móveis, a exceção não é um tema marginal.

A qualidade torna-se visível antes do erro

Para aplicações com muitas variantes de processo, não basta percorrer manualmente alguns caminhos no fim. Alterações de preços, perfis, validações ou interfaces podem desencadear consequências num ponto muito distante. Aqui, o teste automatizado torna-se parte do desempenho: não só tecnicamente, mas a nível organizacional.

Um sistema de testes deveria poder verificar fluxos reais, por exemplo criar uma encomenda, alterar uma posição, gerar uma guia de remessa e controlar uma permissão. Deveria registar evidências e formular resultados de modo que as áreas de negócio os consigam enquadrar. Uma frase como “O processo de expedição não foi concluído após a alteração de morada” ajuda mais do que um stack trace sem comentários.

Para equipas atentas à segurança, também é relevante o local onde estes testes correm. Se capturas de ecrã, credenciais, casos de teste ou passos internos da aplicação não devem sair da empresa, uma abordagem auto-hospedada é muitas vezes mais sensata do que um serviço cloud externo. Com a COCO, podem executar-se testes automatizados para aplicações web e Windows num ambiente dedicado. Isso não é necessário para todas as equipas. Com dados sensíveis, áreas reguladas ou aplicações especializadas internas, o controlo sobre os dados de teste pode, contudo, ser uma vantagem decisiva.

A conceção é boa quando facilita o trabalho

Uma identidade visual forte pode criar confiança. Mostra que uma empresa leva a sério a sua presença digital. No sistema operacional, porém, a conceção tem de fazer ainda mais: orientação sob pressão de tempo. Contraste, tipografia, estados claros e rótulos compreensíveis decidem se alguém conclui uma operação com segurança ou pergunta ao colega.

A contenção é aqui muitas vezes a melhor escolha. Um painel com dez indicadores coloridos pode parecer impressionante e, mesmo assim, esconder o único desvio relevante. Uma vista reduzida que torne visíveis receções de mercadorias em aberto, leituras em falta e prazos de entrega em risco é mais útil. A pergunta não é quanta interface é possível, mas que informação melhora uma decisão.

Isto vale também para aplicações responsivas. A capacidade móvel não significa comprimir cada ecrã de computador num formato menor. Um smartphone na receção de mercadorias talvez precise apenas de leitura, quantidade, localização e confirmação. O pós-processamento detalhado pertence possivelmente a um ecrã maior. Dispositivos diferentes merecem prioridades diferentes, embora acedam à mesma base de dados fiável.

Uma bitola sensata para a próxima decisão

Antes de uma equipa decidir sobre uma nova plataforma, uma automação ou uma reconstrução completa, ajuda uma verificação simples: o fluxo torna-se mais claro, mais rápido ou mais seguro para as pessoas que o executam diariamente? E a solução continua a poder ser compreendida quando mudam requisitos, colaboradores ou interfaces?

Se ambas as respostas forem sólidas, uma bela promessa torna-se um sistema utilizável. Então pure fluidity meets ultimate performance mostra-se não num diapositivo, mas num dia de trabalho calmo em que encomendas, dados e decisões prosseguem sem atrito desnecessário.
Permalink →

SaaS Flow Web: introduzir workflows em segurança com a operação em curso

SaaS Flow Web: introduzir workflows em segurança com a operação em curso

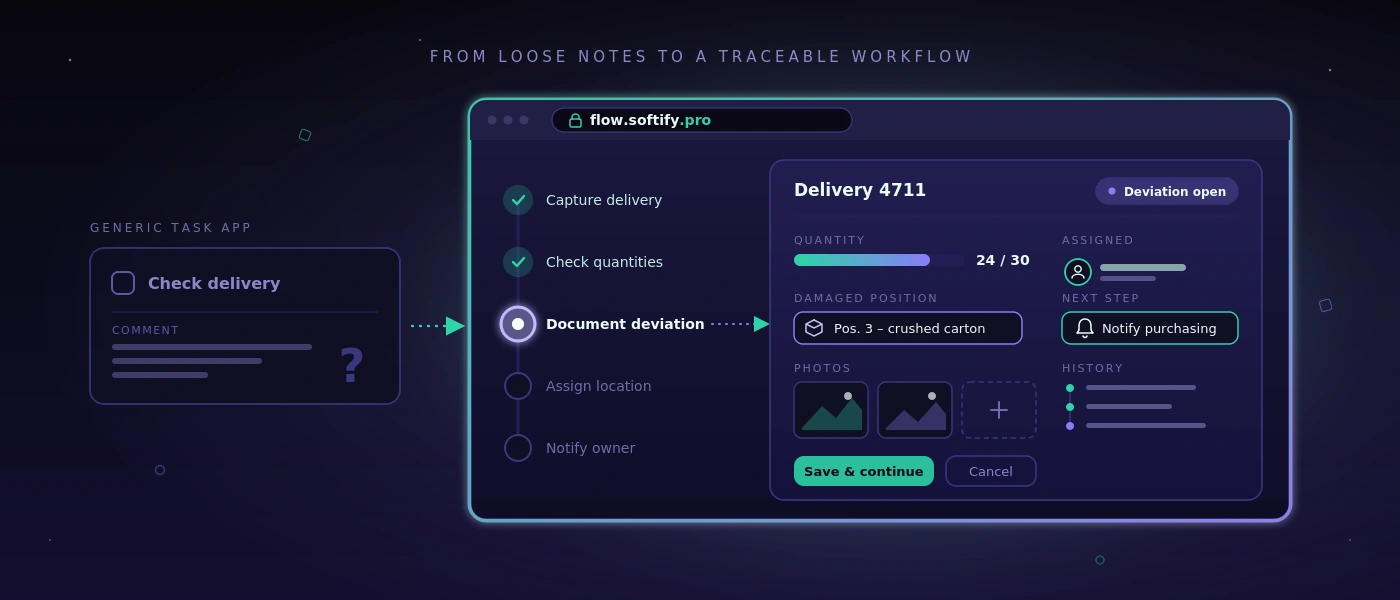
Uma receção de mercadorias não fica parada porque uma equipa não conhece mais um software. Fica parada porque a informação se perde entre e-mail, formulário em papel, ficheiro Excel e telefonema. No SaaS - “Flow Web” em flow.softify.pro - a primeira pergunta não deveria, por isso, ser a interface. O decisivo é se o serviço representa de forma fiável um fluxo de trabalho concreto - também em dias agitados, com responsabilidades em mudança e quando uma entrega não corresponde ao plano.

Para as pequenas e médias empresas, o SaaS faz muitas vezes sentido, porque não têm de construir primeiro servidores, versões e funções básicas próprios. Mas isso não é um passe livre para todos os processos. Quem introduz uma ferramenta que complica o dia a dia ou empurra dados importantes para listas secundárias pouco claras não digitaliza trabalho. Apenas desloca o atrito.

O que o SaaS “Flow Web” tem de oferecer

Um workflow web é bom quando os colaboradores sabem, sem interpretação, o que fazer a seguir. Numa receção de mercadorias isso pode significar: registar a entrega, verificar quantidades face à encomenda, documentar o desvio, atribuir uma localização e, se necessário, informar um responsável. O fluxo não tem de ser espetacular. Tem de ser rastreável, rápido e repetível.

É precisamente aqui que está a diferença entre uma aplicação geral de tarefas e um sistema de processos especializado. Uma aplicação de tarefas pode criar um ponto chamado “Verificar entrega”. Um workflow especializado pode, além disso, registar de que entrega se trata, quem a aceitou, que posição estava danificada, que fotografias existem e se está pendente uma entrega posterior. Estes dados não ficam então como texto livre num único comentário, mas onde a pessoa seguinte precisa deles.

Para uma solução como Flow Web em flow.softify.pro, a avaliação deveria, por isso, começar pelas operações, não por uma lista de funções. Uma empresa com cinco movimentos de armazém por dia precisa de algo diferente de uma equipa de expedição com vários horários-limite, diferentes transportadores e gestão regular de entregas parciais. O SaaS não substitui a compreensão do processo.

Primeiro nomear o estrangulamento, depois configurar

Muitos projetos de digitalização começam demasiado amplos: “Queremos digitalizar o armazém.” Soa plausível, mas leva depressa a um sistema com demasiados ecrãs, casos especiais e documentos de formação. Melhor é uma afirmação precisa como: “As receções de mercadorias só são lançadas no dia seguinte, porque as guias de remessa ficam na secretária no fim do turno.”

De uma frase assim pode derivar-se um início sensato. A primeira versão pode registar guias de remessa, confirmar artigos e quantidades, assinalar desvios e passar o lançamento ao setor responsável. Quando este fluxo funciona, etiquetas, avaliações de fornecedores ou propostas de encomenda automáticas podem ser acrescentadas mais tarde. Nem todo o passo de expansão sensato pertence ao primeiro arranque.

Também uma tabela bem mantida pode ficar se cumprir o seu propósito. Por exemplo, uma análise mensal com poucos participantes num ficheiro existente pode ser mais barata e transparente do que um módulo próprio. O SaaS compensa onde a informação é usada várias vezes, os tempos de tratamento são críticos ou os erros surgem de rupturas de suporte.

As perguntas certas antes da introdução

Antes da configuração, uma equipa deveria percorrer uma operação real do princípio ao fim. Não o processo ideal, mas o caso que cria problemas no dia a dia: quantidade errada, referência em falta, expedição urgente ou uma encomenda com aprovação especial. Assim mostram-se as regras que um sistema tem realmente de representar.

São relevantes, entre outros, estes pontos: quem pode criar, alterar ou encerrar uma operação? Que entradas são obrigatórias e quais apenas úteis? Quando tem de ser informado um responsável? Que dados são passados à contabilidade, expedição ou apoio ao cliente? E o que acontece se o WLAN do armazém for fraco ou um colaborador já não tiver as suas credenciais?

As respostas determinam a qualidade da introdução mais fortemente do que um longo catálogo de requisitos visuais. Um processo de perfis limpo, uma mensagem de erro compreensível e um passo de aprovação documentado evitam na operação geralmente mais esforço do que um relatório adicional na página inicial.

Conservação de dados e perfis não são um assunto secundário

O SaaS é frequentemente tratado como uma mera questão de utilização. Para os responsáveis de operações e de TI é, contudo, pelo menos igualmente importante o que acontece aos dados. Isso diz respeito a dados mestre, informações de entrega, dados de colaboradores, fotografias de danos e possivelmente dados de clientes. Antes da introdução deveriam estar claras as responsabilidades, a conservação e as possibilidades de exportação.

Na prática significa: a empresa tem de saber que dados estão no sistema, quem tem acesso administrativo e como os dados são disponibilizados numa mudança ou cessação de contrato. Uma exportação disponível apenas como ficheiro PDF de leitura difícil raramente ajuda. Para dados operacionais, formatos estruturados e utilizáveis são decisivos.

Também o conceito de permissões merece atenção concreta. No armazém, nem todas as pessoas precisam de ver preços, condições de clientes ou definições globais. Ao mesmo tempo, uma atribuição de direitos demasiado estreita não deve bloquear o fluxo. Fazem sentido perfis alinhados com as atividades reais: receção, planeamento, expedição, chefia de equipa e administração. As alterações críticas deveriam ser rastreáveis, para que, em caso de perguntas, não seja preciso adivinhar quem alterou um lançamento.

O acesso em si deveria ser protegido com bases sólidas. Isso inclui políticas de palavras-passe seguras, uma reposição de palavra-passe regulada, bloqueio de conta após tentativas falhadas repetidas e, onde o perfil de risco o exija, passos de início de sessão adicionais. A segurança parece profissional quando é previsível e não se nota apenas quando alguém ficou bloqueado.

Integração só onde alivia de forma mensurável

Um workflow web muitas vezes só desenvolve o seu valor em interação com sistemas existentes. Pode ser um ERP, uma loja, uma solução de expedição, um registo de tempos ou uma base de dados. Mesmo assim, nem toda a interface é automaticamente sensata. Cada integração cria dependências, quadros de erro e esforço de manutenção.

A pergunta central é: que passo manual a ligação elimina concretamente? Se uma interface poupa por dia 30 minutos de trabalho de transferência e reduz erros de digitação, o benefício é claro. Se apenas espelha uma informação que de qualquer forma é verificada uma vez por semana, uma exportação manual pode, de início, ser a solução mais razoável.

Nas extensões individuais conta a base técnica. Interfaces documentadas, campos de dados claramente definidos e registos de erros rastreáveis facilitam a operação posterior. Se um sistema for ligado a uma aplicação web à medida, tecnologias e estrutura da base de dados deveriam ser escolhidas de forma a manterem-se sustentáveis a longo prazo. Uma aplicação cuidada baseada em PHP 8.4, JavaScript moderno e MySQL 8 vale mais do que uma solução especial impressionante a curto prazo mas sem documentação.

Introdução com a operação em curso

O erro mais frequente é um arranque brusco sem fase de comparação. As equipas têm então de trabalhar de outra forma logo na segunda-feira de manhã, enquanto as perguntas em aberto só surgem de problemas reais. Isso aumenta a rejeição, mesmo que o software em princípio sirva.

Melhor é um piloto limitado com uma equipa, uma variante de processo ou uma zona de local claramente definida. Nesse tempo verifica-se se o registo e as aprovações funcionam, se os termos são compreensíveis e se os casos excecionais aterram de forma limpa. É importante não recolher o feedback apenas como lista de desejos. Cada alteração deveria ser confrontada com o benefício para o tempo de passagem, a taxa de erros ou a transparência.

Também os indicadores deveriam ser definidos cedo. Por exemplo, podem observar-se o tempo de tratamento por receção de mercadorias, o número de desvios em aberto, as consultas sobre o estado de entrega ou os lançamentos de correção. Sem valor de partida, “parece mais rápido” continua a ser a única avaliação. Pode ser verdade, mas não basta para uma decisão de investimento sólida.

A operação precisa de um dono claro

O SaaS reduz o esforço técnico, mas não liberta uma empresa da responsabilidade pelo seu próprio processo. Internamente é preciso alguém que gira perfis, reúna feedback, reconheça necessidades de formação e decida que alterações são realmente necessárias. Esta pessoa não tem de saber programar. Mas deveria compreender o fluxo de trabalho e ter acesso aos responsáveis.

Igualmente importante é uma documentação operacional breve e sólida. Não explica cada ecrã, mas responde às perguntas que surgem no dia a dia: o que fazer perante um lançamento errado? Quem aprova novos utilizadores? Como é comunicada uma falha? Onde estão os dados exportados? Tal clareza evita que um sistema digital volte, após poucos meses, a depender de chamadas pessoais.

Uma boa solução SaaS não se reconhece, por isso, pelo número de itens de menu que oferece. Mostra o seu valor quando uma nova colega consegue tratar uma operação com segurança, um desvio não desaparece e um responsável vê o estado sem telefonar a três pessoas. O Flow Web deveria ser medido precisamente por esta bitola: não por promessas, mas por um dia de trabalho que decorre comprovadamente mais calmo e fiável.

Permalink →

Desenvolvimento web com frameworks atuais: o que as empresas realmente ganham

Desenvolvimento web com frameworks atuais: o que as empresas realmente ganham

Se uma receção de mercadorias ainda oscila entre formulário em papel, telefonema e três ficheiros Excel, um frontend moderno por si só não resolve o problema. O desenvolvimento web com frameworks atuais faz sentido quando simplifica visivelmente os fluxos: os colaboradores veem o passo seguinte, os dados são registados apenas uma vez e a aplicação permanece compreensivelmente sustentável mesmo após o primeiro go-live.

Para as pequenas e médias empresas, a questão do framework não é, por isso, uma questão de fé. O decisivo não é se uma interface traz especialmente muitas palavras técnicas da moda. O decisivo é se os movimentos de armazém, encomendas, verificações ou aprovações atravessam o dia de trabalho de forma fiável - também sob pressão de tempo, em mudanças de turno e com ligação de rede instável.

Os frameworks são um meio, não um objetivo de projeto

Um framework fornece uma estrutura comprovada para tarefas recorrentes: encaminhamento, formulários, gestão de permissões, acesso a dados, testes e a apresentação de interfaces. Isso não reduz automaticamente todos os riscos. Mas evita que um projeto tenha de reinventar sempre de novo as funções básicas.

Numa aplicação web à medida, um framework JavaScript moderno pode, por exemplo, representar de forma sensata ecrãs interativos: uma lista de picking que atualiza continuamente as posições, um planeamento de rotas com mudanças de estado claras ou um protocolo de inspeção que atribui fotografias e comentários diretamente a uma operação. No backend, frameworks PHP consolidados asseguram regras rastreáveis, responsabilidades claramente separadas e interfaces consistentes com a base de dados.

Isto é particularmente relevante quando uma solução inicialmente pequena se torna um sistema operacional usado diariamente para um processo. Um ecrã de entrada para avisos de entrega pode começar de forma contida. Assim que atualiza stocks, emite etiquetas, considera perfis e comunica com um transportador, precisa de uma base técnica limpa. Os frameworks ajudam a não renegociar essa base a cada extensão.

O que os frameworks web atuais fazem concretamente melhor

O valor dos frameworks modernos raramente está em efeitos espetaculares. Mostra-se nas partes invisíveis de uma aplicação. Os formulários podem verificar entradas diretamente, sem que dados errados só se tornem visíveis após o envio. As permissões podem ser definidas centralmente, de modo que um condutor veja outras informações do que o planeamento. As alterações a uma encomenda são guardadas de forma rastreável, em vez de substituírem silenciosamente uma célula de tabela.

No lado do servidor, um ambiente atual com PHP 8.4 e MySQL 8 cria uma base sólida para lógica crítica para o negócio. As transações de base de dados impedem, por exemplo, que um stock seja reduzido enquanto o lançamento correspondente falha. Chaves únicas e regras de validação evitam duplicados. Processos em segundo plano podem gerar documentos ou chamar interfaces sem que a pessoa ao ecrã tenha de esperar.

Também a segurança não é uma função posterior. Um framework atual suporta armazenamento seguro de palavras-passe, proteção contra ataques típicos por entrada de dados, sessões rastreáveis e fluxos de bloqueio de conta definidos. Ainda assim, a implementação continua a ser uma tarefa de projeto: as permissões têm de ser modeladas corretamente do ponto de vista funcional e as funções sensíveis exigem verificações adicionais. Um framework fornece guarda-corpos, mas não sabe quem na empresa pode conceder que aprovação.

Decidir bem sobre o desenvolvimento web com frameworks atuais

A melhor tecnologia não surge de uma lista de ferramentas populares, mas da utilização real. Uma aplicação interna para dez pessoas tem requisitos diferentes de um portal de clientes com vários milhares de acessos simultâneos. Um terminal de armazém com scanner precisa de uma lógica de operação diferente de uma análise de gestão no computador.

Por isso, uma decisão sensata começa com perguntas concretas: que operações custam hoje tempo de forma mensurável? Que dados são transferidos várias vezes? Onde surgem erros porque a informação só se torna visível demasiado tarde? Que tabela existente funciona suficientemente bem e deveria, por agora, ficar? Precisamente o último ponto protege de projetos de digitalização caros sem benefício operacional.

Para muitas aplicações empresariais à medida, um sistema renderizado no servidor com componentes interativos específicos é a escolha mais sensata. Carrega depressa, é gerível de operar e evita complexidade desnecessária. Uma aplicação de página única totalmente desacoplada pode, pelo contrário, ser adequada quando a interface processa muitíssimos estados dinâmicos, tem de funcionar offline ou deve mais tarde disponibilizar as mesmas funções também a uma app móvel.

Ambas podem estar certas do ponto de vista funcional. A pergunta não é: qual framework é o mais moderno? É: qual arquitetura continuará, daqui a dois anos, a ser segura de expandir, testável e compreensível para a própria equipa?

Quando menos técnica é a melhor técnica

Nem todo o processo precisa de um frontend complexo. Um ecrã de entrada enxuto para encomendas internas pode ser mais rápido, mais estável e mais barato do que uma interface elaboradamente animada. Se um ficheiro Excel é mantido apenas uma vez por mês e não causa erros, talvez continue a ser a ferramenta certa.

A complexidade só compensa quando elimina atrito real. Pode ser o caso quando as encomendas são digitadas várias vezes, o estado de entrega tem de ser consultado por telefone ou ninguém tem a certeza de que versão de um documento é a válida. Então uma aplicação central cria um benefício claro: um estado de dados, responsabilidades inequívocas e menos consultas.

A manutenibilidade começa antes da primeira linha de código

Os frameworks são muitas vezes vistos como aceleradores. Isso só é verdade se as regras de negócio estiverem antes suficientemente claras. Um programador pode construir uma máquina de estados de forma tecnicamente limpa. Mas se a sequência de estados se adequa realmente ao processo decide-se no levantamento: quando é que a mercadoria se considera recebida? Quem pode fechar um desvio? O que acontece numa entrega parcial?

Estas decisões devem ser documentadas, tal como interfaces, campos de dados e exceções. Isso não torna os projetos mais lentos. Reduz discussões posteriores, porque se torna visível que regra foi implementada deliberadamente e que pressuposto continua em aberto.

A manutenibilidade mostra-se também em pequenas disciplinas. As alterações à base de dados têm de ser versionadas. Os passos de implementação têm de ser documentados. As mensagens de erro devem ser aproveitáveis para operação e desenvolvimento sem revelar detalhes confidenciais. Testes automatizados verificam a cada alteração os fluxos centrais, por exemplo a criação de uma encomenda, o cálculo de uma quantidade ou a emissão de uma guia de remessa.

Em aplicações críticas, um único tipo de teste não basta. Os testes unitários asseguram regras individuais, os testes de integração verificam a interação com a base de dados e as interfaces, e os testes de ponta a ponta reproduzem no navegador percursos de utilização reais. Para aplicações web e Windows, um ambiente de testes auto-hospedado pode ainda fornecer capturas de ecrã, registos de execução e avaliações compreensíveis, sem entregar desnecessariamente dados de teste internos a serviços cloud externos.

O desempenho nasce da arquitetura e do modelo de dados

Uma interface moderna não se torna rápida só por usar um framework atual. Consultas lentas à base de dados, imagens sobredimensionadas ou interfaces pouco claras continuam lentas, independentemente do frontend. Especialmente em listas de encomendas, artigos ou dados de movimentos, é o modelo de dados que decide a velocidade percebida.

Índices limpos no MySQL 8, consultas paginadas e dados carregados de forma consciente são muitas vezes mais eficazes do que uma otimização posterior da interface. Igualmente importante é um conceito claro de cache. Os dados mestre podem, em certas circunstâncias, ser colocados em cache, os stocks atuais ou o estado de aprovação, pelo contrário, não às cegas. Aqui não existe regra geral, porque o significado funcional dos dados determina quão atuais têm de ser.

O design responsivo também faz parte do planeamento técnico. No ecrã de escritório, uma tabela larga pode fazer sentido. Num scanner de mão ou tablet no armazém, a mesma informação precisa de grandes áreas de toque, caminhos curtos e uma apresentação que continue utilizável mesmo com luvas ou com pouca luz. Pure fluidity meets ultimate performance não significa, neste contexto, o máximo de movimento possível no ecrã. Significa que a aplicação funciona sem atrito no dispositivo que é realmente usado no processo.

O caminho sensato da ideia à operação

Um projeto web sólido começa com um núcleo limitado e verificável. Em vez de automatizar de antemão cada exceção imaginável, escolhe-se um processo que ocorre com frequência e causa esforço percetível. Após a primeira utilização, dados e retornos reais mostram que extensão tem realmente a prioridade seguinte.

A entrega técnica não deveria ocorrer só no fim. As responsabilidades por alojamento, cópias de segurança, monitorização, atualizações e direitos de acesso têm de ser esclarecidas cedo. Um sistema é tão fiável quanto a sua operação. Quem precisa de uma aplicação diariamente para expedição ou tratamento de encomendas precisa de caminhos de recuperação definidos e de uma resposta clara ao que acontece em caso de falha.

A softify.pro aposta, por isso, em tecnologias sustentáveis, entrega documentada e responsabilidade técnica direta em vez de modas passageiras de frameworks. Isso não é um atalho mágico. Cria o pressuposto de que uma aplicação continue a funcionar após o lançamento, possa ser desenvolvida e não se torne o próximo caso especial frágil.

A aplicação web certa, no melhor dos casos, não se sente como um novo projeto de TI. Sente-se como um fluxo que finalmente funciona sem desvios - com substância técnica suficiente para acolher com calma também a próxima alteração na operação.

Permalink →

Entre em contacto

Tem um projeto em mente, um fluxo de trabalho que ainda funciona com folhas de Excel e boa vontade, ou um atraso em testes que a COCO poderia retirar da sua equipa? Conte-nos sobre isso.

Enviar mensagem