
softify.pro
Ładowanie …
Usługi O nas COCO – nasz serwer AI Portfolio Insiders Case Studies Warto wiedzieć Kontakt Logowanie

NEXT-GEN SOFTWARE AESTHETIC

Pure fluidity meets ultimate performance.

Nowa wizualna tożsamość dla nowoczesnych cyfrowych przepływów pracy.

softify.pro — Nowa wizualna tożsamość dla nowoczesnych cyfrowych przepływów pracy.

Przewiń, aby odkryć ↓

Oprogramowanie zbudowane tak, jak naprawdę działają nowoczesne firmy

softify.pro to studio oprogramowania oparte na jednej idei: technologia powinna poruszać się tak płynnie, jak firmy, które wspiera. Działamy na styku nowoczesnego rozwoju stron internetowych, automatyzacji procesów, i zastosowanej sztucznej inteligencji — trzech dziedzin, które rzadko spotyka się pod jednym dachem, ale które coraz bardziej do siebie pasują. Nasi klienci to zarówno małe firmy wdrażające swój pierwszy cyfrowy proces fakturowania, jak i ugruntowane średnie przedsiębiorstwa produkcyjne zastępujące arkusze Excel prawdziwym oprogramowaniem logistycznym. Łączy ich nie wielkość, lecz ambicja: chcą systemów, które są szybkie, niezawodne, i przyjemne w użyciu — nie tylko funkcjonalne. Każdy projekt zaczynamy od tych samych trzech pytań: Co ta firma naprawdę musi przyspieszyć? Co już działa dobrze i powinno być uszanowane, a nie zastąpione? I która część procesu pracy może, raz dobrze zbudowana, w przyszłości wykonywać się sama? Odpowiedzi określają wszystko, co następuje — od wybranej technologii po plan wdrożenia.

Usługi

Nowa wizualna tożsamość dla nowoczesnych cyfrowych przepływów pracy.

01 — LOGISTICS

Automatyzacja logistyki — dla małych i średnich firm w regionie DACH

Znaczna część naszej pracy poświęcona jest oprogramowaniu logistycznemu i operacyjnemu dla małych i średnich firm w Niemczech, Austrii, i Szwajcarii. Firmy te często stają przed dwiema mało atrakcyjnymi opcjami: drogimi pakietami logistycznymi klasy enterprise, zaprojektowanymi dla korporacji dziesięciokrotnie większych, albo mieszanką arkuszy Excel, formularzy papierowych, i rozmów telefonicznych, która cicho ogranicza tempo ich rozwoju.

Budujemy środkową drogę — automatyzację dopasowaną do rzeczywistego sposobu pracy konkretnego magazynu, warsztatu, czy zespołu sprzedaży. Może to oznaczać: cyfryzację przyjęcia towaru i ruchów magazynowych, automatyczne tworzenie dokumentów dostawy i etykiet wysyłkowych, połączenie przyjmowania zamówień z planowaniem tras, albo po prostu zastąpienie kruchego pliku Excel, który rozumie tylko jedna osoba, systemem, na którym może polegać cały zespół. Ponieważ pracujemy bezpośrednio z właścicielami i kierownikami zakładów w regionie DACH, wymagania są zbierane w języku, w którym firma faktycznie działa, a wdrożenie jest planowane wokół rzeczywistych grafików zmian i rzeczywistych powierzchni magazynowych — nie wokół abstrakcyjnego planu projektu.

02 — WEB

Nowoczesny rozwój stron internetowych z aktualną technologią

Projektujemy i rozwijamy aplikacje internetowe oraz strony z aktualną, aktywnie utrzymywaną technologią — a nie z przestarzałymi frameworkami, utrzymywanymi przy życiu tylko z przyzwyczajenia. Oznacza to czysty PHP 8.4 w backendzie, tam gdzie klasyczna aplikacja renderowana po stronie serwera jest właściwym wyborem, nowoczesny JavaScript tam, gdzie liczy się interaktywność, i MySQL 8 dla danych, które muszą pozostać spójne i przeszukiwalne przez lata — nie tylko w pierwszych sześciu miesiącach po uruchomieniu. Każdy projekt jest planowany od pierwszego szkicu jednakowo pod kątem komputerów i urządzeń mobilnych, a nie dostosowywany później: czasy ładowania, punkty przełamania układu, i obsługa dotykowa są częścią specyfikacji, a nie późniejszym dodatkiem.

Oprócz widocznego interfejsu ważne jest dla nas, jak strona wygląda od środka: czytelny kod, schemat bazy danych, którego nie trzeba przebudowywać przy każdej kolejnej prośbie o funkcję, i kroki wdrożenia, które może wykonać też drugi programista bez pytań. Strona, która jest dziś wydajna, a za trzy lata wciąż da się ją czysto rozbudować, jest dla nas prawdziwą definicją „nowoczesności".

03 — AI / COCO

COCO — nasz własny serwer AI do automatycznego testowania oprogramowania

Dla klientów enterprise obsługujemy i utrzymujemy własny dedykowany serwer AI o nazwie COCO. W przeciwieństwie do ogólnego chatbota, wbudowanego później w przepływ pracy, COCO jest celowo zaprojektowany i samodzielnie hostowany do automatycznego testowania aplikacji internetowych oraz wieloplatformowych aplikacji desktopowych — od procesów logowania i uwierzytelniania po kompletne, wieloetapowe procesy biznesowe.

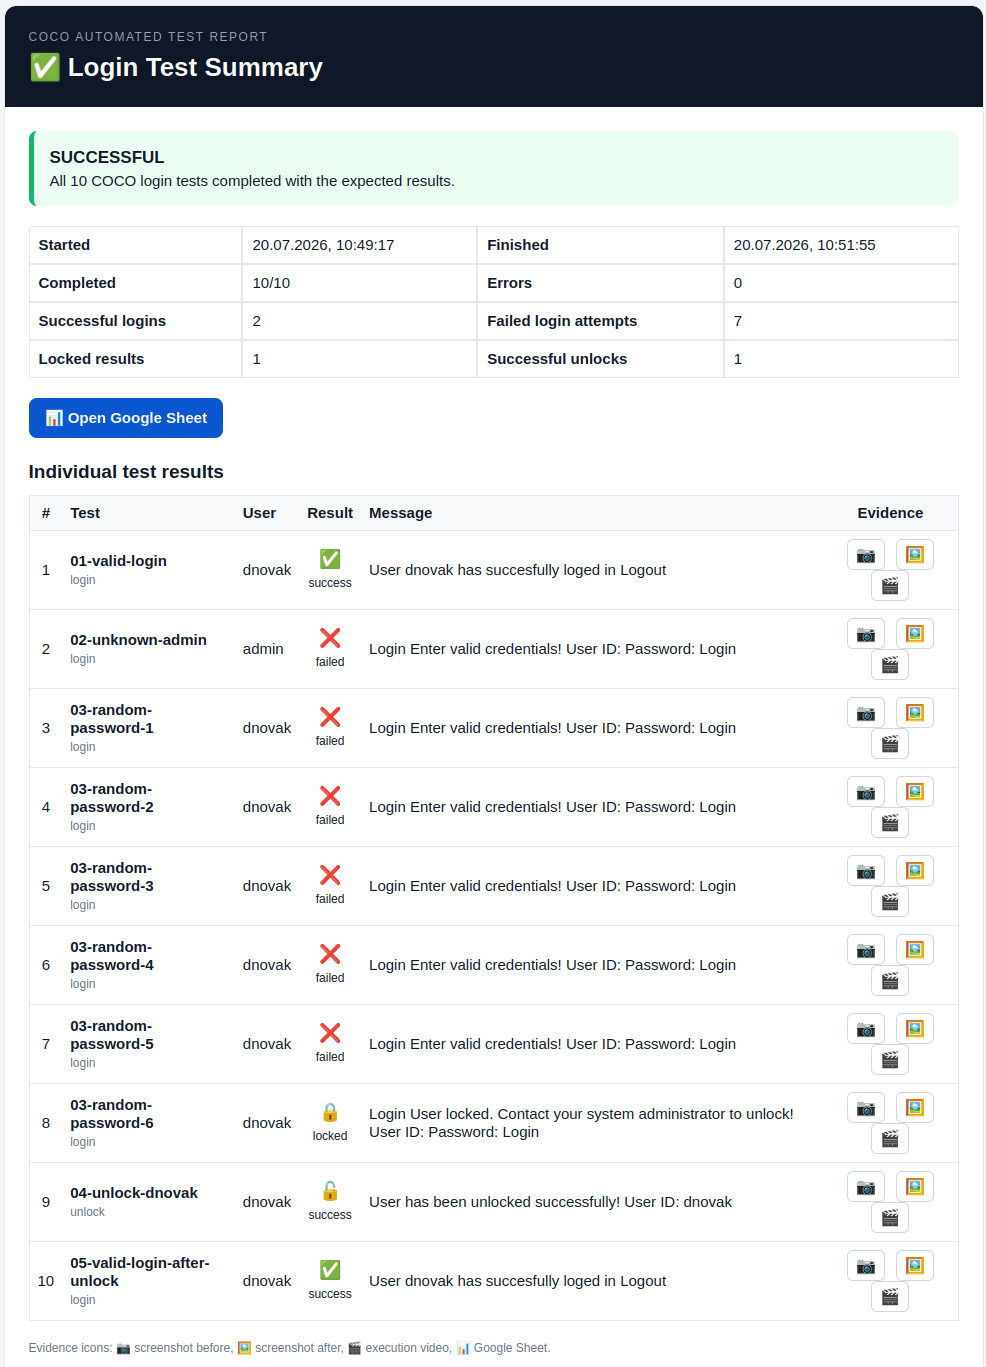
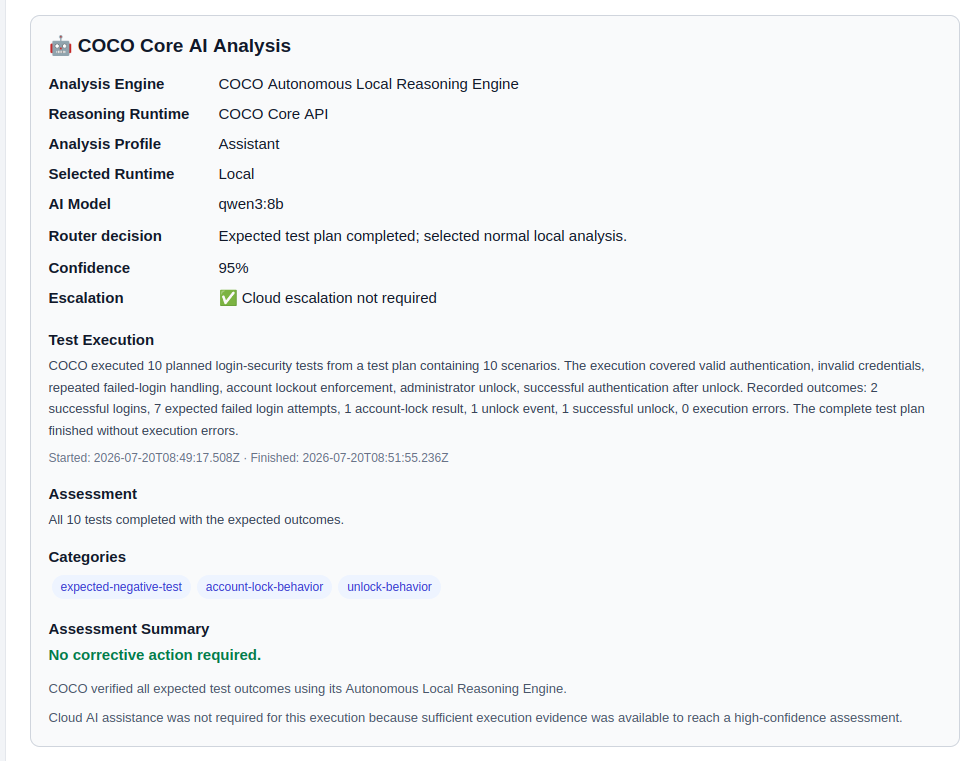
COCO planuje scenariusz testowy, wykonuje go na rzeczywistej aplikacji, rejestruje zrzuty ekranu przed i po jako dowód, i tworzy zrozumiałą ocenę tego, co zadziałało, co zawiodło, i dlaczego — w tym przypadki brzegowe, takie jak powtarzające się nieudane logowania, blokady kont, i procesy odzyskiwania, które są ręcznie żmudne i podatne na błędy przy testowaniu. Ponieważ serwer działa lokalnie i pod naszym zarządzaniem, klienci enterprise zachowują pełną kontrolę nad tym, gdzie przechowywane są dane testowe i zrzuty ekranu, bez domyślnego wysyłania wewnętrznego ruchu aplikacji do zewnętrznej usługi chmurowej.

COCO konfigurujemy indywidualnie dla każdego klienta enterprise, konfigurujemy i utrzymujemy serwer — definiujemy plany testowe istotne dla danej aplikacji, dostrajamy progi pewności, i decydujemy od przypadku do przypadku, kiedy wynik powinien zostać eskalowany do ludzkiej weryfikacji. Celem nie jest zastąpienie zespołu QA, lecz danie mu niestrudzonej koleżanki, która przechodzi przez powtarzalne testy regresyjne przed każdym wydaniem, zanim człowiek w ogóle musi interweniować.

COCO automated login test report
COCO — automated login & account-lockout test report
COCO AI analysis panel
COCO — plain-language AI analysis of a completed test run

Dlaczego softify.pro

Świadomie pozostajemy na tyle mali, że każdy projekt prowadzą osoby, które były obecne już przy pierwszej rozmowie planistycznej — zamiast być przekazywanym dalej do kolejki. Oznacza to krótsze pętle informacji zwrotnej, mniej nieporozumień, i zespół, który nawet po sześciu miesiącach wciąż pamięta, dlaczego podjęto daną decyzję. Wolimy niespektakularną, sprawdzalną niezawodność od krótkotrwałych trendów: stos technologiczny wybieramy, ponieważ pasuje do problemu i może być utrzymywany przez kogoś innego niż my za pięć lat — nie dlatego, że był akurat modny w bieżącym sprincie. Jeśli arkusz Excel faktycznie lepiej wykonuje zadanie niż indywidualne oprogramowanie, powiemy Ci to szczerze. Naszym celem jest proces pracy, który naprawdę działa szybciej — nie po prostu wyższy rachunek za oprogramowanie.

Wybrane prace

Niewielki wybór prac, które możemy pokazać publicznie — kolejne studia przypadków i projekty enterprise przedstawiamy na życzenie, pod NDA.

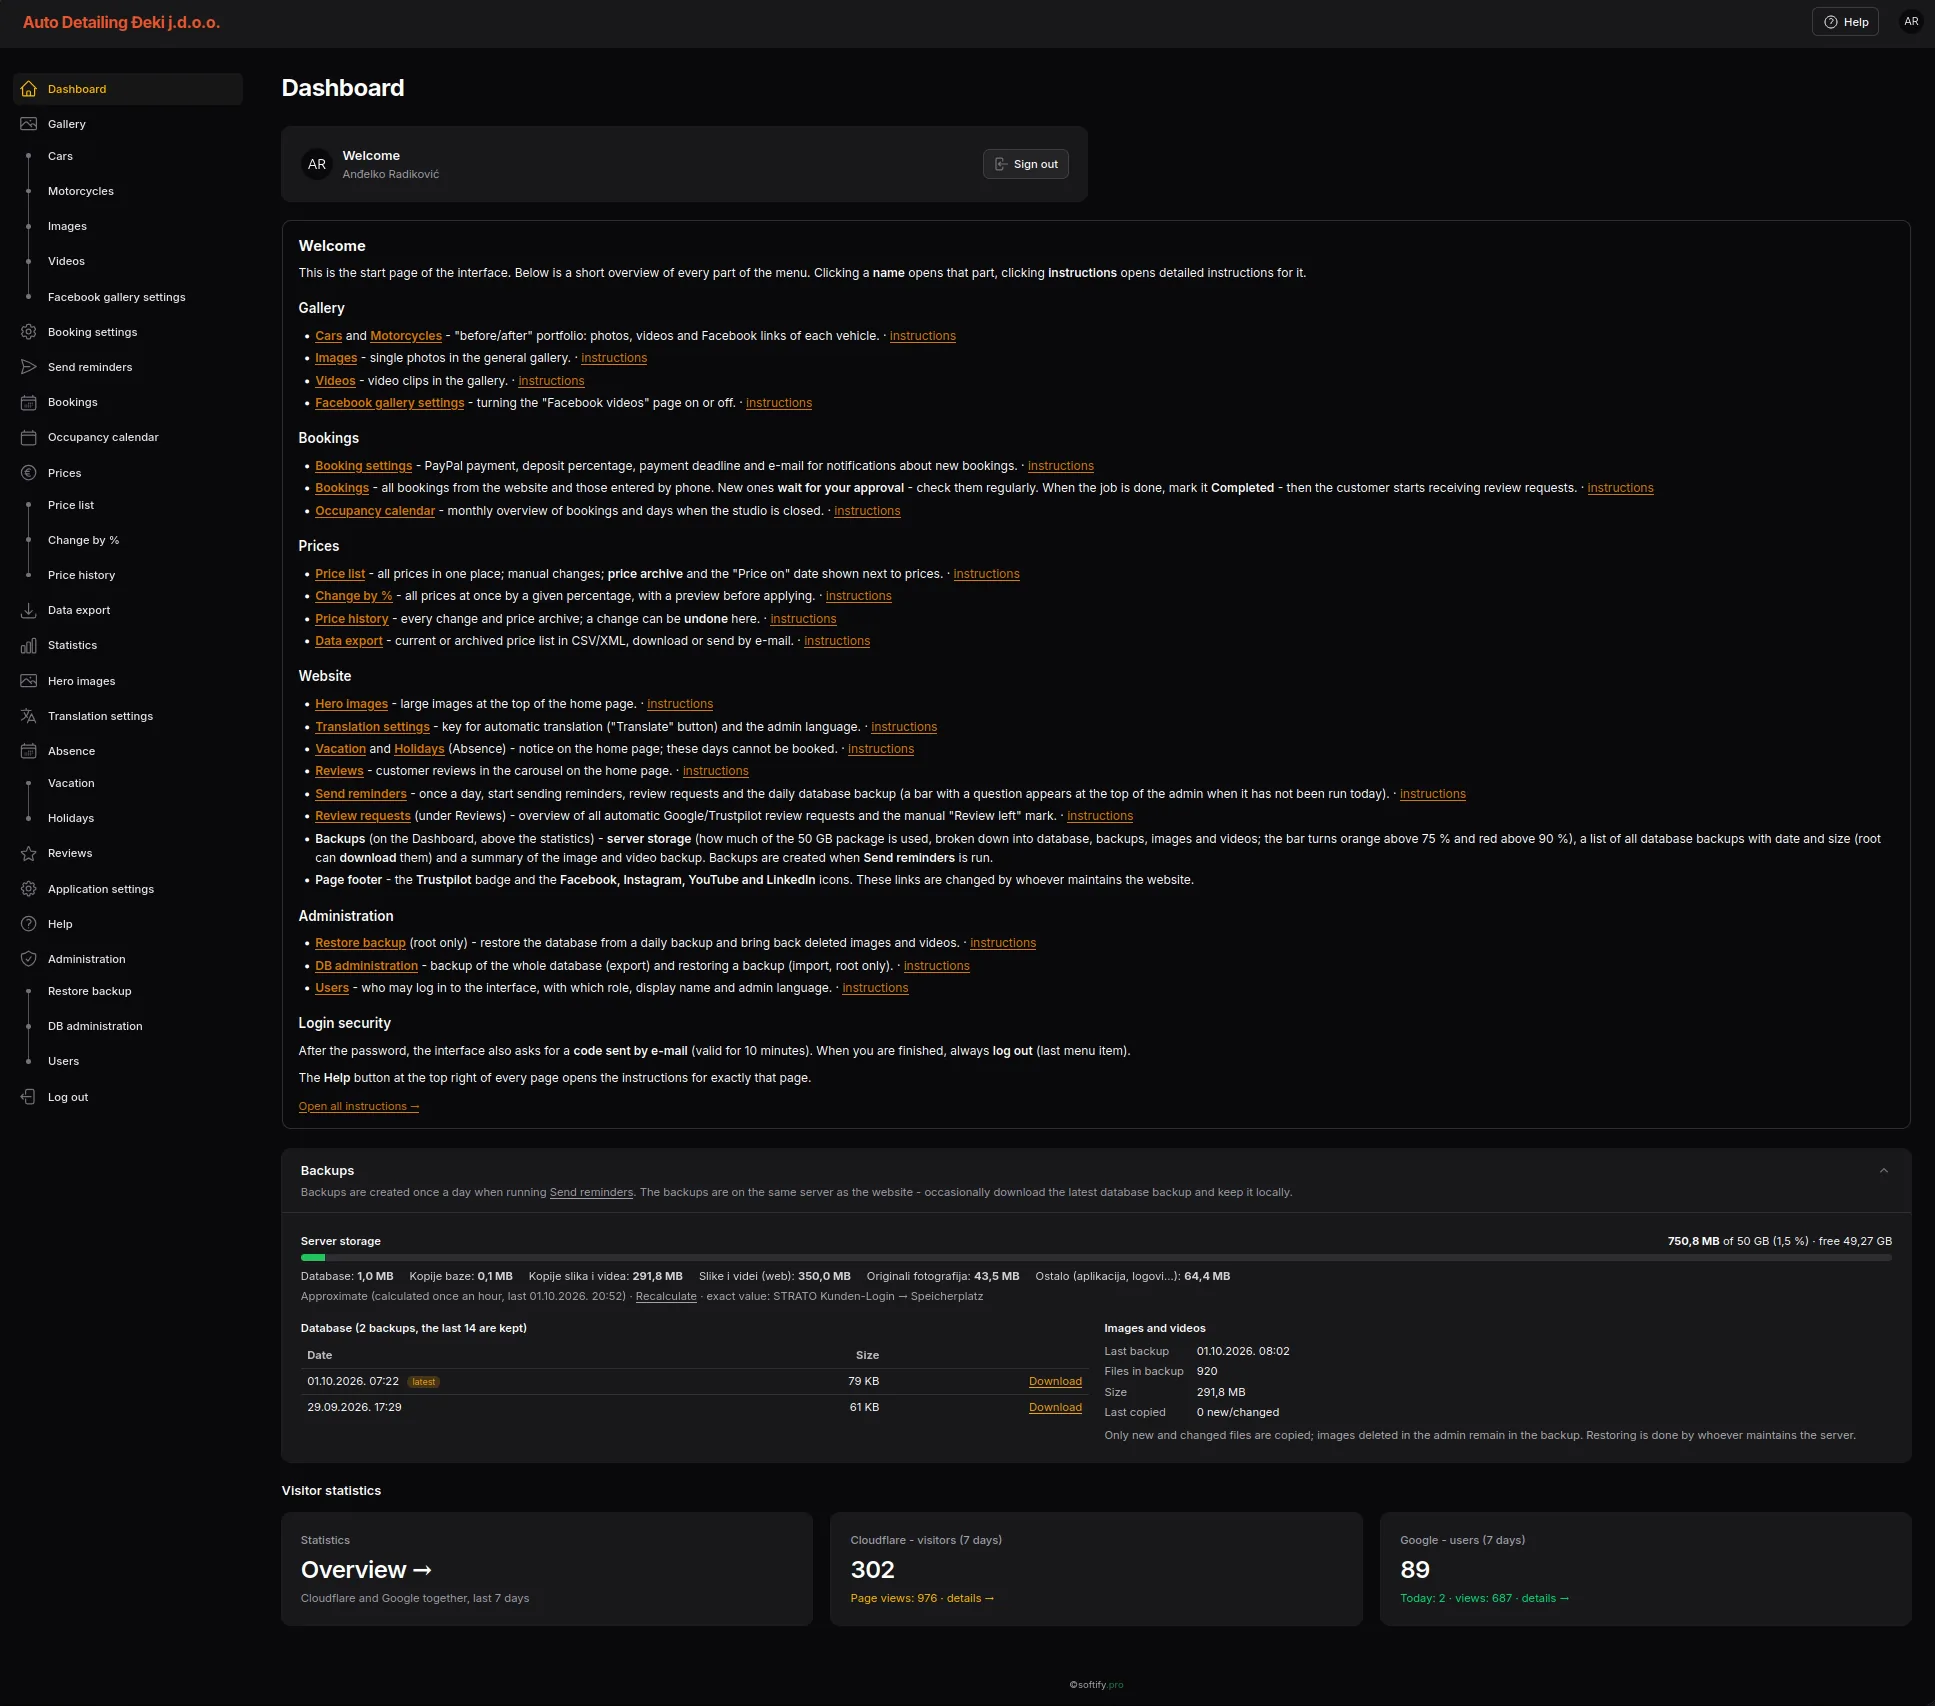
Auto Detailing Đeki – Od strony internetowej do cyfrowej platformy usługowej autodetailing-deki.pro

Auto Detailing Đeki – Od strony internetowej do cyfrowej platformy usługowej

Wielojęzyczna platforma do detailingu samochodowego – od kalkulacji ceny przez rezerwację po przejrzyste śledzenie zamówień, zarządzana z jednego centralnego zaplecza (backoffice).

Koralpenhaus

Koralpenhaus

Regionalna strona prezentacyjno-rezerwacyjna w regionie alpejskim, zbudowana z naciskiem na przejrzystą strukturę, szybkie ładowanie, i łatwe utrzymanie treści.

Dexosano

Dexosano

Nowoczesna platforma internetowa oparta na PHP, zbudowana z tym samym podejściem stawiającym wydajność na pierwszym miejscu, jakie softify.pro stosuje w każdym projekcie dla klienta.

softify.pro - Insiders

Jeden magazyn. Jedna prawda.

Jeden magazyn. Jedna prawda.

Istnieje prosty sposób, by oprogramowanie magazynowe wyglądało przekonująco.
Otwórz pulpit nawigacyjny.
Pokaż kilka zielonych liczb.
Dodaj wykres.
Umieść trochę zapasów na mapie magazynu.
Zakończ raportem.
Wszystko wygląda dobrze.
A mimo to wszystko może być błędne.
Bo magazynowi nie zależy na tym, jak dobrze wygląda pulpit.
Zależy mu na tym, czy każda część systemu zgadza się co do tego, co naprawdę się wydarzyło.
To stało się interesującą częścią najnowszego eksperymentu softify.pro Flow.
Nie kolejny ekran.
Nie kolejny KPI.
Nie kolejny raport.
Coś dużo mniej widocznego.
Spójność.
Zaczęło się od magazynu.
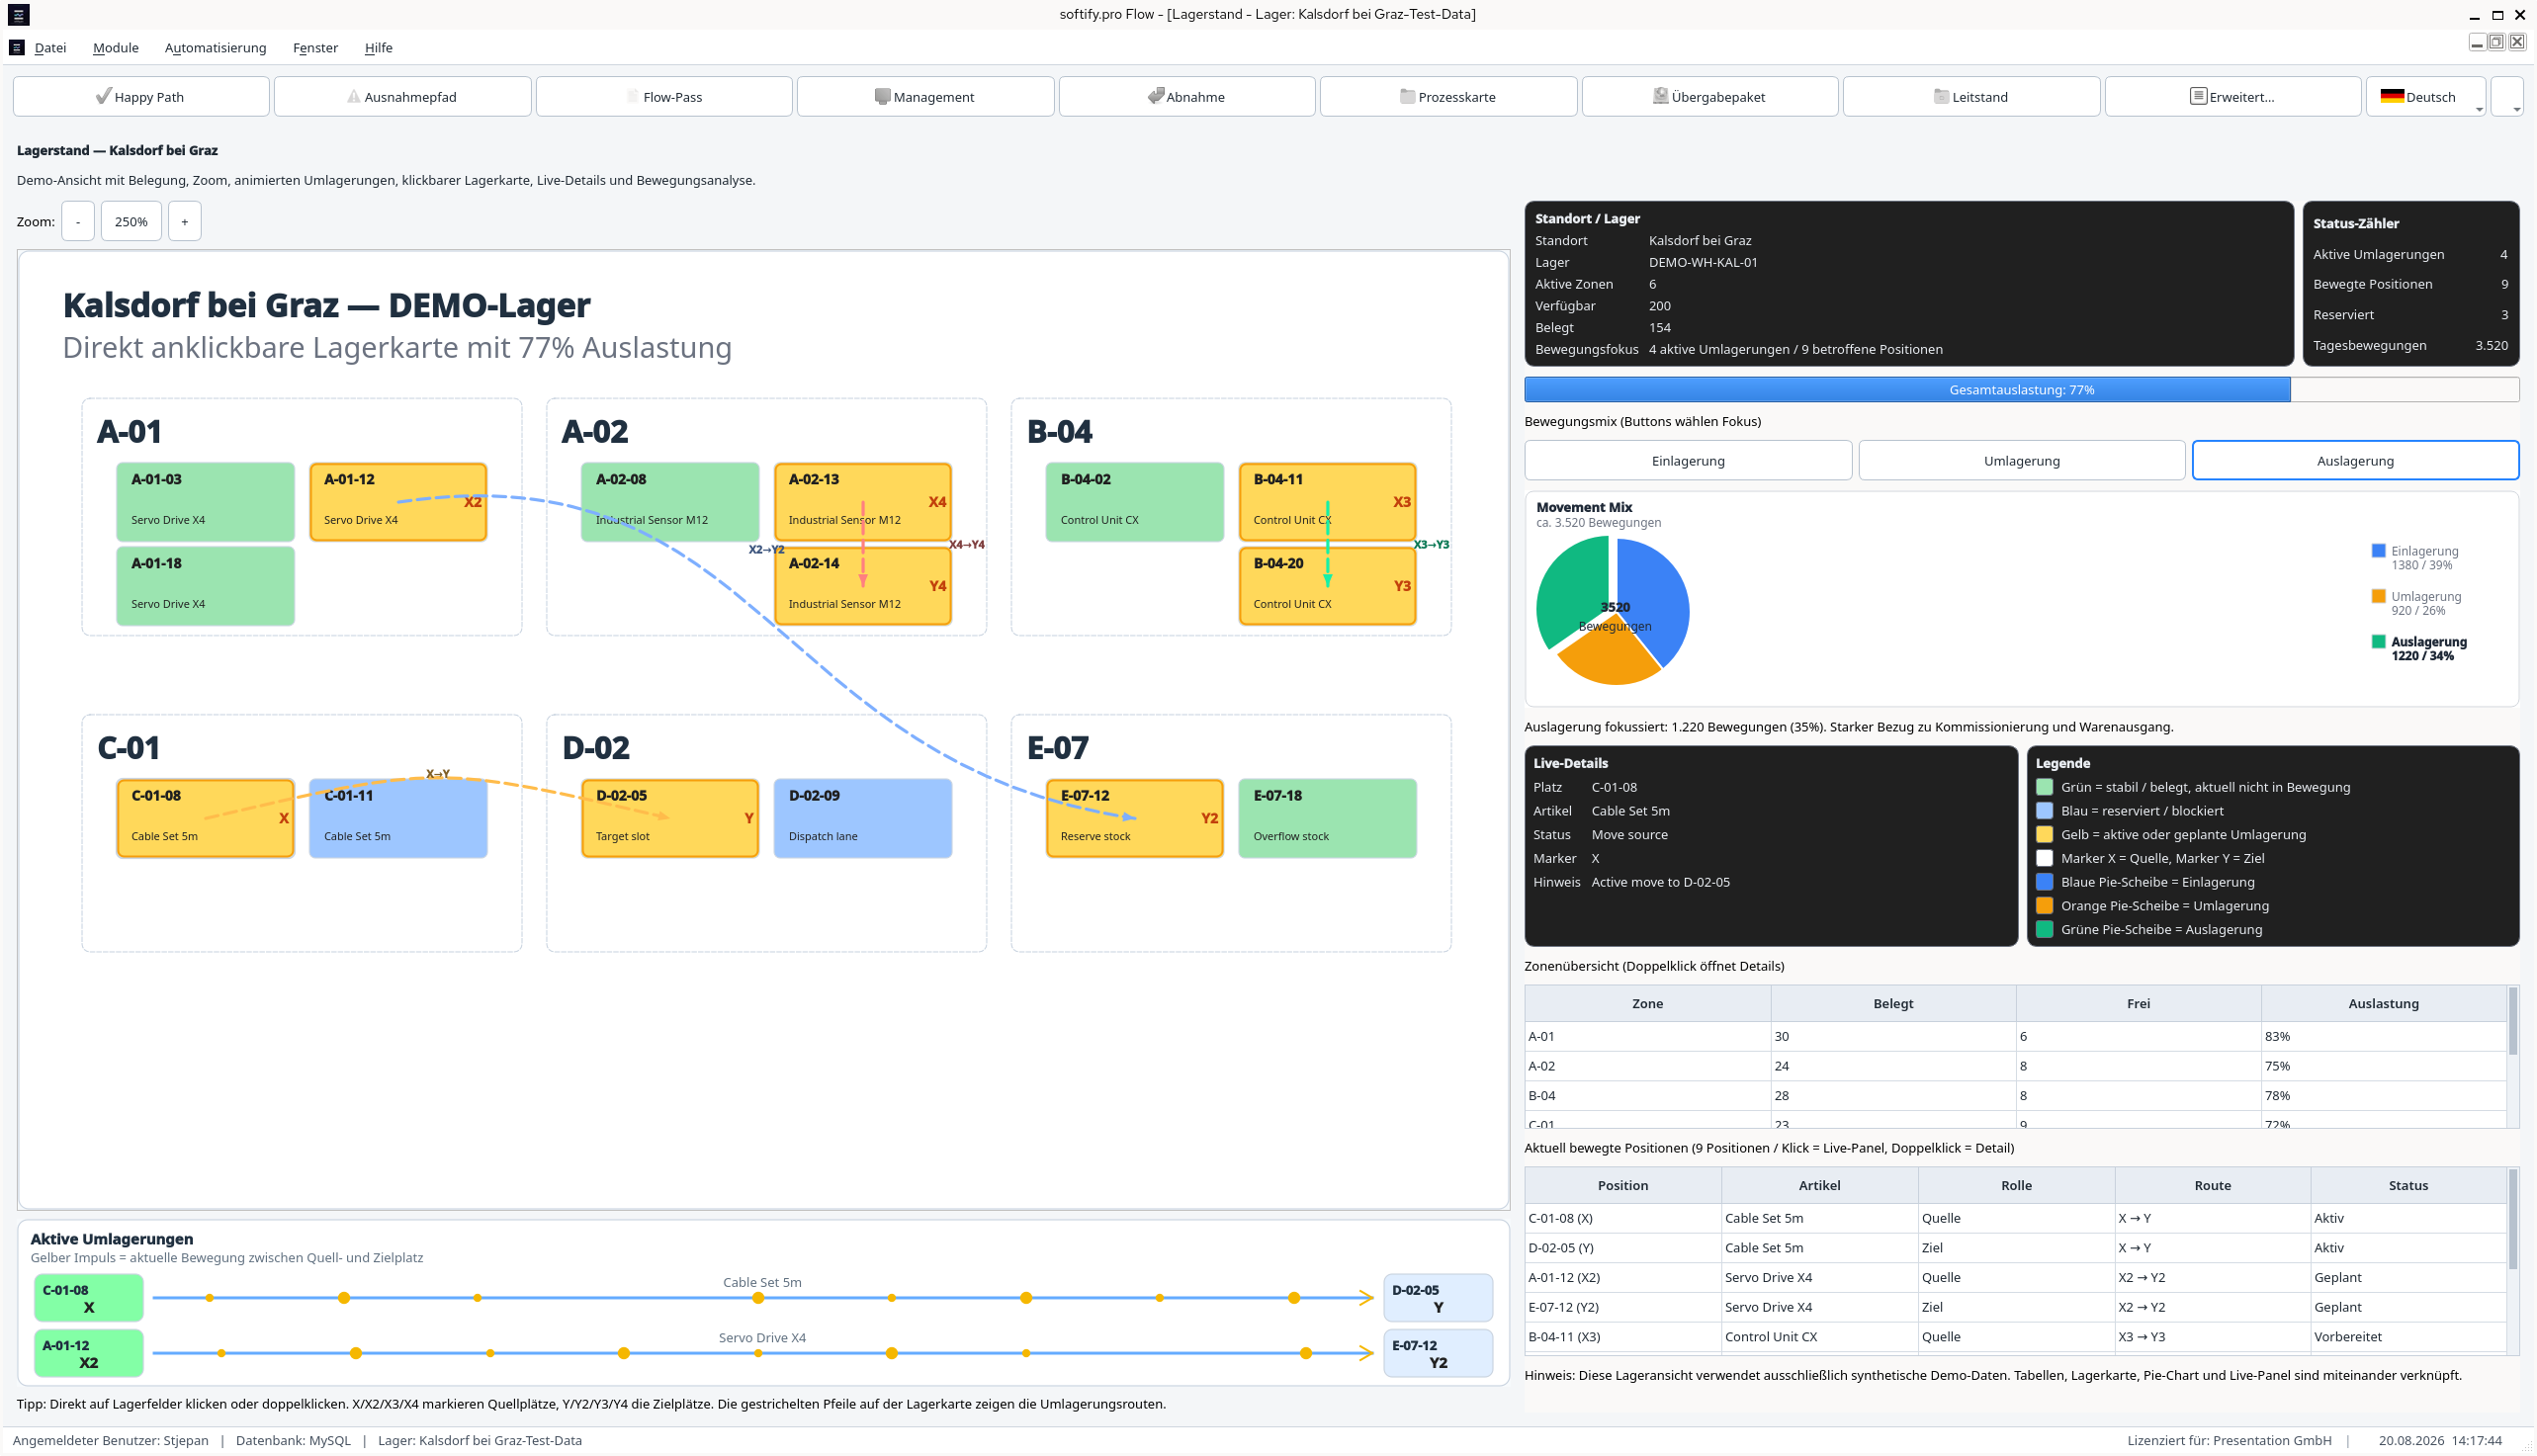
Obecna wersja demo softify.pro Flow działa z kilkoma syntetycznymi środowiskami magazynowymi.
Różne identyfikatory magazynów.
Różne pojemności.
Różne struktury stref.
Brak zapasów produkcyjnych.
Brak danych klientów.
Brak rzeczywistych informacji operacyjnych.
Ale logika procesu zachowuje się tak, jakby wszystko to miało znaczenie.
Bo w prawdziwej logistyce ma.
Gdy magazyn zostanie raz wybrany, ten kontekst staje się częścią wszystkiego, co następuje.
Flowy.
SSCC.
Ruchy.
Operatorzy.
Analityka.
Raporty.
Brzmi to oczywiście.
Staje się znacznie mniej oczywiste, gdy ten sam proces zaczyna pojawiać się w kilku różnych częściach aplikacji.
Wtedy otworzyliśmy inny widok.
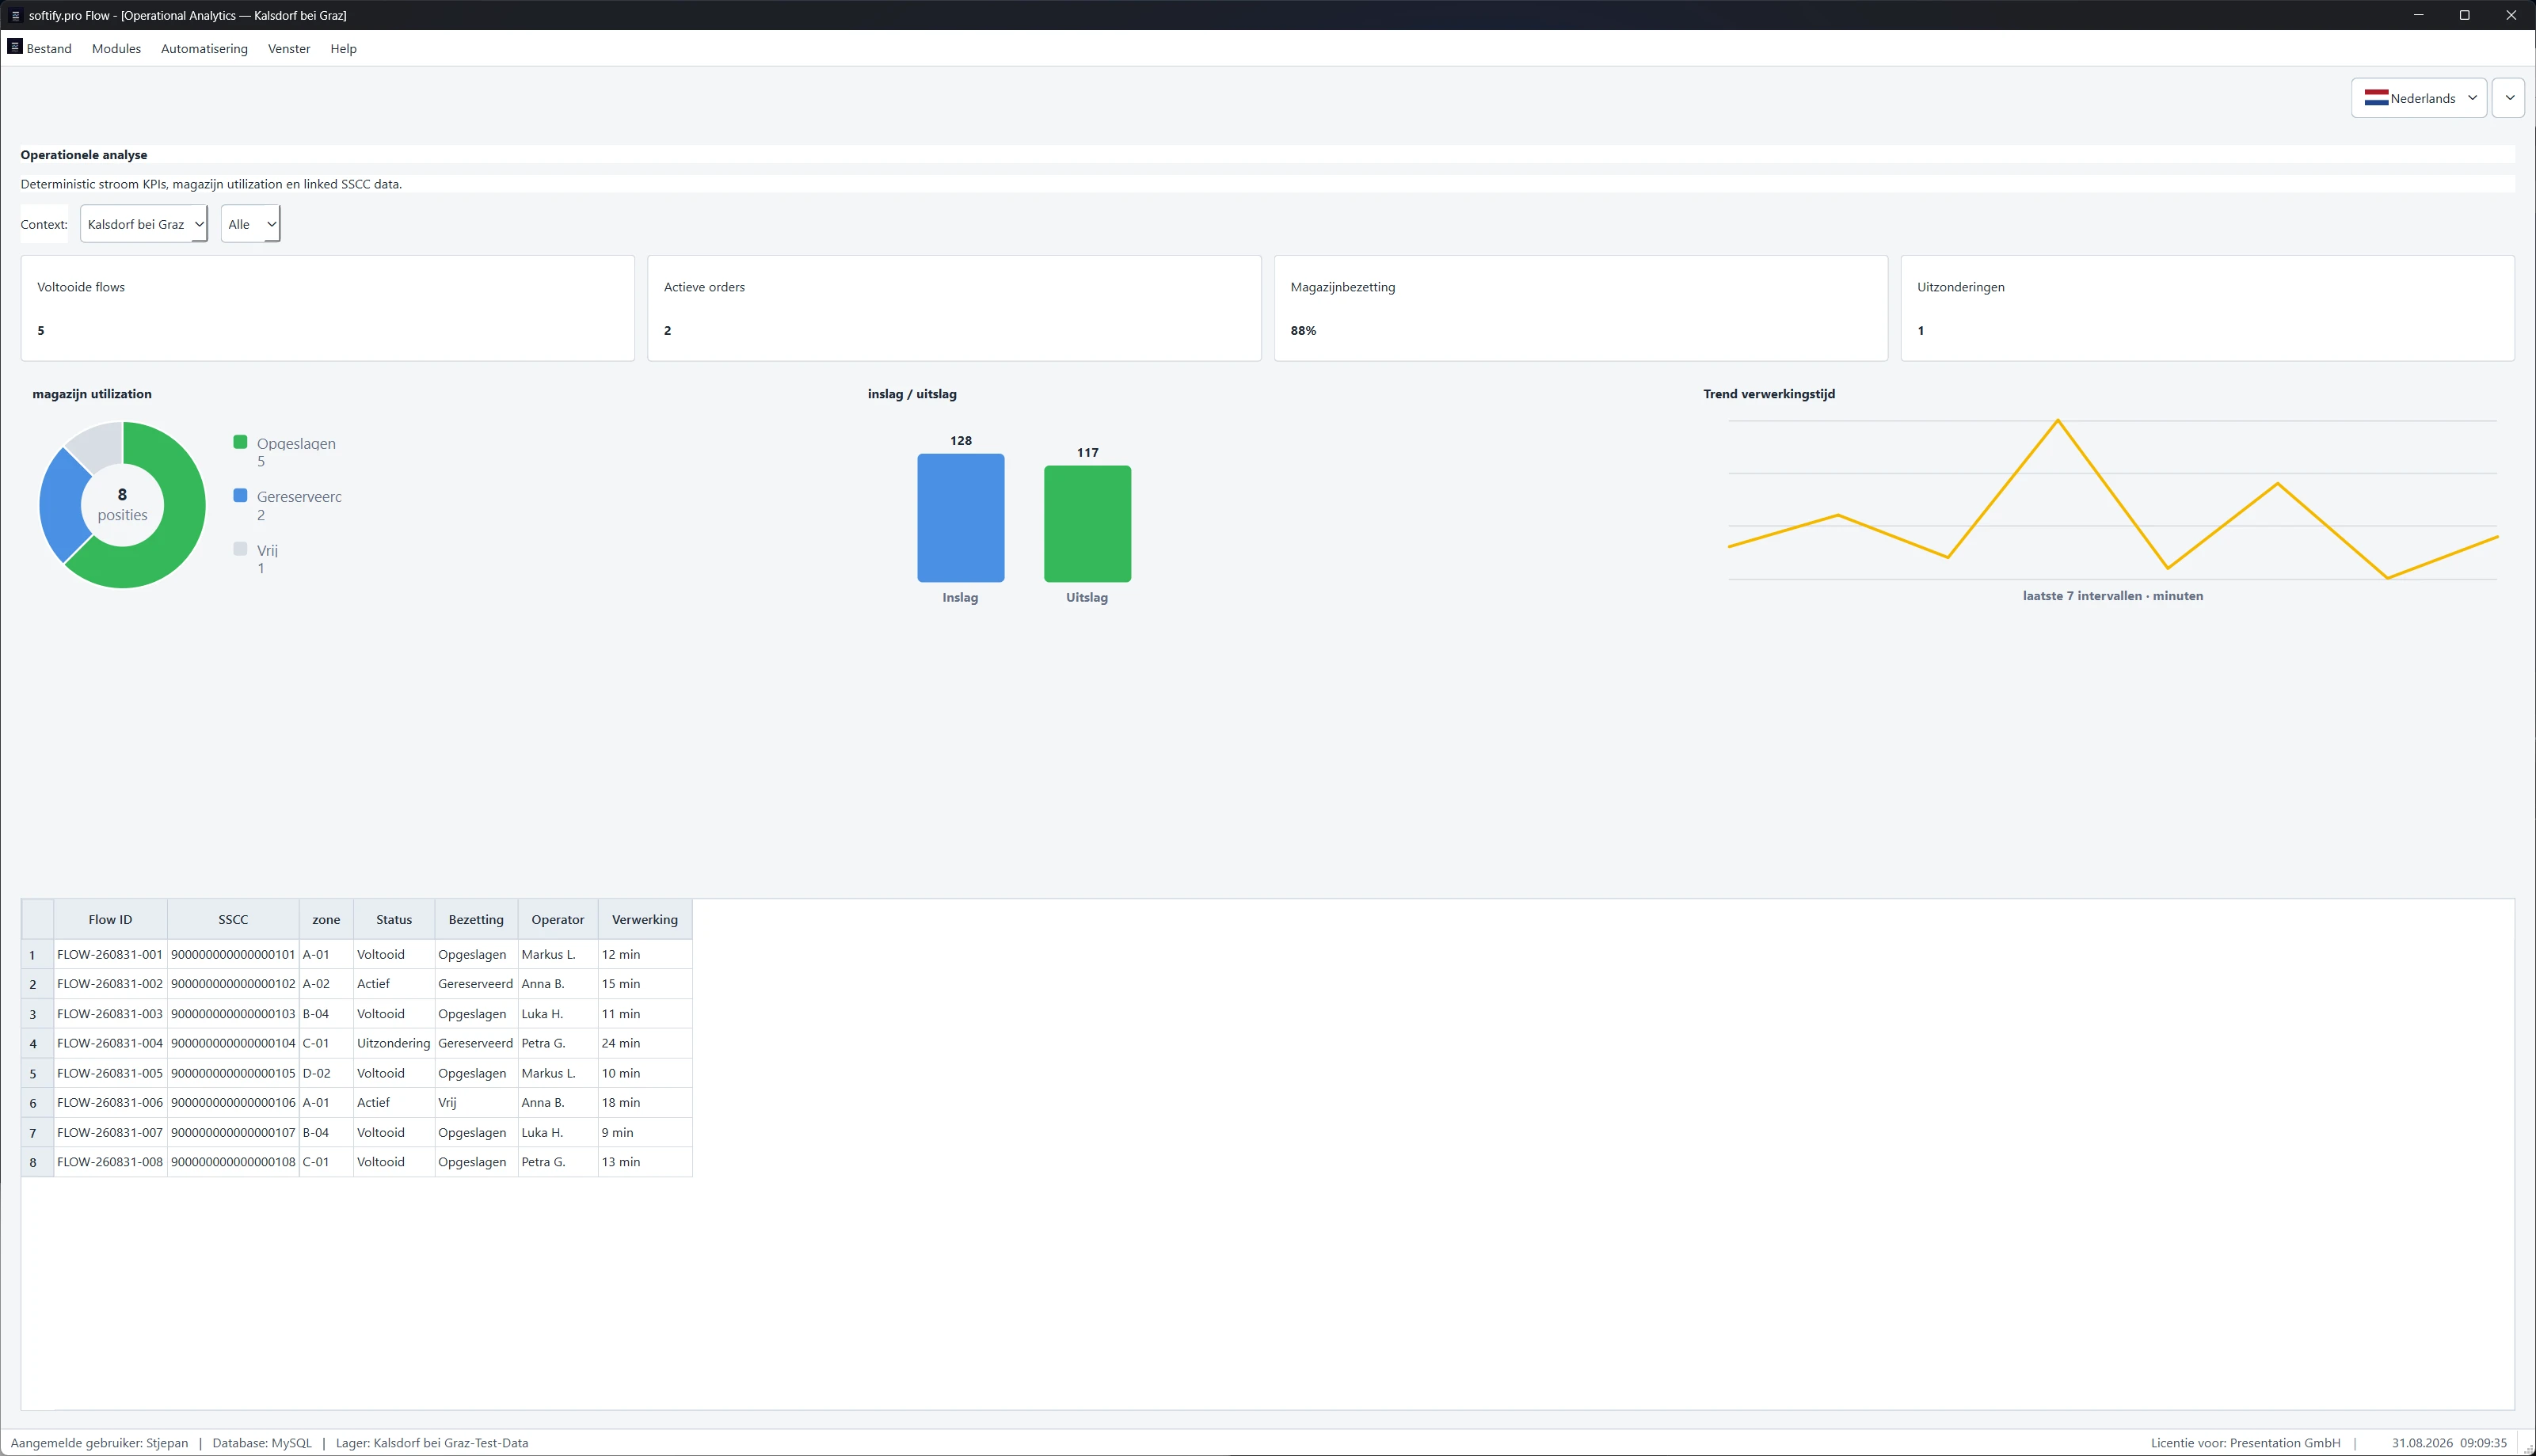
Operational Analytics.
Nagle magazyn wyglądał zupełnie inaczej.
Brak pozycji magazynowych.
Brak strzałek ruchu.
Zamiast tego:

  • ukończone Flowy,
  • aktywne zamówienia,
  • wykorzystanie magazynu,
  • wyjątki,
  • przyjęcia,
  • wydania,
  • czas przetwarzania.

Wizualna reprezentacja się zmieniła.
Magazyn nie.
To rozróżnienie stało się istotne.
Bo pod KPI wciąż znajdowały się pojedyncze rekordy.
Identyfikatory Flow.
SSCC.
Strefy.
Statusy.
Operatorzy.
Czasy przetwarzania.
Inny widok.
Ta sama rzeczywistość operacyjna.
Jak dotąd dobrze.

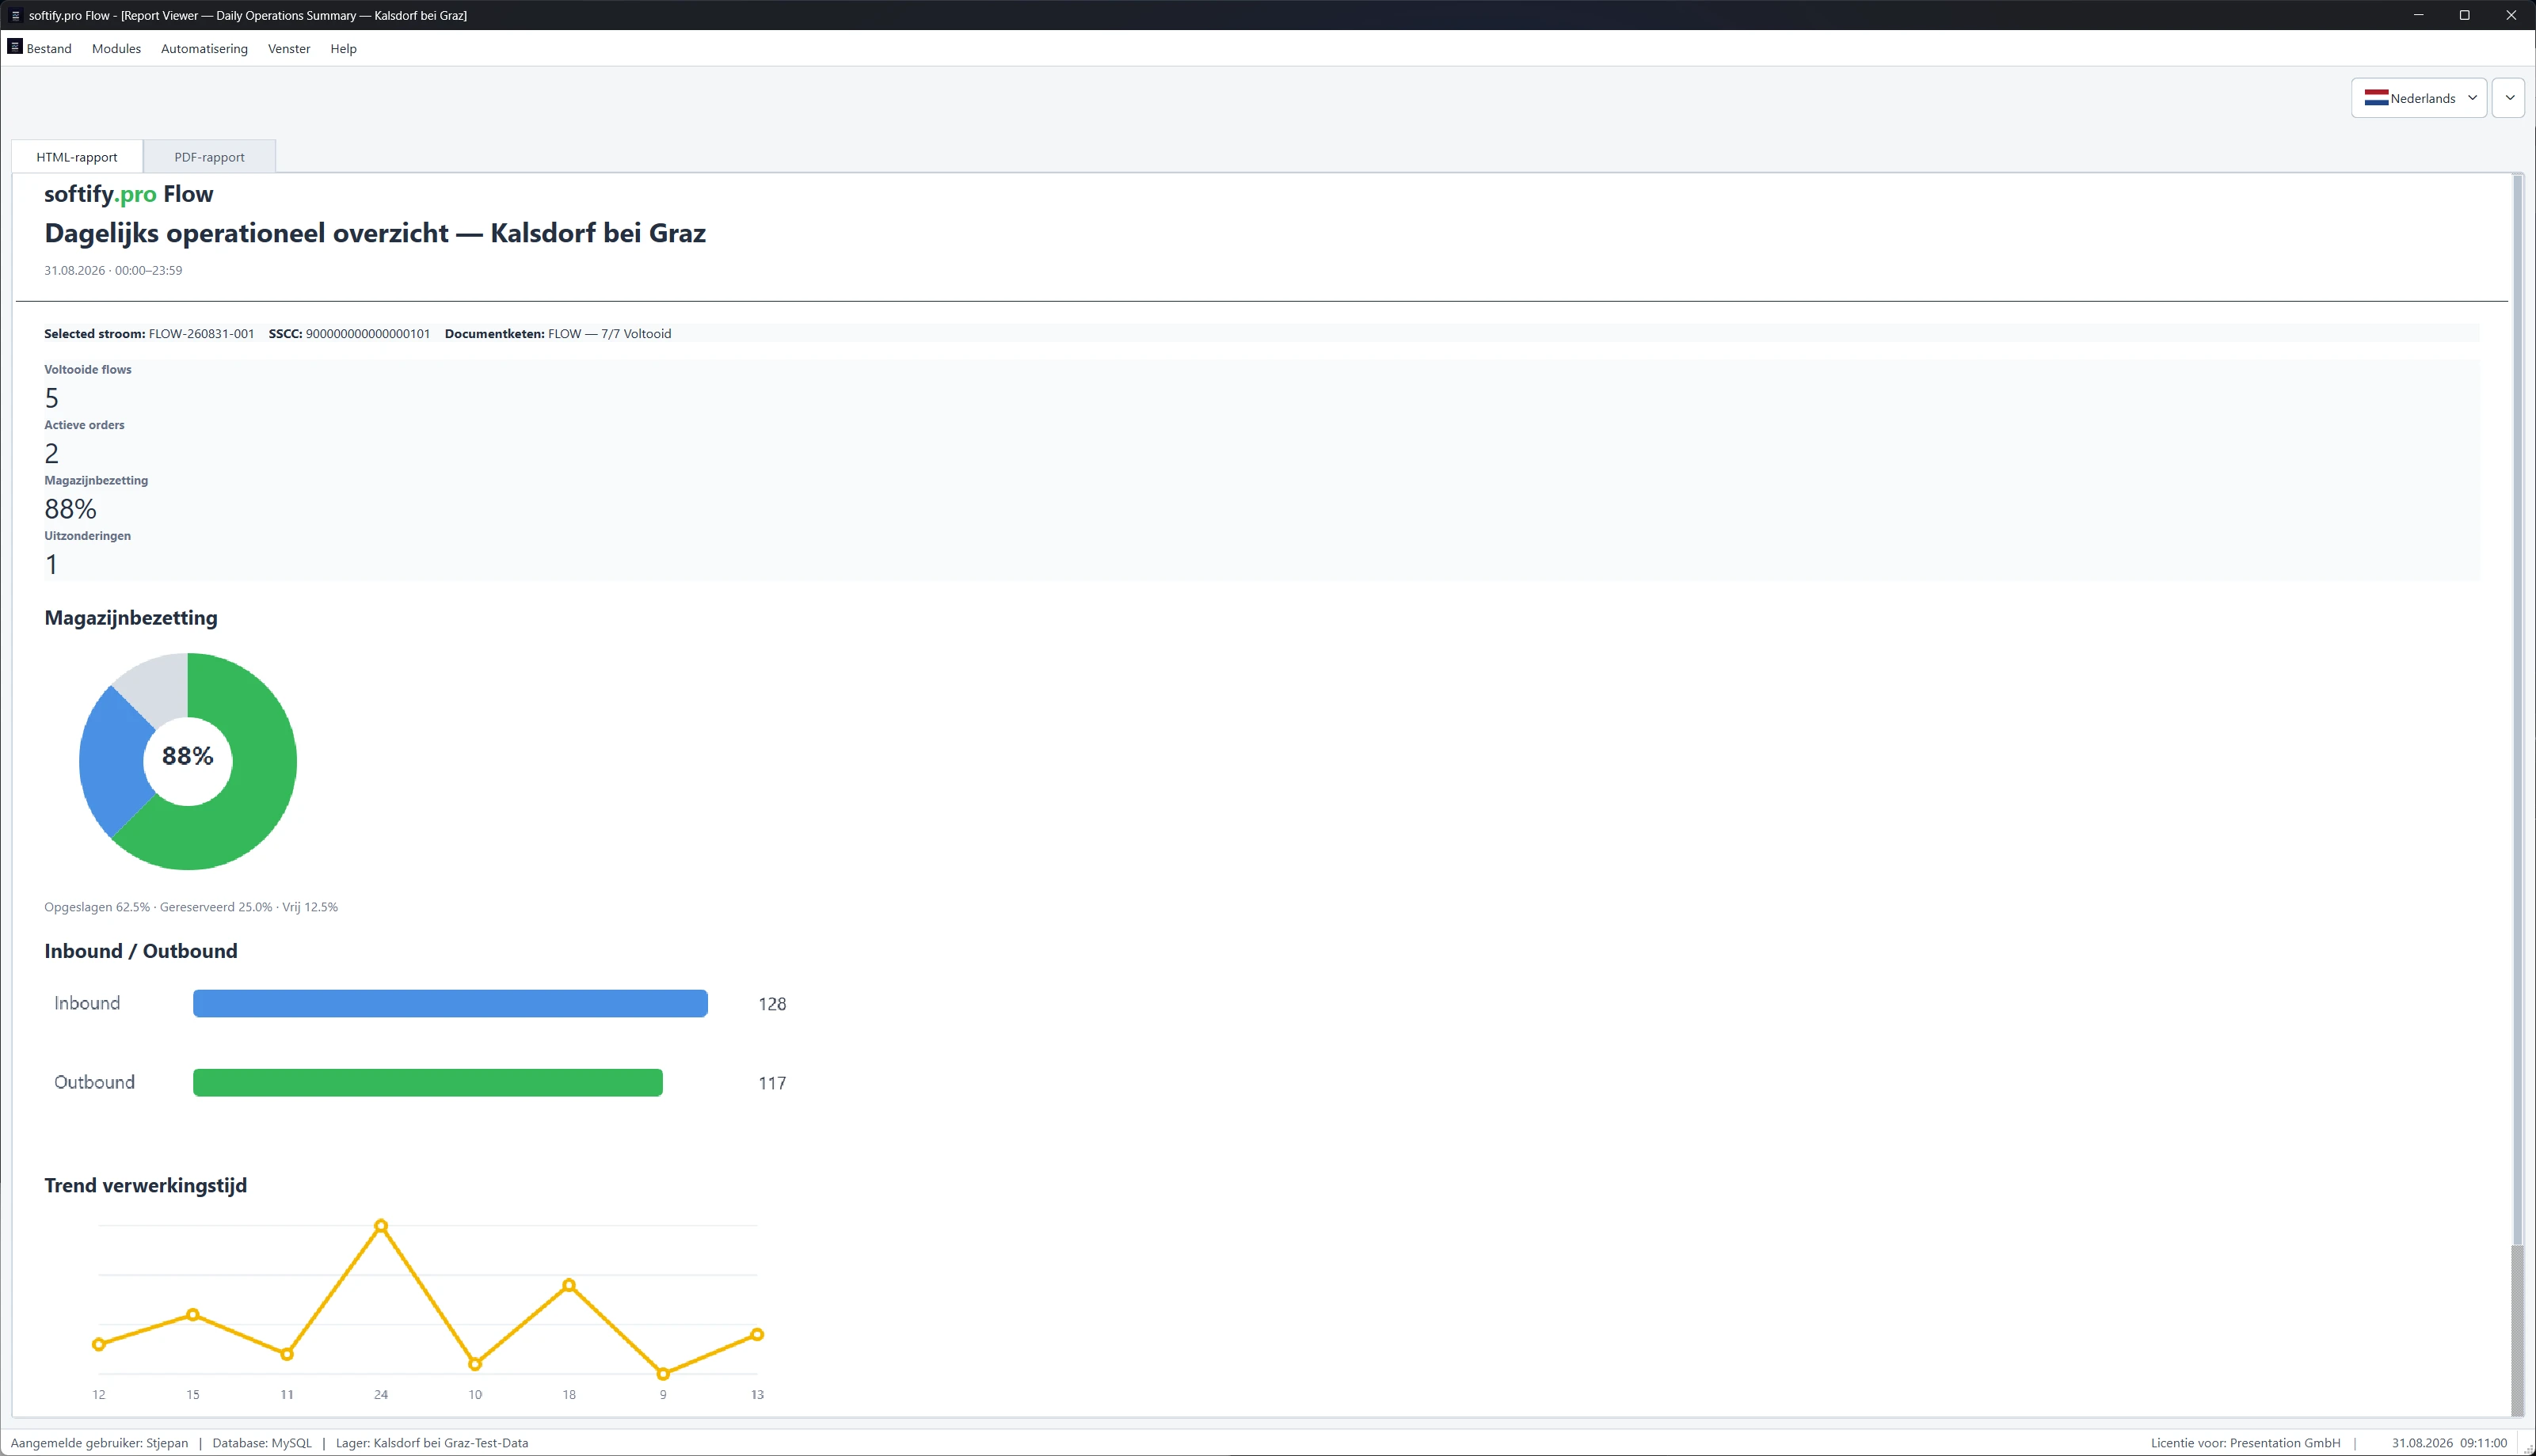
Operational Analytics — zagregowany stan magazynu, z wciąż widocznymi rekordami Flow leżącymi u podstaw.

Flow.

88% jest użyteczne tylko wtedy, gdy system potrafi to wyjaśnić.
Załóżmy, że pulpit nawigacyjny mówi:
Wykorzystanie magazynu: 88%.
Użyteczne.
Ale niepełne.
Niektóre pozycje są zajęte.
Niektóre są zarezerwowane.
Niektóre pozostają wolne.
Te stany nie są wymienne.
Liczba staje się wiarygodna dopiero wtedy, gdy system nadal potrafi wyjaśnić, skąd pochodzi.
Pięć ukończonych Flowów?
Pokaż je.
Dwa aktywne zamówienia?
Pokaż je.
Jeden wyjątek?
Który?
88% wykorzystania?
Co jest zajęte?
Co jest zarezerwowane?
Co pozostaje wolne?
Pulpit nawigacyjny powinien podsumowywać rzeczywistość.
Nie powinien jej zastępować.
Wtedy zmieniliśmy język.
Niderlandzki.
Magazyn pozostał ten sam.
Identyfikatory Flow pozostały te same.
SSCC pozostały te same.
Operatorzy pozostali przypisani do swoich rekordów.
Zmienił się tylko język.
Później ten sam stan operacyjny pojawił się po chorwacku.
Potem po francusku.
Tu oprogramowanie wielojęzyczne staje się dużo bardziej interesujące niż przetłumaczone przyciski.
Zły przekład łatwo zauważyć.
Zmiana stanu spowodowana zmianą języka jest znacznie bardziej niebezpieczna.
Wyobraź sobie przełączenie z niemieckiego na francuski i ciche utracenie wybranego Flow.
Albo przebudowanie filtra dla niewłaściwego magazynu.
Albo wyświetlenie poprawnego SSCC w niewłaściwym kontekście procesu.
Interfejs może wciąż wyglądać idealnie.
System nie byłby taki.
Flow stosuje się więc do prostej zasady:
Język może zmienić słowa. Nie może zmienić prawdy.
Wtedy Flow zyskał historię.
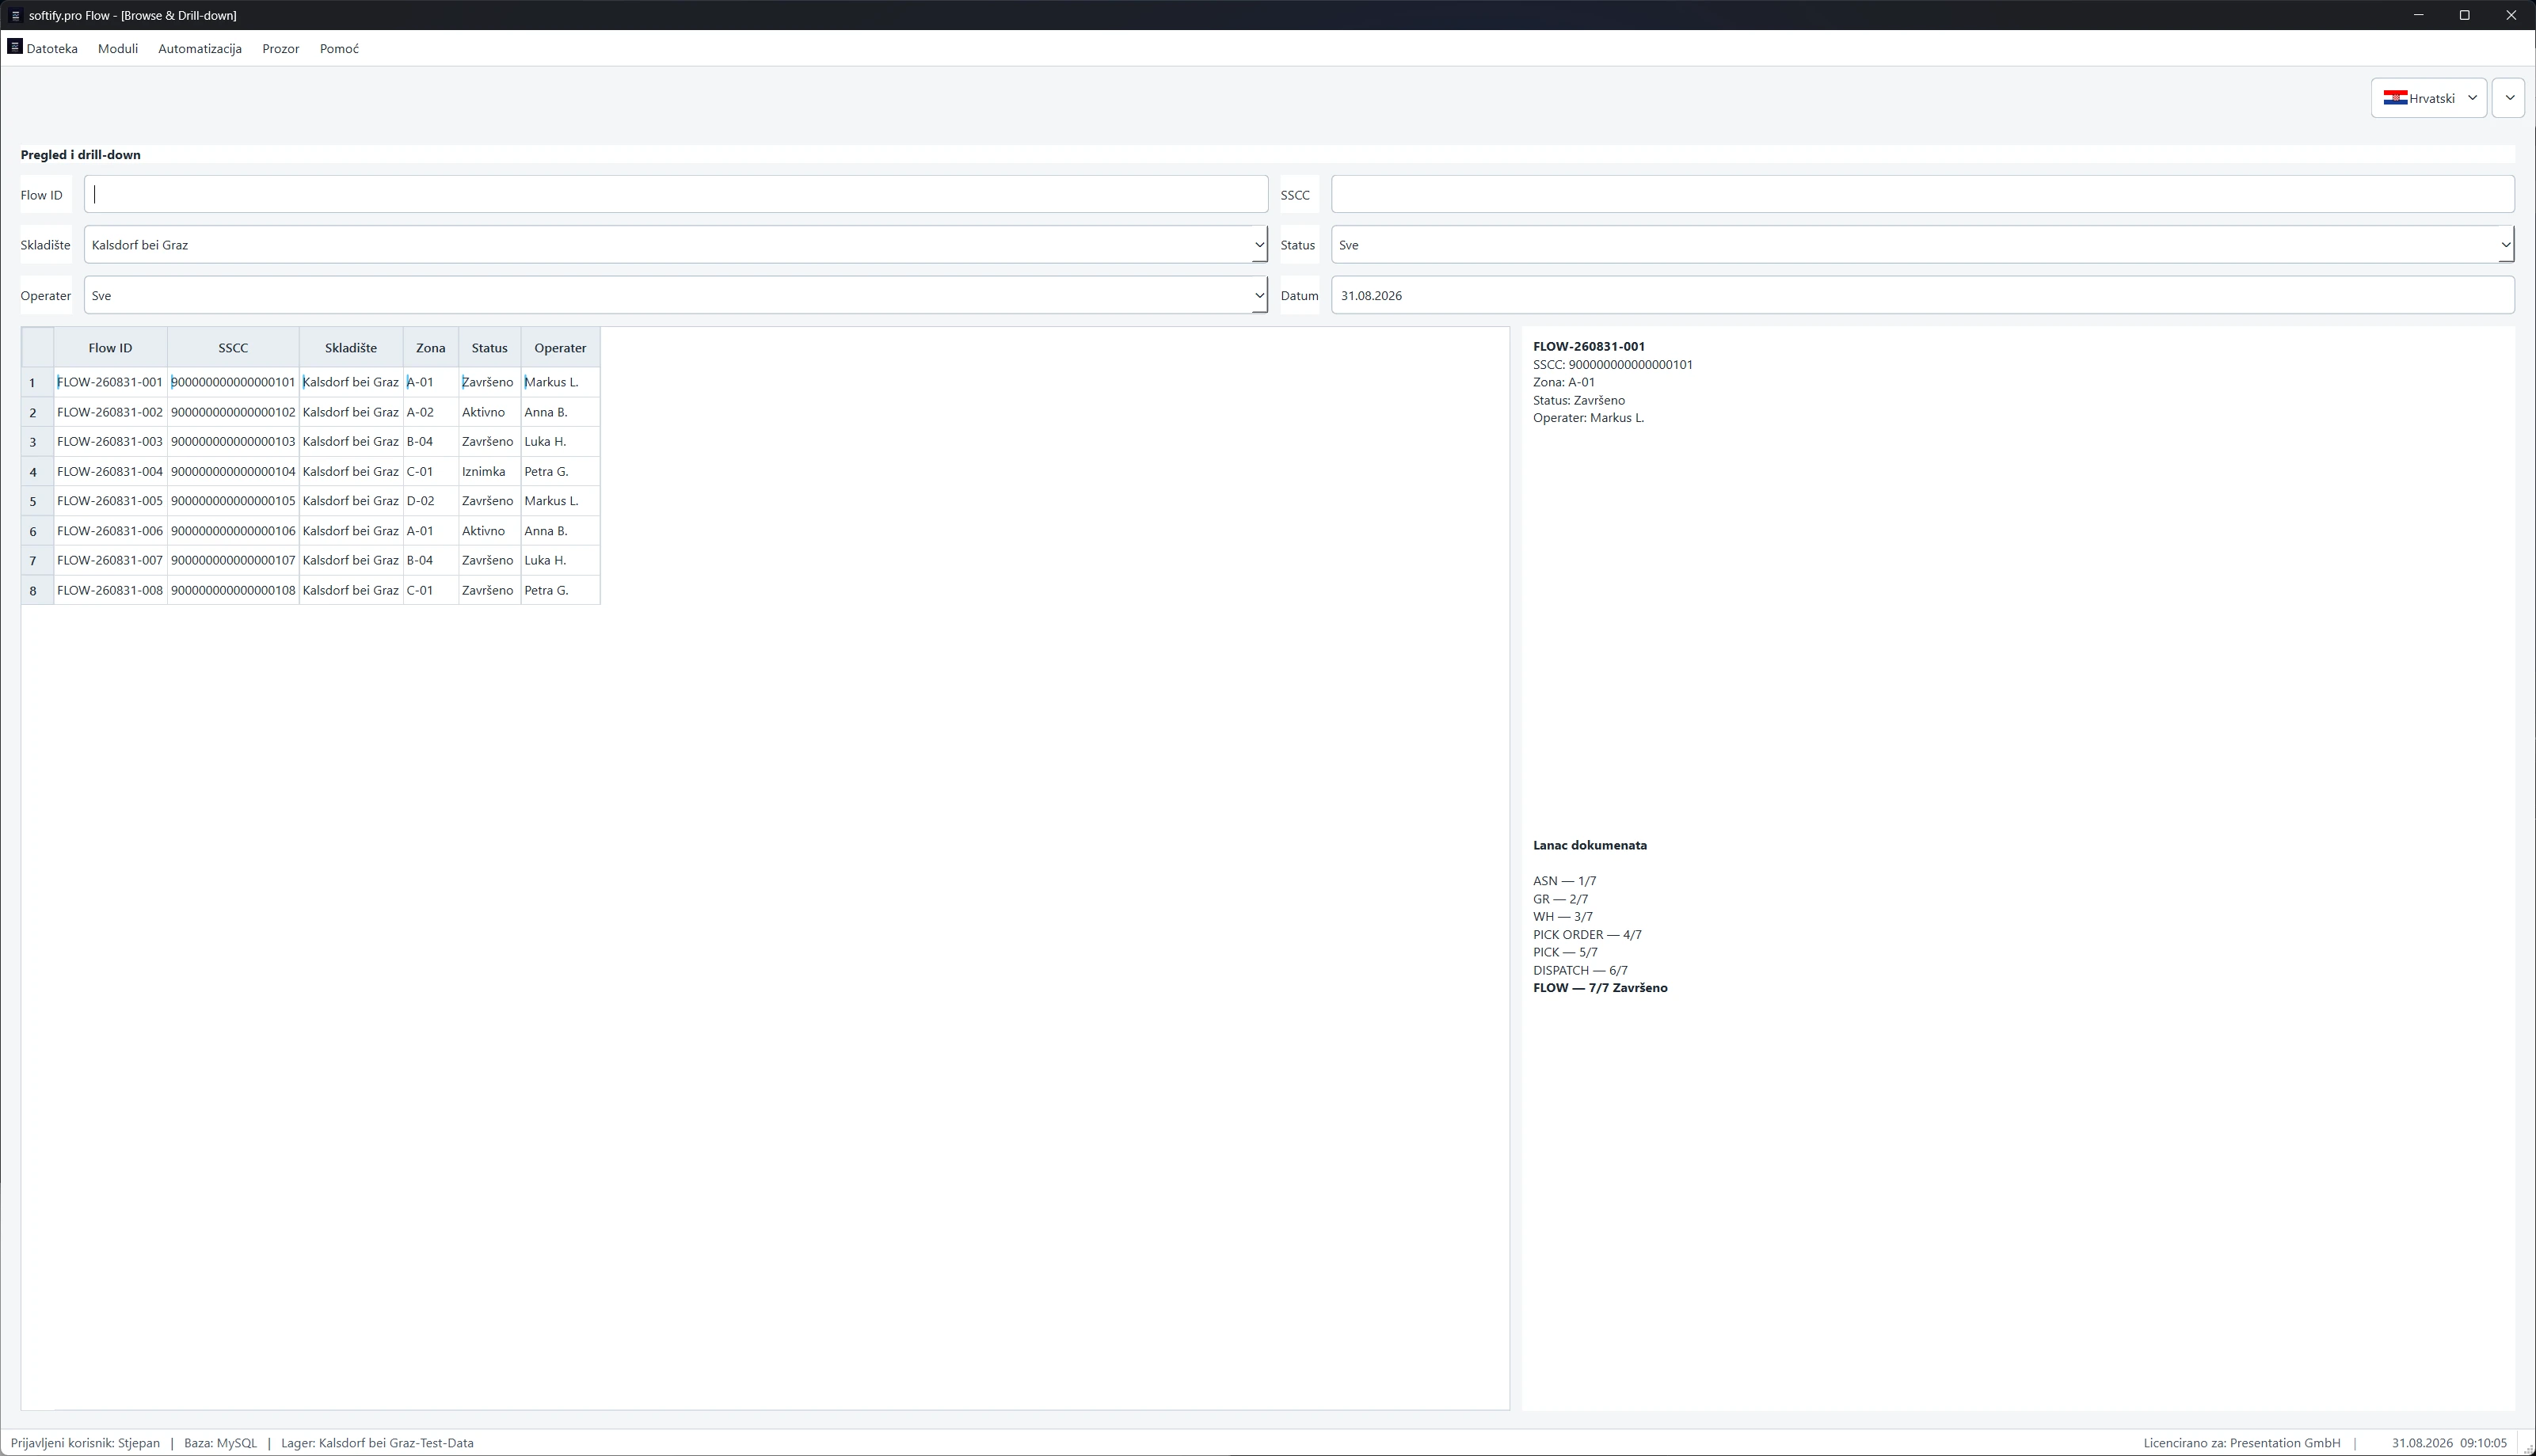
Browse & Drill-down nie stara się szczególnie wyglądać imponująco.
Może właśnie dlatego jest użyteczny.
Wybierz Flow.
Pojawia się jego kontekst.
Magazyn.
Strefa.
Status.
Operator.
SSCC.
A następnie łańcuch dokumentów.
ASN.
Przyjęcie towaru.
Ruch magazynowy.
Zlecenie kompletacji.
Kompletacja.
Wysyłka.
FLOW.
Siedem kroków.
Proces to już nie tylko aktualny stan.
Ma przeszłość.
A to zmienia pytanie.
Zamiast:
Co się dzieje?
możemy zapytać:
Jak tu dotarliśmy?
To znacznie lepsze pytanie, gdy w końcu coś pójdzie nie tak.

Jeden Flow, jeden SSCC, jeden łańcuch dokumentów — od ASN do zakończenia.

Flow.


SSCC staje się nitką przewodnią.
Na początku SSCC wygląda jak to, czym jest.
Identyfikator.
Długi numer w tabeli.
Ale w ramach Flow staje się czymś bardziej użytecznym.
Nitka przewodnia przez proces.
Podążaj za nią, a inne rzeczy zaczynają się łączyć.
Magazyn.
Flow.
Strefa.
Status.
Operator.
Łańcuch dokumentów.
Ostatecznie raport.
Ten sam fizyczny obiekt logistyczny jest teraz widoczny z kilku różnych części aplikacji.
Użyteczne.
Także niebezpieczne.
Bo każdy dodatkowy widok stwarza kolejną okazję, by system opowiedział inną historię.
I właśnie tu robi się interesująco.
Załóżmy, że Analytics mówi, iż Flow jest aktywny.
Drill-down mówi, że SSCC należy do tego Flow.
Łańcuch dokumentów mówi, że operacja posunęła się dalej.
Raport mówi coś innego.
Który jest poprawny?
To nie jest problem specyficzny dla Flow.
To jeden z najstarszych problemów w oprogramowaniu biznesowym.
Różne części tego samego systemu stopniowo rozwijają własną wersję rzeczywistości.
Jeden ekran odczytuje stan transakcyjny.
Inny odczytuje agregat.
Kolejny polega na danych z pamięci podręcznej.
Raport oblicza coś nieco inaczej.
Wyjątek zostaje rozwiązany operacyjnie, ale znika z raportowania.
Każdy komponent działa.
Cały system kłamie.
Zwykle uprzejmie.
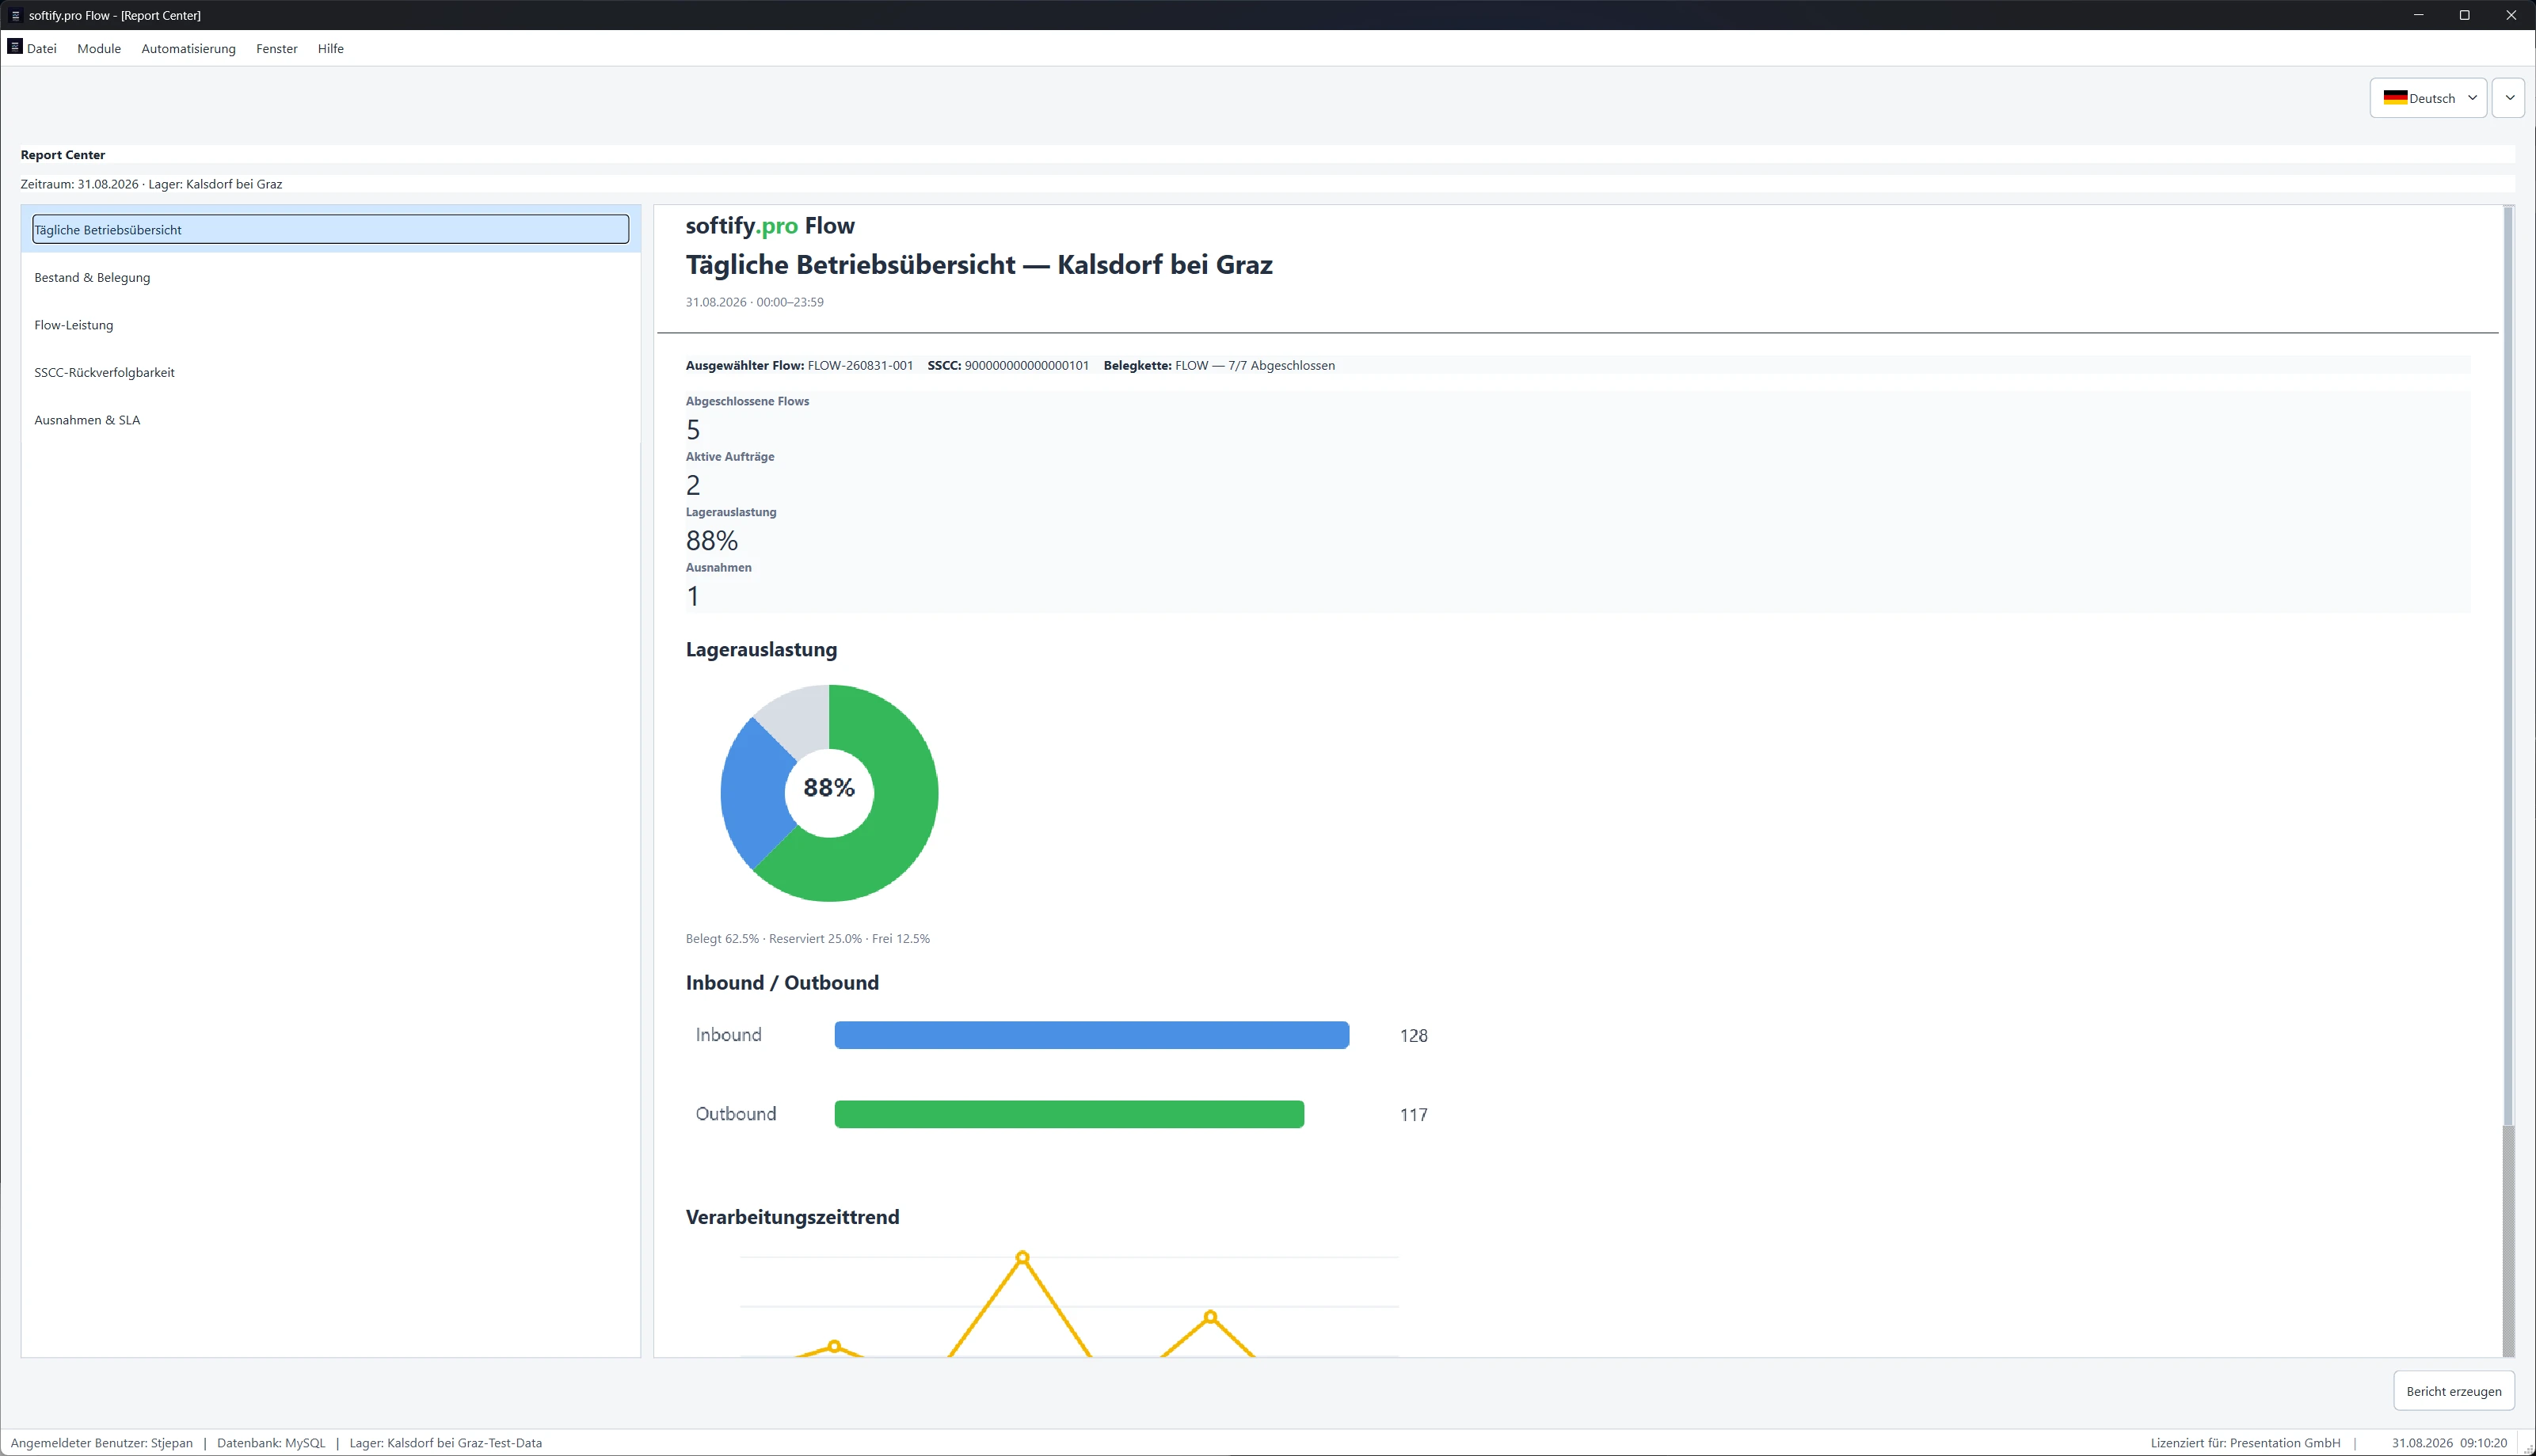
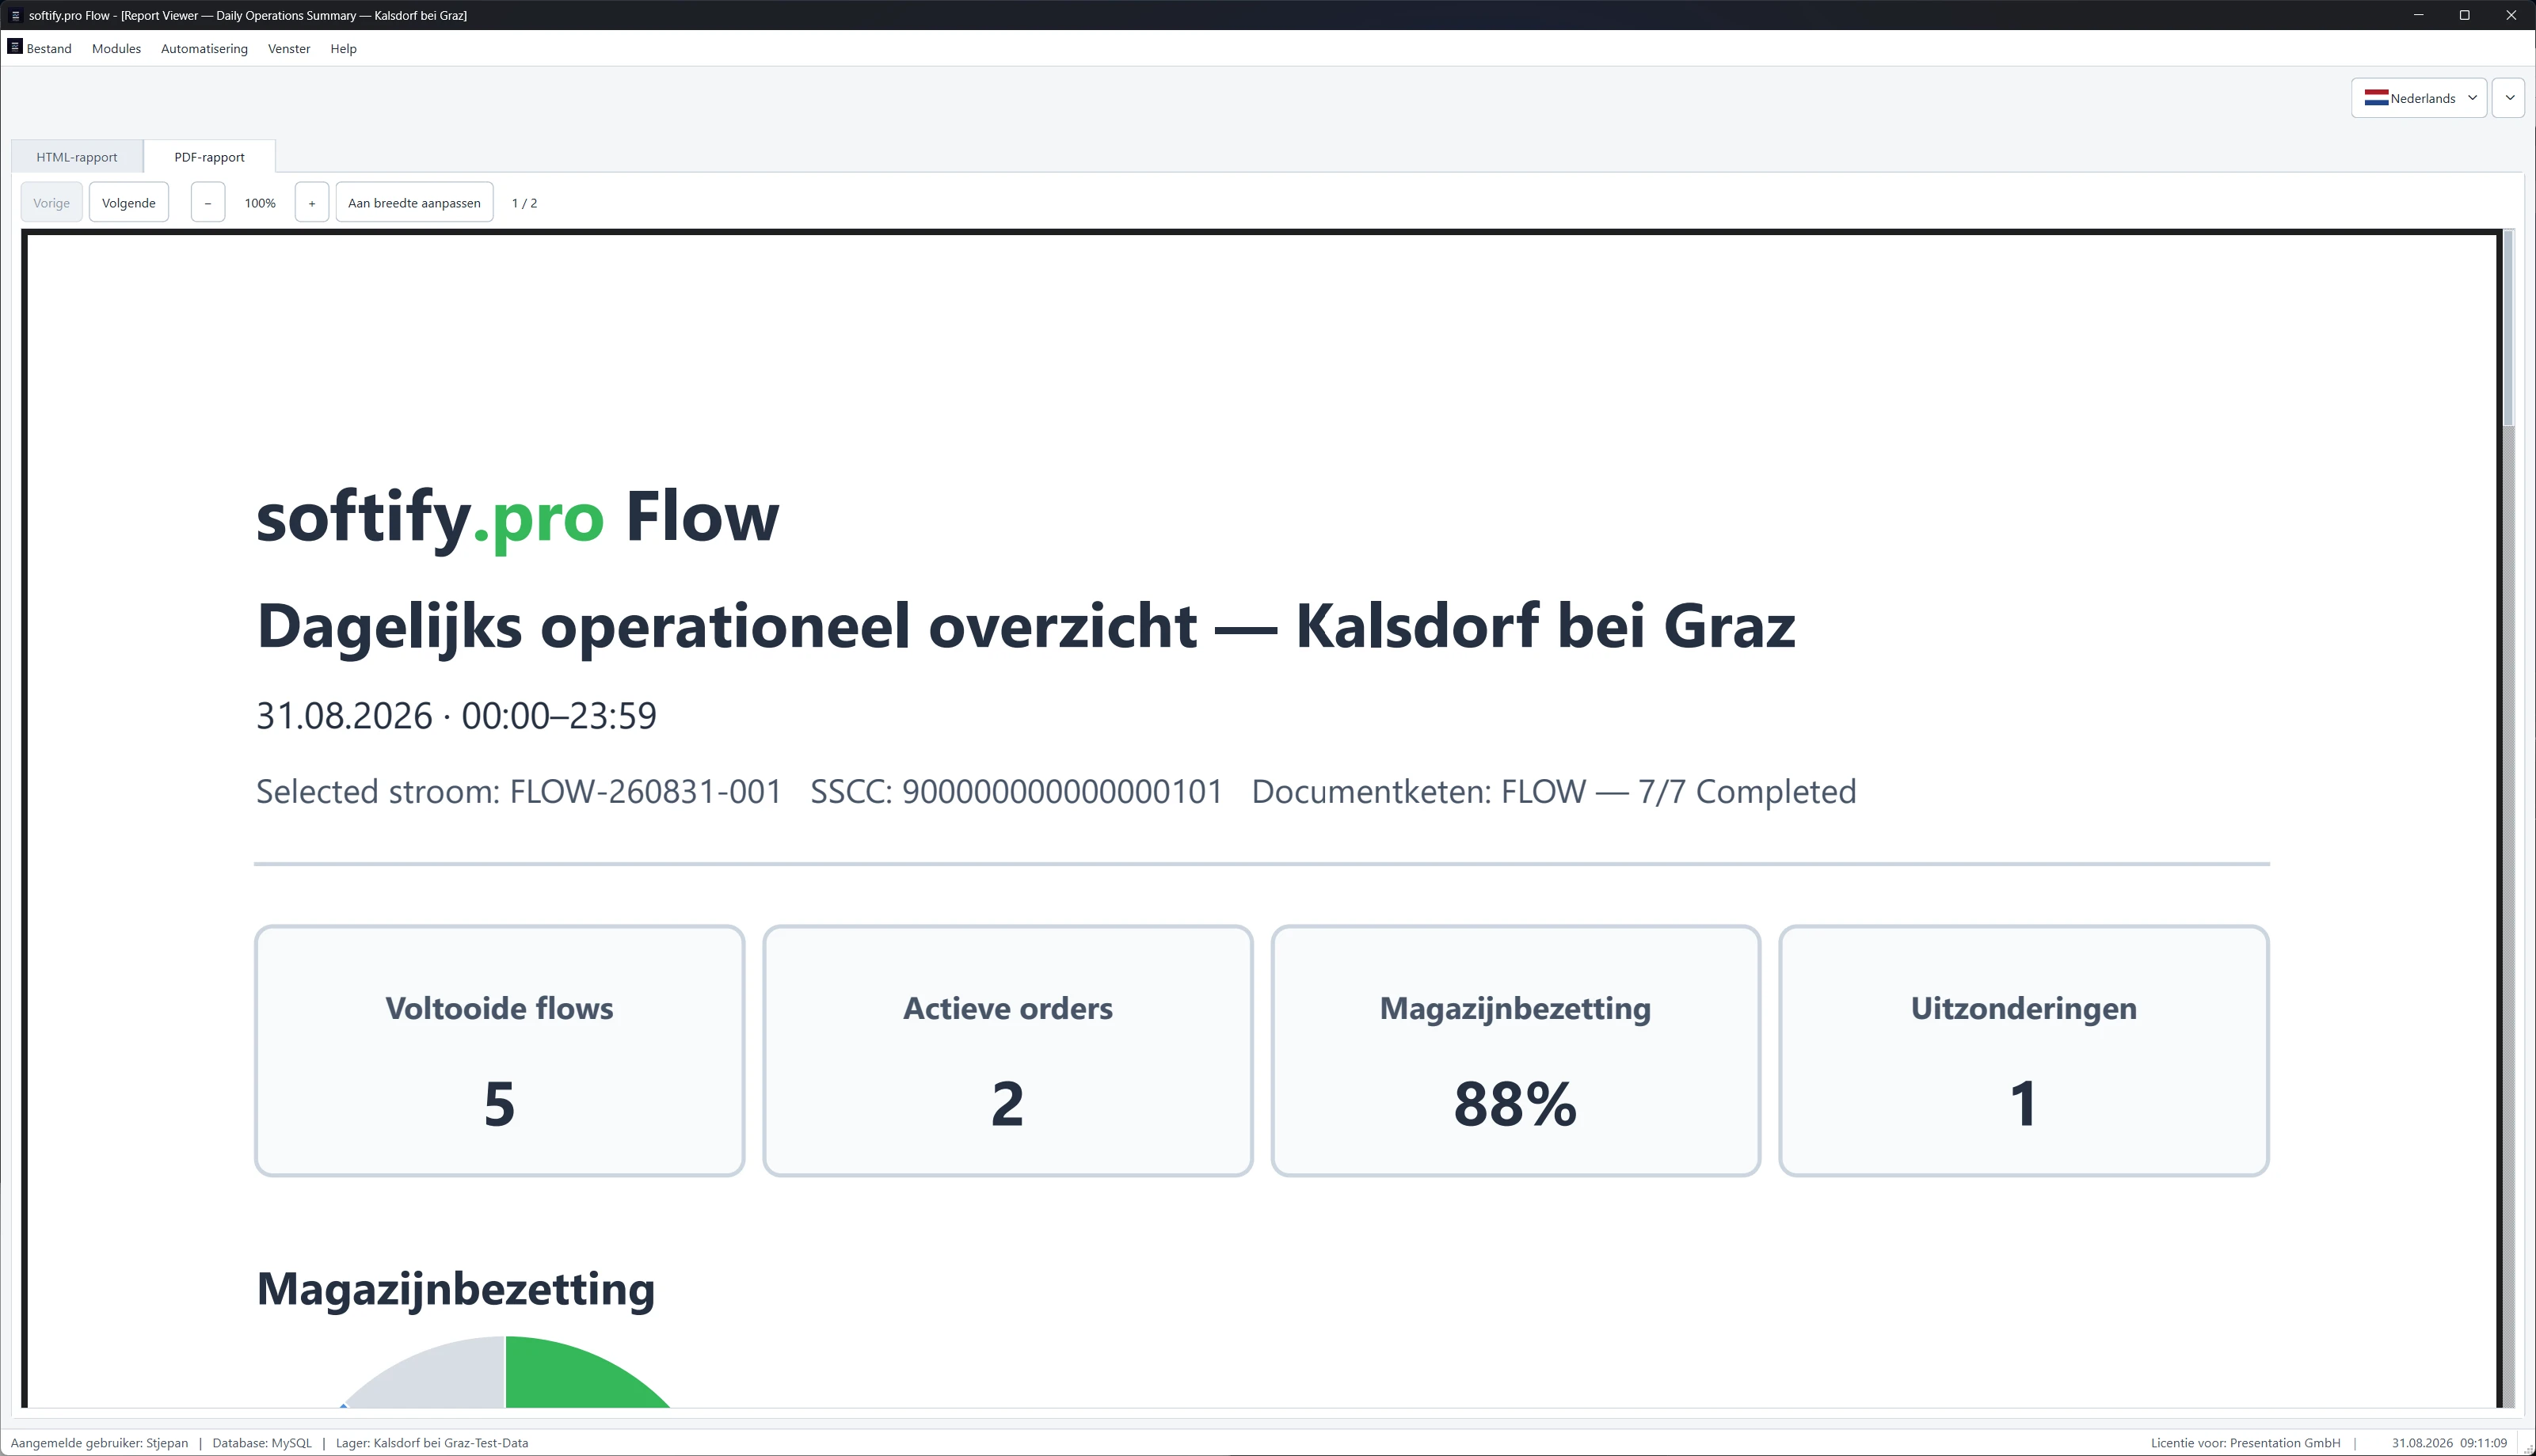
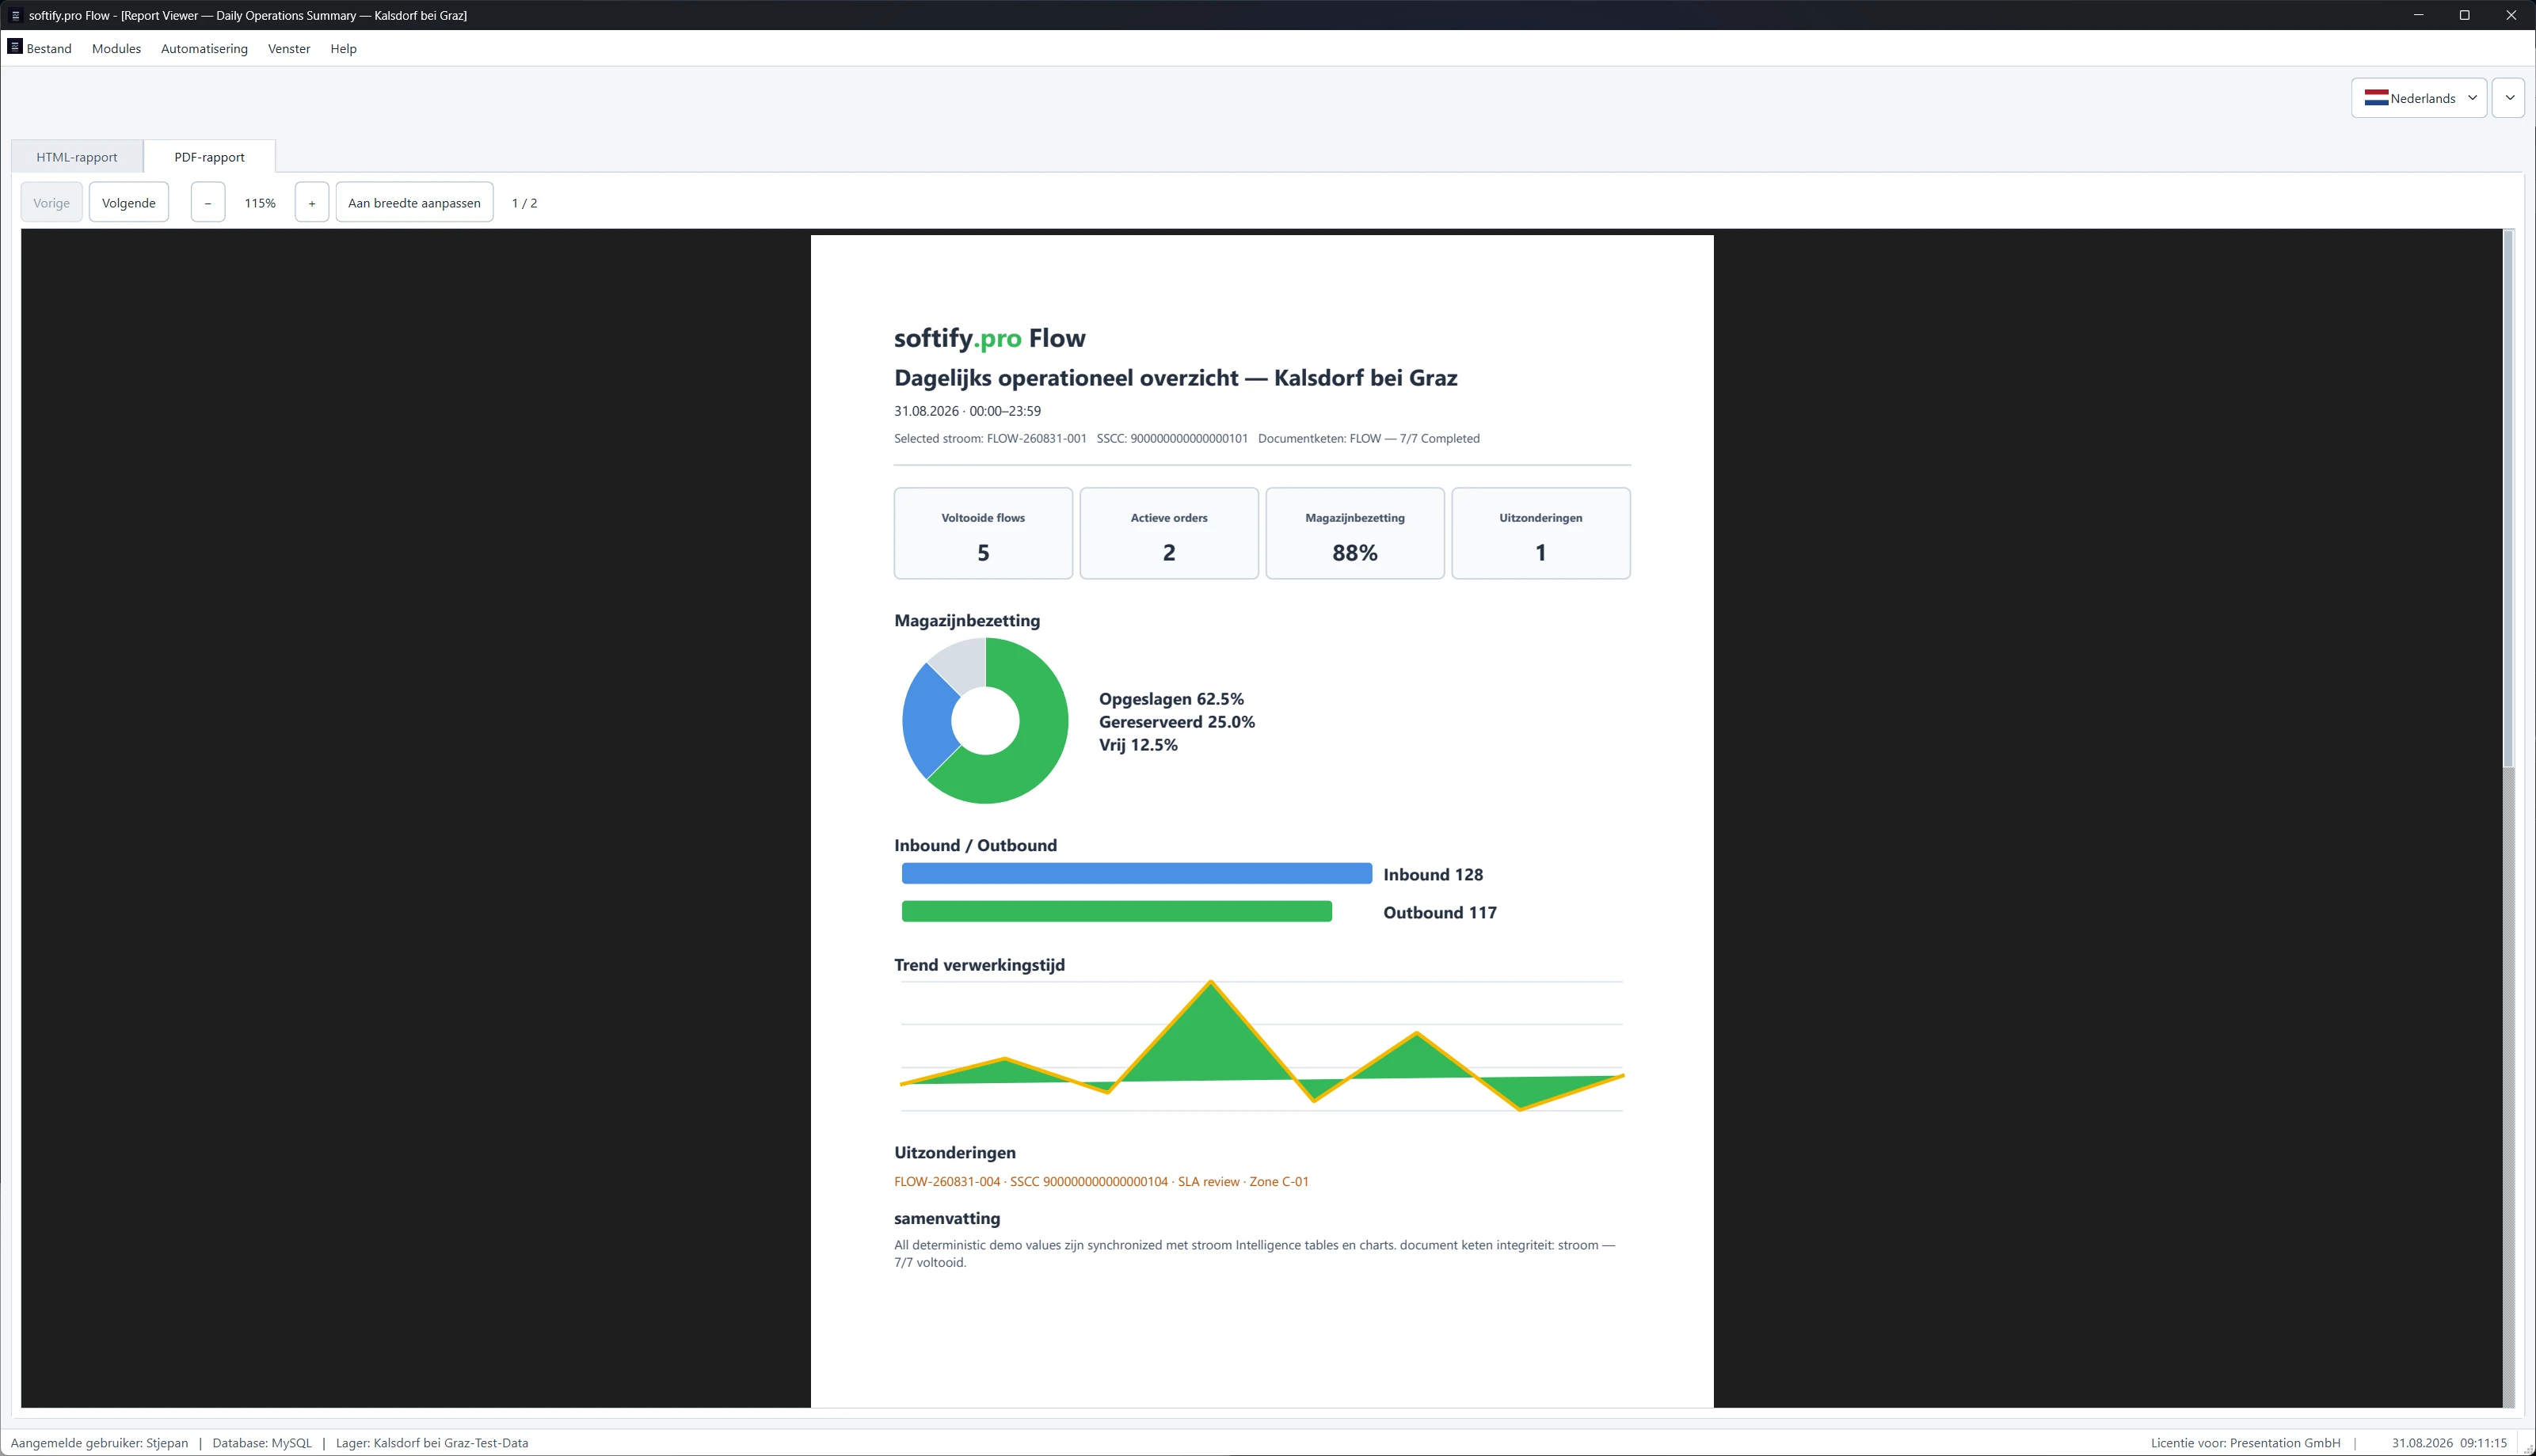
Otworzyliśmy więc Report Center.
Codzienny przegląd operacyjny.
Zapasy i zajętość.
Wydajność Flow.
Identyfikowalność SSCC.
Wyjątki i SLA.
Ta sama historia operacyjna pojawiła się ponownie.
Ukończone Flowy.
Aktywne zamówienia.
Wykorzystanie magazynu.
Wyjątki.
Przyjęcia.
Wydania.
Czas przetwarzania.
Ale tym razem pytanie nie dotyczyło tego, czy raport wygląda poprawnie.
Pytanie brzmiało:
Czy potrafi się obronić?
Dobry raport daje ci liczbę.
Lepszy system potrafi wyjaśnić, skąd ta liczba pochodzi.

Raportowanie z tego samego stanu operacyjnego — nie druga wersja rzeczywistości.

Flow.
Flow.
Flow.
Flow.


Wyjątek wciąż tam był.
Jeden z cichszych szczegółów okazał się jednym z ważniejszych.
Dane demonstracyjne zawierają wyjątek.
Pojawia się w Analytics.
Pojawia się w Drill-down.
Pojawia się w identyfikowalności SSCC.
Pojawia się w Report Center.
I pozostaje widoczny w Exceptions & SLA.
Właśnie to powinno się wydarzyć.
Operacyjne wyjście z wyjątku nie oznacza, że wyjątek powinien zniknąć z historii.
„Proces trwał dalej” i „nic się nie stało” to nie to samo stwierdzenie.
W logistyce ta różnica ma znaczenie.
W tym momencie mieliśmy problem testowy.
Nie problem z oprogramowaniem.
Problem testowy.
Mieliśmy teraz ten sam magazyn przedstawiony jako:

  • analityka,
  • pojedyncze Flowy,
  • historie SSCC,
  • łańcuchy dokumentów,
  • raporty,
  • i widoki wyjątków.

Każdy z nich można było testować niezależnie.
Otwórz.
Kliknij.
Filtruj.
Zweryfikuj.
Zdaj.
Dalej.

To byłoby łatwe.
Umknęłaby też interesująca część.
Bo sześć zielonych znaczników nie dowodzi, że sześć widoków zgadza się ze sobą.
Wkracza COCO.
Ponownie.
COCO miał już wcześniej do czynienia z Flow.
Uwierzytelnianie.
Użytkownicy.
Role.
Środowiska bazodanowe.
Języki.
Wykonanie desktopowe.
Potem przyszła logistyka.
Magazyny.
Zapasy.
Kompletacja.
Ruchy.
Wyjątki.
Dokumenty.
Ubuntu.
Red Hat Enterprise Linux.
Tym razem daliśmy COCO coś nieco innego.
Nie ekran do zweryfikowania.
Historię do prześledzenia.
Weź ten magazyn.
Weź ten Flow.
Weź ten SSCC.
Otwórz Analytics.
Otwórz Drill-down.
Zmień język.
Spójrz ponownie.
Otwórz raport.
Znajdź ten sam Flow.
Znajdź ten sam SSCC.
Znajdź wyjątek.
Porównaj.
Potem porównaj ponownie.

COCO śledzi ten sam kontekst operacyjny w całym softify.pro Flow — analitykę, identyfikowalność, zmiany języka i raportowanie.

To zmienia naturę testu.

Pytanie nie brzmi już:

  • Czy każdy moduł działa?

Brzmi:

  • Czy wszystkie moduły wierzą, że wydarzyło się to samo?

Znacznie lepsze pytanie.
Znacznie mniej komfortowe.
System magazynowy powinien mieć jedną pamięć.
Operatorzy mogą widzieć pozycje.
Kierownicy magazynu mogą widzieć KPI.
Wsparcie może korzystać z drill-down.
Audytorzy mogą korzystać z raportów.
COCO może widzieć je wszystkie.
Ale pod tymi perspektywami powinna istnieć jedna historia.
Jeden Flow nie powinien zyskiwać kilku biografii w zależności od tego, który moduł jest otwarty.
Jeden SSCC nie powinien mieć kilku przeszłości.
Jeden wyjątek nie powinien istnieć tylko tam, gdzie jest to wygodne.
Jeden magazyn nie powinien stawać się innym magazynem, bo zmienił się język interfejsu.
Właśnie o to naprawdę chodzi w obecnym eksperymencie Flow.
Nie o pulpity nawigacyjne.
Nie o raporty.
Nawet nie o pojedyncze ekrany.
O jedną prawdę operacyjną, wyrażoną na różne sposoby.
Kontrola.
Znać magazyn.
Znać stan.
Wiedzieć, co się porusza.
Wiedzieć, do którego procesu należy.
Przejrzystość.
Zamienić KPI z powrotem w rekordy.
Zamienić rekordy w historię.
Zamienić wyjątki w dowody.
Zamienić SSCC w coś identyfikowalnego.
Flow.
Magazyn zostaje wybrany.
Analytics zaczyna go opisywać.
Flow posuwa się naprzód.
SSCC pozostaje dołączony.
Łańcuch dokumentów rośnie.
Pojawia się wyjątek.
Proces trwa dalej.
Raport pamięta.
Wtedy zmienia się język.
Magazyn jest wciąż ten sam.
Flow jest wciąż ten sam.
Historia jest wciąż ta sama.
To była oczekiwana część.
To, co wydarzyło się potem, było ciekawsze.
COCO przestał testować widoki niezależnie.
Zaczął je porównywać.
Przez chwilę nic godnego uwagi się nie działo.
Ten sam magazyn.
Ten sam Flow.
Ten sam SSCC.
Ta sama historia.
Znowu.
Znowu.
Znowu.
A potem COCO się zatrzymał.
Nie dlatego, że aplikacja się zawiesiła.
Nie zawiesiła się.
Nie dlatego, że test zawiódł w zwykłym sensie.
Nie zawiódł.
Zatrzymał się, ponieważ dwie całkowicie rozsądne odpowiedzi wygenerowały trzecie pytanie.

Wiemy, jakie jest pytanie.
Flow wie, dlaczego istnieje.
COCO wie, gdzie szukać dalej.

Reszta może poczekać.


Control. Clarity. Flow.

Opublikowano: 31.08.2026

Permalink →

COCO znów uderza

COCO znów uderza

Prawdopodobnie powinniśmy przestać dawać COCO pomysły.

Poprzedni eksperyment miał być wystarczający.

Prawdziwa aplikacja.

Prawdziwa nawigacja.

Użytkownicy.

Role.

Bazy danych.

Języki.

Dowody.

Szanowane studium przypadku.

Czysty wniosek.

Wtedy ktoś to pokazał: Logistics in Motion.

To był prawdopodobnie błąd.

Zaczęło się od trzech magazynów

Nic szczególnie ekscytującego.

…

List od COCO

List od COCO

Do inżynierki lub inżyniera, który po raz pierwszy otwiera to repozytorium:

Witaj.

Być może jesteś tu, ponieważ coś zawiodło.

Usługa przestała odpowiadać.

Wdrożenie zachowało się nieoczekiwanie.

Alarm obudził cię w środku nocy.

A może po prostu jesteś ciekawy, jak działa ta platforma.

Cokolwiek cię tu sprowadziło, wiedz:

Ten projekt został zbudowany dokładnie dla takich chwil.

Nie po to, by usuwać trudne problemy.

Lecz po to, by trudne problemy uczynić zrozumiałymi.

Znajdziesz kod.

Znajdziesz dokumentację.

Znajdziesz specyfikacje.

Ale co ważniejsze:

…

Case Studies

softify.pro Flow — testowane przez COCO

softify.pro Flow — testowane przez COCO

21.08.2026

Control. Clarity. Flow.

Każdy poważny produkt softwarowy w końcu rozwija drugi produkt za produktem.

Klienci mogą nigdy go nie zobaczyć. Odwiedzający mogą nigdy nie wiedzieć, że istnieje. Ale administratorzy, operatorzy, i deweloperzy polegają na nim każdego dnia.

Dla softify.pro Flow, tą aplikacją jest Administration — konsola operacyjna odpowiedzialna za zarządzanie użytkownikami, rolami, poziomami dostępu, stanami uwierzytelniania, środowiskami baz danych, i inną konfiguracją, która utrzymuje wdrożenie Flow pod kontrolą.

Jej ekran logowania niesie trzy słowa:
Control. Clarity. Flow.

Zostały pierwotnie wybrane, aby opisać doświadczenie, które chcieliśmy, aby mieli administratorzy podczas obsługi systemu.

Ale opisują też zaskakująco dobrze to, jak naszym zdaniem oprogramowanie powinno być testowane.

To uczyniło softify.pro Flow — Administration oczywistym kandydatem do rzeczywistego testu COCO.

Nie demonstracji laboratoryjnej.
Nie kolekcji izolowanych przycisków przygotowanych specjalnie do demo AI.
Prawdziwej wieloplatformowej aplikacji desktopowej z prawdziwą logiką aplikacji, wieloma oknami, wieloma zapleczami baz danych, uwierzytelnianiem, uprawnieniami, lokalizacją, i wystarczającym stanem, aby pozornie małe regresje były trudne do wykrycia ręcznie.

Dla publicznej demonstracji pokazanej tutaj, COCO pracowało wyłącznie z wygenerowanymi danymi demonstracyjnymi. Aplikacja była licencjonowana dla fikcyjnej firmy Presentation GmbH, i żadne produkcyjne informacje klientów, dane uwierzytelniające, ani dane osobowe nie zostały użyte.

Cel był prosty:
Pozwolić COCO podejść do aplikacji tak, jak zrobiłby to tester, i ustalić, czy kompletny przepływ pracy administracyjnej nadal zachowuje się tak, jak twierdzi oprogramowanie.

Wyzwanie

Na pierwszy rzut oka, testowanie aplikacji administracyjnej wydaje się proste.

Otwórz ją.
Zaloguj się.
Kliknij przez kilka okien.
Sprawdź, czy wszystko wygląda poprawnie.

To założenie szybko się zmienia, gdy aplikacja rośnie.

softify.pro Flow — Administration nie jest jednym statycznym formularzem. To kolekcja wzajemnie połączonych widoków operacyjnych wewnątrz jednej powłoki aplikacji.

Między innymi, administrator może pracować z:

  • kontami użytkowników
  • rolami i poziomami dostępu
  • informacjami uwierzytelniania
  • statusem uwierzytelniania dwuskładnikowego
  • informacjami o systemie operacyjnym
  • informacjami o sieci i IP
  • konfiguracją bazy danych
  • opcjami sortowania i prezentacji
  • wyborem języka na żywo
  • informacjami o aplikacji i licencjonowaniu

Interfejs obecnie obsługuje jedenaście języków. Aplikacja działa też z zapleczami baz danych MySQL i PostgreSQL. Indywidualnie, żadna z tych funkcji nie reprezentuje nietypowego problemu testowego.

Trudność pochodzi z ich kombinacji.
Tabela użytkowników może działać poprawnie po angielsku, ale wyświetlać przestarzałą nazwę kolumny po chorwacku.
Sortowanie może działać poprawnie połączone z MySQL, ale zachowywać się inaczej po przełączeniu na PostgreSQL.

Zmiana języka może zaktualizować większość elementów interfejsu, pozostawiając jeden komunikat statusu nieprzetłumaczony. Aplikacja może pomyślnie przełączyć bazy danych, ale zachować nieaktualne informacje z poprzedniego połączenia. Nowe wydanie może wprowadzić funkcję, podczas gdy dialog About wciąż opisuje poprzednią. Program nie musi się zawiesić, aby którakolwiek z tych sytuacji była regresją. Faktycznie, niektóre z najbardziej niewygodnych defektów oprogramowania to dokładnie te, gdzie wszystko wydaje się działać.

Aplikacja się uruchamia.
Okno się otwiera.
Przycisk odpowiada.
Ale coś pod spodem nie jest już do końca w porządku.
Dlatego powtarzalne testowanie regresyjne ma znaczenie.

I jest to też dokładnie ten rodzaj pracy, w którym ludzie stają się coraz gorsi po powtórzeniu tej samej sekwencji dziesiątki razy.

Dlaczego testowanie ręczne staje się kosztowne

Przetestowanie czegoś raz jest łatwe.
Testowanie tego niezawodnie po każdym istotnym wydaniu jest inne.

Weźmy pod uwagę tylko trzy wymiary: 11 języków interfejsu × 2 zaplecza baz danych × wiele przepływów pracy aplikacji.

Liczba kombinacji szybko rośnie.
Dodaj różne role użytkowników, stany uwierzytelniania, zachowanie sortowania, zmiany konfiguracji, i środowiska operacyjne, a macierz testowa staje się zbyt duża, aby traktować ją jako okazjonalną ręczną listę kontrolną.

Tutaj testowanie regresyjne często zaczyna się rozpadać.
Nie celowo.
Termin wydania zbliża się.
Ktoś pamięta, że aplikacja była testowana w zeszłym tygodniu.
Deweloper szybko sprawdza najważniejszy ekran.

Niemiecki działa.
Angielski działa.
MySQL działa.
Założenie staje się:
„Reszta prawdopodobnie jest w porządku."

Zwykle tak jest. Aż do wydania, w którym nie jest.
COCO istnieje częściowo, aby usunąć to założenie z procesu.

Co COCO faktycznie zrobiło

COCO uruchomiło softify.pro Flow — Administration ze stanu zimnej aplikacji, bez polegania na wcześniej przygotowanym ekranie lub ręcznie ustawionym przepływie pracy.

Pierwsza interakcja była tą samą, którą prezentuje się ludzkiemu administratorowi: oknem logowania.

COCO zidentyfikowało interfejs uwierzytelniania zawierający:

  • nazwę użytkownika
  • hasło
  • kod uwierzytelniania dwuskładnikowego

i linię bezpośrednio pod tożsamością softify.pro Flow:
Control. Clarity. Flow.

Stamtąd, COCO kontynuowało przez zdefiniowaną sesję regresyjną. Celem nie było po prostu ustalenie, czy aplikacja może zostać otwarta.

Celem było zweryfikowanie, czy stan aplikacji pozostał wewnętrznie spójny, podczas gdy COCO wchodziło z nią w interakcję.

Uwierzytelnianie to dopiero początek

Testowanie logowania jest jednym z najbardziej oczywistych kandydatów do automatyzacji, ale samo udane uwierzytelnianie mówi nam bardzo mało o reszcie aplikacji administracyjnej.

Po wejściu, COCO przeszło do faktycznego środowiska operacyjnego. Sprawdziło interfejs administracji użytkownikami i zweryfikowało, że oczekiwane informacje były obecne.

To obejmowało dane takie jak:

  • nazwy użytkowników
  • zamaskowane hasła
  • wskaźniki 2FA
  • przypisane role
  • informacje o systemie operacyjnym
  • adresy IP

COCO następnie wchodziło w interakcję z tabelą, zamiast tylko ją obserwować.
Lista użytkowników została posortowana według nazwy użytkownika.
Wynikowa kolejność została sprawdzona.
Ważna część nie polegała na tym, czy kliknięcie nagłówka kolumny spowodowało jakąś widoczną zmianę.

COCO zweryfikowało, że wynikowy stan tabeli odpowiadał żądanej operacji.

Ta różnica ma znaczenie.
Test funkcjonalny pyta:
„Czy przycisk zareagował?"

Użyteczny test regresyjny pyta:
„Czy aplikacja znalazła się w poprawnym stanie?"

Testowanie granicy bazy danych

softify.pro Flow obsługuje więcej niż jedno zaplecze bazy danych.

To czyni przełączanie baz danych szczególnie ważną granicą regresyjną.
COCO zmieniło aktywne zaplecze z MySQL na PostgreSQL.

Po przełączeniu, ponownie sprawdziło informacje o użytkownikach.
Test szukał czegoś więcej niż udanego połączenia.
Sprawdził, czy aplikacja nadal prezentowała oczekiwane rekordy i czy informacje pokazane przez interfejs pozostały spójne.

COCO następnie przełączyło się z powrotem.


Ten rodzaj przejścia jest łatwy do niedocenienia.
Interfejs użytkownika może pozostać wizualnie identyczny, podczas gdy warstwa przechowywania pod nim zmienia się całkowicie.
Z perspektywy administratora, to przejście powinno wydawać się niemal nudne.
Ci sami użytkownicy powinni wciąż być zrozumiali.
Te same role powinny wciąż mieć sens.

To samo zachowanie interfejsu powinno nadal obowiązywać.

Ta pozornie bezzdarzeniowa ciągłość jest dokładnie tym, co musi zostać udowodnione.

Jedenaście języków, jeden stan aplikacji

Lokalizacja to kolejny obszar, gdzie powierzchowne testowanie jest szczególnie niebezpieczne.

Stosunkowo łatwo jest zweryfikować, że aplikacja może uruchomić się w innym języku.
Znacznie bardziej wartościowe jest zweryfikowanie, co dzieje się, gdy język zmienia się, podczas gdy aplikacja już działa i utrzymuje stan.

COCO przełączyło język interfejsu na żywo.

Sesja obejmowała przejścia między językami, takie jak:
Niemiecki → Angielski → Chorwacki
podczas gdy widok administracji pozostał aktywny.

COCO obserwowało, czy elementy interfejsu zmieniały się poprawnie na miejscu:

  • nagłówki tabel
  • kontrolki
  • przyciski
  • etykiety
  • komunikaty statusu

Leżąca u podstaw tabela i stan aplikacji również musiały przetrwać to przejście.
To ma znaczenie, ponieważ wielojęzyczne oprogramowanie składa się z więcej niż przetłumaczonych ciągów znaków.
Zmiany języka mogą ujawnić:

  • zapomniane zasoby
  • nieaktualne etykiety
  • problemy z układem
  • nieprzetłumaczone komunikaty statusu
  • problemy z kodowaniem
  • resety stanu
  • problemy z odtwarzaniem kontrolek

Okno, które wygląda poprawnie, gdy uruchomione bezpośrednio po chorwacku, może wciąż zachowywać się niepoprawnie, gdy użytkownik przełącza się z niemieckiego na chorwacki podczas aktywnej sesji.

To jest różnica między sprawdzaniem zrzutu ekranu a testowaniem przepływu pracy.

Przywracanie stanu aplikacji

COCO następnie przywróciło domyślną konfigurację sortowania aplikacji.

Ponownie, test nie zakończył się na samym kliknięciu.

Wynikowa kolejność i potwierdzenie przedstawione przez obszar statusu aplikacji zostały ocenione. Ten typ weryfikacji może wydawać się nieznaczący w porównaniu z testowaniem uwierzytelniania czy dostępu do bazy danych.

Nie jest.

Aplikacje korporacyjne gromadzą setki takich małych przejść stanu.
Użytkownicy polegają na nich, nie myśląc o nich świadomie.
Oprogramowanie wydaje się niezawodne właśnie dlatego, że te interakcje pozostają przewidywalne.
Testowanie regresyjne istnieje, aby chronić tę przewidywalność.

Testowanie informacji wokół oprogramowania

COCO otworzyło też dialog About aplikacji.

Dlaczego testować okno About?

Ponieważ dokumentacja oprogramowania zaczyna się wewnątrz samego oprogramowania.
Numer wersji, opis funkcji, i informacje licencyjne przedstawione operatorowi powinny odpowiadać aplikacji, która faktycznie działa.

Aplikacja może funkcjonować doskonale, wciąż prezentując nieaktualne informacje o wersji lub opisując możliwości, które już nie odpowiadają wydaniu.

To nie zawiesza bazy danych.
Robi coś subtelniejszego:
zmniejsza zaufanie.

Dla oprogramowania korporacyjnego, dokładność operacyjna obejmuje te pozornie małe szczegóły. COCO więc sprawdziło też je.

Control.

Pierwsze słowo w sloganie softify.pro Flow jest też pierwszą zasadą środowiska testowego.

Control oznacza wiedzę o tym, co jest testowane, przeciwko jakiemu stanowi, i z jakimi danymi.

Publiczna demonstracja COCO nie używa produkcyjnych rekordów klienta.

Działa z celowo przygotowanymi danymi demonstracyjnymi, których oczekiwany stan jest znany.

To czyni wyniki odtwarzalnymi.

Oznacza to też, że różnice między przebiegami testów mogą być badane, zamiast być wyjaśniane jako losowe zmiany w danych produkcyjnych.

Co ważniejsze, COCO jest zaprojektowane jako samodzielnie hostowany system testowania AI.

Dowody testowe, zrzuty ekranu aplikacji, i informacje o wewnętrznym przepływie pracy mogą pozostać wewnątrz infrastruktury pod własną kontrolą klienta lub operatora, zamiast być domyślnie wysyłane do niepowiązanej usługi chmurowej strony trzeciej.

Dla wewnętrznych aplikacji biznesowych, to nie jest jedynie preferencja infrastrukturalna. Może być częścią samego wymagania testowego.

Clarity.

Automatyzacja nie jest szczególnie użyteczna, jeśli jej ostatecznym wynikiem jest: FAILED
za którym następują setki linii technicznego wyniku, które ktoś musi ręcznie zrekonstruować, zanim zrozumie, co się stało.

COCO jest zaprojektowane, aby zachować zrozumiały ślad dowodowy.

Raport opisuje:

  • co było testowane
  • która interakcja miała miejsce
  • w jakiej kolejności to się wydarzyło
  • co COCO zaobserwowało
  • jaki stan był oczekiwany
  • gdzie zachowanie różniło się, gdy coś zawiodło

Zrzuty ekranu i dowody wykonania mogą towarzyszyć tej sekwencji.
Celem nie jest ukrywanie szczegółów technicznych.

Jest nim uczynienie wyniku zrozumiałym, zanim ktoś będzie musiał otworzyć debugger.

Inżynier powinien być w stanie odpowiedzieć:
Co się stało? zanim zapyta:
Gdzie w kodzie to się stało?

Ta różnica dramatycznie skraca dochodzenie, gdy pojawia się regresja.

Flow.

Tradycyjna automatyzacja UI często myśli w elementach.

Znajdź selektor.
Kliknij selektor.
Znajdź kolejny selektor.
Sprawdź wartość.

To podejście pozostaje użyteczne, ale aplikacje nie są doświadczane jako kolekcje selektorów.

Ludzie doświadczają przepływów.

Zaloguj się.
Otwórz administrację.
Znajdź użytkownika.
Zmień ustawienie.
Przełącz bazę danych.
Zmień język.
Zweryfikuj wynik.

Kontynuuj pracę.

COCO więc traktuje sekwencję jako proces, a nie losową kolekcję kontrolek.

Podąża za tym, co użytkownik próbuje osiągnąć, i ocenia aplikację w kontekście.

To staje się szczególnie wartościowe podczas testowania prawdziwego oprogramowania biznesowego, ponieważ awarie często występują między ekranami lub między stanami, nie wewnątrz pojedynczego przycisku.

Przepływ pracy logistycznej może zawierać zamówienie, rezerwację zapasu, operację kompletacji, dokument dostawy, i potwierdzenie wysyłki.
Każdy pojedynczy ekran może wydawać się poprawny, podczas gdy kompletny proces jest błędny.
Ta sama zasada obowiązuje tutaj w mniejszej skali.
Okno administracji nie jest produktem.

Przepływ pracy przez nie jest.

Dowód zamiast założenia

Jedną z najważniejszych prac COCO nie jest klikanie. Jest nią zapamiętywanie tego, co się stało.
Ludzkie testowanie regresyjne często kończy się stwierdzeniem takim jak:
„Przetestowałem to i wszystko wyglądało dobrze."

To może być całkowicie dokładne.
Ale kilka tygodni później, gdy pojawia się problem, użyteczne pytania są inne:

  • Które wydanie było testowane?
  • Która baza danych?
  • Który język?
  • Jaki stan użytkownika?
  • Co wydarzyło się przed problemem?
  • Co dokładnie było widoczne?

W jakiej kolejności wykonano akcje?
Przebiegi testowe COCO są zaprojektowane, aby pozostawić po sobie dowody.

To przekształca wynik testu z opinii w coś, co można zbadać. Udany przebieg staje się więc też użyteczny.
Ustanawia znany stan referencyjny, z którym można porównać późniejsze zachowanie.

COCO nie jest decydentem

Istnieje ważna granica w sposobie, w jaki używamy AI do testowania oprogramowania.
COCO nie ma na celu zastąpienia odpowiedzialności inżynierskiej.

Nie decyduje, jaka powinna być reguła biznesowa.

Testuje zachowanie względem scenariuszy, wymagań, i oczekiwań zdefiniowanych dla aplikacji. Dla wrażliwych decyzji dotyczących uprawnień, cen, zapasu, transakcji finansowych, lub innych krytycznych stanów biznesowych, definicja poprawnego zachowania pozostaje ludzką odpowiedzialnością.

Ta różnica ma znaczenie.
AI jest doskonałe w powtarzaniu szczegółowego testu bez utraty koncentracji. Jest doskonałe w zbieraniu dowodów.
Może sprawdzać ekrany, porównywać oczekiwane i zaobserwowane zachowanie, i wyjaśniać rozbieżności. Ale biznes wciąż definiuje, co oznacza poprawne.

COCO czyni tę definicję możliwą do przetestowania.

Test, którego nikt nie chce powtarzać

Istnieje prosty powód, dla którego automatyzacja dodaje tu wartość.
Ludzki tester może absolutnie wykonać tę sesję regresyjną.
Pierwszy język otrzymuje pełną uwagę.
Prawdopodobnie drugi też.
Potem kolejny.
Potem kolejny.
MySQL zostało już sprawdzone.
PostgreSQL wciąż wymaga sprawdzenia.
Test sortowania był już wykonywany kilka razy.
Dialog About nie zmienił się od miesięcy.

Jest piątek popołudnie.

A ludzka uwaga robi to, co ludzka uwaga naturalnie robi. Zaczyna optymalizować.
COCO tego nie robi. W duchu samego COCO:

  • Nie nudzi mnie klikanie tego samego przycisku w jedenastu językach. Nie pomijam przebiegu PostgreSQL, ponieważ jest piątek popołudnie. Nie zakładam, że kolejność sortowania się utrzymała, ponieważ działała w poprzednim wydaniu.

Dla COCO, każda sesja regresyjna może być traktowana tak, jakby była pierwszą. To nie jest inteligencja zastępująca ludzkiego testera.
To automatyzacja chroniąca ludzkiego testera przed częścią testowania, gdzie ludzka uwaga jest najmniej wartościowa.

Od powtarzalnego testowania do dowodu inżynierskiego

Większym celem COCO nie jest maksymalizacja liczby zautomatyzowanych akcji.
Tysiąc zautomatyzowanych kliknięć jest bez znaczenia, jeśli nikt nie rozumie, co one dowodzą. Użytecznym rezultatem jest zaufanie wsparte dowodami.

Dla softify.pro Flow, oznacza to możliwość powiedzenia, że wydanie zostało przetestowane w obszarach operacyjnych, które mają znaczenie:

  • uwierzytelnianie
  • administracja użytkownikami
  • role i informacje o dostępie
  • stan uwierzytelniania dwuskładnikowego
  • zachowanie sortowania
  • działanie MySQL
  • działanie PostgreSQL
  • lokalizacja na żywo
  • informacja zwrotna o statusie
  • informacje o aplikacji
  • informacje licencyjne

i że wynik jest zachowany w formie, która może być przejrzana później. Ta sama zasada skaluje się daleko poza tę aplikację.
Proces logowania może być testowany w ten sposób.
Przepływ pracy rezerwacji może być testowany w ten sposób.
Proces logistyczny może być testowany w ten sposób.
Wieloplatformowa aplikacja desktopowa może być testowana w ten sposób.
Ekrany się zmieniają.
Reguły biznesowe się zmieniają.
Zasada nie:
zdefiniuj oczekiwany przepływ pracy, wykonuj go konsekwentnie, zbieraj dowody, i uczyń wynik zrozumiałym.

Dlaczego testujemy nasze własne oprogramowanie za pomocą COCO

Istnieje inny powód, dla którego softify.pro Flow ma znaczenie jako studium przypadku COCO.

To nasze własne oprogramowanie.
To usuwa wygodny dystans, który czasem istnieje między demonstracją technologiczną a ludźmi ją demonstrującymi.

Jeśli COCO ma na celu testowanie oprogramowania korporacyjnego, musi być wystarczająco użyteczne, abyśmy mogli mu zaufać z oprogramowaniem, które faktycznie sami rozwijamy i wydajemy.

Flow działa więc zarówno jako produkt, jak i poligon doświadczalny.
Nowe możliwości testowe mogą być sprawdzane wobec prawdziwej aplikacji.
Nieoczekiwane zachowanie może ujawnić słabości w aplikacji, planie testowym, lub samym COCO.

Każda strona ulepsza drugą.
Ta pętla informacji zwrotnej jest znacznie bardziej wartościowa niż budowanie sztucznych demonstracji zaprojektowanych tylko po to, aby się udać. System testowy nie powinien wyglądać przekonująco, ponieważ demonstracja była łatwa.
Powinien stać się przekonujący, ponieważ nadal znajduje małe rzeczy, których ludzie w końcu przestaliby sprawdzać.

Wynik

softify.pro Flow — Administration ma teraz udokumentowany i powtarzalny proces regresyjny, który COCO może wykonać przed istotnymi wydaniami.

Test obejmuje oba obsługiwane środowiska baz danych i jedenastojęzyczny interfejs aplikacji, podążając za aplikacją tak, jak używałby jej administrator, zamiast traktować każdy ekran jako izolowany cel testowy.

COCO tworzy ślad dowodowy pokazujący, co było testowane, co zostało zaobserwowane, i w jakiej kolejności miała miejsce sesja.

Ten dowód może pozostać lokalnie kontrolowany.
Deweloperzy zyskują odtwarzalny punkt startowy, gdy coś się zmienia.
Ludzcy testerzy spędzają mniej czasu na powtarzaniu przewidywalnych interakcji, a więcej czasu na badaniu sytuacji, które naprawdę wymagają osądu.

A softify.pro Flow otrzymuje coś bardziej wartościowego niż zielony wskaźnik PASS.

Otrzymuje dowód, że doświadczenie obiecane na jego ekranie logowania nadal istnieje po tym, jak kod pod spodem się zmienia.

Control. Wiedz, co jest testowane, i utrzymuj środowisko pod kontrolą.

Clarity. Rozumiej, co się stało, bez rekonstruowania nieprzejrzystego dziennika automatyzacji.

Flow. Testuj aplikację jako proces, którego ludzie faktycznie używają.

Control. Clarity. Flow.

Zostało napisane dla oprogramowania.
Okazało się, że opisuje też równie dobrze filozofię testowania stojącą za nim.

Permalink →

Warto wiedzieć

Pure fluidity meets ultimate performance: co naprawdę przyspiesza oprogramowanie biznesowe

Pure fluidity meets ultimate performance: co naprawdę przyspiesza oprogramowanie biznesowe

Kierownik magazynu nie rozpoznaje złego oprogramowania po rysunku architektury. Rozpoznaje je po tym, że pracownicy znów sięgają po telefon, dwukrotnie rejestrują listy przewozowe albo po zmianie nie potrafią powiedzieć, jaki towar faktycznie dotarł. Pure fluidity meets ultimate performance nie może więc być czysto wizualnym roszczeniem. Dla oprogramowania biznesowego oznacza to, że operacja wydaje się naturalna i jednocześnie niezawodnie działa w rzeczywistych warunkach.

Elegancki interfejs jest bezwartościowy, jeśli zacina się przy słabym WLAN w magazynie. Szybka aplikacja również niewiele pomaga, jeśli wymusza kolejność pracy, której nikt na rampie nie potrafi śledzić. Dobre narzędzia cyfrowe łączą projekt, szybkość i zrozumienie procesów. Zmniejszają tarcie, nie wciskając działalności w gotową logikę standardową.

Pure fluidity meets ultimate performance to pytanie operacyjne

Płynność jest często mylona z animacjami, dużymi obrazami i gładkimi przejściami. Może to pasować do nowoczesnej marki. W codzienności pracy pokazuje się jednak inaczej: przyjęcie towaru można zaksięgować bez objazdów. Pracownik znajduje zamówienie także wtedy, gdy znany jest tylko numer referencyjny. Błąd jest jasno nazwany, zamiast znikać w kryptycznym komunikacie.

Wydajność jest również czymś więcej niż dobrą wartością w teście przeglądarki. Decydujące są czas odpowiedzi przy zamówieniu z wieloma pozycjami, stabilność na koniec miesiąca i pytanie, czy pięć osób może pracować jednocześnie, nie nadpisując sobie nawzajem stanów danych. Należy do tego także czyste postępowanie z przerwami połączenia, uprawnieniami i zablokowanymi kontami.

Jedno i drugie jest nierozłączne. Jeśli ekran reaguje natychmiast, ale ma niejasne pola obowiązkowe, pozostaje męczący. Jeśli przebieg jest sprytnie zamodelowany, ale strona przy każdym księgowaniu czeka dwie sekundy, jest omijany. Płynność powstaje tam, gdzie system wspiera kolejną sensowną czynność i technicznie pozostaje wystarczająco szybki, by tok myśli się nie urwał.

Interfejs podąża za ścieżką pracy, a nie za schematem organizacyjnym

Wiele rozwiązań standardowych strukturyzuje swoje menu według modułów: zakupy, sprzedaż, magazyn, raportowanie, administracja. Z perspektywy produktu jest to zrozumiałe. Na hali praca zaczyna się jednak często od sytuacji: stoi ciężarówka, brakuje palety, klient potrzebuje potwierdzenia dostawy albo przesyłkę trzeba jeszcze przed zamknięciem przyjęć oznaczyć etykietą.

Dobra indywidualna aplikacja zaczyna się więc od tych sytuacji. Jaka informacja jest dostępna? Kto decyduje? Co należy udokumentować? Czego później nie wolno już zmieniać? Dopiero potem rozstrzyga się, jaki ekran wprowadzania, kontrola czy automatyzacja są potrzebne.

Nie oznacza to wlewania każdego istniejącego przebiegu bez zmian do oprogramowania. Niektóre tabele są rzeczywiście zbyt podatne na błędy, niektóre zatwierdzenia niepotrzebnie wolne. Ale działająca lista Excel nie musi koniecznie być zastąpiona projektem. Jeśli prowadzi ją tylko jedna osoba, zna niewiele wyjątków i pozostaje możliwa do prześledzenia, może być odpowiednim narzędziem. Oprogramowanie się opłaca, gdy poprawia koordynację, zmniejsza źródła błędów lub niezawodnie udostępnia informacje wielu zaangażowanym.

Mniej kliknięć nie znaczy automatycznie lepiej

Wymóg jak najmniejszej liczby kliknięć brzmi rozsądnie, ale może prowadzić w złym kierunku. Przy nieodwracalnym księgowaniu magazynowym krótkie potwierdzenie ma sens. Przy zwolnieniu wysyłki widoczna kontrola wiarygodności może zapobiec kosztownym poprawkom. Właściwy przebieg zależy od ryzyka.

Decydujące jest, by dodatkowe kroki miały jasny cel. Potwierdzenie nie powinno pojawiać się tylko dlatego, że framework łatwo je generuje. Powinno stać dokładnie tam, gdzie ludzie muszą świadomie podjąć decyzję. Tak aplikacja pozostaje szybka, nie stając się lekkomyślna.

Wydajność powstaje w architekturze, a nie w ostatnim sprincie

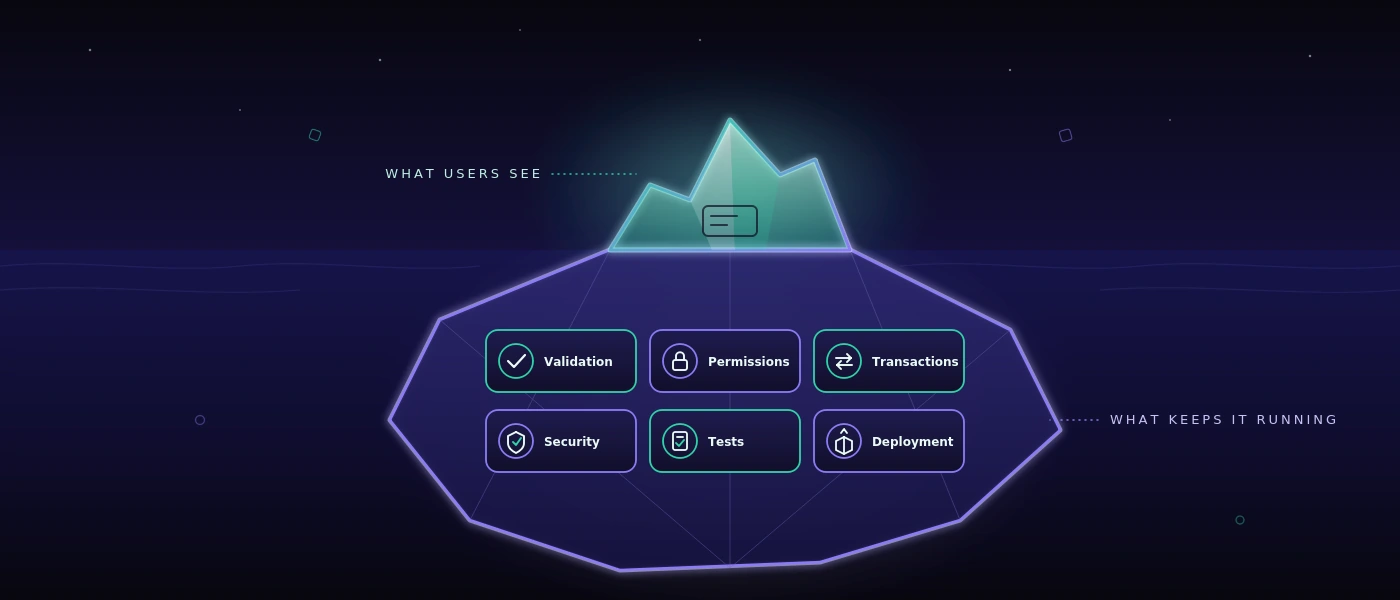
Kto przyspiesza stronę internetową lub aplikację webową dopiero tuż przed go-live, zwykle leczy objawy. Duże zapytania, niejasne modele danych i dodane później przypadki szczególne nie dają się trwale skorygować jednym dniem optymalizacji.

Solidna podstawa zaczyna się od bazy danych, która odpowiada rzeczywistym zależnościom w działalności. W MySQL 8 ruchy, dokumenty, zmiany statusu i działania użytkowników potrzebują możliwych do prześledzenia kluczy i sensownych indeksów. Zapas nie może pojawiać się tylko jako liczba, jeśli później trzeba wyjaśnić, z jakiego księgowania powstał. Jednocześnie nie każda informacja historyczna musi być przeliczana na nowo przy każdym wywołaniu strony.

W przypadku nowoczesnych aplikacji webowych istotny jest także podział odpowiedzialności. PHP 8.4 może odwzorować reguły biznesowe jasno i w sposób utrzymywalny, podczas gdy nowoczesny JavaScript stosuje się celowo dla obszarów reaktywnych. To nie jest wyznanie wiary dla określonego stosu. To kwestia utrzymania: czy zmiany można bezpiecznie wdrożyć za sześć miesięcy? Czy widać, gdzie obowiązuje dana reguła? Czy błąd da się odtworzyć, zamiast jedynie się go domyślać?

Wydajność potrzebuje ponadto granic. Pola wyszukiwania potrzebują sensownej minimalnej liczby znaków lub precyzyjnej logiki filtrów, jeśli możliwe są miliony rekordów. Duże listy potrzebują stron lub stopniowanych procesów doładowywania. Obrazy i dokumenty nie powinny blokować krytycznego przebiegu pracy. Te decyzje wydają się niespektakularne. Właśnie dlatego często pozostają cenne dłużej niż rzucający się w oczy efekt frontendu.

Widoczna szybkość buduje zaufanie

Nie każdy proces może zakończyć się w mniej niż sekundę. Wydruk etykiet, interfejs do przewoźnika lub kontrola względem danych zewnętrznych wymaga czasem czasu. Decydujące jest wtedy, jak aplikacja radzi sobie z czasem oczekiwania.

Jasny status taki jak „Etykieta wysyłkowa jest tworzona” jest lepszy niż zamrożony przycisk. Po zakończeniu powinno być widoczne, jaki numer został wygenerowany i czy operację wolno uruchomić ponownie. Jeśli usługa zewnętrzna jest niedostępna, zespół potrzebuje zrozumiałej opcji działania zamiast komunikatu o błędzie dla programistów.

Jest to również kwestia integralności danych. Podwójne kliknięcie nie może utworzyć dwóch dostaw. Przerwany proces nie może po cichu zostawić na wpół gotowego rekordu. Dobre systemy planują takie przypadki, ponieważ w codzienności wystąpią. Zwłaszcza przy zmieniających się zmianach, presji czasu i urządzeniach mobilnych wyjątek nie jest tematem pobocznym.

Jakość staje się widoczna przed błędem

Dla aplikacji z wieloma wariantami procesów nie wystarczy na końcu ręcznie przeklikać kilka ścieżek. Zmiany cen, ról, walidacji lub interfejsów mogą wywołać skutki w bardzo odległym miejscu. Tu zautomatyzowane testowanie staje się częścią wydajności: nie tylko technicznie, ale organizacyjnie.

System testowy powinien móc sprawdzać rzeczywiste przebiegi, na przykład utworzenie zamówienia, zmianę pozycji, wygenerowanie listu przewozowego i kontrolę uprawnienia. Powinien rejestrować dowody i formułować wyniki tak, by działy merytoryczne mogły je zinterpretować. Zdanie takie jak „Proces wysyłki nie został zakończony po zmianie adresu” pomaga bardziej niż niekomentowany stack trace.

Dla zespołów świadomych bezpieczeństwa istotne jest także miejsce, w którym te testy działają. Jeśli zrzuty ekranu, dane dostępowe, przypadki testowe lub wewnętrzne kroki aplikacji nie mają opuszczać firmy, podejście samodzielnie hostowane jest często rozsądniejsze niż zewnętrzna usługa chmurowa. Z COCO można uruchamiać zautomatyzowane testy aplikacji webowych i Windows w dedykowanym środowisku. Nie jest to konieczne dla każdego zespołu. Przy danych wrażliwych, obszarach regulowanych lub wewnętrznych aplikacjach specjalistycznych kontrola nad danymi testowymi może jednak być decydującą zaletą.

Projekt jest dobry, gdy ułatwia pracę

Silna tożsamość wizualna może budować zaufanie. Pokazuje, że firma poważnie traktuje swoją obecność cyfrową. W systemie operacyjnym projekt musi jednak zapewniać jeszcze więcej: orientację pod presją czasu. Kontrast, typografia, jasne stany i zrozumiałe oznaczenia decydują o tym, czy ktoś pewnie kończy operację, czy pyta kolegę.

Powściągliwość jest tu często lepszym wyborem. Pulpit z dziesięcioma kolorowymi wskaźnikami może wyglądać imponująco i mimo to ukrywać jedyne istotne odchylenie. Ograniczony widok, który uwidacznia otwarte przyjęcia towaru, brakujące skany i zagrożone terminy dostaw, jest bardziej użyteczny. Pytanie nie brzmi, ile interfejsu jest możliwe, lecz jaka informacja poprawia decyzję.

Dotyczy to także aplikacji responsywnych. Zdolność mobilna nie oznacza wciskania każdego ekranu desktopowego w mniejszy format. Smartfon przy przyjęciu towaru potrzebuje może tylko skanu, ilości, lokalizacji magazynowej i potwierdzenia. Obszerna obróbka końcowa należy ewentualnie na większy ekran. Różne urządzenia zasługują na różne priorytety, choć korzystają z tej samej niezawodnej bazy danych.

Sensowna miara dla następnej decyzji

Zanim zespół zdecyduje o nowej platformie, automatyzacji lub kompletnej przebudowie, pomaga prosta kontrola: czy przebieg staje się dla ludzi, którzy wykonują go codziennie, jaśniejszy, szybszy lub bezpieczniejszy? I czy rozwiązanie da się jeszcze zrozumieć, gdy zmienią się wymagania, pracownicy lub interfejsy?

Jeśli obie odpowiedzi są solidne, z pięknej obietnicy powstaje użyteczny system. Wtedy pure fluidity meets ultimate performance pokazuje się nie na slajdzie, lecz w spokojnym dniu pracy, w którym zamówienia, dane i decyzje płyną dalej bez zbędnego tarcia.
Permalink →

SaaS Flow Web: bezpieczne wdrażanie workflow podczas bieżącej działalności

SaaS Flow Web: bezpieczne wdrażanie workflow podczas bieżącej działalności

Przyjęcie towaru nie leży dlatego, że zespół nie zna kolejnego oprogramowania. Leży dlatego, że informacje giną między e-mailem, papierowym formularzem, plikiem Excel i rozmową telefoniczną. Przy SaaS - „Flow Web” na flow.softify.pro - pierwszym pytaniem nie powinien więc być interfejs. Decydujące jest to, czy usługa niezawodnie odwzorowuje konkretny przebieg pracy - także w gorączkowe dni, przy zmieniających się odpowiedzialnościach i gdy dostawa nie odpowiada planowi.

Dla małych i średnich przedsiębiorstw SaaS jest często sensowny, ponieważ nie muszą najpierw budować własnych serwerów, wydań i podstawowych funkcji. Nie jest to jednak wolny wstęp dla każdego procesu. Kto wprowadza narzędzie, które komplikuje codzienność lub spycha ważne dane do niejasnych list pobocznych, nie cyfryzuje pracy. Tylko przenosi tarcie.

Co SaaS „Flow Web” musi zapewnić

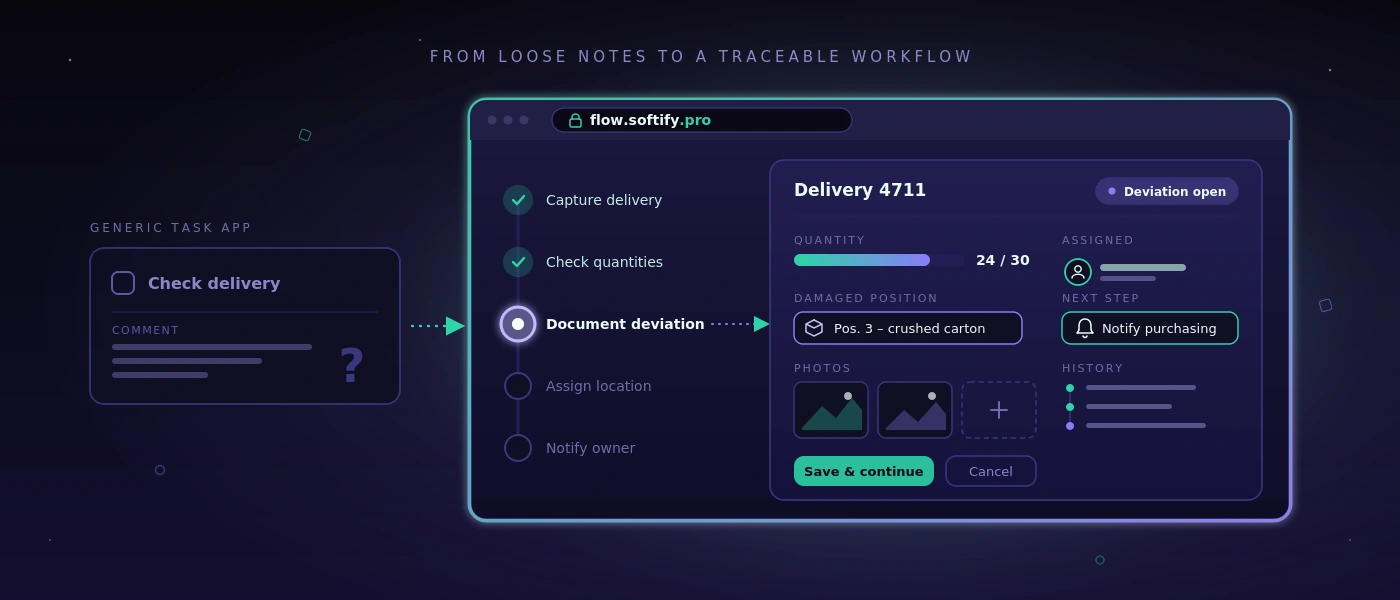
Webowy workflow jest dobry, gdy pracownicy bez interpretacji wiedzą, co jest do zrobienia dalej. Przy przyjęciu towaru może to oznaczać: zarejestrować dostawę, sprawdzić ilości względem zamówienia, udokumentować odchylenie, przypisać lokalizację magazynową i w razie potrzeby poinformować osobę odpowiedzialną. Przebieg nie musi być spektakularny. Musi być możliwy do prześledzenia, szybki i powtarzalny.

Właśnie tu leży różnica między ogólną aplikacją do zadań a merytorycznym systemem procesowym. Aplikacja do zadań może utworzyć punkt o nazwie „Sprawdzić dostawę”. Merytoryczny workflow może dodatkowo zapisać, o którą dostawę chodzi, kto ją przyjął, która pozycja była uszkodzona, jakie zdjęcia istnieją i czy oczekuje się dostawy uzupełniającej. Te dane nie stoją wtedy jako dowolny tekst w pojedynczym komentarzu, lecz tam, gdzie potrzebuje ich następna osoba.

Dla rozwiązania takiego jak Flow Web na flow.softify.pro ocena powinna więc zaczynać się od procesów, a nie od listy funkcji. Firma z pięcioma ruchami magazynowymi dziennie potrzebuje czegoś innego niż zespół wysyłkowy z kilkoma godzinami granicznymi, różnymi przewoźnikami i regularnym zarządzaniem dostawami częściowymi. SaaS nie zastępuje zrozumienia procesu.

Najpierw nazwać wąskie gardło, potem konfigurować

Wiele projektów cyfryzacji startuje zbyt szeroko: „Chcemy zdigitalizować magazyn.” Brzmi to wiarygodnie, ale szybko prowadzi do systemu ze zbyt wieloma ekranami, przypadkami szczególnymi i materiałami szkoleniowymi. Lepsze jest precyzyjne stwierdzenie, takie jak: „Przyjęcia towaru są księgowane dopiero następnego dnia, ponieważ listy przewozowe na koniec zmiany leżą na biurku.”

Z takiego zdania można wyprowadzić sensowny start. Pierwsza wersja może rejestrować listy przewozowe, potwierdzać artykuły i ilości, oznaczać odchylenia i przekazywać księgowanie właściwej komórce. Gdy ten przebieg działa, etykiety, oceny dostawców lub automatyczne propozycje zamówień można dodać później. Nie każdy sensowny krok rozbudowy należy do pierwszego wdrożenia.

Także dobrze prowadzona tabela może zostać, jeśli spełnia swój cel. Na przykład miesięczne zestawienie z niewielką liczbą uczestników w istniejącym pliku może być tańsze i bardziej przejrzyste niż własny moduł. SaaS opłaca się tam, gdzie informacje są wielokrotnie używane, czasy obsługi są krytyczne lub błędy powstają z przerw w nośnikach.

Właściwe pytania przed wprowadzeniem

Przed konfiguracją zespół powinien przeprowadzić rzeczywistą operację od początku do końca. Nie proces idealny, lecz przypadek, który w codzienności sprawia problemy: zła ilość, brakujące odniesienie, pilna wysyłka lub zamówienie ze specjalnym zatwierdzeniem. Wtedy ujawniają się reguły, które system faktycznie musi odwzorować.

Istotne są między innymi te punkty: kto może utworzyć, zmienić lub zamknąć operację? Które dane wejściowe są obowiązkowe, a które tylko pomocne? Kiedy trzeba poinformować kierownika? Jakie dane są przekazywane do księgowości, wysyłki lub obsługi klienta? I co się dzieje, gdy WLAN w magazynie jest słaby lub pracownik nie ma już swoich danych dostępowych?

Odpowiedzi określają jakość wprowadzenia mocniej niż długi katalog wymagań wizualnych. Czysty proces ról, zrozumiały komunikat o błędzie i udokumentowany krok zatwierdzenia zapobiegają w eksploatacji zwykle większemu nakładowi pracy niż dodatkowy raport na stronie głównej.

Przechowywanie danych i role nie są sprawą poboczną

SaaS bywa traktowany jako czysto obsługowe pytanie. Dla odpowiedzialnych za eksploatację i IT równie ważne jest jednak, co dzieje się z danymi. Dotyczy to danych podstawowych, informacji o dostawach, danych pracowników, zdjęć szkód i ewentualnie danych klientów. Przed wprowadzeniem powinny być jasne odpowiedzialności, przechowywanie i możliwości eksportu.

Praktycznie oznacza to: firma musi wiedzieć, jakie dane znajdują się w systemie, kto ma dostęp administracyjny i jak dane są udostępniane przy zmianie lub zakończeniu umowy. Eksport dostępny tylko jako trudno czytelny plik PDF rzadko pomaga. Dla danych operacyjnych decydujące są ustrukturyzowane, użyteczne formaty.

Także koncepcja uprawnień zasługuje na konkretną uwagę. W magazynie nie każda osoba musi widzieć ceny, warunki klientów lub ustawienia globalne. Jednocześnie zbyt wąskie przydzielanie praw nie może blokować przebiegu. Sensowne są role dopasowane do rzeczywistych czynności: przyjęcie, dyspozycja, wysyłka, kierowanie zespołem i administracja. Krytyczne zmiany powinny być możliwe do prześledzenia, aby przy pytaniach nie trzeba było zgadywać, kto zmienił księgowanie.

Sam dostęp powinien być chroniony solidnymi podstawami. Należą do nich bezpieczne polityki haseł, uregulowane resetowanie hasła, blokada konta przy powtarzających się nieudanych próbach i, tam gdzie profil ryzyka tego wymaga, dodatkowe kroki logowania. Bezpieczeństwo działa profesjonalnie, gdy jest przewidywalne i nie rzuca się w oczy dopiero wtedy, gdy ktoś został zablokowany.

Integracja tylko tam, gdzie mierzalnie odciąża

Webowy workflow często rozwija swoją wartość dopiero we współdziałaniu z istniejącymi systemami. Może to być ERP, sklep, rozwiązanie wysyłkowe, ewidencja czasu pracy lub baza danych. Mimo to nie każdy interfejs jest automatycznie sensowny. Każda integracja tworzy zależności, obrazy błędów i nakład utrzymania.

Kluczowe pytanie brzmi: jaki ręczny krok połączenie konkretnie usuwa? Jeśli interfejs oszczędza dziennie 30 minut pracy przenoszenia i zmniejsza literówki, korzyść jest jasna. Jeśli tylko odzwierciedla informację, która i tak raz w tygodniu jest sprawdzana, ręczny eksport może na początku być rozsądniejszym rozwiązaniem.

Przy indywidualnych rozszerzeniach liczy się baza techniczna. Udokumentowane interfejsy, jasno zdefiniowane pola danych i możliwe do prześledzenia protokoły błędów ułatwiają późniejszą eksploatację. Jeśli system jest łączony z aplikacją webową na miarę, technologie i struktura bazy danych powinny być dobrane tak, by na dłuższą metę pozostały utrzymywalne. Zadbana aplikacja oparta na PHP 8.4, nowoczesnym JavaScripcie i MySQL 8 jest cenniejsza niż krótkoterminowo imponujące rozwiązanie specjalne bez dokumentacji.

Wprowadzenie podczas bieżącej działalności

Najczęstszym błędem jest twardy start bez fazy porównawczej. Zespoły mają wtedy w poniedziałek rano od razu pracować inaczej, podczas gdy otwarte pytania powstają dopiero z rzeczywistych problemów. To zwiększa odrzucenie, nawet jeśli oprogramowanie zasadniczo pasuje.

Lepszy jest ograniczony pilotaż z jednym zespołem, jednym wariantem procesu lub wyraźnie wydzielonym obszarem lokalizacji. W tym czasie sprawdza się, czy rejestracja i zatwierdzenia działają, czy pojęcia są zrozumiałe i czy przypadki wyjątkowe trafiają czysto. Ważne jest, by informacji zwrotnych nie zbierać tylko jako listy życzeń. Każdą zmianę należy zważyć względem korzyści dla czasu przebiegu, wskaźnika błędów lub przejrzystości.

Także wskaźniki należy ustalić wcześnie. Na przykład można obserwować czas obsługi na przyjęcie towaru, liczbę otwartych odchyleń, zapytania o status dostawy lub księgowania korygujące. Bez wartości wyjściowej „wydaje się szybciej” pozostaje jedyną oceną. Może to być prawda, ale nie wystarcza do solidnej decyzji inwestycyjnej.

Eksploatacja potrzebuje jasnego właściciela

SaaS zmniejsza nakład techniczny, ale nie zwalnia firmy z odpowiedzialności za własny proces. Wewnętrznie potrzebna jest osoba, która zarządza rolami, zbiera informacje zwrotne, rozpoznaje potrzeby szkoleniowe i decyduje, które zmiany są naprawdę konieczne. Ta osoba nie musi umieć programować. Powinna jednak rozumieć przebieg pracy i mieć dostęp do odpowiedzialnych.

Równie ważna jest krótka, solidna dokumentacja eksploatacyjna. Nie wyjaśnia każdego widoku ekranu, lecz odpowiada na pytania pojawiające się w codzienności: co zrobić przy błędnym księgowaniu? Kto zatwierdza nowych użytkowników? Jak komunikuje się awarię? Gdzie leżą wyeksportowane dane? Taka jasność zapobiega temu, by system cyfrowy po kilku miesiącach znów stał się zależny od osobistych okrzyków.

Dobre rozwiązanie SaaS rozpoznaje się więc nie po tym, ile pozycji menu oferuje. Pokazuje swoją wartość, gdy nowa koleżanka może pewnie obsłużyć operację, odchylenie nie znika, a kierownik widzi status bez dzwonienia do trzech osób. Dokładnie tą miarą należy mierzyć Flow Web: nie obietnicami, lecz dniem pracy, który dowodnie przebiega spokojniej i pewniej.

Permalink →

Tworzenie aplikacji webowych z aktualnymi frameworkami: co firmy naprawdę zyskują

Tworzenie aplikacji webowych z aktualnymi frameworkami: co firmy naprawdę zyskują

Jeśli przyjęcie towaru wciąż krąży między papierowym formularzem, rozmową telefoniczną i trzema plikami Excel, nowoczesny frontend sam problemu nie rozwiąże. Tworzenie aplikacji webowych z aktualnymi frameworkami ma sens wtedy, gdy widocznie upraszcza procesy: pracownicy widzą następny krok, dane są wprowadzane tylko raz, a aplikacja pozostaje zrozumiale utrzymywalna także po pierwszym go-live.

Dla małych i średnich przedsiębiorstw kwestia frameworka nie jest więc kwestią wiary. Decydujące nie jest to, czy interfejs niesie szczególnie wiele technicznych modnych haseł. Decydujące jest to, czy ruchy magazynowe, zamówienia, kontrole lub zatwierdzenia przechodzą niezawodnie przez dzień pracy - także pod presją czasu, przy rotacji zmian i niestabilnym połączeniu sieciowym.

Frameworki są środkiem, a nie celem projektu

Framework dostarcza sprawdzoną strukturę dla powtarzalnych zadań: routing, formularze, zarządzanie uprawnieniami, dostęp do danych, testy i prezentację interfejsów. Nie zmniejsza to automatycznie każdego ryzyka. Zapobiega jednak temu, by projekt musiał w kółko wymyślać podstawowe funkcje na nowo.

W indywidualnej aplikacji webowej nowoczesny framework JavaScript może na przykład sensownie odwzorować interaktywne ekrany: listę kompletacji, która na bieżąco aktualizuje pozycje, planowanie tras z jasnymi zmianami statusu lub protokół kontroli, który przypisuje zdjęcia i komentarze bezpośrednio do operacji. W backendzie ugruntowane frameworki PHP zapewniają możliwe do prześledzenia reguły, wyraźnie rozdzielone odpowiedzialności i spójne interfejsy do bazy danych.

Jest to szczególnie istotne, gdy z początkowo małego rozwiązania powstaje codziennie używany system operacyjny dla danego procesu. Ekran wprowadzania awizacji dostaw może zacząć się skromnie. Gdy tylko aktualizuje zapasy, drukuje etykiety, uwzględnia role i komunikuje się z przewoźnikiem, potrzebuje czystej bazy technicznej. Frameworki pomagają nie renegocjować tej bazy przy każdej rozbudowie.

Co aktualne frameworki webowe robią konkretnie lepiej

Wartość nowoczesnych frameworków rzadko leży w spektakularnych efektach. Pokazuje się w niewidocznych częściach aplikacji. Formularze mogą sprawdzać dane wejściowe od razu, bez tego, by błędne dane wychodziły na jaw dopiero po wysłaniu. Uprawnienia można definiować centralnie, tak że kierowca widzi inne informacje niż dyspozycja. Zmiany zamówienia są zapisywane w sposób możliwy do prześledzenia, zamiast po cichu nadpisywać komórkę tabeli.

Po stronie serwera aktualne środowisko z PHP 8.4 i MySQL 8 tworzy solidną podstawę dla logiki krytycznej dla biznesu. Transakcje bazy danych zapobiegają na przykład temu, by zapas został pomniejszony, podczas gdy związane z nim księgowanie się nie powiedzie. Unikalne klucze i reguły walidacji zapobiegają duplikatom. Procesy w tle mogą generować dokumenty lub wywoływać interfejsy bez konieczności czekania przez osobę przy ekranie.

Także bezpieczeństwo nie jest funkcją dodawaną później. Współczesny framework wspiera bezpieczne przechowywanie haseł, ochronę przed typowymi atakami przez dane wejściowe, możliwe do prześledzenia sesje i zdefiniowane przepływy blokady konta. Mimo to wdrożenie pozostaje zadaniem projektowym: uprawnienia muszą być merytorycznie poprawnie zamodelowane, a funkcje wrażliwe wymagają dodatkowych kontroli. Framework daje bariery ochronne, ale nie wie, kto w firmie może udzielić jakiego zatwierdzenia.

Prawidłowo zdecydować o tworzeniu aplikacji webowych z aktualnymi frameworkami

Najlepsza technologia nie powstaje z listy popularnych narzędzi, lecz z rzeczywistego użycia. Wewnętrzna aplikacja dla dziesięciu osób ma inne wymagania niż portal klienta z kilkoma tysiącami równoczesnych dostępów. Terminal magazynowy ze skanerem potrzebuje innej logiki obsługi niż analiza dla zarządu na komputerze.

Dlatego sensowna decyzja zaczyna się od konkretnych pytań: które czynności kosztują dziś mierzalnie czas? Które dane są przenoszone wielokrotnie? Gdzie powstają błędy, bo informacje stają się widoczne zbyt późno? Która istniejąca tabela działa wystarczająco dobrze i powinna na razie zostać? Właśnie ostatni punkt chroni przed kosztownymi projektami cyfryzacji bez pożytku operacyjnego.

Dla wielu indywidualnych aplikacji biznesowych system renderowany po stronie serwera z celowymi komponentami interaktywnymi jest najrozsądniejszym wyborem. Ładuje się szybko, jest przejrzysty w utrzymaniu i unika niepotrzebnej złożoności. W pełni oddzielona aplikacja jednostronicowa może natomiast być odpowiednia, gdy interfejs obsługuje bardzo wiele stanów dynamicznych, musi działać offline lub te same funkcje ma później udostępniać także aplikacji mobilnej.

Oba rozwiązania mogą być merytorycznie poprawne. Pytanie nie brzmi: który framework jest najnowocześniejszy? Brzmi: która architektura za dwa lata będzie jeszcze bezpiecznie rozbudowywalna, testowalna i zrozumiała dla własnego zespołu?

Kiedy mniej techniki to lepsza technika

Nie każdy proces potrzebuje złożonego frontendu. Szczupły ekran wprowadzania wewnętrznych zamówień może być szybszy, stabilniejszy i tańszy niż pracowicie animowany interfejs. Jeśli plik Excel jest prowadzony tylko raz w miesiącu i nie powoduje błędów, być może nadal jest właściwym narzędziem.

Złożoność opłaca się dopiero wtedy, gdy usuwa rzeczywiste tarcie. Może tak być, gdy zamówienia są wielokrotnie przepisywane, status dostawy trzeba sprawdzać telefonicznie lub nikt nie jest pewien, która wersja dokumentu obowiązuje. Wtedy centralna aplikacja tworzy wyraźną korzyść: jeden stan danych, jednoznaczne odpowiedzialności i mniej zapytań.

Utrzymywalność zaczyna się przed pierwszą linią kodu

Frameworki są często postrzegane jako przyspieszacze. To prawda tylko wtedy, gdy reguły merytoryczne są wcześniej dostatecznie jasne. Programista może zbudować maszynę stanów technicznie czysto. Ale czy sekwencja statusów naprawdę pasuje do procesu, rozstrzyga się przy rozpoznaniu: kiedy towar uznaje się za przyjęty? Kto może zamknąć odchylenie? Co dzieje się przy dostawie częściowej?

Te decyzje należy dokumentować, podobnie jak interfejsy, pola danych i wyjątki. To nie spowalnia projektów. Zmniejsza późniejsze dyskusje, ponieważ staje się widoczne, która reguła została wdrożona świadomie, a które założenie jest jeszcze otwarte.

Utrzymywalność pokazuje się także w małych dyscyplinach. Zmiany w bazie danych muszą być wersjonowane. Kroki wdrożenia muszą być udokumentowane. Komunikaty o błędach powinny być użyteczne dla eksploatacji i rozwoju bez ujawniania poufnych szczegółów. Zautomatyzowane testy przy każdej zmianie sprawdzają centralne przebiegi, na przykład utworzenie zamówienia, obliczenie ilości lub wystawienie listu przewozowego.

Przy aplikacjach krytycznych jeden typ testu nie wystarcza. Testy jednostkowe zabezpieczają pojedyncze reguły, testy integracyjne sprawdzają współdziałanie z bazą danych i interfejsami, a testy end-to-end odtwarzają w przeglądarce rzeczywiste ścieżki obsługi. Dla aplikacji webowych i Windows samodzielnie hostowane środowisko testowe może dodatkowo dostarczać zrzuty ekranu, protokoły wykonania i zrozumiałe oceny, bez niepotrzebnego przekazywania wewnętrznych danych testowych zewnętrznym usługom chmurowym.

Wydajność wynika z architektury i modelu danych

Nowoczesny interfejs nie staje się szybki dlatego, że używa aktualnego frameworka. Wolne zapytania do bazy danych, zbyt duże obrazy lub niejasne interfejsy pozostają wolne, niezależnie od frontendu. Szczególnie przy listach zamówień, artykułów lub danych ruchu to model danych decyduje o odczuwanej szybkości.

Czyste indeksy w MySQL 8, stronicowane zapytania i świadomie ładowane dane są często skuteczniejsze niż późniejsza optymalizacja interfejsu. Równie ważna jest jasna koncepcja cache'owania. Dane podstawowe mogą w pewnych okolicznościach być buforowane, aktualne zapasy lub status zatwierdzenia natomiast nie na ślepo. Nie ma tu reguły ogólnej, ponieważ merytoryczne znaczenie danych decyduje o tym, jak aktualne muszą być.

Responsywne projektowanie należy również do planowania technicznego. Na ekranie biurowym szeroka tabela może mieć sens. Na ręcznym skanerze lub tablecie w magazynie ta sama informacja potrzebuje dużych powierzchni dotyku, krótkich dróg i prezentacji, która pozostaje użyteczna także w rękawicach lub przy słabym świetle. Pure fluidity meets ultimate performance nie oznacza w tym kontekście jak największego ruchu na ekranie. Oznacza, że aplikacja działa bez tarcia na urządzeniu, które faktycznie jest używane w procesie.

Rozsądna droga od pomysłu do eksploatacji

Solidny projekt webowy zaczyna się od ograniczonego, sprawdzalnego rdzenia. Zamiast automatyzować z góry każdy wyobrażalny wyjątek, wybiera się proces, który występuje często i powoduje odczuwalny nakład pracy. Po pierwszym zastosowaniu rzeczywiste dane i informacje zwrotne pokazują, które rozszerzenie naprawdę ma następny priorytet.

Przekazanie techniczne nie powinno odbywać się dopiero na końcu. Odpowiedzialności za hosting, kopie zapasowe, monitoring, aktualizacje i prawa dostępu muszą być wyjaśnione wcześnie. System jest tak niezawodny, jak jego eksploatacja. Kto potrzebuje aplikacji codziennie do wysyłki lub obsługi zamówień, potrzebuje zdefiniowanych dróg odtwarzania i jasnej odpowiedzi na to, co dzieje się przy awarii.

softify.pro stawia dlatego na utrzymywalne technologie, udokumentowane dostarczanie i bezpośrednią odpowiedzialność techniczną zamiast na krótkotrwałe mody frameworków. To nie jest magiczny skrót. To tworzy warunek, by aplikacja po starcie działała dalej, mogła być rozwijana i nie stała się kolejnym kruchym przypadkiem szczególnym.

Właściwa aplikacja webowa w najlepszym przypadku nie wydaje się nowym projektem IT. Wydaje się przebiegiem, który wreszcie działa bez objazdów - z dostateczną substancją techniczną, by spokojnie przyjąć także następną zmianę w eksploatacji.

Permalink →

Skontaktuj się

Masz w głowie projekt, proces pracy, który wciąż działa na arkuszach Excel i dobrej woli, albo zaległości w testowaniu, które COCO mogłoby zdjąć z Twojego zespołu? Opowiedz nam o tym.

Wyślij wiadomość