softify.pro
Ładowanie …
Usługi O nas COCO – nasz serwer AI Portfolio Insiders Case Studies Warto wiedzieć Kontakt Logowanie

Warto wiedzieć

Pure fluidity meets ultimate performance: co naprawdę przyspiesza oprogramowanie biznesowe

Pure fluidity meets ultimate performance: co naprawdę przyspiesza oprogramowanie biznesowe

Kierownik magazynu nie rozpoznaje złego oprogramowania po rysunku architektury. Rozpoznaje je po tym, że pracownicy znów sięgają po telefon, dwukrotnie rejestrują listy przewozowe albo po zmianie nie potrafią powiedzieć, jaki towar faktycznie dotarł. Pure fluidity meets ultimate performance nie może więc być czysto wizualnym roszczeniem. Dla oprogramowania biznesowego oznacza to, że operacja wydaje się naturalna i jednocześnie niezawodnie działa w rzeczywistych warunkach.

Elegancki interfejs jest bezwartościowy, jeśli zacina się przy słabym WLAN w magazynie. Szybka aplikacja również niewiele pomaga, jeśli wymusza kolejność pracy, której nikt na rampie nie potrafi śledzić. Dobre narzędzia cyfrowe łączą projekt, szybkość i zrozumienie procesów. Zmniejszają tarcie, nie wciskając działalności w gotową logikę standardową.

Pure fluidity meets ultimate performance to pytanie operacyjne

Płynność jest często mylona z animacjami, dużymi obrazami i gładkimi przejściami. Może to pasować do nowoczesnej marki. W codzienności pracy pokazuje się jednak inaczej: przyjęcie towaru można zaksięgować bez objazdów. Pracownik znajduje zamówienie także wtedy, gdy znany jest tylko numer referencyjny. Błąd jest jasno nazwany, zamiast znikać w kryptycznym komunikacie.

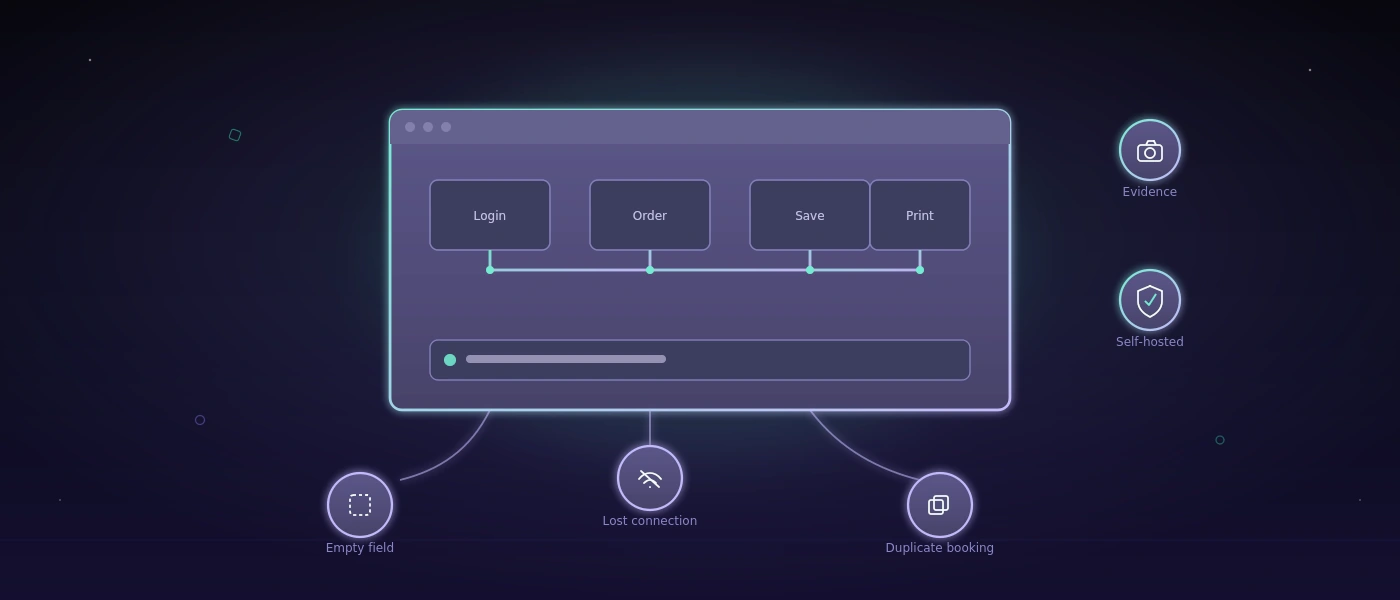
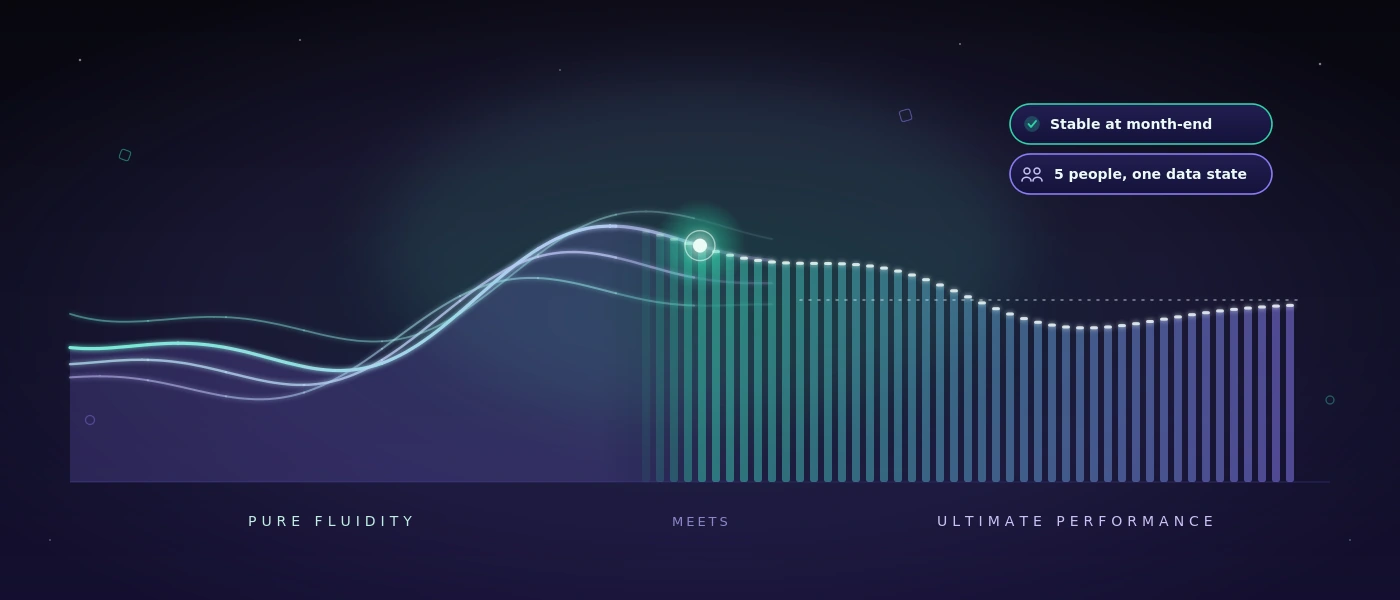
Wydajność jest również czymś więcej niż dobrą wartością w teście przeglądarki. Decydujące są czas odpowiedzi przy zamówieniu z wieloma pozycjami, stabilność na koniec miesiąca i pytanie, czy pięć osób może pracować jednocześnie, nie nadpisując sobie nawzajem stanów danych. Należy do tego także czyste postępowanie z przerwami połączenia, uprawnieniami i zablokowanymi kontami.

Jedno i drugie jest nierozłączne. Jeśli ekran reaguje natychmiast, ale ma niejasne pola obowiązkowe, pozostaje męczący. Jeśli przebieg jest sprytnie zamodelowany, ale strona przy każdym księgowaniu czeka dwie sekundy, jest omijany. Płynność powstaje tam, gdzie system wspiera kolejną sensowną czynność i technicznie pozostaje wystarczająco szybki, by tok myśli się nie urwał.

Interfejs podąża za ścieżką pracy, a nie za schematem organizacyjnym

Wiele rozwiązań standardowych strukturyzuje swoje menu według modułów: zakupy, sprzedaż, magazyn, raportowanie, administracja. Z perspektywy produktu jest to zrozumiałe. Na hali praca zaczyna się jednak często od sytuacji: stoi ciężarówka, brakuje palety, klient potrzebuje potwierdzenia dostawy albo przesyłkę trzeba jeszcze przed zamknięciem przyjęć oznaczyć etykietą.

Dobra indywidualna aplikacja zaczyna się więc od tych sytuacji. Jaka informacja jest dostępna? Kto decyduje? Co należy udokumentować? Czego później nie wolno już zmieniać? Dopiero potem rozstrzyga się, jaki ekran wprowadzania, kontrola czy automatyzacja są potrzebne.

Nie oznacza to wlewania każdego istniejącego przebiegu bez zmian do oprogramowania. Niektóre tabele są rzeczywiście zbyt podatne na błędy, niektóre zatwierdzenia niepotrzebnie wolne. Ale działająca lista Excel nie musi koniecznie być zastąpiona projektem. Jeśli prowadzi ją tylko jedna osoba, zna niewiele wyjątków i pozostaje możliwa do prześledzenia, może być odpowiednim narzędziem. Oprogramowanie się opłaca, gdy poprawia koordynację, zmniejsza źródła błędów lub niezawodnie udostępnia informacje wielu zaangażowanym.

Mniej kliknięć nie znaczy automatycznie lepiej

Wymóg jak najmniejszej liczby kliknięć brzmi rozsądnie, ale może prowadzić w złym kierunku. Przy nieodwracalnym księgowaniu magazynowym krótkie potwierdzenie ma sens. Przy zwolnieniu wysyłki widoczna kontrola wiarygodności może zapobiec kosztownym poprawkom. Właściwy przebieg zależy od ryzyka.

Decydujące jest, by dodatkowe kroki miały jasny cel. Potwierdzenie nie powinno pojawiać się tylko dlatego, że framework łatwo je generuje. Powinno stać dokładnie tam, gdzie ludzie muszą świadomie podjąć decyzję. Tak aplikacja pozostaje szybka, nie stając się lekkomyślna.

Wydajność powstaje w architekturze, a nie w ostatnim sprincie

Kto przyspiesza stronę internetową lub aplikację webową dopiero tuż przed go-live, zwykle leczy objawy. Duże zapytania, niejasne modele danych i dodane później przypadki szczególne nie dają się trwale skorygować jednym dniem optymalizacji.

Solidna podstawa zaczyna się od bazy danych, która odpowiada rzeczywistym zależnościom w działalności. W MySQL 8 ruchy, dokumenty, zmiany statusu i działania użytkowników potrzebują możliwych do prześledzenia kluczy i sensownych indeksów. Zapas nie może pojawiać się tylko jako liczba, jeśli później trzeba wyjaśnić, z jakiego księgowania powstał. Jednocześnie nie każda informacja historyczna musi być przeliczana na nowo przy każdym wywołaniu strony.

W przypadku nowoczesnych aplikacji webowych istotny jest także podział odpowiedzialności. PHP 8.4 może odwzorować reguły biznesowe jasno i w sposób utrzymywalny, podczas gdy nowoczesny JavaScript stosuje się celowo dla obszarów reaktywnych. To nie jest wyznanie wiary dla określonego stosu. To kwestia utrzymania: czy zmiany można bezpiecznie wdrożyć za sześć miesięcy? Czy widać, gdzie obowiązuje dana reguła? Czy błąd da się odtworzyć, zamiast jedynie się go domyślać?

Wydajność potrzebuje ponadto granic. Pola wyszukiwania potrzebują sensownej minimalnej liczby znaków lub precyzyjnej logiki filtrów, jeśli możliwe są miliony rekordów. Duże listy potrzebują stron lub stopniowanych procesów doładowywania. Obrazy i dokumenty nie powinny blokować krytycznego przebiegu pracy. Te decyzje wydają się niespektakularne. Właśnie dlatego często pozostają cenne dłużej niż rzucający się w oczy efekt frontendu.

Widoczna szybkość buduje zaufanie

Nie każdy proces może zakończyć się w mniej niż sekundę. Wydruk etykiet, interfejs do przewoźnika lub kontrola względem danych zewnętrznych wymaga czasem czasu. Decydujące jest wtedy, jak aplikacja radzi sobie z czasem oczekiwania.

Jasny status taki jak „Etykieta wysyłkowa jest tworzona” jest lepszy niż zamrożony przycisk. Po zakończeniu powinno być widoczne, jaki numer został wygenerowany i czy operację wolno uruchomić ponownie. Jeśli usługa zewnętrzna jest niedostępna, zespół potrzebuje zrozumiałej opcji działania zamiast komunikatu o błędzie dla programistów.

Jest to również kwestia integralności danych. Podwójne kliknięcie nie może utworzyć dwóch dostaw. Przerwany proces nie może po cichu zostawić na wpół gotowego rekordu. Dobre systemy planują takie przypadki, ponieważ w codzienności wystąpią. Zwłaszcza przy zmieniających się zmianach, presji czasu i urządzeniach mobilnych wyjątek nie jest tematem pobocznym.

Jakość staje się widoczna przed błędem

Dla aplikacji z wieloma wariantami procesów nie wystarczy na końcu ręcznie przeklikać kilka ścieżek. Zmiany cen, ról, walidacji lub interfejsów mogą wywołać skutki w bardzo odległym miejscu. Tu zautomatyzowane testowanie staje się częścią wydajności: nie tylko technicznie, ale organizacyjnie.

System testowy powinien móc sprawdzać rzeczywiste przebiegi, na przykład utworzenie zamówienia, zmianę pozycji, wygenerowanie listu przewozowego i kontrolę uprawnienia. Powinien rejestrować dowody i formułować wyniki tak, by działy merytoryczne mogły je zinterpretować. Zdanie takie jak „Proces wysyłki nie został zakończony po zmianie adresu” pomaga bardziej niż niekomentowany stack trace.

Dla zespołów świadomych bezpieczeństwa istotne jest także miejsce, w którym te testy działają. Jeśli zrzuty ekranu, dane dostępowe, przypadki testowe lub wewnętrzne kroki aplikacji nie mają opuszczać firmy, podejście samodzielnie hostowane jest często rozsądniejsze niż zewnętrzna usługa chmurowa. Z COCO można uruchamiać zautomatyzowane testy aplikacji webowych i Windows w dedykowanym środowisku. Nie jest to konieczne dla każdego zespołu. Przy danych wrażliwych, obszarach regulowanych lub wewnętrznych aplikacjach specjalistycznych kontrola nad danymi testowymi może jednak być decydującą zaletą.

Projekt jest dobry, gdy ułatwia pracę

Silna tożsamość wizualna może budować zaufanie. Pokazuje, że firma poważnie traktuje swoją obecność cyfrową. W systemie operacyjnym projekt musi jednak zapewniać jeszcze więcej: orientację pod presją czasu. Kontrast, typografia, jasne stany i zrozumiałe oznaczenia decydują o tym, czy ktoś pewnie kończy operację, czy pyta kolegę.

Powściągliwość jest tu często lepszym wyborem. Pulpit z dziesięcioma kolorowymi wskaźnikami może wyglądać imponująco i mimo to ukrywać jedyne istotne odchylenie. Ograniczony widok, który uwidacznia otwarte przyjęcia towaru, brakujące skany i zagrożone terminy dostaw, jest bardziej użyteczny. Pytanie nie brzmi, ile interfejsu jest możliwe, lecz jaka informacja poprawia decyzję.

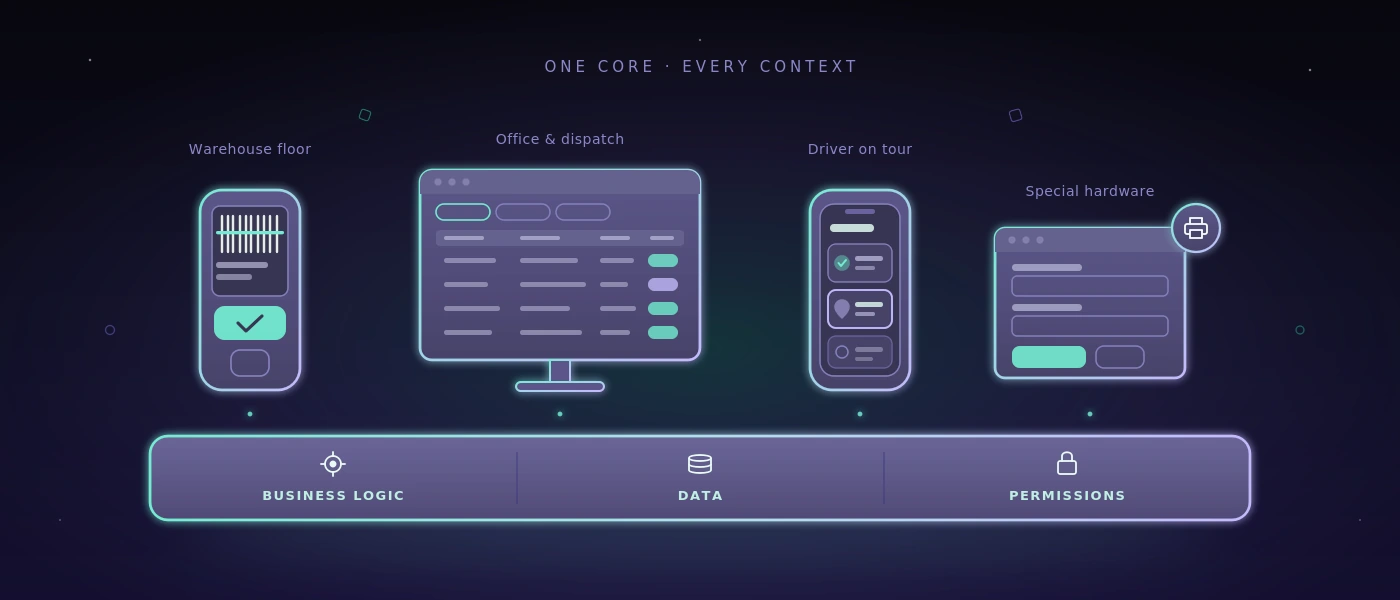
Dotyczy to także aplikacji responsywnych. Zdolność mobilna nie oznacza wciskania każdego ekranu desktopowego w mniejszy format. Smartfon przy przyjęciu towaru potrzebuje może tylko skanu, ilości, lokalizacji magazynowej i potwierdzenia. Obszerna obróbka końcowa należy ewentualnie na większy ekran. Różne urządzenia zasługują na różne priorytety, choć korzystają z tej samej niezawodnej bazy danych.

Sensowna miara dla następnej decyzji

Zanim zespół zdecyduje o nowej platformie, automatyzacji lub kompletnej przebudowie, pomaga prosta kontrola: czy przebieg staje się dla ludzi, którzy wykonują go codziennie, jaśniejszy, szybszy lub bezpieczniejszy? I czy rozwiązanie da się jeszcze zrozumieć, gdy zmienią się wymagania, pracownicy lub interfejsy?

Jeśli obie odpowiedzi są solidne, z pięknej obietnicy powstaje użyteczny system. Wtedy pure fluidity meets ultimate performance pokazuje się nie na slajdzie, lecz w spokojnym dniu pracy, w którym zamówienia, dane i decyzje płyną dalej bez zbędnego tarcia.
Permalink →

SaaS Flow Web: bezpieczne wdrażanie workflow podczas bieżącej działalności

SaaS Flow Web: bezpieczne wdrażanie workflow podczas bieżącej działalności

Przyjęcie towaru nie leży dlatego, że zespół nie zna kolejnego oprogramowania. Leży dlatego, że informacje giną między e-mailem, papierowym formularzem, plikiem Excel i rozmową telefoniczną. Przy SaaS - „Flow Web” na flow.softify.pro - pierwszym pytaniem nie powinien więc być interfejs. Decydujące jest to, czy usługa niezawodnie odwzorowuje konkretny przebieg pracy - także w gorączkowe dni, przy zmieniających się odpowiedzialnościach i gdy dostawa nie odpowiada planowi.

Dla małych i średnich przedsiębiorstw SaaS jest często sensowny, ponieważ nie muszą najpierw budować własnych serwerów, wydań i podstawowych funkcji. Nie jest to jednak wolny wstęp dla każdego procesu. Kto wprowadza narzędzie, które komplikuje codzienność lub spycha ważne dane do niejasnych list pobocznych, nie cyfryzuje pracy. Tylko przenosi tarcie.

Co SaaS „Flow Web” musi zapewnić

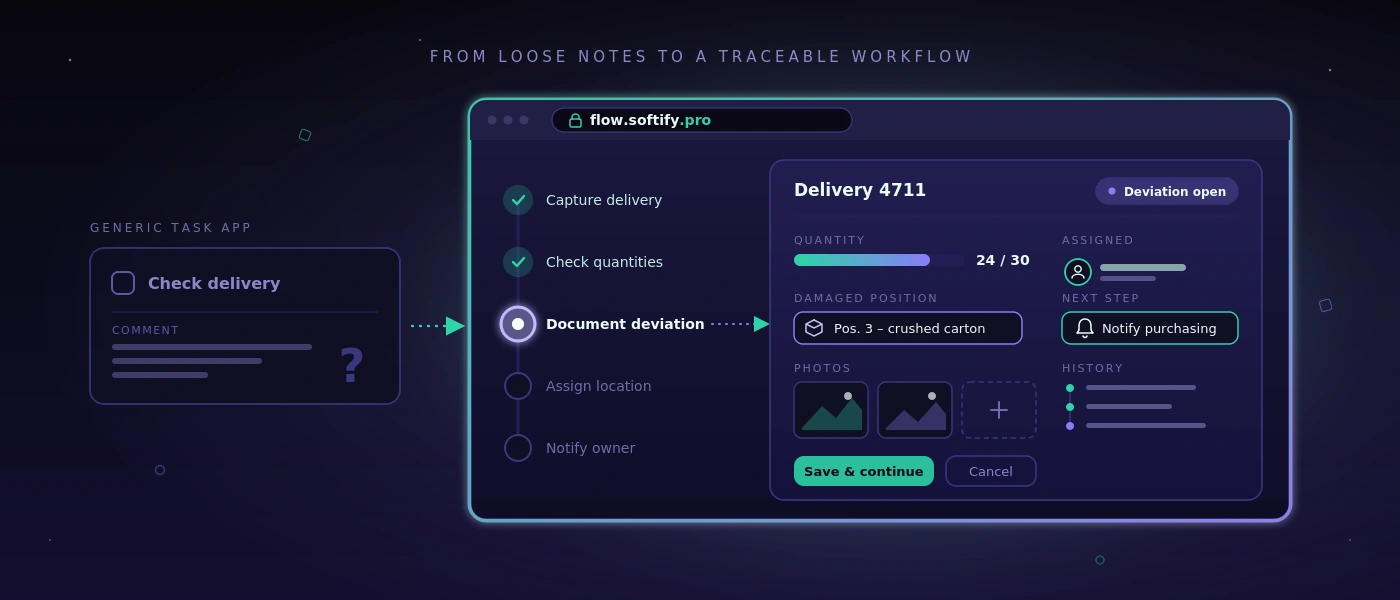
Webowy workflow jest dobry, gdy pracownicy bez interpretacji wiedzą, co jest do zrobienia dalej. Przy przyjęciu towaru może to oznaczać: zarejestrować dostawę, sprawdzić ilości względem zamówienia, udokumentować odchylenie, przypisać lokalizację magazynową i w razie potrzeby poinformować osobę odpowiedzialną. Przebieg nie musi być spektakularny. Musi być możliwy do prześledzenia, szybki i powtarzalny.

Właśnie tu leży różnica między ogólną aplikacją do zadań a merytorycznym systemem procesowym. Aplikacja do zadań może utworzyć punkt o nazwie „Sprawdzić dostawę”. Merytoryczny workflow może dodatkowo zapisać, o którą dostawę chodzi, kto ją przyjął, która pozycja była uszkodzona, jakie zdjęcia istnieją i czy oczekuje się dostawy uzupełniającej. Te dane nie stoją wtedy jako dowolny tekst w pojedynczym komentarzu, lecz tam, gdzie potrzebuje ich następna osoba.

Dla rozwiązania takiego jak Flow Web na flow.softify.pro ocena powinna więc zaczynać się od procesów, a nie od listy funkcji. Firma z pięcioma ruchami magazynowymi dziennie potrzebuje czegoś innego niż zespół wysyłkowy z kilkoma godzinami granicznymi, różnymi przewoźnikami i regularnym zarządzaniem dostawami częściowymi. SaaS nie zastępuje zrozumienia procesu.

Najpierw nazwać wąskie gardło, potem konfigurować

Wiele projektów cyfryzacji startuje zbyt szeroko: „Chcemy zdigitalizować magazyn.” Brzmi to wiarygodnie, ale szybko prowadzi do systemu ze zbyt wieloma ekranami, przypadkami szczególnymi i materiałami szkoleniowymi. Lepsze jest precyzyjne stwierdzenie, takie jak: „Przyjęcia towaru są księgowane dopiero następnego dnia, ponieważ listy przewozowe na koniec zmiany leżą na biurku.”

Z takiego zdania można wyprowadzić sensowny start. Pierwsza wersja może rejestrować listy przewozowe, potwierdzać artykuły i ilości, oznaczać odchylenia i przekazywać księgowanie właściwej komórce. Gdy ten przebieg działa, etykiety, oceny dostawców lub automatyczne propozycje zamówień można dodać później. Nie każdy sensowny krok rozbudowy należy do pierwszego wdrożenia.

Także dobrze prowadzona tabela może zostać, jeśli spełnia swój cel. Na przykład miesięczne zestawienie z niewielką liczbą uczestników w istniejącym pliku może być tańsze i bardziej przejrzyste niż własny moduł. SaaS opłaca się tam, gdzie informacje są wielokrotnie używane, czasy obsługi są krytyczne lub błędy powstają z przerw w nośnikach.

Właściwe pytania przed wprowadzeniem

Przed konfiguracją zespół powinien przeprowadzić rzeczywistą operację od początku do końca. Nie proces idealny, lecz przypadek, który w codzienności sprawia problemy: zła ilość, brakujące odniesienie, pilna wysyłka lub zamówienie ze specjalnym zatwierdzeniem. Wtedy ujawniają się reguły, które system faktycznie musi odwzorować.

Istotne są między innymi te punkty: kto może utworzyć, zmienić lub zamknąć operację? Które dane wejściowe są obowiązkowe, a które tylko pomocne? Kiedy trzeba poinformować kierownika? Jakie dane są przekazywane do księgowości, wysyłki lub obsługi klienta? I co się dzieje, gdy WLAN w magazynie jest słaby lub pracownik nie ma już swoich danych dostępowych?

Odpowiedzi określają jakość wprowadzenia mocniej niż długi katalog wymagań wizualnych. Czysty proces ról, zrozumiały komunikat o błędzie i udokumentowany krok zatwierdzenia zapobiegają w eksploatacji zwykle większemu nakładowi pracy niż dodatkowy raport na stronie głównej.

Przechowywanie danych i role nie są sprawą poboczną

SaaS bywa traktowany jako czysto obsługowe pytanie. Dla odpowiedzialnych za eksploatację i IT równie ważne jest jednak, co dzieje się z danymi. Dotyczy to danych podstawowych, informacji o dostawach, danych pracowników, zdjęć szkód i ewentualnie danych klientów. Przed wprowadzeniem powinny być jasne odpowiedzialności, przechowywanie i możliwości eksportu.

Praktycznie oznacza to: firma musi wiedzieć, jakie dane znajdują się w systemie, kto ma dostęp administracyjny i jak dane są udostępniane przy zmianie lub zakończeniu umowy. Eksport dostępny tylko jako trudno czytelny plik PDF rzadko pomaga. Dla danych operacyjnych decydujące są ustrukturyzowane, użyteczne formaty.

Także koncepcja uprawnień zasługuje na konkretną uwagę. W magazynie nie każda osoba musi widzieć ceny, warunki klientów lub ustawienia globalne. Jednocześnie zbyt wąskie przydzielanie praw nie może blokować przebiegu. Sensowne są role dopasowane do rzeczywistych czynności: przyjęcie, dyspozycja, wysyłka, kierowanie zespołem i administracja. Krytyczne zmiany powinny być możliwe do prześledzenia, aby przy pytaniach nie trzeba było zgadywać, kto zmienił księgowanie.

Sam dostęp powinien być chroniony solidnymi podstawami. Należą do nich bezpieczne polityki haseł, uregulowane resetowanie hasła, blokada konta przy powtarzających się nieudanych próbach i, tam gdzie profil ryzyka tego wymaga, dodatkowe kroki logowania. Bezpieczeństwo działa profesjonalnie, gdy jest przewidywalne i nie rzuca się w oczy dopiero wtedy, gdy ktoś został zablokowany.

Integracja tylko tam, gdzie mierzalnie odciąża

Webowy workflow często rozwija swoją wartość dopiero we współdziałaniu z istniejącymi systemami. Może to być ERP, sklep, rozwiązanie wysyłkowe, ewidencja czasu pracy lub baza danych. Mimo to nie każdy interfejs jest automatycznie sensowny. Każda integracja tworzy zależności, obrazy błędów i nakład utrzymania.

Kluczowe pytanie brzmi: jaki ręczny krok połączenie konkretnie usuwa? Jeśli interfejs oszczędza dziennie 30 minut pracy przenoszenia i zmniejsza literówki, korzyść jest jasna. Jeśli tylko odzwierciedla informację, która i tak raz w tygodniu jest sprawdzana, ręczny eksport może na początku być rozsądniejszym rozwiązaniem.

Przy indywidualnych rozszerzeniach liczy się baza techniczna. Udokumentowane interfejsy, jasno zdefiniowane pola danych i możliwe do prześledzenia protokoły błędów ułatwiają późniejszą eksploatację. Jeśli system jest łączony z aplikacją webową na miarę, technologie i struktura bazy danych powinny być dobrane tak, by na dłuższą metę pozostały utrzymywalne. Zadbana aplikacja oparta na PHP 8.4, nowoczesnym JavaScripcie i MySQL 8 jest cenniejsza niż krótkoterminowo imponujące rozwiązanie specjalne bez dokumentacji.

Wprowadzenie podczas bieżącej działalności

Najczęstszym błędem jest twardy start bez fazy porównawczej. Zespoły mają wtedy w poniedziałek rano od razu pracować inaczej, podczas gdy otwarte pytania powstają dopiero z rzeczywistych problemów. To zwiększa odrzucenie, nawet jeśli oprogramowanie zasadniczo pasuje.

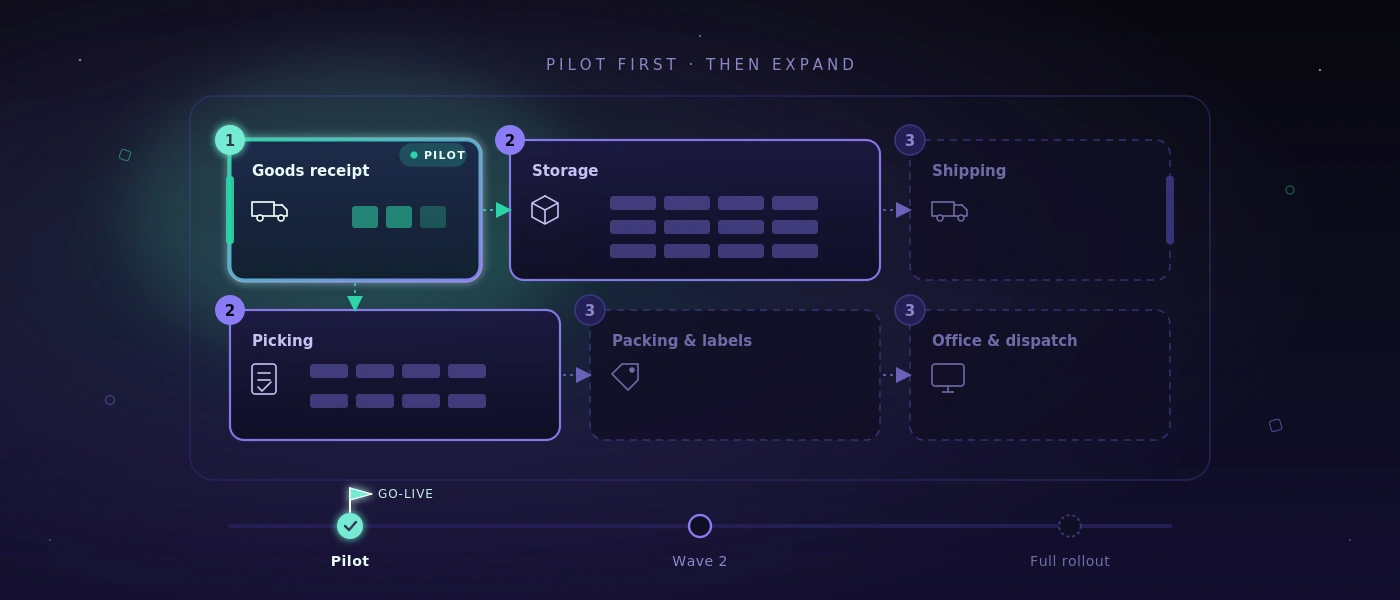
Lepszy jest ograniczony pilotaż z jednym zespołem, jednym wariantem procesu lub wyraźnie wydzielonym obszarem lokalizacji. W tym czasie sprawdza się, czy rejestracja i zatwierdzenia działają, czy pojęcia są zrozumiałe i czy przypadki wyjątkowe trafiają czysto. Ważne jest, by informacji zwrotnych nie zbierać tylko jako listy życzeń. Każdą zmianę należy zważyć względem korzyści dla czasu przebiegu, wskaźnika błędów lub przejrzystości.

Także wskaźniki należy ustalić wcześnie. Na przykład można obserwować czas obsługi na przyjęcie towaru, liczbę otwartych odchyleń, zapytania o status dostawy lub księgowania korygujące. Bez wartości wyjściowej „wydaje się szybciej” pozostaje jedyną oceną. Może to być prawda, ale nie wystarcza do solidnej decyzji inwestycyjnej.

Eksploatacja potrzebuje jasnego właściciela

SaaS zmniejsza nakład techniczny, ale nie zwalnia firmy z odpowiedzialności za własny proces. Wewnętrznie potrzebna jest osoba, która zarządza rolami, zbiera informacje zwrotne, rozpoznaje potrzeby szkoleniowe i decyduje, które zmiany są naprawdę konieczne. Ta osoba nie musi umieć programować. Powinna jednak rozumieć przebieg pracy i mieć dostęp do odpowiedzialnych.

Równie ważna jest krótka, solidna dokumentacja eksploatacyjna. Nie wyjaśnia każdego widoku ekranu, lecz odpowiada na pytania pojawiające się w codzienności: co zrobić przy błędnym księgowaniu? Kto zatwierdza nowych użytkowników? Jak komunikuje się awarię? Gdzie leżą wyeksportowane dane? Taka jasność zapobiega temu, by system cyfrowy po kilku miesiącach znów stał się zależny od osobistych okrzyków.

Dobre rozwiązanie SaaS rozpoznaje się więc nie po tym, ile pozycji menu oferuje. Pokazuje swoją wartość, gdy nowa koleżanka może pewnie obsłużyć operację, odchylenie nie znika, a kierownik widzi status bez dzwonienia do trzech osób. Dokładnie tą miarą należy mierzyć Flow Web: nie obietnicami, lecz dniem pracy, który dowodnie przebiega spokojniej i pewniej.

Permalink →

Tworzenie aplikacji webowych z aktualnymi frameworkami: co firmy naprawdę zyskują

Tworzenie aplikacji webowych z aktualnymi frameworkami: co firmy naprawdę zyskują

Jeśli przyjęcie towaru wciąż krąży między papierowym formularzem, rozmową telefoniczną i trzema plikami Excel, nowoczesny frontend sam problemu nie rozwiąże. Tworzenie aplikacji webowych z aktualnymi frameworkami ma sens wtedy, gdy widocznie upraszcza procesy: pracownicy widzą następny krok, dane są wprowadzane tylko raz, a aplikacja pozostaje zrozumiale utrzymywalna także po pierwszym go-live.

Dla małych i średnich przedsiębiorstw kwestia frameworka nie jest więc kwestią wiary. Decydujące nie jest to, czy interfejs niesie szczególnie wiele technicznych modnych haseł. Decydujące jest to, czy ruchy magazynowe, zamówienia, kontrole lub zatwierdzenia przechodzą niezawodnie przez dzień pracy - także pod presją czasu, przy rotacji zmian i niestabilnym połączeniu sieciowym.

Frameworki są środkiem, a nie celem projektu

Framework dostarcza sprawdzoną strukturę dla powtarzalnych zadań: routing, formularze, zarządzanie uprawnieniami, dostęp do danych, testy i prezentację interfejsów. Nie zmniejsza to automatycznie każdego ryzyka. Zapobiega jednak temu, by projekt musiał w kółko wymyślać podstawowe funkcje na nowo.

W indywidualnej aplikacji webowej nowoczesny framework JavaScript może na przykład sensownie odwzorować interaktywne ekrany: listę kompletacji, która na bieżąco aktualizuje pozycje, planowanie tras z jasnymi zmianami statusu lub protokół kontroli, który przypisuje zdjęcia i komentarze bezpośrednio do operacji. W backendzie ugruntowane frameworki PHP zapewniają możliwe do prześledzenia reguły, wyraźnie rozdzielone odpowiedzialności i spójne interfejsy do bazy danych.

Jest to szczególnie istotne, gdy z początkowo małego rozwiązania powstaje codziennie używany system operacyjny dla danego procesu. Ekran wprowadzania awizacji dostaw może zacząć się skromnie. Gdy tylko aktualizuje zapasy, drukuje etykiety, uwzględnia role i komunikuje się z przewoźnikiem, potrzebuje czystej bazy technicznej. Frameworki pomagają nie renegocjować tej bazy przy każdej rozbudowie.

Co aktualne frameworki webowe robią konkretnie lepiej

Wartość nowoczesnych frameworków rzadko leży w spektakularnych efektach. Pokazuje się w niewidocznych częściach aplikacji. Formularze mogą sprawdzać dane wejściowe od razu, bez tego, by błędne dane wychodziły na jaw dopiero po wysłaniu. Uprawnienia można definiować centralnie, tak że kierowca widzi inne informacje niż dyspozycja. Zmiany zamówienia są zapisywane w sposób możliwy do prześledzenia, zamiast po cichu nadpisywać komórkę tabeli.

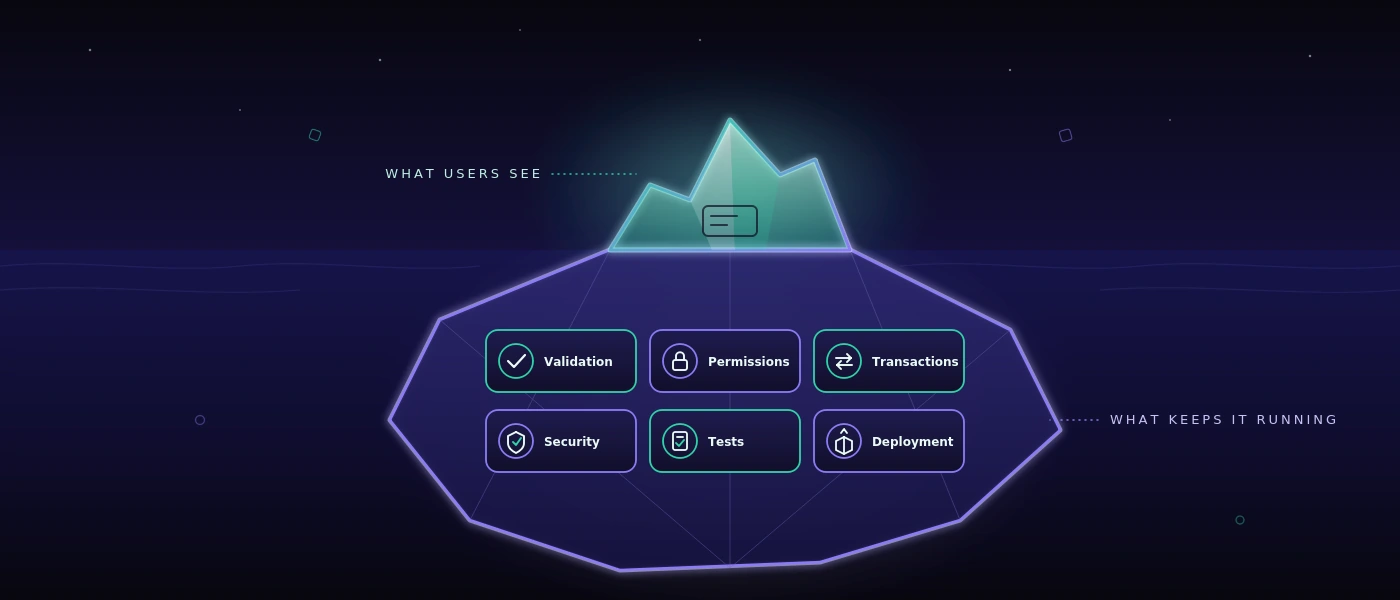
Po stronie serwera aktualne środowisko z PHP 8.4 i MySQL 8 tworzy solidną podstawę dla logiki krytycznej dla biznesu. Transakcje bazy danych zapobiegają na przykład temu, by zapas został pomniejszony, podczas gdy związane z nim księgowanie się nie powiedzie. Unikalne klucze i reguły walidacji zapobiegają duplikatom. Procesy w tle mogą generować dokumenty lub wywoływać interfejsy bez konieczności czekania przez osobę przy ekranie.

Także bezpieczeństwo nie jest funkcją dodawaną później. Współczesny framework wspiera bezpieczne przechowywanie haseł, ochronę przed typowymi atakami przez dane wejściowe, możliwe do prześledzenia sesje i zdefiniowane przepływy blokady konta. Mimo to wdrożenie pozostaje zadaniem projektowym: uprawnienia muszą być merytorycznie poprawnie zamodelowane, a funkcje wrażliwe wymagają dodatkowych kontroli. Framework daje bariery ochronne, ale nie wie, kto w firmie może udzielić jakiego zatwierdzenia.

Prawidłowo zdecydować o tworzeniu aplikacji webowych z aktualnymi frameworkami

Najlepsza technologia nie powstaje z listy popularnych narzędzi, lecz z rzeczywistego użycia. Wewnętrzna aplikacja dla dziesięciu osób ma inne wymagania niż portal klienta z kilkoma tysiącami równoczesnych dostępów. Terminal magazynowy ze skanerem potrzebuje innej logiki obsługi niż analiza dla zarządu na komputerze.

Dlatego sensowna decyzja zaczyna się od konkretnych pytań: które czynności kosztują dziś mierzalnie czas? Które dane są przenoszone wielokrotnie? Gdzie powstają błędy, bo informacje stają się widoczne zbyt późno? Która istniejąca tabela działa wystarczająco dobrze i powinna na razie zostać? Właśnie ostatni punkt chroni przed kosztownymi projektami cyfryzacji bez pożytku operacyjnego.

Dla wielu indywidualnych aplikacji biznesowych system renderowany po stronie serwera z celowymi komponentami interaktywnymi jest najrozsądniejszym wyborem. Ładuje się szybko, jest przejrzysty w utrzymaniu i unika niepotrzebnej złożoności. W pełni oddzielona aplikacja jednostronicowa może natomiast być odpowiednia, gdy interfejs obsługuje bardzo wiele stanów dynamicznych, musi działać offline lub te same funkcje ma później udostępniać także aplikacji mobilnej.

Oba rozwiązania mogą być merytorycznie poprawne. Pytanie nie brzmi: który framework jest najnowocześniejszy? Brzmi: która architektura za dwa lata będzie jeszcze bezpiecznie rozbudowywalna, testowalna i zrozumiała dla własnego zespołu?

Kiedy mniej techniki to lepsza technika

Nie każdy proces potrzebuje złożonego frontendu. Szczupły ekran wprowadzania wewnętrznych zamówień może być szybszy, stabilniejszy i tańszy niż pracowicie animowany interfejs. Jeśli plik Excel jest prowadzony tylko raz w miesiącu i nie powoduje błędów, być może nadal jest właściwym narzędziem.

Złożoność opłaca się dopiero wtedy, gdy usuwa rzeczywiste tarcie. Może tak być, gdy zamówienia są wielokrotnie przepisywane, status dostawy trzeba sprawdzać telefonicznie lub nikt nie jest pewien, która wersja dokumentu obowiązuje. Wtedy centralna aplikacja tworzy wyraźną korzyść: jeden stan danych, jednoznaczne odpowiedzialności i mniej zapytań.

Utrzymywalność zaczyna się przed pierwszą linią kodu

Frameworki są często postrzegane jako przyspieszacze. To prawda tylko wtedy, gdy reguły merytoryczne są wcześniej dostatecznie jasne. Programista może zbudować maszynę stanów technicznie czysto. Ale czy sekwencja statusów naprawdę pasuje do procesu, rozstrzyga się przy rozpoznaniu: kiedy towar uznaje się za przyjęty? Kto może zamknąć odchylenie? Co dzieje się przy dostawie częściowej?

Te decyzje należy dokumentować, podobnie jak interfejsy, pola danych i wyjątki. To nie spowalnia projektów. Zmniejsza późniejsze dyskusje, ponieważ staje się widoczne, która reguła została wdrożona świadomie, a które założenie jest jeszcze otwarte.

Utrzymywalność pokazuje się także w małych dyscyplinach. Zmiany w bazie danych muszą być wersjonowane. Kroki wdrożenia muszą być udokumentowane. Komunikaty o błędach powinny być użyteczne dla eksploatacji i rozwoju bez ujawniania poufnych szczegółów. Zautomatyzowane testy przy każdej zmianie sprawdzają centralne przebiegi, na przykład utworzenie zamówienia, obliczenie ilości lub wystawienie listu przewozowego.

Przy aplikacjach krytycznych jeden typ testu nie wystarcza. Testy jednostkowe zabezpieczają pojedyncze reguły, testy integracyjne sprawdzają współdziałanie z bazą danych i interfejsami, a testy end-to-end odtwarzają w przeglądarce rzeczywiste ścieżki obsługi. Dla aplikacji webowych i Windows samodzielnie hostowane środowisko testowe może dodatkowo dostarczać zrzuty ekranu, protokoły wykonania i zrozumiałe oceny, bez niepotrzebnego przekazywania wewnętrznych danych testowych zewnętrznym usługom chmurowym.

Wydajność wynika z architektury i modelu danych

Nowoczesny interfejs nie staje się szybki dlatego, że używa aktualnego frameworka. Wolne zapytania do bazy danych, zbyt duże obrazy lub niejasne interfejsy pozostają wolne, niezależnie od frontendu. Szczególnie przy listach zamówień, artykułów lub danych ruchu to model danych decyduje o odczuwanej szybkości.

Czyste indeksy w MySQL 8, stronicowane zapytania i świadomie ładowane dane są często skuteczniejsze niż późniejsza optymalizacja interfejsu. Równie ważna jest jasna koncepcja cache'owania. Dane podstawowe mogą w pewnych okolicznościach być buforowane, aktualne zapasy lub status zatwierdzenia natomiast nie na ślepo. Nie ma tu reguły ogólnej, ponieważ merytoryczne znaczenie danych decyduje o tym, jak aktualne muszą być.

Responsywne projektowanie należy również do planowania technicznego. Na ekranie biurowym szeroka tabela może mieć sens. Na ręcznym skanerze lub tablecie w magazynie ta sama informacja potrzebuje dużych powierzchni dotyku, krótkich dróg i prezentacji, która pozostaje użyteczna także w rękawicach lub przy słabym świetle. Pure fluidity meets ultimate performance nie oznacza w tym kontekście jak największego ruchu na ekranie. Oznacza, że aplikacja działa bez tarcia na urządzeniu, które faktycznie jest używane w procesie.

Rozsądna droga od pomysłu do eksploatacji

Solidny projekt webowy zaczyna się od ograniczonego, sprawdzalnego rdzenia. Zamiast automatyzować z góry każdy wyobrażalny wyjątek, wybiera się proces, który występuje często i powoduje odczuwalny nakład pracy. Po pierwszym zastosowaniu rzeczywiste dane i informacje zwrotne pokazują, które rozszerzenie naprawdę ma następny priorytet.

Przekazanie techniczne nie powinno odbywać się dopiero na końcu. Odpowiedzialności za hosting, kopie zapasowe, monitoring, aktualizacje i prawa dostępu muszą być wyjaśnione wcześnie. System jest tak niezawodny, jak jego eksploatacja. Kto potrzebuje aplikacji codziennie do wysyłki lub obsługi zamówień, potrzebuje zdefiniowanych dróg odtwarzania i jasnej odpowiedzi na to, co dzieje się przy awarii.

softify.pro stawia dlatego na utrzymywalne technologie, udokumentowane dostarczanie i bezpośrednią odpowiedzialność techniczną zamiast na krótkotrwałe mody frameworków. To nie jest magiczny skrót. To tworzy warunek, by aplikacja po starcie działała dalej, mogła być rozwijana i nie stała się kolejnym kruchym przypadkiem szczególnym.

Właściwa aplikacja webowa w najlepszym przypadku nie wydaje się nowym projektem IT. Wydaje się przebiegiem, który wreszcie działa bez objazdów - z dostateczną substancją techniczną, by spokojnie przyjąć także następną zmianę w eksploatacji.

Permalink →

Planowanie wdrożenia oprogramowania: jak się udać podczas bieżącej działalności

Planowanie wdrożenia oprogramowania: jak się udać podczas bieżącej działalności

Nowy system rzadko zawodzi dlatego, że brakuje przycisku. Zawodzi w poniedziałek rano: poranna zmiana nie może znaleźć przyjęcia towaru, list przewozowy zostaje wydrukowany dwukrotnie albo plik Excel nagle pozostaje nieoficjalną prawdą. Kto chce zaplanować wdrożenie oprogramowania, musi więc nie tylko wprowadzić funkcje, ale zabezpieczyć rzeczywistą działalność.

Właśnie w magazynie, warsztacie, dyspozycji i administracji wdrożenie nie jest terminem IT. Zmienia ruchy rąk, odpowiedzialności i drogi informacji. Dobre wprowadzenie utrzymuje pracę w ruchu, wcześnie czyni błędy widocznymi i daje pracownikom jasną odpowiedź na decydujące pytanie: co robię inaczej od jutra?

Wdrożenie zaczyna się przed pierwszym szkoleniem

Wiele projektów zaczyna się od listy funkcji: rejestrować zamówienia, księgować ruchy magazynowe, drukować etykiety wysyłkowe, planować trasy. To jest konieczne, ale nie wystarcza. Przed startem musi być jasne, które procesy w pierwszym dniu produkcyjnym mają faktycznie przebiegać przez nowy system - a które świadomie jeszcze nie.

To rozgraniczenie nie jest oznaką niekompletności. Zmniejsza ryzyko. Jeśli średniej wielkości przedsiębiorstwo dotąd koordynowało przyjęcia towaru za pomocą papieru, telefonu i tabel, nie musi pierwszego dnia jednocześnie cyfryzować całego zarządzania zapasami, obsługi zwrotów, planowania tras i oceny dostawców. Sensowny pierwszy zakres mógłby obejmować przyjęcie towaru, jednoznaczne ruchy magazynowe i druk dokumentów dostawy.

Decydujące jest konkretne opisanie procesu docelowego. Nie: „Przyjęcie towaru staje się cyfrowe.” Lecz: „Pracownik skanuje dostawę, sprawdza ilość i stan, przypisuje lokalizację magazynową i w razie odchyleń tworzy sprawę dla zakupów.” Dopiero na tym poziomie widoczne stają się otwarte pytania: co się dzieje przy braku zamówienia? Kto może korygować ilości? Czy dostawę bez etykiety wolno zmagazynować?

Planowanie wdrożenia oprogramowania oznacza: priorytetyzację krytycznych procesów

Nie każdy proces ma to samo znaczenie. Awaria w obszarze utrzymania danych podstawowych może być nieprzyjemna. Awaria przy wysyłce, kompletacji lub zatwierdzaniu faktur może zablokować pracę całego dnia. Dlatego wdrożenie potrzebuje priorytetyzacji według ryzyka operacyjnego, a nie według kolejności w specyfikacji wymagań.

Sprawdził się prosty podział: krytyczne dla biznesu, ważne i odkładalne. Krytyczne dla biznesu są wszystkie procesy, które poruszają towar, pieniądze lub wiążącą komunikację z klientem. Ważne są funkcje, które przyspieszają codzienność, ale których wypadnięcie można przejściowo złagodzić ręcznie. Odkładalne są funkcje komfortu, rzadkie przypadki szczególne lub zestawienia, które na początku mogą jeszcze pochodzić z istniejącego źródła.

Ten podział wpływa na głębokość testów. Dla krytycznego procesu wysyłki nie wystarczy pomyślnie przeklikać pojedyncze zamówienie. Trzeba przetestować także dostawy częściowe, storna, brakujące drukarki, błędne adresy, równoległą obsługę i przekazanie przewoźnikowi. Przy rzadko używanej funkcji statystycznej odpowiedni może być późniejszy cykl testowy.

Zrobić kryteria sukcesu mierzalnymi z wyprzedzeniem

„Aplikacja działa” nie jest kryterium odbioru. Lepsze są sprawdzalne stwierdzenia: przyjęcie towaru z 30 pozycjami można zaksięgować w ciągu dziesięciu minut. Etykiety wysyłkowe drukowane są na przewidzianym stanowisku pracy. Zmiany zapasów pojawiają się natychmiast w dyspozycji. Zablokowane konto użytkownika można ponownie aktywować tylko przez zdefiniowany proces zatwierdzenia.

Takie kryteria łączą dział merytoryczny i rozwój. Zapobiegają też temu, by odbiór stał się zbiorem niejasnych wrażeń. Nie każda informacja zwrotna musi być rozwiązana przed go-live. Ale każda potrzebuje klasyfikacji: błąd krytyczny, istotne ulepszenie lub punkt na późniejszy etap rozbudowy.

Migracja danych: tylko czyste dane zasługują na zaufanie

Stare dane są często niedoceniane. W tabelach znajdują się zduplikowane numery artykułów, różne jednostki, wygasłe adresy klientów i stany magazynowe, których pochodzenia nikt już nie potrafi wyjaśnić. Kto przejmuje te dane bez sprawdzenia, przenosi starą niejasność do nowego systemu - tylko z lepszym interfejsem.

Przed migracją należy ustalić, które dane są naprawdę potrzebne. Często sensowne są aktualne artykuły, aktywni klienci, otwarte zamówienia, istotni dostawcy i sprawdzone stany początkowe. Dane historyczne nie muszą koniecznie przechodzić w całości do nowej aplikacji. Może wystarczyć archiwizacja w czytelnej formie, jeśli pozostają potrzebne jako dowody lub do zapytań.

Szczególnie ważne jest ładowanie próbne. Dane nie są przy tym tylko importowane technicznie, ale sprawdzane merytorycznie: czy ilości, jednostki i przypisania się zgadzają? Czy pola obowiązkowe są kompletne? Czy typowe zamówienia można przy ich pomocy poprawnie obsłużyć? Na go-live potrzebna jest następnie jasna data graniczna. Od kiedy używany jest który system wiodący? Bez tej reguły powstają podwójne prowadzenie i sprzeczne stany.

Praca pilotażowa zamiast jednego wielkiego przełącznika

Big bang może mieć sens, jeśli mały zespół korzysta z jasno wydzielonego procesu, a stare i nowe rozwiązanie nie mogą działać równolegle. W większości środowisk operacyjnych praca pilotażowa jest jednak wyborem lepiej kontrolowalnym.

Pilotaż powinien działać na rzeczywistych przypadkach, ale w ograniczonych ramach: jeden obszar magazynu, jedna zmiana, jedna grupa produktów lub wybrany zespół. Decydujące jest, aby grupa pilotażowa nie obejmowała tylko szczególnie technicznie zorientowanych pracowników. Powinna realistycznie odzwierciedlać późniejszą codzienność, łącznie z ludźmi, którzy pracują pod presją czasu i mają uzasadnione zastrzeżenia.

W pracy pilotażowej okazuje się, czy skanery, drukarki, sieć i uprawnienia działają na rzeczywistym stanowisku. Równie widoczne stają się luki procesowe, których nikt nie wymienił na spotkaniach. Być może towar w codzienności jest najpierw odkładany w miejscu pośrednim. Być może kierowcy potrzebują innego listu przewozowego niż administracja. Takie spostrzeżenia nie są krokiem wstecz. To powód, by przeprowadzić pilotaż przed szerokim startem.

Szkolenie jako sytuacja pracy, a nie oprowadzanie po oprogramowaniu

Szkolenie, które tylko wyjaśnia pozycje menu, daje niewiele pewności. Pracownicy muszą uczyć się na swoich zadaniach: „Przyjmujecie uszkodzoną dostawę”, „Kompletujecie pilne zamówienie”, „Korygujecie błędnie zaksięgowaną ilość”. Kontekst zostaje w pamięci, ponieważ odpowiada codzienności pracy.

Krótkie szkolenia blisko go-live są zazwyczaj skuteczniejsze niż jeden długi termin kilka tygodni wcześniej. Pomagają też zwięzłe instrukcje pracy bezpośrednio na stanowisku. Nie powinny wyjaśniać całego systemu, lecz pokazywać najczęstsze procesy, jasne odpowiedzialności i drogę przy zakłóceniach.

Wyznaczcie ponadto osoby kontaktowe w poszczególnych obszarach. Osoby te nie muszą same rozwiązywać każdego problemu technicznego. Powinny jednak móc rozstrzygnąć, czy chodzi o błąd obsługi, niejasność merytoryczną czy faktyczny błąd systemu. To chroni zespół projektowy przed nieustrukturyzowanymi okrzykami i przyspiesza pomoc dla zmiany.

Go-live potrzebuje planu operacyjnego

Dzień go-live potrzebuje więcej niż godziny. Zdefiniujcie, kto decyduje merytorycznie, kto odpowiada za zmiany techniczne i jakim kanałem zgłaszane są zakłócenia. Przy krytycznych procesach powinno być widoczne, czy działają funkcje centralne: logowanie, uprawnienia, rejestracja danych, interfejsy, druk i kopia zapasowa.

Należy do tego także plan awaryjny. Nie oznacza to, że przy najmniejszym problemie od razu całkowicie wraca się do starego świata. Oznacza to wcześniejsze określenie, jakie zakłócenie uzasadnia zatrzymanie, jak w razie potrzeby dokumentuje się zamówienia i jak później czysto się je rejestruje. Papierowy formularz na kilka godzin może być rozsądny. Stałe równoległe prowadzenie bez końca nie jest.

Szczegóły techniczne się liczą: czy dostępy zostały założone na czas? Czy role i reguły blokady konta działają poprawnie? Czy drukarki etykiet są połączone z właściwymi szablonami? Czy istnieje przetestowana kopia zapasowa bazy danych? W aplikacjach opracowywanych indywidualnie udokumentowane wdrożenia, możliwe do prześledzenia stany wersji i jasna droga poprawiania błędów należą do standardu.

Pierwsze tygodnie decydują o akceptacji

Po starcie zaczyna się faza, w której aplikacja staje się albo narzędziem pracy, albo nielubianym dodatkowym krokiem. Zaplanujcie więc codzienne krótkie pętle informacji zwrotnej. Jakie błędy powtarzają się? Gdzie powstają objazdy? Które pola są źle rozumiane? Jakiego zestawienia kierownikowi naprawdę brakuje?

Nie każda obserwacja wymaga natychmiastowej zmiany. Niektóre problemy rozwiązują się przez precyzyjniejsze reguły pracy lub lepsze szkolenie. Inne pokazują prawdziwe słabości w procesie lub aplikacji. Sztuka polega na tym, by nie mylić jednego z drugim. System nie powinien bez powodu komplikować istniejących działających przebiegów. Jeśli dobrze prowadzona tabela dla rzadkiego przypadku szczególnego nadal jest lepszym rozwiązaniem, może zostać.

Mierzcie efekt za pomocą kilku konkretnych wskaźników: czas obsługi na proces, liczba zapytań, błędne księgowania, ponowne wydruki, otwarte zamówienia lub różnice w zapasach. Dopiero te wartości pokazują, czy wdrożenie faktycznie poprawia działalność - zamiast jedynie wprowadzać nowe maski.

Dobre wdrożenie po kilku tygodniach nie jest już odczuwane jako projekt. Staje się niezawodną rutyną pracy: właściwe dane są tam, gdzie są potrzebne, wyjątki są możliwe do prześledzenia, a zespoły muszą mniej dzwonić za informacjami. Właśnie na to powinno celować planowanie - nie na spektakularny dzień startu, lecz na spokojniejszą, lepiej sterowalną codzienność.

Permalink →

Planowanie Multiplatform Application Development: najpierw proces, potem platforma

Planowanie Multiplatform Application Development: najpierw proces, potem platforma

Kierownik magazynu potwierdza przyjęcie towaru na ręcznym skanerze. Dyspozycja sprawdza ten sam proces w przeglądarce. Kierowca potrzebuje statusu dostawy w trasie na smartfonie. Multiplatform application development brzmi w tym momencie jak pytanie techniczne. W rzeczywistości chodzi najpierw o przebieg operacyjny: jaka praca musi być wykonana gdzie, z jaką niezawodnością i na jakim urządzeniu?

Dla małych i średnich przedsiębiorstw właściwa odpowiedź rzadko brzmi: budujemy wszystko natywnie dla każdej platformy. Częściej brzmi: definiujemy wspólny proces, celowo wybieramy niezbędne interfejsy użytkownika i unikamy podwójnej logiki. To oszczędza nie tylko budżet rozwojowy. Zapobiega też temu, by magazyn, biuro i serwis zewnętrzny pracowały na różnych stanach danych.

Co Multiplatform Application Development ma zapewnić

Multiplatform Application Development oznacza tworzenie aplikacji używanej w wielu środowiskach, na przykład w przeglądarce internetowej, na iOS i Androidzie lub w systemach desktopowych Windows. Pojęcie to bywa sprowadzane do pytania, czy jedna baza kodu może wytworzyć wiele aplikacji. To tylko część decyzji.

W systemach operacyjnych liczy się przede wszystkim, czy aplikacja działa w miejscu użycia. Przyjęcie towaru może potrzebować kamery do odczytu kodów kreskowych, dużych elementów obsługi dla rękawic i użytecznej reakcji przy niestabilnym zasięgu WLAN. Administracja potrzebuje natomiast tabel, filtrów, koncepcji uprawnień i możliwych do prześledzenia dzienników zmian. Kierowca potrzebuje ograniczonego widoku, a nie tego samego interfejsu co dyspozycja.

Wspólna podstawa techniczna może sensownie łączyć te wymagania. Nie może jednak prowadzić do tego, że każda platforma jest obsługiwana jak zły kompromis. Najlepszy wspólny kod jest bezwartościowy, jeśli pracownicy chodzą na skróty, ponieważ aplikacja nie odzwierciedla ich rzeczywistego przepływu pracy.

Najpierw określić proces, potem platformę

Zanim zespoły zaczną rozmawiać o frameworkach, powinny sprawdzić jedną konkretną operację od początku do końca. Weźmy dostawę: zamówienie wpływa, towar jest kompletowany, powstaje list przewozowy, przekazanie jest potwierdzane, a status zwracany do sprzedaży lub obsługi klienta. W którym miejscu powstaje dziś przerwa w nośnikach? Gdzie coś jest notowane na papierze, później przepisywane lub dopytywane telefonicznie?

Ta obserwacja oddziela prawdziwe wymagania platformy od list życzeń. Jeśli tylko dwóch pracowników w biurze używa danej funkcji, dobrze zrobiony interfejs webowy zwykle wystarcza. Jeśli dziesięć osób na hali dokonuje księgowań, mobilny interfejs przyjazny skanerowi może zrobić różnicę. Jeśli istniejący program Windows musi współpracować ze specjalnym sprzętem, integracja desktopowa może być konieczna.

Nie każda funkcja należy na każde urządzenie. To nie jest wada rozwiązania wieloplatformowego, lecz znak czystych decyzji produktowych. Wspólne dane i reguły biznesowe nie oznaczają koniecznie identycznych ekranów.

Trzy pytania, które wyjaśniają koszty i korzyści

Pierwsze pytanie brzmi: jakie urządzenia są już w użyciu i jak długo pozostaną? Firma z zarządzanymi terminalami Windows ma inne wymagania niż serwis zewnętrzny z prywatnymi smartfonami. Drugie brzmi: co się dzieje bez połączenia sieciowego? Zdolność pracy offline znacznie zwiększa nakład, ponieważ dane muszą być przechowywane lokalnie, później synchronizowane i czysto obsługiwane w razie konfliktów. Jest sensowna, jeśli proces inaczej by stanął - nie jako wyposażenie standardowe.

Trzecie pytanie dotyczy skutków awarii. Czy pracownik może dopisać księgowanie później, czy zależy od niego etykieta wysyłkowa, zapas lub zwolnienie bezpieczeństwa? Im bardziej krytyczna operacja, tym silniej trzeba planować uprawnienia, reguły kontroli, powtarzalność i logowanie.

Architektura, która nie rozpada się przy drugiej platformie

W trwałym rozwiązaniu logika biznesowa nie jest rozproszona w wielu interfejsach. Kontrole zapasów, zmiany statusu, zakresy numeracji, uprawnienia i generowanie dokumentów potrzebują centralnej, przetestowanej podstawy. Przeglądarka, aplikacja mobilna i klient desktopowy uzyskują do niej dostęp przez jasno zdefiniowane interfejsy.

Dla wielu wewnętrznych procesów biznesowych nowoczesna aplikacja webowa jest najbardziej ekonomicznym punktem wyjścia. Można ją aktualizować centralnie, nie wymaga instalacji na każdym stanowisku i działa na komputerze, tablecie i smartfonie. Z PHP 8.4, nowoczesnym JavaScriptem i MySQL 8 można zbudować utrzymywalną podstawę, o ile model danych, prawa dostępu i wdrożenie nie będą rozważane dopiero tuż przed uruchomieniem.

Instalowalna aplikacja mobilna lub desktopowa jest dodawana wtedy, gdy przynosi wyraźną korzyść: głęboka integracja ze skanerem, drukarką lub kamerą, niezawodna praca offline, specjalne funkcje w tle lub wymagania zarządzania urządzeniami. To celowa rozbudowa, a nie cel sam w sobie.

Częstym błędem jest pełne ponowne użycie interfejsu użytkownika za wszelką cenę. Technicznie może to wyglądać atrakcyjnie. W praktyce powstają małe teksty na dużych monitorach, przeładowane formularze na smartfonach lub obsługa, która nie pasuje do platformy. Lepiej dzielić model danych, reguły i komponenty tam, gdzie to sensowne, dopasowując obsługę do danego kontekstu.

Spójność danych jest ważniejsza niż wspólna baza kodu

Wiele platform zwiększa ryzyko sprzecznych danych. Zamówienie jest zmieniane w biurze, podczas gdy kierowca nadal widzi starą wersję na swoim urządzeniu. Dwóch pracowników księguje jednocześnie ten sam zapas artykułu. Urządzenie offline odsyła swoje zmiany dopiero po godzinach. Te przypadki nie są tematem pobocznym, lecz sednem architektury.

System potrzebuje więc jednoznacznych tożsamości, znaczników czasu, identyfikowalnych zmian stanu i reguł dla konfliktów. Przy statusie dostawy może wystarczyć ostatnia potwierdzona zmiana. Przy zapasach jest to często zbyt zgrubne. Tam musi być jasne, który ruch został zaksięgowany, z jakiej lokalizacji magazynowej pochodzi i czy korektę trzeba uzasadnić.

Także uprawnienia należy regulować centralnie. Pracownik może mieć prawo rejestrować przyjęcia towaru, ale nie zatwierdzać korekt zapasów. Zewnętrzny kierowca może widzieć tylko swoją trasę. Czasy trwania sesji, uwierzytelnianie wieloskładnikowe dla ról krytycznych i przepływy blokady konta nie są dekoracyjnymi funkcjami bezpieczeństwa. Chronią konkretne procesy i czynią odpowiedzialność widoczną.

Testowanie Multiplatform Application Development tak, jak się pracuje

Aplikacja może się uruchomić na trzech systemach operacyjnych i mimo to zawieść w eksploatacji. Decydujące są przebiegi w rzeczywistych warunkach: skaner reaguje zbyt wolno, drukarka etykiet jest niedostępna, uprawnienie nie działa po zmianie roli albo synchronizacja tworzy podwójne księgowania.

Dlatego procesy krytyczne należy sprawdzać automatycznie. Należą do nich logowanie i zachowanie blokady, rejestracja zamówień, ruchy zapasów, tworzenie dokumentów i obsługa błędnych danych wejściowych. Dla aplikacji webowych i Windows powtarzalne testy można uruchamiać na samodzielnie hostowanej infrastrukturze. Jest to szczególnie istotne, jeśli zrzuty ekranu, wewnętrzne dane zamówień lub dostępy testowe nie mają być przekazywane zewnętrznym usługom chmurowym.

Automatyzacja nie zastępuje kontroli przez ludzi na hali magazynowej. Zapewnia jednak, że znane przebiegi są po zmianach sprawdzane raz po raz. Dobre raporty testowe nie wskazują tylko błędu technicznego, lecz dotknięty proces: nie można utworzyć potwierdzenia dostawy, konto użytkownika pozostaje zablokowane po udanym zatwierdzeniu lub dane trasy nie są aktualizowane.

Kiedy strategia platformy to za dużo

Niektóre firmy nie potrzebują własnej aplikacji. Jeśli wystarcza stabilny dostęp przez przeglądarkę, przebieg rzadko bywa mobilny, a liczba użytkowników pozostaje przejrzysta, responsywna aplikacja webowa jest często rozsądniejszym wyborem. Zmniejsza nakład utrzymania, problemy dystrybucji i liczbę możliwych źródeł błędów.

Także istniejącej tabeli nie trzeba od razu zastępować. Jeśli służy tylko jako proste zestawienie, jest prowadzona przez jedną osobę i nie tworzy podatnych na błędy przekazań, może spełniać swój cel. Czas na system nadchodzi, gdy wiedza tkwi w pojedynczych głowach, wersje się rozchodzą, dopytywania rosną lub operacji nie da się już wiarygodnie prześledzić.

Odwrotnie, szczupła strategia platformy szybko staje się za mała, gdy pracownicy muszą pracować offline, podłączany jest sprzęt lub klienci i partnerzy potrzebują kontrolowanego dostępu. Wtedy warto świadomie sfinansować dodatkowe wymagania, zamiast dobudowywać je później pod presją czasu.

Zacząć od solidnego pilotażu

Dobry start to nie katalog funkcji ze stu punktami, lecz kompletny, mierzalny przebieg. Na przykład: zarejestrować przyjęcie towaru, zaktualizować zapas, udokumentować odchylenie i utworzyć zadanie do wyjaśnienia. Ten pilotaż pokazuje wcześnie, czy model danych, urządzenia, prawa i obsługa do siebie pasują.

Potem rozwiązanie może rosnąć w sensownych krokach: kompletacja, wysyłka, planowanie tras lub analizy. Każde rozszerzenie powinno przejść to samo pytanie: czy skraca rzeczywisty przebieg, zmniejsza błędy lub tworzy wiarygodną przejrzystość? Jeśli nie, może poczekać.

Najsensowniejsza platforma to na koniec nie ta z największą liczbą opcji technicznych. To ta, na której zespół rano szybciej zaczyna pracę, w trakcie zmiany mniej dopytuje i wieczorem może prześledzić, co naprawdę się wydarzyło.

Permalink →

Jak prawidłowo oceniać Test Automation Results

Jak prawidłowo oceniać Test Automation Results

Test regresji może rano zakończyć się 98 procentami udanych przypadków i mimo to nie być dobrą wiadomością. Być może nieudany test to właśnie logowanie dużego klienta. Być może 40 testów pominięto, ponieważ środowisko testowe było niedostępne. Albo przebieg był zielony, ale sprawdzał tylko, czy przyciski istnieją, a nie czy zamówienie faktycznie zostaje zapisane, powstaje list przewozowy i zapas jest poprawnie korygowany. Test automation results nie są stwierdzeniem o jakości, dopóki brakuje ich kontekstu.

Dla kierownictwa QA, rozwoju i działów merytorycznych prawdziwa praca nie polega więc tylko na automatyzowaniu testów. Decydujące jest przygotowanie wyników tak, aby wynikały z nich wiarygodne decyzje: czy wydanie można wdrożyć? Czy błąd trzeba obsłużyć natychmiast? Czy błąd jest nowy, powrócił, czy to tylko problem środowiska testowego? I czy istnieją dowody, które zrozumie także dział merytoryczny bez kodu testowego?

Co Test Automation Results naprawdę mówią

Najprostszy wskaźnik brzmi: zaliczony lub niezaliczony. Jest pomocny, ale rzadko wystarczający. Wysoki odsetek sukcesów może budować zaufanie, jeśli testy obejmują krytyczne przepływy, dane testowe są wiarygodne, a środowisko przypomina późniejszą eksploatację. Jeśli brakuje jednego z tych czynników, liczba pozostaje przede wszystkim sygnałem, że wykonano zautomatyzowany przebieg.

W aplikacjach krytycznych dla biznesu większą wagę mają inne pytania. W rozwiązaniu magazynowym nie każdy ekran jest równie ważny. Błąd wyświetlania w wewnętrznym tekście podpowiedzi może poczekać. Błąd, który przy przyjęciu towaru księguje złą ilość lub generuje etykietę wysyłkową bez adresu odbiorcy, nie może. Dobre wyniki testów ważą więc ryzyka zamiast traktować wszystkie przypadki jednakowo.

Także nieudany test nie jest automatycznie błędem produktu. Może go wywołać wygasłe dane dostępowe, zablokowana rola testowa, niedostępne interfejsy, zmienione dane testowe lub wolne środowisko. Kto nie rozdziela tych przyczyn, produkuje szum. Zespół traci wtedy czas na fałszywe alarmy, podczas gdy prawdziwe błędy toną wśród czerwonych komunikatów statusu.

Cztery typy statusu zamiast jednej czerwonej listy

W praktyce sprawdza się wyraźny podział: błąd merytoryczny, techniczny błąd testu, problem środowiska i oczekiwana zmiana. Błąd merytoryczny oznacza, że aplikacja narusza zdefiniowane wymaganie. Techniczny błąd testu wskazuje raczej na sam test, na przykład selektor, który już nie pasuje po celowo zmienionym interfejsie.

Problem środowiska występuje, gdy na przykład system testowy lub podłączony interfejs jest niedostępny. Oczekiwane zmiany powstają, gdy proces został celowo dostosowany, ale automatyzacja nadal sprawdza stary stan docelowy. Te kategorie nie zapobiegają każdej dyskusji. Ale zapewniają, że dyskusja zaczyna się we właściwym punkcie.

Od przebiegów testowych do raportów gotowych do decyzji

Użyteczny raport nie odpowiada tylko, że coś się nie powiodło, ale co się stało, jak poważne to jest i czy błąd wydaje się powtarzalny. Potrzeba do tego więcej niż listy nazw testów i znaczników czasu.

Do każdego istotnego przebiegu należą sprawdzany build, środowisko testowe, użyta rola, kluczowe dane testowe oraz czas rozpoczęcia i zakończenia. Zwłaszcza przy aplikacjach desktopowych Windows lub złożonych platformach webowych te informacje są potrzebne do zawężenia różnic. Błąd, który występuje tylko pod ograniczoną rolą magazynową, to coś innego niż błąd blokujący każde logowanie.

Wiarygodne wyniki zawierają ponadto możliwe do prześledzenia dowody: zrzuty ekranu, nagrane kroki, komunikaty o błędach i w razie potrzeby logi techniczne. Sam zrzut ekranu może jednak wprowadzać w błąd. Pokazuje moment, a nie przyczynę. Połączenie sekwencji kroków, widocznego stanu i oczekiwanej reakcji jest znacznie bardziej pomocne.

Systemy wspierane przez AI mogą przekształcić te dowody w zrozumiałe oceny. W COCO na przykład testy działają na własnym, samodzielnie hostowanym serwerze AI. Ewaluacja może wyjaśnić, że zamówienie zostało wprawdzie utworzone, ale oczekiwana zmiana statusu nie nastąpiła, i bezpośrednio przypisać nagranie wykonania. Dla zespołów świadomych bezpieczeństwa istotne jest, gdzie przetwarzane są zrzuty ekranu, dane aplikacji i ruch testowy. Lokalna kontrola nie jest automatycznie konieczna, ale przy aplikacjach wewnętrznych i wrażliwych danych może być rozsądniejszą drogą niż zewnętrzna usługa chmurowa.

Właściwy poziom szczegółowości dla różnych odbiorców

Zespoły deweloperskie potrzebują komunikatów o błędach, kroków technicznych i możliwie precyzyjnych wskazówek do odtworzenia. Operations manager potrzebuje natomiast najpierw dotkniętej funkcji, ryzyka biznesowego i jasnej wypowiedzi o zdolności operacyjnej. Obie perspektywy muszą móc powstawać z tego samego wykonania, bez konieczności ręcznego przenoszenia wyników do prezentacji.

Dobry raport zaczyna się więc krótkim poziomem decyzyjnym: wydanie zalecane, wydanie ze znanymi ograniczeniami lub wstrzymanie wydania. Poniżej znajdują się krytyczne odchylenia z priorytetem i dowodem. Szczegóły techniczne następują dopiero potem. To nie uproszczenie kosztem dokładności, lecz czyste rozdzielenie potrzeb informacyjnych.

Mierzenie pokrycia bez łudzenia się bezpieczeństwem

Pokrycie testami przedstawia się często jako wartość procentową. Ta wartość jest użyteczna, gdy jasne jest, co mierzy. Pokrycie kodu pokazuje na przykład, które części kodu programu zostały wykonane podczas testów. To nie dowodzi, że proces biznesowy działa poprawnie. Test może dotknąć wielu wierszy kodu i mimo to nigdy nie sprawdzić, czy na dokumencie pojawia się błędny adres dostawy.

Dla działów merytorycznych pokrycie procesów jest często bardziej wymowne. Opisuje, które rzeczywiste przepływy są chronione: zarejestrować zamówienie, zarezerwować zapas, zaksięgować dostawę częściową, przyjąć zwrot lub zatwierdzić fakturę. Szczególnie cenne są przejścia między systemami i rolami, ponieważ tam często powstają błędy: przy imporcie zamówienia, druku etykiety lub przejściu z biura na terminal magazynowy.

Nie ustalaj priorytetów według liczby możliwych testów, lecz według skutków szkody i częstotliwości zmian. Rzadko używany proces o wysokim ryzyku finansowym lub prawnym zasługuje często na automatyzację wcześniej niż często używany, ale nieszkodliwy widok. Odwrotnie, stabilny, mało krytyczny przepływ może nadal poprzestać na krótkiej kontroli ręcznej. Nie każda kontrola musi być zautomatyzowana tylko dlatego, że można ją zautomatyzować.

Niestabilne testy to osobny problem jakości

Testy, które bez rozpoznawalnej zmiany produktu raz przechodzą, a raz zawodzą, często nazywa się flaky. Niszczą zaufanie szybciej niż trwale czerwony test. Gdy tylko zespoły odruchowo uruchamiają czerwone wyniki ponownie, automatyzacja traci swoją funkcję ostrzegawczą.

Przyczyny są zwykle konkretne: sztywne czasy oczekiwania, wspólnie używane dane testowe, równoległe dostępy, przetwarzanie asynchroniczne lub środowisko, które nie jest resetowane. Krótka trzysekundowa pauza w teście może przypadkowo pomóc, ale nie jest rozwiązaniem. Lepiej czekać na dający się wykazać stan, uczynić dane testowe jednoznacznymi i izolować przepływy od siebie.

Nie każdą niestabilność da się całkowicie uniknąć. Zewnętrzne interfejsy mogą się wahać, a rzeczywista infrastruktura ma awarie. Wtedy raport powinien wyraźnie zaznaczać, czy test z powodu zewnętrznej zależności nie dał się ocenić. Powtórzony przebieg może być sensowny diagnostycznie, ale nie może uczynić pierwszego ustalenia niewidocznym.

Sensowny przebieg po każdym przebiegu testów

Po zautomatyzowanym przebiegu nie każdy wynik powinien być od razu traktowany jednakowo. Najpierw sprawdza się błędy blokujące i krytyczne testy, których nie dało się ocenić. Następnie przychodzi klasyfikacja nowych odchyleń w odniesieniu do znanych, zaakceptowanych problemów. Dopiero wtedy decyzja o wydaniu jest wiarygodna.

Pomocne są ustalone wartości progowe, ale muszą pasować do procesu. Na przykład nieudany test w przepływie płatności lub uprawnień może wywołać natychmiastowe wstrzymanie. Przy czysto kosmetycznym odchyleniu udokumentowany wyjątek może być uzasadniony. Takie reguły nie powinny powstawać dopiero pod presją czasu przed wydaniem.

Równie ważne jest sprzężenie zwrotne: każdy błąd produkcyjny, którego testy nie wykryły, jest powodem, by sprawdzić, czy brakuje scenariusza, wariantu danych testowych lub punktu kontrolnego. Celem nie jest nagromadzenie jak największej liczby testów. Jest nim budowanie, celowo, lepszego zabezpieczenia na podstawie rzeczywistych błędów.

Najbardziej użyteczne wyniki testów to na koniec nie te z najzieleńszym przeglądem. To te, dzięki którym osoba odpowiedzialna może w poniedziałek rano zrozumieć, co sprawdzono, jakie ryzyko pozostaje i jakie działanie jest teraz rozsądne.

Permalink →

Inventory Discrepancy Causes: częste przyczyny różnic w zapasach

Inventory Discrepancy Causes: częste przyczyny różnic w zapasach

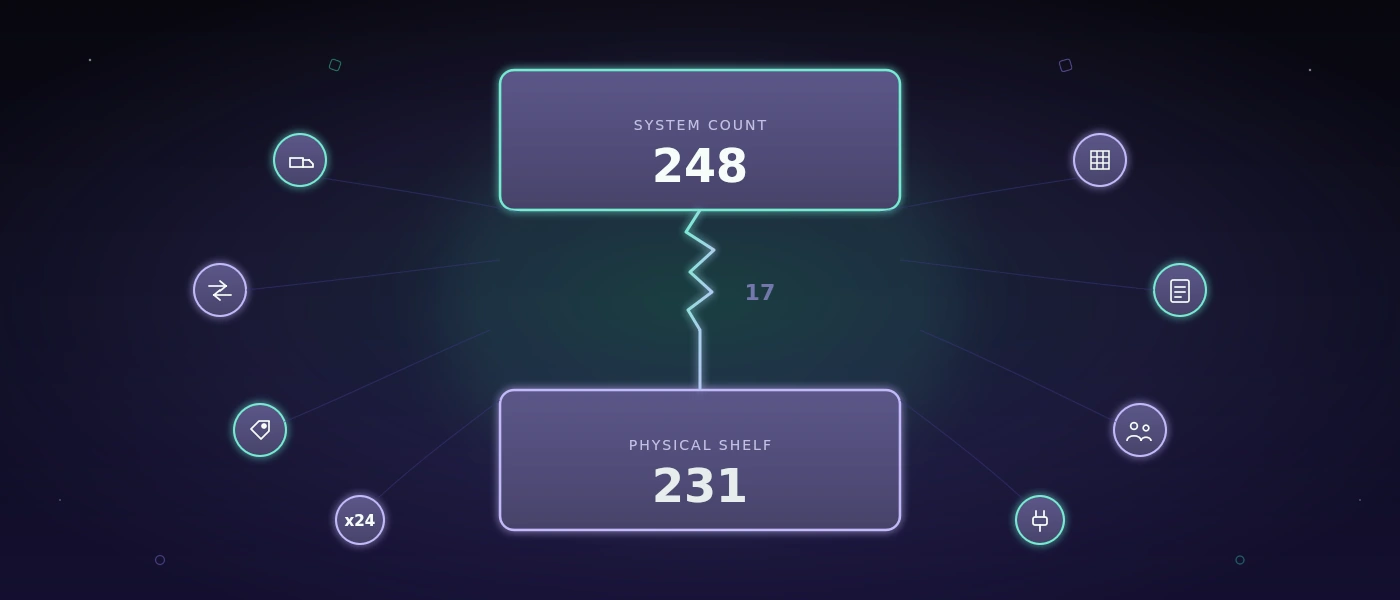
Zapas w systemie wynosi 248 sztuk, na regale leży 231. Te 17 jednostek na pierwszy rzut oka wygląda jak błąd liczenia. Ale właśnie tam często zaczyna się błędna analiza. Inventory discrepancy causes rzadko w praktyce są pojedynczym przeoczeniem. Zwykle powstają tam, gdzie przyjęcie towaru, ruch magazynowy, kompletacja, i księgowanie rozchodzą się czasowo lub organizacyjnie.

Dla małego lub średniego przedsiębiorstwa różnice w zapasach nie są tylko tematem na inwentaryzację. Prowadzą do błędnych zamówień, dostaw ekspresowych, niepotrzebnych zapasów bezpieczeństwa, i obietnic dostaw, których nie da się dotrzymać. Kto czysto rozdzieli przyczyny, nie musi od razu wprowadzać dużego ERP. Często wystarczają jaśniejsze zasady księgowania, odpowiednie urządzenia do rejestracji, i system, który odzwierciedla rzeczywiste procesy pracy.

Inventory discrepancy causes: gdzie powstają różnice

Różnica w zapasach to różnica między zapasem docelowym w wiodącym systemie a rzeczywiście obecnym zapasem. Decydujące jest tutaj słowo "wiodący". Jeśli równolegle prowadzone są plik Excel, lista papierowa, i system zarządzania towarem, praktycznie istnieje kilka prawd. Wtedy różnica nie powstała tylko w magazynie, lecz była już wbudowana w zarządzanie danymi.

Skuteczne przeciwdziałanie zależy więc od rodzaju błędu. Źle policzona paleta wymaga innego rozwiązania niż dostawa, która została fizycznie przyjęta, ale nigdy nie zaksięgowana. Zanim zespoły zrestrukturyzują procesy, powinny ocenić różnice według artykułu, lokalizacji magazynowej, zmiany, typu ruchu, i momentu. Dopiero ten wzorzec pokazuje, czy chodzi o pojedynczy przypadek, czy powtarzający się błąd procesu.

1. Przyjęcia towaru są księgowane z opóźnieniem lub niekompletnie

Przyjęcie towaru to klasyczny punkt przełomowy. Towar przybywa rano, jest odkładany do kontroli, i później przenoszony bezpośrednio do produkcji lub na regał. Księgowanie następuje po południu, następnego dnia, lub wcale. Dopóki towar jest fizycznie obecny, zapas systemowy wydaje się za niski. Jeśli jest już zużyty lub wysłany, błędy wtórne stają się bardziej prawdopodobne.

Szczególnie podatne są dostawy częściowe, artykuły zastępcze, i nadwyżki dostaw. Jeśli na liście przewozowym podana jest jedna ilość, a przychodzi inna, nikt nie powinien po prostu zaksięgować dokumentu "mniej więcej pasująco". Różnica musi pozostać widoczna jako wyjątek, wraz z powodem, odpowiedzialną osobą, i zatwierdzeniem. W przeciwnym razie odchylenie znika z procesu i pojawia się ponownie dopiero przy inwentaryzacji.

2. Ruchy magazynowe zachodzą bez transakcji

Artykuł jest przenoszony z przyjęcia towaru do regału wysokiego składowania, przenoszony z jednego miejsca do strefy kompletacji, lub rezerwowany dla zamówienia. Fizycznie to mały, szybki ruch. W systemie może być decydujący.

Jeśli pracownicy przeorganizowują lokalizacje magazynowe tylko na wyczucie, całkowity zapas może nadal się zgadzać, ale dostępność we właściwym miejscu nie. To powoduje czas poszukiwań, błędy kompletacji, i niepotrzebne jazdy uzupełniające. Dobre rozwiązanie magazynowe nie musi komplikować każdego ruchu. Musi rejestrować nieliczne ruchy, które są istotne dla dostępności, identyfikowalności, i ponownego zamówienia.

W warsztatach lub mniejszych magazynach często sensowniejsze jest utrzymywanie kilku jednoznacznych stref niż teoretycznie idealnej struktury miejsc, której nikt nie utrzymuje na co dzień. Precyzja działa tylko wtedy, gdy pozostaje wykonalna.

3. Kompletacja i wysyłka są księgowane zbyt wcześnie

Wiele zespołów księguje zamówienie podczas kompletacji jako "wydane", mimo że towar nadal leży na miejscu przygotowania. Jeśli zamówienie zostanie następnie zmienione, anulowane, lub wysłane tylko częściowo, zapas systemowy i fizyczny przestają się zgadzać.

Lepsze jest jasne rozdzielenie między zarezerwowane, skompletowane, i wysłane. Nie każda firma potrzebuje do tego złożonych łańcuchów statusów. Ale moment zmniejszenia zapasu musi być jednoznaczny. Dla towaru wysyłkowego leży on często bliżej faktycznego przekazania przewoźnikowi niż pierwszego sięgnięcia po regał.

Zwroty również należą do tego przepływu. Gdy towar wraca, nie jest automatycznie ponownie dostępny. Dopiero kontrola, decyzja o jakości, i składowanie powinny decydować, czy wraca do zapasu sprzedażowego, pozostaje zablokowany, czy zostaje wycofany.

4. Błędne jednostki i błędy danych podstawowych

Karton, opakowanie zbiorcze, rolka, i pojedyncza sztuka mogą dotyczyć tego samego artykułu. Jeśli przeliczenie nie jest czysto utrzymywane, różnice powstają z imponującą prędkością. Pracownik księguje "1", mając na myśli karton z 24 sztukami. System rozumie jedną sztukę.

Błędy danych podstawowych są szczególnie podstępne, ponieważ proces księgowania może wyglądać technicznie poprawnie. Dlatego sprawdź jednostki opakowania, współczynniki przeliczeniowe, ilości minimalne, lokalizacje magazynowe, i numery artykułów. Także podobnie nazwane warianty, na przykład różne długości, kolory, lub partie, są łatwo mylone.

Tutaj nie pomaga żadna ogólna zasada typu "skanuj więcej". Kody kreskowe są tylko tak wiarygodne jak przypisanie za nimi. Przy małych asortymentach czysto utrzymywany katalog artykułów z czytelnymi etykietami może przynieść więcej korzyści niż rozbudowany, ale źle skonfigurowany park skanerów.

5. Równolegle prowadzone tabele i ręczne korekty

Tabela na pulpicie rzadko powstaje z zaniedbania. Zwykle wypełnia rzeczywistą lukę: specjalną rezerwację, brakującą wartość analizy, lub proces, którego istniejące oprogramowanie nie odzwierciedla. Staje się problematyczna, gdy zmienia się w drugą księgę zapasów.

Wtedy przyjęcia są księgowane w systemie, a pobrania notowane w tabeli. Albo korekta następuje tylko tam, gdzie akurat pomaga dla kolejnego zamówienia. Nikt później nie może wiarygodnie wyjaśnić, która wartość obowiązuje.

Nie każda tabela musi zostać zlikwidowana. Kalkulacja do planowania lub analiz może pozostać sensowna. Jednak procesy zmieniające zapas powinny mieć dokładnie jeden wiodący system. Korekty potrzebują kodu przyczyny, znacznika czasu, i idealnie osoby, którą można do nich przypisać. To nie biurokracja dla samej biurokracji, lecz warunek wiarygodnych analiz przyczyn.

6. Błędy liczenia i niewłaściwe metody inwentaryzacji

Nawet poprawne procesy nie chronią przed błędami ludzkimi. Artykuły są liczone podwójnie, palety pomijane, otwarte kartony szacowane, lub lokalizacje magazynowe nie są blokowane podczas liczenia. Roczna pełna inwentaryzacja odkrywa te problemy późno i pod dużą presją.

Dla wielu firm inwentaryzacja ciągła jest rozsądniejszą alternatywą. Szybko rotujące lub cenne artykuły są sprawdzane częściej, stabilne artykuły klasy C rzadziej. Ważne jest nie produkowanie jak największej liczby liczeń, lecz sprawdzanie odchyleń na bieżąco w stosunku do ostatnich ruchów. Jeśli artykuł z różnicą zostaje po prostu skorygowany bez dokumentowania przyczyny, wzorzec pozostaje niewidoczny.

Kontrola krzyżowa jest szczególnie sensowna przy wysokich wartościach, numerach seryjnych, lub partiach. Dla śrub w magazynie materiałów eksploatacyjnych może być ekonomicznie przesadna. Głębokość kontroli powinna odpowiadać ryzyku.

7. Niejasne odpowiedzialności między zmianami i obszarami

Błędy w zapasach powstają często przy przekazaniach. Zmiana poranna przygotowuje towar, zmiana popołudniowa go wysyła. Przyjęcie towaru akceptuje dostawę, dyspozycja równolegle zmienia zamówienie. Każdy pojedynczy krok może być identyfikowalny, ale nikt nie posiada całego procesu.

Dlatego zdefiniuj nie tylko role, ale punkty przekazania: kto potwierdza przyjęcie towaru? Kiedy zmienia się odpowiedzialność za skompletowany towar? Kto sprawdza otwarte wyjątki na koniec zmiany? Wspólna tablica cyfrowa lub prosta lista wyjątków jest często skuteczniejsza niż dodatkowe spotkania.

System powinien uwidaczniać otwarte procesy, zamiast zmuszać pracowników do pamiętania. Na przykład dostawy bez kontroli ilości, kompletacje bez zakończenia wysyłki, lub zwroty bez decyzji o jakości muszą rzucać się w oczy, zanim staną się cichymi błędami zapasów.

8. Słaba integracja systemowa i brakujące reguły kontroli

Jeśli sklep, zarządzanie zamówieniami, magazyn, i księgowość wymieniają dane z opóźnieniem czasowym lub przez plik, mogą powstać podwójne lub brakujące księgowania. Import uruchamia się dwa razy. Interfejs zawodzi po cichu. Zamówienie jest zmieniane po tym, jak jego status wysyłki został już przesłany.

Rozwiązanie niekoniecznie jest pełną wymianą. Często potrzebne są jasno zdefiniowane interfejsy, jednoznaczne numery dokumentów, i kontrole techniczne. Księgowanie magazynowe powinno identyfikowalnie zapisywać, kiedy nastąpiło, z jakiego procesu pochodzi, i czy zostało później anulowane. Krytyczne procesy potrzebują komunikatów o błędach i kolejek, a nie tylko cichego wpisu w pliku dziennika.

Przy indywidualnie opracowanych systemach logistycznych takie reguły można celowo dostosować do działalności: żadnej ujemnej ilości bez zatwierdzenia, żadnego potwierdzenia wysyłki bez pozycji wysyłkowej, żadnego podwójnego przetwarzania tej samej zewnętrznej referencji. Najlepsza reguła nie jest tu najsurowsza, lecz ta, która zatrzymuje prawdziwe błędy, nie blokując działalności przy normalnych wyjątkach.

Systematyczne sprawdzanie różnic w zapasach

Nie zaczynaj od ogólnej korekty. Wybierz dziesięć artykułów z najczęstszymi lub najdroższymi różnicami, i prześledź ich ostatni ruch wstecz: przyjęcie towaru, przesunięcie, pobranie, zwrot, liczenie, i ewentualną ręczną korektę. Jeśli przypadki skupiają się w jednej lokalizacji, jednej zmianie, lub jednym typie ruchu, to solidny punkt wyjścia.

Następnie każdy środek powinien być mierzalny. Jeśli wprowadzane są nowe skany kodów kreskowych, obserwuj nie tylko liczbę skanów, lecz wskaźnik różnic na grupę artykułów. Jeśli dodawany jest nowy status przygotowania, sprawdzaj codziennie otwarte przygotowania. Dobre procesy nie tworzą pozornej precyzji. Wcześnie czynią wyjątki widocznymi i identyfikowalnymi.

Sensowny kolejny krok jest często mały: zdefiniować punkt przekazania, uporządkować lokalizację magazynową, lub technicznie zabezpieczyć powtarzającą się ręczną korektę. Wiarygodne zapasy nie powstają z większej ilości oprogramowania na podejrzenie, lecz z procesów, które są nadal poprawnie wykonalne w chaotyczny wtorek o 16:45.

Permalink →

Jak prawidłowo podejść do automatyzacji procesów w MŚP

Jak prawidłowo podejść do automatyzacji procesów w MŚP

Brakuje listu przewozowego, ponieważ dane wciąż widnieją na karteczce. Przyjęcie towaru jest rejestrowane podwójnie, ponieważ magazyn i biuro pracują na różnych tabelach. Zatwierdzenie się opóźnia, ponieważ odpowiedzialna osoba akurat nie odbiera telefonu. Takie tarcie rzadko kosztuje dużo pieniędzy od razu. Ale w ciągu tygodni sumują się zapytania, czas poszukiwań, korekty błędów, i niepotrzebne oczekiwanie. Właśnie tam ma sens automatyzacja procesów dla MŚP.

Nie chodzi o zastąpienie jak największej liczby czynności oprogramowaniem. Dobra automatyzacja czyni procesy identyfikowalnymi, redukuje unikalne przekazania, i daje pracownikom czas na decyzje wymagające doświadczenia. Jest to szczególnie decydujące w małych i średnich przedsiębiorstwach: zespoły są blisko codziennej działalności. Gdy proces się zacina, często cała zmiana zauważa to natychmiast.

Nie automatyzuj każdego procesu

Najczęstszym błędem jest zaczynanie od najbardziej widocznej irytacji. Może denerwuje plik Excel, może potrzebny jest nowy pulpit nawigacyjny. Obydwie rzeczy mogą być uzasadnione. Ale zdigitalizowany chaos pozostaje chaosem - tylko szybszym i z większą ilością danych.

Przed decyzją techniczną proces powinien być najpierw opisany tak, jak faktycznie przebiega. Nie tak, jak powinien być zapisany w podręczniku. Kto uruchamia proces? Jakie informacje są potrzebne? Gdzie coś jest przenoszone ręcznie? Kto decyduje w przypadku wyjątków? I po czym zespół rozpoznaje, że proces jest zakończony?

Właśnie w magazynie lub w obsłudze zamówień krytyczne miejsca często znajdują się między systemami: zamówienie przychodzi e-mailem, jest kopiowane do tabeli, uzgadniane telefonicznie, a później wprowadzane do oprogramowania wysyłkowego. Każde przekazanie zwiększa prawdopodobieństwo, że ilości, terminy, lub adresy będą się różnić.

Automatyzacja opłaca się szczególnie, gdy proces występuje często, ma jasne zasady, i błędy powodują odczuwalne konsekwencje. Może to być przyjęcie towaru, tworzenie listów przewozowych, przypisywanie ruchów magazynowych, lub przekazywanie zatwierdzonych zamówień do wysyłki. Rzadkie szczególne przypadki z wieloma decyzjami uznaniowymi natomiast często pozostają lepiej obsługiwane ręcznie - przynajmniej na początku.

Automatyzacja procesów dla MŚP zaczyna się od priorytetów

Nie każda niepotrzebna czynność zasługuje od razu na projekt. Proste ustalenie priorytetów wprowadza jasność. Oceń poszczególne procesy według częstotliwości, czasu przetwarzania, kosztów błędów, i zależności. Proces, który zachodzi pięćdziesiąt razy dziennie i za każdym razem oszczędza tylko dwie minuty, może być bardziej ekonomiczny niż skomplikowany proces miesięczny.

Pytanie o skutek błędu jest co najmniej równie ważne. Błędnie wydrukowany dokument wewnętrzny jest irytujący. Błędne przypisanie partii, utracony adres dostawy, lub nieudokumentowane przyjęcie towaru może wywołać reklamacje, pracę poszukiwawczą, i różnice w zapasach. Tam automatyzacja generuje nie tylko tempo, ale i niezawodność.

Sensowny pierwszy krok jest zwykle na tyle mały, by być weryfikowalnym w ciągu kilku tygodni. Na przykład pracownik może rejestrować towary za pomocą kodu kreskowego, system sprawdza artykuł i ilość, aktualizuje zapas w centralnej bazie danych, i w razie potrzeby bezpośrednio generuje dowód przyjęcia magazynowego. Zespół nie musi wtedy zgadywać, która wersja tabeli jest aktualna.

Jasny stan docelowy zamiast listy funkcji

Wiele projektów zaczyna się od długiej listy pożądanych funkcji. Lepszy jest konkretny obraz operacyjny: co powinno być widoczne na końcu procesu bez konieczności pytania? Przy wysyłce mogłoby to oznaczać, że zamówienie po zatwierdzeniu automatycznie otrzymuje listę kompletacyjną, sprawdzany jest adres wysyłki, i może zostać wygenerowana etykieta. Wyjątki trafiają widocznie na listę wyjaśnień, zamiast do niemożliwej do ogarnięcia skrzynki e-mail.

Ten obraz docelowy wymusza użyteczne decyzje. Czy każde zamówienie musi być przetwarzane w pełni automatycznie? Czy też zamówienia powyżej określonej wartości towaru, z odbiegającym adresem dostawy, lub z brakującym zapasem powinny być świadomie przedkładane do weryfikacji? Automatyzacja nie potrzebuje stuprocentowego przetwarzania w ciemno, by przynieść dużą korzyść.

Odpowiednia technika zależy od procesu

Nie istnieje standardowa ścieżka techniczna dla każdego MŚP. Rozwiązanie tabelaryczne może nadal być rozsądne dla przejrzystej analizy. Jest szybko dostosowywalne, znajome, i powoduje niewielki wysiłek wdrożeniowy. Gdy tylko jednak kilka osób pracuje jednocześnie, księgowania muszą być identyfikowalne, lub dane są wymieniane z innymi systemami, napotyka jednak swoje granice.

Wtedy często sensowniejsza jest smukła, specyficzna dla przepływu pracy aplikacja niż przewymiarowany pakiet enterprise. Może ona odzwierciedlić dokładnie te kroki, które są potrzebne w działalności: zarejestrować zamówienie, sprawdzić zapas, przesunąć towar, wygenerować dokument, zaksięgować wysyłkę, i zgłosić zwrotnie status. Nie więcej, ale też nie mniej.

Technicznie mniej liczy się to, czy system reklamuje się najnowszym modnym hasłem. Decydujące są solidne fundamenty: czysto zamodelowana baza danych, identyfikowalne uprawnienia, dzienniki dla istotnych zmian, niezawodne interfejsy, i udokumentowane wdrożenia. Aplikacja oparta na PHP 8.4, nowoczesnym JavaScript, i MySQL 8 może być bardzo dobrze utrzymywalna długoterminowo, jeśli architektura i eksploatacja są przemyślane od początku.

Także integracje zasługują na uwagę. Automatyczna wymiana danych ze sklepem, ERP, dostawcą wysyłki, lub księgowością oszczędza czas tylko wtedy, gdy błędy są obsługiwane widocznie. Co dzieje się przy nieprawidłowym adresie? Czy nieudany wydruk etykiety jest ponawiany? Czy zespół może rozpoznać, które dane zostały przesłane, a które jeszcze brakują? Ciche błędy są bardziej niebezpieczne niż jasno oznaczony przypadek wyjątkowy.

Wdrożenie podczas bieżącej działalności

Nowy system musi dostosować się do zmian zmiany, terminów dostaw, i istniejących rutyn pracy. Dlatego stopniowe wdrożenie jest zwykle bezpieczniejsze niż sztywny termin dla wszystkich obszarów. Zacznij od ograniczonego procesu, grupy produktów, lub obszaru magazynowego. To zmniejsza ryzyko i tworzy prawdziwą informację zwrotną z codzienności.

Praca równoległa nie jest przy tym oznaką niepewności, lecz kontrolowanym testem. Przez ograniczony czas można porównać starą i nową rejestrację. Różnice pokazują nie tylko błędy oprogramowania, ale często również zasady, które dotychczas istniały tylko w głowach poszczególnych pracowników. Te zasady powinny widocznie należeć do procesu - nie trwale do osobistego doświadczenia.

Pracownicy nie powinni być konfrontowani z nowym procesem dopiero podczas szkolenia. Kto wykonuje proces codziennie, wcześnie rozpoznaje skróty, przypadki szczególne, i niepraktyczne maski. Dobre oprogramowanie szanuje tę wiedzę, nie wbudowując bez zmian każdego historycznie wyrosłego wyjątku. Właściwe pytanie brzmi: który wyjątek chroni ważny przypadek biznesowy, a który jest tylko obejściem dla starego problemu?

Uczynić mierzalnym, czy wysiłek się opłaca

Przed startem powinny zostać ustalone dwa lub trzy wskaźniki. Mogą to być czas realizacji na zamówienie, liczba ręcznych korekt, różnice w zapasach, lub czas do wysyłki. Bez wartości wyjściowej każda późniejsza ocena staje się przeczuciem.

Nie każdy efekt pokazuje się natychmiast w złotówkach. Gdy zespół magazynowy zawsze wie, gdzie znajduje się towar, spada liczba przerw. Gdy dokumenty dostawy powstają z tych samych danych co zamówienie, spada ryzyko sprzecznych informacji. A gdy odpowiedzialności są widoczne w systemie, proces mniej zależy od poszczególnych osób.

Automatyzacja wymaga utrzymania i granic

Zautomatyzowany proces nie jest projektem, który zamraża się po uruchomieniu. Struktury artykułów się zmieniają, klienci wymagają nowych dokumentów, dostawcy wysyłki dostosowują interfejsy. Dlatego odpowiedzialności, aktualizacje, kopie zapasowe, i uregulowane obchodzenie się z uprawnieniami należą do właściwego systemu.

Szczególnie w przypadku aplikacji z danymi klientów, zamówień, lub zapasów powinno być jasne, kto otrzymuje dostęp i dlaczego. Role muszą pasować do codziennej pracy: zespół magazynowy potrzebuje innych funkcji niż księgowość czy sprzedaż. Rejestrowane zmiany, bezpieczne przepływy logowania, i testowane przywracania wyglądają niespektakularnie. W przypadku awarii to właśnie te szczegóły decydują, czy działalność może kontynuować pracę.

Także testy są częścią bezpieczeństwa operacyjnego. Powtarzające się kontrole dla wprowadzania zamówień, księgowania zapasów, generowania dokumentów, i zarządzania uprawnieniami zapobiegają temu, by dostosowanie w jednym miejscu uszkodziło działający proces w innym miejscu. Przy krytycznych aplikacjach webowych lub desktopowych kontrolowane, środowisko testowe self-hosted może być sensowne, jeśli zrzuty ekranu, dane testowe, i procesy wewnętrzne nie powinny trafiać do zewnętrznych usług chmurowych.

softify.pro towarzyszy takim przedsięwzięciom z prostą zasadą: najpierw zrozumieć rzeczywisty proces, potem zbudować najmniejsze wykonalne rozwiązanie. Czasami jest to aplikacja szyta na miarę. Czasami wystarczy uporządkować istniejącą tabelę czyściej i zautomatyzować jeden pojedynczy krok przekazania.

Najlepszym następnym krokiem nie jest więc porównanie oprogramowania, lecz przejście przez rzeczywisty proces - od wyzwalacza do zakończenia. Weź zamówienie, przyjęcie towaru, lub reklamację i śledź je z zaangażowanymi osobami. Tam, gdzie informacje są wprowadzane ponownie, nikt nie zna statusu, lub decyzje czekają niepotrzebnie, leży zwykle najsensowniejsze podejście do automatyzacji.

Permalink →

Testowanie aplikacji Windows: praktyczny plan

Testowanie aplikacji Windows: praktyczny plan

Aplikacja Windows może wyglądać schludnie w trybie demo i mimo to spowalniać działalność w poniedziałkowy poranek. Niezapisany list przewozowy, użytkownik zablokowany po trzech nieudanych próbach, lub okno dialogowe drukowania, które po aktualizacji reaguje inaczej, to nie są błędy kosmetyczne. Kto chce wiedzieć, jak testować aplikacje Windows, nie powinien więc zaczynać od pojedynczych przycisków, lecz od procesów, które kosztują pracę, pieniądze, lub identyfikowalność.

Właśnie w magazynie, warsztacie, dyspozycji, i administracji wiele krytycznych procesów przebiega przez oprogramowanie desktopowe rozwijane przez lata. Nie liczy się tam, czy przypadek testowy jest imponująco sformułowany. Decydujące jest to, czy pracownicy mogą niezawodnie wykonywać swoje zadania w realistycznych warunkach - także przy niekompletnych danych, zmieniających się uprawnieniach, wolnych sieciach, i nieplanowanych przerwach.

Testowanie aplikacji Windows zaczyna się od krytycznych procesów

Nie każda funkcja zasługuje na taki sam wysiłek testowy. Rzadko używany eksport z ręczną obróbką następczą należy ocenić inaczej niż księgowanie przyjęcia towaru, tworzenie etykiety, lub codzienne uzgadnianie zamówień. Zacznij więc od prostego pytania: co konkretnie się dzieje, jeśli ten proces zawiedzie?

Wysoki priorytet mają procesy z bezpośrednim wpływem na zapasy, dostawę, fakturowanie, bezpieczeństwo, lub komunikację z klientem. Należą do nich na przykład logowanie i sprawdzanie uprawnień, tworzenie i zmiana danych podstawowych, księgowania transakcji, drukowanie dokumentów, interfejsy do usług ERP lub wysyłkowych, oraz wznowienia po błędzie. Nawet funkcje używane tylko przez małą grupę osób mogą być krytyczne, jeśli blokują zamknięcie miesiąca lub zwolnienie towaru.

Z tych procesów nie powstają abstrakcyjne listy testów, lecz identyfikowalne kroki robocze. Test przyjęcia towaru mógłby na przykład zacząć się od istniejącego zamówienia, zarejestrować dostawę częściową, zgłosić odbiegającą ilość, przypisać lokalizację magazynową, a następnie sprawdzić, czy zapas, dziennik księgowań, i wydrukowany dokument się zgadzają. W ten sposób testujesz rzeczywisty efekt oprogramowania, nie tylko pojedyncze pola wprowadzania.

Zbuduj bazę testową odzwierciedlającą działalność

Wiele błędów staje się widocznych dopiero wtedy, gdy środowisko testowe zbliża się do rzeczywistości. Aplikacja często zachowuje się inaczej z pustym najemcą testowym niż z kilkuletnimi danymi ruchowymi, zablokowanymi artykułami, brakującymi informacjami obowiązkowymi, lub już otwartymi transakcjami.

Dlatego świadomie przygotuj dane testowe. Niekoniecznie potrzebujesz pełnej kopii produkcji. Sensowniejszy jest kontrolowany zbiór danych z typowymi, granicznymi, i celowo błędnymi przypadkami: artykuły z różnymi jednostkami miary, klienci ze specjalnymi warunkami, zamówienia z dostawami częściowymi, użytkownicy z różnymi rolami, i transakcje już w toku przetwarzania. Dane osobowe powinny zostać zanonimizowane lub zastąpione realistycznymi danymi przykładowymi.

Do bazy testowej należy też środowisko techniczne. Udokumentuj wersję Windows, rozdzielczość, skalowanie, zainstalowane drukarki, dyski sieciowe, wersję bazy danych, podłączone usługi, i uprawnienia. Brzmi to sucho, ale oszczędza czas później. Jeśli błąd występuje tylko na stanowiskach ze skalowaniem 125% lub z określonym sterownikiem drukarki, musi to być odtwarzalne.

Nie sprawdzaj tylko przypadku idealnego

Przypadek idealny dowodzi przede wszystkim, że aplikacja została zbudowana dla oczekiwanej ścieżki. W działalności trudne sytuacje powstają obok niej. Co się dzieje, jeśli użytkownik pozostawi pole obowiązkowe puste, wyzwoli to samo księgowanie dwukrotnie, lub straci połączenie podczas zapisywania? Czy transakcja pozostaje spójna? Czy osoba otrzymuje zrozumiały komunikat? Czy może bezpiecznie kontynuować pracę?

W aplikacjach Windows szczególnie istotne są też obsługa i stan. Okna dialogowe mogą pojawiać się w tle, skróty klawiszowe mogą się nakładać, okna wyboru plików mogą blokować przebieg. Sprawdź, czy fokus, komunikaty o błędach, i blokady są jednoznaczne. Wyjątek techniczny bez wskazówki działania nie pomoże kierownikowi zmiany.

Stosuj testy manualne tam, gdzie potrzebny jest osąd

Testy manualne nie są oznaką niewystarczającej dojrzałości. Są niezbędne, gdy powstaje nowy proces, interfejs jest przebudowywany, lub wiedza fachowa decyduje o jakości. Doświadczony kierownik magazynu rozpozna szybciej niż skrypt, czy maska jest zrozumiała pod dużą presją czasu, lub czy ostrzeżenie pojawia się zbyt późno.

Testowanie manualne staje się jednak kosztowne i niewiarygodne, gdy te same stabilne procesy są powtarzane przed każdą wersją. Wtedy wydanie zależy od dostępnych osób, pamięci, i rozproszonych notatek. Właściwy moment przejścia do automatyzacji leży zazwyczaj tam, gdzie proces jest wykonywany często, może spowodować duże szkody, i ma jasne oczekiwane wyniki.

Dobry manualny przypadek testowy opisuje sytuację wyjściową, kroki, oczekiwany wynik, i potrzebne dane. Przy błędzie dodaj zrzut ekranu, znacznik czasu, wersję aplikacji i buildu, oraz dokładną czynność. "Drukowanie nie działa" nie jest użytecznym opisem błędu. "Po zmianie adresu dostawy okno dialogowe drukowania pozostaje otwarte, zamówienie 4711 nie otrzymuje PDF-a, i nie pojawia się żaden komunikat" jest.

Automatyczne testy regresyjne dla powtarzających się ryzyk

Automatyzacja nie sprawdza, czy oprogramowanie jest zasadniczo dobre. Sprawdza, czy wcześniej działające, zdefiniowane procesy nadal działają po zmianie. Jest to szczególnie cenne dla oprogramowania Windows, którego interfejsy, logika bazy danych, i zewnętrzne interfejsy są rozwijane przez lata.

Zacznij od małego. Wybierz najpierw pięć do dziesięciu krytycznych dla biznesu procesów, które powinny być sprawdzane przy każdym wydaniu. Mogą do nich należeć logowanie z przepływem blokady konta, wprowadzanie zamówień, księgowanie magazynowe, drukowanie PDF lub etykiet, zmiana roli, i centralny import. Dopiero gdy te testy działają niezawodnie, opłaca się rozszerzenie na przypadki specjalne.

W przypadku aplikacji desktopowych zautomatyzowane testy często sterują widocznymi elementami interfejsu: oknami, polami wprowadzania, tabelami, przyciskami, i oknami dialogowymi. To działa, ale jest bardziej wrażliwe niż czysty test interfejsu. Małe zmiany układu, wolniejsze komputery, lub niejednoznacznie nazwane elementy mogą przerwać testy. Dlatego programiści, dział biznesowy, i odpowiedzialni za testy powinni wspólnie ustalić, które elementy są stabilnie adresowalne, a które kroki sprawdzające lepiej zabezpieczyć przez bazę danych, dziennik, lub interfejs.

Sensowny test sprawdza ponadto nie tylko to, że przycisk dało się kliknąć. Kontroluje skutek merytoryczny: czy księgowanie zostało zapisane? Czy zapas jest poprawny? Czy wygenerowano dokument? Czy nie utworzono zduplikowanego rekordu? Widoczna interakcja i weryfikowalny wynik idą w parze.

Dowody są częścią wyniku testu

Sam zielony status rzadko wystarcza w krytycznych aplikacjach. Gdy test zawodzi, zespoły szybko potrzebują odpowiedzi na trzy pytania: jaka była sytuacja wyjściowa? Na którym kroku proces zawiódł? Co pokazywała aplikacja w tym momencie?

Zrzuty ekranu, dzienniki wykonania, i ewentualnie nagrania ekranu czynią błędy przedmiotem dyskusji. Znacznie skracają przekazanie między działalnością, QA, i rozwojem. Dla firm regulowanych lub świadomych bezpieczeństwa stanowią ponadto solidną podstawę do śledzenia zatwierdzeń i odchyleń.

Miejsce przechowywania nie jest przy tym sprawą poboczną. Przebiegi testowe mogą zawierać wewnętrzne dane klientów, cenniki, informacje o zamówieniach, lub widoki ekranu. Kto automatycznie testuje wrażliwe aplikacje Windows, powinien wyjaśnić, czy te dane mogą opuścić własną infrastrukturę. Środowisko self-hosted takie jak COCO może być tu sensowne, ponieważ wykonanie testów, dowody, i ocena pozostają pod własną kontrolą. Czy jest to konieczne, zależy od wymagań ochrony danych, sytuacji umownej, i potrzeby ochrony - nie każdy zespół potrzebuje do tego tej samej architektury.

Wbuduj testowanie w proces wydawniczy

Najlepszy katalog testów traci wartość, jeśli jest używany dopiero po chaotycznym wdrożeniu produkcyjnym. Zdefiniuj stały moment: zautomatyzowane regresje kluczowe uruchamiane są przed każdym wydaniem, ręczna akceptacja sprawdza nowe lub zmienione procesy, a znane ograniczenia są otwarcie dokumentowane.

Nie każdy nieudany test musi zatrzymać wydanie. Błąd w rzadko używanym widoku administracyjnym może być akceptowalny, jeśli istnieje bezpieczne obejście i dotknięty obszar jest jasno poinformowany. Błąd, który błędnie księguje zapasy lub niezauważenie blokuje użytkowników, należy traktować inaczej. Ta decyzja powinna być podejmowana na podstawie wpływu na biznes, a nie samej liczby czerwonych testów.

Utrzymuj testy razem z aplikacją. Gdy proces świadomie się zmienia, aktualizuj przypadek testowy, dane testowe, i oczekiwany wynik razem z wymaganiem. Przestarzałe testy generują szum i w końcu są ignorowane. Kilka wiarygodnych sprawdzeń jest cenniejszych niż setki zautomatyzowanych procesów, których wyników nikt już nie traktuje poważnie.

Ostatecznie nie chodzi o symulowanie każdego możliwego do wyobrażenia wejścia. Chodzi o ochronę pracy, która musi ponownie zadziałać następnego ranka. Zacznij od jednego krytycznego procesu, uczyń jego wynik możliwym do udowodnienia, i buduj dalej stamtąd.

Permalink →

Secure test data management bez utraty kontroli

Secure test data management bez utraty kontroli

Nieudany przebieg testu jest irytujący. Udany przebieg testu z prawdziwymi danymi klientów w niewystarczająco zabezpieczonym środowisku może okazać się znacznie droższy. Secure test data management nie rozwiązuje tej sprzeczności jednym narzędziem, lecz jasnymi zasadami dotyczącymi danych, dostępów, środowisk testowych, i dowodów. Dla zespołów, które automatycznie testują aplikacje webowe lub Windows, jest to więc część pracy nad jakością - nie tylko zgodności.

Dlaczego dane testowe stają się problemem bezpieczeństwa

Dane produkcyjne są kuszące dla testów, ponieważ zawierają rzeczywiste przypadki brzegowe: niekompletne adresy, nietypowe kombinacje zamówień, historyczne reguły cenowe, lub błędne dane wejściowe. Ale właśnie te dane często zawierają imiona i nazwiska, dane kontaktowe, informacje umowne, numery personalne, dane bankowe, lub wewnętrzną logikę biznesową.

Ryzyko rzadko powstaje przez pojedynczy rażący błąd. Zwykle rośnie krok po kroku: eksport bazy danych zostaje utworzony na potrzeby testu, umieszczony we wspólnym katalogu, i później skopiowany do innego środowiska. Zewnętrzna usługa otrzymuje zrzuty ekranu do analizy błędów. Konto testowe zachowuje szerokie uprawnienia, ponieważ czyszczenie mogłoby zakłócić kolejny przebieg. Po kilku miesiącach nikt już wiarygodnie nie wie, jakie dane znajdują się gdzie.

W małych i średnich przedsiębiorstwach problem często się nasila z powodu ograniczonych zasobów. Zespół chce dotrzymać terminu wydania, a nie prowadzić własny projekt ochrony danych. Odpowiedzialność jednak pozostaje. Kto wykorzystuje dane do zapewnienia jakości, musi być w stanie prześledzić, jakie dane są przetwarzane, kto ma do nich dostęp, i kiedy zostają ponownie usunięte.

Secure test data management zaczyna się przed przypadkiem testowym

Decydujące pytanie nie brzmi: "Jak chronimy zbiór danych testowych?" Brzmi ono: "Jakiej informacji faktycznie potrzebuje ten test?" Wiele testów regresyjnych nie wymaga w ogóle rzeczywistych odniesień osobowych. Proces wysyłki, na przykład, musi sprawdzić, czy adresy dostawy, wagi, strefy, etykiety, i zmiany statusu są prawidłowo przetwarzane. Wystarczą do tego syntetyczni klienci, wiarygodne dane podstawowe artykułów, i świadomie zdefiniowane przypadki brzegowe.

To rozróżnienie prowadzi do praktycznej klasyfikacji danych. Nie każde środowisko testowe potrzebuje tej samej głębokości danych. Dla testów jednostkowych i integracyjnych często wystarczają w pełni sztuczne zbiory danych. Dla testów end-to-end sensowne mogą być kopie spseudonimizowane, jeśli rzeczywiste wzorce danych są merytorycznie istotne. Dane zbliżone do produkcyjnych powinny być wyjątkiem - z udokumentowanym celem, ograniczonym dostępem, i stałym okresem ważności.

Ważna jest przy tym jakość danych zastępczych. Losowe, fikcyjne dane niewiele pomagają, jeśli nie odzwierciedlają realistycznych zależności. Zbiór danych testowych dla aplikacji magazynowej musi na przykład zawierać warianty artykułów, lokalizacje magazynowe, zablokowane zapasy, dostawy częściowe, i zwroty w spójnej kombinacji. Dobre dane testowe chronią nie tylko dane osobowe. Znajdują błędy, które nigdy nie byłyby widoczne przy pustych tabelach i przykładowym kliencie "Jan Kowalski".

Syntetyzować, maskować, czy minimalizować?

Dane syntetyczne są najbezpieczniejszym wyborem, gdy reguły biznesowe można czysto zamodelować. Powstają celowo z wymagań testowych i nie zawierają żadnej kopii rzeczywistych osób ani transakcji. Wysiłek leży w utrzymaniu: jeśli zmienia się model danych lub pojawiają się nowe reguły procesu, generatory i fixtures muszą rosnąć wraz z nimi.

Maskowanie nadaje się, gdy zachowanie aplikacji silnie zależy od struktur produkcyjnych. Wtedy wrażliwe pola są zastępowane lub zmieniane, podczas gdy relacje są zachowywane. Z imion i nazwisk powstają wiarygodne, ale fikcyjne imiona i nazwiska; z adresów e-mail powstają niedostarczalne adresy testowe; z numerów kont powstają wartości o poprawnym formacie bez rzeczywistego powiązania. Maskowanie jest solidne tylko wtedy, gdy uwzględnia się też wnioski pośrednie. Kombinacja rzadkiej lokalizacji, daty urodzenia, i cechy umownej nadal może uczynić osobę rozpoznawalną.

Minimalizacja danych jest często niedocenianą trzecią drogą. Zamiast kopiować pełny eksport, udostępniany jest tylko niezbędny wycinek. To zmniejsza powierzchnię ataku, zapotrzebowanie na przechowywanie, i wysiłek związany z czyszczeniem. Do testowania logiki rabatowej nikt nie potrzebuje całej rocznej historii klienta.

Dostępy i środowiska muszą odpowiadać ryzyku

Chroniony zbiór danych traci swoją wartość, jeśli znajduje się w swobodnie dostępnym środowisku testowym. Systemy testowe potrzebują więc własnych granic bezpieczeństwa - oddzielnych baz danych, własnych kont usługowych, jasno zdefiniowanych dostępów sieciowych, i braku cichego połączenia z produkcją.

Prawa dostępu powinny opierać się na rolach, nie na współdzielonych kontach. Deweloperzy mogą potrzebować innych praw niż QA, wsparcie, lub zewnętrzni dostawcy usług. Dostęp administratora jest czasem konieczny, ale powinien być ograniczony czasowo, rejestrowany, i powiązany z identyfikowalną zgodą. Także dla kont testowych obowiązują sensowne zasady haseł, uwierzytelnianie wieloskładnikowe tam, gdzie jest dostępne, i przepływy blokady konta przy powtarzających się nieudanych próbach.

Zautomatyzowane testy niosą ze sobą kolejny szczególny przypadek: generują dowody. Zrzuty ekranu, nagrania ekranu, dzienniki, i komunikaty o błędach mogą zawierać wrażliwą treść, nawet gdy baza danych została zamaskowana. Zrzut ekranu maski klienta, ślad przeglądarki z informacjami o sesji, lub dziennik z payloadem API należą do tego samego rozważania ochronnego co baza danych testowych.

Dlatego artefakty testowe potrzebują zasad przechowywania. Nie każdy udany przebieg musi być przechowywany na stałe. Dla krytycznych zatwierdzeń sensowny może być identyfikowalny dowód, na przykład ze znacznikiem czasu, numerem build, wersją testu, i wynikiem. Nieudane przebiegi często wymagają dłuższego okna analizy. Po tym artefakty powinny być automatycznie usuwane. To, co już nie istnieje, nie może zostać przypadkowo udostępnione lub skompromitowane.

Automatyzacja bez niekontrolowanych wycieków danych

Automatyzacja testów wspomagana AI może znacznie przyspieszyć testy, szczególnie w przypadku rozbudowanych aplikacji webowych i Windows. Ale zmienia pytanie o bezpieczeństwo: dokąd trafiają zrzuty ekranu, dane wejściowe, opisy błędów, i ruch aplikacji? Kto je przetwarza? Jak długo tam pozostają?

Dla zespołów świadomych bezpieczeństwa wykonanie self-hosted jest często lepszą architekturą. System taki jak COCO może działać w ramach własnej lub jasno wydzielonej infrastruktury, wykonując kroki testowe, przechowując dowody, i generując zrozumiałe oceny. Nie jest to obowiązkowe w każdej sytuacji. Dla publicznej strony marketingowej z czysto syntetycznymi wartościami formularzy zewnętrzna usługa może być uzasadniona. Przy wewnętrznych aplikacjach biznesowych, portalach klientów, lub oprogramowaniu z procesami osobowymi lokalna kontrola stanowi jednak konkretną przewagę.

Self-hosting nie jest przepustką bez ograniczeń. Eksploatacja wymaga aktualizacji, koncepcji kopii zapasowych, dzienników dostępu, i odpowiedzialnej instancji. W zamian suwerenność danych pozostaje tam, gdzie należy. Właściwe podejście zależy od potrzeby ochrony, istniejących zdolności operacyjnych, i rodzaju testowanej aplikacji - nie od aktualnego szumu wokół konkretnego narzędzia testowego.

Jak zasady stają się działającym procesem

Praktyczny proces nie musi blokować wydania. Zacznij od mapy danych: jakie środowiska testowe istnieją, jakie rodzaje danych się tam znajdują, i jakie systemy generują dodatkowe artefakty? Ta inwentaryzacja zwykle ujawnia już stare eksporty, zapomniane systemy staging, i niejasne odpowiedzialności.

Następnie opłaca się prosta macierz decyzyjna dla każdej klasy testów. Określa ona, czy wystarczą dane syntetyczne, czy wymagane jest maskowanie, czy potrzebny jest jasno uzasadniony wyciąg produkcyjny. Uzupełniają ją właściciele, terminy usunięcia, i role dostępu. Nie musi to być przeładowany zbiór reguł. Krótka, faktycznie przestrzegana wytyczna jest lepsza niż dokument bezpieczeństwa, którego nikt nie znajduje podczas awarii.

Technicznie udostępnianie danych i czyszczenie należą do potoku testowego. Przebieg tworzy potrzebne zbiory danych w sposób odtwarzalny, używa unikalnych oznaczeń, i następnie usuwa je ponownie. To zapobiega wypełnianiu się środowisk testowych danymi resztkowymi i coraz mniejszej wiarygodności wyników z każdym sprintem. Dla procesów krytycznych zespoły powinny dodatkowo sprawdzić, czy dostępy do danych i dowody testowe muszą być rejestrowane w sposób zgodny z audytem.

Bezpieczeństwo, które przyspiesza testowanie

Secure test data management jest często postrzegane jako dodatkowe obciążenie kontrolne. Źle wdrożone, rzeczywiście może nim być. Dobrze wdrożone tworzy jednak niezawodne, powtarzalne warunki początkowe. Zespoły tracą mniej czasu na szukanie użytecznego eksportu danych, unikają zepsutych testów spowodowanych nieoczyszczonymi starymi danymi, i mogą lepiej uzasadniać zatwierdzenia.

Najbardziej sensowny pierwszy krok rzadko jest wielkim projektem platformowym. Weź proces testowy o najwyższym ryzyku lub największym tarciu - na przykład zatwierdzenie wewnętrznej aplikacji zamówień - i uczyń tam widocznymi źródło danych, dostępy, artefakty, i usuwanie. Z tej konkretnej pracy wyrasta rutyna bezpieczeństwa, która nie czyni testów bardziej uciążliwymi, lecz bardziej wiarygodnymi.

Permalink →