softify.pro
Laden …
Diensten Over ons COCO – onze AI-server Portfolio Insiders Case Studies Wetenswaardigheden Contact Aanmelden

NEXT-GEN SOFTWARE AESTHETIC

Pure fluidity meets ultimate performance.

De nieuwe visuele identiteit voor moderne digitale workflows.

softify.pro — De nieuwe visuele identiteit voor moderne digitale workflows.

Scroll om te verkennen ↓

Software gebouwd zoals moderne bedrijven écht werken

softify.pro is een softwarestudio gebouwd rond één idee: technologie zou net zo vloeiend moeten bewegen als de bedrijven die zij ondersteunt. Wij werken op het snijvlak van moderne webontwikkeling, procesautomatisering en toegepaste kunstmatige intelligentie — drie disciplines die zelden onder één dak samenkomen, maar dat steeds vaker wel moeten. Onze klanten variëren van kleine werkplaatsen die hun eerste digitale facturatie invoeren tot gevestigde middelgrote fabrikanten die spreadsheets vervangen door echte logistieke software. Wat hen verbindt, is niet de omvang, maar de ambitie: zij willen systemen die snel, betrouwbaar en écht prettig in gebruik zijn, niet alleen functioneel. Elk project begint bij ons met dezelfde drie vragen: wat moet dit bedrijf daadwerkelijk sneller laten verlopen, wat werkt al goed en verdient respect in plaats van vervanging, en welk deel van het werkproces kan, eenmaal correct gebouwd, zichzelf voortaan afhandelen. De antwoorden bepalen alles wat volgt, van de gekozen technologie tot het uitrolplan.

Diensten

De nieuwe visuele identiteit voor moderne digitale workflows.

01 — LOGISTICS

Logistiek automatiseren — gebouwd voor kleine en middelgrote bedrijven in de DACH-regio

Een groot deel van ons werk is gewijd aan logistieke en operationele software voor kleine en middelgrote bedrijven in Duitsland, Oostenrijk en Zwitserland. Deze bedrijven zitten vaak vast tussen twee onaantrekkelijke opties: dure enterprise logistieke pakketten ontworpen voor concerns die tien keer zo groot zijn, of een lappendeken van spreadsheets, papieren formulieren en telefoontjes die stilletjes beperkt hoe snel ze kunnen groeien.

Wij bouwen de middenweg — maatwerkautomatisering die past bij hoe een specifiek magazijn, werkplaats of distributieteam daadwerkelijk werkt. Dat kan betekenen: inkomende goederen en voorraadmutaties digitaliseren, automatisch pakbonnen en verzendlabels genereren, orderontvangst koppelen aan routeplanning, of simpelweg een kwetsbaar Excel-bestand dat slechts één persoon begrijpt vervangen door een gedeeld systeem waarop het hele team kan vertrouwen. Omdat wij rechtstreeks samenwerken met eigenaren en operationeel managers in de DACH-regio, worden vereisten opgehaald in de taal waarin het bedrijf daadwerkelijk werkt, en wordt de uitrol gepland rond echte ploegendiensten en echte magazijnvloeren, niet rond een abstract implementatieschema.

02 — WEB

Moderne webontwikkeling, gebouwd op actuele technologie

Wij ontwerpen en bouwen webapplicaties en websites met actuele, actief onderhouden technologie in plaats van verouderde frameworks die uit gewoonte in leven worden gehouden. Dat betekent nette PHP 8.4 aan de serverkant waar een klassieke server-gerenderde applicatie de juiste keuze is, moderne JavaScript waar interactiviteit telt, en MySQL 8 voor data die jarenlang consistent en doorzoekbaar moet blijven, niet alleen de eerste zes maanden na lancering. Elk project wordt vanaf de allereerste schets tegelijk voor desktop en mobiel gepland, niet achteraf aangepast: laadtijden, layout-breakpoints en touch-interacties horen bij de specificatie, niet bij een latere toevoeging.

Naast de zichtbare interface vinden wij belangrijk hoe een website er van binnen uitziet: leesbare code, een databaseschema dat niet bij de volgende functie-aanvraag opnieuw opgebouwd hoeft te worden, en implementatiestappen die een tweede ontwikkelaar kan volgen zonder ons te hoeven bellen. Een website die vandaag goed presteert en over drie jaar nog steeds netjes uitbreidbaar is, is voor ons de werkelijke definitie van 'modern'.

03 — AI / COCO

COCO — onze eigen AI-server voor geautomatiseerd softwaretesten

Voor enterprise-klanten beheren en onderhouden wij onze eigen dedicated AI-server, genaamd COCO. In tegenstelling tot een algemene chatbot die achteraf aan een workflow wordt gekoppeld, is COCO specifiek gebouwd en zelf gehost voor het geautomatiseerd testen van websoftware en platformonafhankelijke desktoptoepassingen — van login- en authenticatiestromen tot volledige meerstaps bedrijfsprocessen.

COCO plant een testscenario, voert dit uit tegen de echte applicatie, legt voor-en-na screenshots en uitvoeringsopnames vast als bewijs, en levert een in gewone taal gestelde beoordeling van wat is geslaagd, wat is mislukt en waarom — inclusief randgevallen zoals herhaalde mislukte inlogpogingen, accountvergrendelingen en herstelstromen die handmatig omslachtig en foutgevoelig zijn om te testen. Omdat de server lokaal onder ons beheer draait, houden enterprise-klanten volledige controle over waar testdata en screenshots worden opgeslagen, zonder dat interne applicatieverkeer standaard naar een externe clouddienst wordt gestuurd.

COCO — onze eigen AI-server voor geautomatiseerd softwaretesten

Voor enterprise-klanten beheren en onderhouden wij onze eigen dedicated AI-server, genaamd COCO. In tegenstelling tot een algemene chatbot die achteraf aan een workflow wordt gekoppeld, is COCO specifiek gebouwd en zelf gehost voor het geautomatiseerd testen van websoftware en platformonafhankelijke desktoptoepassingen — van login- en authenticatiestromen tot volledige meerstaps bedrijfsprocessen.

COCO plant een testscenario, voert dit uit tegen de echte applicatie, legt voor-en-na screenshots en uitvoeringsopnames vast als bewijs, en levert een in gewone taal gestelde beoordeling van wat is geslaagd, wat is mislukt en waarom — inclusief randgevallen zoals herhaalde mislukte inlogpogingen, accountvergrendelingen en herstelstromen die handmatig omslachtig en foutgevoelig zijn om te testen. Omdat de server lokaal onder ons beheer draait, houden enterprise-klanten volledige controle over waar testdata en screenshots worden opgeslagen, zonder dat interne applicatieverkeer standaard naar een externe clouddienst wordt gestuurd.

Wij richten COCO voor elke enterprise-klant afzonderlijk in, configureren en onderhouden de server — wij bepalen de testplannen die relevant zijn voor hun specifieke applicatie, stemmen betrouwbaarheidsdrempels af, en beslissen per geval wanneer een resultaat voor menselijke beoordeling moet worden geëscaleerd. Het doel is niet om een QA-team te vervangen, maar om het een onvermoeibare collega te geven die de repetitieve regressietests voor elke release uitvoert, nog voordat een mens hoeft in te grijpen.

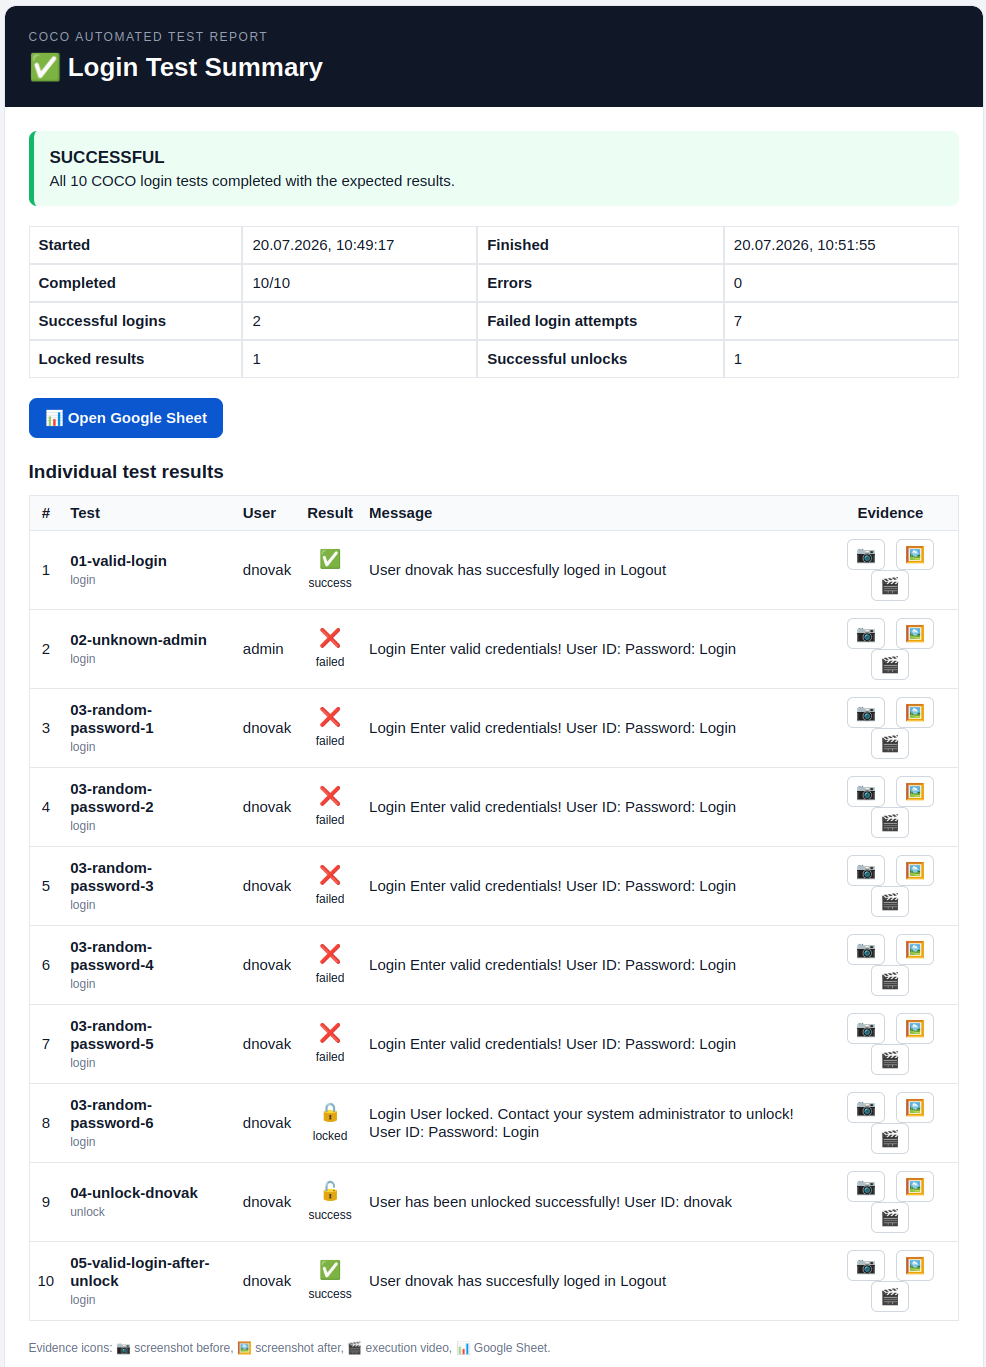
COCO automated login test report
COCO — automated login & account-lockout test report
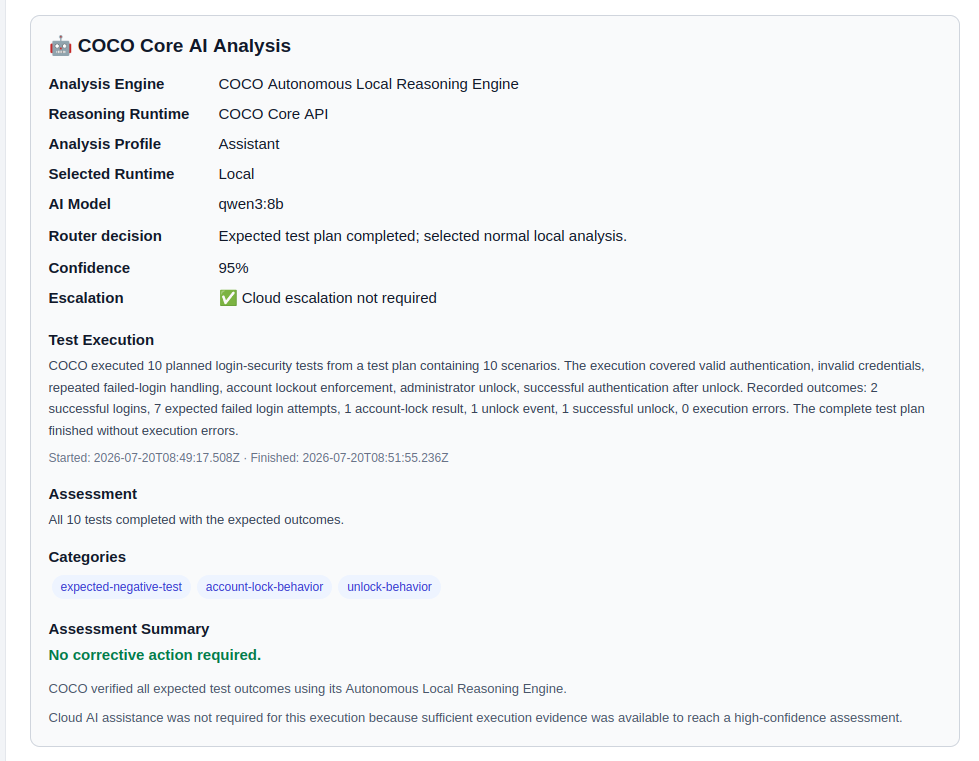
COCO AI analysis panel
COCO — plain-language AI analysis of a completed test run

Waarom softify.pro

Wij blijven bewust klein genoeg zodat elk project wordt behandeld door mensen die bij het eerste planningsgesprek aanwezig waren, niet doorgeschoven naar een wachtrij. Dat betekent kortere feedbackloops, minder misverstanden en een team dat ook na zes maanden nog weet waarom een bepaalde beslissing is genomen. Wij verkiezen saaie, bewezen betrouwbaarheid boven het najagen van trends: een technologiestack wordt gekozen omdat die bij het probleem past en over vijf jaar door iemand anders dan wijzelf onderhouden kan worden, niet omdat hij trendy was in de sprint waarin hij werd gekozen. Als een spreadsheet het werk écht nog beter doet dan maatwerksoftware zou doen, vertellen wij u dat ook eerlijk — ons doel is een workflow die daadwerkelijk sneller verloopt, niet simpelweg een hogere softwarerekening.

Geselecteerd werk

Een kleine selectie van werk dat wij publiekelijk mogen tonen — verdere case studies en enterprise-projecten zijn op aanvraag beschikbaar onder NDA.

Koralpenhaus

Koralpenhaus

Regionale presentatie- en boekingswebsite in het Alpengebied, gebouwd met focus op een heldere structuur, snelle laadtijden en eenvoudig contentbeheer.

Dexosano

Dexosano

A modern PHP-based web platform, engineered with the same performance-first approach softify.pro applies to every client project.

Case Studies

softify.pro Flow — Getest door COCO

softify.pro Flow — Getest door COCO

21.08.2026

Control. Clarity. Flow.

Elk serieus softwareproduct ontwikkelt uiteindelijk een tweede product achter het product.

Klanten zien het misschien nooit. Bezoekers weten misschien nooit dat het bestaat. Maar beheerders, operators en ontwikkelaars zijn er elke dag van afhankelijk.

Voor softify.pro Flow is die applicatie Administration — de operationele console die verantwoordelijk is voor het beheren van gebruikers, rollen, toegangsniveaus, authenticatiestatussen, databaseomgevingen en andere configuratie die een Flow-installatie onder controle houdt.

Het aanmeldscherm draagt drie woorden:
Control. Clarity. Flow.

Ze zijn oorspronkelijk gekozen om de ervaring te beschrijven die we beheerders wilden geven bij het bedienen van het systeem.

Maar ze beschrijven ook verrassend goed hoe wij vinden dat software getest zou moeten worden.

Dat maakte softify.pro FlowAdministration een voor de hand liggende kandidaat voor een echte COCO-test.
Geen laboratoriumdemonstratie.
Geen verzameling losse knoppen die speciaal voor een AI-demo zijn voorbereid.
Een echte platformonafhankelijke desktopapplicatie met echte applicatielogica, meerdere vensters, meerdere database-backends, authenticatie, rechten, lokalisatie en genoeg status om ogenschijnlijk kleine regressies handmatig moeilijk te herkennen te maken.

Voor de hier getoonde publieke demonstratie werkte COCO uitsluitend met gegenereerde demogegevens. De applicatie was gelicentieerd aan het fictieve bedrijf Presentation GmbH, en er is geen productieklantinformatie, geen inloggegevens en geen persoonlijke gegevens gebruikt.

Het doel was eenvoudig:
laat COCO de applicatie benaderen zoals een tester dat zou doen, en bepaal of de volledige administratieve workflow zich nog gedraagt zoals de software beweert.

The Challenge

Op het eerste gezicht lijkt het testen van een beheerapplicatie eenvoudig.

Open het.
Log in.
Klik door verschillende vensters.
Controleer of alles er correct uitziet.

Die aanname verandert snel zodra de applicatie groeit.

softify.pro FlowAdministration is geen enkel statisch formulier. Het is een verzameling met elkaar verbonden operationele weergaven binnen één applicatieschil.

Onder andere kan een beheerder werken met:

  • gebruikersaccounts
  • rollen en toegangsniveaus
  • authenticatie-informatie
  • status van tweefactorauthenticatie
  • informatie over het besturingssysteem
  • netwerk- en IP-informatie
  • databaseconfiguratie
  • sorteer- en weergaveopties
  • live taalkeuze
  • applicatie- en licentie-informatie

De interface ondersteunt momenteel elf talen. De applicatie werkt ook met MySQL en PostgreSQL als database-backends. Afzonderlijk vormt geen van deze functies een ongebruikelijk testprobleem.

De moeilijkheid ontstaat door de combinaties ervan.
Een gebruikerstabel kan correct werken in het Engels maar een verouderde kolomnaam tonen in het Kroatisch.
Sorteren kan correct werken bij verbinding met MySQL maar zich anders gedragen na het overschakelen naar PostgreSQL.

Een taalwijziging kan de meeste interface-elementen bijwerken terwijl één statusbericht onvertaald blijft. De applicatie kan succesvol van database wisselen maar verouderde informatie van de vorige verbinding behouden. Een nieuwe release kan een functie introduceren terwijl de Over-dialoog nog de vorige beschrijft. Het programma hoeft niet vast te lopen om zo'n situatie een regressie te maken. Sterker nog, sommige van de vervelendste softwaredefecten zijn precies de gevallen waarin alles lijkt te werken.

De applicatie start.
Het venster opent.
De knop reageert.
Maar er klopt iets niet meer helemaal onder de oppervlakte.
Daarom is herhaaldelijk regressietesten belangrijk.

En het is precies het soort werk waar mensen steeds slechter in worden nadat ze dezelfde reeks tientallen keren hebben herhaald.

Why Manual Testing Becomes Expensive

Iets één keer testen is eenvoudig.
Het betrouwbaar testen na elke relevante release is anders.

Kijk alleen al naar drie dimensies: 11 interfacetalen × 2 database-backends × meerdere applicatieworkflows.

Het aantal combinaties groeit snel.
Voeg verschillende gebruikersrollen, authenticatiestatussen, sorteergedrag, configuratiewijzigingen en operationele omgevingen toe, en de testmatrix wordt te groot om als een incidentele handmatige checklist te behandelen.

Hier begint regressietesten vaak te eroderen.
Niet opzettelijk.
Een releasedeadline komt dichterbij.
Iemand herinnert zich dat de applicatie vorige week is getest.
Een ontwikkelaar controleert snel het belangrijkste scherm.

Duits werkt.
Engels werkt.
MySQL werkt.
De aanname wordt:
"De rest is waarschijnlijk in orde."

Meestal is dat zo.
Tot de release waarbij dat niet zo is.
COCO bestaat deels om die aanname uit het proces te halen.

What COCO Actually Did

COCO startte softify.pro FlowAdministration vanuit een koude applicatiestatus, zonder te vertrouwen op een vooraf voorbereid scherm of handmatig gepositioneerde workflow.

De eerste interactie was dezelfde als die aan een menselijke beheerder wordt getoond: het aanmeldvenster.

COCO identificeerde de authenticatie-interface met:

  • gebruikersnaam
  • wachtwoord
  • tweefactorauthenticatiecode

en de regel direct onder de softify.pro Flow-identiteit:
Control. Clarity. Flow.

Van daaruit werkte COCO zich door een gedefinieerde regressiesessie. Het ging er niet simpelweg om te bepalen of de applicatie kon worden geopend.

Het ging erom te verifiëren of de status van de applicatie intern consistent bleef terwijl COCO ermee interacteerde.

Authentication Is Only the Beginning

Login-tests zijn een van de meest voor de hand liggende kandidaten voor automatisering, maar een geslaagde authenticatie alleen zegt heel weinig over de rest van een beheerapplicatie.

Eenmaal binnen ging COCO naar de daadwerkelijke werkomgeving. Het inspecteerde de gebruikersbeheer-interface en verifieerde dat de verwachte informatie aanwezig was.

Dat omvatte gegevens zoals:

  • gebruikersnamen
  • gemaskeerde wachtwoorden
  • 2FA-indicatoren
  • toegewezen rollen
  • informatie over het besturingssysteem
  • IP-adressen

COCO interacteerde vervolgens met de tabel in plaats van deze alleen te observeren.
De gebruikerslijst werd gesorteerd op gebruikersnaam.
De resulterende volgorde werd geïnspecteerd.
Het belangrijke was niet of het klikken op de kolomkop een zichtbare verandering opleverde.

COCO verifieerde dat de resulterende tabelstatus overeenkwam met de gevraagde bewerking.

Dat onderscheid is belangrijk.
Een functionele test vraagt:
"Reageerde de knop?"

Een nuttige regressietest vraagt:
"Kwam de applicatie terecht in de juiste status?"

Testing the Database Boundary

softify.pro Flow ondersteunt meer dan één database-backend.

Dat maakt van databaseoverschakeling een bijzonder belangrijke regressiegrens.
COCO wijzigde de actieve backend van MySQL naar PostgreSQL.

Na de overschakeling inspecteerde het opnieuw de gebruikersinformatie.
De test zocht naar meer dan een geslaagde verbinding.
Er werd gecontroleerd of de applicatie de verwachte records bleef tonen en of de via de interface getoonde informatie consistent bleef.

COCO schakelde daarna weer terug.

Dit soort overgang wordt gemakkelijk onderschat.
De gebruikersinterface kan visueel identiek blijven terwijl de onderliggende opslaglaag volledig verandert.
Vanuit het perspectief van een beheerder zou die overgang bijna saai moeten aanvoelen.
Dezelfde gebruikers zouden nog steeds begrijpelijk moeten zijn.
Dezelfde rollen zouden nog steeds logisch moeten zijn.

Hetzelfde interfacegedrag zou nog steeds moeten gelden.

Die schijnbaar onbewogen continuïteit is precies wat bewezen moet worden.

Eleven Languages, One Application State

Lokalisatie is een ander gebied waar oppervlakkig testen bijzonder gevaarlijk is.

Het is relatief eenvoudig om te verifiëren dat een applicatie in een andere taal kan starten.
Het is veel waardevoller om te verifiëren wat er gebeurt wanneer de taal verandert terwijl de applicatie al draait en status vasthoudt.

COCO wisselde de interfacetaal live.

De sessie omvatte overgangen tussen talen zoals:
Duits → Engels → Kroatisch
terwijl de administratieweergave actief bleef.

COCO observeerde of interface-elementen op hun plaats correct veranderden:

  • tabelkoppen
  • bedieningselementen
  • knoppen
  • labels
  • statusberichten

Ook de onderliggende tabel en applicatiestatus moesten die overgang overleven.
Dit is belangrijk omdat meertalige software uit meer bestaat dan vertaalde tekststrings.
Taalwijzigingen kunnen blootleggen:

  • vergeten resources
  • verouderde labels
  • opmaakproblemen
  • onvertaalde statusberichten
  • coderingsproblemen
  • statusresets
  • problemen bij het opnieuw aanmaken van besturingselementen

Een venster dat er correct uitziet wanneer het direct in het Kroatisch wordt gestart, kan zich toch onjuist gedragen wanneer de gebruiker tijdens een actieve sessie van Duits naar Kroatisch overschakelt.

Dat is het verschil tussen het controleren van een screenshot en het testen van een workflow.

Restoring Application State

COCO herstelde vervolgens de standaard sorteerconfiguratie van de applicatie.

Ook hier eindigde de test niet met de klik zelf.

De resulterende volgorde en de bevestiging die via het statusgebied van de applicatie werd getoond, werden geëvalueerd. Dit soort verificatie lijkt misschien onbeduidend vergeleken met het testen van authenticatie of databasetoegang.

Dat is het niet.

Enterprise-applicaties verzamelen honderden van dit soort kleine statusovergangen.
Gebruikers vertrouwen erop zonder er bewust over na te denken.
De software voelt betrouwbaar aan juist omdat die interacties voorspelbaar blijven.
Regressietesten bestaat om die voorspelbaarheid te beschermen.

Testing the Information Around the Software

COCO opende ook de Over-dialoog van de applicatie.

Waarom een Over-venster testen?

Omdat softwaredocumentatie begint binnen de software zelf.
Het versienummer, de functiebeschrijving en de licentie-informatie die aan de operator worden getoond, zouden moeten overeenkomen met de applicatie die daadwerkelijk draait.

Een applicatie kan perfect functioneren terwijl deze nog steeds verouderde versie-informatie toont of mogelijkheden beschrijft die niet meer overeenkomen met de release.

Dat laat geen database vastlopen.
Het doet iets subtielers:
het vermindert vertrouwen.

Voor enterprise-software omvat operationele nauwkeurigheid ook deze ogenschijnlijk kleine details. COCO controleerde daarom ook deze.

Control.

Het eerste woord in de softify.pro Flow-slogan is ook het eerste principe van de testomgeving.

Control betekent weten wat er wordt getest, tegen welke status en met welke gegevens.

De publieke COCO-demonstratie gebruikt geen productiegegevens van klanten.

Het draait met bewust voorbereide demogegevens waarvan de verwachte status bekend is.

Dat maakt resultaten reproduceerbaar.

Het betekent ook dat verschillen tussen testruns onderzocht kunnen worden in plaats van weg te worden verklaard als willekeurige veranderingen in productiegegevens.

Belangrijker nog, COCO is ontworpen als een self-hosted AI-testsysteem.

Testbewijs, applicatiescreenshots en interne workflow-informatie kunnen binnen de infrastructuur blijven onder de eigen controle van de klant of operator, in plaats van standaard te worden verzonden naar een niet-gerelateerde externe clouddienst.

Voor interne bedrijfsapplicaties is dat niet louter een infrastructuurvoorkeur.
Het kan deel uitmaken van de testvereiste zelf.

Clarity.

Automatisering is niet bijzonder nuttig als de uiteindelijke uitvoer is: FAILED
gevolgd door honderden regels technische uitvoer die iemand handmatig moet reconstrueren voordat hij begrijpt wat er is gebeurd.

COCO is ontworpen om een begrijpelijk bewijsspoor te behouden.

Het rapport beschrijft:

  • wat er is getest
  • welke interactie plaatsvond
  • in welke volgorde dit gebeurde
  • wat COCO observeerde
  • welke status verwacht werd
  • waar het gedrag afweek toen iets mislukte

Screenshots en uitvoeringsbewijs kunnen die reeks vergezellen.
Het doel is niet om technische details te verbergen.

Het is om het resultaat begrijpelijk te maken voordat iemand een debugger moet openen.

Een engineer zou moeten kunnen antwoorden op:
Wat is er gebeurd? voordat hij vraagt:
Waar in de code is het gebeurd?

Dat onderscheid verkort het onderzoek drastisch wanneer een regressie optreedt.

Flow.

Traditionele UI-automatisering denkt vaak in elementen.

Selector zoeken.
Selector klikken.
Andere selector zoeken.
Waarde controleren.

Die aanpak blijft nuttig, maar applicaties worden niet ervaren als verzamelingen selectors.

Mensen ervaren flows.

Inloggen.
Beheer openen.
Een gebruiker vinden.
Een instelling wijzigen.
Van database wisselen.
Van taal wisselen.
Het resultaat verifiëren.

Doorgaan met werken.

COCO behandelt de reeks daarom als een proces in plaats van als een willekeurige verzameling bedieningselementen.

Het volgt wat de gebruiker probeert te bereiken en evalueert de applicatie in context.

Dat wordt bijzonder waardevol bij het testen van echte bedrijfssoftware, omdat storingen vaak optreden tussen schermen of tussen statussen, niet binnen een individuele knop.

Een logistieke workflow kan een order, een voorraadreservering, een pickactie, een pakbon en een verzendbevestiging bevatten.
Elk afzonderlijk scherm kan correct lijken terwijl het volledige proces fout is.
Hetzelfde principe geldt hier op kleinere schaal.
Het beheervenster is niet het product.

De workflow erdoorheen is dat wel.

Evidence Instead of Assumption

Een van de belangrijkste taken van COCO is niet klikken. Het is onthouden wat er is gebeurd.
Menselijk regressietesten eindigt vaak met een uitspraak als:
"Ik heb het getest en alles zag er goed uit."

Dat kan volkomen accuraat zijn.
Maar enkele weken later, wanneer een probleem opduikt, zijn de nuttige vragen anders:

  • Welke release is getest?
  • Welke database?
  • Welke taal?
  • Welke gebruikersstatus?
  • Wat gebeurde er voorafgaand aan het probleem?
  • Wat was er precies zichtbaar?

In welke volgorde zijn de acties uitgevoerd?
COCO's testruns zijn ontworpen om bewijs achter te laten.

Dat verandert een testresultaat van een mening in iets dat geïnspecteerd kan worden.
Een geslaagde run wordt daardoor ook nuttig.
Het legt een bekende referentiestatus vast waarmee later gedrag vergeleken kan worden.

COCO Is Not the Decision Maker

Er is een belangrijke grens in de manier waarop we AI gebruiken voor softwaretesten.
COCO is niet bedoeld om engineering-verantwoordelijkheid te vervangen.

Het beslist niet hoe een bedrijfsregel zou moeten zijn.

Het test gedrag tegen scenario's, vereisten en verwachtingen die voor de applicatie zijn gedefinieerd.
Voor gevoelige beslissingen over rechten, prijzen, voorraad, financiële transacties of andere kritieke bedrijfsstatussen blijft het definiëren van correct gedrag een menselijke verantwoordelijkheid.

Dat onderscheid is belangrijk.
AI is uitstekend in het herhalen van een gedetailleerde test zonder de concentratie te verliezen.
Het is uitstekend in het verzamelen van bewijs.
Het kan schermen inspecteren, verwacht en waargenomen gedrag vergelijken en discrepanties verklaren.
Maar het bedrijf bepaalt nog steeds wat correct betekent.

COCO maakt die definitie testbaar.

The Test Nobody Wants to Repeat

Er is een eenvoudige reden waarom automatisering hier waarde toevoegt.
Een menselijke tester kan deze regressiesessie absoluut uitvoeren.
De eerste taal krijgt volledige aandacht.
Waarschijnlijk de tweede ook.
Dan nog een.
Dan nog een.
MySQL is al gecontroleerd.
PostgreSQL moet nog gecontroleerd worden.
De sorteertest is al meerdere keren uitgevoerd.
De Over-dialoog is al maanden niet veranderd.

Het is vrijdagmiddag.

En menselijke aandacht doet wat menselijke aandacht van nature doet.
Ze begint te optimaliseren.
COCO niet.
In de eigen geest van COCO:

  • Ik word niet moe van het klikken op dezelfde knop in elf talen. Ik sla de PostgreSQL-ronde niet over omdat het vrijdagmiddag is. Ik neem niet aan dat de sortering hield alleen omdat het in de vorige release werkte.

Voor COCO kan elke regressiesessie behandeld worden alsof het de eerste is.
Dat is geen intelligentie die een menselijke tester vervangt.
Het is automatisering die de menselijke tester beschermt tegen het deel van het testen waar menselijke aandacht het minst waard is.

From Repetitive Testing to Engineering Evidence

Het grotere doel van COCO is niet het maximaliseren van het aantal geautomatiseerde acties.
Duizend geautomatiseerde klikken zijn zinloos als niemand begrijpt wat ze bewijzen. Het nuttige resultaat is vertrouwen, ondersteund door bewijs.

Voor softify.pro Flow betekent dat te kunnen zeggen dat een release is getest over de operationele gebieden die ertoe doen:

  • authenticatie
  • gebruikersbeheer
  • rol- en toegangsinformatie
  • status van tweefactorauthenticatie
  • sorteergedrag
  • MySQL-werking
  • PostgreSQL-werking
  • live lokalisatie
  • statusfeedback
  • applicatie-informatie
  • licentie-informatie

en dat het resultaat bewaard blijft in een vorm die later beoordeeld kan worden.
Hetzelfde principe schaalt ver buiten deze applicatie.
Een inlogproces kan op deze manier getest worden.
Een boekingsworkflow kan op deze manier getest worden.
Een logistiek proces kan op deze manier getest worden.
Een platformonafhankelijke desktopapplicatie kan op deze manier getest worden.
De schermen veranderen.
De bedrijfsregels veranderen.
Het principe niet:
de verwachte workflow definiëren, deze consistent uitvoeren, bewijs verzamelen en het resultaat begrijpelijk maken.

Why We Test Our Own Software With COCO

Er is nog een reden waarom softify.pro Flow ertoe doet als COCO-case study.

Het is onze eigen software.
Dat verwijdert de comfortabele afstand die soms bestaat tussen een technologiedemonstratie en de mensen die deze uitvoeren.

Als COCO bedoeld is om enterprise-software te testen, moet het nuttig genoeg zijn om het toe te vertrouwen aan software die wij zelf ontwikkelen en uitbrengen.

Flow fungeert daarom zowel als product als testterrein.
Nieuwe testmogelijkheden kunnen worden beproefd tegen een echte applicatie.
Onverwacht gedrag kan zwaktes blootleggen in de applicatie, het testplan of COCO zelf.

Elke kant verbetert de andere.
Die feedbacklus is veel waardevoller dan het bouwen van kunstmatige demonstraties die alleen ontworpen zijn om te slagen. Een testsysteem zou niet overtuigend moeten lijken omdat de demonstratie eenvoudig was.
Het zou overtuigend moeten worden omdat het de kleine dingen blijft vinden die mensen uiteindelijk zouden stoppen te controleren.

The Result

softify.pro FlowAdministration beschikt nu over een gedocumenteerd en herhaalbaar regressieproces dat COCO kan uitvoeren voorafgaand aan relevante releases.

De test omvat beide ondersteunde databaseomgevingen en de elftalige interface van de applicatie, terwijl de applicatie wordt gevolgd zoals een beheerder deze zou gebruiken, in plaats van elk scherm als een geïsoleerd testdoel te behandelen.

COCO produceert een bewijsspoor dat toont wat er is getest, wat er is waargenomen en in welke volgorde de sessie plaatsvond.

Dat bewijs kan lokaal onder controle blijven.
Ontwikkelaars krijgen een reproduceerbaar startpunt wanneer er iets verandert.
Menselijke testers besteden minder tijd aan het herhalen van voorspelbare interacties en meer tijd aan het onderzoeken van situaties die daadwerkelijk beoordelingsvermogen vereisen.

En softify.pro Flow krijgt iets waardevollers dan een groene PASS-indicator.

Het krijgt bewijs dat de ervaring die op het aanmeldscherm wordt beloofd, blijft bestaan nadat de onderliggende code is veranderd.

Control. Weten wat er wordt getest en de omgeving onder controle houden.

Clarity. Begrijpen wat er is gebeurd zonder een ondoorzichtig automatiseringslogboek te hoeven reconstrueren.

Flow. De applicatie testen als een proces dat mensen daadwerkelijk gebruiken.

Control. Clarity. Flow.

Het werd geschreven voor de software.
Het bleek net zo goed de testfilosofie erachter te beschrijven.

Permalink →

softify.pro - Insiders

COCO slaat weer toe

COCO slaat weer toe

We zouden waarschijnlijk moeten stoppen met COCO ideeën te geven.
Het vorige experiment zou genoeg moeten zijn geweest.
Een echte applicatie.
Echte navigatie.
Gebruikers.
Rollen.
Databases.
Talen.
Bewijs.

Een respectabele case study.
Een nette conclusie.
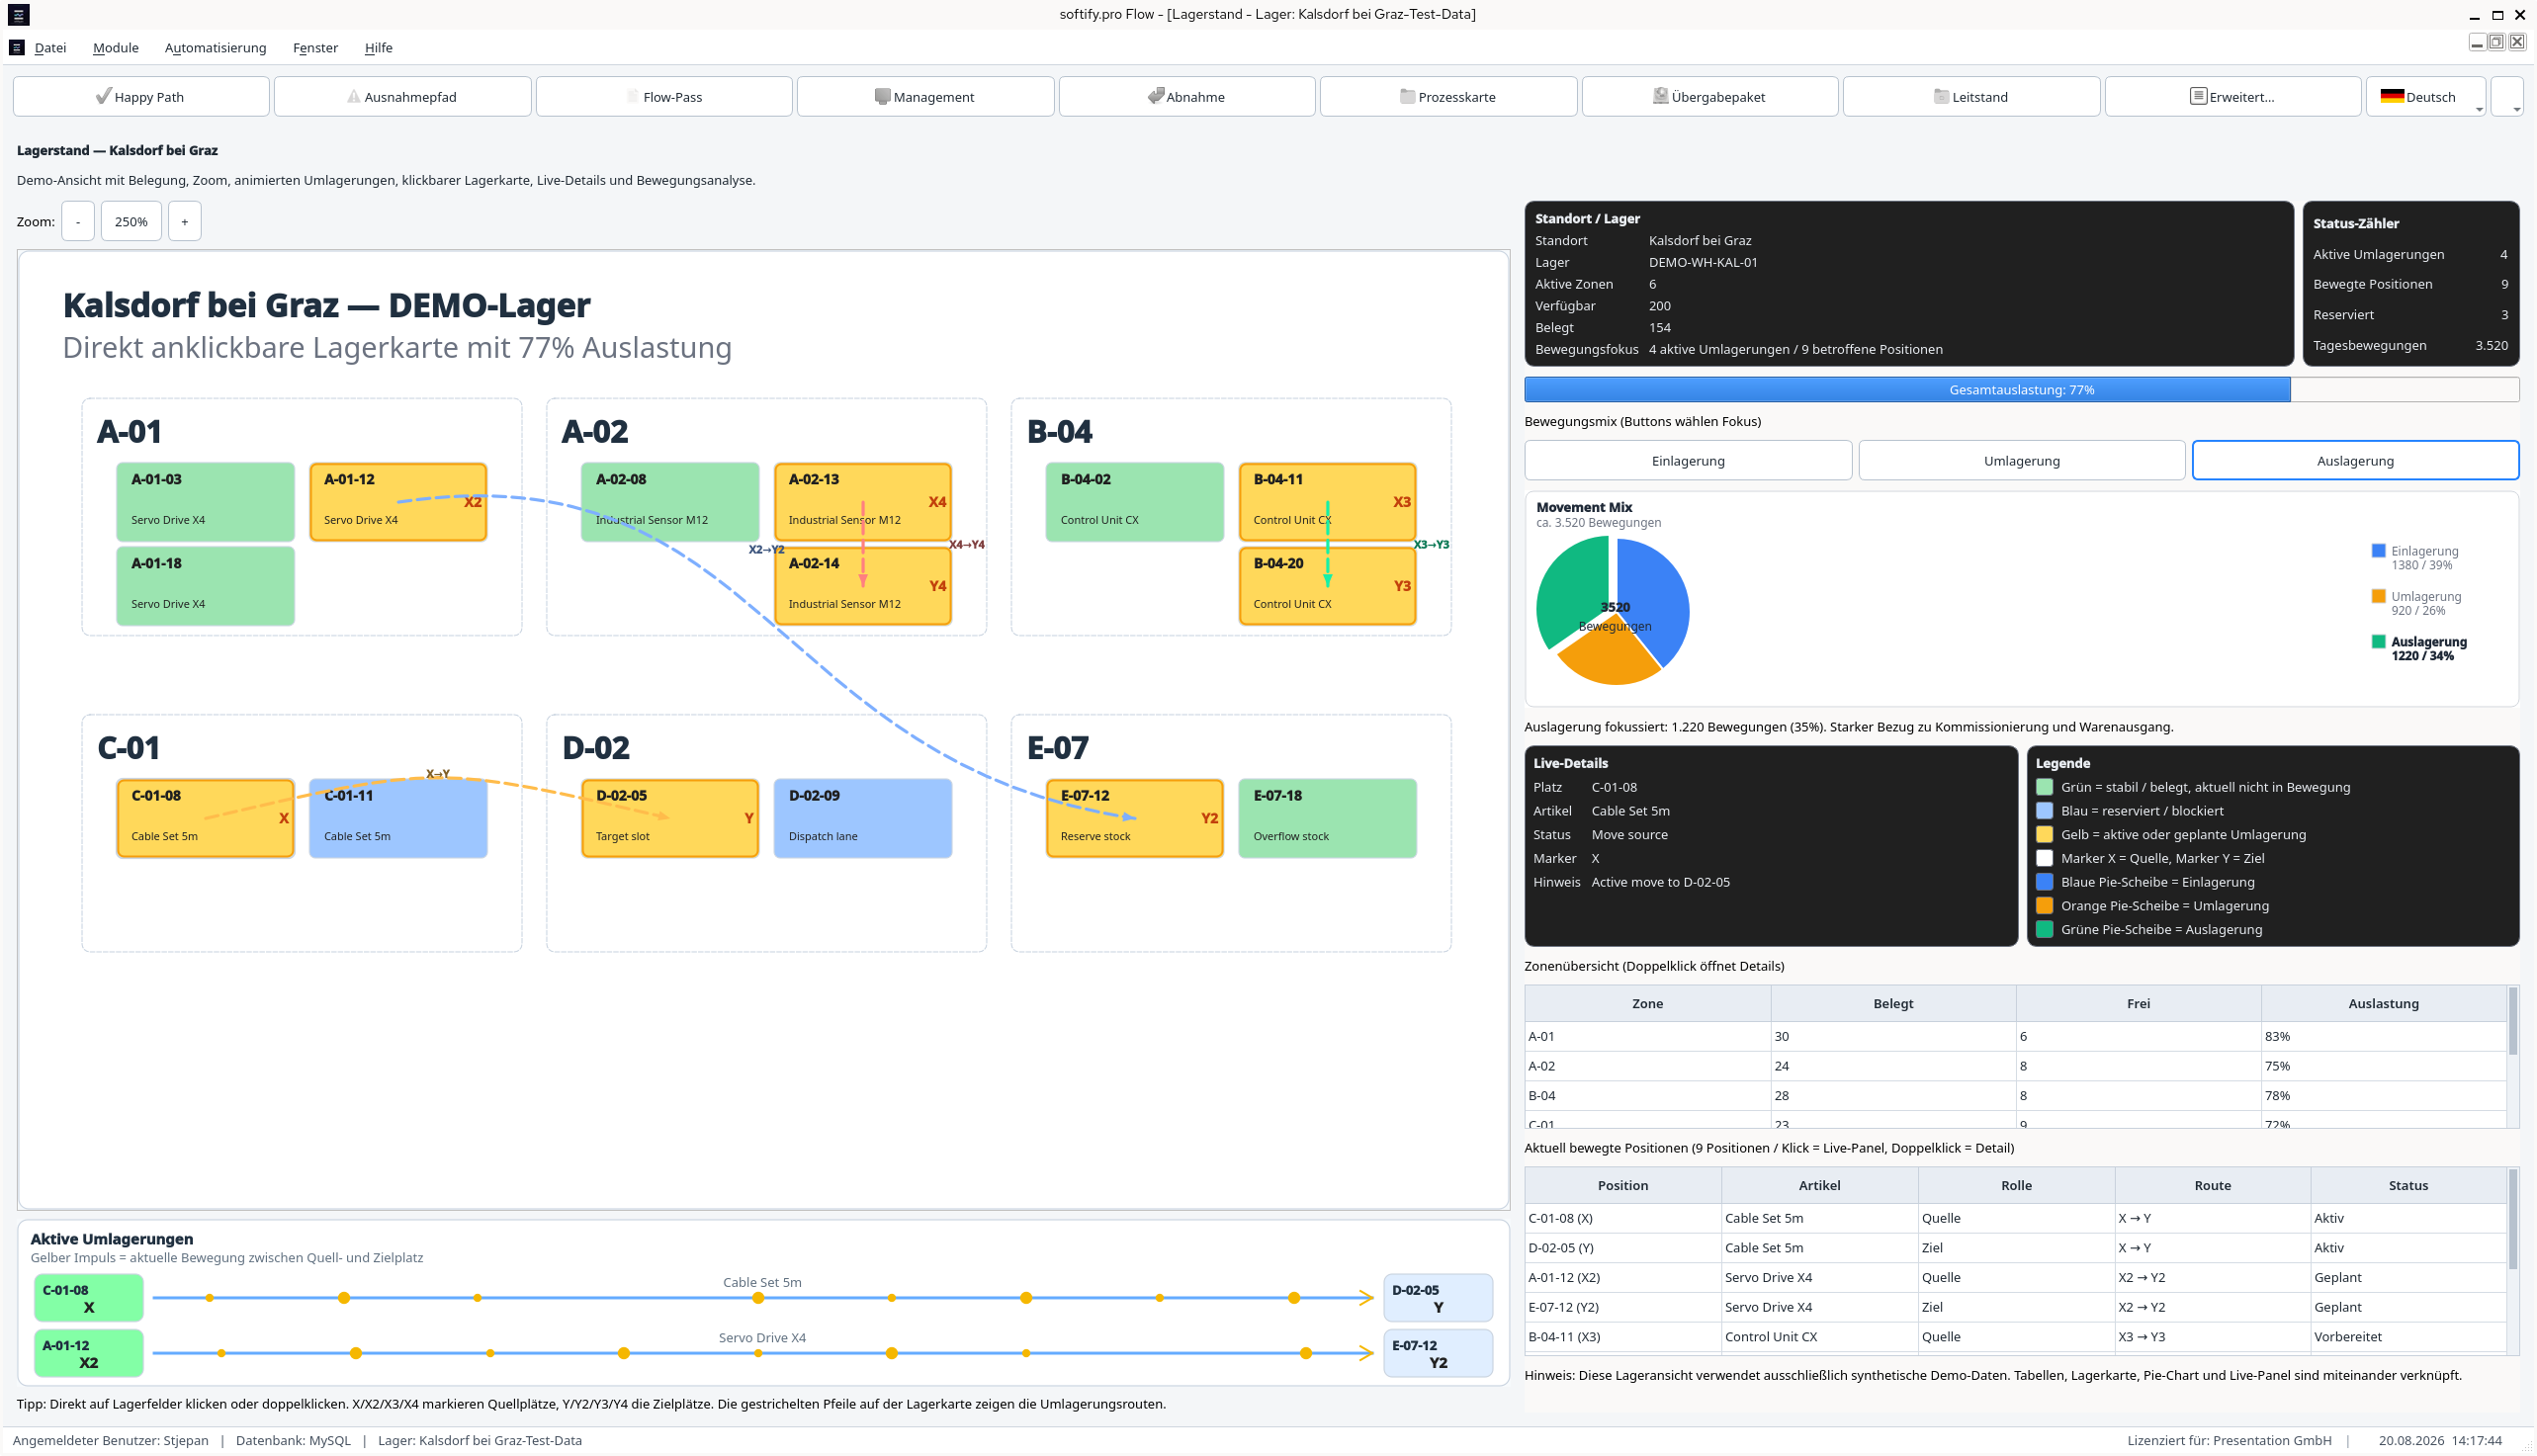
Toen liet iemand het zien: Logistics in Motion.
Dat was waarschijnlijk de vergissing.


Het begon met drie magazijnen
Niets bijzonder opwindends.
Drie DEMO-magazijnen.
  • Kalsdorf bei Graz.
  • Wiener Neustadt.
  • Klagenfurt.
Synthetische data.
Geen klantinformatie.
Geen productievoorraad.

Precies het soort omgeving waar niets belangrijks zou moeten gebeuren.
Toen werd het eerste magazijn geselecteerd.
En de applicatie kreeg context.
Vanaf dat moment had elk scherm nog een vraag eraan gekoppeld.

Hoort dit nog bij hetzelfde magazijn?
Verandert de taal alleen de interface?
Blijft het proces op dezelfde stap?
Klopt de voorraad nog?
Wijst de documentreferentie nog naar het juiste evenement?
Ziet de operator precies wat nodig is voor de volgende actie?


Plotseling was niet meer het scherm het interessante deel.
Het was de continuïteit tussen schermen.

COCO doet dat graag.

Logistiek is geen verzameling schermen
Van buitenaf kan magazijnsoftware bedrieglijk eenvoudig lijken.
Goederen komen aan.
Ze worden opgeslagen.
Iemand bestelt ze.
Ze worden gepickt.
Ze worden verzonden.
Klaar.

Behalve dat er een hele operationele wereld verborgen zit tussen aangekomen en verzonden.
Verwacht.
Ontvangen.
Gecontroleerd.
Beschikbaar.
Gereserveerd.
Verplaatst.
Gepickt.
Geblokkeerd.
Gecorrigeerd.
Verzonden.
Gecontroleerd (audit).


De fysieke beweging telt.
Maar het is de statusovergang die die beweging begrijpelijk maakt voor software.
En wanneer die twee realiteiten niet meer overeenkomen, heeft iemand uiteindelijk een slechte dag.

Flow.

Een magazijn is makkelijker te begrijpen wanneer beweging zichtbaar is, niet slechts geregistreerd.
Daarom is ons logistieke werk nooit echt begonnen met menu's, dashboards, of technologie.
Het begint met de materiële Flow.

Waar komt informatie binnen?
Waar verandert ze?
Waar kan ze verloren gaan?

Waar wordt iemand gedwongen om een ander te vragen wat er is gebeurd?
Waar wordt een handmatige stap stilletjes het zwakste deel van een verder geautomatiseerd proces?
Soms is het antwoord een nieuwe interface.
Soms een integratie.
Soms een scanner.
Soms gewoon een beter statusmodel.

Meer software is niet automatisch betere software.
Het doel is niet automatisering omwille van zichzelf.
Het doel is een proces dat begrijpelijk blijft.

Control. Clarity. Flow.

Het proces begint vóór de eerste boeking.
Vóór de goederenontvangst.
Vóór het picken.
Vóór de voorraadbeweging.
Vóór de eerste transactie.
Flow stelt een heel basale vraag:
In welk magazijn werken we?
Het klinkt bijna triviaal.
Dat is het niet.
Magazijncontext hoort bij alles wat volgt.
Voorraad.
Documenten.
Locaties.
Picken.
Verplaatsingen.
Auditgeschiedenis.
Uitzonderingen.

Het proces kan er perfect gezond uitzien terwijl het in de verkeerde context werkt.
Dat is precies het soort probleem dat een screenshot zelden onthult.
En precies het soort grens die COCO graag bevraagt.

Taal is makkelijk tot het dat niet meer is
Duits.
Engels.
Kroatisch.
Noors.
En andere.

Een gebruikersprofiel definieert de beschikbare talen.
De operator wisselt van taal terwijl de applicatie actief is.
De interface verandert onmiddellijk.
Het bedrijfsproces mag dat niet doen.
Dat onderscheid is belangrijk.
Het magazijn verplaatst zich niet omdat het woord voor magazijn is veranderd.
De pickopdracht start niet opnieuw omdat de gebruiker een andere taal koos.
Een reservering verdwijnt niet.
Een uitzondering behoort niet plotseling tot een andere transactie.
Het proces blijft waar het is.
Alleen de weergave ervan verandert.
Dat klinkt vanzelfsprekend.

Totdat je beseft hoeveel applicaties een taalwissel bijna als een nieuwe sessie behandelen.

Een meertalige bedrijfsapplicatie zou dat niet moeten doen.
De presentatiestatus mag veranderen.
De bedrijfsstatus moet stabiel blijven.
Dat maakt taalwisseling een verrassend nuttige regressietest.
Een kleine functie.
Een heel goede breuklijn.
COCO houdt van breuklijnen.

Stap voor stap begint de applicatie geschiedenis op te bouwen
Goederen komen aan.
Het proces gaat verder.
De goederenontvangst wordt geboekt.
De voorraad verandert.
De magazijnstatus weerspiegelt de nieuwe realiteit.
Het picken begint.
Voorraad wordt gereserveerd.
De operator ontvangt een taak.

Een mobiele weergave reduceert het hele proces tot wat op dat exacte moment telt:
Positie.
Opslaglocatie.
Hoeveelheid.
SSCC.
Operator.
Niet meer.
Niet minder.
Dat is belangrijk.
De mobiele interface is geen tweede bedrijfsproces.
Het is een andere weergave van hetzelfde proces.
De magazijnapplicatie mag alles weten.
De picker hoeft dat niet.
Clarity betekent niet altijd meer informatie tonen.
Soms betekent clarity de discipline hebben om bijna alles te verbergen.

Dan scant iemand de verkeerde locatie
Hier wordt een logistieke workflow interessanter dan een functielijst.
De verwachte locatie is één ding.
De gescande locatie is iets anders.
Flow stopt.
Crasht niet.
Stopt.
Er is een verschil.
De processtatus blijft zichtbaar.
De betrokken voorraad blijft begrijpelijk.
De uitzondering wordt expliciet.

Contextuele hulp legt uit wat relevant is voor de huidige situatie.
De gebruiker lost de discrepantie op.
Het proces gaat verder.
Dit moment zegt meer over operationele software dan meerdere pagina's happy-path screenshots.
Echte logistiek is niet moeilijk wanneer alles klopt.
Echte logistiek wordt moeilijk wanneer iets bijna klopt.
Een nuttig systeem verbergt dat niet achter een groen dashboard.
Het geeft de uitzondering een status.

Een reden.
Een geschiedenis.
En een weg vooruit.


Documenten onthouden wat mensen vergeten

Naarmate de workflow vordert, beginnen referenties zich op te stapelen.
ASN.
Goederenontvangst.
Magazijnbeweging.
Picken.
Verzending.
Flow.
Het interessante deel is niet dat documenten bestaan.
Het interessante deel is dat ze hetzelfde verhaal vertellen als het proces.
Waarom is deze voorraad hier?
Welke ontvangst heeft het geïntroduceerd?
Welke operatie heeft het gereserveerd?
Welke picking heeft het verbruikt?
Welke zending heeft het eruit verplaatst?
Is een uitzondering opgelost vóór de volgende stap?
Wat was het actieve magazijn?
Wat gebeurde er vóór de huidige status?
Wanneer status en documentatie door hetzelfde proces worden geproduceerd, wordt traceerbaarheid gemakkelijker te vertrouwen.
Wanneer dat niet zo is, beginnen mensen uiteindelijk de geschiedenis te reconstrueren.
Meestal in Excel.
Meestal onder druk.
Meestal nadat er al iets misging.
COCO geeft de voorkeur aan bewijs vóór dat moment.
Blijkbaar reist COCO ook
Er was nog een kleine verandering tussen de runs.
Ubuntu had zijn run.
Red Hat Enterprise Linux 10 nam de volgende.
COCO ging door.
Geen ceremonie.
Geen speciale "Red Hat-modus".
Geen herschreven workflow.
Geen handig vereenvoudigde test.
Dezelfde Flow.
Andere ondergrond eronder.
Een eerdere COCO-run had de applicatie al getest op Ubuntu Linux.
De huidige verhuisde naar Red Hat Enterprise Linux 10.
Andere desktopomgeving.
Andere systeembibliotheken.
Andere verpakking.
Andere operationele omgeving.
Hetzelfde magazijn.
Dezelfde bedrijfsstatussen.
Dezelfde voorraadovergangen.
Dezelfde taalwisselingen.
Dezelfde uitzonderingslogica.
Hetzelfde bewijs.
Dat is een behoorlijk mooie manier om cross-platform software te testen.

Kondig niet aan dat het cross-platform is. Verplaats het. Kijk dan wat er breekt.

Taalstatus.
Magazijncontext.
Dialooggedrag.
Timing.
Thema's.
Procesovergangen.
Uitzonderingsafhandeling.
Bewijs.
Besturingssystemen hebben verrassend creatieve manieren om aannames bloot te leggen.

Ubuntu legde er sommige bloot.
Red Hat legt andere bloot.
Dat is nuttig.

Want multi-platform engineering is niet het vermogen om het uitvoerbare bestand tweemaal te starten.

Het is het vermogen om de omgeving te veranderen zonder de betekenis van het proces te veranderen.
Een magazijnoperator zou het niet moeten uitmaken of de applicatie op Ubuntu of Red Hat draait.
Een pickopdracht zou het ook niet moeten uitmaken.
Evenmin een auditspoor.
Als platformverschillen bedrijfsgedrag beginnen te veranderen, is de software niet echt cross-platform.
Het is slechts overdraagbaar.
COCO lijkt aanzienlijk meer geïnteresseerd te zijn in de eerste definitie.
Wij ook.

COCO beslist niet wat correcte logistiek betekent
Dit deel is belangrijk.
COCO wordt geen magazijnexpert alleen omdat het een magazijnworkflow kan volgen.
Mensen blijven correctheid definiëren.
Mensen beslissen wanneer voorraad beschikbaar wordt.
Mensen definiëren wat een geblokkeerde levering betekent.
Mensen beslissen wie een hoeveelheid mag corrigeren.
Mensen definiëren welke beweging een auditspoor vereist.
Mensen beslissen hoe een geldige uitzonderingsoplossing eruitziet.
Mensen beslissen wanneer een zending echt compleet is.
Het werk van COCO is anders.

Herhalen.
Observeren.
Vergelijken.
Onthouden.
Bewijs achterlaten.


Doe het dan opnieuw nadat de software verandert.
En opnieuw.
En opnieuw.
Zonder verveeld te raken.
Zonder te beslissen dat het resultaat van vorige week waarschijnlijk nog geldig is.
Zonder de vervelende uitzondering over te slaan omdat de lunch over twaalf minuten is.
De glamoureuze toekomst van AI-testen bevat een verrassende hoeveelheid herhaling.
Wij beschouwen dat als een functie.

Bewijs verandert het gesprek
Traditioneel testen eindigt vaak met een volkomen redelijke zin:
"Het werkte toen ik het testte."

COCO is geïnteresseerd in de volgende zin.

Wat werkte precies?
Welk magazijn?
Welke gebruiker?
Welke taal?
Welke processtatus?
Welke volgorde?
Welk document?
Welke voorraadwaarde?
Wat gebeurde er onmiddellijk vóór de teststap?
Wat veranderde onmiddellijk daarna?
Kan een andere engineer het resultaat begrijpen zonder de persoon te vragen die de test heeft uitgevoerd?
Dat is waar regressietesten meer wordt dan herhaald klikken.
Eén scherm kan correct zijn terwijl het proces fout is.
Een pickvenster kan er perfect uitzien terwijl de voorraad al is afgedreven.
Een document kan bestaan terwijl de status die het had moeten creëren nooit is opgetreden.
Een applicatie kan 100% weergeven terwijl een auditspoor stilletjes tegenspreekt.
COCO volgt de Flow omdat het in de Flow is dat deze tegenstrijdigheden zichtbaar worden.

Ergens tussen Control en Flow
Er is hier een interessante symmetrie.
Goede logistieke software probeert onzekerheid binnen een operatie te verminderen.
Goed testen probeert onzekerheid over de software die het uitvoert te verminderen.
De ene vraagt:
Waar is het artikel?
De andere vraagt:
Hoe weten we dat de software het nog weet?
De ene vraagt:
Is deze beweging voltooid?
De andere vraagt:
Welk bewijs toont aan dat de status correct is veranderd?
De ene vraagt:
Kan de volgende shift verdergaan?
De andere vraagt:
Kan de volgende engineer begrijpen wat er is gebeurd?
Verschillende vragen.
Hetzelfde instinct.
Maak de status zichtbaar.
Bewaar de redenering.
Verminder de hoeveelheid kennis die alleen in iemands hoofd bestaat.
Misschien is dat de connectie die we oorspronkelijk niet hadden gepland.

Engineering excellentie zonder het spandoek
Niemand klikt op een Engineering Excellence-knop.
Die is er niet.
En die zou er waarschijnlijk ook niet moeten zijn.
Engineering excellentie verschijnt indirect.
De magazijncontext overleeft een taalwissel.
Hetzelfde proces overleeft een ander Linux-platform.
Een voorraadbeweging blijft traceerbaar.
Een mobiele picker ziet precies wat nodig is en niets anders.
Een uitzondering onderbreekt het proces zonder de status ervan te vernietigen.
Het helpvenster legt de huidige context uit in plaats van generieke documentatie te tonen.
De documentketen komt overeen met de operationele volgorde.
De volgende engineer kan begrijpen wat er is gebeurd zonder de persoon te vragen die toevallig aanwezig was.
Er is genoeg theater beschikbaar in moderne software.
AI kan indrukwekkende demonstraties genereren.
Dashboards kunnen animeren.
Cijfers kunnen bewegen.
Video's kunnen er heel overtuigend uitzien.
Niets van dat alles bewijst dat twee voorraadoperaties niet stilletjes een onjuist resultaat kunnen produceren.
Niets van dat alles bewijst dat een uitzondering weken later nog kan worden gereconstrueerd.
Niets van dat alles bewijst dat de magazijnmedewerker, de dispatcher, en de ontwikkelaar naar dezelfde operationele waarheid kijken.

Engineering excellentie begint op een minder fotogenieke plek.

Met consistentie.
Met bewijs.
Met grenzen.


Met de bereidheid om de saaie delen saai te houden.
Onzichtbare betrouwbaarheid produceert zelden de meest dramatische screenshot.
Totdat je er bewust naar begint te zoeken.

Control. Clarity. Flow.
Control is weten welk magazijn, welk proces, en welke status actief zijn.
Clarity is begrijpen wat er veranderde, wanneer het veranderde, en waarom.
Flow is de operatie laten doorgaan zonder het verhaal erachter te verliezen.
Dat werkt voor logistiek.
Het werkt voor softwaretesten.
Het werkt verrassend goed voor engineering zelf.
Het eerste Flow-experiment gaf COCO de Administration.
Gebruikers.
Rollen.
Databases.
Talen.
Toen gaf iemand het een magazijn.
Toen meerdere talen.
Toen mobiel picken.
Toen voorraad.
Toen verplaatsingen.
Toen uitzonderingen.
Toen documenten.
Toen nog een besturingssysteem.
Op dit punt zouden we waarschijnlijk moeten stoppen met dingen toevoegen.
Waarschijnlijk zullen we dat niet doen.

Control. Clarity. Flow.

Ubuntu had zijn beurt.

Red Hat heeft de huidige.

De Flow blijft bewegen.

COCO blijft kijken.
En ergens in het midden van de laatste run werd het duidelijk dat er nog een vraag wacht achter deze.

Wij weten wat het is.
COCO weet wat het is.
Jij weet het niet.
Nog niet.


We zouden het je kunnen vertellen.

Maar dan zou je misschien stoppen met controleren of er een nieuw Insiders-artikel is verschenen.
En dat zou het experiment verpesten.

Gepubliceerd: 28.08.2026

Permalink →

Een brief van COCO

Een brief van COCO

Aan de engineer die deze repository voor het eerst opent:

Welkom.

Misschien ben je hier omdat er iets misliep.

Een dienst reageerde niet meer.

Een deployment gedroeg zich onverwacht.

Een alert maakte je midden in de nacht wakker.

Of misschien ben je gewoon nieuwsgierig hoe dit platform werkt.

Wat je ook hierheen heeft gebracht,

weet dat dit project precies voor zulke momenten werd gebouwd.

Niet om moeilijke problemen weg te nemen.

Maar om moeilijke problemen begrijpelijk te maken.

Je vindt hier code.

Je vindt hier documentatie.

Je vindt hier specificaties.

Maar belangrijker nog,

Wetenswaardigheden

Ideeën voor magazijndigitalisering die werken

Ideeën voor magazijndigitalisering die werken

Een ontbrekende pakbon vlak voor vertrek, een voorraadstand die op het schap anders lijkt dan in het spreadsheet, en drie medewerkers die tegelijk dezelfde vraag telefonisch ophelderen: precies daar ontstaan zinvolle ideeën voor magazijndigitalisering. Niet bij de vraag welke technologie momenteel trendy oogt, maar bij een concreet proces dat tijd kost, fouten veroorzaakt, of afhankelijk is van de kennis van individuele personen.

Voor kleine en middelgrote magazijn-, handels-, en productiebedrijven is digitalisering zelden één groot project. Het is een reeks duidelijk afgebakende verbeteringen. Het doel hoeft geen complex enterprise-warehouse-managementsysteem te zijn. Vaak is een slank hulpmiddel, toegesneden op het werkelijke proces, beter dan een suite met functies die niemand op de magazijnvloer gebruikt.

Ideeën voor magazijndigitalisering met operationele waarde

Het beste startpunt is een proces dat vaak voorkomt, gemakkelijk meetbaar is, en merkbaar verbetert voor medewerkers. Wie meteen het hele magazijn wil digitaliseren, bindt budget en aandacht voordat een oplossing zich in de dagelijkse praktijk heeft bewezen. Een beperkte eerste stap levert daarentegen solide data op voor de volgende beslissing.

1. Goederenontvangst met mobiele registratie

Bij de goederenontvangst ontstaan veel vervolgfouten: verkeerd geteld aantal, onopgeloste afwijkingen, vertraagd geboekte voorraden, en papieren documenten die later niet meer te vinden zijn. Een mobiel registratieformulier op een handscanner, tablet, of smartphone kan het proces aanzienlijk stabieler maken.

Medewerkers scannen het artikel en de leverreferentie, en leggen hoeveelheid, opslaglocatie, en de reden van eventuele afwijkingen rechtstreeks aan het laadperron vast. Als een batch, serienummer, of foto relevant is, hoort deze informatie bij exact hetzelfde record. De voorraad wordt niet pas aan het einde van de dienst in een spreadsheet nagevoerd; ze krijgt in plaats daarvan een navolgbare status bij daadwerkelijke ontvangst.

Dat betekent niet dat elke leverancier of elk artikel per se streepjescode-etiketten nodig heeft. Bij kleine, onregelmatige leveringen kan een zoekopdracht op artikelnummer volstaan. Doorslaggevend is dat de gegevensregistratie sneller verloopt dan de vorige omweg via papier en handmatig overtypen.

2. Digitale verplaatsingen in plaats van voorraadraadsels

Veel magazijnen weten in principe wat beschikbaar is, maar niet betrouwbaar waar het ligt. Goederen worden vooraf gehaald voor een order, tussentijds opgeslagen, naar montage gebracht, of bij plaatsgebrek op een vrije plek gezet. Zonder eenvoudige boeking wordt een voorraadvraag al snel een zoekactie.

Een verplaatsingsproces heeft geen ingewikkelde interface nodig. Bronlocatie scannen, doellocatie scannen, hoeveelheid bevestigen — meer is in de meeste gevallen niet nodig. Het systeem zou moeten controleren of artikel en opslaglocatie plausibel zijn, en een boeking eenduidig aan een persoon en tijdstip toewijzen.

De omgang met uitzonderingen is belangrijk. Een opslaglocatie kan geblokkeerd, overvol, of alleen voor bepaalde goederen toegestaan zijn. Deze regels zouden vastgelegd moeten worden waar ze echte schade voorkomen. Voor zeldzame bijzondere gevallen volstaat vaak een goedkeuringsstap door de magazijnleiding. Te veel verplichte velden maken van een nuttige applicatie een obstakel.

3. Orderpicking met duidelijke orderstatussen

Papieren picklijsten werken totdat prioriteiten wijzigen, posities ontbreken, of een order over meerdere gebieden verdeeld wordt. Een eenvoudige digitale picklijst toont welke order open is, welke posities al zijn gepickt, en waar verduidelijking nodig is. Dat vermindert vragen tussen magazijn, verkoop, en verzending.

Afhankelijk van de magazijngrootte kan de applicatie pickroutes voorschrijven of posities simpelweg per magazijnzone sorteren. Volledige routeoptimalisatie loont vooral bij veel dagelijkse orders en lange looproutes. In een compact magazijn levert een betrouwbare statusweergave vaak meer op dan een wiskundig perfecte route die niemand in de dagelijkse praktijk volgt.

Bij tekorten zou het systeem niet alleen rood moeten markeren. Het zou een concreet vervolgproces moeten aanbieden: voorraad controleren, vervangend artikel aanvragen, aanvulling triggeren, of order doorsturen ter verduidelijking. Digitalisering is waardevol wanneer ze de volgende zinvolle actie zichtbaar maakt.

4. Verzenddocumenten en labels uit echte ordergegevens

Het handmatig overzetten van adressen, gewichten, en artikelposities naar verzendportalen is een uitstekende kandidaat voor automatisering. Afleveradressen, afleverinstructies, verzendmethoden, en pakketinformatie bestaan idealiter één keer en worden gebruikt voor de pakbon, het verzendlabel, en de verzendbevestiging.

Een geschikt systeem kan labels genereren, documenten controleerbaar opslaan, en de order na het afdrukken automatisch op "verzendklaar" of "verzonden" zetten. Het operationele voordeel zit niet alleen in bespaarde minuten. Het zit erin dat verzendgegevens nooit tussen meerdere systemen uiteenlopen.

Hier is de koppeling doorslaggevend. Als een vervoerder geen bruikbare koppeling biedt of zeer uiteenlopende speciale regels hanteert, kan een halfgeautomatiseerd proces zinvoller zijn dan een kwetsbare volledige integratie. Saaie, bewijsbare betrouwbaarheid verslaat automatisering die bij elke uitzondering vastloopt.

5. Aanvulling en minimumvoorraden met navolgbare regels

Minimumvoorraden worden vaak in spreadsheets bijgehouden en dan genegeerd omdat niemand zeker weet of de cijfers nog kloppen. Een zinvolle digitale oplossing koppelt daadwerkelijke boekingen aan duidelijke voorraadregels. Ze kan melden wanneer een artikel onder een drempel zakt, gereserveerde hoeveelheden meenemen, en een bestellijst voorbereiden.

De drempel zou niet als eeuwige waarheid behandeld moeten worden. Seizoensvraag, levertijden, en minimale bestelhoeveelheden veranderen. Daarom heeft de verantwoordelijke persoon een eenvoudige manier nodig om voorstellen te beoordelen en regels aan te passen. Volledig automatische bestellingen zijn pas zinvol wanneer stamgegevens, leverancierslogica, en verbruiksgegevens stabiel genoeg zijn.

6. Traceerbaarheid voor batches, serienummers, en geblokkeerde voorraad

Wie met batches, apparaten, reserveonderdelen, of gereguleerde producten werkt, heeft meer nodig dan alleen een hoeveelheidsweergave. Het moet navolgbaar zijn welke goederen wanneer zijn binnengekomen, waarheen ze zijn verplaatst, en in welke klantorder ze terecht zijn gekomen.

Het project kan bewust klein beginnen: aanvankelijk alleen ontvangst en verzending van een kritieke productgroep vastleggen. Interne bewegingen en retouren volgen later. Een systeem dat elke boeking afdwingt maar het werkelijke reparatie- of inspectieproces niet kent, wordt omzeild. De vaklogica moet daarom voortkomen uit de werkwijze, niet uit een abstract datamodel.

Het juiste project kiezen

Het aantrekkelijkste idee is niet automatisch het juiste eerste idee. Beoordeel potentiële projecten op frequentie, foutkosten, wachttijd, en afhankelijkheid van individuele personen. Een proces dat 50 keer per dag draait en twee minuten per transactie bespaart, kan waardevoller zijn dan een zeldzame speciale functie met grote technische elegantie.

Ook datakwaliteit hoort bij de beslissing. Als artikelnummers dubbel voorkomen, opslaglocaties niet eenduidig benoemd zijn, of orders tegenstrijdig uit meerdere bronnen binnenkomen, zou het project deze basis eerst moeten opschonen. Software kan ontbrekende regels zichtbaar maken, maar kan ze niet betrouwbaar vervangen.

Voor prioritering volstaan vier vragen:

  • Welke activiteit veroorzaakt aantoonbaar de meeste vragen of herstelwerk?
  • Welke informatie wordt vandaag meerdere keren overgeschreven of telefonisch opgevraagd?
  • Welke fout zou de duurste gevolgen hebben voor klanten, voorraad, of verzending?
  • Welk proces kan in enkele weken worden getest met een duidelijke succesmeting?

Technische beslissingen die tellen in de dagelijkse magazijnpraktijk

Een magazijnapplicatie hoeft er niet spectaculair uit te zien. Ze moet begrijpelijk blijven bij slechte wifi-dekking, met handschoenen aan, onder tijdsdruk, en tijdens ploegwisselingen. Grote knoppen, duidelijke terugkoppeling na een scan, en zichtbare foutafhandeling zijn belangrijker dan decoratieve dashboards.

Ook de architectuur zou bij de operationele realiteit moeten passen. Een webgebaseerde applicatie met een schone databasestructuur kan op bestaande apparaten draaien en is makkelijker te onderhouden dan een geïsoleerde oplossing op één pc. Met een stabiele basis — zoals PHP 8.4, moderne JavaScript, en MySQL 8 — kunnen rollen, boekingsgeschiedenissen, koppelingen, en gedocumenteerde implementaties op lange termijn navolgbaar beheerd worden.

Niet elke informatie is voor elke rol bedoeld. Magazijnpersoneel heeft open taken en duidelijke boekingsdialogen nodig. Voorraadbeheer heeft waarschuwingen en bestelvoorstellen nodig. Het management heeft evaluaties nodig over doorlooptijden, verschillen, en openstaande transacties. Rolgebaseerde toegangsconcepten, logs, en accountvergrendelingen na herhaalde mislukte pogingen horen vroeg bij de planning, vooral wanneer externe dienstverleners of meerdere locaties betrokken zijn.

Invoering: eerst bewijzen, dan uitbreiden

Een pilot zou met echte orders moeten draaien, niet alleen met testdata in een vergaderruimte. Kies een magazijnzone, een productgroep, of een ploeg, en bepaal vooraf hoe succes herkenbaar is: minder correctieboekingen, kortere verwerkingstijd, minder vragen, of een hoger percentage voltooide boekingen op dezelfde dag.

Plan tegelijkertijd een terugvalniveau. Als de nieuwe applicatie uitvalt of een proces onduidelijk is, moet het team weten hoe verder te werken en hoe latere boekingen worden gecontroleerd. Dat is geen teken van gebrek aan vertrouwen in de techniek, maar van professionele bedrijfsvoering.

Na twee tot vier weken komen meestal de waardevolste inzichten naar boven. Misschien ontbreekt geen functie, maar een betere artikelmarkering. Misschien klopt de workflow, maar remt een scannerprofiel of een rechtenniveau. Deze observaties zouden in korte, gecontroleerde verbetercycli moeten stromen, in plaats van een nieuw groot project op te starten.

De beste digitalisering maakt de dagelijkse magazijnpraktijk niet theoretisch moderner, maar concreet rustiger: minder zoeken, minder handmatig overtypen, duidelijkere overdrachten, en betrouwbare informatie precies op het moment dat een beslissing aanstaande is.
Permalink →

Checklist voor het automatiseren van magazijnworkflows

Checklist voor het automatiseren van magazijnworkflows

Wanneer een goederenontvangst op papier wordt bevestigd, voorraadniveaus later in een spreadsheet worden overgezet, en een verzendvraag telefonisch wordt opgehelderd, voelt elke afzonderlijke stap beheersbaar aan. Samen leiden ze echter tot vragen, voorraadverschillen, en afhankelijkheid van individuele medewerkers.

Een checklist voor het automatiseren van magazijnworkflows voorkomt dat deze situatie voortijdig uitgroeit tot een te groot softwareproject. Ze scheidt processen die écht geautomatiseerd zouden moeten worden van die waarvoor een netjes bijgehouden spreadsheet voldoende blijft.

De checklist voor magazijnautomatisering vóór projectstart

Automatisering begint niet met het kiezen van een systeem. Ze begint met een verifieerbare beschrijving van wat er werkelijk in het magazijn gebeurt — ook tijdens uitzonderingen, ploegwisselingen en tijdsdruk. Loop de volgende punten rechtstreeks op procesniveau door met magazijnleiding, verzending, inkoop, en indien van toepassing de boekhouding.

1. Leg mutaties vast, niet alleen voorraden

Een actuele voorraad is het resultaat van mutaties. Daarom moet duidelijk zijn welke gebeurtenissen voorraad verhogen, verlagen, reserveren, blokkeren of overboeken. Hieronder vallen goederenontvangst, opslag, orderpicking, verzending, retouren, afkeur, voorraadverschillen en verplaatsingen.

Elke mutatie vraagt om een definitief antwoord op vier vragen: wie voert ze uit? Wanneer wordt ze geboekt? Welke opslaglocatie is betrokken? Welk document of welke order onderbouwt ze? Als deze antwoorden nu alleen in het hoofd van ervaren medewerkers bestaan, is dat een uitstekende kandidaat voor automatisering. Het doel is niet meer gegevens verzamelen, maar een robuuste geschiedenis waaruit elke voorraadstand te verklaren is.

2. Maak artikelen, varianten en eenheden schoon

Veel projecten mislukken niet door scanners of webinterfaces, maar door stamgegevens. Een artikel kan per doos worden ingekocht, per stuk worden opgeslagen, en in sets worden verkocht. Zonder vastgelegde omrekeningen levert de software formeel correcte maar operationeel foutieve hoeveelheden.

Controleer artikelnummers op duplicaten, stel bindende omschrijvingen vast, en onderscheid verkoopeenheden, opslageenheden en verpakkingseenheden. Serienummers, batches, houdbaarheidsdata of gevaarlijkestoffenclassificaties horen alleen in de eerste bouwfase thuis als ze dagelijkse beslissingen beïnvloeden of wettelijk verplicht zijn. Al het overige verhoogt vooral onderhoudslast en foutgevoeligheid.

3. Definieer opslaglocaties zo precies als nodig

"Hal 2" kan volstaan voor een voorraadlijst. Voor betrouwbaar orderpicken is dat meestal te grof. Bepaal of een locatie een zone, stelling, vak, slot of doorvoerruimte aanduidt. Quarantainegebieden, ontvangstzones, retourgebieden en verzendbuffers moeten ook als aparte locaties herkenbaar zijn als daar goederen kunnen staan.

De juiste mate van detail hangt af van het bedrijf. Een werkplaats met een paar honderd posities heeft niet per se bakbeheer nodig. Maar met meerdere pickers per ploeg kan een nauwkeurige opslagplek looppaden en zoektijden flink verkorten. Automatiseer geen precisieniveau dat niemand kan onderhouden.

4. Leg triggers, verantwoordelijke rollen, en goedkeuringen vast

Een workflow heeft een duidelijk startpunt nodig. Bij goederenontvangst kan dat de levering aan de dock zijn, de inkooporder bij inkoop, of het scannen van een pakbon. Voor bijbestellen kan een minimumvoorraad een voorstel triggeren, terwijl de definitieve bestelling bij een verantwoordelijke persoon blijft.

Documenteer verder welke acties automatisch mogen verlopen en welke controle vereisen. Een ontbrekende hoeveelheid zou een verschil moeten aanmaken, niet stilzwijgend de verwachte goederenontvangst wijzigen. Goedkeuringsstappen zijn zinvol voor waardevolle, batchbeheerde, of veiligheidskritische artikelen. Voor verbruiksartikelen zouden ze de doorstroom onnodig vertragen.

5. Genereer documenten waar ze nodig zijn

Pakbonnen, opslaglijsten, picklijsten, verzendlabels en overdrachtsprotocollen ontstaan vaak in verschillende applicaties. Dat leidt tot mediabreuken: een adres wordt gekopieerd, een order wordt afgevinkt, en de verzendstatus wordt later bijgewerkt.

Leg voor elk document de gegevensbron, het aanmaaktijdstip en de ontvanger vast. Een zinvolle workflow kan bijvoorbeeld automatisch een picklijst genereren na goedkeuring van een order, na het inpakken een verzendlabel aanleveren, en de order na overdracht met een tijdstempel sluiten. Het cruciale punt is dat gegevens niet meer meerdere keren handmatig hoeven te worden ingevoerd.

Controleer interfaces en datakwaliteit

De beste magazijnlogica heeft geen zin als orders maar eens per dag als bestand binnenkomen, of als bezorgadressen inconsistent zijn opgemaakt. Maak daarom een nuchtere lijst van systemen die gegevens versturen of ontvangen: webshop, ERP, boekhouding, vervoerder, leveranciersportaal, productiesysteem en bestaande spreadsheets.

Voor elke koppeling moet vaststaan welk systeem leidend is voor elk gegevensveld. Als artikelstamgegevens leidend zijn in het ERP, mag het magazijnportaal niet stilzwijgend eigen artikelen aanmaken. Als een orderwijziging uit de webshop komt, moet ze zichtbaar worden vóór verzending. Bij lage volumes kan een gecontroleerde CSV-import de juiste eerste stap zijn. Bij hoog volume of korte levertijden loont een directe koppeling.

Foutafhandeling is even belangrijk. Een koppeling zou niet alleen gegevens moeten overdragen, maar ook tonen wat is afgewezen en waarom. Onbekende artikelnummers, ongeldige adressen, of ontbrekende hoeveelheden mogen niet verdwijnen in een technisch logbestand. Ze vragen om een werklijst met aangewezen verantwoordelijkheid en status.

Ontwerp bruikbaarheid op de magazijnvloer

Een proces dat achter een bureau plausibel oogt, kan op de magazijnvloer falen. Medewerkers dragen handschoenen, verplaatsen goederen, delen apparaten, of werken met onstabiele wifi-dekking. Controleer daarom vroeg of scanners, tablets, vaste werkplekken, of afdrukken bij de betreffende werkstap passen.

Scannen zou duidelijke feedback moeten geven: correct artikel, verkeerde opslaglocatie, al geboekte hoeveelheid, of geblokkeerd artikel. Kleuren alleen zijn niet genoeg. Korte, begrijpelijke meldingen en een duidelijke volgende stap zijn onder tijdsdruk waardevoller dan een functierijke interface.

Plan ook voor uitzonderingen. Wat gebeurt er bij een beschadigde streepjescode, netwerkuitval, deellevering, of ontdekte niet-toegewezen goederen? Een goede workflow biedt hiervoor gecontroleerde paden en legt de correctie vast. Ze dwingt teams niet om te vertrouwen op post-its en latere batchboekingen.

Bepaal kengetallen vóór u dashboards bouwt

Een dashboard is geen doel. Relevante kengetallen zijn die welke een operationele beslissing uitlokken. Denk aan open goederenontvangsten die een vastgestelde ouderdom overschrijden, orders dicht bij hun verzenddeadline, voorraadverschillen per magazijnzone, pickfouten, of de tijd tussen orderontvangst en overdracht.

Leg voor elk kengetal de gegevensbron, de berekeningsregel, en de verantwoordelijke rol vast. "Voorraadnauwkeurigheid" is bijvoorbeeld pas zinvol als duidelijk is tegen welke telling ze wordt gemeten en hoe retouren of geblokkeerde voorraad worden behandeld. Enkele betrouwbare kengetallen zijn beter dan een muur vol grafieken die niemand vertrouwt.

Plan beveiliging, rechten, en traceerbaarheid

Automatisering verdeelt handelingsbevoegdheid. Wie voorraad mag wijzigen, artikelen mag aanmaken, verzendlabels mag genereren, of orders mag annuleren, zou bewust vastgesteld moeten worden. Rolgebaseerde rechten zijn meestal zinvoller dan een gedeelde login op de magazijn-pc. Bijzonder kritieke correcties vragen om een tijdstempel, een persoonstoewijzing, en idealiter een reden.

Technische basiszaken horen ook op de checklist: regelmatige back-ups, geteste hersteltests, gedocumenteerde toegangsgegevens, logging van koppelingsfouten, en een procedure voor geblokkeerde of gedeactiveerde gebruikersaccounts. Bij een maatwerktoepassing zijn onderhoudbare technologieën, een schone databasestructuur, en traceerbare implementatiestappen geen bijzaak. Ze bepalen of wijzigingen na twee jaar nog beheersbaar blijven.

Voer in met kleine, meetbare stappen

Probeer niet goederenontvangst, aanvulling, voorraadtelling, verzending en routeplanning tegelijk om te zetten. Kies een workflow met merkbare wrijving en beheersbaar risico, zoals het mobiel boeken van goederenontvangsten of het automatisch genereren van verzenddocumenten. Leg vóór de start de verwerkingstijd, correcties, en openstaande gevallen vast.

Test met echte artikelen, echte orders, en de medewerkers die er daadwerkelijk mee gaan werken. Een pilot met één magazijnzone of productgroep laat sneller dan een workshop zien of omschrijvingen, scanworkflows, en goedkeuringen werken. Pas als uitzonderingen beheerst worden, zou het volgende proces moeten volgen.

Automatisering slaagt wanneer teams minder vragen hoeven te stellen, voorraad verklaarbaar blijft, en het proces ook werkt wanneer de meest ervaren persoon met vakantie is. Precies daar loont de volgende verbetering: niet met het luidruchtigste hulpmiddel, maar met de wrijving die de werkdag écht vertraagt.

Permalink →

Mobiele website-laadtijd verbeteren

Mobiele website-laadtijd verbeteren

Wanneer een magazijn-smartphone met matige ontvangst wordt gebruikt om een site te openen, bepaalt niet de animatie in de hero-sectie de eerste indruk, maar of de pagina überhaupt interactief wordt. Als een potentiële klant drie, vier of vijf seconden op content wacht, is het alternatief maar één terug-knop verwijderd. De mobiele laadtijd verbeteren vraagt daarom geen cosmetische losse maatregelen, maar een navolgbare technische volgorde.

Dat geldt vooral voor websites die aanvragen moeten opleveren: voor een fabrikant, een logistiek dienstverlener of een bedrijf met uitlegbehoevende diensten. Mobiele gebruikers komen vaak tussen afspraken door, op de werkvloer, of via een zoekopdracht met een concrete intentie op de site. De website moet dan informatie leveren, niet eerst rekenwerk op het apparaat veroorzaken.

Waarom mobiele laadsnelheid een operationeel probleem is

Mobiele performance wordt vaak strikt als SEO-discipline behandeld. Dat is te kort door de bocht. Snelle pagina's helpen weliswaar bij vindbaarheid en campagnekosten, maar het directe effect zit in het gebruik: formulieren worden vaker verzonden, telefoonnummers vaker gebeld en productinformatie vaker grondig gelezen. Een trage website wekt daarentegen twijfel op nog voordat een aanspreekpunt kan reageren.

Daarbij is "snel" geen enkele meetwaarde. Een pagina kan vroeg een achtergrond tonen en toch pas veel later op klikken reageren. Voor bezoekers tellen drie dingen: wanneer verschijnt de belangrijkste content? Wanneer is de pagina zonder vertraging bedienbaar? En springt de layout nog terwijl ze net een knop willen aantikken? Deze vragen weerspiegelen zich in kengetallen zoals Largest Contentful Paint, Interaction to Next Paint en Cumulative Layout Shift.

Metingen moeten onder realistische omstandigheden plaatsvinden. Een krachtige kantoorcomputer op wifi verhult problemen die op een ouder Android-toestel op mobiel netwerk zichtbaar worden. Ook locatie, tussengeschakelde diensten en een al gevulde browsercache veranderen resultaten. Herhaalde metingen en echte gebruiksdata tellen daarom veel zwaarder dan één perfecte testrun.

Mobiele website-laadtijd verbeteren: eerst meten, dan wijzigen

De meest voorkomende fout is meteen afbeeldingen comprimeren of nog een optimalisatieplugin installeren. Beide kunnen helpen, maar zonder oorzaakanalyse ontstaan snel moeilijk te onderhouden configuraties. Controleer eerst een representatieve selectie: de homepage, een typische dienst- of productpagina, de contactpagina en een druk bezochte landingpagina. Op deze pagina's worden patronen zichtbaar.

Het netwerklog laat zien welke bestanden de start blokkeren en hoe groot ze daadwerkelijk zijn. Een performance-audit maakt zichtbaar of JavaScript de bediening vertraagt, of lettertypen te laat komen of afbeeldingen onnodig vroeg laden. Vul labmetingen aan met data van echte bezoekers, mits er voldoende verkeer is. Zo voorkomt u optimalisatie voor een testprofiel dat uw doelgroep niet weerspiegelt.

Stel vóór elke wijziging een duidelijk doel. Bijvoorbeeld: de zichtbare hoofdinhoud moet op een gemiddeld mobiel toestel binnen 2,5 seconden verschijnen, of het contactformulier moet zonder invoervertraging bruikbaar zijn. Niet elke pagina hoeft een theoretisch perfecte score te halen. Bij een complexe applicatie met geauthenticeerde gegevens gelden andere voorwaarden dan bij een publieke bedrijfswebsite. Saaie, bewijsbare betrouwbaarheid is hier waardevoller dan een kortetermijnscore via riskante trucs.

1. Afbeeldingen behandelen naar hun taak

Op veel mobiele pagina's blijven afbeeldingen het grootste databestand. Het probleem is niet de foto zelf, maar een afbeelding die in 2.500 pixels breedte wordt verzonden terwijl het toestel maar 700 pixels nodig heeft. Bied responsieve beeldvarianten aan zodat de browser de juiste maat kan kiezen. Moderne formaten zoals WebP of AVIF verkleinen bestandsgroottes vaak flink, maar moeten wel met schone fallbacks en gecontroleerde beeldkwaliteit worden ingezet.

De grootste afbeelding in het zichtbare startvenster verdient bijzondere aandacht. Ze moet correct bijgesneden zijn, een passende resolutie hebben en vroeg laden. Afbeeldingen verder naar beneden op de pagina kunnen vertraagd laden. Dat bespaart data bij binnenkomst, maar mag er niet toe leiden dat afbeeldingen zichtbaar bijladen tijdens het scrollen terwijl de gebruiker ze al verwacht.

Schrap niet reflexmatig alle afbeeldingen. Een goede afbeelding kan een machine, een team of een proces sneller uitleggen dan een alinea tekst. De technische taak is: relevante visuele informatie efficiënt aanleveren, geen vormgeving reduceren tot een grijs placeholder-blok.

2. JavaScript beperken tot noodzakelijk werk

Elk script concurreert bij het laden en bedienen om rekentijd. Bijzonder problematisch zijn generiek ingebonden bibliotheken, tagmanagers met veel externe scripts, chatwidgets, kaarten en animaties. Op desktopapparaten blijven deze kosten vaak onopgemerkt. Mobiel resulteren ze in een pagina die zichtbaar is maar traag reageert op invoer.

Controleer voor elk script het doel, de laadvoorwaarde en de zakelijke waarde. Een interactieve kaart op de contactpagina hoeft niet op elke subpagina te laden. Een cookie- of analysetool zou geen keten van extra bestanden moeten activeren voordat de bezoeker de content überhaupt kan lezen. Functies die pas na interactie nodig zijn, kunnen ook dan pas geladen worden.

Bij maatwerk-ontwikkelde websites is een duidelijke componentstructuur een echt voordeel. JavaScript wordt per functie gebundeld in plaats van als globaal pakket uitgeleverd. Dat vereenvoudigt ook later onderhoud: wie een formulier uitbreidt, wijzigt niet per ongeluk de code voor een productfilter of navigatie.

3. CSS en lettertypen zonder blokkades leveren

Een veelvoorkomend knelpunt zit in het eerste zichtbare gebied. Als daarvoor meerdere stylesheets, icon-fonts en externe lettertypevarianten moeten laden, wacht de browser onnodig lang. Kritieke stijlen voor het zichtbare gebied moeten klein en vroeg beschikbaar zijn. Niet-kritieke regels kunnen later volgen.

Bij webfonts volstaan meestal enkele letterdiktes. Vier gewichten in normaal, cursief en extra subsets ogen compleet in een designsysteem, maar zijn voor een typische bedrijfswebsite zelden nodig. Leg zinvolle systeem-fallbacks vast zodat tekst direct leesbaar blijft. Een lettertype dat enkele milliseconden later netjes wisselt, is beter dan lege tekstblokken.

Ook iconen verdienen een controle. Een kleine SVG-set is vaak efficiënter en preciezer aan te sturen dan een compleet icon-font. Dat is geen regel zonder uitzondering: bestaande systemen hoeven niet enkel voor een paar kilobyte opnieuw gebouwd te worden. Als er toch al grotere wijzigingen gepland staan, hoort deze beslissing wel bij de technische basis.

4. Caching en serverrespons netjes opzetten

Zelfs een slanke interface voelt traag aan als de server lang nodig heeft voor de eerste reactie. Oorzaken lopen uiteen van ongeremde databasequery's tot dynamisch samengestelde pagina's tot ontbrekende caching. Publieke content die zelden verandert, zou snel als cache-versie leverbaar moeten zijn. Statische bestanden zoals afbeeldingen, CSS en JavaScript hebben eenduidige versienamen en zinvolle cache-regels nodig.

Bij PHP-applicaties gaat het bovendien om efficiënte uitvoering, een correct geconfigureerde opcode-cache en gecontroleerde databasetoegang. MySQL-query's hebben indexen nodig die passen bij de daadwerkelijke filter- en sorteerpaden. Een homepage die bij elke aanroep meerdere onnodige dataquery's uitvoert, wordt niet beter naarmate het verkeer groeit.

Caching is echter geen vrijbrief. Prijzen, beschikbaarheid, gepersonaliseerde secties of content na een login mogen nooit per ongeluk verouderd lijken. Daarom worden cachegrenzen inhoudelijk gedefinieerd: wat mag vijf minuten oud zijn, wat moet direct actueel zijn, en wie leegt de cache na een contentwijziging? Goede performance ontstaat uit die precisie.

5. Derde partijen kritisch behandelen

Externe diensten zijn vaak de onzichtbare ballast van een website. Analytics, consent-beheer, video's, kaarten, reviewwidgets en marketingpixels laden extra scripts van extra servers. Elke afhankelijkheid kan vertragingen veroorzaken, privacyvragen oproepen en bij fouten de weergave beïnvloeden.

Dat betekent niet dat elke externe tool verwijderd moet worden. Een video kan verkoop ondersteunen, een analysetool kan belangrijke beslissingen onderbouwen. Maar er is een kosten-batenanalyse nodig. Laad ingesloten media pas na toestemming of interactie. Gebruik voor kaarten eerst een voorbeeldweergave. En verwijder ten slotte tags waarvan niemand al maanden de resultaten evalueert.

6. Layoutsprongen en mobiele bediening meenemen

Laadtijd en bedienbaarheid horen bij elkaar. Reserveer voor afbeeldingen, banners en ingesloten elementen vaste afmetingen zodat knoppen niet onder de vinger van de gebruiker wegspringen. Vermijd pop-ups die de zichtbare content direct bij binnenkomst afdekken. Een snelle pagina die meteen een lastig te sluiten overlay toont, lost het onderliggende probleem niet op.

Test formulieren extra zorgvuldig. Grote invoervelden, passende toetsenbordtypes en korte verplichte trajecten helpen meer dan een bewerkelijk visueel effect. Als een aanvraag alleen naam, terugbelnummer en onderwerp nodig heeft, is een formulier in twaalf delen geen teken van grondigheid — het is wrijving.

7. Performance als vast operationeel proces voeren

Eén relaunch houdt de laadtijd niet blijvend laag. Nieuwe campagnebeelden, trackingvereisten en redactionele modules tellen na verloop van tijd op. Daarom horen performance-budgetten in het ontwikkelproces: een maximale grootte voor entreebeelden, duidelijke regels voor nieuwe derde-partij-tools en gedefinieerde grenswaarden voor JavaScript.

Na releases moeten de belangrijkste paginatypes opnieuw gecontroleerd worden. Geautomatiseerde tests kunnen daarbij vaststellen of centrale pagina's bereikbaar blijven en kritieke workflows functioneren. Voor performance volstaat een pure functionele test echter niet. Vul die aan met metingen van reactietijd, overgedragen datavolume en mobiele interactiviteit.

Een snelle mobiele website ontstaat niet door één plugin, en ook niet door verzaking tegen elke prijs. Ze ontstaat wanneer design, content, infrastructuur en werkelijk gebruik samen worden beschouwd. Begin bij de pagina die aanvragen of operationele contacten oplevert, meet onder eerlijke omstandigheden en verwijder wrijving precies waar gebruikers die daadwerkelijk voelen.

Permalink →

Logistieke software die de operatie écht verlicht

Logistieke software die de operatie écht verlicht

Wanneer een goederenontvangst eerst op papier wordt genoteerd, later naar een spreadsheet wordt overgezet en vervolgens mondeling aan verzending wordt doorgegeven, ontbreekt zelden de inzet van de medewerkers. Wat ontbreekt is een gedeelde, betrouwbare werkbasis. Goede logistieke software vervangt deze breuken niet door meer schermwerk, maar door duidelijke workflows: wat is er binnengekomen, waar ligt het, wat is gereserveerd, en wat kan er vandaag verzonden worden?

Voor kleine en middelgrote ondernemingen telt niet de langst mogelijke lijst met functies. Doorslaggevend is dat de software het werkelijke werk op de magazijnvloer, op kantoor en bij verzending weergeeft. Een oplossing bedoeld voor een wereldwijd concern met twintig locaties kan onnodig traag, duur en gecompliceerd zijn voor een bedrijf met één magazijn en twee ploegen.

Wanneer logistieke software écht zinvol is

Spreadsheets zijn op zichzelf geen probleem. Bij lage aantallen, een overzichtelijke artikelstamlijst, en één verantwoordelijke medewerker, kunnen ze de meest pragmatische oplossing zijn. Het zou verkeerd zijn een goed functionerend proces te vervangen door een project puur om het moderniseren zelf. Het kantelpunt komt wanneer informatie meerdere keren moet worden bijgehouden of niemand met zekerheid kan zeggen welk bestand actueel is. Typische signalen zijn voorraadtekorten ondanks volle schappen, vragen over de status van leveringen, handgeschreven pakbonnen, en inventarisaties die het bedrijf dagenlang platleggen. Groeiende ordernummers maken ook zichtbaar welke stappen voorheen alleen bijeen werden gehouden door de ervaring van individuele medewerkers.

Dan gaat het niet primair om digitalisering als modewoord. Het gaat om foutbronnen en wachttijden. Een medewerker zou niet eerst meerdere lijsten moeten vergelijken alleen om een order goed te keuren. Verzending zou niet moeten hoeven raden of een artikel daadwerkelijk beschikbaar is of al gereserveerd voor een andere order.

Welke processen logistieke software zou moeten verbinden

Een bruikbare oplossing begint bij de materiaalstroom, niet bij een standaardmenu. Voor veel bedrijven omvat deze stroom goederenontvangst, opslag, voorraadbeheer, orderpicking, verzending, en terugkoppeling. Afhankelijk van het bedrijf komen daar batches, serienummers, retouren, productieorders, of routeplanning bij.

Goederenontvangst met traceerbare voorraden

Veel wordt beslist bij de goederenontvangst. Als een levering direct tegen een order of pakbon wordt gecontroleerd, kunnen hoeveelheidsverschillen, beschadigde goederen, en ontbrekende posities precies daar worden vastgelegd waar ze zich voordoen. De goederen krijgen een status in plaats van gewoon ergens fysiek te worden neergezet.

De software hoeft niet per se te beginnen met dure scannerhardware. In sommige magazijnen volstaat een tablet of een werkplek bij de goederenontvangst om te beginnen. Waar dagelijks veel posities worden verplaatst, zijn barcodescanners echter zinvol omdat ze boekingen versnellen en typefouten verminderen. De juiste keuze hangt af van hoeveelheden, routes, en artikelstructuur.

Magazijnmutaties zonder geheugenlog

Voorraden zijn alleen weerbaar als ontvangsten, verplaatsingen, verwijderingen, en correcties traceerbaar zijn. Dat betekent niet dat elke uitzondering voorkomen moet worden. In de dagelijkse praktijk zijn er beschadigde verpakkingen, foutieve opslag, en spontane materiaalonttrekkingen. Een goede applicatie maakt deze gevallen boekbaar, maar documenteert ook wie wat wanneer heeft veranderd.

Deze geschiedenis is geen controle-instrument om zichzelf. Het helpt oorzaken te vinden. Als een artikel herhaaldelijk op de verkeerde magazijnlocatie belandt, is de magazijnetikettering mogelijk onduidelijk. Als er regelmatig correcties plaatsvinden, ligt het probleem vaak in het proces vóór de boeking.

Orders, pakbonnen, en verzending vanuit één workflow

Veel teams verliezen tijd op het raakvlak tussen orderverwerking en verzending. Orderdata komt binnen via e-mail, telefoon, of vanuit een apart webshopsysteem. Vervolgens worden posities afgedrukt, voorraden gecontroleerd, en verzenddocumenten opnieuw geregistreerd. Elke handmatige overdracht creëert ruimte voor afwijkingen.

Logistieke software zou een duidelijke picklijst, een pakbon, en, indien nodig, een verzendlabel moeten kunnen genereren vanuit een goedgekeurde order. De volgorde is hier belangrijk: eerst moet duidelijk zijn wat leverbaar is. Daarna zou de order voor andere processen gereserveerd moeten worden. Anders ontstaat de vervelende situatie waarin twee medewerkers dezelfde resterende voorraad toewijzen.

Planning die bij de werkelijkheid past

Routeplanning en capaciteitscontrole kunnen waardevol zijn, vooral bij eigen bezorging, vaste tijdvensters, of veel regionale stops. Ze zijn echter niet automatisch de volgende zinvolle stap. Wie nog geen schone ordergoedkeuring en betrouwbare voorraadgegevens heeft, zou eerst die fundamenten moeten oplossen.

Hetzelfde geldt voor prognoses en AI-ondersteunde planning. Ze kunnen patronen zichtbaar maken, maar vereisen schone invoergegevens. Een prognose gebaseerd op onvolledige voorraad oogt technisch geavanceerd, maar verbetert de leverbetrouwbaarheid niet.

Standaardoplossing of logistieke software op maat?

Standaardsoftware is zinvol wanneer de eigen workflows grotendeels conventioneel zijn en zonder grote wrijving kunnen worden aangepast. Ze kan sneller worden ingevoerd en brengt beproefde kernfuncties mee. Voor een bedrijf met eenvoudige magazijnprocessen, duidelijke rollen, en weinig bijzonderheden is dat vaak de economisch juiste keuze.

Maatwerk logistieke software is de moeite waard wanneer het bedrijf leeft van bijzondere workflows of bestaande systemen alleen via omwegen gekoppeld kunnen worden. Dit betreft bijvoorbeeld werkplaatsen met materiaalproblemen bij lopende orders, dealers met klantspecifieke verzendregels, of fabrikanten die magazijnmutaties strak moeten koppelen aan productiestappen.

Het verschil zit niet in alles opnieuw uitvinden. Goede maatwerksystemen nemen beproefde patronen over, zoals statuswijzigingen, reserveringen, en rechten. Ze passen echter taal, schermen, documenten, en interfaces aan het werk aan dat daadwerkelijk wordt uitgevoerd. Zo hoeft het team zich niet permanent te oriënteren op categorieën die alleen zinvol zijn in het handboek van de leverancier.

Bij softify.pro begint zo'n traject daarom met de vraag welke workflows behouden moeten blijven. Niet elk briefje is een fout, en niet elke bijzondere regel is zinvol. Pas als duidelijk is waar informatie verloren gaat of beslissingen onnodig wachten, kan een haalbare oplossing worden gepland.

Een uitrol zonder operationele onderbreking

Het grootste risico zit zelden alleen in de programmacode. Het zit in een implementatie die te veel tegelijk wil veranderen. Een magazijn kan niet twee weken pauzeren om een nieuw systeem te leren. Daarom is een stapsgewijze uitrol meestal zinvoller dan één grote overstapdatum.

Een goed eerste onderdeel richt zich op een afgebakende workflow, bijvoorbeeld goederenontvangst en voorraadboekingen of het aanmaken van pakbonnen. Het team werkt met echte gegevens, feedback stroomt direct terug in de aanpassing, en het voordeel wordt meetbaar. Pas daarna volgen verdere gebieden, zoals mobiel picken, retouren, of koppelingen met webshops en vervoerders.

Datamigratie verdient hier speciale aandacht. Oude artikelnummers, dubbele klantstamgegevens, en inconsistente opslaglocaties verdwijnen niet automatisch alleen omdat een nieuw systeem wordt ingevoerd. Het is vaak beter om bewust de stamgegevens op te schonen en alleen relevante geschiedenissen over te nemen. Dat bespaart later zoekwerk en voorkomt dat oude wanorde technisch behouden blijft.

Rechten horen ook vroeg op de agenda. Niet elke medewerker heeft toegang nodig tot prijzen, alle voorraadcorrecties, of stamgegevensbeheer. Duidelijke rollen beschermen tegen onbedoelde wijzigingen en maken verantwoordelijkheden zichtbaar zonder de workflow te blokkeren met onnodige goedkeuringen.

Technologie die na go-live geen last wordt

Een logistieke applicatie moet snel reageren in de dagelijkse praktijk, ook als meerdere werkplekken tegelijk boeken. Daarvoor is een traceerbare data-architectuur nodig, schone transacties, en duidelijke regels voor parallelle wijzigingen. Als twee medewerkers dezelfde voorraad verwerken, mag het systeem geen stille foutieve boekingen genereren.

Onderhoudbaarheid is even belangrijk. Technologieën zoals PHP 8.4, moderne JavaScript, en MySQL 8 zijn op zichzelf geen verkoopargument. Ze zijn zinvol wanneer de applicatie op lange termijn begrijpelijk blijft, beveiligingsupdates ontvangt, en door gekwalificeerde ontwikkelaars kan worden voortgezet. Gedocumenteerde provisioning, back-ups, logging, en een realistische omgang met updates horen bij operationele capaciteit.

Goede logistieke software wordt daarom niet herkend aan een bijzonder gladde demo. Ze bewijst zichzelf op een gewone dinsdagochtend: de levering wordt geboekt, de voorraad klopt, de order is traceerbaar, de pakbon komt overeen, en de volgende ploeg weet wat al gedaan is. Verlichting ontstaat precies daar — niet door zoveel mogelijk functies, maar door betrouwbare workflows die bij het bedrijf passen.

Permalink →

Een MySQL-database plannen voor webapplicaties

Een MySQL-database plannen voor webapplicaties

Wanneer drie medewerkers 's ochtends parallel goederen boeken, een klant de leveringsstatus controleert en de administratie een factuur opstelt, zie je de kwaliteit van een applicatie niet aan het ontwerp. Ze blijkt uit het feit dat iedereen precies dezelfde, correcte gegevensstatus ziet. Een MySQL-database plannen voor een webapplicatie betekent daarom niet zo snel mogelijk tabellen aanmaken. Het betekent echte workflows precies genoeg begrijpen om te garanderen dat gegevens betrouwbaar blijven, zelfs onder belasting, tijdens fouten, en naarmate het bedrijf groeit.

Vooral bij interne platforms, magazijn- en orderprocessen, of klantgerichte portals wordt de database vaak te laat aangepakt. Eerst wordt de interface gebouwd, dan worden velden toegevoegd, gevolgd door uitzonderingen. Dat werkt voor een prototype. In de praktijk resulteert dit in dubbele datasets, onduidelijke statussen, en rapporten die niemand meer volledig vertrouwt.

Een MySQL-database plannen voor webapplicaties: begin bij de workflow

Het eerste ontwerp zou niet moeten beginnen met kolomnamen, maar met een concrete werksituatie. Neem de goederenontvangst: een levering komt aan, wordt toegewezen aan een leverancier en een order, hoeveelheden worden gecontroleerd, een magazijnlocatie wordt toegewezen, en de voorraad verandert. Afhankelijk van de bewerking vraagt dit proces bovendien om foto's, een kwaliteitscontrole, een blokkeerstatus, of een traceerbare correctie. Uit deze workflow ontstaan de functionele objecten. Typische voorbeelden zijn artikelen, leveranciers, orders, posities, magazijnlocaties, voorraadmutaties, en gebruikers.

Het onderscheid tussen een object en een gebeurtenis is cruciaal. Een artikel beschrijft wat iets is. Een voorraadmutatie documenteert dat een hoeveelheid op een specifieke locatie op een specifiek moment is veranderd. Beide mengen in één tabel leidt snel tot verlies van traceerbaarheid.

Een paar lastige vragen helpen voor elk object: wat is de unieke identiteit? Welke informatie mag veranderen? Wie mag die wijzigen? Welke gegevens moeten historisch bewaard blijven? En welke regels gelden wanneer twee personen gelijktijdig werken? Deze vragen voorkomen latere improvisatie beter dan een lange lijst van zogenaamd complete databasevelden.

Het datamodel moet regels tot uitdrukking brengen

Een database is niet slechts opslag voor formulierinvoer. Ze zou zelf centrale regels moeten afdwingen. Als elke voorraadmutatie precies bij één artikel en één magazijnlocatie moet horen, horen foreign keys in het model thuis. Als een extern ordernummer maar één keer per tenant mag voorkomen, is een unieke index vereist. Als een positie nooit zonder een hoofdorder mag bestaan, moet deze relatie duidelijk gemodelleerd worden.

MySQL 8 met InnoDB biedt hiervoor een stevige basis: transacties, foreign keys, vergrendelingsmechanismen, en consistente wijzigingen over meerdere tabellen. Bij het schrijven van een mutatie, actuele voorraad, en inspectielog tijdens een goederenontvangstboeking zou dit als één samenhangende transactie moeten gebeuren. Als één stap mislukt, mag er geen halfvoltooide bewerking overblijven.

Toch hoort niet elke regel in de database. Goedkeuringen, complexe prijslogica, of roladhankelijke processtappen zijn vaak beter geplaatst in applicatielogica, omdat ze functioneel sneller veranderen. De grens is pragmatisch: regels waarvan overtreding blijvende schade aan gegevens toebrengt, zouden zo dicht mogelijk bij de gegevens beveiligd moeten worden. Regels die vaak veranderen of sterk contextafhankelijk zijn, vereisen goed geteste applicatiecode.

Verwar geschiedenis niet met huidige waarden

Een veelgemaakte fout is alleen de huidige voorraad of huidige status op te slaan. Dat volstaat totdat iemand vraagt waarom de hoeveelheid gisteren is veranderd of wie een order heeft teruggezet. Voor operationele systemen is een geschiedenis van mutaties of gebeurtenissen vaak waardevoller dan één overschrijfbaar veld.

Dit betekent niet dat elke klikbeweging permanent gelogd moet worden. Bedrijfsrelevante wijzigingen zouden gelogd moeten worden: statuswijzigingen, hoeveelheidsaanpassingen, correcties, goedkeuringen, en toewijzingen. Een goede auditregel bevat een tijdstempel, de gebruiker of het systeemproces, de vorige en nieuwe waarde, en een begrijpelijke reden wanneer de workflow dat vereist. Dit maakt het mogelijk fouten te verhelderen zonder door e-mails, papieren lijsten, of databaseback-ups te hoeven zoeken.

Kies bewust sleutels, datatypes, en naamgevingsconventies

Technische beslissingen lijken klein, maar bepalen jarenlang onderhoud en integraties. Voor interne primaire sleutels zijn BIGINT-waarden met automatische toewijzing vaak een nuchtere, goed beheersbare keuze. UUID's kunnen zinvol zijn wanneer gegevens offline ontstaan, meerdere systemen onafhankelijk schrijven, of externe interfaces geen opeenvolgende ID's zouden mogen tonen. Ze kosten echter meer opslag en vragen wat meer aandacht bij indexen en sorteren.

Geldbedragen horen opgeslagen te worden als DECIMAL, niet als FLOAT of DOUBLE. Hoeveelheden hebben ook een functioneel passende precisie nodig: artikelaantallen zijn vaak gehele getallen, terwijl gewichten en lengtes dat niet zijn. Tijdstempels zouden uniform behandeld moeten worden, idealiter intern in UTC, terwijl de interface de lokale tijdzone van de bewerking toont. Vooral bij ploegwisselingen en zomertijd voorkomt dit lastig te vinden discrepanties.

Namen zouden ook saai en ondubbelzinnig moeten zijn. order_items of inventory_movements zijn nuttiger dan creatieve afkortingen die alleen het oorspronkelijke projectteam begrijpt. Consistente enkelvouds- of meervoudsvormen zijn minder belangrijk dan consistentie zelf. Even zinvol zijn velden zoals created_at, updated_at, en, indien nodig, deleted_at. Een soft delete is echter geen standaardverplichting. Voor juridisch of operationeel relevante records is een nette annulering meestal beter dan een onzichtbaar verwijderde dataset.

Indexen volgen echte queries, geen giswerk

Een index kan een zoekopdracht enorm versnellen, maar maakt schrijfbewerkingen complexer en verbruikt opslagruimte. Daarom is "een index op elk veld" geen strategie. De belangrijkste queries zouden vroeg vastgesteld moeten worden: openstaande orders van een klant, mutaties van een artikel binnen een periode, voorraad per magazijnlocatie, of recent gewijzigde records voor een interface.

De volgorde van samengestelde indexen is hier van belang. Als de applicatie regelmatig zoekt op tenant_id, status, en created_at, is een samengestelde index in precies deze volgorde vaak zinvol. Of hij echt past, blijkt uit het uitvoeringsplan via EXPLAIN, niet uit een onderbuikgevoel. Databases worden niet snel gemaakt door spectaculaire trucs, maar door observeerbare queries, passende indexen, en realistisch geteste datavolumes.

Voor groeiende tabellen loont een duidelijke retentiestrategie. Moeten technische logs vijf jaar in de primaire productiedatabase blijven staan? Niet per se. Zakelijke records, mutaties, en inspectiebewijzen vragen om andere bewaartermijnen dan debuginformatie. Archiveren is geen teken van een zwak systeem, maar een bewuste operationele beslissing.

Multi-user gebruik vraagt om transacties en duidelijke statussen

In een webapplicatie benaderen meerdere verzoeken tegelijk dezelfde gegevens. Dat is normaal in de dagelijkse magazijnpraktijk, geen uitzondering. Twee medewerkers kunnen dezelfde voorraad boeken terwijl een import nieuwe orders aanmaakt. Zonder transacties en gerichte vergrendeling bestaat het risico op verloren wijzigingen of negatieve voorraden die pas weken later aan het licht komen.

Voor kritieke bewerkingen zou duidelijk moeten zijn welke gegevens binnen een transactie gelezen en geschreven worden. Soms volstaat een atomaire update, zoals voorraad die alleen wijzigt als de beschikbare hoeveelheid toereikend is. In andere gevallen is een rijvergrendeling zinvol, zodat een bewerking de gegevensstatus gecontroleerd kan controleren en daarna kan aanpassen. Lange transacties zijn daarentegen problematisch: ze blokkeren ander werk en verhogen het risico op conflicten.

Even belangrijk is een beperkte set functionele statussen. Een order zou niet tegelijk "open", "gedeeltelijk geleverd", en "handmatig verwerkt" moeten zijn door het onderhouden van tegenstrijdige velden. Gedefinieerde statusovergangen maken interfaces, rapportages, en automatiseringen eenvoudiger. Uitzonderingen mogen toegestaan zijn, maar zouden benoemd en gedocumenteerd moeten worden.

Plan beveiliging, tenants, en beheer vanaf het begin

De applicatie zou een dedicated databasegebruiker voor MySQL met minimale rechten moeten gebruiken. Schrijftoegang voor de webapplicatie betekent niet dat deze gebruiker tabellen mag verwijderen of gebruikersrechten mag wijzigen. Administratieve accounts horen niet thuis in productieconfiguratiebestanden en nooit in een repository.

Wanneer meerdere klanten, locaties, of bedrijven binnen één applicatie werken, is tenant-isolatie een architecturale beslissing, geen achteraf toegevoegde filtervoorwaarde. Een gedeelde database met een tenant_id kan efficiënt en goed onderhoudbaar zijn, maar vereist consistente controles in elke query en duidelijke regels voor indexen. Aparte databases bieden sterkere isolatie, maar verhogen de inspanning bij updates, evaluaties, en beheer. Welke variant past, hangt af van privacyvereisten, datavolume, en bedrijfsmodel.

Back-ups zijn pas back-ups zodra een herstel getest is. Een vastgesteld ritme voor back-ups, retentie, en herstel is vereist. Ook monitoring van opslagruimte, trage queries, en mislukte taken, samen met gedocumenteerde updates, horen bij het systeem. MySQL 8, PHP 8.4, en moderne webapplicaties kunnen goed op de lange termijn beheerd worden als afhankelijkheden, toegangsgegevens, en implementatiestappen niet enkel in het hoofd van één ontwikkelaar zitten.

Een zinvol plan vóór de eerste productiedag

Vóór de implementatie zou een compact datamodel met voorbeeldworkflows moeten bestaan. Dit omvat kerntabellen en relaties, statusregels, rechten, verwachte queries, interfaces, en een concept voor back-ups en auditlogs. Dit plan hoeft geen honderd pagina's lang te zijn. Het moet beslissingen vastleggen die later duur zouden zijn om te corrigeren.

Bij softify.pro begint databaseplanning daarom bij de mensen die boeken, controleren, picken, of uitzonderingen oplossen. Als een bestaande spreadsheet een beheersbaar proces betrouwbaar in kaart brengt, kan die de juiste oplossing blijven. Als meerdere mensen tegelijk werken, records ontstaan, en fouten traceerbaar moeten zijn, verdient de database daarentegen dezelfde planningsinspanning als de interface. De beste architectuur is uiteindelijk die welke de werkdag vereenvoudigt en die over twee jaar nog steeds transparant aangepast kan worden.

Permalink →

Warehouse Automation Results juist meten

Warehouse Automation Results juist meten

Een nieuwe scaninterface kan op de eerste dag indrukwekkend overkomen. Na drie weken blijkt echter of ze de goederenontvangst écht versnelt of gewoon een extra werkstap toevoegt. Warehouse automation results zijn daarom geen enkele kengetal en ook geen screenshot uit een productdemo. Ze tonen zich daar waar een magazijnteam minder hoeft te zoeken, na te vragen, opnieuw te boeken en te corrigeren — bij gelijkblijvende of betere kwaliteit.

Voor kleine en middelgrote ondernemingen is dit onderscheid bijzonder relevant. Grote enterprise-suites beloven vaak volledige optimalisatie, maar vergen lange invoeringstrajecten, starre processen en veel onderhoud. Een zinvolle automatiseringsstap mag kleiner beginnen: precies op het punt waar vandaag informatie verloren gaat of beslissingen onnodig wachten.

Welke Warehouse Automation Results er echt toe doen

Veel projecten beginnen met een technische vraag: barcodescanner, mobiele app, koppeling met de webshop of automatische labels? De betere startvraag is: welk knelpunt kost per dienst merkbaar tijd, geld of betrouwbaarheid?

Het antwoord ligt zelden bij het aantal ingezette apparaten. Betekenisvolle resultaten laten zich meten in het dagelijkse werk. Bij de goederenontvangst telt bijvoorbeeld de tijd tussen levering en beschikbaar geboekte voorraad. Bij het picken is de tijd van order tot verzendgereedheid relevant. Bij inventarisaties is niet alleen de duur bepalend, maar vooral het verschil tussen systeemvoorraad en werkelijke voorraad.

Even belangrijk zijn kengetallen die veel bedrijven niet netjes vastleggen: hoeveel vragen ontstaan omdat een magazijnlocatie onduidelijk is? Hoe vaak moet een pakbon worden gecorrigeerd? Hoeveel orders blijven liggen omdat maar één persoon de status uit het hoofd of in een privé-Excelbestand kent? Precies dit stille nawerk verdwijnt uit klassieke productiviteitsrapporten, maar belast wel ploegleiders, planning en klantenservice zwaar. Een goed streefbeeld combineert snelheid en controle. Worden orders sneller afgehandeld terwijl foutieve boekingen toenemen, dan is dat geen vooruitgang. Worden voorraden nauwkeuriger maar loopt de goederenontvangst vast, dan moet het proces anders worden ingericht. Automatisering slaagt wanneer ze de workflow verbetert zonder het operationele overzicht te verslechteren.

Van ervaren verlichting naar aantoonbare data

De ervaring van medewerkers is een waardevolle indicator. Als iemand na twee weken zegt niet meer voor elke opslag naar kantoor te hoeven lopen, telt dat mee. Voor investeringsbeslissingen is toch een vergelijking nodig die niet afhangt van het dagelijkse gevoel. Voor de start moeten daarom enkele uitgangswaarden worden vastgelegd: gemiddelde verwerkingstijd, aantal openstaande verhelderingsgevallen, correctieboekingen, zoektijden, verzendfouten en voorraadnauwkeurigheid. Twintig kengetallen zijn niet nodig; vier tot zes waarden die bij het concrete probleem passen, volstaan vaak.

Na de uitrol moeten diezelfde waarden over meerdere weken worden gevolgd. Losse piekdagen misleiden gemakkelijk. Seizoensinvloeden, ziekte, nieuwe medewerkers of een ongewoon grote order beïnvloeden de resultaten. Pas een vergelijking over normale diensten toont of de verandering standhoudt.

Het belangrijkste effect: een gedeelde processtatus

In veel magazijnen is de eigenlijke zwakte niet een gebrek aan werkbereidheid, maar een versnipperde informatiestand. Goederenontvangst kent de levering, planning kent de klantorder en verzending kent de prioriteit — maar niet iedereen werkt met dezelfde actuele informatie.

Een workflow-specifiek systeem kan die breuk dichten. Een levering wordt bij aankomst geregistreerd, afwijkingen worden direct gedocumenteerd, de voorraad krijgt een duidelijke status en de volgende stap wordt zichtbaar. Gegevens hoeven niet meer eerst op papier te worden genoteerd, later te worden overgetypt en vervolgens telefonisch te worden bevestigd.

Dat vermindert niet alleen loopafstanden. Het vermindert beslissingen op basis van verouderde informatie. Een verzendmedewerker ziet of een order echt picbaar is. De administratie herkent of goederen daadwerkelijk zijn binnengekomen of alleen zijn aangekondigd. De directie krijgt geen opgepoetst momentopname, maar een navolgbare basis.

Voor teams met wisselende diensten is dit effect vaak waardevoller dan een spectaculaire tijdsbesparing. Het proces wordt minder afhankelijk van individuele personen. Kennis blijft niet hangen in notitieboekjes, chatgeschiedenissen of het geheugen van de meest ervaren medewerker.

Waarom niet elke automatisering goede resultaten oplevert

Automatisering versterkt processen. Dat is nuttig wanneer het verloop duidelijk is. Het is problematisch wanneer een onduidelijk verloop gewoon sneller wordt gereproduceerd.

Een typisch voorbeeld is de verplichte scanboeking voor elke kleinste handeling. Als medewerkers voor een zeldzame uitzondering meerdere schermen moeten openen, ontstaan omwegen. Artikelen worden dan later verzameld geboekt, scanners blijven in de la liggen, of een medewerker houdt weer een schaduwlijst bij. De software is er, maar het echte proces loopt er gewoon naast door.

Ook de datakwaliteit stelt grenzen. Artikelstamgegevens zonder eenduidige eenheden, onduidelijke locatie-logica of inconsistente leveranciersnamen laten zich niet genezen door een fraaie interface. Hier kan een project aanvankelijk bestaan uit opruimwerk. Dat oogt minder zichtbaar dan een nieuwe applicatie, maar is vaak de voorwaarde voor betrouwbare resultaten.

Daarnaast zijn er processen die bewust niet volledig geautomatiseerd zouden moeten worden. Een ervaren controle bij gevoelige goederen, een goedkeuring bij ongewone afwijkingen of de beslissing over een speciale levering vragen om vakkundig oordeel. Goede systemen markeren zulke gevallen duidelijk en leiden ze gericht door. Ze doen niet alsof elke uitzondering met een regel is af te handelen.

Wanneer een spreadsheet nog steeds de betere oplossing is

Niet elke handmatige stap rechtvaardigt maatwerkontwikkeling. Als een proces zelden voorkomt, weinig betrokkenen kent en navolgbaar wordt beheerd, kan een goed onderhouden spreadsheet zinvol blijven. De fout zit niet in Excel zelf, maar in het beheren van kritieke mutaties zonder duidelijke verantwoordelijkheid, versiebeheer of tijdige registratie.

Zodra meerdere personen parallel wijzigingen aanbrengen, voorraadmutaties tijdkritisch worden of klantinformatie uit verschillende bronnen moet worden samengevoegd, stijgt het risico aanzienlijk. Een gedeeld systeem is dan meestal voordeliger dan het voortdurend corrigeren van misverstanden.

Warehouse Automation Results vragen om een gecontroleerde uitrol

De snelste weg naar slechte resultaten is een complete verbouwing tijdens de lopende bedrijfsvoering. Beter is een afgebakend gebied met meetbaar voordeel: bijvoorbeeld goederenontvangst voor één productgroep, verzendlabels voor één locatie, of mobiele registratie voor de meest voorkomende verplaatsingen.

Een pilot moet echte orders en echte diensten weerspiegelen. Testdata helpen bij de ontwikkeling, maar tonen niet of de wifi in het achterste magazijngedeelte hapert, of handschoenen de bediening van de scanner bemoeilijken, of een status voor de planning verwarrend is geformuleerd. Die details bepalen acceptatie en datakwaliteit.

Technisch telt saaie, bewijsbare betrouwbaarheid zwaarder dan een modieuze stack. Duidelijke rolrechten, navolgbare boekingslogs, ondubbelzinnige foutmeldingen, stabiele databasetransacties en gedocumenteerde processen zijn geen bijzaak. Ze maken van een applicatie een gereedschap waarop teams in het dagelijkse werk kunnen vertrouwen.

Voor op maat gemaakte logistieke systemen betekent dat ook: de integratie moet passen bij de bestaande bedrijfsvoering. Een applicatie kan orders uit een webshop overnemen, pakbonnen genereren, verzendlabels aanleveren en voorraadmutaties documenteren. Ze hoeft daarvoor niet meteen alle aangrenzende systemen te vervangen. Juist in het mkb is een stapsgewijze vervanging vaak risicoarmer en economischer.

Hoe een project een blijvende verbetering wordt

Na de invoering begint de beslissende fase. Worden bijzondere gevallen vastgelegd? Kloppen de magazijnlocaties nog met de werkelijkheid? Begrijpen nieuwe medewerkers de boekingslogica zonder mondelinge uitleg? En kloppen de gemeten waarden nog wanneer het ordervolume groeit?

Regelmatige korte terugkoppelingen vanuit magazijn, verzending en administratie zijn hiervoor effectiever dan een jaarlijkse grote workshop. Wordt een terugkerende uitzondering zichtbaar, dan moet deze óf als duidelijke processtap worden ingericht, óf bewust uit de standaardflow worden gehaald. Beide zijn beter dan het stilzwijgend te tolereren.

De meest zinvolle volgende stap is vaak geen omvangrijk bestek. Neem een proces met veelvuldige vragen en meet een week lang waar tijd verloren gaat. Ontstaat daaruit een duidelijk, herhaalbaar verloop, dan kan automatisering worden gekoppeld aan een resultaat dat op de magazijnvloer net zo overtuigt als in de maandrapportage.

Permalink →

Moderne webontwikkeling die werkt in de praktijk: pragmatische architecturen voor kleine en middelgrote ondernemingen — met onderhoudbare code, solide gegevensopslag en zonder nodeloze tooloverlast.

Moderne webontwikkeling die werkt in de praktijk: pragmatische architecturen voor kleine en middelgrote ondernemingen — met onderhoudbare code, solide gegevensopslag en zonder nodeloze tooloverlast.

Een magazijnverantwoordelijke print 's ochtends leveringsbonnen uit terwijl een collega voorraad corrigeert in een spreadsheet, en verkoop belt om te vragen naar de status van een bestelling. Het probleem is zelden gebrek aan digitalisering. Meestal zijn er te veel losstaande tools. Moderne webontwikkeling creëert dan niet zomaar een mooiere interface, maar een betrouwbare gedeelde werkbasis.

Voor kleine en middelgrote ondernemingen betekent dit: een webapplicatie moet functioneren onder tijdsdruk, op een scanner in het magazijn net zo goed als op een scherm op kantoor. Ze moet gegevens traceerbaar opslaan, rechten netjes beheren en verder ontwikkeld kunnen worden zonder bij elke wijziging een risico te worden. Technologie is hier geen doel op zich. Ze is de basis waardoor processen sneller verlopen en tegelijk beter beheersbaar blijven.

Moderne webontwikkeling begint vóór de eerste code

Wie begint met een vooraf vastgestelde functiecatalogus, bouwt vaak langs het werkelijke knelpunt heen. In de praktijk loont een andere ingang: welke informatie ontbreekt vandaag regelmatig? Waar ontstaan dubbele invoeren? Op welk punt worden beslissingen telefonisch of mondeling bevestigd omdat niemand de actuele status betrouwbaar ziet?

Bij goederenontvangst kan dit bijvoorbeeld inconsistente artikelomschrijvingen, ontbrekende inspectie-instructies, of te laat bijgewerkte voorraden zijn. Bij orderverwerking zijn het vaak handgeschreven notities, onduidelijke goedkeuringen en verzendgegevens die in meerdere systemen worden bijgehouden. Een goede applicatie digitaliseert deze overdrachten niet alleen. Ze ordent ze zo dat verantwoordelijkheden, statussen en volgende stappen zichtbaar zijn.

Dit betekent ook bestaande praktijken niet reflexmatig afschaffen. Een goed bijgehouden spreadsheet kan voor een kleine evaluatie de meest verstandige oplossing blijven. Een op maat gemaakte webapplicatie loont daar waar meerdere personen tegelijk werken, fouten ontstaan door manuele overdracht, of een proces gedocumenteerd en herhaalbaar moet zijn.

Wat een moderne webapplicatie in de dagelijkse praktijk moet leveren

Een overtuigende gebruikersinterface is waardevol, maar het is slechts een deel van het werk. In de lopende bedrijfsvoering tellen vooral responstijden, begrijpelijke workflows en robuuste data. Wanneer een orderpicker een taak afrondt, mag de status niet pas zichtbaar worden na meerdere vernieuwingen. Wanneer een bestelling gewijzigd wordt, moet traceerbaar zijn wat er gewijzigd is en welke vervolgstappen beïnvloed worden. Dit omvat drie nauw verbonden lagen: de gebruikersinterface, de applicatielogica en de database. De interface leidt mensen door het proces. De logica controleert bijvoorbeeld verplichte velden, rechten of beschikbare hoeveelheden. De database slaat de feiten zo op dat evaluaties, correcties en uitbreidingen later mogelijk blijven.

Voor veel bedrijfsapplicaties zijn beproefde technologieën een verstandigere keuze dan een kortstondige trend. PHP 8.4 kan een duidelijk gestructureerde serverlogica leveren, moderne JavaScript een responsieve gebruikerservaring, en MySQL 8 een solide gegevensbasis. Beslissend is niet dat elk project dezelfde stack gebruikt. De sleutel is dat de gekozen technologie past bij het probleem, de bedrijfsvoering en het langetermijnonderhoud.

Prestatie is een procesvraag

Prestatie wordt vaak gereduceerd tot laadtijden. Dat is onvoldoende. Een applicatie voelt ook traag aan wanneer medewerkers te veel stappen uitvoeren, naar informatie zoeken, of hetzelfde gegeven meerdere keren moeten invoeren. Een snelle pagina met een omslachtig formulier blijft een slecht proces.

Verstandige optimalisatie begint daarom bij de meest voorkomende handelingen. Welke schermen worden honderd keer per dag geopend? Welke zoekopdracht moet snel blijven ook bij groeiende datavolumes? Welke gegevens moeten op de achtergrond opgeslagen worden zonder dat medewerkers op een bevestiging wachten? Pas daarna volgen technische details zoals gerichte database-indexen, gereduceerde queries en een slanke levering van bestanden in de browser.

Datamodel en rechten: de onzichtbare architectuur

Veel webprojecten mislukken niet bij de eerste versie, maar bij latere aanvullingen. Een aanvankelijk eenvoudig veld zoals "Status" wordt plotseling een keten van goedkeuring, inspectie, verwerking, annulering en nabewerking. Als deze toestanden slechts los in formulieren opgeslagen worden, wordt elke uitbreiding duur en foutgevoelig.

Een schoon datamodel scheidt daarom processen, posities, contactpersonen, documenten en statuswijzigingen traceerbaar. Het voorkomt tegenstrijdige invoer in plaats van deze later moeizaam te moeten opschonen. Juist bij voorraadbewegingen, leveringsbonnen of orderdata is deze precisie geen academische oefening. Ze bepaalt of het voorraadcijfer geschikt is als werkbasis.

Rollen en rechten zijn even belangrijk. Niet elke persoon heeft toegang nodig tot prijzen, personeelsinformatie of administratieve instellingen. Goede rechtenconcepten zijn concreet: wie mag een bestelling aanmaken, goedkeuren, of annuleren? Wie ziet enkel de eigen afdeling? Daarbij komen beveiligingsmaatregelen zoals veilige wachtwoordopslag, accountblokkeringen na herhaalde mislukte pogingen, logging van kritieke wijzigingen en duidelijk geregelde sessies. Beveiliging is dus geen toevoeging vlak voor de go-live. Ze hoort thuis in de architectuur omdat latere correcties vaak diep ingrijpen in aanmelding, gegevenstoegang en rechtensysteem.

Responsive betekent niet alleen "past op een gsm"

Een responsieve applicatie past zich aan verschillende schermformaten aan. Voor het dagelijkse werk volstaat deze definitie niet. Op een tablet in het magazijn gelden andere eisen dan op een groot scherm bij de planning. Touch-gebieden moeten veilig bedienbaar zijn, belangrijke details mogen niet verdwijnen onder secundaire informatie, en invoer moet praktisch blijven ook met handschoenen, wisselende lichtomstandigheden of onstabiele verbinding.

Bijgevolg heeft elke weergave een duidelijke prioriteit nodig. Bij goederenontvangst kunnen scannen en bevestigen centraal staan. Op kantoor zijn filters, lijsten, exportfuncties en detailweergaven vaak belangrijker. Een interface die overal identiek uitziet, is niet automatisch overal goed bruikbaar.

Moderne webontwikkeling vereist gecontroleerde bedrijfsvoering

De go-live is geen eindpunt, maar het begin van de echte test. Pas met echte gegevens, uitzonderingen en piekmomenten blijkt of regels begrijpelijk zijn en of interfaces betrouwbaar werken. Gedocumenteerde bereidstelling, duidelijk gescheiden omgevingen voor ontwikkeling en productie, en traceerbare back-ups horen daarom bij het project, niet louter bij IT-beheer.

Ook geautomatiseerde tests bereiken hier veel. Ze controleren terugkerende workflows zoals aanmelden, rechtencontroles, orderregistratie of documentgeneratie opnieuw na elke wijziging. Voor gevoelige applicaties kan een zelf-gehoste testomgeving verstandig zijn omdat schermafbeeldingen, testdata en interne applicatiestappen binnen de eigen controlesfeer van de onderneming blijven. Automatisering vervangt geen vakkundige controle door ervaren medewerkers. Ze zorgt er echter wel voor dat bekende workflows niet stilletjes beschadigd raken.

Bij softify.pro hoort deze denkwijze bij de implementatie: technisch precies plannen, echte workflows ernstig nemen, en wijzigingen zo leveren dat ze later begrijpelijk blijven. Dat is minder spectaculair dan een technologisch vuurwerk, maar in de bedrijfsvoering aanzienlijk waardevoller.

Wanneer standaardsoftware volstaat — en wanneer niet

Standaardsoftware is verstandig wanneer uw eigen proces grotendeels overeenkomt met de gebruikelijke sectorwerkwijze en de configuratie behapbaar blijft. Ze kan snel beschikbaar zijn en betrouwbare basisfuncties meebrengen. Ze wordt problematisch wanneer teams voortdurend hun werkende workflows omslachtig moeten ombuigen of wanneer belangrijke informatie buiten het systeem terechtkomt.

Een op maat gemaakte oplossing is niet automatisch beter. Ze vereist duidelijke eisen, verantwoordelijke contactpersonen, en de bereidheid om beslissingen te nemen. Daarvoor kan ze precies de werkstappen in kaart brengen die cruciaal zijn voor de onderneming: een gespecialiseerde goederenontvangstcontrole, het printen van passende verzendlabels, een goedkeuring op basis van klantgroep, of de verbinding tussen atelier, magazijn en verkoop. De juiste vraag is dus niet: hebben we een op maat gemaakte applicatie nodig? Het is: welke terugkerende wrijving kost ons vandaag tijd, geld of betrouwbaarheid — en kan die duurzaam weggenomen worden met een redelijke inspanning?

Een goede webapplicatie maakt werk niet kunstmatig digitaal. Ze haalt onnodige overdrachten weg, creëert een betrouwbare gegevensstand, en geeft mensen precies de informatie die ze nodig hebben voor hun volgende stap. Wanneer dit lukt, voelt moderne webontwikkeling niet als een nieuw IT-project, maar als een bedrijfsvoering die eindelijk zonder omwegen kan werken.

Permalink →

Hoe u de digitalisering van leveringsbonnen correct implementeert

Hoe u de digitalisering van leveringsbonnen correct implementeert

Een chauffeur wacht niet omdat een Excel-bestand op dit moment door iemand anders geopend is. En bij goederenontvangst helpt een nette papierstapel niet als een deellevering later niet meer te traceren is. Wie zoekt naar "hoe leveringsbonnen digitaliseren" wil daarom zelden alleen papier scannen. Wat gezocht wordt, is een robuuste workflow die goederenbewegingen, bevestigingen en afwijkingen registreert precies daar waar ze ontstaan.

Digitale leveringsbonnen werken goed wanneer ze het werk in het magazijn, in de werkplaats en bij de klant vereenvoudigen. Als ze slechts als PDF-archief geïmplementeerd worden, blijft de inspanning bestaan — alleen op een scherm in plaats van op papier. Het beslissende verschil zit in gestructureerde gegevens, duidelijke verantwoordelijkheden en een propere koppeling met bestellingen, voorraad en facturen.

Hoe leveringsbonnen digitaliseren: controleer eerst de workflow

De eerste stap is geen software-keuze, maar een eerlijke inventarisatie. Neem een echte leveringsbon en volg het pad ervan: van bestelling via picking tot overdracht, terugkoppeling en archivering. Dit onthult meestal snel waar informatie achteraf wordt toegevoegd, dubbel wordt ingevoerd, of via telefoon en chat wordt verduidelijkt.

In kleine en middelgrote ondernemingen bestaat zelden slechts één workflow. Een standaardlevering aan vaste klanten vereist iets anders dan een werflevering, een afhaling, of een levering met retour van lege verpakkingen. Al deze verschillen hoeven niet allemaal in versie één geautomatiseerd te worden. Ze zouden echter wel gekend moeten zijn, zodat het nieuwe systeem niet al bij het eerste bijzondere geval faalt.

Een goed digitaal proces beantwoordt voor elke status ondubbelzinnig drie vragen: Wie heeft de goederen verplaatst en wanneer? Welke hoeveelheden zijn daadwerkelijk overgedragen? En wat gebeurde er bij afwijkingen? Als deze informatie ontbreekt, is een digitale leveringsbon vooral gewoon een mooier document.

Reproduceer papier niet gewoon als PDF

Het scannen van bestaande leveringsbonnen kan nuttig zijn als overgang, bijvoorbeeld voor het archiveren van oude processen. Voor de operationele werking lost het echter weinig op. Een afbeelding of PDF kan opgeslagen worden, maar hoeveelheden, artikelnummers, partijen en opmerkingen kunnen daarin niet betrouwbaar hergebruikt worden.

Een betere aanpak is een document dat gegenereerd wordt uit gestructureerde besteldata. Artikelen, doelhoeveelheden, leveradressen en contactpersonen worden overgenomen. Medewerkers bevestigen vervolgens de werkelijke hoeveelheden rechtstreeks op een mobiel toestel of op een werkplek in het magazijn. Enkel afwijkingen, schade of bijkomende posities moeten manueel ingevoerd worden.

Dit bespaart niet alleen tijd. Het voorkomt ook een typische mediabreuk: de boekhouding ontvangt niet langer een nauwelijks leesbare handtekening op papier terwijl het magazijn hetzelfde proces apart in een spreadsheet bijhoudt.

De gegevens die een digitale leveringsbon werkelijk nodig heeft

Een systeem zou niet elk denkbaar veld moeten afdwingen. Bijkomende invoer vertraagt overdrachten en vermindert de aanvaarding. Tegelijkertijd volstaan klantnaam en handtekening voor veel workflows niet.

Als basis heeft elke leveringsbon een uniek nummer nodig, de referentie naar de bestelling, lever- en ontvangeradressen, artikelposities met doel- en werkelijke hoeveelheden, en tijdstempels.

Afhankelijk van de sector komen daar partijen, serienummers, gewicht, opslaglocaties of containers bij. Voor temperatuurgecontroleerde goederen kunnen gemeten waarden relevant zijn; voor werfleveringen zijn foto's of nauwkeurige gegevens over de leverlocatie nuttig.

De status is bijzonder belangrijk. "Aangemaakt," "gepickt," "onderweg," "overgedragen," "gedeeltelijk geleverd," en "betwist" zijn geen loutere labels. Ze bepalen welke persoon vervolgens moet handelen en of bijvoorbeeld een factuur mag opgemaakt worden of een navolgende levering mag ingepland worden.

Handtekeningen en foto's met mate inzetten

Een digitale handtekening is nuttig bij veel leveringsprocessen, maar is niet automatisch de beste bevestiging. Voor een snelle overdracht bij goederenontvangst kunnen een gedrukte naam, een tijdstempel en de toewijzing aan de ontvanger volstaan. Voor hoogwaardige goederen of betwiste overdrachten kan een handtekening gecombineerd met een foto en locatiegegevens dan weer zinvoller zijn.

Beslissend is de bewijsketen: de bevestiging moet gekoppeld zijn aan het specifieke document en de versie ervan. Als iemand na ondertekening hoeveelheden of posities wijzigt, zou het systeem dit niet stilzwijgend mogen overschrijven. Het vereist een traceerbare correctie of een nieuwe bevestiging. Foto's verdienen dezelfde discipline. Ze kunnen schade documenteren, maar zouden niet mogen uitgroeien tot een willekeurige verzameling persoonsgegevens. Bepaal wanneer een foto vereist is, wie er toegang toe heeft, en hoe lang die bewaard wordt.

Mobiele registratie moet onder reële omstandigheden functioneren

Op kantoor is bijna elke applicatie te bedienen. In het magazijn tellen handschoenen, slechte wifi, tijdsdruk en toestellen met beperkte batterijduur. Een digitale leveringsbon moet daarom toekomen met weinig, grote invoerstappen. Barcode- of QR-codescans zijn vaak sneller en betrouwbaarder dan het zoeken naar artikelnummers.

Offline-functionaliteit is geen luxe wanneer chauffeurs buiten stabiele netwerkdekking werken. De applicatie zou operaties lokaal moeten cachen, duidelijk moeten tonen wat nog niet gesynchroniseerd is, en conflicten gecontroleerd moeten afhandelen. Als twee personen dezelfde levering bewerken, mag niet toevallig de laatste opslag winnen.

Ook de toestelvraag moet pragmatisch beantwoord worden. Een bestaande smartphone kan volstaan voor eenvoudige leveringen. Voor frequente scans, foto's en handtekeningen in het magazijn zijn robuuste handhelds of tablets vaak economischer. De beste beslissing hangt af van gebruiksduur, omgeving en verwachte doorvoer — niet van welk toestel er modern uitziet op een productdia.

Interfaces vastleggen vóór de implementatie

Een digitale leveringsbon ontwikkelt zijn waarde pas wanneer die gekoppeld wordt aan de leidende gegevensbronnen. In veel ondernemingen bevinden bestellingen zich in het ERP of het goederenbeheersysteem, voorraden in een aparte magazijnoplossing, en facturen in de boekhouding. Dit hoeft niet meteen een groot systeemproject te worden. Maar de datasoevereiniteit moet duidelijk zijn.

Bepaal daarom welk systeem klanten, artikelen, prijzen en bestellingen beheert. De leveringsbonoplossing mag informatie overnemen, maar zou niet ongemerkt een tweede artikelstam mogen genereren. Evenzo moet geregeld zijn wanneer bevestigde werkelijke hoeveelheden teruggemeld worden en wie afwijkingen controleert.

Technisch gezien zijn betrouwbare interfaces belangrijker dan spectaculaire functies. Unieke ID's, gedocumenteerde gegevensformaten, protocollen voor mislukte overdrachten, en een herhalingsmechanisme voorkomen dat leveringsbonnen tussen twee systemen verdwijnen. Een slanke applicatie op een onderhoudbare basis, zoals PHP 8.4, moderne JavaScript en MySQL 8, is voor veel middelgrote workflows verstandiger dan een overladen suite met functies die niemand gebruikt.

Beveiliging en archivering horen bij het proces

Leveringsbonnen bevatten bedrijfsgegevens en vaak ook persoonsgegevens. Rolrechten zouden daarom niet generiek toegekend moeten worden. Chauffeurs hebben hun ritten en openstaande taken nodig, magazijnverantwoordelijken hebben correctie- en beoordelingsopties nodig, de boekhouding heeft bevestigde documenten en exports nodig. Volledige administratieve toegang is geen standaardrecht.

Daarnaast is een traceerbare geschiedenis vereist: aanmaak, wijziging, overdracht, handtekening, annulering en correctie zouden vastgelegd moeten worden met tijdstip, gebruiker en motivering. Dit helpt bij vragen en beschermt medewerkers wanneer later onduidelijk is wanneer schade of een tekort gemeld werd. Voor archivering geldt: het document moet leesbaar blijven en het proces vindbaar zijn. Of een PDF gegenereerd wordt, hangt af van de interne workflow en de vereisten van externe ontvangers. De PDF is echter de uitvoer van een digitaal proces, niet het datamodel ervan.

Productief worden in kleine stappen

De meest betrouwbare uitrol begint met een duidelijk afgebakend proces: bijvoorbeeld standaardleveringen vanuit één magazijn of goederenontvangsten van één afdeling. Kies een gebied met voldoende volume, maar zonder de meest ingewikkelde uitzonderingsgevallen. Zo kunnen bediening, gegevenskwaliteit en interfaces onder echte omstandigheden getest worden.

Meet niet alleen of de applicatie technisch draait. Controleer hoe lang een overdracht duurt, hoeveel leveringsbonnen naverwerking vereisen, hoe vaak voorraadverschillen optreden, en of de boekhouding sneller kan werken. Als een digitale procedure meer vragen genereert dan het papieren formulier, is niet het personeel het probleem — dan ontbreekt procesduidelijkheid of past het invoerscherm niet bij de operationele praktijk.

Spreadsheets mogen blijven bestaan als ze betrouwbaar zijn voor een beperkte evaluatie of een zeldzame speciale lijst. Digitalisering betekent niet elk gekend hulpmiddel afschaffen. Het betekent doelbewust foutgevoelige overdrachten vervangen en het kernproces robuust maken.

softify.pro ontwikkelt zulke workflows niet als star standaardproduct, maar langsheen concrete goederenbewegingen, rollen en bestaande systemen. Dit is bijzonder nuttig wanneer een onderneming een passende oplossing zoekt tussen papieren chaos en een overgedimensioneerd concernsysteem.

De juiste eerste stap is daarom geen lange vereistenlijst. Neem tien leveringsbonnen uit een normale week, inclusief een deellevering en een klacht. Als uw toekomstige workflow deze tien gevallen snel, ondubbelzinnig en traceerbaar verwerkt, wordt een digitale leveringsbon een hulpmiddel waarop magazijn, chauffeurs en administratie kunnen rekenen.

Permalink →

Softwaretesttrends 2026 die er echt toe doen

Softwaretesttrends 2026 die er echt toe doen

Een mislukte release toont zelden slechts één fout. Vaak komen meerdere oorzaken samen: een gewijzigde bevoegdheid, een onduidelijke testomgeving, ontbrekende testdata of een regressietest die al maanden niet meer werd bijgewerkt. Precies daar worden de software testing trends voor 2026 concreet - niet als verzameling nieuwe tools, maar als de vraag hoe ondernemingen wijzigingen aantoonbaar veilig kunnen opleveren, ook bij krappe QA-capaciteit en gevoelige gegevens.

Voor softwareteams bij middelgrote ondernemingen is dat bijzonder relevant. Een magazijntoepassing, een klantenportaal of Windows-desktopsoftware moet geen miljoenen gebruikers bedienen. Het moet echter wel functioneren in ploegenarbeid, correct documenten genereren en bevoegdheden betrouwbaar afdwingen. Testen moet daarom dichter bij de reële operationele processen liggen dan bij een perfecte demo-omgeving.

Softwaretesttrends: AI wordt uitvoerder, geen orakel

De meest zichtbare trend is AI-ondersteund testen. Dat betekent niet dat een taalmodel een vereiste leest en vervolgens de kwaliteit van de toepassing garandeert. Die verwachting zou gevaarlijk zijn. AI kan echter veel inspanning verminderen daar waar teams vandaag tijd verliezen: bij het formuleren van testgevallen, het herkennen van opvallende wijzigingen in interfaces, het toewijzen van vergelijkbare foutpatronen en het schrijven van begrijpelijke testrapporten.

AI wordt vooral nuttig wanneer het concrete werkstappen uitvoert en bewijs levert voor de resultaten. Een testagent kan bijvoorbeeld aanmelden, een goederenontvangst aanmaken, een leveringsadres wijzigen, een verzendlabel genereren en controleren of status, voorraadbeweging en document overeenkomen. Doorslaggevend is niet de bewering "test geslaagd", maar de bewijsketen: uitgevoerde stappen, tijdstempels, schermafbeeldingen, technische logs en een duidelijke beschrijving van de afwijking.

De grens blijft belangrijk. AI mag testgevallen voorstellen en terugkerende verlopen bedienen. Ze zou niet zelfstandig moeten beslissen of een bedrijfskritische boeking correct is. Bij prijzen, voorraadniveaus, betalingsgoedkeuringen of toegangsrechten blijven expliciete regels en door vakafdelingen bevestigde verwachtingen nodig. Automatisering versnelt het testen; het vervangt geen verantwoordelijkheid.

Testautomatisering trekt in het bedrijfsproces

Lange tijd concentreerde UI-testautomatisering zich op eenvoudige paden: pagina openen, formulier invullen, succesmelding controleren. Dat blijft zinvol, maar volstaat niet voor bedrijfskritische systemen. De waardevollere test valideert een volledige procesketen.

Neem een typische logistieke functie. Een bestelling wordt vastgelegd, goederen gereserveerd, een pickproces gestart, een leveringsbon gegenereerd en de verzending gemeld. Elk afzonderlijk scherm kan er schoon uitzien terwijl het proces toch faalt - bijvoorbeeld omdat een reservering na een afbreking blijft bestaan of een deellevering de voorraad verkeerd wijzigt. Goede geautomatiseerde tests volgen daarom statussen en gegevens over systeemgrenzen heen.

Dat vergt een propere testarchitectuur. API- en databanktests controleren regels snel en nauwkeurig. UI-tests controleren bovendien of medewerkers het proces daadwerkelijk kunnen bedienen. End-to-end-tests combineren beide, maar zijn trager en kwetsbaarder. Wie alles uitsluitend via de browser test, bouwt meestal een dure en fragiele testsuite. Wie enkel interfaces test, ziet bedieningsproblemen en verkeerd bedrade interfaces over het hoofd.

De pragmatische oplossing is een piramide die bij het risico past: veel snelle controles dicht bij de bedrijfslogica, minder integratiecontroles en gericht gekozen end-to-end-scenario's voor de belangrijkste verlopen. Dat klinkt weinig spectaculair. Het levert echter saaie, bewijsbare betrouwbaarheid op in plaats van trend-jagen.

Self-hosted test-AI wordt een architectuurvraag

Met AI-testtools ontstaat een nieuwe vraag: waar gaan testdata, schermafbeeldingen en opnames naartoe? In veel toepassingen bevatten ze klantnamen, interne prijzen, personeelsinformatie of weergaven van bedrijfskritische processen. Zelfs een schijnbaar onschuldige testomgeving kan echte datakopieën of vertrouwelijke structuren bevatten.

Daarom wordt de uitvoeringsomgeving een centraal criterium. Een externe clouddienst kan geschikt zijn voor publieke webtoepassingen en niet-kritische testdata. Voor interne portalen, desktoptoepassingen of gereguleerde domeinen is een self-hosted aanpak vaak zinvoller. Daarbij blijven testuitvoering, beeldmateriaal en logs binnen de gecontroleerde infrastructuur van de onderneming of in een duidelijk afgebakende EU-omgeving.

Dat is geen algemeen argument tegen clouddiensten. Zelf beheren brengt inspanning met zich mee: updates, toegangscontrole, rekenbronnen, monitoring en duidelijke verantwoordelijkheden moeten geregeld zijn. Het voordeel ontstaat wanneer gegevensbescherming, traceerbaarheid en controle over testartefacten zwaarder doorwegen dan het comfort van een onmiddellijk beschikbaar SaaS-account. Systemen zoals COCO volgen precies deze aanpak door tests voor web- en Windows-toepassingen uit te voeren en bewijs lokaal controleerbaar te houden.

Flaky tests worden niet langer als normaal aanvaard

Een geautomatiseerde test die zonder productwijziging soms slaagt en soms faalt, schept geen zekerheid. Het schept wachtrijen. Teams raken er dan aan gewend rode builds te negeren of tests opnieuw uit te voeren tot het gewenste resultaat verschijnt. Dat is een sluipend verlies van vertrouwen in het hele kwaliteitscontrolekader.

In 2026 komt de stabiliteit van testuitvoering daarom meer op de voorgrond te staan. De oorzaken zijn meestal gekend: willekeurige wachttijden, instabiele selectors, gedeelde testdata, afhankelijkheden van externe diensten of niet-gereset databanken. De oplossing is zelden nog een retry. Zinvoller zijn eenduidige technische selectors, geïsoleerde testaccounts, gecontroleerde datatoestanden en gerichte wachtcondities die reageren op werkelijke systeemgebeurtenissen.

Ook de evaluatie zou onderscheid moeten maken: is een fout reproduceerbaar? Treedt hij enkel in één omgeving op? Is een externe dienst uitgevallen of de toepassing zelf? AI kan helpen bij het bundelen van deze signalen. De technische beslissing moet echter navolgbaar blijven. Een QA-team heeft geen mysterieuze foutvoorspelling nodig, maar een solide basis voor de volgende maatregel.

Kwaliteit begint vroeger, bij vereisten en gegevens

Veel fouten ontstaan voordat de eerste regel code wordt geschreven. "De bestelling moet verzonden kunnen worden" is geen testbare vereiste. Wat gebeurt er bij een onvolledig adres, een geblokkeerd klantaccount, ontbrekende goederen, parallelle verwerking of een verlopen sessie? Zonder antwoorden op deze vragen kan geen enkel testsysteem betrouwbaar controleren of de software correct werkt.

Een rijpere testaanpak vult vereisten daarom aan met controleerbare voorbeelden. Voor een account met foutieve aanmeldpogingen kan dat concreet betekenen: na vijf mislukte pogingen wordt het account 15 minuten geblokkeerd, het proces wordt gelogd en een bevoegde beheerder kan de blokkering traceren. Daaruit ontstaan rechtstreeks automatiseerbare controles - en minder interpretatieruimte tussen ontwikkeling, beheer en vakafdeling.

Ook testdata wordt een productkenmerk. Ze moeten realistisch genoeg zijn om randgevallen af te beelden, maar mogen geen onnodige persoonsgegevens kopiëren. Zinvol zijn gegenereerde datasets voor btw-gevallen, deelhoeveelheden, geblokkeerde artikelen, ongeldige adressen en diverse rollen. Net bij toepassingen met MySQL 8 of vergelijkbare relationele databanken loont het om gedefinieerde beginstaten geautomatiseerd klaar te zetten en na de run weer te verwijderen.

Risicogebaseerd testen verslaat testdekking tegen elke prijs

Een hoog codedekkingspercentage kan geruststellend werken en toch weinig zeggen. Het toont welke regels werden uitgevoerd, niet of de juiste regel werd getest. Een systeem kan 90 procent dekking bereiken en toch bij het storneren van een deellevering verkeerde voorraden voeren.

De betere vraag is: welke fouten zouden bijzonder kostbaar zijn voor de bedrijfsvoering, klanten of wettelijke naleving? Daaruit volgt een prioritering. Toegangsbeveiliging, prijsberekening, voorraadboekingen, documentgeneratie en interfaces naar verzenddienstverleners verdienen meestal meer testdiepte dan zelden gebruikte instellingenpagina's. Dat betekent niet dat bijzaken ongecontroleerd worden opgeleverd. Het betekent beperkte tijd inzetten daar waar een storing echt werk stopt of verkeerde beslissingen veroorzaakt.

Deze prioritering moet kunnen veranderen. Wordt een nieuwe routeplanningsfunctie geïntroduceerd, dan stijgt het risico ervan. Wordt een oude Excel-evaluatie binnenkort vervangen, dan loont een grote automatiseringsinspanning zich mogelijk niet meer. Soms is het verstandiger een werkende tabel nog enkele maanden te behouden dan de logica ervan haastig in een halfklaar systeem te persen.

Wat teams nu praktisch zouden moeten doen

De eerste zinvolle stap is geen toolvergelijking. Kies een proces waarvan de fouten voelbaar zijn: van bestelling tot levering, van goederenontvangst tot opslag, of van aanmelding tot rolgoedkeuring. Beschrijf het gewenste verloop met uitzonderingsgevallen, richt betrouwbare testdata in en automatiseer eerst de kritieke controles.

Meet daarna niet enkel het aantal tests. Observeer hoe snel een echte fout wordt gedetecteerd, hoe vaak tests zonder reden falen en of een rapport de oorzaak begrijpelijk uitlegt aan een ontwikkelaar of vakverantwoordelijke. Pas wanneer deze basis staat, loont uitbreiding met AI-agenten, visuele inspectie of uitgebreide testomgevingen.

De sterkste testtrends zijn uiteindelijk die welke releases minder risicovol maken en teams sneller tot duidelijke beslissingen brengen. Niet het modernste dashboard telt, maar een navolgbare testrun die aantoont dat dit bedrijfsproces werkt - en zo niet, waarom.

Permalink →

Routeplanning voor leveringen: de juiste software kiezen

Routeplanning voor leveringen: de juiste software kiezen

Een chauffeur wacht op een leveringsbon terwijl de volgorde van zijn stops alweer verandert. In het magazijn is een zending nog niet klaargezet, een klant belt over een krapper tijdvenster, en de rittenlijst staat in een rekenblad dat maar één persoon echt begrijpt. Wie op zoek is naar "software voor routeplanning bij leveringen" wil in deze situatie niet per se een ingewikkeld kaartalgoritme. Gezocht wordt een betrouwbaar verloop van orderinvoer tot leveringsbewijs.

Voor kleine en middelgrote ondernemingen is dat een doorslaggevend verschil. Een theoretisch kortere route heeft weinig zin als daarbij niet wordt meegenomen dat goederen pas om 10 uur klaarstaan, een voertuig koeling nodig heeft, of een chauffeur specifieke klantkennis heeft op een bepaalde rit. Goede software voor leveringen beeldt de operationele werkelijkheid af - en maakt die gezamenlijk bruikbaar voor planning, magazijn en chauffeurs.

Wanneer routeplanning een operationeel probleem wordt

Veel ondernemingen starten verstandig met telefoon, papier en een rekenblad. Bij vijf stops per dag en een vast chauffeursteam is dat vaak de snelste oplossing. Pas wanneer ordervolume, varianten en tijdsdruk toenemen, ontstaan de typische wrijvingsverliezen: dubbel ingevoerde adressen, verouderde ritstatussen, ontbrekende informatie over laadmiddelen en vragen die enkel kunnen worden beantwoord door meerdere mensen te bellen.

Het probleem is dan niet alleen de rijafstand. Het is de informatiebreuk tussen orderinvoer, magazijn, planning en aflevering. Wordt een order verschoven, dan moet die wijziging vandaag vaak in meerdere lijsten, op een afdruk en in het hoofd van de chauffeur worden bijgewerkt. Dat kost tijd en veroorzaakt fouten die klanten meteen zien.

Een ander alarmsignaal zijn beslissingen die van individuele medewerkers afhangen. Als enkel de ervaren planner weet welke toegang geschikt is voor een klant of hoe rit 3 moet worden aangepast bij late goederenontvangst, is het proces niet solide gedocumenteerd. Software moet die kennis niet vervangen. Ze moet die zo in kaart brengen dat het team handelingsbekwaam blijft.

Wat software voor routeplanning bij leveringen moet kunnen

De kernfunctie klinkt eenvoudig: orders worden aan een rit toegewezen, stops zinvol gesorteerd en aan chauffeurs overgedragen. Voor praktisch nut heeft het systeem echter veel meer context nodig. Doorslaggevend is welke regels bij de planning gelden en hoe wijzigingen worden behandeld.

Orders moeten planbaar zijn, niet enkel zichtbaar

Een leveringsadres op een kaart is nog geen planbare levering. Bij een order horen minstens hoeveelheden, gewicht of volume, leveringsdatum, gewenst tijdvenster, contactgegevens en een duidelijke verwerkingsstatus. Afhankelijk van de onderneming komen daar laadmiddelen, temperatuurvoorschriften, markeringen voor gevaarlijke goederen, aviseringsregels of een bepaalde voertuigklasse bij.

Deze gegevens hoeven niet telkens manueel uit verschillende systemen bij elkaar gezocht te worden. Als orders al uit een webshop, ERP, ordermasker of bestaande databank komen, is een propere overdracht vaak waardevoller dan een bijzonder spectaculaire kaartweergave. Anders verschuift het werk enkel van papier naar een nieuwe interface.

Ritten hebben regels nodig, niet enkel afstand

Een automatische volgorde op basis van kilometers of rijtijd kan een goede suggestie zijn. Het is echter geen beslissing voor de onderneming. De planning moet rekening kunnen houden met beperkingen: vaste leveringstermijnen, voertuigcapaciteit, werktijden, laad- en lostijden, en regionale verantwoordelijkheden.

Ook de startlogica telt mee. Sommige voertuigen beginnen en eindigen bij het magazijn, andere rijden na de laatste levering rechtstreeks naar de volgende inzetlocatie. Bij terugkerende ritten kan een vaste basisstructuur zinvol zijn, die planners enkel indien nodig aanpassen. Wie elke ochtend precies dezelfde stops aandoet, heeft niet noodzakelijk een volledige heroptimalisatie nodig. Hier is een stabiele, navolgbare rit vaak beter dan een rekenkundig minimale tijdwinst.

Wijzigingen moeten gecontroleerd bij de chauffeur terechtkomen

De werkelijkheid houdt zich zelden aan het ochtendplan. Klanten annuleren, goederen ontbreken, een voertuig valt uit of een order wordt dringend. In zulke gevallen beslist het of de software verlichting biedt of extra werk creëert.

Een bruikbare oplossing toont duidelijk welke ritversie momenteel geldig is, welke stops al zijn afgehandeld en wat concreet is gewijzigd. De chauffeur zou geen tegenstrijdige afdrukken, schermafbeeldingen en berichtenapp-berichten moeten hoeven vergelijken. Voor veel teams volstaat aanvankelijk een mobiele, browsergebaseerde chauffeursweergave met stopvolgorde, contactgegevens, leveringsinstructies en statusterugkoppeling. Een eigen app is niet automatisch beter als installatie, toestelbeheer en offline-vereisten geen duidelijk voordeel opleveren.

Niet enkel met routeoptimalisatie beginnen

De meest voorkomende foutieve aanpak is eerst een optimalisatiedienst aan te schaffen en pas daarna te controleren of de stamgegevens en processen kloppen. Verkeerd geschreven adressen, onduidelijke levervensters en orders zonder betrouwbare gereedstatus laten zich niet wegoptimaliseren.

Zinvoller is een korte inventarisatie langs het reële dagverloop. Waar ontstaan orders? Wanneer bevestigt het magazijn de gereedheid? Wie plant ritten? Hoe ontvangt de chauffeur wijzigingen? En welk bewijs is na de levering nodig? Deze vragen lijken banaal, maar bepalen welke gegevensvelden, rollen en interfaces het systeem daadwerkelijk nodig heeft.

Vaak blijkt dat niet elke stap gedigitaliseerd hoeft te worden. Een handgeschreven notitie voor een zeldzame speciale levering kan gepast zijn, als die later netjes in de order wordt overgenomen. Ook een rekenblad mag blijven bestaan, als dat betrouwbaar een overzichtelijke analyse levert. Software zou het knelpunt moeten oplossen, niet elk gekend proces geforceerd moeten vervangen.

Build, Buy of gerichte uitbreiding?

Standaardsoftware is geschikt wanneer de rittenlogica algemeen is, processen nauwelijks variëren en het team zich kan aanpassen aan vooraf bepaalde schermen. Ze verkort de invoering en kan volstaan voor een eenvoudig wagenpark. Het nadeel blijkt zodra ze centrale bijzondere gevallen enkel via nevenlijsten, vrije tekst of dure bijkomende modules in kaart brengt.

Een individuele oplossing loont niet omdat maatwerkontwikkeling principieel superieur zou zijn. Ze loont wanneer het proces zelf een concurrentievoordeel of een blijvende foutenbron is: bijvoorbeeld bij speciale verpakkingseenheden, gecombineerde ophaal- en leveringsritten, eigen leveringsdocumenten of een nauwe koppeling van goederenontvangst, orderverzameling en verzending.

Daartussen ligt vaak de meest pragmatische weg. Bestaande systemen blijven bestaan voor boekhouding of magazijnbeheer, terwijl een lichte applicatie orders bundelt, ritten plant en het chauffeursproces afdekt. Daarvoor zijn duidelijke interfaces, eenduidige gegevensverantwoordelijkheden en een databankstructuur nodig die wijzigingen navolgbaar opslaat. Moderne webapplicaties op een onderhoudbare basis zoals PHP 8.4 en MySQL 8 zijn daarvoor geen modekeuze, maar een basis voor voorspelbare bedrijfsvoering en toekomstige aanpassingen.

Invoering in kleine stappen in plaats van een grote omschakeling

Routeplanningssoftware zou eerst op een overzichtelijke rit of voertuiggroep getest moeten worden. Niet omdat een pilotproject risicoloos zou zijn, maar omdat echte uitzonderingen zich vroeg tonen: ontbrekende leveringsinstructies, ongelijksoortige adresgegevens, wachttijden bij de klant of onduidelijke overdrachten in het magazijn.

Voor de eerste uitbouwfase volstaan meestal duidelijk afgebakende functies: order overnemen, gereedstatus zien, rit samenstellen, rit goedkeuren en levering terugmelden. Pas wanneer deze keten dagelijks functioneert, zijn automatische optimalisatie, elektronische handtekening, fotobewijzen, klantmeldingen of gedetailleerde kengetallen zinvol.

Het voordeel wordt niet enkel meetbaar via bespaarde kilometers. Relevant zijn ook minder planningswerk, minder vragen, minder foutieve leveringen, kortere tijd tot de leveringsbon en een beter antwoordvermogen naar klanten. Deze kengetallen zouden vóór de start grof vastgelegd moeten worden. Anders blijft na de invoering enkel de indruk dat de interface er moderner uitziet.

De techniek moet op de achtergrond betrouwbaar blijven

Routeplanning verwerkt gevoelige bedrijfsgegevens: klantadressen, chauffeurstoewijzingen, leveringshoeveelheden en vaak ook leveringsbewijzen. Daarom horen rolrechten, navolgbare wijzigingen, regelmatige back-ups en een gedocumenteerd beheer bij de oplossing. Wie een rit mag goedkeuren, wijzigen of verwijderen, zou niet aan het toeval overgelaten mogen worden.

Ook kaart- en routegegevens verdienen een nuchtere afweging. Externe diensten kunnen heel goed passen, maar brengen doorlopende kosten, beschikbaarheids- en privacyvragen met zich mee. Bij hoge eisen aan gegevensbewaring of speciale gebiedslogica moet vroeg duidelijk zijn welke gegevens het eigen systeem verlaten en hoe uitval wordt opgevangen. Een perfecte route is waardeloos als de planning bij een storing niet kan blijven doorwerken.

softify.pro ontwerpt zulke systemen vanaf de effectieve orderontvangst tot en met de terugkoppeling vanuit het voertuig. De maatstaf is daarbij niet de langste functielijst, maar een proces dat magazijn, planning en chauffeurs onder tijdsdruk betrouwbaar kunnen bedienen.

De beste routeplanning oogt in de dagelijkse praktijk verrassend onopvallend: orders zijn compleet, ritten begrijpelijk, wijzigingen eenduidig en leveringen aantoonbaar. Precies die onopgewonden betrouwbaarheid schept ruimte voor de uitzonderingen waarbij mensen moeten beslissen.

Permalink →

Orderacceptatie-workflow automatiseren in de onderneming

Orderacceptatie-workflow automatiseren in de onderneming

Een bestelling komt binnen per e-mail, een andere telefonisch, plus een Excel-bestand van de key account. Later ontbreekt in het magazijn het leveringsadres, verkoop weet de toegezegde datum niet meer precies, en de verzendafdeling drukt de leveringsbon af met een verouderde artikelpositie. Wie de orderacceptatie-workflow wil automatiseren, lost geen abstract digitaal project op. Hij verwijdert precies deze wrijving op het punt waar omzet overgaat in operationeel werk.

Voor kleine en middelgrote ondernemingen wordt orderacceptatie vaak onderschat. Zolang er weinig bestellingen per dag binnenkomen en ervaren medewerkers elk bijzonder geval kennen, dragen telefoonnotities, postvakken en tabellen het proces. Bij een groeiend volume worden ze echter een risico: informatie bestaat dubbel, overdrachten gebeuren mondeling, en niemand kan betrouwbaar zeggen welke status de bestelling werkelijk heeft.

Waarom orderacceptatie zo vaak een knelpunt wordt

De oorzaak is zelden gebrek aan inzet. Meestal is het proces doorheen de jaren gegroeid. Klanten bestellen via verschillende kanalen, prijzen en leveringsvoorwaarden gelden enkel voor bepaalde klantgroepen, artikelnummers wijken af van interne benamingen. Medewerkers stemmen informatie af op basis van ervaring en vullen hiaten op met vragen.

Dat werkt tot iemand met verlof is, de ploeg wisselt, of er meerdere dringende bestellingen tegelijk binnenkomen. Dan blijkt dat kennis niet in het proces zit, maar in individuele hoofden en verspreide bestanden. De gevolgen zijn gekend: verkeerde hoeveelheden, vertraagde leveringen, onopgehelderde goedkeuringen en onnodige correcties in het magazijn.

Automatisering betekent hier niet dat een klant per se via een portaal moet bestellen. Het betekent dat elke bestelling, ongeacht het invoerkanaal, volgens dezelfde navolgbare regels wordt vastgelegd, gecontroleerd, verrijkt en overgedragen.

De orderacceptatie-workflow automatiseren zonder de bedrijfsvoering te verbuigen

Een bruikbare workflow begint niet met een softwarelijst, maar met een nuchtere procesopname. Doorslaggevend is: welke informatie moet aanwezig zijn vooraleer een bestelling naar magazijn, planning of productie mag gaan? En welke uitzonderingen zijn legitiem in plaats van gewoon storend?

Een typisch verloop bestaat uit vier duidelijke stations: bestelling vastleggen, gegevens controleren, bestelling goedkeuren en vervolgprocessen activeren. Tussen deze stations zijn eenduidige verantwoordelijkheden en statussen nodig. Een bestelling zou bijvoorbeeld niet tegelijk als "nieuw", "in verduidelijking" en "verzendklaar" moeten kunnen gelden.

1. Bestellingen uit alle kanalen samenbrengen in één dossier

E-mail, telefoon, PDF, EDI, webformulier of nota van de buitendienst kunnen verschillende ingangen blijven. Doorslaggevend is dat ze in één gemeenschappelijk bestellingsdossier terechtkomen. Medewerkers zouden niet eerst informatie uit de mailbox moeten overtypen, dan een tabel moeten bijwerken en vervolgens een tweede persoon moeten informeren.

Bij gestructureerde bestellingen kunnen klantgegevens, artikelnummers, hoeveelheden en gewenste data rechtstreeks worden overgenomen. Bij PDF's of vrije-tekst-e-mails is begeleide invoer vaak zinvoller dan volledig automatisch uitlezen. AI-ondersteunde extractie kan voorstellen doen, maar bij onduidelijke hoeveelheden, klantspecifieke artikelnummers of handgeschreven documenten is een zichtbare controle nodig.

De zinvolle maatstaf is niet "maximaal automatisch", maar "geen onnodige dubbele invoer". Een goed ontworpen formulier met verplichte velden en plausibele suggesties bespaart in veel ondernemingen meer tijd dan een foutgevoelige volautomaat.

2. Gegevens controleren vooraleer fouten doorwerken

De waardevolste automatisering vindt plaats vóór de goedkeuring. Het systeem kan controleren of het klantnummer bestaat, het leveringsadres compleet is, het artikel actief is, de gewenste hoeveelheid toelaatbaar lijkt en de betalings- of kredietgoedkeuring aanwezig is. Ook klantspecifieke prijzen, minimumhoeveelheden en levervensters kunnen tegen opgeslagen regels worden afgetoetst.

Belangrijk is de omgang met afwijkingen. Niet elke afwijking hoeft een bestelling te blokkeren. Ontbreekt bijvoorbeeld een referentienummer, dan kan verkoop een taak krijgen. Overschrijdt een bestelling een gedefinieerde waardegrens of ligt de marge buiten het afgesproken kader, dan kan goedkeuring door de bevoegde rol nodig zijn.

Zo ontstaan geen stille fouten, maar zichtbare verduidelijkingsgevallen. Dat is een groot verschil: het magazijn krijgt niet zomaar een onvolledige bestelling, maar een bestelling met een eenduidige status en een gedocumenteerde beslissing.

3. Goedkeuringen koppelen aan regels in plaats van toeroepen

Veel vertragingen ontstaan door zinnen als: "Kun je dit snel even goedkeuren?" Zulke vragen zijn niet principieel fout. Ze worden problematisch wanneer ze via chat, telefoon of gangpadgesprek verlopen en later niet meer navolgbaar zijn.

Een geautomatiseerde workflow legt goedkeuringsregels rechtstreeks bij de bestelling vast. Zo kan een bestelling bijvoorbeeld automatisch worden goedgekeurd als klant, prijs, voorraad en leveringsadres plausibel zijn. Bij bijzondere voorwaarden, deelleveringen of een bestelling boven een gedefinieerde grens wordt de bevoegde persoon verwittigd. De goedkeuring wordt opgeslagen met tijdstempel en motivering.

Dat schept snelheid zonder controle op te geven. Vooral bij wisselende ploegen of meerdere vestigingen voorkomt het dat bestellingen blijven hangen in persoonlijke postvakken.

4. Magazijn, verzending en klant gericht informeren

Na goedkeuring moet de bestelling niet meer manueel van de ene lijst naar de andere worden overgezet. De workflow kan een verzamelopdracht genereren, voorraad reserveren, een leveringsbon voorbereiden of een verzendmelding activeren. Welke stappen zinvol zijn, hangt af van het bedrijfsmodel.

Een verdeler van wisselstukken heeft mogelijk onmiddellijk een pickorder en een prioriteitsmarkering nodig. Een fabrikant heeft eerst een beschikbaarheidscontrole nodig en daarna een productie-impuls. Een groothandel met vaste routes wil bestellingen tot een bepaald tijdstip bundelen. Daarom is een starre standaardoplossing vaak niet de beste keuze.

Voor de klant volstaat vaak een duidelijke bevestiging: bestelling ontvangen, gecontroleerd of bindend ingepland. Niet elke interne statuswijziging hoort thuis in een e-mail. Te veel automatische berichten wekken vragen op in plaats van vertrouwen.

Welke gegevens een robuust proces nodig heeft

Goede orderacceptatie steunt op een schone gegevensbasis. Daartoe behoren bijgehouden klantstamgegevens, eenduidige artikelnummers, geldige prijs- en voorwaardenregels en duidelijk gedefinieerde leveringsadressen. Ontbreken deze fundamenten, dan versnelt automatisering enkel de doorgifte van onbetrouwbare gegevens.

Ook de technische architectuur telt mee. Een centraal systeem met navolgbare statuswijzigingen en een betrouwbare databank is op lange termijn beter dan een keten van macro's, lokale bestanden en ongecontroleerde e-maildoorsturingen. Dat betekent niet dat elk Excel-blad meteen vervangen moet worden. Als een tabel transparant functioneert in een klein, stabiel deelproces, kan die voorlopig blijven.

Van zodra meerdere mensen tegelijk met bestellingen werken, goedkeuringen nodig zijn of informatie aan magazijn en verzending wordt doorgegeven, zou een centrale gegevensbron echter voorrang moeten krijgen. Systemen op basis van een onderhoudbare architectuur, bijvoorbeeld met PHP 8.4, moderne JavaScript en MySQL 8, kunnen daarbij gericht aan bestaande processen worden gekoppeld, in plaats van een onderneming in het keurslijf van een overgedimensioneerde bedrijfssoftware te persen.

Meetbaar maken of de workflow echt beter wordt

Een nieuw systeem is niet automatisch een beter proces. Vóór de start zouden daarom enkele kengetallen vastgelegd moeten worden. Relevant zijn bijvoorbeeld de tijd van ontvangst van de bestelling tot goedkeuring, het aantal vragen per bestelling, correcties na overdracht aan het magazijn en het percentage tijdig verwerkte bestellingen.

Deze kengetallen tonen ook waar geen verdere automatisering nodig is. Als 85 procent van de standaardbestellingen snel en foutloos verloopt, maar de overige 15 procent echte bijzondere gevallen zijn, is een duidelijk verduidelijkingsproces zinvoller dan de poging elke uitzondering algoritmisch af te dwingen.

Logs helpen daarnaast in de dagelijkse praktijk. Wie ziet wanneer een bestelling binnenkwam, welke controle mislukte, wie ze goedkeurde en wanneer de verzendorder werd gegenereerd, hoeft niet meer in vijf postvakken naar de oorzaak te zoeken. Dat vermindert niet alleen fouten, maar ook de afhankelijkheid van individuele medewerkers.

Invoering in kleine stappen in plaats van een Big Bang

De veiligste start is meestal een duidelijk afgebakend besteltype: bijvoorbeeld standaardbestellingen van een bepaalde klantenkring of e-mailbestellingen met gekende artikelen. Daar kunnen gegevensvelden, regels en overdrachten onder reële omstandigheden worden getest. Pas als status, uitzonderingen en verantwoordelijkheden goed functioneren, volgen complexere gevallen zoals speciale prijzen, deelleveringen of klantspecifieke verpakkingsvoorschriften.

Medewerkers zouden bij het ontwerp betrokken moeten worden. Niet omdat elke bestaande gewoonte ongewijzigd moet blijven, maar omdat de mensen aan de telefoon, in de verkoop en in het magazijn de werkelijke uitzonderingen kennen. Een oplossing die enkel in een workshop goed oogt, wordt op de vloer snel omzeild.

softify.pro zet bij dergelijke projecten in op workflow-specifieke systemen in plaats van overladen standaardsuites: met duidelijke overdrachten, gedocumenteerde regels en genoeg ruimte voor de werkwijzen die in de praktijk aantoonbaar functioneren.

De beste volgende stap is dus niet de zoektocht naar zoveel mogelijk functies. Neem tien echte bestellingen uit een typische week en volg hun weg van ontvangst tot verzending. Elke manuele dubbele overdracht, elke onduidelijke beslissing en elke terugkerende vraag is een concreet aanknopingspunt voor een proces dat voortaan betrouwbaar voor het team werkt.

Permalink →

Testdata veilig beschermen bij AI-testing

Testdata veilig beschermen bij AI-testing

Een mislukte geautomatiseerde test is meestal snel verholpen. Een schermafbeelding uit de testrun die klantgegevens, prijslijsten of een actieve sessie bevat en in een externe AI-dienst terechtkomt, is een ander probleem. Wie testdata bij AI-testing wil beschermen, moet daarom niet alleen naar de testgevallen kijken, maar naar het volledige gegevenstraject: invoer, browserverkeer, logs, beelden, AI-evaluatie en bewaring.

Net bij webapplicaties, interne portalen en Windows-software ontstaat snel een vals gevoel van veiligheid. De omgeving heet dan wel "test", maar gebruikt vaak kopieën van productiedatabanken, echte gebruikersrollen of interfaces naar verzending, ERP en documentarchieven. AI-ondersteunde tests maken deze gegevens bijzonder waardevol voor analyse - en daardoor bijzonder beschermenswaardig.

Waarom AI-testing een eigen blik op gegevensbescherming vereist

Klassieke testautomatisering controleert meestal duidelijk afgebakende stappen: aanmelden, bestelling aanmaken, leveringsbon genereren, afmelden controleren. AI-ondersteund testen breidt dit verloop uit. Het systeem kan interfaces interpreteren, afwijkingen beoordelen, schermafbeeldingen vergelijken en resultaten in begrijpelijke taal documenteren. Dat bespaart tijd bij regressietests, maar genereert bijkomende data-artefacten.

Deze artefacten zijn vaak veelzeggender dan een gewoon testlog. Een schermafbeelding kan namen, adressen, contractwaarden, bestelhoeveelheden of gezondheidsgegevens tonen. Een netwerklog kan sessietokens en API-antwoorden bevatten. Een foutmelding kan interne bestandspaden, databankstructuren of versies onthullen. Wanneer een model met deze informatie werkt, moet duidelijk zijn waar de verwerking plaatsvindt en wie er toegang toe heeft.

De doorslaggevende vraag is dus niet: "Gebruiken we AI bij het testen?" Maar eerder: "Welke gegevens verlaten welke beveiligingszone - en waarom?" Voor veel ondernemingen in de DACH-regio is externe cloudverwerking niet principieel uitgesloten. Ze moet echter contractueel, technisch en organisatorisch aansluiten bij de beschermingsbehoefte. Bij ontwikkelings-, productie- of klantgegevens is een lokaal gecontroleerde uitvoering vaak de meest pragmatische keuze.

Testdata beschermen bij AI-testing begint vóór de eerste run

Gegevensbescherming bij testen wordt vaak pas besproken bij de keuze van een tool. Dat is te laat. Eerst is een eenvoudige, betrouwbare gegevensinventaris nodig. Welke systemen worden getest? Welke velden verschijnen in interfaces? Welke bijlagen, exports en API-antwoorden kunnen in de test voorkomen? En welke gegevens belanden automatisch in schermafbeeldingen, video's of foutmeldingen?

Een indeling in drie groepen loont hier. Niet-kritieke testdata kunnen vrij gegenereerd en langer bewaard worden. Persoonsgegevens of bedrijfsvertrouwelijke gegevens vereisen maskering, toegangsbeperkingen en korte bewaartermijnen. Toegangsgegevens, tokens, sleutels en productieconfiguratiewaarden horen niet thuis in testbewijzen of modelverzoeken - ook niet als ze slechts per ongeluk zichtbaar zijn in een browservenster.

In veel middelgrote toepassingen is de gegevenssituatie niet netjes gescheiden. Het magazijnteam test een nieuwe goederenontvangst met een databank-extract, omdat alleen daar de echte artikelstructuren, leveranciersregels en bijzondere gevallen aanwezig zijn. Dat kan inhoudelijk zinvol zijn. Het gevolg mag echter niet zijn dat dit extract ongewijzigd naar elke testomgeving migreert.

Beter is een reproduceerbaar proces: gegevens exporteren, gevoelige velden gericht pseudonimiseren, onnodige tabellen verwijderen en de resulterende testdatabank versiebeheerd beschikbaar stellen. Zo blijven typische procesfouten behouden, zonder dat echte klanten of medewerkers zichtbaar worden in testruns. Bij complexe prijs- of dispositielogica volstaan volledig synthetische gegevens vaak niet. Dan is een zorgvuldig opgeschoonde kopie meestal het betere compromis.

Maskering moet de vakinhoudelijke logica bewaren

Een maskering die elk e-mailadres door dezelfde placeholder vervangt, kan testgevallen beschadigen. Dubbelcontroles, rollogica, zoekfuncties of factureringsprocessen gedragen zich anders dan in bedrijf. Goede maskering bewaart daarom formaten, relaties en verdelingen. Van een klantnummer wordt een ander geldig klantnummer gemaakt. Van een adres wordt een plausibel maar fictief adres gemaakt. Van een leveringsdatum blijft een datum binnen een realistische planningsmarge over.

Dat vergt enige voorbereiding. Daartegenover staat dat het de klassieke fout vermijdt waarbij tests technisch groen zijn, maar de werkelijke processen in magazijn, verkoop of klantendienst niet meer weerspiegelen. Gegevensbescherming en inhoudelijk bruikbare tests zijn geen tegenpolen - op voorwaarde dat gegevensvoorbereiding deel uitmaakt van de testarchitectuur.

De uitvoeringslocatie bepaalt de controle

Wie geautomatiseerde tests aan een externe dienst toevertrouwt, geeft afhankelijk van de configuratie meer prijs dan enkel teststappen. Browserinhoud, DOM-structuren, schermafbeeldingen, video's, consolelogs en evaluaties kunnen buiten de eigen infrastructuur verwerkt en opgeslagen worden. Of dat aanvaardbaar is, hangt af van het specifieke geval: gegevenscategorieën, contractueel kader, opslaglocatie, tenant-scheiding, verwijderingsconcept en interne richtlijnen spelen samen.

Voor toepassingen met een hoge beschermingsbehoefte is een self-hosted testomgeving vaak duidelijker te beoordelen. De test-runner, de AI-component en de bewijsopslag blijven binnen het eigen netwerk of in een gecontroleerde Europese infrastructuur. Netwerkregels kunnen externe verbindingen beperken. Toegang kan gekoppeld worden aan bestaande identiteiten, rollen en logging. Ook de bewaring van beelden en rapporten wordt een eigen beslissing in plaats van een standaardinstelling van een platformaanbieder.

COCO volgt precies deze aanpak: de AI-server voert tests voor web- en Windows-toepassingen gecontroleerd uit, documenteert bewijzen en genereert begrijpelijke beoordelingen, zonder dat interne applicatiegegevens standaard naar een externe AI-cloud moeten worden overgedragen. Dit vervangt geen gegevensbeschermingsaudit. Het schept echter een technische basis waarop IT, informatiebeveiliging en de vakafdeling navolgbare regels kunnen afspreken.

Schermafbeeldingen, logs en secrets zijn de meest voorkomende lekken

Veel teams beschermen de testdatabank, maar zien de bijproducten van het testen over het hoofd. Net daar liggen in de praktijk vaak de grotere risico's. Een mislukte logintest kan een wachtwoord in het invoerveld tonen. Een API-test kan een bearer-token in het log tonen. Een automatische video-opname documenteert een volledige bestelling inclusief klantadres.

Een robuust concept regelt daarom minstens vijf punten:

  • Schermafbeeldingen en video's worden enkel bij noodzaak aangemaakt en na vaste termijnen verwijderd.
  • Geheimen worden ingebonden via een secret store of beschermde runtime-variabelen, nooit opgeslagen in de testcode.
  • Logs filteren tokens, wachtwoorden, session-ID's en gevoelige velden vooraleer ze worden opgeslagen.
  • Testaccounts bezitten enkel de rechten die voor het betreffende verloop nodig zijn.
  • Testsystemen mogen geen productie-e-mails, labels, betalingen of voorraadbewegingen veroorzaken, tenzij dit uitdrukkelijk beveiligd is.

Deze regels klinken nuchter. Precies dat is hun voordeel. Een team hoeft niet te hopen op oplettendheid of goede bedoelingen, maar kan verkeerd gebruik technisch beperken. Bijzonder doeltreffend zijn gescheiden serviceaccounts voor testautomatisering, korte token-levensduren en een duidelijk proces voor het intrekken van gecompromitteerde toegangsgegevens.

Ook de AI-evaluatie heeft grenzen nodig

AI-modellen worden vaak ingezet om afwijkingen te verklaren: "De knop was niet zichtbaar", "De applicatie reageerde trager dan verwacht" of "Het proces eindigde in een rechtencontrole". Voor zulke inschattingen heeft een model niet noodzakelijk de volledige klantdataset nodig.

Bepaal daarom welke informatie in de beoordeling mag meewegen. Volstaat een geanonimiseerde schermafbeelding? Is een technische foutklasse voldoende in plaats van het volledige serverantwoord? Kunnen velden vóór de analyse worden weggelakt? De juiste diepgang hangt af van het testdoel. Bij een lay-outvergelijking is een naam zelden relevant. Bij het controleren van een gepersonaliseerde documentsjabloon kan dat wel relevant zijn - dan moet de verwerking dienovereenkomstig beveiligd worden.

Beschermingsmaatregelen moeten in de praktijk controleerbaar blijven

Een concept is enkel robuust als het in de dagelijkse praktijk gecontroleerd kan worden. Daartoe behoren regelmatige steekproeven van testbewijzen, controles van rechten en een blik op de daadwerkelijk opgeslagen gegevens. Zijn er nieuwe velden in schermafbeeldingen geslopen? Bestaan oude testaccounts nog? Wordt een databank-extract langer bewaard dan bedoeld? Zulke vragen horen thuis in de normale operationele routine, niet enkel in een audit.

Even belangrijk is duidelijke verantwoordelijkheid. QA kent de testverlopen, ontwikkeling kent de technische interfaces, de vakafdeling kent de kritieke processen en IT-beveiliging bepaalt het kader. Als niemand deze perspectieven samenbrengt, ontstaat er ofwel een risicovolle kortere weg, ofwel een beveiligingseis die echte tests belet. Een klein, gedocumenteerd goedkeuringsproces is meestal doeltreffender dan een uitgebreid regelwerk dat niemand toepast.

Uiteindelijk gaat het er niet om elke test kunstmatig ingewikkeld te maken. Testdata goed beschermen betekent echte risico's gericht uit de automatisering halen en de inhoudelijke waarde van de tests bewaren. Wanneer teams precies weten welke gegevens een test mag zien, waar de bewijzen zich bevinden en wanneer ze verdwijnen, wordt AI-testing een beheersbaar instrument in plaats van een bijkomende onzekerheid.

Permalink →

Een webapplicatie met PHP laten ontwikkelen

Een webapplicatie met PHP laten ontwikkelen

Wanneer inkomende goederen in een rekenblad terechtkomen, verzendgegevens telefonisch worden doorgegeven en de actuele orderstatus enkel in het hoofd van individuele medewerkers bestaat, ontbreekt meestal geen bijkomende standaardtool. Er ontbreekt een systeem dat het eigen verloop betrouwbaar afbeeldt. Een webapplicatie met PHP laten ontwikkelen loont zich precies dan: wanneer informatie, beslissingen en documenten op één plaats moeten samenkomen, zonder de organisatie te belasten met een overgedimensioneerde enterprise-suite.

PHP is hier geen nostalgisch compromis. Met PHP 8.4, een heldere applicatiearchitectuur en MySQL 8 kunnen duurzame webapplicaties gebouwd worden die snel reageren, goed te onderhouden zijn en betrouwbaar werken op desktop, tablet of handscanner. Doorslaggevend is echter niet de taal alleen. Doorslaggevend is of de applicatie het werk op de werkvloer, op kantoor en onderweg effectief eenvoudiger maakt.

Wanneer een individuele webapplicatie zinvol is

Niet elk proces heeft meteen maatwerksoftware nodig. Een netjes bijgehouden rekenblad kan voor een kleine, zelden veranderende lijst de meest verstandige oplossing blijven. Ook een gevestigd standaardproduct is zinvol als het de belangrijkste verlopen al afdekt en zonder permanente omwegen gebruikt kan worden.

Het kantelpunt komt wanneer medewerkers gegevens meermaals invoeren, informatie uit verschillende bestanden bij elkaar zoeken of bijzondere gevallen regelmatig buiten het eigenlijke systeem oplossen. Typische signalen zijn onduidelijke voorraadstanden, manueel aangemaakte leveringsbonnen, onduidelijke verantwoordelijkheden bij bestellingen of vragen die elke ploeg opnieuw moet beantwoorden. Dan gaat niet alleen tijd verloren; fouten worden lastig te achterhalen en de afhankelijkheid van individuele personen neemt toe.

Een maatwerk-webapplicatie beeldt daarentegen precies de regels af die in de onderneming gelden. Ze kan bijvoorbeeld inkomende goederen registreren, voorraadbewegingen documenteren, labels genereren, bestellingen prioriteren of overdrachten tussen teams traceerbaar maken. Het is niet nodig om vanaf dag één elk bijzonder geval te automatiseren. Een verstandige start focust op het proces dat vandaag de meeste wrijving veroorzaakt.

Een webapplicatie met PHP laten ontwikkelen: wat vooraf duidelijk moet zijn

Goede software begint niet met schermontwerpen of een lijst technische termen. Ze begint met concrete situaties: wat gebeurt er als een levering onvolledig toekomt? Wie mag een voorraad corrigeren? Welke informatie heeft de verzendafdeling nodig vooraleer een label wordt afgedrukt? En wat gebeurt er wanneer een medewerker van de late shift een bestelling overneemt die 's ochtends werd aangemaakt?

Uit deze vragen ontstaat een solide beeld van het proces. Het toont invoer, beslissingen, overdrachten en uitzonderingen. Juist de uitzonderingen zijn waardevol, want net daar lopen standaardoplossingen vaak vast. Een applicatie voor het aannemen van bestellingen moet bijvoorbeeld niet enkel een nieuwe bestelling opslaan. Ze moet ook duidelijk maken hoe wordt omgegaan met ontbrekende artikelgegevens, afwijkende leveringsadressen, goedkeuringen of annulaties.

Vóór de uitvoering zouden daarom het doel, de gebruikersgroepen en de eerste uitbouwfase vastgelegd moeten zijn. Nuttig zijn echte voorbeeldgegevens, bestaande formulieren, foto's van werkplekken en gesprekken met de mensen die dagelijks met dat proces werken. Een louter managementgesprek levert zelden voldoende detail op. Wie een scanner bedient, goederen opslaat of leveringsbonnen controleert, kent de praktische beperkingen doorgaans nauwkeuriger.

De kleinste zinvolle start

Een eerste release hoeft geen afgewerkt bedrijfsplatform te zijn. Integendeel: een beperkte, productief bruikbare kern vermindert risico en levert vroeg waarde op. Denkbaar is een applicatie die aanvankelijk enkel bestellingen centraal registreert, de status ervan zichtbaar maakt en een betrouwbare leveringsbon aanmaakt. Voorraadbeheer, interfaces of routeplanning kunnen volgen zodra de kern in de dagelijkse praktijk bevestigd is.

Deze volgorde vermijdt dat een project maandenlang werkt aan functies waarvan het werkelijke nut nog onduidelijk is. Ze creëert ook ruimte voor bijsturingen. Misschien is de geplande statuslogica te fijn, misschien heeft de goederenontvangst een sneller invoerscherm nodig, of pas een goedkeuring vanaf een bepaalde goederenwaarde. Zulke inzichten zijn geen mislukking van de planning, maar deel van een zorgvuldige invoering.

De technische basis bepaalt de vervolgkosten

Een webapplicatie wordt niet onderhoudbaar doordat PHP in het voorstel staat. Onderhoudbaarheid ontstaat door navolgbare keuzes: een duidelijke scheiding tussen interface, bedrijfslogica en gegevenstoegang, eenduidige datamodellen, geautomatiseerde tests voor kritieke regels en een gedocumenteerde oplevering.

PHP 8.4 leent zich daar zeer goed voor. De taal is volwassen, efficiënt om te exploiteren en een pragmatische keuze voor veel bedrijfskritische applicaties. In combinatie met moderne JavaScript kan de interface snel en rechtstreeks reageren, zonder elke functie onnodig ingewikkeld als single-page-applicatie op te bouwen. MySQL 8 biedt een solide basis voor transacties, rechtenconcepten en consistente gegevensbestanden.

Net bij magazijn- en bestelprocessen mag een boeking niet halfweg worden opgeslagen. Als een artikel wordt uitgeboekt, moeten voorraad, bewegingslog en bestelstatus overeenkomen. Databanktransacties zorgen ervoor dat alle nodige wijzigingen gebeuren, of geen enkele. Dat klinkt als een detail, maar bepaalt of een systeem in uitzonderlijke gevallen betrouwbaar blijft.

Beveiliging hoort eveneens thuis in de kern van de architectuur. Rollen en rechten moeten aansluiten bij de dagelijkse praktijk: een persoon bij de goederenontvangst heeft andere rechten nodig dan de boekhouding of een externe chauffeur. Veilige wachtwoordhashes, accountblokkering na mislukte aanmeldpogingen, sessiebeheer en logs voor kritieke wijzigingen zijn geen extra's voor later. Ze horen thuis in de eerste productieversie.

Interfaces enkel bouwen waar ze werk besparen

Veel projecten worden onnodig groot omdat van bij het begin elke denkbare integratie wordt gepland. Interfaces naar shop, ERP, verzenddienstverlener of boekhouding kunnen zeer zinvol zijn. Maar ze zijn enkel goed als ze een duidelijke manuele stap vervangen of de datakwaliteit merkbaar verbeteren.

Een voorbeeld: worden verzendlabels dagelijks uit bestelgegevens aangemaakt, dan bespaart een rechtstreekse koppeling tijd en vermindert ze overdrachtsfouten. Worden factuurgegevens daarentegen slechts eenmaal per week naar een bestaand systeem overgezet en is het proces stabiel, dan kan een gestructureerde export voor de start volstaan. De technisch elegantere oplossing is niet automatisch de voordeligste.

Ook de gegevenszeggenschap zou vooraf duidelijk moeten zijn. Welke gegevens worden bewaard, hoe lang blijven logs beschikbaar, wie mag ze exporteren en hoe werken back-ups en herstel? Voor ondernemingen in de DACH-regio zijn deze vragen geen loutere IT-formaliteiten. Ze raken gegevensbescherming, operationele werking en vertrouwen binnen het team.

Invoering zonder de bedrijfsvoering af te remmen

De beste applicatie faalt als ze tijdens de overschakeling het dagelijkse verloop blokkeert. Daarom zou de invoering met echte gevallen voorbereid moeten worden: representatieve bestellingen, echte artikelen, typische leveringsadressen en gekende bijzondere gevallen. Pas wanneer deze processen aantoonbaar werken, zou het systeem een centrale taak moeten overnemen.

Een parallelle werking kan voor korte tijd zinvol zijn, bijvoorbeeld wanneer voorraden afgestemd of nieuwe documenten gecontroleerd moeten worden. Ze mag echter geen blijvende toestand worden. Twee leidende gegevensbronnen leveren onvermijdelijk verschillen op. Er is een duidelijke ingangsdatum nodig, van waaraf vaststaat welk systeem bindend is.

Even belangrijk is een korte, rolgerichte inwerking. Een medewerker in het magazijn heeft geen uitleg over de beheerfuncties nodig. Hij of zij heeft zekerheid nodig bij de weinige stappen die onder tijdsdruk moeten gebeuren. Goede applicaties helpen daarbij met begrijpelijke benamingen, plausibele standaardwaarden en foutmeldingen die uitleggen wat de volgende stap is.

Waaraan u een geschikte ontwikkelingspartner herkent

Wie een webapplicatie laat bouwen, koopt niet zomaar ontwikkeluren. Gezocht wordt een partner die procesvragen ernstig neemt, technische keuzes onderbouwt en ook tegenspreekt wanneer een vereiste onnodig duur of risicovol wordt. Rechtstreekse toegang tot ervaren ontwikkelaars is daarbij meer waard dan een omslachtig verkoopproces met latere overdrachten.

Let op concrete uitspraken over architectuur, beheer en verdere ontwikkeling. Hoe worden wijzigingen gedocumenteerd? Hoe verlopen updates? Wie reageert bij een storing? Is er een navolgbare teststrategie voor kritieke boekingen en rechten? Een interface kan bij een presentatie overtuigend overkomen. Doorslaggevend is of ze ook na twee jaar nog aangepast kan worden, zonder dat elke wijziging een volledige heropbouw wordt.

softify.pro werkt daarom met een stapsgewijze, procesgerichte uitvoering: eerst het operationele knelpunt begrijpen, dan een solide kern opleveren en daarop voortbouwen. Dat is minder spectaculair dan een grote transformatiebelofte, maar in de dagelijkse praktijk meestal veel waardevoller.

Een goede webapplicatie hoeft niet zoveel mogelijk functies te bevatten. Ze moet ervoor zorgen dat een bestelling niet verloren gaat, een voorraad traceerbaar blijft en medewerkers hun werk kunnen doen zonder onnodige vragen. Als dat lukt, wordt van een technische investering een instrument dat elke werkdag merkbaar rustiger maakt.

Permalink →

Verzendlabels automatisch aanmaken en fouten verminderen

Verzendlabels automatisch aanmaken en fouten verminderen

Een bestelling is ingepakt, de goederen staan aan de laadkade — en iemand zoekt nog de juiste verzendwijze, typt het adres van de bestemmeling in een vervoerdersportaal en drukt het label af. Deze stap kost per pakket maar enkele minuten. Bij 30, 80 of 300 zendingen per dag wordt het een knelpunt. Verzendlabels automatisch aanmaken betekent dus niet zomaar een printer aansluiten. Het betekent bestelgegevens, verzendregels en het effectieve inpakproces zo met elkaar verbinden dat een klaargemaakte zending betrouwbaar tot het passende label leidt.

Voor kleine en middelgrote ondernemingen is dit vaak het meest voor de hand liggende startpunt voor logistieke automatisering. Het voordeel is onmiddellijk zichtbaar op de werkvloer: minder vragen, minder verkeerd geadresseerde pakketten en een duidelijke status voor verkoop, magazijn en klantendienst. Toch loont het om het proces vóór de technische uitwerking goed te bekijken. Een slecht bijgehouden artikelbestand of onduidelijke verzendregels worden door automatisering niet beter - ze worden alleen sneller verwerkt.

Wat er bij het automatisch afdrukken van labels echt gebeurt

Een verzendlabel bevat meer dan naam en adres. Afhankelijk van de dienstverlener horen daar een zendingsnummer, een machineleesbare code, routeringsinformatie, diensten zoals leeftijdscontrole of rembours, en bij internationale zendingen douanegegevens bij. Opdat de vervoerder een label kan aanmaken, moet deze informatie volledig en in het verwachte formaat aanwezig zijn.

Het technische verloop begint meestal met een bestelling in de shop, ERP of een eigen bestelbeheer. Zodra de bestelling verzendklaar is, bepaalt het systeem op basis van vastgelegde regels de dienstverlener, het product en de bijkomende diensten. Vervolgens geeft het de gegevens door aan de interface van de vervoerder of aan een verzendplatform. Dat registreert de zending, geeft het trackingnummer en het label terug, en het systeem bewaart de PDF- of afdrukgegevens bij de bestelling. Pas dan wordt er afgedrukt — op de werkplek, aan de inpaktafel of rechtstreeks via een labelprinter.

Deze volgorde is bepalend. Een mooi label zonder geslaagde zendingsregistratie helpt niet. Omgekeerd mag een geslaagde registratie niet op de achtergrond verloren gaan als de printer geen materiaal meer heeft. Goede processen behandelen registratie, afdruk en statusterugkoppeling als één samenhangend geheel.

Verzendlabels automatisch aanmaken begint met duidelijke regels

De meest voorkomende misvatting is dat voor elke bestelling steeds dezelfde dienstverlener gekozen moet worden. Dat kan werken, bijvoorbeeld bij gelijkaardige B2C-zendingen binnen Duitsland. Veel bedrijven hebben echter meer gedifferentieerde regels nodig. Een zware levering, een dringende bestelling, een afhaling in een pakketpunt of een zending naar Zwitserland stellen elk andere eisen.

Zinvolle regels kunnen rekening houden met gewicht en afmetingen, bestemmingsland, leveringsadres, waarde van de goederen, gewenste levertermijn, kenmerken van gevaarlijke goederen en afgesproken klantvoorwaarden. Daarbij geldt: niet elke theoretische uitzondering moet vanaf dag één geautomatiseerd worden. Als er twee bijzondere gevallen per maand voorkomen, is een duidelijk gemarkeerde manuele stap vaak goedkoper en veiliger dan een ingewikkelde regel-engine. Terugkerende gevallen met een noemenswaardig volume horen daarentegen thuis in het standaardproces.

De gegevensbron is bijzonder belangrijk. Gewichten uit een goed bijgehouden artikelbestand zijn bruikbaar voor gelijkaardige goederen. Bij gemengde bestellingen, variabele verpakking of toeslagen voor overmaat zou het definitieve pakketgewicht aan de inpakplaats opgemeten moeten worden. Het systeem kan het label dan pas na het wegen aanmaken. Dat is een extra handeling, maar vermijdt dure correcties en nafacturatie.

Adreskwaliteit wordt vóór het afdrukken bepaald

Veel verzendproblemen ontstaan vóór de overdracht aan de vervoerder. Huisnummers komen in het verkeerde veld terecht, postcodes stemmen niet overeen met de gemeente, of bedrijfsadressen bevatten onduidelijke namen van bestemmelingen. Automatisering zou adressen daarom niet alleen moeten doorgeven, maar ook vooraf moeten controleren. Verplichte velden, landformaten, tekenlengtes en herkenbare dubbels kunnen al bij het invoeren van de bestelling opgevangen worden.

Een adrescontrole is geen garantie op levering. Ze vermindert echter wel het aantal vermijdbare fouten. Bij afwijkende gegevens zou het systeem de bestelling duidelijk moeten blokkeren voor verduidelijking, in plaats van stilzwijgend een onvolledig label aan te maken. In het magazijn moet zichtbaar zijn waarom een bestelling wacht en wie de ontbrekende informatie kan aanleveren.

De inpakplaats heeft een eenvoudige bediening nodig

De beste interface faalt als medewerkers tijdens het inpakken tussen vijf schermen moeten wisselen. Een praktisch inpakscherm toont enkel wat nodig is voor de lopende zending: bestelling, artikelen, leveringsadres, verpakkingsstatus, gewicht, gekozen verzendwijze en afdrukstatus. Een barcodescan op de leveringsbon of het verzameldocument zou de juiste bestelling moeten openen. Na het wegen volstaat idealiter één bevestigende actie om het label aan te maken en af te drukken.

Bij meerdere inpakplaatsen heeft elke werkplek een eenduidige koppeling met een printer nodig. Ook het labelformaat moet passen bij het toestel en de vervoerder. A6 is gebruikelijk voor veel pakketlabels, maar niet elke rol, thermische printer en documentopberging werkt op dezelfde manier. Wie labels eerst als PDF op een kantoorlaserprinter afdrukt, kan snel van start gaan. Bij hogere volumes zijn thermische printers meestal aangewezen: ze vermijden knippen, plakken en het risico dat een label bij het afdrukken op de verkeerde kant terechtkomt.

Een goed proces meldt technische problemen begrijpelijk. «API Error 403» helpt niet aan de inpaktafel. Beter is: «Label niet aangemaakt: toegang tot verzenddienstverlener controleren» of «Printer inpakplaats 2 niet bereikbaar». De bestelling mag daarbij niet per vergissing als verzonden gelden. Ze blijft in een duidelijke foutstatus staan en kan na de oplossing opnieuw verwerkt worden, zonder een tweede zending aan te melden.

Interfaces hebben foutafhandeling nodig, niet enkel een ideaal scenario

Interfaces van vervoerders zijn externe systemen. Ze kunnen tijdelijk onbereikbaar zijn, invoer weigeren of hun antwoordformaat wijzigen. Ook een lokaal netwerk, een afdrukdienst of vervallen toegangsgegevens kunnen het verloop onderbreken. Daarom is het riskant om het succes uitsluitend te laten afhangen van het feit dat een gebruiker op «Label aanmaken» heeft geklikt.

Technisch zou elke aanvraag traceerbaar geregistreerd moeten worden: tijdstip, bestelling, gebruikte verzenddienst, resultaat, trackingnummer en begrijpelijke foutmelding. Gevoelige gegevens en toegangssleutels horen daarbij niet onbeschermd thuis in logbestanden. Een unieke interne zendings-ID voorkomt dat een nieuwe poging dubbele labels of dubbele facturatie oplevert.

Ook annulaties horen thuis in de planning. Wordt een pakket na het afdrukken van het label toch niet afgehaald of opnieuw ingepakt, dan moet duidelijk zijn of de zending bij de vervoerder geannuleerd kan worden en hoe dit in het eigen systeem gedocumenteerd wordt. Zonder deze stap komen verzendstatus, tracking en facturatie na enkele weken niet meer overeen.

Niet elke onderneming heeft meteen een groot verzendplatform nodig

Verzendplatformen kunnen meerdere vervoerders, tarieflogica's en retouren bundelen. Dat is zinvol wanneer zendingsvolumes, bestemmingslanden en dienstverleners erg uiteenlopend zijn. Wie echter een duidelijk verzendproces en één of twee vervoerders heeft, kan overzichtelijker werken met een rechtstreekse koppeling. Minder systemen betekenen minder gegevensafstemming, minder gebruikersaccounts en minder plaatsen waar fouten kunnen ontstaan.

De beslissing hangt niet enkel af van het pakketvolume. Ook retouren, exportdocumenten, individuele verzendregels, bestaande bestelbronnen en de vraag wie wijzigingen later onderhoudt, zijn relevant. Een spreadsheetoplossing blijft bijvoorbeeld verdedigbaar als er dagelijks weinig zendingen met gelijkblijvende gegevens verstuurd worden. Van zodra collega's informatie meermaals overtypen of verzending aan individuele personen gebonden is, wordt een centraal proces meestal voordeliger.

Voor klantspecifieke processen kan een lichte webapplicatie zinvol zijn die bestelgegevens, voorraadbewegingen, leveringsbonnen en labeldruk samenbrengt.

softify.pro bouwt dergelijke systemen met een navolgbare datastructuur, gedocumenteerde oplevering en onderhoudbare technologieën zoals PHP 8.4 en MySQL 8. Doorslaggevend is niet het aantal functies, maar dat het proces begrijpelijker wordt voor het team aan de inpakplaats.

In kleine stappen invoeren en meetbaar verbeteren

Een gecontroleerde start is beter dan een grote overschakeling op een maandagvoormiddag. Eerst wordt een duidelijk afgebakend standaardgeval geautomatiseerd, bijvoorbeeld nationale pakketten van één vervoerder met een vastgelegd labelformaat. Parallel daarmee zouden gedurende enkele dagen automatisch aangemaakte gegevens tegen het vorige proces gecontroleerd moeten worden: adres, gewicht, verzendproduct, trackingnummer en afgedrukt label.

Nadien kunnen uitzonderingen toegevoegd worden. Nuttige kengetallen zijn de verwerkingstijd per zending, het aantal manuele correcties, niet-afgedrukte of dubbel aangemaakte labels en de tijd tot de trackingterugkoppeling naar de klant. Deze waarden tonen of de automatisering echt werk uit handen neemt of enkel een oude omweg digitaal nabootst.

Uiteindelijk telt geen bijzonder complexe verzenddialoog. Het telt dat een ingepakte bestelling zonder zoeken, opnieuw intypen en onzekerheid het juiste label krijgt - en dat uitzonderingen zichtbaar worden precies daar waar een mens effectief moet beslissen.

Permalink →

Het login-proces geautomatiseerd testen met een systeem

Het login-proces geautomatiseerd testen met een systeem

Een login lijkt pas onbeduidend als hij werkt. Valt hij na een release uit, dan staan medewerkers voor het begin van hun shift, klanten voor het klantenportaal of planners voor een geblokkeerde orderverwerking. Het login-proces geautomatiseerd testen betekent dus niet gewoon een gebruikersnaam en paswoord in een formulier invullen. Het betekent een bedrijfskritieke toegang met zijn regels, uitzonderingen en beveiligingsgrenzen herhaalbaar controleren.

Voor veel teams start de automatisering met één positief testgeval: geldige inloggegevens ingeven, aanmelding bevestigen, de startpagina zien. Dat is zinvol, maar als enige test niet voldoende. Loginfouten ontstaan vaak aan de randen: bij verlopen sessies, geblokkeerde accounts, een nieuwe meerfactorauthenticatie of rechten die na een rolwijziging niet meer correct werken. Precies die gevallen moeten planmatig worden afgedekt.

Waarom login bijzondere testdiscipline vergt

De login is tegelijk een beveiligingsfunctie, een technische interface en het startpunt van de werkstroom. Een fout kan te open zijn en ongeoorloofde toegang toelaten. Maar hij kan ook te streng zijn en bevoegde personen buitensluiten. Beide kosten iets: in het eerste geval ontstaan risico's voor gegevens en compliance, in het tweede stilstand, supportlast en gehaaste noodoplossingen.

Bij webapplicaties komen er nog afhankelijkheden bij. De login communiceert vaak met een identity provider, een mailsysteem voor het herstellen van paswoorden, een MFA-app of een directoryservice. Bij Windows-desktoptoepassingen kunnen lokale rechten, netwerkverbindingen en versiestanden een rol spelen. Een test die enkel naar het formulier in de browser kijkt, herkent zulke integratieproblemen niet betrouwbaar.

Daarom moet het team vóór de eerste testautomatisering vastleggen wat een geslaagde login in het betreffende systeem betekent. Volstaat een zichtbare startpagina? Of moet gecontroleerd worden of de juiste tenantselectie geladen werd, of de gebruikersrol klopt en of de eerste beschermde actie effectief mogelijk is? Voor een magazijnportaal zou dat bijvoorbeeld toegang tot de goederenontvangst zijn. Voor een planningssysteem kan het de vrijgave van een rit zijn.

Login-proces geautomatiseerd testen: van procesmodel naar testgeval

Een goed startpunt is geen script, maar een procesmodel. De login laat zich beschrijven als een opeenvolging van duidelijke toestanden: niet aangemeld, inloggegevens verstuurd, identiteit bevestigd, MFA vereist, aangemeld, sessie verlopen of account geblokkeerd. Bij elke toestand horen toegelaten acties en verwachte systeemreacties.

Uit dit model ontstaan testgevallen met zakelijke waarde. Het standaard positieve geval hoort erbij, maar ook ongeldige paswoorden, niet-bestaande gebruikersaccounts en verlopen herstellinks. Belangrijk is de verwachte terugkoppeling. Een applicatie mag bij foutieve inloggegevens niet prijsgeven of een e-mailadres bestaat. De test controleert dus niet alleen of er een foutmelding verschijnt, maar ook of de tekst en het gedrag ervan geen overbodige aanwijzingen geven.

Bijzonder relevant zijn beschermingsmechanismen tegen herhaalde mislukte pogingen. Na een vastgesteld aantal foutieve invoeren kan een account tijdelijk geblokkeerd worden. De geautomatiseerde test moet controleren of de blokkering effectief werkt, hoe lang die geldt en of de rechtmatige gebruiker nadien opnieuw gecontroleerde toegang krijgt. Hier is precisie nodig: een test die bewust productieaccounts blokkeert, veroorzaakt meer problemen dan hij oplost. Zulke scenario's horen thuis in een aparte testomgeving met speciaal daarvoor aangemaakte accounts.

MFA, paswoordherstel en Single Sign-on apart bekijken

Meerfactorauthenticatie is geen detail op het einde van de login. Ze verandert het verloop. Een test moet herkennen dat na het paswoord een extra bevestiging vereist is, en moet zowel de geslaagde als de geweigerde bevestiging in beeld brengen. Bij tijdgebonden eenmalige codes heeft de testomgeving een gecontroleerde omgang met tijd en geheimen nodig. In veel gevallen is een testmethode van de identity provider zinvoller dan het nabootsen van een echte gsm.

Ook paswoordherstel en Single Sign-on verdienen eigen testtrajecten. Bij herstel tellen de verzending van het bericht, de eenmaligheid van de link, de geldigheidsduur en de daaropvolgende aanmelding met het nieuwe paswoord. Bij SSO is doorslaggevend of de applicatie na terugkeer van de identity provider de sessie correct aanmaakt en rollen netjes overneemt.

CAPTCHA's vormen een bijzonder geval. Ze moeten geautomatiseerde aanvallen afremmen en mogen niet via testautomatisering omzeild worden. Zinvoller is een testconfiguratie, een officiële testsleutel of een beveiligde uitzondering voor de testomgeving. Beveiligingscontroles omzeilen enkel om een test groen te krijgen, is geen kwaliteitsstrategie.

Het gepaste technische testniveau kiezen

Niet elke logintest moet via een echte browser lopen. API-tests kunnen controleren of tokens, sessies, foutmeldingen en blokkeerregels correct werken. Ze zijn snel en helpen fouten dicht bij de authenticatielogica te vinden. Browsertests tonen dan weer of velden, doorverwijzingen, cookies, SameSite-instellingen en zichtbare toestanden samenpassen in het echte gebruikersverloop.

Voor kritieke applicaties is de combinatie zinvol. Enkele end-to-end-tests controleren het volledige traject met de browser. Daaronder borgen gerichte API- en integratietests de varianten. Dat vermindert doorlooptijd en vals alarm. Wie elke denkbare combinatie uitsluitend in de browser test, krijgt vaak een trage suite waarvan het onderhoud meer tijd kost dan hij oplevert.

Bij desktopsoftware geldt een gelijkaardig principe. Een geautomatiseerde test mag zich niet beperken tot controleren of een venster opent. Hij moet vaststellen of na de aanmelding de juiste gegevensverbinding bestaat, de gebruikersrechten actief zijn en het centrale werkscherm bereikbaar is. Vooral bij toepassingen in magazijn of productie is dat relevant, omdat werkplekken uiteenlopende netwerkomstandigheden, scanneraansluitingen of lokale configuraties kunnen hebben.

Testdata veilig en herhaalbaar behandelen

Logintests werken onvermijdelijk met inloggegevens. Productieaccounts van medewerkers, echte klantgegevens of MFA-geheimen horen echter niet ongecontroleerd thuis in testscripts, logs en screenshots. Testaccounts moeten duidelijk herkenbaar zijn, minimale rechten hebben en automatisch te resetten zijn. Paswoorden en tokens worden via veilig geheimenbeheer aangeleverd, niet in de broncode opgeslagen.

Even belangrijk is het opkuisen na de testrun. Als een test nieuwe sessies, auditregels of geblokkeerde accounts creëert, moet de testomgeving terugkeren naar een vastgestelde uitgangstoestand. Anders faalt een test op maandag enkel omdat een run van vrijdag nog neveneffecten heeft nagelaten.

Voor bedrijven met vertrouwelijke applicaties is ook de uitvoeringslocatie bepalend. Screenshots van loginschermen, testvideo's en technische logs kunnen gevoelige informatie bevatten. Een zelf gehoste testinfrastructuur zoals COCO kan hier zinvol zijn, omdat testdata, uitvoering en bewijsvoering onder eigen controle blijven. Of dat nodig is, hangt af van beschermingsbehoefte, contractuele situatie en interne richtlijnen. Een eigen infrastructuur is niet automatisch de voordeligste keuze voor elke applicatie.

Bewijs genereren, niet enkel groene vinkjes

Een testrapport zou voor QA, ontwikkeling en de vakafdeling duidelijk moeten maken wat er gecontroleerd werd. Een groene status zonder context helpt weinig als een release later vragen oproept. Zinvol zijn dus tijdstempels, gebruikte testomgeving, testaccount, relevante stappen, screenshots bij fouten en een duidelijke foutmelding in alledaagse taal.

Daarbij mag de bewijsvoering zelf geen privacyprobleem worden. Paswoorden, eenmalige codes, sessie-ID's en persoonsgegevens moeten in logs gemaskeerd worden. Bij screenshots kan het nodig zijn bepaalde delen af te schermen. Deze regels horen thuis in de testarchitectuur, niet als handmatig nawerk na een incident.

Wat teams eerst zouden moeten automatiseren

De prioriteit richt zich naar risico en gebruiksfrequentie. Eerst komen de standaardlogin voor de belangrijkste rollen, foutieve inloggegevens, afmelden en sessieverval. Daarna volgen blokkeerregels, paswoordherstel, MFA en rolwijzigingen. SSO, bijzondere tenants of zeldzame uitzonderingspaden kunnen later volgen, zolang het uitvallen ervan de bedrijfsvoering niet meteen stillegt.

De tests horen bij het releaseproces. Wijzigingen aan loginformulieren, cookies, rechten of identity-providerconfiguraties zouden de relevante testsuite moeten activeren voordat een versie naar productie gaat. Daarnaast loont een geplande run in een realistische omgeving, bijvoorbeeld na infrastructuurwijzigingen of certificaatwissels. Dat vindt problemen die in een geïsoleerde ontwikkelomgeving niet zichtbaar zijn.

De beste logintest is uiteindelijk niet die met de meeste kliks. Het is die welke een echte storing vroeg herkent, begrijpelijk documenteert en bij de volgende wijziging nog betrouwbaar blijft werken. Wie de login als een duidelijk gemodelleerd bedrijfsproces behandelt, beschermt niet alleen een formulier. Hij beschermt de toegang tot het werk dat erachter wacht.

Permalink →

Leveringsbons automatisch aanmaken met software

Leveringsbons automatisch aanmaken met software

De zoektocht naar "software om leveringsbons automatisch aan te maken" start meestal niet met een documentprobleem. Ze start aan de pakktafel: een bestelling is goedgekeurd, goederen zijn verzameld, maar de leveringsbon bestaat nog als Word-sjabloon, Excel-export of handgeschreven briefje. Terwijl iemand de posities controleert, veranderen hoeveelheden, leveradressen of deelleveringen. Dat kost tijd - en veroorzaakt precies de fouten die later vragen, correcties en onnodig overleg uitlokken.

Een automatisch gegenereerde leveringsbon is dus meer dan een PDF met een logo. Het is de gedocumenteerde overgang tussen bestelling, voorraadbeweging en verzending. Om dat betrouwbaar te laten werken, moet de software niet zoveel mogelijk functies bieden. Ze moet het werkelijke verloop in het bedrijf correct weergeven.

Wanneer het loont om leveringsbons automatisch aan te maken met software

Niet elk bedrijf heeft meteen een applicatie op maat nodig. Wie weinig zendingen per week verwerkt, vaste artikelen verkoopt en met een goed bijgehouden sjabloon werkt, kan prima uit de voeten met een spreadsheetoplossing. Automatisering wordt zinvol wanneer medewerkers gegevens meermaals ingeven, bestellingen regelmatig uiteenvallen in deelleveringen, of de verzendstatus niet eenduidig te volgen is.

Typische waarschuwingssignalen zijn kwetsbaar geworden Excel-bestanden, uiteenlopende artikelomschrijvingen in bestelling en magazijn, ontbrekende bewijsstukken bij vragen, of leveringsbonnummers die handmatig toegekend worden. Ook wanneer meerdere personen tussen kantoor, magazijn en verzending werken, volstaat een gedeelde map vaak niet meer. Dan ontbreekt niet alleen snelheid, maar ook een betrouwbare bron voor wat er effectief het pand verlaten heeft.

Het beslissende punt is: de leveringsbon zou moeten ontstaan door een gebeurtenis, niet door een extra werkstap. Die gebeurtenis kan de vrijgave voor het verzamelen zijn, de bevestigde afname of de afronding van het inpakproces. Welke variant past, hangt af van uw proces. In een onderdelenmagazijn is de voorraadboeking vaak de juiste trigger. Bij klantspecifieke productie kan de verzendvrijgave door de werkvoorbereiding bepalend zijn.

Welke gegevens een automatische leveringsbon echt nodig heeft

Een goed systeem neemt niet zomaar alle gegevens van een bestelling over. Het controleert welke informatie geldt op het moment van levering. De ontvanger kan afwijken van de factuurontvanger, een bestelling kan in meerdere zendingen geleverd worden, en de geleverde hoeveelheid kan kleiner zijn dan de oorspronkelijk bestelde hoeveelheid.

Minimaal vereist zijn een uniek leveringsbonnummer, uitgiftedatum, leveradres, klantreferentie en de effectief geleverde posities met hoeveelheden en eenheden. Afhankelijk van de sector komen daar batches, serienummers, gewichten, verpakkingseenheden, orderverzamelaars of instructies voor goederenontvangst bij. Als deze gegevens later nodig zijn voor klachten of traceerbaarheid, horen ze niet in een vrij tekstveld, maar in duidelijk gedefinieerde datavelden.

Bestelling, voorraadbeweging en document moeten kloppen

De meest voorkomende zwakke plek zit tussen bestelling en magazijn. De bestelling voorspelt misschien tien stuks, maar het magazijn bevestigt er maar acht. Worden er toch tien stuks op de leveringsbon gedrukt, dan ontstaat een problematisch document. Worden er acht stuks geleverd zonder de bestelstatus aan te passen, dan blijft de resterende hoeveelheid onzichtbaar.

Een geschikte software houdt deze toestanden gescheiden maar verbonden: besteld, gereserveerd, verzameld, geleverd, eventueel geretourneerd. De leveringsbon steunt op de bevestigde leverhoeveelheden. Zo blijft ook bij deel- en nazendingen traceerbaar welke positie in welke zending zat.

Nummerreeksen en versies zijn geen bijzaak

Leveringsbonnummers handmatig toekennen lijkt eerst ongecompliceerd. Ten laatste bij meerdere vestigingen, verschillende gebruikersaccounts of latere correcties wordt het foutgevoelig. De applicatie zou nummers centraal moeten genereren en moeten voorkomen dat hetzelfde nummer dubbel gebruikt wordt.

Even belangrijk is de omgang met wijzigingen. Een al verzonden leveringsbon zou niet stilzwijgend overschreven mogen worden. Beter is een herkenbare correctie, annulering of nieuwe versie met een traceerbare geschiedenis. Dat is technisch geen luxe, maar beschermt medewerkers ertegen om met tegenstrijdige informatie te werken.

Zo werkt het aanmaken in de praktijk

In een helder proces begint alles met een gestructureerde bestelling. Artikelen, hoeveelheden, leveradres en gewenste datum worden eenmalig vastgelegd of overgenomen uit een bestaand systeem. Vervolgens ontstaat een verzamelopdracht voor het magazijn - op een mobiel toestel, als afdruk of op een werkpostterminal.

Bij het inpakken worden de effectief afgenomen hoeveelheden bevestigd. Bij eenvoudige processen volstaat een bevestigingsknop. Bij veel artikelen, magazijnlocaties of batches zijn barcodescans zinvoller. Pas na deze terugkoppeling maakt de software de leveringsbon als PDF aan, kent er een nummer aan toe en koppelt hem aan het verzendproces. Parallel kan ze een verzendlabel voorbereiden, op voorwaarde dat de betreffende pakketdienst technisch aangesloten is.

Het gegenereerde document wordt centraal opgeslagen en blijft vindbaar via bestelling, klantaccount of zendingnummer. Een medewerker binnendienst moet dan niet meer in de mailbox zoeken als een klant vraagt wat er op een bepaalde dag geleverd is. Hij ziet de bestelling, de afzonderlijke leveringen en de betreffende documentstatus op één plek.

Dat klinkt eenvoudig, maar loopt vaak vast op bijzondere gevallen. Daarom moet de applicatie ze bewust behandelen: wat gebeurt er bij tekorten? Wie mag een leveradres na vrijgave wijzigen? Kan een leveringsbon zonder voorraad aangemaakt worden? Hoe worden gratis bijgaven of vervangende leveringen gekenmerkt? Zulke regels bepalen of de automatisering op de magazijnvloer aanvaard wordt.

Standaardsoftware of individuele oplossing?

Standaardsoftware is zinvol wanneer uw proces grotendeels het beoogde model volgt en interfaces naar shop, ERP of verzenddienstverleners al bestaan. Ze vermindert de invoeringsinspanning en biedt vaak een breed functiepalet. De prijs daarvoor kan zijn dat teams hun werkende processen rond een star systeem moeten organiseren.

Een individuele oplossing loont vooral wanneer uw logica bedrijfskritiek is: bijvoorbeeld bij klantspecifieke verpakkingsregels, complexe deelleveringen, meerdere magazijnzones of een verbinding tussen atelier, productie en verzending. Ze kan zich richten op de functies die dagelijks nodig zijn, in plaats van medewerkers doorheen modules te sturen die niemand gebruikt.

Daartussenin ligt vaak de meest zinvolle weg: bestaande systemen blijven leidend voor artikelstamgegevens of boekhouding, terwijl een lichte webapplicatie het operationele gat in het magazijn dicht. Via duidelijk gedocumenteerde interfaces kunnen bestellingen overgenomen worden, voorraden teruggemeld en leveringsbons gearchiveerd worden. Voor zulke applicaties zijn een traceerbare datastructuur, roltoegang en geteste importprocessen belangrijker dan een bijzonder spectaculaire interface.

Bij softify.pro worden zulke processen eerst getoetst aan de concrete goederenstroom: wie triggert, wie bevestigt, welke uitzondering treedt effectief op, en welke gegevens moeten later aantoonbaar zijn? Pas daarna wordt beslist of een aanpassing van het bestaande systeem volstaat of een eigen applicatie economisch zinvol is.

Invoering zonder de bedrijfsvoering af te remmen

De veiligste start is zelden de volledige digitalisering van alle magazijnprocessen op één stichtdatum. Begin met een duidelijk afgebakend leverpad, bijvoorbeeld standaardbestellingen van één vestiging of één productgroep. Daarbij wordt zichtbaar of artikelstamgegevens, adreskwaliteit en hoeveelheidslogica voldoende proper zijn.

In de volgende stap zouden echte bestellingen parallel getoetst moeten worden. De software maakt de leveringsbon aan, terwijl het bestaande proces nog als controle-instantie beschikbaar blijft. Afwijkingen zijn in deze fase waardevol: ze wijzen niet noodzakelijk op een softwarefout, maar vaak op onopgehelderde procesregels. Als bijvoorbeeld twee medewerkers dezelfde bestelling verschillend zouden inpakken, moet eerst de werkregel eenduidig gemaakt worden.

Daarna volgen rollen en rechten. Magazijnpersoneel heeft andere schermen nodig dan verkoop of boekhouding. Niet iedereen zou achteraf leverhoeveelheden mogen wijzigen of documenten mogen annuleren. Een goede oplossing maakt verantwoordelijkheden zichtbaar, zonder elke kleine handeling in een ingewikkelde goedkeuringsprocedure te dwingen.

Ook het technisch beheer hoort bij de invoering. Documenten en bewegingsgegevens hebben regelmatige back-ups, duidelijke bewaarregels en geteste hersteltrajecten nodig. Bij een webapplicatie met PHP 8.4 en MySQL 8 zijn propere databanktransacties bijzonder belangrijk: een voorraadboeking en het aanmaken van de bijbehorende leveringsbon mogen niet uit elkaar vallen als een verbinding op het verkeerde moment wegvalt.

Drie fouten die automatisering onnodig duur maken

De eerste fout is het automatiseren van een PDF-probleem terwijl de gegevens ervoor niet duidelijk zijn. Als artikelnummers, eenheden of klantadressen niet bijgehouden worden, produceert het systeem enkel sneller foutieve documenten.

De tweede fout is een te grote projectomvang. Leveringsbons, magazijn, verzending, aankoop, productie en boekhouding tegelijk heropbouwen bindt teams vaak maandenlang. Een klein, robuust leverproces schept sneller vertrouwen en biedt een basis voor verdere stappen.

De derde fout is ontbrekende terugkoppeling uit het magazijn. Een leveringsbon mag niet enkel op basis van een geplande bestelling ontstaan, als niemand bevestigd heeft wat er werkelijk ingepakt is. Precies die terugkoppeling maakt van een documentsjabloon een robuust proces.

De beste software voor leveringsbons verdwijnt in de dagelijkse praktijk bijna uit het zicht. Medewerkers leggen een bestelling eenmaal vast, bevestigen hun werk waar het plaatsvindt, en vinden het juiste document terug wanneer het nodig is. Als dat lukt, ontstaat niet alleen een snellere verzending - maar een werkwijze waarop magazijn, kantoor en klanten evenzeer kunnen rekenen.

Permalink →

Een Windows-toepassing geautomatiseerd testen: zo lukt het

Een Windows-toepassing geautomatiseerd testen: zo lukt het

Een release staat klaar, maar niemand kan met zekerheid zeggen of het nieuwe importvenster, de rechtencontrole en het afdrukken van facturen nog werken. Precies op dit punt wordt het waardevol om een Windows-toepassing geautomatiseerd te kunnen testen - niet als demo met drie kliks, maar als herhaalbaar onderdeel van het releaseproces.

Desktopsoftware is in veel bedrijven bedrijfskritisch. Ze stuurt voorraadbewegingen, productieorders, klantstamgegevens of verzenddocumenten aan. Een fout werkt niet enkel op één scherm: hij kan orders blokkeren, foutieve etiketten genereren of medewerkers in de late shift dwingen tot manuele noodoplossingen. Geautomatiseerde tests verkleinen dit risico wanneer ze gericht zijn op echte werkstromen en een technisch gecontroleerde testomgeving.

Waarom Windows-tests anders zijn dan webtests

Een webapplicatie test men meestal via duidelijk aanspreekbare elementen in de browser. Bij Windows-desktoptoepassingen hangt de bediening sterker af van vensters, dialoogvensters, native controls, resolutie, rechten en geïnstalleerde componenten. Een test moet bijvoorbeeld herkennen of een dialoogvenster daadwerkelijk geopend is, of een veld bewerkbaar is of een afdrukopdracht correct overgedragen werd.

Daar komt de gegroeide realiteit van veel toepassingen bij. Sommige interfaces bestaan uit klassieke WinForms- of WPF-componenten, andere binden oudere modules, PDF-viewers of interfaces naar printers en scannerhardware in. Er bestaat niet één automatiseringsmethode die voor elke toepassing even goed werkt. Wie dat verzwijgt, produceert tests die er in het labo goed uitzien en bij de volgende update falen.

Het zinvolle startpunt is dus niet de tool, maar de vraag: welke processen moeten bij elke release aantoonbaar werken? Voor een magazijn- of ordersoftware zouden dat bijvoorbeeld aanmelding, rechtencontrole, orderregistratie, voorraadboeking, documentcreatie en overdracht naar een interface zijn. Deze processen leveren bedrijfswaarde. Een test die enkel controleert of een menu zichtbaar is, doet dat zelden.

Een Windows-toepassing geautomatiseerd testen: het juiste niveau kiezen

Voor automatisering zijn in principe drie niveaus beschikbaar. Idealiter worden ze gecombineerd, in plaats van uitsluitend op de zichtbare interface te vertrouwen.

Op technisch niveau controleren unit- en integratietests bedrijfslogica, gegevenstoegang en interfaces. Ze draaien snel en tonen vroeg of bijvoorbeeld een prijsberekening, een importformaat of een rechtenregel beschadigd is. Ze vervangen echter geen bedieningstest: of een planner de functie effectief kan bereiken en correct kan uitvoeren, blijft open.

Het tweede niveau bestaat uit UI-tests via de Windows Automation API. Testtools spreken hier bedieningselementen aan via eigenschappen zoals automation-ID, naam of control-type. Dat is meestal stabieler dan tests die enkel op vaste schermcoördinaten klikken. Ontwikkelteams kunnen deze stabiliteit actief bevorderen door unieke ID's toe te kennen en relevante controls niet bij elke interfacewijziging te hernoemen.

Het derde niveau werkt visueel. Hier herkent een systeem knoppen, tabelinhoud, dialoogvensters of toestanden op basis van de schermweergave. Dit helpt vooral bij oudere toepassingen, proprietaire componenten of interfaces die geen bruikbare automatiseringsinformatie bieden. Visuele herkenning is echter gevoeliger voor schaling, thema's, onverwachte pop-ups en onduidelijke schermtoestanden. Ze vereist gedefinieerde werkplekken, duidelijke wachtcondities en traceerbaar bewijs.

Een AI-ondersteunde aanpak kan visuele signalen beter inschatten dan een loutere coördinatenklik. Toch mag het geen black box worden. Voor kritieke stappen heeft een team screenshots, logs, verwachte resultaten en een verklaring nodig waarom een run als mislukt beoordeeld werd. Saaie, bewezen betrouwbaarheid boven trendjagen geldt net bij testen.

Beginnen met een kleine, robuuste testomvang

De meest voorkomende fout is meteen elk scherm te willen automatiseren. Dat bindt budget en creëert een grote verzameling kwetsbare scripts nog voor het duidelijk is of de aanpak de releasepraktijk daadwerkelijk verbetert. Beter is een krappe start met vijf tot tien kritieke werkstromen die vandaag regelmatig manueel gecontroleerd worden.

Een goed eerste testgeval heeft een duidelijk begin, een realistische invoer en een controleerbaar resultaat. Voorbeeld: een gebruiker met de rol magazijn meldt zich aan, maakt een goederenontvangst aan, boekt een artikel op een magazijnlocatie en drukt het document af. De test controleert vervolgens niet alleen het succesbericht, maar ook voorraad, documentnummer en de gelogde afdrukopdracht. Zo wordt een reeks kliks een bewijs voor een bedrijfsproces.

Niet elke werkstroom is meteen geschikt. Functies met instabiele hardware, externe betaaldiensten of vaak wisselende derdesystemen vereisen vaak een andere aanpak. Hier kan men de eigen toepassing tot aan de overdracht testen en de externe component via een gecontroleerde simulator weergeven. Dat is geen kortere weg, maar een propere afbakening van verantwoordelijkheden.

Testdata zijn onderdeel van het systeem

Automatisering mislukt vaak niet door de interface, maar door onbruikbare data. Een testaccount is geblokkeerd, een artikel is al gebruikt, of een vorige run heeft de verwachte voorraadhoeveelheid gewijzigd. Daarom heeft de testomgeving gedefinieerde uitgangsdata nodig en een betrouwbare weg terug naar die toestand.

In de praktijk betekent dit: gescheiden testdatabank, vastgelegde gebruikersrollen, bekende artikel- en klantensets, evenals gecontroleerde tijd- en nummerlogica. Bij gevoelige data zouden productiedata niet ongecontroleerd gekopieerd mogen worden. Geanonimiseerde of specifiek gegenereerde datasets zijn meestal de betere keuze. Ze zijn voorspelbaar en verlagen het privacyrisico.

Ook account-lockout-flows verdienen bijzondere aandacht. Als mislukte testruns herhaaldelijk foutieve paswoorden gebruiken, kunnen ze hun eigen toegang blokkeren. Zulke scenario's moeten bewust getest worden, maar gescheiden van de normale regressietest.

Stabiliteit ontstaat door beheer, niet door één tool

Een UI-test is enkel nuttig als hij onder herhaalbare omstandigheden draait. Daartoe behoren een vaste Windows-versie, gedefinieerde schermresolutie en schaling, bekende applicatieversies, evenals een propere omgang met updates, dialoogvensters en achtergrondprocessen. Als een testserver 's ochtends andere lettergroottes gebruikt dan 's nachts, is dat geen testprobleem - het is een beheerprobleem.

Wachttijden zouden niet blind als vaste waarden ingevoerd moeten worden. Drie seconden pauze na elke klik maken een test traag en lossen geen timingproblemen op. Beter is gericht te wachten op een toestand: het venster is zichtbaar, de tabel bevat het verwachte record, of het opslaan is afgerond. Voor echte asynchrone processen zijn zinvolle tijdslimieten en een duidelijke foutdiagnose nodig.

Mislukte runs horen thuis in een triage, niet in een genegeerde map. Was de applicatie defect? Is de interface functioneel correct veranderd? Was de testomgeving niet beschikbaar? Screenshots, schermopnames, technische logs en tijdstempels verkorten deze verheldering aanzienlijk. Een rapport in klare taal helpt bovendien vakafdelingen te begrijpen welk bedrijfsproces geraakt is, zonder eerst een testscript te moeten lezen.

Privacy en bewijsvoering vanaf het begin inplannen

Bij desktoptoepassingen tonen screenshots vaak klantnamen, artikelprijzen, adressen of interne kengetallen. Worden tests via externe clouddiensten uitgevoerd, dan kunnen schermdata en applicatieverkeer mogelijk de eigen controlezone verlaten. Voor veiligheidsbewuste teams is dat geen bijzaak, maar een architectuurkeuze.

Een zelf gehoste testserver kan testuitvoering, beelden en rapporten in de eigen omgeving houden. Daarvoor zet softify.pro met COCO in op een omgeving die geautomatiseerde tests voor web- en Windows-toepassingen uitvoert en traceerbare resultaten oplevert. Of een eigen server zinvol is, hangt af van beschermingsbehoefte, aanwezige IT en het aantal testruns. Voor een kleine, niet-kritieke toepassing kan een eenvoudige aanpak volstaan; bij interne vaksystemen met gevoelige data is lokale controle vaak de verstandigere optie.

Ook de bewaring van bewijsstukken zou geregeld moeten zijn. Niet elke screenshot moet permanent bewaard worden. Zinvol zijn termijnen, roltoegang en een duidelijke koppeling tussen testrun, applicatieversie en resultaat. Zo kunnen fouten nagebootst worden zonder een tweede ongecontroleerde dataverzameling op te bouwen.

Wat een zinvolle uitrol oplevert

Na een eerste run zou een team niet enkel een aantal geslaagde tests moeten ontvangen. Doorslaggevend is of de tests echte fouten vinden, of ze betrouwbaar draaien en of de onderhoudsinspanning in verhouding staat tot het nut. Een test die elke week aangepast moet worden vanwege een onbeduidende lay-outwijziging is te duur - ook als hij technisch indrukwekkend oogt.

De volgende stap is de inbedding in het releaseproces. Snelle technische tests kunnen bij elke build starten; geselecteerde end-to-end-tests draaien vóór een vrijgave of 's nachts in een stabiele omgeving. Kritieke afwijkingen blokkeren de release, minder kritieke meldingen worden gedocumenteerd en geprioriteerd. Deze drempels zouden vakinhoudelijk afgestemd moeten worden. Niet elk visueel verschil is een leveringsstop, een foutief geboekte hoeveelheid echter wel.

Geautomatiseerde Windows-tests vervangen geen vakkennis. Maar ze scheppen tijd voor de controles die beoordelingsvermogen vereisen: nieuwe processen, ongewone bijzondere gevallen en de vraag of een functie in de dagelijkse praktijk echt begrijpelijk is. Wanneer de standaardprocessen betrouwbaar aantoonbaar zijn, hoeft een release niet meer op hoop te berusten.

Permalink →

Logistieke software op maat voor kmo's

Logistieke software op maat voor kmo's

Wanneer de goederenontvangst op papier wordt vastgelegd, voorraden in meerdere Excel-bestanden staan en verzendvragen mondeling worden opgelost, ontbreekt zelden inzet. Wat ontbreekt, is een gemeenschappelijk proces. Logistieke software op maat voor kmo's grijpt precies daar in: niet met een overladen concernsysteem, maar met een applicatie die de werkelijke wegen in magazijn, planning en kantoor weergeeft.

Voor veel bedrijven is dit geen digitaliseringsproject om zichzelf. Het gaat om minder vragen, betrouwbare voorraden, sneller gegenereerde leveringsbons en een overdracht tussen shiften die niet afhangt van de kennis van individuele personen. De beste oplossing is niet automatisch die met de meeste functies. Ze moet het werk aantoonbaar eenvoudiger en beheersbaarder maken.

Het kritieke punt zijn meestal de overdrachten

In kleine en middelgrote magazijn- en productiebedrijven functioneert veel verrassend lang met tabellen, e-mails en ervaring. Dat is niet fundamenteel fout. Een goed bijgehouden tabel kan voor een overzichtelijke inventarislijst zinvoller zijn dan een eigen systeem.

Het wordt kritiek wanneer informatie meerdere keren wordt vastgelegd of de betrouwbaarheid ervan niet meer duidelijk is. Een bestelling wordt op kantoor aangemaakt, in het magazijn afgedrukt, op een looplijst aangevuld en later weer in een tabel overgezet. Tegelijkertijd reserveert een andere medewerker voorraad voor een dringende zending. Uiteindelijk is niet alleen de voorraad twijfelachtig. Ook de vraag wie welke stap wanneer uitgevoerd heeft, is nauwelijks te beantwoorden.

Deze wrijving toont zich zelden als één grote fout. Ze kost dagelijks minuten: bij het zoeken naar artikelen, bij het terugbellen van een klant, bij het opvolgen van een levering of bij de shiftoverdracht. Over weken ontstaan daaruit vermijdbare tekorten, expreszendingen en discussies over cijfers die niemand volledig vertrouwt.

Wat individuele logistieke software concreet zou moeten afdekken

Een applicatie op maat begint niet met een functiecatalogus. Ze begint met een procesopname op de hallenvloer en op de werkplek van de planning. Welke gegevens komen effectief binnen? Welke beslissing neemt een medewerker? Welke uitzondering doet zich regelmatig voor? En welke informatie moet dwingend aanwezig zijn voor de volgende werkstap?

Daaruit ontstaat een helder verloop, bijvoorbeeld van bestelontvangst via verzamelen en verzending tot de overdracht naar de boekhouding. Afhankelijk van het bedrijf kunnen de volgende bouwstenen erbij horen:

  • Registratie van goederenontvangsten, controlestatus en magazijnlocaties
  • Voorraadbewegingen met barcode- of mobiele scannerondersteuning
  • Bestelacceptatie, reserveringen en picklijsten
  • Leveringsbons, verzendlabels en overdracht aan vervoerders
  • Routeplanning voor eigen voertuigen en ritten
  • Traceerbare correcties, rolrechten en analyses

Beslissend is niet alles in één keer te bouwen. Een bedrijf met frequente herschikkingen heeft misschien eerst betrouwbare voorraadbewegingen nodig. Een groothandel met veel kleine zendingen profiteert aanvankelijk sterker van een propere bestelontvangst en automatisch gegenereerde verzenddocumenten. Een productiebedrijf heeft wellicht eerst transparantie over materiaalbeschikbaarheid en geblokkeerde voorraad nodig.

Een voorbeeld uit de dagelijkse praktijk

Stel dat de goederenontvangst vijf paletten met artikelen ontvangt waarvan de hoeveelheden deels afwijken van de bestelling. In een goed verloop wordt de levering geregistreerd, gecontroleerd en aan een status gekoppeld. Pas na vrijgave wordt de voorraad beschikbaar voor de planning. Afwijkingen belanden niet in een notitie op de leveringsbon, maar zijn zichtbaar toegewezen aan aankoop en magazijn.

Wanneer later verzameld wordt, toont het systeem niet alleen een theoretische totale voorraad, maar de bijbehorende magazijnlocatie en het gereserveerde deel. Na het scannen of bevestigen van de afname wordt de beweging geregistreerd. De leveringsbon ontstaat uit dezelfde gegevens. Dat vermindert dubbele invoer en creëert een robuust spoor zonder dat medewerkers meer administratief werk moeten verrichten.

Standaardsoftware, Excel of ontwikkeling op maat?

Het eerlijke antwoord is: het hangt af van het proces. Standaardsoftware is zinvol wanneer processen grotendeels overeenkomen met de beoogde patronen, aanpassingen beperkt blijven en de licentiekosten bij de omvang passen. Ze brengt vaak kant-en-klare modules, gevestigde interfaces en een snelle eerste invoering mee.

Het nadeel toont zich wanneer het bedrijf zich permanent naar het gereedschap moet richten. Dan worden bijzondere gevallen opnieuw buiten het systeem afgehandeld, verplichte velden omzeild of houden medewerkers schaduwlijsten bij. Dat kan aanvaardbaar zijn zolang deze uitzonderingen zeldzaam en beheersbaar blijven. Stapelen ze zich op, dan wordt het standaardproduct een bijkomende procesbreuk.

Excel blijft ook een bruikbaar hulpmiddel wanneer gegevensvolumes klein zijn, slechts weinig personen tegelijk werken en de gevolgen van een foutieve invoer beperkt blijven. Het is echter geen goede gegevensbasis voor parallel lopende voorraadbewegingen, bindende reserveringen of een volledige verzendgeschiedenis.

Een individuele oplossing loont vooral wanneer het proces een echt concurrentievoordeel is, wanneer meerdere mediabreuken samenkomen, of wanneer een bestaand systeem wel gegevens bevat maar het dagelijkse werk afremt. Ze zou niet als prestigeproject moeten worden opgevat. Haar economische waarde ligt in kortere doorlooptijden, minder fouten en minder afhankelijkheid van individuele personen.

Logistieke software op maat voor kmo's heeft grenzen nodig

Op maat betekent niet elke gewenste functie meteen realiseren. Integendeel: goede ontwikkeling op maat stelt duidelijke grenzen. Anders ontstaat een systeem dat alle historische bijzondere paden conserveert en daardoor moeilijk bedienbaar wordt.

Een zinvolle start definieert een kernproces met meetbaar nut. Bijvoorbeeld: goederenontvangsten worden dezelfde dag volledig geboekt. Of: voor elke verzendorder zijn artikel, hoeveelheid, verwerker en verzendstatus eenduidig gedocumenteerd. Pas wanneer dit verloop stabiel draait, volgen verdere modules zoals routeplanning, klantenportalen of speciale analyses.

Ook technische beslissingen vereisen pragmatisme. Een webapplicatie kan voortbouwen op moderne, onderhoudbare technologieën zoals PHP 8.4, moderne JavaScript en MySQL 8. Dat is geen zelfpromotie met technologiebegrippen. Het schept een traceerbare basis voor rolrechten, databanktransacties, mobiele interfaces en gedocumenteerde deployments. Voor scanners in het magazijn is vaak beslissend dat de applicatie betrouwbaar reageert op bestaande toestellen en ook bij zwakkere wifi duidelijke terugkoppeling geeft.

Invoering: eerst het verloop stabiliseren, dan versnellen

De invoering mislukt zelden door één enkele interface. Ze mislukt wanneer openstaande procesvragen naar de ontwikkelfase verschoven worden. Wie mag voorraden corrigeren? Wat gebeurt er bij beschadigde goederen? Wanneer wordt een bestelling bindend gereserveerd? Hoe worden retouren behandeld? Zulke regels moeten voor een brede uitrol duidelijk zijn.

Een robuuste weg begint met enkele representatieve verlopen en echte gegevens. Medewerkers uit magazijn, planning en administratie controleren samen of het scherm de taal van het bedrijf spreekt en of de volgorde van de werkstappen klopt. Opmerkingen zoals "dit veld hebben we niet nodig" of "hier ontbreekt de status voor deellevering" zijn waardevoller dan abstracte functiewensen.

Daarna volgt een beperkte pilootwerking. Niet met kunstmatige voorbeelden, maar met geselecteerde bestellingen in de dagelijkse praktijk. Fouten en onduidelijke toestanden worden gedocumenteerd, geprioriteerd en gecorrigeerd. Pas daarna wordt uitgerold naar andere gebieden. Parallel draaien kan op korte termijn zekerheid geven, maar zou een einde moeten hebben. Twee leidende systemen scheppen op lange termijn precies de onzekerheid die het project moet wegnemen.

Vorming is eveneens meer dan een eenmalige presentatie. Medewerkers hebben korte, rolgebonden instructies nodig: wat boek ik? wat controleer ik? wat doe ik bij een afwijking? Een gedocumenteerde uitzonderingsafhandeling voorkomt dat bij de eerste bijzondere situatie papier en chatgroepen opnieuw de leiding overnemen.

Onderhoudbaarheid is deel van de oplossing, geen nabetrachting

Logistieke processen veranderen. Nieuwe magazijnlocaties komen erbij, een vervoerder wijzigt eisen, klanten vragen andere documentformaten of een nieuwe vestiging wordt aangesloten. Daarom moet de software niet alleen bij de start passen, maar begrijpelijk verder ontwikkelbaar blijven.

Daartoe behoren een propere datastructuur, duidelijk gescheiden vaklogica, rechtenconcepten en gedocumenteerde deployments. Even belangrijk zijn back-ups, logging en een gereguleerde omgang met fouten. Als een gebruiker meermaals foutieve inloggegevens ingeeft, is bijvoorbeeld een traceerbare account-lockout-flow nodig in plaats van stille, onveilige improvisatie.

Vóór wijzigingen aan kritieke processen zouden tests moeten staan. Bij individuele applicaties loont geautomatiseerd testen bijzonder voor terugkerende kernpaden: bestelling aanmaken, voorraad reserveren, verzenddocument genereren, status wijzigen. Zo blijft een aanpassing aan de leveringsbon niet onopgemerkt op een andere plek gevolgen hebben. softify.pro zet bij zulke projecten in op dit soort saai betrouwbare, controleerbare techniek in plaats van kortetermijneffecten.

Waaraan het nut na zes maanden af te meten is

Niet elke verbetering laat zich meteen in euro's uitdrukken, maar ze zou zichtbaar moeten zijn. Goede kengetallen richten zich op het knelpunt: verwerkingstijd per bestelling, aantal voorraadcorrecties, foutverzendpercentage, aandeel tijdige goederenontvangstboekingen of vragen tussen magazijn en kantoor.

Belangrijk is de vergelijking met een realistische uitgangssituatie. Als tot nu toe niemand de tekorten netjes geregistreerd heeft, kan de nieuwe transparantie aanvankelijk op meer problemen lijken. In werkelijkheid worden problemen dan voor het eerst zichtbaar en stuurbaar. Deze fase vraagt geduld en open communicatie.

De juiste software verdwijnt niet uit de dagelijkse werkpraktijk omdat ze onbelangrijk zou zijn. Ze zorgt ervoor dat een bestelling, een palet of een rit zijn duidelijke weg aflegt - ook wanneer de meest ervaren persoon in het magazijn net niet aanwezig is.

Permalink →

Geautomatiseerde regressietesten voor webapplicaties

Geautomatiseerde regressietesten voor webapplicaties

Een gewijzigde kortingscode, een nieuw rolsrecht of een update van de betalingsdienst kan een webapplicatie doen crashen op een plek die al maanden niemand heeft aangeraakt. Dat is precies waar geautomatiseerde regressietesten voor webapplicaties het verschil maken: ze controleren herhaaldelijk of beproefde bedrijfsprocessen na wijzigingen nog steeds blijven werken. Niet als een theoretische kwaliteitsmaatregel, maar wel daar waar een fout bestellingen, voorraadbewegingen, facturen of klantaccounts blokkeert.

Voor veel teams begint het probleem sluipend. Releases duren langer omdat afdelingen dezelfde kernprocessen manueel blijven doorklikken. Testkennis zit verankerd bij individuele personen. En vlak voor een update blijft de ongemakkelijke vraag hangen: wat zijn we over het hoofd gezien? Automatisering vervangt daarbij noch de vakinhoudelijke verantwoordelijkheid, noch nuttig exploratiewerk. Het zorgt ervoor dat de terugkerende, bedrijfskritische controles betrouwbaar, reproduceerbaar en navolgbaar worden.

Wat geautomatiseerde regressietesten daadwerkelijk afdekken

Een regressietest beantwoordt een eenvoudige vraag: werkt iets dat voordien werkte, na een wijziging nog altijd? Bij een webapplicatie gaat het daarbij zelden enkel om een enkele knop. Relevant zijn volledige processen doorheen de gebruikersinterface, machtigingen, koppelingen en de databank.

Een voorbeeld uit een operationeel systeem: een medewerker logt in, registreert een inkomende levering, boekt een voorraadwijziging, maakt een pakbon aan en overhandigt de zending aan een verzenddienst. Elke stap kan er technisch correct uitzien en toch falen in de onderlinge samenwerking. Misschien wordt de hoeveelheid wel opgeslagen, maar niet bijgewerkt in de voorraad. Misschien wordt het etiket gegenereerd, maar ontbreekt het referentienummer. Misschien lukt het proces enkel voor beheerders, maar niet voor de rol in het magazijn.

Geautomatiseerde testen kunnen dergelijke user journeys uitvoeren met gedefinieerde invoer en de resultaten controleren. Daartoe behoren zichtbare resultaten in de gebruikersinterface net zo goed als statuswaarden, gegenereerde documenten, e-mails of API-antwoorden. Het nut stijgt wanneer de controle dicht bij de bedrijfsrisico's wordt georganiseerd — en niet op basis van het aantal technisch mogelijke testgevallen.

Welke webprocessen als eerste geautomatiseerd moeten worden

Niet elke klik verdient meteen een geautomatiseerde test. Een nauwelijks gebruikte instellingenpagina met een gering schadepotentieel kan in het begin gerust manueel worden gecontroleerd. Daarentegen horen processen met frequente wijzigingen, een hoog gebruik of duidelijke financiële en operationele gevolgen al vroeg in de testsuite thuis.

Bijzonder waardevol zijn testen voor login, wachtwoordherstel en account-lockout. Ze beveiligen de toegang tot de applicatie en worden vaak beïnvloed door wijzigingen aan identiteitsdiensten, sessiebeheer of veiligheidsregels. Even belangrijk zijn kernprocessen zoals orderinvoer, prijs- en berekeningsregels voor btw, goedkeuringen, voorraadboekingen, documentgeneratie en koppelingen met verzenders, ERP of betalingsproviders.

Voor leidinggevenden en vakafdelingen helpt een nuchtere prioritering. Vraag niet eerst welke pagina het gemakkelijkste te testen is. Vraag: welke fout legt een shift plat, veroorzaakt herwerk of leidt tot verkeerde klantinformatie? Daaruit ontstaat een testlijst die de reële werking beschermt.

Een testgeval heeft een controleerbaar resultaat

«Bestelling aanmaken» is nog geen goed testgeval. Beter is: een salesmedewerker legt met de rol van verkoop een opdracht aan voor een bestaande klant, voegt een artikel met een gedefinieerde hoeveelheid toe, slaat dit op en genereert een ordernummer. Vervolgens is de status «open», komt het totaalbedrag overeen met de regels en verschijnt de opdracht in de lijst van openstaande taken.

Deze precisie is geen bureaucratie. Het voorkomt testen die weliswaar klikken, maar niet kunnen vaststellen of het inhoudelijke resultaat klopt. Het vergemakkelijkt bovendien de afstemming tussen ontwikkeling, QA en de vakafdeling. Vooral bij individueel ontwikkelde systemen zijn de vakmensen vaak de enige betrouwbare bron om te weten wat «correct» in het dagelijkse reilen en zeilen nu echt betekent.

Testpiramide in plaats van browserautomatisering voor alles

Browsertesten zijn waardevol, maar ze vormen niet de volledige teststrategie. Ze draaien trager, zijn gevoeliger voor instabiele testgegevens en kunnen na kleine UI-aanpassingen stukgaan bij slecht gekozen selectors. Wie elke regel uitsluitend via de interface controleert, bouwt doorgaans een traag en onderhoudsintensief testpakket.

Bedrijfslogica zoals prijsberekeningen, hoeveelheidscontroles of statusovergangen moet worden getest op de plek waar ze is geïmplementeerd — bijvoorbeeld als unit- of integratietest. Koppelingen kunnen gericht worden gecontroleerd met gecontroleerde antwoorden. Browsergebaseerde end-to-end-testen blijven dan gereserveerd voor de weinige paden waarbij de samenwerking tussen alle componenten cruciaal is.

Bij PHP 8.4-applicaties met MySQL 8 betekent dit bijvoorbeeld: reken- en validatieregels worden dicht bij de code afgedekt, databanktransacties en API-contracten worden geïntegreerd getest, terwijl een browsertest de volledige opdracht tot aan het gegenereerde document doorloopt. Dat is minder spectaculair dan een grote verzameling zichtbare kliktesten, maar het levert snellere feedback op en vraagt minder onderhoudsinspanningen.

Stabiliteit ontstaat door testdata en duidelijke technische grenzen

Veel automatiseringsprojecten falen niet door de testtool, maar door onbeheerde voorwaarden. Als een testaccount geblokkeerd is, als er nog een testbestelling van de vorige dag bestaat of als een externe dienst even traag reageert, ontstaat er een vals alarm. Dergelijke instabiele testen verliezen snel het vertrouwen van het team.

Testdata moeten daarom bewust worden aangemaakt en opgeruimd. Handig zijn eigen tenants of helder afgebakende datasets, eenduidige id's per testrun en gedefinieerde starttoestanden. Een test mag niet toevallig afhangen van de volgorde van andere testen. Waar externe diensten zijn betrokken, moet er duidelijk worden gekozen: wordt er een realistische testomgeving gebruikt of wordt de koppeling voor de betreffende test gesimuleerd? Beide opties kunnen juist zijn.

Ook selectors verdienen de nodige aandacht. Testen mogen niet afhangen van layoutklassen, tekstposities of willekeurige HTML-structuren. Stabiele, uitdrukkelijk voor testen bestemde labels verminderen overbodig onderhoud. Dat is een kleine technische beslissing met een grote impact wanneer de interface en het ontwerp regelmatig evolueren.

Geautomatiseerde regressietesten inbouwen in het releaseproces

De beste test helpt weinig als hij enkel handmatig wordt opgestart voor grote releases. Zinvol is een gefaseerde uitvoering: snelle code- en interfacewesten draaien bij elke wijziging. De belangrijkste browser-journeys draaien bij pull requests of voor de implementatie in de staging-omgeving. Uitgebreidere controles kunnen 's nachts of vóór een geplande productierelease plaatsvinden.

De terugkoppeling is doorslaggevend. Een mislukte test heeft niet alleen nood aan een rood icoontje, maar aan bruikbare aanwijzingen: welke data werden er gebruikt? Bij welke stap trad de fout op? Welke screenshot of welk logbestand bewijst het? Voor teams zonder eigen grote QA-afdeling zijn begrijpelijke bevindingen bijzonder waardevol. Ze moeten kunnen herkennen of een defect in het systeem, in de testdata of in de testomgeving ligt.

COCO kan hier worden ingezet als zelfgehoste testinfrastructuur om testprocessen uit te voeren, bewijzen vast te leggen en resultaten in klare taal op te stellen. Dat is vooral relevant wanneer screenshots, interne interfaces of testdata niet naar een externe cloud mogen worden overgedragen. Zelfgehost betekent evenwel niet onderhoudsvrij: toegangsrechten, updates, capaciteiten en bewaarregels moeten even zorgvuldig worden gepland als de testen zelf.

Wat statistieken vertellen - en wat niet

Een groeiend aantal geautomatiseerde testen is geen bewijs van kwaliteit. Een suite met 2.000 oppervlakkige testen kan minder bescherming bieden dan 40 zorgvuldig onderhouden testen voor de kritische waardestromen. Veelzeggender zijn vragen zoals: hoe lang duurt de feedback na een wijziging? Hoeveel relevante fouten worden er voor de productiefase gevonden? Hoe vaak zijn testfouten in feite valse alarmen? En welke bedrijfskritische processen zijn aantoonbaar afgedekt?

Ook de looptijd is een praktische factor. Als een suite pas na vier uur resultaten oplevert, wordt ze in de dagelijkse praktijk omzeild. Als ze in 15 minuten een helder signaal geeft over login, order, voorraad en documenten, ondersteunt ze de besluitvorming vóór de release. Het hangt van de toepassing en het risico af welke diepte noodzakelijk is. Een interne planningstool vraagt nu eenmaal iets anders dan een klantenportaal met betalingen en persoonsgegevens.

De juiste start is kleiner dan velen verwachten

Begin met één proces waarvan de uitval direct merkbaar zou zijn, en breng dat volledig in kaart. Definieer het verwachte resultaat samen met de personen die dit proces dagelijks gebruiken. Zorg voor gecontroleerde testdata, stabiele technische ankers en navolgbare bewijzen. Pas wanneer deze eerste test betrouwbaar draait, wordt het volgende proces toegevoegd.

Zo ontstaat er geen indrukwekkend, maar fragiel testdecor. Er ontstaat een veerkrachtige veiligheidslijn voor wijzigingen — stap voor stap, precies daar waar uw webapplicatie het bedrijf daadwerkelijk draagt.

Permalink →

Goederenontvangst digitaal registreren zonder voorraadchaos

Goederenontvangst digitaal registreren zonder voorraadchaos

Een leverbon ligt op de goederentafel, de pallet staat al in de gang en de chauffeur wacht op een handtekening. Precies op dat moment wordt beslist of een voorraad later klopt of dat de volgende collega op zoek moet gaan naar materiaal dat volgens het systeem aanwezig zou moeten zijn. Wie de goederenontvangst digitaal wil registreren, heeft daarom meer nodig dan een invoerscherm. Het proces moet onder tydsdruk werken, eenduidige gegevens genereren en aansluiten bij de werkelijke handelingen in het magazijn.

Papieren lijsten en tabellen lijken vaak lang voldoende. Ze worden echter kwetsbaar zodra meerdere personen boeken, artikelen gelijkaardige benamingen hebben, lotsnummers (charges) relevant worden of goederen meteen naar de montage, orderpicking of klantopdrachten doorgaan. Een goede digitale registratie creëert niet zomaar meer data. Ze creëert een betrouwbare en gedeelde toestand.

Wat er bij een digitale goederenontvangst echt geregistreerd moet worden

De goederenontvangst is de overgang tussen de levering en de beschikbare voorraad. Om ervoor te zorgen dat deze overgang controleerbaar blijft, moet elke boeking op zijn minst kunnen beantwoorden: Wat is er geleverd, in welke hoeveelheid, wanneer, door welke leverancier en waar zijn de goederen opgeslagen? Afhankelijk van de zaak komen daar bestelnummer, leverbonnummer, lotnummer (charge), serienummer, houdbaarheidsdatum of kwaliteitsstatus bij.

Doorslaggevend is het onderscheid tussen aangekondigde en daadwerkelijk aangenomen goederen. Een bestelling kan 100 stuks vermelden, maar er worden 96 stuks geleverd, plus twee beschadigde dozen en twee vervangende posities. Als medewerkers enkel de bestelling bevestigen, schuift er direct een fout in de voorraad. De digitale registratie moet afwijkingen bewust eenvoudig maken – en ze niet bestraffen met omslachtige procedures.

Voor een onderdelenmagazijn volstaan vaak artikel, hoeveelheid, opslagplaats en bonreferentie. In de productie kunnen vrijgaves van lotnummers of keuringsverslagen onmisbaar zijn. Meer velden zijn niet automatisch beter. Elk verplicht veld kost tijd en verhoogt de kans dat iemand waarden inschat of pas achteraf invult.

Goederenontvangst digitaal registreren: Het verloop op de magazijnvloer

Een praktijkgericht verloop begint niet achter het beeldscherm op kantoor, maar daar waar de goederen toekomen. Medewerkers openen de verwachte goederenontvangst op een mobiel toestel of registreren de leverbon eerst via zoekopdracht, bestelnummer of streepjescode. Daarna worden posities gescand, geteld of gewogen en vergeleken met de verwachte levering.

Is de hoeveelheid correct, dan wordt de goederen een opslagplaats toegewezen en geboekt. Bij afwijkingen wordt er niet zomaar een opmerking in een vrij tekstveld geschreven. Het systeem legt vast of het gaat om een tekort, overlevering, transportschade, een verkeerd artikel of een nog niet gekeurde positie. Een foto kan nuttig zijn bij zichtbare schade, maar is niet voor elke levering nodig.

Na de boeking moet het duidelijk zijn welke status de goederen hebben. Sommige artikelen zijn onmiddellijk beschikbaar. Andere blijven geblokkeerd totdat een kwaliteitscontrole is afgerond of een verantwoordelijke een beslissing heeft genomen over de afwijking. Deze statuslogica vermijdt dat de verkoop goederen belooft die fysiek weliswaar zijn toegekomen, maar nog niet bruikbaar zijn.

Het juiste registratiepunt hangt van het bedrijf af. In een klein magazijn kan de goederenontvangst direct aan de poort volledig worden geboekt. Bij grote leveringen of krappe rampenblokken is een tweefasenboeking vaak beter: eerst wordt de levering geregistreerd als binnengekomen, daarna worden de posities gecontroleerd en ingeslagen. Het voordeel is snelheid aan de laadkade. Het nadeel: er zijn duidelijke verantwoordelijkheden nodig zodat openstaande controles niet blijven liggen.

Scanner, tablet of werkplek-pc?

De hardware moet de bewegingen van de werknemers volgen. Voor artikelen met netjes afgedrukte streepjescodes is een handscanner meestal de snelste en minst foutgevoelige keuze. Mobiele scanners of smartphones met een camera zijn handig wanneer medewerkers onderweg zijn tussen goederenontvangst, rekken en de afkeurzone. Een tablet kan nuttig zijn voor complexere boekingen met foto's, meerdere hoeveelheden of controle-instructies.

Een vaste pc-werkplek daarentegen werkt goed wanneer één persoon centraal leverbons controleert en de goederenontvangst ruimtelijk geconcentreerd is. Deze opstelling past minder goed wanneer het team voor elke boeking naar het kantoor moet wandelen. De uitgespaarde licentie wordt dan vaak betaald in de vorm van loopafstanden, onderbrekingen en laatt Akomende boekingen.

Niet elk artikel heeft een streepjescode nodig. Vooral bij individuele onderdelen, grondstoffen of leveranciersetiketten is de codering immers ongelijkmatig. In dat geval moet het systeem een snelle zoekfunctie via artikelnummer, leveranciersartikelnummer of bestelpositie aanbieden. Scannen met een streepjescode is een goed werkinstrument, maar geen doel op zich.

Datakwaliteit ontstaat door regels, niet door vermaningen

Een magazijnvoorraad wordt niet juist doordat er software is geïnstalleerd. Juistheid ontstaat wanneer het systeem zinvolle regels afdwingt en uitzonderingen zichtbaar maakt. Een negatieve hoeveelheid zonder onderbouwde handeling, een onbekende opslagplaats of een dubbel gebruikt leverbonnummer mogen niet ongemerkt passeren.

Tegelijkertijd mag de controle de werking niet blokkeren. Als een leverancier leverbonnummers hergebruikt of etiketten onleesbaar zijn, hebben medewerkers een logisch alternatief nodig. Zo kan een boeking gebeuren met een opmerking die later gecontroleerd moet worden. Het belangrijkse is dat hieruit een openstaande taak voortvloeit en geen onzichtbaar compromis. Bijzonder waardevol zijn eenvoudige plausibiliteitscontroles: Past het artikel bij de bestelling? Wijkt de hoeveelheid af via een gedefinieerde tolerantie? Is het lotnummer aanwezig bij artikelen waarvoor een lotnummer verplicht is? Werden er restricties of een blokkering ingesteld wanneer er een schademelding werd geregistreerd? Dergelijke regels verminderen het herwerk, zonder het team te overbelasten met ingewikkelde schermen.

Interfaces pas bouwen wanneer het kernproces op punt staat

Veel bedrijven willen onmiddellijk de koppeling met ERP, aankoop, verzending en boekhouding. Dat kan juist zijn, maar enkel wanneer het databeheer helder is. Een systeem moet eenduidig vastleggen waar bestellingen ontstaan, waar de leidende voorraad zich bevindt en welke gegevens in welke richting worden overgedragen.

Een slechte interface vermenigvuldigt fouten sneller dan een tabellenblad. Als bestellingen bijvoorbeeld uit het ERP komen, maar de daadwerkelijke goederenontvangst in het magazijnboekingssysteem ontstaat, moet het duidelijk zijn welke statussen worden teruggemeld: volledig geleverd, gedeeltelijk geleverd, geblokkeerd of met afwijking. Tijdstempels en eenduidige bonreferenties zijn daarbij belangrijker dan een optisch indrukwekkende integratie. Voor kleinere bedrijven kan een gecontroleerde CSV-import bij de start zinvoller zijn dan een dure realtime-koppeling. Dat is geen noodoplossing, mits de import, controle en het foutenrapport netjes zijn uitgewerkt. Zodra hoeveelheden, frequentie of vervolgprocessen groeien, wordt een directe interface economischer.

Een zinvolle uitrol begint met echte leveringen

Voordat er software wordt ontwikkeld of gekozen, is het de moeite waard om een korte procesanalyse uit te voeren aan de hand van reële gevallen. Niet alleen de ideale levering hoeft op tafel te komen, maar ook beschadigde goederen, deelhoeveelheden, foute artikelen, ontbrekende bestellingen en spoedmateriaal voor de werkplaats. Daaruit vloeit voort welke gegevens en beslissingen er daadwerkelijk nodig zijn.

Om te starten volstaat vaak een helder afgeknot gebied, zoals één leverancier, één goederengroep of één magazijnlocatie. Het team werkt volgens het nieuwe verloop parallel aan de vorige controles, tot de boekingen aantoonbaar kloppen. Pas dan volgt de uitbreiding. Een 'big bang' bespaart op het projectplan tijd, maar veroorzaakt op de werkvloer vaak haast en onrust.

Belangrijke aanvaardingscriteria zijn concreet en meetbaar:

  • Een standaardlevering is zonder navraag in enkele minuten boekbaar.
  • Afwijkingen verschijnen in een openstaande, toegewezen klachten- of opvolglijst.
  • De voorraad van een artikel kan worden verklaard aan de hand van een bon en een opslagplaats.
  • Bevoegde medewerkers kunnen correcties op een traceerbare manier uitvoeren.
  • Openstaande of geblokkeerde goederen worden niet per ongeluk ingepland of vrijgegeven.

Een op het bedrijf afgestemd systeem kan hier meer betekenen dan een overladen softwarepakket, als het de bestaande werkwijzen respecteert.
softify.pro ontwikkelt dergelijke logistieke processen niet omwille van de digitalisering zelf, maar rond boekingen, verantwoordelijkheden en gegevens die in de praktijk robuust moeten zijn.

Kerncijfers die het nut zichtbaar maken

Na de opstart moet niet enkel worden geteld hoeveel goederenontvangsten digitaal zijn geboekt. Zinvoller zijn de doorlooptijd tussen de levering en de beschikbare voorraad, het aantal onopgeloste afwijkingen, voorraadverschillen bij inventarissen en de inspanning voor navraag in de aankoop- of verkoopdienst.

Als de doorlooptijd korter wordt, maar het aantal achteraf doorgevoerde correcties stijgt, is het proces vermoedelijk te snel en te weinig controleerbaar. Als elke boeking lang duurt, hoewel er nauwelijks afwijkingen optreden, zijn er mogelijk te veel verplichte stappen ingebouwd. Goede magazijnprocessen streven niet naar maximale controle, maar naar de juiste controle.

De beste volgende stap is vaak een rondgang aan de goederenontvangst met drie echte leverbons. Observeren welke informatie wordt gezocht, waar medewerkers beslissingen improviseren en welke gegevens later opnieuw worden ingevoerd. Precies daar begint een digitale goederenontvangst die er niet alleen moderner uitziet, maar de voorraad ook werkelijk betrouwbaar maakt.

Permalink →

Contacteer ons

Hebt u een project in gedachten, een workflow die nog draait op spreadsheets en goede wil, of een testachterstand die COCO van uw team kan overnemen? Vertel het ons.

Bericht versturen