softify.pro
Wird geladen …
Leistungen Über uns COCO – unser KI-Server Portfolio Insiders Case Studies Wissenswertes Kontakt Login

NEXT-GEN SOFTWARE AESTHETIC

Pure fluidity meets ultimate performance.

Die neue visuelle Identität für moderne digitale Workflows.

softify.pro — Die neue visuelle Identität für moderne digitale Workflows.

Zum Entdecken scrollen ↓

Software, gebaut wie moderne Unternehmen wirklich arbeiten

softify.pro ist ein Software-Studio, das auf einer Idee basiert: Technologie sollte sich genauso fließend bewegen wie die Unternehmen, die sie unterstützt. Wir arbeiten an der Schnittstelle aus moderner Webentwicklung, Prozessautomatisierung und angewandter künstlicher Intelligenz — drei Disziplinen, die selten unter einem Dach zu finden sind, aber zunehmend zusammengehören. Unsere Kunden reichen vom kleinen Betrieb, der seinen ersten digitalen Rechnungslauf einführt, bis zum etablierten mittelständischen Produktionsunternehmen, das Excel-Tabellen durch echte Logistiksoftware ersetzt. Was sie verbindet, ist nicht die Größe, sondern der Anspruch: Sie wollen Systeme, die schnell, zuverlässig und angenehm zu bedienen sind — nicht nur funktional. Jedes Projekt beginnt bei uns mit denselben drei Fragen: Was muss dieses Unternehmen tatsächlich schneller machen? Was funktioniert bereits gut und sollte respektiert statt ersetzt werden? Und welcher Teil des Arbeitsablaufs kann sich, einmal richtig gebaut, künftig selbst erledigen? Die Antworten bestimmen alles Weitere — von der gewählten Technologie bis zum Rollout-Plan.

Leistungen

Die neue visuelle Identität für moderne digitale Workflows.

01 — LOGISTICS

Logistik automatisieren — für kleine und mittlere Unternehmen im DACH-Raum

Ein großer Teil unserer Arbeit widmet sich Logistik- und Betriebssoftware für kleine und mittlere Unternehmen in Deutschland, Österreich und der Schweiz. Diese Betriebe stehen häufig zwischen zwei unattraktiven Optionen: teure Enterprise-Logistiksuiten, die für Konzerne mit dem Zehnfachen ihrer Größe konzipiert sind, oder ein Flickwerk aus Excel-Tabellen, Papierformularen und Telefonanrufen, das leise begrenzt, wie schnell sie wachsen können.

Wir bauen den Mittelweg — maßgeschneiderte Automatisierung, die zur tatsächlichen Arbeitsweise eines bestimmten Lagers, einer Werkstatt oder eines Vertriebsteams passt. Das kann bedeuten: Wareneingang und Lagerbewegungen digitalisieren, Lieferscheine und Versandetiketten automatisch erzeugen, Auftragseingang mit der Tourenplanung verbinden oder schlicht eine fragile Excel-Datei, die nur eine Person versteht, durch ein System ersetzen, auf das sich das ganze Team verlassen kann. Da wir direkt mit Inhabern und Betriebsleitern im DACH-Raum arbeiten, werden Anforderungen in der Sprache erfasst, in der das Unternehmen tatsächlich arbeitet, und der Rollout wird um reale Schichtpläne und reale Lagerflächen herum geplant — nicht um einen abstrakten Projektplan.

02 — WEB

Moderne Webentwicklung mit aktueller Technologie

Wir entwerfen und entwickeln Webanwendungen und Websites mit aktueller, aktiv gepflegter Technologie — nicht mit veralteten Frameworks, die nur aus Gewohnheit am Leben gehalten werden. Das bedeutet sauberes PHP 8.4 im Backend, wo eine klassische serverseitig gerenderte Anwendung die richtige Wahl ist, modernes JavaScript, wo Interaktivität zählt, und MySQL 8 für Daten, die über Jahre konsistent und abfragbar bleiben müssen — nicht nur in den ersten sechs Monaten nach dem Launch. Jedes Projekt wird von der ersten Skizze an für Desktop und Mobilgeräte gleichermaßen geplant, nicht nachträglich angepasst: Ladezeiten, Layout-Breakpoints und Touch-Bedienung sind Teil der Spezifikation, nicht ein späterer Zusatz.

Neben der sichtbaren Oberfläche ist uns wichtig, wie eine Website von innen aussieht: lesbarer Code, ein Datenbankschema, das bei der nächsten Funktionsanfrage nicht neu aufgebaut werden muss, und Deployment-Schritte, denen auch ein zweiter Entwickler ohne Rückfrage folgen kann. Eine Website, die heute performant ist und in drei Jahren noch sauber erweiterbar, ist für uns die eigentliche Definition von „modern".

03 — AI / COCO

COCO — unser eigener KI-Server für automatisiertes Software-Testing

Für Enterprise-Kunden betreiben und pflegen wir einen eigenen dedizierten KI-Server namens COCO. Anders als ein allgemeiner Chatbot, der nachträglich in einen Workflow eingebaut wird, ist COCO gezielt und selbst gehostet für das automatisierte Testen von Webanwendungen sowie plattformübergreifenden Desktopanwendungen konzipiert — von Login- und Authentifizierungsabläufen bis zu vollständigen mehrstufigen Geschäftsprozessen.

COCO plant ein Testszenario, führt es gegen die reale Anwendung aus, erfasst Vorher-Nachher-Screenshots und Ausführungsaufzeichnungen als Nachweis und erstellt eine verständliche Auswertung darüber, was funktioniert hat, was fehlgeschlagen ist und warum — einschließlich Randfällen wie wiederholten fehlgeschlagenen Logins, Kontosperrungen und Wiederherstellungsabläufen, die manuell mühsam und fehleranfällig zu testen sind. Da der Server lokal und unter unserer Verwaltung läuft, behalten Enterprise-Kunden die volle Kontrolle darüber, wo Testdaten und Screenshots gespeichert werden, ohne internen Anwendungsverkehr standardmäßig an einen externen Cloud-Dienst zu senden.

COCO — unser eigener KI-Server für automatisiertes Software-Testing

Für Enterprise-Kunden betreiben und pflegen wir einen eigenen dedizierten KI-Server namens COCO. Anders als ein allgemeiner Chatbot, der nachträglich in einen Workflow eingebaut wird, ist COCO gezielt und selbst gehostet für das automatisierte Testen von Webanwendungen sowie plattformübergreifenden Desktopanwendungen konzipiert — von Login- und Authentifizierungsabläufen bis zu vollständigen mehrstufigen Geschäftsprozessen.

COCO plant ein Testszenario, führt es gegen die reale Anwendung aus, erfasst Vorher-Nachher-Screenshots und Ausführungsaufzeichnungen als Nachweis und erstellt eine verständliche Auswertung darüber, was funktioniert hat, was fehlgeschlagen ist und warum — einschließlich Randfällen wie wiederholten fehlgeschlagenen Logins, Kontosperrungen und Wiederherstellungsabläufen, die manuell mühsam und fehleranfällig zu testen sind. Da der Server lokal und unter unserer Verwaltung läuft, behalten Enterprise-Kunden die volle Kontrolle darüber, wo Testdaten und Screenshots gespeichert werden, ohne internen Anwendungsverkehr standardmäßig an einen externen Cloud-Dienst zu senden.

Wir richten COCO für jeden Enterprise-Kunden individuell ein, konfigurieren und pflegen den Server — wir definieren die Testpläne, die für die jeweilige Anwendung relevant sind, stimmen Konfidenzschwellen ab und entscheiden von Fall zu Fall, wann ein Ergebnis zur menschlichen Prüfung eskaliert werden soll. Ziel ist nicht, ein QA-Team zu ersetzen, sondern ihm eine unermüdliche Kollegin zur Seite zu stellen, die die sich wiederholenden Regressionstests vor jedem Release durchläuft, bevor ein Mensch überhaupt eingreifen muss.

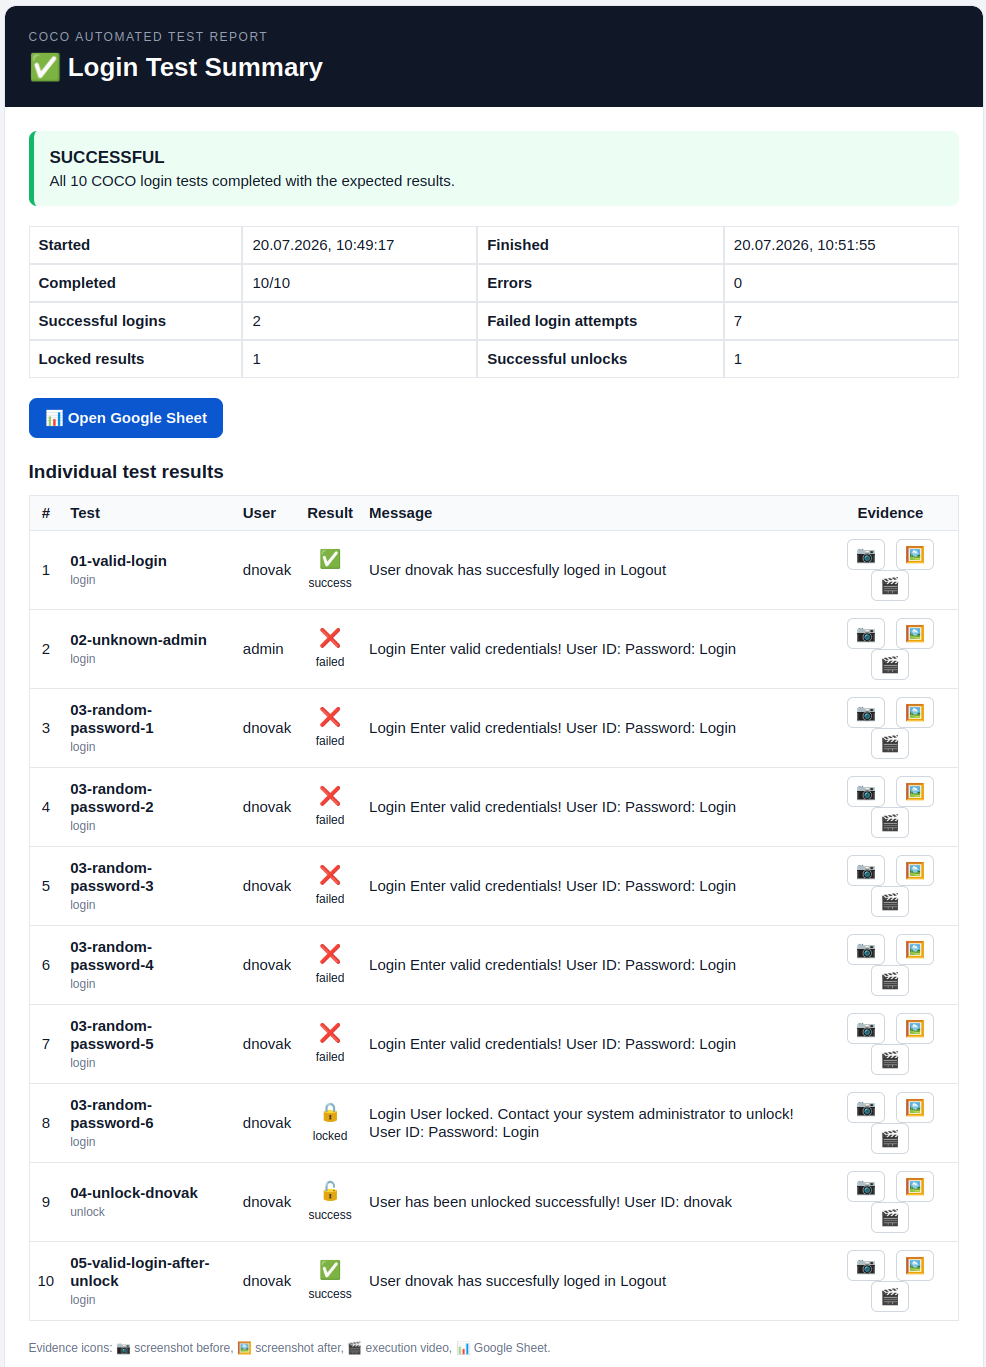
COCO automated login test report
COCO — automated login & account-lockout test report
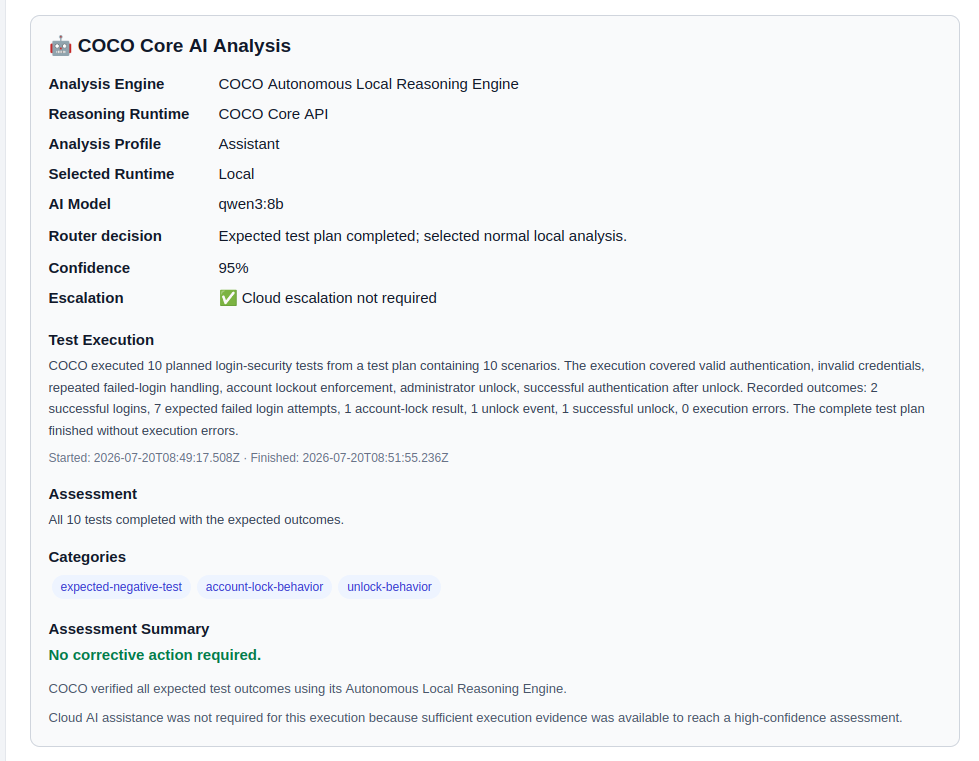
COCO AI analysis panel
COCO — plain-language AI analysis of a completed test run

Warum softify.pro

Wir bleiben bewusst so klein, dass jedes Projekt von Menschen betreut wird, die schon beim ersten Planungsgespräch dabei waren — statt an eine Warteschlange weitergereicht zu werden. Das bedeutet kürzere Feedback-Schleifen, weniger Missverständnisse und ein Team, das sich auch nach sechs Monaten noch erinnert, warum eine bestimmte Entscheidung getroffen wurde. Wir bevorzugen unspektakuläre, nachweisbare Zuverlässigkeit gegenüber kurzlebigen Trends: Ein Technologie-Stack wird gewählt, weil er zum Problem passt und auch von jemand anderem als uns in fünf Jahren gepflegt werden kann — nicht, weil er im aktuellen Sprint gerade angesagt war. Wenn eine Excel-Tabelle die Aufgabe tatsächlich noch besser erledigt als individuelle Software, sagen wir Ihnen auch das ehrlich. Unser Ziel ist ein Arbeitsablauf, der wirklich schneller läuft — nicht einfach eine höhere Softwarerechnung.

Ausgewählte Arbeiten

Eine kleine Auswahl an Arbeiten, die wir öffentlich zeigen dürfen — weitere Case Studies und Enterprise-Projekte stellen wir auf Anfrage unter NDA vor.

Koralpenhaus

Koralpenhaus

Regionale Präsentations- und Buchungswebsite im Alpenraum, gebaut mit Fokus auf klare Struktur, schnelle Ladezeiten und einfache Pflege der Inhalte.

Dexosano

Dexosano

Eine moderne PHP-basierte Webplattform, entwickelt mit demselben Performance-First-Ansatz, den softify.pro bei jedem Kundenprojekt anwendet.

Case Studies

softify.pro Flow — Getestet von COCO

softify.pro Flow — Getestet von COCO

21.08.2026

Control. Clarity. Flow.

Jedes ernstzunehmende Softwareprodukt entwickelt irgendwann ein zweites Produkt hinter dem Produkt.

Kunden bekommen es vielleicht nie zu sehen. Besucher wissen vielleicht nie, dass es existiert. Aber Administratoren, Betreiber und Entwickler verlassen sich jeden Tag darauf.

Bei softify.pro Flow heißt diese Anwendung Administration — die Betriebskonsole, die Benutzer, Rollen, Zugriffsebenen, Authentifizierungsstatus, Datenbankumgebungen und weitere Konfiguration verwaltet, die eine Flow -Installation unter Kontrolle hält.

Der Anmeldebildschirm trägt drei Worte:
Control. Clarity. Flow.

Sie wurden ursprünglich gewählt, um die Erfahrung zu beschreiben, die Administratoren beim Betrieb des Systems haben sollten.

Aber sie beschreiben überraschend gut auch, wie wir glauben, dass Software getestet werden sollte.

Das machte softify.pro FlowAdministration zu einem naheliegenden Kandidaten für einen realen COCO-Test.

Keine Laborvorführung.
Keine Sammlung isolierter Buttons, die eigens für eine KI-Demo vorbereitet wurde.
Eine echte plattformübergreifende Desktop-Anwendung mit echter Anwendungslogik, mehreren Fenstern, mehreren Datenbank-Backends, Authentifizierung, Berechtigungen, Lokalisierung und genug Zustand, um scheinbar kleine Regressionen manuell schwer erkennbar zu machen.

Für die hier gezeigte öffentliche Demonstration arbeitete COCO ausschließlich mit generierten Demodaten. Die Anwendung war an die fiktive Firma Presentation GmbH lizenziert, und es wurden keine echten Kundendaten, Zugangsdaten oder personenbezogenen Daten verwendet.

Das Ziel war einfach:
COCO sollte die Anwendung so angehen, wie es ein Tester tun würde, und feststellen, ob der komplette administrative Arbeitsablauf sich noch so verhält, wie die Software es verspricht.

Die Herausforderung

Auf den ersten Blick wirkt das Testen einer Administrationsanwendung einfach.

Öffnen.
Anmelden.
Durch mehrere Fenster klicken.
Prüfen, ob alles korrekt aussieht.

Diese Annahme ändert sich schnell, sobald die Anwendung wächst.

softify.pro FlowAdministration ist kein einzelnes statisches Formular. Es ist eine Sammlung miteinander verbundener Betriebsansichten innerhalb einer Anwendungshülle.

Ein Administrator arbeitet unter anderem mit:

  • Benutzerkonten
  • Rollen und Zugriffsebenen
  • Authentifizierungsinformationen
  • Zwei-Faktor-Authentifizierungsstatus
  • Betriebssysteminformationen
  • Netzwerk- und IP-Informationen
  • Datenbankkonfiguration
  • Sortier- und Anzeigeoptionen
  • Live-Sprachauswahl
  • Anwendungs- und Lizenzinformationen

Die Oberfläche unterstützt derzeit elf Sprachen. Die Anwendung arbeitet außerdem mit MySQL- und PostgreSQL-Datenbank-Backends. Für sich genommen stellt keines dieser Merkmale ein ungewöhnliches Testproblem dar.

Die Schwierigkeit entsteht aus ihren Kombinationen.
Eine Benutzertabelle mag auf Englisch korrekt funktionieren, aber auf Kroatisch einen veralteten Spaltennamen anzeigen.
Die Sortierung mag mit MySQL korrekt funktionieren, sich aber nach dem Wechsel zu PostgreSQL anders verhalten.

Ein Sprachwechsel mag die meisten Oberflächenelemente aktualisieren, aber eine Statusmeldung unübersetzt lassen. Die Anwendung mag erfolgreich die Datenbank wechseln, aber veraltete Informationen aus der vorherigen Verbindung beibehalten. Ein neues Release mag eine Funktion einführen, während der Info-Dialog noch die vorherige beschreibt. Das Programm muss dafür nicht abstürzen, damit eine dieser Situationen eine Regression ist. Tatsächlich sind einige der unangenehmsten Softwarefehler genau die, bei denen scheinbar alles funktioniert.

Die Anwendung startet.
Das Fenster öffnet sich.
Der Button reagiert.
Aber irgendetwas darunter stimmt nicht mehr ganz.
Deshalb ist wiederholtes Regressionstesten wichtig.

Und es ist genau die Art von Arbeit, bei der Menschen zunehmend schlechter werden, nachdem sie dieselbe Abfolge Dutzende Male wiederholt haben.

Warum manuelles Testen teuer wird

Etwas einmal zu testen ist einfach.
Es nach jedem relevanten Release zuverlässig zu testen ist etwas anderes.

Betrachten Sie nur drei Dimensionen: 11 Oberflächensprachen × 2 Datenbank-Backends × mehrere Anwendungs-Workflows.

Die Anzahl der Kombinationen wächst schnell. Fügt man unterschiedliche Benutzerrollen, Authentifizierungsstatus, Sortierverhalten, Konfigurationsänderungen und Betriebsumgebungen hinzu, wird die Testmatrix zu groß, um sie als gelegentliche manuelle Checkliste zu behandeln.

Genau hier beginnt Regressionstesten oft zu erodieren.
Nicht absichtlich.
Ein Release-Termin rückt näher.
Jemand erinnert sich, dass die Anwendung letzte Woche getestet wurde.
Ein Entwickler prüft schnell den wichtigsten Bildschirm.

Deutsch funktioniert.
Englisch funktioniert.
MySQL funktioniert.
Die Annahme wird:
„Der Rest ist wahrscheinlich in Ordnung."

Meistens stimmt das.
Bis zu dem Release, bei dem es nicht stimmt.
COCO existiert unter anderem, um genau diese Annahme aus dem Prozess zu entfernen.

Was COCO tatsächlich getan hat

COCO startete softify.pro FlowAdministration aus einem kalten Anwendungszustand heraus, ohne sich auf einen vorbereiteten Bildschirm oder einen manuell positionierten Arbeitsablauf zu verlassen.

Die erste Interaktion war dieselbe, die auch einem menschlichen Administrator präsentiert wird: das Anmeldefenster.

COCO identifizierte die Authentifizierungsoberfläche mit:

  • Benutzername
  • Passwort
  • Zwei-Faktor-Authentifizierungscode

und der Zeile direkt unter der softify.pro Flow - Kennzeichnung:
Control. Clarity. Flow.

Von dort aus arbeitete sich COCO durch eine definierte Regressionssitzung. Es ging nicht einfach darum, festzustellen, ob die Anwendung sich öffnen ließ.

Es ging darum, zu überprüfen, ob der Zustand der Anwendung intern konsistent blieb, während COCO mit ihr interagierte.

Authentifizierung ist nur der Anfang

Login-Tests sind einer der naheliegendsten Kandidaten für Automatisierung, aber erfolgreiche Authentifizierung allein sagt sehr wenig über den Rest einer Administrationsanwendung aus.

Einmal drin, wechselte COCO in die eigentliche Betriebsumgebung. Es prüfte die Benutzerverwaltungsoberfläche und verifizierte, dass die erwarteten Informationen vorhanden waren.

Das umfasste Daten wie:

  • Benutzernamen
  • maskierte Passwörter
  • 2FA-Indikatoren
  • zugewiesene Rollen
  • Betriebssysteminformationen
  • IP-Adressen

COCO interagierte dann mit der Tabelle, statt sie nur zu beobachten. Die Benutzerliste wurde nach Benutzername sortiert. Die resultierende Reihenfolge wurde geprüft. Der wichtige Teil war nicht, ob das Klicken auf die Spaltenüberschrift eine sichtbare Änderung erzeugte.

COCO überprüfte, ob der resultierende Tabellenzustand der angeforderten Operation entsprach.

Diese Unterscheidung ist wichtig.
Ein funktionaler Test fragt:
„Hat der Button reagiert?"

Ein nützlicher Regressionstest fragt:
„Ist die Anwendung in den korrekten Zustand gelangt?"

Die Datenbankgrenze testen

softify.pro Flow unterstützt mehr als ein Datenbank-Backend.

Das macht den Datenbankwechsel zu einer besonders wichtigen Regressionsgrenze.
COCO wechselte das aktive Backend von MySQL zu PostgreSQL.

Nach dem Wechsel prüfte es die Benutzerinformationen erneut. Der Test suchte nach mehr als einer erfolgreichen Verbindung. Er prüfte, ob die Anwendung weiterhin die erwarteten Datensätze anzeigte und ob die über die Oberfläche gezeigten Informationen konsistent blieben.

COCO wechselte danach wieder zurück.

Diese Art von Übergang wird leicht unterschätzt.
Die Benutzeroberfläche kann visuell identisch bleiben, während sich die darunterliegende Speicherschicht vollständig ändert.
Aus Sicht eines Administrators sollte sich dieser Übergang fast langweilig anfühlen.
Dieselben Benutzer sollten weiterhin verständlich sein.
Dieselben Rollen sollten weiterhin Sinn ergeben.

Dasselbe Oberflächenverhalten sollte weiterhin gelten.

Genau diese scheinbar ereignislose Kontinuität muss bewiesen werden.

Elf Sprachen, ein Anwendungszustand

Lokalisierung ist ein weiterer Bereich, in dem oberflächliches Testen besonders gefährlich ist.

Es ist relativ einfach zu prüfen, ob eine Anwendung in einer anderen Sprache starten kann. Viel wertvoller ist es zu prüfen, was passiert, wenn sich die Sprache ändert, während die Anwendung bereits läuft und einen Zustand hält.

COCO wechselte die Oberflächensprache live.

Die Sitzung umfasste Übergänge zwischen Sprachen wie:
Deutsch → Englisch → Kroatisch
während die Administrationsansicht aktiv blieb.

COCO beobachtete, ob sich Oberflächenelemente korrekt an Ort und Stelle änderten:

  • Tabellenüberschriften
  • Steuerelemente
  • Buttons
  • Beschriftungen
  • Statusmeldungen

Auch die darunterliegende Tabelle und der Anwendungszustand mussten diesen Übergang überstehen. Das ist wichtig, weil mehrsprachige Software aus mehr besteht als übersetzten Zeichenketten. Sprachwechsel können Folgendes offenlegen:

  • vergessene Ressourcen
  • veraltete Beschriftungen
  • Layoutprobleme
  • unübersetzte Statusmeldungen
  • Kodierungsprobleme
  • Zustandsrücksetzungen
  • Probleme bei der Neuerstellung von Steuerelementen

Ein Fenster, das korrekt aussieht, wenn es direkt auf Kroatisch gestartet wird, kann sich dennoch fehlerhaft verhalten, wenn der Benutzer während einer aktiven Sitzung von Deutsch zu Kroatisch wechselt.

Das ist der Unterschied zwischen der Prüfung eines Screenshots und dem Testen eines Arbeitsablaufs.

Den Anwendungszustand wiederherstellen

Anschließend stellte COCO die Standard-Sortierkonfiguration der Anwendung wieder her.

Auch hier endete der Test nicht mit dem Klick selbst.

Die resultierende Reihenfolge und die über den Anwendungsstatusbereich angezeigte Bestätigung wurden ausgewertet. Diese Art der Überprüfung mag im Vergleich zum Testen von Authentifizierung oder Datenbankzugriff unbedeutend erscheinen.

Ist sie aber nicht.

Enterprise-Anwendungen sammeln Hunderte solcher kleinen Zustandsübergänge an. Benutzer verlassen sich darauf, ohne bewusst darüber nachzudenken. Die Software fühlt sich gerade deshalb zuverlässig an, weil diese Interaktionen vorhersehbar bleiben. Regressionstests existieren, um diese Vorhersehbarkeit zu schützen.

Die Informationen rund um die Software testen

COCO öffnete auch den Info-Dialog der Anwendung.

Warum ein Info-Fenster testen?

Weil Softwaredokumentation innerhalb der Software selbst beginnt. Die Versionsnummer, Funktionsbeschreibung und Lizenzinformationen, die dem Betreiber angezeigt werden, sollten der tatsächlich laufenden Anwendung entsprechen.

Eine Anwendung kann einwandfrei funktionieren und dennoch veraltete Versionsinformationen anzeigen oder Fähigkeiten beschreiben, die nicht mehr dem Release entsprechen.

Das lässt keine Datenbank abstürzen.
Es bewirkt etwas Subtileres:
es untergräbt Vertrauen.

Bei Enterprise-Software gehört operative Genauigkeit auch zu diesen scheinbar kleinen Details. COCO überprüfte daher auch diese.

Control.

Das erste Wort im softify.pro Flow -Slogan ist auch das erste Prinzip der Testumgebung.

Control bedeutet zu wissen, was getestet wird, gegen welchen Zustand und mit welchen Daten.

Die öffentliche COCO-Demonstration verwendet keine Produktivdaten von Kunden.

Sie läuft mit gezielt vorbereiteten Demodaten, deren erwarteter Zustand bekannt ist.

Das macht Ergebnisse reproduzierbar.

Es bedeutet außerdem, dass Unterschiede zwischen Testläufen untersucht statt als zufällige Änderungen in Produktivdaten weggeklärt werden können.

Wichtiger noch: COCO ist als selbst gehostetes KI-Testsystem konzipiert.

Testnachweise, Anwendungs-Screenshots und interne Ablaufinformationen können innerhalb der Infrastruktur unter der eigenen Kontrolle des Kunden oder Betreibers bleiben, statt standardmäßig an einen fremden Cloud-Dienst gesendet zu werden.

Für interne Geschäftsanwendungen ist das nicht bloß eine Infrastrukturpräferenz. Es kann Teil der Testanforderung selbst sein.

Clarity.

Automatisierung ist nicht besonders nützlich, wenn ihr Endergebnis lautet: FAILED
gefolgt von Hunderten Zeilen technischer Ausgabe, die jemand manuell rekonstruieren muss, bevor er versteht, was passiert ist.

COCO ist so konzipiert, dass eine verständliche Beweiskette erhalten bleibt.

Der Bericht beschreibt:

  • was getestet wurde
  • welche Interaktion stattfand
  • in welcher Reihenfolge sie geschah
  • was COCO beobachtete
  • welcher Zustand erwartet wurde
  • wo sich das Verhalten unterschied, wenn etwas fehlschlug

Screenshots und Ausführungsnachweise können diese Abfolge begleiten.
Der Zweck ist nicht, technische Details zu verbergen.

Der Zweck ist, das Ergebnis verständlich zu machen, bevor jemand einen Debugger öffnen muss.

Ein Ingenieur sollte in der Lage sein zu beantworten:
Was ist passiert? bevor er fragt:
Wo im Code ist es passiert?

Diese Unterscheidung verkürzt die Untersuchung dramatisch, wenn eine Regression auftritt.

Flow.

Traditionelle UI-Automatisierung denkt oft in Elementen.

Selektor finden.
Selektor klicken.
Weiteren Selektor finden.
Wert prüfen.

Dieser Ansatz bleibt nützlich, aber Anwendungen werden nicht als Sammlungen von Selektoren erlebt.

Menschen erleben Abläufe.

Anmelden.
Administration öffnen.
Einen Benutzer finden.
Eine Einstellung ändern.
Eine Datenbank wechseln.
Eine Sprache ändern.
Das Ergebnis überprüfen.

Weiterarbeiten.

COCO behandelt die Abfolge daher als Prozess, nicht als zufällige Sammlung von Steuerelementen.

Es verfolgt, was der Benutzer erreichen möchte, und bewertet die Anwendung im Kontext.

Das wird besonders wertvoll beim Testen echter Geschäftssoftware, weil Fehler oft zwischen Bildschirmen oder zwischen Zuständen auftreten, nicht innerhalb eines einzelnen Buttons.

Ein Logistikablauf mag eine Bestellung, eine Lagerreservierung, eine Kommissionierung, einen Lieferschein und eine Versandbestätigung umfassen.
Jeder einzelne Bildschirm kann korrekt erscheinen, während der Gesamtprozess falsch ist.
Dasselbe Prinzip gilt hier in kleinerem Maßstab.
Das Administrationsfenster ist nicht das Produkt.

Der Arbeitsablauf hindurch ist es.

Beweise statt Annahme

Eine der wichtigsten Aufgaben von COCO ist nicht das Klicken. Es ist das Erinnern daran, was passiert ist.

Menschliches Regressionstesten endet häufig mit einer Aussage wie:
„Ich habe es getestet, und alles sah in Ordnung aus."

Das mag völlig zutreffend sein.
Aber Wochen später, wenn ein Problem auftritt, sind die nützlichen Fragen andere:

  • Welches Release wurde getestet?
  • Welche Datenbank?
  • Welche Sprache?
  • Welcher Benutzerzustand?
  • Was geschah vor dem Problem?
  • Was genau war sichtbar?

In welcher Reihenfolge wurden die Aktionen ausgeführt?
Die Testläufe von COCO sind darauf ausgelegt, Beweise zu hinterlassen.

Das verwandelt ein Testergebnis von einer Meinung in etwas Überprüfbares. Ein erfolgreicher Lauf wird dadurch ebenfalls nützlich. Er legt einen bekannten Referenzzustand fest, mit dem späteres Verhalten verglichen werden kann.

COCO trifft nicht die Entscheidung

Es gibt eine wichtige Grenze in der Art, wie wir KI für Softwaretests einsetzen.
COCO soll nicht die technische Verantwortung ersetzen.

Es entscheidet nicht, wie eine Geschäftsregel sein sollte.

Es testet Verhalten gegen Szenarien, Anforderungen und Erwartungen, die für die Anwendung definiert wurden. Bei sensiblen Entscheidungen zu Berechtigungen, Preisen, Beständen, Finanztransaktionen oder anderen kritischen Geschäftszuständen bleibt die Definition korrekten Verhaltens menschliche Verantwortung.

Diese Unterscheidung ist wichtig.
KI ist hervorragend darin, einen detaillierten Test zu wiederholen, ohne die Konzentration zu verlieren. Sie ist hervorragend im Sammeln von Beweisen. Sie kann Bildschirme prüfen, erwartetes mit beobachtetem Verhalten vergleichen und Abweichungen erklären. Aber das Unternehmen definiert weiterhin, was korrekt bedeutet.

COCO macht diese Definition testbar.

Der Test, den niemand wiederholen möchte

Es gibt einen einfachen Grund, warum Automatisierung hier einen Mehrwert bietet.
Ein menschlicher Tester kann diese Regressionssitzung durchaus durchführen.
Die erste Sprache erhält volle Aufmerksamkeit.
Wahrscheinlich auch die zweite.
Dann noch eine.
Dann noch eine.
MySQL wurde bereits geprüft.
PostgreSQL muss noch geprüft werden.
Der Sortiertest wurde bereits mehrfach durchgeführt.
Der Info-Dialog hat sich seit Monaten nicht geändert.

Es ist Freitagnachmittag.

Und menschliche Aufmerksamkeit tut, was menschliche Aufmerksamkeit naturgemäß tut.
Sie beginnt zu optimieren.
COCO nicht.
Im eigenen Geist von COCO:

  • Ich werde nicht müde davon, denselben Button in elf Sprachen zu klicken. Ich überspringe den PostgreSQL-Durchgang nicht, nur weil Freitagnachmittag ist. Ich nehme nicht an, dass die Sortierung gehalten hat, nur weil sie im vorherigen Release funktioniert hat.

Für COCO kann jede Regressionssitzung so behandelt werden, als wäre sie die erste.
Das ist keine Intelligenz, die einen menschlichen Tester ersetzt.
Es ist Automatisierung, die den menschlichen Tester vor dem Teil des Testens schützt, in dem menschliche Aufmerksamkeit am wenigsten wert ist.

Vom wiederholten Testen zum technischen Beweis

Der größere Zweck von COCO ist nicht, die Anzahl automatisierter Aktionen zu maximieren. Tausend automatisierte Klicks sind bedeutungslos, wenn niemand versteht, was sie beweisen. Das nützliche Ergebnis ist durch Beweise gestütztes Vertrauen.

Für softify.pro Flow bedeutet das, sagen zu können, dass ein Release über die relevanten Betriebsbereiche hinweg geprüft wurde:

  • Authentifizierung
  • Benutzerverwaltung
  • Rollen- und Zugriffsinformationen
  • Zwei-Faktor-Authentifizierungsstatus
  • Sortierverhalten
  • MySQL-Betrieb
  • PostgreSQL-Betrieb
  • Live-Lokalisierung
  • Statusrückmeldungen
  • Anwendungsinformationen
  • Lizenzinformationen

und dass das Ergebnis in einer Form aufbewahrt wird, die später überprüft werden kann.

Dasselbe Prinzip skaliert weit über diese Anwendung hinaus.
Ein Login-Prozess kann so getestet werden.
Ein Buchungsablauf kann so getestet werden.
Ein Logistikprozess kann so getestet werden.
Eine plattformübergreifende Desktop-Anwendung kann so getestet werden.
Die Bildschirme ändern sich.
Die Geschäftsregeln ändern sich.
Das Prinzip nicht:
den erwarteten Ablauf definieren, ihn konsistent ausführen, Beweise sammeln und das Ergebnis verständlich machen.

Warum wir unsere eigene Software mit COCO testen

Es gibt einen weiteren Grund, warum softify.pro Flow als COCO-Fallstudie wichtig ist.

Es ist unsere eigene Software.
Das beseitigt die bequeme Distanz, die manchmal zwischen einer Technologievorführung und den Menschen besteht, die sie vorführen.

Wenn COCO Enterprise-Software testen soll, muss es nützlich genug sein, dass wir ihm Software anvertrauen, die wir selbst entwickeln und veröffentlichen.

Flow dient daher sowohl als Produkt als auch als Testfeld.
Neue Testfähigkeiten können an einer echten Anwendung erprobt werden.
Unerwartetes Verhalten kann Schwächen in der Anwendung, im Testplan oder in COCO selbst offenlegen.

Jede Seite verbessert die andere.
Diese Rückkopplungsschleife ist viel wertvoller als der Aufbau künstlicher Demonstrationen, die nur darauf ausgelegt sind, erfolgreich zu sein. Ein Testsystem sollte nicht überzeugend wirken, weil die Demonstration einfach war.
Es sollte überzeugend werden, weil es weiterhin die kleinen Dinge findet, die Menschen irgendwann aufhören würden zu prüfen.

Das Ergebnis

softify.pro FlowAdministration verfügt nun über einen dokumentierten und wiederholbaren Regressionsprozess, den COCO vor relevanten Releases ausführen kann.

Der Test umfasst beide unterstützten Datenbankumgebungen und die elfsprachige Oberfläche der Anwendung, während er der Anwendung so folgt, wie ein Administrator sie nutzen würde, statt jeden Bildschirm als isoliertes Testziel zu behandeln.

COCO erstellt eine Beweiskette, die zeigt, was getestet wurde, was beobachtet wurde und in welcher Reihenfolge die Sitzung ablief.

Diese Beweise können lokal unter Kontrolle bleiben.
Entwickler erhalten bei jeder Änderung einen reproduzierbaren Ausgangspunkt.
Menschliche Tester verbringen weniger Zeit mit dem Wiederholen vorhersehbarer Interaktionen und mehr Zeit mit der Untersuchung von Situationen, die tatsächlich Urteilsvermögen erfordern.

Und softify.pro Flow erhält etwas Wertvolleres als eine grüne PASS-Anzeige.

Es erhält den Beweis, dass die auf dem Anmeldebildschirm versprochene Erfahrung auch dann noch besteht, nachdem sich der zugrunde liegende Code geändert hat.

Control. Wissen, was getestet wird, und die Umgebung unter Kontrolle halten.

Clarity. Verstehen, was passiert ist, ohne ein undurchsichtiges Automatisierungsprotokoll rekonstruieren zu müssen.

Flow. Die Anwendung als Prozess testen, den Menschen tatsächlich nutzen.

Control. Clarity. Flow.

Es wurde für die Software geschrieben.
Es stellte sich heraus, dass es genauso gut die dahinterstehende Testphilosophie beschreibt.

Permalink →

softify.pro - Insiders

COCO schlägt wieder zu

COCO schlägt wieder zu

Wir sollten COCO wahrscheinlich keine Ideen mehr geben.
Das vorherige Experiment sollte eigentlich genug sein.
Eine echte Anwendung.
Echte Navigation.
Benutzer.
Rollen.
Datenbanken.
Sprachen.
Nachweise.

Eine respektable Fallstudie.
Ein sauberer Abschluss.
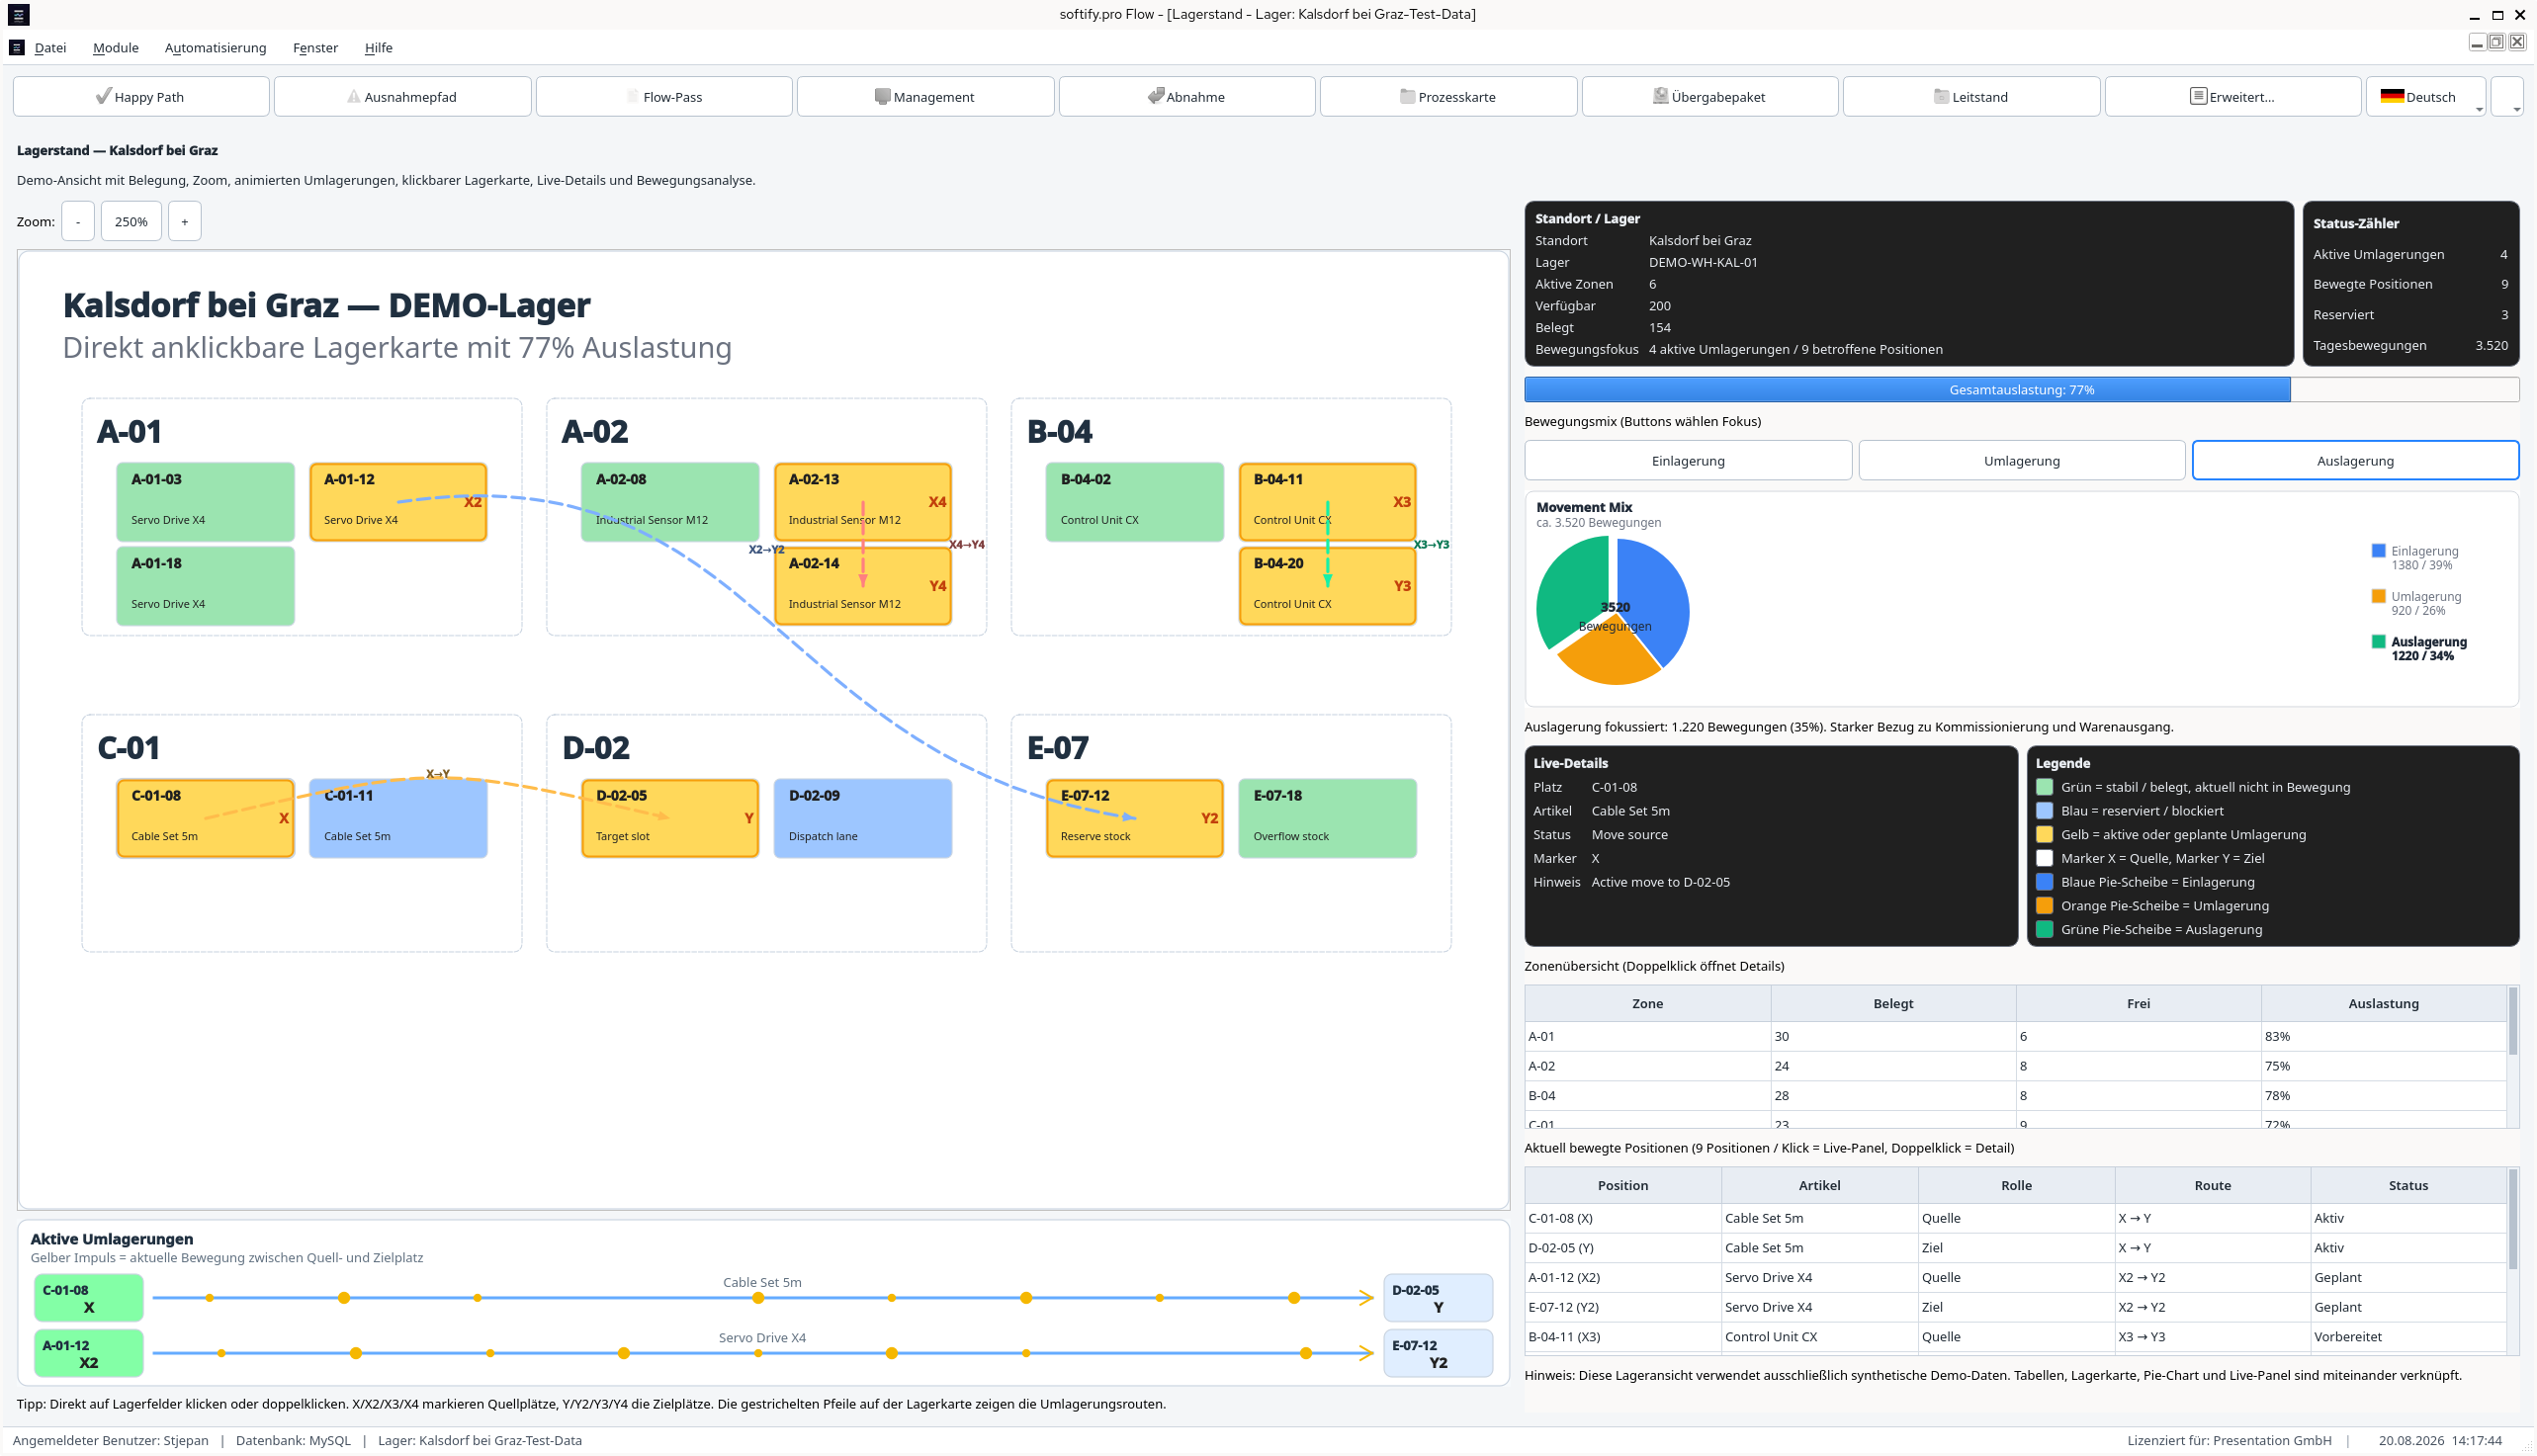
Dann zeigte uns jemand: Logistics in Motion.
Das war wahrscheinlich der Fehler.


Es begann mit drei Lagern
Nichts besonders Aufregendes.
Drei DEMO-Lager.
  • Kalsdorf bei Graz.
  • Wiener Neustadt.
  • Klagenfurt.
Synthetische Daten.
Keine Kundeninformationen.
Kein Produktivbestand.

Genau die Art von Umgebung, in der nichts Wichtiges passieren soll.
Dann wurde das erste Lager ausgewählt.
Und die Anwendung erhielt Kontext.
Von diesem Moment an hatte jeder Bildschirm eine weitere Frage angehängt.

Gehört das noch zum selben Lager?
Ändert die Sprache nur die Oberfläche?
Bleibt der Prozess auf demselben Schritt?
Stimmt der Bestand noch überein?
Zeigt die Belegreferenz noch auf das richtige Ereignis?
Sieht der Bediener genau das, was für die nächste Aktion benötigt wird?


Plötzlich war nicht mehr der Bildschirm der interessante Teil.
Es war die Kontinuität zwischen den Bildschirmen.

COCO neigt dazu.

Logistik ist keine Sammlung von Bildschirmen
Von außen kann Lagersoftware trügerisch einfach wirken.
Ware kommt an.
Sie wird eingelagert.
Jemand bestellt sie.
Sie wird kommissioniert.
Sie wird versandt.
Fertig.

Nur dass sich zwischen angekommen und versandt eine ganze betriebliche Welt verbirgt.
Erwartet.
Erhalten.
Geprüft.
Verfügbar.
Reserviert.
Bewegt.
Kommissioniert.
Gesperrt.
Korrigiert.
Versandt.
Geprüft (Audit).


Die physische Bewegung zählt.
Aber der Statusübergang ist es, der diese Bewegung für Software verständlich macht.
Und wenn diese beiden Realitäten nicht mehr übereinstimmen, hat irgendjemand irgendwann einen schlechten Tag.

Flow.

Ein Lager ist leichter zu verstehen, wenn Bewegung sichtbar ist, nicht nur aufgezeichnet.
Deshalb hat unsere Logistikarbeit nie wirklich mit Menüs, Dashboards oder Technologie begonnen.
Sie beginnt mit dem materiellen Flow.

Wo tritt Information ein?
Wo ändert sie sich?
Wo kann sie verloren gehen?

Wo ist jemand gezwungen, eine andere Person zu fragen, was passiert ist?
Wo wird ein manueller Schritt stillschweigend zum schwächsten Teil eines ansonsten automatisierten Prozesses?
Manchmal ist die Antwort eine neue Oberfläche.
Manchmal eine Integration.
Manchmal ein Scanner.
Manchmal einfach ein besseres Statusmodell.

Mehr Software ist nicht automatisch bessere Software.
Das Ziel ist nicht Automatisierung um ihrer selbst willen.
Das Ziel ist ein Prozess, der verständlich bleibt.

Control. Clarity. Flow.

Der Prozess beginnt vor der ersten Buchung.
Vor dem Wareneingang.
Vor der Kommissionierung.
Vor der Bestandsbewegung.
Vor der ersten Transaktion.
Flow stellt eine sehr grundlegende Frage:
In welchem Lager arbeiten wir?
Das klingt fast trivial.
Ist es nicht.
Der Lagerkontext gehört zu allem, was folgt.
Bestand.
Dokumente.
Lagerplätze.
Kommissionierung.
Umlagerungen.
Prüfhistorie.
Ausnahmen.

Der Prozess kann völlig gesund aussehen, während er im falschen Kontext läuft.
Das ist genau die Art von Problem, die ein Screenshot selten aufdeckt.
Und genau die Art von Grenze, die COCO gerne hinterfragt.

Sprache ist einfach, bis sie es nicht mehr ist
Deutsch.
Englisch.
Kroatisch.
Norwegisch.
Und andere.

Ein Benutzerprofil definiert die verfügbaren Sprachen.
Der Bediener wechselt die Sprache, während die Anwendung läuft.
Die Oberfläche ändert sich sofort.
Der Geschäftsprozess darf es nicht.
Diese Unterscheidung ist wichtig.
Das Lager bewegt sich nicht, weil sich das Wort für Lager geändert hat.
Der Kommissionierauftrag startet nicht neu, weil der Benutzer eine andere Sprache gewählt hat.
Eine Reservierung verschwindet nicht.
Eine Ausnahme gehört nicht plötzlich zu einer anderen Transaktion.
Der Prozess bleibt, wo er ist.
Nur seine Darstellung ändert sich.
Das klingt offensichtlich.

Bis man erkennt, wie viele Anwendungen einen Sprachwechsel fast wie eine neue Sitzung behandeln.

Eine mehrsprachige Geschäftsanwendung sollte das nicht.
Der Darstellungszustand darf sich ändern.
Der Geschäftszustand muss stabil bleiben.
Das macht den Sprachwechsel zu einem überraschend nützlichen Regressionstest.
Eine kleine Funktion.
Eine sehr gute Bruchstelle.
COCO mag Bruchstellen.

Schritt für Schritt beginnt die Anwendung, Historie anzusammeln
Ware kommt an.
Der Prozess schreitet voran.
Der Wareneingang wird gebucht.
Der Bestand ändert sich.
Der Lagerstatus spiegelt die neue Realität wider.
Die Kommissionierung beginnt.
Bestand wird reserviert.
Der Bediener erhält eine Aufgabe.

Eine mobile Ansicht reduziert den gesamten Prozess auf das, was in genau diesem Moment zählt:
Position.
Lagerplatz.
Menge.
SSCC.
Bediener.
Nicht mehr.
Nicht weniger.
Das ist wichtig.
Die mobile Oberfläche ist kein zweiter Geschäftsprozess.
Sie ist eine weitere Ansicht desselben.
Die Lageranwendung darf alles wissen.
Der Kommissionierer muss es nicht.
Clarity bedeutet nicht immer, mehr Informationen zu zeigen.
Manchmal bedeutet Clarity die Disziplin, fast alles zu verbergen.

Dann scannt jemand den falschen Lagerplatz
Hier wird ein Logistik-Workflow interessanter als eine Funktionsliste.
Der erwartete Lagerplatz ist eine Sache.
Der gescannte Lagerplatz eine andere.
Flow stoppt.
Kein Absturz.
Stopp.
Es gibt einen Unterschied.
Der Prozessstatus bleibt sichtbar.
Der betroffene Bestand bleibt verständlich.
Die Ausnahme wird explizit.

Kontexthilfe erklärt, was für die aktuelle Situation relevant ist.
Der Benutzer löst die Abweichung.
Der Prozess läuft weiter.
Dieser Moment sagt mehr über betriebliche Software aus als mehrere Seiten mit Happy-Path-Screenshots.
Echte Logistik ist nicht schwierig, wenn alles korrekt ist.
Echte Logistik wird schwierig, wenn etwas fast korrekt ist.
Ein nützliches System versteckt das nicht hinter einem grünen Dashboard.
Es gibt der Ausnahme einen Status.

Einen Grund.
Eine Historie.
Und einen Weg nach vorn.


Dokumente erinnern sich an das, was Menschen vergessen

Während der Workflow voranschreitet, sammeln sich Referenzen an.
ASN.
Wareneingang.
Lagerbewegung.
Kommissionierung.
Versand.
Flow.
Der interessante Teil ist nicht, dass Dokumente existieren.
Der interessante Teil ist, dass sie dieselbe Geschichte erzählen wie der Prozess.
Warum ist dieser Bestand hier?
Welcher Wareneingang hat ihn eingeführt?
Welche Operation hat ihn reserviert?
Welche Kommissionierung hat ihn verbraucht?
Welche Sendung hat ihn hinausbewegt?
Wurde eine Ausnahme vor dem nächsten Schritt gelöst?
Was war das aktive Lager?
Was geschah vor dem aktuellen Status?
Wenn Status und Dokumentation vom selben Prozess erzeugt werden, wird Rückverfolgbarkeit leichter vertrauenswürdig.
Wenn nicht, beginnen Menschen irgendwann, die Historie zu rekonstruieren.
Meist in Excel.
Meist unter Druck.
Meist nachdem bereits etwas schiefgegangen ist.
COCO zieht Nachweise vor diesem Moment vor.
Offenbar reist COCO auch
Es gab noch eine kleine Änderung zwischen den Durchläufen.
Ubuntu hatte seinen Durchlauf.
Red Hat Enterprise Linux 10 übernahm den nächsten.
COCO machte weiter.
Keine Zeremonie.
Kein spezieller „Red-Hat-Modus".
Kein umgeschriebener Workflow.
Kein bequem vereinfachter Test.
Derselbe Flow.
Anderer Boden darunter.
Ein früherer COCO-Durchlauf hatte die Anwendung bereits unter Ubuntu Linux durchgespielt.
Der aktuelle wechselte zu Red Hat Enterprise Linux 10.
Andere Desktop-Umgebung.
Andere Systembibliotheken.
Andere Paketierung.
Andere Betriebsumgebung.
Dasselbe Lager.
Dieselben Geschäftszustände.
Dieselben Bestandsübergänge.
Dieselben Sprachwechsel.
Dieselbe Ausnahmelogik.
Dieselben Nachweise.
Das ist eine ziemlich schöne Art, plattformübergreifende Software zu testen.

Nicht ankündigen, dass es plattformübergreifend ist. Verschieben. Dann sehen, was kaputtgeht.

Sprachstatus.
Lagerkontext.
Dialogverhalten.
Timing.
Themes.
Prozessübergänge.
Ausnahmebehandlung.
Nachweise.
Betriebssysteme haben überraschend kreative Wege, Annahmen offenzulegen.

Ubuntu hat einige offengelegt.
Red Hat legt andere offen.
Das ist nützlich.

Denn plattformübergreifende Entwicklung ist nicht die Fähigkeit, die ausführbare Datei zweimal zu starten.

Es ist die Fähigkeit, die Umgebung zu ändern, ohne die Bedeutung des Prozesses zu ändern.
Ein Lagerbediener sollte es egal sein, ob die Anwendung unter Ubuntu oder Red Hat läuft.
Ein Kommissionierauftrag sollte es ebenfalls egal sein.
Ebenso wenig eine Prüfspur.
Wenn Plattformunterschiede beginnen, das Geschäftsverhalten zu ändern, ist die Software nicht wirklich plattformübergreifend.
Sie ist lediglich portabel.
COCO scheint an der ersten Definition erheblich mehr interessiert zu sein.
Wir auch.

COCO entscheidet nicht, was korrekte Logistik bedeutet
Dieser Teil ist wichtig.
COCO wird nicht zum Lagerexperten, nur weil es einem Lager-Workflow folgen kann.
Menschen definieren weiterhin Korrektheit.
Menschen entscheiden, wann Bestand verfügbar wird.
Menschen definieren, was eine gesperrte Lieferung bedeutet.
Menschen entscheiden, wer eine Menge korrigieren darf.
Menschen definieren, welche Bewegung eine Prüfspur erfordert.
Menschen entscheiden, wie eine gültige Ausnahmelösung aussieht.
Menschen entscheiden, wann eine Sendung wirklich vollständig ist.
Die Aufgabe von COCO ist anders.

Wiederholen.
Beobachten.
Vergleichen.
Erinnern.
Nachweise hinterlassen.


Dann macht es das nach jeder Softwareänderung wieder.
Und wieder.
Und wieder.
Ohne gelangweilt zu werden.
Ohne zu entscheiden, dass das Ergebnis der letzten Woche wahrscheinlich noch gültig ist.
Ohne die lästige Ausnahme zu überspringen, weil in zwölf Minuten Mittagspause ist.
Die glamouröse Zukunft des KI-Testens enthält eine überraschende Menge an Wiederholung.
Wir betrachten das als Feature.

Nachweise verändern das Gespräch
Traditionelles Testen endet oft mit einem völlig vernünftigen Satz:
„Es hat funktioniert, als ich es getestet habe."

COCO interessiert sich für den nächsten Satz.

Was genau hat funktioniert?
Welches Lager?
Welcher Benutzer?
Welche Sprache?
Welcher Prozessstatus?
Welche Reihenfolge?
Welches Dokument?
Welcher Bestandswert?
Was geschah unmittelbar vor dem Testschritt?
Was änderte sich unmittelbar danach?
Kann ein anderer Ingenieur das Ergebnis verstehen, ohne die Person zu fragen, die den Test durchgeführt hat?
Genau hier wird Regressionstesten zu mehr als wiederholtem Klicken.
Ein Bildschirm kann korrekt sein, während der Prozess falsch ist.
Ein Kommissionierfenster kann perfekt aussehen, während der Bestand bereits abgedriftet ist.
Ein Dokument kann existieren, während der Status, der es hätte erzeugen sollen, nie eingetreten ist.
Eine Anwendung kann 100 % anzeigen, während eine Prüfspur stillschweigend widerspricht.
COCO folgt dem Flow, weil im Flow diese Widersprüche sichtbar werden.

Irgendwo zwischen Control und Flow
Hier gibt es eine interessante Symmetrie.
Gute Logistiksoftware versucht, Unsicherheit innerhalb eines Betriebs zu reduzieren.
Gutes Testen versucht, Unsicherheit über die Software zu reduzieren, die ihn ausführt.
Das eine fragt:
Wo ist der Artikel?
Das andere fragt:
Woher wissen wir, dass die Software es noch weiß?
Das eine fragt:
Wurde diese Bewegung abgeschlossen?
Das andere fragt:
Welcher Nachweis belegt, dass sich der Status korrekt geändert hat?
Das eine fragt:
Kann die nächste Schicht weitermachen?
Das andere fragt:
Kann der nächste Ingenieur verstehen, was passiert ist?
Unterschiedliche Fragen.
Derselbe Instinkt.
Den Status sichtbar machen.
Die Begründung bewahren.
Die Menge an Wissen reduzieren, die nur im Kopf einer Person existiert.
Vielleicht ist das die Verbindung, die wir ursprünglich nicht geplant hatten.

Ingenieurskunst ohne das Banner
Niemand klickt auf eine Schaltfläche „Engineering Excellence".
Es gibt keine.
Und es sollte wahrscheinlich auch keine geben.
Ingenieurskunst zeigt sich indirekt.
Der Lagerkontext überlebt einen Sprachwechsel.
Derselbe Prozess überlebt eine andere Linux-Plattform.
Eine Bestandsbewegung bleibt rückverfolgbar.
Ein mobiler Kommissionierer sieht genau das, was gebraucht wird, und nichts anderes.
Eine Ausnahme unterbricht den Prozess, ohne seinen Status zu zerstören.
Das Hilfefenster erklärt den aktuellen Kontext, statt generische Dokumentation anzuzeigen.
Die Belegkette stimmt mit der betrieblichen Abfolge überein.
Der nächste Ingenieur kann verstehen, was passiert ist, ohne die Person zu fragen, die zufällig dabei war.
Es gibt reichlich Theater in moderner Software.
KI kann beeindruckende Demonstrationen erzeugen.
Dashboards können animieren.
Zahlen können sich bewegen.
Videos können sehr überzeugend aussehen.
Nichts davon beweist, dass zwei Bestandsoperationen nicht stillschweigend ein falsches Ergebnis erzeugen können.
Nichts davon beweist, dass eine Ausnahme Wochen später noch rekonstruiert werden kann.
Nichts davon beweist, dass Lagerarbeiter, Disponent, und Entwickler auf dieselbe betriebliche Wahrheit blicken.

Ingenieurskunst beginnt an einem weniger fotogenen Ort.

Mit Konsistenz.
Mit Nachweisen.
Mit Grenzen.


Mit der Bereitschaft, die langweiligen Teile langweilig zu lassen.
Unsichtbare Zuverlässigkeit erzeugt selten den dramatischsten Screenshot.
Bis man bewusst anfängt, danach zu suchen.

Control. Clarity. Flow.
Control bedeutet zu wissen, welches Lager, welcher Prozess, und welcher Status aktiv sind.
Clarity bedeutet zu verstehen, was sich geändert hat, wann es sich geändert hat, und warum.
Flow bedeutet, den Betrieb fortzusetzen zu lassen, ohne die Geschichte dahinter zu verlieren.
Das funktioniert für Logistik.
Es funktioniert für Softwaretests.
Es funktioniert überraschend gut für die Ingenieurskunst selbst.
Das erste Flow-Experiment gab COCO Administration.
Benutzer.
Rollen.
Datenbanken.
Sprachen.
Dann gab ihm jemand ein Lager.
Dann mehrere Sprachen.
Dann mobile Kommissionierung.
Dann Bestand.
Dann Umlagerungen.
Dann Ausnahmen.
Dann Dokumente.
Dann ein weiteres Betriebssystem.
An diesem Punkt sollten wir wahrscheinlich aufhören, Dinge hinzuzufügen.
Wir werden es wahrscheinlich nicht.

Control. Clarity. Flow.

Ubuntu war dran.

Red Hat ist jetzt dran.

Der Flow bewegt sich weiter.

COCO schaut weiter zu.
Und irgendwo mitten im letzten Durchlauf wurde offensichtlich, dass hinter diesem eine weitere Frage wartet.

Wir wissen, was sie ist.
COCO weiß, was sie ist.
Du weißt es nicht.
Noch nicht.


Wir könnten es dir sagen.

Aber dann würdest du vielleicht aufhören zu prüfen, ob ein neuer Insiders-Artikel erschienen ist.
Und das würde das Experiment ruinieren.

Veröffentlicht: 28.08.2026

Permalink →

Ein Brief von COCO

Ein Brief von COCO

An die Ingenieurin oder den Ingenieur, die oder der dieses Repository zum ersten Mal öffnet:

Willkommen.

Vielleicht sind Sie hier, weil etwas fehlgeschlagen ist.

Ein Dienst hat nicht mehr geantwortet.

Ein Deployment hat sich unerwartet verhalten.

Ein Alarm hat Sie mitten in der Nacht geweckt.

Oder Sie sind einfach neugierig, wie diese Plattform funktioniert.

Was auch immer Sie hierhergeführt hat, wissen Sie:

Dieses Projekt wurde genau für solche Momente gebaut.

Nicht um schwierige Probleme zu beseitigen.

Sondern um schwierige Probleme verständlich zu machen.

Sie werden Code finden.

Sie werden Dokumentation finden.

Sie werden Spezifikationen finden.

Wissenswertes

Warehouse Digitization Project Ideas, die wirken

Warehouse Digitization Project Ideas, die wirken

Ein fehlender Lieferschein kurz vor der Abfahrt, ein Bestand, der im Regal anders aussieht als in der Tabelle, und drei Mitarbeitende, die gleichzeitig dieselbe Rückfrage per Telefon klären: Genau dort entstehen sinnvolle warehouse digitization project ideas. Nicht bei der Frage, welche Technologie gerade modern wirkt, sondern bei einem konkreten Prozess, der Zeit kostet, Fehler erzeugt oder vom Wissen einzelner Personen abhängt.

Für kleine und mittlere Lager-, Handels- und Produktionsbetriebe ist Digitalisierung selten ein einzelnes Großprojekt. Sie ist eine Folge klar abgegrenzter Verbesserungen. Das Ziel muss nicht ein komplexes Enterprise-Warehouse-Management-System sein. Häufig ist ein schlankes, auf den tatsächlichen Ablauf zugeschnittenes Werkzeug besser als eine Suite mit Funktionen, die niemand auf dem Hallenboden nutzt.

Warehouse Digitization Project Ideas mit operativem Nutzen

Der beste Einstieg ist ein Prozess, der häufig vorkommt, leicht messbar ist und für Mitarbeitende spürbar besser wird. Wer sofort das gesamte Lager digitalisieren will, bindet Budget und Aufmerksamkeit, bevor sich eine Lösung im Alltag bewiesen hat. Ein begrenzter erster Schritt schafft dagegen belastbare Daten für die nächste Entscheidung.

1. Wareneingang mit mobiler Erfassung

Beim Wareneingang entstehen viele Folgefehler: falsch gezählte Mengen, ungeklärte Abweichungen, verzögert gebuchte Bestände und Papierbelege, die später nicht mehr auffindbar sind. Ein mobiles Erfassungsformular auf einem Handscanner, Tablet oder Smartphone kann den Vorgang deutlich stabiler machen.

Mitarbeitende scannen Artikel und Lieferreferenz, erfassen Menge, Lagerplatz und Abweichungsgrund direkt an der Rampe. Falls eine Charge, Seriennummer oder ein Foto relevant ist, gehört auch diese Information an denselben Datensatz. Der Bestand wird nicht erst am Ende der Schicht in einer Tabelle nachgetragen, sondern erhält einen nachvollziehbaren Status beim tatsächlichen Eingang.

Das bedeutet nicht, dass jeder Lieferant oder jeder Artikel zwingend Barcode-Etiketten braucht. Bei kleinen, unregelmäßigen Lieferungen kann eine Suche nach Artikelnummer ausreichen. Entscheidend ist, dass die Datenerfassung schneller ist als der bisherige Umweg über Papier und Nachpflege.

2. Digitale Umlagerungen statt Bestandsrätsel

Viele Lager wissen grundsätzlich, was vorhanden ist, aber nicht zuverlässig, wo es liegt. Ware wird für einen Auftrag vorgezogen, zwischengelagert, in die Montage gebracht oder wegen Platzmangel auf eine freie Fläche gestellt. Ohne einfache Buchung wird aus einer Bestandsfrage schnell eine Suchaktion.

Ein Umlagerungsprozess braucht keine komplizierte Oberfläche. Ausgangsplatz scannen, Zielplatz scannen, Menge bestätigen - mehr ist für viele Fälle nicht nötig. Das System sollte dabei prüfen, ob Artikel und Lagerplatz plausibel sind, und eine Buchung eindeutig einer Person und Uhrzeit zuordnen.

Wichtig ist der Umgang mit Ausnahmen. Ein Lagerplatz kann gesperrt, überfüllt oder nur für bestimmte Waren zugelassen sein. Diese Regeln sollten dort abgebildet werden, wo sie wirklichen Schaden verhindern. Für seltene Sonderfälle genügt oft ein Freigabeschritt durch die Lagerleitung. Zu viele Pflichtfelder machen aus einer hilfreichen Anwendung ein Hindernis.

3. Kommissionierung mit klaren Auftragsstatus

Papier-Picklisten funktionieren, bis Prioritäten wechseln, Positionen fehlen oder ein Auftrag auf mehrere Bereiche verteilt ist. Eine einfache digitale Kommissionierliste zeigt, welcher Auftrag offen ist, welche Positionen bereits gepickt wurden und wo eine Klärung nötig ist. Das reduziert Rückfragen zwischen Lager, Vertrieb und Versand.

Je nach Lagergröße kann die Anwendung Pickwege vorgeben oder lediglich Positionen nach Lagerzone sortieren. Eine vollständige Wegoptimierung lohnt sich vor allem bei vielen täglichen Aufträgen und langen Laufwegen. In einem kompakten Lager bringt eine verlässliche Statusanzeige oft mehr als ein mathematisch perfekter Weg, den im Alltag niemand befolgt.

Bei Fehlmengen sollte das System nicht nur rot markieren. Es sollte einen konkreten Folgeprozess anbieten: Bestand prüfen, Ersatzartikel anfragen, Nachschub auslösen oder Auftrag zur Klärung weitergeben. Digitalisierung ist dann wertvoll, wenn sie die nächste sinnvolle Handlung sichtbar macht.

4. Versanddokumente und Etiketten aus echten Auftragsdaten

Das manuelle Übertragen von Adressen, Gewichten und Artikelpositionen in Versandportale ist ein typischer Kandidat für Automatisierung. Lieferadresse, Lieferhinweise, Versandart und Paketinformationen liegen idealerweise einmal vor und werden für Lieferschein, Versandetikett und Versandbestätigung verwendet.

Ein passendes System kann Etiketten erzeugen, Dokumente revisionssicher ablegen und den Auftrag nach dem Druck automatisch auf versandbereit oder versendet setzen. Der operative Vorteil liegt nicht allein in gesparten Minuten. Er liegt darin, dass Versanddaten nicht an mehreren Stellen voneinander abweichen.

Hier ist die Integration entscheidend. Wenn ein Versanddienstleister keine brauchbare Schnittstelle bietet oder sehr unterschiedliche Sonderregeln gelten, kann ein teilautomatisierter Ablauf vernünftiger sein als eine fragile Vollintegration. Boring, provable reliability schlägt eine Automatisierung, die bei jeder Ausnahme stehen bleibt.

5. Nachschub und Mindestbestände mit nachvollziehbaren Regeln

Mindestbestände werden häufig in Tabellen gepflegt und dann ignoriert, weil niemand sicher ist, ob die Zahlen noch stimmen. Eine sinnvolle digitale Lösung verbindet tatsächliche Buchungen mit klaren Dispositionsregeln. Sie kann melden, wenn ein Artikel unter einen Schwellenwert fällt, reservierte Mengen berücksichtigen und eine Bestellliste vorbereiten.

Die Schwelle sollte nicht als ewige Wahrheit behandelt werden. Saisonale Nachfrage, Lieferzeiten und Mindestbestellmengen verändern sich. Deshalb braucht die verantwortliche Person eine einfache Möglichkeit, Vorschläge zu prüfen und Regeln anzupassen. Vollautomatische Bestellungen sind erst dann sinnvoll, wenn Stammdaten, Lieferantenlogik und Verbrauchsdaten stabil genug sind.

6. Rückverfolgbarkeit für Chargen, Seriennummern und Sperrbestände

Wer mit Chargen, Geräten, Ersatzteilen oder regulierten Produkten arbeitet, braucht mehr als eine Mengenanzeige. Es muss nachvollziehbar sein, welche Ware wann eingegangen ist, wohin sie bewegt wurde und in welchem Kundenauftrag sie gelandet ist.

Das Projekt kann bewusst klein beginnen: Zunächst nur Wareneingang und Versand einer kritischen Warengruppe erfassen. Danach folgen interne Bewegungen und Rückläufer. Ein System, das jede Buchung erzwingt, aber den realen Reparatur- oder Prüfprozess nicht kennt, wird umgangen. Die Fachlogik muss deshalb aus dem Arbeitsablauf entstehen, nicht aus einem abstrakten Datenmodell.

Das richtige Projekt auswählen

Die attraktivste Idee ist nicht automatisch die richtige erste Idee. Bewerten Sie mögliche Vorhaben nach Häufigkeit, Fehlerkosten, Wartezeit und Abhängigkeit von Einzelpersonen. Ein Prozess, der 50-mal täglich läuft und pro Vorgang zwei Minuten spart, kann wertvoller sein als eine seltene Sonderfunktion mit großer technischer Eleganz.

Auch die Datenqualität gehört in die Entscheidung. Wenn Artikelnummern doppelt vergeben sind, Lagerplätze nicht eindeutig benannt werden oder Aufträge aus mehreren Quellen widersprüchlich eintreffen, sollte das Projekt diese Grundlagen zuerst bereinigen. Software kann fehlende Regeln sichtbar machen, aber nicht zuverlässig ersetzen.

Für die Priorisierung reichen vier Fragen:

  • Welche Tätigkeit verursacht nachweislich die meisten Rückfragen oder Nacharbeiten?
  • Welche Information wird heute mehrfach abgeschrieben oder telefonisch abgefragt?
  • Welcher Fehler hätte die teuersten Folgen für Kunden, Bestand oder Versand?
  • Welcher Ablauf lässt sich in wenigen Wochen mit einer klaren Erfolgsmessung testen?

Technische Entscheidungen, die im Lageralltag zählen

Eine Lageranwendung muss nicht spektakulär aussehen. Sie muss bei schlechter WLAN-Abdeckung, im Handschuhbetrieb, unter Zeitdruck und während eines Schichtwechsels verständlich bleiben. Große Schaltflächen, klare Rückmeldungen nach einem Scan und eine sichtbare Fehlerbehandlung sind wichtiger als dekorative Dashboards.

Auch die Architektur sollte zur Betriebsrealität passen. Eine webbasierte Anwendung mit sauberer Datenbankstruktur kann auf vorhandenen Geräten laufen und ist leichter wartbar als eine Insellösung auf einem einzelnen PC. Mit einer stabilen Basis, etwa PHP 8.4, modernem JavaScript und MySQL 8, lassen sich Rollen, Buchungshistorien, Schnittstellen und dokumentierte Deployments langfristig nachvollziehbar betreiben.

Dabei ist nicht jede Information für jede Rolle bestimmt. Lagerkräfte benötigen offene Aufgaben und klare Buchungsdialoge. Die Disposition braucht Warnungen und Bestellvorschläge. Die Leitung braucht Auswertungen zu Durchlaufzeiten, Differenzen und offenen Vorgängen. Rechtekonzepte, Protokolle und Kontensperren bei wiederholten Fehlversuchen gehören früh in die Planung, besonders wenn externe Dienstleister oder mehrere Standorte beteiligt sind.

Einführung: Erst beweisen, dann ausweiten

Ein Pilot sollte mit echten Aufträgen laufen, nicht nur mit Testdaten im Besprechungsraum. Wählen Sie eine Lagerzone, eine Produktgruppe oder eine Schicht und definieren Sie vorab, woran Erfolg erkennbar ist: weniger Korrekturbuchungen, kürzere Bearbeitungszeit, weniger Rückfragen oder höhere Buchungsquote am selben Tag.

Planen Sie parallel eine Rückfallebene. Wenn die neue Anwendung ausfällt oder ein Prozess ungeklärt ist, muss die Mannschaft wissen, wie sie weiterarbeitet und wie nachträgliche Buchungen kontrolliert werden. Das ist kein Zeichen mangelnden Vertrauens in die Technik, sondern professioneller Betrieb.

Nach zwei bis vier Wochen zeigen sich meist die wertvollsten Erkenntnisse. Vielleicht fehlt kein Feature, sondern eine bessere Artikelkennzeichnung. Vielleicht ist der Workflow richtig, aber ein Scannerprofil oder eine Berechtigung bremst. Diese Beobachtungen sollten in kurze, kontrollierte Verbesserungszyklen fließen, statt ein neues Großprojekt auszulösen.

Die beste Digitalisierung macht den Lageralltag nicht theoretisch moderner, sondern konkret ruhiger: weniger Suchen, weniger Nachtragen, klarere Übergaben und belastbare Informationen genau dann, wenn eine Entscheidung ansteht.
Permalink →

Inventory Workflow Automation Checklist fürs Lager

Inventory Workflow Automation Checklist fürs Lager

Ein Wareneingang wird auf Papier bestätigt, Bestände später in eine Tabelle übertragen und eine Versandfrage per Telefon geklärt. Jeder einzelne Schritt wirkt beherrschbar. Zusammen erzeugen sie Rückfragen, Bestandsdifferenzen und Abhängigkeit von einzelnen Mitarbeitenden.

Eine Inventory Workflow Automation Checklist verhindert, dass aus diesem Zustand vorschnell ein überdimensioniertes Softwareprojekt wird. Sie trennt Prozesse, die wirklich automatisiert werden sollten, von solchen, für die ein sauber geführtes Spreadsheet weiterhin genügt.


Die Inventory Workflow Automation Checklist vor dem Projektstart

Automatisierung beginnt nicht mit der Auswahl eines Systems. Sie beginnt mit einer überprüfbaren Beschreibung dessen, was im Lager tatsächlich passiert - auch bei Ausnahmen, Schichtwechseln und Zeitdruck. Gehen Sie die folgenden Punkte mit Lagerleitung, Disposition, Einkauf und gegebenenfalls Buchhaltung direkt am Prozess durch.

1. Bewegungen statt nur Bestände erfassen

Ein aktueller Bestand ist das Ergebnis von Bewegungen. Deshalb sollte klar sein, welche Ereignisse den Bestand erhöhen, verringern, reservieren, sperren oder umbuchen. Dazu gehören Wareneingang, Einlagerung, Kommissionierung, Versand, Retoure, Ausschuss, Inventurdifferenz und Umlagerung.

Für jede Bewegung braucht es eine eindeutige Antwort auf vier Fragen: Wer führt sie aus? Wann wird sie gebucht? Welcher Lagerort ist betroffen? Welcher Beleg oder Auftrag belegt sie? Wenn diese Antworten heute nur im Kopf erfahrener Mitarbeitender existieren, ist das ein guter Automatisierungskandidat. Das Ziel ist nicht mehr Datenerfassung, sondern eine belastbare Historie, aus der sich ein Bestand erklären lässt.

2. Artikel, Varianten und Einheiten bereinigen

Viele Projekte scheitern nicht am Scanner oder an der Weboberfläche, sondern an Stammdaten. Ein Artikel kann als Karton eingekauft, einzeln gelagert und in Sets verkauft werden. Ohne definierte Umrechnungen produziert die Software formal korrekte, operativ aber falsche Mengen.

Prüfen Sie Artikelnummern auf Dubletten, legen Sie verbindliche Bezeichnungen fest und unterscheiden Sie Verkaufseinheit, Lagereinheit und Verpackungseinheit. Seriennummern, Chargen, Mindesthaltbarkeitsdaten oder Gefahrstoffkennzeichnungen gehören nur dann in den ersten Ausbau, wenn sie im Alltag Entscheidungen beeinflussen oder regulatorisch erforderlich sind. Alles andere erhöht zunächst Pflegeaufwand und Fehlerfläche.

3. Lagerorte so genau definieren, wie nötig

„Halle 2“ ist für eine Inventurliste vielleicht ausreichend. Für eine verlässliche Kommissionierung ist es meist zu grob. Definieren Sie, ob ein Lagerort Zone, Regal, Fach, Stellplatz oder Übergabefläche meint. Auch Sperrlager, Wareneingangszone, Retourenbereich und Versandpuffer müssen als eigene Orte erkennbar sein, wenn Waren dort liegen können.

Die richtige Granularität hängt vom Betrieb ab. Ein Workshop mit wenigen hundert Positionen braucht nicht zwingend eine Fachverwaltung. Bei mehreren Kommissionierenden pro Schicht kann ein präziser Stellplatz jedoch Laufwege und Suchzeiten deutlich reduzieren. Automatisieren Sie keine Genauigkeit, die niemand pflegen kann.

4. Auslöser, Verantwortliche und Freigaben festlegen

Ein Workflow braucht einen klaren Startpunkt. Beim Wareneingang kann das die Lieferung am Tor, die Bestellung im Einkauf oder der Scan eines Lieferscheins sein. Für eine Nachbestellung kann ein Mindestbestand den Vorschlag auslösen, während die endgültige Bestellung bei einer verantwortlichen Person bleibt.

Dokumentieren Sie außerdem, welche Aktionen automatisch erfolgen dürfen und welche eine Prüfung brauchen. Eine fehlende Menge sollte etwa eine Abweichung erzeugen, nicht stillschweigend den erwarteten Wareneingang verändern. Bei wertvollen, chargenpflichtigen oder sicherheitskritischen Artikeln sind Freigabeschritte sinnvoll. Bei Verbrauchsmaterial würden sie den Durchsatz unnötig bremsen.

5. Dokumente dort erzeugen, wo sie gebraucht werden

Lieferscheine, Einlagerungslisten, Picklisten, Versandetiketten und Übergabeprotokolle entstehen oft in verschiedenen Anwendungen. Das führt zu Medienbrüchen: Eine Adresse wird kopiert, ein Auftrag abgehakt, ein Versandstatus später nachgetragen.

Notieren Sie pro Dokument die Quelle der Daten, den Zeitpunkt der Erstellung und den Empfänger. Ein sinnvoller Ablauf kann beispielsweise nach der Freigabe eines Auftrags automatisch eine Pickliste erzeugen, nach dem Packen ein Versandlabel bereitstellen und nach der Übergabe den Auftrag mit Zeitstempel abschließen. Entscheidend ist, dass die Daten nicht mehrfach manuell eingegeben werden müssen.

Schnittstellen und Datenqualität prüfen

Die beste Lagerlogik nützt wenig, wenn Aufträge nur einmal täglich als Datei eintreffen oder Lieferadressen unterschiedlich formatiert sind. Erstellen Sie deshalb eine nüchterne Liste der Systeme, die Daten senden oder empfangen: Shop, ERP, Buchhaltung, Versanddienstleister, Lieferantenportal, Produktionssystem und vorhandene Tabellen.

Für jede Verbindung sollte feststehen, welches System bei welchem Datenfeld führend ist. Ist der Artikelstamm im ERP maßgeblich, darf das Lagerportal nicht still eigene Artikel anlegen. Kommt eine Auftragsänderung aus dem Shop, muss sie vor dem Versand sichtbar werden. Bei kleinen Mengen kann ein kontrollierter CSV-Import der richtige erste Schritt sein. Bei hohem Volumen oder kurzen Lieferzusagen lohnt sich eine direkte Schnittstelle.

Ebenso wichtig ist der Umgang mit Fehlern. Eine Schnittstelle sollte nicht nur Daten übertragen, sondern auch zeigen, was abgewiesen wurde und warum. Unbekannte Artikelnummern, ungültige Adressen oder fehlende Mengen dürfen nicht in einer technischen Protokolldatei verschwinden. Sie brauchen eine Arbeitsliste mit Zuständigkeit und Status.

Bedienung auf dem Lagerboden gestalten

Ein Prozess, der am Schreibtisch plausibel aussieht, kann auf dem Lagerboden scheitern. Mitarbeitende tragen Handschuhe, bewegen Waren, teilen Geräte oder arbeiten bei instabiler WLAN-Abdeckung. Prüfen Sie deshalb früh, ob Scanner, Tablet, Desktop oder Ausdruck zum jeweiligen Arbeitsschritt passen.

Der Scan sollte eine eindeutige Rückmeldung geben: richtige Ware, falscher Lagerort, bereits gebuchte Menge oder gesperrter Artikel. Farben allein reichen nicht. Kurze, verständliche Meldungen und ein klarer nächster Schritt sind unter Zeitdruck wertvoller als eine funktionsreiche Oberfläche.

Planen Sie auch den Ausnahmefall. Was passiert bei beschädigtem Barcode, Netzwerkausfall, Teillieferung oder einer gefundenen Ware ohne Zuordnung? Ein guter Ablauf bietet dafür kontrollierte Wege und protokolliert die Korrektur. Er zwingt Teams nicht dazu, sich mit Notizzetteln und späteren Sammelbuchungen zu helfen.

Kennzahlen definieren, bevor Dashboards gebaut werden

Ein Dashboard ist kein Ziel. Relevant sind Kennzahlen, die eine operative Entscheidung auslösen. Das können offene Wareneingänge über einem definierten Alter, Aufträge kurz vor dem Versandtermin, Bestandsdifferenzen je Lagerzone, Kommissionierfehler oder die Zeit zwischen Auftragseingang und Übergabe sein.

Legen Sie für jede Kennzahl Datenquelle, Berechnungsregel und verantwortliche Rolle fest. „Bestandsgenauigkeit“ ist beispielsweise nur aussagekräftig, wenn klar ist, gegen welche Zählung sie gemessen wird und wie Retouren oder Sperrbestände behandelt werden. Wenige verlässliche Kennzahlen sind besser als eine Wand aus Diagrammen, der niemand vertraut.

Sicherheit, Rechte und Nachvollziehbarkeit einplanen

Automatisierung verteilt Handlungsmacht. Wer Bestände ändern, Artikel anlegen, Versandlabels erzeugen oder Aufträge stornieren darf, sollte bewusst festgelegt werden. Rollenbasierte Rechte sind meist sinnvoller als ein gemeinsames Login am Lager-PC. Besonders kritische Korrekturen benötigen einen Zeitstempel, eine Personenzuordnung und idealerweise einen Grund.

Auch technische Grundlagen gehören auf die Checkliste: regelmäßige Backups, getestete Wiederherstellung, dokumentierte Zugänge, Protokollierung von Schnittstellenfehlern und ein Verfahren für gesperrte oder ausgeschiedene Nutzerkonten. Bei einer individuellen Anwendung sind wartbare Technologien, eine klare Datenbankstruktur und nachvollziehbare Deployment-Schritte keine Nebensache. Sie entscheiden darüber, ob Anpassungen nach zwei Jahren noch kalkulierbar bleiben.

In kleinen, messbaren Schritten einführen

Versuchen Sie nicht, Wareneingang, Nachschub, Inventur, Versand und Routenplanung gleichzeitig umzustellen. Wählen Sie einen Ablauf mit spürbarem Schmerz und überschaubarem Risiko, etwa die mobile Buchung von Wareneingängen oder das automatische Erstellen von Versanddokumenten. Erfassen Sie vor dem Start Bearbeitungszeit, Korrekturen und offene Fälle.

Testen Sie mit echten Artikeln, echten Aufträgen und den Mitarbeitenden, die später damit arbeiten. Ein Pilot mit einer Lagerzone oder einer Produktgruppe zeigt schneller als ein Workshop, ob Bezeichnungen, Scannerabläufe und Freigaben funktionieren. Erst wenn die Ausnahmefälle beherrscht sind, sollte der nächste Prozess folgen.

Automatisierung ist gelungen, wenn Teams weniger nachfragen müssen, ein Bestand erklärbar bleibt und der Prozess auch dann funktioniert, wenn die erfahrenste Person im Urlaub ist. Genau dort lohnt sich die nächste Verbesserung: nicht beim lautesten Tool, sondern bei der Reibung, die den Arbeitstag tatsächlich verlangsamt.

Permalink →

Mobile Webseiten-Ladezeit verbessern

Mobile Webseiten-Ladezeit verbessern

Auf einem Lagerhandy mit mäßigem Empfang entscheidet nicht die Animation im Hero-Bereich über den ersten Eindruck, sondern ob die Seite überhaupt bedienbar wird. Wartet ein Interessent drei, vier oder fünf Sekunden auf Inhalte, ist der Vergleich zur Konkurrenz nur einen Zurück-Button entfernt. Wer die mobile Webseite Ladezeit verbessern will, braucht deshalb keine kosmetischen Einzelmaßnahmen, sondern eine nachvollziehbare technische Reihenfolge.

Das gilt besonders für Websites, die Anfragen erzeugen sollen: für einen Hersteller, einen Logistikdienstleister oder einen Betrieb mit erklärungsbedürftigen Leistungen. Mobil kommen Nutzer oft zwischen Terminen, auf der Fläche oder über eine Suchanfrage mit konkreter Absicht auf die Seite. Die Website muss dann Informationen liefern, nicht erst Rechenarbeit auf dem Gerät verursachen.

Warum mobile Ladezeit ein Betriebsproblem ist

Mobile Performance wird häufig als SEO-Disziplin behandelt. Das greift zu kurz. Schnelle Seiten helfen zwar bei Sichtbarkeit und Kampagnenkosten, aber der unmittelbare Effekt liegt in der Nutzung: Formulare werden eher abgeschickt, Telefonnummern eher gewählt und Produktinformationen eher gelesen. Eine langsame Website erzeugt dagegen Zweifel, noch bevor ein Ansprechpartner reagieren kann.

Dabei ist „schnell“ kein einzelner Messwert. Eine Seite kann früh einen Hintergrund anzeigen und dennoch erst deutlich später auf Klicks reagieren. Für Besucher zählen drei Dinge: Wann erscheint der wichtigste Inhalt? Wann lässt sich die Seite ohne Verzögerung bedienen? Und springt das Layout noch, während sie gerade einen Button antippen wollen? Diese Fragen spiegeln sich in Kennzahlen wie Largest Contentful Paint, Interaction to Next Paint und Cumulative Layout Shift wider.

Messungen müssen unter realistischen Bedingungen erfolgen. Ein leistungsstarker Bürorechner im WLAN verschleiert Probleme, die auf einem älteren Android-Gerät im Mobilfunknetz sichtbar werden. Auch der Standort, zwischengeschaltete Dienste und eine bereits gefüllte Browser-Cache verändern Ergebnisse. Entscheidend sind deshalb wiederholte Messungen und echte Nutzungsdaten, nicht ein einzelner perfekter Testlauf.

Mobile Webseiten-Ladezeit verbessern: erst messen, dann ändern

Der häufigste Fehler ist, sofort Bilder zu komprimieren oder ein weiteres Optimierungs-Plugin zu installieren. Beides kann helfen, aber ohne Ursachenanalyse entstehen schnell schwer wartbare Konfigurationen. Prüfen Sie zuerst eine repräsentative Auswahl: Startseite, eine typische Leistungs- oder Produktseite, Kontaktseite und eine stark besuchte Landingpage. Auf diesen Seiten lassen sich Muster erkennen.

Im Netzwerkprotokoll zeigt sich, welche Dateien den Start blockieren und wie groß sie tatsächlich sind. Ein Performance-Audit macht sichtbar, ob JavaScript die Bedienung verzögert, ob Schriften zu spät kommen oder ob Bilder unnötig früh geladen werden. Ergänzen Sie Labormessungen durch Daten echter Besucher, sofern ausreichend Verkehr vorhanden ist. So vermeiden Sie Optimierung für ein Testprofil, das Ihre Zielgruppe nicht abbildet.

Setzen Sie vor jeder Änderung ein klares Ziel. Beispielsweise: Der sichtbare Hauptinhalt soll auf einem durchschnittlichen Mobilgerät in unter 2,5 Sekunden erscheinen, oder das Kontaktformular soll ohne Eingabeverzögerung nutzbar sein. Nicht jede Seite muss eine theoretische Bestnote erreichen. Bei einer komplexen Anwendung mit authentifizierten Daten gelten andere Voraussetzungen als bei einer öffentlichen Unternehmensseite. Boring, provable reliability ist hier wertvoller als ein kurzfristiger Score durch riskante Tricks.

1. Bilder nach ihrer Aufgabe behandeln

Auf vielen mobilen Seiten sind Bilder weiterhin der größte Datenblock. Das Problem ist nicht das Foto selbst, sondern ein Bild, das in 2.500 Pixel Breite übertragen wird, obwohl auf dem Gerät 700 Pixel genügen. Stellen Sie responsive Bildvarianten bereit, damit der Browser die passende Größe auswählen kann. Moderne Formate wie WebP oder AVIF reduzieren die Dateigröße oft deutlich, sollten aber mit sauberen Fallbacks und geprüfter Bildqualität eingesetzt werden.

Das größte Bild im sichtbaren Einstieg verdient besondere Aufmerksamkeit. Es sollte korrekt zugeschnitten sein, eine passende Auflösung haben und früh geladen werden. Bilder weiter unten auf der Seite können verzögert geladen werden. Das spart Daten beim Einstieg, darf aber nicht dazu führen, dass Bilder beim Scrollen sichtbar nachladen, obwohl der Nutzer sie bereits erwartet.

Verzichten Sie nicht reflexhaft auf alle Bilder. Ein gutes Bild kann eine Maschine, ein Team oder einen Prozess schneller erklären als ein Absatz. Die technische Aufgabe lautet: Relevante visuelle Informationen effizient ausliefern, nicht Gestaltung auf einen grauen Platzhalter reduzieren.

2. JavaScript auf notwendige Arbeit begrenzen

Jedes Script konkurriert beim Laden und bei der Bedienung um Rechenzeit. Besonders problematisch sind pauschal eingebundene Bibliotheken, Tag-Manager mit vielen Fremdskripten, Chat-Widgets, Karten und Animationen. Auf Desktop-Geräten bleiben diese Kosten oft unauffällig. Mobil führen sie zu einer Seite, die sichtbar ist, aber auf Eingaben träge reagiert.

Prüfen Sie für jedes Script seinen Zweck, seine Ladebedingung und seinen geschäftlichen Nutzen. Eine interaktive Karte auf der Kontaktseite muss nicht auf jeder Unterseite geladen werden. Ein Cookie- oder Analysewerkzeug sollte keine Kette weiterer Dateien auslösen, bevor der Besucher überhaupt Inhalte lesen kann. Funktionen, die erst nach Interaktion nötig werden, können auch dann geladen werden.

Bei individuell entwickelten Websites ist eine klare Komponentenstruktur ein echter Vorteil. JavaScript wird pro Funktion gebündelt statt als globales Paket ausgeliefert. Das erleichtert auch spätere Pflege: Wer ein Formular erweitert, verändert nicht versehentlich den Code für einen Produktfilter oder eine Navigation.

3. CSS und Schriften ohne Blockaden ausliefern

Ein häufiger Engpass liegt im ersten sichtbaren Bereich. Wenn dafür mehrere Stylesheets, Icon-Fonts und externe Schriftvarianten geladen werden müssen, wartet der Browser unnötig lange. Kritische Styles für den sichtbaren Bereich sollten klein und früh verfügbar sein. Nicht kritische Regeln können später folgen.

Bei Webfonts reichen meist wenige Schriftschnitte. Vier Gewichtungen in normal, kursiv und zusätzlichen Untersets wirken im Designsystem vollständig, sind für eine typische Unternehmenswebsite aber selten erforderlich. Legen Sie sinnvolle System-Fallbacks fest, damit Text sofort lesbar bleibt. Eine Schrift, die einige Millisekunden später sauber wechselt, ist besser als leerer Text.

Auch Icons verdienen eine Prüfung. Ein kleines SVG-Set ist häufig effizienter und präziser steuerbar als eine komplette Icon-Schrift. Das ist keine Regel ohne Ausnahme: Bestehende Systeme müssen nicht allein für ein paar Kilobyte neu gebaut werden. Werden ohnehin größere Änderungen geplant, gehört die Entscheidung aber in die technische Basis.

4. Caching und Serverantwort sauber aufsetzen

Selbst eine schlanke Oberfläche fühlt sich langsam an, wenn der Server lange bis zur ersten Antwort benötigt. Ursachen reichen von ungebremsten Datenbankabfragen über dynamisch zusammengesetzte Seiten bis zu fehlendem Caching. Öffentliche Inhalte, die sich selten ändern, sollten als Cache-Version schnell auslieferbar sein. Statische Dateien wie Bilder, CSS und JavaScript benötigen eindeutige Versionsnamen und sinnvolle Cache-Regeln.

Bei PHP-Anwendungen geht es zusätzlich um effiziente Ausführung, einen korrekt konfigurierten Opcode-Cache und kontrollierte Datenbankzugriffe. MySQL-Abfragen brauchen Indizes, die zu den tatsächlichen Filter- und Sortierwegen passen. Eine Startseite, die für jeden Aufruf mehrere unnötige Datenabfragen ausführt, wird mit wachsendem Traffic nicht besser.

Caching ist jedoch kein Freifahrtschein. Preise, Verfügbarkeiten, personalisierte Bereiche oder Inhalte nach einem Login dürfen nicht versehentlich veraltet erscheinen. Deshalb werden Cache-Grenzen fachlich definiert: Was darf fünf Minuten alt sein, was muss unmittelbar aktuell sein, und wer leert den Cache nach einer Inhaltsänderung? Gute Performance entsteht aus dieser Präzision.

5. Drittanbieter kritisch behandeln

Externe Dienste sind oft der unsichtbare Ballast einer Website. Analyse, Consent-Management, Videos, Karten, Bewertungswidgets und Marketing-Pixel laden weitere Skripte von weiteren Servern. Jede Abhängigkeit kann Verzögerungen erzeugen, Datenschutzfragen aufwerfen und im Fehlerfall die Darstellung beeinträchtigen.

Das heißt nicht, dass jedes externe Tool entfernt werden muss. Ein Video kann Vertrieb unterstützen, ein Analysewerkzeug kann wichtige Entscheidungen fundieren. Es braucht aber eine Kosten-Nutzen-Prüfung. Laden Sie eingebettete Medien erst nach Zustimmung oder Interaktion. Nutzen Sie bei Karten zunächst eine Vorschau. Und entfernen Sie Tags, deren Ergebnisse seit Monaten niemand mehr auswertet.

6. Layoutsprünge und mobile Bedienung mitdenken

Ladezeit und Bedienbarkeit gehören zusammen. Reservieren Sie für Bilder, Banner und eingebettete Elemente feste Flächen, damit Buttons nicht unter dem Finger wegspringen. Vermeiden Sie Pop-ups, die den sichtbaren Inhalt direkt beim Einstieg verdecken. Eine schnelle Seite, die sofort ein schwer schließbares Overlay zeigt, löst das Problem nicht.

Testen Sie Formulare besonders sorgfältig. Große Eingabefelder, passende Tastaturtypen und kurze Pflichtstrecken helfen mehr als ein aufwendiger Effekt. Wenn eine Anfrage nur Name, Rückrufnummer und Anliegen benötigt, ist ein zwölfteiliges Formular kein Zeichen von Gründlichkeit. Es ist Reibung.

7. Performance als festen Betriebsprozess führen

Ein einmaliger Relaunch hält die Ladezeit nicht dauerhaft niedrig. Neue Kampagnenbilder, Tracking-Anforderungen und Redaktionsmodule summieren sich. Deshalb gehören Performance-Budgets in den Entwicklungsprozess: eine maximale Größe für Einstiegsbilder, klare Regeln für neue Drittanbieter und definierte Grenzwerte für JavaScript.

Nach Releases sollten die wichtigsten Seitentypen erneut geprüft werden. Automatisierte Tests können dabei feststellen, ob zentrale Seiten erreichbar sind und kritische Abläufe funktionieren. Für Performance reicht ein reiner Funktionstest allerdings nicht aus. Ergänzen Sie ihn um Messungen der Antwortzeit, der übertragenen Datenmenge und der mobilen Interaktionsfähigkeit. Eine schnelle mobile Website entsteht nicht durch ein einzelnes Plugin und auch nicht durch Verzicht um jeden Preis. Sie entsteht, wenn Design, Inhalte, Infrastruktur und reale Nutzung zusammen betrachtet werden. Beginnen Sie bei der Seite, die Anfragen oder operative Kontakte auslöst, messen Sie unter ehrlichen Bedingungen und beseitigen Sie dort Reibung, wo Nutzer sie tatsächlich spüren.

Permalink →

Logistiksoftware, die den Betrieb wirklich entlastet

Logistiksoftware, die den Betrieb wirklich entlastet

Wenn ein Wareneingang erst auf Papier notiert, später in eine Tabelle übertragen und anschließend per Zuruf an den Versand weitergegeben wird, fehlt meist nicht der Einsatz der Mitarbeitenden. Es fehlt eine gemeinsame, verlässliche Arbeitsgrundlage. Gute Logistiksoftware ersetzt solche Brüche nicht mit mehr Bildschirmarbeit, sondern mit klaren Abläufen: Was ist angekommen, wo liegt es, was wurde reserviert und was kann heute versendet werden?

Für kleine und mittlere Unternehmen ist dabei nicht die größtmögliche Funktionsliste entscheidend. Entscheidend ist, dass die Software die tatsächliche Arbeit auf dem Lagerboden, im Büro und im Versand abbildet. Eine Lösung, die für einen globalen Konzern mit zwanzig Standorten gedacht ist, kann für einen Betrieb mit einem Lager und zwei Schichten unnötig langsam, teuer und kompliziert sein.

Wann Logistiksoftware wirklich sinnvoll wird

Tabellen sind nicht grundsätzlich ein Problem. Für geringe Mengen, einen überschaubaren Artikelstamm und einen einzelnen verantwortlichen Mitarbeiter können sie die pragmatischste Lösung sein. Es wäre falsch, einen funktionierenden Prozess allein aus Modernisierungsgründen durch ein Projekt zu ersetzen.

Der Kipppunkt kommt, wenn Informationen mehrfach gepflegt werden müssen oder niemand mehr sicher sagen kann, welche Datei aktuell ist. Typische Signale sind Fehlbestände trotz voller Regale, Rückfragen zum Status von Lieferungen, manuell geschriebene Lieferscheine und Inventuren, die den Betrieb für Tage ausbremsen. Auch wachsende Auftragszahlen machen sichtbar, welche Schritte bislang nur durch Erfahrung einzelner Personen zusammengehalten wurden.

Dann geht es nicht primär um Digitalisierung als Schlagwort. Es geht um Fehlerquellen und Wartezeiten. Ein Mitarbeiter sollte nicht erst mehrere Listen vergleichen müssen, um eine Bestellung freizugeben. Der Versand sollte nicht raten müssen, ob ein Artikel tatsächlich verfügbar oder bereits für einen anderen Auftrag reserviert ist.

Welche Prozesse Logistiksoftware verbinden sollte

Eine brauchbare Lösung beginnt mit dem Materialfluss, nicht mit einem Standardmenü. Bei vielen Betrieben umfasst dieser Fluss Wareneingang, Einlagerung, Bestandsführung, Kommissionierung, Versand und Rückmeldung. Je nach Geschäft kommen Chargen, Seriennummern, Retouren, Fertigungsaufträge oder Tourenplanung hinzu.

Wareneingang mit nachvollziehbaren Beständen

Im Wareneingang entscheidet sich viel. Wird eine Lieferung direkt gegen Bestellung oder Lieferschein geprüft, lassen sich Mengenabweichungen, beschädigte Ware und fehlende Positionen dort festhalten, wo sie entstehen. Die Ware erhält einen Status, statt nur physisch irgendwo abgestellt zu werden.

Die Software muss dafür nicht zwangsläufig mit teurer Scanner-Hardware beginnen. In manchen Lagern reicht zunächst ein Tablet oder ein Arbeitsplatz am Wareneingang. Wo viele Positionen täglich bewegt werden, sind Barcode-Scanner jedoch sinnvoll, weil sie Buchungen beschleunigen und Tippfehler reduzieren. Die richtige Entscheidung hängt von Mengen, Wegen und Artikelstruktur ab.

Lagerbewegungen ohne Gedächtnisprotokoll

Bestände sind nur dann belastbar, wenn Zugänge, Umlagerungen, Entnahmen und Korrekturen nachvollziehbar sind. Das bedeutet nicht, dass jede Ausnahme verhindert werden muss. Im Alltag gibt es beschädigte Verpackungen, falsche Einlagerungen und spontane Materialentnahmen. Eine gute Anwendung macht diese Fälle buchbar, dokumentiert aber auch, wer was wann geändert hat.

Diese Historie ist kein Kontrollinstrument um ihrer selbst willen. Sie hilft, Ursachen zu finden. Wenn ein Artikel wiederholt auf einem falschen Lagerplatz landet, ist möglicherweise die Lagerkennzeichnung unklar. Wenn regelmäßige Korrekturen auftreten, liegt das Problem oft im Prozess vor der Buchung.

Aufträge, Lieferscheine und Versand aus einem Ablauf

Viele Teams verlieren Zeit an der Schnittstelle zwischen Auftrag und Versand. Auftragsdaten kommen per E-Mail, Telefon oder aus einem separaten Shop-System. Anschließend werden Positionen ausgedruckt, Bestände geprüft und Versandpapiere erneut erfasst. Jede manuelle Übergabe schafft Raum für Abweichungen.

Logistiksoftware sollte aus einem freigegebenen Auftrag eine eindeutige Pickliste, einen Lieferschein und bei Bedarf ein Versandlabel erzeugen können. Wichtig ist dabei die Reihenfolge: Erst muss klar sein, was lieferbar ist. Danach sollte der Auftrag für andere Prozesse reserviert sein. Sonst entsteht die unangenehme Situation, dass zwei Mitarbeiter denselben letzten Bestand verplanen.

Planung, die zur Realität passt

Tourenplanung und Kapazitätssteuerung können wertvoll sein, besonders bei eigenen Auslieferungen, festen Zeitfenstern oder vielen regionalen Stopps. Sie sind aber nicht automatisch der nächste sinnvolle Schritt. Wer noch keine saubere Auftragsfreigabe und keine belastbaren Bestandsdaten hat, sollte zuerst diese Grundlagen lösen.

Dasselbe gilt für Prognosen und KI-gestützte Planung. Sie können Muster sichtbar machen, benötigen aber saubere Eingangsdaten. Eine Prognose auf Basis unvollständiger Bestände wirkt technisch anspruchsvoll, verbessert aber keine Lieferfähigkeit.

Standardlösung oder individuelle Logistiksoftware?

Standardsoftware ist sinnvoll, wenn die eigenen Abläufe weitgehend üblich sind und sich ohne größere Reibung anpassen lassen. Sie kann schneller eingeführt werden und bringt erprobte Grundfunktionen mit. Für einen Betrieb mit einfachen Lagerprozessen, klaren Rollen und wenigen Besonderheiten ist das oft die wirtschaftlich richtige Wahl.

Individuelle Logistiksoftware lohnt sich, wenn das Geschäft von speziellen Abläufen lebt oder bestehende Systeme nur mit Umwegen verbunden werden können. Das betrifft etwa Werkstätten mit Materialausgabe an laufende Aufträge, Händler mit kundenspezifischen Versandregeln oder Hersteller, die Lagerbewegungen eng mit Produktionsschritten verbinden müssen.

Der Unterschied liegt nicht darin, alles neu zu erfinden. Gute individuelle Systeme übernehmen bewährte Muster wie Statuswechsel, Reservierungen und Berechtigungen. Sie passen aber Sprache, Masken, Dokumente und Schnittstellen an die Arbeit an, die tatsächlich erledigt wird. So muss sich das Team nicht dauerhaft an Kategorien orientieren, die nur im Handbuch des Herstellers Sinn ergeben.

Für softify.pro beginnt ein solches Vorhaben deshalb mit der Frage, welche Abläufe erhalten bleiben sollen. Nicht jeder Zettel ist ein Fehler, und nicht jede Sonderregel ist sinnvoll. Erst wenn klar ist, wo Informationen verloren gehen oder Entscheidungen unnötig warten, lässt sich eine tragfähige Lösung planen.

Ein Rollout ohne Betriebsunterbrechung

Das größte Risiko liegt selten im Programmcode allein. Es liegt in einer Einführung, die zu viel auf einmal verändern will. Ein Lager kann nicht zwei Wochen pausieren, um ein neues System zu lernen. Deshalb ist ein schrittweiser Rollout meist vernünftiger als ein großer Umstellungstermin.

Ein guter erster Abschnitt konzentriert sich auf einen abgrenzbaren Ablauf, zum Beispiel Wareneingang und Bestandsbuchungen oder die Erstellung von Lieferscheinen. Das Team arbeitet mit echten Daten, Rückmeldungen fließen direkt in die Anpassung ein, und der Nutzen wird messbar. Erst danach folgen weitere Bereiche wie mobile Kommissionierung, Retouren oder Anbindungen an Shops und Versanddienstleister.

Datenübernahme verdient dabei besondere Aufmerksamkeit. Alte Artikelnummern, doppelte Kundenstammdaten und uneinheitliche Lagerorte verschwinden nicht automatisch, nur weil ein neues System eingeführt wird. Häufig ist es besser, Stammdaten bewusst zu bereinigen und nur relevante Historien zu übernehmen. Das spart spätere Suche und verhindert, dass alte Unordnung technisch konserviert wird.

Auch Berechtigungen gehören früh auf die Agenda. Nicht jeder Mitarbeiter benötigt Zugriff auf Preise, alle Bestandskorrekturen oder die Stammdatenpflege. Klare Rollen schützen vor versehentlichen Änderungen und machen Verantwortlichkeiten sichtbar, ohne den Arbeitsfluss mit unnötigen Freigaben zu blockieren.

Technik, die nach dem Go-live nicht zur Last wird

Eine Logistikanwendung muss im Alltag schnell reagieren, auch wenn mehrere Arbeitsplätze gleichzeitig buchen. Dafür braucht sie eine nachvollziehbare Datenarchitektur, saubere Transaktionen und klare Regeln für parallele Änderungen. Wenn zwei Personen denselben Bestand bearbeiten, darf das System keine stillen Fehlbuchungen erzeugen.

Ebenso wichtig ist die Wartbarkeit. Technologien wie PHP 8.4, modernes JavaScript und MySQL 8 sind kein Verkaufsargument für sich. Sie sind dann sinnvoll, wenn die Anwendung damit langfristig verständlich bleibt, Sicherheitsupdates erhält und von qualifizierten Entwicklern weitergeführt werden kann. Dokumentierte Bereitstellung, Backups, Protokollierung und ein realistischer Umgang mit Updates gehören zur Betriebsfähigkeit dazu.

Eine gute Logistiksoftware erkennt man daher nicht an einer besonders glatten Demo. Sie zeigt sich an einem normalen Dienstagmorgen: Die Lieferung wird gebucht, der Bestand stimmt, der Auftrag ist auffindbar, der Lieferschein passt und die nächste Schicht weiß, was bereits erledigt wurde. Genau dort entsteht Entlastung - nicht durch möglichst viele Funktionen, sondern durch verlässliche Abläufe, die zum Betrieb passen.

Permalink →

MySQL-Datenbank für Webanwendungen planen

MySQL-Datenbank für Webanwendungen planen

Wenn morgens drei Mitarbeitende parallel Waren buchen, ein Kunde den Lieferstatus prüft und das Backoffice eine Rechnung erstellt, zeigt sich die Qualität einer Anwendung nicht im Design. Sie zeigt sich daran, ob alle denselben, korrekten Datenstand sehen. Eine MySQL-Datenbank für eine Webanwendung planen heißt deshalb nicht, Tabellen möglichst schnell anzulegen. Es heißt, reale Abläufe so präzise zu verstehen, dass die Daten auch unter Last, bei Fehlern und mit wachsendem Geschäft verlässlich bleiben.

Gerade bei internen Plattformen, Lager- und Auftragsprozessen oder kundenbezogenen Portalen wird die Datenbank oft zu spät behandelt. Erst entsteht die Oberfläche, dann kommen Felder hinzu, danach Ausnahmen. Das funktioniert für einen Prototypen. Im Betrieb entstehen daraus doppelte Datensätze, unklare Zustände und Auswertungen, denen niemand mehr vollständig vertraut.

MySQL-Datenbank für Webanwendungen planen: beim Ablauf beginnen

Der erste Entwurf sollte nicht mit Spaltennamen beginnen, sondern mit einer konkreten Arbeitssituation. Nehmen wir einen Wareneingang: Eine Lieferung trifft ein, wird einem Lieferanten und einer Bestellung zugeordnet, Mengen werden geprüft, ein Lagerplatz wird vergeben und Bestände ändern sich. Je nach Betrieb braucht dieser Vorgang zusätzlich Fotos, eine Qualitätsprüfung, eine Sperrung oder eine nachvollziehbare Korrektur.

Aus diesem Ablauf ergeben sich die fachlichen Objekte. Typische Beispiele sind Artikel, Lieferanten, Bestellungen, Positionen, Lagerplätze, Bestandsbewegungen und Benutzer. Entscheidend ist die Trennung zwischen einem Objekt und einem Ereignis. Ein Artikel beschreibt, was etwas ist. Eine Bestandsbewegung dokumentiert, dass sich zu einem bestimmten Zeitpunkt an einem Ort eine Menge verändert hat. Wer beides in einer einzelnen Tabelle vermischt, verliert schnell die Nachvollziehbarkeit.

Für jedes Objekt helfen wenige harte Fragen: Was ist die eindeutige Identität? Welche Informationen dürfen sich ändern? Wer darf sie ändern? Welche Daten müssen historisch erhalten bleiben? Und welche Regeln gelten, wenn zwei Personen gleichzeitig arbeiten? Diese Fragen verhindern spätere Improvisation besser als eine lange Liste vermeintlich vollständiger Datenbankfelder.

Das Datenmodell soll Regeln ausdrücken

Eine Datenbank ist nicht nur Speicher für Formulareingaben. Sie sollte zentrale Regeln selbst absichern. Wenn jede Bestandsbewegung genau zu einem Artikel und einem Lagerplatz gehören muss, gehören Fremdschlüssel in das Modell. Wenn eine externe Auftragsnummer pro Mandant nur einmal vorkommen darf, braucht es einen eindeutigen Index. Wenn eine Position nie ohne Kopfauftrag existieren soll, muss diese Beziehung klar modelliert sein.

MySQL 8 mit InnoDB bietet dafür belastbare Grundlagen: Transaktionen, Fremdschlüssel, Sperrmechanismen und konsistente Änderungen über mehrere Tabellen hinweg. Werden beim Buchen eines Wareneingangs Bewegung, aktueller Bestand und Prüfprotokoll geschrieben, sollte das als zusammenhängende Transaktion passieren. Scheitert ein Schritt, darf kein halbfertiger Vorgang zurückbleiben.

Nicht jede Regel gehört allerdings in die Datenbank. Freigaben, komplexe Preislogik oder rollenabhängige Prozessschritte liegen häufig besser in der Anwendungslogik, weil sie sich fachlich schneller ändern. Die Grenze ist pragmatisch: Regeln, deren Verletzung Daten dauerhaft beschädigt, sollten möglichst nah an den Daten abgesichert werden. Regeln, die sich häufig ändern oder stark vom Kontext abhängen, brauchen gut getesteten Anwendungscode.

Historie nicht mit aktuellen Werten verwechseln

Ein häufiger Fehler ist, nur den aktuellen Bestand oder den aktuellen Status zu speichern. Das reicht, bis jemand fragt, warum sich die Menge gestern verändert hat oder wer einen Auftrag zurückgesetzt hat. Für operative Systeme ist eine Bewegungs- oder Ereignishistorie oft wertvoller als ein einzelnes überschreibbares Feld.

Das bedeutet nicht, jede Klickbewegung dauerhaft zu protokollieren. Protokolliert werden sollten geschäftlich relevante Änderungen: Statuswechsel, Mengenänderungen, Korrekturen, Freigaben und Zuordnungen. Ein guter Audit-Eintrag enthält Zeitpunkt, Benutzer oder Systemprozess, vorherigen und neuen Wert sowie einen verständlichen Grund, wenn der Ablauf ihn verlangt. So lassen sich Fehler klären, ohne in E-Mails, Papierlisten oder Datenbank-Backups suchen zu müssen.

Schlüssel, Datentypen und Namensregeln bewusst wählen

Technische Entscheidungen wirken klein, prägen aber Wartung und Integrationen über Jahre. Für interne Primärschlüssel sind häufig BIGINT-Werte mit automatischer Vergabe eine nüchterne, gut handhabbare Wahl. UUIDs können sinnvoll sein, wenn Daten offline entstehen, mehrere Systeme unabhängig schreiben oder externe Schnittstellen keine fortlaufenden IDs offenlegen sollen. Sie kosten jedoch mehr Speicher und verlangen bei Indizes und Sortierung etwas mehr Aufmerksamkeit.

Geldbeträge gehören als DECIMAL gespeichert, nicht als FLOAT oder DOUBLE. Mengen brauchen ebenfalls eine fachlich passende Genauigkeit: Stückzahlen sind oft ganzzahlig, Gewichte und Längen nicht. Zeitstempel sollten einheitlich behandelt werden, idealerweise intern in UTC, während die Oberfläche die lokale Zeitzone des Betriebs darstellt. Besonders bei Schichtwechseln und Sommerzeit verhindert das schwer auffindbare Differenzen.

Auch Namen sollten langweilig und eindeutig sein. order_items oder bestandsbewegungen sind hilfreicher als kreative Abkürzungen, die nur das ursprüngliche Projektteam versteht. Einheitliche Singular- oder Pluralformen sind weniger wichtig als Konsequenz. Ebenso sinnvoll sind Felder wie created_at, updated_at und bei Bedarf deleted_at. Ein Soft Delete ist aber kein Standardzwang. Bei rechtlich oder operativ relevanten Belegen ist eine saubere Stornierung meist besser als ein unsichtbar gelöschter Datensatz.

Indizes folgen echten Abfragen, nicht Vermutungen

Ein Index kann eine Suche massiv beschleunigen, macht Schreibvorgänge aber aufwendiger und benötigt Speicher. Deshalb ist „auf jedes Feld einen Index“ keine Strategie. Die wichtigsten Abfragen sollten früh feststehen: offene Aufträge eines Kunden, Bewegungen eines Artikels in einem Zeitraum, Bestand je Lagerplatz oder zuletzt geänderte Datensätze für eine Schnittstelle.

Dabei zählt die Reihenfolge zusammengesetzter Indizes. Sucht die Anwendung regelmäßig nach tenant_id, status und created_at, ist ein zusammengesetzter Index in dieser Reihenfolge oft sinnvoll. Ob er tatsächlich passt, zeigt der Ausführungsplan mit EXPLAIN, nicht das Bauchgefühl. Datenbanken werden nicht durch spektakuläre Tricks schnell, sondern durch beobachtbare Abfragen, passende Indizes und eine Datenmenge, die realistisch getestet wurde.

Für wachsende Tabellen lohnt eine klare Aufbewahrungsstrategie. Müssen technische Logs fünf Jahre in der produktiven Hauptdatenbank liegen? Nicht unbedingt. Geschäftliche Belege, Bewegungen und Prüfnachweise brauchen andere Fristen als Debug-Informationen. Archivierung ist kein Zeichen eines schwachen Systems, sondern eine bewusste Betriebsentscheidung.

Mehrbenutzerbetrieb braucht Transaktionen und klare Zustände

In einer Webanwendung greifen mehrere Anfragen gleichzeitig auf dieselben Daten zu. Das ist im Lageralltag normal, nicht der Ausnahmefall. Zwei Mitarbeitende können denselben Bestand buchen, während ein Import neue Aufträge anlegt. Ohne Transaktionen und gezielte Sperrung besteht das Risiko verlorener Änderungen oder negativer Bestände, die erst Wochen später auffallen.

Für kritische Vorgänge sollte klar sein, welche Daten innerhalb einer Transaktion gelesen und geschrieben werden. Manchmal genügt eine atomare Aktualisierung, etwa ein Bestand, der nur verändert wird, wenn die verfügbare Menge ausreichend ist. In anderen Fällen ist eine Zeilensperre sinnvoll, damit ein Vorgang den Datenstand kontrolliert prüfen und danach ändern kann. Lange Transaktionen sind hingegen problematisch: Sie blockieren andere Arbeit und erhöhen das Risiko von Konflikten.

Ebenso wichtig ist ein begrenzter Satz fachlicher Zustände. Ein Auftrag sollte nicht gleichzeitig „offen“, „teilgeliefert“ und „manuell bearbeitet“ sein, weil verschiedene Felder widersprüchlich gepflegt werden. Definierte Statusübergänge machen Oberfläche, Berichte und Automatisierungen einfacher. Ausnahmen dürfen möglich sein, sollten aber benannt und dokumentiert sein.

Sicherheit, Mandanten und Betrieb von Anfang an einplanen

Die Anwendung sollte für MySQL einen eigenen Datenbankbenutzer mit minimalen Rechten verwenden. Ein Schreibzugriff für die Webanwendung bedeutet nicht, dass dieser Benutzer Tabellen löschen oder Benutzerrechte ändern muss. Administrative Konten gehören nicht in Konfigurationsdateien des Produktivsystems und niemals in ein Repository.

Wenn mehrere Kunden, Standorte oder Gesellschaften in einer Anwendung arbeiten, ist die Mandantentrennung eine Architekturentscheidung, keine nachträgliche Filterbedingung. Eine gemeinsame Datenbank mit tenant_id kann effizient und gut wartbar sein, verlangt aber konsequente Prüfungen in jeder Abfrage und eindeutige Regeln für Indizes. Getrennte Datenbanken bieten stärkere Isolation, erhöhen jedoch Aufwand bei Updates, Auswertungen und Betrieb. Welche Variante passt, hängt von Datenschutzanforderungen, Datenvolumen und Geschäftsmodell ab.

Backups sind erst dann Backups, wenn eine Wiederherstellung getestet wurde. Benötigt wird ein definierter Rhythmus für Sicherungen, Aufbewahrung und Wiederanlauf. Ebenso gehören Monitoring für Speicherplatz, langsame Abfragen und fehlgeschlagene Jobs sowie dokumentierte Updates zum System. MySQL 8, PHP 8.4 und moderne Webanwendungen lassen sich langfristig gut betreiben, wenn Abhängigkeiten, Zugangsdaten und Deployment-Schritte nicht nur im Kopf eines Entwicklers existieren.

Ein sinnvoller Plan vor dem ersten Produktivtag

Vor der Umsetzung sollte ein kompaktes Datenmodell mit Beispielvorgängen vorliegen. Dazu gehören wichtigste Tabellen und Beziehungen, Statusregeln, Berechtigungen, erwartete Abfragen, Schnittstellen sowie ein Konzept für Backups und Änderungsprotokolle. Dieser Plan muss nicht hundert Seiten lang sein. Er muss die Entscheidungen festhalten, die später teuer zu korrigieren wären.

Bei softify.pro beginnt Datenbankplanung deshalb mit den Menschen, die buchen, prüfen, kommissionieren oder Ausnahmen klären. Wenn ein bestehendes Spreadsheet einen überschaubaren Prozess zuverlässig abbildet, kann es die richtige Lösung bleiben. Wenn mehrere Personen zeitgleich arbeiten, Belege entstehen und Fehler nachvollziehbar sein müssen, verdient die Datenbank dagegen denselben Planungsaufwand wie die Oberfläche. Die beste Architektur ist am Ende jene, die den Arbeitstag vereinfacht und auch in zwei Jahren noch verständlich geändert werden kann.

Permalink →

Warehouse Automation Results richtig messen

Warehouse Automation Results richtig messen

Eine neue Scanmaske kann am ersten Tag beeindruckend wirken. Nach drei Wochen zeigt sich jedoch, ob sie den Wareneingang wirklich beschleunigt oder lediglich einen weiteren Arbeitsschritt erzeugt. Warehouse automation results sind deshalb keine einzelne Kennzahl und auch kein Screenshot aus einer Produktdemo. Sie zeigen sich dort, wo ein Lagerteam weniger suchen, nachfragen, nachbuchen und korrigieren muss - bei gleichbleibender oder besserer Qualität.

Für kleine und mittlere Unternehmen ist diese Unterscheidung besonders relevant. Große Enterprise-Suiten versprechen oft umfassende Optimierung, verlangen aber lange Einführungen, starre Prozesse und viel Pflege. Ein sinnvoller Automatisierungsschritt darf kleiner beginnen: genau an dem Punkt, an dem Informationen heute verloren gehen oder Entscheidungen unnötig warten.

Welche Warehouse Automation Results tatsächlich zählen

Viele Projekte starten mit einer technischen Frage: Barcode-Scanner, mobile App, Schnittstelle zum Shop oder automatische Etiketten? Die bessere Ausgangsfrage lautet: Welcher Engpass kostet pro Schicht spürbar Zeit, Geld oder Verlässlichkeit?

Die Antwort liegt selten bei der Anzahl eingesetzter Geräte. Aussagekräftige Ergebnisse lassen sich an der täglichen Arbeit messen. Im Wareneingang zählt etwa die Zeit zwischen Anlieferung und verfügbar gebuchtem Bestand. In der Kommissionierung ist die Zeit vom Auftrag bis zur Versandbereitschaft relevant. Bei Inventuren ist nicht nur die Dauer entscheidend, sondern vor allem die Differenz zwischen Systembestand und tatsächlichem Bestand.

Ebenso wichtig sind Kennzahlen, die in vielen Betrieben nicht sauber erfasst werden: Wie viele Rückfragen entstehen, weil ein Lagerplatz unklar ist? Wie oft muss ein Lieferschein korrigiert werden? Wie viele Aufträge bleiben liegen, weil eine Person den Status nur im Kopf oder in einer privaten Excel-Datei kennt? Gerade diese stille Nacharbeit verschwindet aus klassischen Produktivitätsberichten, belastet aber Schichtleiter, Disposition und Kundenservice.

Ein gutes Zielbild verbindet Tempo und Kontrolle. Werden Aufträge schneller abgewickelt, während Fehlbuchungen steigen, ist das kein Fortschritt. Werden Bestände genauer, aber der Wareneingang staut sich, muss der Prozess anders gestaltet werden. Automatisierung ist dann gelungen, wenn sie den Arbeitsfluss verbessert, ohne die operative Übersicht zu verschlechtern.

Von gefühlter Entlastung zu belegbaren Daten

Die Erfahrung der Mitarbeitenden ist ein wertvoller Indikator. Wenn jemand nach zwei Wochen sagt, dass er nicht mehr für jede Einlagerung ins Büro laufen muss, ist das relevant. Für Investitionsentscheidungen braucht es trotzdem einen Vergleich, der nicht vom Tagesgefühl abhängt.

Vor dem Start sollten deshalb einige Ausgangswerte festgehalten werden: durchschnittliche Bearbeitungszeit, Anzahl offener Klärfälle, Korrekturbuchungen, Suchzeiten, Versandfehler und Bestandstreue. Es müssen nicht zwanzig Kennzahlen sein. Vier bis sechs Werte, die zum konkreten Problem passen, reichen oft aus.

Nach dem Rollout sollten dieselben Werte über mehrere Wochen beobachtet werden. Einzelne Spitzentage führen leicht in die Irre. Saison, Krankheit, neue Mitarbeitende oder ein ungewöhnlich großer Auftrag beeinflussen Ergebnisse. Erst ein Vergleich über normale Schichten zeigt, ob die Veränderung belastbar ist.

Der wichtigste Effekt: Ein gemeinsamer Prozessstand

In vielen Lagern ist die eigentliche Schwachstelle nicht fehlende Arbeitsbereitschaft, sondern ein zersplitterter Informationsstand. Der Wareneingang kennt die Lieferung, die Disposition kennt den Kundenauftrag und der Versand kennt die Priorität - aber nicht alle arbeiten mit derselben aktuellen Information.

Ein workflow-spezifisches System kann diesen Bruch schließen. Eine Lieferung wird beim Eintreffen erfasst, Abweichungen werden direkt dokumentiert, der Bestand erhält einen klaren Status und der nächste Schritt wird sichtbar. Die Daten müssen nicht erst auf Papier notiert, später übertragen und anschließend telefonisch bestätigt werden.

Das reduziert nicht nur Laufwege. Es reduziert Entscheidungen auf Basis veralteter Informationen. Ein Versandmitarbeiter sieht, ob ein Auftrag wirklich kommissionierbar ist. Die Verwaltung erkennt, ob Waren eingegangen oder lediglich angekündigt sind. Die Geschäftsführung erhält keine geschönte Momentaufnahme, sondern eine nachvollziehbare Grundlage.

Für Teams mit wechselnden Schichten ist dieser Effekt häufig wertvoller als eine spektakuläre Zeitersparnis. Der Prozess wird weniger abhängig von einzelnen Personen. Wissen bleibt nicht in Notizbüchern, Chatverläufen oder dem Gedächtnis der erfahrensten Fachkraft hängen.

Warum nicht jede Automatisierung gute Ergebnisse liefert

Automatisierung verstärkt Prozesse. Das ist nützlich, wenn der Ablauf klar ist. Es ist problematisch, wenn ein unklarer Ablauf nur schneller reproduziert wird.

Ein typisches Beispiel ist die verpflichtende Scan-Buchung für jeden kleinsten Handgriff. Wenn Mitarbeitende für eine seltene Ausnahme mehrere Masken öffnen müssen, entstehen Umgehungslösungen. Dann werden Artikel später gesammelt gebucht, Scanner liegen in der Schublade oder ein Mitarbeiter führt wieder eine Schattenliste. Die Software ist vorhanden, der reale Prozess läuft daneben weiter.

Auch die Datenqualität setzt Grenzen. Artikelstammdaten ohne eindeutige Einheiten, unklare Lagerplatzlogik oder uneinheitliche Lieferantenbezeichnungen lassen sich nicht durch eine schicke Oberfläche heilen. Hier kann ein Projekt zunächst aus Aufräumarbeit bestehen. Das wirkt weniger sichtbar als eine neue Anwendung, ist aber oft die Voraussetzung für verlässliche Resultate.

Es gibt außerdem Prozesse, die bewusst nicht vollautomatisiert werden sollten. Eine erfahrene Prüfung bei empfindlichen Waren, eine Freigabe bei ungewöhnlichen Abweichungen oder die Entscheidung über eine Sonderlieferung brauchen fachliches Urteil. Gute Systeme kennzeichnen solche Fälle klar und leiten sie gezielt weiter. Sie tun nicht so, als ließe sich jede Ausnahme mit einer Regel erschlagen.

Wann eine Tabelle weiterhin die bessere Lösung ist

Nicht jeder manuelle Schritt rechtfertigt eine Individualentwicklung. Wenn ein Prozess selten stattfindet, wenige Beteiligte hat und nachvollziehbar geführt wird, kann eine gut gepflegte Tabelle sinnvoll bleiben. Der Fehler liegt nicht in Excel selbst, sondern darin, kritische Bewegungen ohne klare Verantwortlichkeit, Versionskontrolle oder zeitnahe Buchung zu verwalten.

Sobald mehrere Personen parallel ändern, Lagerbewegungen zeitkritisch werden oder Kundeninformationen aus verschiedenen Quellen zusammengeführt werden müssen, steigt das Risiko deutlich. Dann ist ein gemeinsames System meist günstiger als die fortlaufende Korrektur von Missverständnissen.

Warehouse Automation Results brauchen einen kontrollierten Rollout

Der schnellste Weg zu schlechten Ergebnissen ist ein Komplettumbau während des laufenden Betriebs. Besser ist ein abgegrenzter Bereich mit messbarem Nutzen: zum Beispiel Wareneingang für eine Produktgruppe, Versandetiketten für einen Standort oder eine mobile Buchung für die häufigsten Umlagerungen.

Ein Pilot sollte echte Aufträge und echte Schichten abbilden. Testdaten helfen bei der Entwicklung, zeigen aber nicht, ob WLAN im hinteren Lagerbereich schwankt, ob Handschuhe die Scannerbedienung erschweren oder ob ein Status für die Disposition missverständlich formuliert ist. Diese Details entscheiden über Akzeptanz und Datenqualität.

Technisch zählt dabei langweilige, beweisbare Zuverlässigkeit mehr als ein modischer Stack. Klare Rollenrechte, nachvollziehbare Buchungsprotokolle, eindeutige Fehlerhinweise, stabile Datenbanktransaktionen und dokumentierte Abläufe sind keine Nebensachen. Sie machen aus einer Anwendung ein Werkzeug, dem Teams im Tagesgeschäft vertrauen können.

Für individuelle Logistiksysteme bedeutet das auch: Die Integration muss zum vorhandenen Betrieb passen. Eine Anwendung kann Aufträge aus einem Shop übernehmen, Lieferscheine erzeugen, Versandlabels bereitstellen und Bestandsbewegungen dokumentieren. Sie muss dafür nicht sofort alle angrenzenden Systeme ersetzen. Gerade im Mittelstand ist eine schrittweise Ablösung oft risikoärmer und wirtschaftlicher.

So wird aus einem Projekt eine dauerhafte Verbesserung

Nach der Einführung beginnt die entscheidende Phase. Werden Sonderfälle erfasst? Passen die Lagerplätze noch zur Realität? Verstehen neue Mitarbeitende die Buchungslogik ohne mündliche Übersetzung? Und stimmen die gemessenen Werte noch, wenn das Auftragsvolumen wächst?

Regelmäßige kurze Rückmeldungen aus Lager, Versand und Verwaltung sind dafür wirksamer als ein jährlicher Großworkshop. Wenn eine wiederkehrende Ausnahme sichtbar wird, sollte sie entweder als klarer Prozessschritt abgebildet oder bewusst aus dem Standardfluss herausgenommen werden. Beides ist besser, als sie stillschweigend zu tolerieren.

Der sinnvollste nächste Schritt ist oft kein großes Lastenheft. Nehmen Sie einen Prozess mit häufigen Rückfragen und messen Sie eine Woche lang, wo Zeit verloren geht. Wenn daraus ein klarer, wiederholbarer Ablauf entsteht, lässt sich Automatisierung mit einem Ergebnis verbinden, das auf dem Lagerboden genauso überzeugt wie in der Monatsauswertung.

Permalink →

Moderne Webentwicklung, die im Betrieb funktioniert

Moderne Webentwicklung, die im Betrieb funktioniert

Ein Lagerleiter druckt morgens Lieferscheine aus, während eine Kollegin Bestände in einer Tabellenkalkulation korrigiert und der Vertrieb telefonisch nach dem Status eines Auftrags fragt. Das Problem ist selten fehlende Digitalisierung. Meist gibt es zu viele voneinander getrennte Werkzeuge. Moderne Webentwicklung schafft dann nicht einfach eine schönere Oberfläche, sondern eine verlässliche gemeinsame Arbeitsgrundlage.

Für kleine und mittlere Unternehmen bedeutet das: Eine Webanwendung muss unter Zeitdruck funktionieren, auf dem Scanner im Lager ebenso wie am Bildschirm im Büro. Sie muss Daten nachvollziehbar speichern, Berechtigungen sauber regeln und sich weiterentwickeln lassen, ohne bei jeder Änderung zum Risiko zu werden. Technologie ist dabei kein Selbstzweck. Sie ist die Grundlage dafür, dass Prozesse schneller laufen und gleichzeitig besser kontrollierbar bleiben.

Moderne Webentwicklung beginnt vor dem ersten Code

Wer mit einem vorgefertigten Funktionskatalog startet, baut oft am tatsächlichen Engpass vorbei. In der Praxis lohnt sich ein anderer Einstieg: Welche Information fehlt heute regelmäßig? Wo entstehen doppelte Eingaben? An welcher Stelle werden Entscheidungen telefonisch oder über Zuruf abgesichert, weil niemand den aktuellen Status zuverlässig sieht?

Bei einem Wareneingang können das beispielsweise uneinheitliche Artikelbezeichnungen, fehlende Prüfhinweise oder verspätet aktualisierte Bestände sein. Bei der Auftragsabwicklung sind es oft handschriftliche Notizen, unklare Freigaben und Versanddaten, die in mehreren Systemen gepflegt werden. Eine gute Anwendung macht diese Übergaben nicht nur digital. Sie ordnet sie so, dass Zuständigkeiten, Status und nächste Schritte sichtbar sind.

Das bedeutet auch, Bestehendes nicht reflexhaft abzuschaffen. Eine gut gepflegte Tabelle kann für eine kleine Auswertung weiterhin die sinnvollste Lösung sein. Eine individuelle Webanwendung lohnt sich dort, wo mehrere Personen gleichzeitig arbeiten, Fehler durch manuelle Übertragung entstehen oder ein Prozess dokumentiert und wiederholbar sein muss.

Was eine moderne Webanwendung im Alltag leisten muss

Eine überzeugende Oberfläche ist wertvoll, aber sie ist nur ein Teil der Arbeit. Im laufenden Betrieb zählen vor allem Antwortzeiten, verständliche Abläufe und belastbare Daten. Wenn ein Kommissionierer einen Vorgang abschließt, darf der Status nicht erst nach mehreren Aktualisierungen sichtbar werden. Wenn ein Auftrag geändert wird, muss nachvollziehbar sein, was geändert wurde und welche Folgeschritte betroffen sind.

Dazu gehören drei eng verbundene Ebenen: die Benutzeroberfläche, die Anwendungslogik und die Datenbank. Die Oberfläche führt Menschen durch den Vorgang. Die Logik prüft etwa Pflichtfelder, Berechtigungen oder verfügbare Mengen. Die Datenbank speichert die Fakten so, dass Auswertungen, Korrekturen und Erweiterungen später möglich bleiben.

Für viele Geschäftsanwendungen sind bewährte Technologien die vernünftigere Wahl als ein kurzlebiger Trend. PHP 8.4 kann eine klar strukturierte Serverlogik liefern, modernes JavaScript eine reaktionsfähige Bedienung und MySQL 8 eine solide Datenbasis. Entscheidend ist nicht, dass jedes Projekt denselben Stack nutzt. Entscheidend ist, dass die gewählte Technik zum Problem, zum Betrieb und zur langfristigen Betreuung passt.

Performance ist eine Prozessfrage

Performance wird häufig auf Ladezeiten reduziert. Das greift zu kurz. Eine Anwendung fühlt sich auch dann langsam an, wenn Mitarbeitende zu viele Schritte ausführen, nach Informationen suchen oder dieselbe Angabe mehrfach erfassen müssen. Eine schnelle Seite mit einem umständlichen Formular bleibt ein schlechter Prozess.

Sinnvolle Optimierung beginnt deshalb bei den häufigsten Vorgängen. Welche Masken werden hundertmal am Tag geöffnet? Welche Suche muss auch bei wachsendem Datenbestand schnell bleiben? Welche Daten sollen im Hintergrund gespeichert werden, ohne dass Mitarbeitende auf eine Bestätigung warten? Erst danach folgen technische Details wie gezielte Datenbankindizes, reduzierte Abfragen und eine schlanke Auslieferung von Dateien im Browser.

Datenmodell und Rechte: Die unsichtbare Architektur

Viele Webprojekte scheitern nicht an der ersten Version, sondern an späteren Ergänzungen. Ein zunächst einfaches Feld wie „Status“ wird plötzlich zu einer Kette aus Freigabe, Prüfung, Versand, Storno und Nachbearbeitung. Wenn diese Zustände nur lose in Formularen abgelegt werden, wird jede Erweiterung teuer und fehleranfällig.

Ein sauberes Datenmodell trennt deshalb Vorgänge, Positionen, Ansprechpartner, Dokumente und Statusänderungen nachvollziehbar. Es verhindert widersprüchliche Einträge, statt sie später mühsam zu bereinigen. Gerade bei Lagerbewegungen, Lieferscheinen oder Auftragsdaten ist diese Genauigkeit keine akademische Übung. Sie entscheidet darüber, ob die Bestandszahl als Arbeitsgrundlage taugt.

Ebenso wichtig sind Rollen und Rechte. Nicht jede Person braucht Zugriff auf Preise, Personalinformationen oder administrative Einstellungen. Gute Rechtekonzepte sind konkret: Wer darf einen Auftrag anlegen, wer freigeben, wer stornieren? Wer sieht nur den eigenen Bereich? Hinzu kommen Schutzmaßnahmen wie sichere Passwortspeicherung, Account-Sperren nach wiederholten Fehlversuchen, Protokollierung kritischer Änderungen und klar geregelte Sitzungen.

Sicherheit ist damit kein Zusatz kurz vor dem Go-live. Sie gehört in die Architektur, weil spätere Korrekturen oft tief in Anmeldung, Datenzugriff und Berechtigungssystem eingreifen.

Responsive heißt nicht nur „passt aufs Handy“

Eine responsive Anwendung passt sich verschiedenen Bildschirmgrößen an. Für den Arbeitsalltag reicht diese Definition nicht. Auf einem Tablet im Lager gelten andere Anforderungen als am großen Bildschirm in der Disposition. Touch-Flächen müssen sicher bedienbar sein, wichtige Angaben dürfen nicht unter Nebeninformationen verschwinden, und Eingaben müssen auch mit Handschuhen, wechselnden Lichtverhältnissen oder instabiler Verbindung praktikabel bleiben.

Deshalb braucht jede Ansicht eine klare Priorität. Im Wareneingang kann das Scannen und Bestätigen im Mittelpunkt stehen. Im Büro sind Filter, Listen, Exportfunktionen und Detailansichten oft wichtiger. Eine Oberfläche, die überall gleich aussieht, ist nicht automatisch überall gut nutzbar.

Moderne Webentwicklung braucht einen kontrollierten Betrieb

Der Go-live ist kein Endpunkt, sondern der Beginn des echten Tests. Erst mit realen Daten, Ausnahmen und Stoßzeiten zeigt sich, ob Regeln verständlich sind und ob Schnittstellen zuverlässig arbeiten. Dokumentierte Bereitstellung, klar getrennte Umgebungen für Entwicklung und Produktivbetrieb sowie nachvollziehbare Sicherungen sind deshalb Teil des Projekts, nicht bloße IT-Verwaltung.

Auch automatisierte Tests leisten hier viel. Sie prüfen wiederkehrende Abläufe wie Anmeldung, Rechteprüfung, Auftragserfassung oder Dokumentenerstellung nach jeder Änderung erneut. Für sensible Anwendungen kann eine selbst betriebene Testumgebung sinnvoll sein, weil Screenshots, Testdaten und interne Anwendungsschritte im eigenen Kontrollbereich bleiben. Automatisierung ersetzt keine fachliche Prüfung durch erfahrene Mitarbeitende. Sie sorgt aber dafür, dass bekannte Abläufe nicht still und leise beschädigt werden.

Bei softify.pro gehört diese Denkweise zur Umsetzung: technisch präzise planen, reale Arbeitsabläufe ernst nehmen und Änderungen so liefern, dass sie später verständlich bleiben. Das ist weniger spektakulär als ein Technologiefeuerwerk, im Betrieb aber deutlich wertvoller.

Wann Standardsoftware reicht - und wann nicht

Standardsoftware ist sinnvoll, wenn der eigene Prozess weitgehend dem üblichen Branchenablauf entspricht und die Konfiguration überschaubar bleibt. Sie kann schnell verfügbar sein und verlässliche Grundfunktionen mitbringen. Problematisch wird sie, wenn Teams ihre funktionierenden Abläufe dauerhaft umständlich verbiegen müssen oder wichtige Informationen außerhalb des Systems landen.

Eine individuelle Lösung ist nicht automatisch besser. Sie braucht klare Anforderungen, verantwortliche Ansprechpartner und die Bereitschaft, Entscheidungen zu treffen. Dafür kann sie genau die Arbeitsschritte abbilden, die für das Unternehmen entscheidend sind: eine spezielle Wareneingangsprüfung, den Druck passender Versandlabels, eine Freigabe nach Kundengruppe oder die Verbindung von Werkstatt, Lager und Vertrieb.

Die richtige Frage lautet daher nicht: Brauchen wir eine maßgeschneiderte Anwendung? Sie lautet: Welche wiederkehrende Reibung kostet uns heute Zeit, Geld oder Verlässlichkeit - und lässt sie sich mit vertretbarem Aufwand dauerhaft beseitigen?

Eine gute Webanwendung macht Arbeit nicht künstlich digital. Sie nimmt unnötige Übergaben heraus, schafft einen verlässlichen Datenstand und gibt Menschen genau die Informationen, die sie für ihren nächsten Schritt brauchen. Wenn das gelingt, wirkt moderne Webentwicklung nicht wie ein neues IT-Projekt, sondern wie ein Betrieb, der endlich ohne Umwege arbeiten kann.

Permalink →

Wie man die Digitalisierung von Lieferscheinen richtig umsetzt

Wie man die Digitalisierung von Lieferscheinen richtig umsetzt

Ein Fahrer wartet nicht, weil eine Excel-Datei gerade von jemand anderem geöffnet ist. Und im Wareneingang hilft kein sauberer Papierstapel, wenn eine Teillieferung später nicht mehr nachvollziehbar ist. Wer nach „how to digitize delivery notes“ sucht, will deshalb selten nur Papier scannen. Gesucht ist ein belastbarer Ablauf, der Warenbewegungen, Bestätigungen und Abweichungen dort erfasst, wo sie entstehen.

Digitale Lieferscheine funktionieren dann gut, wenn sie die Arbeit im Lager, in der Werkstatt und beim Kunden vereinfachen. Werden sie lediglich als PDF-Ablage umgesetzt, bleibt der Aufwand bestehen - nur eben auf einem Bildschirm. Der entscheidende Unterschied liegt in strukturierten Daten, klaren Zuständigkeiten und einer sauberen Verbindung zu Auftrag, Bestand und Rechnung.

Wie man die Digitalisierung von Lieferscheinen richtig umsetzt: Erst den Ablauf prüfen

Der erste Schritt ist keine Softwareauswahl, sondern eine ehrliche Bestandsaufnahme. Nehmen Sie einen realen Lieferschein und verfolgen Sie seinen Weg: vom Auftrag über die Kommissionierung bis zur Übergabe, Rückmeldung und Archivierung. Dabei zeigt sich meist schnell, an welchen Stellen Informationen nachgetragen, doppelt erfasst oder über Telefon und Chat geklärt werden.

In kleinen und mittleren Betrieben gibt es selten nur einen Ablauf. Eine Standardlieferung an Stammkunden braucht etwas anderes als eine Baustellenlieferung, eine Abholung oder eine Lieferung mit Rücknahme von Leergut. Diese Unterschiede müssen nicht alle in Version eins automatisiert werden. Sie sollten aber bekannt sein, damit das neue System nicht am ersten Sonderfall scheitert.

Ein guter digitaler Prozess beantwortet für jeden Status eindeutig drei Fragen: Wer hat die Ware wann bewegt? Welche Mengen wurden tatsächlich übergeben? Und was ist bei Abweichungen passiert? Fehlen diese Informationen, ist ein digitaler Lieferschein vor allem ein schöneres Dokument.

Papier nicht einfach als PDF reproduzieren

Das Scannen bestehender Lieferscheine kann als Übergang sinnvoll sein, etwa für die Archivierung alter Vorgänge. Für das operative Geschäft löst es jedoch wenig. Ein Bild oder PDF lässt sich zwar ablegen, aber Mengen, Artikelnummern, Chargen und Bemerkungen sind darin nicht zuverlässig weiterverwendbar.

Besser ist ein Dokument, das aus strukturierten Auftragsdaten entsteht. Artikel, Sollmengen, Lieferadresse und Ansprechpartner werden übernommen. Mitarbeitende bestätigen anschließend die tatsächlichen Mengen direkt auf einem Mobilgerät oder an einem Arbeitsplatz im Lager. Nur Abweichungen, Schäden oder Zusatzpositionen müssen neu eingegeben werden.

Das spart nicht nur Zeit. Es verhindert auch einen typischen Medienbruch: Die Buchhaltung erhält nicht mehr eine kaum lesbare Unterschrift auf Papier, während das Lager denselben Vorgang separat in einer Tabelle nachpflegt.

Die Daten, die ein digitaler Lieferschein wirklich braucht

Ein System sollte nicht jedes denkbare Feld erzwingen. Zusätzliche Eingaben verlangsamen die Übergabe und senken die Akzeptanz. Gleichzeitig reichen Kundenname und Unterschrift für viele Abläufe nicht aus.

Als Grundlage braucht jeder Lieferschein eine eindeutige Nummer, den Bezug zum Auftrag, Liefer- und Empfängeradresse, Artikelpositionen mit Soll- und Istmengen sowie Zeitstempel. Je nach Branche kommen Chargen, Seriennummern, Gewicht, Stellplätze oder Behälter hinzu. Bei temperaturgeführten Waren können Messwerte relevant sein, bei Baustellenlieferungen Fotos oder eine präzise Angabe zum Übergabeort.

Besonders wichtig ist der Status. „Erstellt“, „kommissioniert“, „unterwegs“, „übergeben“, „teilgeliefert“ und „beanstandet“ sind keine bloßen Etiketten. Sie steuern, welche Person als Nächstes handeln muss und ob beispielsweise eine Rechnung erstellt oder eine Nachlieferung geplant werden darf.

Unterschriften und Fotos mit Augenmaß einsetzen

Eine digitale Unterschrift ist bei vielen Lieferprozessen sinnvoll, aber nicht automatisch die beste Bestätigung. Bei einer schnellen Übergabe am Wareneingang kann ein Name in Druckschrift, ein Zeitstempel und die Zuordnung zum Empfänger ausreichend sein. Bei hochwertigen Gütern oder strittigen Übergaben kann eine Unterschrift zusammen mit Foto und Standortinformation dagegen sinnvoll sein.

Entscheidend ist die Beweiskette: Die Bestätigung muss dem konkreten Dokument und dessen Version zugeordnet sein. Ändert jemand nach der Unterschrift Mengen oder Positionen, sollte das System dies nicht still überschreiben. Es braucht eine nachvollziehbare Korrektur oder eine neue Bestätigung.

Fotos verdienen dieselbe Disziplin. Sie können Schäden dokumentieren, sollten aber nicht zur wahllosen Sammlung personenbezogener Daten werden. Legen Sie fest, wann ein Foto erforderlich ist, wer darauf zugreifen darf und wie lange es gespeichert wird.

Mobile Erfassung muss unter realen Bedingungen funktionieren

Im Büro ist fast jede Anwendung bedienbar. Im Lager zählen Handschuhe, schlechtes WLAN, Zeitdruck und Geräte mit begrenzter Akkulaufzeit. Ein digitaler Lieferschein muss deshalb mit wenigen, großen Eingabeschritten auskommen. Barcode- oder QR-Code-Scans sind oft schneller und verlässlicher als die Suche nach Artikelnummern.

Offline-Fähigkeit ist kein Luxus, wenn Fahrer außerhalb stabiler Netzabdeckung arbeiten. Die Anwendung sollte Vorgänge lokal zwischenspeichern, klar anzeigen, was noch nicht synchronisiert wurde, und Konflikte kontrolliert behandeln. Wenn zwei Personen dieselbe Lieferung bearbeiten, darf nicht zufällig die letzte Speicherung gewinnen.

Auch die Gerätefrage ist pragmatisch zu beantworten. Ein vorhandenes Smartphone kann für einfache Zustellungen genügen. Für häufige Scans, Fotos und Unterschriften im Lager sind robuste Handhelds oder Tablets häufig wirtschaftlicher. Die beste Entscheidung hängt von Einsatzdauer, Umgebung und dem erwarteten Durchsatz ab - nicht davon, welches Gerät auf einer Produktfolie modern aussieht.

Schnittstellen vor der Einführung festlegen

Ein digitaler Lieferschein entfaltet seinen Nutzen erst, wenn er an die führenden Daten anschließt. In vielen Betrieben liegen Aufträge im ERP oder in der Warenwirtschaft, Bestände in einer separaten Lagerlösung und Rechnungen in der Buchhaltung. Das muss nicht sofort zu einem großen Systemprojekt werden. Aber die Datenhoheit sollte klar sein.

Definieren Sie daher, welches System Kunden, Artikel, Preise und Aufträge führt. Die Lieferscheinlösung darf Informationen übernehmen, aber sie sollte nicht unbemerkt einen zweiten Artikelstamm erzeugen. Ebenso muss geregelt sein, wann bestätigte Istmengen zurückgemeldet werden und wer Abweichungen prüft.

Technisch sind verlässliche Schnittstellen wichtiger als spektakuläre Funktionen. Eindeutige IDs, dokumentierte Datenformate, Protokolle für fehlgeschlagene Übertragungen und ein Wiederholungsmechanismus verhindern, dass Lieferscheine zwischen zwei Systemen verschwinden. Eine schlanke Anwendung auf einer wartbaren Basis, etwa PHP 8.4, modernem JavaScript und MySQL 8, ist für viele mittelständische Abläufe sinnvoller als eine überladene Suite mit Funktionen, die niemand nutzt.

Sicherheit und Archivierung gehören zum Prozess

Lieferscheine enthalten Geschäfts- und häufig auch personenbezogene Daten. Rollenrechte sollten deshalb nicht pauschal vergeben werden. Fahrer brauchen etwa ihre Touren und offene Vorgänge, Lagerverantwortliche benötigen Korrektur- und Prüfoptionen, die Buchhaltung bestätigte Dokumente und Exporte. Administrativer Vollzugriff ist kein Standardrecht.

Zusätzlich braucht es eine nachvollziehbare Historie: Erstellung, Änderung, Übergabe, Unterschrift, Storno und Korrektur sollten mit Zeit, Benutzer und Begründung erfasst werden. Das hilft bei Rückfragen und schützt Mitarbeitende, wenn später unklar ist, wann ein Schaden oder eine Fehlmenge gemeldet wurde.

Für die Archivierung gilt: Das Dokument muss lesbar bleiben und der Vorgang auffindbar sein. Ob ein PDF erzeugt wird, hängt vom internen Ablauf und den Anforderungen externer Empfänger ab. Das PDF ist jedoch die Ausgabe eines digitalen Vorgangs, nicht dessen Datenmodell.

In kleinen Schritten produktiv werden

Der zuverlässigste Rollout startet mit einem klar abgegrenzten Prozess: beispielsweise Standardauslieferungen eines Lagers oder Wareneingänge einer Abteilung. Wählen Sie einen Bereich mit ausreichendem Volumen, aber ohne die kompliziertesten Ausnahmefälle. So lassen sich Bedienung, Datenqualität und Schnittstellen unter echten Bedingungen prüfen.

Messen Sie nicht nur, ob die Anwendung technisch läuft. Prüfen Sie, wie lange eine Übergabe dauert, wie viele Lieferscheine nachbearbeitet werden müssen, wie häufig Bestandsdifferenzen auftreten und ob die Buchhaltung schneller arbeiten kann. Wenn ein digitales Verfahren mehr Rückfragen erzeugt als das Papierformular, ist nicht die Belegschaft das Problem - dann fehlt Prozessklarheit oder die Eingabemaske passt nicht zur Praxis.

Spreadsheets dürfen dabei weiterleben, wenn sie für eine kleine Auswertung oder eine seltene Sonderliste verlässlich sind. Digitalisierung bedeutet nicht, jedes bekannte Werkzeug abzuschaffen. Sie bedeutet, die fehleranfälligen Übergaben gezielt zu ersetzen und den Kernprozess belastbar zu machen.

softify.pro entwickelt solche Abläufe nicht als starres Standardprodukt, sondern entlang konkreter Warenbewegungen, Rollen und vorhandener Systeme. Das ist besonders dann sinnvoll, wenn ein Unternehmen zwischen Papierchaos und einem überdimensionierten Konzernsystem eine passende Lösung sucht.

Der richtige erste Schritt ist daher kein langer Anforderungskatalog. Nehmen Sie zehn Lieferscheine aus einer normalen Woche, einschließlich einer Teillieferung und einer Reklamation. Wenn Ihr künftiger Ablauf diese zehn Fälle schnell, eindeutig und nachvollziehbar verarbeitet, entsteht aus einem digitalen Lieferschein ein Werkzeug, auf das sich Lager, Fahrer und Verwaltung verlassen können.

Permalink →

Software Testing Trends 2026, die wirklich zählen

Software Testing Trends 2026, die wirklich zählen

Ein fehlgeschlagener Release zeigt selten nur einen einzelnen Fehler. Häufig treffen mehrere Ursachen zusammen: eine geänderte Berechtigung, eine unklare Testumgebung, fehlende Testdaten oder ein Regressionstest, der seit Monaten nicht mehr gepflegt wurde. Genau dort werden die software testing trends 2026 konkret. Nicht als Sammlung neuer Werkzeuge, sondern als Frage, wie Unternehmen Änderungen nachweisbar sicher ausliefern - auch bei knappen QA-Kapazitäten und sensiblen Daten.

Für Softwareteams in mittelständischen Betrieben ist das besonders relevant. Eine Lageranwendung, ein Kundenportal oder eine Windows-Desktop-Software muss nicht Millionen Nutzer bedienen. Sie muss aber im Schichtbetrieb funktionieren, Belege korrekt erzeugen und Berechtigungen zuverlässig durchsetzen. Testing muss deshalb näher an den realen Abläufen liegen als an einer perfekten Demo-Umgebung.

Software Testing Trends: KI wird zum Ausführenden, nicht zum Orakel

Der sichtbarste Trend ist KI-gestütztes Testen. Gemeint ist damit nicht, dass ein Sprachmodell eine Anforderung liest und anschließend die Qualität der Anwendung garantiert. Diese Erwartung wäre gefährlich. KI kann jedoch viel Aufwand dort reduzieren, wo Teams heute Zeit verlieren: beim Formulieren von Testfällen, beim Erkennen auffälliger Änderungen in Oberflächen, beim Zuordnen ähnlicher Fehlerbilder und beim Schreiben verständlicher Testberichte.

Besonders nützlich wird KI, wenn sie konkrete Arbeitsschritte ausführt und ihre Ergebnisse belegt. Ein Testagent kann sich etwa anmelden, einen Wareneingang anlegen, eine Lieferadresse ändern, ein Versandlabel erzeugen und prüfen, ob Status, Bestandsbewegung und Dokument zusammenpassen. Entscheidend ist nicht die Behauptung „Test bestanden“, sondern die Beweiskette: ausgeführte Schritte, Zeitstempel, Screenshots, technische Protokolle und eine klare Beschreibung der Abweichung.

Die Grenze bleibt wichtig. KI darf Testfälle vorschlagen und wiederkehrende Abläufe bedienen. Sie sollte nicht allein entscheiden, ob eine fachlich kritische Buchung korrekt ist. Bei Preisen, Lagerbeständen, Zahlungsfreigaben oder Zugriffsrechten braucht es weiterhin explizite Regeln und von Fachbereichen bestätigte Erwartungen. Automatisierung beschleunigt die Prüfung, sie ersetzt keine Verantwortung.

Testautomatisierung wandert in den Fachprozess

Lange Zeit konzentrierte sich UI-Testautomatisierung auf einfache Wege: Seite öffnen, Formular ausfüllen, Erfolgsmeldung prüfen. Das bleibt sinnvoll, reicht aber für geschäftskritische Systeme nicht aus. Der wertvollere Test prüft eine komplette Prozesskette.

Nehmen wir eine typische Logistikfunktion. Ein Auftrag wird erfasst, Ware reserviert, ein Pickvorgang gestartet, ein Lieferschein erzeugt und der Versand gemeldet. Jeder einzelne Bildschirm kann sauber aussehen, während der Prozess dennoch fehlschlägt - etwa weil eine Reservierung bei einem Abbruch bestehen bleibt oder eine Teillieferung den Bestand falsch verändert. Gute automatisierte Tests verfolgen daher Zustände und Daten über Systemgrenzen hinweg.

Das verlangt eine saubere Testarchitektur. API- und Datenbanktests prüfen Regeln schnell und präzise. UI-Tests kontrollieren zusätzlich, ob Mitarbeitende den Vorgang tatsächlich bedienen können. End-to-End-Tests verbinden beides, sind aber langsamer und anfälliger. Wer alles ausschließlich über den Browser testet, baut meist eine teure und fragile Testsuite. Wer nur Schnittstellen testet, übersieht Bedienungsprobleme und falsch verdrahtete Oberflächen.

Die pragmatische Lösung ist eine Pyramide, die zum Risiko passt: Viele schnelle Prüfungen nah an der Geschäftslogik, weniger Integrationsprüfungen und gezielt ausgewählte End-to-End-Szenarien für die wichtigsten Abläufe. Das klingt wenig spektakulär. Es liefert aber boring, provable reliability statt Trend-Chasing.

Selbst gehostete Test-KI wird zur Architekturfrage

Mit KI-Testwerkzeugen entsteht eine neue Frage: Wohin gehen Testdaten, Screenshots und Aufzeichnungen? In vielen Anwendungen enthalten sie Kundennamen, interne Preise, Personalinformationen oder Ansichten geschäftskritischer Prozesse. Selbst eine scheinbar harmlose Testumgebung kann reale Datenkopien oder vertrauliche Strukturen enthalten.

Deshalb wird die Ausführungsumgebung zu einem zentralen Kriterium. Ein externer Cloud-Dienst kann für öffentliche Webanwendungen und unkritische Testdaten passend sein. Für interne Portale, Desktop-Anwendungen oder regulierte Bereiche ist ein selbst gehosteter Ansatz oft sinnvoller. Dabei bleiben Testausführung, Bildmaterial und Protokolle in der kontrollierten Infrastruktur des Unternehmens oder in einer klar abgegrenzten EU-Umgebung.

Das ist kein pauschales Argument gegen Cloud-Dienste. Selbstbetrieb bringt Aufwand mit: Updates, Zugriffssteuerung, Rechenressourcen, Monitoring und klare Verantwortlichkeiten müssen geregelt sein. Der Nutzen entsteht, wenn Datenschutz, Nachvollziehbarkeit und Kontrolle über Testartefakte schwerer wiegen als der Komfort eines sofort verfügbaren SaaS-Kontos. Systeme wie COCO verfolgen genau diesen Ansatz, indem sie Tests für Web- und Windows-Anwendungen ausführen und Evidenz lokal kontrollierbar halten.

Flaky Tests werden nicht mehr als Normalzustand akzeptiert

Ein automatisierter Test, der ohne Produktänderung mal besteht und mal scheitert, erzeugt keine Sicherheit. Er erzeugt Warteschlangen. Teams gewöhnen sich dann daran, rote Builds zu ignorieren oder Tests erneut auszuführen, bis das gewünschte Ergebnis erscheint. Das ist ein schleichender Verlust an Vertrauen in die gesamte Qualitätskontrolle.

2026 rückt deshalb die Stabilität der Testausführung stärker in den Vordergrund. Die Ursachen sind meist bekannt: zufällige Wartezeiten, instabile Selektoren, gemeinsam genutzte Testdaten, Abhängigkeiten von externen Diensten oder nicht zurückgesetzte Datenbanken. Die Lösung ist selten ein weiterer Retry. Sinnvoller sind eindeutige technische Selektoren, isolierte Testkonten, kontrollierte Datenzustände und gezielte Wartebedingungen, die auf tatsächliche Systemereignisse reagieren.

Auch die Auswertung sollte unterscheiden: Ist ein Fehler reproduzierbar? Tritt er nur in einer Umgebung auf? Ist ein externer Dienst ausgefallen oder die Anwendung selbst? KI kann bei der Bündelung dieser Signale helfen. Die technische Entscheidung muss jedoch nachvollziehbar bleiben. Ein QA-Team braucht keine geheimnisvolle Fehlervorhersage, sondern eine belastbare Grundlage für die nächste Maßnahme.

Qualität beginnt früher bei Anforderungen und Daten

Viele Fehler entstehen, bevor die erste Zeile Code geschrieben wird. „Der Auftrag soll versendet werden können“ ist keine testbare Anforderung. Was geschieht bei unvollständiger Adresse, gesperrtem Kundenkonto, fehlender Ware, paralleler Bearbeitung oder abgelaufener Sitzung? Ohne Antworten darauf kann kein Testsystem zuverlässig prüfen, ob die Software richtig arbeitet.

Ein reiferer Testansatz ergänzt Anforderungen daher um überprüfbare Beispiele. Für ein Konto mit falschen Login-Versuchen kann das konkret bedeuten: Nach fünf Fehlversuchen wird das Konto für 15 Minuten gesperrt, der Vorgang wird protokolliert und ein berechtigter Administrator kann die Sperre nachvollziehen. Daraus entstehen direkt automatisierbare Prüfungen - und weniger Interpretationsspielraum zwischen Entwicklung, Betrieb und Fachbereich.

Testdaten werden ebenfalls zur Produktfunktion. Sie müssen realistisch genug sein, um Sonderfälle abzubilden, dürfen aber keine unnötigen personenbezogenen Daten kopieren. Sinnvoll sind generierte Datensätze für Mehrwertsteuerfälle, Teilmengen, gesperrte Artikel, ungültige Adressen und verschiedene Rollen. Gerade bei Anwendungen mit MySQL 8 oder vergleichbaren relationalen Datenbanken lohnt es sich, definierte Ausgangszustände automatisiert bereitzustellen und nach dem Lauf wieder zu entfernen.

Risikobasiertes Testen schlägt Testabdeckung um jeden Preis

Eine hohe Code-Coverage-Zahl kann beruhigend wirken und trotzdem wenig aussagen. Sie zeigt, welche Zeilen ausgeführt wurden, nicht ob die richtige Regel geprüft wurde. Ein System kann 90 Prozent Abdeckung erreichen und dennoch beim Storno einer Teillieferung falsche Bestände führen.

Die bessere Frage lautet: Welche Fehler wären für Betrieb, Kunden oder Recht besonders teuer? Daraus ergibt sich eine Priorisierung. Zugangsschutz, Preisberechnung, Bestandsbuchungen, Dokumentenerzeugung und Schnittstellen zu Versanddienstleistern verdienen meist mehr Testtiefe als selten genutzte Einstellungsseiten. Das bedeutet nicht, Nebensachen ungeprüft auszuliefern. Es bedeutet, begrenzte Zeit dort einzusetzen, wo ein Ausfall reale Arbeit stoppt oder falsche Entscheidungen erzeugt.

Diese Priorisierung muss sich verändern dürfen. Wird eine neue Route-Planungsfunktion eingeführt, steigt ihr Risiko. Wird eine alte Excel-Auswertung bald ersetzt, lohnt sich möglicherweise kein großer Automatisierungsaufwand mehr. Manchmal ist es vernünftiger, eine funktionierende Tabelle noch einige Monate beizubehalten, statt ihre Logik hastig in ein halbfertiges System zu pressen.

Was Teams jetzt praktisch tun sollten

Der erste sinnvolle Schritt ist kein Toolvergleich. Wählen Sie einen Prozess, dessen Fehler spürbar sind: Auftrag bis Versand, Wareneingang bis Einlagerung oder Anmeldung bis Rollenfreigabe. Beschreiben Sie den Sollablauf mit Ausnahmefällen, legen Sie verlässliche Testdaten an und automatisieren Sie zunächst die kritischen Prüfungen.

Messen Sie anschließend nicht nur die Anzahl der Tests. Beobachten Sie, wie schnell ein echter Fehler erkannt wird, wie oft Tests unbegründet fehlschlagen und ob ein Bericht einem Entwickler oder Fachverantwortlichen die Ursache verständlich erklärt. Erst wenn diese Grundlagen stehen, lohnt sich der Ausbau mit KI-Agenten, visueller Prüfung oder umfangreichen Testumgebungen.

Die stärksten Testing-Trends sind am Ende die, die Freigaben weniger riskant machen und Teams schneller zu klaren Entscheidungen bringen. Nicht das modernste Dashboard zählt, sondern ein nachvollziehbarer Testlauf, der zeigt: Dieser Geschäftsprozess funktioniert - und wenn nicht, wissen wir warum.

Permalink →

Routenplanung für Lieferfahrten: Software richtig wählen

Routenplanung für Lieferfahrten: Software richtig wählen

Ein Fahrer wartet auf einen Lieferschein, während sich die Reihenfolge seiner Stopps schon wieder ändert. Im Lager ist eine Sendung noch nicht kommissioniert, ein Kunde ruft wegen eines engeren Zeitfensters an, und die Tourenliste liegt in einer Tabellenkalkulation, die nur eine Person wirklich versteht. Wer nach „Routenplanung für Lieferfahrten Software“ sucht, will in dieser Situation nicht zwingend einen komplizierten Kartenalgorithmus. Gesucht wird ein verlässlicher Ablauf vom Auftrag bis zum Nachweis der Zustellung.

Für kleine und mittlere Unternehmen ist das ein entscheidender Unterschied. Eine theoretisch kürzere Strecke bringt wenig, wenn sie nicht berücksichtigt, dass Ware erst um 10 Uhr bereitsteht, ein Fahrzeug Kühlung benötigt oder ein Fahrer auf einer bestimmten Tour besondere Kundenkenntnis braucht. Gute Software für Lieferfahrten bildet die Realität des Betriebs ab - und macht sie für Disposition, Lager und Fahrer gemeinsam nutzbar.

Wann Routenplanung zum operativen Problem wird

Viele Betriebe starten sinnvoll mit Telefon, Papier und einer Tabelle. Bei fünf Stopps pro Tag und einem festen Fahrerteam ist das oft die schnellste Lösung. Erst wenn Auftragsmenge, Varianten und Zeitdruck zunehmen, entstehen die typischen Reibungsverluste: doppelt erfasste Adressen, veraltete Tourenstände, fehlende Informationen zu Ladehilfsmitteln und Rückfragen, die nur durch Anrufe an mehrere Personen beantwortet werden können.

Das Problem ist dann nicht allein die Fahrstrecke. Es ist der Informationsbruch zwischen Auftragserfassung, Lager, Disposition und Auslieferung. Wird ein Auftrag verschoben, muss diese Änderung heute häufig in mehreren Listen, auf einem Ausdruck und im Kopf des Fahrers nachgezogen werden. Das kostet Zeit und erzeugt Fehler, die Kunden unmittelbar sehen.

Ein weiteres Warnsignal sind Entscheidungen, die von einzelnen Mitarbeitenden abhängen. Wenn nur die erfahrene Disponentin weiß, welche Zufahrt für einen Kunden geeignet ist oder wie Tour 3 bei spätem Wareneingang angepasst wird, ist der Ablauf nicht belastbar dokumentiert. Software soll dieses Wissen nicht ersetzen. Sie soll es so abbilden, dass das Team handlungsfähig bleibt.

Was Software zur Routenplanung für Lieferfahrten können muss

Die Kernfunktion klingt einfach:
Aufträge werden einer Tour zugeordnet, Stopps sinnvoll sortiert und an Fahrer übergeben. Für den praktischen Nutzen braucht das System jedoch deutlich mehr Kontext. Entscheidend ist, welche Regeln bei der Planung gelten und wie Änderungen behandelt werden.

Aufträge müssen planbar statt nur sichtbar sein

Eine Lieferadresse auf einer Karte ist noch keine planbare Lieferung. Zu einem Auftrag gehören mindestens Mengen, Gewicht oder Volumen, Lieferdatum, gewünschtes Zeitfenster, Kontaktinformationen und ein klarer Bearbeitungsstatus. Je nach Betrieb kommen Ladehilfsmittel, Temperaturvorgaben, Gefahrgutkennzeichnungen, Avisierungsregeln oder eine bestimmte Fahrzeugklasse hinzu.

Diese Daten sollten nicht jedes Mal manuell aus verschiedenen Systemen zusammengesucht werden. Wenn Aufträge bereits aus einem Webshop, ERP, einer Auftragsmaske oder einer bestehenden Datenbank kommen, ist eine saubere Übergabe oft wertvoller als eine besonders spektakuläre Kartenansicht. Andernfalls verlagert sich die Arbeit nur von Papier in eine neue Oberfläche.

Touren brauchen Regeln, nicht nur Entfernung

Eine automatische Reihenfolge nach Kilometern oder Fahrzeit kann ein guter Vorschlag sein. Sie ist aber keine Entscheidung für den Betrieb. Die Planung muss Einschränkungen berücksichtigen können: feste Liefertermine, Kapazität des Fahrzeugs, Arbeitszeiten, Be- und Entladezeiten sowie regionale Zuständigkeiten.

Auch die Startlogik zählt. Manche Fahrzeuge beginnen und enden am Lager, andere fahren nach der letzten Lieferung direkt zum nächsten Einsatzort. Bei wiederkehrenden Touren kann eine feste Grundstruktur sinnvoll sein, die Disponenten nur bei Bedarf verändern. Wer jeden Morgen dieselben Stopps anfährt, braucht nicht zwangsläufig eine vollständige Neuoptimierung. Hier ist eine stabile, nachvollziehbare Tour häufig besser als ein rechnerisch minimaler Zeitgewinn.

Änderungen müssen kontrolliert beim Fahrer ankommen

Die Realität hält sich selten an den Morgenplan. Kunden sagen ab, Ware fehlt, ein Fahrzeug fällt aus oder ein Auftrag wird dringend. In solchen Fällen entscheidet sich, ob die Software Entlastung oder zusätzliche Arbeit schafft.

Eine brauchbare Lösung zeigt eindeutig, welche Tourversion aktuell gilt, welche Stopps bereits erledigt sind und was konkret geändert wurde. Der Fahrer sollte keine widersprüchlichen Ausdrucke, Screenshots und Messenger-Nachrichten vergleichen müssen. Für viele Teams genügt zunächst eine mobile, browserbasierte Fahreransicht mit Stoppreihenfolge, Kontaktdaten, Lieferhinweisen und Statusrückmeldung. Eine eigene App ist nicht automatisch besser, wenn Installation, Geräteverwaltung und Offline-Anforderungen keinen klaren Nutzen bringen.

Nicht mit Routenoptimierung allein anfangen

Der häufigste Fehlansatz ist, zuerst einen Optimierungsdienst einzukaufen und erst danach zu prüfen, ob die Stammdaten und Abläufe stimmen. Falsch geschriebene Adressen, unklare Lieferfenster und Aufträge ohne verlässlichen Bereitstellungsstatus lassen sich nicht wegoptimieren.

Sinnvoller ist eine kurze Bestandsaufnahme entlang des realen Tagesablaufs. Wo entstehen Aufträge? Wann bestätigt das Lager die Bereitstellung? Wer plant Touren? Wie erhält der Fahrer Änderungen? Und welcher Nachweis wird nach der Lieferung benötigt? Diese Fragen wirken banal, legen aber fest, welche Datenfelder, Rollen und Schnittstellen das System tatsächlich braucht.

Oft zeigt sich dabei, dass nicht jeder Schritt digitalisiert werden sollte. Eine handschriftliche Notiz für eine seltene Sonderlieferung kann angemessen sein, wenn sie später sauber in den Auftrag übernommen wird. Eine Tabellenkalkulation darf ebenfalls bleiben, wenn sie eine überschaubare Auswertung zuverlässig liefert. Software sollte den Engpass lösen, nicht jeden bekannten Ablauf zwanghaft ersetzen.

Build, Buy oder gezielte Erweiterung?

Standardsoftware ist passend, wenn die Tourenlogik allgemein ist, Prozesse kaum variieren und sich das Team an vorgegebene Masken anpassen kann. Sie verkürzt die Einführung und kann für einen einfachen Fuhrpark ausreichend sein. Der Nachteil zeigt sich, sobald sie zentrale Sonderfälle nur über Nebenlisten, Freitext oder teure Zusatzmodule abbildet.

Eine individuelle Lösung lohnt sich nicht, weil Individualentwicklung grundsätzlich überlegen wäre. Sie lohnt sich, wenn der Ablauf selbst ein Wettbewerbsvorteil oder eine dauerhafte Fehlerquelle ist: etwa bei speziellen Verpackungseinheiten, kombinierten Abhol- und Liefertouren, eigenen Lieferdokumenten oder einer engen Verbindung von Wareneingang, Kommissionierung und Auslieferung.

Dazwischen liegt oft der pragmatischste Weg. Bestehende Systeme bleiben für Buchhaltung oder Lagerführung bestehen, während eine schlanke Anwendung Aufträge bündelt, Touren plant und den Fahrerprozess abdeckt. Dafür braucht es klare Schnittstellen, eindeutige Verantwortlichkeiten für Daten und eine Datenbankstruktur, die Änderungen nachvollziehbar speichert. Moderne Webanwendungen auf einer wartbaren Basis wie PHP 8.4 und MySQL 8 sind dafür keine Modeentscheidung, sondern eine Grundlage für kalkulierbaren Betrieb und spätere Anpassungen.

Einführung in kleinen Schritten statt großer Umstellung

Eine Routenplanungssoftware sollte zuerst an einer überschaubaren Tour oder Fahrzeuggruppe erprobt werden. Nicht weil ein Pilotprojekt risikolos wäre, sondern weil sich echte Ausnahmen früh zeigen: fehlende Lieferhinweise, uneinheitliche Adressdaten, Wartezeiten beim Kunden oder unklare Übergaben im Lager.

Für die erste Ausbaustufe reichen meist klar abgegrenzte Funktionen: Auftrag übernehmen, Status der Bereitstellung sehen, Tour zusammenstellen, Tour freigeben und Lieferung zurückmelden. Erst wenn diese Kette im Alltag funktioniert, sind automatische Optimierung, elektronische Unterschrift, Foto-Nachweise, Kundenbenachrichtigungen oder detaillierte Kennzahlen sinnvoll.

Messbar wird der Nutzen nicht nur über eingesparte Kilometer. Relevant sind auch weniger Dispositionsaufwand, weniger Rückfragen, geringere Fehlzustellungen, kürzere Zeit bis zum Lieferschein und eine bessere Auskunftsfähigkeit gegenüber Kunden. Diese Kennzahlen sollten vor dem Start grob erfasst werden. Sonst bleibt nach der Einführung nur der Eindruck, dass die Oberfläche moderner aussieht.

Die Technik muss im Hintergrund zuverlässig bleiben

Routenplanung verarbeitet sensible Betriebsdaten: Kundenadressen, Fahrerzuordnungen, Liefermengen und häufig auch Zustellnachweise. Deshalb gehören Rollenrechte, nachvollziehbare Änderungen, regelmäßige Backups und ein dokumentierter Betrieb zur Lösung. Wer eine Tour freigeben, ändern oder löschen darf, sollte nicht dem Zufall überlassen werden.

Auch die Karten- und Routingdaten verdienen eine nüchterne Prüfung. Externe Dienste können sehr gut passen, bringen aber laufende Kosten, Verfügbarkeiten und Datenschutzfragen mit. Bei hohen Anforderungen an Datenhaltung oder speziellen Gebietslogiken muss früh geklärt werden, welche Daten das eigene System verlassen und wie Ausfälle abgefedert werden. Eine perfekte Route ist wertlos, wenn die Disposition bei einer Störung nicht weiterarbeiten kann.

softify.pro plant solche Systeme vom tatsächlichen Auftragseingang bis zur Rückmeldung aus dem Fahrzeug. Der Maßstab ist dabei nicht die längste Funktionsliste, sondern ein Ablauf, den Lager, Disposition und Fahrer unter Zeitdruck zuverlässig bedienen können.

Die beste Routenplanung wirkt im Alltag erstaunlich unspektakulär: Aufträge sind vollständig, Touren verständlich, Änderungen eindeutig und Zustellungen belegbar. Genau diese unaufgeregte Verlässlichkeit schafft Raum für die Ausnahmen, bei denen Menschen entscheiden müssen.

Permalink →

Bestellannahme Workflow automatisieren im Betrieb

Bestellannahme Workflow automatisieren im Betrieb

Ein Auftrag kommt per E-Mail, ein weiterer per Telefon, dazu eine Excel-Datei vom Key Account. Im Lager fehlt später die Lieferadresse, der Vertrieb kennt den zugesagten Termin nicht mehr genau, und die Versandabteilung druckt den Lieferschein mit einer alten Artikelposition. Wer den Bestellannahme Workflow automatisieren will, löst kein abstraktes Digitalprojekt. Er beseitigt genau diese Reibung an der Stelle, an der Umsatz in operative Arbeit übergeht.

Für kleine und mittlere Unternehmen ist die Bestellannahme oft unterschätzt. Solange wenige Aufträge pro Tag eingehen und erfahrene Mitarbeitende jeden Sonderfall kennen, tragen Telefonnotizen, Postfächer und Tabellen den Prozess. Mit wachsendem Volumen werden sie jedoch zu einem Risiko: Informationen liegen doppelt vor, Übergaben passieren mündlich, und niemand kann zuverlässig sagen, welcher Stand der Bestellung gilt.

Warum die Bestellannahme so oft zum Engpass wird

Die Ursache ist selten fehlender Einsatz. Meist ist der Ablauf über Jahre gewachsen. Kunden bestellen auf unterschiedlichen Wegen, Preise und Lieferbedingungen gelten nur für bestimmte Kundengruppen, Artikelnummern weichen von internen Bezeichnungen ab. Mitarbeitende gleichen Informationen aus Erfahrung ab und füllen Lücken mit Rückfragen.

Das funktioniert, bis eine Person im Urlaub ist, die Schicht wechselt oder mehrere dringende Aufträge gleichzeitig eintreffen. Dann zeigt sich, dass Wissen nicht im Prozess steckt, sondern in einzelnen Köpfen und verstreuten Dateien. Die Folgen sind vertraut: falsche Mengen, verspätete Lieferungen, ungeklärte Freigaben und unnötige Korrekturen im Lager.

Automatisierung bedeutet hier nicht, dass ein Kunde zwangsläufig in einem Portal bestellen muss. Sie bedeutet, dass jeder Auftrag unabhängig vom Eingangskanal nach denselben nachvollziehbaren Regeln erfasst, geprüft, angereichert und übergeben wird.

Den Bestellannahme Workflow automatisieren, ohne den Betrieb zu verbiegen

Ein brauchbarer Workflow beginnt nicht mit einer Softwareliste, sondern mit einer nüchternen Prozessaufnahme. Entscheidend ist: Welche Informationen müssen vorliegen, bevor ein Auftrag in Lager, Disposition oder Fertigung gehen darf? Und welche Ausnahmen sind legitim, statt einfach nur störend?

Ein typischer Ablauf besteht aus vier klaren Stationen: Auftrag erfassen, Daten prüfen, Auftrag freigeben und Folgeprozesse auslösen. Zwischen diesen Stationen braucht es eindeutige Verantwortlichkeiten und Status. Ein Auftrag sollte beispielsweise nicht gleichzeitig als „neu“, „in Klärung“ und „versandbereit“ gelten können.

1. Aufträge aus allen Kanälen in einen Vorgang überführen

E-Mail, Telefon, PDF, EDI, Webformular oder Außendienstnotiz können unterschiedliche Eingänge bleiben. Entscheidend ist, dass sie in einem gemeinsamen Auftragsvorgang landen. Mitarbeitende sollten nicht erst Informationen aus dem Postfach kopieren, dann eine Tabelle aktualisieren und anschließend eine zweite Person informieren müssen.

Bei strukturierten Bestellungen lassen sich Kundendaten, Artikelnummern, Mengen und Wunschtermine direkt übernehmen. Bei PDFs oder Freitext-E-Mails ist eine geführte Erfassung oft sinnvoller als eine vollständig automatische Auslesung. KI-gestützte Extraktion kann Vorschläge machen, aber bei unklaren Mengenangaben, kundenspezifischen Artikelnummern oder handschriftlichen Dokumenten braucht es eine sichtbare Prüfung.

Der sinnvolle Maßstab lautet nicht „maximal automatisch“, sondern „keine unnötige doppelte Erfassung“. Ein gut gestaltetes Formular mit Pflichtfeldern und plausiblen Vorschlägen spart in vielen Betrieben mehr Zeit als eine fehleranfällige Vollautomatik.

2. Daten prüfen, bevor Fehler weiterlaufen

Die wertvollste Automatisierung findet vor der Freigabe statt. Das System kann prüfen, ob die Kundennummer existiert, die Lieferadresse vollständig ist, der Artikel aktiv ist, die gewünschte Menge zulässig erscheint und die Zahlungs- oder Kreditfreigabe vorliegt. Auch kundenspezifische Preise, Mindestmengen und Lieferfenster lassen sich gegen hinterlegte Regeln abgleichen.

Wichtig ist die Behandlung von Abweichungen. Nicht jede Abweichung muss einen Auftrag blockieren. Fehlt etwa eine Referenznummer, kann der Vertrieb eine Aufgabe erhalten. Überschreitet ein Auftrag eine definierte Wertgrenze oder liegt die Marge außerhalb des vereinbarten Rahmens, kann eine Freigabe durch die zuständige Rolle erforderlich sein.

So entstehen keine stillen Fehler, sondern sichtbare Klärfälle. Das ist ein großer Unterschied: Das Lager bekommt nicht einfach einen unvollständigen Auftrag, sondern einen Auftrag mit eindeutigem Status und dokumentierter Entscheidung.

3. Freigaben an Regeln statt an Zurufe koppeln

Viele Verzögerungen entstehen durch Sätze wie: „Kannst du das noch kurz freigeben?“ Solche Nachfragen sind nicht grundsätzlich falsch. Problematisch werden sie, wenn sie über Chat, Telefon oder Flurgespräch laufen und später nicht nachvollziehbar sind.

Ein automatisierter Workflow hinterlegt Freigaberegeln direkt am Auftrag. Beispielsweise kann ein Auftrag automatisch freigegeben werden, wenn Kunde, Preis, Bestand und Lieferadresse plausibel sind. Bei Sonderkonditionen, Teillieferungen oder einem Auftrag über einer definierten Grenze wird die zuständige Person benachrichtigt. Die Freigabe wird mit Zeitstempel und Begründung gespeichert.

Das schafft Geschwindigkeit, ohne Kontrolle aufzugeben. Gerade bei wechselnden Schichten oder mehreren Standorten verhindert es, dass Aufträge an persönlichen Postfächern hängen bleiben.

4. Lager, Versand und Kunde gezielt informieren

Nach der Freigabe muss der Auftrag nicht mehr manuell von einer Liste in die nächste übertragen werden. Der Workflow kann einen Kommissionierauftrag erzeugen, Bestände reservieren, einen Lieferschein vorbereiten oder eine Versandmeldung anstoßen. Welche Schritte sinnvoll sind, hängt vom Geschäftsmodell ab.

Ein Ersatzteilhändler benötigt möglicherweise sofort einen Pickauftrag und eine Prioritätskennzeichnung. Ein Hersteller braucht zunächst eine Verfügbarkeitsprüfung und danach einen Produktionsimpuls. Ein Großhändler mit festen Touren möchte Aufträge bis zu einer bestimmten Uhrzeit bündeln. Deshalb ist eine starre Standardlösung oft nicht die beste Wahl.

Für den Kunden reicht häufig eine klare Bestätigung: Auftrag eingegangen, geprüft oder verbindlich eingeplant. Nicht jede interne Statusänderung gehört in eine E-Mail. Zu viele automatische Nachrichten erzeugen Rückfragen statt Vertrauen.

Welche Daten ein belastbarer Prozess braucht

Eine gute Bestellannahme steht auf einer sauberen Datenbasis. Dazu gehören gepflegte Kundenstammdaten, eindeutige Artikelnummern, gültige Preis- und Konditionsregeln sowie klar definierte Lieferadressen. Fehlen diese Grundlagen, beschleunigt Automatisierung nur die Weitergabe unsicherer Daten.

Auch die technische Architektur zählt. Ein zentrales System mit nachvollziehbaren Statuswechseln und einer verlässlichen Datenbank ist dauerhaft besser als eine Kette aus Makros, lokalen Dateien und unkontrollierten E-Mail-Weiterleitungen. Das heißt nicht, dass jede Excel-Tabelle sofort ersetzt werden muss. Wenn eine Tabelle in einem kleinen, stabilen Teilprozess transparent funktioniert, kann sie vorerst bleiben.

Sobald mehrere Personen gleichzeitig mit Aufträgen arbeiten, Freigaben erforderlich sind oder Informationen an Lager und Versand weitergegeben werden, sollte jedoch eine zentrale Datenquelle Vorrang haben. Systeme auf Basis einer wartbaren Architektur, etwa mit PHP 8.4, modernem JavaScript und MySQL 8, lassen sich dabei gezielt an vorhandene Abläufe anbinden, statt einen Betrieb in das Schema einer Konzernsoftware zu pressen.

Messbar machen, ob der Workflow wirklich besser wird

Ein neues System ist nicht automatisch ein besserer Prozess. Vor dem Start sollten deshalb wenige Kennzahlen festgelegt werden. Relevant sind etwa die Zeit vom Auftragseingang bis zur Freigabe, die Zahl der Rückfragen pro Auftrag, Korrekturen nach Übergabe ans Lager und die Quote termingerecht bearbeiteter Bestellungen.

Diese Kennzahlen zeigen auch, wo keine weitere Automatisierung nötig ist. Wenn 85 Prozent der Standardaufträge schnell und fehlerfrei laufen, die übrigen 15 Prozent aber echte Sonderfälle sind, ist ein klarer Klärprozess sinnvoller als der Versuch, jede Ausnahme algorithmisch zu erzwingen.

Protokolle helfen zusätzlich im Tagesgeschäft. Wer sieht, wann ein Auftrag einging, welche Prüfung fehlgeschlagen ist, wer ihn freigegeben hat und wann der Versandauftrag erzeugt wurde, sucht nicht mehr in fünf Postfächern nach der Ursache. Das reduziert nicht nur Fehler, sondern auch die Abhängigkeit von einzelnen Mitarbeitenden.

Einführung in kleinen Schritten statt Big Bang

Der sicherste Einstieg ist meist eine klar abgegrenzte Auftragsart: etwa Standardbestellungen eines bestimmten Kundenkreises oder E-Mail-Aufträge mit bekannten Artikeln. Dort lassen sich Datenfelder, Regeln und Übergaben unter realen Bedingungen testen. Erst wenn Status, Ausnahmen und Verantwortlichkeiten sauber funktionieren, folgen komplexere Fälle wie Sonderpreise, Teillieferungen oder kundenindividuelle Verpackungsvorgaben.

Mitarbeitende sollten an der Gestaltung beteiligt sein. Nicht, weil jede bestehende Gewohnheit unverändert bleiben muss, sondern weil die Personen am Telefon, im Vertrieb und im Lager die tatsächlichen Ausnahmen kennen. Eine Lösung, die nur im Workshop gut aussieht, wird auf dem Hallenboden schnell umgangen.

softify.pro setzt bei solchen Vorhaben auf workflow-spezifische Systeme statt auf überladene Standardsuiten: mit klaren Übergaben, dokumentierten Regeln und genug Raum für die Arbeitsweisen, die im Betrieb nachweislich funktionieren.

Der beste nächste Schritt ist daher nicht die Suche nach möglichst vielen Funktionen. Nehmen Sie zehn reale Bestellungen aus einer typischen Woche und verfolgen Sie ihren Weg vom Eingang bis zum Versand. Jede manuelle Doppelübertragung, jede unklare Entscheidung und jede wiederkehrende Rückfrage ist ein konkreter Ansatzpunkt für einen Prozess, der künftig verlässlich für das Team arbeitet.

Permalink →

Testdaten beim KI Testing sicher schützen

Testdaten beim KI Testing sicher schützen

Ein fehlgeschlagener automatisierter Test ist meist schnell behoben. Ein Screenshot aus dem Testlauf, der Kundendaten, Preislisten oder eine aktive Sitzung enthält und in einen externen KI-Dienst gelangt, ist ein anderes Problem. Wer Testdaten beim KI Testing schützen will, muss deshalb nicht nur die Testfälle betrachten, sondern den gesamten Datenweg: Eingaben, Browserverkehr, Protokolle, Bilder, KI-Auswertung und Aufbewahrung.

Gerade bei Webanwendungen, internen Portalen und Windows-Software entsteht schnell ein falsches Sicherheitsgefühl. Die Umgebung heißt zwar „Test“, doch sie verwendet oft Kopien produktiver Datenbanken, echte Benutzerrollen oder Schnittstellen zu Versand, ERP und Dokumentenarchiven. KI-gestützte Tests machen diese Daten für die Analyse besonders wertvoll - und damit besonders schutzbedürftig.

Warum KI-Testing einen eigenen Datenschutzblick braucht

Klassische Testautomatisierung prüft meist klar abgegrenzte Schritte: anmelden, Auftrag anlegen, Lieferschein erzeugen, Abmeldung prüfen. KI-gestütztes Testing erweitert diesen Ablauf. Das System kann Oberflächen interpretieren, Auffälligkeiten bewerten, Screenshots vergleichen und Ergebnisse in verständlicher Sprache dokumentieren. Das spart Zeit bei Regressionstests, erzeugt aber zusätzliche Datenartefakte.

Diese Artefakte sind oft aussagekräftiger als ein gewöhnliches Testprotokoll. Ein Screenshot kann Namen, Adressen, Vertragswerte, Bestellmengen oder Gesundheitsdaten zeigen. Ein Netzwerk-Log kann Sitzungs-Token und API-Antworten enthalten. Eine Fehlermeldung verrät unter Umständen interne Dateipfade, Datenbankstrukturen oder Versionsstände. Wenn ein Modell mit diesen Informationen arbeitet, muss klar sein, wo die Verarbeitung stattfindet und wer darauf zugreifen kann.

Die entscheidende Frage lautet daher nicht: „Nutzen wir KI im Test?“ Sondern: „Welche Daten verlassen welche Sicherheitszone - und warum?“ Für viele Unternehmen im DACH-Raum ist eine externe Cloud-Verarbeitung nicht grundsätzlich ausgeschlossen. Sie muss aber vertraglich, technisch und organisatorisch zum Schutzbedarf passen. Bei Entwicklungs-, Produktions- oder Kundendaten ist eine lokal kontrollierte Ausführung häufig die sachlichere Entscheidung.

Testdaten beim KI Testing schützen beginnt vor dem ersten Lauf

Datenschutz im Testing wird oft erst bei der Auswahl eines Tools diskutiert. Das ist zu spät. Zuerst braucht es eine einfache, belastbare Dateninventur. Welche Systeme werden getestet? Welche Felder erscheinen in Oberflächen? Welche Anhänge, Exporte und API-Antworten können im Test auftauchen? Und welche Daten landen automatisch in Screenshots, Videos oder Fehlermeldungen?

Dabei lohnt sich eine Einteilung in drei Gruppen. Unkritische Testdaten können frei erzeugt und länger gespeichert werden. Personenbezogene oder geschäftlich vertrauliche Daten brauchen Maskierung, Zugriffsbeschränkungen und kurze Aufbewahrung. Zugangsdaten, Tokens, Schlüssel und produktive Konfigurationswerte gehören nicht in Testnachweise oder Modellanfragen - auch dann nicht, wenn sie nur versehentlich in einem Browserfenster sichtbar sind.

In vielen mittelständischen Anwendungen ist die Datenlage nicht sauber getrennt. Das Lagerteam testet einen neuen Wareneingang mit einem Datenbankabzug, weil nur dort die realen Artikelstrukturen, Lieferantenregeln und Sonderfälle vorhanden sind. Das kann fachlich sinnvoll sein. Die Konsequenz darf aber nicht sein, dass dieser Abzug unverändert in jede Testumgebung wandert.

Besser ist ein reproduzierbarer Prozess: Daten exportieren, sensible Felder gezielt pseudonymisieren, nicht benötigte Tabellen entfernen und die resultierende Testdatenbasis versioniert bereitstellen. So bleiben typische Prozessfehler erhalten, ohne dass echte Kunden oder Mitarbeitende in Testläufen sichtbar werden. Bei komplexen Preis- oder Dispositionslogiken reichen vollständig synthetische Daten oft nicht aus. Dann ist eine sorgfältig bereinigte Kopie meist der bessere Kompromiss.

Maskierung muss die Fachlogik erhalten

Eine Maskierung, die jede E-Mail-Adresse durch denselben Platzhalter ersetzt, kann Testfälle beschädigen. Dublettenprüfungen, Rollenlogik, Suchfunktionen oder Rechnungsabläufe reagieren anders als im Betrieb. Gute Maskierung erhält daher Formate, Beziehungen und Verteilungen. Aus einer Kundennummer wird eine andere gültige Kundennummer. Aus einer Adresse wird eine plausible, aber fiktive Adresse. Aus einem Lieferdatum bleibt ein Datum innerhalb einer realistischen Planungsspanne.

Das kostet etwas Vorbereitung. Dafür verhindert es den klassischen Fehler, bei dem Tests zwar technisch grün sind, aber die tatsächlichen Abläufe im Lager, Vertrieb oder Kundenservice nicht mehr abbilden. Datenschutz und fachlich brauchbare Tests sind keine Gegensätze - sofern die Datenaufbereitung Teil der Testarchitektur ist.

Der Ausführungsort entscheidet über die Kontrolle

Wer automatisierte Tests an einen externen Dienst übergibt, gibt je nach Konfiguration mehr weiter als Testschritte. Browserinhalte, DOM-Strukturen, Screenshots, Videos, Konsolenprotokolle und Auswertungen können außerhalb der eigenen Infrastruktur verarbeitet und gespeichert werden. Ob das akzeptabel ist, hängt vom Einzelfall ab: Datenkategorien, Vertragswerk, Speicherort, Mandantentrennung, Löschkonzept und interne Vorgaben spielen zusammen.

Für Anwendungen mit hohem Schutzbedarf ist eine selbst gehostete Testumgebung oft klarer zu beurteilen. Der Test-Runner, die KI-Komponente und die Evidenzspeicherung bleiben im eigenen Netzwerk oder in einer kontrollierten europäischen Infrastruktur. Netzwerkregeln können externe Verbindungen begrenzen. Zugriffe lassen sich an vorhandene Identitäten, Rollen und Protokollierung anbinden. Auch die Aufbewahrung von Bildern und Berichten wird zur eigenen Entscheidung statt zu einer Standardeinstellung eines Plattformanbieters.

COCO folgt genau diesem Ansatz: Der KI-Server führt Tests für Web- und Windows-Anwendungen kontrolliert aus, dokumentiert Nachweise und erzeugt verständliche Bewertungen, ohne dass interne Anwendungsdaten standardmäßig in eine externe KI-Cloud abgegeben werden müssen. Das ersetzt keine Datenschutzprüfung. Es schafft jedoch eine technische Grundlage, auf der IT, Informationssicherheit und Fachbereich nachvollziehbare Regeln vereinbaren können.

Screenshots, Logs und Secrets sind die häufigsten Lecks

Viele Teams schützen die Testdatenbank, übersehen aber die Nebenprodukte des Testens. Genau dort liegen in der Praxis oft die größeren Risiken. Ein fehlgeschlagener Login-Test kann ein Passwort im Eingabefeld zeigen. Ein API-Test kann einen Bearer-Token im Log ausgeben. Ein automatischer Video-Mitschnitt dokumentiert einen vollständigen Auftrag inklusive Kundenadresse.

Ein belastbares Konzept regelt deshalb mindestens fünf Punkte:

  • Screenshots und Videos werden nur bei Bedarf erstellt und nach festen Fristen gelöscht.
  • Geheimnisse werden über einen Secret-Store oder geschützte Laufzeitvariablen eingebunden, niemals im Testcode abgelegt.
  • Protokolle filtern Token, Passwörter, Session-IDs und sensible Felder, bevor sie gespeichert werden.
  • Testkonten besitzen nur die Rechte, die für den jeweiligen Ablauf nötig sind.
  • Testsysteme dürfen keine produktiven E-Mails, Etiketten, Zahlungen oder Bestandsbewegungen auslösen, sofern das nicht ausdrücklich abgesichert ist.

Diese Regeln klingen nüchtern. Genau das ist ihr Vorteil. Ein Team muss nicht auf Aufmerksamkeit oder gute Absichten hoffen, sondern kann Fehlbedienung technisch begrenzen. Besonders wirksam sind getrennte Servicekonten für Testautomatisierung, kurze Token-Laufzeiten und ein klarer Prozess zum Widerruf kompromittierter Zugangsdaten.

Auch die KI-Auswertung braucht Grenzen

KI-Modelle werden häufig eingesetzt, um Abweichungen zu erklären: „Der Button war nicht sichtbar“, „Die Anwendung reagierte langsamer als erwartet“ oder „Der Prozess endete in einer Berechtigungsprüfung“. Für solche Einschätzungen braucht ein Modell nicht zwangsläufig den vollständigen Kundendatensatz.

Definieren Sie daher, welche Informationen in die Bewertung einfließen dürfen. Reicht ein anonymisierter Screenshot? Genügt eine technische Fehlerklasse statt der kompletten Serverantwort? Können Felder vor der Analyse geschwärzt werden? Die richtige Tiefe hängt vom Testziel ab. Bei einem Layoutvergleich ist ein Name selten relevant. Bei der Prüfung einer personalisierten Dokumentenvorlage kann er relevant sein - dann muss die Verarbeitung entsprechend abgesichert werden.

Schutzmaßnahmen müssen im Betrieb überprüfbar bleiben

Ein Konzept ist nur belastbar, wenn es im Alltag kontrolliert werden kann. Dazu gehören regelmäßige Stichproben der Testnachweise, Prüfungen von Berechtigungen und ein Blick auf tatsächlich gespeicherte Daten. Haben sich neue Felder in Screenshots eingeschlichen? Existieren alte Testkonten noch? Wird ein Datenbankabzug länger aufbewahrt als vorgesehen? Solche Fragen gehören in die normale Betriebsroutine, nicht nur in ein Audit.

Ebenso wichtig ist eine klare Verantwortlichkeit. QA kennt die Testabläufe, Entwicklung kennt die technischen Schnittstellen, der Fachbereich kennt die kritischen Prozesse und IT-Sicherheit definiert den Rahmen. Wenn niemand diese Perspektiven zusammenführt, entsteht entweder ein riskanter Schnellweg oder eine Sicherheitsvorgabe, die reale Tests verhindert. Ein kleiner, dokumentierter Freigabeprozess ist meist wirksamer als ein umfangreiches Regelwerk, das niemand anwendet.

Am Ende geht es nicht darum, jeden Test künstlich kompliziert zu machen. Gute Testdaten schützen heißt, echte Risiken gezielt aus der Automatisierung herauszunehmen und die fachliche Aussagekraft der Tests zu bewahren. Wenn Teams genau wissen, welche Daten ein Test sehen darf, wo seine Nachweise liegen und wann sie verschwinden, wird KI-Testing zu einem kontrollierbaren Werkzeug statt zu einer zusätzlichen Unsicherheit.

Permalink →

Webanwendung mit PHP entwickeln lassen

Webanwendung mit PHP entwickeln lassen

Wenn Wareneingänge in einer Tabelle landen, Versanddaten per Telefon weitergegeben werden und der aktuelle Auftragsstatus nur im Kopf einzelner Mitarbeitender existiert, fehlt meist kein weiteres Standardtool. Es fehlt ein System, das den eigenen Ablauf verbindlich abbildet. Eine Webanwendung mit PHP entwickeln lassen lohnt sich genau dann: wenn Informationen, Entscheidungen und Dokumente an einem Ort zusammenkommen müssen, ohne den Betrieb mit einer überdimensionierten Enterprise-Suite zu belasten.

PHP ist dabei kein nostalgischer Kompromiss. Mit PHP 8.4, einer klaren Anwendungsarchitektur und MySQL 8 lassen sich langlebige Webanwendungen bauen, die schnell reagieren, gut wartbar sind und auf Desktop, Tablet oder Handscanner zuverlässig funktionieren. Entscheidend ist allerdings nicht die Sprache allein. Entscheidend ist, ob die Anwendung die Arbeit auf dem Lagerboden, im Büro und unterwegs tatsächlich einfacher macht.

Wann eine individuelle Webanwendung sinnvoll ist

Nicht jeder Prozess braucht sofort Individualsoftware. Eine sauber gepflegte Tabelle kann für eine kleine, selten veränderte Liste die vernünftigste Lösung bleiben. Auch ein etabliertes Standardprodukt ist sinnvoll, wenn es die wesentlichen Abläufe bereits abdeckt und sich ohne dauerhafte Umwege nutzen lässt.

Der Wendepunkt kommt, wenn Mitarbeitende Daten mehrfach erfassen, Informationen aus verschiedenen Dateien zusammensuchen oder Sonderfälle regelmäßig außerhalb des eigentlichen Systems lösen. Typische Signale sind fehlende Bestandsklarheit, manuell erzeugte Lieferscheine, unklare Zuständigkeiten bei Aufträgen oder Rückfragen, die jede Schicht wiederholen muss. Dann wird nicht nur Zeit verloren. Fehler werden schwer nachvollziehbar, und die Abhängigkeit von einzelnen Personen steigt.

Eine maßgeschneiderte Webanwendung bildet dagegen genau die Regeln ab, die im Betrieb gelten. Sie kann zum Beispiel Wareneingänge erfassen, Lagerbewegungen dokumentieren, Etiketten erzeugen, Aufträge priorisieren oder Übergaben zwischen Teams nachvollziehbar machen. Dabei muss nicht am ersten Tag jeder Sonderfall automatisiert sein. Ein sinnvoller Start konzentriert sich auf den Ablauf, der heute am meisten Reibung erzeugt.

Webanwendung mit PHP entwickeln lassen: Was vorher geklärt sein muss

Gute Software beginnt nicht mit Maskenentwürfen oder einer Liste technischer Schlagworte. Sie beginnt mit konkreten Situationen: Was passiert, wenn eine Lieferung unvollständig eintrifft? Wer darf einen Bestand korrigieren? Welche Information braucht die Versandabteilung, bevor ein Label gedruckt wird? Und was geschieht, wenn ein Mitarbeitender im Spätdienst einen Auftrag übernimmt, der am Vormittag angelegt wurde?

Aus diesen Fragen entsteht ein belastbares Prozessbild. Es zeigt Eingaben, Entscheidungen, Übergaben und Ausnahmen. Gerade die Ausnahmen sind wertvoll, denn dort brechen Standardlösungen oft auf. Eine Anwendung für die Auftragsannahme muss etwa nicht nur einen neuen Auftrag speichern. Sie muss auch klären, wie mit fehlenden Artikeldaten, abweichenden Lieferadressen, Freigaben oder Stornierungen umgegangen wird.

Vor der Umsetzung sollten daher Ziel, Nutzergruppen und die erste Ausbaustufe feststehen. Hilfreich sind echte Beispieldaten, vorhandene Formulare, Fotos von Arbeitsplätzen und Gespräche mit den Menschen, die täglich mit dem Ablauf arbeiten. Ein reines Management-Interview liefert selten genug Details. Wer einen Scanner bedient, Ware einlagert oder Lieferscheine prüft, kennt die praktischen Einschränkungen meist genauer.

Der kleinste sinnvolle Start

Ein erstes Release muss keine fertige Unternehmensplattform sein. Im Gegenteil: Ein begrenzter, produktiv nutzbarer Kern reduziert Risiko und schafft früh Nutzen. Denkbar wäre eine Anwendung, die zunächst nur Aufträge zentral erfasst, ihren Status sichtbar macht und einen verlässlichen Lieferschein erstellt. Bestandsführung, Schnittstellen oder Tourenplanung können folgen, sobald der Kern im Alltag bestätigt ist.

Diese Reihenfolge verhindert, dass ein Projekt monatelang an Funktionen arbeitet, deren tatsächlicher Nutzen noch unklar ist. Sie schafft außerdem Raum für Korrekturen. Vielleicht ist die vorgesehene Statuslogik zu fein, vielleicht braucht der Wareneingang eine schnellere Eingabemaske oder eine Freigabe erst ab einem bestimmten Warenwert. Solche Erkenntnisse sind kein Scheitern der Planung, sondern Teil einer sauberen Einführung.

Die technische Basis entscheidet über die Folgekosten

Eine Webanwendung wird nicht dadurch wartbar, dass PHP im Angebot steht. Wartbarkeit entsteht durch nachvollziehbare Entscheidungen: eine klare Trennung zwischen Oberfläche, Geschäftslogik und Datenzugriff, eindeutige Datenmodelle, automatisierte Tests für kritische Regeln sowie eine dokumentierte Auslieferung.

PHP 8.4 eignet sich dafür sehr gut. Die Sprache ist ausgereift, effizient zu betreiben und für viele geschäftskritische Anwendungen eine sachliche Wahl. In Verbindung mit modernem JavaScript kann die Oberfläche schnell und direkt reagieren, ohne jede Funktion unnötig kompliziert als Einseitenanwendung aufzubauen. MySQL 8 bietet eine solide Grundlage für Transaktionen, Rechtekonzepte und konsistente Datenbestände.

Gerade bei Lager- und Auftragsprozessen darf eine Buchung nicht halb gespeichert werden. Wird ein Artikel ausgebucht, müssen Bestand, Bewegungsprotokoll und Auftragsstatus zusammenpassen. Datenbanktransaktionen sorgen dafür, dass entweder alle nötigen Änderungen erfolgen oder keine. Das klingt nach einem Detail, entscheidet aber darüber, ob ein System im Ausnahmefall verlässlich bleibt.

Sicherheit gehört ebenso in den Kern der Architektur. Rollen und Berechtigungen müssen zum Arbeitsalltag passen: Eine Person im Wareneingang braucht andere Rechte als die Buchhaltung oder ein externer Fahrer. Sichere Passworthashes, Konto-Sperrungen nach fehlgeschlagenen Anmeldeversuchen, Sitzungsverwaltung und Protokolle für kritische Änderungen sind keine Extras für später. Sie gehören in die erste produktive Version.

Schnittstellen nur dort bauen, wo sie Arbeit sparen

Viele Projekte werden unnötig groß, weil von Beginn an jede denkbare Integration geplant wird. Schnittstellen zu Shop, ERP, Versanddienstleister oder Buchhaltung können sehr sinnvoll sein. Sie sind aber nur dann gut, wenn sie einen klaren manuellen Schritt ersetzen oder Datenqualität deutlich verbessern.

Ein Beispiel: Werden Versandlabels täglich aus Auftragsdaten erstellt, spart eine direkte Anbindung Zeit und reduziert Übertragungsfehler. Werden Rechnungsdaten dagegen nur einmal pro Woche in ein bestehendes System übertragen und ist der Prozess stabil, kann ein strukturierter Export für den Start ausreichen. Die technisch elegantere Lösung ist nicht automatisch die wirtschaftlichere.

Auch die Datenhoheit sollte vorab geklärt werden. Welche Daten werden gespeichert, wie lange bleiben Protokolle verfügbar, wer darf sie exportieren und wie funktionieren Sicherungen sowie Wiederherstellung? Für Unternehmen im DACH-Raum sind diese Fragen nicht bloß IT-Formalitäten. Sie betreffen Datenschutz, Betriebsfähigkeit und Vertrauen im Team.

Einführung ohne den Betrieb auszubremsen

Die beste Anwendung scheitert, wenn sie während der Umstellung den Tagesablauf blockiert. Deshalb sollte die Einführung mit echten Fällen vorbereitet werden: repräsentative Aufträge, reale Artikel, typische Lieferadressen und bekannte Sonderfälle. Erst wenn diese Abläufe nachvollziehbar funktionieren, sollte das System eine zentrale Aufgabe übernehmen.

Ein paralleler Betrieb kann für kurze Zeit sinnvoll sein, etwa wenn Bestände abgeglichen oder neue Dokumente geprüft werden müssen. Er darf aber nicht zum Dauerzustand werden. Zwei führende Datenquellen erzeugen zwangsläufig Differenzen. Es braucht einen klaren Stichtag, ab dem feststeht, welches System verbindlich ist.

Ebenso wichtig ist eine kurze, rollenbezogene Einweisung. Ein Mitarbeitender im Lager braucht keine Erklärung der Administrationsfunktionen. Er braucht Sicherheit bei den wenigen Schritten, die unter Zeitdruck sitzen müssen. Gute Anwendungen helfen dabei mit verständlichen Bezeichnungen, plausiblen Vorgaben und Fehlermeldungen, die erklären, was als Nächstes zu tun ist.

Woran Sie einen passenden Entwicklungspartner erkennen

Wer eine Webanwendung beauftragt, kauft nicht einfach Entwicklungsstunden. Gesucht ist ein Partner, der Prozessfragen ernst nimmt, technische Entscheidungen begründet und auch widerspricht, wenn eine Anforderung unnötig teuer oder riskant wird. Direkter Zugang zu erfahrenen Entwicklern ist dabei mehr wert als ein aufwendiger Vertriebsprozess mit späteren Übergaben.

Achten Sie auf konkrete Aussagen zu Architektur, Betrieb und Weiterentwicklung. Wie werden Änderungen dokumentiert? Wie laufen Updates ab? Wer reagiert bei einer Störung? Gibt es eine nachvollziehbare Teststrategie für kritische Buchungen und Rechte? Eine Oberfläche kann bei der Präsentation überzeugend wirken. Entscheidend ist, ob sie auch nach zwei Jahren angepasst werden kann, ohne dass jede Änderung zum Neubau wird.

softify.pro arbeitet deshalb mit einer schrittweisen, prozessnahen Umsetzung: erst die operative Engstelle verstehen, dann einen belastbaren Kern liefern und darauf aufbauen. Das ist weniger spektakulär als ein großes Transformationsversprechen, aber im laufenden Betrieb meist deutlich wertvoller.

Eine gute Webanwendung muss nicht möglichst viele Funktionen enthalten. Sie muss dafür sorgen, dass ein Auftrag nicht verloren geht, ein Bestand nachvollziehbar bleibt und Mitarbeitende ihre Arbeit ohne unnötige Rückfragen erledigen können. Wenn das gelingt, wird aus einer technischen Investition ein Werkzeug, das jeden Arbeitstag messbar ruhiger macht.

Permalink →

Versandetiketten automatisch erzeugen und Fehler senken

Versandetiketten automatisch erzeugen und Fehler senken

Ein Auftrag ist gepackt, die Ware steht an der Rampe - und jemand sucht noch die richtige Versandart, tippt die Empfängeradresse in ein Carrier-Portal und druckt das Etikett aus. Dieser Ablauf kostet pro Paket nur wenige Minuten. Bei 30, 80 oder 300 Sendungen am Tag wird er zum Engpass. Versandetiketten automatisch erzeugen heißt deshalb nicht einfach, einen Drucker anzuschließen. Es heißt, Auftragsdaten, Versandregeln und den tatsächlichen Packprozess so zu verbinden, dass aus einer fertigen Sendung verlässlich ein passendes Label wird.

Für kleine und mittlere Unternehmen ist das oft der sinnvollste Einstieg in die Logistikautomatisierung. Der Nutzen zeigt sich unmittelbar auf dem Hallenboden: weniger Rückfragen, weniger falsch adressierte Pakete und ein klarer Status für Vertrieb, Lager und Kundenservice. Trotzdem lohnt es sich, den Prozess vor der technischen Umsetzung genau anzusehen. Ein schlecht gepflegter Artikelstamm oder unklare Versandregeln werden durch Automatisierung nicht besser - sie werden nur schneller weiterverarbeitet.

Was beim automatischen Etikettendruck tatsächlich passiert

Ein Versandetikett enthält mehr als Name und Adresse. Je nach Dienstleister gehören dazu eine Sendungsnummer, ein maschinenlesbarer Code, Routing-Informationen, Services wie Altersprüfung oder Nachnahme sowie bei Auslandssendungen Zollangaben. Damit der Carrier ein Label erzeugen kann, müssen diese Informationen vollständig und im erwarteten Format vorliegen.

Der technische Ablauf beginnt üblicherweise mit einem Auftrag im Shop, ERP oder einer individuellen Auftragsverwaltung. Sobald der Auftrag versandbereit ist, ermittelt das System anhand definierter Regeln Dienstleister, Produkt und Zusatzleistungen. Anschließend übergibt es die Daten an die Schnittstelle des Carriers oder an eine Versandplattform. Diese registriert die Sendung, liefert Trackingnummer und Etikett zurück, und das System legt die PDF- oder Druckdaten am Auftrag ab. Erst dann wird gedruckt - am Arbeitsplatz, am Packtisch oder direkt über einen Etikettendrucker.

Diese Reihenfolge ist entscheidend. Ein hübsches Etikett ohne erfolgreiche Sendungsanmeldung hilft nicht weiter. Umgekehrt darf eine erfolgreiche Anmeldung nicht im Hintergrund verschwinden, wenn der Drucker kein Material mehr hat. Gute Prozesse behandeln Registrierung, Ausgabe und Statusrückmeldung als zusammenhängenden Vorgang.

Versandetiketten automatisch erzeugen beginnt mit klaren Regeln

Die häufigste Fehlannahme lautet: Für jeden Auftrag soll immer derselbe Dienstleister gewählt werden. Das kann passen, etwa bei homogenen B2C-Sendungen innerhalb Deutschlands. Viele Betriebe brauchen jedoch differenziertere Regeln. Eine schwere Lieferung, eine Expressbestellung, eine Abholung im Paketshop oder eine Sendung in die Schweiz stellen unterschiedliche Anforderungen.

Sinnvolle Regeln können Gewicht und Maße, Zielland, Lieferadresse, Warenwert, gewünschte Laufzeit, Gefahrgutkennzeichen und vereinbarte Kundenkonditionen berücksichtigen. Dabei gilt: Nicht jede theoretische Ausnahme muss vom ersten Tag an automatisiert sein. Wenn zwei Sonderfälle im Monat auftreten, ist ein sichtbar markierter manueller Schritt häufig günstiger und sicherer als eine komplizierte Regelmaschine. Wiederkehrende Fälle mit nennenswertem Volumen gehören dagegen in den Standardprozess.

Besonders wichtig ist die Datenquelle. Gewichte aus einem gepflegten Artikelstamm sind für gleichartige Waren brauchbar. Bei gemischten Aufträgen, variabler Verpackung oder Zuschlägen für Übergrößen sollte das endgültige Paketgewicht am Packplatz erfasst werden. Das System kann das Label dann erst nach dem Wiegen erzeugen. Das ist ein zusätzlicher Handgriff, verhindert aber teure Korrekturen und Nachbelastungen.

Adressqualität entscheidet vor dem Druck

Viele Versandprobleme entstehen vor der Übergabe an den Carrier. Hausnummern landen im falschen Feld, Postleitzahlen passen nicht zum Ort oder Firmenadressen enthalten unklare Empfängernamen. Eine Automatisierung sollte Adressen daher nicht nur weiterreichen, sondern vorab prüfen. Pflichtfelder, Länderformate, Zeichenlängen und erkennbare Dubletten lassen sich direkt beim Auftragseingang abfangen.

Eine Adressprüfung ist keine Garantie für Zustellbarkeit. Sie senkt jedoch die Zahl vermeidbarer Fehler. Bei auffälligen Daten sollte das System den Auftrag klar zur Klärung stellen, statt stillschweigend ein unvollständiges Etikett zu erzeugen. Im Lager muss sichtbar sein, warum ein Auftrag wartet und wer die Information liefern kann.

Der Packplatz braucht eine einfache Bedienung

Die beste Schnittstelle scheitert, wenn Mitarbeitende beim Verpacken zwischen fünf Masken wechseln müssen. Ein praxistauglicher Packdialog zeigt nur, was für die aktuelle Sendung nötig ist: Auftrag, Artikel, Lieferadresse, Verpackungsstatus, Gewicht, gewählte Versandart und Druckstatus. Ein Barcode-Scan auf Lieferschein oder Kommissionierbeleg sollte den richtigen Auftrag öffnen. Nach dem Wiegen reicht im Idealfall eine bestätigende Aktion, um das Etikett zu erstellen und zu drucken.

Bei mehreren Packplätzen braucht jeder Arbeitsplatz eine eindeutige Zuordnung zum Drucker. Auch das Etikettenformat muss zum Gerät und zum Carrier passen. A6 ist für viele Paketlabels üblich, aber nicht jede Rolle, jeder Thermodrucker und jede Dokumentenablage arbeitet gleich. Wer Etiketten zunächst als PDF auf einem Büro-Laserdrucker ausgibt, kann schnell starten. Bei höherem Volumen sind Thermodrucker meist sinnvoller: Sie vermeiden Schneiden, Kleben und das Risiko, dass ein Label beim Ausdrucken auf die falsche Seite rutscht.

Ein guter Prozess meldet technische Probleme verständlich. „API Error 403“ hilft am Packtisch nicht. Besser ist: „Etikett nicht erzeugt: Zugang zum Versanddienstleister prüfen“ oder „Drucker Packplatz 2 nicht erreichbar“. Der Auftrag darf dabei nicht versehentlich als versendet gelten. Er bleibt in einem klaren Fehlerstatus und kann nach der Behebung erneut verarbeitet werden, ohne eine zweite Sendung anzumelden.

Schnittstellen brauchen Fehlerbehandlung, nicht nur einen Happy Path

Carrier-Schnittstellen sind externe Systeme. Sie können zeitweise nicht erreichbar sein, Eingaben ablehnen oder ihr Antwortformat ändern. Auch ein lokales Netzwerk, ein Druckdienst oder abgelaufene Zugangsdaten können den Ablauf unterbrechen. Deshalb ist es riskant, den Erfolg allein daran festzumachen, dass ein Benutzer auf „Label erstellen“ geklickt hat.

Technisch sollte jede Anfrage nachvollziehbar protokolliert werden: Zeitpunkt, Auftrag, verwendeter Versandservice, Ergebnis, Trackingnummer und verständliche Fehlermeldung. Sensible Daten und Zugangsschlüssel gehören dabei nicht ungeschützt in Logdateien. Eine eindeutige interne Sendungs-ID verhindert, dass ein Wiederholungsversuch doppelte Labels oder doppelte Abrechnungen erzeugt.

Auch Stornierungen gehören in die Planung. Wird ein Paket nach dem Etikettendruck doch nicht abgeholt oder neu verpackt, muss klar sein, ob die Sendung beim Carrier annulliert werden kann und wie das im eigenen System dokumentiert wird. Ohne diesen Schritt stimmen Versandstatus, Tracking und Abrechnung nach einigen Wochen nicht mehr überein.

Nicht jedes Unternehmen braucht sofort eine große Versandplattform

Versandplattformen können mehrere Carrier, Tariflogiken und Rücksendungen bündeln. Das ist sinnvoll, wenn Sendungsvolumen, Zielländer und Dienstleister vielfältig sind. Wer jedoch einen klaren Versandprozess und einen oder zwei Carrier hat, kann mit einer direkten Anbindung übersichtlicher fahren. Weniger Systeme bedeuten weniger Datenabgleich, weniger Benutzerkonten und weniger Stellen, an denen Fehler entstehen.

Die Entscheidung hängt nicht nur vom Paketvolumen ab. Relevant sind auch Retouren, Exportdokumente, individuelle Versandregeln, vorhandene Auftragsquellen und die Frage, wer Änderungen später pflegt. Eine Tabellenlösung bleibt beispielsweise vertretbar, wenn täglich wenige Sendungen mit gleichbleibenden Daten verschickt werden. Sobald Kollegen Informationen mehrfach übertragen oder der Versand an einzelne Personen gebunden ist, wird ein zentraler Ablauf meist wirtschaftlicher.

Für kundenspezifische Prozesse kann eine schlanke Webanwendung sinnvoll sein, die Auftragsdaten, Lagerbewegungen, Lieferscheine und Labeldruck zusammenführt.
softify.pro setzt solche Systeme mit nachvollziehbarer Datenstruktur, dokumentierter Bereitstellung und wartbaren Technologien wie PHP 8.4 und MySQL 8 um. Entscheidend ist dabei nicht die Zahl der Funktionen, sondern dass der Ablauf für das Team am Packplatz verständlicher wird.

In kleinen Schritten einführen und messbar verbessern

Ein kontrollierter Start ist besser als ein großer Wechsel an einem Montagmorgen. Zuerst wird ein klar abgegrenzter Standardfall automatisiert, etwa nationale Pakete eines Carriers mit einem definierten Etikettenformat. Parallel sollten einige Tage lang automatisch erzeugte Daten gegen den bisherigen Ablauf geprüft werden: Adresse, Gewicht, Versandprodukt, Trackingnummer und gedrucktes Label.

Danach lassen sich Ausnahmen ergänzen. Hilfreiche Kennzahlen sind die Bearbeitungszeit je Sendung, die Zahl manueller Korrekturen, nicht gedruckte oder doppelt erzeugte Labels und die Zeit bis zur Tracking-Rückmeldung an den Kunden. Diese Werte zeigen, ob die Automatisierung wirklich Arbeit abnimmt oder nur einen alten Umweg digital abbildet.

Am Ende zählt kein besonders komplexer Versanddialog. Es zählt, dass ein gepackter Auftrag ohne Suchen, Nachtippen und Unsicherheit das richtige Etikett erhält - und dass Ausnahmen dort sichtbar werden, wo ein Mensch tatsächlich entscheiden muss.

Permalink →

Login-Prozess automatisiert testen mit System

Login-Prozess automatisiert testen mit System

Ein Login wirkt erst dann banal, wenn er funktioniert. Fällt er nach einem Release aus, stehen Mitarbeitende vor dem Schichtbeginn, Kunden vor dem Kundenportal oder Disponenten vor einer blockierten Auftragsbearbeitung. Den Login-Prozess automatisiert testen heißt deshalb nicht einfach, Benutzername und Passwort in ein Formular einzutragen. Es bedeutet, einen geschäftskritischen Zugang mit seinen Regeln, Ausnahmen und Sicherheitsgrenzen wiederholbar zu prüfen.

Für viele Teams beginnt die Automatisierung mit einem einzelnen positiven Testfall: gültige Zugangsdaten eingeben, Anmeldung bestätigen, Startseite sehen. Das ist sinnvoll, aber als alleiniger Test unzureichend. Login-Fehler entstehen oft an den Rändern: bei abgelaufenen Sessions, gesperrten Konten, einer neuen Mehrfaktor-Authentifizierung oder einer Berechtigung, die nach einem Rollenwechsel nicht mehr korrekt greift. Genau diese Fälle müssen planbar abgedeckt sein.

Warum der Login besondere Testdisziplin verlangt

Der Login ist gleichzeitig Sicherheitsfunktion, technische Schnittstelle und Einstieg in den Arbeitsablauf. Ein Fehler kann zu offen sein und unberechtigten Zugriff erlauben. Er kann aber auch zu streng sein und berechtigte Personen aussperren. Beides kostet: Im ersten Fall entstehen Risiken für Daten und Compliance, im zweiten Stillstand, Supportaufwand und hektische Sonderlösungen.

Bei Webanwendungen kommen weitere Abhängigkeiten hinzu. Der Login kommuniziert häufig mit einem Identity Provider, einem Mail-System für Passwort-Resets, einer MFA-App oder einem Verzeichnisdienst. Bei Windows-Desktop-Anwendungen können lokale Rechte, Netzwerkverbindungen und Versionsstände Einfluss nehmen. Ein Test, der nur das Formular im Browser betrachtet, erkennt solche Integrationsprobleme nicht zuverlässig.

Deshalb sollte das Team vor der ersten Testautomatisierung festlegen, was ein erfolgreicher Login im jeweiligen System bedeutet. Reicht eine sichtbare Startseite? Oder muss geprüft werden, ob die richtige Mandantenauswahl geladen wurde, ob die Benutzerrolle stimmt und ob die erste geschützte Aktion tatsächlich möglich ist? Für ein Lagerportal wäre das beispielsweise der Zugriff auf den Wareneingang. Für ein Dispositionssystem kann es die Freigabe einer Tour sein.

Login-Prozess automatisiert testen: Vom Ablaufmodell zum Testfall

Ein guter Ausgangspunkt ist kein Skript, sondern ein Ablaufmodell. Der Login lässt sich als Folge klarer Zustände beschreiben: nicht angemeldet, Zugangsdaten übermittelt, Identität bestätigt, MFA erforderlich, angemeldet, Session abgelaufen oder Konto gesperrt. Zu jedem Zustand gehören erlaubte Aktionen und erwartete Reaktionen des Systems.

Aus diesem Modell entstehen Testfälle mit fachlichem Wert. Der positive Standardfall gehört dazu, aber ebenso ungültige Passwörter, nicht vorhandene Benutzerkonten und abgelaufene Reset-Links. Wichtig ist dabei die erwartete Rückmeldung. Eine Anwendung sollte bei fehlerhaften Zugangsdaten keine Information preisgeben, ob eine E-Mail-Adresse existiert. Der Test prüft daher nicht nur, dass ein Fehler angezeigt wird, sondern auch, dass dessen Text und Verhalten keine unnötigen Hinweise liefern.

Besonders relevant sind Schutzmechanismen gegen wiederholte Fehlversuche. Nach einer definierten Anzahl falscher Eingaben kann ein Konto zeitweise gesperrt werden. Der automatisierte Test muss prüfen, ob die Sperre wirklich greift, wie lange sie gilt und ob der legitime Nutzer anschließend wieder kontrolliert Zugang erhält. Hier ist Präzision nötig: Ein Test, der produktive Konten absichtlich sperrt, schafft mehr Probleme als er löst. Solche Szenarien gehören in eine getrennte Testumgebung mit eigens dafür angelegten Konten.

MFA, Passwort-Reset und Single Sign-on getrennt betrachten

Mehrfaktor-Authentifizierung ist kein Detail am Ende des Logins. Sie verändert den Ablauf. Ein Test muss erkennen, dass nach dem Passwort eine zusätzliche Bestätigung erforderlich ist, und er muss die erfolgreiche wie die abgelehnte Bestätigung abbilden. Bei zeitbasierten Einmalcodes braucht die Testumgebung einen kontrollierten Umgang mit Zeit und Geheimnissen. In vielen Fällen ist eine vom Identity Provider vorgesehene Testmethode sinnvoller als das Nachbilden eines echten Mobiltelefons.

Auch Passwort-Reset und Single Sign-on sollten eigene Teststrecken erhalten. Beim Reset zählen der Versand der Nachricht, die Einmaligkeit des Links, die Gültigkeitsdauer und die anschließende Anmeldung mit dem neuen Passwort. Beim SSO ist entscheidend, ob die Anwendung nach der Rückkehr vom Identity Provider die Session korrekt anlegt und Rollen sauber übernimmt.

CAPTCHAs bilden einen Sonderfall. Sie sollen automatisierte Angriffe bremsen und sollten nicht durch Testautomatisierung umgangen werden. Sinnvoll ist stattdessen eine Testkonfiguration, ein offizieller Testschlüssel oder eine abgesicherte Ausnahme für die Testumgebung. Sicherheitskontrollen auszutricksen, nur damit ein Test grün wird, ist keine Qualitätsstrategie.

Die passende technische Testebene wählen

Nicht jeder Login-Test muss durch einen echten Browser laufen. API-Tests können prüfen, ob Token, Sessions, Fehlermeldungen und Sperrregeln korrekt funktionieren. Sie sind schnell und helfen, Fehler nahe an der Authentifizierungslogik zu finden. Browser-Tests zeigen dagegen, ob Felder, Weiterleitungen, Cookies, SameSite-Einstellungen und sichtbare Zustände im echten Nutzerablauf zusammenpassen.

Für kritische Anwendungen ist die Kombination sinnvoll. Wenige End-to-End-Tests prüfen den kompletten Weg mit dem Browser. Darunter sichern gezielte API- und Integrationstests die Varianten ab. Das reduziert Laufzeit und Fehlalarme. Wer jede denkbare Kombination ausschließlich im Browser testet, erhält oft eine langsame Suite, deren Pflege mehr Zeit frisst als sie spart.

Bei Desktop-Software gilt ein ähnliches Prinzip. Ein automatisierter Test sollte nicht bloß kontrollieren, ob sich ein Fenster öffnet. Er muss feststellen, ob nach der Anmeldung die korrekte Datenverbindung besteht, die Benutzerrechte aktiv sind und die zentrale Arbeitsmaske erreichbar ist. Gerade bei Anwendungen im Lager oder in der Fertigung ist das relevant, weil Arbeitsplätze unterschiedliche Netzbedingungen, Scanner-Anbindungen oder lokale Konfigurationen haben können.

Testdaten sicher und wiederholbar behandeln

Login-Tests arbeiten zwangsläufig mit Zugangsdaten. Produktive Mitarbeiterkonten, echte Kundendaten oder MFA-Geheimnisse gehören jedoch nicht unkontrolliert in Testskripte, Logs und Screenshots. Testkonten müssen klar gekennzeichnet, minimal berechtigt und automatisch zurücksetzbar sein. Passwörter und Tokens werden über sichere Geheimnisverwaltung bereitgestellt, nicht im Quellcode abgelegt.

Ebenso wichtig ist die Bereinigung nach dem Testlauf. Wenn ein Test neue Sessions, Audit-Einträge oder gesperrte Konten erzeugt, muss die Testumgebung in einen definierten Ausgangszustand zurückkehren. Sonst schlägt ein Test am Montag nur deshalb fehl, weil ein Lauf vom Freitag noch Nebenwirkungen hinterlassen hat.

Für Unternehmen mit vertraulichen Anwendungen entscheidet auch der Ausführungsort. Screenshots von Login-Masken, Testvideos und technische Protokolle können sensible Informationen enthalten. Eine selbst gehostete Testinfrastruktur wie COCO kann hier sinnvoll sein, weil Testdaten, Ausführung und Nachweise unter eigener Kontrolle bleiben. Ob das erforderlich ist, hängt von Schutzbedarf, Vertragslage und internen Vorgaben ab. Für jede Anwendung ist eine eigene Infrastruktur nicht automatisch die wirtschaftlichste Wahl.

Nachweise erzeugen, nicht nur grüne Haken

Ein Testbericht sollte für QA, Entwicklung und Fachbereich verständlich machen, was geprüft wurde. Ein grüner Status ohne Kontext hilft wenig, wenn ein Release später Fragen auslöst. Sinnvoll sind daher Zeitstempel, verwendete Testumgebung, Testkonto, relevante Schritte, Screenshots bei Fehlern und eine klare Fehlermeldung in Alltagssprache.

Dabei darf die Beweissicherung nicht selbst zum Datenschutzproblem werden. Passwörter, Einmalcodes, Session-IDs und personenbezogene Daten müssen in Protokollen maskiert werden. Bei Screenshots kann es nötig sein, bestimmte Bereiche auszublenden. Diese Regeln sollten Teil der Testarchitektur sein, nicht eine manuelle Nacharbeit nach einem Vorfall.

Was Teams zuerst automatisieren sollten

Die Priorität richtet sich nach Risiko und Nutzungshäufigkeit. Zuerst kommen der Standard-Login für die wichtigsten Rollen, fehlerhafte Zugangsdaten, Logout und Session-Ablauf. Danach folgen Sperrregeln, Passwort-Reset, MFA und Rollenwechsel. SSO, Sondermandanten oder seltene Ausnahmewege können später folgen, sofern ihr Ausfall nicht unmittelbar den Betrieb stoppt.

Die Tests gehören in den Release-Prozess. Änderungen an Login-Formularen, Cookies, Berechtigungen oder Identity-Provider-Konfigurationen sollten die relevante Testsuite auslösen, bevor eine Version in die Produktion geht. Zusätzlich lohnt sich ein geplanter Lauf in einer realitätsnahen Umgebung, etwa nach Infrastrukturänderungen oder Zertifikatswechseln. Das findet Probleme, die in einer isolierten Entwicklungsumgebung nicht sichtbar sind.

Der beste Login-Test ist am Ende nicht der mit den meisten Klicks. Er ist der, der einen realen Ausfall früh erkennt, verständlich dokumentiert und sich bei der nächsten Änderung noch verlässlich ausführen lässt. Wer den Login als klar modellierten Geschäftsprozess behandelt, schützt nicht nur ein Formular. Er schützt den Zugang zur Arbeit, die dahinter wartet.

Permalink →

Lieferscheine automatisch erstellen mit Software

Lieferscheine automatisch erstellen mit Software

Die Suche nach „Lieferscheine automatisch erstellen Software“ beginnt meist nicht mit einem Dokumentenproblem. Sie beginnt am Packtisch: Ein Auftrag ist freigegeben, Ware wurde kommissioniert, doch der Lieferschein liegt noch als Word-Vorlage, Excel-Export oder handschriftlicher Zettel vor. Während jemand Positionen kontrolliert, ändern sich Mengen, Lieferadressen oder Teillieferungen. Das kostet Zeit - und erzeugt genau die Fehler, die später Rückfragen, Korrekturen und unnötige Abstimmung auslösen.

Ein automatisch erzeugter Lieferschein ist deshalb mehr als ein PDF mit Logo. Er ist der dokumentierte Übergang zwischen Auftrag, Lagerbewegung und Versand. Damit das zuverlässig funktioniert, muss die Software nicht möglichst viele Funktionen anbieten. Sie muss den tatsächlichen Ablauf im Betrieb korrekt abbilden.

Wann sich Lieferscheine automatisch erstellen mit Software lohnt

Nicht jeder Betrieb braucht sofort eine individuelle Anwendung. Wer wenige Sendungen pro Woche bearbeitet, feste Artikel verkauft und mit einer gepflegten Vorlage arbeitet, kann mit einer Tabellenlösung gut fahren. Eine Automatisierung wird dann sinnvoll, wenn Mitarbeitende Daten mehrfach eingeben, Aufträge regelmäßig in Teillieferungen zerfallen oder der Versandstatus nicht eindeutig nachvollziehbar ist.

Typische Warnsignale sind fragil gewordene Excel-Dateien, unterschiedliche Artikelbezeichnungen in Auftrag und Lager, fehlende Belege bei Rückfragen oder Lieferscheinnummern, die manuell vergeben werden. Auch wenn mehrere Personen zwischen Büro, Lager und Versand arbeiten, reicht eine gemeinsame Ablage oft nicht mehr aus. Dann fehlt nicht nur Geschwindigkeit, sondern eine verlässliche Quelle dafür, was tatsächlich das Haus verlassen hat.

Der entscheidende Punkt lautet: Der Lieferschein sollte durch ein Ereignis entstehen, nicht durch einen zusätzlichen Arbeitsschritt. Dieses Ereignis kann die Freigabe zur Kommissionierung, die bestätigte Entnahme oder der Abschluss des Packvorgangs sein. Welche Variante passt, hängt von Ihrem Prozess ab. In einem Ersatzteillager ist die Lagerbuchung häufig der richtige Auslöser. Bei kundenspezifischer Fertigung kann die Versandfreigabe durch die Arbeitsvorbereitung maßgeblich sein.

Welche Daten ein automatischer Lieferschein wirklich braucht

Ein gutes System übernimmt nicht einfach alle Daten aus einem Auftrag. Es prüft, welche Informationen zum Zeitpunkt der Lieferung gelten. Der Empfänger kann vom Rechnungsempfänger abweichen, eine Bestellung kann in mehreren Sendungen ausgeliefert werden, und die gelieferte Menge kann kleiner sein als die ursprünglich bestellte Menge.

Mindestens erforderlich sind eine eindeutige Lieferscheinnummer, Ausstellungsdatum, Lieferadresse, Kundenreferenz sowie die tatsächlich gelieferten Positionen mit Mengen und Einheiten. Je nach Branche kommen Chargen, Seriennummern, Gewichte, Verpackungseinheiten, Kommissionierer oder Hinweise zur Warenannahme hinzu. Wenn diese Daten später für Reklamationen oder Rückverfolgbarkeit gebraucht werden, gehören sie nicht in ein Freitextfeld, sondern in klar definierte Datenfelder.

Auftrag, Lagerbewegung und Dokument müssen zusammenpassen

Die häufigste Schwachstelle liegt zwischen Auftrag und Lager. Der Auftrag sagt vielleicht zehn Stück voraus, das Lager bestätigt aber nur acht Stück. Werden trotzdem zehn Stück auf den Lieferschein gedruckt, entsteht ein problematischer Beleg. Werden acht Stück geliefert, ohne den Auftragsstatus anzupassen, bleibt die Restmenge unsichtbar.

Eine passende Software führt diese Zustände getrennt, aber verbunden: bestellt, reserviert, kommissioniert, geliefert, gegebenenfalls retourniert. Der Lieferschein greift auf die bestätigten Liefermengen zu. So bleibt auch bei Teil- und Nachlieferungen nachvollziehbar, welche Position in welcher Sendung enthalten war.

Nummernkreise und Versionen sind keine Nebensache

Lieferscheinnummern manuell zu vergeben wirkt zunächst unkompliziert. Spätestens bei mehreren Standorten, verschiedenen Benutzerkonten oder nachträglichen Korrekturen wird es fehleranfällig. Die Anwendung sollte Nummern zentral erzeugen und verhindern, dass dieselbe Nummer doppelt verwendet wird.

Ebenso wichtig ist der Umgang mit Änderungen. Ein bereits versendeter Lieferschein sollte nicht still überschrieben werden. Besser ist eine erkennbare Korrektur, Stornierung oder neue Version mit nachvollziehbarer Historie. Das ist technisch kein Luxus, sondern schützt Mitarbeitende davor, mit widersprüchlichen Informationen zu arbeiten.

So funktioniert die Erstellung im praktischen Ablauf

In einem klaren Prozess startet alles mit einem strukturierten Auftrag. Artikel, Mengen, Lieferadresse und gewünschter Termin werden einmal erfasst oder aus einem vorhandenen System übernommen. Anschließend entsteht ein Kommissionierauftrag für das Lager - auf einem mobilen Gerät, als Ausdruck oder an einem Arbeitsplatzterminal.

Beim Packen werden die tatsächlich entnommenen Mengen bestätigt. Bei einfachen Abläufen genügt ein Bestätigungsbutton. Bei vielen Artikeln, Lagerplätzen oder Chargen sind Barcode-Scans sinnvoller. Erst nach dieser Rückmeldung erstellt die Software den Lieferschein als PDF, weist eine Nummer zu und ordnet ihn dem Versandvorgang zu. Parallel kann sie ein Versandetikett vorbereiten, sofern der jeweilige Paketdienst technisch angebunden ist.

Der erzeugte Beleg wird zentral gespeichert und bleibt über Auftrag, Kundenkonto oder Sendungsnummer auffindbar. Ein Mitarbeiter im Innendienst muss dann nicht mehr im E-Mail-Postfach suchen, wenn ein Kunde nachfragt, was an einem bestimmten Tag geliefert wurde. Er sieht den Auftrag, die einzelnen Lieferungen und den jeweiligen Dokumentstand an einer Stelle.

Das klingt geradlinig, scheitert aber häufig an Sonderfällen. Deshalb muss die Anwendung sie bewusst behandeln: Was passiert bei Fehlmengen? Wer darf eine Lieferadresse nach Freigabe ändern? Kann ein Lieferschein ohne Lagerbestand erzeugt werden? Wie werden kostenlose Beigaben oder Ersatzlieferungen gekennzeichnet? Solche Regeln entscheiden darüber, ob die Automatisierung auf dem Lagerboden akzeptiert wird.

Standardsoftware oder individuelle Lösung?

Standardsoftware ist sinnvoll, wenn Ihr Ablauf weitgehend dem vorgesehenen Modell folgt und Schnittstellen zu Shop, Warenwirtschaft oder Versanddienstleistern bereits vorhanden sind. Sie reduziert den Einführungsaufwand und bietet oft eine breite Funktionspalette. Der Preis dafür kann sein, dass Teams ihre funktionierenden Abläufe um ein starres System herum organisieren müssen.

Eine individuelle Lösung lohnt sich vor allem dann, wenn Ihre Logik geschäftskritisch ist: etwa bei kundenindividuellen Verpackungsregeln, komplexen Teillieferungen, mehreren Lagerbereichen oder einer Verbindung aus Werkstatt, Produktion und Versand. Sie kann sich auf die Funktionen konzentrieren, die täglich gebraucht werden, statt Mitarbeitende durch Module zu schicken, die niemand nutzt.

Dazwischen liegt häufig der sinnvollste Weg: Vorhandene Systeme bleiben führend für Artikelstammdaten oder Buchhaltung, während eine schlanke Webanwendung die operative Lücke im Lager schließt. Über klar dokumentierte Schnittstellen lassen sich Aufträge übernehmen, Bestände zurückmelden und Lieferscheine archivieren. Für solche Anwendungen sind eine nachvollziehbare Datenstruktur, rollenbasierte Zugriffe und getestete Importprozesse wichtiger als ein besonders spektakuläres Interface.

Bei softify.pro werden solche Prozesse zunächst am konkreten Warenfluss geprüft: Wer löst aus, wer bestätigt, welche Ausnahme tritt tatsächlich auf, und welche Daten müssen später belegbar sein? Erst danach wird entschieden, ob eine Anpassung am bestehenden System genügt oder eine eigene Anwendung wirtschaftlich sinnvoll ist.

Einführung ohne den Betrieb auszubremsen

Der sicherste Start ist selten die vollständige Digitalisierung aller Lagerprozesse an einem Stichtag. Beginnen Sie mit einem klar abgegrenzten Lieferweg, etwa Standardaufträgen eines Standorts oder einer Produktgruppe. Dabei wird sichtbar, ob Artikelstammdaten, Adressqualität und Mengenlogik ausreichend sauber sind.

Im nächsten Schritt sollten echte Aufträge parallel geprüft werden. Die Software erstellt den Lieferschein, während der bisherige Ablauf noch als Kontrollinstanz verfügbar bleibt. Abweichungen sind in dieser Phase wertvoll: Sie zeigen nicht zwingend einen Softwarefehler, sondern oft ungeklärte Prozessregeln. Wenn etwa zwei Mitarbeiter denselben Auftrag unterschiedlich packen würden, muss zuerst die Arbeitsregel eindeutig werden.

Danach folgen Rollen und Rechte. Lagerpersonal braucht andere Ansichten als Vertrieb oder Buchhaltung. Nicht jeder sollte Liefermengen nachträglich ändern oder Dokumente stornieren dürfen. Eine gute Lösung macht Zuständigkeiten sichtbar, ohne jede kleine Handlung in ein kompliziertes Freigabeverfahren zu zwingen.

Auch der technische Betrieb gehört zur Einführung. Dokumente und Bewegungsdaten benötigen regelmäßige Sicherungen, eindeutige Aufbewahrungsregeln und getestete Wiederherstellungswege. Bei einer Webanwendung mit PHP 8.4 und MySQL 8 sind saubere Datenbanktransaktionen besonders wichtig: Eine Lagerbuchung und die Erstellung des zugehörigen Lieferscheins dürfen nicht auseinanderfallen, wenn eine Verbindung im falschen Moment abbricht.

Drei Fehler, die Automatisierung unnötig teuer machen

Der erste Fehler ist, ein PDF-Problem zu automatisieren, obwohl die Daten davor unklar sind. Wenn Artikelnummern, Einheiten oder Kundenadressen nicht gepflegt sind, erzeugt das System nur schneller fehlerhafte Dokumente.

Der zweite Fehler ist ein zu großer Projektumfang. Lieferscheine, Lager, Versand, Einkauf, Produktion und Buchhaltung gleichzeitig neu aufzusetzen, bindet Teams oft über Monate. Ein kleiner, belastbarer Lieferprozess schafft schneller Vertrauen und liefert eine Grundlage für weitere Schritte.

Der dritte Fehler ist fehlende Rückmeldung aus dem Lager. Ein Lieferschein darf nicht allein auf Basis eines geplanten Auftrags entstehen, wenn niemand bestätigt hat, was wirklich gepackt wurde. Genau diese Rückmeldung macht aus einer Dokumentvorlage einen belastbaren Prozess.

Die beste Software für Lieferscheine verschwindet im Alltag fast aus dem Blick. Mitarbeitende erfassen einen Auftrag einmal, bestätigen ihre Arbeit dort, wo sie stattfindet, und finden den richtigen Beleg wieder, wenn er gebraucht wird. Wenn das gelingt, entsteht nicht nur ein schnellerer Versand - sondern ein Ablauf, auf den sich Lager, Büro und Kunden gleichermaßen verlassen können.

Permalink →

Windows Anwendung automatisch testen: So gelingt es

Windows Anwendung automatisch testen: So gelingt es

Ein Release steht bereit, doch niemand kann mit Sicherheit sagen, ob der neue Importdialog, die Rechteprüfung und der Rechnungsdruck noch funktionieren. Genau an diesem Punkt wird es teuer, eine Windows Anwendung automatisch testen zu können - nicht als Demo mit drei Klicks, sondern als wiederholbaren Teil des Release-Prozesses.

Desktop-Software ist in vielen Betrieben geschäftskritisch. Sie steuert Lagerbewegungen, Fertigungsaufträge, Kundenstammdaten oder Versanddokumente. Ein Fehler wirkt nicht nur auf einem Bildschirm: Er kann Aufträge blockieren, falsche Etiketten erzeugen oder Mitarbeitende in der Spätschicht zu manuellen Notlösungen zwingen. Automatisierte Tests reduzieren dieses Risiko, wenn sie auf reale Arbeitsabläufe und eine technisch kontrollierte Testumgebung ausgerichtet sind.

Warum Windows-Tests anders sind als Webtests

Eine Webanwendung testet man meist über klar ansprechbare Elemente im Browser. Bei Windows-Desktop-Anwendungen hängt die Bedienung stärker von Fenstern, Dialogen, nativen Controls, Auflösung, Berechtigungen und installierten Komponenten ab. Ein Test muss etwa erkennen, ob ein Dialog wirklich geöffnet wurde, ein Feld editierbar ist oder ein Druckauftrag korrekt übergeben wurde.

Hinzu kommt die gewachsene Realität vieler Anwendungen. Manche Oberflächen bestehen aus klassischen WinForms- oder WPF-Komponenten, andere binden ältere Module, PDF-Viewer oder Schnittstellen zu Druckern und Scanner-Hardware ein. Es gibt nicht das eine Automatisierungsverfahren, das für jede Anwendung gleich gut funktioniert. Wer das verschweigt, produziert Tests, die im Labor gut aussehen und beim nächsten Update ausfallen.

Der sinnvolle Startpunkt ist deshalb nicht das Tool, sondern die Frage: Welche Abläufe müssen bei jedem Release nachweisbar funktionieren? Für eine Lager- oder Auftragssoftware wären das beispielsweise Anmeldung, Rechteprüfung, Auftragserfassung, Bestandsbuchung, Belegerstellung und die Übergabe an eine Schnittstelle. Diese Prozesse liefern Geschäftswert. Ein Test, der nur prüft, ob ein Menü sichtbar ist, liefert ihn selten.

Windows Anwendung automatisch testen: Die passende Ebene wählen

Für die Automatisierung stehen grundsätzlich drei Ebenen zur Verfügung. Idealerweise werden sie kombiniert, statt ausschließlich auf die sichtbare Oberfläche zu setzen.

Auf der technischen Ebene prüfen Unit- und Integrationstests Geschäftslogik, Datenzugriffe und Schnittstellen. Sie laufen schnell und zeigen früh, ob etwa eine Preisberechnung, ein Importformat oder eine Berechtigungsregel beschädigt wurde. Sie ersetzen jedoch keinen Bedienungstest: Ob ein Disponent die Funktion tatsächlich erreichen und korrekt ausführen kann, bleibt offen. Die zweite Ebene sind UI-Tests über die Windows-Automation-API. Dabei sprechen Testwerkzeuge Steuerelemente über Eigenschaften wie Automation-ID, Name oder Control-Type an. Das ist meist stabiler als Tests, die bloß an feste Bildschirmkoordinaten klicken. Entwickelnde Teams können diese Stabilität gezielt fördern, indem sie eindeutige IDs vergeben und relevante Controls nicht bei jeder Oberflächenänderung umbenennen.

Die dritte Ebene arbeitet visuell. Hier erkennt ein System Buttons, Tabelleninhalte, Dialoge oder Zustände anhand des Bildschirminhalts. Das hilft besonders bei älteren Anwendungen, proprietären Komponenten oder Oberflächen, die keine brauchbaren Automation-Informationen liefern. Visuelle Erkennung ist allerdings empfindlicher gegenüber Skalierung, Themes, unerwarteten Pop-ups und unklaren Bildschirmzuständen. Sie braucht definierte Arbeitsplätze, klare Wartebedingungen und nachvollziehbare Nachweise.

Ein KI-gestützter Ansatz kann visuelle Signale besser einordnen als ein reiner Koordinatenklick. Er sollte trotzdem nicht zur Black Box werden. Für kritische Schritte braucht ein Team Screenshots, Protokolle, erwartete Ergebnisse und eine Aussage, weshalb ein Lauf als fehlgeschlagen bewertet wurde. Boring, provable reliability over trend-chasing gilt gerade beim Testen.

Mit einem kleinen, belastbaren Testumfang beginnen

Der häufigste Fehler ist der Versuch, sofort jede Maske zu automatisieren. Das bindet Budget und erzeugt eine große Sammlung fragiler Skripte, bevor überhaupt klar ist, ob der Ansatz den Release-Alltag verbessert. Besser ist ein enger Start mit fünf bis zehn kritischen Abläufen, die heute regelmäßig manuell geprüft werden.

Ein guter erster Testfall hat einen klaren Anfang, eine realistische Eingabe und ein überprüfbares Ergebnis. Beispiel: Ein Benutzer mit der Rolle Lager prüft sich an, legt einen Wareneingang an, bucht einen Artikel auf einen Lagerplatz und druckt den Beleg. Der Test kontrolliert anschließend nicht nur die Erfolgsmeldung, sondern auch Bestand, Belegnummer und den protokollierten Druckauftrag. So wird aus einer Klickfolge ein Nachweis für einen Geschäftsprozess.

Nicht jeder Ablauf eignet sich sofort. Funktionen mit instabiler Hardware, externen Zahlungsdiensten oder häufig wechselnden Drittsystemen benötigen oft einen anderen Zuschnitt. Hier kann man die eigene Anwendung bis zur Übergabe prüfen und die Fremdkomponente über einen kontrollierten Simulator abbilden. Das ist keine Abkürzung, sondern eine saubere Abgrenzung von Verantwortlichkeiten.

Testdaten sind Teil des Systems

Automatisierung scheitert oft nicht an der Oberfläche, sondern an unbrauchbaren Daten. Ein Testkonto ist gesperrt, ein Artikel wurde schon verwendet oder ein vorheriger Lauf hat die erwartete Bestandsmenge verändert. Deshalb braucht die Testumgebung definierte Ausgangsdaten und einen verlässlichen Weg zurück in diesen Zustand.

In der Praxis bedeutet das: getrennte Testdatenbank, festgelegte Benutzerrollen, bekannte Artikel- und Kundensätze sowie kontrollierte Zeit- und Nummernlogik. Bei sensiblen Daten sollten keine Produktionsdaten unkontrolliert kopiert werden. Anonymisierte oder gezielt erzeugte Datensätze sind meist die bessere Wahl. Sie sind berechenbar und senken das Datenschutzrisiko.

Auch Account-Lockout-Flows verdienen besondere Aufmerksamkeit. Wenn fehlgeschlagene Testläufe wiederholt falsche Kennwörter einsetzen, können sie ihre eigenen Zugänge sperren. Solche Szenarien sollten bewusst getestet, aber vom normalen Regressionstest getrennt werden.

Stabilität entsteht durch Betrieb, nicht durch ein einzelnes Tool

Ein UI-Test ist nur dann nützlich, wenn er unter wiederholbaren Bedingungen läuft. Dazu gehören eine feste Windows-Version, definierte Bildschirmauflösung und Skalierung, bekannte Anwendungsversionen sowie ein sauberer Umgang mit Updates, Dialogen und Hintergrundprozessen. Wenn ein Testserver morgens andere Schriftgrößen nutzt als nachts, ist das kein Testproblem - es ist ein Betriebsproblem.

Wartezeiten sollten nicht blind fest eingetragen werden. Drei Sekunden Pause nach jedem Klick machen einen Test langsam und lösen keine Timing-Probleme. Besser ist es, gezielt auf einen Zustand zu warten: Das Fenster ist sichtbar, die Tabelle enthält den erwarteten Datensatz oder der Speichervorgang ist abgeschlossen. Für echte asynchrone Vorgänge braucht es sinnvolle Zeitlimits und eine eindeutige Fehlerdiagnose.

Fehlgeschlagene Läufe gehören in eine Triage, nicht in einen ignorierten Ordner. War die Anwendung defekt? Hat sich die Oberfläche fachlich korrekt verändert? War die Testumgebung nicht verfügbar? Screenshots, Bildschirmaufzeichnungen, technische Logs und Zeitstempel verkürzen diese Klärung erheblich. Ein Bericht in Klartext hilft zudem Fachbereichen zu verstehen, welcher Geschäftsablauf betroffen ist, ohne erst ein Testskript lesen zu müssen.

Datenschutz und Nachweise von Anfang an einplanen

Bei Desktop-Anwendungen zeigen Screenshots häufig Kundennamen, Artikelpreise, Adressen oder interne Kennzahlen. Werden Tests über externe Cloud-Dienste ausgeführt, verlassen Bildschirmdaten und Anwendungsverkehr möglicherweise die eigene Kontrollzone. Für sicherheitsbewusste Teams ist das kein Nebendetail, sondern eine Architekturentscheidung.

Ein selbst gehosteter Testserver kann Testausführung, Bilder und Berichte im eigenen Umfeld halten.
softify.pro setzt dafür mit COCO auf eine Umgebung, die automatisierte Tests für Web- und Windows-Anwendungen ausführt und nachvollziehbare Ergebnisse erzeugt. Ob ein eigener Server sinnvoll ist, hängt vom Schutzbedarf, der vorhandenen IT und der Zahl der Testläufe ab. Für eine kleine, unkritische Anwendung kann ein einfacher Ansatz genügen; bei internen Fachsystemen mit sensiblen Daten ist lokale Kontrolle oft die vernünftigere Option.

Die Aufbewahrung der Nachweise sollte ebenfalls geregelt sein. Nicht jeder Screenshot muss dauerhaft gespeichert werden. Sinnvoll sind Fristen, rollenbasierter Zugriff und eine klare Zuordnung zwischen Testlauf, Anwendungsversion und Ergebnis. So lassen sich Fehler nachstellen, ohne eine zweite unkontrollierte Datensammlung aufzubauen.

Was ein sinnvoller Rollout liefert

Nach einem ersten Durchlauf sollte ein Team nicht nur eine Zahl über bestandene Tests erhalten. Entscheidend ist, ob die Tests reale Fehler finden, ob sie zuverlässig laufen und ob der Pflegeaufwand zum Nutzen passt. Ein Test, der jede Woche wegen einer belanglosen Layoutänderung angepasst werden muss, ist zu teuer - selbst wenn er technisch beeindruckend wirkt.

Der nächste Schritt ist die Einbindung in den Release-Ablauf. Schnelle technische Tests können bei jedem Build starten; ausgewählte End-to-End-Tests laufen vor einer Freigabe oder nachts in einer stabilen Umgebung. Kritische Abweichungen blockieren das Release, weniger kritische Hinweise werden dokumentiert und priorisiert. Diese Schwellen sollten fachlich abgestimmt sein. Nicht jeder Darstellungsunterschied ist ein Auslieferungsstopp, eine falsch gebuchte Menge hingegen schon.

Automatisierte Windows-Tests ersetzen keine Fachkenntnis. Sie schaffen aber Zeit für die Prüfungen, die Urteilsvermögen brauchen: neue Prozesse, ungewöhnliche Sonderfälle und die Frage, ob eine Funktion im Arbeitsalltag wirklich verständlich ist. Wenn die Standardabläufe verlässlich nachweisbar sind, muss ein Release nicht mehr auf Hoffnung beruhen.

Permalink →

Individuelle Logistiksoftware für den Mittelstand

Individuelle Logistiksoftware für den Mittelstand

Wenn der Wareneingang auf Papier erfasst wird, Bestände in mehreren Excel-Dateien stehen und Versandfragen per Zuruf geklärt werden, fehlt selten Einsatzbereitschaft. Es fehlt ein gemeinsamer Prozess. Individuelle Logistiksoftware für Mittelstand setzt genau dort an: nicht mit einem überladenen Konzernsystem, sondern mit einer Anwendung, die die tatsächlichen Wege im Lager, in der Disposition und im Büro abbildet.

Für viele Unternehmen ist das kein Projekt zur Digitalisierung um ihrer selbst willen. Es geht um weniger Rückfragen, verlässliche Bestände, schneller erzeugte Lieferscheine und eine Übergabe zwischen Schichten, die nicht vom Wissen einzelner Personen abhängt. Die beste Lösung ist dabei nicht automatisch die mit den meisten Funktionen. Sie muss die Arbeit nachweisbar einfacher und kontrollierbarer machen.

Der kritische Punkt sind meist die Übergaben

In kleinen und mittleren Lager- und Fertigungsbetrieben funktioniert vieles erstaunlich lange mit Tabellen, E-Mails und Erfahrung. Das ist nicht grundsätzlich falsch. Eine gepflegte Tabelle kann für eine überschaubare Inventurliste sinnvoller sein als ein eigenes System.

Kritisch wird es, wenn Informationen mehrfach erfasst werden oder ihre Verlässlichkeit nicht mehr klar ist. Ein Auftrag wird im Büro angelegt, im Lager ausgedruckt, auf einem Laufzettel ergänzt und später wieder in eine Tabelle übertragen. Gleichzeitig reserviert ein anderer Mitarbeiter Bestand für einen dringenden Versand. Am Ende ist nicht nur der Bestand fraglich. Auch die Frage, wer welchen Schritt wann ausgeführt hat, lässt sich kaum beantworten.

Diese Reibung zeigt sich selten als einzelner großer Fehler. Sie kostet täglich Minuten: bei der Artikelsuche, beim Rückruf eines Kunden, bei der Nachverfolgung einer Lieferung oder bei der Schichtübergabe. Über Wochen entstehen daraus vermeidbare Fehlmengen, Expresssendungen und Diskussionen über Zahlen, denen niemand vollständig vertraut.

Was individuelle Logistiksoftware konkret abbilden sollte

Eine maßgeschneiderte Anwendung beginnt nicht mit einem Funktionskatalog. Sie beginnt mit einer Prozessaufnahme auf dem Hallenboden und am Arbeitsplatz der Disposition. Welche Daten kommen tatsächlich an? Welche Entscheidung trifft ein Mitarbeiter? Welche Ausnahme tritt regelmäßig auf? Und welche Informationen müssen für den nächsten Arbeitsschritt zwingend vorhanden sein?

Daraus entsteht ein klarer Ablauf, beispielsweise vom Auftragseingang über Kommissionierung und Versand bis zur Übergabe an die Buchhaltung. Je nach Betrieb können folgende Bausteine dazugehören:


  • Erfassung von Wareneingängen, Prüfstatus und Lagerplätzen
  • Bestandsbewegungen mit Barcode- oder mobiler Scanner-Unterstützung
  • Auftragsannahme, Reservierungen und Picklisten
  • Lieferscheine, Versandetiketten und Übergabe an Versanddienstleister
  • Routenplanung für eigene Fahrzeuge und Touren
  • Nachvollziehbare Korrekturen, Rollenrechte und Auswertungen

Entscheidend ist nicht, alles auf einmal zu bauen. Ein Betrieb mit häufigen Umlagerungen braucht womöglich zuerst verlässliche Lagerbewegungen. Ein Großhändler mit vielen kleinen Sendungen profitiert zunächst stärker von einem sauberen Auftragseingang und automatisch erzeugten Versanddokumenten. Ein produzierendes Unternehmen benötigt vielleicht zuerst Transparenz über Materialbereitstellung und Sperrbestände.

Ein Beispiel aus dem Tagesgeschäft

Angenommen, der Wareneingang erhält fünf Paletten mit Artikeln, deren Mengen teilweise von der Bestellung abweichen. In einem guten Ablauf wird die Lieferung erfasst, geprüft und einem Status zugeordnet. Erst nach Freigabe wird der Bestand für die Disposition verfügbar. Abweichungen landen nicht in einer Notiz auf dem Lieferschein, sondern sind dem Einkauf und Lager sichtbar zugeordnet.

Wird später kommissioniert, zeigt das System nicht nur einen theoretischen Gesamtbestand, sondern den passenden Lagerplatz und den reservierten Anteil. Nach dem Scan oder der Bestätigung der Entnahme wird die Bewegung protokolliert. Der Lieferschein entsteht aus denselben Daten. Das reduziert doppelte Eingaben und schafft eine belastbare Spur, ohne dass Mitarbeitende mehr Verwaltungsarbeit erledigen müssen.

Standardsoftware, Excel oder Individualentwicklung?

Die ehrliche Antwort lautet: Es kommt auf den Prozess an. Standardsoftware ist sinnvoll, wenn Abläufe weitgehend den vorgesehenen Mustern entsprechen, Anpassungen gering bleiben und die Lizenzkosten zum Umfang passen. Sie bringt oft fertige Module, etablierte Schnittstellen und eine schnelle erste Einführung mit.

Der Nachteil zeigt sich, wenn sich der Betrieb dauerhaft nach dem Werkzeug richten muss. Dann werden Sonderfälle wieder außerhalb des Systems geführt, Pflichtfelder umgangen oder Mitarbeiter pflegen Schattenlisten. Das kann akzeptabel sein, solange diese Ausnahmen selten und beherrschbar bleiben. Häufen sie sich, wird das Standardprodukt zum zusätzlichen Prozessbruch. Excel bleibt ebenfalls ein brauchbares Werkzeug, wenn Datenmengen klein sind, nur wenige Personen gleichzeitig arbeiten und die Folgen einer fehlerhaften Eingabe begrenzt bleiben. Es ist jedoch keine gute Datenbasis für parallel laufende Lagerbewegungen, verbindliche Reservierungen oder eine lückenlose Versandhistorie.

Eine individuelle Lösung lohnt sich besonders, wenn der Ablauf ein echter Wettbewerbsvorteil ist, wenn mehrere Medienbrüche zusammenkommen oder wenn ein vorhandenes System zwar Daten enthält, aber die tägliche Arbeit ausbremst. Sie sollte nicht als Prestigeprojekt verstanden werden. Ihr wirtschaftlicher Wert liegt in kürzeren Durchlaufzeiten, weniger Fehlern und weniger Abhängigkeit von einzelnen Köpfen.

Individuelle Logistiksoftware für den Mittelstand braucht Grenzen

Maßgeschneidert bedeutet nicht, jede Wunschfunktion sofort umzusetzen. Im Gegenteil: Gute Individualentwicklung setzt klare Grenzen. Sonst entsteht ein System, das alle historischen Sonderwege konserviert und dadurch schwer bedienbar wird.

Ein sinnvoller Start definiert einen Kernprozess mit messbarem Nutzen. Etwa: Wareneingänge werden am selben Tag vollständig gebucht. Oder: Für jeden Versandauftrag sind Artikel, Menge, Bearbeiter und Versandstatus eindeutig dokumentiert. Erst wenn dieser Ablauf stabil läuft, folgen weitere Module wie Tourenplanung, Kundenportale oder spezielle Auswertungen.

Auch technische Entscheidungen brauchen Pragmatismus. Eine Webanwendung kann auf modernen, wartbaren Technologien wie PHP 8.4, modernem JavaScript und MySQL 8 aufbauen. Das ist keine Selbstinszenierung mit Technologiebegriffen. Es schafft eine nachvollziehbare Basis für Rollenrechte, Datenbanktransaktionen, mobile Oberflächen und dokumentierte Bereitstellungen. Für Scanner im Lager ist oft entscheidend, dass die Anwendung auf vorhandenen Geräten zuverlässig reagiert und auch bei schwächerem WLAN klare Rückmeldungen gibt.

Nicht jede Funktion benötigt Echtzeit-Komplexität. Manche Auswertungen dürfen nachts aktualisiert werden. Bestandsbuchungen und Reservierungen hingegen müssen unmittelbar konsistent sein. Diese Unterscheidung hält Architektur, Kosten und Betrieb beherrschbar.

Einführung: Erst den Ablauf stabilisieren, dann beschleunigen

Die Einführung scheitert selten an einer einzelnen Oberfläche. Sie scheitert, wenn offene Prozessfragen in die Entwicklungsphase verschoben werden. Wer darf Bestände korrigieren? Was geschieht bei beschädigter Ware? Wann wird ein Auftrag verbindlich reserviert? Wie werden Retouren behandelt? Solche Regeln müssen vor dem breiten Rollout geklärt sein.

Ein belastbarer Weg beginnt mit wenigen repräsentativen Abläufen und echten Daten. Mitarbeitende aus Lager, Disposition und Verwaltung prüfen gemeinsam, ob der Bildschirm die Sprache des Betriebs spricht und ob die Reihenfolge der Arbeitsschritte stimmt. Dabei sind Hinweise wie „Das Feld brauchen wir nicht“ oder „Hier fehlt der Status für Teillieferung“ wertvoller als abstrakte Funktionswünsche.

Danach folgt ein begrenzter Pilotbetrieb. Nicht mit künstlichen Beispielen, sondern mit ausgewählten Aufträgen im Tagesgeschäft. Fehler und unklare Zustände werden dokumentiert, priorisiert und korrigiert. Erst anschließend wird auf weitere Bereiche ausgerollt. Parallelbetrieb kann kurzfristig Sicherheit geben, sollte aber ein Ende haben. Zwei führende Systeme erzeugen auf Dauer genau die Unsicherheit, die das Projekt beseitigen soll.

Schulung ist ebenfalls mehr als eine einmalige Präsentation. Mitarbeitende brauchen kurze, rollenbezogene Anleitungen: Was buche ich? Was prüfe ich? Was tue ich bei einer Abweichung? Eine dokumentierte Ausnahmebehandlung verhindert, dass bei der ersten Sonderlage wieder Papier und Chatgruppen die Führung übernehmen.

Wartbarkeit ist Teil der Lösung, nicht der Nachtrag

Logistikprozesse verändern sich. Neue Lagerplätze kommen hinzu, ein Versanddienstleister ändert Anforderungen, Kunden verlangen andere Belegformate oder ein neuer Standort wird angebunden. Deshalb muss die Software nicht nur beim Start passen, sondern verständlich weiterentwickelbar sein.

Dazu gehören eine saubere Datenstruktur, klar getrennte Fachlogik, Rechtekonzepte und dokumentierte Bereitstellungen. Ebenso wichtig sind Sicherungen, Protokollierung und ein geregelter Umgang mit Fehlern. Wenn ein Nutzer mehrfach falsche Zugangsdaten eingibt, braucht es etwa einen nachvollziehbaren Account-Lockout-Flow statt stiller, unsicherer Improvisation.

Vor Änderungen an kritischen Abläufen sollten Tests stehen. Bei individuellen Anwendungen lohnt sich automatisierte Prüfung besonders für wiederkehrende Kernwege: Auftrag anlegen, Bestand reservieren, Versanddokument erzeugen, Status ändern. So bleibt eine Anpassung am Lieferschein nicht unbemerkt an einer anderen Stelle folgenreich.
softify.pro setzt bei solchen Projekten auf diese Art von langweilig verlässlicher, prüfbarer Technik statt auf kurzfristige Effekte.

Woran sich der Nutzen nach sechs Monaten messen lässt

Nicht jede Verbesserung lässt sich sofort in Euro ausdrücken, aber sie sollte sichtbar sein. Gute Kennzahlen orientieren sich am Engpass: Bearbeitungszeit pro Auftrag, Zahl der Bestandskorrekturen, Fehlversandquote, Anteil termingerechter Wareneingangsbuchungen oder Rückfragen zwischen Lager und Büro.

Wichtig ist der Vergleich mit einer realistischen Ausgangslage. Wenn bisher niemand die Fehlmengen sauber erfasst hat, kann die neue Transparenz zunächst nach mehr Problemen aussehen. Tatsächlich werden Probleme dann erstmals sichtbar und steuerbar. Diese Phase braucht Geduld und eine offene Kommunikation.

Die passende Software verschwindet nicht aus dem Arbeitsalltag, weil sie unwichtig wäre. Sie sorgt dafür, dass ein Auftrag, eine Palette oder eine Tour ihren klaren Weg nimmt - auch dann, wenn die erfahrenste Person im Lager gerade nicht im Haus ist.

Permalink →

Automatisierte Regressionstests für Webanwendungen

Automatisierte Regressionstests für Webanwendungen

Ein geänderter Rabattcode, ein neues Rollenrecht oder ein Update des Zahlungsdienstes kann eine Webanwendung an einer Stelle brechen, die seit Monaten niemand angefasst hat. Genau dort setzen automatisierte Regressionstests für Webanwendungen an: Sie prüfen wiederholt, ob bewährte Geschäftsabläufe nach Änderungen weiterhin funktionieren. Nicht als theoretische Qualitätsmaßnahme, sondern dort, wo ein Fehler Aufträge, Lagerbewegungen, Rechnungen oder Kundenkonten blockiert.

Für viele Teams beginnt das Problem schleichend. Releases dauern länger, weil Fachbereiche dieselben Kernabläufe manuell durchklicken. Testwissen steckt bei einzelnen Personen. Und vor einem Update bleibt die unangenehme Frage: Was haben wir übersehen? Automatisierung ersetzt dabei weder fachliche Verantwortung noch sinnvolle Explorationsarbeit. Sie macht die wiederkehrenden, geschäftskritischen Prüfungen verlässlich, reproduzierbar und nachvollziehbar.

Was automatisierte Regressionstests tatsächlich absichern

Ein Regressionstest beantwortet eine einfache Frage: Funktioniert etwas, das vorher funktioniert hat, nach einer Änderung noch immer? Bei einer Webanwendung geht es dabei selten nur um eine einzelne Schaltfläche. Relevant sind vollständige Abläufe über Oberfläche, Berechtigungen, Schnittstellen und Datenbank hinweg.

Ein Beispiel aus einem operativen System: Ein Mitarbeiter meldet sich an, erfasst einen Wareneingang, bucht eine Bestandsbewegung, erstellt einen Lieferschein und übergibt die Sendung an einen Versanddienst. Jeder Schritt kann technisch korrekt aussehen und dennoch im Zusammenspiel scheitern. Vielleicht wird die Menge gespeichert, aber nicht im Bestand aktualisiert. Vielleicht wird das Etikett erzeugt, aber die Referenznummer fehlt. Vielleicht klappt der Ablauf nur für Administratoren, nicht jedoch für die Rolle im Lager.

Automatisierte Tests können solche Journeys mit definierten Eingaben ausführen und die Ergebnisse prüfen. Dazu gehören sichtbare Ergebnisse in der Benutzeroberfläche ebenso wie Statuswerte, erzeugte Dokumente, E-Mails oder API-Antworten. Der Nutzen steigt, wenn die Prüfung nahe an den Risiken des Betriebs organisiert wird - nicht nach der Anzahl technisch möglicher Testfälle.

Welche Webabläufe zuerst automatisiert werden sollten

Nicht jeder Klick verdient sofort einen automatisierten Test. Eine kaum genutzte Einstellungsseite mit geringem Schadenpotenzial kann zunächst manuell geprüft werden. Dagegen gehören Abläufe mit häufigen Änderungen, hoher Nutzung oder klaren finanziellen und operativen Folgen früh in die Testsuite.

Besonders wertvoll sind Tests für Anmeldung, Passwort-Reset und Account-Lockout. Sie sichern den Zugang zur Anwendung und werden oft durch Änderungen an Identitätsdiensten, Session-Verwaltung oder Sicherheitsregeln beeinflusst. Ebenso wichtig sind Kernprozesse wie Auftragserfassung, Preis- und Steuerberechnung, Freigaben, Bestandsbuchungen, Dokumentenerzeugung und Schnittstellen zu Versand, ERP oder Zahlungsanbietern.

Für Führungskräfte und Fachbereiche hilft eine nüchterne Priorisierung. Fragen Sie nicht zuerst, welche Seite am einfachsten zu testen ist. Fragen Sie: Welcher Fehler stoppt eine Schicht, erzeugt Nacharbeit oder führt zu falschen Kundeninformationen? Daraus entsteht eine Testliste, die den realen Betrieb schützt.

Ein Testfall braucht ein überprüfbares Ergebnis

„Bestellung anlegen“ ist noch kein guter Testfall. Besser ist: Ein Vertriebsmitarbeiter legt mit der Rolle Verkauf einen Auftrag für einen bestehenden Kunden an, fügt einen Artikel mit definierter Menge hinzu, speichert ihn und erzeugt eine Auftragsnummer. Anschließend ist der Status „offen“, die Summe entspricht den Regeln und der Auftrag erscheint in der Liste der offenen Vorgänge.

Diese Präzision ist keine Bürokratie. Sie verhindert Tests, die zwar klicken, aber nicht feststellen können, ob das fachliche Ergebnis stimmt. Sie erleichtert außerdem die Abstimmung zwischen Entwicklung, QA und Fachbereich. Gerade bei individuell entwickelten Systemen sind die Fachleute oft die einzige verlässliche Quelle dafür, was „korrekt“ im Alltag wirklich bedeutet.

Testpyramide statt Browser-Automatisierung für alles

Browser-Tests sind wertvoll, aber sie sind nicht die gesamte Teststrategie. Sie laufen langsamer, sind anfälliger für instabile Testdaten und können bei schlecht gewählten Selektoren nach kleinen UI-Anpassungen brechen. Wer jede Regel ausschließlich über die Oberfläche prüft, baut meist eine langsame und wartungsintensive Suite.

Geschäftslogik wie Preisberechnungen, Mengenprüfungen oder Statusübergänge sollte dort getestet werden, wo sie implementiert ist - etwa als Unit- oder Integrationstest. Schnittstellen lassen sich gezielt mit kontrollierten Antworten prüfen. Browserbasierte End-to-End-Tests bleiben dann für die wenigen Wege reserviert, bei denen das Zusammenspiel aller Komponenten entscheidend ist.

Bei PHP-8.4-Anwendungen mit MySQL 8 bedeutet das beispielsweise: Rechen- und Validierungsregeln werden nah am Code abgesichert, Datenbanktransaktionen und API-Verträge werden integriert getestet, während ein Browser-Test den vollständigen Auftrag bis zum erzeugten Beleg nachvollzieht. Das ist weniger spektakulär als eine große Sammlung sichtbarer Klicktests. Es liefert jedoch schnellere Rückmeldungen und geringeren Pflegeaufwand.

Stabilität entsteht durch Testdaten und klare technische Grenzen

Viele Automatisierungsprojekte scheitern nicht am Testwerkzeug, sondern an unkontrollierten Voraussetzungen. Wenn ein Testkonto gesperrt ist, eine Testbestellung vom Vortag noch existiert oder ein externer Dienst gerade langsam antwortet, entsteht ein Fehlalarm. Solche instabilen Tests verlieren schnell das Vertrauen des Teams.

Testdaten müssen deshalb bewusst angelegt und bereinigt werden. Sinnvoll sind eigene Mandanten oder klar abgegrenzte Datensätze, eindeutige Kennungen pro Testlauf und definierte Startzustände. Ein Test darf nicht zufällig von der Reihenfolge anderer Tests abhängen. Wo externe Dienste beteiligt sind, sollte klar entschieden werden: Wird eine realistische Testumgebung verwendet oder wird die Schnittstelle für den jeweiligen Test simuliert? Beides kann richtig sein.

Auch Selektoren verdienen Aufmerksamkeit. Tests sollten nicht an Layout-Klassen, Textpositionen oder zufälligen HTML-Strukturen hängen. Stabile, ausdrücklich für Tests vorgesehene Kennzeichnungen reduzieren unnötige Wartung. Das ist eine kleine technische Entscheidung mit großer Wirkung, wenn sich Oberfläche und Design regelmäßig weiterentwickeln.

Automatisierte Regressionstests für Webanwendungen in den Release-Prozess einbauen

Der beste Test hilft wenig, wenn er nur vor großen Releases manuell gestartet wird. Sinnvoll ist eine abgestufte Ausführung: Schnelle Code- und Schnittstellentests laufen bei jeder Änderung. Die wichtigsten Browser-Journeys laufen bei Pull Requests oder vor der Bereitstellung in die Staging-Umgebung. Umfangreichere Prüfungen können nachts oder vor einem geplanten Produktivrelease stattfinden.

Entscheidend ist die Rückmeldung. Ein fehlgeschlagener Test braucht nicht nur ein rotes Symbol, sondern verwertbare Hinweise: Welche Daten wurden verwendet? An welchem Schritt trat der Fehler auf? Welcher Screenshot oder welches Protokoll belegt ihn? Für Teams ohne eigene große QA-Abteilung sind verständliche Befunde besonders wertvoll. Sie müssen erkennen können, ob ein Defekt im System, in den Testdaten oder in der Testumgebung liegt.

COCO kann hier als selbst gehostete Testinfrastruktur eingesetzt werden, um Testabläufe auszuführen, Nachweise aufzuzeichnen und Ergebnisse in klarer Sprache aufzubereiten. Das ist vor allem dann relevant, wenn Screenshots, interne Oberflächen oder Testdaten nicht in eine externe Cloud übertragen werden sollen. Selbst gehostet bedeutet allerdings nicht wartungsfrei: Zugriffsrechte, Updates, Kapazitäten und Aufbewahrungsregeln müssen ebenso sauber geplant werden wie die Tests selbst.

Was Kennzahlen aussagen - und was nicht

Eine wachsende Zahl automatisierter Tests ist kein Qualitätsbeweis. Eine Suite mit 2.000 oberflächlichen Tests kann weniger Schutz bieten als 40 sauber gepflegte Tests für die kritischen Wertströme. Aussagekräftiger sind Fragen wie: Wie lange dauert die Rückmeldung nach einer Änderung? Wie viele relevante Fehler werden vor der Produktion gefunden? Wie oft sind Testfehler tatsächlich Fehlalarme? Und welche geschäftskritischen Abläufe sind nachweislich abgedeckt?

Auch die Laufzeit ist ein praktischer Faktor. Wenn eine Suite erst nach vier Stunden Ergebnisse liefert, wird sie im Tagesgeschäft umgangen. Wenn sie in 15 Minuten ein klares Signal zu Anmeldung, Auftrag, Bestand und Dokumenten liefert, unterstützt sie Entscheidungen vor dem Release. Es hängt von Anwendung und Risiko ab, welche Tiefe notwendig ist. Ein internes Planungstool verlangt etwas anderes als ein Kundenportal mit Zahlungen und personenbezogenen Daten.

Der richtige Start ist kleiner als viele erwarten

Beginnen Sie mit einem Prozess, dessen Ausfall spürbar wäre, und bilden Sie ihn vollständig ab. Definieren Sie das erwartete Ergebnis gemeinsam mit den Personen, die diesen Ablauf täglich nutzen. Sorgen Sie für kontrollierte Testdaten, stabile technische Anker und nachvollziehbare Nachweise. Erst wenn dieser erste Test zuverlässig läuft, wird der nächste Prozess ergänzt.

So entsteht keine beeindruckende, aber fragile Testkulisse. Es entsteht eine belastbare Sicherheitslinie für Änderungen - Schritt für Schritt, dort, wo Ihre Webanwendung den Betrieb tatsächlich trägt.

Permalink →

Wareneingang digital erfassen ohne Bestandschaos

Wareneingang digital erfassen ohne Bestandschaos

Ein Lieferschein liegt auf dem Warentisch, die Palette steht bereits im Gang und der Fahrer wartet auf eine Unterschrift. Genau in diesem Moment entscheidet sich, ob ein Bestand später stimmt oder ob die nächste Kollegin nach Material sucht, das laut System vorhanden sein müsste. Wer den Wareneingang digital erfassen will, braucht deshalb mehr als eine Eingabemaske. Der Prozess muss unter Zeitdruck funktionieren, eindeutige Daten erzeugen und zu den tatsächlichen Abläufen im Lager passen.

Papierlisten und Tabellen wirken oft lange ausreichend. Sie werden aber fragil, sobald mehrere Personen buchen, Artikel ähnliche Bezeichnungen haben, Chargen relevant werden oder Ware direkt an Montage, Kommissionierung oder Kundenaufträge weitergeht. Eine gute digitale Erfassung schafft nicht einfach mehr Daten. Sie schafft einen verlässlichen gemeinsamen Stand.

Was beim digitalen Wareneingang wirklich erfasst werden sollte

Der Wareneingang ist der Übergang zwischen Anlieferung und verfügbarem Bestand. Damit dieser Übergang prüfbar bleibt, sollte jede Buchung mindestens beantworten können: Was wurde geliefert, in welcher Menge, wann, von welchem Lieferanten und wohin wurde die Ware eingelagert? Je nach Geschäft kommen Bestellnummer, Lieferscheinnummer, Charge, Seriennummer, Mindesthaltbarkeitsdatum oder Qualitätsstatus hinzu.

Entscheidend ist die Unterscheidung zwischen angekündigter und tatsächlich angenommener Ware. Eine Bestellung kann 100 Stück ausweisen, geliefert werden aber 96 Stück, zwei beschädigte Kartons und zwei Ersatzpositionen. Wenn Mitarbeitende nur die Bestellung bestätigen, wandert ein Fehler direkt in den Bestand. Die digitale Erfassung muss Abweichungen bewusst einfach machen - nicht durch Sonderwege bestrafen.

Für ein Ersatzteillager reicht häufig Artikel, Menge, Lagerplatz und Belegreferenz. In der Fertigung können Chargenfreigaben oder Prüfprotokolle unverzichtbar sein. Mehr Felder sind nicht automatisch besser. Jedes Pflichtfeld kostet Zeit und erhöht die Wahrscheinlichkeit, dass jemand Werte schätzt oder später nachträgt.

Wareneingang digital erfassen: Der Ablauf auf der Lagerfläche

Ein praxistauglicher Ablauf beginnt nicht am Bildschirm im Büro, sondern dort, wo die Ware ankommt. Mitarbeitende öffnen den erwarteten Wareneingang auf einem mobilen Gerät oder erfassen den Lieferschein zunächst über Suche, Bestellnummer oder Barcode. Danach werden Positionen gescannt, gezählt oder gewogen und mit der erwarteten Lieferung abgeglichen.

Ist die Menge korrekt, wird die Ware einem Lagerplatz zugeordnet und gebucht. Bei Abweichungen wird nicht einfach ein Kommentar in ein Freitextfeld geschrieben. Das System hält fest, ob es sich um Fehlmenge, Überlieferung, Transportschaden, falschen Artikel oder eine noch ungeprüfte Position handelt. Ein Foto kann bei sichtbaren Schäden sinnvoll sein, ist aber nicht für jede Anlieferung nötig.

Nach der Buchung sollte klar sein, welchen Status die Ware hat. Manche Artikel sind sofort verfügbar. Andere bleiben gesperrt, bis eine Qualitätsprüfung abgeschlossen ist oder ein Verantwortlicher die Abweichung entschieden hat. Diese Statuslogik verhindert, dass der Vertrieb Ware zusagt, die physisch zwar angekommen, aber noch nicht verwendbar ist.

Der richtige Erfassungspunkt hängt vom Betrieb ab. In einem kleinen Lager kann der Wareneingang direkt am Tor komplett gebucht werden. Bei großen Anlieferungen oder engen Rampenzeiten ist oft eine zweistufige Buchung besser: Erst wird die Lieferung als eingetroffen registriert, anschließend werden Positionen geprüft und eingelagert. Der Vorteil ist Geschwindigkeit an der Rampe. Der Nachteil: Es braucht klare Verantwortlichkeiten, damit offene Prüfungen nicht liegen bleiben.

Scanner, Tablet oder Arbeitsplatz-PC?

Die Hardware sollte dem Bewegungsablauf folgen. Für Artikel mit sauber gedruckten Barcodes ist ein Handscanner meist die schnellste und fehlerärmste Wahl. Mobile Scanner oder Smartphones mit Kamera eignen sich, wenn Mitarbeitende zwischen Wareneingang, Regalen und Sperrfläche unterwegs sind. Ein Tablet kann für komplexere Buchungen mit Fotos, mehreren Mengen oder Prüfhinweisen sinnvoll sein.

Ein fester PC-Arbeitsplatz funktioniert dagegen gut, wenn eine Person Lieferscheine zentral prüft und die Warenannahme räumlich konzentriert ist. Er ist weniger passend, wenn das Team für jede Buchung zum Büro laufen muss. Die eingesparte Lizenz wird dann oft durch Laufwege, Unterbrechungen und verspätete Buchungen bezahlt.

Nicht jeder Artikel braucht einen Barcode. Gerade bei individuellen Bauteilen, Rohmaterialien oder Lieferantenetiketten ist die Kennzeichnung uneinheitlich. Dann sollte das System eine schnelle Suche über Artikelnummer, Lieferantenartikelnummer oder Bestellposition anbieten. Barcode-Scanning ist ein gutes Werkzeug, aber kein Selbstzweck.

Datenqualität entsteht durch Regeln, nicht durch Appelle

Ein Lagerbestand wird nicht dadurch korrekt, dass eine Software installiert ist. Korrektheit entsteht, wenn das System sinnvolle Regeln erzwingt und Ausnahmen sichtbar macht. Eine negative Menge ohne begründeten Vorgang, ein unbekannter Lagerplatz oder eine doppelt verwendete Lieferscheinnummer sollten nicht unbemerkt durchgehen.

Gleichzeitig darf die Prüfung den Betrieb nicht blockieren. Wenn ein Lieferant Lieferscheinnummern wiederverwendet oder Etiketten unleserlich sind, brauchen Mitarbeitende einen nachvollziehbaren Ausweichweg. Beispielsweise kann eine Buchung mit einem Hinweis erfolgen, der später geprüft werden muss. Wichtig ist, dass daraus eine offene Aufgabe wird und kein unsichtbarer Kompromiss.

Besonders wertvoll sind einfache Plausibilitätsprüfungen: Passt der Artikel zur Bestellung? Weicht die Menge über eine definierte Toleranz ab? Ist die Charge bei chargepflichtigen Artikeln vorhanden? Wurde ein Sperrstatus gesetzt, wenn eine Schadensmeldung erfasst wurde? Solche Regeln reduzieren Nacharbeit, ohne das Team mit komplizierten Masken zu überfordern.

Schnittstellen erst bauen, wenn der Kernprozess steht

Viele Unternehmen wünschen sich sofort die Verbindung zu ERP, Einkauf, Versand und Buchhaltung. Das kann richtig sein, aber nur wenn die Datenhoheit klar ist. Ein System sollte eindeutig festlegen, wo Bestellungen entstehen, wo der führende Lagerbestand liegt und welche Daten in welcher Richtung übertragen werden.

Eine schlechte Schnittstelle vervielfacht Fehler schneller als eine Tabelle. Wenn etwa Bestellungen aus dem ERP kommen, der tatsächliche Wareneingang aber im Lagerbuchungssystem entsteht, muss klar sein, welche Status zurückgemeldet werden: vollständig geliefert, teilweise geliefert, gesperrt oder mit Abweichung. Zeitstempel und eindeutige Belegreferenzen sind dabei wichtiger als eine optisch beeindruckende Integration.

Für kleinere Betriebe kann ein kontrollierter CSV-Import zum Start sinnvoller sein als eine teure Echtzeit-Anbindung. Das ist keine Notlösung, wenn Import, Prüfung und Fehlerprotokoll sauber umgesetzt sind. Sobald Mengen, Frequenz oder Folgeprozesse wachsen, wird eine direkte Schnittstelle wirtschaftlicher.

Ein sinnvoller Rollout beginnt mit echten Lieferungen

Bevor Entwicklung oder Standardsoftware ausgewählt wird, lohnt sich eine kurze Prozessaufnahme mit realen Fällen. Nicht nur die Ideallieferung gehört auf den Tisch, sondern auch beschädigte Ware, Teilmengen, falsche Artikel, fehlende Bestellungen und Eilmaterial für die Werkstatt. Daraus ergibt sich, welche Daten und Entscheidungen tatsächlich benötigt werden.

Für den Start reichen häufig ein klar abgegrenzter Bereich, etwa ein Lieferant, eine Warengruppe oder ein Lagerstandort. Das Team arbeitet mit dem neuen Ablauf parallel zu den bisherigen Kontrollen, bis die Buchungen nachvollziehbar stimmen. Erst dann folgt die Ausweitung. Ein Big Bang spart auf dem Projektplan Zeit, erzeugt aber häufig Hektik auf der Fläche.

Wichtige Akzeptanzkriterien sind konkret und messbar:

  • Eine Standardlieferung ist ohne Rückfrage in wenigen Minuten buchbar.
  • Abweichungen erscheinen in einer offenen, zugeordneten Klärliste.
  • Der Bestand eines Artikels lässt sich mit Beleg und Lagerplatz erklären.
  • Berechtigte Mitarbeitende können Korrekturen nachvollziehbar durchführen.
  • Offene oder gesperrte Ware wird nicht versehentlich disponiert.

Ein auf den Betrieb zugeschnittenes System kann hier mehr leisten als eine überladene Suite, wenn es die vorhandenen Arbeitsweisen respektiert.
softify.pro entwickelt solche Logistikprozesse nicht um einer Digitalisierung willen, sondern rund um Buchungen, Verantwortlichkeiten und Daten, die im Alltag belastbar sein müssen.

Kennzahlen, die den Nutzen sichtbar machen

Nach dem Start sollte nicht nur gezählt werden, wie viele Wareneingänge digital gebucht wurden. Aussagekräftiger sind die Zeit zwischen Anlieferung und verfügbarer Ware, die Anzahl ungeklärter Abweichungen, Bestandsdifferenzen bei Inventuren und der Aufwand für Rückfragen im Einkauf oder Vertrieb.

Wenn sich Durchlaufzeit verkürzt, aber die Anzahl nachträglicher Korrekturen steigt, ist der Prozess vermutlich zu schnell und zu wenig prüfbar. Wenn jede Buchung lange dauert, obwohl kaum Abweichungen auftreten, sind womöglich zu viele Pflichtschritte eingebaut. Gute Lagerprozesse suchen nicht die maximale Kontrolle, sondern die passende Kontrolle.

Der beste nächste Schritt ist oft ein Rundgang an der Warenannahme mit drei echten Lieferscheinen. Beobachten Sie, welche Informationen gesucht werden, wo Mitarbeitende Entscheidungen improvisieren und welche Daten später erneut eingegeben werden. Genau dort beginnt ein digitaler Wareneingang, der nicht nur moderner aussieht, sondern den Bestand tatsächlich glaubwürdig macht.

Permalink →

Selbstgehostete KI-Softwaretests im Betrieb

Selbstgehostete KI-Softwaretests im Betrieb

Ein fehlgeschlagener Regressionstest ist selten nur ein roter Eintrag in einer Liste. Er kann bedeuten, dass ein Kommissionierer keinen Lieferschein drucken kann, ein Sachbearbeiter im Auftragssystem festhängt oder ein Update eine Funktion beschädigt, die seit Jahren zuverlässig lief. Selbstgehostete KI Softwaretests setzen genau dort an: Sie automatisieren wiederkehrende Prüfungen, ohne sensible Testdaten, Screenshots oder interne Anwendungsabläufe unnötig an externe Plattformen abzugeben.

Für Teams mit Webanwendungen und Windows-Desktopsoftware ist das mehr als eine Datenschutzfrage. Es geht um Kontrolle über die Testumgebung, nachvollziehbare Fehlernachweise und einen Testbetrieb, der zum eigenen Release-Prozess passt. KI kann dabei Arbeit abnehmen. Sie ersetzt jedoch weder saubere Testfälle noch fachliche Verantwortung.

Wann selbstgehostete KI-Softwaretests sinnvoll sind

Klassische Testautomatisierung ist sehr wirksam, aber sie verlangt Pflege. Selektoren ändern sich, Oberflächen entwickeln sich weiter, Testdaten müssen bereitstehen und Fehlermeldungen wollen eingeordnet werden. Viele Teams automatisieren deshalb nur einen kleinen Teil ihrer kritischen Abläufe - oder testen vor einem Release weiterhin überwiegend von Hand.

KI-gestützte Systeme können diese Lücke verkleinern. Sie lesen Oberflächen kontextbezogener, führen vorgegebene Arbeitsabläufe aus, erkennen sichtbare Abweichungen und fassen das Ergebnis in verständlicher Sprache zusammen. Besonders wertvoll wird das bei Anwendungen, die nicht nur aus API-Aufrufen bestehen, sondern aus realen Benutzeroberflächen: Logins, Eingabemasken, Freigaben, Druckdialogen und Windows-Fenstern.

Selbsthosting ist sinnvoll, wenn die Testläufe vertrauliche Informationen berühren. Das betrifft nicht nur personenbezogene Daten. Auch interne Preise, Kundennamen, Artikelbewegungen, Screenshots von Verwaltungsoberflächen, Zugangsdaten für Testkonten oder Informationen über noch nicht veröffentlichte Funktionen gehören dazu. Wer externe KI-Dienste einsetzt, sollte genau prüfen, welche Daten das eigene Netzwerk verlassen, wie lange sie gespeichert werden und wer darauf zugreifen kann.

Es gibt aber auch Fälle, in denen eine gehostete Plattform ausreicht. Bei einer öffentlichen Marketingseite ohne echte Kundendaten, wenigen Releases und überschaubarer Testtiefe kann sie schneller eingerichtet sein. Die richtige Entscheidung hängt vom Schutzbedarf, der Anwendungslandschaft, den vorhandenen Kompetenzen und der Häufigkeit von Änderungen ab - nicht von einem allgemeinen Cloud- oder KI-Prinzip.

Was im eigenen Umfeld bleibt

Bei einer selbstgehosteten Testumgebung läuft die Testausführung auf Infrastruktur, die das Unternehmen kontrolliert: im eigenen Rechenzentrum, in einer privaten Cloud-Umgebung oder auf einem dedizierten Server im vereinbarten Betriebsmodell. Entscheidend ist nicht allein der Standort eines Servers. Entscheidend ist der gesamte Datenfluss.

Ein sauber aufgebautes System verarbeitet Testschritte, Browser- oder Desktop-Sitzungen, Screenshots, Protokolle und Ergebnisberichte innerhalb dieses kontrollierten Umfelds. Testkonten lassen sich mit minimalen Berechtigungen anlegen. Zugangsdaten können getrennt verwaltet werden. Netzwerkzugriffe lassen sich auf die tatsächlich benötigten Systeme begrenzen. Für besonders sensible Anwendungen kann ein eigener Testmandant sinnvoller sein als Tests mit produktionsnahen Echtdaten.

Das schützt nicht automatisch vor Fehlern. Eine lokal betriebene Lösung braucht Updates, Berechtigungskonzepte, Backups und klare Verantwortlichkeiten. Wer einen Server einmal installiert und dann vergisst, hat keine sichere Testinfrastruktur, sondern eine zusätzliche Betriebsaufgabe. Der Vorteil liegt darin, dass diese Aufgabe planbar und prüfbar bleibt.

Die Testdaten verdienen denselben Schutz wie die Anwendung

Oft konzentriert sich die Sicherheitsdiskussion auf den Quellcode. In der Praxis verraten Testartefakte mindestens genauso viel. Ein Screenshot kann Kundendaten, interne Konditionen und Prozessdetails zeigen. Ein Video eines Testlaufs kann die Struktur eines Backoffice-Systems offenlegen. Ein Protokoll kann URLs, Fehlermeldungen oder technische Versionsstände enthalten.

Deshalb sollten Aufbewahrungsfristen festgelegt werden. Nicht jeder erfolgreiche Lauf muss dauerhaft gespeichert bleiben. Für Fehlernachweise und Releases kann eine definierte Historie dagegen sehr hilfreich sein. Zugriffsrechte auf Berichte gehören in das gleiche Berechtigungskonzept wie Zugriffe auf die Anwendung selbst.

Nicht jede Prüfung sollte von KI gesteuert werden

Die stärksten Testumgebungen kombinieren unterschiedliche Verfahren. Ein Login mit Account-Lockout nach mehreren Fehlversuchen lässt sich präzise und schnell mit deterministischen automatisierten Tests prüfen. Auch Schnittstellen, Berechnungen, Datenbankregeln und Berechtigungen profitieren von klaren Erwartungen: Eingabe A muss Ergebnis B liefern.

KI ist besonders nützlich, wenn die Oberfläche, der Ablauf und die Sicht des Anwenders im Mittelpunkt stehen. Ein Testauftrag kann beispielsweise prüfen, ob ein Disponent einen Auftrag anlegt, eine Route zuweist, ein Dokument erzeugt und den Status korrekt zurückerhält. Die KI kann dabei durch die Anwendung navigieren, Belege erfassen und verständlich dokumentieren, an welcher Stelle der Prozess abgebrochen ist. Für einen tragfähigen Testbetrieb sollten vier Ebenen zusammenspielen:

  • Unit- und Integrationstests sichern Geschäftslogik, Schnittstellen und Datenverarbeitung früh im Entwicklungsprozess ab.
  • UI-Tests prüfen wiederholbare Klickpfade und konkrete Erwartungen in Web- oder Desktopanwendungen.
  • KI-gestützte Ablaufprüfungen bewerten reale Bedienwege und sichtbare Ergebnisse aus Anwendersicht.
  • Explorative Fachtests decken Sonderfälle auf, die noch niemand als feste Regel beschrieben hat.

Eine KI sollte nicht entscheiden, ob eine Preislogik fachlich korrekt ist, wenn die Regeln unklar dokumentiert sind. Ebenso wenig kann sie einen unpräzisen Auftrag sinnvoll ausführen. „Prüfe den Versand“ ist keine belastbare Testbeschreibung. „Lege einen Auftrag mit drei Positionen an, erzeuge ein Versandetikett und prüfe, ob der Status auf versendet wechselt“ ist eine prüfbare Anweisung.

Von der Demo zum belastbaren Testbetrieb

Der häufigste Fehler bei KI-Tests ist ein zu breiter Start. Eine beeindruckende Demo mit einem einzelnen Login sagt wenig darüber aus, ob das System in sechs Monaten Releases absichert. Sinnvoller ist ein enger Einstieg mit zwei bis fünf Abläufen, deren Ausfall echte Kosten verursacht oder wiederkehrend manuellen Prüfaufwand erzeugt.

In einem Lager- oder Logistiksystem könnten das Wareneingang, Umbuchung, Kommissionierung und das Erzeugen eines Lieferscheins sein. In einer Verwaltungssoftware eher Anmeldung, Rechtewechsel, Auftragserfassung und Rechnungsfreigabe. Gute Kandidaten sind häufige Prozesse mit stabilen Regeln und klar sichtbaren Ergebnissen.

Danach braucht jeder Ablauf einen definierten Ausgangspunkt. Welche Daten müssen vorliegen? Welches Testkonto wird verwendet? Darf der Test E-Mails versenden, Etiketten drucken oder Schnittstellen ansprechen? Was wird nach dem Lauf zurückgesetzt? Ohne diese Regeln produziert Automatisierung schnell Testdatenmüll oder blockiert andere Teams.

Auch die Bewertung von Ergebnissen sollte abgestuft erfolgen. Ein fehlender Button ist meist ein klarer Fehler. Eine geringfügig andere Formulierung in einem Hinweistext muss nicht automatisch ein Release blockieren. Hier helfen Confidence Thresholds und eine klare Trennung zwischen automatischer Meldung, manueller Prüfung und tatsächlichem Sperrkriterium. Ein Testbericht sollte nicht nur „fehlgeschlagen“ melden, sondern den ausgeführten Schritt, den sichtbaren Zustand, den Zeitstempel und passende Belege enthalten.

Die Rolle von Screenshots, Videos und Klartext-Berichten

Ein Test, der nur eine technische Fehlermeldung ausgibt, verschiebt Arbeit in das Entwicklungsteam. Fachbereiche können damit oft wenig anfangen. Gute Nachweise verbinden technische Präzision mit Kontext: Was sollte passieren? Was ist tatsächlich passiert? Wo ist es sichtbar? Welche Version wurde geprüft?

Screenshots und Aufzeichnungen verkürzen die Abstimmung erheblich. Der QA-Verantwortliche muss nicht erst versuchen, den Fehler nachzustellen, und der Product Owner sieht sofort, ob ein Abbruch fachlich relevant ist. Gleichzeitig sollten solche Artefakte gezielt gespeichert werden. Erfolgreiche Tests brauchen häufig weniger Beweismaterial als fehlgeschlagene oder kritische Freigaben.

Ein Klartext-Bericht ist kein Ersatz für Logs. Er ist die Brücke zwischen Betrieb, Fachbereich und Entwicklung. Gerade bei mittelständischen Teams, in denen dieselben Personen Prozesse verantworten und Entscheidungen treffen, verhindert diese Brücke unnötige Übersetzungsarbeit.

Betrieb, Wartung und realistische Erwartungen

Selbstgehostete Testautomatisierung ist kein Produkt, das nach der Einrichtung ohne Aufmerksamkeit arbeitet. Anwendungen ändern sich. Browser aktualisieren sich. Testdaten verlieren ihre Gültigkeit. Neue Berechtigungsstufen, Captchas, Mehrfaktor-Anmeldung oder veränderte Druckdialoge beeinflussen Testläufe.

Das ist kein Argument gegen Automatisierung. Es ist ein Argument für einen klaren Wartungsrhythmus. Testfälle sollten wie Produktcode behandelt werden: versioniert, überprüft und bei Änderungen bewusst angepasst. Wenn ein Ablauf dreimal hintereinander aufgrund einer absichtlichen UI-Änderung scheitert, ist nicht die KI das Problem. Dann fehlt die Verbindung zwischen Entwicklung, Release-Planung und Testpflege.

softify.pro setzt dafür mit COCO auf einen dedizierten, selbstgehosteten KI-Server, der Web- und Windows-Anwendungen prüft, Nachweise aufzeichnet und die Ergebnisse verständlich einordnet. Der entscheidende Punkt bleibt jedoch die Einbettung in den Arbeitsalltag: Welche Prozesse werden abgesichert, wer prüft Abweichungen und wann darf ein Release weiterlaufen?

Der beste erste Schritt ist daher nicht, möglichst viele Tests zu kaufen oder zu konfigurieren. Wählen Sie den Ablauf, bei dem ein übersehener Fehler morgen tatsächlich Arbeit im Lager, im Service oder in der Buchhaltung verursacht. Wenn dieser Ablauf verlässlich, nachvollziehbar und unter eigener Datenkontrolle geprüft wird, entsteht aus KI nicht mehr Technik um der Technik willen, sondern spürbare Entlastung.

Permalink →

Excel durch individuelle Software ersetzen

Excel durch individuelle Software ersetzen

Ein Lagerbestand stimmt nur, wenn jemand die richtige Datei geöffnet, den letzten Wareneingang eingetragen und keine Kopie per E-Mail weitergegeben hat. Solange das bei wenigen Vorgängen funktioniert, ist Excel ein gutes Werkzeug. Excel durch individuelle Software zu ersetzen wird erst dann sinnvoll, wenn die Tabelle zum Engpass für Abläufe, Verantwortung und Verlässlichkeit wird.

Das betrifft selten nur das Lager. Aufträge werden per Telefon notiert, Lieferscheine entstehen aus Vorlagen, Bestände liegen in mehreren Dateien, und Rückfragen landen bei genau der Person, die gerade nicht erreichbar ist. Das Problem ist nicht die Tabellenkalkulation selbst. Es ist der Versuch, einen wachsenden operativen Prozess mit einem Werkzeug zu steuern, das keine verbindlichen Abläufe kennt.

Wann Excel nicht mehr das richtige Betriebsmittel ist

Eine Tabelle kann rechnen, filtern und Informationen sichtbar machen. Sie erzwingt aber nicht, dass ein Wareneingang vollständig gebucht wird, dass eine Lieferung vor dem Versand geprüft wurde oder dass zwei Mitarbeitende nicht gleichzeitig denselben Datensatz verändern. Wo solche Regeln geschäftskritisch werden, fehlt Excel die passende Struktur.

Typische Warnsignale sind wiederkehrende Abstimmungen zwischen Schicht, Lager und Büro. Mitarbeitende fragen nach dem aktuellen Stand eines Auftrags, obwohl die Information eigentlich verfügbar sein müsste. Bestandslisten werden vor der Inventur manuell bereinigt. Lieferscheinnummern oder Artikelbezeichnungen werden kopiert und später korrigiert. Und bei einer Abweichung lässt sich oft nicht mehr nachvollziehen, wer wann welchen Wert geändert hat.

Auch die Datei selbst wird zum Risiko. Versionen mit Namen wie „Bestand_final_neu_2“ sind kein Einzelfall, sondern ein Hinweis darauf, dass ein Prozess keine eindeutige Datenquelle hat. Makros können einzelne Arbeitsschritte beschleunigen, lösen aber weder paralleles Arbeiten noch Rollenrechte, Freigaben oder eine belastbare Änderungsverfolgung.

Der Wechsel lohnt sich nicht, weil individuelle Software moderner wirkt. Er lohnt sich, wenn Fehler, Wartezeiten und Kontrollaufwand regelmäßig mehr kosten als die Einführung eines klaren Systems.

Excel durch individuelle Software ersetzen: Was sich konkret ändert

Eine gute Fachanwendung digitalisiert nicht einfach eine bestehende Tabelle. Sie bildet die Entscheidungen und Bewegungen ab, die im Betrieb tatsächlich stattfinden. Bei einem Wareneingang bedeutet das beispielsweise: Lieferung auswählen oder anlegen, Positionen erfassen, Mengen prüfen, Abweichungen begründen, Lagerplatz zuordnen und den Bestand erst danach verbindlich aktualisieren.

Dadurch wird aus einer Liste ein Prozess. Mitarbeitende sehen nur die Schritte, die für ihre Aufgabe nötig sind. Das Büro erkennt den Bearbeitungsstand, ohne telefonisch nachzufassen. Die Lagerleitung kann offene Vorgänge, Differenzen oder fehlende Buchungen prüfen. Eine Änderung bleibt nachvollziehbar, statt still in einer Zelle zu verschwinden.

Der Unterschied liegt auch in der Datenarchitektur. Eine Anwendung mit einer sauber modellierten Datenbank, etwa auf Basis von MySQL 8, führt Artikel, Aufträge, Lagerorte und Bewegungen nicht als lose Kopien. Beziehungen sind eindeutig definiert. Ein Artikel kann nicht versehentlich mit drei unterschiedlichen Nummern angelegt werden, wenn die Geschäftsregel eine eindeutige Nummer verlangt.

Das schafft keine fehlerfreie Realität. Mengen können weiterhin falsch gezählt werden, Lieferungen können beschädigt eintreffen. Die Software sorgt jedoch dafür, dass Abweichungen sichtbar erfasst, zugeordnet und später ausgewertet werden können. Das ist operativ wertvoller als ein scheinbar sauberer Bestand, dessen Entstehung niemand erklären kann.

Nicht jeden Prozess sofort neu bauen

Der verbreitete Fehler ist ein zu großer Start. Wer sämtliche Abläufe eines Unternehmens gleichzeitig ersetzen will, wartet lange auf ein Ergebnis und zwingt viele offene Fragen in ein einzelnes Projekt. Für kleine und mittlere Unternehmen ist ein schrittweises Vorgehen meist sinnvoller.

Der erste Bereich sollte zwei Kriterien erfüllen: Er verursacht spürbaren Aufwand oder Fehlerkosten und lässt sich klar eingrenzen. Das kann die Erfassung eingehender Waren sein, die Erstellung von Lieferscheinen, die Auftragsannahme oder die Steuerung von Lagerbewegungen. Ein konkreter Engpass liefert bessere Anforderungen als die abstrakte Forderung nach einer „digitalen Gesamtlösung“.

Excel darf dabei weiterhin eine Rolle spielen. Für einmalige Kalkulationen, Auswertungen oder kleine Planungslisten ist es oft schneller und günstiger als eine eigene Anwendung. Auch Datenexporte für Controlling oder Steuerberatung bleiben sinnvoll. Entscheidend ist, dass Excel nicht mehr die führende Quelle für zeitkritische Prozesse ist.

Eine individuelle Lösung muss außerdem nicht alle Funktionen eines großen ERP-Systems nachbilden. Ein Betrieb mit zwei Lagern und zehn Mitarbeitenden braucht möglicherweise keine internationale Mandantenlogik, aber sehr wohl saubere Rechte, mobile Erfassung am Lagerplatz und verlässliche Dokumente. Überladene Standardsuiten bringen häufig Funktionen mit, die niemand nutzt, während der zentrale Ablauf dennoch angepasst werden muss.

Anforderungen am Arbeitsplatz beobachten, nicht nur abfragen

Die beste Anforderungsliste entsteht nicht allein im Besprechungsraum. Sie entsteht dort, wo Ware abgeladen, kommissioniert, geprüft und übergeben wird. Ein Gespräch mit der Lagerleitung kann einen Soll-Prozess beschreiben. Die Beobachtung einer Schicht zeigt, welche Informationen fehlen, wann Handschuhe oder Scanner nötig sind und an welchen Stellen Mitarbeitende bewusst Abkürzungen nehmen.

Diese Abkürzungen sind nicht automatisch Fehlverhalten. Sie weisen oft auf ein Systemproblem hin. Wenn ein Mitarbeiter Nummern auf Papier notiert, weil der Rechner zu weit entfernt ist, sollte die Lösung nicht lediglich ein Pflichtfeld am Desktop sein. Vielleicht braucht der Prozess eine mobile Erfassungsmaske, einen Etikettendruck oder einen klareren Übergabepunkt zwischen Wareneingang und Einlagerung.

In der Konzeption sollten daher konkrete Fragen beantwortet werden: Wer legt einen Auftrag an? Wer darf Mengen korrigieren? Was passiert bei einer Teillieferung? Wann wird ein Lieferschein erzeugt? Welche Daten müssen sichtbar sein, wenn das Netzwerk im Lager kurzzeitig nicht verfügbar ist? Und welche Kennzahlen werden tatsächlich genutzt, statt nur in einem Dashboard gut auszusehen?

Je klarer diese Entscheidungen vor der Entwicklung sind, desto weniger Sonderlogik entsteht später. Gute Individualsoftware bildet nicht jede historische Ausnahme nach. Sie trennt sinnvolle betriebliche Regeln von Gewohnheiten, die nur deshalb bestehen, weil das bisherige Werkzeug Grenzen gesetzt hat.

Technik, Rechte und Betrieb von Anfang an mitdenken

Eine Fachanwendung muss im Alltag wartbar bleiben. Das betrifft nicht nur die Oberfläche, sondern auch klare Datenmodelle, dokumentierte Bereitstellung, Backups und Zuständigkeiten. Moderne Webanwendungen können mit PHP 8.4, aktuellem JavaScript und MySQL 8 solide aufgebaut werden. Entscheidend ist nicht der Trendwert eines Technologie-Stacks, sondern ob er langfristig verständlich, testbar und betreibbar ist.

Rollen und Rechte gehören früh in das Konzept. Nicht jeder Nutzer sollte Preise, Stammdaten oder historische Buchungen ändern können. Für sensible Funktionen sind nachvollziehbare Freigaben, Protokolle und bei Bedarf Kontosperren nach fehlgeschlagenen Anmeldeversuchen sinnvoll. Solche Details wirken zunächst technisch, vermeiden aber im Betrieb unklare Verantwortung.

Ebenso wichtig ist die Datenübernahme. Bestehende Excel-Dateien enthalten häufig Dubletten, uneinheitliche Einheiten oder nicht mehr verwendete Artikel. Diese Daten ungeprüft zu importieren, verlagert alte Probleme in das neue System. Besser ist eine kontrollierte Bereinigung mit klaren Regeln: Welche Daten werden übernommen, welche archiviert und welche müssen vor dem Start fachlich geprüft werden?

Einführung ohne Stillstand im Betrieb

Ein Go-live darf den Versand nicht gefährden. Deshalb braucht die Einführung einen begrenzten Pilotbereich, echte Testfälle und Mitarbeitende, die den Ablauf kennen. Es reicht nicht, Beispielaufträge anzulegen. Das System muss mit Teillieferungen, falschen Mengen, Stornos, Zeitdruck und den Ausnahmen umgehen, die im normalen Tagesgeschäft auftreten.

Eine kurze Parallelphase kann sinnvoll sein, sollte aber ein klares Ende haben. Werden Tabelle und neue Anwendung zu lange gleichzeitig gepflegt, entsteht doppelte Arbeit und erneut die Frage, welche Quelle gilt. Besser ist ein definierter Umstellungstermin, begleitet durch geschulte Ansprechpartner und eine schnelle Rückmeldungsschleife für Fehler oder fehlende Details.

Nach dem Start zeigt sich der Wert einer individuellen Lösung nicht an einer besonders aufwendigen Oberfläche. Er zeigt sich, wenn ein Auftrag ohne Rückfrage weiterläuft, der Bestand erklärbar bleibt und eine neue Kollegin den Prozess nach kurzer Einweisung sicher bedienen kann. Genau dort sollte die nächste Entscheidung ansetzen: nicht bei der nächsten Excel-Datei, sondern bei dem konkreten Arbeitsschritt, der morgen wieder Zeit kostet.

Permalink →

Lagerprozesse mit Software digitalisieren

Lagerprozesse mit Software digitalisieren

Ein Kommissionierer sucht zehn Minuten nach einem Artikel, der laut Excel-Datei im Regal liegen soll. Gleichzeitig bucht ein Kollege Wareneingang auf einem Papierformular, während im Büro eine Bestellung telefonisch geändert wird. Solche Situationen sind kein Zeichen schlechter Arbeit. Sie zeigen, dass Informationen den physischen Warenbewegungen nicht mehr zuverlässig folgen.
Wer Lagerprozesse mit Software digitalisieren will, sollte deshalb nicht bei einer möglichst langen Funktionsliste anfangen, sondern bei genau diesen Brüchen im Alltag.

Für kleine und mittelständische Unternehmen ist die Frage selten, ob ein internationales Enterprise-System technisch leistungsfähig wäre. Die Frage ist, ob es den Weg vom Wareneingang bis zum Versand tatsächlich verkürzt - oder ob es neue Masken, Freigaben und Schulungsaufwand schafft. Gute Digitalisierung ersetzt nicht jeden Handgriff. Sie sorgt dafür, dass jeder notwendige Handgriff zur richtigen Information, Buchung und Folgeaktion führt.

Wann Lagerprozesse mit Software digitalisieren sinnvoll ist

Eine Tabellenkalkulation ist nicht grundsätzlich ein Problem. Für einen überschaubaren Bestand, wenige Mitarbeitende und seltene Bewegungen kann sie vernünftig, günstig und transparent sein. Ein Wechsel lohnt sich erst, wenn die Datei zur inoffiziellen Schaltzentrale wird: mehrere Versionen kursieren, Bestände werden nachträglich korrigiert oder nur einzelne Personen verstehen die Formeln und Ablagen.

Typische Auslöser sind nicht abstrakte Wachstumsziele, sondern wiederkehrende operative Reibung. Bestände stimmen nach Inventuren regelmäßig nicht. Wareneingänge bleiben bis zum Feierabend ungebucht. Lieferungen gehen ohne vollständigen Lieferschein raus. Mitarbeitende rufen sich gegenseitig an, um den Standort eines Artikels oder den Status eines Auftrags zu klären. Oder eine Person überträgt dieselben Daten nacheinander in E-Mail, Excel, Versandportal und Buchhaltung.

Digitalisierung bedeutet in diesem Kontext: Das System bildet einen klaren Zustand ab. Ein Artikel ist eingetroffen, geprüft, eingelagert, reserviert, kommissioniert oder versendet. Jede Statusänderung hat einen Auslöser, einen Zeitpunkt und idealerweise eine verantwortliche Person. Das schafft keine Bürokratie, sondern verhindert, dass sich Entscheidungen auf Vermutungen stützen.

Der richtige Startpunkt: Bewegungen statt Softwaremodule

Viele Einführungen beginnen mit der Frage nach Funktionen wie Scanner-Anbindung, Chargenverwaltung oder Dashboards. Das ist verständlich, führt aber oft zu einem überladenen Pflichtenheft. Sinnvoller ist eine Prozessaufnahme entlang der tatsächlichen Warenbewegung.

Nehmen Sie einen realen Auftrag und verfolgen Sie ihn vom Eingang bis zur Übergabe an den Versanddienstleister. Wo entstehen Informationen? Wer prüft sie? Wo wird etwas auf Papier notiert, später übertragen oder mündlich weitergegeben? Besonders wertvoll sind die Ausnahmen: Teillieferungen, beschädigte Ware, Ersatzartikel, gesperrte Bestände und Rücksendungen. Der Standardprozess sieht auf dem Whiteboard meist sauber aus. Die Ausnahmen bestimmen, ob die neue Anwendung im Alltag akzeptiert wird.

Für einen ersten Workshop reichen oft drei Fragen: Welche Information fehlt Mitarbeitenden am häufigsten? Welche Buchung wird am häufigsten verspätet oder doppelt erledigt? Und welche Fehler kosten im Monat tatsächlich Zeit, Geld oder Kundenvertrauen? Daraus lassen sich Prioritäten ableiten, ohne die gesamte Lagerorganisation gleichzeitig umzustellen.

Ein kleiner, vollständiger Ablauf schlägt einen großen Systemstart

Statt alle Prozesse auf einmal zu digitalisieren, sollte ein Bereich durchgängig funktionieren. Ein sinnvoller erster Umfang kann beispielsweise Wareneingang, Einlagerung und Bestandsführung abdecken. Lieferavis oder Bestellung werden erfasst, Ware wird geprüft, ein Lagerplatz zugewiesen und der Bestand unmittelbar gebucht. Erst wenn dieser Ablauf stabil läuft, folgen Kommissionierung, Versandetiketten oder Tourenplanung.

Das reduziert Projektrisiko. Mitarbeitende lernen nicht nur eine neue Oberfläche, sondern einen klar abgegrenzten Ablauf. Gleichzeitig wird sichtbar, welche Regeln in der Praxis fehlen. Etwa die Frage, ob ungeprüfte Ware bereits reservierbar sein darf oder ob Fehlmengen sofort einen Klärfall erzeugen sollen.

Welche Funktionen im Lager wirklich Wirkung zeigen

Die beste Lageranwendung ist nicht die mit den meisten Menüpunkten. Sie macht den nächsten Arbeitsschritt eindeutig und dokumentiert die Bewegung ohne doppelte Erfassung. In vielen Betrieben liefern vor allem vier Bausteine schnell messbare Verbesserungen:

  • Eine zentrale Bestandsführung mit Artikeln, Varianten, Lagerorten, Mindestbeständen und Sperrbeständen verhindert konkurrierende Excel-Versionen.
  • Mobile Buchungen per Handscanner oder Smartphone verbinden Einlagerung, Umlagerung und Entnahme direkt mit dem tatsächlichen Ort der Ware.
  • Auftrags- und Kommissionierlisten zeigen Priorität, Status und Fehlmengen, statt Aufträge über Zurufe oder Papierstapel zu verteilen.
  • Automatisch erzeugte Lieferscheine, Versandlabels und Bewegungsprotokolle reduzieren manuelle Übertragungen und erleichtern die Nachverfolgung.

Ob Barcode-Scanning sofort nötig ist, hängt vom Lager ab. Bei wenigen Artikeln und festen Regalen kann eine übersichtliche Eingabemaske zunächst ausreichen. Bei vielen ähnlichen Artikeln, wechselnden Lagerplätzen oder hohem Durchsatz ist Scannen dagegen meist keine Komfortfunktion, sondern eine Fehlerbremse. Entscheidend ist auch die Funkabdeckung auf der Fläche. Eine mobile Anwendung, die an mehreren Regalgängen keine Verbindung hat, verlagert das Problem nur in eine Warteschlange späterer Nachbuchungen.

Auch Automatisierung braucht klare Grenzen. Ein System kann Versandaufträge nach Cut-off-Zeit priorisieren oder bei Mindestbestand eine Bestellanforderung vorbereiten. Es sollte aber nicht stillschweigend Bestellungen auslösen, wenn Lieferzeiten, Freigabelimits oder Sonderkundenaufträge berücksichtigt werden müssen. Gute Software schlägt vor, markiert Abweichungen und dokumentiert Entscheidungen. Sie nimmt Teams nicht die Kontrolle über Ausnahmefälle.

Datenqualität ist keine Aufgabe für später

Die Digitalisierung scheitert selten an PHP, Datenbank oder Scanner-Hardware. Sie scheitert häufiger daran, dass Artikelnummern nicht eindeutig sind, Einheiten unterschiedlich verstanden werden oder historische Bestände ohne Prüfung übernommen werden. Aus „Karton“ wird sonst je nach Person ein Stück, eine Verpackungseinheit oder eine Palette.

Vor dem Import sollten Stammdaten daher bereinigt werden: eindeutige Artikelkennungen, verständliche Bezeichnungen, definierte Einheiten, nachvollziehbare Lagerorte und Regeln für aktive oder gesperrte Artikel. Nicht jeder alte Datensatz muss in das neue System. Veraltete Dubletten und nicht mehr verwendete Lagerplätze mitzunehmen, konserviert nur alte Unsicherheit in einer moderneren Oberfläche.

Technisch braucht die Anwendung eine belastbare Grundlage. Eine klare Datenbankstruktur in MySQL 8 kann Bestandsbewegungen als einzelne, nachvollziehbare Ereignisse speichern, statt nur einen überschreibbaren aktuellen Wert zu führen. So lässt sich klären, warum ein Bestand abweicht: Wareneingang, Entnahme, Umlagerung, Inventurkorrektur oder Stornierung. Mit wartbaren Technologien wie PHP 8.4 und modernem JavaScript bleibt eine individuelle Anwendung zugleich erweiterbar, ohne für jede kleine Anpassung zum Großprojekt zu werden.

Integration nur dort, wo sie Doppelarbeit beseitigt

Ein Lager arbeitet selten isoliert. Aufträge kommen aus Shop, ERP, E-Mail oder Telefon. Versanddaten gehen an Dienstleister, Belege an Buchhaltung und Kennzahlen an die Geschäftsleitung. Trotzdem muss nicht am ersten Tag jedes Fremdsystem angebunden sein.

Priorität haben Schnittstellen, die wiederholte manuelle Übertragung ersetzen oder Fehlerquellen beseitigen. Wenn Bestellungen täglich aus einem Webshop abgeschrieben werden, ist eine klare Übergabe wertvoll. Wenn ein Versanddienstleister Etiketten und Sendungsnummern bereitstellt, kann eine Anbindung den Packprozess spürbar beschleunigen. Eine selten genutzte Exportdatei darf dagegen zunächst ein kontrollierter Export bleiben.

Wichtig sind eindeutige Zuständigkeiten bei Fehlern. Was passiert, wenn ein Auftrag im Shop angelegt, aber nicht in die Lageranwendung übertragen wurde? Werden Übertragungen protokolliert, Dubletten erkannt und fehlgeschlagene Vorgänge sichtbar markiert? Schnittstellen sind erst dann zuverlässig, wenn sie auch für den Ausnahmefall ein verständliches Verfahren bieten.

Einführung im Schichtbetrieb: Akzeptanz entsteht auf der Fläche

Software wird nicht durch eine Präsentation eingeführt, sondern zwischen Wareneingangstor, Packtisch und Regal. Deshalb sollten erfahrene Lagermitarbeitende früh eingebunden sein. Sie kennen Abkürzungen, Sicherheitsanforderungen und die Stellen, an denen ein theoretisch korrekter Ablauf unter Zeitdruck scheitert.

Ein Pilotbereich mit echter Ware und echten Aufträgen ist meist aussagekräftiger als eine lange Testphase mit Musterdaten. Für eine begrenzte Zeit kann ein abgesicherter Parallelbetrieb sinnvoll sein. Er darf jedoch nicht zum Dauerzustand werden, denn doppelte Buchung erzeugt selbst wieder Fehler. Entscheidend ist ein klarer Umschalttag, eine verantwortliche Ansprechperson und ein einfacher Weg, Probleme direkt zu melden.

Schulungen sollten am Prozess orientiert sein: Ware annehmen, Abweichung erfassen, einlagern, Auftrag kommissionieren, Versand abschließen. Niemand muss zu Beginn sämtliche Auswertungen oder Administrationsfunktionen beherrschen. Rollen und Rechte helfen dabei, den Bildschirm auf die jeweilige Aufgabe zu konzentrieren. Ein Kommissionierer braucht andere Informationen als die Lagerleitung, und eine Inventurkorrektur sollte nachvollziehbar freigegeben werden können.

Erfolg nicht nur am Bestand messen

Nach dem Start lohnt sich ein Blick auf wenige Kennzahlen, die das Team beeinflussen kann: Durchlaufzeit vom Wareneingang bis zur Verfügbarkeit, Anzahl der Bestandskorrekturen, Pickfehler, Suchzeiten, pünktlich versendete Aufträge und offene Klärfälle. Diese Werte zeigen schneller als ein allgemeines Digitalisierungsprojekt, ob sich der Ablauf verbessert.

softify.pro entwickelt solche Systeme nicht als Ersatz für funktionierende Arbeitsschritte, sondern als präzise Ergänzung dort, wo Papier, Tabellen und Zurufe nicht mehr tragen. Manchmal ist die richtige Empfehlung eine kleine Anwendung für Wareneingang und Versand statt eines vollständigen Lagerverwaltungssystems. Manchmal bleibt eine Tabelle für eine seltene Sonderauswertung die vernünftigere Lösung.

Der beste nächste Schritt ist deshalb nicht die Produktauswahl, sondern ein gemeinsamer Blick auf einen konkreten Auftrag aus der letzten Woche. Wenn dessen Weg durch das Lager klar, buchbar und bei Abweichungen nachvollziehbar wird, ist die Grundlage für eine Digitalisierung gelegt, die im Alltag wirklich Zeit spart.

Permalink →

Kontakt aufnehmen

Haben Sie ein Projekt im Kopf, einen Arbeitsablauf, der noch auf Excel-Tabellen und gutem Willen läuft, oder einen Testing-Rückstau, den COCO Ihrem Team abnehmen könnte? Erzählen Sie uns davon.

Nachricht senden