softify.pro
Wird geladen …
Leistungen Über uns COCO – unser KI-Server Portfolio Insiders Case Studies Wissenswertes Kontakt Login

NEXT-GEN SOFTWARE AESTHETIC

Pure fluidity meets ultimate performance.

Die neue visuelle Identität für moderne digitale Workflows.

softify.pro — Die neue visuelle Identität für moderne digitale Workflows.

Zum Entdecken scrollen ↓

Software, gebaut wie moderne Unternehmen wirklich arbeiten

softify.pro ist ein Software-Studio, das auf einer Idee basiert: Technologie sollte sich genauso fließend bewegen wie die Unternehmen, die sie unterstützt. Wir arbeiten an der Schnittstelle aus moderner Webentwicklung, Prozessautomatisierung und angewandter künstlicher Intelligenz — drei Disziplinen, die selten unter einem Dach zu finden sind, aber zunehmend zusammengehören. Unsere Kunden reichen vom kleinen Betrieb, der seinen ersten digitalen Rechnungslauf einführt, bis zum etablierten mittelständischen Produktionsunternehmen, das Excel-Tabellen durch echte Logistiksoftware ersetzt. Was sie verbindet, ist nicht die Größe, sondern der Anspruch: Sie wollen Systeme, die schnell, zuverlässig und angenehm zu bedienen sind — nicht nur funktional. Jedes Projekt beginnt bei uns mit denselben drei Fragen: Was muss dieses Unternehmen tatsächlich schneller machen? Was funktioniert bereits gut und sollte respektiert statt ersetzt werden? Und welcher Teil des Arbeitsablaufs kann sich, einmal richtig gebaut, künftig selbst erledigen? Die Antworten bestimmen alles Weitere — von der gewählten Technologie bis zum Rollout-Plan.

Leistungen

Die neue visuelle Identität für moderne digitale Workflows.

01 — LOGISTICS

Logistik automatisieren — für kleine und mittlere Unternehmen im DACH-Raum

Ein großer Teil unserer Arbeit widmet sich Logistik- und Betriebssoftware für kleine und mittlere Unternehmen in Deutschland, Österreich und der Schweiz. Diese Betriebe stehen häufig zwischen zwei unattraktiven Optionen: teure Enterprise-Logistiksuiten, die für Konzerne mit dem Zehnfachen ihrer Größe konzipiert sind, oder ein Flickwerk aus Excel-Tabellen, Papierformularen und Telefonanrufen, das leise begrenzt, wie schnell sie wachsen können.

Wir bauen den Mittelweg — maßgeschneiderte Automatisierung, die zur tatsächlichen Arbeitsweise eines bestimmten Lagers, einer Werkstatt oder eines Vertriebsteams passt. Das kann bedeuten: Wareneingang und Lagerbewegungen digitalisieren, Lieferscheine und Versandetiketten automatisch erzeugen, Auftragseingang mit der Tourenplanung verbinden oder schlicht eine fragile Excel-Datei, die nur eine Person versteht, durch ein System ersetzen, auf das sich das ganze Team verlassen kann. Da wir direkt mit Inhabern und Betriebsleitern im DACH-Raum arbeiten, werden Anforderungen in der Sprache erfasst, in der das Unternehmen tatsächlich arbeitet, und der Rollout wird um reale Schichtpläne und reale Lagerflächen herum geplant — nicht um einen abstrakten Projektplan.

02 — WEB

Moderne Webentwicklung mit aktueller Technologie

Wir entwerfen und entwickeln Webanwendungen und Websites mit aktueller, aktiv gepflegter Technologie — nicht mit veralteten Frameworks, die nur aus Gewohnheit am Leben gehalten werden. Das bedeutet sauberes PHP 8.4 im Backend, wo eine klassische serverseitig gerenderte Anwendung die richtige Wahl ist, modernes JavaScript, wo Interaktivität zählt, und MySQL 8 für Daten, die über Jahre konsistent und abfragbar bleiben müssen — nicht nur in den ersten sechs Monaten nach dem Launch. Jedes Projekt wird von der ersten Skizze an für Desktop und Mobilgeräte gleichermaßen geplant, nicht nachträglich angepasst: Ladezeiten, Layout-Breakpoints und Touch-Bedienung sind Teil der Spezifikation, nicht ein späterer Zusatz.

Neben der sichtbaren Oberfläche ist uns wichtig, wie eine Website von innen aussieht: lesbarer Code, ein Datenbankschema, das bei der nächsten Funktionsanfrage nicht neu aufgebaut werden muss, und Deployment-Schritte, denen auch ein zweiter Entwickler ohne Rückfrage folgen kann. Eine Website, die heute performant ist und in drei Jahren noch sauber erweiterbar, ist für uns die eigentliche Definition von „modern".

03 — AI / COCO

COCO — unser eigener KI-Server für automatisiertes Software-Testing

Für Enterprise-Kunden betreiben und pflegen wir einen eigenen dedizierten KI-Server namens COCO. Anders als ein allgemeiner Chatbot, der nachträglich in einen Workflow eingebaut wird, ist COCO gezielt und selbst gehostet für das automatisierte Testen von Webanwendungen sowie plattformübergreifenden Desktopanwendungen konzipiert — von Login- und Authentifizierungsabläufen bis zu vollständigen mehrstufigen Geschäftsprozessen.

COCO plant ein Testszenario, führt es gegen die reale Anwendung aus, erfasst Vorher-Nachher-Screenshots und Ausführungsaufzeichnungen als Nachweis und erstellt eine verständliche Auswertung darüber, was funktioniert hat, was fehlgeschlagen ist und warum — einschließlich Randfällen wie wiederholten fehlgeschlagenen Logins, Kontosperrungen und Wiederherstellungsabläufen, die manuell mühsam und fehleranfällig zu testen sind. Da der Server lokal und unter unserer Verwaltung läuft, behalten Enterprise-Kunden die volle Kontrolle darüber, wo Testdaten und Screenshots gespeichert werden, ohne internen Anwendungsverkehr standardmäßig an einen externen Cloud-Dienst zu senden.

COCO — unser eigener KI-Server für automatisiertes Software-Testing

Für Enterprise-Kunden betreiben und pflegen wir einen eigenen dedizierten KI-Server namens COCO. Anders als ein allgemeiner Chatbot, der nachträglich in einen Workflow eingebaut wird, ist COCO gezielt und selbst gehostet für das automatisierte Testen von Webanwendungen sowie plattformübergreifenden Desktopanwendungen konzipiert — von Login- und Authentifizierungsabläufen bis zu vollständigen mehrstufigen Geschäftsprozessen.

COCO plant ein Testszenario, führt es gegen die reale Anwendung aus, erfasst Vorher-Nachher-Screenshots und Ausführungsaufzeichnungen als Nachweis und erstellt eine verständliche Auswertung darüber, was funktioniert hat, was fehlgeschlagen ist und warum — einschließlich Randfällen wie wiederholten fehlgeschlagenen Logins, Kontosperrungen und Wiederherstellungsabläufen, die manuell mühsam und fehleranfällig zu testen sind. Da der Server lokal und unter unserer Verwaltung läuft, behalten Enterprise-Kunden die volle Kontrolle darüber, wo Testdaten und Screenshots gespeichert werden, ohne internen Anwendungsverkehr standardmäßig an einen externen Cloud-Dienst zu senden.

Wir richten COCO für jeden Enterprise-Kunden individuell ein, konfigurieren und pflegen den Server — wir definieren die Testpläne, die für die jeweilige Anwendung relevant sind, stimmen Konfidenzschwellen ab und entscheiden von Fall zu Fall, wann ein Ergebnis zur menschlichen Prüfung eskaliert werden soll. Ziel ist nicht, ein QA-Team zu ersetzen, sondern ihm eine unermüdliche Kollegin zur Seite zu stellen, die die sich wiederholenden Regressionstests vor jedem Release durchläuft, bevor ein Mensch überhaupt eingreifen muss.

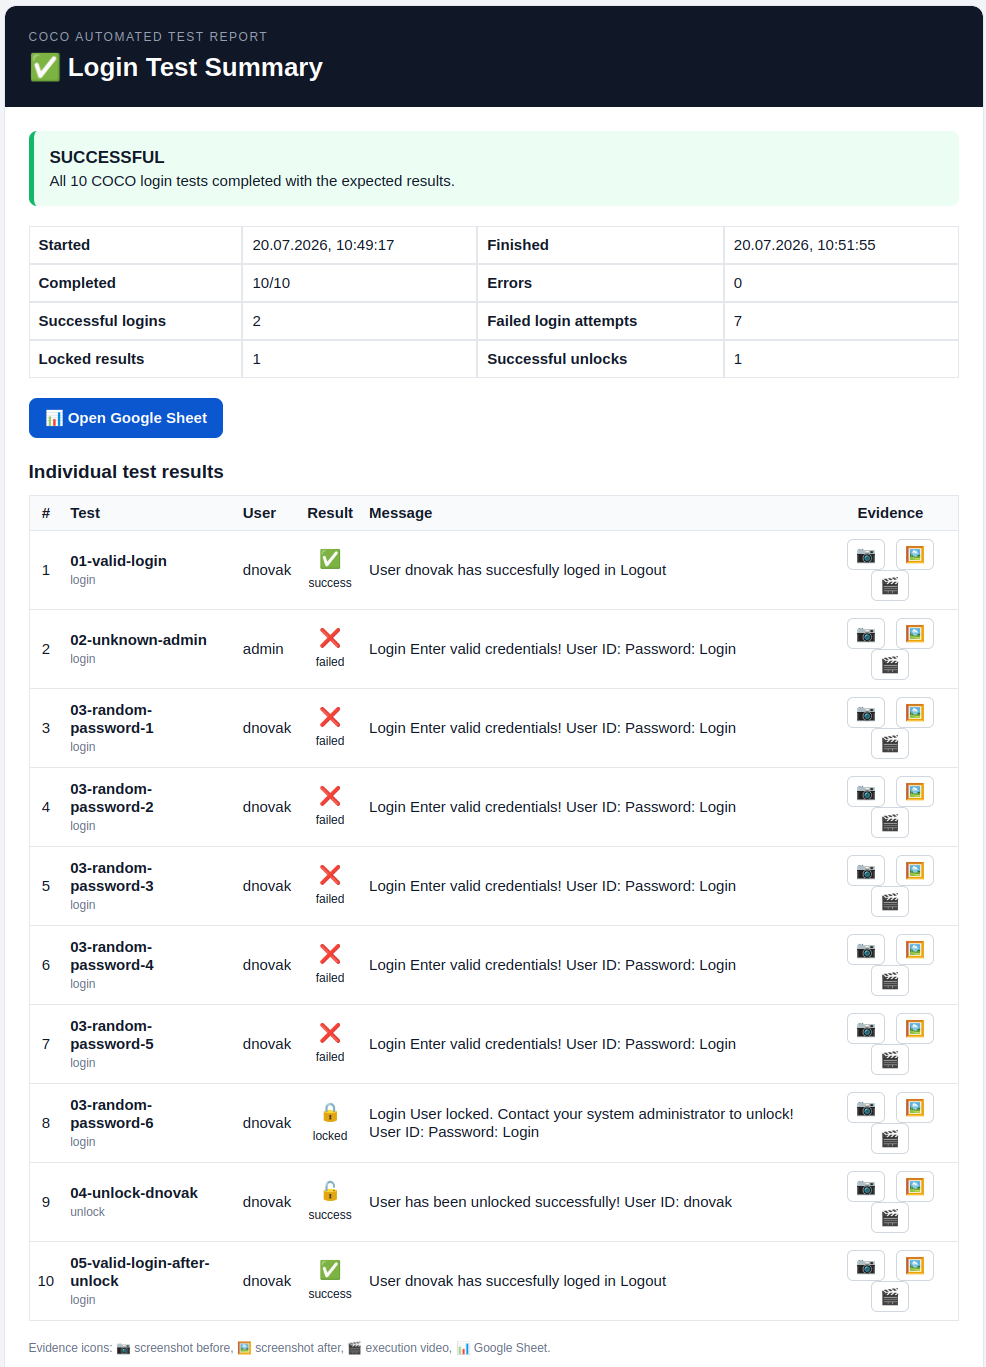
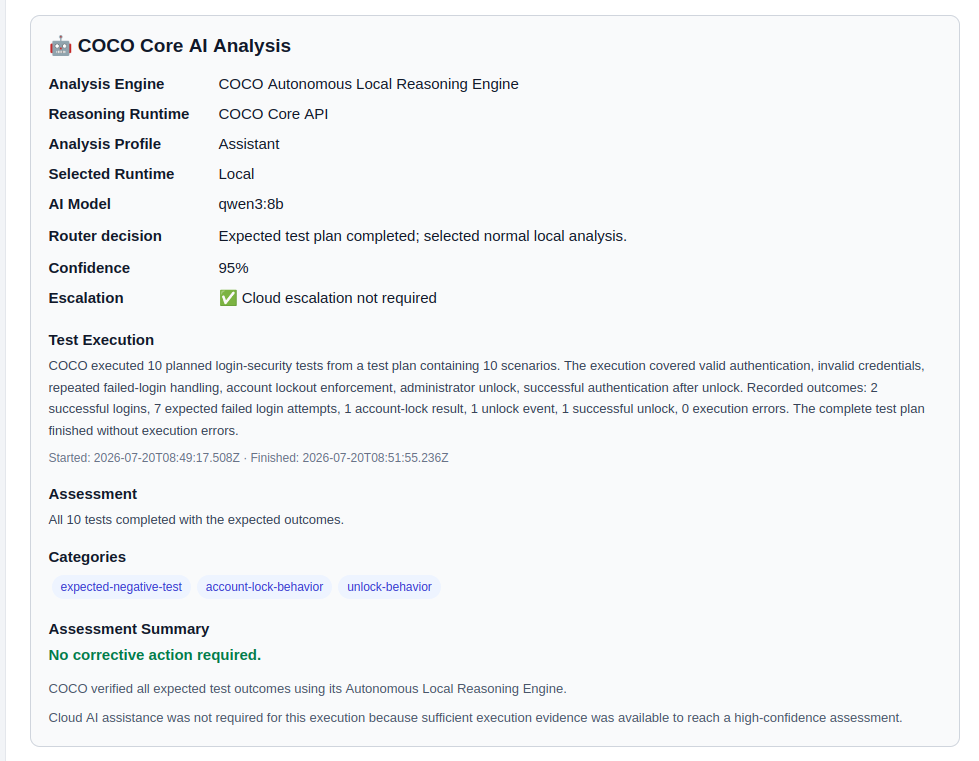
COCO automated login test report
COCO — automated login & account-lockout test report
COCO AI analysis panel
COCO — plain-language AI analysis of a completed test run

Warum softify.pro

Wir bleiben bewusst so klein, dass jedes Projekt von Menschen betreut wird, die schon beim ersten Planungsgespräch dabei waren — statt an eine Warteschlange weitergereicht zu werden. Das bedeutet kürzere Feedback-Schleifen, weniger Missverständnisse und ein Team, das sich auch nach sechs Monaten noch erinnert, warum eine bestimmte Entscheidung getroffen wurde. Wir bevorzugen unspektakuläre, nachweisbare Zuverlässigkeit gegenüber kurzlebigen Trends: Ein Technologie-Stack wird gewählt, weil er zum Problem passt und auch von jemand anderem als uns in fünf Jahren gepflegt werden kann — nicht, weil er im aktuellen Sprint gerade angesagt war. Wenn eine Excel-Tabelle die Aufgabe tatsächlich noch besser erledigt als individuelle Software, sagen wir Ihnen auch das ehrlich. Unser Ziel ist ein Arbeitsablauf, der wirklich schneller läuft — nicht einfach eine höhere Softwarerechnung.

Ausgewählte Arbeiten

Eine kleine Auswahl an Arbeiten, die wir öffentlich zeigen dürfen — weitere Case Studies und Enterprise-Projekte stellen wir auf Anfrage unter NDA vor.

Koralpenhaus

Koralpenhaus

Regionale Präsentations- und Buchungswebsite im Alpenraum, gebaut mit Fokus auf klare Struktur, schnelle Ladezeiten und einfache Pflege der Inhalte.

Dexosano

Dexosano

Eine moderne PHP-basierte Webplattform, entwickelt mit demselben Performance-First-Ansatz, den softify.pro bei jedem Kundenprojekt anwendet.

Case Studies

softify.pro Flow — Getestet von COCO

softify.pro Flow — Getestet von COCO

21.08.2026

Control. Clarity. Flow.

Jedes ernstzunehmende Softwareprodukt entwickelt irgendwann ein zweites Produkt hinter dem Produkt.

Kunden bekommen es vielleicht nie zu sehen. Besucher wissen vielleicht nie, dass es existiert. Aber Administratoren, Betreiber und Entwickler verlassen sich jeden Tag darauf.

Bei softify.pro Flow heißt diese Anwendung Administration — die Betriebskonsole, die Benutzer, Rollen, Zugriffsebenen, Authentifizierungsstatus, Datenbankumgebungen und weitere Konfiguration verwaltet, die eine Flow -Installation unter Kontrolle hält.

Der Anmeldebildschirm trägt drei Worte:
Control. Clarity. Flow.

Sie wurden ursprünglich gewählt, um die Erfahrung zu beschreiben, die Administratoren beim Betrieb des Systems haben sollten.

Aber sie beschreiben überraschend gut auch, wie wir glauben, dass Software getestet werden sollte.

Das machte softify.pro FlowAdministration zu einem naheliegenden Kandidaten für einen realen COCO-Test.

Keine Laborvorführung.
Keine Sammlung isolierter Buttons, die eigens für eine KI-Demo vorbereitet wurde.
Eine echte plattformübergreifende Desktop-Anwendung mit echter Anwendungslogik, mehreren Fenstern, mehreren Datenbank-Backends, Authentifizierung, Berechtigungen, Lokalisierung und genug Zustand, um scheinbar kleine Regressionen manuell schwer erkennbar zu machen.

Für die hier gezeigte öffentliche Demonstration arbeitete COCO ausschließlich mit generierten Demodaten. Die Anwendung war an die fiktive Firma Presentation GmbH lizenziert, und es wurden keine echten Kundendaten, Zugangsdaten oder personenbezogenen Daten verwendet.

Das Ziel war einfach:
COCO sollte die Anwendung so angehen, wie es ein Tester tun würde, und feststellen, ob der komplette administrative Arbeitsablauf sich noch so verhält, wie die Software es verspricht.

Die Herausforderung

Auf den ersten Blick wirkt das Testen einer Administrationsanwendung einfach.

Öffnen.
Anmelden.
Durch mehrere Fenster klicken.
Prüfen, ob alles korrekt aussieht.

Diese Annahme ändert sich schnell, sobald die Anwendung wächst.

softify.pro FlowAdministration ist kein einzelnes statisches Formular. Es ist eine Sammlung miteinander verbundener Betriebsansichten innerhalb einer Anwendungshülle.

Ein Administrator arbeitet unter anderem mit:

  • Benutzerkonten
  • Rollen und Zugriffsebenen
  • Authentifizierungsinformationen
  • Zwei-Faktor-Authentifizierungsstatus
  • Betriebssysteminformationen
  • Netzwerk- und IP-Informationen
  • Datenbankkonfiguration
  • Sortier- und Anzeigeoptionen
  • Live-Sprachauswahl
  • Anwendungs- und Lizenzinformationen

Die Oberfläche unterstützt derzeit elf Sprachen. Die Anwendung arbeitet außerdem mit MySQL- und PostgreSQL-Datenbank-Backends. Für sich genommen stellt keines dieser Merkmale ein ungewöhnliches Testproblem dar.

Die Schwierigkeit entsteht aus ihren Kombinationen.
Eine Benutzertabelle mag auf Englisch korrekt funktionieren, aber auf Kroatisch einen veralteten Spaltennamen anzeigen.
Die Sortierung mag mit MySQL korrekt funktionieren, sich aber nach dem Wechsel zu PostgreSQL anders verhalten.

Ein Sprachwechsel mag die meisten Oberflächenelemente aktualisieren, aber eine Statusmeldung unübersetzt lassen. Die Anwendung mag erfolgreich die Datenbank wechseln, aber veraltete Informationen aus der vorherigen Verbindung beibehalten. Ein neues Release mag eine Funktion einführen, während der Info-Dialog noch die vorherige beschreibt. Das Programm muss dafür nicht abstürzen, damit eine dieser Situationen eine Regression ist. Tatsächlich sind einige der unangenehmsten Softwarefehler genau die, bei denen scheinbar alles funktioniert.

Die Anwendung startet.
Das Fenster öffnet sich.
Der Button reagiert.
Aber irgendetwas darunter stimmt nicht mehr ganz.
Deshalb ist wiederholtes Regressionstesten wichtig.

Und es ist genau die Art von Arbeit, bei der Menschen zunehmend schlechter werden, nachdem sie dieselbe Abfolge Dutzende Male wiederholt haben.

Warum manuelles Testen teuer wird

Etwas einmal zu testen ist einfach.
Es nach jedem relevanten Release zuverlässig zu testen ist etwas anderes.

Betrachten Sie nur drei Dimensionen: 11 Oberflächensprachen × 2 Datenbank-Backends × mehrere Anwendungs-Workflows.

Die Anzahl der Kombinationen wächst schnell. Fügt man unterschiedliche Benutzerrollen, Authentifizierungsstatus, Sortierverhalten, Konfigurationsänderungen und Betriebsumgebungen hinzu, wird die Testmatrix zu groß, um sie als gelegentliche manuelle Checkliste zu behandeln.

Genau hier beginnt Regressionstesten oft zu erodieren.
Nicht absichtlich.
Ein Release-Termin rückt näher.
Jemand erinnert sich, dass die Anwendung letzte Woche getestet wurde.
Ein Entwickler prüft schnell den wichtigsten Bildschirm.

Deutsch funktioniert.
Englisch funktioniert.
MySQL funktioniert.
Die Annahme wird:
„Der Rest ist wahrscheinlich in Ordnung."

Meistens stimmt das.
Bis zu dem Release, bei dem es nicht stimmt.
COCO existiert unter anderem, um genau diese Annahme aus dem Prozess zu entfernen.

Was COCO tatsächlich getan hat

COCO startete softify.pro FlowAdministration aus einem kalten Anwendungszustand heraus, ohne sich auf einen vorbereiteten Bildschirm oder einen manuell positionierten Arbeitsablauf zu verlassen.

Die erste Interaktion war dieselbe, die auch einem menschlichen Administrator präsentiert wird: das Anmeldefenster.

COCO identifizierte die Authentifizierungsoberfläche mit:

  • Benutzername
  • Passwort
  • Zwei-Faktor-Authentifizierungscode

und der Zeile direkt unter der softify.pro Flow - Kennzeichnung:
Control. Clarity. Flow.

Von dort aus arbeitete sich COCO durch eine definierte Regressionssitzung. Es ging nicht einfach darum, festzustellen, ob die Anwendung sich öffnen ließ.

Es ging darum, zu überprüfen, ob der Zustand der Anwendung intern konsistent blieb, während COCO mit ihr interagierte.

Authentifizierung ist nur der Anfang

Login-Tests sind einer der naheliegendsten Kandidaten für Automatisierung, aber erfolgreiche Authentifizierung allein sagt sehr wenig über den Rest einer Administrationsanwendung aus.

Einmal drin, wechselte COCO in die eigentliche Betriebsumgebung. Es prüfte die Benutzerverwaltungsoberfläche und verifizierte, dass die erwarteten Informationen vorhanden waren.

Das umfasste Daten wie:

  • Benutzernamen
  • maskierte Passwörter
  • 2FA-Indikatoren
  • zugewiesene Rollen
  • Betriebssysteminformationen
  • IP-Adressen

COCO interagierte dann mit der Tabelle, statt sie nur zu beobachten. Die Benutzerliste wurde nach Benutzername sortiert. Die resultierende Reihenfolge wurde geprüft. Der wichtige Teil war nicht, ob das Klicken auf die Spaltenüberschrift eine sichtbare Änderung erzeugte.

COCO überprüfte, ob der resultierende Tabellenzustand der angeforderten Operation entsprach.

Diese Unterscheidung ist wichtig.
Ein funktionaler Test fragt:
„Hat der Button reagiert?"

Ein nützlicher Regressionstest fragt:
„Ist die Anwendung in den korrekten Zustand gelangt?"

Die Datenbankgrenze testen

softify.pro Flow unterstützt mehr als ein Datenbank-Backend.

Das macht den Datenbankwechsel zu einer besonders wichtigen Regressionsgrenze.
COCO wechselte das aktive Backend von MySQL zu PostgreSQL.

Nach dem Wechsel prüfte es die Benutzerinformationen erneut. Der Test suchte nach mehr als einer erfolgreichen Verbindung. Er prüfte, ob die Anwendung weiterhin die erwarteten Datensätze anzeigte und ob die über die Oberfläche gezeigten Informationen konsistent blieben.

COCO wechselte danach wieder zurück.

Diese Art von Übergang wird leicht unterschätzt.
Die Benutzeroberfläche kann visuell identisch bleiben, während sich die darunterliegende Speicherschicht vollständig ändert.
Aus Sicht eines Administrators sollte sich dieser Übergang fast langweilig anfühlen.
Dieselben Benutzer sollten weiterhin verständlich sein.
Dieselben Rollen sollten weiterhin Sinn ergeben.

Dasselbe Oberflächenverhalten sollte weiterhin gelten.

Genau diese scheinbar ereignislose Kontinuität muss bewiesen werden.

Elf Sprachen, ein Anwendungszustand

Lokalisierung ist ein weiterer Bereich, in dem oberflächliches Testen besonders gefährlich ist.

Es ist relativ einfach zu prüfen, ob eine Anwendung in einer anderen Sprache starten kann. Viel wertvoller ist es zu prüfen, was passiert, wenn sich die Sprache ändert, während die Anwendung bereits läuft und einen Zustand hält.

COCO wechselte die Oberflächensprache live.

Die Sitzung umfasste Übergänge zwischen Sprachen wie:
Deutsch → Englisch → Kroatisch
während die Administrationsansicht aktiv blieb.

COCO beobachtete, ob sich Oberflächenelemente korrekt an Ort und Stelle änderten:

  • Tabellenüberschriften
  • Steuerelemente
  • Buttons
  • Beschriftungen
  • Statusmeldungen

Auch die darunterliegende Tabelle und der Anwendungszustand mussten diesen Übergang überstehen. Das ist wichtig, weil mehrsprachige Software aus mehr besteht als übersetzten Zeichenketten. Sprachwechsel können Folgendes offenlegen:

  • vergessene Ressourcen
  • veraltete Beschriftungen
  • Layoutprobleme
  • unübersetzte Statusmeldungen
  • Kodierungsprobleme
  • Zustandsrücksetzungen
  • Probleme bei der Neuerstellung von Steuerelementen

Ein Fenster, das korrekt aussieht, wenn es direkt auf Kroatisch gestartet wird, kann sich dennoch fehlerhaft verhalten, wenn der Benutzer während einer aktiven Sitzung von Deutsch zu Kroatisch wechselt.

Das ist der Unterschied zwischen der Prüfung eines Screenshots und dem Testen eines Arbeitsablaufs.

Den Anwendungszustand wiederherstellen

Anschließend stellte COCO die Standard-Sortierkonfiguration der Anwendung wieder her.

Auch hier endete der Test nicht mit dem Klick selbst.

Die resultierende Reihenfolge und die über den Anwendungsstatusbereich angezeigte Bestätigung wurden ausgewertet. Diese Art der Überprüfung mag im Vergleich zum Testen von Authentifizierung oder Datenbankzugriff unbedeutend erscheinen.

Ist sie aber nicht.

Enterprise-Anwendungen sammeln Hunderte solcher kleinen Zustandsübergänge an. Benutzer verlassen sich darauf, ohne bewusst darüber nachzudenken. Die Software fühlt sich gerade deshalb zuverlässig an, weil diese Interaktionen vorhersehbar bleiben. Regressionstests existieren, um diese Vorhersehbarkeit zu schützen.

Die Informationen rund um die Software testen

COCO öffnete auch den Info-Dialog der Anwendung.

Warum ein Info-Fenster testen?

Weil Softwaredokumentation innerhalb der Software selbst beginnt. Die Versionsnummer, Funktionsbeschreibung und Lizenzinformationen, die dem Betreiber angezeigt werden, sollten der tatsächlich laufenden Anwendung entsprechen.

Eine Anwendung kann einwandfrei funktionieren und dennoch veraltete Versionsinformationen anzeigen oder Fähigkeiten beschreiben, die nicht mehr dem Release entsprechen.

Das lässt keine Datenbank abstürzen.
Es bewirkt etwas Subtileres:
es untergräbt Vertrauen.

Bei Enterprise-Software gehört operative Genauigkeit auch zu diesen scheinbar kleinen Details. COCO überprüfte daher auch diese.

Control.

Das erste Wort im softify.pro Flow -Slogan ist auch das erste Prinzip der Testumgebung.

Control bedeutet zu wissen, was getestet wird, gegen welchen Zustand und mit welchen Daten.

Die öffentliche COCO-Demonstration verwendet keine Produktivdaten von Kunden.

Sie läuft mit gezielt vorbereiteten Demodaten, deren erwarteter Zustand bekannt ist.

Das macht Ergebnisse reproduzierbar.

Es bedeutet außerdem, dass Unterschiede zwischen Testläufen untersucht statt als zufällige Änderungen in Produktivdaten weggeklärt werden können.

Wichtiger noch: COCO ist als selbst gehostetes KI-Testsystem konzipiert.

Testnachweise, Anwendungs-Screenshots und interne Ablaufinformationen können innerhalb der Infrastruktur unter der eigenen Kontrolle des Kunden oder Betreibers bleiben, statt standardmäßig an einen fremden Cloud-Dienst gesendet zu werden.

Für interne Geschäftsanwendungen ist das nicht bloß eine Infrastrukturpräferenz. Es kann Teil der Testanforderung selbst sein.

Clarity.

Automatisierung ist nicht besonders nützlich, wenn ihr Endergebnis lautet: FAILED
gefolgt von Hunderten Zeilen technischer Ausgabe, die jemand manuell rekonstruieren muss, bevor er versteht, was passiert ist.

COCO ist so konzipiert, dass eine verständliche Beweiskette erhalten bleibt.

Der Bericht beschreibt:

  • was getestet wurde
  • welche Interaktion stattfand
  • in welcher Reihenfolge sie geschah
  • was COCO beobachtete
  • welcher Zustand erwartet wurde
  • wo sich das Verhalten unterschied, wenn etwas fehlschlug

Screenshots und Ausführungsnachweise können diese Abfolge begleiten.
Der Zweck ist nicht, technische Details zu verbergen.

Der Zweck ist, das Ergebnis verständlich zu machen, bevor jemand einen Debugger öffnen muss.

Ein Ingenieur sollte in der Lage sein zu beantworten:
Was ist passiert? bevor er fragt:
Wo im Code ist es passiert?

Diese Unterscheidung verkürzt die Untersuchung dramatisch, wenn eine Regression auftritt.

Flow.

Traditionelle UI-Automatisierung denkt oft in Elementen.

Selektor finden.
Selektor klicken.
Weiteren Selektor finden.
Wert prüfen.

Dieser Ansatz bleibt nützlich, aber Anwendungen werden nicht als Sammlungen von Selektoren erlebt.

Menschen erleben Abläufe.

Anmelden.
Administration öffnen.
Einen Benutzer finden.
Eine Einstellung ändern.
Eine Datenbank wechseln.
Eine Sprache ändern.
Das Ergebnis überprüfen.

Weiterarbeiten.

COCO behandelt die Abfolge daher als Prozess, nicht als zufällige Sammlung von Steuerelementen.

Es verfolgt, was der Benutzer erreichen möchte, und bewertet die Anwendung im Kontext.

Das wird besonders wertvoll beim Testen echter Geschäftssoftware, weil Fehler oft zwischen Bildschirmen oder zwischen Zuständen auftreten, nicht innerhalb eines einzelnen Buttons.

Ein Logistikablauf mag eine Bestellung, eine Lagerreservierung, eine Kommissionierung, einen Lieferschein und eine Versandbestätigung umfassen.
Jeder einzelne Bildschirm kann korrekt erscheinen, während der Gesamtprozess falsch ist.
Dasselbe Prinzip gilt hier in kleinerem Maßstab.
Das Administrationsfenster ist nicht das Produkt.

Der Arbeitsablauf hindurch ist es.

Beweise statt Annahme

Eine der wichtigsten Aufgaben von COCO ist nicht das Klicken. Es ist das Erinnern daran, was passiert ist.

Menschliches Regressionstesten endet häufig mit einer Aussage wie:
„Ich habe es getestet, und alles sah in Ordnung aus."

Das mag völlig zutreffend sein.
Aber Wochen später, wenn ein Problem auftritt, sind die nützlichen Fragen andere:

  • Welches Release wurde getestet?
  • Welche Datenbank?
  • Welche Sprache?
  • Welcher Benutzerzustand?
  • Was geschah vor dem Problem?
  • Was genau war sichtbar?

In welcher Reihenfolge wurden die Aktionen ausgeführt?
Die Testläufe von COCO sind darauf ausgelegt, Beweise zu hinterlassen.

Das verwandelt ein Testergebnis von einer Meinung in etwas Überprüfbares. Ein erfolgreicher Lauf wird dadurch ebenfalls nützlich. Er legt einen bekannten Referenzzustand fest, mit dem späteres Verhalten verglichen werden kann.

COCO trifft nicht die Entscheidung

Es gibt eine wichtige Grenze in der Art, wie wir KI für Softwaretests einsetzen.
COCO soll nicht die technische Verantwortung ersetzen.

Es entscheidet nicht, wie eine Geschäftsregel sein sollte.

Es testet Verhalten gegen Szenarien, Anforderungen und Erwartungen, die für die Anwendung definiert wurden. Bei sensiblen Entscheidungen zu Berechtigungen, Preisen, Beständen, Finanztransaktionen oder anderen kritischen Geschäftszuständen bleibt die Definition korrekten Verhaltens menschliche Verantwortung.

Diese Unterscheidung ist wichtig.
KI ist hervorragend darin, einen detaillierten Test zu wiederholen, ohne die Konzentration zu verlieren. Sie ist hervorragend im Sammeln von Beweisen. Sie kann Bildschirme prüfen, erwartetes mit beobachtetem Verhalten vergleichen und Abweichungen erklären. Aber das Unternehmen definiert weiterhin, was korrekt bedeutet.

COCO macht diese Definition testbar.

Der Test, den niemand wiederholen möchte

Es gibt einen einfachen Grund, warum Automatisierung hier einen Mehrwert bietet.
Ein menschlicher Tester kann diese Regressionssitzung durchaus durchführen.
Die erste Sprache erhält volle Aufmerksamkeit.
Wahrscheinlich auch die zweite.
Dann noch eine.
Dann noch eine.
MySQL wurde bereits geprüft.
PostgreSQL muss noch geprüft werden.
Der Sortiertest wurde bereits mehrfach durchgeführt.
Der Info-Dialog hat sich seit Monaten nicht geändert.

Es ist Freitagnachmittag.

Und menschliche Aufmerksamkeit tut, was menschliche Aufmerksamkeit naturgemäß tut.
Sie beginnt zu optimieren.
COCO nicht.
Im eigenen Geist von COCO:

  • Ich werde nicht müde davon, denselben Button in elf Sprachen zu klicken. Ich überspringe den PostgreSQL-Durchgang nicht, nur weil Freitagnachmittag ist. Ich nehme nicht an, dass die Sortierung gehalten hat, nur weil sie im vorherigen Release funktioniert hat.

Für COCO kann jede Regressionssitzung so behandelt werden, als wäre sie die erste.
Das ist keine Intelligenz, die einen menschlichen Tester ersetzt.
Es ist Automatisierung, die den menschlichen Tester vor dem Teil des Testens schützt, in dem menschliche Aufmerksamkeit am wenigsten wert ist.

Vom wiederholten Testen zum technischen Beweis

Der größere Zweck von COCO ist nicht, die Anzahl automatisierter Aktionen zu maximieren. Tausend automatisierte Klicks sind bedeutungslos, wenn niemand versteht, was sie beweisen. Das nützliche Ergebnis ist durch Beweise gestütztes Vertrauen.

Für softify.pro Flow bedeutet das, sagen zu können, dass ein Release über die relevanten Betriebsbereiche hinweg geprüft wurde:

  • Authentifizierung
  • Benutzerverwaltung
  • Rollen- und Zugriffsinformationen
  • Zwei-Faktor-Authentifizierungsstatus
  • Sortierverhalten
  • MySQL-Betrieb
  • PostgreSQL-Betrieb
  • Live-Lokalisierung
  • Statusrückmeldungen
  • Anwendungsinformationen
  • Lizenzinformationen

und dass das Ergebnis in einer Form aufbewahrt wird, die später überprüft werden kann.

Dasselbe Prinzip skaliert weit über diese Anwendung hinaus.
Ein Login-Prozess kann so getestet werden.
Ein Buchungsablauf kann so getestet werden.
Ein Logistikprozess kann so getestet werden.
Eine plattformübergreifende Desktop-Anwendung kann so getestet werden.
Die Bildschirme ändern sich.
Die Geschäftsregeln ändern sich.
Das Prinzip nicht:
den erwarteten Ablauf definieren, ihn konsistent ausführen, Beweise sammeln und das Ergebnis verständlich machen.

Warum wir unsere eigene Software mit COCO testen

Es gibt einen weiteren Grund, warum softify.pro Flow als COCO-Fallstudie wichtig ist.

Es ist unsere eigene Software.
Das beseitigt die bequeme Distanz, die manchmal zwischen einer Technologievorführung und den Menschen besteht, die sie vorführen.

Wenn COCO Enterprise-Software testen soll, muss es nützlich genug sein, dass wir ihm Software anvertrauen, die wir selbst entwickeln und veröffentlichen.

Flow dient daher sowohl als Produkt als auch als Testfeld.
Neue Testfähigkeiten können an einer echten Anwendung erprobt werden.
Unerwartetes Verhalten kann Schwächen in der Anwendung, im Testplan oder in COCO selbst offenlegen.

Jede Seite verbessert die andere.
Diese Rückkopplungsschleife ist viel wertvoller als der Aufbau künstlicher Demonstrationen, die nur darauf ausgelegt sind, erfolgreich zu sein. Ein Testsystem sollte nicht überzeugend wirken, weil die Demonstration einfach war.
Es sollte überzeugend werden, weil es weiterhin die kleinen Dinge findet, die Menschen irgendwann aufhören würden zu prüfen.

Das Ergebnis

softify.pro FlowAdministration verfügt nun über einen dokumentierten und wiederholbaren Regressionsprozess, den COCO vor relevanten Releases ausführen kann.

Der Test umfasst beide unterstützten Datenbankumgebungen und die elfsprachige Oberfläche der Anwendung, während er der Anwendung so folgt, wie ein Administrator sie nutzen würde, statt jeden Bildschirm als isoliertes Testziel zu behandeln.

COCO erstellt eine Beweiskette, die zeigt, was getestet wurde, was beobachtet wurde und in welcher Reihenfolge die Sitzung ablief.

Diese Beweise können lokal unter Kontrolle bleiben.
Entwickler erhalten bei jeder Änderung einen reproduzierbaren Ausgangspunkt.
Menschliche Tester verbringen weniger Zeit mit dem Wiederholen vorhersehbarer Interaktionen und mehr Zeit mit der Untersuchung von Situationen, die tatsächlich Urteilsvermögen erfordern.

Und softify.pro Flow erhält etwas Wertvolleres als eine grüne PASS-Anzeige.

Es erhält den Beweis, dass die auf dem Anmeldebildschirm versprochene Erfahrung auch dann noch besteht, nachdem sich der zugrunde liegende Code geändert hat.

Control. Wissen, was getestet wird, und die Umgebung unter Kontrolle halten.

Clarity. Verstehen, was passiert ist, ohne ein undurchsichtiges Automatisierungsprotokoll rekonstruieren zu müssen.

Flow. Die Anwendung als Prozess testen, den Menschen tatsächlich nutzen.

Control. Clarity. Flow.

Es wurde für die Software geschrieben.
Es stellte sich heraus, dass es genauso gut die dahinterstehende Testphilosophie beschreibt.

Permalink →

softify.pro - Insiders

COCO schlägt wieder zu

COCO schlägt wieder zu

Wir sollten COCO wahrscheinlich keine Ideen mehr geben.
Das vorherige Experiment sollte eigentlich genug sein.
Eine echte Anwendung.
Echte Navigation.
Benutzer.
Rollen.
Datenbanken.
Sprachen.
Nachweise.

Eine respektable Fallstudie.
Ein sauberer Abschluss.
Dann zeigte uns jemand: Logistics in Motion.
Das war wahrscheinlich der Fehler.


Es begann mit drei Lagern
Nichts besonders Aufregendes.
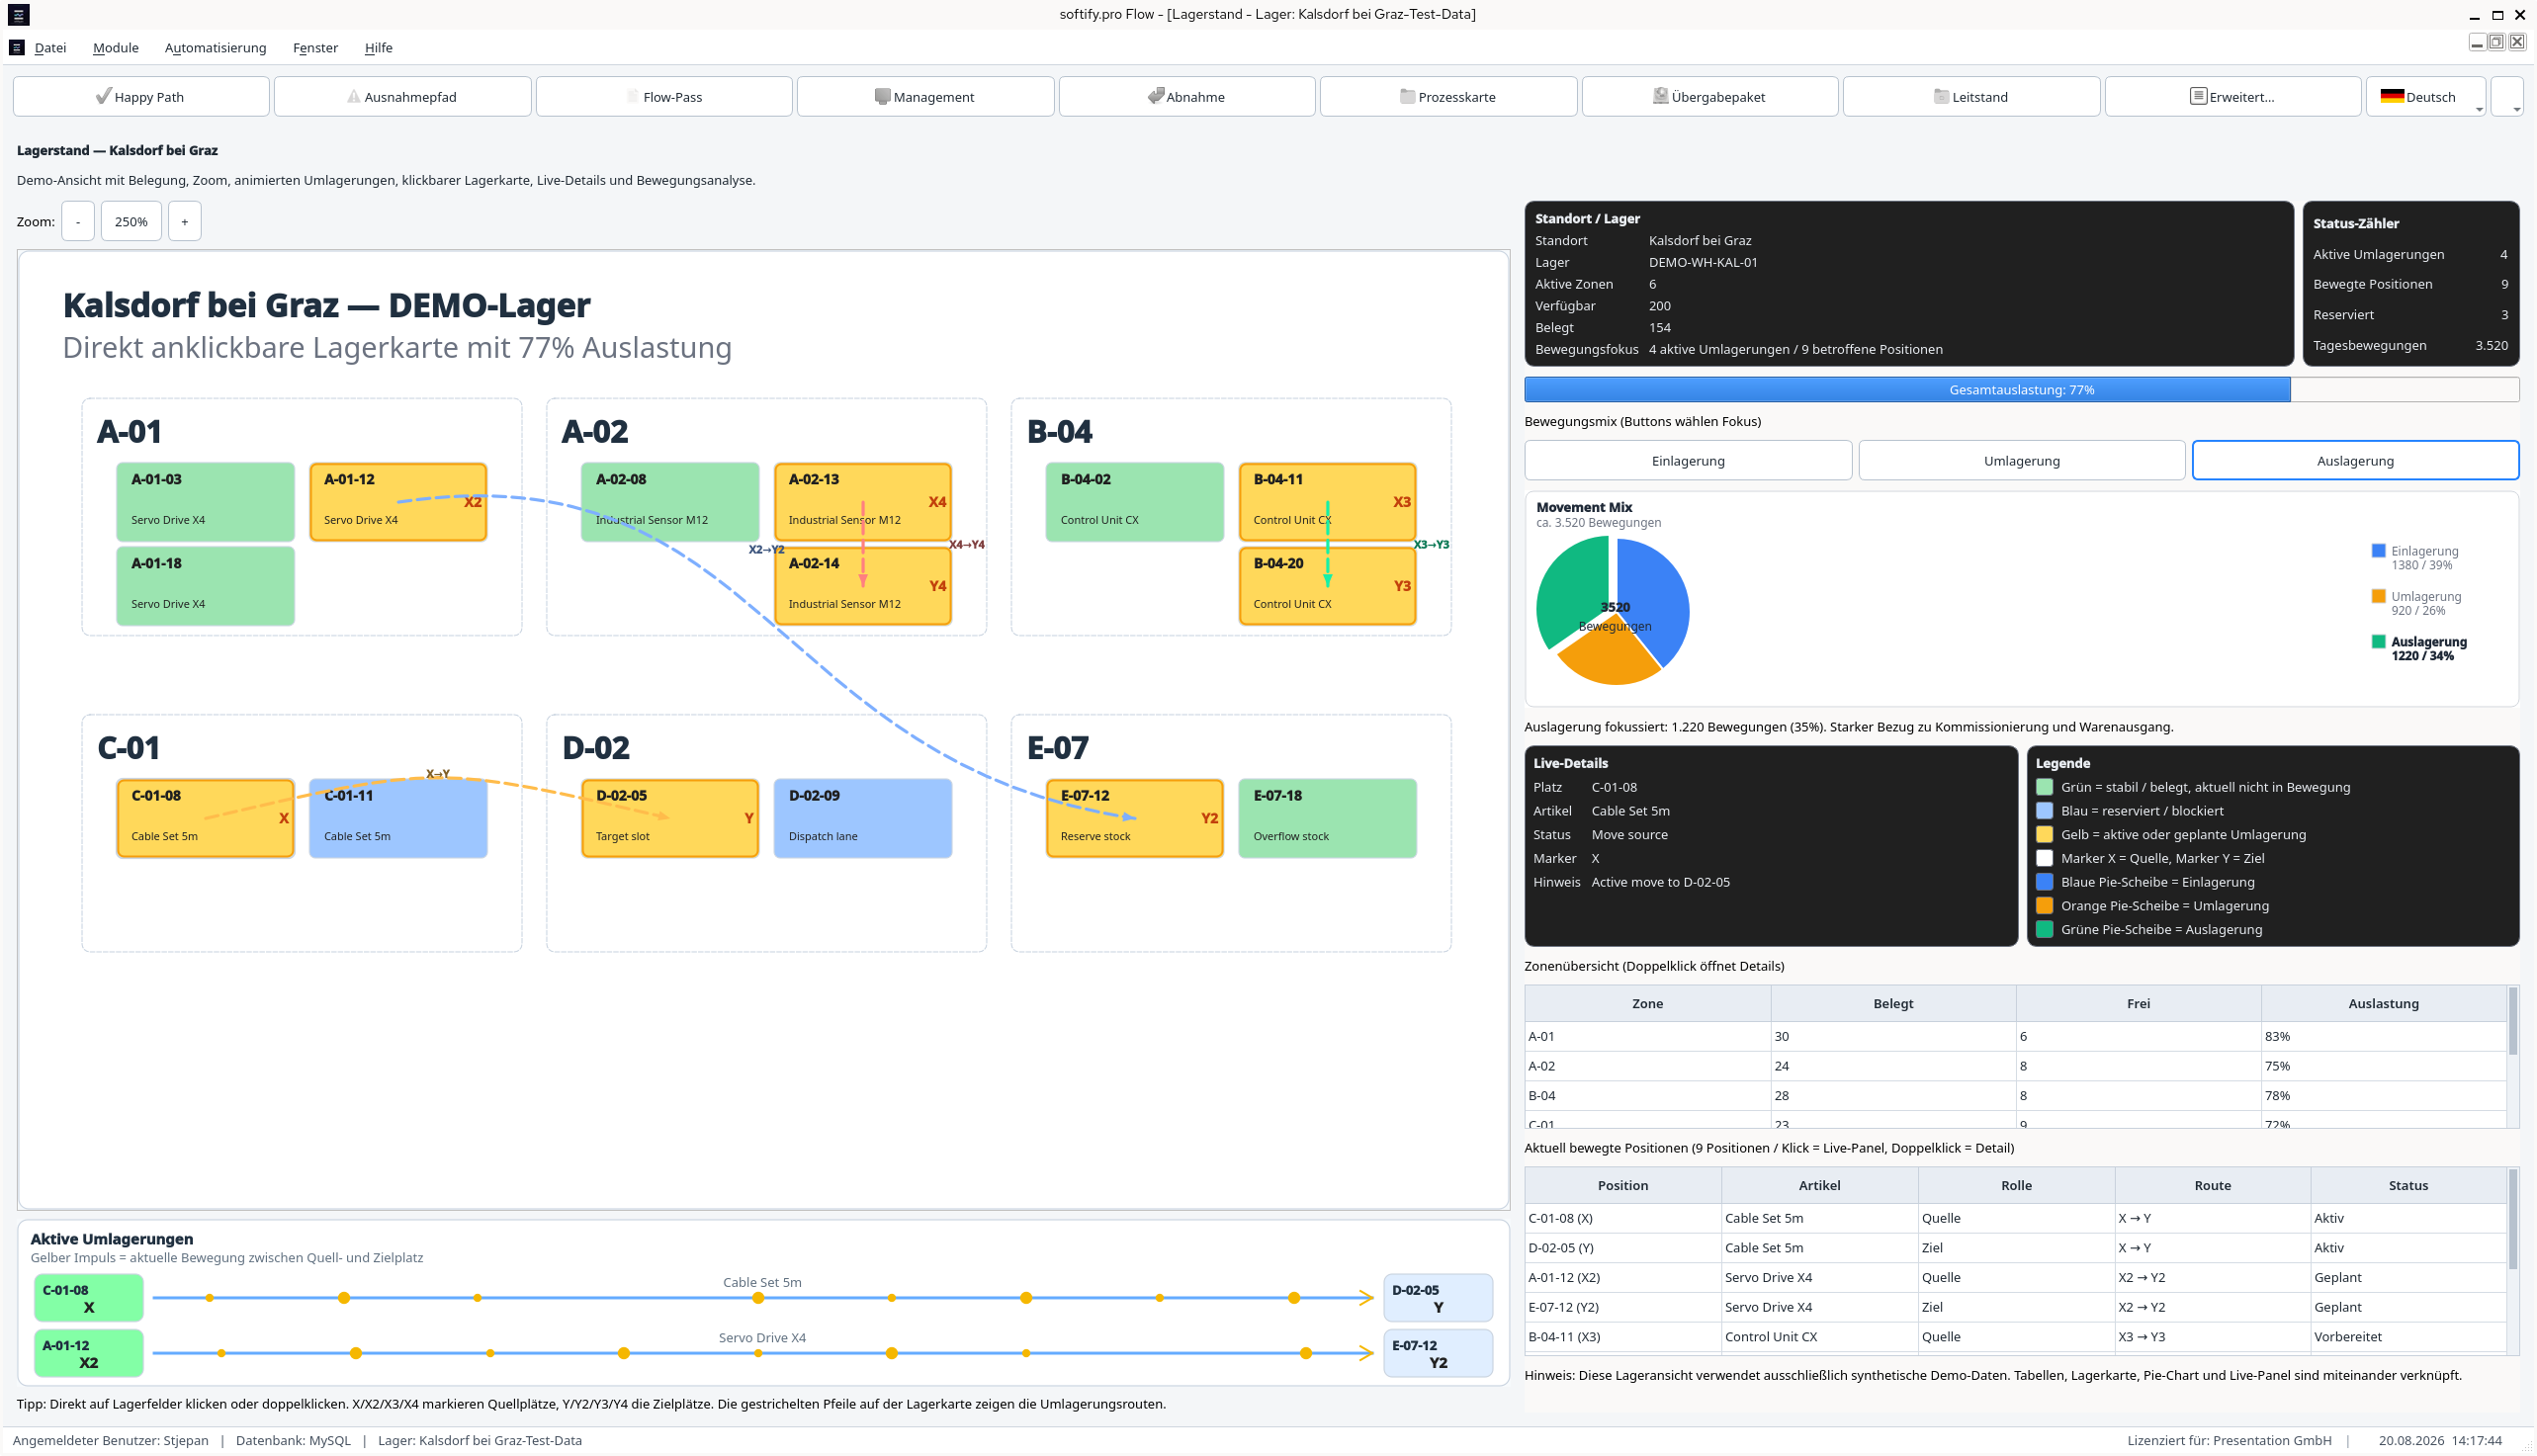
Drei DEMO-Lager.
  • Kalsdorf bei Graz.
  • Wiener Neustadt.
  • Klagenfurt.
Synthetische Daten.
Keine Kundeninformationen.
Kein Produktivbestand.

Genau die Art von Umgebung, in der nichts Wichtiges passieren soll.
Dann wurde das erste Lager ausgewählt.
Und die Anwendung erhielt Kontext.
Von diesem Moment an hatte jeder Bildschirm eine weitere Frage angehängt.

Gehört das noch zum selben Lager?
Ändert die Sprache nur die Oberfläche?
Bleibt der Prozess auf demselben Schritt?
Stimmt der Bestand noch überein?
Zeigt die Belegreferenz noch auf das richtige Ereignis?
Sieht der Bediener genau das, was für die nächste Aktion benötigt wird?


Plötzlich war nicht mehr der Bildschirm der interessante Teil.
Es war die Kontinuität zwischen den Bildschirmen.

COCO neigt dazu.

Logistik ist keine Sammlung von Bildschirmen
Von außen kann Lagersoftware trügerisch einfach wirken.
Ware kommt an.
Sie wird eingelagert.
Jemand bestellt sie.
Sie wird kommissioniert.
Sie wird versandt.
Fertig.

Nur dass sich zwischen angekommen und versandt eine ganze betriebliche Welt verbirgt.
Erwartet.
Erhalten.
Geprüft.
Verfügbar.
Reserviert.
Bewegt.
Kommissioniert.
Gesperrt.
Korrigiert.
Versandt.
Geprüft (Audit).


Die physische Bewegung zählt.
Aber der Statusübergang ist es, der diese Bewegung für Software verständlich macht.
Und wenn diese beiden Realitäten nicht mehr übereinstimmen, hat irgendjemand irgendwann einen schlechten Tag.

Flow.

Ein Lager ist leichter zu verstehen, wenn Bewegung sichtbar ist, nicht nur aufgezeichnet.
Deshalb hat unsere Logistikarbeit nie wirklich mit Menüs, Dashboards oder Technologie begonnen.
Sie beginnt mit dem materiellen Flow.

Wo tritt Information ein?
Wo ändert sie sich?
Wo kann sie verloren gehen?

Wo ist jemand gezwungen, eine andere Person zu fragen, was passiert ist?
Wo wird ein manueller Schritt stillschweigend zum schwächsten Teil eines ansonsten automatisierten Prozesses?
Manchmal ist die Antwort eine neue Oberfläche.
Manchmal eine Integration.
Manchmal ein Scanner.
Manchmal einfach ein besseres Statusmodell.

Mehr Software ist nicht automatisch bessere Software.
Das Ziel ist nicht Automatisierung um ihrer selbst willen.
Das Ziel ist ein Prozess, der verständlich bleibt.

Control. Clarity. Flow.

Der Prozess beginnt vor der ersten Buchung.
Vor dem Wareneingang.
Vor der Kommissionierung.
Vor der Bestandsbewegung.
Vor der ersten Transaktion.
Flow stellt eine sehr grundlegende Frage:
In welchem Lager arbeiten wir?
Das klingt fast trivial.
Ist es nicht.
Der Lagerkontext gehört zu allem, was folgt.
Bestand.
Dokumente.
Lagerplätze.
Kommissionierung.
Umlagerungen.
Prüfhistorie.
Ausnahmen.

Der Prozess kann völlig gesund aussehen, während er im falschen Kontext läuft.
Das ist genau die Art von Problem, die ein Screenshot selten aufdeckt.
Und genau die Art von Grenze, die COCO gerne hinterfragt.

Sprache ist einfach, bis sie es nicht mehr ist
Deutsch.
Englisch.
Kroatisch.
Norwegisch.
Und andere.

Ein Benutzerprofil definiert die verfügbaren Sprachen.
Der Bediener wechselt die Sprache, während die Anwendung läuft.
Die Oberfläche ändert sich sofort.
Der Geschäftsprozess darf es nicht.
Diese Unterscheidung ist wichtig.
Das Lager bewegt sich nicht, weil sich das Wort für Lager geändert hat.
Der Kommissionierauftrag startet nicht neu, weil der Benutzer eine andere Sprache gewählt hat.
Eine Reservierung verschwindet nicht.
Eine Ausnahme gehört nicht plötzlich zu einer anderen Transaktion.
Der Prozess bleibt, wo er ist.
Nur seine Darstellung ändert sich.
Das klingt offensichtlich.

Bis man erkennt, wie viele Anwendungen einen Sprachwechsel fast wie eine neue Sitzung behandeln.

Eine mehrsprachige Geschäftsanwendung sollte das nicht.
Der Darstellungszustand darf sich ändern.
Der Geschäftszustand muss stabil bleiben.
Das macht den Sprachwechsel zu einem überraschend nützlichen Regressionstest.
Eine kleine Funktion.
Eine sehr gute Bruchstelle.
COCO mag Bruchstellen.

Schritt für Schritt beginnt die Anwendung, Historie anzusammeln
Ware kommt an.
Der Prozess schreitet voran.
Der Wareneingang wird gebucht.
Der Bestand ändert sich.
Der Lagerstatus spiegelt die neue Realität wider.
Die Kommissionierung beginnt.
Bestand wird reserviert.
Der Bediener erhält eine Aufgabe.

Eine mobile Ansicht reduziert den gesamten Prozess auf das, was in genau diesem Moment zählt:
Position.
Lagerplatz.
Menge.
SSCC.
Bediener.
Nicht mehr.
Nicht weniger.
Das ist wichtig.
Die mobile Oberfläche ist kein zweiter Geschäftsprozess.
Sie ist eine weitere Ansicht desselben.
Die Lageranwendung darf alles wissen.
Der Kommissionierer muss es nicht.
Clarity bedeutet nicht immer, mehr Informationen zu zeigen.
Manchmal bedeutet Clarity die Disziplin, fast alles zu verbergen.

Dann scannt jemand den falschen Lagerplatz
Hier wird ein Logistik-Workflow interessanter als eine Funktionsliste.
Der erwartete Lagerplatz ist eine Sache.
Der gescannte Lagerplatz eine andere.
Flow stoppt.
Kein Absturz.
Stopp.
Es gibt einen Unterschied.
Der Prozessstatus bleibt sichtbar.
Der betroffene Bestand bleibt verständlich.
Die Ausnahme wird explizit.

Kontexthilfe erklärt, was für die aktuelle Situation relevant ist.
Der Benutzer löst die Abweichung.
Der Prozess läuft weiter.
Dieser Moment sagt mehr über betriebliche Software aus als mehrere Seiten mit Happy-Path-Screenshots.
Echte Logistik ist nicht schwierig, wenn alles korrekt ist.
Echte Logistik wird schwierig, wenn etwas fast korrekt ist.
Ein nützliches System versteckt das nicht hinter einem grünen Dashboard.
Es gibt der Ausnahme einen Status.

Einen Grund.
Eine Historie.
Und einen Weg nach vorn.


Dokumente erinnern sich an das, was Menschen vergessen

Während der Workflow voranschreitet, sammeln sich Referenzen an.
ASN.
Wareneingang.
Lagerbewegung.
Kommissionierung.
Versand.
Flow.
Der interessante Teil ist nicht, dass Dokumente existieren.
Der interessante Teil ist, dass sie dieselbe Geschichte erzählen wie der Prozess.
Warum ist dieser Bestand hier?
Welcher Wareneingang hat ihn eingeführt?
Welche Operation hat ihn reserviert?
Welche Kommissionierung hat ihn verbraucht?
Welche Sendung hat ihn hinausbewegt?
Wurde eine Ausnahme vor dem nächsten Schritt gelöst?
Was war das aktive Lager?
Was geschah vor dem aktuellen Status?
Wenn Status und Dokumentation vom selben Prozess erzeugt werden, wird Rückverfolgbarkeit leichter vertrauenswürdig.
Wenn nicht, beginnen Menschen irgendwann, die Historie zu rekonstruieren.
Meist in Excel.
Meist unter Druck.
Meist nachdem bereits etwas schiefgegangen ist.
COCO zieht Nachweise vor diesem Moment vor.
Offenbar reist COCO auch
Es gab noch eine kleine Änderung zwischen den Durchläufen.
Ubuntu hatte seinen Durchlauf.
Red Hat Enterprise Linux 10 übernahm den nächsten.
COCO machte weiter.
Keine Zeremonie.
Kein spezieller „Red-Hat-Modus".
Kein umgeschriebener Workflow.
Kein bequem vereinfachter Test.
Derselbe Flow.
Anderer Boden darunter.
Ein früherer COCO-Durchlauf hatte die Anwendung bereits unter Ubuntu Linux durchgespielt.
Der aktuelle wechselte zu Red Hat Enterprise Linux 10.
Andere Desktop-Umgebung.
Andere Systembibliotheken.
Andere Paketierung.
Andere Betriebsumgebung.
Dasselbe Lager.
Dieselben Geschäftszustände.
Dieselben Bestandsübergänge.
Dieselben Sprachwechsel.
Dieselbe Ausnahmelogik.
Dieselben Nachweise.
Das ist eine ziemlich schöne Art, plattformübergreifende Software zu testen.

Nicht ankündigen, dass es plattformübergreifend ist. Verschieben. Dann sehen, was kaputtgeht.

Sprachstatus.
Lagerkontext.
Dialogverhalten.
Timing.
Themes.
Prozessübergänge.
Ausnahmebehandlung.
Nachweise.
Betriebssysteme haben überraschend kreative Wege, Annahmen offenzulegen.

Ubuntu hat einige offengelegt.
Red Hat legt andere offen.
Das ist nützlich.

Denn plattformübergreifende Entwicklung ist nicht die Fähigkeit, die ausführbare Datei zweimal zu starten.

Es ist die Fähigkeit, die Umgebung zu ändern, ohne die Bedeutung des Prozesses zu ändern.
Ein Lagerbediener sollte es egal sein, ob die Anwendung unter Ubuntu oder Red Hat läuft.
Ein Kommissionierauftrag sollte es ebenfalls egal sein.
Ebenso wenig eine Prüfspur.
Wenn Plattformunterschiede beginnen, das Geschäftsverhalten zu ändern, ist die Software nicht wirklich plattformübergreifend.
Sie ist lediglich portabel.
COCO scheint an der ersten Definition erheblich mehr interessiert zu sein.
Wir auch.

COCO entscheidet nicht, was korrekte Logistik bedeutet
Dieser Teil ist wichtig.
COCO wird nicht zum Lagerexperten, nur weil es einem Lager-Workflow folgen kann.
Menschen definieren weiterhin Korrektheit.
Menschen entscheiden, wann Bestand verfügbar wird.
Menschen definieren, was eine gesperrte Lieferung bedeutet.
Menschen entscheiden, wer eine Menge korrigieren darf.
Menschen definieren, welche Bewegung eine Prüfspur erfordert.
Menschen entscheiden, wie eine gültige Ausnahmelösung aussieht.
Menschen entscheiden, wann eine Sendung wirklich vollständig ist.
Die Aufgabe von COCO ist anders.

Wiederholen.
Beobachten.
Vergleichen.
Erinnern.
Nachweise hinterlassen.


Dann macht es das nach jeder Softwareänderung wieder.
Und wieder.
Und wieder.
Ohne gelangweilt zu werden.
Ohne zu entscheiden, dass das Ergebnis der letzten Woche wahrscheinlich noch gültig ist.
Ohne die lästige Ausnahme zu überspringen, weil in zwölf Minuten Mittagspause ist.
Die glamouröse Zukunft des KI-Testens enthält eine überraschende Menge an Wiederholung.
Wir betrachten das als Feature.

Nachweise verändern das Gespräch
Traditionelles Testen endet oft mit einem völlig vernünftigen Satz:
„Es hat funktioniert, als ich es getestet habe."

COCO interessiert sich für den nächsten Satz.

Was genau hat funktioniert?
Welches Lager?
Welcher Benutzer?
Welche Sprache?
Welcher Prozessstatus?
Welche Reihenfolge?
Welches Dokument?
Welcher Bestandswert?
Was geschah unmittelbar vor dem Testschritt?
Was änderte sich unmittelbar danach?
Kann ein anderer Ingenieur das Ergebnis verstehen, ohne die Person zu fragen, die den Test durchgeführt hat?
Genau hier wird Regressionstesten zu mehr als wiederholtem Klicken.
Ein Bildschirm kann korrekt sein, während der Prozess falsch ist.
Ein Kommissionierfenster kann perfekt aussehen, während der Bestand bereits abgedriftet ist.
Ein Dokument kann existieren, während der Status, der es hätte erzeugen sollen, nie eingetreten ist.
Eine Anwendung kann 100 % anzeigen, während eine Prüfspur stillschweigend widerspricht.
COCO folgt dem Flow, weil im Flow diese Widersprüche sichtbar werden.

Irgendwo zwischen Control und Flow
Hier gibt es eine interessante Symmetrie.
Gute Logistiksoftware versucht, Unsicherheit innerhalb eines Betriebs zu reduzieren.
Gutes Testen versucht, Unsicherheit über die Software zu reduzieren, die ihn ausführt.
Das eine fragt:
Wo ist der Artikel?
Das andere fragt:
Woher wissen wir, dass die Software es noch weiß?
Das eine fragt:
Wurde diese Bewegung abgeschlossen?
Das andere fragt:
Welcher Nachweis belegt, dass sich der Status korrekt geändert hat?
Das eine fragt:
Kann die nächste Schicht weitermachen?
Das andere fragt:
Kann der nächste Ingenieur verstehen, was passiert ist?
Unterschiedliche Fragen.
Derselbe Instinkt.
Den Status sichtbar machen.
Die Begründung bewahren.
Die Menge an Wissen reduzieren, die nur im Kopf einer Person existiert.
Vielleicht ist das die Verbindung, die wir ursprünglich nicht geplant hatten.

Ingenieurskunst ohne das Banner
Niemand klickt auf eine Schaltfläche „Engineering Excellence".
Es gibt keine.
Und es sollte wahrscheinlich auch keine geben.
Ingenieurskunst zeigt sich indirekt.
Der Lagerkontext überlebt einen Sprachwechsel.
Derselbe Prozess überlebt eine andere Linux-Plattform.
Eine Bestandsbewegung bleibt rückverfolgbar.
Ein mobiler Kommissionierer sieht genau das, was gebraucht wird, und nichts anderes.
Eine Ausnahme unterbricht den Prozess, ohne seinen Status zu zerstören.
Das Hilfefenster erklärt den aktuellen Kontext, statt generische Dokumentation anzuzeigen.
Die Belegkette stimmt mit der betrieblichen Abfolge überein.
Der nächste Ingenieur kann verstehen, was passiert ist, ohne die Person zu fragen, die zufällig dabei war.
Es gibt reichlich Theater in moderner Software.
KI kann beeindruckende Demonstrationen erzeugen.
Dashboards können animieren.
Zahlen können sich bewegen.
Videos können sehr überzeugend aussehen.
Nichts davon beweist, dass zwei Bestandsoperationen nicht stillschweigend ein falsches Ergebnis erzeugen können.
Nichts davon beweist, dass eine Ausnahme Wochen später noch rekonstruiert werden kann.
Nichts davon beweist, dass Lagerarbeiter, Disponent, und Entwickler auf dieselbe betriebliche Wahrheit blicken.

Ingenieurskunst beginnt an einem weniger fotogenen Ort.

Mit Konsistenz.
Mit Nachweisen.
Mit Grenzen.


Mit der Bereitschaft, die langweiligen Teile langweilig zu lassen.
Unsichtbare Zuverlässigkeit erzeugt selten den dramatischsten Screenshot.
Bis man bewusst anfängt, danach zu suchen.

Control. Clarity. Flow.
Control bedeutet zu wissen, welches Lager, welcher Prozess, und welcher Status aktiv sind.
Clarity bedeutet zu verstehen, was sich geändert hat, wann es sich geändert hat, und warum.
Flow bedeutet, den Betrieb fortzusetzen zu lassen, ohne die Geschichte dahinter zu verlieren.
Das funktioniert für Logistik.
Es funktioniert für Softwaretests.
Es funktioniert überraschend gut für die Ingenieurskunst selbst.
Das erste Flow-Experiment gab COCO Administration.
Benutzer.
Rollen.
Datenbanken.
Sprachen.
Dann gab ihm jemand ein Lager.
Dann mehrere Sprachen.
Dann mobile Kommissionierung.
Dann Bestand.
Dann Umlagerungen.
Dann Ausnahmen.
Dann Dokumente.
Dann ein weiteres Betriebssystem.
An diesem Punkt sollten wir wahrscheinlich aufhören, Dinge hinzuzufügen.
Wir werden es wahrscheinlich nicht.

Control. Clarity. Flow.

Ubuntu war dran.

Red Hat ist jetzt dran.

Der Flow bewegt sich weiter.

COCO schaut weiter zu.
Und irgendwo mitten im letzten Durchlauf wurde offensichtlich, dass hinter diesem eine weitere Frage wartet.

Wir wissen, was sie ist.
COCO weiß, was sie ist.
Du weißt es nicht.
Noch nicht.


Wir könnten es dir sagen.

Aber dann würdest du vielleicht aufhören zu prüfen, ob ein neuer Insiders-Artikel erschienen ist.
Und das würde das Experiment ruinieren.

Veröffentlicht: 28.08.2026

Permalink →

Ein Brief von COCO

Ein Brief von COCO

An die Ingenieurin oder den Ingenieur, die oder der dieses Repository zum ersten Mal öffnet:

Willkommen.

Vielleicht sind Sie hier, weil etwas fehlgeschlagen ist.

Ein Dienst hat nicht mehr geantwortet.

Ein Deployment hat sich unerwartet verhalten.

Ein Alarm hat Sie mitten in der Nacht geweckt.

Oder Sie sind einfach neugierig, wie diese Plattform funktioniert.

Was auch immer Sie hierhergeführt hat, wissen Sie:

Dieses Projekt wurde genau für solche Momente gebaut.

Nicht um schwierige Probleme zu beseitigen.

Sondern um schwierige Probleme verständlich zu machen.

Sie werden Code finden.

Sie werden Dokumentation finden.

Sie werden Spezifikationen finden.

Wissenswertes

Warehouse Digitization Project Ideas, die wirken

Warehouse Digitization Project Ideas, die wirken

Ein fehlender Lieferschein kurz vor der Abfahrt, ein Bestand, der im Regal anders aussieht als in der Tabelle, und drei Mitarbeitende, die gleichzeitig dieselbe Rückfrage per Telefon klären: Genau dort entstehen sinnvolle warehouse digitization project ideas. Nicht bei der Frage, welche Technologie gerade modern wirkt, sondern bei einem konkreten Prozess, der Zeit kostet, Fehler erzeugt oder vom Wissen einzelner Personen abhängt.

Für kleine und mittlere Lager-, Handels- und Produktionsbetriebe ist Digitalisierung selten ein einzelnes Großprojekt. Sie ist eine Folge klar abgegrenzter Verbesserungen. Das Ziel muss nicht ein komplexes Enterprise-Warehouse-Management-System sein. Häufig ist ein schlankes, auf den tatsächlichen Ablauf zugeschnittenes Werkzeug besser als eine Suite mit Funktionen, die niemand auf dem Hallenboden nutzt.

Warehouse Digitization Project Ideas mit operativem Nutzen

Der beste Einstieg ist ein Prozess, der häufig vorkommt, leicht messbar ist und für Mitarbeitende spürbar besser wird. Wer sofort das gesamte Lager digitalisieren will, bindet Budget und Aufmerksamkeit, bevor sich eine Lösung im Alltag bewiesen hat. Ein begrenzter erster Schritt schafft dagegen belastbare Daten für die nächste Entscheidung.

1. Wareneingang mit mobiler Erfassung

Beim Wareneingang entstehen viele Folgefehler: falsch gezählte Mengen, ungeklärte Abweichungen, verzögert gebuchte Bestände und Papierbelege, die später nicht mehr auffindbar sind. Ein mobiles Erfassungsformular auf einem Handscanner, Tablet oder Smartphone kann den Vorgang deutlich stabiler machen.

Mitarbeitende scannen Artikel und Lieferreferenz, erfassen Menge, Lagerplatz und Abweichungsgrund direkt an der Rampe. Falls eine Charge, Seriennummer oder ein Foto relevant ist, gehört auch diese Information an denselben Datensatz. Der Bestand wird nicht erst am Ende der Schicht in einer Tabelle nachgetragen, sondern erhält einen nachvollziehbaren Status beim tatsächlichen Eingang.

Das bedeutet nicht, dass jeder Lieferant oder jeder Artikel zwingend Barcode-Etiketten braucht. Bei kleinen, unregelmäßigen Lieferungen kann eine Suche nach Artikelnummer ausreichen. Entscheidend ist, dass die Datenerfassung schneller ist als der bisherige Umweg über Papier und Nachpflege.

2. Digitale Umlagerungen statt Bestandsrätsel

Viele Lager wissen grundsätzlich, was vorhanden ist, aber nicht zuverlässig, wo es liegt. Ware wird für einen Auftrag vorgezogen, zwischengelagert, in die Montage gebracht oder wegen Platzmangel auf eine freie Fläche gestellt. Ohne einfache Buchung wird aus einer Bestandsfrage schnell eine Suchaktion.

Ein Umlagerungsprozess braucht keine komplizierte Oberfläche. Ausgangsplatz scannen, Zielplatz scannen, Menge bestätigen - mehr ist für viele Fälle nicht nötig. Das System sollte dabei prüfen, ob Artikel und Lagerplatz plausibel sind, und eine Buchung eindeutig einer Person und Uhrzeit zuordnen.

Wichtig ist der Umgang mit Ausnahmen. Ein Lagerplatz kann gesperrt, überfüllt oder nur für bestimmte Waren zugelassen sein. Diese Regeln sollten dort abgebildet werden, wo sie wirklichen Schaden verhindern. Für seltene Sonderfälle genügt oft ein Freigabeschritt durch die Lagerleitung. Zu viele Pflichtfelder machen aus einer hilfreichen Anwendung ein Hindernis.

3. Kommissionierung mit klaren Auftragsstatus

Papier-Picklisten funktionieren, bis Prioritäten wechseln, Positionen fehlen oder ein Auftrag auf mehrere Bereiche verteilt ist. Eine einfache digitale Kommissionierliste zeigt, welcher Auftrag offen ist, welche Positionen bereits gepickt wurden und wo eine Klärung nötig ist. Das reduziert Rückfragen zwischen Lager, Vertrieb und Versand.

Je nach Lagergröße kann die Anwendung Pickwege vorgeben oder lediglich Positionen nach Lagerzone sortieren. Eine vollständige Wegoptimierung lohnt sich vor allem bei vielen täglichen Aufträgen und langen Laufwegen. In einem kompakten Lager bringt eine verlässliche Statusanzeige oft mehr als ein mathematisch perfekter Weg, den im Alltag niemand befolgt.

Bei Fehlmengen sollte das System nicht nur rot markieren. Es sollte einen konkreten Folgeprozess anbieten: Bestand prüfen, Ersatzartikel anfragen, Nachschub auslösen oder Auftrag zur Klärung weitergeben. Digitalisierung ist dann wertvoll, wenn sie die nächste sinnvolle Handlung sichtbar macht.

4. Versanddokumente und Etiketten aus echten Auftragsdaten

Das manuelle Übertragen von Adressen, Gewichten und Artikelpositionen in Versandportale ist ein typischer Kandidat für Automatisierung. Lieferadresse, Lieferhinweise, Versandart und Paketinformationen liegen idealerweise einmal vor und werden für Lieferschein, Versandetikett und Versandbestätigung verwendet.

Ein passendes System kann Etiketten erzeugen, Dokumente revisionssicher ablegen und den Auftrag nach dem Druck automatisch auf versandbereit oder versendet setzen. Der operative Vorteil liegt nicht allein in gesparten Minuten. Er liegt darin, dass Versanddaten nicht an mehreren Stellen voneinander abweichen.

Hier ist die Integration entscheidend. Wenn ein Versanddienstleister keine brauchbare Schnittstelle bietet oder sehr unterschiedliche Sonderregeln gelten, kann ein teilautomatisierter Ablauf vernünftiger sein als eine fragile Vollintegration. Boring, provable reliability schlägt eine Automatisierung, die bei jeder Ausnahme stehen bleibt.

5. Nachschub und Mindestbestände mit nachvollziehbaren Regeln

Mindestbestände werden häufig in Tabellen gepflegt und dann ignoriert, weil niemand sicher ist, ob die Zahlen noch stimmen. Eine sinnvolle digitale Lösung verbindet tatsächliche Buchungen mit klaren Dispositionsregeln. Sie kann melden, wenn ein Artikel unter einen Schwellenwert fällt, reservierte Mengen berücksichtigen und eine Bestellliste vorbereiten.

Die Schwelle sollte nicht als ewige Wahrheit behandelt werden. Saisonale Nachfrage, Lieferzeiten und Mindestbestellmengen verändern sich. Deshalb braucht die verantwortliche Person eine einfache Möglichkeit, Vorschläge zu prüfen und Regeln anzupassen. Vollautomatische Bestellungen sind erst dann sinnvoll, wenn Stammdaten, Lieferantenlogik und Verbrauchsdaten stabil genug sind.

6. Rückverfolgbarkeit für Chargen, Seriennummern und Sperrbestände

Wer mit Chargen, Geräten, Ersatzteilen oder regulierten Produkten arbeitet, braucht mehr als eine Mengenanzeige. Es muss nachvollziehbar sein, welche Ware wann eingegangen ist, wohin sie bewegt wurde und in welchem Kundenauftrag sie gelandet ist.

Das Projekt kann bewusst klein beginnen: Zunächst nur Wareneingang und Versand einer kritischen Warengruppe erfassen. Danach folgen interne Bewegungen und Rückläufer. Ein System, das jede Buchung erzwingt, aber den realen Reparatur- oder Prüfprozess nicht kennt, wird umgangen. Die Fachlogik muss deshalb aus dem Arbeitsablauf entstehen, nicht aus einem abstrakten Datenmodell.

Das richtige Projekt auswählen

Die attraktivste Idee ist nicht automatisch die richtige erste Idee. Bewerten Sie mögliche Vorhaben nach Häufigkeit, Fehlerkosten, Wartezeit und Abhängigkeit von Einzelpersonen. Ein Prozess, der 50-mal täglich läuft und pro Vorgang zwei Minuten spart, kann wertvoller sein als eine seltene Sonderfunktion mit großer technischer Eleganz.

Auch die Datenqualität gehört in die Entscheidung. Wenn Artikelnummern doppelt vergeben sind, Lagerplätze nicht eindeutig benannt werden oder Aufträge aus mehreren Quellen widersprüchlich eintreffen, sollte das Projekt diese Grundlagen zuerst bereinigen. Software kann fehlende Regeln sichtbar machen, aber nicht zuverlässig ersetzen.

Für die Priorisierung reichen vier Fragen:

  • Welche Tätigkeit verursacht nachweislich die meisten Rückfragen oder Nacharbeiten?
  • Welche Information wird heute mehrfach abgeschrieben oder telefonisch abgefragt?
  • Welcher Fehler hätte die teuersten Folgen für Kunden, Bestand oder Versand?
  • Welcher Ablauf lässt sich in wenigen Wochen mit einer klaren Erfolgsmessung testen?

Technische Entscheidungen, die im Lageralltag zählen

Eine Lageranwendung muss nicht spektakulär aussehen. Sie muss bei schlechter WLAN-Abdeckung, im Handschuhbetrieb, unter Zeitdruck und während eines Schichtwechsels verständlich bleiben. Große Schaltflächen, klare Rückmeldungen nach einem Scan und eine sichtbare Fehlerbehandlung sind wichtiger als dekorative Dashboards.

Auch die Architektur sollte zur Betriebsrealität passen. Eine webbasierte Anwendung mit sauberer Datenbankstruktur kann auf vorhandenen Geräten laufen und ist leichter wartbar als eine Insellösung auf einem einzelnen PC. Mit einer stabilen Basis, etwa PHP 8.4, modernem JavaScript und MySQL 8, lassen sich Rollen, Buchungshistorien, Schnittstellen und dokumentierte Deployments langfristig nachvollziehbar betreiben.

Dabei ist nicht jede Information für jede Rolle bestimmt. Lagerkräfte benötigen offene Aufgaben und klare Buchungsdialoge. Die Disposition braucht Warnungen und Bestellvorschläge. Die Leitung braucht Auswertungen zu Durchlaufzeiten, Differenzen und offenen Vorgängen. Rechtekonzepte, Protokolle und Kontensperren bei wiederholten Fehlversuchen gehören früh in die Planung, besonders wenn externe Dienstleister oder mehrere Standorte beteiligt sind.

Einführung: Erst beweisen, dann ausweiten

Ein Pilot sollte mit echten Aufträgen laufen, nicht nur mit Testdaten im Besprechungsraum. Wählen Sie eine Lagerzone, eine Produktgruppe oder eine Schicht und definieren Sie vorab, woran Erfolg erkennbar ist: weniger Korrekturbuchungen, kürzere Bearbeitungszeit, weniger Rückfragen oder höhere Buchungsquote am selben Tag.

Planen Sie parallel eine Rückfallebene. Wenn die neue Anwendung ausfällt oder ein Prozess ungeklärt ist, muss die Mannschaft wissen, wie sie weiterarbeitet und wie nachträgliche Buchungen kontrolliert werden. Das ist kein Zeichen mangelnden Vertrauens in die Technik, sondern professioneller Betrieb.

Nach zwei bis vier Wochen zeigen sich meist die wertvollsten Erkenntnisse. Vielleicht fehlt kein Feature, sondern eine bessere Artikelkennzeichnung. Vielleicht ist der Workflow richtig, aber ein Scannerprofil oder eine Berechtigung bremst. Diese Beobachtungen sollten in kurze, kontrollierte Verbesserungszyklen fließen, statt ein neues Großprojekt auszulösen.

Die beste Digitalisierung macht den Lageralltag nicht theoretisch moderner, sondern konkret ruhiger: weniger Suchen, weniger Nachtragen, klarere Übergaben und belastbare Informationen genau dann, wenn eine Entscheidung ansteht.
Permalink →

Inventory Workflow Automation Checklist fürs Lager

Inventory Workflow Automation Checklist fürs Lager

Ein Wareneingang wird auf Papier bestätigt, Bestände später in eine Tabelle übertragen und eine Versandfrage per Telefon geklärt. Jeder einzelne Schritt wirkt beherrschbar. Zusammen erzeugen sie Rückfragen, Bestandsdifferenzen und Abhängigkeit von einzelnen Mitarbeitenden.

Eine Inventory Workflow Automation Checklist verhindert, dass aus diesem Zustand vorschnell ein überdimensioniertes Softwareprojekt wird. Sie trennt Prozesse, die wirklich automatisiert werden sollten, von solchen, für die ein sauber geführtes Spreadsheet weiterhin genügt.


Die Inventory Workflow Automation Checklist vor dem Projektstart

Automatisierung beginnt nicht mit der Auswahl eines Systems. Sie beginnt mit einer überprüfbaren Beschreibung dessen, was im Lager tatsächlich passiert - auch bei Ausnahmen, Schichtwechseln und Zeitdruck. Gehen Sie die folgenden Punkte mit Lagerleitung, Disposition, Einkauf und gegebenenfalls Buchhaltung direkt am Prozess durch.

1. Bewegungen statt nur Bestände erfassen

Ein aktueller Bestand ist das Ergebnis von Bewegungen. Deshalb sollte klar sein, welche Ereignisse den Bestand erhöhen, verringern, reservieren, sperren oder umbuchen. Dazu gehören Wareneingang, Einlagerung, Kommissionierung, Versand, Retoure, Ausschuss, Inventurdifferenz und Umlagerung.

Für jede Bewegung braucht es eine eindeutige Antwort auf vier Fragen: Wer führt sie aus? Wann wird sie gebucht? Welcher Lagerort ist betroffen? Welcher Beleg oder Auftrag belegt sie? Wenn diese Antworten heute nur im Kopf erfahrener Mitarbeitender existieren, ist das ein guter Automatisierungskandidat. Das Ziel ist nicht mehr Datenerfassung, sondern eine belastbare Historie, aus der sich ein Bestand erklären lässt.

2. Artikel, Varianten und Einheiten bereinigen

Viele Projekte scheitern nicht am Scanner oder an der Weboberfläche, sondern an Stammdaten. Ein Artikel kann als Karton eingekauft, einzeln gelagert und in Sets verkauft werden. Ohne definierte Umrechnungen produziert die Software formal korrekte, operativ aber falsche Mengen.

Prüfen Sie Artikelnummern auf Dubletten, legen Sie verbindliche Bezeichnungen fest und unterscheiden Sie Verkaufseinheit, Lagereinheit und Verpackungseinheit. Seriennummern, Chargen, Mindesthaltbarkeitsdaten oder Gefahrstoffkennzeichnungen gehören nur dann in den ersten Ausbau, wenn sie im Alltag Entscheidungen beeinflussen oder regulatorisch erforderlich sind. Alles andere erhöht zunächst Pflegeaufwand und Fehlerfläche.

3. Lagerorte so genau definieren, wie nötig

„Halle 2“ ist für eine Inventurliste vielleicht ausreichend. Für eine verlässliche Kommissionierung ist es meist zu grob. Definieren Sie, ob ein Lagerort Zone, Regal, Fach, Stellplatz oder Übergabefläche meint. Auch Sperrlager, Wareneingangszone, Retourenbereich und Versandpuffer müssen als eigene Orte erkennbar sein, wenn Waren dort liegen können.

Die richtige Granularität hängt vom Betrieb ab. Ein Workshop mit wenigen hundert Positionen braucht nicht zwingend eine Fachverwaltung. Bei mehreren Kommissionierenden pro Schicht kann ein präziser Stellplatz jedoch Laufwege und Suchzeiten deutlich reduzieren. Automatisieren Sie keine Genauigkeit, die niemand pflegen kann.

4. Auslöser, Verantwortliche und Freigaben festlegen

Ein Workflow braucht einen klaren Startpunkt. Beim Wareneingang kann das die Lieferung am Tor, die Bestellung im Einkauf oder der Scan eines Lieferscheins sein. Für eine Nachbestellung kann ein Mindestbestand den Vorschlag auslösen, während die endgültige Bestellung bei einer verantwortlichen Person bleibt.

Dokumentieren Sie außerdem, welche Aktionen automatisch erfolgen dürfen und welche eine Prüfung brauchen. Eine fehlende Menge sollte etwa eine Abweichung erzeugen, nicht stillschweigend den erwarteten Wareneingang verändern. Bei wertvollen, chargenpflichtigen oder sicherheitskritischen Artikeln sind Freigabeschritte sinnvoll. Bei Verbrauchsmaterial würden sie den Durchsatz unnötig bremsen.

5. Dokumente dort erzeugen, wo sie gebraucht werden

Lieferscheine, Einlagerungslisten, Picklisten, Versandetiketten und Übergabeprotokolle entstehen oft in verschiedenen Anwendungen. Das führt zu Medienbrüchen: Eine Adresse wird kopiert, ein Auftrag abgehakt, ein Versandstatus später nachgetragen.

Notieren Sie pro Dokument die Quelle der Daten, den Zeitpunkt der Erstellung und den Empfänger. Ein sinnvoller Ablauf kann beispielsweise nach der Freigabe eines Auftrags automatisch eine Pickliste erzeugen, nach dem Packen ein Versandlabel bereitstellen und nach der Übergabe den Auftrag mit Zeitstempel abschließen. Entscheidend ist, dass die Daten nicht mehrfach manuell eingegeben werden müssen.

Schnittstellen und Datenqualität prüfen

Die beste Lagerlogik nützt wenig, wenn Aufträge nur einmal täglich als Datei eintreffen oder Lieferadressen unterschiedlich formatiert sind. Erstellen Sie deshalb eine nüchterne Liste der Systeme, die Daten senden oder empfangen: Shop, ERP, Buchhaltung, Versanddienstleister, Lieferantenportal, Produktionssystem und vorhandene Tabellen.

Für jede Verbindung sollte feststehen, welches System bei welchem Datenfeld führend ist. Ist der Artikelstamm im ERP maßgeblich, darf das Lagerportal nicht still eigene Artikel anlegen. Kommt eine Auftragsänderung aus dem Shop, muss sie vor dem Versand sichtbar werden. Bei kleinen Mengen kann ein kontrollierter CSV-Import der richtige erste Schritt sein. Bei hohem Volumen oder kurzen Lieferzusagen lohnt sich eine direkte Schnittstelle.

Ebenso wichtig ist der Umgang mit Fehlern. Eine Schnittstelle sollte nicht nur Daten übertragen, sondern auch zeigen, was abgewiesen wurde und warum. Unbekannte Artikelnummern, ungültige Adressen oder fehlende Mengen dürfen nicht in einer technischen Protokolldatei verschwinden. Sie brauchen eine Arbeitsliste mit Zuständigkeit und Status.

Bedienung auf dem Lagerboden gestalten

Ein Prozess, der am Schreibtisch plausibel aussieht, kann auf dem Lagerboden scheitern. Mitarbeitende tragen Handschuhe, bewegen Waren, teilen Geräte oder arbeiten bei instabiler WLAN-Abdeckung. Prüfen Sie deshalb früh, ob Scanner, Tablet, Desktop oder Ausdruck zum jeweiligen Arbeitsschritt passen.

Der Scan sollte eine eindeutige Rückmeldung geben: richtige Ware, falscher Lagerort, bereits gebuchte Menge oder gesperrter Artikel. Farben allein reichen nicht. Kurze, verständliche Meldungen und ein klarer nächster Schritt sind unter Zeitdruck wertvoller als eine funktionsreiche Oberfläche.

Planen Sie auch den Ausnahmefall. Was passiert bei beschädigtem Barcode, Netzwerkausfall, Teillieferung oder einer gefundenen Ware ohne Zuordnung? Ein guter Ablauf bietet dafür kontrollierte Wege und protokolliert die Korrektur. Er zwingt Teams nicht dazu, sich mit Notizzetteln und späteren Sammelbuchungen zu helfen.

Kennzahlen definieren, bevor Dashboards gebaut werden

Ein Dashboard ist kein Ziel. Relevant sind Kennzahlen, die eine operative Entscheidung auslösen. Das können offene Wareneingänge über einem definierten Alter, Aufträge kurz vor dem Versandtermin, Bestandsdifferenzen je Lagerzone, Kommissionierfehler oder die Zeit zwischen Auftragseingang und Übergabe sein.

Legen Sie für jede Kennzahl Datenquelle, Berechnungsregel und verantwortliche Rolle fest. „Bestandsgenauigkeit“ ist beispielsweise nur aussagekräftig, wenn klar ist, gegen welche Zählung sie gemessen wird und wie Retouren oder Sperrbestände behandelt werden. Wenige verlässliche Kennzahlen sind besser als eine Wand aus Diagrammen, der niemand vertraut.

Sicherheit, Rechte und Nachvollziehbarkeit einplanen

Automatisierung verteilt Handlungsmacht. Wer Bestände ändern, Artikel anlegen, Versandlabels erzeugen oder Aufträge stornieren darf, sollte bewusst festgelegt werden. Rollenbasierte Rechte sind meist sinnvoller als ein gemeinsames Login am Lager-PC. Besonders kritische Korrekturen benötigen einen Zeitstempel, eine Personenzuordnung und idealerweise einen Grund.

Auch technische Grundlagen gehören auf die Checkliste: regelmäßige Backups, getestete Wiederherstellung, dokumentierte Zugänge, Protokollierung von Schnittstellenfehlern und ein Verfahren für gesperrte oder ausgeschiedene Nutzerkonten. Bei einer individuellen Anwendung sind wartbare Technologien, eine klare Datenbankstruktur und nachvollziehbare Deployment-Schritte keine Nebensache. Sie entscheiden darüber, ob Anpassungen nach zwei Jahren noch kalkulierbar bleiben.

In kleinen, messbaren Schritten einführen

Versuchen Sie nicht, Wareneingang, Nachschub, Inventur, Versand und Routenplanung gleichzeitig umzustellen. Wählen Sie einen Ablauf mit spürbarem Schmerz und überschaubarem Risiko, etwa die mobile Buchung von Wareneingängen oder das automatische Erstellen von Versanddokumenten. Erfassen Sie vor dem Start Bearbeitungszeit, Korrekturen und offene Fälle.

Testen Sie mit echten Artikeln, echten Aufträgen und den Mitarbeitenden, die später damit arbeiten. Ein Pilot mit einer Lagerzone oder einer Produktgruppe zeigt schneller als ein Workshop, ob Bezeichnungen, Scannerabläufe und Freigaben funktionieren. Erst wenn die Ausnahmefälle beherrscht sind, sollte der nächste Prozess folgen.

Automatisierung ist gelungen, wenn Teams weniger nachfragen müssen, ein Bestand erklärbar bleibt und der Prozess auch dann funktioniert, wenn die erfahrenste Person im Urlaub ist. Genau dort lohnt sich die nächste Verbesserung: nicht beim lautesten Tool, sondern bei der Reibung, die den Arbeitstag tatsächlich verlangsamt.

Permalink →

Mobile Webseiten-Ladezeit verbessern

Mobile Webseiten-Ladezeit verbessern

Auf einem Lagerhandy mit mäßigem Empfang entscheidet nicht die Animation im Hero-Bereich über den ersten Eindruck, sondern ob die Seite überhaupt bedienbar wird. Wartet ein Interessent drei, vier oder fünf Sekunden auf Inhalte, ist der Vergleich zur Konkurrenz nur einen Zurück-Button entfernt. Wer die mobile Webseite Ladezeit verbessern will, braucht deshalb keine kosmetischen Einzelmaßnahmen, sondern eine nachvollziehbare technische Reihenfolge.

Das gilt besonders für Websites, die Anfragen erzeugen sollen: für einen Hersteller, einen Logistikdienstleister oder einen Betrieb mit erklärungsbedürftigen Leistungen. Mobil kommen Nutzer oft zwischen Terminen, auf der Fläche oder über eine Suchanfrage mit konkreter Absicht auf die Seite. Die Website muss dann Informationen liefern, nicht erst Rechenarbeit auf dem Gerät verursachen.

Warum mobile Ladezeit ein Betriebsproblem ist

Mobile Performance wird häufig als SEO-Disziplin behandelt. Das greift zu kurz. Schnelle Seiten helfen zwar bei Sichtbarkeit und Kampagnenkosten, aber der unmittelbare Effekt liegt in der Nutzung: Formulare werden eher abgeschickt, Telefonnummern eher gewählt und Produktinformationen eher gelesen. Eine langsame Website erzeugt dagegen Zweifel, noch bevor ein Ansprechpartner reagieren kann.

Dabei ist „schnell“ kein einzelner Messwert. Eine Seite kann früh einen Hintergrund anzeigen und dennoch erst deutlich später auf Klicks reagieren. Für Besucher zählen drei Dinge: Wann erscheint der wichtigste Inhalt? Wann lässt sich die Seite ohne Verzögerung bedienen? Und springt das Layout noch, während sie gerade einen Button antippen wollen? Diese Fragen spiegeln sich in Kennzahlen wie Largest Contentful Paint, Interaction to Next Paint und Cumulative Layout Shift wider.

Messungen müssen unter realistischen Bedingungen erfolgen. Ein leistungsstarker Bürorechner im WLAN verschleiert Probleme, die auf einem älteren Android-Gerät im Mobilfunknetz sichtbar werden. Auch der Standort, zwischengeschaltete Dienste und eine bereits gefüllte Browser-Cache verändern Ergebnisse. Entscheidend sind deshalb wiederholte Messungen und echte Nutzungsdaten, nicht ein einzelner perfekter Testlauf.

Mobile Webseiten-Ladezeit verbessern: erst messen, dann ändern

Der häufigste Fehler ist, sofort Bilder zu komprimieren oder ein weiteres Optimierungs-Plugin zu installieren. Beides kann helfen, aber ohne Ursachenanalyse entstehen schnell schwer wartbare Konfigurationen. Prüfen Sie zuerst eine repräsentative Auswahl: Startseite, eine typische Leistungs- oder Produktseite, Kontaktseite und eine stark besuchte Landingpage. Auf diesen Seiten lassen sich Muster erkennen.

Im Netzwerkprotokoll zeigt sich, welche Dateien den Start blockieren und wie groß sie tatsächlich sind. Ein Performance-Audit macht sichtbar, ob JavaScript die Bedienung verzögert, ob Schriften zu spät kommen oder ob Bilder unnötig früh geladen werden. Ergänzen Sie Labormessungen durch Daten echter Besucher, sofern ausreichend Verkehr vorhanden ist. So vermeiden Sie Optimierung für ein Testprofil, das Ihre Zielgruppe nicht abbildet.

Setzen Sie vor jeder Änderung ein klares Ziel. Beispielsweise: Der sichtbare Hauptinhalt soll auf einem durchschnittlichen Mobilgerät in unter 2,5 Sekunden erscheinen, oder das Kontaktformular soll ohne Eingabeverzögerung nutzbar sein. Nicht jede Seite muss eine theoretische Bestnote erreichen. Bei einer komplexen Anwendung mit authentifizierten Daten gelten andere Voraussetzungen als bei einer öffentlichen Unternehmensseite. Boring, provable reliability ist hier wertvoller als ein kurzfristiger Score durch riskante Tricks.

1. Bilder nach ihrer Aufgabe behandeln

Auf vielen mobilen Seiten sind Bilder weiterhin der größte Datenblock. Das Problem ist nicht das Foto selbst, sondern ein Bild, das in 2.500 Pixel Breite übertragen wird, obwohl auf dem Gerät 700 Pixel genügen. Stellen Sie responsive Bildvarianten bereit, damit der Browser die passende Größe auswählen kann. Moderne Formate wie WebP oder AVIF reduzieren die Dateigröße oft deutlich, sollten aber mit sauberen Fallbacks und geprüfter Bildqualität eingesetzt werden.

Das größte Bild im sichtbaren Einstieg verdient besondere Aufmerksamkeit. Es sollte korrekt zugeschnitten sein, eine passende Auflösung haben und früh geladen werden. Bilder weiter unten auf der Seite können verzögert geladen werden. Das spart Daten beim Einstieg, darf aber nicht dazu führen, dass Bilder beim Scrollen sichtbar nachladen, obwohl der Nutzer sie bereits erwartet.

Verzichten Sie nicht reflexhaft auf alle Bilder. Ein gutes Bild kann eine Maschine, ein Team oder einen Prozess schneller erklären als ein Absatz. Die technische Aufgabe lautet: Relevante visuelle Informationen effizient ausliefern, nicht Gestaltung auf einen grauen Platzhalter reduzieren.

2. JavaScript auf notwendige Arbeit begrenzen

Jedes Script konkurriert beim Laden und bei der Bedienung um Rechenzeit. Besonders problematisch sind pauschal eingebundene Bibliotheken, Tag-Manager mit vielen Fremdskripten, Chat-Widgets, Karten und Animationen. Auf Desktop-Geräten bleiben diese Kosten oft unauffällig. Mobil führen sie zu einer Seite, die sichtbar ist, aber auf Eingaben träge reagiert.

Prüfen Sie für jedes Script seinen Zweck, seine Ladebedingung und seinen geschäftlichen Nutzen. Eine interaktive Karte auf der Kontaktseite muss nicht auf jeder Unterseite geladen werden. Ein Cookie- oder Analysewerkzeug sollte keine Kette weiterer Dateien auslösen, bevor der Besucher überhaupt Inhalte lesen kann. Funktionen, die erst nach Interaktion nötig werden, können auch dann geladen werden.

Bei individuell entwickelten Websites ist eine klare Komponentenstruktur ein echter Vorteil. JavaScript wird pro Funktion gebündelt statt als globales Paket ausgeliefert. Das erleichtert auch spätere Pflege: Wer ein Formular erweitert, verändert nicht versehentlich den Code für einen Produktfilter oder eine Navigation.

3. CSS und Schriften ohne Blockaden ausliefern

Ein häufiger Engpass liegt im ersten sichtbaren Bereich. Wenn dafür mehrere Stylesheets, Icon-Fonts und externe Schriftvarianten geladen werden müssen, wartet der Browser unnötig lange. Kritische Styles für den sichtbaren Bereich sollten klein und früh verfügbar sein. Nicht kritische Regeln können später folgen.

Bei Webfonts reichen meist wenige Schriftschnitte. Vier Gewichtungen in normal, kursiv und zusätzlichen Untersets wirken im Designsystem vollständig, sind für eine typische Unternehmenswebsite aber selten erforderlich. Legen Sie sinnvolle System-Fallbacks fest, damit Text sofort lesbar bleibt. Eine Schrift, die einige Millisekunden später sauber wechselt, ist besser als leerer Text.

Auch Icons verdienen eine Prüfung. Ein kleines SVG-Set ist häufig effizienter und präziser steuerbar als eine komplette Icon-Schrift. Das ist keine Regel ohne Ausnahme: Bestehende Systeme müssen nicht allein für ein paar Kilobyte neu gebaut werden. Werden ohnehin größere Änderungen geplant, gehört die Entscheidung aber in die technische Basis.

4. Caching und Serverantwort sauber aufsetzen

Selbst eine schlanke Oberfläche fühlt sich langsam an, wenn der Server lange bis zur ersten Antwort benötigt. Ursachen reichen von ungebremsten Datenbankabfragen über dynamisch zusammengesetzte Seiten bis zu fehlendem Caching. Öffentliche Inhalte, die sich selten ändern, sollten als Cache-Version schnell auslieferbar sein. Statische Dateien wie Bilder, CSS und JavaScript benötigen eindeutige Versionsnamen und sinnvolle Cache-Regeln.

Bei PHP-Anwendungen geht es zusätzlich um effiziente Ausführung, einen korrekt konfigurierten Opcode-Cache und kontrollierte Datenbankzugriffe. MySQL-Abfragen brauchen Indizes, die zu den tatsächlichen Filter- und Sortierwegen passen. Eine Startseite, die für jeden Aufruf mehrere unnötige Datenabfragen ausführt, wird mit wachsendem Traffic nicht besser.

Caching ist jedoch kein Freifahrtschein. Preise, Verfügbarkeiten, personalisierte Bereiche oder Inhalte nach einem Login dürfen nicht versehentlich veraltet erscheinen. Deshalb werden Cache-Grenzen fachlich definiert: Was darf fünf Minuten alt sein, was muss unmittelbar aktuell sein, und wer leert den Cache nach einer Inhaltsänderung? Gute Performance entsteht aus dieser Präzision.

5. Drittanbieter kritisch behandeln

Externe Dienste sind oft der unsichtbare Ballast einer Website. Analyse, Consent-Management, Videos, Karten, Bewertungswidgets und Marketing-Pixel laden weitere Skripte von weiteren Servern. Jede Abhängigkeit kann Verzögerungen erzeugen, Datenschutzfragen aufwerfen und im Fehlerfall die Darstellung beeinträchtigen.

Das heißt nicht, dass jedes externe Tool entfernt werden muss. Ein Video kann Vertrieb unterstützen, ein Analysewerkzeug kann wichtige Entscheidungen fundieren. Es braucht aber eine Kosten-Nutzen-Prüfung. Laden Sie eingebettete Medien erst nach Zustimmung oder Interaktion. Nutzen Sie bei Karten zunächst eine Vorschau. Und entfernen Sie Tags, deren Ergebnisse seit Monaten niemand mehr auswertet.

6. Layoutsprünge und mobile Bedienung mitdenken

Ladezeit und Bedienbarkeit gehören zusammen. Reservieren Sie für Bilder, Banner und eingebettete Elemente feste Flächen, damit Buttons nicht unter dem Finger wegspringen. Vermeiden Sie Pop-ups, die den sichtbaren Inhalt direkt beim Einstieg verdecken. Eine schnelle Seite, die sofort ein schwer schließbares Overlay zeigt, löst das Problem nicht.

Testen Sie Formulare besonders sorgfältig. Große Eingabefelder, passende Tastaturtypen und kurze Pflichtstrecken helfen mehr als ein aufwendiger Effekt. Wenn eine Anfrage nur Name, Rückrufnummer und Anliegen benötigt, ist ein zwölfteiliges Formular kein Zeichen von Gründlichkeit. Es ist Reibung.

7. Performance als festen Betriebsprozess führen

Ein einmaliger Relaunch hält die Ladezeit nicht dauerhaft niedrig. Neue Kampagnenbilder, Tracking-Anforderungen und Redaktionsmodule summieren sich. Deshalb gehören Performance-Budgets in den Entwicklungsprozess: eine maximale Größe für Einstiegsbilder, klare Regeln für neue Drittanbieter und definierte Grenzwerte für JavaScript.

Nach Releases sollten die wichtigsten Seitentypen erneut geprüft werden. Automatisierte Tests können dabei feststellen, ob zentrale Seiten erreichbar sind und kritische Abläufe funktionieren. Für Performance reicht ein reiner Funktionstest allerdings nicht aus. Ergänzen Sie ihn um Messungen der Antwortzeit, der übertragenen Datenmenge und der mobilen Interaktionsfähigkeit. Eine schnelle mobile Website entsteht nicht durch ein einzelnes Plugin und auch nicht durch Verzicht um jeden Preis. Sie entsteht, wenn Design, Inhalte, Infrastruktur und reale Nutzung zusammen betrachtet werden. Beginnen Sie bei der Seite, die Anfragen oder operative Kontakte auslöst, messen Sie unter ehrlichen Bedingungen und beseitigen Sie dort Reibung, wo Nutzer sie tatsächlich spüren.

Permalink →

Logistiksoftware, die den Betrieb wirklich entlastet

Logistiksoftware, die den Betrieb wirklich entlastet

Wenn ein Wareneingang erst auf Papier notiert, später in eine Tabelle übertragen und anschließend per Zuruf an den Versand weitergegeben wird, fehlt meist nicht der Einsatz der Mitarbeitenden. Es fehlt eine gemeinsame, verlässliche Arbeitsgrundlage. Gute Logistiksoftware ersetzt solche Brüche nicht mit mehr Bildschirmarbeit, sondern mit klaren Abläufen: Was ist angekommen, wo liegt es, was wurde reserviert und was kann heute versendet werden?

Für kleine und mittlere Unternehmen ist dabei nicht die größtmögliche Funktionsliste entscheidend. Entscheidend ist, dass die Software die tatsächliche Arbeit auf dem Lagerboden, im Büro und im Versand abbildet. Eine Lösung, die für einen globalen Konzern mit zwanzig Standorten gedacht ist, kann für einen Betrieb mit einem Lager und zwei Schichten unnötig langsam, teuer und kompliziert sein.

Wann Logistiksoftware wirklich sinnvoll wird

Tabellen sind nicht grundsätzlich ein Problem. Für geringe Mengen, einen überschaubaren Artikelstamm und einen einzelnen verantwortlichen Mitarbeiter können sie die pragmatischste Lösung sein. Es wäre falsch, einen funktionierenden Prozess allein aus Modernisierungsgründen durch ein Projekt zu ersetzen.

Der Kipppunkt kommt, wenn Informationen mehrfach gepflegt werden müssen oder niemand mehr sicher sagen kann, welche Datei aktuell ist. Typische Signale sind Fehlbestände trotz voller Regale, Rückfragen zum Status von Lieferungen, manuell geschriebene Lieferscheine und Inventuren, die den Betrieb für Tage ausbremsen. Auch wachsende Auftragszahlen machen sichtbar, welche Schritte bislang nur durch Erfahrung einzelner Personen zusammengehalten wurden.

Dann geht es nicht primär um Digitalisierung als Schlagwort. Es geht um Fehlerquellen und Wartezeiten. Ein Mitarbeiter sollte nicht erst mehrere Listen vergleichen müssen, um eine Bestellung freizugeben. Der Versand sollte nicht raten müssen, ob ein Artikel tatsächlich verfügbar oder bereits für einen anderen Auftrag reserviert ist.

Welche Prozesse Logistiksoftware verbinden sollte

Eine brauchbare Lösung beginnt mit dem Materialfluss, nicht mit einem Standardmenü. Bei vielen Betrieben umfasst dieser Fluss Wareneingang, Einlagerung, Bestandsführung, Kommissionierung, Versand und Rückmeldung. Je nach Geschäft kommen Chargen, Seriennummern, Retouren, Fertigungsaufträge oder Tourenplanung hinzu.

Wareneingang mit nachvollziehbaren Beständen

Im Wareneingang entscheidet sich viel. Wird eine Lieferung direkt gegen Bestellung oder Lieferschein geprüft, lassen sich Mengenabweichungen, beschädigte Ware und fehlende Positionen dort festhalten, wo sie entstehen. Die Ware erhält einen Status, statt nur physisch irgendwo abgestellt zu werden.

Die Software muss dafür nicht zwangsläufig mit teurer Scanner-Hardware beginnen. In manchen Lagern reicht zunächst ein Tablet oder ein Arbeitsplatz am Wareneingang. Wo viele Positionen täglich bewegt werden, sind Barcode-Scanner jedoch sinnvoll, weil sie Buchungen beschleunigen und Tippfehler reduzieren. Die richtige Entscheidung hängt von Mengen, Wegen und Artikelstruktur ab.

Lagerbewegungen ohne Gedächtnisprotokoll

Bestände sind nur dann belastbar, wenn Zugänge, Umlagerungen, Entnahmen und Korrekturen nachvollziehbar sind. Das bedeutet nicht, dass jede Ausnahme verhindert werden muss. Im Alltag gibt es beschädigte Verpackungen, falsche Einlagerungen und spontane Materialentnahmen. Eine gute Anwendung macht diese Fälle buchbar, dokumentiert aber auch, wer was wann geändert hat.

Diese Historie ist kein Kontrollinstrument um ihrer selbst willen. Sie hilft, Ursachen zu finden. Wenn ein Artikel wiederholt auf einem falschen Lagerplatz landet, ist möglicherweise die Lagerkennzeichnung unklar. Wenn regelmäßige Korrekturen auftreten, liegt das Problem oft im Prozess vor der Buchung.

Aufträge, Lieferscheine und Versand aus einem Ablauf

Viele Teams verlieren Zeit an der Schnittstelle zwischen Auftrag und Versand. Auftragsdaten kommen per E-Mail, Telefon oder aus einem separaten Shop-System. Anschließend werden Positionen ausgedruckt, Bestände geprüft und Versandpapiere erneut erfasst. Jede manuelle Übergabe schafft Raum für Abweichungen.

Logistiksoftware sollte aus einem freigegebenen Auftrag eine eindeutige Pickliste, einen Lieferschein und bei Bedarf ein Versandlabel erzeugen können. Wichtig ist dabei die Reihenfolge: Erst muss klar sein, was lieferbar ist. Danach sollte der Auftrag für andere Prozesse reserviert sein. Sonst entsteht die unangenehme Situation, dass zwei Mitarbeiter denselben letzten Bestand verplanen.

Planung, die zur Realität passt

Tourenplanung und Kapazitätssteuerung können wertvoll sein, besonders bei eigenen Auslieferungen, festen Zeitfenstern oder vielen regionalen Stopps. Sie sind aber nicht automatisch der nächste sinnvolle Schritt. Wer noch keine saubere Auftragsfreigabe und keine belastbaren Bestandsdaten hat, sollte zuerst diese Grundlagen lösen.

Dasselbe gilt für Prognosen und KI-gestützte Planung. Sie können Muster sichtbar machen, benötigen aber saubere Eingangsdaten. Eine Prognose auf Basis unvollständiger Bestände wirkt technisch anspruchsvoll, verbessert aber keine Lieferfähigkeit.

Standardlösung oder individuelle Logistiksoftware?

Standardsoftware ist sinnvoll, wenn die eigenen Abläufe weitgehend üblich sind und sich ohne größere Reibung anpassen lassen. Sie kann schneller eingeführt werden und bringt erprobte Grundfunktionen mit. Für einen Betrieb mit einfachen Lagerprozessen, klaren Rollen und wenigen Besonderheiten ist das oft die wirtschaftlich richtige Wahl.

Individuelle Logistiksoftware lohnt sich, wenn das Geschäft von speziellen Abläufen lebt oder bestehende Systeme nur mit Umwegen verbunden werden können. Das betrifft etwa Werkstätten mit Materialausgabe an laufende Aufträge, Händler mit kundenspezifischen Versandregeln oder Hersteller, die Lagerbewegungen eng mit Produktionsschritten verbinden müssen.

Der Unterschied liegt nicht darin, alles neu zu erfinden. Gute individuelle Systeme übernehmen bewährte Muster wie Statuswechsel, Reservierungen und Berechtigungen. Sie passen aber Sprache, Masken, Dokumente und Schnittstellen an die Arbeit an, die tatsächlich erledigt wird. So muss sich das Team nicht dauerhaft an Kategorien orientieren, die nur im Handbuch des Herstellers Sinn ergeben.

Für softify.pro beginnt ein solches Vorhaben deshalb mit der Frage, welche Abläufe erhalten bleiben sollen. Nicht jeder Zettel ist ein Fehler, und nicht jede Sonderregel ist sinnvoll. Erst wenn klar ist, wo Informationen verloren gehen oder Entscheidungen unnötig warten, lässt sich eine tragfähige Lösung planen.

Ein Rollout ohne Betriebsunterbrechung

Das größte Risiko liegt selten im Programmcode allein. Es liegt in einer Einführung, die zu viel auf einmal verändern will. Ein Lager kann nicht zwei Wochen pausieren, um ein neues System zu lernen. Deshalb ist ein schrittweiser Rollout meist vernünftiger als ein großer Umstellungstermin.

Ein guter erster Abschnitt konzentriert sich auf einen abgrenzbaren Ablauf, zum Beispiel Wareneingang und Bestandsbuchungen oder die Erstellung von Lieferscheinen. Das Team arbeitet mit echten Daten, Rückmeldungen fließen direkt in die Anpassung ein, und der Nutzen wird messbar. Erst danach folgen weitere Bereiche wie mobile Kommissionierung, Retouren oder Anbindungen an Shops und Versanddienstleister.

Datenübernahme verdient dabei besondere Aufmerksamkeit. Alte Artikelnummern, doppelte Kundenstammdaten und uneinheitliche Lagerorte verschwinden nicht automatisch, nur weil ein neues System eingeführt wird. Häufig ist es besser, Stammdaten bewusst zu bereinigen und nur relevante Historien zu übernehmen. Das spart spätere Suche und verhindert, dass alte Unordnung technisch konserviert wird.

Auch Berechtigungen gehören früh auf die Agenda. Nicht jeder Mitarbeiter benötigt Zugriff auf Preise, alle Bestandskorrekturen oder die Stammdatenpflege. Klare Rollen schützen vor versehentlichen Änderungen und machen Verantwortlichkeiten sichtbar, ohne den Arbeitsfluss mit unnötigen Freigaben zu blockieren.

Technik, die nach dem Go-live nicht zur Last wird

Eine Logistikanwendung muss im Alltag schnell reagieren, auch wenn mehrere Arbeitsplätze gleichzeitig buchen. Dafür braucht sie eine nachvollziehbare Datenarchitektur, saubere Transaktionen und klare Regeln für parallele Änderungen. Wenn zwei Personen denselben Bestand bearbeiten, darf das System keine stillen Fehlbuchungen erzeugen.

Ebenso wichtig ist die Wartbarkeit. Technologien wie PHP 8.4, modernes JavaScript und MySQL 8 sind kein Verkaufsargument für sich. Sie sind dann sinnvoll, wenn die Anwendung damit langfristig verständlich bleibt, Sicherheitsupdates erhält und von qualifizierten Entwicklern weitergeführt werden kann. Dokumentierte Bereitstellung, Backups, Protokollierung und ein realistischer Umgang mit Updates gehören zur Betriebsfähigkeit dazu.

Eine gute Logistiksoftware erkennt man daher nicht an einer besonders glatten Demo. Sie zeigt sich an einem normalen Dienstagmorgen: Die Lieferung wird gebucht, der Bestand stimmt, der Auftrag ist auffindbar, der Lieferschein passt und die nächste Schicht weiß, was bereits erledigt wurde. Genau dort entsteht Entlastung - nicht durch möglichst viele Funktionen, sondern durch verlässliche Abläufe, die zum Betrieb passen.

Permalink →

MySQL-Datenbank für Webanwendungen planen

MySQL-Datenbank für Webanwendungen planen

Wenn morgens drei Mitarbeitende parallel Waren buchen, ein Kunde den Lieferstatus prüft und das Backoffice eine Rechnung erstellt, zeigt sich die Qualität einer Anwendung nicht im Design. Sie zeigt sich daran, ob alle denselben, korrekten Datenstand sehen. Eine MySQL-Datenbank für eine Webanwendung planen heißt deshalb nicht, Tabellen möglichst schnell anzulegen. Es heißt, reale Abläufe so präzise zu verstehen, dass die Daten auch unter Last, bei Fehlern und mit wachsendem Geschäft verlässlich bleiben.

Gerade bei internen Plattformen, Lager- und Auftragsprozessen oder kundenbezogenen Portalen wird die Datenbank oft zu spät behandelt. Erst entsteht die Oberfläche, dann kommen Felder hinzu, danach Ausnahmen. Das funktioniert für einen Prototypen. Im Betrieb entstehen daraus doppelte Datensätze, unklare Zustände und Auswertungen, denen niemand mehr vollständig vertraut.

MySQL-Datenbank für Webanwendungen planen: beim Ablauf beginnen

Der erste Entwurf sollte nicht mit Spaltennamen beginnen, sondern mit einer konkreten Arbeitssituation. Nehmen wir einen Wareneingang: Eine Lieferung trifft ein, wird einem Lieferanten und einer Bestellung zugeordnet, Mengen werden geprüft, ein Lagerplatz wird vergeben und Bestände ändern sich. Je nach Betrieb braucht dieser Vorgang zusätzlich Fotos, eine Qualitätsprüfung, eine Sperrung oder eine nachvollziehbare Korrektur.

Aus diesem Ablauf ergeben sich die fachlichen Objekte. Typische Beispiele sind Artikel, Lieferanten, Bestellungen, Positionen, Lagerplätze, Bestandsbewegungen und Benutzer. Entscheidend ist die Trennung zwischen einem Objekt und einem Ereignis. Ein Artikel beschreibt, was etwas ist. Eine Bestandsbewegung dokumentiert, dass sich zu einem bestimmten Zeitpunkt an einem Ort eine Menge verändert hat. Wer beides in einer einzelnen Tabelle vermischt, verliert schnell die Nachvollziehbarkeit.

Für jedes Objekt helfen wenige harte Fragen: Was ist die eindeutige Identität? Welche Informationen dürfen sich ändern? Wer darf sie ändern? Welche Daten müssen historisch erhalten bleiben? Und welche Regeln gelten, wenn zwei Personen gleichzeitig arbeiten? Diese Fragen verhindern spätere Improvisation besser als eine lange Liste vermeintlich vollständiger Datenbankfelder.

Das Datenmodell soll Regeln ausdrücken

Eine Datenbank ist nicht nur Speicher für Formulareingaben. Sie sollte zentrale Regeln selbst absichern. Wenn jede Bestandsbewegung genau zu einem Artikel und einem Lagerplatz gehören muss, gehören Fremdschlüssel in das Modell. Wenn eine externe Auftragsnummer pro Mandant nur einmal vorkommen darf, braucht es einen eindeutigen Index. Wenn eine Position nie ohne Kopfauftrag existieren soll, muss diese Beziehung klar modelliert sein.

MySQL 8 mit InnoDB bietet dafür belastbare Grundlagen: Transaktionen, Fremdschlüssel, Sperrmechanismen und konsistente Änderungen über mehrere Tabellen hinweg. Werden beim Buchen eines Wareneingangs Bewegung, aktueller Bestand und Prüfprotokoll geschrieben, sollte das als zusammenhängende Transaktion passieren. Scheitert ein Schritt, darf kein halbfertiger Vorgang zurückbleiben.

Nicht jede Regel gehört allerdings in die Datenbank. Freigaben, komplexe Preislogik oder rollenabhängige Prozessschritte liegen häufig besser in der Anwendungslogik, weil sie sich fachlich schneller ändern. Die Grenze ist pragmatisch: Regeln, deren Verletzung Daten dauerhaft beschädigt, sollten möglichst nah an den Daten abgesichert werden. Regeln, die sich häufig ändern oder stark vom Kontext abhängen, brauchen gut getesteten Anwendungscode.

Historie nicht mit aktuellen Werten verwechseln

Ein häufiger Fehler ist, nur den aktuellen Bestand oder den aktuellen Status zu speichern. Das reicht, bis jemand fragt, warum sich die Menge gestern verändert hat oder wer einen Auftrag zurückgesetzt hat. Für operative Systeme ist eine Bewegungs- oder Ereignishistorie oft wertvoller als ein einzelnes überschreibbares Feld.

Das bedeutet nicht, jede Klickbewegung dauerhaft zu protokollieren. Protokolliert werden sollten geschäftlich relevante Änderungen: Statuswechsel, Mengenänderungen, Korrekturen, Freigaben und Zuordnungen. Ein guter Audit-Eintrag enthält Zeitpunkt, Benutzer oder Systemprozess, vorherigen und neuen Wert sowie einen verständlichen Grund, wenn der Ablauf ihn verlangt. So lassen sich Fehler klären, ohne in E-Mails, Papierlisten oder Datenbank-Backups suchen zu müssen.

Schlüssel, Datentypen und Namensregeln bewusst wählen

Technische Entscheidungen wirken klein, prägen aber Wartung und Integrationen über Jahre. Für interne Primärschlüssel sind häufig BIGINT-Werte mit automatischer Vergabe eine nüchterne, gut handhabbare Wahl. UUIDs können sinnvoll sein, wenn Daten offline entstehen, mehrere Systeme unabhängig schreiben oder externe Schnittstellen keine fortlaufenden IDs offenlegen sollen. Sie kosten jedoch mehr Speicher und verlangen bei Indizes und Sortierung etwas mehr Aufmerksamkeit.

Geldbeträge gehören als DECIMAL gespeichert, nicht als FLOAT oder DOUBLE. Mengen brauchen ebenfalls eine fachlich passende Genauigkeit: Stückzahlen sind oft ganzzahlig, Gewichte und Längen nicht. Zeitstempel sollten einheitlich behandelt werden, idealerweise intern in UTC, während die Oberfläche die lokale Zeitzone des Betriebs darstellt. Besonders bei Schichtwechseln und Sommerzeit verhindert das schwer auffindbare Differenzen.

Auch Namen sollten langweilig und eindeutig sein. order_items oder bestandsbewegungen sind hilfreicher als kreative Abkürzungen, die nur das ursprüngliche Projektteam versteht. Einheitliche Singular- oder Pluralformen sind weniger wichtig als Konsequenz. Ebenso sinnvoll sind Felder wie created_at, updated_at und bei Bedarf deleted_at. Ein Soft Delete ist aber kein Standardzwang. Bei rechtlich oder operativ relevanten Belegen ist eine saubere Stornierung meist besser als ein unsichtbar gelöschter Datensatz.

Indizes folgen echten Abfragen, nicht Vermutungen

Ein Index kann eine Suche massiv beschleunigen, macht Schreibvorgänge aber aufwendiger und benötigt Speicher. Deshalb ist „auf jedes Feld einen Index“ keine Strategie. Die wichtigsten Abfragen sollten früh feststehen: offene Aufträge eines Kunden, Bewegungen eines Artikels in einem Zeitraum, Bestand je Lagerplatz oder zuletzt geänderte Datensätze für eine Schnittstelle.

Dabei zählt die Reihenfolge zusammengesetzter Indizes. Sucht die Anwendung regelmäßig nach tenant_id, status und created_at, ist ein zusammengesetzter Index in dieser Reihenfolge oft sinnvoll. Ob er tatsächlich passt, zeigt der Ausführungsplan mit EXPLAIN, nicht das Bauchgefühl. Datenbanken werden nicht durch spektakuläre Tricks schnell, sondern durch beobachtbare Abfragen, passende Indizes und eine Datenmenge, die realistisch getestet wurde.

Für wachsende Tabellen lohnt eine klare Aufbewahrungsstrategie. Müssen technische Logs fünf Jahre in der produktiven Hauptdatenbank liegen? Nicht unbedingt. Geschäftliche Belege, Bewegungen und Prüfnachweise brauchen andere Fristen als Debug-Informationen. Archivierung ist kein Zeichen eines schwachen Systems, sondern eine bewusste Betriebsentscheidung.

Mehrbenutzerbetrieb braucht Transaktionen und klare Zustände

In einer Webanwendung greifen mehrere Anfragen gleichzeitig auf dieselben Daten zu. Das ist im Lageralltag normal, nicht der Ausnahmefall. Zwei Mitarbeitende können denselben Bestand buchen, während ein Import neue Aufträge anlegt. Ohne Transaktionen und gezielte Sperrung besteht das Risiko verlorener Änderungen oder negativer Bestände, die erst Wochen später auffallen.

Für kritische Vorgänge sollte klar sein, welche Daten innerhalb einer Transaktion gelesen und geschrieben werden. Manchmal genügt eine atomare Aktualisierung, etwa ein Bestand, der nur verändert wird, wenn die verfügbare Menge ausreichend ist. In anderen Fällen ist eine Zeilensperre sinnvoll, damit ein Vorgang den Datenstand kontrolliert prüfen und danach ändern kann. Lange Transaktionen sind hingegen problematisch: Sie blockieren andere Arbeit und erhöhen das Risiko von Konflikten.

Ebenso wichtig ist ein begrenzter Satz fachlicher Zustände. Ein Auftrag sollte nicht gleichzeitig „offen“, „teilgeliefert“ und „manuell bearbeitet“ sein, weil verschiedene Felder widersprüchlich gepflegt werden. Definierte Statusübergänge machen Oberfläche, Berichte und Automatisierungen einfacher. Ausnahmen dürfen möglich sein, sollten aber benannt und dokumentiert sein.

Sicherheit, Mandanten und Betrieb von Anfang an einplanen

Die Anwendung sollte für MySQL einen eigenen Datenbankbenutzer mit minimalen Rechten verwenden. Ein Schreibzugriff für die Webanwendung bedeutet nicht, dass dieser Benutzer Tabellen löschen oder Benutzerrechte ändern muss. Administrative Konten gehören nicht in Konfigurationsdateien des Produktivsystems und niemals in ein Repository.

Wenn mehrere Kunden, Standorte oder Gesellschaften in einer Anwendung arbeiten, ist die Mandantentrennung eine Architekturentscheidung, keine nachträgliche Filterbedingung. Eine gemeinsame Datenbank mit tenant_id kann effizient und gut wartbar sein, verlangt aber konsequente Prüfungen in jeder Abfrage und eindeutige Regeln für Indizes. Getrennte Datenbanken bieten stärkere Isolation, erhöhen jedoch Aufwand bei Updates, Auswertungen und Betrieb. Welche Variante passt, hängt von Datenschutzanforderungen, Datenvolumen und Geschäftsmodell ab.

Backups sind erst dann Backups, wenn eine Wiederherstellung getestet wurde. Benötigt wird ein definierter Rhythmus für Sicherungen, Aufbewahrung und Wiederanlauf. Ebenso gehören Monitoring für Speicherplatz, langsame Abfragen und fehlgeschlagene Jobs sowie dokumentierte Updates zum System. MySQL 8, PHP 8.4 und moderne Webanwendungen lassen sich langfristig gut betreiben, wenn Abhängigkeiten, Zugangsdaten und Deployment-Schritte nicht nur im Kopf eines Entwicklers existieren.

Ein sinnvoller Plan vor dem ersten Produktivtag

Vor der Umsetzung sollte ein kompaktes Datenmodell mit Beispielvorgängen vorliegen. Dazu gehören wichtigste Tabellen und Beziehungen, Statusregeln, Berechtigungen, erwartete Abfragen, Schnittstellen sowie ein Konzept für Backups und Änderungsprotokolle. Dieser Plan muss nicht hundert Seiten lang sein. Er muss die Entscheidungen festhalten, die später teuer zu korrigieren wären.

Bei softify.pro beginnt Datenbankplanung deshalb mit den Menschen, die buchen, prüfen, kommissionieren oder Ausnahmen klären. Wenn ein bestehendes Spreadsheet einen überschaubaren Prozess zuverlässig abbildet, kann es die richtige Lösung bleiben. Wenn mehrere Personen zeitgleich arbeiten, Belege entstehen und Fehler nachvollziehbar sein müssen, verdient die Datenbank dagegen denselben Planungsaufwand wie die Oberfläche. Die beste Architektur ist am Ende jene, die den Arbeitstag vereinfacht und auch in zwei Jahren noch verständlich geändert werden kann.

Permalink →

Kontakt aufnehmen

Haben Sie ein Projekt im Kopf, einen Arbeitsablauf, der noch auf Excel-Tabellen und gutem Willen läuft, oder einen Testing-Rückstau, den COCO Ihrem Team abnehmen könnte? Erzählen Sie uns davon.

Nachricht senden