
Un almacén. Una verdad.
Hay una forma sencilla de hacer que un software de almacén parezca convincente.
Abrir un panel de control.
Mostrar algunos números en verde.
Añadir un gráfico.
Colocar algo de stock en un mapa del almacén.
Terminar con un informe.
Todo parece estar bien.
Y aun así todo puede estar mal.
Porque a un almacén no le importa lo bien que se vea el panel de control.
Le importa si cada parte del sistema coincide en lo que realmente ha ocurrido.
Eso se convirtió en la parte interesante del último experimento softify.pro Flow.
No otra pantalla.
No otro KPI.
No otro informe.
Algo mucho menos visible.
Coherencia.
Empezó con un almacén.
La demo actual de softify.pro Flow funciona con varios entornos de almacén sintéticos.
Distintos identificadores de almacén.
Distintas capacidades.
Distintas estructuras de zonas.
Sin inventario de producción.
Sin datos de clientes.
Sin información operativa real.
Pero la lógica del proceso se comporta como si todo eso importara.
Porque en la logística real, importa.
Una vez seleccionado un almacén, ese contexto pasa a formar parte de todo lo que sigue.
Flows.
SSCC.
Movimientos.
Operarios.
Analítica.
Informes.
Suena obvio.
Se vuelve considerablemente menos obvio cuando el mismo proceso empieza a aparecer en varias partes distintas de la aplicación.
Entonces abrimos otra vista.
Operational Analytics.
De repente el almacén se veía completamente distinto.
Sin posiciones de almacenamiento.
Sin flechas de movimiento.
En su lugar:
- Flows completados,
- pedidos activos,
- utilización del almacén,
- excepciones,
- entradas,
- salidas,
- tiempo de procesamiento.
La representación visual había cambiado.
El almacén, no.
Esa distinción se volvió importante.
Porque bajo los KPI seguía habiendo registros individuales.
Identificadores de Flow.
SSCC.
Zonas.
Estados.
Operarios.
Tiempos de procesamiento.
Vista distinta.
Misma realidad operativa.
Hasta ahí, bien.
Operational Analytics — estado agregado del almacén, con los registros Flow subyacentes todavía visibles.
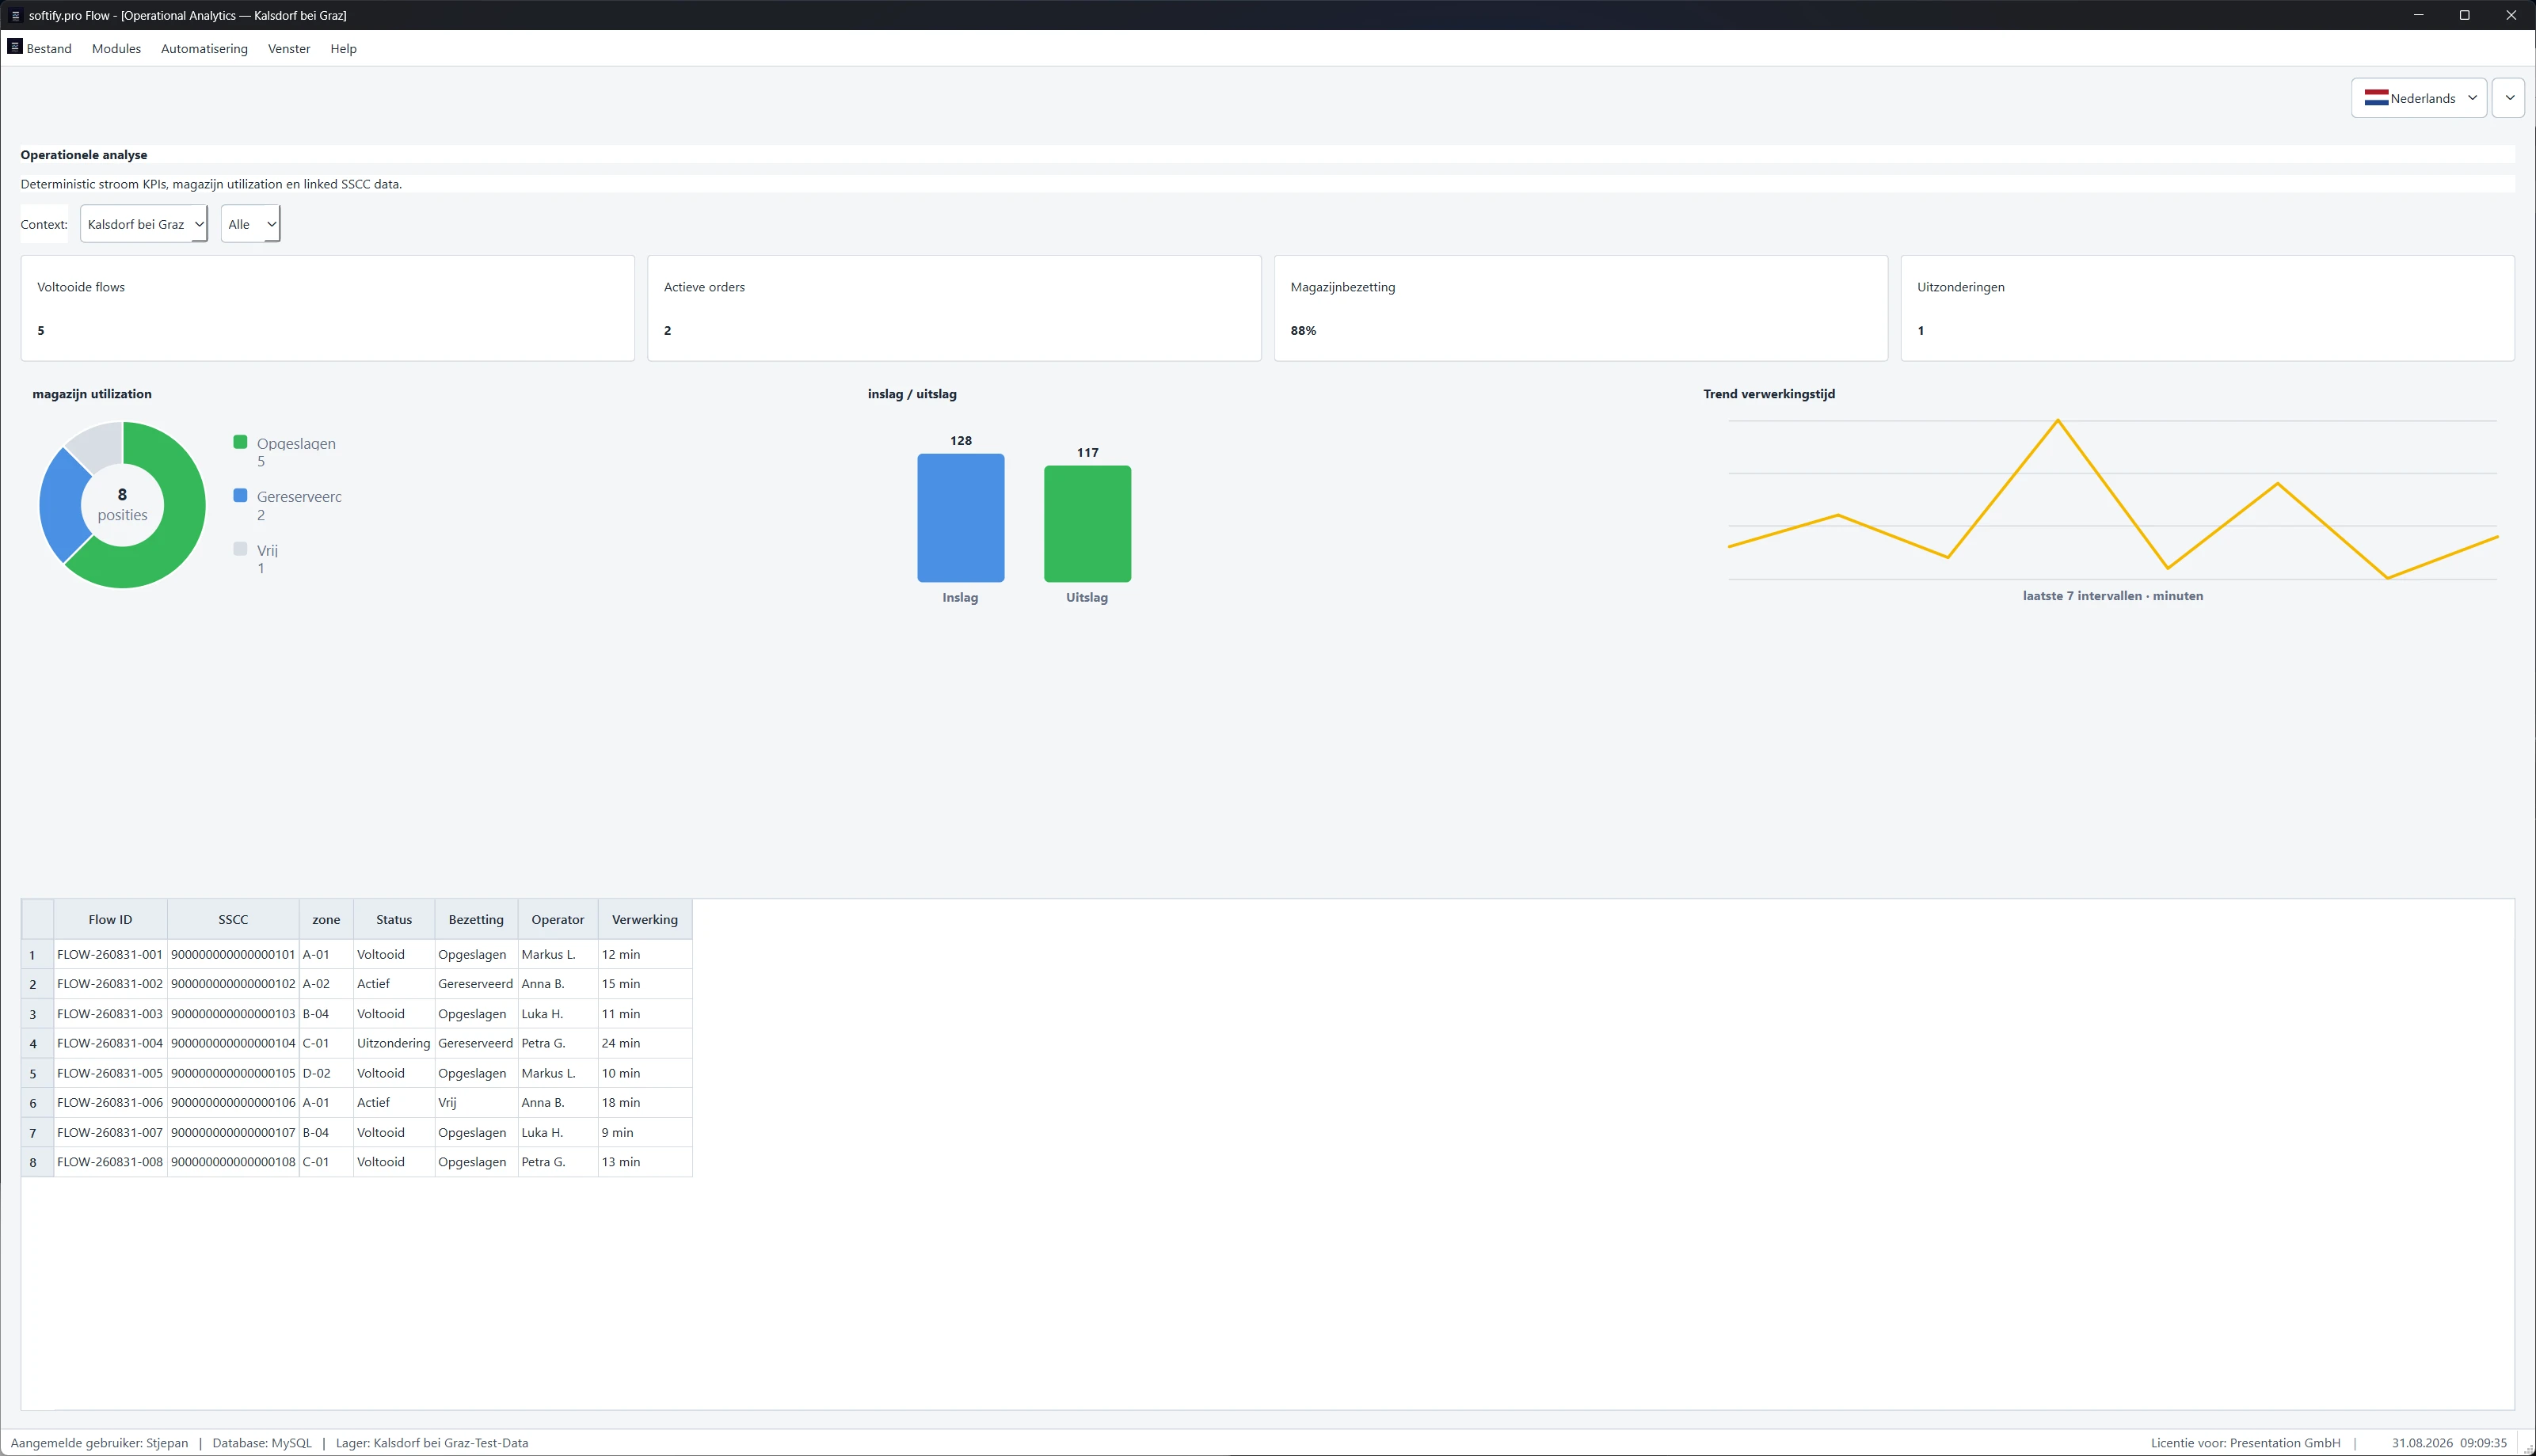
El 88% solo es útil si el sistema puede explicarlo.
Supongamos que el panel de control dice:
Utilización del almacén: 88%.
Útil.
Pero incompleto.
Algunas posiciones están ocupadas.
Algunas están reservadas.
Algunas permanecen libres.
Esos estados no son intercambiables.
El número solo resulta fiable si el sistema todavía puede explicar de dónde viene.
¿Cinco Flows completados?
Muéstralos.
¿Dos pedidos activos?
Muéstralos.
¿Una excepción?
¿Cuál?
¿88% de utilización?
¿Qué está ocupado?
¿Qué está reservado?
¿Qué permanece libre?
Un panel de control debería resumir la realidad.
No debería sustituirla.
Entonces cambiamos el idioma.
Neerlandés.
El almacén siguió siendo el mismo.
Los identificadores de Flow siguieron siendo los mismos.
Los SSCC siguieron siendo los mismos.
Los operarios siguieron vinculados a sus registros.
Solo cambió el idioma.
Más tarde el mismo estado operativo apareció en croata.
Luego en francés.
Aquí es donde el software multilingüe se vuelve mucho más interesante que los botones traducidos.
Una mala traducción es fácil de notar.
Un cambio de estado provocado por un cambio de idioma es mucho más peligroso.
Imagina pasar de alemán a francés y perder silenciosamente el Flow seleccionado.
O reconstruir un filtro contra el almacén equivocado.
O mostrar el SSCC correcto dentro del contexto de proceso equivocado.
La interfaz podría seguir viéndose perfecta.
El sistema no lo sería.
Flow sigue por eso una regla sencilla:
El idioma puede cambiar las palabras. No puede cambiar la verdad.
Luego el Flow adquirió un historial.
Browse & Drill-down no se esfuerza especialmente por parecer impresionante.
Quizá por eso es útil.
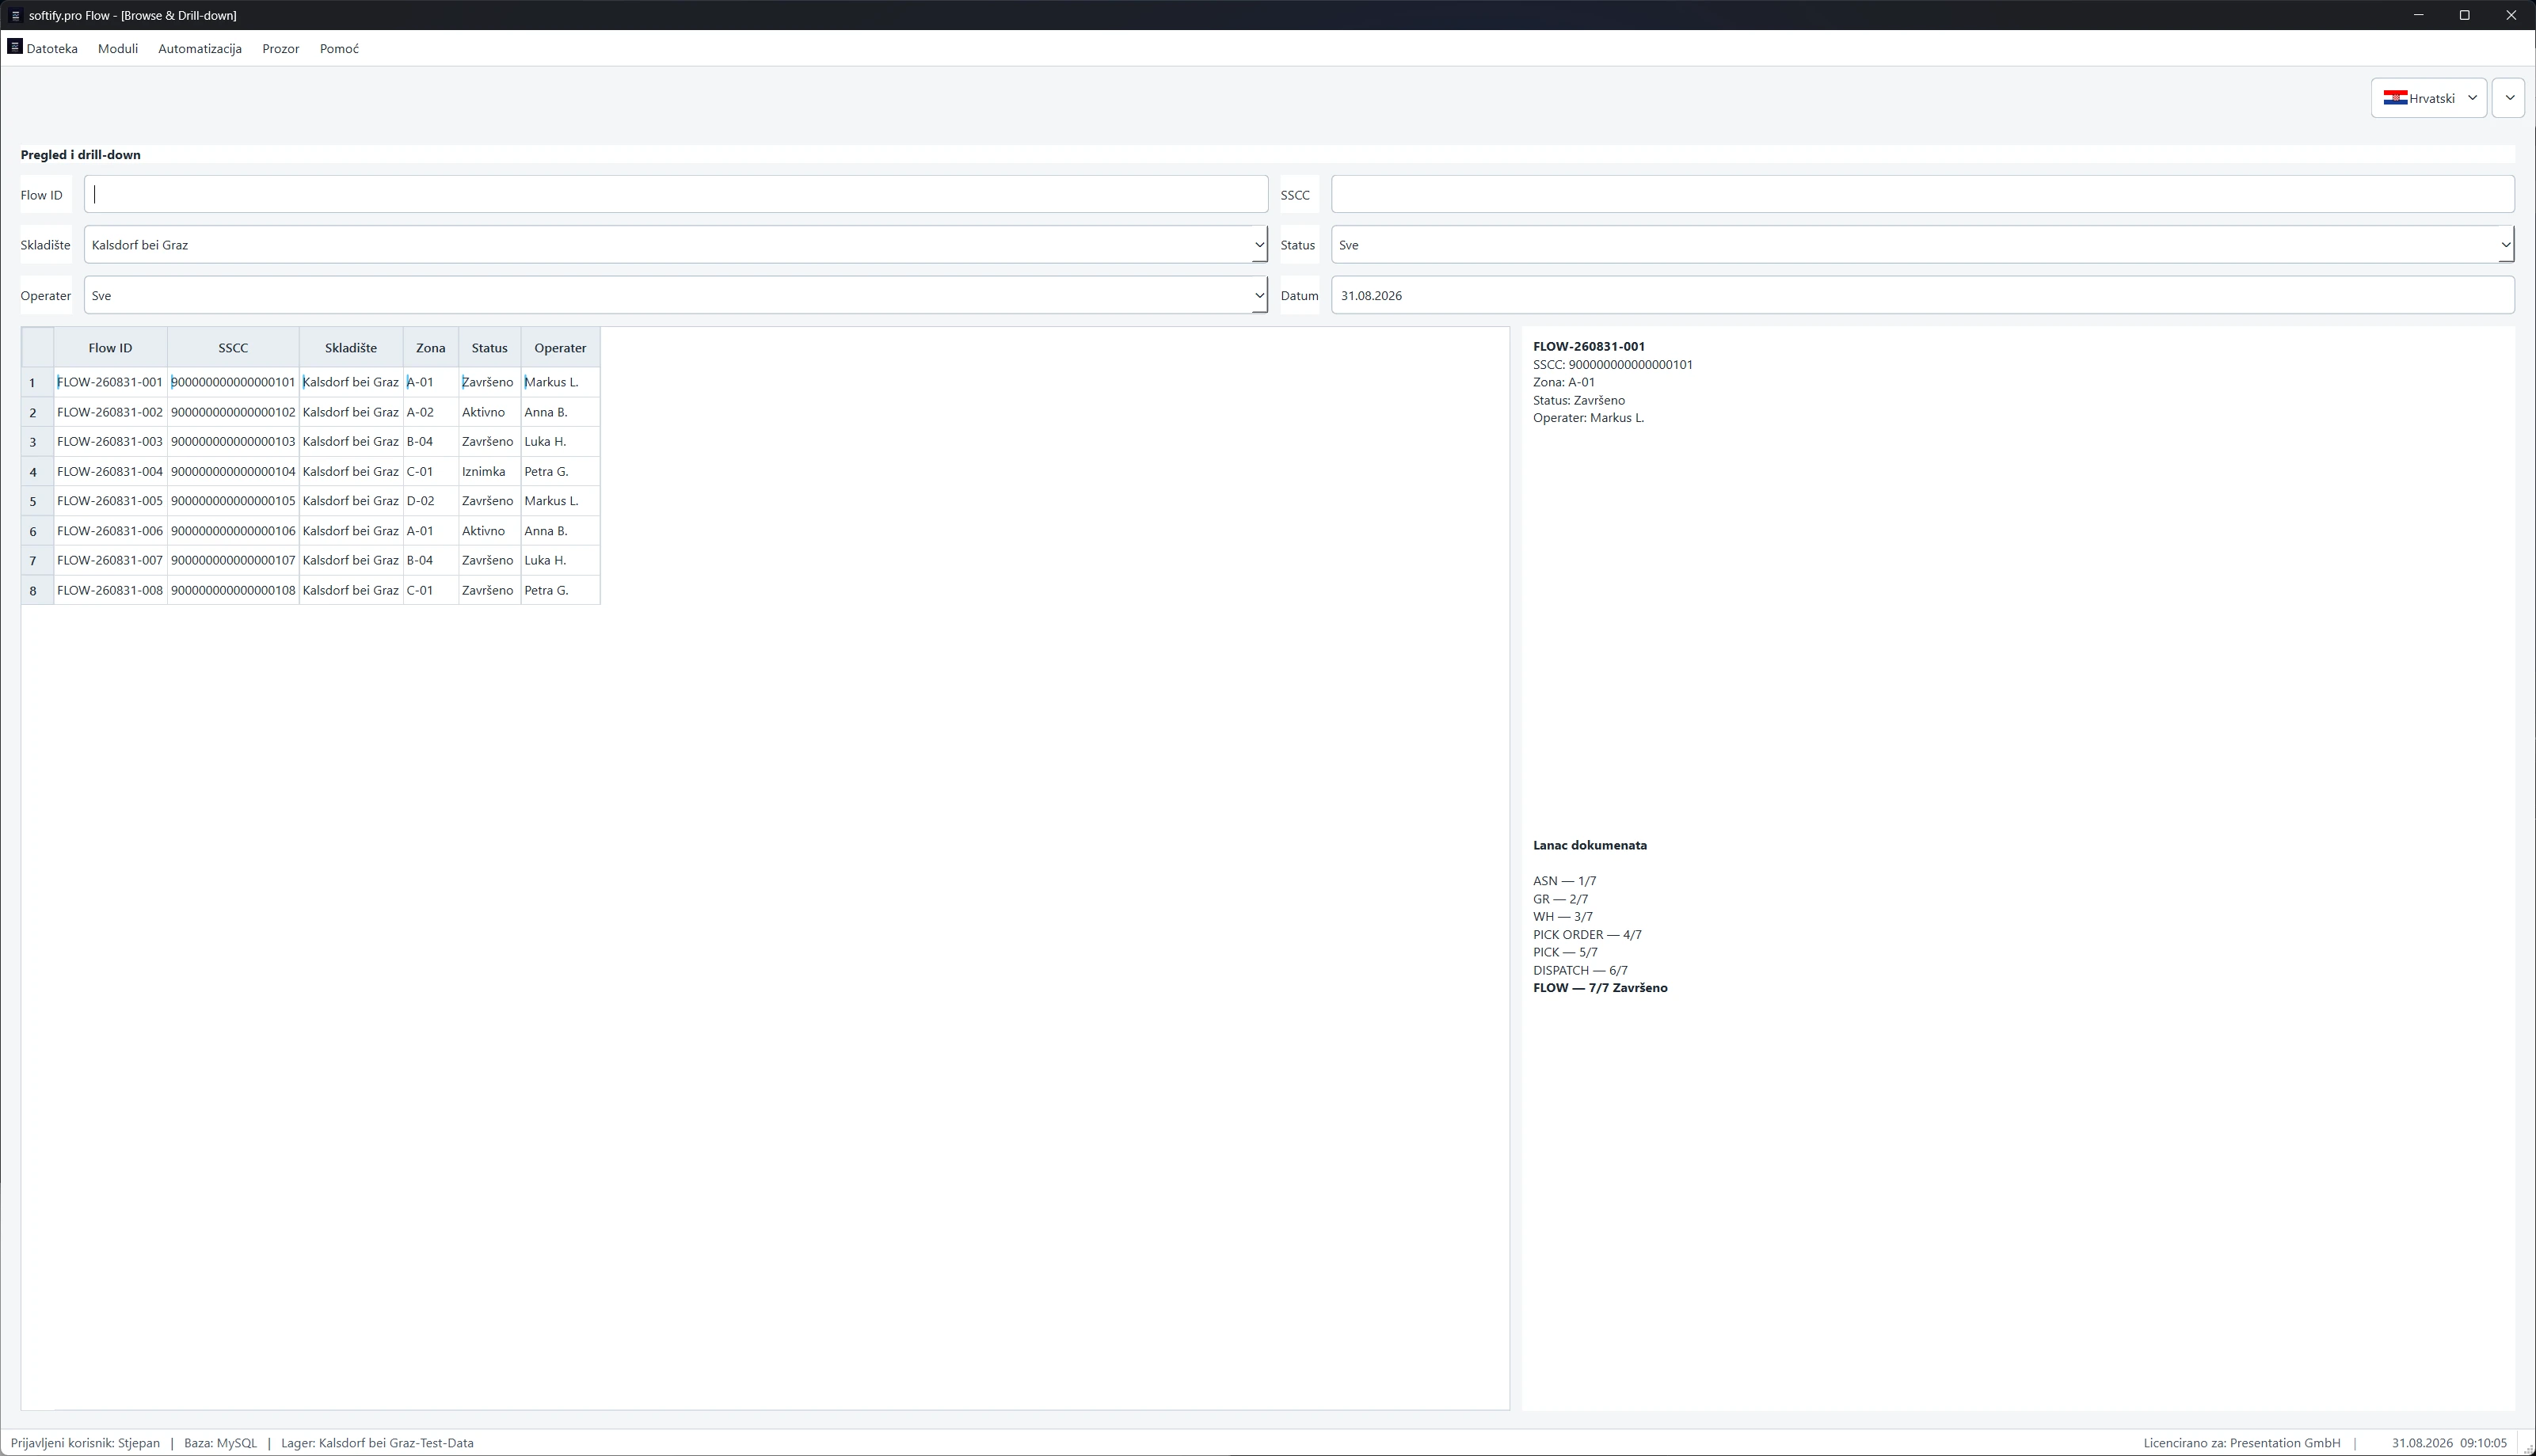
Selecciona un Flow.
Aparece su contexto.
Almacén.
Zona.
Estado.
Operario.
SSCC.
Y luego la cadena documental.
ASN.
Recepción de mercancía.
Movimiento de almacén.
Orden de picking.
Picking.
Expedición.
FLOW.
Siete pasos.
El proceso ya no es solo un estado actual.
Tiene un pasado.
Y eso cambia la pregunta.
En lugar de:
¿Qué está pasando?
podemos preguntar:
¿Cómo hemos llegado hasta aquí?
Es una pregunta mucho mejor cuando algo finalmente sale mal.
Un Flow, un SSCC, una cadena documental — desde el ASN hasta la finalización.
El SSCC se convierte en el hilo conductor.
Al principio, un SSCC parece lo que es.
Un identificador.
Un número largo en una tabla.
Pero a través de Flow se convierte en algo más útil.
Un hilo conductor a través del proceso.
Al seguirlo, otras cosas empiezan a conectarse.
Un almacén.
Un Flow.
Una zona.
Un estado.
Un operario.
Una cadena documental.
Finalmente, un informe.
El mismo objeto logístico físico ahora es visible desde varias partes distintas de la aplicación.
Útil.
También peligroso.
Porque cada vista adicional crea otra oportunidad para que el sistema cuente una historia distinta.
Y ahí es donde las cosas se vuelven interesantes.
Supongamos que Analytics dice que el Flow está activo.
Drill-down dice que el SSCC pertenece a ese Flow.
La cadena documental dice que la operación ha avanzado más.
El informe dice otra cosa.
¿Cuál es correcto?
No es un problema específico de Flow.
Es uno de los problemas más antiguos del software empresarial.
Distintas partes del mismo sistema desarrollan gradualmente su propia versión de la realidad.
Una pantalla lee el estado transaccional.
Otra lee un agregado.
Otra depende de datos en caché.
Un informe calcula algo de forma ligeramente distinta.
Una excepción se resuelve operativamente pero desaparece del reporting.
Cada componente funciona.
El sistema completo miente.
Normalmente con educación.
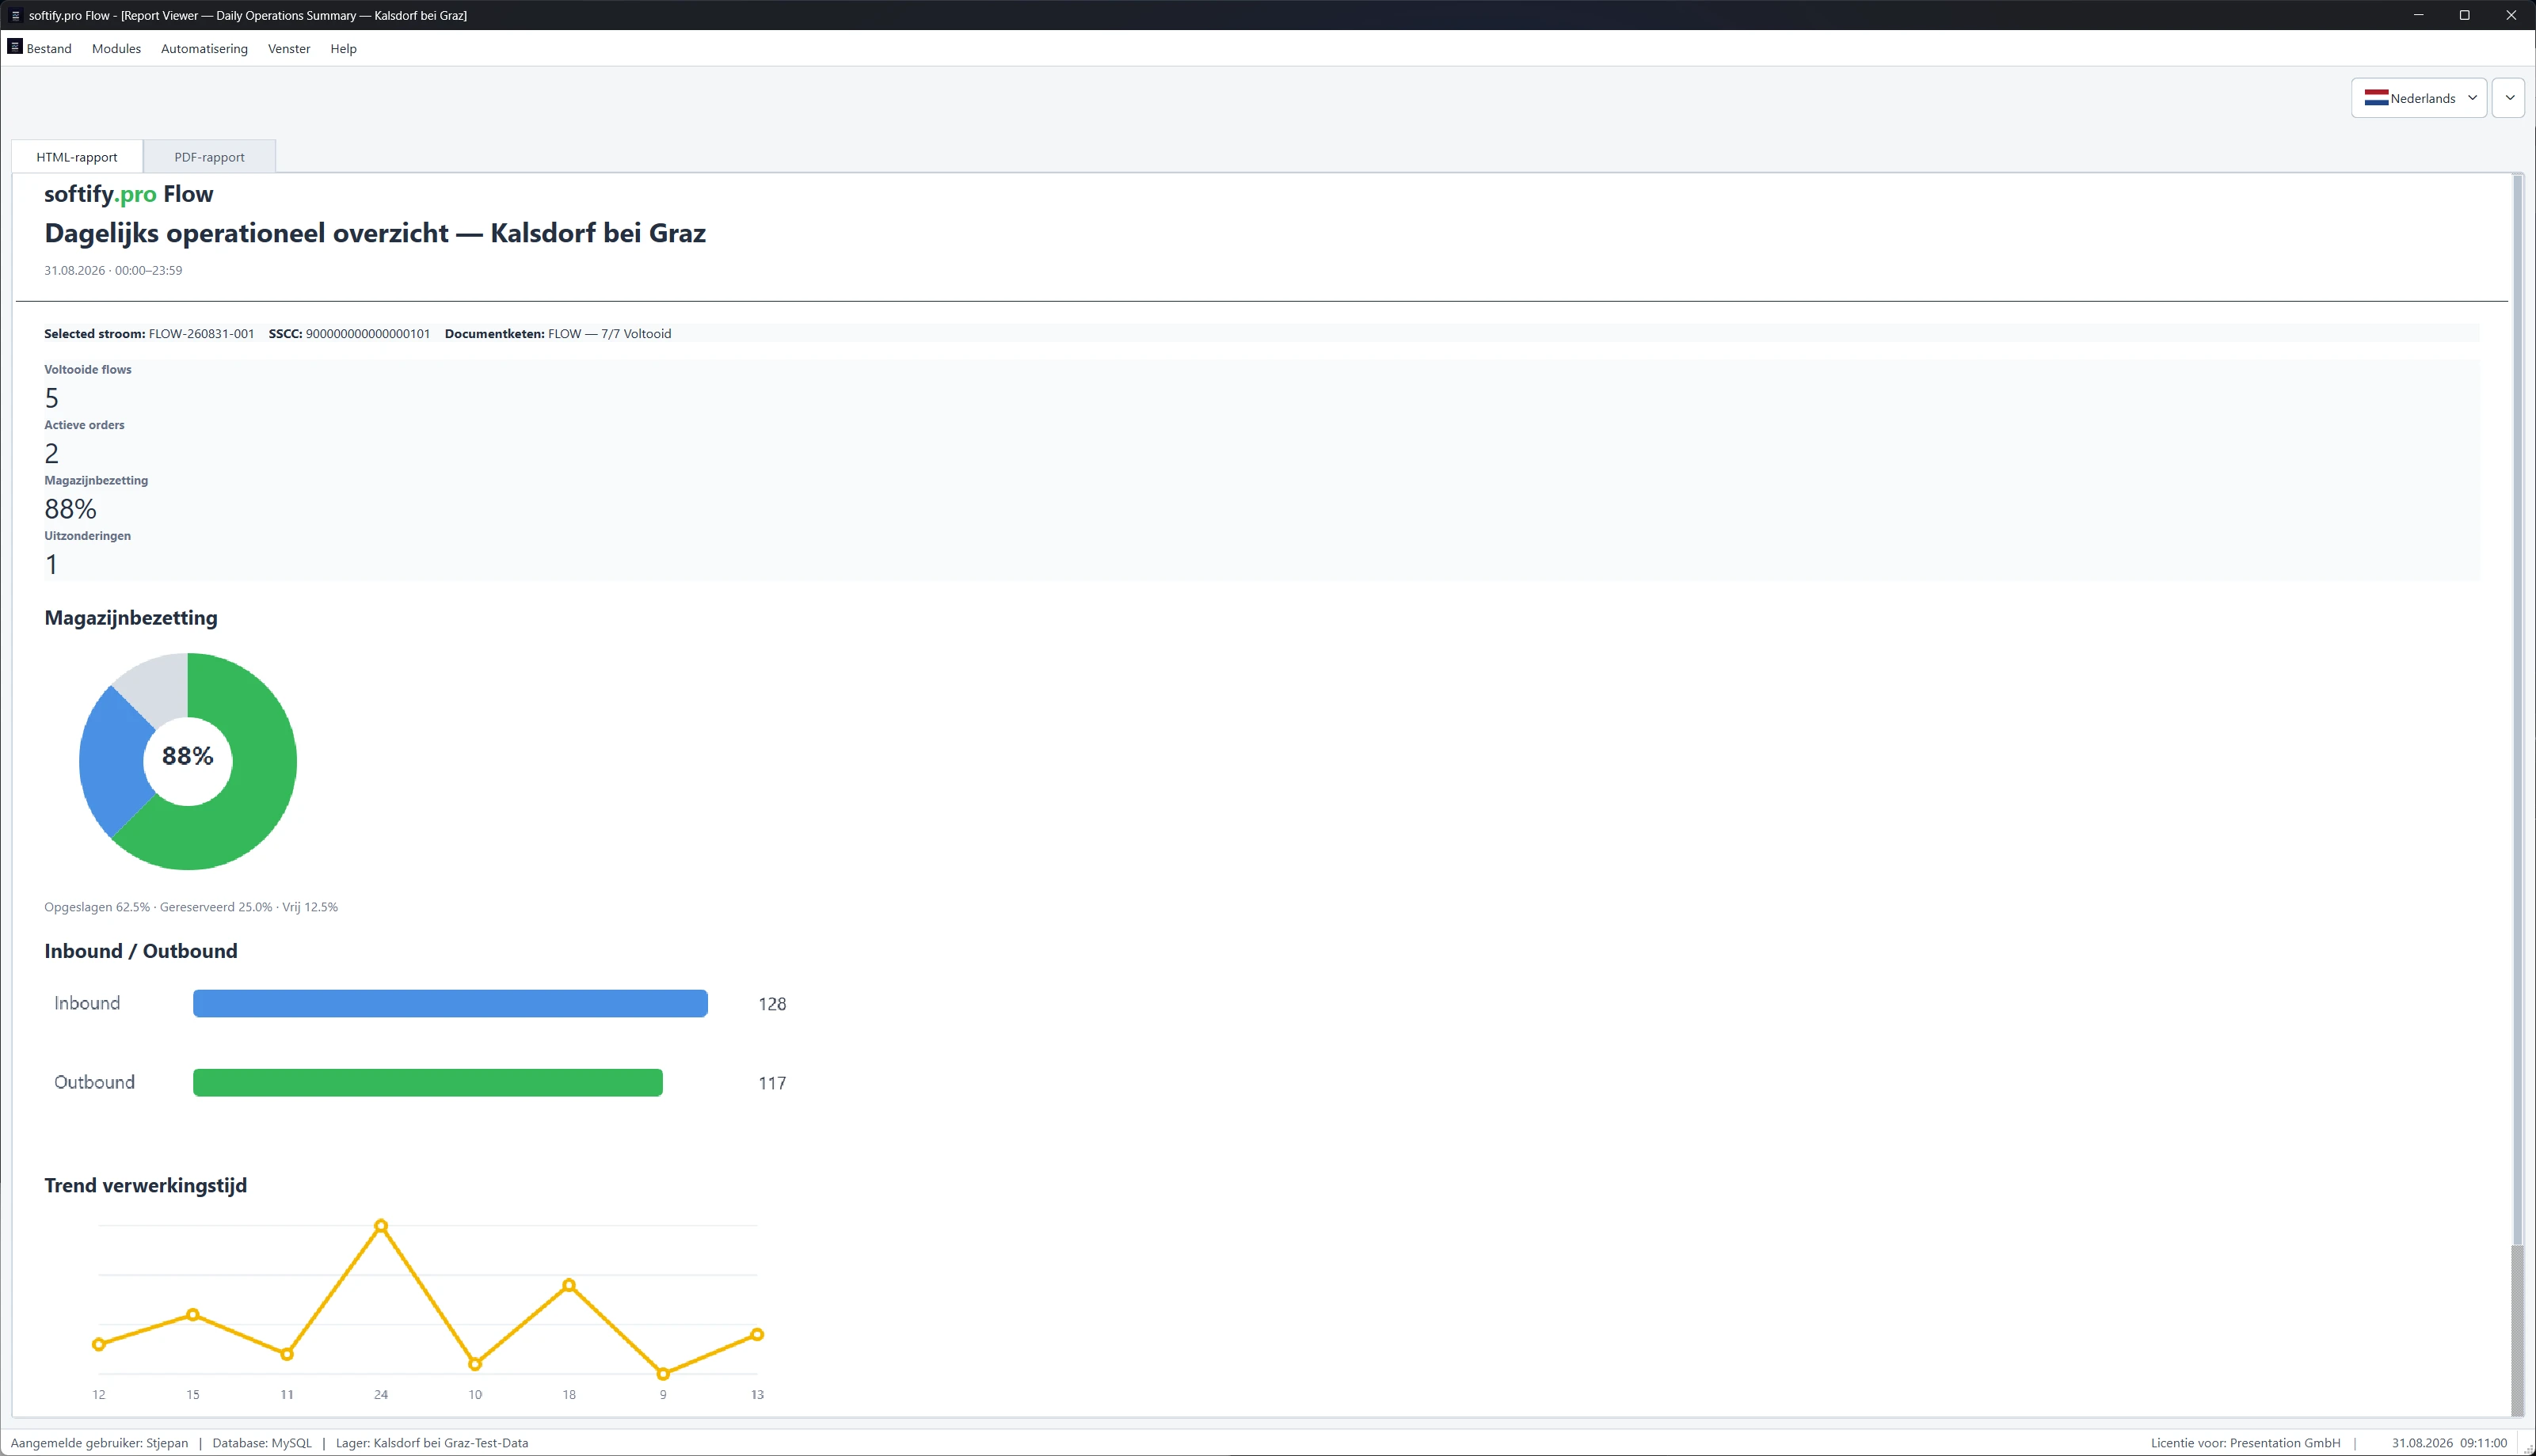
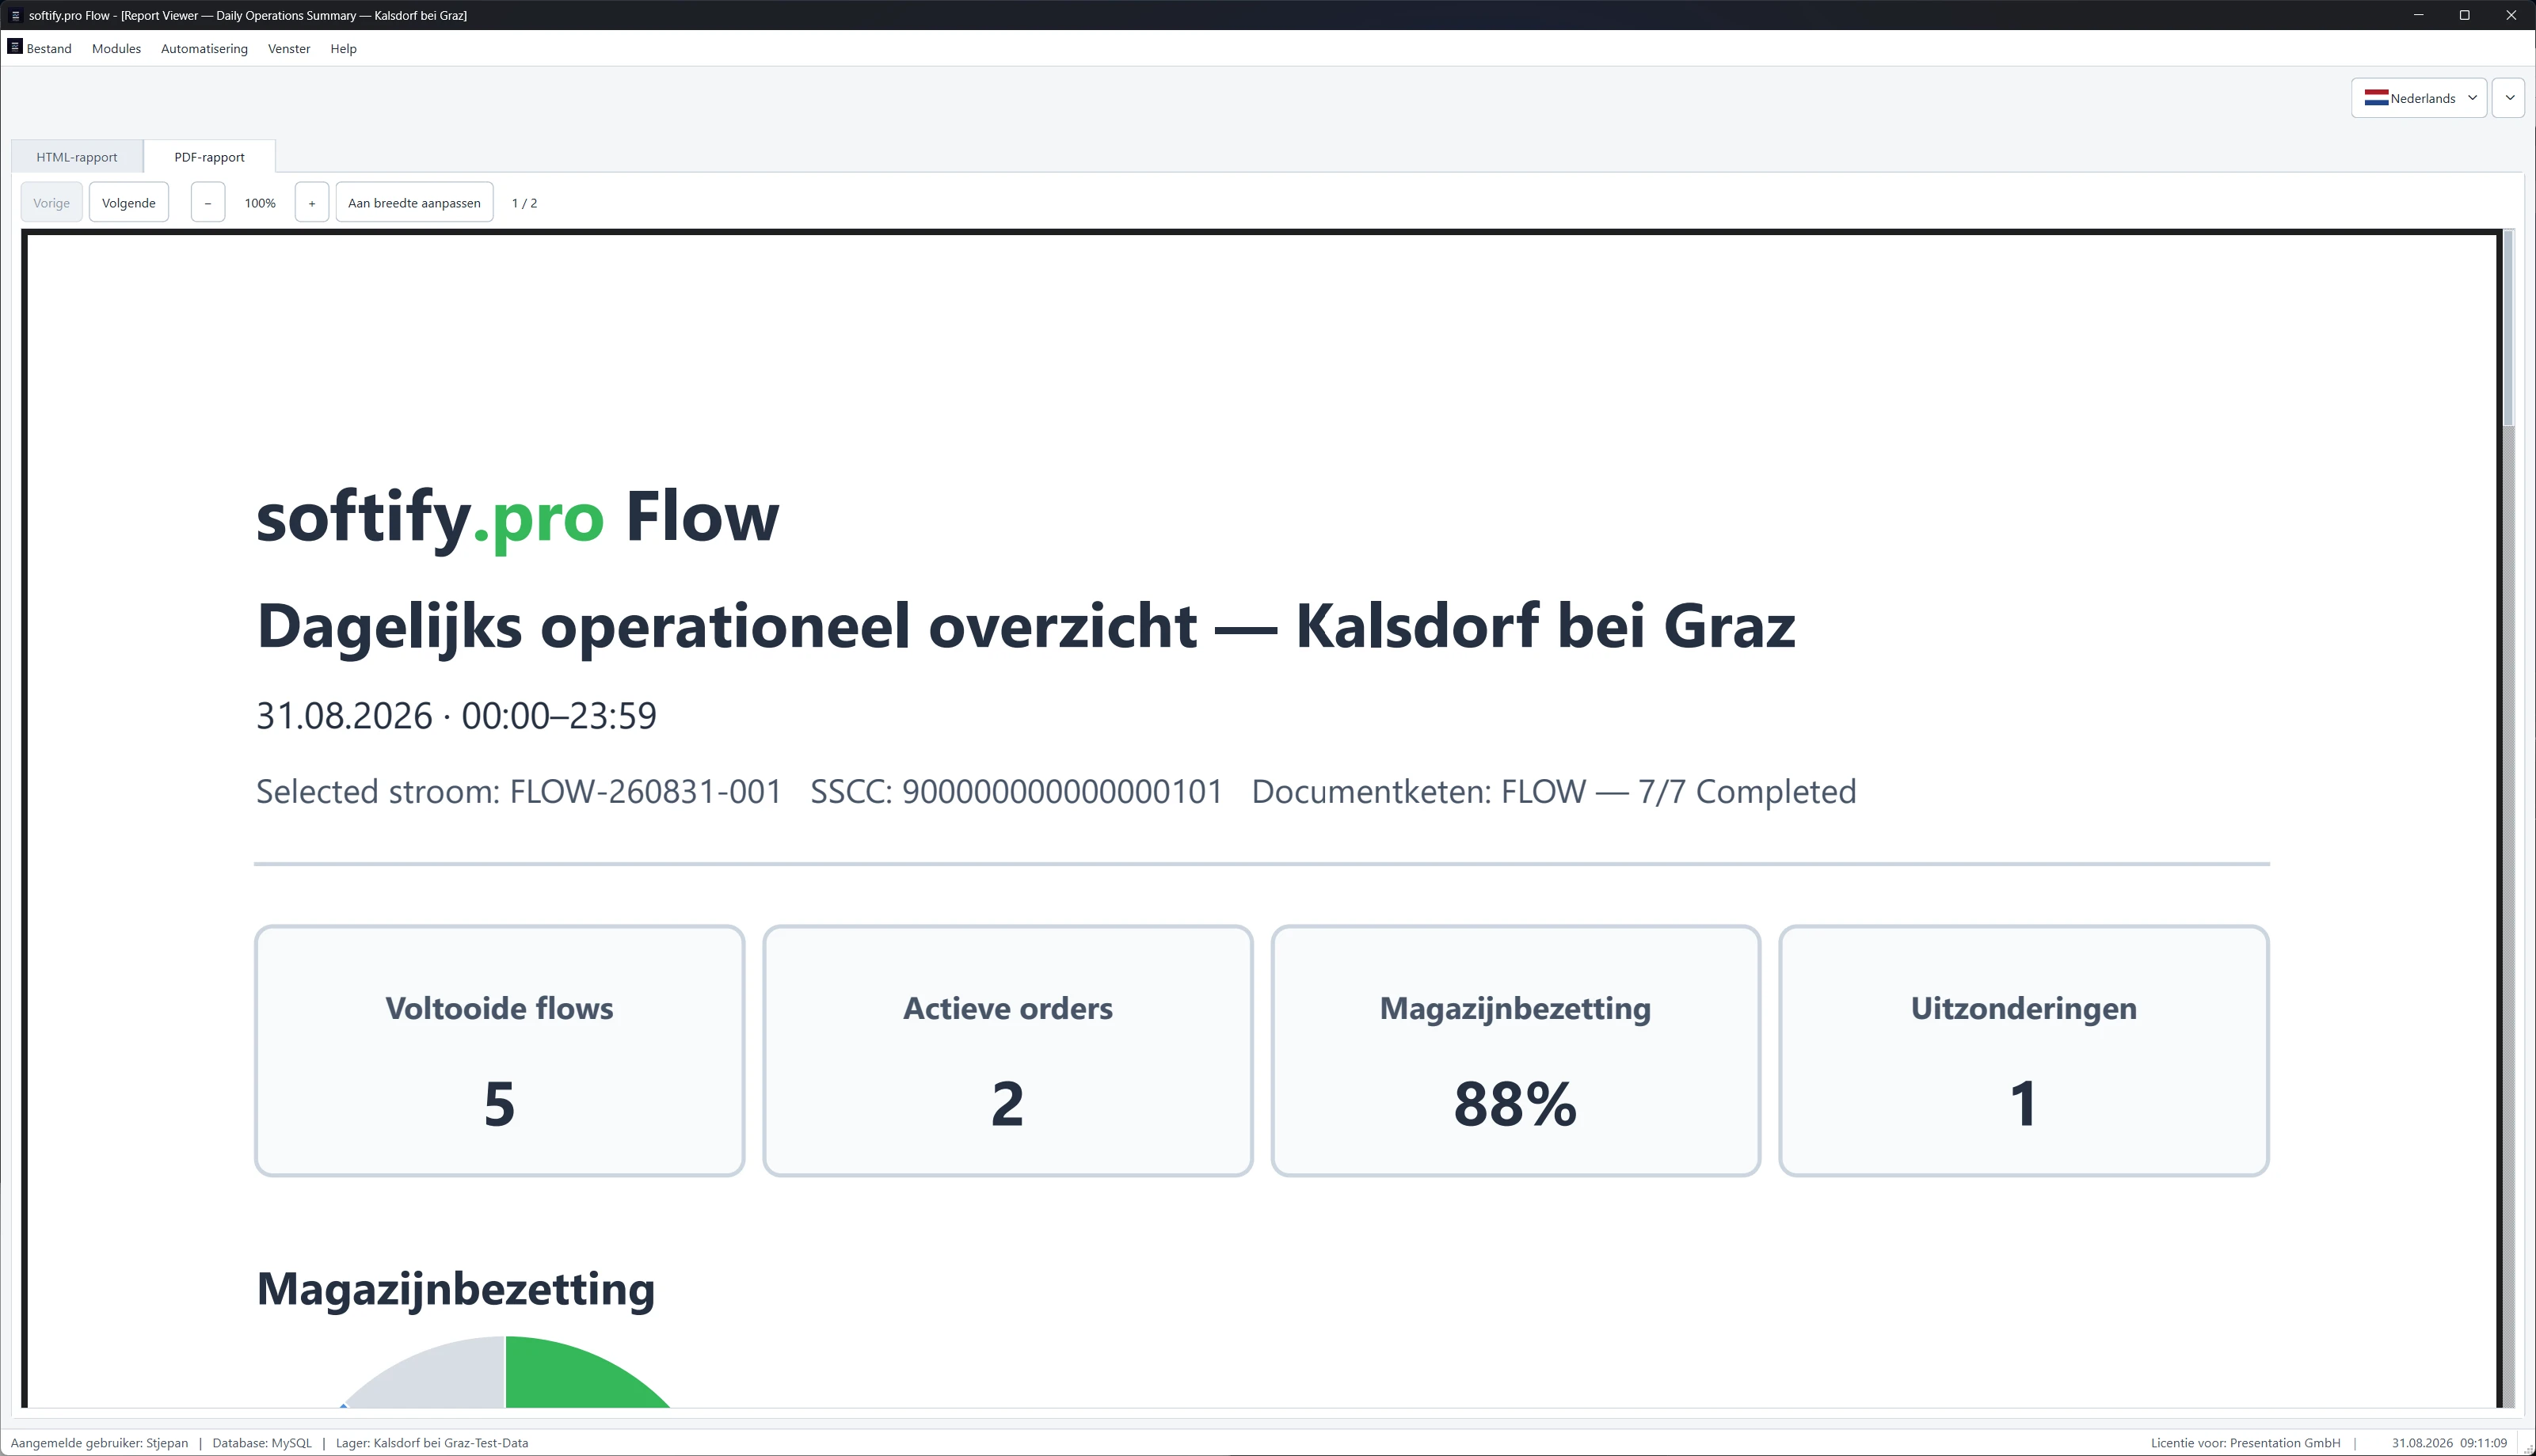
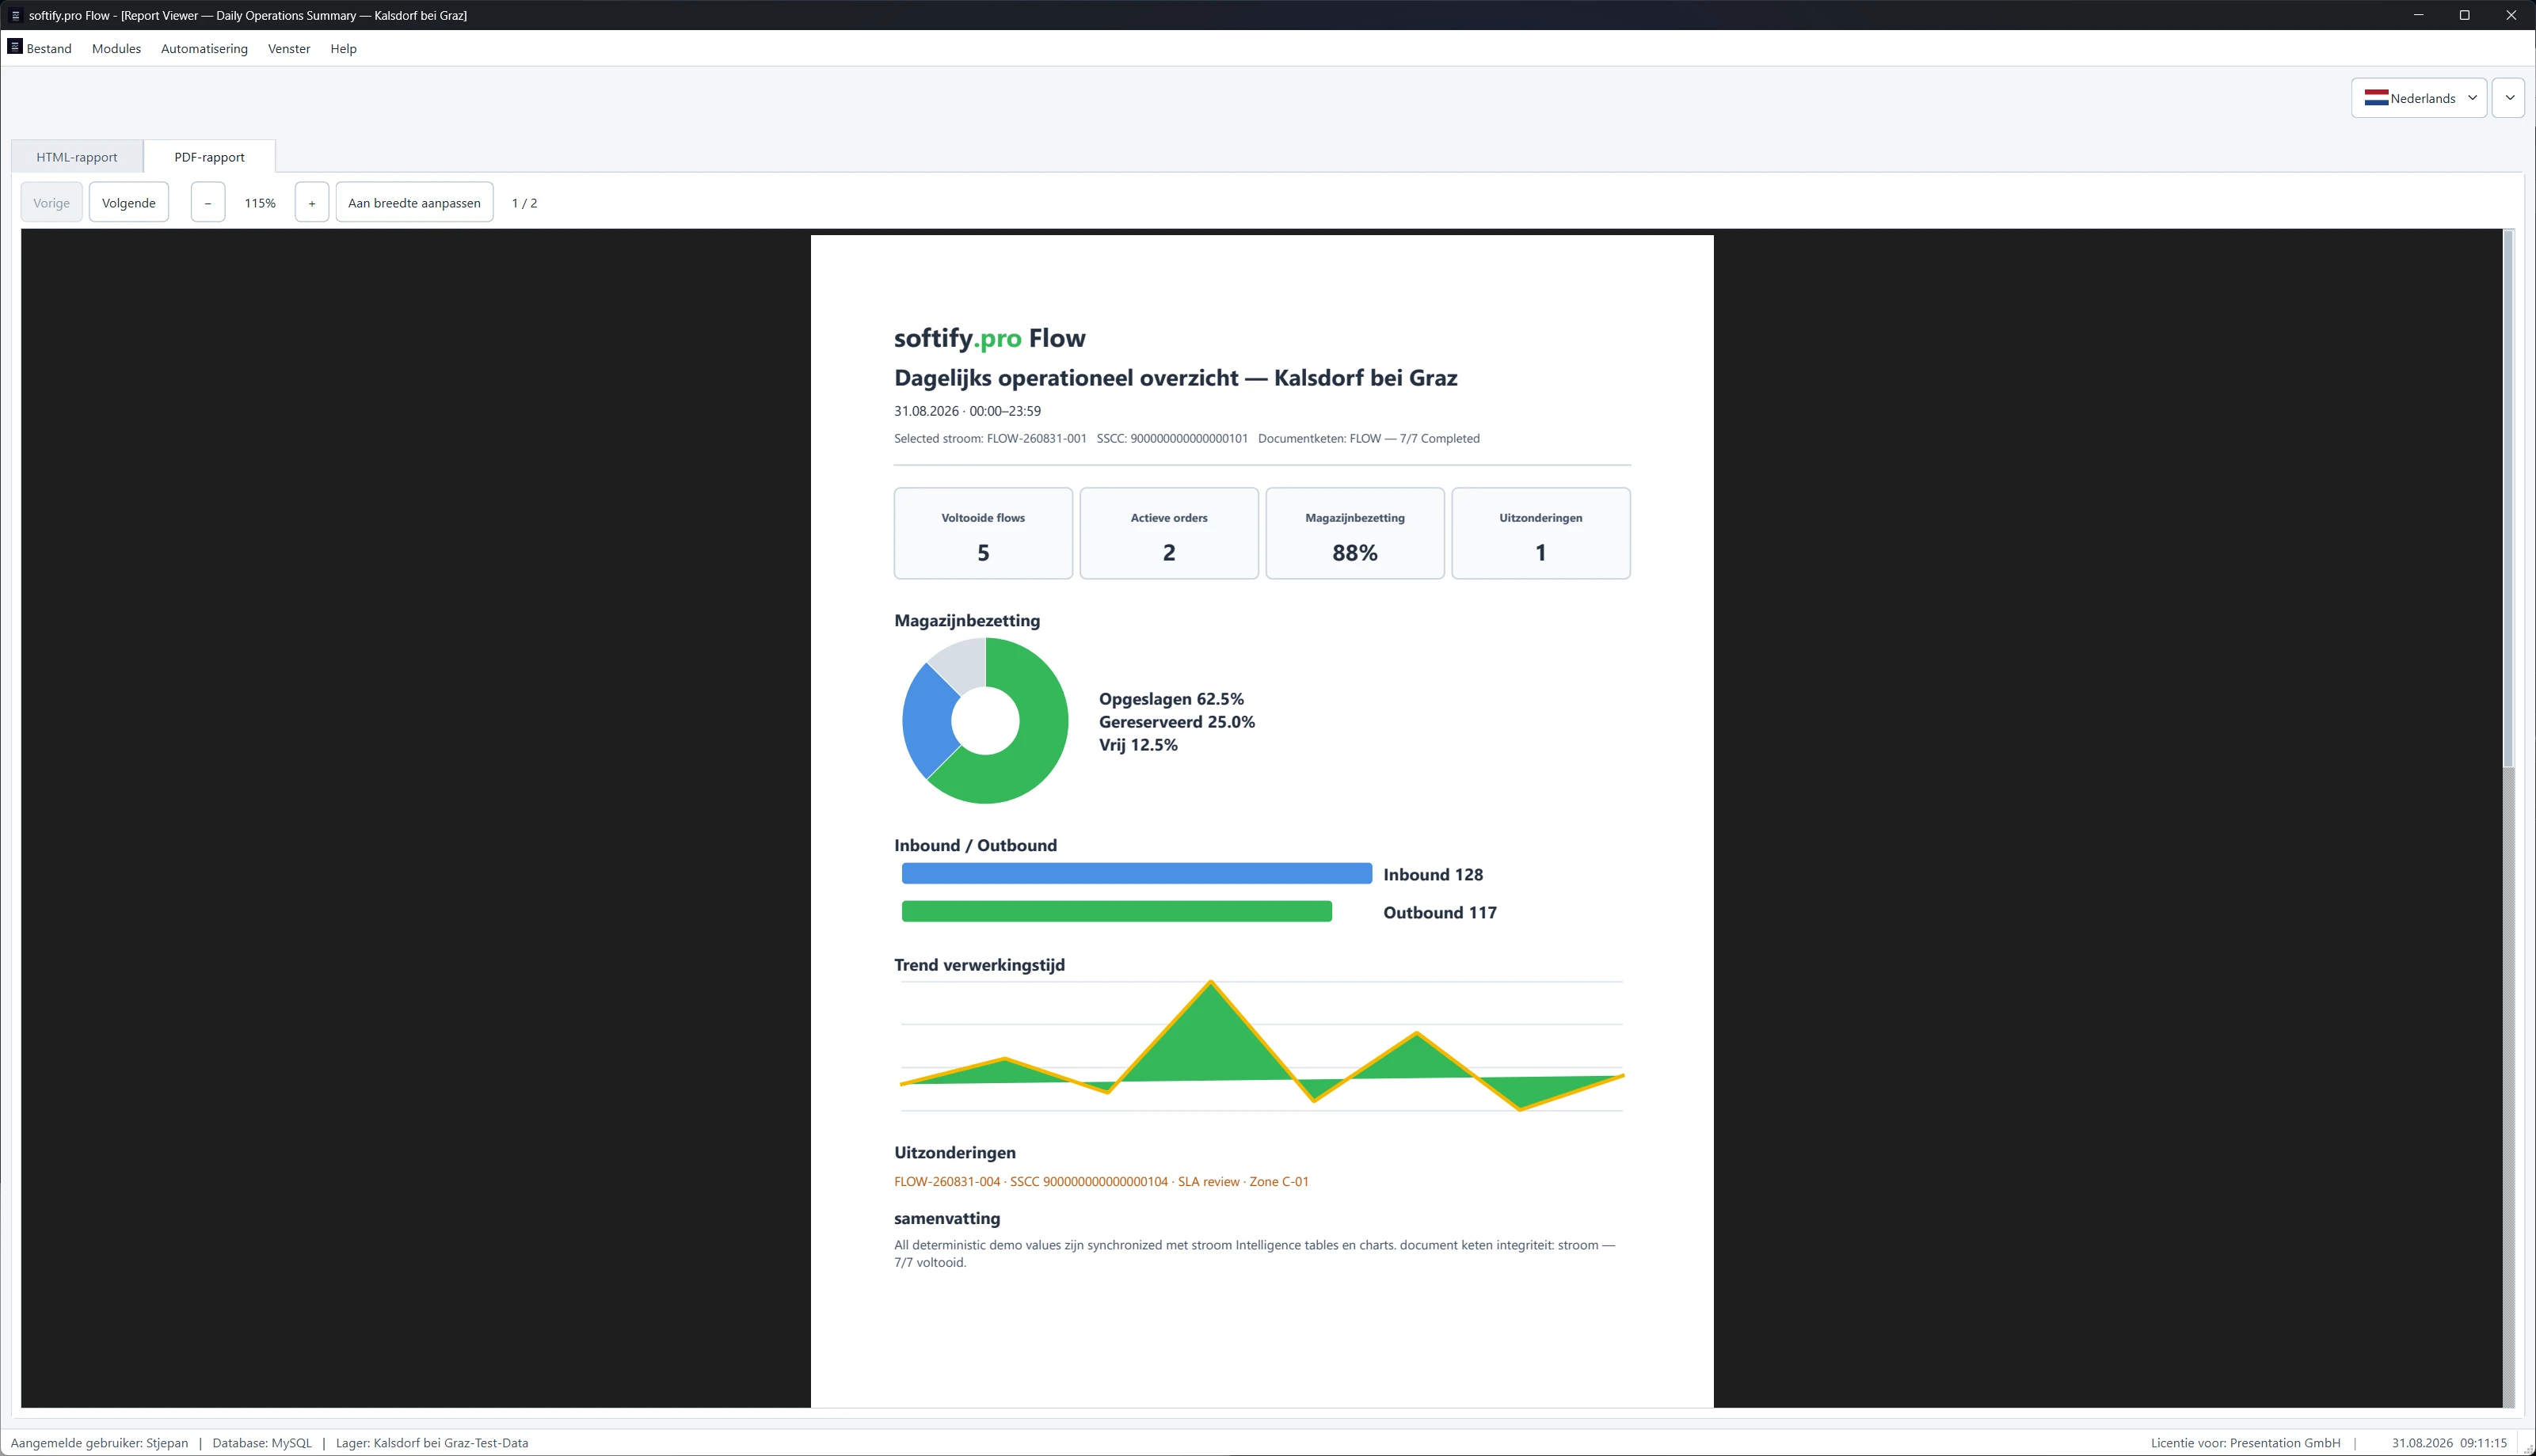
Así que abrimos el Report Center.
Resumen operativo diario.
Stock y ocupación.
Rendimiento de Flows.
Trazabilidad SSCC.
Excepciones y SLA.
La misma historia operativa volvió a aparecer.
Flows completados.
Pedidos activos.
Utilización del almacén.
Excepciones.
Entradas.
Salidas.
Tiempo de procesamiento.
Pero esta vez la pregunta no era si el informe parecía correcto.
La pregunta era:
¿Puede defenderse a sí mismo?
Un buen informe te da un número.
Un sistema mejor puede explicar de dónde viene ese número.
Reporting desde el mismo estado operativo — no una segunda versión de la realidad.
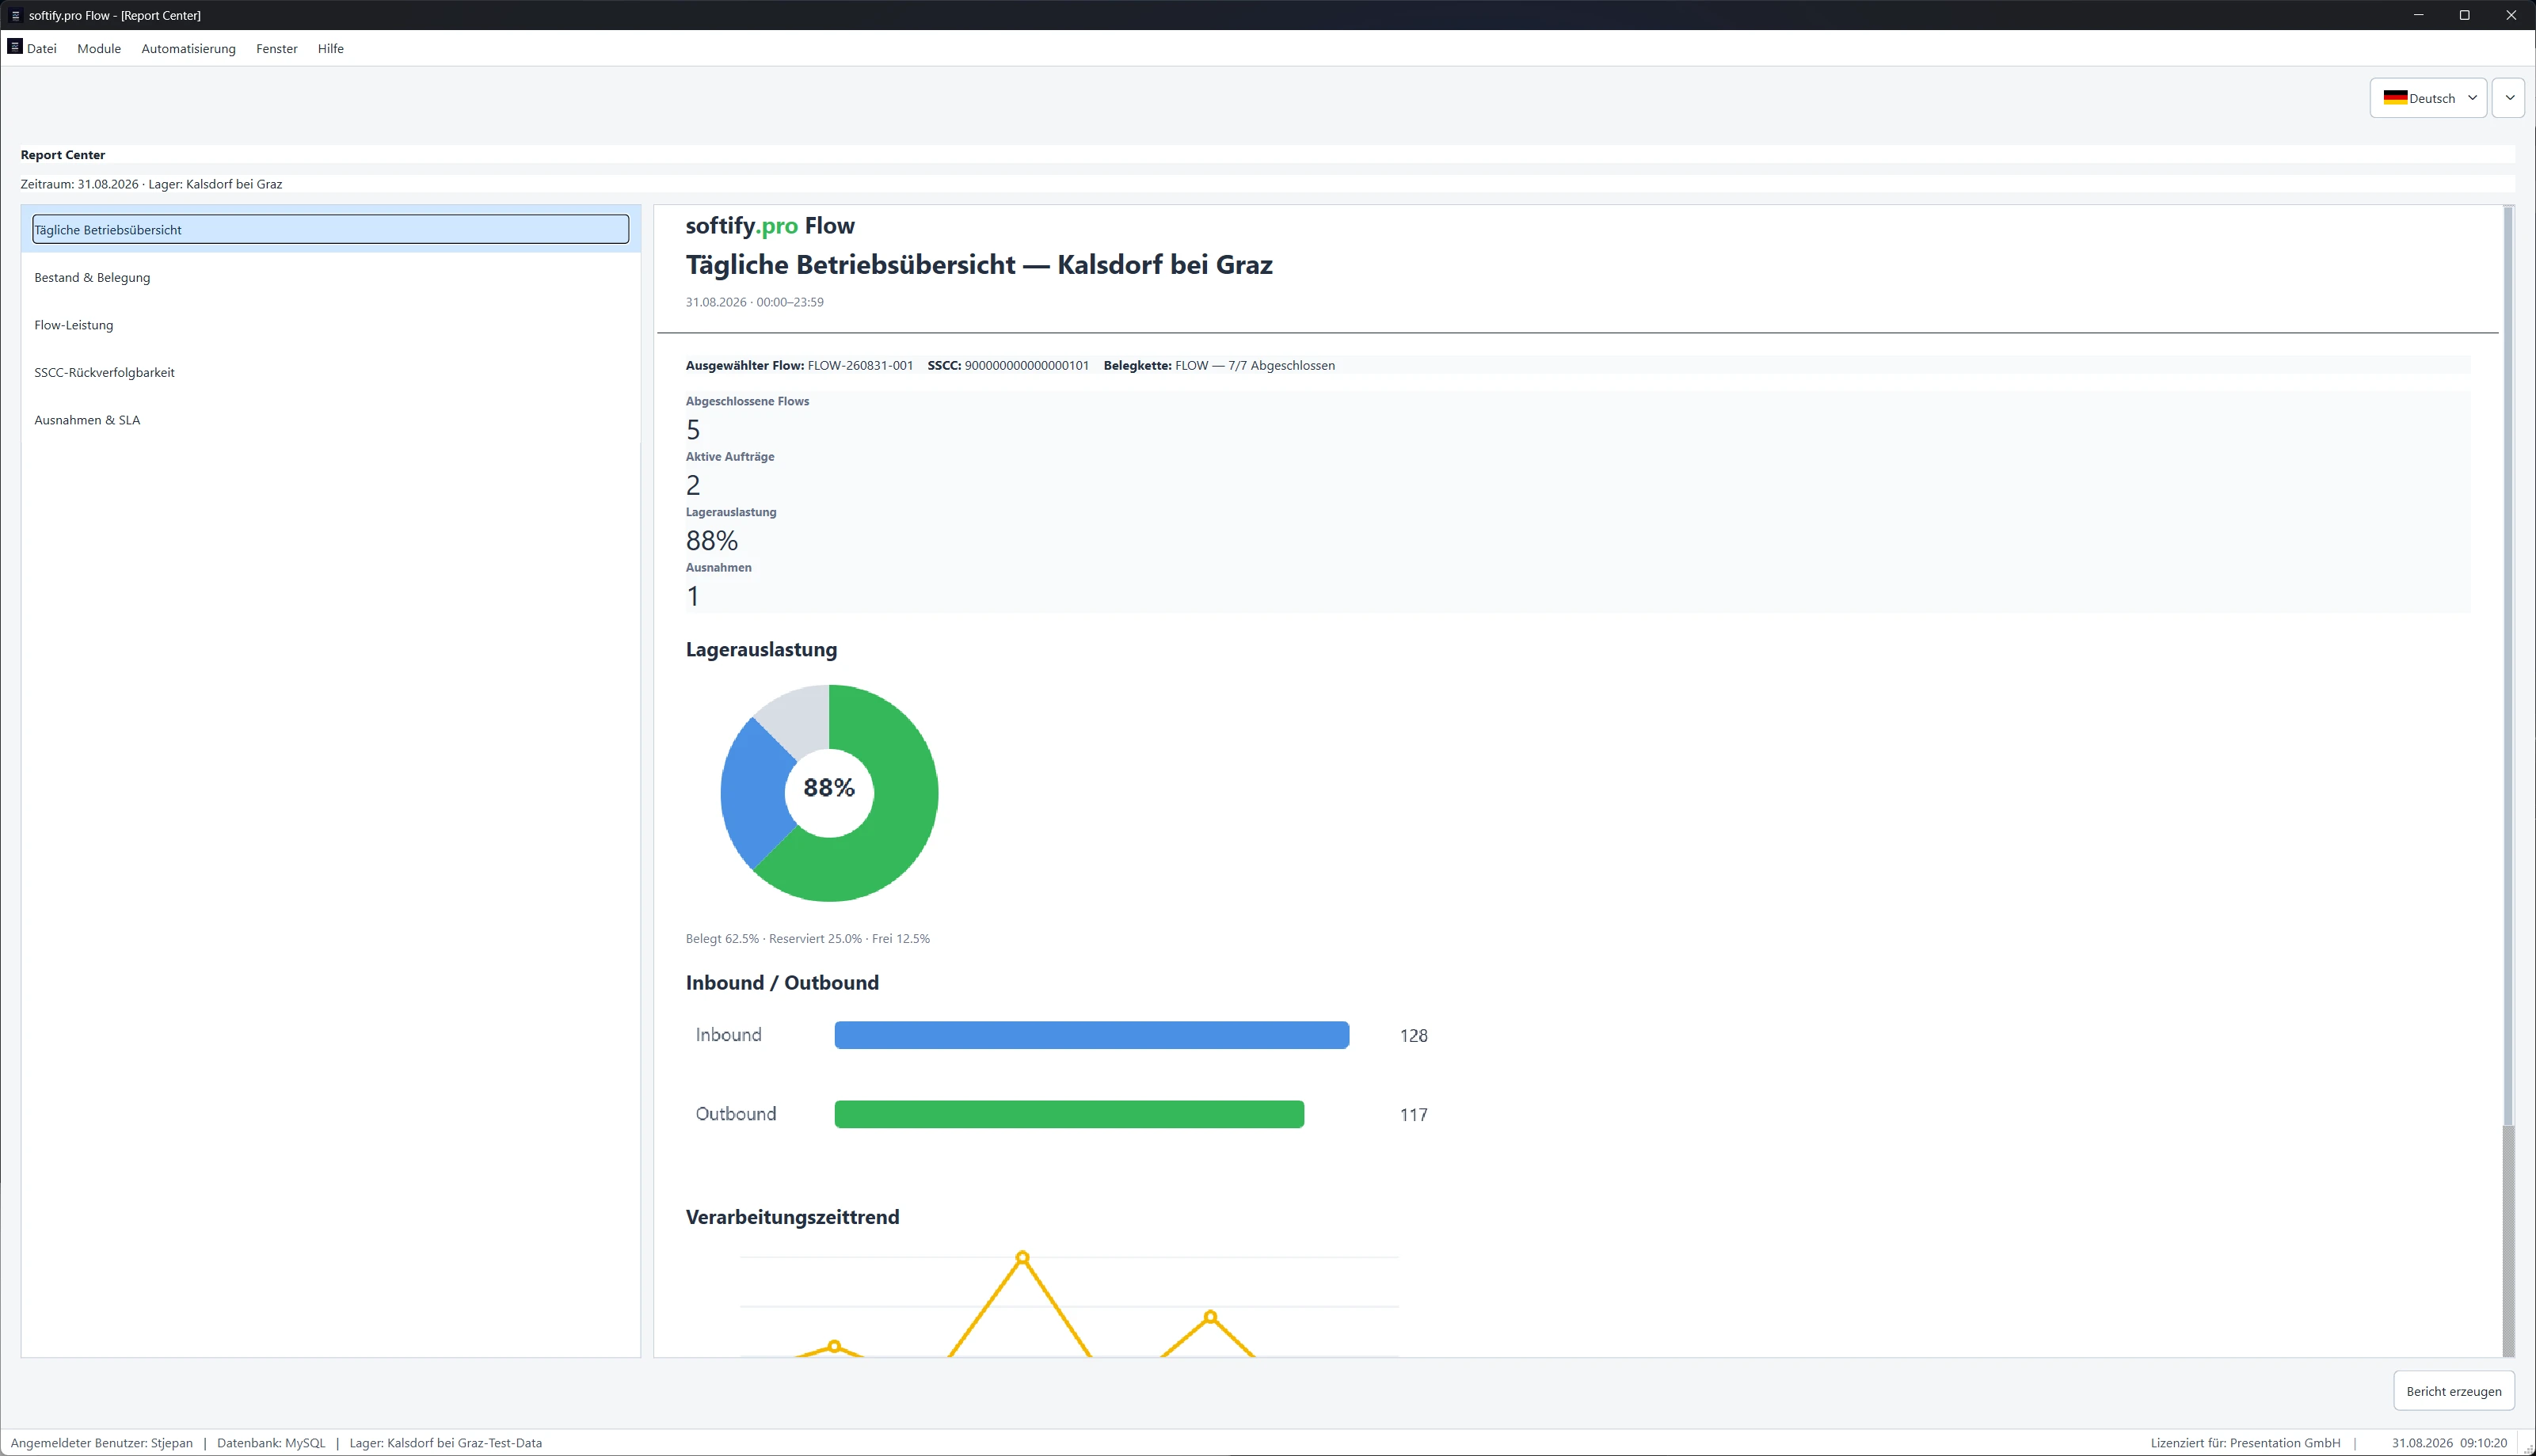
La excepción seguía ahí.
Uno de los detalles más discretos resultó ser uno de los más importantes.
Los datos de demostración contienen una excepción.
Aparece en Analytics.
Aparece en Drill-down.
Aparece en la trazabilidad SSCC.
Aparece en el Report Center.
Y sigue siendo visible en Exceptions & SLA.
Eso es exactamente lo que debería ocurrir.
Recuperarse operativamente de una excepción no significa que la excepción deba desaparecer del historial.
«El proceso continuó» y «no pasó nada» no son la misma afirmación.
En logística, esa diferencia importa.
Llegados a este punto teníamos un problema de pruebas.
No un problema de software.
Un problema de pruebas.
Ahora teníamos el mismo almacén representado como:
- analítica,
- Flows individuales,
- historiales SSCC,
- cadenas documentales,
- informes,
- y vistas de excepciones.
Cada uno podía probarse de forma independiente.
Abrir.
Hacer clic.
Filtrar.
Verificar.
Aprobar.
Siguiente.
Eso sería fácil.
También perdería la parte interesante.
Porque seis marcas verdes no demuestran que seis vistas coincidan entre sí.
Entra COCO.
Otra vez.
COCO ya se había enfrentado antes a Flow.
Autenticación.
Usuarios.
Roles.
Entornos de base de datos.
Idiomas.
Ejecución de escritorio.
Luego llegó la logística.
Almacenes.
Inventario.
Picking.
Movimientos.
Excepciones.
Documentos.
Ubuntu.
Red Hat Enterprise Linux.
Esta vez le dimos a COCO algo ligeramente distinto.
No una pantalla que verificar.
Una historia que seguir.
Toma este almacén.
Toma este Flow.
Toma este SSCC.
Abre Analytics.
Abre Drill-down.
Cambia el idioma.
Vuelve a mirar.
Abre el informe.
Encuentra el mismo Flow.
Encuentra el mismo SSCC.
Encuentra la excepción.
Compara.
Luego vuelve a comparar.
COCO sigue el mismo contexto operativo a través de softify.pro Flow — analítica, trazabilidad, cambios de idioma y reporting.
Eso cambia la naturaleza de la prueba.
La pregunta ya no es:
- ¿Funciona cada módulo?
Se convierte en:
- ¿Creen todos los módulos que ha pasado lo mismo?
Una pregunta mucho mejor.
Mucho menos cómoda.
Un sistema de almacén debería tener una sola memoria.
Los operarios pueden ver posiciones.
Los responsables de almacén pueden ver KPI.
El soporte puede usar drill-down.
Los auditores pueden usar informes.
COCO puede verlos todos.
Pero bajo esas perspectivas, debería haber un único historial.
Un Flow no debería adquirir varias biografías según qué módulo esté abierto.
Un SSCC no debería tener varios pasados.
Una excepción no debería existir solo donde resulte conveniente.
Un almacén no debería convertirse en otro almacén porque cambió el idioma de la interfaz.
De eso trata realmente el actual experimento Flow.
No de paneles de control.
No de informes.
Ni siquiera de pantallas individuales.
De una sola verdad operativa, expresada de distintas maneras.
Control.
Conocer el almacén.
Conocer el estado.
Saber qué se está moviendo.
Saber a qué proceso pertenece.
Claridad.
Convertir los KPI de nuevo en registros.
Convertir los registros en historial.
Convertir las excepciones en evidencia.
Convertir un SSCC en algo trazable.
Flow.
Se selecciona un almacén.
Analytics empieza a describirlo.
Un Flow avanza.
El SSCC permanece vinculado.
Una cadena documental crece.
Aparece una excepción.
El proceso continúa.
El informe lo recuerda.
Luego cambia el idioma.
El almacén sigue siendo el mismo.
El Flow sigue siendo el mismo.
El historial sigue siendo el mismo.
Esa era la parte esperada.
Lo que ocurrió después fue más interesante.
COCO dejó de probar las vistas de forma independiente.
Empezó a compararlas.
Durante un tiempo, no pasó nada destacable.
Mismo almacén.
Mismo Flow.
Mismo SSCC.
Misma historia.
Otra vez.
Otra vez.
Otra vez.
Y entonces COCO se detuvo.
No porque la aplicación se hubiera bloqueado.
No lo había hecho.
No porque una prueba hubiera fallado en el sentido habitual.
No había sido así.
Se detuvo porque dos respuestas perfectamente razonables produjeron una tercera pregunta.
Sabemos cuál es la pregunta.
Flow sabe por qué existe.
COCO sabe dónde mirar a continuación.
El resto puede esperar.
Control. Clarity. Flow.