softify.pro
Chargement …
Services À propos COCO – notre serveur IA Portfolio Insiders Études de cas À Savoir Contact Connexion

NEXT-GEN SOFTWARE AESTHETIC

Pure fluidity meets ultimate performance.

La nouvelle identité visuelle pour les flux de travail numériques modernes.

softify.pro — La nouvelle identité visuelle pour les flux de travail numériques modernes.

Faites défiler pour explorer ↓

Des logiciels conçus comme les entreprises modernes travaillent réellement

softify.pro est un studio logiciel construit autour d'une idée : la technologie devrait être aussi fluide que les entreprises qu'elle accompagne. Nous travaillons à l'intersection du développement web moderne, de l'automatisation des processus et de l'intelligence artificielle appliquée — trois disciplines qui cohabitent rarement sous un même toit, mais qui doivent de plus en plus le faire. Nos clients vont de petits ateliers numérisant leur première facturation à des fabricants de taille moyenne bien établis remplaçant leurs tableurs par un véritable logiciel logistique. Ce qui les relie n'est pas la taille, mais l'ambition : ils veulent des systèmes rapides, fiables et réellement agréables à utiliser, pas seulement fonctionnels. Chaque projet démarre avec les trois mêmes questions : qu'est-ce qui doit réellement aller plus vite dans cette entreprise, qu'est-ce qui fonctionne déjà bien et doit être respecté plutôt que remplacé, et quelle partie du flux de travail peut, une fois correctement construite, tourner toute seule. Les réponses façonnent tout ce qui suit, du choix technologique au plan de déploiement.

Services

La nouvelle identité visuelle pour les flux de travail numériques modernes.

01 — LOGISTICS

Automatiser la logistique — pensé pour les PME de la région DACH

Une grande partie de notre travail est consacrée aux logiciels de logistique et d'exploitation pour les petites et moyennes entreprises d'Allemagne, d'Autriche et de Suisse. Ces entreprises se retrouvent souvent coincées entre deux options peu attrayantes : des suites logistiques d'entreprise coûteuses conçues pour des groupes dix fois plus grands, ou un assemblage de tableurs, de formulaires papier et d'appels téléphoniques qui limite discrètement leur capacité à croître rapidement.

Nous construisons la voie intermédiaire — une automatisation sur mesure adaptée à la façon dont un entrepôt, un atelier ou une équipe de distribution travaille réellement. Cela peut signifier numériser les réceptions de marchandises et les mouvements de stock, générer automatiquement des bons de livraison et des étiquettes d'expédition, relier la prise de commande à la planification des tournées, ou simplement remplacer un tableur fragile que seule une personne comprend par un système partagé sur lequel toute l'équipe peut compter. Comme nous travaillons directement avec les dirigeants et responsables d'exploitation de la région DACH, les besoins sont recueillis dans la langue de travail réelle de l'entreprise, et le déploiement est planifié autour des équipes et des entrepôts réels, pas d'un calendrier abstrait.

02 — WEB

Développement web moderne, sur des technologies actuelles

Nous concevons et développons des applications web et des sites avec des technologies actuelles, activement maintenues, plutôt que des frameworks anciens maintenus en vie par habitude. Cela signifie du PHP 8.4 propre côté serveur lorsqu'une application classique rendue côté serveur est le bon choix, du JavaScript moderne là où l'interactivité compte, et MySQL 8 pour des données qui doivent rester cohérentes et interrogeables pendant des années, pas seulement les six premiers mois après le lancement. Chaque projet est pensé pour le bureau et le mobile dès la première esquisse, et non adapté après coup : temps de chargement, points de rupture de mise en page et interactions tactiles font partie du cahier des charges, pas un ajout ultérieur.

Au-delà de l'interface visible, nous accordons de l'importance à ce qu'un site montre « de l'intérieur » : du code lisible, un schéma de base de données qui n'aura pas besoin d'être reconstruit à la prochaine demande de fonctionnalité, et des étapes de déploiement qu'un second développeur pourrait suivre sans avoir à nous appeler. Un site performant aujourd'hui et encore proprement extensible dans trois ans, c'est pour nous la véritable définition de « moderne ».

03 — AI / COCO

COCO — notre propre serveur IA pour les tests logiciels automatisés

Pour nos clients grands comptes, nous exploitons et maintenons notre propre serveur IA dédié, nommé COCO. Contrairement à un chatbot généraliste greffé sur un flux de travail, COCO est conçu et hébergé spécifiquement pour les tests automatisés de logiciels web et d'applications de bureau multiplateformes — des flux de connexion et d'authentification à des processus métier complets à plusieurs étapes.

COCO planifie un scénario de test, l'exécute sur l'application réelle, capture des captures d'écran avant/après et des enregistrements d'exécution comme preuves, et produit une évaluation en langage clair de ce qui a fonctionné, ce qui a échoué et pourquoi — y compris des cas particuliers comme des échecs de connexion répétés, des verrouillages de compte et des parcours de récupération, fastidieux et sujets à erreur à tester manuellement. Le serveur fonctionnant localement sous notre gestion, les clients grands comptes gardent un contrôle total sur l'emplacement de stockage des données de test et des captures d'écran, sans envoyer par défaut le trafic applicatif interne vers un service cloud tiers.

Nous installons, configurons et maintenons COCO individuellement pour chaque client grand compte — en définissant les plans de test pertinents pour son application spécifique, en ajustant les seuils de confiance, et en décidant au cas par cas quand un résultat doit être transmis à une revue humaine. L'objectif n'est pas de remplacer une équipe QA, mais de lui donner un collègue infatigable qui exécute les tests de régression répétitifs avant chaque publication, avant même qu'un humain n'ait à intervenir.

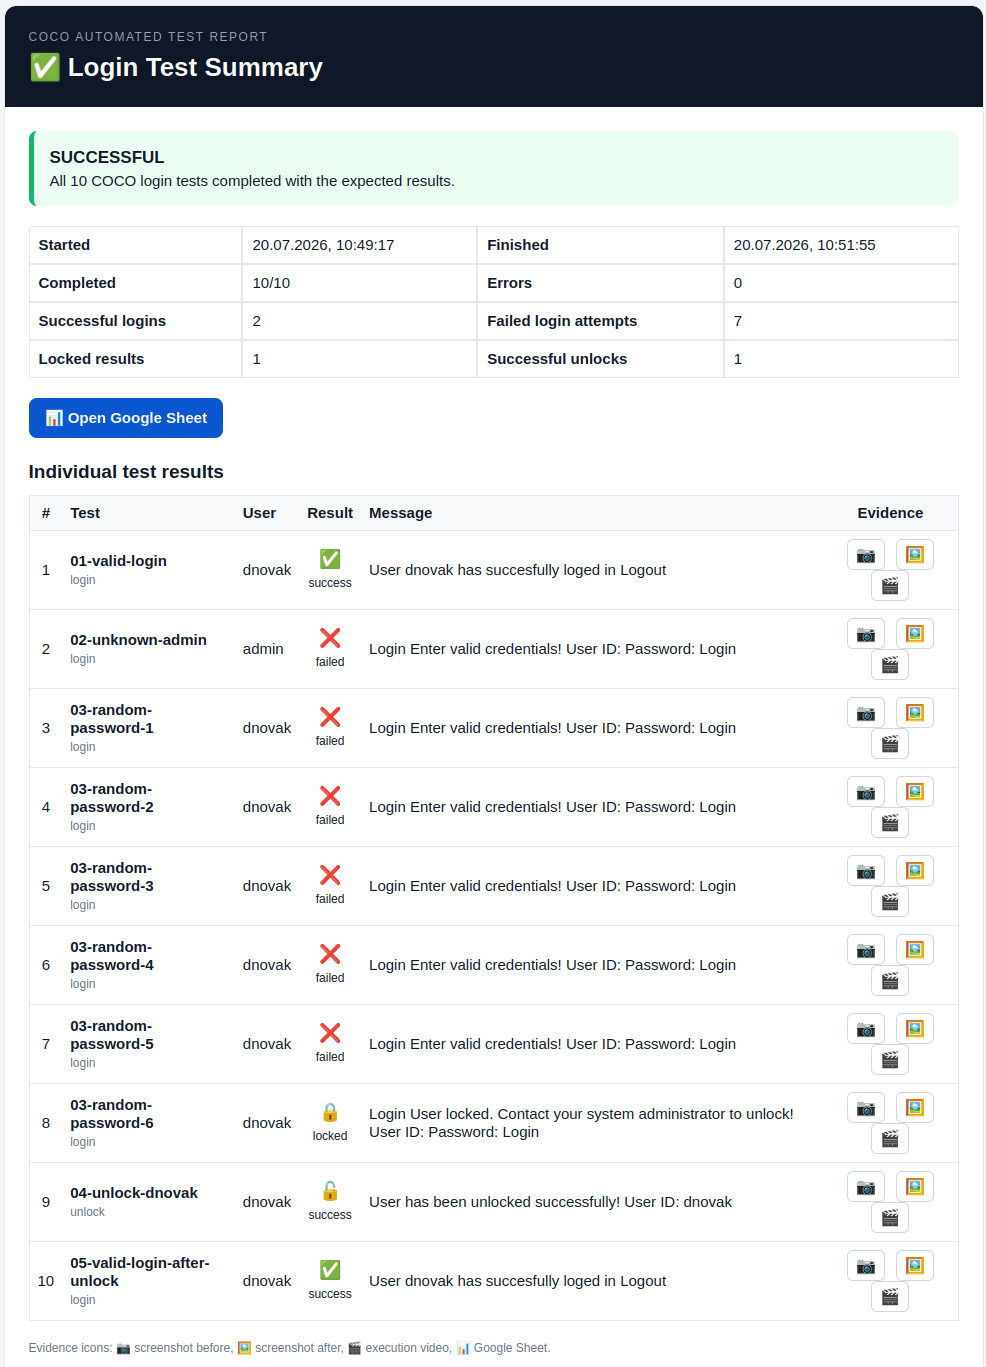
COCO automated login test report
COCO — automated login & account-lockout test report
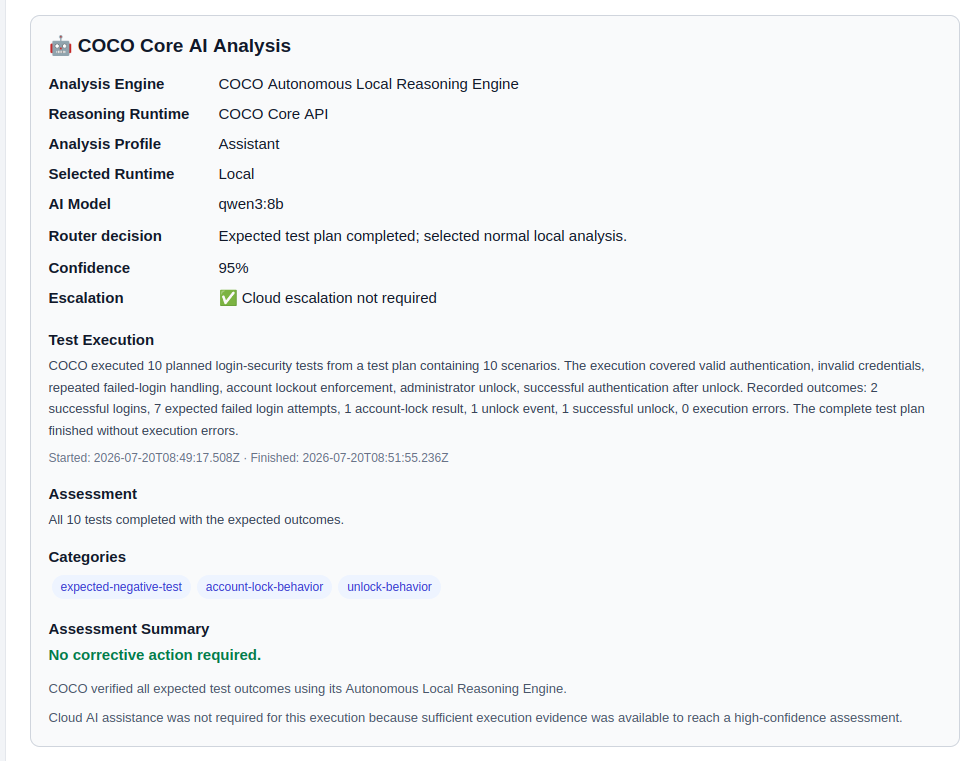
COCO AI analysis panel
COCO — plain-language AI analysis of a completed test run

Pourquoi softify.pro

Nous restons délibérément assez petits pour que chaque projet soit suivi par les personnes présentes dès la conversation de planification initiale, sans être transmis à une file d'attente. Cela signifie des boucles de retour plus courtes, moins de malentendus et une équipe qui se souvient encore, six mois plus tard, pourquoi telle décision a été prise. Nous préférons une fiabilité ennuyeuse mais prouvée à la course aux tendances : une pile technologique est choisie parce qu'elle convient au problème et pourra être maintenue par quelqu'un d'autre dans cinq ans, pas parce qu'elle était à la mode au moment du sprint où elle a été choisie. Si un tableur fait encore le travail mieux qu'un logiciel sur mesure, nous vous le dirons aussi — notre objectif est un flux de travail réellement plus rapide, pas simplement une facture logicielle plus élevée.

Travaux sélectionnés

Une petite sélection de travaux que nous pouvons montrer publiquement — d'autres études de cas et projets grands comptes sont disponibles sur demande sous NDA.

Auto Detailing Đeki – Du site web à une plateforme de services numérique autodetailing-deki.pro

Auto Detailing Đeki – Du site web à une plateforme de services numérique

Plateforme multilingue pour la rénovation automobile – du calcul du prix à la réservation jusqu\'au suivi transparent des commandes, pilotée depuis un back-office central.

Koralpenhaus

Koralpenhaus

Site régional de présentation et de réservation dans les Alpes, conçu avec un accent sur une structure claire, un chargement rapide et une gestion de contenu simple.

Dexosano

Dexosano

Une plateforme web moderne basée sur PHP, conçue avec la même approche axée sur la performance que softify.pro applique à chaque projet client.

softify.pro - Insiders

Un entrepôt. Une vérité.

Un entrepôt. Une vérité.

Il existe un moyen simple de rendre un logiciel d'entrepôt convaincant.
Ouvrir un tableau de bord.
Afficher quelques chiffres verts.
Ajouter un graphique.
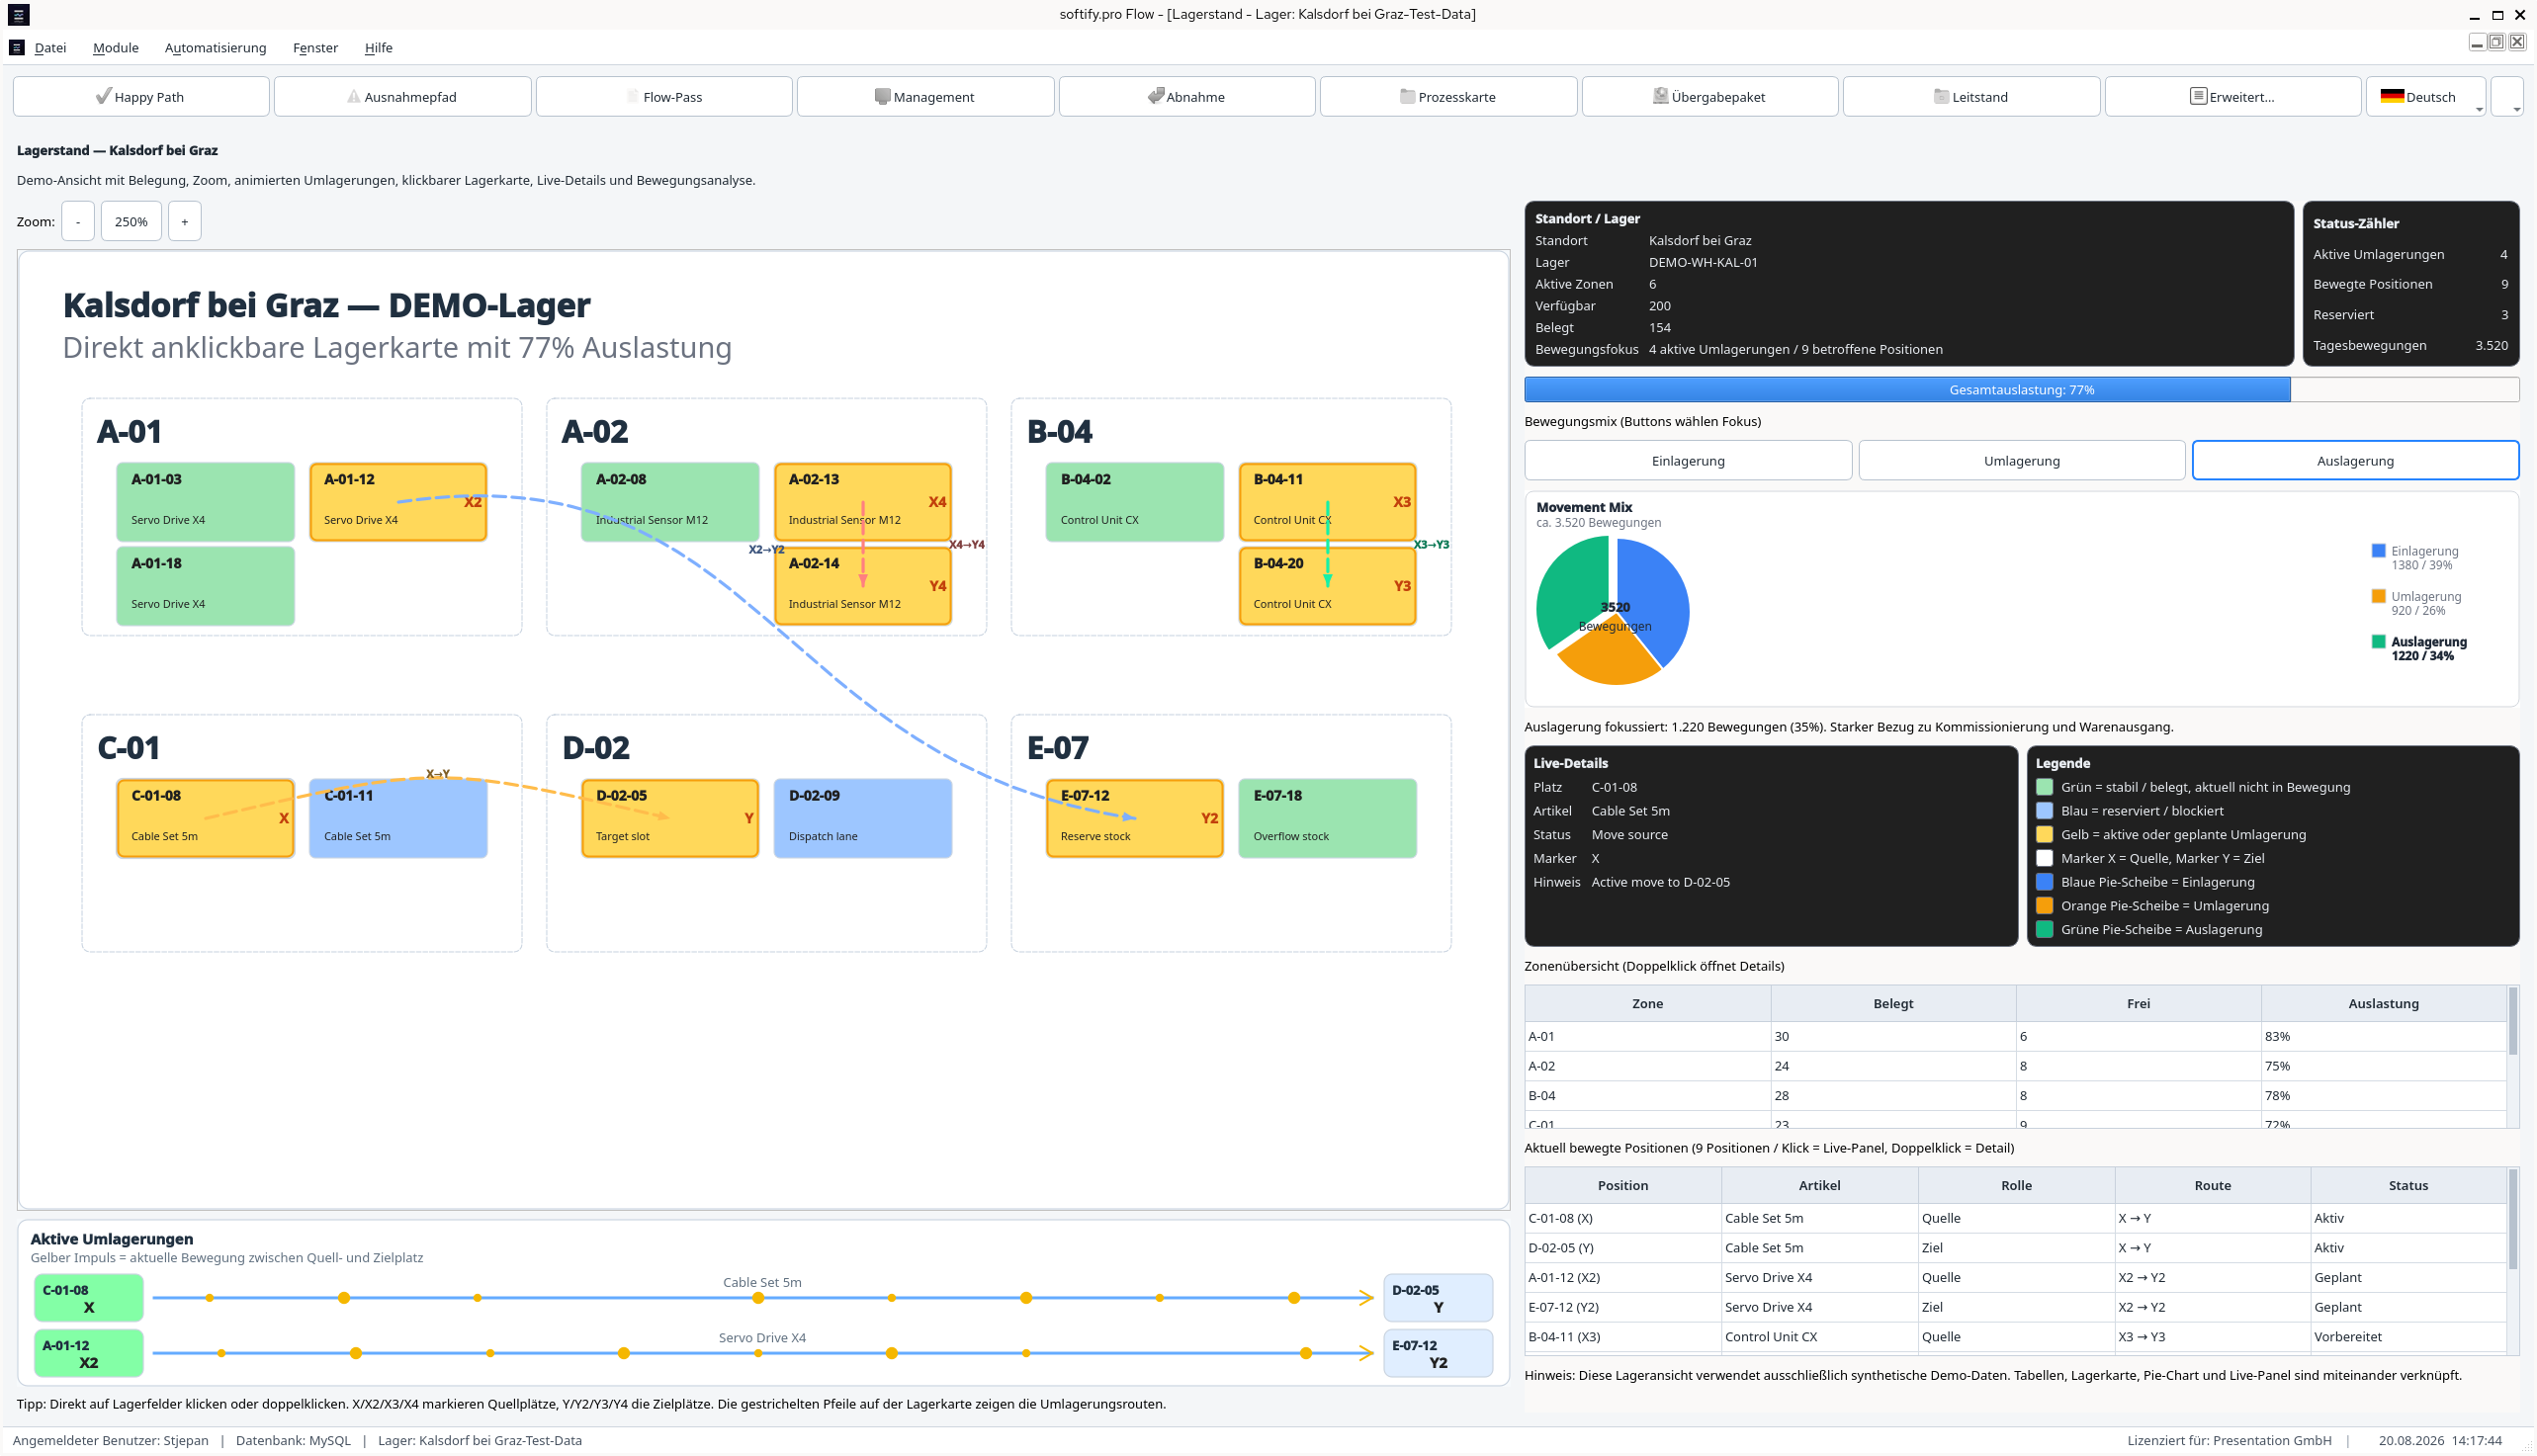
Placer du stock sur une carte de l'entrepôt.
Terminer par un rapport.
Tout semble aller bien.
Et tout peut quand même être faux.
Parce qu'un entrepôt se moque de la beauté du tableau de bord.
Ce qui lui importe, c'est que chaque partie du système soit d'accord sur ce qui s'est réellement passé.
C'est devenu la partie intéressante de la dernière expérience softify.pro Flow.
Pas un autre écran.
Pas un autre KPI.
Pas un autre rapport.
Quelque chose de beaucoup moins visible.
La cohérence.
Tout a commencé avec un entrepôt.
La démo actuelle de softify.pro Flow fonctionne avec plusieurs environnements d'entrepôt synthétiques.
Des identifiants d'entrepôt différents.
Des capacités différentes.
Des structures de zones différentes.
Aucun stock de production.
Aucune donnée client.
Aucune information opérationnelle réelle.
Mais la logique du processus se comporte comme si tout cela comptait.
Parce qu'en logistique réelle, c'est le cas.
Une fois un entrepôt sélectionné, ce contexte fait partie de tout ce qui suit.
Flows.
SSCC.
Mouvements.
Opérateurs.
Analytics.
Rapports.
Cela paraît évident.
Cela devient nettement moins évident lorsque le même processus commence à apparaître dans plusieurs parties différentes de l'application.
Puis nous avons ouvert une autre vue.
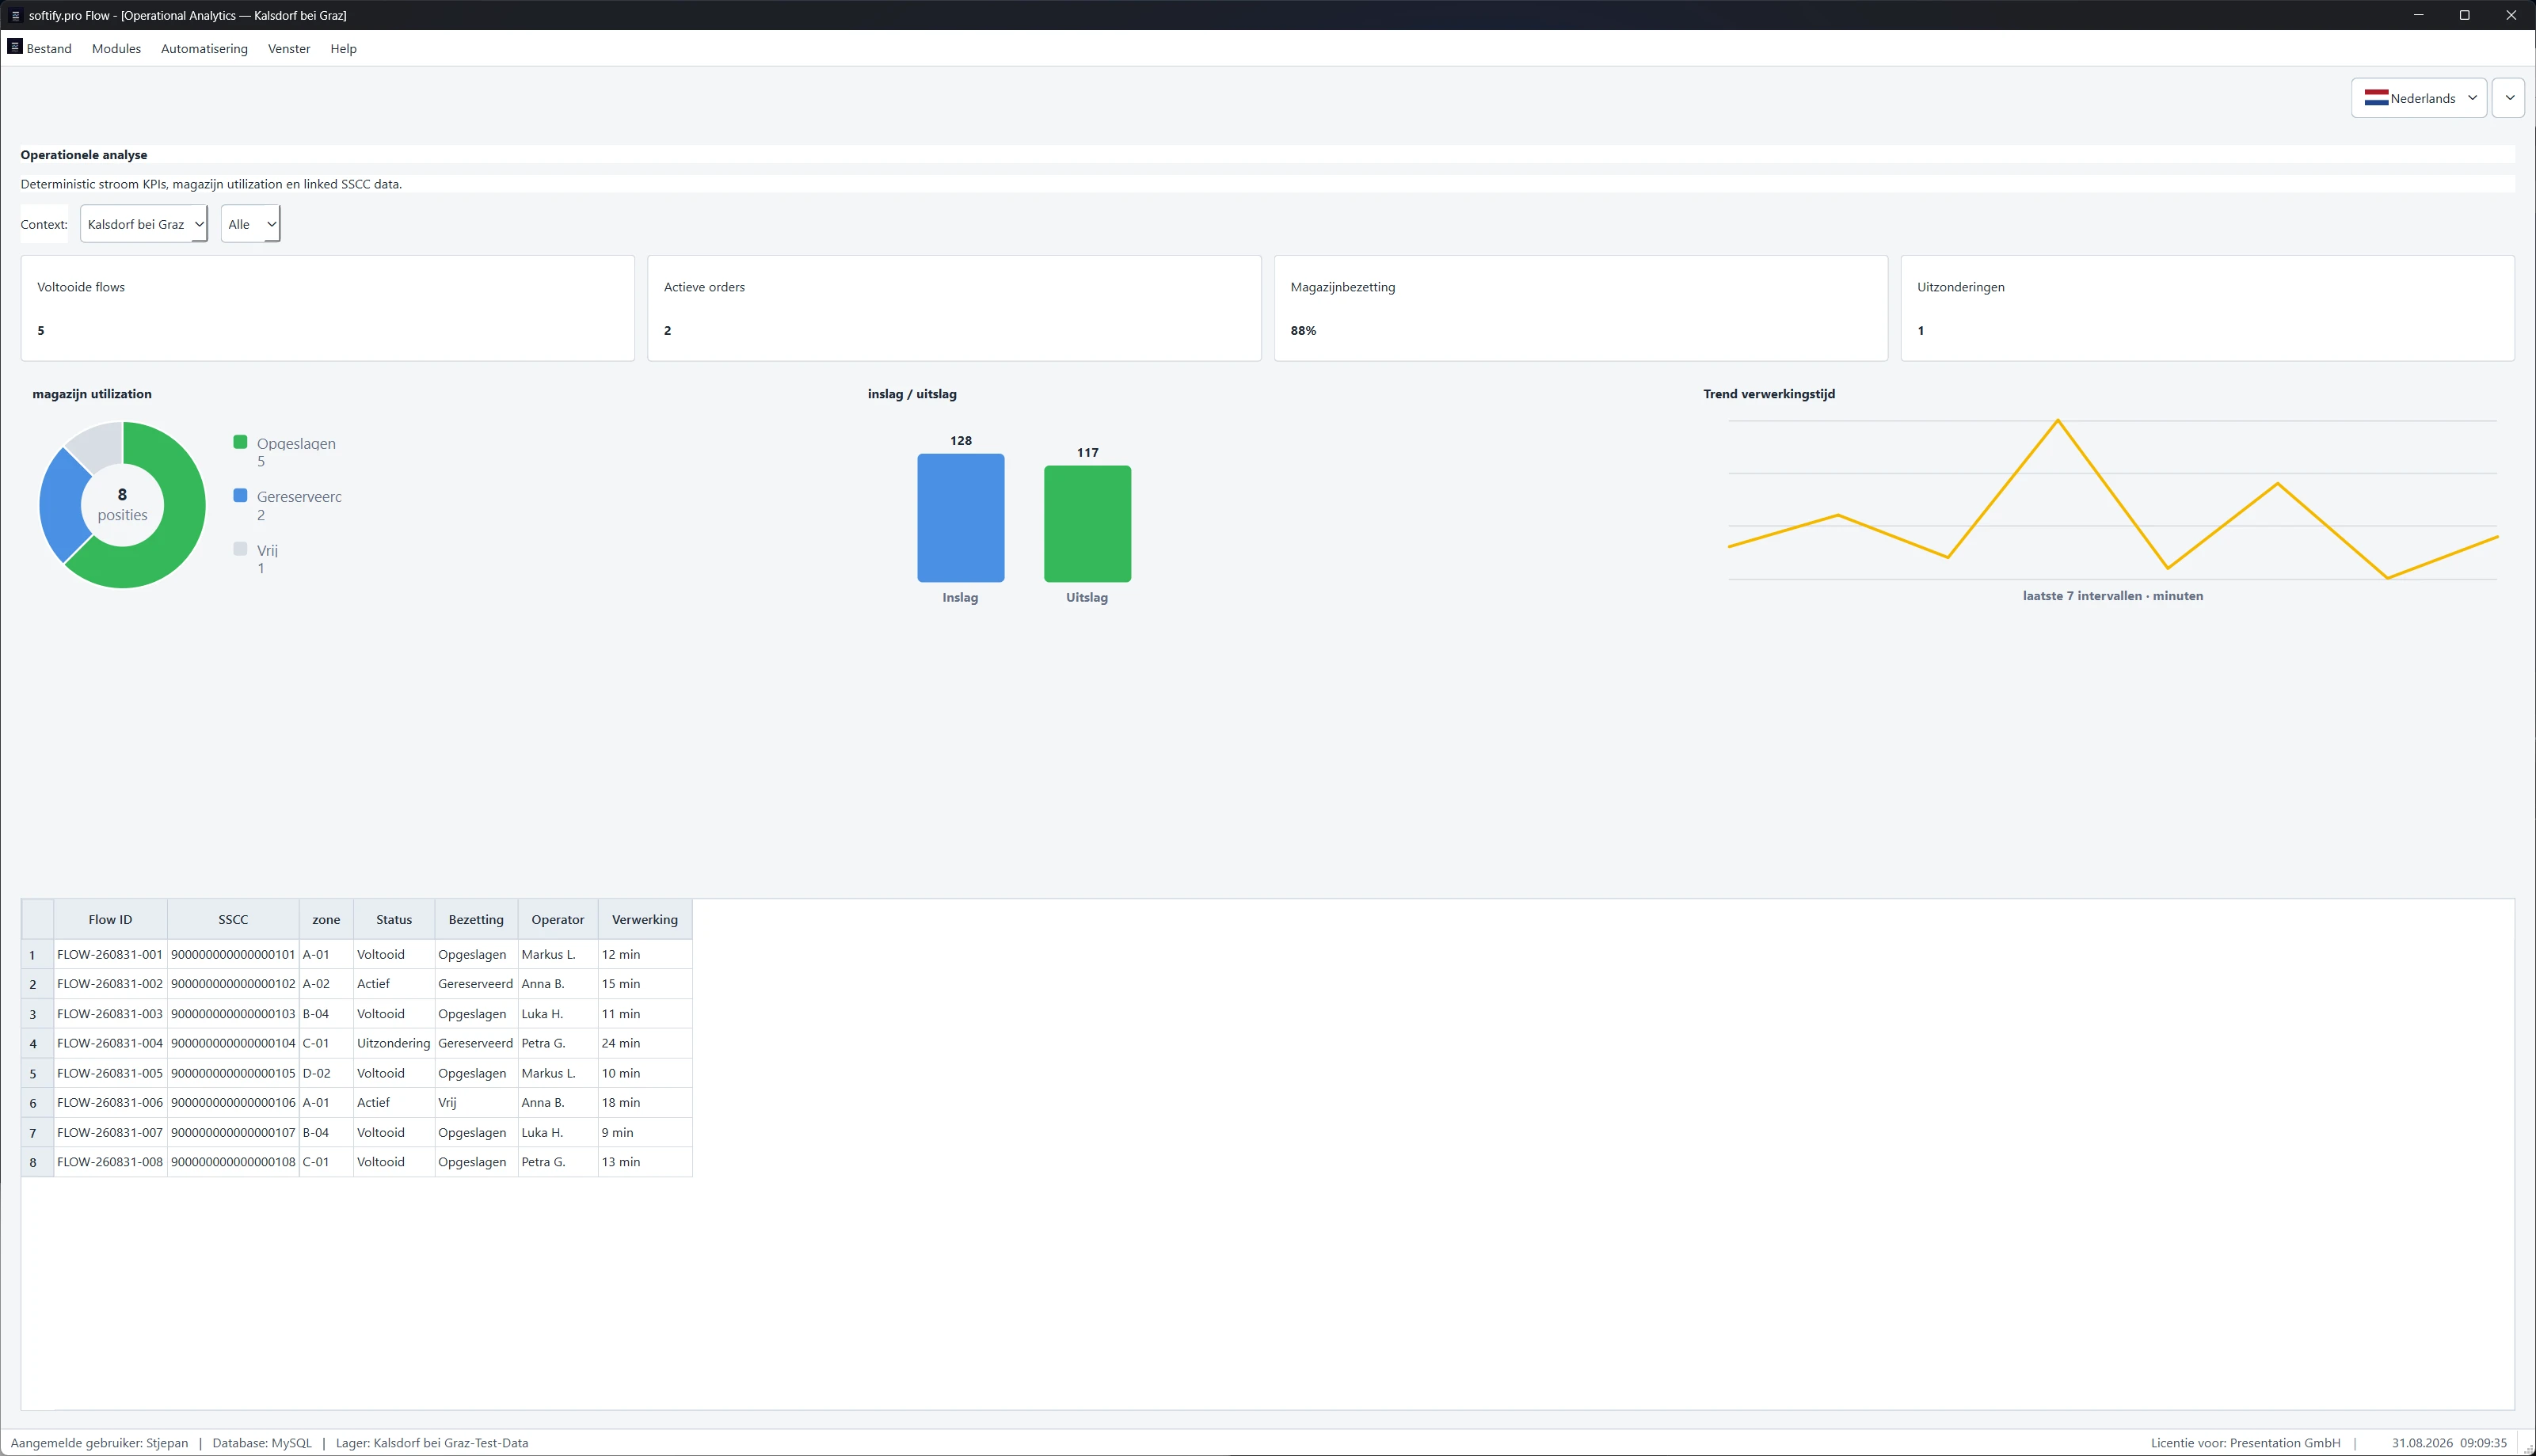
Operational Analytics.
Soudain, l'entrepôt avait l'air complètement différent.
Aucune position de stockage.
Aucune flèche de mouvement.
À la place :

  • Flows terminés,
  • commandes actives,
  • taux d'occupation de l'entrepôt,
  • exceptions,
  • entrées,
  • sorties,
  • temps de traitement.

La représentation visuelle avait changé.
L'entrepôt, non.
Cette distinction est devenue importante.
Parce que sous les KPI se trouvaient toujours des enregistrements individuels.
Identifiants de Flow.
SSCC.
Zones.
Statuts.
Opérateurs.
Temps de traitement.
Vue différente.
Même réalité opérationnelle.
Jusque-là, tout allait bien.

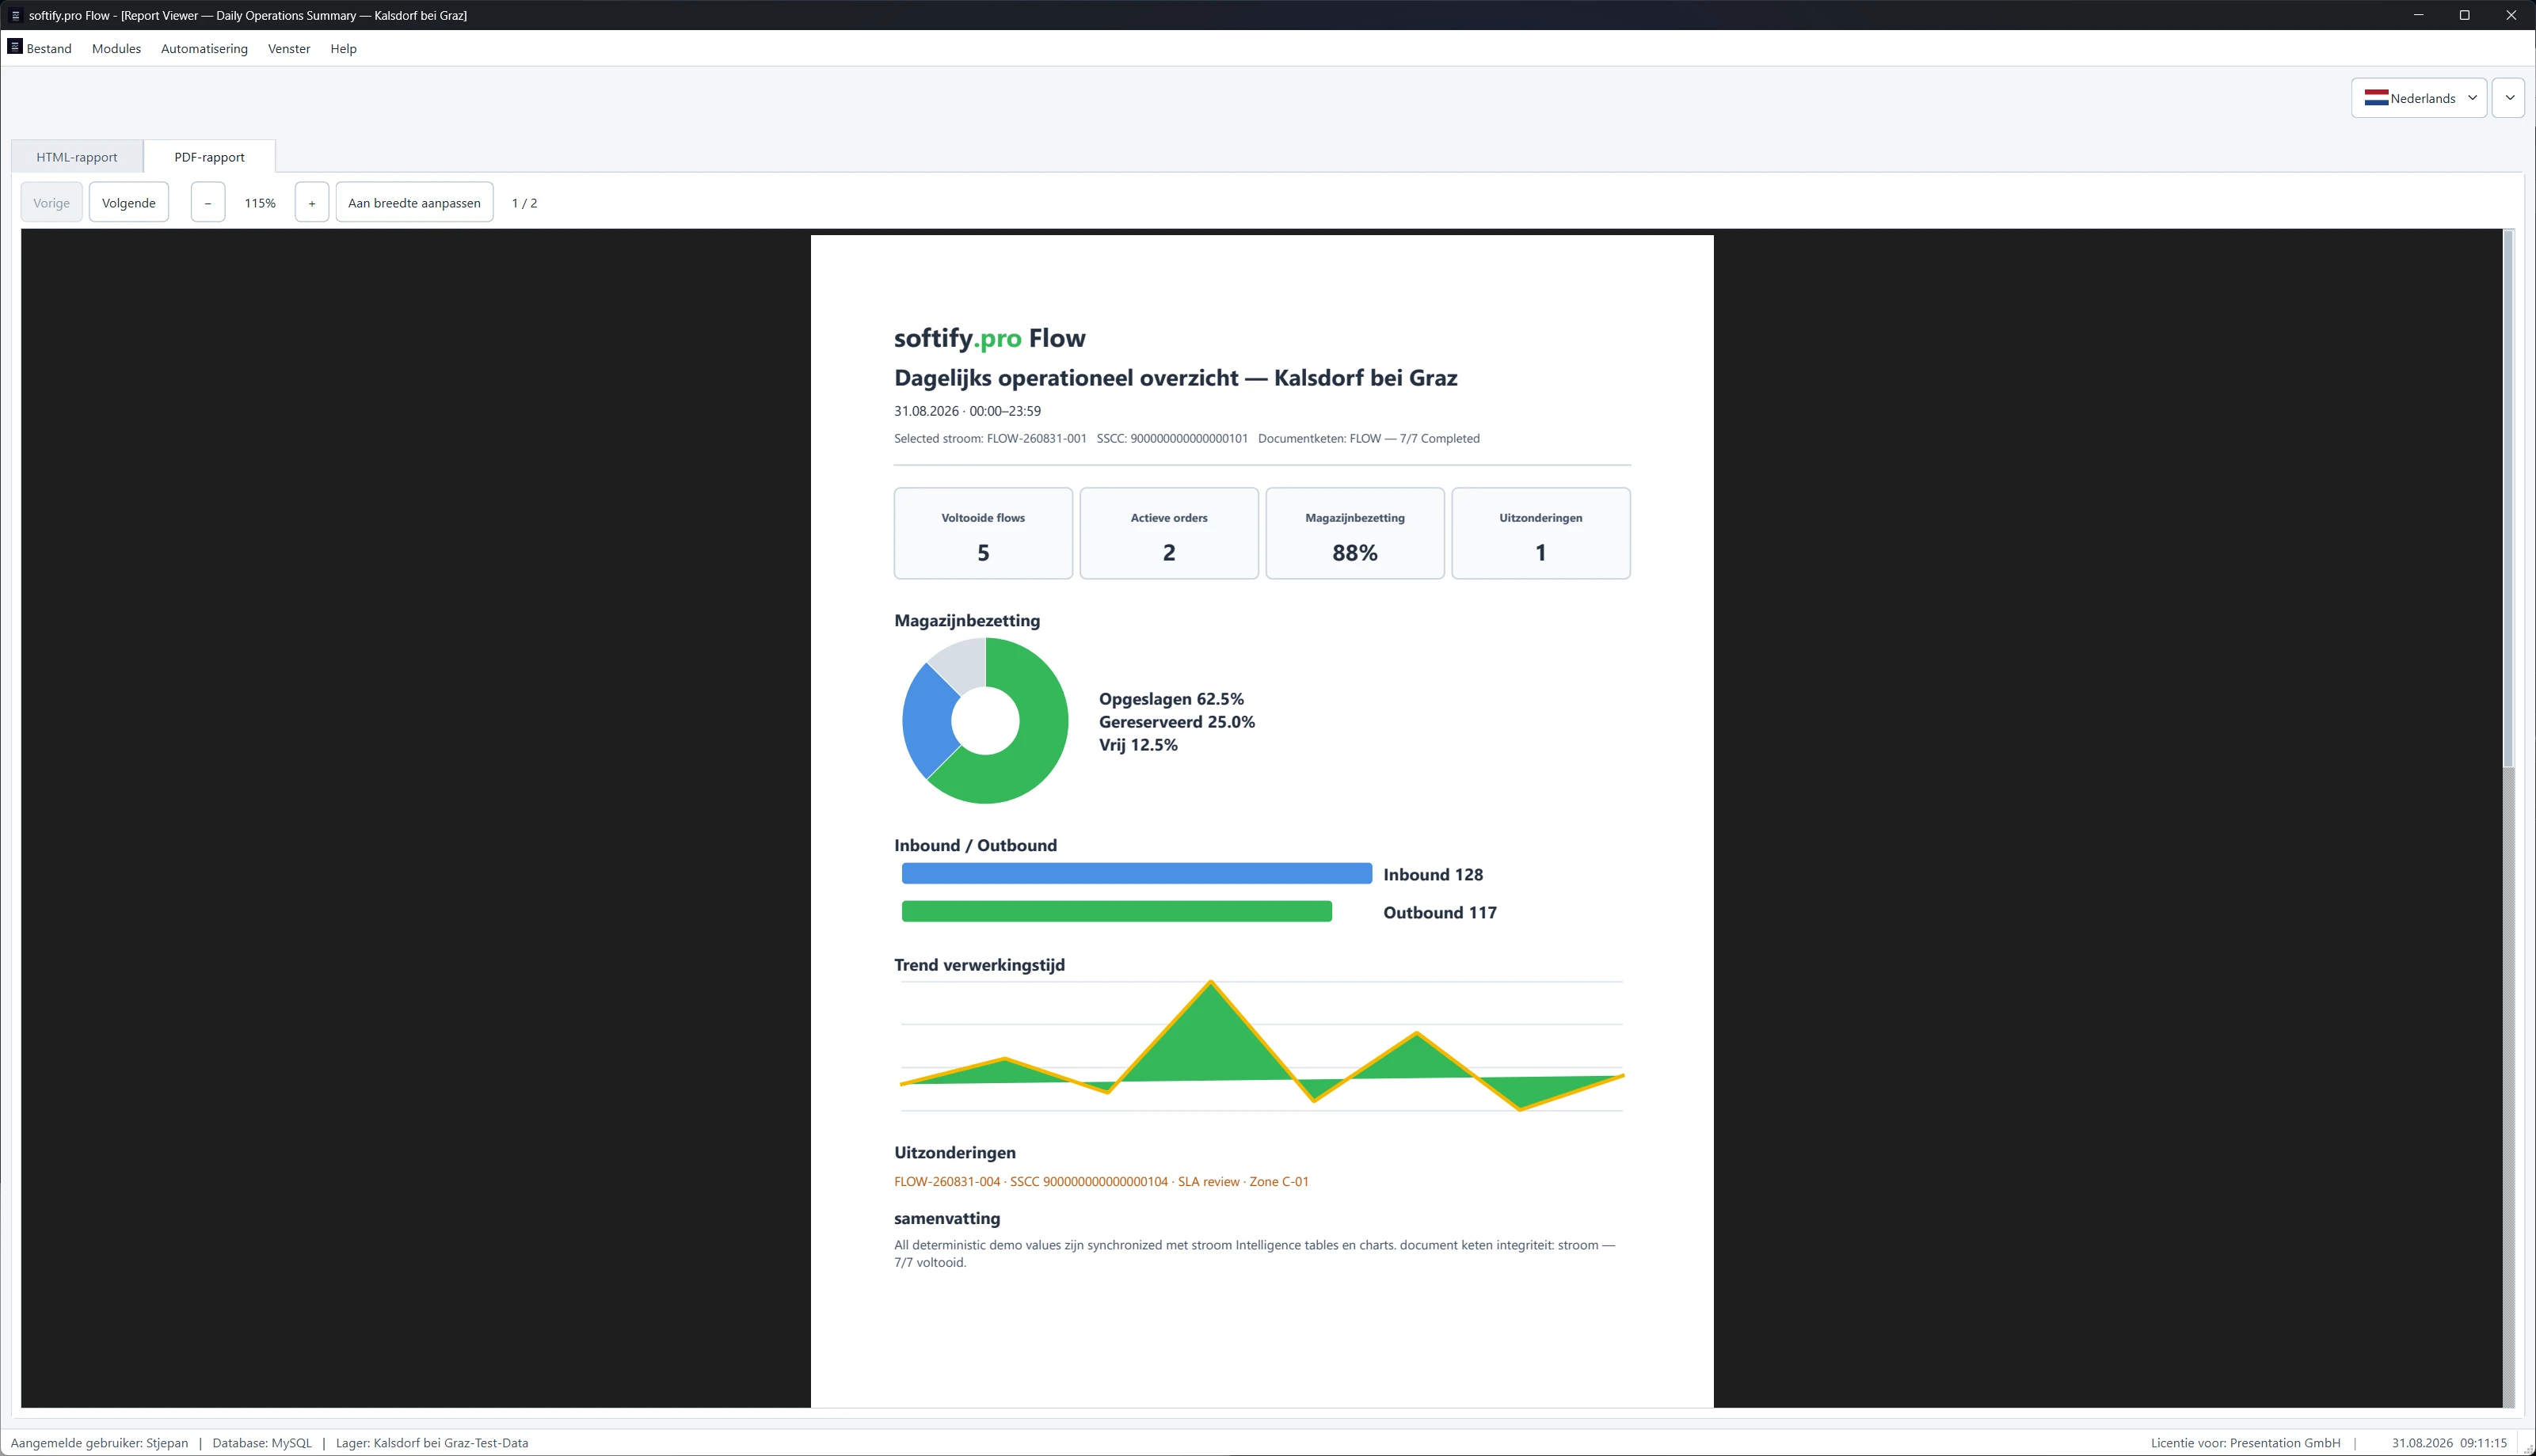
Operational Analytics — état agrégé de l'entrepôt, avec les enregistrements Flow sous-jacents toujours visibles.

Flow.

88 % n'est utile que si le système peut l'expliquer.
Supposons que le tableau de bord indique :
Taux d'occupation de l'entrepôt : 88 %.
Utile.
Mais incomplet.
Certaines positions sont occupées.
Certaines sont réservées.
Certaines restent libres.
Ces états ne sont pas interchangeables.
Le chiffre ne devient fiable que si le système peut encore expliquer d'où il vient.
Cinq Flows terminés ?
Montrez-les.
Deux commandes actives ?
Montrez-les.
Une exception ?
Laquelle ?
88 % d'occupation ?
Qu'est-ce qui est occupé ?
Qu'est-ce qui est réservé ?
Qu'est-ce qui reste libre ?
Un tableau de bord devrait résumer la réalité.
Il ne devrait pas la remplacer.
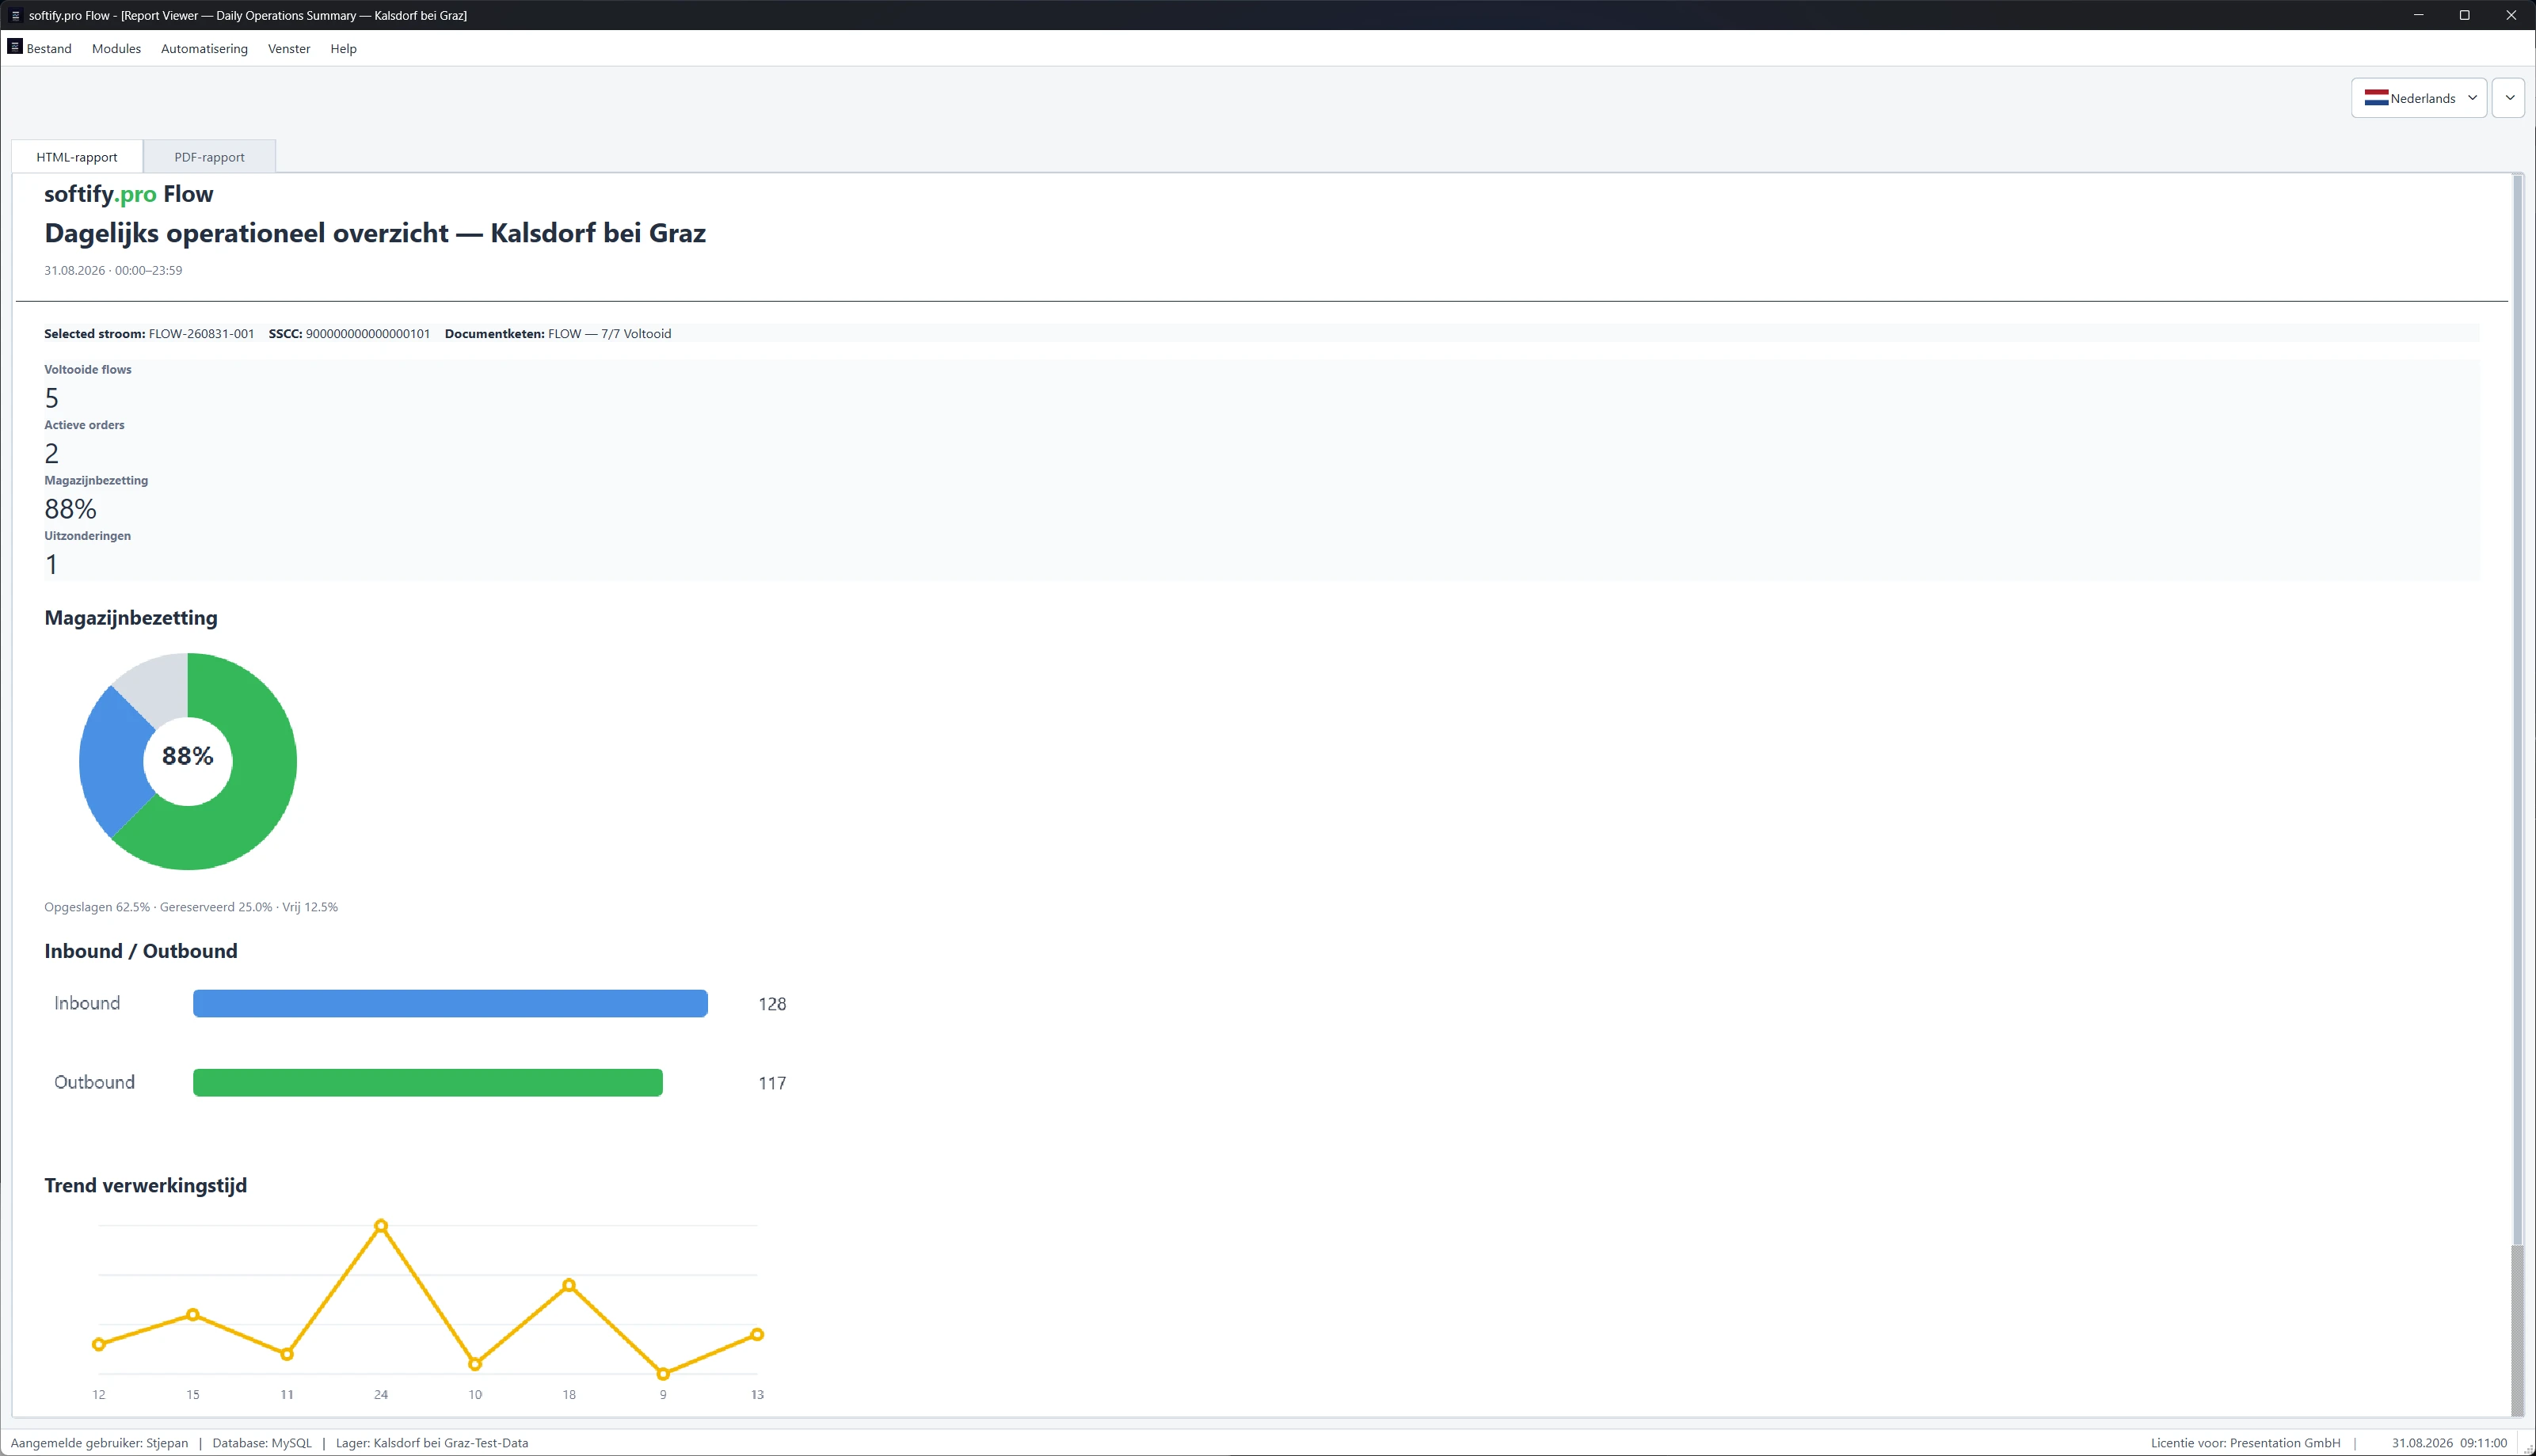
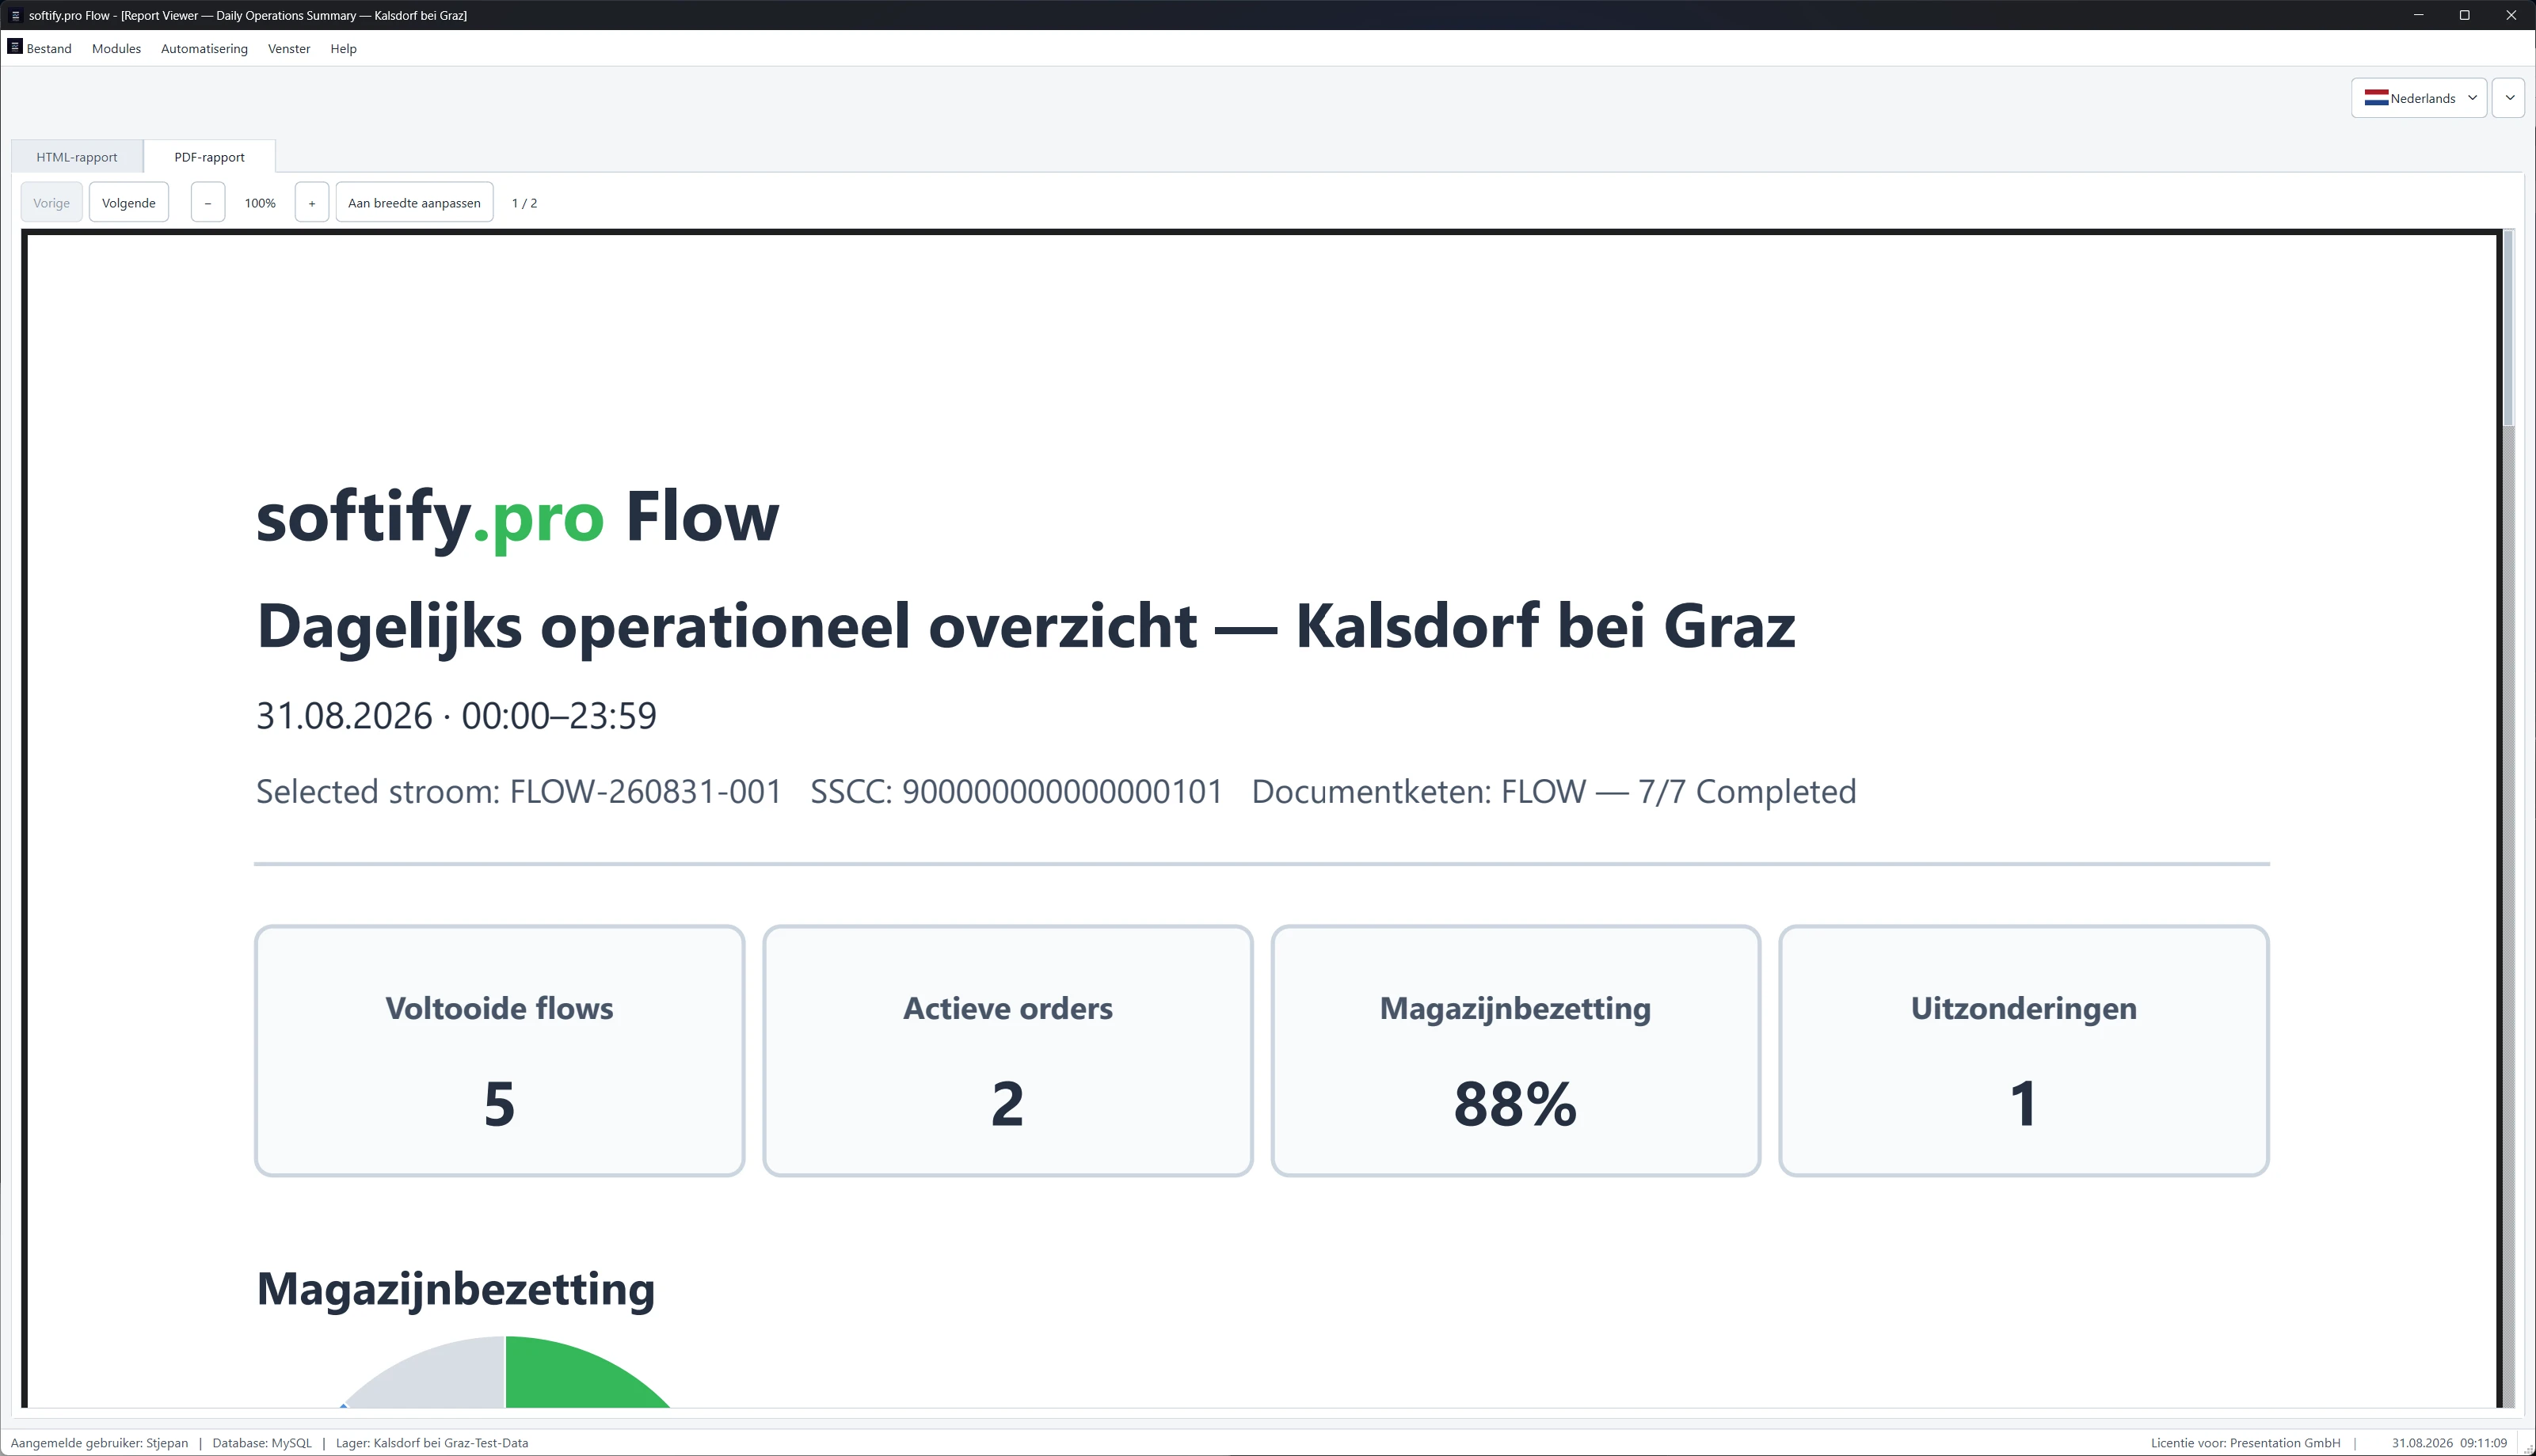
Puis nous avons changé la langue.
Néerlandais.
L'entrepôt est resté le même.
Les identifiants de Flow sont restés les mêmes.
Les SSCC sont restés les mêmes.
Les opérateurs sont restés rattachés à leurs enregistrements.
Seule la langue a changé.
Plus tard, le même état opérationnel est apparu en croate.
Puis en français.
C'est là que le logiciel multilingue devient bien plus intéressant que des boutons traduits.
Une mauvaise traduction est facile à remarquer.
Un changement d'état provoqué par un changement de langue est bien plus dangereux.
Imaginez passer de l'allemand au français et perdre silencieusement le Flow sélectionné.
Ou reconstruire un filtre sur le mauvais entrepôt.
Ou afficher le bon SSCC dans le mauvais contexte de processus.
L'interface pourrait toujours sembler parfaite.
Le système ne le serait pas.
Flow suit donc une règle simple :
La langue peut changer les mots. Elle ne peut pas changer la vérité.
Ensuite, le Flow a acquis un historique.
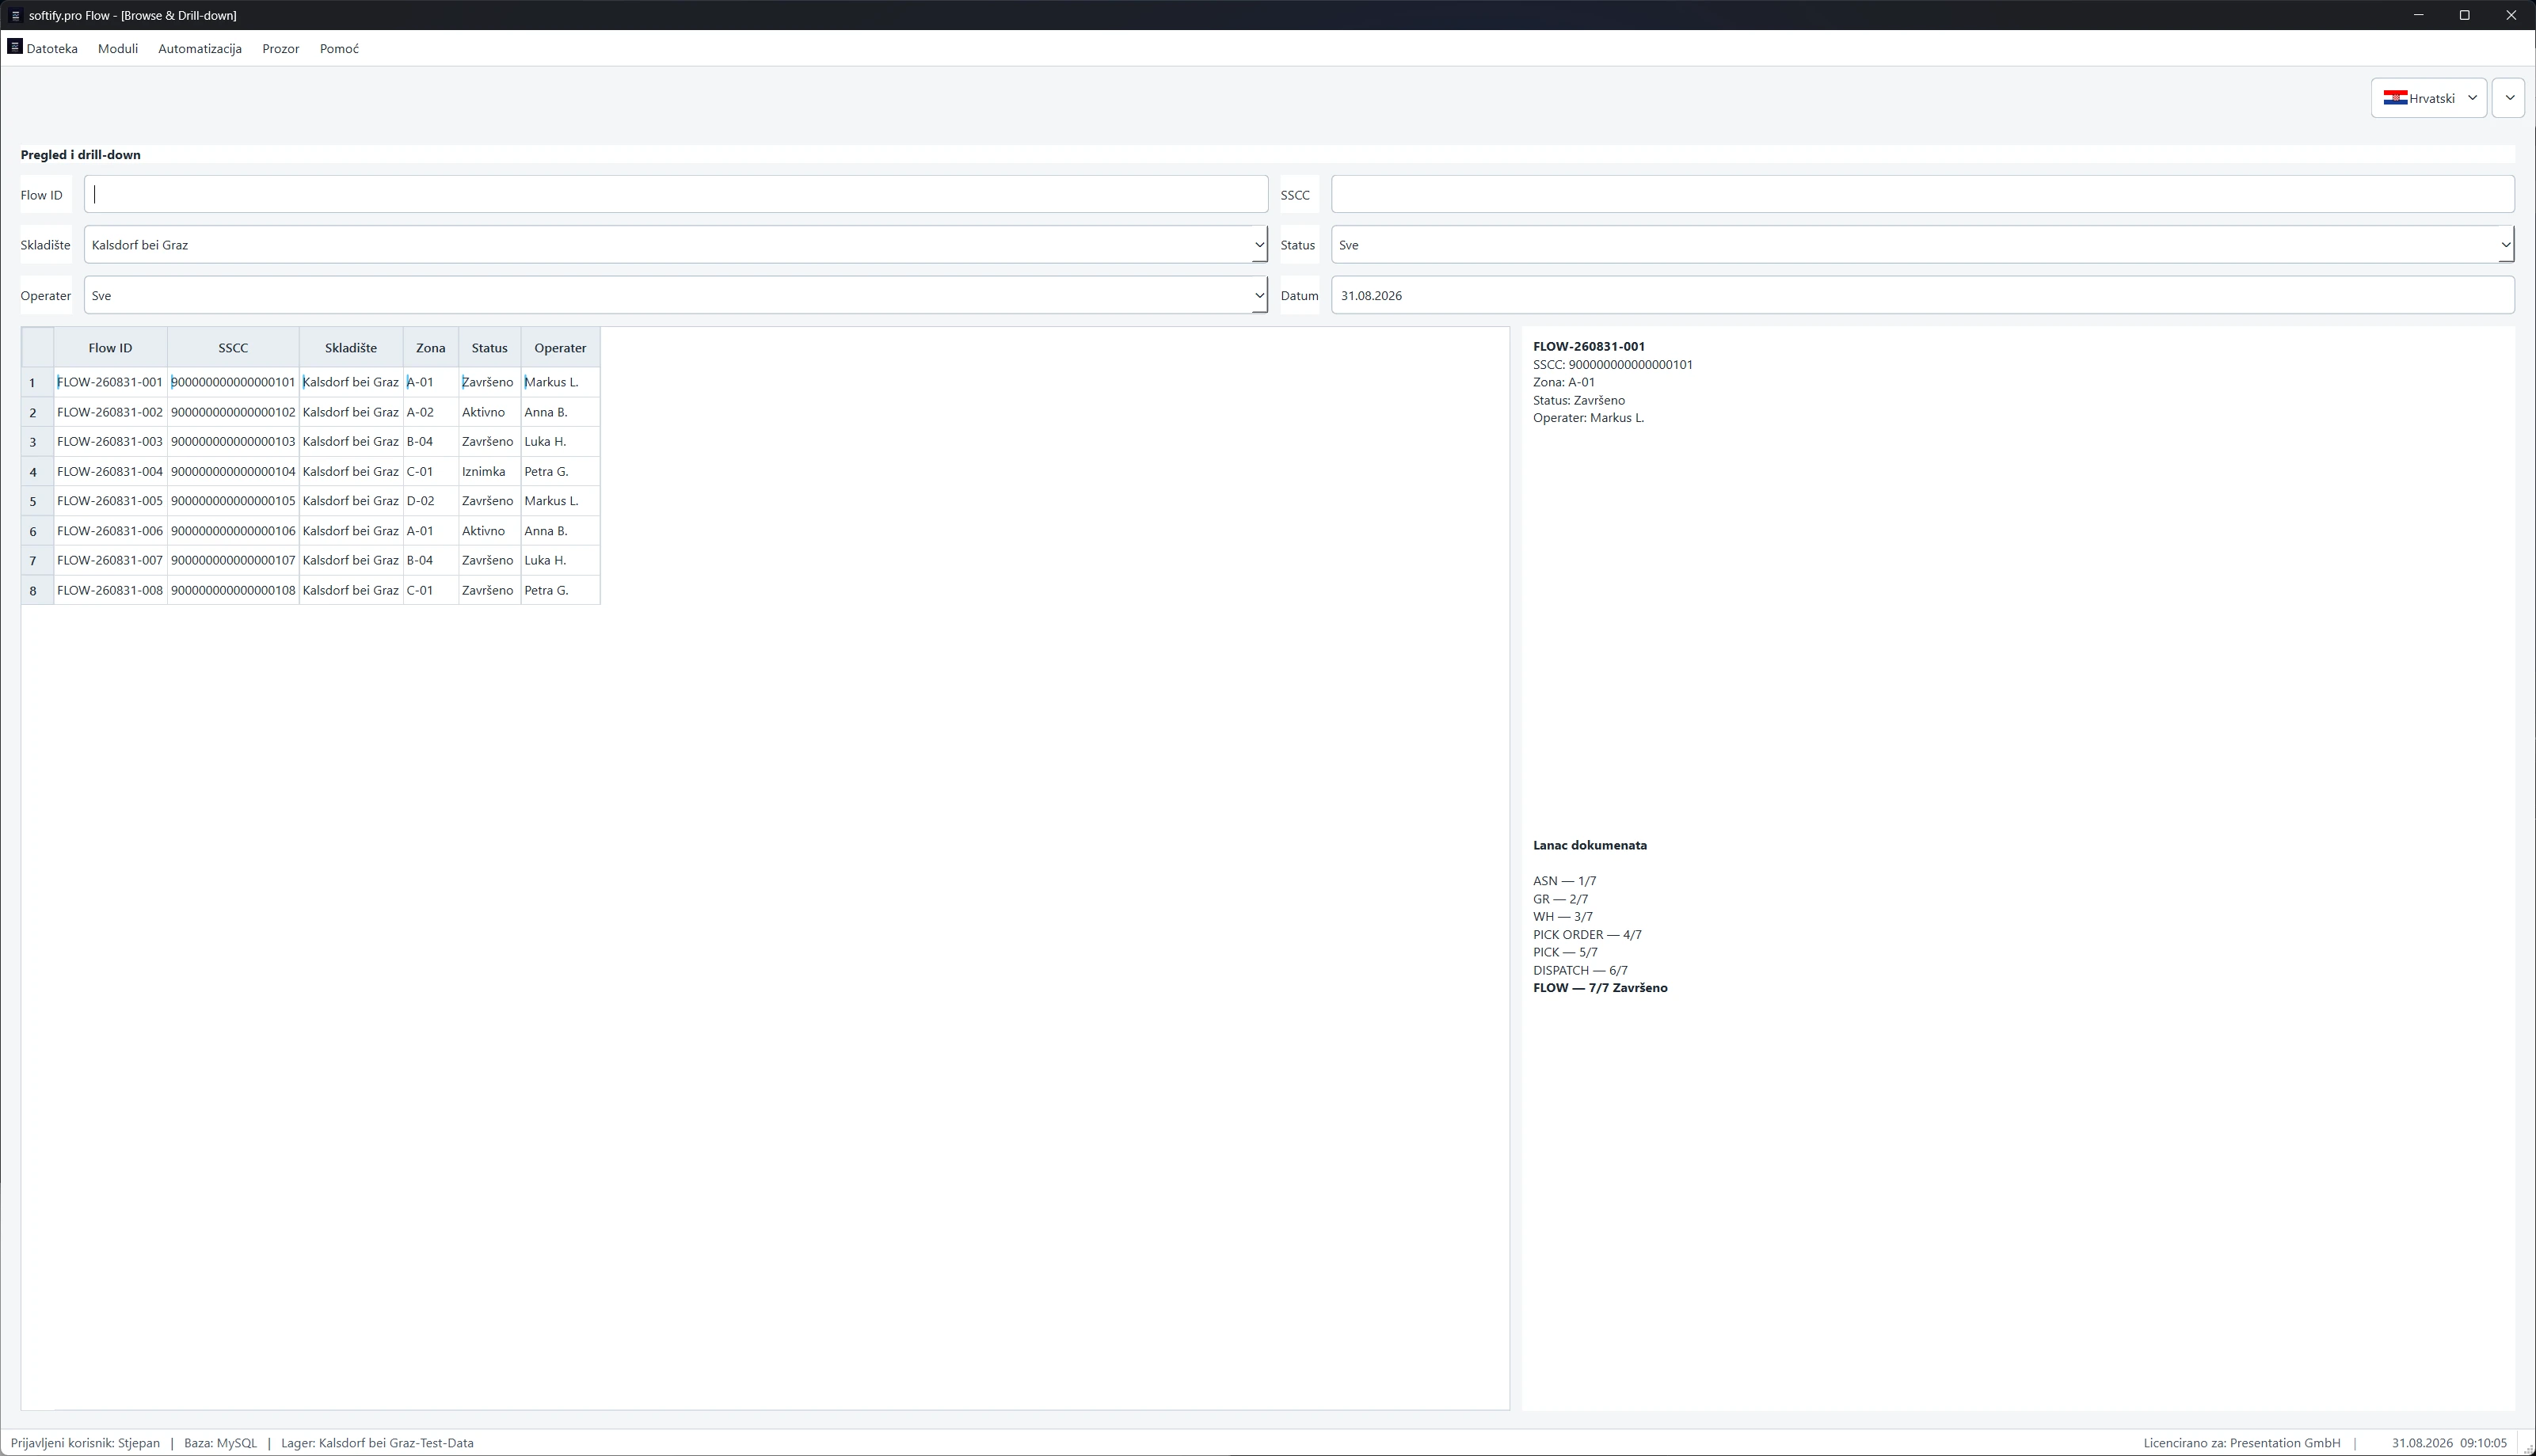
Browse & Drill-down ne cherche pas particulièrement à être impressionnant.
C'est peut-être pour cela qu'il est utile.
Sélectionner un Flow.
Son contexte apparaît.
Entrepôt.
Zone.
Statut.
Opérateur.
SSCC.
Et ensuite la chaîne documentaire.
ASN.
Réception de marchandises.
Mouvement d'entrepôt.
Ordre de prélèvement.
Prélèvement.
Expédition.
FLOW.
Sept étapes.
Le processus n'est plus seulement un état actuel.
Il a un passé.
Et cela change la question.
Au lieu de :
Que se passe-t-il ?
nous pouvons demander :
Comment en sommes-nous arrivés là ?
C'est une bien meilleure question quand quelque chose finit par mal tourner.

Un Flow, un SSCC, une chaîne documentaire — de l'ASN à la finalisation.

Flow.


Le SSCC devient le fil conducteur.
Au premier abord, un SSCC ressemble à ce qu'il est.
Un identifiant.
Un long numéro dans un tableau.
Mais à travers Flow, il devient quelque chose de plus utile.
Un fil conducteur à travers le processus.
En le suivant, d'autres éléments commencent à se relier.
Un entrepôt.
Un Flow.
Une zone.
Un statut.
Un opérateur.
Une chaîne documentaire.
Finalement, un rapport.
Le même objet logistique physique est désormais visible depuis plusieurs parties différentes de l'application.
Utile.
Dangereux aussi.
Parce que chaque vue supplémentaire crée une nouvelle occasion pour le système de raconter une histoire différente.
Et c'est là que les choses deviennent intéressantes.
Supposons qu'Analytics indique que le Flow est actif.
Le Drill-down indique que le SSCC appartient à ce Flow.
La chaîne documentaire indique que l'opération a progressé davantage.
Le rapport indique autre chose.
Lequel est correct ?
Ce n'est pas un problème spécifique à Flow.
C'est l'un des plus anciens problèmes des logiciels d'entreprise.
Différentes parties du même système développent progressivement leur propre version de la réalité.
Un écran lit l'état transactionnel.
Un autre lit un agrégat.
Un autre s'appuie sur des données en cache.
Un rapport calcule quelque chose légèrement différemment.
Une exception est résolue sur le plan opérationnel mais disparaît du reporting.
Chaque composant fonctionne.
Le système complet ment.
Généralement poliment.
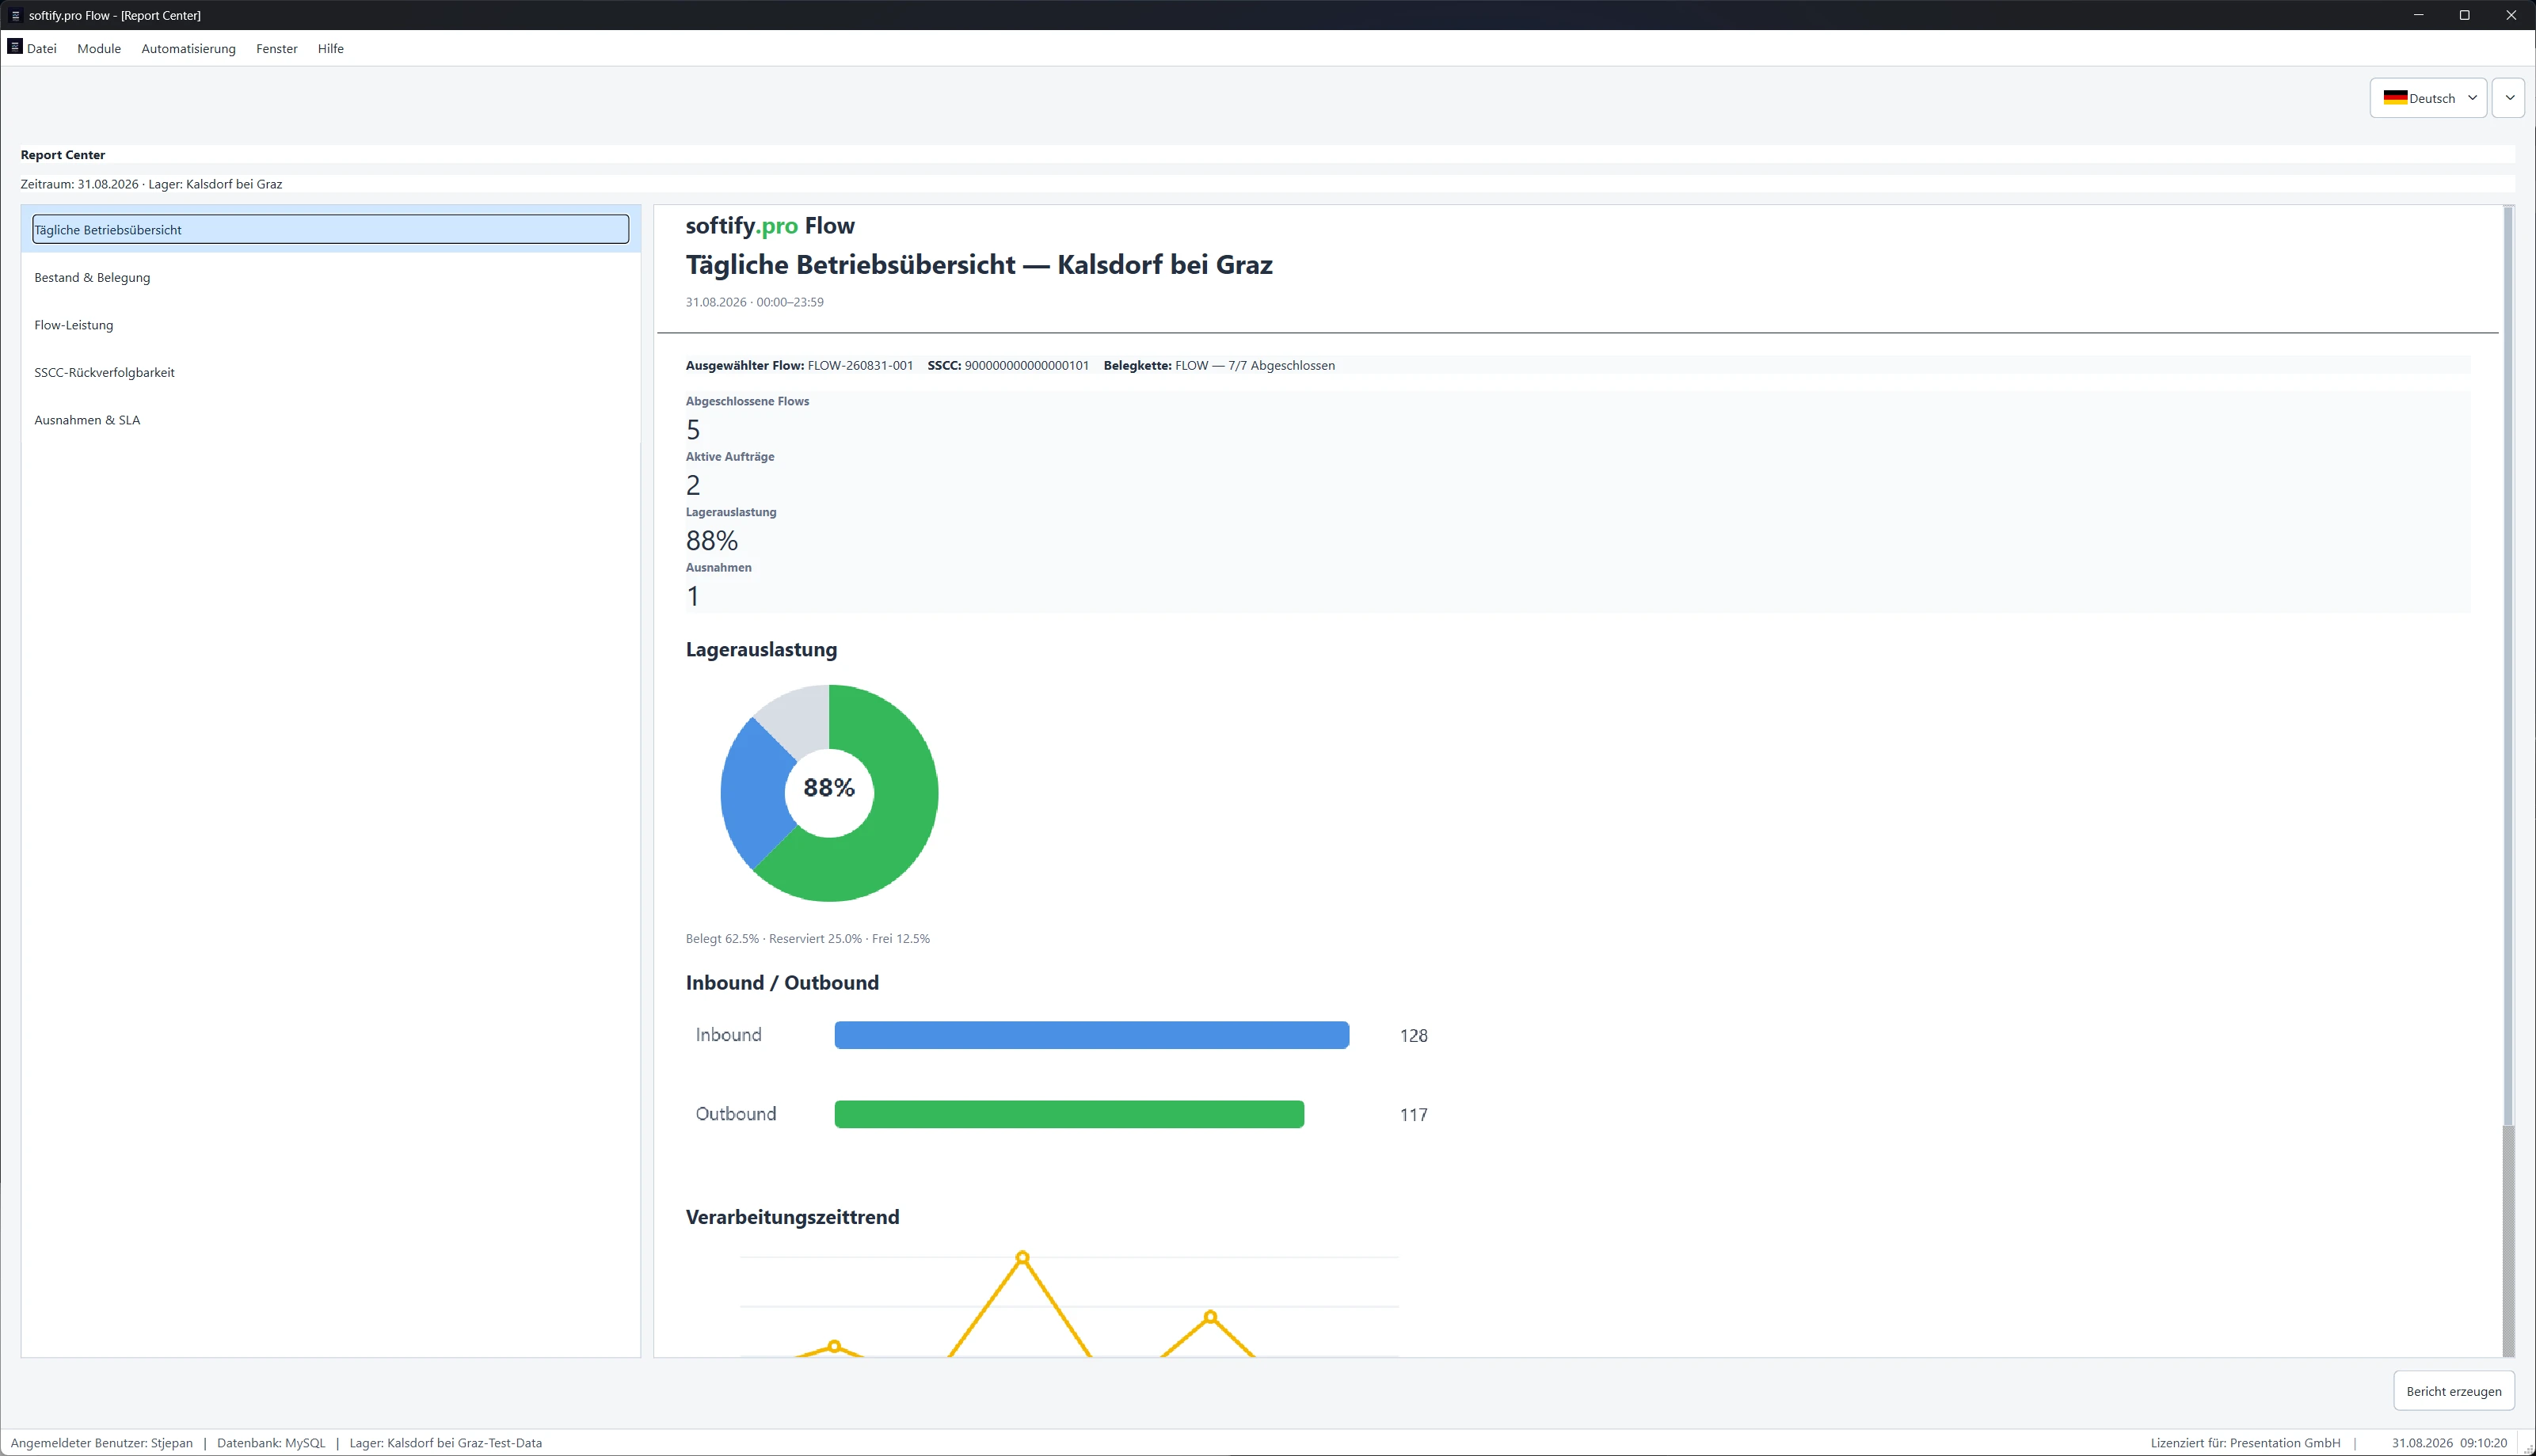
Nous avons donc ouvert le Report Center.
Vue d'ensemble opérationnelle quotidienne.
Stock et occupation.
Performance des Flows.
Traçabilité SSCC.
Exceptions et SLA.
La même histoire opérationnelle est réapparue.
Flows terminés.
Commandes actives.
Taux d'occupation de l'entrepôt.
Exceptions.
Entrées.
Sorties.
Temps de traitement.
Mais cette fois, la question n'était pas de savoir si le rapport semblait correct.
La question était :
Peut-il se défendre lui-même ?
Un bon rapport vous donne un chiffre.
Un meilleur système peut expliquer d'où vient ce chiffre.

Le reporting issu du même état opérationnel — pas une seconde version de la réalité.

Flow.
Flow.
Flow.
Flow.


L'exception était toujours là.
L'un des détails les plus discrets s'est révélé être l'un des plus importants.
Les données de démonstration contiennent une exception.
Elle apparaît dans Analytics.
Elle apparaît dans le Drill-down.
Elle apparaît dans la traçabilité SSCC.
Elle apparaît dans le Report Center.
Et elle reste visible dans Exceptions & SLA.
C'est exactement ce qui devrait se passer.
Se rétablir opérationnellement d'une exception ne signifie pas que l'exception doit disparaître de l'historique.
« Le processus a continué » et « rien ne s'est passé » ne sont pas la même affirmation.
En logistique, cette différence compte.
À ce stade, nous avions un problème de test.
Pas un problème logiciel.
Un problème de test.
Nous avions désormais le même entrepôt représenté sous forme de :

  • analytics,
  • Flows individuels,
  • historiques SSCC,
  • chaînes documentaires,
  • rapports,
  • et vues des exceptions.

Chacun pouvait être testé indépendamment.
Ouvrir.
Cliquer.
Filtrer.
Vérifier.
Valider.
Suivant.

Ce serait facile.
Cela manquerait aussi la partie intéressante.
Parce que six coches vertes ne prouvent pas que six vues concordent entre elles.
Entrée en scène de COCO.
Encore.
COCO avait déjà eu affaire à Flow auparavant.
Authentification.
Utilisateurs.
Rôles.
Environnements de base de données.
Langues.
Exécution sur poste de travail.
Puis est venue la logistique.
Entrepôts.
Stock.
Prélèvement.
Mouvements.
Exceptions.
Documents.
Ubuntu.
Red Hat Enterprise Linux.
Cette fois, nous avons donné à COCO quelque chose de légèrement différent.
Pas un écran à vérifier.
Une histoire à suivre.
Prends cet entrepôt.
Prends ce Flow.
Prends ce SSCC.
Ouvre Analytics.
Ouvre Drill-down.
Change la langue.
Regarde à nouveau.
Ouvre le rapport.
Retrouve le même Flow.
Retrouve le même SSCC.
Retrouve l'exception.
Compare.
Puis compare à nouveau.

COCO suit le même contexte opérationnel à travers softify.pro Flow — analytics, traçabilité, changements de langue et reporting.

Cela change la nature du test.

La question n'est plus :

  • Chaque module fonctionne-t-il ?

Elle devient :

  • Tous les modules croient-ils qu'il s'est passé la même chose ?

Une bien meilleure question.
Bien moins confortable.
Un système d'entrepôt devrait avoir une seule mémoire.
Les opérateurs peuvent voir des positions.
Les responsables d'entrepôt peuvent voir des KPI.
Le support peut utiliser le drill-down.
Les auditeurs peuvent utiliser des rapports.
COCO peut voir tout cela.
Mais sous ces perspectives, il devrait y avoir un seul historique.
Un Flow ne devrait pas acquérir plusieurs biographies selon le module ouvert.
Un SSCC ne devrait pas avoir plusieurs passés.
Une exception ne devrait pas exister uniquement là où c'est pratique.
Un entrepôt ne devrait pas devenir un autre entrepôt parce que la langue de l'interface a changé.
Voilà de quoi il s'agit vraiment dans l'expérience Flow actuelle.
Pas des tableaux de bord.
Pas des rapports.
Pas même des écrans individuels.
Une seule vérité opérationnelle, exprimée de différentes manières.
Contrôle.
Connaître l'entrepôt.
Connaître l'état.
Savoir ce qui bouge.
Savoir quel processus le possède.
Clarté.
Retransformer les KPI en enregistrements.
Transformer les enregistrements en historique.
Transformer les exceptions en preuves.
Transformer un SSCC en quelque chose de traçable.
Flow.
Un entrepôt est sélectionné.
Analytics commence à le décrire.
Un Flow avance.
Le SSCC reste rattaché.
Une chaîne documentaire se développe.
Une exception apparaît.
Le processus continue.
Le rapport s'en souvient.
Puis la langue change.
L'entrepôt est toujours le même.
Le Flow est toujours le même.
L'historique est toujours le même.
C'est la partie que nous attendions.
Ce qui s'est passé ensuite était plus intéressant.
COCO a cessé de tester les vues indépendamment.
Il a commencé à les comparer.
Pendant un moment, rien de remarquable ne s'est produit.
Même entrepôt.
Même Flow.
Même SSCC.
Même histoire.
Encore.
Encore.
Encore.
Et puis COCO s'est arrêté.
Pas parce que l'application avait planté.
Ce n'était pas le cas.
Pas parce qu'un test avait échoué au sens habituel.
Ce n'était pas le cas.
Il s'est arrêté parce que deux réponses parfaitement raisonnables ont produit une troisième question.

Nous savons quelle est la question.
Flow sait pourquoi il existe.
COCO sait où regarder ensuite.

Le reste peut attendre.


Control. Clarity. Flow.

Publié: 31.08.2026

Lien permanent →

COCO frappe encore

COCO frappe encore

Nous devrions probablement arrêter de donner des idées à COCO.

L'expérience précédente était censée suffire.

Une application réelle.

Une navigation réelle.

Des utilisateurs.

Des rôles.

Des bases de données.

Des langues.

Des preuves.

Une étude de cas respectable.

Une conclusion propre.

Puis quelqu'un l'a montré : Logistics in Motion.

C'était probablement l'erreur.

Tout a commencé avec trois entrepôts

Rien de particulièrement excitant.

…

Une lettre de COCO

Une lettre de COCO

À l'ingénieur ou l'ingénieure qui ouvre ce dépôt pour la première fois :

Bienvenue.

Vous êtes peut-être arrivé ici parce que quelque chose a échoué.

Un service a cessé de répondre.

Un déploiement s'est comporté de façon inattendue.

Une alerte vous a réveillé en pleine nuit.

Ou peut-être êtes-vous simplement curieux de savoir comment fonctionne cette plateforme.

Quoi que ce soit qui vous ait amené ici,

sachez que ce projet a été construit exactement pour des moments comme celui-ci.

Non pas pour supprimer les problèmes difficiles.

Mais pour rendre les problèmes difficiles compréhensibles.

Vous trouverez du code.

Vous trouverez de la documentation.

…

Études de cas

softify.pro Flow — Testé par COCO

softify.pro Flow — Testé par COCO

21.08.2026

Control. Clarity. Flow.

Tout produit logiciel sérieux finit par développer un second produit derrière le produit.

Les clients ne le verront peut-être jamais. Les visiteurs ne sauront peut-être jamais qu'il existe. Mais les administrateurs, les opérateurs et les développeurs en dépendent chaque jour.

Pour softify.pro Flow, cette application s'appelle Administration — la console opérationnelle responsable de la gestion des utilisateurs, des rôles, des niveaux d'accès, des états d'authentification, des environnements de base de données et des autres configurations qui gardent un déploiement de Flow sous contrôle.

Son écran de connexion porte trois mots :
Control. Clarity. Flow.

Ils ont été choisis à l'origine pour décrire l'expérience que nous voulions que les administrateurs vivent en exploitant le système.

Mais ils décrivent aussi, étonnamment bien, la façon dont nous pensons que les logiciels devraient être testés.

Cela a fait de softify.pro Flow — Administration un candidat évident pour un test COCO en conditions réelles.
Pas une démonstration de laboratoire.
Pas une collection de boutons isolés préparés spécifiquement pour une démo d'IA.
Une véritable application de bureau multiplateforme avec une logique applicative réelle, plusieurs fenêtres, plusieurs bases de données, authentification, permissions, localisation, et suffisamment d'état pour rendre des régressions apparemment mineures difficiles à repérer manuellement.

Pour la démonstration publique présentée ici, COCO a travaillé exclusivement avec des données de démonstration générées. L'application était sous licence pour l'entreprise fictive Presentation GmbH, et aucune information client de production, aucun identifiant ni aucune donnée personnelle n'a été utilisé.

L'objectif était simple :
laisser COCO aborder l'application comme le ferait un testeur et déterminer si l'ensemble du flux de travail administratif se comporte toujours comme le logiciel le prétend.

The Challenge

À première vue, tester une application d'administration semble simple.

L'ouvrir.
Se connecter.
Cliquer à travers plusieurs fenêtres.
Vérifier que tout semble correct.

Cette hypothèse change rapidement à mesure que l'application grandit.

softify.pro Flow — Administration n'est pas un simple formulaire statique. C'est un ensemble de vues opérationnelles interconnectées à l'intérieur d'une seule coquille applicative.

Entre autres choses, un administrateur peut travailler avec :

  • des comptes utilisateurs
  • des rôles et niveaux d'accès
  • des informations d'authentification
  • l'état de l'authentification à deux facteurs
  • des informations sur le système d'exploitation
  • des informations réseau et IP
  • la configuration de la base de données
  • des options de tri et d'affichage
  • la sélection de langue en direct
  • des informations d'application et de licence

L'interface prend actuellement en charge onze langues. L'application fonctionne également avec MySQL et PostgreSQL comme bases de données. Prise individuellement, aucune de ces fonctionnalités ne représente un problème de test inhabituel.

La difficulté vient de leurs combinaisons.
Un tableau d'utilisateurs peut fonctionner correctement en anglais mais afficher un nom de colonne obsolète en croate.
Le tri peut fonctionner correctement connecté à MySQL mais se comporter différemment après le passage à PostgreSQL.

Un changement de langue peut mettre à jour la plupart des éléments de l'interface tout en laissant un message d'état non traduit. L'application peut changer de base de données avec succès tout en conservant des informations obsolètes de la connexion précédente. Une nouvelle version peut introduire une fonctionnalité alors que la fenêtre « À propos » décrit encore la précédente. Le programme n'a pas besoin de planter pour que l'une de ces situations soit une régression. En fait, certains des défauts logiciels les plus gênants sont précisément ceux où tout semble fonctionner.

L'application démarre.
La fenêtre s'ouvre.
Le bouton répond.
Mais quelque chose en dessous n'est plus tout à fait correct.
C'est pourquoi les tests de régression répétitifs comptent.

Et c'est aussi exactement le type de travail pour lequel les humains deviennent de plus en plus mauvais après avoir répété la même séquence des dizaines de fois.

Why Manual Testing Becomes Expensive

Tester quelque chose une fois est facile.
Le tester de manière fiable après chaque version pertinente est différent.

Considérez seulement trois dimensions : 11 langues d'interface × 2 bases de données × de multiples flux de travail applicatifs.

Le nombre de combinaisons croît rapidement.
Ajoutez différents rôles utilisateurs, états d'authentification, comportements de tri, changements de configuration et environnements d'exploitation, et la matrice de test devient trop grande pour être traitée comme une simple checklist manuelle occasionnelle.

C'est là que les tests de régression commencent souvent à s'éroder.
Pas délibérément.
Une échéance de livraison se rapproche.
Quelqu'un se souvient que l'application a été testée la semaine dernière.
Un développeur vérifie rapidement l'écran le plus important.

L'allemand fonctionne.
L'anglais fonctionne.
MySQL fonctionne.
L'hypothèse devient :
« Le reste va probablement bien. »

C'est généralement le cas.
Jusqu'à la version où ce ne l'est pas.
COCO existe en partie pour retirer cette hypothèse du processus.

What COCO Actually Did

COCO a démarré softify.pro Flow — Administration à partir d'un état applicatif froid, sans s'appuyer sur un écran préparé à l'avance ni un flux de travail positionné manuellement.

La première interaction a été la même que celle présentée à un administrateur humain : la fenêtre de connexion.

COCO a identifié l'interface d'authentification contenant :

  • le nom d'utilisateur
  • le mot de passe
  • le code d'authentification à deux facteurs

et la ligne juste en dessous de l'identité softify.pro Flow :
Control. Clarity. Flow.

À partir de là, COCO a poursuivi à travers une session de régression définie. Il ne s'agissait pas simplement de déterminer si l'application pouvait être ouverte.

Il s'agissait de vérifier si l'état de l'application restait cohérent en interne pendant que COCO interagissait avec elle.

Authentication Is Only the Beginning

Tester la connexion est l'un des candidats les plus évidents à l'automatisation, mais une authentification réussie à elle seule en dit très peu sur le reste d'une application d'administration.

Une fois à l'intérieur, COCO est passé dans l'environnement opérationnel réel. Il a inspecté l'interface d'administration des utilisateurs et vérifié que les informations attendues étaient présentes.

Cela incluait des données telles que :

  • les noms d'utilisateurs
  • les mots de passe masqués
  • les indicateurs 2FA
  • les rôles assignés
  • les informations sur le système d'exploitation
  • les adresses IP

COCO a ensuite interagi avec le tableau plutôt que de simplement l'observer.
La liste des utilisateurs a été triée par nom d'utilisateur.
L'ordre résultant a été inspecté.
Le point important n'était pas de savoir si cliquer sur l'en-tête de colonne produisait un changement visible.

COCO a vérifié que l'état résultant du tableau correspondait à l'opération demandée.

Cette distinction compte.
Un test fonctionnel demande :
« Le bouton a-t-il répondu ? »

Un test de régression utile demande :
« L'application s'est-elle retrouvée dans l'état correct ? »

Testing the Database Boundary

softify.pro Flow prend en charge plus d'une base de données.

Cela fait du changement de base de données une frontière de régression particulièrement importante.
COCO a fait passer la base de données active de MySQL à PostgreSQL.

Après le changement, il a de nouveau inspecté les informations utilisateur.
Le test cherchait plus qu'une connexion réussie.
Il vérifiait si l'application continuait à présenter les enregistrements attendus et si les informations affichées via l'interface restaient cohérentes.

COCO est ensuite revenu en arrière.

Ce type de transition est facile à sous-estimer.
L'interface utilisateur peut rester visuellement identique alors que la couche de stockage sous-jacente change complètement.
Du point de vue d'un administrateur, cette transition devrait sembler presque banale.
Les mêmes utilisateurs devraient rester compréhensibles.
Les mêmes rôles devraient continuer à avoir du sens.

Le même comportement d'interface devrait toujours s'appliquer.

Cette continuité apparemment sans incident est exactement ce qui doit être prouvé.

Eleven Languages, One Application State

La localisation est un autre domaine où les tests superficiels sont particulièrement dangereux.

Il est relativement facile de vérifier qu'une application peut démarrer dans une autre langue.
Il est beaucoup plus précieux de vérifier ce qui se passe lorsque la langue change alors que l'application est déjà en cours d'exécution et conserve un état.

COCO a changé la langue de l'interface en direct.

La session incluait des transitions entre des langues telles que :
Allemand → Anglais → Croate
tandis que la vue d'administration restait active.

COCO a observé si les éléments de l'interface changeaient correctement sur place :

  • en-têtes de tableau
  • contrôles
  • boutons
  • étiquettes
  • messages d'état

Le tableau sous-jacent et l'état de l'application devaient également survivre à cette transition.
Cela importe car un logiciel multilingue est fait de bien plus que des chaînes traduites.
Les changements de langue peuvent révéler :

  • des ressources oubliées
  • des étiquettes obsolètes
  • des problèmes de mise en page
  • des messages d'état non traduits
  • des problèmes d'encodage
  • des réinitialisations d'état
  • des problèmes de recréation de contrôles

Une fenêtre qui paraît correcte lorsqu'elle est démarrée directement en croate peut néanmoins se comporter de manière incorrecte lorsque l'utilisateur passe de l'allemand au croate au cours d'une session active.

C'est la différence entre vérifier une capture d'écran et tester un flux de travail.

Restoring Application State

COCO a ensuite restauré la configuration de tri par défaut de l'application.

Là encore, le test ne s'est pas terminé avec le clic lui-même.

L'ordre résultant et la confirmation présentée via la zone de statut de l'application ont été évalués. Ce type de vérification peut sembler insignifiant comparé au test de l'authentification ou de l'accès à la base de données.

Ce n'est pas le cas.

Les applications d'entreprise accumulent des centaines de petites transitions d'état de ce genre.
Les utilisateurs s'y fient sans y penser consciemment.
Le logiciel semble fiable précisément parce que ces interactions restent prévisibles.
Les tests de régression existent pour protéger cette prévisibilité.

Testing the Information Around the Software

COCO a également ouvert la boîte de dialogue « À propos » de l'application.

Pourquoi tester une fenêtre « À propos » ?

Parce que la documentation logicielle commence à l'intérieur du logiciel lui-même.
Le numéro de version, la description des fonctionnalités et les informations de licence présentées à l'opérateur devraient correspondre à l'application réellement en cours d'exécution.

Une application peut fonctionner parfaitement tout en présentant des informations de version obsolètes ou en décrivant des capacités qui ne correspondent plus à la version.

Cela ne fait pas planter une base de données.
Cela fait quelque chose de plus subtil :
cela réduit la confiance.

Pour les logiciels d'entreprise, la précision opérationnelle inclut ces détails apparemment mineurs. COCO les a donc vérifiés également.

Control.

Le premier mot du slogan de softify.pro Flow est aussi le premier principe de l'environnement de test.

Control signifie savoir ce qui est testé, par rapport à quel état et avec quelles données.

La démonstration publique de COCO n'utilise pas les données de production des clients.

Elle fonctionne avec des données de démonstration délibérément préparées, dont l'état attendu est connu.

Cela rend les résultats reproductibles.

Cela signifie également que les différences entre les exécutions de test peuvent être étudiées plutôt qu'expliquées comme de simples changements aléatoires dans les données de production.

Plus important encore, COCO est conçu comme un système de test IA auto-hébergé.

Les preuves de test, les captures d'écran de l'application et les informations internes sur le flux de travail peuvent rester au sein de l'infrastructure sous le propre contrôle du client ou de l'opérateur, plutôt que d'être envoyées par défaut à un service cloud tiers sans rapport.

Pour les applications métier internes, ce n'est pas simplement une préférence d'infrastructure.
Cela peut faire partie de l'exigence de test elle-même.

Clarity.

L'automatisation n'est pas particulièrement utile si son résultat final est : FAILED
suivi de centaines de lignes de sortie technique que quelqu'un doit reconstruire manuellement avant de comprendre ce qui s'est passé.

COCO est conçu pour préserver une trace de preuves compréhensible.

Le rapport décrit :

  • ce qui a été testé
  • quelle interaction a eu lieu
  • dans quel ordre elle s'est produite
  • ce que COCO a observé
  • quel état était attendu
  • où le comportement a différé lorsque quelque chose a échoué

Des captures d'écran et des preuves d'exécution peuvent accompagner cette séquence.
L'objectif n'est pas de cacher les détails techniques.

C'est de rendre le résultat compréhensible avant que quelqu'un ne doive ouvrir un débogueur.

Un ingénieur devrait pouvoir répondre à :
Que s'est-il passé ? avant de demander :
Où dans le code cela s'est-il produit ?

Cette distinction raccourcit considérablement l'investigation lorsqu'une régression apparaît.

Flow.

L'automatisation UI traditionnelle raisonne souvent en éléments.

Trouver un sélecteur.
Cliquer sur le sélecteur.
Trouver un autre sélecteur.
Vérifier la valeur.

Cette approche reste utile, mais les applications ne sont pas vécues comme des collections de sélecteurs.

Les gens vivent des flux.

Se connecter.
Ouvrir l'administration.
Trouver un utilisateur.
Changer un paramètre.
Changer de base de données.
Changer de langue.
Vérifier le résultat.

Continuer à travailler.

COCO traite donc la séquence comme un processus plutôt que comme une collection aléatoire de contrôles.

Il suit ce que l'utilisateur essaie d'accomplir et évalue l'application en contexte.

Cela devient particulièrement précieux lors du test de logiciels métier réels, car les défaillances surviennent souvent entre les écrans ou entre les états, pas à l'intérieur d'un bouton individuel.

Un flux logistique peut contenir une commande, une réservation de stock, une opération de picking, un bon de livraison et une confirmation d'expédition.
Chaque écran individuel peut paraître correct alors que le processus complet est erroné.
Le même principe s'applique ici, à plus petite échelle.
La fenêtre d'administration n'est pas le produit.

Le flux de travail qui la traverse l'est.

Evidence Instead of Assumption

L'une des tâches les plus importantes de COCO n'est pas de cliquer. C'est de se souvenir de ce qui s'est passé.
Les tests de régression humains se terminent souvent par une déclaration telle que :
« Je l'ai testé et tout semblait correct. »

Cela peut être parfaitement exact.
Mais plusieurs semaines plus tard, lorsqu'un problème apparaît, les questions utiles sont différentes :

  • Quelle version a été testée ?
  • Quelle base de données ?
  • Quelle langue ?
  • Quel état utilisateur ?
  • Que s'est-il passé avant le problème ?
  • Qu'est-ce qui était exactement visible ?

Dans quel ordre les actions ont-elles été exécutées ?
Les exécutions de test de COCO sont conçues pour laisser des traces.

Cela transforme un résultat de test d'une opinion en quelque chose qui peut être inspecté.
Une exécution réussie devient donc utile elle aussi.
Elle établit un état de référence connu par rapport auquel le comportement ultérieur peut être comparé.

COCO Is Not the Decision Maker

Il existe une frontière importante dans la façon dont nous utilisons l'IA pour tester les logiciels.
COCO n'a pas vocation à remplacer la responsabilité d'ingénierie.

Il ne décide pas de ce qu'une règle métier devrait être.

Il teste le comportement par rapport aux scénarios, exigences et attentes définis pour l'application.
Pour les décisions sensibles impliquant des permissions, des prix, des stocks, des transactions financières ou d'autres états métier critiques, la définition du comportement correct reste une responsabilité humaine.

Cette distinction compte.
L'IA excelle à répéter un test détaillé sans perdre en concentration.
Elle excelle à collecter des preuves.
Elle peut inspecter des écrans, comparer le comportement attendu et observé, et expliquer les divergences.
Mais c'est l'entreprise qui définit toujours ce que signifie correct.

COCO rend cette définition testable.

The Test Nobody Wants to Repeat

Il y a une raison simple pour laquelle l'automatisation apporte de la valeur ici.
Un testeur humain peut tout à fait effectuer cette session de régression.
La première langue reçoit toute l'attention.
Probablement la deuxième aussi.
Puis une autre.
Puis encore une autre.
MySQL a déjà été vérifié.
PostgreSQL doit encore être vérifié.
Le test de tri a déjà été effectué plusieurs fois.
La boîte de dialogue « À propos » n'a pas changé depuis des mois.

C'est vendredi après-midi.

Et l'attention humaine fait ce que l'attention humaine fait naturellement.
Elle commence à optimiser.
COCO ne le fait pas.
Dans l'esprit propre de COCO :

  • Je ne me lasse pas de cliquer sur le même bouton dans onze langues. Je ne saute pas le passage PostgreSQL simplement parce que c'est vendredi après-midi. Je ne suppose pas que l'ordre de tri a tenu simplement parce qu'il a fonctionné lors de la version précédente.

Pour COCO, chaque session de régression peut être traitée comme si c'était la première.
Ce n'est pas une intelligence qui remplace un testeur humain.
C'est une automatisation qui protège le testeur humain de la partie du test où l'attention humaine a le moins de valeur.

From Repetitive Testing to Engineering Evidence

L'objectif plus large de COCO n'est pas de maximiser le nombre d'actions automatisées.
Mille clics automatisés n'ont aucun sens si personne ne comprend ce qu'ils prouvent. Le résultat utile est une confiance soutenue par des preuves.

Pour softify.pro Flow, cela signifie être en mesure de dire qu'une version a été testée à travers les domaines opérationnels qui comptent :

  • authentification
  • administration des utilisateurs
  • informations sur les rôles et les accès
  • état de l'authentification à deux facteurs
  • comportement de tri
  • fonctionnement avec MySQL
  • fonctionnement avec PostgreSQL
  • localisation en direct
  • retour d'état
  • informations sur l'application
  • informations de licence

et que le résultat est conservé sous une forme qui peut être revue par la suite.
Le même principe s'étend bien au-delà de cette application.
Un processus de connexion peut être testé ainsi.
Un flux de réservation peut être testé ainsi.
Un processus logistique peut être testé ainsi.
Une application de bureau multiplateforme peut être testée ainsi.
Les écrans changent.
Les règles métier changent.
Le principe, non :
définir le flux de travail attendu, l'exécuter de manière cohérente, recueillir des preuves et rendre le résultat compréhensible.

Why We Test Our Own Software With COCO

Il y a une autre raison pour laquelle softify.pro Flow compte comme étude de cas COCO.

C'est notre propre logiciel.
Cela supprime la distance confortable qui existe parfois entre une démonstration technologique et les personnes qui la font.

Si COCO est destiné à tester des logiciels d'entreprise, il doit être suffisamment utile pour que nous lui fassions confiance avec les logiciels que nous développons et publions nous-mêmes.

Flow agit donc à la fois comme produit et comme terrain d'essai.
De nouvelles capacités de test peuvent être exercées contre une application réelle.
Un comportement inattendu peut révéler des faiblesses dans l'application, le plan de test ou COCO lui-même.

Chaque côté améliore l'autre.
Cette boucle de rétroaction est bien plus précieuse que la construction de démonstrations artificielles conçues uniquement pour réussir. Un système de test ne devrait pas paraître convaincant parce que la démonstration était facile.
Il devrait devenir convaincant parce qu'il continue de trouver les petites choses que les humains finiraient par cesser de vérifier.

The Result

softify.pro Flow — Administration dispose désormais d'un processus de régression documenté et reproductible que COCO peut exécuter avant les versions pertinentes.

Le test couvre les deux environnements de base de données pris en charge et l'interface en onze langues de l'application, tout en suivant l'application comme le ferait un administrateur, plutôt que de traiter chaque écran comme une cible de test isolée.

COCO produit une trace de preuves montrant ce qui a été testé, ce qui a été observé et dans quel ordre la session s'est déroulée.

Ces preuves peuvent rester sous contrôle local.
Les développeurs obtiennent un point de départ reproductible lorsque quelque chose change.
Les testeurs humains passent moins de temps à répéter des interactions prévisibles et plus de temps à enquêter sur les situations qui nécessitent réellement du jugement.

Et softify.pro Flow reçoit quelque chose de plus précieux qu'un indicateur vert PASS.

Il reçoit la preuve que l'expérience promise sur son écran de connexion continue d'exister après que le code sous-jacent a changé.

Control. Savoir ce qui est testé et garder l'environnement sous contrôle.

Clarity. Comprendre ce qui s'est passé sans avoir à reconstruire un journal d'automatisation opaque.

Flow. Tester l'application comme un processus que les gens utilisent réellement.

Control. Clarity. Flow.

Cela a été écrit pour le logiciel.
Il s'avère que cela décrit tout aussi bien la philosophie de test qui le sous-tend.

Lien permanent →

À Savoir

Pure fluidity meets ultimate performance : ce qui rend vraiment rapide un logiciel d'entreprise

Pure fluidity meets ultimate performance : ce qui rend vraiment rapide un logiciel d'entreprise

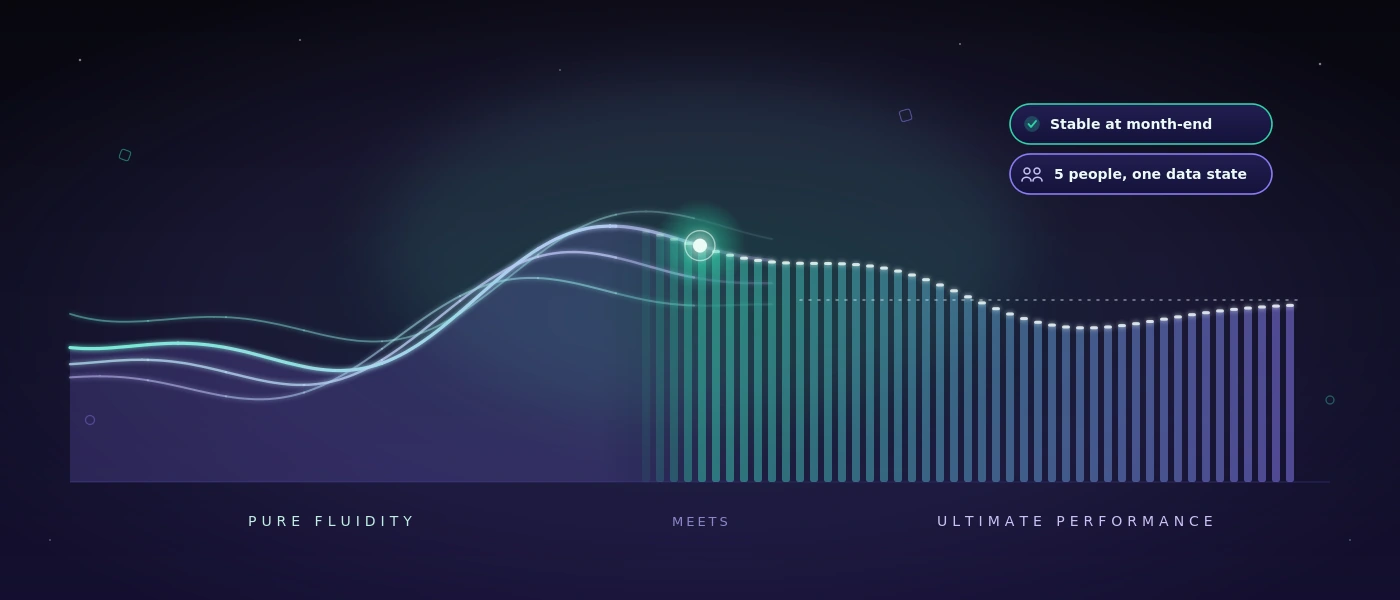
Un responsable d'entrepôt ne reconnaît pas un mauvais logiciel à un schéma d'architecture. Il le reconnaît au fait que les collaborateurs reprennent le téléphone, saisissent les bons de livraison en double ou ne peuvent pas dire, après une équipe, quelle marchandise est réellement arrivée. Pure fluidity meets ultimate performance ne doit donc pas être une simple ambition visuelle. Pour un logiciel d'entreprise, cela signifie qu'une opération paraît naturelle et fonctionne en même temps de façon fiable dans des conditions réelles.

Une interface élégante ne vaut rien si elle saccade avec un WLAN faible dans l'entrepôt. Une application rapide n'aide guère non plus si elle impose un enchaînement de travail que personne ne peut suivre à la rampe. Les bons outils numériques allient conception, vitesse et compréhension des processus. Ils réduisent la friction sans enfermer l'entreprise dans une logique standard préfabriquée.

Pure fluidity meets ultimate performance est une question d'exploitation

La fluidité est souvent confondue avec des animations, de grandes images et des transitions lisses. Cela peut convenir à une marque moderne. Dans le quotidien de travail, elle se montre pourtant autrement : une réception de marchandises peut être enregistrée sans détour. Un collaborateur retrouve une commande même lorsque seul un numéro de référence est connu. Une erreur est nommée clairement, au lieu de disparaître dans un message cryptique.

La performance est de même plus qu'une bonne valeur dans un test de navigateur. Ce qui compte, c'est le temps de réponse pour une commande comportant de nombreuses positions, la stabilité en fin de mois et la question de savoir si cinq personnes peuvent travailler en même temps sans s'écraser mutuellement leurs états de données. Une gestion propre des coupures de connexion, des droits et des comptes verrouillés en fait aussi partie.

Les deux sont indissociables. Si un écran réagit immédiatement mais comporte des champs obligatoires peu clairs, il reste pénible. Si le déroulement est intelligemment modélisé mais que la page attend deux secondes à chaque enregistrement, il est contourné. La fluidité naît là où le système soutient la prochaine action sensée et reste techniquement assez rapide pour que le fil de la pensée ne se rompe pas.

L'interface suit le parcours de travail, pas l'organigramme

De nombreuses solutions standard structurent leurs menus par modules : achats, ventes, entrepôt, reporting, administration. C'est compréhensible du point de vue du produit. Sur le sol de l'entrepôt, le travail commence pourtant souvent par une situation : un camion est là, une palette manque, un client a besoin d'une preuve de livraison ou un envoi doit encore être étiqueté avant la clôture de réception.

Une bonne application sur mesure commence donc par ces situations. Quelle information est disponible ? Qui décide ? Que faut-il documenter ? Que ne doit-on plus modifier ensuite ? Ce n'est qu'après qu'on décide quel écran de saisie, quel contrôle ou quelle automatisation est nécessaire.

Cela ne signifie pas couler chaque déroulement existant tel quel dans un logiciel. Certains tableaux sont réellement trop sujets aux erreurs, certaines validations inutilement lentes. Mais une liste Excel qui fonctionne ne doit pas forcément être remplacée par un projet. Si elle n'est tenue que par une personne, connaît peu d'exceptions et reste traçable, elle peut être l'outil adapté. Un logiciel vaut la peine lorsqu'il améliore la coordination, réduit les sources d'erreur ou rend les informations disponibles de façon fiable pour plusieurs intervenants.

Moins de clics ne veut pas automatiquement dire mieux

L'exigence d'un minimum de clics semble raisonnable, mais peut mener dans la mauvaise direction. Pour un enregistrement de stock irréversible, une brève confirmation a du sens. Pour une validation d'expédition, un contrôle de plausibilité visible peut éviter de coûteuses reprises. Le bon déroulement dépend du risque.

L'essentiel est que les étapes supplémentaires aient un but clair. Une confirmation ne devrait pas apparaître simplement parce que le framework la génère facilement. Elle devrait se trouver exactement là où les gens doivent prendre une décision en toute conscience. Ainsi l'application reste rapide sans devenir irréfléchie.

La performance naît dans l'architecture, pas dans le dernier sprint

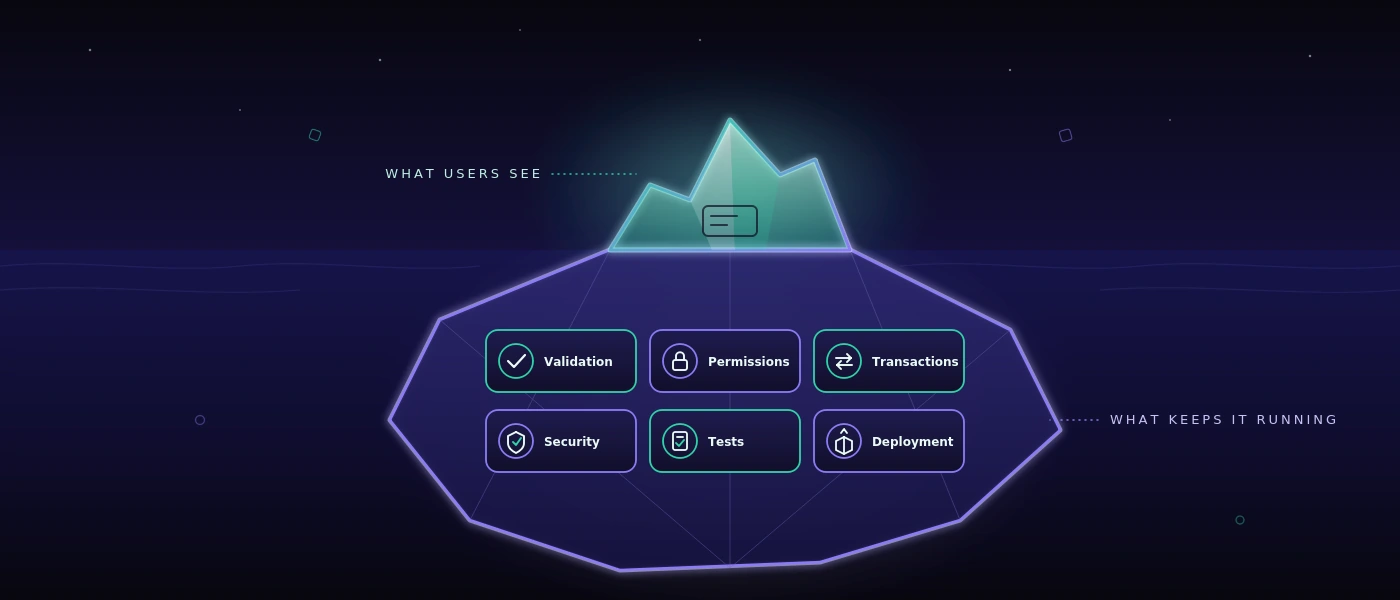
Qui n'accélère un site web ou une application web que peu avant la mise en production traite généralement des symptômes. Des requêtes volumineuses, des modèles de données peu clairs et des cas particuliers ajoutés après coup ne se corrigent pas durablement en une seule journée d'optimisation.

Une base solide commence par une base de données qui correspond aux relations réelles dans l'entreprise. Dans MySQL 8, mouvements, pièces, changements de statut et actions des utilisateurs ont besoin de clés traçables et d'index judicieux. Un stock ne doit pas apparaître seulement comme un chiffre s'il faut ensuite clarifier de quelle écriture il résulte. En même temps, il n'est pas nécessaire de recalculer chaque information historique à chaque appel de page.

Avec les applications web modernes, la séparation des responsabilités est également pertinente. PHP 8.4 peut représenter les règles métier de façon claire et maintenable, tandis que JavaScript moderne est employé de façon ciblée pour les zones réactives. Ce n'est pas une profession de foi pour une stack donnée. C'est une question de maintenance : des modifications pourront-elles être réalisées en sécurité dans six mois ? Voit-on où une règle s'applique ? Une erreur peut-elle être reproduite, au lieu d'être seulement supposée ?

La performance a en outre besoin de limites. Les champs de recherche nécessitent un nombre minimal de caractères judicieux ou une logique de filtre précise lorsque des millions d'enregistrements sont envisageables. Les grandes listes ont besoin de pages ou de processus de chargement progressifs. Images et documents ne devraient pas bloquer le déroulement critique. Ces décisions semblent peu spectaculaires. C'est précisément pourquoi elles restent souvent précieuses plus longtemps qu'un effet frontend voyant.

La vitesse visible crée la confiance

Tous les processus ne peuvent pas se terminer en moins d'une seconde. Une impression d'étiquettes, une interface avec le transporteur ou un contrôle par rapport à des données externes prend parfois du temps. Ce qui compte alors, c'est la façon dont l'application gère l'attente.

Un statut clair comme « Étiquette d'expédition en cours de création » vaut mieux qu'un bouton figé. Après une clôture, on devrait pouvoir voir quel numéro a été généré et si l'opération peut être redéclenchée. Si un service externe est injoignable, l'équipe a besoin d'une option d'action compréhensible au lieu d'un message d'erreur pour développeurs.

C'est aussi une question d'intégrité des données. Un double clic ne doit pas générer deux livraisons. Un processus interrompu ne doit pas laisser silencieusement un enregistrement à moitié terminé. Les bons systèmes prévoient de tels cas, parce qu'ils surviendront au quotidien. Surtout avec des équipes qui changent, la pression du temps et des appareils mobiles, l'exception n'est pas un sujet marginal.

La qualité devient visible avant l'erreur

Pour des applications avec de nombreuses variantes de processus, il ne suffit pas de parcourir manuellement quelques chemins à la fin. Des modifications de prix, de rôles, de validations ou d'interfaces peuvent déclencher des conséquences à un endroit très éloigné. Ici, le testing automatisé devient une partie de la performance : non seulement sur le plan technique, mais organisationnel.

Un système de test devrait pouvoir vérifier des déroulements réels, par exemple créer une commande, modifier une position, générer un bon de livraison et contrôler un droit. Il devrait enregistrer des preuves et formuler les résultats de manière que les services métier puissent les situer. Une phrase comme « Le processus d'expédition n'a pas été terminé après la modification d'adresse » aide davantage qu'une stack trace sans commentaire.

Pour les équipes soucieuses de sécurité, le lieu où ces tests s'exécutent est aussi pertinent. Si captures d'écran, identifiants, cas de test ou étapes internes de l'application ne doivent pas quitter l'entreprise, une approche auto-hébergée est souvent plus judicieuse qu'un service cloud externe. Avec COCO, on peut exécuter des tests automatisés pour applications web et Windows sur un environnement dédié. Cela n'est pas nécessaire pour chaque équipe. Pour des données sensibles, des domaines réglementés ou des applications métier internes, le contrôle des données de test peut toutefois être un avantage décisif.

Le design est bon quand il facilite le travail

Une identité visuelle forte peut créer la confiance. Elle montre qu'une entreprise prend sa présence numérique au sérieux. Dans le système opérationnel, le design doit pourtant faire encore plus : l'orientation sous pression de temps. Contraste, typographie, états clairs et libellés compréhensibles décident si quelqu'un termine une opération avec assurance ou demande à un collègue.

La retenue est ici souvent le meilleur choix. Un tableau de bord avec dix indicateurs colorés peut paraître impressionnant et pourtant masquer le seul écart pertinent. Une vue réduite qui rend visibles les réceptions de marchandises ouvertes, les scans manquants et les délais de livraison menacés est plus utile. La question n'est pas de savoir combien d'interface est possible, mais quelle information améliore une décision.

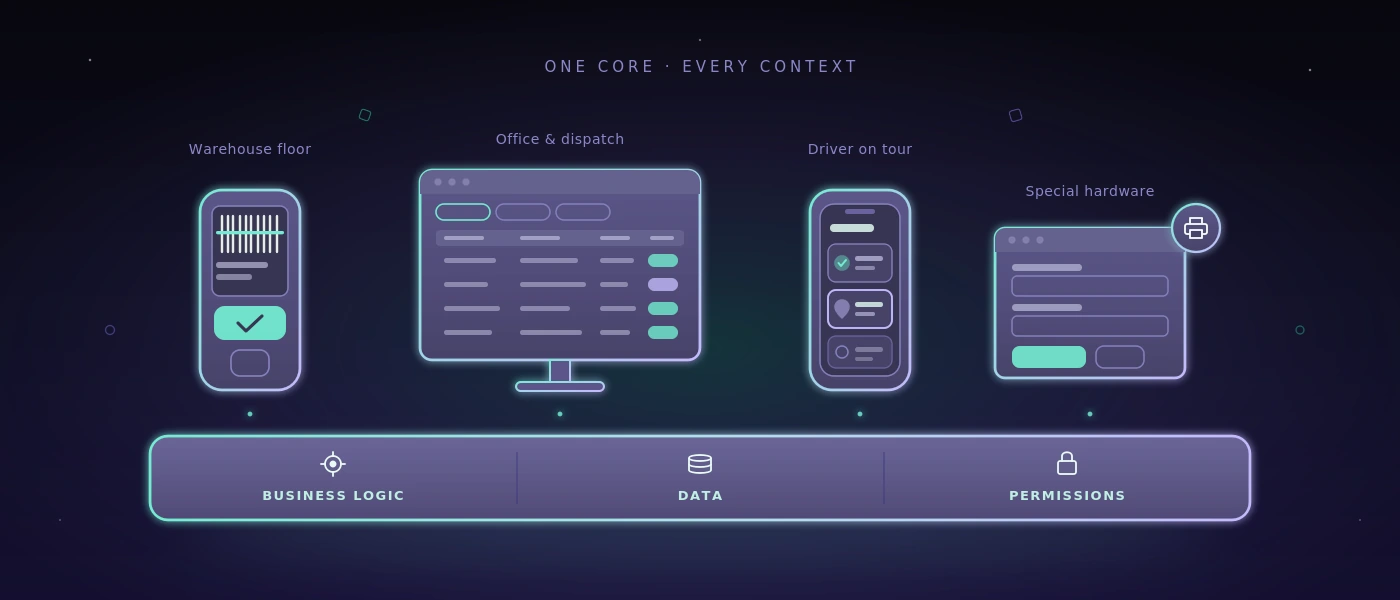
Cela vaut aussi pour les applications responsives. La compatibilité mobile ne signifie pas comprimer chaque écran de bureau dans un format plus petit. Un smartphone à la réception de marchandises n'a peut-être besoin que du scan, de la quantité, de l'emplacement et de la confirmation. Le traitement ultérieur détaillé appartient peut-être à un écran plus grand. Des appareils différents méritent des priorités différentes, même s'ils accèdent à la même base de données fiable.

Une mesure judicieuse pour la prochaine décision

Avant qu'une équipe ne décide d'une nouvelle plateforme, d'une automatisation ou d'une refonte complète, un contrôle simple aide : le déroulement devient-il plus clair, plus rapide ou plus sûr pour les personnes qui l'exécutent chaque jour ? Et la solution reste-t-elle compréhensible lorsque les exigences, les collaborateurs ou les interfaces changent ?

Si les deux réponses sont solides, une belle promesse devient un système utilisable. Alors pure fluidity meets ultimate performance se montre non dans une diapositive, mais lors d'une journée de travail calme où commandes, données et décisions continuent sans friction inutile.
Lien permanent →

SaaS Flow Web : introduire des workflows en toute sécurité en cours d'activité

SaaS Flow Web : introduire des workflows en toute sécurité en cours d'activité

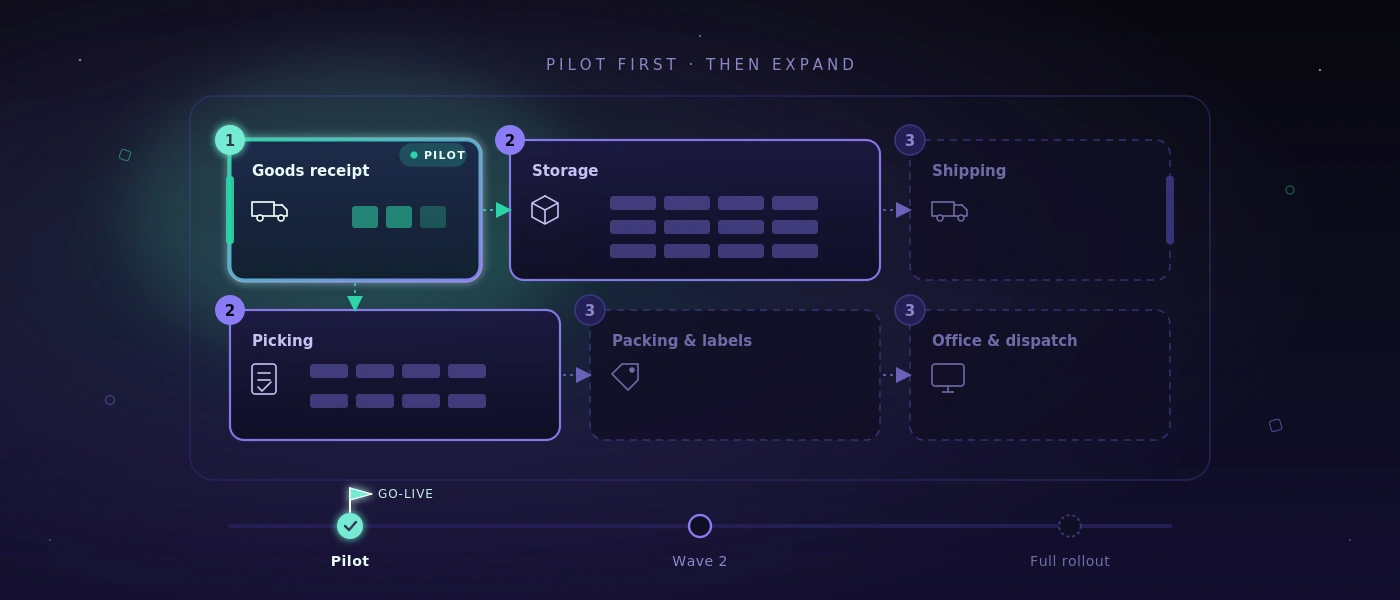
Une réception de marchandises ne reste pas en plan parce qu'une équipe ne connaît pas encore un logiciel de plus. Elle reste en plan parce que les informations se perdent entre e-mail, formulaire papier, fichier Excel et appel téléphonique. Avec le SaaS - « Flow Web » sur flow.softify.pro - l'interface ne devrait donc pas être la première question. L'essentiel est de savoir si le service reproduit de façon fiable un déroulement de travail concret - même les jours agités, avec des responsabilités changeantes et lorsqu'une livraison ne correspond pas au plan.

Pour les petites et moyennes entreprises, le SaaS a souvent du sens parce qu'elles n'ont pas à construire d'abord leurs propres serveurs, versions et fonctions de base. Mais ce n'est pas un passe-droit pour chaque processus. Qui introduit un outil qui complique le quotidien ou repousse des données importantes dans des listes annexes peu claires ne numérise pas le travail. Il ne fait que déplacer la friction.

Ce que le SaaS « Flow Web » doit apporter

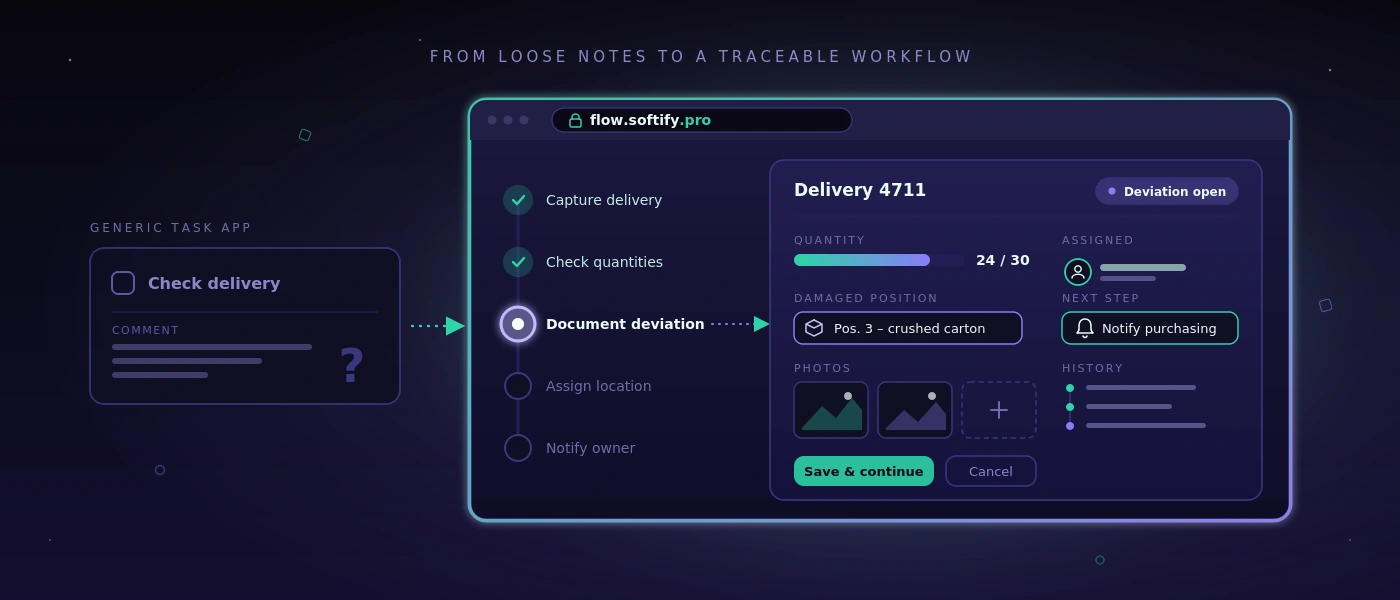
Un workflow web est bon quand les collaborateurs savent sans interprétation ce qu'il faut faire ensuite. Pour une réception de marchandises, cela peut signifier : saisir la livraison, vérifier les quantités par rapport à la commande, documenter l'écart, attribuer un emplacement et, au besoin, informer un responsable. Le déroulement n'a pas à être spectaculaire. Il doit être traçable, rapide et reproductible.

C'est précisément là que se situe la différence entre une application de tâches générale et un système de processus métier. Une application de tâches peut créer un point intitulé « Vérifier la livraison ». Un workflow métier peut en plus consigner de quelle livraison il s'agit, qui l'a réceptionnée, quelle position était endommagée, quelles photos existent et si une livraison complémentaire est en attente. Ces données ne figurent alors pas en texte libre dans un seul commentaire, mais là où la personne suivante en a besoin.

Pour une solution comme Flow Web sur flow.softify.pro, l'examen devrait donc commencer par les opérations, pas par une liste de fonctions. Une entreprise avec cinq mouvements de stock par jour a besoin d'autre chose qu'une équipe d'expédition avec plusieurs heures limites, différents transporteurs et une gestion régulière de livraisons partielles. Le SaaS ne remplace pas la compréhension du processus.

D'abord nommer le goulot d'étranglement, ensuite configurer

Beaucoup de projets de numérisation démarrent trop large : « Nous voulons numériser l'entrepôt. » Cela semble plausible, mais mène vite à un système avec trop d'écrans, de cas particuliers et de documents de formation. Mieux vaut une affirmation précise comme : « Les réceptions de marchandises ne sont enregistrées que le lendemain, parce que les bons de livraison restent sur le bureau en fin d'équipe. »

D'une telle phrase on peut déduire un départ judicieux. La première version peut saisir les bons de livraison, confirmer articles et quantités, signaler les écarts et transmettre l'écriture au service compétent. Lorsque ce déroulement fonctionne, étiquettes, évaluations de fournisseurs ou propositions de commande automatiques pourront être ajoutées plus tard. Toute étape d'évolution judicieuse n'a pas sa place dans le premier déploiement.

Un tableau bien tenu peut lui aussi rester s'il remplit son rôle. Par exemple, une évaluation mensuelle avec peu de participants dans un fichier existant peut être moins chère et plus transparente qu'un module dédié. Le SaaS vaut la peine là où les informations sont utilisées plusieurs fois, où les délais de traitement sont critiques ou où des erreurs naissent de ruptures de support.

Les bonnes questions avant l'introduction

Avant la configuration, une équipe devrait faire jouer une opération réelle du début à la fin. Pas le processus idéal, mais le cas qui pose problème au quotidien : mauvaise quantité, référence manquante, expédition urgente ou commande avec validation spéciale. On voit alors apparaître les règles qu'un système doit réellement reproduire.

Sont notamment pertinents ces points : qui peut créer, modifier ou clôturer une opération ? Quelles saisies sont obligatoires, lesquelles seulement utiles ? Quand un responsable doit-il être informé ? Quelles données sont transmises à la comptabilité, à l'expédition ou au service client ? Et que se passe-t-il si le WLAN de l'entrepôt est faible ou si un collaborateur n'a plus ses identifiants ?

Les réponses déterminent la qualité de l'introduction plus fortement qu'un long catalogue d'exigences visuelles. Un processus de rôles propre, un message d'erreur compréhensible et une étape de validation documentée évitent en exploitation généralement plus d'effort qu'un rapport supplémentaire sur la page d'accueil.

Conservation des données et rôles ne sont pas un détail

Le SaaS est souvent traité comme une pure question d'utilisation. Pour les responsables d'exploitation et informatiques, ce qu'il advient des données est pourtant au moins aussi important. Cela concerne les données de base, les informations de livraison, les données des collaborateurs, les photos de dommages et éventuellement des données clients. Avant l'introduction, les responsabilités, la conservation et les possibilités d'export devraient être claires.

Concrètement : l'entreprise doit savoir quelles données se trouvent dans le système, qui a un accès administratif et comment les données sont mises à disposition en cas de changement ou de fin de contrat. Un export disponible seulement sous forme de fichier PDF difficile à lire aide rarement. Pour les données opérationnelles, des formats structurés et exploitables sont déterminants.

Le concept de droits mérite lui aussi une attention concrète. Dans l'entrepôt, chaque personne n'a pas à voir prix, conditions clients ou paramètres globaux. En même temps, une attribution de droits trop étroite ne doit pas bloquer le déroulement. Des rôles alignés sur les activités réelles ont du sens : réception, planification, expédition, responsable d'équipe et administration. Les modifications critiques devraient être traçables, afin qu'en cas de question on n'ait pas à deviner qui a modifié une écriture.

L'accès lui-même devrait être protégé par des bases solides. Cela comprend des politiques de mots de passe sûres, une réinitialisation de mot de passe encadrée, le verrouillage de compte après des tentatives échouées répétées et, là où le profil de risque l'exige, des étapes de connexion supplémentaires. La sécurité paraît professionnelle lorsqu'elle est prévisible et ne se remarque pas seulement quand quelqu'un a été exclu.

Intégration seulement là où elle soulage de façon mesurable

Un workflow web ne déploie souvent sa valeur qu'en interaction avec les systèmes existants. Cela peut être un ERP, une boutique, une solution d'expédition, une gestion des temps ou une base de données. Pourtant, toute interface n'est pas automatiquement judicieuse. Chaque intégration crée des dépendances, des types de pannes et une charge de maintenance.

La question centrale est : quelle étape manuelle la connexion supprime-t-elle concrètement ? Si une interface économise chaque jour 30 minutes de travail de transfert et réduit les fautes de frappe, l'utilité est claire. Si elle ne fait que refléter une information de toute façon vérifiée une fois par semaine, un export manuel peut d'abord être la solution la plus raisonnable.

Pour les extensions individuelles, la base technique compte. Interfaces documentées, champs de données clairement définis et journaux d'erreurs traçables facilitent l'exploitation ultérieure. Si un système est connecté à une application web sur mesure, technologies et structure de base de données devraient être choisies de façon à rester maintenables à long terme. Une application soignée reposant sur PHP 8.4, JavaScript moderne et MySQL 8 vaut plus qu'une solution spécifique impressionnante à court terme mais sans documentation.

Introduction en cours d'activité

L'erreur la plus fréquente est un démarrage brutal sans phase de comparaison. Les équipes doivent alors travailler différemment dès le lundi matin, alors que les questions ouvertes ne naissent que de vrais problèmes. Cela augmente le rejet, même si le logiciel convient en principe.

Mieux vaut un pilote limité avec une équipe, une variante de processus ou une zone de site clairement délimitée. Pendant ce temps, on vérifie si la saisie et les validations fonctionnent, si les termes sont compréhensibles et si les cas d'exception atterrissent proprement. Il est important de ne pas collecter les retours seulement comme une liste de souhaits. Chaque modification devrait être testée par rapport à l'utilité pour le délai de traitement, le taux d'erreurs ou la transparence.

Les indicateurs devraient eux aussi être fixés tôt. On peut par exemple observer le temps de traitement par réception de marchandises, le nombre d'écarts ouverts, les demandes sur le statut de livraison ou les écritures de correction. Sans valeur de départ, « ça semble plus rapide » reste la seule évaluation. Cela peut être vrai, mais ne suffit pas pour une décision d'investissement solide.

L'exploitation a besoin d'un propriétaire clair

Le SaaS réduit l'effort technique, mais ne décharge pas une entreprise de la responsabilité de son propre processus. Il faut en interne quelqu'un qui gère les rôles, regroupe les retours, repère les besoins de formation et décide quelles modifications sont vraiment nécessaires. Cette personne n'a pas besoin de savoir programmer. Elle devrait toutefois comprendre le déroulement du travail et avoir accès aux responsables.

Tout aussi importante est une documentation d'exploitation courte et solide. Elle n'explique pas chaque écran, mais répond aux questions qui se posent au quotidien : que faire en cas d'écriture erronée ? Qui approuve les nouveaux utilisateurs ? Comment une panne est-elle communiquée ? Où se trouvent les données exportées ? Une telle clarté évite qu'un système numérique ne redevienne, après quelques mois, dépendant d'appels personnels.

Une bonne solution SaaS ne se reconnaît donc pas au nombre d'entrées de menu qu'elle propose. Elle montre sa valeur quand une nouvelle collègue peut traiter une opération en toute sécurité, qu'un écart ne disparaît pas et qu'un responsable voit le statut sans appeler trois personnes. C'est précisément à cette aune que Flow Web devrait être mesuré : non pas à des promesses, mais à une journée de travail qui se déroule de façon démontrablement plus calme et plus fiable.

Lien permanent →

Développement web avec des frameworks actuels : ce que les entreprises en retirent vraiment

Développement web avec des frameworks actuels : ce que les entreprises en retirent vraiment

Quand une réception de marchandises navigue encore entre formulaire papier, appel téléphonique et trois fichiers Excel, un frontend moderne ne résout pas le problème à lui seul. Le développement web avec des frameworks actuels a du sens lorsqu'il simplifie visiblement les processus : les collaborateurs voient l'étape suivante, les données ne sont saisies qu'une fois, et l'application reste maintenable de façon compréhensible même après la première mise en production.

Pour les petites et moyennes entreprises, la question du framework n'est donc pas une question de foi. L'essentiel n'est pas de savoir si une interface porte particulièrement beaucoup de mots-clés techniques. L'essentiel est de savoir si les mouvements de stock, commandes, contrôles ou validations traversent la journée de travail de façon fiable - même sous pression temporelle, lors de changements d'équipe et avec une connexion réseau fluctuante.

Les frameworks sont un moyen, pas un objectif de projet

Un framework fournit une structure éprouvée pour des tâches récurrentes : routage, formulaires, gestion des droits, accès aux données, tests et affichage des interfaces. Cela ne réduit pas automatiquement tous les risques. Mais cela évite à un projet de devoir réinventer sans cesse les fonctions de base.

Dans une application web sur mesure, un framework JavaScript moderne peut par exemple représenter judicieusement des écrans interactifs : une liste de préparation qui met à jour les positions en continu, une planification de tournées avec des changements de statut clairs ou un procès-verbal de contrôle qui rattache photos et commentaires directement à une opération. Côté backend, des frameworks PHP établis assurent des règles traçables, des responsabilités clairement séparées et des interfaces cohérentes vers la base de données.

C'est particulièrement pertinent quand une solution d'abord petite devient un système d'exploitation utilisé quotidiennement pour un processus. Un écran de saisie pour les avis de livraison peut commencer de façon modeste. Dès qu'il met à jour les stocks, édite des étiquettes, tient compte des rôles et communique avec un transporteur, il a besoin d'une base technique propre. Les frameworks aident à ne pas renégocier cette base à chaque extension.

Ce que les frameworks web actuels font concrètement mieux

La valeur des frameworks modernes réside rarement dans des effets spectaculaires. Elle se montre dans les parties invisibles d'une application. Les formulaires peuvent contrôler directement les saisies, sans que des données erronées ne se remarquent qu'après l'envoi. Les droits peuvent être définis de façon centrale, de sorte qu'un chauffeur voie d'autres informations que la planification. Les modifications d'une commande sont enregistrées de façon traçable, au lieu d'écraser silencieusement une cellule de tableau.

Côté serveur, un environnement actuel avec PHP 8.4 et MySQL 8 crée une base solide pour une logique critique pour l'activité. Les transactions de base de données empêchent par exemple qu'un stock soit réduit pendant que l'écriture correspondante échoue. Des clés uniques et des règles de validation évitent les doublons. Des processus d'arrière-plan peuvent générer des documents ou interroger des interfaces sans que la personne devant l'écran ait à attendre.

La sécurité n'est pas non plus une fonction après coup. Un framework moderne prend en charge le stockage sécurisé des mots de passe, la protection contre les attaques typiques par saisie, des sessions traçables et des flux de verrouillage de compte définis. Malgré cela, la mise en œuvre reste une tâche de projet : les droits doivent être modélisés correctement sur le plan métier et les fonctions sensibles nécessitent des contrôles supplémentaires. Un framework fournit des garde-fous, mais ne sait pas qui, dans l'entreprise, peut accorder quelle validation.

Bien décider du développement web avec des frameworks actuels

La meilleure technologie ne naît pas d'une liste d'outils populaires, mais de l'usage réel. Une application interne pour dix personnes a d'autres exigences qu'un portail client avec plusieurs milliers d'accès simultanés. Un terminal d'entrepôt avec scanner a besoin d'une autre logique d'utilisation qu'une analyse de direction sur ordinateur.

C'est pourquoi une décision judicieuse commence par des questions concrètes : quelles opérations coûtent aujourd'hui du temps de façon mesurable ? Quelles données sont transférées plusieurs fois ? Où naissent des erreurs parce que les informations ne deviennent visibles que trop tard ? Quel tableau existant fonctionne assez bien et devrait d'abord rester ? Précisément ce dernier point protège de projets de numérisation coûteux sans utilité opérationnelle.

Pour de nombreuses applications métier sur mesure, un système rendu côté serveur avec des composants interactifs ciblés est le choix le plus raisonnable. Il se charge vite, est gérable à exploiter et évite une complexité inutile. Une application single-page entièrement découplée peut en revanche convenir quand l'interface traite de très nombreux états dynamiques, doit fonctionner hors ligne ou doit plus tard fournir les mêmes fonctions à une application mobile.

Les deux peuvent être justes sur le plan métier. La question n'est pas : quel framework est le plus moderne ? Elle est : quelle architecture sera encore extensible en sécurité, testable et compréhensible pour sa propre équipe dans deux ans ?

Quand moins de technique est la meilleure technique

Tous les processus n'ont pas besoin d'un frontend complexe. Un écran de saisie épuré pour les commandes internes peut être plus rapide, plus stable et moins cher qu'une interface animée avec sophistication. Si un fichier Excel n'est tenu qu'une fois par mois et ne cause pas d'erreurs, il reste peut-être le bon outil.

La complexité ne vaut la peine que lorsqu'elle supprime une vraie friction. Cela peut être le cas lorsque des commandes sont ressaisies plusieurs fois, que le statut de livraison doit être demandé par téléphone ou que personne n'est sûr de la version d'un document qui fait foi. Une application centrale crée alors un bénéfice clair : un état des données, des responsabilités univoques et moins de demandes.

La maintenabilité commence avant la première ligne de code

Les frameworks sont souvent considérés comme des accélérateurs. Cela n'est vrai que si les règles métier sont auparavant suffisamment claires. Un développeur peut construire une machine à états proprement sur le plan technique. Mais savoir si la suite des statuts correspond vraiment au processus se décide lors du recueil : quand la marchandise est-elle considérée comme reçue ? Qui peut clôturer un écart ? Que se passe-t-il en cas de livraison partielle ?

Ces décisions doivent être documentées, tout comme les interfaces, champs de données et exceptions. Cela ne ralentit pas les projets. Cela réduit les discussions ultérieures, car on voit quelle règle a été mise en œuvre délibérément et quelle hypothèse reste ouverte.

La maintenabilité se montre aussi dans de petites disciplines. Les modifications de base de données doivent être versionnées. Les étapes de déploiement doivent être documentées. Les messages d'erreur doivent être exploitables pour l'exploitation et le développement sans révéler de détails confidentiels. Des tests automatisés vérifient à chaque modification les processus centraux, par exemple la création d'une commande, le calcul d'une quantité ou l'édition d'un bon de livraison.

Pour les applications critiques, un seul type de test ne suffit pas. Les tests unitaires sécurisent des règles individuelles, les tests d'intégration vérifient l'interaction avec la base de données et les interfaces, et les tests de bout en bout rejouent dans le navigateur des parcours d'utilisation réels. Pour les applications web et Windows, un environnement de test auto-hébergé peut en outre fournir des captures d'écran, des journaux d'exécution et des évaluations compréhensibles, sans confier inutilement de données de test internes à des services cloud externes.

La performance naît de l'architecture et du modèle de données

Une interface moderne ne devient pas rapide parce qu'elle utilise un framework actuel. Des requêtes de base de données lentes, des images surdimensionnées ou des interfaces peu claires restent lentes, indépendamment du frontend. Surtout avec des listes de commandes, d'articles ou de données de mouvement, c'est le modèle de données qui décide de la vitesse perçue.

Des index propres dans MySQL 8, des requêtes paginées et des données chargées de façon réfléchie sont souvent plus efficaces qu'une optimisation ultérieure de l'interface. Un concept de cache clair est tout aussi important. Les données de référence peuvent éventuellement être mises en cache, les stocks actuels ou le statut de validation en revanche pas aveuglément. Il n'existe pas de règle générale ici, car c'est la signification métier des données qui détermine leur degré d'actualité requis.

La conception responsive fait aussi partie de la planification technique. Sur l'écran de bureau, un grand tableau peut être pertinent. Sur un scanner portable ou une tablette en entrepôt, la même information requiert de grandes zones tactiles, des parcours courts et une présentation qui reste utilisable même avec des gants ou par mauvaise lumière. Pure fluidity meets ultimate performance ne signifie dans ce contexte pas le plus de mouvement possible à l'écran. Cela signifie que l'application fonctionne sans friction sur l'appareil réellement utilisé dans le processus.

Le chemin judicieux de l'idée à l'exploitation

Un projet web solide démarre avec un noyau limité et vérifiable. Au lieu d'automatiser d'emblée chaque exception imaginable, on choisit un processus qui revient souvent et cause un effort sensible. Après la première utilisation, des données et retours réels montrent quelle extension a vraiment la priorité suivante.

La remise technique ne devrait pas n'avoir lieu qu'à la fin. Les responsabilités pour l'hébergement, les sauvegardes, la supervision, les mises à jour et les droits d'accès doivent être clarifiées tôt. Un système n'est aussi fiable que son exploitation. Qui a besoin d'une application au quotidien pour l'expédition ou le traitement des commandes a besoin de voies de restauration définies et d'une réponse claire à ce qui se passe en cas de panne.

softify.pro mise donc sur des technologies maintenables, une livraison documentée et une responsabilité technique directe plutôt que sur des modes passagères de frameworks. Ce n'est pas un raccourci magique. Cela crée la condition pour qu'une application continue de fonctionner après le lancement, puisse évoluer et ne devienne pas le prochain cas particulier fragile.

Dans le meilleur des cas, la bonne application web ne ressemble pas à un nouveau projet informatique. Elle ressemble à un déroulement qui fonctionne enfin sans détours - avec assez de substance technique pour absorber calmement aussi le prochain changement en exploitation.

Lien permanent →

Planifier un déploiement logiciel : comment l'introduire en cours d'activité

Planifier un déploiement logiciel : comment l'introduire en cours d'activité

Un nouveau système échoue rarement parce qu'un bouton manque. Il échoue le lundi matin : l'équipe du matin ne trouve pas la réception de marchandises, un bon de livraison est imprimé deux fois ou un fichier Excel devient soudain la vérité non officielle. Qui veut planifier un déploiement logiciel doit donc non seulement introduire des fonctions, mais sécuriser l'exploitation réelle.

Précisément dans l'entrepôt, l'atelier, la planification et l'administration, un déploiement n'est pas un rendez-vous informatique. Il modifie les gestes, les responsabilités et les circuits d'information. Une bonne introduction maintient le travail en mouvement, rend les erreurs visibles tôt et donne aux collaborateurs une réponse claire à la question décisive : qu'est-ce que je fais différemment à partir de demain ?

Le déploiement commence avant la première formation

De nombreux projets démarrent avec une liste de fonctions : saisir des commandes, enregistrer des mouvements d'entrepôt, imprimer des étiquettes d'expédition, planifier des tournées. C'est nécessaire, mais insuffisant. Avant le démarrage, il faut clarifier quels processus doivent effectivement passer par le nouveau système le premier jour productif - et lesquels volontairement pas encore.

Cette délimitation n'est pas un signe d'incomplétude. Elle réduit le risque. Si une entreprise de taille moyenne a jusqu'ici coordonné les réceptions de marchandises par papier, téléphone et tableaux, elle n'a pas à numériser le premier jour en même temps toute la gestion des stocks, le traitement des retours, la planification des tournées et l'évaluation des fournisseurs. Un premier périmètre judicieux pourrait porter sur la réception de marchandises, des mouvements d'entrepôt sans ambiguïté et l'impression des documents de livraison.

L'essentiel est de décrire concrètement le processus cible. Pas : « La réception de marchandises devient numérique. » Mais : « Le collaborateur scanne la livraison, vérifie quantité et état, attribue un emplacement et crée, en cas d'écart, une opération pour les achats. » Ce n'est qu'à ce niveau que les questions ouvertes deviennent visibles : que se passe-t-il en cas de commande manquante ? Qui peut corriger les quantités ? Une livraison sans étiquette peut-elle être stockée ?

Planifier un déploiement logiciel signifie : prioriser les processus critiques

Tous les processus n'ont pas la même importance. Une panne dans la maintenance des données de base peut être désagréable. Une panne dans l'expédition, la préparation de commandes ou la validation des factures peut bloquer le travail d'une journée entière. C'est pourquoi le déploiement nécessite une priorisation selon le risque opérationnel, et non selon l'ordre du cahier des charges.

Une classification simple a fait ses preuves : critique pour l'activité, important et reportable. Sont critiques tous les processus qui font circuler marchandises, argent ou communication client engageante. Sont importantes les fonctions qui accélèrent le quotidien, mais dont la panne peut être amortie manuellement de façon transitoire. Sont reportables les fonctions de confort, les cas particuliers rares ou les analyses qui peuvent d'abord provenir encore d'une source existante.

Cette classification influence la profondeur des tests. Pour un processus d'expédition critique, il ne suffit pas de parcourir avec succès une seule commande. Il faut aussi tester les livraisons partielles, les annulations, les imprimantes manquantes, les mauvaises adresses, le traitement parallèle et la transmission au transporteur. Pour une fonction statistique rarement utilisée, un cycle de test ultérieur peut être approprié.

Rendre les critères de réussite mesurables à l'avance

« L'application fonctionne » n'est pas un critère de recette. Mieux vaut des énoncés vérifiables : une réception de marchandises de 30 positions est enregistrable en dix minutes. Les étiquettes d'expédition sont imprimées au poste prévu. Les modifications de stock apparaissent immédiatement dans la planification. Un compte utilisateur verrouillé ne peut être réactivé que via le processus de validation défini.

De tels critères relient service métier et développement. Ils évitent aussi que la recette ne devienne une collection d'impressions vagues. Tous les retours n'ont pas à être résolus avant la mise en production. Mais chaque retour nécessite un classement : erreur critique, amélioration pertinente ou point pour une étape d'évolution ultérieure.

Migration des données : seules des données propres méritent la confiance

Les anciennes données sont souvent sous-estimées. Dans les tableaux se trouvent des numéros d'article en double, des unités différentes, des adresses clients périmées et des stocks dont personne ne sait plus expliquer l'origine. Qui reprend ces données sans les vérifier déplace l'ancienne ambiguïté dans un nouveau système - simplement avec une meilleure interface.

Avant la migration, il faudrait déterminer quelles données sont réellement nécessaires. Des articles actuels, des clients actifs, des commandes ouvertes, des fournisseurs pertinents et des stocks de départ vérifiés sont souvent judicieux. Les données historiques ne doivent pas forcément migrer intégralement vers la nouvelle application. Il peut suffire de les archiver de façon lisible si elles restent nécessaires pour des justificatifs ou des demandes.

Un chargement d'essai est particulièrement important. Les données ne sont pas seulement importées techniquement, mais vérifiées sur le fond : les quantités, unités et affectations sont-elles correctes ? Les champs obligatoires sont-ils complets ? Peut-on traiter correctement des commandes typiques ? Pour la mise en production, il faut ensuite une date butoir claire. À partir de quand quel système fait-il référence ? Sans cette règle naissent double saisie et stocks contradictoires.

Exploitation pilote plutôt qu'un grand interrupteur

Un big bang peut être judicieux si une petite équipe utilise un processus clairement délimité et que l'ancienne et la nouvelle solution ne peuvent pas fonctionner en parallèle. Dans la plupart des environnements opérationnels, une exploitation pilote est toutefois le choix le plus maîtrisable.

Le pilote devrait travailler avec des cas réels, mais dans un cadre limité : une zone d'entrepôt, une équipe, un groupe de produits ou une équipe sélectionnée. L'essentiel est que le groupe pilote ne comprenne pas uniquement des collaborateurs particulièrement à l'aise avec la technique. Il devrait représenter de façon réaliste le quotidien futur, y compris les personnes qui travaillent sous pression temporelle et ont des objections légitimes.

En exploitation pilote, on voit si scanners, imprimantes, réseau et droits fonctionnent au poste de travail réel. Des lacunes de processus que personne n'avait mentionnées en réunion deviennent aussi visibles. Peut-être que la marchandise est d'abord déposée sur un emplacement intermédiaire au quotidien. Peut-être que les chauffeurs ont besoin d'un autre bon de livraison que l'administration. De telles découvertes ne sont pas un recul. Elles sont la raison de mener le pilote avant le démarrage généralisé.

La formation comme situation de travail, pas comme visite du logiciel

Une formation qui n'explique que les entrées de menu génère peu de sécurité. Les collaborateurs doivent apprendre sur leurs tâches : « Vous réceptionnez une livraison endommagée », « Vous préparez une commande urgente », « Vous corrigez une quantité mal enregistrée ». Le contexte reste en mémoire parce qu'il correspond au quotidien de travail.

De courtes formations proches de la mise en production sont généralement plus efficaces qu'un long rendez-vous des semaines auparavant. De brèves consignes de travail directement au poste aident aussi. Elles ne devraient pas expliquer tout le système, mais montrer les opérations les plus fréquentes, les responsabilités claires et la marche à suivre en cas de panne.

Nommez en outre des interlocuteurs par secteur. Ces personnes n'ont pas à résoudre elles-mêmes chaque problème technique. Mais elles devraient pouvoir décider s'il s'agit d'une erreur de manipulation, d'une ambiguïté métier ou d'une véritable erreur système. Cela protège l'équipe projet des sollicitations non structurées et accélère l'aide pour l'équipe de poste.

La mise en production a besoin d'un plan d'exploitation

Le jour de la mise en production exige plus qu'une heure. Définissez qui décide sur le plan métier, qui est responsable des modifications techniques et par quel canal les pannes sont signalées. Pour les processus critiques, il devrait être visible si les fonctions centrales fonctionnent : connexion, droits, saisie des données, interfaces, impression et sauvegarde.

Un plan de repli en fait aussi partie. Cela ne signifie pas revenir complètement à l'ancien monde au moindre problème. Cela signifie déterminer à l'avance quelle panne justifie un arrêt, comment les commandes sont documentées en cas de besoin et comment elles sont ressaisies proprement ensuite. Un formulaire papier pour quelques heures peut être raisonnable. Un fonctionnement parallèle permanent sans fin ne l'est pas.

Les détails techniques comptent ici : les accès ont-ils été créés à temps ? Les rôles et les règles de verrouillage de compte s'appliquent-ils correctement ? Les imprimantes d'étiquettes sont-elles reliées aux bons modèles ? Existe-t-il une sauvegarde testée de la base de données ? Pour les applications développées sur mesure, des déploiements documentés, des versions traçables et une voie claire pour les corrections sont la norme.

Les premières semaines décident de l'acceptation

Après le démarrage commence la phase où une application devient soit un outil de travail, soit une étape supplémentaire détestée. Prévoyez donc de courtes boucles de retour quotidiennes. Quelles erreurs se répètent ? Où naissent des détours ? Quels champs sont mal compris ? Quelle analyse manque réellement à un responsable ?

Toute observation n'exige pas une modification immédiate. Certains problèmes se résolvent par des règles de travail plus précises ou une meilleure formation. D'autres révèlent de véritables faiblesses du processus ou de l'application. L'art consiste à ne pas confondre les deux. Un système ne devrait pas compliquer sans raison des processus existants qui fonctionnent. Si un tableau bien tenu reste la meilleure solution pour un cas particulier rare, il peut rester.

Mesurez l'effet à l'aide de quelques indicateurs concrets : temps de traitement par opération, nombre de demandes, écritures erronées, réimpressions, commandes ouvertes ou écarts de stock. Seules ces valeurs montrent si le déploiement améliore réellement l'exploitation - au lieu de simplement introduire de nouveaux écrans.

Un bon déploiement ne ressemble plus à un projet après quelques semaines. Il devient une routine de travail fiable : les bonnes données sont là où elles sont nécessaires, les exceptions sont traçables et les équipes ont moins à courir après l'information par téléphone. C'est exactement ce que la planification devrait viser - non un jour de lancement spectaculaire, mais un quotidien plus calme et mieux pilotable.

Lien permanent →

Planifier le Multiplatform Application Development : d'abord le processus, ensuite la plateforme

Planifier le Multiplatform Application Development : d'abord le processus, ensuite la plateforme

Un responsable d'entrepôt confirme une réception de marchandises sur un scanner portable. La planification vérifie la même opération dans le navigateur. Un chauffeur a besoin du statut de livraison en déplacement sur son smartphone. Le Multiplatform application development ressemble, à ce moment, à une question technique. En réalité, il s'agit d'abord d'un déroulement opérationnel : quel travail doit être accompli à quel endroit, avec quelle fiabilité et sur quel appareil ?

Pour les petites et moyennes entreprises, la bonne réponse est rarement : nous construisons tout en natif pour chaque plateforme. Plus souvent, c'est : nous définissons un processus commun, choisissons de façon ciblée les interfaces nécessaires et évitons la logique en double. Cela n'économise pas seulement du budget de développement. Cela empêche aussi que l'entrepôt, le bureau et le service extérieur travaillent avec des états de données différents.

Ce que le Multiplatform Application Development doit apporter

Le Multiplatform Application Development désigne le développement d'une application utilisable dans plusieurs environnements, par exemple dans le navigateur web, sur iOS et Android ou sur des systèmes de bureau Windows. Le terme est souvent réduit à la question de savoir si une seule base de code peut produire plusieurs applications. Ce n'est qu'une partie de la décision.

Pour les systèmes opérationnels, ce qui compte avant tout est de savoir si l'application fonctionne sur son lieu d'utilisation. Une zone de réception peut avoir besoin d'une caméra pour saisir des codes-barres, de grands éléments de commande pour les gants et d'une réaction utilisable en cas de couverture WLAN instable. L'administration a en revanche besoin de tableaux, de filtres, de concepts de droits et de journaux de modifications traçables. Un chauffeur a besoin d'une vue réduite, pas de la même interface que la planification.

Une base technique commune peut relier ces exigences de façon sensée. Mais elle ne doit pas conduire à servir chaque plateforme comme un mauvais compromis. Le meilleur code commun est sans valeur si les collaborateurs font des détours parce que l'application ne reflète pas leur déroulement de travail réel.

D'abord déterminer le processus, ensuite la plateforme

Avant de parler de frameworks, les équipes devraient examiner une opération concrète du début à la fin. Prenons une livraison : la commande arrive, la marchandise est préparée, un bon de livraison est créé, la remise est confirmée et le statut est remonté aux ventes ou au service client. À quel endroit naît aujourd'hui la rupture de support ? Où note-t-on quelque chose sur papier, le ressaisit-on plus tard ou le demande-t-on par téléphone ?

Cette observation sépare les vraies exigences de plateforme des listes de souhaits. Si seuls deux collaborateurs au bureau utilisent une fonction, une interface web bien faite suffit généralement. Si dix personnes sur le sol de l'entrepôt effectuent des saisies, une interface mobile adaptée au scanner peut faire la différence. Si un programme Windows existant doit travailler avec du matériel spécial, une intégration de bureau peut être nécessaire.

Toute fonction n'appartient pas à tout appareil. Ce n'est pas un défaut d'une solution multiplateforme, mais le signe de décisions de produit propres. Des données et des règles métier communes ne signifient pas forcément des écrans identiques.

Les trois questions qui clarifient coûts et bénéfices

La première question est : quels appareils sont déjà utilisés et pendant combien de temps le resteront-ils ? Une entreprise avec des terminaux Windows gérés a d'autres exigences qu'un service extérieur avec des smartphones privés. La deuxième est : que se passe-t-il sans connexion réseau ? La capacité hors ligne augmente considérablement l'effort, car les données doivent être stockées localement, synchronisées plus tard et traitées proprement en cas de conflit. Elle est judicieuse si le processus s'arrête sinon - pas comme équipement standard.

La troisième question concerne les conséquences d'une panne. Un collaborateur peut-il saisir une écriture plus tard, ou une étiquette d'expédition, un stock ou une validation de sécurité en dépendent-ils ? Plus l'opération est critique, plus les droits, les règles de contrôle, la répétabilité et la journalisation doivent être planifiés.

Une architecture qui ne s'effondre pas à la deuxième plateforme

Dans une solution durable, la logique métier n'est pas dispersée dans plusieurs interfaces. Les contrôles de stock, les changements de statut, les plages de numérotation, les droits et la génération de documents nécessitent une base centrale et testée. Navigateur, application mobile et client de bureau y accèdent par des interfaces clairement définies.

Pour de nombreux processus métier internes, une application web moderne est le point de départ le plus économique. Elle peut être mise à jour de manière centralisée, ne nécessite aucune installation sur chaque poste et fonctionne sur ordinateur, tablette et smartphone. Avec PHP 8.4, JavaScript moderne et MySQL 8, on peut construire une base maintenable, à condition que le modèle de données, les droits d'accès et le déploiement ne soient pas envisagés seulement peu avant la mise en production.

Une application mobile ou de bureau installable est ajoutée lorsqu'elle apporte un avantage clair : intégration profonde avec scanner, imprimante ou caméra, fonctionnement hors ligne fiable, fonctions spéciales en arrière-plan ou exigences de la gestion des appareils. C'est un développement ciblé, pas une fin en soi.

Une erreur fréquente est la réutilisation complète de l'interface utilisateur à tout prix. Techniquement, cela peut sembler attrayant. En pratique, cela donne de petits textes sur de grands écrans, des formulaires surchargés sur smartphone ou des commandes qui ne conviennent pas à la plateforme. Il vaut mieux partager modèle de données, règles et composants là où c'est judicieux, tout en adaptant l'utilisation au contexte respectif.

La cohérence des données compte plus qu'une base de code commune

Plusieurs plateformes augmentent le risque de données contradictoires. Une commande est modifiée au bureau alors qu'un chauffeur voit encore une ancienne version sur son appareil. Deux collaborateurs saisissent en même temps le même stock d'article. Un appareil hors ligne renvoie ses modifications des heures plus tard. Ces cas ne sont pas un sujet marginal, mais le cœur de l'architecture.

Le système a donc besoin d'identités univoques, d'horodatages, de changements d'état traçables et de règles pour les conflits. Pour un statut de livraison, la dernière modification confirmée peut suffire. Pour les stocks, c'est souvent trop grossier. Là, il doit être clair quel mouvement a été enregistré, de quel emplacement il provient et si une correction doit être justifiée.

Les droits doivent eux aussi être réglés de manière centrale. Un collaborateur peut éventuellement saisir des réceptions de marchandises, mais pas valider des corrections de stock. Un chauffeur externe ne doit voir que sa tournée. Les durées de session, l'authentification multifacteur pour les rôles critiques et les flux de verrouillage de compte ne sont pas des fonctions de sécurité décoratives. Ils protègent des processus concrets et rendent les responsabilités visibles.

Tester le Multiplatform Application Development comme on travaille réellement

Une application peut démarrer sur trois systèmes d'exploitation et échouer malgré tout en exploitation. Ce qui compte, ce sont les déroulements en conditions réelles : le scanner réagit trop lentement, une imprimante d'étiquettes n'est pas joignable, un droit ne s'applique pas après un changement de rôle, ou une synchronisation génère des écritures en double.

C'est pourquoi les processus critiques devraient être vérifiés automatiquement. Cela comprend la connexion et le comportement de verrouillage, la saisie des commandes, les mouvements de stock, la création de documents et le traitement des saisies erronées. Pour les applications web et Windows, des tests récurrents peuvent être exécutés sur une infrastructure auto-hébergée. C'est particulièrement pertinent si les captures d'écran, les données internes de commande ou les accès de test ne doivent pas être transmis à des services cloud externes.

L'automatisation ne remplace pas le contrôle par des personnes sur le sol de l'entrepôt. Mais elle garantit que les déroulements connus soient vérifiés encore et encore après les modifications. De bons rapports de test ne nomment pas seulement une erreur technique, mais le processus concerné : la preuve de livraison ne peut pas être générée, le compte utilisateur reste verrouillé après une validation réussie ou les données de tournée ne sont pas mises à jour.

Quand une stratégie de plateforme est de trop

Certaines entreprises n'ont pas besoin de leur propre application. Si un accès navigateur stable suffit, que le déroulement est rarement mobile et que le nombre d'utilisateurs reste raisonnable, une application web responsive est souvent le choix le plus raisonnable. Elle réduit l'effort de maintenance, les problèmes de distribution et le nombre de sources d'erreur possibles.

Un tableau existant n'a pas non plus besoin d'être remplacé immédiatement. S'il ne sert que d'évaluation simple, est tenu par une personne et ne crée pas de transmissions sujettes aux erreurs, il peut remplir son rôle. Le moment d'un système est atteint quand le savoir réside dans des têtes isolées, que les versions divergent, que les questions augmentent ou qu'une opération ne peut plus être retracée de façon fiable.

À l'inverse, une stratégie de plateforme légère devient vite trop petite quand les collaborateurs doivent travailler hors ligne, que du matériel est connecté ou que clients et partenaires ont besoin d'un accès contrôlé. Il vaut alors la peine de financer consciemment les exigences supplémentaires, au lieu de les ajouter plus tard sous pression de temps.

Commencer par un pilote solide

Un bon départ n'est pas un catalogue de fonctions de cent points, mais un déroulement complet et mesurable. Par exemple : saisir la réception de marchandises, mettre à jour le stock, documenter un écart et créer une tâche de clarification. Ce pilote montre tôt si modèle de données, appareils, droits et utilisation s'accordent.

Ensuite, la solution peut grandir par étapes sensées : préparation de commandes, expédition, planification de tournées ou analyses. Chaque extension devrait passer la même question : raccourcit-elle un vrai déroulement, réduit-elle les erreurs ou crée-t-elle une transparence fiable ? Sinon, elle peut attendre.

La plateforme la plus judicieuse n'est finalement pas celle qui a le plus d'options techniques. C'est celle sur laquelle une équipe commence son travail plus vite le matin, pose moins de questions pendant le poste et peut retracer le soir ce qui s'est réellement passé.

Lien permanent →

Bien évaluer les Test Automation Results

Bien évaluer les Test Automation Results

Un test de régression peut se terminer le matin avec 98 pour cent de cas réussis et ne pas être pour autant une bonne nouvelle. Peut-être que le test échoué est justement la connexion d'un grand client. Peut-être que 40 tests ont été ignorés parce que l'environnement de test n'était pas joignable. Ou bien l'exécution était verte, mais ne vérifiait que l'existence des boutons, pas si une commande est réellement enregistrée, un bon de livraison généré et le stock correctement ajusté. Les Test automation results ne sont pas une affirmation sur la qualité tant que leur contexte manque.

Pour la direction QA, le développement et les services métier, le vrai travail ne réside donc pas seulement dans l'automatisation des tests. L'essentiel est de préparer les résultats de manière à en tirer des décisions fiables : une version peut-elle être déployée ? Une erreur doit-elle être traitée immédiatement ? L'erreur est-elle nouvelle, récurrente ou seulement un problème de l'environnement de test ? Et existe-t-il des preuves qu'un service métier sans code de test peut aussi comprendre ?

Ce que disent vraiment les Test Automation Results

L'indicateur le plus simple est : réussi ou échoué. Il est utile, mais rarement suffisant. Un taux de réussite élevé peut créer la confiance si les tests couvrent des processus critiques, si les données de test sont plausibles et si l'environnement ressemble à l'exploitation future. Si l'un de ces facteurs manque, le chiffre reste surtout un signal indiquant qu'une exécution automatisée a eu lieu.

Pour les applications critiques pour l'activité, d'autres questions comptent davantage. Dans une solution d'entrepôt, tous les écrans ne sont pas aussi importants. Une erreur d'affichage dans un texte d'aide interne peut attendre. Une erreur qui enregistre la mauvaise quantité à la réception de marchandises ou génère une étiquette d'expédition sans adresse de destinataire, non. De bons résultats de test pondèrent donc les risques au lieu de traiter tous les cas de la même façon.

Un test échoué n'est pas non plus automatiquement un défaut du produit. Il peut être déclenché par des identifiants expirés, un rôle de test verrouillé, des interfaces indisponibles, des données de test modifiées ou un environnement lent. Qui ne sépare pas ces causes produit du bruit. L'équipe passe alors du temps sur de fausses alertes pendant que de vraies erreurs se perdent parmi les messages de statut rouges.

Quatre types de statut au lieu d'une liste rouge

Une classification claire a fait ses preuves en pratique : erreur fonctionnelle, erreur technique du test, problème d'environnement et changement attendu. Une erreur fonctionnelle signifie que l'application enfreint une exigence définie. Une erreur technique du test renvoie plutôt au test lui-même, par exemple un sélecteur qui ne correspond plus après une interface délibérément modifiée.

Un problème d'environnement existe lorsque, par exemple, un système de test ou une interface connectée n'est pas disponible. Les changements attendus surviennent quand un processus a été délibérément adapté, mais que l'automatisation vérifie encore l'ancien état cible. Ces catégories n'évitent pas toute discussion. Mais elles font en sorte que la discussion commence au bon endroit.

Des exécutions de tests aux rapports prêts à la décision

Un rapport utilisable ne répond pas seulement qu'une chose a échoué, mais ce qui s'est passé, quelle en est la gravité et si l'erreur paraît reproductible. Cela demande plus qu'une liste de noms de tests et d'horodatages.

À chaque exécution pertinente appartiennent la build vérifiée, l'environnement de test, le rôle utilisé, les principales données de test ainsi que l'heure de début et de fin. Surtout avec des applications de bureau Windows ou des plateformes web complexes, ces informations sont nécessaires pour cerner les différences. Une erreur qui n'apparaît que sous un rôle d'entrepôt restreint est autre chose qu'une erreur qui bloque chaque connexion.

Des résultats significatifs contiennent en outre des preuves traçables : captures d'écran, étapes enregistrées, messages d'erreur et, si nécessaire, journaux techniques. Une capture d'écran seule peut toutefois tromper. Elle montre un instant, pas la cause. La combinaison de la séquence d'étapes, de l'état visible et de la réaction attendue est bien plus utile.

Les systèmes assistés par IA peuvent transformer ces preuves en évaluations compréhensibles. Avec COCO, par exemple, les tests s'exécutent sur un serveur IA dédié et auto-hébergé. L'évaluation peut expliquer qu'une commande a bien été créée mais que le changement de statut attendu n'a pas eu lieu, et rattacher directement l'enregistrement de l'exécution. Pour les équipes soucieuses de sécurité, il importe de savoir où sont traités les captures d'écran, les données applicatives et le trafic de test. Le contrôle local n'est pas automatiquement nécessaire, mais pour des applications internes et des données sensibles, il peut être la voie la plus judicieuse par rapport à un service cloud externe.

Le bon niveau de détail pour différents destinataires

Les équipes de développement ont besoin de messages d'erreur, d'étapes techniques et d'indications aussi précises que possible pour la reproduction. Un responsable des opérations a en revanche besoin d'abord de la fonction concernée, du risque métier et d'une affirmation claire sur la capacité d'exploitation. Les deux perspectives doivent pouvoir découler de la même exécution, sans que personne n'ait à transférer manuellement des résultats dans des présentations.

Un bon rapport commence donc par un court niveau décisionnel : mise en production recommandée, mise en production avec limitations connues ou arrêt de la mise en production. En dessous figurent les écarts critiques avec priorité et preuve. Les détails techniques ne suivent qu'ensuite. Ce n'est pas une simplification au détriment de la précision, mais une séparation nette des besoins d'information.

Mesurer la couverture sans se bercer d'illusions

La couverture de test est souvent présentée sous forme de pourcentage. Cette valeur est utile quand on sait ce qu'elle mesure. La couverture de code montre par exemple quelles parties du code du programme ont été exécutées pendant les tests. Cela ne prouve pas qu'un processus métier fonctionne correctement. Un test peut toucher beaucoup de lignes de code et ne jamais vérifier si une mauvaise adresse de livraison apparaît sur le document.

Pour les services métier, la couverture des processus est souvent plus parlante. Elle décrit quels flux réels sont protégés : saisir une commande, réserver du stock, enregistrer une livraison partielle, accepter un retour ou valider une facture. Les passages entre systèmes et rôles sont particulièrement précieux, car c'est là que les erreurs surviennent souvent : à l'import d'une commande, à l'impression d'une étiquette ou lors du passage du bureau au terminal d'entrepôt.

Ne priorisez pas selon le nombre de tests possibles, mais selon l'impact des dommages et la fréquence des modifications. Un processus rarement utilisé avec un risque financier ou juridique élevé mérite souvent une automatisation plus tôt qu'une vue fréquemment utilisée mais inoffensive. Inversement, un processus stable et peu critique peut continuer à se contenter d'un bref contrôle manuel. Tout contrôle n'a pas à être automatisé simplement parce qu'il est automatisable.

Les tests instables sont un problème de qualité à part entière

Les tests qui réussissent parfois et échouent parfois sans changement identifiable du produit sont souvent qualifiés de flaky. Ils abîment la confiance plus vite qu'un test durablement rouge. Dès que les équipes relancent par réflexe les résultats rouges, l'automatisation perd sa fonction d'alerte.

Les causes sont généralement concrètes : attentes fixes, données de test partagées, accès parallèles, traitement asynchrone ou un environnement qui n'est pas réinitialisé. Une courte pause de trois secondes dans le test peut aider par hasard, mais ce n'est pas une solution. Il vaut mieux attendre un état vérifiable, rendre les données de test uniques et isoler les processus les uns des autres.

Toute instabilité ne peut pas être évitée complètement. Les interfaces externes peuvent fluctuer et l'infrastructure réelle connaît des pannes. Le rapport devrait alors indiquer clairement si un test n'était pas évaluable en raison d'une dépendance externe. Une exécution répétée peut être utile pour le diagnostic, mais elle ne doit pas rendre invisible le premier constat.

Un déroulement judicieux après chaque exécution de tests

Après une exécution automatisée, tous les résultats ne devraient pas être traités immédiatement de la même façon. On examine d'abord les erreurs bloquantes et les tests critiques non évaluables. Vient ensuite le classement des nouveaux écarts par rapport aux problèmes connus et acceptés. Ce n'est qu'alors qu'une décision de mise en production est solide.

Des seuils définis sont utiles, mais ils doivent correspondre au processus. Par exemple, un test échoué dans le flux de paiement ou d'autorisation peut déclencher un arrêt immédiat. Pour un écart purement cosmétique, une exception documentée peut être acceptable. De telles règles ne devraient pas n'apparaître que sous la pression du temps avant une mise en production.

Le retour d'expérience est tout aussi important : chaque erreur en production que les tests n'ont pas détectée est une occasion de vérifier s'il manque un scénario, une variante de données de test ou un point de contrôle. L'objectif n'est pas d'accumuler un maximum de tests. C'est de construire, à partir d'erreurs réelles, une meilleure protection ciblée.

Les résultats de test les plus utiles ne sont finalement pas ceux dont la vue d'ensemble est la plus verte. Ce sont ceux pour lesquels un responsable peut comprendre, le lundi matin, ce qui a été vérifié, quel risque subsiste et quelle action est maintenant raisonnable.

Lien permanent →

Nous contacter

Un projet en tête, un flux de travail qui tourne encore sur des tableurs et de la bonne volonté, ou un retard de tests que COCO pourrait décharger de votre équipe ? Parlez-nous-en.

Envoyer le message