softify.pro
A carregar …
Serviços Sobre nós COCO – o nosso servidor de IA Portefólio Insiders Case Studies Vale a pena saber Contacto Login

NEXT-GEN SOFTWARE AESTHETIC

Pure fluidity meets ultimate performance.

A nova identidade visual para fluxos de trabalho digitais modernos.

softify.pro — A nova identidade visual para fluxos de trabalho digitais modernos.

Deslize para descobrir ↓

Software construído como as empresas modernas realmente trabalham

A softify.pro é um estúdio de software baseado numa ideia: a tecnologia deve mover-se tão fluidamente como as empresas que apoia. Trabalhamos na interseção entre o desenvolvimento web moderno, a automação de processos, e a inteligência artificial aplicada — três disciplinas raramente encontradas sob o mesmo teto, mas cada vez mais interligadas. Os nossos clientes vão desde a pequena empresa que introduz o seu primeiro processo de faturação digital, até à empresa de produção de média dimensão já estabelecida que substitui folhas de Excel por software de logística verdadeiro. O que os une não é a dimensão, mas a exigência: querem sistemas rápidos, fiáveis, e agradáveis de usar — não apenas funcionais. Cada projeto começa connosco com as mesmas três perguntas: O que é que esta empresa realmente precisa de acelerar? O que já funciona bem e deve ser respeitado em vez de substituído? E que parte do fluxo de trabalho pode, uma vez bem construída, passar a executar-se sozinha no futuro? As respostas determinam tudo o resto — desde a tecnologia escolhida até ao plano de implementação.

Serviços

A nova identidade visual para fluxos de trabalho digitais modernos.

01 — LOGISTICS

Automatização da logística — para pequenas e médias empresas na região DACH

Uma grande parte do nosso trabalho é dedicada a software de logística e operações para pequenas e médias empresas na Alemanha, Áustria, e Suíça. Estas empresas encontram-se frequentemente entre duas opções pouco atrativas: pacotes de logística enterprise caros, concebidos para grupos empresariais dez vezes maiores, ou uma mistura de folhas de Excel, formulários em papel, e chamadas telefónicas, que limita silenciosamente a rapidez com que podem crescer.

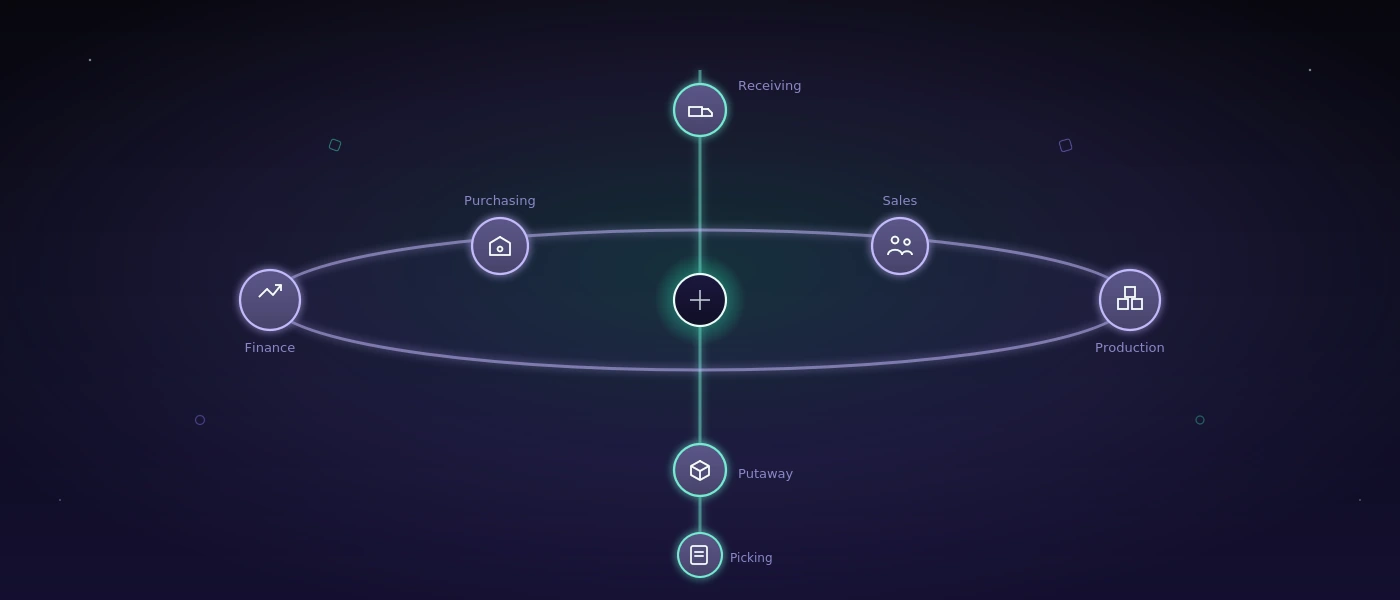
Construímos o caminho intermédio — automação à medida que se adapta à forma real de trabalhar de um determinado armazém, oficina, ou equipa de vendas. Isto pode significar: digitalizar a receção de mercadorias e os movimentos de armazém, gerar automaticamente guias de remessa e etiquetas de envio, ligar a receção de encomendas ao planeamento de rotas, ou simplesmente substituir um ficheiro Excel frágil, que só uma pessoa entende, por um sistema em que toda a equipa pode confiar. Como trabalhamos diretamente com proprietários e gestores de operações na região DACH, os requisitos são recolhidos no idioma em que a empresa realmente opera, e a implementação é planeada em torno de escalas de turnos reais e áreas de armazém reais — não em torno de um plano de projeto abstrato.

02 — WEB

Desenvolvimento web moderno com tecnologia atual

Concebemos e desenvolvemos aplicações web e websites com tecnologia atual e ativamente mantida — não com frameworks desatualizadas, mantidas vivas apenas por hábito. Isso significa PHP 8.4 limpo no backend, onde uma aplicação clássica renderizada no servidor é a escolha certa, JavaScript moderno onde a interatividade importa, e MySQL 8 para dados que precisam de permanecer consistentes e pesquisáveis ao longo dos anos — não apenas nos primeiros seis meses após o lançamento. Cada projeto é planeado desde o primeiro esboço igualmente para desktop e dispositivos móveis, não adaptado posteriormente: os tempos de carregamento, os pontos de quebra de layout, e a interação tátil fazem parte da especificação, não um acréscimo posterior.

Para além da interface visível, importa-nos como um website é por dentro: código legível, um esquema de base de dados que não precisa de ser reconstruído a cada novo pedido de funcionalidade, e passos de implementação que um segundo programador também consegue seguir sem perguntas. Um website que é hoje performante e que daqui a três anos ainda pode ser expandido de forma limpa é, para nós, a verdadeira definição de "moderno".

03 — AI / COCO

COCO — o nosso próprio servidor de IA para testes automatizados de software

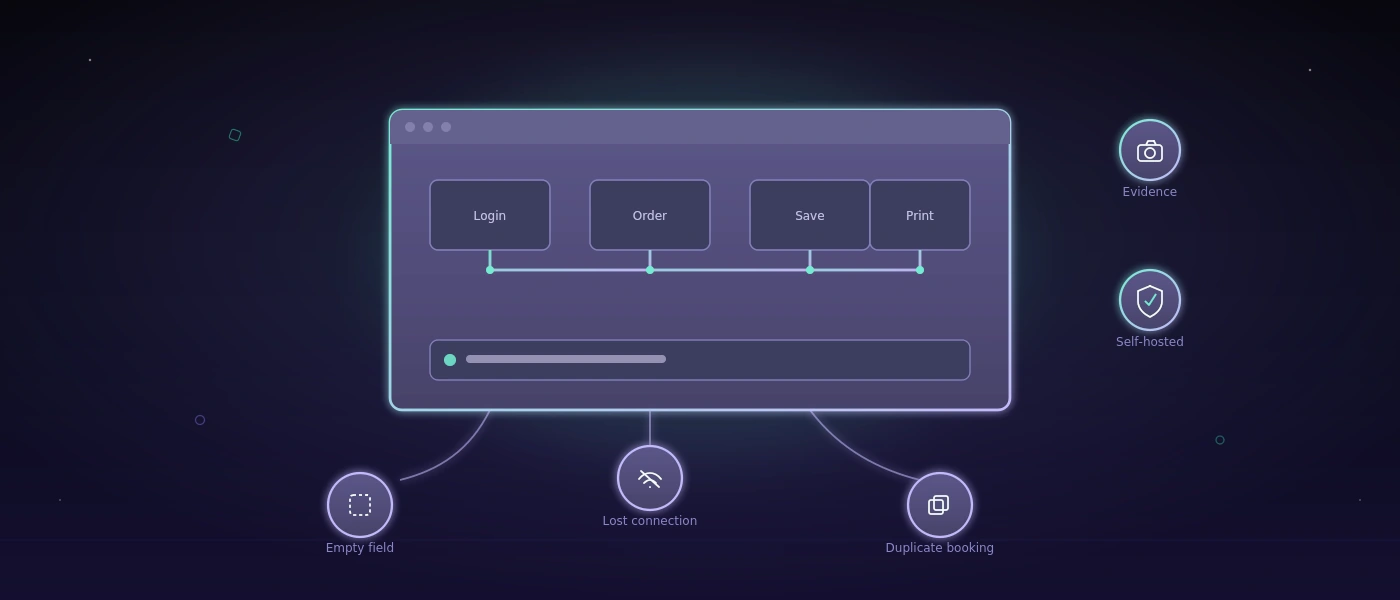
Para clientes enterprise, operamos e mantemos o nosso próprio servidor de IA dedicado chamado COCO. Ao contrário de um chatbot genérico, incorporado posteriormente a um fluxo de trabalho, a COCO foi concebida de forma direcionada e alojada autonomamente para o teste automatizado de aplicações web, bem como aplicações de secretária multiplataforma — desde processos de login e autenticação até processos de negócio completos e multietapas.

A COCO planeia um cenário de teste, executa-o contra a aplicação real, captura capturas de ecrã antes e depois como evidência, e cria uma avaliação compreensível do que funcionou, o que falhou, e porquê — incluindo casos extremos como logins falhados repetidos, bloqueios de conta, e processos de recuperação, que são trabalhosos e propensos a erros quando testados manualmente. Como o servidor funciona localmente e sob a nossa gestão, os clientes enterprise mantêm controlo total sobre onde os dados de teste e as capturas de ecrã são armazenados, sem enviar por defeito o tráfego interno da aplicação para um serviço de cloud de terceiros não relacionado.

Configuramos a COCO individualmente para cada cliente enterprise, configuramos e mantemos o servidor — definimos os planos de teste relevantes para a aplicação em questão, ajustamos os limiares de confiança, e decidimos caso a caso quando um resultado deve ser escalado para revisão humana. O objetivo não é substituir uma equipa de QA, mas dar-lhe uma colega incansável que percorre os testes de regressão repetitivos antes de cada lançamento, antes de um humano sequer precisar de intervir.

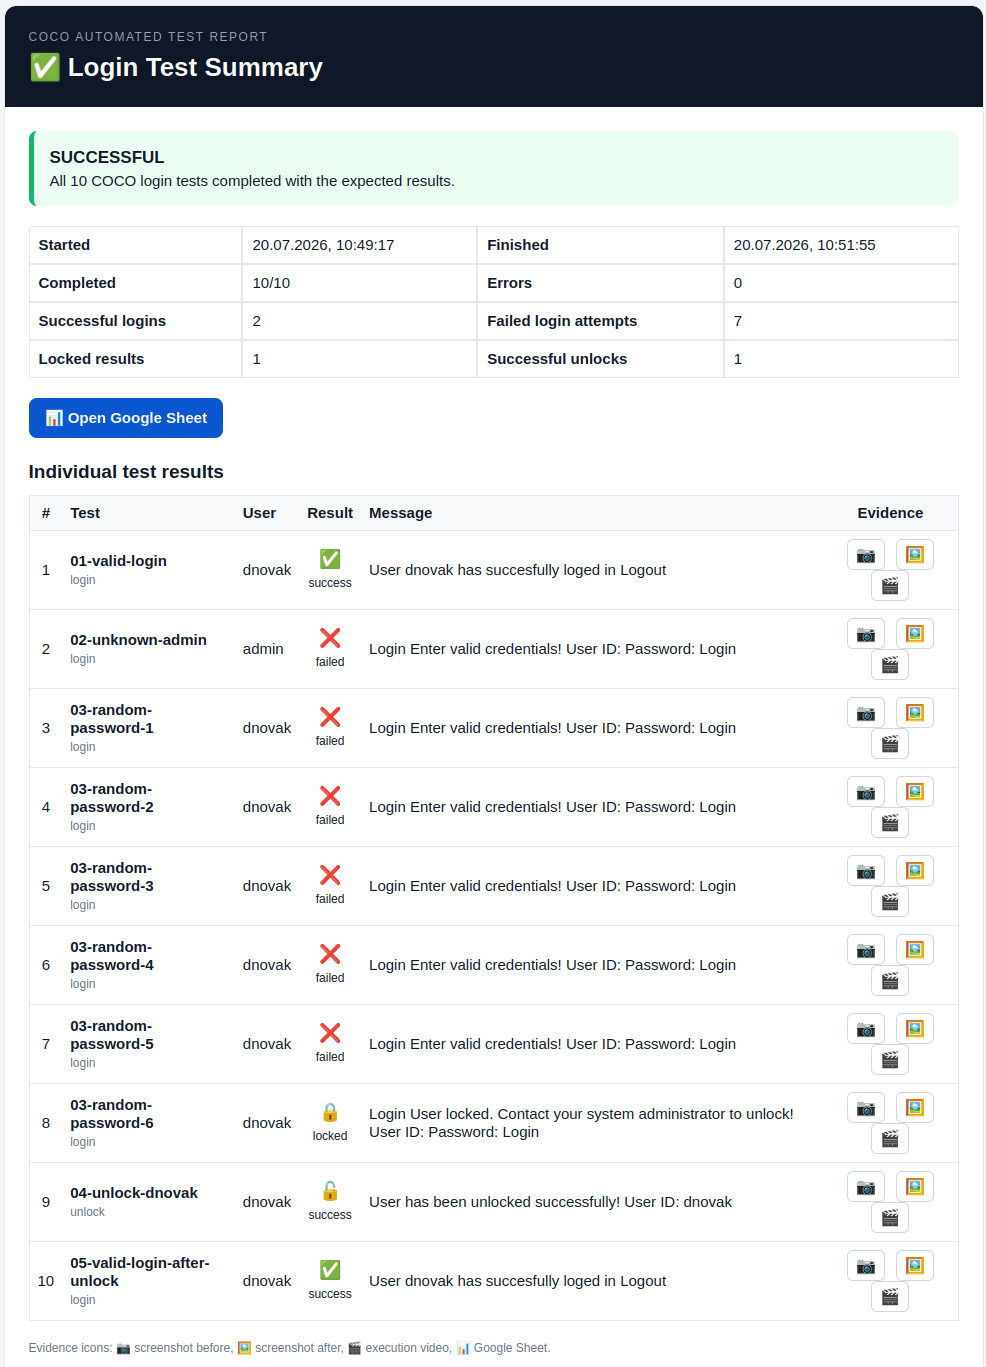
COCO automated login test report
COCO — automated login & account-lockout test report
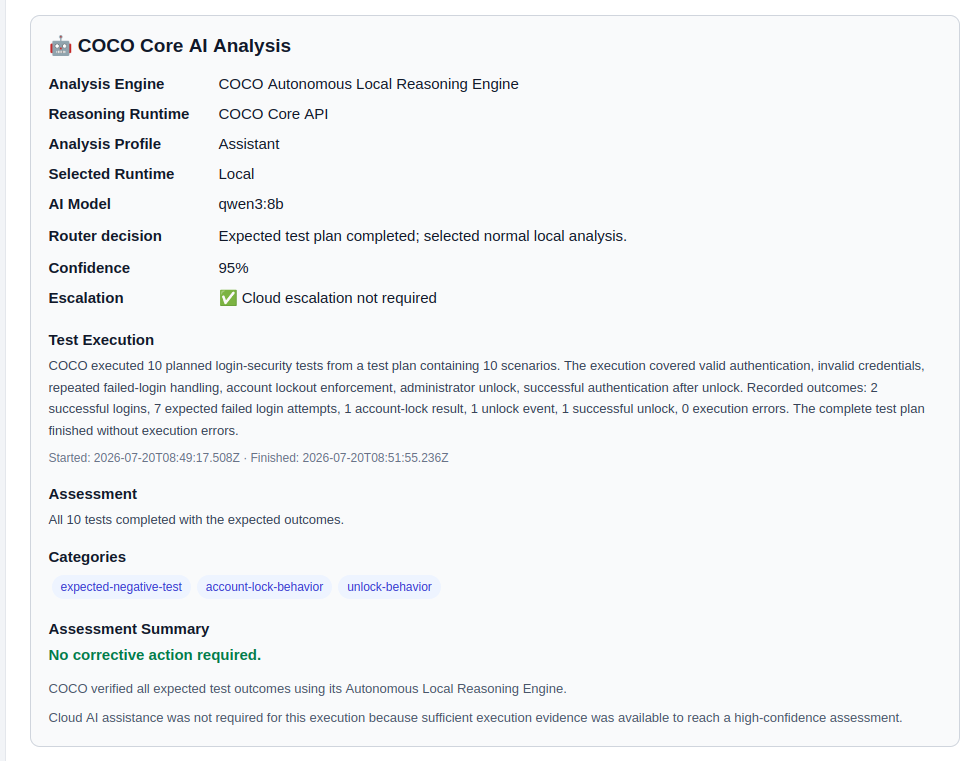
COCO AI analysis panel
COCO — plain-language AI analysis of a completed test run

Porquê a softify.pro

Mantemo-nos deliberadamente pequenos, para que cada projeto seja conduzido por pessoas que já estiveram presentes na primeira reunião de planeamento — em vez de ser transferido para uma fila de espera. Isto significa ciclos de feedback mais curtos, menos mal-entendidos, e uma equipa que, mesmo seis meses depois, ainda se lembra porque é que uma determinada decisão foi tomada. Preferimos uma fiabilidade discreta e comprovável a tendências passageiras: escolhemos uma stack tecnológica porque se adequa ao problema e pode ser mantida por outra pessoa daqui a cinco anos — não porque estava na moda no sprint atual. Se uma folha de Excel realmente cumprir melhor a tarefa do que software personalizado, diremos isso com honestidade. O nosso objetivo é um fluxo de trabalho que funcione verdadeiramente mais rápido — não simplesmente uma fatura de software mais elevada.

Trabalhos selecionados

Uma pequena seleção de trabalhos que podemos mostrar publicamente — apresentamos mais casos de estudo e projetos enterprise a pedido, sob NDA.

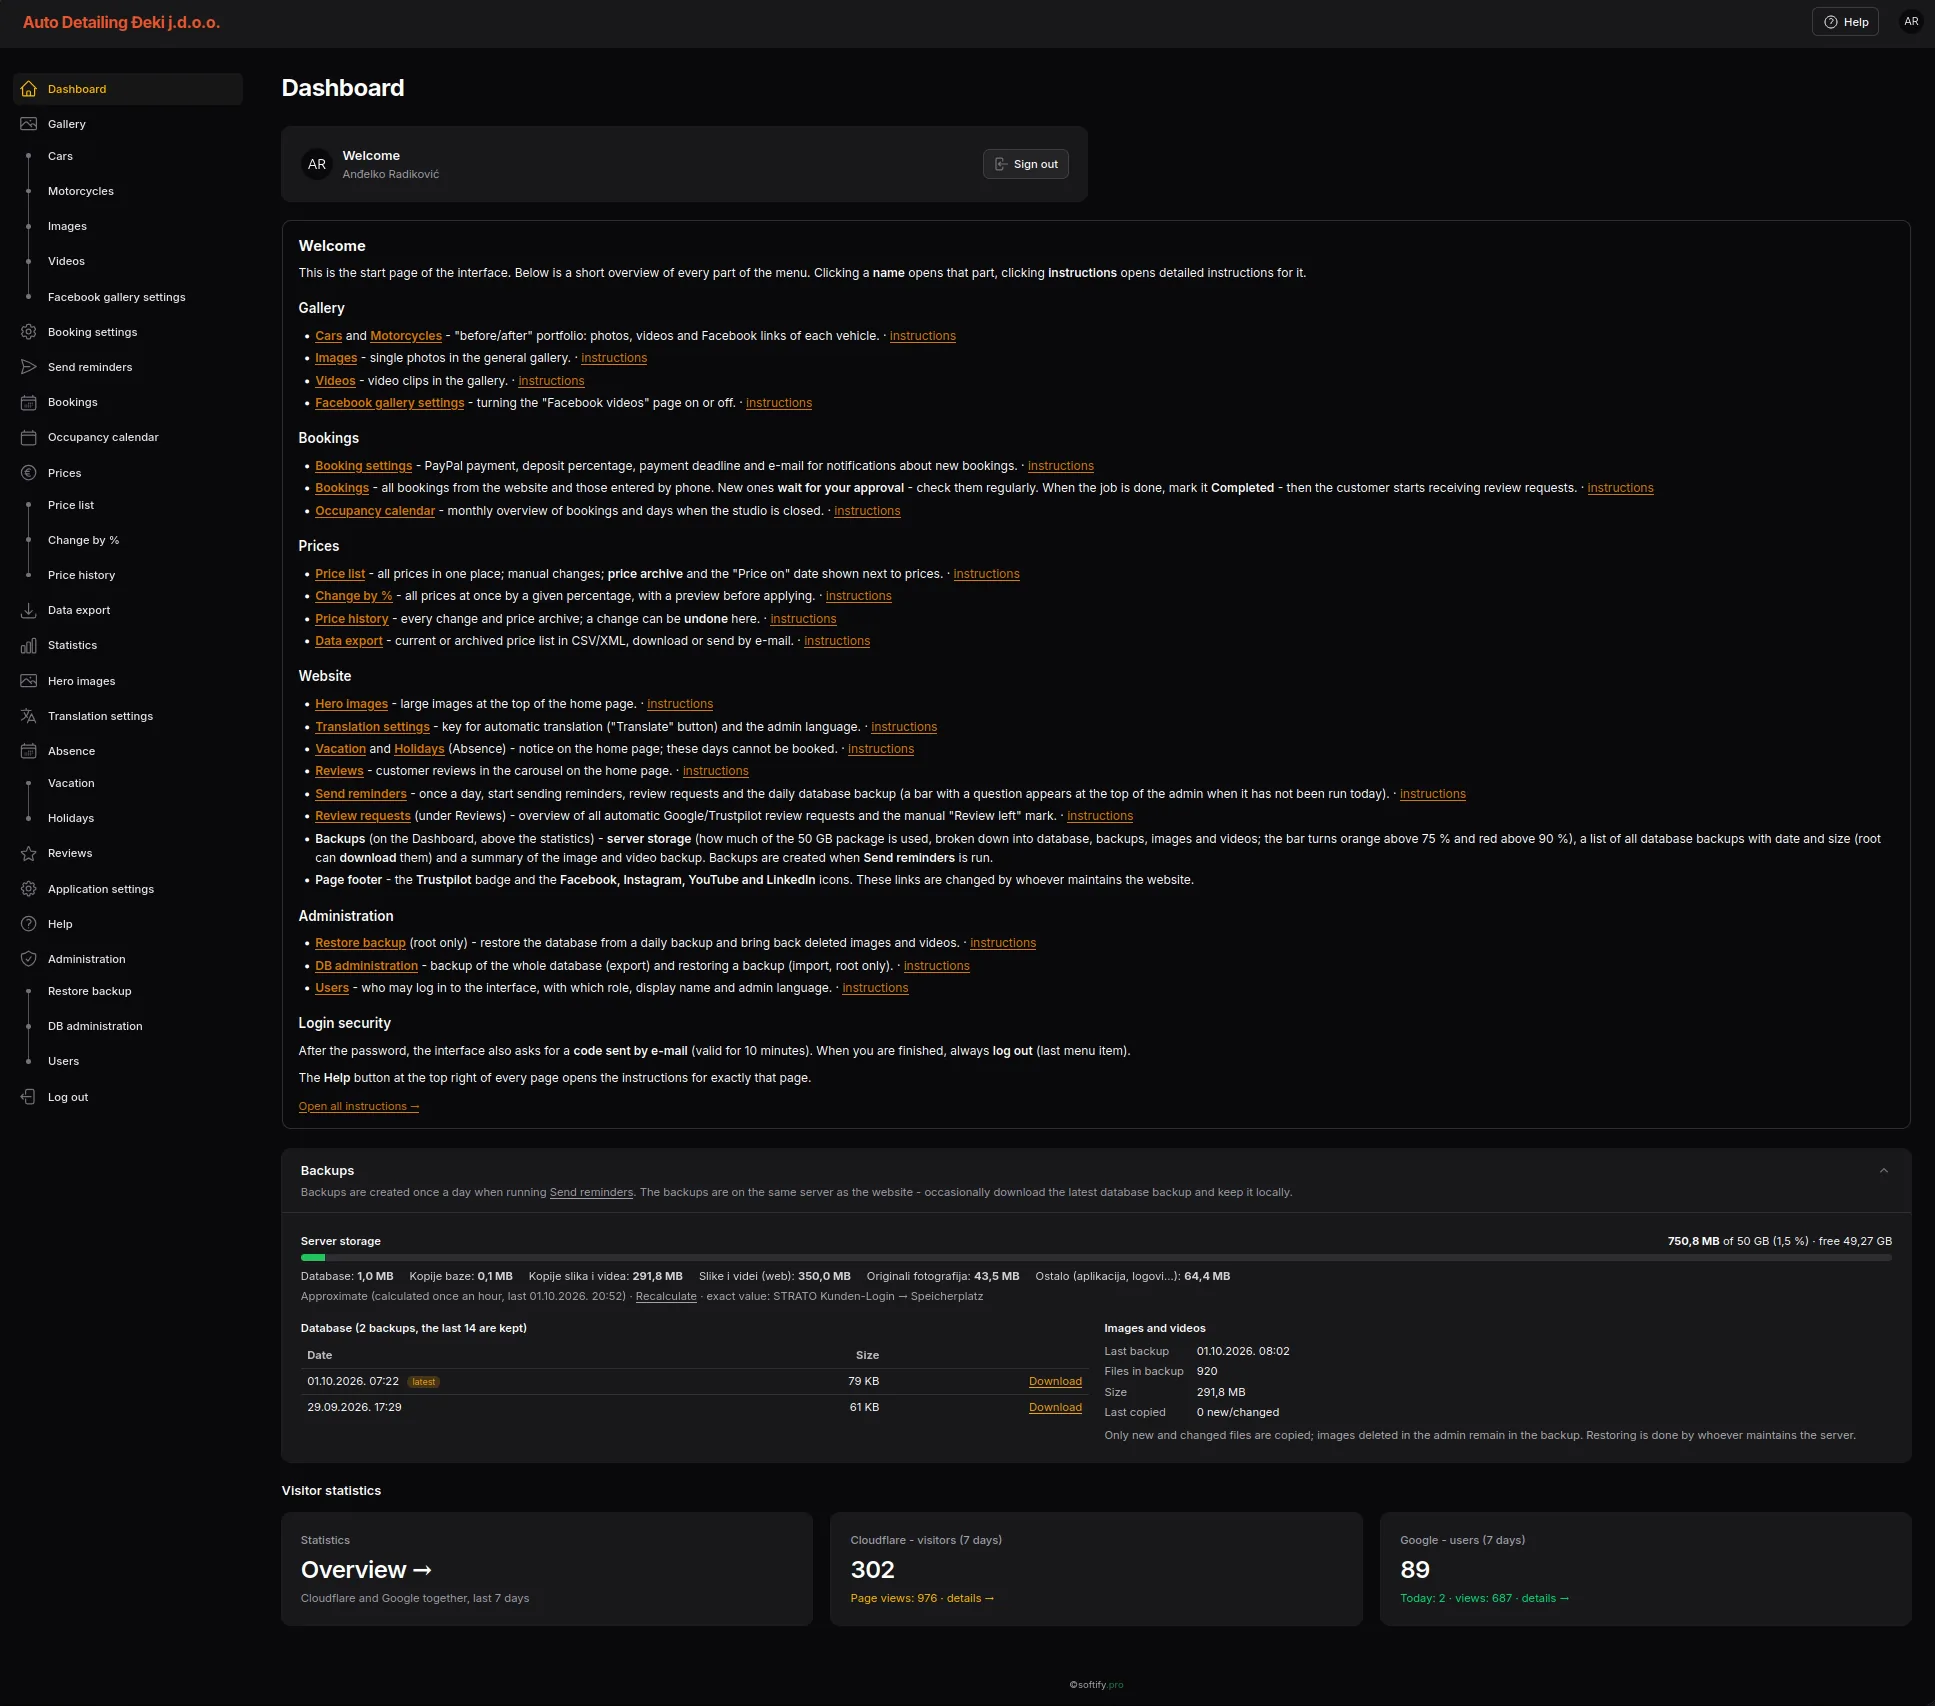
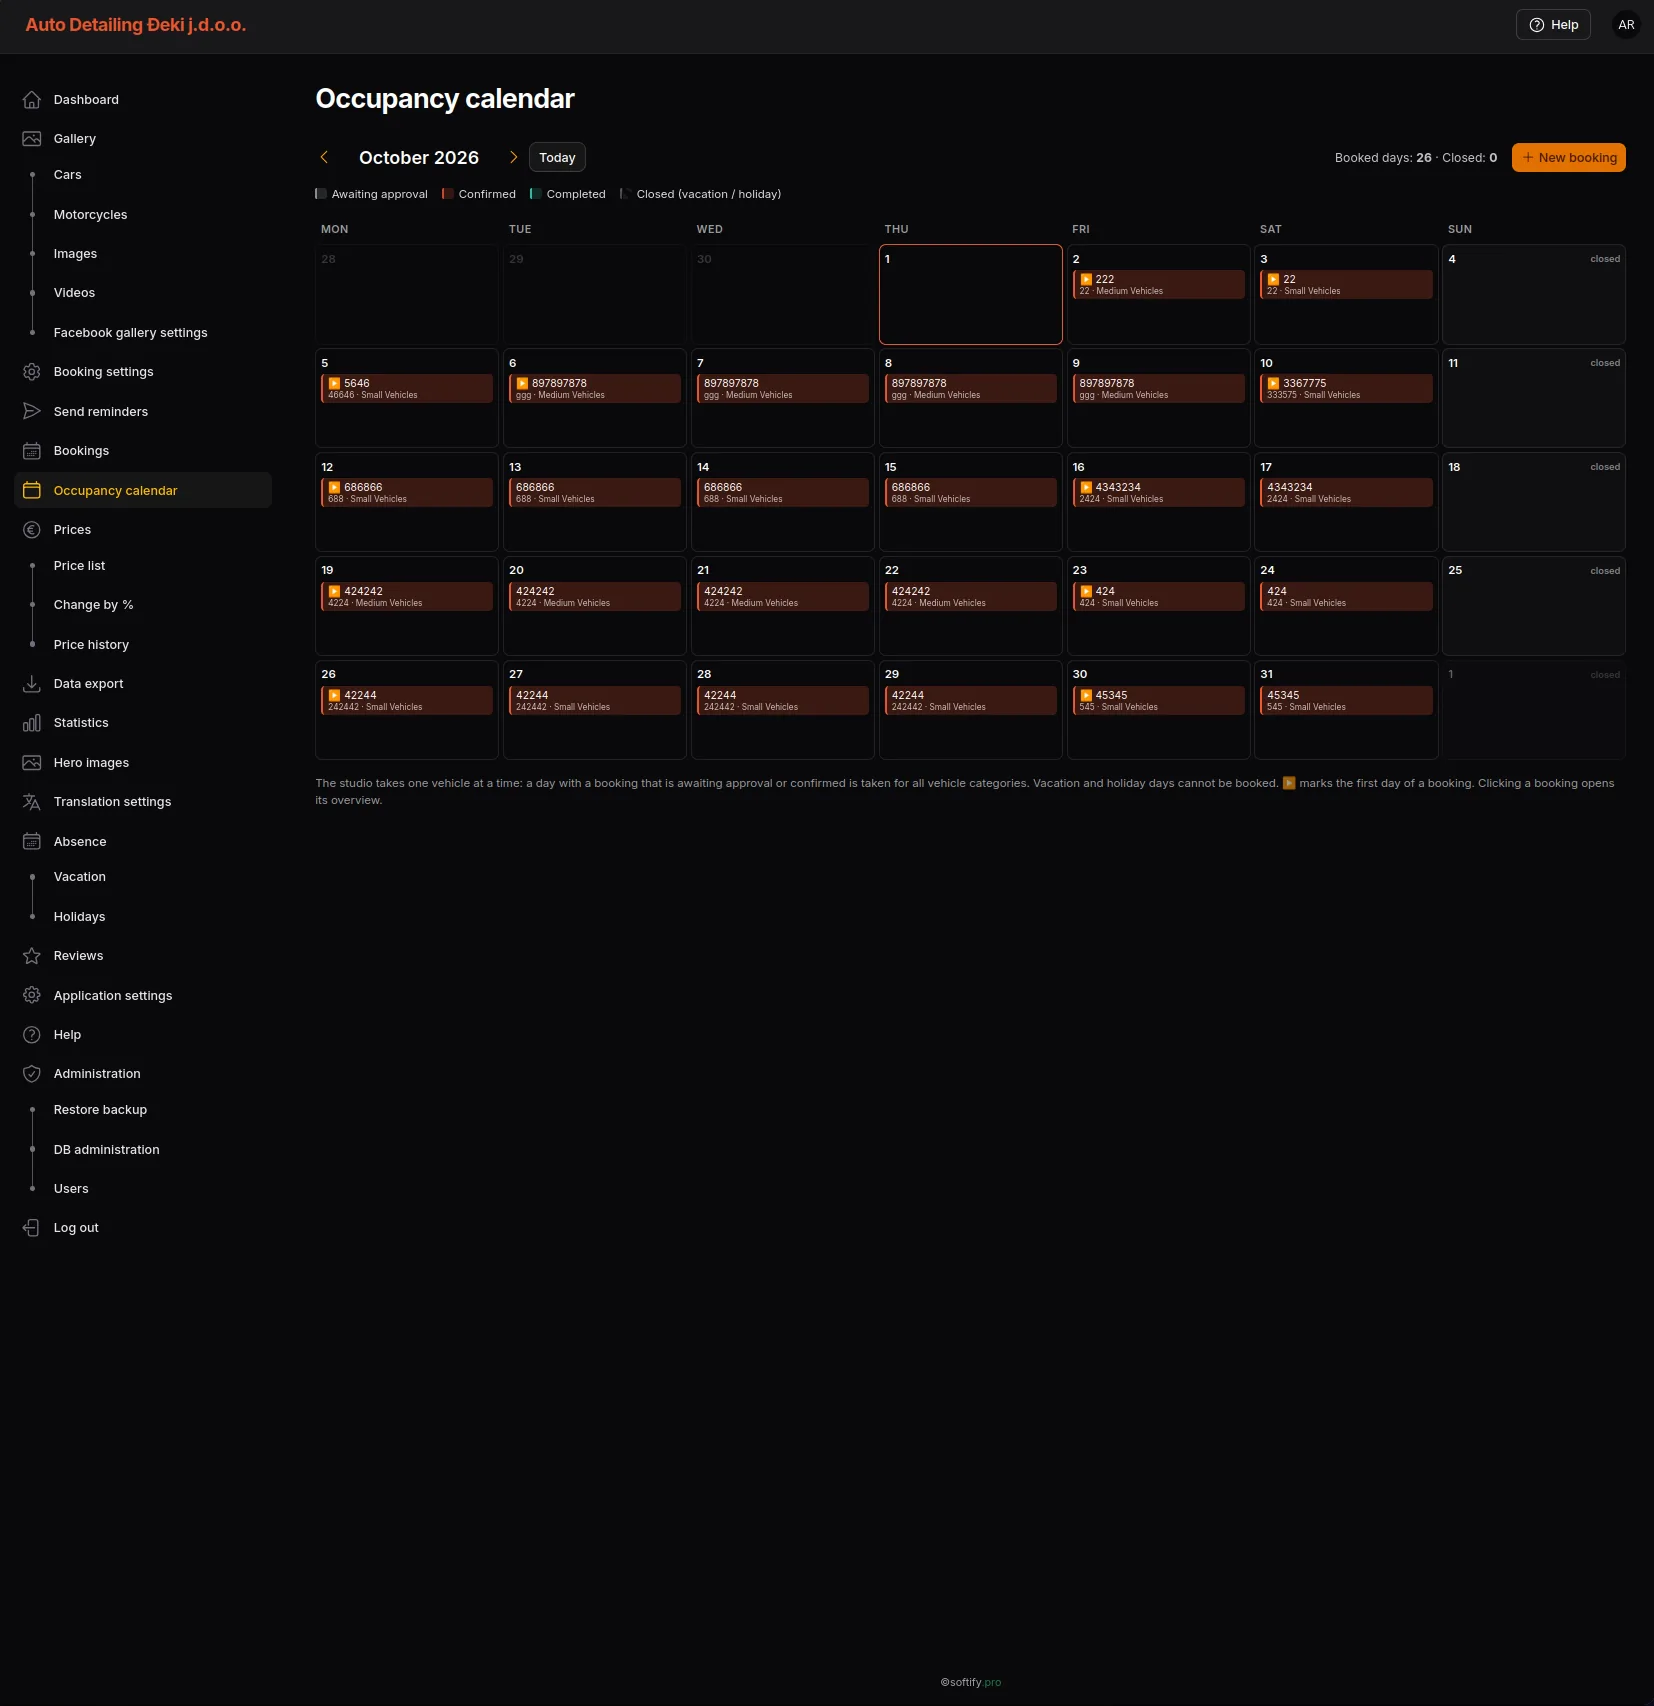
Auto Detailing Đeki – Do site a uma plataforma de serviços digital autodetailing-deki.pro

Auto Detailing Đeki – Do site a uma plataforma de serviços digital

Plataforma multilingue para detailing automóvel – desde o cálculo do preço, passando pela reserva, até ao acompanhamento transparente das encomendas, gerida a partir de um back office central.

Koralpenhaus

Koralpenhaus

Website regional de apresentação e reservas na região alpina, construído com foco numa estrutura clara, carregamento rápido, e manutenção fácil de conteúdo.

Dexosano

Dexosano

Uma plataforma web moderna baseada em PHP, desenvolvida com a mesma abordagem que prioriza o desempenho que a softify.pro aplica em cada projeto de cliente.

softify.pro - Insiders

Um armazém. Uma verdade.

Um armazém. Uma verdade.

Há uma forma simples de fazer um software de armazém parecer convincente.
Abrir um painel.
Mostrar alguns números a verde.
Adicionar um gráfico.
Colocar algum stock num mapa do armazém.
Terminar com um relatório.
Tudo parece estar bem.
E, ainda assim, tudo pode estar errado.
Porque a um armazém não interessa quão bonito o painel parece.
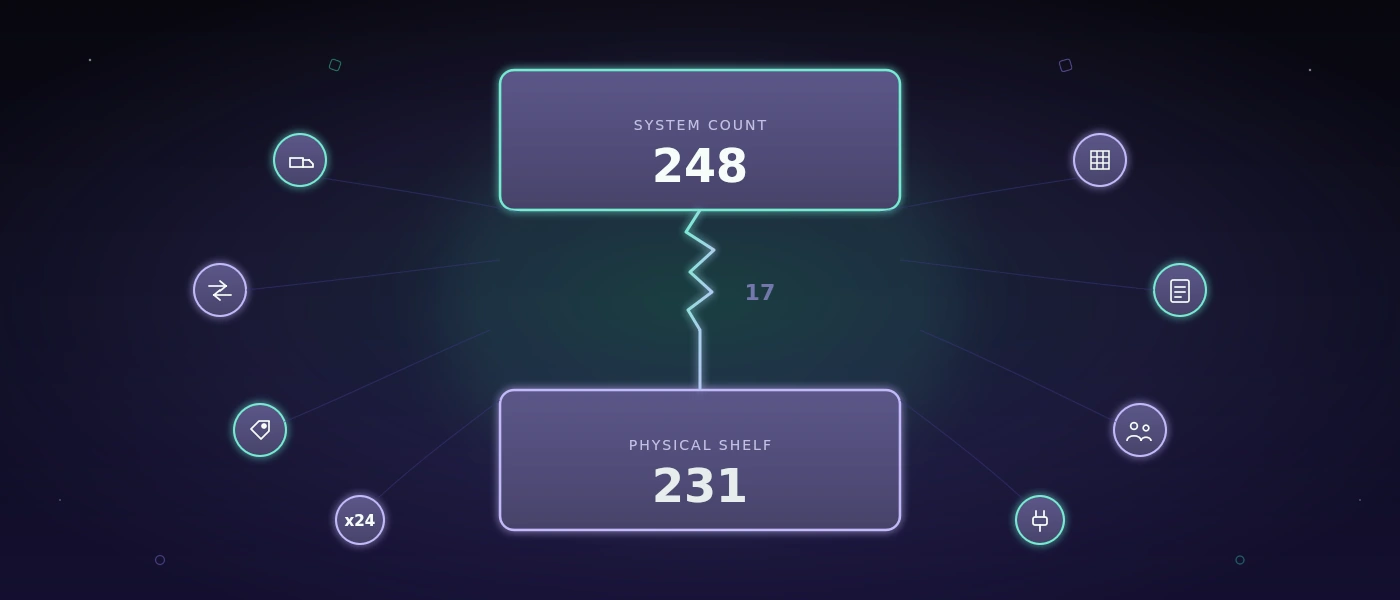
Interessa-lhe se cada parte do sistema concorda sobre o que realmente aconteceu.
Isso tornou-se a parte interessante da mais recente experiência softify.pro Flow.
Não outro ecrã.
Não outro KPI.
Não outro relatório.
Algo muito menos visível.
Consistência.
Começou com um armazém.
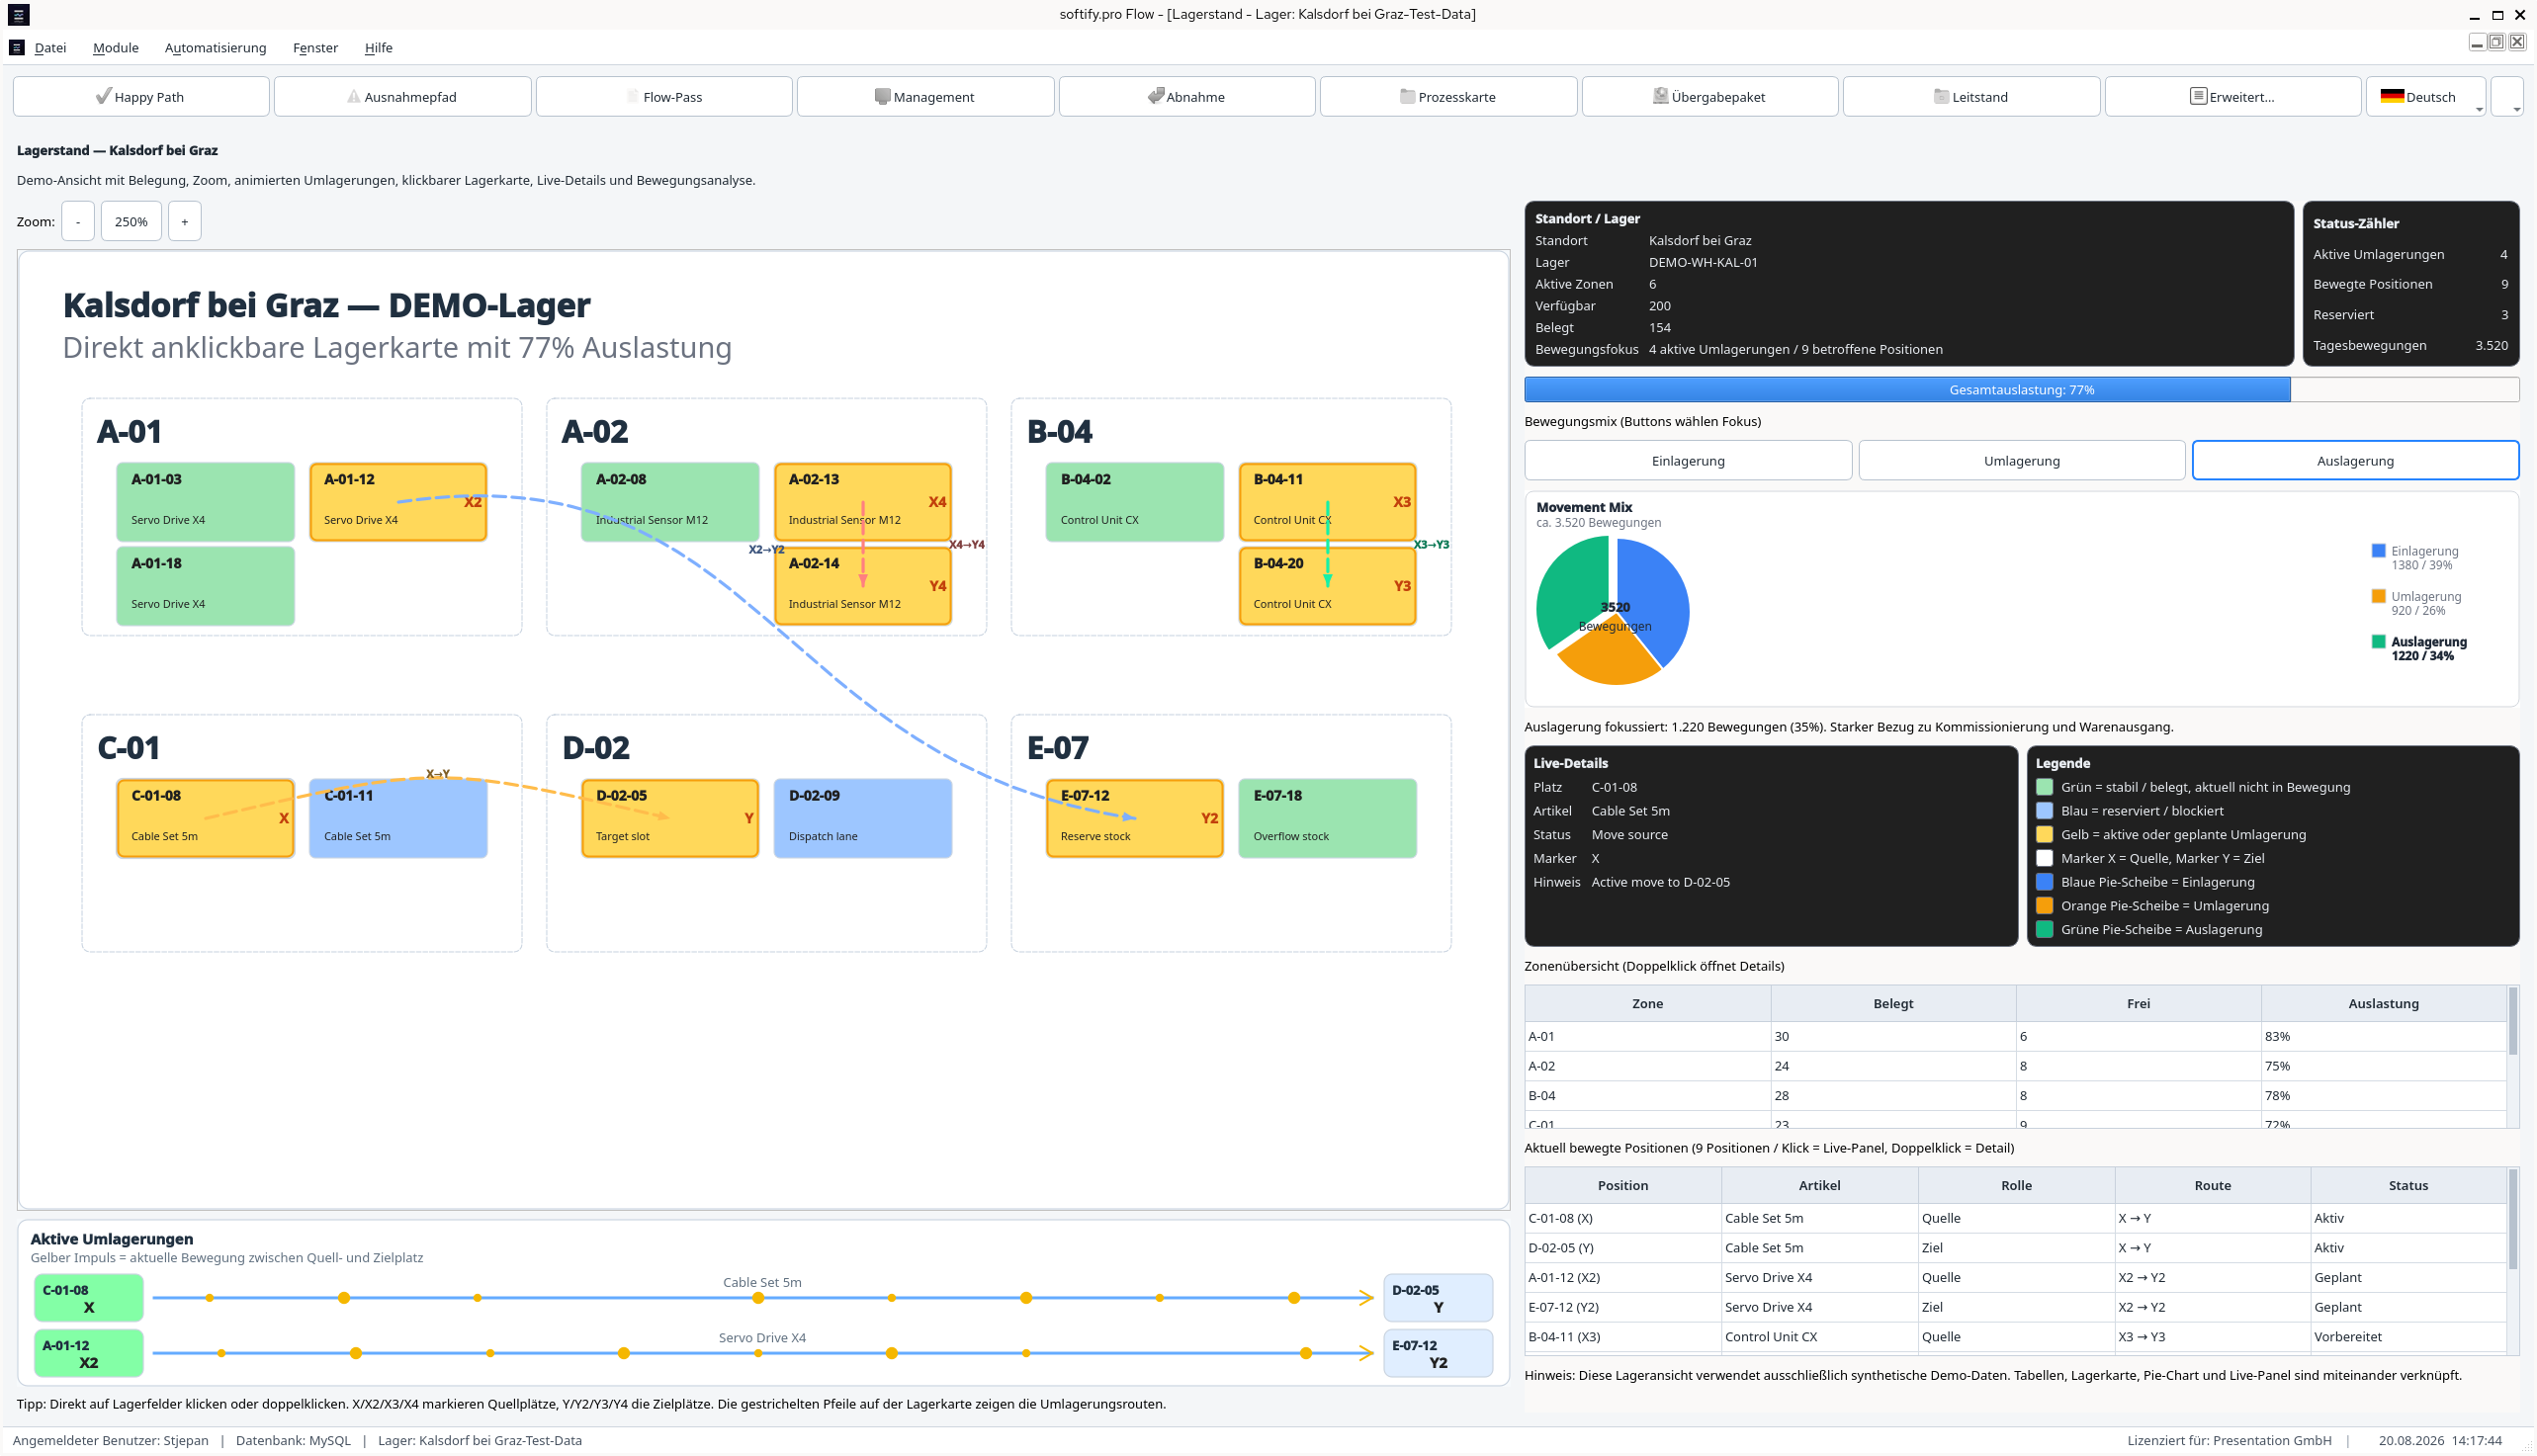
A demo atual do softify.pro Flow funciona com vários ambientes de armazém sintéticos.
Diferentes IDs de armazém.
Diferentes capacidades.
Diferentes estruturas de zona.
Sem inventário de produção.
Sem dados de clientes.
Sem informação operacional real.
Mas a lógica do processo comporta-se como se tudo isso importasse.
Porque na logística real, importa.
Assim que um armazém é selecionado, esse contexto torna-se parte de tudo o que se segue.
Flows.
SSCCs.
Movimentos.
Operadores.
Analytics.
Relatórios.
Isso soa óbvio.
Torna-se consideravelmente menos óbvio quando o mesmo processo começa a aparecer em várias partes diferentes da aplicação.
Depois abrimos outra vista.
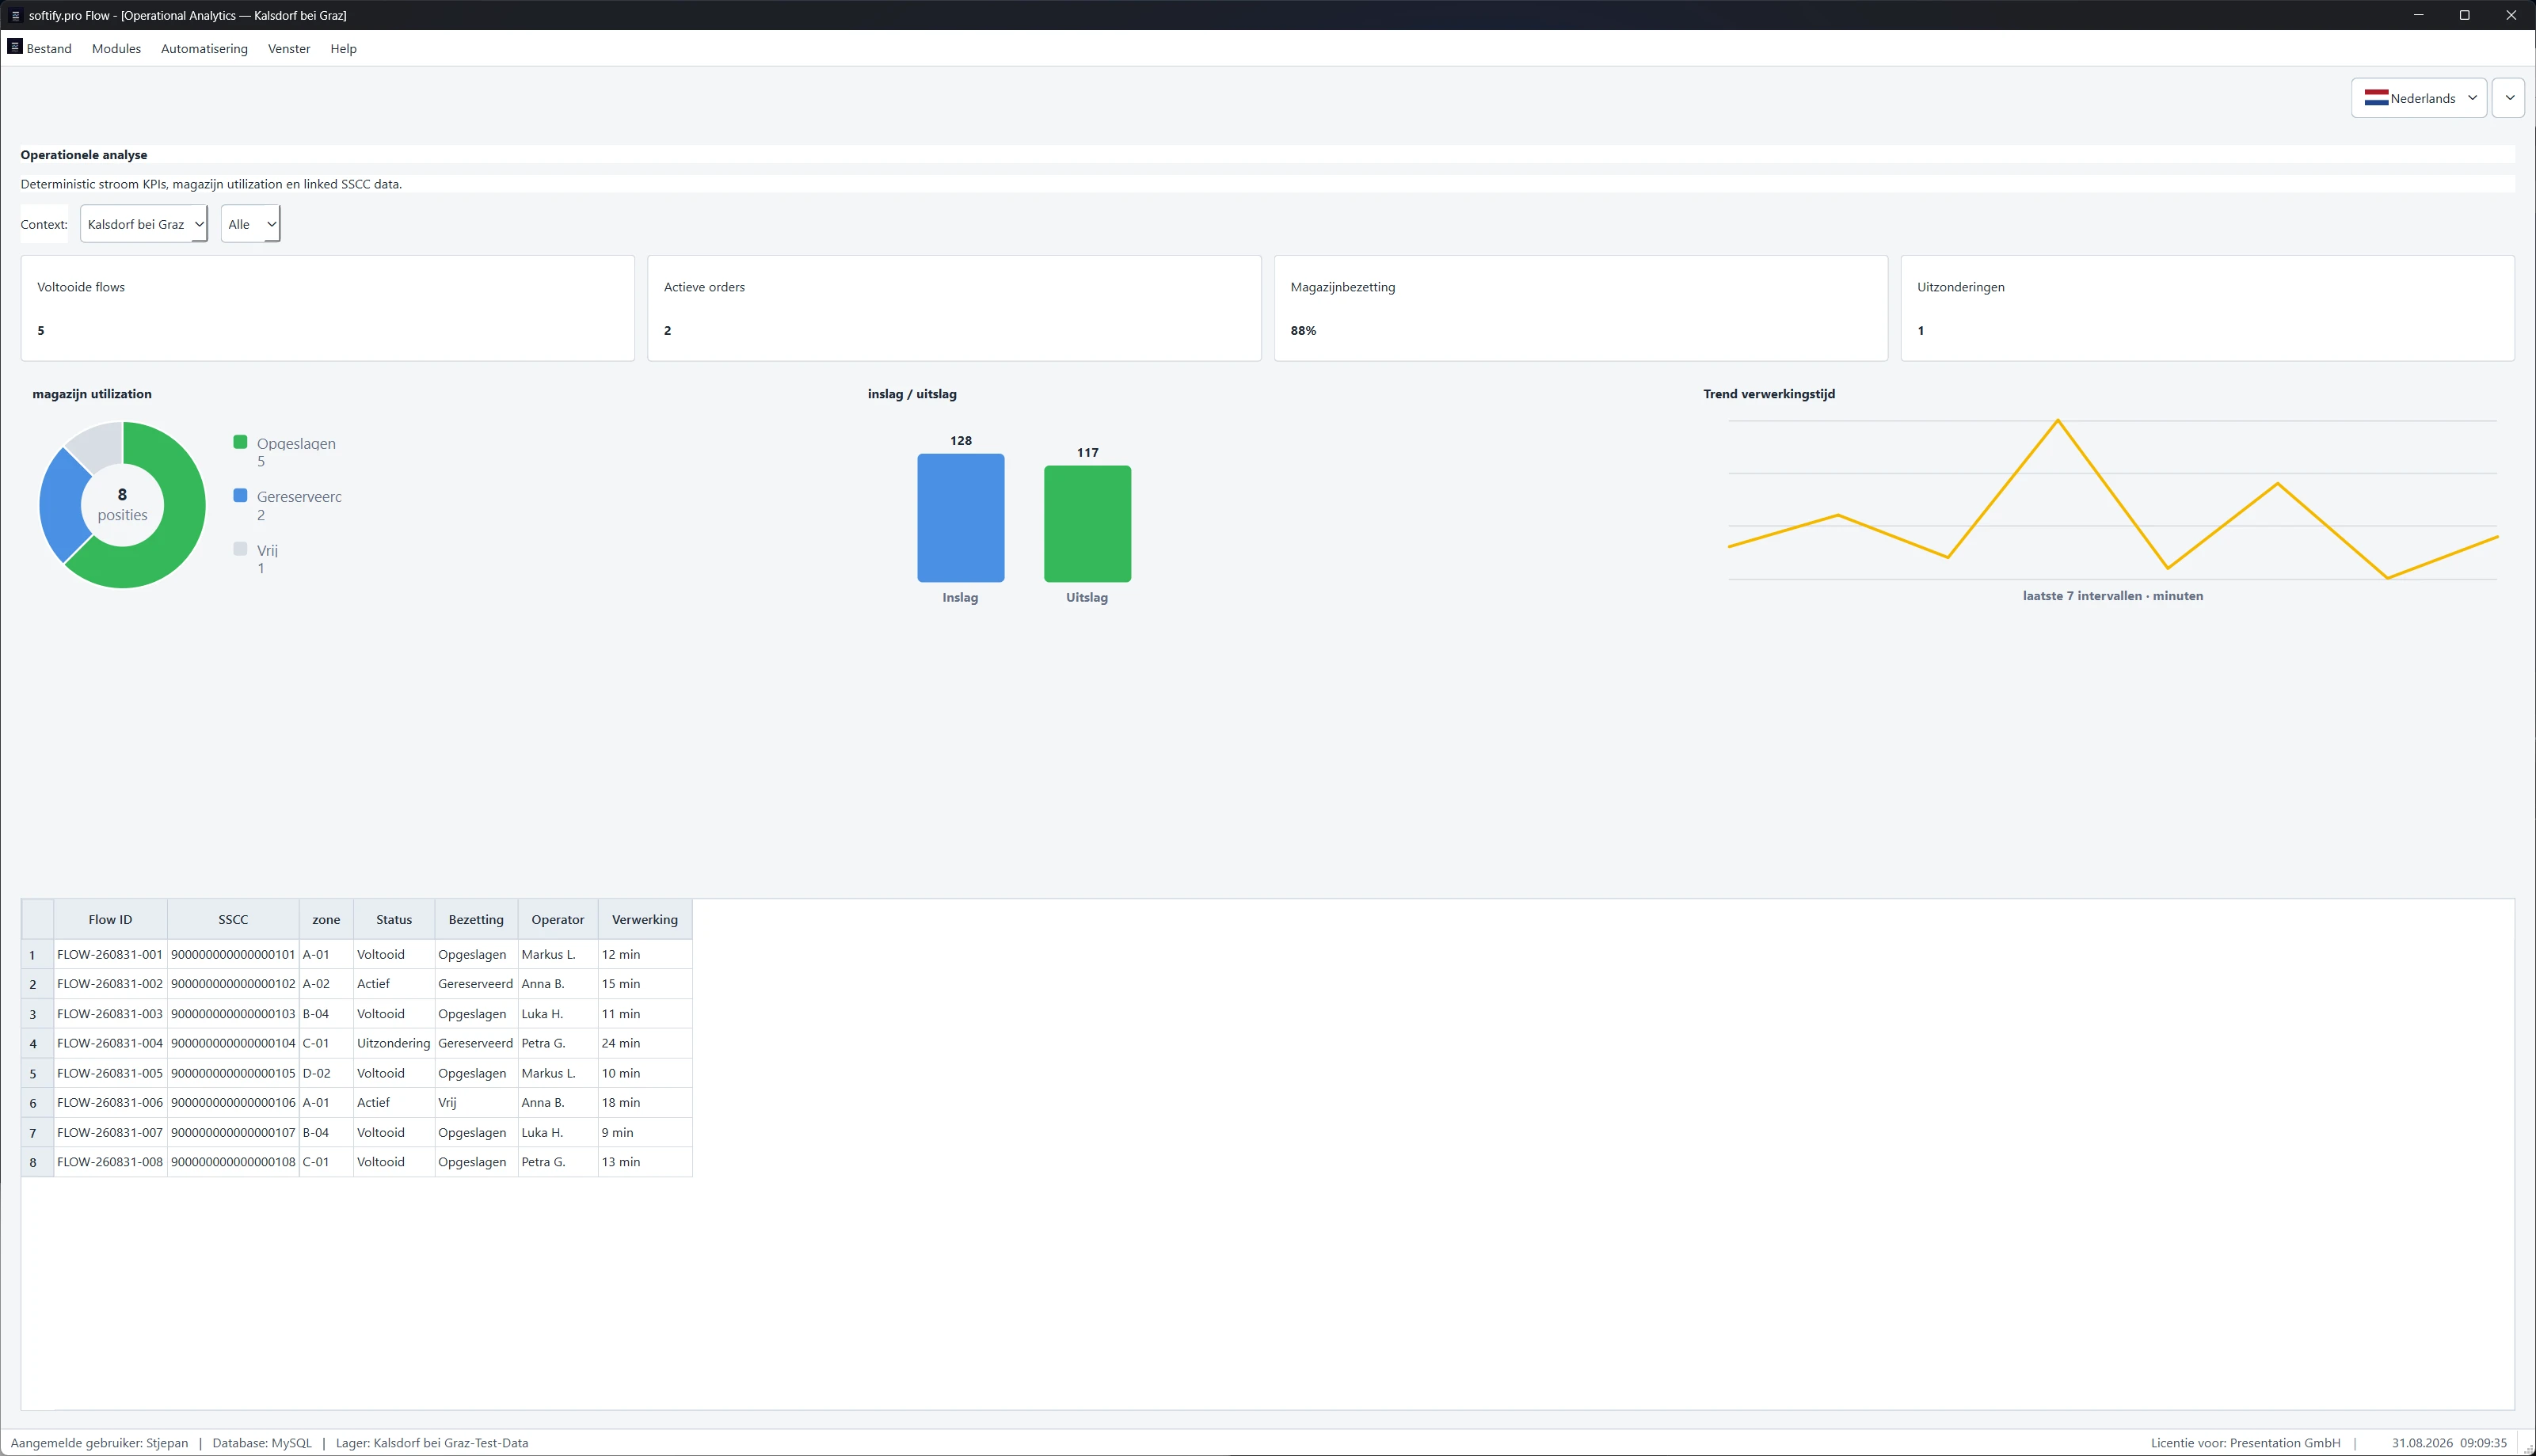
Operational Analytics.
De repente, o armazém parecia completamente diferente.
Sem posições de armazenamento.
Sem setas de movimento.
Em vez disso:

  • Flows concluídos,
  • encomendas ativas,
  • utilização do armazém,
  • exceções,
  • entradas,
  • saídas,
  • tempo de processamento.

A representação visual tinha mudado.
O armazém não.
Essa distinção tornou-se importante.
Porque por baixo dos KPIs continuavam a existir registos individuais.
IDs de Flow.
SSCCs.
Zonas.
Estados.
Operadores.
Tempos de processamento.
Vista diferente.
Mesma realidade operacional.
Até aqui, tudo bem.

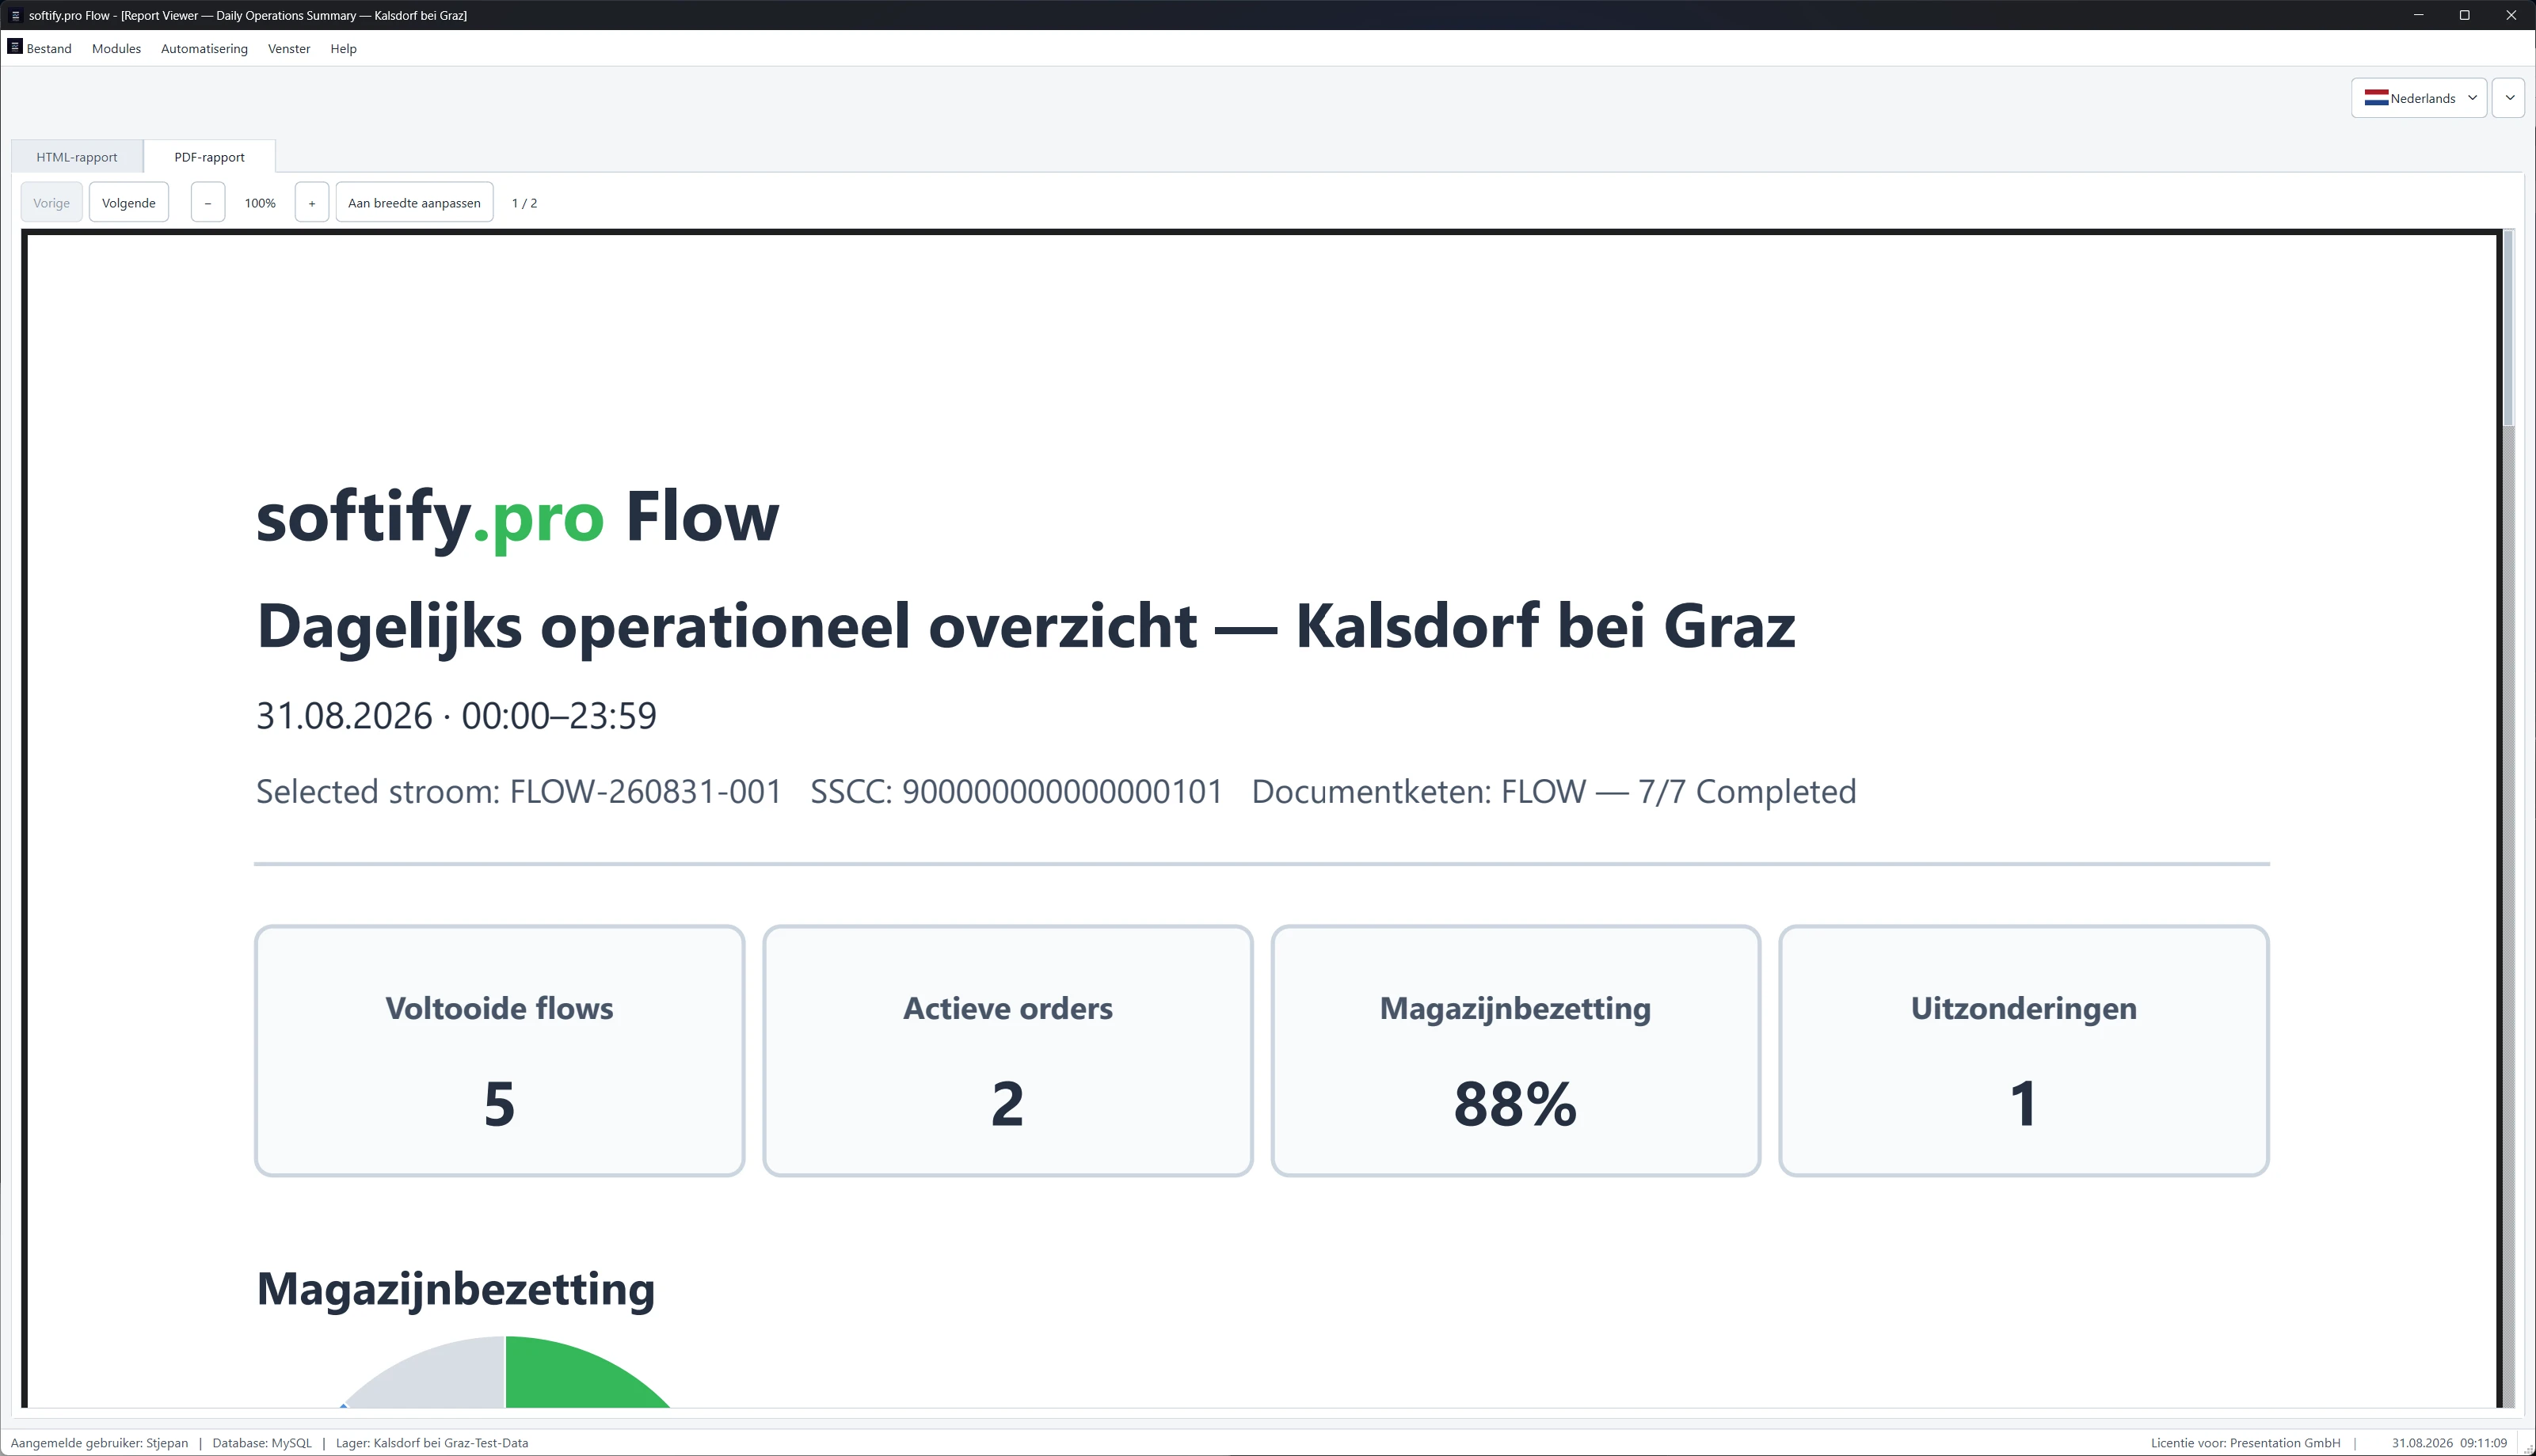
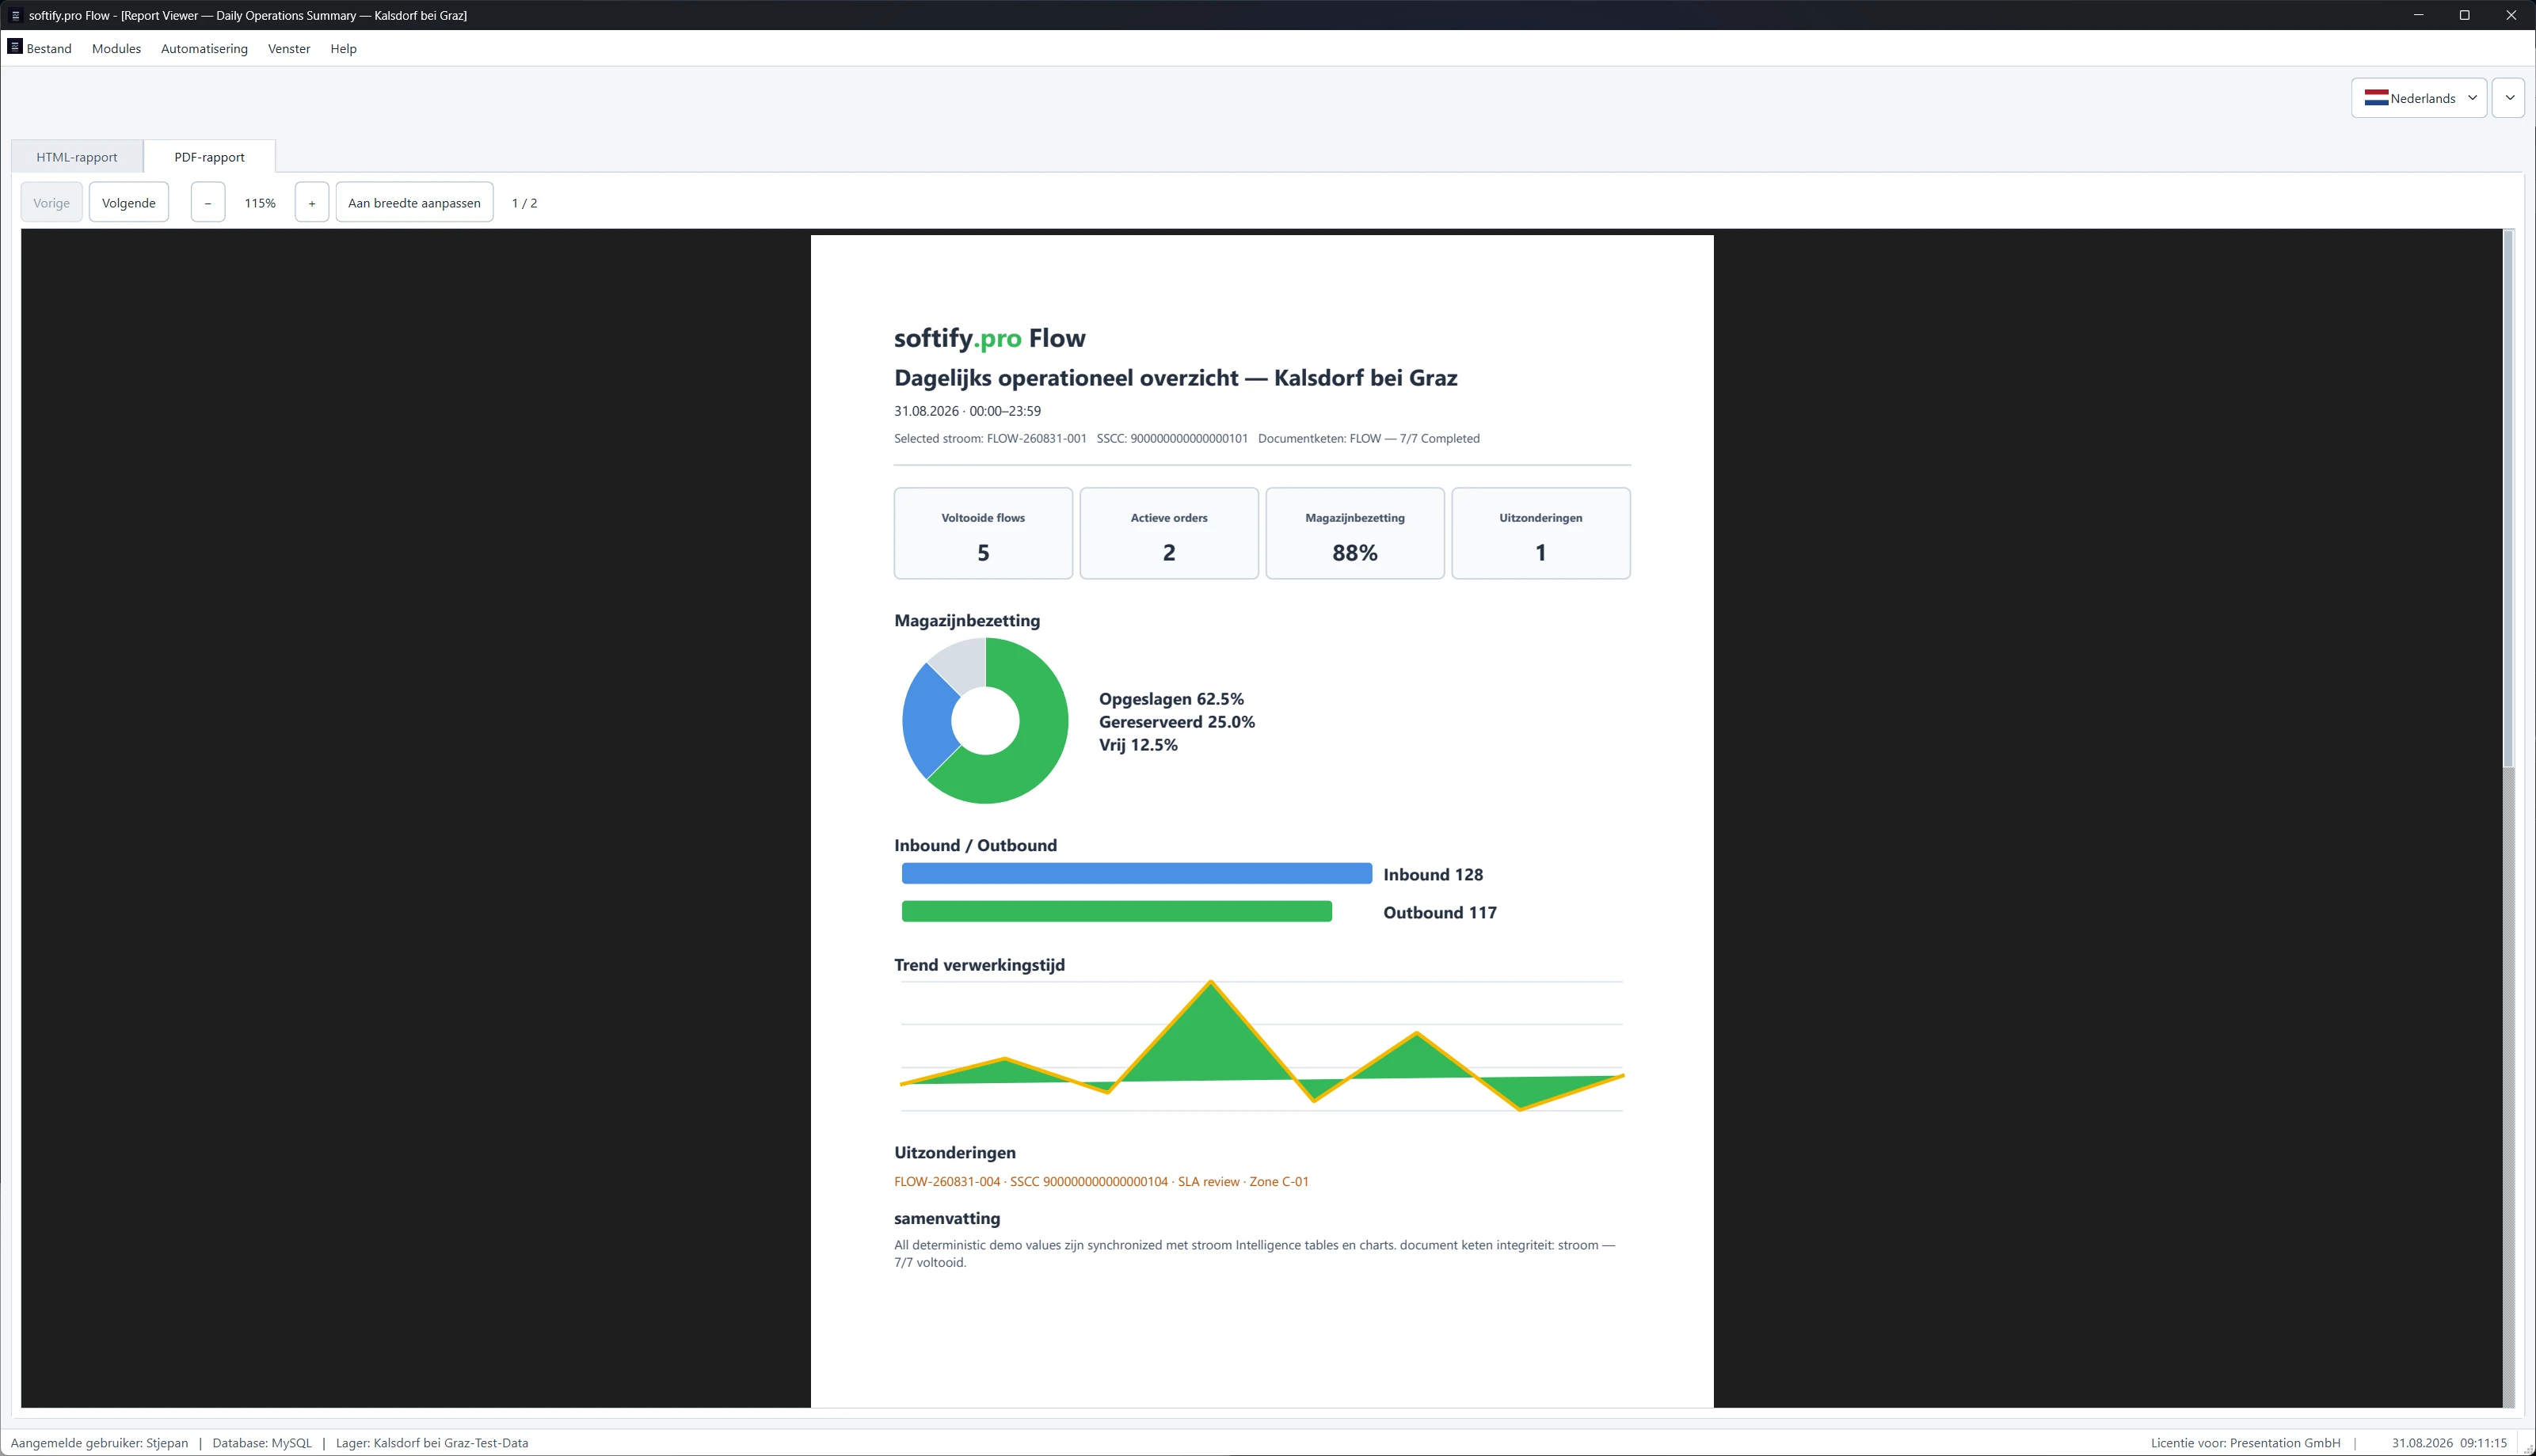
Operational Analytics — estado agregado do armazém, com os registos Flow subjacentes ainda visíveis.

Flow.

88% só é útil se o sistema o conseguir explicar.
Suponhamos que o painel diz:
Utilização do armazém: 88%.
Útil.
Mas incompleto.
Algumas posições estão ocupadas.
Algumas estão reservadas.
Algumas permanecem livres.
Esses estados não são intermutáveis.
O número só se torna fiável se o sistema ainda conseguir explicar de onde veio.
Cinco Flows concluídos?
Mostre-os.
Duas encomendas ativas?
Mostre-as.
Uma exceção?
Qual?
88% de utilização?
O que está ocupado?
O que está reservado?
O que permanece livre?
Um painel deve resumir a realidade.
Não deve substituí-la.
Depois mudámos o idioma.
Neerlandês.
O armazém permaneceu o mesmo.
Os IDs de Flow permaneceram os mesmos.
Os SSCCs permaneceram os mesmos.
Os operadores permaneceram associados aos seus registos.
Só o idioma mudou.
Mais tarde, o mesmo estado operacional apareceu em croata.
Depois em francês.
É aqui que o software multilingue se torna muito mais interessante do que botões traduzidos.
Uma má tradução é fácil de notar.
Uma mudança de estado causada por uma mudança de idioma é muito mais perigosa.
Imagine mudar de alemão para francês e perder silenciosamente o Flow selecionado.
Ou reconstruir um filtro contra o armazém errado.
Ou mostrar o SSCC correto dentro do contexto de processo errado.
A interface pode continuar a parecer perfeita.
O sistema não seria.
Por isso, o Flow segue uma regra simples:
O idioma pode mudar as palavras. Não pode mudar a verdade.
Depois o Flow adquiriu um histórico.
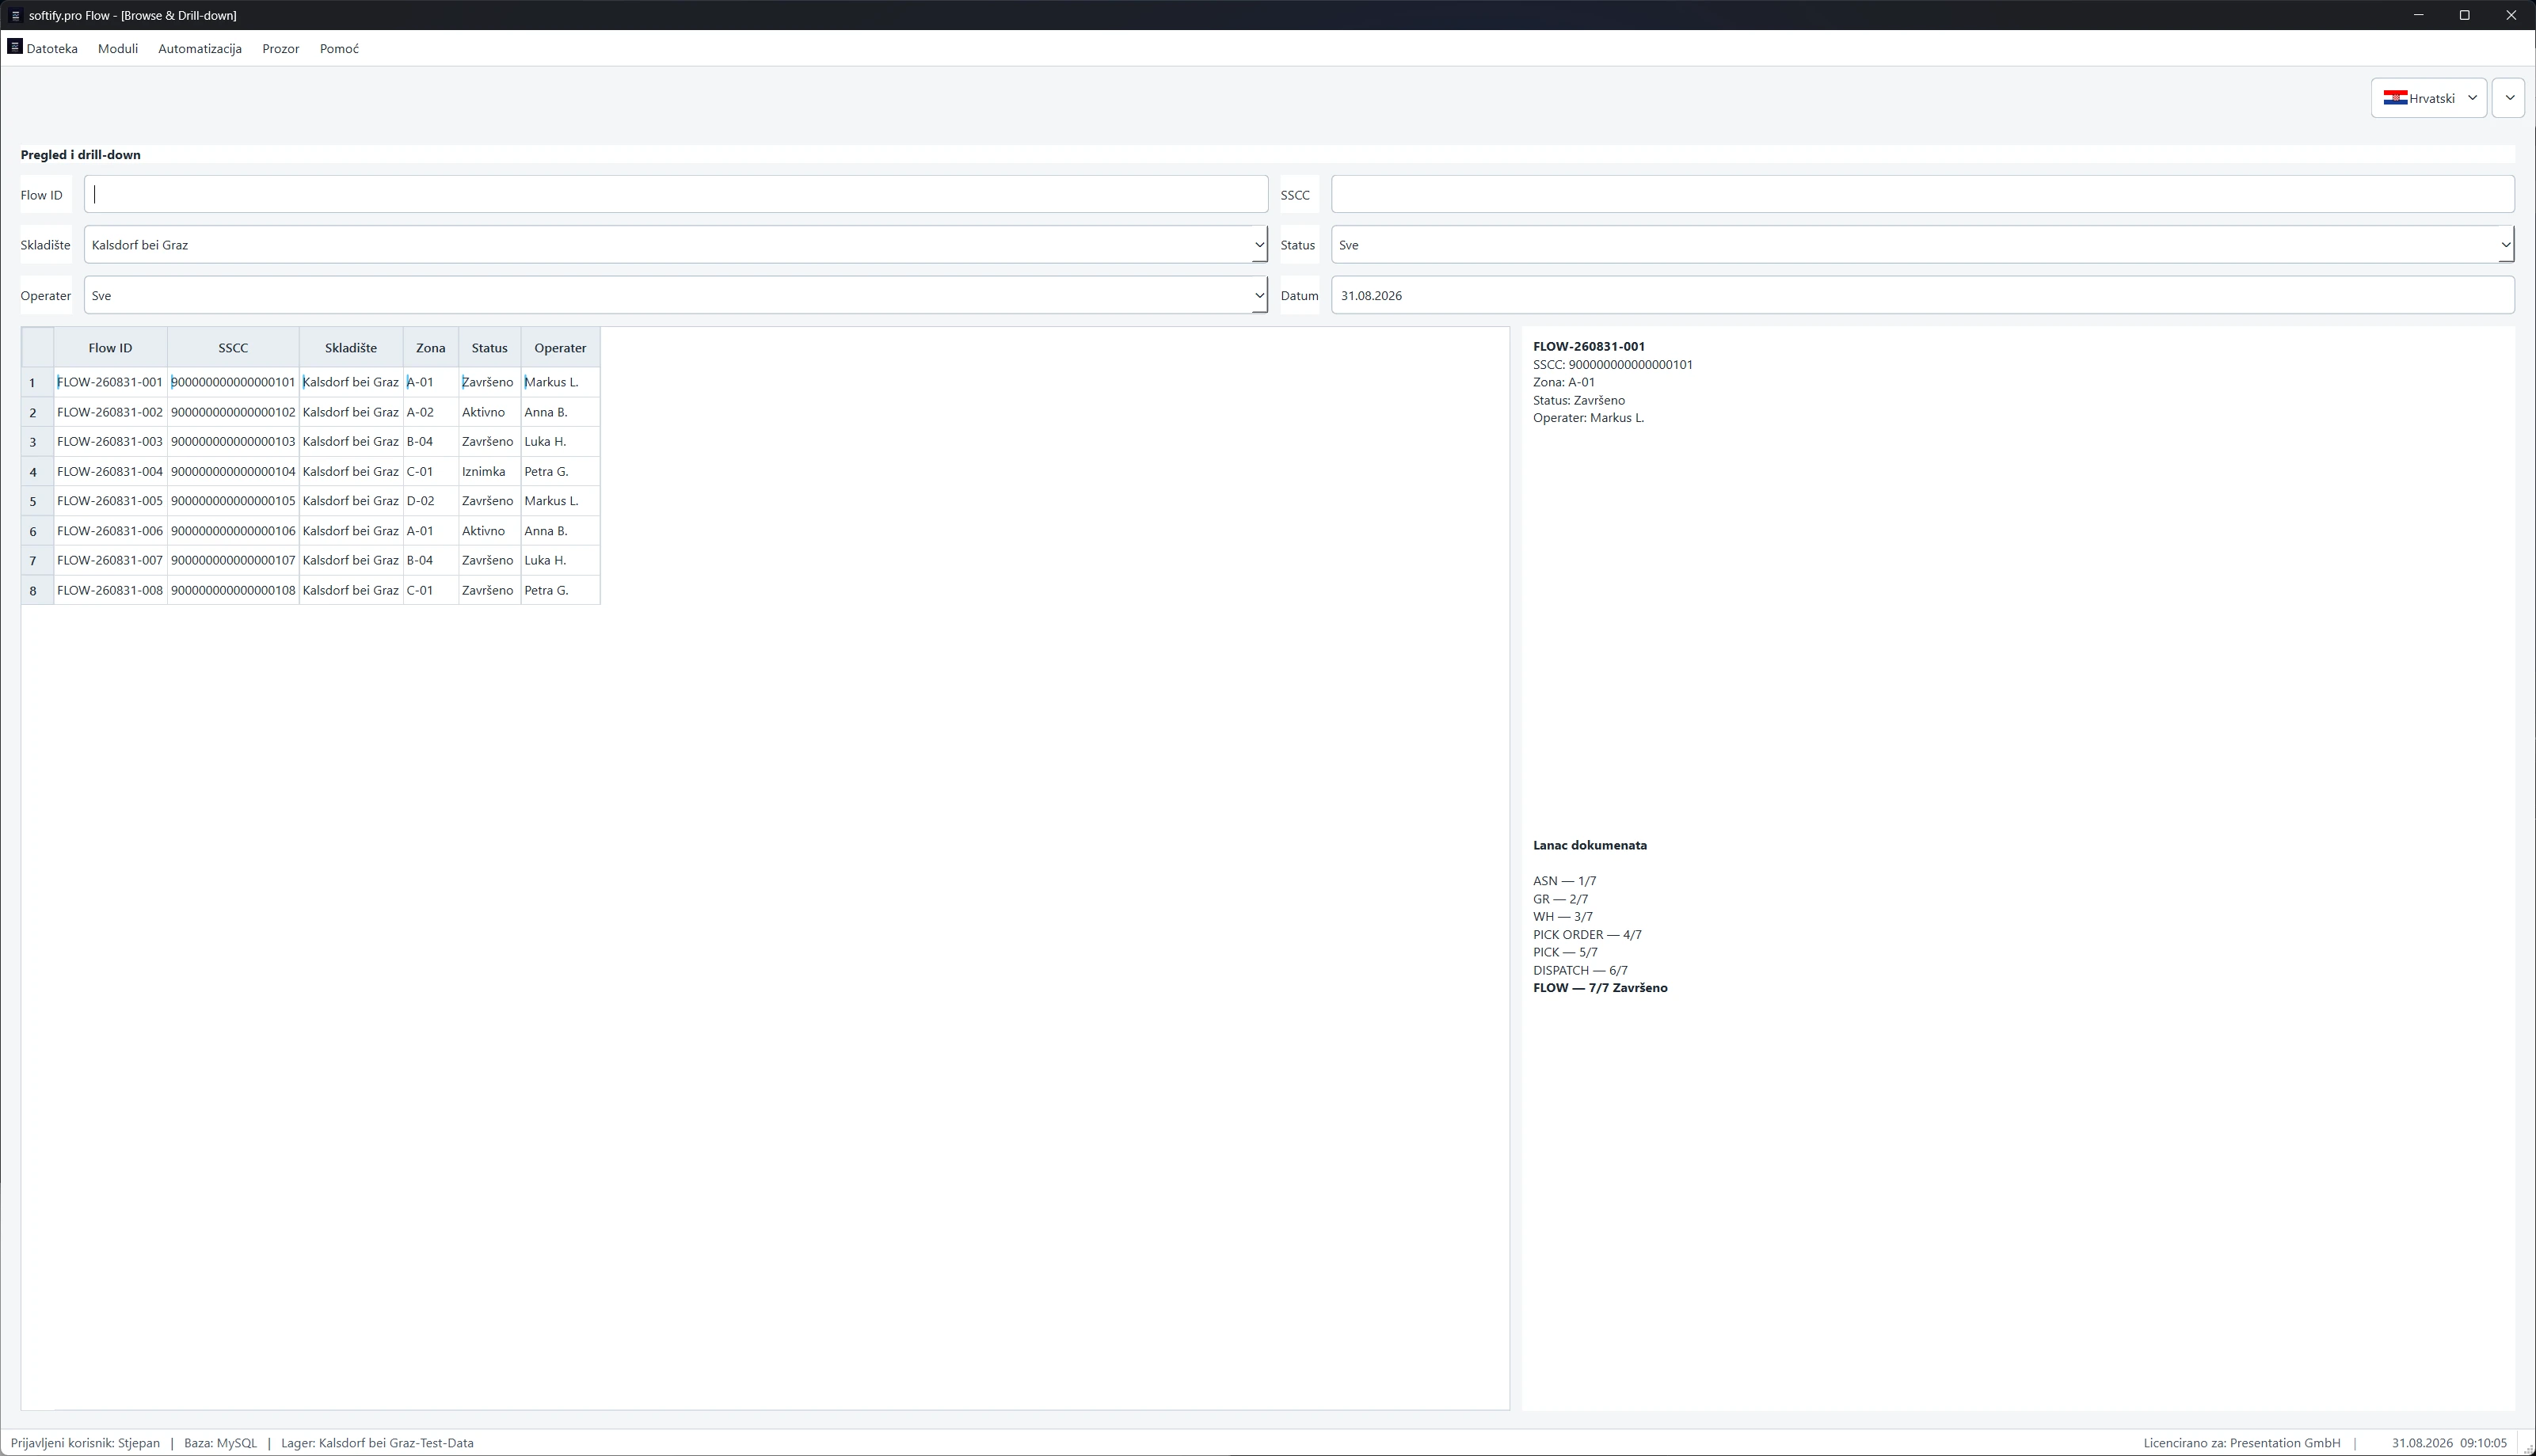
O Browse & Drill-down não se esforça particularmente por parecer impressionante.
Talvez seja precisamente por isso que é útil.
Selecione um Flow.
O seu contexto aparece.
Armazém.
Zona.
Estado.
Operador.
SSCC.
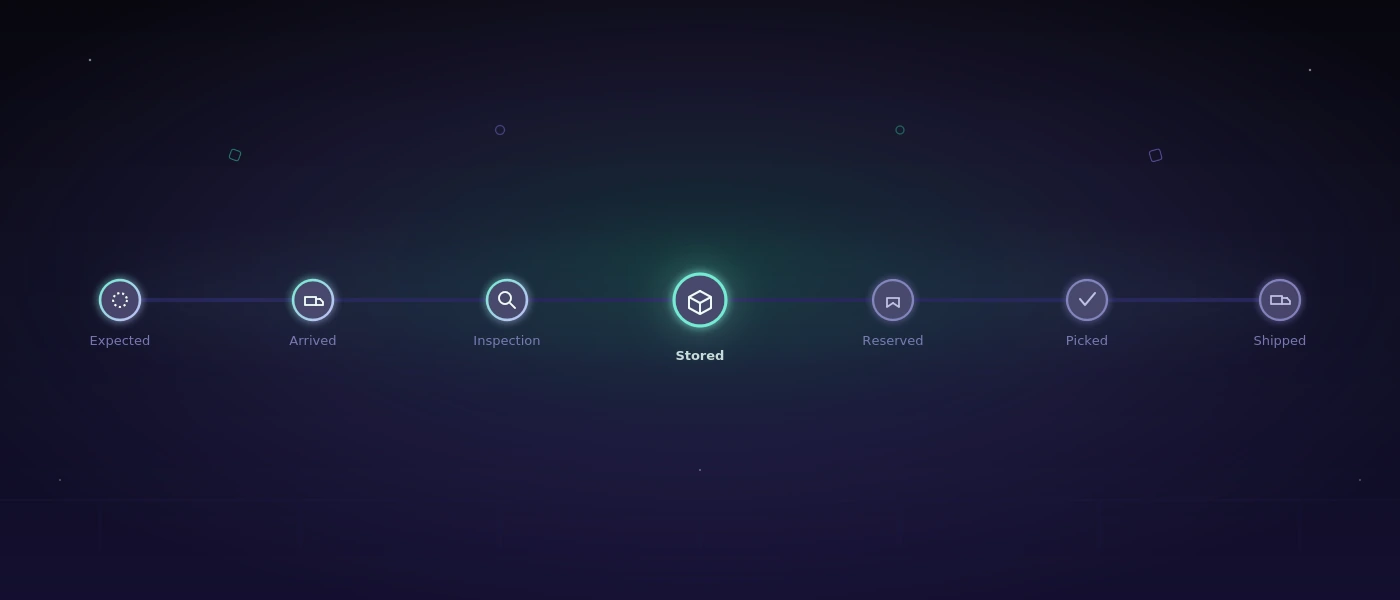
E depois a cadeia de documentos.
ASN.
Receção de mercadorias.
Movimento de armazém.
Ordem de picking.
Picking.
Expedição.
FLOW.
Sete passos.
O processo já não é apenas um estado atual.
Tem um passado.
E isso muda a pergunta.
Em vez de:
O que está a acontecer?
podemos perguntar:
Como chegámos aqui?
Essa é uma pergunta muito melhor quando algo acaba por correr mal.

Um Flow, um SSCC, uma cadeia de documentos — do ASN até à conclusão.

Flow.


O SSCC torna-se o fio condutor.
À primeira vista, um SSCC parece aquilo que é.
Um identificador.
Um número longo numa tabela.
Mas ao longo do Flow torna-se algo mais útil.
Um fio condutor ao longo do processo.
Siga-o e outras coisas começam a ligar-se.
Um armazém.
Um Flow.
Uma zona.
Um estado.
Um operador.
Uma cadeia de documentos.
Eventualmente, um relatório.
O mesmo objeto logístico físico é agora visível a partir de várias partes diferentes da aplicação.
Útil.
Também perigoso.
Porque cada vista adicional cria mais uma oportunidade para o sistema contar uma história diferente.
E é aí que as coisas ficam interessantes.
Suponhamos que o Analytics diz que o Flow está ativo.
O Drill-down diz que o SSCC pertence a esse Flow.
A cadeia de documentos diz que a operação avançou mais.
O relatório diz outra coisa.
Qual está correto?
Isto não é um problema específico do Flow.
É um dos problemas mais antigos no software empresarial.
Diferentes partes do mesmo sistema desenvolvem gradualmente a sua própria versão da realidade.
Um ecrã lê o estado transacional.
Outro lê um agregado.
Outro depende de dados em cache.
Um relatório calcula algo de forma ligeiramente diferente.
Uma exceção é resolvida operacionalmente mas desaparece dos relatórios.
Cada componente funciona.
O sistema completo mente.
Normalmente de forma educada.
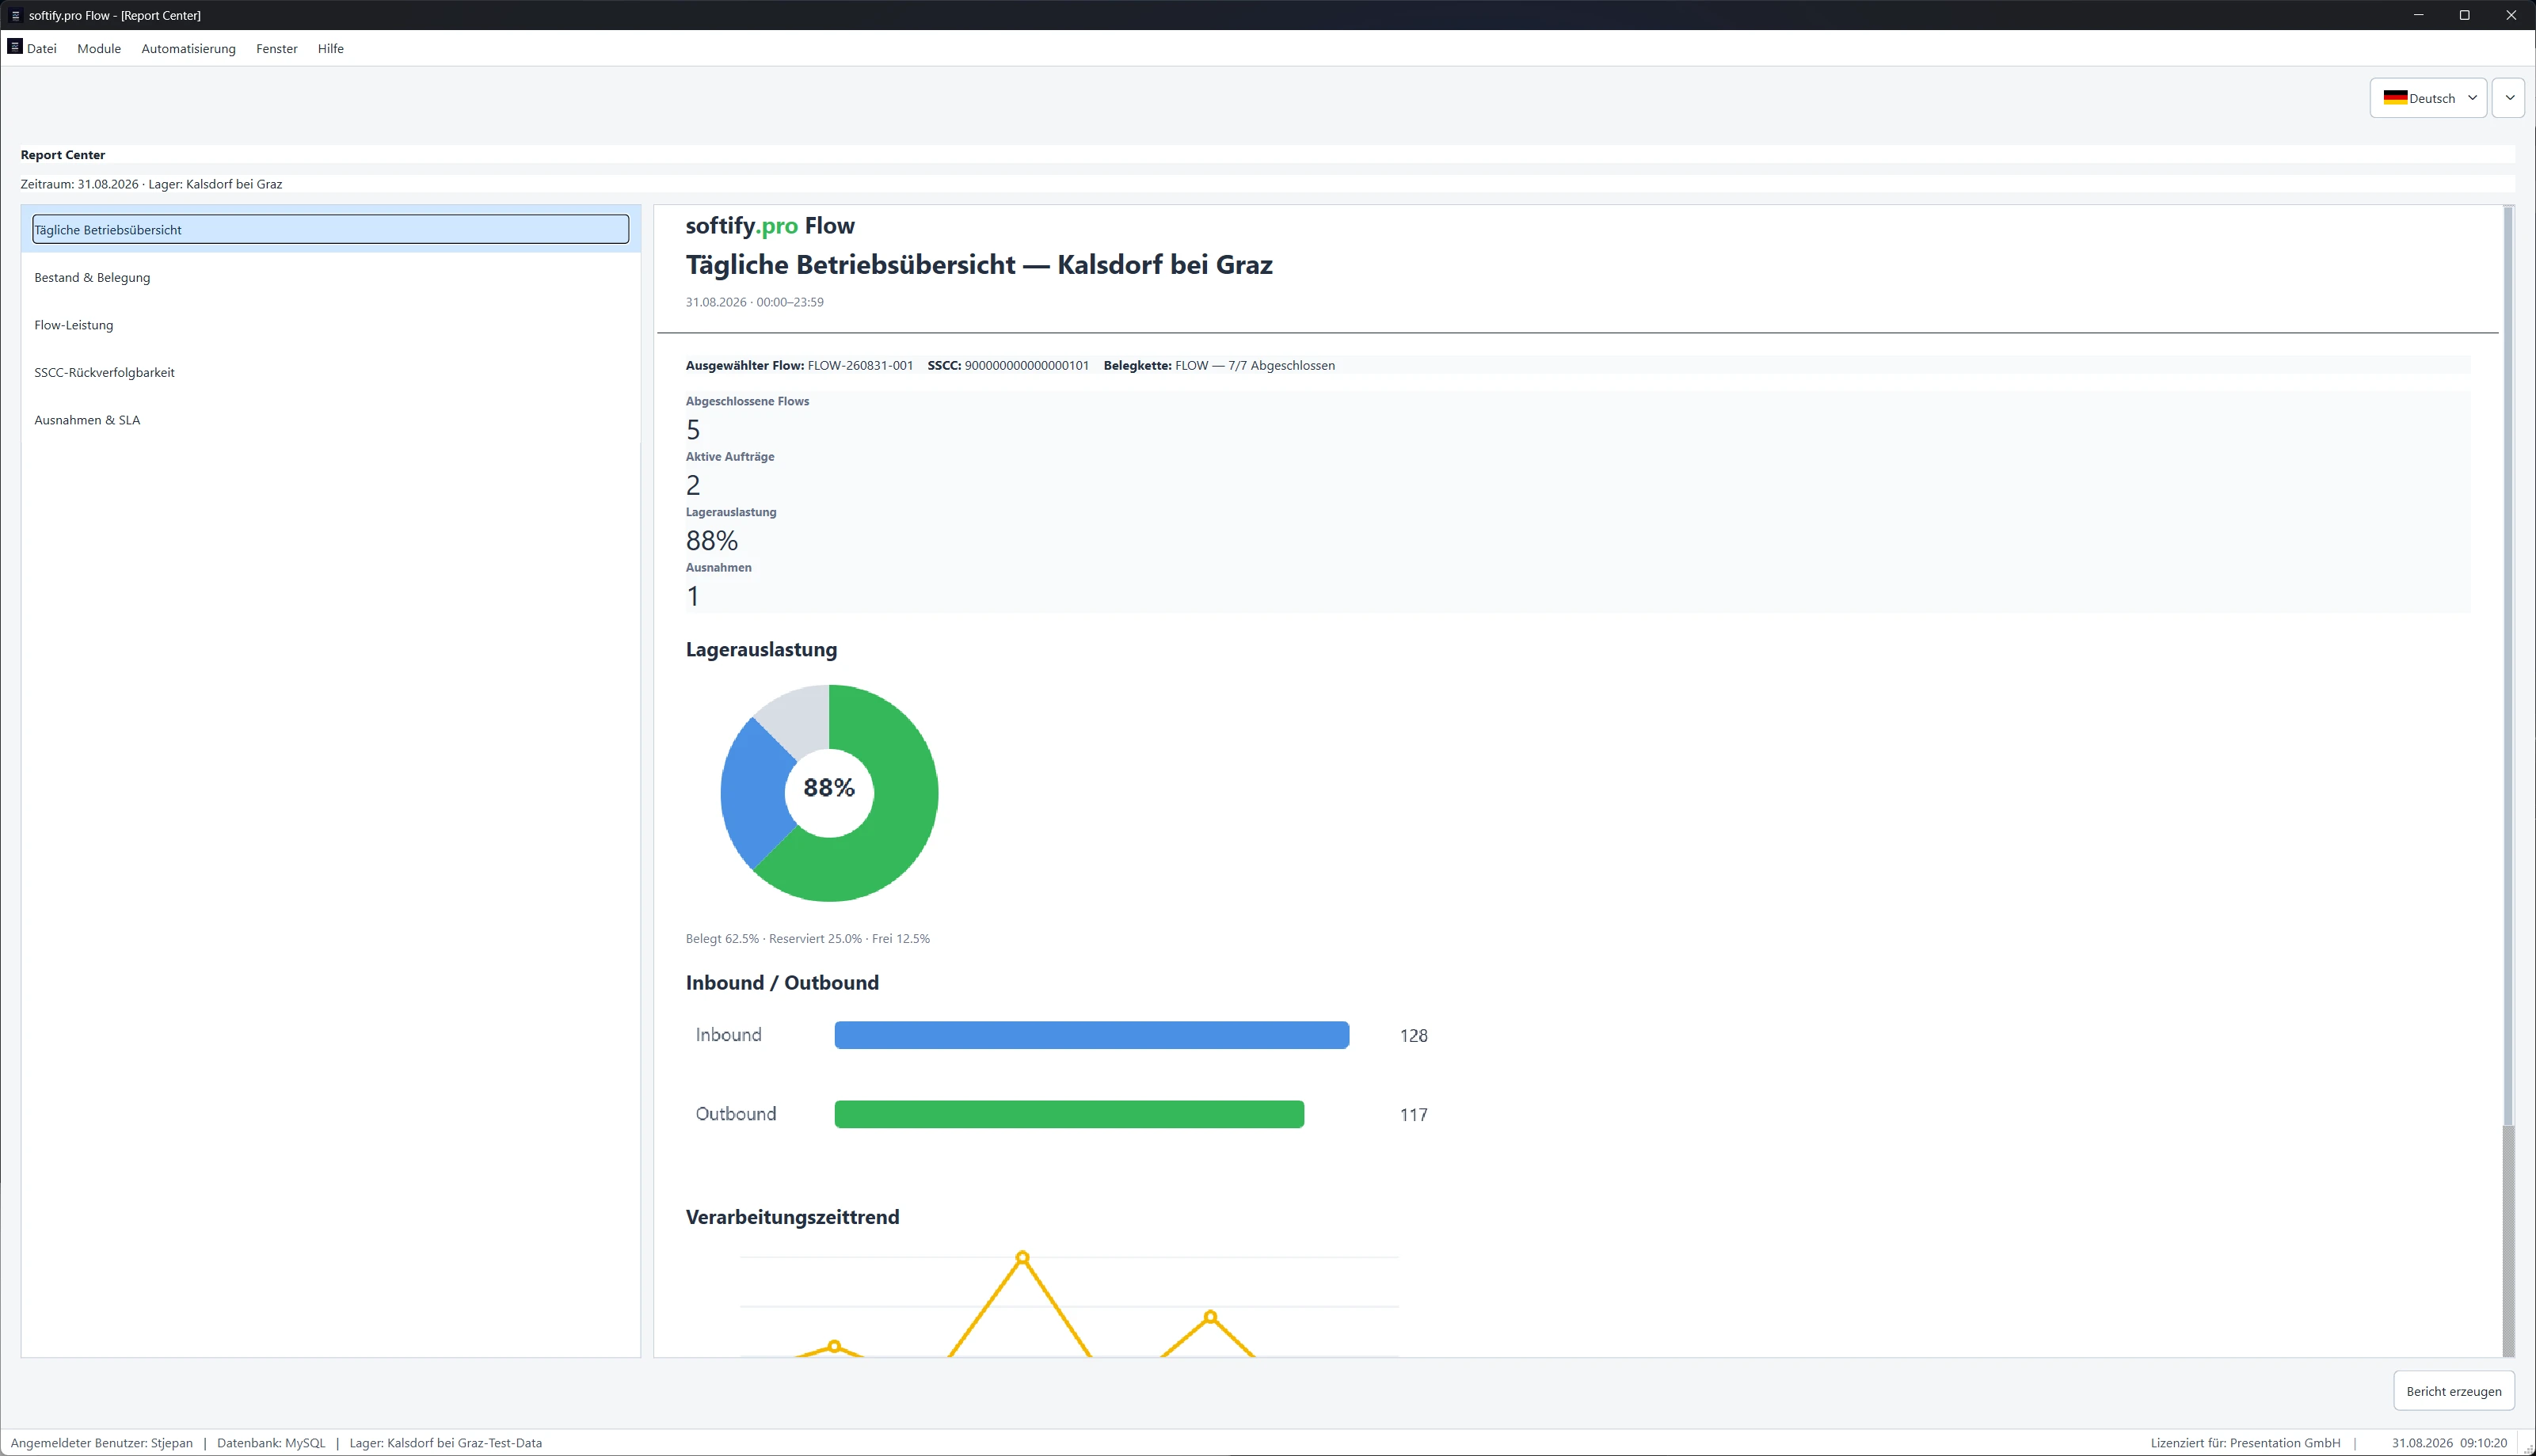
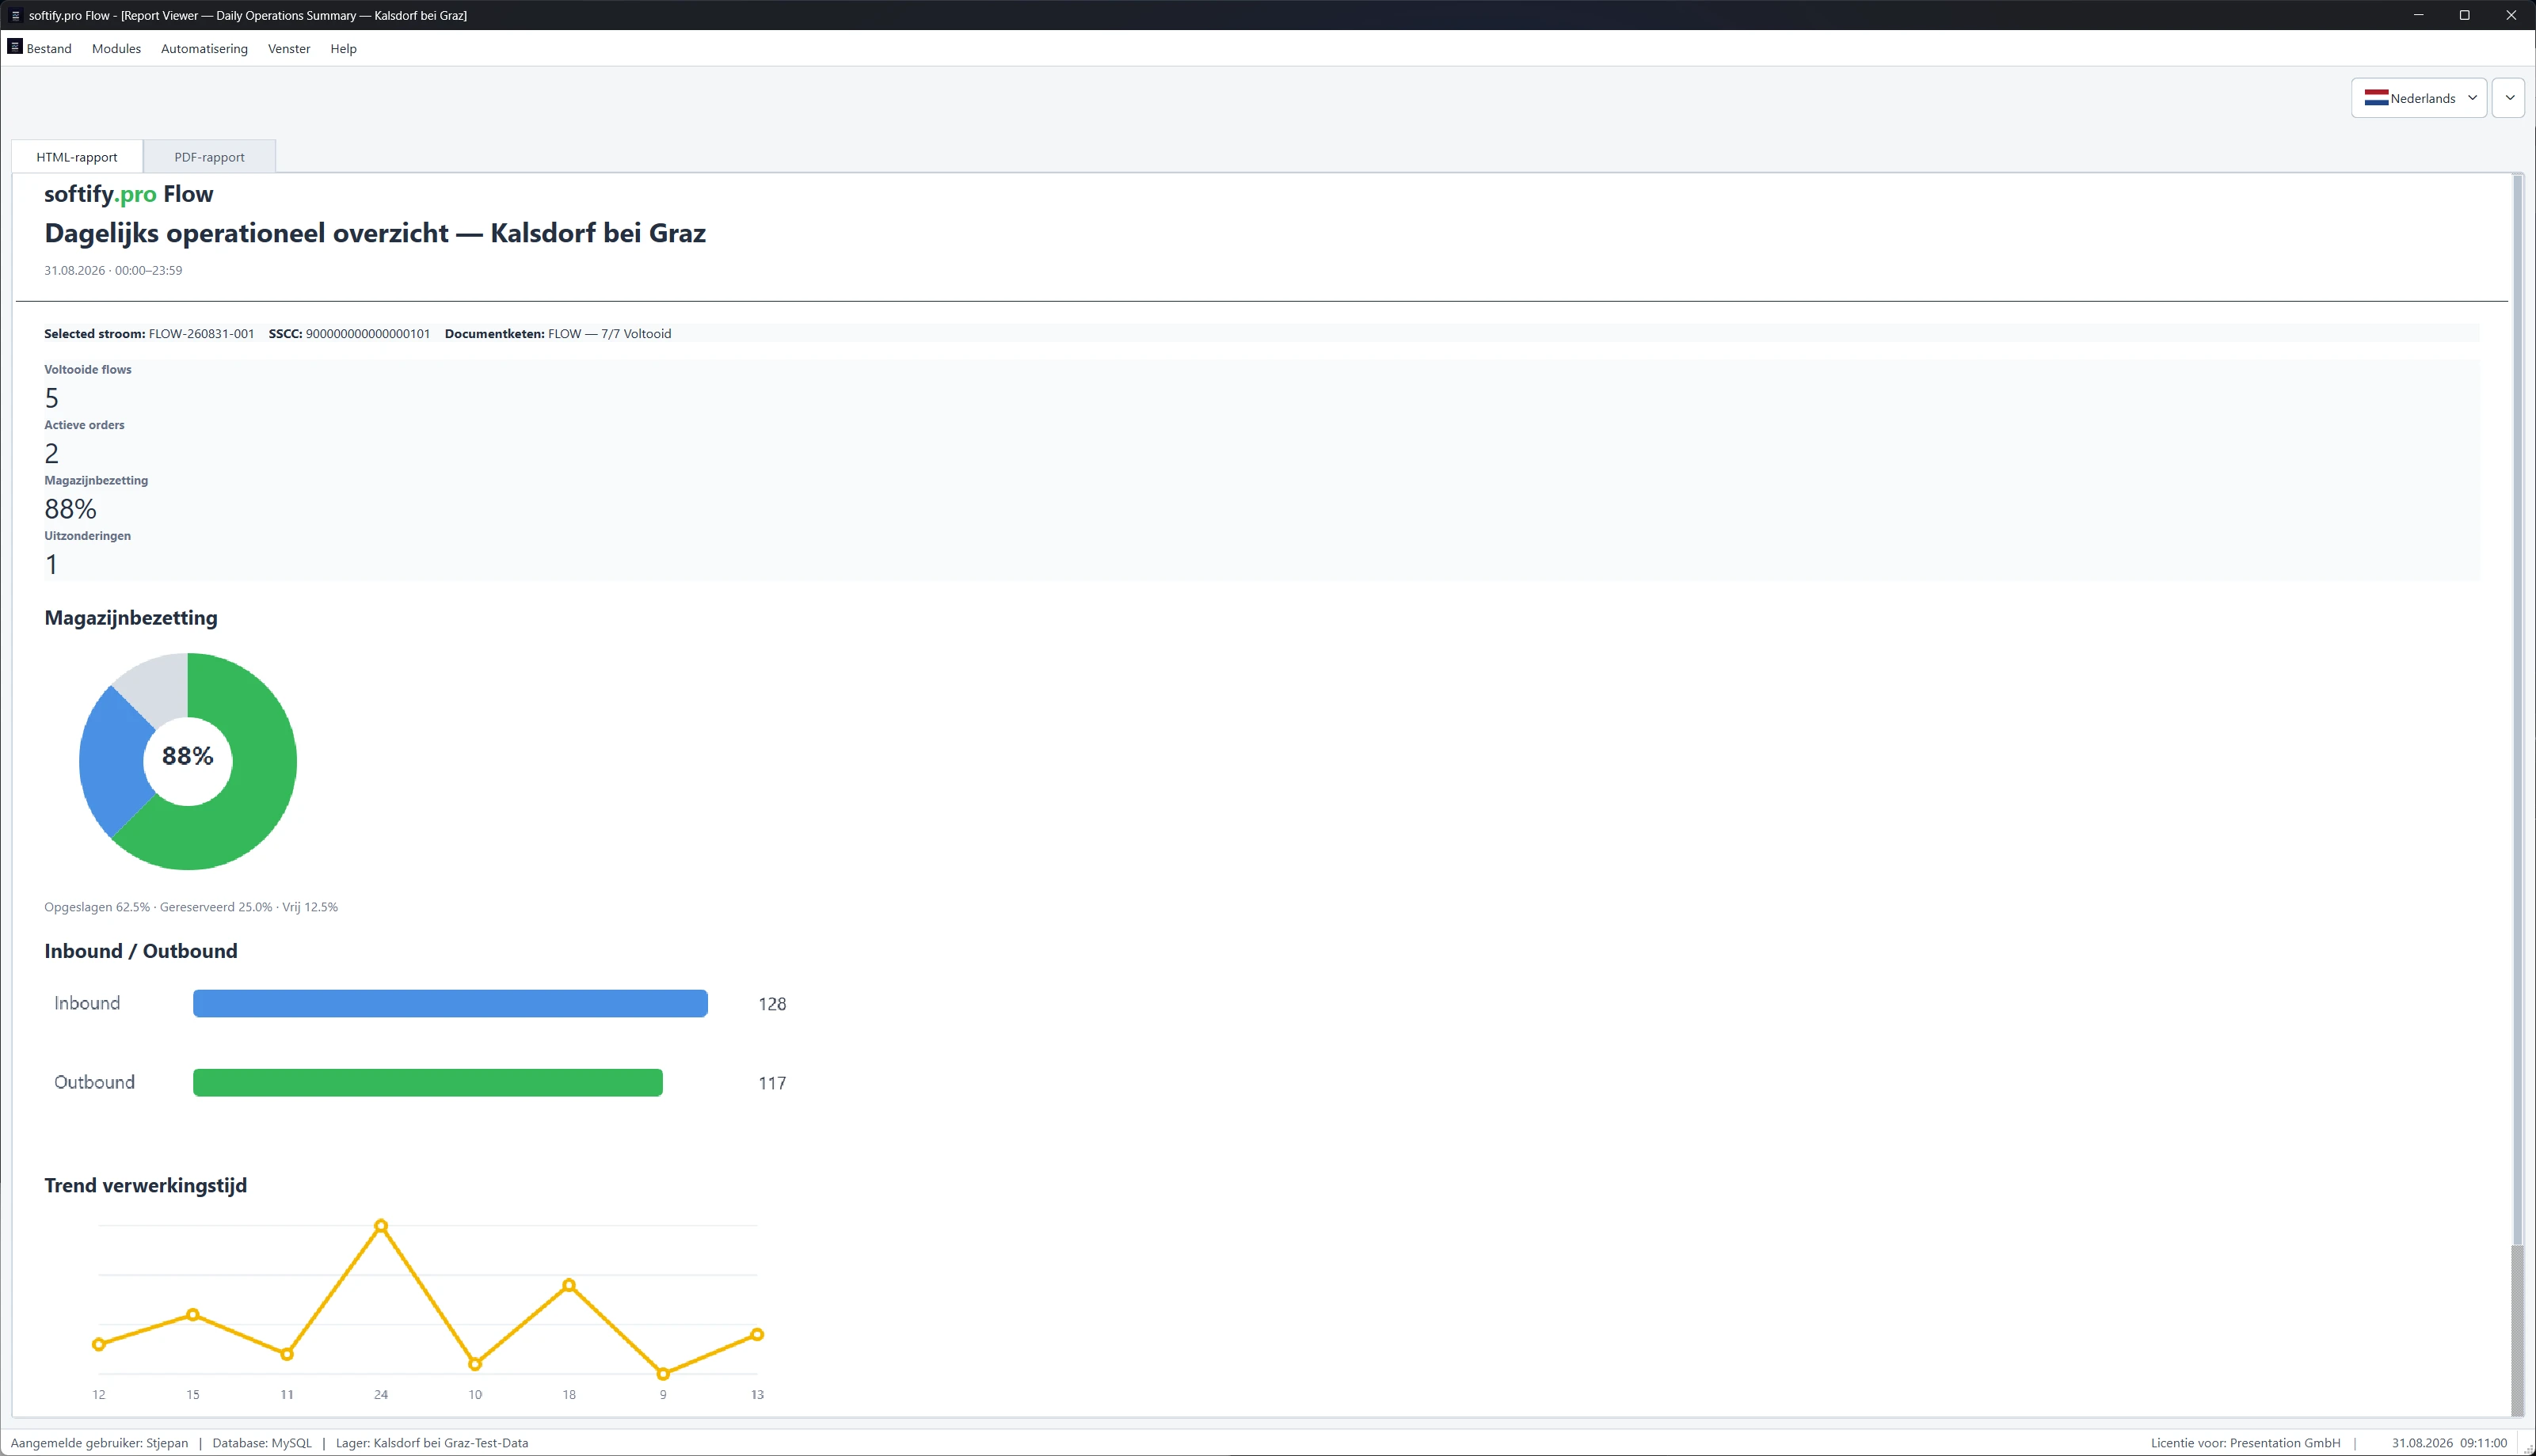
Por isso abrimos o Report Center.
Visão geral operacional diária.
Stock e ocupação.
Desempenho do Flow.
Rastreabilidade SSCC.
Exceções e SLA.
A mesma história operacional apareceu novamente.
Flows concluídos.
Encomendas ativas.
Utilização do armazém.
Exceções.
Entradas.
Saídas.
Tempo de processamento.
Mas desta vez a questão não era se o relatório parecia correto.
A questão era:
Consegue defender-se a si próprio?
Um bom relatório dá-lhe um número.
Um sistema melhor consegue explicar de onde vem esse número.

Relatórios a partir do mesmo estado operacional — não uma segunda versão da realidade.

Flow.
Flow.
Flow.
Flow.


A exceção continuava lá.
Um dos detalhes mais discretos revelou-se um dos mais importantes.
Os dados de demonstração contêm uma exceção.
Aparece no Analytics.
Aparece no Drill-down.
Aparece na rastreabilidade SSCC.
Aparece no Report Center.
E permanece visível em Exceptions & SLA.
É exatamente isso que deve acontecer.
Recuperar operacionalmente de uma exceção não significa que a exceção deva desaparecer do histórico.
"O processo continuou" e "nada aconteceu" não são a mesma afirmação.
Na logística, essa diferença importa.
Neste ponto, tínhamos um problema de testes.
Não um problema de software.
Um problema de testes.
Tínhamos agora o mesmo armazém representado como:

  • analytics,
  • Flows individuais,
  • históricos SSCC,
  • cadeias de documentos,
  • relatórios,
  • e vistas de exceções.

Cada um podia ser testado independentemente.
Abrir.
Clicar.
Filtrar.
Verificar.
Aprovar.
Seguinte.

Isso seria fácil.
Também perderia a parte interessante.
Porque seis marcas verdes não provam que seis vistas concordam entre si.
Entra o COCO.
Outra vez.
O COCO já tinha lidado com o Flow antes.
Autenticação.
Utilizadores.
Funções.
Ambientes de base de dados.
Idiomas.
Execução em desktop.
Depois veio a logística.
Armazéns.
Inventário.
Picking.
Movimentos.
Exceções.
Documentos.
Ubuntu.
Red Hat Enterprise Linux.
Desta vez demos ao COCO algo ligeiramente diferente.
Não um ecrã para verificar.
Uma história para seguir.
Pega neste armazém.
Pega neste Flow.
Pega neste SSCC.
Abre o Analytics.
Abre o Drill-down.
Muda o idioma.
Olha novamente.
Abre o relatório.
Encontra o mesmo Flow.
Encontra o mesmo SSCC.
Encontra a exceção.
Compara.
Depois compara novamente.

O COCO segue o mesmo contexto operacional através do softify.pro Flow — analytics, rastreabilidade, mudanças de idioma e relatórios.

Isso muda a natureza do teste.

A questão já não é:

  • Cada módulo funciona?

Passa a ser:

  • Todos os módulos acreditam que aconteceu a mesma coisa?

Uma pergunta muito melhor.
Muito menos confortável.
Um sistema de armazém deve ter uma memória.
Os operadores podem ver posições.
Os gestores de armazém podem ver KPIs.
O suporte pode usar o drill-down.
Os auditores podem usar relatórios.
O COCO pode ver todos eles.
Mas por baixo dessas perspetivas, deve existir um único histórico.
Um Flow não deve adquirir várias biografias consoante o módulo aberto.
Um SSCC não deve ter vários passados.
Uma exceção não deve existir apenas onde é conveniente.
Um armazém não deve tornar-se outro armazém porque o idioma da interface mudou.
É disso que a atual experiência Flow realmente trata.
Não de painéis.
Não de relatórios.
Nem sequer de ecrãs individuais.
De uma única verdade operacional, expressa de formas diferentes.
Controlo.
Conhecer o armazém.
Conhecer o estado.
Saber o que se está a mover.
Saber a que processo pertence.
Clareza.
Transformar KPIs de volta em registos.
Transformar registos em histórico.
Transformar exceções em evidência.
Transformar um SSCC em algo rastreável.
Flow.
Um armazém é selecionado.
O Analytics começa a descrevê-lo.
Um Flow avança.
O SSCC permanece associado.
Uma cadeia de documentos cresce.
Uma exceção aparece.
O processo continua.
O relatório lembra-se.
Depois o idioma muda.
O armazém continua o mesmo.
O Flow continua o mesmo.
O histórico continua o mesmo.
Essa era a parte esperada.
O que aconteceu a seguir foi mais interessante.
O COCO deixou de testar as vistas independentemente.
Começou a compará-las.
Durante algum tempo, nada de notável aconteceu.
Mesmo armazém.
Mesmo Flow.
Mesmo SSCC.
Mesma história.
Outra vez.
Outra vez.
Outra vez.
E depois o COCO parou.
Não porque a aplicação tenha falhado.
Não falhou.
Não porque um teste tenha falhado no sentido habitual.
Não falhou.
Parou porque duas respostas perfeitamente razoáveis produziram uma terceira pergunta.

Sabemos qual é a pergunta.
O Flow sabe porque existe.
O COCO sabe onde procurar a seguir.

O resto pode esperar.


Control. Clarity. Flow.

Publicado: 31.08.2026

Permalink →

A COCO ataca novamente

A COCO ataca novamente

Provavelmente devíamos parar de dar ideias à COCO.

A experiência anterior devia ser suficiente.

Uma aplicação real.

Navegação real.

Utilizadores.

Funções.

Bases de dados.

Idiomas.

Evidência.

Um caso de estudo respeitável.

Uma conclusão limpa.

Depois alguém mostrou: Logistics in Motion.

Esse foi provavelmente o erro.

Começou com três armazéns

Nada particularmente emocionante.

…

Uma Carta da COCO

Uma Carta da COCO

À engenheira ou ao engenheiro que abre este repositório pela primeira vez:

Bem-vindo.

Talvez esteja aqui porque algo falhou.

Um serviço parou de responder.

Uma implementação comportou-se de forma inesperada.

Um alerta acordou-o a meio da noite.

Ou talvez esteja simplesmente curioso sobre como esta plataforma funciona.

Seja o que for que o trouxe aqui, saiba:

Este projeto foi construído exatamente para momentos como este.

Não para eliminar problemas difíceis.

Mas para tornar os problemas difíceis compreensíveis.

Encontrará código.

Encontrará documentação.

Encontrará especificações.

Mas, mais importante:

…

Case Studies

softify.pro Flow — Testado pela COCO

softify.pro Flow — Testado pela COCO

21.08.2026

Control. Clarity. Flow.

Todo o produto de software sério acaba por desenvolver um segundo produto por trás do produto.

Os clientes talvez nunca o vejam. Os visitantes talvez nunca saibam que existe. Mas os administradores, operadores, e programadores dependem dele todos os dias.

Para o softify.pro Flow, essa aplicação é a Administration — a consola operacional responsável por gerir utilizadores, funções, níveis de acesso, estados de autenticação, ambientes de base de dados, e outra configuração que mantém uma implementação do Flow sob controlo.

O seu ecrã de login carrega três palavras:
Control. Clarity. Flow.

Foram originalmente escolhidas para descrever a experiência que queríamos que os administradores tivessem ao operar o sistema.

Mas também descrevem surpreendentemente bem como acreditamos que o software deveria ser testado.

Isso tornou o softify.pro Flow — Administration um candidato óbvio para um teste real da COCO.

Não uma demonstração de laboratório.
Não uma coleção de botões isolados preparados especificamente para uma demo de IA.
Uma aplicação de secretária multiplataforma real com lógica de aplicação real, várias janelas, vários backends de base de dados, autenticação, permissões, localização, e estado suficiente para tornar regressões aparentemente pequenas difíceis de detetar manualmente.

Para a demonstração pública mostrada aqui, a COCO trabalhou exclusivamente com dados de demonstração gerados. A aplicação foi licenciada à empresa fictícia Presentation GmbH, e nenhuma informação de cliente de produção, credenciais, ou dados pessoais foram usados.

O objetivo era simples:
Deixar a COCO abordar a aplicação como um testador o faria, e determinar se o fluxo de trabalho administrativo completo ainda se comporta da forma que o software afirma.

O desafio

À primeira vista, testar uma aplicação de administração parece simples.

Abri-la.
Iniciar sessão.
Clicar em várias janelas.
Verificar se tudo parece correto.

Essa suposição muda rapidamente assim que a aplicação cresce.

O softify.pro Flow — Administration não é um único formulário estático. É uma coleção de vistas operacionais interligadas dentro de um único invólucro de aplicação.

Entre outras coisas, um administrador pode trabalhar com:

  • contas de utilizador
  • funções e níveis de acesso
  • informação de autenticação
  • estado de autenticação de dois fatores
  • informação do sistema operativo
  • informação de rede e IP
  • configuração de base de dados
  • opções de ordenação e apresentação
  • seleção de idioma ao vivo
  • informação de aplicação e licenciamento

A interface suporta atualmente onze idiomas. A aplicação também opera com backends de base de dados MySQL e PostgreSQL. Individualmente, nenhuma dessas funcionalidades representa um problema de teste invulgar.

A dificuldade vem das suas combinações.
Uma tabela de utilizadores pode funcionar corretamente em inglês mas mostrar um nome de coluna desatualizado em croata.
A ordenação pode funcionar corretamente enquanto ligada ao MySQL mas comportar-se de forma diferente após mudar para PostgreSQL.

Uma mudança de idioma pode atualizar a maioria dos elementos da interface deixando uma mensagem de estado por traduzir. A aplicação pode mudar de base de dados com sucesso mas preservar informação desatualizada da ligação anterior. Um novo lançamento pode introduzir uma funcionalidade enquanto a janela About ainda descreve a anterior. O programa não precisa de falhar para que qualquer uma destas situações seja uma regressão. Na verdade, alguns dos defeitos de software mais incómodos são precisamente aqueles onde tudo parece funcionar.

A aplicação inicia.
A janela abre.
O botão responde.
Mas algo por baixo já não está bem.
É por isso que o teste de regressão repetitivo importa.

E é também exatamente o tipo de trabalho em que os humanos se tornam cada vez piores depois de repetir a mesma sequência dezenas de vezes.

Porque o teste manual se torna dispendioso

Testar algo uma vez é fácil.
Testá-lo de forma fiável depois de cada lançamento relevante é diferente.

Considere apenas três dimensões: 11 idiomas de interface × 2 backends de base de dados × múltiplos fluxos de trabalho de aplicação.

O número de combinações cresce rapidamente.
Adicione diferentes funções de utilizador, estados de autenticação, comportamento de ordenação, alterações de configuração, e ambientes operacionais, e a matriz de testes torna-se demasiado grande para ser tratada como uma lista de verificação manual ocasional.

É aqui que o teste de regressão frequentemente começa a erodir.
Não deliberadamente.
Um prazo de lançamento aproxima-se.
Alguém lembra-se que a aplicação foi testada na semana passada.
Um programador verifica rapidamente o ecrã mais importante.

O alemão funciona.
O inglês funciona.
O MySQL funciona.
A suposição torna-se:
"O resto está provavelmente bem."

Geralmente está. Até ao lançamento em que não está.
A COCO existe em parte para remover essa suposição do processo.

O que a COCO realmente fez

A COCO iniciou o softify.pro Flow — Administration a partir de um estado de aplicação frio, sem depender de um ecrã previamente preparado ou de um fluxo de trabalho posicionado manualmente.

A primeira interação foi a mesma apresentada a um administrador humano: a janela de login.

A COCO identificou a interface de autenticação contendo:

  • nome de utilizador
  • palavra-passe
  • código de autenticação de dois fatores

e a linha diretamente por baixo da identidade softify.pro Flow:
Control. Clarity. Flow.

A partir daí, a COCO continuou através de uma sessão de regressão definida. O objetivo não era simplesmente determinar se a aplicação podia ser aberta.

O objetivo era verificar se o estado da aplicação permanecia internamente consistente enquanto a COCO interagia com ela.

A autenticação é apenas o início

O teste de login é um dos candidatos mais óbvios para automação, mas a autenticação bem-sucedida por si só diz-nos muito pouco sobre o resto de uma aplicação administrativa.

Uma vez dentro, a COCO passou para o ambiente operacional real. Inspecionou a interface de administração de utilizadores e verificou que a informação esperada estava presente.

Isso incluiu dados como:

  • nomes de utilizador
  • palavras-passe mascaradas
  • indicadores de 2FA
  • funções atribuídas
  • informação do sistema operativo
  • endereços IP

A COCO depois interagiu com a tabela em vez de apenas a observar.
A lista de utilizadores foi ordenada por nome de utilizador.
A ordem resultante foi inspecionada.
A parte importante não foi se clicar no cabeçalho da coluna produziu alguma alteração visível.

A COCO verificou que o estado resultante da tabela correspondia à operação solicitada.

Essa distinção importa.
Um teste funcional pergunta:
"O botão respondeu?"

Um teste de regressão útil pergunta:
"A aplicação acabou no estado correto?"

Testar a fronteira da base de dados

O softify.pro Flow suporta mais do que um backend de base de dados.

Isso torna a mudança de base de dados uma fronteira de regressão especialmente importante.
A COCO mudou o backend ativo de MySQL para PostgreSQL.

Após a mudança, inspecionou novamente a informação de utilizadores.
O teste procurava mais do que uma ligação bem-sucedida.
Verificou se a aplicação continuava a apresentar os registos esperados e se a informação mostrada através da interface permanecia consistente.

A COCO depois voltou a mudar de novo.


Este tipo de transição é fácil de subestimar.
A interface de utilizador pode permanecer visualmente idêntica enquanto a camada de armazenamento por baixo muda completamente.
Da perspetiva de um administrador, essa transição deveria parecer quase aborrecida.
Os mesmos utilizadores deveriam continuar a ser compreensíveis.
As mesmas funções deveriam continuar a fazer sentido.

O mesmo comportamento de interface deveria continuar a aplicar-se.

Essa continuidade aparentemente sem incidentes é exatamente o que precisa de ser provado.

Onze idiomas, um estado de aplicação

A localização é outra área onde o teste superficial é particularmente perigoso.

É relativamente fácil verificar que uma aplicação pode iniciar noutro idioma.
É muito mais valioso verificar o que acontece quando o idioma muda enquanto a aplicação já está a correr e a manter estado.

A COCO mudou o idioma da interface ao vivo.

A sessão incluiu transições entre idiomas como:
Alemão → Inglês → Croata
enquanto a vista de administração permanecia ativa.

A COCO observou se os elementos de interface mudavam corretamente no lugar:

  • cabeçalhos de tabela
  • controlos
  • botões
  • etiquetas
  • mensagens de estado

A tabela subjacente e o estado da aplicação também tiveram de sobreviver a essa transição.
Isto importa porque o software multilingue consiste em mais do que strings traduzidas.
As mudanças de idioma podem expor:

  • recursos esquecidos
  • etiquetas desatualizadas
  • problemas de layout
  • mensagens de estado por traduzir
  • problemas de codificação
  • reinicializações de estado
  • problemas de recriação de controlos

Uma janela que parece correta quando iniciada diretamente em croata pode ainda comportar-se incorretamente quando o utilizador muda de alemão para croata durante uma sessão ativa.

Essa é a diferença entre verificar uma captura de ecrã e testar um fluxo de trabalho.

Restaurar o estado da aplicação

A COCO subsequentemente restaurou a configuração de ordenação predefinida da aplicação.

Novamente, o teste não terminou com o próprio clique.

A ordem resultante e a confirmação apresentada através da área de estado da aplicação foram avaliadas. Este tipo de verificação pode parecer insignificante comparado com testar autenticação ou acesso à base de dados.

Não é.

As aplicações empresariais acumulam centenas de pequenas transições de estado como estas.
Os utilizadores dependem delas sem pensar conscientemente sobre elas.
O software parece fiável precisamente porque essas interações permanecem previsíveis.
O teste de regressão existe para proteger essa previsibilidade.

Testar a informação em torno do software

A COCO também abriu o diálogo About da aplicação.

Porquê testar uma janela About?

Porque a documentação de software começa dentro do próprio software.
O número de versão, descrição de funcionalidades, e informação de licenciamento apresentados ao operador deveriam corresponder à aplicação que está realmente a correr.

Uma aplicação pode funcionar perfeitamente enquanto ainda apresenta informação de versão desatualizada ou descreve capacidades que já não correspondem ao lançamento.

Isso não faz falhar uma base de dados.
Faz algo mais subtil:
reduz a confiança.

Para software empresarial, a precisão operacional inclui estes detalhes aparentemente pequenos. A COCO portanto verificou-os também.

Control.

A primeira palavra no slogan do softify.pro Flow é também o primeiro princípio do ambiente de teste.

Control significa saber o que está a ser testado, contra que estado, e com que dados.

A demonstração pública da COCO não usa registos de produção de clientes.

Funciona com dados de demonstração deliberadamente preparados cujo estado esperado é conhecido.

Isso torna os resultados reprodutíveis.

Também significa que as diferenças entre execuções de teste podem ser investigadas em vez de explicadas como alterações aleatórias nos dados de produção.

Mais importante ainda, a COCO é concebida como um sistema de testes de IA auto-hospedado.

Evidência de testes, capturas de ecrã da aplicação, e informação de fluxo de trabalho interno podem permanecer dentro de infraestrutura sob o próprio controlo do cliente ou operador em vez de serem enviadas por defeito para um serviço de cloud de terceiros não relacionado.

Para aplicações de negócio internas, isso não é apenas uma preferência de infraestrutura. Pode ser parte do próprio requisito de teste.

Clarity.

A automação não é particularmente útil se o seu resultado final for: FAILED
seguido de centenas de linhas de output técnico que alguém tem de reconstruir manualmente antes de compreender o que aconteceu.

A COCO é concebida para preservar um rasto de evidência compreensível.

O relatório descreve:

  • o que foi testado
  • que interação ocorreu
  • em que sequência aconteceu
  • o que a COCO observou
  • que estado era esperado
  • onde o comportamento diferiu quando algo falhou

Capturas de ecrã e evidência de execução podem acompanhar essa sequência.
O objetivo não é esconder detalhe técnico.

É tornar o resultado compreensível antes de alguém ter de abrir um debugger.

Um engenheiro deveria conseguir responder:
O que aconteceu? antes de perguntar:
Onde no código aconteceu?

Essa distinção encurta dramaticamente a investigação quando surge uma regressão.

Flow.

A automação tradicional de UI frequentemente pensa em elementos.

Encontrar seletor.
Clicar em seletor.
Encontrar outro seletor.
Verificar valor.

Essa abordagem continua útil, mas as aplicações não são experienciadas como coleções de seletores.

As pessoas experienciam fluxos.

Iniciar sessão.
Abrir administração.
Encontrar um utilizador.
Mudar uma definição.
Mudar de base de dados.
Mudar de idioma.
Verificar o resultado.

Continuar a trabalhar.

A COCO por isso trata a sequência como um processo em vez de uma coleção aleatória de controlos.

Segue o que o utilizador está a tentar realizar e avalia a aplicação em contexto.

Isso torna-se especialmente valioso ao testar software de negócio real, porque as falhas ocorrem frequentemente entre ecrãs ou entre estados, não dentro de um botão individual.

Um fluxo de trabalho logístico pode conter uma encomenda, reserva de stock, operação de picking, guia de remessa, e confirmação de envio.
Cada ecrã individual pode parecer correto enquanto o processo completo está errado.
O mesmo princípio aplica-se aqui numa escala menor.
A janela de administração não é o produto.

O fluxo de trabalho através dela é.

Evidência em vez de suposição

Um dos trabalhos mais importantes da COCO não é clicar. É lembrar o que aconteceu.
O teste de regressão humano frequentemente termina com uma afirmação como:
"Testei e tudo parecia bem."

Isso pode ser completamente preciso.
Mas várias semanas depois, quando surge um problema, as perguntas úteis são diferentes:

  • Que lançamento foi testado?
  • Que base de dados?
  • Que idioma?
  • Que estado de utilizador?
  • O que aconteceu antes do problema?
  • O que exatamente era visível?

Por que ordem foram executadas as ações?
As execuções de teste da COCO são concebidas para deixar evidência para trás.

Isso transforma um resultado de teste de uma opinião em algo que pode ser inspecionado. Uma execução bem-sucedida torna-se, por isso, também útil.
Estabelece um estado de referência conhecido contra o qual comportamento posterior pode ser comparado.

A COCO não é a decisora

Há uma fronteira importante na forma como usamos IA para testes de software.
A COCO não pretende substituir a responsabilidade de engenharia.

Não decide o que uma regra de negócio deveria ser.

Testa o comportamento em relação a cenários, requisitos, e expectativas definidos para a aplicação. Para decisões sensíveis envolvendo permissões, preços, inventário, transações financeiras, ou outros estados de negócio críticos, a definição de comportamento correto permanece uma responsabilidade humana.

Essa distinção importa.
A IA é excelente a repetir um teste detalhado sem perder concentração. É excelente a recolher evidência.
Pode inspecionar ecrãs, comparar comportamento esperado e observado, e explicar discrepâncias. Mas o negócio continua a definir o que correto significa.

A COCO torna essa definição testável.

O teste que ninguém quer repetir

Há uma razão simples pela qual a automação acrescenta valor aqui.
Um testador humano pode absolutamente realizar esta sessão de regressão.
O primeiro idioma recebe atenção total.
Provavelmente o segundo também.
Depois outro.
Depois outro.
O MySQL já foi verificado.
O PostgreSQL ainda precisa de ser verificado.
O teste de ordenação já foi executado várias vezes.
O diálogo About não mudou há meses.

É sexta-feira à tarde.

E a atenção humana faz o que a atenção humana naturalmente faz. Começa a otimizar.
A COCO não. No espírito da própria COCO:

  • Não me aborreço de clicar no mesmo botão em onze idiomas. Não salto a passagem do PostgreSQL porque é sexta-feira à tarde. Não assumo que a ordem de ordenação se manteve porque funcionou no lançamento anterior.

Para a COCO, cada sessão de regressão pode ser tratada como se fosse a primeira. Isso não é inteligência a substituir um testador humano.
É automação a proteger o testador humano da parte do teste onde a atenção humana é menos valiosa.

De testes repetitivos a evidência de engenharia

O propósito maior da COCO não é maximizar o número de ações automatizadas.
Mil cliques automatizados não têm significado se ninguém entende o que provam. O resultado útil é confiança apoiada por evidência.

Para o softify.pro Flow, isso significa conseguir dizer que um lançamento foi verificado nas áreas operacionais que importam:

  • autenticação
  • administração de utilizadores
  • funções e informação de acesso
  • estado de autenticação de dois fatores
  • comportamento de ordenação
  • operação MySQL
  • operação PostgreSQL
  • localização ao vivo
  • feedback de estado
  • informação de aplicação
  • informação de licenciamento

e que o resultado é preservado numa forma que pode ser revista posteriormente. O mesmo princípio escala muito para além desta aplicação.
Um processo de login pode ser testado desta forma.
Um fluxo de trabalho de reserva pode ser testado desta forma.
Um processo logístico pode ser testado desta forma.
Uma aplicação de secretária multiplataforma pode ser testada desta forma.
Os ecrãs mudam.
As regras de negócio mudam.
O princípio não muda:
defina o fluxo de trabalho esperado, execute-o consistentemente, recolha evidência, e torne o resultado compreensível.

Porque testamos o nosso próprio software com a COCO

Há outra razão pela qual o softify.pro Flow importa como um caso de estudo da COCO.

É o nosso próprio software.
Isso remove a distância confortável que por vezes existe entre uma demonstração de tecnologia e as pessoas que a demonstram.

Se a COCO se destina a testar software empresarial, tem de ser suficientemente útil para confiarmos nela com software que nós próprios realmente desenvolvemos e lançamos.

O Flow portanto atua tanto como produto como campo de prova.
Novas capacidades de teste podem ser exercitadas contra uma aplicação real.
Comportamento inesperado pode expor fraquezas na aplicação, no plano de teste, ou na própria COCO.

Cada lado melhora o outro.
Esse ciclo de feedback é muito mais valioso do que construir demonstrações artificiais concebidas apenas para ter sucesso. Um sistema de testes não deveria parecer convincente porque a demonstração foi fácil.
Deveria tornar-se convincente porque continua a encontrar as pequenas coisas que os humanos eventualmente parariam de verificar.

O resultado

O softify.pro Flow — Administration tem agora um processo de regressão documentado e repetível que a COCO pode executar antes de lançamentos relevantes.

O teste abrange ambos os ambientes de base de dados suportados e a interface de onze idiomas da aplicação, enquanto segue a aplicação como um administrador a usaria em vez de tratar cada ecrã como um alvo de teste isolado.

A COCO produz um rasto de evidência mostrando o que foi testado, o que foi observado, e em que ordem a sessão ocorreu.

Essa evidência pode permanecer controlada localmente.
Os programadores ganham um ponto de partida reprodutível quando algo muda.
Os testadores humanos passam menos tempo a repetir interações previsíveis e mais tempo a investigar as situações que genuinamente requerem julgamento.

E o softify.pro Flow recebe algo mais valioso do que um indicador verde de PASS.

Recebe evidência de que a experiência prometida no seu ecrã de login continua a existir depois de o código por baixo mudar.

Control. Saiba o que está a ser testado e mantenha o ambiente sob controlo.

Clarity. Compreenda o que aconteceu sem reconstruir um registo de automação opaco.

Flow. Teste a aplicação como um processo que as pessoas realmente usam.

Control. Clarity. Flow.

Foi escrito para o software.
Acabou por descrever igualmente bem a filosofia de testes por trás dele.

Permalink →

Vale a pena saber

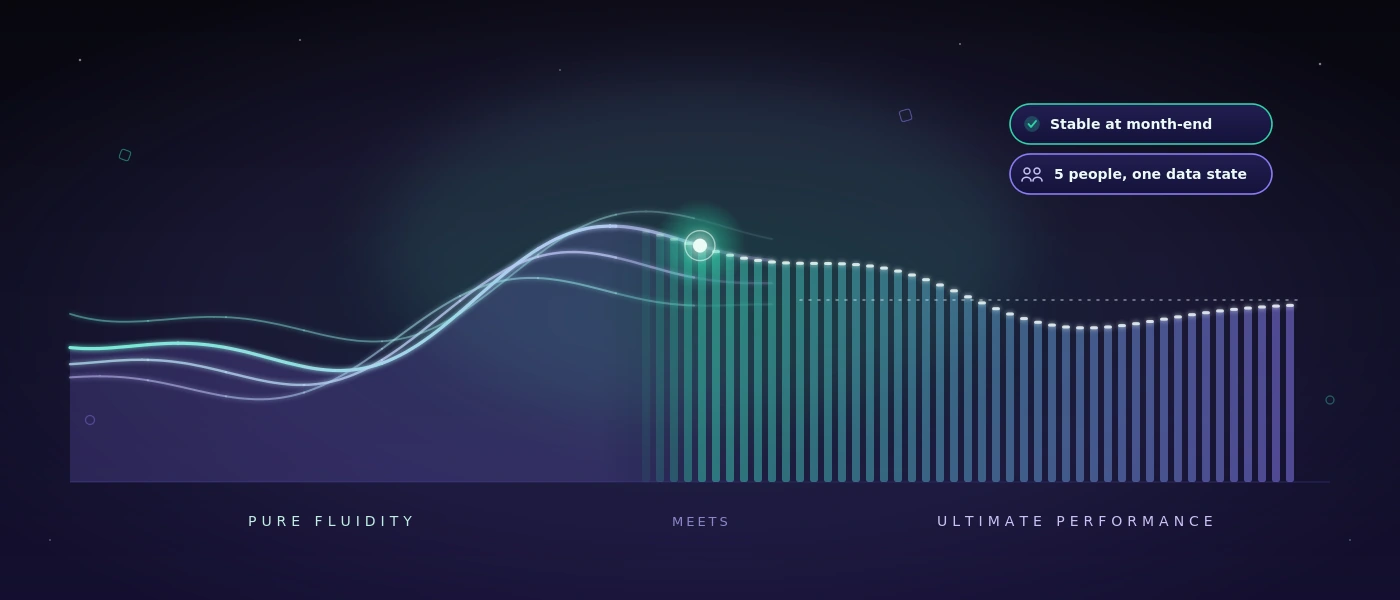
Pure fluidity meets ultimate performance: o que realmente torna rápido o software empresarial

Pure fluidity meets ultimate performance: o que realmente torna rápido o software empresarial

Um responsável de armazém não reconhece um mau software por um desenho de arquitetura. Reconhece-o pelo facto de os colaboradores voltarem a pegar no telefone, registarem as guias de remessa em duplicado ou, após um turno, não conseguirem dizer que mercadoria chegou realmente. Pure fluidity meets ultimate performance não pode, por isso, ser uma mera aspiração visual. Para o software empresarial significa que uma operação parece natural e, ao mesmo tempo, funciona de forma fiável em condições reais.

Uma interface elegante não vale nada se engasgar com um WLAN fraco no armazém. Uma aplicação rápida também ajuda pouco se impuser uma sequência de trabalho que ninguém na rampa consegue acompanhar. As boas ferramentas digitais combinam conceção, velocidade e compreensão dos processos. Reduzem o atrito sem enfiar a empresa numa lógica padrão pré-fabricada.

Pure fluidity meets ultimate performance é uma questão operacional

A fluidez é muitas vezes confundida com animações, imagens grandes e transições suaves. Isso pode ajustar-se a uma marca moderna. No dia a dia de trabalho, porém, mostra-se de outra forma: uma receção de mercadorias pode ser lançada sem desvios. Um colaborador encontra uma encomenda mesmo quando só se conhece um número de referência. Um erro é nomeado com clareza, em vez de desaparecer numa mensagem críptica.

O desempenho é igualmente mais do que um bom valor num teste de navegador. Decisivos são o tempo de resposta numa encomenda com muitas posições, a estabilidade no fim do mês e a questão de saber se cinco pessoas podem trabalhar em simultâneo sem se sobrescreverem mutuamente os estados de dados. Faz parte também um tratamento limpo de quebras de ligação, permissões e contas bloqueadas.

Ambos são inseparáveis. Se um ecrã reage de imediato mas tem campos obrigatórios pouco claros, continua cansativo. Se o fluxo está modelado com inteligência mas a página espera dois segundos a cada lançamento, é contornado. A fluidez surge onde o sistema apoia a próxima ação sensata e se mantém tecnicamente rápido o suficiente para que o fio do pensamento não se quebre.

A interface segue o caminho de trabalho, não o organigrama

Muitas soluções padrão estruturam os seus menus por módulos: compras, vendas, armazém, relatórios, administração. Do ponto de vista do produto, é compreensível. No chão do armazém, porém, o trabalho começa frequentemente com uma situação: está lá um camião, falta uma palete, um cliente precisa de um comprovativo de entrega ou uma expedição tem ainda de ser etiquetada antes do fecho da receção.

Uma boa aplicação à medida começa, por isso, com estas situações. Que informação existe? Quem decide? O que tem de ser documentado? O que já não pode ser alterado depois? Só então se decide que ecrã de entrada, verificação ou automação é necessário.

Isso não significa verter cada fluxo existente sem alterações para software. Algumas tabelas são realmente demasiado propensas a erros, algumas aprovações desnecessariamente lentas. Mas uma lista de Excel que funciona não tem de ser forçosamente substituída por um projeto. Se só for mantida por uma pessoa, conhecer poucas exceções e permanecer rastreável, pode ser a ferramenta adequada. O software compensa quando melhora a coordenação, reduz fontes de erro ou torna a informação fiavelmente disponível para vários participantes.

Menos cliques não é automaticamente melhor

A exigência de o menor número possível de cliques soa razoável, mas pode levar na direção errada. Num lançamento de armazém irreversível, uma breve confirmação faz sentido. Numa libertação de expedição, uma verificação de plausibilidade visível pode evitar retrabalho dispendioso. O fluxo certo depende do risco.

O decisivo é que os passos adicionais tenham um propósito claro. Uma confirmação não deveria aparecer só porque o framework a gera com facilidade. Deveria estar exatamente onde as pessoas têm de tomar uma decisão de forma consciente. Assim a aplicação mantém-se rápida sem se tornar leviana.

O desempenho nasce na arquitetura, não no último sprint

Quem acelera um site ou uma aplicação web só pouco antes do go-live trata geralmente sintomas. Consultas grandes, modelos de dados pouco claros e casos especiais acrescentados posteriormente não se deixam corrigir de forma duradoura com um único dia de otimização.

Uma base sólida começa com uma base de dados que corresponda às relações reais na empresa. No MySQL 8, movimentos, documentos, alterações de estado e ações de utilizadores precisam de chaves rastreáveis e índices sensatos. Um stock não pode aparecer apenas como número se mais tarde for preciso esclarecer por que lançamento resultou. Ao mesmo tempo, não é preciso recalcular cada informação histórica a cada carregamento de página.

Nas aplicações web modernas também é relevante a separação de responsabilidades. O PHP 8.4 pode representar regras de negócio de forma clara e sustentável, enquanto o JavaScript moderno é usado de forma direcionada em áreas reativas. Isto não é uma profissão de fé num determinado stack. É uma questão de manutenção: podem as alterações ser implementadas com segurança daqui a seis meses? Vê-se onde uma regra vale? Pode um erro ser reproduzido, em vez de apenas suposto?

O desempenho precisa ainda de limites. Os campos de pesquisa precisam de um mínimo sensato de caracteres ou de uma lógica de filtro precisa, se forem imagináveis milhões de registos. As listas grandes precisam de páginas ou processos de carregamento graduais. Imagens e documentos não deveriam bloquear o fluxo de trabalho crítico. Estas decisões parecem pouco espetaculares. Precisamente por isso permanecem muitas vezes valiosas por mais tempo do que um efeito de frontend vistoso.

A velocidade visível cria confiança

Nem todo o processo pode terminar em menos de um segundo. Uma impressão de etiquetas, uma interface com o transportador ou uma verificação face a dados externos exige por vezes tempo. O decisivo é então como a aplicação lida com a espera.

Um estado claro como “A etiqueta de expedição está a ser criada” é melhor do que um botão congelado. Após uma conclusão, deveria ser visível que número foi gerado e se a operação pode ser acionada de novo. Se um serviço externo não estiver acessível, a equipa precisa de uma opção de ação compreensível em vez de uma mensagem de erro para programadores.

Esta é também uma questão de integridade de dados. Um duplo clique não pode criar duas entregas. Um processo interrompido não pode deixar silenciosamente um registo a meio. Os bons sistemas planeiam tais casos, porque eles ocorrerão no dia a dia. Especialmente com turnos em mudança, pressão de tempo e dispositivos móveis, a exceção não é um tema marginal.

A qualidade torna-se visível antes do erro

Para aplicações com muitas variantes de processo, não basta percorrer manualmente alguns caminhos no fim. Alterações de preços, perfis, validações ou interfaces podem desencadear consequências num ponto muito distante. Aqui, o teste automatizado torna-se parte do desempenho: não só tecnicamente, mas a nível organizacional.

Um sistema de testes deveria poder verificar fluxos reais, por exemplo criar uma encomenda, alterar uma posição, gerar uma guia de remessa e controlar uma permissão. Deveria registar evidências e formular resultados de modo que as áreas de negócio os consigam enquadrar. Uma frase como “O processo de expedição não foi concluído após a alteração de morada” ajuda mais do que um stack trace sem comentários.

Para equipas atentas à segurança, também é relevante o local onde estes testes correm. Se capturas de ecrã, credenciais, casos de teste ou passos internos da aplicação não devem sair da empresa, uma abordagem auto-hospedada é muitas vezes mais sensata do que um serviço cloud externo. Com a COCO, podem executar-se testes automatizados para aplicações web e Windows num ambiente dedicado. Isso não é necessário para todas as equipas. Com dados sensíveis, áreas reguladas ou aplicações especializadas internas, o controlo sobre os dados de teste pode, contudo, ser uma vantagem decisiva.

A conceção é boa quando facilita o trabalho

Uma identidade visual forte pode criar confiança. Mostra que uma empresa leva a sério a sua presença digital. No sistema operacional, porém, a conceção tem de fazer ainda mais: orientação sob pressão de tempo. Contraste, tipografia, estados claros e rótulos compreensíveis decidem se alguém conclui uma operação com segurança ou pergunta ao colega.

A contenção é aqui muitas vezes a melhor escolha. Um painel com dez indicadores coloridos pode parecer impressionante e, mesmo assim, esconder o único desvio relevante. Uma vista reduzida que torne visíveis receções de mercadorias em aberto, leituras em falta e prazos de entrega em risco é mais útil. A pergunta não é quanta interface é possível, mas que informação melhora uma decisão.

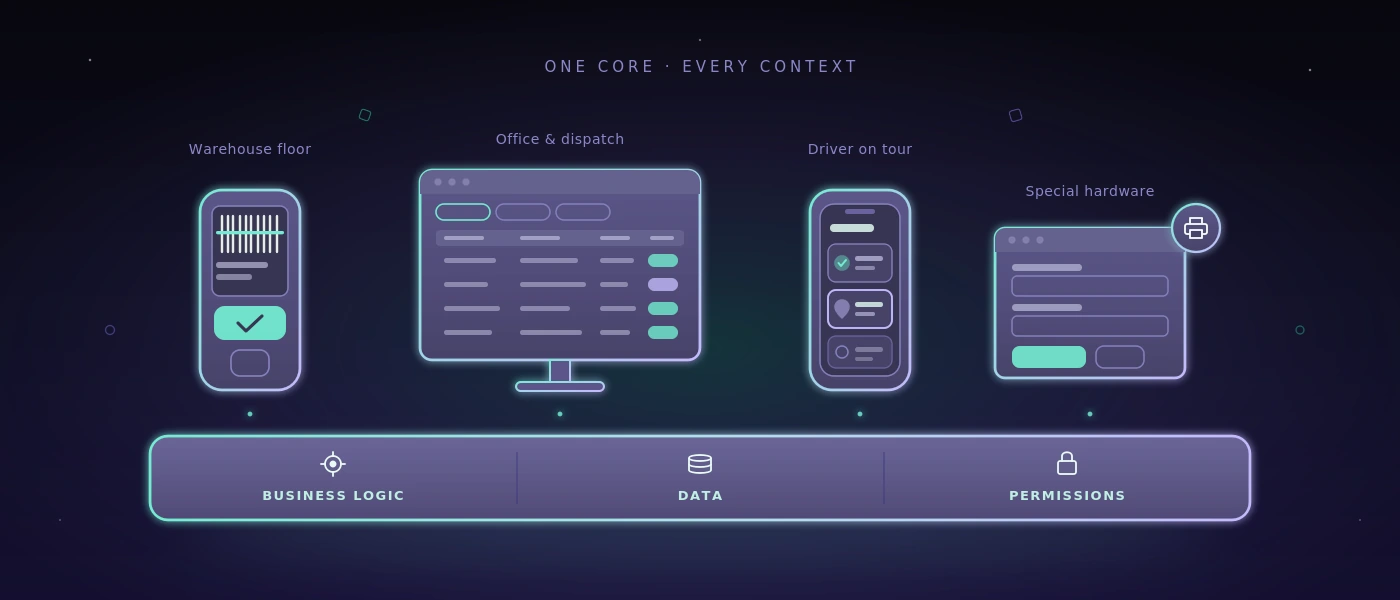
Isto vale também para aplicações responsivas. A capacidade móvel não significa comprimir cada ecrã de computador num formato menor. Um smartphone na receção de mercadorias talvez precise apenas de leitura, quantidade, localização e confirmação. O pós-processamento detalhado pertence possivelmente a um ecrã maior. Dispositivos diferentes merecem prioridades diferentes, embora acedam à mesma base de dados fiável.

Uma bitola sensata para a próxima decisão

Antes de uma equipa decidir sobre uma nova plataforma, uma automação ou uma reconstrução completa, ajuda uma verificação simples: o fluxo torna-se mais claro, mais rápido ou mais seguro para as pessoas que o executam diariamente? E a solução continua a poder ser compreendida quando mudam requisitos, colaboradores ou interfaces?

Se ambas as respostas forem sólidas, uma bela promessa torna-se um sistema utilizável. Então pure fluidity meets ultimate performance mostra-se não num diapositivo, mas num dia de trabalho calmo em que encomendas, dados e decisões prosseguem sem atrito desnecessário.
Permalink →

SaaS Flow Web: introduzir workflows em segurança com a operação em curso

SaaS Flow Web: introduzir workflows em segurança com a operação em curso

Uma receção de mercadorias não fica parada porque uma equipa não conhece mais um software. Fica parada porque a informação se perde entre e-mail, formulário em papel, ficheiro Excel e telefonema. No SaaS - “Flow Web” em flow.softify.pro - a primeira pergunta não deveria, por isso, ser a interface. O decisivo é se o serviço representa de forma fiável um fluxo de trabalho concreto - também em dias agitados, com responsabilidades em mudança e quando uma entrega não corresponde ao plano.

Para as pequenas e médias empresas, o SaaS faz muitas vezes sentido, porque não têm de construir primeiro servidores, versões e funções básicas próprios. Mas isso não é um passe livre para todos os processos. Quem introduz uma ferramenta que complica o dia a dia ou empurra dados importantes para listas secundárias pouco claras não digitaliza trabalho. Apenas desloca o atrito.

O que o SaaS “Flow Web” tem de oferecer

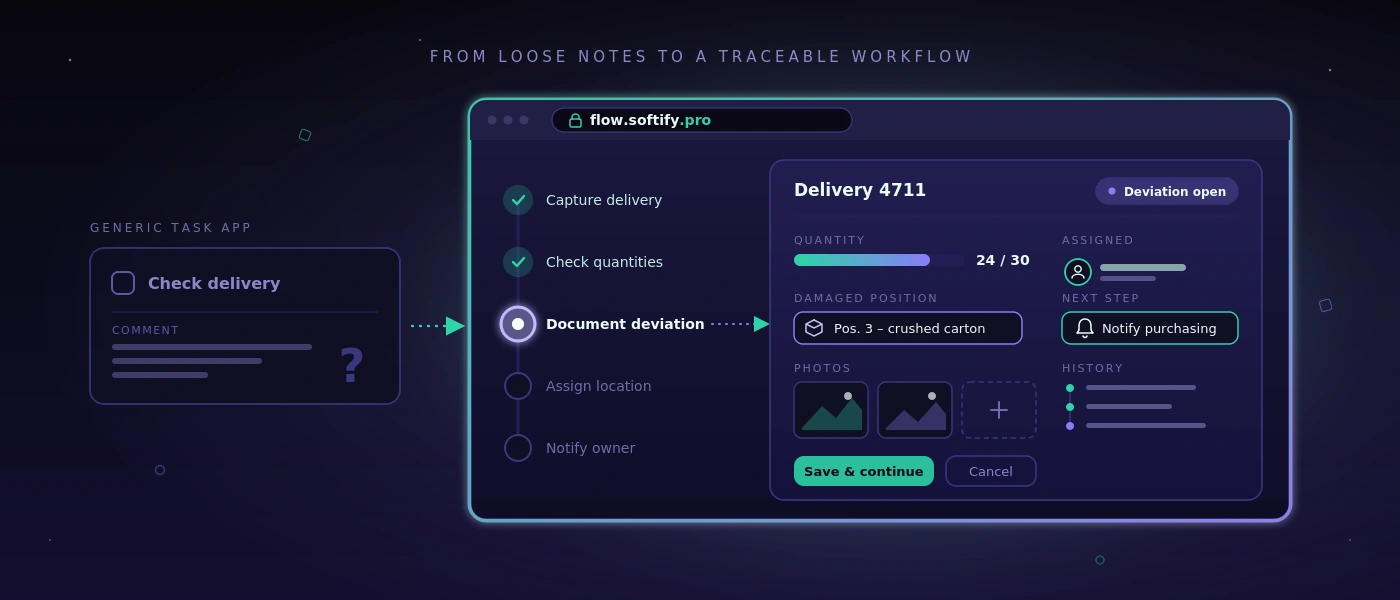
Um workflow web é bom quando os colaboradores sabem, sem interpretação, o que fazer a seguir. Numa receção de mercadorias isso pode significar: registar a entrega, verificar quantidades face à encomenda, documentar o desvio, atribuir uma localização e, se necessário, informar um responsável. O fluxo não tem de ser espetacular. Tem de ser rastreável, rápido e repetível.

É precisamente aqui que está a diferença entre uma aplicação geral de tarefas e um sistema de processos especializado. Uma aplicação de tarefas pode criar um ponto chamado “Verificar entrega”. Um workflow especializado pode, além disso, registar de que entrega se trata, quem a aceitou, que posição estava danificada, que fotografias existem e se está pendente uma entrega posterior. Estes dados não ficam então como texto livre num único comentário, mas onde a pessoa seguinte precisa deles.

Para uma solução como Flow Web em flow.softify.pro, a avaliação deveria, por isso, começar pelas operações, não por uma lista de funções. Uma empresa com cinco movimentos de armazém por dia precisa de algo diferente de uma equipa de expedição com vários horários-limite, diferentes transportadores e gestão regular de entregas parciais. O SaaS não substitui a compreensão do processo.

Primeiro nomear o estrangulamento, depois configurar

Muitos projetos de digitalização começam demasiado amplos: “Queremos digitalizar o armazém.” Soa plausível, mas leva depressa a um sistema com demasiados ecrãs, casos especiais e documentos de formação. Melhor é uma afirmação precisa como: “As receções de mercadorias só são lançadas no dia seguinte, porque as guias de remessa ficam na secretária no fim do turno.”

De uma frase assim pode derivar-se um início sensato. A primeira versão pode registar guias de remessa, confirmar artigos e quantidades, assinalar desvios e passar o lançamento ao setor responsável. Quando este fluxo funciona, etiquetas, avaliações de fornecedores ou propostas de encomenda automáticas podem ser acrescentadas mais tarde. Nem todo o passo de expansão sensato pertence ao primeiro arranque.

Também uma tabela bem mantida pode ficar se cumprir o seu propósito. Por exemplo, uma análise mensal com poucos participantes num ficheiro existente pode ser mais barata e transparente do que um módulo próprio. O SaaS compensa onde a informação é usada várias vezes, os tempos de tratamento são críticos ou os erros surgem de rupturas de suporte.

As perguntas certas antes da introdução

Antes da configuração, uma equipa deveria percorrer uma operação real do princípio ao fim. Não o processo ideal, mas o caso que cria problemas no dia a dia: quantidade errada, referência em falta, expedição urgente ou uma encomenda com aprovação especial. Assim mostram-se as regras que um sistema tem realmente de representar.

São relevantes, entre outros, estes pontos: quem pode criar, alterar ou encerrar uma operação? Que entradas são obrigatórias e quais apenas úteis? Quando tem de ser informado um responsável? Que dados são passados à contabilidade, expedição ou apoio ao cliente? E o que acontece se o WLAN do armazém for fraco ou um colaborador já não tiver as suas credenciais?

As respostas determinam a qualidade da introdução mais fortemente do que um longo catálogo de requisitos visuais. Um processo de perfis limpo, uma mensagem de erro compreensível e um passo de aprovação documentado evitam na operação geralmente mais esforço do que um relatório adicional na página inicial.

Conservação de dados e perfis não são um assunto secundário

O SaaS é frequentemente tratado como uma mera questão de utilização. Para os responsáveis de operações e de TI é, contudo, pelo menos igualmente importante o que acontece aos dados. Isso diz respeito a dados mestre, informações de entrega, dados de colaboradores, fotografias de danos e possivelmente dados de clientes. Antes da introdução deveriam estar claras as responsabilidades, a conservação e as possibilidades de exportação.

Na prática significa: a empresa tem de saber que dados estão no sistema, quem tem acesso administrativo e como os dados são disponibilizados numa mudança ou cessação de contrato. Uma exportação disponível apenas como ficheiro PDF de leitura difícil raramente ajuda. Para dados operacionais, formatos estruturados e utilizáveis são decisivos.

Também o conceito de permissões merece atenção concreta. No armazém, nem todas as pessoas precisam de ver preços, condições de clientes ou definições globais. Ao mesmo tempo, uma atribuição de direitos demasiado estreita não deve bloquear o fluxo. Fazem sentido perfis alinhados com as atividades reais: receção, planeamento, expedição, chefia de equipa e administração. As alterações críticas deveriam ser rastreáveis, para que, em caso de perguntas, não seja preciso adivinhar quem alterou um lançamento.

O acesso em si deveria ser protegido com bases sólidas. Isso inclui políticas de palavras-passe seguras, uma reposição de palavra-passe regulada, bloqueio de conta após tentativas falhadas repetidas e, onde o perfil de risco o exija, passos de início de sessão adicionais. A segurança parece profissional quando é previsível e não se nota apenas quando alguém ficou bloqueado.

Integração só onde alivia de forma mensurável

Um workflow web muitas vezes só desenvolve o seu valor em interação com sistemas existentes. Pode ser um ERP, uma loja, uma solução de expedição, um registo de tempos ou uma base de dados. Mesmo assim, nem toda a interface é automaticamente sensata. Cada integração cria dependências, quadros de erro e esforço de manutenção.

A pergunta central é: que passo manual a ligação elimina concretamente? Se uma interface poupa por dia 30 minutos de trabalho de transferência e reduz erros de digitação, o benefício é claro. Se apenas espelha uma informação que de qualquer forma é verificada uma vez por semana, uma exportação manual pode, de início, ser a solução mais razoável.

Nas extensões individuais conta a base técnica. Interfaces documentadas, campos de dados claramente definidos e registos de erros rastreáveis facilitam a operação posterior. Se um sistema for ligado a uma aplicação web à medida, tecnologias e estrutura da base de dados deveriam ser escolhidas de forma a manterem-se sustentáveis a longo prazo. Uma aplicação cuidada baseada em PHP 8.4, JavaScript moderno e MySQL 8 vale mais do que uma solução especial impressionante a curto prazo mas sem documentação.

Introdução com a operação em curso

O erro mais frequente é um arranque brusco sem fase de comparação. As equipas têm então de trabalhar de outra forma logo na segunda-feira de manhã, enquanto as perguntas em aberto só surgem de problemas reais. Isso aumenta a rejeição, mesmo que o software em princípio sirva.

Melhor é um piloto limitado com uma equipa, uma variante de processo ou uma zona de local claramente definida. Nesse tempo verifica-se se o registo e as aprovações funcionam, se os termos são compreensíveis e se os casos excecionais aterram de forma limpa. É importante não recolher o feedback apenas como lista de desejos. Cada alteração deveria ser confrontada com o benefício para o tempo de passagem, a taxa de erros ou a transparência.

Também os indicadores deveriam ser definidos cedo. Por exemplo, podem observar-se o tempo de tratamento por receção de mercadorias, o número de desvios em aberto, as consultas sobre o estado de entrega ou os lançamentos de correção. Sem valor de partida, “parece mais rápido” continua a ser a única avaliação. Pode ser verdade, mas não basta para uma decisão de investimento sólida.

A operação precisa de um dono claro

O SaaS reduz o esforço técnico, mas não liberta uma empresa da responsabilidade pelo seu próprio processo. Internamente é preciso alguém que gira perfis, reúna feedback, reconheça necessidades de formação e decida que alterações são realmente necessárias. Esta pessoa não tem de saber programar. Mas deveria compreender o fluxo de trabalho e ter acesso aos responsáveis.

Igualmente importante é uma documentação operacional breve e sólida. Não explica cada ecrã, mas responde às perguntas que surgem no dia a dia: o que fazer perante um lançamento errado? Quem aprova novos utilizadores? Como é comunicada uma falha? Onde estão os dados exportados? Tal clareza evita que um sistema digital volte, após poucos meses, a depender de chamadas pessoais.

Uma boa solução SaaS não se reconhece, por isso, pelo número de itens de menu que oferece. Mostra o seu valor quando uma nova colega consegue tratar uma operação com segurança, um desvio não desaparece e um responsável vê o estado sem telefonar a três pessoas. O Flow Web deveria ser medido precisamente por esta bitola: não por promessas, mas por um dia de trabalho que decorre comprovadamente mais calmo e fiável.

Permalink →

Desenvolvimento web com frameworks atuais: o que as empresas realmente ganham

Desenvolvimento web com frameworks atuais: o que as empresas realmente ganham

Se uma receção de mercadorias ainda oscila entre formulário em papel, telefonema e três ficheiros Excel, um frontend moderno por si só não resolve o problema. O desenvolvimento web com frameworks atuais faz sentido quando simplifica visivelmente os fluxos: os colaboradores veem o passo seguinte, os dados são registados apenas uma vez e a aplicação permanece compreensivelmente sustentável mesmo após o primeiro go-live.

Para as pequenas e médias empresas, a questão do framework não é, por isso, uma questão de fé. O decisivo não é se uma interface traz especialmente muitas palavras técnicas da moda. O decisivo é se os movimentos de armazém, encomendas, verificações ou aprovações atravessam o dia de trabalho de forma fiável - também sob pressão de tempo, em mudanças de turno e com ligação de rede instável.

Os frameworks são um meio, não um objetivo de projeto

Um framework fornece uma estrutura comprovada para tarefas recorrentes: encaminhamento, formulários, gestão de permissões, acesso a dados, testes e a apresentação de interfaces. Isso não reduz automaticamente todos os riscos. Mas evita que um projeto tenha de reinventar sempre de novo as funções básicas.

Numa aplicação web à medida, um framework JavaScript moderno pode, por exemplo, representar de forma sensata ecrãs interativos: uma lista de picking que atualiza continuamente as posições, um planeamento de rotas com mudanças de estado claras ou um protocolo de inspeção que atribui fotografias e comentários diretamente a uma operação. No backend, frameworks PHP consolidados asseguram regras rastreáveis, responsabilidades claramente separadas e interfaces consistentes com a base de dados.

Isto é particularmente relevante quando uma solução inicialmente pequena se torna um sistema operacional usado diariamente para um processo. Um ecrã de entrada para avisos de entrega pode começar de forma contida. Assim que atualiza stocks, emite etiquetas, considera perfis e comunica com um transportador, precisa de uma base técnica limpa. Os frameworks ajudam a não renegociar essa base a cada extensão.

O que os frameworks web atuais fazem concretamente melhor

O valor dos frameworks modernos raramente está em efeitos espetaculares. Mostra-se nas partes invisíveis de uma aplicação. Os formulários podem verificar entradas diretamente, sem que dados errados só se tornem visíveis após o envio. As permissões podem ser definidas centralmente, de modo que um condutor veja outras informações do que o planeamento. As alterações a uma encomenda são guardadas de forma rastreável, em vez de substituírem silenciosamente uma célula de tabela.

No lado do servidor, um ambiente atual com PHP 8.4 e MySQL 8 cria uma base sólida para lógica crítica para o negócio. As transações de base de dados impedem, por exemplo, que um stock seja reduzido enquanto o lançamento correspondente falha. Chaves únicas e regras de validação evitam duplicados. Processos em segundo plano podem gerar documentos ou chamar interfaces sem que a pessoa ao ecrã tenha de esperar.

Também a segurança não é uma função posterior. Um framework atual suporta armazenamento seguro de palavras-passe, proteção contra ataques típicos por entrada de dados, sessões rastreáveis e fluxos de bloqueio de conta definidos. Ainda assim, a implementação continua a ser uma tarefa de projeto: as permissões têm de ser modeladas corretamente do ponto de vista funcional e as funções sensíveis exigem verificações adicionais. Um framework fornece guarda-corpos, mas não sabe quem na empresa pode conceder que aprovação.

Decidir bem sobre o desenvolvimento web com frameworks atuais

A melhor tecnologia não surge de uma lista de ferramentas populares, mas da utilização real. Uma aplicação interna para dez pessoas tem requisitos diferentes de um portal de clientes com vários milhares de acessos simultâneos. Um terminal de armazém com scanner precisa de uma lógica de operação diferente de uma análise de gestão no computador.

Por isso, uma decisão sensata começa com perguntas concretas: que operações custam hoje tempo de forma mensurável? Que dados são transferidos várias vezes? Onde surgem erros porque a informação só se torna visível demasiado tarde? Que tabela existente funciona suficientemente bem e deveria, por agora, ficar? Precisamente o último ponto protege de projetos de digitalização caros sem benefício operacional.

Para muitas aplicações empresariais à medida, um sistema renderizado no servidor com componentes interativos específicos é a escolha mais sensata. Carrega depressa, é gerível de operar e evita complexidade desnecessária. Uma aplicação de página única totalmente desacoplada pode, pelo contrário, ser adequada quando a interface processa muitíssimos estados dinâmicos, tem de funcionar offline ou deve mais tarde disponibilizar as mesmas funções também a uma app móvel.

Ambas podem estar certas do ponto de vista funcional. A pergunta não é: qual framework é o mais moderno? É: qual arquitetura continuará, daqui a dois anos, a ser segura de expandir, testável e compreensível para a própria equipa?

Quando menos técnica é a melhor técnica

Nem todo o processo precisa de um frontend complexo. Um ecrã de entrada enxuto para encomendas internas pode ser mais rápido, mais estável e mais barato do que uma interface elaboradamente animada. Se um ficheiro Excel é mantido apenas uma vez por mês e não causa erros, talvez continue a ser a ferramenta certa.

A complexidade só compensa quando elimina atrito real. Pode ser o caso quando as encomendas são digitadas várias vezes, o estado de entrega tem de ser consultado por telefone ou ninguém tem a certeza de que versão de um documento é a válida. Então uma aplicação central cria um benefício claro: um estado de dados, responsabilidades inequívocas e menos consultas.

A manutenibilidade começa antes da primeira linha de código

Os frameworks são muitas vezes vistos como aceleradores. Isso só é verdade se as regras de negócio estiverem antes suficientemente claras. Um programador pode construir uma máquina de estados de forma tecnicamente limpa. Mas se a sequência de estados se adequa realmente ao processo decide-se no levantamento: quando é que a mercadoria se considera recebida? Quem pode fechar um desvio? O que acontece numa entrega parcial?

Estas decisões devem ser documentadas, tal como interfaces, campos de dados e exceções. Isso não torna os projetos mais lentos. Reduz discussões posteriores, porque se torna visível que regra foi implementada deliberadamente e que pressuposto continua em aberto.

A manutenibilidade mostra-se também em pequenas disciplinas. As alterações à base de dados têm de ser versionadas. Os passos de implementação têm de ser documentados. As mensagens de erro devem ser aproveitáveis para operação e desenvolvimento sem revelar detalhes confidenciais. Testes automatizados verificam a cada alteração os fluxos centrais, por exemplo a criação de uma encomenda, o cálculo de uma quantidade ou a emissão de uma guia de remessa.

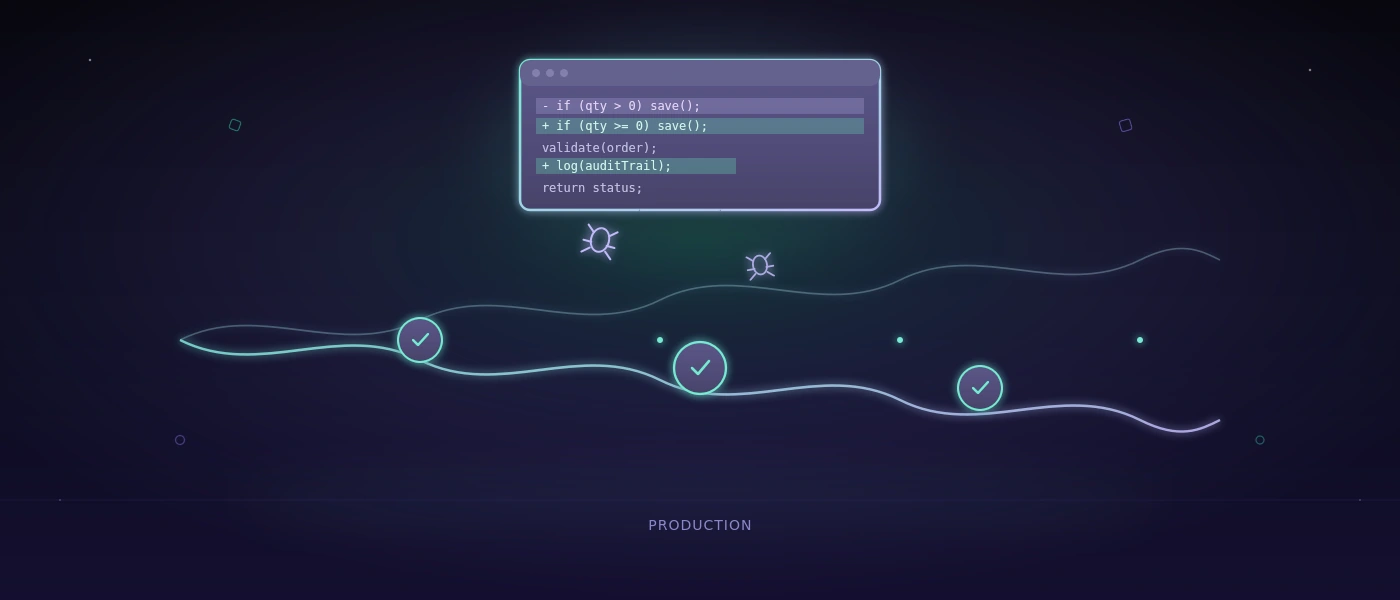
Em aplicações críticas, um único tipo de teste não basta. Os testes unitários asseguram regras individuais, os testes de integração verificam a interação com a base de dados e as interfaces, e os testes de ponta a ponta reproduzem no navegador percursos de utilização reais. Para aplicações web e Windows, um ambiente de testes auto-hospedado pode ainda fornecer capturas de ecrã, registos de execução e avaliações compreensíveis, sem entregar desnecessariamente dados de teste internos a serviços cloud externos.

O desempenho nasce da arquitetura e do modelo de dados

Uma interface moderna não se torna rápida só por usar um framework atual. Consultas lentas à base de dados, imagens sobredimensionadas ou interfaces pouco claras continuam lentas, independentemente do frontend. Especialmente em listas de encomendas, artigos ou dados de movimentos, é o modelo de dados que decide a velocidade percebida.

Índices limpos no MySQL 8, consultas paginadas e dados carregados de forma consciente são muitas vezes mais eficazes do que uma otimização posterior da interface. Igualmente importante é um conceito claro de cache. Os dados mestre podem, em certas circunstâncias, ser colocados em cache, os stocks atuais ou o estado de aprovação, pelo contrário, não às cegas. Aqui não existe regra geral, porque o significado funcional dos dados determina quão atuais têm de ser.

O design responsivo também faz parte do planeamento técnico. No ecrã de escritório, uma tabela larga pode fazer sentido. Num scanner de mão ou tablet no armazém, a mesma informação precisa de grandes áreas de toque, caminhos curtos e uma apresentação que continue utilizável mesmo com luvas ou com pouca luz. Pure fluidity meets ultimate performance não significa, neste contexto, o máximo de movimento possível no ecrã. Significa que a aplicação funciona sem atrito no dispositivo que é realmente usado no processo.

O caminho sensato da ideia à operação

Um projeto web sólido começa com um núcleo limitado e verificável. Em vez de automatizar de antemão cada exceção imaginável, escolhe-se um processo que ocorre com frequência e causa esforço percetível. Após a primeira utilização, dados e retornos reais mostram que extensão tem realmente a prioridade seguinte.

A entrega técnica não deveria ocorrer só no fim. As responsabilidades por alojamento, cópias de segurança, monitorização, atualizações e direitos de acesso têm de ser esclarecidas cedo. Um sistema é tão fiável quanto a sua operação. Quem precisa de uma aplicação diariamente para expedição ou tratamento de encomendas precisa de caminhos de recuperação definidos e de uma resposta clara ao que acontece em caso de falha.

A softify.pro aposta, por isso, em tecnologias sustentáveis, entrega documentada e responsabilidade técnica direta em vez de modas passageiras de frameworks. Isso não é um atalho mágico. Cria o pressuposto de que uma aplicação continue a funcionar após o lançamento, possa ser desenvolvida e não se torne o próximo caso especial frágil.

A aplicação web certa, no melhor dos casos, não se sente como um novo projeto de TI. Sente-se como um fluxo que finalmente funciona sem desvios - com substância técnica suficiente para acolher com calma também a próxima alteração na operação.

Permalink →

Planear a implementação de software: como o conseguir com a operação em curso

Planear a implementação de software: como o conseguir com a operação em curso

Um sistema novo raramente falha porque falta um botão. Falha na segunda-feira de manhã: o turno da manhã não encontra a receção de mercadorias, uma guia de remessa é impressa duas vezes ou um ficheiro Excel passa de repente a ser a verdade não oficial. Quem quer planear uma implementação de software tem, por isso, de fazer mais do que introduzir funções: tem de assegurar a operação real.

Precisamente no armazém, na oficina, no planeamento e na administração, uma implementação não é uma marcação de TI. Altera gestos, responsabilidades e vias de informação. Uma boa introdução mantém o trabalho em movimento, torna os erros visíveis cedo e dá aos colaboradores uma resposta clara à pergunta decisiva: o que faço de diferente a partir de amanhã?

A implementação começa antes da primeira formação

Muitos projetos começam com uma lista de funcionalidades: registar encomendas, lançar movimentos de armazém, imprimir etiquetas de expedição, planear rotas. Isso é necessário, mas não basta. Antes do arranque tem de estar claro que processos devem, no primeiro dia produtivo, passar efetivamente pelo novo sistema - e quais, deliberadamente, ainda não.

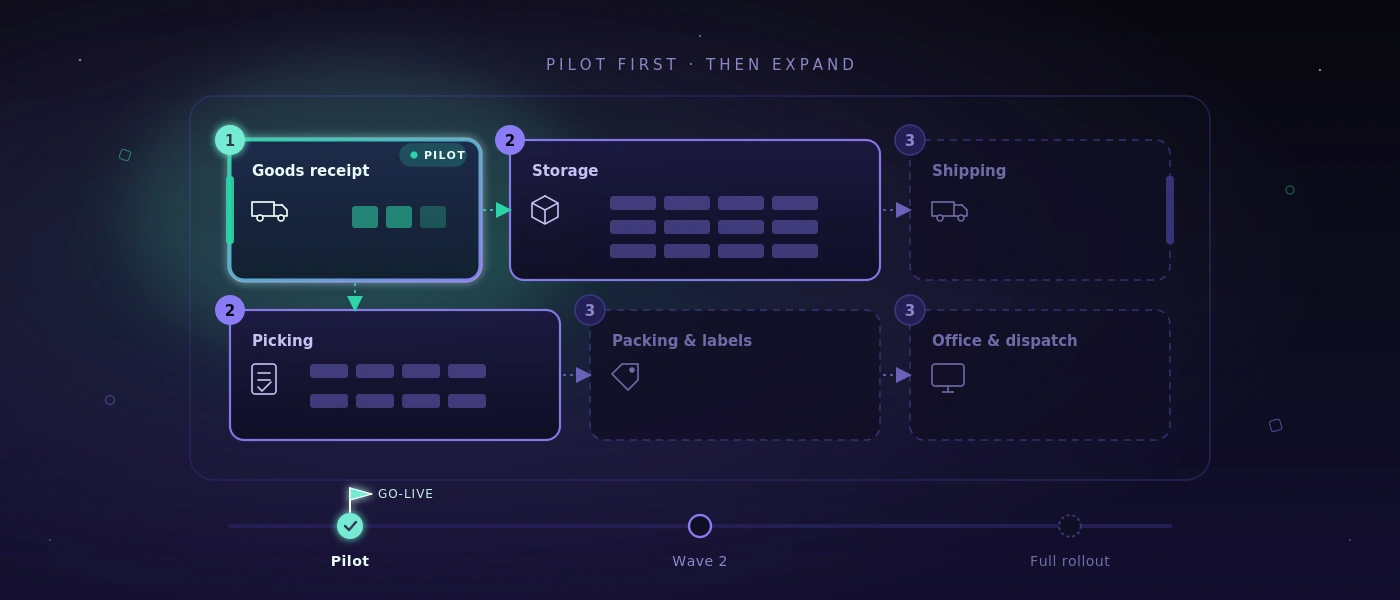
Esta delimitação não é sinal de incompletude. Reduz o risco. Se uma empresa de média dimensão coordenou até agora as receções de mercadorias por papel, telefone e tabelas, não precisa de digitalizar no primeiro dia, em simultâneo, toda a gestão de stocks, o tratamento de devoluções, o planeamento de rotas e a avaliação de fornecedores. Um primeiro âmbito sensato poderia estar na receção de mercadorias, em movimentos de armazém inequívocos e na impressão de documentos de entrega.

O decisivo é descrever concretamente o processo-alvo. Não: «A receção de mercadorias passa a digital.» Mas: «O colaborador digitaliza a entrega, verifica a quantidade e o estado, atribui uma localização e, em caso de desvios, cria um processo para as compras.» Só a este nível ficam visíveis as perguntas em aberto: o que acontece se faltar a encomenda? Quem pode corrigir quantidades? Pode uma entrega sem etiqueta ser armazenada?

Planear uma implementação de software significa: priorizar os fluxos críticos

Nem todo o processo tem o mesmo peso. Uma falha na manutenção de dados mestre pode ser desagradável. Uma falha na expedição, no picking ou na aprovação de faturas pode bloquear o trabalho de um dia inteiro. Por isso, a implementação precisa de uma priorização segundo o risco operacional, não segundo a ordem do caderno de encargos.

Uma classificação simples tem-se revelado útil: crítico para o negócio, importante e adiável. São críticos todos os fluxos que movimentam mercadoria, dinheiro ou comunicação vinculativa com clientes. São importantes as funções que aceleram o dia a dia, mas cuja falha pode ser amortecida manualmente de forma transitória. São adiáveis as funções de conforto, os casos especiais raros ou as análises que, no início, ainda podem vir de uma fonte existente.

Esta classificação influencia a profundidade dos testes. Para um processo de expedição crítico não basta percorrer com sucesso uma única encomenda. Têm também de ser testadas entregas parciais, estornos, impressoras em falta, moradas erradas, processamento paralelo e a transferência para o transportador. Para uma função estatística raramente usada, pode ser adequado um ciclo de testes posterior.

Tornar mensuráveis de antemão os critérios de sucesso

«A aplicação funciona» não é um critério de aceitação. Melhores são afirmações verificáveis: uma receção de mercadorias com 30 posições pode ser lançada em dez minutos. As etiquetas de expedição são impressas no posto previsto. As alterações de stock aparecem imediatamente no planeamento. Uma conta de utilizador bloqueada só pode ser reativada através do processo de aprovação definido.

Tais critérios ligam a área de negócio e o desenvolvimento. Evitam também que a aceitação se transforme numa coleção de impressões vagas. Nem todo o feedback tem de ser resolvido antes do go-live. Mas cada feedback precisa de uma classificação: erro crítico, melhoria relevante ou ponto para uma fase de expansão posterior.

Migração de dados: só dados limpos merecem confiança

Os dados antigos são frequentemente subestimados. Nas tabelas encontram-se números de artigo duplicados, unidades diferentes, moradas de clientes expiradas e stocks cuja origem já ninguém consegue explicar. Quem assume estes dados sem os verificar transfere a antiga indefinição para um novo sistema - só que com melhor interface.

Antes da migração deve determinar-se que dados são realmente necessários. Frequentemente fazem sentido artigos atuais, clientes ativos, encomendas em aberto, fornecedores relevantes e stocks iniciais verificados. Os registos históricos não têm necessariamente de passar por completo para a nova aplicação. Pode bastar arquivá-los de forma legível, se continuarem necessários para comprovativos ou consultas.

Particularmente importante é uma carga de teste. Os dados não são apenas importados tecnicamente, mas verificados funcionalmente: as quantidades, unidades e atribuições estão corretas? Os campos obrigatórios estão completos? Conseguem processar-se corretamente encomendas típicas com eles? Para o go-live é depois necessária uma data-limite clara. A partir de quando é usado que sistema principal? Sem esta regra surgem manutenção duplicada e stocks contraditórios.

Operação-piloto em vez de um grande interruptor

Um big bang pode fazer sentido se uma pequena equipa usar um processo claramente delimitado e a solução antiga e a nova não puderem funcionar em paralelo. Na maioria dos ambientes operacionais, contudo, uma operação-piloto é a escolha mais controlável.

O piloto deve trabalhar com casos reais, mas num âmbito limitado: uma zona de armazém, um turno, um grupo de produtos ou uma equipa selecionada. O decisivo é que o grupo-piloto não inclua apenas colaboradores especialmente aficionados da tecnologia. Deve representar de forma realista o dia a dia posterior, incluindo as pessoas que trabalham sob pressão de tempo e têm objeções legítimas.

Na operação-piloto vê-se se scanners, impressoras, rede e permissões funcionam no posto de trabalho real. Igualmente ficam visíveis lacunas de processo que ninguém mencionou nas reuniões. Talvez a mercadoria seja, no dia a dia, primeiro colocada num local intermédio. Talvez os condutores precisem de uma guia de remessa diferente da da administração. Tais descobertas não são um retrocesso. São a razão para realizar o piloto antes do arranque generalizado.

A formação como situação de trabalho, não como visita guiada ao software

Uma formação que só explica itens de menu gera pouca segurança. Os colaboradores têm de aprender nas suas tarefas: «Aceita uma entrega danificada», «Prepara uma encomenda urgente», «Corrige uma quantidade mal lançada». O contexto fixa-se porque corresponde ao dia a dia de trabalho.

Formações curtas junto ao go-live são geralmente mais eficazes do que uma marcação longa semanas antes. Ajudam também instruções de trabalho concisas diretamente no posto. Não devem explicar o sistema inteiro, mas mostrar as operações mais frequentes, responsabilidades claras e o caminho em caso de falhas.

Nomeie ainda pessoas de contacto por área. Estas pessoas não têm de resolver elas próprias cada problema técnico. Mas devem poder decidir se se trata de um erro de utilização, uma indefinição funcional ou um erro real do sistema. Isso protege a equipa do projeto de interpelações desestruturadas e acelera a ajuda ao turno.

O go-live precisa de um plano operacional

O dia do go-live precisa de mais do que uma hora. Defina quem decide a nível funcional, quem é responsável pelas alterações técnicas e por que canal as falhas são reportadas. Em fluxos críticos deve ser visível se as funções centrais funcionam: início de sessão, permissões, captura de dados, interfaces, impressão e cópia de segurança.

Um plano de contingência faz igualmente parte. Isso não significa regressar por completo ao velho mundo ao mínimo problema. Significa determinar antecipadamente que falha justifica uma paragem, como se documentam as encomendas em caso de necessidade e como se registam depois de forma limpa. Um formulário em papel durante poucas horas pode ser razoável. Uma gestão paralela permanente sem fim não é.

Os detalhes técnicos contam aqui: os acessos foram criados a tempo? Os perfis e as regras de bloqueio de conta funcionam corretamente? As impressoras de etiquetas estão ligadas aos modelos certos? Existe uma cópia de segurança testada da base de dados? Em aplicações desenvolvidas à medida, implementações documentadas, estados de versão rastreáveis e um caminho claro para correções de erros são o padrão.

As primeiras semanas decidem a aceitação

Após o arranque começa a fase em que uma aplicação se torna ou uma ferramenta de trabalho ou um passo adicional detestado. Planeie por isso breves ciclos de feedback diários. Que erros se repetem? Onde surgem desvios? Que campos são mal compreendidos? Que análise falta realmente a um responsável?

Nem toda a observação exige uma alteração imediata. Alguns problemas resolvem-se com regras de trabalho mais precisas ou melhor formação. Outros revelam fragilidades reais no processo ou na aplicação. A arte consiste em não confundir ambos. Um sistema não deve complicar, sem motivo, fluxos existentes que funcionam. Se uma tabela bem mantida continua a ser a melhor solução para um caso especial raro, pode ficar.

Meça o efeito com alguns indicadores concretos: tempo de processamento por operação, número de consultas, lançamentos errados, reimpressões, encomendas em aberto ou discrepâncias de stock. Só estes valores mostram se a implementação melhora realmente a operação - em vez de apenas introduzir novos ecrãs.

Uma boa implementação, após algumas semanas, já não se sente como um projeto. Torna-se uma rotina de trabalho fiável: os dados certos estão onde são necessários, as exceções são rastreáveis e as equipas têm de andar menos ao telefone atrás de informação. É exatamente a isso que o planeamento deve visar - não a um dia de arranque espetacular, mas a um dia a dia mais calmo e mais bem controlável.

Permalink →

Planear o Multiplatform Application Development: primeiro o processo, depois a plataforma

Planear o Multiplatform Application Development: primeiro o processo, depois a plataforma

Um responsável de armazém confirma uma receção de mercadorias no scanner de mão. O planeamento verifica a mesma operação no navegador. Um condutor precisa do estado de entrega em viagem no smartphone. O Multiplatform application development soa, neste momento, a uma questão técnica. Na verdade, trata-se primeiro de um fluxo operacional: que trabalho tem de ser feito onde, com que fiabilidade e com que dispositivo?

Para as pequenas e médias empresas, a resposta certa raramente é: construímos tudo de forma nativa para cada plataforma. Com mais frequência é: definimos um processo comum, escolhemos de forma direcionada as interfaces necessárias e evitamos a lógica duplicada. Isso não poupa apenas orçamento de desenvolvimento. Evita também que o armazém, o escritório e o serviço externo trabalhem com estados de dados diferentes.

O que o Multiplatform Application Development deve proporcionar

O Multiplatform Application Development designa o desenvolvimento de uma aplicação utilizável em vários ambientes, por exemplo no navegador web, em iOS e Android ou em sistemas de secretária Windows. O termo é muitas vezes reduzido à questão de saber se uma única base de código pode gerar várias aplicações. Isso é apenas parte da decisão.

Para sistemas operacionais, o que importa sobretudo é se a aplicação funciona no local de utilização. Uma zona de receção pode precisar de uma câmara para capturar códigos de barras, elementos de controlo grandes para luvas e uma reação utilizável com cobertura WLAN instável. A administração precisa, pelo contrário, de tabelas, filtros, conceitos de permissões e registos de alterações rastreáveis. Um condutor precisa de uma vista reduzida, não da mesma interface que o planeamento.

Uma base técnica comum pode ligar estes requisitos de forma sensata. Mas não deve levar a que cada plataforma seja servida como um mau compromisso. O melhor código partilhado é inútil se os colaboradores fazem desvios porque a aplicação não reflete o seu fluxo de trabalho real.

Primeiro determinar o processo, depois a plataforma

Antes de as equipas falarem de frameworks, deveriam examinar uma operação concreta do princípio ao fim. Tomemos uma entrega: entra a encomenda, a mercadoria é preparada, surge uma guia de remessa, a entrega é confirmada e o estado é reportado de volta às vendas ou ao apoio ao cliente. Em que ponto surge hoje a rutura de suporte? Onde se anota algo em papel, se digita mais tarde ou se pergunta por telefone?

Esta observação separa os requisitos reais de plataforma das listas de desejos. Se apenas dois colaboradores no escritório usam uma função, uma interface web bem feita costuma bastar. Se dez pessoas no chão do armazém fazem lançamentos, uma interface móvel adequada ao scanner pode fazer a diferença. Se um programa Windows existente tem de trabalhar com hardware especial, pode ser necessária uma integração de secretária.

Nem toda a função pertence a todo o dispositivo. Isso não é um defeito de uma solução multiplataforma, mas sinal de decisões de produto limpas. Dados e regras de negócio comuns não significam necessariamente ecrãs idênticos.

As três perguntas que esclarecem custos e benefícios

A primeira pergunta é: que dispositivos já estão em uso e durante quanto tempo continuarão a estar? Uma empresa com terminais Windows geridos tem requisitos diferentes de um serviço externo com smartphones privados. A segunda é: o que acontece sem ligação de rede? A capacidade offline aumenta consideravelmente o esforço, porque os dados têm de ser guardados localmente, sincronizados mais tarde e tratados de forma limpa em caso de conflitos. Faz sentido se o processo, de outro modo, parar - não como equipamento padrão.

A terceira pergunta diz respeito às consequências de uma falha. Pode um colaborador registar um lançamento mais tarde, ou dele depende uma etiqueta de expedição, um stock ou uma libertação de segurança? Quanto mais crítica a operação, mais fortemente têm de ser planeados permissões, regras de verificação, repetibilidade e registo.

Uma arquitetura que não se desfaz na segunda plataforma

Numa solução sustentável, a lógica de negócio não está espalhada por várias interfaces. Verificações de stock, mudanças de estado, intervalos de numeração, permissões e geração de documentos precisam de uma base central e testada. Navegador, aplicação móvel e cliente de secretária acedem a ela através de interfaces claramente definidas.

Para muitos processos empresariais internos, uma aplicação web moderna é o ponto de partida mais económico. Pode ser atualizada centralmente, não precisa de instalação em cada posto e funciona em computador, tablet e smartphone. Com PHP 8.4, JavaScript moderno e MySQL 8 pode construir-se uma base sustentável, desde que o modelo de dados, os direitos de acesso e a implementação não sejam considerados só pouco antes do arranque.

Uma aplicação móvel ou de secretária instalável é acrescentada quando traz uma vantagem clara: integração profunda com scanner, impressora ou câmara, operação offline fiável, funções especiais em segundo plano ou requisitos da gestão de dispositivos. É uma expansão direcionada, não um fim em si mesmo.

Um erro frequente é a reutilização completa da interface de utilizador a todo o custo. Tecnicamente pode parecer atraente. Na prática surgem textos pequenos em monitores grandes, formulários sobrecarregados em smartphones ou comandos que não se adequam à plataforma. É melhor partilhar modelo de dados, regras e componentes onde faz sentido, adaptando a utilização ao respetivo contexto.

A consistência dos dados é mais importante do que uma base de código comum

Várias plataformas aumentam o risco de dados contraditórios. Uma encomenda é alterada no escritório enquanto um condutor ainda vê uma versão antiga no seu dispositivo. Dois colaboradores lançam em simultâneo o mesmo stock de artigo. Um dispositivo offline reenvia as suas alterações horas depois. Estes casos não são um tema marginal, mas o núcleo da arquitetura.

O sistema precisa, por isso, de identidades inequívocas, carimbos temporais, mudanças de estado rastreáveis e regras para conflitos. Num estado de entrega, a última alteração confirmada pode bastar. Em stocks, isso é muitas vezes demasiado grosseiro. Aí tem de ficar claro que movimento foi lançado, de que localização provém e se uma correção tem de ser justificada.

Também as permissões devem ser reguladas centralmente. Um colaborador pode, talvez, registar receções de mercadorias, mas não aprovar correções de stock. Um condutor externo só pode ver o seu percurso. Durações de sessão, autenticação multifator para perfis críticos e fluxos de bloqueio de conta não são funções de segurança decorativas. Protegem processos concretos e tornam as responsabilidades visíveis.

Testar o Multiplatform Application Development como se trabalha

Uma aplicação pode arrancar em três sistemas operativos e, mesmo assim, falhar na operação. Decisivos são os fluxos em condições reais: o scanner reage demasiado devagar, uma impressora de etiquetas não está acessível, uma permissão não produz efeito após uma mudança de perfil, ou uma sincronização gera lançamentos duplicados.

Por isso, os processos críticos devem ser verificados automaticamente. Isso inclui início de sessão e comportamento de bloqueio, registo de encomendas, movimentos de stock, criação de documentos e o tratamento de entradas erradas. Para aplicações web e Windows, testes recorrentes podem ser executados numa infraestrutura auto-hospedada. Isto é particularmente relevante se capturas de ecrã, dados internos de encomendas ou acessos de teste não devem ser transmitidos a serviços cloud externos.

A automação não substitui a verificação por pessoas no chão do armazém. Mas garante que os fluxos conhecidos são controlados uma e outra vez após alterações. Bons relatórios de teste não nomeiam apenas um erro técnico, mas o processo afetado: o comprovativo de entrega não pode ser gerado, a conta de utilizador permanece bloqueada após aprovação bem-sucedida ou os dados do percurso não são atualizados.

Quando uma estratégia de plataforma é demais

Algumas empresas não precisam de uma app própria. Se um acesso estável pelo navegador basta, o fluxo raramente é móvel e o número de utilizadores se mantém gerível, uma aplicação web responsiva é muitas vezes a escolha mais sensata. Reduz o esforço de manutenção, os problemas de distribuição e o número de possíveis fontes de erro.

Também uma tabela existente não tem de ser substituída de imediato. Se serve apenas como avaliação simples, é mantida por uma pessoa e não cria transferências propensas a erros, pode cumprir o seu propósito. O momento para um sistema chega quando o conhecimento está em cabeças individuais, as versões divergem, as perguntas aumentam ou uma operação já não pode ser rastreada de forma fiável.

Inversamente, uma estratégia de plataforma enxuta torna-se depressa demasiado pequena quando os colaboradores têm de trabalhar offline, é ligado hardware ou clientes e parceiros precisam de acesso controlado. Então vale a pena financiar conscientemente os requisitos adicionais, em vez de os acrescentar mais tarde sob pressão de tempo.

Começar com um piloto sólido

Um bom começo não é um catálogo de funcionalidades com cem pontos, mas um fluxo completo e mensurável. Por exemplo: registar a receção de mercadorias, atualizar o stock, documentar um desvio e criar uma tarefa de esclarecimento. Este piloto mostra cedo se modelo de dados, dispositivos, direitos e utilização se encaixam.

Depois, a solução pode crescer em passos sensatos: picking, expedição, planeamento de percursos ou análises. Cada extensão deveria passar a mesma pergunta: encurta um fluxo real, reduz erros ou cria transparência fiável? Se não, pode esperar.

A plataforma mais sensata, no final, não é a que tem mais opções técnicas. É aquela em que uma equipa começa o trabalho mais depressa de manhã, pergunta menos durante o turno e pode rastrear à noite o que realmente aconteceu.

Permalink →

Avaliar corretamente os Test Automation Results

Avaliar corretamente os Test Automation Results

Um teste de regressão pode terminar de manhã com 98 por cento de casos bem-sucedidos e, mesmo assim, não ser uma boa notícia. Talvez o teste falhado seja precisamente o início de sessão de um grande cliente. Talvez 40 testes tenham sido ignorados porque o ambiente de teste não estava acessível. Ou a execução estava verde, mas só verificava se os botões existem, não se uma encomenda é realmente guardada, uma guia de remessa gerada e o stock corretamente ajustado. Os Test automation results não são uma afirmação sobre qualidade enquanto lhes faltar o contexto.

Para a direção de QA, o desenvolvimento e as áreas de negócio, o verdadeiro trabalho não está, portanto, apenas em automatizar testes. O decisivo é preparar os resultados de modo que deles surjam decisões fiáveis: pode uma versão ser lançada? Tem de se tratar um erro de imediato? O erro é novo, recorrente ou apenas um problema do ambiente de teste? E existem evidências que também uma área de negócio sem código de teste consiga acompanhar?

O que os Test Automation Results realmente dizem

O indicador mais simples é: aprovado ou reprovado. É útil, mas raramente suficiente. Uma taxa de sucesso elevada pode criar confiança se os testes cobrirem fluxos críticos, os dados de teste forem plausíveis e o ambiente se assemelhar à operação posterior. Se faltar um destes fatores, o número continua a ser sobretudo um sinal de que uma execução automatizada foi realizada.

Em aplicações críticas para o negócio, pesam mais outras perguntas. Numa solução de armazém, nem todos os ecrãs são igualmente importantes. Um erro de apresentação num texto de aviso interno pode esperar. Um erro que contabiliza a quantidade errada na receção de mercadorias ou gera uma etiqueta de expedição sem morada do destinatário, não. Bons resultados de teste ponderam, por isso, os riscos em vez de tratar todos os casos de forma igual.

Também um teste falhado não é automaticamente um defeito do produto. Pode ser desencadeado por credenciais expiradas, um perfil de teste bloqueado, interfaces indisponíveis, dados de teste alterados ou um ambiente lento. Quem não separa estas causas produz ruído. A equipa gasta então tempo com falsos alarmes enquanto erros reais se perdem entre mensagens de estado vermelhas.

Quatro tipos de estado em vez de uma lista vermelha

Na prática, tem-se revelado útil uma classificação clara: erro funcional, falha técnica do teste, problema de ambiente e alteração esperada. Um erro funcional significa que a aplicação viola um requisito definido. Uma falha técnica do teste aponta antes para o próprio teste, por exemplo um seletor que deixou de corresponder após uma interface deliberadamente alterada.

Existe um problema de ambiente quando, por exemplo, um sistema de teste ou uma interface ligada não está disponível. As alterações esperadas surgem quando um processo foi deliberadamente ajustado, mas a automação ainda verifica o antigo estado-alvo. Estas categorias não evitam toda a discussão. Mas garantem que a discussão começa no ponto certo.

De execuções de testes a relatórios prontos para decisão

Um relatório utilizável não responde apenas que algo falhou, mas o que aconteceu, quão grave é e se o erro parece reproduzível. Para isso é preciso mais do que uma lista de nomes de testes e carimbos temporais.

A cada execução relevante pertencem a build verificada, o ambiente de teste, o perfil utilizado, os dados de teste centrais, bem como a hora de início e de fim. Especialmente em aplicações de secretária Windows ou plataformas web complexas, estas informações são necessárias para delimitar diferenças. Um erro que só ocorre sob um perfil de armazém restrito é algo diferente de um erro que bloqueia cada início de sessão.

Resultados significativos contêm ainda evidências rastreáveis: capturas de ecrã, passos gravados, mensagens de erro e, se necessário, registos técnicos. Uma captura de ecrã isolada pode, contudo, enganar. Mostra um momento, não a causa. A combinação de sequência de passos, estado visível e reação esperada é muito mais útil.

Os sistemas assistidos por IA podem transformar estas evidências em avaliações compreensíveis. Com a COCO, por exemplo, os testes correm num servidor de IA próprio e auto-hospedado. A avaliação pode explicar que uma encomenda foi criada, mas a mudança de estado esperada não ocorreu, e associar diretamente a gravação da execução. Para equipas atentas à segurança, é relevante onde são processados as capturas de ecrã, os dados da aplicação e o tráfego de teste. O controlo local não é automaticamente necessário, mas em aplicações internas e dados sensíveis pode ser o caminho mais sensato do que um serviço cloud externo.

O nível de detalhe certo para diferentes destinatários

As equipas de desenvolvimento precisam de mensagens de erro, passos técnicos e indicações o mais precisas possível para a reprodução. Um operations manager precisa, pelo contrário, primeiro da função afetada, do risco de negócio e de uma afirmação clara sobre a capacidade operacional. Ambas as perspetivas têm de poder surgir da mesma execução, sem que alguém tenha de transferir manualmente resultados para apresentações.

Um bom relatório começa, por isso, com um breve nível de decisão: lançamento recomendado, lançamento com limitações conhecidas ou parar o lançamento. Por baixo estão os desvios críticos com prioridade e evidência. Os detalhes técnicos seguem só depois. Isso não é uma simplificação à custa da precisão, mas uma separação limpa das necessidades de informação.

Medir a cobertura sem se iludir com falsa segurança

A cobertura de testes é frequentemente apresentada como valor percentual. Esse valor é útil quando está claro o que mede. A cobertura de código mostra, por exemplo, que partes do código do programa foram executadas durante os testes. Isso não prova que um processo de negócio funcione corretamente. Um teste pode tocar em muitas linhas de código e, mesmo assim, nunca verificar se uma morada de entrega errada aparece no documento.

Para as áreas de negócio, a cobertura de processos é frequentemente mais reveladora. Descreve que fluxos reais estão protegidos: registar uma encomenda, reservar stock, contabilizar uma entrega parcial, aceitar uma devolução ou aprovar uma fatura. Particularmente valiosas são as transições entre sistemas e perfis, porque é aí que frequentemente surgem erros: na importação de uma encomenda, na impressão de uma etiqueta ou na mudança do escritório para o terminal de armazém.

Não priorize pelo número de testes possíveis, mas pelo impacto do dano e pela frequência de alterações. Um processo raramente usado com elevado risco financeiro ou legal merece frequentemente uma automação mais cedo do que uma vista muito usada, mas inofensiva. Inversamente, um fluxo estável e pouco crítico pode continuar a contentar-se com uma breve verificação manual. Nem toda a verificação tem de ser automatizada só porque é automatizável.

Testes instáveis são um problema de qualidade à parte

Testes que, sem alteração reconhecível do produto, ora passam ora falham são frequentemente designados flaky. Danificam a confiança mais depressa do que um teste permanentemente vermelho. Assim que as equipas reiniciam por reflexo resultados vermelhos, a automação perde a sua função de alerta.

As causas são geralmente concretas: esperas fixas, dados de teste partilhados, acessos paralelos, processamento assíncrono ou um ambiente que não é reposto. Uma curta pausa de três segundos no teste pode ajudar por acaso, mas não é uma solução. É melhor esperar por um estado demonstrável, tornar os dados de teste únicos e isolar os fluxos uns dos outros.

Nem toda a instabilidade pode ser totalmente evitada. Interfaces externas podem oscilar e a infraestrutura real tem falhas. Nesse caso, o relatório deve assinalar claramente se um teste não pôde ser avaliado devido a uma dependência externa. Uma execução repetida pode ser útil para diagnóstico, mas não deve tornar invisível a primeira constatação.

Um procedimento sensato após cada execução de testes

Após uma execução automatizada, nem todos os resultados devem ser imediatamente tratados da mesma forma. Primeiro verificam-se os erros bloqueantes e os testes críticos não avaliáveis. Depois segue-se a classificação dos novos desvios face a problemas conhecidos e aceites. Só então uma decisão de lançamento é sólida.

Limiares definidos ajudam, mas têm de se ajustar ao processo. Por exemplo, um teste falhado no fluxo de pagamentos ou de permissões pode desencadear uma paragem imediata. Perante um desvio puramente cosmético, uma exceção documentada pode ser defensável. Tais regras não deveriam surgir apenas sob pressão de tempo antes de um lançamento.

Igualmente importante é o feedback: cada erro de produção que os testes não detetaram é um motivo para verificar se falta um cenário, uma variante de dados de teste ou um ponto de controlo. O objetivo não é acumular o maior número possível de testes. É construir, a partir de erros reais, uma melhor proteção de forma direcionada.

Os resultados de teste mais úteis, no final, não são os de visão geral mais verde. São aqueles com os quais um responsável pode compreender na segunda-feira de manhã o que foi verificado, que risco permanece e que ação é agora sensata.

Permalink →

Inventory Discrepancy Causes: razões comuns para discrepâncias de stock

Inventory Discrepancy Causes: razões comuns para discrepâncias de stock

O sistema indica 248 unidades em stock, na prateleira estão 231. Estas 17 unidades parecem à primeira vista um erro de contagem. Mas é precisamente aí que começa frequentemente a análise errada. As inventory discrepancy causes raramente são, na prática, um descuido isolado. Na maioria das vezes surgem onde a receção de mercadorias, o movimento de armazém, a preparação de pedidos, e a contabilização divergem no tempo ou organizacionalmente.

Para uma pequena ou média empresa, as discrepâncias de stock não são apenas um tema para o inventário físico. Levam a encomendas erradas, entregas expresso, stocks de segurança desnecessários, e promessas de entrega que não podem ser cumpridas. Quem separa as causas de forma clara não precisa de introduzir imediatamente um grande ERP. Frequentemente bastam regras de contabilização mais claras, dispositivos de captura adequados, e um sistema que reflita os processos de trabalho reais.

Inventory discrepancy causes: onde surgem as diferenças

Uma discrepância de stock é a diferença entre o stock-alvo no sistema principal e o stock realmente presente. Decisiva aqui é a palavra "principal". Se um ficheiro Excel, uma lista em papel, e um sistema de gestão de mercadorias forem mantidos em paralelo, existem praticamente várias verdades. Nesse caso, a diferença não surgiu apenas no armazém, mas já estava integrada na gestão dos dados.

A contramedida eficaz depende, portanto, do tipo de erro. Uma palete mal contada precisa de uma solução diferente de uma entrega aceite fisicamente, mas nunca contabilizada. Antes de as equipas reestruturarem processos, deveriam avaliar as diferenças por artigo, localização, turno, tipo de movimento, e momento. Só este padrão mostra se se trata de um caso isolado ou de um erro de processo recorrente.

1. As receções de mercadorias são contabilizadas tarde ou de forma incompleta

A receção de mercadorias é um ponto de rutura clássico. A mercadoria chega de manhã, é posta de lado para inspeção, e mais tarde levada diretamente para a produção ou para a prateleira. A contabilização ocorre à tarde, no dia seguinte, ou nunca. Enquanto a mercadoria estiver fisicamente presente, o stock do sistema parece demasiado baixo. Se já estiver consumida ou expedida, os erros subsequentes tornam-se mais prováveis.

Especialmente propensas são as entregas parciais, os artigos substitutos, e as entregas em excesso. Se na guia de remessa consta uma quantidade, mas chega uma quantidade diferente, ninguém deve simplesmente contabilizar o documento "mais ou menos correspondente". A discrepância deve permanecer visível como exceção, incluindo motivo, pessoa responsável, e aprovação. Caso contrário, o desvio desaparece da operação e só reaparece no inventário físico.

2. Os movimentos de armazém ocorrem sem transação

Um artigo é colocado da receção de mercadorias para o armazém em altura, movido de uma posição para a zona de picking, ou reservado para um pedido. Fisicamente, é um movimento pequeno e rápido. No sistema, pode ser decisivo.

Se os colaboradores reorganizam as localizações de armazenamento apenas por intuição, o stock total talvez ainda esteja correto, mas a disponibilidade no lugar certo não. Isso causa tempo de procura, erros de picking, e viagens de reabastecimento desnecessárias. Uma boa solução de armazém não precisa de tornar cada movimento complicado. Tem de registar os poucos movimentos relevantes para disponibilidade, rastreabilidade, e reposição.

Em oficinas ou armazéns mais pequenos, é frequentemente mais sensato manter algumas zonas inequívocas do que uma estrutura de posições teoricamente perfeita que ninguém mantém no dia a dia. A precisão só funciona se permanecer praticável.

3. O picking e a expedição são contabilizados demasiado cedo

Muitas equipas contabilizam um pedido como "dado de saída" no momento do picking, embora a mercadoria ainda esteja numa posição de preparação. Se o pedido for depois alterado, cancelado, ou expedido apenas parcialmente, o stock do sistema e o stock físico deixam de coincidir.

Melhor é uma separação clara entre reservado, preparado, e expedido. Nem todas as empresas precisam de cadeias de estado complexas para isso. Mas o momento da redução do stock tem de ser inequívoco. Para mercadoria de expedição, está frequentemente mais próximo da entrega efetiva ao transportador do que do primeiro gesto em direção à prateleira.

As devoluções também pertencem a este fluxo. Quando a mercadoria regressa, não fica automaticamente disponível de novo. Só a inspeção, a decisão de qualidade, e o armazenamento deveriam determinar se volta ao stock vendável, fica bloqueada, ou é abatida.

4. Unidades erradas e erros de dados mestre

Uma caixa, uma embalagem, um rolo, e uma peça individual podem referir-se ao mesmo artigo. Se a conversão não for mantida corretamente, surgem diferenças a uma velocidade impressionante. Um colaborador contabiliza "1", querendo dizer uma caixa com 24 peças. O sistema entende uma peça.

Os erros de dados mestre são especialmente insidiosos porque o processo de contabilização pode parecer tecnicamente correto. Por isso, verifique as unidades de embalagem, os fatores de conversão, as quantidades mínimas, as localizações, e os números de artigo. Também as variantes com nomes semelhantes, por exemplo comprimentos, cores, ou lotes diferentes, são facilmente confundidas.

Aqui não ajuda nenhuma regra geral como "digitalizar mais". Os códigos de barras são apenas tão fiáveis quanto a associação por trás deles. Para sortidos pequenos, um registo de artigos bem mantido com etiquetas legíveis pode conseguir mais do que um parque extenso, mas mal configurado, de scanners.

5. Tabelas paralelas e correções manuais

A tabela no ambiente de trabalho raramente surge por negligência. Normalmente preenche uma lacuna real: uma reserva especial, um valor de avaliação em falta, ou um processo que o software existente não representa. Torna-se problemática quando se transforma no segundo livro de stock.

Nesse caso, as entradas são contabilizadas no sistema, mas as saídas anotadas na tabela. Ou uma correção só ocorre onde precisamente ajuda o próximo pedido. Ninguém consegue depois explicar de forma fiável qual o valor válido.

Nem toda a tabela precisa de ser eliminada. Um cálculo para planeamento ou análises pode continuar a ser sensato. No entanto, as operações que alteram o stock deveriam ter exatamente um sistema principal. Os ajustes precisam de um código de motivo, uma marca temporal, e idealmente uma pessoa que possa ser rastreada. Isso não é burocracia por si só, mas o pré-requisito para análises de causas sólidas.

6. Erros de contagem e métodos de inventário inadequados

Mesmo processos corretos não protegem contra erros humanos. Os artigos são contados duas vezes, as paletes são ignoradas, as caixas abertas estimadas, ou as localizações não bloqueadas durante a contagem. Um inventário completo anual descobre estes problemas tarde e sob grande pressão.

Para muitas empresas, um inventário cíclico é a alternativa mais sensata. Os artigos de rotação rápida ou de valor são verificados mais frequentemente, os artigos C estáveis com menos frequência. O importante não é produzir o maior número possível de contagens, mas verificar os desvios atempadamente em relação aos últimos movimentos. Se um artigo com discrepância é simplesmente corrigido sem documentar a causa, o padrão permanece invisível.

Uma contracontagem é especialmente sensata para valores elevados, números de série, ou lotes. Para parafusos num armazém de consumíveis pode ser economicamente excessiva. A profundidade do controlo deve ajustar-se ao risco.

7. Responsabilidades pouco claras entre turnos e áreas

Os erros de stock surgem frequentemente nas transferências. O turno da manhã prepara a mercadoria, o turno da tarde expede-a. A receção de mercadorias aceita uma entrega, enquanto o planeamento altera o pedido em paralelo. Cada passo individual pode ser rastreável, mas ninguém é dono da operação completa.

Por isso, defina não apenas funções, mas pontos de transferência: quem confirma a receção de mercadorias? Quando muda a responsabilidade pela mercadoria preparada? Quem verifica as exceções em aberto no final do turno? Um quadro digital partilhado ou uma lista simples de exceções é frequentemente mais eficaz do que reuniões adicionais.

O sistema deveria tornar as operações em aberto visíveis, em vez de obrigar os colaboradores a lembrarem-se. Por exemplo, entregas sem verificação de quantidade, picks sem conclusão de expedição, ou devoluções sem decisão de qualidade têm de se destacar antes de se tornarem erros silenciosos de stock.

8. Integração de sistemas fraca e regras de validação em falta

Se a loja, a gestão de encomendas, o armazém, e a contabilidade trocam dados com desfasamento temporal ou por ficheiro, podem surgir contabilizações duplicadas ou em falta. Uma importação é executada duas vezes. Uma interface falha silenciosamente. Um pedido é alterado depois de o seu estado de expedição já ter sido transferido.

A solução não é necessariamente uma substituição completa. Frequentemente são necessárias interfaces claramente definidas, números de documento inequívocos, e verificações técnicas. Uma contabilização de armazém deveria guardar de forma rastreável quando ocorreu, de que operação resulta, e se foi posteriormente cancelada. Os processos críticos precisam de mensagens de erro e filas de espera, não apenas de uma entrada silenciosa no ficheiro de registo.

Com sistemas de logística desenvolvidos à medida, essas regras podem ser adaptadas de forma direcionada à operação: nenhuma quantidade negativa sem aprovação, nenhuma confirmação de expedição sem posição de expedição, nenhum processamento duplicado da mesma referência externa. A melhor regra aqui não é a mais rigorosa, mas a que impede erros reais sem bloquear a operação em exceções normais.

Verificar discrepâncias de stock sistematicamente

Não comece com uma correção generalizada. Escolha os dez artigos com as diferenças mais frequentes ou mais caras, e rastreie o seu último movimento para trás: receção de mercadorias, transferência, saída, devolução, contagem, e qualquer ajuste manual. Se os casos se concentrarem numa localização, num turno, ou num tipo de movimento, isso é um ponto de partida sólido.

Depois disso, cada medida deveria ser mensurável. Se forem introduzidas novas leituras de código de barras, observe não apenas o número de leituras, mas a taxa de discrepância por grupo de artigos. Se for adicionado um novo estado para preparação, verifique diariamente as preparações em aberto. Bons processos não produzem precisão aparente. Tornam as exceções visíveis e rastreáveis precocemente.

O próximo passo sensato é frequentemente pequeno: definir um ponto de transferência, limpar uma localização, ou assegurar tecnicamente uma correção manual recorrente. Stocks fiáveis não surgem de mais software por suspeita, mas de processos ainda corretamente executáveis numa terça-feira caótica às 16:45.

Permalink →

Abordar corretamente a automação de processos para PME

Abordar corretamente a automação de processos para PME

Falta uma guia de remessa porque os dados ainda estão num papelinho. Uma receção de mercadorias é registada duas vezes porque o armazém e o escritório trabalham com tabelas diferentes. Uma aprovação atrasa-se porque a pessoa responsável não atende o telefone naquele momento. Este tipo de atrito raramente custa muito dinheiro de uma só vez. Mas ao longo de semanas somam-se pedidos de esclarecimento, tempos de procura, correções de erros, e esperas desnecessárias. É precisamente aí que a automação de processos para PME faz sentido.

Não se trata de substituir o maior número possível de atividades por software. Uma boa automação torna os processos rastreáveis, reduz transferências evitáveis, e dá aos colaboradores tempo para decisões que requerem experiência. Isso é especialmente decisivo nas pequenas e médias empresas: as equipas estão próximas do negócio diário. Quando um processo emperra, muitas vezes o turno inteiro nota imediatamente.

Não automatizar todos os processos

O erro mais comum é começar pelo incómodo mais visível. Talvez um ficheiro Excel irrite, talvez seja necessário um novo painel de controlo. Ambos podem ser justificados. Mas um caos digitalizado continua a ser caos - só que mais rápido e com mais dados.

Antes de uma decisão técnica, o fluxo deve primeiro ser descrito tal como realmente acontece. Não como deveria constar no manual. Quem desencadeia o processo? Que informação é necessária? Onde é algo transferido manualmente? Quem decide em caso de exceções? E como reconhece a equipa que o processo está concluído?

Precisamente no armazém ou no processamento de encomendas, os pontos críticos situam-se frequentemente entre sistemas: uma encomenda chega por e-mail, é copiada para uma tabela, coordenada por telefone, e mais tarde introduzida num software de expedição. Cada transferência aumenta a probabilidade de as quantidades, prazos, ou endereços divergirem.

Uma automação compensa especialmente quando um processo ocorre com frequência, tem regras claras, e os erros causam consequências percetíveis. Isso pode ser a receção de mercadorias, a criação de guias de remessa, a atribuição de movimentos de armazém, ou a passagem de encomendas aprovadas para a expedição. Casos especiais raros com muitas decisões discricionárias, por outro lado, muitas vezes continuam a ser melhor geridos manualmente - pelo menos inicialmente.

A automação de processos para PME começa com prioridades

Nem toda a atividade desnecessária merece imediatamente um projeto. Uma priorização simples cria clareza. Avalie os diferentes fluxos por frequência, tempo de processamento, custos de erro, e dependências. Um processo que ocorre cinquenta vezes por dia e poupa apenas dois minutos de cada vez pode ser mais económico do que um processo mensal complicado.

A questão da consequência do erro é pelo menos igualmente importante. Um documento interno mal impresso é irritante. Uma atribuição de lote errada, um endereço de entrega perdido, ou uma receção de mercadorias não documentada pode desencadear reclamações, trabalho de procura, e discrepâncias de stock. Aí a automação gera não apenas rapidez, mas fiabilidade.

Um primeiro passo sensato costuma ser suficientemente pequeno para ser verificável em poucas semanas. Por exemplo, um colaborador pode registar mercadorias através de um código de barras, o sistema verifica artigo e quantidade, atualiza o stock numa base de dados central, e gera diretamente um recibo de armazenamento se necessário. A equipa não tem depois de adivinhar qual a versão de uma tabela que está atualizada.

Um estado-alvo claro em vez de uma lista de funcionalidades

Muitos projetos começam com uma longa lista de funcionalidades desejadas. Melhor é uma imagem operacional concreta: o que deve ser visível no final de um processo sem necessidade de perguntar? Na expedição, isso poderia significar que uma encomenda, após aprovação, recebe automaticamente uma lista de picking, o endereço de expedição é verificado, e pode ser gerada uma etiqueta. As exceções aterram de forma visível numa lista de esclarecimento, em vez de numa caixa de correio eletrónico inabarcável.

Esta imagem-alvo obriga a decisões úteis. Cada encomenda tem de ser processada de forma totalmente automática? Ou devem as encomendas acima de um determinado valor de mercadoria, com endereço de entrega divergente, ou com stock em falta, ser deliberadamente submetidas a verificação? A automação não precisa de um processamento a cem por cento às escuras para criar um grande benefício.

A técnica adequada depende do fluxo

Não existe um caminho técnico padrão para todas as PME. Uma solução em tabela ainda pode ser razoável para uma avaliação gerível. É rapidamente adaptada, familiar, e causa pouco esforço de implementação. Assim que várias pessoas trabalham simultaneamente, os lançamentos têm de ser rastreáveis, ou dados são trocados com outros sistemas, atinge, porém, os seus limites.

Nesse caso, uma aplicação enxuta e específica do fluxo é frequentemente mais sensata do que uma suite empresarial sobredimensionada. Pode representar exatamente os passos necessários na operação: registar encomenda, verificar stock, mover mercadoria, gerar documento, registar expedição, e reportar estado. Nem mais, mas também nem menos.

Tecnicamente, importa menos se um sistema anuncia a palavra da moda mais recente. Decisivas são bases sólidas: uma base de dados modelada de forma limpa, permissões rastreáveis, registos para alterações relevantes, interfaces fiáveis, e implementações documentadas. Uma aplicação baseada em PHP 8.4, JavaScript moderno, e MySQL 8 pode ser muito bem mantível a longo prazo, se a arquitetura e a operação forem pensadas desde o início.

As integrações também merecem atenção. Uma troca automática de dados com loja, ERP, prestador de serviços de expedição, ou contabilidade só poupa tempo se os erros forem tratados de forma visível. O que acontece com um endereço inválido? Uma impressão de etiqueta falhada é repetida? A equipa consegue ver quais dados foram transferidos e quais ainda faltam? Erros silenciosos são mais perigosos do que um caso excecional claramente assinalado.

Implementação durante a operação contínua

Um novo sistema tem de se adaptar a mudanças de turno, prazos de entrega, e rotinas de trabalho existentes. Por isso, uma implementação gradual é geralmente mais segura do que uma data-limite rígida para todas as áreas. Comece com um processo delimitado, um grupo de produtos, ou uma área de armazém. Isso reduz o risco e gera feedback real do dia a dia.

O funcionamento paralelo não é, portanto, sinal de insegurança, mas um teste controlado. Durante um tempo limitado, o registo antigo e o novo podem ser comparados. As diferenças não revelam apenas erros de software, mas frequentemente também regras que até agora só existiam na cabeça de colaboradores individuais. Essas regras devem pertencer de forma visível ao processo - não permanentemente à experiência pessoal.

Os colaboradores não devem ser confrontados com o novo fluxo apenas na formação. Quem executa o processo diariamente reconhece atalhos, casos especiais, e ecrãs pouco práticos precocemente. Um bom software respeita este conhecimento, sem incorporar inalterada cada exceção historicamente desenvolvida. A pergunta certa é: que exceção protege um caso de negócio importante, e qual é apenas uma solução alternativa para um problema antigo?

Tornar mensurável se o esforço compensa

Antes do início devem ser definidos dois ou três indicadores. Podem ser o tempo de ciclo por encomenda, número de correções manuais, discrepâncias de stock, ou o tempo até à expedição. Sem um valor de partida, cada avaliação posterior torna-se uma questão de intuição.

Nem todo o efeito se mostra imediatamente em euros. Quando uma equipa de armazém sabe a qualquer momento onde se encontra a mercadoria, diminui o número de interrupções. Quando os documentos de entrega surgem dos mesmos dados que a encomenda, diminui o risco de informações contraditórias. E quando as responsabilidades são visíveis no sistema, um processo depende menos de pessoas individuais.

A automação precisa de manutenção e limites

Um fluxo automatizado não é um projeto que congela após o go-live. As estruturas de artigos mudam, os clientes exigem novos documentos, os prestadores de serviços de expedição adaptam interfaces. Por isso, responsabilidades, atualizações, cópias de segurança, e uma gestão regulada de permissões fazem parte do sistema propriamente dito.

Especialmente em aplicações com dados de clientes, encomendas, ou stock, deve ser claro quem obtém acesso e porquê. As funções têm de se adequar ao dia a dia de trabalho: uma equipa de armazém precisa de funções diferentes da contabilidade ou das vendas. Alterações registadas, fluxos de início de sessão seguros, e restauros testados parecem pouco espetaculares. Em caso de incidente, são precisamente estes detalhes que decidem se a operação pode continuar a funcionar.

Os testes também fazem parte da segurança operacional. Verificações recorrentes para entrada de encomendas, contabilização de stock, geração de documentos, e gestão de direitos evitam que uma alteração num ponto danifique um fluxo funcional noutro. Para aplicações web ou de secretária críticas, um ambiente de testes auto-hospedado e controlado pode fazer sentido, se capturas de ecrã, dados de teste, e processos internos não devem chegar a serviços cloud externos.

A softify.pro acompanha este tipo de projetos com um princípio simples: primeiro compreender o fluxo real, depois construir a menor solução viável. Às vezes é uma aplicação feita à medida. Às vezes basta estruturar uma tabela existente de forma mais limpa e automatizar um único passo de transferência.

O melhor próximo passo não é, portanto, uma comparação de software, mas um percurso por um processo real - do desencadeador até à conclusão. Pegue numa encomenda, numa receção de mercadorias, ou numa reclamação e acompanhe-a com as pessoas envolvidas. Onde a informação é reintroduzida, ninguém conhece o estado, ou decisões esperam desnecessariamente, encontra-se geralmente a abordagem mais sensata para a automação.

Permalink →

Testar aplicações Windows: um plano prático

Testar aplicações Windows: um plano prático

Uma aplicação Windows pode parecer limpa em modo demo e mesmo assim abrandar a operação numa segunda-feira de manhã. Uma guia de remessa não guardada, um utilizador bloqueado após três tentativas falhadas, ou uma caixa de diálogo de impressão que reage de forma diferente após uma atualização não são bugs cosméticos. Quem quer saber como testar aplicações Windows não deve, portanto, começar por botões individuais, mas pelos fluxos que custam trabalho, dinheiro, ou rastreabilidade.

Precisamente no armazém, na oficina, na expedição, e na administração, muitos processos críticos passam por software de secretária desenvolvido ao longo dos anos. Aí não importa se um caso de teste está formulado de forma impressionante. O que importa é se os colaboradores conseguem realizar as suas tarefas de forma fiável em condições realistas - incluindo dados incompletos, permissões variáveis, redes lentas, e interrupções não planeadas.

Testar aplicações Windows começa pelos fluxos críticos

Nem todas as funções merecem o mesmo esforço de teste. Uma exportação raramente usada com retrabalho manual deve ser avaliada de forma diferente da contabilização de uma receção de mercadorias, a criação de uma etiqueta, ou a reconciliação diária de encomendas. Comece, portanto, com uma pergunta simples: o que acontece concretamente se este fluxo falhar?

Têm alta prioridade os processos com impacto direto no stock, entrega, faturação, segurança, ou comunicação com o cliente. Isto inclui, por exemplo, o início de sessão e a verificação de permissões, a criação e alteração de dados mestre, as contabilizações de transações, a impressão de documentos, as interfaces com serviços ERP ou de envio, bem como a recuperação após um erro. Mesmo funções usadas apenas por um pequeno grupo de pessoas podem ser críticas se bloquearem um fecho mensal ou a libertação de mercadoria.

Destes fluxos não surgem listas de teste abstratas, mas sim passos de trabalho rastreáveis. Um teste de receção de mercadorias poderia, por exemplo, começar com uma encomenda existente, registar uma entrega parcial, reportar uma quantidade divergente, atribuir uma localização de armazém, e depois verificar se o stock, o registo de contabilizações, e o documento impresso correspondem. Assim testa o efeito real do software, não apenas campos de entrada individuais.

Criar uma base de teste que reflita a operação

Muitos erros só se tornam visíveis quando o ambiente de teste se aproxima da realidade. Uma aplicação comporta-se frequentemente de forma diferente com um inquilino de teste vazio do que com vários anos de dados de movimentos, artigos bloqueados, informação obrigatória em falta, ou operações já abertas.

Por isso, configure dados de teste de forma deliberada. Não precisa necessariamente de uma cópia completa da produção. Faz mais sentido um conjunto de dados controlado com casos típicos, limite, e deliberadamente errados: artigos com diferentes unidades de medida, clientes com condições especiais, encomendas com entregas parciais, utilizadores com diferentes funções, e operações já em processamento. Os dados pessoais devem, nesse caso, ser anonimizados ou substituídos por dados de exemplo realistas.

Também faz parte da base de teste o ambiente técnico. Documente a versão do Windows, resolução, escala, impressoras instaladas, unidades de rede, versão da base de dados, serviços ligados, e permissões. Isto soa árido, mas poupa tempo mais tarde. Se um erro ocorrer apenas em postos de trabalho com escala a 125% ou com um determinado controlador de impressora, isso tem de ser reproduzível.

Não verificar apenas o caso ideal

O caso ideal prova sobretudo que a aplicação foi construída para o percurso esperado. Na operação, as situações difíceis surgem ao lado dele. O que acontece se um utilizador deixar um campo obrigatório vazio, disparar a mesma contabilização duas vezes, ou perder a ligação durante o guardar? A operação permanece consistente? A pessoa recebe uma mensagem compreensível? Consegue continuar a trabalhar em segurança?

Nas aplicações Windows, o manuseamento e o estado são também particularmente relevantes. As caixas de diálogo podem aparecer em segundo plano, os atalhos de teclado podem sobrepor-se, as caixas de diálogo de seleção de ficheiros podem bloquear o fluxo. Verifique se o foco, as mensagens de erro, e os bloqueios são inequívocos. Uma exceção técnica sem indicação de ação não ajuda o chefe de turno.

Usar testes manuais onde é necessário juízo

Os testes manuais não são sinal de maturidade insuficiente. São indispensáveis quando surge um novo fluxo, uma interface é reconstruída, ou o conhecimento especializado determina a qualidade. Um chefe de armazém experiente reconhece mais depressa do que um script se um ecrã é compreensível sob grande pressão de tempo, ou se um aviso aparece demasiado tarde.

O teste manual torna-se, contudo, dispendioso e pouco fiável quando os mesmos fluxos estáveis são repetidos antes de cada versão. Nesse caso, o lançamento depende de pessoas disponíveis, memória, e notas dispersas. O momento certo para passar à automação encontra-se geralmente onde um processo é executado com frequência, pode causar danos significativos, e tem resultados esperados claros.

Um bom caso de teste manual descreve a situação inicial, os passos, o resultado esperado, e os dados necessários. Perante um erro, adicione uma captura de ecrã, carimbo temporal, versão da aplicação e da build, bem como a ação exata. "A impressão não funciona" não é uma descrição de erro utilizável. "Após alterar o endereço de entrega, a caixa de diálogo de impressão permanece aberta, a encomenda 4711 não recebe um PDF, e não aparece qualquer mensagem" é.

Testes de regressão automatizados para riscos recorrentes

A automação não verifica se um software é fundamentalmente bom. Verifica se fluxos definidos que anteriormente funcionavam continuam a funcionar após uma alteração. Isso é especialmente valioso para software Windows cujas interfaces, lógica de base de dados, e interfaces externas são desenvolvidas ao longo dos anos.

Comece por pouco. Escolha primeiro cinco a dez fluxos críticos para o negócio que devem ser verificados a cada lançamento. Entre eles podem estar o início de sessão com um fluxo de bloqueio de conta, a entrada de encomendas, a contabilização de armazém, a impressão de PDF ou etiquetas, a mudança de função, e uma importação central. Só quando estes testes funcionam de forma fiável é que compensa a expansão para casos especiais.

Nas aplicações de secretária, os testes automatizados costumam controlar elementos visíveis da interface: janelas, campos de entrada, tabelas, botões, e caixas de diálogo. Isso funciona, mas é mais frágil do que um teste puro de interface. Pequenas alterações de layout, computadores mais lentos, ou elementos nomeados de forma ambígua podem quebrar testes. Por isso, programadores, área de negócio, e responsáveis de teste devem determinar em conjunto quais os elementos que são endereçáveis de forma estável e quais os passos de verificação que ficam melhor assegurados através da base de dados, de um registo, ou de uma interface.

Um teste sensato também não verifica apenas se um botão pôde ser clicado. Controla a consequência funcional: a contabilização foi guardada? O stock está correto? Foi gerado um documento? Não foi criado nenhum registo duplicado? Interação visível e resultado verificável andam de mãos dadas.

As evidências fazem parte do resultado do teste

Um estado verde por si só raramente é suficiente em aplicações críticas. Quando um teste falha, as equipas precisam rapidamente de uma resposta a três perguntas: qual era a situação inicial? Em que passo o fluxo falhou? O que mostrava a aplicação nesse momento?

Capturas de ecrã, registos de execução, e, quando aplicável, gravações de ecrã tornam os erros discutíveis. Encurtam consideravelmente a transferência entre operação, QA, e desenvolvimento. Para empresas reguladas ou atentas à segurança, são também uma base sólida para rastrear aprovações e desvios.

Aqui, o local de armazenamento não é uma questão secundária. As execuções de teste podem conter dados internos de clientes, listas de preços, informações de encomendas, ou vistas de ecrã. Quem automatiza testes para aplicações Windows sensíveis deve esclarecer se esses dados podem sair da própria infraestrutura. Um ambiente auto-hospedado como o COCO pode fazer sentido aqui, porque a execução dos testes, as evidências, e a avaliação permanecem sob o próprio controlo. Se isso é necessário depende dos requisitos de proteção de dados, da situação contratual, e da necessidade de proteção - nem todas as equipas precisam da mesma arquitetura para isso.

Integrar os testes no processo de lançamento

O melhor catálogo de testes perde valor se só for usado depois de uma entrada em produção precipitada. Defina um momento fixo: as regressões centrais automatizadas correm antes de cada lançamento, a aceitação manual verifica fluxos novos ou alterados, e as limitações conhecidas são documentadas abertamente.

Nem todo o teste falhado tem de parar um lançamento. Um erro numa vista de administração raramente usada pode ser aceitável se existir uma solução alternativa segura e a área afetada estiver claramente informada. Um erro que contabiliza stocks incorretamente ou bloqueia utilizadores sem que se note deve ser tratado de forma diferente. Essa decisão deve ser tomada com base no impacto no negócio, não na mera contagem de testes vermelhos.

Mantenha os testes junto com a aplicação. Quando um processo muda deliberadamente, atualize o caso de teste, os dados de teste, e o resultado esperado em conjunto com o requisito. Testes desatualizados criam ruído e acabam por ser ignorados. Algumas verificações fiáveis valem mais do que centenas de fluxos automatizados cujos resultados já ninguém leva a sério.

No final, não se trata de simular todas as entradas imagináveis. Trata-se de proteger o trabalho que tem de voltar a funcionar na manhã seguinte. Comece com um único processo crítico, torne o seu resultado demonstrável, e construa a partir daí.

Permalink →

Secure test data management sem perder o controlo

Secure test data management sem perder o controlo

Uma execução de teste falhada é irritante. Uma execução de teste bem-sucedida com dados reais de clientes num ambiente insuficientemente protegido pode revelar-se consideravelmente mais cara. O secure test data management não resolve essa contradição com uma única ferramenta, mas com regras claras para dados, acessos, ambientes de teste, e evidências. Para equipas que testam de forma automatizada aplicações web ou Windows, isso faz por isso parte do trabalho de qualidade - não apenas de conformidade.

Por que os dados de teste se tornam um problema de segurança

Os dados de produção são tentadores para os testes porque contêm casos limite reais: endereços incompletos, combinações de encomendas invulgares, regras de preços históricas, ou entradas incorretas. Mas precisamente esses dados contêm frequentemente nomes, dados de contacto, informações contratuais, números de pessoal, dados bancários, ou lógica de negócio interna.

O risco raramente surge de um único erro flagrante. Geralmente cresce passo a passo: uma exportação da base de dados é criada para um teste, colocada num diretório partilhado, e posteriormente copiada para outro ambiente. Um serviço externo recebe capturas de ecrã para análise de erros. Uma conta de teste mantém permissões amplas porque uma limpeza poderia perturbar a próxima execução. Após alguns meses, já ninguém sabe com fiabilidade que dados estão onde.

Nas pequenas e médias empresas, o problema é frequentemente agravado por capacidades limitadas. A equipa quer cumprir um prazo de lançamento, não gerir o seu próprio projeto de proteção de dados. A responsabilidade mantém-se, contudo. Quem usa dados para garantia de qualidade tem de conseguir rastrear que dados são processados, quem tem acesso, e quando são novamente removidos.

O secure test data management começa antes do caso de teste

A questão decisiva não é: "Como protegemos o conjunto de dados de teste?" É: "Que informação é que este teste realmente precisa?" Muitos testes de regressão não requerem quaisquer referências pessoais reais. Um processo de expedição, por exemplo, tem de verificar se os endereços de entrega, pesos, zonas, etiquetas, e alterações de estado são processados corretamente. Para isso bastam clientes sintéticos, dados mestre de artigos plausíveis, e casos limite definidos deliberadamente.

Esta distinção conduz a uma classificação de dados prática. Nem todos os ambientes de teste precisam da mesma profundidade de dados. Para testes unitários e de integração, conjuntos de dados totalmente artificiais são muitas vezes suficientes. Para testes end-to-end, cópias pseudonimizadas podem fazer sentido se padrões de dados reais forem funcionalmente relevantes. Dados semelhantes aos de produção deveriam ser a exceção - com um propósito documentado, acesso limitado, e uma vida útil fixa.

Importante aqui é a qualidade dos dados substitutos. Dados fictícios aleatórios ajudam pouco se não refletirem dependências realistas. Um conjunto de dados de teste para uma aplicação de armazém deve, por exemplo, conter variantes de artigos, locais de armazenamento, stock bloqueado, entregas parciais, e devoluções numa combinação coerente. Bons dados de teste não protegem apenas informação pessoal. Encontram erros que nunca se tornariam visíveis com tabelas vazias e o cliente exemplo "João Silva".

Sintetizar, mascarar, ou minimizar?

Os dados sintéticos são a escolha mais segura quando as regras de negócio podem ser modeladas de forma limpa. Surgem de forma específica a partir dos requisitos de teste e não contêm qualquer cópia de pessoas ou operações reais. O esforço reside na manutenção: se o modelo de dados mudar ou forem adicionadas novas regras de processo, geradores e fixtures têm de crescer em conjunto.

A mascaragem é adequada quando o comportamento de uma aplicação depende fortemente de estruturas de produção. Nesse caso, os campos sensíveis são substituídos ou alterados, enquanto as relações são preservadas. Os nomes tornam-se nomes plausíveis mas fictícios; os endereços de e-mail tornam-se endereços de teste não entregáveis; os números de conta tornam-se valores com formato correto sem qualquer associação real. Uma mascaragem só é sólida se as deduções indiretas também forem consideradas. Uma combinação de um local raro, data de nascimento, e característica contratual pode continuar a tornar uma pessoa identificável.

A minimização de dados é frequentemente o terceiro caminho subestimado. Em vez de copiar uma exportação completa, apenas é fornecida a fatia necessária. Isso reduz a superfície de ataque, a necessidade de armazenamento, e o esforço de limpeza. Para testar uma lógica de desconto, ninguém precisa de todo o histórico de um ano de um cliente.

Os acessos e ambientes têm de corresponder ao risco

Um conjunto de dados protegido perde o seu valor se estiver num ambiente de teste livremente acessível. Os sistemas de teste precisam, portanto, das suas próprias fronteiras de segurança - bases de dados separadas, contas de serviço próprias, acessos de rede claramente definidos, e nenhuma ligação silenciosa à produção.

Os direitos de acesso deveriam basear-se em funções, não em contas partilhadas. Os programadores podem precisar de direitos diferentes dos de QA, suporte, ou fornecedores externos de serviços. Os acessos de administrador são por vezes necessários, mas deveriam ser limitados no tempo, registados, e associados a uma aprovação rastreável. Também para as contas de teste se aplicam regras de palavra-passe sensatas, autenticação multifator onde disponível, e fluxos de bloqueio de conta perante tentativas falhadas repetidas.

Os testes automatizados trazem consigo outro caso especial: geram evidências. Capturas de ecrã, gravações de ecrã, registos, e mensagens de erro podem conter conteúdo sensível, mesmo quando a base de dados foi mascarada. Uma captura de ecrã de um ecrã de cliente, um rasto de navegador com informação de sessão, ou um registo com um payload de API pertencem à mesma consideração de proteção que a base de dados de teste.

Por isso, os artefactos de teste precisam de regras de retenção. Nem toda a execução bem-sucedida tem de ser armazenada permanentemente. Para aprovações críticas, uma evidência rastreável pode fazer sentido, por exemplo com carimbo temporal, número de build, versão de teste, e resultado. As execuções falhadas necessitam muitas vezes de uma janela de análise mais longa. Depois disso, os artefactos deveriam ser eliminados automaticamente. O que já não existe não pode ser partilhado ou comprometido por acidente.

Automação sem fugas de dados descontroladas

A automação de testes assistida por IA pode acelerar consideravelmente os testes, especialmente em aplicações web e Windows extensas. Mas muda a questão de segurança: para onde vão as capturas de ecrã, entradas, descrições de erros, e tráfego da aplicação? Quem os processa? Quanto tempo lá permanecem?

Para equipas conscientes da segurança, a execução auto-hospedada é frequentemente a melhor arquitetura. Um sistema como o COCO pode funcionar dentro da própria infraestrutura, ou de uma claramente delimitada, executando passos de teste, armazenando evidências, e gerando avaliações compreensíveis. Isso não é obrigatório em todas as situações. Para uma página de marketing pública com valores de formulário puramente sintéticos, um serviço externo pode ser aceitável. Em aplicações empresariais internas, portais de clientes, ou software com processos pessoais, porém, o controlo local é uma vantagem concreta.

A auto-hospedagem não é um passe livre. A operação exige atualizações, conceitos de cópia de segurança, registos de acesso, e uma entidade responsável. Em troca, a soberania dos dados permanece onde pertence. A abordagem correta depende da necessidade de proteção, das capacidades operacionais existentes, e do tipo de aplicação testada - não do hype atual em torno de uma determinada ferramenta de teste.

Como as regras se tornam num processo funcional

Um processo praticável não tem de bloquear o lançamento. Comece com um mapa de dados: que ambientes de teste existem, que tipos de dados lá se encontram, e que sistemas geram artefactos adicionais? Este inventário geralmente já revela exportações antigas, sistemas de staging esquecidos, e responsabilidades pouco claras.

Depois disso, vale a pena uma matriz de decisão simples por classe de teste. Determina se dados sintéticos bastam, se é necessária uma mascaragem, ou se é necessário um extrato de produção claramente justificado. É complementada por proprietários, prazos de eliminação, e funções de acesso. Isto não tem de ser um conjunto de regras sobrecarregado. Uma diretriz curta e realmente seguida é melhor do que um documento de segurança que ninguém encontra durante um incidente.

Tecnicamente, o fornecimento e a limpeza de dados pertencem ao pipeline de teste. Uma execução cria de forma reproduzível os conjuntos de dados de que necessita, usa marcadores únicos, e depois remove-os novamente. Isso impede que os ambientes de teste se encham de dados residuais e que os resultados se tornem menos fiáveis a cada sprint. Para processos críticos, as equipas deveriam adicionalmente verificar se os acessos a dados e as evidências de teste precisam de ser registados de forma auditável.

Segurança que torna o teste mais rápido

O secure test data management é frequentemente visto como um encargo de controlo adicional. Mal implementado, pode de facto sê-lo. Bem implementado, porém, cria condições de partida fiáveis e repetíveis. As equipas perdem menos tempo à procura de uma exportação de dados utilizável, evitam testes quebrados devido a dados residuais não limpos, e conseguem justificar melhor as aprovações.

O primeiro passo mais sensato raramente é um grande projeto de plataforma. Escolha o processo de teste com o maior risco ou a maior fricção - por exemplo, a aprovação de uma aplicação interna de encomendas - e torne aí visíveis a fonte de dados, os acessos, os artefactos, e a eliminação. Desse trabalho concreto nasce uma rotina de segurança que não torna os testes mais pesados, mas sim mais credíveis.

Permalink →

Warehouse Software vs ERP

Warehouse Software vs ERP

Uma receção de mercadoria chega ao mesmo tempo que um picking urgente, dois colaboradores perguntam pela localização de um artigo, e uma guia de remessa já foi corrigida à mão. É precisamente nestes momentos que a questão Warehouse Software vs ERP se torna prática. Não se trata da interface mais moderna nem da lista de funcionalidades mais longa. Trata-se de saber se a informação está disponível exatamente onde uma decisão tem de ser tomada em segundos.

Muitas pequenas e médias empresas na região DACH começam com um ERP, uma folha de cálculo e muita experiência na equipa. Isso pode funcionar durante muito tempo. Os problemas começam quando os stocks divergem entre sistemas, os tempos de procura aumentam e cada caso especial tem de ser resolvido aos gritos pelo armazém. Nessa altura, surge muitas vezes a ideia de um grande projeto de ERP, mesmo que talvez baste digitalizar um único processo de armazém claramente delimitado.

Warehouse Software vs ERP: a diferença no dia a dia

Um sistema ERP representa a empresa em amplitude. Tipicamente liga compras, vendas, dados-mestre de artigos, contabilidade, produção, faturação e planeamento. A sua força está em fazer convergir dados comerciais e operacionais num quadro comum. Uma encomenda é criada, uma fatura emitida, uma necessidade planeada, um stock valorizado.

O warehouse software, muitas vezes chamado WMS ou gestão de armazém, trabalha mais perto dos movimentos reais dentro do armazém. Apoia a receção de mercadoria, a arrumação em stock, as transferências, o picking, o inventário, a expedição e as devoluções. Responde a perguntas que o ERP muitas vezes só representa de forma grosseira: em que localização está a mercadoria? Que stock está realmente disponível? Que lote foi expedido? Que encomenda tem prioridade? Quem confirmou a transferência?

Esta distinção não é absoluta. Existem ERP com funções de armazém alargadas e produtos WMS ligados a processos de encomendas ou de compras. O que decide, portanto, não é o rótulo da oferta, mas a profundidade operacional. Um ERP pode gerir dez localizações e mesmo assim ser pouco prático se os colaboradores tiverem de abrir vários ecrãs para cada movimento, ou só registar os dados mais tarde.

O ERP é a fonte comercial

Quando uma encomenda tem de ser faturada, uma ordem de compra despoletada ou uma valorização de material criada, isso pertence, na maioria das empresas, ao ERP. É aí que costuma estar a lógica principal de artigos e clientes. Este papel não deveria ser duplicado de ânimo leve. Dois sistemas independentes para preços, referências de artigo ou encomendas não criam segurança, criam trabalho de reconciliação.

Um ERP é particularmente útil quando o desafio central é transversal: compras e produção têm de ser planeadas em conjunto, os dados financeiros têm de permanecer consistentes, ou várias empresas do grupo trabalham com os mesmos processos. Quem ainda não tem essa base não deveria esperar que uma solução puramente de armazém substitua todos os processos da empresa.

O warehouse software controla o movimento

No armazém, porém, não conta apenas o que teoricamente existe no sistema. Conta o que acabou de chegar ao portão três, que posição está livre e se a mercadoria foi reservada para uma encomenda confirmada. Uma boa solução de armazém reduz o atrito exatamente nesses pontos.

Isso pode começar com scanners móveis: a mercadoria é lida na receção de mercadoria, atribuída a uma localização e imediatamente assinalada como disponível. Durante o picking, o sistema conduz por uma sequência sensata, verifica artigo e quantidade e gera, quando necessário, etiquetas de expedição ou documentos de entrega. O registo não acontece horas mais tarde num posto de escritório, mas dentro do próprio processo.

O benefício não está só na velocidade. Registos rastreáveis tornam os erros visíveis. Se um stock não bate certo, é possível apurar quando faltou um movimento ou quando foi confirmado de forma errada. Isso é muito mais fiável do que uma correção mensal numa folha de cálculo.

Quando um módulo de ERP é suficiente

Um módulo de ERP existente pode ser a escolha certa quando a organização do armazém é gerível e a equipa consegue trabalhar de forma fiável com os processos. Um único armazém, localizações fixas, poucas linhas de encomenda e nenhum requisito rígido de lote ou número de série são condições típicas. Também com um volume de expedição reduzido, um componente de sistema adicional pode gerar mais manutenção do que benefício.

Antes de adquirir um novo sistema, vale a pena fazer um teste realista: consegue um colaborador registar por completo uma receção, uma transferência e uma expedição sem um papel de apontamentos? O stock é visível por localização? As diferenças de um inventário são rastreáveis? Os documentos são criados sem dupla introdução de dados? Se a resposta for maioritariamente sim, uma expansão talvez não seja urgente.

A folha de cálculo também pode continuar a existir, se cumprir de forma limpa um propósito limitado, por exemplo um planeamento sazonal de capacidade ou uma análise pontual. Uma boa solução não substitui todas as formas de trabalhar conhecidas. Substitui os passos manuais em que erros, tempo de espera ou falta de transparência custam realmente dinheiro.

Quando uma solução de armazém especializada compensa

O ponto de viragem chega normalmente de forma gradual. Primeiro, um colaborador pergunta mais vezes por um artigo. Depois, mantêm-se os stocks mais altos por precaução, porque ninguém sabe ao certo o stock realmente disponível. Por fim, os envios atrasam-se porque guias de remessa, etiquetas e correções de stock passam por ferramentas diferentes.

Um warehouse software especializado compensa especialmente quando várias destas condições se conjugam:

  • são geridas várias zonas de armazém, localizações ou armazéns externos
  • receções, transferências e picking acontecem diariamente em grande número
  • é preciso rastrear lotes, números de série, prazos de validade ou stock bloqueado
  • transportadoras, impressoras de etiquetas ou scanners móveis têm de ser integrados no processo
  • a realidade operacional se afasta cada vez mais do que o ERP mostra

Esta lista não é uma recomendação de compra automática. Uma empresa com muitas linhas de encomenda pode funcionar bem com um ERP bem configurado. Ao contrário, uma pequena empresa pode precisar cedo de uma aplicação de armazém leve, se cada peça tiver de ser rastreável ou várias equipas tiverem de registar em simultâneo.

A questão da integração pesa muitas vezes mais do que as funcionalidades

A pergunta mais difícil em Warehouse Software vs ERP raramente é: que sistema sabe fazer mais? A pergunta melhor é: que dados têm de fluir, quando, para que sistema?

Em muitos casos, o ERP continua a ser a referência para artigos, clientes, encomendas e documentos comerciais. A aplicação de armazém assume a execução operacional. Recebe encomendas libertadas, executa os movimentos de armazém e devolve o estado, as quantidades, os lotes ou os números de expedição. Assim, cada lado tem uma tarefa clara.

Esta interface precisa de regras concretas. O que acontece a uma alteração de encomenda depois de o picking já ter começado? Pode um stock de armazém ficar negativo? Que registo é válido em caso de falha de rede? Como se bloqueiam artigos assinalados no controlo de qualidade? Sem estas decisões, até uma API tecnicamente limpa se torna uma nova fonte de erros.

Para pequenas e médias empresas, uma implementação por fases é muitas vezes mais sensata do que uma mudança completa. Pode introduzir-se primeiro a receção de mercadoria com leitura de código de barras. Seguem-se depois as localizações e as transferências, mais tarde o picking e a expedição. Assim, as exceções reais são identificadas cedo, sem apostar toda a operação num único dia de transição.

Produto standard, expansão do ERP ou aplicação à medida?

Um WMS standard compensa quando os processos próprios são, em grande parte, convencionais e uma integração existente encaixa com o ERP. Traz rapidamente funcionalidades comprovadas para a operação. O preço a pagar pode ser as equipas terem de adaptar os seus fluxos de trabalho a modelos fixos, ou pagar por funcionalidades enterprise raramente usadas.

Expandir o ERP faz sentido quando a profundidade operacional necessária está realmente disponível e a utilização funciona no chão do armazém. Não se deve avaliar apenas a demonstração do produto, mas sim um fluxo real com scanner, luvas, Wi-Fi instável e pressão de tempo antes da partida.

Uma aplicação à medida torna-se interessante quando o processo sustenta a vantagem competitiva da empresa, ou o software standard obriga permanentemente a desvios. Pode ser um processo de receção de mercadoria particular, uma ligação entre oficina e armazém, guias de remessa especiais ou uma lógica de rotas própria. Nesse caso, a solução não deveria ser tornada artificialmente grande. Um processo claro, modelado de forma limpa e construído sobre uma base técnica sustentável, vale mais do que uma plataforma que, em teoria, consegue fazer tudo.

A softify.pro desenvolve sistemas deste tipo ao longo de movimentos e responsabilidades concretas: desde a receção de mercadoria, passando pelos registos de armazém, até aos documentos de expedição. O modelo de dados, as permissões, os casos de erro e a manutenção posterior permanecem parte da implementação, não tarefas para algum dia depois do go-live.

Perguntas que devem ser colocadas antes da decisão

Nem todos os requisitos têm de ser automatizados no primeiro dia. Mas devem ser decididos de forma deliberada. Os responsáveis deveriam clarificar com a equipa de armazém, as vendas e a contabilidade que dados são de referência, que erros ocorrem hoje mais frequentemente e que indicadores serão realmente necessários mais tarde. Uma bonita vista geral de stocks ajuda pouco se ninguém souber se as quantidades reservadas, bloqueadas e disponíveis são tratadas de forma diferente.

Igualmente importante é a responsabilidade pelos dados-mestre. Os processos de armazém raramente falham por causa de um botão em falta. Falham por causa de referências de artigo inconsistentes, unidades de medida mal mantidas e regras não esclarecidas para artigos substitutos ou conversões de unidades. O software pode tornar estes problemas visíveis. Mas não os pode resolver sem decisões tomadas dentro da empresa.

A escolha certa não é, portanto, automaticamente ERP ou warehouse software. Nasce da distância entre o seu processo atual e o processo que a sua equipa realmente tem de executar de forma fiável. Comece por um movimento que hoje custa tempo ou gera erros, e verifique que sistema representa esse movimento de forma mais clara, rápida e rastreável.

Permalink →

Automatizar a receção de mercadoria

Automatizar a receção de mercadoria

Um camião está parado no portão, dois colaboradores verificam guias de remessa, e a lista de stocks ainda está no computador do escritório. É precisamente aqui que a questão how to automate goods receiving começa a tornar-se prática. Não porque cada armazém precise de uma grande implementação de ERP. Mas porque uma receção de mercadoria em falta, atrasada ou mal registada tem consequências: os stocks não batem certo, as encomendas ficam à espera, as reclamações tornam-se difíceis de rastrear e o turno começa com perguntas por esclarecer.

Automatizar a receção de mercadoria não significa substituir pessoas por scanners. Significa gerir verificações, registos e documentos recorrentes de forma a que a equipa no portão possa decidir depressa e o stock fique depois fiável. Para pequenas e médias empresas, um fluxo de trabalho leve e adequado costuma valer mais do que um sistema de grande grupo cheio de funções que ninguém usa.

O que realmente se perde na receção manual de mercadoria

As guias de remessa em papel e as folhas de cálculo Excel funcionam muitas vezes tempo suficiente para adiar um investimento. O problema não surge por causa de uma caixa isolada. Surge quando os desvios se acumulam: uma entrega parcial só é anotada mais tarde, um lote não pode ser associado, uma palete acaba na zona errada, ou o registo da receção só acontece no fim do dia.

Nesse ponto existem várias verdades ao mesmo tempo. O fornecedor comunica que entregou. No armazém a mercadoria está fisicamente presente. O planeamento ainda não vê stock disponível. A contabilidade tem um documento, mas nenhuma confirmação de quantidade ou dano. Os colaboradores reconciliam esta informação por telefone, e-mail e experiência. Isso custa tempo e torna o processo dependente de pessoas individuais.

A automatização cria uma única fonte partilhada e atualizada para a operação. Regista não só o stock previsto, mas também o que realmente aconteceu no portão: quem recebeu, quando, em que quantidade, com que desvio, e para onde vai a mercadoria a seguir.

How to automate goods receiving com um fluxo claro

O ponto de partida certo não é escolher um scanner ou uma aplicação de armazém. Primeiro, o processo real tem de se tornar visível. Percorra uma receção de mercadoria típica, desde a data de entrega anunciada até à arrumação em stock. Observe também os casos especiais pelo caminho, porque são eles que determinam se uma solução aguenta o dia a dia.

Um fluxo digital costuma ser composto por cinco decisões consecutivas. A entrega é identificada, verificada face à encomenda ou à chegada esperada, a quantidade real é registada, os desvios são documentados e a mercadoria é atribuída a uma localização de armazém ou a um passo de verificação adicional. Cada passo deveria pedir apenas os dados de facto necessários nesse ponto.

1. Disponibilizar antecipadamente as entregas esperadas

Se existirem encomendas de compra, ordens de produção ou avisos de expedição, o armazém deveria poder vê-los antes da chegada. À chegada, a pessoa responsável seleciona o fornecedor, lê um número de encomenda ou procura uma entrega em aberto. O sistema mostra os artigos esperados, as quantidades e, se aplicável, números de lote ou de série.

Isto encurta claramente a receção. Mais importante ainda, porém, é a lógica de verificação: a equipa não tem de decidir de memória se 18 em vez de 20 caixas são aceitáveis. O desvio torna-se visível e pode receber um motivo. Para entregas não anunciadas, o fluxo precisa de um caminho controlado, por exemplo como receção provisória libertada pelas compras ou pelo planeamento.

2. Usar códigos de barras onde realmente poupam tempo

Um leitor de códigos de barras ou a câmara de um dispositivo móvel resistente é, para muitos armazéns, o ponto de entrada mais sensato. Uma leitura reduz erros de digitação e acelera movimentos recorrentes. A condição, no entanto, é que as referências de artigo, as unidades de embalagem e as etiquetas sejam mantidas de forma consistente. Um scanner não resolve dados-mestre pouco claros.

Nem toda a mercadoria precisa de rastreabilidade por número de série. Para parafusos ou consumíveis padrão, artigo, quantidade e localização são muitas vezes suficientes. Para peças sobresselentes em garantia, produtos regulados ou componentes destinados à produção, o lote, o número de série, o prazo de validade e o estado de inspeção podem ser obrigatórios. A profundidade do registo deve corresponder ao risco, não a um modelo de software genérico.

3. Tratar os desvios como um processo normal

Uma boa receção digital de mercadoria não tenta evitar todos os desvios. Torna-os simples e demonstravelmente geríveis. Faltas, sobreentregas, danos de transporte, artigos errados e lotes bloqueados precisam de estados claros em vez de notas manuscritas na guia de remessa.

Numa entrega danificada, por exemplo, pode tirar-se uma fotografia diretamente no local de receção, registar a quantidade como bloqueada e informar automaticamente as compras. O stock disponível mantém-se correto enquanto a mercadoria segue fisicamente para uma zona de quarentena. Isto evita que peças danificadas sejam recolhidas por engano ou usadas na produção.

A regra não tem de ser sempre totalmente automática. Para quantidades pequenas, uma sobreentrega pode ser aceite diretamente. Para artigos caros ou relevantes para a segurança, deveria ser exigida uma libertação. Estes limiares pertencem ao processo e têm de continuar ajustáveis mais tarde.

4. Desencadear a arrumação imediatamente

Uma receção só fica operacionalmente completa quando é claro onde está a mercadoria, ou porque é que ainda não pode ser arrumada. O sistema pode sugerir uma localização fixa, dar preferência a uma zona de reabastecimento, ou determinar uma área de destino com base no grupo de artigos, na gama de temperatura e na capacidade disponível.

Para armazéns de dimensão gerível, muitas vezes basta uma lógica de localização clara com poucas zonas. A otimização de rotas complexa só vale a pena quando o volume, os percursos e a estrutura de pessoal a justificam. Quem recebe dez paletes por dia não precisa de um projeto de otimização que demore mais tempo do que aquele que poupa. Uma leitura fiável da localização de armazenamento é muitas vezes o maior avanço.

Depois da arrumação, o sistema atualiza o stock e o registo de movimentos. Vendas, planeamento ou produção veem assim o estado sem terem de perguntar ao armazém. Se um artigo só puder ficar disponível depois de um controlo de qualidade, o sistema separa o stock físico do stock disponível.

Que dados a receção de mercadoria realmente precisa

Um processo digital torna-se rapidamente impopular se pedir demasiados campos no portão. Ao mesmo tempo, sem um mínimo de dados faltam as provas para esclarecimentos posteriores. Na maioria das empresas de média dimensão, estas informações fazem sentido:

  • Fornecedor e referência à encomenda ou à guia de remessa
  • Artigo, quantidade aceite e unidade de embalagem
  • Momento da operação e pessoa responsável
  • Localização ou estado como inspeção, bloqueio ou quarentena
  • Motivo do desvio, fotografias e libertação quando necessário

Campos adicionais só deveriam ser obrigatórios quando permitem uma decisão concreta. Quando o lote é obrigatório, o respetivo número não é um extra, é informação central. Um comentário livre em cada entrega, pelo contrário, é muitas vezes preenchido apenas para o formulário parecer completo.

A integração decide a relação entre benefício e esforço

A receção de mercadoria não pode surgir como uma nova solução isolada ao lado das compras, da produção e da contabilidade. Pelo menos os dados-mestre de artigos, as encomendas em aberto e as alterações de stock têm de ser trocados de forma fiável. Se isto acontece através de uma interface ERP existente, de importações de dados ou de um processo intermédio desenvolvido para o efeito, depende do panorama de sistemas já existente.

Com sistemas ERP mais antigos, uma integração completa em tempo real nem sempre é rentável. Uma importação verificada em intervalos fixos pode ser perfeitamente suficiente se as quantidades e os prazos o permitirem. Para peças sobresselentes imediatamente afetas a encomendas urgentes, pelo contrário, um registo quase em tempo real conta mais. Aqui, a tecnologia segue o ritmo do negócio.

A operacionalidade também faz parte do planeamento. Os dispositivos precisam de contas de utilizador, papéis claros e um comportamento definido em caso de falha de rede. Uma receção de mercadoria móvel não tem necessariamente de funcionar offline. Mas se as falhas de Wi-Fi ocorrerem regularmente, um buffer local com sincronização rastreável não é um luxo, é parte da fiabilidade do processo.

Implementação em pequenos passos em vez de um big bang

Comece com um fornecedor, um grupo de produtos ou uma área de armazém claramente delimitada. Meça não só a duração por registo, mas também o retrabalho, as diferenças por esclarecer e as questões entre o armazém e o escritório. A partir daí torna-se visível se a automatização realmente alivia o trabalho.

Forme com guias de remessa reais do dia a dia, incluindo entregas danificadas ou incompletas. Um processo que só funciona com uma entrega perfeitamente conforme não é automatização, é uma demonstração. Os colaboradores da receção de mercadoria deveriam poder ajudar a definir as regras, porque conhecem as exceções.

A softify.pro desenvolve estes fluxos deliberadamente de forma específica ao workflow: desde a leitura móvel até ao movimento de stock documentado e a uma ligação estável aos sistemas existentes. O que conta aqui não é a lista de funcionalidades mais longa, mas sim um sistema que permanece rastreável sob pressão de tempo e que pode ser operado e mantido tecnicamente.

O melhor passo seguinte não é, portanto, uma comparação de software, mas uma hora a analisar as últimas dez entregas problemáticas. Se conseguir dizer, para cada uma delas, onde se perdeu tempo e que informação faltava, já existe o primeiro esboço de uma melhor receção de mercadoria.

Permalink →

Vantagens da preparação de encomendas com código de barras para armazéns de pequena e média dimensão

Vantagens da preparação de encomendas com código de barras para armazéns de pequena e média dimensão

Um artigo errado na caixa raramente custa apenas o preço da devolução. Ocupa tempo no armazém, gera pedidos de esclarecimento no escritório e, no pior dos casos, prejudica a relação com o cliente. É por isso que as vantagens da preparação de encomendas com código de barras não se notam primeiro num indicador técnico, mas numa expedição mais tranquila: os colaboradores sabem o que fazer a seguir e as divergências são detetadas onde surgem.

Para armazéns de pequena e média dimensão, isto é particularmente relevante. Muitos processos funcionam inicialmente com listas em papel, ficheiros Excel, instruções dadas em voz alta e a experiência de pessoas concretas. Isso não é errado em si. Com um volume controlável, uma folha de cálculo pode até ser a ferramenta mais sensata. Mas, quando aumentam a variedade de artigos, o número de encomendas, as mudanças de turno ou os requisitos de rastreabilidade, a solução provisória pragmática torna-se rapidamente uma fonte de erros.

O que a preparação de encomendas com código de barras muda no dia a dia

Na preparação de encomendas com código de barras, uma leitura não confirma apenas que alguém fez alguma coisa. Liga encomenda, localização, artigo e quantidade num passo de trabalho rastreável. O sistema indica a recolha seguinte, o colaborador lê a localização e o artigo, introduz a quantidade se necessário e recebe de imediato uma resposta.

A ordem das verificações é decisiva. Se um colaborador ler primeiro o artigo e só depois a localização, o sistema consegue detetar um artigo errado, mas não evitar um percurso desfavorável. Na prática, a sequência localização, artigo, quantidade dá frequentemente bons resultados. Em processos com lotes, números de série ou prazos de validade, somam-se outras verificações. Quais delas são necessárias depende do risco, e não do que seria tecnicamente possível.

Um bom sistema não substitui uma organização sensata do armazém. Torna, no entanto, visível quando essa organização não é respeitada no dia a dia. Se a mercadoria estiver numa localização não prevista, o erro não é descoberto apenas no inventário, mas no momento da leitura.

As principais vantagens da preparação de encomendas com código de barras: menos trocas exatamente onde surgem

As listas em papel exigem concentração permanente: ler a referência, encontrar o compartimento, comparar a embalagem, assinalar a quantidade. Sob pressão de tempo, caixas semelhantes, designações quase idênticas ou uma tarefa interrompida bastam para provocar um erro. O código de barras traz uma identificação inequívoca a esse momento.

O leitor não substitui o raciocínio, mas assume o controlo que as pessoas têm mais dificuldade em manter de forma duradoura no trabalho de rotina. Se o artigo não corresponder à encomenda, a resposta deve ser clara: artigo errado, artigo esperado, próximo passo razoável. Um simples sinal vermelho de aviso ajuda pouco se não ficar claro como resolver a divergência.

Os registos tornam o stock mais fiável

O stock só é útil se puder sustentar decisões. Quem planeia reposições, promete prazos de entrega ou disponibiliza material para a produção precisa de mais do que um número da semana passada. Se as saídas só forem transcritas de uma lista no fim do turno ou posteriormente, surgem janelas temporais com dados pouco claros.

Uma leitura pode registar a saída de imediato. Assim, diminui a diferença entre o movimento físico e o stock digital. Isso não significa que cada número esteja automaticamente certo. Mercadoria mal etiquetada, transferências não registadas e stock danificado continuam a ser questões reais. Mas as causas podem ser delimitadas muito melhor, porque cada movimento tem uma hora, uma encomenda e, se aplicável, uma referência de utilizador.

Isto é especialmente útil nos processos de reposição. Se um compartimento ficar abaixo do stock pretendido, o sistema pode criar uma ordem de reposição ou, pelo menos, torná-lo visível. Os preparadores deixam assim de procurar mercadoria de substituição a meio de uma encomenda, enquanto o cliente espera pelo seu envio.

Integração mais rápida sem depender do conhecimento de alguns

Os operadores de armazém experientes conhecem de cor os percursos, os casos especiais e o aspeto dos artigos. Esse conhecimento é valioso, mas arriscado como único sistema operativo. Em férias, doença ou crescimento, as equipas ficam sob pressão quando os novos colaboradores têm primeiro de aprender durante semanas que fila de estantes corresponde a uma abreviatura interna.

Uma boa interface móvel guia ao longo da encomenda numa linguagem compreensível. Mostra a localização, o artigo, a quantidade prevista e, se necessário, uma imagem ou indicações sobre a embalagem. A leitura confirma o passo. Os novos colegas não se tornam especialistas de imediato, mas podem colaborar com segurança muito mais cedo.

O mesmo se aplica a trabalhadores temporários e a turnos variáveis. O pressuposto é que os dados mestre estejam bem mantidos. Um sistema não consegue extrair uma instrução clara de uma designação de artigo como «peça pequena azul nova». A digitalização expõe estas fragilidades - e isso é muitas vezes um efeito secundário útil.

Rastreabilidade em reclamações e inventários

Quando um cliente comunica uma quantidade em falta, sem dados de processo começa muitas vezes uma busca por pilhas de papel, listas de expedição e memórias. Com registos baseados em código de barras, é possível verificar que encomenda foi processada e quando, que linha foi confirmada e se houve uma correção ou uma quantidade parcial.

Não é uma garantia contra reclamações. Mas encurta o esclarecimento e separa suposições de factos. Os inventários também beneficiam: as diferenças podem não só ser contadas, mas também analisadas com base nos movimentos. Se as correções se acumulam num determinado compartimento, num grupo de artigos ou após uma determinada passagem de testemunho no processo, surge um ponto de partida concreto para melhorias.

Processos mensuráveis em vez de intuição

Muitos armazéns sabem que «à tarde fica apertado» ou que certas encomendas demoram invulgarmente. Sem registos de hora e passos de processo, continua a ser uma intuição. Se forem registados o início da recolha, a leitura, a interrupção, a conclusão e a entrega, os estrangulamentos podem ser distinguidos com clareza.

Talvez não seja a preparação que é lenta, mas a mercadoria que é arrumada demasiado tarde. Talvez surjam tempos de espera no posto de embalagem ou um único compartimento seja visitado com uma frequência desproporcionada. Estes dados não devem ser entendidos como uma ferramenta de controlo generalizado do desempenho. O seu valor está, antes de mais, em identificar percursos desnecessários, reposições em falta e passagens de testemunho pouco claras.

O benefício depende da conceção do processo

A preparação de encomendas com código de barras não é um fim em si mesmo, e nem todos os armazéns precisam de um software de gestão de armazém abrangente. Com poucas encomendas, um sortido reduzido e pessoal fixo, um processo bem conduzido com listas simples pode ser mais económico. Um projeto faz sentido quando os custos de recolhas erradas, tempos de procura, incerteza sobre o stock ou retrabalho manual se fazem sentir regularmente.

Também a questão do hardware merece uma análise sóbria. Um smartphone com leitura por câmara pode ser suficiente para os primeiros processos. Com elevada frequência de leitura, luvas, má iluminação ou ambientes exigentes, os leitores portáteis dedicados são normalmente mais rápidos e menos propensos a erros. A cobertura de rede é igualmente decisiva. Se o Wi-Fi falhar numa zona do armazém, a aplicação precisa de uma estratégia clara: armazenamento temporário offline com sincronização posterior, ou um processo que não trate essa área em dispositivos móveis.

A qualidade das etiquetas é tão importante como o software. Um código de barras numa etiqueta de compartimento gasta ou um identificador de artigo atribuído em duplicado compromete todo o processo. Antes do arranque, as localizações devem ser identificadas de forma inequívoca, as unidades definidas e os casos especiais críticos esclarecidos: como se trata uma embalagem aberta? O que acontece em caso de rutura? Quem pode corrigir uma quantidade? O que acontece à mercadoria sem código legível?

Como implementar sem interromper a operação

O ponto de partida mais fiável raramente é a mudança total. Comece por uma área bem delimitada, por exemplo as encomendas de expedição mais frequentes ou um grupo de artigos com muitas trocas. Aí é possível testar a sequência de leitura, as mensagens de erro e as etiquetas em operação real, sem transformar todo o armazém ao mesmo tempo.

Antes da implementação técnica, deve ser levantado o percurso real de uma encomenda - desde a entrada da encomenda, passando pela reserva e pela recolha, até ao posto de embalagem e à etiqueta de envio. O que conta não é o processo ideal de um organigrama, mas o fluxo que o turno efetivamente utiliza. Os requisitos mais valiosos estão muitas vezes em pequenas exceções: encomendas agrupadas, artigos de substituição, recolhas parciais ou a devolução de mercadoria que não é necessária.

Depois, são necessárias regras claras para as exceções. Um colaborador tem de poder comunicar uma falta de stock sem contornar a encomenda de forma informal. Uma pessoa autorizada tem de poder efetuar correções de forma rastreável. E, se existirem interfaces com a loja online, o ERP ou a transportadora, o estado das encomendas e os registos de stock devem estar claramente definidos. A dupla manutenção de dados é um sinal de alerta, não uma solução permanente.

Em sistemas à medida, a softify.pro começa precisamente neste ponto: não com um pacote enterprise sobrecarregado, mas com os passos de leitura e registo comprovadamente necessários para a operação concreta do armazém. Uma base de dados fácil de manter, interfaces claramente documentadas e ecrãs compreensíveis valem mais do que uma longa lista de funções raramente utilizadas.

Um primeiro ponto de verificação sensato

Pegue em dez encomendas típicas e acompanhe-as desde a entrada até à entrega para expedição. Registe em que pontos os colaboradores têm de procurar, perguntar, introduzir dados mais tarde ou confiar na memória. É exatamente aí que se decide se a preparação de encomendas com código de barras traz vantagens - e que processo de leitura se adequa realmente ao armazém.

Permalink →

Testes auto-hospedados vs cloud

Testes auto-hospedados vs cloud

Um teste de regressão falhado raramente é apenas uma entrada vermelha num painel. Pode significar que um ecrã de expedição no armazém gera etiquetas erradas, um portal de clientes deixa de aceitar encomendas, ou uma aplicação Windows falha durante uma transição de turno. A questão self hosted testing vs cloud não é, portanto, sobre infraestrutura como um fim em si mesma. É sobre que dados um processo de teste toca, quem o controla, e com que fiabilidade funciona em condições operacionais reais.

As plataformas de teste baseadas na cloud podem estar operacionais rapidamente. Para muitas equipas, isso é sensato, especialmente ao testar uma aplicação web pública e precisar de capacidade de execução adicional a curto prazo. Os ambientes de teste auto-hospedados, por outro lado, exigem uma configuração técnica deliberada. Mas devolvem à empresa o controlo sobre dados de teste, caminhos de rede, direitos de acesso, e operação. A escolha certa não depende de um princípio geral, mas da aplicação, do risco, e da capacidade operacional disponível.

Self Hosted Testing vs Cloud: Do que se trata realmente

O debate é frequentemente reduzido demasiado ao custo inicial. Uma solução na cloud parece mais barata porque não é necessário adquirir servidores nem configurar um ambiente. Um servidor de testes dedicado parece à primeira vista mais trabalhoso, porque o sistema operativo, atualizações, controlo de acesso, monitorização, e cópias de segurança têm todos de ser planeados.

Esse cálculo fica aquém. O que importa são os custos contínuos de uma estratégia de testes: tempos de espera antes dos lançamentos, deteção de erros após execuções de teste incompletas, coordenação com proteção de dados e segurança da informação, bem como as consequências de uma implementação defeituosa. Se uma equipa examina regularmente aplicações empresariais sensíveis, a carga organizacional adicional de serviços externos pode superar a operação de um ambiente próprio claramente delimitado.

Também "cloud" não é um modelo uniforme. Alguns fornecedores armazenam apenas registos de testes, outros processam capturas de ecrã, gravações de vídeo, credenciais, conteúdo DOM, ou tráfego de rede. Com testes assistidos por IA, dados de imagem e texto podem adicionalmente chegar a modelos externos ou subcontratados para avaliação. Quem olha apenas para a localização de um centro de dados frequentemente ignora a questão mais importante: que dados realmente saem da própria zona de controlo, e que regras contratuais e de eliminação se aplicam?

Quando os testes na cloud são a escolha sensata

Os testes na cloud não são fundamentalmente um problema de segurança, e a auto-hospedagem não é automaticamente a melhor arquitetura. Para uma nova loja online publicamente acessível ou uma plataforma de marketing, um ambiente na cloud pode ser muito adequado. A equipa pode cobrir rapidamente variantes de navegador e dispositivo sem manter as suas próprias máquinas de execução. Com carga de teste flutuante, a escalabilidade elástica é também uma vantagem real.

Equipas de desenvolvimento pequenas com poucos dados de teste claramente anonimizados também frequentemente beneficiam de um serviço gerido. Não deveriam investir o seu tempo a operar uma plataforma quando o gargalo está antes em casos de teste em falta, critérios de aceitação pouco claros, ou dados de teste instáveis. Um servidor próprio não resolve esses problemas.

A cloud encaixa particularmente bem quando a aplicação não precisa de acesso de rede interno, nenhum dado pessoal ou crítico para o negócio aparece nos fluxos de teste, e um curto prazo de execução importa mais do que um controlo profundo da infraestrutura. O pré-requisito é uma configuração cuidadosa: contas de teste separadas, sem dados reais de clientes, tokens limitados, períodos de retenção rastreáveis, e um conceito de direitos claro.

Quando os testes auto-hospedados se tornam mais sensatos

A situação é diferente para aplicações apenas acessíveis na rede da empresa ou que representam processos operacionais centrais. Um software de armazém ou produção processa frequentemente movimentos de artigos, moradas de entrega, stocks, números de série, e lógica de preços. Uma execução de teste pode gerar capturas de ecrã de ecrãs de encomenda, descarregar documentos, ou iniciar sessão com funções de utilizador. Tais dados não deveriam ser dispersos despercebidamente por vários sistemas externos.

Os testes auto-hospedados permitem colocar a execução dos testes perto da aplicação. O servidor de testes pode funcionar no mesmo segmento de rede ou numa DMZ controlada. As regras de firewall são definidas de forma direcionada, as aplicações internas não precisam de ser abertas para um serviço externo, e os registos permanecem sob administração própria. Isso é frequentemente especialmente relevante para aplicações desktop Windows, uma vez que estas raramente são concebidas para plataformas de teste externas.

Para indústrias reguladas, requisitos de cliente maiores, ou diretrizes de segurança internas, esta arquitetura é frequentemente mais fácil de auditar. Isso não significa que cada auditoria seja automaticamente aprovada. Um servidor próprio também precisa de gestão de patches, encriptação, direitos baseados em funções, cópias de segurança, e procedimentos operacionais documentados. A diferença está em que a empresa toma estas decisões por si própria e pode demonstrá-las.

Na softify.pro, o COCO é por isso concebido como um servidor de IA dedicado e auto-hospedado: as execuções de teste para aplicações web e Windows executam-se localmente, as evidências são registadas, e os resultados são avaliados em linguagem clara. Isso não substitui a aprovação por especialistas de domínio. Mas garante que o tráfego de teste, capturas de ecrã, e avaliações podem permanecer onde a empresa retém a soberania dos dados.

Comparar custos corretamente: operação contra atrito

Uma comparação sensata abrange mais do que o preço da licença contra o preço do hardware. Na cloud, surgem taxas recorrentes por utilizador, minuto de teste, execução paralela, ou consumo de IA. Estes custos são inicialmente previsíveis, mas podem aumentar significativamente com a crescente cobertura de testes. A isso somam-se possíveis despesas para contratos empresariais, acordos de tratamento de dados, e auditorias de segurança.

Com a auto-hospedagem, surgem investimentos para infraestrutura e configuração. Isso pode incluir máquinas virtuais, armazenamento, acesso de rede, monitorização, e o tempo de uma equipa tecnicamente responsável. Estes custos permanecem mesmo quando poucos testes estão a decorrer. Para um projeto com lançamentos raros, esse é um bom argumento contra uma solução própria sobredimensionada.

Com testes de regressão regulares, o panorama muda. Se os mesmos fluxos de trabalho críticos para o negócio precisarem de ser verificados todas as semanas, a capacidade interna previsível é frequentemente mais económica do que custos variáveis de plataforma e ciclos de aprovação manuais. A abordagem torna-se especialmente valiosa quando os casos de teste são usados durante anos e evoluem juntamente com a aplicação empresarial. A manutenibilidade importa então mais do que um início rápido mas difícil de controlar.

A qualidade não depende do modelo de alojamento

Um equívoco comum diz: os testes na cloud seriam automaticamente mais modernos, os testes auto-hospedados automaticamente mais estáveis. Nenhuma das afirmações é verdadeira. A qualidade dos testes surge de cenários sensatos, dados de teste resilientes, identificadores estáveis na interface, e expectativas claras sobre o resultado.

Um teste não deveria apenas verificar se um botão é clicável. Para um processamento de encomendas, pode, por exemplo, criar uma encomenda, verificar uma quantidade disponível, gerar uma guia de remessa, e assegurar que a função correta pode aprovar a operação. Num programa desktop, pode verificar a importação de um ficheiro, o tratamento de erros, e a saída de um documento. Só tais fluxos ponta a ponta mostram se uma alteração danificou o processo real.

A IA pode ajudar a detetar alterações de interface, documentar passos de forma compreensível, e priorizar anomalias. No entanto, não deveria tornar-se uma caixa negra. As equipas precisam de capturas de ecrã ou outras evidências, passos de teste rastreáveis, e limiares definidos para quando um resultado conta como aprovado, incerto, ou falhado. Precisamente em verificações visuais, um limiar de confiança é sensato, para que pequenos desvios de layout esperados não bloqueiem cada lançamento.

As questões operacionais antes da decisão

Antes de uma equipa se comprometer, deveria rastrear concretamente o caminho de uma execução de teste. Onde executa o teste? A que sistemas se autentica? Que dados vê? Onde são armazenadas capturas de ecrã, registos, e relatórios? Quem pode ler, eliminar, ou exportar resultados? Estas questões são mais práticas do que uma decisão geral a favor ou contra a cloud.

Igualmente importante é a responsabilidade após o go-live. Quem atualiza navegadores e agentes de teste? Quem reage quando um certificado expira? Como são rodadas as credenciais? E como se garante que um teste não desencadeia acidentalmente um registo de expedição real ou uma notificação de cliente? Uma boa automação de testes precisa de ambientes separados e mecanismos de proteção, não apenas bons scripts.

Um modelo híbrido pode ser sensato. Interfaces públicas e verificações de navegador amplamente distribuídas correm na cloud, enquanto processos empresariais internos permanecem num servidor de testes próprio. Isso reduz a carga operacional, sem ceder em bloco fluxos de trabalho sensíveis para o exterior. O pré-requisito é uma fronteira clara entre as duas áreas, não uma operação mista confusa.

A melhor decisão é a que se ajusta ao risco real e à realidade operacional própria. Se uma folha de cálculo ainda suporta fiavelmente um processo, não precisa de se tornar num grande sistema. Mas se dados de teste e aplicações internas pertencem antes ao núcleo do negócio, o controlo não é um luxo, mas um requisito objetivo para software fiável.

Permalink →

Inventory Management no armazém

Inventory Management no armazém

Uma peça em falta raramente se nota ao contar no armazém. Normalmente só se revela quando uma encomenda não pode ser embalada, um técnico está diante de uma prateleira vazia, ou as compras procuram por telefone uma promessa de entrega. Um bom Inventory Management não previne estas surpresas com mais tabelas, mas com uma imagem fiável do que está disponível, onde se encontra, e o que acontece a seguir com isso.

Para pequenas e médias empresas, isto não é uma questão do maior sistema ERP possível. Decisivo é se os funcionários na receção de mercadoria, armazém, e expedição conseguem trabalhar com poucos passos claros - mesmo sob pressão de tempo, através de mudanças de turno, e quando uma entrega sai diferente do planeado.

Inventory Management começa com movimentos, não com listas de stock

Uma lista de stock é uma fotografia instantânea. Pode estar correta e ainda assim ajudar pouco se ninguém conseguir perceber por que motivo uma quantidade mudou. Um sistema resiliente trata, portanto, o stock como resultado de movimentos documentados: a mercadoria chega, é controlada, armazenada, reservada, feita picking, transferida, expedida, ou corrigida.

Cada movimento precisa de um motivo claro, uma marca temporal, uma pessoa responsável, e idealmente uma ligação a uma transação específica. Isso pode ser uma encomenda de compra, uma encomenda de cliente, uma guia de remessa, ou uma ordem de produção. Isso transforma o número "24 unidades disponíveis" numa afirmação verificável: foram registadas 30 unidades, quatro estão reservadas para duas encomendas, e nenhuma transferência em aberto distorce o stock disponível.

Esta distinção é especialmente relevante para peças escassas. Fisicamente presente, reservado, e livremente disponível são três estados diferentes. Se forem misturados, as vendas prometem mercadoria que o armazém já precisa para outra encomenda. Se forem mantidos limpos, uma equipa pode decidir cedo: reencomendar, reprioritizar, ou dar ao cliente uma resposta realista.

Onde os processos manuais tipicamente falham

As folhas de cálculo não são fundamentalmente erradas. Para um pequeno sortimento, um local de armazenamento, e poucos movimentos por semana, podem ser mais económicas do que uma aplicação dedicada. Tornam-se problemáticas assim que várias pessoas trabalham simultaneamente ou o stock é atualizado a partir de várias fontes.

É então que surgem as lacunas conhecidas: a receção de mercadoria fica em papel na secretária, o ficheiro Excel foi alterado localmente, uma transferência foi apenas acordada verbalmente, e a expedição só regista depois do horário de trabalho. O stock não é necessariamente errado, mas está desfasado no tempo e a sua origem é pouco clara. É precisamente isso que o torna inadequado para decisões operacionais.

A estrutura organizacional também desempenha um papel. Um local central precisa de fluxos diferentes de uma empresa com armazéns satélite, veículos de serviço, ou uma produção que retira material. Quem representa estas diferenças com uma única coluna de texto livre, desloca a lógica para as cabeças de funcionários individuais. Isso funciona até essa pessoa tirar férias ou o volume de encomendas aumentar.

Definir o processo antes do software

Um projeto sensato não começa com a pergunta sobre qual scanner comprar ou qual interface parece moderna. Primeiro tem de estar claro que decisões o sistema deve apoiar. Para isso, frequentemente bastam observações concretas do dia a dia: como é a mercadoria aceite hoje? Quando conta como controlada? Quem pode corrigir stocks? O que acontece com mercadoria danificada? E em que ponto uma encomenda fica vinculativamente reservada?

Destas respostas surgem algumas regras vinculativas. Por exemplo, a receção de mercadoria só pode ser registada após um controlo de quantidade. Artigos sem local de armazenamento não devem aparecer como prontos a armazenar. As correções de stock exigem um código de motivo e permanecem visíveis no histórico. A mercadoria expedida não é apagada silenciosamente, mas atribuída à encomenda através de uma baixa documentada.

Isso é menos espetacular do que uma grande apresentação de digitalização, mas muito mais valioso na operação. Quando as regras são inequívocas, o software pode verificá-las de forma fiável. Quando permanecem pouco claras, cada nova aplicação apenas acelera passos de trabalho contraditórios.

Dados mestre: começar pequeno, manter com consistência

Nem todo artigo precisa de dez classificações desde o início. Uma base utilizável consiste frequentemente em número de artigo, descrição, unidade, estado de armazém ativo, e uma ou mais localizações de armazém. Consoante o negócio, acrescentam-se lotes, números de série, stocks mínimos, números de artigo do fornecedor, ou datas de validade.

Importante é a consistência, não a quantidade de campos. Dois números de artigo para o mesmo artigo físico, ou unidades variáveis como "caixa", "embalagem", e "unidade" sem regra de conversão, geram erros posteriores quase automaticamente. Um sistema pode tecnicamente permitir tais entradas. Deveria limitá-las onde põem em risco o processo.

Que funcionalidades realmente ajudam no armazém

Para muitos armazéns de média dimensão, um núcleo claro é mais valioso do que um catálogo de funcionalidades sobrecarregado. Este núcleo abrange tipicamente quatro áreas:

  • Receção de mercadoria com referência de encomenda, controlo de quantidade, e armazenamento
  • Movimentos de armazém entre localizações e áreas definidas
  • Reserva de encomendas, picking, e confirmação de expedição
  • Inventário e correções de stock com histórico rastreável

Complementarmente, a impressão de etiquetas, leitura de códigos de barras, guias de remessa, etiquetas de expedição, ou uma transferência para contabilidade e sistemas de loja podem poupar muito tempo. Mas deveriam basear-se num modelo de movimento limpo. Uma impressão rápida de etiquetas ajuda pouco se a leitura não atribuir inequivocamente o artigo à localização de armazém ou encomenda corretas.

Na utilização também conta o ambiente. Um funcionário com luvas na receção de mercadoria precisa de ações grandes e inequívocas e o mínimo possível de introdução de texto. Uma despachante no posto de trabalho, por outro lado, precisa de filtros, funções de pesquisa, e uma vista sobre transações em aberto. Ambos os papéis podem usar os mesmos dados, mas não precisam da mesma interface.

Tempo real não significa que cada número é incontestável

Muitas empresas desejam stock em tempo real. Isso é sensato, mas o termo é frequentemente usado de forma demasiado genérica. Um stock pode ser atualizado imediatamente após cada leitura e ainda assim estar errado se um processo permanecer incompleto. Se a mercadoria for lida mas não controlada, o número está tecnicamente atualizado e operacionalmente questionável.

Por isso todo sistema precisa de uma gestão de exceções. Diferenças na receção de mercadoria, embalagens danificadas, devoluções, e artigos não localizáveis não são casos marginais. Fazem parte do dia a dia. Bons processos marcam-nos visivelmente, em vez de forçar os funcionários a listas paralelas improvisadas.

As permissões também merecem atenção. Nem toda pessoa deveria poder alterar dados mestre de artigos ou corrigir registos históricos. Um conceito de direitos prático separa operações de rotina de intervenções de maior risco. Isso não só protege contra erros, como também facilita a análise de causas quando um stock se desvia inesperadamente.

Integração apenas onde melhora o processo

O Inventory Management raramente está sozinho. As encomendas podem vir de uma loja online, um registo por e-mail, uma solução setorial, ou diretamente das vendas. Os transportadores precisam de dados de morada e pesos. A contabilidade espera documentos numa forma específica.

Uma integração compensa quando elimina o registo duplicado ou reduz fontes de erro. Não é automaticamente sensata só porque uma interface está disponível. Especialmente em processos que cresceram organicamente, uma importação clara com controlo pode ser mais fiável do que um acoplamento permanente em tempo real que transmite dados errados sem ser notado.

Tecnicamente, a solução deveria permanecer rastreável: interfaces inequívocas, transferências registadas, mensagens de erro compreensíveis, e uma estrutura de base de dados que não esconde alterações. Com uma aplicação bem mantida baseada em PHP 8.4 e MySQL 8, tais processos podem ser implementados de forma enxuta, sem forçar equipas a um sistema corporativo global. O decisivo não é o rótulo tecnológico, mas se a manutenção, extensões, e correções de dados permanecem controláveis também daqui a três anos.

Implementação em passos pequenos e mensuráveis

Um big bang raramente é a melhor escolha num armazém. Mais seguro é um começo limitado, por exemplo com receção de mercadoria e uma área de armazém selecionada. Nesta fase podem observar-se tempos de leitura, tipos de erro, casos especiais em aberto, e a qualidade dos dados mestre. Só depois seguem a reserva, expedição, ou locais adicionais.

A operação paralela pode ser sensata nesse contexto, mas apenas com um fim claro. Dois stocks principais durante um período prolongado criam exatamente o problema que a nova solução deve resolver. Melhor é uma transição definida com inventário, dados mestre limpos, e responsabilidades para as primeiras semanas.

O sucesso não se vê em quantas funcionalidades foram ativadas. Vê-se em se surgem menos perguntas de acompanhamento, se as encomendas são embaladas mais completamente, e se uma equipa consegue explicar sem trabalho de detetive por que motivo um stock de artigo parece o que parece.

Se o processo atual com uma tabela bem mantida funciona realmente de forma estável, deveria poder permanecer. Mas se a informação continua a perder-se entre papel, chamadas telefónicas, e vários ficheiros, o próximo passo sensato não é uma ferramenta maior, mas um processo claro que torna visível cada movimento de armazém importante.

Permalink →

Os testes auto-hospedados são seguros?

Os testes auto-hospedados são seguros?

Um teste de regressão falhado é irritante. Uma captura de ecrã de um sistema ERP interno que acaba sem controlo num serviço externo é um incidente de segurança. É precisamente por isso que os líderes de QA e responsáveis de TI se colocam a questão: are self hosted tests secure? A resposta honesta é: podem ser claramente mais seguros do que alternativas baseadas na cloud, mas apenas se a operação for levada tão a sério como os próprios testes.

A automação de testes auto-hospedada desloca o controlo sobre a execução, dados de teste, capturas de ecrã, registos, e direitos de acesso para a própria infraestrutura. Isso reduz dependências e caminhos de dados desnecessários. No entanto, não substitui uma arquitetura de segurança. Um servidor de testes interno mal mantido continua a ser um servidor mal mantido.

Os testes auto-hospedados são mais seguros do que os testes na cloud?

A diferença decisiva não está em saber se um teste corre localmente ou de forma automatizada. Está em onde os dados são processados, quem pode aceder a eles, e que limites técnicos se aplicam.

Com um serviço de testes operado externamente, frequentemente saem da empresa vários artefactos: credenciais para contas de teste, URLs de aplicações internas, conteúdo DOM, capturas de ecrã, vídeos de execuções de testes, registos de erros, e possivelmente extratos de base de dados. Mesmo que um fornecedor cumpra elevados padrões de segurança, surge uma relação adicional de confiança e contratual. Para aplicações com dados de clientes, pessoal, produção, ou financeiros, isto pode ser um obstáculo relevante.

Um sistema auto-hospedado pode ser operado dentro da própria rede ou de um ambiente da UE claramente delimitado. A instância de teste acede diretamente a sistemas de staging, aceitação, ou testes isolados. As provas de teste permanecem onde também se encontram a aplicação e a sua responsabilidade operacional. Isto é especialmente sensato ao testar aplicações desktop Windows, portais web internos, ou sistemas com dados de processo sensíveis.

Mas a auto-hospedagem não é automaticamente mais segura. Quem opera um servidor de testes com acesso remoto aberto, contas de administrador partilhadas, e palavras-passe permanentemente válidas, apenas deslocou os riscos. A questão, portanto, não é apenas: cloud ou on-premises? Mas: o ambiente de teste está demonstravelmente protegido e é permanentemente mantível?

Are self hosted tests secure? Depende destes limites

Uma plataforma de testes segura precisa de limites técnicos e organizacionais claros. Para pequenas e médias empresas, isto não tem de parecer um programa corporativo. Apenas tem de ser implementado de forma consistente e documentado.

Separar o ambiente de teste da produção

Os testes automatizados devem encontrar erros, não desencadear encomendas, modificar guias de remessa, ou registar movimentos de stock. Por isso os testes precisam de um ambiente separado com interfaces próprias, inquilinos de teste, e dados de teste. Onde uma cópia completa da produção não é necessária, isso é frequentemente até desnecessariamente arriscado.

Para um portal de armazém ou encomendas, isso pode significar: os utilizadores de teste podem registar receções de mercadoria e gerar etiquetas de expedição, mas os documentos gerados não vão para nenhuma impressora real nem transportadora real. As chaves API apontam para pontos finais sandbox. O envio de e-mail é intercetado ou limitado a destinatários internos. Assim um teste permanece significativo sem produzir consequências operacionais.

A separação também deveria aplicar-se ao nível da rede. O servidor de testes só precisa das ligações que realmente requer. O acesso geral a toda a rede interna é conveniente, mas raramente justificável. A segmentação limita o dano se uma conta de teste ou um componente do sistema for comprometido.

Tratar as credenciais como acessos de produção

A automação de testes frequentemente precisa de dados de acesso. Isso é normal, mas estes dados não pertencem a scripts de teste, ficheiros de configuração no código-fonte, ou históricos de chat. Palavras-passe, tokens, e certificados deveriam ser carregados a partir de uma gestão controlada de segredos. As contas de teste recebem apenas os direitos que o fluxo concreto exige.

Também o acesso à própria plataforma de testes precisa de papéis. Um programador talvez precise de iniciar execuções de teste e ler resultados, mas não alterar a configuração de rede. Um departamento pode consultar relatórios, mas não precisa de acesso a dados de acesso armazenados. Os direitos de administração deveriam estar ligados a pessoas, não acoplados a uma conta partilhada.

Além disso, autenticação multifator, regras de palavra-passe razoáveis, e fluxos de bloqueio de conta pertencem ao padrão mínimo. Precisamente os sistemas de teste são frequentemente tratados como menos críticos. Os atacantes veem isso de forma diferente: gostam de usar ambientes de teste como ponto de entrada, porque é lá que residem acessos, nomes internos, e detalhes técnicos.

Minimizar os dados de teste e mascará-los de forma direcionada

O erro mais comum não é um método de encriptação em falta, mas demasiada informação real no conjunto de teste. Para a maioria dos testes de regressão, ninguém precisa de nomes reais de clientes, endereços reais, ou processos de pessoal completos. Conjuntos de dados sintéticos, cópias mascaradas, e casos especiais deliberadamente criados são frequentemente suficientes.

Há exceções. Alguns erros só aparecem com estruturas de dados reais, sequências de caracteres invulgares, ou constelações de permissões complexas. Então uma cópia controlada, pseudonimizada pode fazer sentido. O decisivo é que esta decisão seja tomada deliberadamente e tenha um prazo de eliminação. As bases de dados de teste não deveriam continuar a funcionar durante anos como uma cópia sombra esquecida da produção.

Capturas de ecrã e vídeos merecem a mesma atenção. São valiosos para a deteção de erros, mas podem mostrar dados de conta, preços internos, ou conteúdo pessoal. Defina quais artefactos são registados, quem pode vê-los, e quando são automaticamente eliminados. Um relatório de teste não precisa de armazenar cada captura de ecrã para sempre para ser probatório.

Operar o servidor como um produto

Um servidor de testes auto-hospedado não é um dispositivo que se instala uma vez e depois se esquece. A segurança operacional surge de manutenção repetível: atualizações de segurança atempadas para o sistema operativo, navegador, executor de testes, e dependências; suportes de dados e caminhos de transporte encriptados; cópias de segurança monitorizadas; registo centralizado; bem como um tratamento claro de avisos de segurança.

Especialmente em testes orientados por navegador, o ritmo de atualização é relevante. Motores de navegador desatualizados e bibliotecas de automação podem conter vulnerabilidades conhecidas ou tornar os testes pouco fiáveis. Ambos custam tempo. Implementações documentadas e janelas de manutenção fixas não são, portanto, um acréscimo burocrático, mas a base para resultados reprodutíveis.

Para um servidor de testes de IA dedicado como o COCO, aplica-se o mesmo. A execução local não protege o conteúdo sensível da aplicação por magia. Cria controlo sobre onde são processados a avaliação assistida por IA, capturas de ecrã, e registos de teste. Esse controlo tem de ser preenchido com gestão de patches, permissões, separação de rede, e regras de retenção claras.

Onde a auto-hospedagem tem os seus limites

Os serviços na cloud não são inseguros por definição. Um fornecedor especializado pode oferecer mais pessoal de segurança, monitorização mais amadurecida, e redundância mais profissional do que uma empresa com um único papel de TI sobrecarregado. Quem não tem capacidade para operação, atualizações, e resposta a incidentes, pode criar um risco maior com um sistema auto-hospedado mal mantido.

Por outro lado, muitas plataformas de teste externas simplesmente não são um bom ajuste de processo para aplicações especializadas internas. Se uma aplicação só é acessível na rede da empresa, se as execuções de teste mostram ecrãs e documentos confidenciais, ou se os dados não devem sair do próprio domínio de controlo, a operação local é frequentemente a solução mais clara.

A decisão sensata depende da necessidade de proteção e da capacidade operacional. Para um site de marketing público sem logins sensíveis, um serviço de testes na cloud pode ser apropriado. Para software de despacho interno, um portal de clientes com dados pessoais, ou uma aplicação Windows na rede de produção, muito fala a favor de um ambiente controlado, auto-hospedado.

Uma verificação de segurança prática antes do lançamento

Antes de os testes automatizados serem implementados, um responsável deveria conseguir responder a estas perguntas sem adivinhar:

  • A que sistemas, bases de dados, e interfaces pode o servidor de testes aceder?
  • Que dados aparecem em capturas de ecrã, vídeos, registos, e avaliações de IA?
  • Onde estão armazenadas as credenciais, e quando são rotacionadas?
  • Quem pode iniciar execuções de teste, ler resultados, e administrar sistemas?
  • Com que rapidez são aplicadas as atualizações críticas, e como isso é verificado?
  • Quando são eliminados os artefactos de teste e os dados já não necessários?

Estas perguntas parecem sóbrias. É precisamente esse o seu valor. A segurança raramente surge de uma única ferramenta ou de um diagrama de arquitetura impressionante. Surge quando responsabilidades, fluxos de dados, e limites técnicos permanecem verificáveis no dia a dia.

Quem constrói automação de testes deveria primeiro clarificar a necessidade de proteção da aplicação e depois escolher a arquitetura mais pequena que seja sensata. Um servidor de testes claramente delimitado com poucas contas autorizadas é frequentemente mais valioso do que uma plataforma sobrecarregada que ninguém consegue manter de forma fiável. Boring, provable reliability também vence, mesmo em testes, a solução espetacular mas opaca.

Permalink →

Warehouse Management Systems: O que realmente importa

Warehouse Management Systems: O que realmente importa

Quando um funcionário na receção de mercadoria anota a mesma linha de entrega em papel, depois transfere-a para uma tabela, e depois esclarece aos gritos pelo corredor onde será armazenada, raramente falta vontade de trabalhar. O que falta é um processo partilhado. Os Warehouse Management Systems criam esse processo documentando movimentos de mercadoria, stocks, e tarefas subsequentes num só lugar. Para pequenas e médias empresas, o decisivo não é a lista de funções mais longa, mas se o software representa de forma fiável o percurso de uma mercadoria pelo próprio armazém.

O que os Warehouse Management Systems têm de conseguir no dia a dia

Um Warehouse Management System, ou WMS abreviadamente, não é simplesmente uma melhor lista de stock. Controla ou documenta os processos físicos no armazém: receção de mercadoria, controlo de qualidade, armazenamento, transferência, picking, embalagem, expedição, e inventário. Cada registo responde a uma pergunta operacional simples: o que está onde, em que quantidade, em que estado, e quem desencadeou o movimento?

À primeira vista, esta clareza parece banal. Mas evita cadeias de erros típicas. Um artigo foi entregue, mas ainda não foi controlado. Uma palete está na receção de mercadoria, mas já aparece como disponível no sistema. Uma encomenda é feita picking embora a mercadoria devesse estar reservada para uma encomenda de cliente mais importante. Sem estados e movimentos claramente definidos, uma única incerteza transforma-se rapidamente numa promessa de entrega errada.

Para muitos armazéns de média dimensão, o benefício não começa com controlo totalmente automatizado. Ordens de armazenamento já rastreadas, localizações inequívocas, e registos móveis podem reduzir consideravelmente os tempos de procura. O decisivo é que os funcionários já não tenham de traduzir entre papel, telefone, e-mail, e várias tabelas.

Nem todo armazém precisa de uma grande suite

O mercado oferece sistemas empresariais extensos com funções para redes globais multi-localização, gestão aduaneira complexa, tecnologia de transporte automatizada, e lógica de otimização muito fina. Isso pode ser correto se estes requisitos realmente existirem. Mas para uma empresa com um ou poucos armazéns, prioridades mutáveis, e processos especiais bem estabelecidos, tal suite pode gerar mais atrito do que benefício.

Os custos então não residem apenas nas licenças. Surgem em longos projetos de implementação, adaptações extensas, formação, e dependência de especialistas externos. Mesmo um sistema com cem configurações não resolve um problema se os chefes de turno tiverem de abrir um ticket para correções quotidianas.

A alternativa não significa necessariamente um desenvolvimento totalmente à medida. Um produto padrão pode ser sensato quando os seus fluxos principais se adequam e as adaptações permanecem deliberadamente limitadas. Da mesma forma, uma tabela existente ainda pode ser a melhor solução, por exemplo para uma avaliação rara e gerível. Torna-se crítica apenas quando várias pessoas trabalham com ela simultaneamente, registam movimentos com atraso, ou a tabela deve tornar-se a verdade operacional sobre a mercadoria disponível.

A solução certa orienta-se pelo volume de processo real e pelo custo dos erros. Cinco picks errados por semana significam algo diferente num armazém de peças sobressalentes com encomendas de clientes críticas em termos de tempo do que cinco desvios num stock de arquivo de rotação lenta.

Captar primeiro os processos, não escolher os ecrãs

Muitos projetos WMS começam com uma demonstração de produto. Aí os responsáveis veem painéis elegantes, vistas de scanner, e indicadores coloridos. Mais útil é primeiro uma volta pelo armazém durante um dia de trabalho normal. Onde chega a mercadoria? Quem controla quantidades e danos? Quando é que um artigo recebe o seu número de lote ou de série? Como se decide para que local vai? E o que acontece quando a realidade se desvia da encomenda?

Estas perguntas lançam a base para uma solução que será aceite mais tarde. Um processo-alvo bem documentado não descreve apenas o caso ideal. Também contém exceções: entregas parciais, mercadoria danificada, chegadas não anunciadas, faltas de stock, devoluções, e stock bloqueado. São precisamente estes casos que decidem se os funcionários confiam no sistema ou voltam a pegar em papéis.

Os estados são mais importantes do que interfaces bonitas

Um conjunto de dados limpo distingue por exemplo "esperado", "chegado", "em controlo", "armazenado", "reservado", "picking feito", e "expedido". Quais os estados necessários depende da empresa. Poucos demais ocultam diferenças relevantes. Demasiados abrandam os registos e são contornados.

A regra deveria ser: cada estado tem de ter uma consequência operacional. Se a mercadoria estiver bloqueada, não deve ser feito picking. Se estiver reservada, tem de estar visível para que encomenda. Se estiver armazenada, tem de estar registada uma localização. Assim, as regras de dados tornam-se fiabilidade prática do processo.

Os scanners só ajudam em registos claros

Os códigos de barras e dispositivos móveis reduzem erros de digitação e aceleram movimentos. Mas não substituem uma decisão de processo. Uma leitura tem de desencadear uma ação compreensível: verificar artigo, confirmar quantidade, escolher localização de destino, ou concluir encomenda. Se um funcionário tiver de adivinhar após cada leitura qual o ecrã seguinte, o fluxo está desenhado de forma demasiado complicada.

A questão do hardware também deve ser respondida de forma pragmática. Para algumas equipas, smartphones com função de leitura adequada e capa protetora robusta bastam. Outras precisam de scanners portáteis industriais, porque luvas, refrigeração, quedas, ou turnos longos assim o exigem. Um piloto na área real do armazém mostra mais do que uma apresentação na secretária.


A base técnica decide após o go-live

Um WMS tem de funcionar corretamente mesmo quando receções de mercadoria são registadas, encomendas são feitas picking, e stocks são controlados simultaneamente. Daí resultam requisitos que muitas vezes se perdem nas conversas iniciais: registos de movimento inequívocos, permissões baseadas em funções, correções rastreáveis, interfaces fiáveis, e cópias de segurança que são realmente restauráveis numa emergência.

Um stock não deveria ser simplesmente sobrescrito. Melhor é um modelo de movimento: entrada, saída, transferência, bloqueio, ou correção geram cada um um registo documentado. Assim, pode-se rastrear mais tarde por que uma quantidade diverge. Isso é tão valioso para inventários como para esclarecer um caso de reclamação de cliente.

As permissões têm de corresponder à responsabilidade. Um picker precisa de funções diferentes de um responsável de armazém que aprova correções de stock. Para alterações críticas, justificações, aprovações de quatro olhos, ou pelo menos um registo de alterações imutável fazem sentido. O esforço depende do perfil de risco, mas a questão deve ser esclarecida antes do início.

As interfaces merecem a mesma atenção. Um armazém raramente trabalha isolado. Encomendas vêm de uma loja, um ERP, ou importação estruturada. Dados de expedição vão para sistemas de transportadoras, guias de remessa e etiquetas são geradas, dados de stock fluem de volta. Cada interface precisa de responsabilidades claras para casos de erro. O que acontece se uma etiqueta de expedição foi gerada mas a confirmação não chega ao WMS? Sem lógica de repetição e fila de erros visível, tais casos ficam presos a pessoas individuais.

Para soluções personalizadas, tecnologias sustentáveis não são um assunto secundário. Uma aplicação rastreável com estrutura de base de dados clara, implementações documentadas, e integrações testadas permanece gerível mesmo após mudanças de pessoal. Uma arquitetura da moda não ajuda se ninguém conseguir rastrear uma importação com falhas.

Implementação em passos pequenos e controláveis

Um big bang cria risco evitável. Frequentemente é mais sensato digitalizar primeiro um processo delimitado, como a receção de mercadoria para um grupo de produtos ou o picking numa área de armazém. A equipa verifica assim não só funções, mas também formulações, rotas de leitura, distâncias percorridas, e responsabilidades.

Os dados mestre são aqui frequentemente o verdadeiro estaleiro. Os números de artigo têm de ser inequívocos, as unidades de medida consistentes, as localizações de armazém estruturadas de forma sensata, e as unidades de embalagem claramente definidas. Um sistema não pode fornecer stocks fiáveis se o mesmo artigo aparecer sob três designações diferentes, ou uma "caixa" significar quantidades diferentes consoante o fornecedor.

Durante a fase piloto, os indicadores devem permanecer simples: quanto tempo demora a receção de mercadoria? Quantos registos têm de ser corrigidos? Quantos pickings são incorretos? Com que frequência se procura mercadoria? Nem toda melhoria se manifesta imediatamente numa grande rubrica de custos. Menos perguntas de acompanhamento e informação de entrega mais fiável já podem retirar pressão considerável da operação diária.

A formação funciona melhor diretamente no processo. Os funcionários não precisam de uma visita abstrata por todos os itens de menu. Precisam de saber como registar a próxima entrega, reportar um desvio, ou corrigir uma leitura errada. Para os primeiros turnos após o arranque, deveria estar contactável uma pessoa responsável que possa tomar decisões rapidamente.

A pergunta certa para a escolha

Nos Warehouse Management Systems a questão central não é: que software consegue fazer mais? É: que fluxos de trabalho têm de se tornar mais rápidos, mais claros, e mais rastreáveis todos os dias para a nossa equipa?

Quem descrever primeiro estes fluxos de trabalho de forma clara pode avaliar objetivamente software padrão, extensões, ou uma aplicação feita à medida. O resultado não precisa de parecer espetacular. Deveria assegurar que a mercadoria encontra o seu caminho, o stock permanece fiável, e as pessoas no armazém passam menos tempo a procurar, perguntar, e corrigir posteriormente.

Permalink →

Custom Logistics Software vs Spreadsheets

Custom Logistics Software vs Spreadsheets

Uma receção de mercadoria chega mais cedo do que o anunciado, dois funcionários alteram em paralelo a mesma lista de stock, e o motorista espera por uma guia de remessa cuja última versão ninguém sabe indicar com certeza. Situações como esta decidem a pergunta "custom logistics software vs spreadsheets" não de forma teórica, mas entre a receção de mercadoria, a localização de armazém, e a rampa.

As tabelas não são fundamentalmente o problema. São rápidas de criar, familiares a todos, e frequentemente surpreendentemente eficazes para tarefas claramente delimitadas. Tornam-se problemáticas quando devem servir como sistema operativo de um processo de armazém ou distribuição em crescimento. Então um ficheiro transforma-se num processo crítico - sem regras vinculativas, estados rastreáveis, ou um histórico sólido.

Quando as folhas de cálculo no armazém são a escolha certa

Uma tabela faz sentido quando o processo é gerível, pouco frequente, e controlado por poucas pessoas. Isso pode ser, por exemplo, um planeamento mensal de necessidades, uma preparação pontual de inventário, ou uma avaliação de preços de fornecedores. Também pode ser suficiente para um pequeno stock com um responsável, desde que as alterações não ocorram sob pressão de tempo e nenhum processo subsequente dependa automaticamente dela.

A vantagem não está apenas nos baixos custos de licenciamento. As equipas podem ajustar colunas, verificar cálculos, e configurar um novo formulário em poucos minutos. Quem ainda não compreendeu um processo estável não deveria apressar-se a transformá-lo em software. Uma boa tabela pode primeiro tornar visível quais dados são realmente necessários e quais campos são mantidos apenas por hábito.

Seria, portanto, errado tratar cada ficheiro Excel como um atraso. A pergunta decisiva é: a tabela é uma ferramenta de trabalho para uma pessoa, ou uma fonte partilhada para decisões operacionais? Assim que várias funções dependem dos mesmos dados, o risco aumenta consideravelmente.

Custom Logistics Software vs Spreadsheets: O ponto de viragem

A mudança geralmente não é desencadeada pelo número de linhas. Uma tabela com 20.000 posições pode funcionar, enquanto um ficheiro com 200 linhas já leva a erros. O que importa é a simultaneidade, os passos do processo, e as consequências de uma informação incorreta.

Um sinal de alerta típico é a questão das versões. Se os stocks, encomendas em aberto, ou datas de entrega estiverem em ficheiros com nomes como "final_novo", "final_novo2", e "realmente_final", o que falta não é uma melhor estrutura de pastas. Falta um estado de dados vinculativo. O mesmo se aplica quando os funcionários têm de telefonar uns aos outros para saber se a mercadoria chegou, se uma encomenda foi liberada, ou se um veículo já foi carregado.

O ponto de viragem é atingido quando uma entrada desencadeia várias ações subsequentes. Uma receção de mercadoria então não altera apenas um número no stock. Pode iniciar um controlo de qualidade, atribuir uma localização de armazém, marcar uma encomenda como parcialmente entregue, e mostrar às vendas um artigo disponível. Se estes passos forem coordenados manualmente através de ficheiros, papel, e telefonemas, os desvios dificilmente são evitáveis.

Torna-se especialmente crítico durante mudanças de turno e ausências. Quando apenas uma pessoa experiente sabe qual marcação de cor numa lista significa um bloqueio, ou qual fórmula calcula um stock de segurança, o processo não é sólido. Funciona apenas enquanto essa pessoa estiver disponível.

O que o software personalizado realmente faz melhor

O software logístico personalizado não é simplesmente uma tabela com uma interface bonita. O seu valor surge de fluxos de trabalho controlados. Cada registo recebe uma marca temporal inequívoca, uma pessoa responsável, e um estado rastreável. Os funcionários não veem apenas dados, mas a próxima ação permitida.

Numa receção de mercadoria, isso pode significar na prática: selecionar a entrega, registar a quantidade, documentar qualquer desvio, imprimir a etiqueta, e confirmar o armazenamento. Só depois é que o stock é libertado. Para o picking, o sistema pode agrupar encomendas por prioridade, mostrar localizações de armazém numa ordem sensata, e gerar uma guia de remessa apenas quando as linhas estiverem confirmadas.

Não se trata de complexidade desnecessária. Isso evita que o mesmo artigo seja reservado duas vezes, que uma entrega parcial conte como completa, ou que uma guia de remessa seja impressa com base em dados desatualizados. Regras simples também ajudam: campos obrigatórios para lotes, motivos de bloqueio para mercadoria danificada, verificações de plausibilidade nas quantidades, e permissões para registos de correção.

Uma aplicação bem planeada não cobre imediatamente cada caso especial. Concentra-se nos processos que custam tempo diariamente ou produzem erros regularmente. Para uma empresa, isso pode ser a gestão de movimentos de contentores; para outra, a captura rápida de mercadoria recebida com dispositivos móveis. O software padrão frequentemente só conhece estas particularidades como um módulo adicional dispendioso, ou nem sequer isso.

O custo oculto da tabela

O custo de licenciamento de uma tabela é baixo. O custo do processo não pode ser. Surge em perguntas de acompanhamento, retrabalho, tempos de pesquisa, manutenção duplicada, e stocks mal planeados. Surge também quando uma equipa tem de verificar à noite que dados mudaram desde a manhã.

Estes custos permanecem frequentemente invisíveis porque estão distribuídos por muitas funções. O gestor de armazém verifica stocks, as vendas internas corrigem datas de entrega, a contabilidade procura comprovativos, e a gestão recebe números com atraso. Nenhuma atividade individual parece dramática. Juntas, abrandam o rendimento e a capacidade de planeamento.

Uma decisão sólida não deveria, portanto, comparar apenas preços de software. Meça, durante duas a três semanas, quantas transferências manuais uma encomenda atravessa, com que frequência a informação é solicitada, e que erros se repetem. As consequências também são relevantes: um stock incorreto leva a uma correção interna ou a uma entrega perdida?

Nem todo o problema precisa de uma grande suite

Muitas empresas de média dimensão na região DACH hesitam com razão perante sistemas empresariais extensos. Implementações longas, ecrãs rígidos, e modelos de licenciamento para funções que nunca são usadas raramente resolvem um problema concreto de armazém. Mas a alternativa não tem de significar ficar com ficheiros dispersos.

Entre os dois extremos encontra-se uma aplicação específica para o fluxo de trabalho. Pode, por exemplo, ligar a receção de encomendas, receção de mercadoria, movimentos de stock, etiquetas de expedição, e guias de remessa num sistema partilhado, sem trazer de imediato contabilidade financeira completa, lógica corporativa global, e vinte línguas estrangeiras.

A base técnica é decisiva. Uma aplicação com uma estrutura de base de dados clara, interfaces documentadas, e permissões rastreáveis permanece adaptável. Tecnologias como PHP 8.4, JavaScript moderno, e MySQL 8 não são um fim em si mesmas aqui. Usadas corretamente, criam uma base sustentável para funções, históricos de registo, documentos impressos, e relatórios - mesmo quando os processos mudam daqui a dois anos.

Como a mudança consegue ter sucesso sem interromper a operação

O maior perigo não é a técnica, mas um primeiro passo demasiado grande. Quem tenta limpar todos os ficheiros históricos e mapear cada caso excecional antes do lançamento, adia o benefício por meses. Melhor é um começo claro e verificável.

Comece com um processo que ocorre frequentemente e é bem delimitável, como a receção de mercadoria com registo de stock, ou o envio com guia de remessa e etiqueta. Defina com precisão quando a operação começa, quais dados são estritamente necessários, quem concede que aprovação, e quando é considerada concluída. Disso resultam não apenas ecrãs, mas regras de trabalho sólidas.

A migração de dados também requer pragmatismo. Artigos ativos, fornecedores, localizações de armazém, e encomendas em aberto têm de estar limpos. Os stocks antigos históricos, por outro lado, podem frequentemente ser arquivados, em vez de serem importados para o novo sistema com grande esforço. A operação paralela pode fazer sentido, mas apenas com uma data final fixa. Caso contrário, surgem duas verdades em vez de uma melhor.

O valor de um parceiro técnico direto mostra-se durante a implementação.

softify.pro por isso não trabalha a partir de uma lista abstrata de funcionalidades, mas esclarece fluxos onde eles realmente acontecem: na receção, no corredor do armazém, na embalagem, e na entrega à expedição. Um bom software respeita rotinas funcionais e só altera o que efetivamente torna o processo mais fiável.

A decisão pode ser verificada através de três perguntas

Primeiro: várias pessoas precisam de confiar simultaneamente em dados atuais? Segundo: um registo desencadeia processos subsequentes que hoje são assegurados manualmente? Terceiro: um erro pode levar a um atraso na entrega, stock incorreto, fatura errada, ou pesquisa demorada? Se estas perguntas forem maioritariamente respondidas com sim, a tabela provavelmente já não é o sistema de referência correto.

Se a resposta permanecer maioritariamente não, ela pode continuar a ser uma solução razoável. Então compensa mais unificar ficheiros, definir responsabilidades, e documentar fórmulas críticas. A técnica não deveria ser maior do que o problema.

O próximo passo sensato não é, portanto, um projeto de digitalização geral, mas um olhar partilhado sobre um fluxo de trabalho concreto juntamente com as pessoas que o executam diariamente. Aí torna-se rapidamente visível se uma tabela bem mantida é suficiente - ou se um software fiável deveria finalmente assumir o trabalho que hoje fica preso entre papel, telefone, e várias versões do mesmo ficheiro.

Permalink →

Entre em contacto

Tem um projeto em mente, um fluxo de trabalho que ainda funciona com folhas de Excel e boa vontade, ou um atraso em testes que a COCO poderia retirar da sua equipa? Conte-nos sobre isso.

Enviar mensagem