softify.pro
Načítání …
Služby O nás COCO – náš AI server Portfolio Insiders Case Studies Stojí za to vědět Kontakt Přihlášení

NEXT-GEN SOFTWARE AESTHETIC

Pure fluidity meets ultimate performance.

Nová vizuální identita pro moderní digitální pracovní postupy.

softify.pro — Nová vizuální identita pro moderní digitální pracovní postupy.

Posuňte pro objevení ↓

Software postavený tak, jak moderní firmy skutečně fungují

softify.pro je softwarové studio založené na jedné myšlence: technologie by se měla pohybovat stejně plynule jako podniky, které podporuje. Působíme na průsečíku moderního webového vývoje, automatizace procesů, a aplikované umělé inteligence — tří disciplín, které se zřídka nacházejí pod jednou střechou, ale stále více k sobě patří. Naši zákazníci sahají od malého provozu, který zavádí své první digitální fakturování, až po etablovaný středně velký výrobní podnik, který nahrazuje Excelové tabulky skutečným logistickým softwarem. Spojuje je ne velikost, ale nárok: chtějí systémy, které jsou rychlé, spolehlivé, a příjemné k používání — nejen funkční. Každý projekt u nás začíná stejnými třemi otázkami: Co musí tato firma skutečně zrychlit? Co už funguje dobře a mělo by být respektováno namísto nahrazeno? A která část pracovního postupu se může, jednou správně postavená, v budoucnu vykonávat sama? Odpovědi určují vše ostatní — od zvolené technologie až po plán zavedení.

Služby

Nová vizuální identita pro moderní digitální pracovní postupy.

01 — LOGISTICS

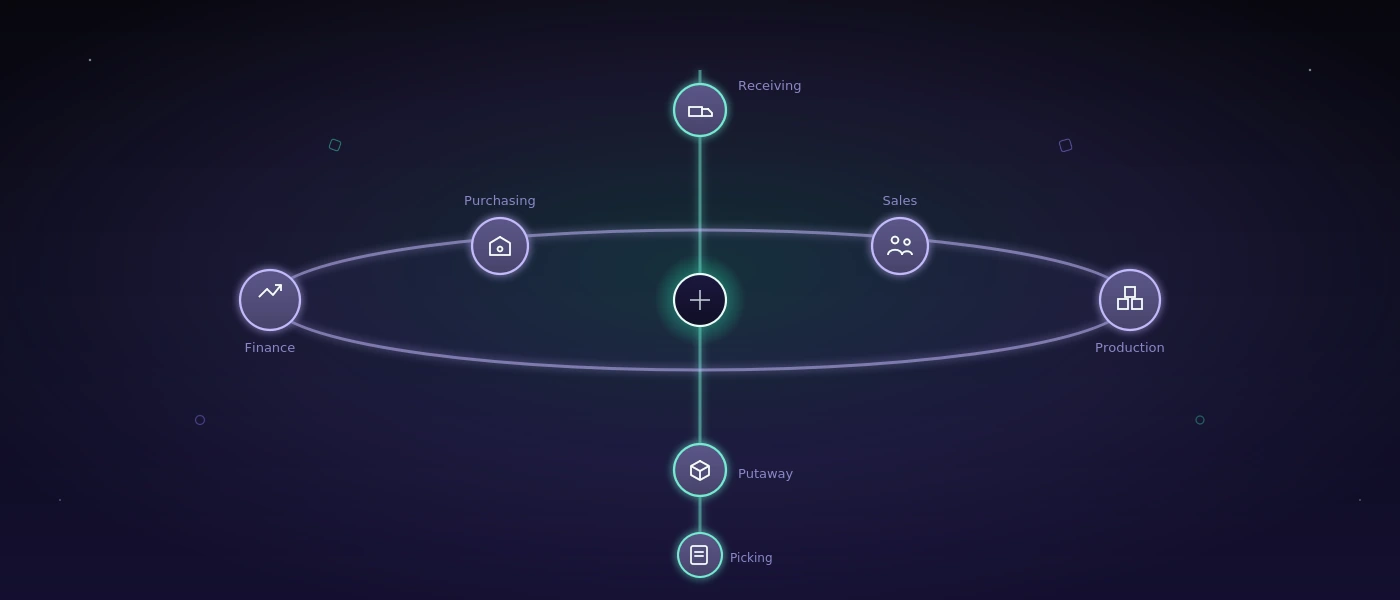
Automatizace logistiky — pro malé a střední podniky v regionu DACH

Velká část naší práce je věnována logistickému a provoznímu softwaru pro malé a střední podniky v Německu, Rakousku, a Švýcarsku. Tyto podniky často stojí mezi dvěma neatraktivními možnostmi: drahými enterprise logistickými balíky, navrženými pro koncerny desetkrát větší, nebo směsí Excelových tabulek, papírových formulářů, a telefonátů, která tiše omezuje, jak rychle mohou růst.

Stavíme střední cestu — automatizaci na míru, která odpovídá skutečnému způsobu práce konkrétního skladu, dílny, nebo obchodního týmu. To může znamenat: digitalizaci příjmu zboží a skladových pohybů, automatické vytváření dodacích listů a přepravních štítků, propojení příjmu objednávek s plánováním tras, nebo jednoduše nahrazení křehkého Excelového souboru, kterému rozumí jen jedna osoba, systémem, na který se může spolehnout celý tým. Protože pracujeme přímo s majiteli a provozními vedoucími v regionu DACH, požadavky se zaznamenávají v jazyce, ve kterém firma skutečně funguje, a zavedení se plánuje kolem skutečných směnových plánů a skutečných skladových ploch — ne kolem abstraktního projektového plánu.

02 — WEB

Moderní webový vývoj s aktuální technologií

Navrhujeme a vyvíjíme webové aplikace a stránky s aktuální, aktivně udržovanou technologií — ne se zastaralými frameworky, udržovanými při životě jen ze zvyku. To znamená čistý PHP 8.4 na backendu, tam kde je klasická serverově renderovaná aplikace správnou volbou, moderní JavaScript tam, kde záleží na interaktivitě, a MySQL 8 pro data, která musí zůstat konzistentní a vyhledávatelná po léta — ne jen v prvních šesti měsících po spuštění. Každý projekt je plánován od prvního náčrtu stejně pro desktop i mobilní zařízení, ne dodatečně upravovaný: doby načítání, body zlomu rozvržení, a dotykové ovládání jsou součástí specifikace, ne pozdějším doplňkem.

Kromě viditelného rozhraní nám záleží na tom, jak stránka vypadá zevnitř: čitelný kód, databázové schéma, které není třeba při dalším požadavku na funkci přestavovat, a kroky nasazení, které dokáže bez dotazů následovat i druhý vývojář. Stránka, která je dnes výkonná a za tři roky ji bude stále možné čistě rozšiřovat, je pro nás skutečnou definicí „moderního“.

03 — AI / COCO

COCO — náš vlastní AI server pro automatizované testování softwaru

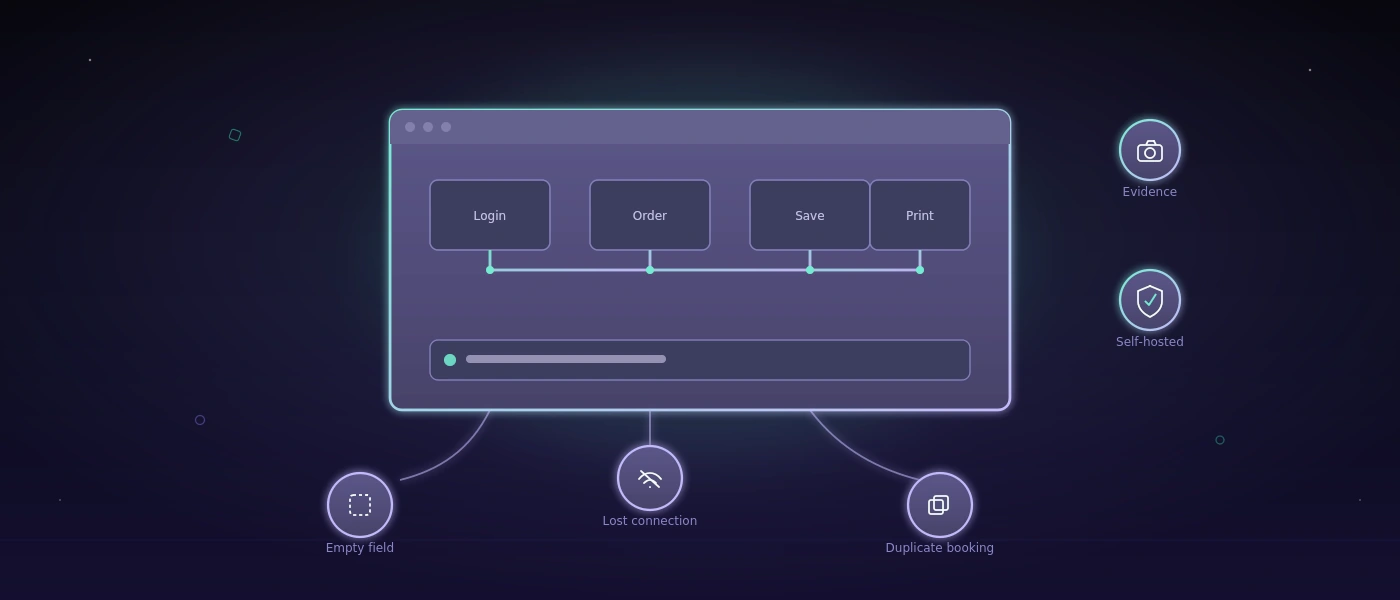
Pro enterprise zákazníky provozujeme a udržujeme vlastní dedikovaný AI server s názvem COCO. Na rozdíl od obecného chatbota, dodatečně vestavěného do pracovního postupu, je COCO cíleně a samostatně hostovaný pro automatizované testování webových aplikací i multiplatformních desktopových aplikací — od přihlašovacích a autentizačních procesů až po kompletní vícestupňové obchodní procesy.

COCO naplánuje testovací scénář, spustí ho proti skutečné aplikaci, zachytí snímky obrazovky před a po jako důkaz, a vytvoří srozumitelné vyhodnocení toho, co fungovalo, co selhalo, a proč — včetně hraničních případů, jako jsou opakovaná neúspěšná přihlášení, zablokování účtů, a procesy obnovy, které jsou ručně náročné a náchylné k chybám při testování. Protože server běží lokálně a pod naší správou, enterprise zákazníci si zachovávají plnou kontrolu nad tím, kde se ukládají testovací data a snímky obrazovky, bez výchozího odesílání interního provozu aplikace externí cloudové službě.

COCO individuálně nastavujeme pro každého enterprise zákazníka, konfigurujeme a udržujeme server — definujeme testovací plány relevantní pro danou aplikaci, ladíme prahové hodnoty důvěry, a od případu k případu rozhodujeme, kdy má být výsledek eskalován k lidské kontrole. Cílem není nahradit QA tým, ale dát mu neúnavnou kolegyni, která prochází opakující se regresní testy před každým vydáním, dříve než musí člověk vůbec zasáhnout.

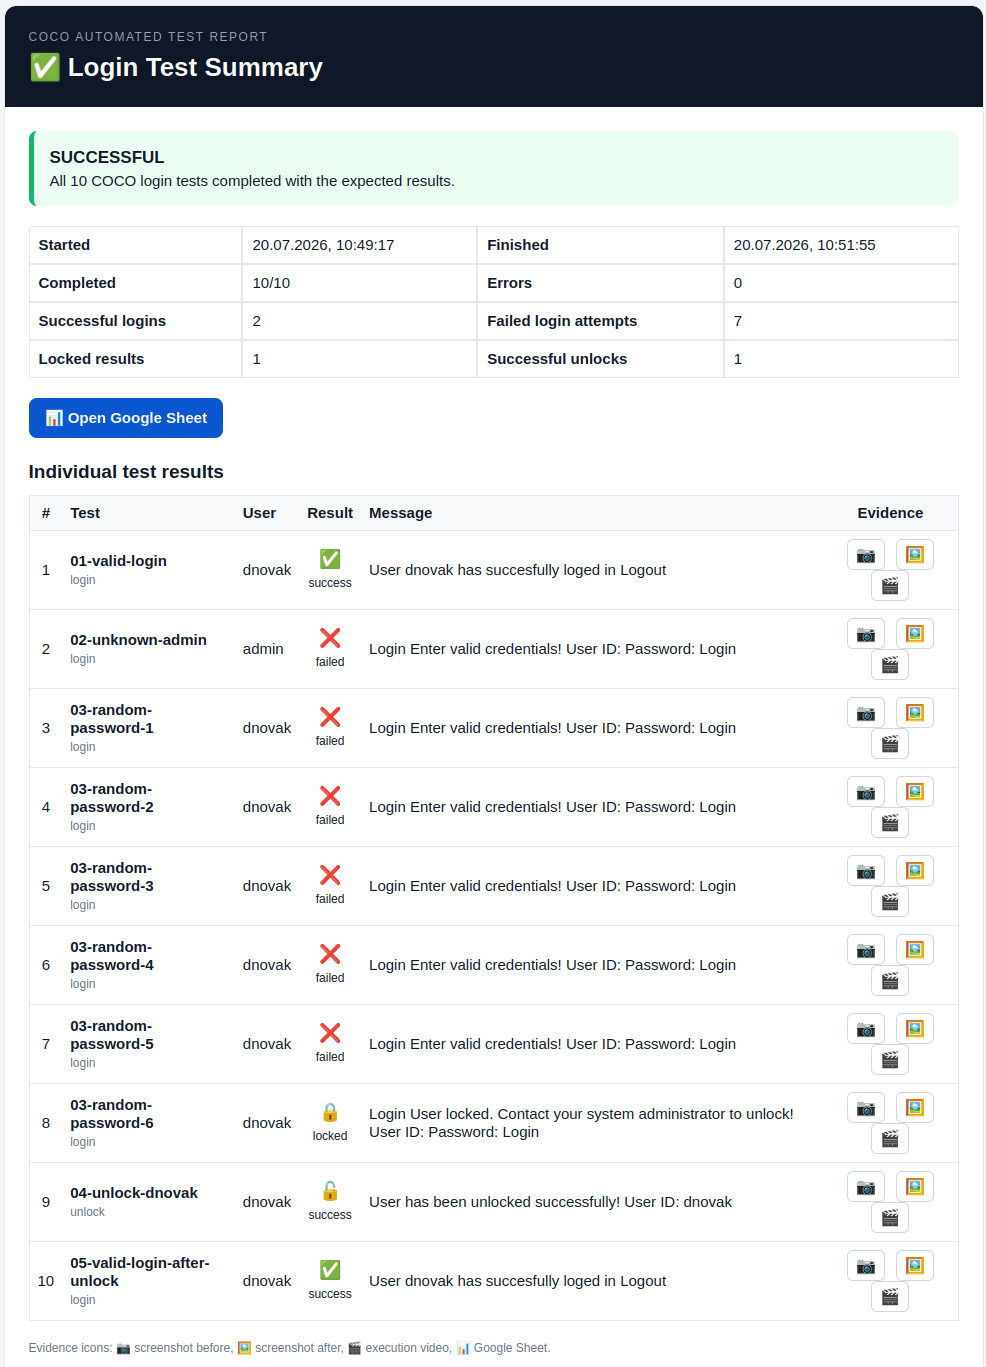
COCO automated login test report
COCO — automated login & account-lockout test report
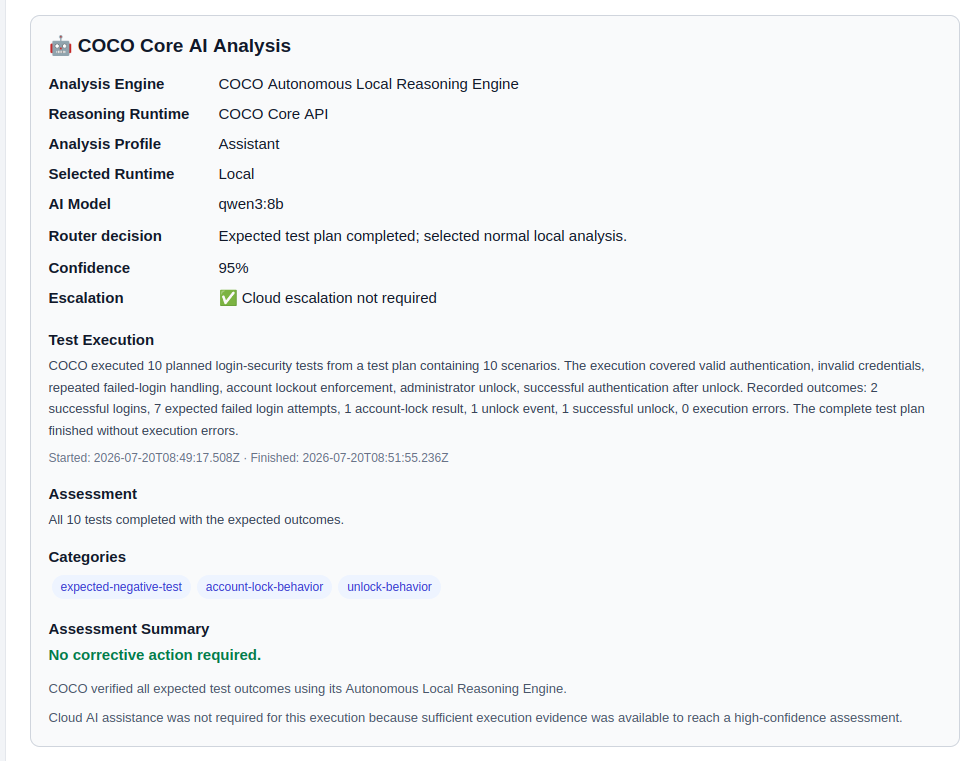
COCO AI analysis panel
COCO — plain-language AI analysis of a completed test run

Proč softify.pro

Vědomě zůstáváme tak malí, že každý projekt vedou lidé, kteří byli přítomni už při prvním plánovacím rozhovoru — místo aby byl předán do fronty. To znamená kratší smyčky zpětné vazby, méně nedorozumění, a tým, který si i po šesti měsících stále pamatuje, proč bylo přijato určité rozhodnutí. Upřednostňujeme nenápadnou, prokazatelnou spolehlivost před krátkodobými trendy: technologický stack vybíráme proto, že se hodí k problému a může ho udržovat i někdo jiný než my za pět let — ne proto, že byl zrovna populární v aktuálním sprintu. Pokud Excelová tabulka danou úlohu skutečně zvládá lépe než individuální software, řekneme vám to upřímně. Naším cílem je pracovní proces, který skutečně běží rychleji — ne jednoduše vyšší účet za software.

Vybrané práce

Malý výběr prací, které smíme veřejně ukázat — další případové studie a enterprise projekty představíme na vyžádání, pod NDA.

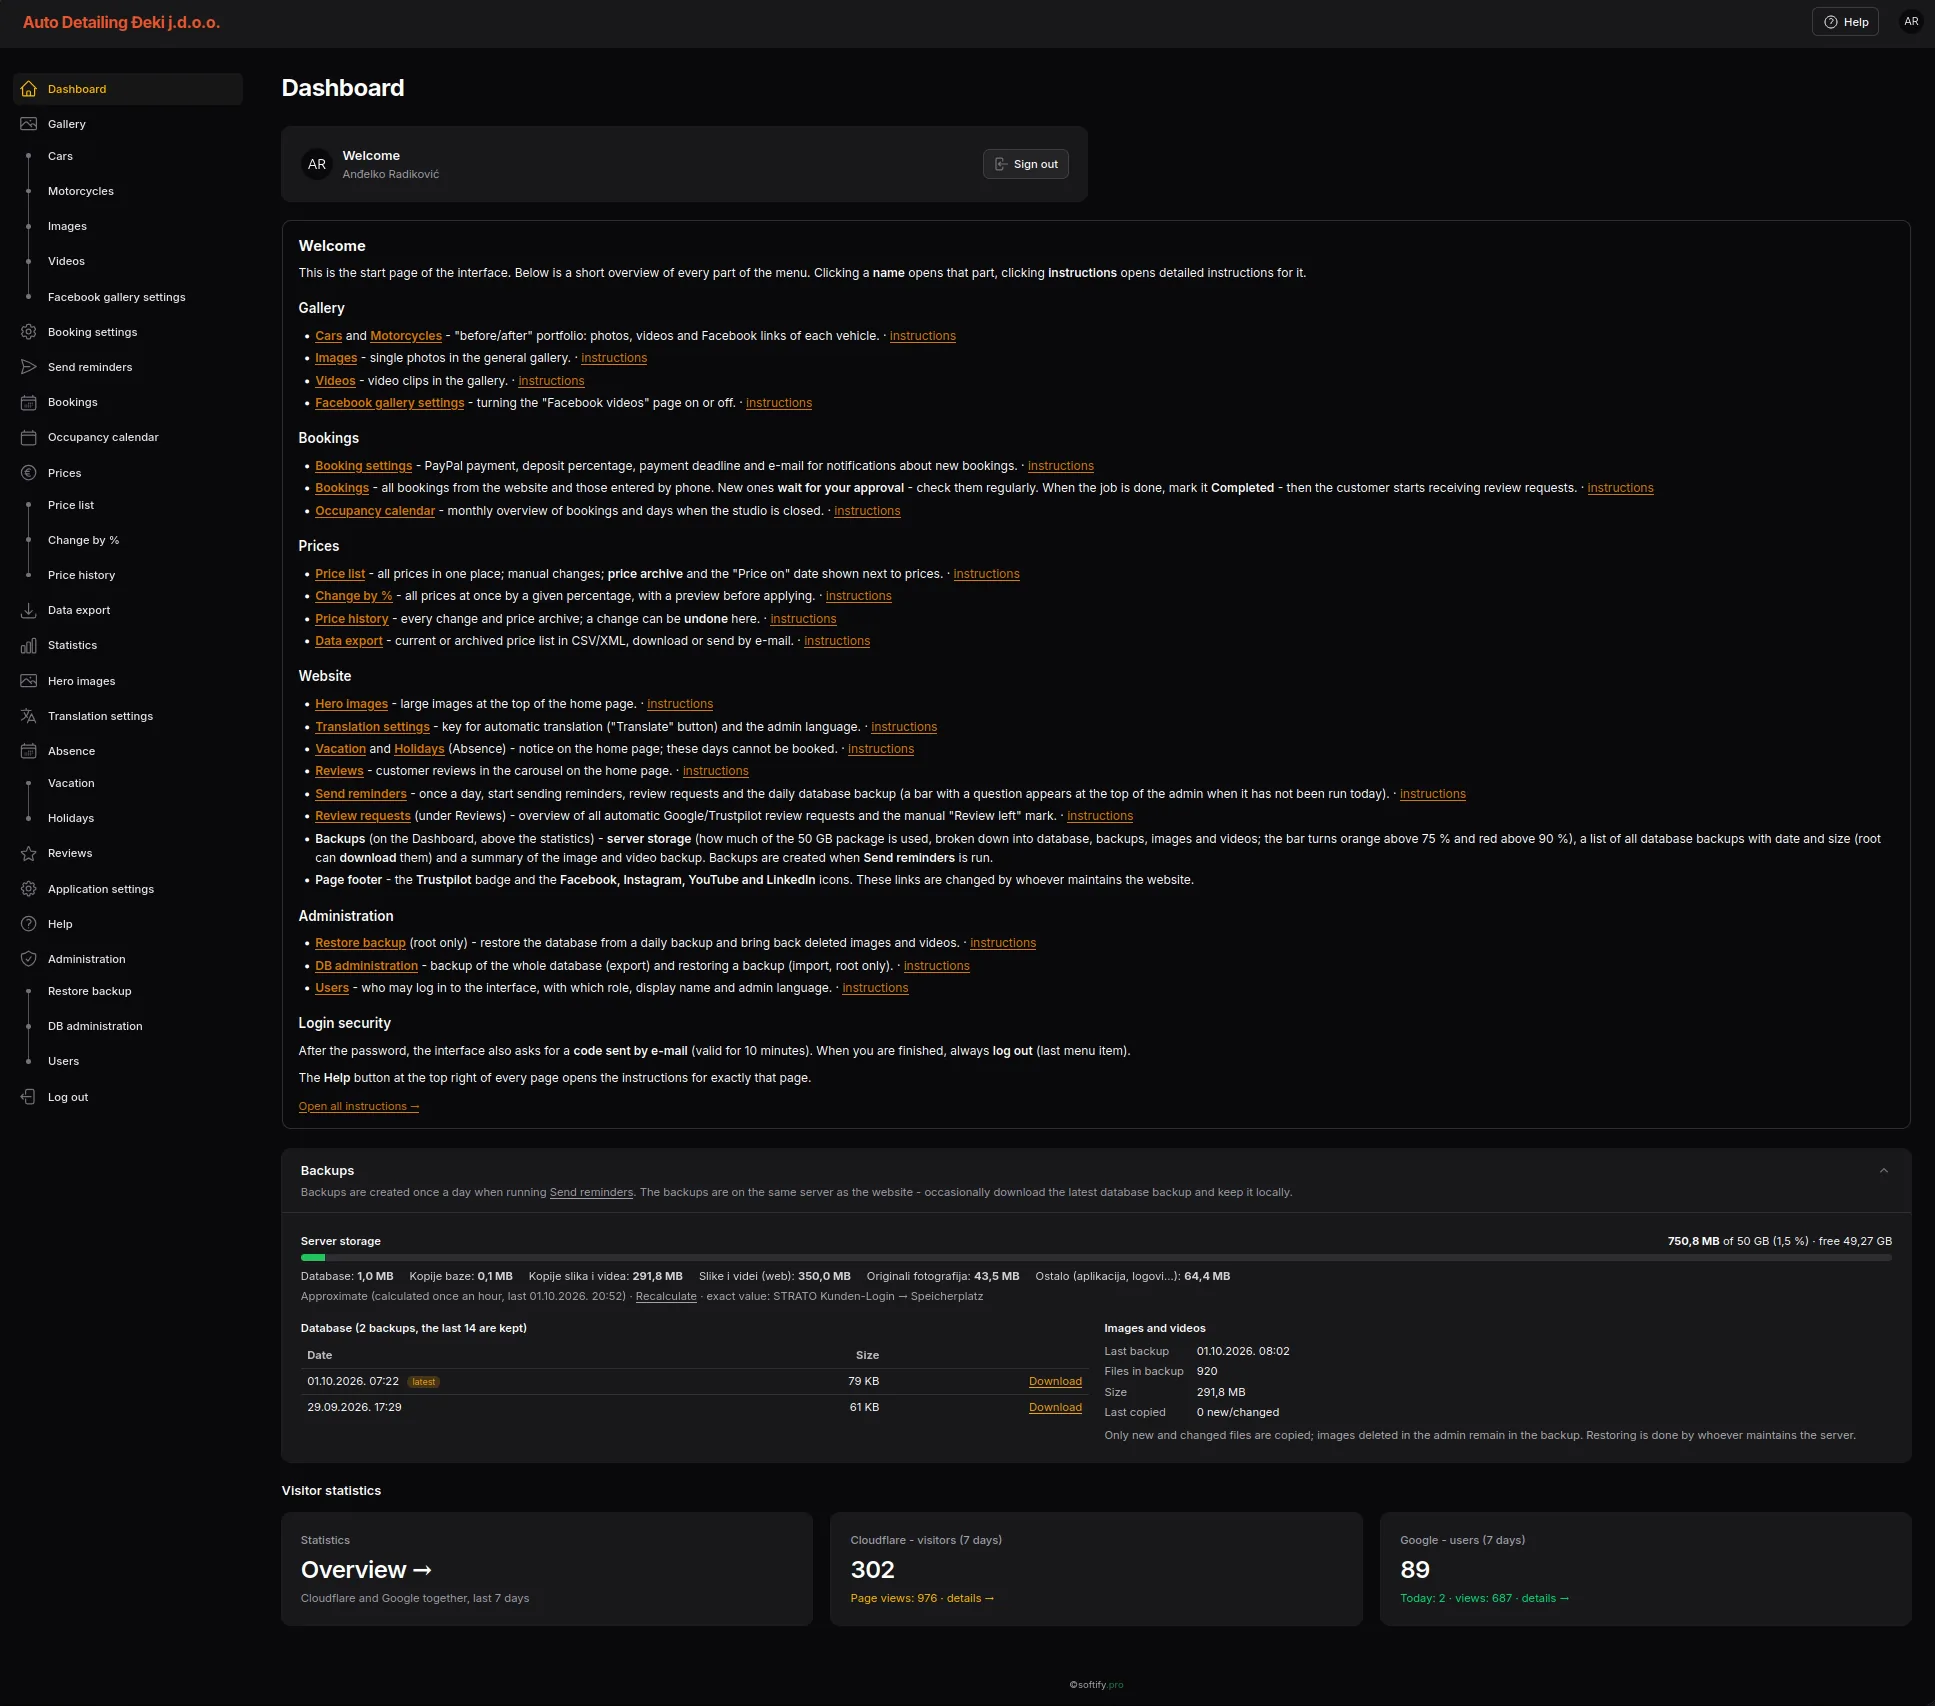
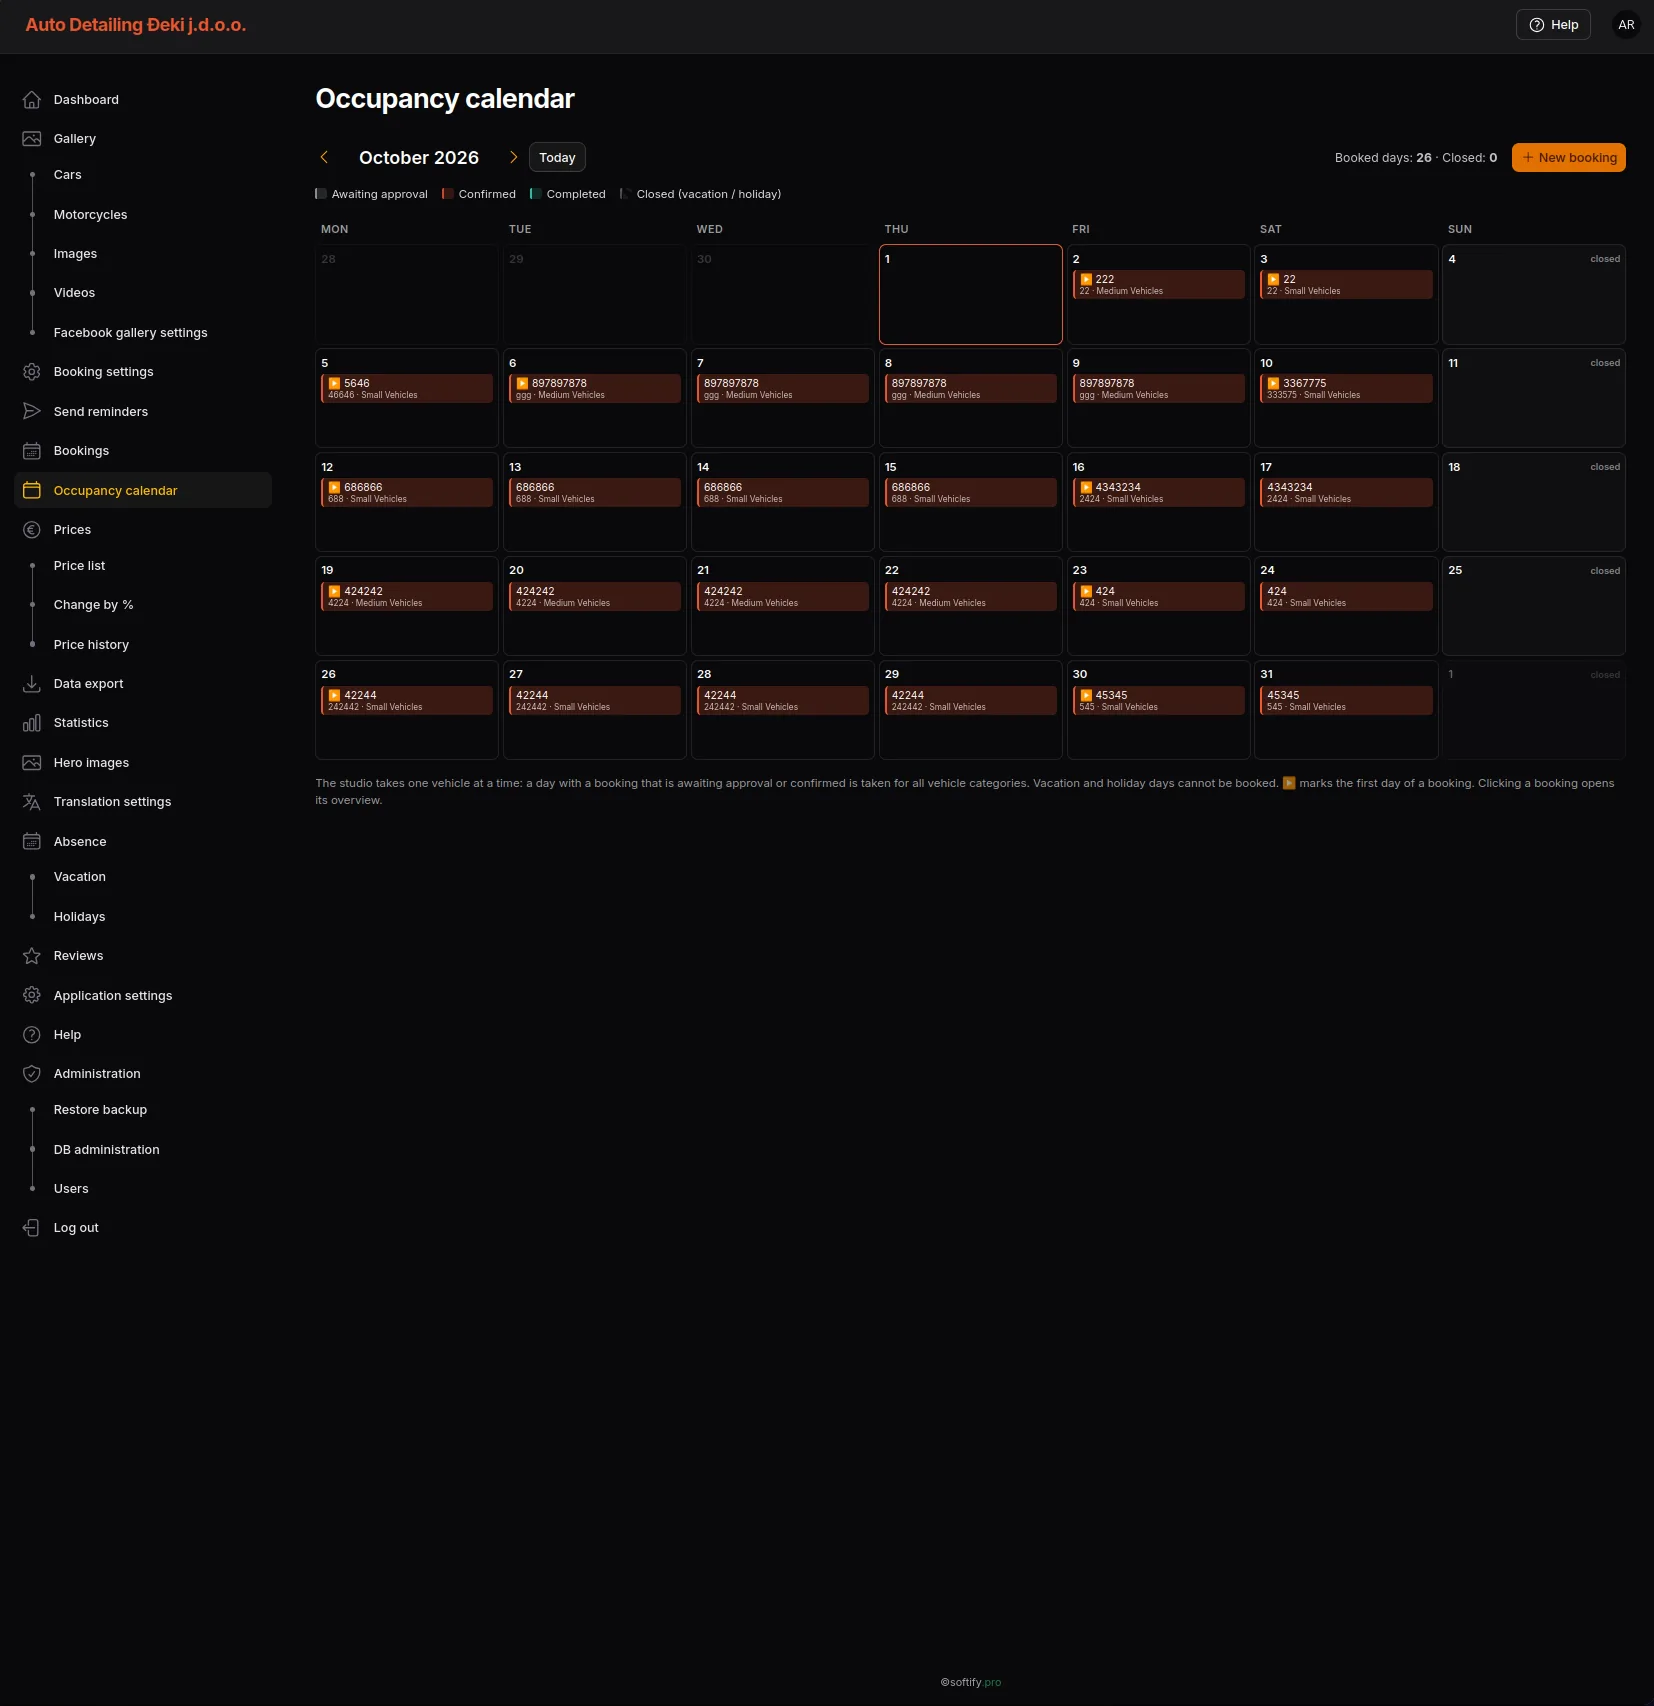
Auto Detailing Đeki – Od webu k digitální servisní platformě autodetailing-deki.pro

Auto Detailing Đeki – Od webu k digitální servisní platformě

Vícejazyčná platforma pro detailing vozidel – od kalkulace ceny přes rezervaci až po transparentní sledování zakázek, řízená z jednoho centrálního backoffice.

Koralpenhaus

Koralpenhaus

Regionální prezentační a rezervační webová stránka v alpské oblasti, postavená s důrazem na jasnou strukturu, rychlé načítání, a snadnou údržbu obsahu.

Dexosano

Dexosano

Moderní webová platforma založená na PHP, vyvinutá se stejným přístupem upřednostňujícím výkon, jaký softify.pro uplatňuje u každého projektu pro klienta.

softify.pro - Insiders

Jeden sklad. Jedna pravda.

Jeden sklad. Jedna pravda.

Existuje jednoduchý způsob, jak udělat skladový software přesvědčivým.
Otevřít dashboard.
Ukázat pár zelených čísel.
Přidat graf.
Umístit trochu zásob na mapu skladu.
Skončit reportem.
Vše vypadá v pořádku.
A přesto může být vše špatně.
Protože skladu je jedno, jak dobře vypadá dashboard.
Zajímá ho, zda se každá část systému shoduje na tom, co se skutečně stalo.
To se stalo zajímavou částí nejnovějšího experimentu softify.pro Flow.
Ne další obrazovka.
Ne další KPI.
Ne další report.
Něco mnohem méně viditelného.
Konzistence.
Začalo to skladem.
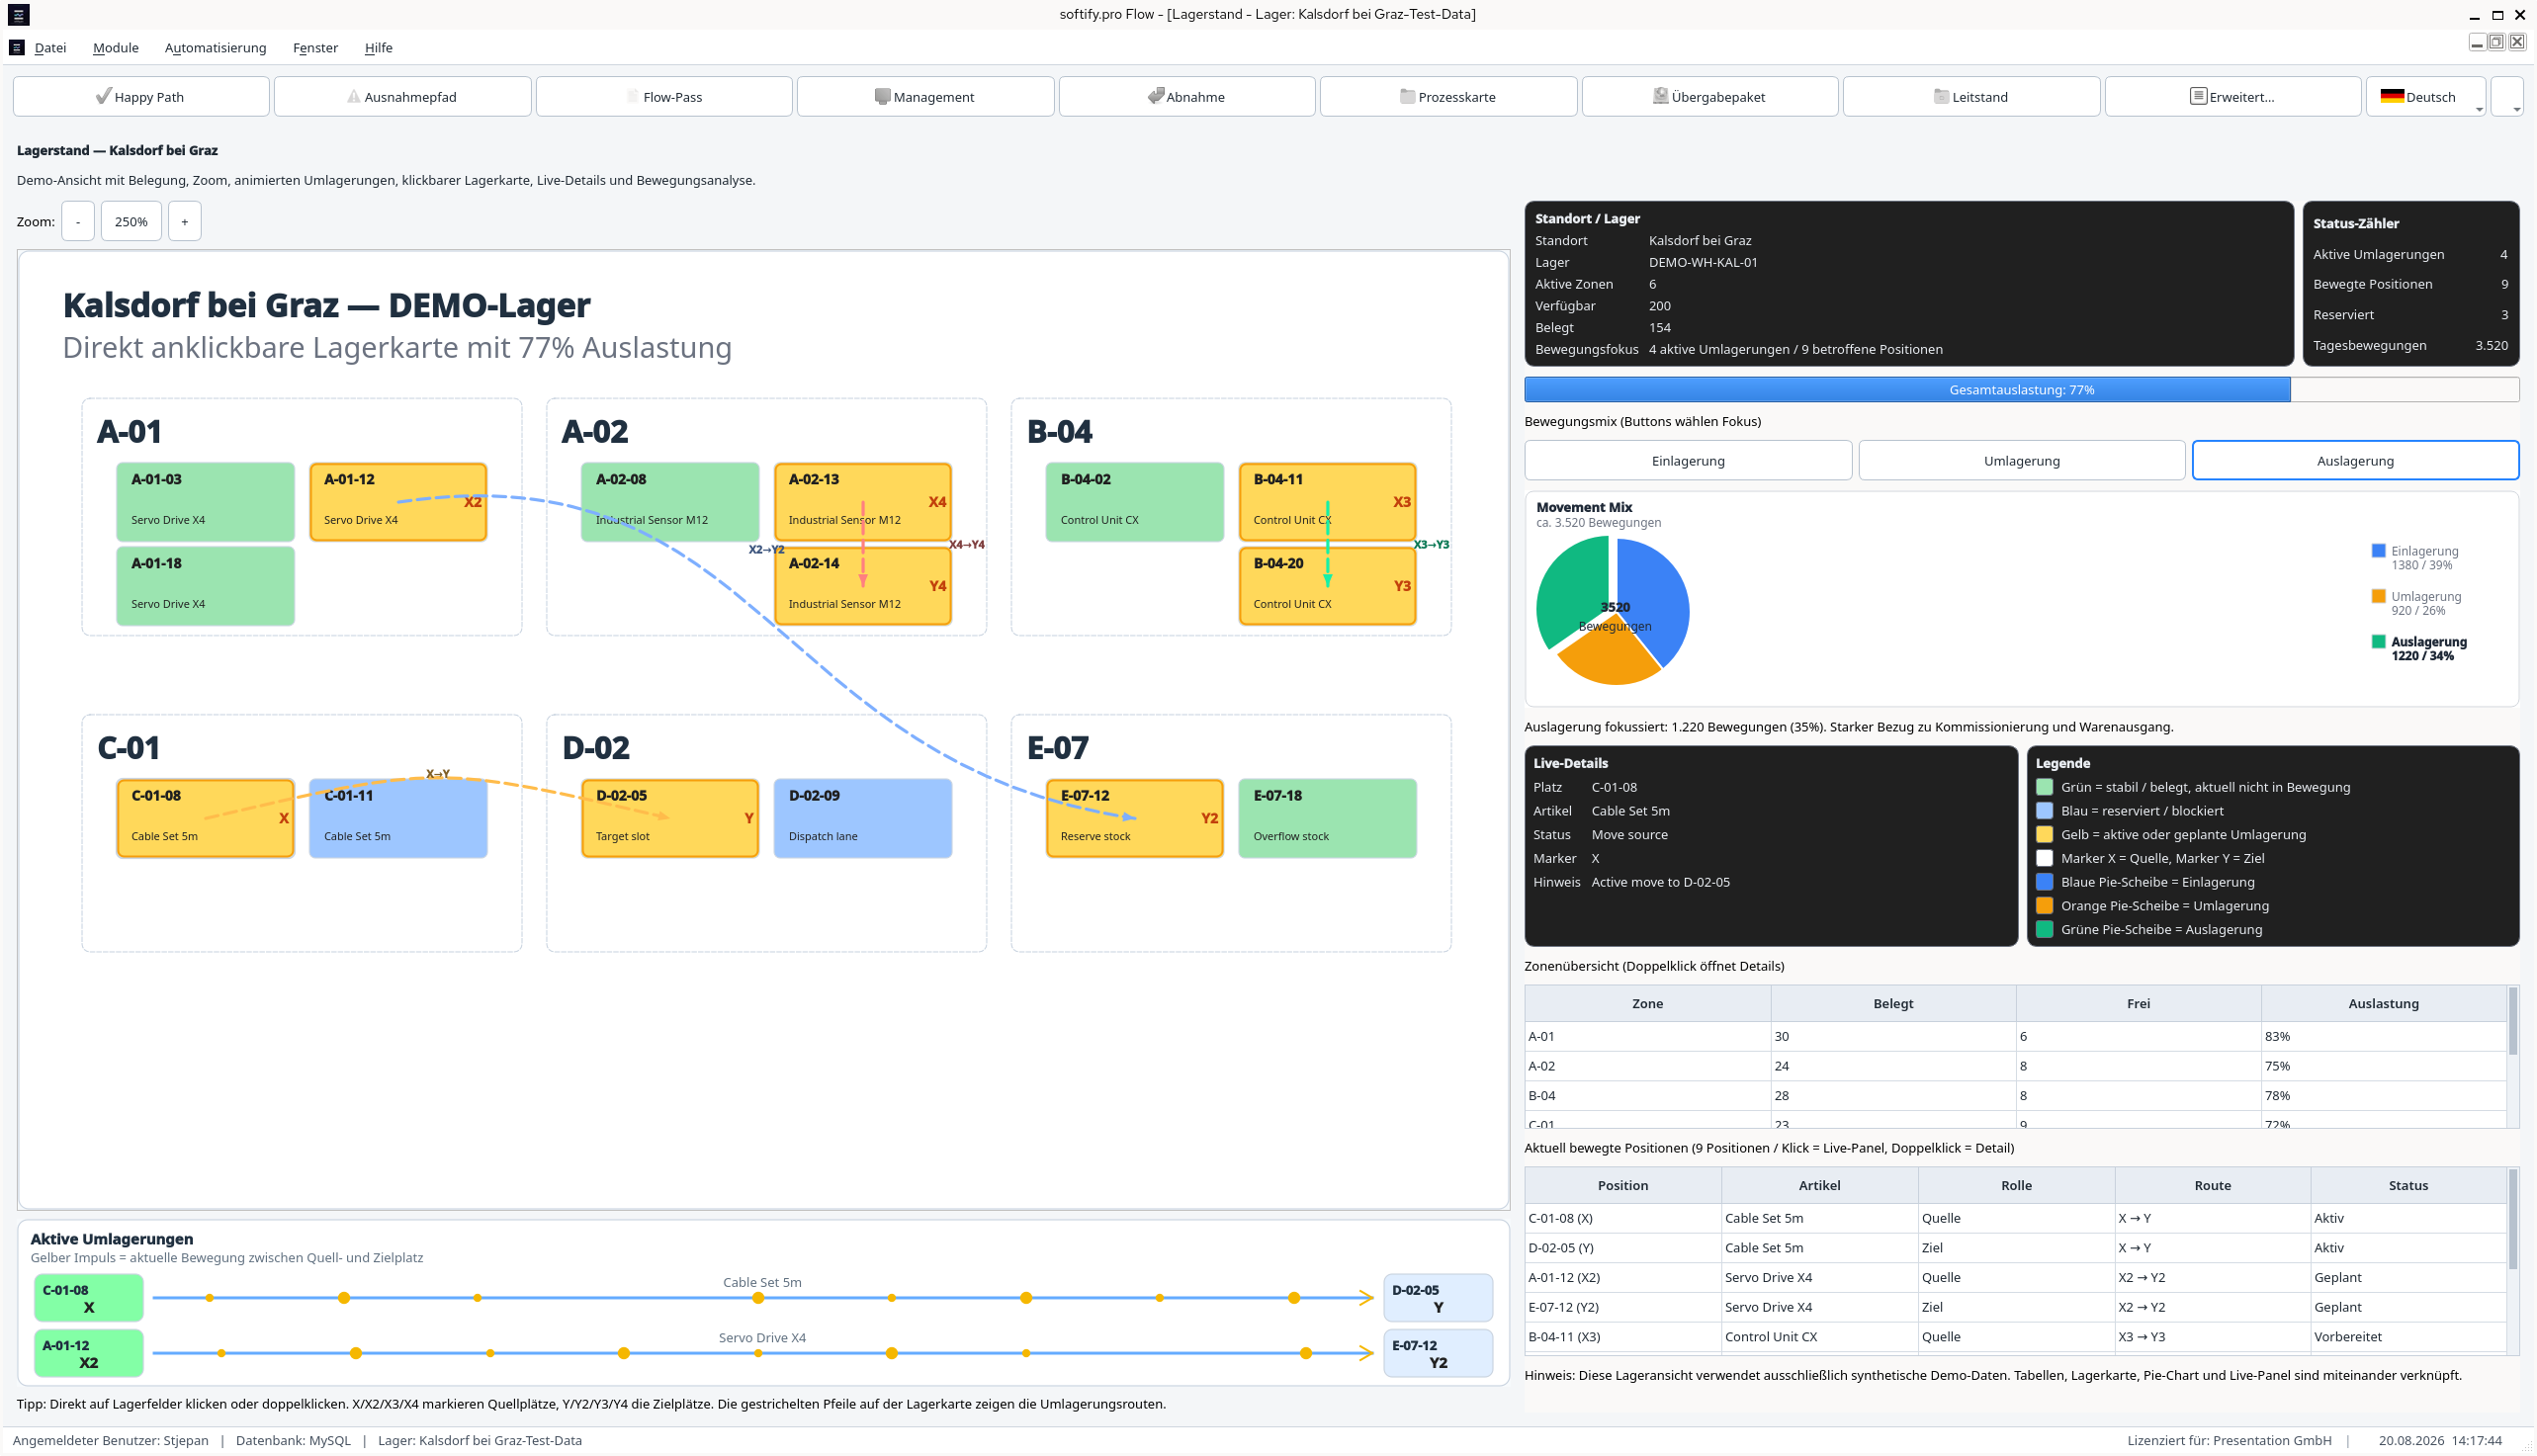
Aktuální demo softify.pro Flow pracuje s několika syntetickými skladovými prostředími.
Různá ID skladů.
Různé kapacity.
Různé struktury zón.
Žádné produkční zásoby.
Žádná zákaznická data.
Žádné skutečné provozní informace.
Ale procesní logika se chová, jako by na tom všem záleželo.
Protože ve skutečné logistice na tom záleží.
Jakmile je sklad jednou vybrán, tento kontext se stává součástí všeho, co následuje.
Flow.
SSCC.
Pohyby.
Operátoři.
Analytika.
Reporty.
Zní to samozřejmě.
Stává se to výrazně méně samozřejmé, jakmile se stejný proces začne objevovat ve více různých částech aplikace.
Pak jsme otevřeli jiný pohled.
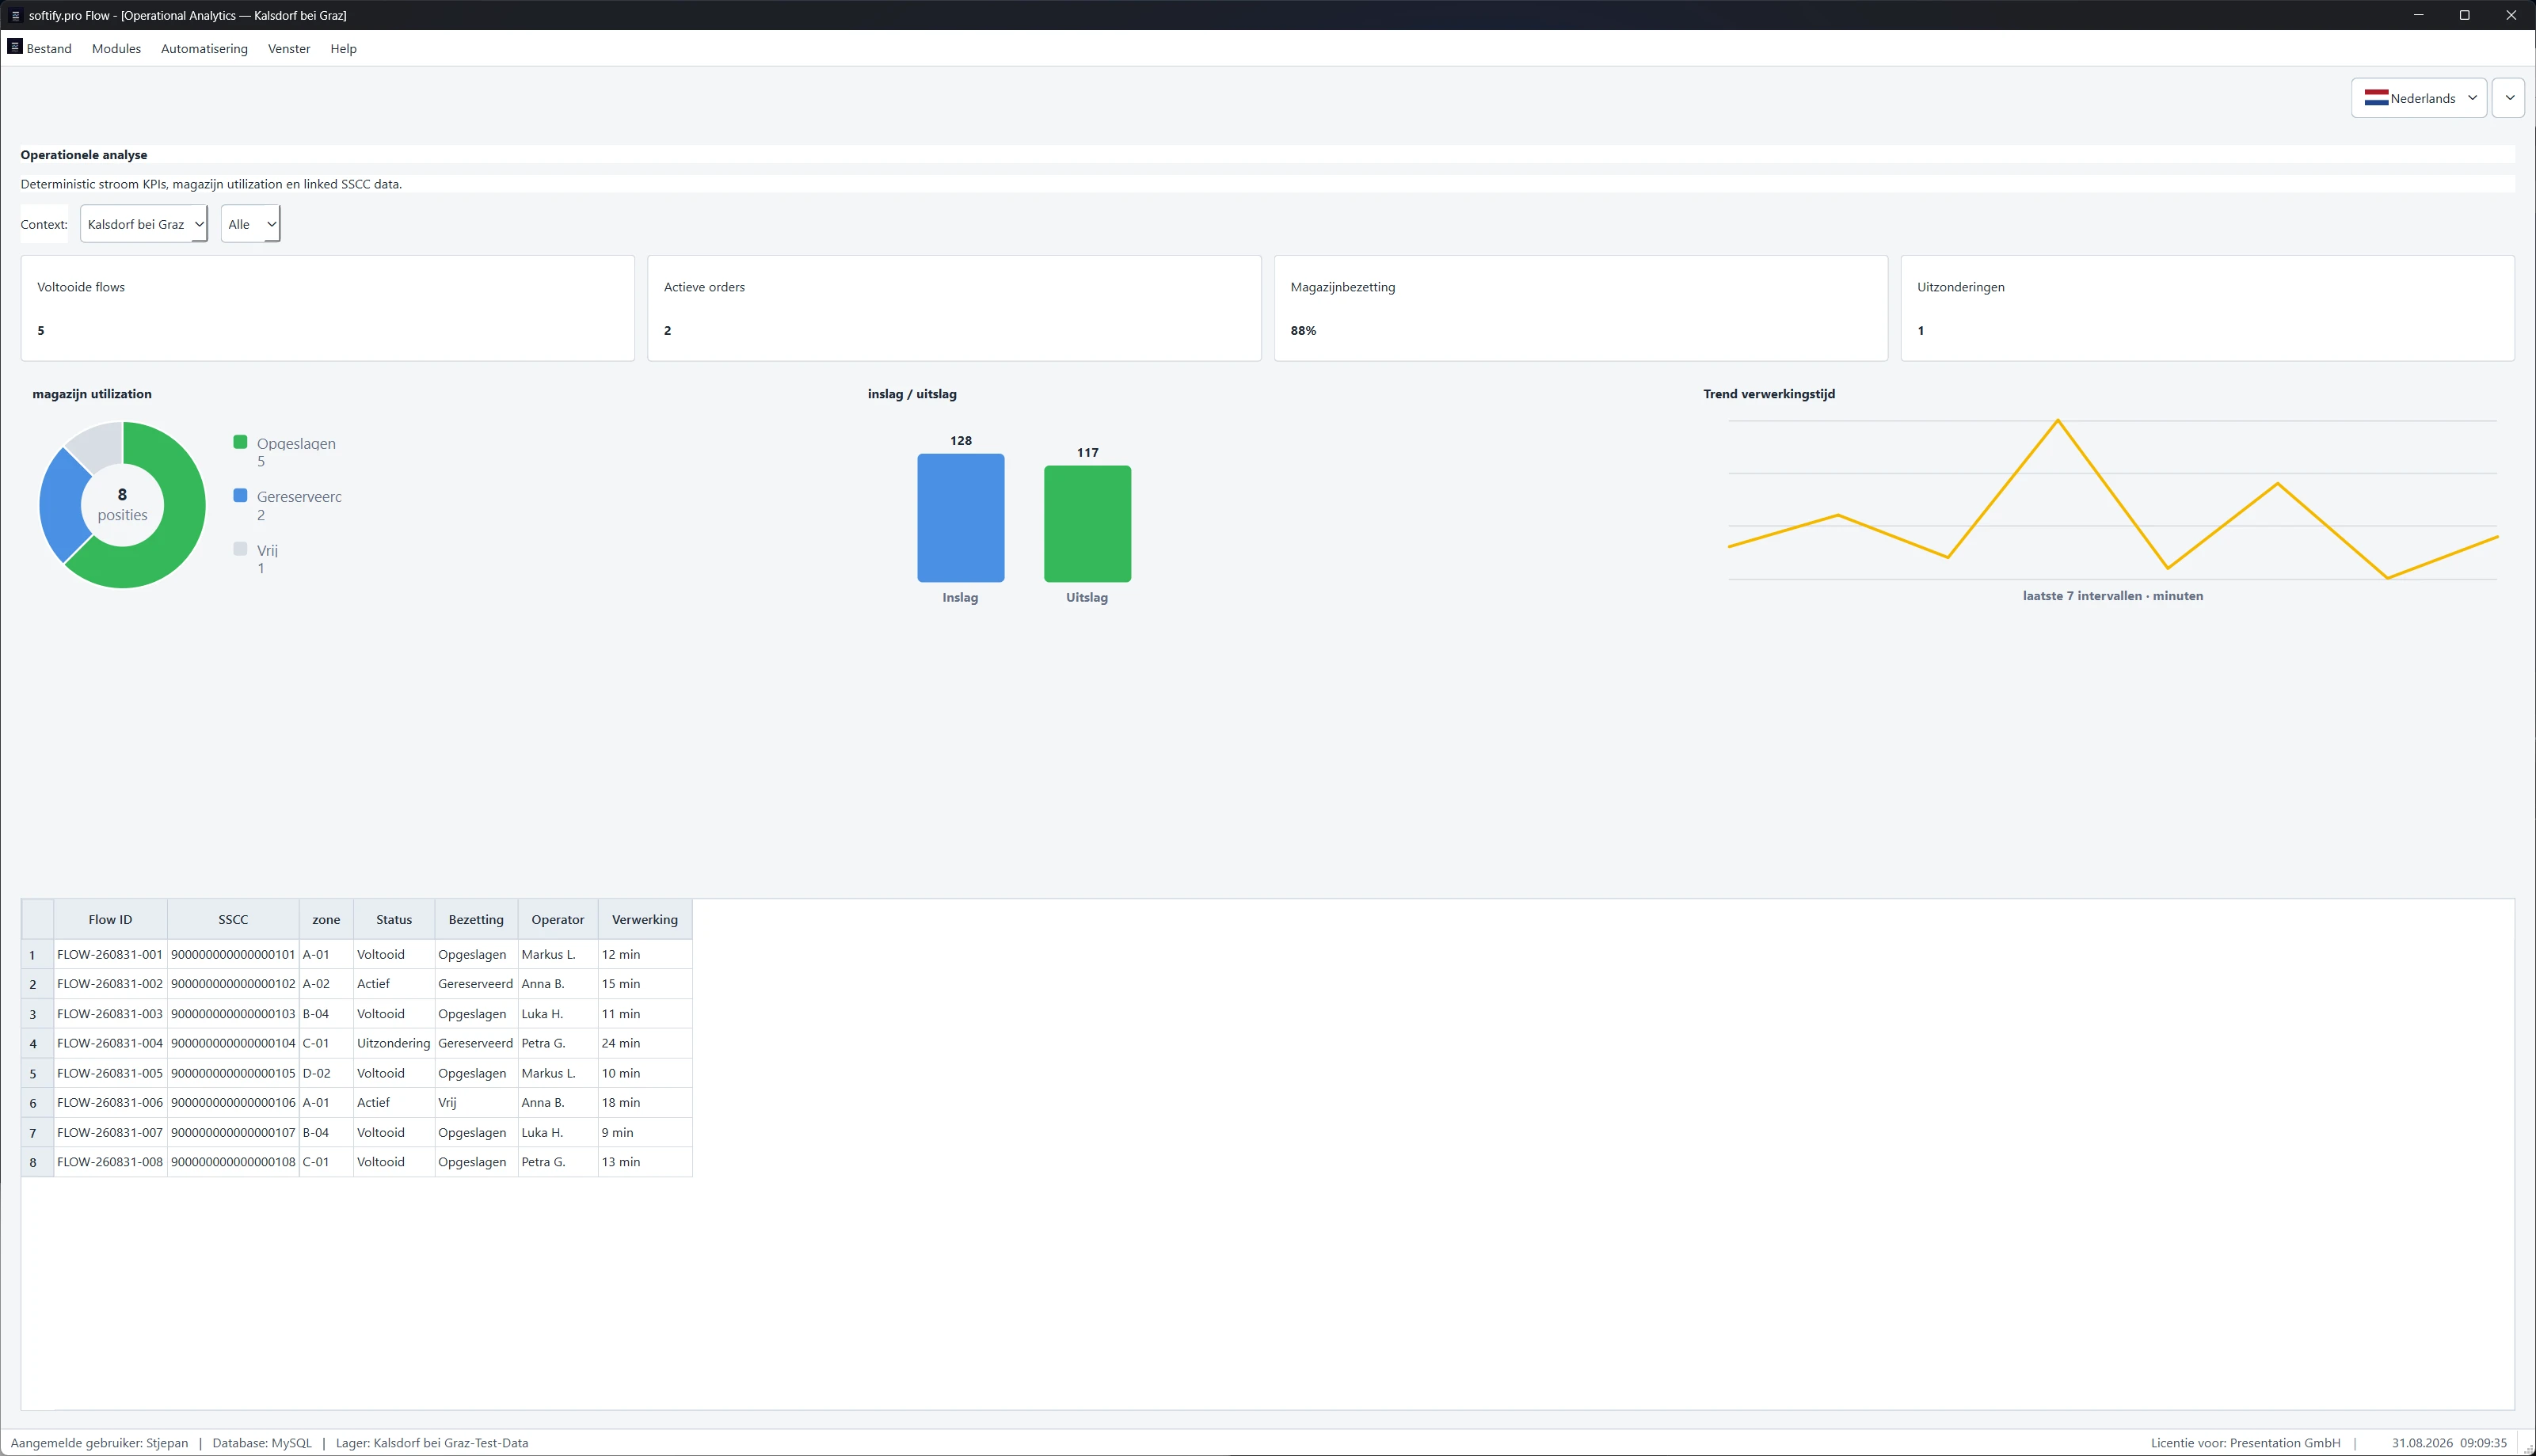
Operational Analytics.
Sklad najednou vypadal úplně jinak.
Žádné skladové pozice.
Žádné šipky pohybu.
Místo toho:

  • dokončené Flow,
  • aktivní objednávky,
  • využití skladu,
  • výjimky,
  • příjem,
  • výdej,
  • doba zpracování.

Vizuální reprezentace se změnila.
Sklad ne.
Toto rozlišení se stalo důležitým.
Protože pod KPI stále byly jednotlivé záznamy.
ID Flow.
SSCC.
Zóny.
Statusy.
Operátoři.
Doby zpracování.
Jiný pohled.
Stejná provozní realita.
Zatím dobré.

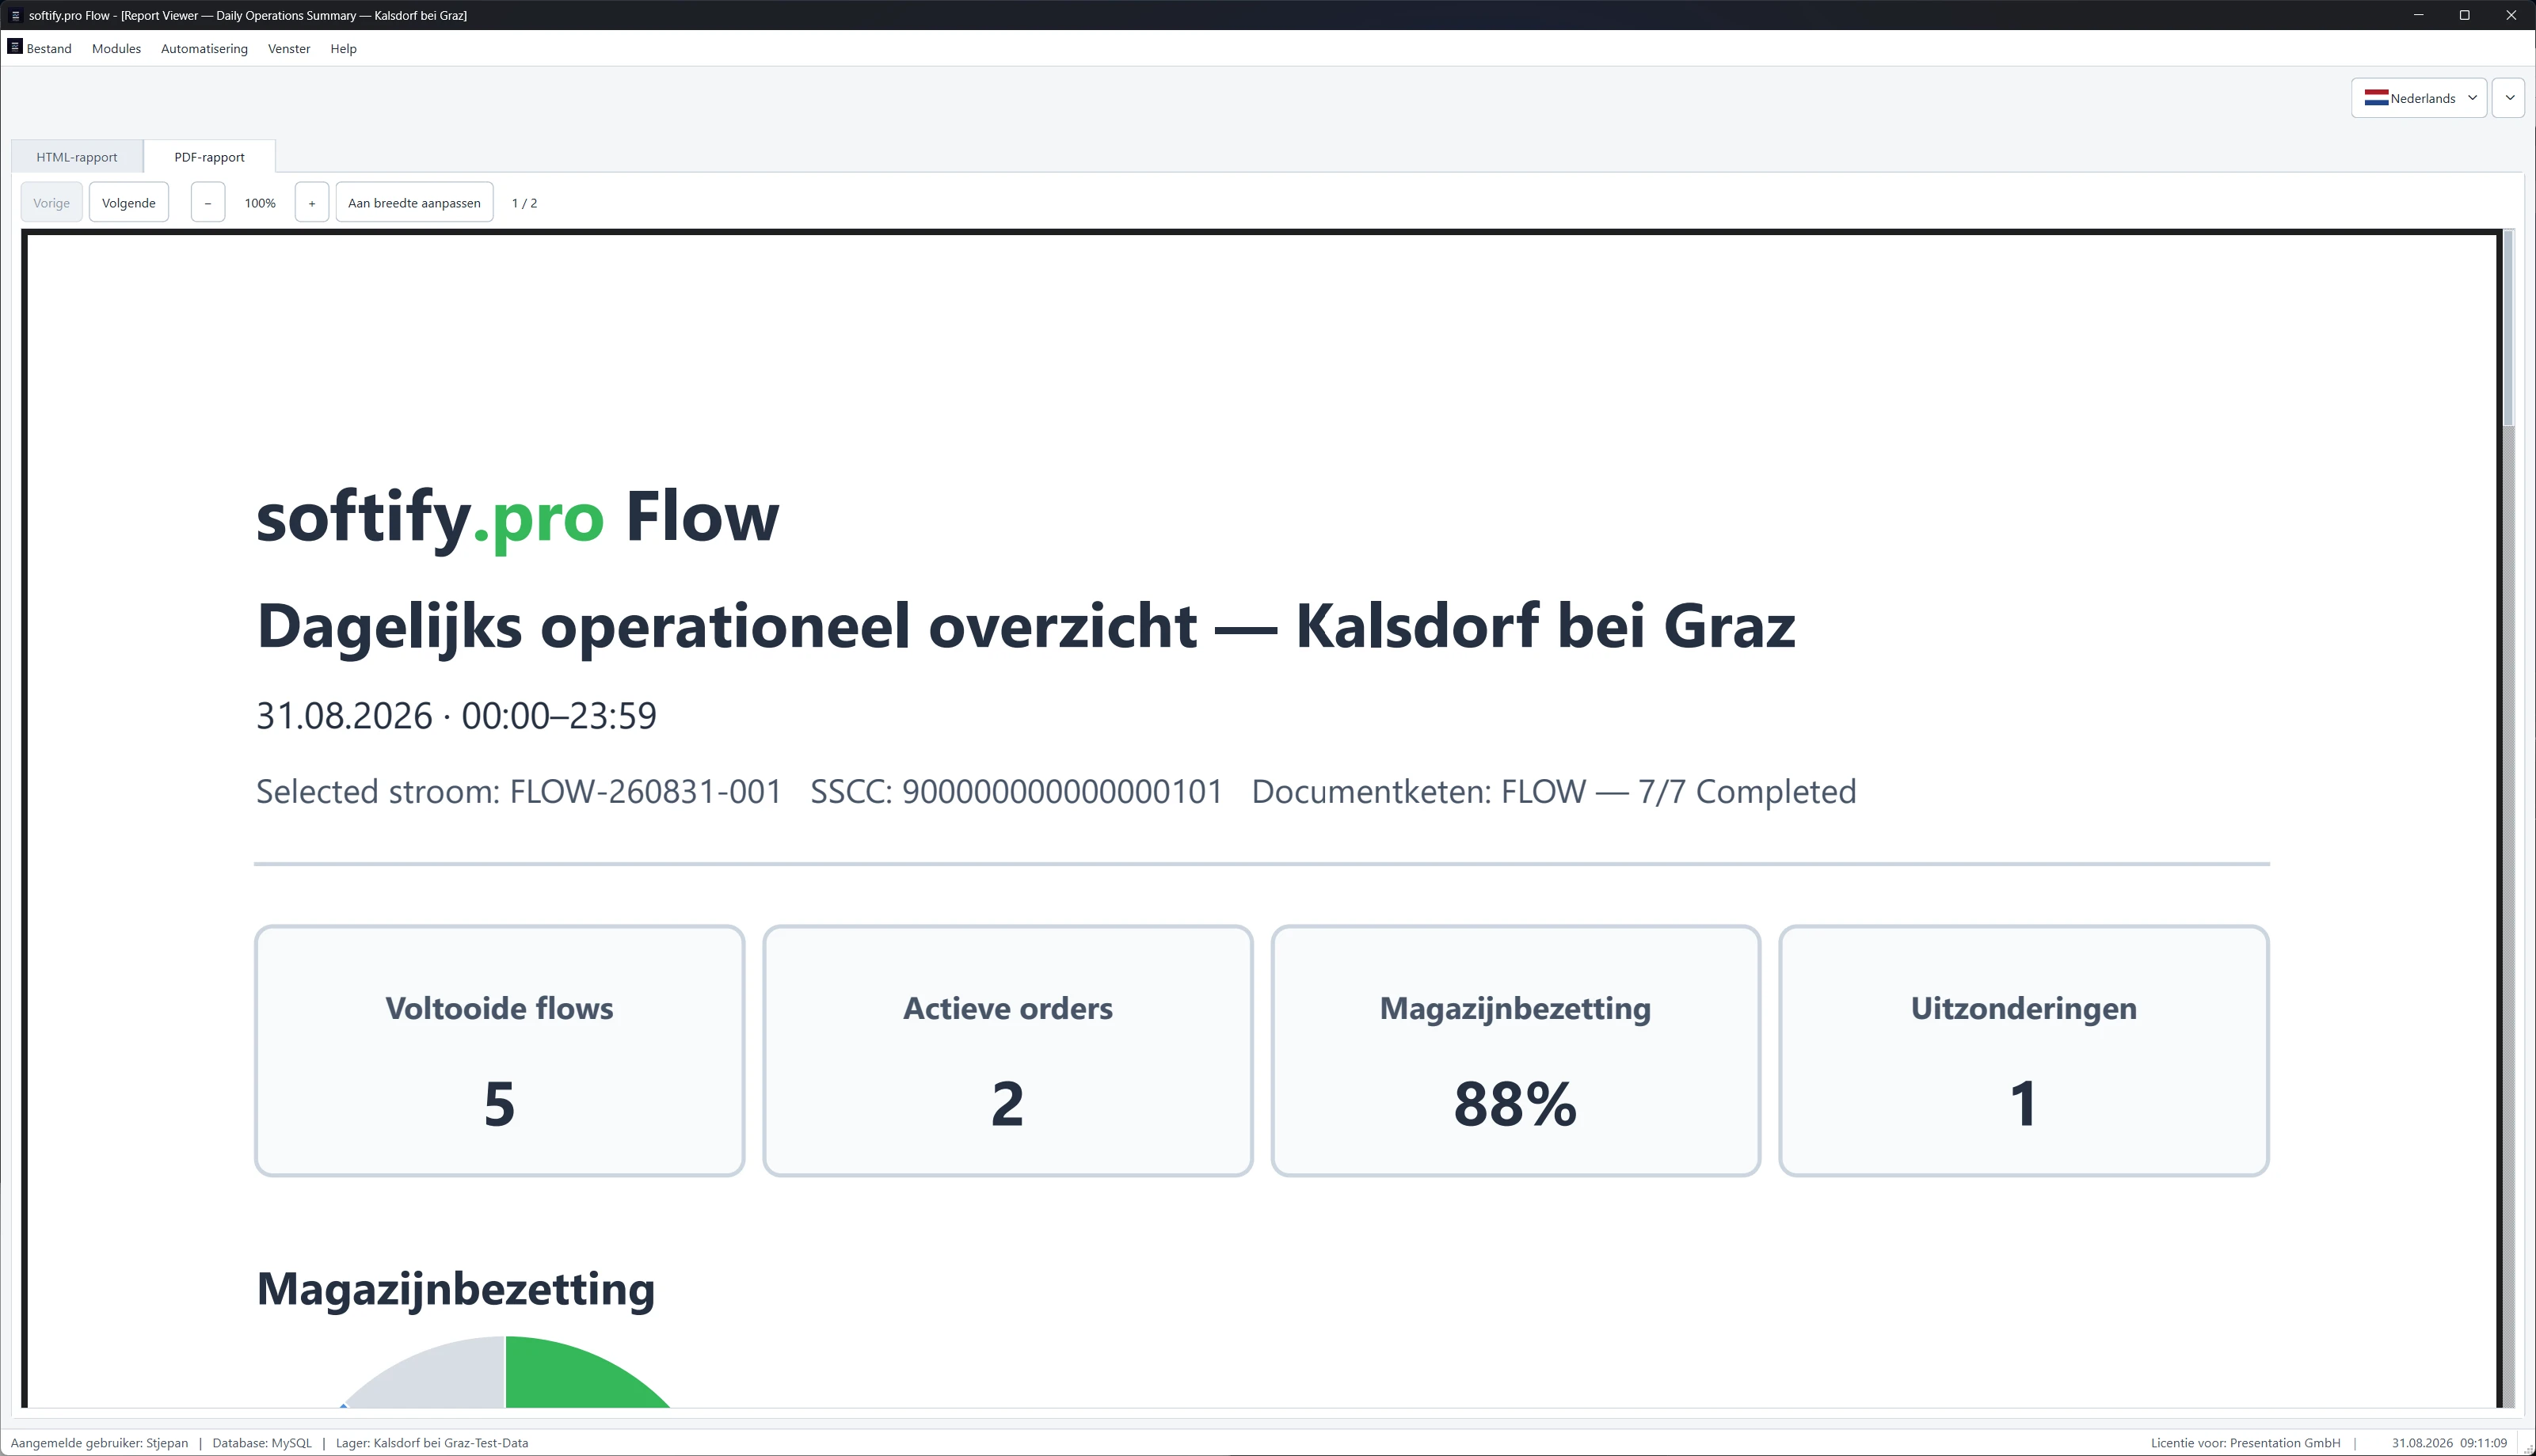
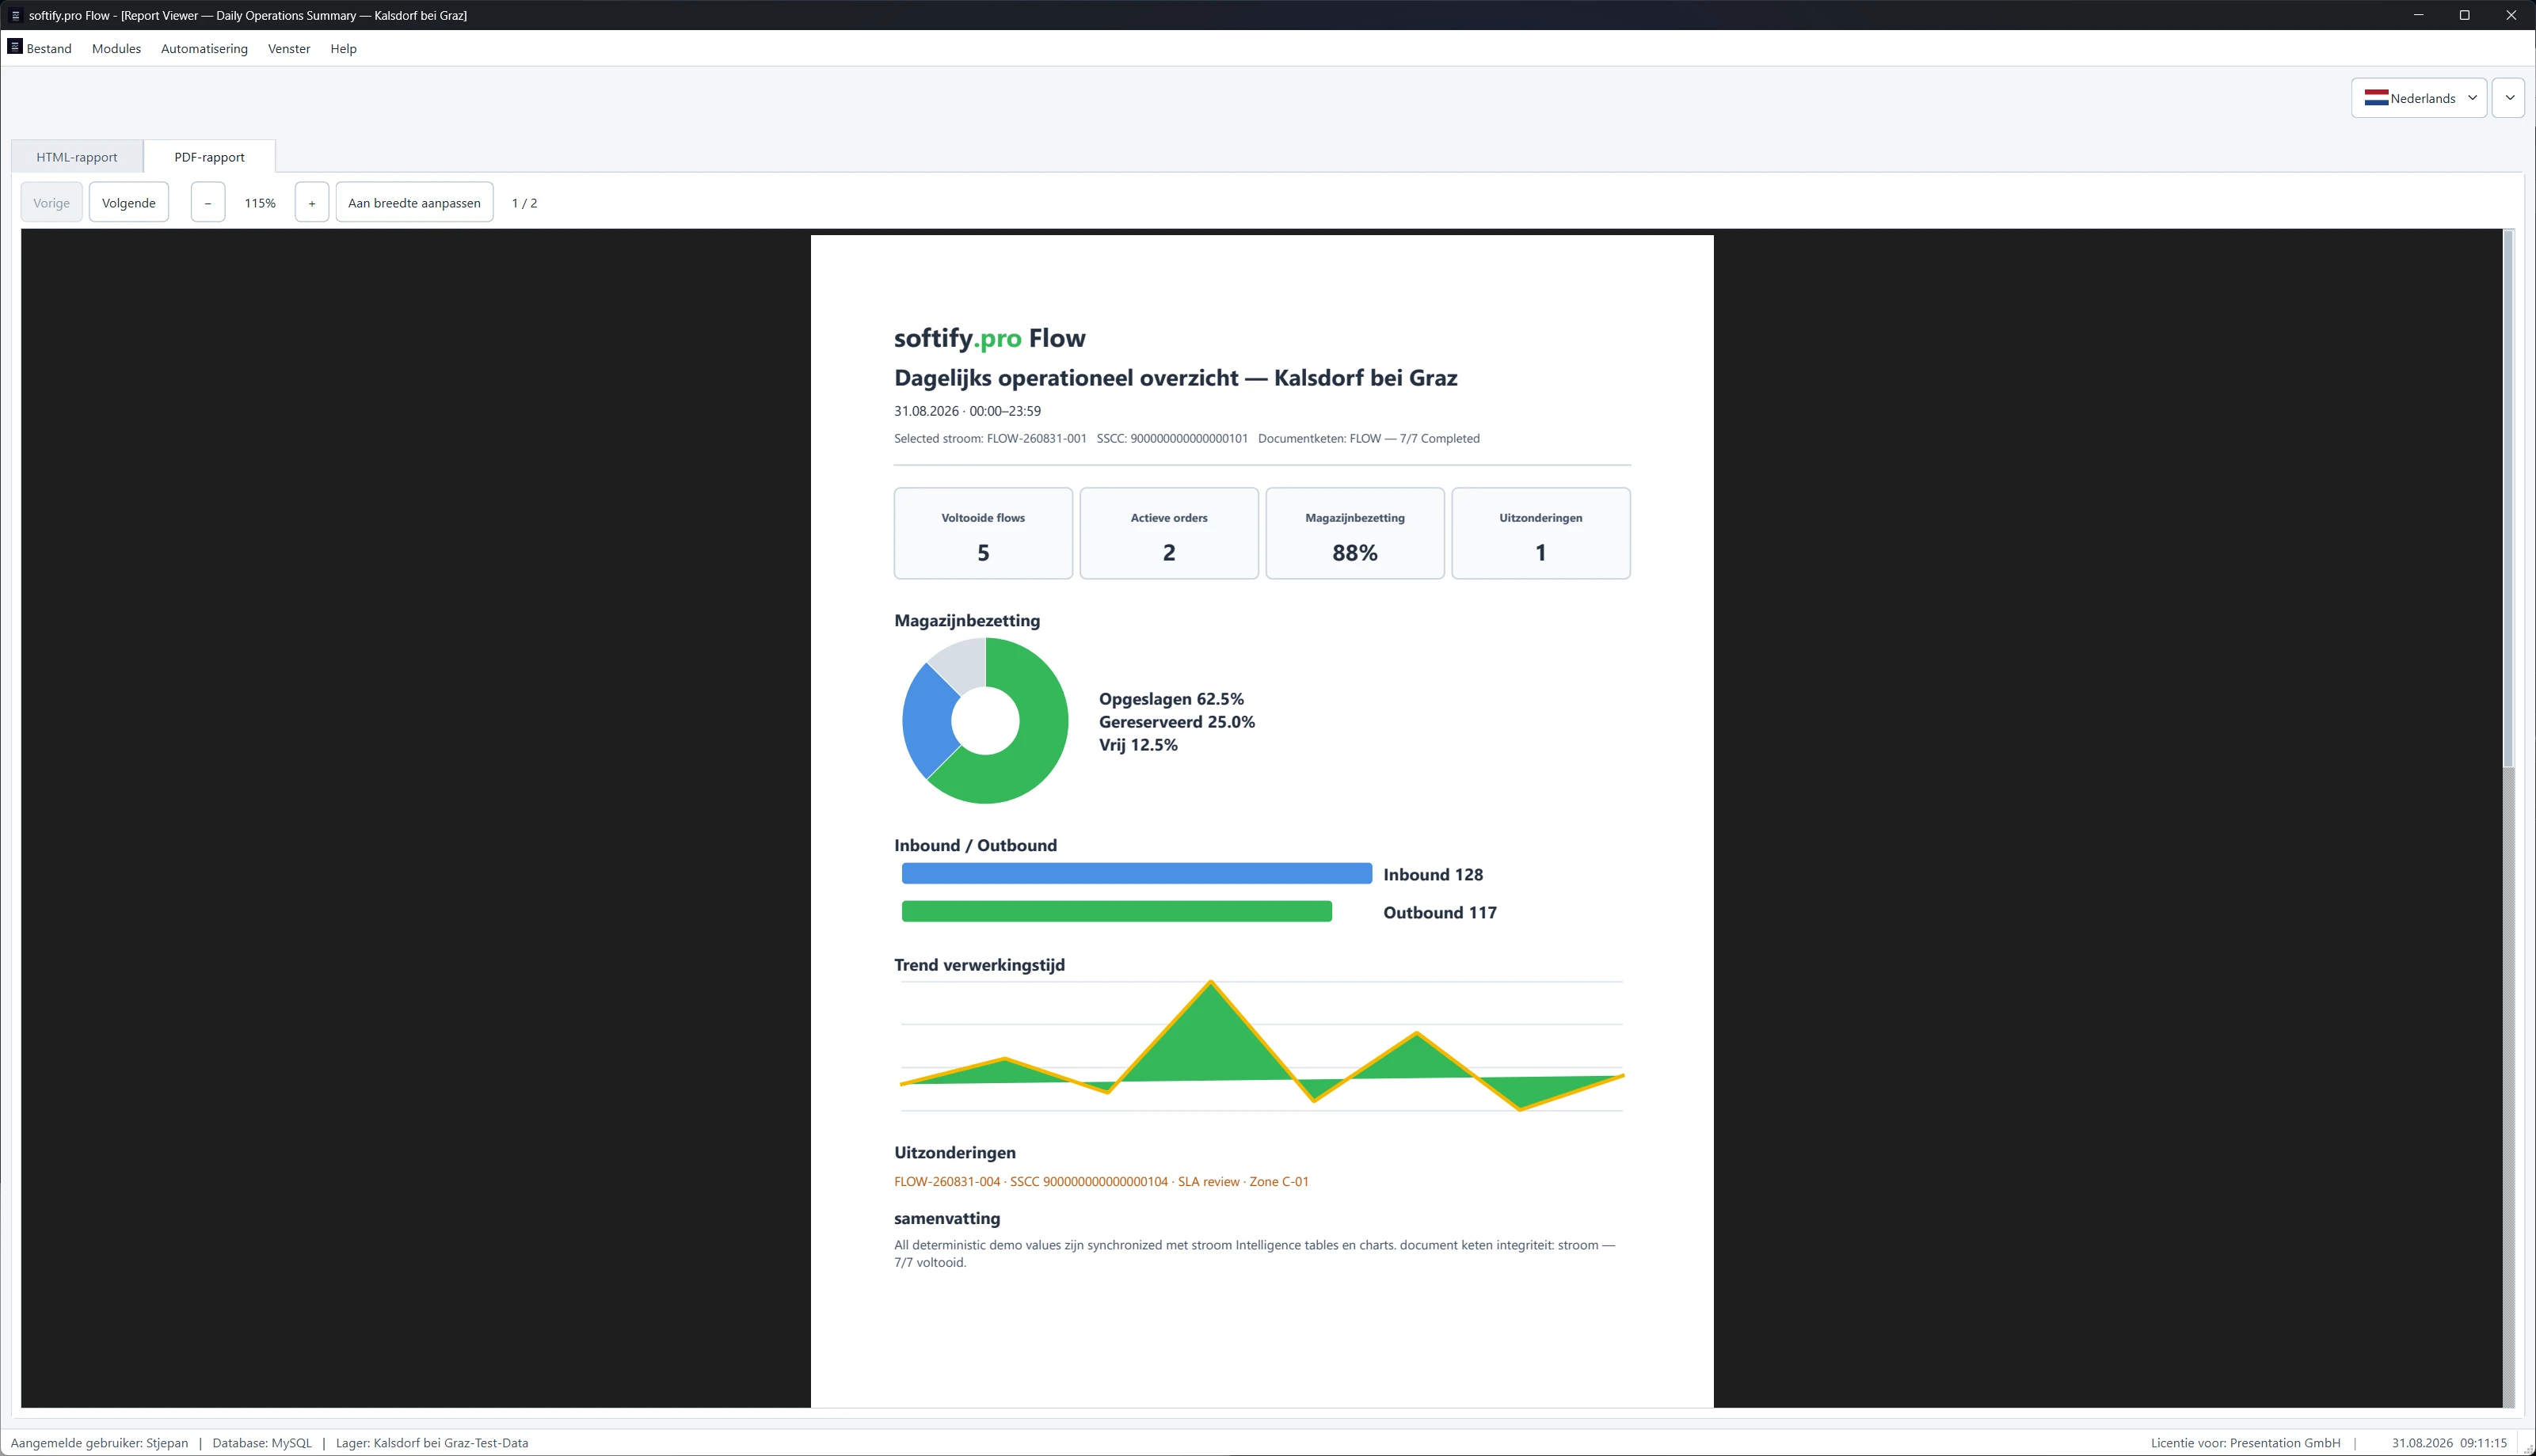
Operational Analytics — agregovaný stav skladu, se stále viditelnými podkladovými Flow záznamy.

Flow.

88 % je užitečných jen tehdy, pokud to systém dokáže vysvětlit.
Předpokládejme, že dashboard říká:
Využití skladu: 88 %.
Užitečné.
Ale neúplné.
Některé pozice jsou obsazené.
Některé jsou rezervované.
Některé zůstávají volné.
Tyto stavy nejsou zaměnitelné.
Číslo se stává důvěryhodným, až když systém ještě dokáže vysvětlit, odkud pochází.
Pět dokončených Flow?
Ukaž je.
Dvě aktivní objednávky?
Ukaž je.
Jedna výjimka?
Která?
88 % využití?
Co je obsazené?
Co je rezervované?
Co zůstává volné?
Dashboard by měl shrnovat realitu.
Neměl by ji nahrazovat.
Pak jsme změnili jazyk.
Nizozemština.
Sklad zůstal stejný.
ID Flow zůstala stejná.
SSCC zůstaly stejné.
Operátoři zůstali propojeni se svými záznamy.
Změnil se jen jazyk.
Později se stejný provozní stav objevil v chorvatštině.
Pak ve francouzštině.
Tady se vícejazyčný software stává mnohem zajímavějším než přeložená tlačítka.
Špatný překlad je snadné si všimnout.
Změna stavu způsobená změnou jazyka je mnohem nebezpečnější.
Představte si přepnutí z němčiny do francouzštiny a tiché ztracení vybraného Flow.
Nebo přestavění filtru proti špatnému skladu.
Nebo zobrazení správného SSCC ve špatném procesním kontextu.
Rozhraní by přesto mohlo vypadat dokonale.
Systém by takový nebyl.
Flow proto dodržuje jednoduché pravidlo:
Jazyk může změnit slova. Nesmí změnit pravdu.
Pak Flow získal historii.
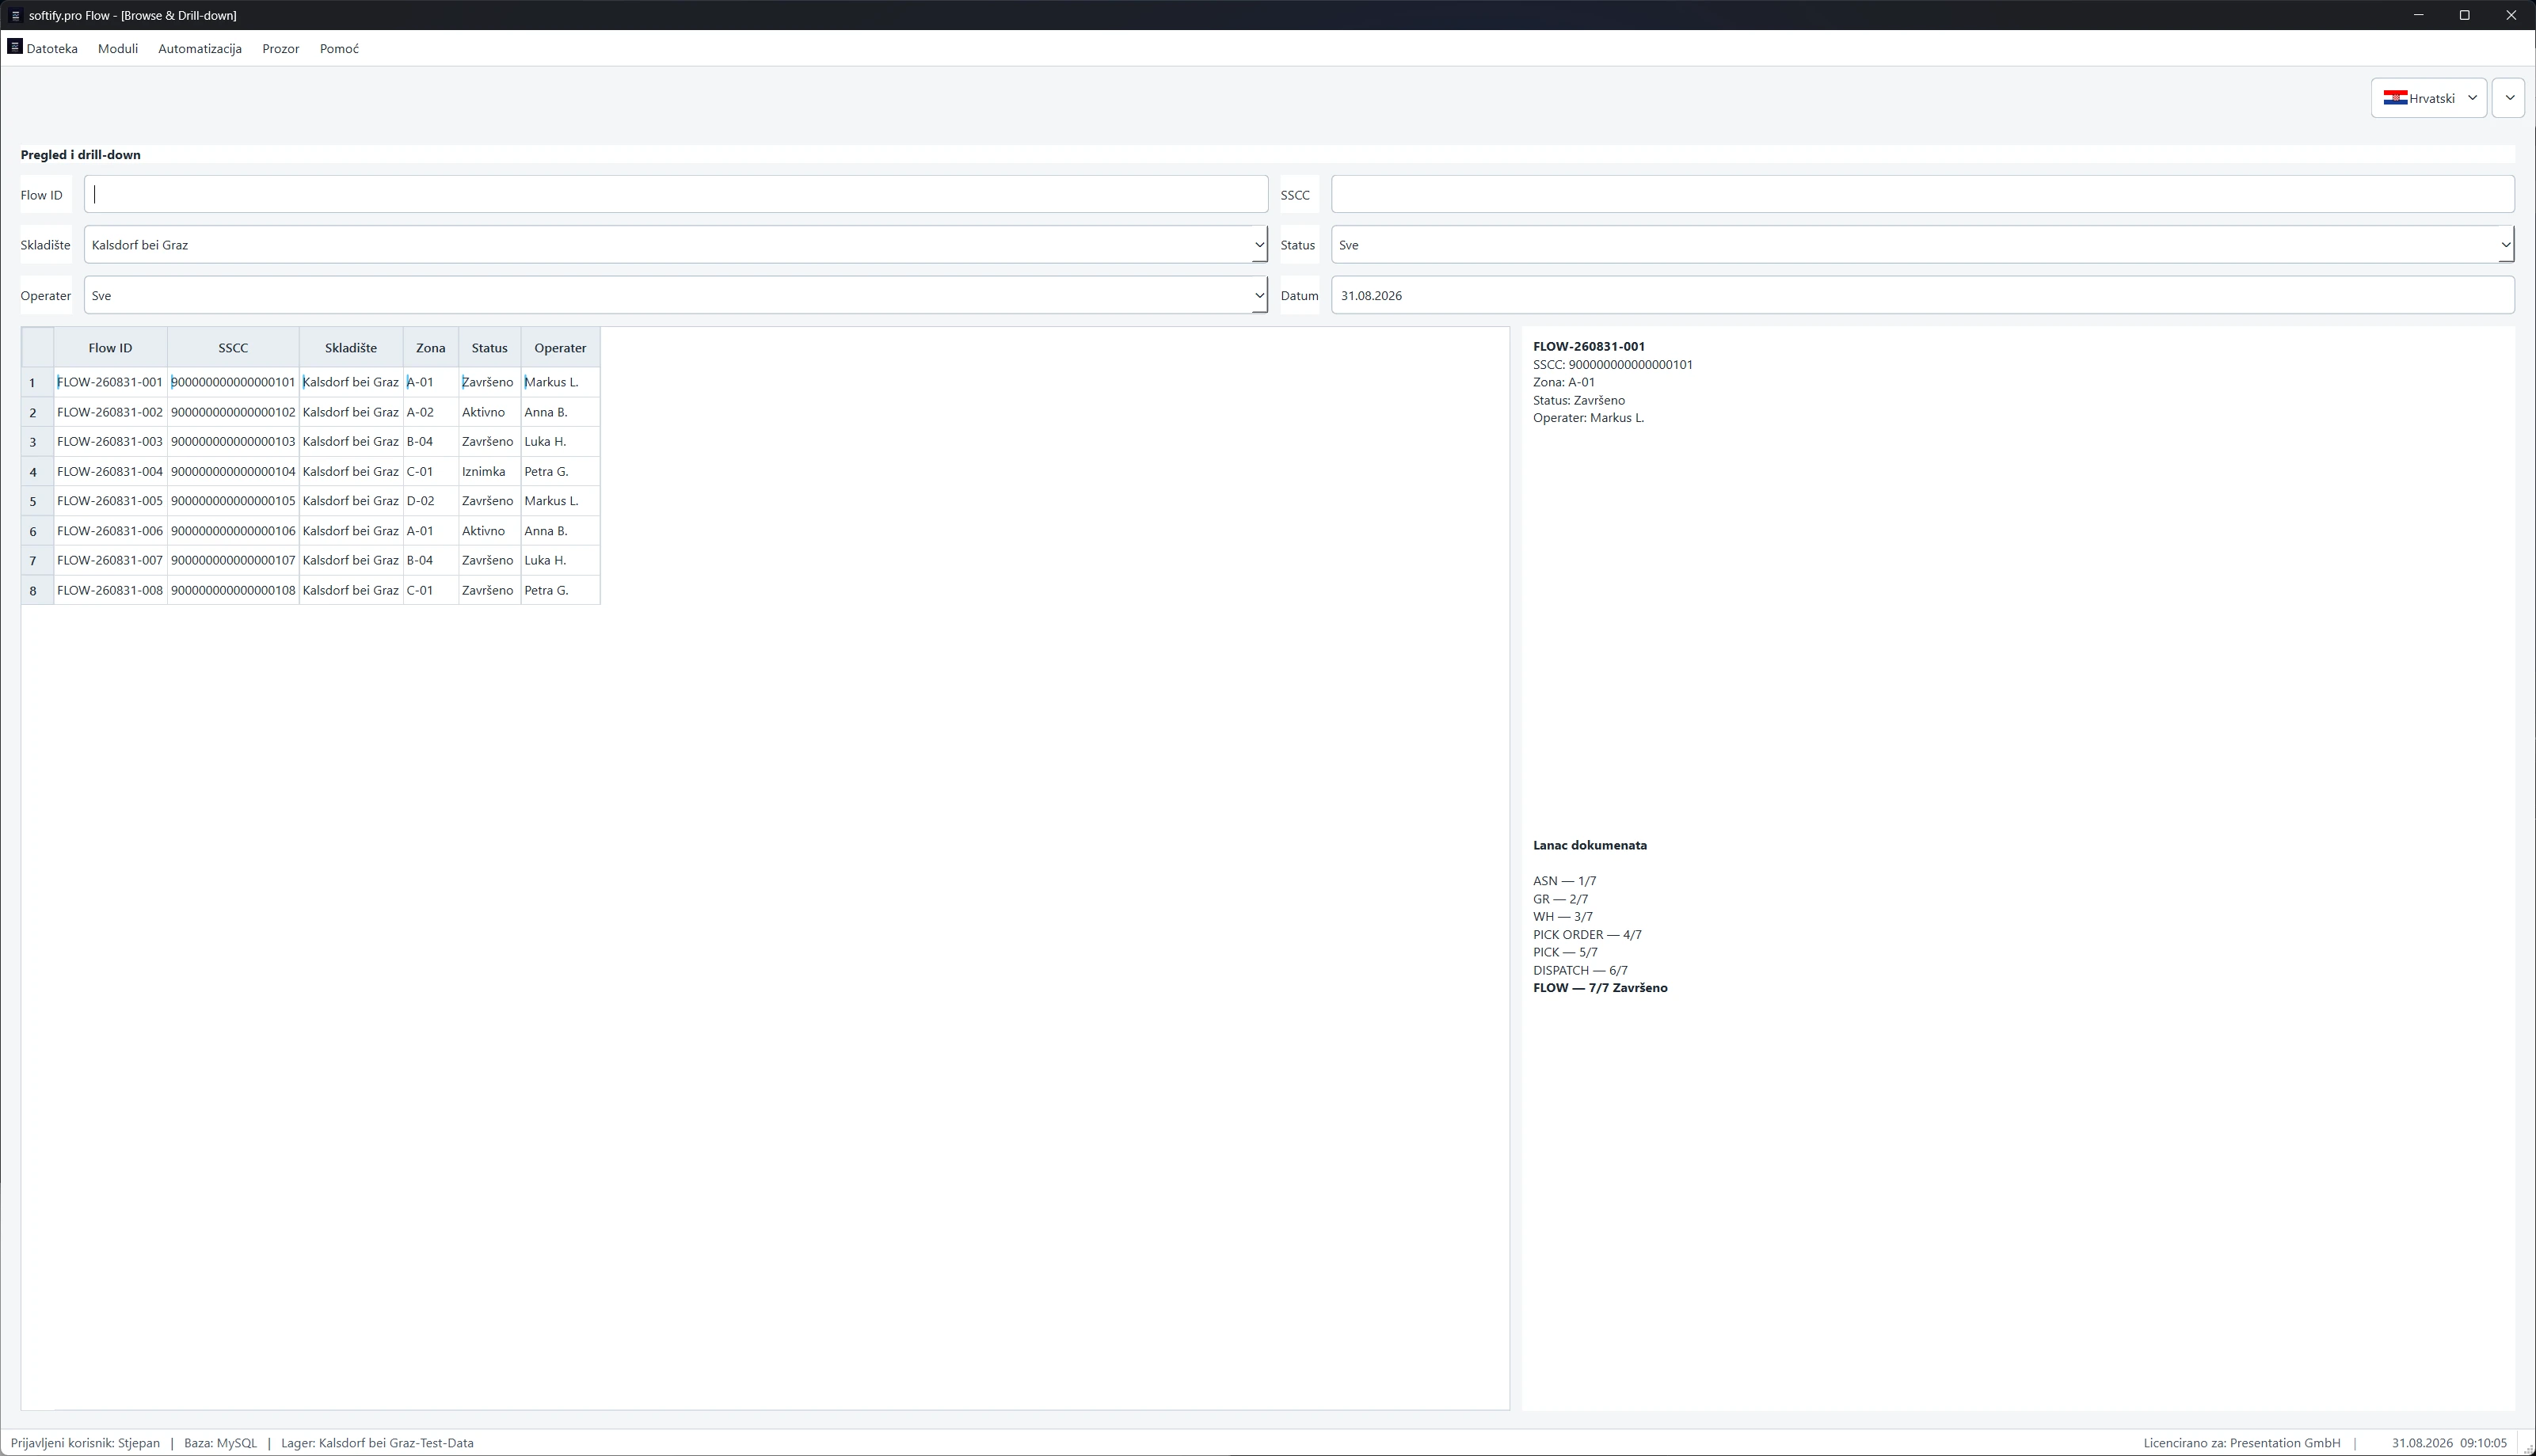
Browse & Drill-down se obzvlášť nesnaží působit impozantně.
Možná je právě proto užitečný.
Vyberte Flow.
Objeví se jeho kontext.
Sklad.
Zóna.
Status.
Operátor.
SSCC.
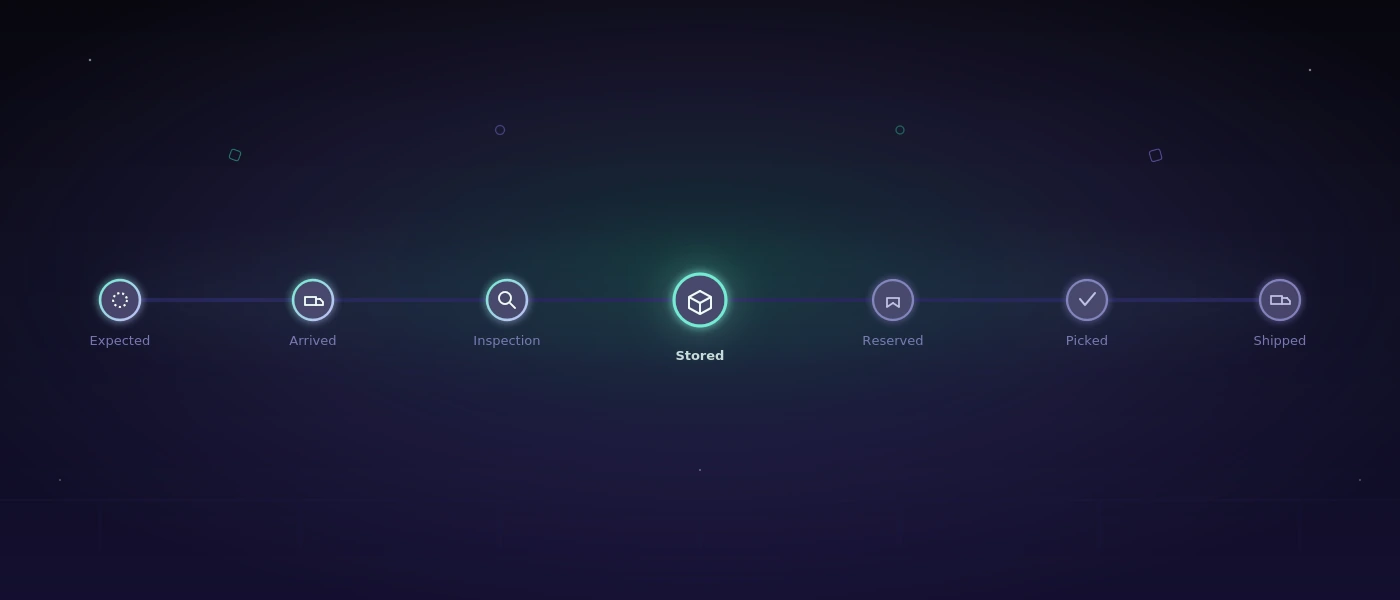
A pak řetězec dokladů.
ASN.
Příjem zboží.
Skladový pohyb.
Příkaz k vyskladnění.
Vyskladnění.
Expedice.
FLOW.
Sedm kroků.
Proces už není jen aktuální stav.
Má minulost.
A to mění otázku.
Místo:
Co se děje?
se můžeme zeptat:
Jak jsme se sem dostali?
To je mnohem lepší otázka, když se nakonec něco pokazí.

Jeden Flow, jedno SSCC, jeden řetězec dokladů — od ASN po dokončení.

Flow.


SSCC se stává nití.
Zpočátku SSCC vypadá tak, jak skutečně je.
Identifikátor.
Dlouhé číslo v tabulce.
Ale napříč Flow se stává něčím užitečnějším.
Nit vedoucí celým procesem.
Sledujte ji a další věci se začnou propojovat.
Sklad.
Flow.
Zóna.
Status.
Operátor.
Řetězec dokladů.
Nakonec report.
Stejný fyzický logistický objekt je nyní viditelný z několika různých částí aplikace.
Užitečné.
Také nebezpečné.
Protože každý další pohled vytváří další příležitost pro systém, aby vyprávěl jiný příběh.
A přesně tam se to stává zajímavým.
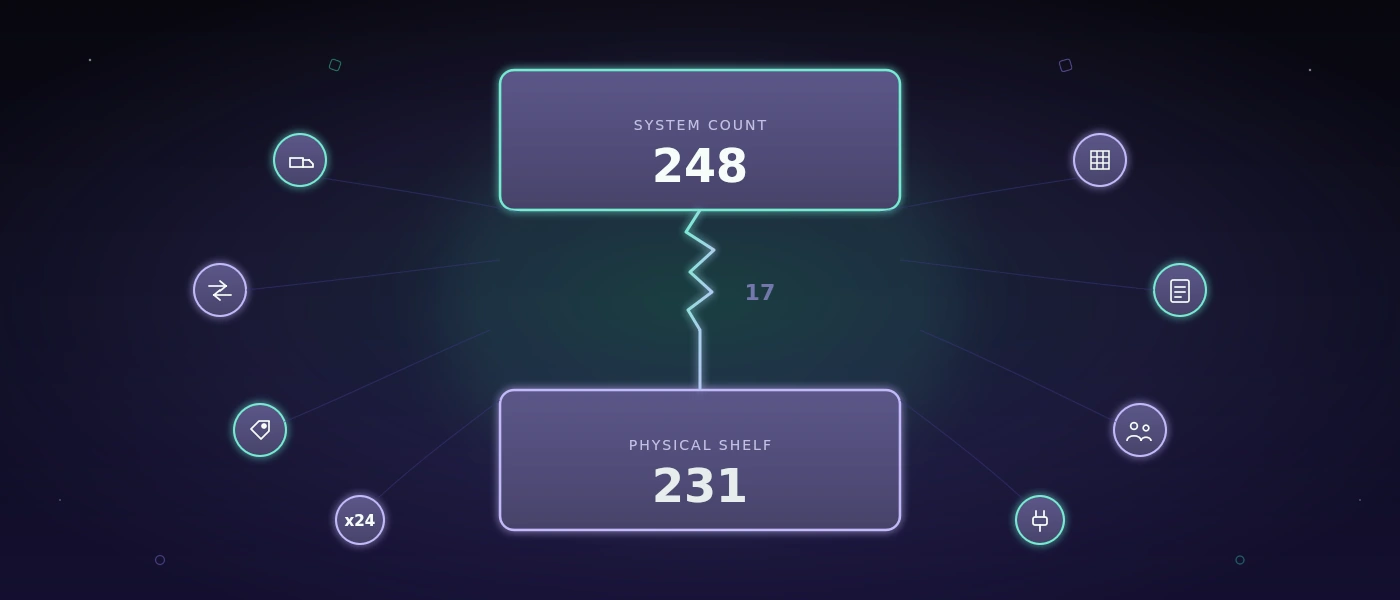
Předpokládejme, že Analytics říká, že Flow je aktivní.
Drill-down říká, že SSCC patří k tomuto Flow.
Řetězec dokladů říká, že operace postoupila dále.
Report říká něco jiného.
Který je správný?
Toto není problém specifický pro Flow.
Je to jeden z nejstarších problémů v podnikovém softwaru.
Různé části téhož systému postupně vyvíjejí vlastní verzi reality.
Jedna obrazovka čte transakční stav.
Jiná čte agregát.
Další se spoléhá na data v cache.
Report počítá něco mírně odlišně.
Výjimka se provozně vyřeší, ale zmizí z reportování.
Každá komponenta funguje.
Celý systém lže.
Obvykle slušně.
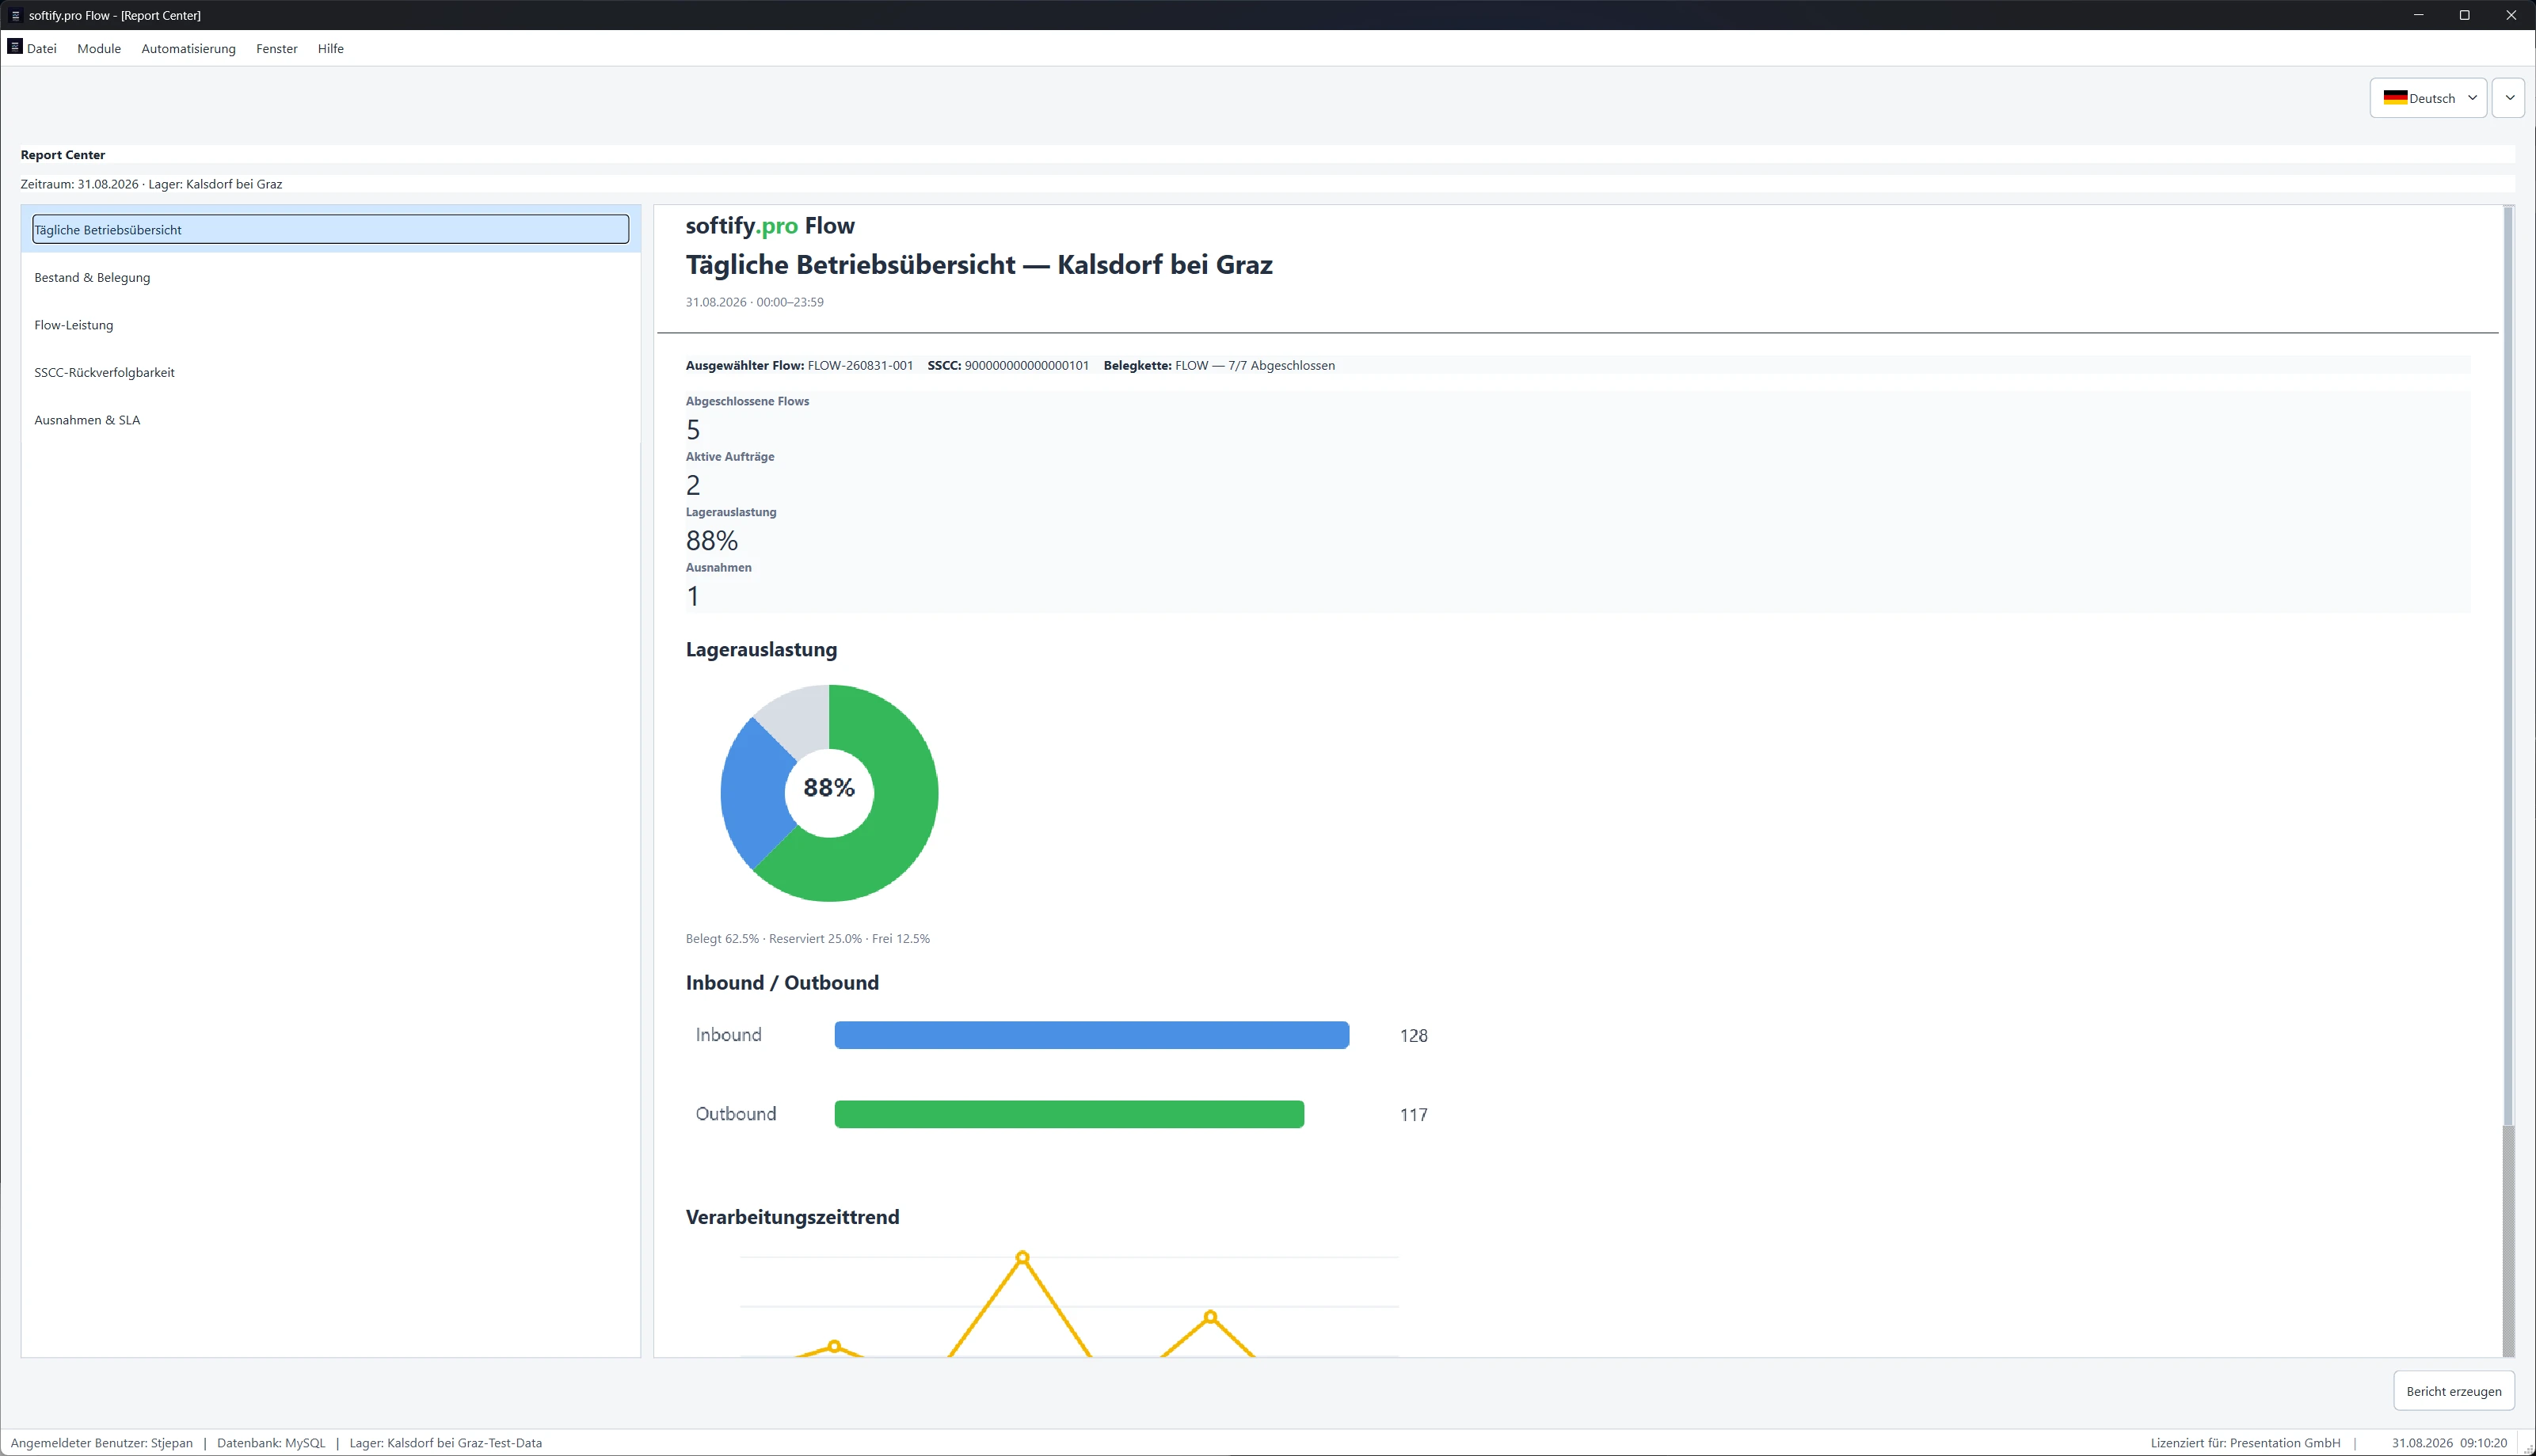
Tak jsme otevřeli Report Center.
Denní provozní přehled.
Zásoby a obsazenost.
Výkon Flow.
Sledovatelnost SSCC.
Výjimky a SLA.
Stejný provozní příběh se objevil znovu.
Dokončené Flow.
Aktivní objednávky.
Využití skladu.
Výjimky.
Příjem.
Výdej.
Doba zpracování.
Ale tentokrát otázka nebyla, zda report vypadá správně.
Otázka byla:
Dokáže se obhájit sám?
Dobrý report vám dá číslo.
Lepší systém dokáže vysvětlit, odkud to číslo pochází.

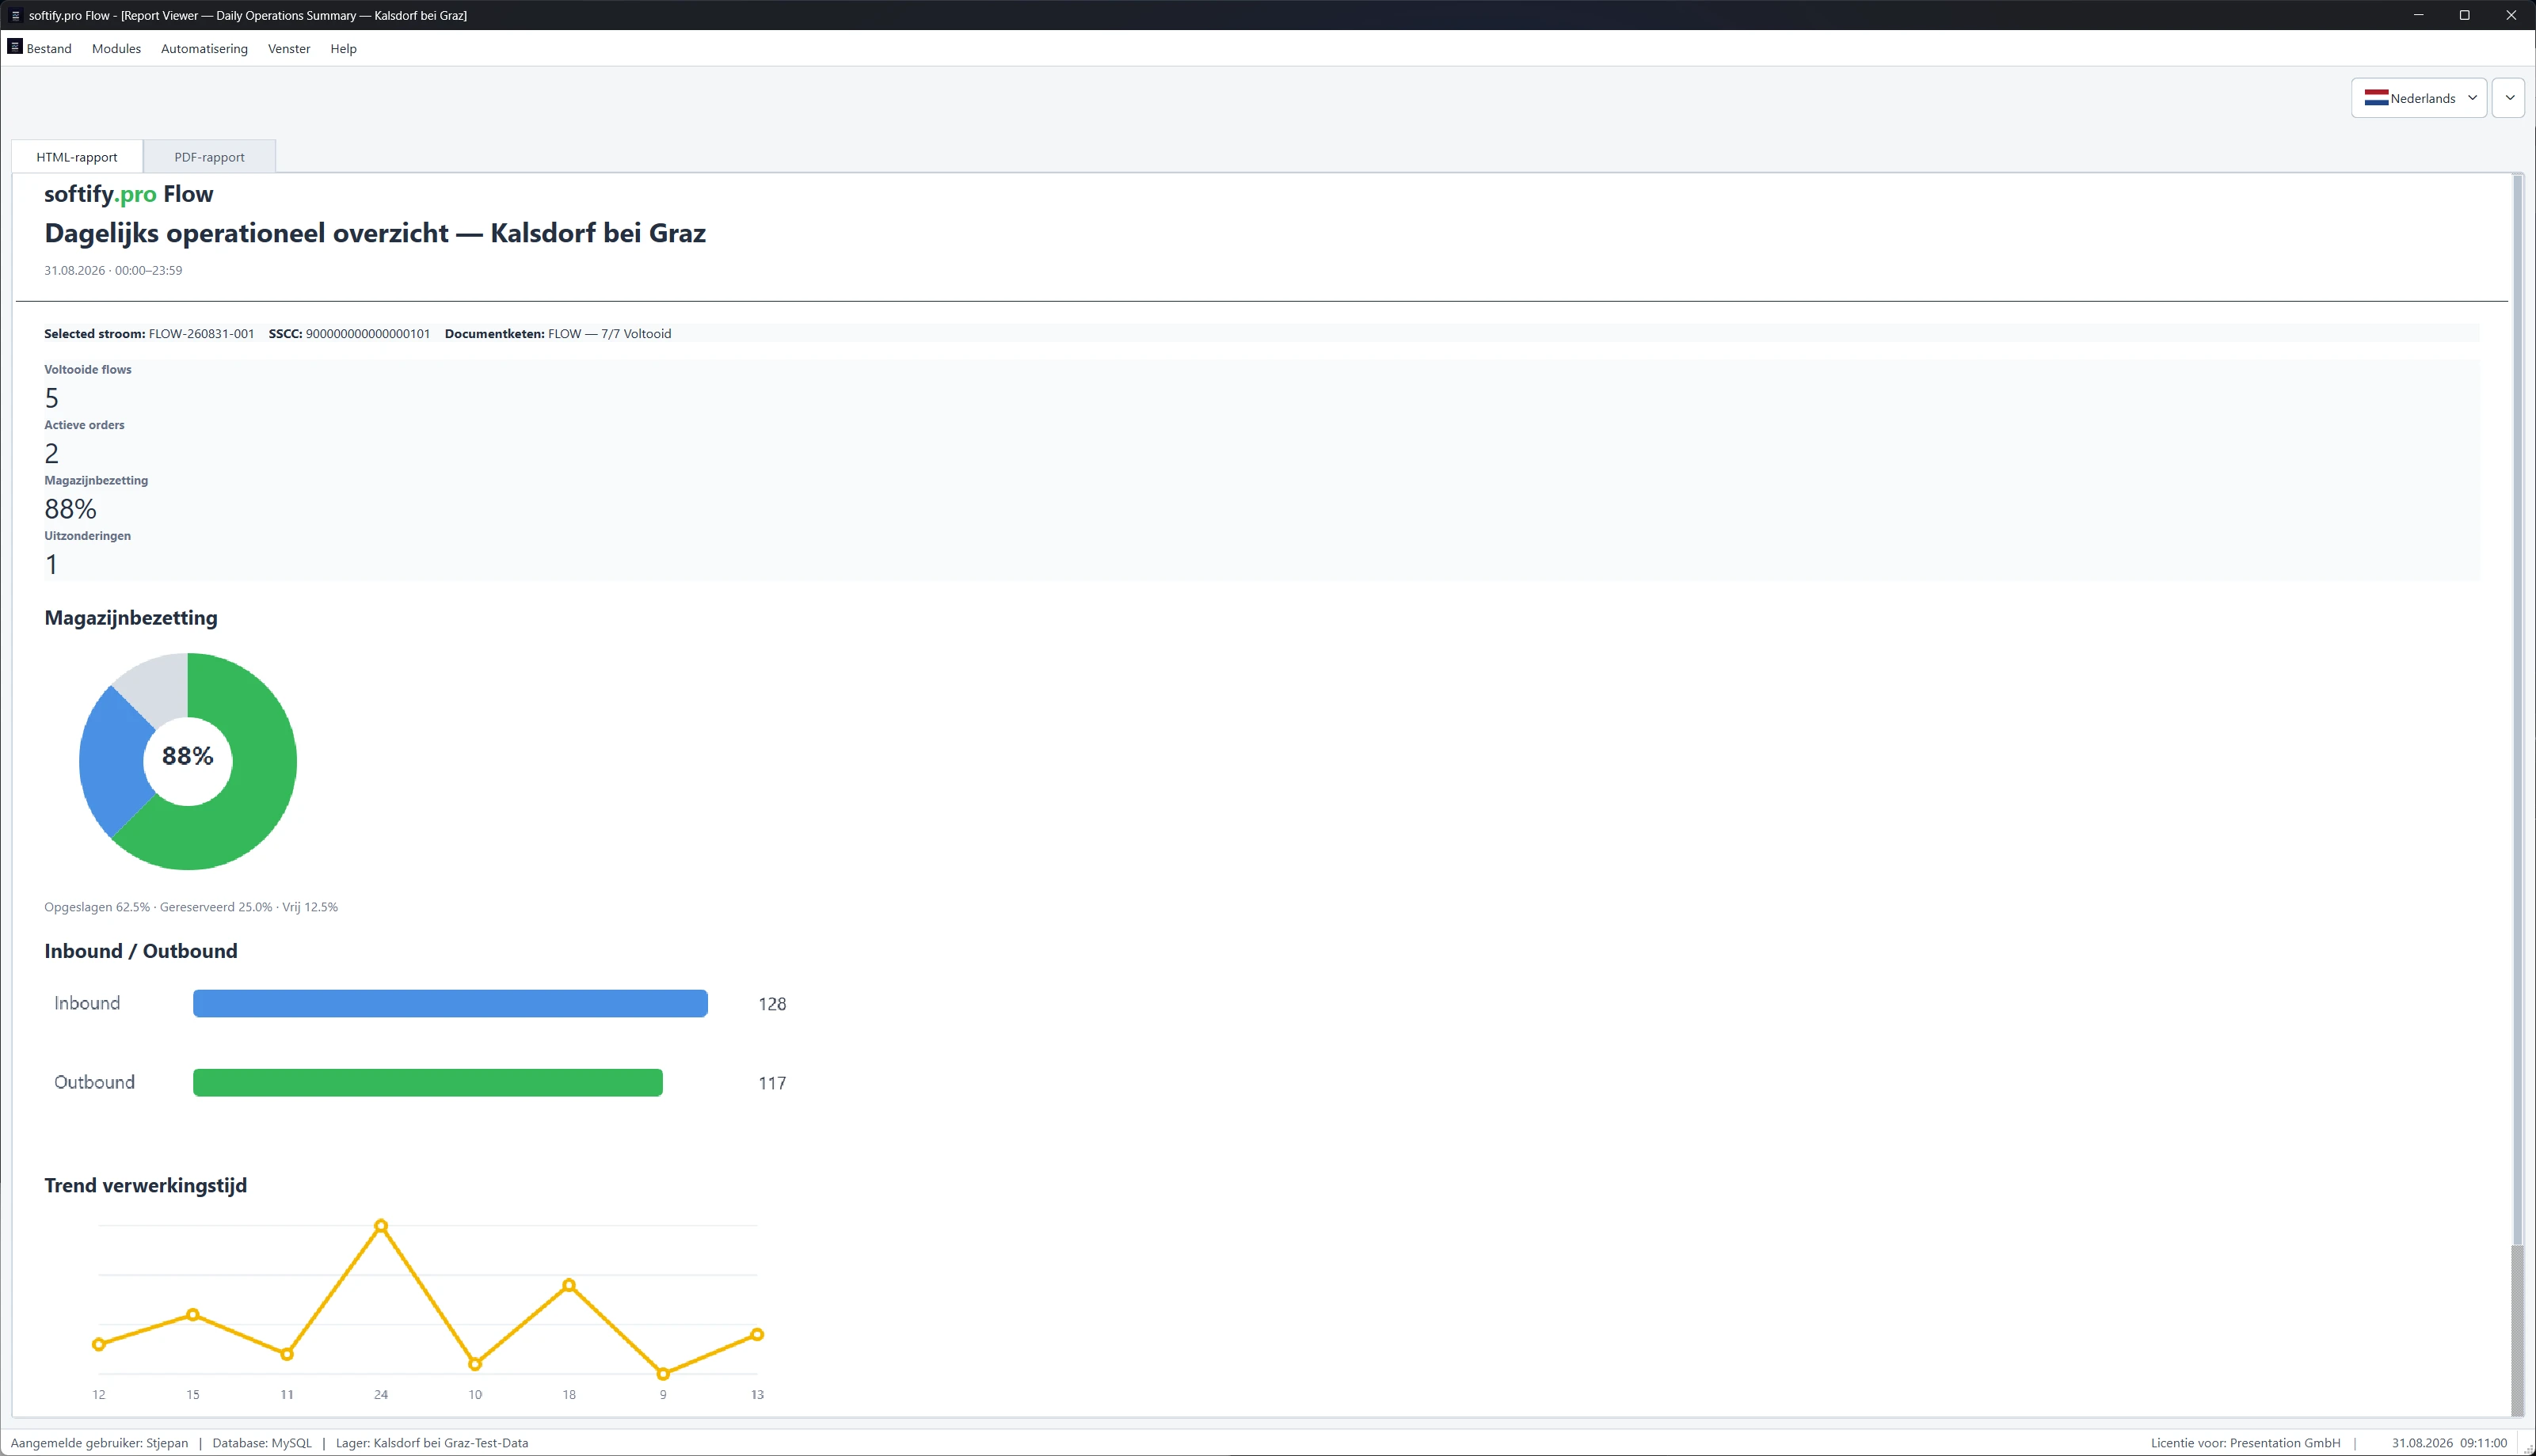
Reportování ze stejného provozního stavu — ne druhá verze reality.

Flow.
Flow.
Flow.
Flow.


Výjimka tam stále byla.
Jeden z tišších detailů se ukázal být jedním z důležitějších.
Demo data obsahují výjimku.
Objevuje se v Analytics.
Objevuje se v Drill-down.
Objevuje se ve sledovatelnosti SSCC.
Objevuje se v Report Center.
A zůstává viditelná v Exceptions & SLA.
Přesně to by se mělo stát.
Provozní zotavení z výjimky neznamená, že výjimka by měla zmizet z historie.
„Proces pokračoval" a „nic se nestalo" nejsou stejné tvrzení.
V logistice na tomto rozdílu záleží.
V tomto bodě jsme měli testovací problém.
Ne softwarový problém.
Testovací problém.
Nyní jsme měli stejný sklad zobrazený jako:

  • analytika,
  • jednotlivé Flow,
  • historie SSCC,
  • řetězce dokladů,
  • reporty,
  • a pohledy na výjimky.

Každý z nich šlo testovat nezávisle.
Otevřít.
Kliknout.
Filtrovat.
Ověřit.
Projít.
Další.

To by bylo snadné.
Zároveň by to přehlédlo zajímavou část.
Protože šest zelených fajfek nedokazuje, že se šest pohledů navzájem shoduje.
Nastupuje COCO.
Znovu.
COCO se s Flow již dříve zabýval.
Autentizace.
Uživatelé.
Role.
Databázová prostředí.
Jazyky.
Desktopové provádění.
Pak přišla logistika.
Sklady.
Zásoby.
Vyskladnění.
Pohyby.
Výjimky.
Doklady.
Ubuntu.
Red Hat Enterprise Linux.
Tentokrát jsme dali COCO něco mírně odlišného.
Ne obrazovku k ověření.
Příběh ke sledování.
Vezmi tento sklad.
Vezmi tento Flow.
Vezmi toto SSCC.
Otevři Analytics.
Otevři Drill-down.
Změň jazyk.
Podívej se znovu.
Otevři report.
Najdi stejný Flow.
Najdi stejné SSCC.
Najdi výjimku.
Porovnej.
Pak porovnej znovu.

COCO sleduje stejný provozní kontext napříč softify.pro Flow — analytiku, sledovatelnost, změny jazyka a reportování.

To mění povahu testu.

Otázka už nezní:

  • Funguje každý modul?

Zní:

  • Věří všechny moduly, že se stalo totéž?

Mnohem lepší otázka.
Mnohem méně pohodlná.
Skladový systém by měl mít jednu paměť.
Operátoři možná vidí pozice.
Vedoucí skladu možná vidí KPI.
Podpora možná používá drill-down.
Auditoři možná používají reporty.
COCO možná vidí všechny.
Ale pod těmito perspektivami by měla existovat jedna historie.
Jeden Flow by neměl získat několik biografií podle toho, který modul je otevřený.
Jedno SSCC by nemělo mít několik minulostí.
Jedna výjimka by neměla existovat jen tam, kde je to pohodlné.
Jeden sklad by se neměl stát jiným skladem jen proto, že se změnil jazyk rozhraní.
Přesně o tom je současný experiment Flow.
Ne o dashboardech.
Ne o reportech.
Ani o jednotlivých obrazovkách.
O jedné provozní pravdě, vyjádřené různými způsoby.
Kontrola.
Znát sklad.
Znát stav.
Vědět, co se pohybuje.
Vědět, kterému procesu to patří.
Jasnost.
Přeměnit KPI zpět na záznamy.
Přeměnit záznamy na historii.
Přeměnit výjimky na důkazy.
Přeměnit SSCC na něco sledovatelného.
Flow.
Sklad je vybrán.
Analytics ho začíná popisovat.
Flow postupuje.
SSCC zůstává připojeno.
Řetězec dokladů roste.
Objeví se výjimka.
Proces pokračuje.
Report si pamatuje.
Pak se změní jazyk.
Sklad je stále stejný.
Flow je stále stejný.
Historie je stále stejná.
To byla očekávaná část.
To, co se stalo poté, bylo zajímavější.
COCO přestal testovat pohledy nezávisle.
Začal je porovnávat.
Chvíli se nedělo nic pozoruhodného.
Stejný sklad.
Stejný Flow.
Stejné SSCC.
Stejný příběh.
Znovu.
Znovu.
Znovu.
A pak se COCO zastavil.
Ne proto, že aplikace spadla.
Nespadla.
Ne proto, že test selhal v obvyklém smyslu.
Neselhal.
Zastavil se, protože dvě naprosto rozumné odpovědi vyprodukovaly třetí otázku.

Víme, jaká je otázka.
Flow ví, proč existuje.
COCO ví, kam se podívat dál.

Zbytek může počkat.


Control. Clarity. Flow.

Publikováno: 31.08.2026

Permalink →

COCO opět udeřilo

COCO opět udeřilo

Pravděpodobně bychom měli přestat dávat COCO nápady.

Předchozí experiment měl být dostatečný.

Skutečná aplikace.

Skutečná navigace.

Uživatelé.

Role.

Databáze.

Jazyky.

Důkazy.

Respektovaná případová studie.

Čistý závěr.

Pak to někdo ukázal: Logistics in Motion.

To byla pravděpodobně chyba.

Začalo to třemi sklady

Nic zvlášť vzrušujícího.

…

Dopis od COCO

Dopis od COCO

Inženýrce nebo inženýrovi, který tento repozitář otevírá poprvé:

Vítejte.

Možná jste zde, protože něco selhalo.

Služba přestala odpovídat.

Nasazení se zachovalo neočekávaně.

Upozornění vás probudilo uprostřed noci.

Nebo vás jednoduše zajímá, jak tato platforma funguje.

Ať vás sem přivedlo cokoli, vězte:

Tento projekt byl postaven přesně pro takové chvíle.

Ne proto, aby odstraňoval obtížné problémy.

Ale aby obtížné problémy učinil srozumitelnými.

Najdete kód.

Najdete dokumentaci.

Najdete specifikace.

Ale co je důležitější:

…

Case Studies

softify.pro Flow — testováno pomocí COCO

softify.pro Flow — testováno pomocí COCO

21.08.2026

Control. Clarity. Flow.

Každý vážný softwarový produkt nakonec vyvine druhý produkt za produktem.

Zákazníci ho možná nikdy neuvidí. Návštěvníci možná nikdy nebudou vědět, že existuje. Ale administrátoři, operátoři, a vývojáři se na něj spoléhají každý den.

Pro softify.pro Flow je touto aplikací Administration — provozní konzole odpovědná za správu uživatelů, rolí, úrovní přístupu, stavů autentizace, prostředí databází, a další konfigurace, která udržuje nasazení Flow pod kontrolou.

Její přihlašovací obrazovka nese tři slova:
Control. Clarity. Flow.

Byla původně zvolena, aby popsala zážitek, který jsme chtěli, aby administrátoři měli při provozování systému.

Ale také překvapivě dobře popisují, jak podle nás má být software testován.

To udělalo softify.pro Flow — Administration zjevným kandidátem na skutečný test COCO.

Ne laboratorní demonstraci.
Ne sbírku izolovaných tlačítek připravených speciálně pro AI demo.
Skutečnou multiplatformní desktopovou aplikaci se skutečnou logikou aplikace, více okny, více backendy databází, autentizací, oprávněními, lokalizací, a dostatečným stavem, aby zdánlivě malé regrese byly těžko postřehnutelné ručně.

Pro veřejnou demonstraci ukázanou zde, COCO pracovalo výhradně s vygenerovanými demonstračními daty. Aplikace byla licencována pro fiktivní firmu Presentation GmbH, a žádné produkční informace zákazníků, přihlašovací údaje, ani osobní údaje nebyly použity.

Cíl byl jednoduchý:
Nechat COCO přistupovat k aplikaci tak, jak by to udělal tester, a určit, zda se kompletní administrativní pracovní postup stále chová tak, jak software tvrdí.

Výzva

Na první pohled se testování administrativní aplikace zdá jednoduché.

Otevři ji.
Přihlas se.
Klikni přes několik oken.
Zkontroluj, zda vše vypadá správně.

Tento předpoklad se rychle mění, jakmile aplikace roste.

softify.pro Flow — Administration není jeden statický formulář. Je to sbírka vzájemně propojených provozních pohledů uvnitř jednoho obalu aplikace.

Mimo jiné může administrátor pracovat s:

  • uživatelskými účty
  • rolemi a úrovněmi přístupu
  • autentizačními informacemi
  • stavem dvoufaktorové autentizace
  • informacemi o operačním systému
  • síťovými a IP informacemi
  • konfigurací databáze
  • možnostmi třídění a prezentace
  • výběrem jazyka naživo
  • informacemi o aplikaci a licencování

Rozhraní momentálně podporuje jedenáct jazyků. Aplikace také funguje s backendy databází MySQL a PostgreSQL. Jednotlivě žádná z těchto funkcí nepředstavuje neobvyklý testovací problém.

Obtíž pochází z jejich kombinací.
Tabulka uživatelů může fungovat správně v angličtině, ale zobrazovat zastaralý název sloupce v chorvatštině.
Třídění může fungovat správně připojené k MySQL, ale chovat se jinak po přepnutí na PostgreSQL.

Změna jazyka může aktualizovat většinu prvků rozhraní, přičemž ponechá jednu statusovou zprávu nepřeloženou. Aplikace může úspěšně přepnout databáze, ale zachovat zastaralé informace z předchozího připojení. Nové vydání může zavést funkci, zatímco dialog About stále popisuje předchozí. Program se nemusí zhroutit, aby kterákoli z těchto situací byla regresí. Ve skutečnosti některé z nejnepříjemnějších softwarových defektů jsou přesně ty, kde vše vypadá, že funguje.

Aplikace se spustí.
Okno se otevře.
Tlačítko reaguje.
Ale něco pod povrchem už není zcela v pořádku.
Proto je opakované regresní testování důležité.

A je to také přesně ten druh práce, ve které se lidé stávají čím dál horšími po opakování stejné sekvence desítky krát.

Proč se ruční testování stává nákladným

Otestovat něco jednou je jednoduché.
Testovat to spolehlivě po každém relevantním vydání je jiné.

Zvažte jen tři rozměry: 11 jazyků rozhraní × 2 backendy databází × více pracovních postupů aplikace.

Počet kombinací rychle roste.
Přidejte různé uživatelské role, stavy autentizace, chování třídění, změny konfigurace, a provozní prostředí, a testovací matice se stává příliš velkou, aby se s ní zacházelo jako s příležitostným ručním kontrolním seznamem.

Zde regresní testování často začíná erodovat.
Ne záměrně.
Termín vydání se blíží.
Někdo si vzpomene, že aplikace byla testována minulý týden.
Vývojář rychle zkontroluje nejdůležitější obrazovku.

Němčina funguje.
Angličtina funguje.
MySQL funguje.
Předpoklad se stává:
„Zbytek je pravděpodobně v pořádku."

Obvykle je. Až do vydání, kde není.
COCO existuje částečně proto, aby tento předpoklad odstranilo z procesu.

Co COCO skutečně udělalo

COCO spustilo softify.pro Flow — Administration ze studeného stavu aplikace, bez spoléhání na dříve připravenou obrazovku nebo ručně umístěný pracovní postup.

První interakce byla stejná, jaká se prezentuje lidskému administrátorovi: přihlašovací okno.

COCO identifikovalo autentizační rozhraní obsahující:

  • uživatelské jméno
  • heslo
  • kód dvoufaktorové autentizace

a řádek přímo pod identitou softify.pro Flow:
Control. Clarity. Flow.

Odtud COCO pokračovalo přes definovanou regresní relaci. Cílem nebylo jednoduše určit, zda se aplikace dá otevřít.

Cílem bylo ověřit, zda stav aplikace zůstal interně konzistentní, zatímco s ní COCO interagovalo.

Autentizace je jen začátek

Testování přihlášení je jedním z nejzjevnějších kandidátů na automatizaci, ale samotná úspěšná autentizace nám říká velmi málo o zbytku administrativní aplikace.

Po vstupu se COCO přesunulo do skutečného provozního prostředí. Prozkoumalo rozhraní administrace uživatelů a ověřilo, že očekávané informace byly přítomny.

To zahrnovalo data jako:

  • uživatelská jména
  • maskovaná hesla
  • ukazatele 2FA
  • přiřazené role
  • informace o operačním systému
  • IP adresy

COCO pak interagovalo s tabulkou, místo aby ji jen pozorovalo.
Seznam uživatelů byl seřazen podle uživatelského jména.
Výsledné pořadí bylo prozkoumáno.
Důležitou částí nebylo, zda kliknutí na hlavičku sloupce vyvolalo nějakou viditelnou změnu.

COCO ověřilo, že výsledný stav tabulky odpovídal požadované operaci.

Tento rozdíl je důležitý.
Funkční test se ptá:
„Reagovalo tlačítko?"

Užitečný regresní test se ptá:
„Skončila aplikace ve správném stavu?"

Testování hranice databáze

softify.pro Flow podporuje více než jeden backend databáze.

To dělá přepínání databází obzvlášť důležitou regresní hranicí.
COCO změnilo aktivní backend z MySQL na PostgreSQL.

Po přepnutí znovu prozkoumalo informace o uživatelích.
Test hledal víc než úspěšné připojení.
Zkontroloval, zda aplikace nadále prezentovala očekávané záznamy a zda informace zobrazené přes rozhraní zůstaly konzistentní.

COCO se pak znovu přepnulo zpět.


Tento druh přechodu je snadné podcenit.
Uživatelské rozhraní může zůstat vizuálně identické, zatímco vrstva úložiště pod ním se úplně mění.
Z pohledu administrátora by měl tento přechod působit téměř nudně.
Stejní uživatelé by měli být stále srozumitelní.
Stejné role by měly stále dávat smysl.

Stejné chování rozhraní by mělo stále platit.

Tato zdánlivě neudálostná kontinuita je přesně to, co je třeba dokázat.

Jedenáct jazyků, jeden stav aplikace

Lokalizace je další oblast, kde je povrchní testování obzvlášť nebezpečné.

Je relativně snadné ověřit, že se aplikace dokáže spustit v jiném jazyce.
Je mnohem hodnotnější ověřit, co se stane, když se jazyk změní, zatímco aplikace už běží a udržuje stav.

COCO přepínalo jazyk rozhraní naživo.

Relace zahrnovala přechody mezi jazyky jako:
němčina → angličtina → chorvatština
zatímco pohled administrace zůstal aktivní.

COCO pozorovalo, zda se prvky rozhraní měnily správně na místě:

  • hlavičky tabulek
  • ovládací prvky
  • tlačítka
  • štítky
  • statusové zprávy

Podkladová tabulka a stav aplikace také musely přežít tento přechod.
Toto záleží, protože vícejazyčný software se skládá z více než přeložených řetězců.
Změny jazyka mohou odhalit:

  • zapomenuté zdroje
  • zastaralé štítky
  • problémy s rozvržením
  • nepřeložené statusové zprávy
  • problémy s kódováním
  • resety stavu
  • problémy s překreslováním ovládacích prvků

Okno, které vypadá správně, když je spuštěno přímo v chorvatštině, se může stále chovat nesprávně, když uživatel přepne z němčiny na chorvatštinu během aktivní relace.

To je rozdíl mezi kontrolou snímku obrazovky a testováním pracovního postupu.

Obnovení stavu aplikace

COCO následně obnovilo výchozí konfiguraci třídění aplikace.

Opět, test neskončil samotným kliknutím.

Výsledné pořadí a potvrzení prezentované přes oblast statusu aplikace byly vyhodnoceny. Tento typ ověření se může zdát bezvýznamný ve srovnání s testováním autentizace nebo přístupu k databázi.

Není.

Podnikové aplikace akumulují stovky takových malých přechodů stavu.
Uživatelé se na ně spoléhají, aniž by o nich vědomě přemýšleli.
Software působí spolehlivě právě proto, že tyto interakce zůstávají předvídatelné.
Regresní testování existuje, aby chránilo tuto předvídatelnost.

Testování informací kolem softwaru

COCO také otevřelo dialog About aplikace.

Proč testovat okno About?

Protože softwarová dokumentace začíná uvnitř samotného softwaru.
Číslo verze, popis funkcí, a licenční informace prezentované operátorovi by měly odpovídat aplikaci, která skutečně běží.

Aplikace může fungovat dokonale, přičemž stále prezentuje zastaralé informace o verzi nebo popisuje schopnosti, které už neodpovídají vydání.

Toto nezhroutí databázi.
Dělá něco jemnějšího:
snižuje důvěru.

Pro podnikový software provozní přesnost zahrnuje tyto zdánlivě malé detaily. COCO je proto také zkontrolovalo.

Control.

První slovo ve sloganu softify.pro Flow je také prvním principem testovacího prostředí.

Control znamená vědět, co se testuje, oproti jakému stavu, a s jakými daty.

Veřejná demonstrace COCO nepoužívá produkční záznamy klienta.

Běží se záměrně připravenými demonstračními daty, jejichž očekávaný stav je znám.

To dělá výsledky reprodukovatelnými.

Také to znamená, že rozdíly mezi testovacími běhy lze zkoumat, místo aby byly vysvětlovány jako náhodné změny v produkčních datech.

Ještě důležitější je, že COCO je navrženo jako samostatně hostovaný systém AI testování.

Testovací důkazy, snímky obrazovky aplikace, a interní informace o pracovním postupu mohou zůstat uvnitř infrastruktury pod vlastní kontrolou zákazníka nebo operátora, místo aby byly ve výchozím nastavení odesílány do nesouvisející cloudové služby třetí strany.

Pro interní obchodní aplikace to není jen infrastrukturní preference. Může to být součástí samotného testovacího požadavku.

Clarity.

Automatizace není obzvlášť užitečná, pokud je jejím konečným výstupem: FAILED
následovaný stovkami řádků technického výstupu, které někdo musí ručně zrekonstruovat, než pochopí, co se stalo.

COCO je navrženo tak, aby zachovalo srozumitelnou důkazní stopu.

Zpráva popisuje:

  • co bylo testováno
  • která interakce se uskutečnila
  • v jakém pořadí se to stalo
  • co COCO pozorovalo
  • jaký stav se očekával
  • kde se chování lišilo, když něco selhalo

Snímky obrazovky a důkazy provedení mohou tuto sekvenci doprovázet.
Účelem není skrýt technické detaily.

Je jím udělat výsledek srozumitelným předtím, než někdo musí otevřít debugger.

Inženýr by měl být schopen odpovědět:
Co se stalo? předtím, než se zeptá:
Kde v kódu se to stalo?

Tento rozdíl dramaticky zkracuje vyšetřování, když se objeví regrese.

Flow.

Tradiční UI automatizace často myslí v prvcích.

Najdi selektor.
Klikni na selektor.
Najdi další selektor.
Zkontroluj hodnotu.

Tento přístup zůstává užitečný, ale aplikace se nezažívají jako sbírky selektorů.

Lidé zažívají toky.

Přihlas se.
Otevři administraci.
Najdi uživatele.
Změň nastavení.
Přepni databázi.
Změň jazyk.
Ověř výsledek.

Pokračuj v práci.

COCO proto považuje sekvenci za proces, ne za náhodnou sbírku ovládacích prvků.

Sleduje, co se uživatel snaží dosáhnout, a hodnotí aplikaci v kontextu.

To se stává obzvlášť hodnotné při testování skutečného podnikového softwaru, protože selhání se často vyskytují mezi obrazovkami nebo mezi stavy, ne uvnitř jednotlivého tlačítka.

Logistický pracovní postup může obsahovat objednávku, rezervaci zásoby, operaci vychystávání, dodací list, a potvrzení expedice.
Každá jednotlivá obrazovka může vypadat správně, zatímco kompletní proces je špatný.
Stejný princip platí zde v menším měřítku.
Okno administrace není produktem.

Pracovní postup skrz něj je.

Důkaz místo předpokladu

Jednou z nejdůležitějších úloh COCO není klikání. Je jí zapamatování si toho, co se stalo.
Lidské regresní testování často končí tvrzením jako:
„Otestoval jsem to a vše vypadalo v pořádku."

To může být zcela přesné.
Ale o několik týdnů později, když se objeví problém, jsou užitečné otázky jiné:

  • Které vydání bylo testováno?
  • Která databáze?
  • Který jazyk?
  • Jaký byl stav uživatele?
  • Co se stalo před problémem?
  • Co přesně bylo viditelné?

V jakém pořadí byly akce provedeny?
Testovací běhy COCO jsou navrženy tak, aby za sebou zanechaly důkazy.

To transformuje výsledek testu z názoru na něco, co lze prozkoumat. Úspěšný běh se proto také stává užitečným.
Ustanovuje známý referenční stav, oproti kterému lze porovnat pozdější chování.

COCO není ten, kdo rozhoduje

Existuje důležitá hranice ve způsobu, jakým používáme AI k testování softwaru.
COCO nemá za cíl nahradit inženýrskou odpovědnost.

Nerozhoduje o tom, jaké by mělo být obchodní pravidlo.

Testuje chování oproti scénářům, požadavkům, a očekáváním definovaným pro aplikaci. Pro citlivá rozhodnutí zahrnující oprávnění, ceny, zásobu, finanční transakce, nebo jiné kritické obchodní stavy, definice správného chování zůstává lidskou odpovědností.

Tento rozdíl je důležitý.
AI je vynikající v opakování podrobného testu bez ztráty koncentrace. Je vynikající ve sbírání důkazů.
Může zkontrolovat obrazovky, porovnat očekávané a pozorované chování, a vysvětlit nesrovnalosti. Ale byznys stále definuje, co znamená správné.

COCO dělá tuto definici testovatelnou.

Test, který nikdo nechce opakovat

Existuje jednoduchý důvod, proč automatizace zde přidává hodnotu.
Lidský tester dokáže tuto regresní relaci absolutně provést.
První jazyk dostává plnou pozornost.
Pravděpodobně i druhý.
Pak další.
Pak další.
MySQL už bylo zkontrolováno.
PostgreSQL ještě potřebuje zkontrolovat.
Test třídění už byl proveden několikrát.
Dialog About se nezměnil měsíce.

Je páteční odpoledne.

A lidská pozornost dělá to, co lidská pozornost přirozeně dělá. Začíná optimalizovat.
COCO ne. V duchu samotného COCO:

  • Nenudí mě klikání na stejné tlačítko v jedenácti jazycích. Nepřeskakuji přechod PostgreSQL, protože je páteční odpoledne. Nepředpokládám, že pořadí třídění se zachovalo, protože fungovalo v předchozím vydání.

Pro COCO lze každou regresní relaci považovat za první. To není inteligence nahrazující lidského testera.
Je to automatizace chránící lidského testera před částí testování, kde je lidská pozornost nejméně hodnotná.

Od opakovaného testování k inženýrskému důkazu

Větším účelem COCO není maximalizovat počet automatizovaných akcí.
Tisíc automatizovaných kliknutí je bezvýznamných, pokud nikdo nerozumí tomu, co dokazují. Užitečným výsledkem je důvěra podpořená důkazy.

Pro softify.pro Flow to znamená být schopen říct, že vydání bylo prověřeno napříč provozními oblastmi, na kterých záleží:

  • autentizace
  • administrace uživatelů
  • role a informace o přístupu
  • stav dvoufaktorové autentizace
  • chování třídění
  • provoz MySQL
  • provoz PostgreSQL
  • živá lokalizace
  • statusová zpětná vazba
  • informace o aplikaci
  • licenční informace

a že výsledek je zachován ve formě, kterou lze později prozkoumat. Stejný princip se škáluje daleko za tuto aplikaci.
Proces přihlášení lze testovat takto.
Pracovní postup rezervace lze testovat takto.
Logistický proces lze testovat takto.
Multiplatformní desktopovou aplikaci lze testovat takto.
Obrazovky se mění.
Obchodní pravidla se mění.
Princip ne:
definuj očekávaný pracovní postup, prováděj ho konzistentně, sbírej důkazy, a udělej výsledek srozumitelným.

Proč testujeme náš vlastní software pomocí COCO

Existuje další důvod, proč je softify.pro Flow důležitý jako případová studie COCO.

Je to náš vlastní software.
To odstraňuje pohodlný odstup, který někdy existuje mezi technologickou demonstrací a lidmi, kteří ji demonstrují.

Pokud má COCO testovat podnikový software, musí být dostatečně užitečné, abychom mu mohli důvěřovat se softwarem, který skutečně sami vyvíjíme a vydáváme.

Flow tedy funguje jak jako produkt, tak jako zkušební prostor.
Nové testovací schopnosti lze prověřit oproti skutečné aplikaci.
Neočekávané chování může odhalit slabiny v aplikaci, testovacím plánu, nebo samotném COCO.

Každá strana zlepšuje tu druhou.
Tato smyčka zpětné vazby je mnohem hodnotnější než budování umělých demonstrací navržených jen k tomu, aby uspěly. Testovací systém by neměl vypadat přesvědčivě, protože demonstrace byla jednoduchá.
Měl by se stát přesvědčivým, protože nadále nachází malé věci, které by lidé nakonec přestali kontrolovat.

Výsledek

softify.pro Flow — Administration má nyní zdokumentovaný a opakovatelný regresní proces, který COCO může provést před relevantními vydáními.

Test pokrývá obě podporovaná databázová prostředí a jedenáctijazyčné rozhraní aplikace, přičemž sleduje aplikaci tak, jak by ji používal administrátor, místo aby traktoval každou obrazovku jako izolovaný testovací cíl.

COCO vytváří důkazní stopu ukazující, co bylo testováno, co bylo pozorováno, a v jakém pořadí se relace uskutečnila.

Tento důkaz může zůstat lokálně kontrolovaný.
Vývojáři získávají reprodukovatelný výchozí bod, když se něco změní.
Lidští testeři tráví méně času opakováním předvídatelných interakcí a více času zkoumáním situací, které skutečně vyžadují úsudek.

A softify.pro Flow dostává něco hodnotnějšího než zelený indikátor PASS.

Dostává důkaz, že zážitek slíbený na jeho přihlašovací obrazovce nadále existuje i poté, co se kód pod ní změní.

Control. Věz, co se testuje, a udržuj prostředí pod kontrolou.

Clarity. Rozuměj tomu, co se stalo, bez rekonstrukce neprůhledného automatizačního deníku.

Flow. Testuj aplikaci jako proces, který lidé skutečně používají.

Control. Clarity. Flow.

Bylo to napsáno pro software.
Ukázalo se, že to stejně dobře popisuje i testovací filozofii za ním.

Permalink →

Stojí za to vědět

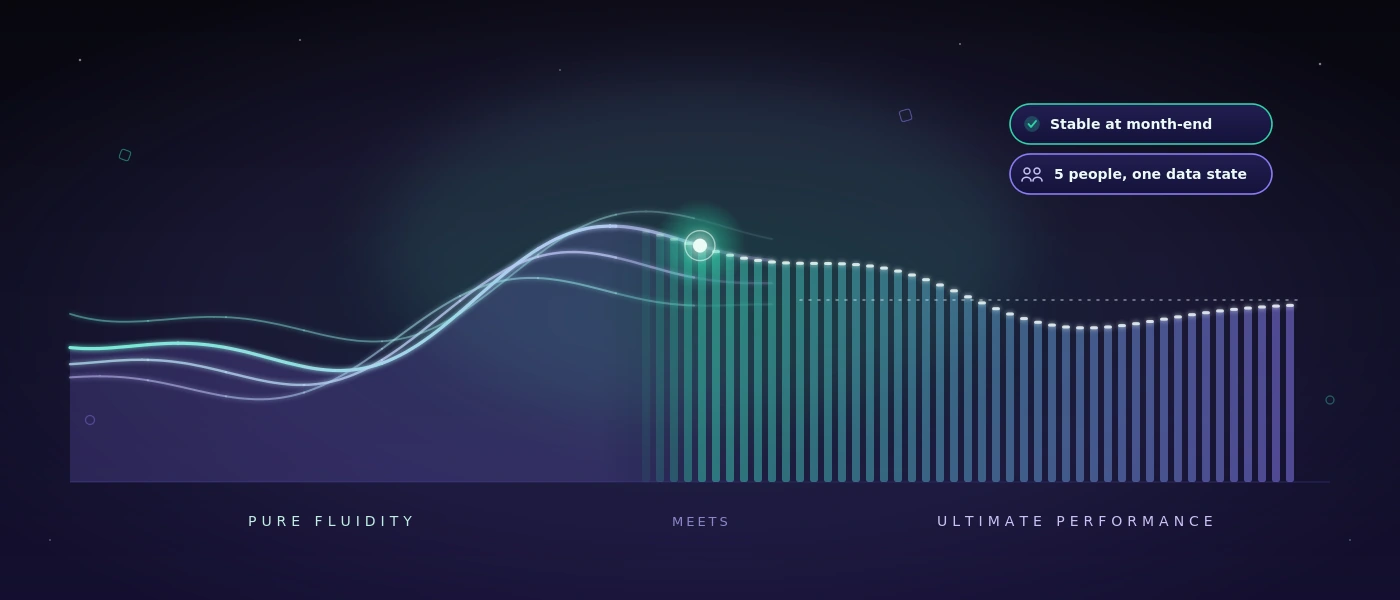
Pure fluidity meets ultimate performance: co skutečně zrychluje podnikový software

Pure fluidity meets ultimate performance: co skutečně zrychluje podnikový software

Vedoucí skladu nepozná špatný software podle výkresu architektury. Pozná ho podle toho, že zaměstnanci opět sahají po telefonu, zaevidují dodací listy dvakrát nebo po směně neumějí říct, jaké zboží skutečně dorazilo. Pure fluidity meets ultimate performance proto nesmí být pouhým vizuálním nárokem. Pro podnikový software to znamená, že operace působí přirozeně a zároveň spolehlivě funguje v reálných podmínkách.

Elegantní rozhraní je bezcenné, pokud se seká při slabé WLAN ve skladu. Rychlá aplikace také málo pomáhá, pokud vynucuje pracovní pořadí, které na rampě nikdo nedokáže sledovat. Dobré digitální nástroje spojují design, rychlost a porozumění procesům. Snižují tření, aniž by podnik tlačily do předem připravené standardní logiky.

Pure fluidity meets ultimate performance je provozní otázka

Plynulost se často zaměňuje s animacemi, velkými obrázky a hladkými přechody. To může pasovat k moderní značce. V pracovní každodennosti se však ukazuje jinak: příjem zboží lze zaúčtovat bez oklik. Zaměstnanec najde objednávku i tehdy, když je známo jen referenční číslo. Chyba se jasně pojmenuje, místo aby zmizela v kryptickém hlášení.

Výkon je stejně tak víc než dobrá hodnota v testu prohlížeče. Rozhodující jsou doba odezvy u objednávky s mnoha položkami, stabilita na konci měsíce a otázka, zda může pět osob pracovat současně, aniž by si navzájem přepisovaly stavy dat. Patří k tomu i čisté zacházení s přerušeními spojení, oprávněními a zablokovanými účty.

Obojí je neoddělitelné. Pokud obrazovka reaguje okamžitě, ale má nejasná povinná pole, zůstává namáhavá. Pokud je postup chytře namodelován, ale stránka při každém zaúčtování čeká dvě sekundy, obchází se. Plynulost vzniká tam, kde systém podporuje další smysluplnou činnost a technicky zůstává dost rychlý, aby se myšlenka nepřerušila.

Rozhraní sleduje pracovní cestu, ne organizační schéma

Mnohá standardní řešení strukturují svá menu podle modulů: nákup, prodej, sklad, reporting, administrace. Z pohledu produktu je to srozumitelné. Na podlaze haly se však práce často začíná situací: stojí kamion, chybí paleta, zákazník potřebuje doklad o dodání nebo zásilku je třeba ještě před uzávěrkou příjmu označit štítkem.

Dobrá individuální aplikace proto začíná těmito situacemi. Jaká informace je k dispozici? Kdo rozhoduje? Co je třeba zdokumentovat? Co se později už nesmí měnit? Teprve poté se rozhodne, jaká vstupní obrazovka, kontrola nebo automatizace je potřebná.

To neznamená odlít každý existující postup beze změny do softwaru. Některé tabulky jsou skutečně příliš náchylné k chybám, některá schválení zbytečně pomalá. Ale fungující seznam Excel nemusí být nutně nahrazen projektem. Pokud ho udržuje jen jedna osoba, zná málo výjimek a zůstává sledovatelný, může být vhodným nástrojem. Software se vyplatí, když zlepšuje koordinaci, snižuje zdroje chyb nebo spolehlivě zpřístupňuje informace více zúčastněným.

Méně kliků není automaticky lepší

Požadavek na co nejméně kliků zní rozumně, ale může vést špatným směrem. U nevratného skladového zaúčtování je krátké potvrzení smysluplné. U uvolnění expedice může viditelná kontrola věrohodnosti zabránit drahému dodatečnému opravování. Správný postup závisí na riziku.

Rozhodující je, aby další kroky měly jasný účel. Potvrzení by se nemělo objevit jen proto, že ho framework snadno vytvoří. Mělo by stát přesně tam, kde musí lidé vědomě učinit rozhodnutí. Tak aplikace zůstane rychlá, aniž by se stala lehkomyslnou.

Výkon vzniká v architektuře, ne v posledním šprintu

Kdo zrychluje webovou stránku nebo webovou aplikaci až těsně před go-live, léčí obvykle symptomy. Velké dotazy, nejasné datové modely a dodatečně přidané zvláštní případy nelze trvale opravit jediným optimalizačním dnem.

Spolehlivý základ začíná databází, která odpovídá skutečným vztahům v podniku. V MySQL 8 potřebují pohyby, doklady, změny stavů a akce uživatelů sledovatelné klíče a smysluplné indexy. Zásoba se nesmí jevit jen jako číslo, pokud se později musí objasnit, z kterého zaúčtování vznikla. Zároveň se nemusí každá historická informace přepočítávat při každém načtení stránky.

U moderních webových aplikací je relevantní i oddělení odpovědností. PHP 8.4 dokáže obchodní pravidla zobrazit jasně a udržitelně, zatímco moderní JavaScript se používá cíleně pro reaktivní oblasti. To není vyznání víry pro určitý stack. Je to otázka údržby: dají se změny za šest měsíců bezpečně zrealizovat? Je viditelné, kde pravidlo platí? Dá se chyba reprodukovat, místo aby se jen předpokládala?

Výkon navíc potřebuje hranice. Vyhledávací pole potřebují smysluplný minimální počet znaků nebo přesnou logiku filtrování, pokud jsou představitelné miliony záznamů. Velké seznamy potřebují stránky nebo odstupňované procesy dodatečného načítání. Obrázky a dokumenty by neměly blokovat kritický pracovní postup. Tato rozhodnutí působí nenápadně. Právě proto zůstávají často hodnotná déle než nápadný frontendový efekt.

Viditelná rychlost vytváří důvěru

Ne každý proces se může skončit za méně než sekundu. Tisk štítků, rozhraní k přepravci nebo kontrola vůči externím datům si občas vyžaduje čas. Rozhodující je pak, jak aplikace zachází s čekací dobou.

Jasný stav jako „Expediční štítek se vytváří“ je lepší než zamrzlé tlačítko. Po ukončení by mělo být viditelné, jaké číslo bylo vygenerováno a zda se operace smí spustit znovu. Pokud externí služba není dostupná, tým potřebuje srozumitelnou možnost jednání místo chybového hlášení pro vývojáře.

Je to i otázka integrity dat. Dvojklik nesmí vytvořit dvě dodávky. Přerušený proces nesmí tiše zanechat polotovarový záznam. Dobré systémy plánují takové případy, protože v každodennosti nastanou. Zejména při měnících se směnách, časovém tlaku a mobilních zařízeních není výjimka okrajovým tématem.

Kvalita se stává viditelnou před chybou

Pro aplikace s mnoha variantami procesů nestačí na konci ručně proklikat několik cest. Změny cen, rolí, validací nebo rozhraní mohou vyvolat následky na velmi vzdáleném místě. Zde se automatizované testování stává součástí výkonu: nejen technicky, ale organizačně.

Testovací systém by měl umět ověřovat reálné postupy, například vytvořit objednávku, změnit položku, vygenerovat dodací list a zkontrolovat oprávnění. Měl by zaznamenávat důkazy a formulovat výsledky tak, aby je odborné útvary dokázaly zařadit. Věta jako „Expediční proces nebyl po změně adresy dokončen“ pomůže víc než nekomentovaný stack trace.

Pro bezpečnostně uvědomělé týmy je relevantní i místo, na kterém tyto testy běží. Pokud snímky obrazovky, přístupové údaje, testovací případy nebo interní kroky aplikace nemají opustit podnik, je samostatně hostovaný přístup často rozumnější než externí cloudová služba. S COCO lze automatizované testy pro webové aplikace a aplikace Windows spouštět v dedikovaném prostředí. Není to potřeba pro každý tým. U citlivých dat, regulovaných oblastí nebo interních odborných aplikací však může být kontrola nad testovacími daty rozhodující výhodou.

Design je dobrý, když usnadňuje práci

Silná vizuální identita může vytvářet důvěru. Ukazuje, že podnik bere svou digitální přítomnost vážně. V provozním systému však musí design dosáhnout ještě víc: orientaci pod časovým tlakem. Kontrast, typografie, jasné stavy a srozumitelné popisky rozhodují o tom, zda někdo operaci s jistotou dokončí, nebo se zeptá kolegy.

Zdrženlivost je zde často lepší volbou. Přehledový panel s deseti barevnými ukazateli může vypadat působivě a přesto zakrýt jedinou relevantní odchylku. Redukované zobrazení, které zviditelňuje otevřené příjmy zboží, chybějící skeny a ohrožené termíny dodání, je užitečnější. Otázka nezní, kolik rozhraní je možné, ale jaká informace zlepšuje rozhodnutí.

To platí i pro responzivní aplikace. Mobilní schopnost neznamená stlačit každou obrazovku počítače do menšího formátu. Smartphone při příjmu zboží potřebuje možná jen sken, množství, skladové místo a potvrzení. Rozsáhlé dodatečné zpracování patří případně na větší obrazovku. Různá zařízení si zaslouží různé priority, i když přistupují ke stejné spolehlivé datové základně.

Smysluplné měřítko pro další rozhodnutí

Než tým rozhodne o nové platformě, automatizaci nebo úplné novostavbě, pomáhá jednoduchá kontrola: stává se postup pro lidi, kteří ho denně provádějí, jasnějším, rychlejším nebo bezpečnějším? A dá se řešení ještě porozumět, když se změní požadavky, zaměstnanci nebo rozhraní?

Pokud jsou obě odpovědi spolehlivé, z krásného příslibu se stane použitelný systém. Tehdy se pure fluidity meets ultimate performance neukáže na snímku, ale v klidném pracovním dni, v němž objednávky, data a rozhodnutí plynou dál bez zbytečného tření.
Permalink →

SaaS Flow Web: bezpečné zavedení workflow během běžného provozu

SaaS Flow Web: bezpečné zavedení workflow během běžného provozu

Příjem zboží nezůstane ležet proto, že tým nezná další software. Zůstane ležet proto, že se informace ztrácejí mezi e-mailem, papírovým formulářem, souborem Excel a telefonátem. U SaaS - „Flow Web“ na flow.softify.pro - by proto první otázkou nemělo být rozhraní. Rozhodující je, zda služba spolehlivě zobrazuje konkrétní pracovní postup - i v hektických dnech, při měnících se odpovědnostech a když dodávka neodpovídá plánu.

Pro malé a střední podniky je SaaS často smysluplný, protože nemusejí nejprve budovat vlastní servery, vydání a základní funkce. Není to však volná vstupenka pro každý proces. Kdo zavede nástroj, který dělá každodennost složitější nebo vytlačuje důležitá data do nejasných vedlejších seznamů, nedigitalizuje práci. Jen přesouvá tření.

Co musí SaaS „Flow Web“ poskytovat

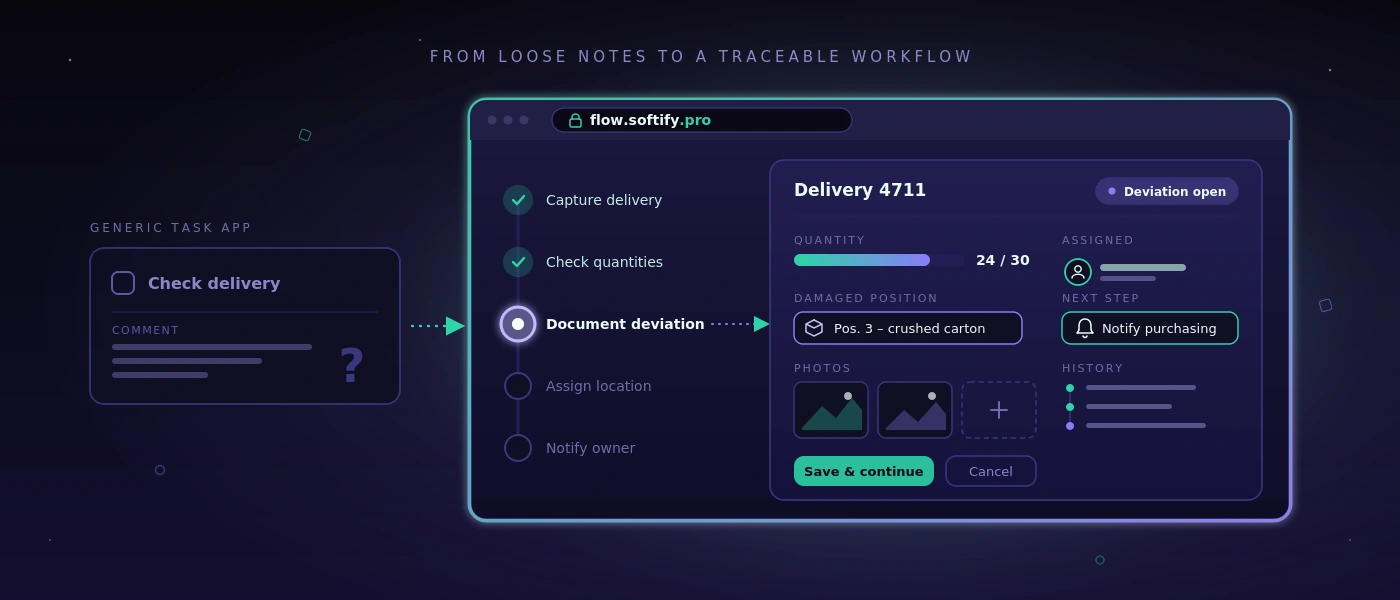
Webový workflow je dobrý, když zaměstnanci bez výkladu vědí, co mají udělat dál. Při převzetí zboží to může znamenat: zaevidovat dodávku, zkontrolovat množství vůči objednávce, zdokumentovat odchylku, přiřadit skladové místo a v případě potřeby informovat odpovědnou osobu. Postup nemusí být efektní. Musí být sledovatelný, rychlý a opakovatelný.

Právě zde leží rozdíl mezi obecnou aplikací na úkoly a odborným procesním systémem. Aplikace na úkoly může vytvořit položku s názvem „Zkontrolovat dodávku“. Odborný workflow může navíc zaznamenat, o kterou dodávku jde, kdo ji převzal, která položka byla poškozená, jaké fotografie existují a zda čeká dodatečná dodávka. Tato data pak nestojí jako volný text v jednom komentáři, ale tam, kde je potřebuje další osoba.

U řešení jako Flow Web na flow.softify.pro by proto posuzování mělo začít u operací, ne u seznamu funkcí. Podnik s pěti skladovými pohyby denně potřebuje něco jiného než expediční tým s několika uzávěrkovými časy, různými přepravci a pravidelným řízením částečných dodávek. SaaS nenahrazuje porozumění procesu.

Nejprve pojmenovat úzké místo, poté konfigurovat

Mnohé digitalizační projekty začínají příliš široce: „Chceme zdigitalizovat sklad.“ Zní to uvěřitelně, ale rychle to vede k systému s příliš mnoha obrazovkami, zvláštními případy a školicími materiály. Lepší je přesné vyjádření jako: „Příjmy zboží se zaúčtují až následující den, protože dodací listy na konci směny leží na stole.“

Z takové věty lze odvodit smysluplný začátek. První verze může evidovat dodací listy, potvrzovat artikly a množství, označovat odchylky a předat zaúčtování příslušnému místu. Když tento postup funguje, štítky, hodnocení dodavatelů nebo automatické návrhy objednávek lze doplnit později. Ne každý smysluplný krok rozšíření patří do prvního nasazení.

I dobře udržovaná tabulka může zůstat, pokud plní svůj účel. Například měsíční vyhodnocení s několika účastníky v existujícím souboru může být levnější a transparentnější než vlastní modul. SaaS se vyplatí tam, kde se informace používají vícekrát, doby zpracování jsou kritické nebo chyby vznikají z přerušení médií.

Správné otázky před zavedením

Před konfigurací by měl tým projít skutečnou operaci od začátku do konce. Ne ideální proces, ale případ, který dělá v každodennosti problémy: nesprávné množství, chybějící reference, naléhavá expedice nebo objednávka se zvláštním schválením. Přitom se ukážou pravidla, která musí systém skutečně zobrazit.

Relevantní jsou mimo jiné tyto body: kdo smí operaci vytvořit, změnit nebo uzavřít? Které vstupy jsou povinné, které jen užitečné? Kdy musí být informován vedoucí? Která data se předávají účetnictví, expedici nebo zákaznickému servisu? A co se stane, pokud je WLAN ve skladu slabá nebo zaměstnanec už nemá své přístupové údaje?

Odpovědi určují kvalitu zavedení silněji než dlouhý katalog vizuálních požadavků. Čistý proces rolí, srozumitelné chybové hlášení a zdokumentovaný krok schválení zabraňují v provozu obvykle většímu úsilí než další přehled na úvodní stránce.

Uchovávání dat a role nejsou vedlejší věc

SaaS se často bere jako čistě obslužná otázka. Pro provozní a IT odpovědné je však přinejmenším stejně důležité, co se děje s daty. Týká se to kmenových dat, informací o dodávkách, dat zaměstnanců, fotografií škod a případně dat zákazníků. Před zavedením by měly být jasné odpovědnosti, uchovávání a možnosti exportu.

Prakticky to znamená: podnik musí vědět, která data jsou v systému, kdo má administrátorský přístup a jak se data poskytují při změně nebo ukončení smlouvy. Export dostupný jen jako obtížně čitelný soubor PDF jen zřídka pomůže. Pro provozní data jsou rozhodující strukturované, použitelné formáty.

I koncept oprávnění si zaslouží konkrétní pozornost. Ve skladu nemusí každá osoba vidět ceny, zákaznické podmínky nebo globální nastavení. Zároveň příliš úzké přidělování práv nesmí blokovat postup. Smysluplné jsou role zaměřené na skutečné činnosti: převzetí, dispozice, expedice, vedení týmu a administrace. Kritické změny by měly být sledovatelné, aby se při dotazech nemuselo hádat, kdo změnil zaúčtování.

Samotný přístup by měl být chráněn pevnými základy. Patří sem bezpečné politiky hesel, upravený reset hesla, zablokování účtu při opakovaných neúspěšných pokusech a, kde to profil rizika vyžaduje, dodatečné kroky přihlášení. Bezpečnost působí profesionálně, když je předvídatelná a nepozná se až tehdy, když byl někdo vyloučen.

Integrace jen tam, kde měřitelně odlehčuje

Webový workflow často rozvine svou hodnotu až v souhře s existujícími systémy. Může to být ERP, e-shop, expediční řešení, evidence pracovní doby nebo databáze. Přesto není každé rozhraní automaticky smysluplné. Každá integrace vytváří závislosti, obrazy chyb a náklady na údržbu.

Ústřední otázka zní: jaký ruční krok spojení konkrétně odstraní? Pokud rozhraní denně ušetří 30 minut přenosové práce a sníží překlepy, přínos je jasný. Pokud jen zrcadlí informaci, která se stejně jednou týdně kontroluje, může být zpočátku rozumnějším řešením ruční export.

U individuálních rozšíření rozhoduje technický základ. Zdokumentovaná rozhraní, jasně definovaná datová pole a sledovatelné protokoly chyb usnadňují pozdější provoz. Pokud se systém připojuje k webové aplikaci na míru, technologie a struktura databáze by se měly zvolit tak, aby zůstaly dlouhodobě udržovatelné. Udržovaná aplikace na bázi PHP 8.4, moderního JavaScriptu a MySQL 8 je cennější než krátkodobě působivé zvláštní řešení bez dokumentace.

Zavedení během běžného provozu

Nejčastější chybou je tvrdý start bez srovnávací fáze. Týmy mají pak v pondělí ráno hned pracovat jinak, zatímco otevřené otázky vznikají až ze skutečných problémů. To zvyšuje odmítání, i když software v zásadě vyhovuje.

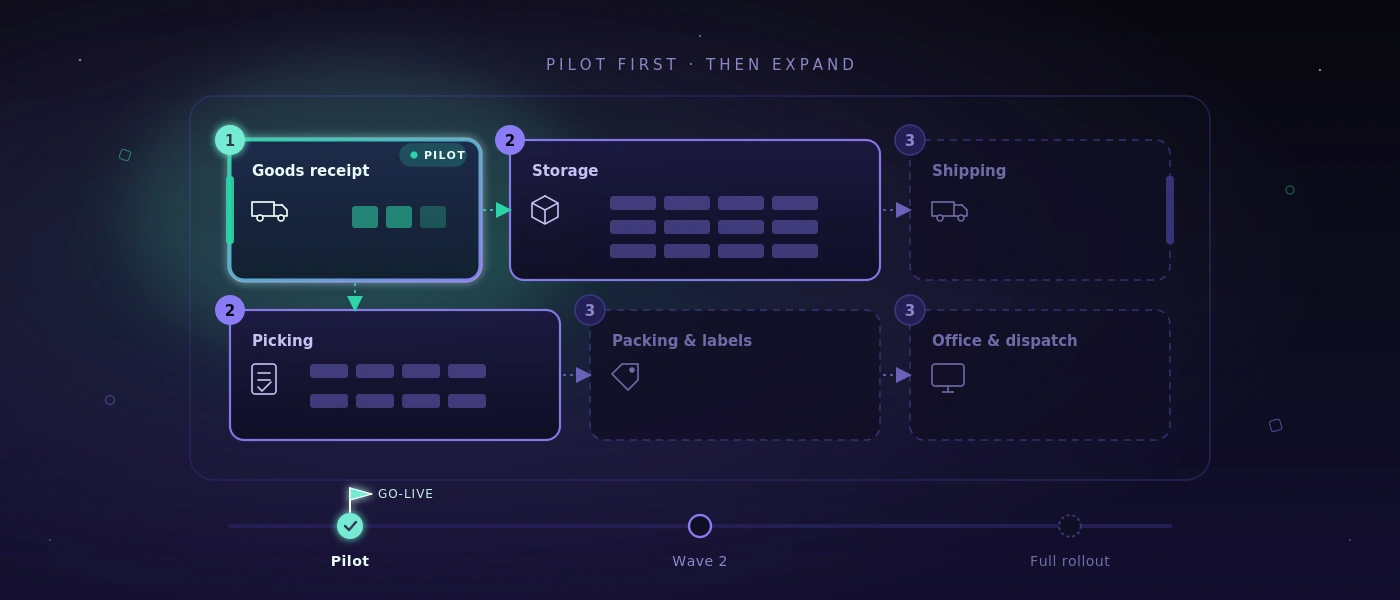
Lepší je omezený pilot s jedním týmem, jednou variantou procesu nebo jasně vymezenou oblastí lokality. V této době se ověřuje, zda evidence a schválení fungují, zda jsou pojmy srozumitelné a zda výjimečné případy přistanou čistě. Důležité je nesbírat zpětnou vazbu jen jako seznam přání. Každá změna by se měla posoudit vůči přínosu pro dobu průběhu, míru chyb nebo transparentnost.

I ukazatele by se měly stanovit včas. Například lze sledovat dobu zpracování na převzetí zboží, počet otevřených odchylek, dotazy ke stavu dodávky nebo opravná zaúčtování. Bez výchozí hodnoty zůstává „působí rychleji“ jediným hodnocením. To může být pravda, ale na spolehlivé investiční rozhodnutí to nestačí.

Provoz potřebuje jasného vlastníka

SaaS snižuje technickou námahu, ale nezbavuje podnik odpovědnosti za vlastní proces. Interně je potřeba někdo, kdo spravuje role, shromažďuje zpětnou vazbu, rozpoznává potřebu školení a rozhoduje, které změny jsou skutečně nezbytné. Tato osoba nemusí umět programovat. Měla by však rozumět pracovnímu postupu a mít přístup k odpovědným.

Stejně důležitá je krátká, spolehlivá provozní dokumentace. Nevysvětluje každou obrazovku, ale odpovídá na otázky, které se vyskytují v každodennosti: co dělat při chybném zaúčtování? Kdo schvaluje nové uživatele? Jak se komunikuje výpadek? Kde jsou exportovaná data? Taková jasnost brání tomu, aby se digitální systém po několika měsících opět stal závislým na osobních zvoláních.

Dobré řešení SaaS se proto nepozná podle toho, kolik položek menu nabízí. Svou hodnotu ukazuje, když nová kolegyně dokáže operaci zpracovat s jistotou, odchylka nezmizí a vedoucí vidí stav bez telefonátu třem osobám. Přesně tímto měřítkem by se měl měřit Flow Web: ne sliby, ale pracovním dnem, který prokazatelně probíhá klidněji a spolehlivěji.

Permalink →

Webový vývoj s aktuálními frameworky: co z toho firmy skutečně mají

Webový vývoj s aktuálními frameworky: co z toho firmy skutečně mají

Pokud příjem zboží stále kolísá mezi papírovým formulářem, telefonátem a třemi soubory Excel, moderní frontend sám problém nevyřeší. Webový vývoj s aktuálními frameworky dává smysl tehdy, když viditelně zjednodušuje postupy: zaměstnanci vidí další krok, data se zadávají jen jednou a aplikace zůstává srozumitelně udržovatelná i po prvním go-live.

Pro malé a střední podniky proto otázka frameworku není otázkou víry. Rozhodující není, zda rozhraní nese obzvlášť mnoho technických módních slov. Rozhodující je, zda skladové pohyby, objednávky, kontroly nebo schválení procházejí spolehlivě pracovním dnem - i pod časovým tlakem, při střídání směn a kolísavém síťovém připojení.

Frameworky jsou prostředek, ne cíl projektu

Framework poskytuje osvědčenou strukturu pro opakující se úlohy: routing, formuláře, správu oprávnění, přístup k datům, testy a zobrazení rozhraní. To automaticky nesníží každé riziko. Zabrání to však tomu, aby musel projekt základní funkce vymýšlet stále znovu.

U individuální webové aplikace může moderní framework JavaScript například smysluplně zobrazit interaktivní obrazovky: seznam komisionování, který průběžně aktualizuje položky, plánování tras s jasnými změnami stavů nebo kontrolní protokol, který přiřazuje fotografie a komentáře přímo k operaci. V backendu zajišťují etablované frameworky PHP sledovatelná pravidla, jasně oddělené odpovědnosti a konzistentní rozhraní k databázi.

To je obzvlášť důležité, když se z původně malého řešení stane denně používaný provozní systém pro nějaký proces. Vstupní obrazovka pro avíza dodávek může začít přehledně. Jakmile aktualizuje zásoby, tiskne štítky, zohledňuje role a komunikuje s přepravcem, potřebuje čistý technický základ. Frameworky pomáhají tento základ při každém rozšíření znovu nevyjednávat.

Co aktuální webové frameworky konkrétně dělají lépe

Hodnota moderních frameworků jen zřídka spočívá v efektních efektech. Ukazuje se v neviditelných částech aplikace. Formuláře mohou kontrolovat vstupy přímo, aniž by chybná data vyšla najevo až po odeslání. Oprávnění lze definovat centrálně, takže řidič vidí jiné informace než dispozice. Změny objednávky se ukládají sledovatelně, místo aby tiše přepsaly buňku tabulky.

Na straně serveru vytváří aktuální prostředí s PHP 8.4 a MySQL 8 spolehlivý základ pro obchodně kritickou logiku. Databázové transakce zabraňují například tomu, aby se zásoba snížila, zatímco příslušné zaúčtování selže. Jedinečné klíče a validační pravidla předcházejí duplicitám. Procesy na pozadí mohou vytvářet dokumenty nebo volat rozhraní, aniž by musela osoba u obrazovky čekat.

Ani bezpečnost není dodatečná funkce. Moderní framework podporuje bezpečné ukládání hesel, ochranu před typickými útoky přes vstupy, sledovatelné relace a definované postupy zablokování účtu. Přesto zůstává realizace projektovou úlohou: oprávnění se musí odborně správně modelovat a citlivé funkce vyžadují dodatečné kontroly. Framework poskytuje ochranná zábradlí, ale neví, kdo v podniku smí udělit jaké schválení.

Správně rozhodnout o webovém vývoji s aktuálními frameworky

Nejlepší technologie nevzniká ze seznamu oblíbených nástrojů, ale ze skutečného používání. Interní aplikace pro deset osob má jiné požadavky než zákaznický portál s několika tisíci souběžných přístupů. Skladový terminál se skenerem potřebuje jinou logiku obsluhy než manažerská analýza na počítači.

Proto smysluplné rozhodnutí začíná konkrétními otázkami: které postupy dnes měřitelně stojí čas? Která data se přenášejí vícekrát? Kde vznikají chyby, protože informace jsou viditelné příliš pozdě? Která existující tabulka funguje dost dobře a měla by zpočátku zůstat? Právě poslední bod chrání před drahými digitalizačními projekty bez provozního přínosu.

Pro mnohé individuální obchodní aplikace je nejrozumnější volbou systém renderovaný na straně serveru s cílenými interaktivními komponentami. Rychle se načte, je přehledný na provoz a vyhýbá se zbytečné složitosti. Zcela oddělená jednostránková aplikace může být naopak vhodná, když rozhraní zpracovává velmi mnoho dynamických stavů, musí fungovat offline nebo mají stejné funkce později poskytovat i mobilní aplikaci.

Obojí může být odborně správné. Otázka nezní: který framework je nejmodernější? Zní: která architektura bude za dva roky stále bezpečně rozšiřitelná, testovatelná a srozumitelná pro vlastní tým?

Kdy je méně techniky lepší technikou

Ne každý proces potřebuje složitý frontend. Štíhlá vstupní obrazovka pro interní objednávky může být rychlejší, stabilnější a levnější než pracně animované rozhraní. Pokud se soubor Excel udržuje jen jednou měsíčně a nezpůsobuje chyby, je možná nadále správným nástrojem.

Složitost se vyplatí až tehdy, když odstraňuje skutečné tření. Může to být tak, když se objednávky vícekrát přepisují, stav dodávky se musí zjišťovat telefonicky nebo si nikdo není jistý, která verze dokumentu platí. Tehdy vytváří centrální aplikace jasný přínos: jeden stav dat, jednoznačné odpovědnosti a méně dotazů.

Udržovatelnost začíná před prvním řádkem kódu

Frameworky se často považují za urychlovače. To platí jen tehdy, pokud jsou odborná pravidla předtím dostatečně jasná. Vývojář může stavový automat postavit technicky čistě. Zda však posloupnost stavů skutečně sedí na proces, rozhoduje se při zjištění: kdy se zboží považuje za přijaté? Kdo smí uzavřít odchylku? Co se stane při částečné dodávce?

Tato rozhodnutí patří zdokumentovat, stejně jako rozhraní, datová pole a výjimky. To projekty nezpomaluje. Snižuje to pozdější diskuse, protože se stane viditelným, které pravidlo bylo vědomě implementováno a který předpoklad je ještě otevřený.

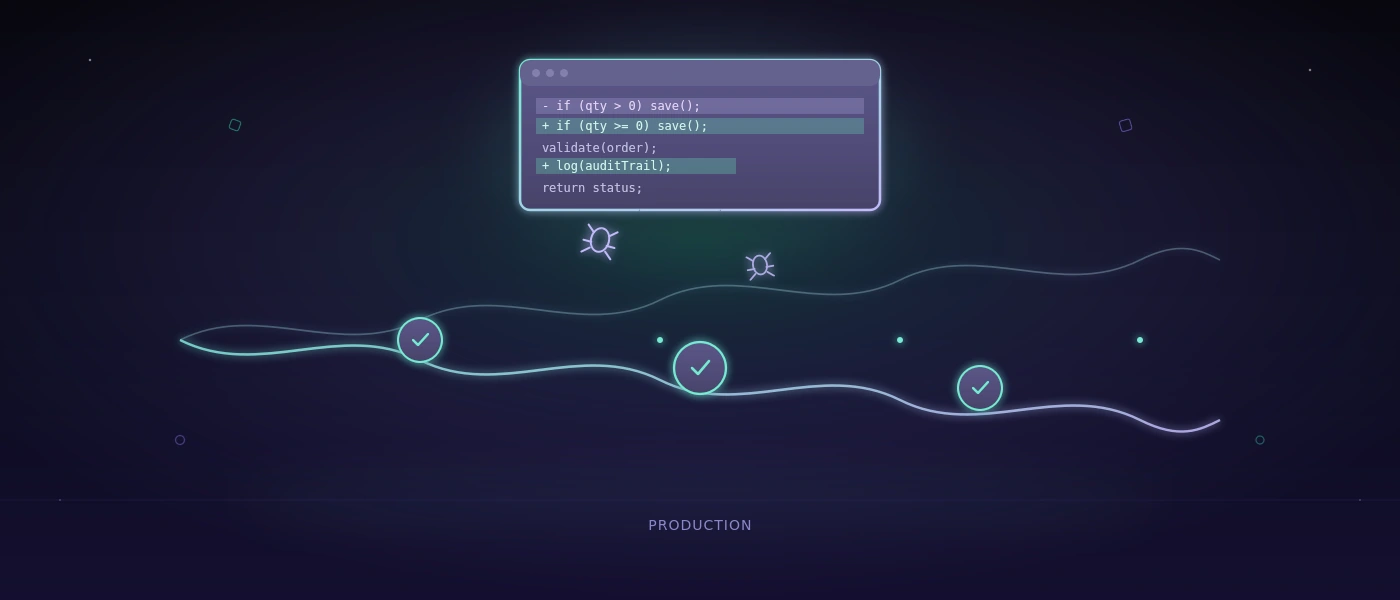
Udržovatelnost se ukazuje i v malých disciplínách. Změny databáze musí být verzované. Kroky nasazení musí být zdokumentované. Chybová hlášení mají být použitelná pro provoz a vývoj bez prozrazování důvěrných podrobností. Automatizované testy při každé změně kontrolují centrální postupy, například vytvoření objednávky, výpočet množství nebo vystavení dodacího listu.

U kritických aplikací jeden typ testu nestačí. Jednotkové testy zajišťují jednotlivá pravidla, integrační testy kontrolují souhru s databází a rozhraními a end-to-end testy přehrávají v prohlížeči skutečné obslužné cesty. Pro webové aplikace a aplikace Windows může samostatně hostované testovací prostředí navíc poskytovat snímky obrazovky, protokoly provedení a srozumitelná hodnocení, bez zbytečného předávání interních testovacích dat externím cloudovým službám.

Výkon vzniká z architektury a datového modelu

Moderní rozhraní se nestane rychlým tím, že používá aktuální framework. Pomalé databázové dotazy, nadměrné obrázky nebo nejasná rozhraní zůstávají pomalé, nezávisle na frontendu. Zejména u seznamů objednávek, artiklů nebo pohybových dat rozhoduje datový model o pocitové rychlosti.

Čisté indexy v MySQL 8, stránkované dotazy a vědomě načtená data jsou často účinnější než pozdější optimalizace na rozhraní. Stejně důležitý je jasný koncept cachování. Kmenová data se mohou za určitých okolností ukládat do vyrovnávací paměti, aktuální zásoby nebo stav schválení však ne naslepo. Zde neexistuje paušální pravidlo, protože odborný význam dat určuje, jak aktuální musí být.

Responzivní design patří také k technickému plánování. Na kancelářské obrazovce může být široká tabulka smysluplná. Na ručním skeneru nebo tabletu ve skladu potřebuje stejná informace velké dotykové plochy, krátké cesty a zobrazení, které zůstane použitelné i s rukavicemi nebo při špatném světle. Pure fluidity meets ultimate performance neznamená v tomto kontextu co nejvíce pohybu na obrazovce. Znamená, že aplikace funguje bez tření na zařízení, které se v procesu skutečně používá.

Smysluplná cesta od nápadu k provozu

Spolehlivý webový projekt začíná omezeným, ověřitelným jádrem. Místo toho, aby se předem automatizovala každá myslitelná výjimka, vybere se proces, který se vyskytuje často a způsobuje citelnou námahu. Po prvním nasazení ukážou skutečná data a zpětné vazby, které rozšíření má skutečně další prioritu.

Technické předání by nemělo proběhnout až na konci. Odpovědnosti za hosting, zálohy, monitoring, aktualizace a přístupová práva se musí objasnit včas. Systém je tak spolehlivý, jaký je jeho provoz. Kdo potřebuje aplikaci denně pro expedici nebo zpracování objednávek, potřebuje definované cesty obnovy a jasnou odpověď na to, co se stane při poruše.

softify.pro proto sází na udržovatelné technologie, zdokumentované dodání a přímou technickou odpovědnost namísto krátkodobých frameworkových módních vln. Není to kouzelná zkratka. Vytváří to předpoklad, aby aplikace po spuštění fungovala dál, dala se rozvíjet a nestala se dalším křehkým zvláštním případem.

Správná webová aplikace se v nejlepším případě nejeví jako nový IT projekt. Jeví se jako postup, který konečně funguje bez obchůzek - s dostatkem technické podstaty k tomu, aby klidně přijala i další změnu v provozu.

Permalink →

Plánování nasazení softwaru: jak uspět během běžného provozu

Plánování nasazení softwaru: jak uspět během běžného provozu

Nový systém málokdy selže proto, že chybí tlačítko. Selže v pondělí ráno: ranní směna nenajde příjem zboží, dodací list se vytiskne dvakrát nebo se soubor Excel najednou stane neoficiální pravdou. Kdo chce naplánovat nasazení softwaru, proto nemusí jen zavést funkce, ale zabezpečit skutečný provoz.

Právě ve skladu, dílně, dispozici a administrativě není nasazení IT termínem. Mění pohyby rukou, odpovědnosti a cesty informací. Dobré zavedení udržuje práci v pohybu, včas činí chyby viditelnými a dává zaměstnancům jasnou odpověď na rozhodující otázku: co dělám od zítřka jinak?

Nasazení začíná před prvním školením

Mnohé projekty začínají seznamem funkcí: evidovat objednávky, zaúčtovat skladové pohyby, tisknout expediční štítky, plánovat trasy. To je nezbytné, ale nestačí. Před startem musí být jasné, které procesy mají v první produktivní den skutečně běžet přes nový systém - a které vědomě ještě ne.

Toto vymezení není znakem neúplnosti. Snižuje riziko. Pokud středně velký podnik dosud koordinoval příjmy zboží papírem, telefonem a tabulkami, nemusí první den současně digitalizovat celé řízení zásob, vyřizování vratek, plánování tras a hodnocení dodavatelů. Smysluplný první rozsah by mohl ležet v převzetí zboží, jednoznačných skladových pohybech a tisku dodacích dokumentů.

Rozhodující je konkrétně popsat cílový proces. Ne: „Příjem zboží se stane digitálním.“ Ale: „Zaměstnanec naskenuje dodávku, zkontroluje množství a stav, přiřadí skladové místo a při odchylkách vytvoří případ pro nákup.“ Teprve na této úrovni se stanou viditelnými otevřené otázky: co se stane při chybějící objednávce? Kdo smí opravovat množství? Smí se dodávka bez štítku uskladnit?

Plánovat nasazení softwaru znamená: upřednostnit kritické procesy

Ne každý proces má stejný význam. Výpadek v oblasti údržby kmenových dat může být nepříjemný. Výpadek při expedici, komisionování nebo schvalování faktur může zablokovat práci celého dne. Proto nasazení potřebuje prioritizaci podle provozního rizika, ne podle pořadí ve specifikaci požadavků.

Osvědčilo se jednoduché rozdělení: obchodně kritické, důležité a odložitelné. Obchodně kritické jsou všechny procesy, které pohybují zbožím, penězi nebo závaznou komunikací se zákazníky. Důležité jsou funkce, které urychlují každodennost, ale jejichž výpadek lze dočasně zmírnit ručně. Odložitelné jsou komfortní funkce, vzácné zvláštní případy nebo vyhodnocení, která zpočátku ještě mohou pocházet z existujícího zdroje.

Toto rozdělení ovlivňuje hloubku testování. Pro kritický expediční proces nestačí úspěšně proklikat jednu objednávku. Testovat se musí i částečné dodávky, storna, chybějící tiskárny, nesprávné adresy, paralelní zpracování a předání přepravci. U zřídka používané statistické funkce může být vhodný pozdější testovací cyklus.

Udělat kritéria úspěchu měřitelnými předem

„Aplikace běží“ není kritériem přejímky. Lepší jsou ověřitelná tvrzení: příjem zboží s 30 položkami je zaúčtovatelný do deseti minut. Expediční štítky se tisknou na určeném pracovišti. Změny zásob se okamžitě zobrazují v dispozici. Zablokovaný uživatelský účet lze znovu aktivovat pouze přes definovaný proces schválení.

Taková kritéria spojují odborný útvar a vývoj. Zabraňují také tomu, aby se přejímka stala sbírkou nejasných dojmů. Ne každá zpětná vazba musí být vyřešena před go-live. Ale každá potřebuje zařazení: kritická chyba, relevantní zlepšení nebo bod pro pozdější fázi rozšíření.

Migrace dat: důvěru si zaslouží jen čistá data

Stará data se často podceňují. V tabulkách se nacházejí duplicitní čísla artiklů, různé jednotky, prošlé adresy zákazníků a stavy zásob, jejichž původ už nikdo nedokáže vysvětlit. Kdo tato data převezme bez kontroly, přesouvá starou nejasnost do nového systému - jen s lepším rozhraním.

Před migrací by se mělo stanovit, která data jsou skutečně potřeba. Často jsou smysluplné aktuální artikly, aktivní zákazníci, otevřené objednávky, relevantní dodavatelé a ověřené počáteční stavy. Historické záznamy nemusí nutně přejít celé do nové aplikace. Může stačit archivovat je čitelně, pokud zůstávají potřebné pro důkazy nebo dotazy.

Obzvlášť důležité je zkušební nahrání. Data se přitom nejen technicky importují, ale i odborně kontrolují: sedí množství, jednotky a přiřazení? Jsou povinná pole úplná? Dají se s nimi správně zpracovat typické objednávky? Pro go-live je poté potřeba jasný rozhodný den. Od kdy se používá který vedoucí systém? Bez tohoto pravidla vzniká dvojí vedení a protichůdné stavy.

Pilotní provoz místo velkého spínače

Big bang může být smysluplný, pokud malý tým používá jasně vymezený proces a staré i nové řešení nemohou fungovat paralelně. Ve většině operativních prostředí je však pilotní provoz lépe kontrolovatelnou volbou.

Pilot by měl pracovat se skutečnými případy, ale v omezeném rámci: jedna skladová oblast, jedna směna, jedna skupina produktů nebo vybraný tým. Rozhodující je, aby pilotní skupina nezahrnovala jen obzvlášť technicky zdatné zaměstnance. Měla by realisticky zobrazovat pozdější každodennost, včetně lidí, kteří pracují pod časovým tlakem a mají oprávněné námitky.

V pilotním provozu se ukáže, zda skenery, tiskárny, síť a oprávnění fungují na skutečném pracovišti. Stejně se stanou viditelnými procesní mezery, které nikdo na poradách nezmínil. Možná se zboží v každodennosti nejprve odkládá na mezimísto. Možná řidiči potřebují jiný dodací list než administrativa. Taková poznání nejsou krokem zpět. Jsou důvodem, proč pilot provést před plošným startem.

Školení jako pracovní situace, ne jako prohlídka softwaru

Školení, které jen vysvětluje položky menu, vytváří málo jistoty. Zaměstnanci se musí učit na svých úkolech: „Přebíráte poškozenou dodávku“, „Komisionujete naléhavou objednávku“, „Opravujete nesprávně zaúčtované množství“. Kontext zůstane v paměti, protože odpovídá pracovní každodennosti.

Krátká školení blízko go-live jsou obvykle účinnější než jeden dlouhý termín týdny předem. Pomáhají i stručné pracovní pokyny přímo na pracovišti. Neměly by vysvětlovat celý systém, ale ukázat nejčastější postupy, jasné odpovědnosti a cestu při poruchách.

Určete navíc kontaktní osoby pro jednotlivé oblasti. Tyto osoby nemusí samy řešit každý technický problém. Měly by však umět rozhodnout, zda jde o chybu obsluhy, odbornou nejasnost nebo skutečnou chybu systému. To chrání projektový tým před nestrukturovanými zvoláními a urychluje pomoc pro směnu.

Go-live potřebuje provozní plán

Den go-live potřebuje víc než čas. Definujte, kdo rozhoduje odborně, kdo odpovídá za technické změny a přes který kanál se hlásí poruchy. U kritických procesů by mělo být viditelné, zda fungují centrální funkce: přihlášení, oprávnění, sběr dat, rozhraní, tisk a zálohování.

K tomu patří i plán návratu. To neznamená při nejmenším problému se hned úplně vrátit do starého světa. Znamená to předem určit, která porucha ospravedlňuje zastavení, jak se objednávky v nouzi dokumentují a jak se dodatečně čistě zaevidují. Papírový formulář na několik hodin může být rozumný. Trvalé paralelní vedení bez konce není.

Technické detaily zde počítají: byly přístupy založeny včas? Fungují role a pravidla zablokování účtu správně? Jsou tiskárny štítků propojeny se správnými šablonami? Existuje otestovaná záloha databáze? U individuálně vyvinutých aplikací patří ke standardu zdokumentovaná nasazení, sledovatelné stavy verzí a jasná cesta pro opravy chyb.

První týdny rozhodují o akceptaci

Po startu se začíná fáze, v níž se aplikace stane buď pracovním nástrojem, nebo neoblíbeným dodatečným krokem. Plánujte proto denní krátké smyčky zpětné vazby. Jaké chyby se opakují? Kde vznikají obchůzky? Která pole se chápou nesprávně? Jaké vyhodnocení vedoucí osobě skutečně chybí?

Ne každé pozorování vyžaduje okamžitou změnu. Některé problémy se vyřeší přesnějšími pracovními pravidly nebo lepším školením. Jiné ukazují skutečné slabiny v procesu nebo v aplikaci. Umění spočívá v tom, nezaměňovat jedno s druhým. Systém by neměl bez důvodu komplikovat existující fungující postupy. Pokud je dobře udržovaná tabulka pro vzácný zvláštní případ nadále lepším řešením, může zůstat.

Měřte účinek pomocí několika konkrétních ukazatelů: doba zpracování na postup, počet dotazů, chybná zaúčtování, opakované tisky, otevřené objednávky nebo rozdíly v zásobách. Teprve tyto hodnoty ukážou, zda nasazení skutečně zlepšuje provoz - místo toho, aby jen zavedlo nové masky.

Dobré nasazení se po několika týdnech nejeví jako projekt. Stane se spolehlivou pracovní rutinou: správná data jsou tam, kde jsou potřeba, výjimky jsou sledovatelné a týmy musí méně telefonovat za informacemi. Přesně na to by mělo plánování mířit - ne na působivý den startu, ale na klidnější, lépe řiditelnou každodennost.

Permalink →

Plánování Multiplatform Application Development: nejprve proces, potom platforma

Plánování Multiplatform Application Development: nejprve proces, potom platforma

Vedoucí skladu potvrzuje příjem zboží na ručním skeneru. Dispozice kontroluje stejný proces v prohlížeči. Řidič potřebuje stav dodávky na cestě na chytrém telefonu. Multiplatform application development zní v tuto chvíli jako technická otázka. Ve skutečnosti jde nejprve o provozní postup: jaká práce se musí vykonat kde, s jakou spolehlivostí a na jakém zařízení?

Pro malé a střední podniky je správná odpověď zřídka: vše postavíme nativně pro každou platformu. Častěji zní: definujeme společný proces, cíleně vybereme potřebná uživatelská rozhraní a vyhneme se dvojí logice. To neušetří jen vývojový rozpočet. Zabrání to také tomu, aby sklad, kancelář a externí služba pracovaly s různými stavy dat.

Co má Multiplatform Application Development přinést

Multiplatform Application Development označuje vývoj aplikace, kterou lze používat ve více prostředích, například ve webovém prohlížeči, na iOS a Androidu nebo na desktopových systémech Windows. Pojem se často redukuje na otázku, zda jedna kódová základna dokáže vytvořit více aplikací. To je jen část rozhodnutí.

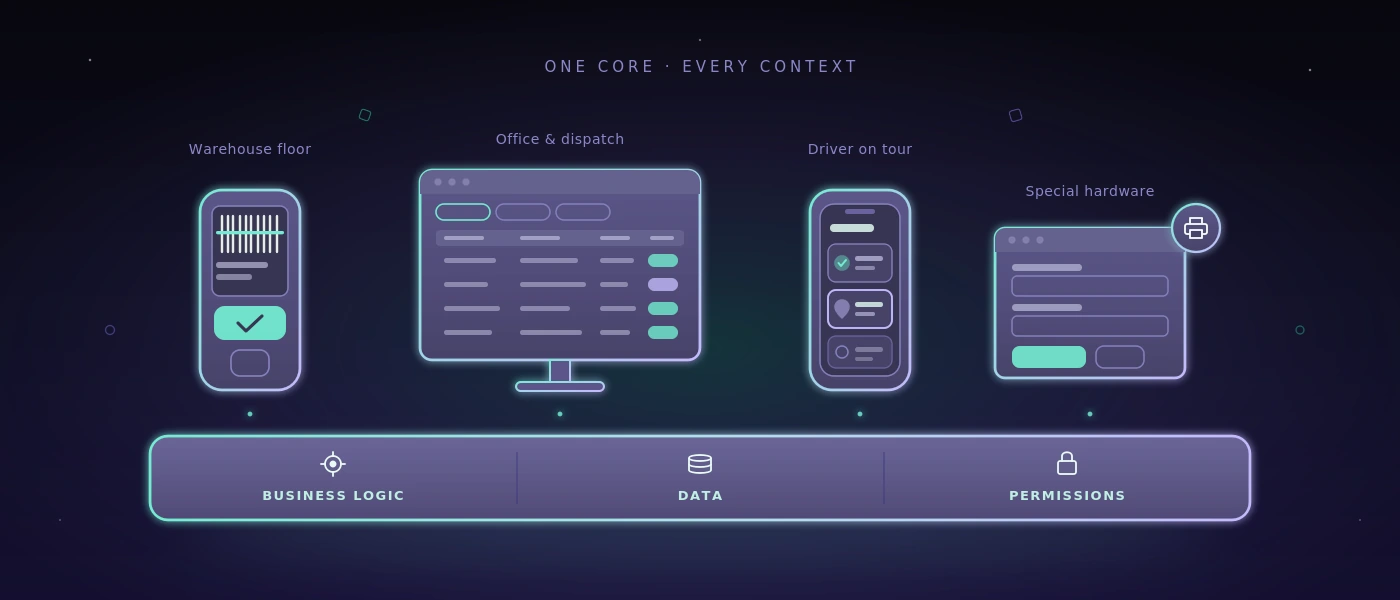
U provozních systémů záleží především na tom, zda aplikace funguje na místě použití. Příjem zboží může potřebovat kameru k snímání čárových kódů, velké ovládací prvky pro rukavice a použitelnou reakci při nestabilním pokrytí WLAN. Administrativa naopak potřebuje tabulky, filtry, koncepty oprávnění a sledovatelné protokoly změn. Řidič potřebuje zredukované zobrazení, ne stejné rozhraní jako dispozice.

Společný technický základ může tyto požadavky smysluplně propojit. Nesmí však vést k tomu, že každá platforma se obsluhuje jako špatný kompromis. Nejlepší společný kód je bezcenný, pokud zaměstnanci chodí oklikami, protože aplikace nezobrazuje jejich skutečný pracovní postup.

Nejprve určit proces, poté platformu

Než týmy mluví o frameworcích, měly by prověřit jednu konkrétní operaci od začátku do konce. Vezměme dodávku: objednávka přijde, zboží se komisionuje, vznikne dodací list, předání se potvrdí a stav se nahlásí zpět obchodu nebo zákaznickému servisu. Na kterém místě vzniká dnes přerušení médií? Kde se něco zapisuje na papír, později přepisuje nebo ptá telefonicky?

Toto pozorování odděluje skutečné požadavky na platformu od seznamů přání. Pokud funkci používají jen dva zaměstnanci v kanceláři, dobře udělané webové rozhraní obvykle stačí. Pokud zaúčtování provádí deset lidí na podlaze haly, mobilní rozhraní vhodné pro skener může způsobit rozdíl. Pokud musí existující program Windows pracovat se speciálním hardwarem, může být nutná desktopová integrace.

Ne každá funkce patří na každé zařízení. To není nedostatek multiplatformního řešení, ale znak čistých produktových rozhodnutí. Společná data a obchodní pravidla nemusí znamenat identické obrazovky.

Tři otázky, které objasní náklady a přínos

První otázka zní: jaká zařízení jsou již v používání a jak dlouho v něm zůstanou? Podnik se spravovanými terminály Windows má jiné požadavky než externí služba se soukromými chytrými telefony. Druhá zní: co se stane bez síťového připojení? Offline schopnost výrazně zvyšuje náklady, protože data se musí lokálně ukládat, později synchronizovat a při konfliktech čistě zpracovat. Je smysluplná, pokud by se jinak proces zastavil - ne jako standardní výbava.

Třetí otázka se týká následků výpadku. Může zaměstnanec zaúčtování doplnit později, nebo na něm závisí expediční štítek, zásoba či bezpečnostní uvolnění? Čím kritičtější je proces, tím silněji se musí plánovat oprávnění, kontrolní pravidla, opakovatelnost a zaznamenávání.

Architektura, která se nerozpadne u druhé platformy

U udržitelného řešení není obchodní logika roztroušena ve více rozhraních. Kontroly zásob, změny stavů, číselné řady, oprávnění a tvorba dokumentů potřebují centrální, otestovaný základ. Prohlížeč, mobilní aplikace a desktopový klient k němu přistupují přes jasně definovaná rozhraní.

Pro mnohé interní obchodní procesy je moderní webová aplikace nejhospodárnějším východiskem. Dá se centrálně aktualizovat, nevyžaduje instalaci na každém pracovišti a funguje na počítači, tabletu a chytrém telefonu. S PHP 8.4, moderním JavaScriptem a MySQL 8 lze vybudovat udržitelný základ, pokud se datový model, přístupová práva a nasazení nezvažují až těsně před spuštěním.

Instalovatelná mobilní nebo desktopová aplikace se přidá tehdy, když přináší jasnou výhodu: hlubokou integraci se skenerem, tiskárnou nebo kamerou, spolehlivý offline provoz, speciální funkce na pozadí nebo požadavky správy zařízení. Je to cílené rozšíření, ne samoúčel.

Častou chybou je úplné opětovné použití uživatelského rozhraní za každou cenu. Technicky to může vypadat atraktivně. V praxi vznikají malé texty na velkých monitorech, přetížené formuláře na chytrých telefonech nebo ovládání, které neodpovídá platformě. Lepší je sdílet datový model, pravidla a komponenty tam, kde to dává smysl, a ovládání přizpůsobit příslušnému kontextu.

Konzistence dat je důležitější než společná kódová základna

Více platforem zvyšuje nebezpečí protichůdných dat. Objednávka se změní v kanceláři, zatímco řidič na svém zařízení ještě vidí starou verzi. Dva zaměstnanci zaúčtují současně stejnou zásobu artiklu. Offline zařízení odešle své změny zpět až o hodiny později. Tyto případy nejsou okrajovým tématem, ale jádrem architektury.

Systém proto potřebuje jednoznačné identity, časová razítka, sledovatelné změny stavů a pravidla pro konflikty. U stavu dodávky může stačit poslední potvrzená změna. U zásob je to často příliš hrubé. Tam musí být jasné, který pohyb se zaúčtoval, ze kterého skladového místa pochází a zda se musí oprava zdůvodnit.

I oprávnění patří upravit centrálně. Zaměstnanec smí možná evidovat příjmy zboží, ale ne schvalovat opravy zásob. Externí řidič smí vidět jen svou trasu. Délky relací, vícefaktorové ověření u kritických rolí a postupy zablokování účtu nejsou dekorativní bezpečnostní funkce. Chrání konkrétní procesy a činí odpovědnosti viditelnými.

Testovat Multiplatform Application Development tak, jak se pracuje

Aplikace se může spustit na třech operačních systémech a přesto selhat v provozu. Rozhodující jsou průběhy v reálných podmínkách: skener reaguje příliš pomalu, tiskárna štítků není dostupná, oprávnění nezabere po změně role nebo synchronizace vytvoří dvojitá zaúčtování.

Proto by se měly kritické procesy ověřovat automatizovaně. Patří sem přihlášení a chování při zablokování, zadávání objednávek, pohyby zásob, tvorba dokumentů a zpracování chybných vstupů. Pro webové aplikace a aplikace Windows lze opakující se testy spouštět na samostatně hostované infrastruktuře. To je obzvlášť důležité, pokud se snímky obrazovky, interní data objednávek nebo testovací přístupy nemají předávat externím cloudovým službám.

Automatizace nenahrazuje kontrolu lidmi na podlaze skladu. Zajišťuje však, že známé průběhy se po změnách kontrolují znovu a znovu. Dobré testovací zprávy nepojmenovávají jen technickou chybu, ale dotčený proces: doklad o dodávce nelze vytvořit, uživatelský účet zůstává po úspěšném uvolnění zablokovaný nebo se data trasy neaktualizují.

Kdy je strategie platformy příliš

Některé podniky nepotřebují vlastní aplikaci. Pokud stačí stabilní přístup přes prohlížeč, postup je zřídka mobilní a počet uživatelů zůstává přehledný, je responzivní webová aplikace často rozumnější volbou. Snižuje náklady na údržbu, problémy s distribucí a počet možných zdrojů chyb.

Ani existující tabulku není třeba hned nahradit. Pokud slouží jen jako jednoduché vyhodnocení, udržuje ji jedna osoba a nevytváří chybově náchylná předání, může splnit svůj účel. Čas na systém nastává, když znalosti sedí v jednotlivých hlavách, verze se rozcházejí, dotazy přibývají nebo se operace už nedá spolehlivě sledovat.

Naopak, štíhlá strategie platformy se rychle stane příliš malou, když zaměstnanci musí pracovat offline, připojuje se hardware nebo zákazníci a partneři potřebují kontrolovaný přístup. Tehdy se vyplatí dodatečné požadavky vědomě financovat, místo aby se později dostavovaly pod časovým tlakem.

Začít spolehlivým pilotem

Dobrý začátek není katalog funkcí se sto body, ale úplný, měřitelný postup. Například: zaevidovat příjem zboží, aktualizovat zásobu, zdokumentovat odchylku a vytvořit úkol k objasnění. Tento pilot včas ukáže, zda k sobě pasuje datový model, zařízení, práva a ovládání.

Poté může řešení růst ve smysluplných krocích: komisionování, expedice, plánování tras nebo vyhodnocení. Každé rozšíření by mělo obstát u stejné otázky: zkracuje skutečný postup, snižuje chyby nebo vytváří spolehlivou transparentnost? Pokud ne, může počkat.

Nejsmysluplnější platforma nakonec není ta s nejvíce technickými možnostmi. Je to ta, na které tým ráno rychleji začne pracovat, během směny méně ptá a večer může sledovat, co se skutečně stalo.

Permalink →

Jak správně hodnotit Test Automation Results

Jak správně hodnotit Test Automation Results

Regresní test může ráno skončit s 98 procenty úspěšných případů a přesto nebýt dobrou zprávou. Možná je neúspěšný test právě přihlášení velkého zákazníka. Možná se 40 testů přeskočilo, protože testovací prostředí nebylo dostupné. Nebo byl běh zelený, ale kontroloval jen to, zda tlačítka existují, ne zda se objednávka skutečně uloží, vytvoří se dodací list a zásoba se správně upraví. Test automation results nejsou výrokem o kvalitě, dokud chybí jejich kontext.

Pro vedení QA, vývoj a odborné útvary proto skutečná práce nespočívá jen v automatizaci testů. Rozhodující je připravit výsledky tak, aby z nich vznikala spolehlivá rozhodnutí: dá se vydání nasadit? Musí se chyba řešit okamžitě? Je chyba nová, opakovaná, nebo jen problém testovacího prostředí? A existují důkazy, kterým porozumí i odborný útvar bez testovacího kódu?

Co Test Automation Results skutečně vypovídají

Nejjednodušší ukazatel zní: prošel nebo neprošel. Je užitečný, ale zřídka dostačující. Vysoký podíl úspěšnosti může vytvářet důvěru, pokud testy pokrývají kritické procesy, testovací data jsou věrohodná a prostředí se podobá pozdějšímu provozu. Pokud chybí jeden z těchto faktorů, číslo zůstává především signálem, že se provedl automatizovaný průběh.

U obchodně kritických aplikací mají větší váhu jiné otázky. Ve skladovém řešení není každá obrazovka stejně důležitá. Chyba zobrazení ve vnitřním textu upozornění může počkat. Chyba, která při příjmu zboží zaúčtuje nesprávné množství nebo vytvoří expediční štítek bez adresy příjemce, ne. Dobré výsledky testů proto váží rizika místo toho, aby všechny případy braly stejně.

Ani neúspěšný test není automaticky chybou produktu. Může ho vyvolat prošlá platnost přístupových údajů, zablokovaná testovací role, nedostupná rozhraní, změněná testovací data nebo pomalé prostředí. Kdo tyto příčiny neodliší, vytváří šum. Tým pak tráví čas falešnými poplachy, zatímco skutečné chyby zanikají mezi červenými stavovými hlášeními.

Čtyři typy stavu místo jednoho červeného seznamu

V praxi se osvědčuje jasné rozdělení: odborná chyba, technická chyba testu, problém prostředí a očekávaná změna. Odborná chyba znamená, že aplikace porušuje definovaný požadavek. Technická chyba testu poukazuje spíše na samotný test, například selektor, který už nesedí po záměrně změněném rozhraní.

Problém prostředí nastává, když například testovací systém nebo připojené rozhraní není dostupné. Očekávané změny vznikají, když se proces záměrně upravil, ale automatizace ještě kontroluje starý cílový stav. Tyto kategorie nezabraňují každé diskusi. Ale zaručují, že diskuse začne na správném místě.

Od testovacích běhů ke zprávám připraveným k rozhodnutí

Použitelná zpráva neodpovídá jen na to, že něco selhalo, ale co se stalo, jak je to závažné a zda se chyba jeví jako reprodukovatelná. Je k tomu potřeba víc než seznam názvů testů a časových razítek.

Ke každému relevantnímu běhu patří ověřovaný build, testovací prostředí, použitá role, klíčová testovací data a čas začátku a konce. Zejména u desktopových aplikací Windows nebo složitých webových platforem jsou tyto informace potřebné ke zúžení rozdílů. Chyba, která se vyskytuje jen pod omezenou skladovou rolí, je něco jiného než chyba, která blokuje každé přihlášení.

Významné výsledky obsahují navíc sledovatelné důkazy: snímky obrazovky, zaznamenané kroky, chybová hlášení a v případě potřeby technické protokoly. Samotný snímek obrazovky však může klamat. Ukazuje okamžik, ne příčinu. Kombinace pořadí kroků, viditelného stavu a očekávané reakce je podstatně užitečnější.

Systémy podporované umělou inteligencí mohou tyto důkazy převést na srozumitelná hodnocení. U COCO například testy běží na vlastním, samostatně hostovaném AI serveru. Vyhodnocení může vysvětlit, že objednávka byla sice vytvořena, ale očekávaná změna stavu nenastala, a přímo přiřadit záznam provedení. Pro bezpečnostně uvědomělé týmy je relevantní, kde se zpracovávají snímky obrazovky, data aplikace a testovací provoz. Lokální kontrola není automaticky nezbytná, ale u interních aplikací a citlivých dat může být rozumnější cestou než externí cloudová služba.

Správná úroveň detailu pro různé příjemce

Vývojové týmy potřebují chybová hlášení, technické kroky a co nejpřesnější pokyny k reprodukci. Provozní manažer naopak potřebuje nejprve dotčenou funkci, obchodní riziko a jasné vyjádření k provozuschopnosti. Obě perspektivy musí moci vzniknout ze stejného provedení, aniž by někdo musel ručně přenášet výsledky do prezentací.

Dobrá zpráva proto začíná krátkou rozhodovací úrovní: vydání doporučeno, vydání se známými omezeními nebo zastavit vydání. Pod tím stojí kritické odchylky s prioritou a důkazem. Technické podrobnosti následují až poté. To není zjednodušení na úkor přesnosti, ale čisté oddělení informačních potřeb.

Měřit pokrytí bez klamání se o jistotě

Pokrytí testy se často znázorňuje jako procentuální hodnota. Tato hodnota je užitečná, když je jasné, co měří. Pokrytí kódu ukazuje například, které části programového kódu se provedly během testů. To nedokazuje, že obchodní proces funguje správně. Test se může dotknout mnoha řádků kódu a přesto nikdy neověřit, zda se na dokumentu objeví nesprávná dodací adresa.

Pro odborné útvary je pokrytí procesů často výpovědnější. Popisuje, které skutečné průběhy jsou chráněny: zaevidovat objednávku, rezervovat zásobu, zaúčtovat částečnou dodávku, přijmout vratku nebo schválit fakturu. Obzvlášť cenné jsou přechody mezi systémy a rolemi, protože tam často vznikají chyby: při importu objednávky, tisku štítku nebo při přechodu z kanceláře na skladový terminál.

Neurčujte priority podle počtu možných testů, ale podle dosahu škody a frekvence změn. Zřídka používaný proces s vysokým finančním nebo právním rizikem si často zaslouží automatizaci dříve než často používané, ale neškodné zobrazení. Naopak, stabilní, málo kritický průběh může nadále vystačit s krátkou ruční kontrolou. Ne každou kontrolu je třeba automatizovat jen proto, že se dá automatizovat.

Nestabilní testy jsou samostatný problém kvality

Testy, které bez rozpoznatelné změny produktu jednou projdou a jednou selžou, se často označují jako flaky. Poškozují důvěru rychleji než trvale červený test. Jakmile týmy reflexivně znovu spouštějí červené výsledky, automatizace ztrácí svou varovnou funkci.

Příčiny jsou obvykle konkrétní: pevné čekací doby, společně používaná testovací data, paralelní přístupy, asynchronní zpracování nebo prostředí, které se neobnovuje. Krátká tříslekundová pauza v testu může náhodou pomoci, ale není řešením. Lepší je čekat na prokazatelný stav, učinit testovací data jednoznačnými a izolovat průběhy od sebe.

Ne každou nestabilitu lze zcela vyloučit. Externí rozhraní mohou kolísat a skutečná infrastruktura má výpadky. Zpráva by pak měla jasně označit, zda se test kvůli externí závislosti nedal vyhodnotit. Opakovaný běh může být pro diagnostiku smysluplný, ale nesmí učinit první zjištění neviditelným.

Smysluplný postup po každém testovacím běhu

Po automatizovaném běhu by se neměl každý výsledek hned brát stejně. Nejprve se zkontrolují blokující chyby a kritické testy, které se nedaly vyhodnotit. Poté následuje zařazení nových odchylek vůči známým, akceptovaným problémům. Teprve potom je rozhodnutí o vydání spolehlivé.

Užitečné jsou stanovené prahové hodnoty, ale musí odpovídat procesu. Například neúspěšný test v platebním nebo autorizačním toku může spustit okamžité zastavení. U čistě kosmetické odchylky může být zdokumentovaná výjimka obhajitelná. Taková pravidla by neměla vznikat až pod časovým tlakem před vydáním.

Stejně důležitá je zpětná vazba: každá produkční chyba, kterou testy nezachytily, je důvodem zkontrolovat, zda nechybí scénář, varianta testovacích dat nebo kontrolní bod. Cílem není nahromadit co nejvíce testů. Je jím budovat ze skutečných chyb cíleně lepší zabezpečení.

Nejužitečnější výsledky testů nejsou nakonec ty s nejzelenějším přehledem. Jsou to ty, u kterých může odpovědná osoba v pondělí ráno pochopit, co se ověřilo, jaké riziko zůstává a jaký krok je nyní rozumný.

Permalink →

Inventory Discrepancy Causes: časté příčiny rozdílů v zásobách

Inventory Discrepancy Causes: časté příčiny rozdílů v zásobách

Zásoba v systému říká 248 kusů, na regálu leží 231. Těchto 17 jednotek působí nejprve jako chyba počítání. Ale přesně tam často začíná nesprávná analýza. Inventory discrepancy causes jsou v praxi zřídka jediné přehlédnutí. Většinou vznikají tam, kde se příjem zboží, skladový pohyb, komisionování, a zaúčtování časově nebo organizačně rozcházejí.

Pro malý nebo střední podnik nejsou rozdíly v zásobách jen tématem pro inventuru. Vedou k chybným objednávkám, expresním dodávkám, zbytečným bezpečnostním zásobám, a dodacím příslibům, které nelze dodržet. Kdo čistě oddělí příčiny, nemusí hned zavést velký ERP. Často stačí jasnější pravidla zaúčtování, vhodná zařízení pro evidenci, a systém, který odráží reálné pracovní procesy.

Inventory discrepancy causes: kde vznikají rozdíly

Rozdíl v zásobách je rozdíl mezi cílovou zásobou ve vedoucím systému a skutečně přítomnou zásobou. Rozhodující je zde slovo "vedoucí". Pokud se paralelně vedou Excel soubor, papírový seznam, a systém řízení zboží, prakticky existuje více pravd. Tehdy rozdíl nevznikl jen ve skladu, ale byl již zabudován do řízení dat.

Účinné protiopatření proto závisí na typu chyby. Nesprávně spočítaná paleta potřebuje jiné řešení než dodávka, která byla fyzicky přijata, ale nikdy zaúčtována. Než týmy přestaví procesy, měly by vyhodnotit rozdíly podle artiklu, skladové lokality, směny, typu pohybu, a okamžiku. Až tento vzor ukáže, zda jde o jednotlivý případ nebo opakující se procesní chybu.

1. Příjmy zboží se zaúčtují opožděně nebo neúplně

Příjem zboží je klasický bod zlomu. Zboží přijde ráno, odloží se ke kontrole, a později se přenese přímo do výroby nebo na regál. Zaúčtování se děje odpoledne, druhý den, nebo vůbec. Dokud je zboží fyzicky přítomno, zásoba systému se jeví příliš nízká. Pokud je již spotřebováno nebo vyexpedováno, následné chyby se stávají pravděpodobnějšími.

Obzvlášť náchylné jsou částečné dodávky, náhradní artikly, a nadměrné dodávky. Pokud je na dodacím listu uvedeno jedno množství, ale přijde jiné množství, nikdo by neměl jednoduše zaúčtovat doklad "nějak odpovídajícím způsobem". Rozdíl musí zůstat viditelný jako výjimka, včetně důvodu, odpovědné osoby, a schválení. Jinak odchylka zmizí z procesu a znovu se objeví až při inventuře.

2. Skladové pohyby se dějí bez transakce

Artikl se přemístí z příjmu zboží do vysokoregálového skladu, přemístí se z přihrádky do komisionační zóny, nebo se rezervuje pro objednávku. Fyzicky je to malý, rychlý pohyb. V systému může být rozhodující.

Pokud zaměstnanci přeuspořádávají skladové lokality jen podle pocitu, celková zásoba možná ještě bude sedět, ale dostupnost na správném místě ne. To způsobuje čas hledání, chybné komisionování, a zbytečné doplňovací jízdy. Dobré skladové řešení nemusí složitě zpracovávat každý pohyb. Musí zaznamenávat těch několik pohybů, které jsou relevantní pro dostupnost, sledovatelnost, a doobjednávání.

V dílnách nebo menších skladech je často smysluplnější udržovat několik jednoznačných zón než teoreticky dokonalou strukturu přihrádek, kterou nikdo v každodennosti neudržuje. Přesnost funguje jen tehdy, pokud zůstává proveditelná.

3. Komisionování a expedice se zaúčtují příliš brzy

Mnohé týmy zaúčtují objednávku při pickingu jako "vyskladněnou", ačkoli zboží ještě leží na přípravném místě. Pokud se objednávka následně změní, stornuje, nebo jen částečně vyexpeduje, systémová a fyzická zásoba se už neshodují.

Lepší je jasné oddělení mezi rezervované, komisionované, a vyexpedované. Ne každý podnik k tomu potřebuje složité stavové řetězce. Ale okamžik snížení zásoby musí být jednoznačný. U expedičního zboží je často blíže skutečnému předání přepravci než prvnímu sáhnutí na regál.

I vratky patří do tohoto procesu. Pokud se zboží vrátí, není automaticky opět dostupné. Až kontrola, rozhodnutí o kvalitě, a uskladnění by měly určit, zda se vrátí do prodejní zásoby, zůstane blokované, nebo bude vyřazeno.

4. Nesprávné jednotky a chyby kmenových dat

Karton, balení, role, a jednotlivý kus se mohou týkat stejného artiklu. Pokud přepočet není čistě udržován, vznikají rozdíly ohromující rychlostí. Zaměstnanec zaúčtuje "1", přičemž myslí karton s 24 kusy. Systém rozumí jednomu kusu.

Chyby kmenových dat jsou obzvlášť záludné, protože proces zaúčtování může vypadat technicky správně. Proto zkontrolujte balicí jednotky, přepočítací faktory, minimální množství, skladové lokality, a čísla artiklů. I podobně pojmenované varianty, například různé délky, barvy, nebo šarže, se snadno zamění.

Zde nepomůže paušální pravidlo jako "více skenovat". Čárové kódy jsou jen tak spolehlivé jako přiřazení za nimi. Při malých sortimentech může čistě udržovaný kmen artiklů s dobře čitelnými štítky dosáhnout více než rozsáhlá, ale špatně nakonfigurovaná krajina skenerů.

5. Paralelně vedené tabulky a ruční korekce

Tabulka na pracovní ploše vzniká zřídka z nedbalosti. Většinou vyplňuje reálnou mezeru: speciální rezervaci, chybějící hodnotu vyhodnocení, nebo proces, který stávající software nezobrazuje. Problematickou se stává, když se stane druhou knihou zásob.

Tehdy se přírůstky zaúčtují v systému, ale úbytky zaznamenají v tabulce. Nebo korekce probíhá jen tam, kde zrovna pomáhá další objednávce. Nikdo později nedokáže spolehlivě vysvětlit, která hodnota platí.

Ne každá tabulka se musí zrušit. Kalkulace pro plánování nebo analýzy může zůstat smysluplná. Ale procesy měnící zásobu by měly mít přesně jeden vedoucí systém. Úpravy potřebují kód důvodu, časové razítko, a ideálně osobu, kterou lze vysledovat. To není byrokracie pro byrokracii, ale předpoklad pro spolehlivé analýzy příčin.

6. Chyby počítání a nevhodné metody inventury

Ani správné procesy nechrání před lidskými chybami. Artikly se počítají dvakrát, palety se přehlédnou, otevřené kartony se odhadují, nebo se skladové lokality neblokují během počítání. Roční plná inventura odhalí tyto problémy pozdě a pod vysokým tlakem.

Pro mnohé provozy je průběžná inventura rozumnější alternativou. Rychle obrátkové nebo hodnotné artikly se kontrolují častěji, stabilní C-artikly méně často. Důležité není produkovat co nejvíce počítání, ale včas kontrolovat odchylky vůči posledním pohybům. Pokud se rozdílový artikl jednoduše opraví bez dokumentace příčiny, vzor zůstává neviditelný.

Protikontrola je obzvlášť smysluplná u vysokých hodnot, sériových čísel, nebo šarží. U šroubů ve spotřebním skladu může být ekonomicky přehnaná. Hloubka kontroly by měla odpovídat riziku.

7. Nejasné odpovědnosti mezi směnami a oblastmi

Chyby zásob vznikají často při předávkách. Ranní směna připraví zboží, odpolední směna ho vyexpeduje. Příjem zboží přijme dodávku, dispozice paralelně změní objednávku. Každý jednotlivý krok může být sledovatelný, ale nikdo nevlastní celý proces.

Proto definujte nejen role, ale i předávací body: kdo potvrzuje příjem zboží? Kdy se mění odpovědnost za komisionované zboží? Kdo kontroluje otevřené výjimky na konci směny? Společná digitální tabule nebo jednoduchý seznam výjimek je často účinnější než další schůzky.

Systém by měl zviditelnit otevřené procesy místo toho, aby nutil zaměstnance si pamatovat. Například dodávky bez kontroly množství, komisionování bez ukončení expedice, nebo vratky bez rozhodnutí o kvalitě musí upoutat pozornost dříve, než se stanou tichými chybami zásob.

8. Slabá integrace systémů a chybějící kontrolní pravidla

Pokud obchod, správa objednávek, sklad, a účetnictví vyměňují data s časovým posunem nebo přes soubor, mohou vzniknout dvojí nebo chybějící zaúčtování. Import se spustí dvakrát. Rozhraní tiše selže. Objednávka se změní poté, co už byl přenesen její stav expedice.

Řešení není nutně úplná náhrada. Často jsou potřeba jasně definovaná rozhraní, jednoznačná čísla dokladů, a technické kontroly. Skladové zaúčtování by mělo sledovatelně ukládat, kdy nastalo, z jakého procesu pochází, a zda bylo později stornováno. Kritické procesy potřebují chybová hlášení a fronty, nejen tichý záznam v log souboru.

U individuálně vyvinutých logistických systémů lze taková pravidla cíleně přizpůsobit provozu: žádné záporné množství bez schválení, žádné potvrzení expedice bez expediční pozice, žádné dvojí zpracování stejné externí reference. Nejlepší pravidlo zde není nejpřísnější, ale to, které zastaví skutečné chyby, aniž by blokovalo provoz při běžných výjimkách.

Systematicky kontrolovat rozdíly v zásobách

Nezačínejte s plošnou korekcí. Vyberte deset artiklů s nejčastějšími nebo nejdražšími rozdíly, a sledujte jejich poslední pohyb zpětně: příjem zboží, přemístění, úbytek, vratka, počítání, a případná ruční úprava. Pokud se případy shlukují na jednom místě, jedné směně, nebo jednom typu pohybu, je to pevný výchozí bod.

Poté by mělo být každé opatření měřitelné. Pokud se zavedou nová skenování čárových kódů, nesledujte jen počet skenování, ale míru rozdílů podle skupiny artiklů. Pokud se doplní nový stav pro přípravu, denně kontrolujte otevřené přípravy. Dobré procesy nevytvářejí zdánlivou přesnost. Dělají výjimky brzy viditelnými a sledovatelnými.

Smysluplný další krok je často malý: definovat předávací bod, vyčistit skladovou lokalitu, nebo technicky zajistit opakující se ruční korekci. Spolehlivé zásoby nevznikají z více softwaru na podezření, ale z procesů, které jsou i v hektické úterý v 16:45 stále správně proveditelné.

Permalink →

Jak správně přistupovat k automatizaci procesů pro MSP

Jak správně přistupovat k automatizaci procesů pro MSP

Dodací list chybí, protože údaje jsou stále na papírku. Příjem zboží je zaznamenán dvakrát, protože sklad a kancelář pracují s různými tabulkami. Schválení se opožďuje, protože odpovědná osoba právě nezvedá telefon. Takové tření zřídka stojí hodně peněz najednou. Ale během týdnů se sčítají dotazy, čas hledání, opravy chyb, a zbytečné čekání. Přesně tam má smysl automatizace procesů pro MSP.

Nejde o to nahradit co nejvíce činností softwarem. Dobrá automatizace dělá postupy sledovatelnými, snižuje zbytečná předávání, a dává zaměstnancům čas na rozhodnutí, která vyžadují zkušenosti. To je obzvlášť rozhodující v malých a středních podnicích: týmy jsou blízko každodennímu provozu. Když se proces zasekne, celá směna si to často všimne okamžitě.

Neautomatizovat každý proces

Nejčastější chybou je začít s nejviditelnější nepříjemností. Možná vadí soubor Excel, možná je potřeba nový dashboard. Obojí může být oprávněné. Ale digitalizovaný chaos zůstává chaosem - jen rychlejším a s více daty.

Před technickým rozhodnutím by měl být postup nejprve popsán tak, jak skutečně probíhá. Ne jak by měl být napsán v příručce. Kdo spouští postup? Jaké informace jsou potřeba? Kde se něco ručně přenáší? Kdo rozhoduje při výjimkách? A podle čeho tým pozná, že postup je dokončen?

Právě ve skladu nebo při zpracování objednávek se kritická místa často nacházejí mezi systémy: objednávka přijde e-mailem, zkopíruje se do tabulky, telefonicky se odsouhlasí, a později se zadá do přepravního softwaru. Každé předání zvyšuje pravděpodobnost, že se množství, termíny, nebo adresy budou lišit.

Automatizace se vyplatí obzvlášť tehdy, když se proces vyskytuje často, má jasná pravidla, a chyby způsobují citelné následky. Může to být příjem zboží, vytváření dodacích listů, přiřazování skladových pohybů, nebo předávání schválených objednávek expedici. Vzácné zvláštní případy s mnoha diskrečními rozhodnutími naopak často zůstávají lépe řízeny ručně - alespoň zpočátku.

Automatizace procesů pro MSP začíná prioritami

Ne každá zbytečná činnost si okamžitě zaslouží projekt. Jednoduché stanovení priorit přináší jasnost. Zhodnoťte jednotlivé postupy podle frekvence, doby zpracování, nákladů na chyby, a závislostí. Postup, který se děje padesátkrát denně a pokaždé ušetří jen dvě minuty, může být ekonomičtější než komplikovaný měsíční proces.

Otázka důsledku chyby je minimálně stejně důležitá. Nesprávně vytištěný interní dokument je nepříjemný. Nesprávné přiřazení šarže, ztracená dodací adresa, nebo nezdokumentovaný příjem zboží může vyvolat reklamace, práci s hledáním, a rozdíly v zásobách. Tam automatizace vytváří nejen tempo, ale i spolehlivost.

Smysluplný první krok je obvykle dostatečně malý na to, aby byl ověřitelný během několika týdnů. Například zaměstnanec může evidovat zboží přes čárový kód, systém ověří artikl a množství, aktualizuje zásobu v centrální databázi, a podle potřeby přímo vytvoří skladový doklad. Tým pak nemusí hádat, která verze tabulky je aktuální.

Jasný cílový stav místo seznamu funkcí

Mnohé projekty začínají dlouhým seznamem požadovaných funkcí. Lepší je konkrétní provozní obraz: co by mělo být na konci postupu viditelné bez dalších dotazů? Při expedici by to mohlo znamenat, že objednávka po schválení automaticky dostane sběrný seznam, dodací adresa se ověří, a může se vytvořit štítek. Výjimky viditelně skončí v seznamu k objasnění, místo v nepřehledné e-mailové schránce.

Tento cílový obraz nutí k užitečným rozhodnutím. Musí se každá objednávka zpracovat zcela automaticky? Nebo by se objednávky nad určitou hodnotu zboží, s odchylnou dodací adresou, nebo s chybějící zásobou měly vědomě předložit ke kontrole? Automatizace nepotřebuje stoprocentní zpracování naslepo, aby vytvořila velký užitek.

Vhodná technika závisí na postupu

Neexistuje standardní technická cesta pro každé MSP. Tabulkové řešení může nadále zůstat rozumné pro přehledné vyhodnocení. Je rychle přizpůsobené, důvěrně známé, a způsobuje malé zaváděcí úsilí. Jakmile ale pracuje více osob současně, zaúčtování musí být sledovatelná, nebo se data vyměňují s jinými systémy, naráží na své hranice.

Tehdy je často smysluplnější štíhlá, workflow-specifická aplikace než předimenzovaná enterprise sada. Může přesně zobrazit kroky, které jsou v provozu potřeba: zaevidovat objednávku, ověřit zásobu, přesunout zboží, vytvořit dokument, zaúčtovat expedici, a nahlásit stav zpět. Ne více, ale ani méně.

Technicky přitom méně záleží na tom, zda systém propaguje nejnovější módní slovo. Rozhodující jsou pevné základy: čistě modelovaná databáze, sledovatelná oprávnění, protokoly pro relevantní změny, spolehlivá rozhraní, a dokumentovaná nasazení. Aplikace na bázi PHP 8.4, moderního JavaScriptu, a MySQL 8 může být dlouhodobě velmi dobře udržovatelná, pokud jsou architektura a provoz promyšleny od začátku.

I integrace si zaslouží pozornost. Automatická výměna dat s obchodem, ERP, přepravním poskytovatelem, nebo účetnictvím šetří čas jen tehdy, pokud jsou chyby řešeny viditelně. Co se stane u neplatné adresy? Zkouší se neúspěšný tisk štítku znovu? Vidí tým, která data byla přenesena a která ještě chybí? Tiché chyby jsou nebezpečnější než jasně označený výjimečný případ.

Zavedení během běžného provozu

Nový systém se musí přizpůsobit střídání směn, dodacím termínům, a existujícím pracovním rutinám. Proto je postupné zavádění obvykle bezpečnější než tvrdý termín pro všechny oblasti. Začněte ohraničeným procesem, produktovou skupinou, nebo skladovou oblastí. To snižuje riziko a vytváří skutečnou zpětnou vazbu z každodennosti.

Paralelní provoz přitom není znakem nejistoty, ale kontrolovaným testem. Po omezenou dobu lze porovnat starou a novou evidenci. Rozdíly neukazují jen softwarové chyby, ale často i pravidla, která dosud existovala jen v hlavách jednotlivých zaměstnanců. Tato pravidla viditelně patří do procesu - ne trvale do osobní zkušenosti.

Zaměstnanci by neměli být konfrontováni s novým postupem až při školení. Kdo proces provádí denně, brzy rozpozná zkratky, zvláštní případy, a nepraktické masky. Dobrý software respektuje tyto znalosti, aniž by neměnně zabudoval každou historicky vzniklou výjimku. Správná otázka zní: která výjimka chrání důležitý obchodní případ, a která je jen obchvatem pro starý problém?

Učinit měřitelným, zda se námaha vyplatí

Před startem by měly být stanoveny dva nebo tři ukazatele. Může to být průběžná doba na objednávku, počet ručních korekcí, rozdíly v zásobách, nebo čas do expedice. Bez výchozí hodnoty se každé pozdější hodnocení stane pocitem.

Ne každý efekt se okamžitě projeví v korunách. Když skladový tým vždy ví, kde se zboží nachází, klesá počet přerušení. Když dodací dokumenty vznikají ze stejných dat jako objednávka, klesá riziko protichůdných údajů. A když jsou odpovědnosti viditelné v systému, postup méně závisí na jednotlivých osobách.

Automatizace potřebuje údržbu a hranice

Automatizovaný postup není projekt, který zamrzne po nasazení. Struktury artiklů se mění, zákazníci vyžadují nové dokumenty, přepravní poskytovatelé přizpůsobují rozhraní. Proto odpovědnosti, aktualizace, zálohy, a regulované zacházení s oprávněními patří k samotnému systému.

Obzvlášť u aplikací s daty zákazníků, objednávek, nebo zásob by mělo být jasné, kdo získá přístup a proč. Role musí odpovídat pracovní každodennosti: skladový tým potřebuje jiné funkce než účetnictví nebo prodej. Zaznamenané změny, bezpečné přihlašovací toky, a testované obnovy působí neefektně. V případě poruchy právě tyto detaily rozhodují, zda může provoz pokračovat v práci.

I testy jsou součástí provozní bezpečnosti. Opakované kontroly pro zadávání objednávek, skladové zaúčtování, tvorbu dokumentů, a správu práv zabraňují tomu, aby úprava na jednom místě poškodila fungující postup na jiném místě. U kritických webových nebo desktopových aplikací může být smysluplné kontrolované, samostatně hostované testovací prostředí, pokud snímky obrazovky, testovací data, a interní procesy nemají dosáhnout externích cloudových služeb.

softify.pro doprovází takové projekty jednoduchou zásadou: nejprve pochopit skutečný postup, poté postavit nejmenší udržitelné řešení. Někdy je to aplikace na míru. Někdy stačí existující tabulku strukturovat čistěji a automatizovat jeden jediný krok předání.

Nejlepším dalším krokem proto není srovnání softwaru, ale průchod skutečným postupem - od spouštěče po dokončení. Vezměte objednávku, příjem zboží, nebo reklamaci a sledujte ji se zúčastněnými osobami. Tam, kde se informace zadávají znovu, nikdo nezná stav, nebo rozhodnutí zbytečně čekají, se obvykle nachází nejsmysluplnější přístup k automatizaci.

Permalink →

Testování Windows aplikací: praktický plán

Testování Windows aplikací: praktický plán

Windows aplikace může v demo režimu vypadat upraveně a přesto v pondělí ráno zpomalit provoz. Neuložený dodací list, uživatel zablokovaný po třech neúspěšných pokusech, nebo dialog tisku, který po aktualizaci reaguje jinak, nejsou kosmetické chyby. Kdo chce vědět, jak testovat Windows aplikace, by proto neměl začínat jednotlivými tlačítky, ale procesy, které stojí práci, peníze, nebo sledovatelnost.

Právě ve skladu, dílně, dispozici, a administrativě probíhá mnoho kritických procesů přes desktopový software vyvíjený v průběhu let. Tam nezáleží na tom, zda je testovací případ působivě formulován. Rozhodující je, zda zaměstnanci spolehlivě dokážou vykonávat své úkoly za realistických podmínek - i při neúplných datech, měnících se oprávněních, pomalých sítích, a neplánovaných přerušeních.

Testování Windows aplikací začíná kritickými procesy

Nezaslouží si každá funkce stejné úsilí při testování. Zřídka používaný export s manuálním dopracováním je třeba hodnotit jinak než zaúčtování příjmu zboží, vytvoření štítku, nebo denní odsouhlasení objednávek. Začněte proto jednoduchou otázkou: co se konkrétně stane, pokud tento proces selže?

Vysokou prioritu mají procesy s přímým vlivem na zásoby, dodávku, fakturaci, bezpečnost, nebo komunikaci se zákazníkem. Sem patří například přihlášení a kontrola práv, vytvoření a změna kmenových dat, zaúčtování transakcí, tisk dokumentů, rozhraní na ERP nebo přepravní služby, jakož i obnovení po chybě. I funkce, které používá jen malá skupina lidí, mohou být kritické, pokud blokují měsíční uzávěrku nebo uvolnění zboží.

Z těchto procesů nevznikají abstraktní seznamy testů, ale sledovatelné pracovní kroky. Test příjmu zboží by mohl například začít existující objednávkou, zaznamenat částečnou dodávku, nahlásit odchylné množství, přiřadit skladové místo, a poté ověřit, zda se shodují zásoby, protokol zaúčtování, a vytištěný dokument. Tak testujete skutečný účinek softwaru, nejen jednotlivá vstupní pole.

Vytvořit testovací základnu, která odráží provoz

Mnohé chyby se stanou viditelnými až tehdy, když se testovací prostředí přiblíží realitě. Aplikace se s prázdným testovacím nájemcem často chová jinak než s víceletými pohybovými daty, blokovanými artikly, chybějícími povinnými informacemi, nebo již otevřenými transakcemi.

Proto vědomě vytvořte testovací data. Nemusíte nutně potřebovat úplnou kopii produkce. Smysluplnější je kontrolovaný soubor dat s typickými, hraničními, a záměrně chybnými případy: artikly s různými měrnými jednotkami, zákazníci se speciálními podmínkami, objednávky s částečnými dodávkami, uživatelé s různými rolemi, a transakce, které jsou již ve zpracování. Osobní údaje by měly být přitom anonymizovány nebo nahrazeny realistickými vzorovými daty.

K testovací základně patří i technické prostředí. Dokumentujte verzi Windows, rozlišení, škálování, nainstalované tiskárny, síťové disky, verzi databáze, připojené služby, a oprávnění. Zní to suchopárně, ale později to šetří čas. Pokud se chyba vyskytuje jen na pracovištích se škálováním 125% nebo s určitým ovladačem tiskárny, musí to být reprodukovatelné.

Neověřovat jen ideální případ

Ideální případ především dokazuje, že aplikace byla postavena pro očekávanou cestu. V provozu vznikají obtížné situace vedle toho. Co se stane, pokud uživatel nechá povinné pole prázdné, spustí stejné zaúčtování dvakrát, nebo ztratí spojení během ukládání? Zůstává transakce konzistentní? Dostane osoba srozumitelnou zprávu? Může bezpečně pokračovat v práci?

U Windows aplikací jsou kromě toho obzvlášť relevantní obsluha a stav. Dialogová okna se mohou objevit na pozadí, klávesové zkratky se mohou překrývat, dialogy výběru souborů mohou blokovat průběh. Ověřte, zda jsou fokus, chybová hlášení, a blokování jednoznačné. Technická výjimka bez pokynu k jednání nepomůže vedoucímu směny.

Manuální testy nasadit tam, kde je potřeba úsudek

Manuální testy nejsou znakem nedostatečné vyspělosti. Jsou nepostradatelné, když vzniká nový proces, přestavuje se rozhraní, nebo o kvalitě rozhoduje odborné poznání. Zkušený vedoucí skladu rozpozná rychleji než skript, zda je maska srozumitelná pod vysokým časovým tlakem, nebo zda se upozornění objeví příliš pozdě.

Manuální testování se však stává nákladným a nespolehlivým, když se stejné stabilní procesy opakují před každou verzí. Pak uvolnění závisí na dostupných osobách, paměti, a roztroušených poznámkách. Správný přechod na automatizaci se obvykle nachází tam, kde se proces vykonává často, může způsobit velkou škodu, a má jasné očekávané výsledky.

Dobrý manuální testovací případ popisuje výchozí situaci, kroky, očekávaný výsledek, a potřebná data. Při chybě doplňte snímek obrazovky, časové razítko, verzi aplikace a buildu, jakož i přesnou akci. "Tisk nefunguje" není použitelný popis chyby. "Po změně dodací adresy zůstává dialog tisku otevřený, objednávka 4711 nedostane PDF, a nezobrazí se žádná zpráva" je.

Automatizované regresní testy pro opakující se rizika

Automatizace neověřuje, zda je software zásadně dobrý. Ověřuje, zda dříve fungující, definované procesy fungují i po změně. To je obzvlášť cenné u Windows softwaru, jehož rozhraní, logika databáze, a externí rozhraní se vyvíjejí po léta.

Začněte malým krokem. Vyberte si nejprve pět až deset obchodně kritických procesů, které by se měly ověřovat při každém vydání. Sem mohou patřit přihlášení s account-lockout postupem, zadávání objednávek, skladové zaúčtování, tisk PDF nebo štítků, změna role, a centrální import. Až když tyto testy běží spolehlivě, vyplatí se rozšíření na speciální případy.

U desktopových aplikací automatizované testy často řídí viditelné prvky rozhraní: okna, vstupní pole, tabulky, tlačítka, a dialogy. To funguje, ale je citlivější než čistý test rozhraní. Malé změny rozvržení, pomalejší počítače, nebo nejednoznačně pojmenované prvky mohou testy pokazit. Proto by vývojáři, odborný útvar, a odpovědní za testování měli společně určit, které prvky jsou stabilně adresovatelné a které kontrolní kroky je lepší zajistit přes databázi, protokol, nebo rozhraní.

Smysluplný test navíc neověřuje jen to, že se dalo kliknout na tlačítko. Kontroluje odborný důsledek: bylo zaúčtování uloženo? Je zásoba správná? Byl vytvořen dokument? Nebyl vytvořen duplicitní záznam? Viditelná interakce a ověřitelný výsledek patří k sobě.

Důkazy jsou součástí výsledku testu

Samotný zelený stav u kritických aplikací málokdy stačí. Když test selže, týmy rychle potřebují odpověď na tři otázky: jaká byla výchozí situace? Na jakém kroku proces selhal? Co aplikace v tom momentě zobrazovala?

Snímky obrazovky, protokoly průběhu, a případně záznamy obrazovky dělají chyby předmětem diskuse. Výrazně zkracují předání mezi provozem, QA, a vývojem. Pro regulované nebo bezpečnostně uvědomělé společnosti jsou navíc spolehlivým základem pro sledování schválení a odchylek.

Přitom místo uložení není vedlejší záležitostí. Testovací běhy mohou obsahovat interní zákaznická data, ceníky, informace o objednávkách, nebo pohledy na obrazovku. Kdo automatizovaně testuje citlivé Windows aplikace, by měl objasnit, zda tato data smí opustit vlastní infrastrukturu. Samostatně hostované prostředí jako COCO zde může být smysluplné, protože provádění testů, důkazy, a hodnocení zůstávají pod vlastní kontrolou. Zda je to nutné, závisí na požadavcích na ochranu údajů, smluvní situaci, a potřebě ochrany - ne každý tým potřebuje k tomu stejnou architekturu.

Zabudovat testování do procesu vydávání

Nejlepší katalog testů ztrácí hodnotu, pokud se použije až po hektickém nasazení do produkce. Definujte pevný okamžik: automatizované jádrové regrese běží před každým vydáním, manuální akceptace ověřuje nové nebo změněné procesy, a známá omezení se otevřeně dokumentují.

Nemusí každý neúspěšný test zastavit vydání. Chyba ve zřídka používaném administrativním zobrazení může být přijatelná, pokud existuje bezpečné řešení a dotčená oblast je jasně informována. Chyba, která nesprávně zaúčtuje zásoby nebo nepozorovaně zablokuje uživatele, se musí řešit jinak. Toto rozhodnutí by se mělo přijmout podle obchodního dopadu, ne podle pouhého počtu červených testů.

Udržujte testy společně s aplikací. Když se proces záměrně mění, aktualizujte testovací případ, testovací data, a očekávaný výsledek společně s požadavkem. Zastaralé testy vytvářejí šum a nakonec se ignorují. Několik důvěryhodných kontrol je cennějších než stovky automatizovaných procesů, jejichž výsledky už nikdo nebere vážně.

Nakonec nejde o simulaci každého myslitelného vstupu. Jde o ochranu práce, která musí opět fungovat další ráno. Začněte jediným kritickým procesem, učiňte jeho výsledek prokazatelným, a stavějte odtud dál.

Permalink →

Secure test data management bez ztráty kontroly

Secure test data management bez ztráty kontroly

Neúspěšný testovací běh je nepříjemný. Úspěšný testovací běh se skutečnými zákaznickými daty v nedostatečně chráněném prostředí může být výrazně dražší. Secure test data management neřeší tento rozpor jediným nástrojem, ale jasnými pravidly pro data, přístupy, testovací prostředí, a důkazy. Pro týmy, které automatizovaně testují webové nebo Windows aplikace, to proto patří ke kvalitativní práci - nejen k souladu s předpisy.

Proč se testovací data stávají bezpečnostním problémem

Produkční data jsou pro testy lákavá, protože obsahují skutečné okrajové případy: neúplné adresy, neobvyklé kombinace objednávek, historická cenová pravidla, nebo chybné vstupy. Právě tato data však často obsahují jména, kontaktní údaje, smluvní informace, personální čísla, bankovní údaje, nebo interní obchodní logiku.

Riziko zřídka vzniká jednou hrubou chybou. Většinou roste postupně: export databáze se vytvoří pro test, uloží se do sdíleného adresáře, a později se zkopíruje do dalšího prostředí. Externí služba dostane snímky obrazovky pro analýzu chyb. Testovací účet si zachová rozsáhlá práva, protože vyčištění by mohlo narušit další běh. Po několika měsících už nikdo spolehlivě neví, která data se kde nacházejí.

V malých a středních podnicích se problém často vyostřuje kvůli omezeným kapacitám. Tým chce dodržet termín vydání, ne provozovat vlastní projekt ochrany údajů. Odpovědnost přesto zůstává. Kdo používá data k zajištění kvality, musí být schopen sledovat, jaká data se zpracovávají, kdo k nim má přístup, a kdy se znovu odstraní.

Secure test data management začíná před testovacím případem

Rozhodující otázka nezní: "Jak chráníme testovací datový fond?" Zní: "Jakou informaci tento test skutečně potřebuje?" Mnohé regresní testy nepotřebují vůbec skutečné osobní reference. Zásilkový proces musí například ověřit, zda se dodací adresy, hmotnosti, zóny, štítky, a změny stavu zpracovávají správně. K tomu stačí syntetičtí zákazníci, věrohodná kmenová data artiklů, a vědomě definované hraniční případy.

Toto rozlišení vede k praktické klasifikaci dat. Ne každé testovací prostředí potřebuje stejnou hloubku dat. Pro jednotkové a integrační testy často stačí zcela umělé datové sady. Pro end-to-end testy mohou být smysluplné pseudonymizované kopie, pokud jsou skutečné datové vzory odborně relevantní. Data podobná produkčním by měla být výjimkou - s dokumentovaným účelem, omezeným přístupem, a pevnou dobou životnosti.

Důležitá je přitom kvalita náhradních dat. Náhodná fantazijní data pomáhají málo, pokud nezobrazují realistické závislosti. Testovací datová sada pro skladovou aplikaci musí například obsahovat varianty artiklů, skladová místa, blokované zásoby, částečné dodávky, a vrácení zboží v souladné kombinaci. Dobrá testovací data nechrání jen osobní informace. Nacházejí chyby, které by s prázdnými tabulkami a vzorovým zákazníkem "Jan Novák" nikdy nebyly viditelné.

Syntetizovat, maskovat, nebo minimalizovat?

Syntetická data jsou nejbezpečnější volbou, když se odborná pravidla dají čistě modelovat. Vznikají cíleně z testovacích požadavků a neobsahují žádnou kopii skutečných osob ani transakcí. Úsilí spočívá v údržbě: pokud se změní datový model nebo přibudou nová procesní pravidla, generátory a fixtures musí růst spolu s nimi.

Maskování se hodí, když chování aplikace silně závisí na produkčních strukturách. Přitom se citlivá pole nahrazují nebo mění, zatímco vztahy zůstávají zachovány. Ze jmen se stávají věrohodná, ale fiktivní jména; z e-mailových adres se stávají nedoručitelné testovací adresy; z čísel účtů se stávají hodnoty se správným formátem bez skutečné vazby. Maskování je odolné jen tehdy, pokud se zohlední i nepřímé závěry. Kombinace vzácného místa, data narození, a smluvní vlastnosti může osobu stále identifikovat.

Minimalizace dat je často podceňovanou třetí cestou. Místo kopírování úplného exportu se poskytuje jen potřebný výsek. To snižuje útočnou plochu, potřeby úložiště, a náročnost čištění. Na test slevové logiky nikdo nepotřebuje celou roční historii zákazníka.

Přístupy a prostředí musí odpovídat riziku

Chráněná datová sada ztrácí svou hodnotu, pokud se nachází ve volně dostupném testovacím prostředí. Testovací systémy proto potřebují vlastní bezpečnostní hranice - oddělené databáze, vlastní servisní účty, jasně definované síťové přístupy, a žádné tiché propojení s produkcí.

Přístupová práva by měla být založena na rolích, ne na sdílených účtech. Vývojáři mohou potřebovat jiná práva než QA, podpora, nebo externí poskytovatelé služeb. Administrátorské přístupy jsou někdy nutné, ale měly by být časově omezené, zaznamenávané, a spojené s prokazatelným schválením. I pro testovací účty platí smysluplná pravidla hesel, vícefaktorová autentizace tam, kde je dostupná, a postupy blokování účtu při opakovaných neúspěšných pokusech.

Automatizované testy přinášejí další zvláštní případ: generují důkazy. Snímky obrazovky, záznamy obrazovky, protokoly, a chybová hlášení mohou obsahovat citlivý obsah, i když byla databáze maskována. Snímek obrazovky zákaznické masky, prohlížečová stopa s informacemi o relaci, nebo protokol s API payloadem patří do stejné úvahy o ochraně jako testovací databáze.

Proto testovací artefakty potřebují pravidla uchovávání. Ne každý úspěšný běh se musí trvale ukládat. Pro kritická schválení může být smysluplný sledovatelný důkaz, například s časovým razítkem, číslem buildu, verzí testu, a výsledkem. Neúspěšné běhy často potřebují delší období na analýzu. Poté by artefakty měly být automaticky odstraňovány. Co už neexistuje, nemůže být náhodně sdíleno nebo kompromitováno.

Automatizace bez nekontrolovaných úniků dat

AI podporovaná testovací automatizace může výrazně urychlit testy, zejména u rozsáhlých webových a Windows aplikací. Mění však bezpečnostní otázku: kam jdou snímky obrazovky, vstupy, popisy chyb, a aplikační provoz? Kdo je zpracovává? Jak dlouho tam zůstávají?

Pro bezpečnostně uvědomělé týmy je samostatně hostované provádění často lepší architekturou. Systém jako COCO může běžet v rámci vlastní nebo jasně ohraničené infrastruktury, provádět testovací kroky, ukládat důkazy, a generovat srozumitelná hodnocení. To není v každé situaci povinné. Pro veřejnou marketingovou stránku s čistě syntetickými hodnotami formulářů může být externí služba opodstatněná. U interních odborných aplikací, zákaznických portálů, nebo softwaru s osobními procesy je však lokální kontrola konkrétní výhodou.

Samostatné hostování není volný průkaz. Provoz vyžaduje aktualizace, koncepty zálohování, protokoly přístupu, a odpovědný subjekt. Na oplátku suverenita dat zůstává tam, kam patří. Správný přístup závisí na potřebě ochrany, existujících provozních schopnostech, a typu testované aplikace - ne na aktuálním hypu kolem konkrétního testovacího nástroje.

Jak se z pravidel stává funkční proces

Praktický proces nemusí blokovat vydání. Začněte s mapou dat: jaká testovací prostředí existují, jaké typy dat se tam nacházejí, a jaké systémy generují další artefakty? Tato inventarizace obvykle už odhalí staré exporty, zapomenuté staging systémy, a nejasné odpovědnosti.

Poté se vyplatí jednoduchá rozhodovací matice pro každou třídu testu. Určuje, zda stačí syntetická data, je nutné maskování, nebo je potřeba jasně odůvodněný produkční výtah. Doplní se vlastníky, lhůtami smazání, a přístupovými rolemi. Nemusí to být přetížený soubor pravidel. Krátká, skutečně dodržovaná směrnice je lepší než bezpečnostní dokument, který nikdo nenajde během výpadku.

Technicky patří poskytování dat a čištění do testovací pipeline. Běh reprodukovatelně vytváří potřebné datové sady, používá jedinečná označení, a poté je znovu odstraňuje. To zabraňuje tomu, aby se testovací prostředí plnila zbytkovými daty a výsledky byly s každým sprintem méně důvěryhodné. Pro kritické procesy by týmy měly navíc ověřit, zda přístupy k datům a testovací důkazy musí být zaznamenávány způsobem vhodným pro audit.

Bezpečnost, která zrychluje testování

Secure test data management je často považován za dodatečnou kontrolní zátěž. Špatně implementovaný to skutečně může být. Dobře implementovaný však vytváří spolehlivé, opakovatelné výchozí podmínky. Týmy ztrácejí méně času hledáním použitelného exportu dat, vyhýbají se poškozeným testům kvůli nevyčištěným starým datům, a mohou lépe odůvodnit schválení.

Nejsmysluplnějším prvním krokem je jen zřídka velký platformový projekt. Vezměte testovací proces s nejvyšším rizikem nebo největším třením - například schválení interní objednávkové aplikace - a udělejte tam viditelnými zdroj dat, přístupy, artefakty, a mazání. Z této konkrétní práce vzniká bezpečnostní rutina, která testy nedělá těžkopádnějšími, ale důvěryhodnějšími.

Permalink →

Warehouse Software vs ERP

Warehouse Software vs ERP

Příjem zboží přichází současně s naléhavým kompletováním zakázky, dva zaměstnanci se ptají na skladové místo artiklu, a dodací list už byl ručně opraven. Přesně v takových okamžicích se otázka Warehouse Software vs ERP stává praktickou. Nejde o nejmodernější rozhraní ani nejdelší seznam funkcí. Jde o to, zda je informace dostupná přesně tam, kde je třeba rozhodnout během vteřin.

Mnoho malých a středních podniků v regionu DACH začíná s ERP, tabulkovým procesorem a velkými zkušenostmi v týmu. To může dlouho fungovat. Problémy nastávají teprve tehdy, když se zásoby mezi systémy začnou rozcházet, časy hledání rostou a každý zvláštní případ se musí řešit křikem přes sklad. V tu chvíli se na stole často objeví velký projekt ERP, přestože možná stačí digitalizovat jediný jasně vymezený skladový proces.

Warehouse Software vs ERP: rozdíl v každodenní praxi

Systém ERP zobrazuje podnik do šířky. Typicky propojuje nákup, prodej, kmenová data artiklů, účetnictví, výrobu, fakturaci a plánování. Jeho síla spočívá v tom, že obchodní a provozní data se sbíhají ve společném rámci. Zakázka se vytvoří, faktura vystaví, potřeba naplánuje, zásoba ocení.

Warehouse software, často nazývaný WMS nebo správa skladu, pracuje blíže ke skutečným pohybům uvnitř skladu. Podporuje příjem zboží, uskladnění, přesuny, kompletaci, inventuru, expedici a vrácení zboží. Odpovídá na otázky, které ERP často zobrazuje jen hrubě: na jakém místě zboží leží? Jaká zásoba je skutečně dostupná? Která šarže byla odeslána? Která zakázka má přednost? Kdo potvrdil přesun?

Toto rozhraní není absolutní. Existují ERP s rozsáhlými skladovými funkcemi a WMS produkty napojené na objednávkové nebo nákupní procesy. Rozhodující tedy není označení na nabídce, nýbrž provozní hloubka. ERP může spravovat deset skladových míst, a přesto být nepraktický, pokud zaměstnanci musí při každém pohybu otevírat několik obrazovek nebo data zapisovat až později.

ERP je obchodní zdroj

Když je třeba zakázku vyfakturovat, spustit nákupní objednávku nebo vytvořit ocenění materiálu, patří to ve většině podniků do ERP. Tam se obvykle nachází vedoucí logika artiklů a zákazníků. Tuto roli by se nemělo lehkovážně zdvojovat. Dva na sobě nezávislé systémy pro ceny, čísla artiklů nebo objednávky nevytvářejí jistotu, ale práci na sladění.

ERP je obzvláště užitečný, když je centrální výzva meziresortní: nákup a výrobu je třeba plánovat společně, finanční data musí zůstat konzistentní, nebo více společností pracuje se stejnými procesy. Kdo takový základ ještě nemá, neměl by očekávat, že čistě skladové řešení nahradí všechny podnikové procesy.

Warehouse software řídí pohyb

Ve skladu ale nezáleží jen na tom, co teoreticky existuje v systému. Záleží na tom, co právě dorazilo k bráně tři, které místo je volné a zda bylo zboží rezervováno pro potvrzenou zakázku. Dobré skladové řešení snižuje tření přesně v těchto bodech.

To může začít mobilními skenery: zboží se skenuje při příjmu zboží, přiřadí se ke skladovému místu a okamžitě se hlásí jako dostupné. Při kompletaci systém vede smysluplným pořadím, kontroluje artikl a množství a podle potřeby generuje přepravní štítky nebo dodací dokumenty. Zaúčtování neprobíhá o hodiny později na kancelářském pracovišti, ale přímo v rámci procesu.

Přínos nespočívá jen v rychlosti. Vysledovatelná zaúčtování zviditelňují chyby. Pokud zásoba nesedí, lze zjistit, kdy pohyb chyběl nebo byl nesprávně potvrzen. To je mnohem spolehlivější než měsíční oprava v tabulce.

Kdy stačí modul ERP

Existující modul ERP může být správnou volbou, když je organizace skladu přehledná a tým dokáže spolehlivě pracovat se stávajícími procesy. Jeden sklad, pevná místa, málo položek zakázky a žádné přísné požadavky na šarži či sériové číslo jsou typické podmínky. I při nízkém objemu expedice může dodatečná systémová součást přinést více údržby než užitku.

Před pořízením nového systému se vyplatí střízlivý test: dokáže zaměstnanec plně zaúčtovat příjem zboží, přesun a expedici bez papírku? Je zásoba viditelná podle skladového místa? Dají se vysledovat rozdíly z inventury? Vznikají dokumenty bez dvojího zadávání? Pokud jsou tyto odpovědi převážně ano, rozšíření možná není naléhavé.

I tabulkový procesor může zůstat, pokud čistě plní omezený účel, například sezónní plánování kapacit nebo jednorázové vyhodnocení. Dobré řešení nenahrazuje každý známý způsob práce. Nahrazuje ty ruční kroky, u kterých chyby, čekací doba nebo chybějící transparentnost skutečně stojí peníze.

Kdy dává smysl specializované skladové řešení

Zlomový bod přichází většinou postupně. Nejprve se zaměstnanec stále častěji ptá na artikl. Pak se zásoby pro jistotu udržují vyšší, protože nikdo s jistotou nezná skutečně dostupnou zásobu. Nakonec se zásilky opožďují, protože dodací listy, štítky a opravy zásob procházejí přes různé nástroje.

Specializovaný warehouse software dává obzvlášť smysl, když se sejde více z těchto podmínek:

  • spravuje se více skladových oblastí, skladových míst nebo externích skladů
  • příjmy zboží, přesuny a kompletace probíhají denně ve vysokém počtu
  • je třeba sledovat šarže, sériová čísla, data spotřeby nebo blokované zásoby
  • do procesu je třeba zapojit přepravce, tiskárny štítků nebo mobilní skenery
  • provozní realita se stále častěji odchyluje od zobrazení v ERP

Seznam není automatickým doporučením ke koupi. Podnik s mnoha položkami může dobře fungovat s dobře nastaveným ERP. Naopak malý podnik může brzy potřebovat štíhlou skladovou aplikaci, pokud musí být vysledovatelná každá součástka nebo musí současně zaúčtovávat více týmů.

Otázka integrace často rozhoduje více než funkce

Nejtěžší otázka u Warehouse Software vs ERP zřídka zní: který systém umí víc? Lepší otázka zní: která data musí kdy proudit do kterého systému?

V mnoha případech zůstává ERP vedoucím pro artikly, zákazníky, zakázky a obchodní doklady. Skladová aplikace přebírá provozní realizaci. Přijímá uvolněné zakázky, provádí skladové pohyby a zpětně hlásí stav, množství, šarže nebo čísla zásilek. Tím dostane každá strana jasný úkol.

Toto rozhraní potřebuje konkrétní pravidla. Co se stane se změnou zakázky poté, co kompletace už začala? Smí skladová zásoba klesnout do záporu? Které zaúčtování platí při výpadku sítě? Jak se blokují artikly, které upoutají pozornost při kontrole kvality? Bez těchto rozhodnutí se i technicky čisté API stává novým zdrojem chyb.

Pro malé a střední podniky je postupné zavádění často rozumnější než úplná výměna. Nejprve lze zavést příjem zboží se skenováním čárových kódů. Pak následují skladová místa a přesuny, později kompletace a expedice. Tak se skutečné výjimky rozpoznají včas, aniž by celý provoz závisel na jediném dni přechodu.

Standardní produkt, rozšíření ERP, nebo řešení na míru?

Standardní WMS se vyplatí, když jsou vlastní procesy z velké části běžné a existující integrace sedí s ERP. Rychle přináší do provozu osvědčené funkce. Cenou za to může být, že týmy musí přizpůsobit své postupy pevným šablonám, nebo doplácet za zřídka využívané enterprise funkce.

Rozšíření ERP dává smysl, když je potřebná provozní hloubka skutečně dostupná a obsluha funguje na podlaze haly. Ověřit by se neměla jen demoverze produktu, ale skutečný postup se skenerem, rukavicemi, kolísavým wifi a časovým tlakem před odjezdem.

Řešení na míru se stává zajímavým, když proces nese konkurenční výhodu podniku, nebo standardní software trvale vynucuje oklikami. Může jít o zvláštní proces příjmu zboží, propojení dílny a skladu, speciální dodací listy nebo vlastní logiku tras. Pak by se řešení nemělo uměle zvětšovat. Jasný proces, čistě namodelovaný a postavený na udržovatelném technickém základu, má větší hodnotu než platforma, která teoreticky umí vše.

softify.pro vyvíjí takové systémy podél konkrétních pohybů a odpovědností: od příjmu zboží přes skladová zaúčtování až po expediční dokumenty. Datový model, oprávnění, chybové stavy a pozdější údržba přitom zůstávají součástí realizace, nikoli úkoly na někdy po spuštění do ostrého provozu.

Otázky, které patří na stůl před rozhodnutím

Ne každý požadavek je třeba automatizovat první den. Měl by být ale vědomě rozhodnut. Odpovědní by si měli se skladovým týmem, obchodem a účetnictvím vyjasnit, která data jsou vedoucí, jaké chyby dnes vznikají nejčastěji a jaké ukazatele budou později skutečně potřeba. Hezký přehled zásob pomůže málo, pokud nikdo neví, zda se rezervované, blokované a dostupné množství zpracovává odlišně.

Stejně důležitá je odpovědnost za kmenová data. Skladové procesy zřídka selhávají kvůli chybějícímu tlačítku. Selhávají kvůli nejednotným číslům artiklů, neudržovaným měrným jednotkám a nevyjasněným pravidlům pro náhradní artikly nebo přepočty jednotek. Software může tyto problémy zviditelnit. Nemůže je ale vyřešit bez rozhodnutí zevnitř podniku.

Správná volba tedy není automaticky ERP nebo warehouse software. Vzniká z odstupu mezi vaším současným procesem a procesem, který váš tým skutečně musí spolehlivě vykonávat. Začněte u jednoho pohybu, který dnes stojí čas nebo vytváří chyby, a ověřte, který systém tento pohyb zobrazuje nejjasněji, nejrychleji a nejvysledovatelněji.

Permalink →

Automatizace příjmu zboží

Automatizace příjmu zboží

Nákladní auto stojí u brány, dva zaměstnanci kontrolují dodací listy a seznam zásob stále leží na počítači v kanceláři. Přesně tady se otázka how to automate goods receiving začíná stávat praktickou. Ne proto, že by každý sklad potřeboval velké zavedení ERP. Ale proto, že chybějící, opožděný nebo špatně zaúčtovaný příjem zboží má následky: stavy nesedí, objednávky čekají, reklamace se těžko dohledávají a směna začíná otázkami, které je třeba vyjasnit.

Automatizovat příjem zboží neznamená nahradit lidi skenery. Znamená to vést opakující se kontroly, zaúčtování a dokumenty tak, aby se tým u brány mohl rychle rozhodovat a aby byl stav zásob poté spolehlivý. Pro malé a střední podniky je štíhlý, vhodně přizpůsobený proces obvykle hodnotnější než koncernový systém plný funkcí, které nikdo nepoužívá.

Co se při ručním příjmu zboží skutečně ztrácí

Papírové dodací listy a tabulky Excel často fungují dostatečně dlouho na to, aby se investice odložila. Problém nevzniká u jednotlivého kartonu. Vzniká, když se hromadí odchylky: dílčí dodávka se zapíše až později, šarži nelze přiřadit, paleta skončí ve špatné zóně, nebo se zaúčtování příjmu provede až na konci dne.

Pak existuje několik pravd zároveň. Dodavatel hlásí dodáno. Ve skladu zboží fyzicky stojí. Dispozice ještě nevidí dostupný stav. Účetnictví má doklad, ale žádné potvrzení o množství či poškození. Zaměstnanci tyto informace slaďují telefonicky, e-mailem a na základě zkušenosti. To stojí čas a činí proces závislým na jednotlivých osobách.

Automatizace vytváří jeden společný, aktuální zdroj pro danou operaci. Zaznamenává nejen plánovaný stav, ale i to, co se skutečně stalo u brány: kdo převzal, kdy, v jakém množství, s jakou odchylkou a kam zboží dál směřuje.

How to automate goods receiving s jasným postupem

Správným začátkem není výběr skeneru nebo skladové aplikace. Nejprve musí být viditelný reálný proces. Projděte si typický příjem zboží od ohlášeného termínu dodání až po uskladnění. Sledujte přitom i zvláštní případy, protože právě ty rozhodují, zda řešení obstojí v běžném provozu.

Digitální postup se obvykle skládá z pěti na sebe navazujících rozhodnutí. Dodávka se identifikuje, zkontroluje se proti objednávce nebo očekávanému dodání, zaznamená se skutečné množství, zdokumentují se odchylky a zboží se přiřadí ke skladovému místu nebo dalšímu kontrolnímu kroku. Každý krok by měl vyžadovat pouze ta data, která jsou v daném bodě skutečně potřeba.

1. Předem zpřístupnit očekávané dodávky

Pokud existují nákupní objednávky, výrobní příkazy nebo avíza o dodání, sklad by je měl vidět ještě před příjezdem. Při příjezdu odpovědná osoba vybere dodavatele, naskenuje číslo objednávky nebo vyhledá otevřenou dodávku. Systém zobrazí očekávané položky, množství a případně čísla šarží nebo sériová čísla.

To výrazně zkracuje přejímku. Ještě důležitější je ale kontrolní logika: tým se nemusí rozhodovat zpaměti, zda je 18 místo 20 kartonů přijatelných. Odchylka se stane viditelnou a lze ji doplnit důvodem. U neohlášených dodávek potřebuje proces kontrolovanou cestu, například jako předběžný příjem zboží se schválením nákupu nebo dispozice.

2. Používat čárové kódy tam, kde skutečně šetří čas

Čtečka čárových kódů nebo fotoaparát robustního mobilního zařízení je pro mnoho skladů nejsmysluplnějším začátkem. Sken snižuje překlepy a zrychluje opakující se pohyby. Předpokladem však je, že čísla položek, balicí jednotky a štítky jsou vedeny konzistentně. Skener neřeší nejasná kmenová data.

Ne každé zboží potřebuje sledování podle sériového čísla. U šroubů nebo standardního spotřebního materiálu často stačí položka, množství a skladové místo. U náhradních dílů v záruce, regulovaných produktů nebo komponentů pro výrobu mohou být šarže, sériové číslo, datum minimální trvanlivosti a stav kontroly povinné. Hloubka zaznamenávání by měla odpovídat riziku, ne obecné softwarové šabloně.

3. Zacházet s odchylkami jako s normálním procesem

Dobrý digitální příjem zboží se nesnaží zabránit každé odchylce. Dělá ji jednoduchou a prokazatelně zvládnutelnou. Chybějící množství, nadměrné dodávky, přepravní škody, špatné položky a blokované šarže potřebují jasné stavy místo ručně psaných poznámek na dodacím listu.

U poškozené dodávky lze například pořídit fotografii přímo na místě přejímky, množství zaúčtovat jako blokované a automaticky informovat nákup. Dostupný stav zůstává správný, zatímco zboží fyzicky putuje do karanténní zóny. To zabraňuje, aby se poškozené díly omylem zkompletovaly nebo použily ve výrobě.

Pravidlo nemusí být vždy plně automatické. U malých množství lze nadměrnou dodávku přijmout přímo. U drahých nebo bezpečnostně relevantních položek by mělo být vyžadováno schválení. Tyto prahové hodnoty patří do procesu a musí zůstat později upravitelné.

4. Okamžitě spustit uskladnění

Přejímka je provozně kompletní až tehdy, když je jasné, kde se zboží nachází nebo proč je ještě nelze uskladnit. Systém může navrhnout pevné skladové místo, upřednostnit doplňovací zónu nebo na základě skupiny položek, teplotního rozsahu a dostupné kapacity určit cílovou oblast.

Pro přehledné sklady často stačí jasná logika míst s několika zónami. Složitá optimalizace tras má smysl jen tehdy, když ji odůvodňuje objem, přepravní vzdálenosti a personální struktura. Kdo přijímá deset palet denně, nepotřebuje optimalizační projekt, který trvá déle než ušetřený čas. Spolehlivý sken skladového místa je často větším pokrokem.

Po uskladnění systém aktualizuje stav a protokol pohybů. Prodej, dispozice nebo výroba tak vidí stav, aniž by se museli ptát skladu. Pokud smí být položka dostupná až po kontrole kvality, systém odděluje fyzický stav od dostupného stavu.

Jaká data příjem zboží skutečně potřebuje

Digitální proces se rychle stává neoblíbeným, pokud u brány vyžaduje příliš mnoho polí. Zároveň bez minima dat chybí důkazy pro pozdější vyjasnění. Ve většině středně velkých podniků jsou tyto informace smysluplné:

  • Dodavatel a odkaz na objednávku nebo dodací list
  • Položka, přijaté množství a balicí jednotka
  • Časový okamžik a odpovědná osoba
  • Skladové místo nebo stav jako kontrola, blokovaný sklad nebo karanténa
  • Důvod odchylky, fotografie a schválení dle potřeby

Další pole by měla být povinná pouze tehdy, umožňují-li konkrétní rozhodnutí. Je-li šarže povinná, číslo šarže není doplňkem, nýbrž klíčovou informací. Naproti tomu volná poznámka u každé dodávky se často vyplňuje jen proto, aby formulář působil kompletně.

Integrace rozhoduje o poměru přínosu a nákladů

Příjem zboží nesmí vzniknout jako nové izolované řešení vedle nákupu, výroby a účetnictví. Přinejmenším kmenová data položek, otevřené objednávky a změny stavů musí být spolehlivě vyměňovány. Zda se to děje přes existující rozhraní ERP, importy dat nebo cíleně vyvinutý mezikrok, závisí na stávající systémové krajině.

U starších ERP systémů není plná integrace v reálném čase vždy ekonomická. Ověřený import v pevných intervalech může zcela postačovat, pokud to množství a termíny umožňují. U náhradních dílů, které jsou okamžitě dispozičně přiřazeny naléhavým objednávkám, je naopak důležitější téměř okamžité zaúčtování. Technika zde následuje tempo byznysu.

K plánování patří i provozní spolehlivost. Zařízení potřebují uživatelské účty, jasné role a definované chování při výpadku sítě. Mobilní příjem zboží nemusí nutně fungovat offline. Pokud však výpadky Wi-Fi nastávají pravidelně, lokální vyrovnávací paměť s dohledatelnou synchronizací není luxus, ale součást spolehlivosti procesu.

Zavádění v malých krocích místo velkého třesku

Začněte s jedním dodavatelem, jednou skupinou zboží nebo jasně vymezenou skladovou oblastí. Měřte nejen dobu na zaúčtování, ale i dopracování, nevyjasněné rozdíly a dotazy mezi skladem a kanceláří. Z toho se ukáže, zda automatizace skutečně ulehčuje.

Školte na skutečných, každodenních dodacích listech včetně poškozených nebo neúplných dodávek. Proces, který funguje jen při dokonale odpovídající dodávce, není automatizace, ale předvádění. Zaměstnanci na příjmu zboží by se měli podílet na tvorbě pravidel, protože znají výjimečné případy.

softify.pro vyvíjí takové postupy záměrně specificky podle daného workflow: od mobilního skenu přes zdokumentovaný pohyb zásob až po stabilní připojení ke stávajícím systémům. Rozhodující není nejdelší seznam funkcí, ale systém, který zůstává přehledný pod časovým tlakem a lze jej technicky provozovat a udržovat.

Nejlepším dalším krokem proto není srovnávání softwaru, ale hodinový pohled na posledních deset problematických dodávek. Pokud u každé z nich dokážete říct, kde se ztratil čas a jaká informace chyběla, první návrh lepšího příjmu zboží už existuje.

Permalink →

Výhody vychystávání s podporou čárových kódů pro malé a střední sklady

Výhody vychystávání s podporou čárových kódů pro malé a střední sklady

Chybný artikl v krabici málokdy stojí jen cenu vratky. Váže čas ve skladu, vyvolává dotazy v kanceláři a v nejhorším případě poškodí vztah se zákazníkem. Výhody vychystávání s podporou čárových kódů se proto neprojeví nejprve v technickém ukazateli, ale v klidnější expedici: zaměstnanci vědí, co mají udělat dál, a odchylky se odhalí tam, kde vznikají.

Pro malé a střední sklady je to obzvlášť důležité. Mnoho procesů zpočátku funguje s papírovými seznamy, soubory Excel, pokyny volanými přes sklad a zkušenostmi jednotlivců. To samo o sobě není špatně. Při přehledném objemu může být tabulka dokonce rozumnějším nástrojem. Jakmile však roste počet položek, objednávek, střídání směn nebo požadavky na dohledatelnost, stává se z pragmatického provizoria rychle zdroj chyb.

Co vychystávání s podporou čárových kódů mění v každodenní práci

Při vychystávání s podporou čárových kódů sken nepotvrzuje jen to, že někdo něco udělal. Propojuje zakázku, skladové místo, artikl a množství v jeden dohledatelný pracovní krok. Systém určí další pick, zaměstnanec naskenuje skladové místo a artikl, v případě potřeby zadá množství a okamžitě dostane zpětnou vazbu.

Rozhodující je pořadí kontroly. Pokud zaměstnanec naskenuje nejprve artikl a teprve potom skladové místo, systém sice rozpozná chybný artikl, ale nezabrání nevýhodné trase. V praxi se často osvědčuje pořadí skladové místo, artikl, množství. U procesů se šaržemi, sériovými čísly nebo datem minimální trvanlivosti přibývají další kontroly. Které z nich jsou nutné, závisí na riziku, nikoli na tom, co by bylo technicky možné.

Dobrý systém nenahradí smysluplné uspořádání skladu. Ukáže však, kdy se toto uspořádání v běžném provozu nedodržuje. Leží-li zboží na místě, které pro ně není určeno, chyba se neodhalí až při inventuře, ale už při skenování.

Nejdůležitější výhody vychystávání s podporou čárových kódů: méně záměn přímo tam, kde vznikají

Papírové seznamy vyžadují neustálou koncentraci: přečíst číslo artiklu, najít přihrádku, porovnat obal, odškrtnout množství. Pod časovým tlakem stačí podobné krabice, téměř totožné názvy nebo přerušený úkon a chyba je na světě. Čárový kód přináší v tomto okamžiku jednoznačnou identifikaci.

Skener přitom nenahrazuje myšlení, ale přebírá kontrolu, kterou lidé při rutinní práci nejhůře dlouhodobě udrží. Pokud artikl neodpovídá zakázce, zpětná vazba by měla být jasná: chybný artikl, očekávaný artikl, další smysluplný krok. Pouhý červený varovný signál příliš nepomůže, pokud není zřejmé, jak odchylku odstranit.

Díky zaúčtování jsou zásoby spolehlivější

Stavy zásob jsou užitečné jen tehdy, když se o ně lze opřít při rozhodování. Kdo plánuje doobjednávky, slibuje termíny dodání nebo připravuje materiál pro výrobu, potřebuje víc než číslo z minulého týdne. Pokud se výdeje přepisují ze seznamu až na konci směny nebo dodatečně, vznikají časová okna s nejasným stavem dat.

Sken může výdej zaúčtovat okamžitě. Tím se zmenšuje rozdíl mezi fyzickým pohybem a digitálním stavem zásob. Neznamená to, že každé číslo je automaticky správné. Chybně označené zboží, nezaúčtované přesuny a poškozené zásoby zůstávají reálnými tématy. Příčiny však lze výrazně lépe zúžit, protože každý pohyb má čas, zakázku a případně vazbu na uživatele.

Zvlášť užitečné je to u doplňování. Pokud stav v přihrádce klesne pod cílovou zásobu, systém může vytvořit příkaz k doplnění nebo to alespoň zviditelnit. Vychystávači pak nemusejí hledat náhradní zboží uprostřed zakázky, zatímco zákazník čeká na zásilku.

Rychlejší zaučení bez závislosti na znalostech jednotlivců

Zkušení skladníci znají trasy, zvláštní případy a vzhled artiklů zpaměti. Tyto znalosti jsou cenné, ale jako jediný provozní systém riskantní. Při dovolených, nemocech nebo růstu se týmy dostávají pod tlak, když se noví zaměstnanci musí týdny učit, kterou řadu regálů znamená interní zkratka.

Dobré mobilní rozhraní provádí zakázkou srozumitelným jazykem. Zobrazuje skladové místo, artikl, požadované množství a v případě potřeby obrázek nebo pokyny k balení. Sken krok potvrdí. Z nových kolegyň a kolegů se tím nestanou okamžitě odborníci, ale mohou mnohem dříve bezpečně pracovat.

Totéž platí pro brigádníky a střídající se směny. Předpokladem je, že kmenová data jsou udržovaná. Systém nedokáže odvodit jasný pokyn z názvu artiklu typu „díl malý modrý nový“. Digitalizace takové slabiny odhalí - a právě to bývá užitečným vedlejším efektem.

Dohledatelnost při reklamacích a inventurách

Když zákazník nahlásí chybějící množství, bez procesních dat často začíná hledání v hromadách papírů, expedičních seznamech a vzpomínkách. Díky zaúčtování pomocí čárových kódů lze ověřit, která zakázka byla kdy zpracována, která položka byla potvrzena a zda došlo ke korekci nebo dílčímu množství.

Není to záruka proti reklamacím. Zkracuje to však objasňování a odděluje domněnky od faktů. Přínos mají i inventury: rozdíly lze nejen spočítat, ale také prošetřit na základě pohybů. Pokud se korekce hromadí u určité přihrádky, skupiny artiklů nebo po určitém předání v procesu, vzniká konkrétní výchozí bod pro zlepšení.

Měřitelné procesy místo pocitů

Mnoho skladů ví, že „odpoledne je to na hraně“ nebo že některé zakázky trvají neobvykle dlouho. Bez časových razítek a procesních kroků zůstává jen pocit. Pokud se zaznamenává začátek picku, sken, přerušení, dokončení a předání, lze úzká místa jasně rozlišit.

Možná není pomalé vychystávání, ale zboží se zaskladňuje příliš pozdě. Možná vznikají čekací doby na balicím pracovišti nebo je jedna přihrádka navštěvována nepřiměřeně často. Tato data by se neměla chápat jako nástroj plošné kontroly výkonu. Jejich hodnota spočívá především v odhalení zbytečných tras, chybějícího doplňování a nejasných předání.

Přínos závisí na návrhu procesu

Vychystávání s podporou čárových kódů není samoúčelné a ne každý sklad potřebuje rozsáhlý systém řízení skladu. Při malém počtu zakázek, malém sortimentu a stálých zaměstnancích může být pečlivě vedený proces s jednoduchými seznamy hospodárnější. Projekt dává smysl tehdy, když jsou náklady na chybné picky, hledání, nejistotu stavů nebo ruční dodělávky pravidelně znatelné.

I otázka hardwaru si zaslouží střízlivý pohled. Pro první procesy může stačit chytrý telefon se skenováním kamerou. Při vysoké frekvenci skenování, práci v rukavicích, špatném osvětlení nebo drsném prostředí jsou specializované ruční skenery obvykle rychlejší a méně náchylné k chybám. Rozhodující je také pokrytí sítí. Pokud v některé zóně skladu vypadne Wi-Fi, potřebuje aplikace jasnou strategii: offline ukládání s pozdější synchronizací, nebo proces, v němž se tato oblast mobilně nezpracovává.

Kvalita etiket je stejně důležitá jako software. Čárový kód na ošoupaném štítku přihrádky nebo dvakrát přidělený identifikátor artiklu podkopává celý proces. Před spuštěním by měla být skladová místa jednoznačně označena, jednotky definovány a kritické zvláštní případy vyjasněny: Jak se zachází s načatým balením? Co se stane při chybějící zásobě? Kdo smí opravit množství? Co se děje se zbožím bez čitelného kódu?

Jak zavést systém bez přerušení provozu

Nejspolehlivějším začátkem je málokdy úplný přechod. Začněte s jasně vymezenou oblastí, například s nejčastějšími expedičními zakázkami nebo se skupinou artiklů, u níž dochází k mnoha záměnám. Tam lze pořadí skenování, chybová hlášení a etikety ověřit v reálném provozu, aniž by se najednou přestavoval celý provoz.

Před technickou realizací by se měla zmapovat skutečná cesta zakázky - od přijetí přes rezervaci a pick až po balicí pracoviště a přepravní štítek. Nerozhoduje cílový proces z organigramu, ale postup, který směna skutečně používá. Nejcennější požadavky se často skrývají v drobných výjimkách: souhrnných zakázkách, náhradních artiklech, částečném vychystání nebo vracení nepotřebného zboží.

Poté jsou potřeba jednoznačná pravidla pro výjimky. Zaměstnanec musí mít možnost nahlásit chybějící zásobu, aniž by zakázku neformálně obešel. Oprávněná osoba musí mít možnost provádět opravy dohledatelným způsobem. A pokud existují rozhraní na e-shop, ERP nebo přepravce, měly by být stav zakázky a skladová zaúčtování jasně definovány. Dvojí správa dat je varovný signál, nikoli trvalé řešení.

U systémů na míru začíná softify.pro právě v tomto bodě: ne přetíženým enterprise balíkem, ale kroky skenování a zaúčtování, které jsou pro konkrétní skladový provoz prokazatelně nutné. Udržovatelná datová základna, jasně zdokumentovaná rozhraní a srozumitelné uživatelské obrazovky mají přitom větší hodnotu než dlouhý seznam málo používaných funkcí.

Smysluplný první kontrolní bod

Vezměte deset typických zakázek a sledujte je od přijetí až po předání do expedice. Poznamenejte si, na kterých místech musí zaměstnanci hledat, doptávat se, dodatečně doplňovat data nebo spoléhat na paměť. Právě tam se rozhoduje, zda vychystávání s podporou čárových kódů přinese výhody - a jaký proces skenování skutečně sedí danému skladu.

Permalink →

Samostatně hostované testování vs cloud

Samostatně hostované testování vs cloud

Neúspěšný regresní test je zřídka jen červený záznam v přehledu. Může znamenat, že obrazovka expedice ve skladu generuje nesprávné štítky, zákaznický portál přestane přijímat objednávky, nebo aplikace Windows spadne při předání směny. Otázka self hosted testing vs cloud se proto netýká infrastruktury jako samoúčelu. Jde o to, jakých dat se testovací proces dotýká, kdo ho kontroluje, a jak spolehlivě funguje v reálných provozních podmínkách.

Cloudové testovací platformy mohou být rychle připraveny k použití. Pro mnohé týmy je to smysluplné, zejména když testují veřejně dostupnou webovou aplikaci a krátkodobě potřebují dodatečnou vykonávací kapacitu. Samostatně hostovaná testovací prostředí naopak vyžadují uvědomělé technické sestavení. Vracejí však kontrolu nad testovacími daty, síťovými cestami, přístupovými právy, a provozem zpět podniku. Správná volba nezávisí na obecné zásadě, ale na aplikaci, riziku, a dostupné provozní schopnosti.

Self Hosted Testing vs Cloud: O co skutečně jde

Debata se často příliš zužuje na počáteční náklady. Cloudové řešení působí levněji, protože není třeba pořizovat servery ani nastavovat prostředí. Vlastní testovací server působí na první pohled náročněji, protože je třeba plánovat operační systém, aktualizace, řízení přístupu, monitorování, a zálohování.

Tento výpočet je nedostatečný. Rozhodující jsou průběžné náklady testovací strategie: čekací doby před vydáními, hledání chyb po neúplných testovacích bězích, koordinace s ochranou dat a informační bezpečností, jakož i důsledky chybného nasazení. Pokud tým pravidelně zkoumá citlivé podnikové aplikace, dodatečná organizační zátěž externích služeb může být větší než provoz jasně ohraničeného vlastního prostředí.

Ani "cloud" není jednotný model. Někteří poskytovatelé ukládají jen testovací protokoly, jiní zpracovávají snímky obrazovky, videozáznamy, přístupové údaje, DOM obsah, nebo síťový provoz. Při AI podporovaném testování se navíc mohou obrazová a textová data dostat k externím modelům nebo subdodavatelům k vyhodnocení. Kdo se dívá jen na lokalitu datového centra, často přehlíží důležitější otázku: která data skutečně opouštějí vlastní kontrolní zónu, a jaká smluvní a mazací pravidla pro ně platí?

Kdy je cloudové testování rozumnou volbou

Cloudové testování není v zásadě bezpečnostní problém, a samostatné hostování není automaticky lepší architektura. Pro nový, veřejně dostupný webový obchod nebo marketingovou platformu může být cloudové prostředí velmi vhodné. Tým může rychle pokrýt varianty prohlížeče a zařízení bez udržování vlastních vykonávacích strojů. Při kolísavé testovací zátěži je elastické škálování rovněž reálnou výhodou.

I malé vývojářské týmy s malým množstvím jasně anonymizovaných testovacích dat často profitují ze spravované služby. Neměly by investovat svůj čas do provozu platformy, když úzké hrdlo spočívá spíše v chybějících testovacích případech, nejasných akceptačních kritériích, nebo nestabilních testovacích datech. Vlastní server tyto problémy neřeší.

Cloud se hodí obzvlášť dobře, když aplikace nepotřebuje interní síťový přístup, v testovacích tocích se nevyskytují žádná osobní ani obchodně kritická data, a krátká doba přípravy je důležitější než hluboká kontrola infrastruktury. Předpokladem je pečlivá konfigurace: oddělené testovací účty, žádná skutečná zákaznická data, omezené tokeny, sledovatelné doby uchovávání, a jasný koncept práv.

Kdy se samostatně hostované testování stává smysluplnějším

Jinak je tomu u aplikací, které jsou dostupné jen v podnikové síti nebo zobrazují operativní klíčové procesy. Skladový nebo výrobní software často zpracovává pohyby artiklů, dodací adresy, zásoby, sériová čísla, a cenovou logiku. Testovací běh může přitom generovat snímky obrazovky objednávkových masek, stahovat doklady, nebo se přihlašovat s uživatelskými rolemi. Taková data by neměla být nepozorovaně rozptylována přes několik externích systémů.

Samostatně hostované testování umožňuje umístit vykonávání testů blízko aplikace. Testovací server může běžet ve stejném síťovém segmentu nebo v kontrolované DMZ. Pravidla firewallu se nastavují cíleně, interní aplikace se nemusí otevírat pro externí službu, a protokoly zůstávají pod vlastní správou. To je často obzvlášť relevantní pro desktopové aplikace Windows, jelikož ty jsou zřídka navrženy pro externí testovací platformy.

Pro regulovaná odvětví, větší zákaznické požadavky, nebo interní bezpečnostní směrnice je tato architektura často snáze prověřitelná. To neznamená, že každá prověrka automaticky projde. I vlastní server potřebuje správu oprav, šifrování, práva podle rolí, zálohy, a zdokumentované provozní postupy. Rozdíl spočívá v tom, že podnik tato rozhodnutí dělá sám a umí je prokázat.

V softify.pro je proto COCO koncipován jako dedikovaný, samostatně hostovaný AI server: testovací běhy pro webové a Windows aplikace se vykonávají lokálně, důkazy se zaznamenávají, a výsledky se hodnotí ve srozumitelném jazyce. To nenahrazuje odborné schválení. Ale zajišťuje, aby testovací provoz, snímky obrazovky, a vyhodnocení mohly zůstat tam, kde si podnik ponechává suverenitu nad daty.

Správné porovnávání nákladů: provoz proti tření

Smysluplné porovnání zahrnuje více než cenu licence proti ceně hardwaru. V cloudu vznikají opakující se poplatky podle uživatelů, testovacích minut, paralelních vykonání, nebo spotřeby AI. Tyto náklady jsou zpočátku plánovatelné, ale mohou s rostoucím pokrytím testů výrazně stoupat. K tomu se přidávají možné náklady na enterprise smlouvy, smlouvy o zpracování údajů, a bezpečnostní prověrky.

Při samostatném hostování vznikají investice do infrastruktury a nastavení. To může zahrnovat virtuální stroje, úložiště, síťový přístup, monitorování, a čas technicky odpovědného týmu. Tyto náklady zůstávají i tehdy, když běží málo testů. Pro projekt se vzácnými vydáními je to dobrý argument proti předimenzovanému vlastnímu řešení.

Při pravidelném regresním testování se obraz mění. Pokud se každý týden musí kontrolovat stejné obchodně kritické pracovní postupy, vypočitatelné interní kapacity jsou často ekonomičtější než variabilní náklady platformy a manuální schvalovací smyčky. Přístup se stává obzvlášť hodnotným, když se testovací případy používají roky a dále se vyvíjejí spolu s odbornou aplikací. Udržovatelnost je tehdy důležitější než rychlý, ale těžko kontrolovatelný začátek.

Kvalita nezávisí na modelu hostování

Častý omyl říká: cloudové testy jsou automaticky modernější, samostatně hostované testy automaticky stabilnější. Ani jedno není pravda. Kvalita testů vzniká ze smysluplných scénářů, odolných testovacích dat, stabilních identifikátorů v rozhraní, a jasných očekávání výsledku.

Test by neměl jen kontrolovat, zda je tlačítko klikatelné. Pro zpracování objednávky může například vytvořit objednávku, zkontrolovat dostupné množství, vygenerovat dodací list, a zajistit, aby správná role směla schválit operaci. U desktopového programu může ověřit import souboru, zpracování chyb, a výstup dokumentu. Až takové end-to-end toky ukazují, zda změna poškodila reálný proces.

AI může přitom pomoci rozpoznávat změny rozhraní, srozumitelně dokumentovat kroky, a prioritizovat anomálie. Neměla by se však stát černou skříňkou. Týmy potřebují snímky obrazovky nebo jiné důkazy, sledovatelné testovací kroky, a definované prahové hodnoty pro to, kdy se výsledek počítá jako úspěšný, nejistý, nebo neúspěšný. Právě u vizuálních kontrol je práh spolehlivosti smysluplný, aby malé, očekávané odchylky rozvržení neblokovaly každé vydání.

Provozní otázky před rozhodnutím

Předtím, než se tým rozhodne, měl by konkrétně zaznamenat cestu testovacího běhu. Kde běží test? Do kterých systémů se přihlašuje? Jaká data vidí? Kde se ukládají snímky obrazovky, protokoly, a zprávy? Kdo smí číst, mazat, nebo exportovat výsledky? Tyto otázky jsou praktičtější než paušální rozhodnutí pro nebo proti cloudu.

Stejně důležitá je odpovědnost po spuštění. Kdo aktualizuje prohlížeče a testovací agenty? Kdo reaguje, když certifikát vyprší? Jak se rotují přístupové údaje? A jak se zajišťuje, aby test náhodou nespustil skutečné zaúčtování expedice nebo zákaznické oznámení? Dobrá automatizace testů potřebuje oddělená prostředí a ochranné mechanismy, nejen dobré skripty.

Hybridní model může být smysluplný. Veřejná rozhraní a široce rozšířené kontroly prohlížeče běží v cloudu, zatímco interní odborné procesy zůstávají na vlastním testovacím serveru. To snižuje provozní zátěž, bez paušálního odevzdání citlivých toků navenek. Předpokladem je jasná hranice mezi oběma oblastmi, ne nepřehledný smíšený provoz.

Nejlepší rozhodnutí je to, které odpovídá skutečnému riziku a vlastní provozní realitě. Pokud tabulka ještě stále spolehlivě nese proces, nemusí se z ní stát velký systém. Pokud však testovací data a interní aplikace patří k obchodnímu jádru, kontrola není luxus, ale věcný požadavek na spolehlivý software.

Permalink →

Inventory Management ve skladu

Inventory Management ve skladu

Chybějící díl se při počítání ve skladu zřídka zpozoruje. Většinou se ukáže až tehdy, když objednávku nelze zabalit, montér stojí před prázdným regálem, nebo nákup telefonicky hledá potvrzení dodání. Dobrý Inventory Management nezabraňuje těmto překvapením více tabulkami, ale spolehlivým obrazem toho, co je k dispozici, kde se to nachází, a co se s tím dále děje.

Pro malé a střední podniky to není otázka co největšího ERP systému. Rozhodující je, zda zaměstnanci při příjmu zboží, ve skladu, a při expedici mohou pracovat s několika jasnými kroky - i pod časovým tlakem, přes změny směn, a když dodávka dopadne jinak, než bylo plánováno.

Inventory Management začíná pohyby, ne seznamy zásob

Seznam zásob je okamžitý snímek. Může být správný a přesto málo pomoct, pokud nikdo nedokáže vysledovat, proč se množství změnilo. Odolný systém proto považuje zásoby za důsledek zdokumentovaných pohybů: zboží přichází, kontroluje se, uskladňuje, rezervuje, kompletuje, přesouvá, expeduje, nebo opravuje.

Každý pohyb potřebuje jasný důvod, časový údaj, odpovědnou osobu, a podle možnosti souvislost s konkrétní transakcí. To může být objednávka nákupu, objednávka zákazníka, dodací list, nebo výrobní příkaz. Díky tomu se z čísla "24 kusů dostupných" stává ověřitelné tvrzení: 30 kusů bylo zaúčtováno, čtyři jsou rezervovány pro dvě objednávky, a žádný otevřený přesun nezkresluje dostupnou zásobu.

Toto rozlišení je obzvlášť relevantní u nedostatkových dílů. Fyzicky přítomné, rezervované, a volně dostupné jsou tři různé stavy. Pokud se smíchají, prodej slibuje zboží, které sklad již potřebuje pro jinou objednávku. Pokud se vedou čistě, tým se může včas rozhodnout: doobjednat, přeprioritizovat, nebo dát zákazníkovi realistickou odpověď.

Kde se manuální procesy typicky lámou

Tabulky nejsou zásadně nesprávné. Pro malý sortiment, jedno skladové místo, a málo pohybů týdně mohou být ekonomičtější než vlastní aplikace. Stávají se problematickými, jakmile současně pracuje více osob nebo se zásoby aktualizují z více zdrojů.

Tehdy vznikají známé mezery: příjem zboží leží jako papír na stole, Excel soubor byl lokálně změněn, přesun byl dohodnut jen ústně, a expedice zaúčtuje až po pracovní době. Zásoba není nutně nesprávná, ale je časově posunutá a její původ je nejasný. Právě to ji činí nevhodnou pro operativní rozhodnutí.

Také organizační struktura hraje roli. Centrální místo potřebuje jiné procesy než podnik s externími sklady, servisními vozidly, nebo výrobou, která odebírá materiál. Kdo tyto rozdíly zobrazuje jedním sloupcem volného textu, přesouvá logiku do hlav jednotlivých zaměstnanců. To funguje, dokud ta osoba nemá dovolenou nebo se objem objednávek nezvýší.

Určit proces před softwarem

Smysluplný projekt nezačíná otázkou, který skener se koupí nebo které rozhraní vypadá moderně. Nejprve musí být jasné, které rozhodnutí má systém podporovat. K tomu často stačí konkrétní pozorování z každodenní praxe: jak se dnes přijímá zboží? Kdy se považuje za zkontrolované? Kdo smí opravovat zásoby? Co se děje s poškozeným zbožím? A v kterém bodě se objednávka závazně rezervuje?

Z těchto odpovědí vzniká několik závazných pravidel. Například příjem zboží smí být zaúčtován až po kontrole množství. Artikly bez skladového místa se nesmí zobrazovat jako připravené k uskladnění. Opravy zásob vyžadují kód důvodu a zůstávají viditelné v historii. Expedované zboží se nemaže tichým způsobem, ale přiřazuje se objednávce prostřednictvím zdokumentovaného odpisu.

To je méně efektní než velká prezentace digitalizace, ale v provozu podstatně cennější. Když jsou pravidla jednoznačná, software je může spolehlivě kontrolovat. Když zůstávají nejasná, každá nová aplikace jen urychluje protichůdné pracovní kroky.

Kmenová data: začít malým, důsledně udržovat

Ne každý artikl potřebuje na začátku deset klasifikací. Použitelný základ tvoří často číslo artiklu, označení, jednotka, aktivní skladový stav, a jedno nebo více skladových míst. V závislosti na podnikání přibývají šarže, sériová čísla, minimální zásoby, čísla artiklů dodavatele, nebo data expirace.

Důležitá je důslednost, ne množství polí. Dvě čísla artiklu pro tentýž fyzický artikl, nebo měnící se jednotky jako "karton", "balení", a "kus" bez pravidla přepočtu, generují pozdější chyby téměř automaticky. Systém může technicky povolit taková zadání. Měl by je omezit tam, kde ohrožují průběh.

Které funkce skutečně pomáhají ve skladu

Pro mnohé středně velké sklady je jasné jádro cennější než přetížený katalog funkcí. Toto jádro obvykle zahrnuje čtyři oblasti:

  • Příjem zboží s referencí objednávky, kontrolou množství, a uskladněním
  • Skladové pohyby mezi definovanými místy a oblastmi
  • Rezervaci objednávky, kompletaci, a potvrzení expedice
  • Inventuru a opravy zásob se sledovatelnou historií

Doplňkově může tisk štítků, skenování čárových kódů, dodací listy, přepravní štítky, nebo předání účetnictví a systémům obchodu ušetřit hodně času. Ale měly by stavět na čistém pohybovém modelu. Rychlý tisk štítků málo pomůže, pokud skenování nepřiřadí artikl jednoznačně správnému skladovému místu nebo objednávce.

Při obsluze je důležité i prostředí. Zaměstnanec s rukavicemi při příjmu zboží potřebuje velké, jednoznačné akce a co nejméně textového vstupu. Dispečerka na pracovišti naopak potřebuje filtry, vyhledávací funkce, a přehled otevřených transakcí. Obě role smí používat stejná data, ale nepotřebují stejné rozhraní.

Reálný čas neznamená, že každé číslo je nezpochybnitelné

Mnohé podniky si přejí zásoby v reálném čase. To je smysluplné, ale pojem se často používá příliš hrubě. Zásoba se může aktualizovat bezprostředně po každém skenování a přesto být nesprávná, pokud proces zůstává neúplný. Pokud se zboží skenuje, ale nekontroluje, číslo je technicky aktuální a operativně sporné.

Proto každý systém potřebuje zacházení s výjimkami. Rozdíly při příjmu zboží, poškozené obaly, vratky, a nenajitelné artikly nejsou okrajové případy. Patří do každodennosti. Dobré procesy je viditelně označují, místo aby nutily zaměstnance k improvizovaným vedlejším seznamům.

I oprávnění si zaslouží pozornost. Ne každá osoba by měla umět měnit kmenová data artiklů nebo opravovat historická zaúčtování. Praktický koncept práv odděluje rutinní operace od zásahů s vyšším rizikem. To chrání nejen před chybami, ale usnadňuje i analýzu příčin, když zásoba neočekávaně odchýlí.

Integrace jen tam, kde zlepšuje průběh

Inventory Management zřídka stojí sám. Objednávky mohou přicházet z internetového obchodu, e-mailového zaznamenávání, odvětvového řešení, nebo přímo z prodeje. Přepravci potřebují adresní údaje a hmotnosti. Účetnictví očekává doklady v určité formě.

Integrace se vyplatí, když eliminuje dvojité zadávání nebo snižuje zdroje chyb. Není automaticky smysluplná jen proto, že je k dispozici rozhraní. Zejména u organicky vyrostlých procesů může být jasný import s kontrolou spolehlivější než trvalé propojení v reálném čase, které nepozorovaně přenáší chybná data.

Technicky by řešení mělo zůstat sledovatelné: jednoznačná rozhraní, zaznamenávané přenosy, srozumitelné chybové zprávy, a struktura databáze, která neskrývá změny. S dobře udržovanou aplikací na základě PHP 8.4 a MySQL 8 se takové procesy dají realizovat úsporně, aniž by se týmy nutily do globálního koncernového systému. Rozhodující není technologické označení, ale zda zůstanou údržba, rozšíření, a opravy dat kontrolovatelné i za tři roky.

Zavedení v malých, měřitelných krocích

Big bang je ve skladu zřídka nejlepší volbou. Bezpečnější je ohraničený start, například s příjmem zboží a jednou vybranou skladovou oblastí. V této fázi lze pozorovat skenovací časy, typy chyb, otevřené speciální případy, a kvalitu kmenových dat. Až poté následuje rezervace, expedice, nebo další lokality.

Paralelní provoz může být přitom smysluplný, ale jen s jasným koncem. Dvě vedoucí zásoby po delší dobu vytvářejí přesně ten problém, který má nové řešení odstranit. Lepší je stanovený přechod s inventurou, vyčištěnými kmenovými daty, a odpovědnostmi pro první týdny.

Úspěch se neprojevuje v tom, kolik funkcí bylo aktivováno. Projevuje se v tom, zda vzniká méně zpětných dotazů, zda se objednávky balí kompletněji, a zda tým dokáže bez detektivního pátrání vysvětlit, proč zásoba artiklu vypadá tak, jak vypadá.

Pokud aktuální proces s dobře udržovanou tabulkou skutečně funguje stabilně, měl by smět zůstat. Ale pokud se informace nadále ztrácejí mezi papírem, telefonáty, a několika soubory, dalším smysluplným krokem není větší nástroj, ale jasný průběh, který zviditelňuje každý důležitý skladový pohyb.

Permalink →

Jsou samostatně hostované testy bezpečné?

Jsou samostatně hostované testy bezpečné?

Neúspěšný regresní test je otravný. Snímek obrazovky z interního ERP systému, který nekontrolovaně skončí u externí služby, je bezpečnostní incident. Právě proto si QA vedoucí a IT odpovědní kladou otázku: are self hosted tests secure? Upřímná odpověď zní: mohou být výrazně bezpečnější než cloudové alternativy, ale jen pokud se provoz bere stejně vážně jako samotné testy.

Samostatně hostovaná automatizace testů přesouvá kontrolu nad prováděním, testovacími daty, snímky obrazovky, protokoly, a přístupovými právy do vlastní infrastruktury. To snižuje závislosti a zbytečné datové cesty. Nenahrazuje to však bezpečnostní architekturu. Špatně udržovaný interní testovací server zůstává špatně udržovaným serverem.

Jsou self-hosted testy bezpečnější než cloudové testy?

Rozhodující rozdíl není v tom, zda test běží lokálně nebo automatizovaně. Je v tom, kde jsou data zpracovávána, kdo k nim může přistupovat, a jaké technické hranice platí.

U externě provozované testovací služby firmu často opouští několik artefaktů: přístupové údaje pro testovací účty, URL adresy interních aplikací, DOM obsah, snímky obrazovky, videa z testovacích běhů, chybové protokoly, a případně výpisy z databází. I když poskytovatel splňuje vysoké bezpečnostní standardy, vzniká dodatečný vztah důvěry a smluvní vztah. Pro aplikace se zákaznickými, personálními, produkčními, nebo finančními daty to může být relevantní překážka.

Samostatně hostovaný systém lze provozovat v rámci vlastní sítě nebo jasně ohraničeného prostředí EU. Testovací instance přistupuje přímo ke staging, akceptačním, nebo izolovaným testovacím systémům. Testovací důkazy zůstávají tam, kde se nachází i aplikace a její provozní odpovědnost. To je obzvlášť smysluplné při testování desktopových Windows aplikací, interních webových portálů, nebo systémů s citlivými procesními daty.

Ale samostatné hostování není automaticky bezpečnější. Kdo provozuje testovací server s otevřeným vzdáleným přístupem, společně používanými administrátorskými účty, a trvale platnými hesly, pouze přesunul rizika. Otázka tedy nezní jen: cloud nebo on-premises? Ale: je testovací prostředí prokazatelně zabezpečeno a trvale udržovatelné?

Are self hosted tests secure? Záleží na těchto hranicích

Bezpečná testovací platforma potřebuje jasné technické a organizační hranice. Pro malé a střední podniky to nemusí vypadat jako koncernový program. Musí to být jen důsledně implementováno a zdokumentováno.

Oddělit testovací prostředí od produkčního provozu

Automatizované testy mají nacházet chyby, ne spouštět objednávky, měnit dodací listy, nebo knihovat skladové pohyby. Proto testy potřebují oddělené prostředí s vlastními rozhraními, testovacími nájemci, a testovacími daty. Kde není potřeba úplná kopie produkce, je to často dokonce zbytečně rizikové.

Pro skladový nebo objednávkový portál to může znamenat: testovací uživatelé smí zaznamenávat příjmy zboží a generovat přepravní štítky, ale vygenerované dokumenty nejdou k žádné skutečné tiskárně ani žádnému skutečnému spedičnímu partnerovi. API klíče ukazují na sandbox koncové body. Odesílání e-mailů je zachycováno nebo omezeno na interní příjemce. Tak zůstává test smysluplný bez vytváření provozních důsledků.

Oddělení by mělo platit i na úrovni sítě. Testovací server potřebuje jen ta spojení, která skutečně vyžaduje. Paušální přístup do celé interní sítě je pohodlný, ale zřídka odůvodnitelný. Segmentace omezuje škodu, pokud je testovací účet nebo komponenta systému kompromitována.

Zacházet s přístupovými údaji jako s produkčními přístupy

Automatizace testů často potřebuje přihlašovací údaje. To je normální, ale tato data nepatří do testovacích skriptů, konfiguračních souborů ve zdrojovém kódu, nebo historií chatů. Hesla, tokeny, a certifikáty by se měly načítat z kontrolované správy tajemství. Testovací účty dostávají jen práva, která konkrétní proces vyžaduje.

I přístup k samotné testovací platformě potřebuje role. Vývojář možná musí spouštět testovací běhy a číst výsledky, ale neměnit síťovou konfiguraci. Odborný útvar může prohlížet zprávy, ale nepotřebuje přístup k uloženým přihlašovacím údajům. Administrátorská práva by měla být vázána na osoby, ne navázána na sdílený účet.

Navíc k minimálnímu standardu patří vícefaktorové přihlášení, přiměřená pravidla hesel, a toky uzamčení účtu. Právě testovací systémy jsou často považovány za méně kritické. Útočníci to vidí jinak: rádi využívají testovací prostředí jako vstupní bod, protože se tam nacházejí přístupy, interní názvy, a technické detaily.

Minimalizovat testovací data a cíleně maskovat

Nejčastější chybou není chybějící metoda šifrování, ale příliš mnoho skutečných informací v testovacím fondu. Pro většinu regresních testů nikdo nepotřebuje skutečná jména zákazníků, skutečné adresy, nebo úplné personální spisy. Syntetické datové sady, maskované kopie, a vědomě vytvořené speciální případy často stačí.

Existují výjimky. Některé chyby se objevují jen u skutečných datových struktur, neobvyklých řetězců znaků, nebo složitých konstelací oprávnění. Tehdy může být smysluplná kontrolovaná, pseudonymizovaná kopie. Rozhodující je, že toto rozhodnutí je učiněno vědomě a má lhůtu smazání. Testovací databáze by neměly běžet roky jako zapomenutá stínová kopie produkce.

Snímky obrazovky a videa si zaslouží stejnou pozornost. Jsou cenné pro hledání chyb, ale mohou zobrazovat údaje o účtu, interní ceny, nebo osobní obsahy. Stanovte, které artefakty se zaznamenávají, kdo je smí vidět, a kdy se automaticky smažou. Testovací zpráva nemusí ukládat každý snímek obrazovky navždy, aby byla důkazní.

Provozovat server jako produkt

Samostatně hostovaný testovací server není zařízení, které se jednou nainstaluje a pak zapomene. Provozní bezpečnost vzniká opakovatelnou péčí: včasné bezpečnostní aktualizace pro operační systém, prohlížeč, testovací runner, a závislosti; šifrovaná datová média a přenosové cesty; monitorované zálohy; centrální protokolování; jakož i jasné zacházení s bezpečnostními upozorněními.

Obzvlášť u testů řízených prohlížečem je relevantní rytmus aktualizací. Zastaralé prohlížečové jádra a automatizační knihovny mohou obsahovat známé zranitelnosti nebo činit testy nespolehlivými. Obojí stojí čas. Zdokumentovaná nasazení a pevná servisní okna proto nejsou byrokratický doplněk, nýbrž základ pro reprodukovatelné výsledky.

Pro dedikovaný AI testovací server jako COCO platí totéž. Lokální provádění nechrání citlivý obsah aplikace magií. Vytváří kontrolu nad tím, kde se zpracovává AI podporované vyhodnocení, snímky obrazovky, a testovací protokoly. Tato kontrola musí být naplněna správou oprav, oprávněními, síťovým oddělením, a jasnými pravidly uchovávání.

Kde má samostatné hostování své hranice

Cloudové služby nejsou z definice nebezpečné. Specializovaný poskytovatel může nabídnout více bezpečnostního personálu, vyspělejší dohled, a profesionálnější redundanci než podnik s jedinou přetíženou IT rolí. Kdo nemá kapacitu pro provoz, aktualizace, a reakci na incidenty, může se špatně udržovaným samostatně hostovaným systémem vytvořit vyšší riziko.

Na druhou stranu mnohé externí testovací platformy jednoduše nejsou dobrým procesním přizpůsobením pro interní odborné aplikace. Pokud je aplikace dostupná jen ve firemní síti, pokud testovací běhy zobrazují důvěrné masky a doklady, nebo pokud data nemají opustit vlastní kontrolní oblast, lokální provoz je často jasnějším řešením.

Rozumné rozhodnutí závisí na potřebě ochrany a na provozní schopnosti. Pro veřejnou marketingovou stránku bez citlivých přihlášení může být cloudová testovací služba přiměřená. Pro interní dispoziční software, zákaznický portál s osobními údaji, nebo Windows aplikaci v produkční síti mluví hodně ve prospěch kontrolovaného, samostatně hostovaného prostředí.

Praktická bezpečnostní kontrola před startem

Předtím, než se zavedou automatizované testy, by měl odpovědný pracovník umět odpovědět na tyto otázky bez hádání:

  • Ke kterým systémům, databázím, a rozhraním smí testovací server přistupovat?
  • Jaká data se objevují ve snímcích obrazovky, videích, protokolech, a AI vyhodnoceních?
  • Kde se nacházejí přístupové údaje, a kdy se rotují?
  • Kdo smí spouštět testovací běhy, číst výsledky, a administrovat systémy?
  • Jak rychle se nasazují kritické aktualizace, a jak se to kontroluje?
  • Kdy se smažou testovací artefakty a již nepotřebná data?

Tyto otázky působí věcně. Přesně to je jejich hodnota. Bezpečnost vzniká zřídka díky jedinému nástroji nebo působivému architektonickému diagramu. Vzniká, když odpovědnosti, datové toky, a technické hranice zůstávají ověřitelné v každodenní praxi.

Kdo buduje automatizaci testů, měl by nejprve objasnit potřebu ochrany aplikace a poté zvolit nejmenší smysluplnou architekturu. Čistě ohraničený testovací server s málo oprávněnými účty je často hodnotnější než přetížená platforma, kterou nikdo nedokáže spolehlivě udržovat. Boring, provable reliability porazí i v testování spektakulární, ale neprůhledné řešení.

Permalink →

Warehouse Management Systems: Co skutečně záleží

Warehouse Management Systems: Co skutečně záleží

Když zaměstnanec při příjmu zboží zapíše stejnou dodací položku na papír, později ji přenese do tabulky, a pak vykřičí přes uličku, kam se uskladní, málokdy chybí ochota pracovat. Chybí společný proces. Warehouse Management Systems vytvářejí tento proces tím, že dokumentují pohyby zboží, zásoby, a navazující úkoly na jednom místě. Pro malé a střední firmy není rozhodující nejdelší seznam funkcí, ale to, zda software spolehlivě zobrazuje cestu zboží vlastním skladem.

Co musí Warehouse Management Systems dosahovat v každodenním provozu

Warehouse Management System, zkráceně WMS, není jednoduše lepší seznam zásob. Řídí nebo dokumentuje fyzické procesy ve skladu: příjem zboží, kontrolu kvality, uskladnění, přesun, kompletaci, balení, expedici, a inventuru. Každé zaúčtování odpovídá na jednoduchou operativní otázku: co je kde, v jakém množství, v jakém stavu, a kdo vyvolal pohyb?

Tato jasnost působí na první pohled banálně. Ale zabraňuje typickým řetězcům chyb. Artikl je sice dodán, ale ještě není zkontrolován. Paleta stojí při příjmu zboží, ale v systému je již vedena jako dostupná. Objednávka se kompletuje, ačkoli zboží by mělo být rezervováno pro důležitější zákaznickou objednávku. Bez jasně definovaných stavů a pohybů z jedné jediné nejasnosti rychle vznikne nesprávný příslib dodání.

Pro mnohé středně velké sklady přínos nezačíná plně automatizovaným řízením. Již sledované úkoly uskladnění, jednoznačná skladová místa, a mobilní zaúčtování mohou výrazně zkrátit časy hledání. Rozhodující je, aby zaměstnanci už nemuseli překládat mezi papírem, telefonem, e-mailem, a několika tabulkami.

Ne každý sklad potřebuje velkou sadu

Trh nabízí rozsáhlé podnikové systémy s funkcemi pro globální sítě s více lokalitami, komplexní celní odbavování, automatizovanou dopravníkovou techniku, a velmi jemnou optimalizační logiku. To může být správné, pokud tyto požadavky skutečně existují. Ale pro podnik s jedním nebo několika sklady, měnícími se prioritami, a zaběhnutými zvláštními procesy může taková sada vytvořit více tření než užitku.

Náklady pak nespočívají jen v licencích. Vznikají v dlouhých projektech zavádění, rozsáhlých úpravách, školeních, a závislosti na externích specialistech. Ani systém se sto nastaveními neřeší problém, pokud vedoucí směn musí pro běžné opravy otevřít tiket.

Alternativa nemusí nutně znamenat úplný individuální vývoj. Standardní produkt může být smysluplný, když jeho základní procesy vyhovují a úpravy zůstávají vědomě omezené. Stejně tak existující tabulka může nadále být nejlepším řešením, například pro vzácné, přehledné vyhodnocení. Kritickou se stává až tehdy, když s ní současně pracuje více osob, zaznamenává pohyby se zpožděním, nebo má tabulka být provozní pravdou o dostupném zboží.

Správné řešení se řídí skutečným objemem procesů a náklady na chyby. Pět nesprávných kompletací týdně znamená něco jiného ve skladu náhradních dílů s časově kritickými zákaznickými objednávkami než pět odchylek v pomalu rotujícím archivním zásobě.

Nejprve zaznamenat procesy, ne vybírat obrazovky

Mnohé WMS projekty začínají produktovou ukázkou. Tam odpovědní vidí elegantní přehledové panely, pohledy skeneru, a barevné ukazatele. Užitečnější je nejprve procházka skladem během běžného pracovního dne. Kde přichází zboží? Kdo kontroluje množství a poškození? Kdy artikl dostane své číslo šarže nebo sériové číslo? Jak se rozhoduje, na které místo jde? A co se stane, když realita odchyluje se od objednávky?

Tyto otázky kladou základ pro řešení, které bude později akceptováno. Dobře zdokumentovaný cílový proces nepopisuje jen ideální případ. Obsahuje i výjimky: částečné dodávky, poškozené zboží, neohlášené dodávky, nedostatky zásob, vratky, a blokované zásoby. Právě tyto případy rozhodují o tom, zda zaměstnanci důvěřují systému, nebo sáhnou znovu po lístečcích.

Stavy jsou důležitější než hezká rozhraní

Čistá datová sada rozlišuje například "očekávaný", "přišlý", "v kontrole", "uskladněný", "rezervovaný", "kompletovaný", a "expedovaný". Které stavy jsou potřeba, závisí na podniku. Příliš málo zakrývá relevantní rozdíly. Příliš mnoho zpomaluje zaúčtování a obchází se.

Pravidlo by mělo znít: každý stav musí mít operativní důsledek. Pokud je zboží blokované, nesmí být kompletováno. Pokud je rezervované, musí být viditelné, pro kterou objednávku. Pokud je uskladněné, musí být zaznamenáno skladové místo. Tak se datová pravidla stávají praktickou spolehlivostí procesu.

Skenery pomáhají jen při jasných zaúčtováních

Čárové kódy a mobilní zařízení snižují překlepy a urychlují pohyby. Ale nenahrazují rozhodnutí o procesu. Skenování musí vyvolat srozumitelnou akci: zkontrolovat artikl, potvrdit množství, vybrat cílové místo, nebo dokončit objednávku. Pokud zaměstnanec musí po každém skenování hádat, jaká obrazovka následuje, tok je navržen příliš komplikovaně.

I otázka hardwaru by měla být zodpovězena pragmaticky. Pro některé týmy postačují smartphony s vhodnou funkcí skenování a pevným ochranným pouzdrem. Jiné potřebují průmyslové ruční skenery, protože rukavice, chlazení, pády, nebo dlouhé směny to vyžadují. Pilotní projekt na skutečné skladové ploše ukáže více než prezentace za stolem.


Technický základ rozhoduje po spuštění

WMS musí fungovat správně i tehdy, když se současně zaúčtovávají příjmy zboží, kompletují objednávky, a kontrolují zásoby. Z toho vyplývají požadavky, které se v raných rozhovorech často ztrácejí: jednoznačné záznamy pohybů, oprávnění podle rolí, sledovatelné opravy, spolehlivá rozhraní, a zálohy, které jsou v nouzové situaci skutečně obnovitelné.

Zásoba by neměla být jednoduše přepsána. Lepší je model pohybu: příjem, výdej, přesun, blokace, nebo oprava generují každá zaznamenaný záznam. Tím se dá později sledovat, proč se množství odchyluje. To je stejně cenné pro inventury jako pro objasnění případu zákaznické reklamace.

Oprávnění musí odpovídat odpovědnosti. Kompletátor potřebuje jiné funkce než vedoucí skladu, který schvaluje opravy zásob. Pro kritické změny jsou smysluplná zdůvodnění, schválení na čtyři oči, nebo alespoň neměnný protokol změn. Úsilí závisí na rizikovém profilu, ale otázka by měla být objasněna před začátkem.

Rozhraní si zaslouží stejnou pozornost. Sklad pracuje zřídka izolovaně. Objednávky přicházejí z obchodu, ERP, nebo strukturovaného importu. Údaje o přepravě jdou do systémů dopravců, generují se dodací listy a štítky, údaje o zásobách se vrací zpět. Každé rozhraní potřebuje jasné odpovědnosti pro případy chyb. Co se stane, pokud byl vygenerován přepravní štítek, ale potvrzení se nedostane do WMS? Bez logiky opakování a viditelné fronty chyb zůstávají takové případy zaseklé u jednotlivých osob.

Pro řešení na míru nejsou udržovatelné technologie vedlejší věcí. Sledovatelná aplikace s jasnou strukturou databáze, zdokumentovanými nasazeními, a testovanými integracemi zůstává zvládnutelná i po personálních změnách. Trendová architektura nepomůže, pokud nikdo nedokáže vysledovat chybný import.

Zavádění v malých, kontrolovatelných krocích

Big bang vytváří vyhnutelné riziko. Často je smysluplnější nejprve digitalizovat ohraničený proces, například příjem zboží pro jednu produktovou skupinu nebo kompletaci v jedné skladové oblasti. Tým přitom ověřuje nejen funkce, ale i formulace, cesty skenování, chodby, a odpovědnosti.

Kmenová data jsou zde často skutečným staveništěm. Čísla artiklů musí být jednoznačná, měrné jednotky konzistentní, skladová místa smysluplně strukturovaná, a balicí jednotky jasně definované. Systém nemůže dodávat spolehlivé zásoby, pokud se stejný artikl objevuje pod třemi různými označeními, nebo "bedna" znamená různá množství podle dodavatele.

Během pilotní fáze by měly ukazatele zůstat jednoduché: jak dlouho trvá příjem zboží? Kolik zaúčtování je třeba opravit? Kolik kompletací je chybných? Jak často se zboží hledá? Ne každé zlepšení se okamžitě projeví jako velká nákladová položka. Méně zpětných dotazů a spolehlivější informace o dodání mohou už odlehčit podstatný tlak z každodenního provozu.

Školení funguje nejlépe přímo u procesu. Zaměstnanci nepotřebují abstraktní provedení přes všechny položky menu. Musí vědět, jak zaúčtovat svou další dodávku, nahlásit odchylku, nebo opravit nesprávné skenování. Pro první směny po spuštění by měla být dostupná odpovědná osoba, která dokáže rychle přijímat rozhodnutí.

Správná otázka pro výběr

U Warehouse Management Systems ústřední otázka nezní: který software umí nejvíc? Zní: které pracovní postupy musí být pro náš tým každý den rychlejší, jednoznačnější, a sledovatelnější?

Kdo tyto pracovní postupy nejprve jasně popíše, může věcně zhodnotit standardní software, rozšíření, nebo aplikaci na míru. Výsledek nemusí působit spektakulárně. Měl by zajistit, aby zboží našlo svou cestu, zásoba zůstala důvěryhodná, a lidé ve skladu trávili méně času hledáním, dotazováním, a dodatečnou opravou.

Permalink →

Custom Logistics Software vs Spreadsheets

Custom Logistics Software vs Spreadsheets

Příjem zboží přichází dříve, než bylo ohlášeno, dva zaměstnanci souběžně mění stejný seznam zásob, a řidič čeká na dodací list, jehož poslední verzi nikdo neumí s jistotou pojmenovat. Takové situace rozhodují otázku "custom logistics software vs spreadsheets" ne teoreticky, ale mezi příjmem zboží, skladovou pozicí, a rampou.

Tabulky nejsou zásadně problém. Rychle se vytvářejí, jsou všem známé, a často překvapivě účinné pro jasně ohraničené úkoly. Stávají se problematickými, když mají sloužit jako operační systém rostoucího skladového nebo distribučního procesu. Tehdy se ze souboru stává kritický proces - bez závazných pravidel, dohledatelných stavů, nebo pevné historie.

Kdy jsou tabulkové kalkulace ve skladu správnou volbou

Tabulka má smysl, když je proces přehledný, vzácný, a řízený malým počtem osob. To může být například měsíční plánování potřeb, jednorázová příprava inventury, nebo hodnocení cen dodavatelů. Může stačit i pro malou zásobu s jedním odpovědným, pokud se změny nedějí pod časovým tlakem a žádné navazující procesy na ní automaticky nezávisí.

Výhoda není jen v nízkých licenčních nákladech. Týmy mohou přizpůsobit sloupce, kontrolovat výpočty, a nastavit nový formulář během několika minut. Kdo ještě nepochopil stabilní proces, neměl by se ukvapovat s jeho přeléváním do softwaru. Dobrá tabulka může nejprve zviditelnit, která data jsou skutečně potřeba a která pole se udržují jen ze zvyku.

Bylo by proto chybou zacházet s každým Excel souborem jako s resty. Rozhodující otázka zní: je tabulka pracovním nástrojem pro jednu osobu nebo sdíleným zdrojem pro provozní rozhodnutí? Jakmile na stejných datech závisí více rolí, riziko výrazně stoupá.

Custom Logistics Software vs Spreadsheets: Bod zlomu

Změnu obvykle nespouští počet řádků. Tabulka s 20 000 položkami může fungovat, zatímco soubor s 200 řádky už vede k chybám. Rozhodující je souběžnost, kroky procesu, a důsledky nesprávné informace.

Typickým varovným signálem je otázka verzí. Pokud se zásoby, otevřené objednávky, nebo termíny dodání nacházejí v souborech s názvy jako "finální_nová", "finální_nová2", a "opravdu_finální", nechybí lepší struktura složek. Chybí závazný stav dat. Totéž platí, když si zaměstnanci musí telefonovat, aby zjistili, zda zboží dorazilo, zda byla objednávka uvolněna, nebo zda bylo vozidlo již naloženo.

Bod zlomu je dosažen, když jeden vstup spouští více navazujících akcí. Příjem zboží pak nemění jen číslo v zásobě. Může spustit kontrolu kvality, přiřadit skladovou pozici, označit objednávku jako částečně dodanou, a zobrazit prodeji dostupný artikl. Pokud jsou tyto kroky koordinovány manuálně přes soubory, papír, a telefonáty, odchylkám se lze těžko vyhnout.

Obzvlášť kritické se to stává při směnných výměnách a absencích. Když jen jedna zkušená osoba ví, které barevné označení v seznamu znamená blokaci, nebo který vzorec počítá bezpečnostní zásobu, proces není robustní. Funguje jen dokud je tato osoba k dispozici.

Co software na míru skutečně dělá lépe

Logistický software na míru není jednoduše tabulka s pěkným rozhraním. Jeho hodnota vzniká z kontrolovaných pracovních postupů. Každé zaúčtování dostane jednoznačný časový údaj, odpovědnou osobu, a dohledatelný stav. Zaměstnanci nevidí jen data, ale další povolenou akci.

Při příjmu zboží to může v praxi znamenat: výběr dodávky, zaznamenání množství, zdokumentování odchylky, vytištění štítku, a potvrzení uskladnění. Teprve poté se zásoba uvolní. Pro kompletaci může systém seskupit objednávky podle priority, zobrazit skladové pozice ve smysluplném pořadí, a vytvořit dodací list až, když jsou položky potvrzeny.

Nejde o zbytečnou složitost. Zabraňuje to tomu, aby byl stejný artikl rezervován dvakrát, aby se částečná dodávka počítala jako kompletní, nebo aby se dodací list vytiskl na základě zastaralých dat. Pomáhají i jednoduchá pravidla: povinná pole pro šarže, důvody blokace pro poškozené zboží, kontroly věrohodnosti u množství, a oprávnění pro opravná zaúčtování.

Dobře naplánovaná aplikace nepokrývá hned každý zvláštní případ. Soustředí se na procesy, které denně stojí čas nebo pravidelně produkují chyby. Pro jednu firmu to může být správa pohybů kontejnerů, pro jinou rychlé zaznamenávání příchozího zboží mobilními zařízeními. Standardní software tyto zvláštnosti často zná jen jako drahý doplňkový modul, nebo vůbec.

Skryté náklady tabulky

Licenční náklady tabulky jsou nízké. Náklady procesu nemohou být. Vznikají ve zpětných dotazech, přepracování, čase hledání, dvojí údržbě, a nesprávně naplánovaných zásobách. Vznikají i tehdy, když tým musí večer zkontrolovat, která data se od rána změnila.

Tyto náklady často zůstávají neviditelné, protože jsou rozděleny mezi mnoho rolí. Vedoucí skladu kontroluje zásoby, vnitřní obchod opravuje termíny dodání, účetnictví hledá doklady, a vedení dostává čísla se zpožděním. Žádná jednotlivá činnost nepůsobí dramaticky. Dohromady zpomalují průtok a plánovatelnost.

Solidní rozhodnutí by proto nemělo srovnávat jen ceny softwaru. Měřte po dobu dvou až tří týdnů, kolik manuálních předání objednávka projde, jak často jsou vyžadovány informace, a které chyby se opakují. Relevantní jsou i důsledky: vede nesprávná zásoba k interní korekci nebo k zmeškané dodávce?

Ne každý problém potřebuje velkou sadu

Mnoho středních firem v regionu DACH právem váhá před rozsáhlými enterprise systémy. Dlouhá zavádění, rigidní masky, a licenční modely pro funkce, které se nikdy nepoužijí, zřídka řeší konkrétní skladový problém. Alternativa však nemusí znamenat zůstat u roztroušených souborů.

Mezi oběma extrémy leží aplikace specifická pro pracovní postup. Může například propojit přijímání objednávek, příjem zboží, skladové pohyby, expediční štítky, a dodací listy v jednom společném systému, aniž by hned přinesla kompletní finanční účetnictví, globální koncernovou logiku, a dvacet cizích jazyků.

Rozhodující je technický základ. Aplikace s jasnou strukturou databáze, zdokumentovanými rozhraními, a dohledatelnými oprávněními zůstává přizpůsobitelná. Technologie jako PHP 8.4, moderní JavaScript, a MySQL 8 zde nejsou samoúčelné. Správně použité vytvářejí udržovatelný základ pro role, historie zaúčtování, tiskové dokumenty, a vyhodnocení - i když se procesy za dva roky změní.

Jak se podaří přechod bez narušení provozu

Největším nebezpečím není technika, ale příliš velký první krok. Kdo se pokouší vyčistit všechny historické soubory a před startem zmapovat každý výjimečný případ, odsouvá přínos o měsíce. Lepší je jasný, ověřitelný začátek.

Začněte s procesem, který se vyskytuje často a je dobře ohraničitelný, například příjem zboží se skladovým zaúčtováním, nebo expedice s dodacím listem a štítkem. Přesně přitom definujte, kdy operace začíná, která data jsou nezbytně nutná, kdo uděluje jaké schválení, a kdy se považuje za dokončenou. Z toho vznikají nejen obrazovky, ale pevná pracovní pravidla.

Převzetí dat rovněž vyžaduje pragmatismus. Aktivní artikly, dodavatelé, skladové pozice, a otevřené objednávky musí být čisté. Historické staré zásoby naopak lze často archivovat, místo aby se s velkým úsilím importovaly do nového systému. Paralelní provoz může být smysluplný, ale jen s pevným koncovým datem. Jinak vzniknou dvě pravdy místo jedné lepší.

Při zavádění se ukazuje hodnota přímého technického partnera.

softify.pro proto nepracuje z abstraktního seznamu funkcí, ale objasňuje pracovní postupy tam, kde skutečně probíhají: při převzetí, ve skladové uličce, při balení, a při předání expedici. Dobrý software respektuje fungující rutiny a mění jen to, co proces skutečně dělá spolehlivějším.

Rozhodnutí lze prověřit na třech otázkách

Za prvé: musí více osob současně důvěřovat aktuálním datům? Za druhé: spouští zaúčtování navazující procesy, které se dnes zajišťují manuálně? Za třetí: může chyba vést ke zpoždění dodávky, nesprávné zásobě, nesprávné faktuře, nebo zdlouhavému hledání? Pokud se na tyto otázky převážně odpovídá ano, tabulka pravděpodobně už není správným vedoucím systémem.

Pokud odpověď zůstává převážně ne, může nadále být rozumným řešením. Pak se více vyplatí sjednotit soubory, stanovit odpovědnosti, a zdokumentovat kritické vzorce. Technika by neměla být větší než problém.

Dalším smysluplným krokem tedy není paušální projekt digitalizace, ale společný pohled na konkrétní pracovní postup společně s lidmi, kteří ho denně vykonávají. Tam se rychle ukáže, zda dobře vedená tabulka postačuje - nebo zda by spolehlivý software měl konečně převzít práci, která dnes zůstává uvíznutá mezi papírem, telefonem, a několika verzemi téhož souboru.

Permalink →

Navázat kontakt

Máte v hlavě projekt, pracovní proces, který stále běží na Excelových tabulkách a dobré vůli, nebo zásobník testování, který by COCO mohlo převzít od vašeho týmu? Řekněte nám o tom.

Odeslat zprávu