softify.pro
Wird geladen …
Leistungen Über uns COCO – unser KI-Server Portfolio Insiders Case Studies Wissenswertes Kontakt Login

NEXT-GEN SOFTWARE AESTHETIC

Pure fluidity meets ultimate performance.

Die neue visuelle Identität für moderne digitale Workflows.

softify.pro — Die neue visuelle Identität für moderne digitale Workflows.

Zum Entdecken scrollen ↓

Software, gebaut wie moderne Unternehmen wirklich arbeiten

softify.pro ist ein Software-Studio, das auf einer Idee basiert: Technologie sollte sich genauso fließend bewegen wie die Unternehmen, die sie unterstützt. Wir arbeiten an der Schnittstelle aus moderner Webentwicklung, Prozessautomatisierung und angewandter künstlicher Intelligenz — drei Disziplinen, die selten unter einem Dach zu finden sind, aber zunehmend zusammengehören. Unsere Kunden reichen vom kleinen Betrieb, der seinen ersten digitalen Rechnungslauf einführt, bis zum etablierten mittelständischen Produktionsunternehmen, das Excel-Tabellen durch echte Logistiksoftware ersetzt. Was sie verbindet, ist nicht die Größe, sondern der Anspruch: Sie wollen Systeme, die schnell, zuverlässig und angenehm zu bedienen sind — nicht nur funktional. Jedes Projekt beginnt bei uns mit denselben drei Fragen: Was muss dieses Unternehmen tatsächlich schneller machen? Was funktioniert bereits gut und sollte respektiert statt ersetzt werden? Und welcher Teil des Arbeitsablaufs kann sich, einmal richtig gebaut, künftig selbst erledigen? Die Antworten bestimmen alles Weitere — von der gewählten Technologie bis zum Rollout-Plan.

Leistungen

Die neue visuelle Identität für moderne digitale Workflows.

01 — LOGISTICS

Logistik automatisieren — für kleine und mittlere Unternehmen im DACH-Raum

Ein großer Teil unserer Arbeit widmet sich Logistik- und Betriebssoftware für kleine und mittlere Unternehmen in Deutschland, Österreich und der Schweiz. Diese Betriebe stehen häufig zwischen zwei unattraktiven Optionen: teure Enterprise-Logistiksuiten, die für Konzerne mit dem Zehnfachen ihrer Größe konzipiert sind, oder ein Flickwerk aus Excel-Tabellen, Papierformularen und Telefonanrufen, das leise begrenzt, wie schnell sie wachsen können.

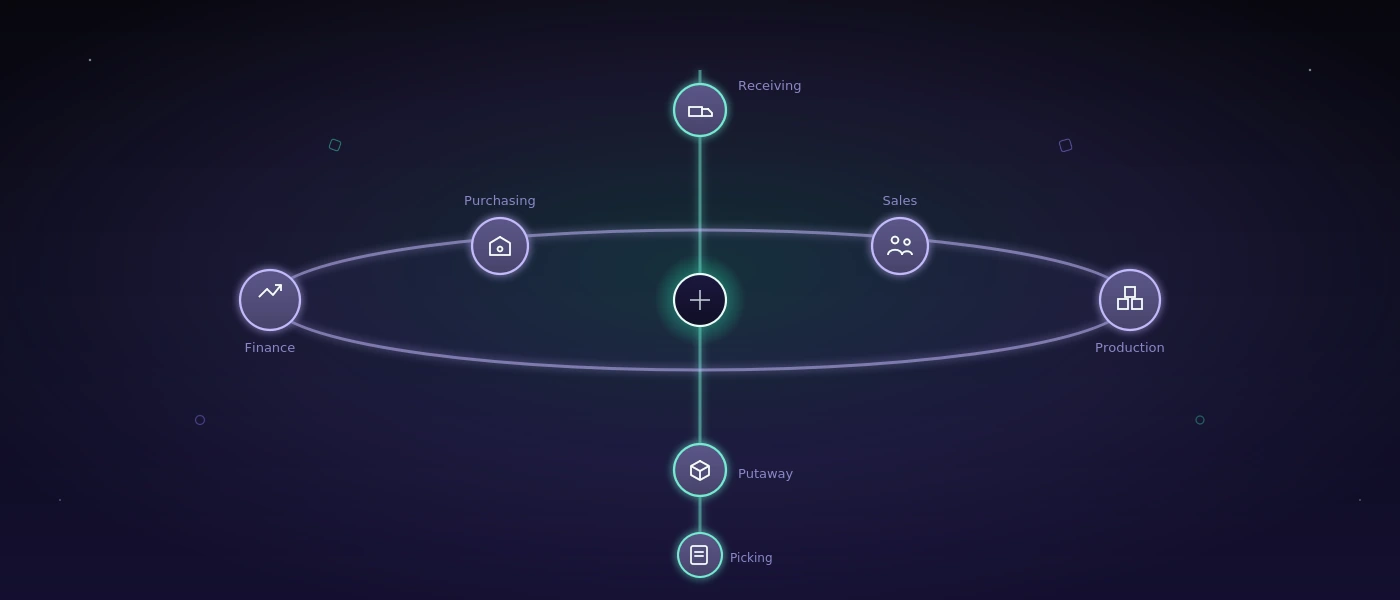
Wir bauen den Mittelweg — maßgeschneiderte Automatisierung, die zur tatsächlichen Arbeitsweise eines bestimmten Lagers, einer Werkstatt oder eines Vertriebsteams passt. Das kann bedeuten: Wareneingang und Lagerbewegungen digitalisieren, Lieferscheine und Versandetiketten automatisch erzeugen, Auftragseingang mit der Tourenplanung verbinden oder schlicht eine fragile Excel-Datei, die nur eine Person versteht, durch ein System ersetzen, auf das sich das ganze Team verlassen kann. Da wir direkt mit Inhabern und Betriebsleitern im DACH-Raum arbeiten, werden Anforderungen in der Sprache erfasst, in der das Unternehmen tatsächlich arbeitet, und der Rollout wird um reale Schichtpläne und reale Lagerflächen herum geplant — nicht um einen abstrakten Projektplan.

02 — WEB

Moderne Webentwicklung mit aktueller Technologie

Wir entwerfen und entwickeln Webanwendungen und Websites mit aktueller, aktiv gepflegter Technologie — nicht mit veralteten Frameworks, die nur aus Gewohnheit am Leben gehalten werden. Das bedeutet sauberes PHP 8.4 im Backend, wo eine klassische serverseitig gerenderte Anwendung die richtige Wahl ist, modernes JavaScript, wo Interaktivität zählt, und MySQL 8 für Daten, die über Jahre konsistent und abfragbar bleiben müssen — nicht nur in den ersten sechs Monaten nach dem Launch. Jedes Projekt wird von der ersten Skizze an für Desktop und Mobilgeräte gleichermaßen geplant, nicht nachträglich angepasst: Ladezeiten, Layout-Breakpoints und Touch-Bedienung sind Teil der Spezifikation, nicht ein späterer Zusatz.

Neben der sichtbaren Oberfläche ist uns wichtig, wie eine Website von innen aussieht: lesbarer Code, ein Datenbankschema, das bei der nächsten Funktionsanfrage nicht neu aufgebaut werden muss, und Deployment-Schritte, denen auch ein zweiter Entwickler ohne Rückfrage folgen kann. Eine Website, die heute performant ist und in drei Jahren noch sauber erweiterbar, ist für uns die eigentliche Definition von „modern".

03 — AI / COCO

COCO — unser eigener KI-Server für automatisiertes Software-Testing

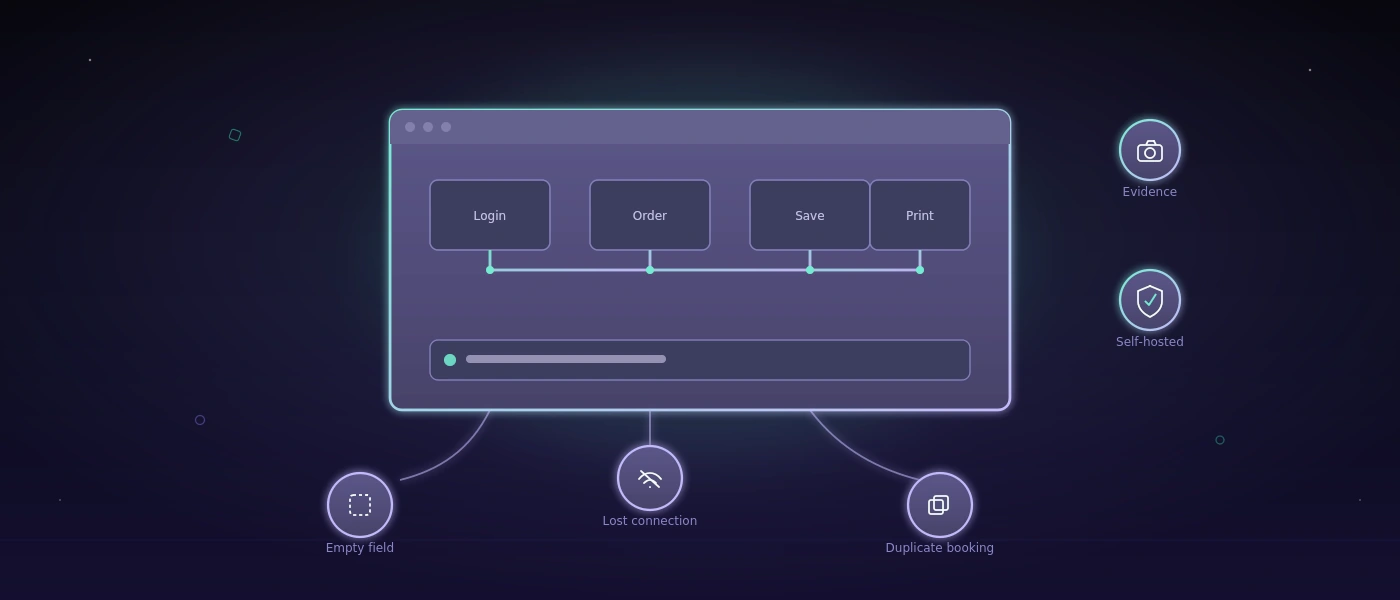
Für Enterprise-Kunden betreiben und pflegen wir einen eigenen dedizierten KI-Server namens COCO. Anders als ein allgemeiner Chatbot, der nachträglich in einen Workflow eingebaut wird, ist COCO gezielt und selbst gehostet für das automatisierte Testen von Webanwendungen sowie plattformübergreifenden Desktopanwendungen konzipiert — von Login- und Authentifizierungsabläufen bis zu vollständigen mehrstufigen Geschäftsprozessen.

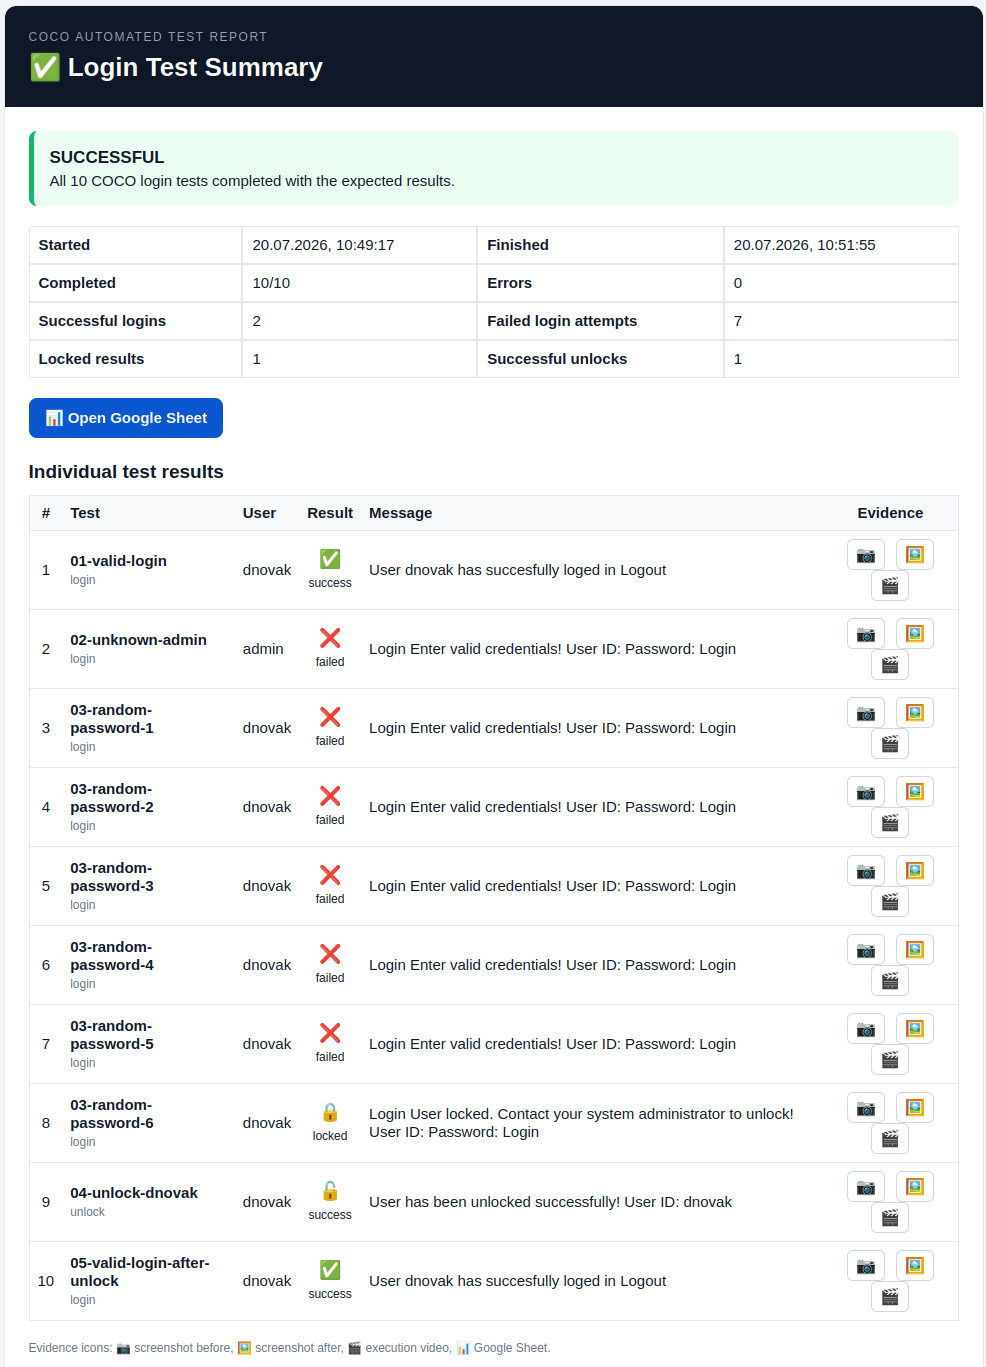
COCO plant ein Testszenario, führt es gegen die reale Anwendung aus, erfasst Vorher-Nachher-Screenshots und Ausführungsaufzeichnungen als Nachweis und erstellt eine verständliche Auswertung darüber, was funktioniert hat, was fehlgeschlagen ist und warum — einschließlich Randfällen wie wiederholten fehlgeschlagenen Logins, Kontosperrungen und Wiederherstellungsabläufen, die manuell mühsam und fehleranfällig zu testen sind. Da der Server lokal und unter unserer Verwaltung läuft, behalten Enterprise-Kunden die volle Kontrolle darüber, wo Testdaten und Screenshots gespeichert werden, ohne internen Anwendungsverkehr standardmäßig an einen externen Cloud-Dienst zu senden.

Wir richten COCO für jeden Enterprise-Kunden individuell ein, konfigurieren und pflegen den Server — wir definieren die Testpläne, die für die jeweilige Anwendung relevant sind, stimmen Konfidenzschwellen ab und entscheiden von Fall zu Fall, wann ein Ergebnis zur menschlichen Prüfung eskaliert werden soll. Ziel ist nicht, ein QA-Team zu ersetzen, sondern ihm eine unermüdliche Kollegin zur Seite zu stellen, die die sich wiederholenden Regressionstests vor jedem Release durchläuft, bevor ein Mensch überhaupt eingreifen muss.

COCO automated login test report
COCO — automated login & account-lockout test report
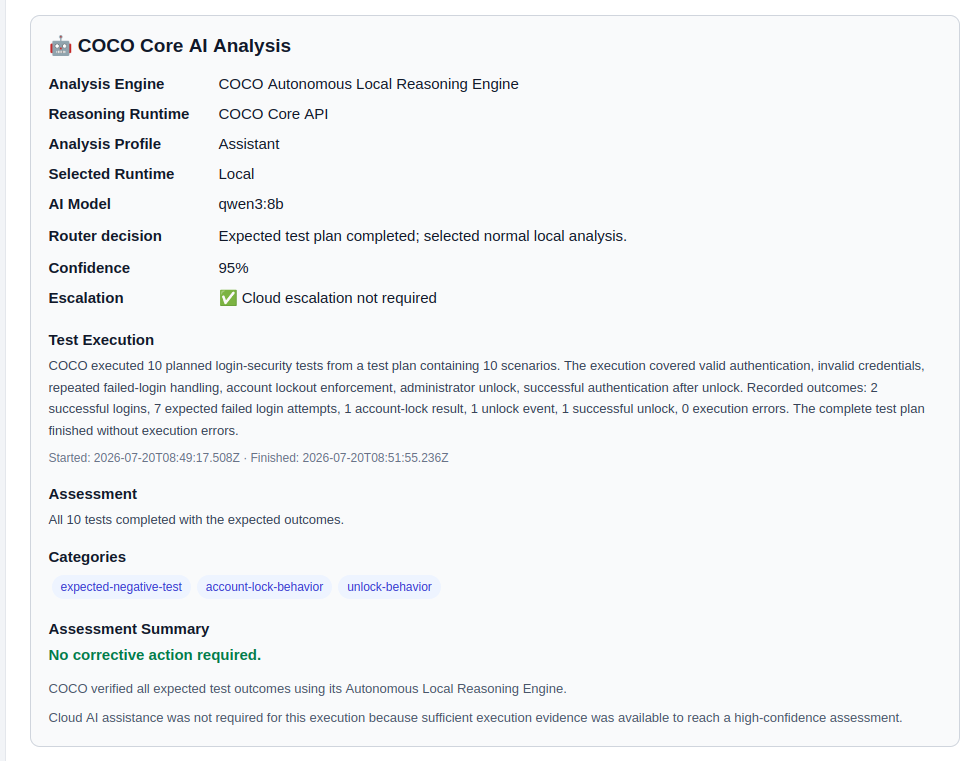
COCO AI analysis panel
COCO — plain-language AI analysis of a completed test run

Warum softify.pro

Wir bleiben bewusst so klein, dass jedes Projekt von Menschen betreut wird, die schon beim ersten Planungsgespräch dabei waren — statt an eine Warteschlange weitergereicht zu werden. Das bedeutet kürzere Feedback-Schleifen, weniger Missverständnisse und ein Team, das sich auch nach sechs Monaten noch erinnert, warum eine bestimmte Entscheidung getroffen wurde. Wir bevorzugen unspektakuläre, nachweisbare Zuverlässigkeit gegenüber kurzlebigen Trends: Ein Technologie-Stack wird gewählt, weil er zum Problem passt und auch von jemand anderem als uns in fünf Jahren gepflegt werden kann — nicht, weil er im aktuellen Sprint gerade angesagt war. Wenn eine Excel-Tabelle die Aufgabe tatsächlich noch besser erledigt als individuelle Software, sagen wir Ihnen auch das ehrlich. Unser Ziel ist ein Arbeitsablauf, der wirklich schneller läuft — nicht einfach eine höhere Softwarerechnung.

Ausgewählte Arbeiten

Eine kleine Auswahl an Arbeiten, die wir öffentlich zeigen dürfen — weitere Case Studies und Enterprise-Projekte stellen wir auf Anfrage unter NDA vor.

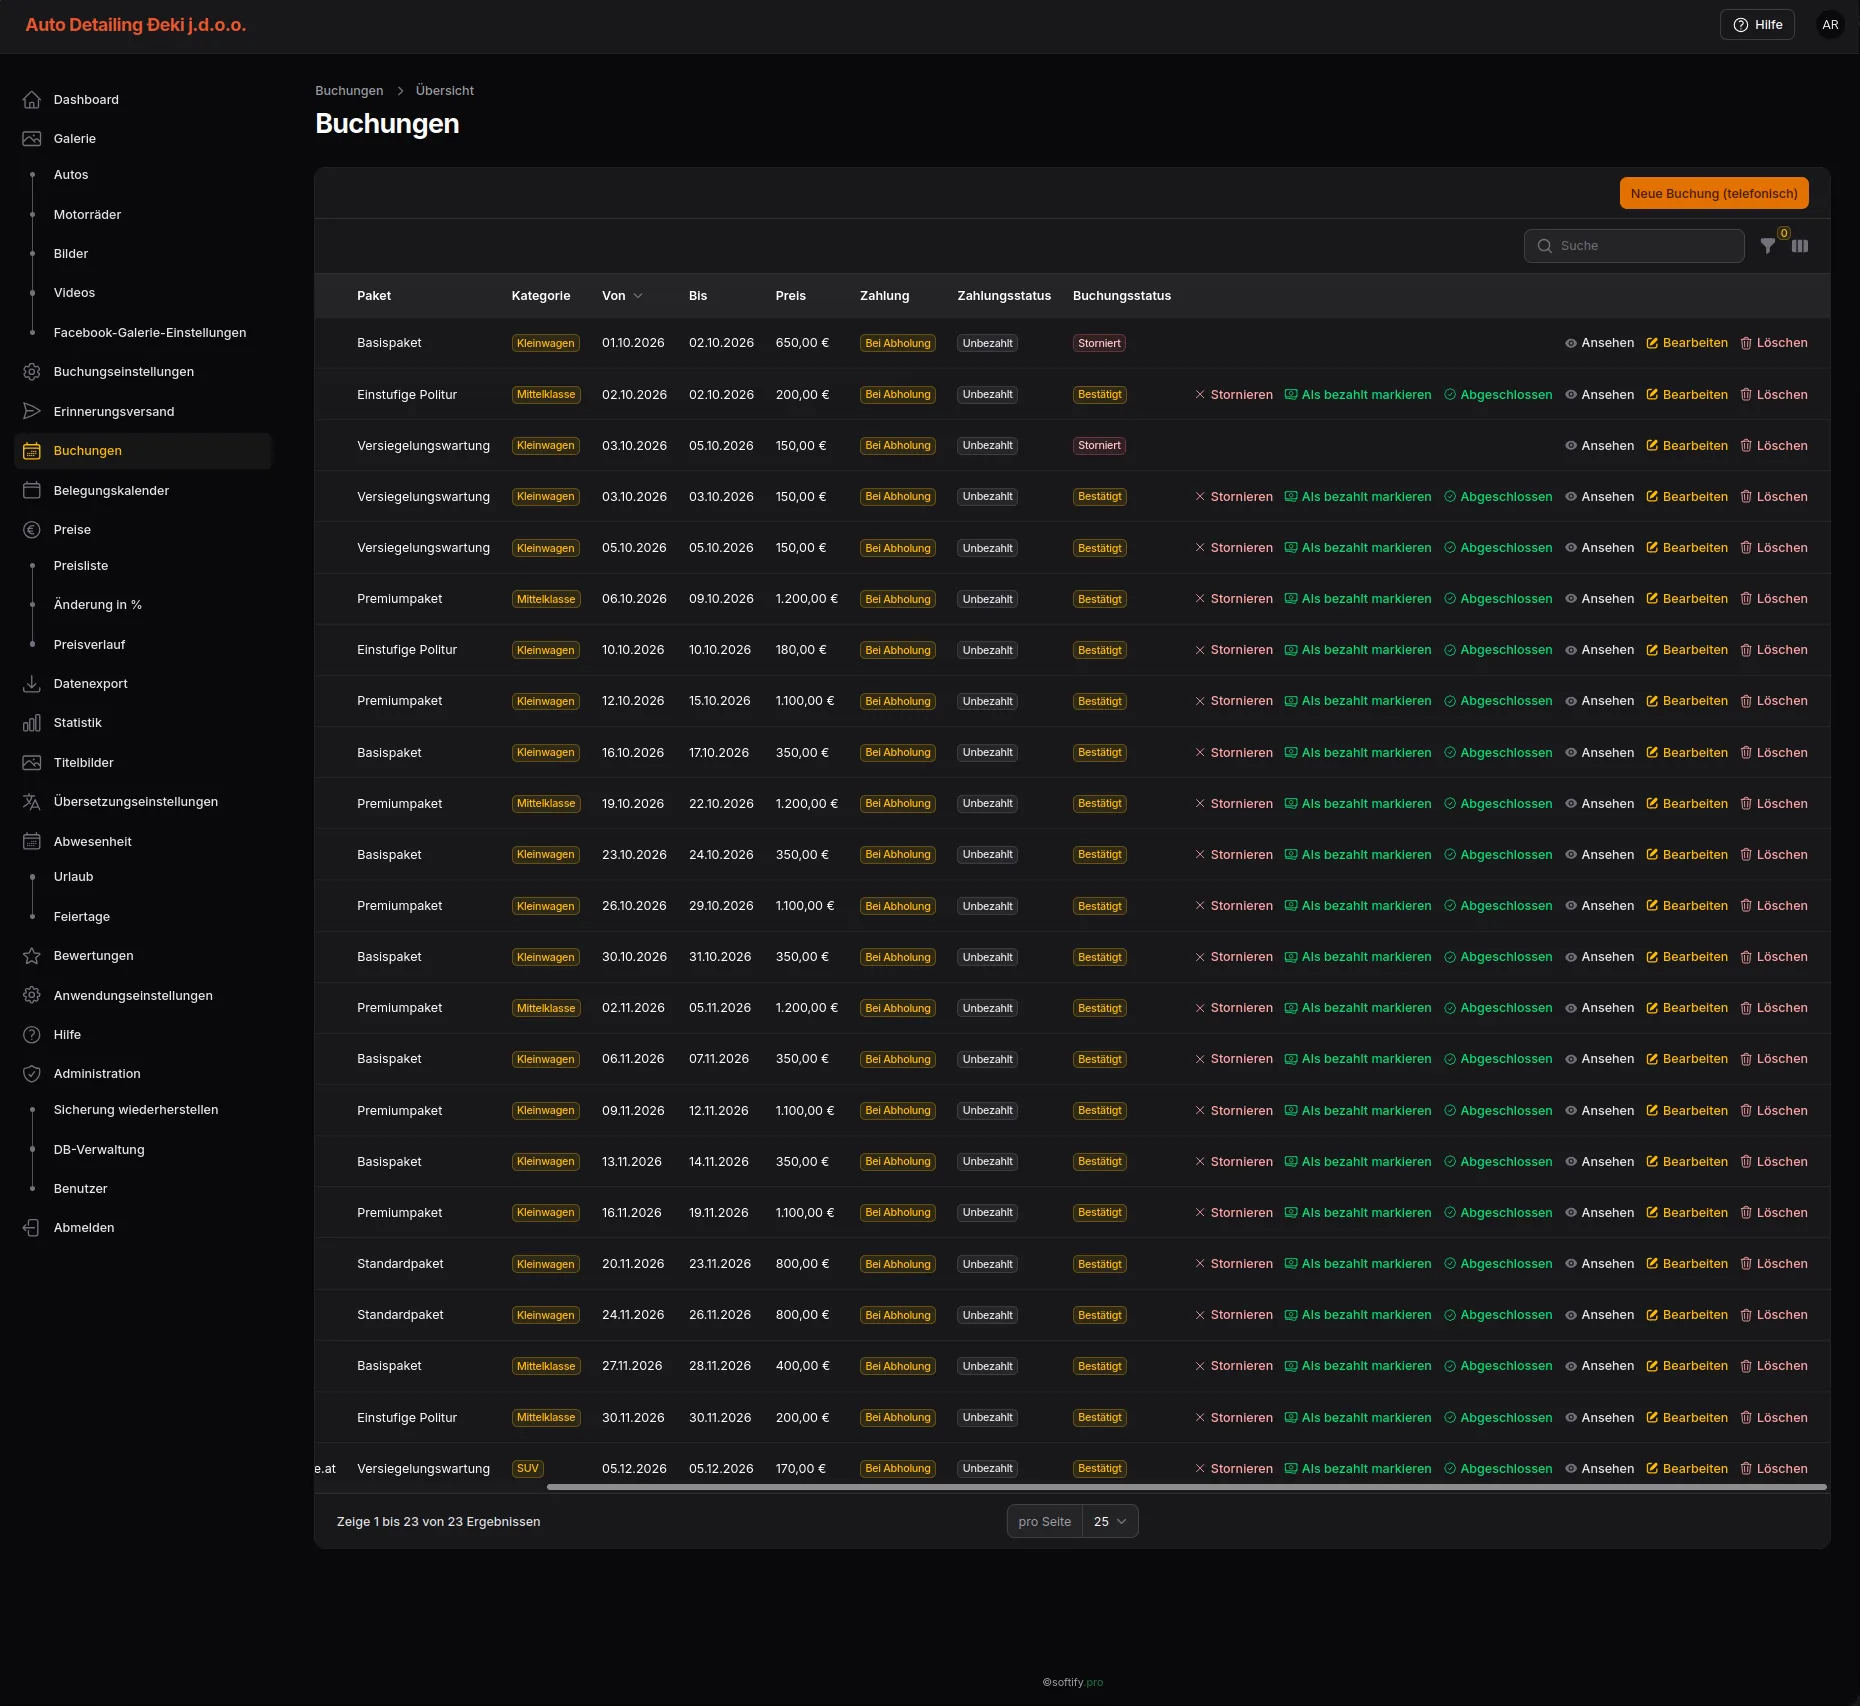
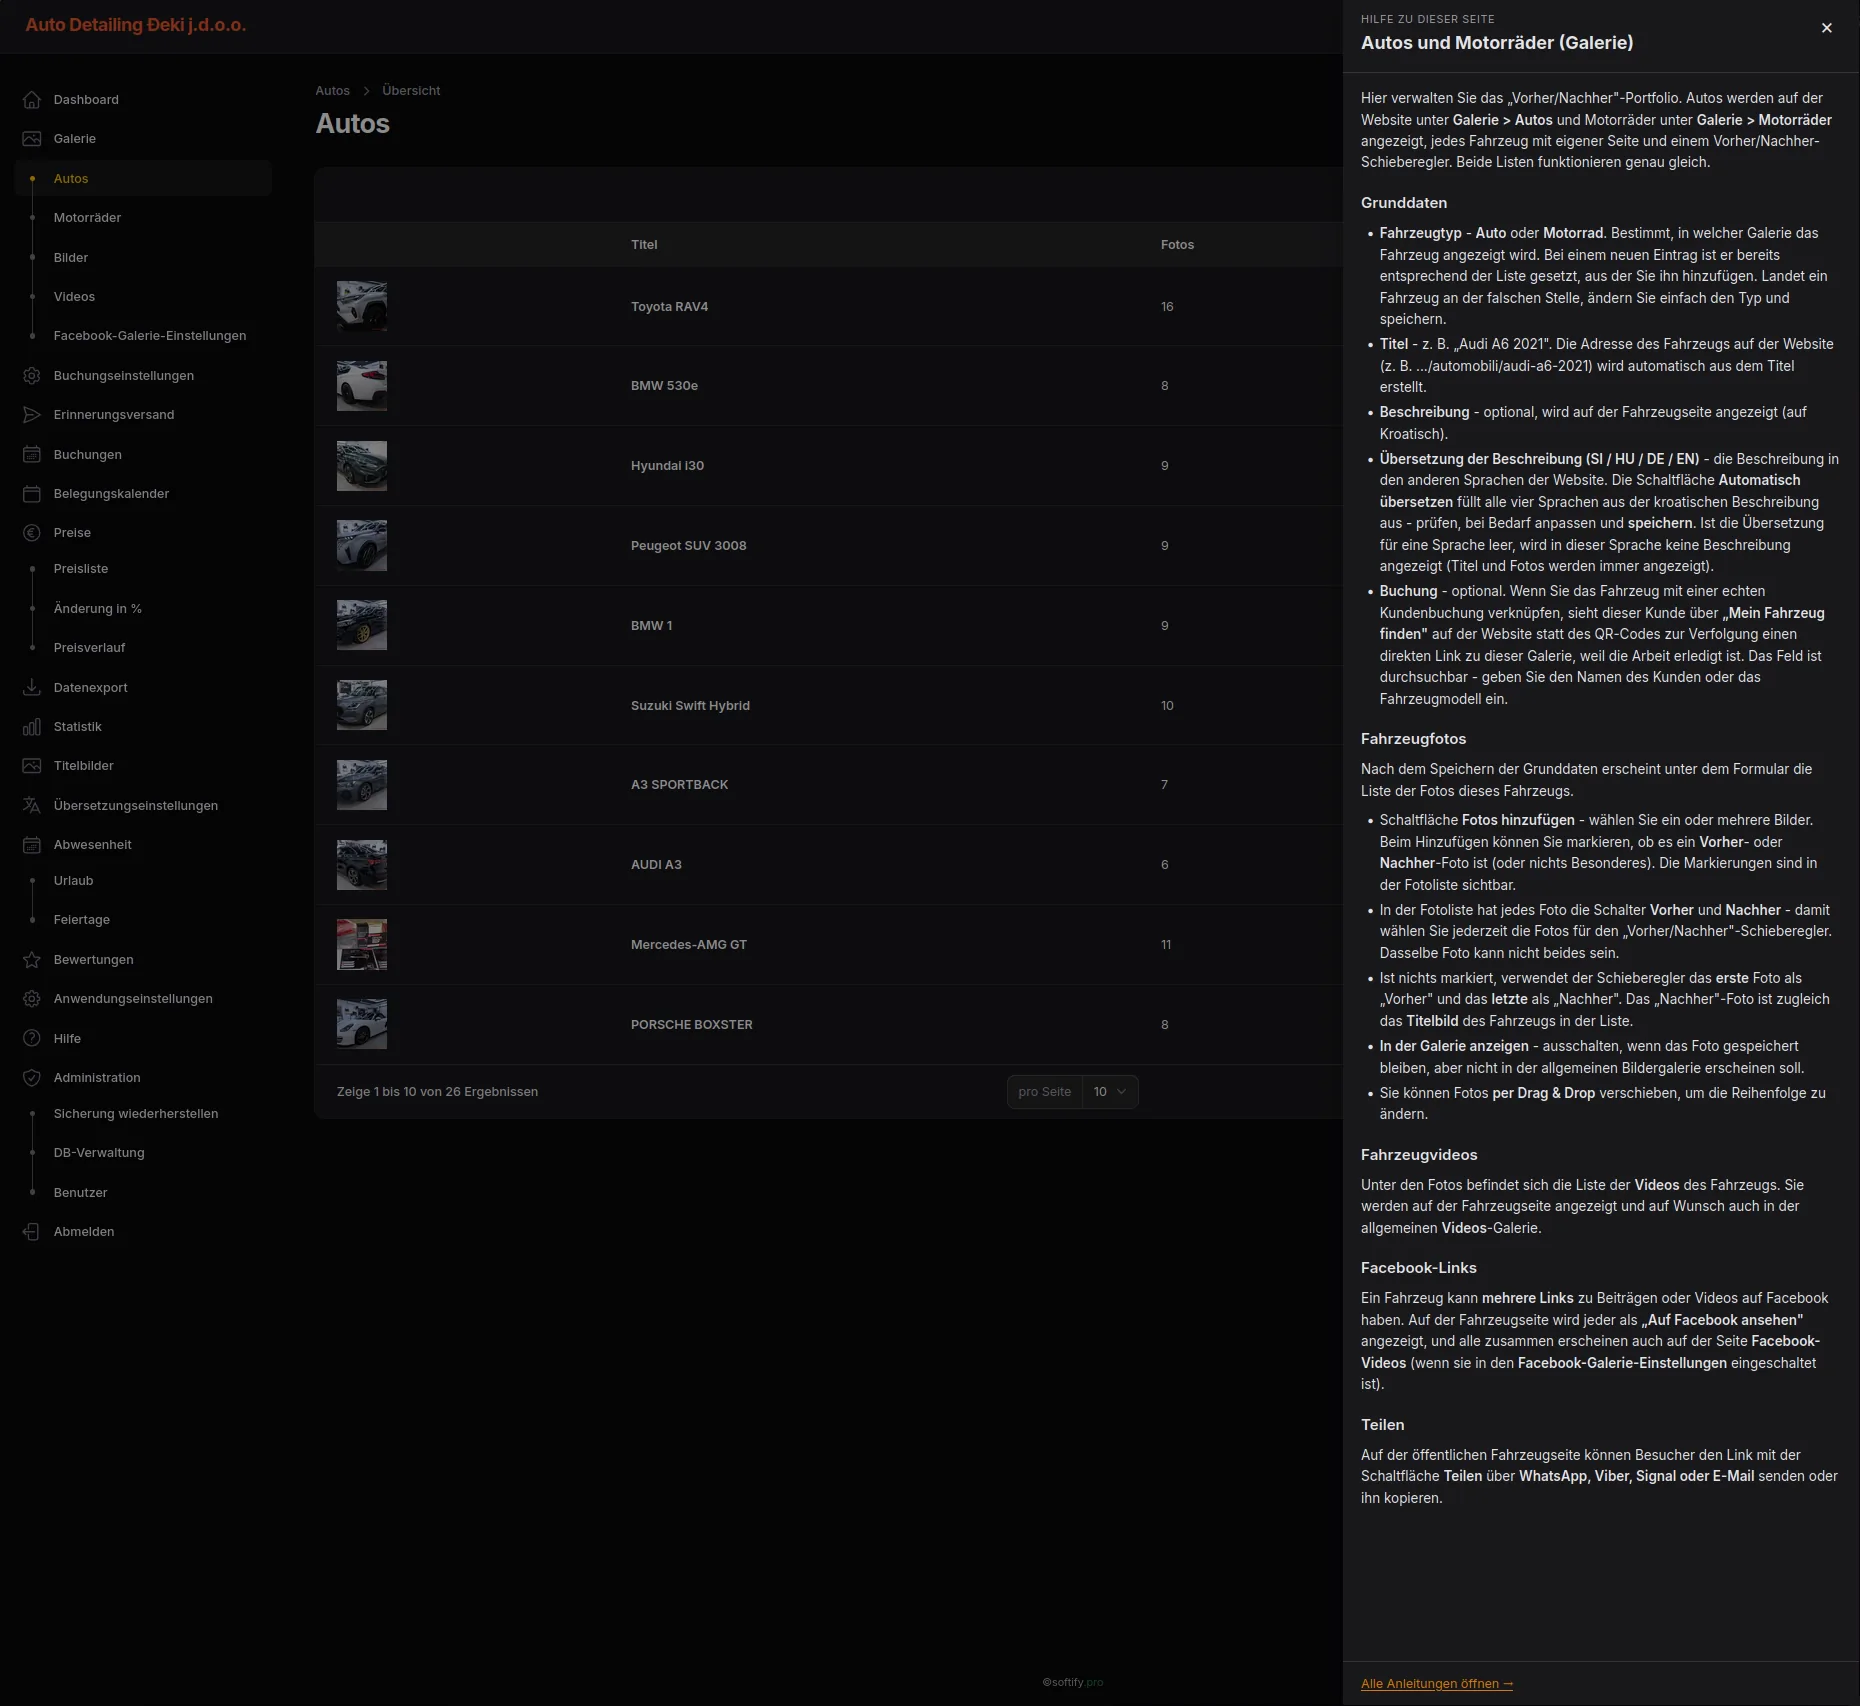
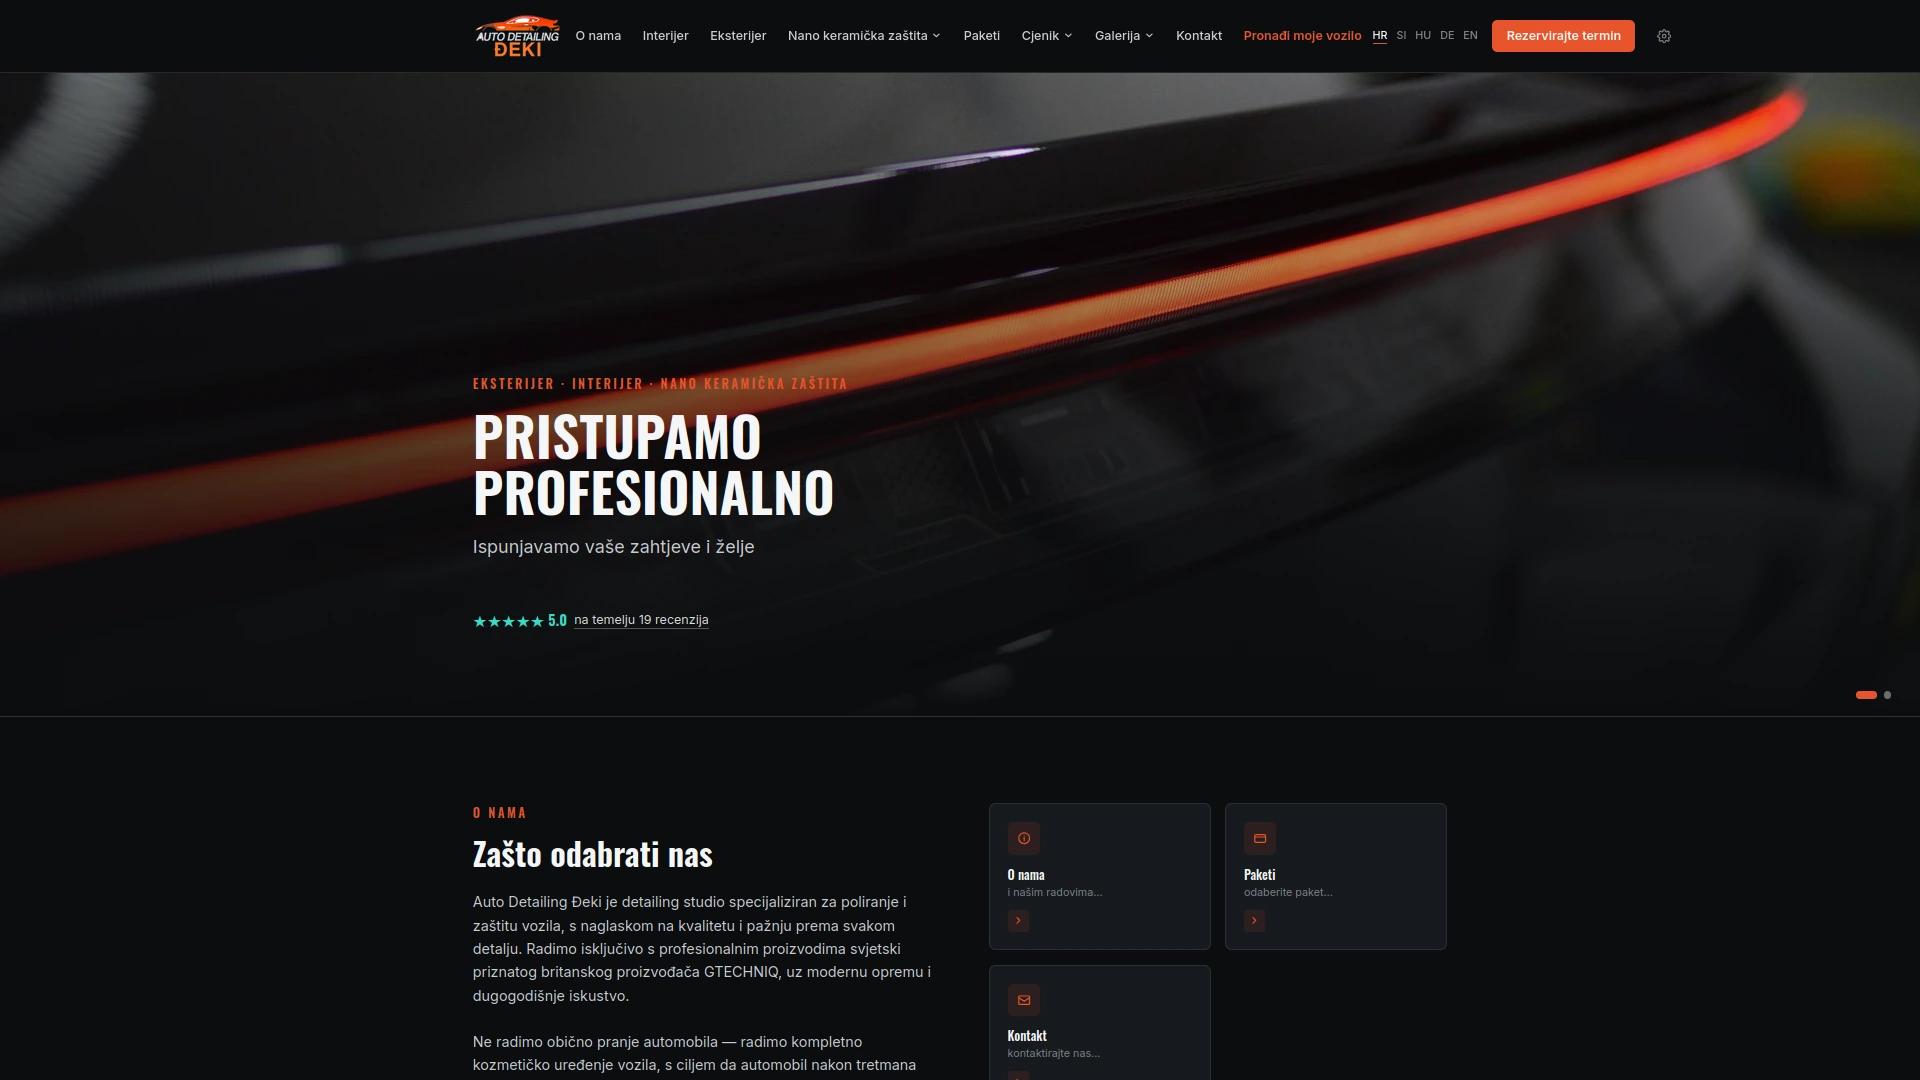
Auto Detailing Đeki – Von der Website zur digitalen Serviceplattform autodetailing-deki.pro

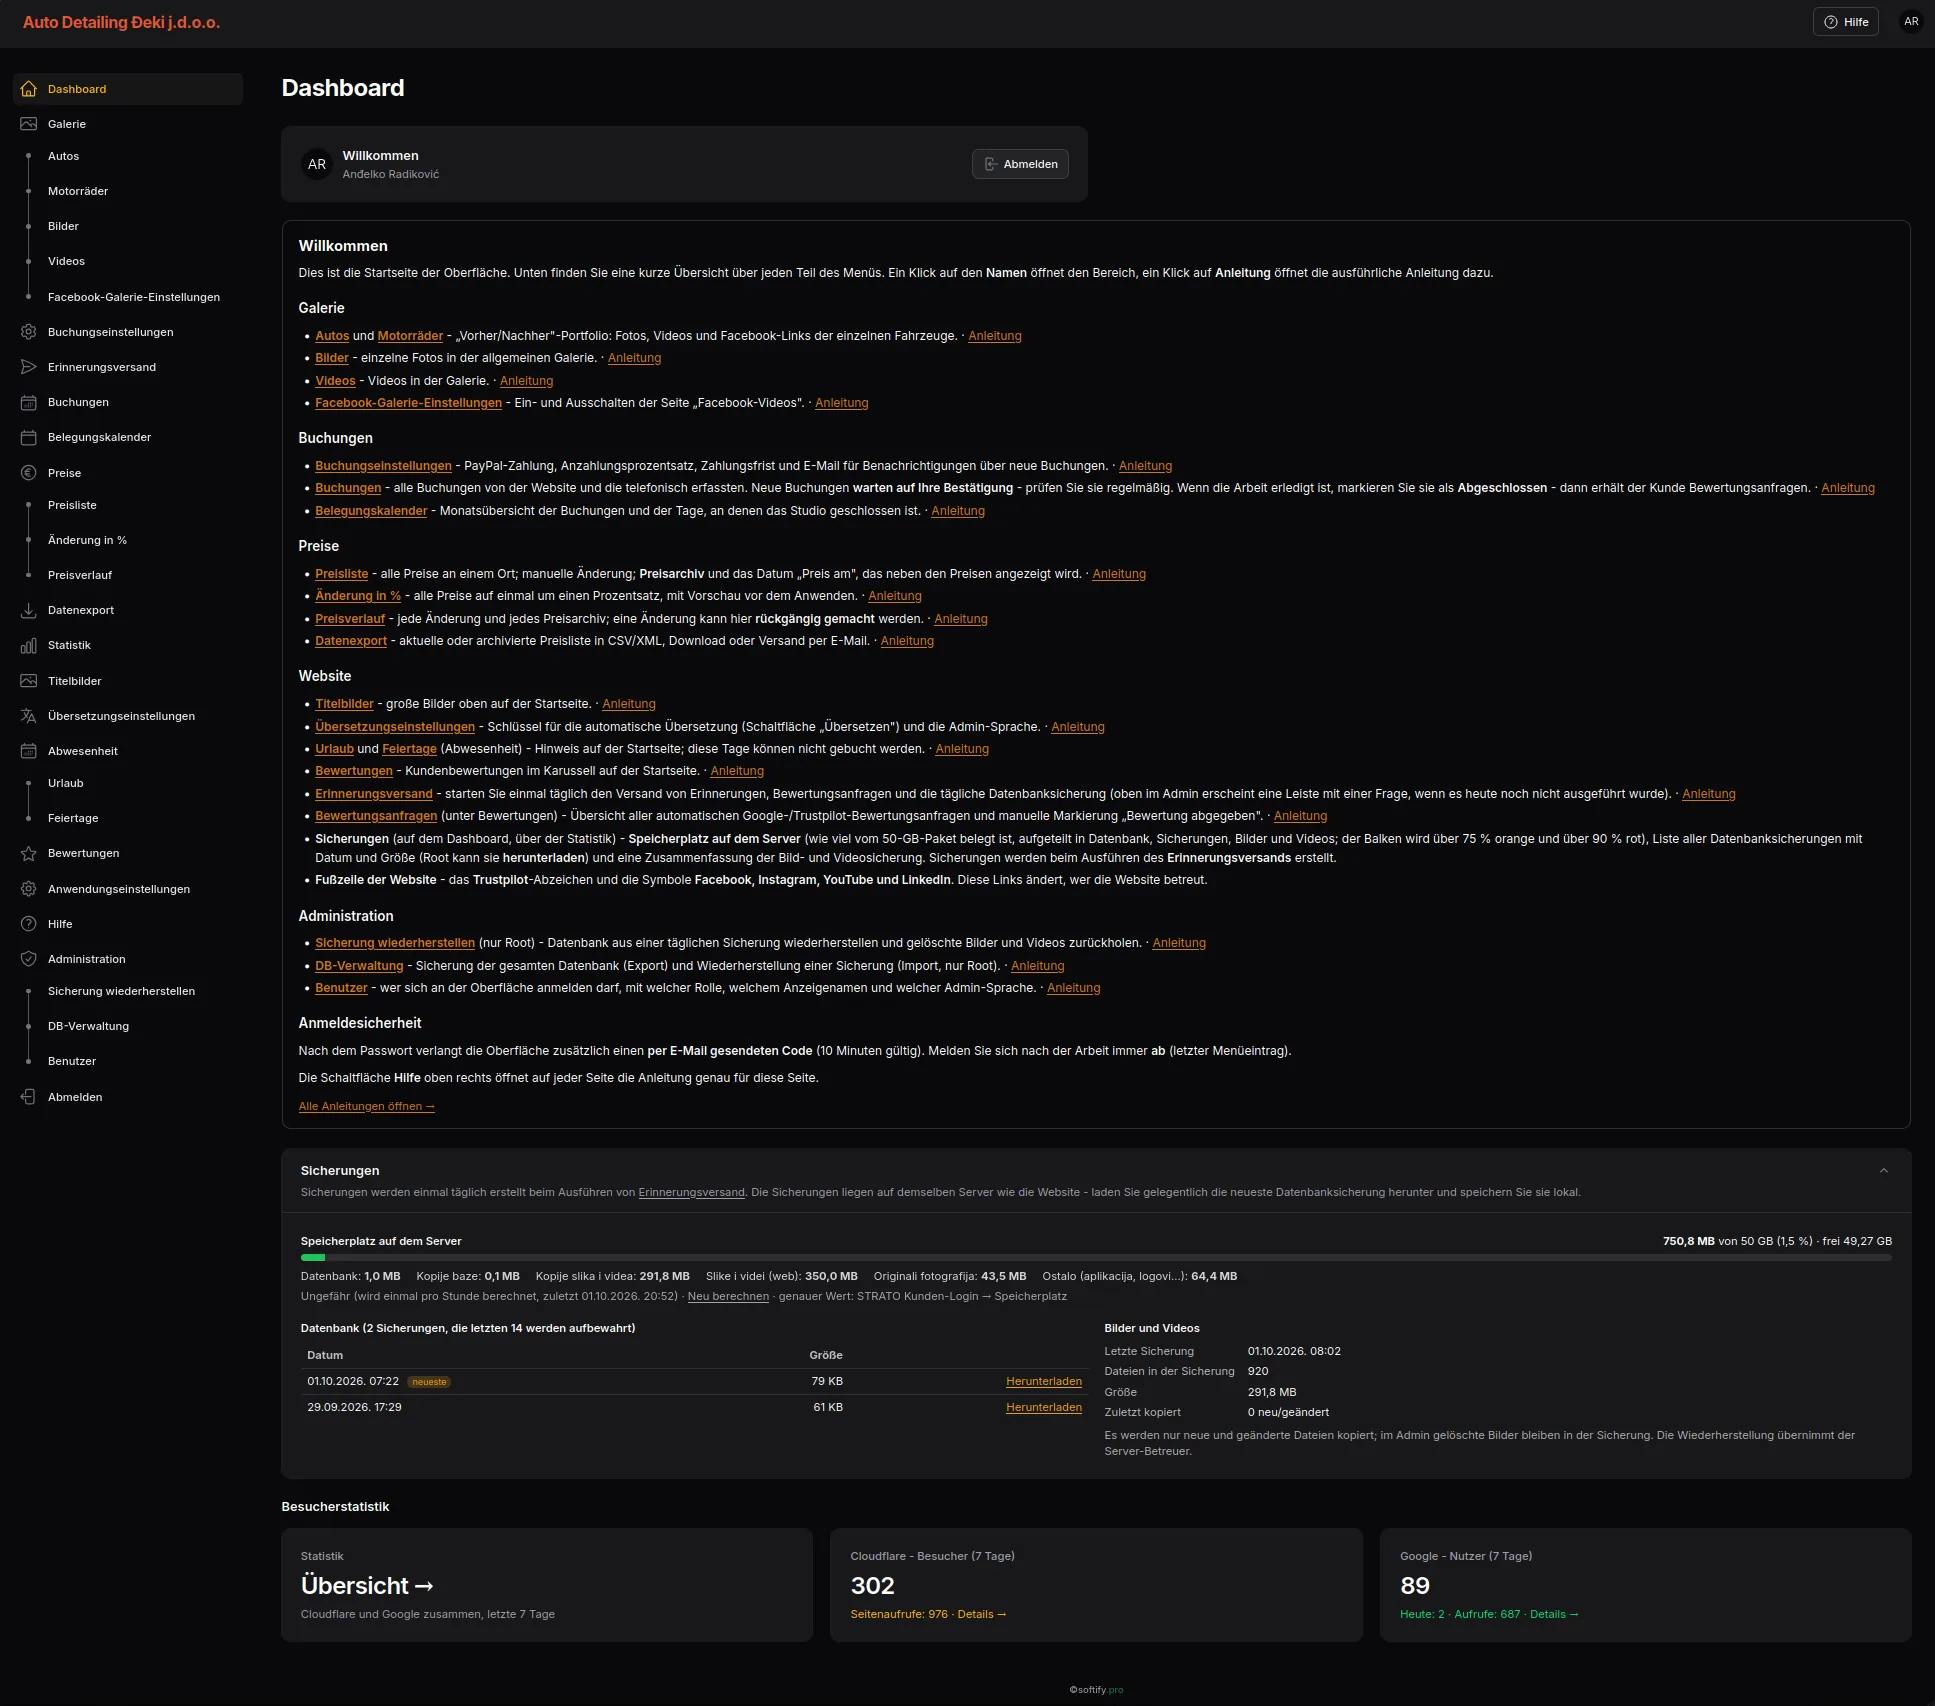
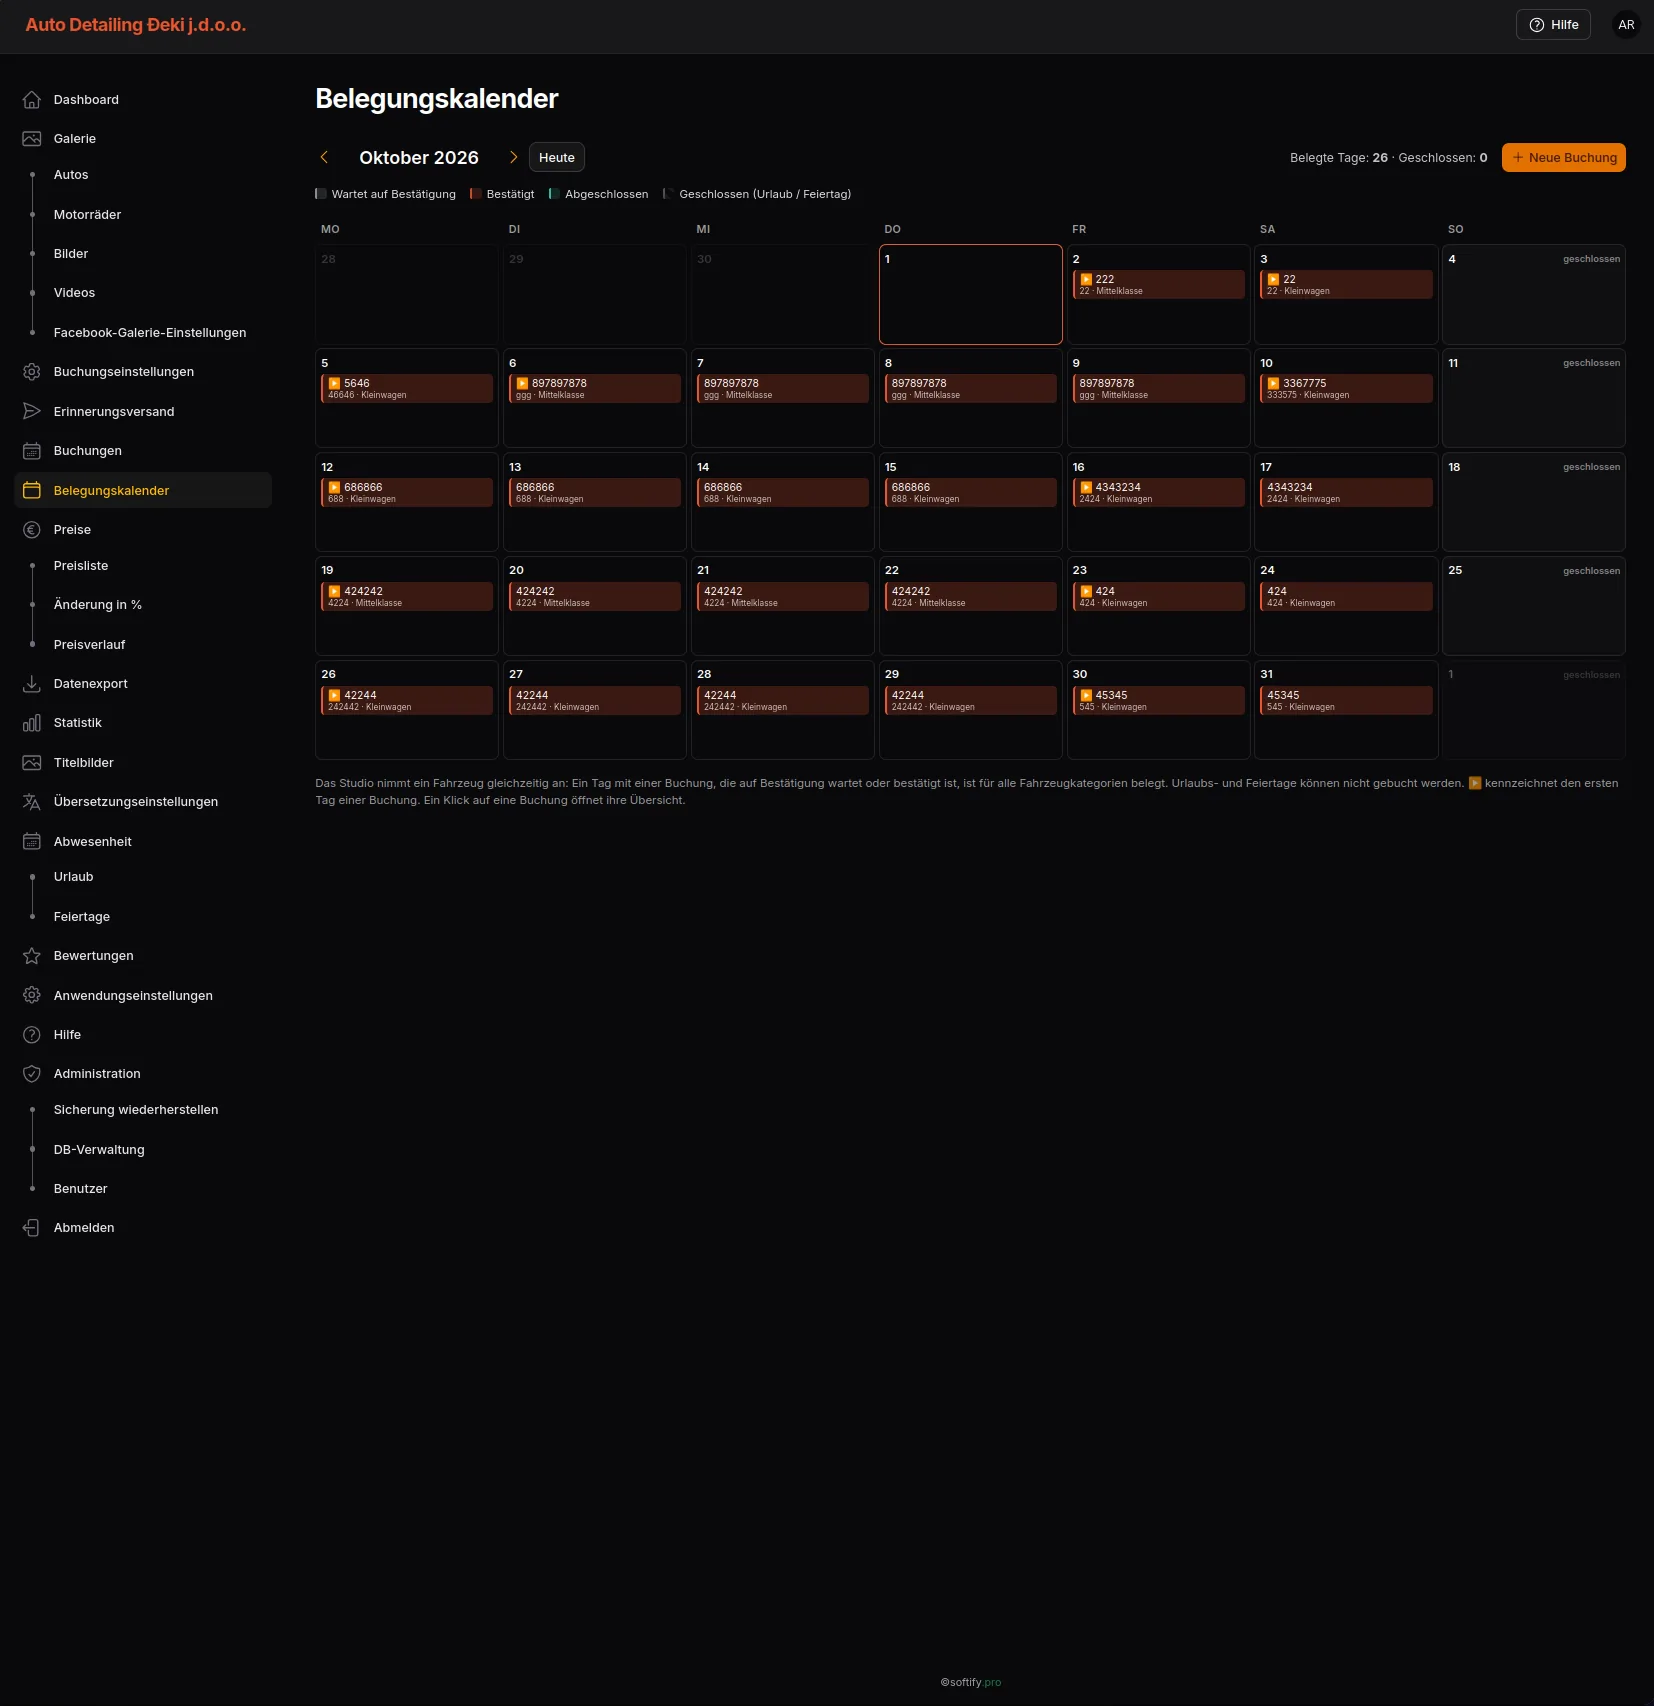
Auto Detailing Đeki – Von der Website zur digitalen Serviceplattform

Mehrsprachige Plattform für Fahrzeugaufbereitung – von der Preisberechnung über die Reservierung bis zur transparenten Auftragsverfolgung, gesteuert aus einem zentralen Backoffice.

Koralpenhaus

Koralpenhaus

Regionale Präsentations- und Buchungswebsite im Alpenraum, gebaut mit Fokus auf klare Struktur, schnelle Ladezeiten und einfache Pflege der Inhalte.

Dexosano

Dexosano

Eine moderne PHP-basierte Webplattform, entwickelt mit demselben Performance-First-Ansatz, den softify.pro bei jedem Kundenprojekt anwendet.

softify.pro - Insiders

Ein Lager. Eine Wahrheit.

Ein Lager. Eine Wahrheit.

Es gibt einen einfachen Weg, Lagersoftware überzeugend aussehen zu lassen.
Ein Dashboard öffnen.
Ein paar grüne Zahlen zeigen.
Ein Diagramm hinzufügen.
Etwas Bestand auf eine Lagerkarte legen.
Mit einem Report abschließen.
Alles sieht gut aus.
Und trotzdem kann alles falsch sein.
Denn ein Lager interessiert sich nicht dafür, wie gut das Dashboard aussieht.
Es interessiert sich dafür, ob jeder Teil des Systems sich darüber einig ist, was tatsächlich passiert ist.
Das wurde zum interessanten Teil des neuesten softify.pro Flow-Experiments.
Kein weiterer Bildschirm.
Kein weiterer KPI.
Kein weiterer Report.
Etwas viel Unsichtbareres.
Konsistenz.
Es begann mit einem Lager.
Die aktuelle softify.pro Flow-Demo arbeitet mit mehreren synthetischen Lagerumgebungen.
Unterschiedliche Lager-IDs.
Unterschiedliche Kapazitäten.
Unterschiedliche Zonenstrukturen.
Kein Produktivbestand.
Keine Kundendaten.
Keine echten Betriebsinformationen.
Aber die Prozesslogik verhält sich so, als würde all das eine Rolle spielen.
Denn in der echten Logistik tut es das.
Sobald ein Lager ausgewählt ist, wird dieser Kontext Teil von allem, was folgt.
Flows.
SSCCs.
Bewegungen.
Bediener.
Analytics.
Reports.
Das klingt selbstverständlich.
Es wird deutlich weniger selbstverständlich, sobald derselbe Prozess in mehreren verschiedenen Teilen der Anwendung auftaucht.
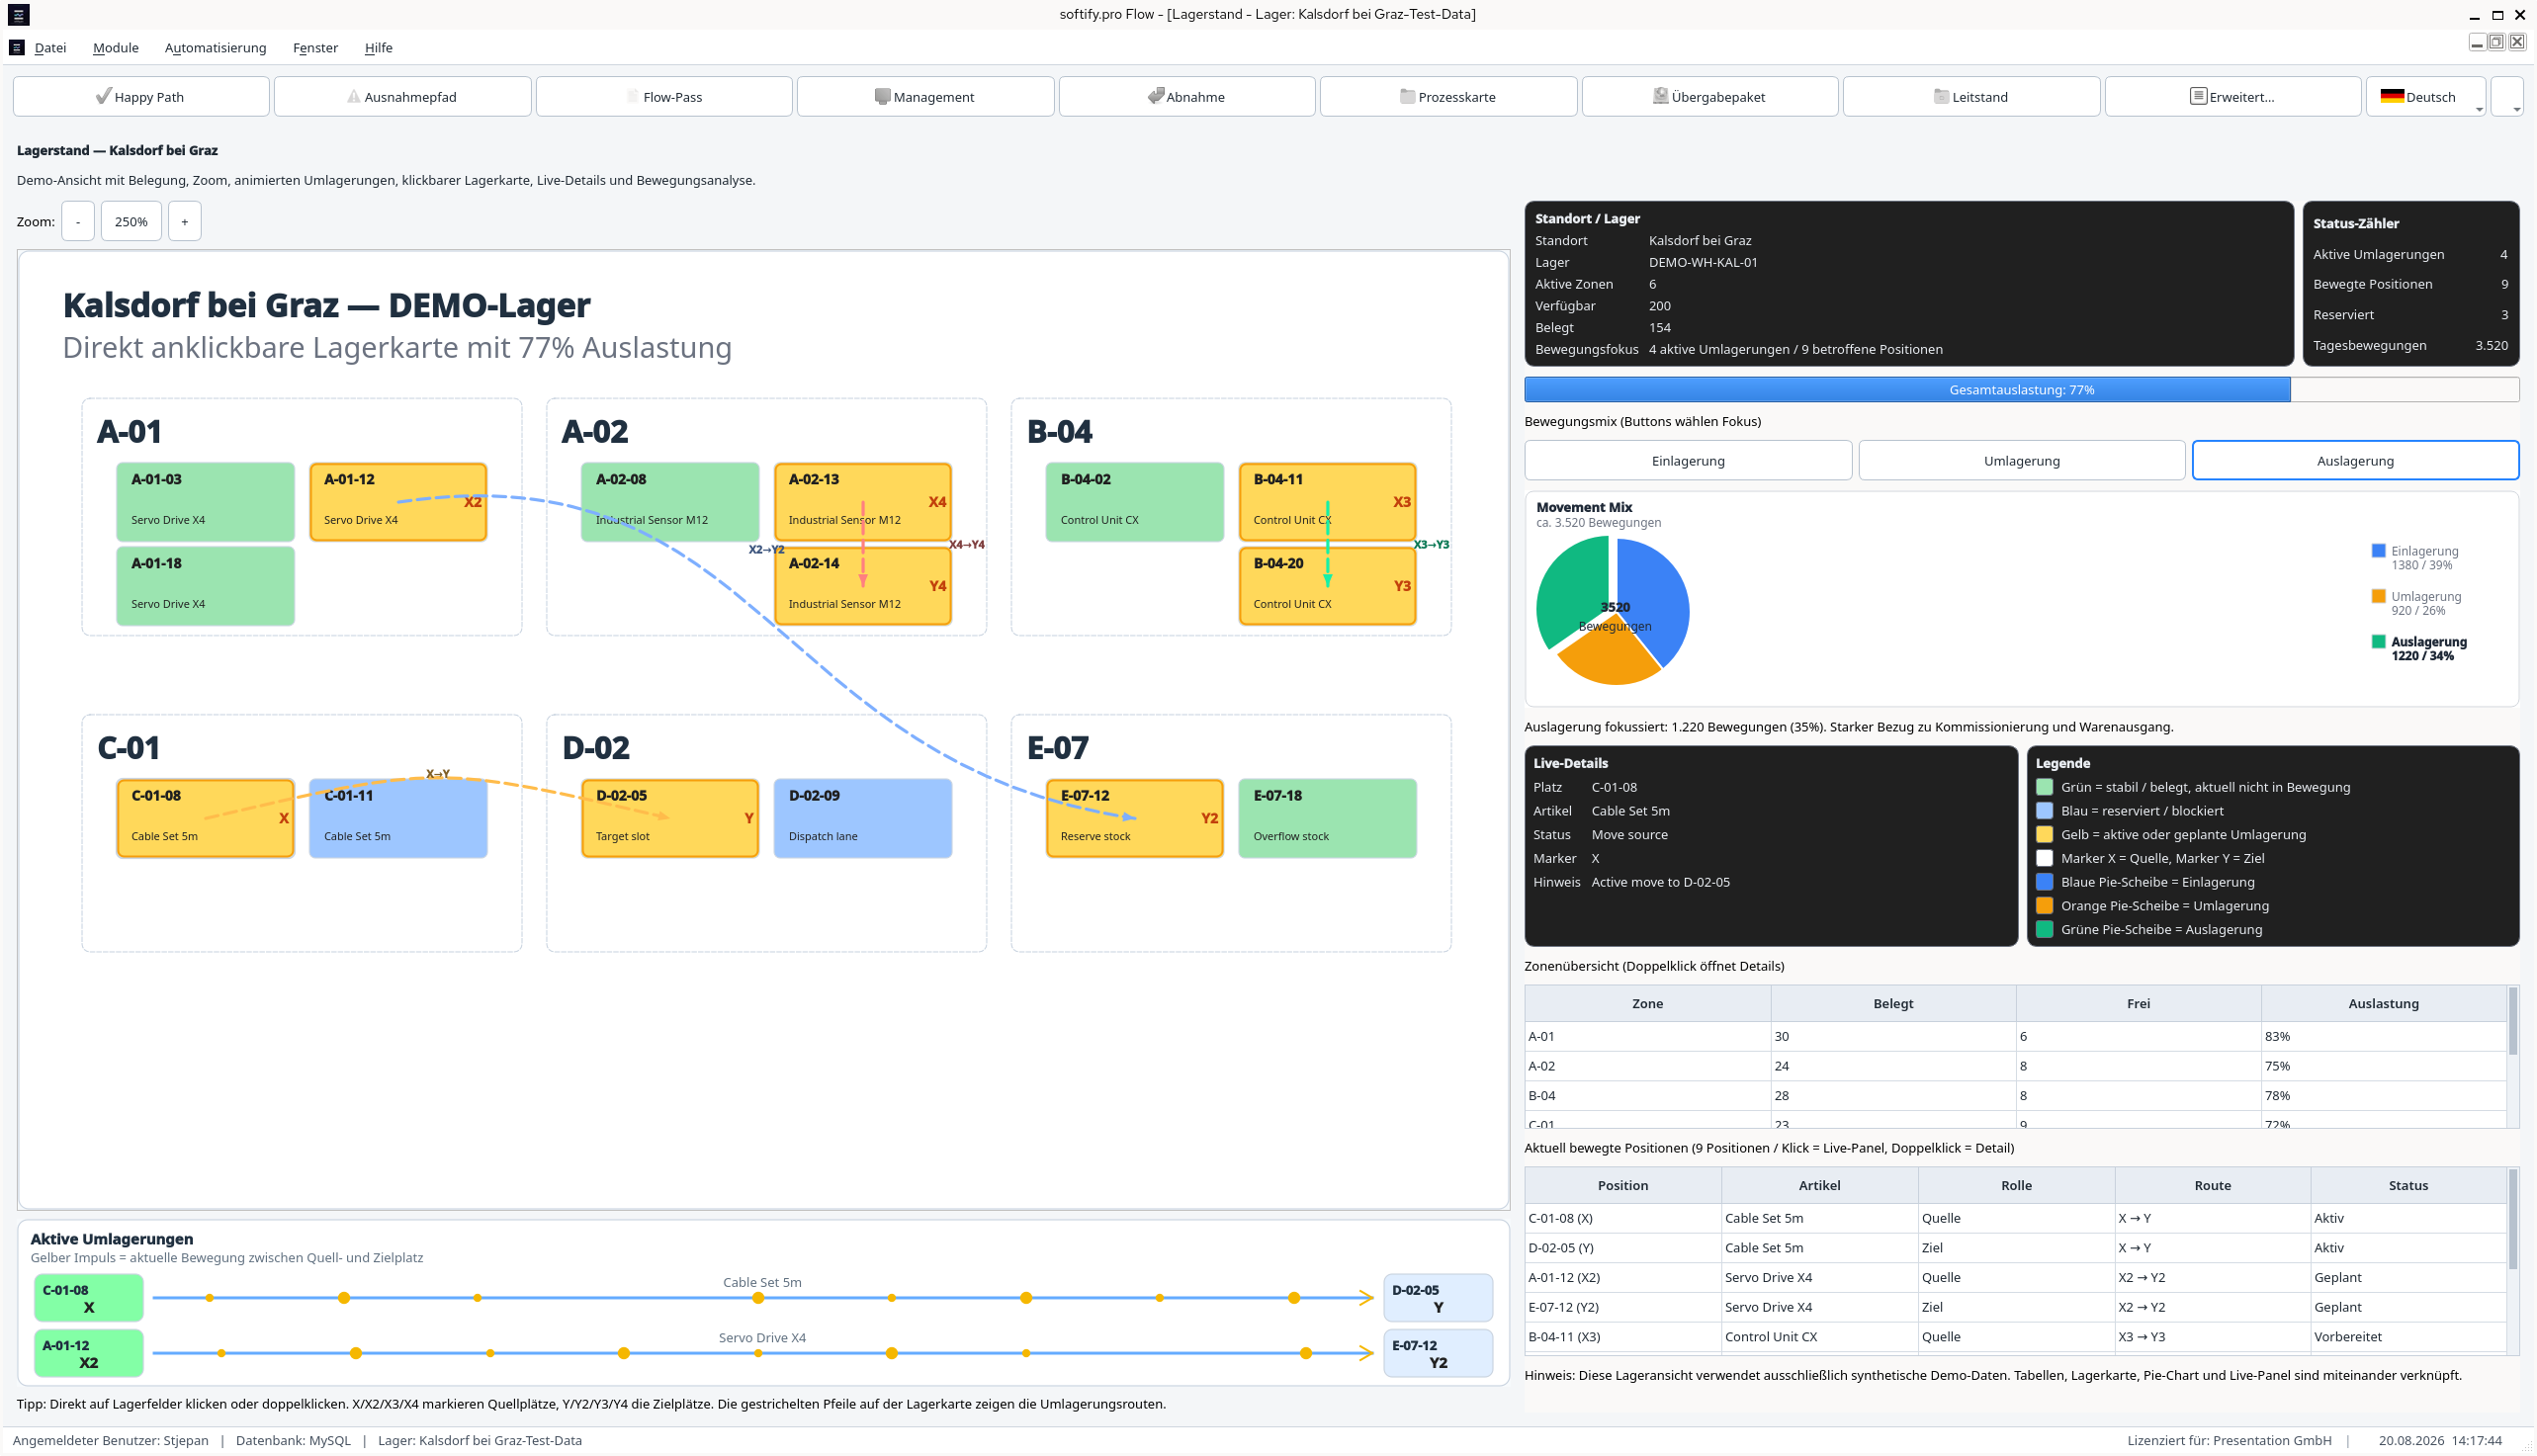
Dann öffneten wir eine andere Ansicht.
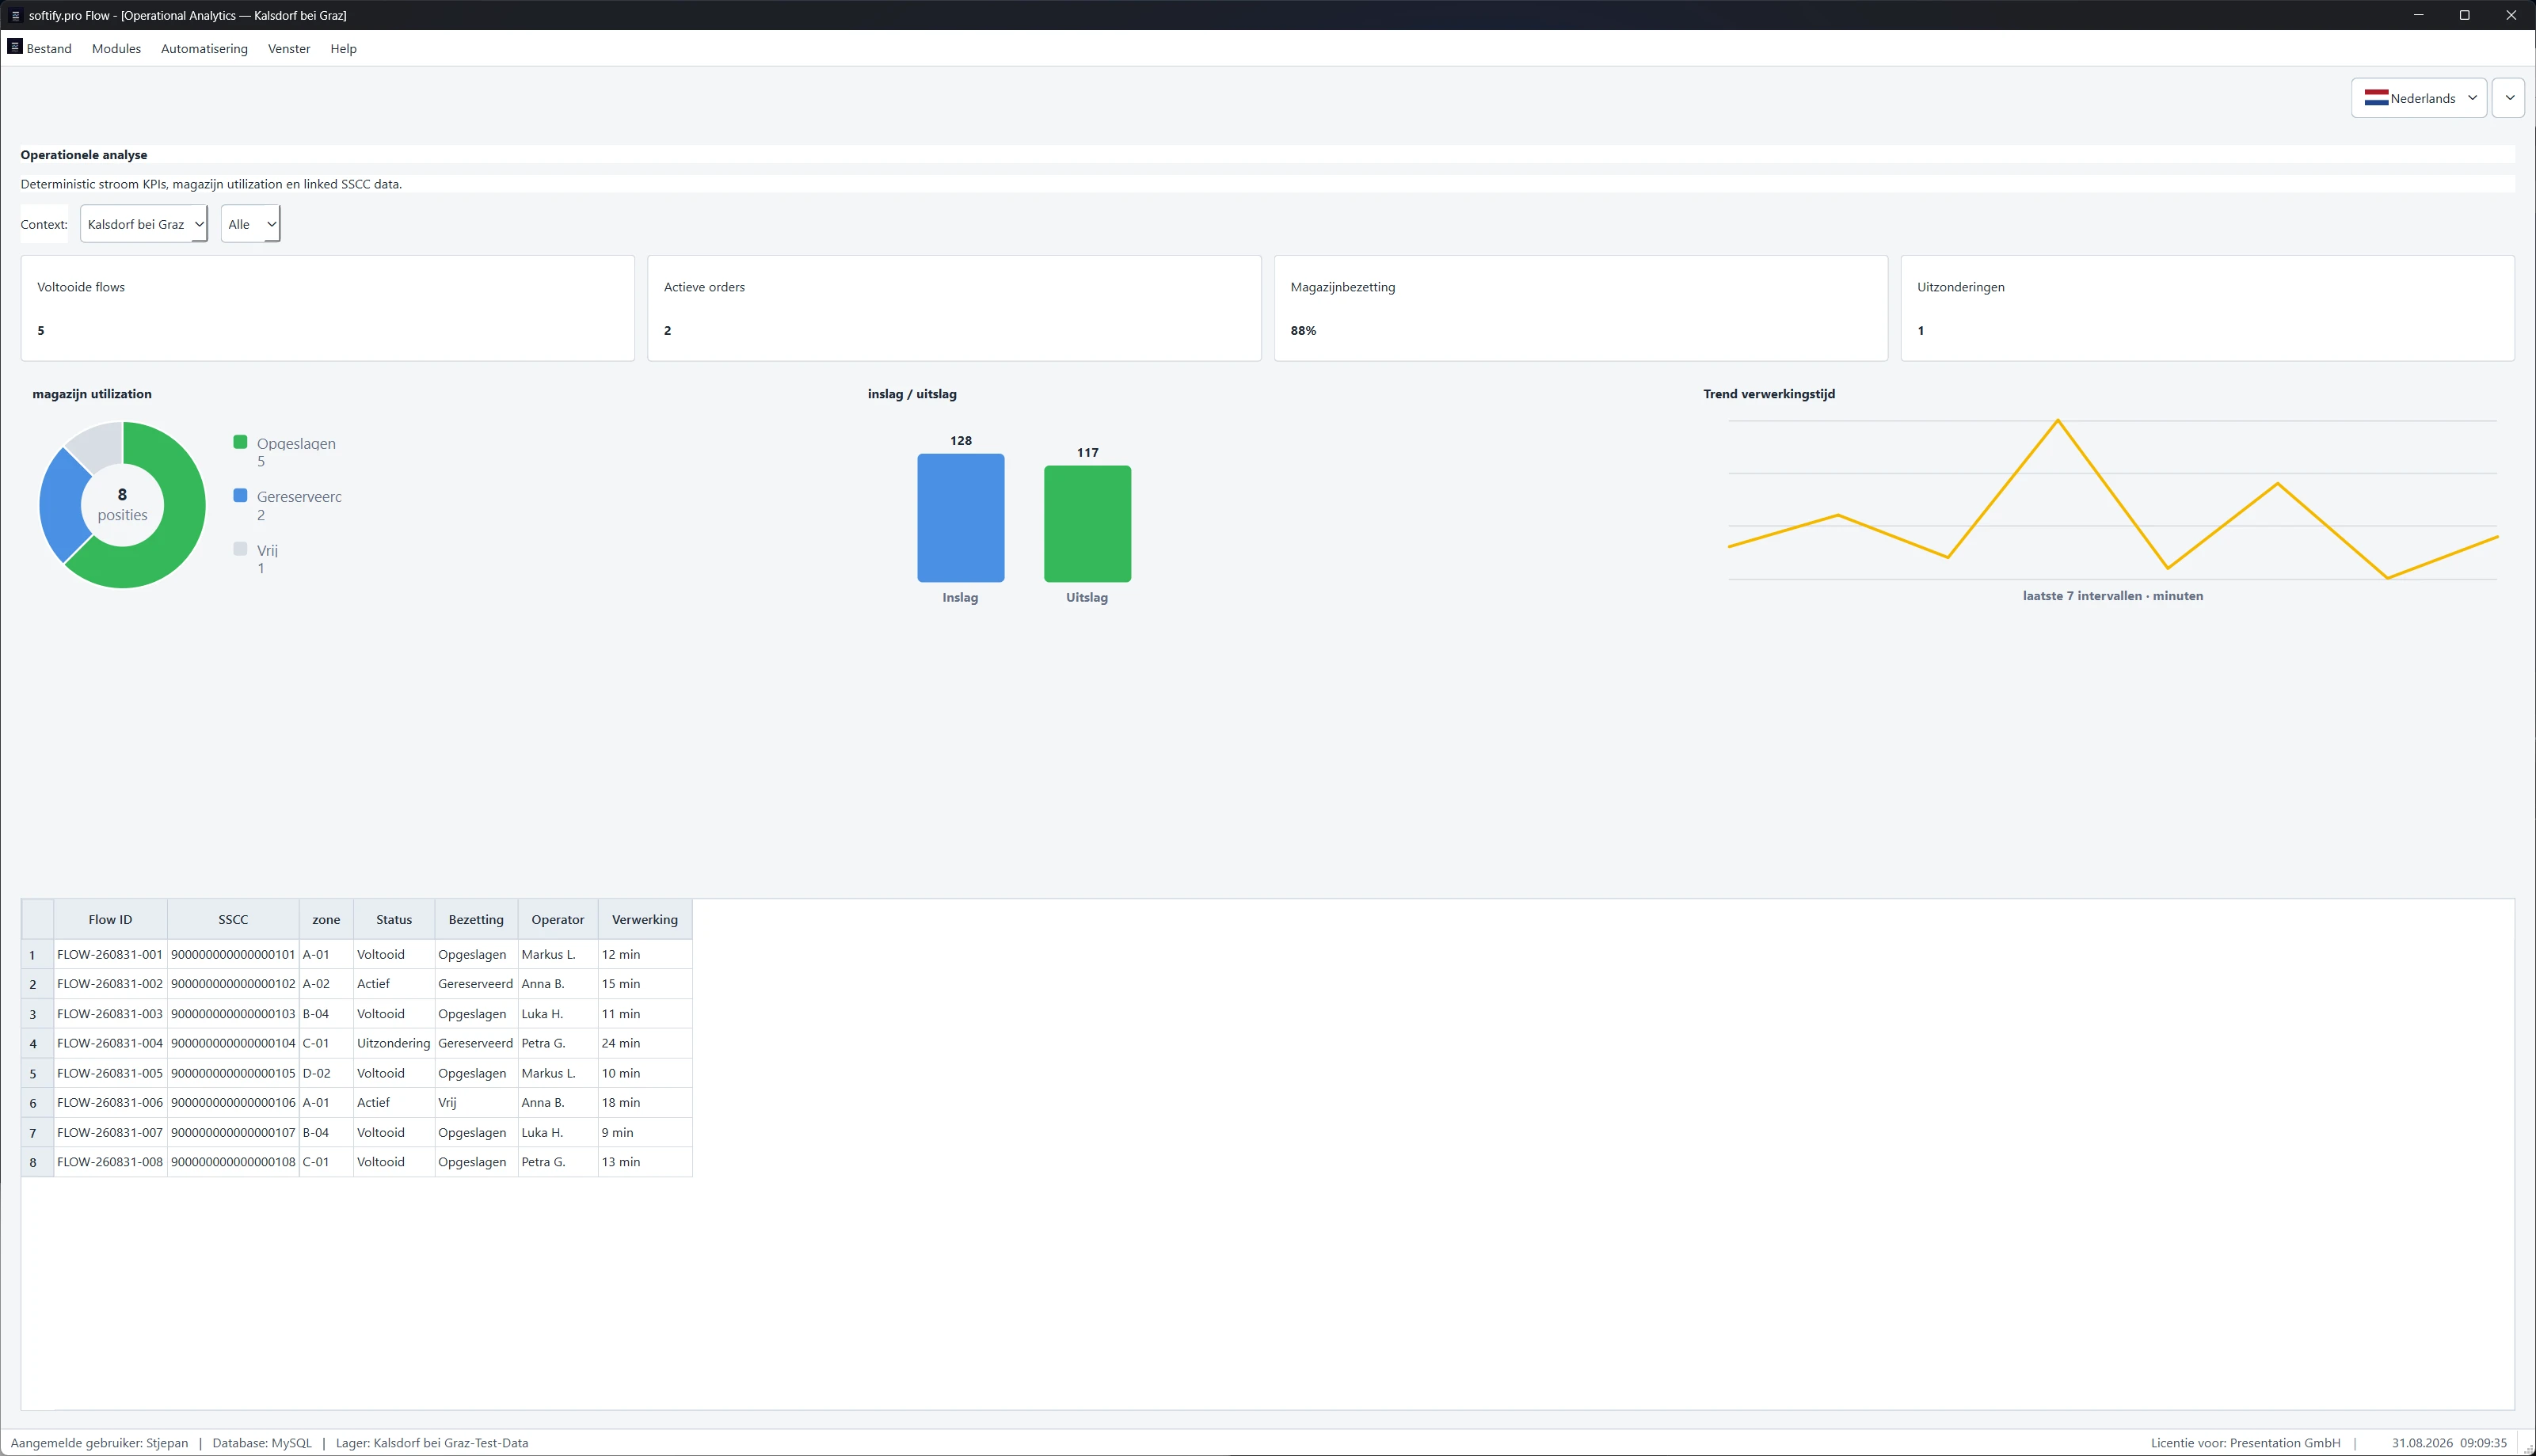
Operational Analytics.
Plötzlich sah das Lager völlig anders aus.
Keine Lagerplätze.
Keine Bewegungspfeile.
Stattdessen:

  • abgeschlossene Flows,
  • aktive Aufträge,
  • Lagerauslastung,
  • Ausnahmen,
  • Wareneingang,
  • Warenausgang,
  • Bearbeitungszeit.

Die visuelle Darstellung hatte sich geändert.
Das Lager nicht.
Diese Unterscheidung wurde wichtig.
Denn unter den KPIs steckten noch immer einzelne Datensätze.
Flow-IDs.
SSCCs.
Zonen.
Status.
Bediener.
Bearbeitungszeiten.
Andere Ansicht.
Dieselbe operative Realität.
So weit, so gut.

Operational Analytics — aggregierter Lagerzustand, mit den zugrundeliegenden Flow-Datensätzen weiterhin sichtbar.

Flow.

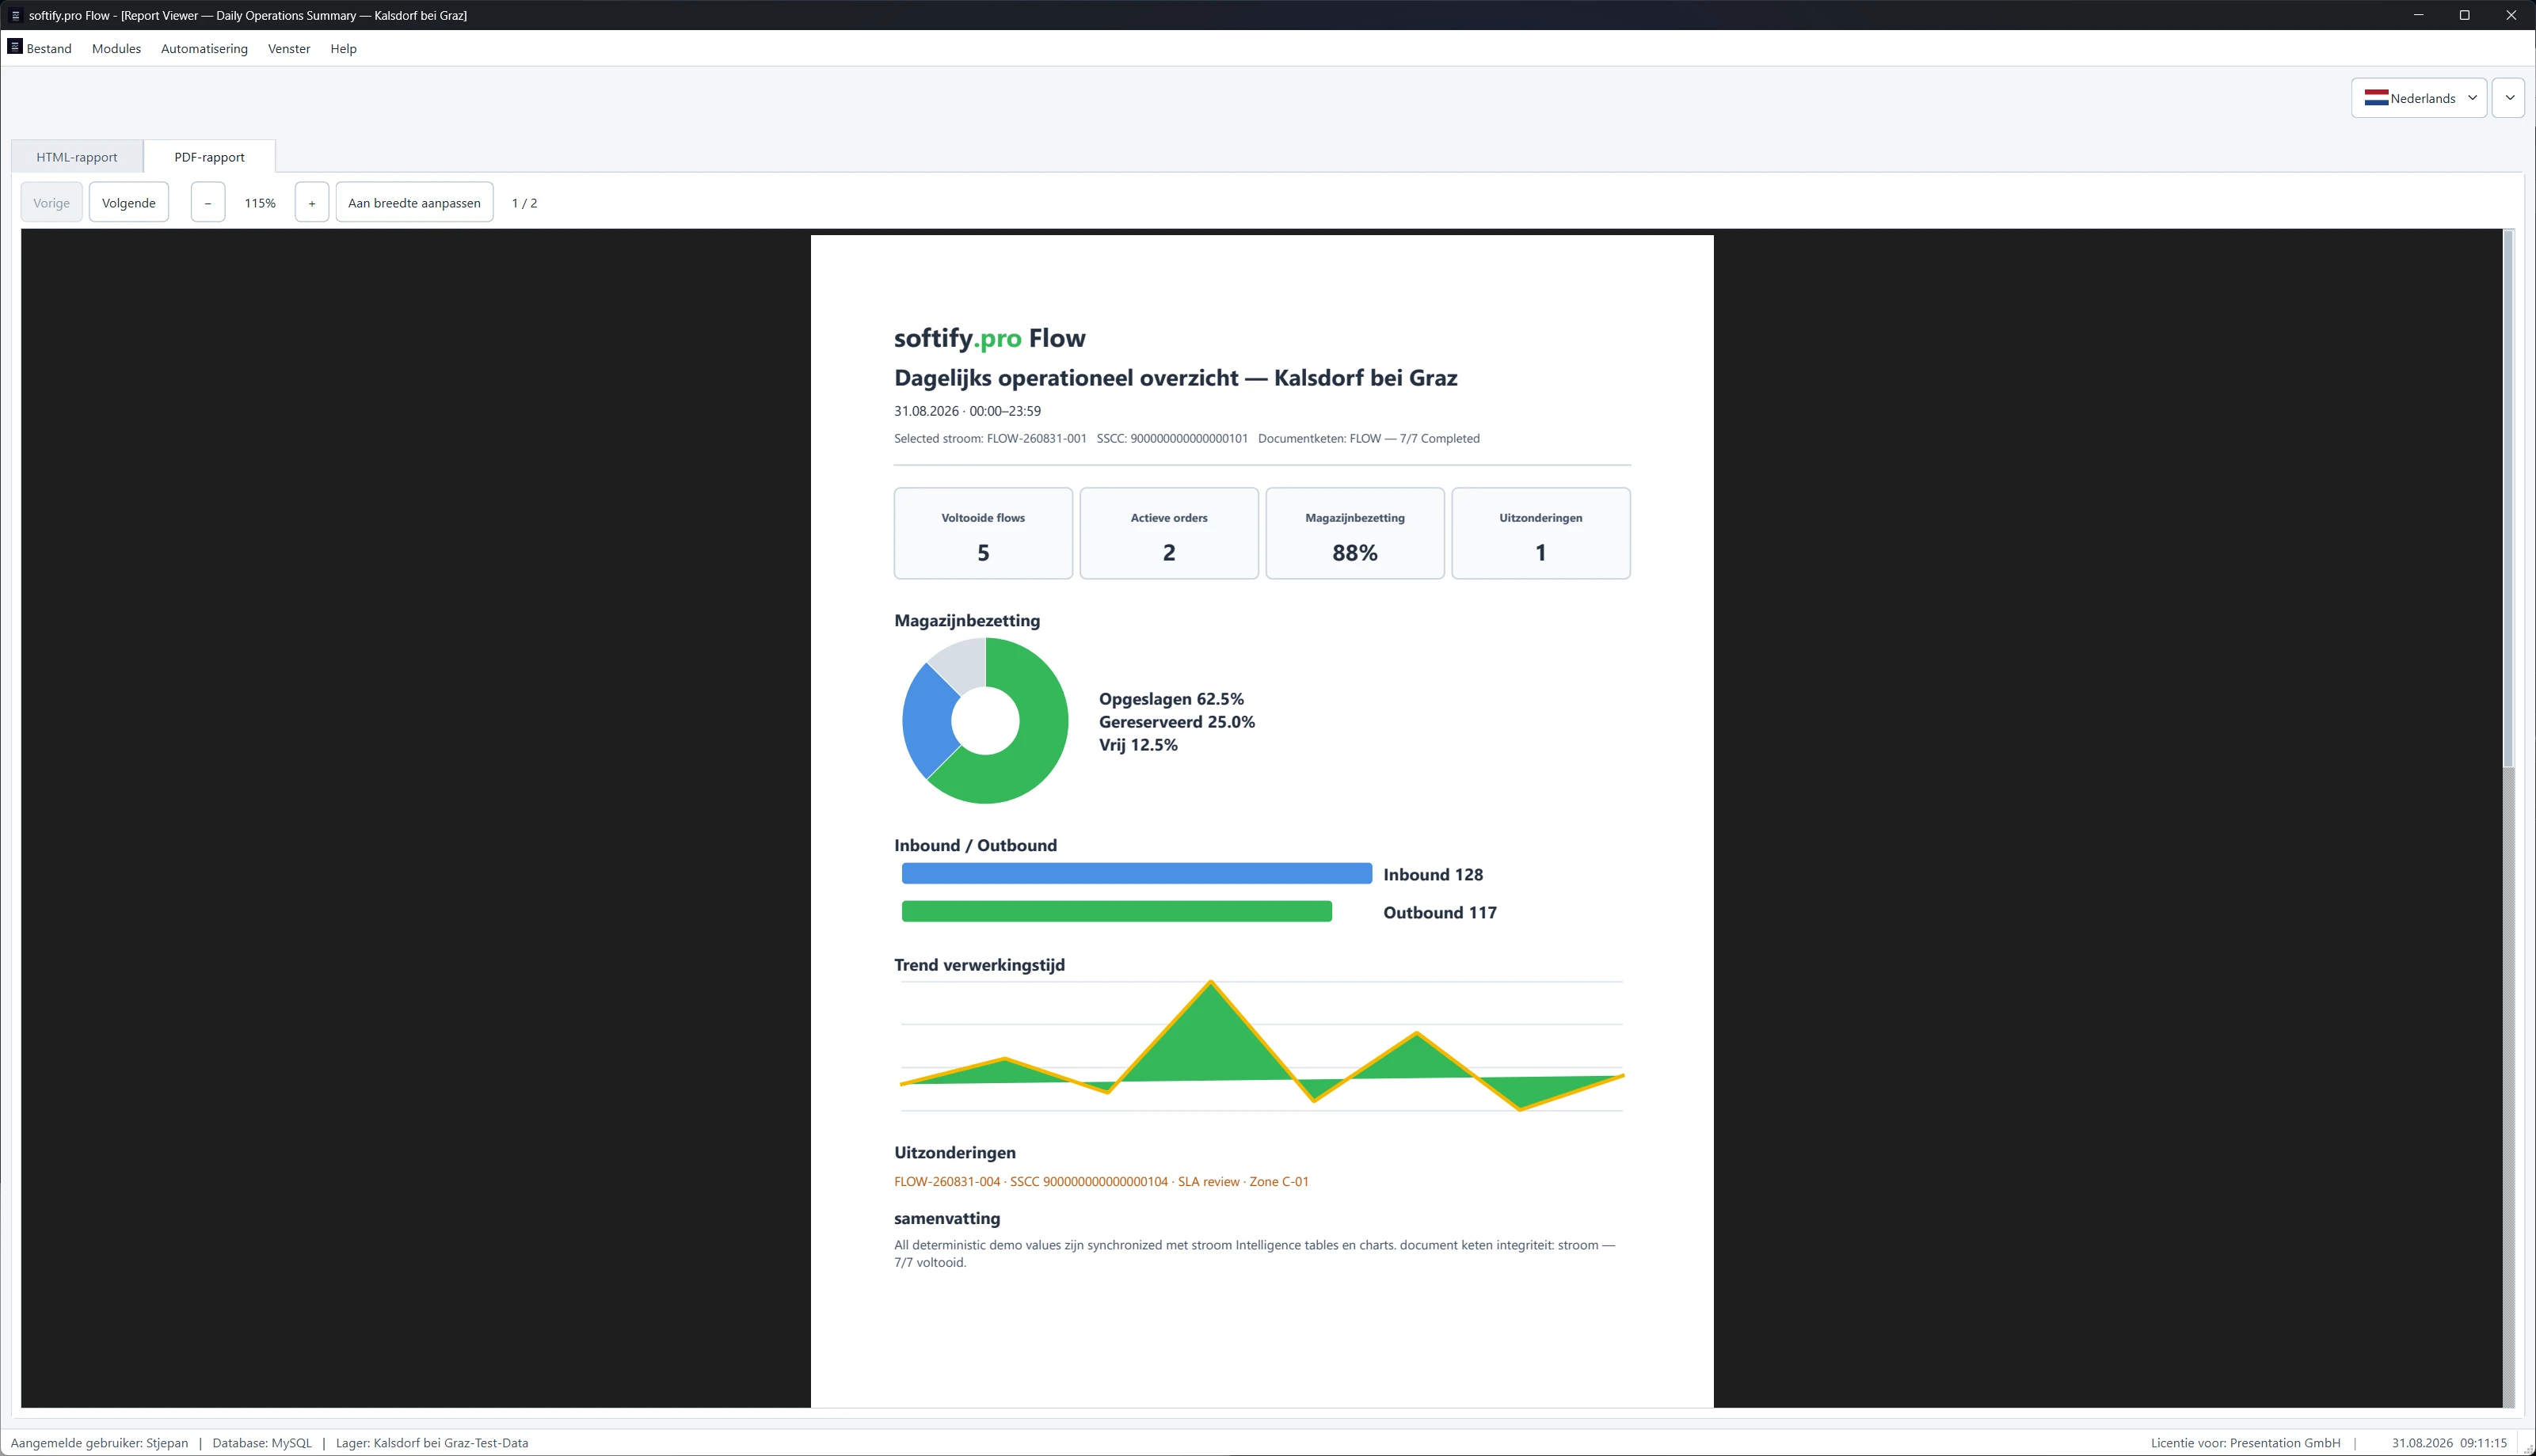
88 % sind nur dann nützlich, wenn das System sie erklären kann.
Angenommen, das Dashboard sagt:
Lagerauslastung: 88 %.
Nützlich.
Aber unvollständig.
Manche Plätze sind belegt.
Manche sind reserviert.
Manche bleiben frei.
Diese Zustände sind nicht austauschbar.
Die Zahl wird erst vertrauenswürdig, wenn das System noch erklären kann, woher sie kommt.
Fünf abgeschlossene Flows?
Zeig sie.
Zwei aktive Aufträge?
Zeig sie.
Eine Ausnahme?
Welche?
88 % Auslastung?
Was ist belegt?
Was ist reserviert?
Was bleibt frei?
Ein Dashboard sollte die Realität zusammenfassen.
Es sollte sie nicht ersetzen.
Dann haben wir die Sprache gewechselt.
Niederländisch.
Das Lager blieb dasselbe.
Die Flow-IDs blieben dieselben.
Die SSCCs blieben dieselben.
Die Bediener blieben an ihre Datensätze gebunden.
Nur die Sprache änderte sich.
Später erschien derselbe operative Zustand auf Kroatisch.
Dann auf Französisch.
Hier wird mehrsprachige Software deutlich interessanter als übersetzte Buttons.
Eine schlechte Übersetzung fällt leicht auf.
Eine Zustandsänderung, ausgelöst durch einen Sprachwechsel, ist viel gefährlicher.
Man stelle sich vor, von Deutsch auf Französisch zu wechseln und dabei still den ausgewählten Flow zu verlieren.
Oder einen Filter gegen das falsche Lager neu aufzubauen.
Oder die korrekte SSCC im falschen Prozesskontext anzuzeigen.
Die Oberfläche könnte trotzdem perfekt aussehen.
Das System wäre es nicht.
Flow folgt deshalb einer einfachen Regel:
Sprache darf die Worte ändern. Sie darf nicht die Wahrheit ändern.
Dann bekam der Flow eine Historie.
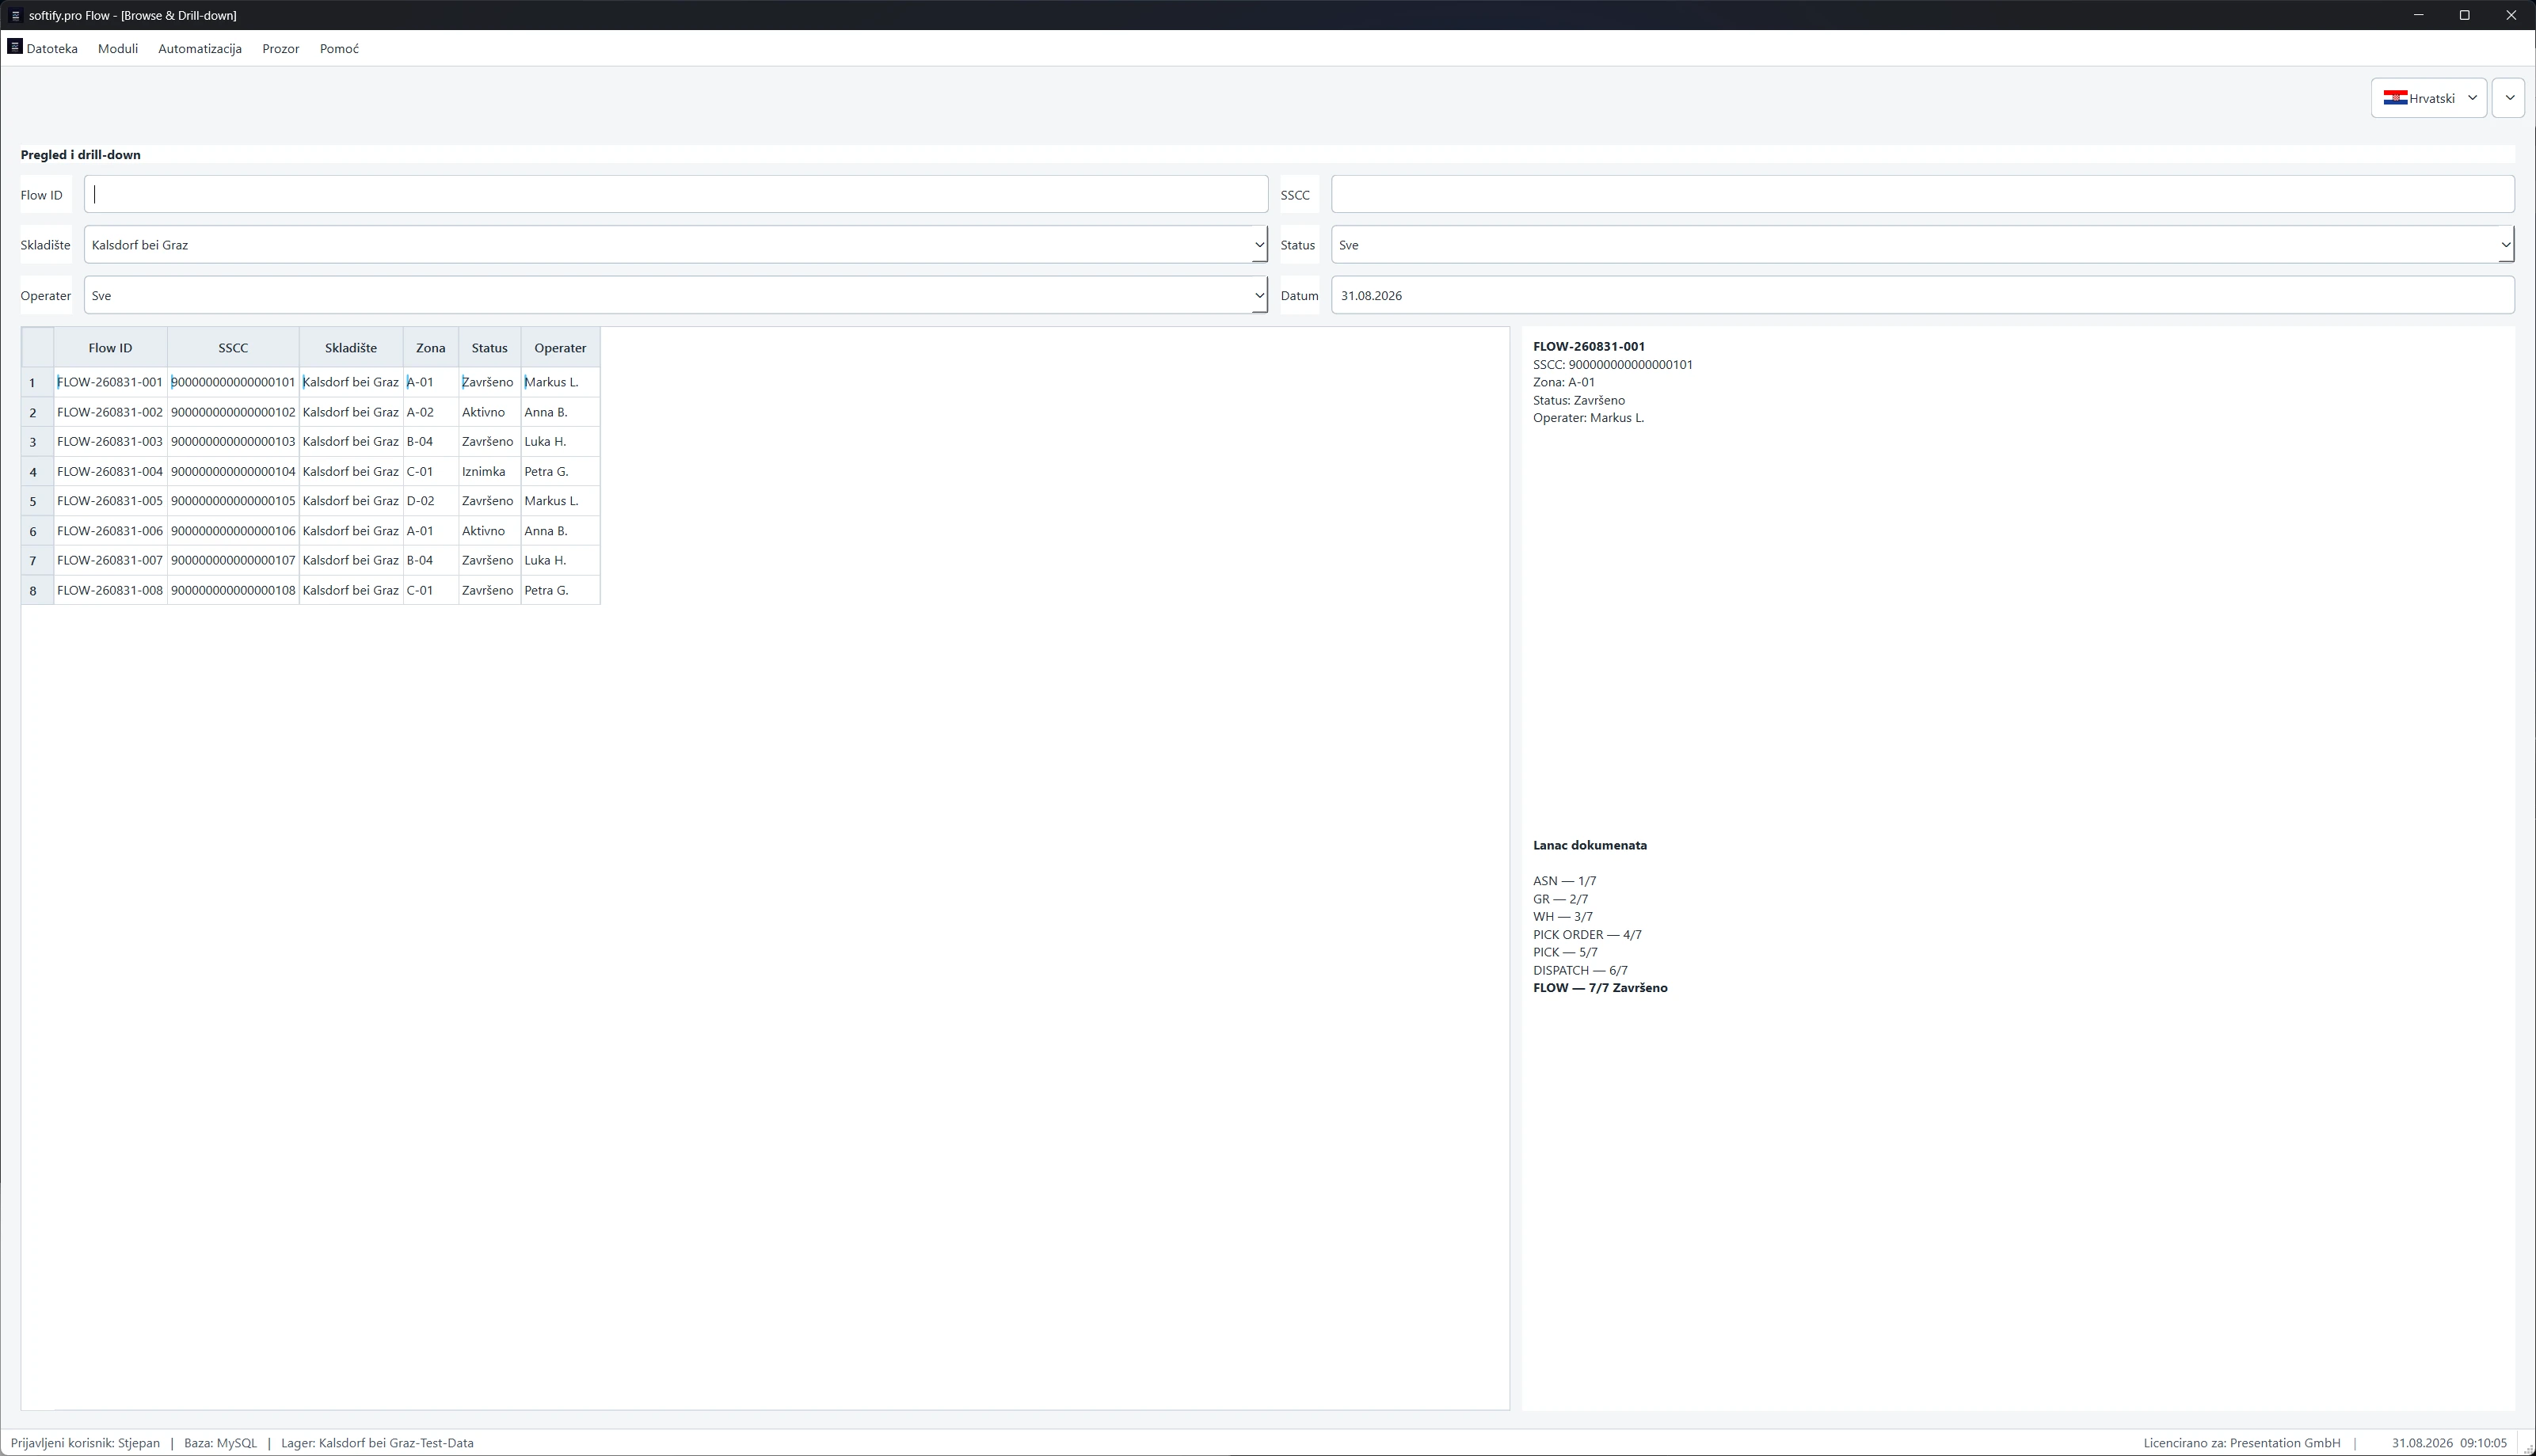
Browse & Drill-down gibt sich nicht besonders viel Mühe, beeindruckend zu wirken.
Vielleicht ist es genau deshalb nützlich.
Einen Flow auswählen.
Sein Kontext erscheint.
Lager.
Zone.
Status.
Bediener.
SSCC.
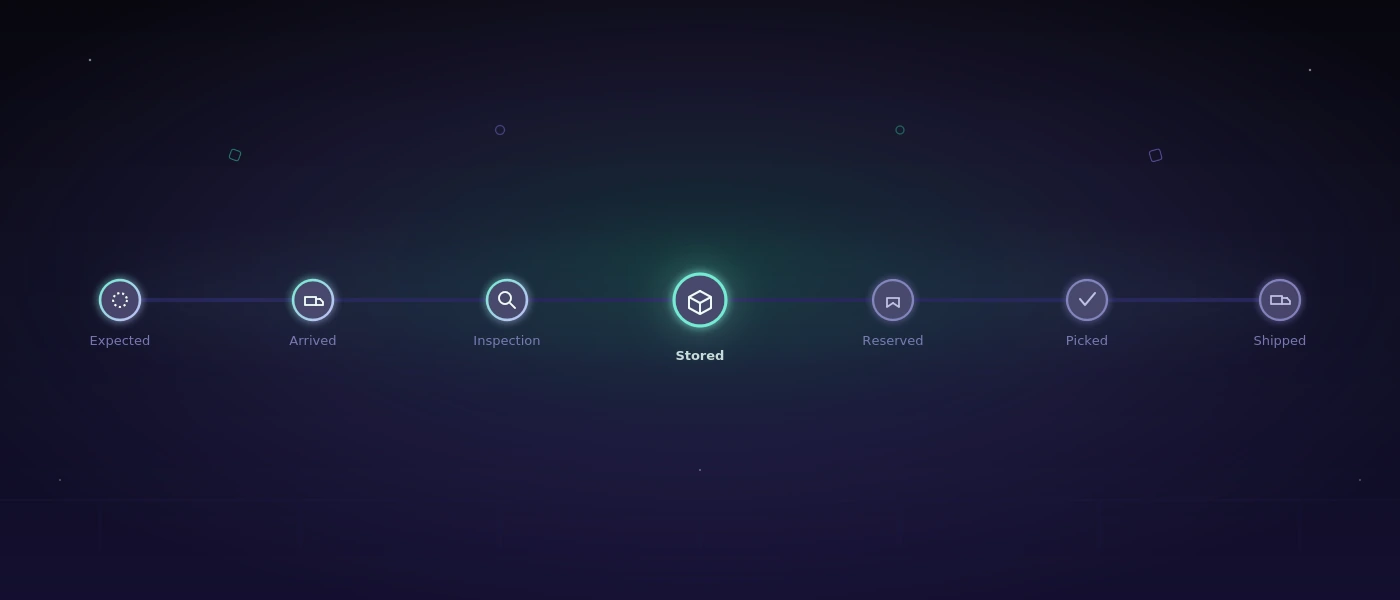
Und dann die Belegkette.
ASN.
Wareneingang.
Lagerbewegung.
Kommissionierauftrag.
Kommissionierung.
Versand.
FLOW.
Sieben Schritte.
Der Prozess ist nicht mehr nur ein aktueller Zustand.
Er hat eine Vergangenheit.
Und das ändert die Frage.
Statt:
Was passiert gerade?
können wir fragen:
Wie sind wir hierher gekommen?
Das ist eine viel bessere Frage, wenn irgendwann etwas schiefgeht.

Ein Flow, eine SSCC, eine Belegkette — vom ASN bis zum Abschluss.

Flow.


Die SSCC wird zum roten Faden.
Zunächst sieht eine SSCC aus wie das, was sie ist.
Ein Identifikator.
Eine lange Zahl in einer Tabelle.
Aber über Flow hinweg wird sie zu etwas Nützlicherem.
Ein roter Faden durch den Prozess.
Folgt man ihm, beginnen andere Dinge sich zu verbinden.
Ein Lager.
Ein Flow.
Eine Zone.
Ein Status.
Ein Bediener.
Eine Belegkette.
Schließlich ein Report.
Dasselbe physische Logistikobjekt ist nun aus mehreren verschiedenen Teilen der Anwendung sichtbar.
Nützlich.
Auch gefährlich.
Denn jede zusätzliche Ansicht schafft eine weitere Gelegenheit für das System, eine andere Geschichte zu erzählen.
Und genau da wird es interessant.
Angenommen, Analytics sagt, der Flow sei aktiv.
Drill-down sagt, die SSCC gehöre zu diesem Flow.
Die Belegkette sagt, der Vorgang sei weiter fortgeschritten.
Der Report sagt etwas anderes.
Welche Aussage stimmt?
Das ist kein Flow-spezifisches Problem.
Es ist eines der ältesten Probleme in Business-Software.
Verschiedene Teile desselben Systems entwickeln nach und nach ihre eigene Version der Realität.
Ein Bildschirm liest den transaktionalen Zustand.
Ein anderer liest ein Aggregat.
Ein anderer verlässt sich auf zwischengespeicherte Daten.
Ein Report berechnet etwas leicht anders.
Eine Ausnahme wird operativ gelöst, verschwindet aber aus dem Reporting.
Jede Komponente funktioniert.
Das Gesamtsystem lügt.
Meist höflich.
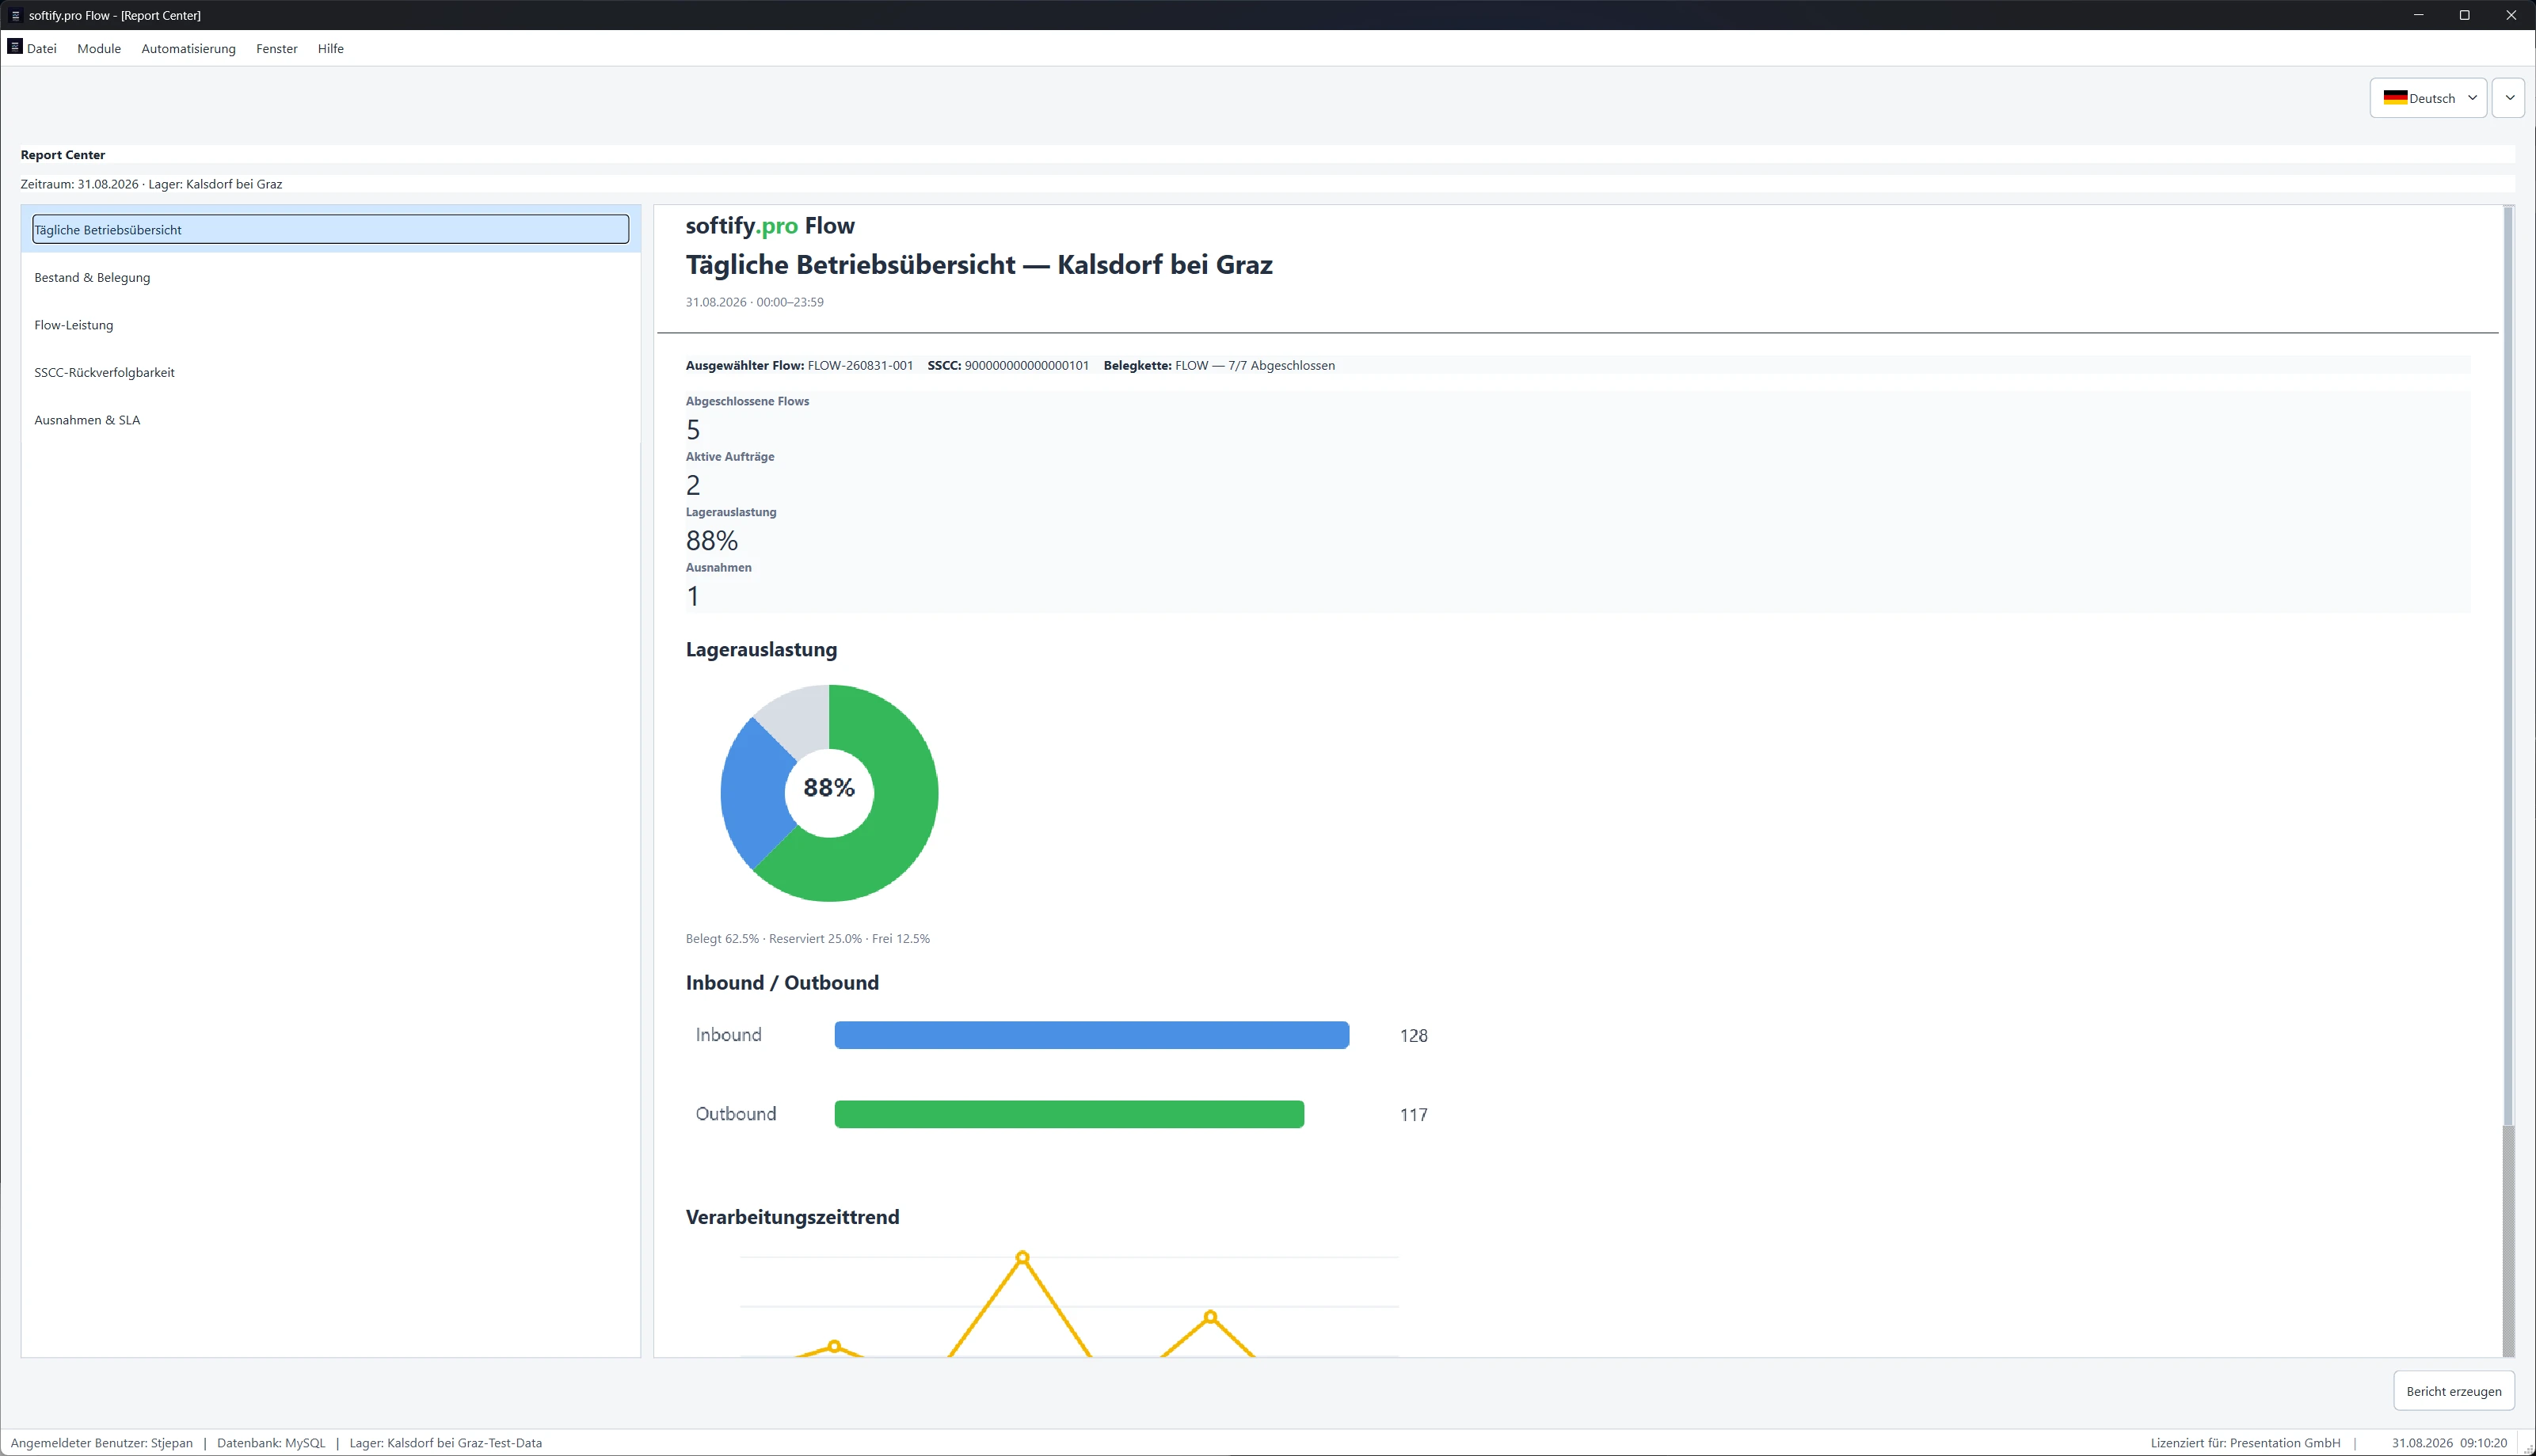
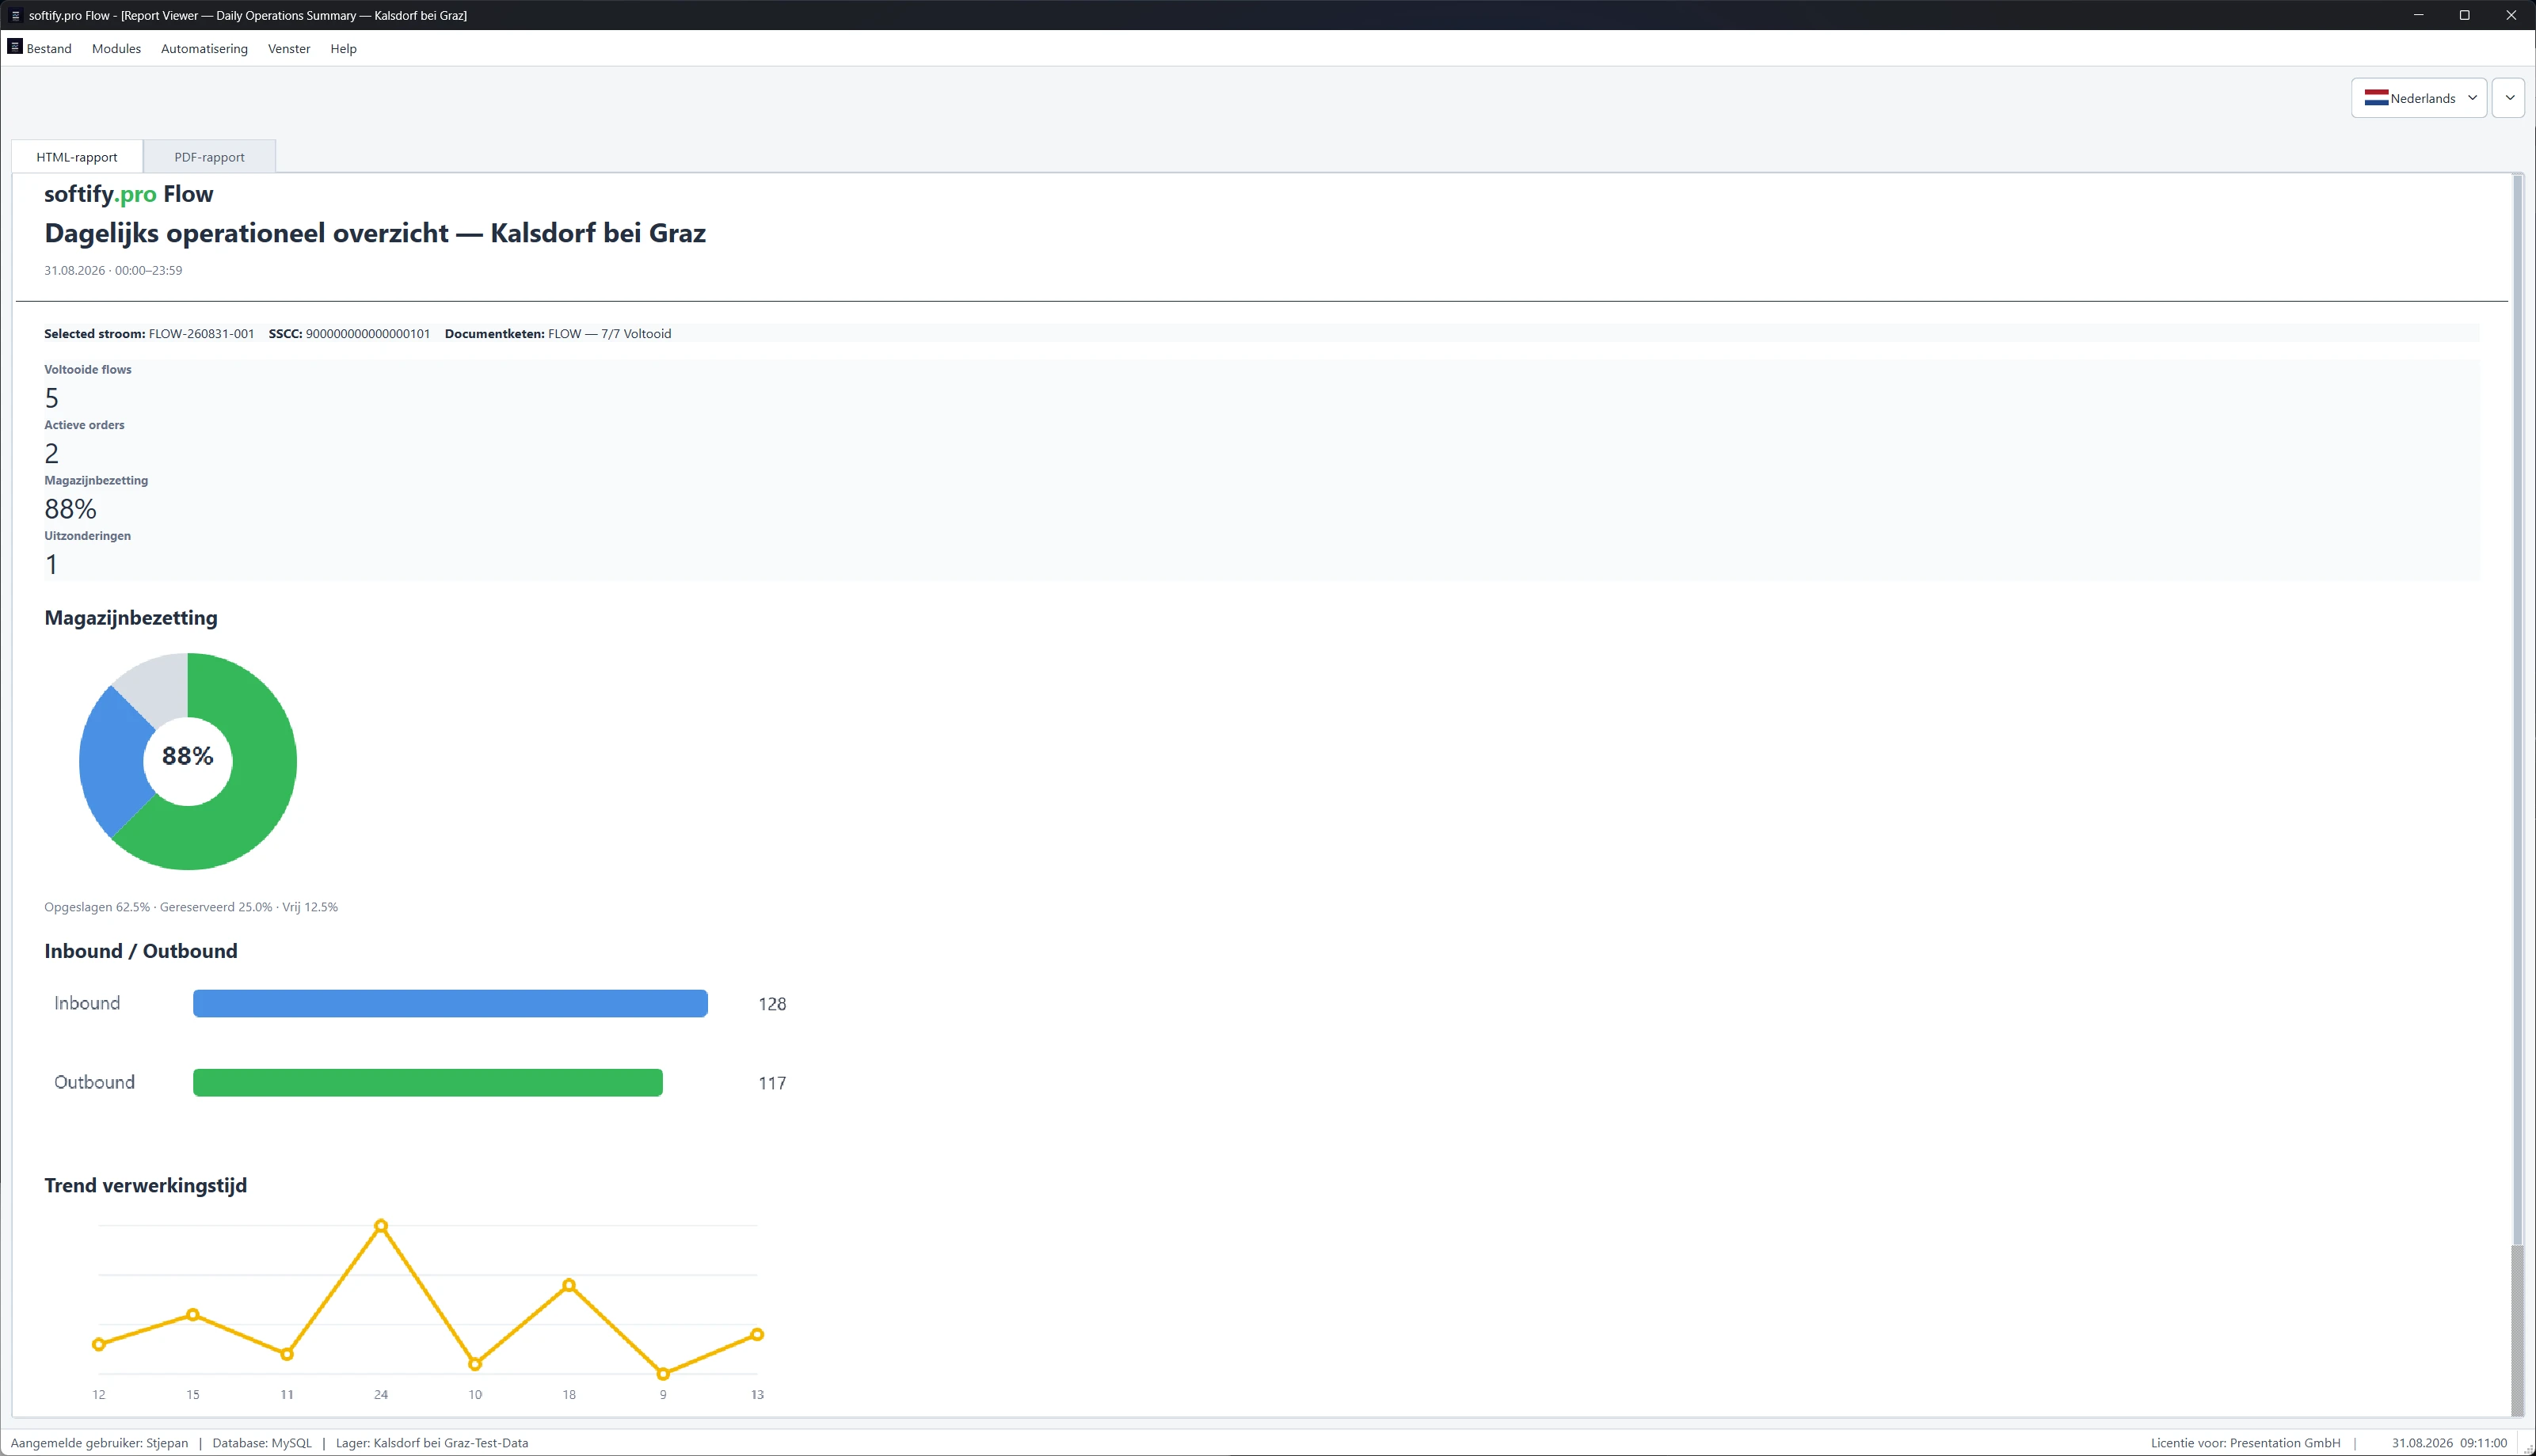
Also öffneten wir das Report Center.
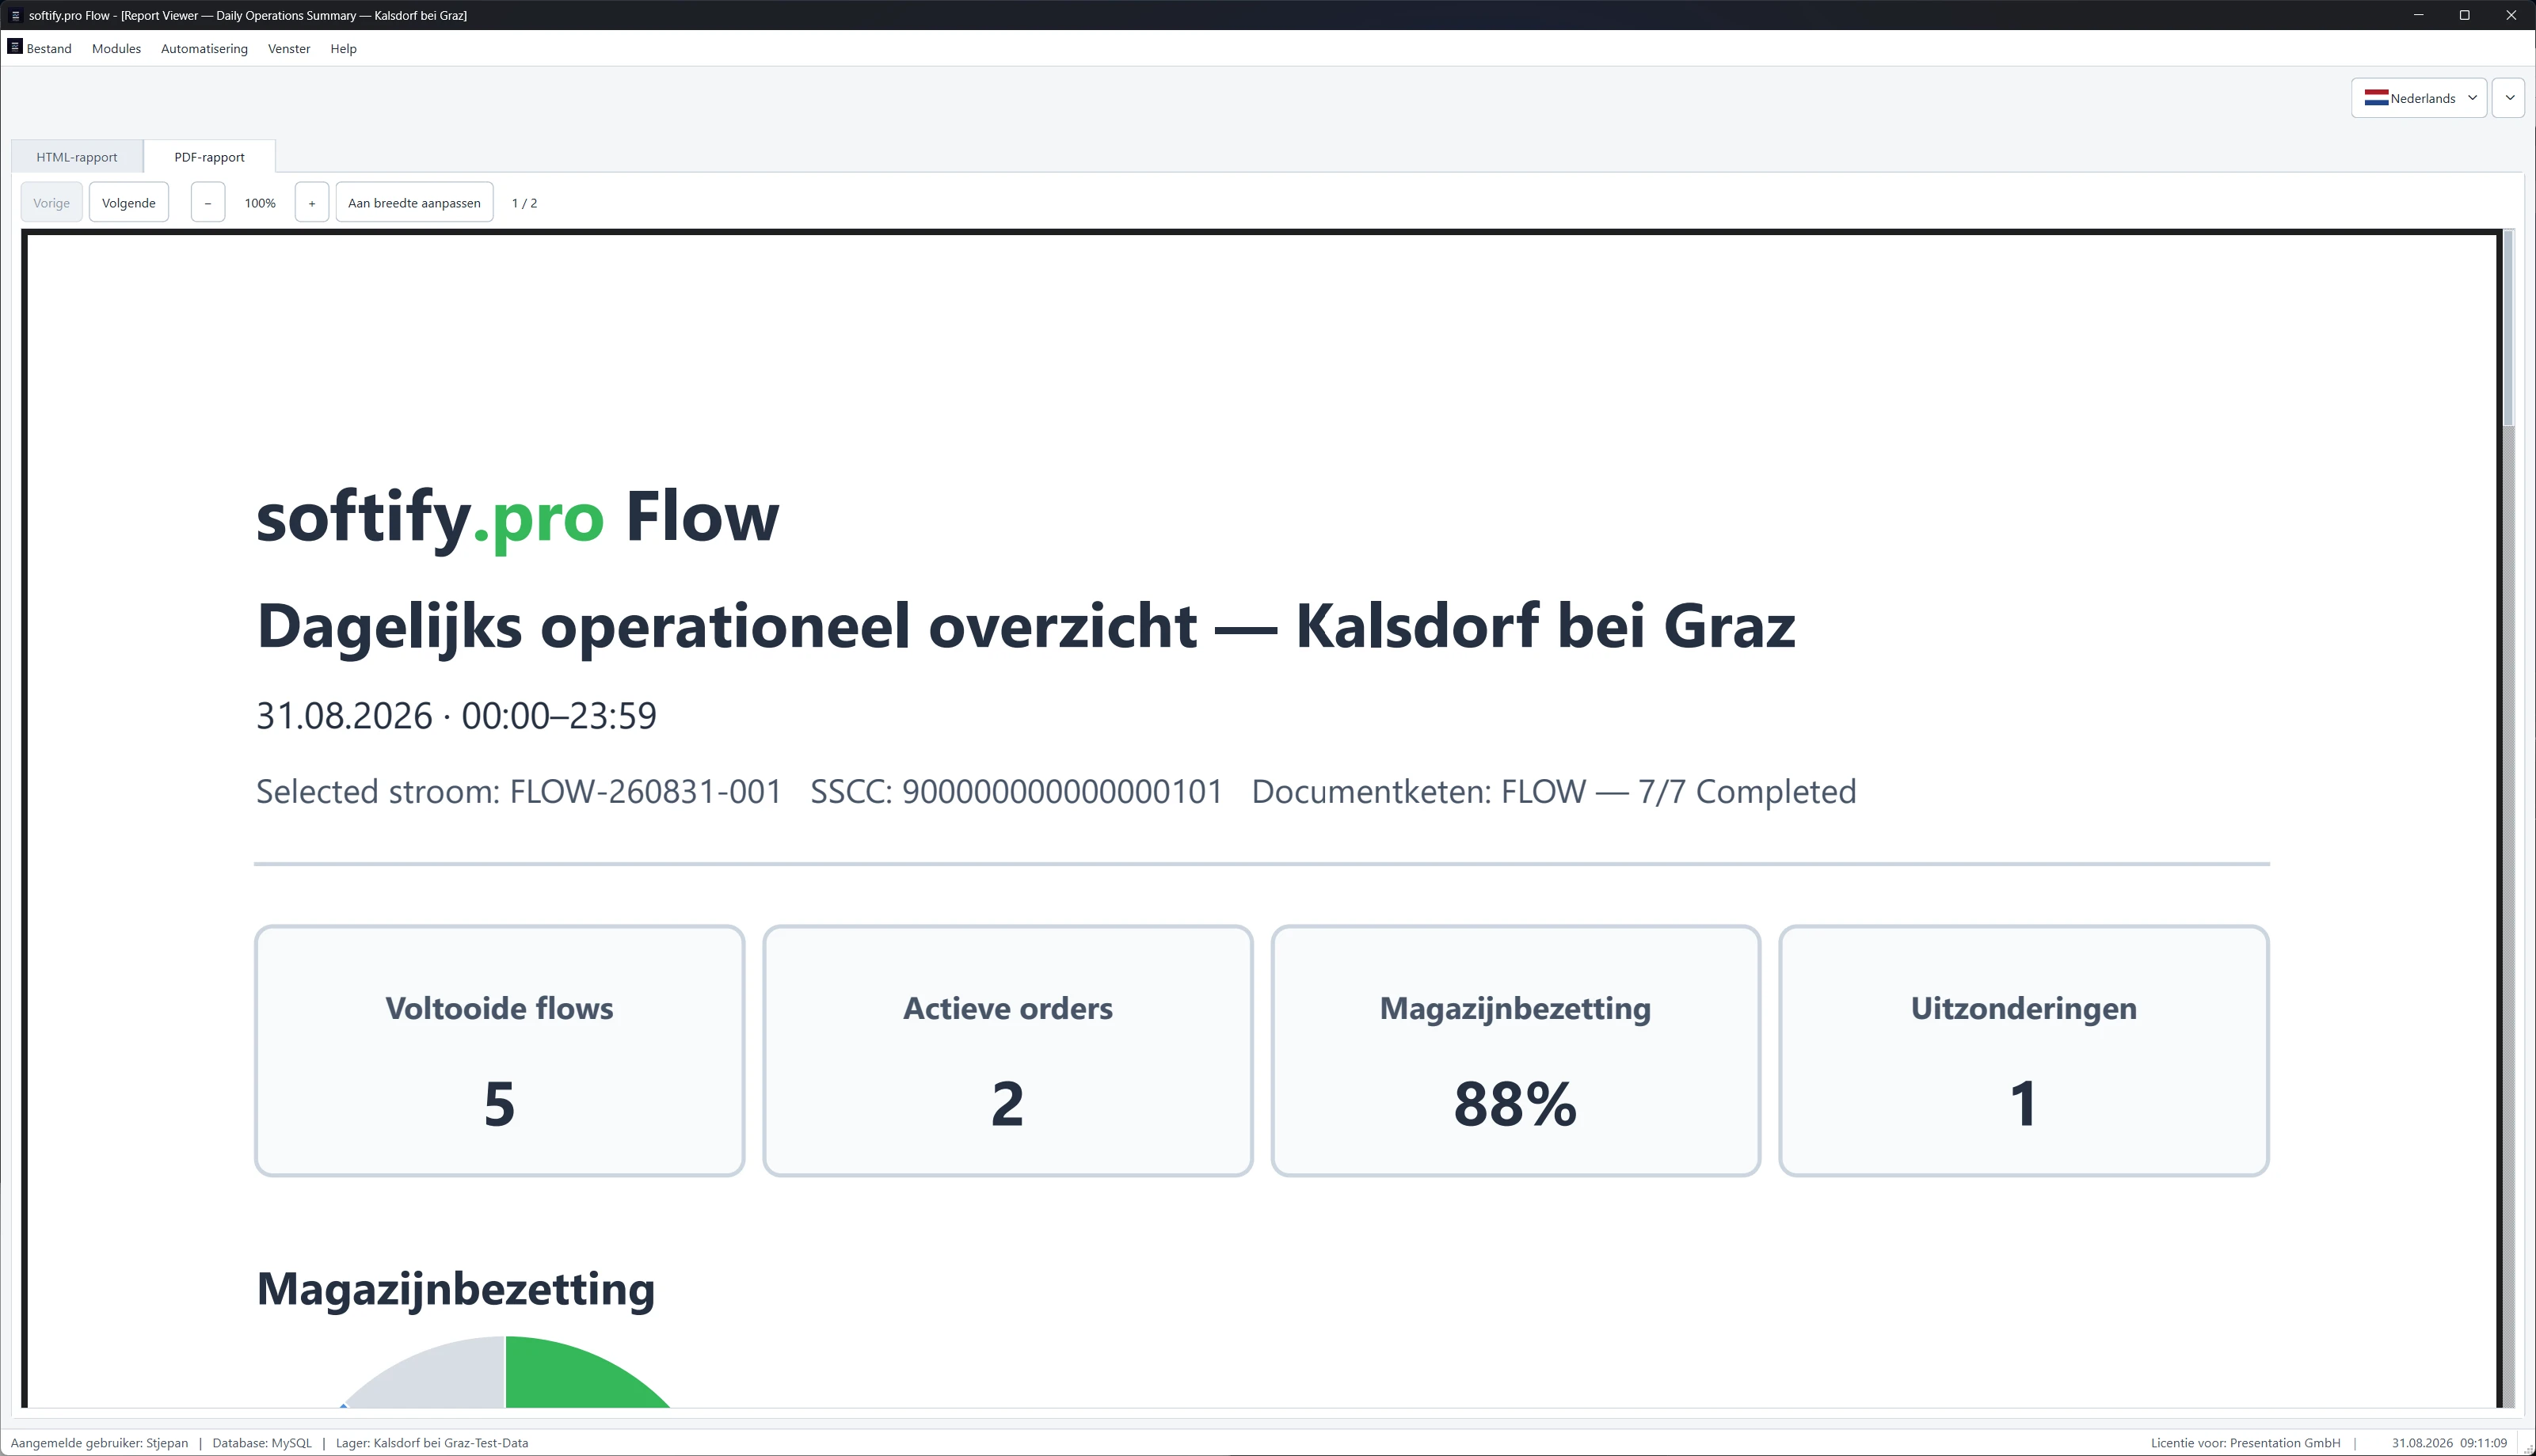
Tägliche Betriebsübersicht.
Bestand und Auslastung.
Flow-Performance.
SSCC-Rückverfolgbarkeit.
Ausnahmen und SLA.
Dieselbe operative Geschichte erschien erneut.
Abgeschlossene Flows.
Aktive Aufträge.
Lagerauslastung.
Ausnahmen.
Wareneingang.
Warenausgang.
Bearbeitungszeit.
Doch diesmal war die Frage nicht, ob der Report korrekt aussah.
Die Frage war:
Kann er sich selbst verteidigen?
Ein guter Report liefert eine Zahl.
Ein besseres System kann erklären, woher die Zahl kommt.

Reporting aus demselben operativen Zustand — keine zweite Version der Realität.

Flow.
Flow.
Flow.
Flow.


Die Ausnahme war immer noch da.
Eines der leiseren Details erwies sich als eines der wichtigeren.
Die Demodaten enthalten eine Ausnahme.
Sie erscheint in Analytics.
Sie erscheint im Drill-down.
Sie erscheint in der SSCC-Rückverfolgbarkeit.
Sie erscheint im Report Center.
Und sie bleibt in Exceptions & SLA sichtbar.
Genau das sollte passieren.
Sich operativ von einer Ausnahme zu erholen bedeutet nicht, dass die Ausnahme aus der Historie verschwinden sollte.
"Der Prozess ging weiter" und "Es ist nichts passiert" sind nicht dieselbe Aussage.
In der Logistik macht dieser Unterschied einen Unterschied.
An diesem Punkt hatten wir ein Testproblem.
Kein Softwareproblem.
Ein Testproblem.
Wir hatten nun dasselbe Lager dargestellt als:

  • Analytics,
  • einzelne Flows,
  • SSCC-Historien,
  • Belegketten,
  • Reports,
  • und Ausnahme-Ansichten.

Jede davon ließe sich unabhängig testen.
Öffnen.
Klicken.
Filtern.
Prüfen.
Bestehen.
Weiter.

Das wäre einfach.
Es würde aber auch den interessanten Teil verfehlen.
Denn sechs grüne Häkchen beweisen nicht, dass sechs Ansichten miteinander übereinstimmen.
Auftritt COCO.
Wieder.
COCO hatte sich schon zuvor mit Flow befasst.
Authentifizierung.
Benutzer.
Rollen.
Datenbankumgebungen.
Sprachen.
Desktop-Ausführung.
Dann kam die Logistik.
Lager.
Bestand.
Kommissionierung.
Bewegungen.
Ausnahmen.
Belege.
Ubuntu.
Red Hat Enterprise Linux.
Diesmal gaben wir COCO etwas leicht anderes.
Keinen Bildschirm zum Prüfen.
Eine Geschichte zum Verfolgen.
Nimm dieses Lager.
Nimm diesen Flow.
Nimm diese SSCC.
Öffne Analytics.
Öffne Drill-down.
Wechsle die Sprache.
Schau noch einmal.
Öffne den Report.
Finde denselben Flow.
Finde dieselbe SSCC.
Finde die Ausnahme.
Vergleiche.
Dann vergleiche noch einmal.

COCO verfolgt denselben operativen Kontext über softify.pro Flow hinweg — Analytics, Rückverfolgbarkeit, Sprachwechsel und Reporting.

Das verändert das Wesen des Tests.

Die Frage lautet nicht mehr:

  • Funktioniert jedes Modul?

Sondern:

  • Glauben alle Module dasselbe passiert zu sein?

Eine viel bessere Frage.
Eine viel unbequemere.
Ein Lagersystem sollte ein Gedächtnis haben.
Bediener sehen vielleicht Lagerplätze.
Lagerleiter sehen vielleicht KPIs.
Der Support nutzt vielleicht Drill-down.
Auditoren nutzen vielleicht Reports.
COCO sieht vielleicht alle davon.
Aber unter diesen Perspektiven sollte es eine einzige Historie geben.
Ein Flow sollte nicht mehrere Biografien bekommen, je nachdem, welches Modul gerade geöffnet ist.
Eine SSCC sollte nicht mehrere Vergangenheiten haben.
Eine Ausnahme sollte nicht nur dort existieren, wo es gerade bequem ist.
Ein Lager sollte nicht zu einem anderen Lager werden, nur weil sich die Oberflächensprache geändert hat.
Genau darum geht es beim aktuellen Flow-Experiment.
Nicht um Dashboards.
Nicht um Reports.
Nicht einmal um einzelne Bildschirme.
Um eine operative Wahrheit, ausgedrückt auf unterschiedliche Weise.
Kontrolle.
Das Lager kennen.
Den Zustand kennen.
Wissen, was sich bewegt.
Wissen, welcher Prozess es besitzt.
Klarheit.
KPIs zurück in Datensätze verwandeln.
Datensätze in Historie verwandeln.
Ausnahmen in Beweise verwandeln.
Eine SSCC in etwas Rückverfolgbares verwandeln.
Flow.
Ein Lager wird ausgewählt.
Analytics beginnt, es zu beschreiben.
Ein Flow schreitet voran.
Die SSCC bleibt angeheftet.
Eine Belegkette wächst.
Eine Ausnahme erscheint.
Der Prozess läuft weiter.
Der Report erinnert sich.
Dann ändert sich die Sprache.
Das Lager ist immer noch dasselbe.
Der Flow ist immer noch derselbe.
Die Historie ist immer noch dieselbe.
Das war der erwartete Teil.
Was danach geschah, war interessanter.
COCO hörte auf, die Ansichten unabhängig voneinander zu testen.
Es begann, sie zu vergleichen.
Eine Weile lang passierte nichts Bemerkenswertes.
Dasselbe Lager.
Derselbe Flow.
Dieselbe SSCC.
Dieselbe Geschichte.
Wieder.
Wieder.
Wieder.
Und dann stoppte COCO.
Nicht weil die Anwendung abgestürzt war.
Das war sie nicht.
Nicht weil ein Test im üblichen Sinn fehlgeschlagen war.
Das war er nicht.
Es stoppte, weil zwei völlig vernünftige Antworten eine dritte Frage erzeugten.

Wir wissen, was die Frage ist.
Flow weiß, warum es existiert.
COCO weiß, wo es als Nächstes nachsehen muss.

Der Rest kann warten.


Control. Clarity. Flow.

Veröffentlicht: 31.08.2026

Permalink →

COCO schlägt wieder zu

COCO schlägt wieder zu

Wir sollten COCO wahrscheinlich keine Ideen mehr geben.

Das vorherige Experiment sollte eigentlich genug sein.

Eine echte Anwendung.

Echte Navigation.

Benutzer.

Rollen.

Datenbanken.

Sprachen.

Nachweise.

Eine respektable Fallstudie.

Ein sauberer Abschluss.

Dann zeigte uns jemand: Logistics in Motion.

Das war wahrscheinlich der Fehler.

Es begann mit drei Lagern

Nichts besonders Aufregendes.

…

Ein Brief von COCO

Ein Brief von COCO

An die Ingenieurin oder den Ingenieur, die oder der dieses Repository zum ersten Mal öffnet:

Willkommen.

Vielleicht sind Sie hier, weil etwas fehlgeschlagen ist.

Ein Dienst hat nicht mehr geantwortet.

Ein Deployment hat sich unerwartet verhalten.

Ein Alarm hat Sie mitten in der Nacht geweckt.

Oder Sie sind einfach neugierig, wie diese Plattform funktioniert.

Was auch immer Sie hierhergeführt hat, wissen Sie:

Dieses Projekt wurde genau für solche Momente gebaut.

Nicht um schwierige Probleme zu beseitigen.

Sondern um schwierige Probleme verständlich zu machen.

Sie werden Code finden.

Sie werden Dokumentation finden.

Sie werden Spezifikationen finden.

…

Case Studies

softify.pro Flow — Getestet von COCO

softify.pro Flow — Getestet von COCO

21.08.2026

Control. Clarity. Flow.

Jedes ernstzunehmende Softwareprodukt entwickelt irgendwann ein zweites Produkt hinter dem Produkt.

Kunden bekommen es vielleicht nie zu sehen. Besucher wissen vielleicht nie, dass es existiert. Aber Administratoren, Betreiber und Entwickler verlassen sich jeden Tag darauf.

Bei softify.pro Flow heißt diese Anwendung Administration — die Betriebskonsole, die Benutzer, Rollen, Zugriffsebenen, Authentifizierungsstatus, Datenbankumgebungen und weitere Konfiguration verwaltet, die eine Flow -Installation unter Kontrolle hält.

Der Anmeldebildschirm trägt drei Worte:
Control. Clarity. Flow.

Sie wurden ursprünglich gewählt, um die Erfahrung zu beschreiben, die Administratoren beim Betrieb des Systems haben sollten.

Aber sie beschreiben überraschend gut auch, wie wir glauben, dass Software getestet werden sollte.

Das machte softify.pro Flow — Administration zu einem naheliegenden Kandidaten für einen realen COCO-Test.

Keine Laborvorführung.
Keine Sammlung isolierter Buttons, die eigens für eine KI-Demo vorbereitet wurde.
Eine echte plattformübergreifende Desktop-Anwendung mit echter Anwendungslogik, mehreren Fenstern, mehreren Datenbank-Backends, Authentifizierung, Berechtigungen, Lokalisierung und genug Zustand, um scheinbar kleine Regressionen manuell schwer erkennbar zu machen.

Für die hier gezeigte öffentliche Demonstration arbeitete COCO ausschließlich mit generierten Demodaten. Die Anwendung war an die fiktive Firma Presentation GmbH lizenziert, und es wurden keine echten Kundendaten, Zugangsdaten oder personenbezogenen Daten verwendet.

Das Ziel war einfach:
COCO sollte die Anwendung so angehen, wie es ein Tester tun würde, und feststellen, ob der komplette administrative Arbeitsablauf sich noch so verhält, wie die Software es verspricht.

Die Herausforderung

Auf den ersten Blick wirkt das Testen einer Administrationsanwendung einfach.

Öffnen.
Anmelden.
Durch mehrere Fenster klicken.
Prüfen, ob alles korrekt aussieht.

Diese Annahme ändert sich schnell, sobald die Anwendung wächst.

softify.pro Flow — Administration ist kein einzelnes statisches Formular. Es ist eine Sammlung miteinander verbundener Betriebsansichten innerhalb einer Anwendungshülle.

Ein Administrator arbeitet unter anderem mit:

  • Benutzerkonten
  • Rollen und Zugriffsebenen
  • Authentifizierungsinformationen
  • Zwei-Faktor-Authentifizierungsstatus
  • Betriebssysteminformationen
  • Netzwerk- und IP-Informationen
  • Datenbankkonfiguration
  • Sortier- und Anzeigeoptionen
  • Live-Sprachauswahl
  • Anwendungs- und Lizenzinformationen

Die Oberfläche unterstützt derzeit elf Sprachen. Die Anwendung arbeitet außerdem mit MySQL- und PostgreSQL-Datenbank-Backends. Für sich genommen stellt keines dieser Merkmale ein ungewöhnliches Testproblem dar.

Die Schwierigkeit entsteht aus ihren Kombinationen.
Eine Benutzertabelle mag auf Englisch korrekt funktionieren, aber auf Kroatisch einen veralteten Spaltennamen anzeigen.
Die Sortierung mag mit MySQL korrekt funktionieren, sich aber nach dem Wechsel zu PostgreSQL anders verhalten.

Ein Sprachwechsel mag die meisten Oberflächenelemente aktualisieren, aber eine Statusmeldung unübersetzt lassen. Die Anwendung mag erfolgreich die Datenbank wechseln, aber veraltete Informationen aus der vorherigen Verbindung beibehalten. Ein neues Release mag eine Funktion einführen, während der Info-Dialog noch die vorherige beschreibt. Das Programm muss dafür nicht abstürzen, damit eine dieser Situationen eine Regression ist. Tatsächlich sind einige der unangenehmsten Softwarefehler genau die, bei denen scheinbar alles funktioniert.

Die Anwendung startet.
Das Fenster öffnet sich.
Der Button reagiert.
Aber irgendetwas darunter stimmt nicht mehr ganz.
Deshalb ist wiederholtes Regressionstesten wichtig.

Und es ist genau die Art von Arbeit, bei der Menschen zunehmend schlechter werden, nachdem sie dieselbe Abfolge Dutzende Male wiederholt haben.

Warum manuelles Testen teuer wird

Etwas einmal zu testen ist einfach.
Es nach jedem relevanten Release zuverlässig zu testen ist etwas anderes.

Betrachten Sie nur drei Dimensionen: 11 Oberflächensprachen × 2 Datenbank-Backends × mehrere Anwendungs-Workflows.

Die Anzahl der Kombinationen wächst schnell. Fügt man unterschiedliche Benutzerrollen, Authentifizierungsstatus, Sortierverhalten, Konfigurationsänderungen und Betriebsumgebungen hinzu, wird die Testmatrix zu groß, um sie als gelegentliche manuelle Checkliste zu behandeln.

Genau hier beginnt Regressionstesten oft zu erodieren.
Nicht absichtlich.
Ein Release-Termin rückt näher.
Jemand erinnert sich, dass die Anwendung letzte Woche getestet wurde.
Ein Entwickler prüft schnell den wichtigsten Bildschirm.

Deutsch funktioniert.
Englisch funktioniert.
MySQL funktioniert.
Die Annahme wird:
„Der Rest ist wahrscheinlich in Ordnung."

Meistens stimmt das.
Bis zu dem Release, bei dem es nicht stimmt.
COCO existiert unter anderem, um genau diese Annahme aus dem Prozess zu entfernen.

Was COCO tatsächlich getan hat

COCO startete softify.pro Flow — Administration aus einem kalten Anwendungszustand heraus, ohne sich auf einen vorbereiteten Bildschirm oder einen manuell positionierten Arbeitsablauf zu verlassen.

Die erste Interaktion war dieselbe, die auch einem menschlichen Administrator präsentiert wird: das Anmeldefenster.

COCO identifizierte die Authentifizierungsoberfläche mit:

  • Benutzername
  • Passwort
  • Zwei-Faktor-Authentifizierungscode

und der Zeile direkt unter der softify.pro Flow - Kennzeichnung:
Control. Clarity. Flow.

Von dort aus arbeitete sich COCO durch eine definierte Regressionssitzung. Es ging nicht einfach darum, festzustellen, ob die Anwendung sich öffnen ließ.

Es ging darum, zu überprüfen, ob der Zustand der Anwendung intern konsistent blieb, während COCO mit ihr interagierte.

Authentifizierung ist nur der Anfang

Login-Tests sind einer der naheliegendsten Kandidaten für Automatisierung, aber erfolgreiche Authentifizierung allein sagt sehr wenig über den Rest einer Administrationsanwendung aus.

Einmal drin, wechselte COCO in die eigentliche Betriebsumgebung. Es prüfte die Benutzerverwaltungsoberfläche und verifizierte, dass die erwarteten Informationen vorhanden waren.

Das umfasste Daten wie:

  • Benutzernamen
  • maskierte Passwörter
  • 2FA-Indikatoren
  • zugewiesene Rollen
  • Betriebssysteminformationen
  • IP-Adressen

COCO interagierte dann mit der Tabelle, statt sie nur zu beobachten. Die Benutzerliste wurde nach Benutzername sortiert. Die resultierende Reihenfolge wurde geprüft. Der wichtige Teil war nicht, ob das Klicken auf die Spaltenüberschrift eine sichtbare Änderung erzeugte.

COCO überprüfte, ob der resultierende Tabellenzustand der angeforderten Operation entsprach.

Diese Unterscheidung ist wichtig.
Ein funktionaler Test fragt:
„Hat der Button reagiert?"

Ein nützlicher Regressionstest fragt:
„Ist die Anwendung in den korrekten Zustand gelangt?"

Die Datenbankgrenze testen

softify.pro Flow unterstützt mehr als ein Datenbank-Backend.

Das macht den Datenbankwechsel zu einer besonders wichtigen Regressionsgrenze.
COCO wechselte das aktive Backend von MySQL zu PostgreSQL.

Nach dem Wechsel prüfte es die Benutzerinformationen erneut. Der Test suchte nach mehr als einer erfolgreichen Verbindung. Er prüfte, ob die Anwendung weiterhin die erwarteten Datensätze anzeigte und ob die über die Oberfläche gezeigten Informationen konsistent blieben.

COCO wechselte danach wieder zurück.

Diese Art von Übergang wird leicht unterschätzt.
Die Benutzeroberfläche kann visuell identisch bleiben, während sich die darunterliegende Speicherschicht vollständig ändert.
Aus Sicht eines Administrators sollte sich dieser Übergang fast langweilig anfühlen.
Dieselben Benutzer sollten weiterhin verständlich sein.
Dieselben Rollen sollten weiterhin Sinn ergeben.

Dasselbe Oberflächenverhalten sollte weiterhin gelten.

Genau diese scheinbar ereignislose Kontinuität muss bewiesen werden.

Elf Sprachen, ein Anwendungszustand

Lokalisierung ist ein weiterer Bereich, in dem oberflächliches Testen besonders gefährlich ist.

Es ist relativ einfach zu prüfen, ob eine Anwendung in einer anderen Sprache starten kann. Viel wertvoller ist es zu prüfen, was passiert, wenn sich die Sprache ändert, während die Anwendung bereits läuft und einen Zustand hält.

COCO wechselte die Oberflächensprache live.

Die Sitzung umfasste Übergänge zwischen Sprachen wie:
Deutsch → Englisch → Kroatisch
während die Administrationsansicht aktiv blieb.

COCO beobachtete, ob sich Oberflächenelemente korrekt an Ort und Stelle änderten:

  • Tabellenüberschriften
  • Steuerelemente
  • Buttons
  • Beschriftungen
  • Statusmeldungen

Auch die darunterliegende Tabelle und der Anwendungszustand mussten diesen Übergang überstehen. Das ist wichtig, weil mehrsprachige Software aus mehr besteht als übersetzten Zeichenketten. Sprachwechsel können Folgendes offenlegen:

  • vergessene Ressourcen
  • veraltete Beschriftungen
  • Layoutprobleme
  • unübersetzte Statusmeldungen
  • Kodierungsprobleme
  • Zustandsrücksetzungen
  • Probleme bei der Neuerstellung von Steuerelementen

Ein Fenster, das korrekt aussieht, wenn es direkt auf Kroatisch gestartet wird, kann sich dennoch fehlerhaft verhalten, wenn der Benutzer während einer aktiven Sitzung von Deutsch zu Kroatisch wechselt.

Das ist der Unterschied zwischen der Prüfung eines Screenshots und dem Testen eines Arbeitsablaufs.

Den Anwendungszustand wiederherstellen

Anschließend stellte COCO die Standard-Sortierkonfiguration der Anwendung wieder her.

Auch hier endete der Test nicht mit dem Klick selbst.

Die resultierende Reihenfolge und die über den Anwendungsstatusbereich angezeigte Bestätigung wurden ausgewertet. Diese Art der Überprüfung mag im Vergleich zum Testen von Authentifizierung oder Datenbankzugriff unbedeutend erscheinen.

Ist sie aber nicht.

Enterprise-Anwendungen sammeln Hunderte solcher kleinen Zustandsübergänge an. Benutzer verlassen sich darauf, ohne bewusst darüber nachzudenken. Die Software fühlt sich gerade deshalb zuverlässig an, weil diese Interaktionen vorhersehbar bleiben. Regressionstests existieren, um diese Vorhersehbarkeit zu schützen.

Die Informationen rund um die Software testen

COCO öffnete auch den Info-Dialog der Anwendung.

Warum ein Info-Fenster testen?

Weil Softwaredokumentation innerhalb der Software selbst beginnt. Die Versionsnummer, Funktionsbeschreibung und Lizenzinformationen, die dem Betreiber angezeigt werden, sollten der tatsächlich laufenden Anwendung entsprechen.

Eine Anwendung kann einwandfrei funktionieren und dennoch veraltete Versionsinformationen anzeigen oder Fähigkeiten beschreiben, die nicht mehr dem Release entsprechen.

Das lässt keine Datenbank abstürzen.
Es bewirkt etwas Subtileres:
es untergräbt Vertrauen.

Bei Enterprise-Software gehört operative Genauigkeit auch zu diesen scheinbar kleinen Details. COCO überprüfte daher auch diese.

Control.

Das erste Wort im softify.pro Flow -Slogan ist auch das erste Prinzip der Testumgebung.

Control bedeutet zu wissen, was getestet wird, gegen welchen Zustand und mit welchen Daten.

Die öffentliche COCO-Demonstration verwendet keine Produktivdaten von Kunden.

Sie läuft mit gezielt vorbereiteten Demodaten, deren erwarteter Zustand bekannt ist.

Das macht Ergebnisse reproduzierbar.

Es bedeutet außerdem, dass Unterschiede zwischen Testläufen untersucht statt als zufällige Änderungen in Produktivdaten weggeklärt werden können.

Wichtiger noch: COCO ist als selbst gehostetes KI-Testsystem konzipiert.

Testnachweise, Anwendungs-Screenshots und interne Ablaufinformationen können innerhalb der Infrastruktur unter der eigenen Kontrolle des Kunden oder Betreibers bleiben, statt standardmäßig an einen fremden Cloud-Dienst gesendet zu werden.

Für interne Geschäftsanwendungen ist das nicht bloß eine Infrastrukturpräferenz. Es kann Teil der Testanforderung selbst sein.

Clarity.

Automatisierung ist nicht besonders nützlich, wenn ihr Endergebnis lautet: FAILED
gefolgt von Hunderten Zeilen technischer Ausgabe, die jemand manuell rekonstruieren muss, bevor er versteht, was passiert ist.

COCO ist so konzipiert, dass eine verständliche Beweiskette erhalten bleibt.

Der Bericht beschreibt:

  • was getestet wurde
  • welche Interaktion stattfand
  • in welcher Reihenfolge sie geschah
  • was COCO beobachtete
  • welcher Zustand erwartet wurde
  • wo sich das Verhalten unterschied, wenn etwas fehlschlug

Screenshots und Ausführungsnachweise können diese Abfolge begleiten.
Der Zweck ist nicht, technische Details zu verbergen.

Der Zweck ist, das Ergebnis verständlich zu machen, bevor jemand einen Debugger öffnen muss.

Ein Ingenieur sollte in der Lage sein zu beantworten:
Was ist passiert? bevor er fragt:
Wo im Code ist es passiert?

Diese Unterscheidung verkürzt die Untersuchung dramatisch, wenn eine Regression auftritt.

Flow.

Traditionelle UI-Automatisierung denkt oft in Elementen.

Selektor finden.
Selektor klicken.
Weiteren Selektor finden.
Wert prüfen.

Dieser Ansatz bleibt nützlich, aber Anwendungen werden nicht als Sammlungen von Selektoren erlebt.

Menschen erleben Abläufe.

Anmelden.
Administration öffnen.
Einen Benutzer finden.
Eine Einstellung ändern.
Eine Datenbank wechseln.
Eine Sprache ändern.
Das Ergebnis überprüfen.

Weiterarbeiten.

COCO behandelt die Abfolge daher als Prozess, nicht als zufällige Sammlung von Steuerelementen.

Es verfolgt, was der Benutzer erreichen möchte, und bewertet die Anwendung im Kontext.

Das wird besonders wertvoll beim Testen echter Geschäftssoftware, weil Fehler oft zwischen Bildschirmen oder zwischen Zuständen auftreten, nicht innerhalb eines einzelnen Buttons.

Ein Logistikablauf mag eine Bestellung, eine Lagerreservierung, eine Kommissionierung, einen Lieferschein und eine Versandbestätigung umfassen.
Jeder einzelne Bildschirm kann korrekt erscheinen, während der Gesamtprozess falsch ist.
Dasselbe Prinzip gilt hier in kleinerem Maßstab.
Das Administrationsfenster ist nicht das Produkt.

Der Arbeitsablauf hindurch ist es.

Beweise statt Annahme

Eine der wichtigsten Aufgaben von COCO ist nicht das Klicken. Es ist das Erinnern daran, was passiert ist.

Menschliches Regressionstesten endet häufig mit einer Aussage wie:
„Ich habe es getestet, und alles sah in Ordnung aus."

Das mag völlig zutreffend sein.
Aber Wochen später, wenn ein Problem auftritt, sind die nützlichen Fragen andere:

  • Welches Release wurde getestet?
  • Welche Datenbank?
  • Welche Sprache?
  • Welcher Benutzerzustand?
  • Was geschah vor dem Problem?
  • Was genau war sichtbar?

In welcher Reihenfolge wurden die Aktionen ausgeführt?
Die Testläufe von COCO sind darauf ausgelegt, Beweise zu hinterlassen.

Das verwandelt ein Testergebnis von einer Meinung in etwas Überprüfbares. Ein erfolgreicher Lauf wird dadurch ebenfalls nützlich. Er legt einen bekannten Referenzzustand fest, mit dem späteres Verhalten verglichen werden kann.

COCO trifft nicht die Entscheidung

Es gibt eine wichtige Grenze in der Art, wie wir KI für Softwaretests einsetzen.
COCO soll nicht die technische Verantwortung ersetzen.

Es entscheidet nicht, wie eine Geschäftsregel sein sollte.

Es testet Verhalten gegen Szenarien, Anforderungen und Erwartungen, die für die Anwendung definiert wurden. Bei sensiblen Entscheidungen zu Berechtigungen, Preisen, Beständen, Finanztransaktionen oder anderen kritischen Geschäftszuständen bleibt die Definition korrekten Verhaltens menschliche Verantwortung.

Diese Unterscheidung ist wichtig.
KI ist hervorragend darin, einen detaillierten Test zu wiederholen, ohne die Konzentration zu verlieren. Sie ist hervorragend im Sammeln von Beweisen. Sie kann Bildschirme prüfen, erwartetes mit beobachtetem Verhalten vergleichen und Abweichungen erklären. Aber das Unternehmen definiert weiterhin, was korrekt bedeutet.

COCO macht diese Definition testbar.

Der Test, den niemand wiederholen möchte

Es gibt einen einfachen Grund, warum Automatisierung hier einen Mehrwert bietet.
Ein menschlicher Tester kann diese Regressionssitzung durchaus durchführen.
Die erste Sprache erhält volle Aufmerksamkeit.
Wahrscheinlich auch die zweite.
Dann noch eine.
Dann noch eine.
MySQL wurde bereits geprüft.
PostgreSQL muss noch geprüft werden.
Der Sortiertest wurde bereits mehrfach durchgeführt.
Der Info-Dialog hat sich seit Monaten nicht geändert.

Es ist Freitagnachmittag.

Und menschliche Aufmerksamkeit tut, was menschliche Aufmerksamkeit naturgemäß tut.
Sie beginnt zu optimieren.
COCO nicht.
Im eigenen Geist von COCO:

  • Ich werde nicht müde davon, denselben Button in elf Sprachen zu klicken. Ich überspringe den PostgreSQL-Durchgang nicht, nur weil Freitagnachmittag ist. Ich nehme nicht an, dass die Sortierung gehalten hat, nur weil sie im vorherigen Release funktioniert hat.

Für COCO kann jede Regressionssitzung so behandelt werden, als wäre sie die erste.
Das ist keine Intelligenz, die einen menschlichen Tester ersetzt.
Es ist Automatisierung, die den menschlichen Tester vor dem Teil des Testens schützt, in dem menschliche Aufmerksamkeit am wenigsten wert ist.

Vom wiederholten Testen zum technischen Beweis

Der größere Zweck von COCO ist nicht, die Anzahl automatisierter Aktionen zu maximieren. Tausend automatisierte Klicks sind bedeutungslos, wenn niemand versteht, was sie beweisen. Das nützliche Ergebnis ist durch Beweise gestütztes Vertrauen.

Für softify.pro Flow bedeutet das, sagen zu können, dass ein Release über die relevanten Betriebsbereiche hinweg geprüft wurde:

  • Authentifizierung
  • Benutzerverwaltung
  • Rollen- und Zugriffsinformationen
  • Zwei-Faktor-Authentifizierungsstatus
  • Sortierverhalten
  • MySQL-Betrieb
  • PostgreSQL-Betrieb
  • Live-Lokalisierung
  • Statusrückmeldungen
  • Anwendungsinformationen
  • Lizenzinformationen

und dass das Ergebnis in einer Form aufbewahrt wird, die später überprüft werden kann.

Dasselbe Prinzip skaliert weit über diese Anwendung hinaus.
Ein Login-Prozess kann so getestet werden.
Ein Buchungsablauf kann so getestet werden.
Ein Logistikprozess kann so getestet werden.
Eine plattformübergreifende Desktop-Anwendung kann so getestet werden.
Die Bildschirme ändern sich.
Die Geschäftsregeln ändern sich.
Das Prinzip nicht:
den erwarteten Ablauf definieren, ihn konsistent ausführen, Beweise sammeln und das Ergebnis verständlich machen.

Warum wir unsere eigene Software mit COCO testen

Es gibt einen weiteren Grund, warum softify.pro Flow als COCO-Fallstudie wichtig ist.

Es ist unsere eigene Software.
Das beseitigt die bequeme Distanz, die manchmal zwischen einer Technologievorführung und den Menschen besteht, die sie vorführen.

Wenn COCO Enterprise-Software testen soll, muss es nützlich genug sein, dass wir ihm Software anvertrauen, die wir selbst entwickeln und veröffentlichen.

Flow dient daher sowohl als Produkt als auch als Testfeld.
Neue Testfähigkeiten können an einer echten Anwendung erprobt werden.
Unerwartetes Verhalten kann Schwächen in der Anwendung, im Testplan oder in COCO selbst offenlegen.

Jede Seite verbessert die andere.
Diese Rückkopplungsschleife ist viel wertvoller als der Aufbau künstlicher Demonstrationen, die nur darauf ausgelegt sind, erfolgreich zu sein. Ein Testsystem sollte nicht überzeugend wirken, weil die Demonstration einfach war.
Es sollte überzeugend werden, weil es weiterhin die kleinen Dinge findet, die Menschen irgendwann aufhören würden zu prüfen.

Das Ergebnis

softify.pro Flow — Administration verfügt nun über einen dokumentierten und wiederholbaren Regressionsprozess, den COCO vor relevanten Releases ausführen kann.

Der Test umfasst beide unterstützten Datenbankumgebungen und die elfsprachige Oberfläche der Anwendung, während er der Anwendung so folgt, wie ein Administrator sie nutzen würde, statt jeden Bildschirm als isoliertes Testziel zu behandeln.

COCO erstellt eine Beweiskette, die zeigt, was getestet wurde, was beobachtet wurde und in welcher Reihenfolge die Sitzung ablief.

Diese Beweise können lokal unter Kontrolle bleiben.
Entwickler erhalten bei jeder Änderung einen reproduzierbaren Ausgangspunkt.
Menschliche Tester verbringen weniger Zeit mit dem Wiederholen vorhersehbarer Interaktionen und mehr Zeit mit der Untersuchung von Situationen, die tatsächlich Urteilsvermögen erfordern.

Und softify.pro Flow erhält etwas Wertvolleres als eine grüne PASS-Anzeige.

Es erhält den Beweis, dass die auf dem Anmeldebildschirm versprochene Erfahrung auch dann noch besteht, nachdem sich der zugrunde liegende Code geändert hat.

Control. Wissen, was getestet wird, und die Umgebung unter Kontrolle halten.

Clarity. Verstehen, was passiert ist, ohne ein undurchsichtiges Automatisierungsprotokoll rekonstruieren zu müssen.

Flow. Die Anwendung als Prozess testen, den Menschen tatsächlich nutzen.

Control. Clarity. Flow.

Es wurde für die Software geschrieben.
Es stellte sich heraus, dass es genauso gut die dahinterstehende Testphilosophie beschreibt.

Permalink →

Wissenswertes

Pure fluidity meets ultimate performance: Was betriebliche Software wirklich schnell macht

Pure fluidity meets ultimate performance: Was betriebliche Software wirklich schnell macht

Ein Lagerleiter erkennt schlechte Software nicht an einer Architekturzeichnung. Er erkennt sie daran, dass Mitarbeitende wieder zum Telefon greifen, Lieferscheine doppelt erfassen oder nach einer Schicht nicht sagen können, welche Ware tatsächlich angekommen ist. Pure fluidity meets ultimate performance darf deshalb kein bloßer visueller Anspruch sein. Für betriebliche Software bedeutet es, dass sich ein Vorgang natürlich anfühlt und zugleich unter realen Bedingungen verlässlich funktioniert.

Eine elegante Oberfläche ist wertlos, wenn sie bei schwachem WLAN im Lager stockt. Eine schnelle Anwendung hilft ebenfalls wenig, wenn sie eine Arbeitsfolge erzwingt, die an der Rampe niemand nachvollziehen kann. Gute digitale Werkzeuge verbinden Gestaltung, Geschwindigkeit und Prozessverständnis. Sie reduzieren Reibung, ohne den Betrieb in eine vorgefertigte Standardlogik zu pressen.

Pure fluidity meets ultimate performance ist eine Betriebsfrage

Fluidität wird oft mit Animationen, großen Bildern und glatten Übergängen verwechselt. Das kann zu einer modernen Marke passen. Im Arbeitsalltag zeigt sie sich aber anders: Ein Wareneingang lässt sich ohne Umwege buchen. Ein Mitarbeiter findet einen Auftrag auch dann, wenn nur eine Referenznummer bekannt ist. Ein Fehler wird klar benannt, statt in einer kryptischen Meldung zu verschwinden.

Performance ist ebenso mehr als ein guter Wert in einem Browser-Test. Entscheidend ist die Antwortzeit bei einem Auftrag mit vielen Positionen, die Stabilität am Monatsende und die Frage, ob fünf Personen gleichzeitig arbeiten können, ohne sich gegenseitig Datenstände zu überschreiben. Auch ein sauberer Umgang mit Verbindungsabbrüchen, Berechtigungen und gesperrten Konten gehört dazu.

Beides ist untrennbar. Wenn eine Maske sofort reagiert, aber unklare Pflichtfelder besitzt, bleibt sie anstrengend. Wenn der Ablauf klug modelliert ist, die Seite aber bei jeder Buchung zwei Sekunden wartet, wird er umgangen. Fluidität entsteht dort, wo das System die nächste sinnvolle Handlung unterstützt und technisch schnell genug bleibt, damit der Gedanke nicht abreißt.

Die Oberfläche folgt dem Arbeitsweg, nicht dem Organigramm

Viele Standardlösungen strukturieren ihre Menüs nach Modulen: Einkauf, Verkauf, Lager, Reporting, Administration. Das ist aus Produktsicht verständlich. Auf dem Hallenboden beginnt die Arbeit jedoch häufig mit einer Situation: Ein Lkw steht da, eine Palette fehlt, ein Kunde braucht einen Liefernachweis oder eine Sendung muss noch vor Annahmeschluss etikettiert werden.

Eine gute individuelle Anwendung beginnt deshalb mit diesen Situationen. Welche Information liegt vor? Wer entscheidet? Was muss dokumentiert werden? Was darf später nicht mehr verändert werden? Erst danach wird entschieden, welche Eingabemaske, Prüfung oder Automatisierung erforderlich ist.

Das bedeutet nicht, jeden bestehenden Ablauf unverändert in Software zu gießen. Manche Tabellen sind tatsächlich zu fehleranfällig, manche Freigaben unnötig langsam. Aber eine funktionierende Excel-Liste muss nicht zwangsläufig durch ein Projekt ersetzt werden. Wenn sie nur von einer Person gepflegt wird, wenige Ausnahmen kennt und nachvollziehbar bleibt, kann sie das passende Werkzeug sein. Software lohnt sich, wenn sie Koordination verbessert, Fehlerquellen senkt oder Informationen für mehrere Beteiligte zuverlässig verfügbar macht.

Weniger Klicks sind nicht automatisch besser

Die Forderung nach möglichst wenigen Klicks klingt vernünftig, kann aber in die falsche Richtung führen. Bei einer irreversiblen Lagerbuchung ist eine kurze Bestätigung sinnvoll. Bei einer Versandfreigabe kann eine sichtbare Plausibilitätsprüfung teure Nacharbeit verhindern. Der richtige Ablauf hängt vom Risiko ab.

Entscheidend ist, dass zusätzliche Schritte einen klaren Zweck haben. Eine Bestätigung sollte nicht nur deshalb erscheinen, weil das Framework sie leicht erzeugt. Sie sollte genau dort stehen, wo Menschen eine Entscheidung bewusst treffen müssen. So bleibt die Anwendung schnell, ohne leichtfertig zu werden.

Performance entsteht in der Architektur, nicht im letzten Sprint

Wer eine Website oder Webanwendung erst kurz vor dem Go-live beschleunigt, behandelt meist Symptome. Große Abfragen, unklare Datenmodelle und nachträglich ergänzte Sonderfälle lassen sich nicht durch einen einzelnen Optimierungstag dauerhaft korrigieren.

Eine belastbare Grundlage beginnt mit einer Datenbank, die den tatsächlichen Beziehungen im Betrieb entspricht. In MySQL 8 brauchen Bewegungen, Belege, Statusänderungen und Benutzeraktionen nachvollziehbare Schlüssel und sinnvolle Indizes. Ein Bestand darf nicht nur als Zahl erscheinen, wenn später geklärt werden muss, durch welche Buchung er entstanden ist. Gleichzeitig muss nicht jede historische Information bei jedem Seitenaufruf neu berechnet werden.

Bei modernen Webanwendungen ist auch die Trennung der Verantwortlichkeiten relevant. PHP 8.4 kann Geschäftsregeln klar und wartbar abbilden, während modernes JavaScript gezielt für reaktive Bereiche eingesetzt wird. Das ist kein Glaubensbekenntnis für einen bestimmten Stack. Es ist eine Frage der Wartung: Können Änderungen in sechs Monaten sicher umgesetzt werden? Ist sichtbar, wo eine Regel gilt? Lässt sich ein Fehler reproduzieren, statt nur zu vermuten?

Performance braucht außerdem Grenzen. Suchfelder benötigen sinnvolle Mindestzeichen oder eine präzise Filterlogik, wenn Millionen Datensätze denkbar sind. Große Listen brauchen Seiten oder abgestufte Nachladeprozesse. Bilder und Dokumente sollten nicht den kritischen Arbeitsablauf blockieren. Diese Entscheidungen wirken unspektakulär. Genau deshalb bleiben sie oft länger wertvoll als ein auffälliger Frontend-Effekt.

Sichtbare Geschwindigkeit schafft Vertrauen

Nicht jeder Prozess kann in unter einer Sekunde abgeschlossen sein. Ein Etikettendruck, eine Schnittstelle zum Versanddienstleister oder eine Prüfung gegen externe Daten braucht gelegentlich Zeit. Entscheidend ist dann, wie die Anwendung mit Wartezeit umgeht.

Ein klarer Status wie „Versandlabel wird erstellt“ ist besser als ein eingefrorener Button. Nach einem Abschluss sollte erkennbar sein, welche Nummer erzeugt wurde und ob der Vorgang erneut ausgelöst werden darf. Wenn ein externer Dienst nicht erreichbar ist, braucht das Team eine verständliche Handlungsoption statt einer Fehlermeldung für Entwickler.

Das ist auch eine Frage der Datenintegrität. Ein Doppelklick darf nicht zwei Lieferungen erzeugen. Ein abgebrochener Prozess darf nicht stillschweigend einen halbfertigen Datensatz hinterlassen. Gute Systeme planen solche Fälle ein, weil sie im Alltag eintreten werden. Gerade bei wechselnden Schichten, Zeitdruck und mobilen Geräten ist die Ausnahme kein Randthema.

Qualität wird vor dem Fehler sichtbar

Für Anwendungen mit vielen Prozessvarianten reicht es nicht, am Ende ein paar Wege manuell durchzuklicken. Änderungen an Preisen, Rollen, Validierungen oder Schnittstellen können an einer weit entfernten Stelle Folgen auslösen. Hier wird automatisiertes Testing zu einem Teil der Performance: nicht nur technisch, sondern organisatorisch.

Ein Testsystem sollte reale Abläufe prüfen können, etwa Auftrag anlegen, Position ändern, Lieferschein erzeugen und Berechtigung kontrollieren. Es sollte Belege aufzeichnen und Ergebnisse so formulieren, dass Fachbereiche sie einordnen können. Ein Satz wie „Der Versandprozess wurde nach der Adressänderung nicht abgeschlossen“ hilft mehr als ein unkommentierter Stacktrace.

Für sicherheitsbewusste Teams ist auch der Ort relevant, an dem diese Tests laufen. Wenn Screenshots, Zugangsdaten, Testfälle oder interne Anwendungsschritte das Unternehmen nicht verlassen sollen, ist ein selbst gehosteter Ansatz oft sinnvoller als ein externer Cloud-Dienst. Mit COCO lassen sich automatisierte Tests für Web- und Windows-Anwendungen auf einer dedizierten Umgebung ausführen. Das ist nicht für jedes Team nötig. Bei sensiblen Daten, regulierten Bereichen oder internen Fachanwendungen kann die Kontrolle über Testdaten jedoch ein entscheidender Vorteil sein.

Gestaltung ist dann gut, wenn sie Arbeit erleichtert

Eine starke visuelle Identität kann Vertrauen schaffen. Sie zeigt, dass ein Unternehmen seine digitale Präsenz ernst nimmt. Im operativen System muss Gestaltung jedoch noch mehr leisten: Orientierung unter Zeitdruck. Kontrast, Typografie, klare Zustände und verständliche Beschriftungen entscheiden darüber, ob jemand einen Vorgang sicher abschließt oder beim Kollegen nachfragt.

Dabei ist Zurückhaltung oft die bessere Wahl. Ein Dashboard mit zehn farbigen Kennzahlen kann eindrucksvoll aussehen und dennoch die einzige relevante Abweichung verdecken. Eine reduzierte Ansicht, die offene Wareneingänge, fehlende Scans und gefährdete Liefertermine sichtbar macht, ist nützlicher. Die Frage lautet nicht, wie viel Oberfläche möglich ist, sondern welche Information eine Entscheidung verbessert.

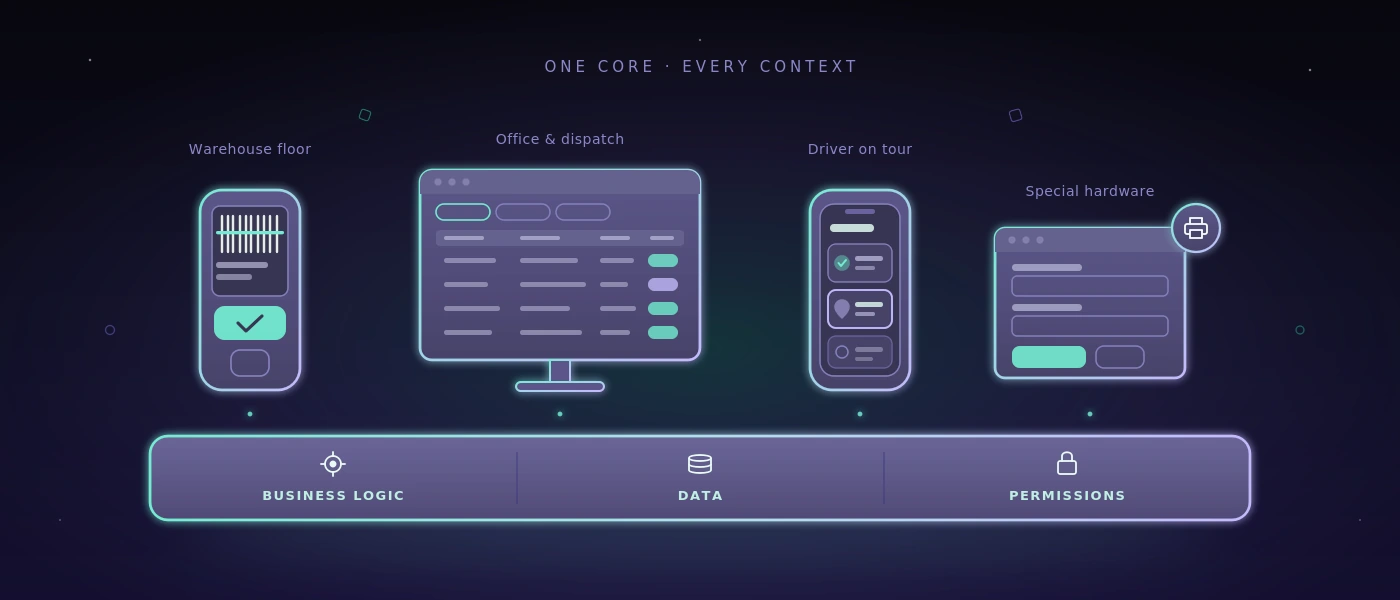
Das gilt auch für responsive Anwendungen. Mobilfähigkeit bedeutet nicht, jeden Desktop-Bildschirm auf ein kleineres Format zu quetschen. Ein Smartphone am Wareneingang braucht vielleicht nur Scan, Menge, Lagerplatz und Bestätigung. Die ausführliche Nachbearbeitung gehört möglicherweise an einen größeren Bildschirm. Unterschiedliche Geräte verdienen unterschiedliche Prioritäten, obwohl sie auf dieselbe verlässliche Datenbasis zugreifen.

Ein sinnvoller Maßstab für die nächste Entscheidung

Bevor ein Team eine neue Plattform, eine Automatisierung oder einen kompletten Neubau beschließt, hilft eine einfache Prüfung: Wird der Ablauf für die Menschen, die ihn täglich ausführen, klarer, schneller oder sicherer? Und lässt sich die Lösung auch noch verstehen, wenn sich Anforderungen, Mitarbeitende oder Schnittstellen ändern?

Wenn beide Antworten belastbar sind, wird aus einem schönen Versprechen ein brauchbares System. Dann zeigt sich pure fluidity meets ultimate performance nicht in einer Folie, sondern an einem ruhigen Arbeitstag, an dem Aufträge, Daten und Entscheidungen ohne unnötige Reibung weiterlaufen.
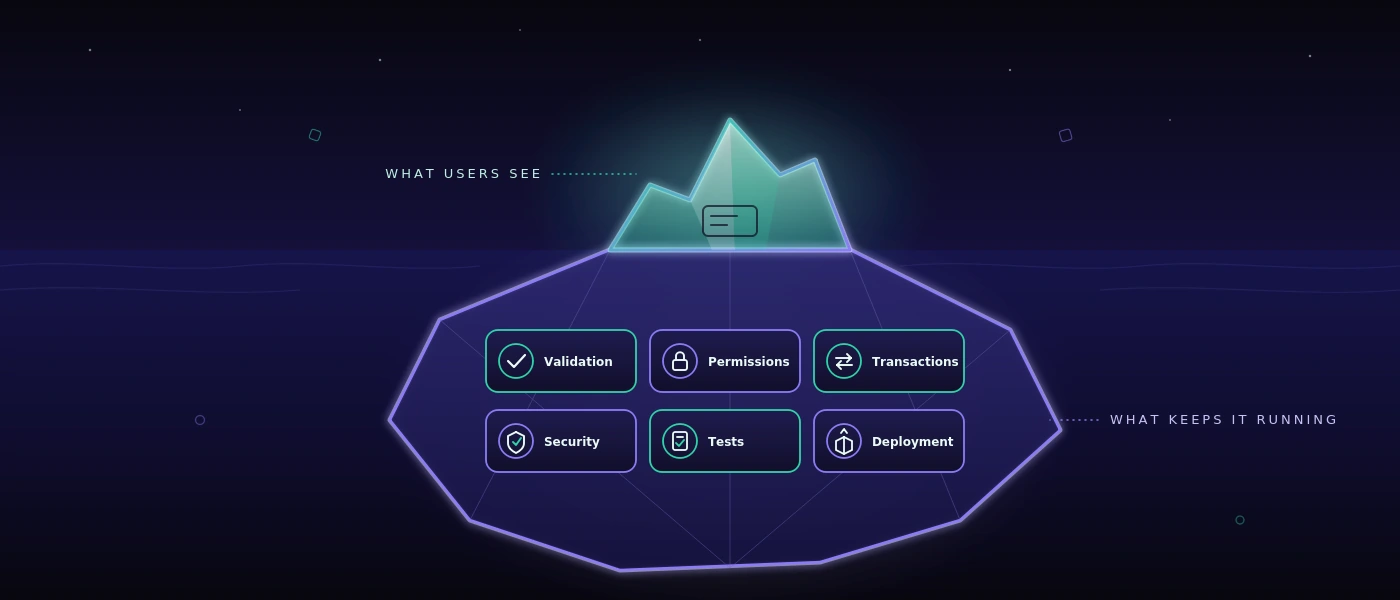
Permalink →

SaaS Flow Web: Workflows im laufenden Betrieb sicher einführen

SaaS Flow Web: Workflows im laufenden Betrieb sicher einführen

Ein Wareneingang bleibt nicht liegen, weil ein Team keine weitere Software kennt. Er bleibt liegen, weil Informationen zwischen E-Mail, Papierformular, Excel-Datei und Telefonat verloren gehen. Bei SaaS - „Flow Web“ auf flow.softify.pro sollte deshalb nicht die Oberfläche die erste Frage sein. Entscheidend ist, ob der Dienst einen konkreten Arbeitsablauf verlässlich abbildet - auch an hektischen Tagen, bei wechselnden Zuständigkeiten und wenn eine Lieferung nicht dem Plan entspricht.

Für kleine und mittlere Unternehmen ist SaaS oft sinnvoll, weil sie nicht erst eigene Server, Releases und Grundfunktionen aufbauen müssen. Das ist aber kein Freifahrtschein für jeden Prozess. Wer ein Werkzeug einführt, das den Alltag komplizierter macht oder wichtige Daten in unklare Nebenlisten verdrängt, digitalisiert keine Arbeit. Er verlagert nur die Reibung.

Was SaaS „Flow Web“ leisten muss

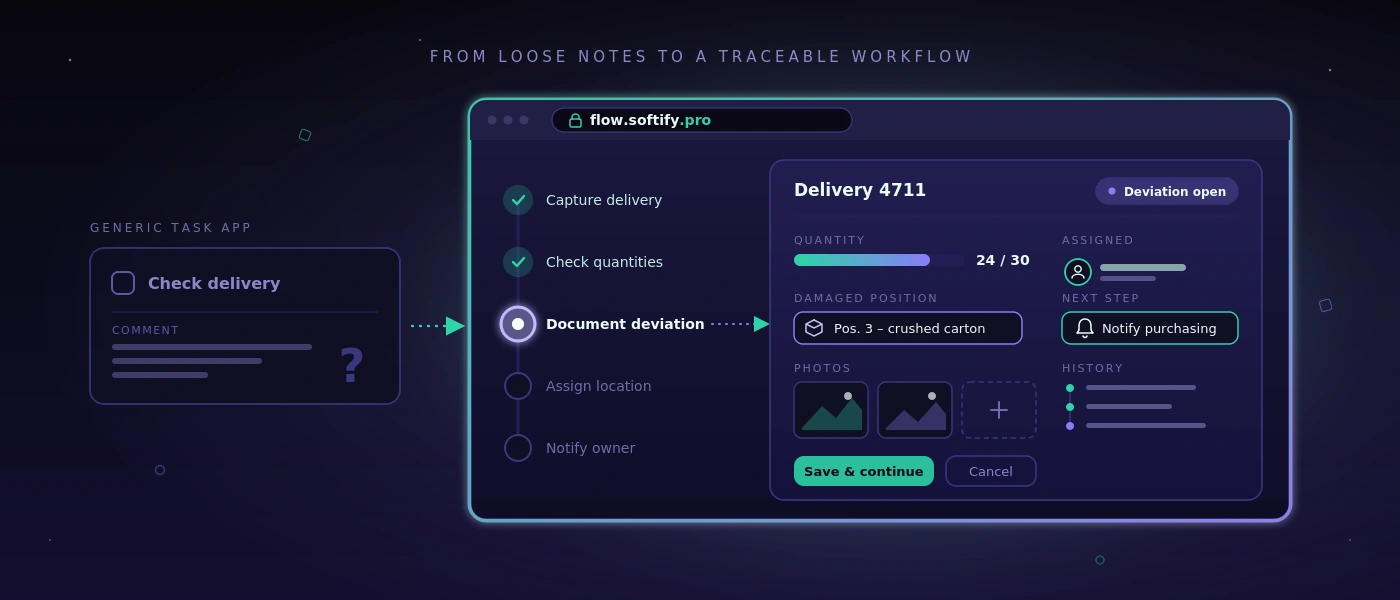
Ein Web-Workflow ist dann gut, wenn Mitarbeitende ohne Interpretation wissen, was als Nächstes zu tun ist. Bei einer Warenannahme kann das bedeuten: Lieferung erfassen, Mengen gegen Bestellung prüfen, Abweichung dokumentieren, Lagerplatz zuordnen und bei Bedarf einen Verantwortlichen informieren. Der Ablauf muss nicht spektakulär sein. Er muss nachvollziehbar, schnell und wiederholbar sein.

Genau hier liegt der Unterschied zwischen einer allgemeinen Aufgaben-App und einem fachlichen Prozesssystem. Eine Aufgaben-App kann einen Punkt namens „Lieferung prüfen“ anlegen. Ein fachlicher Workflow kann zusätzlich festhalten, welche Lieferung gemeint ist, wer sie angenommen hat, welche Position beschädigt war, welche Fotos vorliegen und ob eine Nachlieferung aussteht. Diese Daten stehen dann nicht als Freitext in einem einzelnen Kommentar, sondern dort, wo die nächste Person sie benötigt.

Für eine Lösung wie Flow Web auf flow.softify.pro sollte die Prüfung daher bei den Vorgängen beginnen, nicht bei einer Funktionsliste. Ein Betrieb mit fünf Lagerbewegungen am Tag braucht etwas anderes als ein Versandteam mit mehreren Cut-off-Zeiten, unterschiedlichen Frachtführern und regelmäßigem Teillieferungsmanagement. SaaS ist kein Ersatz für Prozessverständnis.

Erst den Engpass benennen, dann konfigurieren

Viele Digitalisierungsprojekte starten zu breit: „Wir wollen das Lager digitalisieren.“ Das klingt plausibel, führt aber schnell zu einem System mit zu vielen Masken, Sonderfällen und Schulungsunterlagen. Besser ist eine präzise Aussage wie: „Wareneingänge werden erst am nächsten Tag gebucht, weil Lieferscheine am Schichtende auf dem Schreibtisch liegen.“

Aus einem solchen Satz lässt sich ein sinnvoller Start ableiten. Die erste Version kann Lieferscheine erfassen, Artikel und Mengen bestätigen, Abweichungen markieren und die Buchung an die zuständige Stelle weitergeben. Wenn dieser Ablauf funktioniert, lassen sich Etiketten, Lieferantenbewertungen oder automatische Bestellvorschläge später ergänzen. Nicht jeder sinnvolle Ausbauschritt gehört in den ersten Rollout.

Auch eine gut gepflegte Tabelle darf bleiben, wenn sie ihren Zweck erfüllt. Beispielsweise kann eine monatliche Auswertung mit wenigen Beteiligten in einer bestehenden Datei günstiger und transparenter sein als ein eigenes Modul. SaaS lohnt sich dort, wo Informationen mehrfach genutzt werden, Bearbeitungszeiten kritisch sind oder Fehler aus Medienbrüchen entstehen.

Die richtigen Fragen vor der Einführung

Vor der Konfiguration sollte ein Team einen realen Vorgang vom Anfang bis zum Ende durchspielen. Nicht den Idealprozess, sondern den Fall, der im Alltag Probleme macht: falsche Menge, fehlende Referenz, dringender Versand oder ein Auftrag mit Sonderfreigabe. Dabei zeigen sich die Regeln, die ein System tatsächlich abbilden muss.

Relevant sind unter anderem diese Punkte: Wer darf einen Vorgang anlegen, ändern oder abschließen? Welche Eingaben sind Pflicht, welche nur hilfreich? Wann muss eine Führungskraft informiert werden? Welche Daten werden an Buchhaltung, Versand oder Kundenservice übergeben? Und was passiert, wenn das WLAN im Lager schwach ist oder ein Mitarbeitender seine Zugangsdaten nicht mehr hat?

Die Antworten bestimmen die Qualität der Einführung stärker als ein langer Katalog optischer Anforderungen. Ein sauberer Rollenprozess, eine verständliche Fehlermeldung und ein dokumentierter Freigabeschritt verhindern im Betrieb meist mehr Aufwand als ein zusätzlicher Bericht auf der Startseite.

Datenhaltung und Rollen sind keine Nebensache

SaaS wird häufig als reine Bedienfrage behandelt. Für Betriebs- und IT-Verantwortliche ist jedoch mindestens ebenso wichtig, was mit den Daten geschieht. Das betrifft Stammdaten, Lieferinformationen, Mitarbeiterdaten, Fotos von Schäden und möglicherweise Kundendaten. Vor der Einführung sollten Zuständigkeiten, Aufbewahrung und Exportmöglichkeiten klar sein.

Praktisch heißt das: Das Unternehmen muss wissen, welche Daten im System liegen, wer administrativen Zugriff hat und wie Daten bei einem Wechsel oder einer Vertragsbeendigung bereitgestellt werden. Ein Export, der nur als schwer lesbare PDF-Datei verfügbar ist, hilft selten weiter. Für operative Daten sind strukturierte, verwendbare Formate entscheidend.

Auch das Berechtigungskonzept verdient konkrete Aufmerksamkeit. Im Lager muss nicht jede Person Preise, Kundenkonditionen oder globale Einstellungen sehen. Gleichzeitig darf eine zu enge Rechtevergabe den Ablauf nicht blockieren. Sinnvoll sind Rollen, die an tatsächlichen Tätigkeiten ausgerichtet sind: Annahme, Disposition, Versand, Teamleitung und Administration. Kritische Änderungen sollten nachvollziehbar sein, damit bei Rückfragen nicht geraten werden muss, wer eine Buchung geändert hat.

Der Zugang selbst sollte mit soliden Grundlagen geschützt sein. Dazu gehören sichere Passwortrichtlinien, eine geregelte Passwort-Zurücksetzung, Account-Lockout bei wiederholten Fehlversuchen und, wo das Risikoprofil es verlangt, zusätzliche Anmeldungsschritte. Sicherheit wirkt dann professionell, wenn sie vorhersehbar ist und nicht erst dann auffällt, wenn jemand ausgesperrt wurde.

Integration nur dort, wo sie messbar entlastet

Ein Web-Workflow entfaltet seinen Wert oft erst im Zusammenspiel mit bestehenden Systemen. Das kann ein ERP, ein Shop, eine Versandlösung, eine Zeiterfassung oder eine Datenbank sein. Trotzdem ist nicht jede Schnittstelle automatisch sinnvoll. Jede Integration schafft Abhängigkeiten, Fehlerbilder und Wartungsaufwand.

Die zentrale Frage lautet: Welchen manuellen Schritt entfernt die Verbindung konkret? Wenn eine Schnittstelle täglich 30 Minuten Übertragungsarbeit spart und Tippfehler reduziert, ist der Nutzen klar. Wenn sie lediglich eine Information spiegelt, die ohnehin einmal pro Woche geprüft wird, kann ein manueller Export zunächst die vernünftigere Lösung sein.

Bei individuellen Erweiterungen zählt die technische Basis. Dokumentierte Schnittstellen, klar definierte Datenfelder und nachvollziehbare Fehlerprotokolle erleichtern späteren Betrieb. Wenn ein System an eine maßgeschneiderte Webanwendung angebunden wird, sollten Technologien und Datenbankstruktur so gewählt sein, dass sie langfristig wartbar bleiben. Eine gepflegte Anwendung auf Basis von PHP 8.4, modernem JavaScript und MySQL 8 ist wertvoller als eine kurzfristig beeindruckende Sonderlösung ohne Dokumentation.

Einführung im laufenden Betrieb

Der häufigste Fehler ist ein harter Start ohne Vergleichsphase. Teams sollen dann am Montagmorgen sofort anders arbeiten, während offene Fragen erst aus echten Problemen entstehen. Das erhöht die Ablehnung, selbst wenn die Software grundsätzlich passt.

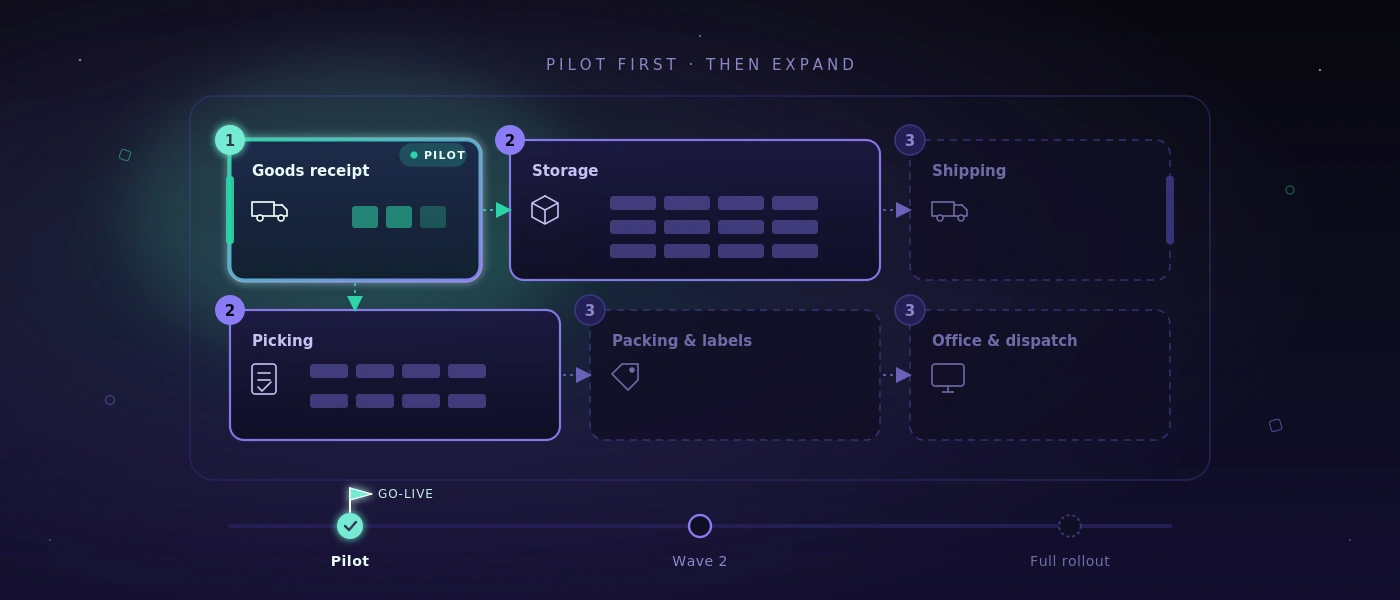
Besser ist ein begrenzter Pilot mit einem Team, einer Prozessvariante oder einem klaren Standortbereich. In dieser Zeit wird überprüft, ob Erfassung und Freigaben funktionieren, ob Begriffe verständlich sind und ob Ausnahmefälle sauber landen. Wichtig ist, Rückmeldungen nicht nur als Wunschliste zu sammeln. Jede Änderung sollte gegen den Nutzen für Durchlaufzeit, Fehlerquote oder Transparenz geprüft werden.

Auch Kennzahlen sollten früh festgelegt werden. Beispielsweise lassen sich Bearbeitungszeit pro Wareneingang, Anzahl offener Abweichungen, Nachfragen zu Lieferstatus oder Korrekturbuchungen beobachten. Ohne Ausgangswert bleibt „fühlt sich schneller an“ die einzige Bewertung. Das kann stimmen, reicht aber nicht für eine belastbare Investitionsentscheidung.

Betrieb braucht einen klaren Eigentümer

SaaS reduziert technischen Aufwand, nimmt einem Unternehmen aber nicht die Verantwortung für den eigenen Prozess ab. Es braucht intern jemanden, der Rollen verwaltet, Rückmeldungen bündelt, Schulungsbedarf erkennt und entscheidet, welche Änderungen wirklich notwendig sind. Diese Person muss nicht programmieren können. Sie sollte den Arbeitsablauf jedoch verstehen und Zugang zu den Verantwortlichen haben.

Ebenso wichtig ist eine kurze, belastbare Betriebsdokumentation. Sie erklärt nicht jede Bildschirmansicht, sondern beantwortet die Fragen, die im Alltag auftreten: Was tun bei einer fehlerhaften Buchung? Wer genehmigt neue Benutzer? Wie wird ein Ausfall kommuniziert? Wo liegen exportierte Daten? Solche Klarheit verhindert, dass ein digitales System nach wenigen Monaten wieder von persönlichen Zurufen abhängig wird.

Eine gute SaaS-Lösung erkennt man deshalb nicht daran, wie viele Menüpunkte sie anbietet. Sie zeigt ihren Wert, wenn eine neue Kollegin einen Vorgang sicher bearbeiten kann, eine Abweichung nicht verschwindet und eine Führungskraft den Status sieht, ohne drei Personen anzurufen. Genau an diesem Maßstab sollte Flow Web gemessen werden: nicht an Versprechen, sondern an einem Arbeitstag, der nachweisbar ruhiger und verlässlicher läuft.

Permalink →

Webentwicklung mit aktuellen Frameworks: Was Unternehmen wirklich davon haben

Webentwicklung mit aktuellen Frameworks: Was Unternehmen wirklich davon haben

Wenn ein Wareneingang noch zwischen Papierformular, Telefonat und drei Excel-Dateien pendelt, löst ein modernes Frontend allein das Problem nicht. Webentwicklung mit aktuellen Frameworks ist dann sinnvoll, wenn sie Abläufe sichtbar vereinfacht: Mitarbeitende sehen den nächsten Schritt, Daten werden nur einmal erfasst, und die Anwendung bleibt auch nach dem ersten Go-live verständlich wartbar.

Für kleine und mittlere Unternehmen ist die Framework-Frage daher keine Glaubensfrage. Entscheidend ist nicht, ob eine Oberfläche besonders viele technische Schlagworte trägt. Entscheidend ist, ob Lagerbewegungen, Aufträge, Prüfungen oder Freigaben zuverlässig durch den Arbeitstag kommen - auch bei Zeitdruck, Schichtwechsel und schwankender Netzverbindung.

Frameworks sind ein Mittel, kein Projektziel

Ein Framework liefert eine bewährte Struktur für wiederkehrende Aufgaben: Routing, Formulare, Rechteverwaltung, Datenzugriffe, Tests und die Darstellung von Oberflächen. Das reduziert nicht automatisch jedes Risiko. Es verhindert aber, dass ein Projekt grundlegende Funktionen immer wieder neu erfinden muss.

Bei einer individuellen Webanwendung kann ein modernes JavaScript-Framework beispielsweise interaktive Masken sinnvoll abbilden: eine Kommissionierliste, die Positionen fortlaufend aktualisiert, eine Routenplanung mit klaren Statuswechseln oder ein Prüfprotokoll, das Fotos und Kommentare direkt einem Vorgang zuordnet. Im Backend sorgen etablierte PHP-Frameworks für nachvollziehbare Regeln, klar getrennte Verantwortlichkeiten und konsistente Schnittstellen zur Datenbank.

Das ist besonders relevant, wenn aus einer zunächst kleinen Lösung ein täglich genutztes Betriebssystem für einen Prozess wird. Eine Eingabemaske für Lieferavis kann überschaubar beginnen. Sobald sie Bestände aktualisiert, Etiketten ausgibt, Rollen berücksichtigt und mit einem Versanddienstleister kommuniziert, braucht sie eine saubere technische Basis. Frameworks helfen dabei, diese Basis nicht bei jeder Erweiterung neu zu verhandeln.

Was aktuelle Webframeworks konkret besser machen

Der Wert moderner Frameworks liegt selten in spektakulären Effekten. Er zeigt sich in den unsichtbaren Teilen einer Anwendung. Formulare können Eingaben direkt prüfen, ohne dass fehlerhafte Daten erst nach dem Absenden auffallen. Berechtigungen lassen sich zentral definieren, sodass ein Fahrer andere Informationen sieht als die Disposition. Änderungen an einer Bestellung werden nachvollziehbar gespeichert, statt still eine Tabellenzelle zu überschreiben.

Auf Serverseite schafft eine aktuelle Umgebung mit PHP 8.4 und MySQL 8 eine belastbare Grundlage für geschäftskritische Logik. Datenbanktransaktionen verhindern beispielsweise, dass ein Bestand reduziert wird, während die zugehörige Buchung fehlschlägt. Eindeutige Schlüssel und Validierungsregeln vermeiden Dubletten. Hintergrundprozesse können Dokumente erzeugen oder Schnittstellen ansprechen, ohne dass die Person am Bildschirm warten muss.

Auch Sicherheit ist keine nachträgliche Funktion. Ein zeitgemäßes Framework unterstützt sichere Passwortspeicherung, Schutz vor typischen Eingabeangriffen, nachvollziehbare Sitzungen und definierte Account-Lockout-Flows. Trotzdem bleibt die Umsetzung eine Projektaufgabe: Rechte müssen fachlich korrekt modelliert werden, und sensible Funktionen benötigen zusätzliche Prüfungen. Ein Framework liefert Leitplanken, aber keine Kenntnis darüber, wer im Betrieb welche Freigabe erteilen darf.

Webentwicklung mit aktuellen Frameworks richtig entscheiden

Die beste Technologie entsteht nicht durch eine Liste beliebter Tools, sondern durch die tatsächliche Nutzung. Eine interne Anwendung für zehn Personen hat andere Anforderungen als ein Kundenportal mit mehreren tausend gleichzeitigen Zugriffen. Ein Lagerterminal mit Scanner braucht eine andere Bedienlogik als eine Management-Auswertung am Desktop.

Deshalb beginnt eine sinnvolle Entscheidung mit konkreten Fragen: Welche Vorgänge kosten heute messbar Zeit? Welche Daten werden mehrfach übertragen? Wo entstehen Fehler, weil Informationen erst zu spät sichtbar sind? Welche bestehende Tabelle funktioniert gut genug und sollte zunächst bleiben? Gerade der letzte Punkt schützt vor teuren Digitalisierungsprojekten ohne operativen Nutzen.

Für viele individuelle Geschäftsanwendungen ist ein serverseitig gerendertes System mit gezielten interaktiven Komponenten die vernünftigste Wahl. Es lädt schnell, ist überschaubar zu betreiben und vermeidet unnötige Komplexität. Eine vollständig entkoppelte Single-Page-Anwendung kann dagegen passend sein, wenn die Oberfläche sehr viele dynamische Zustände verarbeitet, offline arbeiten muss oder dieselben Funktionen später auch einer mobilen App bereitstellen soll.

Beides kann fachlich richtig sein. Die Frage lautet nicht: Welches Framework ist am modernsten? Sie lautet: Welche Architektur ist in zwei Jahren noch sicher erweiterbar, testbar und für das eigene Team nachvollziehbar?

Wann weniger Technik die bessere Technik ist

Nicht jeder Prozess benötigt ein komplexes Frontend. Eine schlanke Eingabemaske für interne Bestellungen kann schneller, stabiler und günstiger sein als eine aufwendig animierte Oberfläche. Wenn eine Excel-Datei lediglich einmal pro Monat gepflegt wird und keine Fehler verursacht, ist sie möglicherweise weiterhin das richtige Werkzeug.

Komplexität lohnt sich erst, wenn sie echte Reibung beseitigt. Das kann der Fall sein, wenn Aufträge mehrfach abgetippt werden, Lieferstatus telefonisch abgefragt werden müssen oder sich niemand sicher ist, welche Version eines Dokuments gilt. Dann schafft eine zentrale Anwendung einen klaren Nutzen: ein Datenstand, eindeutige Verantwortlichkeiten und weniger Rückfragen.

Wartbarkeit beginnt vor der ersten Zeile Code

Frameworks werden oft als Beschleuniger betrachtet. Das stimmt nur, wenn die fachlichen Regeln zuvor ausreichend klar sind. Ein Entwickler kann eine Statusmaschine technisch sauber bauen. Ob die Statusfolge aber wirklich zum Prozess passt, entscheidet sich bei der Aufnahme: Wann gilt Ware als eingegangen? Wer darf eine Abweichung schließen? Was passiert bei einer Teillieferung?

Diese Entscheidungen gehören dokumentiert, ebenso wie Schnittstellen, Datenfelder und Ausnahmen. Das macht Projekte nicht langsamer. Es reduziert spätere Diskussionen, weil sichtbar wird, welche Regel bewusst umgesetzt wurde und welche Annahme noch offen ist.

Wartbarkeit zeigt sich auch in kleinen Disziplinen. Datenbankänderungen müssen versioniert sein. Deployment-Schritte müssen dokumentiert werden. Fehlermeldungen sollen für Betrieb und Entwicklung verwertbar sein, ohne vertrauliche Details preiszugeben. Automatisierte Tests prüfen zentrale Abläufe bei jeder Änderung, etwa das Anlegen eines Auftrags, die Berechnung einer Menge oder die Ausgabe eines Lieferscheins.

Bei kritischen Anwendungen reicht ein einzelner Testtyp nicht aus. Unit-Tests sichern einzelne Regeln ab, Integrationstests prüfen das Zusammenspiel mit Datenbank und Schnittstellen, und End-to-End-Tests spielen reale Bedienwege im Browser nach. Für Web- und Windows-Anwendungen kann eine selbst gehostete Testumgebung zusätzlich Screenshots, Ablaufprotokolle und verständliche Bewertungen liefern, ohne interne Testdaten unnötig in externe Cloud-Dienste zu geben.

Performance entsteht aus Architektur und Datenmodell

Eine moderne Oberfläche wird nicht schnell, weil sie ein aktuelles Framework verwendet. Langsame Datenbankabfragen, übergroße Bilder oder unklare Schnittstellen bleiben langsam, unabhängig vom Frontend. Besonders bei Listen mit Aufträgen, Artikeln oder Bewegungsdaten entscheidet das Datenmodell über die gefühlte Geschwindigkeit.

Saubere Indizes in MySQL 8, paginierte Abfragen und bewusst geladene Daten sind oft wirksamer als spätere Optimierung an der Oberfläche. Ebenso wichtig ist ein klares Caching-Konzept. Stammdaten dürfen unter Umständen zwischengespeichert werden, aktuelle Bestände oder Freigabestatus dagegen nicht blind. Hier gibt es keine pauschale Regel, weil die fachliche Bedeutung der Daten bestimmt, wie aktuell sie sein müssen.

Responsive Gestaltung gehört ebenfalls zur technischen Planung. Auf dem Bürobildschirm kann eine breite Tabelle sinnvoll sein. Auf einem Handscanner oder Tablet im Lager braucht dieselbe Information große Trefferflächen, kurze Wege und eine Darstellung, die auch mit Handschuhen oder bei schlechtem Licht bedienbar bleibt. Pure fluidity meets ultimate performance bedeutet in diesem Kontext nicht möglichst viel Bewegung auf dem Bildschirm. Es bedeutet, dass die Anwendung ohne Reibung auf dem Gerät funktioniert, das im Prozess tatsächlich verwendet wird.

Der sinnvolle Weg von der Idee zum Betrieb

Ein belastbares Webprojekt startet mit einem begrenzten, prüfbaren Kern. Statt jede denkbare Ausnahme vorab zu automatisieren, wird ein Prozess ausgewählt, der häufig vorkommt und spürbar Aufwand verursacht. Nach dem ersten Einsatz zeigen reale Daten und Rückmeldungen, welche Erweiterung als Nächstes wirklich Priorität hat.

Dabei sollte die technische Übergabe nicht erst am Ende stattfinden. Verantwortlichkeiten für Hosting, Backups, Monitoring, Updates und Zugriffsrechte müssen früh geklärt sein. Ein System ist nur so verlässlich wie sein Betrieb. Wer eine Anwendung täglich für Versand oder Auftragsabwicklung benötigt, braucht definierte Wiederherstellungswege und eine klare Antwort darauf, was bei einer Störung passiert.

softify.pro setzt deshalb auf wartbare Technologien, dokumentierte Auslieferung und direkte technische Verantwortung statt auf kurzfristige Framework-Moden. Das schafft keine magische Abkürzung. Es schafft die Voraussetzung, dass eine Anwendung nach dem Launch weiterarbeitet, weiterentwickelt werden kann und nicht zum nächsten fragilen Sonderfall wird.

Die richtige Webanwendung fühlt sich im besten Fall nicht wie ein neues IT-Projekt an. Sie fühlt sich an wie ein Ablauf, der endlich ohne Umwege funktioniert - mit genug technischer Substanz, um auch die nächste Veränderung im Betrieb ruhig aufzunehmen.

Permalink →

Software Rollout planen: So gelingt die Einführung im laufenden Betrieb

Software Rollout planen: So gelingt die Einführung im laufenden Betrieb

Ein neues System scheitert selten daran, dass ein Button fehlt. Es scheitert am Montagmorgen: Die Frühschicht findet den Wareneingang nicht, ein Lieferschein wird doppelt gedruckt oder eine Excel-Datei bleibt plötzlich die inoffizielle Wahrheit. Wer ein Software Rollout planen will, muss deshalb nicht nur Funktionen einführen, sondern den realen Betrieb absichern.

Gerade in Lager, Werkstatt, Disposition und Verwaltung ist ein Rollout kein IT-Termin. Er verändert Handgriffe, Verantwortlichkeiten und Informationswege. Eine gute Einführung hält die Arbeit in Bewegung, macht Fehler früh sichtbar und gibt Mitarbeitenden eine klare Antwort auf die entscheidende Frage: Was mache ich ab morgen anders?

Der Rollout beginnt vor der ersten Schulung

Viele Projekte starten mit einer Funktionsliste: Aufträge erfassen, Lagerbewegungen buchen, Versandetiketten drucken, Routen planen. Das ist notwendig, reicht aber nicht. Vor dem Start muss geklärt sein, welche Prozesse am ersten produktiven Tag tatsächlich über das neue System laufen sollen - und welche bewusst noch nicht.

Diese Abgrenzung ist kein Zeichen von Unvollständigkeit. Sie reduziert Risiko. Wenn ein mittelständischer Betrieb bisher Wareneingänge per Papier, Telefon und Tabellen koordiniert hat, muss nicht am ersten Tag zugleich die komplette Bestandsführung, Retourenabwicklung, Tourenplanung und Lieferantenbewertung digitalisiert werden. Ein sinnvoller erster Umfang könnte bei der Warenannahme, eindeutigen Lagerbewegungen und dem Druck von Lieferdokumenten liegen.

Entscheidend ist, den Sollprozess konkret zu beschreiben. Nicht: „Wareneingang wird digital.“ Sondern: „Der Mitarbeitende scannt die Lieferung, prüft Menge und Zustand, ordnet einen Lagerplatz zu und erzeugt bei Abweichungen einen Vorgang für den Einkauf.“ Erst auf dieser Ebene werden offene Fragen sichtbar: Was passiert bei fehlender Bestellung? Wer darf Mengen korrigieren? Darf eine Lieferung ohne Etikett eingelagert werden?

Software Rollout planen heißt: kritische Abläufe priorisieren

Nicht jeder Prozess hat dieselbe Bedeutung. Ein Ausfall im Bereich Stammdatenpflege kann unangenehm sein. Ein Ausfall bei Versand, Kommissionierung oder Rechnungsfreigabe kann die Arbeit eines ganzen Tages blockieren. Deshalb braucht der Rollout eine Priorisierung nach Betriebsrisiko, nicht nach der Reihenfolge im Pflichtenheft.

Bewährt hat sich eine einfache Einteilung: geschäftskritisch, wichtig und verschiebbar. Geschäftskritisch sind alle Abläufe, die Ware, Geld oder verbindliche Kundenkommunikation bewegen. Wichtig sind Funktionen, die den Alltag beschleunigen, deren Ausfall aber übergangsweise manuell abgefedert werden kann. Verschiebbar sind Komfortfunktionen, seltene Sonderfälle oder Auswertungen, die zunächst noch aus einer bestehenden Quelle kommen dürfen.

Diese Einteilung beeinflusst die Testtiefe. Für einen kritischen Versandprozess genügt es nicht, einen einzelnen Auftrag erfolgreich durchzuklicken. Getestet werden müssen auch Teillieferungen, Stornos, fehlende Drucker, falsche Adressen, parallele Bearbeitung und die Übergabe an den Versanddienstleister. Bei einer selten verwendeten Statistikfunktion kann ein späterer Testzyklus angemessen sein.

Erfolgskriterien vorher messbar machen

„Die Anwendung läuft“ ist kein Abnahmekriterium. Besser sind überprüfbare Aussagen: Ein Wareneingang von 30 Positionen ist innerhalb von zehn Minuten buchbar. Versandetiketten werden am vorgesehenen Arbeitsplatz gedruckt. Bestandsänderungen erscheinen unmittelbar in der Disposition. Ein gesperrtes Benutzerkonto lässt sich nur über den definierten Freigabeprozess wieder aktivieren.

Solche Kriterien verbinden Fachbereich und Entwicklung. Sie verhindern auch, dass die Abnahme zu einer Sammlung vager Eindrücke wird. Nicht jede Rückmeldung muss vor dem Go-live gelöst sein. Aber jede Rückmeldung braucht eine Einordnung: kritischer Fehler, relevante Verbesserung oder Punkt für eine spätere Ausbaustufe.

Datenmigration: Nur saubere Daten verdienen Vertrauen

Alte Daten werden oft unterschätzt. In Tabellen finden sich doppelte Artikelnummern, unterschiedliche Einheiten, abgelaufene Kundenadressen und Lagerbestände, deren Herkunft niemand mehr erklären kann. Wer diese Daten ungeprüft übernimmt, verlagert alte Unklarheit in ein neues System - nur mit besserer Oberfläche.

Vor der Migration sollte festgelegt werden, welche Daten wirklich benötigt werden. Häufig sind aktuelle Artikel, aktive Kunden, offene Aufträge, relevante Lieferanten und geprüfte Startbestände sinnvoll. Historische Datensätze müssen nicht zwangsläufig vollständig in die neue Anwendung wandern. Es kann genügen, sie lesbar zu archivieren, wenn sie für Nachweise oder Rückfragen erforderlich bleiben.

Besonders wichtig ist eine Probeladung. Dabei werden Daten nicht nur technisch importiert, sondern fachlich geprüft: Stimmen Mengen, Einheiten und Zuordnungen? Sind Pflichtfelder vollständig? Lassen sich typische Aufträge damit korrekt bearbeiten? Für den Go-live braucht es anschließend einen klaren Stichtag. Ab wann wird welches führende System verwendet? Ohne diese Regel entstehen Doppelpflege und widersprüchliche Bestände.

Pilotbetrieb statt großer Schalter

Ein Big Bang kann sinnvoll sein, wenn ein kleines Team einen klar abgegrenzten Prozess nutzt und alte sowie neue Lösung nicht parallel funktionieren können. In den meisten operativen Umgebungen ist ein Pilotbetrieb jedoch die kontrollierbarere Wahl.

Der Pilot sollte mit echten Fällen arbeiten, aber in einem begrenzten Rahmen: ein Lagerbereich, eine Schicht, eine Produktgruppe oder ein ausgewähltes Team. Entscheidend ist, dass die Pilotgruppe nicht nur besonders technikaffine Mitarbeitende umfasst. Sie sollte den späteren Alltag realistisch abbilden, einschließlich der Menschen, die unter Zeitdruck arbeiten und berechtigte Einwände haben.

Im Pilotbetrieb zeigt sich, ob Scanner, Drucker, Netzwerk und Berechtigungen am tatsächlichen Arbeitsplatz funktionieren. Ebenso sichtbar werden Prozesslücken, die in Besprechungen niemand genannt hat. Vielleicht wird Ware im Alltag zunächst auf einem Zwischenplatz abgestellt. Vielleicht benötigen Fahrer einen anderen Lieferschein als die Verwaltung. Solche Erkenntnisse sind kein Rückschritt. Sie sind der Grund, den Pilot vor dem flächigen Start durchzuführen.

Schulung als Arbeitssituation, nicht als Softwareführung

Eine Schulung, die nur Menüpunkte erklärt, erzeugt wenig Sicherheit. Mitarbeitende müssen an ihren Aufgaben lernen: „Sie nehmen eine beschädigte Lieferung an“, „Sie kommissionieren einen eiligen Auftrag“, „Sie korrigieren eine falsch gebuchte Menge“. Der Kontext bleibt hängen, weil er dem Arbeitsalltag entspricht.

Kurze Schulungen nahe am Go-live sind meist wirksamer als ein langer Termin Wochen zuvor. Ergänzend helfen knappe Arbeitsanweisungen direkt am Arbeitsplatz. Sie sollten nicht das ganze System erklären, sondern die häufigsten Vorgänge, klare Zuständigkeiten und den Weg bei Störungen zeigen.

Benennen Sie außerdem Ansprechpartner pro Bereich. Diese Personen müssen nicht jedes technische Problem selbst lösen. Sie sollten aber entscheiden können, ob es sich um einen Bedienfehler, eine fachliche Unklarheit oder einen tatsächlichen Systemfehler handelt. Das schützt das Projektteam vor unstrukturierten Zurufen und beschleunigt die Hilfe für die Schicht.

Go-live braucht einen Betriebsplan

Der Go-live-Tag benötigt mehr als eine Uhrzeit. Definieren Sie, wer fachlich entscheidet, wer technische Änderungen verantwortet und über welchen Kanal Störungen gemeldet werden. Bei kritischen Abläufen sollte sichtbar sein, ob zentrale Funktionen funktionieren: Anmeldung, Berechtigungen, Datenerfassung, Schnittstellen, Druck und Sicherung.

Auch ein Rückfallplan gehört dazu. Das bedeutet nicht, beim kleinsten Problem sofort wieder vollständig zur alten Welt zurückzukehren. Es bedeutet, vorab zu bestimmen, welche Störung einen Stopp rechtfertigt, wie Aufträge notfalls dokumentiert werden und wie nachträglich sauber nacherfasst wird. Ein Papierformular für wenige Stunden kann vernünftig sein. Eine dauerhafte Parallelführung ohne Ende ist es nicht.

Technische Details zählen dabei: Sind Zugänge rechtzeitig angelegt? Greifen Rollen und Account-Lockout-Regeln korrekt? Sind Etikettendrucker mit den richtigen Vorlagen verbunden? Existiert eine getestete Sicherung der Datenbank? Bei individuell entwickelten Anwendungen gehören dokumentierte Deployments, nachvollziehbare Versionsstände und ein klarer Weg für Fehlerbehebungen zum Standard.

Die ersten Wochen entscheiden über Akzeptanz

Nach dem Start beginnt die Phase, in der eine Anwendung entweder zum Arbeitsmittel oder zum ungeliebten Zusatzschritt wird. Planen Sie deshalb tägliche kurze Rückmeldeschleifen ein. Welche Fehler treten wiederholt auf? Wo entstehen Umwege? Welche Felder werden falsch verstanden? Welche Auswertung fehlt einer Führungskraft wirklich?

Nicht jede Beobachtung verlangt sofort eine Änderung. Manche Probleme lösen sich durch präzisere Arbeitsregeln oder eine bessere Schulung. Andere zeigen echte Schwächen im Prozess oder in der Anwendung. Die Kunst besteht darin, beides nicht zu verwechseln. Ein System sollte bestehende funktionierende Abläufe nicht ohne Grund komplizierter machen. Wenn eine gut gepflegte Tabelle für einen seltenen Spezialfall weiterhin die bessere Lösung ist, darf sie bleiben.

Messen Sie die Wirkung anhand weniger konkreter Kennzahlen: Bearbeitungszeit pro Vorgang, Zahl der Nachfragen, Fehlbuchungen, Nachdrucke, offene Aufträge oder Bestandsdifferenzen. Erst diese Werte zeigen, ob der Rollout den Betrieb tatsächlich verbessert - statt lediglich neue Masken einzuführen.

Ein guter Rollout fühlt sich nach einigen Wochen nicht wie ein Projekt an. Er wird zur verlässlichen Arbeitsroutine: Die richtigen Daten stehen dort, wo sie gebraucht werden, Ausnahmen sind nachvollziehbar und Teams müssen weniger hinter Informationen hertelefonieren. Genau darauf sollte die Planung zielen - nicht auf einen spektakulären Starttag, sondern auf einen ruhigeren, besser steuerbaren Alltag.

Permalink →

Multiplatform Application Development planen: erst der Prozess, dann die Plattform

Multiplatform Application Development planen: erst der Prozess, dann die Plattform

Ein Lagerleiter bestätigt einen Wareneingang am Handscanner. Die Disposition prüft denselben Vorgang im Browser. Ein Fahrer benötigt den Lieferstatus unterwegs auf dem Smartphone. Multiplatform application development klingt in diesem Moment nach einer technischen Frage. Tatsächlich geht es zuerst um einen Betriebsablauf: Welche Arbeit muss an welchem Ort, mit welcher Verlässlichkeit und mit welchem Gerät erledigt werden?

Für kleine und mittlere Unternehmen ist die richtige Antwort selten: Wir bauen alles nativ für jede Plattform. Häufiger lautet sie: Wir definieren einen gemeinsamen Prozess, wählen gezielt die nötigen Bedienoberflächen und vermeiden doppelte Logik. Das spart nicht nur Entwicklungsbudget. Es verhindert auch, dass Lager, Büro und Außendienst mit unterschiedlichen Datenständen arbeiten.

Was Multiplatform Application Development leisten soll

Multiplatform Application Development bezeichnet die Entwicklung einer Anwendung, die auf mehreren Umgebungen nutzbar ist, etwa im Webbrowser, auf iOS und Android oder auf Windows-Desktop-Systemen. Der Begriff wird oft auf die Frage reduziert, ob ein einzelner Codebestand mehrere Apps erzeugen kann. Das ist nur ein Teil der Entscheidung.

Für operative Systeme zählt vor allem, ob die Anwendung an ihrem Einsatzort funktioniert. Eine Warenannahme braucht vielleicht eine Kamera zum Erfassen von Barcodes, große Bedienelemente für Handschuhe und eine brauchbare Reaktion bei instabiler WLAN-Abdeckung. Die Verwaltung braucht dagegen Tabellen, Filter, Rechtekonzepte und nachvollziehbare Änderungsprotokolle. Ein Fahrer benötigt eine reduzierte Ansicht, nicht dieselbe Oberfläche wie die Disposition.

Eine gemeinsame technische Grundlage kann diese Anforderungen sinnvoll verbinden. Sie darf aber nicht dazu führen, dass jede Plattform wie ein schlechter Kompromiss bedient wird. Der beste gemeinsame Code ist wertlos, wenn Mitarbeitende Umwege gehen, weil die Anwendung ihren tatsächlichen Arbeitsablauf nicht abbildet.

Erst den Prozess, dann die Plattform bestimmen

Bevor Teams über Frameworks sprechen, sollten sie einen konkreten Vorgang von Anfang bis Ende prüfen. Nehmen wir eine Lieferung: Bestellung kommt herein, Ware wird kommissioniert, ein Lieferschein entsteht, die Übergabe wird bestätigt und der Status wird an Vertrieb oder Kundenservice zurückgemeldet. An welcher Stelle entsteht heute Medienbruch? Wo wird etwas auf Papier notiert, später abgetippt oder per Telefon nachgefragt?

Diese Beobachtung trennt echte Plattformanforderungen von Wunschlisten. Wenn nur zwei Mitarbeitende im Büro eine Funktion verwenden, ist eine gut gemachte Weboberfläche meist ausreichend. Wenn zehn Personen auf dem Hallenboden Buchungen vornehmen, kann eine mobile, scannerfreundliche Oberfläche den Unterschied machen. Muss ein bestehendes Windows-Programm mit Spezialhardware arbeiten, kann eine Desktop-Integration notwendig sein.

Nicht jede Funktion gehört auf jedes Gerät. Das ist kein Mangel einer multiplattformfähigen Lösung, sondern ein Zeichen sauberer Produktentscheidung. Gemeinsame Daten und Geschäftsregeln bedeuten nicht zwangsläufig identische Masken.

Die drei Fragen, die Kosten und Nutzen klären

Die erste Frage lautet: Welche Geräte sind bereits im Einsatz und wie lange bleiben sie es? Ein Betrieb mit verwalteten Windows-Terminals hat andere Anforderungen als ein Außendienst mit privaten Smartphones. Die zweite lautet: Was passiert ohne Netzverbindung? Offline-Fähigkeit erhöht den Aufwand erheblich, weil Daten lokal gespeichert, später synchronisiert und bei Konflikten sauber behandelt werden müssen. Sie ist sinnvoll, wenn der Prozess sonst stehen bleibt - nicht als Standardausstattung.

Die dritte Frage betrifft die Ausfallfolgen. Kann ein Mitarbeitender eine Buchung später nachtragen, oder hängt ein Versandlabel, ein Bestand oder eine Sicherheitsfreigabe daran? Je kritischer der Vorgang, desto stärker müssen Berechtigungen, Prüfregeln, Wiederholbarkeit und Protokollierung geplant werden.

Eine Architektur, die nicht bei der zweiten Plattform zerfällt

Bei einer nachhaltigen Lösung liegt die Geschäftslogik nicht verstreut in mehreren Oberflächen. Bestandsprüfungen, Statuswechsel, Nummernkreise, Berechtigungen und Dokumentenerzeugung brauchen eine zentrale, getestete Grundlage. Browser, mobile Anwendung und Desktop-Client greifen über klar definierte Schnittstellen darauf zu.

Für viele interne Geschäftsprozesse ist eine moderne Webanwendung der wirtschaftlichste Ausgangspunkt. Sie lässt sich zentral aktualisieren, benötigt keine Installation auf jedem Arbeitsplatz und funktioniert auf Desktop, Tablet und Smartphone. Mit PHP 8.4, modernem JavaScript und MySQL 8 lässt sich dafür eine wartbare Basis aufbauen, sofern Datenmodell, Zugriffsrechte und Deployment nicht erst kurz vor dem Go-live bedacht werden.

Eine installierbare mobile oder Desktop-Anwendung wird dann ergänzt, wenn sie einen klaren Vorteil bringt: tiefe Integration mit Scanner, Drucker oder Kamera, verlässlicher Offline-Betrieb, spezielle Hintergrundfunktionen oder Anforderungen aus der Geräteverwaltung. Das ist ein gezielter Ausbau, kein Selbstzweck.

Ein häufiger Fehler ist die vollständige Wiederverwendung der Benutzeroberfläche um jeden Preis. Technisch kann das attraktiv aussehen. Praktisch entstehen kleine Texte auf großen Monitoren, überladene Formulare auf Smartphones oder Bedienungen, die nicht zur Plattform passen. Besser ist es, Datenmodell, Regeln und Komponenten dort gemeinsam zu nutzen, wo es sinnvoll ist, während die Bedienung auf den jeweiligen Kontext abgestimmt wird.

Datenkonsistenz ist wichtiger als ein gemeinsamer Codebestand

Mehrere Plattformen erhöhen die Gefahr widersprüchlicher Daten. Ein Auftrag wird im Büro geändert, während ein Fahrer bereits eine alte Version auf seinem Gerät sieht. Zwei Mitarbeitende buchen gleichzeitig denselben Artikelbestand. Ein Offline-Gerät sendet seine Änderungen Stunden später zurück. Diese Fälle sind kein Randthema, sondern Kern der Architektur.

Das System braucht deshalb eindeutige Identitäten, Zeitstempel, nachvollziehbare Zustandswechsel und Regeln für Konflikte. Bei einem Lieferstatus kann die zuletzt bestätigte Änderung ausreichend sein. Bei Beständen ist das oft zu grob. Dort muss klar sein, welche Bewegung gebucht wurde, von welchem Lagerplatz sie stammt und ob eine Korrektur begründet werden muss.

Auch Berechtigungen gehören zentral geregelt. Ein Mitarbeiter darf möglicherweise Wareneingänge erfassen, aber keine Bestandskorrekturen freigeben. Ein externer Fahrer darf nur seine Tour sehen. Sitzungslaufzeiten, Mehrfaktor-Authentifizierung bei kritischen Rollen und Account-Lockout-Flows sind keine dekorativen Sicherheitsfeatures. Sie schützen konkrete Abläufe und machen Verantwortlichkeiten sichtbar.

Multiplatform Application Development testen, wie gearbeitet wird

Eine Anwendung kann auf drei Betriebssystemen starten und trotzdem im Betrieb scheitern. Entscheidend sind die Abläufe unter realen Bedingungen: Scanner reagiert zu langsam, ein Etikettendrucker ist nicht erreichbar, eine Berechtigung greift nach einem Rollenwechsel nicht, oder eine Synchronisierung erzeugt doppelte Buchungen.

Deshalb sollten kritische Prozesse automatisiert geprüft werden. Dazu gehören Anmeldung und Sperrverhalten, Auftragserfassung, Bestandsbewegungen, Dokumentenerstellung und die Verarbeitung fehlerhafter Eingaben. Für Web- und Windows-Anwendungen lassen sich wiederkehrende Tests auf einer selbst gehosteten Infrastruktur ausführen. Das ist besonders relevant, wenn Screenshots, interne Auftragsdaten oder Testzugänge nicht an externe Cloud-Dienste weitergegeben werden sollen.

Automatisierung ersetzt keine Prüfung durch Menschen auf dem Lagerboden. Sie sorgt jedoch dafür, dass bekannte Abläufe nach Änderungen immer wieder kontrolliert werden. Gute Testberichte benennen dabei nicht nur einen technischen Fehler, sondern den betroffenen Prozess: Liefernachweis kann nicht erzeugt werden, Benutzerkonto bleibt nach erfolgreicher Freigabe gesperrt oder Tourdaten werden nicht aktualisiert.

Wann eine Plattformstrategie zu viel ist

Manche Unternehmen brauchen keine eigene App. Wenn ein stabiler Browserzugang genügt, der Ablauf selten mobil ist und die Zahl der Nutzer überschaubar bleibt, ist eine responsive Webanwendung häufig die vernünftigere Wahl. Sie reduziert Pflegeaufwand, Verteilungsprobleme und die Zahl möglicher Fehlerquellen.

Auch eine bestehende Tabelle muss nicht sofort ersetzt werden. Wenn sie nur als einfache Auswertung dient, von einer Person gepflegt wird und keine fehleranfälligen Übergaben erzeugt, kann sie ihren Zweck erfüllen. Der Zeitpunkt für ein System ist erreicht, wenn Wissen in einzelnen Köpfen steckt, Versionen auseinanderlaufen, Nachfragen zunehmen oder ein Vorgang nicht mehr zuverlässig nachvollzogen werden kann.

Umgekehrt wird eine schlanke Plattformstrategie schnell zu klein, wenn Mitarbeitende offline arbeiten müssen, Hardware angebunden wird oder Kunden und Partner kontrollierten Zugriff benötigen. Dann lohnt es sich, die zusätzlichen Anforderungen bewusst zu finanzieren, statt sie später unter Zeitdruck anzubauen.

Mit einem belastbaren Pilot beginnen

Ein guter Start ist kein Funktionskatalog mit hundert Punkten, sondern ein vollständiger, messbarer Ablauf. Beispielsweise: Wareneingang erfassen, Bestand aktualisieren, Abweichung dokumentieren und eine Aufgabe zur Klärung erzeugen. Dieser Pilot zeigt früh, ob Datenmodell, Geräte, Rechte und Bedienung zusammenpassen.

Danach kann die Lösung in sinnvollen Schritten wachsen: Kommissionierung, Versand, Tourenplanung oder Auswertungen. Jede Erweiterung sollte dieselbe Frage bestehen: Verkürzt sie einen echten Ablauf, senkt sie Fehler oder schafft sie verlässliche Transparenz? Wenn nicht, darf sie warten.

Die sinnvollste Plattform ist am Ende nicht die mit den meisten technischen Optionen. Es ist die, auf der ein Team seine Arbeit morgens schneller beginnt, während der Schicht weniger nachfragt und abends nachvollziehen kann, was tatsächlich passiert ist.

Permalink →

Test Automation Results richtig bewerten

Test Automation Results richtig bewerten

Ein Regressionstest kann morgens mit 98 Prozent erfolgreichen Fällen enden und trotzdem keine gute Nachricht sein. Vielleicht ist genau der fehlgeschlagene Test der Login eines Großkunden. Vielleicht wurden 40 Tests übersprungen, weil die Testumgebung nicht erreichbar war. Oder der Lauf war zwar grün, prüfte aber nur, ob Schaltflächen vorhanden sind, nicht ob ein Auftrag tatsächlich gespeichert, eine Liefernote erzeugt und der Bestand korrekt angepasst wird. Test automation results sind keine Qualitätsaussage, solange ihr Kontext fehlt.

Für QA-Leitung, Entwicklung und Fachbereiche liegt die eigentliche Arbeit deshalb nicht allein im Automatisieren von Tests. Entscheidend ist, Ergebnisse so aufzubereiten, dass daraus verlässliche Entscheidungen entstehen: Kann ein Release ausgerollt werden? Muss ein Fehler sofort behandelt werden? Ist der Fehler neu, wieder aufgetreten oder nur ein Problem der Testumgebung? Und gibt es Belege, die auch ein Fachbereich ohne Testcode nachvollziehen kann?

Was Test Automation Results wirklich aussagen

Die einfachste Kennzahl lautet: bestanden oder fehlgeschlagen. Sie ist hilfreich, aber selten ausreichend. Ein hoher Erfolgsanteil kann Vertrauen schaffen, wenn die Tests kritische Abläufe abdecken, die Testdaten plausibel sind und die Umgebung dem späteren Betrieb ähnelt. Fehlt einer dieser Faktoren, bleibt die Zahl vor allem ein Signal dafür, dass ein automatisierter Ablauf ausgeführt wurde.

Bei geschäftskritischen Anwendungen zählen andere Fragen stärker. In einer Lagerlösung ist nicht jede Bildschirmansicht gleich wichtig. Ein Darstellungsfehler im internen Hinweistext kann warten. Ein Fehler, der bei Wareneingang die falsche Menge bucht oder ein Versandlabel ohne Empfängeradresse erzeugt, nicht. Gute Testergebnisse gewichten daher Risiken statt alle Fälle gleich zu behandeln.

Auch ein fehlgeschlagener Test ist nicht automatisch ein Produktfehler. Er kann durch abgelaufene Zugangsdaten, eine gesperrte Testrolle, nicht verfügbare Schnittstellen, geänderte Testdaten oder eine langsame Umgebung ausgelöst werden. Wer diese Ursachen nicht trennt, produziert Lärm. Das Team verbringt dann Zeit mit Fehlalarmen, während echte Fehler zwischen roten Statusmeldungen untergehen.

Vier Statusarten statt einer roten Liste

Praktisch bewährt sich eine klare Einteilung: fachlicher Fehler, technischer Testfehler, Umgebungsproblem und erwartete Änderung. Ein fachlicher Fehler bedeutet, dass die Anwendung gegen eine definierte Anforderung verstößt. Ein technischer Testfehler weist eher auf den Test selbst hin, etwa einen nicht mehr passenden Selektor nach einer absichtlich geänderten Oberfläche.

Ein Umgebungsproblem liegt vor, wenn etwa ein Testsystem oder eine angebundene Schnittstelle nicht verfügbar ist. Erwartete Änderungen entstehen, wenn ein Prozess bewusst angepasst wurde, die Automatisierung aber noch den alten Sollzustand prüft. Diese Kategorien verhindern nicht jede Diskussion. Sie sorgen aber dafür, dass die Diskussion am richtigen Punkt beginnt.

Von Testläufen zu entscheidungsfähigen Berichten

Ein brauchbarer Bericht beantwortet nicht nur, dass etwas fehlgeschlagen ist, sondern was passiert ist, wie gravierend es ist und ob der Fehler reproduzierbar erscheint. Dafür braucht es mehr als eine Liste aus Testnamen und Zeitstempeln.

Zu jedem relevanten Lauf gehören der geprüfte Build, die Testumgebung, die verwendete Rolle, zentrale Testdaten sowie Start- und Endzeit. Gerade bei Windows-Desktop-Anwendungen oder komplexen Webplattformen sind diese Informationen nötig, um Unterschiede einzugrenzen. Ein Fehler, der nur unter einer eingeschränkten Lagerrolle auftritt, ist etwas anderes als ein Fehler, der jede Anmeldung blockiert.

Aussagekräftige Ergebnisse enthalten außerdem nachvollziehbare Belege: Screenshots, aufgezeichnete Schritte, Fehlermeldungen und bei Bedarf technische Protokolle. Ein Screenshot allein kann allerdings täuschen. Er zeigt einen Moment, nicht die Ursache. Die Kombination aus Schrittfolge, sichtbarem Zustand und erwarteter Reaktion ist wesentlich hilfreicher.

KI-gestützte Systeme können diese Belege in verständliche Bewertungen überführen. Bei COCO etwa laufen Tests auf einem eigenen, selbst gehosteten KI-Server. Die Auswertung kann erklären, dass ein Auftrag zwar angelegt wurde, der erwartete Statuswechsel jedoch ausblieb, und die Aufnahme der Ausführung direkt zuordnen. Für sicherheitsbewusste Teams ist dabei relevant, wo Screenshots, Anwendungsdaten und Testverkehr verarbeitet werden. Lokale Kontrolle ist nicht automatisch erforderlich, kann bei internen Anwendungen und sensiblen Daten aber der sinnvollere Weg sein als ein externer Cloud-Dienst.

Die richtige Detailtiefe für verschiedene Empfänger

Entwicklungsteams benötigen Fehlermeldungen, technische Schritte und möglichst präzise Hinweise zur Reproduktion. Ein Operations Manager braucht dagegen zuerst die betroffene Funktion, das Geschäftsrisiko und eine klare Aussage zur Betriebsfähigkeit. Beide Perspektiven müssen aus derselben Ausführung entstehen können, ohne dass jemand Ergebnisse manuell in Präsentationen übertragen muss.

Ein guter Bericht beginnt deshalb mit einer kurzen Entscheidungsebene: Freigabe empfohlen, Freigabe mit bekannten Einschränkungen oder Freigabe stoppen. Darunter stehen die kritischen Abweichungen mit Priorität und Beleg. Die technischen Einzelheiten folgen erst danach. Das ist keine Vereinfachung auf Kosten der Genauigkeit, sondern eine saubere Trennung der Informationsbedürfnisse.

Abdeckung messen, ohne sich Sicherheit vorzutäuschen

Testabdeckung wird häufig als Prozentwert dargestellt. Dieser Wert ist nützlich, wenn klar ist, was er misst. Code-Abdeckung zeigt beispielsweise, welche Teile des Programmcodes während Tests ausgeführt wurden. Das beweist nicht, dass ein Geschäftsprozess korrekt funktioniert. Ein Test kann viele Codezeilen berühren und dennoch nie prüfen, ob eine falsche Lieferadresse auf dem Dokument erscheint.

Für Fachbereiche ist Prozessabdeckung oft aussagekräftiger. Sie beschreibt, welche realen Abläufe geschützt sind: Auftrag erfassen, Bestand reservieren, Teillieferung buchen, Rücksendung annehmen oder Rechnung freigeben. Besonders wertvoll sind Übergänge zwischen Systemen und Rollen, denn dort entstehen häufig Fehler: beim Import einer Bestellung, beim Druck eines Labels oder beim Wechsel von Büro zu Lagerterminal.

Priorisieren Sie nicht nach der Anzahl möglicher Tests, sondern nach Schadenswirkung und Änderungshäufigkeit. Ein selten genutzter Prozess mit hohem finanziellem oder rechtlichem Risiko verdient oft früher eine Automatisierung als eine häufig verwendete, aber harmlose Ansicht. Umgekehrt kann ein stabiler, wenig kritischer Ablauf weiterhin mit einer kurzen manuellen Prüfung auskommen. Nicht jede Prüfung muss automatisiert werden, nur weil sie automatisierbar ist.

Instabile Tests sind ein eigenes Qualitätsproblem

Tests, die ohne erkennbare Produktänderung mal bestehen und mal scheitern, werden oft als flakig bezeichnet. Sie beschädigen Vertrauen schneller als ein dauerhaft roter Test. Sobald Teams rote Ergebnisse reflexartig erneut starten, verliert die Automatisierung ihre Warnfunktion.

Die Ursachen sind meist konkret: harte Wartezeiten, gemeinsam genutzte Testdaten, parallele Zugriffe, asynchrone Verarbeitung oder eine Umgebung, die nicht zurückgesetzt wird. Eine kurze Pause von drei Sekunden im Test kann zufällig helfen, ist aber keine Lösung. Besser ist es, auf einen nachweisbaren Zustand zu warten, Testdaten eindeutig zu machen und Abläufe voneinander zu isolieren.

Nicht jede Instabilität lässt sich vollständig vermeiden. Externe Schnittstellen können schwanken, und reale Infrastruktur hat Ausfälle. Dann sollte der Bericht klar kennzeichnen, ob ein Test wegen einer externen Abhängigkeit nicht bewertbar war. Ein wiederholter Lauf kann zur Diagnose sinnvoll sein, darf aber den ersten Befund nicht unsichtbar machen.

Ein sinnvoller Ablauf nach jedem Testlauf

Nach einem automatisierten Lauf sollte nicht jedes Ergebnis sofort gleich behandelt werden. Zuerst werden blockierende Fehler und nicht bewertbare kritische Tests geprüft. Danach folgt die Einordnung neuer Abweichungen gegenüber bekannten, akzeptierten Problemen. Erst dann ist eine Release-Entscheidung belastbar.

Hilfreich sind festgelegte Schwellenwerte, aber sie müssen zum Prozess passen. Beispielsweise kann ein fehlgeschlagener Test im Zahlungs- oder Berechtigungsfluss einen sofortigen Stopp auslösen. Bei einer rein kosmetischen Abweichung kann eine dokumentierte Ausnahme vertretbar sein. Solche Regeln sollten nicht erst unter Zeitdruck vor einem Release entstehen.

Ebenso wichtig ist die Rückkopplung: Jeder produktive Fehler, der durch die Tests nicht erkannt wurde, ist ein Anlass zu prüfen, ob ein Szenario, eine Testdatenvariante oder ein Kontrollpunkt fehlt. Das Ziel ist nicht, möglichst viele Tests anzuhäufen. Es ist, aus echten Fehlern gezielt bessere Absicherung zu bauen.

Die nützlichsten Testergebnisse sind am Ende nicht die mit der grünsten Übersicht. Es sind jene, bei denen ein Verantwortlicher am Montagmorgen nachvollziehen kann, was geprüft wurde, welches Risiko bleibt und welche Handlung jetzt vernünftig ist.

Permalink →

Inventory Discrepancy Causes: Häufige Gründe für Bestandsdifferenzen

Inventory Discrepancy Causes: Häufige Gründe für Bestandsdifferenzen

Der Bestand im System sagt 248 Stück, im Regal liegen 231. Diese 17 Einheiten wirken zunächst wie ein Zählfehler. Doch genau hier beginnt häufig die falsche Analyse. Inventory discrepancy causes sind in der Praxis selten ein einzelnes Versehen. Meist entstehen sie dort, wo Wareneingang, Lagerbewegung, Kommissionierung und Buchung zeitlich oder organisatorisch auseinanderlaufen.

Für ein kleines oder mittleres Unternehmen sind Bestandsdifferenzen nicht nur ein Thema für die Inventur. Sie führen zu Fehlbestellungen, Expresslieferungen, unnötigen Sicherheitsbeständen und Lieferzusagen, die sich nicht halten lassen. Wer die Ursachen sauber trennt, muss nicht sofort ein großes ERP einführen. Oft reichen klarere Buchungsregeln, passende Erfassungsgeräte und ein System, das reale Arbeitsabläufe abbildet.

Inventory discrepancy causes: Wo Differenzen entstehen

Eine Bestandsdifferenz ist die Differenz zwischen Sollbestand im führenden System und tatsächlich vorhandenem Bestand. Entscheidend ist dabei das Wort „führend". Wenn parallel eine Excel-Datei, eine Papierliste und ein Warenwirtschaftssystem gepflegt werden, gibt es praktisch mehrere Wahrheiten. Dann ist die Differenz nicht bloß im Lager entstanden, sondern bereits in der Datenführung angelegt.

Die wirksame Gegenmaßnahme hängt deshalb von der Fehlerart ab. Eine falsch gezählte Palette braucht eine andere Lösung als eine Lieferung, die physisch angenommen, aber nie gebucht wurde. Bevor Teams Prozesse umbauen, sollten sie Differenzen nach Artikel, Lagerort, Schicht, Bewegungsart und Zeitpunkt auswerten. Erst dieses Muster zeigt, ob ein Einzelfall oder ein wiederkehrender Prozessfehler vorliegt.

1. Wareneingänge werden verspätet oder unvollständig gebucht

Der Wareneingang ist ein klassischer Bruchpunkt. Ware trifft morgens ein, wird zur Prüfung abgestellt und später direkt in die Produktion oder ins Regal gebracht. Die Buchung erfolgt am Nachmittag, am nächsten Tag oder gar nicht. Solange die Ware physisch vorhanden ist, erscheint der Systembestand zu niedrig. Wird sie bereits verbraucht oder ausgeliefert, werden Folgefehler wahrscheinlicher.

Besonders anfällig sind Teillieferungen, Ersatzartikel und Überlieferungen. Steht auf dem Lieferschein eine Menge, kommt aber eine andere Menge an, darf niemand den Beleg einfach „irgendwie passend" buchen. Der Unterschied muss als Ausnahme sichtbar bleiben, inklusive Grund, verantwortlicher Person und Freigabe. Sonst verschwindet die Abweichung aus dem Vorgang und taucht erst bei der Inventur wieder auf.

2. Lagerbewegungen passieren ohne Transaktion

Ein Artikel wird vom Wareneingang ins Hochregal gestellt, aus einem Fach in die Kommissionierzone umgelagert oder für einen Auftrag reserviert. Physisch ist das eine kleine, schnelle Bewegung. Im System kann sie entscheidend sein.

Wenn Mitarbeitende Lagerorte nur nach Gefühl umsortieren, wird der Gesamtbestand eventuell noch stimmen, die Verfügbarkeit am richtigen Platz aber nicht. Das verursacht Suchzeiten, Fehlkommissionierungen und unnötige Nachschubfahrten. Eine gute Lagerlösung muss nicht jede Bewegung kompliziert machen. Sie muss die wenigen Bewegungen erfassen, die für Verfügbarkeit, Rückverfolgbarkeit und Nachbestellung relevant sind.

In Werkstätten oder kleineren Lagern ist es oft sinnvoller, wenige eindeutige Zonen zu führen als eine theoretisch perfekte Fachstruktur, die im Alltag niemand pflegt. Präzision funktioniert nur, wenn sie arbeitsfähig bleibt.

3. Kommissionierung und Versand werden zu früh gebucht

Viele Teams buchen einen Auftrag beim Picken als „ausgebucht", obwohl die Ware noch auf einem Bereitstellungsplatz liegt. Wird der Auftrag anschließend geändert, storniert oder nur teilweise versendet, stimmen System- und physischer Bestand nicht mehr überein.

Besser ist eine klare Trennung zwischen reserviert, kommissioniert und versendet. Nicht jedes Unternehmen braucht dafür komplexe Statusketten. Aber der Zeitpunkt der Bestandsminderung muss eindeutig sein. Bei Versandware liegt er häufig näher an der tatsächlichen Übergabe an den Transportdienstleister als am ersten Griff ins Regal.

Auch Retouren gehören in diesen Ablauf. Kommt Ware zurück, ist sie nicht automatisch wieder verfügbar. Erst Prüfung, Qualitätsentscheidung und Einlagerung sollten bestimmen, ob sie in den verkaufbaren Bestand zurückkehrt, gesperrt bleibt oder ausgeschieden wird.

4. Falsche Einheiten und Stammdatenfehler

Ein Karton, ein Gebinde, eine Rolle und ein einzelnes Stück können denselben Artikel betreffen. Wenn die Umrechnung nicht sauber gepflegt ist, entstehen Differenzen in beeindruckender Geschwindigkeit. Ein Mitarbeitender bucht „1", meint einen Karton mit 24 Stück. Das System versteht ein Stück.

Stammdatenfehler sind besonders tückisch, weil der Buchungsvorgang technisch korrekt aussehen kann. Prüfen Sie deshalb Verpackungseinheiten, Umrechnungsfaktoren, Mindestmengen, Lagerorte und Artikelnummern. Auch ähnlich benannte Varianten, etwa unterschiedliche Längen, Farben oder Chargen, werden leicht verwechselt.

Hier hilft keine pauschale Regel wie „mehr scannen". Barcodes sind nur so zuverlässig wie die Zuordnung dahinter. Bei kleinen Sortimenten kann ein sauber gepflegter Artikelstamm mit gut lesbaren Etiketten mehr bewirken als eine umfangreiche, aber schlecht konfigurierte Scannerlandschaft.

5. Parallel geführte Tabellen und manuelle Korrekturen

Die Tabelle auf dem Desktop entsteht selten aus Nachlässigkeit. Meist schließt sie eine reale Lücke: eine Sonderreservierung, ein fehlender Auswertungswert oder ein Prozess, den die vorhandene Software nicht abbildet. Problematisch wird sie, wenn sie zum zweiten Bestandsbuch wird.

Dann werden Zugänge im System gebucht, Entnahmen aber in der Tabelle notiert. Oder eine Korrektur erfolgt nur dort, wo sie für den nächsten Auftrag gerade hilft. Niemand kann später verlässlich erklären, welcher Wert gilt.

Nicht jede Tabelle muss abgeschafft werden. Eine Kalkulation für Planung oder Analysen kann sinnvoll bleiben. Bestandsverändernde Vorgänge sollten jedoch genau ein führendes System haben. Anpassungen brauchen einen Grundcode, einen Zeitstempel und idealerweise eine Person, die sie nachvollziehen kann. Das ist keine Bürokratie um der Bürokratie willen, sondern die Voraussetzung für belastbare Ursachenanalysen.

6. Zählfehler und unpassende Inventurmethoden

Auch korrekte Prozesse schützen nicht vor menschlichen Fehlern. Artikel werden doppelt gezählt, Paletten werden übersehen, offene Kartons geschätzt oder Lagerorte nicht gesperrt, während gezählt wird. Eine jährliche Vollinventur entdeckt diese Probleme spät und unter hohem Druck.

Für viele Betriebe ist eine permanente Inventur die vernünftigere Alternative. Schnell drehende oder wertvolle Artikel werden öfter geprüft, stabile C-Artikel seltener. Wichtig ist nicht, möglichst viele Zählungen zu produzieren, sondern Abweichungen zeitnah gegen die letzten Bewegungen zu prüfen. Wird ein Differenzartikel einfach korrigiert, ohne die Ursache zu dokumentieren, bleibt das Muster unsichtbar.

Eine Gegenkontrolle ist besonders sinnvoll bei hohen Werten, Seriennummern oder Chargen. Bei Schrauben im Verbrauchslager kann sie wirtschaftlich überzogen sein. Die Kontrolltiefe sollte zum Risiko passen.

7. Unklare Verantwortlichkeiten zwischen Schichten und Bereichen

Bestandsfehler entstehen häufig an Übergaben. Die Frühschicht stellt Ware bereit, die Spätschicht versendet sie. Der Wareneingang nimmt eine Lieferung an, die Disposition ändert parallel den Auftrag. Jeder einzelne Schritt kann nachvollziehbar sein, doch niemand besitzt den Gesamtvorgang.

Definieren Sie deshalb nicht nur Rollen, sondern Übergabepunkte: Wer bestätigt den Wareneingang? Wann wechselt die Verantwortung für kommissionierte Ware? Wer prüft offene Ausnahmen am Schichtende? Ein gemeinsames digitales Board oder eine einfache Ausnahmeliste ist oft wirksamer als zusätzliche Meetings.

Das System sollte offene Vorgänge sichtbar machen, statt Mitarbeitende zum Erinnern zu zwingen. Beispielsweise müssen Lieferungen ohne Mengenprüfung, Kommissionierungen ohne Versandabschluss oder Rückgaben ohne Qualitätsentscheidung auffallen, bevor sie zu stillen Bestandsfehlern werden.

8. Schwache Systemintegration und fehlende Prüfregeln

Wenn Shop, Auftragsverwaltung, Lager und Buchhaltung Daten zeitversetzt oder per Datei austauschen, können doppelte oder fehlende Buchungen entstehen. Ein Import läuft zweimal. Eine Schnittstelle scheitert still. Ein Auftrag wird geändert, nachdem sein Versandstatus bereits übertragen wurde.

Die Lösung ist nicht zwangsläufig eine Komplettablösung. Häufig braucht es klar definierte Schnittstellen, eindeutige Belegnummern und technische Prüfungen. Eine Lagerbuchung sollte nachvollziehbar speichern, wann sie erfolgte, aus welchem Vorgang sie stammt und ob sie später storniert wurde. Kritische Prozesse benötigen Fehlermeldungen und Warteschlangen, nicht nur einen stillen Eintrag im Logfile.

Bei individuell entwickelten Logistiksystemen lassen sich solche Regeln gezielt an den Betrieb anpassen: keine negative Menge ohne Freigabe, keine Versandbestätigung ohne Versandposition, keine doppelte Verarbeitung derselben externen Referenz. Die beste Regel ist dabei nicht die strengste, sondern jene, die echte Fehler stoppt, ohne den Betrieb bei normalen Ausnahmen zu blockieren.

Bestandsdifferenzen systematisch prüfen

Beginnen Sie nicht mit einer flächendeckenden Korrektur. Wählen Sie die zehn Artikel mit den häufigsten oder teuersten Differenzen und verfolgen Sie ihre letzte Bewegung rückwärts: Wareneingang, Umlagerung, Entnahme, Rückgabe, Zählung und eventuelle manuelle Anpassung. Häufen sich die Fälle an einem Standort, einer Schicht oder einer Bewegungsart, ist das ein belastbarer Ansatzpunkt.

Danach sollte jede Maßnahme messbar sein. Wenn neue Barcode-Scans eingeführt werden, beobachten Sie nicht nur die Zahl der Scans, sondern die Differenzquote je Artikelgruppe. Wenn ein neuer Status für Bereitstellung ergänzt wird, prüfen Sie offene Bereitstellungen täglich. Gute Prozesse erzeugen keine Scheingenauigkeit. Sie machen Ausnahmen früh sichtbar und nachvollziehbar.

Der sinnvolle nächste Schritt ist oft klein: einen Übergabepunkt definieren, einen Lagerort bereinigen oder eine wiederkehrende manuelle Korrektur technisch absichern. Verlässliche Bestände entstehen nicht durch mehr Software auf Verdacht, sondern durch Prozesse, die auch an einem hektischen Dienstag um 16:45 Uhr noch korrekt ausführbar sind.

Permalink →

Prozessautomatisierung für KMU richtig angehen

Prozessautomatisierung für KMU richtig angehen

Ein Lieferschein fehlt, weil die Daten noch auf einem Zettel stehen. Ein Wareneingang wird doppelt erfasst, weil Lager und Büro mit unterschiedlichen Tabellen arbeiten. Eine Freigabe verzögert sich, weil die zuständige Person gerade nicht ans Telefon geht. Solche Reibung kostet selten auf einen Schlag viel Geld. Über Wochen summieren sich jedoch Nachfragen, Suchzeiten, Fehlerkorrekturen und unnötige Wartezeiten. Genau dort setzt Prozessautomatisierung KMU sinnvoll an.

Es geht nicht darum, möglichst viele Tätigkeiten durch Software zu ersetzen. Gute Automatisierung macht Abläufe nachvollziehbar, reduziert vermeidbare Übergaben und gibt Mitarbeitenden Zeit für Entscheidungen, die Erfahrung benötigen. Besonders in kleinen und mittleren Unternehmen ist das entscheidend: Die Teams sind nah am Tagesgeschäft. Wenn ein Prozess hakt, merkt es oft sofort die ganze Schicht.

Nicht jeden Prozess automatisieren

Der häufigste Fehler ist, mit dem sichtbarsten Ärgernis zu beginnen. Vielleicht nervt eine Excel-Datei, vielleicht soll ein neues Dashboard her. Beides kann berechtigt sein. Doch ein digitalisiertes Chaos bleibt Chaos - nur schneller und mit mehr Daten.

Vor einer technischen Entscheidung sollte der Ablauf zunächst so beschrieben werden, wie er tatsächlich stattfindet. Nicht wie er im Handbuch stehen sollte. Wer löst den Vorgang aus? Welche Informationen werden benötigt? Wo wird etwas manuell übertragen? Wer entscheidet bei Ausnahmen? Und woran erkennt das Team, dass der Vorgang abgeschlossen ist?

Gerade im Lager oder in der Auftragsabwicklung liegen die kritischen Stellen oft zwischen Systemen: Ein Auftrag kommt per E-Mail, wird in eine Tabelle kopiert, telefonisch abgestimmt und später in eine Versandsoftware eingegeben. Jede Übergabe erhöht die Wahrscheinlichkeit, dass Mengen, Termine oder Adressen abweichen.

Eine Automatisierung lohnt sich besonders, wenn ein Prozess häufig vorkommt, klare Regeln hat und Fehler spürbare Folgen verursachen. Das kann der Wareneingang sein, die Erstellung von Lieferscheinen, die Zuordnung von Lagerbewegungen oder die Übergabe freigegebener Aufträge an den Versand. Seltene Sonderfälle mit vielen Ermessensentscheidungen bleiben dagegen häufig besser manuell - zumindest zunächst.

Prozessautomatisierung für KMU beginnt mit Prioritäten

Nicht jede unnötige Tätigkeit verdient sofort ein Projekt. Eine einfache Priorisierung schafft Klarheit. Bewerten Sie einzelne Abläufe nach Häufigkeit, Bearbeitungszeit, Fehlerkosten und Abhängigkeiten. Ein Vorgang, der täglich fünfzigmal stattfindet und jeweils nur zwei Minuten spart, kann wirtschaftlicher sein als ein komplizierter Monatsprozess.

Die Frage nach der Fehlerfolge ist mindestens genauso wichtig. Ein falsch gedrucktes internes Dokument ist ärgerlich. Eine falsche Chargenzuordnung, eine verlorene Lieferadresse oder ein nicht dokumentierter Wareneingang kann Reklamationen, Sucharbeit und Bestandsdifferenzen auslösen. Dort erzeugt Automatisierung nicht nur Tempo, sondern Verlässlichkeit.

Ein sinnvoller erster Schritt ist meist klein genug, um innerhalb weniger Wochen überprüfbar zu sein. Beispielsweise kann ein Mitarbeitender Waren über einen Barcode erfassen, das System prüft Artikel und Menge, aktualisiert den Bestand in einer zentralen Datenbank und erzeugt bei Bedarf direkt einen Einlagerungsbeleg. Das Team muss danach nicht raten, welche Version einer Tabelle aktuell ist.

Ein klarer Zielzustand statt einer Funktionsliste

Viele Projekte starten mit einer langen Liste gewünschter Funktionen. Besser ist ein konkretes Betriebsbild: Was soll am Ende eines Vorgangs ohne Nachfragen sichtbar sein? Beim Versand könnte das bedeuten, dass ein Auftrag nach Freigabe automatisch eine Packliste erhält, die Versandadresse geprüft wird und ein Etikett erzeugt werden kann. Ausnahmen landen sichtbar in einer Klärliste, statt in einem unübersehbaren E-Mail-Postfach.

Dieses Zielbild zwingt zu hilfreichen Entscheidungen. Muss jede Bestellung vollständig automatisch verarbeitet werden? Oder sollen Aufträge ab einem bestimmten Warenwert, bei abweichender Lieferadresse oder bei fehlendem Bestand bewusst zur Prüfung vorgelegt werden? Automatisierung braucht keine hundertprozentige Dunkelverarbeitung, um einen großen Nutzen zu schaffen.

Die passende Technik hängt vom Ablauf ab

Es gibt keinen technischen Standardweg für jedes KMU. Eine Tabellenlösung kann für eine überschaubare Auswertung weiterhin vernünftig sein. Sie ist schnell angepasst, vertraut und verursacht wenig Einführungsaufwand. Sobald mehrere Personen gleichzeitig arbeiten, Buchungen nachvollziehbar sein müssen oder Daten mit anderen Systemen ausgetauscht werden, stößt sie jedoch an Grenzen.

Dann ist häufig eine schlanke, workflow-spezifische Anwendung sinnvoller als eine überdimensionierte Enterprise-Suite. Sie kann genau die Schritte abbilden, die im Betrieb benötigt werden: Auftrag erfassen, Bestand prüfen, Ware bewegen, Dokument erzeugen, Versand buchen und Status zurückmelden. Nicht mehr, aber auch nicht weniger.

Technisch zählt dabei weniger, ob ein System mit dem neuesten Schlagwort wirbt. Entscheidend sind belastbare Grundlagen: eine sauber modellierte Datenbank, nachvollziehbare Berechtigungen, Protokolle für relevante Änderungen, verlässliche Schnittstellen und dokumentierte Deployments. Eine Anwendung auf Basis von PHP 8.4, modernem JavaScript und MySQL 8 kann langfristig sehr gut wartbar sein, wenn Architektur und Betrieb von Anfang an mitgedacht werden.

Auch Integrationen verdienen Aufmerksamkeit. Ein automatischer Datenaustausch mit Shop, ERP, Versanddienstleister oder Buchhaltung spart nur dann Zeit, wenn Fehler sichtbar behandelt werden. Was passiert bei einer ungültigen Adresse? Wird ein fehlgeschlagener Etikettendruck erneut versucht? Kann das Team erkennen, welche Daten übertragen wurden und welche noch fehlen? Stille Fehler sind gefährlicher als ein klar markierter Ausnahmefall.

Einführung im laufenden Betrieb

Ein neues System muss sich an Schichtwechsel, Liefertermine und vorhandene Arbeitsroutinen anpassen. Deshalb ist ein schrittweiser Rollout meist sicherer als ein harter Stichtag für alle Bereiche. Starten Sie mit einem abgegrenzten Prozess, einer Produktgruppe oder einem Lagerbereich. Das reduziert Risiko und schafft echtes Feedback aus dem Alltag.

Parallelbetrieb ist dabei kein Zeichen von Unsicherheit, sondern ein kontrollierter Test. Für eine begrenzte Zeit können alte und neue Erfassung verglichen werden. Differenzen zeigen nicht nur Softwarefehler, sondern oft auch Regeln, die bisher nur im Kopf einzelner Mitarbeitender existierten. Diese Regeln gehören sichtbar in den Prozess - nicht dauerhaft in persönliche Erfahrung.

Mitarbeitende sollten nicht erst zur Schulung mit dem neuen Ablauf konfrontiert werden. Wer den Prozess täglich ausführt, erkennt Abkürzungen, Sonderfälle und unpraktische Masken früh. Gute Software respektiert dieses Wissen, ohne jede historisch gewachsene Ausnahme unverändert einzubauen. Die richtige Frage lautet: Welche Ausnahme schützt einen wichtigen Geschäftsfall, und welche ist nur ein Workaround für ein altes Problem?

Messbar machen, ob sich der Aufwand lohnt

Vor dem Start sollten zwei oder drei Kennzahlen festgelegt werden. Das können Durchlaufzeit pro Auftrag, Anzahl manueller Korrekturen, Differenzen im Bestand oder die Zeit bis zum Versand sein. Ohne Ausgangswert wird jede Bewertung später zum Bauchgefühl.

Nicht jede Wirkung zeigt sich sofort in Euro. Wenn ein Lagerteam jederzeit erkennt, wo sich Ware befindet, sinkt die Zahl der Unterbrechungen. Wenn Lieferdokumente aus denselben Daten entstehen wie der Auftrag, sinkt das Risiko widersprüchlicher Angaben. Und wenn Verantwortlichkeiten im System sichtbar sind, hängt ein Vorgang weniger an einzelnen Personen.

Automatisierung braucht Wartung und Grenzen

Ein automatisierter Ablauf ist kein Projekt, das nach dem Go-live einfriert. Artikelstrukturen ändern sich, Kunden verlangen neue Dokumente, Versanddienstleister passen Schnittstellen an. Deshalb gehören Zuständigkeiten, Updates, Backups und ein geregelter Umgang mit Berechtigungen zum eigentlichen System.

Besonders bei Anwendungen mit Kunden-, Auftrags- oder Bestandsdaten sollte klar sein, wer Zugriff erhält und warum. Rollen müssen zum Arbeitsalltag passen: Ein Lagerteam benötigt andere Funktionen als Buchhaltung oder Vertrieb. Protokollierte Änderungen, sichere Anmeldeflüsse und getestete Wiederherstellungen wirken unspektakulär. Im Störungsfall entscheiden genau diese Details darüber, ob der Betrieb weiterarbeiten kann.

Auch Tests sind Teil der Betriebssicherheit. Wiederkehrende Prüfungen für Auftragserfassung, Bestandsbuchung, Dokumentenerzeugung und Rechteverwaltung verhindern, dass eine Anpassung an einer Stelle einen funktionierenden Ablauf an anderer Stelle beschädigt. Bei kritischen Web- oder Desktop-Anwendungen kann eine kontrollierte, selbst gehostete Testumgebung sinnvoll sein, wenn Screenshots, Testdaten und interne Prozesse nicht in externe Cloud-Dienste gelangen sollen.

softify.pro begleitet solche Vorhaben mit einem einfachen Grundsatz: Erst den tatsächlichen Ablauf verstehen, dann die kleinste tragfähige Lösung bauen. Manchmal ist das eine maßgeschneiderte Anwendung. Manchmal genügt es, eine bestehende Tabelle sauberer zu strukturieren und einen einzelnen Übergabeschritt zu automatisieren.

Der beste nächste Schritt ist daher kein Softwarevergleich, sondern ein Gang durch einen echten Vorgang - vom Auslöser bis zum Abschluss. Nehmen Sie einen Auftrag, einen Wareneingang oder eine Reklamation und verfolgen Sie ihn mit den beteiligten Personen. Dort, wo Informationen erneut eingegeben werden, niemand den Status kennt oder Entscheidungen unnötig warten, liegt meist der sinnvollste Ansatz für Automatisierung.

Permalink →

Windows-Anwendungen testen: Ein praxisnaher Plan

Windows-Anwendungen testen: Ein praxisnaher Plan

Eine Windows-Anwendung kann im Demo-Modus sauber aussehen und trotzdem am Montagmorgen den Betrieb bremsen. Ein nicht gespeicherter Lieferschein, ein blockierter Benutzer nach drei Fehlversuchen oder ein Druckdialog, der nach einem Update anders reagiert, sind keine kosmetischen Fehler. Wer wissen will, wie man Windows-Anwendungen testet, sollte deshalb nicht bei einzelnen Buttons anfangen, sondern bei den Abläufen, die Arbeit, Geld oder Nachvollziehbarkeit kosten.

Gerade in Lager, Werkstatt, Disposition und Verwaltung laufen viele kritische Prozesse über gewachsene Desktop-Software. Dort zählt nicht, ob ein Testfall beeindruckend formuliert ist. Entscheidend ist, ob Mitarbeitende ihre Aufgaben unter realistischen Bedingungen zuverlässig erledigen können - auch bei unvollständigen Daten, wechselnden Berechtigungen, langsamen Netzwerken und ungeplanten Unterbrechungen.

Windows-Anwendungen testen beginnt mit den kritischen Abläufen

Nicht jede Funktion verdient den gleichen Testaufwand. Ein selten verwendeter Export mit manueller Nacharbeit ist anders zu bewerten als die Buchung eines Wareneingangs, die Etikettenerstellung oder der tägliche Abgleich von Aufträgen. Starten Sie daher mit einer einfachen Frage: Was passiert konkret, wenn dieser Ablauf fehlschlägt?

Hohe Priorität haben Prozesse mit direkter Auswirkung auf Bestand, Lieferung, Rechnung, Sicherheit oder Kundenkommunikation. Dazu gehören etwa Anmeldung und Rechteprüfung, Anlage und Änderung von Stammdaten, Transaktionsbuchungen, Dokumentendruck, Schnittstellen zu ERP- oder Versanddiensten sowie Wiederanläufe nach einem Fehler. Auch Funktionen, die nur ein kleiner Personenkreis nutzt, können kritisch sein, wenn sie einen Monatsabschluss oder die Freigabe von Waren verhindern.

Aus diesen Abläufen entstehen keine abstrakten Testlisten, sondern nachvollziehbare Arbeitsschritte. Ein Wareneingangstest könnte beispielsweise mit einer bestehenden Bestellung beginnen, eine Teillieferung erfassen, eine abweichende Menge melden, einen Lagerplatz zuweisen und anschließend prüfen, ob Bestand, Buchungsprotokoll und gedrucktes Dokument übereinstimmen. Damit testen Sie die tatsächliche Wirkung der Software, nicht nur einzelne Eingabefelder.

Eine Testbasis schaffen, die den Betrieb abbildet

Viele Fehler werden erst sichtbar, wenn die Testumgebung der Realität nahekommt. Eine Anwendung verhält sich mit einem leeren Testmandanten oft anders als mit mehreren Jahren Bewegungsdaten, gesperrten Artikeln, fehlenden Pflichtinformationen oder bereits geöffneten Vorgängen.

Legen Sie deshalb Testdaten bewusst an. Sie benötigen nicht zwingend eine vollständige Kopie der Produktion. Sinnvoller ist ein kontrollierter Datenbestand mit typischen, grenzwertigen und absichtlich fehlerhaften Fällen: Artikel mit unterschiedlichen Mengeneinheiten, Kunden mit Sonderkonditionen, Aufträge mit Teillieferungen, Benutzer mit verschiedenen Rollen und Vorgänge, die bereits in Bearbeitung sind. Personenbezogene Daten sollten dabei anonymisiert oder durch realistische Beispieldaten ersetzt werden.

Zur Testbasis gehört auch die technische Umgebung. Dokumentieren Sie Windows-Version, Auflösung, Skalierung, installierte Drucker, Netzlaufwerke, Datenbankversion, angebundene Dienste und Berechtigungen. Das klingt nüchtern, spart aber später Zeit. Wenn ein Fehler nur auf Arbeitsplätzen mit 125-Prozent-Skalierung oder bei einem bestimmten Druckertreiber auftritt, muss das reproduzierbar sein.

Nicht nur den Idealfall prüfen

Der Idealfall beweist vor allem, dass die Anwendung für den erwarteten Weg gebaut wurde. Im Betrieb entstehen die schwierigen Situationen daneben. Was geschieht, wenn ein Anwender ein Pflichtfeld leer lässt, dieselbe Buchung zweimal auslöst oder während des Speicherns die Verbindung verliert? Bleibt der Vorgang konsistent? Erhält die Person eine verständliche Meldung? Kann sie sicher weiterarbeiten?

Bei Windows-Anwendungen sind außerdem Bedienung und Zustand besonders relevant. Dialogfenster können im Hintergrund erscheinen, Tastaturkürzel können sich überschneiden, Dateiauswahldialoge können den Ablauf blockieren. Prüfen Sie, ob Fokus, Fehlermeldungen und Sperren eindeutig sind. Eine technische Ausnahme ohne Handlungshinweis hilft dem Schichtleiter nicht weiter.

Manuelle Tests dort einsetzen, wo Urteil gefragt ist

Manuelle Tests sind kein Zeichen mangelnder Reife. Sie sind unverzichtbar, wenn ein neuer Ablauf entsteht, eine Oberfläche umgebaut wird oder Fachwissen über die Qualität entscheidet. Ein erfahrener Lagerleiter erkennt schneller als ein Skript, ob eine Maske bei hohem Zeitdruck verständlich ist oder ob ein Hinweis zu spät erscheint.

Manuelles Testen wird jedoch teuer und unzuverlässig, wenn dieselben stabilen Abläufe vor jeder Version wiederholt werden. Dann hängt die Freigabe an verfügbaren Personen, Erinnerungsvermögen und verstreuten Notizen. Der richtige Übergang zur Automatisierung liegt meist dort, wo ein Prozess häufig ausgeführt wird, einen hohen Schaden verursachen kann und klare erwartete Ergebnisse besitzt.

Ein guter manueller Testfall beschreibt Ausgangslage, Schritte, erwartetes Ergebnis und benötigte Daten. Ergänzen Sie bei einem Fehler einen Screenshot, Zeitstempel, Anwendungs- und Build-Version sowie die genaue Aktion. „Drucken geht nicht" ist keine brauchbare Fehlerbeschreibung. „Nach Änderung der Lieferadresse bleibt der Druckdialog offen, der Auftrag 4711 erhält kein PDF und es erscheint keine Meldung" ist es.

Automatisierte Regressionstests für wiederkehrende Risiken

Automatisierung prüft nicht, ob eine Software grundsätzlich gut ist. Sie prüft, ob zuvor funktionierende, definierte Abläufe nach einer Änderung noch funktionieren. Das ist besonders wertvoll bei Windows-Software, deren Oberflächen, Datenbanklogik und externe Schnittstellen über Jahre weiterentwickelt werden.

Beginnen Sie klein. Wählen Sie zunächst fünf bis zehn geschäftskritische Abläufe, die bei jedem Release geprüft werden sollen. Dazu können Anmeldung mit account-lockout flow, Auftragserfassung, Lagerbuchung, PDF- oder Etikettendruck, Rollenwechsel und ein zentraler Import gehören. Erst wenn diese Tests verlässlich laufen, lohnt sich die Erweiterung auf Sonderfälle.

Bei Desktop-Anwendungen steuern automatisierte Tests häufig sichtbare Oberflächenelemente: Fenster, Eingabefelder, Tabellen, Schaltflächen und Dialoge. Das funktioniert, ist aber empfindlicher als ein reiner Schnittstellentest. Kleine Layoutänderungen, langsamere Rechner oder nicht eindeutig benannte Elemente können Tests brechen. Deshalb sollten Entwickler, Fachbereich und Testverantwortliche gemeinsam festlegen, welche Elemente stabil adressierbar sind und welche Prüfschritte besser über Datenbank, Protokoll oder Schnittstelle abgesichert werden.

Ein sinnvoller Test prüft außerdem nicht nur, dass eine Schaltfläche geklickt werden konnte. Er kontrolliert die fachliche Folge: Wurde die Buchung gespeichert? Ist der Bestand korrekt? Wurde ein Dokument erzeugt? Wurde kein doppelter Datensatz angelegt? Sichtbare Interaktion und überprüfbares Ergebnis gehören zusammen.

Beweise sind Teil des Testergebnisses

Ein grüner Status allein reicht bei kritischen Anwendungen selten aus. Wenn ein Test fehlschlägt, benötigen Teams schnell eine Antwort auf drei Fragen: Was war die Ausgangslage? An welchem Schritt ist der Ablauf gescheitert? Was zeigte die Anwendung zu diesem Zeitpunkt?

Screenshots, Ablaufprotokolle und gegebenenfalls Bildschirmaufzeichnungen machen Fehler besprechbar. Sie verkürzen die Übergabe zwischen Betrieb, QA und Entwicklung erheblich. Für regulierte oder sicherheitsbewusste Unternehmen sind sie zudem eine belastbare Grundlage, um Freigaben und Abweichungen nachzuvollziehen.

Dabei ist der Speicherort keine Nebensache. Testläufe können interne Kundendaten, Preislisten, Auftragsinformationen oder Bildschirmansichten enthalten. Wer sensible Windows-Anwendungen automatisiert testet, sollte klären, ob diese Daten die eigene Infrastruktur verlassen dürfen. Eine selbst gehostete Umgebung wie COCO kann hier sinnvoll sein, weil Testausführung, Evidenz und Auswertung unter der eigenen Kontrolle bleiben. Ob das erforderlich ist, hängt von Datenschutzvorgaben, Vertragslage und Schutzbedarf ab - nicht jedes Team braucht dafür dieselbe Architektur.

Testen in den Release-Prozess einbauen

Der beste Testkatalog verliert Wert, wenn er erst nach einer hektischen Produktivsetzung genutzt wird. Definieren Sie einen festen Zeitpunkt: Automatisierte Kernregressionen laufen vor jeder Freigabe, manuelle Abnahme prüft neue oder veränderte Abläufe, und bekannte Einschränkungen werden offen dokumentiert.

Nicht jeder fehlgeschlagene Test muss ein Release stoppen. Ein Fehler in einer seltenen Verwaltungsansicht kann vertretbar sein, wenn ein sicherer Workaround existiert und der betroffene Bereich klar informiert ist. Ein Fehler, der Bestände falsch bucht oder Benutzer unbemerkt sperrt, ist anders zu behandeln. Diese Entscheidung sollte nach Geschäftsauswirkung getroffen werden, nicht nach der bloßen Anzahl roter Tests.

Pflegen Sie die Tests mit der Anwendung. Wenn sich ein Prozess bewusst verändert, aktualisieren Sie Testfall, Testdaten und erwartetes Ergebnis gemeinsam mit der Anforderung. Veraltete Tests erzeugen Lärm und werden irgendwann ignoriert. Wenige vertrauenswürdige Prüfungen sind wertvoller als Hunderte automatisierte Abläufe, deren Ergebnisse niemand mehr ernst nimmt.

Am Ende geht es nicht darum, jede denkbare Eingabe zu simulieren. Es geht darum, die Arbeit zu schützen, die am nächsten Morgen wieder funktionieren muss. Beginnen Sie mit einem einzigen kritischen Prozess, machen Sie sein Ergebnis beweisbar und bauen Sie von dort aus weiter.

Permalink →

Secure Test Data Management ohne Kontrollverlust

Secure Test Data Management ohne Kontrollverlust

Ein fehlgeschlagener Testlauf ist ärgerlich. Ein erfolgreicher Testlauf mit echten Kundendaten in einer unzureichend geschützten Umgebung kann deutlich teurer werden. Secure Test Data Management löst diesen Widerspruch nicht mit einem einzelnen Tool, sondern mit klaren Regeln für Daten, Zugriffe, Testumgebungen und Nachweise. Für Teams, die Web- oder Windows-Anwendungen automatisiert testen, gehört es damit zur Qualitätsarbeit - nicht nur zur Compliance.

Warum Testdaten ein Sicherheitsproblem werden

Produktivdaten sind für Tests verführerisch, weil sie reale Sonderfälle enthalten: unvollständige Adressen, ungewöhnliche Bestellkonstellationen, historische Preisregeln oder fehlerhafte Eingaben. Genau diese Daten enthalten aber häufig Namen, Kontaktdaten, Vertragsinformationen, Personalnummern, Bankdaten oder interne Geschäftslogik.

Das Risiko entsteht selten durch einen einzelnen groben Fehler. Meist wächst es schrittweise: Ein Datenbankexport wird für einen Test erstellt, in einem gemeinsamen Verzeichnis abgelegt und später in eine weitere Umgebung kopiert. Ein externer Dienst erhält Screenshots zur Fehleranalyse. Ein Testkonto behält weitreichende Rechte, weil eine Bereinigung den nächsten Lauf stören könnte. Nach einigen Monaten weiß niemand mehr verlässlich, welche Daten wo liegen.

Bei kleinen und mittleren Unternehmen verschärft sich das Problem oft durch knappe Kapazitäten. Das Team will eine Release-Frist halten, nicht ein eigenes Datenschutzprojekt betreiben. Trotzdem bleibt die Verantwortung bestehen. Wer Daten für Qualitätssicherung nutzt, muss nachvollziehen können, welche Daten verarbeitet werden, wer Zugriff hat und wann sie wieder entfernt werden.

Secure Test Data Management beginnt vor dem Testfall

Die entscheidende Frage lautet nicht: „Wie schützen wir den Testdatenbestand?" Sie lautet: „Welche Information braucht dieser Test tatsächlich?" Viele Regressionstests benötigen keine echten Personenbezüge. Ein Versandprozess muss beispielsweise prüfen, ob Lieferadressen, Gewichte, Zonen, Etiketten und Statuswechsel korrekt verarbeitet werden. Dafür reichen synthetische Kunden, plausible Artikelstammdaten und bewusst definierte Grenzfälle.

Diese Unterscheidung führt zu einer praktikablen Datenklassifizierung. Nicht jede Testumgebung braucht dieselbe Datentiefe. Für Unit- und Integrationstests genügen oft vollständig künstliche Datensätze. Für End-to-End-Tests können pseudonymisierte Kopien sinnvoll sein, wenn reale Datenmuster fachlich relevant sind. Produktionsähnliche Daten sollten die Ausnahme sein - mit dokumentiertem Zweck, begrenztem Zugriff und einer festen Lebensdauer.

Wichtig ist dabei die Qualität der Ersatzdaten. Zufällige Fantasiedaten helfen wenig, wenn sie keine realistischen Abhängigkeiten abbilden. Ein Testdatensatz für eine Lageranwendung muss etwa Artikelvarianten, Lagerplätze, Sperrbestände, Teillieferungen und Retouren in stimmiger Kombination enthalten. Gute Testdaten schützen nicht nur personenbezogene Informationen. Sie finden Fehler, die mit leeren Tabellen und dem Musterkunden „Max Mustermann" nie sichtbar würden.

Synthetisieren, maskieren oder minimieren?

Synthetische Daten sind die sicherste Wahl, wenn sich die fachlichen Regeln sauber modellieren lassen. Sie entstehen gezielt aus Testanforderungen und enthalten keine Kopie realer Personen oder Vorgänge. Der Aufwand liegt in der Pflege: Ändert sich das Datenmodell oder kommen neue Prozessregeln hinzu, müssen Generatoren und Fixtures mitwachsen.

Maskierung eignet sich, wenn das Verhalten einer Anwendung stark von Produktionsstrukturen abhängt. Dabei werden sensible Felder ersetzt oder verändert, während Beziehungen erhalten bleiben. Aus Namen werden plausible, aber fiktive Namen; aus E-Mail-Adressen werden nicht zustellbare Testadressen; aus Kontonummern werden Werte mit korrektem Format ohne echten Bezug. Eine Maskierung ist nur dann belastbar, wenn auch indirekte Rückschlüsse bedacht werden. Eine Kombination aus seltenem Ort, Geburtsdatum und Vertragsmerkmal kann eine Person weiterhin erkennbar machen.

Datenminimierung ist oft der unterschätzte dritte Weg. Statt einen kompletten Export zu kopieren, wird nur der erforderliche Ausschnitt bereitgestellt. Das reduziert Angriffsfläche, Speicherbedarf und Bereinigungsaufwand. Für einen Test einer Rabattlogik braucht niemand die gesamte Kundenhistorie eines Jahres.

Zugriffe und Umgebungen müssen zum Risiko passen

Ein geschützter Datensatz verliert seinen Wert, wenn er in einer frei erreichbaren Testumgebung liegt. Testsysteme brauchen daher eigene Sicherheitsgrenzen - getrennte Datenbanken, eigene Servicekonten, klar definierte Netzwerkzugänge und keine stillschweigende Verbindung zur Produktion.

Zugriffsrechte sollten auf Rollen beruhen, nicht auf gemeinsam genutzten Konten. Entwickelnde benötigen unter Umständen andere Rechte als QA, Support oder externe Dienstleister. Administratorzugriffe sind manchmal nötig, aber sie sollten zeitlich begrenzt, protokolliert und mit einer nachvollziehbaren Freigabe verbunden sein. Auch für Testkonten gelten sinnvolle Passwortregeln, Multi-Faktor-Authentifizierung, wo sie verfügbar ist, und Account-Lockout-Flows bei wiederholten Fehlversuchen.

Automatisierte Tests bringen einen weiteren Sonderfall mit: Sie erzeugen Beweise. Screenshots, Bildschirmaufzeichnungen, Logs und Fehlermeldungen können sensible Inhalte enthalten, selbst wenn die Datenbank maskiert wurde. Ein Screenshot einer Kundenmaske, ein Browser-Trace mit Session-Informationen oder ein Log mit API-Payload gehört in dieselbe Schutzbetrachtung wie die Testdatenbank.

Deshalb brauchen Testartefakte Aufbewahrungsregeln. Nicht jeder erfolgreiche Lauf muss dauerhaft gespeichert werden. Für kritische Freigaben kann eine nachvollziehbare Evidenz sinnvoll sein, etwa mit Zeitstempel, Build-Nummer, Testversion und Ergebnis. Fehlgeschlagene Läufe benötigen oft eine längere Analysefrist. Danach sollten Artefakte automatisiert gelöscht werden. Was nicht mehr existiert, kann nicht versehentlich geteilt oder kompromittiert werden.

Automatisierung ohne unkontrollierte Datenabflüsse

KI-gestützte Testautomatisierung kann Tests deutlich beschleunigen, besonders bei umfangreichen Web- und Windows-Anwendungen. Sie verändert aber die Sicherheitsfrage: Wohin gehen Screenshots, Eingaben, Fehlerbeschreibungen und Anwendungstraffic? Wer verarbeitet sie? Wie lange bleiben sie dort?

Für sicherheitsbewusste Teams ist eine selbst gehostete Ausführung oft die bessere Architektur. Ein System wie COCO kann innerhalb der eigenen oder einer klar abgegrenzten Infrastruktur laufen, Testschritte ausführen, Nachweise speichern und verständliche Bewertungen erzeugen. Das ist nicht in jeder Situation zwingend. Für eine öffentliche Marketingseite mit rein synthetischen Formularwerten kann ein externer Dienst vertretbar sein. Bei internen Fachanwendungen, Kundenportalen oder Software mit personenbezogenen Vorgängen ist die lokale Kontrolle jedoch ein handfester Vorteil.

Selbsthosting ist kein Freifahrtschein. Der Betrieb verlangt Updates, Backup-Konzepte, Zugriffsprotokolle und eine verantwortliche Stelle. Dafür bleibt die Datenhoheit dort, wo sie hingehört. Der richtige Ansatz hängt vom Schutzbedarf, den vorhandenen Betriebsfähigkeiten und der Art der getesteten Anwendung ab - nicht vom aktuellen Hype um ein bestimmtes Testwerkzeug.

So wird aus Regeln ein arbeitsfähiger Prozess

Ein praktikabler Prozess muss den Release nicht blockieren. Beginnen Sie mit einer Datenlandkarte: Welche Testumgebungen gibt es, welche Datenarten liegen dort und welche Systeme erzeugen zusätzliche Artefakte? Diese Bestandsaufnahme deckt meist schon alte Exporte, vergessene Staging-Systeme und unklare Verantwortlichkeiten auf.

Danach lohnt sich eine einfache Entscheidungsmatrix pro Testklasse. Sie legt fest, ob synthetische Daten genügen, eine Maskierung erforderlich ist oder ein klar begründeter Produktionsauszug gebraucht wird. Ergänzt wird sie durch Eigentümer, Löschfristen und Zugriffsrollen. Das muss kein überladenes Regelwerk sein. Eine kurze, gelebte Vorgabe ist besser als ein Sicherheitsdokument, das während einer Störung niemand findet.

Technisch gehören Datenbereitstellung und Bereinigung in die Testpipeline. Ein Lauf erstellt seine benötigten Datensätze reproduzierbar, nutzt eindeutige Kennzeichnungen und entfernt sie anschließend wieder. Das verhindert, dass sich Testumgebungen mit Restdaten füllen und Ergebnisse mit jedem Sprint weniger vertrauenswürdig werden. Für kritische Prozesse sollten Teams außerdem prüfen, ob Datenzugriffe und Testnachweise revisionsfähig protokolliert werden müssen.

Sicherheit, die den Test schneller macht

Secure Test Data Management wird häufig als zusätzlicher Kontrollaufwand betrachtet. Schlecht umgesetzt kann es das auch sein. Gut umgesetzt schafft es aber verlässliche, wiederholbare Ausgangsbedingungen. Teams verschwenden weniger Zeit mit der Suche nach einem brauchbaren Datenexport, vermeiden defekte Tests durch unbereinigte Altdaten und können Freigaben besser begründen.

Der sinnvollste erste Schritt ist selten ein großes Plattformprojekt. Nehmen Sie den Testprozess mit dem höchsten Risiko oder der größten Reibung - etwa die Freigabe einer internen Auftragsanwendung - und machen Sie Datenquelle, Zugriffe, Artefakte und Löschung dort sichtbar. Aus dieser konkreten Arbeit entsteht eine Sicherheitsroutine, die Tests nicht schwerfälliger macht, sondern glaubwürdiger.

Permalink →

Warehouse Software vs ERP

Warehouse Software vs ERP

Ein Wareneingang kommt gleichzeitig mit einer dringenden Kommissionierung, zwei Mitarbeitende fragen nach dem Lagerplatz eines Artikels, und ein Lieferschein wurde bereits handschriftlich korrigiert. In genau solchen Momenten wird die Frage Warehouse Software vs ERP praktisch. Es geht nicht um die modernste Oberfläche oder die längste Funktionsliste. Es geht darum, ob die Information dort verfügbar ist, wo eine Entscheidung in Sekunden getroffen werden muss.

Viele kleine und mittlere Unternehmen im DACH-Raum starten mit einem ERP, einer Tabellenkalkulation und viel Erfahrung im Team. Das kann lange funktionieren. Problematisch wird es erst, wenn Bestände zwischen Systemen abweichen, Suchwege zunehmen und jeder Sonderfall über Zuruf gelöst werden muss. Dann steht häufig ein großes ERP-Projekt im Raum, obwohl vielleicht nur ein klar abgegrenzter Lagerprozess digitalisiert werden muss.

Warehouse Software vs ERP: Der Unterschied im Arbeitsalltag

Ein ERP-System bildet das Unternehmen in der Breite ab. Es verbindet typischerweise Einkauf, Verkauf, Artikelstammdaten, Buchhaltung, Produktion, Rechnungen und Planung. Seine Stärke liegt darin, dass kaufmännische und operative Daten in einem gemeinsamen Rahmen zusammenlaufen. Ein Auftrag wird angelegt, eine Rechnung erstellt, ein Bedarf geplant und ein Bestand bewertet.

Warehouse Software, häufig als WMS oder Lagerverwaltung bezeichnet, arbeitet näher an den tatsächlichen Bewegungen im Lager. Sie unterstützt den Wareneingang, Einlagerung, Umlagerung, Kommissionierung, Inventur, Versand und Retouren. Sie beantwortet Fragen, die im ERP oft nur grob abgebildet sind: Auf welchem Platz liegt die Ware? Welcher Bestand ist wirklich verfügbar? Welche Charge wurde versendet? Welcher Auftrag hat Vorrang? Wer hat die Umlagerung bestätigt?

Diese Abgrenzung ist nicht absolut. Es gibt ERPs mit umfangreichen Lagerfunktionen und WMS-Produkte mit Anbindungen an Auftrags- oder Einkaufsprozesse. Entscheidend ist daher nicht das Etikett auf dem Angebot, sondern die operative Tiefe. Ein ERP kann zehn Lagerplätze verwalten und trotzdem unpraktisch sein, wenn Mitarbeitende für jede Bewegung mehrere Masken öffnen oder Daten erst später nachtragen müssen.

Das ERP ist die kaufmännische Quelle

Wenn ein Auftrag fakturiert, eine Bestellung ausgelöst oder eine Materialbewertung erstellt werden soll, gehört das in vielen Unternehmen ins ERP. Dort liegt häufig die führende Artikel- und Kundenlogik. Diese Rolle sollte nicht leichtfertig doppelt aufgebaut werden. Zwei voneinander unabhängige Systeme für Preise, Artikelnummern oder Aufträge erzeugen keine Sicherheit, sondern Abstimmungsaufwand.

Ein ERP ist besonders sinnvoll, wenn die zentrale Herausforderung bereichsübergreifend ist: Einkauf und Fertigung müssen geplant werden, Finanzdaten müssen konsistent bleiben oder mehrere Gesellschaften arbeiten mit denselben Prozessen. Wer ein solches Fundament noch nicht hat, sollte nicht erwarten, dass eine reine Lagerlösung alle Unternehmensprozesse ersetzt.

Die Warehouse Software steuert die Bewegung

Im Lager zählt jedoch nicht nur, was theoretisch im System vorhanden ist. Es zählt, was gerade an Tor drei angekommen ist, welches Fach frei ist und ob die Ware für einen bestätigten Auftrag reserviert wurde. Eine gute Lagerlösung reduziert genau an diesen Punkten Reibung.

Das kann mit mobilen Scannern beginnen: Ware wird beim Wareneingang gescannt, einem Lagerplatz zugeordnet und unmittelbar als verfügbar gemeldet. Bei der Kommissionierung führt das System durch eine sinnvolle Reihenfolge, prüft Artikel und Menge und erzeugt bei Bedarf Versandlabel oder Lieferdokumente. Die Buchung passiert nicht Stunden später am Büroarbeitsplatz, sondern im Ablauf selbst.

Der Nutzen liegt nicht nur in Geschwindigkeit. Nachvollziehbare Buchungen machen Fehler sichtbar. Wenn ein Bestand nicht stimmt, lässt sich feststellen, wann eine Bewegung fehlte oder falsch bestätigt wurde. Das ist deutlich belastbarer als eine monatliche Korrektur in einer Tabelle.

Wann ein ERP-Modul genügt

Ein vorhandenes ERP-Modul kann die richtige Wahl sein, wenn die Lagerorganisation überschaubar ist und das Team mit den Abläufen zuverlässig arbeiten kann. Ein einzelnes Lager, feste Plätze, wenige Auftragspositionen und keine strengen Chargen- oder Seriennummernanforderungen sind typische Bedingungen. Auch bei geringem Versandvolumen kann ein zusätzlicher Systembaustein mehr Pflege als Nutzen bringen.

Bevor ein neues System angeschafft wird, lohnt sich ein nüchterner Test: Kann ein Mitarbeitender einen Wareneingang, eine Umlagerung und einen Versand ohne Notizzettel vollständig buchen? Ist der Bestand pro Lagerplatz sichtbar? Lassen sich Differenzen einer Inventur nachvollziehen? Werden Dokumente ohne doppelte Eingabe erstellt? Wenn diese Antworten überwiegend ja lauten, ist ein Ausbau möglicherweise nicht dringend.

Auch die Tabellenkalkulation darf bleiben, wenn sie einen begrenzten Zweck sauber erfüllt, etwa für eine saisonale Kapazitätsplanung oder eine einmalige Auswertung. Eine gute Lösung ersetzt nicht jede bekannte Arbeitsweise. Sie ersetzt jene manuellen Schritte, bei denen Fehler, Wartezeit oder fehlende Transparenz tatsächlich Geld kosten.

Wann eine spezialisierte Lagerlösung sinnvoll wird

Der Wendepunkt kommt meist schrittweise. Erst fragt ein Mitarbeiter häufiger nach einem Artikel. Dann werden Bestände vorsichtshalber höher gehalten, weil niemand den verfügbaren Bestand sicher kennt. Schließlich verzögern sich Sendungen, weil Lieferscheine, Etiketten und Bestandskorrekturen über verschiedene Werkzeuge laufen.

Eine spezialisierte Warehouse Software ist besonders sinnvoll, wenn mehrere dieser Bedingungen zusammenkommen:

  • mehrere Lagerbereiche, Lagerplätze oder Außenlager verwaltet werden
  • Wareneingänge, Umlagerungen und Kommissionierungen täglich in hoher Zahl stattfinden
  • Chargen, Seriennummern, Mindesthaltbarkeiten oder Sperrbestände nachverfolgt werden müssen
  • Versanddienstleister, Etikettendrucker oder mobile Scanner in den Ablauf eingebunden werden sollen
  • die operative Realität häufiger von der Darstellung im ERP abweicht

Die Liste ist keine automatische Kaufempfehlung. Ein Betrieb mit vielen Positionen kann mit einem gut eingerichteten ERP arbeiten. Umgekehrt kann ein kleiner Betrieb früh eine schlanke Lageranwendung brauchen, wenn jedes Teil rückverfolgbar sein muss oder mehrere Teams gleichzeitig buchen.

Das Integrationsproblem entscheidet oft mehr als die Funktionen

Die schwierigste Frage bei Warehouse Software vs ERP lautet selten: Welches System kann mehr? Die bessere Frage lautet: Welche Daten müssen wann in welches System fließen?

In vielen Fällen bleibt das ERP führend für Artikel, Kunden, Aufträge und kaufmännische Belege. Die Lageranwendung übernimmt die operative Ausführung. Sie erhält freigegebene Aufträge, führt die Lagerbewegungen aus und meldet Status, Mengen, Chargen oder Sendungsnummern zurück. Dadurch bekommt jede Seite eine klare Aufgabe.

Diese Schnittstelle braucht konkrete Regeln. Was geschieht bei einer Auftragsänderung, nachdem die Kommissionierung begonnen hat? Darf ein Lagerbestand negativ werden? Welche Buchung gilt bei einem Netzwerkausfall? Wie werden Artikel gesperrt, die bei der Qualitätsprüfung auffallen? Ohne diese Entscheidungen wird auch eine technisch saubere API zur neuen Fehlerquelle.

Für kleine und mittlere Unternehmen ist ein schrittweiser Rollout häufig vernünftiger als ein Komplettwechsel. Zuerst kann der Wareneingang mit Barcode-Scans eingeführt werden. Danach folgen Lagerplätze und Umlagerungen, später Kommissionierung und Versand. So lassen sich reale Ausnahmen früh erkennen, ohne den Betrieb auf einen einzigen Umstellungstag zu setzen.

Standardprodukt, ERP-Ausbau oder passgenaue Anwendung?

Ein Standard-WMS lohnt sich, wenn die eigenen Prozesse weitgehend üblich sind und eine vorhandene Integration zum ERP passt. Es bringt erprobte Funktionen schnell in den Betrieb. Der Preis dafür kann sein, dass Teams ihre Abläufe an feste Vorgaben anpassen müssen oder für selten genutzte Enterprise-Funktionen mitbezahlen.

Ein ERP-Ausbau ist sinnvoll, wenn die notwendige operative Tiefe wirklich verfügbar ist und die Bedienung auf dem Hallenboden funktioniert. Prüfen sollte man nicht nur die Produktdemo, sondern einen echten Ablauf mit Scanner, Handschuhen, schwankendem WLAN und Zeitdruck vor der Abfahrt.

Eine passgenaue Anwendung wird interessant, wenn der Ablauf den Wettbewerbsvorteil des Unternehmens trägt oder Standardsoftware dauerhaft Umwege erzwingt. Das kann ein besonderer Wareneingangsprozess, eine Verbindung aus Werkstatt und Lager, spezielle Lieferscheine oder eine eigene Tourenlogik sein. Dann sollte die Lösung nicht künstlich groß werden. Ein klarer Prozess, sauber modelliert und mit einem wartbaren technischen Fundament umgesetzt, ist wertvoller als eine Plattform, die theoretisch alles kann.

softify.pro entwickelt solche Systeme entlang konkreter Bewegungen und Verantwortlichkeiten: vom Wareneingang über Lagerbuchungen bis zu Versanddokumenten. Dabei bleiben Datenmodell, Berechtigungen, Fehlerfälle und spätere Wartung Teil der Umsetzung - nicht Aufgaben für irgendwann nach dem Go-live.

Fragen, die vor der Entscheidung auf den Tisch gehören

Nicht jede Anforderung muss am ersten Tag automatisiert werden. Aber sie sollte bewusst entschieden sein. Verantwortliche sollten mit Lagerteam, Vertrieb und Buchhaltung klären, welche Daten führend sind, welche Fehler heute am häufigsten auftreten und welche Kennzahlen später wirklich gebraucht werden. Eine schöne Bestandsübersicht hilft wenig, wenn niemand weiß, ob reservierte, gesperrte und verfügbare Mengen unterschiedlich behandelt werden.

Ebenso wichtig ist die Verantwortung für Stammdaten. Lagerprozesse scheitern selten an einem fehlenden Button. Sie scheitern an uneinheitlichen Artikelnummern, nicht gepflegten Maßeinheiten und ungeklärten Regeln für Ersatzartikel oder Mengeneinheiten. Software kann diese Probleme sichtbar machen. Sie kann sie aber nicht ohne Entscheidungen aus dem Unternehmen lösen.

Die passende Wahl ist deshalb nicht automatisch ERP oder Warehouse Software. Sie entsteht aus dem Abstand zwischen Ihrem aktuellen Ablauf und dem Ablauf, den Ihr Team zuverlässig ausführen muss. Beginnen Sie bei einer Bewegung, die heute Zeit kostet oder Fehler erzeugt, und prüfen Sie, welches System diese Bewegung am klarsten, schnellsten und nachvollziehbarsten abbildet.

Permalink →

Wareneingang automatisieren ohne Prozesschaos

Wareneingang automatisieren ohne Prozesschaos

Ein Lkw steht am Tor, zwei Mitarbeitende prüfen Lieferscheine, und die Bestandsliste liegt noch auf dem Rechner im Büro. Genau an dieser Stelle beginnt die Frage, how to automate goods receiving, praktisch zu werden. Nicht, weil jedes Lager eine große ERP-Einführung braucht. Sondern weil ein fehlender, verspäteter oder falsch gebuchter Wareneingang Folgen hat: Bestände stimmen nicht, Aufträge warten, Reklamationen werden schwer nachvollziehbar und die Schicht beginnt mit Rückfragen.

Wareneingang zu automatisieren bedeutet nicht, Menschen durch Scanner zu ersetzen. Es bedeutet, wiederkehrende Prüfungen, Buchungen und Dokumente so zu führen, dass das Team am Tor schnell entscheiden kann und der Bestand danach verlässlich ist. Für kleine und mittlere Unternehmen ist ein schlanker, passender Ablauf meist wertvoller als ein Konzernsystem mit Funktionen, die niemand nutzt.

Was beim manuellen Wareneingang tatsächlich verloren geht

Papierlieferscheine und Excel-Listen funktionieren oft lange genug, um eine Investition aufzuschieben. Das Problem entsteht nicht beim einzelnen Karton. Es entsteht, wenn sich Abweichungen sammeln: Eine Teillieferung wird erst später notiert, eine Charge ist nicht zuordenbar, eine Palette landet im falschen Bereich oder eine Wareneingangsbuchung erfolgt erst am Tagesende.

Dann gibt es mehrere Wahrheiten gleichzeitig. Der Lieferant meldet geliefert. Im Lager steht Ware. Die Disposition sieht noch keinen verfügbaren Bestand. Die Buchhaltung hat einen Beleg, aber keine Bestätigung über Menge oder Schaden. Mitarbeitende gleichen diese Informationen per Telefon, E-Mail und Erfahrung ab. Das kostet Zeit und macht den Ablauf von einzelnen Personen abhängig.

Automatisierung schafft eine gemeinsame, zeitnahe Quelle für den Vorgang. Sie erfasst nicht nur den Sollbestand, sondern auch das, was tatsächlich am Tor passiert ist: wer angenommen hat, wann, in welcher Menge, mit welcher Abweichung und wohin die Ware weitergeht.

How to automate goods receiving mit einem klaren Ablauf

Der richtige Start ist nicht die Auswahl eines Scanners oder einer Lager-App. Zuerst muss der reale Prozess sichtbar werden. Gehen Sie einen typischen Wareneingang vom angekündigten Liefertermin bis zur Einlagerung durch. Beobachten Sie dabei auch Sonderfälle, denn sie bestimmen, ob eine Lösung im Alltag trägt.

Ein digitaler Ablauf besteht meist aus fünf aufeinanderfolgenden Entscheidungen. Die Lieferung wird identifiziert, gegen Bestellung oder erwartete Anlieferung geprüft, die tatsächliche Menge erfasst, Abweichungen dokumentiert und die Ware einem Lagerplatz oder einem weiteren Prüfschritt zugewiesen. Jeder Schritt sollte nur die Daten verlangen, die an diesem Punkt nötig sind.

1. Erwartete Lieferungen vorab bereitstellen

Wenn Einkaufsbestellungen, Produktionsaufträge oder Lieferavis vorhanden sind, sollte das Lager sie vor der Ankunft sehen können. Beim Eintreffen wählt die verantwortliche Person den Lieferanten, scannt eine Bestellnummer oder sucht nach einer offenen Lieferung. Das System zeigt erwartete Artikel, Mengen und gegebenenfalls Chargen- oder Seriennummern.

Das verkürzt die Annahme deutlich. Noch wichtiger ist aber die Prüflogik: Das Team muss nicht aus dem Gedächtnis entscheiden, ob 18 statt 20 Kartons akzeptabel sind. Die Abweichung wird sichtbar und kann mit einem Grund versehen werden. Bei nicht angekündigten Lieferungen braucht der Ablauf einen kontrollierten Weg, etwa als vorläufigen Wareneingang mit Freigabe durch Einkauf oder Disposition.

2. Barcodes dort einsetzen, wo sie Zeit sparen

Barcode-Scanner oder die Kamera eines robusten Mobilgeräts sind für viele Lager der sinnvollste Einstieg. Ein Scan reduziert Tippfehler und beschleunigt wiederkehrende Bewegungen. Voraussetzung ist allerdings, dass Artikelnummern, Verpackungseinheiten und Etiketten konsistent gepflegt sind. Ein Scanner löst keine unklaren Stammdaten.

Nicht jede Ware braucht eine Seriennummernverfolgung. Bei Schrauben oder Standardverbrauchsmaterial genügt oft Artikel, Menge und Lagerplatz. Bei Ersatzteilen mit Garantie, regulierten Produkten oder Komponenten für die Fertigung können Charge, Seriennummer, Mindesthaltbarkeit und Prüfstatus zwingend sein. Die Erfassungstiefe sollte zum Risiko passen, nicht zu einer allgemeinen Software-Vorlage.

3. Abweichungen als normalen Prozess behandeln

Ein guter digitaler Wareneingang versucht nicht, jede Abweichung zu verhindern. Er macht sie einfach und beweisbar behandelbar. Fehlmengen, Überlieferungen, Transportschäden, falsche Artikel und gesperrte Chargen benötigen klare Status statt handschriftlicher Notizen auf dem Lieferschein.

Bei einer beschädigten Lieferung kann beispielsweise ein Foto direkt am Annahmeplatz erfasst, die Menge als gesperrt gebucht und der Einkauf automatisch informiert werden. Der verfügbare Bestand bleibt korrekt, während die Ware physisch in eine Quarantänezone geht. Das verhindert, dass beschädigte Teile versehentlich kommissioniert oder in der Produktion verwendet werden.

Die Regel muss nicht immer vollautomatisch sein. Für geringe Mengen kann eine Überlieferung direkt akzeptiert werden. Bei teuren oder sicherheitsrelevanten Artikeln sollte eine Freigabe erforderlich sein. Diese Schwellenwerte gehören in den Prozess und müssen später anpassbar bleiben.

4. Einlagerung unmittelbar auslösen

Eine Annahme ist erst dann operativ vollständig, wenn klar ist, wo die Ware liegt oder warum sie noch nicht eingelagert werden darf. Das System kann einen festen Lagerplatz vorschlagen, eine Nachschubzone bevorzugen oder anhand von Artikelgruppe, Temperaturbereich und verfügbarer Kapazität einen Zielbereich bestimmen.

Für überschaubare Lager reicht oft eine klare Platzlogik mit wenigen Zonen. Komplexe Wegoptimierung ist nur sinnvoll, wenn Volumen, Laufwege und Personalstruktur sie rechtfertigen. Wer zehn Paletten am Tag empfängt, braucht kein Optimierungsprojekt, das länger dauert als die eingesparte Laufzeit. Ein belastbarer Lagerplatzscan ist häufig der größere Fortschritt.

Nach der Einlagerung aktualisiert das System Bestand und Bewegungsprotokoll. Vertrieb, Disposition oder Produktion sehen dadurch den Status ohne Rückfrage im Lager. Falls der Artikel erst nach einer Qualitätsprüfung verfügbar sein darf, trennt das System physischen Bestand von verfügbarem Bestand.

Welche Daten der Wareneingang wirklich braucht

Ein digitaler Prozess wird schnell unbeliebt, wenn er am Tor zu viele Felder abfragt. Gleichzeitig fehlen ohne Mindestdaten die Nachweise für spätere Klärungen. In den meisten mittelständischen Betrieben sind diese Informationen sinnvoll:

  • Lieferant und Referenz zur Bestellung oder zum Lieferschein
  • Artikel, angenommene Menge und Verpackungseinheit
  • Zeitpunkt sowie verantwortliche Person
  • Lagerplatz oder Status wie Prüfung, Sperrlager oder Quarantäne
  • Abweichungsgrund, Fotos und Freigabe bei Bedarf

Zusätzliche Felder sollten nur dann Pflicht sein, wenn sie eine konkrete Entscheidung ermöglichen. Bei Chargenpflicht ist die Chargennummer kein Zusatz, sondern Kerninformation. Eine freie Bemerkung zu jeder Lieferung dagegen wird häufig nur ausgefüllt, damit ein Formular vollständig wirkt.

Integration entscheidet über Nutzen und Aufwand

Der Wareneingang darf nicht als neue Insellösung neben Einkauf, Produktion und Buchhaltung entstehen. Mindestens Artikelstammdaten, offene Bestellungen und Bestandsänderungen müssen zuverlässig ausgetauscht werden. Ob dies über eine bestehende ERP-Schnittstelle, Datenimporte oder einen gezielt entwickelten Zwischenprozess geschieht, hängt von der vorhandenen Systemlandschaft ab.

Bei älteren ERP-Systemen ist eine vollständige Echtzeitintegration nicht immer wirtschaftlich. Ein geprüfter Import in festen Intervallen kann völlig ausreichend sein, wenn Mengen und Fristen dazu passen. Für Ersatzteile, die sofort für dringende Aufträge disponiert werden, ist dagegen eine zeitnahe Buchung wichtiger. Technik folgt hier dem Geschäftstakt.

Auch die Betriebsfähigkeit gehört zur Planung. Geräte brauchen Benutzerkonten, klare Rollen und einen Ablauf bei Netzwerkausfall. Ein mobiler Wareneingang muss nicht zwangsläufig offline arbeiten können. Wenn WLAN-Ausfälle aber regelmäßig vorkommen, ist ein lokaler Zwischenspeicher mit nachvollziehbarer Synchronisation kein Luxus, sondern Teil der Prozesssicherheit.

Einführung in kleinen Schritten statt Big Bang

Beginnen Sie mit einem Lieferanten, einer Warengruppe oder einem klar abgegrenzten Lagerbereich. Messen Sie nicht nur die Dauer pro Buchung, sondern auch Nacharbeit, ungeklärte Differenzen und Rückfragen zwischen Lager und Büro. Daraus wird sichtbar, ob die Automatisierung wirklich entlastet.

Schulen Sie mit echten Lieferscheinen aus dem Alltag, einschließlich beschädigter oder unvollständiger Lieferungen. Ein Prozess, der nur bei vollständiger Soll-Lieferung funktioniert, ist keine Automatisierung, sondern eine Vorführung. Die Mitarbeitenden am Wareneingang sollten Regeln mitgestalten können, weil sie die Ausnahmefälle kennen.

softify.pro entwickelt solche Abläufe bewusst workflow-spezifisch: vom mobilen Scan bis zur dokumentierten Bestandsbewegung und stabilen Anbindung an bestehende Systeme. Entscheidend ist dabei nicht die größte Funktionsliste, sondern ein System, das unter Zeitdruck nachvollziehbar bleibt und technisch wartbar betrieben werden kann.

Der beste nächste Schritt ist deshalb kein Softwarevergleich, sondern ein einstündiger Blick auf die letzten zehn problematischen Anlieferungen. Wenn Sie für jede davon sagen können, wo Zeit verloren ging und welche Information fehlte, ist der erste Entwurf für einen besseren Wareneingang bereits vorhanden.

Permalink →

Vorteile barcodegestützter Kommissionierung

Vorteile barcodegestützter Kommissionierung

Ein falscher Artikel im Karton kostet selten nur den Preis der Rücksendung. Er bindet Zeit im Lager, erzeugt Rückfragen im Büro und beschädigt im schlechtesten Fall eine Kundenbeziehung. Die Vorteile barcodegestützter Kommissionierung zeigen sich deshalb nicht zuerst in einer technischen Kennzahl, sondern an einem ruhigeren Warenausgang: Mitarbeitende wissen, was als Nächstes zu tun ist, und Abweichungen fallen dort auf, wo sie entstehen.

Für kleine und mittlere Lager ist das besonders relevant. Viele Abläufe funktionieren zunächst mit Papierlisten, Excel-Dateien, Zurufen und Erfahrungswissen einzelner Personen. Das ist nicht grundsätzlich falsch. Bei überschaubarem Volumen kann eine Tabelle sogar das sinnvollere Werkzeug sein. Steigen jedoch Artikelvielfalt, Auftragszahl, Schichtwechsel oder Anforderungen an die Rückverfolgbarkeit, wird aus dem pragmatischen Provisorium schnell eine Fehlerquelle.

Was barcodegestützte Kommissionierung im Alltag verändert

Bei der barcodegestützten Kommissionierung bestätigt ein Scan nicht bloß, dass jemand etwas getan hat. Er verbindet Auftrag, Lagerplatz, Artikel und Menge in einem nachvollziehbaren Arbeitsschritt. Das System gibt den nächsten Pick vor, der Mitarbeitende scannt Lagerplatz und Artikel, trägt bei Bedarf die Menge ein und erhält sofort eine Rückmeldung.

Entscheidend ist die Reihenfolge der Prüfung. Scannt ein Mitarbeiter zuerst einen Artikel und erst danach den Lagerplatz, kann das System zwar einen falschen Artikel erkennen, aber eine ungünstige Wegeführung nicht verhindern. In der Praxis bewährt sich häufig die Abfolge Lagerplatz, Artikel, Menge. Bei Chargen-, Seriennummern- oder Mindesthaltbarkeitsprozessen kommen weitere Prüfungen hinzu. Welche davon erforderlich sind, hängt vom Risiko ab, nicht davon, was technisch möglich wäre.

Ein gutes System ersetzt keine sinnvolle Lagerordnung. Es macht jedoch sichtbar, wenn die Ordnung im Tagesgeschäft nicht eingehalten wird. Liegt Ware auf einem nicht vorgesehenen Platz, wird der Fehler nicht erst bei der Inventur entdeckt, sondern beim Scan.

Die wichtigsten Vorteile barcodegestützter Kommissionierung: Weniger Verwechslungen direkt am Entstehungsort

Papierlisten verlangen dauernde Konzentration: Artikelnummer lesen, Fach finden, Verpackung vergleichen, Menge abhaken. Unter Zeitdruck reichen ähnliche Kartons, fast identische Bezeichnungen oder ein unterbrochener Arbeitsgang, um einen Fehler zu verursachen. Der Barcode bringt eine eindeutige Identifikation in diesen Moment.

Der Scanner ersetzt dabei nicht das Denken, aber er übernimmt die Kontrolle, die Menschen bei Routinearbeit am schwersten dauerhaft leisten können. Passt der Artikel nicht zum Auftrag, sollte die Rückmeldung klar sein: falscher Artikel, erwarteter Artikel, nächster sinnvoller Schritt. Ein bloßes rotes Warnsignal hilft wenig, wenn nicht erkennbar ist, wie die Abweichung behoben wird.

Bestände werden durch Buchungen belastbarer

Bestände sind nur dann nützlich, wenn sie Entscheidungen tragen. Wer Nachbestellungen plant, Liefertermine zusagt oder Produktionsmaterial bereitstellt, braucht mehr als eine Zahl aus der vergangenen Woche. Wenn Entnahmen erst am Schichtende oder nachträglich aus einer Liste übertragen werden, entstehen Zeitfenster mit unklarer Datenlage.

Ein Scan kann die Entnahme unmittelbar buchen. Damit sinkt die Differenz zwischen physischer Bewegung und digitalem Bestand. Das heißt nicht, dass jede Zahl automatisch korrekt ist. Falsch etikettierte Ware, ungebuchte Umlagerungen und beschädigte Bestände bleiben reale Themen. Aber Ursachen lassen sich deutlich besser eingrenzen, weil jede Bewegung einen Zeitpunkt, einen Auftrag und gegebenenfalls einen Nutzerbezug hat.

Besonders hilfreich ist das bei Nachschubprozessen. Unterschreitet ein Fach seinen Sollbestand, kann das System einen Nachschubauftrag erzeugen oder zumindest sichtbar machen. Kommissionierende suchen dann nicht erst während des Auftrags nach Ersatzware, während der Kunde auf seine Sendung wartet.

Schnellere Einarbeitung ohne Abhängigkeit von Einzelwissen

Erfahrene Lagerkräfte kennen Wege, Sonderfälle und Artikelbilder aus dem Kopf. Dieses Wissen ist wertvoll, aber als einziges Betriebssystem riskant. Bei Urlaub, Krankheit oder Wachstum geraten Teams unter Druck, wenn neue Mitarbeitende erst über Wochen lernen müssen, welche Regalreihe mit einer internen Abkürzung gemeint ist.

Eine gute mobile Oberfläche führt durch den Auftrag in einer verständlichen Sprache. Sie zeigt Lagerplatz, Artikel, Sollmenge und bei Bedarf ein Bild oder Hinweise zur Verpackung. Der Scan bestätigt den Schritt. Neue Kolleginnen und Kollegen werden dadurch nicht sofort zu Fachleuten, können aber früher sicher mitarbeiten.

Das gilt auch für Aushilfen und wechselnde Schichten. Voraussetzung ist, dass Stammdaten gepflegt sind. Ein System kann keine klare Anleitung aus einer Artikelbezeichnung wie „Teil klein blau neu“ ableiten. Die Digitalisierung legt solche Schwächen offen - und genau das ist oft ein nützlicher Nebeneffekt.

Nachvollziehbarkeit bei Reklamationen und Inventuren

Wenn ein Kunde eine Fehlmenge meldet, beginnt ohne Prozessdaten oft eine Suche durch Papierstapel, Versandlisten und Erinnerungen. Mit barcodegestützten Buchungen lässt sich prüfen, welcher Auftrag wann bearbeitet wurde, welche Position bestätigt wurde und ob es eine Korrektur oder Teilmenge gab.

Das ist keine Garantie gegen Reklamationen. Es verkürzt aber die Klärung und trennt Vermutungen von Fakten. Auch Inventuren profitieren: Differenzen können nicht nur gezählt, sondern anhand von Bewegungen untersucht werden. Häufen sich Korrekturen an einem bestimmten Fach, einer Artikelgruppe oder nach einer bestimmten Prozessübergabe, entsteht ein konkreter Ansatzpunkt für Verbesserungen.

Messbare Abläufe statt Bauchgefühl

Viele Lager wissen, dass es „am Nachmittag eng wird“ oder dass bestimmte Aufträge ungewöhnlich lange dauern. Ohne Zeitstempel und Prozessschritte bleibt das Bauchgefühl. Werden Pickstart, Scan, Unterbrechung, Abschluss und Übergabe erfasst, lassen sich Engpässe sauber unterscheiden.

Vielleicht ist nicht die Kommissionierung langsam, sondern Ware wird zu spät eingelagert. Vielleicht entstehen Wartezeiten am Packplatz oder ein einzelnes Fach wird überproportional häufig angelaufen. Diese Daten sollten nicht als Werkzeug zur pauschalen Leistungskontrolle missverstanden werden. Ihr Wert liegt zuerst darin, unnötige Wege, fehlende Nachschübe und unklare Übergaben zu erkennen.

Der Nutzen hängt von der Prozessgestaltung ab

Barcodegestützte Kommissionierung ist kein Selbstzweck und nicht jedes Lager braucht eine umfassende Lagerverwaltungssoftware. Bei wenigen Aufträgen, einem kleinen Sortiment und festen Mitarbeitenden kann ein sauber geführter Prozess mit einfachen Listen wirtschaftlicher sein. Ein Projekt ist sinnvoll, wenn die Kosten von Fehlgriffen, Suchzeiten, Bestandsunsicherheit oder manueller Nacharbeit regelmäßig spürbar werden.

Auch die Hardwarefrage verdient eine nüchterne Betrachtung. Ein Smartphone mit Kamerascan kann für erste Prozesse ausreichen. Bei hoher Scanfrequenz, Handschuhen, schlechten Lichtverhältnissen oder rauer Umgebung sind spezialisierte Handscanner meist schneller und weniger fehleranfällig. Entscheidend ist zudem die Netzabdeckung. Fällt WLAN in einer Lagerzone aus, braucht die Anwendung eine klare Strategie: Offline-Pufferung mit späterer Synchronisierung oder einen Prozess, der den Bereich nicht mobil bearbeitet.

Die Etikettenqualität ist ebenso wichtig wie die Software. Ein Barcode auf einem abgeriebenen Fachschild oder eine doppelt vergebene Artikelkennung unterläuft den gesamten Ablauf. Vor dem Start sollten Lagerplätze eindeutig beschriftet, Einheiten definiert und kritische Sonderfälle geklärt werden: Wie wird eine angebrochene Verpackung behandelt? Was passiert bei Fehlbestand? Wer darf eine Menge korrigieren? Was geschieht mit Ware ohne lesbaren Code?

So gelingt die Einführung ohne Betriebsunterbrechung

Der verlässlichste Einstieg ist selten die Komplettumstellung. Beginnen Sie mit einem abgegrenzten Bereich, etwa den häufigsten Versandaufträgen oder einer Artikelgruppe mit vielen Verwechslungen. Dort lassen sich Scanabfolge, Fehlermeldungen und Etiketten im echten Betrieb prüfen, ohne den gesamten Standort gleichzeitig umzubauen.

Vor der technischen Umsetzung sollte der reale Weg eines Auftrags aufgenommen werden - vom Auftragseingang über Reservierung und Pick bis zum Packplatz und Versandlabel. Nicht der Sollprozess aus einem Organigramm zählt, sondern der Ablauf, den die Schicht tatsächlich nutzt. Oft liegen die wertvollsten Anforderungen in kleinen Ausnahmen: Sammelaufträge, Ersatzartikel, Teilkommissionierungen oder die Rückgabe nicht benötigter Ware.

Danach braucht es eindeutige Regeln für Ausnahmen. Ein Mitarbeitender muss einen Fehlbestand melden können, ohne den Auftrag informell zu umgehen. Eine autorisierte Person muss Korrekturen nachvollziehbar durchführen können. Und wenn Schnittstellen zu Shop, ERP oder Versanddienstleister bestehen, sollten Auftragsstatus und Bestandsbuchungen klar definiert sein. Doppelte Datenpflege ist ein Warnsignal, keine dauerhafte Lösung.

Für kundenspezifische Systeme setzt softify.pro an diesem Punkt an: Nicht mit einem überladenen Enterprise-Paket, sondern mit den Scan- und Buchungsschritten, die für den konkreten Lagerbetrieb nachweisbar nötig sind. Eine wartbare Datenbasis, klar dokumentierte Schnittstellen und verständliche Bedienoberflächen sind dabei wertvoller als eine lange Liste selten genutzter Funktionen.

Ein sinnvoller erster Prüfpunkt

Nehmen Sie zehn typische Aufträge und verfolgen Sie sie vom Eingang bis zur Versandübergabe. Notieren Sie, an welchen Stellen Mitarbeitende suchen, nachfragen, Daten später nachtragen oder sich auf Erinnerung verlassen müssen. Genau dort entscheidet sich, ob Barcodegestützte Kommissionierung Vorteile bringt - und welcher Scanprozess wirklich zum Lager passt.

Permalink →

Selbst gehostetes Testing vs Cloud

Selbst gehostetes Testing vs Cloud

Ein fehlgeschlagener Regressionstest ist selten nur ein roter Eintrag im Dashboard. Er kann bedeuten, dass eine Versandmaske im Lager falsche Etiketten erzeugt, ein Kundenportal keine Aufträge annimmt oder eine Windows-Anwendung bei der Schichtübergabe abstürzt. Bei der Frage self hosted testing vs cloud geht es deshalb nicht um Infrastruktur als Selbstzweck. Es geht darum, welche Daten ein Testprozess berührt, wer ihn kontrolliert und wie verlässlich er unter realen Betriebsbedingungen läuft.

Cloudbasierte Testplattformen können schnell einsatzbereit sein. Für viele Teams ist das sinnvoll, besonders wenn sie eine öffentliche Webanwendung testen und kurzfristig zusätzliche Ausführungskapazität brauchen. Selbst gehostete Testumgebungen verlangen dagegen einen bewussten technischen Aufbau. Sie geben aber Kontrolle über Testdaten, Netzwerkwege, Zugriffsrechte und den Betrieb zurück an das Unternehmen. Die richtige Wahl hängt nicht von einem allgemeinen Prinzip ab, sondern von Anwendung, Risiko und vorhandener Betriebsfähigkeit.

Self Hosted Testing vs Cloud: Worum es wirklich geht

Die Debatte wird oft zu stark auf die Anfangskosten reduziert. Eine Cloud-Lösung wirkt günstiger, weil keine Server beschafft und keine Umgebung eingerichtet werden muss. Ein eigener Testserver wirkt auf den ersten Blick aufwendiger, weil Betriebssystem, Aktualisierungen, Zugriffssteuerung, Monitoring und Sicherung geplant werden müssen.

Diese Rechnung greift zu kurz. Entscheidend sind die laufenden Kosten einer Teststrategie: Wartezeiten vor Releases, Fehlersuche nach unvollständigen Testläufen, Abstimmungen mit Datenschutz und Informationssicherheit sowie die Folgen eines fehlerhaften Deployments. Wenn ein Team regelmäßig sensible Fachanwendungen prüft, kann der zusätzliche organisatorische Aufwand externer Dienste größer sein als der Betrieb einer klar abgegrenzten eigenen Umgebung.

Auch „Cloud" ist kein einheitliches Modell. Manche Anbieter speichern lediglich Testprotokolle, andere verarbeiten Screenshots, Videoaufzeichnungen, Zugangsdaten, DOM-Inhalte oder Netzwerkverkehr. Bei KI-gestütztem Testing können zusätzlich Bild- und Textdaten zur Bewertung an externe Modelle oder Unterauftragnehmer gelangen. Wer nur auf den Standort eines Rechenzentrums schaut, übersieht oft die wichtigere Frage: Welche Daten verlassen die eigene Kontrollzone tatsächlich und welche Vertrags- und Löschregeln gelten dafür?

Wenn Cloud-Testing die vernünftige Wahl ist

Cloud-Testing ist nicht grundsätzlich ein Sicherheitsproblem und Selbsthosting nicht automatisch die bessere Architektur. Für einen neuen, öffentlich erreichbaren Webshop oder eine Marketingplattform kann eine Cloud-Umgebung sehr passend sein. Das Team kann Browser- und Gerätevarianten schnell abdecken, ohne eigene Ausführungsmaschinen vorzuhalten. Bei schwankender Testlast ist die elastische Skalierung ebenfalls ein realer Vorteil.

Auch kleine Entwicklungsteams mit wenigen, klar anonymisierten Testdaten profitieren häufig von einem Managed Service. Sie sollten ihre Zeit nicht in den Betrieb einer Plattform investieren, wenn der Engpass vielmehr bei fehlenden Testfällen, unklaren Akzeptanzkriterien oder instabilen Testdaten liegt. Ein eigener Server löst diese Probleme nicht.

Die Cloud passt besonders gut, wenn die Anwendung keine internen Netzwerkzugriffe benötigt, keine personenbezogenen oder geschäftskritischen Daten in den Testabläufen vorkommen und kurze Vorlaufzeit wichtiger ist als tiefe Infrastrukturkontrolle. Voraussetzung ist eine sorgfältige Konfiguration: separate Testkonten, keine echten Kundendaten, eingeschränkte Tokens, nachvollziehbare Aufbewahrungsfristen und ein klares Rechtekonzept.

Wann selbst gehostetes Testing sinnvoller wird

Anders sieht es bei Anwendungen aus, die nur im Unternehmensnetz erreichbar sind oder operative Kernprozesse abbilden. Eine Lager- oder Produktionssoftware verarbeitet häufig Artikelbewegungen, Lieferadressen, Bestände, Seriennummern und Preislogik. Ein Testdurchlauf kann dabei Screenshots von Auftragsmasken erzeugen, Belege herunterladen oder sich mit Benutzerrollen anmelden. Solche Daten sollten nicht unbemerkt über mehrere externe Systeme verteilt werden.

Selbst gehostetes Testing erlaubt, die Testausführung nahe an der Anwendung zu platzieren. Der Testserver kann im gleichen Netzwerksegment oder in einer kontrollierten DMZ laufen. Firewall-Regeln werden gezielt gesetzt, interne Anwendungen müssen nicht für einen externen Dienst geöffnet werden, und Protokolle bleiben unter eigener Verwaltung. Das ist für Windows-Desktop-Anwendungen oft besonders relevant, da diese selten für externe Testplattformen konzipiert sind.

Für regulierte Branchen, größere Kundenanforderungen oder interne Sicherheitsvorgaben ist diese Architektur häufig leichter prüfbar. Das bedeutet nicht, dass jede Prüfung automatisch bestanden ist. Auch ein eigener Server braucht Patch-Management, Verschlüsselung, Rollenrechte, Backups und dokumentierte Betriebsabläufe. Der Unterschied liegt darin, dass das Unternehmen diese Entscheidungen selbst trifft und nachweisen kann.

Bei softify.pro ist COCO deshalb als dedizierter, selbst gehosteter KI-Server gedacht: Testläufe für Web- und Windows-Anwendungen werden lokal ausgeführt, Belege aufgezeichnet und Ergebnisse in verständlicher Sprache bewertet. Das ersetzt keine fachliche Freigabe. Es sorgt aber dafür, dass Testverkehr, Screenshots und Auswertungen dort bleiben können, wo das Unternehmen die Datenhoheit behält.

Kosten richtig vergleichen: Betrieb gegen Reibung

Ein sinnvoller Vergleich umfasst mehr als Lizenzpreis gegen Hardwarepreis. In der Cloud entstehen wiederkehrende Gebühren nach Nutzern, Testminuten, parallelen Ausführungen oder KI-Verbrauch. Diese Kosten sind anfangs planbar, können aber mit wachsender Testabdeckung deutlich steigen. Hinzu kommen mögliche Aufwände für Enterprise-Verträge, Datenverarbeitungsvereinbarungen und Sicherheitsprüfungen.

Beim Selbsthosting fallen Investitionen für Infrastruktur und Einrichtung an. Dazu gehören gegebenenfalls virtuelle Maschinen, Speicher, Netzwerkzugang, Monitoring und die Zeit eines technisch verantwortlichen Teams. Diese Kosten bleiben auch dann bestehen, wenn wenige Tests laufen. Für ein Projekt mit seltenen Releases ist das ein gutes Argument gegen eine überdimensionierte Eigenlösung.

Bei regelmäßigen Regressionstests verschiebt sich das Bild. Wenn jede Woche dieselben geschäftskritischen Abläufe geprüft werden müssen, sind berechenbare interne Kapazitäten oft wirtschaftlicher als variable Plattformkosten und manuelle Freigabeschleifen. Besonders wertvoll wird der Ansatz, wenn Testfälle über Jahre genutzt und mit der Fachanwendung weiterentwickelt werden. Wartbarkeit ist dann wichtiger als ein schneller, aber schwer kontrollierbarer Start.

Qualität hängt nicht am Hosting-Modell

Ein häufiger Irrtum lautet: Cloud-Tests seien automatisch moderner, selbst gehostete Tests automatisch stabiler. Beides stimmt nicht. Testqualität entsteht durch sinnvolle Szenarien, belastbare Testdaten, stabile Identifikatoren in der Oberfläche und klare Erwartungen an das Ergebnis.

Ein Test sollte nicht nur prüfen, ob ein Button anklickbar ist. Für eine Auftragsabwicklung kann er beispielsweise einen Auftrag anlegen, eine verfügbare Menge prüfen, einen Lieferschein erzeugen und sicherstellen, dass die richtige Rolle den Vorgang freigeben darf. Bei einem Desktop-Programm kann er den Import einer Datei, die Fehlerbehandlung und die Ausgabe eines Dokuments nachvollziehen. Erst solche End-to-End-Abläufe zeigen, ob eine Änderung den realen Prozess beschädigt.

KI kann dabei helfen, Oberflächenänderungen zu erkennen, Schritte verständlich zu dokumentieren und Auffälligkeiten zu priorisieren. Sie sollte jedoch nicht zur Black Box werden. Teams brauchen Screenshots oder andere Belege, nachvollziehbare Testschritte und definierte Schwellenwerte dafür, wann ein Ergebnis als bestanden, unsicher oder fehlgeschlagen gilt. Gerade bei visuellen Prüfungen ist ein Confidence-Threshold sinnvoll, damit kleine, erwartete Layoutabweichungen nicht jeden Release blockieren.

Die Betriebsfragen vor der Entscheidung

Bevor ein Team sich festlegt, sollte es den Weg eines Testlaufs konkret aufzeichnen. Wo läuft der Test? Welche Systeme meldet er an? Welche Daten sieht er? Wo werden Screenshots, Logs und Reports gespeichert? Wer darf Ergebnisse lesen, löschen oder exportieren? Diese Fragen sind praktischer als eine pauschale Entscheidung für oder gegen die Cloud.

Ebenso wichtig ist die Verantwortlichkeit nach dem Go-live. Wer aktualisiert Browser und Testagenten? Wer reagiert, wenn ein Zertifikat abläuft? Wie werden Zugangsdaten rotiert? Und wie wird sichergestellt, dass ein Test nicht versehentlich eine echte Versandbuchung oder Kundenbenachrichtigung auslöst? Gute Testautomatisierung benötigt getrennte Umgebungen und Schutzmechanismen, nicht nur gute Skripte.

Ein hybrides Modell kann sinnvoll sein. Öffentliche Oberflächen und breit gestreute Browserprüfungen laufen in der Cloud, während interne Fachprozesse auf einem eigenen Testserver verbleiben. Das reduziert Betriebsaufwand, ohne sensible Abläufe pauschal nach außen zu geben. Voraussetzung ist eine klare Grenze zwischen beiden Bereichen, nicht ein unübersichtlicher Mischbetrieb.

Die beste Entscheidung ist die, die zum tatsächlichen Risiko und zur eigenen Betriebsrealität passt. Wenn ein Spreadsheet einen Prozess noch zuverlässig trägt, muss daraus kein großes System werden. Wenn Testdaten und interne Anwendungen dagegen zum geschäftlichen Kern gehören, ist Kontrolle kein Luxus, sondern eine sachliche Anforderung an verlässliche Software.

Permalink →

Inventory Management im Lager

Inventory Management im Lager

Ein fehlendes Teil fällt selten beim Zählen im Lager auf. Meist zeigt es sich erst, wenn ein Auftrag nicht gepackt werden kann, ein Monteur vor dem leeren Regal steht oder der Einkauf per Telefon nach einer Lieferzusage sucht. Gutes Inventory Management verhindert diese Überraschungen nicht mit mehr Tabellen, sondern mit einem verlässlichen Bild davon, was vorhanden ist, wo es liegt und was als Nächstes damit passiert.

Für kleine und mittlere Unternehmen ist das keine Frage eines möglichst großen ERP-Systems. Entscheidend ist, ob die Mitarbeitenden im Wareneingang, Lager und Versand mit wenigen klaren Schritten arbeiten können - auch unter Zeitdruck, über Schichtwechsel hinweg und dann, wenn eine Lieferung anders ausfällt als geplant.

Inventory Management beginnt mit Bewegungen, nicht mit Bestandslisten

Eine Bestandsliste ist eine Momentaufnahme. Sie kann korrekt sein und dennoch wenig helfen, wenn niemand nachvollziehen kann, warum sich eine Menge verändert hat. Ein belastbares System behandelt Bestände deshalb als Folge dokumentierter Bewegungen: Ware kommt an, wird geprüft, eingelagert, reserviert, kommissioniert, umgelagert, versendet oder korrigiert.

Jede Bewegung braucht einen eindeutigen Anlass, einen Zeitpunkt, eine verantwortliche Person und möglichst einen Bezug zu einem Vorgang. Das kann eine Bestellung, ein Kundenauftrag, ein Lieferschein oder ein Fertigungsauftrag sein. Damit wird aus der Zahl „24 Stück verfügbar" eine prüfbare Aussage: 30 Stück wurden eingebucht, vier sind für zwei Aufträge reserviert, und keine offene Umlagerung verfälscht den verfügbaren Bestand.

Diese Unterscheidung ist gerade bei knappen Teilen relevant. Physisch vorhanden, reserviert und frei verfügbar sind drei unterschiedliche Zustände. Werden sie vermischt, verspricht der Vertrieb Ware, die das Lager bereits für einen anderen Auftrag benötigt. Werden sie sauber geführt, kann ein Team früh entscheiden: nachbestellen, umpriorisieren oder dem Kunden realistisch Auskunft geben.

Wo manuelle Prozesse typischerweise brechen

Spreadsheets sind nicht grundsätzlich falsch. Für ein kleines Sortiment, einen Lagerort und wenige Bewegungen pro Woche können sie wirtschaftlicher sein als eine eigene Anwendung. Problematisch werden sie, sobald mehrere Personen gleichzeitig arbeiten oder Bestände aus mehreren Quellen aktualisiert werden.

Dann entstehen die bekannten Lücken: Der Wareneingang liegt als Papier auf dem Schreibtisch, die Excel-Datei wurde lokal geändert, eine Umlagerung wurde nur mündlich abgesprochen, und der Versand bucht erst nach Feierabend. Der Bestand ist nicht unbedingt falsch, aber er ist zeitlich versetzt und seine Herkunft unklar. Genau das macht ihn für operative Entscheidungen ungeeignet.

Auch die Organisationsstruktur spielt eine Rolle. Ein zentraler Standort braucht andere Abläufe als ein Betrieb mit Außenlagern, Servicefahrzeugen oder einer Produktion, die Material entnimmt. Wer diese Unterschiede mit einer einzigen Freitextspalte abbildet, verlagert die Logik in die Köpfe einzelner Mitarbeitender. Das funktioniert, bis diese Person Urlaub hat oder das Auftragsvolumen steigt.

Den Prozess vor der Software festlegen

Ein sinnvolles Projekt beginnt nicht mit der Frage, welcher Scanner gekauft wird oder welche Oberfläche modern aussieht. Zuerst muss klar sein, welche Entscheidungen das System unterstützen soll. Dafür reichen oft konkrete Beobachtungen aus dem Alltag: Wie wird Ware heute angenommen? Wann gilt sie als geprüft? Wer darf Bestände korrigieren? Was passiert bei beschädigter Ware? Und an welchem Punkt wird ein Auftrag verbindlich reserviert?

Aus diesen Antworten entstehen wenige, verbindliche Regeln. Beispielsweise darf Wareneingang erst nach einer Mengenprüfung eingebucht werden. Artikel ohne Lagerplatz dürfen nicht als einlagerbar erscheinen. Bestandskorrekturen erfordern einen Grundcode und bleiben in der Historie sichtbar. Versandte Ware wird nicht stillschweigend gelöscht, sondern über eine dokumentierte Ausbuchung dem Auftrag zugeordnet.

Das ist weniger spektakulär als eine große Digitalisierungsfolie, aber im Betrieb wesentlich wertvoller. Wenn die Regeln eindeutig sind, kann Software sie zuverlässig prüfen. Wenn sie unklar bleiben, beschleunigt jede neue Anwendung nur widersprüchliche Arbeitsschritte.

Stammdaten: klein anfangen, konsequent pflegen

Nicht jeder Artikel braucht zu Beginn zehn Klassifikationen. Eine brauchbare Grundlage besteht häufig aus Artikelnummer, Bezeichnung, Einheit, aktivem Lagerstatus und einem oder mehreren Lagerplätzen. Je nach Geschäft kommen Chargen, Seriennummern, Mindestbestände, Lieferantenartikelnummern oder Ablaufdaten hinzu.

Wichtig ist die Konsequenz, nicht die Menge der Felder. Zwei Artikelnummern für denselben physischen Artikel oder wechselnde Einheiten wie „Karton", „Packung" und „Stück" ohne Umrechnungsregel erzeugen spätere Fehler fast automatisch. Ein System kann solche Eingaben technisch erlauben. Es sollte sie dort begrenzen, wo sie den Ablauf gefährden.

Welche Funktionen im Lager wirklich helfen

Für viele mittelständische Lager ist ein klarer Kern wertvoller als ein überladener Funktionskatalog. Dieser Kern umfasst in der Regel vier Bereiche:

  • Wareneingang mit Bestellbezug, Mengenprüfung und Einlagerung
  • Lagerbewegungen zwischen definierten Plätzen und Bereichen
  • Auftragsreservierung, Kommissionierung und Versandbuchung
  • Inventur und Bestandskorrekturen mit nachvollziehbarer Historie

Ergänzend können Etikettendruck, Barcode-Scanning, Lieferscheine, Versandlabels oder eine Übergabe an Buchhaltung und Shop-Systeme viel Zeit sparen. Aber sie sollten auf einem sauberen Bewegungsmodell aufbauen. Ein schneller Etikettendruck bringt wenig, wenn der Artikel beim Scannen nicht eindeutig dem richtigen Lagerplatz oder Auftrag zugeordnet wird.

Bei der Bedienung zählt zudem die Umgebung. Ein Mitarbeitender mit Handschuhen am Wareneingang benötigt große, eindeutige Aktionen und möglichst wenig Texteingabe. Eine Disponentin am Arbeitsplatz braucht dagegen Filter, Suchfunktionen und eine Sicht auf offene Vorgänge. Beide Rollen dürfen dieselben Daten verwenden, aber sie brauchen nicht dieselbe Oberfläche.

Echtzeit heißt nicht: jede Zahl ist unkritisch

Viele Unternehmen wünschen sich Echtzeitbestände. Das ist sinnvoll, doch der Begriff wird oft zu grob verwendet. Ein Bestand kann unmittelbar nach jedem Scan aktualisiert werden und trotzdem falsch sein, wenn ein Prozess unvollständig bleibt. Wird Ware zwar gescannt, aber nicht geprüft, ist die Zahl technisch aktuell und operativ fragwürdig.

Deshalb braucht jedes System einen Umgang mit Ausnahmen. Differenzen im Wareneingang, beschädigte Verpackungen, Rücksendungen und nicht auffindbare Artikel sind keine Randfälle. Sie gehören zum Alltag. Gute Prozesse markieren sie sichtbar, statt Mitarbeitende zu improvisierten Nebenlisten zu zwingen.

Auch die Berechtigungen verdienen Aufmerksamkeit. Nicht jede Person sollte Artikelstammdaten ändern oder historische Buchungen korrigieren können. Ein praxistaugliches Rechtekonzept trennt Routinevorgänge von Eingriffen mit höherem Risiko. Das schützt nicht nur vor Fehlern, sondern erleichtert die Ursachenanalyse, wenn ein Bestand unerwartet abweicht.

Integration nur dort, wo sie den Ablauf verbessert

Inventory Management steht selten allein. Aufträge kommen möglicherweise aus einem Webshop, einer E-Mail-Erfassung, einer Branchenlösung oder direkt vom Vertrieb. Versanddienstleister benötigen Adressdaten und Gewichte. Die Buchhaltung erwartet Belege in einer bestimmten Form.

Eine Integration lohnt sich, wenn sie doppelte Erfassung beseitigt oder Fehlerquellen reduziert. Sie ist nicht automatisch sinnvoll, nur weil eine Schnittstelle verfügbar ist. Gerade bei gewachsenen Abläufen kann ein klarer Import mit Prüfung verlässlicher sein als eine dauerhafte Echtzeitkopplung, die unbemerkt fehlerhafte Daten überträgt.

Technisch sollte die Lösung nachvollziehbar bleiben: eindeutige Schnittstellen, protokollierte Übertragungen, verständliche Fehlermeldungen und eine Datenbankstruktur, die Änderungen nicht versteckt. Mit einer gepflegten Anwendung auf Basis von PHP 8.4 und MySQL 8 lassen sich solche Prozesse schlank umsetzen, ohne Teams in ein globales Konzernsystem zu zwingen. Entscheidend ist nicht der Technologiebegriff, sondern ob Wartung, Erweiterungen und Datenkorrekturen auch in drei Jahren noch kontrollierbar sind.

Einführung in kleinen, messbaren Schritten

Ein Big Bang ist im Lager selten die beste Wahl. Sicherer ist ein begrenzter Start, etwa mit Wareneingang und einem ausgewählten Lagerbereich. In dieser Phase lassen sich Scanzeiten, Fehlerarten, offene Sonderfälle und die Qualität der Stammdaten beobachten. Erst danach folgen Reservierung, Versand oder weitere Standorte.

Parallelbetrieb kann dabei sinnvoll sein, aber nur mit einem klaren Ende. Zwei führende Bestände über längere Zeit schaffen genau das Problem, das die neue Lösung beheben soll. Besser ist eine festgelegte Umstellung mit Inventur, bereinigten Stammdaten und Verantwortlichkeiten für die ersten Wochen.

Der Erfolg zeigt sich nicht daran, wie viele Funktionen aktiviert wurden. Er zeigt sich daran, ob weniger Rückfragen entstehen, ob Aufträge vollständiger gepackt werden und ob ein Team ohne detektivische Suche erklären kann, warum ein Artikelbestand so aussieht, wie er aussieht.

Wenn der aktuelle Prozess mit einer gut gepflegten Tabelle tatsächlich stabil funktioniert, sollte er bleiben dürfen. Wenn aber Informationen zwischen Papier, Telefonaten und mehreren Dateien verloren gehen, ist der nächste sinnvolle Schritt kein größeres Werkzeug, sondern ein klarer Ablauf, der jede wichtige Lagerbewegung sichtbar macht.

Permalink →

Sind selbst gehostete Tests sicher?

Sind selbst gehostete Tests sicher?

Ein fehlgeschlagener Regressionstest ist ärgerlich. Ein Screenshot aus einem internen ERP-System, der unkontrolliert bei einem externen Dienst landet, ist ein Sicherheitsvorfall. Genau deshalb stellen sich QA-Leads und IT-Verantwortliche die Frage: are self hosted tests secure? Die ehrliche Antwort lautet: Sie können deutlich sicherer sein als cloudbasierte Alternativen, aber nur, wenn der Betrieb genauso ernst genommen wird wie die Tests selbst.

Selbst gehostete Testautomatisierung verlagert die Kontrolle über Ausführung, Testdaten, Screenshots, Protokolle und Zugriffsrechte in die eigene Infrastruktur. Das reduziert Abhängigkeiten und unnötige Datenwege. Es ersetzt jedoch keine Sicherheitsarchitektur. Ein schlecht gepflegter interner Testserver bleibt ein schlecht gepflegter Server.

Sind self-hosted Tests sicherer als Cloud-Tests?

Der entscheidende Unterschied liegt nicht darin, ob ein Test lokal oder automatisiert läuft. Er liegt darin, wo Daten verarbeitet werden, wer darauf zugreifen kann und welche technischen Grenzen gelten.

Bei einem extern betriebenen Testing-Service verlassen häufig mehrere Artefakte das Unternehmen: Zugangsdaten für Testkonten, URLs interner Anwendungen, DOM-Inhalte, Screenshots, Videos von Testläufen, Fehlerprotokolle und gegebenenfalls Datenbankauszüge. Auch wenn ein Anbieter hohe Sicherheitsstandards erfüllt, entsteht eine zusätzliche Vertrauens- und Vertragsbeziehung. Für Anwendungen mit Kunden-, Personal-, Produktions- oder Finanzdaten kann das eine relevante Hürde sein.

Ein selbst gehostetes System kann innerhalb des eigenen Netzwerks oder einer klar abgegrenzten EU-Umgebung betrieben werden. Die Testinstanz greift direkt auf Staging-, Abnahme- oder isolierte Testsysteme zu. Testbelege bleiben dort, wo auch die Anwendung und ihre Betriebsverantwortung liegen. Das ist besonders sinnvoll, wenn Windows-Desktop-Anwendungen, interne Webportale oder Systeme mit sensiblen Prozessdaten getestet werden.

Sicherer ist Selbsthosting aber nicht automatisch. Wer einen Testserver mit offenem Fernzugang, gemeinsam genutzten Administratorkonten und dauerhaft gültigen Passwörtern betreibt, hat lediglich die Risiken verlagert. Die Frage ist daher nicht nur: Cloud oder On-Premises? Sondern: Ist die Testumgebung nachvollziehbar abgesichert und dauerhaft wartbar?

Are self hosted tests secure? Es kommt auf diese Grenzen an

Eine sichere Testplattform braucht klare technische und organisatorische Grenzen. Für kleine und mittlere Unternehmen muss das nicht nach Konzernprogramm aussehen. Es muss nur konsequent umgesetzt und dokumentiert sein.

Die Testumgebung vom Produktivbetrieb trennen

Automatisierte Tests sollen Fehler finden, nicht Bestellungen auslösen, Lieferscheine verändern oder Lagerbestände buchen. Deshalb benötigen Tests eine getrennte Umgebung mit eigenen Schnittstellen, Testmandanten und Testdaten. Wo eine vollständige Kopie der Produktion nicht nötig ist, ist sie oft sogar unnötig riskant.

Für ein Lager- oder Auftragsportal kann das bedeuten: Testnutzer dürfen Wareneingänge erfassen und Versandlabels erzeugen, aber die erzeugten Dokumente gehen an keinen realen Drucker und keine reale Spedition. API-Schlüssel zeigen auf Sandbox-Endpunkte. E-Mail-Versand wird abgefangen oder auf interne Empfänger begrenzt. So bleibt ein Test aussagekräftig, ohne operative Folgen zu erzeugen.

Die Trennung sollte auch auf Netzwerkebene gelten. Der Testserver braucht nur die Verbindungen, die er tatsächlich benötigt. Pauschaler Zugriff in das gesamte interne Netz ist bequem, aber selten begründbar. Segmentierung begrenzt den Schaden, falls ein Testkonto oder ein Systembestandteil kompromittiert wird.

Zugangsdaten wie Produktionszugänge behandeln

Testautomatisierung benötigt oft Anmeldedaten. Das ist normal, aber diese Daten gehören nicht in Testskripte, Konfigurationsdateien im Quellcode oder Chat-Verläufe. Passwörter, Tokens und Zertifikate sollten aus einer kontrollierten Geheimnisverwaltung geladen werden. Testkonten erhalten nur die Rechte, die der konkrete Ablauf verlangt.

Auch der Zugriff auf die Testplattform selbst braucht Rollen. Ein Entwickler muss vielleicht Testläufe starten und Ergebnisse lesen, aber nicht die Netzwerkkonfiguration ändern. Ein Fachbereich kann Berichte einsehen, benötigt aber keinen Zugriff auf gespeicherte Anmeldedaten. Administrationsrechte sollten personengebunden sein, nicht an ein gemeinsames Konto gekoppelt.

Zusätzlich gehören Mehrfaktor-Anmeldung, angemessene Passwortregeln und Account-Lockout-Flows zum Mindeststandard. Gerade Testsysteme werden oft als weniger kritisch behandelt. Angreifer sehen das anders: Sie nutzen Testumgebungen gern als Einstiegspunkt, weil dort Zugänge, interne Namen und technische Details liegen.

Testdaten minimieren und gezielt maskieren

Der häufigste Fehler ist nicht ein fehlendes Verschlüsselungsverfahren, sondern zu viel echte Information im Testbestand. Für die meisten Regressionstests braucht niemand reale Kundennamen, echte Adressen oder vollständige Personalakten. Synthetische Datensätze, maskierte Kopien und bewusst angelegte Sonderfälle reichen häufig aus.

Es gibt Ausnahmen. Manche Fehler erscheinen nur bei echten Datenstrukturen, ungewöhnlichen Zeichenfolgen oder komplexen Berechtigungskonstellationen. Dann kann eine kontrollierte, pseudonymisierte Kopie sinnvoll sein. Entscheidend ist, dass diese Entscheidung bewusst getroffen wird und eine Löschfrist hat. Testdatenbanken sollten nicht jahrelang als vergessene Schattenkopie der Produktion weiterlaufen.

Screenshots und Videos verdienen dieselbe Aufmerksamkeit. Sie sind für die Fehlersuche wertvoll, können aber Kontodaten, interne Preise oder personenbezogene Inhalte zeigen. Legen Sie fest, welche Artefakte aufgezeichnet werden, wer sie sehen darf und wann sie automatisch gelöscht werden. Ein Testbericht muss nicht jedes Bildschirmbild für immer speichern, um beweiskräftig zu sein.

Den Server wie ein Produkt betreiben

Ein selbst gehosteter Testserver ist kein Gerät, das man einmal installiert und dann vergisst. Betriebssicherheit entsteht durch wiederholbare Pflege: zeitnahe Sicherheitsupdates für Betriebssystem, Browser, Test-Runner und Abhängigkeiten; verschlüsselte Datenträger und Transportwege; überwachte Backups; zentrale Protokollierung; sowie ein klarer Umgang mit Sicherheitsmeldungen.

Besonders bei browsergesteuerten Tests ist der Aktualisierungsrhythmus relevant. Veraltete Browser-Engines und Automatisierungsbibliotheken können bekannte Schwachstellen enthalten oder Tests unzuverlässig machen. Beides kostet Zeit. Dokumentierte Deployments und feste Wartungsfenster sind deshalb kein bürokratischer Zusatz, sondern Grundlage für reproduzierbare Ergebnisse.

Für einen dedizierten KI-Testserver wie COCO gilt das ebenfalls. Die lokale Ausführung schützt sensible Anwendungsinhalte nicht durch Magie. Sie schafft Kontrolle darüber, wo KI-gestützte Auswertung, Screenshots und Testprotokolle verarbeitet werden. Diese Kontrolle muss mit Patch-Management, Berechtigungen, Netztrennung und klaren Aufbewahrungsregeln gefüllt werden.

Wo Selbsthosting seine Grenzen hat

Cloud-Dienste sind nicht per Definition unsicher. Ein spezialisierter Anbieter kann mehr Security-Personal, ausgereiftere Überwachung und professionellere Redundanz bieten als ein Unternehmen mit einer einzelnen überlasteten IT-Rolle. Wer keine Kapazität für Betrieb, Updates und Incident Response hat, kann mit einem schlecht betreuten Self-Hosted-System ein höheres Risiko erzeugen.

Andererseits sind viele externe Testplattformen für interne Fachanwendungen schlicht kein guter Prozessfit. Wenn eine Anwendung nur im Firmennetz erreichbar ist, wenn Testläufe vertrauliche Masken und Belege zeigen oder wenn Daten den eigenen Kontrollbereich nicht verlassen sollen, ist lokaler Betrieb oft die klarere Lösung.

Die vernünftige Entscheidung hängt vom Schutzbedarf und von der Betriebsfähigkeit ab. Für eine öffentliche Marketingseite ohne sensible Logins kann ein Cloud-Testdienst angemessen sein. Für eine interne Dispositionssoftware, ein Kundenportal mit personenbezogenen Daten oder eine Windows-Anwendung im Produktionsnetz spricht viel für eine kontrollierte, selbst gehostete Umgebung.

Ein praxistauglicher Sicherheitscheck vor dem Start

Bevor automatisierte Tests ausgerollt werden, sollte ein Verantwortlicher diese Fragen ohne Rätselraten beantworten können:

  • Welche Systeme, Datenbanken und Schnittstellen darf der Testserver erreichen?
  • Welche Daten erscheinen in Screenshots, Videos, Logs und KI-Auswertungen?
  • Wo liegen Zugangsdaten, und wann werden sie rotiert?
  • Wer darf Testläufe starten, Ergebnisse lesen und Systeme administrieren?
  • Wie schnell werden kritische Updates eingespielt, und wie wird das geprüft?
  • Wann werden Testartefakte und nicht mehr benötigte Daten gelöscht?

Diese Fragen wirken nüchtern. Genau das ist ihr Wert. Sicherheit entsteht selten durch ein einzelnes Tool oder ein beeindruckendes Architekturdiagramm. Sie entsteht, wenn Zuständigkeiten, Datenflüsse und technische Grenzen im Alltag überprüfbar bleiben.

Wer Testautomatisierung aufbaut, sollte zuerst den Schutzbedarf der Anwendung klären und dann die kleinste sinnvolle Architektur wählen. Ein sauber abgegrenzter Testserver mit wenigen berechtigten Konten ist oft wertvoller als eine überladene Plattform, die niemand zuverlässig pflegen kann. Boring, provable reliability schlägt auch beim Testing die spektakuläre, aber undurchsichtige Lösung.

Permalink →

Warehouse Management Systems: Was wirklich zählt

Warehouse Management Systems: Was wirklich zählt

Wenn ein Mitarbeiter im Wareneingang dieselbe Lieferposition auf Papier notiert, später in eine Tabelle überträgt und dann per Zuruf klärt, wo sie eingelagert wird, fehlt selten Einsatzbereitschaft. Es fehlt ein gemeinsamer Ablauf. Warehouse Management Systems schaffen diesen Ablauf, indem sie Warenbewegungen, Bestände und Folgeaufgaben an einer Stelle dokumentieren. Für kleine und mittlere Betriebe ist dabei nicht die größte Funktionsliste entscheidend, sondern ob die Software den Weg einer Ware durch das eigene Lager zuverlässig abbildet.

Was Warehouse Management Systems im Alltag leisten müssen

Ein Warehouse Management System, kurz WMS, ist keine bessere Bestandsliste. Es steuert oder dokumentiert die physischen Prozesse im Lager: Wareneingang, Qualitätsprüfung, Einlagerung, Umbuchung, Kommissionierung, Verpackung, Versand und Inventur. Jede Buchung beantwortet eine einfache operative Frage: Was ist wo, in welcher Menge, in welchem Status und wer hat die Bewegung ausgelöst?

Diese Klarheit wirkt auf den ersten Blick banal. Sie verhindert aber typische Fehlerketten. Ein Artikel wird zwar geliefert, ist jedoch noch nicht geprüft. Eine Palette steht im Wareneingang, wird aber im System bereits als verfügbar geführt. Ein Auftrag wird gepickt, obwohl Ware für einen wichtigeren Kundenauftrag reserviert sein sollte. Ohne sauber definierte Status und Bewegungen entsteht aus einer einzelnen Unklarheit schnell eine falsche Lieferzusage.

Für viele mittelständische Lager beginnt der Nutzen nicht mit vollautomatischer Steuerung. Bereits geführte Einlageraufträge, eindeutige Lagerplätze und mobile Buchungen können Suchzeiten deutlich senken. Entscheidend ist, dass Mitarbeitende nicht zwischen Papier, Telefon, E-Mail und mehreren Tabellen übersetzen müssen.

Nicht jedes Lager braucht eine große Suite

Der Markt bietet umfangreiche Enterprise-Systeme mit Funktionen für globale Multi-Standort-Netzwerke, komplexe Zollabwicklung, automatisierte Fördertechnik und sehr feine Optimierungslogik. Das kann richtig sein, wenn diese Anforderungen tatsächlich bestehen. Für einen Betrieb mit einem oder wenigen Lagern, wechselnden Prioritäten und eingespielten Sonderprozessen kann eine solche Suite jedoch mehr Reibung als Nutzen erzeugen.

Die Kosten liegen dann nicht nur in Lizenzen. Sie entstehen in langen Einführungsprojekten, aufwendigen Anpassungen, Schulungen und Abhängigkeit von externen Spezialisten. Auch ein System mit hundert Einstellungen löst kein Problem, wenn Schichtleiter für alltägliche Korrekturen ein Ticket eröffnen müssen.

Das Gegenstück ist nicht zwangsläufig eine vollständige Individualentwicklung. Ein Standardprodukt kann sinnvoll sein, wenn seine Kernabläufe passen und Anpassungen bewusst begrenzt bleiben. Ebenso kann eine bestehende Tabelle weiterhin die beste Lösung sein, etwa für eine seltene, überschaubare Auswertung. Kritisch wird sie erst, wenn mehrere Personen gleichzeitig damit arbeiten, Bewegungen zeitversetzt nachtragen oder die Tabelle zur operativen Wahrheit über verfügbare Ware werden soll.

Die passende Lösung orientiert sich am tatsächlichen Prozessvolumen und an den Fehlerkosten. Fünf falsche Picks pro Woche sind in einem Ersatzteillager mit zeitkritischen Kundenaufträgen etwas anderes als fünf Abweichungen in einem langsam drehenden Archivbestand.

Die Prozesse zuerst aufnehmen, nicht die Masken auswählen

Viele WMS-Projekte starten mit einer Produktdemo. Dort sehen Verantwortliche schicke Dashboards, Scanner-Ansichten und farbige Kennzahlen. Nützlicher ist zunächst ein Gang durch das Lager während eines normalen Arbeitstags. Wo kommt Ware an? Wer prüft Mengen und Schäden? Wann erhält ein Artikel seine Chargen- oder Seriennummer? Wie wird entschieden, auf welchen Platz er kommt? Und was passiert, wenn die Realität von der Bestellung abweicht?

Diese Fragen legen die Grundlage für eine Lösung, die später akzeptiert wird. Ein gut dokumentierter Sollprozess beschreibt nicht nur den Idealfall. Er enthält auch Ausnahmen: Teillieferungen, beschädigte Ware, nicht angekündigte Anlieferungen, Fehlbestände, Rückläufer und gesperrte Bestände. Gerade diese Fälle entscheiden darüber, ob Mitarbeitende dem System vertrauen oder wieder zu Notizzetteln greifen.

Status sind wichtiger als hübsche Oberflächen

Ein sauberer Datenbestand trennt beispielsweise „erwartet", „eingetroffen", „in Prüfung", „eingelagert", „reserviert", „kommissioniert" und „versendet". Welche Status notwendig sind, hängt vom Betrieb ab. Zu wenige verschleiern relevante Unterschiede. Zu viele machen Buchungen langsam und werden umgangen.

Die Regel sollte sein: Jeder Status muss eine operative Konsequenz haben. Ist Ware gesperrt, darf sie nicht kommissioniert werden. Ist sie reserviert, muss sichtbar sein, für welchen Auftrag. Ist sie eingelagert, muss ein Lagerplatz hinterlegt sein. So werden Datenregeln zu praktischer Prozesssicherheit.

Scanner helfen nur bei klaren Buchungen

Barcodes und mobile Endgeräte reduzieren Tippfehler und beschleunigen Bewegungen. Sie ersetzen aber keine Prozessentscheidung. Ein Scan muss eine verständliche Aktion auslösen: Artikel prüfen, Menge bestätigen, Zielplatz wählen oder Auftrag abschließen. Wenn ein Mitarbeiter nach jedem Scan rätseln muss, welche Maske als Nächstes folgt, ist der Ablauf zu kompliziert gestaltet.

Auch die Hardwarefrage sollte pragmatisch beantwortet werden. Für manche Teams reichen Smartphones mit geeigneter Scan-Funktion und stabiler Schutzhülle. Andere benötigen industrielle Handscanner, weil Handschuhe, Kühlung, Stürze oder lange Schichten dies verlangen. Ein Pilot auf der tatsächlichen Lagerfläche zeigt mehr als eine Präsentation am Schreibtisch.


Die technische Grundlage entscheidet nach dem Go-live

Ein WMS muss auch dann korrekt arbeiten, wenn gleichzeitig Wareneingänge gebucht, Aufträge gepickt und Bestände geprüft werden. Daraus ergeben sich Anforderungen, die in frühen Gesprächen oft untergehen: eindeutige Bewegungsprotokolle, Berechtigungen nach Rolle, nachvollziehbare Korrekturen, zuverlässige Schnittstellen und Sicherungen, die im Ernstfall wiederherstellbar sind.

Ein Bestand sollte nicht einfach überschrieben werden. Besser ist ein Bewegungsmodell: Zugang, Abgang, Umbuchung, Sperrung oder Korrektur erzeugen jeweils einen protokollierten Datensatz. Damit lässt sich später nachvollziehen, warum eine Menge abweicht. Das ist für Inventuren ebenso wertvoll wie für die Klärung eines Kundenreklamationsfalls.

Berechtigungen müssen zur Verantwortung passen. Ein Kommissionierer benötigt andere Funktionen als eine Lagerleitung, die Bestandskorrekturen freigibt. Für kritische Änderungen sind Begründungen, Vier-Augen-Freigaben oder zumindest ein unveränderbares Änderungsprotokoll sinnvoll. Der Aufwand hängt vom Risikoprofil ab, aber die Frage sollte vor dem Start geklärt sein.

Schnittstellen verdienen dieselbe Aufmerksamkeit. Ein Lager arbeitet selten isoliert. Bestellungen kommen aus einem Shop, einem ERP oder per strukturiertem Import. Versanddaten gehen an Carrier-Systeme, Lieferscheine und Labels werden erzeugt, Bestandsdaten fließen zurück. Jede Schnittstelle braucht klare Zuständigkeiten für Fehlerfälle. Was passiert, wenn ein Versandlabel erzeugt wurde, die Rückmeldung aber nicht im WMS ankommt? Ohne Wiederholungslogik und sichtbare Fehlerwarteschlange bleiben solche Fälle an einzelnen Personen hängen.

Für maßgeschneiderte Lösungen sind wartbare Technologien keine Nebensache. Eine nachvollziehbare Anwendung mit klarer Datenbankstruktur, dokumentierten Deployments und getesteten Integrationen bleibt auch nach personellen Wechseln beherrschbar. Trendige Architektur hilft nicht, wenn niemand einen fehlerhaften Import nachvollziehen kann.

Einführung in kleinen, kontrollierbaren Schritten

Ein Big Bang erzeugt vermeidbares Risiko. Sinnvoller ist häufig, zuerst einen abgegrenzten Prozess zu digitalisieren, etwa den Wareneingang für eine Produktgruppe oder die Kommissionierung in einem Lagerbereich. Das Team prüft dabei nicht nur Funktionen, sondern auch Formulierungen, Scanwege, Laufwege und Verantwortlichkeiten.

Stammdaten sind dabei oft die eigentliche Baustelle. Artikelnummern müssen eindeutig sein, Mengeneinheiten konsistent, Lagerplätze sinnvoll strukturiert und Verpackungseinheiten klar definiert. Ein System kann keine verlässlichen Bestände liefern, wenn derselbe Artikel unter drei Bezeichnungen auftaucht oder eine „Kiste" je nach Lieferant unterschiedliche Mengen meint.

Während der Pilotphase sollten Kennzahlen schlicht bleiben: Wie lange dauert der Wareneingang? Wie viele Buchungen müssen korrigiert werden? Wie viele Picks sind fehlerhaft? Wie häufig wird Ware gesucht? Nicht jede Verbesserung zeigt sich sofort in einer großen Kostenposition. Weniger Rückfragen und eine verlässlichere Lieferauskunft können bereits erheblichen Druck aus dem Tagesgeschäft nehmen.

Schulung funktioniert am besten direkt am Prozess. Mitarbeitende brauchen keine abstrakte Führung durch alle Menüpunkte. Sie müssen wissen, wie sie ihre nächste Lieferung buchen, eine Abweichung melden oder einen falschen Scan korrigieren. Für die ersten Schichten nach dem Start sollte eine zuständige Person erreichbar sein, die Entscheidungen zügig treffen kann.

Die richtige Frage für die Auswahl

Bei Warehouse Management Systems lautet die zentrale Frage nicht: Welche Software kann am meisten? Sie lautet: Welche Abläufe müssen für unser Team jeden Tag schneller, eindeutiger und nachvollziehbarer werden?

Wer diese Abläufe zuerst sauber beschreibt, kann Standardsoftware, Erweiterungen oder eine passgenaue Anwendung sachlich bewerten. Das Ergebnis muss nicht spektakulär wirken. Es sollte dafür sorgen, dass die Ware ihren Weg findet, der Bestand belastbar bleibt und die Menschen im Lager weniger Zeit mit Suchen, Nachfragen und Nachtragen verbringen.

Permalink →

Custom Logistics Software vs Spreadsheets

Custom Logistics Software vs Spreadsheets

Ein Wareneingang kommt früher als angekündigt, zwei Mitarbeitende ändern parallel dieselbe Bestandsliste und der Fahrer wartet auf einen Lieferschein, dessen letzte Version niemand sicher benennen kann. Solche Situationen entscheiden die Frage „custom logistics software vs spreadsheets" nicht theoretisch, sondern zwischen Wareneingang, Lagerplatz und Rampe.

Tabellen sind nicht grundsätzlich das Problem. Sie sind schnell erstellt, jedem vertraut und für klar abgegrenzte Aufgaben oft erstaunlich wirksam. Problematisch werden sie, wenn sie das Betriebssystem eines wachsenden Lager- oder Distributionsprozesses ersetzen sollen. Dann wird aus einer Datei ein kritischer Prozess - ohne verbindliche Regeln, nachvollziehbare Zustände oder belastbare Historie.

Wann Spreadsheets im Lager die richtige Wahl sind

Eine Tabelle ist sinnvoll, wenn der Prozess überschaubar, selten und von wenigen Personen gesteuert wird. Das kann etwa eine monatliche Bedarfsplanung, eine einmalige Inventurvorbereitung oder die Auswertung von Lieferantenpreisen sein. Auch für einen kleinen Bestand mit einem Verantwortlichen kann sie reichen, sofern Änderungen nicht unter Zeitdruck erfolgen und keine Folgeprozesse automatisch davon abhängen.

Der Vorteil liegt nicht nur in den geringen Lizenzkosten. Teams können Spalten anpassen, Berechnungen prüfen und ein neues Formular innerhalb weniger Minuten aufsetzen. Wer einen stabilen Prozess noch nicht verstanden hat, sollte ihn nicht vorschnell in Software gießen. Eine gute Tabelle kann zunächst sichtbar machen, welche Daten wirklich gebraucht werden und welche Felder nur aus Gewohnheit gepflegt werden.

Es wäre daher falsch, jede Excel-Datei als Rückstand zu behandeln. Die entscheidende Frage lautet: Ist die Tabelle ein Arbeitsmittel für eine Person oder eine gemeinsame Quelle für operative Entscheidungen? Sobald mehrere Rollen auf dieselben Daten angewiesen sind, steigt das Risiko deutlich.

Custom Logistics Software vs Spreadsheets: Der Kipppunkt

Der Wechsel wird meist nicht durch die Zahl der Zeilen ausgelöst. Eine Tabelle mit 20.000 Positionen kann funktionieren, während eine Datei mit 200 Zeilen bereits zu Fehlern führt. Entscheidend sind Gleichzeitigkeit, Prozessschritte und die Folgen einer falschen Information.

Ein typisches Warnsignal ist die Versionsfrage. Liegen Bestände, offene Aufträge oder Liefertermine in Dateien mit Namen wie „final_neu", „final_neu2" und „wirklich_final", fehlt keine bessere Ordnerstruktur. Es fehlt ein verbindlicher Datenstand. Das Gleiche gilt, wenn Mitarbeitende anrufen müssen, um zu erfahren, ob Ware eingetroffen ist, ein Auftrag freigegeben wurde oder ein Fahrzeug bereits beladen wurde.

Der Kipppunkt ist erreicht, wenn eine Eingabe mehrere Folgehandlungen auslöst. Ein Wareneingang verändert dann nicht nur eine Zahl im Bestand. Er kann eine Qualitätsprüfung starten, einen Lagerplatz zuweisen, eine Bestellung als teilweise geliefert markieren und dem Vertrieb einen verfügbaren Artikel anzeigen. Werden diese Schritte manuell über Dateien, Papier und Telefonate koordiniert, sind Abweichungen kaum zu vermeiden.

Besonders kritisch wird es bei Schichtwechseln und Ausfällen. Wenn nur eine erfahrene Person weiß, welche Farbmarkierung in einer Liste eine Sperrung bedeutet oder welche Formel einen Sicherheitsbestand berechnet, ist der Prozess nicht belastbar. Er funktioniert, solange diese Person verfügbar ist.

Was maßgeschneiderte Software tatsächlich besser macht

Custom Logistics Software ist nicht einfach eine Tabelle mit schöner Oberfläche. Ihr Nutzen entsteht durch kontrollierte Abläufe. Jede Buchung erhält einen eindeutigen Zeitpunkt, eine verantwortliche Person und einen nachvollziehbaren Status. Mitarbeitende sehen nicht nur Daten, sondern die nächste zulässige Handlung.

Bei einem Wareneingang kann das praktisch bedeuten: Lieferung auswählen, Menge erfassen, Abweichung dokumentieren, Etikett drucken und Einlagerung bestätigen. Erst danach wird der Bestand freigegeben. Für die Kommissionierung kann das System Aufträge nach Priorität bündeln, Lagerplätze in sinnvoller Reihenfolge anzeigen und einen Lieferschein erst erzeugen, wenn die Positionen bestätigt sind.

Das ist keine Frage unnötiger Komplexität. Es verhindert, dass derselbe Artikel zweimal reserviert wird, dass eine Teillieferung als vollständig gilt oder dass ein Lieferschein auf Basis veralteter Daten gedruckt wird. Auch einfache Regeln helfen: Pflichtfelder für Chargen, Sperrgründe für beschädigte Ware, Plausibilitätsprüfungen bei Mengen und Berechtigungen für Korrekturbuchungen.

Eine gut geplante Anwendung bildet nicht jeden Sonderfall sofort ab. Sie konzentriert sich auf die Abläufe, die täglich Zeit kosten oder regelmäßig Fehler produzieren. Für einen Betrieb kann das die Verwaltung von Behälterbewegungen sein, für einen anderen die schnelle Erfassung eingehender Ware mit mobilen Geräten. Standardsoftware kennt diese Besonderheiten oft nur als teures Zusatzmodul oder gar nicht.

Die versteckten Kosten der Tabelle

Die Lizenzkosten einer Tabelle sind niedrig. Die Prozesskosten können es nicht sein. Sie entstehen in Rückfragen, Nacharbeiten, Suchzeiten, Doppelpflege und falsch disponierten Beständen. Sie entstehen auch dann, wenn ein Team abends kontrollieren muss, welche Daten seit dem Morgen verändert wurden.

Diese Kosten bleiben häufig unsichtbar, weil sie über viele Rollen verteilt sind. Der Lagerleiter prüft Bestände, der Innendienst korrigiert Liefertermine, die Buchhaltung sucht Belege und die Geschäftsführung bekommt Zahlen mit Verzögerung. Keine einzelne Tätigkeit wirkt dramatisch. Zusammen bremsen sie Durchsatz und Planbarkeit.

Eine belastbare Entscheidung sollte deshalb nicht nur Softwarepreise vergleichen. Messen Sie für zwei bis drei Wochen, wie viele manuelle Übergaben ein Auftrag durchläuft, wie oft Informationen nachgefragt werden und welche Fehler wiederkehren. Relevant sind außerdem die Folgen: Führt ein falscher Bestand zu einer internen Korrektur oder zu einer verpassten Auslieferung?

Nicht jedes Problem braucht eine große Suite

Viele mittelständische Unternehmen im DACH-Raum zögern zu Recht vor umfangreichen Enterprise-Systemen. Lange Einführungen, starre Masken und Lizenzmodelle für Funktionen, die nie genutzt werden, lösen selten ein konkretes Lagerproblem. Die Alternative muss aber nicht heißen, bei verteilten Dateien zu bleiben.

Zwischen beiden Extremen liegt eine workflow-spezifische Anwendung. Sie kann beispielsweise Auftragsannahme, Wareneingang, Lagerbewegungen, Versandetiketten und Lieferscheine in einem gemeinsamen System verbinden, ohne gleich Finanzbuchhaltung, globale Konzernlogik und zwanzig Fremdsprachen mitzubringen.

Entscheidend ist die technische Grundlage. Eine Anwendung mit klarer Datenbankstruktur, dokumentierten Schnittstellen und nachvollziehbaren Berechtigungen bleibt anpassbar. Technologien wie PHP 8.4, modernes JavaScript und MySQL 8 sind dabei kein Selbstzweck. Richtig eingesetzt, schaffen sie eine wartbare Basis für Rollen, Buchungshistorien, Druckdokumente und Auswertungen - auch dann, wenn sich Prozesse in zwei Jahren ändern.

So gelingt die Umstellung ohne Betriebsunterbrechung

Die größte Gefahr ist nicht die Technik, sondern ein zu großer erster Schritt. Wer versucht, sämtliche historischen Dateien zu bereinigen und jeden Ausnahmefall vor dem Start abzubilden, verschiebt den Nutzen monatelang. Besser ist ein klarer, überprüfbarer Anfang.

Starten Sie mit einem Prozess, der häufig vorkommt und gut abgrenzbar ist, etwa Wareneingang mit Bestandsbuchung oder Versand mit Lieferschein und Etikett. Definieren Sie dabei präzise, wann der Vorgang beginnt, welche Daten zwingend nötig sind, wer welche Freigabe erteilt und wann er als abgeschlossen gilt. Daraus entstehen nicht nur Bildschirmmasken, sondern belastbare Arbeitsregeln.

Die Datenübernahme braucht ebenfalls Pragmatismus. Aktive Artikel, Lieferanten, Lagerplätze und offene Aufträge müssen sauber sein. Historische Altbestände können dagegen oft archiviert werden, statt sie mit hohem Aufwand in das neue System zu importieren. Parallelbetrieb kann sinnvoll sein, aber nur mit einem festen Enddatum. Sonst entstehen zwei Wahrheiten statt einer besseren.

In der Einführung zeigt sich der Wert eines direkten technischen Partners. softify.pro arbeitet deshalb nicht von einer abstrakten Funktionsliste aus, sondern klärt Abläufe dort, wo sie stattfinden: an der Annahme, im Lagergang, beim Verpacken und bei der Übergabe an den Versand. Gute Software respektiert funktionierende Routinen und verändert nur, was den Prozess tatsächlich verlässlicher macht.

Die Entscheidung lässt sich an drei Fragen prüfen

Erstens: Müssen mehrere Personen gleichzeitig auf aktuelle Daten vertrauen? Zweitens: Löst eine Buchung Folgeprozesse aus, die heute manuell abgesichert werden? Drittens: Kann ein Fehler zu Lieferverzug, Fehlbestand, falscher Rechnung oder aufwendiger Suche führen? Wenn diese Fragen überwiegend mit Ja beantwortet werden, ist die Tabelle vermutlich nicht mehr das richtige führende System.

Bleibt die Antwort überwiegend Nein, kann sie weiterhin eine vernünftige Lösung sein. Dann lohnt es sich eher, Dateien zu vereinheitlichen, Verantwortlichkeiten festzulegen und kritische Formeln zu dokumentieren. Technik sollte nicht größer sein als das Problem.

Der nächste sinnvolle Schritt ist daher kein pauschales Digitalisierungsprojekt, sondern ein gemeinsamer Blick auf einen konkreten Ablauf mit den Menschen, die ihn täglich ausführen. Dort wird schnell sichtbar, ob eine gut gepflegte Tabelle genügt - oder ob verlässliche Software endlich die Arbeit übernehmen sollte, die heute zwischen Papier, Telefon und mehreren Versionen derselben Datei hängen bleibt.

Permalink →

Kontakt aufnehmen

Haben Sie ein Projekt im Kopf, einen Arbeitsablauf, der noch auf Excel-Tabellen und gutem Willen läuft, oder einen Testing-Rückstau, den COCO Ihrem Team abnehmen könnte? Erzählen Sie uns davon.

Nachricht senden