softify.pro
A carregar …
Serviços Sobre nós COCO – o nosso servidor de IA Portefólio Insiders Case Studies Vale a pena saber Contacto Login

Vale a pena saber

Pure fluidity meets ultimate performance: o que realmente torna rápido o software empresarial

Pure fluidity meets ultimate performance: o que realmente torna rápido o software empresarial

Um responsável de armazém não reconhece um mau software por um desenho de arquitetura. Reconhece-o pelo facto de os colaboradores voltarem a pegar no telefone, registarem as guias de remessa em duplicado ou, após um turno, não conseguirem dizer que mercadoria chegou realmente. Pure fluidity meets ultimate performance não pode, por isso, ser uma mera aspiração visual. Para o software empresarial significa que uma operação parece natural e, ao mesmo tempo, funciona de forma fiável em condições reais.

Uma interface elegante não vale nada se engasgar com um WLAN fraco no armazém. Uma aplicação rápida também ajuda pouco se impuser uma sequência de trabalho que ninguém na rampa consegue acompanhar. As boas ferramentas digitais combinam conceção, velocidade e compreensão dos processos. Reduzem o atrito sem enfiar a empresa numa lógica padrão pré-fabricada.

Pure fluidity meets ultimate performance é uma questão operacional

A fluidez é muitas vezes confundida com animações, imagens grandes e transições suaves. Isso pode ajustar-se a uma marca moderna. No dia a dia de trabalho, porém, mostra-se de outra forma: uma receção de mercadorias pode ser lançada sem desvios. Um colaborador encontra uma encomenda mesmo quando só se conhece um número de referência. Um erro é nomeado com clareza, em vez de desaparecer numa mensagem críptica.

O desempenho é igualmente mais do que um bom valor num teste de navegador. Decisivos são o tempo de resposta numa encomenda com muitas posições, a estabilidade no fim do mês e a questão de saber se cinco pessoas podem trabalhar em simultâneo sem se sobrescreverem mutuamente os estados de dados. Faz parte também um tratamento limpo de quebras de ligação, permissões e contas bloqueadas.

Ambos são inseparáveis. Se um ecrã reage de imediato mas tem campos obrigatórios pouco claros, continua cansativo. Se o fluxo está modelado com inteligência mas a página espera dois segundos a cada lançamento, é contornado. A fluidez surge onde o sistema apoia a próxima ação sensata e se mantém tecnicamente rápido o suficiente para que o fio do pensamento não se quebre.

A interface segue o caminho de trabalho, não o organigrama

Muitas soluções padrão estruturam os seus menus por módulos: compras, vendas, armazém, relatórios, administração. Do ponto de vista do produto, é compreensível. No chão do armazém, porém, o trabalho começa frequentemente com uma situação: está lá um camião, falta uma palete, um cliente precisa de um comprovativo de entrega ou uma expedição tem ainda de ser etiquetada antes do fecho da receção.

Uma boa aplicação à medida começa, por isso, com estas situações. Que informação existe? Quem decide? O que tem de ser documentado? O que já não pode ser alterado depois? Só então se decide que ecrã de entrada, verificação ou automação é necessário.

Isso não significa verter cada fluxo existente sem alterações para software. Algumas tabelas são realmente demasiado propensas a erros, algumas aprovações desnecessariamente lentas. Mas uma lista de Excel que funciona não tem de ser forçosamente substituída por um projeto. Se só for mantida por uma pessoa, conhecer poucas exceções e permanecer rastreável, pode ser a ferramenta adequada. O software compensa quando melhora a coordenação, reduz fontes de erro ou torna a informação fiavelmente disponível para vários participantes.

Menos cliques não é automaticamente melhor

A exigência de o menor número possível de cliques soa razoável, mas pode levar na direção errada. Num lançamento de armazém irreversível, uma breve confirmação faz sentido. Numa libertação de expedição, uma verificação de plausibilidade visível pode evitar retrabalho dispendioso. O fluxo certo depende do risco.

O decisivo é que os passos adicionais tenham um propósito claro. Uma confirmação não deveria aparecer só porque o framework a gera com facilidade. Deveria estar exatamente onde as pessoas têm de tomar uma decisão de forma consciente. Assim a aplicação mantém-se rápida sem se tornar leviana.

O desempenho nasce na arquitetura, não no último sprint

Quem acelera um site ou uma aplicação web só pouco antes do go-live trata geralmente sintomas. Consultas grandes, modelos de dados pouco claros e casos especiais acrescentados posteriormente não se deixam corrigir de forma duradoura com um único dia de otimização.

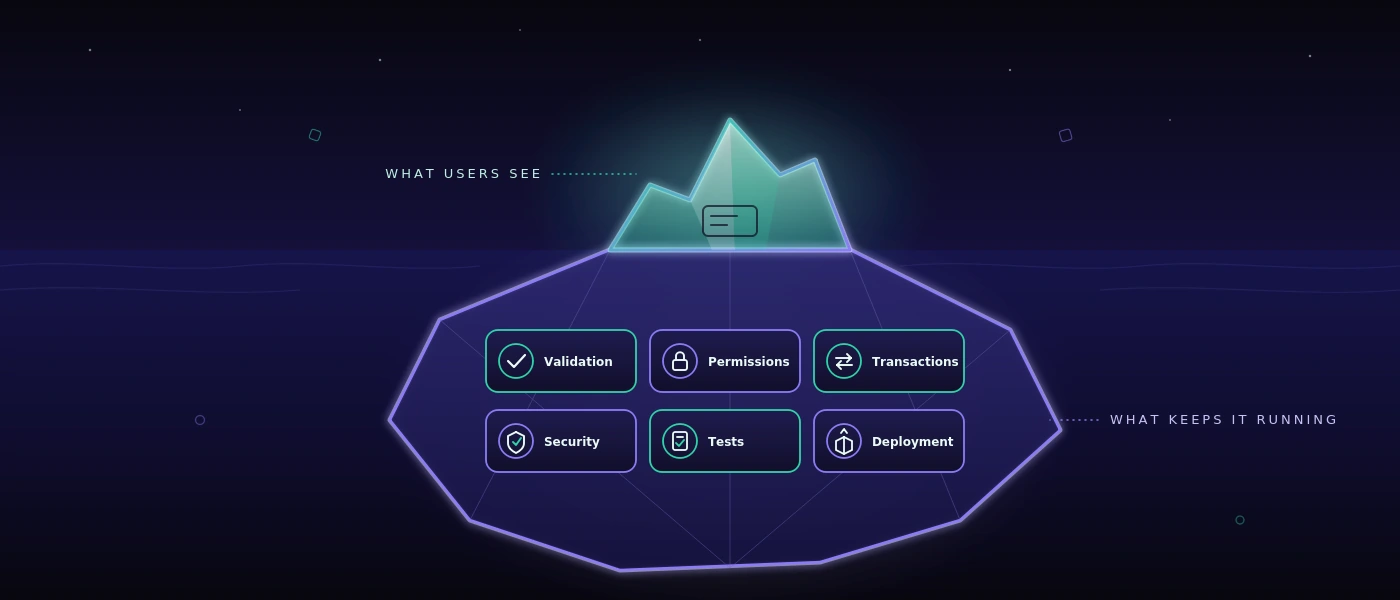
Uma base sólida começa com uma base de dados que corresponda às relações reais na empresa. No MySQL 8, movimentos, documentos, alterações de estado e ações de utilizadores precisam de chaves rastreáveis e índices sensatos. Um stock não pode aparecer apenas como número se mais tarde for preciso esclarecer por que lançamento resultou. Ao mesmo tempo, não é preciso recalcular cada informação histórica a cada carregamento de página.

Nas aplicações web modernas também é relevante a separação de responsabilidades. O PHP 8.4 pode representar regras de negócio de forma clara e sustentável, enquanto o JavaScript moderno é usado de forma direcionada em áreas reativas. Isto não é uma profissão de fé num determinado stack. É uma questão de manutenção: podem as alterações ser implementadas com segurança daqui a seis meses? Vê-se onde uma regra vale? Pode um erro ser reproduzido, em vez de apenas suposto?

O desempenho precisa ainda de limites. Os campos de pesquisa precisam de um mínimo sensato de caracteres ou de uma lógica de filtro precisa, se forem imagináveis milhões de registos. As listas grandes precisam de páginas ou processos de carregamento graduais. Imagens e documentos não deveriam bloquear o fluxo de trabalho crítico. Estas decisões parecem pouco espetaculares. Precisamente por isso permanecem muitas vezes valiosas por mais tempo do que um efeito de frontend vistoso.

A velocidade visível cria confiança

Nem todo o processo pode terminar em menos de um segundo. Uma impressão de etiquetas, uma interface com o transportador ou uma verificação face a dados externos exige por vezes tempo. O decisivo é então como a aplicação lida com a espera.

Um estado claro como “A etiqueta de expedição está a ser criada” é melhor do que um botão congelado. Após uma conclusão, deveria ser visível que número foi gerado e se a operação pode ser acionada de novo. Se um serviço externo não estiver acessível, a equipa precisa de uma opção de ação compreensível em vez de uma mensagem de erro para programadores.

Esta é também uma questão de integridade de dados. Um duplo clique não pode criar duas entregas. Um processo interrompido não pode deixar silenciosamente um registo a meio. Os bons sistemas planeiam tais casos, porque eles ocorrerão no dia a dia. Especialmente com turnos em mudança, pressão de tempo e dispositivos móveis, a exceção não é um tema marginal.

A qualidade torna-se visível antes do erro

Para aplicações com muitas variantes de processo, não basta percorrer manualmente alguns caminhos no fim. Alterações de preços, perfis, validações ou interfaces podem desencadear consequências num ponto muito distante. Aqui, o teste automatizado torna-se parte do desempenho: não só tecnicamente, mas a nível organizacional.

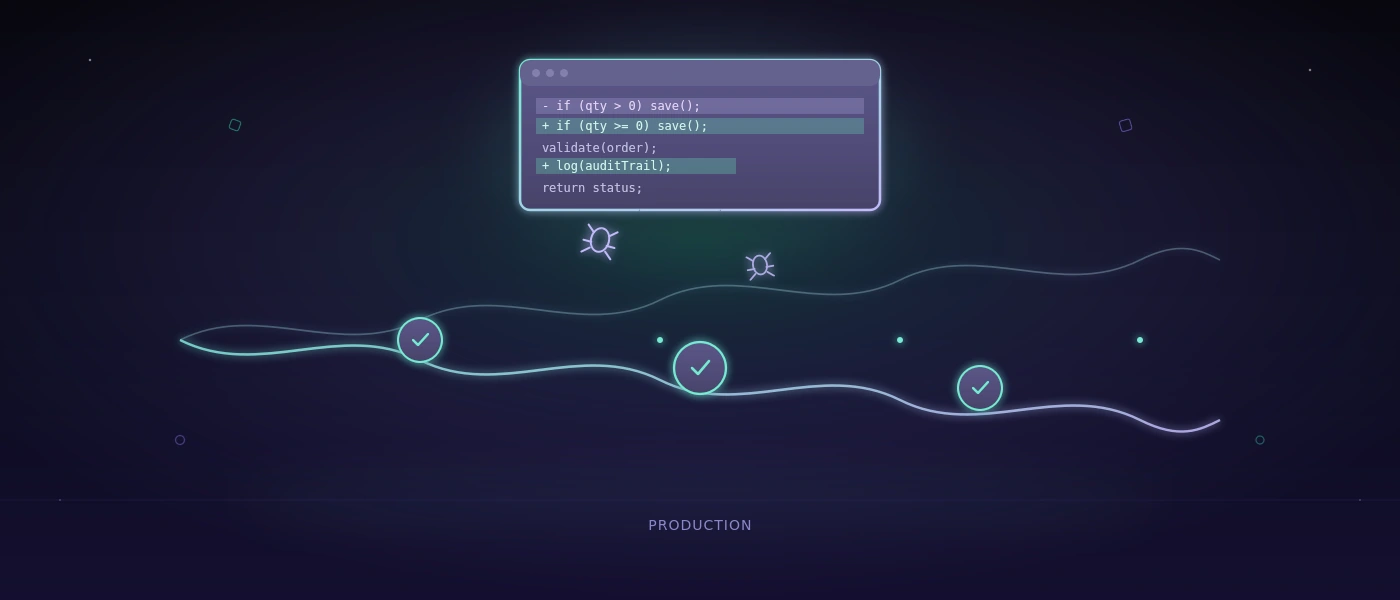
Um sistema de testes deveria poder verificar fluxos reais, por exemplo criar uma encomenda, alterar uma posição, gerar uma guia de remessa e controlar uma permissão. Deveria registar evidências e formular resultados de modo que as áreas de negócio os consigam enquadrar. Uma frase como “O processo de expedição não foi concluído após a alteração de morada” ajuda mais do que um stack trace sem comentários.

Para equipas atentas à segurança, também é relevante o local onde estes testes correm. Se capturas de ecrã, credenciais, casos de teste ou passos internos da aplicação não devem sair da empresa, uma abordagem auto-hospedada é muitas vezes mais sensata do que um serviço cloud externo. Com a COCO, podem executar-se testes automatizados para aplicações web e Windows num ambiente dedicado. Isso não é necessário para todas as equipas. Com dados sensíveis, áreas reguladas ou aplicações especializadas internas, o controlo sobre os dados de teste pode, contudo, ser uma vantagem decisiva.

A conceção é boa quando facilita o trabalho

Uma identidade visual forte pode criar confiança. Mostra que uma empresa leva a sério a sua presença digital. No sistema operacional, porém, a conceção tem de fazer ainda mais: orientação sob pressão de tempo. Contraste, tipografia, estados claros e rótulos compreensíveis decidem se alguém conclui uma operação com segurança ou pergunta ao colega.

A contenção é aqui muitas vezes a melhor escolha. Um painel com dez indicadores coloridos pode parecer impressionante e, mesmo assim, esconder o único desvio relevante. Uma vista reduzida que torne visíveis receções de mercadorias em aberto, leituras em falta e prazos de entrega em risco é mais útil. A pergunta não é quanta interface é possível, mas que informação melhora uma decisão.

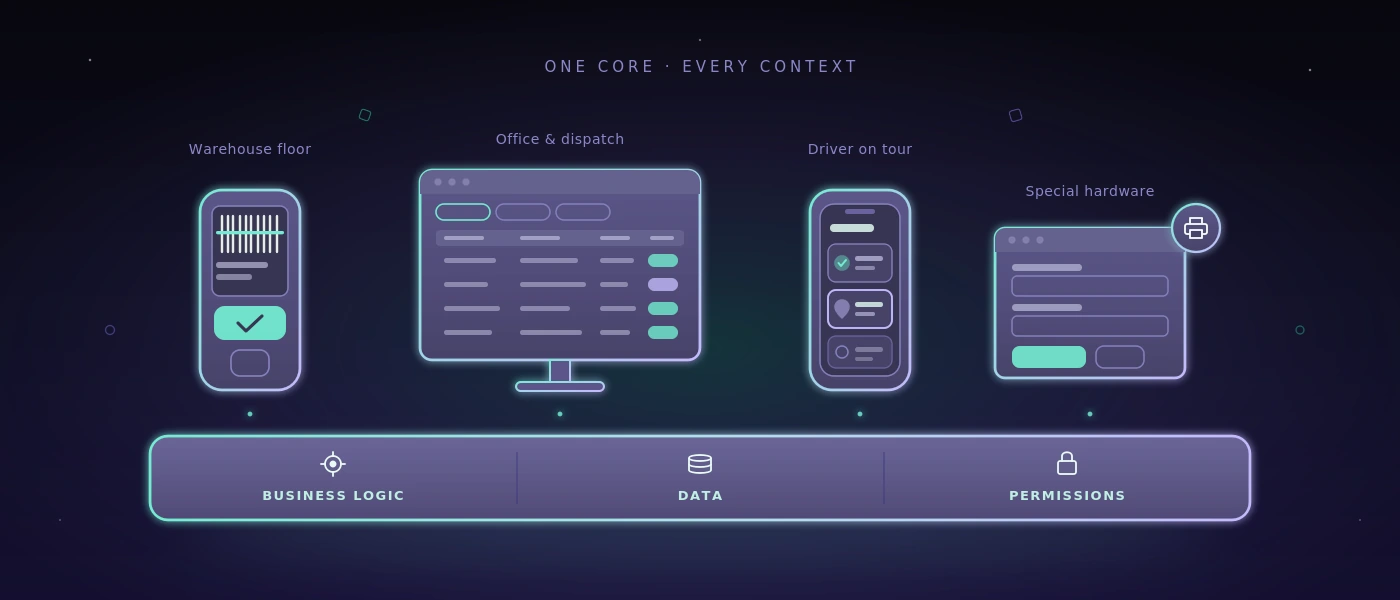
Isto vale também para aplicações responsivas. A capacidade móvel não significa comprimir cada ecrã de computador num formato menor. Um smartphone na receção de mercadorias talvez precise apenas de leitura, quantidade, localização e confirmação. O pós-processamento detalhado pertence possivelmente a um ecrã maior. Dispositivos diferentes merecem prioridades diferentes, embora acedam à mesma base de dados fiável.

Uma bitola sensata para a próxima decisão

Antes de uma equipa decidir sobre uma nova plataforma, uma automação ou uma reconstrução completa, ajuda uma verificação simples: o fluxo torna-se mais claro, mais rápido ou mais seguro para as pessoas que o executam diariamente? E a solução continua a poder ser compreendida quando mudam requisitos, colaboradores ou interfaces?

Se ambas as respostas forem sólidas, uma bela promessa torna-se um sistema utilizável. Então pure fluidity meets ultimate performance mostra-se não num diapositivo, mas num dia de trabalho calmo em que encomendas, dados e decisões prosseguem sem atrito desnecessário.
Permalink →

SaaS Flow Web: introduzir workflows em segurança com a operação em curso

SaaS Flow Web: introduzir workflows em segurança com a operação em curso

Uma receção de mercadorias não fica parada porque uma equipa não conhece mais um software. Fica parada porque a informação se perde entre e-mail, formulário em papel, ficheiro Excel e telefonema. No SaaS - “Flow Web” em flow.softify.pro - a primeira pergunta não deveria, por isso, ser a interface. O decisivo é se o serviço representa de forma fiável um fluxo de trabalho concreto - também em dias agitados, com responsabilidades em mudança e quando uma entrega não corresponde ao plano.

Para as pequenas e médias empresas, o SaaS faz muitas vezes sentido, porque não têm de construir primeiro servidores, versões e funções básicas próprios. Mas isso não é um passe livre para todos os processos. Quem introduz uma ferramenta que complica o dia a dia ou empurra dados importantes para listas secundárias pouco claras não digitaliza trabalho. Apenas desloca o atrito.

O que o SaaS “Flow Web” tem de oferecer

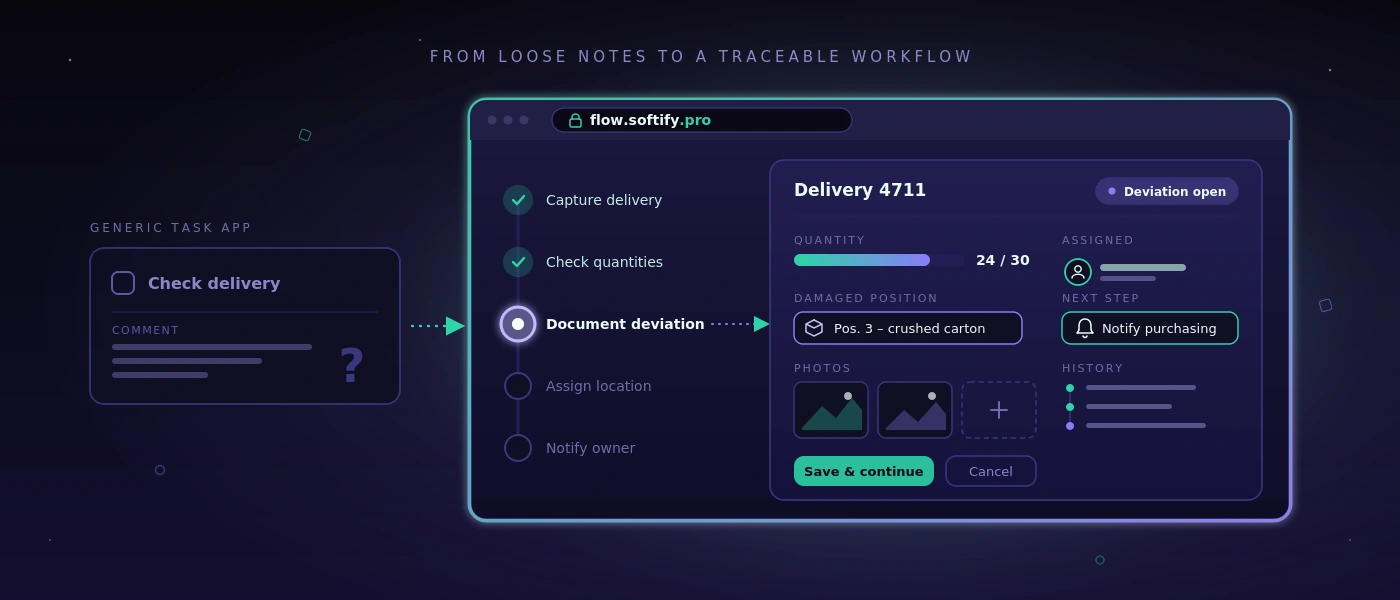
Um workflow web é bom quando os colaboradores sabem, sem interpretação, o que fazer a seguir. Numa receção de mercadorias isso pode significar: registar a entrega, verificar quantidades face à encomenda, documentar o desvio, atribuir uma localização e, se necessário, informar um responsável. O fluxo não tem de ser espetacular. Tem de ser rastreável, rápido e repetível.

É precisamente aqui que está a diferença entre uma aplicação geral de tarefas e um sistema de processos especializado. Uma aplicação de tarefas pode criar um ponto chamado “Verificar entrega”. Um workflow especializado pode, além disso, registar de que entrega se trata, quem a aceitou, que posição estava danificada, que fotografias existem e se está pendente uma entrega posterior. Estes dados não ficam então como texto livre num único comentário, mas onde a pessoa seguinte precisa deles.

Para uma solução como Flow Web em flow.softify.pro, a avaliação deveria, por isso, começar pelas operações, não por uma lista de funções. Uma empresa com cinco movimentos de armazém por dia precisa de algo diferente de uma equipa de expedição com vários horários-limite, diferentes transportadores e gestão regular de entregas parciais. O SaaS não substitui a compreensão do processo.

Primeiro nomear o estrangulamento, depois configurar

Muitos projetos de digitalização começam demasiado amplos: “Queremos digitalizar o armazém.” Soa plausível, mas leva depressa a um sistema com demasiados ecrãs, casos especiais e documentos de formação. Melhor é uma afirmação precisa como: “As receções de mercadorias só são lançadas no dia seguinte, porque as guias de remessa ficam na secretária no fim do turno.”

De uma frase assim pode derivar-se um início sensato. A primeira versão pode registar guias de remessa, confirmar artigos e quantidades, assinalar desvios e passar o lançamento ao setor responsável. Quando este fluxo funciona, etiquetas, avaliações de fornecedores ou propostas de encomenda automáticas podem ser acrescentadas mais tarde. Nem todo o passo de expansão sensato pertence ao primeiro arranque.

Também uma tabela bem mantida pode ficar se cumprir o seu propósito. Por exemplo, uma análise mensal com poucos participantes num ficheiro existente pode ser mais barata e transparente do que um módulo próprio. O SaaS compensa onde a informação é usada várias vezes, os tempos de tratamento são críticos ou os erros surgem de rupturas de suporte.

As perguntas certas antes da introdução

Antes da configuração, uma equipa deveria percorrer uma operação real do princípio ao fim. Não o processo ideal, mas o caso que cria problemas no dia a dia: quantidade errada, referência em falta, expedição urgente ou uma encomenda com aprovação especial. Assim mostram-se as regras que um sistema tem realmente de representar.

São relevantes, entre outros, estes pontos: quem pode criar, alterar ou encerrar uma operação? Que entradas são obrigatórias e quais apenas úteis? Quando tem de ser informado um responsável? Que dados são passados à contabilidade, expedição ou apoio ao cliente? E o que acontece se o WLAN do armazém for fraco ou um colaborador já não tiver as suas credenciais?

As respostas determinam a qualidade da introdução mais fortemente do que um longo catálogo de requisitos visuais. Um processo de perfis limpo, uma mensagem de erro compreensível e um passo de aprovação documentado evitam na operação geralmente mais esforço do que um relatório adicional na página inicial.

Conservação de dados e perfis não são um assunto secundário

O SaaS é frequentemente tratado como uma mera questão de utilização. Para os responsáveis de operações e de TI é, contudo, pelo menos igualmente importante o que acontece aos dados. Isso diz respeito a dados mestre, informações de entrega, dados de colaboradores, fotografias de danos e possivelmente dados de clientes. Antes da introdução deveriam estar claras as responsabilidades, a conservação e as possibilidades de exportação.

Na prática significa: a empresa tem de saber que dados estão no sistema, quem tem acesso administrativo e como os dados são disponibilizados numa mudança ou cessação de contrato. Uma exportação disponível apenas como ficheiro PDF de leitura difícil raramente ajuda. Para dados operacionais, formatos estruturados e utilizáveis são decisivos.

Também o conceito de permissões merece atenção concreta. No armazém, nem todas as pessoas precisam de ver preços, condições de clientes ou definições globais. Ao mesmo tempo, uma atribuição de direitos demasiado estreita não deve bloquear o fluxo. Fazem sentido perfis alinhados com as atividades reais: receção, planeamento, expedição, chefia de equipa e administração. As alterações críticas deveriam ser rastreáveis, para que, em caso de perguntas, não seja preciso adivinhar quem alterou um lançamento.

O acesso em si deveria ser protegido com bases sólidas. Isso inclui políticas de palavras-passe seguras, uma reposição de palavra-passe regulada, bloqueio de conta após tentativas falhadas repetidas e, onde o perfil de risco o exija, passos de início de sessão adicionais. A segurança parece profissional quando é previsível e não se nota apenas quando alguém ficou bloqueado.

Integração só onde alivia de forma mensurável

Um workflow web muitas vezes só desenvolve o seu valor em interação com sistemas existentes. Pode ser um ERP, uma loja, uma solução de expedição, um registo de tempos ou uma base de dados. Mesmo assim, nem toda a interface é automaticamente sensata. Cada integração cria dependências, quadros de erro e esforço de manutenção.

A pergunta central é: que passo manual a ligação elimina concretamente? Se uma interface poupa por dia 30 minutos de trabalho de transferência e reduz erros de digitação, o benefício é claro. Se apenas espelha uma informação que de qualquer forma é verificada uma vez por semana, uma exportação manual pode, de início, ser a solução mais razoável.

Nas extensões individuais conta a base técnica. Interfaces documentadas, campos de dados claramente definidos e registos de erros rastreáveis facilitam a operação posterior. Se um sistema for ligado a uma aplicação web à medida, tecnologias e estrutura da base de dados deveriam ser escolhidas de forma a manterem-se sustentáveis a longo prazo. Uma aplicação cuidada baseada em PHP 8.4, JavaScript moderno e MySQL 8 vale mais do que uma solução especial impressionante a curto prazo mas sem documentação.

Introdução com a operação em curso

O erro mais frequente é um arranque brusco sem fase de comparação. As equipas têm então de trabalhar de outra forma logo na segunda-feira de manhã, enquanto as perguntas em aberto só surgem de problemas reais. Isso aumenta a rejeição, mesmo que o software em princípio sirva.

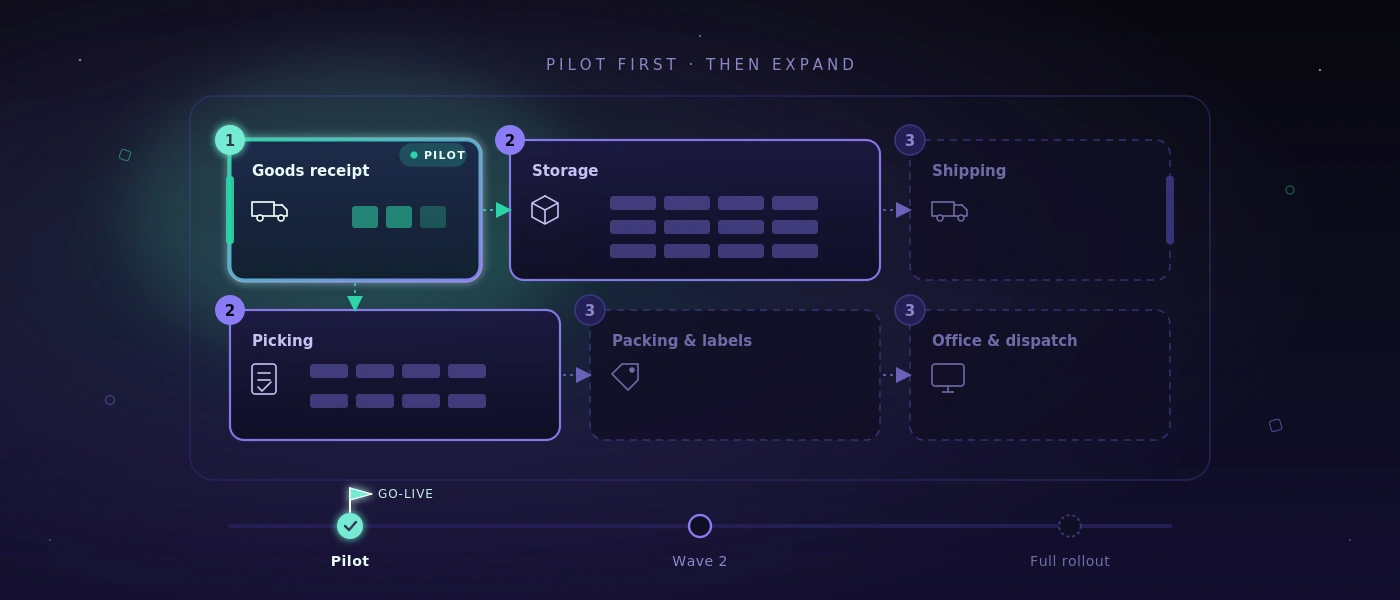
Melhor é um piloto limitado com uma equipa, uma variante de processo ou uma zona de local claramente definida. Nesse tempo verifica-se se o registo e as aprovações funcionam, se os termos são compreensíveis e se os casos excecionais aterram de forma limpa. É importante não recolher o feedback apenas como lista de desejos. Cada alteração deveria ser confrontada com o benefício para o tempo de passagem, a taxa de erros ou a transparência.

Também os indicadores deveriam ser definidos cedo. Por exemplo, podem observar-se o tempo de tratamento por receção de mercadorias, o número de desvios em aberto, as consultas sobre o estado de entrega ou os lançamentos de correção. Sem valor de partida, “parece mais rápido” continua a ser a única avaliação. Pode ser verdade, mas não basta para uma decisão de investimento sólida.

A operação precisa de um dono claro

O SaaS reduz o esforço técnico, mas não liberta uma empresa da responsabilidade pelo seu próprio processo. Internamente é preciso alguém que gira perfis, reúna feedback, reconheça necessidades de formação e decida que alterações são realmente necessárias. Esta pessoa não tem de saber programar. Mas deveria compreender o fluxo de trabalho e ter acesso aos responsáveis.

Igualmente importante é uma documentação operacional breve e sólida. Não explica cada ecrã, mas responde às perguntas que surgem no dia a dia: o que fazer perante um lançamento errado? Quem aprova novos utilizadores? Como é comunicada uma falha? Onde estão os dados exportados? Tal clareza evita que um sistema digital volte, após poucos meses, a depender de chamadas pessoais.

Uma boa solução SaaS não se reconhece, por isso, pelo número de itens de menu que oferece. Mostra o seu valor quando uma nova colega consegue tratar uma operação com segurança, um desvio não desaparece e um responsável vê o estado sem telefonar a três pessoas. O Flow Web deveria ser medido precisamente por esta bitola: não por promessas, mas por um dia de trabalho que decorre comprovadamente mais calmo e fiável.

Permalink →

Desenvolvimento web com frameworks atuais: o que as empresas realmente ganham

Desenvolvimento web com frameworks atuais: o que as empresas realmente ganham

Se uma receção de mercadorias ainda oscila entre formulário em papel, telefonema e três ficheiros Excel, um frontend moderno por si só não resolve o problema. O desenvolvimento web com frameworks atuais faz sentido quando simplifica visivelmente os fluxos: os colaboradores veem o passo seguinte, os dados são registados apenas uma vez e a aplicação permanece compreensivelmente sustentável mesmo após o primeiro go-live.

Para as pequenas e médias empresas, a questão do framework não é, por isso, uma questão de fé. O decisivo não é se uma interface traz especialmente muitas palavras técnicas da moda. O decisivo é se os movimentos de armazém, encomendas, verificações ou aprovações atravessam o dia de trabalho de forma fiável - também sob pressão de tempo, em mudanças de turno e com ligação de rede instável.

Os frameworks são um meio, não um objetivo de projeto

Um framework fornece uma estrutura comprovada para tarefas recorrentes: encaminhamento, formulários, gestão de permissões, acesso a dados, testes e a apresentação de interfaces. Isso não reduz automaticamente todos os riscos. Mas evita que um projeto tenha de reinventar sempre de novo as funções básicas.

Numa aplicação web à medida, um framework JavaScript moderno pode, por exemplo, representar de forma sensata ecrãs interativos: uma lista de picking que atualiza continuamente as posições, um planeamento de rotas com mudanças de estado claras ou um protocolo de inspeção que atribui fotografias e comentários diretamente a uma operação. No backend, frameworks PHP consolidados asseguram regras rastreáveis, responsabilidades claramente separadas e interfaces consistentes com a base de dados.

Isto é particularmente relevante quando uma solução inicialmente pequena se torna um sistema operacional usado diariamente para um processo. Um ecrã de entrada para avisos de entrega pode começar de forma contida. Assim que atualiza stocks, emite etiquetas, considera perfis e comunica com um transportador, precisa de uma base técnica limpa. Os frameworks ajudam a não renegociar essa base a cada extensão.

O que os frameworks web atuais fazem concretamente melhor

O valor dos frameworks modernos raramente está em efeitos espetaculares. Mostra-se nas partes invisíveis de uma aplicação. Os formulários podem verificar entradas diretamente, sem que dados errados só se tornem visíveis após o envio. As permissões podem ser definidas centralmente, de modo que um condutor veja outras informações do que o planeamento. As alterações a uma encomenda são guardadas de forma rastreável, em vez de substituírem silenciosamente uma célula de tabela.

No lado do servidor, um ambiente atual com PHP 8.4 e MySQL 8 cria uma base sólida para lógica crítica para o negócio. As transações de base de dados impedem, por exemplo, que um stock seja reduzido enquanto o lançamento correspondente falha. Chaves únicas e regras de validação evitam duplicados. Processos em segundo plano podem gerar documentos ou chamar interfaces sem que a pessoa ao ecrã tenha de esperar.

Também a segurança não é uma função posterior. Um framework atual suporta armazenamento seguro de palavras-passe, proteção contra ataques típicos por entrada de dados, sessões rastreáveis e fluxos de bloqueio de conta definidos. Ainda assim, a implementação continua a ser uma tarefa de projeto: as permissões têm de ser modeladas corretamente do ponto de vista funcional e as funções sensíveis exigem verificações adicionais. Um framework fornece guarda-corpos, mas não sabe quem na empresa pode conceder que aprovação.

Decidir bem sobre o desenvolvimento web com frameworks atuais

A melhor tecnologia não surge de uma lista de ferramentas populares, mas da utilização real. Uma aplicação interna para dez pessoas tem requisitos diferentes de um portal de clientes com vários milhares de acessos simultâneos. Um terminal de armazém com scanner precisa de uma lógica de operação diferente de uma análise de gestão no computador.

Por isso, uma decisão sensata começa com perguntas concretas: que operações custam hoje tempo de forma mensurável? Que dados são transferidos várias vezes? Onde surgem erros porque a informação só se torna visível demasiado tarde? Que tabela existente funciona suficientemente bem e deveria, por agora, ficar? Precisamente o último ponto protege de projetos de digitalização caros sem benefício operacional.

Para muitas aplicações empresariais à medida, um sistema renderizado no servidor com componentes interativos específicos é a escolha mais sensata. Carrega depressa, é gerível de operar e evita complexidade desnecessária. Uma aplicação de página única totalmente desacoplada pode, pelo contrário, ser adequada quando a interface processa muitíssimos estados dinâmicos, tem de funcionar offline ou deve mais tarde disponibilizar as mesmas funções também a uma app móvel.

Ambas podem estar certas do ponto de vista funcional. A pergunta não é: qual framework é o mais moderno? É: qual arquitetura continuará, daqui a dois anos, a ser segura de expandir, testável e compreensível para a própria equipa?

Quando menos técnica é a melhor técnica

Nem todo o processo precisa de um frontend complexo. Um ecrã de entrada enxuto para encomendas internas pode ser mais rápido, mais estável e mais barato do que uma interface elaboradamente animada. Se um ficheiro Excel é mantido apenas uma vez por mês e não causa erros, talvez continue a ser a ferramenta certa.

A complexidade só compensa quando elimina atrito real. Pode ser o caso quando as encomendas são digitadas várias vezes, o estado de entrega tem de ser consultado por telefone ou ninguém tem a certeza de que versão de um documento é a válida. Então uma aplicação central cria um benefício claro: um estado de dados, responsabilidades inequívocas e menos consultas.

A manutenibilidade começa antes da primeira linha de código

Os frameworks são muitas vezes vistos como aceleradores. Isso só é verdade se as regras de negócio estiverem antes suficientemente claras. Um programador pode construir uma máquina de estados de forma tecnicamente limpa. Mas se a sequência de estados se adequa realmente ao processo decide-se no levantamento: quando é que a mercadoria se considera recebida? Quem pode fechar um desvio? O que acontece numa entrega parcial?

Estas decisões devem ser documentadas, tal como interfaces, campos de dados e exceções. Isso não torna os projetos mais lentos. Reduz discussões posteriores, porque se torna visível que regra foi implementada deliberadamente e que pressuposto continua em aberto.

A manutenibilidade mostra-se também em pequenas disciplinas. As alterações à base de dados têm de ser versionadas. Os passos de implementação têm de ser documentados. As mensagens de erro devem ser aproveitáveis para operação e desenvolvimento sem revelar detalhes confidenciais. Testes automatizados verificam a cada alteração os fluxos centrais, por exemplo a criação de uma encomenda, o cálculo de uma quantidade ou a emissão de uma guia de remessa.

Em aplicações críticas, um único tipo de teste não basta. Os testes unitários asseguram regras individuais, os testes de integração verificam a interação com a base de dados e as interfaces, e os testes de ponta a ponta reproduzem no navegador percursos de utilização reais. Para aplicações web e Windows, um ambiente de testes auto-hospedado pode ainda fornecer capturas de ecrã, registos de execução e avaliações compreensíveis, sem entregar desnecessariamente dados de teste internos a serviços cloud externos.

O desempenho nasce da arquitetura e do modelo de dados

Uma interface moderna não se torna rápida só por usar um framework atual. Consultas lentas à base de dados, imagens sobredimensionadas ou interfaces pouco claras continuam lentas, independentemente do frontend. Especialmente em listas de encomendas, artigos ou dados de movimentos, é o modelo de dados que decide a velocidade percebida.

Índices limpos no MySQL 8, consultas paginadas e dados carregados de forma consciente são muitas vezes mais eficazes do que uma otimização posterior da interface. Igualmente importante é um conceito claro de cache. Os dados mestre podem, em certas circunstâncias, ser colocados em cache, os stocks atuais ou o estado de aprovação, pelo contrário, não às cegas. Aqui não existe regra geral, porque o significado funcional dos dados determina quão atuais têm de ser.

O design responsivo também faz parte do planeamento técnico. No ecrã de escritório, uma tabela larga pode fazer sentido. Num scanner de mão ou tablet no armazém, a mesma informação precisa de grandes áreas de toque, caminhos curtos e uma apresentação que continue utilizável mesmo com luvas ou com pouca luz. Pure fluidity meets ultimate performance não significa, neste contexto, o máximo de movimento possível no ecrã. Significa que a aplicação funciona sem atrito no dispositivo que é realmente usado no processo.

O caminho sensato da ideia à operação

Um projeto web sólido começa com um núcleo limitado e verificável. Em vez de automatizar de antemão cada exceção imaginável, escolhe-se um processo que ocorre com frequência e causa esforço percetível. Após a primeira utilização, dados e retornos reais mostram que extensão tem realmente a prioridade seguinte.

A entrega técnica não deveria ocorrer só no fim. As responsabilidades por alojamento, cópias de segurança, monitorização, atualizações e direitos de acesso têm de ser esclarecidas cedo. Um sistema é tão fiável quanto a sua operação. Quem precisa de uma aplicação diariamente para expedição ou tratamento de encomendas precisa de caminhos de recuperação definidos e de uma resposta clara ao que acontece em caso de falha.

A softify.pro aposta, por isso, em tecnologias sustentáveis, entrega documentada e responsabilidade técnica direta em vez de modas passageiras de frameworks. Isso não é um atalho mágico. Cria o pressuposto de que uma aplicação continue a funcionar após o lançamento, possa ser desenvolvida e não se torne o próximo caso especial frágil.

A aplicação web certa, no melhor dos casos, não se sente como um novo projeto de TI. Sente-se como um fluxo que finalmente funciona sem desvios - com substância técnica suficiente para acolher com calma também a próxima alteração na operação.

Permalink →

Planear a implementação de software: como o conseguir com a operação em curso

Planear a implementação de software: como o conseguir com a operação em curso

Um sistema novo raramente falha porque falta um botão. Falha na segunda-feira de manhã: o turno da manhã não encontra a receção de mercadorias, uma guia de remessa é impressa duas vezes ou um ficheiro Excel passa de repente a ser a verdade não oficial. Quem quer planear uma implementação de software tem, por isso, de fazer mais do que introduzir funções: tem de assegurar a operação real.

Precisamente no armazém, na oficina, no planeamento e na administração, uma implementação não é uma marcação de TI. Altera gestos, responsabilidades e vias de informação. Uma boa introdução mantém o trabalho em movimento, torna os erros visíveis cedo e dá aos colaboradores uma resposta clara à pergunta decisiva: o que faço de diferente a partir de amanhã?

A implementação começa antes da primeira formação

Muitos projetos começam com uma lista de funcionalidades: registar encomendas, lançar movimentos de armazém, imprimir etiquetas de expedição, planear rotas. Isso é necessário, mas não basta. Antes do arranque tem de estar claro que processos devem, no primeiro dia produtivo, passar efetivamente pelo novo sistema - e quais, deliberadamente, ainda não.

Esta delimitação não é sinal de incompletude. Reduz o risco. Se uma empresa de média dimensão coordenou até agora as receções de mercadorias por papel, telefone e tabelas, não precisa de digitalizar no primeiro dia, em simultâneo, toda a gestão de stocks, o tratamento de devoluções, o planeamento de rotas e a avaliação de fornecedores. Um primeiro âmbito sensato poderia estar na receção de mercadorias, em movimentos de armazém inequívocos e na impressão de documentos de entrega.

O decisivo é descrever concretamente o processo-alvo. Não: «A receção de mercadorias passa a digital.» Mas: «O colaborador digitaliza a entrega, verifica a quantidade e o estado, atribui uma localização e, em caso de desvios, cria um processo para as compras.» Só a este nível ficam visíveis as perguntas em aberto: o que acontece se faltar a encomenda? Quem pode corrigir quantidades? Pode uma entrega sem etiqueta ser armazenada?

Planear uma implementação de software significa: priorizar os fluxos críticos

Nem todo o processo tem o mesmo peso. Uma falha na manutenção de dados mestre pode ser desagradável. Uma falha na expedição, no picking ou na aprovação de faturas pode bloquear o trabalho de um dia inteiro. Por isso, a implementação precisa de uma priorização segundo o risco operacional, não segundo a ordem do caderno de encargos.

Uma classificação simples tem-se revelado útil: crítico para o negócio, importante e adiável. São críticos todos os fluxos que movimentam mercadoria, dinheiro ou comunicação vinculativa com clientes. São importantes as funções que aceleram o dia a dia, mas cuja falha pode ser amortecida manualmente de forma transitória. São adiáveis as funções de conforto, os casos especiais raros ou as análises que, no início, ainda podem vir de uma fonte existente.

Esta classificação influencia a profundidade dos testes. Para um processo de expedição crítico não basta percorrer com sucesso uma única encomenda. Têm também de ser testadas entregas parciais, estornos, impressoras em falta, moradas erradas, processamento paralelo e a transferência para o transportador. Para uma função estatística raramente usada, pode ser adequado um ciclo de testes posterior.

Tornar mensuráveis de antemão os critérios de sucesso

«A aplicação funciona» não é um critério de aceitação. Melhores são afirmações verificáveis: uma receção de mercadorias com 30 posições pode ser lançada em dez minutos. As etiquetas de expedição são impressas no posto previsto. As alterações de stock aparecem imediatamente no planeamento. Uma conta de utilizador bloqueada só pode ser reativada através do processo de aprovação definido.

Tais critérios ligam a área de negócio e o desenvolvimento. Evitam também que a aceitação se transforme numa coleção de impressões vagas. Nem todo o feedback tem de ser resolvido antes do go-live. Mas cada feedback precisa de uma classificação: erro crítico, melhoria relevante ou ponto para uma fase de expansão posterior.

Migração de dados: só dados limpos merecem confiança

Os dados antigos são frequentemente subestimados. Nas tabelas encontram-se números de artigo duplicados, unidades diferentes, moradas de clientes expiradas e stocks cuja origem já ninguém consegue explicar. Quem assume estes dados sem os verificar transfere a antiga indefinição para um novo sistema - só que com melhor interface.

Antes da migração deve determinar-se que dados são realmente necessários. Frequentemente fazem sentido artigos atuais, clientes ativos, encomendas em aberto, fornecedores relevantes e stocks iniciais verificados. Os registos históricos não têm necessariamente de passar por completo para a nova aplicação. Pode bastar arquivá-los de forma legível, se continuarem necessários para comprovativos ou consultas.

Particularmente importante é uma carga de teste. Os dados não são apenas importados tecnicamente, mas verificados funcionalmente: as quantidades, unidades e atribuições estão corretas? Os campos obrigatórios estão completos? Conseguem processar-se corretamente encomendas típicas com eles? Para o go-live é depois necessária uma data-limite clara. A partir de quando é usado que sistema principal? Sem esta regra surgem manutenção duplicada e stocks contraditórios.

Operação-piloto em vez de um grande interruptor

Um big bang pode fazer sentido se uma pequena equipa usar um processo claramente delimitado e a solução antiga e a nova não puderem funcionar em paralelo. Na maioria dos ambientes operacionais, contudo, uma operação-piloto é a escolha mais controlável.

O piloto deve trabalhar com casos reais, mas num âmbito limitado: uma zona de armazém, um turno, um grupo de produtos ou uma equipa selecionada. O decisivo é que o grupo-piloto não inclua apenas colaboradores especialmente aficionados da tecnologia. Deve representar de forma realista o dia a dia posterior, incluindo as pessoas que trabalham sob pressão de tempo e têm objeções legítimas.

Na operação-piloto vê-se se scanners, impressoras, rede e permissões funcionam no posto de trabalho real. Igualmente ficam visíveis lacunas de processo que ninguém mencionou nas reuniões. Talvez a mercadoria seja, no dia a dia, primeiro colocada num local intermédio. Talvez os condutores precisem de uma guia de remessa diferente da da administração. Tais descobertas não são um retrocesso. São a razão para realizar o piloto antes do arranque generalizado.

A formação como situação de trabalho, não como visita guiada ao software

Uma formação que só explica itens de menu gera pouca segurança. Os colaboradores têm de aprender nas suas tarefas: «Aceita uma entrega danificada», «Prepara uma encomenda urgente», «Corrige uma quantidade mal lançada». O contexto fixa-se porque corresponde ao dia a dia de trabalho.

Formações curtas junto ao go-live são geralmente mais eficazes do que uma marcação longa semanas antes. Ajudam também instruções de trabalho concisas diretamente no posto. Não devem explicar o sistema inteiro, mas mostrar as operações mais frequentes, responsabilidades claras e o caminho em caso de falhas.

Nomeie ainda pessoas de contacto por área. Estas pessoas não têm de resolver elas próprias cada problema técnico. Mas devem poder decidir se se trata de um erro de utilização, uma indefinição funcional ou um erro real do sistema. Isso protege a equipa do projeto de interpelações desestruturadas e acelera a ajuda ao turno.

O go-live precisa de um plano operacional

O dia do go-live precisa de mais do que uma hora. Defina quem decide a nível funcional, quem é responsável pelas alterações técnicas e por que canal as falhas são reportadas. Em fluxos críticos deve ser visível se as funções centrais funcionam: início de sessão, permissões, captura de dados, interfaces, impressão e cópia de segurança.

Um plano de contingência faz igualmente parte. Isso não significa regressar por completo ao velho mundo ao mínimo problema. Significa determinar antecipadamente que falha justifica uma paragem, como se documentam as encomendas em caso de necessidade e como se registam depois de forma limpa. Um formulário em papel durante poucas horas pode ser razoável. Uma gestão paralela permanente sem fim não é.

Os detalhes técnicos contam aqui: os acessos foram criados a tempo? Os perfis e as regras de bloqueio de conta funcionam corretamente? As impressoras de etiquetas estão ligadas aos modelos certos? Existe uma cópia de segurança testada da base de dados? Em aplicações desenvolvidas à medida, implementações documentadas, estados de versão rastreáveis e um caminho claro para correções de erros são o padrão.

As primeiras semanas decidem a aceitação

Após o arranque começa a fase em que uma aplicação se torna ou uma ferramenta de trabalho ou um passo adicional detestado. Planeie por isso breves ciclos de feedback diários. Que erros se repetem? Onde surgem desvios? Que campos são mal compreendidos? Que análise falta realmente a um responsável?

Nem toda a observação exige uma alteração imediata. Alguns problemas resolvem-se com regras de trabalho mais precisas ou melhor formação. Outros revelam fragilidades reais no processo ou na aplicação. A arte consiste em não confundir ambos. Um sistema não deve complicar, sem motivo, fluxos existentes que funcionam. Se uma tabela bem mantida continua a ser a melhor solução para um caso especial raro, pode ficar.

Meça o efeito com alguns indicadores concretos: tempo de processamento por operação, número de consultas, lançamentos errados, reimpressões, encomendas em aberto ou discrepâncias de stock. Só estes valores mostram se a implementação melhora realmente a operação - em vez de apenas introduzir novos ecrãs.

Uma boa implementação, após algumas semanas, já não se sente como um projeto. Torna-se uma rotina de trabalho fiável: os dados certos estão onde são necessários, as exceções são rastreáveis e as equipas têm de andar menos ao telefone atrás de informação. É exatamente a isso que o planeamento deve visar - não a um dia de arranque espetacular, mas a um dia a dia mais calmo e mais bem controlável.

Permalink →

Planear o Multiplatform Application Development: primeiro o processo, depois a plataforma

Planear o Multiplatform Application Development: primeiro o processo, depois a plataforma

Um responsável de armazém confirma uma receção de mercadorias no scanner de mão. O planeamento verifica a mesma operação no navegador. Um condutor precisa do estado de entrega em viagem no smartphone. O Multiplatform application development soa, neste momento, a uma questão técnica. Na verdade, trata-se primeiro de um fluxo operacional: que trabalho tem de ser feito onde, com que fiabilidade e com que dispositivo?

Para as pequenas e médias empresas, a resposta certa raramente é: construímos tudo de forma nativa para cada plataforma. Com mais frequência é: definimos um processo comum, escolhemos de forma direcionada as interfaces necessárias e evitamos a lógica duplicada. Isso não poupa apenas orçamento de desenvolvimento. Evita também que o armazém, o escritório e o serviço externo trabalhem com estados de dados diferentes.

O que o Multiplatform Application Development deve proporcionar

O Multiplatform Application Development designa o desenvolvimento de uma aplicação utilizável em vários ambientes, por exemplo no navegador web, em iOS e Android ou em sistemas de secretária Windows. O termo é muitas vezes reduzido à questão de saber se uma única base de código pode gerar várias aplicações. Isso é apenas parte da decisão.

Para sistemas operacionais, o que importa sobretudo é se a aplicação funciona no local de utilização. Uma zona de receção pode precisar de uma câmara para capturar códigos de barras, elementos de controlo grandes para luvas e uma reação utilizável com cobertura WLAN instável. A administração precisa, pelo contrário, de tabelas, filtros, conceitos de permissões e registos de alterações rastreáveis. Um condutor precisa de uma vista reduzida, não da mesma interface que o planeamento.

Uma base técnica comum pode ligar estes requisitos de forma sensata. Mas não deve levar a que cada plataforma seja servida como um mau compromisso. O melhor código partilhado é inútil se os colaboradores fazem desvios porque a aplicação não reflete o seu fluxo de trabalho real.

Primeiro determinar o processo, depois a plataforma

Antes de as equipas falarem de frameworks, deveriam examinar uma operação concreta do princípio ao fim. Tomemos uma entrega: entra a encomenda, a mercadoria é preparada, surge uma guia de remessa, a entrega é confirmada e o estado é reportado de volta às vendas ou ao apoio ao cliente. Em que ponto surge hoje a rutura de suporte? Onde se anota algo em papel, se digita mais tarde ou se pergunta por telefone?

Esta observação separa os requisitos reais de plataforma das listas de desejos. Se apenas dois colaboradores no escritório usam uma função, uma interface web bem feita costuma bastar. Se dez pessoas no chão do armazém fazem lançamentos, uma interface móvel adequada ao scanner pode fazer a diferença. Se um programa Windows existente tem de trabalhar com hardware especial, pode ser necessária uma integração de secretária.

Nem toda a função pertence a todo o dispositivo. Isso não é um defeito de uma solução multiplataforma, mas sinal de decisões de produto limpas. Dados e regras de negócio comuns não significam necessariamente ecrãs idênticos.

As três perguntas que esclarecem custos e benefícios

A primeira pergunta é: que dispositivos já estão em uso e durante quanto tempo continuarão a estar? Uma empresa com terminais Windows geridos tem requisitos diferentes de um serviço externo com smartphones privados. A segunda é: o que acontece sem ligação de rede? A capacidade offline aumenta consideravelmente o esforço, porque os dados têm de ser guardados localmente, sincronizados mais tarde e tratados de forma limpa em caso de conflitos. Faz sentido se o processo, de outro modo, parar - não como equipamento padrão.

A terceira pergunta diz respeito às consequências de uma falha. Pode um colaborador registar um lançamento mais tarde, ou dele depende uma etiqueta de expedição, um stock ou uma libertação de segurança? Quanto mais crítica a operação, mais fortemente têm de ser planeados permissões, regras de verificação, repetibilidade e registo.

Uma arquitetura que não se desfaz na segunda plataforma

Numa solução sustentável, a lógica de negócio não está espalhada por várias interfaces. Verificações de stock, mudanças de estado, intervalos de numeração, permissões e geração de documentos precisam de uma base central e testada. Navegador, aplicação móvel e cliente de secretária acedem a ela através de interfaces claramente definidas.

Para muitos processos empresariais internos, uma aplicação web moderna é o ponto de partida mais económico. Pode ser atualizada centralmente, não precisa de instalação em cada posto e funciona em computador, tablet e smartphone. Com PHP 8.4, JavaScript moderno e MySQL 8 pode construir-se uma base sustentável, desde que o modelo de dados, os direitos de acesso e a implementação não sejam considerados só pouco antes do arranque.

Uma aplicação móvel ou de secretária instalável é acrescentada quando traz uma vantagem clara: integração profunda com scanner, impressora ou câmara, operação offline fiável, funções especiais em segundo plano ou requisitos da gestão de dispositivos. É uma expansão direcionada, não um fim em si mesmo.

Um erro frequente é a reutilização completa da interface de utilizador a todo o custo. Tecnicamente pode parecer atraente. Na prática surgem textos pequenos em monitores grandes, formulários sobrecarregados em smartphones ou comandos que não se adequam à plataforma. É melhor partilhar modelo de dados, regras e componentes onde faz sentido, adaptando a utilização ao respetivo contexto.

A consistência dos dados é mais importante do que uma base de código comum

Várias plataformas aumentam o risco de dados contraditórios. Uma encomenda é alterada no escritório enquanto um condutor ainda vê uma versão antiga no seu dispositivo. Dois colaboradores lançam em simultâneo o mesmo stock de artigo. Um dispositivo offline reenvia as suas alterações horas depois. Estes casos não são um tema marginal, mas o núcleo da arquitetura.

O sistema precisa, por isso, de identidades inequívocas, carimbos temporais, mudanças de estado rastreáveis e regras para conflitos. Num estado de entrega, a última alteração confirmada pode bastar. Em stocks, isso é muitas vezes demasiado grosseiro. Aí tem de ficar claro que movimento foi lançado, de que localização provém e se uma correção tem de ser justificada.

Também as permissões devem ser reguladas centralmente. Um colaborador pode, talvez, registar receções de mercadorias, mas não aprovar correções de stock. Um condutor externo só pode ver o seu percurso. Durações de sessão, autenticação multifator para perfis críticos e fluxos de bloqueio de conta não são funções de segurança decorativas. Protegem processos concretos e tornam as responsabilidades visíveis.

Testar o Multiplatform Application Development como se trabalha

Uma aplicação pode arrancar em três sistemas operativos e, mesmo assim, falhar na operação. Decisivos são os fluxos em condições reais: o scanner reage demasiado devagar, uma impressora de etiquetas não está acessível, uma permissão não produz efeito após uma mudança de perfil, ou uma sincronização gera lançamentos duplicados.

Por isso, os processos críticos devem ser verificados automaticamente. Isso inclui início de sessão e comportamento de bloqueio, registo de encomendas, movimentos de stock, criação de documentos e o tratamento de entradas erradas. Para aplicações web e Windows, testes recorrentes podem ser executados numa infraestrutura auto-hospedada. Isto é particularmente relevante se capturas de ecrã, dados internos de encomendas ou acessos de teste não devem ser transmitidos a serviços cloud externos.

A automação não substitui a verificação por pessoas no chão do armazém. Mas garante que os fluxos conhecidos são controlados uma e outra vez após alterações. Bons relatórios de teste não nomeiam apenas um erro técnico, mas o processo afetado: o comprovativo de entrega não pode ser gerado, a conta de utilizador permanece bloqueada após aprovação bem-sucedida ou os dados do percurso não são atualizados.

Quando uma estratégia de plataforma é demais

Algumas empresas não precisam de uma app própria. Se um acesso estável pelo navegador basta, o fluxo raramente é móvel e o número de utilizadores se mantém gerível, uma aplicação web responsiva é muitas vezes a escolha mais sensata. Reduz o esforço de manutenção, os problemas de distribuição e o número de possíveis fontes de erro.

Também uma tabela existente não tem de ser substituída de imediato. Se serve apenas como avaliação simples, é mantida por uma pessoa e não cria transferências propensas a erros, pode cumprir o seu propósito. O momento para um sistema chega quando o conhecimento está em cabeças individuais, as versões divergem, as perguntas aumentam ou uma operação já não pode ser rastreada de forma fiável.

Inversamente, uma estratégia de plataforma enxuta torna-se depressa demasiado pequena quando os colaboradores têm de trabalhar offline, é ligado hardware ou clientes e parceiros precisam de acesso controlado. Então vale a pena financiar conscientemente os requisitos adicionais, em vez de os acrescentar mais tarde sob pressão de tempo.

Começar com um piloto sólido

Um bom começo não é um catálogo de funcionalidades com cem pontos, mas um fluxo completo e mensurável. Por exemplo: registar a receção de mercadorias, atualizar o stock, documentar um desvio e criar uma tarefa de esclarecimento. Este piloto mostra cedo se modelo de dados, dispositivos, direitos e utilização se encaixam.

Depois, a solução pode crescer em passos sensatos: picking, expedição, planeamento de percursos ou análises. Cada extensão deveria passar a mesma pergunta: encurta um fluxo real, reduz erros ou cria transparência fiável? Se não, pode esperar.

A plataforma mais sensata, no final, não é a que tem mais opções técnicas. É aquela em que uma equipa começa o trabalho mais depressa de manhã, pergunta menos durante o turno e pode rastrear à noite o que realmente aconteceu.

Permalink →

Avaliar corretamente os Test Automation Results

Avaliar corretamente os Test Automation Results

Um teste de regressão pode terminar de manhã com 98 por cento de casos bem-sucedidos e, mesmo assim, não ser uma boa notícia. Talvez o teste falhado seja precisamente o início de sessão de um grande cliente. Talvez 40 testes tenham sido ignorados porque o ambiente de teste não estava acessível. Ou a execução estava verde, mas só verificava se os botões existem, não se uma encomenda é realmente guardada, uma guia de remessa gerada e o stock corretamente ajustado. Os Test automation results não são uma afirmação sobre qualidade enquanto lhes faltar o contexto.

Para a direção de QA, o desenvolvimento e as áreas de negócio, o verdadeiro trabalho não está, portanto, apenas em automatizar testes. O decisivo é preparar os resultados de modo que deles surjam decisões fiáveis: pode uma versão ser lançada? Tem de se tratar um erro de imediato? O erro é novo, recorrente ou apenas um problema do ambiente de teste? E existem evidências que também uma área de negócio sem código de teste consiga acompanhar?

O que os Test Automation Results realmente dizem

O indicador mais simples é: aprovado ou reprovado. É útil, mas raramente suficiente. Uma taxa de sucesso elevada pode criar confiança se os testes cobrirem fluxos críticos, os dados de teste forem plausíveis e o ambiente se assemelhar à operação posterior. Se faltar um destes fatores, o número continua a ser sobretudo um sinal de que uma execução automatizada foi realizada.

Em aplicações críticas para o negócio, pesam mais outras perguntas. Numa solução de armazém, nem todos os ecrãs são igualmente importantes. Um erro de apresentação num texto de aviso interno pode esperar. Um erro que contabiliza a quantidade errada na receção de mercadorias ou gera uma etiqueta de expedição sem morada do destinatário, não. Bons resultados de teste ponderam, por isso, os riscos em vez de tratar todos os casos de forma igual.

Também um teste falhado não é automaticamente um defeito do produto. Pode ser desencadeado por credenciais expiradas, um perfil de teste bloqueado, interfaces indisponíveis, dados de teste alterados ou um ambiente lento. Quem não separa estas causas produz ruído. A equipa gasta então tempo com falsos alarmes enquanto erros reais se perdem entre mensagens de estado vermelhas.

Quatro tipos de estado em vez de uma lista vermelha

Na prática, tem-se revelado útil uma classificação clara: erro funcional, falha técnica do teste, problema de ambiente e alteração esperada. Um erro funcional significa que a aplicação viola um requisito definido. Uma falha técnica do teste aponta antes para o próprio teste, por exemplo um seletor que deixou de corresponder após uma interface deliberadamente alterada.

Existe um problema de ambiente quando, por exemplo, um sistema de teste ou uma interface ligada não está disponível. As alterações esperadas surgem quando um processo foi deliberadamente ajustado, mas a automação ainda verifica o antigo estado-alvo. Estas categorias não evitam toda a discussão. Mas garantem que a discussão começa no ponto certo.

De execuções de testes a relatórios prontos para decisão

Um relatório utilizável não responde apenas que algo falhou, mas o que aconteceu, quão grave é e se o erro parece reproduzível. Para isso é preciso mais do que uma lista de nomes de testes e carimbos temporais.

A cada execução relevante pertencem a build verificada, o ambiente de teste, o perfil utilizado, os dados de teste centrais, bem como a hora de início e de fim. Especialmente em aplicações de secretária Windows ou plataformas web complexas, estas informações são necessárias para delimitar diferenças. Um erro que só ocorre sob um perfil de armazém restrito é algo diferente de um erro que bloqueia cada início de sessão.

Resultados significativos contêm ainda evidências rastreáveis: capturas de ecrã, passos gravados, mensagens de erro e, se necessário, registos técnicos. Uma captura de ecrã isolada pode, contudo, enganar. Mostra um momento, não a causa. A combinação de sequência de passos, estado visível e reação esperada é muito mais útil.

Os sistemas assistidos por IA podem transformar estas evidências em avaliações compreensíveis. Com a COCO, por exemplo, os testes correm num servidor de IA próprio e auto-hospedado. A avaliação pode explicar que uma encomenda foi criada, mas a mudança de estado esperada não ocorreu, e associar diretamente a gravação da execução. Para equipas atentas à segurança, é relevante onde são processados as capturas de ecrã, os dados da aplicação e o tráfego de teste. O controlo local não é automaticamente necessário, mas em aplicações internas e dados sensíveis pode ser o caminho mais sensato do que um serviço cloud externo.

O nível de detalhe certo para diferentes destinatários

As equipas de desenvolvimento precisam de mensagens de erro, passos técnicos e indicações o mais precisas possível para a reprodução. Um operations manager precisa, pelo contrário, primeiro da função afetada, do risco de negócio e de uma afirmação clara sobre a capacidade operacional. Ambas as perspetivas têm de poder surgir da mesma execução, sem que alguém tenha de transferir manualmente resultados para apresentações.

Um bom relatório começa, por isso, com um breve nível de decisão: lançamento recomendado, lançamento com limitações conhecidas ou parar o lançamento. Por baixo estão os desvios críticos com prioridade e evidência. Os detalhes técnicos seguem só depois. Isso não é uma simplificação à custa da precisão, mas uma separação limpa das necessidades de informação.

Medir a cobertura sem se iludir com falsa segurança

A cobertura de testes é frequentemente apresentada como valor percentual. Esse valor é útil quando está claro o que mede. A cobertura de código mostra, por exemplo, que partes do código do programa foram executadas durante os testes. Isso não prova que um processo de negócio funcione corretamente. Um teste pode tocar em muitas linhas de código e, mesmo assim, nunca verificar se uma morada de entrega errada aparece no documento.

Para as áreas de negócio, a cobertura de processos é frequentemente mais reveladora. Descreve que fluxos reais estão protegidos: registar uma encomenda, reservar stock, contabilizar uma entrega parcial, aceitar uma devolução ou aprovar uma fatura. Particularmente valiosas são as transições entre sistemas e perfis, porque é aí que frequentemente surgem erros: na importação de uma encomenda, na impressão de uma etiqueta ou na mudança do escritório para o terminal de armazém.

Não priorize pelo número de testes possíveis, mas pelo impacto do dano e pela frequência de alterações. Um processo raramente usado com elevado risco financeiro ou legal merece frequentemente uma automação mais cedo do que uma vista muito usada, mas inofensiva. Inversamente, um fluxo estável e pouco crítico pode continuar a contentar-se com uma breve verificação manual. Nem toda a verificação tem de ser automatizada só porque é automatizável.

Testes instáveis são um problema de qualidade à parte

Testes que, sem alteração reconhecível do produto, ora passam ora falham são frequentemente designados flaky. Danificam a confiança mais depressa do que um teste permanentemente vermelho. Assim que as equipas reiniciam por reflexo resultados vermelhos, a automação perde a sua função de alerta.

As causas são geralmente concretas: esperas fixas, dados de teste partilhados, acessos paralelos, processamento assíncrono ou um ambiente que não é reposto. Uma curta pausa de três segundos no teste pode ajudar por acaso, mas não é uma solução. É melhor esperar por um estado demonstrável, tornar os dados de teste únicos e isolar os fluxos uns dos outros.

Nem toda a instabilidade pode ser totalmente evitada. Interfaces externas podem oscilar e a infraestrutura real tem falhas. Nesse caso, o relatório deve assinalar claramente se um teste não pôde ser avaliado devido a uma dependência externa. Uma execução repetida pode ser útil para diagnóstico, mas não deve tornar invisível a primeira constatação.

Um procedimento sensato após cada execução de testes

Após uma execução automatizada, nem todos os resultados devem ser imediatamente tratados da mesma forma. Primeiro verificam-se os erros bloqueantes e os testes críticos não avaliáveis. Depois segue-se a classificação dos novos desvios face a problemas conhecidos e aceites. Só então uma decisão de lançamento é sólida.

Limiares definidos ajudam, mas têm de se ajustar ao processo. Por exemplo, um teste falhado no fluxo de pagamentos ou de permissões pode desencadear uma paragem imediata. Perante um desvio puramente cosmético, uma exceção documentada pode ser defensável. Tais regras não deveriam surgir apenas sob pressão de tempo antes de um lançamento.

Igualmente importante é o feedback: cada erro de produção que os testes não detetaram é um motivo para verificar se falta um cenário, uma variante de dados de teste ou um ponto de controlo. O objetivo não é acumular o maior número possível de testes. É construir, a partir de erros reais, uma melhor proteção de forma direcionada.

Os resultados de teste mais úteis, no final, não são os de visão geral mais verde. São aqueles com os quais um responsável pode compreender na segunda-feira de manhã o que foi verificado, que risco permanece e que ação é agora sensata.

Permalink →

Inventory Discrepancy Causes: razões comuns para discrepâncias de stock

Inventory Discrepancy Causes: razões comuns para discrepâncias de stock

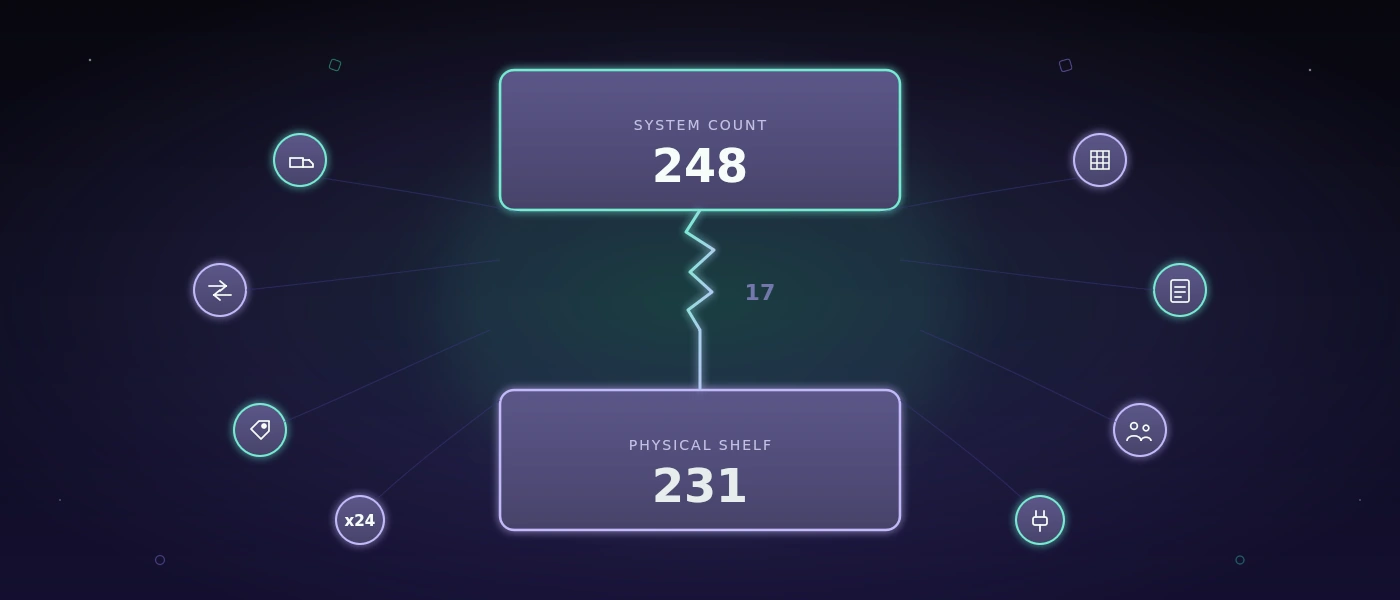
O sistema indica 248 unidades em stock, na prateleira estão 231. Estas 17 unidades parecem à primeira vista um erro de contagem. Mas é precisamente aí que começa frequentemente a análise errada. As inventory discrepancy causes raramente são, na prática, um descuido isolado. Na maioria das vezes surgem onde a receção de mercadorias, o movimento de armazém, a preparação de pedidos, e a contabilização divergem no tempo ou organizacionalmente.

Para uma pequena ou média empresa, as discrepâncias de stock não são apenas um tema para o inventário físico. Levam a encomendas erradas, entregas expresso, stocks de segurança desnecessários, e promessas de entrega que não podem ser cumpridas. Quem separa as causas de forma clara não precisa de introduzir imediatamente um grande ERP. Frequentemente bastam regras de contabilização mais claras, dispositivos de captura adequados, e um sistema que reflita os processos de trabalho reais.

Inventory discrepancy causes: onde surgem as diferenças

Uma discrepância de stock é a diferença entre o stock-alvo no sistema principal e o stock realmente presente. Decisiva aqui é a palavra "principal". Se um ficheiro Excel, uma lista em papel, e um sistema de gestão de mercadorias forem mantidos em paralelo, existem praticamente várias verdades. Nesse caso, a diferença não surgiu apenas no armazém, mas já estava integrada na gestão dos dados.

A contramedida eficaz depende, portanto, do tipo de erro. Uma palete mal contada precisa de uma solução diferente de uma entrega aceite fisicamente, mas nunca contabilizada. Antes de as equipas reestruturarem processos, deveriam avaliar as diferenças por artigo, localização, turno, tipo de movimento, e momento. Só este padrão mostra se se trata de um caso isolado ou de um erro de processo recorrente.

1. As receções de mercadorias são contabilizadas tarde ou de forma incompleta

A receção de mercadorias é um ponto de rutura clássico. A mercadoria chega de manhã, é posta de lado para inspeção, e mais tarde levada diretamente para a produção ou para a prateleira. A contabilização ocorre à tarde, no dia seguinte, ou nunca. Enquanto a mercadoria estiver fisicamente presente, o stock do sistema parece demasiado baixo. Se já estiver consumida ou expedida, os erros subsequentes tornam-se mais prováveis.

Especialmente propensas são as entregas parciais, os artigos substitutos, e as entregas em excesso. Se na guia de remessa consta uma quantidade, mas chega uma quantidade diferente, ninguém deve simplesmente contabilizar o documento "mais ou menos correspondente". A discrepância deve permanecer visível como exceção, incluindo motivo, pessoa responsável, e aprovação. Caso contrário, o desvio desaparece da operação e só reaparece no inventário físico.

2. Os movimentos de armazém ocorrem sem transação

Um artigo é colocado da receção de mercadorias para o armazém em altura, movido de uma posição para a zona de picking, ou reservado para um pedido. Fisicamente, é um movimento pequeno e rápido. No sistema, pode ser decisivo.

Se os colaboradores reorganizam as localizações de armazenamento apenas por intuição, o stock total talvez ainda esteja correto, mas a disponibilidade no lugar certo não. Isso causa tempo de procura, erros de picking, e viagens de reabastecimento desnecessárias. Uma boa solução de armazém não precisa de tornar cada movimento complicado. Tem de registar os poucos movimentos relevantes para disponibilidade, rastreabilidade, e reposição.

Em oficinas ou armazéns mais pequenos, é frequentemente mais sensato manter algumas zonas inequívocas do que uma estrutura de posições teoricamente perfeita que ninguém mantém no dia a dia. A precisão só funciona se permanecer praticável.

3. O picking e a expedição são contabilizados demasiado cedo

Muitas equipas contabilizam um pedido como "dado de saída" no momento do picking, embora a mercadoria ainda esteja numa posição de preparação. Se o pedido for depois alterado, cancelado, ou expedido apenas parcialmente, o stock do sistema e o stock físico deixam de coincidir.

Melhor é uma separação clara entre reservado, preparado, e expedido. Nem todas as empresas precisam de cadeias de estado complexas para isso. Mas o momento da redução do stock tem de ser inequívoco. Para mercadoria de expedição, está frequentemente mais próximo da entrega efetiva ao transportador do que do primeiro gesto em direção à prateleira.

As devoluções também pertencem a este fluxo. Quando a mercadoria regressa, não fica automaticamente disponível de novo. Só a inspeção, a decisão de qualidade, e o armazenamento deveriam determinar se volta ao stock vendável, fica bloqueada, ou é abatida.

4. Unidades erradas e erros de dados mestre

Uma caixa, uma embalagem, um rolo, e uma peça individual podem referir-se ao mesmo artigo. Se a conversão não for mantida corretamente, surgem diferenças a uma velocidade impressionante. Um colaborador contabiliza "1", querendo dizer uma caixa com 24 peças. O sistema entende uma peça.

Os erros de dados mestre são especialmente insidiosos porque o processo de contabilização pode parecer tecnicamente correto. Por isso, verifique as unidades de embalagem, os fatores de conversão, as quantidades mínimas, as localizações, e os números de artigo. Também as variantes com nomes semelhantes, por exemplo comprimentos, cores, ou lotes diferentes, são facilmente confundidas.

Aqui não ajuda nenhuma regra geral como "digitalizar mais". Os códigos de barras são apenas tão fiáveis quanto a associação por trás deles. Para sortidos pequenos, um registo de artigos bem mantido com etiquetas legíveis pode conseguir mais do que um parque extenso, mas mal configurado, de scanners.

5. Tabelas paralelas e correções manuais

A tabela no ambiente de trabalho raramente surge por negligência. Normalmente preenche uma lacuna real: uma reserva especial, um valor de avaliação em falta, ou um processo que o software existente não representa. Torna-se problemática quando se transforma no segundo livro de stock.

Nesse caso, as entradas são contabilizadas no sistema, mas as saídas anotadas na tabela. Ou uma correção só ocorre onde precisamente ajuda o próximo pedido. Ninguém consegue depois explicar de forma fiável qual o valor válido.

Nem toda a tabela precisa de ser eliminada. Um cálculo para planeamento ou análises pode continuar a ser sensato. No entanto, as operações que alteram o stock deveriam ter exatamente um sistema principal. Os ajustes precisam de um código de motivo, uma marca temporal, e idealmente uma pessoa que possa ser rastreada. Isso não é burocracia por si só, mas o pré-requisito para análises de causas sólidas.

6. Erros de contagem e métodos de inventário inadequados

Mesmo processos corretos não protegem contra erros humanos. Os artigos são contados duas vezes, as paletes são ignoradas, as caixas abertas estimadas, ou as localizações não bloqueadas durante a contagem. Um inventário completo anual descobre estes problemas tarde e sob grande pressão.

Para muitas empresas, um inventário cíclico é a alternativa mais sensata. Os artigos de rotação rápida ou de valor são verificados mais frequentemente, os artigos C estáveis com menos frequência. O importante não é produzir o maior número possível de contagens, mas verificar os desvios atempadamente em relação aos últimos movimentos. Se um artigo com discrepância é simplesmente corrigido sem documentar a causa, o padrão permanece invisível.

Uma contracontagem é especialmente sensata para valores elevados, números de série, ou lotes. Para parafusos num armazém de consumíveis pode ser economicamente excessiva. A profundidade do controlo deve ajustar-se ao risco.

7. Responsabilidades pouco claras entre turnos e áreas

Os erros de stock surgem frequentemente nas transferências. O turno da manhã prepara a mercadoria, o turno da tarde expede-a. A receção de mercadorias aceita uma entrega, enquanto o planeamento altera o pedido em paralelo. Cada passo individual pode ser rastreável, mas ninguém é dono da operação completa.

Por isso, defina não apenas funções, mas pontos de transferência: quem confirma a receção de mercadorias? Quando muda a responsabilidade pela mercadoria preparada? Quem verifica as exceções em aberto no final do turno? Um quadro digital partilhado ou uma lista simples de exceções é frequentemente mais eficaz do que reuniões adicionais.

O sistema deveria tornar as operações em aberto visíveis, em vez de obrigar os colaboradores a lembrarem-se. Por exemplo, entregas sem verificação de quantidade, picks sem conclusão de expedição, ou devoluções sem decisão de qualidade têm de se destacar antes de se tornarem erros silenciosos de stock.

8. Integração de sistemas fraca e regras de validação em falta

Se a loja, a gestão de encomendas, o armazém, e a contabilidade trocam dados com desfasamento temporal ou por ficheiro, podem surgir contabilizações duplicadas ou em falta. Uma importação é executada duas vezes. Uma interface falha silenciosamente. Um pedido é alterado depois de o seu estado de expedição já ter sido transferido.

A solução não é necessariamente uma substituição completa. Frequentemente são necessárias interfaces claramente definidas, números de documento inequívocos, e verificações técnicas. Uma contabilização de armazém deveria guardar de forma rastreável quando ocorreu, de que operação resulta, e se foi posteriormente cancelada. Os processos críticos precisam de mensagens de erro e filas de espera, não apenas de uma entrada silenciosa no ficheiro de registo.

Com sistemas de logística desenvolvidos à medida, essas regras podem ser adaptadas de forma direcionada à operação: nenhuma quantidade negativa sem aprovação, nenhuma confirmação de expedição sem posição de expedição, nenhum processamento duplicado da mesma referência externa. A melhor regra aqui não é a mais rigorosa, mas a que impede erros reais sem bloquear a operação em exceções normais.

Verificar discrepâncias de stock sistematicamente

Não comece com uma correção generalizada. Escolha os dez artigos com as diferenças mais frequentes ou mais caras, e rastreie o seu último movimento para trás: receção de mercadorias, transferência, saída, devolução, contagem, e qualquer ajuste manual. Se os casos se concentrarem numa localização, num turno, ou num tipo de movimento, isso é um ponto de partida sólido.

Depois disso, cada medida deveria ser mensurável. Se forem introduzidas novas leituras de código de barras, observe não apenas o número de leituras, mas a taxa de discrepância por grupo de artigos. Se for adicionado um novo estado para preparação, verifique diariamente as preparações em aberto. Bons processos não produzem precisão aparente. Tornam as exceções visíveis e rastreáveis precocemente.

O próximo passo sensato é frequentemente pequeno: definir um ponto de transferência, limpar uma localização, ou assegurar tecnicamente uma correção manual recorrente. Stocks fiáveis não surgem de mais software por suspeita, mas de processos ainda corretamente executáveis numa terça-feira caótica às 16:45.

Permalink →

Abordar corretamente a automação de processos para PME

Abordar corretamente a automação de processos para PME

Falta uma guia de remessa porque os dados ainda estão num papelinho. Uma receção de mercadorias é registada duas vezes porque o armazém e o escritório trabalham com tabelas diferentes. Uma aprovação atrasa-se porque a pessoa responsável não atende o telefone naquele momento. Este tipo de atrito raramente custa muito dinheiro de uma só vez. Mas ao longo de semanas somam-se pedidos de esclarecimento, tempos de procura, correções de erros, e esperas desnecessárias. É precisamente aí que a automação de processos para PME faz sentido.

Não se trata de substituir o maior número possível de atividades por software. Uma boa automação torna os processos rastreáveis, reduz transferências evitáveis, e dá aos colaboradores tempo para decisões que requerem experiência. Isso é especialmente decisivo nas pequenas e médias empresas: as equipas estão próximas do negócio diário. Quando um processo emperra, muitas vezes o turno inteiro nota imediatamente.

Não automatizar todos os processos

O erro mais comum é começar pelo incómodo mais visível. Talvez um ficheiro Excel irrite, talvez seja necessário um novo painel de controlo. Ambos podem ser justificados. Mas um caos digitalizado continua a ser caos - só que mais rápido e com mais dados.

Antes de uma decisão técnica, o fluxo deve primeiro ser descrito tal como realmente acontece. Não como deveria constar no manual. Quem desencadeia o processo? Que informação é necessária? Onde é algo transferido manualmente? Quem decide em caso de exceções? E como reconhece a equipa que o processo está concluído?

Precisamente no armazém ou no processamento de encomendas, os pontos críticos situam-se frequentemente entre sistemas: uma encomenda chega por e-mail, é copiada para uma tabela, coordenada por telefone, e mais tarde introduzida num software de expedição. Cada transferência aumenta a probabilidade de as quantidades, prazos, ou endereços divergirem.

Uma automação compensa especialmente quando um processo ocorre com frequência, tem regras claras, e os erros causam consequências percetíveis. Isso pode ser a receção de mercadorias, a criação de guias de remessa, a atribuição de movimentos de armazém, ou a passagem de encomendas aprovadas para a expedição. Casos especiais raros com muitas decisões discricionárias, por outro lado, muitas vezes continuam a ser melhor geridos manualmente - pelo menos inicialmente.

A automação de processos para PME começa com prioridades

Nem toda a atividade desnecessária merece imediatamente um projeto. Uma priorização simples cria clareza. Avalie os diferentes fluxos por frequência, tempo de processamento, custos de erro, e dependências. Um processo que ocorre cinquenta vezes por dia e poupa apenas dois minutos de cada vez pode ser mais económico do que um processo mensal complicado.

A questão da consequência do erro é pelo menos igualmente importante. Um documento interno mal impresso é irritante. Uma atribuição de lote errada, um endereço de entrega perdido, ou uma receção de mercadorias não documentada pode desencadear reclamações, trabalho de procura, e discrepâncias de stock. Aí a automação gera não apenas rapidez, mas fiabilidade.

Um primeiro passo sensato costuma ser suficientemente pequeno para ser verificável em poucas semanas. Por exemplo, um colaborador pode registar mercadorias através de um código de barras, o sistema verifica artigo e quantidade, atualiza o stock numa base de dados central, e gera diretamente um recibo de armazenamento se necessário. A equipa não tem depois de adivinhar qual a versão de uma tabela que está atualizada.

Um estado-alvo claro em vez de uma lista de funcionalidades

Muitos projetos começam com uma longa lista de funcionalidades desejadas. Melhor é uma imagem operacional concreta: o que deve ser visível no final de um processo sem necessidade de perguntar? Na expedição, isso poderia significar que uma encomenda, após aprovação, recebe automaticamente uma lista de picking, o endereço de expedição é verificado, e pode ser gerada uma etiqueta. As exceções aterram de forma visível numa lista de esclarecimento, em vez de numa caixa de correio eletrónico inabarcável.

Esta imagem-alvo obriga a decisões úteis. Cada encomenda tem de ser processada de forma totalmente automática? Ou devem as encomendas acima de um determinado valor de mercadoria, com endereço de entrega divergente, ou com stock em falta, ser deliberadamente submetidas a verificação? A automação não precisa de um processamento a cem por cento às escuras para criar um grande benefício.

A técnica adequada depende do fluxo

Não existe um caminho técnico padrão para todas as PME. Uma solução em tabela ainda pode ser razoável para uma avaliação gerível. É rapidamente adaptada, familiar, e causa pouco esforço de implementação. Assim que várias pessoas trabalham simultaneamente, os lançamentos têm de ser rastreáveis, ou dados são trocados com outros sistemas, atinge, porém, os seus limites.

Nesse caso, uma aplicação enxuta e específica do fluxo é frequentemente mais sensata do que uma suite empresarial sobredimensionada. Pode representar exatamente os passos necessários na operação: registar encomenda, verificar stock, mover mercadoria, gerar documento, registar expedição, e reportar estado. Nem mais, mas também nem menos.

Tecnicamente, importa menos se um sistema anuncia a palavra da moda mais recente. Decisivas são bases sólidas: uma base de dados modelada de forma limpa, permissões rastreáveis, registos para alterações relevantes, interfaces fiáveis, e implementações documentadas. Uma aplicação baseada em PHP 8.4, JavaScript moderno, e MySQL 8 pode ser muito bem mantível a longo prazo, se a arquitetura e a operação forem pensadas desde o início.

As integrações também merecem atenção. Uma troca automática de dados com loja, ERP, prestador de serviços de expedição, ou contabilidade só poupa tempo se os erros forem tratados de forma visível. O que acontece com um endereço inválido? Uma impressão de etiqueta falhada é repetida? A equipa consegue ver quais dados foram transferidos e quais ainda faltam? Erros silenciosos são mais perigosos do que um caso excecional claramente assinalado.

Implementação durante a operação contínua

Um novo sistema tem de se adaptar a mudanças de turno, prazos de entrega, e rotinas de trabalho existentes. Por isso, uma implementação gradual é geralmente mais segura do que uma data-limite rígida para todas as áreas. Comece com um processo delimitado, um grupo de produtos, ou uma área de armazém. Isso reduz o risco e gera feedback real do dia a dia.

O funcionamento paralelo não é, portanto, sinal de insegurança, mas um teste controlado. Durante um tempo limitado, o registo antigo e o novo podem ser comparados. As diferenças não revelam apenas erros de software, mas frequentemente também regras que até agora só existiam na cabeça de colaboradores individuais. Essas regras devem pertencer de forma visível ao processo - não permanentemente à experiência pessoal.

Os colaboradores não devem ser confrontados com o novo fluxo apenas na formação. Quem executa o processo diariamente reconhece atalhos, casos especiais, e ecrãs pouco práticos precocemente. Um bom software respeita este conhecimento, sem incorporar inalterada cada exceção historicamente desenvolvida. A pergunta certa é: que exceção protege um caso de negócio importante, e qual é apenas uma solução alternativa para um problema antigo?

Tornar mensurável se o esforço compensa

Antes do início devem ser definidos dois ou três indicadores. Podem ser o tempo de ciclo por encomenda, número de correções manuais, discrepâncias de stock, ou o tempo até à expedição. Sem um valor de partida, cada avaliação posterior torna-se uma questão de intuição.

Nem todo o efeito se mostra imediatamente em euros. Quando uma equipa de armazém sabe a qualquer momento onde se encontra a mercadoria, diminui o número de interrupções. Quando os documentos de entrega surgem dos mesmos dados que a encomenda, diminui o risco de informações contraditórias. E quando as responsabilidades são visíveis no sistema, um processo depende menos de pessoas individuais.

A automação precisa de manutenção e limites

Um fluxo automatizado não é um projeto que congela após o go-live. As estruturas de artigos mudam, os clientes exigem novos documentos, os prestadores de serviços de expedição adaptam interfaces. Por isso, responsabilidades, atualizações, cópias de segurança, e uma gestão regulada de permissões fazem parte do sistema propriamente dito.

Especialmente em aplicações com dados de clientes, encomendas, ou stock, deve ser claro quem obtém acesso e porquê. As funções têm de se adequar ao dia a dia de trabalho: uma equipa de armazém precisa de funções diferentes da contabilidade ou das vendas. Alterações registadas, fluxos de início de sessão seguros, e restauros testados parecem pouco espetaculares. Em caso de incidente, são precisamente estes detalhes que decidem se a operação pode continuar a funcionar.

Os testes também fazem parte da segurança operacional. Verificações recorrentes para entrada de encomendas, contabilização de stock, geração de documentos, e gestão de direitos evitam que uma alteração num ponto danifique um fluxo funcional noutro. Para aplicações web ou de secretária críticas, um ambiente de testes auto-hospedado e controlado pode fazer sentido, se capturas de ecrã, dados de teste, e processos internos não devem chegar a serviços cloud externos.

A softify.pro acompanha este tipo de projetos com um princípio simples: primeiro compreender o fluxo real, depois construir a menor solução viável. Às vezes é uma aplicação feita à medida. Às vezes basta estruturar uma tabela existente de forma mais limpa e automatizar um único passo de transferência.

O melhor próximo passo não é, portanto, uma comparação de software, mas um percurso por um processo real - do desencadeador até à conclusão. Pegue numa encomenda, numa receção de mercadorias, ou numa reclamação e acompanhe-a com as pessoas envolvidas. Onde a informação é reintroduzida, ninguém conhece o estado, ou decisões esperam desnecessariamente, encontra-se geralmente a abordagem mais sensata para a automação.

Permalink →

Testar aplicações Windows: um plano prático

Testar aplicações Windows: um plano prático

Uma aplicação Windows pode parecer limpa em modo demo e mesmo assim abrandar a operação numa segunda-feira de manhã. Uma guia de remessa não guardada, um utilizador bloqueado após três tentativas falhadas, ou uma caixa de diálogo de impressão que reage de forma diferente após uma atualização não são bugs cosméticos. Quem quer saber como testar aplicações Windows não deve, portanto, começar por botões individuais, mas pelos fluxos que custam trabalho, dinheiro, ou rastreabilidade.

Precisamente no armazém, na oficina, na expedição, e na administração, muitos processos críticos passam por software de secretária desenvolvido ao longo dos anos. Aí não importa se um caso de teste está formulado de forma impressionante. O que importa é se os colaboradores conseguem realizar as suas tarefas de forma fiável em condições realistas - incluindo dados incompletos, permissões variáveis, redes lentas, e interrupções não planeadas.

Testar aplicações Windows começa pelos fluxos críticos

Nem todas as funções merecem o mesmo esforço de teste. Uma exportação raramente usada com retrabalho manual deve ser avaliada de forma diferente da contabilização de uma receção de mercadorias, a criação de uma etiqueta, ou a reconciliação diária de encomendas. Comece, portanto, com uma pergunta simples: o que acontece concretamente se este fluxo falhar?

Têm alta prioridade os processos com impacto direto no stock, entrega, faturação, segurança, ou comunicação com o cliente. Isto inclui, por exemplo, o início de sessão e a verificação de permissões, a criação e alteração de dados mestre, as contabilizações de transações, a impressão de documentos, as interfaces com serviços ERP ou de envio, bem como a recuperação após um erro. Mesmo funções usadas apenas por um pequeno grupo de pessoas podem ser críticas se bloquearem um fecho mensal ou a libertação de mercadoria.

Destes fluxos não surgem listas de teste abstratas, mas sim passos de trabalho rastreáveis. Um teste de receção de mercadorias poderia, por exemplo, começar com uma encomenda existente, registar uma entrega parcial, reportar uma quantidade divergente, atribuir uma localização de armazém, e depois verificar se o stock, o registo de contabilizações, e o documento impresso correspondem. Assim testa o efeito real do software, não apenas campos de entrada individuais.

Criar uma base de teste que reflita a operação

Muitos erros só se tornam visíveis quando o ambiente de teste se aproxima da realidade. Uma aplicação comporta-se frequentemente de forma diferente com um inquilino de teste vazio do que com vários anos de dados de movimentos, artigos bloqueados, informação obrigatória em falta, ou operações já abertas.

Por isso, configure dados de teste de forma deliberada. Não precisa necessariamente de uma cópia completa da produção. Faz mais sentido um conjunto de dados controlado com casos típicos, limite, e deliberadamente errados: artigos com diferentes unidades de medida, clientes com condições especiais, encomendas com entregas parciais, utilizadores com diferentes funções, e operações já em processamento. Os dados pessoais devem, nesse caso, ser anonimizados ou substituídos por dados de exemplo realistas.

Também faz parte da base de teste o ambiente técnico. Documente a versão do Windows, resolução, escala, impressoras instaladas, unidades de rede, versão da base de dados, serviços ligados, e permissões. Isto soa árido, mas poupa tempo mais tarde. Se um erro ocorrer apenas em postos de trabalho com escala a 125% ou com um determinado controlador de impressora, isso tem de ser reproduzível.

Não verificar apenas o caso ideal

O caso ideal prova sobretudo que a aplicação foi construída para o percurso esperado. Na operação, as situações difíceis surgem ao lado dele. O que acontece se um utilizador deixar um campo obrigatório vazio, disparar a mesma contabilização duas vezes, ou perder a ligação durante o guardar? A operação permanece consistente? A pessoa recebe uma mensagem compreensível? Consegue continuar a trabalhar em segurança?

Nas aplicações Windows, o manuseamento e o estado são também particularmente relevantes. As caixas de diálogo podem aparecer em segundo plano, os atalhos de teclado podem sobrepor-se, as caixas de diálogo de seleção de ficheiros podem bloquear o fluxo. Verifique se o foco, as mensagens de erro, e os bloqueios são inequívocos. Uma exceção técnica sem indicação de ação não ajuda o chefe de turno.

Usar testes manuais onde é necessário juízo

Os testes manuais não são sinal de maturidade insuficiente. São indispensáveis quando surge um novo fluxo, uma interface é reconstruída, ou o conhecimento especializado determina a qualidade. Um chefe de armazém experiente reconhece mais depressa do que um script se um ecrã é compreensível sob grande pressão de tempo, ou se um aviso aparece demasiado tarde.

O teste manual torna-se, contudo, dispendioso e pouco fiável quando os mesmos fluxos estáveis são repetidos antes de cada versão. Nesse caso, o lançamento depende de pessoas disponíveis, memória, e notas dispersas. O momento certo para passar à automação encontra-se geralmente onde um processo é executado com frequência, pode causar danos significativos, e tem resultados esperados claros.

Um bom caso de teste manual descreve a situação inicial, os passos, o resultado esperado, e os dados necessários. Perante um erro, adicione uma captura de ecrã, carimbo temporal, versão da aplicação e da build, bem como a ação exata. "A impressão não funciona" não é uma descrição de erro utilizável. "Após alterar o endereço de entrega, a caixa de diálogo de impressão permanece aberta, a encomenda 4711 não recebe um PDF, e não aparece qualquer mensagem" é.

Testes de regressão automatizados para riscos recorrentes

A automação não verifica se um software é fundamentalmente bom. Verifica se fluxos definidos que anteriormente funcionavam continuam a funcionar após uma alteração. Isso é especialmente valioso para software Windows cujas interfaces, lógica de base de dados, e interfaces externas são desenvolvidas ao longo dos anos.

Comece por pouco. Escolha primeiro cinco a dez fluxos críticos para o negócio que devem ser verificados a cada lançamento. Entre eles podem estar o início de sessão com um fluxo de bloqueio de conta, a entrada de encomendas, a contabilização de armazém, a impressão de PDF ou etiquetas, a mudança de função, e uma importação central. Só quando estes testes funcionam de forma fiável é que compensa a expansão para casos especiais.

Nas aplicações de secretária, os testes automatizados costumam controlar elementos visíveis da interface: janelas, campos de entrada, tabelas, botões, e caixas de diálogo. Isso funciona, mas é mais frágil do que um teste puro de interface. Pequenas alterações de layout, computadores mais lentos, ou elementos nomeados de forma ambígua podem quebrar testes. Por isso, programadores, área de negócio, e responsáveis de teste devem determinar em conjunto quais os elementos que são endereçáveis de forma estável e quais os passos de verificação que ficam melhor assegurados através da base de dados, de um registo, ou de uma interface.

Um teste sensato também não verifica apenas se um botão pôde ser clicado. Controla a consequência funcional: a contabilização foi guardada? O stock está correto? Foi gerado um documento? Não foi criado nenhum registo duplicado? Interação visível e resultado verificável andam de mãos dadas.

As evidências fazem parte do resultado do teste

Um estado verde por si só raramente é suficiente em aplicações críticas. Quando um teste falha, as equipas precisam rapidamente de uma resposta a três perguntas: qual era a situação inicial? Em que passo o fluxo falhou? O que mostrava a aplicação nesse momento?

Capturas de ecrã, registos de execução, e, quando aplicável, gravações de ecrã tornam os erros discutíveis. Encurtam consideravelmente a transferência entre operação, QA, e desenvolvimento. Para empresas reguladas ou atentas à segurança, são também uma base sólida para rastrear aprovações e desvios.

Aqui, o local de armazenamento não é uma questão secundária. As execuções de teste podem conter dados internos de clientes, listas de preços, informações de encomendas, ou vistas de ecrã. Quem automatiza testes para aplicações Windows sensíveis deve esclarecer se esses dados podem sair da própria infraestrutura. Um ambiente auto-hospedado como o COCO pode fazer sentido aqui, porque a execução dos testes, as evidências, e a avaliação permanecem sob o próprio controlo. Se isso é necessário depende dos requisitos de proteção de dados, da situação contratual, e da necessidade de proteção - nem todas as equipas precisam da mesma arquitetura para isso.

Integrar os testes no processo de lançamento

O melhor catálogo de testes perde valor se só for usado depois de uma entrada em produção precipitada. Defina um momento fixo: as regressões centrais automatizadas correm antes de cada lançamento, a aceitação manual verifica fluxos novos ou alterados, e as limitações conhecidas são documentadas abertamente.

Nem todo o teste falhado tem de parar um lançamento. Um erro numa vista de administração raramente usada pode ser aceitável se existir uma solução alternativa segura e a área afetada estiver claramente informada. Um erro que contabiliza stocks incorretamente ou bloqueia utilizadores sem que se note deve ser tratado de forma diferente. Essa decisão deve ser tomada com base no impacto no negócio, não na mera contagem de testes vermelhos.

Mantenha os testes junto com a aplicação. Quando um processo muda deliberadamente, atualize o caso de teste, os dados de teste, e o resultado esperado em conjunto com o requisito. Testes desatualizados criam ruído e acabam por ser ignorados. Algumas verificações fiáveis valem mais do que centenas de fluxos automatizados cujos resultados já ninguém leva a sério.

No final, não se trata de simular todas as entradas imagináveis. Trata-se de proteger o trabalho que tem de voltar a funcionar na manhã seguinte. Comece com um único processo crítico, torne o seu resultado demonstrável, e construa a partir daí.

Permalink →

Secure test data management sem perder o controlo

Secure test data management sem perder o controlo

Uma execução de teste falhada é irritante. Uma execução de teste bem-sucedida com dados reais de clientes num ambiente insuficientemente protegido pode revelar-se consideravelmente mais cara. O secure test data management não resolve essa contradição com uma única ferramenta, mas com regras claras para dados, acessos, ambientes de teste, e evidências. Para equipas que testam de forma automatizada aplicações web ou Windows, isso faz por isso parte do trabalho de qualidade - não apenas de conformidade.

Por que os dados de teste se tornam um problema de segurança

Os dados de produção são tentadores para os testes porque contêm casos limite reais: endereços incompletos, combinações de encomendas invulgares, regras de preços históricas, ou entradas incorretas. Mas precisamente esses dados contêm frequentemente nomes, dados de contacto, informações contratuais, números de pessoal, dados bancários, ou lógica de negócio interna.

O risco raramente surge de um único erro flagrante. Geralmente cresce passo a passo: uma exportação da base de dados é criada para um teste, colocada num diretório partilhado, e posteriormente copiada para outro ambiente. Um serviço externo recebe capturas de ecrã para análise de erros. Uma conta de teste mantém permissões amplas porque uma limpeza poderia perturbar a próxima execução. Após alguns meses, já ninguém sabe com fiabilidade que dados estão onde.

Nas pequenas e médias empresas, o problema é frequentemente agravado por capacidades limitadas. A equipa quer cumprir um prazo de lançamento, não gerir o seu próprio projeto de proteção de dados. A responsabilidade mantém-se, contudo. Quem usa dados para garantia de qualidade tem de conseguir rastrear que dados são processados, quem tem acesso, e quando são novamente removidos.

O secure test data management começa antes do caso de teste

A questão decisiva não é: "Como protegemos o conjunto de dados de teste?" É: "Que informação é que este teste realmente precisa?" Muitos testes de regressão não requerem quaisquer referências pessoais reais. Um processo de expedição, por exemplo, tem de verificar se os endereços de entrega, pesos, zonas, etiquetas, e alterações de estado são processados corretamente. Para isso bastam clientes sintéticos, dados mestre de artigos plausíveis, e casos limite definidos deliberadamente.

Esta distinção conduz a uma classificação de dados prática. Nem todos os ambientes de teste precisam da mesma profundidade de dados. Para testes unitários e de integração, conjuntos de dados totalmente artificiais são muitas vezes suficientes. Para testes end-to-end, cópias pseudonimizadas podem fazer sentido se padrões de dados reais forem funcionalmente relevantes. Dados semelhantes aos de produção deveriam ser a exceção - com um propósito documentado, acesso limitado, e uma vida útil fixa.

Importante aqui é a qualidade dos dados substitutos. Dados fictícios aleatórios ajudam pouco se não refletirem dependências realistas. Um conjunto de dados de teste para uma aplicação de armazém deve, por exemplo, conter variantes de artigos, locais de armazenamento, stock bloqueado, entregas parciais, e devoluções numa combinação coerente. Bons dados de teste não protegem apenas informação pessoal. Encontram erros que nunca se tornariam visíveis com tabelas vazias e o cliente exemplo "João Silva".

Sintetizar, mascarar, ou minimizar?

Os dados sintéticos são a escolha mais segura quando as regras de negócio podem ser modeladas de forma limpa. Surgem de forma específica a partir dos requisitos de teste e não contêm qualquer cópia de pessoas ou operações reais. O esforço reside na manutenção: se o modelo de dados mudar ou forem adicionadas novas regras de processo, geradores e fixtures têm de crescer em conjunto.

A mascaragem é adequada quando o comportamento de uma aplicação depende fortemente de estruturas de produção. Nesse caso, os campos sensíveis são substituídos ou alterados, enquanto as relações são preservadas. Os nomes tornam-se nomes plausíveis mas fictícios; os endereços de e-mail tornam-se endereços de teste não entregáveis; os números de conta tornam-se valores com formato correto sem qualquer associação real. Uma mascaragem só é sólida se as deduções indiretas também forem consideradas. Uma combinação de um local raro, data de nascimento, e característica contratual pode continuar a tornar uma pessoa identificável.

A minimização de dados é frequentemente o terceiro caminho subestimado. Em vez de copiar uma exportação completa, apenas é fornecida a fatia necessária. Isso reduz a superfície de ataque, a necessidade de armazenamento, e o esforço de limpeza. Para testar uma lógica de desconto, ninguém precisa de todo o histórico de um ano de um cliente.

Os acessos e ambientes têm de corresponder ao risco

Um conjunto de dados protegido perde o seu valor se estiver num ambiente de teste livremente acessível. Os sistemas de teste precisam, portanto, das suas próprias fronteiras de segurança - bases de dados separadas, contas de serviço próprias, acessos de rede claramente definidos, e nenhuma ligação silenciosa à produção.

Os direitos de acesso deveriam basear-se em funções, não em contas partilhadas. Os programadores podem precisar de direitos diferentes dos de QA, suporte, ou fornecedores externos de serviços. Os acessos de administrador são por vezes necessários, mas deveriam ser limitados no tempo, registados, e associados a uma aprovação rastreável. Também para as contas de teste se aplicam regras de palavra-passe sensatas, autenticação multifator onde disponível, e fluxos de bloqueio de conta perante tentativas falhadas repetidas.

Os testes automatizados trazem consigo outro caso especial: geram evidências. Capturas de ecrã, gravações de ecrã, registos, e mensagens de erro podem conter conteúdo sensível, mesmo quando a base de dados foi mascarada. Uma captura de ecrã de um ecrã de cliente, um rasto de navegador com informação de sessão, ou um registo com um payload de API pertencem à mesma consideração de proteção que a base de dados de teste.

Por isso, os artefactos de teste precisam de regras de retenção. Nem toda a execução bem-sucedida tem de ser armazenada permanentemente. Para aprovações críticas, uma evidência rastreável pode fazer sentido, por exemplo com carimbo temporal, número de build, versão de teste, e resultado. As execuções falhadas necessitam muitas vezes de uma janela de análise mais longa. Depois disso, os artefactos deveriam ser eliminados automaticamente. O que já não existe não pode ser partilhado ou comprometido por acidente.

Automação sem fugas de dados descontroladas

A automação de testes assistida por IA pode acelerar consideravelmente os testes, especialmente em aplicações web e Windows extensas. Mas muda a questão de segurança: para onde vão as capturas de ecrã, entradas, descrições de erros, e tráfego da aplicação? Quem os processa? Quanto tempo lá permanecem?

Para equipas conscientes da segurança, a execução auto-hospedada é frequentemente a melhor arquitetura. Um sistema como o COCO pode funcionar dentro da própria infraestrutura, ou de uma claramente delimitada, executando passos de teste, armazenando evidências, e gerando avaliações compreensíveis. Isso não é obrigatório em todas as situações. Para uma página de marketing pública com valores de formulário puramente sintéticos, um serviço externo pode ser aceitável. Em aplicações empresariais internas, portais de clientes, ou software com processos pessoais, porém, o controlo local é uma vantagem concreta.

A auto-hospedagem não é um passe livre. A operação exige atualizações, conceitos de cópia de segurança, registos de acesso, e uma entidade responsável. Em troca, a soberania dos dados permanece onde pertence. A abordagem correta depende da necessidade de proteção, das capacidades operacionais existentes, e do tipo de aplicação testada - não do hype atual em torno de uma determinada ferramenta de teste.

Como as regras se tornam num processo funcional

Um processo praticável não tem de bloquear o lançamento. Comece com um mapa de dados: que ambientes de teste existem, que tipos de dados lá se encontram, e que sistemas geram artefactos adicionais? Este inventário geralmente já revela exportações antigas, sistemas de staging esquecidos, e responsabilidades pouco claras.

Depois disso, vale a pena uma matriz de decisão simples por classe de teste. Determina se dados sintéticos bastam, se é necessária uma mascaragem, ou se é necessário um extrato de produção claramente justificado. É complementada por proprietários, prazos de eliminação, e funções de acesso. Isto não tem de ser um conjunto de regras sobrecarregado. Uma diretriz curta e realmente seguida é melhor do que um documento de segurança que ninguém encontra durante um incidente.

Tecnicamente, o fornecimento e a limpeza de dados pertencem ao pipeline de teste. Uma execução cria de forma reproduzível os conjuntos de dados de que necessita, usa marcadores únicos, e depois remove-os novamente. Isso impede que os ambientes de teste se encham de dados residuais e que os resultados se tornem menos fiáveis a cada sprint. Para processos críticos, as equipas deveriam adicionalmente verificar se os acessos a dados e as evidências de teste precisam de ser registados de forma auditável.

Segurança que torna o teste mais rápido

O secure test data management é frequentemente visto como um encargo de controlo adicional. Mal implementado, pode de facto sê-lo. Bem implementado, porém, cria condições de partida fiáveis e repetíveis. As equipas perdem menos tempo à procura de uma exportação de dados utilizável, evitam testes quebrados devido a dados residuais não limpos, e conseguem justificar melhor as aprovações.

O primeiro passo mais sensato raramente é um grande projeto de plataforma. Escolha o processo de teste com o maior risco ou a maior fricção - por exemplo, a aprovação de uma aplicação interna de encomendas - e torne aí visíveis a fonte de dados, os acessos, os artefactos, e a eliminação. Desse trabalho concreto nasce uma rotina de segurança que não torna os testes mais pesados, mas sim mais credíveis.

Permalink →

Warehouse Software vs ERP

Warehouse Software vs ERP

Uma receção de mercadoria chega ao mesmo tempo que um picking urgente, dois colaboradores perguntam pela localização de um artigo, e uma guia de remessa já foi corrigida à mão. É precisamente nestes momentos que a questão Warehouse Software vs ERP se torna prática. Não se trata da interface mais moderna nem da lista de funcionalidades mais longa. Trata-se de saber se a informação está disponível exatamente onde uma decisão tem de ser tomada em segundos.

Muitas pequenas e médias empresas na região DACH começam com um ERP, uma folha de cálculo e muita experiência na equipa. Isso pode funcionar durante muito tempo. Os problemas começam quando os stocks divergem entre sistemas, os tempos de procura aumentam e cada caso especial tem de ser resolvido aos gritos pelo armazém. Nessa altura, surge muitas vezes a ideia de um grande projeto de ERP, mesmo que talvez baste digitalizar um único processo de armazém claramente delimitado.

Warehouse Software vs ERP: a diferença no dia a dia

Um sistema ERP representa a empresa em amplitude. Tipicamente liga compras, vendas, dados-mestre de artigos, contabilidade, produção, faturação e planeamento. A sua força está em fazer convergir dados comerciais e operacionais num quadro comum. Uma encomenda é criada, uma fatura emitida, uma necessidade planeada, um stock valorizado.

O warehouse software, muitas vezes chamado WMS ou gestão de armazém, trabalha mais perto dos movimentos reais dentro do armazém. Apoia a receção de mercadoria, a arrumação em stock, as transferências, o picking, o inventário, a expedição e as devoluções. Responde a perguntas que o ERP muitas vezes só representa de forma grosseira: em que localização está a mercadoria? Que stock está realmente disponível? Que lote foi expedido? Que encomenda tem prioridade? Quem confirmou a transferência?

Esta distinção não é absoluta. Existem ERP com funções de armazém alargadas e produtos WMS ligados a processos de encomendas ou de compras. O que decide, portanto, não é o rótulo da oferta, mas a profundidade operacional. Um ERP pode gerir dez localizações e mesmo assim ser pouco prático se os colaboradores tiverem de abrir vários ecrãs para cada movimento, ou só registar os dados mais tarde.

O ERP é a fonte comercial

Quando uma encomenda tem de ser faturada, uma ordem de compra despoletada ou uma valorização de material criada, isso pertence, na maioria das empresas, ao ERP. É aí que costuma estar a lógica principal de artigos e clientes. Este papel não deveria ser duplicado de ânimo leve. Dois sistemas independentes para preços, referências de artigo ou encomendas não criam segurança, criam trabalho de reconciliação.

Um ERP é particularmente útil quando o desafio central é transversal: compras e produção têm de ser planeadas em conjunto, os dados financeiros têm de permanecer consistentes, ou várias empresas do grupo trabalham com os mesmos processos. Quem ainda não tem essa base não deveria esperar que uma solução puramente de armazém substitua todos os processos da empresa.

O warehouse software controla o movimento

No armazém, porém, não conta apenas o que teoricamente existe no sistema. Conta o que acabou de chegar ao portão três, que posição está livre e se a mercadoria foi reservada para uma encomenda confirmada. Uma boa solução de armazém reduz o atrito exatamente nesses pontos.

Isso pode começar com scanners móveis: a mercadoria é lida na receção de mercadoria, atribuída a uma localização e imediatamente assinalada como disponível. Durante o picking, o sistema conduz por uma sequência sensata, verifica artigo e quantidade e gera, quando necessário, etiquetas de expedição ou documentos de entrega. O registo não acontece horas mais tarde num posto de escritório, mas dentro do próprio processo.

O benefício não está só na velocidade. Registos rastreáveis tornam os erros visíveis. Se um stock não bate certo, é possível apurar quando faltou um movimento ou quando foi confirmado de forma errada. Isso é muito mais fiável do que uma correção mensal numa folha de cálculo.

Quando um módulo de ERP é suficiente

Um módulo de ERP existente pode ser a escolha certa quando a organização do armazém é gerível e a equipa consegue trabalhar de forma fiável com os processos. Um único armazém, localizações fixas, poucas linhas de encomenda e nenhum requisito rígido de lote ou número de série são condições típicas. Também com um volume de expedição reduzido, um componente de sistema adicional pode gerar mais manutenção do que benefício.

Antes de adquirir um novo sistema, vale a pena fazer um teste realista: consegue um colaborador registar por completo uma receção, uma transferência e uma expedição sem um papel de apontamentos? O stock é visível por localização? As diferenças de um inventário são rastreáveis? Os documentos são criados sem dupla introdução de dados? Se a resposta for maioritariamente sim, uma expansão talvez não seja urgente.

A folha de cálculo também pode continuar a existir, se cumprir de forma limpa um propósito limitado, por exemplo um planeamento sazonal de capacidade ou uma análise pontual. Uma boa solução não substitui todas as formas de trabalhar conhecidas. Substitui os passos manuais em que erros, tempo de espera ou falta de transparência custam realmente dinheiro.

Quando uma solução de armazém especializada compensa

O ponto de viragem chega normalmente de forma gradual. Primeiro, um colaborador pergunta mais vezes por um artigo. Depois, mantêm-se os stocks mais altos por precaução, porque ninguém sabe ao certo o stock realmente disponível. Por fim, os envios atrasam-se porque guias de remessa, etiquetas e correções de stock passam por ferramentas diferentes.

Um warehouse software especializado compensa especialmente quando várias destas condições se conjugam:

  • são geridas várias zonas de armazém, localizações ou armazéns externos
  • receções, transferências e picking acontecem diariamente em grande número
  • é preciso rastrear lotes, números de série, prazos de validade ou stock bloqueado
  • transportadoras, impressoras de etiquetas ou scanners móveis têm de ser integrados no processo
  • a realidade operacional se afasta cada vez mais do que o ERP mostra

Esta lista não é uma recomendação de compra automática. Uma empresa com muitas linhas de encomenda pode funcionar bem com um ERP bem configurado. Ao contrário, uma pequena empresa pode precisar cedo de uma aplicação de armazém leve, se cada peça tiver de ser rastreável ou várias equipas tiverem de registar em simultâneo.

A questão da integração pesa muitas vezes mais do que as funcionalidades

A pergunta mais difícil em Warehouse Software vs ERP raramente é: que sistema sabe fazer mais? A pergunta melhor é: que dados têm de fluir, quando, para que sistema?

Em muitos casos, o ERP continua a ser a referência para artigos, clientes, encomendas e documentos comerciais. A aplicação de armazém assume a execução operacional. Recebe encomendas libertadas, executa os movimentos de armazém e devolve o estado, as quantidades, os lotes ou os números de expedição. Assim, cada lado tem uma tarefa clara.

Esta interface precisa de regras concretas. O que acontece a uma alteração de encomenda depois de o picking já ter começado? Pode um stock de armazém ficar negativo? Que registo é válido em caso de falha de rede? Como se bloqueiam artigos assinalados no controlo de qualidade? Sem estas decisões, até uma API tecnicamente limpa se torna uma nova fonte de erros.

Para pequenas e médias empresas, uma implementação por fases é muitas vezes mais sensata do que uma mudança completa. Pode introduzir-se primeiro a receção de mercadoria com leitura de código de barras. Seguem-se depois as localizações e as transferências, mais tarde o picking e a expedição. Assim, as exceções reais são identificadas cedo, sem apostar toda a operação num único dia de transição.

Produto standard, expansão do ERP ou aplicação à medida?

Um WMS standard compensa quando os processos próprios são, em grande parte, convencionais e uma integração existente encaixa com o ERP. Traz rapidamente funcionalidades comprovadas para a operação. O preço a pagar pode ser as equipas terem de adaptar os seus fluxos de trabalho a modelos fixos, ou pagar por funcionalidades enterprise raramente usadas.

Expandir o ERP faz sentido quando a profundidade operacional necessária está realmente disponível e a utilização funciona no chão do armazém. Não se deve avaliar apenas a demonstração do produto, mas sim um fluxo real com scanner, luvas, Wi-Fi instável e pressão de tempo antes da partida.

Uma aplicação à medida torna-se interessante quando o processo sustenta a vantagem competitiva da empresa, ou o software standard obriga permanentemente a desvios. Pode ser um processo de receção de mercadoria particular, uma ligação entre oficina e armazém, guias de remessa especiais ou uma lógica de rotas própria. Nesse caso, a solução não deveria ser tornada artificialmente grande. Um processo claro, modelado de forma limpa e construído sobre uma base técnica sustentável, vale mais do que uma plataforma que, em teoria, consegue fazer tudo.

A softify.pro desenvolve sistemas deste tipo ao longo de movimentos e responsabilidades concretas: desde a receção de mercadoria, passando pelos registos de armazém, até aos documentos de expedição. O modelo de dados, as permissões, os casos de erro e a manutenção posterior permanecem parte da implementação, não tarefas para algum dia depois do go-live.

Perguntas que devem ser colocadas antes da decisão

Nem todos os requisitos têm de ser automatizados no primeiro dia. Mas devem ser decididos de forma deliberada. Os responsáveis deveriam clarificar com a equipa de armazém, as vendas e a contabilidade que dados são de referência, que erros ocorrem hoje mais frequentemente e que indicadores serão realmente necessários mais tarde. Uma bonita vista geral de stocks ajuda pouco se ninguém souber se as quantidades reservadas, bloqueadas e disponíveis são tratadas de forma diferente.

Igualmente importante é a responsabilidade pelos dados-mestre. Os processos de armazém raramente falham por causa de um botão em falta. Falham por causa de referências de artigo inconsistentes, unidades de medida mal mantidas e regras não esclarecidas para artigos substitutos ou conversões de unidades. O software pode tornar estes problemas visíveis. Mas não os pode resolver sem decisões tomadas dentro da empresa.

A escolha certa não é, portanto, automaticamente ERP ou warehouse software. Nasce da distância entre o seu processo atual e o processo que a sua equipa realmente tem de executar de forma fiável. Comece por um movimento que hoje custa tempo ou gera erros, e verifique que sistema representa esse movimento de forma mais clara, rápida e rastreável.

Permalink →

Automatizar a receção de mercadoria

Automatizar a receção de mercadoria

Um camião está parado no portão, dois colaboradores verificam guias de remessa, e a lista de stocks ainda está no computador do escritório. É precisamente aqui que a questão how to automate goods receiving começa a tornar-se prática. Não porque cada armazém precise de uma grande implementação de ERP. Mas porque uma receção de mercadoria em falta, atrasada ou mal registada tem consequências: os stocks não batem certo, as encomendas ficam à espera, as reclamações tornam-se difíceis de rastrear e o turno começa com perguntas por esclarecer.

Automatizar a receção de mercadoria não significa substituir pessoas por scanners. Significa gerir verificações, registos e documentos recorrentes de forma a que a equipa no portão possa decidir depressa e o stock fique depois fiável. Para pequenas e médias empresas, um fluxo de trabalho leve e adequado costuma valer mais do que um sistema de grande grupo cheio de funções que ninguém usa.

O que realmente se perde na receção manual de mercadoria

As guias de remessa em papel e as folhas de cálculo Excel funcionam muitas vezes tempo suficiente para adiar um investimento. O problema não surge por causa de uma caixa isolada. Surge quando os desvios se acumulam: uma entrega parcial só é anotada mais tarde, um lote não pode ser associado, uma palete acaba na zona errada, ou o registo da receção só acontece no fim do dia.

Nesse ponto existem várias verdades ao mesmo tempo. O fornecedor comunica que entregou. No armazém a mercadoria está fisicamente presente. O planeamento ainda não vê stock disponível. A contabilidade tem um documento, mas nenhuma confirmação de quantidade ou dano. Os colaboradores reconciliam esta informação por telefone, e-mail e experiência. Isso custa tempo e torna o processo dependente de pessoas individuais.

A automatização cria uma única fonte partilhada e atualizada para a operação. Regista não só o stock previsto, mas também o que realmente aconteceu no portão: quem recebeu, quando, em que quantidade, com que desvio, e para onde vai a mercadoria a seguir.

How to automate goods receiving com um fluxo claro

O ponto de partida certo não é escolher um scanner ou uma aplicação de armazém. Primeiro, o processo real tem de se tornar visível. Percorra uma receção de mercadoria típica, desde a data de entrega anunciada até à arrumação em stock. Observe também os casos especiais pelo caminho, porque são eles que determinam se uma solução aguenta o dia a dia.

Um fluxo digital costuma ser composto por cinco decisões consecutivas. A entrega é identificada, verificada face à encomenda ou à chegada esperada, a quantidade real é registada, os desvios são documentados e a mercadoria é atribuída a uma localização de armazém ou a um passo de verificação adicional. Cada passo deveria pedir apenas os dados de facto necessários nesse ponto.

1. Disponibilizar antecipadamente as entregas esperadas

Se existirem encomendas de compra, ordens de produção ou avisos de expedição, o armazém deveria poder vê-los antes da chegada. À chegada, a pessoa responsável seleciona o fornecedor, lê um número de encomenda ou procura uma entrega em aberto. O sistema mostra os artigos esperados, as quantidades e, se aplicável, números de lote ou de série.

Isto encurta claramente a receção. Mais importante ainda, porém, é a lógica de verificação: a equipa não tem de decidir de memória se 18 em vez de 20 caixas são aceitáveis. O desvio torna-se visível e pode receber um motivo. Para entregas não anunciadas, o fluxo precisa de um caminho controlado, por exemplo como receção provisória libertada pelas compras ou pelo planeamento.

2. Usar códigos de barras onde realmente poupam tempo

Um leitor de códigos de barras ou a câmara de um dispositivo móvel resistente é, para muitos armazéns, o ponto de entrada mais sensato. Uma leitura reduz erros de digitação e acelera movimentos recorrentes. A condição, no entanto, é que as referências de artigo, as unidades de embalagem e as etiquetas sejam mantidas de forma consistente. Um scanner não resolve dados-mestre pouco claros.

Nem toda a mercadoria precisa de rastreabilidade por número de série. Para parafusos ou consumíveis padrão, artigo, quantidade e localização são muitas vezes suficientes. Para peças sobresselentes em garantia, produtos regulados ou componentes destinados à produção, o lote, o número de série, o prazo de validade e o estado de inspeção podem ser obrigatórios. A profundidade do registo deve corresponder ao risco, não a um modelo de software genérico.

3. Tratar os desvios como um processo normal

Uma boa receção digital de mercadoria não tenta evitar todos os desvios. Torna-os simples e demonstravelmente geríveis. Faltas, sobreentregas, danos de transporte, artigos errados e lotes bloqueados precisam de estados claros em vez de notas manuscritas na guia de remessa.

Numa entrega danificada, por exemplo, pode tirar-se uma fotografia diretamente no local de receção, registar a quantidade como bloqueada e informar automaticamente as compras. O stock disponível mantém-se correto enquanto a mercadoria segue fisicamente para uma zona de quarentena. Isto evita que peças danificadas sejam recolhidas por engano ou usadas na produção.

A regra não tem de ser sempre totalmente automática. Para quantidades pequenas, uma sobreentrega pode ser aceite diretamente. Para artigos caros ou relevantes para a segurança, deveria ser exigida uma libertação. Estes limiares pertencem ao processo e têm de continuar ajustáveis mais tarde.

4. Desencadear a arrumação imediatamente

Uma receção só fica operacionalmente completa quando é claro onde está a mercadoria, ou porque é que ainda não pode ser arrumada. O sistema pode sugerir uma localização fixa, dar preferência a uma zona de reabastecimento, ou determinar uma área de destino com base no grupo de artigos, na gama de temperatura e na capacidade disponível.

Para armazéns de dimensão gerível, muitas vezes basta uma lógica de localização clara com poucas zonas. A otimização de rotas complexa só vale a pena quando o volume, os percursos e a estrutura de pessoal a justificam. Quem recebe dez paletes por dia não precisa de um projeto de otimização que demore mais tempo do que aquele que poupa. Uma leitura fiável da localização de armazenamento é muitas vezes o maior avanço.

Depois da arrumação, o sistema atualiza o stock e o registo de movimentos. Vendas, planeamento ou produção veem assim o estado sem terem de perguntar ao armazém. Se um artigo só puder ficar disponível depois de um controlo de qualidade, o sistema separa o stock físico do stock disponível.

Que dados a receção de mercadoria realmente precisa

Um processo digital torna-se rapidamente impopular se pedir demasiados campos no portão. Ao mesmo tempo, sem um mínimo de dados faltam as provas para esclarecimentos posteriores. Na maioria das empresas de média dimensão, estas informações fazem sentido:

  • Fornecedor e referência à encomenda ou à guia de remessa
  • Artigo, quantidade aceite e unidade de embalagem
  • Momento da operação e pessoa responsável
  • Localização ou estado como inspeção, bloqueio ou quarentena
  • Motivo do desvio, fotografias e libertação quando necessário

Campos adicionais só deveriam ser obrigatórios quando permitem uma decisão concreta. Quando o lote é obrigatório, o respetivo número não é um extra, é informação central. Um comentário livre em cada entrega, pelo contrário, é muitas vezes preenchido apenas para o formulário parecer completo.

A integração decide a relação entre benefício e esforço

A receção de mercadoria não pode surgir como uma nova solução isolada ao lado das compras, da produção e da contabilidade. Pelo menos os dados-mestre de artigos, as encomendas em aberto e as alterações de stock têm de ser trocados de forma fiável. Se isto acontece através de uma interface ERP existente, de importações de dados ou de um processo intermédio desenvolvido para o efeito, depende do panorama de sistemas já existente.

Com sistemas ERP mais antigos, uma integração completa em tempo real nem sempre é rentável. Uma importação verificada em intervalos fixos pode ser perfeitamente suficiente se as quantidades e os prazos o permitirem. Para peças sobresselentes imediatamente afetas a encomendas urgentes, pelo contrário, um registo quase em tempo real conta mais. Aqui, a tecnologia segue o ritmo do negócio.

A operacionalidade também faz parte do planeamento. Os dispositivos precisam de contas de utilizador, papéis claros e um comportamento definido em caso de falha de rede. Uma receção de mercadoria móvel não tem necessariamente de funcionar offline. Mas se as falhas de Wi-Fi ocorrerem regularmente, um buffer local com sincronização rastreável não é um luxo, é parte da fiabilidade do processo.

Implementação em pequenos passos em vez de um big bang

Comece com um fornecedor, um grupo de produtos ou uma área de armazém claramente delimitada. Meça não só a duração por registo, mas também o retrabalho, as diferenças por esclarecer e as questões entre o armazém e o escritório. A partir daí torna-se visível se a automatização realmente alivia o trabalho.

Forme com guias de remessa reais do dia a dia, incluindo entregas danificadas ou incompletas. Um processo que só funciona com uma entrega perfeitamente conforme não é automatização, é uma demonstração. Os colaboradores da receção de mercadoria deveriam poder ajudar a definir as regras, porque conhecem as exceções.

A softify.pro desenvolve estes fluxos deliberadamente de forma específica ao workflow: desde a leitura móvel até ao movimento de stock documentado e a uma ligação estável aos sistemas existentes. O que conta aqui não é a lista de funcionalidades mais longa, mas sim um sistema que permanece rastreável sob pressão de tempo e que pode ser operado e mantido tecnicamente.

O melhor passo seguinte não é, portanto, uma comparação de software, mas uma hora a analisar as últimas dez entregas problemáticas. Se conseguir dizer, para cada uma delas, onde se perdeu tempo e que informação faltava, já existe o primeiro esboço de uma melhor receção de mercadoria.

Permalink →

Vantagens da preparação de encomendas com código de barras para armazéns de pequena e média dimensão

Vantagens da preparação de encomendas com código de barras para armazéns de pequena e média dimensão

Um artigo errado na caixa raramente custa apenas o preço da devolução. Ocupa tempo no armazém, gera pedidos de esclarecimento no escritório e, no pior dos casos, prejudica a relação com o cliente. É por isso que as vantagens da preparação de encomendas com código de barras não se notam primeiro num indicador técnico, mas numa expedição mais tranquila: os colaboradores sabem o que fazer a seguir e as divergências são detetadas onde surgem.

Para armazéns de pequena e média dimensão, isto é particularmente relevante. Muitos processos funcionam inicialmente com listas em papel, ficheiros Excel, instruções dadas em voz alta e a experiência de pessoas concretas. Isso não é errado em si. Com um volume controlável, uma folha de cálculo pode até ser a ferramenta mais sensata. Mas, quando aumentam a variedade de artigos, o número de encomendas, as mudanças de turno ou os requisitos de rastreabilidade, a solução provisória pragmática torna-se rapidamente uma fonte de erros.

O que a preparação de encomendas com código de barras muda no dia a dia

Na preparação de encomendas com código de barras, uma leitura não confirma apenas que alguém fez alguma coisa. Liga encomenda, localização, artigo e quantidade num passo de trabalho rastreável. O sistema indica a recolha seguinte, o colaborador lê a localização e o artigo, introduz a quantidade se necessário e recebe de imediato uma resposta.

A ordem das verificações é decisiva. Se um colaborador ler primeiro o artigo e só depois a localização, o sistema consegue detetar um artigo errado, mas não evitar um percurso desfavorável. Na prática, a sequência localização, artigo, quantidade dá frequentemente bons resultados. Em processos com lotes, números de série ou prazos de validade, somam-se outras verificações. Quais delas são necessárias depende do risco, e não do que seria tecnicamente possível.

Um bom sistema não substitui uma organização sensata do armazém. Torna, no entanto, visível quando essa organização não é respeitada no dia a dia. Se a mercadoria estiver numa localização não prevista, o erro não é descoberto apenas no inventário, mas no momento da leitura.

As principais vantagens da preparação de encomendas com código de barras: menos trocas exatamente onde surgem

As listas em papel exigem concentração permanente: ler a referência, encontrar o compartimento, comparar a embalagem, assinalar a quantidade. Sob pressão de tempo, caixas semelhantes, designações quase idênticas ou uma tarefa interrompida bastam para provocar um erro. O código de barras traz uma identificação inequívoca a esse momento.

O leitor não substitui o raciocínio, mas assume o controlo que as pessoas têm mais dificuldade em manter de forma duradoura no trabalho de rotina. Se o artigo não corresponder à encomenda, a resposta deve ser clara: artigo errado, artigo esperado, próximo passo razoável. Um simples sinal vermelho de aviso ajuda pouco se não ficar claro como resolver a divergência.

Os registos tornam o stock mais fiável

O stock só é útil se puder sustentar decisões. Quem planeia reposições, promete prazos de entrega ou disponibiliza material para a produção precisa de mais do que um número da semana passada. Se as saídas só forem transcritas de uma lista no fim do turno ou posteriormente, surgem janelas temporais com dados pouco claros.

Uma leitura pode registar a saída de imediato. Assim, diminui a diferença entre o movimento físico e o stock digital. Isso não significa que cada número esteja automaticamente certo. Mercadoria mal etiquetada, transferências não registadas e stock danificado continuam a ser questões reais. Mas as causas podem ser delimitadas muito melhor, porque cada movimento tem uma hora, uma encomenda e, se aplicável, uma referência de utilizador.

Isto é especialmente útil nos processos de reposição. Se um compartimento ficar abaixo do stock pretendido, o sistema pode criar uma ordem de reposição ou, pelo menos, torná-lo visível. Os preparadores deixam assim de procurar mercadoria de substituição a meio de uma encomenda, enquanto o cliente espera pelo seu envio.

Integração mais rápida sem depender do conhecimento de alguns

Os operadores de armazém experientes conhecem de cor os percursos, os casos especiais e o aspeto dos artigos. Esse conhecimento é valioso, mas arriscado como único sistema operativo. Em férias, doença ou crescimento, as equipas ficam sob pressão quando os novos colaboradores têm primeiro de aprender durante semanas que fila de estantes corresponde a uma abreviatura interna.

Uma boa interface móvel guia ao longo da encomenda numa linguagem compreensível. Mostra a localização, o artigo, a quantidade prevista e, se necessário, uma imagem ou indicações sobre a embalagem. A leitura confirma o passo. Os novos colegas não se tornam especialistas de imediato, mas podem colaborar com segurança muito mais cedo.

O mesmo se aplica a trabalhadores temporários e a turnos variáveis. O pressuposto é que os dados mestre estejam bem mantidos. Um sistema não consegue extrair uma instrução clara de uma designação de artigo como «peça pequena azul nova». A digitalização expõe estas fragilidades - e isso é muitas vezes um efeito secundário útil.

Rastreabilidade em reclamações e inventários

Quando um cliente comunica uma quantidade em falta, sem dados de processo começa muitas vezes uma busca por pilhas de papel, listas de expedição e memórias. Com registos baseados em código de barras, é possível verificar que encomenda foi processada e quando, que linha foi confirmada e se houve uma correção ou uma quantidade parcial.

Não é uma garantia contra reclamações. Mas encurta o esclarecimento e separa suposições de factos. Os inventários também beneficiam: as diferenças podem não só ser contadas, mas também analisadas com base nos movimentos. Se as correções se acumulam num determinado compartimento, num grupo de artigos ou após uma determinada passagem de testemunho no processo, surge um ponto de partida concreto para melhorias.

Processos mensuráveis em vez de intuição

Muitos armazéns sabem que «à tarde fica apertado» ou que certas encomendas demoram invulgarmente. Sem registos de hora e passos de processo, continua a ser uma intuição. Se forem registados o início da recolha, a leitura, a interrupção, a conclusão e a entrega, os estrangulamentos podem ser distinguidos com clareza.

Talvez não seja a preparação que é lenta, mas a mercadoria que é arrumada demasiado tarde. Talvez surjam tempos de espera no posto de embalagem ou um único compartimento seja visitado com uma frequência desproporcionada. Estes dados não devem ser entendidos como uma ferramenta de controlo generalizado do desempenho. O seu valor está, antes de mais, em identificar percursos desnecessários, reposições em falta e passagens de testemunho pouco claras.

O benefício depende da conceção do processo

A preparação de encomendas com código de barras não é um fim em si mesmo, e nem todos os armazéns precisam de um software de gestão de armazém abrangente. Com poucas encomendas, um sortido reduzido e pessoal fixo, um processo bem conduzido com listas simples pode ser mais económico. Um projeto faz sentido quando os custos de recolhas erradas, tempos de procura, incerteza sobre o stock ou retrabalho manual se fazem sentir regularmente.

Também a questão do hardware merece uma análise sóbria. Um smartphone com leitura por câmara pode ser suficiente para os primeiros processos. Com elevada frequência de leitura, luvas, má iluminação ou ambientes exigentes, os leitores portáteis dedicados são normalmente mais rápidos e menos propensos a erros. A cobertura de rede é igualmente decisiva. Se o Wi-Fi falhar numa zona do armazém, a aplicação precisa de uma estratégia clara: armazenamento temporário offline com sincronização posterior, ou um processo que não trate essa área em dispositivos móveis.

A qualidade das etiquetas é tão importante como o software. Um código de barras numa etiqueta de compartimento gasta ou um identificador de artigo atribuído em duplicado compromete todo o processo. Antes do arranque, as localizações devem ser identificadas de forma inequívoca, as unidades definidas e os casos especiais críticos esclarecidos: como se trata uma embalagem aberta? O que acontece em caso de rutura? Quem pode corrigir uma quantidade? O que acontece à mercadoria sem código legível?

Como implementar sem interromper a operação

O ponto de partida mais fiável raramente é a mudança total. Comece por uma área bem delimitada, por exemplo as encomendas de expedição mais frequentes ou um grupo de artigos com muitas trocas. Aí é possível testar a sequência de leitura, as mensagens de erro e as etiquetas em operação real, sem transformar todo o armazém ao mesmo tempo.

Antes da implementação técnica, deve ser levantado o percurso real de uma encomenda - desde a entrada da encomenda, passando pela reserva e pela recolha, até ao posto de embalagem e à etiqueta de envio. O que conta não é o processo ideal de um organigrama, mas o fluxo que o turno efetivamente utiliza. Os requisitos mais valiosos estão muitas vezes em pequenas exceções: encomendas agrupadas, artigos de substituição, recolhas parciais ou a devolução de mercadoria que não é necessária.

Depois, são necessárias regras claras para as exceções. Um colaborador tem de poder comunicar uma falta de stock sem contornar a encomenda de forma informal. Uma pessoa autorizada tem de poder efetuar correções de forma rastreável. E, se existirem interfaces com a loja online, o ERP ou a transportadora, o estado das encomendas e os registos de stock devem estar claramente definidos. A dupla manutenção de dados é um sinal de alerta, não uma solução permanente.

Em sistemas à medida, a softify.pro começa precisamente neste ponto: não com um pacote enterprise sobrecarregado, mas com os passos de leitura e registo comprovadamente necessários para a operação concreta do armazém. Uma base de dados fácil de manter, interfaces claramente documentadas e ecrãs compreensíveis valem mais do que uma longa lista de funções raramente utilizadas.

Um primeiro ponto de verificação sensato

Pegue em dez encomendas típicas e acompanhe-as desde a entrada até à entrega para expedição. Registe em que pontos os colaboradores têm de procurar, perguntar, introduzir dados mais tarde ou confiar na memória. É exatamente aí que se decide se a preparação de encomendas com código de barras traz vantagens - e que processo de leitura se adequa realmente ao armazém.

Permalink →

Testes auto-hospedados vs cloud

Testes auto-hospedados vs cloud

Um teste de regressão falhado raramente é apenas uma entrada vermelha num painel. Pode significar que um ecrã de expedição no armazém gera etiquetas erradas, um portal de clientes deixa de aceitar encomendas, ou uma aplicação Windows falha durante uma transição de turno. A questão self hosted testing vs cloud não é, portanto, sobre infraestrutura como um fim em si mesma. É sobre que dados um processo de teste toca, quem o controla, e com que fiabilidade funciona em condições operacionais reais.

As plataformas de teste baseadas na cloud podem estar operacionais rapidamente. Para muitas equipas, isso é sensato, especialmente ao testar uma aplicação web pública e precisar de capacidade de execução adicional a curto prazo. Os ambientes de teste auto-hospedados, por outro lado, exigem uma configuração técnica deliberada. Mas devolvem à empresa o controlo sobre dados de teste, caminhos de rede, direitos de acesso, e operação. A escolha certa não depende de um princípio geral, mas da aplicação, do risco, e da capacidade operacional disponível.

Self Hosted Testing vs Cloud: Do que se trata realmente

O debate é frequentemente reduzido demasiado ao custo inicial. Uma solução na cloud parece mais barata porque não é necessário adquirir servidores nem configurar um ambiente. Um servidor de testes dedicado parece à primeira vista mais trabalhoso, porque o sistema operativo, atualizações, controlo de acesso, monitorização, e cópias de segurança têm todos de ser planeados.

Esse cálculo fica aquém. O que importa são os custos contínuos de uma estratégia de testes: tempos de espera antes dos lançamentos, deteção de erros após execuções de teste incompletas, coordenação com proteção de dados e segurança da informação, bem como as consequências de uma implementação defeituosa. Se uma equipa examina regularmente aplicações empresariais sensíveis, a carga organizacional adicional de serviços externos pode superar a operação de um ambiente próprio claramente delimitado.

Também "cloud" não é um modelo uniforme. Alguns fornecedores armazenam apenas registos de testes, outros processam capturas de ecrã, gravações de vídeo, credenciais, conteúdo DOM, ou tráfego de rede. Com testes assistidos por IA, dados de imagem e texto podem adicionalmente chegar a modelos externos ou subcontratados para avaliação. Quem olha apenas para a localização de um centro de dados frequentemente ignora a questão mais importante: que dados realmente saem da própria zona de controlo, e que regras contratuais e de eliminação se aplicam?

Quando os testes na cloud são a escolha sensata

Os testes na cloud não são fundamentalmente um problema de segurança, e a auto-hospedagem não é automaticamente a melhor arquitetura. Para uma nova loja online publicamente acessível ou uma plataforma de marketing, um ambiente na cloud pode ser muito adequado. A equipa pode cobrir rapidamente variantes de navegador e dispositivo sem manter as suas próprias máquinas de execução. Com carga de teste flutuante, a escalabilidade elástica é também uma vantagem real.

Equipas de desenvolvimento pequenas com poucos dados de teste claramente anonimizados também frequentemente beneficiam de um serviço gerido. Não deveriam investir o seu tempo a operar uma plataforma quando o gargalo está antes em casos de teste em falta, critérios de aceitação pouco claros, ou dados de teste instáveis. Um servidor próprio não resolve esses problemas.

A cloud encaixa particularmente bem quando a aplicação não precisa de acesso de rede interno, nenhum dado pessoal ou crítico para o negócio aparece nos fluxos de teste, e um curto prazo de execução importa mais do que um controlo profundo da infraestrutura. O pré-requisito é uma configuração cuidadosa: contas de teste separadas, sem dados reais de clientes, tokens limitados, períodos de retenção rastreáveis, e um conceito de direitos claro.

Quando os testes auto-hospedados se tornam mais sensatos

A situação é diferente para aplicações apenas acessíveis na rede da empresa ou que representam processos operacionais centrais. Um software de armazém ou produção processa frequentemente movimentos de artigos, moradas de entrega, stocks, números de série, e lógica de preços. Uma execução de teste pode gerar capturas de ecrã de ecrãs de encomenda, descarregar documentos, ou iniciar sessão com funções de utilizador. Tais dados não deveriam ser dispersos despercebidamente por vários sistemas externos.

Os testes auto-hospedados permitem colocar a execução dos testes perto da aplicação. O servidor de testes pode funcionar no mesmo segmento de rede ou numa DMZ controlada. As regras de firewall são definidas de forma direcionada, as aplicações internas não precisam de ser abertas para um serviço externo, e os registos permanecem sob administração própria. Isso é frequentemente especialmente relevante para aplicações desktop Windows, uma vez que estas raramente são concebidas para plataformas de teste externas.

Para indústrias reguladas, requisitos de cliente maiores, ou diretrizes de segurança internas, esta arquitetura é frequentemente mais fácil de auditar. Isso não significa que cada auditoria seja automaticamente aprovada. Um servidor próprio também precisa de gestão de patches, encriptação, direitos baseados em funções, cópias de segurança, e procedimentos operacionais documentados. A diferença está em que a empresa toma estas decisões por si própria e pode demonstrá-las.

Na softify.pro, o COCO é por isso concebido como um servidor de IA dedicado e auto-hospedado: as execuções de teste para aplicações web e Windows executam-se localmente, as evidências são registadas, e os resultados são avaliados em linguagem clara. Isso não substitui a aprovação por especialistas de domínio. Mas garante que o tráfego de teste, capturas de ecrã, e avaliações podem permanecer onde a empresa retém a soberania dos dados.

Comparar custos corretamente: operação contra atrito

Uma comparação sensata abrange mais do que o preço da licença contra o preço do hardware. Na cloud, surgem taxas recorrentes por utilizador, minuto de teste, execução paralela, ou consumo de IA. Estes custos são inicialmente previsíveis, mas podem aumentar significativamente com a crescente cobertura de testes. A isso somam-se possíveis despesas para contratos empresariais, acordos de tratamento de dados, e auditorias de segurança.

Com a auto-hospedagem, surgem investimentos para infraestrutura e configuração. Isso pode incluir máquinas virtuais, armazenamento, acesso de rede, monitorização, e o tempo de uma equipa tecnicamente responsável. Estes custos permanecem mesmo quando poucos testes estão a decorrer. Para um projeto com lançamentos raros, esse é um bom argumento contra uma solução própria sobredimensionada.

Com testes de regressão regulares, o panorama muda. Se os mesmos fluxos de trabalho críticos para o negócio precisarem de ser verificados todas as semanas, a capacidade interna previsível é frequentemente mais económica do que custos variáveis de plataforma e ciclos de aprovação manuais. A abordagem torna-se especialmente valiosa quando os casos de teste são usados durante anos e evoluem juntamente com a aplicação empresarial. A manutenibilidade importa então mais do que um início rápido mas difícil de controlar.

A qualidade não depende do modelo de alojamento

Um equívoco comum diz: os testes na cloud seriam automaticamente mais modernos, os testes auto-hospedados automaticamente mais estáveis. Nenhuma das afirmações é verdadeira. A qualidade dos testes surge de cenários sensatos, dados de teste resilientes, identificadores estáveis na interface, e expectativas claras sobre o resultado.

Um teste não deveria apenas verificar se um botão é clicável. Para um processamento de encomendas, pode, por exemplo, criar uma encomenda, verificar uma quantidade disponível, gerar uma guia de remessa, e assegurar que a função correta pode aprovar a operação. Num programa desktop, pode verificar a importação de um ficheiro, o tratamento de erros, e a saída de um documento. Só tais fluxos ponta a ponta mostram se uma alteração danificou o processo real.

A IA pode ajudar a detetar alterações de interface, documentar passos de forma compreensível, e priorizar anomalias. No entanto, não deveria tornar-se uma caixa negra. As equipas precisam de capturas de ecrã ou outras evidências, passos de teste rastreáveis, e limiares definidos para quando um resultado conta como aprovado, incerto, ou falhado. Precisamente em verificações visuais, um limiar de confiança é sensato, para que pequenos desvios de layout esperados não bloqueiem cada lançamento.

As questões operacionais antes da decisão

Antes de uma equipa se comprometer, deveria rastrear concretamente o caminho de uma execução de teste. Onde executa o teste? A que sistemas se autentica? Que dados vê? Onde são armazenadas capturas de ecrã, registos, e relatórios? Quem pode ler, eliminar, ou exportar resultados? Estas questões são mais práticas do que uma decisão geral a favor ou contra a cloud.

Igualmente importante é a responsabilidade após o go-live. Quem atualiza navegadores e agentes de teste? Quem reage quando um certificado expira? Como são rodadas as credenciais? E como se garante que um teste não desencadeia acidentalmente um registo de expedição real ou uma notificação de cliente? Uma boa automação de testes precisa de ambientes separados e mecanismos de proteção, não apenas bons scripts.

Um modelo híbrido pode ser sensato. Interfaces públicas e verificações de navegador amplamente distribuídas correm na cloud, enquanto processos empresariais internos permanecem num servidor de testes próprio. Isso reduz a carga operacional, sem ceder em bloco fluxos de trabalho sensíveis para o exterior. O pré-requisito é uma fronteira clara entre as duas áreas, não uma operação mista confusa.

A melhor decisão é a que se ajusta ao risco real e à realidade operacional própria. Se uma folha de cálculo ainda suporta fiavelmente um processo, não precisa de se tornar num grande sistema. Mas se dados de teste e aplicações internas pertencem antes ao núcleo do negócio, o controlo não é um luxo, mas um requisito objetivo para software fiável.

Permalink →

Inventory Management no armazém

Inventory Management no armazém

Uma peça em falta raramente se nota ao contar no armazém. Normalmente só se revela quando uma encomenda não pode ser embalada, um técnico está diante de uma prateleira vazia, ou as compras procuram por telefone uma promessa de entrega. Um bom Inventory Management não previne estas surpresas com mais tabelas, mas com uma imagem fiável do que está disponível, onde se encontra, e o que acontece a seguir com isso.

Para pequenas e médias empresas, isto não é uma questão do maior sistema ERP possível. Decisivo é se os funcionários na receção de mercadoria, armazém, e expedição conseguem trabalhar com poucos passos claros - mesmo sob pressão de tempo, através de mudanças de turno, e quando uma entrega sai diferente do planeado.

Inventory Management começa com movimentos, não com listas de stock

Uma lista de stock é uma fotografia instantânea. Pode estar correta e ainda assim ajudar pouco se ninguém conseguir perceber por que motivo uma quantidade mudou. Um sistema resiliente trata, portanto, o stock como resultado de movimentos documentados: a mercadoria chega, é controlada, armazenada, reservada, feita picking, transferida, expedida, ou corrigida.

Cada movimento precisa de um motivo claro, uma marca temporal, uma pessoa responsável, e idealmente uma ligação a uma transação específica. Isso pode ser uma encomenda de compra, uma encomenda de cliente, uma guia de remessa, ou uma ordem de produção. Isso transforma o número "24 unidades disponíveis" numa afirmação verificável: foram registadas 30 unidades, quatro estão reservadas para duas encomendas, e nenhuma transferência em aberto distorce o stock disponível.

Esta distinção é especialmente relevante para peças escassas. Fisicamente presente, reservado, e livremente disponível são três estados diferentes. Se forem misturados, as vendas prometem mercadoria que o armazém já precisa para outra encomenda. Se forem mantidos limpos, uma equipa pode decidir cedo: reencomendar, reprioritizar, ou dar ao cliente uma resposta realista.

Onde os processos manuais tipicamente falham

As folhas de cálculo não são fundamentalmente erradas. Para um pequeno sortimento, um local de armazenamento, e poucos movimentos por semana, podem ser mais económicas do que uma aplicação dedicada. Tornam-se problemáticas assim que várias pessoas trabalham simultaneamente ou o stock é atualizado a partir de várias fontes.

É então que surgem as lacunas conhecidas: a receção de mercadoria fica em papel na secretária, o ficheiro Excel foi alterado localmente, uma transferência foi apenas acordada verbalmente, e a expedição só regista depois do horário de trabalho. O stock não é necessariamente errado, mas está desfasado no tempo e a sua origem é pouco clara. É precisamente isso que o torna inadequado para decisões operacionais.

A estrutura organizacional também desempenha um papel. Um local central precisa de fluxos diferentes de uma empresa com armazéns satélite, veículos de serviço, ou uma produção que retira material. Quem representa estas diferenças com uma única coluna de texto livre, desloca a lógica para as cabeças de funcionários individuais. Isso funciona até essa pessoa tirar férias ou o volume de encomendas aumentar.

Definir o processo antes do software

Um projeto sensato não começa com a pergunta sobre qual scanner comprar ou qual interface parece moderna. Primeiro tem de estar claro que decisões o sistema deve apoiar. Para isso, frequentemente bastam observações concretas do dia a dia: como é a mercadoria aceite hoje? Quando conta como controlada? Quem pode corrigir stocks? O que acontece com mercadoria danificada? E em que ponto uma encomenda fica vinculativamente reservada?

Destas respostas surgem algumas regras vinculativas. Por exemplo, a receção de mercadoria só pode ser registada após um controlo de quantidade. Artigos sem local de armazenamento não devem aparecer como prontos a armazenar. As correções de stock exigem um código de motivo e permanecem visíveis no histórico. A mercadoria expedida não é apagada silenciosamente, mas atribuída à encomenda através de uma baixa documentada.

Isso é menos espetacular do que uma grande apresentação de digitalização, mas muito mais valioso na operação. Quando as regras são inequívocas, o software pode verificá-las de forma fiável. Quando permanecem pouco claras, cada nova aplicação apenas acelera passos de trabalho contraditórios.

Dados mestre: começar pequeno, manter com consistência

Nem todo artigo precisa de dez classificações desde o início. Uma base utilizável consiste frequentemente em número de artigo, descrição, unidade, estado de armazém ativo, e uma ou mais localizações de armazém. Consoante o negócio, acrescentam-se lotes, números de série, stocks mínimos, números de artigo do fornecedor, ou datas de validade.

Importante é a consistência, não a quantidade de campos. Dois números de artigo para o mesmo artigo físico, ou unidades variáveis como "caixa", "embalagem", e "unidade" sem regra de conversão, geram erros posteriores quase automaticamente. Um sistema pode tecnicamente permitir tais entradas. Deveria limitá-las onde põem em risco o processo.

Que funcionalidades realmente ajudam no armazém

Para muitos armazéns de média dimensão, um núcleo claro é mais valioso do que um catálogo de funcionalidades sobrecarregado. Este núcleo abrange tipicamente quatro áreas:

  • Receção de mercadoria com referência de encomenda, controlo de quantidade, e armazenamento
  • Movimentos de armazém entre localizações e áreas definidas
  • Reserva de encomendas, picking, e confirmação de expedição
  • Inventário e correções de stock com histórico rastreável

Complementarmente, a impressão de etiquetas, leitura de códigos de barras, guias de remessa, etiquetas de expedição, ou uma transferência para contabilidade e sistemas de loja podem poupar muito tempo. Mas deveriam basear-se num modelo de movimento limpo. Uma impressão rápida de etiquetas ajuda pouco se a leitura não atribuir inequivocamente o artigo à localização de armazém ou encomenda corretas.

Na utilização também conta o ambiente. Um funcionário com luvas na receção de mercadoria precisa de ações grandes e inequívocas e o mínimo possível de introdução de texto. Uma despachante no posto de trabalho, por outro lado, precisa de filtros, funções de pesquisa, e uma vista sobre transações em aberto. Ambos os papéis podem usar os mesmos dados, mas não precisam da mesma interface.

Tempo real não significa que cada número é incontestável

Muitas empresas desejam stock em tempo real. Isso é sensato, mas o termo é frequentemente usado de forma demasiado genérica. Um stock pode ser atualizado imediatamente após cada leitura e ainda assim estar errado se um processo permanecer incompleto. Se a mercadoria for lida mas não controlada, o número está tecnicamente atualizado e operacionalmente questionável.

Por isso todo sistema precisa de uma gestão de exceções. Diferenças na receção de mercadoria, embalagens danificadas, devoluções, e artigos não localizáveis não são casos marginais. Fazem parte do dia a dia. Bons processos marcam-nos visivelmente, em vez de forçar os funcionários a listas paralelas improvisadas.

As permissões também merecem atenção. Nem toda pessoa deveria poder alterar dados mestre de artigos ou corrigir registos históricos. Um conceito de direitos prático separa operações de rotina de intervenções de maior risco. Isso não só protege contra erros, como também facilita a análise de causas quando um stock se desvia inesperadamente.

Integração apenas onde melhora o processo

O Inventory Management raramente está sozinho. As encomendas podem vir de uma loja online, um registo por e-mail, uma solução setorial, ou diretamente das vendas. Os transportadores precisam de dados de morada e pesos. A contabilidade espera documentos numa forma específica.

Uma integração compensa quando elimina o registo duplicado ou reduz fontes de erro. Não é automaticamente sensata só porque uma interface está disponível. Especialmente em processos que cresceram organicamente, uma importação clara com controlo pode ser mais fiável do que um acoplamento permanente em tempo real que transmite dados errados sem ser notado.

Tecnicamente, a solução deveria permanecer rastreável: interfaces inequívocas, transferências registadas, mensagens de erro compreensíveis, e uma estrutura de base de dados que não esconde alterações. Com uma aplicação bem mantida baseada em PHP 8.4 e MySQL 8, tais processos podem ser implementados de forma enxuta, sem forçar equipas a um sistema corporativo global. O decisivo não é o rótulo tecnológico, mas se a manutenção, extensões, e correções de dados permanecem controláveis também daqui a três anos.

Implementação em passos pequenos e mensuráveis

Um big bang raramente é a melhor escolha num armazém. Mais seguro é um começo limitado, por exemplo com receção de mercadoria e uma área de armazém selecionada. Nesta fase podem observar-se tempos de leitura, tipos de erro, casos especiais em aberto, e a qualidade dos dados mestre. Só depois seguem a reserva, expedição, ou locais adicionais.

A operação paralela pode ser sensata nesse contexto, mas apenas com um fim claro. Dois stocks principais durante um período prolongado criam exatamente o problema que a nova solução deve resolver. Melhor é uma transição definida com inventário, dados mestre limpos, e responsabilidades para as primeiras semanas.

O sucesso não se vê em quantas funcionalidades foram ativadas. Vê-se em se surgem menos perguntas de acompanhamento, se as encomendas são embaladas mais completamente, e se uma equipa consegue explicar sem trabalho de detetive por que motivo um stock de artigo parece o que parece.

Se o processo atual com uma tabela bem mantida funciona realmente de forma estável, deveria poder permanecer. Mas se a informação continua a perder-se entre papel, chamadas telefónicas, e vários ficheiros, o próximo passo sensato não é uma ferramenta maior, mas um processo claro que torna visível cada movimento de armazém importante.

Permalink →

Os testes auto-hospedados são seguros?

Os testes auto-hospedados são seguros?

Um teste de regressão falhado é irritante. Uma captura de ecrã de um sistema ERP interno que acaba sem controlo num serviço externo é um incidente de segurança. É precisamente por isso que os líderes de QA e responsáveis de TI se colocam a questão: are self hosted tests secure? A resposta honesta é: podem ser claramente mais seguros do que alternativas baseadas na cloud, mas apenas se a operação for levada tão a sério como os próprios testes.

A automação de testes auto-hospedada desloca o controlo sobre a execução, dados de teste, capturas de ecrã, registos, e direitos de acesso para a própria infraestrutura. Isso reduz dependências e caminhos de dados desnecessários. No entanto, não substitui uma arquitetura de segurança. Um servidor de testes interno mal mantido continua a ser um servidor mal mantido.

Os testes auto-hospedados são mais seguros do que os testes na cloud?

A diferença decisiva não está em saber se um teste corre localmente ou de forma automatizada. Está em onde os dados são processados, quem pode aceder a eles, e que limites técnicos se aplicam.

Com um serviço de testes operado externamente, frequentemente saem da empresa vários artefactos: credenciais para contas de teste, URLs de aplicações internas, conteúdo DOM, capturas de ecrã, vídeos de execuções de testes, registos de erros, e possivelmente extratos de base de dados. Mesmo que um fornecedor cumpra elevados padrões de segurança, surge uma relação adicional de confiança e contratual. Para aplicações com dados de clientes, pessoal, produção, ou financeiros, isto pode ser um obstáculo relevante.

Um sistema auto-hospedado pode ser operado dentro da própria rede ou de um ambiente da UE claramente delimitado. A instância de teste acede diretamente a sistemas de staging, aceitação, ou testes isolados. As provas de teste permanecem onde também se encontram a aplicação e a sua responsabilidade operacional. Isto é especialmente sensato ao testar aplicações desktop Windows, portais web internos, ou sistemas com dados de processo sensíveis.

Mas a auto-hospedagem não é automaticamente mais segura. Quem opera um servidor de testes com acesso remoto aberto, contas de administrador partilhadas, e palavras-passe permanentemente válidas, apenas deslocou os riscos. A questão, portanto, não é apenas: cloud ou on-premises? Mas: o ambiente de teste está demonstravelmente protegido e é permanentemente mantível?

Are self hosted tests secure? Depende destes limites

Uma plataforma de testes segura precisa de limites técnicos e organizacionais claros. Para pequenas e médias empresas, isto não tem de parecer um programa corporativo. Apenas tem de ser implementado de forma consistente e documentado.

Separar o ambiente de teste da produção

Os testes automatizados devem encontrar erros, não desencadear encomendas, modificar guias de remessa, ou registar movimentos de stock. Por isso os testes precisam de um ambiente separado com interfaces próprias, inquilinos de teste, e dados de teste. Onde uma cópia completa da produção não é necessária, isso é frequentemente até desnecessariamente arriscado.

Para um portal de armazém ou encomendas, isso pode significar: os utilizadores de teste podem registar receções de mercadoria e gerar etiquetas de expedição, mas os documentos gerados não vão para nenhuma impressora real nem transportadora real. As chaves API apontam para pontos finais sandbox. O envio de e-mail é intercetado ou limitado a destinatários internos. Assim um teste permanece significativo sem produzir consequências operacionais.

A separação também deveria aplicar-se ao nível da rede. O servidor de testes só precisa das ligações que realmente requer. O acesso geral a toda a rede interna é conveniente, mas raramente justificável. A segmentação limita o dano se uma conta de teste ou um componente do sistema for comprometido.

Tratar as credenciais como acessos de produção

A automação de testes frequentemente precisa de dados de acesso. Isso é normal, mas estes dados não pertencem a scripts de teste, ficheiros de configuração no código-fonte, ou históricos de chat. Palavras-passe, tokens, e certificados deveriam ser carregados a partir de uma gestão controlada de segredos. As contas de teste recebem apenas os direitos que o fluxo concreto exige.

Também o acesso à própria plataforma de testes precisa de papéis. Um programador talvez precise de iniciar execuções de teste e ler resultados, mas não alterar a configuração de rede. Um departamento pode consultar relatórios, mas não precisa de acesso a dados de acesso armazenados. Os direitos de administração deveriam estar ligados a pessoas, não acoplados a uma conta partilhada.

Além disso, autenticação multifator, regras de palavra-passe razoáveis, e fluxos de bloqueio de conta pertencem ao padrão mínimo. Precisamente os sistemas de teste são frequentemente tratados como menos críticos. Os atacantes veem isso de forma diferente: gostam de usar ambientes de teste como ponto de entrada, porque é lá que residem acessos, nomes internos, e detalhes técnicos.

Minimizar os dados de teste e mascará-los de forma direcionada

O erro mais comum não é um método de encriptação em falta, mas demasiada informação real no conjunto de teste. Para a maioria dos testes de regressão, ninguém precisa de nomes reais de clientes, endereços reais, ou processos de pessoal completos. Conjuntos de dados sintéticos, cópias mascaradas, e casos especiais deliberadamente criados são frequentemente suficientes.

Há exceções. Alguns erros só aparecem com estruturas de dados reais, sequências de caracteres invulgares, ou constelações de permissões complexas. Então uma cópia controlada, pseudonimizada pode fazer sentido. O decisivo é que esta decisão seja tomada deliberadamente e tenha um prazo de eliminação. As bases de dados de teste não deveriam continuar a funcionar durante anos como uma cópia sombra esquecida da produção.

Capturas de ecrã e vídeos merecem a mesma atenção. São valiosos para a deteção de erros, mas podem mostrar dados de conta, preços internos, ou conteúdo pessoal. Defina quais artefactos são registados, quem pode vê-los, e quando são automaticamente eliminados. Um relatório de teste não precisa de armazenar cada captura de ecrã para sempre para ser probatório.

Operar o servidor como um produto

Um servidor de testes auto-hospedado não é um dispositivo que se instala uma vez e depois se esquece. A segurança operacional surge de manutenção repetível: atualizações de segurança atempadas para o sistema operativo, navegador, executor de testes, e dependências; suportes de dados e caminhos de transporte encriptados; cópias de segurança monitorizadas; registo centralizado; bem como um tratamento claro de avisos de segurança.

Especialmente em testes orientados por navegador, o ritmo de atualização é relevante. Motores de navegador desatualizados e bibliotecas de automação podem conter vulnerabilidades conhecidas ou tornar os testes pouco fiáveis. Ambos custam tempo. Implementações documentadas e janelas de manutenção fixas não são, portanto, um acréscimo burocrático, mas a base para resultados reprodutíveis.

Para um servidor de testes de IA dedicado como o COCO, aplica-se o mesmo. A execução local não protege o conteúdo sensível da aplicação por magia. Cria controlo sobre onde são processados a avaliação assistida por IA, capturas de ecrã, e registos de teste. Esse controlo tem de ser preenchido com gestão de patches, permissões, separação de rede, e regras de retenção claras.

Onde a auto-hospedagem tem os seus limites

Os serviços na cloud não são inseguros por definição. Um fornecedor especializado pode oferecer mais pessoal de segurança, monitorização mais amadurecida, e redundância mais profissional do que uma empresa com um único papel de TI sobrecarregado. Quem não tem capacidade para operação, atualizações, e resposta a incidentes, pode criar um risco maior com um sistema auto-hospedado mal mantido.

Por outro lado, muitas plataformas de teste externas simplesmente não são um bom ajuste de processo para aplicações especializadas internas. Se uma aplicação só é acessível na rede da empresa, se as execuções de teste mostram ecrãs e documentos confidenciais, ou se os dados não devem sair do próprio domínio de controlo, a operação local é frequentemente a solução mais clara.

A decisão sensata depende da necessidade de proteção e da capacidade operacional. Para um site de marketing público sem logins sensíveis, um serviço de testes na cloud pode ser apropriado. Para software de despacho interno, um portal de clientes com dados pessoais, ou uma aplicação Windows na rede de produção, muito fala a favor de um ambiente controlado, auto-hospedado.

Uma verificação de segurança prática antes do lançamento

Antes de os testes automatizados serem implementados, um responsável deveria conseguir responder a estas perguntas sem adivinhar:

  • A que sistemas, bases de dados, e interfaces pode o servidor de testes aceder?
  • Que dados aparecem em capturas de ecrã, vídeos, registos, e avaliações de IA?
  • Onde estão armazenadas as credenciais, e quando são rotacionadas?
  • Quem pode iniciar execuções de teste, ler resultados, e administrar sistemas?
  • Com que rapidez são aplicadas as atualizações críticas, e como isso é verificado?
  • Quando são eliminados os artefactos de teste e os dados já não necessários?

Estas perguntas parecem sóbrias. É precisamente esse o seu valor. A segurança raramente surge de uma única ferramenta ou de um diagrama de arquitetura impressionante. Surge quando responsabilidades, fluxos de dados, e limites técnicos permanecem verificáveis no dia a dia.

Quem constrói automação de testes deveria primeiro clarificar a necessidade de proteção da aplicação e depois escolher a arquitetura mais pequena que seja sensata. Um servidor de testes claramente delimitado com poucas contas autorizadas é frequentemente mais valioso do que uma plataforma sobrecarregada que ninguém consegue manter de forma fiável. Boring, provable reliability também vence, mesmo em testes, a solução espetacular mas opaca.

Permalink →

Warehouse Management Systems: O que realmente importa

Warehouse Management Systems: O que realmente importa

Quando um funcionário na receção de mercadoria anota a mesma linha de entrega em papel, depois transfere-a para uma tabela, e depois esclarece aos gritos pelo corredor onde será armazenada, raramente falta vontade de trabalhar. O que falta é um processo partilhado. Os Warehouse Management Systems criam esse processo documentando movimentos de mercadoria, stocks, e tarefas subsequentes num só lugar. Para pequenas e médias empresas, o decisivo não é a lista de funções mais longa, mas se o software representa de forma fiável o percurso de uma mercadoria pelo próprio armazém.

O que os Warehouse Management Systems têm de conseguir no dia a dia

Um Warehouse Management System, ou WMS abreviadamente, não é simplesmente uma melhor lista de stock. Controla ou documenta os processos físicos no armazém: receção de mercadoria, controlo de qualidade, armazenamento, transferência, picking, embalagem, expedição, e inventário. Cada registo responde a uma pergunta operacional simples: o que está onde, em que quantidade, em que estado, e quem desencadeou o movimento?

À primeira vista, esta clareza parece banal. Mas evita cadeias de erros típicas. Um artigo foi entregue, mas ainda não foi controlado. Uma palete está na receção de mercadoria, mas já aparece como disponível no sistema. Uma encomenda é feita picking embora a mercadoria devesse estar reservada para uma encomenda de cliente mais importante. Sem estados e movimentos claramente definidos, uma única incerteza transforma-se rapidamente numa promessa de entrega errada.

Para muitos armazéns de média dimensão, o benefício não começa com controlo totalmente automatizado. Ordens de armazenamento já rastreadas, localizações inequívocas, e registos móveis podem reduzir consideravelmente os tempos de procura. O decisivo é que os funcionários já não tenham de traduzir entre papel, telefone, e-mail, e várias tabelas.

Nem todo armazém precisa de uma grande suite

O mercado oferece sistemas empresariais extensos com funções para redes globais multi-localização, gestão aduaneira complexa, tecnologia de transporte automatizada, e lógica de otimização muito fina. Isso pode ser correto se estes requisitos realmente existirem. Mas para uma empresa com um ou poucos armazéns, prioridades mutáveis, e processos especiais bem estabelecidos, tal suite pode gerar mais atrito do que benefício.

Os custos então não residem apenas nas licenças. Surgem em longos projetos de implementação, adaptações extensas, formação, e dependência de especialistas externos. Mesmo um sistema com cem configurações não resolve um problema se os chefes de turno tiverem de abrir um ticket para correções quotidianas.

A alternativa não significa necessariamente um desenvolvimento totalmente à medida. Um produto padrão pode ser sensato quando os seus fluxos principais se adequam e as adaptações permanecem deliberadamente limitadas. Da mesma forma, uma tabela existente ainda pode ser a melhor solução, por exemplo para uma avaliação rara e gerível. Torna-se crítica apenas quando várias pessoas trabalham com ela simultaneamente, registam movimentos com atraso, ou a tabela deve tornar-se a verdade operacional sobre a mercadoria disponível.

A solução certa orienta-se pelo volume de processo real e pelo custo dos erros. Cinco picks errados por semana significam algo diferente num armazém de peças sobressalentes com encomendas de clientes críticas em termos de tempo do que cinco desvios num stock de arquivo de rotação lenta.

Captar primeiro os processos, não escolher os ecrãs

Muitos projetos WMS começam com uma demonstração de produto. Aí os responsáveis veem painéis elegantes, vistas de scanner, e indicadores coloridos. Mais útil é primeiro uma volta pelo armazém durante um dia de trabalho normal. Onde chega a mercadoria? Quem controla quantidades e danos? Quando é que um artigo recebe o seu número de lote ou de série? Como se decide para que local vai? E o que acontece quando a realidade se desvia da encomenda?

Estas perguntas lançam a base para uma solução que será aceite mais tarde. Um processo-alvo bem documentado não descreve apenas o caso ideal. Também contém exceções: entregas parciais, mercadoria danificada, chegadas não anunciadas, faltas de stock, devoluções, e stock bloqueado. São precisamente estes casos que decidem se os funcionários confiam no sistema ou voltam a pegar em papéis.

Os estados são mais importantes do que interfaces bonitas

Um conjunto de dados limpo distingue por exemplo "esperado", "chegado", "em controlo", "armazenado", "reservado", "picking feito", e "expedido". Quais os estados necessários depende da empresa. Poucos demais ocultam diferenças relevantes. Demasiados abrandam os registos e são contornados.

A regra deveria ser: cada estado tem de ter uma consequência operacional. Se a mercadoria estiver bloqueada, não deve ser feito picking. Se estiver reservada, tem de estar visível para que encomenda. Se estiver armazenada, tem de estar registada uma localização. Assim, as regras de dados tornam-se fiabilidade prática do processo.

Os scanners só ajudam em registos claros

Os códigos de barras e dispositivos móveis reduzem erros de digitação e aceleram movimentos. Mas não substituem uma decisão de processo. Uma leitura tem de desencadear uma ação compreensível: verificar artigo, confirmar quantidade, escolher localização de destino, ou concluir encomenda. Se um funcionário tiver de adivinhar após cada leitura qual o ecrã seguinte, o fluxo está desenhado de forma demasiado complicada.

A questão do hardware também deve ser respondida de forma pragmática. Para algumas equipas, smartphones com função de leitura adequada e capa protetora robusta bastam. Outras precisam de scanners portáteis industriais, porque luvas, refrigeração, quedas, ou turnos longos assim o exigem. Um piloto na área real do armazém mostra mais do que uma apresentação na secretária.


A base técnica decide após o go-live

Um WMS tem de funcionar corretamente mesmo quando receções de mercadoria são registadas, encomendas são feitas picking, e stocks são controlados simultaneamente. Daí resultam requisitos que muitas vezes se perdem nas conversas iniciais: registos de movimento inequívocos, permissões baseadas em funções, correções rastreáveis, interfaces fiáveis, e cópias de segurança que são realmente restauráveis numa emergência.

Um stock não deveria ser simplesmente sobrescrito. Melhor é um modelo de movimento: entrada, saída, transferência, bloqueio, ou correção geram cada um um registo documentado. Assim, pode-se rastrear mais tarde por que uma quantidade diverge. Isso é tão valioso para inventários como para esclarecer um caso de reclamação de cliente.

As permissões têm de corresponder à responsabilidade. Um picker precisa de funções diferentes de um responsável de armazém que aprova correções de stock. Para alterações críticas, justificações, aprovações de quatro olhos, ou pelo menos um registo de alterações imutável fazem sentido. O esforço depende do perfil de risco, mas a questão deve ser esclarecida antes do início.

As interfaces merecem a mesma atenção. Um armazém raramente trabalha isolado. Encomendas vêm de uma loja, um ERP, ou importação estruturada. Dados de expedição vão para sistemas de transportadoras, guias de remessa e etiquetas são geradas, dados de stock fluem de volta. Cada interface precisa de responsabilidades claras para casos de erro. O que acontece se uma etiqueta de expedição foi gerada mas a confirmação não chega ao WMS? Sem lógica de repetição e fila de erros visível, tais casos ficam presos a pessoas individuais.

Para soluções personalizadas, tecnologias sustentáveis não são um assunto secundário. Uma aplicação rastreável com estrutura de base de dados clara, implementações documentadas, e integrações testadas permanece gerível mesmo após mudanças de pessoal. Uma arquitetura da moda não ajuda se ninguém conseguir rastrear uma importação com falhas.

Implementação em passos pequenos e controláveis

Um big bang cria risco evitável. Frequentemente é mais sensato digitalizar primeiro um processo delimitado, como a receção de mercadoria para um grupo de produtos ou o picking numa área de armazém. A equipa verifica assim não só funções, mas também formulações, rotas de leitura, distâncias percorridas, e responsabilidades.

Os dados mestre são aqui frequentemente o verdadeiro estaleiro. Os números de artigo têm de ser inequívocos, as unidades de medida consistentes, as localizações de armazém estruturadas de forma sensata, e as unidades de embalagem claramente definidas. Um sistema não pode fornecer stocks fiáveis se o mesmo artigo aparecer sob três designações diferentes, ou uma "caixa" significar quantidades diferentes consoante o fornecedor.

Durante a fase piloto, os indicadores devem permanecer simples: quanto tempo demora a receção de mercadoria? Quantos registos têm de ser corrigidos? Quantos pickings são incorretos? Com que frequência se procura mercadoria? Nem toda melhoria se manifesta imediatamente numa grande rubrica de custos. Menos perguntas de acompanhamento e informação de entrega mais fiável já podem retirar pressão considerável da operação diária.

A formação funciona melhor diretamente no processo. Os funcionários não precisam de uma visita abstrata por todos os itens de menu. Precisam de saber como registar a próxima entrega, reportar um desvio, ou corrigir uma leitura errada. Para os primeiros turnos após o arranque, deveria estar contactável uma pessoa responsável que possa tomar decisões rapidamente.

A pergunta certa para a escolha

Nos Warehouse Management Systems a questão central não é: que software consegue fazer mais? É: que fluxos de trabalho têm de se tornar mais rápidos, mais claros, e mais rastreáveis todos os dias para a nossa equipa?

Quem descrever primeiro estes fluxos de trabalho de forma clara pode avaliar objetivamente software padrão, extensões, ou uma aplicação feita à medida. O resultado não precisa de parecer espetacular. Deveria assegurar que a mercadoria encontra o seu caminho, o stock permanece fiável, e as pessoas no armazém passam menos tempo a procurar, perguntar, e corrigir posteriormente.

Permalink →

Custom Logistics Software vs Spreadsheets

Custom Logistics Software vs Spreadsheets

Uma receção de mercadoria chega mais cedo do que o anunciado, dois funcionários alteram em paralelo a mesma lista de stock, e o motorista espera por uma guia de remessa cuja última versão ninguém sabe indicar com certeza. Situações como esta decidem a pergunta "custom logistics software vs spreadsheets" não de forma teórica, mas entre a receção de mercadoria, a localização de armazém, e a rampa.

As tabelas não são fundamentalmente o problema. São rápidas de criar, familiares a todos, e frequentemente surpreendentemente eficazes para tarefas claramente delimitadas. Tornam-se problemáticas quando devem servir como sistema operativo de um processo de armazém ou distribuição em crescimento. Então um ficheiro transforma-se num processo crítico - sem regras vinculativas, estados rastreáveis, ou um histórico sólido.

Quando as folhas de cálculo no armazém são a escolha certa

Uma tabela faz sentido quando o processo é gerível, pouco frequente, e controlado por poucas pessoas. Isso pode ser, por exemplo, um planeamento mensal de necessidades, uma preparação pontual de inventário, ou uma avaliação de preços de fornecedores. Também pode ser suficiente para um pequeno stock com um responsável, desde que as alterações não ocorram sob pressão de tempo e nenhum processo subsequente dependa automaticamente dela.

A vantagem não está apenas nos baixos custos de licenciamento. As equipas podem ajustar colunas, verificar cálculos, e configurar um novo formulário em poucos minutos. Quem ainda não compreendeu um processo estável não deveria apressar-se a transformá-lo em software. Uma boa tabela pode primeiro tornar visível quais dados são realmente necessários e quais campos são mantidos apenas por hábito.

Seria, portanto, errado tratar cada ficheiro Excel como um atraso. A pergunta decisiva é: a tabela é uma ferramenta de trabalho para uma pessoa, ou uma fonte partilhada para decisões operacionais? Assim que várias funções dependem dos mesmos dados, o risco aumenta consideravelmente.

Custom Logistics Software vs Spreadsheets: O ponto de viragem

A mudança geralmente não é desencadeada pelo número de linhas. Uma tabela com 20.000 posições pode funcionar, enquanto um ficheiro com 200 linhas já leva a erros. O que importa é a simultaneidade, os passos do processo, e as consequências de uma informação incorreta.

Um sinal de alerta típico é a questão das versões. Se os stocks, encomendas em aberto, ou datas de entrega estiverem em ficheiros com nomes como "final_novo", "final_novo2", e "realmente_final", o que falta não é uma melhor estrutura de pastas. Falta um estado de dados vinculativo. O mesmo se aplica quando os funcionários têm de telefonar uns aos outros para saber se a mercadoria chegou, se uma encomenda foi liberada, ou se um veículo já foi carregado.

O ponto de viragem é atingido quando uma entrada desencadeia várias ações subsequentes. Uma receção de mercadoria então não altera apenas um número no stock. Pode iniciar um controlo de qualidade, atribuir uma localização de armazém, marcar uma encomenda como parcialmente entregue, e mostrar às vendas um artigo disponível. Se estes passos forem coordenados manualmente através de ficheiros, papel, e telefonemas, os desvios dificilmente são evitáveis.

Torna-se especialmente crítico durante mudanças de turno e ausências. Quando apenas uma pessoa experiente sabe qual marcação de cor numa lista significa um bloqueio, ou qual fórmula calcula um stock de segurança, o processo não é sólido. Funciona apenas enquanto essa pessoa estiver disponível.

O que o software personalizado realmente faz melhor

O software logístico personalizado não é simplesmente uma tabela com uma interface bonita. O seu valor surge de fluxos de trabalho controlados. Cada registo recebe uma marca temporal inequívoca, uma pessoa responsável, e um estado rastreável. Os funcionários não veem apenas dados, mas a próxima ação permitida.

Numa receção de mercadoria, isso pode significar na prática: selecionar a entrega, registar a quantidade, documentar qualquer desvio, imprimir a etiqueta, e confirmar o armazenamento. Só depois é que o stock é libertado. Para o picking, o sistema pode agrupar encomendas por prioridade, mostrar localizações de armazém numa ordem sensata, e gerar uma guia de remessa apenas quando as linhas estiverem confirmadas.

Não se trata de complexidade desnecessária. Isso evita que o mesmo artigo seja reservado duas vezes, que uma entrega parcial conte como completa, ou que uma guia de remessa seja impressa com base em dados desatualizados. Regras simples também ajudam: campos obrigatórios para lotes, motivos de bloqueio para mercadoria danificada, verificações de plausibilidade nas quantidades, e permissões para registos de correção.

Uma aplicação bem planeada não cobre imediatamente cada caso especial. Concentra-se nos processos que custam tempo diariamente ou produzem erros regularmente. Para uma empresa, isso pode ser a gestão de movimentos de contentores; para outra, a captura rápida de mercadoria recebida com dispositivos móveis. O software padrão frequentemente só conhece estas particularidades como um módulo adicional dispendioso, ou nem sequer isso.

O custo oculto da tabela

O custo de licenciamento de uma tabela é baixo. O custo do processo não pode ser. Surge em perguntas de acompanhamento, retrabalho, tempos de pesquisa, manutenção duplicada, e stocks mal planeados. Surge também quando uma equipa tem de verificar à noite que dados mudaram desde a manhã.

Estes custos permanecem frequentemente invisíveis porque estão distribuídos por muitas funções. O gestor de armazém verifica stocks, as vendas internas corrigem datas de entrega, a contabilidade procura comprovativos, e a gestão recebe números com atraso. Nenhuma atividade individual parece dramática. Juntas, abrandam o rendimento e a capacidade de planeamento.

Uma decisão sólida não deveria, portanto, comparar apenas preços de software. Meça, durante duas a três semanas, quantas transferências manuais uma encomenda atravessa, com que frequência a informação é solicitada, e que erros se repetem. As consequências também são relevantes: um stock incorreto leva a uma correção interna ou a uma entrega perdida?

Nem todo o problema precisa de uma grande suite

Muitas empresas de média dimensão na região DACH hesitam com razão perante sistemas empresariais extensos. Implementações longas, ecrãs rígidos, e modelos de licenciamento para funções que nunca são usadas raramente resolvem um problema concreto de armazém. Mas a alternativa não tem de significar ficar com ficheiros dispersos.

Entre os dois extremos encontra-se uma aplicação específica para o fluxo de trabalho. Pode, por exemplo, ligar a receção de encomendas, receção de mercadoria, movimentos de stock, etiquetas de expedição, e guias de remessa num sistema partilhado, sem trazer de imediato contabilidade financeira completa, lógica corporativa global, e vinte línguas estrangeiras.

A base técnica é decisiva. Uma aplicação com uma estrutura de base de dados clara, interfaces documentadas, e permissões rastreáveis permanece adaptável. Tecnologias como PHP 8.4, JavaScript moderno, e MySQL 8 não são um fim em si mesmas aqui. Usadas corretamente, criam uma base sustentável para funções, históricos de registo, documentos impressos, e relatórios - mesmo quando os processos mudam daqui a dois anos.

Como a mudança consegue ter sucesso sem interromper a operação

O maior perigo não é a técnica, mas um primeiro passo demasiado grande. Quem tenta limpar todos os ficheiros históricos e mapear cada caso excecional antes do lançamento, adia o benefício por meses. Melhor é um começo claro e verificável.

Comece com um processo que ocorre frequentemente e é bem delimitável, como a receção de mercadoria com registo de stock, ou o envio com guia de remessa e etiqueta. Defina com precisão quando a operação começa, quais dados são estritamente necessários, quem concede que aprovação, e quando é considerada concluída. Disso resultam não apenas ecrãs, mas regras de trabalho sólidas.

A migração de dados também requer pragmatismo. Artigos ativos, fornecedores, localizações de armazém, e encomendas em aberto têm de estar limpos. Os stocks antigos históricos, por outro lado, podem frequentemente ser arquivados, em vez de serem importados para o novo sistema com grande esforço. A operação paralela pode fazer sentido, mas apenas com uma data final fixa. Caso contrário, surgem duas verdades em vez de uma melhor.

O valor de um parceiro técnico direto mostra-se durante a implementação.

softify.pro por isso não trabalha a partir de uma lista abstrata de funcionalidades, mas esclarece fluxos onde eles realmente acontecem: na receção, no corredor do armazém, na embalagem, e na entrega à expedição. Um bom software respeita rotinas funcionais e só altera o que efetivamente torna o processo mais fiável.

A decisão pode ser verificada através de três perguntas

Primeiro: várias pessoas precisam de confiar simultaneamente em dados atuais? Segundo: um registo desencadeia processos subsequentes que hoje são assegurados manualmente? Terceiro: um erro pode levar a um atraso na entrega, stock incorreto, fatura errada, ou pesquisa demorada? Se estas perguntas forem maioritariamente respondidas com sim, a tabela provavelmente já não é o sistema de referência correto.

Se a resposta permanecer maioritariamente não, ela pode continuar a ser uma solução razoável. Então compensa mais unificar ficheiros, definir responsabilidades, e documentar fórmulas críticas. A técnica não deveria ser maior do que o problema.

O próximo passo sensato não é, portanto, um projeto de digitalização geral, mas um olhar partilhado sobre um fluxo de trabalho concreto juntamente com as pessoas que o executam diariamente. Aí torna-se rapidamente visível se uma tabela bem mantida é suficiente - ou se um software fiável deveria finalmente assumir o trabalho que hoje fica preso entre papel, telefone, e várias versões do mesmo ficheiro.

Permalink →

Desenvolvimento web para empresas

Desenvolvimento web para empresas

Um website pode ter bom aspeto e ainda assim criar trabalho todas as segundas-feiras: os dados de produtos são mantidos em duplicado, os pedidos chegam incompletos à caixa de entrada, as alterações precisam de ajuda externa. A procura de uma empresa de desenvolvimento web não deveria, portanto, terminar em cores, frameworks, ou um portfólio elegante. O que importa é se a solução cria menos atrito no trabalho diário e continua compreensível de operar mesmo daqui a três anos.

Para pequenas e médias empresas, esta não é uma questão académica. Em oficinas, armazéns, e organizações de vendas, orçamentos, encomendas, informações de entrega, e pedidos de clientes frequentemente encontram processos que cresceram organicamente. Alguns deles merecem software. Outros continuam a funcionar melhor com uma tabela mantida de forma limpa. Um bom desenvolvimento web reconhece a diferença, em vez de transformar cada problema num grande projeto digital.

O que o desenvolvimento web tem de oferecer às empresas

Um website empresarial é frequentemente o primeiro ponto de contacto. Tem de carregar rapidamente, funcionar em dispositivos móveis, e guiar claramente os visitantes para um pedido, candidatura, ou encomenda. Mas assim que processa dados, mapeia funções internas, ou desencadeia processos, torna-se uma aplicação web. Então contam outras questões: Quem pode ver o quê? De onde vêm os dados? O que acontece com uma entrada errada? Como é implementada uma atualização sem perturbar a operação?

A diferença é prática. Uma página de marketing pode contentar-se com algumas áreas de conteúdo claramente estruturadas. Um portal de clientes, um processo de encomenda, ou uma ferramenta interna de armazém, por outro lado, precisa de permissões rastreáveis, uma estrutura de base de dados robusta, e casos especiais definidos. Se uma receção de mercadoria for entregue apenas parcialmente ou uma encomenda tiver de ser alterada posteriormente, o sistema não pode acabar num estado indefinido.

O desenvolvimento web para empresas não significa, portanto, apenas programar páginas. Significa implementar regras de negócio de forma que permaneçam compreensíveis para os utilizadores e controláveis para a empresa.

Primeiro verificar o fluxo, depois planear a interface

Um projeto começa muitas vezes com um desejo como "Precisamos de um portal". Esse é um começo sensato, mas ainda não um requisito suficiente. Antes do primeiro design, os caminhos reais de uma informação deveriam tornar-se visíveis: quem a cria, quem a verifica, quem a complementa, e quem voltará a precisar dela mais tarde?

Tomemos o processamento de encomendas. Em muitas empresas, um pedido chega por e-mail ou telefone, é anotado numa tabela, transferido mais tarde para outro sistema, e depois reprocessado novamente para o armazém ou a expedição. O atraso raramente se deve a um único passo. Surge nas transferências, nas perguntas de acompanhamento, e nos diferentes estados dos dados.

Uma boa análise pergunta, portanto, concretamente sobre o dia a dia:

  • Que informações são introduzidas várias vezes hoje?
  • Onde surgem a maioria das perguntas de acompanhamento ou correções?
  • Que exceções ocorrem regularmente, embora não estejam documentadas em lado nenhum?
  • Que funções precisam de acesso, e que dados não devem poder alterar?
  • Em que reconhece a equipa, no final, que uma transação está realmente concluída?

Estas perguntas soam sóbrias. É precisamente essa a sua vantagem. Impedem que se construa uma aplicação visualmente convincente em torno de um processo idealizado que ninguém realmente usa na operação. Especialmente no armazém e na logística, contam as condições reais: os leitores são operados com luvas, os turnos mudam, o Wi-Fi não é igualmente bom em todo o lado, e uma guia de remessa não deve surgir apenas depois de vários cliques.

Nem todo o fluxo pertence, porém, a uma aplicação. Uma pequena lista com poucos registos estáveis pode ser mais rápida e económica como tabela. O software compensa quando os dados fluem entre pessoas ou áreas, quando falta a rastreabilidade, ou quando o trabalho manual gera repetidamente perda de tempo e erros.

A base técnica determina o esforço posterior

Muitos sistemas parecem semelhantes na primeira demonstração. A diferença mostra-se nas alterações, no crescimento, e nas perturbações. Uma aplicação deveria, portanto, basear-se em tecnologias que a equipa possa manter a longo prazo, em vez de apostar numa moda passageira.

Para muitas aplicações web críticas para o negócio, uma stack com PHP 8.4, JavaScript moderno, e MySQL 8 é uma escolha pragmática. É capaz, bem compreensível, e adequada para requisitos típicos como portais, gestão de encomendas, geração de documentos, ou ferramentas internas. Isso não é um dogma. Para aplicações muito interativas, integrações especiais, ou elevadas necessidades em tempo real, outra arquitetura pode fazer sentido. A tecnologia deveria seguir a tarefa, não o contrário.

Mais importante do que o nome de uma framework são decisões claras sobre dados e estados. Uma encomenda, por exemplo, precisa de valores de estado inequívocos em vez de texto livre. As alterações deveriam ser rastreáveis. Os dados de clientes, preços, e permissões não devem divergir por tabelas dispersas e interfaces improvisadas. Quem mais tarde precisar de saber por que motivo uma etiqueta de expedição foi criada ou uma encomenda bloqueada, precisa de um histórico rastreável.

A segurança também pertence à construção básica. Isso inclui permissões baseadas em funções, armazenamento seguro de palavras-passe, fluxos de bloqueio de conta para tentativas falhadas repetidas, ambientes de teste e produção separados, e atualizações regulares. A segurança não é um único plugin acrescentado no final do projeto. Surge de responsabilidades limpas e de uma arquitetura que tem em conta os casos de erro.

A velocidade é um requisito operacional

Páginas lentas não custam apenas visibilidade nos motores de busca. Causam desistências em pedidos e tempo de espera desnecessário na atividade diária. Num website público, o tempo de carregamento, a apresentação móvel, e uma estrutura de página clara decidem se os interessados sequer entram em contacto. Numa aplicação interna, dois ou três segundos de espera por cada registo somam-se de forma percetível ao longo do dia de trabalho.

O desempenho não começa com um projeto de otimização posterior. Imagens, consultas à base de dados, cache, JavaScript, e alojamento têm de ser planeados adequadamente desde o início. Aqui vale a regra: nem toda a aplicação precisa de complexidade técnica máxima. Uma ferramenta interna simples com poucos utilizadores não precisa de uma arquitetura para milhões de chamadas simultâneas. Precisa de caminhos curtos, cópias de segurança fiáveis, e um comportamento que permaneça previsível no dia a dia.

O mesmo princípio aplica-se à operação responsiva. "Compatível com dispositivos móveis" não significa que um ecrã de secretária de alguma forma encolhe para um smartphone. Quem verifica guias de remessa em movimento, reporta um dano, ou corrige um stock, precisa de elementos de controlo grandes, feedback claro, e o mínimo possível de introdução desnecessária.

Da ideia à operação: entregar em pequenos passos

Grandes cadernos de encargos prometem segurança, mas frequentemente levam as equipas a esperar meses por uma primeira versão utilizável. Um caminho melhor é um primeiro passo de expansão claramente delimitado. Deveria resolver um problema real, como o registo centralizado de receções de mercadoria ou a geração automática de documentos de entrega. Depois disso, com feedback real, pode decidir-se o que traz o maior benefício a seguir.

Isso não significa trabalhar sem planeamento. Pelo contrário: o modelo de dados, as funções, as interfaces, e o conceito operacional têm de ser esclarecidos cedo. O âmbito funcional pode, ainda assim, crescer passo a passo. Assim, os pressupostos tornam-se visíveis antes de se tornarem dispendiosos.

Uma entrega profissional envolve mais do que credenciais de acesso. Passos de implementação documentados, cópias de segurança, monitorização, responsabilidades, e documentação técnica compreensível tornam um sistema independente de pessoas individuais. Se apenas o programador original souber como uma atualização é implementada, a aplicação não está terminada - está ligada a uma pessoa.

Como reconhecer um parceiro adequado

Uma empresa de desenvolvimento web não tem de oferecer todas as tecnologias imagináveis. Mas deveria fazer as perguntas certas e ser capaz de justificar decisões. É aconselhável cautela se já na primeira conversa for prometida uma plataforma abrangente, sem que ninguém tenha visto os processos existentes.

Um parceiro adequado fala sobre manutenção, qualidade dos dados, e implementação tão abertamente quanto sobre design. Explica que requisitos as funções padrão podem cobrir e onde o desenvolvimento individual faz sentido. Também indica o custo de pedidos especiais. Uma funcionalidade pode ser tecnicamente viável e ainda assim não ter benefício suficiente.

Pergunte sobre detalhes operacionais concretos: Como são testadas as alterações? Como funciona um rollback? Onde residem os dados sensíveis? Quem responde em caso de falha? Como são geridas as permissões? Boas respostas não têm de ser longas, mas são específicas. "Trataremos disso mais tarde" não é uma estratégia para processos críticos do negócio.

Para equipas com software existente, a questão da integração é também central. Uma nova aplicação não tem de substituir tudo. Pode inicialmente assumir dados de um sistema existente, gerar documentos, ou preencher um processo em falta. O primeiro passo mais sensato muitas vezes não é a grande substituição, mas a eliminação direcionada de um estrangulamento.

O software deve clarificar o trabalho, não deslocá-lo

A melhor aplicação web não se destaca na operação pela sofisticação técnica, mas por menos perguntas de acompanhamento, dados fiáveis, e tempos de processamento mais curtos. Respeita formas de trabalho funcionais, torna as exceções visíveis, e pode continuar a ser desenvolvida sem medo da próxima atualização.

Antes de iniciar um projeto, pegue numa operação concreta do seu dia a dia e siga-a desde o primeiro contacto até à conclusão. Onde a informação espera, desaparece, ou é capturada em duplicado, encontra-se geralmente a abordagem mais sensata para o desenvolvimento web.

Permalink →

Logistics Automation Software que realmente se adequa

Logistics Automation Software que realmente se adequa

Uma receção de mercadoria é anotada em papel, a alteração de stock é passada mais tarde para uma folha de cálculo e a expedição telefona ao armazém porque o endereço de entrega ficou num e-mail. É precisamente nestas passagens de testemunho que uma empresa perde tempo e fiabilidade. O Logistics Automation Software não deve encobrir esta fricção com um grande mundo novo de processos, mas ligar de forma rastreável as tarefas do dia a dia.

Para as pequenas e médias empresas, esta é uma tarefa diferente da introdução de uma plataforma de grande grupo. Um responsável de armazém não precisa de 200 funções que só se tornam compreensíveis após três dias de formação. Precisa de um estado claro: o que chegou, onde está, o que tem de sair hoje e o que ainda falta? Uma boa automatização responde a estas perguntas onde o trabalho acontece.

O que o Logistics Automation Software tem de fazer na prática

O termo soa abrangente, mas os casos de utilização com sentido são, em regra, muito concretos. Uma empresa processa, por exemplo, a mercadoria que chega, regista movimentos de stock, emite guias de remessa, imprime etiquetas de envio e planeia entregas. Se cada posto precisa do seu próprio ficheiro, de um acesso separado ou de um grito pelo armazém, surgem atrasos e cadeias de erros.

Um software adequado reúne a informação num único fluxo de trabalho. Uma encomenda pode gerar automaticamente uma ordem de picking. A leitura de um artigo confirma a saída e atualiza o stock. Concluída a operação, é criada uma guia de remessa com as linhas corretas, enquanto o estado da expedição fica visível para as vendas ou para o planeamento. Parece simples. É precisamente por isso que tem valor: o software não substitui uma lógica que funciona, evita que ela tenha de ser reconstruída a cada rutura de suporte.

O que conta é a ordem. Primeiro tem de estar claro que dados desencadeiam um evento e quem decide sobre ele. Só então vale a pena automatizar regras. Quem digitaliza um processo pouco claro obtém apenas uma confusão mais rápida.

Escolher primeiro os processos certos

Nem toda a tarefa manual merece de imediato uma aplicação. Uma folha de cálculo pequena e bem mantida pode ser melhor para um caso especial raro do que um módulo que tem de ser mantido permanentemente. A alavanca económica está normalmente em processos com muita repetição, muitas passagens de testemunho ou consequências sentidas em caso de erro.

Candidatos típicos são as receções de mercadoria com estado de inspeção, as transferências entre zonas, o picking de encomendas recorrentes, os documentos de expedição e o planeamento de rotas. Também a receção de encomendas é muitas vezes um bom ponto de partida, quando as encomendas vindas de chamadas telefónicas, e-mails e formulários são primeiro reunidas à mão.

Quatro perguntas ajudam na escolha:

  • Com que frequência se executa o processo por semana?
  • Em que ponto os dados são registados ou transferidos mais do que uma vez?
  • Que erros causam retrabalho, faltas de stock ou entregas atrasadas?
  • Que exceções têm os colaboradores de continuar a decidir por si?

A última pergunta evita um erro comum. Automatizar não tem de significar que cada decisão é tomada sem pessoas. Perante mercadoria danificada, entregas incompletas ou pedidos de clientes em cima da hora, a equipa precisa de uma forma clara de suspender uma operação, corrigi-la e prosseguir com uma justificação. Um sistema sem esses caminhos parece coerente no papel, mas no armazém torna-se depressa um obstáculo.

Da receção à expedição: um fluxo contínuo

Imaginemos um comerciante de média dimensão com armazém e distribuição própria. Hoje, a mercadoria é contada no cais, anotada num formulário e só introduzida no sistema perto do fim do turno. As vendas veem por isso o novo stock demasiado tarde. Numa expedição urgente, a guia de remessa é criada em separado e o motorista recebe a informação por telefone.

Num fluxo automatizado com critério, a receção de mercadoria começa com uma operação digital. Os colaboradores registam entrega, artigo e quantidade e, opcionalmente, lote ou número de série, diretamente no posto de trabalho ou em dispositivo móvel. Os desvios não ficam escondidos numa nota à margem, mas recebem um estado como «Verificação necessária». Só após a libertação a mercadoria fica disponível como stock utilizável.

O passo seguinte nasce de necessidades reais: uma encomenda é libertada, o armazém recebe uma lista de picking ou uma vista móvel por localização e cada registo documenta o que foi efetivamente retirado. Daí resultam a guia de remessa e os dados de expedição a partir da mesma fonte. Ninguém tem de voltar a digitar linhas nem de verificar qual é a versão do ficheiro em vigor.

Para o planeamento, o sistema pode agrupar entregas em aberto por zona, janela de entrega, peso ou capacidade do veículo. O planeamento de rotas não é aqui sempre o primeiro passo sensato. Se os endereços estiverem incompletos ou as encomendas só forem libertadas pouco antes da partida, deve melhorar-se primeiro a qualidade dos dados e a clareza das encomendas. Rotas otimizadas não ajudam se a base for pouco fiável.

Software padrão ou solução à medida?

O software padrão faz sentido quando a empresa trabalha com processos habituais e aceita adaptar-se aos ecrãs, perfis e processos previstos. Pode ser introduzido rapidamente, em especial com requisitos claros, como a impressão de etiquetas ou uma gestão de stock simples. O preço são muitas vezes compromissos em casos especiais, interfaces e adaptações posteriores.

Um Logistics Automation Software à medida torna-se interessante quando a particularidade operacional não é um caso marginal, mas determina o sucesso do negócio. Pode ser uma lógica de embalamento especial, um processo de aprovação em vários níveis, a ligação entre oficina e armazém ou um modelo de entrega próprio. Nesse caso, é muitas vezes mais sensato representar de forma dirigida os poucos processos centrais do que introduzir uma suite abrangente com muitos módulos por usar.

À medida, porém, não significa sem limites. Cada função especial exige uma justificação técnica, testes, documentação e manutenção. Um bom trabalho de projeto pergunta por isso também: pode este passo ser simplificado? Basta uma configuração? Continua a folha de cálculo a ser a melhor solução para este processo excecional? Estas perguntas protegem o orçamento e a equipa de uma complexidade desnecessária.

Tecnologia que aguenta o dia a dia

A interface decide se os colaboradores usam um sistema de bom grado. A base técnica decide se ele pode ser operado de forma fiável também ao fim de anos. Para processos críticos do negócio, fazem parte do equipamento básico modelos de dados rastreáveis, perfis e permissões, registos das alterações importantes e cópias de segurança regulares.

Num registo de armazém tem de ser possível ver quem alterou que stock e quando, e de que operação provém a alteração. Quando vários utilizadores estão ativos em simultâneo, o stock não pode ser falseado por entradas contraditórias. Com impressoras, leitores ou interfaces de transportadoras são necessários estados de erro claros em vez de falhas silenciosas. Uma etiqueta que não foi impressa tem de estar visível como passo de trabalho em aberto.

A manutenibilidade é também um requisito operacional. Uma aplicação web sobre uma arquitetura compreensível, por exemplo com PHP 8.4, JavaScript moderno e MySQL 8, pode ser verificada e ampliada melhor a longo prazo do que um conjunto de soluções isoladas difíceis de acompanhar. Uma implementação documentada, ambientes de teste e de produção separados e testes automatizados não são um luxo. Reduzem o risco de uma pequena alteração na guia de remessa afetar de repente a libertação de encomendas.

A proteção de dados e o controlo de acessos merecem a mesma sobriedade. Nem todos os utilizadores precisam de preços, margens ou dados-mestre de clientes. Sobretudo em equipas distribuídas, os acessos, dispositivos e permissões devem ser concebidos de modo a não travar desnecessariamente o trabalho diário, mas a manter-se controláveis numa mudança de colaborador ou na perda de um dispositivo.

Introdução em etapas com sentido

A função mais forte ajuda pouco se uma equipa não a consegue usar no trabalho por turnos. Por isso, uma introdução gradual é muitas vezes mais sólida do que uma grande data de arranque. Primeiro, coloca-se em produção um processo delimitado, por exemplo a receção de mercadoria de um grupo de produtos ou a criação de documentos de expedição. A equipa trabalha com ele em condições reais e as questões em aberto são esclarecidas com casos reais.

Depois seguem-se outros processos e interfaces. Esta sequência cria confiança, porque os colaboradores veem que o feedback se traduz em melhorias concretas. Ao mesmo tempo, limita o risco: se um novo fluxo de leitura tiver de ser ajustado, não pára toda a logística.

Os indicadores devem ser acordados antes do início. Podem ser o tempo de passagem da encomenda à expedição, o número de correções manuais, as faltas de stock ou a duração dos trabalhos de fecho diário. Nem toda a melhoria aparece de imediato num número espetacular. Menos pedidos de esclarecimento entre armazém e escritório, uma passagem de turno fiável e históricos de operações fáceis de encontrar são também um alívio mensurável.

A softify.pro desenvolve estes sistemas a partir do fluxo de trabalho, com envolvimento técnico direto em vez de uma passagem do conceito para a execução. A bitola mantém-se deliberadamente pragmática: a solução deve funcionar no chão do armazém, não apenas numa apresentação.

Como reconhecer uma decisão sólida

Uma boa decisão não começa com uma lista de funções, mas com um dia de trabalho observado. Peça que lhe mostrem onde a informação nasce, espera, se perde ou é corrigida depois. Não fale apenas com a direção, mas também com as pessoas da receção de mercadoria, do armazém e da expedição. Elas conhecem as exceções que nenhum organigrama torna visíveis.

Verifique depois se o fornecedor faz perguntas concretas sobre dados, perfis, dispositivos, interfaces e operação. Quem promete de imediato uma solução completa sem compreender os processos existentes vende mais volume de software do que resolução de problemas. É igualmente crítico um projeto que não preveja uma regulação clara para manutenção, correção de erros e adaptações posteriores.

A melhor automatização não se sente como burocracia adicional. Dá à equipa tempo para os casos em que a experiência realmente conta: avaliar corretamente uma entrega inesperada, informar um cliente a tempo ou resolver um estrangulamento antes que se torne um problema.

Permalink →

A IA consegue testar software de desktop?

A IA consegue testar software de desktop?

Um funcionário regista a receção de mercadoria numa aplicação Windows, imprime uma guia de remessa, e entrega os dados à contabilidade. Após uma atualização, uma caixa de diálogo aparece noutro local, um campo perde o foco, a impressão já não é iniciada. A pergunta "can AI test desktop software" é, portanto, menos teórica do que parece: consegue um sistema detetar erros como este antes do próximo turno da manhã?

Sim. A IA consegue testar software de desktop Windows, especialmente onde a automação clássica falha perante interfaces em mudança, controlos inconsistentes, ou scripts dispendiosos de manter. No entanto, não é um substituto para objetivos de teste claros, dados de teste limpos, e responsabilidade de negócio. O seu valor surge quando assume de forma fiável o trabalho repetível e direciona as pessoas para os casos que exigem discernimento.

A IA consegue testar software de desktop - e o que significa isso na prática?

Os testes de desktop não verificam apenas se uma janela abre. Numa operação real, trata-se de fluxos de trabalho completos: início de sessão com lógica de bloqueio correta, entrada de encomendas, seleção de um artigo, registo de stock, impressão de etiquetas, mensagens de erro para dados inválidos, e a entrega correta a um sistema conectado.

Um ambiente de teste alimentado por IA consegue executar estes fluxos de trabalho numa máquina Windows, avaliar a interface visível, e gerar evidências. Consegue, por exemplo, reconhecer botões pelo texto e posição, ler conteúdo de caixas de diálogo, e comparar capturas de ecrã com o estado esperado. Ao contrário de um script rígido, consegue lidar melhor com pequenas alterações visuais - por exemplo, quando um ícone, um espaçamento, ou o identificador técnico exato de um elemento de controlo muda.

Isto é especialmente relevante para aplicações de negócio que cresceram ao longo do tempo. Muitos destes programas não têm uma API moderna para cada processo. Alguns usam interfaces proprietárias, tabelas incorporadas, ou componentes difíceis de abordar com automação de UI convencional. Um agente de IA consegue operar a aplicação mais como um utilizador treinado faria: ler o ecrã, escolher uma ação, verificar o resultado.

A palavra "mais" é escolhida deliberadamente. A IA não vê automaticamente o processo de negócio por trás de um campo de entrada. Consegue determinar que uma guia de remessa foi criada. Se a condição de entrega correta tinha de ser usada para um determinado cliente exige uma expectativa definida ao nível do negócio.

Onde os testes de IA fazem sentido para aplicações Windows

O melhor ponto de partida são fluxos de trabalho que ocorrem frequentemente, são críticos para o negócio, e hoje são verificados manualmente. Uma equipa não precisa de automatizar todo o catálogo de testes para isso. É melhor escolher os poucos processos cuja falha custa diretamente tempo, dinheiro, ou confiança.

No armazém, produção, e planeamento, isto frequentemente inclui a criação e registo de receções de mercadoria, os processos de picking e expedição, as correções de stock autorizadas, a impressão de etiquetas, e os fluxos de importação e exportação. Em aplicações comerciais, o início de sessão, a mudança de permissões, a criação de faturas, a manutenção de dados mestre, e as transferências de interface são candidatos típicos.

A IA é especialmente útil onde um lançamento atualmente desencadeia um dia de controlo manual. Um testador então percorre uma longa lista com cliques, documenta anomalias, e mais tarde tenta reconstruir exatamente o que aconteceu. As execuções automatizadas podem transferir esta parte para a noite ou para um processo de lançamento fixo. De manhã, não existe apenas um estado, mas um registo de teste com capturas de ecrã, marcas temporais, e uma descrição compreensível do desvio.

Os testes de regressão também beneficiam. Quando uma nova funcionalidade é incorporada na caixa de diálogo de encomendas, os processos existentes não deveriam quebrar sem serem notados. A IA repete cenários definidos após cada alteração relevante. Isso não elimina todos os riscos, mas evita que fluxos de trabalho centrais conhecidos permaneçam por verificar apenas porque falta tempo.

O que a IA consegue verificar de forma fiável - e o que não consegue

Os testes de interface baseados em IA são fortes em expectativas observáveis. "O número da encomenda aparece após gravar." "Um aviso é mostrado quando falta um campo obrigatório." "O stock diminui em cinco." "A caixa de diálogo de impressão contém a impressora pretendida." Afirmações como estas traduzem-se em passos de verificação concretos.

Os requisitos formulados de forma imprecisa tornam-se mais difíceis. "A interface deve parecer profissional" ou "o programa deve ser rápido" não são casos de teste suficientes. Aqui são necessários critérios: tempo máximo de espera sob carga definida, um layout aprovado, ou regras de aceitação claras para mensagens de erro.

Também em casos especiais de negócio complexos, o teste humano continua a ser indispensável. Se uma regra de devolução se aplica a um único contrato-quadro, alguém com conhecimento do processo tem de decidir se o resultado está correto. A IA consegue preparar, executar, e documentar o caso. Não deveria inventar por conta própria novas regras de negócio.

Outro limite é a estabilidade do ambiente. Os testes de desktop dependem da resolução do ecrã, das permissões de utilizador, da conectividade de rede, dos controladores de impressora, dos dados de teste, e, quando relevante, do hardware conectado. Se uma impressora de etiquetas está offline, um teste falhado pode ser um defeito genuíno - ou um problema de ambiente. Bons sistemas de teste distinguem estes casos e reportam-nos de forma transparente, em vez de classificar tudo genericamente como erro do produto.

A base técnica decide o valor

Um teste de desktop utilizável é mais do que uma sequência de cliques do rato. Precisa de uma máquina controlada ou um ambiente Windows virtual, contas de utilizador definidas, dados de partida reprodutíveis, e regras claras para reposições. Caso contrário, o teste verifica um estado diferente na terça-feira do que na segunda-feira, produzindo discussões em vez de certeza.

Igualmente decisivas são as evidências. Um visto verde sem contexto ajuda pouco quando um departamento de negócio reporta um erro. Cada execução deveria, portanto, vir acompanhada dos passos executados, capturas de ecrã em pontos importantes, mensagens de erro visíveis, e uma marca temporal. Perante desvios, tem de ser claro se a aplicação respondeu incorretamente, um elemento esperado não foi encontrado, ou o ambiente de teste estava bloqueado.

Para aplicações sensíveis, a questão de onde ocorre a execução não é um assunto secundário. Capturas de ecrã, credenciais, dados de clientes, e ecrãs de processo internos podem conter informação confidencial. Quem executa testes através de serviços externos deveria verificar cuidadosamente que dados saem do seu próprio ambiente, durante quanto tempo são armazenados, e quem obtém acesso.

Para equipas com requisitos correspondentes, um ambiente auto-alojado pode fazer mais sentido.

softify.pro opera para este fim a COCO, o seu próprio servidor de IA para testes web e de aplicações automatizados. A execução, as evidências de teste, e a avaliação podem permanecer dentro do ambiente empresarial controlado. Isso não é necessário para todas as aplicações, mas para sistemas de negócio internos, dados pessoais, ou requisitos de TI rigorosos, é frequentemente a arquitetura mais limpa.

Como uma equipa começa sem deixar um projeto de automação de testes descontrolar-se

Um começo sensato não começa com a escolha de uma ferramenta, mas com um processo. Escolha um fluxo de trabalho que é verificado pelo menos semanalmente e cujas consequências de erro são rastreáveis. Um processo de expedição adequa-se melhor do que uma coleção de vinte ecrãs aleatórios.

Depois descreva o percurso de negócio em frases claras: situação inicial, entradas, estados intermédios esperados, resultado final esperado. Adicione também o caso negativo. O que tem de acontecer se faltar um número de lote, um utilizador não tiver permissão, ou o stock não for suficiente? São precisamente estas regras que são frequentemente ignoradas nos testes manuais, embora possam tornar-se dispendiosas no dia a dia.

Depois segue-se um piloto limitado com dados de teste estáveis e um ambiente definido. Não meça apenas se o teste funciona. Meça quantos minutos de verificação manual substitui, quantos falsos alarmes ocorrem, e se as evidências são suficientes para o desenvolvimento e o departamento de negócio. Só quando esta base funciona é que vale a pena expandir para mais processos.

A manutenção pertence a isto desde o início. Se um ecrã muda ao nível do negócio, a expectativa também tem de ser ajustada. Isso não é um argumento contra a automação. É manutenção normal de software - comparável a atualizar uma instrução de trabalho quando um processo de armazém muda.

Nem todos os cliques têm de ser automatizados

Algumas equipas esperam cobertura completa dos testes de IA. Isso leva rapidamente a custos elevados para casos excecionais raros, cuja verificação seria mais rápida e fiável feita manualmente. Uma boa estratégia de teste prioriza, em vez disso, por risco, frequência, e ritmo de mudança.

Uma caixa de diálogo de administração raramente usada com baixa consequência de erro pode continuar a ser verificada com uma breve lista de verificação manual. Uma receção de mercadoria diária com vários passos subsequentes, por outro lado, merece testes de regressão automatizados e evidências limpas. Boring, provable reliability vence aqui uma coleção de testes grande mas frágil.

Comece com o processo onde um erro seria realmente sentido no dia de trabalho seguinte. Quando este fluxo de trabalho é verificado de forma automatizada, rastreável, e repetível no seu próprio ambiente, a automação de testes torna-se numa vantagem operacional fiável - não mais um projeto de TI com bons slides.

Permalink →

Quando devem as empresas substituir as folhas de cálculo?

Quando devem as empresas substituir as folhas de cálculo?

Um responsável de armazém imprime de manhã uma lista de stock. Duas horas depois, as vendas registaram uma encomenda, a quantidade da receção de mercadoria foi corrigida e um colega abriu um ficheiro antigo de um anexo de e-mail. Os números já não coincidem. É precisamente neste ponto que surge a pergunta: Quando devem as empresas substituir as folhas de cálculo? Não quando um ficheiro se torna confuso uma vez, mas quando se transforma no estrangulamento invisível de um processo em curso.

As folhas de cálculo não são sinal de má organização. Para cálculos, análises pontuais, pequenos volumes de dados e decisões com poucos intervenientes, são muitas vezes a ferramenta certa. São flexíveis, familiares e estão disponíveis sem arrancar um projeto. Tornam-se problemáticas apenas quando uma única folha deve ser, ao mesmo tempo, base de dados, instrução de trabalho, fluxo de aprovação, arquivo de documentos e canal de comunicação.

As folhas de cálculo são boas - até passarem a suportar um processo

Muitas empresas em crescimento mantêm-se fiéis aos seus ficheiros porque estes foram construídos com cuidado ao longo de anos. Neles estão números de artigo, casos especiais, conhecimento sobre fornecedores e lógicas de cálculo comprovadas. Isso merece respeito. Um sistema de substituição que ignore esta realidade gera resistência e, na pior das hipóteses, novos desvios.

A pergunta decisiva não é, por isso: "O Excel é mau?", mas sim: "A nossa equipa consegue trabalhar de forma fiável com esta ferramenta, mesmo quando mudam o volume de encomendas, os turnos ou os responsáveis?" Se a resposta depender regularmente de uma pessoa em particular, de uma unidade de rede partilhada ou da disciplina de todos os envolvidos, o limite foi muitas vezes atingido.

Isto torna-se particularmente evidente no armazém, na oficina e no planeamento. Um stock que só é reconciliado posteriormente não é um stock fiável. Um comprovativo de entrega que tem de ser montado manualmente a partir de vários ficheiros não custa apenas tempo. Dificulta esclarecimentos posteriores, o acompanhamento e uma passagem de testemunho limpa entre colaboradores.

Quando devem as empresas substituir as folhas de cálculo?

Não existe um momento universal nem um número mágico de linhas. Uma empresa com 500 artigos pode trabalhar bem com uma folha simples, enquanto outra com 50 artigos precisa de um sistema há muito tempo. O que é decisivo é a carga operacional: com que frequência mudam os dados, quem os utiliza e que consequências tem um erro?

Um gatilho claro é o conflito de versões. Quando as equipas enviam ficheiros com nomes como "Stock_final_novo2" ou os colegas têm de perguntar qual é a coluna atualmente válida, falta uma fonte de dados vinculativa. Também o trabalho manual de cópia entre a lista de encomendas, a visão geral do armazém, o ficheiro de expedição e a preparação da faturação é um sinal. Cada transferência cria mais uma oportunidade para dígitos trocados, entradas duplicadas ou atualizações esquecidas.

Igualmente críticos são os processos sem responsabilidade rastreável. Quem alterou uma quantidade? Quando foi registada uma receção de mercadoria? Porque foi adiada uma encomenda? Numa folha de cálculo, as alterações podem, é certo, ser parcialmente registadas. No dia a dia, porém, isso raramente é tão claro e utilizável como num processo que regista de forma deliberada lançamentos, mudanças de estado e ações dos utilizadores.

Outro ponto é a velocidade do trabalho. Se, antes de embalar, os colaboradores têm primeiro de pesquisar num ficheiro, verificar um stock, copiar dados à mão e depois gerar uma etiqueta de expedição num portal separado, a folha de cálculo passa a ditar o ritmo no chão do armazém. Os custos não surgem então apenas em minutos. Mostram-se em interrupções, pedidos de esclarecimento, envios errados e no conhecimento que existe apenas na cabeça de algumas pessoas.

Os riscos estão muitas vezes entre duas células

As folhas de cálculo raramente falham de forma espetacular. Muitas vezes são pequenos desvios que se propagam: uma fórmula arrastada de forma errada, um filtro que não abrange todas as linhas, um número guardado como texto em vez de número ou uma fórmula sobrescrita por engano. Estes erros permanecem por descobrir durante muito tempo precisamente quando a equipa trabalha sob pressão de tempo.

Nos processos críticos para o negócio, junta-se um segundo risco: a falta de condução do processo. Uma folha pode mostrar que uma encomenda existe. Mas não garante de forma fiável que todos os passos necessários ocorrem pela ordem correta. Tem de estar concluído um controlo de qualidade antes da expedição? Pode criar-se uma guia de remessa sem picking confirmado? Deve uma encomenda ir automaticamente para esclarecimento quando falta stock? Estas regras não pertencem a lembretes, células coloridas ou fórmulas "se-então" complicadas quando decidem todos os dias sobre a correção dos processos.

Com o crescimento da equipa, as permissões também se tornam relevantes. Nem todos precisam de poder alterar preços, manter dados mestre ou corrigir operações concluídas. Uma aplicação feita à medida pode representar claramente os perfis, registar ações sensíveis e, por exemplo, bloquear uma conta após várias tentativas falhadas. Isto não é tecnologia exagerada. É uma resposta limpa à questão da responsabilidade.

Nem todos os problemas precisam de um grande ERP

A alternativa à folha de cálculo não é automaticamente uma suite empresarial global com longos projetos de implementação. Para muitas pequenas e médias empresas, esse seria o passo errado: demasiadas funções, processos demasiado rígidos, custos de licenciamento elevados e um sistema que não se adapta suficientemente à empresa.

Muitas vezes, faz mais sentido uma aplicação focada no estrangulamento concreto. Pode ser um sistema para receção de mercadoria, movimentos de stock e localizações de armazém. Pode registar encomendas de e-mails ou formulários de forma estruturada, gerar guias de remessa, preparar etiquetas de expedição ou planear rotas segundo regras claras. O decisivo não é introduzir o máximo de software possível. O decisivo é que a ação seguinte fique clara para a pessoa responsável.

Uma boa solução pode, além disso, começar a funcionar ao lado das ferramentas existentes. A contabilidade, o ERP ou os prestadores de serviços de expedição não têm de ser substituídos de imediato. Muitas vezes, uma interface fiável ou uma exportação limpa é o caminho mais pragmático. O benefício surge quando deixam de existir entradas duplicadas e os dados operacionais estão atualizados onde são necessários.

Como verificar a necessidade real de agir

Em vez de comparar logo propostas de software, vale a pena olhar para um processo concreto. Tome, por exemplo, o percurso de uma encomenda desde a entrada até à expedição. Anote não só os passos oficiais, mas também chamadas telefónicas, notas em papel, mensagens privadas de chat e os pontos em que alguém transfere informação de um ficheiro para outro sistema.

Pergunte depois: onde é que os colaboradores esperam por informações? Onde é que os dados são introduzidos várias vezes? Que decisão depende da experiência e não de regras visíveis? E que erros seriam caros se o volume de encomendas duplicasse dentro de seis meses? Esta análise costuma mostrar, mais depressa do que qualquer lista de funcionalidades, se uma folha de cálculo ainda chega.

Nem toda a anomalia justifica um desenvolvimento à medida. Se um relatório é elaborado mensalmente por uma pessoa e um erro é fácil de corrigir, a folha de cálculo continua muitas vezes a fazer sentido. Se, porém, várias pessoas dependem diariamente de dados atualizados, se são movimentadas mercadorias físicas ou se são necessários comprovativos perante clientes, a conta muda. Nessa altura, a empresa já paga há muito pelos limites da ferramenta - apenas repartidos por horas de trabalho, correções de erros e atrasos.

Uma substituição tem de continuar a ser sustentável

Quem substitui folhas de cálculo não deve comprar apenas uma interface mais bonita. A estrutura de dados, as regras e a operação da aplicação decidem se a solução ainda funciona de forma fiável ao fim de dois anos. Para uma aplicação web enxuta, por exemplo, PHP 8.4, JavaScript moderno e MySQL 8 podem ser uma base deliberadamente sóbria: fácil de manter, eficiente e sem dependência de modas passageiras.

Igualmente importante é a introdução. Um sistema deve primeiro estabilizar os processos reais, e não cobrir de uma só vez todos os desejos imagináveis. Uma primeira área claramente delimitada - por exemplo, a receção de mercadoria e o lançamento de stock - cria confiança. Depois, expedição, documentos de entrega ou análises podem ser acrescentados sobre uma base de dados consistente.

As folhas antigas não desaparecem necessariamente de imediato. Algumas permanecem como arquivo, para análises especiais ou como exportação controlada. O objetivo não é banir as folhas de cálculo. O objetivo é aliviá-las de tarefas para as quais nunca foram concebidas como sistema operativo permanente.

Se a sua equipa verifica regularmente qual é o ficheiro correto, quem foi o último a alterar algo ou se uma encomenda foi realmente processada por completo, isso não é uma pequena falha organizativa. É uma boa ocasião para observar o processo em conjunto no posto de trabalho real - antes que o próximo pico de crescimento transforme uma folha frágil num estrangulamento diário.

Permalink →

AI testing platforms para testes de regressão

AI testing platforms para testes de regressão

Um lançamento está funcionalmente concluído, mas ninguém pode dizer com certeza se a nova importação de preços danificou a entrada de encomendas, as permissões de utilizador, ou o processo de expedição. É precisamente aqui que as AI testing platforms se tornam interessantes. Não porque fazem desaparecer magicamente o trabalho de qualidade humano, mas porque conseguem executar de forma fiável verificações recorrentes, documentá-las de forma visível, e tornar os desvios compreensíveis.

Para equipas com aplicações web ou Windows que cresceram ao longo do tempo, isto é um problema prático, não um projeto de inovação. Os fluxos de trabalho críticos frequentemente desenvolvem-se ao longo de anos: uma encomenda é criada, um stock de armazém é registado, um PDF é gerado, uma interface é notificada. Uma pequena alteração num ecrã de introdução pode ter consequências num local inesperado. Os testes de regressão manuais são então lentos, dependentes de pessoas individuais, e especialmente propensos a erros sob pressão de tempo.

O que as AI testing platforms realmente oferecem

A automação de testes clássica segue passos escritos previamente. Isso permanece sensato e necessário para muitas verificações. Uma plataforma alimentada por IA pode, adicionalmente, trabalhar com uma aplicação através da sua interface, reconhecer conteúdo, executar passos de teste, e classificar anomalias em linguagem natural. Pode, por exemplo, verificar se um utilizador autorizado consegue registar uma receção de mercadoria, se uma conta bloqueada é corretamente rejeitada, ou se uma guia de remessa continua a ser gerada após uma alteração.

O benefício decisivo não está apenas em clicar num botão. Os bons sistemas ligam execução, observação, e prova. Uma execução de teste deveria, portanto, incluir passos rastreáveis, capturas de ecrã ou gravações, marcas temporais, os dados de teste utilizados, e uma avaliação clara. Quando um teste falha, a equipa precisa de mais do que a mensagem "assertion failed". Tem de conseguir ver em que ecrã, em que estado, e por que motivo o desvio ocorreu.

A IA pode acelerar este trabalho. No entanto, não substitui a decisão sobre o que é realmente crítico para o negócio. Um modelo pode reconhecer que uma caixa de diálogo parece diferente. Se essa alteração representa um erro, um novo design deliberado, ou apenas uma diferença inofensiva na renderização do navegador, continua a ser uma questão de regras, contexto, e aprovação.

Nem toda verificação pertence à IA

O erro mais comum durante a implementação é mirar demasiado alto. Uma plataforma não deveria, à partida, cobrir todas as funções de um sistema. Deveria proteger os fluxos de trabalho cuja falha seria dispendiosa, arriscada, ou intensiva em mão-de-obra. Num software de logística, tipicamente isso é a entrada de encomendas, os movimentos de inventário, a impressão de etiquetas ou documentos, as funções de utilizador, e as transferências de interface. Numa aplicação web comercial, o início de sessão, a aprovação de faturas, as exportações, e o estado de pagamento podem estar no centro.

Um começo sensato consiste num pequeno conjunto de testes de ponta a ponta estáveis. Um teste aqui não cobre apenas um único clique, mas um processo de trabalho completo. Por exemplo: um utilizador inicia sessão, cria uma encomenda, confirma as linhas, gera uma guia de remessa, e verifica se a transação aparece na vista geral. Verificações como estas fornecem uma relevância de negócio mais elevada do que muitos testes isolados para campos individuais.

Isso não significa que todos os tipos de teste devam passar pela interface do utilizador. As equipas de desenvolvimento ainda precisam de testes unitários e de integração rápidos, próximos do código. Estes testes encontram erros técnicos cedo e a baixo custo. Os testes de IA baseados em UI complementam-nos onde a interação entre interface, permissões, base de dados, documentos, e serviços externos precisa de ser verificada. Quem testa tudo apenas através da interface obtém execuções de teste lentas e difíceis de manter. Quem testa exclusivamente no código pode ignorar erros que afetam diretamente os utilizadores.

A estabilidade nasce de boas condições de teste

Os testes automatizados nem sempre falham devido a um erro do produto. Dados de teste instáveis, permissões de utilizador em mudança, sistemas de teste inacessíveis, ou alterações paralelas podem igualmente ser a causa. Por isso o ambiente de teste faz parte da decisão da plataforma.

As contas de teste deveriam ser inequívocas e ter permissões conhecidas. Os dados devem ser reiniciados de forma reprodutível antes de cada execução, ou recriados de forma específica. Os sistemas externos também exigem uma decisão: uma integração de expedição ou pagamento é verificada contra um ambiente de teste seguro, simulada com um stub controlado, ou deliberadamente excluída do fluxo? Não existe uma resposta universalmente correta. O que importa é que a afirmação de um teste permaneça clara.

Para aprovações críticas, também vale a pena ter um nível de confiança definido. Uma diferença visual com baixa confiança não deveria bloquear automaticamente um lançamento. Um documento de expedição em falta após uma entrega registada com sucesso, por outro lado, é uma falha grave. Bons processos de teste distinguem entre indícios a verificar e critérios de aprovação claros.

A soberania dos dados não é uma questão secundária nos testes de IA

Assim que um teste é executado numa aplicação real, pode ver informação confidencial: nomes de clientes, preços, moradas, números de artigo internos, capturas de ecrã de aplicações de negócio, ou conteúdo de documentos. Se tais dados forem transmitidos a serviços externos juntamente com gravações de ecrã e registos de teste, isso é uma decisão de arquitetura com consequências para a proteção de dados, a segurança da informação, e os contratos.

Precisamente para aplicações web e Windows internas, a pergunta "a plataforma funciona?" não é suficiente. Os responsáveis deveriam verificar onde as execuções de teste são realizadas, onde as capturas de ecrã e registos são armazenados, que dados um modelo de IA processa, e quem obtém acesso administrativo. Os períodos de retenção e os conceitos de eliminação também pertencem aqui. Um relatório de teste pode ser uma evidência valiosa para um lançamento, mas não deveria preservar informação sensível indefinidamente.

Para organizações com requisitos elevados, uma execução auto-alojada pode ser a solução mais adequada. Mantém o tráfego de teste, os dados de teste, e as evidências no seu próprio ambiente controlado. Isso aumenta um pouco o esforço operacional: atualizações, acessos, capacidades, e monitorização requerem responsabilidade. Em troca, o controlo técnico e organizacional permanece onde frequentemente pertence. Com a COCO, a softify.pro aposta exatamente neste modelo: testes automatizados para aplicações web e Windows com retenção local de dados e evidências de teste rastreáveis.

Como reconhecer uma plataforma adequada

Uma escolha convincente começa com as aplicações existentes, não com uma demonstração de produto. Uma plataforma pode parecer impressionante numa aplicação de exemplo limpa e encontrar os seus limites num ecrã de secretária mais antigo, num ambiente Citrix, ou num início de sessão complexo. Uma breve prova de conceito com dois ou três fluxos de trabalho de negócio reais diz muito mais do que uma lista de funcionalidades.

Nesse processo, as equipas deveriam prestar especial atenção a quatro pontos:

  • Cobertura de aplicações: A solução suporta os navegadores web existentes, as aplicações de ambiente de trabalho Windows, e, quando relevante, cenários de ambiente de trabalho remoto ou Citrix?
  • Rastreabilidade: Cada execução fornece passos compreensíveis, capturas de ecrã, registos, e uma justificação de por que um teste é considerado aprovado ou falhado?
  • Modelo operacional: A nuvem, um ambiente privado, ou o auto-alojamento adequam-se aos requisitos de segurança, aos recursos de TI disponíveis, e aos dados de teste?
  • Manutenibilidade: Os departamentos de negócio conseguem rever os fluxos de teste enquanto as equipas técnicas gerem de forma limpa o versionamento, as aprovações, e a execução repetível?

A isto acresce a integração no processo de lançamento. Um teste que só é iniciado por pedido ajuda menos do que uma execução programada antes da implementação ou após uma alteração relevante. Ao mesmo tempo, nem toda pequena atualização de estilo deveria desencadear um teste completo de horas. Processos maduros selecionam testes por risco: um teste de fumo curto após cada implementação, regressões direcionadas para alterações em módulos críticos, e execuções mais extensas antes de lançamentos maiores.

Relatórios claros em vez de teatro de testes

A automação de testes produz facilmente atividade sem discernimento. Centenas de marcas verdes soam bem, mas se ninguém consegue dizer que processos de negócio protegem, são dificilmente geríveis. Um relatório utilizável responde a perguntas simples: O que foi verificado? Com que resultado? Que versão foi afetada? O que alguém precisa de decidir agora?

As avaliações em linguagem simples podem poupar muito tempo aqui, desde que se baseiem em dados de execução reais. "O utilizador conseguiu iniciar sessão, criar a encomenda, e gerar a guia de remessa" é mais útil para um responsável de negócio do que uma coleção de seletores técnicos. Em caso de falhas, a profundidade técnica continua a ser importante. QA e desenvolvimento precisam da captura de ecrã, dos dados de registo, e de passos reproduzíveis, não apenas de um resumo de IA.

Implementação sem perturbar a operação corrente

A melhor implementação começa com um processo em que um erro teria um impacto notável e cujo fluxo é suficientemente estável. Isso pode ser o fecho de fim de dia, a aprovação de encomendas, ou uma função central numa plataforma de clientes. Em conjunto com o departamento de negócio e a equipa técnica, define-se o que conta como sucesso, que dados de teste são utilizados, e quem avalia uma falha.

Depois segue-se um ritmo controlado: construir testes, executá-los repetidamente, reduzir falsos alarmes, e só depois vinculá-los de forma obrigatória às aprovações. Este passo intermédio é importante. Quem implementa testes automatizados imediatamente como uma barreira rígida, enquanto o ambiente e os dados ainda estão a mudar, cria resistência em vez de confiança. Quem, pelo contrário, liga visivelmente os resultados a erros reais e lançamentos estáveis, constrói aceitação.

As AI testing platforms não substituem uma boa arquitetura de software, responsabilidade de negócio, ou decisões de lançamento limpas. Usadas corretamente, porém, devolvem às equipas algo muito concreto: tempo para os casos que precisam de discernimento, e evidências sólidas para os fluxos de trabalho que simplesmente têm de funcionar. O primeiro teste mais sensato é, portanto, raramente o mais espetacular - mas sim o processo em que, na segunda-feira de manhã, já ninguém precisa de se perguntar se o sistema ainda faz o que a operação espera dele.

Permalink →

Documentar automaticamente as evidências de testes

Documentar automaticamente as evidências de testes

Um teste de regressão falhado é irritante. Um teste aprovado sem evidência utilizável é frequentemente pouco melhor. Quem quer documentar automaticamente as evidências de testes não resolve, portanto, um simples problema de relatórios. Trata-se de uma resposta sólida a perguntas concretas: O que foi testado? Em qual versão? Com que dados de entrada? O que realmente aconteceu no ecrã? E consegue um programador, responsável de QA, ou auditor reconstruir o resultado mais tarde?

Precisamente em aplicações web e Windows críticas para o negócio, estas perguntas não surgem apenas na auditoria. Surgem quando, após um lançamento, uma encomenda é processada incorretamente, quando um cliente reporta um erro invulgar, ou quando uma equipa tem de distinguir entre "parece bem" e "comprovadamente verificado" antes de um lançamento. Listas Excel mantidas manualmente, capturas de ecrã em conversas de chat, e notas de teste soltas só são suficientes enquanto o âmbito e a taxa de alteração se mantiverem reduzidos.

Porque é que as evidências de teste manuais se tornam rapidamente pouco fiáveis

Em muitas equipas, a documentação começa com boas intenções. Um testador regista o resultado, adiciona uma captura de ecrã, e anota a versão testada. Sob pressão de tempo, porém, isto transforma-se rapidamente numa rotina abreviada: marcar a caixa, passar o erro, próximo caso de teste. Isto é compreensível, especialmente nos testes de regressão recorrentes - mas não é sólido.

O problema não está em colaboradores individuais. A documentação manual está sempre em competição com o trabalho de teste efetivo. Assim que é necessário verificar dez, cinquenta, ou várias centenas de casos por lançamento, ou falta tempo para evidências limpas, ou as evidências tornam-se tão extensas que já ninguém as avalia. A isto acrescem lacunas típicas: uma captura de ecrã mostra um estado, mas não a sequência anterior. Um registo de teste nomeia o caso, mas não o número de build utilizado. Um erro foi corrigido, mas não é visível quando e como a correção foi novamente verificada.

Para aplicações que gerem processamento de encomendas, movimentos de armazém, preços, permissões de utilizador, ou interfaces, isto é mais do que uma questão de conveniência. Um teste não documentado não pode contar de forma fiável como uma verificação de risco concluída. Isto aplica-se especialmente quando uma alteração aparentemente pequena num local desencadeia efeitos secundários em processos adjacentes.

O que uma evidência de teste utilizável realmente precisa de conter

Uma evidência de teste não é simplesmente uma captura de ecrã com um visto verde. Liga o caso de teste ao seu contexto técnico e de negócio. No mínimo, deve ser possível identificar mais tarde qual a aplicação, qual a versão, e qual o ambiente de teste que foram verificados. Igualmente importantes são a hora de início, a hora de fim, o resultado, e uma atribuição clara ao respetivo passo de teste.

Em testes de UI automatizados, a evidência deveria também capturar as ações realizadas e os resultados observados. Exemplo: um teste cria uma encomenda, verifica o total da linha, gera uma guia de remessa, e depois verifica o estado na área de expedição. Um bom registo não regista apenas "aprovado". Mostra em que passo a verificação teve lugar, que valor esperado o sistema deveria devolver, e que valor devolveu efetivamente.

Capturas de ecrã ou pequenas gravações de ecrã são valiosas aqui, mas nem sempre obrigatórias para cada passo bem-sucedido individual. Custam espaço de armazenamento e podem conter dados sensíveis. Geralmente faz sentido uma estratégia escalonada: em verificações falhadas, é guardada automaticamente uma evidência visual completa; em casos padrão bem-sucedidos, bastam dados de registo estruturados e evidências selecionadas. Que profundidade é necessária depende do risco, da frequência de alteração, e do ambiente regulatório.

A evidência tem de ser legível e tecnicamente utilizável

Os programadores precisam de detalhes como mensagens de erro, valores esperados/reais, marcas temporais, e o passo concreto no fluxo de teste. Os departamentos de negócio e os responsáveis de lançamento, por outro lado, precisam de uma declaração compreensível: que processos de negócio foram verificados, o que passou, e onde é necessária ação?

Ambas as perspetivas deveriam surgir da mesma execução de teste. Se uma equipa de QA exporta ficheiros de registo técnicos e depois escreve manualmente um resumo de gestão, surge novamente uma quebra de suporte propensa a erros. Melhor é um sistema que capture os dados brutos de forma estruturada e gere a partir deles uma avaliação clara, sem esconder os detalhes técnicos.

Documentar automaticamente as evidências de testes: a sequência correta

A automação funciona melhor quando está ligada a riscos claramente definidos. Nem todos os cliques em todas as aplicações precisam de ser imediatamente automatizados e totalmente documentados. O ponto de partida é geralmente fluxos de trabalho estáveis, frequentemente repetidos, e críticos para o negócio: início de sessão e verificação de permissões, entrada de encomendas, cálculo de preços, geração de documentos, registo de armazém, ou transferência de dados para uma interface.

Para cada fluxo de trabalho, define-se primeiro o que conta como teste aprovado. "O ecrã parece correto" é demasiado vago para isso. Melhores são condições de verificação concretas: um utilizador com a função de armazém não deve poder alterar preços. O número da guia de remessa é gerado. A quantidade reduz o stock disponível. Após cinco tentativas falhadas, ativa-se o bloqueio da conta. Critérios como estes tornam os casos de teste repetíveis e as evidências comparáveis.

A execução do teste deveria então iniciar-se automaticamente com dados de contexto. Isto inclui número de build ou versão, ambiente de destino, navegador ou sistema operativo, estado dos dados de teste, e marca temporal. Durante a execução, o sistema regista os passos individuais, os resultados esperados e reais, bem como anomalias técnicas. Em caso de desvios, gera evidências, como capturas de ecrã, mensagens de erro, ou uma gravação da sequência relevante.

O resultado final não é uma pasta de ficheiros não estruturada, mas uma execução de teste com um estado. Idealmente, é possível rastrear desde uma decisão de lançamento até ao passo individual porque é que um teste foi avaliado como aprovado ou falhado. É precisamente essa ligação que reduz consideravelmente as discussões após um incidente.

Onde a IA ajuda genuinamente - e onde não ajuda

A IA pode acelerar notavelmente a documentação e a avaliação. Pode avaliar estados de ecrã, assinalar desvios notórios, e resumir execuções de teste em linguagem compreensível. Para grandes volumes de testes, isto ajuda as equipas de QA a não terem de ler manualmente cada execução bem-sucedida. Uma avaliação com limiar de confiança pode ainda destacar casos em que a deteção é incerta e uma verificação humana continua a ser necessária.

Mesmo assim, a IA não deveria decidir sozinha sobre lançamentos críticos. Em áreas como autorização de pagamentos, permissões, lógica de preços, ou documentos legalmente relevantes, são necessários critérios de verificação determinísticos. Um montante esperado ou está corretamente calculado ou não está. Uma função tem acesso ou não tem. A IA complementa aqui a análise de conteúdo visual e linguístico, mas não substitui uma regra de negócio claramente definida.

A forma como os dados são tratados é também uma decisão de arquitetura. Capturas de ecrã de aplicações internas podem mostrar dados de clientes, preços, moradas, ou informações de produção. Quem documenta automaticamente as evidências de testes deveria, portanto, decidir antecipadamente onde estas evidências são armazenadas, quem as pode consultar, e por quanto tempo são conservadas. Para equipas conscientes da segurança, uma infraestrutura de testes auto-alojada como a COCO pode fazer sentido, porque o tráfego de teste, as gravações, e a avaliação permanecem no seu próprio ambiente controlado.

Períodos de retenção, acessos, e qualidade das evidências

Mais evidências não são automaticamente melhores evidências. Um arquivo de capturas de ecrã que cresce durante anos sem modelo de funções nem conceito de retenção cria um novo risco. Fazem sentido períodos de retenção escalonados: manter mais tempo as execuções de teste falhadas ou relevantes para o lançamento, condensar ou eliminar os testes de rotina bem-sucedidos após um período definido, e anonimizar precocemente os dados de teste sensíveis.

Igualmente decisiva é a imutabilidade. Se os resultados dos testes puderem ser editados posteriormente sem deixar rasto, perdem valor como evidência. As alterações aos casos de teste, resultados, ou estado de lançamento deveriam, portanto, ser registadas. Isso não significa que cada relatório de teste precise de software de auditoria complicado. Mas responsabilidades, marcas temporais, e históricos rastreáveis fazem parte do equipamento básico.

Comece com um processo que realmente incomoda

O primeiro passo de automação mais sensato raramente é o maior. Escolha um fluxo de trabalho que seja verificado a cada lançamento, custe muitos minutos manuais, e tenha consequências percetíveis em caso de erro. Isso pode ser a entrada de encomendas no portal web, a geração de um documento de expedição, ou um conceito de permissões numa aplicação Windows.

Defina para este fluxo de trabalho critérios de sucesso claros, as evidências necessárias, e um destinatário responsável pelos testes falhados. Após alguns lançamentos, torna-se rapidamente claro se as evidências são suficientemente compreensíveis, se são gerados demasiados dados, e que testes deveriam seguir-se a seguir. Assim, não cresce uma máquina de documentação por si própria, mas sim uma cadeia de verificação que protege os lançamentos mais rapidamente e fornece respostas sólidas em caso de problemas.

Permalink →

Documentar digitalmente os movimentos de stock

Documentar digitalmente os movimentos de stock

Uma diferença de 24 unidades no sistema soa, à primeira vista, gerível. Torna-se problemática quando ninguém consegue dizer se a mercadoria foi armazenada no local errado, retirada para uma encomenda, danificada, ou nunca registada. Quem quer documentar digitalmente os movimentos de stock não cria, portanto, simplesmente mais dados. Cria um histórico rastreável para cada item em stock - e com ele uma base sólida para compras, produção, expedição e inventário.

Para armazéns pequenos e médios, isto raramente é um caso para uma suite empresarial abrangente. O que importa é um sistema que reflita os percursos reais que a mercadoria efetivamente faz: receção de mercadoria no portão, transferência entre estantes, retirada de material na oficina, picking, devoluções, e correções após o inventário. Quantas menos vezes as equipas tiverem de alternar entre papel, Excel e avisos verbais e vários programas, mais fiáveis se tornam os números.

Documentar digitalmente os movimentos de stock começa na transação

Um nível de stock atual só responde a uma pergunta: quanto existe neste momento? Para o trabalho operacional, isso muitas vezes não basta. Quando surgem questões, a equipa também precisa de respostas a outras perguntas: Quando é que o stock mudou? Quem fez o registo? De onde veio a mercadoria, para onde foi, e qual a operação comercial que o desencadeou?

É exatamente aqui que reside a diferença entre uma simples lista de stock e uma documentação digital de movimentos. Cada alteração é guardada como uma transação própria e imutável. O nível de stock resulta então dessas transações. Se, por exemplo, um artigo é transferido da localização A-03 para B-12, o sistema tem de ligar de forma rastreável um movimento de saída e um de entrada. Se material é retirado para uma ordem de produção, o registo pertence a essa ordem - não apenas a uma variação de quantidade anónima.

Este princípio não evita totalmente os erros. No entanto, torna-os localizáveis. Uma correção não sobrescreve então o valor antigo, mas sim cria um novo registo de correção com um motivo. Isso é menos prático do que alterar diretamente um número, mas significativamente melhor para inventários, reclamações e reconciliações internas.

Que dados são realmente necessários por movimento

Muitos projetos tornam-se desnecessariamente complicados porque, desde o início, se prevê cada campo imaginável. Para um funcionamento fiável, bastam geralmente poucas informações, bem mantidas. O que importa não é o comprimento do formulário, mas que cada registo permaneça inequívoco em termos de conteúdo.

Um registo de movimento deve conter, no mínimo, esta informação:

  • Artigo ou material, incluindo um número de artigo único
  • Quantidade e unidade, por exemplo peças, metros, quilogramas, ou caixas
  • Tipo de movimento, por exemplo entrada, retirada, transferência, devolução, ou correção
  • Local de origem e destino, na medida em que o tipo de movimento envolva ambos
  • Data e hora, a pessoa que executa, e uma referência documental rastreável

A referência documental pode ser uma encomenda, uma guia de remessa, uma encomenda de cliente, uma ordem de produção, ou uma posição de inventário. Poupa tempo mais tarde, porque o registo não precisa primeiro de ser interpretado através de comentários. O texto livre continua útil para exceções, mas não deve substituir a informação obrigatória.

Para artigos sujeitos a lote, número de série, ou prazo de validade, acrescentam-se outras características. Deve então ficar claro, por exemplo, de que lote foi retirado, ou qual o prazo de validade afetado. Isto não é um detalhe para mais tarde: se a rastreabilidade for exigida, tem de funcionar diretamente dentro do fluxo de registo.

Adaptar os tipos de movimento ao fluxo real de mercadorias

As categorias mais sensatas não surgem numa oficina em torno de um diagrama de processo abstrato, mas sim numa volta pelo armazém. Onde é a mercadoria efetivamente recebida? Quem decide sobre o stock bloqueado? Quando é que o material é dado de baixa: na entrega à oficina, no início da produção, ou só no consumo?

Receção de mercadoria e controlo de qualidade

Na receção de mercadoria, a mercadoria deve primeiro ser verificada face à encomenda ou à guia de remessa. Um registo digital pode reunir diretamente a quantidade, o fornecedor, o número de documento, a localização de armazenamento, e opcionalmente o lote. Se for necessária uma inspeção, a mercadoria não deve aparecer automaticamente como livremente disponível. Um estado como "em verificação" ou "bloqueado" impede que material não verificado seja recolhido por engano.

Transferência e entregas internas

As transferências são particularmente esquecidas com frequência porque não geram nenhum documento externo visível. O resultado é que o stock total está correto, mas ninguém encontra a mercadoria no local esperado. Os registos móveis através de leitor portátil, tablet, ou um simples formulário web ajudam aqui, desde que exijam poucas entradas. Um formulário no ecrã complicado é contornado na operação diária - independentemente de quão bem a base de dados por trás foi planeada.

Retirada, expedição e devolução

Nas retiradas, o registo tem de corresponder ao propósito adequado. Material para uma ordem de trabalho, mercadoria para uma encomenda de cliente, e sucata são, em substância, transações diferentes. Podem, sim, reduzir o mesmo stock de artigo, mas exigem avaliações diferentes. As devoluções também deveriam ser o seu próprio tipo de movimento. Caso contrário, permanece por esclarecer se um artigo é reutilizável, precisa de inspeção, ou deve ser dado de baixa.

O registo tem de funcionar no chão do armazém

A digitalização raramente falha porque uma equipa não compreende a sua utilidade. Falha mais frequentemente devido a cinco cliques adicionais, Wi-Fi instável, números de artigo pouco claros, ou um registo que só pode ser concluído no PC do escritório após o fim do turno.

Por isso, vale a pena definir um fluxo claro por função. Na receção de mercadoria, escolhe-se tipicamente a encomenda ou a guia de remessa, digitaliza-se o artigo, confirma-se a quantidade, e atribui-se uma localização de armazenamento. No picking, muitas vezes basta abrir a encomenda, digitalizar a posição, e confirmar a retirada. Os responsáveis de armazém precisam ainda de funções para bloqueios, correções, e contagens de inventário, incluindo a obrigatoriedade de indicar o motivo da correção.

As leituras de código de barras ou QR reduzem os erros de transcrição quando os artigos e as localizações de armazenamento estão claramente rotulados. Mas não substituem a manutenção de dados mestre. Se existirem cinco grafias diferentes para o mesmo artigo, ou se os locais forem nomeados de forma informal, um leitor apenas acelera o registo errado. Antes da implementação técnica, os números de artigo, as unidades, as localizações de armazenamento, e as responsabilidades devem ser limpos.

A capacidade offline é também uma questão a ponderar. Num armazém pequeno com rede estável, uma aplicação baseada em navegador pode ser suficiente. Para armazéns remotos, pavilhões grandes, ou ligações pouco fiáveis, um armazenamento local intermédio pode fazer sentido. Nesse caso, tem de estar claramente definido como são fundidos os registos duplicados ou desfasados no tempo.

Uma implementação sensata em vez de um grande dia de mudança

Uma mudança completa numa data limite parece decidida, mas cria um risco desnecessário. É melhor começar com um âmbito delimitado: por exemplo, receção de mercadoria e transferências para um grupo de artigos ou uma zona de armazém. Aí, torna-se rapidamente visível que tipos de movimento faltam, que ecrãs de entrada são demasiado lentos, e que casos especiais realmente ocorrem com regularidade.
Para o arranque, a equipa precisa de um saldo inicial verificado. Este pode provir de um inventário, de uma lista de stock limpa, ou de uma transição controlada. É importante documentar claramente a transição: até que momento se aplica o sistema antigo, e a partir de quando é o novo sistema determinante? As listas mantidas em paralelo só são úteis a curto prazo, para controlo, no máximo. Se permanecerem de forma permanente, surgem duas verdades.

Após duas a quatro semanas, os responsáveis não deveriam olhar apenas para a precisão do stock. Igualmente reveladores são o número de correções subsequentes, as referências documentais em falta, os tempos de pesquisa, e os registos feitos fora dos processos previstos. Estas observações fornecem melhores requisitos do que uma longa lista de desejos elaborada antes do início do projeto.

Base técnica: rastreável e sustentável

Por trás de um ecrã de registo simples, é necessária uma estrutura de dados limpa. Artigos, localizações de armazenamento, movimentos, documentos, e permissões de utilizador devem ser modelados separadamente. Cada registo precisa de um ID único, uma marca temporal, e uma atribuição a uma conta de utilizador. As alterações a transações críticas pertencem a um registo de auditoria.

Para muitas aplicações de média dimensão, uma aplicação web leve com uma base de dados relacional como o MySQL 8 é uma base adequada. Pode processar entradas de leitor, representar permissões baseadas em funções, gerar diários de movimentos, e entregar dados a processos de expedição ou encomendas. O que importa é menos a framework utilizada do que uma lógica de dados documentada, regras de registo testadas, e um conceito operacional com cópias de segurança, direitos de acesso, e procedimentos de recuperação.

Nem todos os movimentos precisam de ser transmitidos imediatamente a todos os outros sistemas. A sincronização em tempo real faz sentido quando a expedição, uma loja online, ou a produção dependem diretamente das quantidades disponíveis. Noutros casos, bastam transferências controladas em intervalos fixos. Mais integração significa também mais fontes de erro e mais responsabilidade em caso de falhas.

Quando uma folha de cálculo ainda é suficiente

Uma folha de cálculo não é, fundamentalmente, um problema. Com poucos artigos, uma localização de armazenamento fixa, e uma pessoa que mantém consistentemente as entradas e saídas, pode ser económica. A mudança torna-se compensadora quando várias pessoas registam em simultâneo, as localizações de armazenamento se tornam relevantes, os documentos precisam de ser ligados, ou regularmente não é claro porque é que um stock diverge.

O próximo passo certo não é, então, o software o maior possível, mas sim uma solução que apoie com precisão o fluxo de mercadorias existente. Uma boa documentação digital não torna o trabalho mais espetacular. Garante que um registo acontece no momento do movimento - e que a resposta à próxima pergunta sobre o stock já está no sistema.

Permalink →

Ideias de projetos de digitalização de armazém

Ideias de projetos de digitalização de armazém

Uma guia de remessa em falta mesmo antes da partida, um nível de inventário que parece diferente na prateleira do que na folha de cálculo, e três funcionários a esclarecer simultaneamente a mesma questão por telefone: é precisamente aqui que surgem ideias de projetos de digitalização de armazém sensatas. Não a partir da pergunta sobre que tecnologia parece atualmente na moda, mas a partir de um processo concreto que custa tempo, gera erros, ou depende do conhecimento de pessoas individuais.

Para pequenas e médias empresas de armazenamento, comércio, e fabrico, a digitalização é raramente um único grande projeto. É uma sequência de melhorias claramente definidas. O objetivo não tem de ser um sistema complexo de gestão de armazém empresarial. Frequentemente, uma ferramenta enxuta adaptada ao fluxo de trabalho real é melhor do que um pacote com funcionalidades que ninguém no chão do armazém usa.

Ideias de projetos de digitalização de armazém com valor operacional

O melhor ponto de entrada é um processo que ocorre frequentemente, é facilmente mensurável, e melhora percetivelmente para os funcionários. Quem quer digitalizar imediatamente todo o armazém imobiliza orçamento e atenção antes de uma solução se ter provado nas operações diárias. Um primeiro passo limitado, em contraste, cria dados resilientes para a próxima decisão.

1. Receção de mercadoria com captura móvel de dados

Na receção de mercadoria, originam-se muitos erros a jusante: quantidades incorretamente contadas, discrepâncias não resolvidas, registos de inventário atrasados, e documentos em papel que já não podem ser encontrados mais tarde. Um formulário de captura móvel num scanner portátil, tablet, ou smartphone pode tornar o processo significativamente mais estável.

Os funcionários digitalizam o artigo e a referência de entrega, capturando a quantidade, localização de armazenamento, e a razão de qualquer discrepância diretamente na doca de carga. Se um lote, número de série, ou fotografia for relevante, esta informação pertence exatamente ao mesmo registo de dados. O inventário não é adicionado retroativamente a uma folha de cálculo no final do turno; em vez disso, recebe um estado rastreável na receção real.

Isto não significa que todos os fornecedores ou artigos requerem estritamente etiquetas de código de barras. Para entregas pequenas e irregulares, uma pesquisa por número de artigo pode ser suficiente. O fator decisivo é que a captura de dados é mais rápida do que a solução alternativa anterior de papel e transcrição manual.

2. Realocações digitais em vez de enigmas de inventário

Muitos armazéns sabem fundamentalmente o que está disponível, mas não sabem com fiabilidade onde está localizado. A mercadoria é puxada para a frente para uma encomenda, armazenada temporariamente, levada para a montagem, ou colocada numa área aberta devido a restrições de espaço. Sem um registo simples, uma questão de inventário transforma-se rapidamente numa operação de busca.

Um processo de realocação não precisa de uma interface complicada. Digitalize a localização de origem, digitalize a localização de destino, confirme a quantidade — nada mais é necessário na maioria dos casos. O sistema deveria verificar se o artigo e a localização de armazenamento são plausíveis e atribuir claramente um registo a uma pessoa e registo de tempo.

O tratamento de exceções é importante. Uma localização de armazenamento pode ser bloqueada, sobrecarregada, ou aprovada apenas para mercadoria específica. Estas regras deveriam ser mapeadas onde previnem dano real. Para casos especiais raros, um passo de aprovação pela gestão do armazém é frequentemente suficiente. Demasiados campos obrigatórios transformam uma aplicação útil num obstáculo.

3. Picking de encomendas com estado de encomenda claro

As listas de picking em papel funcionam até as prioridades mudarem, posições estarem em falta, ou uma encomenda estar dividida por várias áreas. Uma lista de picking digital simples mostra que encomenda está em aberto, que posições já foram feitas, e onde é necessário esclarecimento. Isto reduz as consultas entre os departamentos de armazém, vendas, e expedição.

Dependendo do tamanho do armazém, a aplicação pode ditar os percursos de picking ou simplesmente ordenar as posições por zona de armazém. A otimização completa de percurso compensa principalmente com muitas encomendas diárias e percursos longos a pé. Num armazém compacto, uma exibição de estado fiável frequentemente traz mais do que uma rota matematicamente perfeita que ninguém segue na prática diária.

Em caso de faltas, o sistema não deveria apenas destacar coisas a vermelho. Deveria oferecer um processo de acompanhamento concreto: verificar inventário, solicitar artigos substitutos, desencadear reposição, ou passar a encomenda para esclarecimento. A digitalização é valiosa quando torna visível a próxima ação sensata.

4. Documentos de envio e etiquetas a partir de dados de encomenda reais

Transferir manualmente endereços, pesos, e posições de artigos para portais de expedição é um candidato primário para automação. Os endereços de entrega, instruções de entrega, métodos de envio, e informação de pacote idealmente existem uma vez e são usados para a guia de remessa, etiqueta de envio, e confirmação de envio.

Um sistema adequado pode gerar etiquetas, armazenar documentos de forma à prova de auditoria, e definir automaticamente a encomenda para "pronto para envio" ou "enviado" após a impressão. A vantagem operacional não reside apenas nos minutos poupados. Reside em garantir que os dados de envio nunca divergem entre vários sistemas.

A integração é crucial aqui. Se um prestador de serviços de expedição não oferece uma interface utilizável ou envolve regras especiais muito diferentes, um fluxo de trabalho semiautomatizado pode ser mais sensato do que uma integração completa frágil. A fiabilidade aborrecida e comprovável vence a automação que para em cada exceção.

5. Reposição e níveis mínimos de stock com regras rastreáveis

Os níveis mínimos de stock são frequentemente mantidos em folhas de cálculo e depois ignorados porque ninguém tem a certeza se os números ainda são precisos. Uma solução digital sensata liga os registos reais com regras claras de controlo de inventário. Pode notificar quando um artigo cai abaixo de um limite, ter em conta as quantidades reservadas, e preparar uma lista de ordens de compra.

O limite não deveria ser tratado como uma verdade eterna. A procura sazonal, tempos de entrega, e quantidades mínimas de encomenda mudam. Por isso, a pessoa responsável precisa de uma forma simples de rever sugestões e ajustar regras. As encomendas totalmente automatizadas só são sensatas assim que os dados mestre, lógica de fornecedores, e dados de consumo forem suficientemente estáveis.

6. Rastreabilidade para lotes, números de série, e stock bloqueado

Quem trabalha com lotes, dispositivos, peças sobressalentes, ou produtos regulados precisa de mais do que uma exibição de quantidade. Tem de ser rastreável que mercadoria chegou quando, para onde foi movida, e em que encomenda de cliente acabou.

O projeto pode começar deliberadamente pequeno: registando inicialmente apenas a receção e envio de um grupo de produtos crítico. Os movimentos internos e devoluções seguem-se mais tarde. Um sistema que força todos os registos mas não compreende o processo real de reparação ou inspeção será contornado. A lógica de negócio tem, por isso, de se originar do fluxo de trabalho, não de um modelo de dados abstrato.

Selecionar o projeto certo

A ideia mais atraente não é automaticamente a ideia certa para começar. Avalie os projetos potenciais com base em frequência, custos de erro, tempo de espera, e dependência de indivíduos. Um processo que corre 50 vezes por dia e poupa dois minutos por transação pode ser mais valioso do que uma funcionalidade especial rara com grande elegância técnica. A qualidade dos dados também pertence ao processo de tomada de decisão. Se os números de artigo estão duplicados, as localizações de armazenamento não têm nomes únicos, ou as encomendas chegam de forma contraditória a partir de várias fontes, o projeto deveria primeiro limpar estas fundações. O software pode tornar visíveis as regras em falta, mas não pode substituí-las de forma fiável. Quatro perguntas bastam para a priorização:

  • Que atividade causa comprovadamente mais consultas ou retrabalho?
  • Que informação é atualmente transcrita várias vezes ou consultada por telefone?
  • Que erro teria as consequências mais dispendiosas para clientes, inventário, ou expedição?
  • Que fluxo de trabalho pode ser testado em algumas semanas com uma medição de sucesso clara?

Decisões técnicas que contam nas operações diárias de armazém

Uma aplicação de armazém não precisa de parecer espetacular. Tem de permanecer compreensível sob má cobertura Wi-Fi, com luvas, sob pressão de tempo, e durante mudanças de turno. Botões grandes, feedback claro após uma digitalização, e tratamento de erros visível são mais importantes do que dashboards decorativos.

A arquitetura também deveria corresponder à realidade operacional. Uma aplicação baseada na web com uma estrutura de base de dados limpa pode correr em dispositivos existentes e é mais fácil de manter do que uma solução isolada num único PC. Com uma base estável — como PHP 8.4, modern JavaScript, and MySQL 8 — funções, históricos de registo, interfaces, e implementações documentadas podem ser operadas de forma transparente a longo prazo.

Nem toda a informação se destina a todas as funções. O pessoal de armazém precisa de tarefas em aberto e diálogos de registo claros. O controlo de inventário precisa de avisos e sugestões de reposição. A gestão precisa de avaliações relativas a tempos de débito, discrepâncias, e transações em aberto. Os conceitos de acesso baseados em funções, registos, e bloqueios de conta após tentativas falhadas repetidas pertencem cedo à fase de planeamento, especialmente quando prestadores de serviços externos ou várias localizações estão envolvidos.

Implementação: primeiro prove, depois expanda

Um piloto deveria correr com encomendas reais, não apenas dados de teste numa sala de reuniões. Escolha uma zona de armazém, um grupo de produtos, ou um turno e defina antecipadamente como o sucesso será reconhecido: menos registos de correção, tempo de processamento mais curto, menos consultas, ou uma taxa de conclusão de registo mais elevada no mesmo dia.

Planeie um nível de recurso em paralelo. Se a nova aplicação falhar ou um processo for pouco claro, a equipa tem de saber como continuar a trabalhar e como os registos subsequentes serão controlados. Isto não é um sinal de falta de confiança na tecnologia, mas de operações profissionais. Após duas a quatro semanas, surgem geralmente as ideias mais valiosas. Talvez não falte uma funcionalidade, mas sim uma melhor rotulagem de artigos. Talvez o fluxo de trabalho esteja correto, mas um perfil de scanner ou permissão esteja a causar um estrangulamento. Estas observações deveriam fluir para ciclos de melhoria curtos e controlados em vez de desencadear um novo grande projeto.

A melhor digitalização não torna o trabalho diário de armazém teoricamente mais moderno, mas concretamente mais calmo: menos procura, menos transcrição manual, transferências mais claras, e informação fiável precisamente quando uma decisão está pendente.

Permalink →

Lista de verificação para automação do fluxo de trabalho de inventário

Lista de verificação para automação do fluxo de trabalho de inventário

Quando uma receção de mercadoria é confirmada em papel, os níveis de inventário são depois transferidos para uma folha de cálculo, e uma questão de envio é esclarecida por telefone, cada passo individual parece gerível. Juntos, criam consultas, discrepâncias de inventário, e dependência de funcionários individuais.

Uma Lista de verificação para automação do fluxo de trabalho de inventário evita que esta condição se transforme prematuramente num projeto de software sobredimensionado. Separa processos que genuinamente deveriam ser automatizados daqueles para os quais uma folha de cálculo bem mantida continua a ser suficiente.

A Lista de verificação para automação do fluxo de trabalho de inventário antes do lançamento do projeto

A automação não começa com a seleção de um sistema. Começa com uma descrição verificável do que realmente acontece no armazém — mesmo durante exceções, mudanças de turno, e pressão de tempo. Percorra os seguintes pontos diretamente ao nível do processo com a gestão do armazém, expedição, compras, e, se aplicável, contabilidade.

1. Registe movimentos em vez de apenas inventários

Um inventário atual é o resultado de movimentos. Por isso, deveria ficar claro que eventos aumentam, diminuem, reservam, bloqueiam, ou transferem o stock. Estes incluem receção de mercadoria, arrumação, picking de encomendas, expedição, devoluções, sucata, discrepâncias de inventário, e realocação.

Cada movimento requer uma resposta definitiva a quatro perguntas: quem o executa? Quando é registado? Que localização de armazenamento é afetada? Que documento ou encomenda o fundamenta? Se estas respostas atualmente só existem nas cabeças de funcionários experientes, esse é um candidato primário para automação. O objetivo não é mais recolha de dados, mas um histórico resiliente a partir do qual qualquer nível de inventário pode ser explicado.

2. Limpe artigos, variantes, e unidades

Muitos projetos falham não por causa de scanners ou interfaces web, mas devido a dados mestre. Um artigo pode ser comprado como caixa, armazenado individualmente, e vendido em conjuntos. Sem conversões definidas, o software produz quantidades formalmente corretas mas operacionalmente incorretas.

Verifique números de artigo quanto a duplicados, estabeleça descrições vinculativas, e distinga entre unidades de venda, unidades de armazenamento, e unidades de embalagem. Números de série, lotes, datas de validade, ou classificações de materiais perigosos só deveriam ser incluídos na construção inicial se influenciarem decisões diárias ou forem legalmente exigidos. Tudo o resto inicialmente aumenta a sobrecarga de manutenção e a superfície de erro.

3. Defina localizações de armazenamento tão precisamente quanto necessário

"Pavilhão 2" pode ser suficiente para uma lista de inventário. Para picking de encomendas fiável, é geralmente demasiado grosseiro. Defina se uma localização se refere a uma zona, estante, bay, ranhura, ou área de transferência. As áreas de quarentena, zonas de receção de mercadoria, áreas de devolução, e buffers de expedição também têm de ser reconhecíveis como localizações distintas se a mercadoria puder aí residir.

A granularidade certa depende da operação. Uma oficina com algumas centenas de posições não requer estritamente gestão de compartimentos. No entanto, com vários pickers por turno, uma ranhura de armazenamento precisa pode reduzir significativamente os percursos e tempos de procura. Não automatize um nível de precisão que ninguém consegue manter.

4. Estabeleça gatilhos, funções responsáveis, e aprovações

Um fluxo de trabalho precisa de um ponto de partida claro. Na receção de mercadoria, isto pode ser a entrega na doca, a ordem de compra nas compras, ou a leitura de uma guia de remessa. Para reposição, um nível mínimo de stock pode desencadear uma proposta, enquanto a encomenda final permanece com uma pessoa responsável.

Além disso, documente que ações podem ocorrer automaticamente e quais requerem revisão. Uma quantidade em falta deveria criar uma discrepância, não alterar silenciosamente a receção de mercadoria esperada. Os passos de aprovação são sensatos para artigos valiosos, geridos por lote, ou críticos para a segurança. Para consumíveis, atrasariam desnecessariamente o débito.

5. Gere documentos onde são necessários

As guias de remessa, listas de arrumação, listas de picking, etiquetas de envio, e protocolos de entrega frequentemente originam-se em aplicações diferentes. Isto leva a quebras de suporte: um endereço é copiado, uma encomenda é verificada, e o estado de envio é atualizado mais tarde.

Anote a fonte de dados, o registo de tempo de criação, e o destinatário para cada documento. Um fluxo de trabalho sensato poderia, por exemplo, gerar automaticamente uma lista de picking depois de uma encomenda ser aprovada, fornecer uma etiqueta de envio depois da embalagem, e fechar a encomenda com um registo de tempo após a entrega. O ponto crucial é que os dados já não precisam de ser introduzidos manualmente várias vezes.

Verifique interfaces e qualidade de dados

A melhor lógica de armazém é inútil se as encomendas só chegam uma vez por dia como um ficheiro ou se os endereços de entrega são formatados de forma inconsistente. Por isso, crie uma lista sóbria dos sistemas que enviam ou recebem dados: loja, ERP, contabilidade, prestador de serviços de expedição, portal de fornecedores, sistema de produção, e folhas de cálculo existentes.

Para cada ligação, deveria ficar estabelecido qual sistema é autoritativo para cada campo de dados. Se os dados mestre de artigos são autoritativos no ERP, o portal do armazém não pode criar silenciosamente os seus próprios artigos. Se uma alteração de encomenda vem da loja, tem de se tornar visível antes do envio. Para volumes baixos, uma importação CSV controlada pode ser o primeiro passo certo. Para volume elevado ou promessas de entrega curtas, uma interface direta vale a pena.

O tratamento de erros é igualmente importante. Uma interface não deveria apenas transferir dados, mas também mostrar o que foi rejeitado e porquê. Números de artigo desconhecidos, endereços inválidos, ou quantidades em falta não podem desaparecer num ficheiro de registo técnico. Requerem uma lista de trabalho com responsabilidade e estado designados.

Conceba a usabilidade no chão do armazém

Um processo que parece plausível numa secretária pode falhar no chão do armazém. Os funcionários usam luvas, movem mercadoria, partilham dispositivos, ou trabalham com cobertura Wi-Fi instável. Por isso, verifique cedo se scanners, tablets, computadores de secretária, ou impressos se ajustam ao respetivo passo de trabalho.

A digitalização deveria fornecer feedback claro: artigo correto, localização de armazenamento errada, quantidade já registada, ou artigo bloqueado. As cores por si só não são suficientes. Mensagens curtas e compreensíveis e um próximo passo claro são mais valiosos sob pressão de tempo do que uma interface rica em funcionalidades.

Planeie também para exceções. O que acontece durante um código de barras danificado, uma falha de rede, uma entrega parcial, ou mercadoria não atribuída descoberta? Um bom fluxo de trabalho oferece caminhos controlados para isto e regista a correção. Não força as equipas a confiar em notas adesivas e registos em lote posteriores.

Defina métricas antes de construir dashboards

Um dashboard não é um objetivo. As métricas relevantes são aquelas que desencadeiam uma decisão operacional. Estas podem incluir receções de mercadoria em aberto que excedem uma idade definida, encomendas próximas do seu prazo de envio, discrepâncias de inventário por zona de armazém, erros de picking, ou o tempo decorrido entre a receção da encomenda e a entrega.

Defina a fonte de dados, regra de cálculo, e função responsável para cada métrica. A "precisão de inventário", por exemplo, só é significativa quando fica claro contra que contagem é medida e como as devoluções ou stock bloqueado são tratados. Algumas métricas fiáveis são melhores do que uma parede de gráficos em que ninguém confia.

Planeie segurança, permissões, e rastreabilidade

A automação distribui agência. Quem tem permissão para modificar inventário, criar artigos, gerar etiquetas de envio, ou cancelar encomendas deveria ser deliberadamente estabelecido. As permissões baseadas em funções são geralmente mais sensatas do que um login partilhado no PC do armazém. As correções particularmente críticas requerem um registo de tempo, uma atribuição de pessoal, e idealmente uma razão.

Os fundamentos técnicos também pertencem à lista de verificação: cópias de segurança regulares, recuperação testada, credenciais de acesso documentadas, registo de erros de interface, e um procedimento para contas de utilizador bloqueadas ou desativadas. Numa aplicação personalizada, tecnologias mantíveis, uma estrutura de base de dados limpa, e passos de implementação rastreáveis não são detalhes menores. Determinam se as modificações permanecem calculáveis ao fim de dois anos.

Implemente em passos pequenos e mensuráveis

Não tente converter receção de mercadoria, reposição, contagem de inventário, expedição, e planeamento de rotas tudo de uma vez. Escolha um fluxo de trabalho com atrito notável e risco gerível, como o registo móvel de receções de mercadoria ou a geração automatizada de documentos de envio. Antes de começar, registe o tempo de processamento, correções, e casos em aberto.

Teste com artigos reais, encomendas reais, e os funcionários que realmente trabalharão com eles. Um piloto com uma zona de armazém ou grupo de produtos mostra mais rapidamente do que um workshop se as descrições, fluxos de trabalho de digitalização, e aprovações funcionam. Só quando as exceções estiverem dominadas é que o próximo processo deveria seguir-se.

A automação tem sucesso quando as equipas precisam de fazer menos perguntas, o inventário permanece explicável, e o processo funciona mesmo quando a pessoa mais experiente está de férias. É precisamente aí que a próxima melhoria vale a pena: não com a ferramenta mais ruidosa, mas com o atrito que genuinamente abranda o dia de trabalho.

Permalink →

Melhorar os tempos de carregamento do site móvel

Melhorar os tempos de carregamento do site móvel

Quando um smartphone de armazém com má receção é usado para aceder a um site, não é a animação da secção principal que determina a primeira impressão, mas sim se a página se torna sequer interativa. Se um potencial cliente espera três, quatro, ou cinco segundos pelo conteúdo, a alternativa está apenas a um botão de retrocesso de distância. Melhorar os tempos de carregamento do site móvel requer uma sequência técnica rastreável em vez de soluções cosméticas rápidas.

Isto aplica-se particularmente a sites concebidos para gerar consultas: para um fabricante, um prestador de serviços logísticos, ou uma empresa que oferece serviços complexos. Os utilizadores móveis frequentemente acedem a páginas entre compromissos, no chão do armazém, ou através de pesquisas com intenção concreta. O site tem de entregar informação em vez de causar processamento pesado no dispositivo.

Porque a velocidade de carregamento móvel é um problema operacional

O desempenho móvel é frequentemente tratado estritamente como uma disciplina de SEO. Isso fica aquém. As páginas rápidas ajudam com a visibilidade e os custos de campanha, mas o efeito imediato reside no uso real: os formulários são submetidos mais frequentemente, os números de telefone são marcados com mais frequência, e a informação do produto é lida atentamente. Um site lento, pelo contrário, cria dúvida antes mesmo de um contacto poder responder.

"Rápido" não é uma única métrica. Uma página pode exibir um fundo cedo mas permanecer sem resposta a cliques durante um tempo considerável. Para os visitantes, três fatores importam: quando aparece o conteúdo mais importante? Quando pode a página ser operada sem atraso? E o layout ainda se desloca enquanto tentam tocar num botão? Estas questões refletem-se em métricas como o Largest Contentful Paint, o Interaction to Next Paint, e o Cumulative Layout Shift.

As medições têm de acontecer sob condições realistas. Um computador de escritório potente em Wi-Fi mascara problemas que se tornam óbvios num dispositivo Android mais antigo numa rede celular. A localização, serviços intermediários, e uma cache de browser pré-preenchida também alteram os resultados. Medições repetidas e dados reais de utilizadores importam muito mais do que uma única execução de teste perfeita.

Melhorar os tempos de carregamento do site móvel: primeiro meça, depois mude

O erro mais comum é comprimir imediatamente imagens ou instalar mais um plugin de otimização. Ambos podem ajudar, mas sem análise da causa raiz, criam rapidamente configurações difíceis de manter. Verifique primeiro uma seleção representativa: a página inicial, uma página típica de serviço ou produto, a página de contactos, e uma landing page de alto tráfego. Os padrões tornam-se visíveis através destas páginas.

O registo de rede revela que ficheiros bloqueiam a inicialização e o quão grandes realmente são. Uma auditoria de desempenho mostra se o JavaScript atrasa a operação, se as fontes chegam tarde, ou se as imagens carregam desnecessariamente cedo. Complemente as medições em laboratório com dados de visitantes reais se o tráfego o permitir. Isto evita otimizar para um perfil de teste que não reflete o seu público-alvo real.

Defina um objetivo claro antes de cada alteração. Por exemplo: o conteúdo principal visível deveria aparecer num dispositivo móvel médio em menos de 2,5 segundos, ou o formulário de contacto deveria ser utilizável sem atraso de entrada. Nem toda a página requer uma pontuação máxima teórica. As aplicações complexas com dados autenticados têm pré-requisitos diferentes dos sites corporativos públicos. A fiabilidade aborrecida e comprovável é aqui mais valiosa do que uma pontuação de curto prazo impulsionada por truques arriscados.

1. Trate as imagens de acordo com o seu propósito

Em muitas páginas móveis, as imagens continuam a ser o maior bloco de dados. O problema não é a fotografia em si, mas uma imagem transmitida a uma largura de 2500 pixels quando o dispositivo só requer 700 pixels. Forneça variantes de imagem responsivas para que o browser possa selecionar o tamanho apropriado. Formatos modernos como WebP ou AVIF frequentemente reduzem significativamente os tamanhos de ficheiro, embora devam ser implementados com alternativas limpas e qualidade de imagem verificada.

A maior imagem na área visível inicial merece atenção especial. Deveria estar corretamente recortada, usar uma resolução adequada, e carregar cedo. As imagens mais abaixo na página podem carregar de forma preguiçosa. Isto poupa dados na entrada, embora não deva fazer com que as imagens apareçam visivelmente ao rolar enquanto o utilizador já as espera.

Não descarte reflexivamente todas as imagens. Uma boa imagem pode explicar uma máquina, uma equipa, ou um processo mais rapidamente do que um parágrafo de texto. A tarefa técnica é entregar informação visual relevante de forma eficiente em vez de reduzir o design a caixas cinzentas de espaço reservado.

2. Limite o JavaScript ao trabalho necessário

Cada script compete por tempo de processamento durante o carregamento e interação. Bibliotecas uniformemente integradas, gestores de tags com vários scripts de terceiros, widgets de chat, mapas, e animações são particularmente problemáticos. Em dispositivos de secretária, estes custos frequentemente passam despercebidos. Em dispositivos móveis, resultam numa página que é visível mas reage lentamente às entradas.

Verifique o propósito, condição de carregamento, e valor de negócio de cada script. Um mapa interativo na página de contactos não precisa de carregar em todas as subpáginas. Uma ferramenta de cookies ou análise não deveria desencadear uma cadeia de ficheiros adicionais antes de o visitante poder sequer ler o conteúdo. As funcionalidades necessárias apenas após interação podem ser carregadas sob demanda.

Para sites desenvolvidos à medida, uma estrutura de componentes clara é um verdadeiro ativo. O JavaScript é agrupado por função em vez de ser enviado como um monólito global. Isto também simplifica a manutenção posterior: estender um formulário não altera acidentalmente o código de um filtro de produto ou navegação.

3. Entregue CSS e fontes sem bloqueios

Um estrangulamento frequente reside dentro da área visível inicial. Se várias folhas de estilo, fontes de ícones, e variantes de fontes externas tiverem de carregar para isso, o browser espera desnecessariamente muito tempo. Os estilos críticos para a secção visível deveriam ser pequenos e disponíveis cedo. As regras não críticas podem seguir mais tarde.

Para fontes web, geralmente bastam algumas espessuras. Quatro espessuras em normal, itálico, e subconjuntos adicionais parecem completas num sistema de design, mas raramente são necessárias para um site corporativo típico. Defina alternativas de sistema sensatas para que o texto permaneça imediatamente legível. Uma fonte que muda de forma limpa alguns milissegundos depois é superior a blocos de texto vazios.

Os ícones também merecem uma revisão. Um pequeno conjunto SVG é frequentemente mais eficiente e precisamente controlável do que uma fonte de ícones completa. Esta regra permite exceções: os sistemas existentes não precisam de ser reconstruídos puramente por causa de alguns kilobytes. No entanto, se já estiverem planeadas alterações maiores, esta decisão pertence à base técnica.

4. Configure a cache e a resposta do servidor de forma limpa

Mesmo uma interface enxuta parece lenta se o servidor demorar demasiado tempo a entregar a resposta inicial. As causas vão desde consultas de base de dados não otimizadas e páginas compiladas dinamicamente até cache em falta. O conteúdo público que muda pouco frequentemente deveria ser servível rapidamente como uma versão em cache. Os ficheiros estáticos como imagens, CSS, e JavaScript requerem nomes de versão distintos e regras de cache sensatas.

Para aplicações PHP, isto envolve adicionalmente uma execução eficiente, uma cache de opcode corretamente configurada, e acesso controlado à base de dados. As consultas MySQL precisam de índices que correspondam aos caminhos reais de filtragem e ordenação. Uma página inicial que executa várias consultas de dados redundantes em cada pedido não melhorará à medida que o tráfego cresce.

No entanto, a cache não é um cheque em branco. Os preços, disponibilidades, secções personalizadas, ou conteúdo pós-login nunca devem parecer desatualizados por engano. Os limites da cache são, por isso, definidos com precisão: o que pode ter cinco minutos, o que tem de estar imediatamente atualizado, e quem limpa a cache após modificações de conteúdo? O bom desempenho decorre desta precisão.

5. Trate os fornecedores terceiros de forma crítica

Os serviços externos constituem frequentemente o lastro invisível de um site. Análise, gestão de consentimento, vídeos, mapas, widgets de avaliação, e pixels de marketing carregam scripts adicionais de servidores externos. Cada dependência pode causar atrasos, levantar questões de privacidade, e prejudicar a renderização se ocorrerem erros.

Isto não significa que toda a ferramenta externa tenha de ser removida. Um vídeo pode apoiar as vendas, e uma ferramenta de análise pode fundamentar decisões-chave. No entanto, é necessária uma análise de custo-benefício. Carregue meios incorporados apenas após consentimento ou interação. Use espaços reservados para mapas inicialmente. Finalmente, remova tags cujos dados ninguém avaliou há meses.

6. Tenha em conta as mudanças de layout e a usabilidade móvel

A velocidade de carregamento e a usabilidade andam de mãos dadas. Reserve dimensões fixas para imagens, banners, e elementos incorporados para que os botões não se desloquem debaixo do dedo do utilizador. Evite pop-ups que cobrem o conteúdo visível logo à entrada. Uma página rápida que exibe imediatamente uma sobreposição difícil de fechar não resolve o problema central.

Teste os formulários com especial cuidado. Campos de entrada grandes, tipos de teclado apropriados, e caminhos obrigatórios curtos ajudam mais do que efeitos visuais elaborados. Se uma consulta só requer um nome, um número de retorno de chamada, e um pedido, um formulário de doze partes não é sinal de minúcia — é atrito.

7. Gira o desempenho como um processo operacional permanente

Um relançamento único não mantém os tempos de carregamento baixos permanentemente. Novas imagens de campanha, requisitos de rastreamento, e módulos editoriais acumulam-se ao longo do tempo. Os orçamentos de desempenho, por isso, pertencem ao processo de desenvolvimento: um tamanho máximo de ficheiro para imagens iniciais, regras claras para novas ferramentas de terceiros, e limites definidos para JavaScript.

Após os lançamentos, os tipos de página chave deveriam ser reavaliados. Os testes automatizados podem determinar se as páginas centrais permanecem alcançáveis e se os fluxos de trabalho críticos funcionam corretamente. Para o desempenho, no entanto, um teste puramente funcional é insuficiente. Complemente-o com medições de tempo de resposta, volume de dados transferidos, e interatividade móvel.

Um site móvel rápido não é criado por um único plugin, nem através de privação a todo o custo. Surge quando o design, conteúdo, infraestrutura, e uso do mundo real são considerados em conjunto. Comece pela página que gera consultas ou contactos operacionais, meça em condições honestas, e elimine o atrito onde quer que os utilizadores realmente o sintam.

Permalink →

Software de logística que realmente alivia as operações

Software de logística que realmente alivia as operações

Quando uma receção de mercadoria é primeiro anotada em papel, depois transferida para uma folha de cálculo, e depois transmitida à expedição de viva voz, raramente é a dedicação dos funcionários que está em falta. O que falta é uma base de trabalho partilhada e fiável. Um bom software de logística não substitui essas fraturas com mais trabalho no ecrã, mas com fluxos de trabalho claros: o que chegou, onde está localizado, o que foi reservado, e o que pode ser expedido hoje?

Para pequenas e médias empresas, não é a maior lista possível de funções que importa. O fator decisivo é que o software mapeia o trabalho real no chão do armazém, no escritório, e na expedição. Uma solução destinada a uma corporação global com vinte localizações pode ser desnecessariamente lenta, cara, e complicada para uma operação com um armazém e dois turnos.

Quando o software de logística faz genuinamente sentido

As folhas de cálculo não são fundamentalmente um problema. Para quantidades baixas, uma lista de artigos mestre gerível, e um único funcionário responsável, podem ser a solução mais pragmática. Seria errado substituir um processo funcional por um projeto apenas pelo bem da modernização. O ponto de viragem chega quando a informação tem de ser mantida várias vezes ou ninguém consegue dizer com certeza qual ficheiro é o atual. Sinais típicos são faltas de stock apesar de prateleiras cheias, consultas sobre o estado das entregas, guias de remessa escritas manualmente, e contagens de stock que param as operações durante dias. Os números crescentes de encomendas também tornam visível quais passos eram anteriormente mantidos unidos apenas pela experiência de pessoas individuais.

Então não se trata principalmente de digitalização como palavra da moda. Trata-se de fontes de erro e tempos de espera. Um funcionário não deveria ter de comparar várias listas primeiro só para aprovar uma encomenda. A expedição não deveria ter de adivinhar se um artigo está realmente disponível ou já reservado para outra encomenda.

Que processos o software de logística deveria ligar

Uma solução utilizável começa com o fluxo de material, não com um menu padrão. Para muitas empresas, este fluxo abrange a receção de mercadoria, arrumação, gestão de inventário, picking de encomendas, expedição, e feedback. Dependendo do negócio, são adicionados lotes, números de série, devoluções, ordens de fabrico, ou planeamento de rotas.

Receção de mercadoria com inventários rastreáveis

Muito é decidido na receção de mercadoria. Se uma entrega é verificada diretamente contra uma encomenda ou guia de remessa, as discrepâncias de quantidade, mercadoria danificada, e posições em falta podem ser registadas exatamente onde ocorrem. A mercadoria recebe um estado em vez de simplesmente ser fisicamente estacionada algures.

O software não tem necessariamente de começar com hardware de scanner caro. Em alguns armazéns, um tablet ou um posto de trabalho na área de receção de mercadoria é suficiente para começar. Onde muitas posições são movimentadas diariamente, no entanto, os leitores de código de barras são sensatos porque aceleram os registos e reduzem os erros de digitação. A decisão certa depende das quantidades, percursos, e estrutura de artigos.

Movimentos de armazém sem um registo de memória

Os inventários só são resilientes se as receções, realocações, remoções, e correções forem rastreáveis. Isto não significa que toda exceção tem de ser evitada. Nas operações diárias, há embalagens danificadas, arrumações incorretas, e retiradas espontâneas de material. Uma boa aplicação torna estes casos registáveis, mas também documenta quem alterou o quê e quando.

Este histórico não é um instrumento de controlo pelo seu próprio bem. Ajuda a encontrar causas. Se um artigo repetidamente acaba na localização de armazenamento errada, a rotulagem do armazém pode não ser clara. Se ocorrem correções regulares, o problema muitas vezes reside no processo anterior ao registo.

Encomendas, guias de remessa, e expedição a partir de um único fluxo de trabalho

Muitas equipas perdem tempo na interface entre o processamento de encomendas e a expedição. Os dados da encomenda chegam por e-mail, telefone, ou de um sistema de loja separado. Subsequentemente, as posições são impressas, os inventários são verificados, e os documentos de envio são registados novamente. Cada transferência manual cria espaço para discrepâncias.

O software de logística deveria conseguir gerar uma lista de picking clara, uma guia de remessa, e, se necessário, uma etiqueta de envio a partir de uma encomenda aprovada. A sequência é importante aqui: primeiro, tem de ficar claro o que é entregável. Depois, a encomenda deveria ser reservada para outros processos. Caso contrário, surge a situação desagradável em que dois funcionários alocam o mesmo inventário remanescente.

Planeamento que corresponde à realidade

O planeamento de rotas e o controlo de capacidade podem ser valiosos, especialmente com entregas próprias, janelas de tempo fixas, ou muitas paragens regionais. No entanto, não são automaticamente o próximo passo sensato. Quem ainda não tem uma aprovação de encomendas limpa e dados de inventário fiáveis deveria resolver primeiro esses fundamentos.

O mesmo se aplica a previsões e planeamento apoiado por IA. Podem tornar padrões visíveis, mas requerem dados de entrada limpos. Uma previsão baseada em inventário incompleto parece tecnicamente sofisticada, mas não melhora a capacidade de entrega.

Solução padrão ou software de logística personalizado?

O software padrão é sensato quando os seus próprios fluxos de trabalho são em grande parte convencionais e podem ser adaptados sem grande atrito. Pode ser introduzido mais rapidamente e traz funções centrais comprovadas. Para uma operação com processos de armazém simples, funções claras, e poucas peculiaridades, essa é frequentemente a escolha economicamente correta.

O software de logística personalizado vale a pena quando o negócio vive de fluxos de trabalho especiais ou os sistemas existentes só podem ser ligados através de desvios. Isto diz respeito, por exemplo, a oficinas com saídas de material para encomendas em curso, revendedores com regras de envio específicas do cliente, ou fabricantes que têm de ligar estreitamente os movimentos de armazém com os passos de produção.

A diferença não reside em reinventar tudo. Os bons sistemas personalizados adotam padrões comprovados como alterações de estado, reservas, e permissões. No entanto, adaptam a linguagem, máscaras, documentos, e interfaces ao trabalho que é realmente realizado. Assim, a equipa não tem de se orientar permanentemente por categorias que só fazem sentido no manual do fabricante.

Para a softify.pro, tal empreendimento começa, por isso, com a questão de quais fluxos de trabalho deveriam ser preservados. Nem todo o papel é um erro, e nem toda a regra especial faz sentido. Só quando fica claro onde a informação se perde ou as decisões esperam desnecessariamente é que uma solução viável pode ser planeada.

Uma implementação sem interrupção operacional

O maior risco raramente está apenas no código do programa. Está numa implementação que quer mudar demasiado de uma só vez. Um armazém não pode parar durante duas semanas para aprender um novo sistema. Por isso, uma implementação passo a passo é geralmente mais sensata do que uma grande data de transição.

Uma boa primeira secção foca-se num fluxo de trabalho delimitado, por exemplo, receção de mercadoria e registos de inventário ou a criação de guias de remessa. A equipa trabalha com dados reais, o feedback flui diretamente para a adaptação, e o benefício torna-se mensurável. Só depois é que se seguem outras áreas, como picking móvel, devoluções, ou ligações a lojas e prestadores de serviços de expedição.

A migração de dados merece especial atenção aqui. Números de artigo antigos, dados mestre de clientes duplicados, e localizações de armazenamento inconsistentes não desaparecem automaticamente só porque um novo sistema é introduzido. É frequentemente melhor limpar deliberadamente os dados mestre e adotar apenas históricos relevantes. Isto poupa pesquisas posteriores e evita que a antiga desordem seja tecnicamente conservada.

As permissões também pertencem cedo à agenda. Nem todos os funcionários precisam de acesso a preços, todas as correções de inventário, ou manutenção de dados mestre. Funções claras protegem contra modificações acidentais e tornam as responsabilidades visíveis sem bloquear o fluxo de trabalho com aprovações desnecessárias.

Tecnologia que não se torna um fardo após o lançamento

Uma aplicação de logística tem de reagir rapidamente nas operações diárias, mesmo que vários postos de trabalho registem simultaneamente. Para isso, precisa de uma arquitetura de dados rastreável, transações limpas, e regras claras para modificações paralelas. Se dois funcionários processam o mesmo inventário, o sistema não pode gerar registos incorretos silenciosos.

A manutibilidade é igualmente importante. Tecnologias como PHP 8.4, JavaScript moderno, e MySQL 8 não são um ponto de venda em si mesmas. São sensatas quando a aplicação permanece compreensível a longo prazo, recebe atualizações de segurança, e pode ser continuada por programadores qualificados. O provisionamento documentado, cópias de segurança, registo, e um tratamento realista de atualizações fazem parte da capacidade operacional.

Um bom software de logística não é, por isso, reconhecido por uma demonstração particularmente sofisticada. Mostra-se numa terça-feira normal de manhã: a entrega é registada, o inventário está correto, a encomenda é rastreável, a guia de remessa corresponde, e o próximo turno sabe o que já foi feito. O alívio é criado precisamente aí — não através do maior número possível de funções, mas através de fluxos de trabalho fiáveis que se ajustam à operação.

Permalink →

Planear uma base de dados MySQL para aplicações web

Planear uma base de dados MySQL para aplicações web

Quando três funcionários registam mercadoria em paralelo de manhã, um cliente verifica o estado da entrega, e o back office cria uma fatura, a qualidade de uma aplicação não se mostra no seu design. Demonstra-se em saber se todos veem exatamente o mesmo estado de dados correto. Planear uma base de dados MySQL para uma aplicação web não significa, por isso, criar tabelas o mais rapidamente possível. Significa compreender os fluxos de trabalho reais com precisão suficiente para garantir que os dados permanecem fiáveis mesmo sob carga, durante erros, e à medida que o negócio cresce.

Especialmente em plataformas internas, processos de armazém e encomendas, ou portais voltados para o cliente, a base de dados é frequentemente tratada demasiado tarde. Primeiro a interface é construída, depois são adicionados campos, seguidos de exceções. Isso funciona para um protótipo. Nas operações, isto resulta em conjuntos de dados duplicados, estados pouco claros, e relatórios em que já ninguém confia totalmente.

Planear uma base de dados MySQL para aplicações web: comece pelo fluxo de trabalho

O primeiro esboço não deveria começar com nomes de colunas, mas com uma situação de trabalho concreta. Tome uma receção de mercadoria: uma entrega chega, é atribuída a um fornecedor e a uma encomenda, as quantidades são verificadas, uma localização de armazenamento é atribuída, e o inventário muda. Dependendo da operação, este processo requer adicionalmente fotografias, uma inspeção de qualidade, um estado de retenção, ou uma correção rastreável. Deste fluxo de trabalho emergem os objetos funcionais. Exemplos típicos são artigos, fornecedores, encomendas, posições, localizações de armazenamento, movimentos de inventário, e utilizadores.

A distinção entre um objeto e um evento é crucial. Um artigo descreve o que algo é. Um movimento de inventário documenta que uma quantidade mudou numa localização específica num momento específico. Misturar ambos numa única tabela leva rapidamente a uma perda de rastreabilidade.

Algumas perguntas difíceis ajudam para cada objeto: qual é a identidade única? Que informação pode mudar? Quem tem permissão para a mudar? Que dados têm de ser retidos historicamente? E que regras se aplicam quando duas pessoas trabalham simultaneamente? Estas perguntas previnem a improvisação subsequente melhor do que uma longa lista de campos de base de dados supostamente completos.

O modelo de dados deveria expressar regras

Uma base de dados não é meramente armazenamento para entradas de formulário. Deveria fazer cumprir as regras centrais por si mesma. Se cada movimento de inventário tiver de pertencer exatamente a um artigo e uma localização de armazenamento, as chaves estrangeiras pertencem ao modelo. Se um número de encomenda externo só puder ocorrer uma vez por inquilino, é necessário um índice único. Se uma posição nunca devesse existir sem uma encomenda-cabeçalho, esta relação tem de ser modelada claramente.

O MySQL 8 com InnoDB fornece bases robustas para isto: transações, chaves estrangeiras, mecanismos de bloqueio, e alterações consistentes através de várias tabelas. Ao escrever um movimento, inventário atual, e registo de inspeção durante um registo de receção de mercadoria, isto deveria acontecer como uma transação coesa. Se um passo falhar, nenhuma operação meio-terminada pode permanecer.

No entanto, nem toda a regra pertence à base de dados. As aprovações, lógica de preços complexa, ou passos de processo dependentes de função são frequentemente melhor colocados na lógica da aplicação porque mudam funcionalmente mais depressa. O limite é pragmático: as regras cuja violação danifica permanentemente os dados deveriam ser protegidas o mais perto possível dos dados. As regras que mudam frequentemente ou dependem fortemente do contexto requerem código de aplicação bem testado.

Não confunda o histórico com os valores atuais

Um erro comum é armazenar apenas o inventário atual ou o estado atual. Isso é suficiente até alguém perguntar porque é que a quantidade mudou ontem ou quem reiniciou uma encomenda. Para sistemas operacionais, um histórico de movimentos ou eventos é frequentemente mais valioso do que um único campo sobrescrevível.

Isto não significa registar permanentemente cada movimento de clique. As alterações relevantes para o negócio deveriam ser registadas: alterações de estado, modificações de quantidade, correções, aprovações, e atribuições. Uma boa entrada de auditoria contém um registo de tempo, utilizador ou processo do sistema, valor anterior e novo, e uma razão compreensível quando o fluxo de trabalho o exige. Isto torna possível esclarecer erros sem ter de procurar em e-mails, listas em papel, ou cópias de segurança da base de dados.

Escolha chaves, tipos de dados, e convenções de nomenclatura de forma consciente

As decisões técnicas parecem pequenas, mas moldam a manutenção e integrações ao longo dos anos. Para chaves primárias internas, os valores BIGINT com atribuição automática são frequentemente uma escolha sóbria e facilmente gerível. Os UUIDs podem ser sensatos quando os dados se originam offline, vários sistemas escrevem de forma independente, ou as interfaces externas não deveriam expor IDs sequenciais. No entanto, custam mais armazenamento e requerem um pouco mais de atenção com índices e ordenação.

Os valores monetários devem ser armazenados como DECIMAL, não FLOAT ou DOUBLE. As quantidades também precisam de uma precisão funcionalmente apropriada: as contagens de itens são frequentemente números inteiros, enquanto os pesos e comprimentos não são. Os registos de tempo deveriam ser tratados de forma uniforme, idealmente internamente em UTC, enquanto a interface exibe o fuso horário local da operação. Especialmente durante mudanças de turno e horário de verão, isto previne discrepâncias difíceis de encontrar.

Os nomes também deveriam ser aborrecidos e inequívocos. order_items ou inventory_movements são mais úteis do que abreviaturas criativas que só a equipa de projeto original entende. Formas singulares ou plurais consistentes são menos importantes do que a consistência. Igualmente sensatos são campos como created_at, updated_at, e, quando necessário, deleted_at. Uma eliminação suave não é, no entanto, uma obrigação padrão. Para registos legalmente ou operacionalmente relevantes, um cancelamento limpo é geralmente melhor do que um conjunto de dados invisivelmente eliminado.

Os índices seguem as consultas reais, não a adivinhação

Um índice pode acelerar massivamente uma pesquisa, mas torna as operações de escrita mais complexas e consome armazenamento. Por isso, "um índice em cada campo" não é uma estratégia. As consultas mais importantes deveriam ser estabelecidas cedo: encomendas em aberto de um cliente, movimentos de um artigo dentro de um período, inventário por localização de armazenamento, ou registos recentemente modificados para uma interface.

A ordem dos índices compostos importa aqui. Se a aplicação pesquisa regularmente por tenant_id, status, e created_at, um índice composto exatamente nesta ordem é frequentemente sensato. Se realmente se ajusta é mostrado pelo plano de execução usando EXPLAIN, não por intuição. As bases de dados não se tornam rápidas por truques espetaculares, mas por consultas observáveis, índices correspondentes, e volumes de dados testados realisticamente.

Para tabelas em crescimento, uma estratégia de retenção clara vale a pena. Os registos técnicos precisam de estar na base de dados de produção primária durante cinco anos? Não necessariamente. Os registos de negócio, movimentos, e provas de inspeção requerem períodos de retenção diferentes dos da informação de depuração. O arquivamento não é sinal de um sistema fraco, mas uma decisão operacional deliberada.

A operação multiutilizador requer transações e estados claros

Numa aplicação web, vários pedidos acedem aos mesmos dados simultaneamente. Isto é normal nas operações diárias de armazém, não uma exceção. Dois funcionários podem registar o mesmo inventário enquanto uma importação cria novas encomendas. Sem transações e bloqueio direcionado, existe o risco de modificações perdidas ou inventários negativos que só se tornam aparentes semanas depois.

Para operações críticas, deveria ser claro que dados são lidos e escritos dentro de uma transação. Por vezes uma atualização atómica é suficiente, tal como um inventário que só é alterado se a quantidade disponível for suficiente. Noutros casos, um bloqueio de linha é sensato para que uma operação possa verificar o estado dos dados de forma controlada e modificá-lo depois. As transações longas, por outro lado, são problemáticas: bloqueiam outro trabalho e aumentam o risco de conflitos.

Igualmente importante é um conjunto limitado de estados funcionais. Uma encomenda não deveria ser "aberta", "parcialmente entregue", e "processada manualmente" simultaneamente devido a campos conflituantes serem mantidos. As transições de estado definidas tornam as interfaces, relatórios, e automações mais simples. As exceções podem ser permitidas, mas deveriam ser nomeadas e documentadas.

Planeie a segurança, inquilinos, e operações desde o início

A aplicação deveria usar um utilizador de base de dados dedicado para o MySQL com privilégios mínimos. O acesso de escrita para a aplicação web não significa que este utilizador precise de eliminar tabelas ou alterar privilégios de utilizador. As contas administrativas não pertencem a ficheiros de configuração de produção e nunca a um repositório.

Quando vários clientes, localizações, ou empresas trabalham dentro de uma aplicação, o isolamento de inquilinos é uma decisão arquitetónica, não uma condição de filtro retroativa. Uma base de dados partilhada com um tenant_id pode ser eficiente e facilmente gerível, mas exige verificações consistentes em cada consulta e regras claras para índices. As bases de dados separadas oferecem isolamento mais forte, mas aumentam o esforço em atualizações, avaliações, e operações. Que variante se ajusta depende dos requisitos de privacidade de dados, volume de dados, e modelo de negócio.

As cópias de segurança só são cópias de segurança depois de uma restauração ter sido testada. É necessário um ritmo definido para cópias de segurança, retenção, e recuperação. Da mesma forma, a monitorização do espaço de armazenamento, consultas lentas, e tarefas falhadas, juntamente com atualizações documentadas, pertencem ao sistema. O MySQL 8, PHP 8.4, e aplicações web modernas podem ser bem operados a longo prazo se as dependências, credenciais de acesso, e passos de implementação não residirem apenas na cabeça de um programador.

Um plano sensato antes do primeiro dia em produção

Antes da implementação, deveria existir um modelo de dados compacto com fluxos de trabalho de exemplo. Isto inclui tabelas e relações chave, regras de estado, permissões, consultas esperadas, interfaces, e um conceito para cópias de segurança e registos de auditoria. Este plano não precisa de ter cem páginas. Tem de capturar decisões que mais tarde seriam dispendiosas de corrigir.

Na softify.pro, o planeamento de bases de dados começa, por isso, com as pessoas que registam, verificam, fazem picking, ou resolvem exceções. Se uma folha de cálculo existente mapeia de forma fiável um processo gerível, pode continuar a ser a solução correta. Se várias pessoas trabalham simultaneamente, surgem registos, e os erros têm de ser rastreáveis, a base de dados merece, por outro lado, o mesmo esforço de planeamento que a interface. A melhor arquitetura, no final, é aquela que simplifica o dia de trabalho e ainda pode ser alterada de forma transparente daqui a dois anos.

Permalink →

Medir corretamente os resultados da automação de armazém

Medir corretamente os resultados da automação de armazém

Uma nova interface de digitalização pode parecer impressionante no primeiro dia. Ao fim de três semanas, no entanto, torna-se claro se genuinamente acelera a receção de mercadoria ou apenas cria um passo de trabalho adicional. Os resultados da automação de armazém não são, por isso, uma única métrica, nem são uma captura de ecrã de uma demonstração de produto. Manifestam-se onde uma equipa de armazém tem de procurar, perguntar, reintroduzir, e corrigir menos — mantendo ou melhorando a qualidade.

Para pequenas e médias empresas, esta distinção é particularmente relevante. Os grandes pacotes empresariais prometem frequentemente uma otimização abrangente, mas exigem implementações longas, processos rígidos, e manutenção pesada. Um passo de automação sensato pode começar mais pequeno: precisamente no ponto onde a informação atualmente se perde ou as decisões esperam desnecessariamente.

Que resultados de automação de armazém realmente contam

Muitos projetos começam com uma questão técnica: leitor de código de barras, aplicação móvel, interface de loja, ou etiquetas automáticas? A melhor pergunta inicial é: que estrangulamento custa notavelmente tempo, dinheiro, ou fiabilidade por turno?

A resposta raramente reside no número de dispositivos implementados. Resultados significativos podem ser medidos no trabalho diário. Na receção de mercadoria, por exemplo, o que conta é o tempo entre a entrega e o inventário registado como disponível. No picking, é relevante o tempo desde a encomenda até à prontidão de envio. Durante a contagem de stock, a duração não é o único fator decisivo; a diferença entre o inventário do sistema e o inventário real é o que mais importa.

Igualmente importantes são métricas que muitas operações não registam de forma limpa: quantas consultas surgem porque uma localização de armazenamento não é clara? Com que frequência uma guia de remessa tem de ser corrigida? Quantas encomendas permanecem por processar porque só uma pessoa sabe o estado na sua cabeça ou numa folha de cálculo privada? Exatamente este retrabalho silencioso desaparece dos relatórios de produtividade clássicos, mas sobrecarrega fortemente os supervisores de turno, expedidores, e o serviço ao cliente. Uma boa imagem-alvo combina velocidade e controlo. Se as encomendas são processadas mais depressa enquanto os registos incorretos aumentam, isso não é progresso. Se os inventários se tornam mais precisos mas as receções de mercadoria se acumulam, o processo tem de ser redesenhado. A automação tem sucesso quando melhora o fluxo de trabalho sem degradar a visão geral operacional.

Do alívio percebido aos dados verificáveis

A experiência dos funcionários é um indicador valioso. Quando alguém diz, após duas semanas, que já não tem de correr para o escritório a cada arrumação, isso importa. Para decisões de investimento, no entanto, ainda é necessária uma comparação independente dos sentimentos diários. Antes do lançamento, deveriam por isso ser registados valores de referência: tempo médio de processamento, número de casos de esclarecimento em aberto, entradas de correção, tempos de pesquisa, erros de expedição, e precisão do inventário. Vinte métricas não são necessárias; quatro a seis valores correspondentes ao problema específico são frequentemente suficientes.

Após a implementação, estes mesmos valores deveriam ser observados durante várias semanas. Dias de pico individuais facilmente enganam. A sazonalidade, doença, novos funcionários, ou uma encomenda invulgarmente grande influenciam os resultados. Só uma comparação entre turnos normais mostra se a alteração é robusta.

O efeito mais importante: um estado de processo partilhado

Em muitos armazéns, a vulnerabilidade real não é a falta de vontade de trabalhar, mas um estado fragmentado de informação. A receção de mercadoria conhece a entrega, a expedição conhece a encomenda do cliente, e o envio conhece a prioridade — mas nem todos trabalham com a mesma informação atual.

Um sistema específico para o fluxo de trabalho pode fechar esta lacuna. Uma entrega é registada à chegada, as discrepâncias são documentadas diretamente, o inventário recebe um estado claro, e o próximo passo torna-se visível. Os dados já não precisam de ser anotados em papel, transferidos mais tarde, e depois confirmados por telefone.

Isto não só reduz os percursos a pé. Reduz decisões baseadas em informação desatualizada. Um funcionário de expedição vê se uma encomenda é realmente passível de picking. A gestão reconhece se a mercadoria chegou ou está apenas anunciada. A liderança executiva não recebe um retrato embelezado, mas uma base rastreável.

Para equipas com turnos rotativos, este efeito é frequentemente mais valioso do que uma poupança de tempo espetacular. O processo torna-se menos dependente de pessoas individuais. O conhecimento já não fica preso em cadernos, históricos de chat, ou na memória do especialista mais experiente.

Porque nem toda a automação produz bons resultados

A automação reforça os processos. Isto é útil quando o fluxo de trabalho é claro. É problemático quando um fluxo de trabalho pouco claro é apenas reproduzido mais depressa.

Um exemplo típico é o registo obrigatório por digitalização para cada micro-ação individual. Se os funcionários tiverem de abrir vários ecrãs para uma exceção rara, surgem soluções alternativas. Os artigos são então registados coletivamente mais tarde, os leitores ficam numa gaveta, ou um funcionário volta a manter uma lista sombra. O software está presente, mas o processo real continua ao seu lado.

A qualidade dos dados também estabelece limites. Dados mestre de artigos sem unidades claras, lógica de localização de armazenamento pouco clara, ou designações de fornecedores inconsistentes não podem ser curados por uma interface sofisticada. Aqui, um projeto pode inicialmente consistir em trabalho de limpeza. Isso parece menos visível do que uma nova aplicação, mas é frequentemente o pré-requisito para resultados fiáveis.

Além disso, há processos que deliberadamente não deveriam ser totalmente automatizados. A inspeção experiente durante mercadoria sensível, a aprovação de discrepâncias invulgares, ou decidir sobre uma entrega especial requerem julgamento profissional. Os bons sistemas assinalam claramente tais casos e encaminham-nos propositadamente. Não fingem que toda a exceção pode ser resolvida com uma regra.

Quando uma folha de cálculo continua a ser a melhor solução

Nem todos os passos manuais justificam desenvolvimento personalizado. Se um processo ocorre raramente, envolve poucos participantes, e é tratado de forma rastreável, uma folha de cálculo bem mantida pode continuar a ser sensata. A falha reside não no próprio Excel, mas em gerir movimentos críticos sem responsabilidade clara, controlo de versões, ou registo atempado.

Assim que várias pessoas modificam em paralelo, os movimentos de inventário se tornam críticos em termos de tempo, ou informação de clientes de várias fontes precisa de ser consolidada, o risco aumenta significativamente. Um sistema partilhado é então geralmente mais barato do que corrigir continuamente mal-entendidos.

Os resultados da automação de armazém requerem uma implementação controlada

O caminho mais rápido para maus resultados é uma reformulação completa durante as operações em curso. Uma área delimitada com benefício mensurável é melhor: por exemplo, receção de mercadoria para um grupo de produtos, etiquetas de envio para um local, ou registo móvel para as relocalizações mais frequentes.

Um piloto deveria mapear encomendas reais e turnos reais. Os dados de teste ajudam no desenvolvimento, mas não mostram se o Wi-Fi flutua na parte de trás do armazém, se as luvas dificultam a operação do leitor, ou se um estado é formulado de forma confusa para a expedição. Estes detalhes determinam a aceitação e a qualidade dos dados.

Tecnicamente, a fiabilidade aborrecida e comprovável conta mais do que uma stack na moda. Permissões de funções claras, registos de gravação rastreáveis, indicações de erro inequívocas, transações de base de dados estáveis, e fluxos de trabalho documentados não são assuntos secundários. Transformam uma aplicação numa ferramenta em que as equipas podem confiar no dia a dia do negócio.

Para sistemas logísticos individuais, isto também significa: a integração tem de se ajustar às operações existentes. Uma aplicação pode adotar encomendas de uma loja, gerar guias de remessa, fornecer etiquetas de envio, e documentar movimentos de inventário. Não precisa de substituir imediatamente todos os sistemas adjacentes. Particularmente em pequenas e médias empresas, a substituição passo a passo é frequentemente menos arriscada e mais económica.

Como um projeto se torna numa melhoria permanente

A fase crucial começa após a implementação. As exceções são capturadas? As localizações de armazenamento ainda correspondem à realidade? Os novos funcionários compreendem a lógica de registo sem tradução verbal? E os valores medidos continuam válidos quando o volume de encomendas cresce?

Ciclos regulares de feedback curtos do armazém, expedição, e administração são mais eficazes para isto do que um grande workshop anual. Quando uma exceção recorrente se torna visível, deveria ser mapeada como um passo de processo claro ou conscientemente removida do fluxo padrão. Ambas as opções são melhores do que tolerá-la silenciosamente.

O passo seguinte mais sensato não é frequentemente um documento de especificação extenso. Pegue num processo com consultas frequentes e meça durante uma semana onde se perde tempo. Se daí surgir um fluxo de trabalho claro e repetível, a automação pode ser combinada com um resultado que convence tanto no chão do armazém como na avaliação mensal.

Permalink →

Desenvolvimento web moderno nas operações

Desenvolvimento web moderno nas operações

Um gestor de armazém imprime guias de remessa de manhã enquanto um colega corrige o inventário numa folha de cálculo, e as vendas telefonam para perguntar sobre o estado de uma encomenda. O problema raramente é a falta de digitalização. Na maioria das vezes, há simplesmente demasiadas ferramentas desconectadas. O desenvolvimento web moderno cria então não apenas uma interface mais bonita, mas uma base de trabalho partilhada e fiável.

Para pequenas e médias empresas, isto significa: uma aplicação web tem de funcionar sob pressão de tempo, num scanner no armazém tal como num ecrã no escritório. Tem de armazenar dados de forma rastreável, gerir permissões de forma limpa, e permitir desenvolvimento futuro sem se tornar um risco a cada modificação. A tecnologia não é um fim em si mesma. É a base para fazer os processos correrem mais depressa, permanecendo mais controláveis.

O desenvolvimento web moderno começa antes do primeiro código

Quem começa com um catálogo de funções pré-definido está frequentemente a construir a passar ao lado do estrangulamento real. Na prática, vale a pena um ponto de entrada diferente: que informação está atualmente em falta numa base regular? Onde ocorrem entradas duplicadas? Em que ponto as decisões são sustentadas por telefone ou acordo verbal porque ninguém vê de forma fiável o estado atual?

Durante a receção de mercadoria, isto pode manifestar-se como descrições de artigos inconsistentes, instruções de inspeção em falta, ou inventários atualizados tardiamente. No processamento de encomendas, são frequentemente notas manuscritas, aprovações pouco claras, e dados de envio mantidos em vários sistemas. Uma boa aplicação não se limita a digitalizar estas transferências. Organiza-as de forma que as responsabilidades, estados, e próximos passos sejam visíveis.

Isto também significa não abolir reflexivamente práticas existentes. Uma folha de cálculo bem mantida pode continuar a ser a solução mais sensata para uma pequena avaliação. Uma aplicação web personalizada vale a pena onde várias pessoas trabalham simultaneamente, os erros surgem de transcrição manual, ou um processo precisa de ser documentado e repetível.

O que uma aplicação web moderna tem de entregar nas operações diárias

Uma interface de utilizador convincente é valiosa, mas é apenas parte do trabalho. Nas operações contínuas, os tempos de resposta, fluxos de trabalho compreensíveis, e dados resilientes contam acima de tudo. Quando um operador de picking completa uma tarefa, o estado não pode tornar-se visível só após várias atualizações. Quando uma encomenda é alterada, tem de ser rastreável o que foi alterado e quais os passos subsequentes afetados. Isto inclui três camadas estreitamente ligadas: a interface de utilizador, a lógica da aplicação, e a base de dados. A interface guia as pessoas através do processo. A lógica verifica coisas como campos obrigatórios, permissões, ou quantidades disponíveis. A base de dados armazena factos de uma forma que permite que avaliações, correções, e expansões permaneçam possíveis mais tarde.

Para muitas aplicações de negócio, tecnologias comprovadas são uma escolha mais sensata do que uma tendência de curta duração. O PHP 8.4 pode fornecer lógica de servidor claramente estruturada, o JavaScript moderno proporciona uma experiência de utilizador responsiva, e o MySQL 8 oferece uma base de dados sólida. O fator decisivo não é que todos os projetos usem a mesma stack. A chave é que a tecnologia escolhida se ajuste ao problema, à operação, e à manutenção a longo prazo.

O desempenho é uma questão de processo

O desempenho é frequentemente reduzido a tempos de carregamento. Isso fica aquém. Uma aplicação também parece lenta quando os funcionários executam demasiados passos, procuram informação, ou têm de introduzir o mesmo detalhe várias vezes. Uma página rápida com um formulário incómodo continua a ser um processo mau.

A otimização sensata, por isso, começa com as operações mais frequentes. Que ecrãs são abertos cem vezes por dia? Que pesquisa tem de permanecer rápida mesmo à medida que o volume de dados cresce? Que dados deveriam ser guardados em segundo plano sem os funcionários esperarem por confirmação? Só depois é que se seguem os detalhes técnicos, como índices de base de dados direcionados, consultas reduzidas, e entrega enxuta de ficheiros no browser.

Modelo de dados e permissões: a arquitetura invisível

Muitos projetos web falham não na primeira versão, mas em adições subsequentes. Um campo inicialmente simples como "Estado" transforma-se subitamente numa cadeia de aprovação, inspeção, processamento, cancelamento, e acompanhamento. Se estes estados forem apenas vagamente armazenados em formulários, cada extensão torna-se dispendiosa e propensa a erros.

Um modelo de dados limpo, por isso, separa processos, posições, contactos, documentos, e alterações de estado de forma rastreável. Previne entradas contraditórias em vez de as limpar laboriosamente mais tarde. Especialmente com movimentos de armazém, guias de remessa, ou dados de encomendas, esta precisão não é um exercício académico. Determina se os números de inventário são fiáveis como base de trabalho.

As funções e permissões são igualmente importantes. Nem todas as pessoas precisam de acesso a preços, informação de pessoal, ou definições administrativas. Os bons conceitos de permissões são concretos: quem tem permissão para criar uma encomenda, aprová-la, ou cancelá-la? Quem vê apenas o seu próprio departamento? Medidas de proteção adicionais incluem armazenamento seguro de palavras-passe, bloqueio de contas após tentativas falhadas repetidas, registo de alterações críticas, e sessões claramente reguladas. A segurança não é, portanto, um extra pouco antes do lançamento. Pertence à arquitetura porque correções subsequentes frequentemente interferem profundamente na autenticação, no acesso a dados, e no sistema de permissões.

Responsivo não significa apenas "cabe num telemóvel"

Uma aplicação responsiva adapta-se a diferentes tamanhos de ecrã. Para o trabalho diário, esta definição não é suficiente. Num tablet no armazém, aplicam-se requisitos diferentes dos de um ecrã grande na expedição. As áreas de toque têm de ser operáveis de forma segura, os detalhes importantes não podem desaparecer sob informação secundária, e as entradas têm de permanecer práticas mesmo com luvas, condições de iluminação variáveis, ou uma ligação instável.

Consequentemente, cada vista requer uma prioridade clara. Na receção de mercadoria, a digitalização e confirmação podem ocupar o centro das atenções. No escritório, filtros, listas, funções de exportação, e vistas detalhadas são frequentemente mais importantes. Uma interface que parece idêntica em todo o lado não é automaticamente utilizável em todo o lado.

O desenvolvimento web moderno requer operações controladas

O lançamento não é um ponto final, mas o início do teste real. Só com dados reais, exceções, e horários de pico é que se torna evidente se as regras são compreensíveis e se as interfaces funcionam de forma fiável. O provisionamento documentado, ambientes claramente separados para desenvolvimento e produção, e cópias de segurança rastreáveis fazem, por isso, parte do projeto, não apenas administração de TI.

Os testes automatizados também conseguem muito aqui. Voltam a verificar fluxos de trabalho recorrentes, tais como login, verificações de permissões, entrada de encomendas, ou geração de documentos após cada alteração. Para aplicações sensíveis, um ambiente de teste auto-hospedado pode ser sensato porque as capturas de ecrã, dados de teste, e passos internos da aplicação permanecem dentro da esfera de controlo da própria empresa. A automação não substitui a revisão especializada por funcionários experientes. No entanto, garante que fluxos de trabalho conhecidos não são silenciosamente quebrados.

Na softify.pro, esta mentalidade faz parte da implementação: planear com precisão técnica, levar a sério os fluxos de trabalho reais, e entregar alterações de uma forma que os mantém compreensíveis mais tarde. Isso é menos espetacular do que um fogo de artifício tecnológico, mas significativamente mais valioso nas operações.

Quando o software padrão é suficiente — e quando não é

O software padrão é sensato quando o seu próprio processo corresponde em grande parte aos fluxos de trabalho padrão da indústria e a configuração permanece gerível. Pode estar disponível rapidamente e trazer funções centrais fiáveis. Torna-se problemático quando as equipas são forçadas a dobrar continuamente os seus fluxos de trabalho funcionais de forma incómoda ou quando informação vital acaba fora do sistema.

Uma solução personalizada não é automaticamente melhor. Requer requisitos claros, contactos responsáveis, e a prontidão para tomar decisões. Em troca, pode mapear os passos de trabalho exatos que são críticos para a empresa: uma inspeção especializada de receção de mercadoria, impressão de etiquetas de envio correspondentes, uma aprovação baseada no grupo de clientes, ou a ligação da oficina, armazém, e vendas. A pergunta correta não é, por isso: precisamos de uma aplicação à medida? É: que atrito recorrente nos está atualmente a custar tempo, dinheiro, ou fiabilidade — e pode ser permanentemente eliminado com um esforço razoável?

Uma boa aplicação web não torna o trabalho artificialmente digital. Remove transferências desnecessárias, estabelece um estado de dados fiável, e dá às pessoas exatamente a informação de que precisam para o seu próximo passo. Quando isso é conseguido, o desenvolvimento web moderno não parece um novo projeto de TI, mas uma operação que finalmente pode funcionar sem desvios.

Permalink →

Como implementar corretamente a digitalização de guias de remessa

Como implementar corretamente a digitalização de guias de remessa

Um motorista não espera porque um ficheiro Excel está atualmente aberto por outra pessoa. E na receção de mercadoria, uma pilha organizada de papel não serve de nada se uma entrega parcial não puder ser rastreada mais tarde. Quem procura "como digitalizar guias de remessa" raramente está, por isso, apenas à procura de digitalizar papel. O que se procura é um fluxo de trabalho resiliente que regista movimentos de mercadoria, confirmações, e discrepâncias exatamente onde ocorrem.

As guias de remessa digitais funcionam bem quando simplificam o trabalho no armazém, na oficina, e com o cliente. Se forem implementadas apenas como um arquivo PDF, o esforço permanece — apenas num ecrã. A diferença decisiva reside em dados estruturados, responsabilidades claras, e uma ligação limpa a encomendas, inventário, e faturas.

Como digitalizar guias de remessa: primeiro verifique o fluxo de trabalho

O primeiro passo não é a seleção de software, mas uma avaliação honesta do estado atual. Pegue numa guia de remessa real e trace o seu percurso: da encomenda ao picking, à entrega, ao feedback, e ao arquivo. Isto geralmente revela rapidamente onde a informação é adicionada retroativamente, introduzida duas vezes, ou esclarecida por telefone e chat.

Em pequenas e médias empresas, raramente existe apenas um fluxo de trabalho. Uma entrega padrão a clientes regulares requer algo diferente de uma entrega numa obra, uma recolha, ou uma entrega que envolva a devolução de contentores vazios. Nem todas estas diferenças precisam de ser automatizadas na versão um. No entanto, deveriam ser conhecidas para que o novo sistema não falhe logo no primeiro caso especial.

Um bom processo digital responde inequivocamente a três perguntas para cada estado: quem moveu a mercadoria e quando? Que quantidades foram realmente entregues? E o que aconteceu em caso de discrepâncias? Se esta informação estiver em falta, uma guia de remessa digital é principalmente apenas um documento mais bonito.

Não reproduza simplesmente o papel como PDF

Digitalizar guias de remessa existentes pode ser útil como transição, tal como para arquivar processos antigos. Para o negócio operacional, no entanto, resolve pouco. Uma imagem ou PDF pode ser armazenado, mas quantidades, números de artigo, lotes, e observações não podem ser reutilizados de forma fiável dentro dele.

Uma melhor abordagem é um documento gerado a partir de dados de encomenda estruturados. Artigos, quantidades alvo, endereços de entrega, e pessoas de contacto são adotados. Os funcionários confirmam então as quantidades reais diretamente num dispositivo móvel ou num posto de trabalho no armazém. Só discrepâncias, danos, ou posições adicionais precisam de ser introduzidas manualmente.

Isto não só poupa tempo. Também previne uma quebra de suporte típica: a contabilidade já não recebe uma assinatura mal legível em papel enquanto o armazém mantém separadamente o mesmo processo numa folha de cálculo.

Os dados de que uma guia de remessa digital realmente precisa

Um sistema não deveria forçar todos os campos concebíveis. Entradas adicionais atrasam as entregas e reduzem a aceitação. Ao mesmo tempo, um nome de cliente e assinatura são insuficientes para muitos fluxos de trabalho.

Como base, cada guia de remessa requer um número único, a referência à encomenda, endereços de entrega e destinatário, posições de artigo com quantidades alvo e reais, e registos de tempo.

Dependendo da indústria, são adicionados lotes, números de série, peso, localizações de armazenamento, ou contentores. Para mercadoria com controlo de temperatura, os valores medidos podem ser relevantes; para entregas em obras, fotografias ou detalhes precisos da localização de entrega são úteis.

O estado é particularmente importante. "Criado", "picking feito", "em trânsito", "entregue", "parcialmente entregue", e "contestado" não são meras etiquetas. Ditam qual a pessoa que tem de agir a seguir e se, por exemplo, uma fatura pode ser gerada ou uma nova entrega agendada.

Implementar assinaturas e fotografias com sentido de proporção

Uma assinatura digital é útil em muitos processos de entrega, mas não é automaticamente a melhor confirmação. Para uma entrega rápida na receção de mercadoria, um nome impresso, um registo de tempo, e a atribuição do destinatário podem ser suficientes. Para mercadoria de alto valor ou entregas contestadas, uma assinatura combinada com uma fotografia e informação de localização pode fazer mais sentido.

O fator decisivo é a cadeia de evidência: a confirmação tem de ser mapeada para o documento específico e a sua versão. Se alguém alterar quantidades ou posições depois de assinar, o sistema não deveria sobrepor isto silenciosamente. Requer uma correção rastreável ou uma nova confirmação. As fotografias merecem a mesma disciplina. Podem documentar danos, mas não deveriam transformar-se numa coleção indiscriminada de dados pessoais. Defina quando é necessária uma fotografia, quem lhe pode aceder, e durante quanto tempo é armazenada.

A entrada de dados móvel tem de funcionar em condições reais

No escritório, quase qualquer aplicação é operável. No armazém, luvas, Wi-Fi fraco, pressão de tempo, e dispositivos com autonomia de bateria limitada importam. Uma guia de remessa digital tem, por isso, de se gerir com poucos e grandes passos de entrada. As leituras de código de barras ou QR code são frequentemente mais rápidas e fiáveis do que procurar números de artigo.

A capacidade offline não é um luxo quando os motoristas trabalham fora de uma cobertura de rede estável. A aplicação deveria armazenar operações em cache localmente, indicar claramente o que ainda não foi sincronizado, e tratar conflitos de forma controlada. Se duas pessoas editarem a mesma entrega, a última gravação não pode vencer por coincidência.

A questão do hardware também tem de ser respondida pragmaticamente. Um smartphone existente pode ser suficiente para entregas simples. Para digitalizações, fotografias, e assinaturas frequentes no armazém, dispositivos portáteis robustos ou tablets são frequentemente mais económicos. A melhor decisão depende da duração operacional, do ambiente, e do débito esperado — não de qual dispositivo parece moderno num slide de produto.

Definir interfaces antes da implementação

Uma guia de remessa digital só revela o seu valor quando se liga às fontes de dados principais. Em muitas empresas, as encomendas residem no ERP ou sistema de gestão de inventário, os inventários numa solução de armazém separada, e as faturas na contabilidade. Isto não tem de se tornar instantaneamente num grande projeto de sistema. Mas a soberania de dados tem de ser clara.

Por isso, defina qual sistema mantém clientes, artigos, preços, e encomendas. A solução de guia de remessa pode adotar informação, mas não deveria gerar despercebidamente um segundo registo mestre de artigos. Da mesma forma, tem de ser regulado quando as quantidades reais confirmadas são reportadas de volta e quem revê as discrepâncias.

Tecnicamente, interfaces fiáveis são mais importantes do que funções espetaculares. IDs únicos, formatos de dados documentados, protocolos para transferências falhadas, e um mecanismo de nova tentativa previnem que as guias de remessa desapareçam entre dois sistemas. Uma aplicação enxuta sobre uma base sustentável, como PHP 8.4, JavaScript moderno, e MySQL 8, é mais sensata para muitos fluxos de trabalho de médias empresas do que um pacote sobrecarregado com funcionalidades que ninguém usa.

Segurança e arquivo pertencem ao processo

As guias de remessa contêm dados de negócio e frequentemente pessoais. As permissões de funções, por isso, não deveriam ser atribuídas globalmente. Os motoristas precisam dos seus circuitos e tarefas em aberto, os gestores de armazém requerem opções de correção e revisão, e a contabilidade precisa de documentos confirmados e exportações. O acesso total administrativo não é um direito padrão.

Adicionalmente, é necessário um histórico rastreável: criação, modificação, entrega, assinatura, cancelamento, e correção deveriam ser registados com tempo, utilizador, e justificação. Isto ajuda com consultas e protege os funcionários quando mais tarde não é claro quando um dano ou uma falta foi reportado. Para o arquivo, a regra é: o documento tem de permanecer legível e o processo localizável. Se um PDF é gerado depende dos fluxos de trabalho internos e dos requisitos dos destinatários externos. No entanto, o PDF é o resultado de um processo digital, não o seu modelo de dados.

Tornar-se produtivo em pequenos passos

A implementação mais fiável começa com um processo claramente delimitado: por exemplo, expedições padrão de um armazém ou receções de mercadoria de um departamento. Escolha uma área com volume suficiente, mas sem os casos de exceção mais complicados. Isto permite testar a operação, a qualidade dos dados, e as interfaces em condições reais.

Não meça apenas se a aplicação funciona tecnicamente. Verifique quanto tempo demora uma entrega, quantas guias de remessa requerem retrabalho, com que frequência ocorrem discrepâncias de inventário, e se a contabilidade consegue trabalhar mais depressa. Se um procedimento digital gera mais consultas do que o formulário em papel, a força de trabalho não é o problema — falta clareza de processo, ou a máscara de entrada não se ajusta à prática operacional.

As folhas de cálculo podem continuar a existir se forem fiáveis para uma avaliação limitada ou uma lista especial rara. A digitalização não significa abolir todas as ferramentas conhecidas. Significa substituir deliberadamente entregas propensas a erros e tornar o processo central robusto.

A softify.pro desenvolve tais fluxos de trabalho não como produtos padrão rígidos, mas em torno de movimentos de mercadoria concretos, funções, e sistemas existentes. Isto é particularmente útil quando uma empresa procura uma solução adequada entre o caos do papel e um sistema empresarial sobredimensionado.

O passo certo inicial não é, por isso, um longo catálogo de requisitos. Pegue em dez guias de remessa de uma semana normal, incluindo uma entrega parcial e uma reclamação. Se o seu futuro fluxo de trabalho processar estes dez casos de forma rápida, clara, e rastreável, uma guia de remessa digital transforma-se numa ferramenta em que o armazém, os motoristas, e a administração podem confiar.

Permalink →

Tendências de testes de software para 2026 que realmente contam

Tendências de testes de software para 2026 que realmente contam

Um lançamento falhado raramente mostra apenas um único erro. Frequentemente, várias causas juntam-se: uma permissão alterada, um ambiente de teste pouco claro, dados de teste em falta, ou um teste de regressão que não é mantido há meses. É precisamente aqui que as tendências de testes de software para 2026 se tornam concretas — não como uma coleção de novas ferramentas, mas como uma questão de como as empresas podem entregar alterações com segurança verificável, mesmo com capacidades de QA reduzidas e dados sensíveis.

Para equipas de software em empresas de média dimensão, isto é particularmente relevante. Uma aplicação de armazém, um portal de clientes, ou software de secretária Windows não precisa de servir milhões de utilizadores. No entanto, tem de funcionar em operações por turnos, gerar documentos corretamente, e aplicar permissões de forma fiável. Os testes, por isso, têm de estar mais próximos dos fluxos de trabalho operacionais reais do que de um ambiente de demonstração impecável.

Tendências de testes de software: a IA torna-se a executora, não o oráculo

A tendência mais visível é o teste apoiado por IA. Isto não significa que um modelo de linguagem lê um requisito e subsequentemente garante a qualidade da aplicação. Essa expectativa seria perigosa. No entanto, a IA pode reduzir significativamente o esforço onde as equipas perdem tempo hoje: formular casos de teste, reconhecer alterações notáveis nas interfaces de utilizador, atribuir padrões de erro semelhantes, e escrever relatórios de teste compreensíveis.

A IA torna-se particularmente útil quando executa passos de trabalho concretos e fornece evidência para os seus resultados. Um agente de teste pode, por exemplo, iniciar sessão, criar uma receção de mercadoria, alterar um endereço de entrega, gerar uma etiqueta de envio, e verificar se o estado, o movimento de inventário, e o documento coincidem. O fator decisivo não é a afirmação "teste aprovado", mas a cadeia de evidência: passos executados, registos de tempo, capturas de ecrã, registos técnicos, e uma descrição clara do desvio.

O limite continua a ser importante. A IA pode sugerir casos de teste e tratar fluxos de trabalho recorrentes. Não deveria decidir independentemente se um registo de negócio criticamente sensível está correto. Para preços, níveis de inventário, aprovações de pagamento, ou direitos de acesso, continuam a ser necessárias regras explícitas e expectativas confirmadas pelos departamentos de negócio. A automação acelera os testes; não substitui a responsabilidade.

A automação de testes migra para o processo de negócio

Durante muito tempo, a automação de testes de UI concentrou-se em caminhos simples: abrir página, preencher formulário, verificar mensagem de sucesso. Isso continua a ser útil, mas não é suficiente para sistemas críticos para o negócio. O teste mais valioso valida uma cadeia de processo inteira.

Tomemos uma função logística típica. Uma encomenda é registada, mercadoria é reservada, um processo de picking é iniciado, uma guia de remessa é gerada, e o envio é reportado. Cada ecrã individual pode parecer limpo enquanto o processo ainda falha — por exemplo, porque uma reserva persiste após uma anulação ou uma entrega parcial altera incorretamente o inventário. Bons testes automatizados, por isso, rastreiam estados e dados através das fronteiras do sistema.

Isto exige uma arquitetura de teste limpa. Os testes de API e de base de dados verificam regras rápida e precisamente. Os testes de UI controlam adicionalmente se os funcionários conseguem realmente operar o processo. Os testes de ponta a ponta combinam ambos, mas são mais lentos e mais frágeis. Quem testa tudo exclusivamente através do browser geralmente constrói um conjunto de testes caro e frágil. Quem testa apenas interfaces ignora problemas operacionais e interfaces de utilizador mal ligadas.

A solução pragmática é uma pirâmide que se adequa ao risco: muitas verificações rápidas próximas da lógica de negócio, menos verificações de integração, e cenários de ponta a ponta selecionados seletivamente para os fluxos de trabalho mais importantes. Isto soa pouco glamoroso. No entanto, entrega uma fiabilidade aborrecida e comprovável em vez de perseguição de tendências.

A IA de teste auto-hospedada torna-se uma questão arquitetónica

Com as ferramentas de teste de IA, surge uma nova questão: para onde vão os dados de teste, capturas de ecrã, e gravações? Em muitas aplicações, contêm nomes de clientes, preços internos, informação de pessoal, ou vistas de processos críticos para o negócio. Mesmo um ambiente de teste aparentemente inofensivo pode conter cópias de dados reais ou estruturas confidenciais.

Por isso, o ambiente de execução torna-se um critério central. Um serviço de cloud externo pode ser apropriado para aplicações web públicas e dados de teste não críticos. Para portais internos, aplicações de secretária, ou áreas reguladas, uma abordagem auto-hospedada é frequentemente mais sensata. Nesta configuração, a execução de testes, o material de imagem, e os registos permanecem dentro da infraestrutura controlada da empresa ou de um ambiente da UE claramente delimitado.

Isto não é um argumento genérico contra os serviços de cloud. A autogestão traz esforço: atualizações, controlo de acesso, recursos computacionais, monitorização, e responsabilidades claras têm de ser geridas. O benefício surge quando a proteção de dados, a rastreabilidade, e o controlo sobre os artefactos de teste superam a conveniência de uma conta SaaS instantaneamente disponível. Sistemas como a COCO seguem precisamente esta abordagem ao executar testes para aplicações web e Windows, mantendo a evidência controlável localmente.

Os testes instáveis já não são aceites como normais

Um teste automatizado que às vezes passa e às vezes falha sem uma alteração do produto não gera segurança. Gera filas de espera. As equipas então habituam-se a ignorar builds vermelhos ou a executar novamente os testes até aparecer o resultado desejado. Isto é uma perda progressiva de confiança em todo o quadro de controlo de qualidade.

Em 2026, a estabilidade da execução de testes passa mais para primeiro plano. As causas são geralmente conhecidas: tempos de espera aleatórios, seletores instáveis, dados de teste partilhados, dependências de serviços externos, ou bases de dados não repostas. A solução raramente é outra tentativa. Mais sensatos são seletores técnicos inequívocos, contas de teste isoladas, estados de dados controlados, e condições de espera direcionadas que reagem a eventos reais do sistema.

A avaliação também deveria diferenciar: um erro é reprodutível? Ocorre apenas num ambiente? Um serviço externo falhou ou foi a própria aplicação? A IA pode ajudar a agrupar estes sinais. No entanto, a decisão técnica tem de permanecer rastreável. Uma equipa de QA não precisa de uma previsão de erros misteriosa, mas de uma base resiliente para a próxima medida.

A qualidade começa mais cedo, com requisitos e dados

Muitos erros ocorrem antes de ser escrita a primeira linha de código. "A encomenda deveria poder ser enviada" não é um requisito testável. O que acontece no caso de um endereço incompleto, uma conta de cliente bloqueada, mercadoria em falta, processamento paralelo, ou uma sessão expirada? Sem respostas a estas perguntas, nenhum sistema de teste consegue verificar de forma fiável se o software está a funcionar corretamente.

Uma abordagem de teste mais madura, por isso, complementa os requisitos com exemplos verificáveis. Para uma conta com tentativas de login incorretas, isto pode significar concretamente: após cinco tentativas falhadas, a conta é bloqueada durante 15 minutos, o processo é registado, e um administrador autorizado pode rastrear o bloqueio. Isto produz diretamente verificações automatizáveis — e menos espaço para interpretação entre o desenvolvimento, as operações, e o departamento de negócio.

Os dados de teste também se tornam uma funcionalidade do produto. Têm de ser suficientemente realistas para mapear casos extremos, mas não devem copiar dados pessoais desnecessários. São úteis conjuntos de dados gerados para casos de IVA, quantidades parciais, artigos bloqueados, endereços inválidos, e várias funções. Especialmente com aplicações que usam MySQL 8 ou bases de dados relacionais comparáveis, compensa provisionar automaticamente estados iniciais definidos e removê-los após a execução.

Os testes baseados no risco vencem a cobertura de testes a qualquer custo

Um número elevado de cobertura de código pode ser tranquilizador, dizendo, no entanto, muito pouco. Mostra que linhas foram executadas, não se a regra correta foi testada. Um sistema pode alcançar 90 por cento de cobertura e ainda assim levar a inventário incorreto durante o cancelamento de uma entrega parcial.

A melhor pergunta é: que erros seriam particularmente dispendiosos para as operações, os clientes, ou a conformidade legal? Isto resulta numa priorização. A proteção de acesso, o cálculo de preços, os registos de inventário, a geração de documentos, e as interfaces para prestadores de serviços de expedição geralmente merecem mais profundidade de teste do que páginas de configuração raramente usadas. Isto não significa entregar assuntos secundários sem verificação. Significa aplicar tempo limitado onde uma falha pára o trabalho real ou gera decisões erradas.

Esta priorização tem de poder mudar. Se uma nova função de planeamento de rotas for introduzida, o seu risco aumenta. Se uma avaliação Excel antiga estiver prestes a ser substituída, um grande esforço de automação pode já não valer a pena. Às vezes é mais sensato manter uma folha de cálculo funcional durante alguns meses em vez de forçar apressadamente a sua lógica num sistema meio-acabado.

O que as equipas deveriam fazer agora na prática

O primeiro passo sensato não é uma comparação de ferramentas. Escolha um processo cujas falhas sejam tangíveis: da encomenda à entrega, da receção de mercadoria à arrumação, ou do login à aprovação de função. Descreva o fluxo de trabalho alvo com casos excecionais, configure dados de teste fiáveis, e primeiro automatize as verificações críticas. Posteriormente, não meça apenas o número de testes. Observe com que rapidez um erro real é detetado, com que frequência os testes falham sem causa, e se um relatório explica a causa de forma compreensível a um programador ou responsável de negócio. Só quando estas fundações estiverem estabelecidas é que a expansão com agentes de IA, inspeção visual, ou ambientes de teste extensivos vale a pena. As tendências de teste mais fortes são, em última análise, aquelas que tornam os lançamentos menos arriscados e levam as equipas a decisões claras mais rapidamente. Não é o dashboard mais moderno que conta, mas uma execução de teste rastreável que mostra que este processo de negócio funciona — e, se não funcionar, saber porquê.

Permalink →

Planeamento de rotas para viagens de entrega: escolher o software certo

Planeamento de rotas para viagens de entrega: escolher o software certo

Um motorista está à espera de uma guia de remessa enquanto a sequência das suas paragens muda mais uma vez. No armazém, uma expedição ainda não foi feita, um cliente está a ligar sobre uma janela de tempo mais apertada, e a lista de circuitos está sentada numa folha de cálculo que só uma pessoa realmente compreende. Quem procura "software de planeamento de rotas para viagens de entrega" nesta situação não está necessariamente à procura de um algoritmo de mapa complicado. O que procura é um fluxo de trabalho fiável desde a entrada da encomenda até à prova de entrega.

Para pequenas e médias empresas, esta é uma diferença decisiva. Uma rota teoricamente mais curta serve de pouco se não tiver em conta que a mercadoria só está pronta às 10h, um veículo requer refrigeração, ou um motorista possui conhecimento específico do cliente num determinado circuito. Um bom software para viagens de entrega reflete a realidade das operações — tornando-o utilizável em conjunto pela expedição, pelo armazém, e pelos motoristas.

Quando o planeamento de rotas se torna um problema operacional

Muitas empresas começam de forma sensata usando chamadas telefónicas, papel, e uma folha de cálculo. Com cinco paragens por dia e uma equipa fixa de motoristas, esta é frequentemente a solução mais rápida. Só quando o volume de encomendas, as variantes, e a pressão de tempo aumentam é que ocorrem perdas de atrito típicas: endereços introduzidos duas vezes, estados de circuito desatualizados, informação em falta sobre porta-cargas, e consultas que só podem ser respondidas ligando a várias pessoas.

O problema então não é apenas a distância percorrida. É a lacuna de informação entre a receção de encomendas, o armazém, a expedição, e a entrega. Se uma encomenda for adiada, esta alteração atualmente muitas vezes tem de ser seguida através de várias listas, num impresso, e na cabeça do motorista. Isto custa tempo e cria erros que os clientes veem imediatamente.

Outro sinal de alerta são decisões que dependem de funcionários individuais. Se apenas o expedidor experiente sabe qual entrada é adequada para um cliente específico, ou como o circuito 3 deve ser ajustado no caso de uma receção de mercadoria tardia, o fluxo de trabalho não está robustamente documentado. O software não deveria substituir este conhecimento. Deveria mapeá-lo de forma que a equipa permaneça capaz de agir.

O que o software de planeamento de rotas para viagens de entrega tem de conseguir fazer

A função central soa simples: as encomendas são atribuídas a um circuito, as paragens são ordenadas de forma sensata, e entregues aos motoristas. Para utilidade prática, no entanto, o sistema requer significativamente mais contexto. Os fatores decisivos são que regras se aplicam durante o planeamento e como as alterações são tratadas.

As encomendas têm de ser planeáveis, não apenas visíveis

Um endereço de entrega num mapa ainda não constitui uma entrega planeável. Uma encomenda requer pelo menos quantidades, peso ou volume, data de entrega, janela de tempo desejada, informação de contacto, e um estado de processamento claro. Dependendo do negócio, podem também ser adicionados porta-cargas, requisitos de temperatura, marcações de mercadorias perigosas, regras de notificação, ou uma classe de veículo específica.

Estes dados não deveriam ter de ser reunidos manualmente de vários sistemas de cada vez. Se as encomendas já provêm de uma loja online, ERP, máscara de entrada de encomendas, ou uma base de dados existente, uma transferência limpa é frequentemente mais valiosa do que uma vista de mapa particularmente espetacular. Caso contrário, o trabalho apenas se desloca do papel para uma nova interface de utilizador.

Os circuitos precisam de regras, não apenas de distância

Uma sequência automática baseada em quilómetros ou tempo de condução pode ser uma boa sugestão. No entanto, não é uma decisão para o negócio. O planeamento tem de conseguir ter em conta restrições: datas de entrega fixas, capacidade do veículo, horas de trabalho, tempos de carga e descarga, bem como responsabilidades regionais.

A lógica de partida também importa. Alguns veículos começam e terminam no armazém, enquanto outros conduzem diretamente para o seu próximo local operacional após a última entrega. Para circuitos recorrentes, uma estrutura básica fixa pode ser útil, que os expedidores só modificam quando necessário. Quem conduz exatamente as mesmas paragens todas as manhãs não necessita necessariamente de uma reotimização completa. Aqui, um circuito estável e rastreável é frequentemente melhor do que uma poupança de tempo matematicamente mínima.

As alterações têm de chegar ao motorista de forma controlada

A realidade raramente adere ao plano matinal. Os clientes cancelam, a mercadoria falta, um veículo avaria, ou uma encomenda torna-se urgente. Nestes casos, decide-se se o software proporciona alívio ou cria trabalho adicional.

Uma solução utilizável mostra claramente qual a versão do circuito atualmente válida, quais as paragens já concluídas, e o que especificamente foi alterado. O motorista não deveria ter de comparar impressos contraditórios, capturas de ecrã, e mensagens de aplicações de mensagens. Para muitas equipas, uma vista de motorista móvel, baseada em browser, com sequência de paragens, dados de contacto, guias de remessa, e feedback de estado é inicialmente suficiente. Uma aplicação dedicada não é automaticamente melhor se a instalação, gestão de dispositivos, e requisitos offline não proporcionarem um benefício claro.

Não comece apenas com a otimização de rotas

A abordagem falhada mais comum é adquirir primeiro um serviço de otimização e só depois verificar se os dados mestre e os fluxos de trabalho estão corretos. Endereços mal escritos, janelas de entrega pouco claras, e encomendas sem um estado de aprovisionamento fiável não podem ser otimizados. Um breve levantamento ao longo da rotina diária real é mais sensato. De onde vêm as encomendas? Quando o armazém confirma a disponibilidade? Quem planeia os circuitos? Como recebe o motorista as alterações? E que prova é necessária após a entrega? Estas perguntas podem parecer banais, mas determinam que campos de dados, funções, e interfaces o sistema realmente precisa.

Frequentemente verifica-se que nem todos os passos deveriam ser digitalizados. Uma nota manuscrita para uma entrega especial rara pode ser apropriada se depois for transferida de forma limpa para a encomenda. Uma folha de cálculo também pode permanecer se entregar de forma fiável uma avaliação gerível. O software deveria resolver o estrangulamento, em vez de substituir forçadamente todo o fluxo de trabalho conhecido.

Construir, comprar, ou extensão direcionada?

O software padrão é apropriado quando a lógica de circuitos é geral, os processos raramente variam, e a equipa se pode adaptar a máscaras dadas. Encurta a implementação e pode ser suficiente para uma frota de veículos simples. A desvantagem torna-se evidente assim que mapeia casos especiais centrais apenas através de listas secundárias, texto livre, ou módulos adicionais dispendiosos.

Uma solução personalizada não vale a pena porque o desenvolvimento personalizado é inerentemente superior. Vale a pena quando o próprio fluxo de trabalho é uma vantagem competitiva ou uma fonte persistente de erros: por exemplo, com unidades de embalagem especiais, circuitos combinados de recolha e entrega, documentos de entrega próprios, ou uma integração estreita de receção de mercadoria, picking, e expedição.

O caminho mais pragmático situa-se frequentemente algures no meio. Os sistemas existentes permanecem no lugar para contabilidade ou gestão de armazém, enquanto uma aplicação enxuta agrupa encomendas, planeia circuitos, e cobre o fluxo de trabalho do motorista. Isto requer interfaces claras, responsabilidades de dados inequívocas, e uma estrutura de base de dados que armazena alterações de forma rastreável. As aplicações web modernas construídas sobre uma base sustentável, como PHP 8.4 e MySQL 8, não são uma decisão de moda para isto, mas sim uma base para operações previsíveis e ajustes futuros.

Implementação em pequenos passos em vez de uma grande reformulação

O software de planeamento de rotas deveria primeiro ser testado num circuito ou grupo de veículos gerível. Não porque um projeto piloto está isento de risco, mas porque as exceções reais aparecem cedo: instruções de entrega em falta, dados de endereço inconsistentes, tempos de espera no cliente, ou transferências pouco claras no armazém.

Para a fase de expansão inicial, geralmente são suficientes funções claramente definidas: assumir a encomenda, ver o estado de aprovisionamento, montar o circuito, aprovar o circuito, e reportar a entrega. A otimização automática, assinaturas eletrónicas, prova fotográfica, notificações ao cliente, ou métricas-chave detalhadas só se tornam sensatas assim que esta cadeia funciona de forma fiável nas operações diárias.

O benefício não é medido apenas pelos quilómetros poupados. O esforço de expedição reduzido, menos consultas, menos entregas erradas, tempos mais curtos até à guia de remessa, e melhor capacidade de resposta face aos clientes são igualmente relevantes. Estas métricas deveriam ser aproximadamente captadas antes do lançamento. Caso contrário, a única impressão que resta após a implementação é que a interface de utilizador parece mais moderna.

A tecnologia tem de permanecer fiável em segundo plano

O planeamento de rotas processa dados operacionais sensíveis: endereços de clientes, atribuições de motoristas, quantidades de entrega, e frequentemente provas de entrega. Por isso, permissões de funções, modificações rastreáveis, cópias de segurança regulares, e operações documentadas fazem parte da solução. Quem tem permissão para aprovar, modificar, ou eliminar um circuito não deveria ser deixado ao acaso.

Os dados de mapas e rotas também merecem um exame sóbrio. Os serviços externos podem encaixar muito bem, mas trazem custos contínuos, considerações de disponibilidade, e questões de privacidade de dados. Quando estão envolvidos requisitos elevados de retenção de dados ou logística regional especial, tem de ficar claro desde cedo que dados saem do próprio sistema da empresa e como as interrupções são amortecidas. Uma rota perfeita não tem valor se a expedição não puder continuar a trabalhar durante uma perturbação.

A softify.pro planeia tais sistemas desde a receção real de encomendas até ao feedback do veículo. O ponto de referência aqui não é a lista de funcionalidades mais longa, mas um fluxo de trabalho que o armazém, a expedição, e os motoristas podem operar de forma fiável sob pressão de tempo. O melhor planeamento de rotas parece surpreendentemente pouco espetacular nas operações diárias: as encomendas estão completas, os circuitos são compreensíveis, as alterações são inequívocas, e as entregas são verificáveis. É precisamente esta fiabilidade pouco excitante que cria espaço para as exceções em que os humanos têm de decidir.

Permalink →

Automatizar o fluxo de trabalho de receção de encomendas

Automatizar o fluxo de trabalho de receção de encomendas

Uma encomenda chega por e-mail, outra por telefone, mais um ficheiro Excel do cliente-chave. Mais tarde no armazém, falta o endereço de entrega, as vendas já não sabem a data de entrega exata prometida, e o departamento de expedição imprime a guia de remessa com uma posição de artigo desatualizada. Quem quer automatizar o fluxo de trabalho de receção de encomendas não está a resolver um projeto digital abstrato. Está a eliminar precisamente este atrito no ponto onde a receita se transforma em trabalho operacional.

Para pequenas e médias empresas, a receção de encomendas é frequentemente subestimada. Enquanto chegam poucas encomendas por dia e os funcionários experientes conhecem cada caso especial, notas telefónicas, caixas de correio, e folhas de cálculo suportam o processo. Com o aumento do volume, no entanto, tornam-se um risco: a informação está presente em duplicado, as transferências acontecem verbalmente, e ninguém consegue dizer com fiabilidade qual o estado da encomenda que se aplica.

Porque é que a receção de encomendas se torna tão frequentemente um estrangulamento

A causa raramente é falta de esforço. Geralmente, o fluxo de trabalho cresceu ao longo de anos. Os clientes encomendam através de canais diferentes, os preços e condições de entrega aplicam-se apenas a grupos de clientes específicos, e os números de artigo diferem das designações internas. Os funcionários reconciliam a informação a partir da experiência e preenchem lacunas com consultas.

Isto funciona até alguém estar de férias, os turnos mudarem, ou várias encomendas urgentes chegarem simultaneamente. Nessa altura, torna-se evidente que o conhecimento não reside no processo, mas em mentes individuais e ficheiros dispersos. As consequências são familiares: quantidades erradas, entregas atrasadas, aprovações por resolver, e correções desnecessárias no armazém. A automação aqui não significa que um cliente tenha necessariamente de encomendar através de um portal. Significa que cada encomenda, independentemente do seu canal de entrada, é registada, verificada, enriquecida, e transferida de acordo com as mesmas regras rastreáveis.

Automatizar o fluxo de trabalho de receção de encomendas sem distorcer as operações

Um fluxo de trabalho utilizável não começa com uma lista de software, mas com uma análise de processo sóbria. As perguntas cruciais são: que informação tem de estar disponível antes de uma encomenda poder ir para o armazém, expedição, ou produção? E que exceções são legítimas em vez de simplesmente perturbadoras? Um fluxo de trabalho típico consiste em quatro fases claras: registar a encomenda, verificar os dados, aprovar a encomenda, e desencadear processos subsequentes. Entre estas fases, são necessárias responsabilidades e estados claros. Por exemplo, uma encomenda não deveria poder ser considerada "nova", "em esclarecimento", e "pronta para envio" ao mesmo tempo.

1. Consolidar encomendas de todos os canais num único processo

E-mail, telefone, PDF, EDI, formulário web, ou notas de serviço de campo podem permanecer pontos de entrada diferentes. O fator decisivo é que aterram num processo de encomendas partilhado. Os funcionários não deveriam primeiro ter de copiar informação da caixa de correio, depois atualizar uma folha de cálculo, e subsequentemente informar uma segunda pessoa.

Para encomendas estruturadas, os dados do cliente, números de artigo, quantidades, e datas solicitadas podem ser adotados diretamente. Para PDFs ou e-mails de texto livre, a entrada guiada é frequentemente mais sensata do que a extração totalmente automática. A extração apoiada por IA pode fazer sugestões, mas para quantidades pouco claras, números de artigo específicos do cliente, ou documentos manuscritos, é necessária uma revisão visível. O parâmetro sensato não é "automação máxima", mas sim "nenhuma entrada duplicada desnecessária". Um formulário bem concebido com campos obrigatórios e sugestões plausíveis poupa mais tempo em muitas operações do que uma automação completa propensa a erros.

2. Verificar os dados antes que os erros se propaguem

A automação mais valiosa ocorre antes da aprovação. O sistema pode verificar se o número de cliente existe, o endereço de entrega está completo, o artigo está ativo, a quantidade solicitada parece permissível, e está presente a aprovação de pagamento ou crédito. Os preços específicos do cliente, quantidades mínimas, e janelas de entrega também podem ser comparados com regras armazenadas.

O tratamento de desvios é importante. Nem todo o desvio precisa de bloquear uma encomenda. Se, por exemplo, faltar um número de referência, as vendas podem receber uma tarefa. Se uma encomenda exceder um limite de valor definido ou a margem cair fora do quadro acordado, pode ser necessária aprovação pela função responsável. Isto previne erros silenciosos e cria casos visíveis para esclarecimento. Essa é uma grande diferença: o armazém não recebe simplesmente uma encomenda incompleta, mas uma encomenda com um estado claro e uma decisão documentada.

3. Ligar aprovações a regras em vez de pedidos verbais

Muitos atrasos surgem de frases como: "podes aprovar isto rapidamente?" Tais consultas não são fundamentalmente erradas. Tornam-se problemáticas quando decorrem via chat, telefone, ou conversa de corredor e são posteriormente impossíveis de rastrear.

Um fluxo de trabalho automatizado armazena regras de aprovação diretamente ao nível da encomenda. Por exemplo, uma encomenda pode ser aprovada automaticamente se o cliente, preço, inventário, e endereço de entrega forem plausíveis. Para condições especiais, entregas parciais, ou uma encomenda que exceda um limite definido, a pessoa responsável é notificada. A aprovação é guardada com um registo de tempo e justificação.

Isto cria velocidade sem abdicar do controlo. Particularmente no caso de turnos rotativos ou vários locais, evita que as encomendas fiquem presas em caixas de correio pessoais.

4. Informar o armazém, a expedição, e os clientes de forma direcionada

Após a aprovação, a encomenda já não precisa de ser transferida manualmente de uma lista para a seguinte. O fluxo de trabalho pode gerar uma ordem de picking, reservar inventário, preparar uma guia de remessa, ou desencadear uma notificação de envio. Que passos fazem sentido depende do modelo de negócio.

Um vendedor de peças sobressalentes pode precisar imediatamente de uma ordem de picking e etiquetagem de prioridade. Um fabricante precisa primeiro de uma verificação de disponibilidade e depois de um impulso de produção. Um grossista com circuitos de entrega fixos quer agrupar encomendas até um determinado horário. Por isso, uma solução padrão rígida frequentemente não é a melhor escolha.

Para o cliente, uma confirmação clara é frequentemente suficiente: encomenda recebida, verificada, ou agendada de forma vinculativa. Nem toda a alteração de estado interna pertence a um e-mail. Demasiadas mensagens automatizadas geram consultas em vez de confiança.

Que dados um processo robusto requer

Uma boa receção de encomendas assenta numa base de dados limpa. Isto inclui dados mestre de clientes mantidos, números de artigo únicos, regras de preços e condições válidas, e endereços de entrega claramente definidos. Se estes fundamentos estiverem em falta, a automação apenas acelera a transmissão de dados pouco fiáveis. A arquitetura técnica também conta. Um sistema central com alterações de estado rastreáveis e uma base de dados fiável é permanentemente melhor do que uma cadeia de macros, ficheiros locais, e reencaminhamento de e-mails descontrolado. Isto não significa que toda a folha Excel tenha de ser substituída imediatamente.

Se uma folha de cálculo funciona de forma transparente num subprocesso pequeno e estável, pode permanecer por agora. No entanto, assim que várias pessoas trabalham com encomendas simultaneamente, são necessárias aprovações, ou a informação é transmitida ao armazém e expedição, uma fonte de dados central deveria ter precedência. Sistemas baseados numa arquitetura sustentável, como com PHP 8.4, JavaScript moderno, e MySQL 8, podem ser integrados com precisão nos fluxos de trabalho existentes em vez de forçar uma operação no esquema de um pacote de software empresarial.

Tornar mensurável se o fluxo de trabalho está realmente a melhorar

Um novo sistema não é automaticamente um processo melhor. Antes do lançamento, deveriam por isso ser estabelecidas algumas métricas-chave. As métricas relevantes incluem o tempo desde a receção da encomenda até à aprovação, o número de consultas por encomenda, correções após a transferência para o armazém, e a taxa de encomendas processadas a tempo.

Estas métricas também mostram onde não é necessária mais automação. Se 85 por cento das encomendas padrão decorrem rapidamente e sem erros, mas os restantes 15 por cento são casos especiais genuínos, um processo de esclarecimento claro é mais sensato do que tentar forçar algoritmicamente cada exceção. Os registos também ajudam nas operações diárias. Quem consegue ver quando uma encomenda chegou, que verificação falhou, quem a aprovou, e quando foi gerada a ordem de expedição já não procura a causa em cinco caixas de correio. Isto reduz não só os erros, mas também a dependência de funcionários individuais.

Introdução em pequenos passos em vez de um Big Bang

A entrada mais segura é geralmente um tipo de encomenda claramente definido: por exemplo, encomendas padrão de um grupo de clientes específico ou encomendas por e-mail com artigos conhecidos. Os campos de dados, regras, e transferências podem ser testados aí em condições reais. Só quando os estados, exceções, e responsabilidades funcionam de forma limpa é que se seguem casos mais complexos, como preços especiais, entregas parciais, ou especificações de embalagem individuais do cliente.

Os funcionários devem ser envolvidos na conceção. Não porque cada hábito existente tenha de permanecer inalterado, mas porque as pessoas ao telefone, nas vendas, e no armazém conhecem as exceções reais. Uma solução que apenas parece boa numa oficina é rapidamente contornada no chão do armazém.

Para tais projetos, a softify.pro conta com sistemas específicos para o fluxo de trabalho em vez de pacotes padrão sobrecarregados: com transferências claras, regras documentadas, e espaço suficiente para os métodos de trabalho que demonstravelmente funcionam dentro do negócio.

O melhor passo seguinte não é, por isso, a procura pelo máximo de funcionalidades possível. Pegue em dez encomendas reais de uma semana típica e trace o seu percurso desde a receção até ao envio. Cada dupla transferência manual, cada decisão pouco clara, e cada consulta recorrente é um ponto de partida concreto para um processo que funcionará de forma fiável para a equipa no futuro.

Permalink →

Proteger dados de teste durante os testes com IA

Proteger dados de teste durante os testes com IA

Um teste automatizado falhado normalmente resolve-se depressa. Uma captura de ecrã de uma execução de testes que contém dados de clientes, listas de preços ou uma sessão ativa e que acaba num serviço externo de IA é um problema diferente. Quem quer proteger os dados de teste durante os testes com IA tem, por isso, de considerar não só os casos de teste, mas todo o percurso dos dados: entradas, tráfego do browser, registos (logs), imagens, avaliação por IA e retenção.

Especialmente em aplicações web, portais internos e software para Windows, surge rapidamente uma falsa sensação de segurança. O ambiente pode chamar-se "teste", mas muitas vezes usa cópias de bases de dados de produção, papéis de utilizador reais ou interfaces com expedição, ERP e arquivos de documentos. Os testes assistidos por IA tornam estes dados particularmente valiosos para análise — e, por isso, particularmente carecidos de proteção.

Por que razão os testes com IA exigem uma perspetiva própria de proteção de dados

A automação de testes clássica normalmente verifica passos claramente definidos: iniciar sessão, criar uma encomenda, gerar uma guia de remessa, verificar o encerramento de sessão. Os testes assistidos por IA alargam este fluxo de trabalho. O sistema consegue interpretar interfaces de utilizador, avaliar anomalias, comparar capturas de ecrã e documentar resultados em linguagem compreensível. Isto poupa tempo em testes de regressão, mas gera artefactos de dados adicionais.

Estes artefactos são frequentemente mais expressivos do que um registo de teste comum. Uma captura de ecrã pode mostrar nomes, moradas, valores contratuais, quantidades de encomendas ou dados de saúde. Um registo de rede pode conter tokens de sessão e respostas da API. Uma mensagem de erro pode revelar caminhos internos de ficheiros, estruturas de bases de dados ou números de versão. Quando um modelo trabalha com esta informação, tem de ficar claro onde ocorre o processamento e quem lhe pode aceder.

A questão decisiva não é, portanto: "Usamos IA nos testes?" Mas antes: "Que dados saem de que zona de segurança — e porquê?" Para muitas empresas na região DACH, o processamento externo na cloud não está fundamentalmente excluído. Contudo, tem de corresponder às exigências de proteção a nível contratual, técnico e organizacional. Para dados de desenvolvimento, produção ou clientes, uma execução controlada localmente é frequentemente a decisão mais pragmática.

Proteger os dados de teste durante os testes com IA começa antes da primeira execução

A proteção de dados nos testes é muitas vezes discutida apenas na altura de escolher a ferramenta. Isso já é tarde demais. Primeiro, é necessário um inventário de dados simples e fiável. Que sistemas estão a ser testados? Que campos aparecem nas interfaces de utilizador? Que anexos, exportações e respostas de API podem surgir no teste? E que dados acabam automaticamente em capturas de ecrã, vídeos ou mensagens de erro?

Aqui vale a pena fazer uma divisão em três grupos. Os dados de teste não críticos podem ser gerados livremente e guardados por mais tempo. Os dados pessoais ou comercialmente confidenciais exigem mascaramento, restrições de acesso e períodos de retenção curtos. Credenciais de acesso, tokens, chaves e valores de configuração de produção não pertencem às evidências de teste nem aos pedidos ao modelo — mesmo que apenas visíveis por acidente numa janela do browser.

Em muitas aplicações de média dimensão, a situação dos dados não está claramente separada. A equipa de armazém testa uma nova receção de mercadorias com um extrato da base de dados, porque só lá estão presentes as estruturas reais dos artigos, as regras dos fornecedores e os casos especiais. Isso pode fazer sentido tecnicamente. A consequência, porém, não pode ser que esse extrato migre inalterado para todos os ambientes de teste.

Um processo reprodutível é melhor: exportar os dados, pseudonimizar de forma direcionada os campos sensíveis, remover tabelas desnecessárias e disponibilizar a base de dados de teste resultante de forma versionada. Assim, preservam-se os erros de processo típicos sem que clientes ou colaboradores reais fiquem visíveis nas execuções de teste. Para lógica de preços ou de disposição complexa, os dados totalmente sintéticos são muitas vezes insuficientes. Nesse caso, uma cópia cuidadosamente depurada costuma ser o melhor compromisso.

O mascaramento tem de preservar a lógica de negócio

Um mascaramento que substitui cada endereço de e-mail pelo mesmo marcador de posição pode prejudicar os casos de teste. As verificações de duplicados, a lógica de papéis, as funções de pesquisa ou os fluxos de faturação comportam-se de forma diferente em relação ao ambiente de produção. Um bom mascaramento preserva, por isso, formatos, relações e distribuições. Um número de cliente torna-se noutro número de cliente válido. Uma morada torna-se uma morada plausível, mas fictícia. Uma data de entrega permanece uma data dentro de um horizonte de planeamento realista.

Isto exige alguma preparação. Em troca, evita o erro clássico em que os testes estão tecnicamente "verdes" mas já não refletem os fluxos de trabalho reais no armazém, nas vendas ou no serviço ao cliente. A proteção de dados e os testes funcionalmente úteis não são opostos — desde que a preparação dos dados faça parte da arquitetura de testes.

O local de execução determina o controlo

Quem entrega testes automatizados a um serviço externo entrega, dependendo da configuração, mais do que apenas os passos de teste. O conteúdo do browser, as estruturas DOM, as capturas de ecrã, os vídeos, os registos de consola e as avaliações podem ser processados e armazenados fora da própria infraestrutura. Se isso é aceitável depende do caso concreto: categorias de dados, enquadramento contratual, localização de armazenamento, separação de inquilinos (tenants), conceito de eliminação e diretrizes internas atuam em conjunto.

Para aplicações com necessidades de proteção elevadas, um ambiente de teste alojado internamente (self-hosted) é frequentemente mais fácil de avaliar. O executor de testes, o componente de IA e o armazenamento de evidências permanecem dentro da própria rede da empresa ou numa infraestrutura europeia controlada. Regras de rede podem limitar ligações externas. O acesso pode estar associado a identidades, papéis e registos existentes. A retenção de imagens e relatórios torna-se assim uma decisão própria, e não uma predefinição de um fornecedor de plataforma.

O COCO segue precisamente esta abordagem: o servidor de IA executa testes para aplicações web e Windows de forma controlada, documenta evidências e gera avaliações compreensíveis sem que os dados internos da aplicação tenham de ser entregues, por predefinição, a uma cloud de IA externa. Isto não substitui uma auditoria de proteção de dados. No entanto, cria uma base técnica sobre a qual o departamento de TI, a segurança da informação e a área de negócio podem acordar regras rastreáveis.

Capturas de ecrã, registos e segredos são as fugas mais comuns

Muitas equipas protegem a base de dados de teste, mas ignoram os subprodutos dos testes. Na prática, é precisamente aí que residem os maiores riscos. Um teste de início de sessão falhado pode mostrar uma palavra-passe no campo de entrada. Um teste de API pode imprimir um bearer token no registo. Uma gravação de vídeo automática documenta uma encomenda completa, incluindo a morada do cliente. Um conceito robusto regula, por isso, pelo menos cinco pontos:

  • As capturas de ecrã e os vídeos só são criados quando necessário e eliminados após prazos fixos.
  • Os segredos são integrados através de um cofre de segredos (secret store) ou de variáveis de runtime protegidas, nunca armazenados no código de teste.
  • Os registos filtram tokens, palavras-passe, IDs de sessão e campos sensíveis antes de serem guardados.
  • As contas de teste possuem apenas os direitos necessários para o respetivo fluxo de trabalho.
  • Os sistemas de teste não podem desencadear e-mails, etiquetas, pagamentos ou movimentos de stock de produção, a menos que isso esteja explicitamente assegurado.

Estas regras soam sóbrias. É precisamente essa a sua vantagem. Uma equipa não tem de confiar na atenção ou na boa-fé, mas pode limitar tecnicamente o mau uso. Particularmente eficazes são contas de serviço separadas para a automação de testes, tempos de vida curtos para os tokens e um processo claro para revogar credenciais de acesso comprometidas.

A avaliação por IA também precisa de limites

Os modelos de IA são frequentemente utilizados para explicar discrepâncias: "O botão não estava visível", "A aplicação reagiu mais lentamente do que o esperado" ou "O processo terminou numa verificação de permissões". Para estas avaliações, um modelo não precisa necessariamente do conjunto completo de dados de clientes.

Por isso, defina que informação pode entrar na avaliação. Uma captura de ecrã anonimizada é suficiente? Basta uma classe técnica de erro em vez da resposta completa do servidor? Os campos podem ser ocultados antes da análise? A profundidade correta depende do objetivo do teste. Numa comparação de layout, um nome raramente é relevante. Ao verificar um modelo de documento personalizado, pode ser relevante — e nesse caso o processamento tem de ser devidamente protegido.

As medidas de proteção têm de continuar verificáveis em operação

Um conceito só é robusto se puder ser controlado na operação diária. Isto inclui verificações pontuais regulares das evidências de teste, revisões de permissões e uma análise aos dados efetivamente armazenados. Infiltraram-se novos campos nas capturas de ecrã? Ainda existem contas de teste antigas? Um extrato de base de dados está a ser mantido mais tempo do que o previsto? Estas questões fazem parte da rotina operacional normal, não apenas de uma auditoria. Igualmente importante é uma responsabilização clara. O QA conhece os fluxos de teste, o desenvolvimento conhece as interfaces técnicas, a área de negócio conhece os processos críticos e a segurança de TI define o enquadramento. Se ninguém juntar estas perspetivas, cria-se ou um atalho arriscado, ou uma especificação de segurança que impede testes reais. Um processo de aprovação pequeno e documentado costuma ser mais eficaz do que um extenso conjunto de regras que ninguém aplica.

No final, não se trata de tornar artificialmente complicado todos os testes. Proteger bem os dados de teste significa remover deliberadamente riscos reais da automação, preservando ao mesmo tempo a validade funcional dos testes. Quando as equipas sabem exatamente que dados um teste pode ver, onde residem as suas evidências e quando desaparecem, os testes com IA tornam-se uma ferramenta controlável em vez de uma incerteza adicional.

Permalink →

Mandar desenvolver uma aplicação web com PHP

Mandar desenvolver uma aplicação web com PHP

Quando a receção de mercadorias acaba numa folha de cálculo, os dados de expedição são transmitidos por telefone e o estado atual de uma encomenda existe apenas na cabeça de colaboradores individuais, o que normalmente falta não é mais uma ferramenta padrão. O que falta é um sistema que reflita de forma fiável o próprio fluxo de trabalho. Mandar desenvolver uma aplicação web em PHP vale precisamente a pena nesse ponto: quando informação, decisões e documentos precisam de convergir num só lugar, sem sobrecarregar a operação com um pacote empresarial sobredimensionado.

O PHP não é aqui um compromisso nostálgico. Com PHP 8.4, uma arquitetura de aplicação clara e MySQL 8, podem construir-se aplicações web duradouras, que respondem rapidamente, são fáceis de manter e funcionam de forma fiável em computadores, tablets ou leitores portáteis. No entanto, o que decide não é apenas a linguagem. O fator decisivo é se a aplicação efetivamente facilita o trabalho no armazém, no escritório e em movimento.

Quando faz sentido uma aplicação web à medida

Nem todos os processos exigem imediatamente software à medida. Uma folha de cálculo bem mantida pode continuar a ser a solução mais sensata para uma lista pequena e pouco variável. Um produto padrão consolidado também é útil se já cobrir os fluxos de trabalho essenciais e puder ser utilizado sem soluções alternativas permanentes.

O ponto de viragem chega quando os colaboradores introduzem dados várias vezes, recolhem informação de vários ficheiros, ou resolvem regularmente casos especiais fora do sistema real. Sinais típicos incluem níveis de stock pouco claros, guias de remessa criadas manualmente, responsabilidades ambíguas pelas encomendas, ou perguntas que todos os turnos têm de repetir. Nesse ponto, não se perde apenas tempo; os erros tornam-se difíceis de rastrear e a dependência de pessoas individuais aumenta.

Uma aplicação web à medida, por outro lado, reflete precisamente as regras que se aplicam ao negócio. Pode, por exemplo, registar a receção de mercadorias, documentar movimentos de stock, gerar etiquetas, priorizar encomendas ou tornar rastreáveis as passagens de responsabilidade entre equipas. Nem todos os casos especiais precisam de ser automatizados no primeiro dia. Um início sensato foca-se no fluxo de trabalho que atualmente gera mais fricção.

Mandar desenvolver uma aplicação web em PHP: o que deve ser esclarecido previamente

Um bom software não começa com maquetas de ecrã ou uma lista de termos técnicos. Começa com situações concretas: o que acontece quando uma entrega chega incompleta? Quem pode corrigir um nível de stock? Que informação precisa o departamento de expedição antes de uma etiqueta ser impressa? E o que acontece quando um colaborador do turno da tarde assume uma encomenda criada de manhã?

Destas perguntas surge uma imagem robusta do processo. Ela mostra entradas, decisões, passagens de responsabilidade e exceções. As exceções, em particular, são valiosas porque é precisamente aí que as soluções padrão frequentemente falham. Uma aplicação para receção de encomendas, por exemplo, não precisa apenas de guardar uma nova encomenda. Também tem de esclarecer como são tratados dados de artigos em falta, moradas de entrega diferentes, aprovações ou cancelamentos.

Antes da implementação, deve por isso estabelecer-se o objetivo, os grupos de utilizadores e a primeira fase de lançamento. Recursos úteis incluem dados de amostra reais, formulários existentes, fotografias dos postos de trabalho e conversas com as pessoas que trabalham diariamente com o fluxo de trabalho. Uma simples entrevista de gestão raramente fornece detalhe suficiente. Quem opera um leitor, armazena mercadorias ou verifica guias de remessa costuma conhecer com mais precisão as limitações práticas.

O menor início sensato

Um primeiro lançamento não precisa de ser uma plataforma empresarial acabada. Pelo contrário: um núcleo limitado e produtivamente utilizável reduz o risco e cria valor desde cedo. Uma opção concebível seria uma aplicação que, inicialmente, apenas regista encomendas de forma centralizada, torna visível o seu estado e cria uma guia de remessa fiável. A gestão de stock, as interfaces ou o planeamento de rotas podem seguir-se assim que o núcleo for validado no dia a dia da operação.

Esta sequência evita que um projeto trabalhe durante meses em funcionalidades cujo benefício real ainda não é claro. Também cria espaço para correções. Talvez a lógica de estados planeada seja demasiado granular, talvez a receção de mercadorias precise de uma máscara de entrada mais rápida ou de aprovação apenas acima de um determinado valor. Tais constatações não são falhas de planeamento, mas sim parte de uma implementação bem-feita.

A base técnica determina os custos subsequentes

Uma aplicação web não se torna sustentável apenas porque o PHP é mencionado na proposta. A sustentabilidade resulta de decisões rastreáveis: uma separação clara entre interface, lógica de negócio e acesso a dados, modelos de dados inequívocos, testes automatizados para regras críticas e implementação documentada.

O PHP 8.4 é muito adequado para isso. A linguagem é madura, eficiente de operar e uma escolha pragmática para muitas aplicações de missão crítica. Combinado com JavaScript moderno, a interface pode responder de forma rápida e direta, sem construir desnecessariamente cada funcionalidade de forma complicada como uma aplicação de página única. O MySQL 8 fornece uma base sólida para transações, conceitos de permissões e conjuntos de dados consistentes.

Particularmente nos processos de armazém e de encomendas, um registo não pode ficar guardado a meio. Se um artigo é dado como saído, o stock, os registos de movimento e o estado da encomenda têm de coincidir. As transações de base de dados garantem que ocorrem todas as alterações necessárias, ou nenhuma. Isto parece um detalhe, mas determina se um sistema permanece fiável em casos excecionais.

A segurança também pertence ao núcleo da arquitetura. Papéis e permissões têm de se adequar à rotina diária: uma pessoa na receção de mercadorias precisa de direitos diferentes dos da contabilidade ou de um motorista externo. Hashes de palavra-passe seguros, bloqueio de contas após tentativas de início de sessão falhadas, gestão de sessões e registos de alterações críticas não são extras para mais tarde. Pertencem à primeira versão de produção.

Construir interfaces apenas onde poupam trabalho

Muitos projetos tornam-se desnecessariamente grandes porque toda a integração concebível é planeada desde o início. Interfaces para lojas online, ERPs, prestadores de serviços de expedição ou contabilidade podem ser muito úteis. No entanto, só são boas se substituírem um passo manual claro ou melhorarem significativamente a qualidade dos dados.

Por exemplo: se etiquetas de envio são criadas diariamente a partir de dados de encomendas, uma integração direta poupa tempo e reduz erros de transmissão. Se, por outro lado, os dados de faturação são transferidos para um sistema existente apenas uma vez por semana e o processo é estável, uma exportação estruturada pode ser suficiente para começar. A solução tecnicamente mais elegante não é automaticamente a mais económica.

A soberania dos dados também deve ser esclarecida com antecedência. Que dados são armazenados, durante quanto tempo os registos permanecem disponíveis, quem pode exportá-los e como funcionam as cópias de segurança e a recuperação? Para empresas na região DACH, estas questões não são meras formalidades de TI. Dizem respeito à proteção de dados, à capacidade operacional e à confiança dentro da equipa.

Implementação sem abrandar a operação

A melhor aplicação falha se bloquear a rotina diária durante a transição. Por isso, a implementação deve ser preparada com casos reais: encomendas representativas, artigos reais, moradas de entrega típicas e casos especiais conhecidos. Só quando estes fluxos de trabalho funcionarem de forma rastreável é que o sistema deve assumir uma tarefa central.

A operação em paralelo pode ser útil por pouco tempo, por exemplo quando é necessário reconciliar stocks ou verificar novos documentos. No entanto, não pode tornar-se um estado permanente. Duas fontes de dados líderes criam inevitavelmente discrepâncias. É necessária uma data-alvo clara a partir da qual fica estabelecido qual sistema é vinculativo.

Igualmente importante é uma formação curta e orientada por papel. Um colaborador no armazém não precisa de uma explicação das funções de administração. Precisa de confiança nos poucos passos que tem de executar sob pressão de tempo. Boas aplicações ajudam com termos compreensíveis, valores predefinidos plausíveis e mensagens de erro que explicam o que fazer a seguir.

Como reconhecer um parceiro de desenvolvimento adequado

Quem encomenda uma aplicação web não está simplesmente a comprar horas de desenvolvimento. É necessário um parceiro que leve a sério as questões de processo, justifique decisões técnicas e até contrarie quando um requisito se torna desnecessariamente dispendioso ou arriscado. O acesso direto a programadores experientes vale aqui mais do que um processo de vendas elaborado com transferências subsequentes.

Preste atenção a afirmações concretas sobre arquitetura, operação e desenvolvimento futuro. Como são documentadas as alterações? Como decorrem as atualizações? Quem responde durante uma indisponibilidade? Existe uma estratégia de teste rastreável para registos e permissões críticas? Uma interface pode parecer convincente durante uma apresentação. O fator decisivo é se ainda pode ser adaptada ao fim de dois anos sem que cada alteração se transforme numa reconstrução completa.

Por isso, a softify.pro trabalha de forma faseada e orientada ao processo: primeiro compreender o estrangulamento operacional, depois entregar um núcleo robusto e construir a partir dele. Isto é menos espetacular do que uma grande promessa de transformação, mas na operação contínua costuma ser significativamente mais valioso. Uma boa aplicação web não precisa de conter o maior número possível de funcionalidades. Tem de garantir que uma encomenda não se perde, que o stock permanece rastreável e que os colaboradores conseguem concluir o seu trabalho sem perguntas desnecessárias. Quando isso é conseguido, um investimento técnico torna-se numa ferramenta que torna cada dia de trabalho mensuravelmente mais tranquilo.

Permalink →

Gerar etiquetas de envio automaticamente e reduzir erros

Gerar etiquetas de envio automaticamente e reduzir erros

Uma encomenda está embalada, a mercadoria encontra-se na rampa — e alguém ainda está à procura do método de envio correto, a digitar a morada do destinatário num portal da transportadora e a imprimir a etiqueta. Este fluxo de trabalho demora apenas alguns minutos por pacote. Com 30, 80 ou 300 envios por dia, torna-se um estrangulamento. Gerar etiquetas de envio automaticamente não significa, portanto, simplesmente ligar uma impressora. Significa ligar os dados da encomenda, as regras de envio e o processo real de embalagem de tal forma que um envio concluído se transforme de forma fiável numa etiqueta correspondente.

Para pequenas e médias empresas, este é frequentemente o ponto de entrada mais sensato para a automação logística. Os benefícios tornam-se imediatamente visíveis no armazém: menos questões, menos pacotes mal endereçados e um estado claro para as vendas, o armazém e o serviço ao cliente. No entanto, vale a pena analisar de perto o processo antes da implementação técnica. Um ficheiro de dados-mestre de artigos mal mantido ou regras de envio pouco claras não melhoram com a automação — apenas são processados mais rapidamente.

O que acontece realmente durante a impressão automática de etiquetas

Uma etiqueta de envio contém mais do que apenas um nome e uma morada. Dependendo do prestador de serviço, isto inclui um número de rastreio, um código legível por máquina, informação de encaminhamento, serviços como verificação de idade ou pagamento na entrega, e informação aduaneira para envios internacionais. Para que a transportadora gere uma etiqueta, esta informação tem de estar completa e no formato esperado. O fluxo de trabalho técnico começa normalmente com uma encomenda na loja online, no ERP, ou num sistema personalizado de gestão de encomendas. Assim que a encomenda está pronta a ser enviada, o sistema determina o prestador de serviço, o produto e os serviços adicionais com base em regras definidas.

Em seguida, transfere os dados para a interface da transportadora ou para uma plataforma de envios. Esta última regista o envio, devolve o número de rastreio e a etiqueta, e o sistema guarda o PDF ou os dados de impressão associados à encomenda. Só então é impressa — no posto de trabalho, na mesa de embalagem, ou diretamente através de uma impressora de etiquetas.

Esta sequência é fundamental. Uma etiqueta bonita sem um registo de envio bem-sucedido não ajuda. Inversamente, um registo bem-sucedido não pode desaparecer em segundo plano se a impressora ficar sem material. Bons processos tratam o registo, a produção e a resposta de estado como uma operação coesa.

Gerar etiquetas de envio automaticamente começa com regras claras

O equívoco mais comum é: o mesmo prestador de serviço deve ser sempre selecionado para todas as encomendas. Isso pode funcionar, por exemplo, com envios B2C homogéneos dentro da Alemanha. No entanto, muitas empresas precisam de regras mais diferenciadas. Uma entrega pesada, uma encomenda expresso, um levantamento num ponto de recolha ou um envio para a Suíça colocam requisitos diferentes.

Regras sensatas podem ter em conta o peso e as dimensões, o país de destino, a morada de entrega, o valor da mercadoria, o prazo de entrega desejado, as marcações de mercadorias perigosas e as condições acordadas com o cliente. A regra prática aqui é: nem toda a exceção teórica precisa de ser automatizada desde o primeiro dia. Se ocorrem dois casos especiais por mês, um passo manual visivelmente assinalado é frequentemente mais barato e mais seguro do que um motor de regras complicado. Casos recorrentes com volume significativo, por outro lado, pertencem ao processo padrão.

A fonte de dados é particularmente importante. Os pesos de um ficheiro de dados-mestre de artigos bem mantido são utilizáveis para mercadorias semelhantes. Para encomendas mistas, embalagem variável, ou sobretaxas para artigos volumosos, o peso final do pacote deve ser registado no posto de embalagem. O sistema pode então gerar a etiqueta apenas após a pesagem. Este é um passo manual adicional, mas evita correções e faturação adicional dispendiosas.

A qualidade da morada decide antes da impressão

Muitos problemas de envio surgem antes da entrega à transportadora. Números de porta acabam no campo errado, os códigos postais não correspondem à cidade, ou as moradas de empresas contêm nomes de destinatário pouco claros. A automação não deve, por isso, limitar-se a transmitir moradas, mas verificá-las com antecedência. Campos obrigatórios, formatos por país, comprimentos de carateres e duplicados reconhecíveis podem ser interceptados diretamente na introdução da encomenda.

A verificação de morada não é uma garantia de entrega. No entanto, reduz o número de erros evitáveis. No caso de dados suspeitos, o sistema deve colocar claramente a encomenda em espera para esclarecimento, em vez de gerar silenciosamente uma etiqueta incompleta. Deve ser visível no armazém porque razão uma encomenda está à espera e quem pode fornecer a informação.

O posto de embalagem precisa de uma operação simples

A melhor interface falha se os colaboradores tiverem de alternar entre cinco ecrãs durante a embalagem. Um diálogo de embalagem prático mostra apenas o que é necessário para o envio atual: encomenda, artigos, morada de entrega, estado de embalagem, peso, método de envio escolhido e estado de impressão. Uma leitura de código de barras na guia de remessa ou na lista de picking deve abrir a encomenda correta. Após a pesagem, idealmente basta uma única ação de confirmação para criar e imprimir a etiqueta.

Com vários postos de embalagem, cada posto de trabalho precisa de uma atribuição clara a uma impressora. O formato da etiqueta também tem de corresponder ao dispositivo e à transportadora. O A6 é comum para muitas etiquetas de encomendas, mas nem todos os rolos, impressoras térmicas e alimentadores de documentos funcionam da mesma forma. Quem começa por gerar etiquetas em PDF numa impressora laser de escritório pode começar rapidamente. Para volumes mais elevados, as impressoras térmicas são geralmente mais sensatas: evitam o corte, a colagem e o risco de uma etiqueta deslizar para o lado errado durante a impressão.

Um bom processo comunica os problemas técnicos de forma compreensível. "Erro de API 403" não ajuda na mesa de embalagem. É melhor: "Etiqueta não criada: verifique o acesso ao prestador de serviço de envio" ou "Impressora do posto de embalagem 2 inacessível." A encomenda não pode, neste processo, ser erradamente considerada enviada. Permanece num estado de erro claro e pode ser processada novamente após a resolução, sem registar um segundo envio.

As interfaces precisam de tratamento de erros, não apenas de um caminho ideal

As interfaces das transportadoras são sistemas externos. Podem estar temporariamente inacessíveis, rejeitar entradas ou alterar o seu formato de resposta. Uma rede local, um serviço de impressão ou credenciais de acesso expiradas também podem interromper o fluxo de trabalho. Por isso, é arriscado associar o sucesso apenas ao facto de um utilizador ter clicado em "Criar etiqueta".

Tecnicamente, todos os pedidos devem ser registados de forma rastreável: carimbo de data/hora, encomenda, serviço de envio utilizado, resultado, número de rastreio e mensagem de erro compreensível. Dados sensíveis e chaves de acesso não devem constar, desprotegidos, em ficheiros de registo. Um ID de envio interno único evita que uma nova tentativa gere etiquetas duplicadas ou faturação duplicada.

Os cancelamentos também pertencem ao planeamento. Se um pacote acaba por não ser recolhido ou é reembalado após a impressão da etiqueta, tem de ficar claro se o envio pode ser cancelado junto da transportadora e como isso é documentado no sistema interno. Sem este passo, o estado de envio, o rastreio e a faturação deixarão de coincidir ao fim de algumas semanas.

Nem toda a empresa precisa imediatamente de uma grande plataforma de envios

As plataformas de envio podem agrupar várias transportadoras, lógicas tarifárias e devoluções. Isto faz sentido se os volumes de envio, os países de destino e os prestadores de serviço forem diversos. No entanto, quem tem um processo de envio claro e uma ou duas transportadoras pode operar de forma mais transparente com uma ligação direta. Menos sistemas significam menos reconciliação de dados, menos contas de utilizador e menos pontos onde podem surgir erros.

A decisão não depende apenas do volume de pacotes. Devoluções, documentos de exportação, regras de envio individuais, fontes de encomendas existentes, e a questão de quem manterá as alterações mais tarde também são relevantes. Uma solução baseada em folha de cálculo continua a ser defensável, por exemplo, se forem enviados diariamente poucos envios com dados consistentes. Assim que os colegas transferem informação várias vezes ou o envio fica dependente de pessoas individuais, um fluxo de trabalho centralizado torna-se normalmente mais económico.

Para processos específicos do cliente, uma aplicação web leve pode fazer sentido, reunindo dados de encomendas, movimentos de stock, guias de remessa e impressão de etiquetas.
A softify.pro implementa estes sistemas com uma estrutura de dados rastreável, provisionamento documentado e tecnologias fáceis de manter, como PHP 8.4 e MySQL 8. O fator decisivo não é o número de funcionalidades, mas sim que o fluxo de trabalho se torne mais compreensível para a equipa na mesa de embalagem.

Introduzir em pequenos passos e melhorar de forma mensurável

Um início controlado é melhor do que uma grande mudança numa segunda-feira de manhã. Primeiro, automatiza-se um caso padrão claramente definido, como encomendas nacionais de uma transportadora com um formato de etiqueta definido. Em paralelo, os dados gerados automaticamente devem ser verificados em relação ao fluxo de trabalho anterior durante alguns dias: morada, peso, produto de envio, número de rastreio e etiqueta impressa.

As exceções podem depois ser adicionadas posteriormente. Métricas úteis incluem o tempo de processamento por envio, o número de correções manuais, etiquetas não impressas ou duplicadas, e o tempo até que a resposta de rastreio seja fornecida ao cliente. Estes valores mostram se a automação está verdadeiramente a assumir trabalho ou apenas a mapear digitalmente um desvio antigo.

No final, o que conta não é um diálogo de envio particularmente complexo. O que conta é que uma encomenda embalada receba a etiqueta correta sem procura, reintrodução e incerteza — e que as exceções se tornem visíveis onde um humano realmente tem de tomar uma decisão.

Permalink →

Testar o processo de login de forma automatizada

Testar o processo de login de forma automatizada

Testar o processo de login de forma automatizada só se torna uma questão banal quando funciona. Se falhar depois de um lançamento, os funcionários enfrentam o início de um turno, os clientes encontram-se bloqueados fora do portal de clientes, ou os expedidores lidam com o processamento de encomendas bloqueado. Testar automaticamente o processo de login, por isso, não significa simplesmente introduzir um nome de utilizador e palavra-passe num formulário. Significa verificar repetidamente um ponto de acesso crítico para o negócio, com todas as suas regras, exceções, e limites de segurança.

Para muitas equipas, a automação começa com um único caso de teste positivo: introduzir credenciais válidas, confirmar o login, e ver a página inicial. Isto faz sentido, mas por si só é insuficiente como único teste. Os erros de login ocorrem frequentemente nas margens: com sessões expiradas, contas bloqueadas, um novo método de autenticação multifator, ou permissões que já não se aplicam corretamente após uma mudança de função. Precisamente estes cenários precisam de ser cobertos de forma planeada.

Porque é que o login exige disciplina de teste especial

O login é simultaneamente uma função de segurança, uma interface técnica, e o ponto de entrada para o fluxo de trabalho. Um erro pode ser demasiado permissivo, permitindo acesso não autorizado. Inversamente, também pode ser demasiado restritivo, bloqueando indivíduos autorizados. Ambos são dispendiosos: o primeiro caso cria riscos para os dados e a conformidade, enquanto o segundo causa tempo de inatividade, sobrecarga de suporte, e soluções de emergência apressadas.

Para aplicações web, entram em jogo dependências adicionais. O login comunica frequentemente com um fornecedor de identidade, um sistema de correio para redefinições de palavra-passe, uma aplicação MFA, ou um serviço de diretório. Para aplicações de secretária Windows, direitos locais, ligações de rede, e estados de versão podem exercer influência. Um teste que apenas olha para o formulário num browser não consegue detetar de forma fiável tais problemas de integração.

Por isso, antes de iniciar qualquer automação de testes, a equipa deve definir o que significa um login bem-sucedido no respetivo sistema. Uma página inicial visível é suficiente? Ou tem de se verificar se a seleção correta do inquilino foi carregada, se a função do utilizador está correta, e se a primeira ação protegida é realmente possível? Para um portal de armazém, isto seria, por exemplo, o acesso à receção de mercadoria. Para um sistema de expedição, poderia ser a liberação de um circuito.

Testar automaticamente o processo de login: do modelo de fluxo de trabalho ao caso de teste

Um bom ponto de partida não é um script, mas um modelo de fluxo de trabalho. O login pode ser descrito como uma sequência de estados claros: sessão terminada, credenciais transmitidas, identidade confirmada, MFA necessário, sessão iniciada, sessão expirada, ou conta bloqueada. Cada estado inclui ações permitidas e respostas esperadas do sistema.

Deste modelo emergem casos de teste com valor de negócio. O caso positivo padrão pertence aqui, mas também palavras-passe inválidas, contas de utilizador inexistentes, e links de redefinição expirados. O feedback esperado é importante aqui. No caso de credenciais defeituosas, uma aplicação não deve revelar se um endereço de e-mail existe. O teste, por isso, verifica não só se um erro é exibido, mas também se o seu texto e comportamento não fornecem pistas desnecessárias.

Os mecanismos de proteção contra tentativas falhadas repetidas são especialmente relevantes. Após um número definido de introduções incorretas, uma conta pode ser temporariamente bloqueada. O teste automatizado tem de verificar se o bloqueio realmente entra em vigor, quanto tempo dura, e se o utilizador legítimo recupera subsequentemente o acesso controlado. É necessária precisão aqui: um teste que bloqueia intencionalmente contas de produção cria mais problemas do que resolve. Tais cenários pertencem a um ambiente de teste separado com contas especialmente criadas.

Considerar o MFA, a redefinição de palavra-passe, e o Single Sign-On separadamente

A autenticação multifator não é um pormenor menor no final do login. Muda o fluxo de trabalho. Um teste tem de reconhecer que é necessária confirmação adicional após a palavra-passe, e tem de mapear tanto a confirmação bem-sucedida como a rejeitada. Para códigos únicos baseados em tempo, o ambiente de teste requer um tratamento controlado de tempo e segredos. Em muitos casos, um método de teste fornecido pelo fornecedor de identidade é mais sensato do que recriar um telemóvel real.

A redefinição de palavra-passe e o Single Sign-On também devem receber as suas próprias vias de teste. Para uma redefinição, a transmissão da mensagem, a unicidade do link, o período de validade, e o login subsequente com a nova palavra-passe importam. Para o SSO, é crucial se a aplicação cria corretamente a sessão e assume de forma limpa as funções após o regresso do fornecedor de identidade.

Os CAPTCHAs formam um caso especial. Destinam-se a atrasar ataques automatizados e não devem ser contornados através de automação de testes. Em vez disso, uma configuração de teste, uma chave de teste oficial, ou uma exceção segura para o ambiente de teste é sensata. Enganar controlos de segurança apenas para que um teste fique verde não é uma estratégia de qualidade.

Escolher a camada técnica de teste apropriada

Nem todo o teste de login tem de correr através de um browser real. Os testes de API podem verificar se tokens, sessões, mensagens de erro, e regras de bloqueio funcionam corretamente. São rápidos e ajudam a encontrar erros próximos da lógica de autenticação. Os testes de browser, por outro lado, mostram se os campos, redirecionamentos, cookies, definições SameSite, e estados visíveis se encaixam no fluxo de trabalho real do utilizador.

Para aplicações críticas, a combinação é sensata. Alguns testes de ponta a ponta verificam o percurso completo usando o browser. Por baixo disso, testes de API e integração direcionados protegem as variantes. Isto reduz o tempo de execução e os falsos alarmes. Quem testa todas as combinações concebíveis exclusivamente no browser frequentemente acaba com um conjunto de testes lento cuja manutenção consome mais tempo do que poupa.

Para software de secretária, aplica-se um princípio semelhante. Um teste automatizado não deve apenas verificar se uma janela abre. Tem de determinar se a ligação de dados correta existe após o login, se os direitos do utilizador estão ativos, e se a máscara de trabalho central é acessível. Isto é particularmente relevante para aplicações no armazém ou na produção, porque os postos de trabalho podem ter condições de rede diferentes, ligações de scanner, ou configurações locais.

Tratar os dados de teste de forma segura e repetível

Os testes de login trabalham inevitavelmente com credenciais. Contas de produção de funcionários, dados reais de clientes, ou segredos MFA, contudo, não pertencem de forma descontrolada a scripts de teste, registos, e capturas de ecrã. As contas de teste têm de estar claramente rotuladas, minimamente privilegiadas, e restauráveis automaticamente. As palavras-passe e tokens são fornecidos através de gestão segura de segredos, em vez de serem armazenados no código-fonte.

A limpeza após uma execução de teste é igualmente importante. Se um teste cria novas sessões, entradas de auditoria, ou contas bloqueadas, o ambiente de teste tem de regressar a um estado inicial definido. Caso contrário, um teste na segunda-feira falha simplesmente porque uma execução de sexta-feira deixou efeitos secundários.

Para empresas com aplicações confidenciais, o local de execução também é decisivo. Capturas de ecrã de máscaras de login, vídeos de teste, e registos técnicos podem conter informação sensível. Uma infraestrutura de teste auto-hospedada como a COCO pode fazer sentido aqui porque os dados de teste, a execução, e as evidências permanecem sob o próprio controlo. Se isto é necessário depende das necessidades de proteção, situações contratuais, e diretrizes internas. Uma infraestrutura separada não é automaticamente a escolha mais económica para todas as aplicações.

Gerar evidências, não apenas marcas verdes

Um relatório de teste deve tornar compreensível para o QA, o desenvolvimento, e o departamento de negócio o que foi testado. Um estado verde sem contexto ajuda pouco se um lançamento desencadear questões mais tarde. Registos de tempo, o ambiente de teste usado, a conta de teste, passos relevantes, capturas de ecrã em caso de erros, e uma mensagem de erro clara em linguagem do dia a dia são, por isso, úteis.

Neste contexto, a recolha de evidências não pode tornar-se ela própria um problema de proteção de dados. Palavras-passe, códigos únicos, IDs de sessão, e dados pessoais têm de ser mascarados nos registos. Para capturas de ecrã, pode ser necessário desfocar certas áreas. Estas regras devem fazer parte da arquitetura de teste, não um retrabalho manual após um incidente.

O que as equipas devem automatizar primeiro

A prioridade é guiada pelo risco e pela frequência de utilização. Primeiro vem o login padrão para as funções mais importantes, credenciais defeituosas, logout, e expiração de sessão. A seguir seguem-se as regras de bloqueio, a redefinição de palavra-passe, o MFA, e as mudanças de função. O SSO, inquilinos especiais, ou vias de exceção raras podem seguir mais tarde, desde que a sua falha não pare imediatamente as operações.

Os testes pertencem ao processo de lançamento. As alterações a formulários de login, cookies, permissões, ou configuração do fornecedor de identidade devem desencadear o conjunto de testes relevante antes de uma versão entrar em produção. Além disso, vale a pena uma execução planeada num ambiente realista, como após alterações de infraestrutura ou renovações de certificados. Isto encontra problemas que não são visíveis num ambiente de desenvolvimento isolado.

No final, o melhor teste de login não é o que tem mais cliques. É aquele que deteta uma falha real cedo, a documenta de forma compreensível, e ainda pode ser executado de forma fiável durante a próxima alteração. Quem trata o login como um processo de negócio claramente modelado protege mais do que apenas um formulário. Protege o acesso ao trabalho que espera por trás dele.

Permalink →

Criar guias de remessa automaticamente com software

Criar guias de remessa automaticamente com software

A procura por "software para criar guias de remessa automaticamente" geralmente não começa com um problema de documentos. Começa na mesa de embalagem: uma encomenda é aprovada, a mercadoria foi separada (picking), mas a guia de remessa ainda existe como um modelo Word, uma exportação Excel, ou uma folha manuscrita. Enquanto alguém verifica linhas de artigo, quantidades, endereços de entrega, ou as expedições parciais mudam. Isto demora tempo — e cria precisamente os erros que mais tarde desencadeiam consultas, correções, e coordenação desnecessária.

Uma guia de remessa gerada automaticamente é, por isso, mais do que um PDF com um logótipo. É a transição documentada entre a encomenda, o movimento de inventário, e o envio. Para que isto funcione de forma fiável, o software não precisa de oferecer o máximo de funcionalidades possível. Tem de mapear corretamente o fluxo de trabalho real na operação.

Quando vale a pena criar guias de remessa automaticamente com software

Nem todas as empresas precisam imediatamente de uma aplicação personalizada. Quem processa poucas expedições por semana, vende artigos fixos, e trabalha com um modelo bem mantido, pode safar-se bem com uma solução de folha de cálculo. A automação torna-se sensata quando os funcionários introduzem dados várias vezes, as encomendas se dividem regularmente em expedições parciais, ou o estado de envio não pode ser claramente rastreado. Os sinais de alerta típicos são ficheiros Excel que se tornaram frágeis, descrições de artigos diferentes na encomenda e no armazém, registos em falta para consultas, ou números de guia de remessa atribuídos manualmente. Mesmo quando várias pessoas trabalham entre o escritório, o armazém, e a expedição, uma pasta partilhada frequentemente já não é suficiente. Nessa altura, não só falta velocidade, como uma fonte fiável sobre o que realmente saiu do edifício.

O ponto decisivo é: a guia de remessa deve ser criada por um evento, não por um passo de trabalho adicional. Este evento pode ser a liberação para picking, a remoção confirmada, ou a conclusão do processo de embalagem. Qual variante se ajusta depende do seu processo. Num armazém de peças sobressalentes, o registo de inventário é frequentemente o gatilho certo. Na produção específica do cliente, a liberação de envio pela preparação do trabalho pode ser decisiva.

De que dados uma guia de remessa automática realmente precisa

Um bom sistema não se limita a assumir todos os dados de uma encomenda. Verifica que informação se aplica no momento da entrega. O destinatário pode diferir do destinatário da fatura, uma encomenda pode ser expedida em vários envios, e a quantidade entregue pode ser menor do que a quantidade originalmente encomendada.

No mínimo, são necessários: um número de guia de remessa único, data de emissão, endereço de entrega, referência do cliente, e as linhas de artigo efetivamente entregues com quantidades e unidades. Dependendo do setor, acrescentam-se lotes, números de série, pesos, unidades de embalagem, operadores de picking, ou instruções de receção de mercadoria. Se estes dados forem necessários mais tarde para reclamações ou rastreabilidade, pertencem a campos de dados claramente definidos, não a um campo de texto livre.

A encomenda, o movimento de inventário, e o documento têm de coincidir

A vulnerabilidade mais comum situa-se entre a encomenda e o armazém. A encomenda pode prever dez peças, mas o armazém confirma apenas oito peças. Se, mesmo assim, se imprimirem dez peças na guia de remessa, cria-se um documento problemático. Se se entregarem oito peças sem ajustar o estado da encomenda, a quantidade restante permanece invisível.

Um software adequado mantém estes estados separados mas ligados: encomendado, reservado, separado (picking), entregue, devolvido se aplicável. A guia de remessa acede às quantidades de entrega confirmadas. Isto torna rastreável qual linha de artigo foi incluída em qual expedição, mesmo com entregas parciais e subsequentes.

Séries de números e versões não são pormenores menores

Atribuir números de guia de remessa manualmente parece inicialmente descomplicado. O mais tardar com vários locais, diferentes contas de utilizador, ou correções subsequentes, torna-se propenso a erros. A aplicação deve gerar números centralmente e evitar que o mesmo número seja usado duas vezes. Igualmente importante é o tratamento de alterações. Uma guia de remessa já expedida não deve ser silenciosamente substituída. É melhor uma correção reconhecível, cancelamento, ou nova versão com um histórico rastreável. Tecnicamente, isto não é um luxo, mas protege os funcionários de trabalharem com informação contraditória.

Como funciona a criação na prática

Num processo claro, tudo começa com uma encomenda estruturada. Artigos, quantidades, endereço de entrega, e data desejada são registados uma vez ou importados de um sistema existente. Em seguida, cria-se uma ordem de picking para o armazém — num dispositivo móvel, como impressão, ou num terminal de posto de trabalho.

Durante a embalagem, as quantidades efetivamente removidas são confirmadas. Para fluxos de trabalho simples, um botão de confirmação é suficiente. Para muitos artigos, locais de armazenamento, ou lotes, as leituras de código de barras são mais sensatas. Só após este feedback é que o software cria a guia de remessa como PDF, atribui um número, e a associa ao processo de envio. Em paralelo, pode preparar uma etiqueta de envio, desde que o respetivo serviço de encomendas esteja tecnicamente ligado.

O documento gerado é armazenado centralmente e permanece rastreável através da encomenda, conta de cliente, ou número de rastreio. Um funcionário de vendas interno já não precisa de procurar na sua caixa de entrada de e-mail quando um cliente pergunta o que foi entregue num dia específico. Vê a encomenda, as entregas individuais, e o respetivo estado do documento num único local.

Isto parece simples, mas frequentemente falha em casos especiais. Por isso, a aplicação tem de os tratar deliberadamente: o que acontece em caso de faltas? Quem pode alterar um endereço de entrega após a liberação? Pode gerar-se uma guia de remessa sem inventário? Como são marcadas as ofertas ou entregas de substituição? Tais regras determinam se a automação é aceite no chão do armazém.

Software padrão ou solução personalizada?

O software padrão faz sentido se o seu fluxo de trabalho segue em grande parte o modelo previsto e já existem interfaces para a loja online, planeamento de recursos empresariais (ERP), ou prestadores de serviços de expedição. Reduz o esforço de implementação e frequentemente oferece uma vasta gama de funcionalidades. O preço para isto pode ser que as equipas tenham de organizar os seus fluxos de trabalho funcionais em torno de um sistema rígido. Uma solução personalizada vale especialmente a pena quando a sua lógica é crítica para o negócio: por exemplo, com regras de embalagem específicas do cliente, expedições parciais complexas, múltiplas áreas de armazém, ou uma combinação de oficina, produção, e expedição. Pode focar-se nas funções necessárias diariamente em vez de enviar os funcionários através de módulos que ninguém usa.

Frequentemente, o caminho mais sensato situa-se algures no meio: os sistemas existentes permanecem líderes para os dados mestre de artigos ou contabilidade, enquanto uma aplicação web enxuta fecha a lacuna operacional no armazém. Através de interfaces claramente documentadas, as encomendas podem ser importadas, o inventário reportado de volta, e as guias de remessa arquivadas. Para tais aplicações, uma estrutura de dados rastreável, acesso baseado em funções, e processos de importação testados são mais importantes do que uma interface particularmente espetacular.

Na softify.pro, tais processos são primeiro verificados em relação ao fluxo concreto de mercadorias: quem desencadeia, quem confirma, que exceção realmente ocorre, e que dados têm de ser prováveis mais tarde? Só então se decide se uma adaptação ao sistema existente é suficiente ou se uma aplicação dedicada faz sentido económico.

Implementação sem abrandar as operações

O início mais seguro raramente é a digitalização completa de todos os processos de armazém numa única data-alvo. Comece com um percurso de entrega claramente definido, como encomendas padrão de um local ou categoria de produto. Isto revela se os dados mestre de artigos, a qualidade dos endereços, e a lógica de quantidades são suficientemente limpos.

No passo seguinte, encomendas reais devem ser testadas em paralelo. O software cria a guia de remessa enquanto o fluxo de trabalho anterior permanece disponível como instância de controlo. Os desvios são valiosos nesta fase: não indicam necessariamente um erro de software, mas frequentemente regras de processo por resolver. Se, por exemplo, dois funcionários embalassem a mesma encomenda de forma diferente, a regra de trabalho tem de ser primeiro esclarecida.

A seguir vêm as funções e direitos. O pessoal do armazém precisa de vistas diferentes das vendas ou da contabilidade. Nem todos devem poder alterar subsequentemente as quantidades de entrega ou cancelar documentos. Uma boa solução torna as responsabilidades visíveis sem forçar cada ação menor num processo de aprovação complicado.

As operações técnicas também fazem parte da implementação. Os documentos e dados de transação requerem cópias de segurança regulares, regras de retenção claras, e caminhos de recuperação testados. Numa aplicação web usando PHP 8.4 e MySQL 8, as transações de base de dados limpas são particularmente importantes: um registo de inventário e a criação da guia de remessa correspondente não podem falhar se uma ligação cair no momento errado.

Três erros que tornam a automação desnecessariamente cara

O primeiro erro é automatizar um problema de PDF quando os dados antes dele não são claros. Se os números de artigo, unidades, ou endereços de clientes não forem mantidos, o sistema apenas produz documentos errados mais rapidamente.

O segundo erro é um âmbito de projeto demasiado grande. Configurar simultaneamente guias de remessa, armazém, expedição, compras, produção, e contabilidade frequentemente prende as equipas durante meses. Um processo de entrega pequeno e resiliente constrói confiança mais rapidamente e fornece uma base para passos futuros. O terceiro erro é o feedback em falta do armazém. Uma guia de remessa não deve ser criada apenas com base numa encomenda planeada se ninguém tiver confirmado o que foi realmente embalado. É precisamente este feedback que transforma um modelo de documento num processo resiliente.

O melhor software para guias de remessa quase desaparece da vista nas operações diárias. Os funcionários introduzem uma encomenda uma vez, confirmam o seu trabalho onde ele acontece, e encontram novamente o documento correto quando é necessário. Quando isto é bem-sucedido, cria não apenas um envio mais rápido — mas um fluxo de trabalho no qual o armazém, o escritório, e os clientes podem igualmente confiar.

Permalink →

Testar automaticamente uma aplicação Windows

Testar automaticamente uma aplicação Windows

Uma versão está pronta, mas ninguém consegue afirmar com certeza se o novo diálogo de importação, a verificação de permissões e a impressão de faturas continuam a funcionar. É precisamente neste ponto que conseguir testar automaticamente uma aplicação Windows se torna valioso — não como uma demonstração com três cliques, mas como parte repetível do processo de lançamento.

O software de desktop é crítico para o negócio em muitas operações. Controla movimentos de stock, ordens de fabrico, dados-mestre de clientes ou documentos de expedição. Um erro afeta mais do que apenas um ecrã: pode bloquear encomendas, gerar etiquetas incorretas ou forçar os colaboradores do turno da noite a soluções manuais alternativas. Os testes automatizados reduzem este risco quando se concentram em fluxos de trabalho reais e num ambiente de teste tecnicamente controlado.

Por que os testes Windows são diferentes dos testes web

Uma aplicação web é geralmente testada através de elementos claramente endereçáveis no browser. Com aplicações desktop Windows, o funcionamento depende mais fortemente de janelas, diálogos, controlos nativos, resolução, permissões e componentes instalados. Um teste tem de determinar, por exemplo, se um diálogo realmente abriu, se um campo é editável, ou se um trabalho de impressão foi transferido corretamente.

A isto acresce a realidade amadurecida de muitas aplicações. Algumas interfaces consistem em componentes clássicos WinForms ou WPF, enquanto outras associam módulos mais antigos, visualizadores de PDF, ou interfaces com impressoras e hardware de digitalização. Não existe um único procedimento de automação que funcione igualmente bem para todas as aplicações. Quem oculta isto produz testes que parecem bons no laboratório e falham na próxima atualização.

O ponto de partida sensato não é, por isso, a ferramenta, mas a pergunta: que processos têm de funcionar de forma demonstrável em cada versão? Para software de stock ou de encomendas, seriam estes: início de sessão, verificação de permissões, introdução de encomendas, registo de stock, criação de documentos e transferência para uma interface. Estes processos entregam valor de negócio. Um teste que apenas verifica se um menu está visível raramente o faz.

Testar automaticamente uma aplicação Windows: escolher a camada certa

Fundamentalmente, existem três camadas disponíveis para a automação. Idealmente, são combinadas em vez de depender exclusivamente da interface de utilizador visível.

Ao nível técnico, os testes unitários e de integração verificam a lógica de negócio, o acesso a dados e as interfaces. Executam-se rapidamente e mostram cedo se um cálculo de preço, formato de importação ou regra de permissão foi quebrado. No entanto, não substituem um teste operacional: se um despachante consegue realmente aceder à função e executá-la corretamente permanece em aberto.
A segunda camada consiste em testes de UI através da Windows Automation API. As ferramentas de teste dirigem-se aqui aos elementos de controlo usando propriedades como ID de automação, nome ou tipo de controlo. Isto é geralmente mais estável do que testes que se limitam a clicar em coordenadas fixas do ecrã. As equipas de desenvolvimento podem promover ativamente esta estabilidade atribuindo IDs únicos e não renomeando controlos relevantes a cada alteração de interface.

A terceira camada funciona visualmente. Aqui, um sistema reconhece botões, conteúdos de tabelas, diálogos ou estados com base no conteúdo do ecrã. Isto ajuda particularmente com aplicações mais antigas, componentes proprietários, ou interfaces que não fornecem informação de automação útil. No entanto, o reconhecimento visual é mais sensível a escalonamento, temas, pop-ups inesperados e estados de ecrã pouco claros. Requer postos de trabalho definidos, condições de espera claras e evidências rastreáveis.

Uma abordagem assistida por IA pode classificar sinais visuais melhor do que um simples clique em coordenadas. Ainda assim, não deve tornar-se uma caixa preta. Para passos críticos, uma equipa precisa de capturas de ecrã, registos, resultados esperados e uma declaração sobre porque razão uma execução foi avaliada como falhada. Uma fiabilidade aborrecida e comprovável, em vez de perseguir tendências, aplica-se especialmente ao testar.

Começar com um âmbito de teste pequeno e fiável

O erro mais comum é tentar automatizar imediatamente todos os ecrãs. Isto consome orçamento e cria uma grande coleção de scripts frágeis antes de sequer ficar claro se a abordagem melhora as versões do dia a dia. É melhor um início restrito com cinco a dez fluxos de trabalho críticos que atualmente são verificados manualmente numa base regular.

Um bom primeiro caso de teste tem um início claro, uma entrada realista e um resultado verificável.
Exemplo: um utilizador com o papel de armazém inicia sessão, cria uma receção de mercadorias, regista um artigo numa localização de armazenamento, e imprime o documento. O teste verifica então não apenas a mensagem de sucesso, mas também o stock, o número do documento e o trabalho de impressão registado. Assim, uma sequência de cliques torna-se prova de um processo de negócio.

Nem todos os fluxos de trabalho são imediatamente adequados. Funções com hardware instável, serviços de pagamento externos, ou sistemas de terceiros frequentemente alterados exigem muitas vezes uma configuração diferente. Aqui, pode testar a sua própria aplicação até ao momento da transferência e mapear o componente externo através de um simulador controlado. Isto não é um atalho, mas uma demarcação clara de responsabilidades.

Os dados de teste são parte do sistema

A automação frequentemente falha não por causa da interface, mas por causa de dados inutilizáveis. Uma conta de teste está bloqueada, um artigo já foi utilizado, ou uma execução anterior alterou a quantidade de stock esperada. Por isso, o ambiente de teste precisa de dados iniciais definidos e de uma forma fiável de voltar a este estado.

Na prática, isto significa: bases de dados de teste separadas, papéis de utilizador fixos, conjuntos de artigos e clientes conhecidos, bem como lógica controlada de tempo e números. Para dados sensíveis, os dados de produção não devem ser copiados de forma descontrolada. Conjuntos de dados anonimizados ou gerados especificamente são geralmente a melhor escolha. São previsíveis e reduzem os riscos de proteção de dados.

Os fluxos de bloqueio de conta também merecem atenção especial. Se execuções de teste falhadas usarem repetidamente palavras-passe incorretas, podem bloquear o seu próprio acesso. Tais cenários devem ser testados de forma consciente, mas separados do teste de regressão normal.

A estabilidade vem da operação, não de uma única ferramenta

Um teste de UI só é útil se for executado sob condições repetíveis. Isto inclui uma versão fixa do Windows, resolução e escalonamento de ecrã definidos, versões de aplicação conhecidas, e um tratamento limpo de atualizações, diálogos e processos em segundo plano. Se um servidor de teste utiliza tamanhos de letra diferentes de manhã e à noite, isso não é um problema de teste — é um problema de operação.

Os tempos de espera não devem ser introduzidos cegamente como valores fixos. Uma pausa de três segundos após cada clique torna um teste lento e não resolve problemas de temporização. É melhor esperar especificamente por um estado: a janela está visível, a tabela contém o registo de dados esperado, ou o processo de gravação está concluído. Processos assíncronos reais requerem limites de tempo sensatos e diagnósticos de erro claros. As execuções falhadas pertencem à triagem, não a uma pasta ignorada.

A aplicação estava avariada? A interface mudou de forma funcionalmente correta? O ambiente de teste estava indisponível? Capturas de ecrã, gravações de ecrã, registos técnicos e carimbos de data/hora encurtam consideravelmente este esclarecimento. Um relatório em texto simples também ajuda os departamentos a compreender qual o processo de negócio afetado, sem ter de ler primeiro um script de teste.

Planear a proteção de dados e as evidências desde o início

Em aplicações desktop, as capturas de ecrã frequentemente mostram nomes de clientes, preços de artigos, moradas ou indicadores-chave internos. Se os testes forem executados através de serviços de cloud externos, os dados do ecrã e o tráfego da aplicação podem sair da sua própria zona de controlo. Para equipas conscientes da segurança, isto não é um detalhe menor, mas uma decisão arquitetónica.

Um servidor de teste self-hosted pode manter a execução dos testes, as imagens e os relatórios no seu próprio ambiente.
Para este fim, a softify.pro utiliza o COCO, um ambiente que executa testes automatizados para aplicações web e Windows e gera resultados rastreáveis. Se um servidor dedicado faz sentido depende dos requisitos de proteção, do TI existente e do número de execuções de teste. Para uma aplicação pequena e não crítica, uma abordagem simples pode ser suficiente; para sistemas internos especializados com dados sensíveis, o controlo local é frequentemente a opção mais sensata.

A retenção de evidências também deve ser regulamentada. Nem todas as capturas de ecrã precisam de ser armazenadas permanentemente. Prazos, acesso baseado em papéis, e uma atribuição clara entre a execução do teste, a versão da aplicação e o resultado são úteis. Isto torna possível reproduzir erros sem construir uma segunda coleção de dados descontrolada.

O que uma implementação sensata proporciona

Após uma execução inicial, uma equipa não deve receber apenas um número de testes aprovados. O fator decisivo é se os testes encontram erros reais, se funcionam de forma fiável, e se o esforço de manutenção corresponde ao benefício. Um teste que tem de ser ajustado todas as semanas devido a uma alteração de layout insignificante é demasiado dispendioso — mesmo que pareça tecnicamente impressionante.

O próximo passo é a integração no processo de lançamento. Testes técnicos rápidos podem começar com cada build; testes end-to-end selecionados são executados antes da aprovação ou durante a noite num ambiente estável. Desvios críticos bloqueiam o lançamento, notas menos críticas são documentadas e priorizadas. Estes limiares devem ser acordados tecnicamente. Nem toda a diferença visual é um bloqueio à entrega, mas uma quantidade incorretamente registada certamente é.

Os testes Windows automatizados não substituem a especialização. No entanto, criam tempo para verificações que exigem julgamento: novos processos, casos especiais invulgares, e a questão de saber se uma função é verdadeiramente compreensível no trabalho do dia a dia. Quando os processos padrão são fiavelmente verificáveis, um lançamento deixa de ter de depender da esperança.

Permalink →

Software de logística personalizado para PME

Software de logística personalizado para PME

Se a receção de mercadorias é registada em papel, os níveis de stock estão espalhados por vários ficheiros Excel, e as questões de expedição são resolvidas de boca em boca, raramente é falta de dedicação o problema. O que falta é um processo partilhado. O software de logística personalizado para pequenas e médias empresas propõe-se corrigir exatamente isso: não com um sistema empresarial sobrecarregado, mas com uma aplicação que mapeia os fluxos de trabalho reais no armazém, no departamento de expedição e no escritório.

Para muitas empresas, isto não é um projeto de digitalização pela digitalização. Trata-se de menos questões, níveis de stock fiáveis, guias de remessa geradas mais rapidamente, e uma passagem de turno que não depende do conhecimento de indivíduos. A melhor solução não é automaticamente a que tem mais funcionalidades. Tem de tornar o trabalho demonstravelmente mais simples e mais controlável.

O ponto crítico é normalmente nas transições

Em pequenas e médias empresas de armazenagem e fabrico, muitas coisas funcionam surpreendentemente bem durante muito tempo usando folhas de cálculo, e-mails e experiência. Isto não é fundamentalmente errado. Uma folha de cálculo bem mantida pode ser mais sensata para uma lista de stock gerível do que um sistema dedicado.

Torna-se crítico quando a informação é registada várias vezes ou a sua fiabilidade deixa de ser clara. Uma encomenda é criada no escritório, impressa no armazém, complementada numa folha de rota, e mais tarde transferida de volta para uma folha de cálculo. Ao mesmo tempo, outro colaborador reserva stock para um envio urgente. No final, não só o nível de stock é questionável, como a questão de quem realizou qual passo e quando dificilmente pode ser respondida.

Esta fricção raramente se manifesta como um único erro grave. Custa minutos todos os dias: ao procurar artigos, ao devolver a chamada de um cliente, ao rastrear uma entrega, ou durante as passagens de turno. Ao longo de semanas, isto resulta em faltas evitáveis, envios expresso, e discussões sobre números em que ninguém confia completamente.

O que o software de logística personalizado deve mapear especificamente

Uma aplicação feita à medida não começa com um catálogo de funcionalidades. Começa com uma análise de processos no chão de fábrica e no posto de trabalho do despachante. Que dados chegam realmente? Que decisões toma um colaborador? Que exceções ocorrem regularmente? E que informação tem de estar presente para que o próximo passo de trabalho possa avançar?

A partir daqui, surge um fluxo de trabalho claro — por exemplo, desde a receção de encomendas, o picking e a expedição até à passagem para a contabilidade. Dependendo do negócio, os seguintes blocos de construção podem estar incluídos:

  • Registo da receção de mercadorias, estado de inspeção e localizações de armazenamento
  • Movimentos de stock apoiados por códigos de barras ou leitores móveis
  • Aceitação de encomendas, reservas e listas de picking
  • Guias de remessa, etiquetas de envio e entrega a prestadores de serviços logísticos
  • Planeamento de rotas para veículos e circuitos próprios
  • Correções rastreáveis, permissões baseadas em papéis e avaliações

O fator decisivo não é construir tudo de uma vez. Um negócio com relocalizações frequentes pode precisar primeiro de movimentos de stock fiáveis. Um grossista com muitos envios pequenos beneficiará inicialmente mais de uma receção de encomendas limpa e documentos de envio gerados automaticamente. Uma empresa fabril poderá precisar primeiro de transparência quanto ao aprovisionamento de materiais e ao stock bloqueado.

Um exemplo da operação diária

Suponha que o departamento de receção de mercadorias recebe cinco paletes de artigos, cujas quantidades diferem parcialmente da encomenda. Num bom fluxo de trabalho, a entrega é registada, verificada e recebe um estado. Só depois da aprovação é que o stock fica disponível para expedição. As discrepâncias não acabam numa nota anexada à guia de remessa, mas são visivelmente atribuídas às compras e ao armazém.

Quando o picking ocorre mais tarde, o sistema mostra não apenas um stock total teórico, mas a localização de armazenamento correspondente e a parte reservada. Após a digitalização ou confirmação da remoção, o movimento é registado. A guia de remessa é gerada a partir dos mesmos dados. Isto reduz entradas duplicadas e cria um registo de auditoria fiável, sem que os colaboradores tenham de realizar trabalho administrativo extra.

Software padrão, Excel, ou desenvolvimento personalizado?

A resposta honesta é: depende do processo.

O software padrão faz sentido quando os fluxos de trabalho correspondem em grande parte aos padrões pretendidos, os ajustes permanecem mínimos, e os custos de licenciamento se ajustam ao âmbito. Frequentemente traz módulos prontos, interfaces estabelecidas, e um lançamento inicial rápido.

A desvantagem torna-se evidente quando o negócio tem de se adaptar permanentemente à ferramenta. Nesse caso, os casos especiais são novamente tratados fora do sistema, os campos obrigatórios são contornados, ou os colaboradores mantêm listas paralelas. Isto pode ser aceitável enquanto estas exceções permanecerem raras e geríveis. Se se acumularem, o produto padrão transforma-se numa perturbação adicional do processo.

O Excel também continua a ser uma ferramenta útil quando os volumes de dados são pequenos, apenas algumas pessoas trabalham simultaneamente, e as consequências de uma entrada incorreta permanecem limitadas. No entanto, não é uma boa base de dados para movimentos de armazém paralelos, reservas vinculativas, ou um histórico de envio completo.

Uma solução personalizada compensa particularmente quando o fluxo de trabalho é uma verdadeira vantagem competitiva, quando várias rupturas de suporte se juntam, ou quando um sistema existente contém dados mas abranda o trabalho diário. Não deve ser entendida como um projeto de prestígio. O seu valor económico reside em prazos de entrega mais curtos, menos erros, e menor dependência de mentes individuais.

O software de logística personalizado para PME precisa de limites

Feito à medida não significa implementar imediatamente todas as funcionalidades desejadas. Pelo contrário: um bom desenvolvimento personalizado estabelece limites claros. Caso contrário, cria-se um sistema que preserva todos os caminhos especiais históricos, tornando-o difícil de usar.

Um início sensato define um processo central com benefícios mensuráveis. Por exemplo: a receção de mercadorias é completamente registada no mesmo dia. Ou: artigos, quantidades, processador, e estado de envio são claramente documentados para cada ordem de expedição. Só quando este fluxo de trabalho funciona de forma estável é que seguem mais módulos, como planeamento de rotas, portais de clientes, ou avaliações especiais.

As decisões técnicas também exigem pragmatismo. Uma aplicação web pode ser construída sobre tecnologias modernas e sustentáveis como PHP 8.4, JavaScript moderno, e MySQL 8. Isto não é autopromoção com termos técnicos da moda; cria uma base rastreável para permissões de papéis, transações de base de dados, interfaces móveis, e implementações documentadas. Para leitores no armazém, é frequentemente crucial que a aplicação responda de forma fiável nos dispositivos existentes e forneça um feedback claro mesmo com Wi-Fi mais fraco.

Nem todas as funcionalidades requerem complexidade em tempo real. Alguns relatórios podem ser atualizados durante a noite, enquanto os registos de stock e as reservas têm de ser imediatamente consistentes. Esta distinção mantém a arquitetura, os custos, e a operação geríveis.

Implementação: estabilizar primeiro o fluxo de trabalho, depois acelerar

A implementação raramente falha por causa de uma única interface. Falha quando as questões de processo em aberto são adiadas para a fase de desenvolvimento. Quem pode corrigir o stock? O que acontece com mercadoria danificada? Quando é que uma encomenda fica vinculativamente reservada? Como são tratadas as devoluções? Tais regras têm de ser esclarecidas antes de um lançamento alargado.

Um caminho fiável começa com alguns fluxos de trabalho representativos e dados reais. Colaboradores do armazém, da expedição e da administração verificam em conjunto se o ecrã fala a linguagem do negócio e se a sequência dos passos de trabalho está correta. Neste processo, feedback como "não precisamos deste campo" ou "falta aqui o estado para entrega parcial" é mais valioso do que pedidos abstratos de funcionalidades.

Segue-se uma operação piloto limitada — não com exemplos artificiais, mas com encomendas selecionadas no negócio diário. Erros e estados pouco claros são documentados, priorizados, e corrigidos. Só então o lançamento é alargado a outras áreas. As operações paralelas podem fornecer segurança a curto prazo, mas devem ter uma data de fim. Dois sistemas líderes criam permanentemente exatamente a incerteza que o projeto se destina a eliminar.

A formação é também mais do que uma apresentação única. Os colaboradores precisam de instruções curtas e específicas para o seu papel: o que registo? O que verifico? O que faço em caso de discrepância? O tratamento documentado de exceções impede que o papel e os grupos de chat assumam a liderança no momento em que surge a primeira situação especial.

A sustentabilidade é parte da solução, não uma reflexão tardia

Os processos logísticos mudam. Adicionam-se novas localizações de armazenamento, um prestador de serviços logísticos altera os seus requisitos, os clientes exigem formatos de documento diferentes, ou é ligado um novo local. Por isso, o software não só tem de se adequar no lançamento, como também tem de ser compreensivelmente extensível.

Isto inclui uma estrutura de dados limpa, lógica de negócio claramente separada, conceitos de permissões, e implementações documentadas. Igualmente importantes são as cópias de segurança, o registo (logging), e o tratamento regulado de erros. Se um utilizador introduzir dados de acesso incorretos várias vezes, é necessário um fluxo de bloqueio de conta rastreável, em vez de uma improvisação silenciosa e insegura.

Os testes devem preceder alterações a fluxos de trabalho críticos. Em aplicações personalizadas, os testes automatizados são particularmente compensadores para caminhos centrais recorrentes: criar uma encomenda, reservar stock, gerar um documento de envio, alterar o estado. Isto garante que uma modificação à guia de remessa não causa inadvertidamente consequências noutro local.
A softify.pro conta com este tipo de tecnologia aborrecidamente fiável e testável para tais projetos, em vez de efeitos de curta duração.

O que medir para avaliar os benefícios após seis meses

Nem toda a melhoria pode ser imediatamente expressa em euros, mas deve ser visível. Bons indicadores-chave de desempenho (KPIs) concentram-se no estrangulamento: tempo de processamento por encomenda, número de correções de stock, taxa de envios incorretos, proporção de registos de receção de mercadorias pontuais, ou consultas entre o armazém e o escritório.

O importante é a comparação com uma linha de base realista. Se ninguém registou anteriormente as faltas de forma limpa, a nova transparência pode inicialmente parecer mais problemas. Na realidade, os problemas estão simplesmente a tornar-se visíveis e geríveis pela primeira vez. Esta fase requer paciência e comunicação aberta.

O software certo não desaparece do trabalho diário por ser sem importância. Assegura que uma encomenda, uma palete, ou um circuito segue o seu caminho claro — mesmo quando a pessoa mais experiente no armazém está fora do escritório.

Permalink →

Testes de regressão automatizados para aplicações web

Testes de regressão automatizados para aplicações web

Um código de desconto modificado, uma nova permissão de função, ou uma atualização do serviço de pagamento pode quebrar uma aplicação web num ponto que ninguém tocou há meses. É precisamente aqui que entram os testes de regressão automatizados para aplicações web: verificam repetidamente se os processos de negócio comprovados continuam a funcionar após alterações. Não como uma medida teórica de qualidade, mas precisamente onde um erro bloquearia encomendas, movimentos de stock, faturas, ou contas de clientes.

Para muitas equipas, o problema começa de forma insidiosa. Os lançamentos demoram mais porque os departamentos clicam manualmente pelos mesmos fluxos de trabalho principais. O conhecimento de testes está trancado em pessoas individuais. E antes de uma atualização, permanece a pergunta incómoda: o que é que falhámos? A automação não substitui nem a responsabilidade funcional nem o trabalho exploratório significativo. Torna as verificações recorrentes e críticas para o negócio fiáveis, reprodutíveis, e verificáveis.

O que os testes de regressão automatizados realmente protegem

Um teste de regressão responde a uma pergunta simples: algo que funcionava antes ainda funciona depois de uma alteração? Numa aplicação web, raramente se trata apenas de um único botão. O que importa são os fluxos de trabalho de ponta a ponta que atravessam a interface de utilizador, as permissões, as interfaces, e a base de dados.

Um exemplo de um sistema operacional: um funcionário inicia sessão, regista uma receção de mercadoria, regista um movimento de inventário, cria uma guia de remessa, e entrega a expedição a um serviço de transporte. Cada passo individual pode parecer tecnicamente correto e, no entanto, falhar na sua interação. Talvez a quantidade seja guardada, mas não atualizada no inventário. Talvez a etiqueta seja gerada, mas o número de referência esteja em falta. Talvez o fluxo de trabalho apenas funcione para administradores, mas não para a função de armazém.

Os testes automatizados podem executar tais percursos com entradas definidas e verificar os resultados. Isto inclui resultados visíveis na interface de utilizador, bem como valores de estado, documentos gerados, e-mails, ou respostas de API. O benefício aumenta quando as verificações são organizadas próximo dos riscos operacionais — não com base no número de casos de teste tecnicamente possíveis.

Que fluxos de trabalho web devem ser automatizados primeiro

Nem todo clique merece imediatamente um teste automatizado. Uma página de configurações raramente usada com baixo potencial de dano pode ser inicialmente verificada manualmente. Em contraste, os fluxos de trabalho com alterações frequentes, uso elevado, ou consequências financeiras e operacionais claras pertencem cedo ao conjunto de testes.

Os testes de login, redefinição de palavra-passe, e bloqueio de conta são particularmente valiosos. Protegem o acesso à aplicação e são frequentemente afetados por alterações a serviços de identidade, gestão de sessões, ou regras de segurança. Igualmente importantes são os processos centrais, como a entrada de encomendas, o cálculo de preços e impostos, as aprovações, os registos de inventário, a geração de documentos, e as interfaces para expedição, ERP, ou fornecedores de pagamentos.

Uma priorização sensata ajuda tanto a gestão como os departamentos de negócio. Não pergunte primeiro qual página é mais fácil de testar. Pergunte: que erro para um turno, causa retrabalho, ou leva a informação incorreta para o cliente? Daqui surge uma lista de testes que protege a operação real.

Um caso de teste precisa de um resultado verificável

"Criar encomenda" ainda não é um bom caso de teste. Um melhor seria: um representante de vendas com a função de vendas cria uma encomenda para um cliente existente, adiciona um artigo com uma quantidade definida, guarda-a, e gera um número de encomenda. Depois, o estado é "aberto", o total cumpre as regras, e a encomenda aparece na lista de transações em aberto.

Esta precisão não é burocracia. Evita testes que clicam sem conseguir determinar se o resultado de negócio está correto. Também facilita o alinhamento entre o desenvolvimento, o QA, e os departamentos de negócio. Especialmente em sistemas desenvolvidos à medida, os especialistas de domínio são frequentemente a única fonte fiável sobre o que "correto" realmente significa na operação diária.

Pirâmide de testes em vez de automação do browser para tudo

Os testes de browser são valiosos, mas não são toda a estratégia de testes. Correm mais devagar, são mais vulneráveis a dados de teste instáveis, e podem quebrar após pequenos ajustes de UI se os seletores forem mal escolhidos. Quem verifica cada regra exclusivamente através da superfície constrói um conjunto lento e exigente em manutenção.

A lógica de negócio, como cálculos de preços, verificações de quantidade, ou transições de estado, deve ser testada onde está implementada — por exemplo, como um teste unitário ou de integração. As interfaces podem ser testadas especificamente com respostas controladas. Os testes de ponta a ponta baseados em browser permanecem então reservados para os poucos percursos onde a interação de todos os componentes é crucial.

Para aplicações PHP 8.4 com MySQL 8, por exemplo, isto significa: as regras de cálculo e validação são protegidas junto ao código, as transações da base de dados e os contratos de API são testados por integração, enquanto um teste de browser acompanha a encomenda completa até ao documento gerado. Isto é menos espetacular do que uma grande coleção de testes de clique visíveis. No entanto, proporciona feedback mais rápido e menor esforço de manutenção.

A estabilidade vem de dados de teste e de fronteiras técnicas claras

Muitos projetos de automação falham não por causa da ferramenta de teste, mas devido a pré-requisitos não controlados. Se uma conta de teste está bloqueada, uma encomenda de teste do dia anterior ainda existe, ou um serviço externo responde lentamente, ocorre um falso alarme. Tais testes instáveis perdem rapidamente a confiança da equipa.

Os dados de teste devem, por isso, ser criados e limpos intencionalmente. São essenciais inquilinos separados ou conjuntos de dados claramente isolados, identificadores únicos por execução de teste, e estados iniciais definidos. Um teste não pode depender aleatoriamente da ordem de execução de outros testes. Onde estão envolvidos serviços externos, deve ser tomada uma decisão clara: é usado um ambiente de teste realista, ou a interface é simulada para o respetivo teste? Ambas as abordagens podem estar corretas.

Os seletores também merecem atenção. Os testes não devem depender de classes de layout, posições de texto, ou estruturas HTML aleatórias. Atributos estáveis explicitamente destinados a testes reduzem a manutenção desnecessária. Esta é uma pequena decisão técnica com um grande impacto quando a interface e o design evoluem regularmente.

Integrar testes de regressão automatizados no processo de lançamento

O melhor teste ajuda pouco se apenas for iniciado manualmente antes de grandes lançamentos. Uma execução em níveis faz sentido: testes rápidos de código e interface correm a cada alteração. Os percursos de browser mais importantes correm durante pull requests ou antes da implementação no ambiente de staging. Verificações mais extensas podem acontecer durante a noite ou antes de um lançamento de produção agendado.

O feedback é crucial. Um teste falhado precisa não apenas de um ícone vermelho, mas de informações acionáveis: que dados foram usados? Em que passo ocorreu o erro? Que captura de ecrã ou registo o comprova? Para equipas sem um grande departamento de QA dedicado, conclusões claras são particularmente valiosas. Precisam de conseguir identificar se um defeito está no sistema, nos dados de teste, ou no ambiente de teste.

A COCO pode ser usada aqui como infraestrutura de teste auto-hospedada para executar fluxos de trabalho de teste, registar evidências, e apresentar resultados em linguagem simples. Isto é particularmente relevante quando capturas de ecrã, interfaces internas, ou dados de teste não devem ser transferidos para uma cloud externa. Auto-hospedado, contudo, não significa sem manutenção: os direitos de acesso, atualizações, capacidade, e regras de retenção têm de ser planeados com o mesmo cuidado que os próprios testes.

O que as métricas revelam — e o que não revelam

Um número crescente de testes automatizados não é prova de qualidade. Um conjunto com 2.000 testes superficiais pode oferecer menos proteção do que 40 testes bem mantidos para fluxos de valor críticos. Mais reveladoras são perguntas como: quanto tempo demora o feedback após uma alteração? Quantos erros relevantes são detetados antes da produção? Com que frequência as falhas de teste são na verdade falsos alarmes? E que processos críticos para o negócio estão comprovadamente cobertos?

O tempo de execução também é um fator prático. Se um conjunto demora quatro horas a entregar resultados, será contornado no dia a dia. Se entrega um sinal claro sobre login, encomenda, inventário, e documentos em 15 minutos, apoia a tomada de decisões antes do lançamento. A profundidade necessária depende da aplicação e do risco. Uma ferramenta interna de planeamento exige algo diferente de um portal de clientes que processa pagamentos e dados pessoais.

O início certo é mais pequeno do que muitos esperam

Comece com um processo cuja falha seria notoriamente sentida, e mapeie-o completamente. Defina o resultado esperado juntamente com as pessoas que usam este fluxo de trabalho diariamente. Garanta dados de teste controlados, âncoras técnicas estáveis, e evidências rastreáveis. Só quando este primeiro teste corre de forma fiável é que o próximo processo deve ser adicionado.

Desta forma, não acaba com um cenário de testes impressionante mas frágil. Em vez disso, cria uma linha de segurança resiliente para as alterações — passo a passo, precisamente onde a sua aplicação web efetivamente sustenta o negócio operacional.

Permalink →

Registar digitalmente a receção de mercadoria

Registar digitalmente a receção de mercadoria

Uma guia de remessa está pousada na mesa de embalagem, a palete já se encontra no corredor, e o motorista espera por uma assinatura. É exatamente neste momento que se decide se os níveis de stock estarão corretos mais tarde, ou se o próximo colega andará à procura de material que, segundo o sistema, deveria estar disponível. Quem quer registar digitalmente a receção de mercadoria precisa, por isso, de mais do que um simples ecrã de entrada. O processo tem de funcionar sob pressão de tempo, gerar dados inequívocos, e ajustar-se aos fluxos de trabalho reais do armazém.

As listas em papel e as folhas de cálculo muitas vezes parecem suficientes durante muito tempo. Tornam-se, contudo, frágeis assim que várias pessoas registam em simultâneo, os artigos têm designações semelhantes, os números de lote se tornam relevantes, ou a mercadoria vai diretamente para a montagem, picking, ou encomendas de clientes. Um bom sistema de registo digital não se limita a criar mais dados. Cria um estado de verdade fiável e partilhado.

O que deve realmente ser registado na receção digital de mercadoria

A receção de mercadoria é a transição entre a entrega e o inventário disponível. Para que esta transição permaneça verificável, cada registo deve, no mínimo, conseguir responder a: O que foi entregue, em que quantidade, quando, de que fornecedor, e onde a mercadoria foi armazenada? Dependendo do negócio, também se acrescentam números de encomenda de compra, números de guia de remessa, números de lote, números de série, datas de validade, ou estados de qualidade.

A distinção crucial está entre a mercadoria encomendada e a efetivamente aceite. Uma encomenda pode indicar 100 unidades, mas são entregues 96 unidades, duas caixas danificadas, e dois artigos de substituição. Se os funcionários se limitarem a confirmar a encomenda, um erro entra diretamente no inventário. O registo digital tem de tornar simples o tratamento de discrepâncias — não penalizá-las com processos alternativos.

Para um armazém de peças sobressalentes, artigo, quantidade, local de armazenamento, e referência do documento são muitas vezes suficientes. Na produção, aprovações de lote ou registos de inspeção podem ser indispensáveis. Mais campos não são automaticamente melhores. Cada campo obrigatório custa tempo e aumenta a probabilidade de alguém estimar valores ou adicioná-los mais tarde.

Registar digitalmente a receção de mercadoria: o fluxo de trabalho no chão de armazém

Um fluxo de trabalho prático não começa num computador de escritório, mas sim onde a mercadoria chega. Os funcionários abrem a receção de mercadoria esperada num dispositivo móvel ou registam primeiro a guia de remessa através de pesquisa, número de encomenda, ou código de barras. Depois, os artigos são digitalizados, contados, ou pesados e reconciliados com a entrega esperada.

Se a quantidade estiver correta, a mercadoria é atribuída a um local de armazenamento e registada. Em caso de discrepâncias, um comentário não é simplesmente escrito num campo de texto livre. O sistema regista se se trata de uma falta, um excesso, dano de transporte, artigo incorreto, ou uma posição não verificada. Uma fotografia pode ser útil para danos visíveis, mas não é necessária em todas as entregas.

Após o registo, o estado da mercadoria deve estar claro. Alguns artigos ficam imediatamente disponíveis. Outros permanecem bloqueados até que uma inspeção de qualidade seja concluída ou um gestor tenha resolvido a discrepância. Esta lógica de estados impede que as vendas prometam mercadoria que chegou fisicamente mas ainda não está utilizável.

O ponto certo de registo depende da operação. Num armazém pequeno, a receção de mercadoria pode ser completamente registada diretamente no portão. Para grandes entregas ou horários de cais apertados, um processo de registo em duas etapas é frequentemente melhor: primeiro, a entrega é registada como chegada, e posteriormente os artigos são inspecionados e arrumados. A vantagem é a velocidade no cais. A desvantagem: exige responsabilidades claras para que as inspeções pendentes não fiquem esquecidas.

Scanner, tablet, ou computador fixo?

O hardware deve acompanhar o movimento do fluxo de trabalho. Para artigos com códigos de barras bem impressos, um scanner portátil é geralmente a escolha mais rápida e menos propensa a erros. Scanners móveis ou smartphones com câmara são adequados quando os funcionários se movem entre a área de receção de mercadoria, prateleiras, e zonas de acesso restrito. Um tablet pode fazer sentido para registos mais complexos que envolvam fotografias, várias quantidades, ou notas de inspeção.

Um posto de trabalho de computador fixo, por outro lado, funciona bem quando uma pessoa verifica centralmente as guias de remessa e a receção de mercadoria está espacialmente concentrada. É menos adequado se a equipa tiver de correr para o escritório em cada transação. Os custos de licença poupados são então frequentemente pagos através de distâncias percorridas, interrupções, e registos atrasados. Nem todos os artigos precisam de um código de barras. Especialmente com componentes personalizados, matérias-primas, ou etiquetas de fornecedores, a rotulagem é inconsistente. Nestes casos, o sistema deve oferecer uma pesquisa rápida por número de artigo, número de artigo do fornecedor, ou posição da encomenda de compra. A leitura de código de barras é uma ótima ferramenta, mas não um fim em si mesma.

A qualidade dos dados vem de regras, não de apelos

A precisão do inventário não acontece simplesmente porque um software foi instalado. A precisão é alcançada quando o sistema impõe regras sensatas e torna as exceções visíveis. Uma quantidade negativa sem um processo justificado, um local de armazenamento desconhecido, ou um número de guia de remessa reutilizado não devem passar despercebidos.

Ao mesmo tempo, a inspeção não pode bloquear as operações. Se um fornecedor reutilizar números de guia de remessa ou as etiquetas forem ilegíveis, os funcionários precisam de um caminho alternativo rastreável. Por exemplo, um registo pode ser feito com uma nota que deve ser verificada mais tarde. O importante é que isto se transforme numa tarefa aberta, em vez de um compromisso invisível.

As verificações simples de plausibilidade são particularmente valiosas: O artigo corresponde à encomenda? A quantidade desvia-se além de uma tolerância definida? O número de lote está presente para artigos que requerem lote? Foi definido um estado de bloqueio quando foi registado um relatório de danos? Tais regras reduzem o retrabalho sem sobrecarregar a equipa com ecrãs de entrada complicados.

Construa interfaces apenas quando o processo central estiver estabelecido

Muitas empresas querem imediatamente uma ligação ao ERP, compras, expedição, e contabilidade. Isso pode estar certo, mas apenas se a soberania dos dados estiver claramente definida. Um sistema deve estabelecer inequivocamente onde se originam as encomendas, onde se localiza o inventário mestre, e que dados são transferidos em que direção.

Uma interface fraca multiplica erros mais rapidamente do que uma folha de cálculo. Por exemplo, se as encomendas vêm do ERP, mas a receção de mercadoria real é criada no sistema de gestão de armazém, tem de ficar claro quais estados são reportados de volta: totalmente entregue, parcialmente entregue, bloqueado, ou com desvios. Os registos de tempo e as referências de documentos únicas são aqui mais importantes do que uma integração visualmente impressionante.

Para operações mais pequenas, uma importação CSV controlada pode fazer mais sentido para começar do que uma ligação dispendiosa em tempo real. Isto não é uma solução temporária se a importação, inspeção, e registo de erros forem implementados de forma limpa. Assim que os volumes, a frequência, ou os processos a jusante crescerem, uma interface direta torna-se mais económica.

Um lançamento significativo começa com entregas reais

Antes de se escolher desenvolvimento ou software padrão, vale a pena fazer uma breve análise de processo com casos reais. Não só a entrega ideal deve estar em cima da mesa, mas também mercadoria danificada, quantidades parciais, artigos incorretos, encomendas em falta, e material urgente para a oficina. Isto revela que dados e decisões são realmente necessários.

Para começar, uma área claramente definida é frequentemente suficiente — como um fornecedor, um grupo de produtos, ou um local de armazenamento. A equipa trabalha com o novo fluxo de trabalho em paralelo com as verificações anteriores até que as transações estejam comprovadamente corretas. Só depois segue a expansão. Um "big bang" poupa tempo no plano do projeto, mas frequentemente cria caos no terreno.

Os critérios de aceitação importantes são concretos e mensuráveis:

  • Uma entrega padrão pode ser registada em poucos minutos sem perguntas.
  • As discrepâncias aparecem numa lista de esclarecimento aberta e atribuída.
  • O inventário de um artigo pode ser explicado com um documento e local de armazenamento.
  • Os funcionários autorizados podem realizar correções de forma rastreável.
  • A mercadoria em aberto ou bloqueada não é alocada por engano.

Um sistema adaptado à operação pode conseguir mais aqui do que um pacote sobrecarregado, se respeitar os métodos de trabalho existentes.
A softify.pro desenvolve estes processos logísticos não por causa da digitalização em si, mas sim em torno de registos, responsabilidades, e dados que têm de ser robustos na operação diária.

Indicadores-chave que tornam os benefícios visíveis

Após o lançamento, o indicador a acompanhar não deve ser simplesmente quantas receções de mercadoria foram registadas digitalmente. Mais significativos são o tempo entre a entrega e a mercadoria disponível, o número de discrepâncias não resolvidas, as variações de inventário durante a contagem física, e o esforço gasto em consultas nas compras ou nas vendas.

Se o tempo de processamento diminui mas o número de correções subsequentes aumenta, o processo é provavelmente demasiado rápido e insuficientemente verificável. Se cada transação demora muito tempo apesar de quase não ocorrerem discrepâncias, pode haver demasiados passos obrigatórios incorporados. Os bons processos de armazém não procuram o controlo máximo, mas sim o controlo apropriado.

O melhor passo seguinte é frequentemente um percurso pela área de receção de mercadoria com três guias de remessa reais. Observe que informação está a ser procurada, onde os funcionários improvisam decisões, e que dados são introduzidos novamente mais tarde. É precisamente aí que começa uma receção digital de mercadoria que não só parece mais moderna, mas que realmente torna o inventário credível.

Permalink →

Testes de software com IA self-hosted em operação

Testes de software com IA self-hosted em operação

Um teste de regressão falhado raramente é apenas uma entrada vermelha numa lista. Pode significar que um trabalhador do armazém não consegue imprimir uma guia de remessa, um funcionário administrativo ficou preso no sistema de gestão de encomendas, ou uma atualização quebrou uma funcionalidade que funcionava de forma fiável há anos. É precisamente aí que entram os testes de software com IA self-hosted: automatizam verificações recorrentes sem expor desnecessariamente dados de teste sensíveis, capturas de ecrã ou fluxos de trabalho internos da aplicação a plataformas externas.

Para equipas com aplicações web e software desktop Windows, isto é mais do que uma questão de privacidade de dados. Trata-se de controlo sobre o ambiente de teste, registos de erro rastreáveis, e uma operação de testes que se ajusta ao próprio processo de lançamento. A IA pode retirar carga de trabalho, mas não substitui nem casos de teste limpos nem a responsabilidade profissional.

Quando faz sentido testar software com IA self-hosted

A automação clássica de testes é muito eficaz, mas exige manutenção. Os seletores mudam, as interfaces evoluem, os dados de teste têm de estar disponíveis, e as mensagens de erro precisam de ser classificadas. Por isso, muitas equipas automatizam apenas uma pequena parte dos seus fluxos de trabalho críticos — ou ainda dependem predominantemente de testes manuais antes de um lançamento.

Os sistemas assistidos por IA podem reduzir esta lacuna. Leem as interfaces de forma mais contextual, executam fluxos de trabalho predefinidos, reconhecem desvios visíveis, e resumem os resultados numa linguagem compreensível. Isto torna-se especialmente valioso para aplicações que não consistem apenas em chamadas de API, mas em interfaces de utilizador reais: logins, máscaras de entrada, aprovações, diálogos de impressão, e janelas do Windows.

O self-hosting faz sentido quando as execuções de teste tocam em informação confidencial. Isto não diz respeito apenas a dados pessoais. Preços internos, nomes de clientes, movimentos de artigos, capturas de ecrã de interfaces administrativas, credenciais de acesso para contas de teste, ou informação sobre funcionalidades ainda não lançadas também se enquadram aqui. Quem usa serviços de IA externos deve verificar cuidadosamente que dados saem da própria rede, durante quanto tempo são armazenados, e quem lhes pode aceder.

No entanto, também há casos em que uma plataforma alojada é suficiente. Para uma página de marketing pública sem dados reais de clientes, poucos lançamentos, e profundidade de testes gerível, pode ser configurada mais rapidamente. A decisão certa depende dos requisitos de proteção, do panorama de aplicações, das competências existentes, e da frequência de alterações — não de um princípio geral de cloud ou de IA.

O que permanece no próprio ambiente

Num ambiente de teste self-hosted, a execução dos testes decorre em infraestrutura controlada pela empresa: no seu próprio centro de dados, num ambiente de cloud privada, ou num servidor dedicado sob um modelo operacional acordado. A localização de um servidor não é o único fator decisivo. O que importa é todo o fluxo de dados.

Um sistema bem estruturado processa os passos de teste, sessões de browser ou desktop, capturas de ecrã, registos, e relatórios de teste dentro deste ambiente controlado. As contas de teste podem ser criadas com permissões mínimas. As credenciais de acesso podem ser geridas separadamente. O acesso à rede pode ser restrito aos sistemas efetivamente necessários. Para aplicações particularmente sensíveis, um inquilino de teste dedicado pode fazer mais sentido do que testar com dados reais semelhantes à produção.

Isto não protege automaticamente contra erros. Uma solução operada localmente exige atualizações, conceitos de permissões, cópias de segurança, e responsabilidades claras. Quem instala um servidor uma vez e depois se esquece dele não tem uma infraestrutura de testes segura, mas sim um encargo operacional adicional. A vantagem reside no facto de esta tarefa permanecer previsível e verificável.

Os dados de teste merecem a mesma proteção que a aplicação

As discussões de segurança concentram-se frequentemente no código-fonte. Na prática, os artefactos de teste revelam pelo menos tanto. Uma captura de ecrã pode mostrar dados de clientes, termos internos, e detalhes de processos. Um vídeo de uma execução de teste pode expor a estrutura de um sistema de back-office. Um ficheiro de registo pode conter URLs, mensagens de erro, ou números de versão técnicos.

Por isso, devem ser definidos períodos de retenção. Nem toda a execução bem-sucedida precisa de ser armazenada permanentemente. Por outro lado, um histórico definido pode ser muito útil para a verificação de erros e lançamentos. Os direitos de acesso aos relatórios pertencem ao mesmo conceito de permissões que o acesso à própria aplicação.

Nem toda a verificação deve ser conduzida por IA

Os ambientes de teste mais robustos combinam diferentes métodos. Um login com bloqueio de conta após várias tentativas falhadas pode ser testado de forma precisa e rápida com testes automatizados determinísticos. Interfaces, cálculos, regras de base de dados, e permissões também beneficiam de expectativas claras: a entrada A tem de produzir o resultado B.

A IA é particularmente útil quando a interface de utilizador, o fluxo de trabalho, e a perspetiva do utilizador são o foco. Por exemplo, uma tarefa de teste pode verificar se um despachante cria uma encomenda, atribui uma rota, gera um documento, e recebe corretamente o estado de volta. A IA pode navegar pela aplicação, capturar documentos, e documentar de forma compreensível em que ponto o processo se interrompeu. Para uma operação de testes sustentável, quatro níveis devem trabalhar em conjunto:

  • Os testes unitários e de integração protegem a lógica de negócio, as interfaces, e o processamento de dados numa fase inicial do processo de desenvolvimento.
  • Os testes de UI verificam caminhos de clique repetíveis e expectativas concretas em aplicações web ou desktop.
  • As verificações de fluxo de trabalho assistidas por IA avaliam caminhos operacionais reais e resultados visíveis do ponto de vista do utilizador.
  • Os testes exploratórios de domínio revelam casos especiais que ainda ninguém descreveu como uma regra fixa.

Uma IA não deve decidir se a lógica de preços está correta do ponto de vista do negócio se as regras estiverem documentadas de forma pouco clara. Também não consegue executar de forma significativa uma instrução precisa. "Verificar o envio" não é uma descrição de teste robusta. "Criar uma encomenda com três itens de linha, gerar uma etiqueta de envio, e verificar se o estado muda para enviado" é uma instrução verificável.

Do demo a operações de teste robustas

O erro mais comum nos testes com IA é começar de forma demasiado ampla. Um demo impressionante com um único login diz pouco sobre se o sistema vai proteger os lançamentos daqui a seis meses. É muito mais sensato uma entrada mais restrita com dois a cinco fluxos de trabalho cuja falha causa custos reais ou cria um esforço de teste manual recorrente. Num sistema de armazém ou logística, estes poderiam ser a receção de mercadorias, a transferência de stock, o picking de encomendas, e a geração de uma guia de remessa. Em software administrativo, antes o login, a alteração de permissões, a introdução de encomendas, e a aprovação de faturas. Bons candidatos são processos frequentes com regras estáveis e resultados claramente visíveis.

Depois disso, cada fluxo de trabalho precisa de um ponto de partida definido. Que dados têm de estar presentes? Que conta de teste é usada? O teste pode enviar e-mails, imprimir etiquetas, ou aceder a interfaces? O que é reposto após a execução? Sem estas regras, a automação rapidamente produz confusão nos dados de teste ou bloqueia outras equipas.

A avaliação dos resultados também deve ser escalonada. Um botão em falta é geralmente um bug claro. Uma formulação ligeiramente diferente num texto de dica não tem automaticamente de bloquear um lançamento. Limiares de confiança e uma separação clara entre notificação automatizada, revisão manual, e critérios de bloqueio reais ajudam aqui. Um relatório de teste não deve apenas reportar "falhou", mas conter o passo executado, o estado visível, o carimbo de data/hora, e evidências apropriadas.

O papel das capturas de ecrã, vídeos, e relatórios em texto simples

Um teste que apenas produz uma mensagem de erro técnica transfere trabalho para a equipa de desenvolvimento. Os departamentos de negócio muitas vezes não conseguem tirar grande proveito de tal informação. Boas evidências combinam precisão técnica com contexto: o que deveria acontecer? O que aconteceu realmente? Onde é visível? Que versão foi testada?

As capturas de ecrã e gravações encurtam consideravelmente a coordenação. O gestor de QA não tem primeiro de tentar reproduzir o bug, e o dono do produto vê imediatamente se uma interrupção é relevante para o negócio. Ao mesmo tempo, esses artefactos devem ser armazenados seletivamente. Os testes bem-sucedidos frequentemente requerem menos evidências do que lançamentos falhados ou críticos.

Um relatório em texto simples não substitui os registos. É a ponte entre a operação, o departamento de negócio, e o desenvolvimento. Especialmente em equipas de média dimensão, onde as mesmas pessoas são responsáveis pelos processos e tomam decisões, esta ponte evita trabalho de tradução desnecessário.
Operação, manutenção, e expectativas realistas

A automação de testes self-hosted não é um produto que funciona sem atenção após a configuração. As aplicações mudam. Os browsers atualizam-se. Os dados de teste perdem a sua validade. Novos níveis de permissão, captchas, autenticação multifator, ou diálogos de impressão alterados afetam as execuções de teste.

Isto não é um argumento contra a automação. É um argumento a favor de um calendário de manutenção claro. Os casos de teste devem ser tratados como código de produto: versionados, revistos, e conscientemente ajustados quando ocorrem alterações. Se um fluxo de trabalho falhar três vezes seguidas devido a uma alteração intencional de UI, a IA não é o problema. O que falta então é a ligação entre o desenvolvimento, o planeamento de lançamentos, e a manutenção de testes.

Com o COCO, a softify.pro conta com um servidor de IA dedicado e self-hosted para este fim, que testa aplicações web e Windows, regista evidências, e categoriza claramente os resultados. No entanto, o ponto crucial continua a ser a integração nos processos de trabalho diários: que processos estão protegidos, quem revê os desvios, e quando é que um lançamento pode avançar?

O melhor primeiro passo não é, por isso, comprar ou configurar o maior número possível de testes. Escolha o fluxo de trabalho onde um erro despercebido amanhã causaria efetivamente trabalho no armazém, no serviço, ou na contabilidade. Quando este fluxo de trabalho é testado de forma fiável, rastreável, e sob o seu próprio controlo de dados, a IA deixa de ser tecnologia pela tecnologia e torna-se um alívio percetível.

Permalink →

Substituir o Excel por software personalizado

Substituir o Excel por software personalizado

A precisão do inventário depende inteiramente de alguém abrir o ficheiro correto, registar a receção de mercadoria mais recente, e garantir que não foram distribuídas cópias por e-mail. Enquanto o volume de transações for baixo, o Excel é uma ótima ferramenta. Substituir o Excel por software personalizado só faz sentido quando a folha de cálculo se torna um estrangulamento para os fluxos de trabalho, a responsabilização, e a fiabilidade.

Isto raramente afeta apenas o armazém. As encomendas são recebidas por telefone, as guias de remessa são geradas a partir de modelos, os dados de inventário estão divididos em vários ficheiros, e as perguntas de acompanhamento acabam sempre exatamente na pessoa que está indisponível no momento. O problema não é a folha de cálculo em si. É a tentativa de gerir um processo operacional em crescimento com uma ferramenta que não impõe procedimentos operacionais padrão.

Quando o Excel deixa de ser a ferramenta operacional certa

Uma folha de cálculo consegue calcular, filtrar, e tornar a informação visível. No entanto, não impõe que uma receção de mercadoria seja registada por completo, que uma entrega seja verificada antes do envio, ou que dois funcionários não modifiquem o mesmo registo simultaneamente. Onde essas regras se tornam críticas para o negócio, o Excel carece da estrutura adequada.

Os sinais de alerta típicos incluem reconciliações recorrentes entre turnos, o armazém, e o escritório. Os funcionários perguntam pelo estado atual de uma encomenda, apesar de essa informação dever estar prontamente disponível. As listas de inventário são limpas manualmente antes da contagem física. Os números das guias de remessa ou as descrições dos artigos são copiados e corrigidos mais tarde. E quando ocorrem discrepâncias, muitas vezes já não é rastreável quem alterou que valor e quando.

O próprio ficheiro também se torna um risco. Versões com nomes como "Inventário_final_novo_2" não são incidentes isolados; são um indício de que um processo carece de uma única fonte de verdade. As macros podem acelerar passos de trabalho individuais, mas não resolvem nem a colaboração paralela nem as permissões baseadas em funções, aprovações, ou registos de auditoria fiáveis.

A transição não vale a pena porque o software personalizado parece mais moderno. Vale a pena quando os erros, tempos de espera, e o esforço de controlo custam regularmente mais do que a introdução de um sistema claro.

Substituir o Excel por software personalizado: o que muda em termos concretos

Uma boa aplicação empresarial não se limita a digitalizar uma folha de cálculo existente. Reflete as decisões e movimentos reais que ocorrem na operação. Para uma receção de mercadoria, por exemplo, isto significa: selecionar ou criar uma entrega, registar as linhas de artigos, verificar quantidades, fornecer uma justificação para discrepâncias, atribuir um local de armazenamento, e só depois de todos estes passos atualizar o inventário de forma vinculativa.

Como resultado, uma lista transforma-se num processo. Os funcionários só veem os passos necessários para a sua tarefa específica. O escritório consegue ver o estado de processamento sem ter de fazer o acompanhamento por telefone. A gestão pode rever transações abertas, discrepâncias, ou entradas em falta. Uma alteração permanece rastreável em vez de desaparecer silenciosamente dentro de uma célula.

A diferença também reside na arquitetura de dados. Uma aplicação com uma base de dados modelada de forma limpa, como baseada em MySQL 8, não armazena artigos, encomendas, locais de armazenamento, e movimentos como cópias soltas. As relações são claramente definidas. Um artigo não pode ser acidentalmente criado com três números diferentes se a regra de negócio exigir um identificador único.

Isto não cria uma realidade sem erros. As quantidades ainda podem ser contadas incorretamente, e as entregas podem chegar danificadas. No entanto, o software garante que as discrepâncias são visivelmente registadas, atribuídas, e disponibilizadas para análise posterior. Operacionalmente, isso é muito mais valioso do que um inventário aparentemente limpo cuja origem ninguém consegue explicar.

Não reconstrua todos os processos de imediato

O erro comum é começar demasiado grande. Quem tenta substituir de uma só vez todos os processos de uma empresa espera muito tempo por um resultado e força muitas questões em aberto num único projeto. Para pequenas e médias empresas, uma abordagem passo a passo costuma fazer mais sentido.

A primeira área deve cumprir dois critérios: causa esforço ou custos de erro notáveis, e pode ser claramente delimitada. Isto poderia ser o registo de mercadoria recebida, a geração de guias de remessa, a receção de encomendas, ou o controlo de movimentos de inventário. Um estrangulamento concreto fornece requisitos melhores do que a exigência abstrata de uma "solução digital completa".
O Excel ainda pode desempenhar um papel aqui. Para cálculos pontuais, análises, ou pequenas listas de planeamento, é frequentemente mais rápido e mais barato do que uma aplicação personalizada. As exportações de dados para controlo de gestão ou consultores fiscais também continuam úteis. O fator crucial é que o Excel deixe de ser a fonte principal para processos sensíveis ao tempo.

Além disso, uma solução personalizada não precisa de replicar todas as funções de um grande sistema ERP. Uma empresa com dois armazéns e dez funcionários pode não precisar de lógica multi-inquilino, mas certamente precisa de permissões limpas, leitura móvel no local de armazenamento, e documentos fiáveis. Os pacotes de software padrão sobrecarregados frequentemente incluem funcionalidades que ninguém usa, enquanto o fluxo de trabalho principal ainda tem de ser personalizado.

Observe os requisitos no local de trabalho, não apenas pergunte sobre eles

A melhor lista de requisitos não é criada apenas numa sala de reuniões. É criada onde a mercadoria é descarregada, separada (picking), verificada, e entregue. Uma conversa com a gestão do armazém pode descrever um processo ideal. Observar um turno revela que informação está em falta, quando são necessárias luvas ou scanners, e em que pontos os funcionários encurtam intencionalmente os passos.

Estes atalhos não são automaticamente má conduta. Frequentemente apontam para um problema do sistema. Se um funcionário anota números em papel porque o computador está demasiado longe, a solução não deveria ser apenas tornar um campo obrigatório num ecrã de secretária. Talvez o processo precise de uma máscara de introdução de dados móvel, impressão de etiquetas, ou um ponto de transferência mais claro entre a receção de mercadoria e o armazenamento.

Por isso, questões concretas devem ser respondidas durante a fase de conceção: Quem cria uma encomenda? Quem pode corrigir quantidades? O que acontece em caso de entrega parcial? Quando é gerada uma guia de remessa? Que dados devem estar visíveis se a rede no armazém estiver temporariamente indisponível? E que indicadores-chave de desempenho são realmente usados em vez de apenas parecerem bem num dashboard?

Quanto mais claras forem estas decisões antes do início do desenvolvimento, menos lógica personalizada é criada mais tarde. Um bom software personalizado não replica todas as exceções históricas. Separa regras operacionais sensatas de hábitos que só existem porque a ferramenta anterior impunha limitações.

Considerar a tecnologia, permissões, e operações desde o primeiro dia

Uma aplicação empresarial deve permanecer sustentável na operação diária. Isto diz respeito não só à interface do utilizador, mas também a modelos de dados limpos, implementação documentada, cópias de segurança, e responsabilidades claras. As aplicações web modernas podem ser construídas de forma sólida usando PHP 8.4, JavaScript atualizado, e MySQL 8. O fator decisivo não é o apelo modista de uma stack tecnológica, mas sim se é compreensível, testável, e operável a longo prazo.

As funções e permissões pertencem ao conceito desde as fases iniciais. Nem todos os utilizadores deveriam poder alterar preços, dados mestre, ou registos históricos. Para funções sensíveis, são úteis aprovações rastreáveis, registos do sistema, e, se necessário, bloqueios de conta após tentativas de início de sessão falhadas. Estes detalhes parecem inicialmente técnicos, mas evitam linhas de responsabilidade indistintas durante a operação.

A migração de dados é igualmente importante. Os ficheiros Excel existentes frequentemente contêm duplicados, unidades inconsistentes, ou artigos que já não estão em uso. Importar estes dados sem verificação apenas transfere problemas antigos para o novo sistema. Uma limpeza controlada com regras claras é muito melhor: Que dados serão migrados, quais serão arquivados, e quais devem ser revistos de uma perspetiva de negócio antes do lançamento?

Implementação sem tempo de inatividade operacional

Um arranque em produção não pode colocar em risco as operações de envio. Por isso, a implementação requer uma fase piloto limitada, casos de teste reais, e funcionários que conheçam o fluxo de trabalho. Não basta apenas criar encomendas de exemplo. O sistema tem de conseguir lidar com entregas parciais, quantidades incorretas, cancelamentos, pressão de tempo, e as exceções que ocorrem na atividade normal do dia a dia.

Uma fase paralela curta pode ser útil, mas deve ter uma data de fim clara. Se a folha de cálculo e a nova aplicação forem mantidas simultaneamente durante demasiado tempo, isso cria trabalho duplicado e traz de volta a questão de qual fonte é válida. É melhor uma data de mudança definida, acompanhada de pessoas de contacto formadas e um ciclo rápido de feedback para erros ou detalhes em falta.

Após o lançamento, o valor de uma solução personalizada não se mede por uma interface de utilizador particularmente elaborada. Mostra-se quando uma encomenda avança sem questões, o inventário permanece explicável, e um novo colega consegue operar o processo com segurança após uma breve introdução. É precisamente aí que a próxima decisão deve começar: não com o próximo ficheiro Excel, mas sim com o passo de trabalho específico que amanhã voltará a desperdiçar tempo.

Permalink →

Digitalizar processos de armazém com software

Digitalizar processos de armazém com software

Um operador de picking passa dez minutos à procura de um artigo que, segundo um ficheiro Excel, deveria estar na prateleira. Ao mesmo tempo, um colega regista a receção de mercadoria num formulário em papel enquanto uma encomenda é alterada por telefone no escritório. Situações como estas não são sinal de mau trabalho. Mostram que a informação já não acompanha de forma fiável os movimentos físicos das mercadorias. Quem quer digitalizar processos de armazém com software não deveria, por isso, começar pela lista de funcionalidades mais longa possível, mas sim por exatamente estas fraturas do dia a dia.
Quando faz sentido digitalizar processos de armazém com software

Uma folha de cálculo não é inerentemente um problema. Para um inventário manejável, uma equipa pequena, e movimentos pouco frequentes, pode ser sensata, económica, e transparente. A mudança só compensa quando o ficheiro se transforma num centro de controlo não oficial: circulam várias versões, os níveis de stock são corrigidos retroativamente, ou apenas algumas pessoas compreendem as fórmulas e a estrutura do ficheiro.

Os gatilhos típicos não são objetivos abstratos de crescimento, mas sim atritos operacionais recorrentes. Os níveis de stock não coincidem consistentemente após contagens físicas. As receções de mercadoria permanecem por registar até ao fecho. As entregas saem sem uma guia de remessa completa. Os funcionários telefonam uns aos outros para esclarecer a localização de um artigo ou o estado de uma encomenda. Ou uma pessoa transfere exatamente os mesmos dados sequencialmente para o e-mail, Excel, um portal de envio, e a contabilidade.

Neste contexto, digitalização significa: o sistema reflete um estado claro. Um artigo chegou, foi inspecionado, arrumado, reservado, separado (picking), ou enviado. Cada alteração de estado tem um gatilho, um registo de tempo, e idealmente uma pessoa responsável. Isto não cria burocracia; pelo contrário, evita que as decisões se baseiem em suposições.

O ponto de partida certo: movimentos físicos em vez de módulos de software

Muitas implementações começam com perguntas sobre funcionalidades como integração de scanners, gestão de lotes, ou dashboards. Isso é compreensível, mas frequentemente leva a uma especificação sobrecarregada. Faz mais sentido mapear os processos ao longo do movimento real das mercadorias.

Pegue numa encomenda real e siga-a desde a receção até à entrega ao transportador. Onde é gerada a informação? Quem a verifica? Onde é que algo é anotado em papel, transferido mais tarde, ou transmitido verbalmente? As exceções são particularmente valiosas: entregas parciais, mercadoria danificada, artigos de substituição, stock bloqueado, e devoluções. O processo padrão normalmente parece organizado num quadro branco. As exceções determinam se a nova aplicação será aceite na operação diária.

Para um workshop inicial, três perguntas costumam bastar: Que informação falta mais frequentemente aos funcionários? Qual a transação mais frequentemente atrasada ou feita duas vezes? E que erros custam realmente tempo, dinheiro, ou confiança do cliente todos os meses? As prioridades podem derivar-se disto sem ser necessário reformular toda a organização do armazém de uma só vez.

Um fluxo de trabalho pequeno e completo vence um grande lançamento de sistema

Em vez de digitalizar todos os processos de uma vez, uma área deve funcionar sem falhas de ponta a ponta. Um âmbito inicial sensato pode cobrir, por exemplo, receção de mercadoria, arrumação, e gestão de inventário. Um aviso de expedição antecipado ou uma encomenda é registada, a mercadoria é inspecionada, é atribuído um local de armazenamento, e o stock é registado imediatamente. Só depois deste fluxo de trabalho funcionar de forma estável é que se seguem o picking, as etiquetas de envio, ou o planeamento de rotas.
Isto reduz o risco do projeto. Os funcionários não aprendem apenas uma nova interface de utilizador, mas sim um fluxo de trabalho claramente definido. Ao mesmo tempo, torna-se evidente quais as regras que faltam na prática — como a questão de saber se mercadoria não inspecionada já pode ser reservável, ou se quantidades em falta devem desencadear imediatamente um caso para esclarecimento.
Que funcionalidades de armazém têm realmente impacto

A melhor aplicação de armazém não é a que tem mais opções de menu. É a que torna inequívoco o próximo passo de trabalho e documenta o movimento sem entrada duplicada de dados. Em muitas empresas, quatro blocos essenciais em particular oferecem melhorias rapidamente mensuráveis:

  • A gestão centralizada de inventário com artigos, variantes, locais de armazenamento, níveis mínimos de stock, e stock bloqueado evita versões concorrentes de Excel.
  • As transações móveis via scanners portáteis ou smartphones ligam diretamente a arrumação, transferência, e remoção à localização real da mercadoria.
  • As listas de encomendas e picking mostram prioridade, estado, e faltas em vez de distribuir encomendas através de chamadas verbais ou pilhas de papel.
  • As guias de remessa, etiquetas de envio, e registos de movimento gerados automaticamente reduzem transferências manuais de dados e facilitam o rastreio.

Se a leitura de código de barras é imediatamente necessária depende do armazém. Com poucos artigos e prateleiras fixas, um ecrã de entrada claro pode ser suficiente inicialmente. Com muitos artigos semelhantes, locais de armazenamento que mudam, ou elevado volume, a leitura geralmente não é uma funcionalidade de conveniência, mas sim um travão de erros. Uma cobertura Wi-Fi fiável em todo o espaço também é crucial. Uma aplicação móvel que perde a ligação em vários corredores apenas transfere o problema para uma fila posterior de registos retroativos adiados.

A automação também precisa de limites claros. Um sistema pode priorizar encomendas de envio com base em horários limite, ou preparar uma requisição de compra quando o stock atinge o nível mínimo. No entanto, não deve desencadear encomendas silenciosamente quando é necessário ter em conta prazos de entrega, limites de aprovação, ou encomendas especiais de clientes. Um bom software sugere opções, assinala discrepâncias, e documenta decisões. Não retira às equipas o controlo sobre os casos excecionais.

Para pequenas e médias empresas, a questão raramente é se um sistema empresarial internacional seria tecnicamente capaz. A questão é se realmente encurta o caminho da receção de mercadoria até ao envio — ou se cria novos ecrãs de entrada, aprovações, e sobrecarga de formação. Uma boa digitalização não substitui cada tarefa manual individual. Garante que cada tarefa manual necessária conduz à informação, registo, e ação subsequente corretos.

A qualidade dos dados não é uma tarefa para mais tarde

A digitalização raramente falha devido ao PHP, bases de dados, ou hardware de scanner. Falha mais frequentemente porque os números de artigo são ambíguos, as unidades são entendidas de forma diferente, ou os registos históricos de inventário são importados sem serem verificados. Caso contrário, dependendo da pessoa envolvida, uma "caixa" pode subitamente significar uma única peça, uma unidade de embalagem, ou uma palete.

Os dados mestres devem, por isso, ser limpos antes da importação: identificadores de artigo inequívocos, descrições claras, unidades definidas, locais de armazenamento rastreáveis, e regras para artigos ativos ou bloqueados. Nem todos os conjuntos de dados antigos precisam de ser transferidos para o novo sistema. Arrastar duplicados desatualizados e locais de armazenamento em desuso apenas preserva a antiga incerteza dentro de uma interface mais moderna.

A nível técnico, a aplicação precisa de uma base sólida. Uma estrutura de base de dados clara em MySQL 8 pode armazenar movimentos de inventário como eventos individuais e rastreáveis, em vez de apenas manter um único valor atual substituível. Isto permite esclarecer porque é que um nível de stock se desvia: receção de mercadoria, remoção, transferência, ajuste de inventário, ou cancelamento. Com tecnologias sustentáveis como o PHP 8.4 e JavaScript moderno, uma aplicação personalizada também permanece extensível sem se transformar num grande projeto por cada pequeno ajuste.

Integração apenas onde elimina trabalho duplicado

Um armazém raramente opera isoladamente. As encomendas vêm de uma loja online, ERP, e-mail, ou telefone. Os dados de envio vão para prestadores de serviços, os documentos para a contabilidade, e os indicadores-chave para a gestão. Mesmo assim, nem todos os sistemas de terceiros precisam de ser ligados no primeiro dia.

A prioridade vai para interfaces que substituem a entrada manual repetitiva de dados ou eliminam fontes de erro. Se as encomendas forem transcritas de uma loja online todos os dias, um mecanismo de transferência limpo é valioso. Se um prestador de serviços de envio fornecer etiquetas e números de rastreio, uma integração pode acelerar visivelmente o processo de embalagem. Por outro lado, um ficheiro de exportação raramente usado pode permanecer, por agora, em segurança como uma exportação manual controlada.

Responsabilidades claras em caso de erros são essenciais. O que acontece se uma encomenda for criada na loja, mas não for transmitida com sucesso à aplicação de armazém? As transmissões são registadas, os duplicados reconhecidos, e os processos falhados claramente assinalados? As interfaces só são verdadeiramente fiáveis quando também fornecem um procedimento compreensível para o tratamento de exceções.

Implementação em operação por turnos: a aceitação ganha-se no terreno

O software não é introduzido através de uma apresentação, mas sim entre o cais de carga, a mesa de embalagem, e a prateleira. Por isso, o pessoal experiente de armazém deve ser envolvido desde cedo. Conhecem os atalhos, os requisitos de segurança, e os pontos exatos onde um fluxo de trabalho teoricamente correto falha sob pressão de tempo.

Uma área piloto com mercadoria real e encomendas reais é geralmente mais significativa do que uma longa fase de testes com dados de amostra. Uma operação paralela segura pode ser útil por um tempo limitado. No entanto, não deve tornar-se um estado permanente, porque a dupla entrada de dados gera erros por si só. Um dia de transição claro, uma pessoa de contacto designada, e uma forma simples de reportar problemas diretamente são cruciais.

A formação deve ser orientada para o processo: receber mercadoria, registar uma discrepância, arrumar artigos, fazer picking de uma encomenda, e concluir o envio. Ninguém precisa de dominar todas as ferramentas de avaliação ou funções de administração logo no início. As funções e permissões ajudam a manter o ecrã focado na respetiva tarefa. Um operador de picking precisa de informação diferente da gestão de armazém, e um ajuste de inventário deve exigir um processo de aprovação rastreável.

Medir o sucesso por mais do que apenas níveis de stock

Após o lançamento, vale a pena observar alguns indicadores-chave de desempenho que a equipa consegue realmente influenciar: tempo de espera desde a receção de mercadoria até à disponibilidade, número de ajustes de inventário, erros de picking, tempos de pesquisa, envios pontuais, e casos abertos para esclarecimento. Estas métricas mostram se o fluxo de trabalho está a melhorar muito mais rapidamente do que um projeto geral de digitalização o faria.

A softify.pro desenvolve estes sistemas não como substituto de passos de trabalho funcionais, mas sim como um complemento preciso onde papel, folhas de cálculo, e chamadas verbais já não são suficientes. Por vezes, a recomendação certa é uma pequena aplicação para receção de mercadoria e envio, em vez de um sistema completo de gestão de armazém. Por vezes, uma folha de cálculo continua a ser a solução mais sensata para uma análise especial rara.

O melhor próximo passo não é, por isso, a seleção do produto, mas sim um olhar conjunto sobre uma encomenda concreta da semana passada. Assim que o seu percurso pelo armazém se tornar claro, registável, e rastreável em caso de desvios, está lançada a base para uma digitalização que realmente poupa tempo na operação diária.

Permalink →