softify.pro
Laster …
Tjenester Om oss COCO – vår AI-server Portefølje Insiders Case-studier Godt å vite Kontakt Logg inn

Godt å vite

Pure fluidity meets ultimate performance: hva som virkelig gjør forretningsprogramvare rask

Pure fluidity meets ultimate performance: hva som virkelig gjør forretningsprogramvare rask

En lagersjef kjenner ikke igjen dårlig programvare på en arkitekturtegning. Vedkommende kjenner den igjen på at medarbeidere igjen griper etter telefonen, registrerer følgesedler dobbelt eller etter et skift ikke kan si hvilke varer som faktisk er kommet. Pure fluidity meets ultimate performance må derfor ikke være et blott visuelt krav. For forretningsprogramvare betyr det at en sak føles naturlig og samtidig fungerer pålitelig under reelle forhold.

Et elegant grensesnitt er verdiløst hvis det hakker ved svakt WLAN i lageret. En rask applikasjon hjelper likeledes lite hvis den tvinger fram en arbeidsrekkefølge som ingen ved rampen kan følge. Gode digitale verktøy forener utforming, hastighet og prosessforståelse. De reduserer friksjon uten å presse virksomheten inn i en ferdiglaget standardlogikk.

Pure fluidity meets ultimate performance er et driftsspørsmål

Flyt forveksles ofte med animasjoner, store bilder og myke overganger. Det kan passe til et moderne merke. I arbeidshverdagen viser den seg likevel annerledes: et varemottak kan bokføres uten omveier. En medarbeider finner en ordre også når bare et referansenummer er kjent. En feil benevnes tydelig, i stedet for å forsvinne i en kryptisk melding.

Ytelse er likeledes mer enn en god verdi i en nettlesertest. Avgjørende er responstiden ved en ordre med mange posisjoner, stabiliteten ved månedsskiftet og spørsmålet om fem personer kan arbeide samtidig uten å overskrive hverandres datagrunnlag. Også en ren håndtering av tilkoblingsbrudd, rettigheter og sperrede kontoer hører med.

Begge er uatskillelige. Hvis et skjermbilde reagerer umiddelbart men har uklare obligatoriske felt, forblir det slitsomt. Hvis forløpet er klokt modellert men siden venter to sekunder ved hver bokføring, blir det omgått. Flyt oppstår der systemet støtter neste fornuftige handling og teknisk forblir raskt nok til at tankerekken ikke brytes.

Grensesnittet følger arbeidsveien, ikke organisasjonskartet

Mange standardløsninger strukturerer menyene sine etter moduler: innkjøp, salg, lager, rapportering, administrasjon. Fra et produktperspektiv er det forståelig. På lagergulvet begynner arbeidet imidlertid ofte med en situasjon: en lastebil står der, en pall mangler, en kunde trenger et leveringsbevis eller en forsendelse må merkes før mottaket stenger.

En god individuell applikasjon begynner derfor med disse situasjonene. Hvilken informasjon foreligger? Hvem avgjør? Hva må dokumenteres? Hva må ikke endres senere? Først deretter avgjøres hvilket inndataskjema, hvilken kontroll eller automatisering som er nødvendig.

Det betyr ikke å støpe hvert eksisterende forløp uendret i programvare. Noen tabeller er virkelig for feilutsatte, noen godkjenninger unødig trege. Men en fungerende Excel-liste må ikke nødvendigvis erstattes av et prosjekt. Hvis den bare vedlikeholdes av én person, kjenner få unntak og forblir sporbar, kan den være det passende verktøyet. Programvare lønner seg når den forbedrer koordineringen, reduserer feilkilder eller gjør informasjon pålitelig tilgjengelig for flere involverte.

Færre klikk er ikke automatisk bedre

Kravet om færrest mulig klikk høres fornuftig ut, men kan føre i feil retning. Ved en uopprettelig lagerbokføring er en kort bekreftelse meningsfull. Ved en forsendelsesgodkjenning kan en synlig sannsynlighetskontroll forhindre dyr etterarbeid. Riktig forløp avhenger av risikoen.

Avgjørende er at ekstra steg har et klart formål. En bekreftelse bør ikke dukke opp bare fordi rammeverket lett genererer den. Den bør stå nøyaktig der mennesker bevisst må ta en beslutning. Slik forblir applikasjonen rask uten å bli lettsindig.

Ytelse oppstår i arkitekturen, ikke i den siste sprinten

Den som fremskynder et nettsted eller en webapplikasjon først kort før go-live, behandler som regel symptomer. Store spørringer, uklare datamodeller og i etterkant tilføyde spesialtilfeller lar seg ikke varig korrigere med én enkelt optimaliseringsdag.

Et bærekraftig grunnlag begynner med en database som tilsvarer de faktiske sammenhengene i virksomheten. I MySQL 8 trenger bevegelser, bilag, statusendringer og brukerhandlinger sporbare nøkler og fornuftige indekser. En beholdning må ikke bare fremstå som et tall hvis det senere må avklares hvilken bokføring den oppsto av. Samtidig trenger ikke hver historisk informasjon å beregnes på nytt ved hvert sidekall.

Ved moderne webapplikasjoner er også ansvarsfordelingen relevant. PHP 8.4 kan avbilde forretningsregler tydelig og vedlikeholdbart, mens moderne JavaScript brukes målrettet for reaktive områder. Det er ingen trosbekjennelse for en bestemt stack. Det er et vedlikeholdsspørsmål: kan endringer gjennomføres trygt om seks måneder? Er det synlig hvor en regel gjelder? La en feil seg reprodusere, i stedet for bare å mistenkes?

Ytelse trenger dessuten grenser. Søkefelt trenger fornuftige minimumstegn eller en presis filterlogikk hvis millioner av poster er tenkelige. Store lister trenger sider eller trinnvise etterlastingsprosesser. Bilder og dokumenter bør ikke blokkere den kritiske arbeidsflyten. Disse beslutningene virker lite spektakulære. Nettopp derfor forblir de ofte verdifulle lenger enn en iøynefallende frontend-effekt.

Synlig hastighet skaper tillit

Ikke hver prosess kan være ferdig på under et sekund. En etikettutskrift, et grensesnitt mot transportøren eller en kontroll mot eksterne data tar av og til tid. Avgjørende er da hvordan applikasjonen håndterer ventetid.

En tydelig status som «Forsendelsesetikett opprettes» er bedre enn en frossen knapp. Etter en avslutning bør det være synlig hvilket nummer som ble opprettet og om saken kan utløses på nytt. Hvis en ekstern tjeneste ikke er tilgjengelig, trenger teamet et forståelig handlingsalternativ i stedet for en feilmelding for utviklere.

Det er også et spørsmål om dataintegritet. Et dobbeltklikk må ikke opprette to leveranser. En avbrutt prosess må ikke i stillhet etterlate en halvferdig post. Gode systemer planlegger for slike tilfeller fordi de vil inntreffe i hverdagen. Spesielt ved skiftende skift, tidspress og mobile enheter er unntaket ikke noe randtema.

Kvalitet blir synlig før feilen

For applikasjoner med mange prosessvarianter er det ikke nok å klikke seg manuelt gjennom noen veier til slutt. Endringer i priser, roller, valideringer eller grensesnitt kan utløse følger på et fjerntliggende sted. Her blir automatisert testing en del av ytelsen: ikke bare teknisk, men organisatorisk.

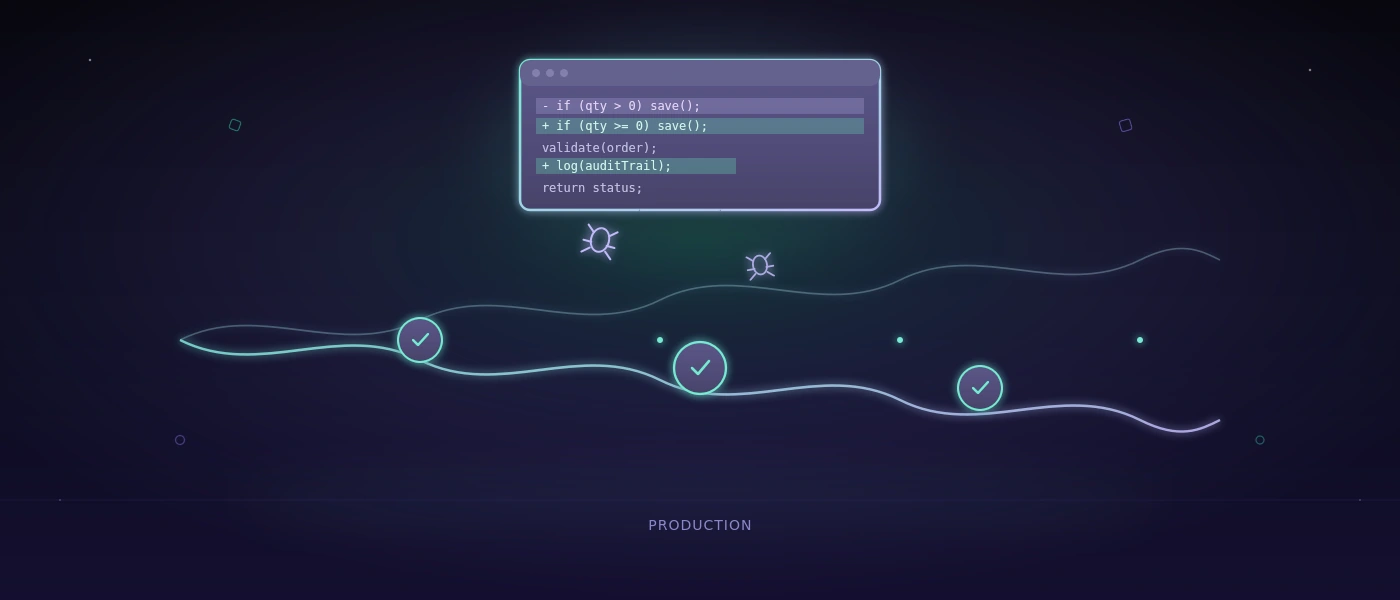
Et testsystem bør kunne kontrollere reelle forløp, for eksempel opprette en ordre, endre en posisjon, generere en følgeseddel og kontrollere en rettighet. Det bør registrere bevis og formulere resultater slik at fagavdelinger kan plassere dem. En setning som «Forsendelsesprosessen ble ikke fullført etter adresseendringen» hjelper mer enn en ukommentert stacktrace.

For sikkerhetsbevisste team er også stedet relevant der disse testene kjører. Hvis skjermbilder, påloggingsopplysninger, testtilfeller eller interne applikasjonssteg ikke skal forlate bedriften, er en selvhostet tilnærming ofte fornuftigere enn en ekstern skytjeneste. Med COCO kan automatiserte tester for web- og Windows-applikasjoner kjøres i et dedikert miljø. Det er ikke nødvendig for hvert team. Ved sensitive data, regulerte områder eller interne fagapplikasjoner kan kontrollen over testdata likevel være en avgjørende fordel.

Utforming er god når den letter arbeidet

En sterk visuell identitet kan skape tillit. Den viser at en bedrift tar sin digitale tilstedeværelse på alvor. I det operative systemet må utformingen imidlertid yte enda mer: orientering under tidspress. Kontrast, typografi, tydelige tilstander og forståelige betegnelser avgjør om noen avslutter en sak trygt eller spør kollegaen.

Tilbakeholdenhet er her ofte det bedre valget. Et dashbord med ti fargede nøkkeltall kan se imponerende ut og likevel skjule det eneste relevante avviket. En redusert visning som gjør åpne varemottak, manglende skanninger og truede leveringstider synlige, er mer nyttig. Spørsmålet lyder ikke hvor mye grensesnitt som er mulig, men hvilken informasjon som forbedrer en beslutning.

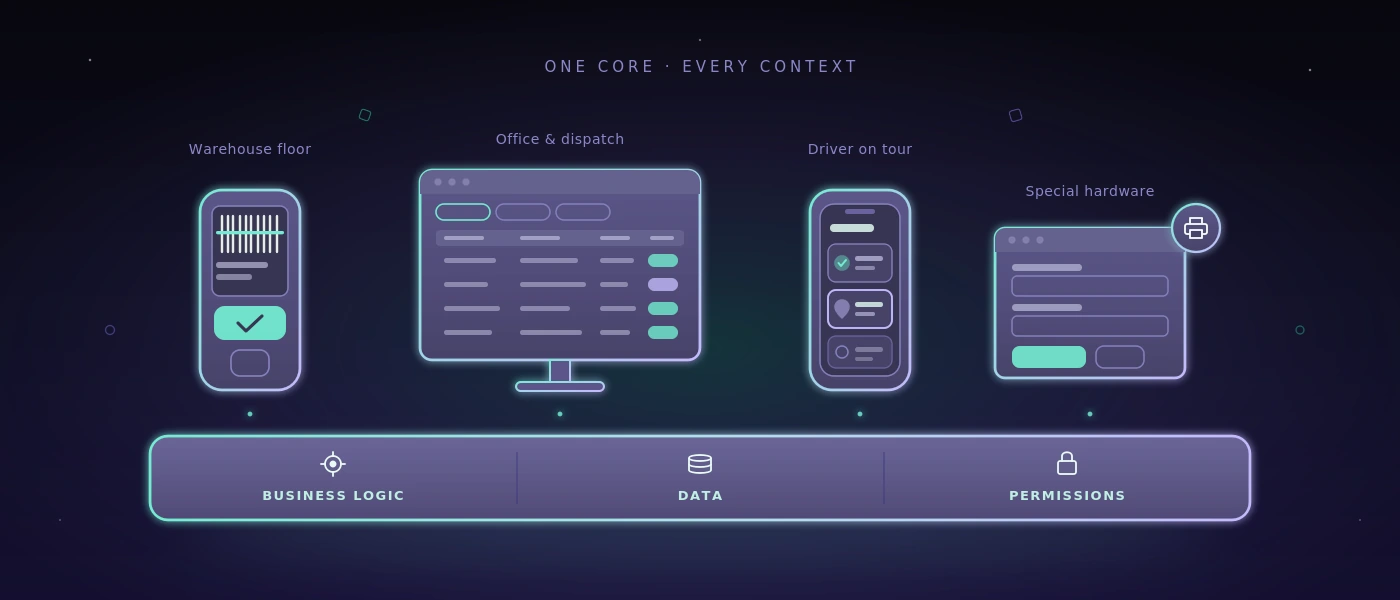
Det gjelder også responsive applikasjoner. Mobilkapasitet betyr ikke å presse hvert skrivebordsbilde inn i et mindre format. En smarttelefon ved varemottaket trenger kanskje bare skanning, mengde, lagerplass og bekreftelse. Den utførlige etterbehandlingen hører muligens hjemme på en større skjerm. Ulike enheter fortjener ulike prioriteringer, selv om de bruker det samme pålitelige datagrunnlaget.

En fornuftig målestokk for neste beslutning

Før et team bestemmer seg for en ny plattform, en automatisering eller en fullstendig nybygging, hjelper en enkel kontroll: blir forløpet klarere, raskere eller tryggere for menneskene som utfører det daglig? Og lar løsningen seg fortsatt forstå når krav, medarbeidere eller grensesnitt endres?

Hvis begge svarene holder, blir et vakkert løfte et brukbart system. Da viser pure fluidity meets ultimate performance seg ikke på et lysbilde, men på en rolig arbeidsdag der ordrer, data og beslutninger fortsetter uten unødig friksjon.
Permalenke →

SaaS Flow Web: innføre arbeidsflyter trygt under løpende drift

SaaS Flow Web: innføre arbeidsflyter trygt under løpende drift

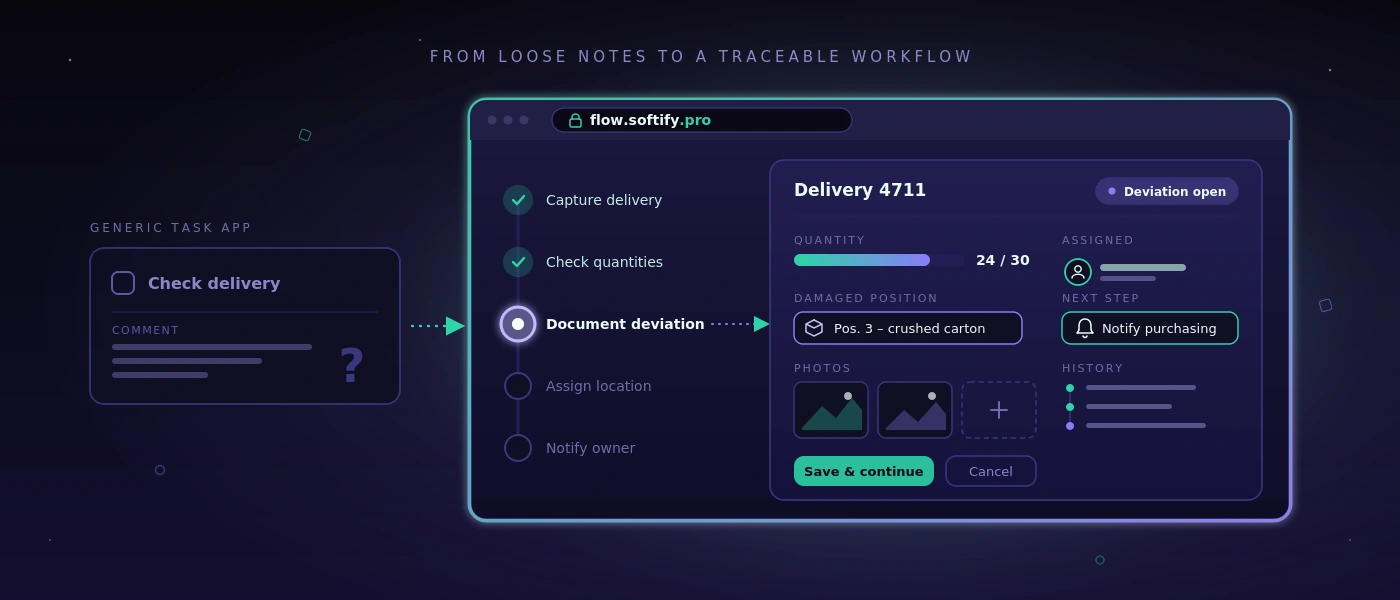
Et varemottak blir ikke liggende fordi et team ikke kjenner enda en programvare. Det blir liggende fordi informasjon går tapt mellom e-post, papirskjema, Excel-fil og telefonsamtale. Ved SaaS - «Flow Web» på flow.softify.pro - bør derfor ikke grensesnittet være det første spørsmålet. Avgjørende er om tjenesten pålitelig avbilder en konkret arbeidsflyt - også på hektiske dager, ved skiftende ansvar og når en leveranse ikke tilsvarer planen.

For små og mellomstore bedrifter er SaaS ofte fornuftig, fordi de ikke først må bygge egne servere, utgivelser og grunnfunksjoner. Men det er ikke noe fribillett for hver prosess. Den som innfører et verktøy som gjør hverdagen mer komplisert eller presser viktige data inn i uklare sidelister, digitaliserer ikke arbeid. Vedkommende flytter bare friksjonen.

Hva SaaS «Flow Web» må yte

En nettbasert arbeidsflyt er god når medarbeidere uten tolkning vet hva som skal gjøres neste. Ved et varemottak kan det bety: registrere leveransen, kontrollere mengder mot bestillingen, dokumentere avvik, tildele lagerplass og ved behov informere en ansvarlig. Forløpet trenger ikke være spektakulært. Det må være sporbart, raskt og gjentakbart.

Akkurat her ligger forskjellen mellom en generell oppgaveapp og et faglig prosessystem. En oppgaveapp kan opprette et punkt som heter «Kontrollere leveranse». En faglig arbeidsflyt kan i tillegg registrere hvilken leveranse som menes, hvem som tok imot den, hvilken posisjon som var skadet, hvilke bilder som finnes og om en ettersendelse er utestående. Disse dataene står da ikke som fritekst i en enkelt kommentar, men der neste person trenger dem.

For en løsning som Flow Web på flow.softify.pro bør vurderingen derfor begynne ved sakene, ikke ved en funksjonsliste. En bedrift med fem lagerbevegelser om dagen trenger noe annet enn et forsendelsesteam med flere cut-off-tider, ulike transportører og regelmessig håndtering av delleveranser. SaaS er ingen erstatning for prosessforståelse.

Først navngi flaskehalsen, deretter konfigurere

Mange digitaliseringsprosjekter starter for bredt: «Vi vil digitalisere lageret.» Det høres plausibelt ut, men fører raskt til et system med for mange skjermbilder, spesialtilfeller og opplæringsmateriell. Bedre er en presis uttalelse som: «Varemottak bokføres først neste dag, fordi følgesedler ved skiftslutt ligger på skrivebordet.»

Fra en slik setning kan en fornuftig start utledes. Den første versjonen kan registrere følgesedler, bekrefte artikler og mengder, markere avvik og føre bokføringen videre til ansvarlig enhet. Når dette forløpet fungerer, kan etiketter, leverandørvurderinger eller automatiske bestillingsforslag legges til senere. Ikke hvert fornuftig utbyggingstrinn hører hjemme i den første utrullingen.

Også en velholdt tabell kan bli hvis den oppfyller sitt formål. For eksempel kan en månedlig evaluering med få involverte i en eksisterende fil være rimeligere og mer transparent enn en egen modul. SaaS lønner seg der informasjon brukes flere ganger, behandlingstider er kritiske eller feil oppstår fra mediebrudd.

De riktige spørsmålene før innføringen

Før konfigurasjonen bør et team spille gjennom en virkelig sak fra begynnelse til slutt. Ikke idealprosessen, men tilfellet som skaper problemer i hverdagen: feil mengde, manglende referanse, hastig forsendelse eller en ordre med spesialgodkjenning. Der viser reglene seg som et system faktisk må avbilde.

Relevante er blant annet disse punktene: hvem får opprette, endre eller avslutte en sak? Hvilke inndata er obligatoriske, hvilke bare nyttige? Når må en leder informeres? Hvilke data overleveres til regnskap, forsendelse eller kundeservice? Og hva skjer hvis WLAN i lageret er svakt eller en medarbeider ikke lenger har påloggingsopplysningene sine?

Svarene bestemmer kvaliteten på innføringen sterkere enn en lang katalog med visuelle krav. En ren rolleprosess, en forståelig feilmelding og et dokumentert godkjenningssteg forhindrer i drift som regel mer arbeid enn en ekstra rapport på startsiden.

Datalagring og roller er ingen bisak

SaaS behandles ofte som et rent betjeningsspørsmål. For drifts- og IT-ansvarlige er det imidlertid minst like viktig hva som skjer med dataene. Det gjelder stamdata, leveringsinformasjon, medarbeiderdata, bilder av skader og eventuelt kundedata. Før innføringen bør ansvar, oppbevaring og eksportmuligheter være klare.

Praktisk betyr det: bedriften må vite hvilke data som ligger i systemet, hvem som har administrativ tilgang og hvordan data stilles til rådighet ved bytte eller opphør av avtale. En eksport som bare er tilgjengelig som tungt lesbar PDF-fil hjelper sjelden. For operative data er strukturerte, brukbare formater avgjørende.

Også rettighetskonseptet fortjener konkret oppmerksomhet. I lageret trenger ikke hver person å se priser, kundevilkår eller globale innstillinger. Samtidig må en for snever rettighetstildeling ikke blokkere flyten. Fornuftige er roller som er innrettet etter faktiske oppgaver: mottak, disposisjon, forsendelse, teamledelse og administrasjon. Kritiske endringer bør være sporbare, slik at man ved spørsmål ikke må gjette hvem som endret en bokføring.

Selve tilgangen bør beskyttes med solide grunnlag. Dit hører sikre passordpolicyer, en regulert tilbakestilling av passord, kontolåsing ved gjentatte mislykkede forsøk og, der risikoprofilen krever det, ytterligere påloggingssteg. Sikkerhet virker profesjonell når den er forutsigbar og ikke merkes først når noen er blitt låst ute.

Integrasjon bare der den målbart avlaster

En nettbasert arbeidsflyt utfolder ofte sin verdi først i samspill med eksisterende systemer. Det kan være et ERP, en nettbutikk, en forsendelsesløsning, en tidsregistrering eller en database. Likevel er ikke hvert grensesnitt automatisk fornuftig. Hver integrasjon skaper avhengigheter, feilbilder og vedlikeholdsarbeid.

Det sentrale spørsmålet lyder: hvilket manuelt steg fjerner forbindelsen konkret? Hvis et grensesnitt hver dag sparer 30 minutter overføringsarbeid og reduserer skrivefeil, er nytten klar. Hvis det bare speiler en informasjon som uansett kontrolleres én gang i uken, kan en manuell eksport først være den fornuftigere løsningen.

Ved individuelle utvidelser teller det tekniske grunnlaget. Dokumenterte grensesnitt, tydelig definerte datafelt og sporbare feilprotokoller letter senere drift. Hvis et system kobles til en skreddersydd webapplikasjon, bør teknologier og databasestruktur velges slik at de forblir vedlikeholdbare på lang sikt. En velholdt applikasjon basert på PHP 8.4, moderne JavaScript og MySQL 8 er mer verdifull enn en kortsiktig imponerende spesialløsning uten dokumentasjon.

Innføring under løpende drift

Den vanligste feilen er en hard start uten sammenligningsfase. Team skal da mandag morgen straks arbeide annerledes, mens åpne spørsmål først oppstår fra virkelige problemer. Det øker avvisningen, selv om programvaren i prinsippet passer.

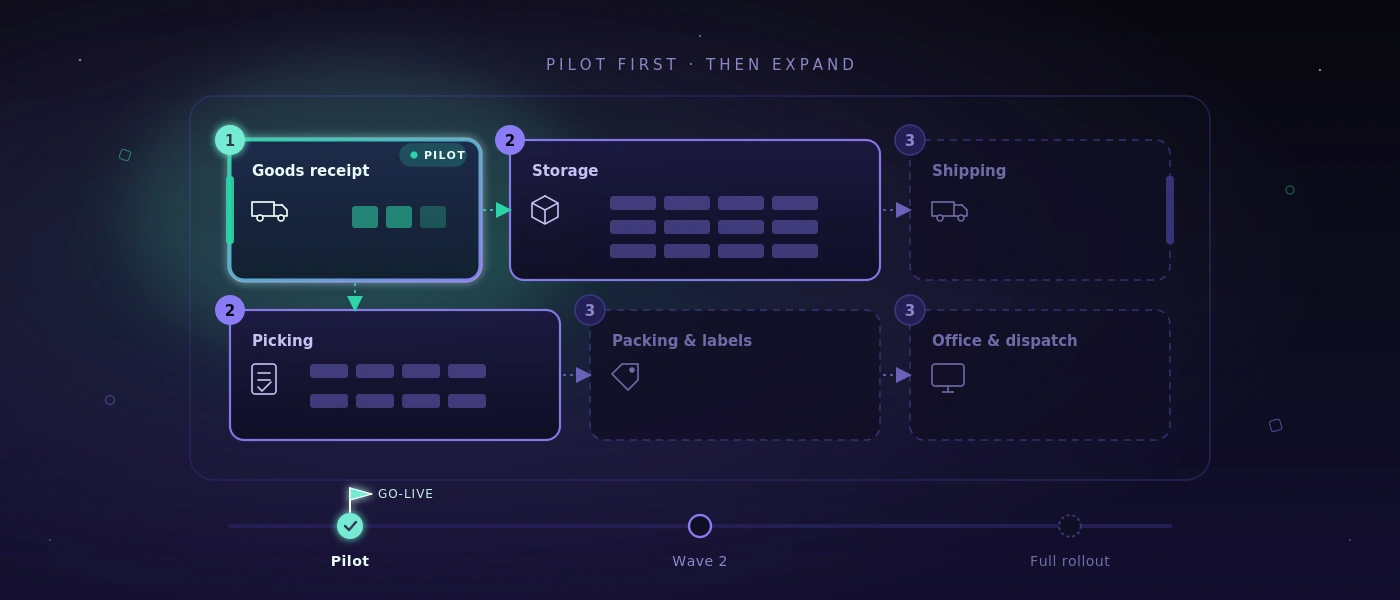
Bedre er en begrenset pilot med ett team, én prosessvariant eller et tydelig avgrenset stedsområde. I denne tiden kontrolleres det om registrering og godkjenninger fungerer, om begreper er forståelige og om unntakstilfeller lander rent. Viktig er å ikke bare samle tilbakemeldinger som en ønskeliste. Hver endring bør prøves mot nytten for gjennomløpstid, feilrate eller transparens.

Også nøkkeltall bør fastsettes tidlig. For eksempel kan behandlingstid per varemottak, antall åpne avvik, forespørsler om leveringsstatus eller korreksjonsbokføringer følges. Uten utgangsverdi forblir «føles raskere» den eneste vurderingen. Det kan stemme, men er ikke nok for en holdbar investeringsbeslutning.

Drift trenger en tydelig eier

SaaS reduserer teknisk innsats, men fritar ikke en bedrift fra ansvaret for sin egen prosess. Internt trengs noen som forvalter roller, samler tilbakemeldinger, oppdager opplæringsbehov og avgjør hvilke endringer som virkelig er nødvendige. Denne personen trenger ikke kunne programmere. Vedkommende bør imidlertid forstå arbeidsflyten og ha tilgang til de ansvarlige.

Like viktig er en kort, holdbar driftsdokumentasjon. Den forklarer ikke hvert skjermbilde, men besvarer spørsmålene som oppstår i hverdagen: hva gjøre ved en feilaktig bokføring? Hvem godkjenner nye brukere? Hvordan kommuniseres et avbrudd? Hvor ligger eksporterte data? Slik klarhet forhindrer at et digitalt system etter noen måneder igjen blir avhengig av personlige tilrop.

En god SaaS-løsning kjenner man derfor ikke igjen på hvor mange menypunkter den tilbyr. Den viser sin verdi når en ny kollega trygt kan behandle en sak, et avvik ikke forsvinner og en leder ser statusen uten å ringe tre personer. Nettopp etter denne målestokken bør Flow Web måles: ikke etter løfter, men etter en arbeidsdag som påviselig går roligere og mer pålitelig.

Permalenke →

Webutvikling med aktuelle rammeverk: hva bedrifter virkelig får ut av det

Webutvikling med aktuelle rammeverk: hva bedrifter virkelig får ut av det

Hvis et varemottak fortsatt pendler mellom papirskjema, telefonsamtale og tre Excel-filer, løser ikke et moderne frontend problemet alene. Webutvikling med aktuelle rammeverk er fornuftig når den synlig forenkler forløp: medarbeidere ser neste steg, data registreres bare én gang, og applikasjonen forblir forståelig vedlikeholdbar også etter den første go-live.

For små og mellomstore bedrifter er rammeverksspørsmålet derfor ingen trosspørsmål. Avgjørende er ikke om et grensesnitt bærer spesielt mange tekniske moteord. Avgjørende er om lagerbevegelser, ordrer, kontroller eller godkjenninger kommer pålitelig gjennom arbeidsdagen - også under tidspress, skiftbytter og svingende nettverksforbindelse.

Rammeverk er et middel, ikke et prosjektmål

Et rammeverk leverer en velprøvd struktur for gjentakende oppgaver: routing, skjemaer, rettighetsstyring, datatilgang, tester og visning av grensesnitt. Det reduserer ikke automatisk hver risiko. Men det forhindrer at et prosjekt gang på gang må finne opp grunnleggende funksjoner på nytt.

Ved en individuell webapplikasjon kan et moderne JavaScript-rammeverk for eksempel fornuftig avbilde interaktive skjermbilder: en plukkliste som fortløpende oppdaterer posisjoner, en ruteplanlegging med klare statusbytter eller en kontrollprotokoll som knytter bilder og kommentarer direkte til en sak. I backend sørger etablerte PHP-rammeverk for sporbare regler, tydelig adskilte ansvarsområder og konsistente grensesnitt mot databasen.

Det er spesielt relevant når en i utgangspunktet liten løsning blir et daglig brukt driftssystem for en prosess. Et inndataskjema for leveringsvarsler kan begynne oversiktlig. Så snart det oppdaterer lagerbeholdninger, skriver ut etiketter, tar hensyn til roller og kommuniserer med en transportør, trenger det en ren teknisk basis. Rammeverk hjelper til med å ikke forhandle om denne basisen på nytt ved hver utvidelse.

Hva aktuelle webrammeverk konkret gjør bedre

Verdien av moderne rammeverk ligger sjelden i spektakulære effekter. Den viser seg i de usynlige delene av en applikasjon. Skjemaer kan kontrollere inndata direkte, uten at feilaktige data oppdages først etter innsending. Rettigheter kan defineres sentralt, slik at en sjåfør ser annen informasjon enn disposisjonen. Endringer i en bestilling lagres sporbart, i stedet for stille å overskrive en tabellcelle.

På serversiden skaper et aktuelt miljø med PHP 8.4 og MySQL 8 et bæredyktig grunnlag for forretningskritisk logikk. Databasetransaksjoner forhindrer for eksempel at en beholdning reduseres mens den tilhørende bokføringen mislykkes. Unike nøkler og valideringsregler unngår duplikater. Bakgrunnsprosesser kan opprette dokumenter eller kalle grensesnitt uten at personen ved skjermen må vente.

Heller ikke sikkerhet er en funksjon i etterkant. Et tidsmessig rammeverk støtter sikker passordlagring, beskyttelse mot typiske inndataangrep, sporbare sesjoner og definerte kontolåsingsflyter. Likevel forblir gjennomføringen en prosjektoppgave: rettigheter må modelleres faglig riktig, og sensitive funksjoner trenger ekstra kontroller. Et rammeverk gir rekkverk, men ingen kunnskap om hvem i bedriften som kan gi hvilken godkjenning.

Å avgjøre webutvikling med aktuelle rammeverk riktig

Den beste teknologien oppstår ikke gjennom en liste over populære verktøy, men gjennom den faktiske bruken. En intern applikasjon for ti personer har andre krav enn en kundeportal med flere tusen samtidige tilganger. En lagerterminal med skanner trenger en annen betjeningslogikk enn en ledelsesanalyse på skrivebordet.

Derfor begynner en fornuftig beslutning med konkrete spørsmål: hvilke forløp koster i dag målbart tid? Hvilke data overføres flere ganger? Hvor oppstår feil fordi informasjon blir synlig for sent? Hvilken eksisterende tabell fungerer godt nok og bør til å begynne med bli? Nettopp det siste punktet beskytter mot dyre digitaliseringsprosjekter uten operativ nytte.

For mange individuelle forretningsapplikasjoner er et servergjengitt system med målrettede interaktive komponenter det fornuftigste valget. Det laster raskt, er oversiktlig å drifte og unngår unødvendig kompleksitet. En fullstendig frikoblet single-page-applikasjon kan derimot være passende når grensesnittet håndterer svært mange dynamiske tilstander, må fungere offline eller senere skal stille de samme funksjonene til rådighet også for en mobilapp.

Begge kan være faglig riktige. Spørsmålet lyder ikke: hvilket rammeverk er mest moderne? Det lyder: hvilken arkitektur er om to år fortsatt trygt utvidbar, testbar og forståelig for eget team?

Når mindre teknikk er bedre teknikk

Ikke hver prosess trenger et komplekst frontend. Et slankt inndataskjema for interne bestillinger kan være raskere, mer stabilt og rimeligere enn et omstendelig animert grensesnitt. Hvis en Excel-fil bare vedlikeholdes én gang i måneden og ikke forårsaker feil, er den muligens fortsatt det riktige verktøyet.

Kompleksitet lønner seg først når den fjerner reell friksjon. Det kan være tilfellet når ordrer tastes inn flere ganger, leveringsstatus må etterspørres per telefon eller ingen er sikker på hvilken versjon av et dokument som gjelder. Da skaper en sentral applikasjon en klar nytte: ett datagrunnlag, entydige ansvarsområder og færre forespørsler.
Vedlikeholdbarhet begynner før første kodelinje

Rammeverk blir ofte sett som akseleratorer. Det stemmer bare hvis de faglige reglene på forhånd er tilstrekkelig klare. En utvikler kan bygge en tilstandsmaskin teknisk rent. Men om statusrekkefølgen virkelig passer til prosessen, avgjøres ved kartleggingen: når regnes varer som mottatt? Hvem får lukke et avvik? Hva skjer ved en delleveranse?

Disse beslutningene hører dokumentert, i likhet med grensesnitt, datafelt og unntak. Det gjør ikke prosjekter langsommere. Det reduserer senere diskusjoner, fordi det blir synlig hvilken regel som ble bevisst gjennomført og hvilken antakelse som fortsatt er åpen.

Vedlikeholdbarhet viser seg også i små disipliner. Databaseendringer må versjoneres. Driftsettingssteg må dokumenteres. Feilmeldinger skal være brukbare for drift og utvikling uten å avsløre konfidensielle detaljer. Automatiserte tester kontrollerer ved hver endring sentrale forløp, for eksempel opprettelsen av en ordre, beregningen av en mengde eller utskriften av en følgeseddel.

Ved kritiske applikasjoner er ikke én enkelt testtype nok. Enhetstester sikrer enkeltregler, integrasjonstester kontrollerer samspillet med database og grensesnitt, og ende-til-ende-tester spiller av virkelige betjeningsveier i nettleseren. For web- og Windows-applikasjoner kan et selvhostet testmiljø i tillegg levere skjermbilder, kjøringsprotokoller og forståelige vurderinger, uten å unødig gi interne testdata til eksterne skytjenester.

Ytelse oppstår fra arkitektur og datamodell

Et moderne grensesnitt blir ikke raskt fordi det bruker et aktuelt rammeverk. Trege databasespørringer, overdimensjonerte bilder eller uklare grensesnitt forblir trege, uavhengig av frontend. Spesielt ved lister med ordrer, artikler eller bevegelsesdata avgjør datamodellen den opplevde hastigheten.

Rene indekser i MySQL 8, paginerte spørringer og bevisst lastede data er ofte mer effektive enn senere optimalisering i grensesnittet. Like viktig er et tydelig cachingkonsept. Stamdata kan under visse omstendigheter bufres, aktuelle beholdninger eller godkjenningsstatus derimot ikke blindt. Her finnes ingen generell regel, fordi datas faglige betydning bestemmer hvor aktuelle de må være.

Responsiv utforming hører også med til den tekniske planleggingen. På kontorskjermen kan en bred tabell være fornuftig. På en håndskanner eller et nettbrett i lageret trenger den samme informasjonen store trykkflater, korte veier og en visning som forblir brukbar også med hansker eller i dårlig lys. Pure fluidity meets ultimate performance betyr i denne sammenhengen ikke mest mulig bevegelse på skjermen. Det betyr at applikasjonen fungerer uten friksjon på enheten som faktisk brukes i prosessen.

Den fornuftige veien fra idé til drift

Et solid webprosjekt starter med en begrenset, etterprøvbar kjerne. I stedet for å automatisere hvert tenkelig unntak på forhånd, velges en prosess som forekommer ofte og forårsaker merkbar innsats. Etter første bruk viser virkelige data og tilbakemeldinger hvilken utvidelse som virkelig har neste prioritet.

Den tekniske overleveringen bør ikke skje først på slutten. Ansvar for hosting, sikkerhetskopier, overvåking, oppdateringer og tilgangsrettigheter må avklares tidlig. Et system er bare så pålitelig som driften av det. Den som daglig trenger en applikasjon til forsendelse eller ordrebehandling, trenger definerte gjenopprettingsveier og et klart svar på hva som skjer ved en forstyrrelse.

softify.pro satser derfor på vedlikeholdbare teknologier, dokumentert levering og direkte teknisk ansvar i stedet for kortlivede rammeverksmoter. Det er ingen magisk snarvei. Det skaper forutsetningen for at en applikasjon etter lanseringen fortsetter å virke, kan videreutvikles og ikke blir det neste skjøre spesialtilfellet.

Den rette webapplikasjonen føles i beste fall ikke som et nytt IT-prosjekt. Den føles som et forløp som endelig fungerer uten omveier - med nok teknisk substans til å ta imot også den neste endringen i driften med ro.

Permalenke →

Planlegge en programvareutrulling: slik lykkes innføringen under løpende drift

Planlegge en programvareutrulling: slik lykkes innføringen under løpende drift

Et nytt system mislykkes sjelden fordi en knapp mangler. Det mislykkes mandag morgen: morgenskiftet finner ikke varemottaket, en følgeseddel skrives ut to ganger eller en Excel-fil blir plutselig den uoffisielle sannheten. Den som vil planlegge en programvareutrulling, må derfor ikke bare innføre funksjoner, men sikre den reelle driften.

Nettopp i lager, verksted, disposisjon og administrasjon er en utrulling ikke en IT-avtale. Den endrer håndgrep, ansvar og informasjonsveier. En god innføring holder arbeidet i bevegelse, gjør feil synlige tidlig og gir medarbeidere et klart svar på det avgjørende spørsmålet: hva gjør jeg annerledes fra i morgen?

Utrullingen begynner før den første opplæringen

Mange prosjekter starter med en funksjonsliste: registrere ordrer, bokføre lagerbevegelser, skrive ut forsendelsesetiketter, planlegge ruter. Det er nødvendig, men ikke nok. Før start må det være avklart hvilke prosesser som faktisk skal gå via det nye systemet den første produktive dagen - og hvilke som bevisst ikke skal det ennå.

Denne avgrensningen er ikke et tegn på ufullstendighet. Den reduserer risiko. Hvis en mellomstor bedrift hittil har koordinert varemottak via papir, telefon og tabeller, trenger den ikke første dag samtidig å digitalisere hele lagerstyringen, returhåndteringen, turplanleggingen og leverandørvurderingen. Et fornuftig første omfang kunne ligge i varemottaket, entydige lagerbevegelser og utskrift av leveringsdokumenter.

Avgjørende er å beskrive målprosessen konkret. Ikke: «Varemottaket blir digitalt.» Men: «Medarbeideren skanner leveransen, kontrollerer mengde og tilstand, tildeler en lagerplass og oppretter ved avvik en sak for innkjøp.» Først på dette nivået blir åpne spørsmål synlige: hva skjer ved manglende bestilling? Hvem får korrigere mengder? Får en leveranse uten etikett lagres inn?

Å planlegge en programvareutrulling betyr: prioritere kritiske flyter

Ikke hver prosess har samme betydning. Et utfall innen stamdatavedlikehold kan være ubehagelig. Et utfall ved forsendelse, plukking eller fakturagodkjenning kan blokkere en hel dags arbeid. Derfor trenger utrullingen en prioritering etter driftsrisiko, ikke etter rekkefølgen i kravspesifikasjonen.

En enkel inndeling har vist seg å fungere: forretningskritisk, viktig og utsettbar. Forretningskritiske er alle flyter som beveger varer, penger eller bindende kundekommunikasjon. Viktige er funksjoner som gjør hverdagen raskere, men hvis bortfall midlertidig kan dempes manuelt. Utsettbare er komfortfunksjoner, sjeldne spesialtilfeller eller evalueringer som til å begynne med fortsatt kan komme fra en eksisterende kilde.

Denne inndelingen påvirker testdybden. For en kritisk forsendelsesprosess er det ikke nok å klikke seg gjennom én enkelt ordre vellykket. Testes må også delleveranser, kanselleringer, manglende skrivere, feil adresser, parallell behandling og overleveringen til transportøren. For en sjelden brukt statistikkfunksjon kan en senere testsyklus være passende.

Gjør suksesskriterier målbare på forhånd

«Applikasjonen kjører» er ikke et akseptkriterium. Bedre er etterprøvbare utsagn: et varemottak på 30 posisjoner kan bokføres innen ti minutter. Forsendelsesetiketter skrives ut på den tiltenkte arbeidsplassen. Lagerendringer vises umiddelbart i disposisjonen. En sperret brukerkonto kan bare reaktiveres via den definerte godkjenningsprosessen.

Slike kriterier forbinder fagavdeling og utvikling. De forhindrer også at godkjenningen blir en samling vage inntrykk. Ikke hver tilbakemelding må være løst før go-live. Men hver tilbakemelding trenger en innplassering: kritisk feil, relevant forbedring eller punkt for et senere utbyggingstrinn.

Datamigrering: bare rene data fortjener tillit

Gamle data undervurderes ofte. I tabeller finnes doble artikkelnumre, ulike enheter, utløpte kundeadresser og lagerbeholdninger hvis opprinnelse ingen lenger kan forklare. Den som overtar disse dataene uten kontroll, flytter gammel uklarhet inn i et nytt system - bare med et bedre grensesnitt.

Før migreringen bør det fastsettes hvilke data som virkelig trengs. Ofte er aktuelle artikler, aktive kunder, åpne ordrer, relevante leverandører og kontrollerte inngangsbeholdninger fornuftige. Historiske poster trenger ikke nødvendigvis å flytte helt over til den nye applikasjonen. Det kan holde å arkivere dem lesbart, hvis de forblir nødvendige for bevis eller forespørsler.

Spesielt viktig er en prøvelasting. Da importeres data ikke bare teknisk, men kontrolleres faglig: stemmer mengder, enheter og tilordninger? Er obligatoriske felt komplette? Lar typiske ordrer seg behandle riktig med dem? For go-live trengs deretter en klar stoppdato. Fra når brukes hvilket ledende system? Uten denne regelen oppstår dobbeltvedlikehold og motstridende beholdninger.

Pilotdrift i stedet for en stor bryter

En big bang kan være fornuftig hvis et lite team bruker en tydelig avgrenset prosess og den gamle og den nye løsningen ikke kan fungere parallelt. I de fleste operative miljøer er pilotdrift likevel det mer kontrollerbare valget.

Piloten bør arbeide med reelle tilfeller, men innenfor en begrenset ramme: ett lagerområde, ett skift, én produktgruppe eller et utvalgt team. Avgjørende er at pilotgruppen ikke bare omfatter spesielt teknikkinteresserte medarbeidere. Den bør gjenspeile den senere hverdagen realistisk, inkludert menneskene som arbeider under tidspress og har berettigede innvendinger.

I pilotdriften viser det seg om skannere, skrivere, nettverk og rettigheter fungerer på den faktiske arbeidsplassen. Likeledes blir prosesshull synlige som ingen nevnte i møter. Kanskje settes varer i hverdagen først på en mellomplass. Kanskje trenger sjåfører en annen følgeseddel enn administrasjonen. Slike erkjennelser er ikke et tilbakeskritt. De er grunnen til å gjennomføre piloten før den brede starten.

Opplæring som arbeidssituasjon, ikke som programvarerunde

En opplæring som bare forklarer menypunkter, skaper lite trygghet. Medarbeidere må lære på sine oppgaver: «Dere tar imot en skadet leveranse», «Dere plukker en hastig ordre», «Dere korrigerer en feilbokført mengde». Konteksten setter seg fordi den tilsvarer arbeidshverdagen.

Korte opplæringer nær go-live er som regel mer effektive enn én lang avtale uker i forveien. Dessuten hjelper kortfattede arbeidsinstrukser direkte på arbeidsplassen. De bør ikke forklare hele systemet, men vise de hyppigste forløpene, klare ansvarsområder og veien ved forstyrrelser.

Utpek dessuten kontaktpersoner per område. Disse personene trenger ikke selv å løse hvert tekniske problem. Men de bør kunne avgjøre om det dreier seg om en betjeningsfeil, en faglig uklarhet eller en faktisk systemfeil. Det beskytter prosjektteamet mot ustrukturerte tilrop og fremskynder hjelpen til skiftet.

Go-live trenger en driftsplan

Go-live-dagen trenger mer enn et klokkeslett. Definer hvem som avgjør faglig, hvem som er ansvarlig for tekniske endringer og via hvilken kanal forstyrrelser meldes. Ved kritiske flyter bør det være synlig om sentrale funksjoner fungerer: pålogging, rettigheter, datainnhenting, grensesnitt, utskrift og sikkerhetskopiering.

Også en reserveplan hører med. Det betyr ikke at man ved minste problem straks vender helt tilbake til den gamle verden. Det betyr å bestemme på forhånd hvilken forstyrrelse som rettferdiggjør et stopp, hvordan ordrer om nødvendig dokumenteres og hvordan man etterpå registrerer rent. Et papirskjema noen timer kan være fornuftig. En permanent parallellføring uten ende er det ikke.

Tekniske detaljer teller her: er tilganger opprettet i tide? Virker roller og kontolåsingsregler riktig? Er etikettskrivere koblet til de riktige malene? Finnes det en testet sikkerhetskopi av databasen? Ved individuelt utviklede applikasjoner hører dokumenterte driftsettinger, sporbare versjonsstatuser og en klar vei for feilretting til standarden.

De første ukene avgjør aksepten

Etter starten begynner fasen der en applikasjon enten blir et arbeidsmiddel eller et uønsket ekstra steg. Planlegg derfor korte daglige tilbakemeldingsrunder. Hvilke feil oppstår gjentatte ganger? Hvor oppstår omveier? Hvilke felt misforstås? Hvilken evaluering mangler en leder egentlig?

Ikke hver observasjon krever en umiddelbar endring. Noen problemer løses gjennom mer presise arbeidsregler eller bedre opplæring. Andre viser reelle svakheter i prosessen eller applikasjonen. Kunsten er å ikke forveksle de to. Et system bør ikke uten grunn gjøre eksisterende fungerende forløp mer kompliserte. Hvis en velholdt tabell for et sjeldent spesialtilfelle fortsatt er den bedre løsningen, får den bli.

Mål effekten ved hjelp av noen få konkrete nøkkeltall: behandlingstid per forløp, antall forespørsler, feilbokføringer, omutskrifter, åpne ordrer eller lagerdifferanser. Først disse verdiene viser om utrullingen faktisk forbedrer driften - i stedet for bare å innføre nye skjermbilder.

En god utrulling føles etter noen uker ikke lenger som et prosjekt. Den blir en pålitelig arbeidsrutine: de riktige dataene står der de trengs, unntak er sporbare og team må ringe mindre etter informasjon. Akkurat det bør planleggingen sikte mot - ikke en spektakulær startdag, men en roligere, bedre styrbar hverdag.

Permalenke →

Planlegge Multiplatform Application Development: først prosessen, deretter plattformen

Planlegge Multiplatform Application Development: først prosessen, deretter plattformen

En lagersjef bekrefter et varemottak på håndskanneren. Disposisjonen kontrollerer den samme prosessen i nettleseren. En sjåfør trenger leveringsstatusen underveis på smarttelefonen. Multiplatform application development høres i dette øyeblikket ut som et teknisk spørsmål. I virkeligheten handler det først om en driftsflyt: hvilket arbeid må gjøres hvor, med hvilken pålitelighet og med hvilken enhet?

For små og mellomstore bedrifter er det riktige svaret sjelden: vi bygger alt nativt for hver plattform. Oftere lyder det: vi definerer en felles prosess, velger målrettet de nødvendige brukergrensesnittene og unngår dobbel logikk. Det sparer ikke bare utviklingsbudsjett. Det forhindrer også at lager, kontor og feltservice arbeider med ulike datagrunnlag.

Hva Multiplatform Application Development skal oppnå

Multiplatform Application Development betegner utviklingen av en applikasjon som kan brukes i flere miljøer, for eksempel i nettleseren, på iOS og Android eller på Windows-skrivebordssystemer. Begrepet reduseres ofte til spørsmålet om én enkelt kodebase kan skape flere apper. Det er bare en del av beslutningen.

For operative systemer teller først og fremst om applikasjonen fungerer der den brukes. Et varemottak kan trenge et kamera for å lese strekkoder, store betjeningselementer for hansker og en brukbar reaksjon ved ustabil WLAN-dekning. Administrasjonen trenger derimot tabeller, filtre, rettighetskonsepter og sporbare endringslogger. En sjåfør trenger en redusert visning, ikke samme grensesnitt som disposisjonen.

Et felles teknisk grunnlag kan forene disse kravene på en fornuftig måte. Men det må ikke føre til at hver plattform betjenes som et dårlig kompromiss. Den beste felles koden er verdiløs hvis medarbeidere tar omveier fordi applikasjonen ikke avspeiler deres faktiske arbeidsflyt.

Først bestemme prosessen, deretter plattformen

Før team snakker om rammeverk, bør de granske ett konkret forløp fra begynnelse til slutt. Ta en levering: ordren kommer inn, varer plukkes, en følgeseddel opprettes, overleveringen bekreftes og statusen rapporteres tilbake til salg eller kundeservice. Hvor oppstår mediebruddet i dag? Hvor noteres noe på papir, tastes inn senere eller etterspørres per telefon?

Denne observasjonen skiller ekte plattformkrav fra ønskelister. Hvis bare to medarbeidere på kontoret bruker en funksjon, er et godt laget webgrensesnitt som regel nok. Hvis ti personer på lagergulvet gjør bokføringer, kan et mobilt, skannervennlig grensesnitt utgjøre forskjellen. Må et eksisterende Windows-program arbeide med spesialmaskinvare, kan en skrivebordsintegrasjon være nødvendig.

Ikke hver funksjon hører hjemme på hver enhet. Det er ingen mangel ved en multiplattformløsning, men et tegn på rene produktbeslutninger. Felles data og forretningsregler betyr ikke nødvendigvis identiske skjermbilder.

De tre spørsmålene som avklarer kostnad og nytte

Det første spørsmålet lyder: hvilke enheter er allerede i bruk, og hvor lenge forblir de det? En bedrift med administrerte Windows-terminaler har andre krav enn en feltservice med private smarttelefoner. Det andre lyder: hva skjer uten nettverksforbindelse? Offline-evne øker innsatsen betydelig, fordi data må lagres lokalt, synkroniseres senere og håndteres rent ved konflikter. Den er fornuftig hvis prosessen ellers stopper opp - ikke som standardutstyr.

Det tredje spørsmålet gjelder følgene av et utfall. Kan en medarbeider registrere en bokføring i etterkant, eller henger en forsendelsesetikett, en lagerbeholdning eller en sikkerhetsgodkjenning på den? Jo mer kritisk prosessen er, desto sterkere må rettigheter, kontrollregler, gjentakbarhet og logging planlegges.

En arkitektur som ikke faller sammen ved den andre plattformen

Ved en bærekraftig løsning ligger forretningslogikken ikke spredt i flere grensesnitt. Lagerkontroller, statusbytter, nummerserier, rettigheter og dokumentgenerering trenger et sentralt, testet grunnlag. Nettleser, mobilapplikasjon og skrivebordsklient får tilgang via klart definerte grensesnitt.

For mange interne forretningsprosesser er en moderne webapplikasjon det mest økonomiske utgangspunktet. Den kan oppdateres sentralt, krever ingen installasjon på hver arbeidsplass og fungerer på PC, nettbrett og smarttelefon. Med PHP 8.4, moderne JavaScript og MySQL 8 kan det bygges et vedlikeholdbart fundament, forutsatt at datamodell, tilgangsrettigheter og utrulling ikke vurderes først kort før go-live.

En installerbar mobil- eller skrivebordsapplikasjon legges til når den gir en klar fordel: dyp integrasjon med skanner, skriver eller kamera, pålitelig offline-drift, spesielle bakgrunnsfunksjoner eller krav fra enhetsadministrasjonen. Det er en målrettet utbygging, ikke et mål i seg selv.

En vanlig feil er fullstendig gjenbruk av brukergrensesnittet for enhver pris. Teknisk kan det se attraktivt ut. I praksis oppstår små tekster på store skjermer, overbelastede skjemaer på smarttelefoner eller betjening som ikke passer til plattformen. Bedre er å dele datamodell, regler og komponenter der det er fornuftig, mens betjeningen tilpasses den respektive konteksten.

Datakonsistens er viktigere enn en felles kodebase

Flere plattformer øker faren for motstridende data. En ordre endres på kontoret mens en sjåfør fortsatt ser en gammel versjon på enheten sin. To medarbeidere bokfører samtidig den samme artikkelbeholdningen. En offline-enhet sender endringene sine tilbake timer senere. Disse tilfellene er ikke et randtema, men kjernen i arkitekturen.

Systemet trenger derfor entydige identiteter, tidsstempler, sporbare tilstandsbytter og regler for konflikter. Ved en leveringsstatus kan den sist bekreftede endringen være tilstrekkelig. Ved lagerbeholdninger er det ofte for grovt. Der må det være klart hvilken bevegelse som ble bokført, fra hvilken lagerplass den stammer og om en korrigering må begrunnes.

Også rettigheter bør reguleres sentralt. En medarbeider kan kanskje registrere varemottak, men ikke godkjenne lagerkorrigeringer. En ekstern sjåfør skal bare se sin egen tur. Sesjonsvarighet, flerfaktorautentisering for kritiske roller og kontolåsingsflyter er ikke dekorative sikkerhetsfunksjoner. De beskytter konkrete forløp og gjør ansvar synlig.

Teste Multiplatform Application Development slik man faktisk arbeider

En applikasjon kan starte på tre operativsystemer og likevel mislykkes i drift. Avgjørende er forløpene under reelle forhold: skanneren reagerer for sakte, en etikettskriver er ikke tilgjengelig, en rettighet slår ikke inn etter et rollebytte, eller en synkronisering skaper doble bokføringer.

Derfor bør kritiske prosesser kontrolleres automatisert. Dit hører innlogging og sperreatferd, ordreregistrering, lagerbevegelser, dokumentopprettelse og behandlingen av feilaktige inndata. For web- og Windows-applikasjoner kan gjentakende tester kjøres på en selvhostet infrastruktur. Det er spesielt relevant hvis skjermbilder, interne ordredata eller testtilganger ikke skal gis videre til eksterne skytjenester.

Automatisering erstatter ikke kontroll av mennesker på lagergulvet. Men den sørger for at kjente forløp kontrolleres gang på gang etter endringer. Gode testrapporter nevner ikke bare en teknisk feil, men den berørte prosessen: leveringsbevis kan ikke opprettes, brukerkonto forblir sperret etter vellykket godkjenning eller turdata oppdateres ikke.

Når en plattformstrategi er for mye

Noen bedrifter trenger ingen egen app. Hvis en stabil nettlesertilgang er nok, flyten sjelden er mobil og antallet brukere forblir oversiktlig, er en responsiv webapplikasjon ofte det fornuftigste valget. Den reduserer vedlikeholdsinnsats, distribusjonsproblemer og antallet mulige feilkilder.

Heller ikke en eksisterende tabell må erstattes umiddelbart. Hvis den bare fungerer som enkel evaluering, vedlikeholdes av én person og ikke skaper feilutsatte overleveringer, kan den oppfylle sitt formål. Tidspunktet for et system er nådd når kunnskap sitter i enkeltes hoder, versjoner glir fra hverandre, oppfølgingsspørsmål øker eller et forløp ikke lenger kan spores pålitelig.

Omvendt blir en slank plattformstrategi raskt for liten når medarbeidere må arbeide offline, maskinvare kobles til eller kunder og partnere trenger kontrollert tilgang. Da lønner det seg å finansiere de tilkommende kravene bevisst, i stedet for å bygge dem på senere under tidspress.

Begynn med en solid pilot

En god start er ikke en funksjonskatalog med hundre punkter, men en fullstendig, målbar flyt. For eksempel: registrere varemottak, oppdatere lager, dokumentere avvik og opprette en oppgave for avklaring. Denne piloten viser tidlig om datamodell, enheter, rettigheter og betjening passer sammen.

Deretter kan løsningen vokse i fornuftige trinn: plukking, forsendelse, turplanlegging eller evalueringer. Hver utvidelse bør bestå det samme spørsmålet: forkorter den en ekte flyt, reduserer den feil eller skaper den pålitelig åpenhet? Hvis ikke, kan den vente.

Den mest fornuftige plattformen er til slutt ikke den med flest tekniske alternativer. Det er den der et team begynner arbeidet raskere om morgenen, spør mindre under skiftet og kan spore om kvelden hva som faktisk skjedde.

Permalenke →

Å vurdere Test Automation Results riktig

Å vurdere Test Automation Results riktig

En regresjonstest kan om morgenen ende med 98 prosent vellykkede tilfeller og likevel ikke være gode nyheter. Kanskje er den mislykkede testen akkurat innloggingen til en storkunde. Kanskje ble 40 tester hoppet over fordi testmiljøet ikke var tilgjengelig. Eller kjøringen var grønn, men sjekket bare om knapper finnes, ikke om en ordre faktisk lagres, en følgeseddel genereres og lageret justeres riktig. Test automation results er ingen kvalitetspåstand så lenge konteksten deres mangler.

For QA-ledelse, utvikling og fagavdelinger ligger det egentlige arbeidet derfor ikke bare i å automatisere tester. Avgjørende er å tilrettelegge resultatene slik at pålitelige beslutninger oppstår: kan en utgivelse rulles ut? Må en feil håndteres umiddelbart? Er feilen ny, gjentatt eller bare et problem i testmiljøet? Og finnes det bevis som også en fagavdeling uten testkode kan følge?

Hva Test Automation Results egentlig sier

Det enkleste nøkkeltallet lyder: bestått eller ikke bestått. Det er nyttig, men sjelden tilstrekkelig. En høy suksessandel kan skape tillit hvis testene dekker kritiske flyter, testdataene er plausible og miljøet ligner den senere driften. Mangler en av disse faktorene, forblir tallet først og fremst et signal om at en automatisert kjøring ble utført.

Ved forretningskritiske applikasjoner veier andre spørsmål tyngre. I en lagerløsning er ikke hvert skjermbilde like viktig. En visningsfeil i en intern hjelpetekst kan vente. En feil som bokfører feil mengde ved varemottak eller genererer en forsendelsesetikett uten mottakeradresse, kan ikke det. Gode testresultater veier derfor risikoer i stedet for å behandle alle tilfeller likt.

Heller ikke en mislykket test er automatisk en produktfeil. Den kan utløses av utløpt påloggingsinformasjon, en sperret testrolle, utilgjengelige grensesnitt, endrede testdata eller et tregt miljø. Den som ikke skiller disse årsakene, produserer støy. Teamet bruker da tid på falske alarmer mens ekte feil forsvinner blant røde statusmeldinger.

Fire statustyper i stedet for én rød liste

I praksis har en tydelig inndeling vist seg å fungere: faglig feil, teknisk testfeil, miljøproblem og forventet endring. En faglig feil betyr at applikasjonen bryter et definert krav. En teknisk testfeil peker heller mot selve testen, for eksempel en selektor som ikke lenger passer etter et bevisst endret grensesnitt.

Et miljøproblem foreligger når for eksempel et testsystem eller et tilkoblet grensesnitt ikke er tilgjengelig. Forventede endringer oppstår når en prosess er bevisst tilpasset, men automatiseringen fortsatt kontrollerer den gamle måltilstanden. Disse kategoriene forhindrer ikke enhver diskusjon. Men de sørger for at diskusjonen begynner på riktig punkt.

Fra testkjøringer til beslutningsklare rapporter

En brukbar rapport svarer ikke bare på at noe mislyktes, men hva som skjedde, hvor alvorlig det er og om feilen virker reproduserbar. Det krever mer enn en liste med testnavn og tidsstempler.

Til hver relevant kjøring hører den kontrollerte builden, testmiljøet, rollen som ble brukt, sentrale testdata samt start- og sluttid. Særlig ved Windows-skrivebordsapplikasjoner eller komplekse nettplattformer trengs denne informasjonen for å avgrense forskjeller. En feil som bare oppstår under en begrenset lagerrolle, er noe annet enn en feil som blokkerer hver pålogging.

Meningsfulle resultater inneholder dessuten sporbare bevis: skjermbilder, innspilte trinn, feilmeldinger og ved behov tekniske logger. Et skjermbilde alene kan imidlertid lure. Det viser et øyeblikk, ikke årsaken. Kombinasjonen av trinnrekkefølge, synlig tilstand og forventet reaksjon er betydelig mer nyttig.

KI-støttede systemer kan omforme disse bevisene til forståelige vurderinger. Hos COCO for eksempel kjøres tester på en egen, selvhostet KI-server. Evalueringen kan forklare at en ordre riktignok ble opprettet, men at den forventede statusendringen uteble, og direkte knytte opptaket av kjøringen til dette. For sikkerhetsbevisste team er det relevant hvor skjermbilder, applikasjonsdata og testtrafikk behandles. Lokal kontroll er ikke automatisk nødvendig, men kan ved interne applikasjoner og sensitive data være den fornuftigere veien enn en ekstern skytjeneste.

Riktig detaljnivå for ulike mottakere

Utviklingsteam trenger feilmeldinger, tekniske trinn og så presise anvisninger som mulig for reproduksjon. En operations manager trenger derimot først den berørte funksjonen, forretningsrisikoen og en klar uttalelse om driftsevnen. Begge perspektiver må kunne oppstå fra samme kjøring, uten at noen manuelt må overføre resultater til presentasjoner.

En god rapport begynner derfor med et kort beslutningsnivå: utgivelse anbefalt, utgivelse med kjente begrensninger eller stopp utgivelsen. Under står de kritiske avvikene med prioritet og bevis. De tekniske detaljene følger først etterpå. Det er ingen forenkling på bekostning av nøyaktighet, men en ren adskillelse av informasjonsbehov.

Måle dekning uten å innbille seg sikkerhet

Testdekning fremstilles ofte som en prosentverdi. Denne verdien er nyttig når det er klart hva den måler. Kodedekning viser for eksempel hvilke deler av programkoden som ble kjørt under tester. Det beviser ikke at en forretningsprosess fungerer riktig. En test kan berøre mange kodelinjer og likevel aldri kontrollere om en feil leveringsadresse dukker opp på dokumentet.

For fagavdelinger er prosessdekning ofte mer talende. Den beskriver hvilke reelle flyter som er beskyttet: registrere en ordre, reservere lager, bokføre en delleveranse, ta imot en retur eller godkjenne en faktura. Spesielt verdifulle er overgangene mellom systemer og roller, for der oppstår ofte feil: ved import av en bestilling, ved utskrift av en etikett eller ved bytte fra kontor til lagerterminal.

Prioriter ikke etter antall mulige tester, men etter skadevirkning og endringsfrekvens. En sjelden brukt prosess med høy økonomisk eller juridisk risiko fortjener ofte automatisering tidligere enn en ofte brukt, men harmløs visning. Omvendt kan en stabil, lite kritisk flyt fortsatt klare seg med en kort manuell kontroll. Ikke hver kontroll må automatiseres bare fordi den kan automatiseres.

Ustabile tester er et eget kvalitetsproblem

Tester som uten gjenkjennelig produktendring av og til består og av og til mislykkes, kalles ofte flaky. De skader tilliten raskere enn en permanent rød test. Så snart team refleksmessig starter røde resultater på nytt, mister automatiseringen sin varslingsfunksjon.

Årsakene er som regel konkrete: faste ventetider, felles brukte testdata, parallelle tilganger, asynkron behandling eller et miljø som ikke tilbakestilles. En kort pause på tre sekunder i testen kan tilfeldigvis hjelpe, men er ingen løsning. Bedre er å vente på en påviselig tilstand, gjøre testdata entydige og isolere flyter fra hverandre.

Ikke all ustabilitet kan unngås helt. Eksterne grensesnitt kan svinge, og reell infrastruktur har utfall. Da bør rapporten tydelig markere om en test ikke lot seg vurdere på grunn av en ekstern avhengighet. En gjentatt kjøring kan være fornuftig for diagnose, men må ikke gjøre det første funnet usynlig.

Et fornuftig forløp etter hver testkjøring

Etter en automatisert kjøring bør ikke hvert resultat umiddelbart behandles likt. Først kontrolleres blokkerende feil og kritiske tester som ikke lot seg vurdere. Deretter følger innplasseringen av nye avvik mot kjente, aksepterte problemer. Først da er en utgivelsesbeslutning holdbar.

Fastsatte terskelverdier hjelper, men de må passe til prosessen. For eksempel kan en mislykket test i betalings- eller tilgangsflyten utløse et umiddelbart stopp. Ved et rent kosmetisk avvik kan et dokumentert unntak være forsvarlig. Slike regler bør ikke først oppstå under tidspress før en utgivelse.

Like viktig er tilbakemeldingen: hver produksjonsfeil som testene ikke oppdaget, er en anledning til å sjekke om et scenario, en testdatavariant eller et kontrollpunkt mangler. Målet er ikke å hope opp flest mulig tester. Det er å bygge bedre sikring, målrettet, ut fra reelle feil.

De mest nyttige testresultatene er til slutt ikke de med den grønneste oversikten. Det er de der en ansvarlig mandag morgen kan forstå hva som ble kontrollert, hvilken risiko som gjenstår og hvilken handling som nå er fornuftig.

Permalenke →

Inventory Discrepancy Causes: vanlige årsaker til lagerdifferanser

Inventory Discrepancy Causes: vanlige årsaker til lagerdifferanser

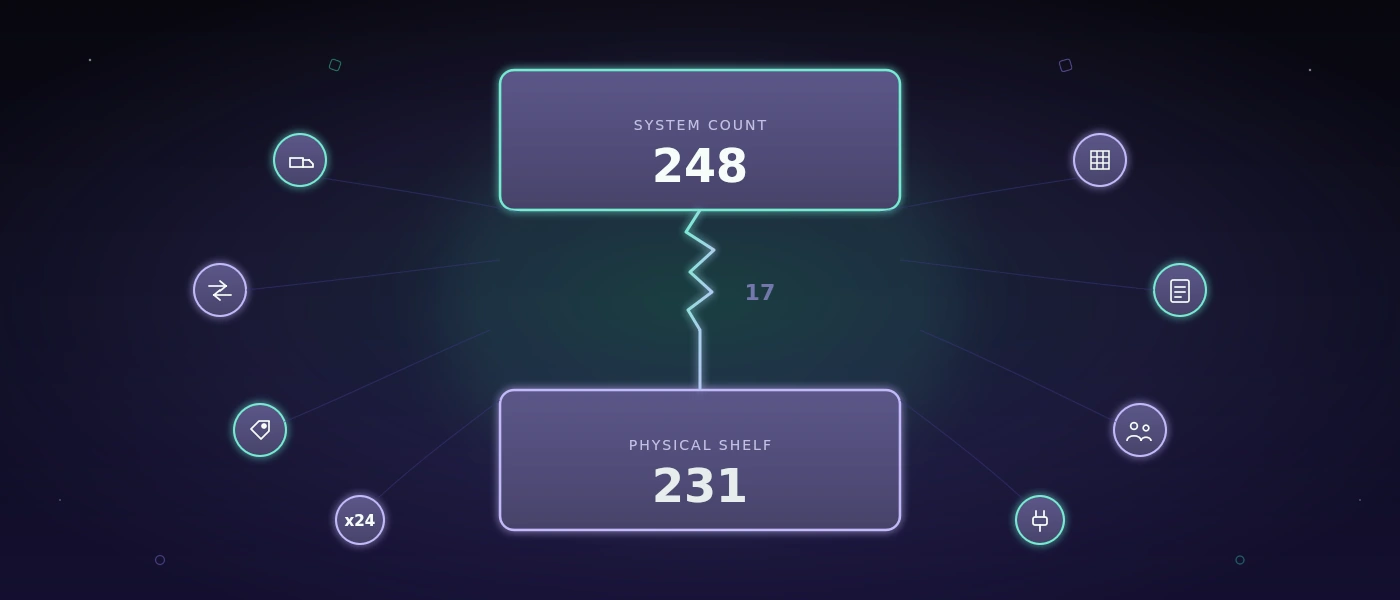
Lageret i systemet sier 248 stykker, på hyllen ligger det 231. Disse 17 enhetene virker først som en tellefeil. Men det er nettopp der den feilaktige analysen ofte begynner. Inventory discrepancy causes er i praksis sjelden en enkelt forglemmelse. Oftest oppstår de der varemottak, lagerbevegelse, plukking, og bokføring driver fra hverandre i tid eller organisatorisk.

For en liten eller mellomstor bedrift er lagerdifferanser ikke bare et tema for varetellingen. De fører til feilbestillinger, ekspressleveranser, unødvendige sikkerhetslagre, og leveringsløfter som ikke kan holdes. Den som skiller årsakene rent, trenger ikke innføre et stort ERP-system med en gang. Ofte er tydeligere bokføringsregler, passende registreringsenheter, og et system som gjenspeiler reelle arbeidsprosesser nok.

Inventory discrepancy causes: hvor differanser oppstår

En lagerdifferanse er differansen mellom børverdien i det ledende systemet og det faktisk tilstedeværende lageret. Avgjørende her er ordet "ledende". Hvis en Excel-fil, en papirliste, og et varehåndteringssystem vedlikeholdes parallelt, finnes det praktisk talt flere sannheter. Da har differansen ikke bare oppstått i lageret, men var allerede innebygd i datahåndteringen.

Den effektive mottiltaket avhenger derfor av feiltypen. En feiltalt pall trenger en annen løsning enn en levering som fysisk ble mottatt, men aldri bokført. Før team restrukturerer prosesser, bør de evaluere differanser etter artikkel, lagerplass, skift, bevegelsestype, og tidspunkt. Først dette mønsteret viser om det dreier seg om et enkelttilfelle eller en tilbakevendende prosessfeil.

1. Varemottak bokføres sent eller ufullstendig

Varemottak er et klassisk bruddpunkt. Varer ankommer om morgenen, settes til side for kontroll, og flyttes senere direkte til produksjon eller hyllen. Bokføringen skjer om ettermiddagen, neste dag, eller ikke i det hele tatt. Så lenge varene fysisk er til stede, fremstår systemlageret for lavt. Er de allerede forbrukt eller utlevert, blir følgefeil mer sannsynlige.

Spesielt utsatt er delleveranser, erstatningsartikler, og overleveranser. Står det en mengde på følgeseddelen, men en annen mengde ankommer, bør ingen bare bokføre dokumentet "omtrent passende". Differansen må forbli synlig som unntak, inkludert årsak, ansvarlig person, og godkjenning. Ellers forsvinner avviket fra prosessen og dukker først opp igjen ved varetellingen.

2. Lagerbevegelser skjer uten transaksjon

En artikkel plasseres fra varemottak inn i høylager, flyttes fra en hylleplass til plukksonen, eller reserveres for en ordre. Fysisk er det en liten, rask bevegelse. I systemet kan den være avgjørende.

Hvis medarbeidere omorganiserer lagerplasser kun etter følelse, kan det totale lageret fortsatt stemme, men tilgjengeligheten på riktig sted ikke. Det forårsaker søketid, feilplukk, og unødvendige påfyllingsturer. En god lagerløsning trenger ikke gjøre hver bevegelse komplisert. Den må registrere de få bevegelsene som er relevante for tilgjengelighet, sporbarhet, og etterbestilling.

I verksteder eller mindre lagre er det ofte fornuftigere å opprettholde noen få entydige soner enn en teoretisk perfekt hyllestruktur som ingen vedlikeholder i hverdagen. Presisjon fungerer bare hvis den forblir arbeidsfør.

3. Plukking og forsendelse bokføres for tidlig

Mange team bokfører en ordre som "utbokført" ved plukking, selv om varen fortsatt ligger på en klargjøringsplass. Endres ordren deretter, kanselleres, eller sendes bare delvis, stemmer ikke lenger system- og fysisk lager overens.

Bedre er en klar separasjon mellom reservert, plukket, og sendt. Ikke alle bedrifter trenger komplekse statuskjeder for dette. Men tidspunktet for lagerreduksjonen må være entydig. For forsendelsesvarer ligger det ofte nærmere den faktiske overleveringen til transportøren enn det første grepet mot hyllen.

Også returer hører til denne flyten. Kommer varer tilbake, er de ikke automatisk tilgjengelige igjen. Først kontroll, kvalitetsbeslutning, og innlagring bør bestemme om de går tilbake til salgbart lager, forblir sperret, eller kasseres.

4. Feil enheter og stamdatafeil

En eske, en forpakning, en rull, og et enkelt stykke kan alle gjelde samme artikkel. Hvis omregningen ikke vedlikeholdes rent, oppstår differanser med imponerende hastighet. En medarbeider bokfører "1", mener en eske med 24 stykker. Systemet forstår ett stykke.

Stamdatafeil er spesielt lumske fordi bokføringsprosessen kan se teknisk korrekt ut. Kontroller derfor emballasjeenheter, omregningsfaktorer, minimumsmengder, lagerplasser, og artikkelnumre. Også lignende navngitte varianter, for eksempel ulike lengder, farger, eller partier, forveksles lett.

Her hjelper ingen generell regel som "skann mer". Strekkoder er bare like pålitelige som koblingen bak. Ved små sortimenter kan en rent vedlikeholdt artikkelstamme med lett lesbare etiketter oppnå mer enn et omfattende, men dårlig konfigurert skannerlandskap.

5. Parallelle tabeller og manuelle korrigeringer

Den tabellen på skrivebordet oppstår sjelden av slurv. Oftest fyller den et reelt gap: en spesialreservasjon, en manglende evalueringsverdi, eller en prosess som den eksisterende programvaren ikke avbilder. Den blir problematisk når den blir den andre lagerboken.

Da bokføres innganger i systemet, men uttak noteres i tabellen. Eller en korrigering skjer bare der den akkurat hjelper neste ordre. Ingen kan senere pålitelig forklare hvilken verdi som gjelder.

Ikke hver tabell trenger å avskaffes. En beregning for planlegging eller analyser kan forbli fornuftig. Lagerendrende prosesser bør imidlertid ha nøyaktig ett ledende system. Justeringer trenger en årsakskode, et tidsstempel, og ideelt sett en person som kan spores. Det er ikke byråkrati for byråkratiets skyld, men forutsetningen for solide årsaksanalyser.

6. Tellefeil og uegnede varetellingsmetoder

Selv korrekte prosesser beskytter ikke mot menneskelige feil. Artikler telles dobbelt, paller overses, åpne esker estimeres, eller lagerplasser sperres ikke mens man teller. En årlig fulltelling oppdager disse problemene sent og under høyt press.

For mange virksomheter er en syklisk telling det fornuftigere alternativet. Raskt omløpende eller verdifulle artikler kontrolleres oftere, stabile C-artikler sjeldnere. Viktig er ikke å produsere flest mulig tellinger, men å kontrollere avvik i tide mot de siste bevegelsene. Korrigeres en differanseartikkel bare uten å dokumentere årsaken, forblir mønsteret usynlig.

En motkontroll er spesielt fornuftig ved høye verdier, serienumre, eller partier. For skruer i et forbrukslager kan den være økonomisk overdreven. Kontrolldybden bør matche risikoen.

7. Uklare ansvarsforhold mellom skift og områder

Lagerfeil oppstår ofte ved overleveringer. Tidligskiftet klargjør varer, senskiftet sender dem. Varemottaket aksepterer en levering, disposisjonen endrer parallelt ordren. Hvert enkelt steg kan være sporbart, men ingen eier hele prosessen.

Definer derfor ikke bare roller, men overleveringspunkter: hvem bekrefter varemottaket? Når skifter ansvaret for plukket vare? Hvem kontrollerer åpne unntak ved skiftslutt? En felles digital tavle eller en enkel unntaksliste er ofte mer effektiv enn ekstra møter.

Systemet bør gjøre åpne prosesser synlige, i stedet for å tvinge medarbeidere til å huske. For eksempel må leveranser uten mengdekontroll, plukkinger uten forsendelsesavslutning, eller returer uten kvalitetsbeslutning legges merke til før de blir stille lagerfeil.

8. Svak systemintegrasjon og manglende kontrollregler

Hvis butikk, ordrehåndtering, lager, og regnskap utveksler data med tidsforsinkelse eller via fil, kan doble eller manglende bokføringer oppstå. En import kjøres to ganger. Et grensesnitt feiler stille. En ordre endres etter at forsendelsesstatusen allerede er overført.

Løsningen er ikke nødvendigvis en fullstendig erstatning. Ofte trengs klart definerte grensesnitt, entydige dokumentnumre, og tekniske kontroller. En lagerbokføring bør sporbart lagre når den skjedde, fra hvilken prosess den stammer, og om den senere ble kansellert. Kritiske prosesser trenger feilmeldinger og køer, ikke bare en stille oppføring i loggfilen.

Med skreddersydd utviklede logistikksystemer kan slike regler tilpasses målrettet til driften: ingen negativ mengde uten godkjenning, ingen forsendelsesbekreftelse uten forsendelsesposisjon, ingen dobbel behandling av samme eksterne referanse. Den beste regelen her er ikke den strengeste, men den som stopper reelle feil uten å blokkere driften ved normale unntak.

Kontrollere lagerdifferanser systematisk

Begynn ikke med en overordnet korrigering. Velg de ti artiklene med de hyppigste eller dyreste differansene, og spor deres siste bevegelse bakover: varemottak, omlagring, uttak, retur, telling, og eventuell manuell justering. Klynger tilfellene seg rundt ett sted, ett skift, eller én bevegelsestype, er det et solid utgangspunkt.

Deretter bør hvert tiltak være målbart. Innføres nye strekkodeskanninger, observer ikke bare antall skanninger, men differanseraten per artikkelgruppe. Legges en ny status for klargjøring til, kontroller åpne klargjøringer daglig. Gode prosesser skaper ikke skinnpresisjon. De gjør unntak synlige og sporbare tidlig.

Det fornuftige neste steget er ofte lite: definer et overleveringspunkt, rydd opp en lagerplass, eller sikre teknisk en tilbakevendende manuell korrigering. Pålitelige lagre oppstår ikke av mer programvare på mistanke, men av prosesser som fortsatt er korrekt gjennomførbare en hektisk tirsdag klokken 16:45.

Permalenke →

Å gjøre prosessautomatisering riktig for SMB-er

Å gjøre prosessautomatisering riktig for SMB-er

En følgeseddel mangler fordi dataene fortsatt står på en lapp. En varemottak registreres to ganger fordi lager og kontor jobber med forskjellige tabeller. En godkjenning forsinkes fordi den ansvarlige personen ikke svarer på telefonen akkurat nå. Slik friksjon koster sjelden mye penger på en gang. Men over uker summeres forespørsler, søketid, feilrettinger, og unødvendig venting. Nettopp der er prosessautomatisering for SMB-er fornuftig.

Det handler ikke om å erstatte flest mulig aktiviteter med programvare. God automatisering gjør prosesser sporbare, reduserer unngåelige overleveringer, og gir medarbeidere tid til beslutninger som krever erfaring. Det er spesielt avgjørende i små og mellomstore bedrifter: teamene er nær den daglige driften. Når en prosess hakker, merker ofte hele skiftet det umiddelbart.

Ikke automatiser hver prosess

Den vanligste feilen er å begynne med det mest synlige irritasjonsmomentet. Kanskje irriterer en Excel-fil, kanskje trengs et nytt dashboard. Begge deler kan være berettiget. Men et digitalisert kaos forblir kaos - bare raskere og med mer data.

Før en teknisk beslutning bør prosessen først beskrives slik den faktisk foregår. Ikke slik den burde stå i håndboken. Hvem utløser prosessen? Hvilken informasjon trengs? Hvor overføres noe manuelt? Hvem bestemmer ved unntak? Og hvordan gjenkjenner teamet at prosessen er fullført?

Nettopp i lageret eller ordrebehandlingen ligger de kritiske punktene ofte mellom systemer: en ordre kommer per e-post, kopieres inn i en tabell, avstemmes per telefon, og legges senere inn i en fraktprogramvare. Hver overlevering øker sannsynligheten for at mengder, datoer, eller adresser avviker.

En automatisering lønner seg spesielt når en prosess forekommer ofte, har klare regler, og feil forårsaker merkbare konsekvenser. Det kan være varemottak, opprettelse av følgesedler, tildeling av lagerbevegelser, eller overlevering av godkjente ordrer til frakt. Sjeldne spesialtilfeller med mange skjønnsmessige avgjørelser forblir derimot ofte bedre håndtert manuelt - i det minste til å begynne med.

Prosessautomatisering for SMB-er begynner med prioriteringer

Ikke enhver unødvendig aktivitet fortjener umiddelbart et prosjekt. En enkel prioritering skaper klarhet. Vurder enkeltprosesser etter frekvens, behandlingstid, feilkostnader, og avhengigheter. En prosess som skjer femti ganger daglig og bare sparer to minutter hver gang, kan være mer økonomisk enn en komplisert månedlig prosess.

Spørsmålet om feilkonsekvensen er minst like viktig. Et feilaktig utskrevet internt dokument er irriterende. En feilaktig batchtildeling, en tapt leveringsadresse, eller et udokumentert varemottak kan utløse reklamasjoner, søkearbeid, og lagerdifferanser. Der skaper automatisering ikke bare tempo, men pålitelighet.

Et fornuftig første steg er som regel lite nok til å være verifiserbart i løpet av noen uker. For eksempel kan en medarbeider registrere varer via en strekkode, systemet kontrollerer artikkel og mengde, oppdaterer lageret i en sentral database, og genererer om nødvendig direkte et lagringsbilag. Teamet trenger da ikke å gjette hvilken versjon av en tabell som er gjeldende.

En klar måltilstand i stedet for en funksjonsliste

Mange prosjekter starter med en lang liste over ønskede funksjoner. Bedre er et konkret driftsbilde: hva skal være synlig ved slutten av en prosess uten at noen trenger å spørre? Ved frakt kunne det bety at en ordre etter godkjenning automatisk får en plukkliste, leveringsadressen kontrolleres, og en etikett kan genereres. Unntak havner synlig i en avklaringsliste, i stedet for i en uoversiktlig e-postinnboks.

Dette målbildet tvinger frem nyttige beslutninger. Må hver bestilling behandles helt automatisk? Eller bør ordrer over en bestemt vareverdi, med avvikende leveringsadresse, eller med manglende lager, bevisst legges frem for kontroll? Automatisering trenger ikke hundre prosent mørkebehandling for å skape stor nytte.

Den passende teknikken avhenger av prosessen

Det finnes ingen teknisk standardvei for hver SMB. En tabelløsning kan fortsatt være fornuftig for en oversiktlig evaluering. Den er raskt tilpasset, kjent, og forårsaker lite innføringsinnsats. Så snart flere personer jobber samtidig, bokføringer må være sporbare, eller data utveksles med andre systemer, støter den imidlertid på grenser.

Da er ofte en slank, arbeidsflytspesifikk applikasjon mer fornuftig enn en overdimensjonert enterprise-suite. Den kan avbilde nøyaktig de trinnene som trengs i driften: registrere ordre, kontrollere lager, flytte vare, generere dokument, bokføre frakt, og rapportere status tilbake. Ikke mer, men heller ikke mindre.

Teknisk sett spiller det mindre rolle om et system reklamerer med det nyeste moteordet. Avgjørende er solide grunnlag: en rent modellert database, sporbare rettigheter, logger for relevante endringer, pålitelige grensesnitt, og dokumenterte driftsettinger. En applikasjon basert på PHP 8.4, moderne JavaScript, og MySQL 8 kan være svært godt vedlikeholdbar på lang sikt, hvis arkitektur og drift tenkes gjennom fra starten.

Også integrasjoner fortjener oppmerksomhet. En automatisk datautveksling med butikk, ERP, fraktleverandør, eller regnskap sparer bare tid hvis feil håndteres synlig. Hva skjer ved en ugyldig adresse? Forsøkes en mislykket etikettutskrift på nytt? Kan teamet se hvilke data som er overført og hvilke som fortsatt mangler? Stille feil er farligere enn et tydelig merket unntakstilfelle.

Innføring under løpende drift

Et nytt system må tilpasse seg skiftbytter, leveringsfrister, og eksisterende arbeidsrutiner. Derfor er en trinnvis utrulling som regel sikrere enn en hard frist for alle områder. Start med en avgrenset prosess, en produktgruppe, eller et lagerområde. Det reduserer risiko og skaper ekte tilbakemelding fra hverdagen.

Paralleldrift er dermed ikke et tegn på usikkerhet, men en kontrollert test. I en begrenset periode kan gammel og ny registrering sammenlignes. Forskjeller avslører ikke bare programvarefeil, men ofte også regler som hittil bare har eksistert i hodet til enkeltmedarbeidere. Disse reglene hører synlig hjemme i prosessen - ikke permanent i personlig erfaring.

Medarbeidere bør ikke konfronteres med den nye prosessen først under opplæringen. Den som utfører prosessen daglig, gjenkjenner snarveier, spesialtilfeller, og upraktiske skjermer tidlig. God programvare respekterer denne kunnskapen, uten å bygge inn hvert historisk utviklet unntak uendret. Det riktige spørsmålet er: hvilket unntak beskytter et viktig forretningstilfelle, og hvilket er bare en omvei for et gammelt problem?

Gjøre det målbart om innsatsen lønner seg

Før start bør to eller tre nøkkeltall fastsettes. Det kan være gjennomløpstid per ordre, antall manuelle rettelser, lagerdifferanser, eller tiden til frakt. Uten en utgangsverdi blir enhver senere vurdering til en magefølelse.

Ikke enhver effekt viser seg umiddelbart i kroner. Når et lagerteam alltid vet hvor varer befinner seg, synker antallet avbrudd. Når leveringsdokumenter oppstår fra de samme dataene som ordren, synker risikoen for motstridende opplysninger. Og når ansvar er synlig i systemet, avhenger en prosess mindre av enkeltpersoner.

Automatisering trenger vedlikehold og grenser

En automatisert prosess er ikke et prosjekt som fryser etter go-live. Artikkelstrukturer endres, kunder krever nye dokumenter, fraktleverandører tilpasser grensesnitt. Derfor hører ansvar, oppdateringer, sikkerhetskopier, og en regulert håndtering av rettigheter til selve systemet.

Spesielt for applikasjoner med kunde-, ordre-, eller lagerdata bør det være klart hvem som får tilgang og hvorfor. Roller må passe til arbeidshverdagen: et lagerteam trenger andre funksjoner enn regnskap eller salg. Loggede endringer, sikre påloggingsflyter, og testede gjenopprettinger virker uspektakulære. Ved en driftsforstyrrelse avgjør nettopp disse detaljene om driften kan fortsette.

Også tester er en del av driftssikkerheten. Tilbakevendende kontroller for ordreregistrering, lagerbokføring, dokumentgenerering, og rettighetsstyring forhindrer at en tilpasning ett sted skader en fungerende prosess et annet sted. For kritiske web- eller skrivebordsapplikasjoner kan et kontrollert, selvhostet testmiljø være fornuftig, hvis skjermbilder, testdata, og interne prosesser ikke skal nå eksterne skytjenester.

softify.pro følger slike prosjekter med et enkelt prinsipp: først forstå den faktiske prosessen, deretter bygge den minste bærekraftige løsningen. Noen ganger er det en skreddersydd applikasjon. Noen ganger er det nok å strukturere en eksisterende tabell renere og automatisere ett enkelt overleveringstrinn.

Det beste neste steget er derfor ingen programvaresammenligning, men en gjennomgang av en reell prosess - fra utløser til fullføring. Ta en ordre, et varemottak, eller en reklamasjon og følg den med de involverte personene. Der informasjon legges inn på nytt, ingen kjenner statusen, eller beslutninger venter unødvendig, ligger som regel den mest fornuftige tilnærmingen til automatisering.

Permalenke →

Teste Windows-applikasjoner: en praktisk plan

Teste Windows-applikasjoner: en praktisk plan

En Windows-applikasjon kan se ren ut i demomodus og likevel bremse driften mandag morgen. En ulagret følgeseddel, en bruker som blokkeres etter tre mislykkede forsøk, eller en utskriftsdialog som reagerer annerledes etter en oppdatering, er ikke kosmetiske feil. Den som vil vite hvordan man tester Windows-applikasjoner, bør derfor ikke begynne med enkeltstående knapper, men med prosessene som koster arbeid, penger, eller sporbarhet.

Nettopp i lager, verksted, utsendelse, og administrasjon går mange kritiske prosesser gjennom skrivebordsprogramvare som har vokst fram over årene. Der teller det ikke om et testtilfelle er imponerende formulert. Avgjørende er om medarbeidere pålitelig kan utføre sine oppgaver under realistiske forhold - også med ufullstendige data, skiftende rettigheter, trege nettverk, og uplanlagte avbrudd.

Å teste Windows-applikasjoner begynner med de kritiske prosessene

Ikke alle funksjoner fortjener samme testinnsats. En sjelden brukt eksport med manuelt etterarbeid bør vurderes annerledes enn bokføring av en varemottak, etikettoppretting, eller den daglige ordreavstemmingen. Start derfor med et enkelt spørsmål: hva skjer konkret hvis denne prosessen mislykkes?

Høy prioritet har prosesser med direkte innvirkning på lager, levering, fakturering, sikkerhet, eller kundekommunikasjon. Dit hører for eksempel innlogging og rettighetskontroll, opprettelse og endring av stamdata, transaksjonsbokføringer, dokumentutskrift, grensesnitt mot ERP- eller forsendelsestjenester, samt gjenoppretting etter en feil. Selv funksjoner som bare en liten gruppe bruker, kan være kritiske hvis de blokkerer en månedsavslutning eller frigivelse av varer.

Fra disse prosessene oppstår ikke abstrakte testlister, men sporbare arbeidstrinn. En varemottakstest kunne for eksempel begynne med en eksisterende ordre, registrere en dellevering, rapportere en avvikende mengde, tildele en lagerplass, og deretter kontrollere om lagerbeholdning, bokføringslogg, og utskrevet dokument stemmer overens. Slik tester du programvarens faktiske effekt, ikke bare enkeltstående innmatingsfelt.

Bygg et testgrunnlag som gjenspeiler driften

Mange feil blir først synlige når testmiljøet nærmer seg virkeligheten. En applikasjon oppfører seg ofte annerledes med en tom testleietaker enn med flere års bevegelsesdata, sperrede artikler, manglende obligatorisk informasjon, eller allerede åpnede transaksjoner.

Sett derfor opp testdata bevisst. Du trenger ikke nødvendigvis en fullstendig kopi av produksjonen. Mer fornuftig er en kontrollert datamengde med typiske, grense-, og bevisst feilaktige tilfeller: artikler med ulike måleenheter, kunder med spesialvilkår, ordrer med delleveranser, brukere med ulike roller, og transaksjoner som allerede er under behandling. Personopplysninger bør anonymiseres eller erstattes med realistiske eksempeldata.

Til testgrunnlaget hører også det tekniske miljøet. Dokumenter Windows-versjon, oppløsning, skalering, installerte skrivere, nettverksstasjoner, databaseversjon, tilkoblede tjenester, og rettigheter. Det høres nøkternt ut, men sparer tid senere. Hvis en feil bare oppstår på arbeidsstasjoner med 125 prosent skalering eller med en bestemt skriverdriver, må det være reproduserbart.

Ikke bare kontroller idealtilfellet

Idealtilfellet beviser først og fremst at applikasjonen er bygget for den forventede veien. I driften oppstår de vanskelige situasjonene ved siden av. Hva skjer hvis en bruker lar et obligatorisk felt stå tomt, utløser samme bokføring to ganger, eller mister forbindelsen under lagring? Forblir transaksjonen konsistent? Får personen en forståelig melding? Kan hen fortsette å arbeide trygt?

Ved Windows-applikasjoner er dessuten betjening og tilstand spesielt relevant. Dialogvinduer kan dukke opp i bakgrunnen, hurtigtaster kan overlappe, filvalgsdialoger kan blokkere forløpet. Kontroller om fokus, feilmeldinger, og sperrer er entydige. Et teknisk unntak uten handlingsanvisning hjelper ikke skiftlederen videre.

Bruk manuelle tester der det kreves skjønn

Manuelle tester er ikke et tegn på manglende modenhet. De er uunnværlige når en ny prosess oppstår, et grensesnitt bygges om, eller fagkunnskap avgjør kvaliteten. En erfaren lagersjef oppdager raskere enn et skript om en skjerm er forståelig under høyt tidspress, eller om en advarsel kommer for sent.

Manuell testing blir imidlertid dyr og upålitelig når de samme stabile prosessene gjentas før hver versjon. Da avhenger utgivelsen av tilgjengelige personer, hukommelse, og spredte notater. Det riktige overgangspunktet til automatisering ligger som regel der en prosess kjøres ofte, kan forårsake stor skade, og har klare forventede resultater.

Et godt manuelt testtilfelle beskriver utgangssituasjon, trinn, forventet resultat, og nødvendige data. Ved en feil, legg til et skjermbilde, tidsstempel, applikasjons- og byggversjon, samt den nøyaktige handlingen. «Utskrift virker ikke» er ikke en brukbar feilbeskrivelse. «Etter endring av leveringsadressen forblir utskriftsdialogen åpen, ordre 4711 får ingen PDF, og det vises ingen melding» er det.

Automatiserte regresjonstester for tilbakevendende risikoer

Automatisering kontrollerer ikke om programvare grunnleggende sett er god. Den kontrollerer om tidligere fungerende, definerte prosesser fortsatt fungerer etter en endring. Det er spesielt verdifullt for Windows-programvare hvis grensesnitt, databaselogikk, og eksterne grensesnitt videreutvikles over årene.

Start smått. Velg først fem til ti forretningskritiske prosesser som bør kontrolleres ved hver utgivelse. Dit kan innlogging med en account-lockout-flyt, ordreregistrering, lagerbokføring, PDF- eller etikettutskrift, rollebytte, og en sentral import høre. Først når disse testene kjører pålitelig, lønner det seg å utvide til spesialtilfeller.

Ved skrivebordsapplikasjoner styrer automatiserte tester ofte synlige grensesnittelementer: vinduer, innmatingsfelt, tabeller, knapper, og dialoger. Det fungerer, men er mer sårbart enn en ren grensesnittstest. Små layoutendringer, tregere maskiner, eller tvetydig navngitte elementer kan bryte tester. Derfor bør utviklere, fagavdeling, og testansvarlige i fellesskap fastsette hvilke elementer som er stabilt adresserbare, og hvilke kontrolltrinn som bedre sikres via database, logg, eller grensesnitt.

En fornuftig test kontrollerer dessuten ikke bare at en knapp kunne klikkes. Den kontrollerer den forretningsmessige konsekvensen: ble bokføringen lagret? Er lagerbeholdningen korrekt? Ble et dokument generert? Ble ingen duplikat opprettet? Synlig interaksjon og verifiserbart resultat hører sammen.

Bevis er en del av testresultatet

En grønn status alene er sjelden nok for kritiske applikasjoner. Når en test mislykkes, trenger team raskt svar på tre spørsmål: hva var utgangssituasjonen? Ved hvilket trinn mislyktes prosessen? Hva viste applikasjonen på det tidspunktet?

Skjermbilder, kjøringslogger, og eventuelt skjermopptak gjør feil diskuterbare. De forkorter overleveringen mellom drift, QA, og utvikling betydelig. For regulerte eller sikkerhetsbevisste selskaper er de dessuten et solid grunnlag for å spore godkjenninger og avvik.

Lagringsstedet er ikke en bisak her. Testkjøringer kan inneholde interne kundedata, prislister, ordreinformasjon, eller skjermvisninger. Den som automatisert tester sensitive Windows-applikasjoner, bør avklare om disse dataene får forlate egen infrastruktur. Et selvhostet miljø som COCO kan være fornuftig her, fordi testkjøring, bevis, og evaluering forblir under egen kontroll. Om det er nødvendig, avhenger av personvernkrav, avtalesituasjon, og beskyttelsesbehov - ikke alle team trenger samme arkitektur for det.

Bygg testing inn i utgivelsesprosessen

Den beste testkatalogen mister verdi hvis den først brukes etter en hektisk produksjonssetting. Definer et fast tidspunkt: automatiserte kjerneregresjoner kjøres før hver utgivelse, manuell akseptanse kontrollerer nye eller endrede prosesser, og kjente begrensninger dokumenteres åpent.

Ikke hver mislykkede test trenger å stoppe en utgivelse. En feil i en sjelden brukt administrasjonsvisning kan være akseptabel hvis en trygg omvei finnes og det berørte området er tydelig informert. En feil som bokfører lagerbeholdning feil eller ubemerket blokkerer brukere, må behandles annerledes. Denne beslutningen bør tas basert på forretningspåvirkning, ikke bare antallet røde tester.

Vedlikehold testene sammen med applikasjonen. Når en prosess bevisst endres, oppdater testtilfelle, testdata, og forventet resultat sammen med kravet. Utdaterte tester skaper støy og blir til slutt ignorert. Noen få pålitelige kontroller er mer verdifulle enn hundrevis av automatiserte prosesser hvis resultater ingen lenger tar på alvor.

Til syvende og sist handler det ikke om å simulere hver tenkelige inndata. Det handler om å beskytte arbeidet som må fungere igjen neste morgen. Start med én eneste kritisk prosess, gjør resultatet dens bevisbart, og bygg videre derfra.

Permalenke →

Secure test data management uten å miste kontrollen

Secure test data management uten å miste kontrollen

En mislykket testkjøring er irriterende. En vellykket testkjøring med ekte kundedata i et utilstrekkelig beskyttet miljø kan vise seg å bli betydelig dyrere. Secure test data management løser ikke denne motsetningen med ett enkelt verktøy, men med tydelige regler for data, tilgang, testmiljøer, og bevis. For team som automatisert tester web- eller Windows-applikasjoner, hører dette derfor til kvalitetsarbeidet - ikke bare til etterlevelse.

Hvorfor testdata blir et sikkerhetsproblem

Produksjonsdata er forlokkende for tester fordi de inneholder reelle spesialtilfeller: ufullstendige adresser, uvanlige ordrekombinasjoner, historiske prisregler, eller feilaktige inndata. Men nettopp disse dataene inneholder ofte navn, kontaktopplysninger, kontraktsinformasjon, personalnumre, bankopplysninger, eller intern forretningslogikk.

Risikoen oppstår sjelden av én enkelt grov feil. Den vokser vanligvis trinnvis: en databaseeksport opprettes for en test, legges i en delt katalog, og kopieres senere til et annet miljø. En ekstern tjeneste mottar skjermbilder for feilanalyse. En testkonto beholder omfattende rettigheter fordi en opprydding kan forstyrre neste kjøring. Etter noen måneder vet ingen lenger pålitelig hvilke data som ligger hvor.

Hos små og mellomstore bedrifter forverres problemet ofte av knapp kapasitet. Teamet vil holde en utgivelsesfrist, ikke drive et eget personvernprosjekt. Ansvaret består likevel. Den som bruker data til kvalitetssikring må kunne spore hvilke data som behandles, hvem som har tilgang, og når de fjernes igjen.

Secure test data management begynner før testtilfellet

Det avgjørende spørsmålet er ikke: «Hvordan beskytter vi testdatabeholdningen?» Det er: «Hvilken informasjon trenger denne testen egentlig?» Mange regresjonstester trenger ingen reelle personreferanser i det hele tatt. En forsendelsesprosess må for eksempel kontrollere om leveringsadresser, vekter, soner, etiketter, og statusendringer behandles korrekt. Til det er syntetiske kunder, plausible artikkelstamdata, og bevisst definerte grensetilfeller nok.

Dette skillet fører til en praktisk dataklassifisering. Ikke alle testmiljøer trenger samme datadybde. For enhets- og integrasjonstester holder det ofte med helt kunstige datasett. For ende-til-ende-tester kan pseudonymiserte kopier være fornuftige, hvis reelle datamønstre er faglig relevante. Produksjonslignende data bør være unntaket - med dokumentert formål, begrenset tilgang, og en fast levetid.

Viktig her er kvaliteten på erstatningsdataene. Tilfeldige fantasidata hjelper lite hvis de ikke gjenspeiler realistiske avhengigheter. Et testdatasett for en lagerapplikasjon må for eksempel inneholde artikkelvarianter, lagerplasser, sperret beholdning, delleveranser, og returer i en samstemt kombinasjon. God testdata beskytter ikke bare personopplysninger. De finner feil som aldri ville blitt synlige med tomme tabeller og eksempelkunden «Ola Nordmann».

Syntetisere, maskere, eller minimere?

Syntetiske data er det tryggeste valget når de faglige reglene kan modelleres rent. De oppstår målrettet fra testkrav og inneholder ingen kopi av reelle personer eller transaksjoner. Innsatsen ligger i vedlikeholdet: endrer datamodellen seg eller kommer det nye prosessregler, må generatorer og fixtures vokse med.

Maskering egner seg når en applikasjons oppførsel er sterkt avhengig av produksjonsstrukturer. Da erstattes eller endres sensitive felt, mens relasjoner beholdes. Navn blir plausible, men fiktive navn; e-postadresser blir ikke-leverbare testadresser; kontonumre blir verdier med korrekt format uten reell tilknytning. En maskering er bare robust hvis også indirekte slutninger tas med i betraktningen. En kombinasjon av et sjeldent sted, fødselsdato, og kontraktsegenskap kan fortsatt gjøre en person identifiserbar.

Dataminimering er ofte den undervurderte tredje veien. I stedet for å kopiere en fullstendig eksport, tilbys bare det nødvendige utsnittet. Det reduserer angrepsflaten, lagringsbehovet, og opprydningsinnsatsen. For å teste en rabattlogikk trenger ingen hele et års kundehistorikk.

Tilgang og miljøer må matche risikoen

Et beskyttet datasett mister sin verdi hvis det ligger i et fritt tilgjengelig testmiljø. Testsystemer trenger derfor egne sikkerhetsgrenser - separate databaser, egne tjenestekontoer, klart definert nettverkstilgang, og ingen stilltiende forbindelse til produksjon.

Tilgangsrettigheter bør baseres på roller, ikke på delte kontoer. Utviklere kan trenge andre rettigheter enn QA, support, eller eksterne tjenesteleverandører. Administratortilgang er noen ganger nødvendig, men bør være tidsbegrenset, logget, og knyttet til en sporbar godkjenning. Også for testkontoer gjelder fornuftige passordregler, multifaktorautentisering der den er tilgjengelig, og kontosperreflyter ved gjentatte mislykkede forsøk.

Automatiserte tester bringer med seg enda et spesialtilfelle: de genererer bevis. Skjermbilder, skjermopptak, logger, og feilmeldinger kan inneholde sensitivt innhold, selv når databasen er maskert. Et skjermbilde av en kundeskjerm, et nettlesersport med øktinformasjon, eller en logg med API-nyttelast hører til samme beskyttelsesvurdering som testdatabasen.

Derfor trenger testartefakter oppbevaringsregler. Ikke hver vellykkede kjøring trenger å lagres permanent. For kritiske godkjenninger kan sporbart bevis være fornuftig, for eksempel med tidsstempel, byggnummer, testversjon, og resultat. Mislykkede kjøringer trenger ofte et lengre analysevindu. Etter det bør artefakter slettes automatisk. Det som ikke lenger finnes, kan ikke ved et uhell deles eller kompromitteres.

Automatisering uten ukontrollerte datalekkasjer

KI-støttet testautomatisering kan betydelig fremskynde tester, spesielt for omfattende web- og Windows-applikasjoner. Men det endrer sikkerhetsspørsmålet: hvor går skjermbilder, inndata, feilbeskrivelser, og applikasjonstrafikk? Hvem behandler dem? Hvor lenge blir de der?

For sikkerhetsbevisste team er selvhostet kjøring ofte den bedre arkitekturen. Et system som COCO kan kjøre innenfor egen eller en klart avgrenset infrastruktur, utføre teststeg, lagre bevis, og generere forståelige vurderinger. Det er ikke obligatorisk i alle situasjoner. For en offentlig markedsføringsside med rent syntetiske skjemaverdier kan en ekstern tjeneste være forsvarlig. Ved interne fagapplikasjoner, kundeportaler, eller programvare med personrelaterte prosesser er lokal kontroll imidlertid en konkret fordel.

Selvhosting er ikke et frikort. Driften krever oppdateringer, sikkerhetskopikonsepter, tilgangslogger, og en ansvarlig instans. Til gjengjeld forblir datasuvereniteten der den hører hjemme. Den riktige tilnærmingen avhenger av beskyttelsesbehov, eksisterende driftsevne, og typen testet applikasjon - ikke av det aktuelle hypet rundt et bestemt testverktøy.

Slik blir regler til en arbeidsdyktig prosess

En gjennomførbar prosess trenger ikke å blokkere utgivelsen. Begynn med et datakart: hvilke testmiljøer finnes, hvilke datatyper ligger der, og hvilke systemer genererer ytterligere artefakter? Denne kartleggingen avdekker som regel allerede gamle eksporter, glemte staging-systemer, og uklare ansvarsforhold.

Deretter lønner det seg med en enkel beslutningsmatrise per testklasse. Den fastsetter om syntetiske data er nok, en maskering er nødvendig, eller om et klart begrunnet produksjonsutdrag trengs. Den suppleres med eiere, slettefrister, og tilgangsroller. Det trenger ikke være et overbelastet regelverk. En kort, faktisk fulgt retningslinje er bedre enn et sikkerhetsdokument som ingen finner under en driftsforstyrrelse.

Teknisk hører dataklargjøring og opprydding hjemme i testpipelinen. En kjøring oppretter de datasettene den trenger reproduserbart, bruker unike merkinger, og fjerner dem deretter igjen. Det hindrer at testmiljøer fylles med restdata og resultater blir mindre pålitelige for hver sprint. For kritiske prosesser bør team dessuten sjekke om datatilgang og testbevis må logges på en revisjonssikker måte.

Sikkerhet som gjør testingen raskere

Secure test data management blir ofte betraktet som ekstra kontrollbyrde. Dårlig implementert kan det virkelig være det. Godt implementert skaper det imidlertid pålitelige, repeterbare utgangsforhold. Team kaster bort mindre tid på å lete etter en brukbar dataeksport, unngår ødelagte tester på grunn av uoppryddet gammel data, og kan bedre begrunne godkjenninger.

Det mest fornuftige første trinnet er sjelden et stort plattformprosjekt. Ta testprosessen med høyest risiko eller størst friksjon - for eksempel godkjenningen av en intern ordreapplikasjon - og gjør datakilde, tilgang, artefakter, og sletting synlige der. Fra dette konkrete arbeidet vokser det frem en sikkerhetsrutine som ikke gjør testene tyngre, men mer troverdige.

Permalenke →

Warehouse Software vs ERP

Warehouse Software vs ERP

Et varemottak kommer inn samtidig med en akutt plukkejobb, to medarbeidere spør etter lagerplassen til en vare, og en følgeseddel er allerede rettet for hånd. Det er nettopp i slike øyeblikk at spørsmålet Warehouse Software vs ERP blir praktisk. Det handler ikke om det mest moderne grensesnittet eller den lengste funksjonslisten. Det handler om hvorvidt informasjonen er tilgjengelig akkurat der en beslutning må tas på sekunder.

Mange små og mellomstore bedrifter i DACH-regionen starter med et ERP, et regneark og mye erfaring i teamet. Det kan fungere lenge. Problemene begynner først når beholdningen avviker mellom systemer, søketiden øker og hvert spesialtilfelle må løses ved å rope gjennom lageret. Da dukker det ofte opp et stort ERP-prosjekt, selv om det kanskje bare er én klart avgrenset lagerprosess som trenger å digitaliseres.

Warehouse Software vs ERP: forskjellen i hverdagen

Et ERP-system avbilder virksomheten i bredden. Det kobler typisk sammen innkjøp, salg, varestamdata, regnskap, produksjon, fakturering og planlegging. Styrken ligger i at kommersielle og operative data flyter sammen i ett felles rammeverk. En ordre opprettes, en faktura utstedes, et behov planlegges, en beholdning verdsettes.

Warehouse software, ofte kalt WMS eller lagerstyringssystem, jobber nærmere de faktiske bevegelsene inne i lageret. Det støtter varemottak, plassering på lager, omflyttinger, plukking, varetelling, forsendelse og returer. Det svarer på spørsmål som ERP-et ofte bare avbilder grovt: hvilken plass ligger varen på? Hvilken beholdning er faktisk tilgjengelig? Hvilket parti ble sendt? Hvilken ordre har prioritet? Hvem bekreftet omflyttingen?

Dette skillet er ikke absolutt. Det finnes ERP-er med omfattende lagerfunksjoner og WMS-produkter koblet til ordre- eller innkjøpsprosesser. Avgjørende er derfor ikke etiketten på tilbudet, men den operative dybden. Et ERP kan håndtere ti lagerplasser og likevel være upraktisk hvis de ansatte må åpne flere skjermer for hver bevegelse eller registrere data først i etterkant.

ERP-et er den kommersielle kilden

Når en ordre skal faktureres, en innkjøpsordre utløses eller en materialverdsettelse opprettes, hører det i de fleste bedrifter hjemme i ERP-et. Der ligger vanligvis den ledende vare- og kundelogikken. Denne rollen bør ikke lettvint bygges opp dobbelt. To uavhengige systemer for priser, varenumre eller ordrer skaper ikke trygghet, men avstemmingsarbeid.

Et ERP er spesielt nyttig når den sentrale utfordringen er avdelingsovergripende: innkjøp og produksjon må planlegges sammen, finansdata må forbli konsistente, eller flere selskaper jobber med de samme prosessene. Den som ennå ikke har et slikt fundament, bør ikke forvente at en ren lagerløsning erstatter alle bedriftens prosesser.

Warehouse software styrer bevegelsen

På lageret teller likevel ikke bare det som teoretisk finnes i systemet. Det som teller, er det som akkurat har ankommet port tre, hvilken hylle som er ledig, og om varen er reservert for en bekreftet ordre. En god lagerløsning reduserer friksjon nettopp på disse punktene.

Det kan begynne med mobile skannere: varer skannes ved varemottaket, tildeles en lagerplass og meldes umiddelbart som tilgjengelig. Under plukking leder systemet gjennom en hensiktsmessig rekkefølge, kontrollerer vare og mengde og genererer forsendelsesetiketter eller leveringsdokumenter ved behov. Bokføringen skjer ikke timer senere på en kontorplass, men inne i selve prosessen.

Nytten ligger ikke bare i hastighet. Sporbare bokføringer gjør feil synlige. Hvis en beholdning ikke stemmer, kan man fastslå når en bevegelse manglet eller ble bekreftet feil. Det er langt mer pålitelig enn en månedlig korrigering i et regneark.

Når en ERP-modul er nok

En eksisterende ERP-modul kan være det riktige valget når lagerorganiseringen er oversiktlig og teamet kan jobbe pålitelig med prosessene. Ett enkelt lager, faste plasser, få ordrelinjer og ingen strenge krav til parti eller serienummer er typiske forutsetninger. Også ved lavt forsendelsesvolum kan en ekstra systemkomponent gi mer vedlikehold enn nytte.

Før et nytt system anskaffes, lønner det seg med en nøktern test: kan en medarbeider bokføre et varemottak, en omflytting og en forsendelse fullstendig uten lapp? Er beholdningen synlig per lagerplass? Kan avvik fra en varetelling spores tilbake? Opprettes dokumenter uten dobbel registrering? Hvis svarene stort sett er ja, er en utvidelse kanskje ikke presserende.

Også regnearket får bli værende, hvis det ryddig fyller et avgrenset formål, for eksempel sesongbasert kapasitetsplanlegging eller en engangsanalyse. En god løsning erstatter ikke enhver kjent arbeidsmåte. Den erstatter de manuelle trinnene der feil, ventetid eller manglende åpenhet faktisk koster penger.

Når en spesialisert lagerløsning blir fornuftig

Vendepunktet kommer som regel gradvis. Først spør en medarbeider oftere etter en vare. Deretter holdes beholdningen høyere for sikkerhets skyld, fordi ingen sikkert kjenner den faktisk tilgjengelige beholdningen. Til slutt forsinkes forsendelser fordi følgesedler, etiketter og beholdningskorrigeringer går gjennom ulike verktøy.

En spesialisert warehouse software blir spesielt fornuftig når flere av disse betingelsene inntreffer samtidig:

  • flere lagerområder, lagerplasser eller eksterne lagre forvaltes
  • varemottak, omflyttinger og plukking skjer daglig i stort antall
  • partier, serienumre, holdbarhetsdatoer eller sperret beholdning må spores
  • fraktleverandører, etikettskrivere eller mobile skannere skal bygges inn i prosessen
  • den operative virkeligheten stadig oftere avviker fra det ERP-et viser

Listen er ingen automatisk kjøpsanbefaling. En virksomhet med mange ordrelinjer kan fungere godt med et godt innrettet ERP. Omvendt kan en liten virksomhet tidlig trenge en slank lagerapplikasjon hvis hver del må være sporbar eller flere team må bokføre samtidig.

Integrasjonsspørsmålet veier ofte tyngre enn funksjonene

Det vanskeligste spørsmålet i Warehouse Software vs ERP er sjelden: hvilket system kan mer? Det bedre spørsmålet er: hvilke data må flyte når til hvilket system?

I mange tilfeller forblir ERP-et ledende for varer, kunder, ordrer og kommersielle bilag. Lagerapplikasjonen overtar den operative utførelsen. Den mottar frigitte ordrer, utfører lagerbevegelsene og melder tilbake status, mengder, partier eller forsendelsesnumre. Slik får hver side en klar oppgave.

Dette grensesnittet trenger konkrete regler. Hva skjer med en ordreendring etter at plukkingen allerede har startet? Får en lagerbeholdning bli negativ? Hvilken bokføring gjelder ved et nettverksbrudd? Hvordan sperres varer som avdekkes ved kvalitetskontroll? Uten disse beslutningene blir også et teknisk rent API en ny feilkilde.

For små og mellomstore bedrifter er en trinnvis utrulling ofte mer fornuftig enn et fullstendig bytte. Først kan varemottaket innføres med strekkodeskanning. Deretter følger lagerplasser og omflyttinger, senere plukking og forsendelse. Slik oppdages reelle unntak tidlig, uten å satse hele driften på én omstillingsdag.

Standardprodukt, ERP-utvidelse eller skreddersydd applikasjon?

Et standard-WMS lønner seg når egne prosesser i stor grad er vanlige og en eksisterende integrasjon passer ERP-et. Det bringer utprøvde funksjoner raskt inn i driften. Prisen for det kan være at team må tilpasse sine arbeidsmåter til faste maler, eller betale for enterprise-funksjoner de sjelden bruker.

En ERP-utvidelse er fornuftig når den nødvendige operative dybden faktisk er tilgjengelig og betjeningen fungerer på lagergulvet. Man bør ikke bare vurdere produktdemoen, men et reelt forløp med skanner, hansker, ustabil wifi og tidspress før avgang.

En skreddersydd applikasjon blir interessant når prosessen bærer virksomhetens konkurransefortrinn, eller standardprogramvare permanent tvinger frem omveier. Det kan være en spesiell varemottaksprosess, en kobling mellom verksted og lager, spesielle følgesedler eller en egen rutelogikk. Da bør løsningen ikke gjøres kunstig stor. En klar prosess, ryddig modellert og bygget på et vedlikeholdbart teknisk fundament, er mer verdt enn en plattform som teoretisk kan alt.

softify.pro utvikler slike systemer ut fra konkrete bevegelser og ansvarsområder: fra varemottak via lagerbokføringer til forsendelsesdokumenter. Datamodell, rettigheter, feilsituasjoner og senere vedlikehold forblir en del av gjennomføringen, ikke oppgaver for en gang etter driftsstart.

Spørsmål som bør på bordet før beslutningen

Ikke ethvert behov må automatiseres på dag én. Men det bør avgjøres bevisst. Ansvarlige bør avklare med lagerteamet, salg og regnskap hvilke data som er ledende, hvilke feil som oftest oppstår i dag, og hvilke nøkkeltall som faktisk vil trengs senere. En pen beholdningsoversikt hjelper lite hvis ingen vet om reservert, sperret og tilgjengelig mengde behandles ulikt.

Like viktig er ansvaret for stamdata. Lagerprosesser mislykkes sjelden på grunn av en manglende knapp. De mislykkes på grunn av inkonsistente varenumre, dårlig vedlikeholdte måleenheter og uavklarte regler for erstatningsvarer eller enhetsomregninger. Programvare kan gjøre disse problemene synlige. Den kan ikke løse dem uten beslutninger tatt inne i virksomheten.

Det riktige valget er derfor ikke automatisk ERP eller warehouse software. Det oppstår fra avstanden mellom din nåværende prosess og den prosessen teamet ditt faktisk må utføre pålitelig. Begynn med én bevegelse som koster tid eller skaper feil i dag, og undersøk hvilket system som avbilder den bevegelsen klarest, raskest og mest sporbart.

Permalenke →

Automatisere varemottak

Automatisere varemottak

En lastebil står ved porten, to medarbeidere kontrollerer følgesedler, og lagerlisten ligger fortsatt på datamaskinen på kontoret. Akkurat her begynner spørsmålet how to automate goods receiving å bli praktisk. Ikke fordi hvert lager trenger en stor ERP-innføring. Men fordi et manglende, forsinket eller feilbokført varemottak får konsekvenser: beholdningen stemmer ikke, ordrer venter, reklamasjoner blir vanskelige å spore, og skiftet starter med spørsmål som må avklares.

Å automatisere varemottak betyr ikke å erstatte mennesker med skannere. Det betyr å håndtere gjentakende kontroller, bokføringer og dokumenter slik at teamet ved porten kan bestemme raskt, og at beholdningen deretter er pålitelig. For små og mellomstore bedrifter er en slank, tilpasset arbeidsflyt vanligvis mer verdifull enn et konsernsystem fullt av funksjoner ingen bruker.

Hva som faktisk går tapt ved manuelt varemottak

Papirfølgesedler og regneark fungerer ofte lenge nok til å utsette en investering. Problemet oppstår ikke ved en enkelt kartong. Det oppstår når avvik hoper seg opp: en delleveranse noteres først senere, et parti kan ikke spores tilbake, en pall havner i feil sone, eller et varemottak bokføres først mot slutten av dagen.

Da finnes det flere sannheter samtidig. Leverandøren melder levert. I lageret står varen fysisk. Disponeringen ser ennå ingen tilgjengelig beholdning. Regnskap har et bilag, men ingen bekreftelse på mengde eller skade. Medarbeiderne avstemmer denne informasjonen per telefon, e-post og erfaring. Det koster tid og gjør prosessen avhengig av enkeltpersoner.

Automatisering skaper én felles, oppdatert kilde for hendelsen. Den fanger ikke bare forventet beholdning, men også det som faktisk skjedde ved porten: hvem som tok imot, når, i hvilken mengde, med hvilket avvik, og hvor varen går videre.

How to automate goods receiving med en klar arbeidsflyt

Det riktige utgangspunktet er ikke valget av en skanner eller en lager-app. Først må den reelle prosessen bli synlig. Gå gjennom et typisk varemottak fra den varslede leveringsdatoen til plassering på lager. Observer også spesialtilfellene underveis, for de avgjør om en løsning holder i det daglige.

En digital arbeidsflyt består vanligvis av fem påfølgende beslutninger. Leveransen identifiseres, kontrolleres mot ordren eller den forventede ankomsten, den faktiske mengden registreres, avvik dokumenteres, og varen tildeles en lagerplass eller et ytterligere kontrolltrinn. Hvert trinn bør bare be om de dataene som faktisk trengs der.

1. Gjør forventede leveranser tilgjengelige på forhånd

Hvis det finnes innkjøpsordrer, produksjonsordrer eller varslinger om forsendelse, bør lageret kunne se dem før ankomst. Ved ankomst velger den ansvarlige personen leverandøren, skanner et ordrenummer eller søker etter en åpen leveranse. Systemet viser forventede varer, mengder og eventuelt parti- eller serienummer.

Det forkorter mottaket betydelig. Enda viktigere er imidlertid kontrollogikken: teamet trenger ikke å avgjøre fra hukommelsen om 18 kartonger i stedet for 20 er akseptabelt. Avviket blir synlig og kan tildeles en årsak. For uvarslede leveranser trenger arbeidsflyten en kontrollert vei, for eksempel som et midlertidig varemottak som frigis av innkjøp eller disponering.

2. Bruk strekkoder der de faktisk sparer tid

En strekkodeleser eller kameraet på en robust mobil enhet er for mange lagre det mest hensiktsmessige utgangspunktet. En skanning reduserer skrivefeil og øker farten på gjentakende bevegelser. Forutsetningen er imidlertid at varenumre, emballasjeenheter og etiketter vedlikeholdes konsekvent. En skanner løser ikke uklare stamdata.

Ikke all vare trenger serienummersporing. For skruer eller standard forbruksmateriell er ofte vare, mengde og lagerplass nok. For reservedeler med garanti, regulerte produkter eller komponenter til produksjon kan parti, serienummer, holdbarhetsdato og kontrollstatus være obligatorisk. Registreringsdybden bør tilpasses risikoen, ikke en generell programvaremal.

3. Behandle avvik som en normal prosess

Et godt digitalt varemottak forsøker ikke å forhindre hvert avvik. Det gjør avvik enkle og bevisbart håndterbare. Manko, overleveranser, transportskader, feil varer og sperrede partier trenger tydelige statuser i stedet for håndskrevne notater på følgeseddelen.

Ved en skadet leveranse kan for eksempel et bilde tas direkte ved mottaksstedet, mengden bokføres som sperret, og innkjøp informeres automatisk. Tilgjengelig beholdning forblir korrekt mens varen fysisk går til en karantenesone. Det hindrer at skadede deler ved en feil blir plukket eller brukt i produksjonen.

Regelen trenger ikke alltid være fullautomatisk. For små mengder kan en overleveranse aksepteres direkte. For dyre eller sikkerhetsrelevante varer bør en frigivelse kreves. Disse terskelverdiene hører hjemme i prosessen og må forbli justerbare senere.

4. Utløs plassering på lager umiddelbart

En mottakelse er først operativt fullstendig når det er klart hvor varen befinner seg, eller hvorfor den ennå ikke kan legges på lager. Systemet kan foreslå en fast lagerplass, foretrekke en påfyllingssone, eller bestemme et målområde basert på varegruppe, temperaturområde og tilgjengelig kapasitet.

For oversiktlige lagre er ofte en klar plasslogikk med få soner nok. Kompleks ruteoptimalisering er bare fornuftig når volum, gangveier og bemanningsstruktur begrunner det. Den som mottar ti paller om dagen, trenger ikke et optimaliseringsprosjekt som tar lengre tid enn den tiden det sparer. En pålitelig lagerplass-skanning er ofte det største fremskrittet.

Etter plassering på lager oppdaterer systemet beholdning og bevegelseslogg. Salg, disponering eller produksjon ser dermed statusen uten å måtte spørre lageret. Hvis en vare først kan bli tilgjengelig etter en kvalitetskontroll, skiller systemet fysisk beholdning fra tilgjengelig beholdning.

Hvilke data varemottak faktisk trenger

En digital prosess blir raskt upopulær hvis den ber om for mange felt ved porten. Samtidig mangler, uten et minimum av data, bevisene for senere avklaringer. I de fleste mellomstore bedrifter er denne informasjonen fornuftig:

  • Leverandør og referanse til ordren eller følgeseddelen
  • Vare, akseptert mengde og emballasjeenhet
  • Tidspunkt samt ansvarlig person
  • Lagerplass eller status som kontroll, sperret lager eller karantene
  • Avviksårsak, bilder og frigivelse ved behov

Ytterligere felt bør bare være obligatoriske når de muliggjør en konkret beslutning. Ved partikrav er partinummeret ikke et tillegg, men kjerneinformasjon. En fritekstkommentar til hver leveranse, derimot, fylles ofte bare ut for at et skjema skal virke fullstendig.

Integrasjon avgjør forholdet mellom nytte og innsats

Varemottak må ikke oppstå som en ny øyløsning ved siden av innkjøp, produksjon og regnskap. Minst varestamdata, åpne ordrer og beholdningsendringer må utveksles pålitelig. Om dette skjer via et eksisterende ERP-grensesnitt, dataimporter eller en spesialutviklet mellomprosess, avhenger av det eksisterende systemlandskapet.

Med eldre ERP-systemer er fullstendig sanntidsintegrasjon ikke alltid økonomisk. En kontrollert import med faste intervaller kan være fullt tilstrekkelig hvis mengder og frister tillater det. For reservedeler som umiddelbart disponeres til hastesaker, teller derimot en nær sanntidsbokføring mer. Teknikken følger her forretningens tempo.

Også driftssikkerhet hører med i planleggingen. Enheter trenger brukerkontoer, klare roller og en definert atferd ved nettverksbrudd. Et mobilt varemottak trenger ikke nødvendigvis kunne fungere offline. Men hvis wifi-brudd skjer regelmessig, er en lokal buffer med sporbar synkronisering ingen luksus, men en del av prosessens pålitelighet.

Innføring i små steg i stedet for et big bang

Begynn med én leverandør, én varegruppe eller ett klart avgrenset lagerområde. Mål ikke bare tiden per bokføring, men også etterarbeid, uavklarte differanser og spørsmål mellom lager og kontor. Det viser om automatiseringen faktisk avlaster.

Tren med ekte følgesedler fra hverdagen, inkludert skadde eller ufullstendige leveranser. En prosess som bare fungerer ved en perfekt samsvarende leveranse, er ikke automatisering, men en demonstrasjon. Medarbeidere ved varemottak bør kunne være med på å utforme reglene, fordi de kjenner unntakstilfellene.

softify.pro utvikler slike arbeidsflyter bevisst arbeidsflytspesifikt: fra den mobile skanningen til den dokumenterte lagerbevegelsen og en stabil tilkobling til eksisterende systemer. Avgjørende her er ikke den lengste funksjonslisten, men et system som forblir sporbart under tidspress og som kan driftes og vedlikeholdes teknisk.

Det beste neste steget er derfor ingen programvaresammenligning, men en times gjennomgang av de ti siste problematiske leveransene. Hvis du for hver av dem kan si hvor tid gikk tapt og hvilken informasjon som manglet, finnes allerede det første utkastet til et bedre varemottak.

Permalenke →

Fordeler med strekkodebasert plukking for små og mellomstore lagre

Fordeler med strekkodebasert plukking for små og mellomstore lagre

En feil vare i esken koster sjelden bare prisen for returen. Den binder opp tid på lageret, skaper spørsmål på kontoret og skader i verste fall et kundeforhold. Fordelene med strekkodebasert plukking viser seg derfor ikke først i et teknisk nøkkeltall, men i en roligere utlevering: medarbeiderne vet hva som skal gjøres videre, og avvik oppdages der de oppstår.

For små og mellomstore lagre er dette særlig relevant. Mange prosesser fungerer i starten med papirlister, Excel-filer, rop over hallen og enkeltpersoners erfaring. Det er ikke galt i seg selv. Ved et oversiktlig volum kan et regneark til og med være det fornuftigste verktøyet. Men når vareutvalget, antall ordrer, skiftbytter eller kravene til sporbarhet øker, blir den pragmatiske nødløsningen fort en feilkilde.

Hva strekkodebasert plukking endrer i hverdagen

Ved strekkodebasert plukking bekrefter en skanning ikke bare at noen har gjort noe. Den knytter ordre, lagerplass, vare og antall sammen i ett sporbart arbeidstrinn. Systemet angir neste plukk, medarbeideren skanner lagerplass og vare, legger inn antallet ved behov og får umiddelbar tilbakemelding.

Rekkefølgen på kontrollen er avgjørende. Skanner en medarbeider først varen og deretter lagerplassen, kan systemet riktignok oppdage feil vare, men ikke hindre en ugunstig gangrute. I praksis fungerer rekkefølgen lagerplass, vare, antall ofte godt. Ved prosesser med batch, serienummer eller best før-dato kommer flere kontroller i tillegg. Hvilke som trengs, avhenger av risikoen, ikke av hva som ville vært teknisk mulig.

Et godt system erstatter ikke en fornuftig lagerorden. Men det synliggjør når ordenen ikke følges i det daglige. Ligger varer på en plass som ikke er tiltenkt dem, oppdages feilen ikke først ved varetellingen, men ved skanningen.

De viktigste fordelene med strekkodebasert plukking: færre forvekslinger der de oppstår

Papirlister krever konstant konsentrasjon: lese varenummeret, finne hyllen, sammenligne emballasjen, krysse av antallet. Under tidspress er like esker, nesten identiske betegnelser eller et avbrutt arbeidsmoment nok til å gi en feil. Strekkoden gir en entydig identifikasjon akkurat i dette øyeblikket.

Skanneren erstatter ikke tenkningen, men den overtar den kontrollen mennesker har vanskeligst for å opprettholde over tid i rutinearbeid. Passer varen ikke til ordren, bør tilbakemeldingen være tydelig: feil vare, forventet vare, neste fornuftige steg. Et rent rødt varselsignal hjelper lite hvis det ikke fremgår hvordan avviket skal rettes.

Posteringer gjør lagerbeholdningen mer pålitelig

Beholdninger er bare nyttige hvis de kan bære beslutninger. Den som planlegger etterbestillinger, lover leveringsdatoer eller stiller produksjonsmateriell til rådighet, trenger mer enn et tall fra forrige uke. Hvis uttak først overføres fra en liste ved skiftslutt eller i etterkant, oppstår tidsvinduer med uklart datagrunnlag.

En skanning kan postere uttaket umiddelbart. Dermed minker forskjellen mellom fysisk bevegelse og digital beholdning. Det betyr ikke at hvert tall automatisk er riktig. Feilmerkede varer, ikke-posterte omflyttinger og skadet beholdning er fortsatt reelle problemstillinger. Men årsakene kan avgrenses langt bedre, fordi hver bevegelse har et tidspunkt, en ordre og eventuelt en brukertilknytning.

Dette er særlig nyttig i påfyllingsprosesser. Faller en hylleplass under ønsket beholdning, kan systemet opprette en påfyllingsordre eller i det minste synliggjøre behovet. Plukkerne slipper da å lete etter erstatningsvarer midt i en ordre mens kunden venter på sendingen sin.

Raskere opplæring uten avhengighet av enkeltpersoners kunnskap

Erfarne lagermedarbeidere kan ruter, spesialtilfeller og varenes utseende utenat. Denne kunnskapen er verdifull, men risikabel som eneste operativsystem. Ved ferie, sykdom eller vekst kommer teamene under press når nye medarbeidere først må bruke uker på å lære hvilken hyllerad en intern forkortelse viser til.

Et godt mobilt grensesnitt leder gjennom ordren på et forståelig språk. Det viser lagerplass, vare, bestilt antall og ved behov et bilde eller merknader om emballasjen. Skanningen bekrefter steget. Nye kolleger blir ikke eksperter over natten, men kan jobbe trygt mye tidligere.

Det samme gjelder for ekstrahjelp og skiftende vakter. Forutsetningen er at grunndataene er vedlikeholdt. Et system kan ikke utlede en tydelig instruks fra en varebetegnelse som «del liten blå ny». Digitaliseringen avdekker slike svakheter - og nettopp det er ofte en nyttig bieffekt.

Sporbarhet ved reklamasjoner og varetellinger

Når en kunde melder om manglende antall, begynner det uten prosessdata ofte en leting gjennom papirbunker, forsendelseslister og hukommelse. Med strekkodebaserte posteringer kan man kontrollere hvilken ordre som ble behandlet når, hvilken linje som ble bekreftet og om det var en korrigering eller et delantall.

Dette er ingen garanti mot reklamasjoner. Men det forkorter oppklaringen og skiller antakelser fra fakta. Også varetellinger drar nytte av det: differanser kan ikke bare telles, men også undersøkes ut fra bevegelsene. Hoper korrigeringene seg opp ved en bestemt hylleplass, i en varegruppe eller etter en bestemt overlevering i prosessen, oppstår et konkret utgangspunkt for forbedringer.

Målbare prosesser i stedet for magefølelse

Mange lagre vet at «det blir trangt på ettermiddagen» eller at visse ordrer tar uvanlig lang tid. Uten tidsstempler og prosesstrinn forblir det en magefølelse. Registreres plukkstart, skanning, avbrudd, avslutning og overlevering, kan flaskehalser skilles tydelig fra hverandre.

Kanskje er det ikke plukkingen som går sakte, men varene som settes på lager for sent. Kanskje oppstår det ventetid ved pakkestasjonen, eller én hylleplass besøkes uforholdsmessig ofte. Disse dataene bør ikke misforstås som et verktøy for generell prestasjonskontroll. Verdien ligger først og fremst i å avdekke unødvendige gangruter, manglende påfyllinger og uklare overleveringer.

Nytten avhenger av hvordan prosessen utformes

Strekkodebasert plukking er ikke et mål i seg selv, og ikke alle lagre trenger et omfattende lagerstyringssystem. Med få ordrer, et lite sortiment og faste medarbeidere kan en ryddig prosess med enkle lister være mer økonomisk. Et prosjekt gir mening når kostnadene ved feilplukk, letetid, usikre beholdninger eller manuelt etterarbeid merkes jevnlig.

Også maskinvarespørsmålet fortjener en nøktern vurdering. En smarttelefon med kameraskanning kan være nok for de første prosessene. Ved høy skannefrekvens, hansker, dårlige lysforhold eller røffe omgivelser er dedikerte håndskannere som regel raskere og mindre feilutsatte. Avgjørende er dessuten nettverksdekningen. Faller wifi ut i en lagersone, trenger applikasjonen en tydelig strategi: offline-bufring med senere synkronisering eller en prosess der området ikke håndteres mobilt.

Etikettkvaliteten er like viktig som programvaren. En strekkode på et slitt hylleskilt eller en dobbelt tildelt vareidentitet undergraver hele flyten. Før oppstart bør lagerplasser merkes entydig, enheter defineres og kritiske spesialtilfeller avklares: Hvordan håndteres en åpnet forpakning? Hva skjer ved manglende beholdning? Hvem kan korrigere et antall? Hva skjer med varer uten lesbar kode?

Slik lykkes innføringen uten driftsavbrudd

Den mest pålitelige starten er sjelden en fullstendig omlegging. Begynn med et avgrenset område, for eksempel de hyppigste forsendelsesordrene eller en varegruppe med mange forvekslinger. Der kan skannerekkefølge, feilmeldinger og etiketter testes i reell drift uten at hele anlegget bygges om samtidig.

Før den tekniske implementeringen bør den faktiske veien til en ordre kartlegges - fra ordremottak via reservasjon og plukk til pakkestasjon og fraktetikett. Det som teller, er ikke idealprosessen fra et organisasjonskart, men flyten skiftet faktisk bruker. De mest verdifulle kravene ligger ofte i små unntak: samleordrer, erstatningsvarer, delplukk eller retur av varer som ikke trengs.

Deretter trengs entydige regler for unntak. En medarbeider må kunne melde fra om manglende beholdning uten å omgå ordren uformelt. En autorisert person må kunne utføre korrigeringer på en sporbar måte. Og finnes det integrasjoner mot nettbutikk, ERP eller transportør, bør ordrestatus og lagerposteringer være tydelig definert. Dobbelt datavedlikehold er et varselsignal, ikke en varig løsning.

For skreddersydde systemer tar softify.pro utgangspunkt nettopp her: ikke i en overlesset enterprise-pakke, men i de skanne- og posteringstrinnene som dokumenterbart trengs for den konkrete lagerdriften. Et vedlikeholdbart datagrunnlag, tydelig dokumenterte grensesnitt og forståelige brukergrensesnitt er mer verdt enn en lang liste med sjelden brukte funksjoner.

Et fornuftig første kontrollpunkt

Ta ti typiske ordrer og følg dem fra mottak til overlevering til forsendelse. Noter hvor medarbeiderne må lete, spørre, legge inn data i etterkant eller stole på hukommelsen. Nettopp der avgjøres det om strekkodebasert plukking gir fordeler - og hvilken skanneprosess som virkelig passer lageret.

Permalenke →

Selvhostet testing vs sky

Selvhostet testing vs sky

En mislykket regresjonstest er sjelden bare en rød oppføring i et dashbord. Det kan bety at en fraktskjerm i lageret genererer feil etiketter, en kundeportal slutter å godta bestillinger, eller en Windows-applikasjon krasjer under et skiftbytte. Spørsmålet om self hosted testing vs cloud handler derfor ikke om infrastruktur som et mål i seg selv. Det handler om hvilke data en testprosess berører, hvem som kontrollerer den, og hvor pålitelig den kjører under reelle driftsforhold.

Skybaserte testplattformer kan være raskt operative. For mange team er det fornuftig, spesielt når de tester en offentlig webapplikasjon og trenger ekstra utførelseskapasitet på kort varsel. Selvhostede testmiljøer krever derimot en bevisst teknisk oppsett. Men de gir tilbake kontrollen over testdata, nettverksveier, tilgangsrettigheter, og drift til selskapet. Det riktige valget avhenger ikke av et generelt prinsipp, men av applikasjonen, risikoen, og den tilgjengelige driftsevnen.

Self Hosted Testing vs Cloud: Hva det egentlig handler om

Debatten reduseres ofte for mye til de innledende kostnadene. En skyløsning virker billigere fordi ingen servere trenger å anskaffes og ingen miljø trenger å settes opp. En egen testserver virker ved første øyekast mer omfattende, fordi operativsystem, oppdateringer, tilgangskontroll, overvåking, og sikkerhetskopiering alle må planlegges.

Denne beregningen kommer til kort. Avgjørende er de løpende kostnadene ved en teststrategi: ventetider før utgivelser, feilsøking etter ufullstendige testkjøringer, koordinering med personvern og informasjonssikkerhet, samt konsekvensene av en feilaktig driftsetting. Hvis et team regelmessig undersøker sensitive fagapplikasjoner, kan den ekstra organisatoriske belastningen fra eksterne tjenester overstige driften av et klart avgrenset eget miljø.

Heller ikke "sky" er en enhetlig modell. Noen leverandører lagrer bare testlogger, andre behandler skjermbilder, videoopptak, påloggingsdata, DOM-innhold, eller nettverkstrafikk. Med AI-støttet testing kan i tillegg bilde- og tekstdata nå eksterne modeller eller underleverandører for evaluering. Den som bare ser på plasseringen til et datasenter, går ofte glipp av det viktigere spørsmålet: hvilke data forlater faktisk den egne kontrollsonen, og hvilke avtale- og slettingsregler gjelder for dem?

Når skytesting er det fornuftige valget

Skytesting er ikke grunnleggende et sikkerhetsproblem, og selvhosting er ikke automatisk den bedre arkitekturen. For en ny, offentlig tilgjengelig nettbutikk eller en markedsføringsplattform kan et skymiljø være svært passende. Teamet kan raskt dekke nettleser- og enhetsvarianter uten å vedlikeholde egne utførelsesmaskiner. Ved svingende testbelastning er elastisk skalering også en reell fordel.

Små utviklingsteam med få, tydelig anonymiserte testdata drar også ofte nytte av en administrert tjeneste. De bør ikke investere tiden sin i å drifte en plattform når flaskehalsen heller ligger i manglende testtilfeller, uklare aksepterkriterier, eller ustabile testdata. En egen server løser ikke disse problemene.

Skyen passer spesielt godt når applikasjonen ikke trenger intern nettverkstilgang, ingen personopplysninger eller forretningskritiske data forekommer i testflytene, og kort ledetid er viktigere enn dyp infrastrukturkontroll. Forutsetningen er en nøye konfigurasjon: separate testkontoer, ingen ekte kundedata, begrensede tokener, sporbare oppbevaringsperioder, og et tydelig rettighetskonsept.

Når selvhostet testing blir mer fornuftig

Annerledes ser det ut for applikasjoner som bare er tilgjengelige i bedriftsnettverket eller som representerer operative kjerneprosesser. Lager- eller produksjonsprogramvare behandler ofte artikkelbevegelser, leveringsadresser, lagerbeholdning, serienumre, og prislogikk. En testkjøring kan da generere skjermbilder av ordreskjermer, laste ned dokumenter, eller logge inn med brukerroller. Slike data bør ikke spres ubemerket over flere eksterne systemer.

Selvhostet testing gjør det mulig å plassere testutførelsen nær applikasjonen. Testserveren kan kjøre i samme nettverkssegment eller i en kontrollert DMZ. Brannmurregler settes målrettet, interne applikasjoner trenger ikke å åpnes for en ekstern tjeneste, og logger forblir under egen forvaltning. Dette er ofte spesielt relevant for Windows-skrivebordsapplikasjoner, siden disse sjelden er utformet for eksterne testplattformer.

For regulerte bransjer, større kundekrav, eller interne sikkerhetsretningslinjer er denne arkitekturen ofte lettere å revidere. Det betyr ikke at hver revisjon automatisk bestås. En egen server trenger også patchhåndtering, kryptering, rollebaserte rettigheter, sikkerhetskopier, og dokumenterte driftsrutiner. Forskjellen ligger i at selskapet selv tar disse beslutningene og kan dokumentere dem.

Hos softify.pro er COCO derfor tenkt som en dedikert, selvhostet AI-server: testkjøringer for web- og Windows-applikasjoner utføres lokalt, bevis registreres, og resultater vurderes i forståelig språk. Det erstatter ikke fagkyndig godkjenning. Men det sikrer at testtrafikk, skjermbilder, og evalueringer kan forbli der selskapet beholder datasuverenitet.

Sammenligne kostnader riktig: drift mot friksjon

En fornuftig sammenligning omfatter mer enn lisenspris mot maskinvarepris. I skyen oppstår tilbakevendende avgifter per bruker, testminutt, parallell utførelse, eller AI-forbruk. Disse kostnadene er i utgangspunktet forutsigbare, men kan øke betydelig med voksende testdekning. I tillegg kommer mulige utgifter for enterprise-avtaler, databehandleravtaler, og sikkerhetsrevisjoner.

Ved selvhosting oppstår investeringer for infrastruktur og oppsett. Dette kan omfatte virtuelle maskiner, lagring, nettverkstilgang, overvåking, og tiden til et teknisk ansvarlig team. Disse kostnadene forblir også når få tester kjører. For et prosjekt med sjeldne utgivelser er dette et godt argument mot en overdimensjonert egen løsning.

Ved regelmessig regresjonstesting skifter bildet. Hvis de samme forretningskritiske arbeidsflytene må sjekkes hver uke, er forutsigbar intern kapasitet ofte mer økonomisk enn variable plattformkostnader og manuelle godkjenningssløyfer. Tilnærmingen blir spesielt verdifull når testtilfeller brukes i årevis og videreutvikles sammen med fagapplikasjonen. Vedlikeholdbarhet blir da viktigere enn en rask, men vanskelig kontrollerbar start.

Kvalitet avhenger ikke av hostingmodellen

En vanlig misforståelse sier: skytester ville automatisk være mer moderne, selvhostede tester automatisk mer stabile. Ingen av delene stemmer. Testkvalitet oppstår gjennom fornuftige scenarier, robuste testdata, stabile identifikatorer i grensesnittet, og tydelige forventninger til resultatet.

En test bør ikke bare sjekke om en knapp er klikkbar. For en ordrebehandling kan den for eksempel opprette en ordre, sjekke en tilgjengelig mengde, generere en følgeseddel, og sikre at riktig rolle får godkjenne prosessen. Ved et skrivebordsprogram kan den verifisere importen av en fil, feilhåndteringen, og utdataen av et dokument. Først slike ende-til-ende-flyter viser om en endring har skadet den reelle prosessen.

AI kan hjelpe med å oppdage grensesnittendringer, dokumentere trinn forståelig, og prioritere avvik. Den bør imidlertid ikke bli en svart boks. Team trenger skjermbilder eller andre bevis, sporbare testtrinn, og definerte terskler for når et resultat regnes som bestått, usikkert, eller mislykket. Spesielt ved visuelle kontroller er en konfidensterskel fornuftig, slik at små, forventede layoutavvik ikke blokkerer hver utgivelse.

Driftsspørsmålene før beslutningen

Før et team forplikter seg, bør det konkret spore veien til en testkjøring. Hvor kjører testen? Hvilke systemer logger den seg på? Hvilke data ser den? Hvor lagres skjermbilder, logger, og rapporter? Hvem får lese, slette, eller eksportere resultater? Disse spørsmålene er mer praktiske enn en generell beslutning for eller mot skyen.

Like viktig er ansvaret etter driftsstart. Hvem oppdaterer nettlesere og testagenter? Hvem reagerer når et sertifikat utløper? Hvordan roteres påloggingsdata? Og hvordan sikres det at en test ikke ved et uhell utløser en reell fraktbokføring eller kundevarsel? God testautomatisering trenger separate miljøer og beskyttelsesmekanismer, ikke bare gode skript.

En hybridmodell kan være fornuftig. Offentlige grensesnitt og bredt distribuerte nettleserkontroller kjører i skyen, mens interne fagprosesser blir på en egen testserver. Dette reduserer driftsbelastningen, uten å gi bort sensitive arbeidsflyter til utsiden samlet. Forutsetningen er en tydelig grense mellom de to områdene, ikke en uoversiktlig blandet drift.

Den beste beslutningen er den som passer til den faktiske risikoen og den egne driftsvirkeligheten. Hvis et regneark fortsatt bærer en prosess pålitelig, trenger det ikke bli et stort system av det. Men hvis testdata og interne applikasjoner derimot hører til forretningskjernen, er kontroll ingen luksus, men et saklig krav for pålitelig programvare.

Permalenke →

Inventory Management på lageret

Inventory Management på lageret

En manglende del legges sjelden merke til under telling i lageret. Vanligvis viser den seg først når en ordre ikke kan pakkes, en montør står foran en tom hylle, eller innkjøp leter på telefon etter et leveringsløfte. God Inventory Management forhindrer ikke disse overraskelsene med flere tabeller, men med et pålitelig bilde av hva som finnes, hvor det ligger, og hva som skjer med det videre.

For små og mellomstore bedrifter er ikke dette et spørsmål om det størst mulige ERP-systemet. Avgjørende er om ansatte i varemottak, lager, og forsendelse kan jobbe med noen få klare trinn - også under tidspress, over skiftbytter, og når en levering blir annerledes enn planlagt.

Inventory Management begynner med bevegelser, ikke lagerlister

En lagerliste er et øyeblikksbilde. Den kan være korrekt og likevel hjelpe lite hvis ingen kan spore hvorfor en mengde har endret seg. Et robust system behandler derfor lagerbeholdning som resultatet av dokumenterte bevegelser: varer ankommer, kontrolleres, legges på lager, reserveres, plukkes, flyttes, sendes, eller korrigeres.

Hver bevegelse trenger en klar årsak, et tidspunkt, en ansvarlig person, og helst en kobling til en spesifikk transaksjon. Det kan være en innkjøpsordre, en kundeordre, en følgeseddel, eller en produksjonsordre. Det gjør tallet "24 stykker tilgjengelig" til en verifiserbar påstand: 30 enheter ble bokført, fire er reservert for to ordre, og ingen åpen omflytting forvrenger den tilgjengelige lagerbeholdningen.

Dette skillet er spesielt relevant ved knappe deler. Fysisk til stede, reservert, og fritt tilgjengelig er tre forskjellige tilstander. Blandes de sammen, lover salg varer som lageret allerede trenger for en annen ordre. Holdes de rene, kan et team beslutte tidlig: etterbestille, omprioritere, eller gi kunden et realistisk svar.

Hvor manuelle prosesser typisk bryter sammen

Regneark er ikke grunnleggende feil. For et lite sortiment, ett lagersted, og få bevegelser per uke kan de være mer økonomiske enn en egen applikasjon. De blir problematiske så snart flere personer jobber samtidig eller lagerbeholdning oppdateres fra flere kilder.

Da oppstår de kjente hullene: varemottaket ligger som papir på skrivebordet, Excel-filen ble endret lokalt, en omflytting ble bare avtalt muntlig, og forsendelse bokfører først etter arbeidstid. Lagerbeholdningen er ikke nødvendigvis feil, men den er tidsforskjøvet og opprinnelsen er uklar. Det er nettopp det som gjør den uegnet for operative beslutninger.

Organisasjonsstrukturen spiller også en rolle. Et sentralt sted trenger andre arbeidsflyter enn en bedrift med utelagre, servicekjøretøy, eller en produksjon som tar ut materiale. Den som kartlegger disse forskjellene med én enkelt fritekstkolonne, flytter logikken inn i hodene til enkeltansatte. Det fungerer helt til den personen har ferie eller ordrevolumet øker.

Definer prosessen før programvaren

Et fornuftig prosjekt starter ikke med spørsmålet om hvilken skanner som skal kjøpes eller hvilket grensesnitt som ser moderne ut. Først må det være klart hvilke beslutninger systemet skal støtte. For det holder det ofte med konkrete observasjoner fra hverdagen: hvordan tas varer imot i dag? Når regnes det som kontrollert? Hvem får korrigere lagerbeholdning? Hva skjer med skadet vare? Og på hvilket punkt blir en ordre bindende reservert?

Fra disse svarene oppstår noen få bindende regler. For eksempel kan varemottak først bokføres etter en mengdekontroll. Artikler uten lagerplass skal ikke fremstå som klare for innlagring. Lagerkorreksjoner krever en årsakskode og forblir synlige i historikken. Sendt vare slettes ikke stilltiende, men tildeles ordren gjennom en dokumentert utbokføring.

Det er mindre spektakulært enn en stor digitaliseringspresentasjon, men vesentlig mer verdifullt i drift. Når reglene er entydige, kan programvaren pålitelig kontrollere dem. Når de forblir uklare, akselererer hver nye applikasjon bare motstridende arbeidstrinn.

Stamdata: start smått, vedlikehold konsekvent

Ikke hver artikkel trenger ti klassifiseringer fra begynnelsen av. Et brukbart grunnlag består ofte av artikkelnummer, betegnelse, enhet, aktiv lagerstatus, og én eller flere lagerplasser. Avhengig av virksomheten kommer partier, serienumre, minimumslagre, leverandørens artikkelnumre, eller utløpsdatoer i tillegg.

Viktig er konsekvensen, ikke antallet felt. To artikkelnumre for samme fysiske artikkel, eller skiftende enheter som "kartong", "pakke", og "stykk" uten omregningsregel, genererer senere feil nesten automatisk. Et system kan teknisk tillate slike innføringer. Det bør begrense dem der de setter arbeidsflyten i fare.

Hvilke funksjoner som virkelig hjelper i lageret

For mange mellomstore lagre er en tydelig kjerne mer verdifull enn en overlesset funksjonskatalog. Denne kjernen omfatter vanligvis fire områder:

  • Varemottak med ordrereferanse, mengdekontroll, og innlagring
  • Lagerbevegelser mellom definerte plasser og soner
  • Ordrereservasjon, plukking, og forsendelsesbekreftelse
  • Telling og lagerkorreksjoner med sporbar historikk

I tillegg kan etikettutskrift, strekkodeskanning, følgesedler, fraktetiketter, eller en overlevering til regnskap og butikksystemer spare mye tid. Men de bør bygge på en ren bevegelsesmodell. Rask etikettutskrift hjelper lite hvis skanning ikke entydig tildeler artikkelen til riktig lagerplass eller ordre.

Ved bruken teller også omgivelsene. En ansatt med hansker ved varemottak trenger store, entydige handlinger og minst mulig tekstinntasting. En disponent på arbeidsplassen trenger derimot filtre, søkefunksjoner, og en oversikt over åpne transaksjoner. Begge roller kan bruke de samme dataene, men trenger ikke samme grensesnitt.

Sanntid betyr ikke at hvert tall er ubestridelig

Mange bedrifter ønsker seg lagerbeholdning i sanntid. Det er fornuftig, men begrepet brukes ofte for grovt. En lagerbeholdning kan oppdateres umiddelbart etter hver skanning og likevel være feil hvis en prosess forblir ufullstendig. Skannes varen, men kontrolleres ikke, er tallet teknisk aktuelt og operativt tvilsomt.

Derfor trenger hvert system en håndtering av unntak. Avvik ved varemottak, skadet emballasje, returer, og varer som ikke kan finnes, er ikke randtilfeller. De hører til hverdagen. Gode prosesser markerer dem synlig, i stedet for å tvinge ansatte til improviserte sidelister.

Også rettighetene fortjener oppmerksomhet. Ikke enhver person bør kunne endre artikkelstamdata eller korrigere historiske bokføringer. Et praktisk rettighetskonsept skiller rutinetransaksjoner fra inngrep med høyere risiko. Det beskytter ikke bare mot feil, men letter også årsaksanalysen når en lagerbeholdning avviker uventet.

Integrasjon bare der den forbedrer arbeidsflyten

Inventory Management står sjelden alene. Ordre kan komme fra en nettbutikk, en e-postregistrering, en bransjeløsning, eller direkte fra salg. Fraktleverandører trenger adressedata og vekter. Regnskapet forventer bilag i en bestemt form.

En integrasjon lønner seg når den eliminerer dobbel registrering eller reduserer feilkilder. Den er ikke automatisk fornuftig bare fordi et grensesnitt er tilgjengelig. Spesielt ved organisk vokste prosesser kan en klar import med kontroll være mer pålitelig enn en permanent sanntidskobling som ubemerket overfører feilaktige data.

Teknisk bør løsningen forbli sporbar: entydige grensesnitt, loggførte overføringer, forståelige feilmeldinger, og en databasestruktur som ikke skjuler endringer. Med en godt vedlikeholdt applikasjon basert på PHP 8.4 og MySQL 8 kan slike prosesser implementeres slankt, uten å tvinge team inn i et globalt konsernsystem. Avgjørende er ikke teknologibetegnelsen, men om vedlikehold, utvidelser, og datakorreksjoner forblir kontrollerbare også om tre år.

Innføring i små, målbare steg

En big bang er sjelden det beste valget i et lager. Tryggere er en avgrenset start, for eksempel med varemottak og ett utvalgt lagerområde. I denne fasen kan skannetider, feiltyper, åpne spesialtilfeller, og kvaliteten på stamdata observeres. Først etterpå følger reservasjon, forsendelse, eller flere lokasjoner.

Parallell drift kan være fornuftig der, men bare med en klar slutt. To ledende lagerbeholdninger over lengre tid skaper nettopp det problemet den nye løsningen skal rette opp. Bedre er en fastsatt overgang med telling, opprydde stamdata, og ansvar for de første ukene.

Suksessen viser seg ikke i hvor mange funksjoner som ble aktivert. Den viser seg i om det oppstår færre oppfølgingsspørsmål, om ordre pakkes mer fullstendig, og om et team kan forklare uten detektivarbeid hvorfor en artikkels lagerbeholdning ser ut som den gjør.

Hvis den nåværende prosessen med et godt vedlikeholdt regneark faktisk fungerer stabilt, bør den få lov til å bli værende. Men hvis informasjon fortsetter å gå tapt mellom papir, telefonsamtaler, og flere filer, er det neste fornuftige steget ikke et større verktøy, men en tydelig prosess som gjør hver viktig lagerbevegelse synlig.

Permalenke →

Er selvhostede tester sikre?

Er selvhostede tester sikre?

En mislykket regresjonstest er irriterende. Et skjermbilde fra et internt ERP-system som havner ukontrollert hos en ekstern tjeneste, er en sikkerhetshendelse. Nettopp derfor stiller QA-ledere og IT-ansvarlige seg spørsmålet: are self hosted tests secure? Det ærlige svaret er: de kan være betydelig sikrere enn skybaserte alternativer, men bare hvis driften tas like alvorlig som testene selv.

Selvhostet testautomatisering flytter kontrollen over utførelse, testdata, skjermbilder, logger, og tilgangsrettigheter til egen infrastruktur. Det reduserer avhengigheter og unødvendige datastier. Det erstatter imidlertid ingen sikkerhetsarkitektur. En dårlig vedlikeholdt intern testserver forblir en dårlig vedlikeholdt server.

Er self-hosted tester sikrere enn skytester?

Den avgjørende forskjellen ligger ikke i om en test kjører lokalt eller automatisert. Den ligger i hvor data behandles, hvem som kan få tilgang til det, og hvilke tekniske grenser som gjelder.

Med en eksternt drevet testtjeneste forlater ofte flere artefakter bedriften: påloggingsdata for testkontoer, URL-er til interne applikasjoner, DOM-innhold, skjermbilder, videoer av testkjøringer, feillogger, og eventuelt databaseutdrag. Selv om en leverandør oppfyller høye sikkerhetsstandarder, oppstår et ekstra tillits- og avtaleforhold. For applikasjoner med kunde-, personal-, produksjons-, eller finansdata kan dette være en relevant hindring.

Et selvhostet system kan drives innenfor eget nettverk eller et klart avgrenset EU-miljø. Testinstansen får direkte tilgang til staging-, akseptanse-, eller isolerte testsystemer. Testbevis blir værende der hvor også applikasjonen og dens driftsansvar befinner seg. Dette er spesielt fornuftig når man tester Windows-skrivebordsapplikasjoner, interne webportaler, eller systemer med sensitive prosessdata.

Men selvhosting er ikke automatisk sikrere. Den som driver en testserver med åpen fjerntilgang, delte administratorkontoer, og permanent gyldige passord, har bare flyttet risikoene. Spørsmålet er derfor ikke bare: sky eller on-premises? Men: er testmiljøet påviselig sikret og varig vedlikeholdbart?

Are self hosted tests secure? Det kommer an på disse grensene

En sikker testplattform trenger klare tekniske og organisatoriske grenser. For små og mellomstore bedrifter trenger ikke dette å se ut som et konsernprogram. Det må bare implementeres konsekvent og dokumenteres.

Skille testmiljøet fra produksjonsdrift

Automatiserte tester skal finne feil, ikke utløse bestillinger, endre følgesedler, eller bokføre lagerbevegelser. Derfor trenger tester et separat miljø med egne grensesnitt, testleietakere, og testdata. Der en fullstendig kopi av produksjonen ikke er nødvendig, er det ofte til og med unødvendig risikabelt.

For en lager- eller ordreportal kan det bety: testbrukere får registrere varemottak og generere fraktetiketter, men de genererte dokumentene går ikke til noen ekte skriver eller ekte speditør. API-nøkler peker mot sandkasse-endepunkter. E-postutsending avskjæres eller begrenses til interne mottakere. Slik forblir en test meningsfull uten å produsere operative konsekvenser.

Adskillelsen bør også gjelde på nettverksnivå. Testserveren trenger bare de tilkoblingene den faktisk krever. Generell tilgang til hele det interne nettverket er praktisk, men sjelden begrunnbart. Segmentering begrenser skaden hvis en testkonto eller en systemkomponent blir kompromittert.

Behandle påloggingsdata som produksjonstilganger

Testautomatisering trenger ofte påloggingsdata. Det er normalt, men denne dataen hører ikke hjemme i testskript, konfigurasjonsfiler i kildekoden, eller chattelogger. Passord, tokener, og sertifikater bør lastes fra en kontrollert hemmelighetshåndtering. Testkontoer får bare de rettighetene den konkrete prosessen krever.

Også tilgang til selve testplattformen trenger roller. En utvikler må kanskje starte testkjøringer og lese resultater, men ikke endre nettverkskonfigurasjonen. En fagavdeling kan se rapporter, men trenger ikke tilgang til lagrede påloggingsdata. Administrasjonsrettigheter bør være personbundet, ikke koblet til en delt konto.

I tillegg hører flerfaktorautentisering, rimelige passordregler, og kontosperringsflyter til minimumsstandarden. Nettopp testsystemer blir ofte behandlet som mindre kritiske. Angripere ser det annerledes: de bruker gjerne testmiljøer som inngangspunkt, fordi tilganger, interne navn, og tekniske detaljer ligger der.

Minimer testdata og maskér målrettet

Den vanligste feilen er ikke en manglende krypteringsmetode, men for mye ekte informasjon i testbeholdningen. For de fleste regresjonstester trenger ingen ekte kundenavn, ekte adresser, eller fullstendige personalmapper. Syntetiske datasett, maskerte kopier, og bevisst opprettede spesialtilfeller er ofte nok.

Det finnes unntak. Noen feil dukker bare opp med ekte datastrukturer, uvanlige tegnsekvenser, eller komplekse tillatelseskonstellasjoner. Da kan en kontrollert, pseudonymisert kopi være fornuftig. Avgjørende er at denne beslutningen tas bevisst og har en slettefrist. Testdatabaser bør ikke fortsette å kjøre i årevis som en glemt skyggekopi av produksjonen.

Skjermbilder og videoer fortjener samme oppmerksomhet. De er verdifulle for feilsøking, men kan vise kontodata, interne priser, eller personopplysninger. Fastsett hvilke artefakter som registreres, hvem som får se dem, og når de automatisk slettes. En testrapport trenger ikke lagre hvert skjermbilde for alltid for å være bevisende.

Drift serveren som et produkt

En selvhostet testserver er ikke en enhet man installerer én gang og deretter glemmer. Driftssikkerhet oppstår gjennom repeterbart vedlikehold: rettidige sikkerhetsoppdateringer for operativsystem, nettleser, testrunner, og avhengigheter; krypterte datamedier og transportveier; overvåkede sikkerhetskopier; sentralisert logging; samt en tydelig håndtering av sikkerhetsmeldinger.

Spesielt ved nettleserstyrte tester er oppdateringsrytmen relevant. Utdaterte nettlesermotorer og automatiseringsbiblioteker kan inneholde kjente sårbarheter eller gjøre tester upålitelige. Begge deler koster tid. Dokumenterte driftsettinger og faste vedlikeholdsvinduer er derfor ikke et byråkratisk tillegg, men grunnlaget for reproduserbare resultater.

For en dedikert AI-testserver som COCO gjelder det samme. Den lokale utførelsen beskytter ikke sensitivt applikasjonsinnhold ved magi. Den skaper kontroll over hvor AI-støttet evaluering, skjermbilder, og testlogger behandles. Denne kontrollen må fylles med patch-håndtering, tillatelser, nettverksskille, og tydelige oppbevaringsregler.

Hvor selvhosting har sine grenser

Skytjenester er ikke usikre per definisjon. En spesialisert leverandør kan tilby mer sikkerhetspersonell, mer moden overvåking, og mer profesjonell redundans enn en bedrift med en enkelt overbelastet IT-rolle. Den som mangler kapasitet for drift, oppdateringer, og hendelseshåndtering, kan skape høyere risiko med et dårlig vedlikeholdt selvhostet system.

På den annen side er mange eksterne testplattformer rett og slett ikke en god prosesspasning for interne fagapplikasjoner. Hvis en applikasjon bare er tilgjengelig i bedriftsnettverket, hvis testkjøringer viser konfidensielle masker og dokumenter, eller hvis data ikke bør forlate eget kontrollområde, er lokal drift ofte den tydeligere løsningen.

Den fornuftige beslutningen avhenger av beskyttelsesbehov og driftsevne. For en offentlig markedsføringsside uten sensitive innlogginger kan en skytesttjeneste være passende. For intern disposisjonsprogramvare, en kundeportal med personopplysninger, eller en Windows-applikasjon i produksjonsnettverket taler mye for et kontrollert, selvhostet miljø.

En praktisk sikkerhetssjekk før oppstart

Før automatiserte tester rulles ut, bør en ansvarlig kunne svare på disse spørsmålene uten gjetting:

  • Hvilke systemer, databaser, og grensesnitt får testserveren nå?
  • Hvilke data vises i skjermbilder, videoer, logger, og AI-evalueringer?
  • Hvor lagres påloggingsdata, og når roteres de?
  • Hvem får starte testkjøringer, lese resultater, og administrere systemer?
  • Hvor raskt implementeres kritiske oppdateringer, og hvordan kontrolleres dette?
  • Når slettes testartefakter og data som ikke lenger trengs?

Disse spørsmålene virker nøkterne. Nettopp det er deres verdi. Sikkerhet oppstår sjelden gjennom ett enkelt verktøy eller et imponerende arkitekturdiagram. Den oppstår når ansvar, dataflyter, og tekniske grenser forblir verifiserbare i hverdagen.

Den som bygger testautomatisering, bør først avklare applikasjonens beskyttelsesbehov og deretter velge den minste fornuftige arkitekturen. En ryddig avgrenset testserver med få autoriserte kontoer er ofte mer verdifull enn en overbelastet plattform som ingen kan vedlikeholde pålitelig. Boring, provable reliability slår også innen testing den spektakulære, men ugjennomsiktige løsningen.

Permalenke →

Warehouse Management Systems: Hva som virkelig betyr noe

Warehouse Management Systems: Hva som virkelig betyr noe

Når en ansatt i varemottaket noterer den samme leveringslinjen på papir, senere overfører den til et regneark, og deretter avklarer ved å rope over gangen hvor den skal lagres, mangler det sjelden arbeidsvilje. Det som mangler er en felles prosess. Warehouse Management Systems skaper denne prosessen ved å dokumentere varebevegelser, lagerbeholdning, og oppfølgingsoppgaver på ett sted. For små og mellomstore bedrifter er det ikke den lengste funksjonslisten som er avgjørende, men om programvaren pålitelig kartlegger en vares vei gjennom eget lager.

Hva Warehouse Management Systems må levere i hverdagen

Et Warehouse Management System, forkortet WMS, er ikke bare en bedre lagerliste. Det styrer eller dokumenterer de fysiske prosessene i lageret: varemottak, kvalitetskontroll, innlagring, omflytting, plukking, pakking, forsendelse, og telling. Hver bokføring besvarer et enkelt operativt spørsmål: hva er hvor, i hvilken mengde, i hvilken status, og hvem har utløst bevegelsen?

Denne klarheten virker ved første øyekast banal. Men den forhindrer typiske feilkjeder. En artikkel er riktignok levert, men er ennå ikke kontrollert. En pall står i varemottaket, men vises allerede som tilgjengelig i systemet. En ordre plukkes selv om varen burde være reservert for en viktigere kundeordre. Uten klart definerte statuser og bevegelser blir en enkelt uklarhet raskt til et feilaktig leveringsløfte.

For mange mellomstore lager begynner nytten ikke med fullautomatisert styring. Allerede sporede innlagringsordre, entydige lagerplasser, og mobile bokføringer kan merkbart redusere søketider. Avgjørende er at ansatte ikke lenger trenger å oversette mellom papir, telefon, e-post, og flere regneark.

Ikke ethvert lager trenger en stor pakkeløsning

Markedet tilbyr omfattende enterprise-systemer med funksjoner for globale multi-lokasjonsnettverk, kompleks tollbehandling, automatisert transportteknikk, og svært finmasket optimaliseringslogikk. Det kan være riktig valg hvis disse kravene faktisk finnes. Men for en bedrift med ett eller få lagre, skiftende prioriteringer, og innarbeidede spesialprosesser kan en slik pakkeløsning skape mer friksjon enn nytte.

Kostnadene ligger da ikke bare i lisenser. De oppstår i lange innføringsprosjekter, omfattende tilpasninger, opplæring, og avhengighet av eksterne spesialister. Selv et system med hundre innstillinger løser ikke et problem hvis skiftledere må åpne en sak for hverdagslige korreksjoner.

Alternativet trenger ikke nødvendigvis bety fullstendig egenutvikling. Et standardprodukt kan være fornuftig når kjerneprosessene passer og tilpasninger bevisst forblir begrenset. På samme måte kan et eksisterende regneark fortsatt være den beste løsningen, for eksempel for en sjelden, oversiktlig evaluering. Det blir kritisk først når flere personer arbeider med det samtidig, registrerer bevegelser med forsinkelse, eller regnearket skal bli den operative sannheten om tilgjengelig vare.

Den riktige løsningen styres av det faktiske prosessvolumet og feilkostnadene. Fem feilaktige plukk per uke betyr noe annet i et reservedelslager med tidskritiske kundeordre enn fem avvik i et sakte roterende arkivlager.

Kartlegg prosessene først, ikke velg skjermene

Mange WMS-prosjekter begynner med en produktdemo. Der ser ansvarlige stilrene dashbord, skannervisninger, og fargerike nøkkeltall. Mer nyttig er først en runde gjennom lageret i løpet av en normal arbeidsdag. Hvor kommer varen inn? Hvem kontrollerer mengder og skader? Når får en artikkel sitt parti- eller serienummer? Hvordan avgjøres det hvilken plass den skal ha? Og hva skjer når virkeligheten avviker fra bestillingen?

Disse spørsmålene legger grunnlaget for en løsning som senere godtas. En godt dokumentert målprosess beskriver ikke bare idealtilfellet. Den inneholder også unntak: dellevering, skadet vare, uanmeldte leveranser, lagermangel, returer, og sperret lager. Nettopp disse tilfellene avgjør om ansatte stoler på systemet eller griper til lapper igjen.

Statuser er viktigere enn pene grensesnitt

Et rent datasett skiller for eksempel mellom "forventet", "ankommet", "under kontroll", "innlagret", "reservert", "plukket", og "sendt". Hvilke statuser som er nødvendige, avhenger av virksomheten. For få skjuler relevante forskjeller. For mange gjør bokføringer trege og blir omgått.

Regelen bør være: hver status må ha en operativ konsekvens. Er varen sperret, skal den ikke plukkes. Er den reservert, må det være synlig for hvilken ordre. Er den innlagret, må en lagerplass være registrert. Slik blir dataregler til praktisk prosessikkerhet.

Skannere hjelper bare ved klare bokføringer

Strekkoder og mobile enheter reduserer skrivefeil og øker hastigheten på bevegelser. Men de erstatter ikke en prosessbeslutning. En skanning må utløse en forståelig handling: kontroller artikkel, bekreft mengde, velg destinasjonsplass, eller fullfør ordre. Hvis en ansatt etter hver skanning må gjette hvilken skjerm som kommer neste, er arbeidsflyten for komplisert utformet.

Også maskinvarespørsmålet bør besvares pragmatisk. For noen team er smarttelefoner med egnet skannefunksjon og robust beskyttelsesdeksel nok. Andre trenger industrielle håndskannere, fordi hansker, kjøling, fall, eller lange skift krever det. En pilot på det faktiske lagergulvet viser mer enn en presentasjon ved skrivebordet.


Det tekniske grunnlaget avgjør etter driftsstart

Et WMS må fungere korrekt selv når varemottak bokføres, ordre plukkes, og lagerbeholdning kontrolleres samtidig. Det gir krav som ofte forsvinner i tidlige samtaler: entydige bevegelseslogger, rollebaserte rettigheter, sporbare korreksjoner, pålitelige grensesnitt, og sikkerhetskopier som faktisk kan gjenopprettes i en nødsituasjon.

En lagerbeholdning bør ikke bare overskrives. Bedre er en bevegelsesmodell: inngang, utgang, omflytting, sperring, eller korreksjon genererer hver en loggført post. Slik kan man senere spore hvorfor en mengde avviker. Dette er like verdifullt for tellinger som for å oppklare en kundereklamasjonssak.

Rettigheter må matche ansvar. En plukker trenger andre funksjoner enn en lagersjef som godkjenner lagerkorreksjoner. For kritiske endringer er begrunnelser, firøyegodkjenninger, eller minst en uforanderlig endringslogg fornuftig. Innsatsen avhenger av risikoprofilen, men spørsmålet bør avklares før start.

Grensesnitt fortjener samme oppmerksomhet. Et lager arbeider sjelden isolert. Bestillinger kommer fra en butikk, et ERP, eller strukturert import. Forsendelsesdata går til transportørsystemer, følgesedler og etiketter genereres, lagerdata flyter tilbake. Hvert grensesnitt trenger klart ansvar for feiltilfeller. Hva skjer hvis en forsendelsesetikett er generert, men bekreftelsen ikke når WMS-et? Uten repetisjonslogikk og synlig feilkø blir slike tilfeller hengende hos enkeltpersoner.

For skreddersydde løsninger er vedlikeholdbare teknologier ikke en bisak. En sporbar applikasjon med tydelig databasestruktur, dokumenterte driftsettinger, og testede integrasjoner forblir håndterbar også etter personellskifter. Trendy arkitektur hjelper ikke hvis ingen kan spore en feilaktig import.

Innføring i små, kontrollerbare steg

En big bang skaper unngåelig risiko. Ofte er det mer fornuftig å først digitalisere en avgrenset prosess, for eksempel varemottaket for en produktgruppe eller plukkingen i ett lagerområde. Teamet kontrollerer da ikke bare funksjoner, men også formuleringer, skanneruter, gangveier, og ansvarsområder.

Stamdata er ofte den egentlige byggeplassen her. Artikkelnumre må være entydige, måleenheter konsistente, lagerplasser fornuftig strukturert, og emballasjeenheter tydelig definert. Et system kan ikke levere pålitelig lagerbeholdning hvis samme artikkel dukker opp under tre forskjellige betegnelser, eller en "kasse" betyr forskjellige mengder avhengig av leverandør.

Under pilotfasen bør nøkkeltallene forbli enkle: hvor lang tid tar varemottaket? Hvor mange bokføringer må korrigeres? Hvor mange plukk er feilaktige? Hvor ofte letes det etter vare? Ikke enhver forbedring viser seg umiddelbart som en stor kostnadspost. Færre oppfølgingsspørsmål og mer pålitelig leveringsinformasjon kan allerede fjerne betydelig press fra den daglige driften.

Opplæring fungerer best direkte ved prosessen. Ansatte trenger ikke en abstrakt gjennomgang av alle menypunkter. De må vite hvordan de bokfører sin neste leveranse, melder et avvik, eller korrigerer en feil skanning. For de første skiftene etter oppstart bør en ansvarlig person være tilgjengelig som raskt kan ta beslutninger.

Det riktige spørsmålet for valget

Ved Warehouse Management Systems er det sentrale spørsmålet ikke: hvilken programvare kan mest? Det er: hvilke arbeidsflyter må bli raskere, tydeligere, og mer sporbare hver dag for teamet vårt?

Den som først beskriver disse arbeidsflytene tydelig, kan objektivt evaluere standardprogramvare, utvidelser, eller en skreddersydd applikasjon. Resultatet trenger ikke virke spektakulært. Det bør sørge for at varen finner sin vei, lagerbeholdningen forblir pålitelig, og menneskene på lageret bruker mindre tid på å lete, spørre, og korrigere i etterkant.

Permalenke →

Custom Logistics Software vs Spreadsheets

Custom Logistics Software vs Spreadsheets

Et varemottak kommer tidligere enn annonsert, to ansatte endrer den samme lagerlisten parallelt, og sjåføren venter på en følgeseddel hvis siste versjon ingen med sikkerhet kan navngi. Slike situasjoner avgjør spørsmålet "custom logistics software vs spreadsheets" ikke teoretisk, men mellom varemottak, lagerplass, og rampe.

Tabeller er ikke grunnleggende problemet. De er raske å lage, kjent for alle, og ofte overraskende effektive for klart avgrensede oppgaver. De blir problematiske når de skal fungere som operativsystem for en voksende lager- eller distribusjonsprosess. Da blir en fil til en kritisk prosess - uten bindende regler, sporbare tilstander, eller en solid historikk.

Når regneark i lageret er riktig valg

Et ark er fornuftig når prosessen er oversiktlig, sjelden, og styrt av få personer. Det kan for eksempel være en månedlig behovsplanlegging, en engangs inventarforberedelse, eller en evaluering av leverandørpriser. Det kan også holde for et lite lager med én ansvarlig, forutsatt at endringer ikke skjer under tidspress og ingen etterfølgende prosesser automatisk avhenger av det.

Fordelen ligger ikke bare i de lave lisenskostnadene. Team kan tilpasse kolonner, sjekke beregninger, og sette opp et nytt skjema i løpet av noen minutter. Den som ennå ikke har forstått en stabil prosess, bør ikke haste med å støpe den inn i programvare. Et godt ark kan først synliggjøre hvilke data som faktisk trengs og hvilke felter som bare vedlikeholdes av vane.

Det ville derfor være feil å behandle hver Excel-fil som en etterslep. Det avgjørende spørsmålet er: er arket et arbeidsverktøy for én person, eller en delt kilde for operative beslutninger? Så snart flere roller er avhengige av de samme dataene, øker risikoen merkbart.

Custom Logistics Software vs Spreadsheets: Vippepunktet

Skiftet utløses vanligvis ikke av antall rader. Et ark med 20 000 posisjoner kan fungere, mens en fil med 200 rader allerede fører til feil. Avgjørende er samtidighet, prosesstrinn, og konsekvensene av feil informasjon.

Et typisk varselsignal er versjonsspørsmålet. Hvis lagerbeholdning, åpne ordrer, eller leveringsdatoer ligger i filer med navn som "endelig_ny", "endelig_ny2", og "virkelig_endelig", er det ikke en bedre mappestruktur som mangler. Det mangler en bindende datatilstand. Det samme gjelder når ansatte må ringe hverandre for å finne ut om varer har ankommet, en ordre er frigitt, eller et kjøretøy allerede er lastet.

Vippepunktet er nådd når én registrering utløser flere etterfølgende handlinger. Et varemottak endrer da ikke bare et tall i lageret. Det kan starte en kvalitetskontroll, tildele en lagerplass, merke en ordre som delvis levert, og vise salg en tilgjengelig artikkel. Hvis disse trinnene koordineres manuelt via filer, papir, og telefonsamtaler, er avvik vanskelige å unngå.

Det blir spesielt kritisk ved skiftbytter og fravær. Når bare én erfaren person vet hvilken fargemarkering i en liste som betyr en sperre, eller hvilken formel som beregner et sikkerhetslager, er prosessen ikke robust. Den fungerer bare så lenge den personen er tilgjengelig.

Hva skreddersydd programvare faktisk gjør bedre

Skreddersydd logistikkprogramvare er ikke bare et ark med et pent grensesnitt. Verdien oppstår gjennom kontrollerte arbeidsflyter. Hver bokføring får et entydig tidspunkt, en ansvarlig person, og en sporbar status. Ansatte ser ikke bare data, men neste tillatte handling.

Ved et varemottak kan det praktisk bety: velge levering, registrere mengde, dokumentere avvik, skrive ut etikett, og bekrefte lagring. Først deretter frigis lageret. For plukking kan systemet samle ordrer etter prioritet, vise lagerplasser i en fornuftig rekkefølge, og først generere en følgeseddel når posisjonene er bekreftet.

Dette handler ikke om unødvendig kompleksitet. Det forhindrer at samme artikkel reserveres to ganger, at en dellevering telles som fullstendig, eller at en følgeseddel skrives ut basert på utdaterte data. Enkle regler hjelper også: obligatoriske felt for partier, sperregrunner for skadet gods, plausibilitetskontroller på mengder, og rettigheter for korreksjonsbokføringer.

En godt planlagt applikasjon dekker ikke hvert spesialtilfelle med en gang. Den fokuserer på prosessene som daglig koster tid eller regelmessig gir feil. For én bedrift kan det være håndtering av containerbevegelser, for en annen den raske registreringen av innkommende varer med mobile enheter. Standardprogramvare kjenner ofte disse særegenhetene bare som en dyr tilleggsmodul, eller ikke i det hele tatt.

Arkets skjulte kostnader

Lisenskostnaden for et ark er lav. Prosesskostnaden kan ikke være det. Den oppstår i oppfølgingsspørsmål, etterarbeid, søketid, dobbelt vedlikehold, og feilplanlagt lagerbeholdning. Den oppstår også når et team om kvelden må sjekke hvilke data som er endret siden morgenen.

Disse kostnadene forblir ofte usynlige fordi de er spredt over mange roller. Lagersjefen sjekker lagerbeholdning, innesalg korrigerer leveringsdatoer, regnskap leter etter bilag, og ledelsen får tall med forsinkelse. Ingen enkelt aktivitet virker dramatisk. Sammen bremser de gjennomstrømning og planleggbarhet.

En solid beslutning bør derfor ikke bare sammenligne programvarepriser. Mål over to til tre uker hvor mange manuelle overleveringer en ordre går gjennom, hvor ofte informasjon etterspørres, og hvilke feil som gjentar seg. Relevante er også konsekvensene: fører feil lagerbeholdning til en intern korreksjon eller en tapt levering?

Ikke ethvert problem trenger en stor pakkeløsning

Mange mellomstore bedrifter i DACH-regionen nøler med rette foran omfattende enterprise-systemer. Lange innføringer, stive masker, og lisensmodeller for funksjoner som aldri brukes løser sjelden et konkret lagerproblem. Men alternativet trenger ikke bety å bli værende ved spredte filer.

Mellom disse to ytterpunktene ligger en arbeidsflytspesifikk applikasjon. Den kan for eksempel koble sammen ordremottak, varemottak, lagerbevegelser, forsendelsesetiketter, og følgesedler i ett felles system, uten å med det samme bringe med seg full regnskapsføring, global konsernlogikk, og tjue fremmedspråk.

Avgjørende er det tekniske grunnlaget. En applikasjon med en tydelig databasestruktur, dokumenterte grensesnitt, og sporbare rettigheter forblir tilpasningsdyktig. Teknologier som PHP 8.4, moderne JavaScript, og MySQL 8 er ikke et mål i seg selv her. Riktig brukt skaper de et vedlikeholdbart grunnlag for roller, bokføringshistorikk, utskriftsdokumenter, og rapporter - selv når prosesser endres om to år.

Slik lykkes overgangen uten å forstyrre driften

Den største faren er ikke teknikken, men et for stort første steg. Den som prøver å rydde opp i alle historiske filer og kartlegge hvert unntakstilfelle før oppstart, utsetter fordelen i flere måneder. Bedre er en klar, verifiserbar start.

Start med en prosess som forekommer ofte og er godt avgrensbar, for eksempel varemottak med lagerbokføring, eller forsendelse med følgeseddel og etikett. Definer da presist når prosessen begynner, hvilke data som er strengt nødvendige, hvem som gir hvilken godkjenning, og når den regnes som avsluttet. Ut av dette oppstår ikke bare skjermmasker, men solide arbeidsregler.

Dataoverføringen krever også pragmatisme. Aktive artikler, leverandører, lagerplasser, og åpne ordrer må være rene. Historiske gamle lagerbeholdninger kan derimot ofte arkiveres, i stedet for å importeres til det nye systemet med stor innsats. Parallell drift kan være fornuftig, men bare med en fast sluttdato. Ellers oppstår to sannheter i stedet for én bedre.

Ved innføringen viser verdien av en direkte teknisk partner seg.

softify.pro jobber derfor ikke ut fra en abstrakt funksjonsliste, men klargjør arbeidsflyter der de faktisk skjer: ved mottak, i lagergangen, ved pakking, og ved overlevering til forsendelse. God programvare respekterer fungerende rutiner og endrer bare det som faktisk gjør prosessen mer pålitelig.

Beslutningen kan prøves mot tre spørsmål

For det første: må flere personer samtidig stole på oppdaterte data? For det andre: utløser en bokføring etterfølgende prosesser som i dag sikres manuelt? For det tredje: kan en feil føre til leveringsforsinkelse, feil lagerbeholdning, feil faktura, eller tidkrevende søk? Hvis disse spørsmålene hovedsakelig besvares med ja, er arket sannsynligvis ikke lenger riktig ledende system.

Forblir svaret hovedsakelig nei, kan det fortsatt være en fornuftig løsning. Da lønner det seg heller å ensarte filer, definere ansvarsområder, og dokumentere kritiske formler. Teknikken bør ikke være større enn problemet.

Det neste fornuftige steget er derfor ikke et generelt digitaliseringsprosjekt, men et felles blikk på en konkret arbeidsflyt sammen med menneskene som utfører den daglig. Der blir det raskt synlig om et godt vedlikeholdt ark er tilstrekkelig - eller om pålitelig programvare endelig bør overta arbeidet som i dag blir sittende fast mellom papir, telefon, og flere versjoner av samme fil.

Permalenke →

Webutvikling for bedrifter

Webutvikling for bedrifter

Et nettsted kan se bra ut og likevel skape arbeid hver mandag: produktdata vedlikeholdes dobbelt, henvendelser havner ufullstendige i innboksen, endringer krever ekstern hjelp. Søket etter et webutviklingsselskap bør derfor ikke stoppe ved farger, rammeverk, eller en flott portefølje. Avgjørende er om løsningen skaper mindre friksjon i det daglige arbeidet og fortsatt er forståelig å drifte om tre år.

For små og mellomstore bedrifter er dette ikke et akademisk spørsmål. I verksteder, lagre, og salgsorganisasjoner møter tilbud, bestillinger, leveringsinformasjon, og kundehenvendelser ofte prosesser som har vokst organisk frem. Noen av dem fortjener programvare. Andre fungerer fortsatt bedre med et ryddig ført ark. God webutvikling gjenkjenner forskjellen, i stedet for å forvandle hvert problem til et stort digitalt prosjekt.

Hva webutvikling må levere for bedrifter

Et bedriftsnettsted er ofte det første kontaktpunktet. Det må laste raskt, fungere på mobile enheter, og tydelig lede besøkende mot en henvendelse, søknad, eller bestilling. Men så snart det behandler data, avbilder interne roller, eller utløser prosesser, blir det en webapplikasjon. Da teller andre spørsmål: Hvem får se hva? Hvor kommer dataene fra? Hva skjer ved en feilaktig inntasting? Hvordan rulles en oppdatering ut uten å forstyrre driften?

Forskjellen er praktisk. En markedsføringsside kan klare seg med få, tydelig strukturerte innholdsområder. En kundeportal, en bestillingsprosess, eller et internt lagerverktøy trenger derimot sporbare rettigheter, en robust databasestruktur, og definerte spesialtilfeller. Hvis et varemottak bare leveres delvis eller en ordre må endres i ettertid, må ikke systemet ende i en udefinert tilstand.

Webutvikling for bedrifter betyr derfor ikke bare å programmere sider. Det betyr å implementere forretningsregler slik at de forblir forståelige for brukere og kontrollerbare for bedriften.

Sjekk først prosessen, planlegg deretter grensesnittet

Et prosjekt starter ofte med et ønske som "Vi trenger en portal". Det er en fornuftig start, men ikke ennå et tilstrekkelig krav. Før den første designen bør de faktiske veiene til en informasjon bli synlige: hvem oppretter den, hvem kontrollerer den, hvem supplerer den, og hvem trenger den igjen senere?

Ta ordrebehandlingen. I mange bedrifter kommer en henvendelse inn via e-post eller telefon, blir notert i et ark, senere overført til et annet system, og deretter bearbeidet på nytt for lager eller forsendelse. Forsinkelsen skyldes sjelden ett enkelt trinn. Den oppstår ved overleveringene, oppfølgingsspørsmålene, og de forskjellige datatilstandene.

En god analyse spør derfor konkret om hverdagen:

  • Hvilken informasjon tastes inn flere ganger i dag?
  • Hvor oppstår de fleste oppfølgingsspørsmålene eller korrigeringene?
  • Hvilke unntak forekommer regelmessig, selv om de ikke er dokumentert noe sted?
  • Hvilke roller trenger tilgang, og hvilke data skal de ikke kunne endre?
  • Hva gjenkjenner teamet til slutt at en transaksjon virkelig er fullført på?

Disse spørsmålene høres nøkterne ut. Det er nettopp deres fordel. De forhindrer at en visuelt overbevisende applikasjon bygges rundt en idealisert prosess som ingen faktisk bruker i driften. Spesielt i lager og logistikk teller reelle forhold: skannere betjenes med hansker, skift skifter, WiFi er ikke like godt overalt, og en følgeseddel skal ikke først oppstå etter flere klikk.

Ikke enhver prosess hører imidlertid hjemme i en applikasjon. En liten liste med få, stabile oppføringer kan være raskere og billigere som ark. Programvare lønner seg når data flyter mellom personer eller områder, når sporbarhet mangler, eller når manuelt arbeid gjentatte ganger skaper tidstap og feil.

Det tekniske grunnlaget avgjør den senere innsatsen

Mange systemer virker like i den første demoen. Forskjellen viser seg ved endringer, vekst, og forstyrrelser. En applikasjon bør derfor bygge på teknologier teamet kan vedlikeholde på lang sikt, i stedet for å satse på kortvarig hype.

For mange forretningskritiske webapplikasjoner er en stack med PHP 8.4, moderne JavaScript, og MySQL 8 et pragmatisk valg. Den er kapabel, godt forståelig, og egnet for typiske krav som portaler, ordrehåndtering, dokumentgenerering, eller interne verktøy. Det er ikke et dogme. Ved svært interaktive applikasjoner, spesielle integrasjoner, eller høye sanntidsbehov kan en annen arkitektur være fornuftig. Teknologien bør følge oppgaven, ikke omvendt.

Viktigere enn navnet på et rammeverk er tydelige beslutninger rundt data og tilstander. En ordre trenger for eksempel entydige statusverdier i stedet for fritekst. Endringer bør være sporbare. Kundedata, priser, og rettigheter må ikke drive fra hverandre over spredte ark og improviserte grensesnitt. Den som senere trenger å vite hvorfor en forsendelsesetikett ble opprettet eller en ordre ble sperret, trenger en sporbar historikk.

Også sikkerhet hører til grunnkonstruksjonen. Dit hører rollebaserte rettigheter, sikker passordlagring, kontosperreflyter ved gjentatte mislykkede forsøk, adskilte test- og produksjonsmiljøer, samt regelmessige oppdateringer. Sikkerhet er ikke en enkelt plugin på slutten av prosjektet. Den oppstår gjennom ryddige ansvarsområder og en arkitektur som tar høyde for feiltilfeller.

Hastighet er et driftskrav

Trege sider koster ikke bare synlighet i søkemotorer. De skaper frafall ved henvendelser og unødvendig ventetid i den daglige driften. På et offentlig nettsted avgjør lastetid, mobilvisning, og en tydelig sidestruktur om interessenter i det hele tatt tar kontakt. I en intern applikasjon summerer to eller tre sekunders ventetid ved hver bokføring merkbart opp gjennom arbeidsdagen.

Ytelse begynner ikke med et senere optimaliseringsprosjekt. Bilder, databasespørringer, caching, JavaScript, og hosting må planlegges hensiktsmessig fra starten. Her gjelder: ikke hver applikasjon trenger maksimal teknisk kompleksitet. Et enkelt internt verktøy med få brukere trenger ikke en arkitektur for millioner samtidige kall. Det trenger korte veier, pålitelige sikkerhetskopier, og en atferd som forblir forutsigbar i hverdagen.

Samme prinsipp gjelder for responsiv betjening. "Mobiltilpasset" betyr ikke at en desktopmaske på en eller annen måte krymper til en smarttelefon. Den som sjekker følgesedler på farten, melder en skade, eller korrigerer et lagersaldo, trenger store betjeningselementer, tydelige tilbakemeldinger, og så lite unødvendig inntasting som mulig.

Fra idé til drift: lever i små steg

Store kravspesifikasjoner lover sikkerhet, men fører ofte til at team venter måneder på en første brukbar versjon. En bedre vei er et klart avgrenset første utvidelsestrinn. Det bør løse et reelt problem, for eksempel den sentrale registreringen av varemottak eller den automatiske genereringen av leveringsdokumenter. Deretter kan man med reell tilbakemelding avgjøre hva som gir størst nytte som neste steg.

Det betyr ikke å jobbe uten planlegging. Tvert imot: datamodell, roller, grensesnitt, og driftskonsept må avklares tidlig. Funksjonsomfanget kan likevel vokse trinnvis. Slik blir antakelser synlige før de blir dyre.

En profesjonell overlevering omfatter mer enn tilgangsdata. Dokumenterte utrullingstrinn, sikkerhetskopier, overvåking, ansvarsområder, og forståelig teknisk dokumentasjon gjør et system uavhengig av enkeltpersoner. Hvis bare den opprinnelige utvikleren vet hvordan en oppdatering rulles ut, er applikasjonen ikke ferdig, men personbundet.

Hvordan du kjenner igjen en passende partner

Et webutviklingsselskap trenger ikke å tilby hver tenkelige teknologi. Men det bør stille de riktige spørsmålene og kunne begrunne beslutninger. Forsiktighet er på sin plass hvis en omfattende plattform allerede loves i den første samtalen, uten at noen har sett de eksisterende prosessene.

En passende partner snakker like åpent om vedlikehold, datakvalitet, og innføring som om design. Den forklarer hvilke krav standardfunksjoner kan dekke og hvor individuell utvikling blir fornuftig. Den nevner også kostnadene ved spesialønsker. En funksjon kan være teknisk gjennomførbar og likevel ikke ha tilstrekkelig nytte.

Spør om konkrete driftsdetaljer: Hvordan testes endringer? Hvordan fungerer en rollback? Hvor ligger sensitive data? Hvem reagerer ved et avbrudd? Hvordan forvaltes rettigheter? Gode svar trenger ikke være lange, men de er spesifikke. "Det tar vi oss av senere" er ingen strategi for forretningskritiske prosesser.

For team med eksisterende programvare er integrasjonsspørsmålet også sentralt. En ny applikasjon trenger ikke å erstatte alt. Den kan først overta data fra et eksisterende system, generere dokumenter, eller fylle inn en manglende prosess. Det mest fornuftige første steget er ofte ikke den store erstatningen, men den målrettede fjerningen av en flaskehals.

Programvare skal klargjøre arbeid, ikke flytte det

Den beste webapplikasjonen skiller seg ikke ut i drift gjennom teknisk raffinement, men gjennom færre oppfølgingsspørsmål, pålitelige data, og kortere gjennomløpstider. Den respekterer fungerende arbeidsmåter, gjør unntak synlige, og lar seg videreutvikle uten frykt for neste oppdatering.

Før du starter et prosjekt, ta en konkret handling fra din hverdag og følg den fra første kontakt til avslutning. Der informasjon venter, forsvinner, eller registreres dobbelt, ligger som regel den mest fornuftige tilnærmingen til webutvikling.

Permalenke →

Logistics Automation Software som faktisk passer

Logistics Automation Software som faktisk passer

Et varemottak noteres på papir, lagerendringen overføres senere til et regneark, og forsendelsen ringer til lageret fordi leveringsadressen ligger i en e-post. Det er nettopp i slike overleveringer at en virksomhet mister tid og pålitelighet. Logistics Automation Software skal ikke dekke over denne friksjonen med en stor ny prosessverden, men knytte sammen de daglige håndgrepene på en sporbar måte.

For små og mellomstore virksomheter er dette en annen oppgave enn å innføre en konsernplattform. En lagersjef trenger ikke 200 funksjoner som først blir forståelige etter tre opplæringsdager. Han eller hun trenger en klar status: hva er kommet inn, hvor ligger det, hva må ut i dag, og hva mangler fortsatt? God automatisering svarer på disse spørsmålene der arbeidet skjer.

Hva Logistics Automation Software må levere i praksis

Begrepet høres bredt ut, men de fornuftige bruksområdene er som oftest svært konkrete. En virksomhet behandler for eksempel innkommende varer, bokfører lagerbevegelser, lager følgesedler, skriver ut fraktetiketter og planlegger leveranser. Hvis hver arbeidsstasjon trenger sin egen fil, en egen tilgang eller et rop over gulvet, oppstår det forsinkelser og feilkjeder.

En passende programvare samler informasjonen i én arbeidsflyt. En ordre kan automatisk opprette et plukkoppdrag. Skanning av en vare bekrefter uttaket og oppdaterer beholdningen. Etter avslutning opprettes en følgeseddel med riktige linjer, mens forsendelsesstatusen blir synlig for salg eller disponering. Det høres enkelt ut. Nettopp derfor er det verdifullt: programvaren erstatter ikke logikk som fungerer, men hindrer at den må rekonstrueres på nytt ved hvert mediebrudd.

Rekkefølgen er avgjørende. Først må det være klart hvilke data som utløser en hendelse, og hvem som avgjør det. Først da lønner det seg å automatisere regler. Den som digitaliserer en uklar arbeidsgang, får bare raskere uklarhet.

Velg de riktige prosessene først

Ikke alle manuelle oppgaver fortjener en applikasjon med en gang. Et lite, ryddig vedlikeholdt regneark kan være bedre for et sjeldent spesialtilfelle enn en modul som må vedlikeholdes permanent. Den økonomiske spaken ligger som regel i arbeidsganger med mye gjentakelse, mange overleveringer eller merkbare følger av feil.

Typiske kandidater er varemottak med kontrollstatus, omflyttinger mellom soner, plukking av gjentakende ordrer, forsendelsesdokumenter og ruteplanlegging. Også ordremottaket er ofte et godt utgangspunkt når bestillinger fra telefonsamtaler, e-poster og skjemaer først samles manuelt.

Fire spørsmål hjelper i utvelgelsen:

  • Hvor ofte gjennomføres arbeidsgangen per uke?
  • På hvilket punkt registreres eller overføres data flere ganger?
  • Hvilke feil forårsaker etterarbeid, lagerdifferanser eller forsinkede leveranser?
  • Hvilke unntakstilfeller må medarbeiderne fortsatt avgjøre selv?

Det siste spørsmålet forhindrer en utbredt feil. Automatisering trenger ikke bety at hver beslutning tas uten mennesker. Ved skadde varer, ufullstendige leveranser eller kundeønsker med kort varsel trenger teamet en tydelig mulighet til å stanse en transaksjon, rette den og fortsette med en begrunnelse. Et system uten slike veier virker konsekvent på papiret, men blir raskt et hinder på lageret.

Fra varemottak til forsendelse: en gjennomgående arbeidsflyt

Ta en mellomstor forhandler med lager og egen utkjøring. I dag telles varene ved porten, noteres på et skjema og registreres i systemet først mot slutten av skiftet. Salg ser derfor den nye beholdningen for sent. Ved en ekspressforsendelse opprettes følgeseddelen separat, og sjåføren får informasjonen sin på telefon.

I en hensiktsmessig automatisert arbeidsflyt begynner varemottaket med en digital transaksjon. Medarbeiderne registrerer levering, vare og mengde og eventuelt batch eller serienummer direkte på arbeidsplassen eller mobilt. Avvik gjemmes ikke bort i et sidenotat, men får en status som «Kontroll påkrevd». Først etter frigivelse står varen klar som tilgjengelig beholdning.

Neste steg oppstår av reelle krav: en ordre frigis, lageret får en plukkliste eller en mobilvisning sortert etter lagerplass, og hver bokføring dokumenterer hva som faktisk ble tatt ut. Følgeseddel og forsendelsesdata oppstår da fra samme kilde. Ingen må taste inn linjer på nytt eller sjekke hvilken filversjon som gjelder akkurat nå.

For disponeringen kan systemet samle åpne leveranser etter område, leveringsvindu, vekt eller kjøretøykapasitet. Ruteplanlegging er her ikke alltid det første fornuftige steget. Hvis adresser er ufullstendige eller ordrer først frigis kort før avgang, bør datakvaliteten og ordreklarheten forbedres først. Optimaliserte ruter hjelper ikke hvis grunnlaget er upålitelig.

Standardprogramvare eller individuell løsning?

Standardprogramvare er fornuftig når virksomheten arbeider med vanlige arbeidsganger og godtar å tilpasse seg de forutsatte skjermbildene, rollene og prosessene. Den kan innføres raskt, særlig ved klare krav som etikettutskrift eller enkel lagerstyring. Prisen er ofte kompromisser ved spesialtilfeller, grensesnitt og senere tilpasninger.

En individuell Logistics Automation Software blir interessant når den operative egenarten ikke er et randtilfelle, men avgjør forretningssuksessen. Det kan være en spesiell pakkelogikk, en flertrinns godkjenningsprosess, koblingen mellom verksted og lager eller en egen leveringsmodell. Da er det ofte mer fornuftig å avbilde de få kjerneprosessene målrettet enn å innføre en omfattende pakke med mange ubrukte moduler.

Individuell betyr likevel ikke grenseløs. Hver spesialfunksjon trenger en faglig begrunnelse, tester, dokumentasjon og vedlikehold. Godt prosjektarbeid spør derfor også: kan dette steget forenkles? Holder en konfigurasjon? Forblir et regneark den beste løsningen for denne unntaksprosessen? Disse spørsmålene beskytter budsjett og team mot unødvendig kompleksitet.

Teknikk som holder i hverdagen

Brukergrensesnittet avgjør om medarbeiderne bruker et system med glede. Det tekniske grunnlaget avgjør om det kan drives pålitelig også etter år. For forretningskritiske prosesser hører sporbare datamodeller, roller og rettigheter, logger over viktige endringer og jevnlige sikkerhetskopier med til grunnutstyret.

Ved en lagerbokføring må det kunne ses hvem som har endret hvilken beholdning og når, og fra hvilken transaksjon endringen stammer. Når flere brukere er aktive samtidig, må ikke beholdningen forvrenges av motstridende inntastinger. Ved skrivere, skannere eller grensesnitt mot transportører trengs det tydelige feilstatuser i stedet for stille feil. En etikett som ikke ble skrevet ut, må være synlig som et åpent arbeidstrinn.

Vedlikeholdbarhet er også et driftskrav. En webapplikasjon på en forståelig arkitektur, for eksempel med PHP 8.4, moderne JavaScript og MySQL 8, lar seg på lang sikt lettere kontrollere og utvide enn en samling av vanskelig gjennomskuelige enkeltløsninger. Dokumentert utrulling, adskilte test- og produksjonsmiljøer og automatiserte tester er ingen luksus. De reduserer risikoen for at en liten endring i følgeseddelen plutselig påvirker ordrefrigivelsen.

Personvern og tilgangskontroll fortjener den samme nøkternheten. Ikke alle brukere trenger priser, marginer eller kundestamdata. Særlig i distribuerte team bør tilganger, enheter og rettigheter utformes slik at de ikke bremser hverdagsarbeidet unødvendig, men likevel forblir kontrollerbare ved utskifting av ansatte eller en tapt enhet.

Innføring i fornuftige etapper

Den sterkeste funksjonen hjelper lite hvis et team ikke kan bruke den i skiftdrift. Derfor er en trinnvis innføring ofte mer robust enn én stor stikkdato. Først settes en avgrenset arbeidsgang i produksjon, for eksempel varemottaket for en produktgruppe eller opprettelsen av forsendelsespapirer. Teamet arbeider med det under reelle forhold, og åpne spørsmål avklares på virkelige tilfeller.

Deretter følger flere prosesser og grensesnitt. Denne rekkefølgen skaper tillit fordi medarbeiderne ser at tilbakemeldinger blir til konkrete forbedringer. Samtidig begrenser den risikoen: hvis en ny skanneflyt må justeres, stopper ikke hele logistikken.

Måltall bør avtales før oppstart. Det kan være gjennomløpstid fra ordre til forsendelse, antall manuelle rettelser, lagerdifferanser eller hvor lang tid dagsavslutningen tar. Ikke enhver forbedring viser seg med en gang i et spektakulært nøkkeltall. Færre oppfølgingsspørsmål mellom lager og kontor, en pålitelig skiftoverlevering og sporbare transaksjonshistorikker er også målbar avlastning.

softify.pro utvikler slike systemer ut fra arbeidsflyten, med direkte teknisk deltakelse i stedet for en overlevering fra konsept til gjennomføring. Målestokken forblir bevisst pragmatisk: løsningen skal fungere på lagergulvet, ikke bare i en presentasjon.

Slik kjenner du igjen en bærekraftig beslutning

En god beslutning begynner ikke med en funksjonsliste, men med en observert arbeidsdag. La deg vise hvor informasjon oppstår, venter, går tapt eller korrigeres i etterkant. Snakk ikke bare med ledelsen, men også med menneskene ved varemottaket, på lageret og i forsendelsen. De kjenner unntakene som ingen organisasjonskart gjør synlige.

Sjekk deretter om leverandøren stiller konkrete spørsmål om data, roller, enheter, grensesnitt og drift. Den som straks lover en totalløsning uten å forstå de eksisterende arbeidsgangene, selger heller programvareomfang enn problemløsning. Like kritisk er et prosjekt som ikke har noen klar regulering av vedlikehold, feilretting og senere tilpasninger.

Den beste automatiseringen føles ikke som ekstra byråkrati. Den gir teamet tid til de tilfellene der erfaring virkelig teller: å vurdere en uventet levering riktig, å informere en kunde i tide eller å løse en flaskehals før den blir et problem.

Permalenke →

Kan AI teste desktop-programvare?

Kan AI teste desktop-programvare?

En ansatt bokfører varemottak i en Windows-applikasjon, skriver ut en følgeseddel, og overleverer dataene til regnskap. Etter en oppdatering vises en dialogboks på et annet sted, et felt mister fokus, utskriften starter ikke lenger. Spørsmålet "can AI test desktop software" er derfor mindre teoretisk enn det høres ut: kan et system oppdage slike feil før neste tidligvakt?

Ja. AI kan teste Windows-desktopprogramvare, spesielt der klassisk automatisering feiler på skiftende grensesnitt, inkonsistente kontroller, eller skript som er dyre å vedlikeholde. Den er imidlertid ingen erstatning for tydelige testmål, rene testdata, og forretningsansvar. Verdien oppstår når den pålitelig overtar repeterbart arbeid og retter mennesker mot tilfellene som krever skjønn.

Kan AI teste desktop-programvare - og hva betyr det i praksis?

Desktop-tester sjekker ikke bare om et vindu åpnes. I reell drift handler det om fullstendige arbeidsflyter: innlogging med korrekt sperrelogikk, ordreregistrering, valg av en artikkel, lagerbokføring, etikettutskrift, feilmeldinger for ugyldige data, og den korrekte overleveringen til et tilkoblet system.

Et AI-drevet testmiljø kan kjøre disse arbeidsflytene på en Windows-maskin, vurdere det synlige grensesnittet, og generere bevis. Den kan for eksempel gjenkjenne knapper basert på tekst og posisjon, lese innhold fra dialogbokser, og sammenligne skjermbilder med den forventede tilstanden. I motsetning til et stivt skript kan den bedre håndtere mindre visuelle endringer - for eksempel når et ikon, en avstand, eller den nøyaktige tekniske identifikatoren til et kontrollelement endres.

Dette er spesielt relevant for forretningsapplikasjoner som har vokst over tid. Mange av disse programmene har ikke et moderne API for hver prosess. Noen bruker proprietære grensesnitt, innebygde tabeller, eller komponenter som er vanskelige å adressere med konvensjonell UI-automatisering. En AI-agent kan betjene applikasjonen mer slik en trent bruker gjør: lese skjermen, velge en handling, sjekke resultatet.

Ordet "mer" er bevisst valgt. AI ser ikke automatisk forretningsprosessen bak et inntastingsfelt. Den kan fastslå at en følgeseddel ble opprettet. Om riktig leveringsbetingelse måtte brukes for en bestemt kunde krever en forretningsmessig definert forventning.

Hvor AI-tester er fornuftige for Windows-applikasjoner

Det beste utgangspunktet er arbeidsflyter som skjer ofte, er forretningskritiske, og i dag kontrolleres manuelt. Et team trenger ikke automatisere hele testkatalogen for dette. Bedre er det å velge de få prosessene hvis svikt direkte koster tid, penger, eller tillit.

I lager, produksjon, og planlegging hører hit ofte opprettelsen og bokføringen av varemottak, plukke- og forsendelsesprosesser, autoriserte lagerkorreksjoner, utskrift av etiketter, samt import- og eksportprosesser. I kommersielle applikasjoner er innlogging, rettighetsbytte, fakturaopprettelse, stamdatavedlikehold, og grensesnittoverføringer typiske kandidater.

AI er spesielt nyttig der en utgivelse for tiden utløser en manuell kontrolldag. En tester klikker da gjennom en lang liste, dokumenterer avvik, og prøver senere å rekonstruere nøyaktig hva som skjedde. Automatiserte kjøringer kan flytte denne delen til natten eller til en fast utgivelsesprosess. Om morgenen foreligger det ikke bare en status, men en testlogg med skjermbilder, tidsstempler, og en forståelig beskrivelse av avviket.

Regresjonstester drar også nytte. Når en ny funksjon bygges inn i ordredialogen, skal eksisterende prosesser ikke gå i stykker ubemerket. AI-en gjentar definerte scenarier etter hver relevante endring. Det eliminerer ikke enhver risiko, men det forhindrer at kjente kjerneprosesser forblir ukontrollerte bare fordi tiden ikke strekker til.

Hva AI pålitelig kan kontrollere - og hva den ikke kan

AI-baserte grensesnitttester er sterke på observerbare forventninger. "Ordrenummeret vises etter lagring." "En advarsel vises hvis et obligatorisk felt mangler." "Lagersaldoen reduseres med fem." "Utskriftsdialogen inneholder den tiltenkte skriveren." Slike utsagn oversettes til konkrete kontrolltrinn.

Vanskeligere blir krav som er upresist formulert. "Grensesnittet skal se profesjonelt ut" eller "programmet skal være raskt" er ikke tilstrekkelige testtilfeller. Her trengs kriterier: maksimal ventetid under definert belastning, et godkjent oppsett, eller tydelige aksept-regler for feilmeldinger.

Også ved komplekse forretningsmessige spesialtilfeller forblir menneskelig testing uunnværlig. Hvis en returregel gjelder for én rammeavtale, må noen med prosesskunnskap avgjøre om resultatet er korrekt. AI kan forberede, utføre, og dokumentere tilfellet. Den bør ikke egenrådig finne opp nye forretningsregler.

En annen grense er miljøets stabilitet. Desktop-tester avhenger av skjermoppløsning, brukerrettigheter, nettverkstilkobling, skriverdrivere, testdata, og, der relevant, tilkoblet maskinvare. Hvis en etikettskriver er offline, kan en mislykket test være en reell feil - eller et miljøproblem. Gode testsystemer skiller disse tilfellene og rapporterer dem transparent, i stedet for å vurdere alt generelt som en produktfeil.

Det tekniske grunnlaget avgjør nytten

En brukbar desktop-test er mer enn en rekke museklikk. Den trenger en kontrollert maskin eller et virtuelt Windows-miljø, definerte brukerkontoer, reproduserbare utgangsdata, og tydelige regler for tilbakestillinger. Ellers kontrollerer testen en annen tilstand på tirsdag enn på mandag og skaper diskusjoner i stedet for sikkerhet.

Like avgjørende er bevis. Et grønt hakemerke uten kontekst hjelper lite når en forretningsavdeling rapporterer en feil. Hver kjøring bør derfor følges av de utførte trinnene, skjermbilder på viktige punkter, synlige feilmeldinger, og en tidsangivelse. Ved avvik må det være tydelig om applikasjonen reagerte feil, et forventet element ikke ble funnet, eller testmiljøet var blokkert.

Ved sensitive applikasjoner er spørsmålet om hvor utførelsen skjer ingen bisak. Skjermbilder, tilgangsdata, kundedata, og interne prosesskjermer kan inneholde konfidensiell informasjon. Den som kjører tester via eksterne tjenester bør nøye kontrollere hvilke data som forlater eget miljø, hvor lenge de lagres, og hvem som får tilgang.

For team med tilsvarende krav kan et selvhostet miljø være mer fornuftig.

softify.pro drifter til dette formålet COCO, en egen AI-server for automatisert web- og applikasjonstesting. Utførelse, testbevis, og evaluering kan forbli innenfor det kontrollerte bedriftsmiljøet. Det er ikke nødvendig for hver applikasjon, men for interne forretningssystemer, personopplysninger, eller strenge IT-krav er det ofte den renere arkitekturen.

Slik starter et team uten å la et testautomatiseringsprosjekt skli ut

En fornuftig start begynner ikke med et verktøyvalg, men med en prosess. Ta en arbeidsflyt som kontrolleres minst ukentlig og hvis feilkonsekvenser er sporbare. En forsendelsesprosess passer bedre enn en samling av tjue tilfeldige skjermbilder.

Beskriv deretter den forretningsmessige veien i klare setninger: utgangssituasjon, inndata, forventede mellomtilstander, forventet sluttresultat. Legg også til det negative tilfellet. Hva må skje hvis et batchnummer mangler, en bruker ikke har tillatelse, eller lageret ikke er tilstrekkelig? Nettopp disse reglene hoppes ofte over i manuelle tester, selv om de kan bli kostbare i hverdagen.

Deretter følger et begrenset pilotprosjekt med stabile testdata og et definert miljø. Mål ikke bare om testen kjører. Mål hvor mange manuelle kontrollminutter den erstatter, hvor mange falske alarmer som oppstår, og om bevisene er tilstrekkelige for utvikling og forretningsavdelingen. Først når dette grunnlaget fungerer, lønner det seg å utvide til flere prosesser.

Vedlikehold hører til fra starten av. Hvis en skjerm endres forretningsmessig, må også forventningen tilpasses. Det er ikke et argument mot automatisering. Det er normalt programvarevedlikehold - sammenlignbart med å oppdatere en arbeidsinstruksjon når en lagerprosess endres.

Ikke hvert klikk må automatiseres

Noen team forventer full dekning fra AI-tester. Det fører raskt til høye kostnader for sjeldne unntakstilfeller, hvis kontroll manuelt ville vært raskere og mer pålitelig. En god teststrategi prioriterer i stedet etter risiko, hyppighet, og endringstempo.

En sjelden brukt administrasjonsdialog med lav feilkonsekvens kan fortsatt kontrolleres med en kort manuell sjekkliste. Et daglig varemottak med flere påfølgende trinn fortjener derimot automatiserte regresjonstester og rene bevis. Boring, provable reliability vinner her over en stor, men skjør testsamling.

Begynn med prosessen der en feil virkelig ville merkes neste arbeidsdag. Når denne arbeidsflyten kontrolleres automatisert, sporbart, og repeterbart i ditt eget miljø, blir testautomatisering et pålitelig driftsfortrinn - ikke enda et IT-prosjekt med fine lysbilder.

Permalenke →

Når bør bedrifter erstatte regneark?

Når bør bedrifter erstatte regneark?

En lagersjef skriver ut en lagerliste om morgenen. To timer senere har salg registrert en ordre, mengden ved et varemottak er korrigert, og en kollega har åpnet en gammel fil fra et e-postvedlegg. Tallene stemmer ikke lenger. Akkurat her oppstår spørsmålet: Når bør bedrifter erstatte regneark? Ikke når en fil en gang blir uoversiktlig, men når den blir den usynlige flaskehalsen i en pågående prosess.

Regneark er ikke et tegn på dårlig organisering. For kalkyler, engangsanalyser, små datamengder og beslutninger med få involverte er de ofte det riktige verktøyet. De er fleksible, kjente og tilgjengelige uten at et prosjekt må startes. Problematiske blir de først når ett enkelt regneark skal være database, arbeidsinstruks, godkjenningsflyt, dokumentarkiv og kommunikasjonskanal på én gang.

Regneark er gode - helt til de skal bære en prosess

Mange voksende virksomheter holder fast ved filene sine fordi de er bygget opp med omhu gjennom mange år. Her ligger artikkelnumre, spesialtilfeller, leverandørkunnskap og utprøvd beregningslogikk. Det fortjener respekt. Et erstatningssystem som ignorerer denne virkeligheten skaper motstand og, i verste fall, nye omveier.

Det avgjørende spørsmålet er derfor ikke: «Er Excel dårlig?» Men: «Kan teamet vårt arbeide pålitelig med dette verktøyet, selv når ordrevolum, skift eller ansvarlige endres?» Hvis svaret jevnlig avhenger av én bestemt person, et delt nettverksområde eller disiplinen til alle involverte, er grensen ofte nådd.

Dette blir spesielt tydelig på lageret, i verkstedet og i planleggingen. En beholdning som først avstemmes i etterkant, er ikke en pålitelig beholdning. Et leveringsbevis som settes sammen manuelt fra flere filer, koster ikke bare tid. Det vanskeliggjør oppfølgingsspørsmål, sporbarhet og en ryddig overlevering mellom medarbeidere.

Når bør bedrifter erstatte regneark?

Det finnes ikke noe universelt tidspunkt og ingen magisk radantall. En bedrift med 500 posisjoner kan fungere godt med et enkelt regneark, mens en annen med 50 posisjoner for lengst trenger et system. Avgjørende er den operative belastningen: hvor ofte endres data, hvem bruker dem, og hvilke følger har en feil?

En tydelig utløser er versjonskonflikten. Når team sender rundt filer med navn som «Beholdning_final_ny2», eller kolleger må spørre hvilken kolonne som gjelder akkurat nå, mangler en bindende datakilde. Også manuelt kopieringsarbeid mellom ordreliste, lageroversikt, forsendelsesfil og fakturaforberedelse er et signal. Hver overføring skaper enda en anledning til ombyttede sifre, doble oppføringer eller glemte oppdateringer.

Like kritiske er prosesser uten sporbart ansvar. Hvem har endret en mengde? Når ble et varemottak bokført? Hvorfor ble en ordre satt på vent? I et regneark kan endringer riktignok delvis logges. I hverdagen er det likevel sjelden like entydig og brukbart som i en prosess som bevisst registrerer bokføringer, statusendringer og brukerhandlinger.

Et annet punkt er arbeidstempoet. Hvis medarbeidere før pakking først må lete i en fil, kontrollere en beholdning, taste inn data på nytt og deretter lage en fraktetikett i en separat portal, blir regnearket den som styrer tempoet på lagergulvet. Kostnadene oppstår da ikke bare i minutter. De viser seg i avbrudd, oppfølgingsspørsmål, feilforsendelser og kunnskap som bare finnes i hodet til enkeltpersoner.

Risikoene ligger ofte mellom to celler

Regneark svikter sjelden spektakulært. Ofte er det små avvik som forplanter seg: en feil dratt formel, et filter som ikke omfatter alle rader, et tall lagret som tekst i stedet for som tall eller en formel som ved en feiltakelse er overskrevet. Slike feil forblir lenge uoppdaget, nettopp når teamet arbeider under tidspress.

Ved forretningskritiske prosesser kommer en annen risiko i tillegg: manglende prosessstyring. Et regneark kan vise at en ordre finnes. Men det sikrer ikke pålitelig at alle nødvendige trinn skjer i riktig rekkefølge. Må en kvalitetskontroll være avsluttet før forsendelse? Kan en følgeseddel opprettes uten bekreftet plukking? Skal en ordre automatisk gå til avklaring når beholdningen mangler? Slike regler hører ikke hjemme i påminnelser, fargede celler eller kompliserte hvis-så-formler når de hver dag avgjør om prosessene går riktig for seg.

Også tilganger blir relevante når teamet vokser. Ikke alle trenger å få endre priser, vedlikeholde stamdata eller korrigere avsluttede transaksjoner. En skreddersydd applikasjon kan tydelig avbilde roller, logge sensitive handlinger og for eksempel sperre en konto etter flere mislykkede forsøk. Det er ikke overdreven teknikk. Det er et ryddig svar på ansvar.

Ikke ethvert problem trenger et stort ERP

Alternativet til regnearket er ikke automatisk en global enterprise-pakke med lange innføringsprosjekter. For mange små og mellomstore bedrifter ville det vært feil steg: for mange funksjoner, for stive prosesser, høye lisenskostnader og et system som ikke tilpasser seg virksomheten godt nok.

Mer fornuftig er ofte en fokusert applikasjon for den konkrete flaskehalsen. Det kan være et system for varemottak, lagerbevegelser og lagerplasser. Det kan fange opp ordrer fra e-poster eller skjemaer på en strukturert måte, opprette følgesedler, forberede fraktetiketter eller planlegge ruter etter tydelige regler. Det avgjørende er ikke å innføre mest mulig programvare. Det avgjørende er at neste handling blir entydig for den ansvarlige personen.

En god løsning kan dessuten starte ved siden av eksisterende verktøy. Regnskap, ERP eller fraktleverandører trenger ikke å erstattes med en gang. Ofte er et pålitelig grensesnitt eller en ryddig eksport den mer pragmatiske veien. Nytten oppstår når dobbeltregistrering faller bort og operative data er oppdaterte der de trengs.

Slik vurderer dere det faktiske handlingsbehovet

I stedet for å sammenligne programvaretilbud med en gang, lønner det seg å se på én konkret prosess. Ta for eksempel veien en ordre tar fra mottak til forsendelse. Skriv ned ikke bare de offisielle trinnene, men også telefonsamtaler, lapper, private chatmeldinger og stedene der noen overfører informasjon fra én fil til et annet system.

Spør dere deretter: Hvor venter medarbeidere på informasjon? Hvor blir data lagt inn flere ganger? Hvilken beslutning avhenger av erfaring i stedet for synlige regler? Og hvilke feil ville blitt dyre hvis ordrevolumet dobles om seks måneder? Denne analysen viser som regel raskere enn noen funksjonsliste om et regneark fortsatt er nok.

Ikke enhver avvikende observasjon rettferdiggjør en skreddersydd utvikling. Hvis en rapport lages månedlig av én person og en feil er lett å rette, er regnearket ofte fortsatt fornuftig. Men hvis flere personer daglig er avhengige av oppdaterte data, hvis fysiske varer flyttes, eller hvis det kreves dokumentasjon overfor kunder, endrer regnestykket seg. Da har bedriften for lengst betalt for verktøyets begrensninger - bare fordelt på arbeidstid, feilretting og forsinkelser.

En erstatning må kunne vedlikeholdes

Den som erstatter regneark, bør ikke bare kjøpe et penere grensesnitt. Datastrukturen, reglene og driften av applikasjonen avgjør om løsningen fortsatt fungerer pålitelig etter to år. For en slank webapplikasjon kan for eksempel PHP 8.4, moderne JavaScript og MySQL 8 være et bevisst nøkternt fundament: lett å vedlikeholde, ytelsessterkt og uten avhengighet av kortvarige trender.

Like viktig er innføringen. Et system bør først stabilisere reelle prosesser, ikke dekke alle tenkelige ønsker samtidig. Et tydelig avgrenset første område - for eksempel varemottak og lagerbokføring - skaper tillit. Deretter kan forsendelse, leveransedokumenter eller analyser legges til på et konsistent datagrunnlag.

De gamle regnearkene forsvinner ikke nødvendigvis med en gang. Noen blir værende som arkiv, for spesialanalyser eller som kontrollert eksport. Målet er ikke å forvise regneark. Målet er å avlaste dem fra oppgaver de aldri var ment å ha som permanent operativsystem.

Hvis teamet deres jevnlig sjekker hvilken fil som stemmer, hvem som sist endret noe, eller om en ordre virkelig er behandlet fullstendig, er det ikke en liten organisatorisk skavank. Det er en god anledning til å se på prosessen sammen på den faktiske arbeidsplassen - før neste vekstspiss gjør et skjørt regneark til en daglig flaskehals.

Permalenke →

AI testing platforms for regresjonstester

AI testing platforms for regresjonstester

En utgivelse er funksjonelt ferdig, men ingen kan med sikkerhet si om den nye prisimporten har skadet ordreregistreringen, brukerrettighetene, eller forsendelsesprosessen. Nettopp her blir AI testing platforms interessante. Ikke fordi de trollbinder bort menneskelig kvalitetsarbeid, men fordi de pålitelig kan kjøre tilbakevendende kontroller, dokumentere dem synlig, og gjøre avvik forståelige.

For team med web- eller Windows-applikasjoner som har vokst over tid, er dette et praktisk problem, ikke et innovasjonsprosjekt. Kritiske arbeidsflyter utvikler seg ofte over år: en ordre opprettes, et lagersaldo bokføres, en PDF genereres, et grensesnitt varsles. En liten endring i et inntastingsskjema kan få konsekvenser på et uventet sted. Manuelle regresjonstester er da langsomme, avhengige av enkeltpersoner, og spesielt feilutsatte under tidspress.

Hva AI testing platforms faktisk leverer

Klassisk testautomatisering følger forhåndsskrevne trinn. Det forblir fornuftig og nødvendig for mange kontroller. En AI-drevet plattform kan i tillegg jobbe med en applikasjon gjennom grensesnittet, gjenkjenne innhold, utføre teststeg, og klassifisere avvik på naturlig språk. Den kan for eksempel kontrollere om en autorisert bruker kan bokføre en varemottak, om en sperret konto korrekt avvises, eller om en følgeseddel fortsatt genereres etter en endring.

Den avgjørende fordelen ligger ikke bare i å klikke på en knapp. Gode systemer kobler sammen utførelse, observasjon, og bevis. En testkjøring bør derfor inkludere sporbare trinn, skjermbilder eller opptak, tidsstempler, brukte testdata, og en tydelig vurdering. Når en test mislykkes, trenger teamet mer enn meldingen "assertion failed". Det må kunne se på hvilken skjerm, i hvilken tilstand, og av hvilken grunn avviket oppsto.

AI kan fremskynde dette arbeidet. Den erstatter imidlertid ikke beslutningen om hva som virkelig er forretningskritisk. En modell kan gjenkjenne at en dialogboks ser annerledes ut. Om den endringen representerer en feil, en bevisst ny design, eller bare en ufarlig renderingsforskjell i nettleseren, forblir et spørsmål om regler, kontekst, og godkjenning.

Ikke enhver kontroll hører hjemme i AI

Den vanligste feilen ved innføringen er å sikte for høyt. En plattform bør ikke først dekke hver funksjon i et system. Den bør sikre arbeidsflytene hvis svikt ville være kostbar, risikabel, eller arbeidsintensiv. I logistikkprogramvare er dette typisk ordreregistrering, lagerbevegelser, etikett- eller dokumentutskrift, brukerroller, og grensesnittoverføringer. I en kommersiell webapplikasjon kan innlogging, fakturagodkjenning, eksporter, og betalingsstatus stå i sentrum.

En fornuftig start består av et lite sett stabile ende-til-ende-tester. En test her dekker ikke bare et enkelt klikk, men en fullstendig arbeidsprosess. For eksempel: en bruker logger inn, oppretter en ordre, bekrefter posisjonene, genererer en følgeseddel, og kontrollerer om transaksjonen vises i oversikten. Slike kontroller gir høyere forretningsrelevans enn mange isolerte tester for enkeltfelt.

Det betyr ikke at hver type test bør kjøres gjennom brukergrensesnittet. Utviklingsteam trenger fortsatt raske enhets- og integrasjonstester nær koden. Disse testene finner tekniske feil tidlig og billig. UI-baserte AI-tester utfyller dem der samspillet mellom grensesnitt, tillatelser, database, dokumenter, og eksterne tjenester må kontrolleres. Den som tester alt bare gjennom grensesnittet, får trege og vanskelig vedlikeholdbare testkjøringer. Den som tester utelukkende i koden, kan overse feil som direkte rammer brukere.

Stabilitet oppstår gjennom gode testbetingelser

Automatiserte tester mislykkes ikke alltid på grunn av en produktfeil. Ustabile testdata, skiftende brukerrettigheter, utilgjengelige testsystemer, eller parallelle endringer kan like gjerne være årsaken. Derfor hører testmiljøet til plattformbeslutningen.

Testkontoer bør være entydige og ha kjente rettigheter. Data må enten tilbakestilles reproduserbart før hver kjøring eller målrettet gjenopprettes. Eksterne systemer krever også en beslutning: kontrolleres en frakt- eller betalingsintegrasjon mot et sikkert testmiljø, simuleres den med en kontrollert stub, eller utelates den bevisst fra flyten? Det finnes ikke noe universelt riktig svar. Avgjørende er at et tests utsagn forblir tydelig.

For kritiske godkjenninger lønner det seg også å ha et definert konfidensnivå. En visuell forskjell med lav konfidens bør ikke automatisk blokkere en utgivelse. Et manglende forsendelsesdokument etter en vellykket bokført levering er derimot en alvorlig feil. Gode testprosesser skiller mellom hint å kontrollere og tydelige godkjenningskriterier.

Datasuverenitet er ikke en sidesak ved AI-tester

Så snart en test kjøres mot en reell applikasjon, kan den se konfidensiell informasjon: kundenavn, priser, adresser, interne artikkelnumre, skjermbilder fra forretningsapplikasjoner, eller innhold fra dokumenter. Hvis slike data overføres til eksterne tjenester sammen med skjermopptak og testlogger, er det en arkitekturbeslutning med konsekvenser for personvern, informasjonssikkerhet, og avtaler.

Nettopp for interne web- og Windows-applikasjoner er ikke spørsmålet "fungerer plattformen?" nok. Ansvarlige bør kontrollere hvor testkjøringer utføres, hvor skjermbilder og logger lagres, hvilke data en AI-modell behandler, og hvem som får administrativ tilgang. Oppbevaringstider og slettekonsepter hører også hit. En testrapport kan være verdifullt bevis for en utgivelse, men bør ikke bevare sensitiv informasjon på ubestemt tid.

For organisasjoner med økte krav kan en selvhostet kjøring være den mer egnede løsningen. Den holder testtrafikk, testdata, og bevis i eget kontrollert miljø. Det øker driftsinnsatsen noe: oppdateringer, tilganger, kapasiteter, og overvåking krever ansvar. Til gjengjeld forblir den tekniske og organisatoriske kontrollen der den ofte hører hjemme. Med COCO satser softify.pro nettopp på denne modellen: automatiserte tester for web- og Windows-applikasjoner med lokal datalagring og sporbare testbevis.

Hva som kjennetegner en passende plattform

Et overbevisende valg begynner med de eksisterende applikasjonene, ikke med en produktdemo. En plattform kan virke imponerende i en ren eksempelapplikasjon og støte på grenser ved en eldre skrivebordsmaske, et Citrix-miljø, eller en kompleks innlogging. En kort proof of concept med to eller tre reelle forretningsflyter sier mye mer enn en funksjonsliste.

Team bør derfor være spesielt oppmerksomme på fire punkter:

  • Applikasjonsdekning: Støtter løsningen de eksisterende nettleserne, Windows-skrivebordsapplikasjonene, og, der relevant, eksternt skrivebord- eller Citrix-scenarier?
  • Sporbarhet: Leverer hver kjøring forståelige trinn, skjermbilder, logger, og en begrunnelse for hvorfor en test anses som bestått eller mislykket?
  • Driftsmodell: Passer sky, et privat miljø, eller selvhosting til sikkerhetskravene, de tilgjengelige IT-ressursene, og testdataene?
  • Vedlikeholdbarhet: Kan forretningsavdelinger gjennomgå testflyter mens tekniske team rent styrer versjonering, godkjenninger, og repeterbar utførelse?

I tillegg kommer integrasjonen i utgivelsesprosessen. En test som bare startes på forespørsel, hjelper mindre enn en planlagt kjøring før utrulling eller etter en relevant endring. Samtidig bør ikke hver liten stylingoppdatering utløse en timelang fullstendig test. Modne prosesser velger tester etter risiko: en kort røyktest etter hver utrulling, målrettede regresjoner ved endringer i kritiske moduler, og mer omfattende kjøringer før større utgivelser.

Klare rapporter i stedet for testteater

Testautomatisering produserer lett aktivitet uten innsikt. Hundrevis av grønne haker høres bra ut, men hvis ingen kan si hvilke forretningsprosesser de sikrer, er de knapt styrbare. En brukbar rapport svarer på enkle spørsmål: Hva ble kontrollert? Med hvilket resultat? Hvilken versjon var berørt? Hva må noen bestemme nå?

Klarspråkvurderinger kan spare mye tid her, forutsatt at de baserer seg på reelle kjøringsdata. "Brukeren kunne logge inn, opprette ordren, og generere følgeseddelen" er mer nyttig for en forretningsansvarlig enn en samling tekniske selektorer. Ved feil forblir den tekniske dybden likevel viktig. QA og utvikling trenger skjermbildet, loggdataene, og reproduserbare trinn, ikke bare et AI-sammendrag.

Innføring uten å forstyrre løpende drift

Den beste innføringen begynner med en prosess der en feil ville ha en merkbar innvirkning og hvis forløp er tilstrekkelig stabilt. Det kan være dagsavslutningen, ordregodkjenningen, eller en kjernefunksjon i en kundeplattform. Sammen med forretningsavdelingen og det tekniske teamet fastsettes hva som teller som suksess, hvilke testdata som brukes, og hvem som vurderer en feil.

Deretter følger en kontrollert rytme: bygge tester, kjøre dem gjentatte ganger, redusere falske alarmer, og først da binde dem bindende inn i godkjenninger. Dette mellomsteget er viktig. Den som setter inn automatiserte tester umiddelbart som en hard sperre, mens miljø og data fortsatt svinger, skaper motstand i stedet for tillit. Den som i stedet synlig kobler resultatene til reelle feil og stabile utgivelser, bygger aksept.

AI testing platforms er ingen erstatning for god programvarearkitektur, forretningsansvar, eller rene utgivelsesbeslutninger. Riktig brukt gir de imidlertid teamene noe svært konkret tilbake: tid til sakene som krever skjønn, og solide bevis for arbeidsflytene som rett og slett må fungere. Den mest fornuftige første testen er derfor sjelden den mest spektakulære - men prosessen der ingen på mandagsmorgenen lenger trenger å lure på om systemet fortsatt gjør det driften forventer av det.

Permalenke →

Automatisk dokumentasjon av testbevis

Automatisk dokumentasjon av testbevis

En mislykket regresjonstest er irriterende. En bestått test uten anvendbart bevis er ofte knapt bedre. Den som vil dokumentere testbevis automatisk løser derfor ikke et rent rapporteringsproblem. Det handler om et solid svar på konkrete spørsmål: Hva ble testet? I hvilken versjon? Med hvilke inndata? Hva skjedde egentlig på skjermen? Og kan en utvikler, QA-ansvarlig, eller revisor rekonstruere resultatet senere?

Nettopp for forretningskritiske web- og Windows-applikasjoner oppstår disse spørsmålene ikke først ved revisjon. De dukker opp når en ordre behandles feil etter en utgivelse, når en kunde rapporterer en uvanlig feil, eller når et team må skille mellom "ser bra ut" og "bevist verifisert" før en utgivelse. Manuelt vedlikeholdte Excel-lister, skjermbilder i chattråder, og løse testnotater er tilstrekkelig kun så lenge omfang og endringstakt forblir lite.

Hvorfor manuelt testbevis raskt blir upålitelig

I mange team begynner dokumentasjonen med gode intensjoner. En tester registrerer resultatet, legger til et skjermbilde, og noterer den testede versjonen. Under tidspress blir dette imidlertid raskt en forkortet rutine: hake av, gi videre feilen, neste testtilfelle. Dette er forståelig, spesielt for tilbakevendende regresjonstester - men det er ikke solid.

Problemet ligger ikke hos enkeltansatte. Manuell dokumentasjon konkurrerer alltid med det faktiske testarbeidet. Så snart ti, femti, eller flere hundre tilfeller må kontrolleres per utgivelse, mangler enten tiden for rene bevis, eller bevisene blir så omfattende at ingen lenger evaluerer dem. I tillegg kommer typiske hull: et skjermbilde viser en tilstand, men ikke det foregående forløpet. En testlogg navngir tilfellet, men ikke det brukte build-nummeret. En feil er rettet, men det er ikke synlig når og hvordan rettelsen ble verifisert på nytt.

For applikasjoner med ordrebehandling, lagerbevegelser, priser, brukerrettigheter, eller grensesnitt er dette mer enn et komfortspørsmål. En udokumentert test kan ikke pålitelig telle som en fullført risikokontroll. Det gjelder spesielt når en tilsynelatende liten endring ett sted utløser bivirkninger i tilstøtende prosesser.

Hva et brukbart testbevis faktisk må inneholde

Et testbevis er ikke bare et skjermbilde med et grønt hakemerke. Det kobler testtilfellet til sin tekniske og forretningsmessige kontekst. Minst må det senere være identifiserbart hvilken applikasjon, hvilken versjon, og hvilket testmiljø som ble kontrollert. Like viktig er starttid, sluttid, resultat, og en klar tilordning til det respektive teststeget.

Ved automatiserte UI-tester bør beviset dessuten fange opp de utførte handlingene og de observerte resultatene. Eksempel: en test oppretter en ordre, kontrollerer linjesummen, genererer en følgeseddel, og kontrollerer deretter statusen i forsendelsesområdet. En god logg registrerer ikke bare "bestått". Den viser ved hvilket steg kontrollen fant sted, hvilken forventet verdi systemet skulle levere, og hvilken verdi det faktisk leverte.

Skjermbilder eller korte skjermopptak er verdifulle her, men ikke alltid obligatoriske for hvert enkelt vellykket steg. De koster lagringsplass og kan inneholde sensitive data. Vanligvis gir en trinnvis strategi mening: ved mislykkede kontroller lagres automatisk et fullstendig visuelt bevis; ved vellykkede standardtilfeller er strukturerte loggdata og utvalgte bevis tilstrekkelig. Hvor mye dybde som kreves, avhenger av risiko, endringsfrekvens, og regulatorisk miljø.

Beviset må være lesbart og teknisk anvendbart

Utviklere trenger detaljer som feilmeldinger, forventede/faktiske verdier, tidsstempler, og det konkrete steget i testforløpet. Forretningsavdelinger og utgivelsesansvarlige trenger derimot en forståelig uttalelse: hvilke forretningsprosesser ble kontrollert, hva besto, og hvor trengs det tiltak?

Begge perspektiver bør komme fra samme testkjøring. Hvis et QA-team eksporterer tekniske loggfiler og deretter manuelt skriver et ledelsessammendrag, oppstår igjen et feilutsatt mediebrudd. Bedre er et system som fanger rådata strukturert og genererer en klar vurdering fra det, uten å skjule tekniske detaljer.

Automatisk dokumentasjon av testbevis: riktig forløp

Automatisering fungerer best når den er koblet til klart definerte risikoer. Ikke hvert klikk i hver applikasjon må umiddelbart automatiseres og fullstendig dokumenteres. Utgangspunktet er vanligvis stabile, ofte gjentatte, og forretningskritiske arbeidsflyter: innlogging og rettighetskontroll, ordreregistrering, prisberegning, dokumentgenerering, lagerbokføring, eller dataoverføring til et grensesnitt.

For hver arbeidsflyt fastsettes først hva som teller som en bestått test. "Skjermen ser riktig ut" er for vagt for det. Bedre er konkrete testbetingelser: en bruker med rollen lager skal ikke kunne endre priser. Følgeseddelnummeret genereres. Mengden reduserer tilgjengelig lager. Etter fem mislykkede forsøk aktiveres kontosperren. Slike kriterier gjør testtilfeller repeterbare og bevis sammenlignbare.

Testkjøringen bør da starte automatisk med kontekstdata. Dette inkluderer build- eller versjonsnummer, målmiljø, nettleser eller operativsystem, testdatastatus, og tidsstempel. Under kjøringen logger systemet de enkelte stegene, de forventede og faktiske resultatene, samt tekniske avvik. Ved avvik genererer det bevis, som skjermbilder, feilmeldinger, eller en opptak av det relevante forløpet.

Sluttresultatet er ikke en ustrukturert filmappe, men en testkjøring med en status. Ideelt sett kan man spore tilbake fra en utgivelsesbeslutning til det enkelte steget hvorfor en test ble vurdert som bestått eller mislykket. Nettopp denne koblingen reduserer diskusjoner etter en hendelse betydelig.

Hvor AI virkelig hjelper - og hvor ikke

AI kan merkbart fremskynde dokumentasjon og evaluering. Den kan vurdere skjermtilstander, markere iøynefallende avvik, og oppsummere testkjøringer i forståelig språk. Ved store testmengder hjelper dette QA-team med å slippe å lese hver vellykkede kjøring manuelt. En vurdering med konfidensgrense kan dessuten fremheve tilfeller der deteksjonen er usikker og en menneskelig kontroll fortsatt er nødvendig.

Likevel bør ikke AI alene bestemme over kritiske utgivelser. For områder som betalingsautorisasjon, rettigheter, prislogikk, eller juridisk relevante dokumenter trengs deterministiske testkriterier. Et forventet beløp er enten korrekt beregnet eller ikke. En rolle har tilgang eller ikke. AI utfyller her analysen av visuelt og språklig innhold, men erstatter ikke en ryddig definert forretningsregel.

Også håndtering av data er en arkitekturbeslutning. Skjermbilder fra interne applikasjoner kan vise kundedata, priser, adresser, eller produksjonsinformasjon. Den som dokumenterer testbevis automatisk, bør derfor på forhånd bestemme hvor disse bevisene lagres, hvem som kan se dem, og hvor lenge de oppbevares. For sikkerhetsbevisste team kan en selvhostet testinfrastruktur som COCO gi mening, fordi testtrafikk, opptak, og evaluering forblir i eget kontrollert miljø.

Oppbevaringstider, tilgang, og bevisets kvalitet

Mer bevis er ikke automatisk bedre bevis. Et skjermbildelager som vokser i årevis uten rollemodell og oppbevaringskonsept skaper en ny risiko. Trinnvise oppbevaringstider gir mening: behold mislykkede eller utgivelsesrelevante testkjøringer lenger, komprimer eller slett vellykkede rutinetester etter en definert periode, og anonymiser sensitive testdata tidlig.

Like avgjørende er uforanderligheten. Hvis testresultater kan redigeres i ettertid uten spor, mister de verdi som bevis. Endringer i testtilfeller, resultater, eller utgivelsesstatus bør derfor logges. Det betyr ikke at hver testrapport trenger komplisert revisjonsprogramvare. Men ansvar, tidsstempler, og sporbare historikker hører til grunnutstyret.

Begynn med en prosess som virkelig gjør vondt

Det mest fornuftige første automatiseringssteget er sjelden det største. Velg en arbeidsflyt som kontrolleres ved hver utgivelse, koster mange manuelle minutter, og har merkbare konsekvenser ved en feil. Det kan være ordreregistrering i webportalen, generering av et forsendelsesdokument, eller et rettighetskonsept i en Windows-applikasjon.

Definer klare suksesskriterier for denne arbeidsflyten, de nødvendige bevisene, og en ansvarlig mottaker for mislykkede tester. Etter noen utgivelser blir det raskt klart om bevisene er forståelige nok, om det oppstår for mye data, og hvilke tester som bør følge deretter. Slik vokser ingen dokumentasjonsmaskin for sin egen skyld, men en verifiseringskjede som sikrer utgivelser raskere og leverer solide svar ved problemer.

Permalenke →

Digital dokumentasjon av lagerbevegelser

Digital dokumentasjon av lagerbevegelser

Et avvik på 24 stykker i systemet høres i utgangspunktet overkommelig ut. Det blir problematisk når ingen kan si om varen ble feillagret, tatt ut for en ordre, skadet, eller aldri bokført. Den som vil dokumentere lagerbevegelser digitalt, skaper derfor ikke bare mer data. Den skaper en sporbar historikk for hver lagervare - og dermed et solid grunnlag for innkjøp, produksjon, forsendelse og varetelling.

For små og mellomstore lagre er dette sjelden et tilfelle for en omfattende enterprise-pakke. Avgjørende er et system som gjenspeiler varenes reelle veier: varemottak ved porten, flytting mellom hyller, materialuttak på verkstedet, plukking, retur og korrigeringer etter varetelling. Jo sjeldnere team må veksle mellom papir, Excel og muntlig beskjed og flere programmer, desto mer pålitelige blir tallene.

Å dokumentere lagerbevegelser digitalt starter med transaksjonen

En aktuell lagerbeholdning svarer bare på ett spørsmål: hvor mye finnes akkurat nå? For det operative arbeidet er det ofte ikke nok. Ved oppfølgingsspørsmål trenger teamet også svar på andre spørsmål: Når endret beholdningen seg? Hvem utførte bokføringen? Hvor kom varen fra, hvor gikk den, og hvilken forretningstransaksjon utløste det?

Nettopp her ligger forskjellen mellom en enkel lagerliste og digital bevegelsesdokumentasjon. Hver endring lagres som en egen, uforanderlig transaksjon. Beholdningen oppstår deretter fra disse transaksjonene. Hvis for eksempel en artikkel flyttes fra plass A-03 til B-12, må systemet sporbart koble sammen en utgående og en inngående bevegelse. Hvis materiale tas ut til en produksjonsordre, hører bokføringen til den ordren - ikke bare til en anonym mengdeendring.

Dette prinsippet forhindrer ikke feil fullstendig. Det gjør dem imidlertid sporbare. En korrigering overskriver da ikke den gamle verdien, men skaper en ny korrigeringspost med en årsak. Det er mindre praktisk enn å endre et tall direkte, men betydelig bedre for varetellinger, reklamasjoner og interne avstemminger.

Hvilke data som virkelig trengs per bevegelse

Mange prosjekter blir unødvendig kompliserte fordi hvert tenkelige felt planlegges inn fra starten. For pålitelig drift er det som regel nok med noen få, ryddig vedlikeholdte opplysninger. Avgjørende er ikke lengden på skjemaet, men at hver bokføring forblir entydig i sak.

En bevegelsesbokføring bør minst inneholde denne informasjonen:

  • Artikkel eller materiale, inkludert et unikt artikkelnummer
  • Mengde og enhet, for eksempel stykk, meter, kilogram eller kartong
  • Bevegelsestype, for eksempel mottak, uttak, flytting, retur eller korrigering
  • Kilde- og målsted, i den grad bevegelsestypen gjelder begge
  • Tidspunkt, utførende person, og en sporbar dokumentreferanse

Dokumentreferansen kan være en bestilling, en følgeseddel, en kundeordre, en produksjonsordre, eller en varetellingsposisjon. Den sparer tid senere, fordi bokføringen ikke først må tolkes via kommentarer. Fritekst forblir nyttig for unntak, men bør ikke erstatte obligatorisk informasjon.

For artikler med krav om batch, serienummer, eller holdbarhet, kommer ytterligere kjennetegn til. Da må det for eksempel være klart hvilket batch det ble tatt ut fra, eller hvilken holdbarhetsdato som er berørt. Dette er ikke en detalj for senere: hvis sporbarhet er påkrevd, må den fungere direkte i bokføringsflyten.

Tilpasse bevegelsestypene til den reelle vareflyten

De mest fornuftige kategoriene oppstår ikke i en workshop rundt et abstrakt prosessdiagram, men på en runde gjennom lageret. Hvor mottas varen faktisk? Hvem bestemmer over sperret lager? Når skrives materiale ut: ved overlevering til verkstedet, ved produksjonsstart, eller først ved forbruk?

Varemottak og kvalitetskontroll

Ved varemottak bør varen først kontrolleres mot bestilling eller følgeseddel. En digital registrering kan direkte samle mengde, leverandør, dokumentnummer, lagerplass, og eventuelt batch. Hvis en kontroll er nødvendig, bør varen ikke automatisk fremstå som fritt tilgjengelig. En status som "under kontroll" eller "sperret" forhindrer at ukontrollert materiale ved en feiltakelse blir plukket.

Flytting og interne overleveringer

Flyttinger blir spesielt ofte glemt fordi de ikke genererer noe synlig eksternt dokument. Resultatet er at totalbeholdningen stemmer, men ingen finner varen på forventet sted. Mobile bokføringer via håndholdt skanner, nettbrett, eller et enkelt webskjema hjelper her, forutsatt at de krever få inntastinger. Et komplisert skjermskjema blir omgått i den daglige driften - uavhengig av hvor godt databasen bak er planlagt.

Uttak, forsendelse og retur

Ved uttak må bokføringen passe til riktig formål. Materiale til en arbeidsordre, varer til en kundeordre, og kassasjon er i sak forskjellige transaksjoner. De kan riktignok redusere samme artikkellager, men krever ulike analyser. Retur bør også være en egen bevegelsestype. Ellers forblir det uklart om en artikkel er gjenbrukbar, må kontrolleres, eller skal skrives ut.

Registreringen må fungere på lagergulvet

Digitalisering mislykkes sjelden fordi et team ikke forstår nytten. Den mislykkes oftere på grunn av fem ekstra klikk, ustabil WiFi, uklare artikkelnumre, eller en bokføring som først kan fullføres på kontor-PC-en etter skiftets slutt.

Derfor lønner det seg å definere en klar arbeidsflyt per rolle. Ved varemottak velges typisk bestilling eller følgeseddel, artikkelen skannes, mengden bekreftes, og en lagerplass tildeles. Ved plukking er det ofte nok å åpne ordren, skanne posisjonen, og bekrefte uttaket. Lagersjefer trenger i tillegg funksjoner for sperringer, korrigeringer, og varetellinger, inkludert et krav om å oppgi årsak til korrigeringen.

Strekkode- eller QR-skanning reduserer overføringsfeil når artikler og lagerplasser er ryddig merket. Men de erstatter ikke vedlikehold av stamdata. Finnes det fem forskjellige skrivemåter for samme artikkel, eller navngis plasser uformelt, akselererer en skanner bare feil bokføring. Før den tekniske utrullingen bør artikkelnumre, enheter, lagerplasser og ansvar ryddes opp.

Også offline-evne er en avveining. I et lite lager med stabilt nettverk kan en nettleserbasert applikasjon være tilstrekkelig. For fjernlagre, store haller, eller upålitelige forbindelser kan lokal mellomlagring være fornuftig. Da må det være klart regulert hvordan doble eller tidsforskjøvede bokføringer slås sammen.

En fornuftig utrulling i stedet for én stor omstillingsdag

En fullstendig overgang på én skjæringsdato virker beslutsom, men skaper unødvendig risiko. Bedre er det å starte med et avgrenset område: for eksempel varemottak og flyttinger for én artikkelgruppe eller ett lagerområde. Der viser det seg raskt hvilke bevegelsestyper som mangler, hvilke inntastingsskjermer som er for trege, og hvilke spesialtilfeller som faktisk forekommer regelmessig.

For starten trenger teamet en verifisert startbeholdning. Denne kan komme fra en varetelling, en ryddet lagerliste, eller en kontrollert overtakelse. Viktig er å dokumentere overgangen tydelig: frem til hvilket tidspunkt gjelder det gamle systemet, fra når er det nye systemet styrende? Parallelt førte lister er høyst kortsiktig nyttige for kontroll. Blir de værende permanent, oppstår to sannheter.

Etter to til fire uker bør de ansvarlige ikke bare se på lagernøyaktigheten. Like talende er antallet etterfølgende korrigeringer, manglende dokumentreferanser, søketider, og bokføringer utenfor de tiltenkte prosessene. Disse observasjonene gir bedre krav enn en lang ønskeliste utarbeidet før prosjektstart.

Teknisk grunnlag: sporbart og vedlikeholdbart

Bak et enkelt bokføringsskjermbilde trengs en ren datastruktur. Artikler, lagerplasser, bevegelser, dokumenter, og brukerrettigheter bør modelleres separat. Hver bokføring trenger en unik ID, et tidsstempel, og en tilknytning til brukerkontoen. Endringer i kritiske transaksjoner hører hjemme i en kontrollogg.

For mange mellomstore applikasjoner er en slank webapplikasjon med en relasjonsdatabase som MySQL 8 et egnet grunnlag. Den kan bearbeide skannerinndata, avbilde rollebaserte rettigheter, generere bevegelsesjournaler, og overlevere data til forsendelses- eller ordreprosesser. Avgjørende er mindre rammeverket som brukes enn en dokumentert datalogikk, testede bokføringsregler, og et driftskonsept med sikkerhetskopier, tilgangsrettigheter, og gjenopprettingsrutiner.

Ikke hver bevegelse må umiddelbart overføres til hvert annet system. Sanntidssynkronisering er fornuftig når forsendelse, en nettbutikk, eller produksjon er direkte avhengig av tilgjengelige mengder. I andre tilfeller er kontrollerte overleveringer med faste intervaller nok. Mer integrasjon betyr også flere feilkilder og mer ansvar ved driftsavbrudd.

Når et regneark fortsatt er nok

Et regneark er ikke grunnleggende et problem. Med få artikler, en fast lagerplass, og én person som konsekvent vedlikeholder inn- og utganger, kan det være økonomisk. Overgangen blir fornuftig når flere personer bokfører samtidig, lagerplasser blir relevante, dokumenter må lenkes, eller det regelmessig er uklart hvorfor en beholdning avviker.

Det riktige neste steget er da ikke størst mulig programvare, men en løsning som presist støtter den eksisterende vareflyten. God digital dokumentasjon gjør ikke arbeidet mer spektakulært. Den sørger for at en bokføring skjer i bevegelsens øyeblikk - og at svaret på det neste lagerspørsmålet allerede ligger i systemet.

Permalenke →

Ideer for lagerdigitalisering som fungerer

Ideer for lagerdigitalisering som fungerer

En manglende følgeseddel rett før avgang, en lagerbeholdning som ser annerledes ut på hyllen enn i regnearket, og tre ansatte som samtidig avklarer det samme spørsmålet per telefon: nettopp der oppstår fornuftige ideer for lagerdigitalisering. Ikke fra spørsmålet om hvilken teknologi som akkurat nå virker trendy, men fra en konkret prosess som koster tid, skaper feil, eller avhenger av enkeltpersoners kunnskap.

For små og mellomstore lager-, handels-, og produksjonsbedrifter er digitalisering sjelden ett stort prosjekt. Det er en sekvens av tydelig avgrensede forbedringer. Målet trenger ikke være et komplekst enterprise-lagerstyringssystem. Ofte er et slankt verktøy, skreddersydd for den faktiske arbeidsflyten, bedre enn en pakke med funksjoner som ingen på lagergulvet bruker.

Ideer for lagerdigitalisering med operativ verdi

Det beste inngangspunktet er en prosess som skjer ofte, er lett å måle, og merkbart forbedres for de ansatte. Den som ønsker å digitalisere hele lageret med det samme, binder budsjett og oppmerksomhet før en løsning har bevist seg i hverdagen. Et begrenset første steg skaper derimot solide data for neste beslutning.

1. Varemottak med mobil registrering

Ved varemottak oppstår mange følgefeil: feiltalte mengder, uavklarte avvik, forsinket bokførte lagre, og papirdokumenter som senere ikke lenger kan finnes. Et mobilt registreringsskjema på en håndskanner, nettbrett, eller smarttelefon kan gjøre prosessen betydelig mer stabil.

Ansatte skanner artikkelen og leveransereferansen, og registrerer mengde, lagerplass, og årsaken til eventuelle avvik direkte ved lastekaien. Hvis et parti, serienummer, eller bilde er relevant, hører denne informasjonen til nøyaktig samme post. Lageret ettergføres ikke i et regneark ved skiftets slutt; det får i stedet en sporbar status ved faktisk mottak.

Det betyr ikke at hver leverandør eller artikkel strengt tatt trenger strekkodeetiketter. For små, uregelmessige leveranser kan et søk på artikkelnummer holde. Det avgjørende er at dataregistreringen er raskere enn den tidligere omveien via papir og manuell avskrift.

2. Digitale flyttinger i stedet for lagergåter

Mange lagre vet i utgangspunktet hva som er tilgjengelig, men ikke pålitelig hvor det befinner seg. Varer hentes på forhånd til en ordre, mellomlagres, bringes til montering, eller plasseres på et ledig område på grunn av plassmangel. Uten enkel bokføring blir et lagerspørsmål raskt en søkeoperasjon.

En flytteprosess trenger ikke et komplisert grensesnitt. Skann utgangsplassen, skann destinasjonsplassen, bekreft mengden — mer trengs som regel ikke. Systemet bør kontrollere om artikkel og lagerplass er plausible, og tydelig tilordne en bokføring til en person og et tidsstempel.

Håndtering av unntak er viktig. En lagerplass kan være blokkert, overfylt, eller godkjent bare for spesifikke varer. Disse reglene bør kartlegges der de forhindrer reell skade. For sjeldne spesialtilfeller er det ofte nok med et godkjenningssteg fra lagerledelsen. For mange obligatoriske felt gjør en nyttig applikasjon til en hindring.

3. Ordreplukking med tydelige ordrestatuser

Papirplukklister fungerer helt til prioriteringer endres, posisjoner mangler, eller en ordre fordeles på flere områder. En enkel digital plukkliste viser hvilken ordre som er åpen, hvilke posisjoner som allerede er plukket, og hvor avklaring er nødvendig. Dette reduserer henvendelser mellom lager, salg, og forsendelse.

Avhengig av lagerstørrelsen kan applikasjonen diktere plukkveier eller ganske enkelt sortere posisjoner etter lagersone. Full ruteoptimalisering lønner seg først og fremst med mange daglige ordrer og lange gangveier. På et kompakt lager gir en pålitelig statusvisning ofte mer enn en matematisk perfekt rute som ingen følger i hverdagen.

Ved manko bør systemet ikke bare markere rødt. Det bør tilby en konkret oppfølgingsprosess: sjekk lager, be om erstatningsartikler, utløs etterfylling, eller send ordren videre til avklaring. Digitalisering er verdifull når den gjør neste fornuftige handling synlig.

4. Forsendelsesdokumenter og etiketter fra reelle ordredata

Manuell overføring av adresser, vekter, og artikkelposisjoner til forsendelsesportaler er en utmerket kandidat for automatisering. Leveringsadresser, leveringsinstrukser, forsendelsesmetoder, og pakkeinformasjon finnes ideelt sett bare én gang og brukes til følgeseddelen, forsendelsesetiketten, og forsendelsesbekreftelsen.

Et egnet system kan generere etiketter, lagre dokumenter på en sporbar måte, og automatisk sette ordren til "klar for forsendelse" eller "sendt" etter utskrift. Den operative fordelen ligger ikke bare i sparte minutter. Den ligger i å sikre at forsendelsesdata aldri avviker mellom flere systemer.

Her er integrasjonen avgjørende. Hvis en transportør ikke tilbyr et brukbart grensesnitt eller involverer svært ulike spesialregler, kan en halvautomatisert arbeidsflyt være mer fornuftig enn en skjør full integrasjon. Kjedelig, dokumenterbar pålitelighet slår automatisering som stopper opp ved hvert unntak.

5. Etterfylling og minimumslagernivåer med sporbare regler

Minimumslagernivåer vedlikeholdes ofte i regneark og ignoreres deretter fordi ingen er sikre på om tallene fortsatt stemmer. En fornuftig digital løsning kobler faktiske bokføringer med tydelige lagerstyringsregler. Den kan varsle når en artikkel faller under en terskel, ta hensyn til reserverte mengder, og forberede en bestillingsliste.

Terskelen bør ikke behandles som en evig sannhet. Sesongetterspørsel, leveringstider, og minste bestillingsmengder endrer seg. Derfor trenger den ansvarlige personen en enkel måte å gjennomgå forslag og justere regler på. Fullautomatiske bestillinger er først fornuftige når stamdata, leverandørlogikk, og forbruksdata er stabile nok.

6. Sporbarhet for partier, serienumre, og blokkert lager

Den som jobber med partier, enheter, reservedeler, eller regulerte produkter trenger mer enn bare en mengdevisning. Det må være sporbart hvilke varer som ankom når, hvor de ble flyttet, og i hvilken kundeordre de endte opp.

Prosjektet kan bevisst starte lite: registrer først bare mottak og forsendelse av en kritisk produktgruppe. Interne bevegelser og returer følger senere. Et system som tvinger frem hver bokføring, men ikke forstår den reelle reparasjons- eller inspeksjonsprosessen, vil bli omgått. Forretningslogikken må derfor stamme fra arbeidsflyten, ikke fra en abstrakt datamodell.

Velge riktig prosjekt

Den mest attraktive ideen er ikke automatisk den riktige første ideen. Evaluer potensielle prosjekter basert på frekvens, feilkostnader, ventetid, og avhengighet av enkeltpersoner. En prosess som kjøres 50 ganger daglig og sparer to minutter per transaksjon kan være mer verdifull enn en sjelden spesialfunksjon med stor teknisk eleganse.

Datakvalitet hører også hjemme i beslutningen. Hvis artikkelnumre er duplisert, lagerplasser ikke navngis entydig, eller ordrer kommer motstridende fra flere kilder, bør prosjektet først rydde opp i disse grunnlagene. Programvare kan gjøre manglende regler synlige, men kan ikke pålitelig erstatte dem.

Fire spørsmål er nok for prioritering:

  • Hvilken aktivitet forårsaker dokumentert flest henvendelser eller omarbeid?
  • Hvilken informasjon avskrives i dag flere ganger eller etterspørres per telefon?
  • Hvilken feil ville hatt de dyreste konsekvensene for kunder, lager, eller forsendelse?
  • Hvilken arbeidsflyt kan testes på noen få uker med tydelig suksessmåling?

Tekniske beslutninger som teller i den daglige lagerdriften

En lagerapplikasjon trenger ikke se spektakulær ut. Den må forbli forståelig ved dårlig Wi-Fi-dekning, med hansker på, under tidspress, og under skiftbytter. Store knapper, tydelig tilbakemelding etter en skanning, og synlig feilhåndtering er viktigere enn dekorative dashbord.

Arkitekturen bør også passe til den operative virkeligheten. En nettbasert applikasjon med en ren databasestruktur kan kjøre på eksisterende enheter og er lettere å vedlikeholde enn en isolert løsning på én PC. Med et stabilt fundament — som PHP 8.4, moderne JavaScript, og MySQL 8 — kan roller, bokføringshistorikk, grensesnitt, og dokumenterte driftsettinger driftes sporbart over lang tid.

Ikke all informasjon er ment for hver rolle. Lagerpersonell trenger åpne oppgaver og tydelige bokføringsdialoger. Lagerstyring trenger advarsler og etterfyllingsforslag. Ledelsen trenger evalueringer av gjennomløpstider, avvik, og åpne transaksjoner. Rollebaserte tilgangskonsepter, logger, og kontosperringer etter gjentatte mislykkede forsøk hører tidlig hjemme i planleggingen, spesielt når eksterne tjenesteleverandører eller flere lokasjoner er involvert.

Innføring: bevis først, utvid deretter

En pilot bør kjøres med reelle ordrer, ikke bare testdata i et møterom. Velg en lagersone, en produktgruppe, eller et skift, og definer på forhånd hvordan suksess skal gjenkjennes: færre korrigeringsbokføringer, kortere behandlingstid, færre henvendelser, eller en høyere fullføringsgrad for bokføringer samme dag.

Planlegg parallelt et reservenivå. Hvis den nye applikasjonen svikter eller en prosess er uklar, må teamet vite hvordan de skal fortsette å jobbe og hvordan senere bokføringer kontrolleres. Dette er ikke et tegn på manglende tillit til teknologien, men til profesjonell drift.

Etter to til fire uker dukker de mest verdifulle innsiktene som regel opp. Kanskje mangler ikke en funksjon, men bedre artikkelmerking. Kanskje er arbeidsflyten riktig, men en skannerprofil eller rettighet skaper en flaskehals. Disse observasjonene bør gå inn i korte, kontrollerte forbedringssykluser, i stedet for å utløse et nytt stort prosjekt.

Den beste digitaliseringen gjør ikke lagerhverdagen teoretisk mer moderne, men konkret roligere: mindre søking, mindre manuell avskrift, tydeligere overleveringer, og pålitelig informasjon nettopp når en beslutning venter.

Permalenke →

Sjekkliste for å automatisere lagerarbeidsflyter

Sjekkliste for å automatisere lagerarbeidsflyter

Når en varemottak bekreftes på papir, lagernivåer senere overføres til et regneark, og et spørsmål om forsendelse avklares per telefon, føles hvert enkelt trinn håndterbart. Sammen skaper de imidlertid henvendelser, lagerdifferanser, og avhengighet av enkeltansatte.

En sjekkliste for å automatisere lagerarbeidsflyter forhindrer at denne situasjonen for tidlig vokser til et overdimensjonert programvareprosjekt. Den skiller prosesser som virkelig bør automatiseres fra de der et ryddig regneark fortsatt er tilstrekkelig.

Sjekklisten for lagerautomatisering før prosjektstart

Automatisering starter ikke med å velge et system. Den starter med en verifiserbar beskrivelse av hva som faktisk skjer på lageret — også under unntak, skiftbytter, og tidspress. Gå gjennom følgende punkter direkte på prosessnivå sammen med lagerledelse, forsendelse, innkjøp, og eventuelt regnskap.

1. Registrer bevegelser, ikke bare lagerbeholdning

En gjeldende lagerbeholdning er resultatet av bevegelser. Derfor bør det være tydelig hvilke hendelser øker, reduserer, reserverer, blokkerer, eller overfører lager. Dette inkluderer varemottak, plassering, ordreplukking, forsendelse, returer, kassering, lagerdifferanser, og flyttinger.

Hver bevegelse krever et definitivt svar på fire spørsmål: hvem utfører den? Når bokføres den? Hvilken lagerplass berøres? Hvilket dokument eller hvilken ordre underbygger den? Hvis disse svarene i dag bare finnes i hodet til erfarne medarbeidere, er det en ideell kandidat for automatisering. Målet er ikke mer datainnsamling, men en robust historikk som ethvert lagernivå kan forklares fra.

2. Rydd opp i artikler, varianter, og enheter

Mange prosjekter mislykkes ikke på grunn av skannere eller nettgrensesnitt, men på grunn av stamdata. En artikkel kan kjøpes per kartong, lagres enkeltvis, og selges i sett. Uten definerte omregninger produserer programvaren formelt korrekte, men operativt feilaktige mengder.

Kontroller artikkelnumre for duplikater, etabler bindende beskrivelser, og skill mellom salgsenheter, lagerenheter, og emballasjeenheter. Serienumre, partier, utløpsdatoer, eller farlig gods-klassifiseringer bør bare inkluderes i den første oppbyggingen hvis de påvirker daglige beslutninger eller er lovpålagte. Alt annet øker i utgangspunktet vedlikeholdsbyrden og feiloverflaten.

3. Definer lagerplasser så presist som nødvendig

"Hall 2" kan holde for en lagerliste. For pålitelig ordreplukking er det som regel for grovt. Definer om en plassering refererer til en sone, reol, bay, slot, eller gjennomgangsområde. Karanteneområder, mottakssoner, returområder, og forsendelsesbuffere må også være gjenkjennelige som distinkte plasseringer hvis varer kan befinne seg der.

Riktig detaljnivå avhenger av virksomheten. Et verksted med noen hundre posisjoner trenger ikke strengt tatt fakkforvaltning. Men med flere plukkere per skift kan en presis lagerplass betydelig redusere gangveier og søketider. Ikke automatiser et presisjonsnivå ingen kan vedlikeholde.

4. Etabler utløsere, ansvarlige roller, og godkjenninger

En arbeidsflyt trenger et tydelig startpunkt. Ved varemottak kan dette være leveransen ved dokken, innkjøpsordren i innkjøp, eller skanningen av en følgeseddel. For etterfylling kan et minimumslager utløse et forslag, mens den endelige ordren forblir hos en ansvarlig person.

Dokumenter dessuten hvilke handlinger som kan skje automatisk og hvilke som krever gjennomgang. En manglende mengde bør skape en differanse, ikke stille endre forventet varemottak. Godkjenningstrinn er fornuftige for verdifulle, partihåndterte, eller sikkerhetskritiske artikler. For forbruksvarer ville de unødvendig bremse gjennomstrømningen.

5. Generer dokumenter der de trengs

Følgesedler, plasseringslister, plukklister, forsendelsesetiketter, og overleveringsprotokoller oppstår ofte i ulike applikasjoner. Dette fører til mediebrudd: en adresse kopieres, en ordre krysses av, og forsendelsesstatus oppdateres senere.

Noter datakilde, opprettelsestidsstempel, og mottaker for hvert dokument. En fornuftig arbeidsflyt kan for eksempel automatisk generere en plukkliste etter at en ordre er godkjent, levere en forsendelsesetikett etter pakking, og lukke ordren med et tidsstempel etter overlevering. Det avgjørende er at data ikke lenger trenger å tastes inn manuelt flere ganger.

Kontroller grensesnitt og datakvalitet

Den beste lagerlogikken er nytteløs hvis ordrer bare kommer én gang daglig som en fil, eller hvis leveringsadresser er inkonsekvent formatert. Lag derfor en nøktern liste over systemene som sender eller mottar data: nettbutikk, ERP, regnskap, transportør, leverandørportal, produksjonssystem, og eksisterende regneark.

For hver forbindelse bør det fastslås hvilket system som er autoritativt for hvert datafelt. Hvis artikkelstamdata er autoritativ i ERP-systemet, må ikke lagerportalen stille opprette egne artikler. Hvis en ordreendring kommer fra nettbutikken, må den bli synlig før forsendelse. For lave volumer kan en kontrollert CSV-import være det riktige første steget. For høyt volum eller korte leveringsløfter lønner et direkte grensesnitt seg.

Feilhåndtering er like viktig. Et grensesnitt bør ikke bare overføre data, men også vise hva som ble avvist og hvorfor. Ukjente artikkelnumre, ugyldige adresser, eller manglende mengder må ikke forsvinne i en teknisk loggfil. De krever en arbeidsliste med utpekt ansvar og status.

Utform brukervennlighet på lagergulvet

En prosess som virker plausibel ved et skrivebord, kan mislykkes på lagergulvet. Ansatte bruker hansker, flytter varer, deler enheter, eller jobber med ustabil Wi-Fi-dekning. Kontroller derfor tidlig om skannere, nettbrett, faste arbeidsstasjoner, eller papirutskrifter passer til det respektive arbeidstrinnet.

Skanning bør gi tydelig tilbakemelding: riktig artikkel, feil lagerplass, allerede bokført mengde, eller blokkert artikkel. Bare farger er ikke nok. Korte, forståelige meldinger og et tydelig neste steg er mer verdifullt under tidspress enn et funksjonsrikt grensesnitt.

Planlegg også for unntak. Hva skjer ved en skadet strekkode, nettverksbrudd, delleveranse, eller oppdaget utildelt vare? En god arbeidsflyt tilbyr kontrollerte veier for dette og logger korrigeringen. Den tvinger ikke team til å stole på gule lapper og senere batch-bokføringer.

Definer måltall før dere bygger dashbord

Et dashbord er ikke et mål. Relevante måltall er de som utløser en operativ beslutning. Dette kan inkludere åpne varemottak som overskrider en definert alder, ordrer nær sin forsendelsesfrist, lagerdifferanser per lagersone, plukkfeil, eller tiden fra ordremottak til overlevering.

Definer datakilde, beregningsregel, og ansvarlig rolle for hvert måltall. "Lagernøyaktighet" er for eksempel bare meningsfullt når det er klart hvilken telling den måles mot og hvordan returer eller blokkert lager håndteres. Noen få pålitelige måltall er bedre enn en vegg av diagrammer som ingen stoler på.

Planlegg sikkerhet, rettigheter, og sporbarhet

Automatisering fordeler handlingskraft. Hvem som får endre lager, opprette artikler, generere forsendelsesetiketter, eller kansellere ordrer bør bevisst fastsettes. Rollebaserte rettigheter er som regel mer fornuftige enn en delt innlogging på lager-PC-en. Spesielt kritiske korrigeringer krever et tidsstempel, en persontildeling, og helst en årsak.

Tekniske grunnleggende elementer hører også hjemme på sjekklisten: regelmessige sikkerhetskopier, testet gjenoppretting, dokumenterte tilgangsopplysninger, logging av grensesnittfeil, og en prosedyre for blokkerte eller deaktiverte brukerkontoer. I en skreddersydd applikasjon er vedlikeholdbare teknologier, en ren databasestruktur, og sporbare driftsettingssteg ikke bagateller. De avgjør om endringer forblir håndterbare etter to år.

Gjennomfør i små, målbare steg

Ikke prøv å omgjøre varemottak, etterfylling, lagertelling, forsendelse, og ruteplanlegging samtidig. Velg en arbeidsflyt med merkbar friksjon og håndterbar risiko, som mobil bokføring av varemottak eller automatisk generering av forsendelsesdokumenter. Registrer behandlingstid, korrigeringer, og åpne saker før dere starter.

Test med reelle artikler, reelle ordrer, og de ansatte som faktisk skal jobbe med dem. En pilot med én lagersone eller produktgruppe viser raskere enn en workshop om beskrivelser, skanningsflyter, og godkjenninger fungerer. Først når unntakene er mestret bør neste prosess følge.

Automatisering lykkes når team trenger å stille færre spørsmål, lager forblir forklarbart, og prosessen fungerer selv når den mest erfarne personen er på ferie. Nettopp der lønner den neste forbedringen seg: ikke med det mest bråkete verktøyet, men med friksjonen som virkelig bremser arbeidsdagen.

Permalenke →

Forbedre lastetiden på mobile nettsider

Forbedre lastetiden på mobile nettsider

Når en lagermobil med dårlig dekning brukes til å besøke et nettsted, er det ikke animasjonen i hero-seksjonen som avgjør førsteinntrykket, men om siden i det hele tatt blir interaktiv. Hvis en potensiell kunde venter tre, fire eller fem sekunder på innhold, er alternativet bare en tilbake-knapp unna. Å forbedre mobile nettsiders lastetider krever en sporbar teknisk rekkefølge, ikke kosmetiske enkelttiltak.

Dette gjelder spesielt nettsteder som skal generere henvendelser: for en produsent, en logistikkleverandør eller en bedrift med forklaringstrengende tjenester. Mobile brukere besøker ofte sider mellom avtaler, på lagergulvet, eller via et søk med konkret hensikt. Nettstedet må da levere informasjon, ikke først forårsake tung prosessering på enheten.

Hvorfor mobil lastehastighet er et driftsproblem

Mobilytelse behandles ofte strengt som en SEO-disiplin. Det er utilstrekkelig. Raske sider hjelper riktignok synlighet og kampanjekostnader, men den umiddelbare effekten ligger i faktisk bruk: skjemaer sendes oftere inn, telefonnumre tastes oftere, og produktinformasjon leses grundigere. Et treigt nettsted skaper derimot tvil allerede før en kontaktperson rekker å svare.

"Rask" er ikke ett enkelt måltall. En side kan vise en bakgrunn tidlig og likevel forbli uresponsiv for klikk lenge. For besøkende teller tre ting: når vises det viktigste innholdet? Når kan siden brukes uten forsinkelse? Og hopper layouten fortsatt mens de prøver å trykke på en knapp? Disse spørsmålene gjenspeiles i måltall som Largest Contentful Paint, Interaction to Next Paint og Cumulative Layout Shift.

Målinger må skje under realistiske forhold. En kraftig kontor-PC på Wi-Fi skjuler problemer som blir tydelige på en eldre Android-enhet på mobilnett. Plassering, mellomliggende tjenester og en allerede fylt nettleser-cache endrer også resultatene. Gjentatte målinger og ekte brukerdata teller derfor mye mer enn én perfekt testkjøring.

Forbedre mobile nettsiders lastetider: mål først, endre deretter

Den vanligste feilen er å umiddelbart komprimere bilder eller installere enda et optimaliseringsplugin. Begge deler kan hjelpe, men uten årsaksanalyse oppstår raskt vanskelig vedlikeholdbare konfigurasjoner. Sjekk først et representativt utvalg: forsiden, en typisk tjeneste- eller produktside, kontaktsiden og en høytrafikkert landingsside. På disse sidene blir mønstre synlige.

Nettverksloggen avslører hvilke filer som blokkerer oppstarten og hvor store de faktisk er. En ytelsesrevisjon viser om JavaScript forsinker bruken, om skrifttyper kommer for sent, eller om bilder lastes unødvendig tidlig. Suppler labmålinger med data fra ekte besøkende hvis trafikken tillater det. Slik unngår du å optimalisere for en testprofil som ikke gjenspeiler din faktiske målgruppe.

Sett et klart mål før hver endring. For eksempel: det synlige hovedinnholdet bør vises på en gjennomsnittlig mobilenhet på under 2,5 sekunder, eller kontaktskjemaet bør være brukbart uten inntastingsforsinkelse. Ikke hver side trenger en teoretisk toppscore. En kompleks applikasjon med autentiserte data har andre forutsetninger enn et offentlig bedriftsnettsted. Kjedelig, dokumenterbar pålitelighet er her mer verdifull enn en kortsiktig score oppnådd med risikable triks.

1. Behandle bilder etter deres oppgave

På mange mobile sider forblir bilder den største datablokken. Problemet er ikke bildet i seg selv, men et bilde som overføres i 2500 piksler bredde når enheten bare trenger 700 piksler. Tilby responsive bildevarianter slik at nettleseren kan velge riktig størrelse. Moderne formater som WebP eller AVIF reduserer ofte filstørrelsen betydelig, men bør implementeres med rene reserveløsninger og kontrollert bildekvalitet.

Det største bildet i det synlige startvinduet fortjener spesiell oppmerksomhet. Det bør være riktig beskåret, ha en passende oppløsning og lastes tidlig. Bilder lenger ned på siden kan lastes forsinket. Det sparer data ved inngang, men må ikke føre til at bilder synlig etterlastes ved rulling når brukeren allerede forventer dem.

Ikke fjern alle bilder refleksmessig. Et godt bilde kan forklare en maskin, et team eller en prosess raskere enn et tekstavsnitt. Den tekniske oppgaven er: å levere relevant visuell informasjon effektivt, ikke redusere design til grå plassholderbokser.

2. Begrens JavaScript til nødvendig arbeid

Hvert skript konkurrerer om prosesseringstid ved lasting og bruk. Spesielt problematiske er sjablongmessig inkluderte biblioteker, taggbehandlere med mange tredjepartsskript, chat-widgeter, kart og animasjoner. På stasjonære enheter forblir disse kostnadene ofte upåaktet. På mobil resulterer de i en side som er synlig, men reagerer trått på inndata.

Kontroller for hvert skript dets formål, lastebetingelse og forretningsverdi. Et interaktivt kart på kontaktsiden trenger ikke å lastes på hver underside. Et cookie- eller analyseverktøy bør ikke utløse en kjede av ytterligere filer før den besøkende i det hele tatt kan lese innholdet. Funksjoner som bare trengs etter interaksjon, kan også lastes da.

For skreddersydde nettsteder er en tydelig komponentstruktur en reell fordel. JavaScript samles per funksjon i stedet for å leveres som en global pakke. Dette forenkler også senere vedlikehold: den som utvider et skjema, endrer ikke ved et uhell koden for et produktfilter eller en navigasjon.

3. Lever CSS og skrifttyper uten blokkeringer

En vanlig flaskehals ligger i det første synlige området. Hvis flere stilark, ikonfonter og eksterne skriftvarianter må lastes for det, venter nettleseren unødvendig lenge. Kritiske stiler for det synlige området bør være små og tilgjengelige tidlig. Ikke-kritiske regler kan følge senere.

For nettfonter holder det vanligvis med noen få vekter. Fire vekter i normal, kursiv og ekstra delsett virker komplette i et designsystem, men trengs sjelden for et typisk bedriftsnettsted. Definer fornuftige systemreserveløsninger slik at tekst forblir lesbar umiddelbart. En skrifttype som bytter rent noen millisekunder senere, er bedre enn tomme tekstblokker.

Også ikoner fortjener en gjennomgang. Et lite SVG-sett er ofte mer effektivt og presist styrbart enn en komplett ikonfont. Denne regelen tillater unntak: eksisterende systemer trenger ikke bygges om bare for noen få kilobyte. Men hvis større endringer uansett er planlagt, hører denne avgjørelsen hjemme i det tekniske grunnlaget.

4. Sett opp caching og serverrespons ryddig

Selv et slankt grensesnitt føles treigt hvis serveren bruker for lang tid på det første svaret. Årsaker spenner fra ubremsede databasespørringer, via dynamisk sammensatte sider, til manglende caching. Offentlig innhold som sjelden endres, bør kunne leveres raskt som en bufret versjon. Statiske filer som bilder, CSS og JavaScript trenger entydige versjonsnavn og fornuftige cache-regler.

For PHP-applikasjoner handler det i tillegg om effektiv utførelse, en korrekt konfigurert opcode-cache og kontrollert databasetilgang. MySQL-spørringer trenger indekser som matcher de faktiske filtrerings- og sorteringsveiene. En forside som utfører flere unødvendige dataspørringer ved hvert kall, blir ikke bedre etter hvert som trafikken vokser.

Caching er imidlertid ikke et blankofullmakt. Priser, tilgjengelighet, personaliserte seksjoner eller innhold etter innlogging må aldri ved en feil virke utdaterte. Derfor defineres cachegrenser presist: hva kan være fem minutter gammelt, hva må være umiddelbart oppdatert, og hvem tømmer cachen etter en innholdsendring? God ytelse oppstår fra denne presisjonen.

5. Behandle tredjepartsleverandører kritisk

Eksterne tjenester er ofte den usynlige ballasten på et nettsted. Analyse, samtykkehåndtering, videoer, kart, anmeldelseswidgeter og markedsføringspiksler laster ytterligere skript fra ytterligere servere. Hver avhengighet kan forårsake forsinkelser, reise personvernspørsmål og svekke visningen ved feil.

Det betyr ikke at hvert eksterne verktøy må fjernes. En video kan støtte salg, et analyseverktøy kan underbygge viktige beslutninger. Men det trengs en kost-nytte-analyse. Last inn innebygde medier først etter samtykke eller interaksjon. Bruk i første omgang en plassholder for kart. Og fjern til slutt tagger hvis resultater ingen har evaluert på flere måneder.

6. Ta hensyn til layouthopp og mobil brukervennlighet

Lastetid og brukervennlighet hører sammen. Reserver faste dimensjoner for bilder, bannere og innebygde elementer slik at knapper ikke hopper unna under brukerens finger. Unngå popup-vinduer som dekker synlig innhold rett ved inngang. En rask side som umiddelbart viser et vanskelig lukkbart overlegg, løser ikke grunnproblemet.

Test skjemaer med ekstra omhu. Store inndatafelt, passende tastaturtyper og korte obligatoriske strekninger hjelper mer enn en omfattende visuell effekt. Hvis en henvendelse bare trenger navn, tilbakeringingsnummer og emne, er et skjema i tolv deler ikke et tegn på grundighet — det er friksjon.
7. Led ytelse som en permanent driftsprosess

En engangslansering holder ikke lastetiden lav permanent. Nye kampanjebilder, sporingskrav og redaksjonelle moduler summerer seg over tid. Derfor hører ytelsesbudsjetter hjemme i utviklingsprosessen: en maksimal størrelse for inngangsbilder, tydelige regler for nye tredjepartsverktøy og definerte grenseverdier for JavaScript.

Etter utgivelser bør de viktigste sidetypene vurderes på nytt. Automatiserte tester kan da fastslå om sentrale sider forblir tilgjengelige og kritiske arbeidsflyter fungerer. For ytelse er imidlertid en ren funksjonstest ikke tilstrekkelig. Suppler den med målinger av responstid, overført datamengde og mobil interaktivitet.

Et raskt mobilt nettsted oppstår ikke gjennom ett enkelt plugin, og heller ikke gjennom avkall for enhver pris. Det oppstår når design, innhold, infrastruktur og reell bruk vurderes sammen. Start med siden som genererer henvendelser eller operative kontakter, mål under ærlige forhold, og fjern friksjon nøyaktig der brukerne faktisk merker den.

Permalenke →

Logistikkprogramvare som virkelig avlaster driften

Logistikkprogramvare som virkelig avlaster driften

Når en varemottak først noteres på papir, senere overføres til et regneark, og til slutt formidles til forsendelse muntlig, er det sjelden medarbeidernes innsats som mangler. Det som mangler er et delt, pålitelig arbeidsgrunnlag. God logistikkprogramvare erstatter ikke disse bruddene med mer skjermarbeid, men med tydelige arbeidsflyter: hva har kommet inn, hvor befinner det seg, hva er reservert, og hva kan sendes i dag?

For små og mellomstore bedrifter er det ikke den lengst mulige funksjonslisten som teller. Det avgjørende er at programvaren gjenspeiler det faktiske arbeidet på lagergulvet, på kontoret og ved forsendelse. En løsning ment for et globalt konsern med tjue lokasjoner kan være unødvendig treg, dyr, og komplisert for en virksomhet med ett lager og to skift.

Når logistikkprogramvare virkelig gir mening

Regneark er ikke i seg selv et problem. For lave volumer, en oversiktlig artikkelstamliste, og én ansvarlig medarbeider kan de være den mest pragmatiske løsningen. Det ville være feil å erstatte en fungerende prosess med et prosjekt bare for moderniseringens skyld. Vendepunktet kommer når informasjon må vedlikeholdes flere steder eller ingen med sikkerhet kan si hvilken fil som er oppdatert. Typiske signaler er lagermangel til tross for fulle hyller, forespørsler om leveringsstatus, håndskrevne følgesedler, og varetellinger som stanser driften i flere dager. Voksende ordreantall gjør også synlig hvilke trinn som tidligere bare ble holdt sammen av enkeltpersoners erfaring.

Da handler det ikke primært om digitalisering som moteord. Det handler om feilkilder og ventetider. En medarbeider bør ikke måtte sammenligne flere lister bare for å godkjenne en ordre. Forsendelse bør ikke måtte gjette om en artikkel faktisk er tilgjengelig eller allerede reservert for en annen ordre.

Hvilke prosesser logistikkprogramvare bør koble sammen

En brukbar løsning starter med materialflyten, ikke med en standardmeny. For mange virksomheter omfatter denne flyten varemottak, plassering, lagerstyring, ordreplukking, forsendelse, og tilbakemelding. Avhengig av virksomheten kommer partier, serienumre, returer, produksjonsordrer, eller ruteplanlegging i tillegg.

Varemottak med sporbare lagre

Mye avgjøres ved varemottak. Hvis en leveranse sjekkes direkte mot en ordre eller følgeseddel, kan mengdeavvik, skadet gods, og manglende posisjoner registreres nøyaktig der de oppstår. Varene får en status i stedet for bare å bli fysisk plassert et sted.

Programvaren trenger ikke nødvendigvis starte med dyr skannermaskinvare. På noen lagre er et nettbrett eller en arbeidsstasjon ved varemottaket tilstrekkelig for å komme i gang. Der mange posisjoner flyttes daglig, er strekkodelesere imidlertid fornuftige fordi de fremskynder bokføringer og reduserer tastefeil. Riktig beslutning avhenger av volumer, ruter, og artikkelstruktur.

Lagerbevegelser uten en minnelogg

Lagre er bare robuste hvis mottak, flyttinger, uttak, og korrigeringer er sporbare. Det betyr ikke at hvert unntak må forhindres. I den daglige driften finnes skadet emballasje, feil plassering, og spontane materialuttak. En god applikasjon gjør disse tilfellene bokførbare, men dokumenterer også hvem som endret hva og når.

Denne historikken er ikke et kontrollinstrument for sin egen skyld. Den hjelper med å finne årsaker. Hvis en artikkel gjentatte ganger havner på feil lagerplass, kan lagermerkingen være uklar. Hvis regelmessige korrigeringer skjer, ligger problemet ofte i prosessen før bokføringen.

Ordrer, følgesedler, og forsendelse fra én arbeidsflyt

Mange team taper tid i grensesnittet mellom ordrebehandling og forsendelse. Ordredata kommer via e-post, telefon, eller fra et separat nettbutikksystem. Deretter skrives posisjoner ut, lagre kontrolleres, og forsendelsesdokumenter registreres på nytt. Hver manuelle overføring skaper rom for avvik.

Logistikkprogramvare bør kunne generere en tydelig plukkliste, en følgeseddel, og om nødvendig en forsendelsesetikett fra en godkjent ordre. Rekkefølgen er viktig her: først må det være klart hva som er leverbart. Deretter bør ordren reserveres for andre prosesser. Ellers oppstår den ubehagelige situasjonen der to medarbeidere tildeler samme gjenværende lager.

Planlegging som samsvarer med virkeligheten

Ruteplanlegging og kapasitetskontroll kan være verdifullt, spesielt med egne leveranser, faste tidsvinduer, eller mange regionale stopp. De er imidlertid ikke automatisk det neste fornuftige steget. Den som ennå ikke har ren ordregodkjenning og pålitelige lagerdata, bør løse disse grunnlagene først.

Det samme gjelder for prognoser og AI-støttet planlegging. De kan gjøre mønstre synlige, men krever rene inndata. En prognose basert på ufullstendig lager ser teknisk sofistikert ut, men forbedrer ikke leveringsevnen.

Standardløsning eller skreddersydd logistikkprogramvare?

Standardprogramvare er fornuftig når egne arbeidsflyter i stor grad er konvensjonelle og kan tilpasses uten stor friksjon. Den kan innføres raskere og bringer med seg utprøvde kjernefunksjoner. For en virksomhet med enkle lagerprosesser, tydelige roller, og få særegenheter er det ofte det økonomisk riktige valget.
Skreddersydd logistikkprogramvare er verdt det når virksomheten lever av spesielle arbeidsflyter eller eksisterende systemer bare kan kobles via omveier. Dette gjelder for eksempel verksteder med materialproblemer for pågående ordrer, forhandlere med kundespesifikke forsendelsesregler, eller produsenter som må koble lagerbevegelser tett til produksjonstrinn.

Forskjellen ligger ikke i å finne opp alt på nytt. Gode skreddersydde systemer tar i bruk utprøvde mønstre som statusendringer, reservasjoner, og rettigheter. De tilpasser imidlertid språk, skjermbilder, dokumenter, og grensesnitt til arbeidet som faktisk utføres. Slik trenger ikke teamet å forholde seg permanent til kategorier som bare gir mening i produsentens håndbok.

Hos softify.pro starter derfor et slikt prosjekt med spørsmålet om hvilke arbeidsflyter som bør bevares. Ikke hver papirlapp er en feil, og ikke hver spesialregel gir mening. Først når det er klart hvor informasjon går tapt eller beslutninger venter unødvendig, kan en gjennomførbar løsning planlegges.

En utrulling uten driftsavbrudd

Den største risikoen ligger sjelden bare i programkoden. Den ligger i en implementering som vil endre for mye på én gang. Et lager kan ikke stanse i to uker for å lære et nytt system. Derfor er en trinnvis utrulling som regel mer fornuftig enn en stor overgangsdato.

En god første del fokuserer på en avgrenset arbeidsflyt, for eksempel varemottak og lagerbokføringer eller opprettelse av følgesedler. Teamet jobber med reelle data, tilbakemeldinger flyter direkte inn i tilpasningen, og nytten blir målbar. Først deretter følger flere områder, som mobil plukking, returer, eller koblinger til nettbutikker og transportører.

Datamigrering fortjener spesiell oppmerksomhet her. Gamle artikkelnumre, dupliserte kundestamdata, og inkonsekvente lagerplasser forsvinner ikke automatisk bare fordi et nytt system innføres. Det er ofte bedre å bevisst rydde opp i stamdata og bare ta over relevant historikk. Dette sparer senere søking og forhindrer at gammel uorden blir teknisk bevart.

Rettigheter hører også tidlig hjemme på agendaen. Ikke alle medarbeidere trenger tilgang til priser, alle lagerkorrigeringer, eller stamdatavedlikehold. Tydelige roller beskytter mot utilsiktede endringer og gjør ansvar synlig uten å blokkere arbeidsflyten med unødvendige godkjenninger.

Teknologi som ikke blir en byrde etter lansering

En logistikkapplikasjon må reagere raskt i den daglige driften, selv om flere arbeidsstasjoner bokfører samtidig. Til dette trengs en sporbar dataarkitektur, rene transaksjoner, og tydelige regler for parallelle endringer. Hvis to medarbeidere behandler samme lager, må ikke systemet generere stille feilaktige bokføringer.

Vedlikeholdbarhet er like viktig. Teknologier som PHP 8.4, moderne JavaScript, og MySQL 8 er ikke et salgsargument i seg selv. De er fornuftige når applikasjonen forblir forståelig på lang sikt, mottar sikkerhetsoppdateringer, og kan videreføres av kvalifiserte utviklere. Dokumentert provisjonering, sikkerhetskopier, logging, og en realistisk håndtering av oppdateringer er del av den operative evnen.

God logistikkprogramvare gjenkjennes derfor ikke på en spesielt polert demo. Den viser seg en vanlig tirsdag morgen: leveransen bokføres, lageret stemmer, ordren er sporbar, følgeseddelen matcher, og neste skift vet hva som allerede er gjort. Avlastningen oppstår nettopp der — ikke gjennom flest mulig funksjoner, men gjennom pålitelige arbeidsflyter som passer virksomheten.

Permalenke →

Planlegge en MySQL-database for nettapplikasjoner

Planlegge en MySQL-database for nettapplikasjoner

Når tre ansatte bestiller varer parallelt om morgenen, en kunde sjekker leveringsstatus, og administrasjonen lager en faktura, vises ikke kvaliteten til en applikasjon i designet. Den vises i om alle ser nøyaktig samme, korrekte datastatus. Å planlegge en MySQL-database for en nettapplikasjon betyr derfor ikke å lage tabeller så raskt som mulig. Det betyr å forstå reelle arbeidsflyter presist nok til å sikre at data forblir pålitelige selv under belastning, ved feil, og etter hvert som virksomheten vokser.

Spesielt i interne plattformer, lager- og ordreprosesser, eller kundevendte portaler, blir databasen ofte håndtert for sent. Først bygges grensesnittet, deretter legges felt til, fulgt av unntak. Det fungerer for en prototype. I drift resulterer dette i duplikerte datasett, uklare tilstander, og rapporter ingen lenger stoler helt på.

Planlegge en MySQL-database for nettapplikasjoner: start med arbeidsflyten

Det første utkastet bør ikke starte med kolonnenavn, men med en konkret arbeidssituasjon. Ta varemottak: en leveranse ankommer, tildeles en leverandør og en ordre, mengder kontrolleres, en lagerplass tildeles, og lageret endres. Avhengig av operasjonen krever denne prosessen i tillegg bilder, en kvalitetskontroll, en sperrestatus, eller en sporbar korreksjon. Fra denne arbeidsflyten vokser de funksjonelle objektene frem. Typiske eksempler er artikler, leverandører, ordrer, posisjoner, lagerplasser, lagerbevegelser, og brukere.

Skillet mellom et objekt og en hendelse er avgjørende. En artikkel beskriver hva noe er. En lagerbevegelse dokumenterer at en mengde endret seg på et bestemt sted på et bestemt tidspunkt. Å blande begge i én tabell fører raskt til tap av sporbarhet.

Noen vanskelige spørsmål hjelper for hvert objekt: hva er den unike identiteten? Hvilken informasjon kan endres? Hvem kan endre den? Hvilke data må bevares historisk? Og hvilke regler gjelder når to personer jobber samtidig? Disse spørsmålene forhindrer senere improvisasjon bedre enn en lang liste med angivelig komplette databasefelt.

Datamodellen bør uttrykke regler

En database er ikke bare lagring for skjemainndata. Den bør selv håndheve sentrale regler. Hvis hver lagerbevegelse må tilhøre nøyaktig én artikkel og én lagerplass, hører fremmednøkler hjemme i modellen. Hvis et eksternt ordrenummer bare kan forekomme én gang per tenant, kreves en unik indeks. Hvis en posisjon aldri bør eksistere uten en hovedordre, må denne relasjonen modelleres tydelig.

MySQL 8 med InnoDB gir et solid grunnlag for dette: transaksjoner, fremmednøkler, låsemekanismer, og konsistente endringer på tvers av flere tabeller. Ved skriving av en bevegelse, gjeldende lager, og inspeksjonslogg under en varemottaksbokføring bør dette skje som én sammenhengende transaksjon. Hvis ett trinn feiler, skal ingen halvferdig operasjon bli stående.

Men ikke alle regler hører hjemme i databasen. Godkjenninger, kompleks prislogikk, eller rolleavhengige prosesstrinn plasseres ofte bedre i applikasjonslogikken fordi de endres raskere funksjonelt. Grensen er pragmatisk: regler hvis brudd permanent skader data bør sikres så nært dataene som mulig. Regler som endres ofte eller er sterkt avhengige av konteksten, krever godt testet applikasjonskode.

Ikke forveksle historikk med gjeldende verdier

En vanlig feil er å bare lagre gjeldende lager eller gjeldende status. Det holder til noen spør hvorfor mengden endret seg i går eller hvem som tilbakestilte en ordre. For operative systemer er en historikk over bevegelser eller hendelser ofte mer verdifull enn ett enkelt overskrivbart felt.

Dette betyr ikke at hver klikkbevegelse må logges permanent. Forretningsrelevante endringer bør logges: statusendringer, mengdejusteringer, korreksjoner, godkjenninger, og tildelinger. En god revisjonspost inneholder et tidsstempel, brukeren eller systemprosessen, forrige og ny verdi, og en forståelig begrunnelse når arbeidsflyten krever det. Dette gjør det mulig å avklare feil uten å måtte lete gjennom e-poster, papirlister, eller databasebackuper.

Velg nøkler, datatyper, og navnekonvensjoner bevisst

Tekniske beslutninger virker små, men former vedlikehold og integrasjoner i årevis. For interne primærnøkler er BIGINT-verdier med automatisk tildeling ofte et nøkternt, lett håndterbart valg. UUID-er kan være fornuftige når data oppstår offline, flere systemer skriver uavhengig, eller eksterne grensesnitt ikke bør eksponere sekvensielle ID-er. De koster imidlertid mer lagringsplass og krever litt mer oppmerksomhet med indekser og sortering.

Pengebeløp bør lagres som DECIMAL, ikke FLOAT eller DOUBLE. Mengder trenger også en funksjonelt passende presisjon: artikkelantall er ofte heltall, mens vekter og lengder ikke er det. Tidsstempler bør håndteres enhetlig, helst internt i UTC, mens grensesnittet viser den lokale tidssonen for operasjonen. Spesielt ved skiftbytter og sommertid forhindrer dette vanskelig oppdagbare avvik.

Navn bør også være kjedelige og entydige. order_items eller inventory_movements er mer nyttige enn kreative forkortelser som bare det opprinnelige prosjektteamet forstår. Konsekvente entalls- eller flertallsformer er mindre viktige enn konsistens i seg selv. Like fornuftige er felt som created_at, updated_at, og, ved behov, deleted_at. En myk sletting er likevel ikke en standardforpliktelse. For juridisk eller operativt relevante poster er en ren kansellering vanligvis bedre enn et usynlig slettet datasett.

Indekser følger faktiske spørringer, ikke gjetning

En indeks kan akselerere et søk massivt, men gjør skriveoperasjoner mer komplekse og bruker lagringsplass. Derfor er "en indeks på hvert felt" ingen strategi. De viktigste spørringene bør etableres tidlig: åpne ordrer for en kunde, bevegelser for en artikkel innenfor en periode, lager per lagerplass, eller nylig endrede poster for et grensesnitt.

Rekkefølgen på sammensatte indekser har betydning her. Hvis applikasjonen regelmessig søker etter tenant_id, status, og created_at, er en sammensatt indeks i nettopp denne rekkefølgen ofte fornuftig. Om den faktisk passer, vises av utførelsesplanen via EXPLAIN, ikke av magefølelse. Databaser blir ikke raske av spektakulære triks, men av observerbare spørringer, matchende indekser, og realistisk testede datavolumer.

For voksende tabeller lønner det seg med en tydelig oppbevaringsstrategi. Må tekniske logger ligge i den primære produksjonsdatabasen i fem år? Ikke nødvendigvis. Forretningsposter, bevegelser, og inspeksjonsbevis krever andre oppbevaringsperioder enn feilsøkingsinformasjon. Arkivering er ikke et tegn på et svakt system, men en bevisst driftsbeslutning.

Flerbrukerdrift krever transaksjoner og tydelige tilstander

I en nettapplikasjon får flere forespørsler tilgang til de samme dataene samtidig. Dette er normalt i daglig lagerdrift, ikke et unntak. To ansatte kan bestille det samme lageret mens en import lager nye ordrer. Uten transaksjoner og målrettet låsing er det risiko for tapte endringer eller negative lagerbeholdninger som først blir synlige uker senere.

For kritiske operasjoner bør det være tydelig hvilke data som leses og skrives innenfor en transaksjon. Noen ganger er en atomær oppdatering tilstrekkelig, som lager som bare endres hvis tilgjengelig mengde er nok. I andre tilfeller er en radlås fornuftig, slik at en operasjon kan kontrollere datatilstanden på en kontrollert måte og endre den etterpå. Lange transaksjoner er derimot problematiske: de blokkerer annet arbeid og øker risikoen for konflikter.

Like viktig er et begrenset sett med funksjonelle tilstander. En ordre bør ikke være "åpen," "delvis levert," og "manuelt behandlet" samtidig på grunn av vedlikehold av motstridende felt. Definerte statusoverganger forenkler grensesnitt, rapporter, og automatiseringer. Unntak kan tillates, men bør navngis og dokumenteres.

Planlegg sikkerhet, tenanter, og drift fra begynnelsen

Applikasjonen bør bruke en dedikert databasebruker for MySQL med minimale rettigheter. Skrivetilgang for nettapplikasjonen betyr ikke at denne brukeren trenger å kunne slette tabeller eller endre brukerrettigheter. Administrative kontoer hører ikke hjemme i produksjonskonfigurasjonsfiler og aldri i et repositorium.

Når flere kunder, steder, eller selskaper jobber innenfor én applikasjon, er tenant-isolasjon en arkitektonisk beslutning, ikke en filterbetingelse lagt til i ettertid. En delt database med en tenant_id kan være effektiv og lett å vedlikeholde, men krever konsistente kontroller i hver spørring og tydelige regler for indekser. Separate databaser gir sterkere isolasjon, men øker innsatsen ved oppdateringer, evalueringer, og drift. Hvilken variant som passer, avhenger av personvernkrav, datavolum, og forretningsmodell.

Sikkerhetskopier er bare sikkerhetskopier når en gjenoppretting er testet. En fastsatt rytme for sikkerhetskopiering, oppbevaring, og gjenoppretting er nødvendig. Likeledes hører overvåking av lagringsplass, trege spørringer, og mislykkede jobber, sammen med dokumenterte oppdateringer, til systemet. MySQL 8, PHP 8.4, og moderne nettapplikasjoner kan driftes godt på lang sikt hvis avhengigheter, tilgangsopplysninger, og utrullingstrinn ikke bare finnes i hodet til én utvikler.

En fornuftig plan før den første dagen i produksjon

Før implementering bør det finnes en kompakt datamodell med eksempelarbeidsflyter. Dette inkluderer nøkkeltabeller og relasjoner, statusregler, rettigheter, forventede spørringer, grensesnitt, og et konsept for sikkerhetskopier og revisjonslogger. Denne planen trenger ikke å være hundre sider lang. Den må fange opp beslutninger som senere ville vært kostbare å rette opp.

Hos softify.pro starter databaseplanlegging derfor med menneskene som bestiller, kontrollerer, plukker, eller løser unntak. Hvis et eksisterende regneark pålitelig kartlegger en håndterbar prosess, kan det forbli den riktige løsningen. Hvis flere personer jobber samtidig, poster oppstår, og feil må være sporbare, fortjener databasen derimot samme planleggingsinnsats som grensesnittet. Den beste arkitekturen er til syvende og sist den som forenkler arbeidsdagen og som fortsatt kan endres transparent om to år.

Permalenke →

Mål Warehouse Automation Results riktig

Mål Warehouse Automation Results riktig

Et nytt skannegrensesnitt kan virke imponerende den første dagen. Etter tre uker viser det seg imidlertid om det virkelig fremskynder varemottaket eller bare skaper et ekstra arbeidstrinn. Warehouse automation results er derfor ikke et enkelt måltall, og heller ikke et skjermbilde fra en produktdemo. De viser seg der et lagerteam må søke, spørre, ombooke og korrigere mindre — mens kvaliteten opprettholdes eller forbedres.

For små og mellomstore bedrifter er dette skillet spesielt relevant. Store enterprise-pakker lover ofte omfattende optimalisering, men krever lange innføringer, stive prosesser og mye vedlikehold. Et fornuftig automatiseringssteg kan gjerne starte mindre: nøyaktig der informasjon i dag går tapt eller beslutninger venter unødvendig.

Hvilke Warehouse Automation Results som faktisk teller

Mange prosjekter starter med et teknisk spørsmål: strekkodeleser, mobilapp, koblet til nettbutikken eller automatiske etiketter? Det bedre utgangsspørsmålet er: hvilken flaskehals koster merkbart tid, penger eller pålitelighet per skift?

Svaret ligger sjelden i antallet innførte enheter. Meningsfulle resultater kan måles i det daglige arbeidet. Ved varemottak teller for eksempel tiden mellom levering og tilgjengelig bokført lager. Ved plukking er tiden fra ordre til forsendelsesklar relevant. Ved varetelling er det ikke bare varigheten som avgjør, men først og fremst forskjellen mellom systemlager og faktisk lager.

Like viktige er måltall som mange virksomheter ikke registrerer ordentlig: hvor mange henvendelser oppstår fordi en lagerplass er uklar? Hvor ofte må en følgeseddel korrigeres? Hvor mange ordrer blir liggende fordi bare én person kjenner statusen utenat eller i et privat regneark? Nettopp dette stille etterarbeidet forsvinner fra klassiske produktivitetsrapporter, men belaster skiftledere, planlegging og kundeservice tungt. Et godt målbilde kombinerer fart og kontroll. Blir ordrer håndtert raskere mens feilaktige bokføringer øker, er ikke det fremgang. Blir lagerbeholdningen mer nøyaktig, men varemottaket stanser opp, må prosessen utformes på nytt. Automatisering lykkes når den forbedrer arbeidsflyten uten å svekke den operative oversikten.

Fra opplevd lettelse til verifiserbare data

Medarbeidernes erfaring er en verdifull indikator. Når noen sier etter to uker at de ikke lenger må løpe til kontoret for hver innlagring, betyr det noe. For investeringsbeslutninger trengs likevel en sammenligning som ikke avhenger av dagsformen. Før oppstart bør derfor noen utgangsverdier registreres: gjennomsnittlig behandlingstid, antall åpne avklaringssaker, korrigeringsposteringer, søketider, forsendelsesfeil og lagernøyaktighet. Tjue måltall er ikke nødvendig; ofte holder det med fire til seks verdier som passer det konkrete problemet.

Etter utrullingen bør de samme verdiene observeres over flere uker. Enkelte toppdager villeder lett. Sesongvariasjoner, sykdom, nye medarbeidere eller en uvanlig stor ordre påvirker resultatene. Først en sammenligning over normale skift viser om endringen er solid.

Den viktigste effekten: en felles prosesstilstand

På mange lagre er den egentlige svakheten ikke manglende arbeidsvilje, men en fragmentert informasjonstilstand. Varemottaket kjenner leveransen, planleggingen kjenner kundeordren, og forsendelsen kjenner prioriteten — men ikke alle jobber med den samme oppdaterte informasjonen.

Et arbeidsflytspesifikt system kan lukke dette gapet. En leveranse registreres ved ankomst, avvik dokumenteres direkte, lageret får en tydelig status, og neste steg blir synlig. Data trenger ikke lenger først noteres på papir, overføres senere og deretter bekreftes per telefon.

Dette reduserer ikke bare gangavstander. Det reduserer beslutninger basert på utdatert informasjon. En forsendelsesmedarbeider ser om en ordre virkelig er plukkbar. Administrasjonen ser om varer faktisk har kommet inn eller bare er varslet. Ledelsen får ikke et pyntet øyeblikksbilde, men et sporbart grunnlag.

For team med roterende skift er denne effekten ofte mer verdifull enn en spektakulær tidsbesparelse. Prosessen blir mindre avhengig av enkeltpersoner. Kunnskap blir ikke sittende fast i notatbøker, chattehistorikk eller den mest erfarne medarbeiderens hukommelse.

Hvorfor ikke all automatisering gir gode resultater

Automatisering forsterker prosesser. Det er nyttig når forløpet er tydelig. Det er problematisk når et uklart forløp bare gjengis raskere.

Et typisk eksempel er obligatorisk skannebokføring for hvert minste håndgrep. Hvis medarbeidere må åpne flere skjermer for et sjeldent unntak, oppstår omveier. Artikler bokføres da samlet senere, skannere blir liggende i skuffen, eller en medarbeider fører igjen en skyggeliste. Programvaren finnes, men den reelle prosessen fortsetter ved siden av den.

Også datakvaliteten setter grenser. Artikkelstamdata uten klare enheter, uklar lagerplasslogikk eller inkonsekvente leverandørbetegnelser lar seg ikke leges med et flott grensesnitt. Her kan et prosjekt i starten bestå av opprydningsarbeid. Det virker mindre synlig enn en ny applikasjon, men er ofte forutsetningen for pålitelige resultater.

I tillegg finnes det prosesser som bevisst ikke bør fullautomatiseres. Erfaren kontroll av sensitive varer, godkjenning av uvanlige avvik eller beslutning om en spesialleveranse krever faglig skjønn. Gode systemer merker slike tilfeller tydelig og leder dem målrettet videre. De later ikke som om ethvert unntak kan løses med en regel.

Når et regneark fortsatt er den bedre løsningen

Ikke ethvert manuelt trinn rettferdiggjør skreddersydd utvikling. Hvis en prosess skjer sjelden, involverer få deltakere og håndteres sporbart, kan et godt vedlikeholdt regneark forbli fornuftig. Feilen ligger ikke i Excel i seg selv, men i å håndtere kritiske bevegelser uten tydelig ansvar, versjonskontroll eller rettidig registrering.

Så snart flere personer endrer parallelt, lagerbevegelser blir tidskritiske, eller kundeinformasjon fra ulike kilder må samles, øker risikoen betydelig. Et felles system er da vanligvis billigere enn å kontinuerlig rette opp misforståelser.

Warehouse Automation Results krever en kontrollert utrulling

Den raskeste veien til dårlige resultater er en total ombygging midt i pågående drift. Bedre er et avgrenset område med målbar nytte: for eksempel varemottak for én produktgruppe, forsendelsesetiketter for ett sted, eller mobil registrering for de vanligste flyttingene.

En pilot bør gjenspeile reelle ordrer og reelle skift. Testdata hjelper under utviklingen, men viser ikke om wifi svinger i den bakre lagerdelen, om hansker gjør skannerbruk vanskelig, eller om en status er formulert forvirrende for planleggingen. Disse detaljene avgjør aksept og datakvalitet.

Teknisk sett teller kjedelig, bevisbar pålitelighet mer enn en trendy teknologistabel. Klare rolletilganger, sporbare bokføringslogger, entydige feilmeldinger, stabile databasetransaksjoner og dokumenterte prosesser er ikke bagateller. De gjør en applikasjon til et verktøy team kan stole på i den daglige driften.

For skreddersydde logistikksystemer betyr dette også: integrasjonen må passe til eksisterende drift. En applikasjon kan motta ordrer fra en nettbutikk, generere følgesedler, tilby forsendelsesetiketter og dokumentere lagerbevegelser. Den trenger ikke straks erstatte alle tilstøtende systemer. Nettopp i små og mellomstore bedrifter er en trinnvis utfasing ofte mindre risikofylt og mer økonomisk.

Slik blir et prosjekt en varig forbedring

Etter innføringen begynner den avgjørende fasen. Blir spesialtilfeller fanget opp? Stemmer lagerplassene fortsatt med virkeligheten? Forstår nye medarbeidere bokføringslogikken uten muntlig forklaring? Og holder de målte verdiene fortsatt stikk når ordrevolumet vokser?

Regelmessig kort tilbakemelding fra lager, forsendelse og administrasjon er mer effektivt for dette enn en stor årlig workshop. Når et tilbakevendende unntak blir synlig, bør det enten avbildes som et tydelig prosesstrinn eller bevisst tas ut av standardflyten. Begge deler er bedre enn å tolerere det stilltiende.

Det mest fornuftige neste steget er ofte ikke et omfattende kravdokument. Ta en prosess med hyppige henvendelser og mål i en uke hvor tiden går tapt. Hvis det oppstår en tydelig, gjentakbar arbeidsflyt av dette, kan automatisering kobles til et resultat som overbeviser like mye på lagergulvet som i den månedlige oppfølgingen.

Permalenke →

Moderne webutvikling som fungerer i drift: Pragmatiske arkitekturer for små og mellomstore bedrifter — med vedlikeholdbar kode, solid datalagring og uten unødvendig verktøyoverbelastning.

Moderne webutvikling som fungerer i drift: Pragmatiske arkitekturer for små og mellomstore bedrifter — med vedlikeholdbar kode, solid datalagring og uten unødvendig verktøyoverbelastning.

En lagersjef skriver ut følgesedler om morgenen mens en kollega korrigerer lager i et regneark, og salg ringer for å spørre om status på en ordre. Problemet er sjelden manglende digitalisering. Som regel finnes det for mange atskilte verktøy. Moderne webutvikling skaper da ikke bare et penere grensesnitt, men et pålitelig felles arbeidsgrunnlag.

For små og mellomstore bedrifter betyr dette: En webapplikasjon må fungere under tidspress, på en skanner på lageret like mye som på en skjerm på kontoret. Den må lagre data sporbart, håndtere rettigheter rent, og kunne videreutvikles uten å bli en risiko ved hver endring. Teknologi er ikke et mål i seg selv her. Den er grunnlaget for at prosesser skal gå raskere og samtidig forbli bedre kontrollerbare.

Moderne webutvikling begynner før den første koden

Den som starter med en forhåndsdefinert funksjonskatalog, bygger ofte forbi den faktiske flaskehalsen. I praksis lønner det seg med en annen inngang: Hvilken informasjon mangler regelmessig i dag? Hvor oppstår doble registreringer? På hvilket punkt sikres beslutninger via telefon eller muntlig fordi ingen pålitelig ser den aktuelle statusen?

Ved varemottak kan dette for eksempel være inkonsistente varebeskrivelser, manglende inspeksjonsinstruksjoner eller sent oppdaterte lagre. Ved ordrebehandling er det ofte håndskrevne notater, uklare godkjenninger og fraktdata som vedlikeholdes i flere systemer. En god applikasjon gjør ikke bare disse overleveringene digitale. Den ordner dem slik at ansvar, status og neste trinn blir synlige.

Dette betyr også at man ikke reflektorisk avskaffer eksisterende praksis. Et godt vedlikeholdt regneark kan fortsatt være den mest fornuftige løsningen for en liten evaluering. En skreddersydd webapplikasjon lønner seg der flere personer jobber samtidig, feil oppstår gjennom manuell overføring, eller en prosess må dokumenteres og være repeterbar.

Hva en moderne webapplikasjon må levere i hverdagen

Et overbevisende brukergrensesnitt er verdifullt, men det er bare en del av arbeidet. I løpende drift teller først og fremst responstider, forståelige arbeidsflyter og robuste data. Når en plukker fullfører en oppgave, må ikke statusen bli synlig først etter flere oppdateringer. Når en ordre endres, må det være sporbart hva som ble endret og hvilke etterfølgende trinn som er berørt. Dette omfatter tre tett forbundne lag: brukergrensesnittet, applikasjonslogikken og databasen. Grensesnittet leder mennesker gjennom prosessen. Logikken sjekker for eksempel obligatoriske felt, rettigheter eller tilgjengelige mengder. Databasen lagrer fakta på en måte som gjør at evalueringer, korrigeringer og utvidelser forblir mulige senere.

For mange forretningsapplikasjoner er utprøvde teknologier et mer fornuftig valg enn en kortvarig trend. PHP 8.4 kan levere klart strukturert serverlogikk, moderne JavaScript en responsiv brukeropplevelse, og MySQL 8 et solid datagrunnlag. Det avgjørende er ikke at hvert prosjekt bruker samme stack. Nøkkelen er at den valgte teknologien passer til problemet, driften og den langsiktige vedlikeholdet.

Ytelse er et prosessspørsmål

Ytelse blir ofte redusert til lastetider. Det er utilstrekkelig. En applikasjon føles også treg når ansatte utfører for mange trinn, søker etter informasjon, eller må registrere den samme opplysningen flere ganger. En rask side med et tungvint skjema forblir en dårlig prosess.

Fornuftig optimalisering begynner derfor med de vanligste operasjonene. Hvilke skjermer åpnes hundre ganger om dagen? Hvilket søk må forbli raskt selv når datamengden vokser? Hvilke data bør lagres i bakgrunnen uten at ansatte venter på en bekreftelse? Først deretter følger tekniske detaljer som målrettede databaseindekser, reduserte spørringer og slank levering av filer i nettleseren.

Datamodell og rettigheter: Den usynlige arkitekturen

Mange webprosjekter mislykkes ikke på den første versjonen, men på senere tillegg. Et opprinnelig enkelt felt som «Status» blir plutselig en kjede av godkjenning, inspeksjon, behandling, kansellering og etterbehandling. Hvis disse tilstandene bare lagres løst i skjemaer, blir hver utvidelse dyr og feilutsatt.

En ren datamodell skiller derfor prosesser, posisjoner, kontaktpersoner, dokumenter og statusendringer sporbart. Den forhindrer motstridende oppføringer i stedet for å møysommelig rydde dem opp senere. Spesielt ved lagerbevegelser, følgesedler eller ordredata er denne presisjonen ingen akademisk øvelse. Den avgjør om lagertallet duger som arbeidsgrunnlag.

Roller og rettigheter er like viktige. Ikke hver person trenger tilgang til priser, personalinformasjon eller administrative innstillinger. Gode rettighetskonsepter er konkrete: Hvem har lov til å opprette en ordre, godkjenne den, eller kansellere den? Hvem ser bare sin egen avdeling? I tillegg kommer beskyttelsestiltak som sikker passordlagring, kontosperringer etter gjentatte mislykkede forsøk, logging av kritiske endringer og klart regulerte økter. Sikkerhet er dermed ikke et tillegg like før lansering. Den hører hjemme i arkitekturen fordi senere korreksjoner ofte griper dypt inn i pålogging, datatilgang og rettighetssystem.

Responsiv betyr ikke bare «passer på mobilen»

En responsiv applikasjon tilpasser seg forskjellige skjermstørrelser. For hverdagsarbeidet er ikke denne definisjonen tilstrekkelig. På et nettbrett på lageret gjelder andre krav enn på en stor skjerm i disponeringen. Berøringsflater må være trygt betjenbare, viktige detaljer må ikke forsvinne under sekundær informasjon, og registreringer må forbli praktiske selv med hansker, skiftende lysforhold eller ustabil forbindelse.

Følgelig trenger hver visning en tydelig prioritet. I varemottaket kan skanning og bekreftelse stå i sentrum. På kontoret er filtre, lister, eksportfunksjoner og detaljvisninger ofte viktigere. Et grensesnitt som ser identisk ut overalt, er ikke automatisk brukbart overalt.

Moderne webutvikling krever kontrollert drift

Lanseringen er ikke et sluttpunkt, men begynnelsen på den virkelige testen. Først med reelle data, unntak og rushtider viser det seg om regler er forståelige og om grensesnitt fungerer pålitelig. Dokumentert klargjøring, tydelig atskilte miljøer for utvikling og produksjon, samt sporbare sikkerhetskopier hører derfor til prosjektet, ikke bare IT-administrasjon.

Også automatiserte tester utretter mye her. De sjekker tilbakevendende arbeidsflyter som pålogging, rettighetssjekk, ordreregistrering eller dokumentgenerering på nytt etter hver endring. For sensitive applikasjoner kan et selvhostet testmiljø være fornuftig fordi skjermbilder, testdata og interne applikasjonstrinn forblir innenfor bedriftens eget kontrollområde. Automatisering erstatter ingen faglig gjennomgang av erfarne ansatte. Den sørger imidlertid for at kjente arbeidsflyter ikke stille og rolig blir skadet.

Hos softify.pro er denne tankegangen en del av implementeringen: planlegge teknisk presist, ta reelle arbeidsflyter på alvor, og levere endringer på en måte som holder dem forståelige senere. Dette er mindre spektakulært enn et teknologifyrverkeri, men i drift betydelig mer verdifullt.

Når standardprogramvare er nok — og når den ikke er det

Standardprogramvare er fornuftig når din egen prosess i stor grad samsvarer med den vanlige bransjeflyten, og konfigurasjonen forblir overkommelig. Den kan være raskt tilgjengelig og bringe pålitelige grunnfunksjoner. Den blir problematisk når team permanent må vri sine fungerende arbeidsflyter på tungvinte måter, eller når viktig informasjon havner utenfor systemet.

En individuell løsning er ikke automatisk bedre. Den krever tydelige krav, ansvarlige kontaktpersoner, og beredskap til å ta beslutninger. Til gjengjeld kan den kartlegge nøyaktig de arbeidstrinnene som er avgjørende for bedriften: en spesialisert varemottakskontroll, utskrift av matchende fraktetiketter, en godkjenning basert på kundegruppe, eller forbindelsen mellom verksted, lager og salg. Det riktige spørsmålet er derfor ikke: Trenger vi en skreddersydd applikasjon? Det er: Hvilken tilbakevendende friksjon koster oss i dag tid, penger eller pålitelighet — og kan den fjernes permanent med rimelig innsats?

En god webapplikasjon gjør ikke arbeid kunstig digitalt. Den fjerner unødvendige overleveringer, etablerer en pålitelig datatilstand, og gir mennesker nøyaktig den informasjonen de trenger for sitt neste trinn. Når dette lykkes, føles ikke moderne webutvikling som et nytt IT-prosjekt, men som en drift som endelig kan jobbe uten omveier.

Permalenke →

Slik gjennomfører du digitaliseringen av følgesedler riktig

Slik gjennomfører du digitaliseringen av følgesedler riktig

En sjåfør venter ikke fordi en Excel-fil for øyeblikket er åpnet av noen andre. Og i varemottaket hjelper ingen ryddig papirbunke hvis en delleveranse senere ikke lenger kan spores. Den som søker etter «hvordan digitalisere følgesedler», ser derfor sjelden bare etter å skanne papir. Det som søkes, er en robust arbeidsflyt som registrerer varebevegelser, bekreftelser og avvik der de oppstår.

Digitale følgesedler fungerer godt når de forenkler arbeidet på lageret, i verkstedet og hos kunden. Hvis de bare implementeres som et PDF-arkiv, forblir innsatsen den samme — bare på en skjerm i stedet. Den avgjørende forskjellen ligger i strukturerte data, tydelig ansvar og en ren tilkobling til ordre, lager og faktura.

Hvordan digitalisere følgesedler: Sjekk arbeidsflyten først

Det første trinnet er ikke programvarevalg, men en ærlig kartlegging. Ta en reell følgeseddel og følg dens vei: fra ordre via plukking til overlevering, tilbakemelding og arkivering. Dette avslører som regel raskt hvor informasjon legges til i etterkant, registreres dobbelt, eller avklares via telefon og chat.

I små og mellomstore bedrifter finnes det sjelden bare én arbeidsflyt. En standardleveranse til faste kunder krever noe annet enn en byggeplassleveranse, en henting, eller en leveranse med retur av emballasje. Ikke alle disse forskjellene trenger å automatiseres i versjon én. De bør imidlertid være kjent, slik at det nye systemet ikke mislykkes ved det aller første spesialtilfellet.

En god digital prosess besvarer entydig tre spørsmål for hver status: Hvem flyttet varene og når? Hvilke mengder ble faktisk overlevert? Og hva skjedde ved avvik? Hvis denne informasjonen mangler, er en digital følgeseddel først og fremst bare et penere dokument.

Ikke bare reproduser papir som en PDF

Å skanne eksisterende følgesedler kan være nyttig som en overgang, for eksempel for arkivering av gamle prosesser. For den operative virksomheten løser det imidlertid lite. Et bilde eller en PDF kan lagres, men mengder, varenumre, partier og merknader kan ikke pålitelig gjenbrukes i den.

En bedre tilnærming er et dokument generert fra strukturerte ordredata. Varer, målmengder, leveringsadresser og kontaktpersoner overtas. Ansatte bekrefter deretter de faktiske mengdene direkte på en mobil enhet eller på en arbeidsplass på lageret. Bare avvik, skader eller tilleggsposisjoner må registreres manuelt.

Dette sparer ikke bare tid. Det forhindrer også et typisk mediebrudd: regnskapet mottar ikke lenger en knapt lesbar signatur på papir mens lageret separat vedlikeholder den samme prosessen i et regneark.

Dataene en digital følgeseddel faktisk trenger

Et system bør ikke tvinge frem hvert tenkelig felt. Ekstra registreringer bremser overleveringer og reduserer aksept. Samtidig er kundenavn og signatur ikke tilstrekkelig for mange arbeidsflyter.

Som grunnlag trenger hver følgeseddel et unikt nummer, referansen til ordren, leverings- og mottakeradresser, vareposisjoner med mål- og faktiske mengder, samt tidsstempler.

Avhengig av bransjen kommer partier, serienumre, vekt, lagerplasser eller beholdere i tillegg. For temperaturkontrollerte varer kan måleverdier være relevante; for byggeplassleveranser er bilder eller presise leveringsstedsopplysninger nyttige.

Statusen er spesielt viktig. «Opprettet», «plukket», «underveis», «overlevert», «delvis levert» og «bestridt» er ikke bare etiketter. De styrer hvilken person som må handle videre, og om for eksempel en faktura kan genereres eller en etterleveranse planlegges.

Bruk signaturer og bilder med måtehold

En digital signatur er nyttig i mange leveringsprosesser, men er ikke automatisk den beste bekreftelsen. For en rask overlevering ved varemottak kan et trykt navn, et tidsstempel og mottakertilordningen være tilstrekkelig. For høyverdige varer eller omtvistede overleveringer kan en signatur kombinert med et bilde og stedsinformasjon i stedet gi mening.

Det avgjørende er beviskjeden: bekreftelsen må knyttes til det konkrete dokumentet og dets versjon. Hvis noen endrer mengder eller posisjoner etter signering, bør systemet ikke stille overskrive dette. Det krever en sporbar korreksjon eller en ny bekreftelse. Bilder fortjener samme disiplin. De kan dokumentere skader, men bør ikke bli en vilkårlig samling av personopplysninger. Definer når et bilde er nødvendig, hvem som har tilgang til det, og hvor lenge det lagres.

Mobil registrering må fungere under reelle forhold

På kontoret er nesten enhver applikasjon betjenbar. På lageret teller hansker, dårlig WiFi, tidspress og enheter med begrenset batterilevetid. En digital følgeseddel må derfor klare seg med få, store registreringstrinn. Strekkode- eller QR-kodeskanning er ofte raskere og mer pålitelig enn å søke etter varenumre.

Offline-evne er ingen luksus når sjåfører jobber utenfor stabil nettverksdekning. Applikasjonen bør mellomlagre operasjoner lokalt, tydelig vise hva som ennå ikke er synkronisert, og håndtere konflikter kontrollert. Hvis to personer redigerer samme leveranse, må ikke den siste lagringen vinne tilfeldig.

Også enhetsspørsmålet må besvares pragmatisk. En eksisterende smarttelefon kan være tilstrekkelig for enkle leveranser. For hyppige skanninger, bilder og signaturer på lageret er robuste håndholdte enheter eller nettbrett ofte mer økonomiske. Den beste beslutningen avhenger av driftstid, miljø og forventet gjennomstrømning — ikke av hvilken enhet som ser moderne ut på et produktbilde.

Definer grensesnitt før innføring

En digital følgeseddel utvikler sin verdi først når den kobles til de ledende datakildene. I mange bedrifter ligger ordrer i ERP eller varehåndteringssystemet, lagre i en separat lagerløsning, og fakturaer i regnskapet. Dette trenger ikke umiddelbart bli et stort systemprosjekt. Men datasuvereniteten bør være tydelig.

Definer derfor hvilket system som vedlikeholder kunder, varer, priser og ordrer. Følgeseddelløsningen kan overta informasjon, men den bør ikke ubemerket generere en ny varestamme. Likeledes må det reguleres når bekreftede faktiske mengder rapporteres tilbake, og hvem som gjennomgår avvik.

Teknisk sett er pålitelige grensesnitt viktigere enn spektakulære funksjoner. Unike ID-er, dokumenterte dataformater, protokoller for mislykkede overføringer og en gjentaksmekanisme forhindrer at følgesedler forsvinner mellom to systemer. En slank applikasjon på et vedlikeholdbart grunnlag, som PHP 8.4, moderne JavaScript og MySQL 8, er mer fornuftig for mange mellomstore arbeidsflyter enn en overbelastet suite med funksjoner ingen bruker.

Sikkerhet og arkivering hører til prosessen

Følgesedler inneholder forretningsdata og ofte også personopplysninger. Rollerettigheter bør derfor ikke tildeles generelt. Sjåfører trenger sine turer og åpne oppgaver, lageransvarlige trenger korreksjons- og gjennomgangsmuligheter, regnskapet trenger bekreftede dokumenter og eksporter. Administrativ full tilgang er ingen standardrettighet.

I tillegg trengs en sporbar historikk: opprettelse, endring, overlevering, signatur, kansellering og korreksjon bør registreres med tid, bruker og begrunnelse. Dette hjelper ved tilbakespørsmål og beskytter ansatte når det senere er uklart når en skade eller mangel ble rapportert. For arkivering gjelder: dokumentet må forbli lesbart og prosessen søkbar. Om en PDF genereres, avhenger av den interne arbeidsflyten og eksterne mottakeres krav. PDF-en er imidlertid utdataen fra en digital prosess, ikke dens datamodell.

Bli produktiv i små steg

Den mest pålitelige utrullingen starter med en klart avgrenset prosess: for eksempel standardleveranser fra ett lager eller varemottak i en avdeling. Velg et område med tilstrekkelig volum, men uten de mest kompliserte unntakstilfellene. Dette gjør det mulig å teste betjening, datakvalitet og grensesnitt under reelle forhold.

Ikke mål bare om applikasjonen fungerer teknisk. Sjekk hvor lang tid en overlevering tar, hvor mange følgesedler som krever etterbehandling, hvor ofte lagerdifferanser oppstår, og om regnskapet kan jobbe raskere. Hvis en digital prosedyre genererer flere tilbakespørsmål enn papirskjemaet, er det ikke arbeidsstyrken som er problemet — da mangler prosessklarhet, eller registreringsmasken passer ikke til praksis.

Regneark kan fortsette å leve hvis de er pålitelige for en liten evaluering eller en sjelden spesialliste. Digitalisering betyr ikke å avskaffe hvert kjente verktøy. Det betyr å bevisst erstatte feilutsatte overleveringer og gjøre kjerneprosessen robust.

softify.pro utvikler slike arbeidsflyter ikke som et stivt standardprodukt, men langs konkrete varebevegelser, roller og eksisterende systemer. Dette er spesielt nyttig når en bedrift søker en passende løsning mellom papirkaos og et overdimensjonert konsernsystem.

Det riktige første steget er derfor ingen lang kravkatalog. Ta ti følgesedler fra en normal uke, inkludert en delleveranse og en reklamasjon. Hvis din fremtidige arbeidsflyt behandler disse ti tilfellene raskt, entydig og sporbart, blir en digital følgeseddel til et verktøy som lager, sjåfører og administrasjon kan stole på.

Permalenke →

Programvaretesting-trender 2026 som virkelig teller

Programvaretesting-trender 2026 som virkelig teller

En mislykket utgivelse viser sjelden bare én enkelt feil. Ofte møtes flere årsaker: en endret tillatelse, et uklart testmiljø, manglende testdata, eller en regresjonstest som ikke har blitt vedlikeholdt på måneder. Nettopp der blir trendene innen programvaretesting for 2026 konkrete — ikke som en samling nye verktøy, men som et spørsmål om hvordan bedrifter kan levere endringer med verifiserbar sikkerhet, selv med knappe QA-kapasiteter og sensitive data.

For programvareteam i mellomstore bedrifter er dette spesielt relevant. En lagerapplikasjon, en kundeportal eller en Windows-skrivebordsprogramvare trenger ikke betjene millioner av brukere. Den må imidlertid fungere i skiftdrift, generere dokumenter korrekt og pålitelig håndheve rettigheter. Testing må derfor være nærmere reelle operative arbeidsflyter enn et perfekt demomiljø.

Trender innen programvaretesting: AI blir utføreren, ikke oraklet

Den mest synlige trenden er AI-støttet testing. Dette betyr ikke at en språkmodell leser et krav og deretter garanterer applikasjonens kvalitet. Den forventningen ville vært farlig. AI kan imidlertid betydelig redusere innsatsen der team i dag mister tid: formulere testtilfeller, gjenkjenne iøynefallende endringer i brukergrensesnitt, tilordne lignende feilmønstre og skrive forståelige testrapporter.

AI blir spesielt nyttig når den utfører konkrete arbeidstrinn og gir bevis for resultatene sine. En testagent kan for eksempel logge inn, opprette et varemottak, endre en leveringsadresse, generere en fraktetikett og sjekke om status, lagerbevegelse og dokument stemmer overens. Det avgjørende er ikke påstanden «test bestått», men beviskjeden: utførte trinn, tidsstempler, skjermbilder, tekniske logger og en tydelig beskrivelse av avviket.

Grensen forblir viktig. AI kan foreslå testtilfeller og håndtere tilbakevendende arbeidsflyter. Den bør ikke alene avgjøre om en faglig kritisk forretningsbokføring er korrekt. For priser, lagernivåer, betalingsgodkjenninger eller tilgangsrettigheter trengs fortsatt eksplisitte regler og forventninger bekreftet av forretningsavdelinger. Automatisering akselererer kontrollen; den erstatter ikke ansvar.

Testautomatisering vandrer inn i forretningsprosessen

I lang tid fokuserte UI-testautomatisering på enkle veier: åpne side, fylle ut skjema, sjekke suksessmelding. Det forblir nyttig, men er ikke tilstrekkelig for forretningskritiske systemer. Den mer verdifulle testen verifiserer en hel prosesskjede.

Ta en typisk logistikkfunksjon. En ordre registreres, varer reserveres, en plukkeprosess startes, en følgeseddel genereres, og frakt rapporteres. Hver enkelt skjerm kan se ren ut mens prosessen likevel mislykkes — for eksempel fordi en reservasjon vedvarer etter et avbrudd, eller en delleveranse feilaktig endrer lageret. Gode automatiserte tester sporer derfor tilstander og data på tvers av systemgrenser.

Dette krever en ren testarkitektur. API- og databasetester sjekker regler raskt og presist. UI-tester kontrollerer i tillegg om ansatte faktisk kan betjene prosessen. Ende-til-ende-tester kombinerer begge, men er tregere og mer sårbare. Den som tester alt utelukkende via nettleseren, bygger vanligvis en dyr og skjør testsuite. Den som bare tester grensesnitt, overser betjeningsproblemer og feilkoblede brukergrensesnitt.

Den pragmatiske løsningen er en pyramide som passer risikoen: mange raske kontroller nær forretningslogikken, færre integrasjonskontroller, og selektivt utvalgte ende-til-ende-scenarier for de viktigste arbeidsflytene. Det høres lite spektakulært ut. Det leverer imidlertid boring, provable reliability i stedet for trend-chasing.

Selvhostet test-AI blir et arkitekturspørsmål

Med AI-testverktøy oppstår et nytt spørsmål: Hvor går testdata, skjermbilder og opptak? I mange applikasjoner inneholder de kundenavn, interne priser, personalinformasjon eller visninger av forretningskritiske prosesser. Selv et tilsynelatende ufarlig testmiljø kan inneholde reelle datakopier eller konfidensielle strukturer.

Derfor blir utførelsesmiljøet et sentralt kriterium. En ekstern skytjeneste kan være passende for offentlige webapplikasjoner og ukritiske testdata. For interne portaler, skrivebordsapplikasjoner eller regulerte områder er en selvhostet tilnærming ofte mer fornuftig. I dette oppsettet forblir testutførelse, bildemateriale og logger innenfor bedriftens kontrollerte infrastruktur eller et klart avgrenset EU-miljø.

Dette er ikke et generelt argument mot skytjenester. Selvdrift medfører innsats: oppdateringer, tilgangskontroll, dataressurser, overvåking og tydelige ansvarsområder må håndteres. Nytten oppstår når personvern, sporbarhet og kontroll over testartefakter veier tyngre enn bekvemmeligheten ved en umiddelbart tilgjengelig SaaS-konto. Systemer som COCO følger nettopp denne tilnærmingen ved å utføre tester for web- og Windows-applikasjoner mens de holder bevis lokalt kontrollerbart.

Ustabile tester aksepteres ikke lenger som normalt

En automatisert test som noen ganger består og noen ganger mislykkes uten en produktendring, skaper ikke sikkerhet. Den skaper køer. Team blir da vant til å ignorere røde builds eller kjøre tester på nytt til ønsket resultat vises. Dette er et snikende tap av tillit til hele kvalitetskontrollrammeverket.

I 2026 flytter derfor stabiliteten i testutførelsen mer i forgrunnen. Årsakene er som regel kjente: tilfeldige ventetider, ustabile selektorer, delt testdata, avhengigheter av eksterne tjenester, eller ikke-tilbakestilte databaser. Løsningen er sjelden nok et forsøk til. Mer fornuftig er entydige tekniske selektorer, isolerte testkontoer, kontrollerte datatilstander og målrettede ventebetingelser som reagerer på faktiske systemhendelser.

Evalueringen bør også differensiere: Er en feil reproduserbar? Oppstår den bare i ett miljø? Har en ekstern tjeneste sviktet eller applikasjonen selv? AI kan hjelpe med å samle disse signalene. Den tekniske beslutningen må imidlertid forbli sporbar. Et QA-team trenger ikke en mystisk feilprediksjon, men et robust grunnlag for neste tiltak.

Kvalitet begynner tidligere med krav og data

Mange feil oppstår før den første linjen kode skrives. «Ordren skal kunne sendes» er ikke et testbart krav. Hva skjer ved en ufullstendig adresse, en sperret kundekonto, manglende varer, parallell behandling, eller en utløpt økt? Uten svar på disse spørsmålene kan ikke noe testsystem pålitelig sjekke om programvaren fungerer korrekt.

En mer moden testtilnærming supplerer derfor krav med verifiserbare eksempler. For en konto med feilaktige påloggingsforsøk kan dette konkret bety: Etter fem mislykkede forsøk sperres kontoen i 15 minutter, prosessen logges, og en autorisert administrator kan spore sperringen. Dette gir direkte automatiserbare kontroller — og mindre tolkningsrom mellom utvikling, drift og forretningsavdeling.

Testdata blir også en produktfunksjon. Den må være realistisk nok til å kartlegge spesialtilfeller, men må ikke kopiere unødvendige personopplysninger. Genererte datasett for MVA-tilfeller, delmengder, sperrede varer, ugyldige adresser og ulike roller er nyttige. Spesielt ved applikasjoner med MySQL 8 eller sammenlignbare relasjonsdatabaser lønner det seg å tilby definerte starttilstander automatisert og fjerne dem etter kjøringen.

Risikobasert testing slår testdekning for enhver pris

Et høyt kodedekningstall kan virke betryggende, men likevel si lite. Det viser hvilke linjer som ble utført, ikke om riktig regel ble testet. Et system kan oppnå 90 prosent dekning og likevel føre til feilaktig lager ved kansellering av en delleveranse.

Det bedre spørsmålet er: Hvilke feil ville vært spesielt kostbare for drift, kunder eller juridisk etterlevelse? Dette gir en prioritering. Tilgangsbeskyttelse, prisberegning, lagerbokføringer, dokumentgenerering og grensesnitt mot fraktleverandører fortjener som regel mer testdybde enn sjelden brukte innstillingssider. Dette betyr ikke å levere sideting ukontrollert. Det betyr å bruke begrenset tid der en svikt stopper reelt arbeid eller skaper feilaktige beslutninger.

Denne prioriteringen må få lov til å endre seg. Hvis en ny ruteplanleggingsfunksjon innføres, øker risikoen. Hvis en gammel Excel-evaluering snart skal erstattes, lønner det seg kanskje ikke lenger med en stor automatiseringsinnsats. Noen ganger er det mer fornuftig å beholde et fungerende regneark noen måneder til i stedet for hastig å presse logikken inn i et halvferdig system.

Hva team praktisk bør gjøre nå

Det første fornuftige trinnet er ingen verktøysammenligning. Velg en prosess hvis feil er merkbare: ordre til levering, varemottak til hyllelegging, eller pålogging til rollegodkjenning. Beskriv ønsket arbeidsflyt med unntakstilfeller, sett opp pålitelig testdata, og automatiser først de kritiske kontrollene. Deretter, ikke bare mål antall tester. Observer hvor raskt en reell feil oppdages, hvor ofte tester mislykkes uten grunn, og om en rapport forklarer årsaken forståelig for en utvikler eller ansvarlig i virksomheten. Først når disse grunnlagene er på plass, lønner det seg med utvidelse med AI-agenter, visuell inspeksjon eller omfattende testmiljøer. De sterkeste testtrendene er til syvende og sist de som gjør utgivelser mindre risikable og bringer team raskere til klare beslutninger. Det er ikke det mest moderne dashbordet som teller, men en sporbar testkjøring som viser: Denne forretningsprosessen fungerer — og hvis ikke, vet vi hvorfor.

Permalenke →

Ruteplanlegging for leveringsturer: Velge riktig programvare

Ruteplanlegging for leveringsturer: Velge riktig programvare

En sjåfør venter på en følgeseddel mens rekkefølgen på stoppene deres allerede endrer seg igjen. På lageret er en forsendelse ennå ikke plukket, en kunde ringer om et strammere tidsvindu, og turlisten ligger i et regneark som bare én person virkelig forstår. Den som søker etter «ruteplanleggingsprogramvare for leveringsturer» i denne situasjonen, ser ikke nødvendigvis etter en komplisert kartalgoritme. Det de leter etter, er en pålitelig arbeidsflyt fra ordreregistrering til leveringsbevis.

For små og mellomstore bedrifter er dette en avgjørende forskjell. En teoretisk kortere rute hjelper lite hvis den ikke tar hensyn til at varer ikke er klare før klokken 10, et kjøretøy trenger kjøling, eller en sjåfør har spesifikk kundekunnskap på en bestemt tur. God programvare for leveringsturer gjenspeiler driftens virkelighet — og gjør den felles brukbar for disponering, lager og sjåfører.

Når ruteplanlegging blir et operativt problem

Mange bedrifter starter fornuftig med telefon, papir og et regneark. Med fem stopp per dag og et fast sjåførteam er dette ofte den raskeste løsningen. Først når ordrevolum, varianter og tidspress øker, oppstår de typiske friksjonstapene: dobbeltregistrerte adresser, utdaterte turstatuser, manglende informasjon om lastebærere og tilbakespørsmål som bare kan besvares ved å ringe flere personer.

Problemet er da ikke bare kjørestrekningen. Det er informasjonsgapet mellom ordremottak, lager, disponering og levering. Hvis en ordre utsettes, må denne endringen i dag ofte følges opp i flere lister, på en utskrift og i sjåførens hode. Dette koster tid og skaper feil som kunder umiddelbart ser.

Et annet varselsignal er beslutninger som avhenger av enkeltansatte. Hvis bare den erfarne disponenten vet hvilken innkjørsel som passer for en bestemt kunde, eller hvordan tur 3 skal justeres ved sent varemottak, er arbeidsflyten ikke dokumentert robust. Programvare skal ikke erstatte denne kunnskapen. Den skal kartlegge den slik at teamet forblir handlingsdyktig.

Hva ruteplanleggingsprogramvare for leveringsturer må kunne

Kjernefunksjonen høres enkel ut: ordrer tildeles en tur, stopp sorteres fornuftig og overleveres til sjåfører. For praktisk nytte trenger systemet imidlertid betydelig mer kontekst. Det avgjørende er hvilke regler som gjelder ved planlegging og hvordan endringer håndteres.

Ordrer må være planleggbare, ikke bare synlige

En leveringsadresse på et kart utgjør ennå ikke en planleggbar levering. En ordre krever minst mengder, vekt eller volum, leveringsdato, ønsket tidsvindu, kontaktinformasjon og en tydelig behandlingsstatus. Avhengig av virksomheten kan lastebærere, temperaturkrav, farlig gods-merking, avvarslingsregler eller en bestemt kjøretøyklasse også komme i tillegg.

Disse dataene bør ikke måtte samles manuelt fra ulike systemer hver gang. Hvis ordrer allerede kommer fra en nettbutikk, ERP, en ordremaske eller en eksisterende database, er en ren overlevering ofte mer verdifull enn en spesielt spektakulær kartvisning. Ellers forskyves arbeidet bare fra papir til et nytt grensesnitt.

Turer trenger regler, ikke bare avstand

En automatisk rekkefølge basert på kilometer eller kjøretid kan være et godt forslag. Den er imidlertid ingen beslutning for virksomheten. Planleggingen må kunne ta hensyn til begrensninger: faste leveringsdatoer, kjøretøykapasitet, arbeidstider, laste- og lossetider samt regionale ansvarsområder.

Startlogikken teller også. Noen kjøretøy begynner og slutter på lageret, mens andre kjører direkte til sitt neste oppdragssted etter den siste leveransen. For tilbakevendende turer kan en fast grunnstruktur være nyttig, som disponenter bare endrer ved behov. Den som kjører nøyaktig de samme stoppene hver morgen, trenger ikke nødvendigvis en fullstendig ny optimalisering. Her er en stabil, sporbar tur ofte bedre enn en matematisk minimal tidsbesparelse.

Endringer må nå sjåføren på en kontrollert måte

Virkeligheten følger sjelden morgenplanen. Kunder avbestiller, varer mangler, et kjøretøy bryter sammen, eller en ordre blir hastende. I slike tilfeller avgjøres det om programvaren gir avlastning eller skaper ekstra arbeid.

En brukbar løsning viser tydelig hvilken turversjon som gjelder for øyeblikket, hvilke stopp som allerede er fullført, og hva som konkret er endret. Sjåføren bør ikke måtte sammenligne motstridende utskrifter, skjermbilder og meldingsapp-meldinger. For mange team er det i utgangspunktet tilstrekkelig med en mobil, nettleserbasert sjåførvisning med stopprekkefølge, kontaktdata, leveringsinstruksjoner og statustilbakemelding. En egen app er ikke automatisk bedre hvis installasjon, enhetsadministrasjon og offline-krav ikke gir noen klar nytte.

Ikke start med ruteoptimalisering alene

Den vanligste feilaktige tilnærmingen er å kjøpe en optimaliseringstjeneste først og først etterpå sjekke om stamdata og arbeidsflyter stemmer. Feilstavede adresser, uklare leveringsvinduer og ordrer uten pålitelig tilgjengelighetsstatus kan ikke optimaliseres bort. En kort kartlegging langs den reelle hverdagen er mer fornuftig. Hvor oppstår ordrer? Når bekrefter lageret tilgjengelighet? Hvem planlegger turer? Hvordan mottar sjåføren endringer? Og hvilket bevis kreves etter levering? Disse spørsmålene kan virke banale, men de avgjør hvilke datafelt, roller og grensesnitt systemet faktisk trenger.

Det viser seg ofte at ikke hvert trinn bør digitaliseres. Et håndskrevet notat for en sjelden spesialleveranse kan være passende hvis det senere overføres rent til ordren. Et regneark kan også forbli hvis det pålitelig leverer en overkommelig evaluering. Programvare bør løse flaskehalsen, ikke tvangsmessig erstatte hver kjente arbeidsflyt.

Bygge, kjøpe eller målrettet utvidelse?

Standardprogramvare er passende når turlogikken er generell, prosesser sjelden varierer og teamet kan tilpasse seg gitte masker. Den forkorter innføringen og kan være tilstrekkelig for en enkel kjøretøypark. Ulempen viser seg så snart den kartlegger sentrale spesialtilfeller bare via sidelister, fritekst eller dyre tilleggsmoduler.

En individuell løsning lønner seg ikke fordi individuell utvikling grunnleggende er overlegen. Den lønner seg når arbeidsflyten selv er en konkurransefordel eller en vedvarende feilkilde: for eksempel med spesielle emballasjeenheter, kombinerte henting- og leveringsturer, egne leveringsdokumenter, eller en tett forbindelse mellom varemottak, plukking og levering.

Mellom disse ligger ofte den mest pragmatiske veien. Eksisterende systemer forblir for regnskap eller lagerstyring, mens en slank applikasjon samler ordrer, planlegger turer og dekker sjåførprosessen. Dette krever tydelige grensesnitt, entydig dataansvar og en databasestruktur som lagrer endringer sporbart. Moderne webapplikasjoner på et vedlikeholdbart grunnlag som PHP 8.4 og MySQL 8 er ingen motebeslutning for dette, men snarere et grunnlag for kalkulerbar drift og senere tilpasninger.

Innføring i små steg i stedet for en stor omstilling

Ruteplanleggingsprogramvare bør først testes på en overkommelig tur eller kjøretøygruppe. Ikke fordi et pilotprosjekt ville være risikofritt, men fordi reelle unntak viser seg tidlig: manglende leveringsinstruksjoner, uensartede adressedata, ventetider hos kunden eller uklare overleveringer på lageret.

For den første utvidelsesfasen er som regel klart avgrensede funksjoner tilstrekkelig: overta ordre, se tilgjengelighetsstatus, sette sammen tur, godkjenne tur og rapportere tilbake levering. Først når denne kjeden fungerer i hverdagen, er automatisk optimalisering, elektronisk signatur, fotobevis, kundevarslinger eller detaljerte nøkkeltall fornuftige.

Nytten måles ikke bare i sparte kilometer. Relevante er også mindre disponeringsarbeid, færre tilbakespørsmål, færre feilleveranser, kortere tid til følgeseddelen og bedre svarevne overfor kunder. Disse nøkkeltallene bør kartlegges grovt før oppstart. Ellers blir bare inntrykket etter innføringen at grensesnittet ser mer moderne ut.

Teknologien må forbli pålitelig i bakgrunnen

Ruteplanlegging behandler sensitive driftsdata: kundeadresser, sjåførtildelinger, leveringsmengder og ofte leveringsbevis. Derfor hører rollerettigheter, sporbare endringer, regelmessige sikkerhetskopier og dokumentert drift til løsningen. Hvem som har lov til å godkjenne, endre eller slette en tur, bør ikke overlates til tilfeldighetene.

Også kart- og rutedata fortjener en saklig gjennomgang. Eksterne tjenester kan passe svært godt, men de medfører løpende kostnader, tilgjengelighetshensyn og personvernspørsmål. Ved høye krav til datalagring eller spesiell regional logistikk må det avklares tidlig hvilke data som forlater eget system og hvordan avbrudd dempes. En perfekt rute er verdiløs hvis disponeringen ikke kan fortsette å jobbe under en forstyrrelse.

softify.pro planlegger slike systemer fra det faktiske ordremottaket helt til tilbakemelding fra kjøretøyet. Målestokken her er ikke den lengste funksjonslisten, men en arbeidsflyt som lager, disponering og sjåfører pålitelig kan betjene under tidspress. Den beste ruteplanleggingen ser overraskende uspektakulær ut i hverdagen: ordrer er komplette, turer er forståelige, endringer er entydige og leveranser er dokumenterbare. Nettopp denne rolige påliteligheten skaper rom for unntakene der mennesker må bestemme.

Permalenke →

Automatisere ordremottak-arbeidsflyten i drift

Automatisere ordremottak-arbeidsflyten i drift

En ordre kommer per e-post, en annen per telefon, i tillegg en Excel-fil fra nøkkelkunden. Senere på lageret mangler leveringsadressen, salg vet ikke lenger nøyaktig hvilken leveringsdato som ble lovet, og fraktavdelingen skriver ut følgeseddelen med en utdatert vareposisjon. Den som vil automatisere ordremottak-arbeidsflyten, løser ikke et abstrakt digitalt prosjekt. De eliminerer nettopp denne friksjonen på punktet der omsetning blir til operativt arbeid.

For små og mellomstore bedrifter er ordremottak ofte undervurdert. Så lenge få ordrer kommer inn per dag og erfarne ansatte kjenner hvert spesialtilfelle, bærer telefonnotater, postkasser og regneark prosessen. Med økende volum blir de imidlertid en risiko: informasjon foreligger dobbelt, overleveringer skjer muntlig, og ingen kan pålitelig si hvilken status ordren har.

Hvorfor ordremottak så ofte blir en flaskehals

Årsaken er sjelden manglende innsats. Vanligvis har arbeidsflyten vokst over flere år. Kunder bestiller via ulike kanaler, priser og leveringsbetingelser gjelder bare for spesifikke kundegrupper, og varenumre avviker fra interne betegnelser. Ansatte avstemmer informasjon fra erfaring og fyller hull med tilbakespørsmål.

Dette fungerer til noen er på ferie, skiftet endres, eller flere hastende ordrer ankommer samtidig. Da viser det seg at kunnskapen ikke ligger i prosessen, men i enkeltpersoners hoder og spredte filer. Konsekvensene er kjente: feil mengder, forsinkede leveranser, uavklarte godkjenninger og unødvendige korrigeringer på lageret. Automatisering betyr her ikke at en kunde nødvendigvis må bestille gjennom en portal. Det betyr at hver ordre, uavhengig av innkommende kanal, registreres, kontrolleres, beriket og overlevert etter de samme sporbare reglene.

Automatisere ordremottak-arbeidsflyten uten å vri driften ut av form

En brukbar arbeidsflyt starter ikke med en programvareliste, men med en nøktern prosessanalyse. De avgjørende spørsmålene er: Hvilken informasjon må foreligge før en ordre kan gå til lager, disponering eller produksjon? Og hvilke unntak er legitime i stedet for bare forstyrrende? En typisk arbeidsflyt består av fire tydelige stasjoner: registrere ordren, kontrollere dataene, godkjenne ordren og utløse etterfølgende prosesser. Mellom disse stasjonene kreves tydelig ansvar og status. En ordre bør for eksempel ikke kunne anses som «ny», «under avklaring» og «klar for frakt» samtidig.

1. Samle ordrer fra alle kanaler til én prosess

E-post, telefon, PDF, EDI, webskjema eller feltservicenotater kan forbli forskjellige innganger. Det avgjørende er at de havner i en felles ordreprosess. Ansatte bør ikke først måtte kopiere informasjon fra postkassen, deretter oppdatere et regneark, og deretter informere en annen person.

For strukturerte ordrer kan kundedata, varenumre, mengder og ønskede datoer overtas direkte. For PDF-er eller fritekst-e-poster er veiledet registrering ofte mer fornuftig enn helautomatisk uthenting. AI-støttet uttrekk kan gi forslag, men ved uklare mengder, kundespesifikke varenumre eller håndskrevne dokumenter trengs en synlig gjennomgang. Den fornuftige målestokken er ikke «maksimal automatisering», men «ingen unødvendig dobbeltregistrering». Et godt utformet skjema med obligatoriske felt og plausible forslag sparer mer tid i mange virksomheter enn feilutsatt full automatikk.

2. Kontrollere data før feil forplanter seg

Den mest verdifulle automatiseringen skjer før godkjenning. Systemet kan sjekke om kundenummeret finnes, leveringsadressen er komplett, varen er aktiv, den ønskede mengden fremstår tillatt, og betalings- eller kredittgodkjenning foreligger. Kundespesifikke priser, minimumsmengder og leveringsvinduer kan også matches mot lagrede regler.

Håndteringen av avvik er viktig. Ikke hvert avvik trenger å blokkere en ordre. Hvis for eksempel et referansenummer mangler, kan salg motta en oppgave. Hvis en ordre overskrider en definert verdigrense eller marginen faller utenfor det avtalte rammeverket, kan godkjenning fra den ansvarlige rollen kreves. Dette forhindrer stille feil og skaper synlige avklaringssaker. Det er en stor forskjell: lageret får ikke bare en ufullstendig ordre, men en ordre med tydelig status og dokumentert beslutning.

3. Koble godkjenninger til regler i stedet for muntlige forespørsler

Mange forsinkelser oppstår fra fraser som: «Kan du fort godkjenne dette?» Slike forespørsler er ikke grunnleggende feil. De blir problematiske når de går via chat, telefon eller korridorsamtale og senere ikke kan spores.

En automatisert arbeidsflyt lagrer godkjenningsregler direkte på ordrenivå. For eksempel kan en ordre godkjennes automatisk hvis kunde, pris, lager og leveringsadresse er plausible. For spesialvilkår, delleveranser eller en ordre som overskrider en definert grense, varsles den ansvarlige personen. Godkjenningen lagres med tidsstempel og begrunnelse.

Dette skaper hastighet uten å gi opp kontroll. Spesielt ved roterende skift eller flere lokasjoner forhindrer det at ordrer blir sittende fast i personlige postkasser.

4. Informere lager, frakt og kunder på en målrettet måte

Etter godkjenning trenger ikke ordren lenger overføres manuelt fra en liste til den neste. Arbeidsflyten kan generere en plukkeordre, reservere lager, forberede en følgeseddel eller utløse en fraktmelding. Hvilke trinn som gir mening, avhenger av forretningsmodellen.

En reservedelsforhandler kan umiddelbart trenge en plukkeordre og prioritetsmerking. En produsent trenger først en tilgjengelighetssjekk og deretter en produksjonsimpuls. En grossist med faste leveranseruter ønsker å samle ordrer opp til et bestemt tidspunkt. Derfor er en rigid standardløsning ofte ikke det beste valget.

For kunden er en tydelig bekreftelse ofte tilstrekkelig: ordre mottatt, kontrollert, eller bindende planlagt. Ikke hver interne statusendring hører hjemme i en e-post. For mange automatiske meldinger genererer tilbakespørsmål i stedet for tillit.

Hvilke data en robust prosess krever

Godt ordremottak står på et rent datagrunnlag. Dette inkluderer vedlikeholdte kundestamdata, entydige varenumre, gyldige pris- og betingelsesregler samt klart definerte leveringsadresser. Hvis disse grunnleggende elementene mangler, akselererer automatisering bare overføringen av upålitelige data. Teknisk arkitektur teller også. Et sentralt system med sporbare statusendringer og en pålitelig database er permanent bedre enn en kjede av makroer, lokale filer og ukontrollert e-postvideresending. Dette betyr ikke at hvert Excel-ark må erstattes umiddelbart.

Hvis et regneark fungerer transparent i en liten, stabil delprosess, kan det forbli inntil videre. Så snart flere personer jobber med ordrer samtidig, godkjenninger kreves, eller informasjon videreformidles til lager og frakt, bør imidlertid en sentral datakilde ha forrang. Systemer basert på en vedlikeholdbar arkitektur, for eksempel med PHP 8.4, moderne JavaScript og MySQL 8, kan da kobles målrettet til eksisterende arbeidsflyter i stedet for å tvinge en virksomhet inn i skjemaet til en konsernprogramvare.

Gjør det målbart om arbeidsflyten virkelig blir bedre

Et nytt system er ikke automatisk en bedre prosess. Før lansering bør derfor noen få nøkkeltall fastsettes. Relevante er for eksempel tiden fra ordreregistrering til godkjenning, antall tilbakespørsmål per ordre, korrigeringer etter overlevering til lageret og andelen ordrer behandlet i tide.

Disse nøkkeltallene viser også hvor ytterligere automatisering ikke er nødvendig. Hvis 85 prosent av standardordrene går raskt og feilfritt, men de resterende 15 prosentene er ekte spesialtilfeller, er en tydelig avklaringsprosess mer fornuftig enn å prøve å tvinge frem hvert unntak algoritmisk.

Logger hjelper også i den daglige driften. Den som ser når en ordre kom inn, hvilken kontroll som mislyktes, hvem som godkjente den, og når fraktordren ble opprettet, søker ikke lenger i fem postkasser etter årsaken. Dette reduserer ikke bare feil, men også avhengigheten av enkeltansatte.

Innføring i små steg i stedet for Big Bang

Den sikreste inngangen er vanligvis en klart avgrenset ordretype: for eksempel standardordrer fra en bestemt kundekrets eller e-postordrer med kjente varer. Der kan datafelt, regler og overleveringer testes under reelle forhold. Først når statuser, unntak og ansvar fungerer rent, følger mer komplekse tilfeller som spesialpriser, delleveranser eller kundeindividuelle emballasjespesifikasjoner.

Ansatte bør involveres i utformingen. Ikke fordi hver eksisterende vane må forbli uendret, men fordi personene ved telefonen, i salg og på lageret kjenner de faktiske unntakene. En løsning som bare ser bra ut i en workshop, blir raskt omgått på hallgulvet.

For slike prosjekter satser softify.pro på arbeidsflytspesifikke systemer i stedet for overbelastede standardpakker: med tydelige overleveringer, dokumenterte regler og nok rom for arbeidsmåtene som beviselig fungerer i virksomheten.

Det beste neste steget er derfor ikke søket etter flest mulig funksjoner. Ta ti reelle ordrer fra en typisk uke og følg deres vei fra mottak til frakt. Hver manuelle dobbeltoverføring, hver uklare beslutning og hvert tilbakevendende tilbakespørsmål er et konkret utgangspunkt for en prosess som fremover vil jobbe pålitelig for teamet.

Permalenke →

Beskytte testdata sikkert under AI-testing

Beskytte testdata sikkert under AI-testing

En mislykket automatisert test er vanligvis raskt fikset. Et skjermbilde fra testkjøringen som inneholder kundedata, prislister eller en aktiv økt og havner i en ekstern AI-tjeneste, er et annet problem. Den som vil beskytte testdata under AI-testing, må derfor ikke bare vurdere testtilfellene, men hele datastien: inndata, nettlesertrafikk, logger, bilder, AI-evaluering og oppbevaring.

Spesielt ved webapplikasjoner, interne portaler og Windows-programvare oppstår det raskt en falsk følelse av sikkerhet. Miljøet kalles riktignok «test», men det bruker ofte kopier av produktive databaser, ekte brukerroller eller grensesnitt mot frakt, ERP og dokumentarkiver. AI-støttede tester gjør denne dataen spesielt verdifull for analyse — og dermed spesielt beskyttelsesverdig.

Hvorfor AI-testing krever et eget personvernperspektiv

Klassisk testautomatisering sjekker vanligvis tydelig avgrensede trinn: logge inn, opprette en ordre, generere en følgeseddel, sjekke utlogging. AI-støttet testing utvider denne arbeidsflyten. Systemet kan tolke grensesnitt, evaluere avvik, sammenligne skjermbilder og dokumentere resultater på forståelig språk. Dette sparer tid ved regresjonstester, men genererer ekstra dataartefakter.

Disse artefaktene er ofte mer talende enn en vanlig testlogg. Et skjermbilde kan vise navn, adresser, kontraktsverdier, ordremengder eller helsedata. En nettverkslogg kan inneholde øktnøkler og API-svar. En feilmelding kan avsløre interne filstier, databasestrukturer eller versjonsstatuser. Når en modell arbeider med denne informasjonen, må det være klart hvor behandlingen finner sted og hvem som kan få tilgang til den.

Det avgjørende spørsmålet er derfor ikke: «Bruker vi AI i testingen?» Men heller: «Hvilke data forlater hvilken sikkerhetssone — og hvorfor?» For mange bedrifter i DACH-regionen er ekstern skybehandling ikke prinsipielt utelukket. Den må imidlertid matche beskyttelsesbehovet kontraktsmessig, teknisk og organisatorisk. For utviklings-, produksjons- eller kundedata er en lokalt kontrollert utførelse ofte den mer saklige beslutningen.

Å beskytte testdata under AI-testing begynner før den første kjøringen

Personvern i testing diskuteres ofte først ved valg av verktøy. Det er for sent. Først trengs en enkel, pålitelig datainventering. Hvilke systemer testes? Hvilke felt vises i grensesnitt? Hvilke vedlegg, eksporter og API-svar kan dukke opp i testen? Og hvilke data havner automatisk i skjermbilder, videoer eller feilmeldinger?

En inndeling i tre grupper lønner seg her. Ukritiske testdata kan genereres fritt og lagres lenger. Personopplysninger eller forretningsmessig konfidensielle data trenger maskering, tilgangsbegrensninger og kort oppbevaringstid. Tilgangsdata, tokener, nøkler og produktive konfigurasjonsverdier hører ikke hjemme i testbevis eller modellforespørsler — ikke engang når de bare ved et uhell er synlige i et nettleservindu.

I mange mellomstore applikasjoner er datasituasjonen ikke rent atskilt. Lagerteamet tester et nytt varemottak med et databaseutdrag fordi bare der finnes de reelle varestrukturene, leverandørreglene og spesialtilfellene. Det kan være faglig fornuftig. Konsekvensen må imidlertid ikke være at dette utdraget vandrer uendret inn i hvert testmiljø.

Bedre er en reproduserbar prosess: eksporter data, pseudonymiser sensitive felt målrettet, fjern unødvendige tabeller og gjør det resulterende testdatagrunnlaget tilgjengelig versjonert. Slik bevares typiske prosessfeil uten at reelle kunder eller ansatte blir synlige i testkjøringer. Ved kompleks pris- eller disponeringslogikk er fullstendig syntetiske data ofte utilstrekkelige. Da er en nøye renset kopi vanligvis det bedre kompromisset.

Maskering må bevare forretningslogikken

En maskering som erstatter hver e-postadresse med samme plassholder, kan skade testtilfeller. Duplikatsjekker, rollelogikk, søkefunksjoner eller faktureringsflyter reagerer annerledes enn i drift. God maskering bevarer derfor formater, relasjoner og fordelinger. Et kundenummer blir et annet gyldig kundenummer. En adresse blir en plausibel, men fiktiv adresse. En leveringsdato forblir en dato innenfor et realistisk planleggingsspenn.

Dette koster litt forberedelse. Til gjengjeld forhindrer det den klassiske feilen der tester er teknisk grønne, men ikke lenger kartlegger de faktiske arbeidsflytene på lager, salg eller kundeservice. Personvern og faglig brukbare tester er ingen motsetninger — forutsatt at databehandlingen er en del av testarkitekturen.

Utførelsesstedet avgjør kontrollen

Den som overlater automatiserte tester til en ekstern tjeneste, gir avhengig av konfigurasjonen fra seg mer enn testtrinn. Nettleserinnhold, DOM-strukturer, skjermbilder, videoer, konsollogger og evalueringer kan behandles og lagres utenfor egen infrastruktur. Om dette er akseptabelt, avhenger av det enkelte tilfellet: datakategorier, avtaleverk, lagringssted, leietakerseparasjon, slettekonsept og interne retningslinjer spiller sammen.

For applikasjoner med høyt beskyttelsesbehov er et selvhostet testmiljø ofte klarere å vurdere. Testkjøreren, AI-komponenten og bevislagringen forblir i eget nettverk eller i en kontrollert europeisk infrastruktur. Nettverksregler kan begrense eksterne forbindelser. Tilgang kan knyttes til eksisterende identiteter, roller og logging. Også oppbevaringen av bilder og rapporter blir en egen beslutning i stedet for en standardinnstilling fra en plattformleverandør.

COCO følger nettopp denne tilnærmingen: AI-serveren utfører tester for web- og Windows-applikasjoner kontrollert, dokumenterer bevis og genererer forståelige evalueringer uten at interne applikasjonsdata som standard må gis til en ekstern AI-sky. Dette erstatter ingen personvernrevisjon. Det skaper imidlertid et teknisk grunnlag som IT, informasjonssikkerhet og forretningsavdeling kan bli enige om sporbare regler på.

Skjermbilder, logger og hemmeligheter er de vanligste lekkasjene

Mange team beskytter testdatabasen, men overser biproduktene av testing. Nettopp der ligger i praksis ofte de større risikoene. En mislykket påloggingstest kan vise et passord i inndatafeltet. En API-test kan skrive ut en bearer-token i loggen. Et automatisk videoopptak dokumenterer en fullstendig ordre inkludert kundeadresse. Et robust konsept regulerer derfor minst fem punkter:

  • Skjermbilder og videoer opprettes bare ved behov og slettes etter faste frister.
  • Hemmeligheter integreres via en hemmelighetslagring eller beskyttede kjøretidsvariabler, aldri lagret i testkoden.
  • Logger filtrerer tokener, passord, økt-ID-er og sensitive felt før de lagres.
  • Testkontoer har bare rettighetene som er nødvendige for den respektive arbeidsflyten.
  • Testsystemer må ikke utløse produktive e-poster, etiketter, betalinger eller lagerbevegelser med mindre dette er eksplisitt sikret.

Disse reglene høres nøkterne ut. Det er nettopp deres fordel. Et team trenger ikke håpe på oppmerksomhet eller gode intensjoner, men kan teknisk begrense feilbruk. Spesielt effektive er separate tjenestekontoer for testautomatisering, korte tokenlevetider og en tydelig prosess for tilbakekalling av kompromitterte tilgangsdata.

Også AI-evalueringen trenger grenser

AI-modeller brukes ofte til å forklare avvik: «Knappen var ikke synlig», «Applikasjonen reagerte tregere enn forventet», eller «Prosessen endte i en rettighetssjekk». For slike vurderinger trenger ikke en modell nødvendigvis det fullstendige kundedatasettet.

Definer derfor hvilken informasjon som får flyte inn i evalueringen. Er et anonymisert skjermbilde tilstrekkelig? Er en teknisk feilklasse nok i stedet for det fullstendige serversvaret? Kan felt sladdes før analyse? Riktig dybde avhenger av testmålet. I en layoutsammenligning er et navn sjelden relevant. Ved kontroll av en personalisert dokumentmal kan det være relevant — da må behandlingen sikres tilsvarende.

Beskyttelsestiltak må forbli verifiserbare i drift

Et konsept er bare robust hvis det kan kontrolleres i hverdagen. Dette inkluderer regelmessige stikkprøver av testbevis, gjennomganger av rettigheter og et blikk på faktisk lagrede data. Har nye felt sneket seg inn i skjermbilder? Finnes gamle testkontoer fortsatt? Beholdes et databaseutdrag lenger enn tiltenkt? Slike spørsmål hører hjemme i den normale driftsrutinen, ikke bare i en revisjon. Like viktig er tydelig ansvar. QA kjenner testarbeidsflytene, utvikling kjenner de tekniske grensesnittene, forretningsavdelingen kjenner de kritiske prosessene, og IT-sikkerhet definerer rammen. Hvis ingen bringer disse perspektivene sammen, oppstår enten en risikabel snarvei eller en sikkerhetsspesifikasjon som forhindrer reelle tester. En liten, dokumentert godkjenningsprosess er vanligvis mer effektiv enn et omfattende regelverk som ingen bruker.

Til syvende og sist handler det ikke om å gjøre hver test kunstig komplisert. Å beskytte testdata godt betyr å bevisst fjerne reelle risikoer fra automatiseringen samtidig som testenes faglige gyldighet bevares. Når team vet nøyaktig hvilke data en test får se, hvor bevisene ligger, og når de forsvinner, blir AI-testing et kontrollerbart verktøy i stedet for en ekstra usikkerhet.

Permalenke →

Få utviklet en webapplikasjon med PHP

Få utviklet en webapplikasjon med PHP

Når varemottak havner i et regneark, fraktdata overføres per telefon og den gjeldende ordrestatusen bare finnes i hodet på enkeltansatte, mangler det vanligvis ikke enda et standardverktøy. Det som mangler er et system som pålitelig kartlegger den egne arbeidsflyten. Å få utviklet en webapplikasjon med PHP lønner seg nettopp da: når informasjon, beslutninger og dokumenter må komme sammen på ett sted uten å belaste driften med en overdimensjonert bedriftspakke.

PHP er ingen nostalgisk kompromiss her. Med PHP 8.4, en tydelig applikasjonsarkitektur og MySQL 8 kan man bygge langvarige webapplikasjoner som reagerer raskt, er enkle å vedlikeholde og fungerer pålitelig på skrivebord, nettbrett eller håndskanner. Det avgjørende er imidlertid ikke språket alene. Det avgjørende er om applikasjonen faktisk gjør arbeidet på lagergulvet, på kontoret og på farten enklere.

Når en skreddersydd webapplikasjon gir mening

Ikke hver prosess trenger umiddelbart skreddersydd programvare. Et rent vedlikeholdt regneark kan forbli den mest fornuftige løsningen for en liten, sjelden endret liste. Også et etablert standardprodukt er fornuftig hvis det allerede dekker de vesentlige arbeidsflytene og kan brukes uten permanente omveier.

Vendepunktet kommer når ansatte legger inn data flere ganger, samler informasjon fra ulike filer, eller regelmessig løser spesialtilfeller utenfor det faktiske systemet. Typiske signaler er uklare lagernivåer, manuelt genererte følgesedler, uklare ansvarsområder for ordrer, eller tilbakespørsmål som hvert skift må gjenta. Da går ikke bare tid tapt. Feil blir vanskelige å spore, og avhengigheten av enkeltpersoner øker.

En skreddersydd webapplikasjon kartlegger derimot nøyaktig de reglene som gjelder i virksomheten. Den kan for eksempel registrere varemottak, dokumentere lagerbevegelser, generere etiketter, prioritere ordrer eller gjøre overleveringer mellom team sporbare. Ikke hvert spesialtilfelle trenger å automatiseres dag én. En fornuftig start fokuserer på arbeidsflyten som akkurat nå skaper mest friksjon.
Å få utviklet en webapplikasjon med PHP: Hva som må avklares på forhånd

God programvare starter ikke med skjermskisser eller en liste over tekniske moteord. Den starter med konkrete situasjoner: Hva skjer når en leveranse ankommer ufullstendig? Hvem har lov til å korrigere et lager? Hvilken informasjon trenger fraktavdelingen før en etikett skrives ut? Og hva skjer når en ansatt på kveldsskiftet overtar en ordre som ble opprettet på formiddagen?

Fra disse spørsmålene oppstår et robust prosessbilde. Det viser inndata, beslutninger, overleveringer og unntak. Nettopp unntakene er verdifulle fordi standardløsninger ofte bryter sammen der. En applikasjon for ordremottak trenger for eksempel ikke bare å lagre en ny ordre. Den må også avklare hvordan manglende varedata, avvikende leveringsadresser, godkjenninger eller kanselleringer håndteres.

Før implementering bør derfor mål, brukergrupper og det første utviklingstrinnet fastsettes. Nyttige ressurser inkluderer reelle eksempeldata, eksisterende skjemaer, bilder av arbeidsplasser og samtaler med menneskene som jobber med arbeidsflyten daglig. Et rent lederintervju gir sjelden nok detaljer. Den som betjener en skanner, lagrer varer eller sjekker følgesedler, kjenner vanligvis de praktiske begrensningene mer nøyaktig.

Den minste fornuftige starten

En første utgivelse trenger ikke å være en ferdig bedriftsplattform. Tvert imot: en begrenset, produktivt brukbar kjerne reduserer risiko og skaper verdi tidlig. Et tenkelig alternativ ville være en applikasjon som i utgangspunktet bare registrerer ordrer sentralt, gjør statusen deres synlig og oppretter en pålitelig følgeseddel. Lagerstyring, grensesnitt eller ruteplanlegging kan følge så snart kjernen er bekreftet i hverdagen.

Denne rekkefølgen forhindrer at et prosjekt jobber i månedsvis med funksjoner hvis faktiske nytte fortsatt er uklar. Den skaper også rom for korrigeringer. Kanskje er den planlagte statuslogikken for finkornet, kanskje trenger varemottaket en raskere innmatingsskjerm eller en godkjenning først over en viss verdi. Slike erkjennelser er ingen planleggingssvikt, men en del av en ren innføring.

Det tekniske grunnlaget avgjør følgekostnadene

En webapplikasjon blir ikke vedlikeholdbar bare fordi PHP nevnes i tilbudet. Vedlikeholdbarhet oppstår gjennom sporbare beslutninger: en tydelig separasjon mellom grensesnitt, forretningslogikk og datatilgang, entydige datamodeller, automatiserte tester for kritiske regler samt dokumentert levering.

PHP 8.4 egner seg svært godt til dette. Språket er modent, effektivt å drifte og et saklig valg for mange forretningskritiske applikasjoner. I kombinasjon med moderne JavaScript kan grensesnittet reagere raskt og direkte uten å unødvendig bygge hver funksjon komplisert som en enkeltsideapplikasjon. MySQL 8 gir et solid grunnlag for transaksjoner, rettighetskonsepter og konsistente datasett.

Spesielt ved lager- og ordreprosesser må ikke en bokføring lagres halvveis. Hvis en vare bokføres ut, må lager, bevegelseslogg og ordrestatus stemme overens. Databasetransaksjoner sørger for at enten alle nødvendige endringer skjer, eller ingen. Dette høres ut som en detalj, men avgjør om et system forblir pålitelig i unntakstilfeller.

Sikkerhet hører også hjemme i kjernen av arkitekturen. Roller og rettigheter må passe til den daglige rutinen: en person i varemottaket trenger andre rettigheter enn regnskap eller en ekstern sjåfør. Sikre passordhasher, kontosperringer etter mislykkede påloggingsforsøk, øktstyring og logger for kritiske endringer er ikke ekstrafunksjoner for senere. De hører hjemme i den første produksjonsversjonen.

Bygg grensesnitt bare der de sparer arbeid

Mange prosjekter blir unødvendig store fordi hver tenkelige integrasjon planlegges fra begynnelsen. Grensesnitt mot butikk, ERP, fraktleverandør eller regnskap kan være svært nyttige. De er imidlertid bare gode hvis de erstatter et tydelig manuelt trinn eller vesentlig forbedrer datakvaliteten.

Et eksempel: Hvis fraktetiketter opprettes daglig fra ordredata, sparer en direkte tilkobling tid og reduserer overføringsfeil. Hvis fakturadata derimot bare overføres én gang i uken til et eksisterende system og prosessen er stabil, kan en strukturert eksport være tilstrekkelig for starten. Den teknisk mer elegante løsningen er ikke automatisk den mer økonomiske.

Datasuverenitet bør også avklares på forhånd. Hvilke data lagres, hvor lenge forblir logger tilgjengelige, hvem har lov til å eksportere dem, og hvordan fungerer sikkerhetskopiering og gjenoppretting? For bedrifter i DACH-regionen er disse spørsmålene ikke bare IT-formaliteter. De angår personvern, driftsevne og tillit i teamet.

Innføring uten å bremse driften

Den beste applikasjonen mislykkes hvis den blokkerer den daglige rutinen under overgangen. Derfor bør innføringen forberedes med reelle tilfeller: representative ordrer, reelle varer, typiske leveringsadresser og kjente spesialtilfeller. Først når disse arbeidsflytene fungerer sporbart, bør systemet overta en sentral oppgave.

Parallell drift kan være fornuftig i kort tid, for eksempel når lagre må avstemmes eller nye dokumenter kontrolleres. Den må imidlertid ikke bli en permanent tilstand. To ledende datakilder skaper uunngåelig avvik. Det trengs en tydelig skjæringsdato hvorfra det er fastsatt hvilket system som er bindende.

Like viktig er en kort, rollebasert innføring. En ansatt på lageret trenger ingen forklaring av administrasjonsfunksjoner. De trenger trygghet i de få trinnene som må gjøres under tidspress. Gode applikasjoner hjelper med forståelige betegnelser, fornuftige standardverdier og feilmeldinger som forklarer hva som skal gjøres videre.

Slik gjenkjenner du en passende utviklingspartner

Den som bestiller en webapplikasjon kjøper ikke bare utviklingstimer. Det som trengs er en partner som tar prosessspørsmål på alvor, begrunner tekniske beslutninger og også sier imot når et krav blir unødvendig dyrt eller risikabelt. Direkte tilgang til erfarne utviklere er her mer verdt enn en omfattende salgsprosess med senere overleveringer.

Vær oppmerksom på konkrete uttalelser om arkitektur, drift og videreutvikling. Hvordan dokumenteres endringer? Hvordan foregår oppdateringer? Hvem reagerer ved en driftsforstyrrelse? Finnes det en sporbar teststrategi for kritiske bokføringer og rettigheter? Et grensesnitt kan virke overbevisende under presentasjonen. Det avgjørende er om det fortsatt kan tilpasses etter to år uten at hver endring blir en fullstendig ombygging.

softify.pro jobber derfor med en trinnvis, prosessnær implementering: først forstå den operative flaskehalsen, deretter levere en robust kjerne og bygge videre på den. Dette er mindre spektakulært enn et stort transformasjonsløfte, men i løpende drift vanligvis betydelig mer verdifullt.

En god webapplikasjon trenger ikke å inneholde flest mulig funksjoner. Den må sørge for at en ordre ikke går tapt, et lager forblir sporbart, og ansatte kan fullføre arbeidet sitt uten unødvendige tilbakespørsmål. Når det lykkes, blir en teknisk investering til et verktøy som gjør hver arbeidsdag målbart roligere.

Permalenke →

Generere fraktetiketter automatisk og redusere feil

Generere fraktetiketter automatisk og redusere feil

En ordre er pakket, varene står ved rampen — og noen leter fortsatt etter riktig fraktmetode, skriver mottakeradressen inn i en transportørportal og skriver ut etiketten. Denne arbeidsflyten tar bare noen minutter per pakke. Ved 30, 80 eller 300 forsendelser om dagen blir det en flaskehals. Å generere fraktetiketter automatisk betyr derfor ikke bare å koble til en skriver. Det betyr å koble sammen ordredata, fraktregler og den faktiske pakkeprosessen slik at en ferdig forsendelse pålitelig blir en matchende etikett.

For små og mellomstore bedrifter er dette ofte den mest fornuftige inngangen til logistikkautomatisering. Nytten viser seg umiddelbart på lagergulvet: færre tilbakespørsmål, færre feiladresserte pakker og en tydelig status for salg, lager og kundeservice. Likevel lønner det seg å se nøye på prosessen før teknisk implementering. Et dårlig vedlikeholdt vareregister eller uklare fraktregler blir ikke bedre av automatisering — de blir bare behandlet raskere.

Hva som faktisk skjer ved automatisk etikettutskrift

En fraktetikett inneholder mer enn bare navn og adresse. Avhengig av leverandør inkluderer dette et sporingsnummer, en maskinlesbar kode, ruteinformasjon, tjenester som alderssjekk eller postoppkrav, samt tolldata for internasjonale forsendelser. For at transportøren skal kunne generere en etikett, må denne informasjonen være fullstendig og i forventet format. Den tekniske arbeidsflyten begynner vanligvis med en ordre i nettbutikken, ERP eller et skreddersydd ordrehåndteringssystem. Så snart ordren er klar for frakt, fastsetter systemet leverandør, produkt og tilleggstjenester basert på definerte regler.

Deretter overfører den dataene til transportørens grensesnitt eller til en fraktplattform. Denne registrerer forsendelsen, returnerer sporingsnummer og etikett, og systemet lagrer PDF-en eller utskriftsdataene mot ordren. Først da skrives det ut — på arbeidsplassen, pakkebordet eller direkte via en etikettskriver.

Denne rekkefølgen er avgjørende. En pen etikett uten vellykket forsendelsesregistrering hjelper ikke. Omvendt må ikke en vellykket registrering forsvinne i bakgrunnen hvis skriveren går tom for materiale. Gode prosesser behandler registrering, utskrift og statustilbakemelding som en sammenhengende operasjon.

Å generere fraktetiketter automatisk starter med tydelige regler

Den vanligste misforståelsen er: Nøyaktig samme leverandør bør alltid velges for hver ordre. Det kan fungere, for eksempel ved homogene B2C-forsendelser innenfor Tyskland. Mange virksomheter trenger imidlertid mer differensierte regler. En tung leveranse, en ekspressordre, en henting på et pakkeutsalg eller en forsendelse til Sveits stiller ulike krav.

Fornuftige regler kan ta hensyn til vekt og mål, destinasjonsland, leveringsadresse, varevverdi, ønsket leveringstid, faresgodsmerker og avtalte kundevilkår. Her gjelder: Ikke hvert teoretiske unntak trenger å automatiseres fra dag én. Hvis to spesialtilfeller oppstår per måned, er et synlig merket manuelt trinn ofte billigere og sikrere enn en komplisert regelmotor. Tilbakevendende tilfeller med betydelig volum hører derimot hjemme i standardprosessen.

Datakilden er spesielt viktig. Vekter fra et velholdt vareregister er brukbare for lignende varer. Ved blandede ordrer, variabel emballasje eller tillegg for overstørrelse bør den endelige pakkevekten registreres ved pakkestasjonen. Systemet kan da generere etiketten først etter veiing. Dette er et ekstra manuelt trinn, men det forhindrer dyre korrigeringer og etterbelastninger.

Adressekvalitet avgjør før utskrift

Mange fraktproblemer oppstår før overlevering til transportøren. Husnumre havner i feil felt, postnumre stemmer ikke med byen, eller firmaadresser inneholder uklare mottakernavn. Automatisering bør derfor ikke bare videresende adresser, men sjekke dem på forhånd. Obligatoriske felt, landformater, tegnlengder og gjenkjennelige duplikater kan fanges opp direkte ved ordreregistrering.

Adresseverifisering er ingen garanti for leveringsdyktighet. Den reduserer imidlertid antallet unngåelige feil. Ved iøynefallende data bør systemet tydelig sette ordren på vent for avklaring i stedet for stille å generere en ufullstendig etikett. Det må være synlig på lageret hvorfor en ordre venter og hvem som kan gi informasjonen.

Pakkestasjonen trenger enkel betjening

Det beste grensesnittet mislykkes hvis ansatte må bytte mellom fem skjermer under pakking. En praktisk pakkedialog viser bare det som er nødvendig for den aktuelle forsendelsen: ordre, varer, leveringsadresse, emballasjestatus, vekt, valgt fraktmetode og utskriftsstatus. Et strekkodeskann på følgeseddelen eller plukkelisten bør åpne riktig ordre. Etter veiing er det i idealfallet nok med én bekreftende handling for å opprette og skrive ut etiketten.

Med flere pakkestasjoner trenger hver arbeidsplass en tydelig tilknytning til en skriver. Etikettformatet må også passe til enheten og transportøren. A6 er vanlig for mange pakkeetiketter, men ikke hver rull, termoskriver og dokumentskuff fungerer likt. Den som først skriver ut etiketter som PDF på en kontorlaserskriver, kan starte raskt. Ved høyere volum er termoskrivere vanligvis mer fornuftige: de unngår klipping, liming og risikoen for at en etikett skli til feil side under utskrift.

En god prosess rapporterer tekniske problemer forståelig. «API Error 403» hjelper ikke ved pakkebordet. Bedre er: «Etikett ikke opprettet: Sjekk tilgang til fraktleverandør» eller «Skriver pakkestasjon 2 utilgjengelig.» Ordren må ikke ved en feiltakelse anses som sendt i prosessen. Den forblir i en tydelig feilstatus og kan behandles på nytt etter utbedring uten å registrere en andre forsendelse.

Grensesnitt trenger feilhåndtering, ikke bare en happy path

Transportørgrensesnitt er eksterne systemer. De kan være midlertidig utilgjengelige, avvise inndata eller endre svarformatet sitt. Et lokalt nettverk, en utskriftstjeneste eller utløpte tilgangsdata kan også avbryte arbeidsflyten. Derfor er det risikabelt å knytte suksess utelukkende til at en bruker har klikket på «Opprett etikett».

Teknisk sett bør hver forespørsel logges sporbart: tidsstempel, ordre, brukt fraktjeneste, resultat, sporingsnummer og forståelig feilmelding. Sensitive data og tilgangsnøkler hører ikke ubeskyttet hjemme i loggfiler. En unik intern forsendelses-ID forhindrer at et nytt forsøk genererer duplikate etiketter eller dupliserte faktureringer.

Kanselleringer hører også hjemme i planleggingen. Hvis en pakke til slutt ikke hentes eller pakkes om etter etikettutskrift, må det være klart om forsendelsen kan kanselleres hos transportøren og hvordan dette dokumenteres i det interne systemet. Uten dette trinnet vil fraktstatus, sporing og fakturering ikke lenger stemme overens etter noen uker.

Ikke hver bedrift trenger umiddelbart en stor fraktplattform

Fraktplattformer kan samle flere transportører, tarifflogikk og returer. Dette gir mening hvis forsendelsesvolumer, destinasjonsland og leverandører er varierte. Den som imidlertid har en tydelig fraktprosess og én eller to transportører, kan kjøre mer oversiktlig med en direkte tilkobling. Færre systemer betyr mindre dataavstemming, færre brukerkontoer og færre steder hvor feil kan oppstå.

Beslutningen avhenger ikke bare av pakkevolum. Relevante er også returer, eksportdokumenter, individuelle fraktregler, eksisterende ordrekilder og spørsmålet om hvem som vedlikeholder endringer senere. En regnearkløsning forblir for eksempel forsvarlig hvis få forsendelser med konsistente data sendes daglig. Så snart kolleger overfører informasjon flere ganger eller frakt er bundet til enkeltpersoner, blir en sentralisert arbeidsflyt vanligvis mer økonomisk.

For kundespesifikke prosesser kan en slank webapplikasjon være fornuftig som samler ordredata, lagerbevegelser, følgesedler og etikettutskrift.
softify.pro implementerer slike systemer med en sporbar datastruktur, dokumentert utrulling og vedlikeholdbare teknologier som PHP 8.4 og MySQL 8. Det avgjørende er ikke antall funksjoner, men at arbeidsflyten blir mer forståelig for teamet ved pakkebordet.

Innfør i små steg og forbedre målbart

En kontrollert start er bedre enn en stor endring en mandagmorgen. Først automatiseres et klart definert standardtilfelle, for eksempel nasjonale pakker fra én transportør med et definert etikettformat. Parallelt bør automatisk genererte data sjekkes mot den tidligere arbeidsflyten i noen dager: adresse, vekt, fraktprodukt, sporingsnummer og trykt etikett.

Unntak kan deretter legges til i etterkant. Nyttige nøkkeltall er behandlingstid per forsendelse, antall manuelle korrigeringer, ikke-utskrevne eller dupliserte etiketter og tiden frem til sporingstilbakemelding til kunden. Disse verdiene viser om automatiseringen virkelig tar over arbeid eller bare digitalt kartlegger en gammel omvei.

Til syvende og sist teller ikke en spesielt kompleks fraktdialog. Det som teller, er at en pakket ordre får riktig etikett uten søking, omskriving og usikkerhet — og at unntak blir synlige der et menneske faktisk må ta en beslutning.

Permalenke →

Automatisk teste påloggingsprosessen med et system

Automatisk teste påloggingsprosessen med et system

En pålogging virker banal først når den fungerer. Hvis den slutter å fungere etter en utgivelse, står ansatte foran skiftstart, kunder foran kundeportalen eller disponenter foran en blokkert ordrebehandling. Å automatisk teste påloggingsprosessen betyr derfor ikke bare å fylle ut brukernavn og passord i et skjema. Det betyr å gjentatte ganger kontrollere en forretningskritisk inngang med dens regler, unntak og sikkerhetsgrenser.

For mange team starter automatiseringen med ett enkelt positivt testtilfelle: skriv inn gyldige påloggingsdata, bekreft pålogging, se startsiden. Det er fornuftig, men utilstrekkelig som eneste test. Påloggingsfeil oppstår ofte i kantene: ved utløpte økter, sperrede kontoer, en ny flerfaktorautentisering eller en rettighet som ikke lenger virker korrekt etter en rolleendring. Nettopp disse tilfellene må dekkes planmessig.

Hvorfor påloggingen krever spesiell testdisiplin

Påloggingen er samtidig en sikkerhetsfunksjon, et teknisk grensesnitt og inngangen til arbeidsflyten. En feil kan være for åpen og tillate uautorisert tilgang. Den kan også være for streng og stenge ute autoriserte personer. Begge koster: i det første tilfellet oppstår risikoer for data og etterlevelse, i det andre driftsstans, supportinnsats og hektiske nødløsninger.

Ved webapplikasjoner kommer flere avhengigheter i tillegg. Påloggingen kommuniserer ofte med en identitetsleverandør, et e-postsystem for passordtilbakestillinger, en MFA-app eller en katalogtjeneste. Ved Windows-skrivebordsapplikasjoner kan lokale rettigheter, nettverksforbindelser og versjonsstatus ha innflytelse. En test som bare ser på skjemaet i nettleseren, gjenkjenner ikke slike integrasjonsproblemer pålitelig.

Derfor bør teamet før den første testautomatiseringen fastslå hva en vellykket pålogging betyr i det respektive systemet. Er en synlig startside tilstrekkelig? Eller må det sjekkes om riktig leietakervalg ble lastet, om brukerrollen stemmer, og om den første beskyttede handlingen faktisk er mulig? For en lagerportal ville dette for eksempel være tilgang til varemottak. For et disponeringssystem kan det være godkjenningen av en tur.

Automatisk teste påloggingsprosessen: Fra arbeidsflytmodell til testtilfelle

Et godt utgangspunkt er ikke et skript, men en arbeidsflytmodell. Påloggingen kan beskrives som en sekvens av tydelige tilstander: utlogget, påloggingsdata overført, identitet bekreftet, MFA kreves, pålogget, økt utløpt, eller konto sperret. Til hver tilstand hører tillatte handlinger og forventede systemresponser.

Fra denne modellen oppstår testtilfeller med forretningsverdi. Det positive standardtilfellet hører med, men også ugyldige passord, ikke-eksisterende brukerkontoer og utløpte tilbakestillingslenker. Den forventede tilbakemeldingen er viktig her. Ved feilaktige påloggingsdata bør en applikasjon ikke avsløre om en e-postadresse eksisterer. Testen sjekker derfor ikke bare at en feil vises, men også at teksten og oppførselen ikke gir unødvendige hint.

Spesielt relevante er beskyttelsesmekanismer mot gjentatte mislykkede forsøk. Etter et definert antall feilaktige oppføringer kan en konto midlertidig sperres. Den automatiserte testen må sjekke om sperringen faktisk trer i kraft, hvor lenge den varer, og om den legitime brukeren deretter får kontrollert tilgang tilbake. Presisjon er nødvendig her: en test som bevisst sperrer produksjonskontoer, skaper flere problemer enn den løser. Slike scenarier hører hjemme i et separat testmiljø med spesielt opprettede kontoer.

Vurdere MFA, passordtilbakestilling og Single Sign-On separat

Flerfaktorautentisering er ingen detalj på slutten av påloggingen. Den endrer arbeidsflyten. En test må gjenkjenne at ytterligere bekreftelse kreves etter passordet, og den må kartlegge både vellykket og avvist bekreftelse. For tidsbaserte engangskoder trenger testmiljøet kontrollert håndtering av tid og hemmeligheter. I mange tilfeller er en testmetode levert av identitetsleverandøren mer fornuftig enn å gjenskape en reell mobiltelefon.

Passordtilbakestilling og Single Sign-On bør også få sine egne testspor. Ved en tilbakestilling teller overføringen av meldingen, lenkens unikhet, gyldighetsperioden og den etterfølgende påloggingen med det nye passordet. Ved SSO er det avgjørende om applikasjonen korrekt oppretter økten og rent overtar roller etter tilbakekomsten fra identitetsleverandøren.

CAPTCHA-er utgjør et spesialtilfelle. De er ment å bremse automatiserte angrep og bør ikke omgås via testautomatisering. I stedet er en testkonfigurasjon, en offisiell testnøkkel eller et sikret unntak for testmiljøet fornuftig. Å lure sikkerhetskontroller bare for at en test skal bli grønn, er ingen kvalitetsstrategi.

Velge riktig teknisk testnivå

Ikke hver påloggingstest må kjøres gjennom en ekte nettleser. API-tester kan verifisere om tokener, økter, feilmeldinger og sperreregler fungerer korrekt. De er raske og hjelper med å finne feil nær autentiseringslogikken. Nettlesertester viser derimot om felt, omdirigeringer, informasjonskapsler, SameSite-innstillinger og synlige tilstander passer sammen i den reelle brukerflyten.

For kritiske applikasjoner er kombinasjonen fornuftig. Noen få ende-til-ende-tester sjekker den komplette veien med nettleseren. Under det sikrer målrettede API- og integrasjonstester variantene. Dette reduserer kjøretid og falske alarmer. Den som tester hver tenkelige kombinasjon utelukkende i nettleseren, ender ofte opp med en treg suite hvis vedlikehold spiser mer tid enn den sparer.

For skrivebordsprogramvare gjelder et lignende prinsipp. En automatisert test bør ikke bare kontrollere om et vindu åpnes. Den må fastslå om den korrekte dataforbindelsen finnes etter pålogging, om brukerrettighetene er aktive, og om den sentrale arbeidsmasken er tilgjengelig. Dette er spesielt relevant for applikasjoner på lageret eller i produksjonen fordi arbeidsplasser kan ha ulike nettverksforhold, skannertilkoblinger eller lokale konfigurasjoner.

Håndtere testdata trygt og repeterbart

Påloggingstester jobber uunngåelig med påloggingsdata. Produktive ansattkontoer, reelle kundedata eller MFA-hemmeligheter hører imidlertid ikke ukontrollert hjemme i testskript, logger og skjermbilder. Testkontoer må være tydelig merket, minimalt privilegerte og automatisk gjenopprettbare. Passord og tokener leveres via sikker hemmelighetshåndtering i stedet for å lagres i kildekoden.

Like viktig er opprydding etter en testkjøring. Hvis en test oppretter nye økter, revisjonsoppføringer eller sperrede kontoer, må testmiljøet gå tilbake til en definert starttilstand. Ellers mislykkes en test på mandag bare fordi en kjøring fra fredag har etterlatt seg sideeffekter.

For bedrifter med konfidensielle applikasjoner er også utførelsesstedet avgjørende. Skjermbilder av påloggingsskjermer, testvideoer og tekniske logger kan inneholde sensitiv informasjon. En selvhostet testinfrastruktur som COCO kan være fornuftig her fordi testdata, utførelse og bevis forblir under egen kontroll. Om dette er nødvendig, avhenger av beskyttelsesbehov, avtalesituasjon og interne retningslinjer. En egen infrastruktur er ikke automatisk det mest økonomiske valget for hver applikasjon.

Generere bevis, ikke bare grønne haker

En testrapport bør gjøre det forståelig for QA, utvikling og forretningsavdeling hva som ble testet. En grønn status uten kontekst hjelper lite hvis en utgivelse senere utløser spørsmål. Nyttig er derfor tidsstempler, brukt testmiljø, testkonto, relevante trinn, skjermbilder ved feil og en tydelig feilmelding på hverdagsspråk.

I denne sammenhengen må bevissikringen ikke selv bli et personvernproblem. Passord, engangskoder, økt-ID-er og personopplysninger må maskeres i logger. For skjermbilder kan det være nødvendig å tåkelegge visse områder. Disse reglene bør være en del av testarkitekturen, ikke manuelt etterarbeid etter en hendelse.

Hva team bør automatisere først

Prioriteten styres av risiko og bruksfrekvens. Først kommer standardpålogging for de viktigste rollene, feilaktige påloggingsdata, utlogging og øktutløp. Deretter følger sperreregler, passordtilbakestilling, MFA og rolleendringer. SSO, spesialleietakere eller sjeldne unntaksveier kan følge senere, forutsatt at deres bortfall ikke umiddelbart stopper driften.

Testene hører hjemme i utgivelsesprosessen. Endringer i påloggingsskjemaer, informasjonskapsler, rettigheter eller identitetsleverandørkonfigurasjon bør utløse den relevante testsuiten før en versjon går i produksjon. I tillegg lønner det seg med en planlagt kjøring i et realistisk miljø, for eksempel etter infrastrukturendringer eller sertifikatbytter. Dette finner problemer som ikke er synlige i et isolert utviklingsmiljø.
Til syvende og sist er den beste påloggingstesten ikke den med flest klikk. Det er den som oppdager et reelt bortfall tidlig, dokumenterer det forståelig, og fortsatt kan utføres pålitelig ved neste endring. Den som behandler påloggingen som en klart modellert forretningsprosess, beskytter ikke bare et skjema. Den beskytter tilgangen til arbeidet som venter bak.

Permalenke →

Opprette følgesedler automatisk med programvare

Opprette følgesedler automatisk med programvare

Søket etter "programvare for å opprette følgesedler automatisk" starter vanligvis ikke med et dokumentproblem. Det starter ved pakkebordet: en ordre er godkjent, varer er plukket, men følgeseddelen finnes fortsatt som en Word-mal, Excel-eksport eller håndskrevet lapp. Mens noen kontrollerer linjeposter, endrer mengder, leveringsadresser eller delleveranser seg. Dette tar tid — og skaper nettopp de feilene som senere utløser tilbakespørsmål, korrigeringer og unødvendig koordinering.

En automatisk generert følgeseddel er derfor mer enn en PDF med logo. Det er den dokumenterte overgangen mellom ordre, lagerbevegelse og frakt. For at dette skal fungere pålitelig, trenger ikke programvaren å tilby flest mulig funksjoner. Den må korrekt kartlegge den faktiske arbeidsflyten i virksomheten.

Når det lønner seg å opprette følgesedler automatisk med programvare

Ikke hver virksomhet trenger umiddelbart en skreddersydd applikasjon. Den som håndterer få forsendelser per uke, selger faste varer og jobber med en velholdt mal, kan klare seg godt med en regnearkløsning. Automatisering blir fornuftig når ansatte legger inn data flere ganger, ordrer regelmessig deles opp i delleveranser, eller fraktstatusen ikke kan spores tydelig. Typiske varselsignaler er Excel-filer som har blitt skjøre, ulike varebeskrivelser i ordre og lager, manglende dokumenter ved tilbakespørsmål, eller følgeseddelnumre som tildeles manuelt. Selv når flere personer jobber mellom kontor, lager og frakt, er en delt mappe ofte ikke lenger tilstrekkelig. Da mangler ikke bare hastighet, men en pålitelig kilde til hva som faktisk forlot bygningen.
Det avgjørende punktet er: Følgeseddelen bør opprettes av en hendelse, ikke av et ekstra arbeidstrinn. Denne hendelsen kan være godkjenningen for plukking, den bekreftede uttakingen eller fullføringen av pakkeprosessen. Hvilken variant som passer, avhenger av din prosess. I et reservedelslager er lagerbokføringen ofte den riktige utløseren. Ved kundespesifikk produksjon kan fraktgodkjenning gjennom arbeidsforberedelse være avgjørende.

Hvilke data en automatisk følgeseddel virkelig trenger

Et godt system tar ikke bare over all data fra en ordre. Det sjekker hvilken informasjon som gjelder på leveringstidspunktet. Mottakeren kan avvike fra fakturamottakeren, en ordre kan leveres i flere forsendelser, og den leverte mengden kan være mindre enn den opprinnelig bestilte mengden.

Minimum kreves et unikt følgeseddelnummer, utstedelsesdato, leveringsadresse, kundereferanse samt de faktisk leverte linjepostene med mengder og enheter. Avhengig av bransjen kommer partier, serienumre, vekter, emballasjeenheter, plukkere eller instruksjoner for varemottak i tillegg. Hvis disse dataene senere trengs for reklamasjoner eller sporbarhet, hører de hjemme i klart definerte datafelt, ikke et fritekstfelt.

Ordre, lagerbevegelse og dokument må stemme overens

Den vanligste svakheten ligger mellom ordren og lageret. Ordren kan forutsi ti stykker, men lageret bekrefter bare åtte stykker. Hvis ti stykker likevel trykkes på følgeseddelen, oppstår et problematisk dokument. Hvis åtte stykker leveres uten å justere ordrestatusen, forblir restmengden usynlig.

En egnet programvare holder disse tilstandene atskilt, men koblet: bestilt, reservert, plukket, levert, eventuelt returnert. Følgeseddelen henter de bekreftede leveringsmengdene. Dette gjør det sporbart hvilken linjepost som inngikk i hvilken forsendelse, også ved del- og etterleveranser.

Nummerserier og versjoner er ingen bisak

Å tildele følgeseddelnumre manuelt virker i utgangspunktet ukomplisert. Senest ved flere lokasjoner, ulike brukerkontoer eller etterfølgende korrigeringer blir det feilutsatt. Applikasjonen bør generere numre sentralt og forhindre at samme nummer brukes to ganger. Like viktig er håndteringen av endringer. En allerede sendt følgeseddel bør ikke overskrives stille. Bedre er en gjenkjennelig korrigering, kansellering eller ny versjon med sporbar historikk. Dette er teknisk sett ingen luksus, men beskytter ansatte mot å jobbe med motstridende informasjon.
Slik fungerer opprettelsen i praksis

I en tydelig prosess starter alt med en strukturert ordre. Varer, mengder, leveringsadresse og ønsket dato registreres én gang eller importeres fra et eksisterende system. Deretter opprettes en plukkeordre for lageret — på en mobil enhet, som utskrift eller ved en arbeidsplassterminal.

Under pakking bekreftes de faktisk uttatte mengdene. For enkle arbeidsflyter er det tilstrekkelig med en bekreftelsesknapp. For mange varer, lagerplasser eller partier er strekkodeskanning mer fornuftig. Først etter denne tilbakemeldingen oppretter programvaren følgeseddelen som PDF, tildeler et nummer og knytter den til fraktprosessen. Parallelt kan den forberede en fraktetikett, forutsatt at den respektive pakketjenesten er teknisk tilkoblet.

Det genererte dokumentet lagres sentralt og forblir sporbart via ordre, kundekonto eller sporingsnummer. En innesalgsmedarbeider trenger da ikke lenger å søke i e-postinnboksen når en kunde spør hva som ble levert en bestemt dag. De ser ordren, individuelle leveranser og respektiv dokumentstatus på ett sted.

Dette høres greit ut, men mislykkes ofte i spesialtilfeller. Derfor må applikasjonen bevisst håndtere dem: Hva skjer ved mangler? Hvem har lov til å endre en leveringsadresse etter godkjenning? Kan en følgeseddel genereres uten lager? Hvordan merkes gratisvarer eller erstatningsleveranser? Slike regler avgjør om automatiseringen aksepteres på lagergulvet.

Standardprogramvare eller individuell løsning?

Standardprogramvare gir mening hvis arbeidsflyten din i stor grad følger den tiltenkte modellen, og grensesnitt mot nettbutikk, varehåndteringssystem eller fraktleverandører allerede finnes. Den reduserer implementeringsinnsatsen og tilbyr ofte et bredt funksjonsutvalg. Prisen for dette kan være at team må organisere sine fungerende arbeidsflyter rundt et stivt system.

En individuell løsning er spesielt verdt bryet når logikken din er forretningskritisk: for eksempel med kundespesifikke pakkeregler, komplekse delleveranser, flere lagerområder eller en kombinasjon av verksted, produksjon og frakt. Den kan fokusere på funksjonene som trengs daglig, i stedet for å sende ansatte gjennom moduler ingen bruker.

Ofte ligger den mest fornuftige veien midt imellom: Eksisterende systemer forblir ledende for varestamdata eller regnskap, mens en slank webapplikasjon lukker det operative gapet på lageret. Via klart dokumenterte grensesnitt kan ordrer importeres, lager rapporteres tilbake og følgesedler arkiveres. For slike applikasjoner er en sporbar datastruktur, rollebasert tilgang og testede importprosesser viktigere enn et spesielt spektakulært grensesnitt.

Hos softify.pro sjekkes slike prosesser først mot den konkrete varestrømmen: Hvem utløser, hvem bekrefter, hvilket unntak oppstår faktisk, og hvilke data må kunne dokumenteres senere? Først deretter avgjøres det om en tilpasning av det eksisterende systemet er tilstrekkelig, eller om en egen applikasjon er økonomisk fornuftig.

Innføring uten å bremse driften

Den sikreste starten er sjelden den fullstendige digitaliseringen av alle lagerprosesser på én skjæringsdato. Start med en klart avgrenset leveringsvei, for eksempel standardordrer fra ett sted eller en produktgruppe. Dette avdekker om varestamdata, adressekvalitet og mengdelogikk er tilstrekkelig rene.

I neste trinn bør reelle ordrer testes parallelt. Programvaren oppretter følgeseddelen mens den tidligere arbeidsflyten fortsatt er tilgjengelig som en kontrollinstans. Avvik er verdifulle i denne fasen: de indikerer ikke nødvendigvis en programvarefeil, men ofte uavklarte prosessregler. Hvis for eksempel to ansatte ville pakket samme ordre forskjellig, må arbeidsregelen først bli tydelig.

Deretter kommer roller og rettigheter. Lagerpersonell trenger andre visninger enn salg eller regnskap. Ikke alle bør få lov til å endre leveringsmengder i etterkant eller kansellere dokumenter. En god løsning gjør ansvar synlig uten å tvinge hver liten handling inn i en komplisert godkjenningsprosess.

Teknisk drift er også en del av innføringen. Dokumenter og transaksjonsdata trenger regelmessige sikkerhetskopier, tydelige oppbevaringsregler og testede gjenopprettingsveier. I en webapplikasjon med PHP 8.4 og MySQL 8 er rene databasetransaksjoner spesielt viktige: en lagerbokføring og opprettelsen av den tilhørende følgeseddelen må ikke falle fra hverandre hvis en forbindelse brytes på feil tidspunkt.

Tre feil som gjør automatisering unødvendig dyrt

Den første feilen er å automatisere et PDF-problem når dataene før det er uklare. Hvis varenumre, enheter eller kundeadresser ikke vedlikeholdes, produserer systemet bare feilaktige dokumenter raskere.

Den andre feilen er et for stort prosjektomfang. Å sette opp følgesedler, lager, frakt, innkjøp, produksjon og regnskap samtidig binder ofte team i måneder. En liten, motstandsdyktig leveringsprosess bygger tillit raskere og gir et grunnlag for videre trinn.

Den tredje feilen er manglende tilbakemelding fra lageret. En følgeseddel må ikke opprettes utelukkende basert på en planlagt ordre hvis ingen har bekreftet hva som faktisk ble pakket. Nettopp denne tilbakemeldingen gjør en dokumentmal til en motstandsdyktig prosess.

Den beste programvaren for følgesedler forsvinner nesten fra synet i hverdagen. Ansatte registrerer en ordre én gang, bekrefter arbeidet sitt der det finner sted, og finner det riktige dokumentet igjen når det trengs. Når dette lykkes, oppstår ikke bare raskere frakt — men en arbeidsflyt som lager, kontor og kunder like mye kan stole på.

Permalenke →

Automatisert testing av Windows-applikasjoner: Slik lykkes du

Automatisert testing av Windows-applikasjoner: Slik lykkes du

En utgivelse er klar, men ingen kan si med sikkerhet om den nye importdialogen, rettighetssjekken og fakturautskriften fortsatt fungerer. Nettopp på dette punktet blir det dyrt å kunne teste en Windows-applikasjon automatisk — ikke som en demo med tre klikk, men som en repeterbar del av utgivelsesprosessen.

Skrivebordsprogramvare er forretningskritisk i mange virksomheter. Den styrer lagerbevegelser, produksjonsordrer, kundestamdata eller fraktdokumenter. En feil påvirker mer enn bare en skjerm: den kan blokkere ordrer, generere feil etiketter eller tvinge ansatte på kveldsskift til manuelle nødløsninger. Automatiserte tester reduserer denne risikoen når de fokuserer på reelle arbeidsflyter og et teknisk kontrollert testmiljø.

Hvorfor Windows-tester er annerledes enn webtester

En webapplikasjon testes vanligvis via tydelig adresserbare elementer i nettleseren. Med Windows-skrivebordsapplikasjoner avhenger driften mer av vinduer, dialoger, native kontroller, oppløsning, rettigheter og installerte komponenter. En test må for eksempel fastslå om en dialog faktisk har åpnet seg, om et felt er redigerbart, eller om en utskriftsjobb ble overført korrekt.

I tillegg kommer den utviklede virkeligheten til mange applikasjoner. Noen grensesnitt består av klassiske WinForms- eller WPF-komponenter, mens andre binder inn eldre moduler, PDF-visere eller grensesnitt mot skrivere og skannermaskinvare. Det finnes ikke én automatiseringsmetode som fungerer like godt for hver applikasjon. Den som skjuler dette, produserer tester som ser bra ut i laboratoriet og feiler ved neste oppdatering.
Det fornuftige utgangspunktet er derfor ikke verktøyet, men spørsmålet: Hvilke prosesser må bevisbart fungere ved hver utgivelse? For lager- eller ordreprogramvare ville dette være pålogging, rettighetssjekk, ordreregistrering, lagerbokføring, dokumentopprettelse og overlevering til et grensesnitt. Disse prosessene leverer forretningsverdi. En test som bare sjekker om en meny er synlig, gjør det sjelden.
Teste en Windows-applikasjon automatisk: Velge riktig nivå

Tre nivåer er i utgangspunktet tilgjengelige for automatisering. Ideelt sett kombineres de, i stedet for utelukkende å stole på det synlige brukergrensesnittet.
På det tekniske nivået sjekker enhets- og integrasjonstester forretningslogikk, datatilgang og grensesnitt. De kjører raskt og viser tidlig om for eksempel en prisberegning, et importformat eller en rettighetsregel er ødelagt. De erstatter imidlertid ingen betjeningstest: om en disponent faktisk kan nå funksjonen og utføre den korrekt, forblir åpent.
Det andre nivået består av UI-tester via Windows Automation API. Testverktøy adresserer her kontrollelementer ved hjelp av egenskaper som automasjons-ID, navn eller kontrolltype. Dette er vanligvis mer stabilt enn tester som bare klikker på faste skjermkoordinater. Utviklingsteam kan aktivt fremme denne stabiliteten ved å tildele unike ID-er og ikke gi nytt navn til relevante kontroller ved hver grensesnittendring.

Det tredje nivået fungerer visuelt. Her gjenkjenner et system knapper, tabellinnhold, dialoger eller tilstander basert på skjerminnholdet. Dette hjelper spesielt ved eldre applikasjoner, proprietære komponenter eller grensesnitt som ikke gir nyttig automasjonsinformasjon. Visuell gjenkjenning er imidlertid mer følsom for skalering, temaer, uventede popup-vinduer og uklare skjermtilstander. Den krever definerte arbeidsstasjoner, tydelige ventebetingelser og sporbart bevis.

En AI-støttet tilnærming kan klassifisere visuelle signaler bedre enn et rent koordinatklikk. Likevel bør den ikke bli en svart boks. For kritiske trinn trenger et team skjermbilder, logger, forventede resultater og en uttalelse om hvorfor en kjøring ble vurdert som mislykket. Boring, provable reliability over trend-chasing gjelder spesielt ved testing.

Start med et lite, pålitelig testomfang

Den vanligste feilen er å prøve å automatisere hver skjerm umiddelbart. Dette binder budsjett og skaper en stor samling skjøre skript før det i det hele tatt er klart om tilnærmingen forbedrer utgivelseshverdagen. Bedre er en smal start med fem til ti kritiske arbeidsflyter som i dag sjekkes manuelt regelmessig.

Et godt første testtilfelle har en tydelig begynnelse, realistisk inndata og et verifiserbart resultat.
Eksempel: En bruker med lagerrollen logger på, oppretter et varemottak, bokfører en vare til en lagerplass og skriver ut dokumentet. Testen sjekker deretter ikke bare suksessmeldingen, men også lager, dokumentnummer og den loggede utskriftsjobben. Slik blir en klikksekvens et bevis på en forretningsprosess.

Ikke hver arbeidsflyt er umiddelbart egnet. Funksjoner med ustabil maskinvare, eksterne betalingstjenester eller ofte skiftende tredjepartssystemer krever ofte en annen oppsett. Her kan man teste sin egen applikasjon frem til overleveringen og kartlegge den eksterne komponenten via en kontrollert simulator. Dette er ingen snarvei, men en ren avgrensning av ansvarsområder.

Testdata er en del av systemet

Automatisering mislykkes ofte ikke på grunn av grensesnittet, men på grunn av ubrukelig data. En testkonto er sperret, en vare er allerede brukt, eller en tidligere kjøring endret den forventede lagermengden. Derfor trenger testmiljøet definerte startdata og en pålitelig vei tilbake til denne tilstanden.

I praksis betyr dette: separate testdatabaser, faste brukerroller, kjente vare- og kundesett, samt kontrollert tids- og nummerlogikk. For sensitive data bør produksjonsdata ikke kopieres ukontrollert. Anonymiserte eller spesifikt genererte datasett er vanligvis det bedre valget. De er forutsigbare og reduserer personvernrisiko.

Kontosperringsflyter fortjener også spesiell oppmerksomhet. Hvis mislykkede testkjøringer gjentatte ganger bruker feil passord, kan de sperre sin egen tilgang. Slike scenarier bør testes bevisst, men adskilt fra den normale regresjonstesten.

Stabilitet oppstår gjennom drift, ikke et enkelt verktøy

En UI-test er bare nyttig hvis den kjører under repeterbare forhold. Dette inkluderer en fast Windows-versjon, definert skjermoppløsning og skalering, kjente applikasjonsversjoner og ren håndtering av oppdateringer, dialoger og bakgrunnsprosesser. Hvis en testserver bruker forskjellige skriftstørrelser om morgenen enn om natten, er ikke det et testproblem — det er et driftsproblem.

Ventetider bør ikke angis blindt som faste verdier. Tre sekunders pause etter hvert klikk gjør en test treg og løser ingen timingproblemer. Bedre er å spesifikt vente på en tilstand: vinduet er synlig, tabellen inneholder den forventede posten, eller lagringsprosessen er fullført. Reelle asynkrone prosesser krever fornuftige tidsgrenser og tydelig feildiagnostikk. Mislykkede kjøringer hører hjemme i en triage, ikke en ignorert mappe.

Var applikasjonen ødelagt? Endret grensesnittet seg funksjonelt korrekt? Var testmiljøet utilgjengelig? Skjermbilder, skjermopptak, tekniske logger og tidsstempler forkorter denne avklaringen betydelig. En klartekstrapport hjelper også avdelinger med å forstå hvilken forretningsprosess som er berørt, uten å måtte lese et testskript først.

Planlegg personvern og bevis fra starten

I skrivebordsapplikasjoner viser skjermbilder ofte kundenavn, varepriser, adresser eller interne nøkkeltall. Hvis tester kjøres via eksterne skytjenester, kan skjermdata og applikasjonstrafikk forlate den egne kontrollsonen. For sikkerhetsbevisste team er ikke dette en mindre detalj, men en arkitekturbeslutning.

En selvhostet testserver kan holde testutførelse, bilder og rapporter i eget miljø.
Til dette formålet bruker softify.pro COCO, et miljø som utfører automatiserte tester for web- og Windows-applikasjoner og genererer sporbare resultater. Om en egen server gir mening, avhenger av beskyttelsesbehov, eksisterende IT og antall testkjøringer. For en liten, ukritisk applikasjon kan en enkel tilnærming være tilstrekkelig; for interne fagsystemer med sensitive data er lokal kontroll ofte det mer fornuftige alternativet.

Oppbevaringen av bevis bør også reguleres. Ikke hvert skjermbilde trenger å lagres permanent. Frister, rollebasert tilgang og en tydelig tilordning mellom testkjøring, applikasjonsversjon og resultat er nyttige. Dette gjør det mulig å reprodusere feil uten å bygge opp en annen ukontrollert datasamling.

Hva en fornuftig utrulling leverer

Etter en første kjøring bør et team ikke bare motta et antall beståtte tester. Det avgjørende er om testene finner reelle feil, om de kjører pålitelig, og om vedlikeholdsinnsatsen samsvarer med nytten. En test som må justeres hver uke på grunn av en ubetydelig layoutendring, er for dyr — selv om den ser teknisk imponerende ut.

Neste steg er integrering i utgivelsesprosessen. Raske tekniske tester kan starte ved hver build; utvalgte ende-til-ende-tester kjøres før godkjenning eller om natten i et stabilt miljø. Kritiske avvik blokkerer utgivelsen, mindre kritiske merknader dokumenteres og prioriteres. Disse terskelverdiene bør avtales faglig. Ikke hver visuelle forskjell er en leveringsstopp, men en feilaktig bokført mengde er det definitivt.

Automatiserte Windows-tester erstatter ikke fagkunnskap. De skaper imidlertid tid til kontrollene som krever skjønn: nye prosesser, uvanlige spesialtilfeller og spørsmålet om en funksjon virkelig er forståelig i hverdagen. Når standardprosessene er pålitelig verifiserbare, trenger ikke en utgivelse lenger å basere seg på håp.

Permalenke →

Skreddersydd logistikkprogramvare for små og mellomstore bedrifter

Skreddersydd logistikkprogramvare for små og mellomstore bedrifter

Hvis varemottak registreres på papir, lagernivåer er spredt over flere Excel-filer og fraktspørsmål avklares muntlig, er det sjelden manglende innsatsvilje som er problemet. Det som mangler er en felles prosess. Skreddersydd logistikkprogramvare for små og mellomstore bedrifter tar sikte på å fikse nettopp dette: ikke med et overbelastet konsernsystem, men med en applikasjon som kartlegger de faktiske arbeidsflytene på lageret, i disponeringen og på kontoret.

For mange bedrifter er dette ikke et digitaliseringsprosjekt for sin egen skyld. Det handler om færre tilbakespørsmål, pålitelige lagernivåer, raskere genererte følgesedler og en skiftoverlevering som ikke avhenger av enkeltpersoners kunnskap. Den beste løsningen er ikke automatisk den med flest funksjoner. Den må bevisbart gjøre arbeidet enklere og mer kontrollerbart.

Det kritiske punktet er som regel overleveringene

I små og mellomstore lager- og produksjonsbedrifter fungerer mye forbausende lenge med regneark, e-post og erfaring. Det er ikke grunnleggende feil. Et velholdt regneark kan være mer fornuftig for en overkommelig varetellingsliste enn et eget system.

Det blir kritisk når informasjon registreres flere ganger eller påliteligheten ikke lenger er tydelig. En ordre opprettes på kontoret, skrives ut på lageret, suppleres på en følgeseddel og overføres senere tilbake til et regneark. Samtidig reserverer en annen ansatt lager for en hastesending. Til slutt er ikke bare lageret tvilsomt. Også spørsmålet om hvem som utførte hvilket trinn og når, kan knapt besvares.

Denne friksjonen viser seg sjelden som en enkelt stor feil. Den koster minutter hver dag: ved varesøk, ved tilbakeringing til en kunde, ved sporing av en leveranse eller ved skiftoverlevering. Over uker oppstår derav unngåelige mangler, ekspressforsendelser og diskusjoner om tall ingen fullt ut stoler på.

Hva skreddersydd logistikkprogramvare konkret bør kartlegge

En skreddersydd applikasjon starter ikke med en funksjonskatalog. Den starter med en prosesskartlegging på hallgulvet og ved disponeringens arbeidsplass. Hvilke data kommer faktisk inn? Hvilken beslutning tar en ansatt? Hvilket unntak oppstår regelmessig? Og hvilken informasjon må foreligge for at neste arbeidstrinn skal kunne fortsette?

Av dette oppstår en tydelig arbeidsflyt — for eksempel fra ordremottak, plukking og forsendelse til overlevering til regnskap. Avhengig av virksomheten kan følgende byggeklosser inngå:

  • Registrering av varemottak, inspeksjonsstatus og lagerplasser
  • Lagerbevegelser støttet av strekkoder eller mobile skannere
  • Ordremottak, reservasjoner og plukklister
  • Følgesedler, fraktetiketter og overlevering til logistikktjenesteleverandører
  • Ruteplanlegging for egne kjøretøy og turer
  • Sporbare korrigeringer, rollebaserte rettigheter og evalueringer

Det avgjørende er ikke å bygge alt på én gang. En bedrift med hyppige flyttinger trenger kanskje pålitelige lagerbevegelser først. En grossist med mange små forsendelser drar først mest nytte av et rent ordremottak og automatisk genererte fraktdokumenter. En produksjonsbedrift trenger kanskje først innsikt i materialtilgjengelighet og sperret lager.

Et eksempel fra hverdagen

Anta at varemottaket mottar fem paller med varer hvis mengder delvis avviker fra bestillingen. I en god arbeidsflyt registreres leveransen, kontrolleres og tildeles en status. Først etter godkjenning blir lageret tilgjengelig for disponering. Avvik havner ikke i et notat festet til følgeseddelen, men tildeles synlig til innkjøp og lager.

Når plukking skjer senere, viser systemet ikke bare et teoretisk totallager, men den matchende lagerplassen og den reserverte andelen. Etter skanning eller bekreftelse av uttaket logges bevegelsen. Følgeseddelen genereres fra samme data. Dette reduserer dobbel registrering og skaper et pålitelig spor uten at ansatte må utføre mer administrativt arbeid.

Standardprogramvare, Excel eller skreddersydd utvikling?

Det ærlige svaret er: det kommer an på prosessen. Standardprogramvare gir mening når arbeidsflyter stort sett samsvarer med tiltenkte mønstre, tilpasninger forblir minimale og lisenskostnadene passer omfanget. Den kommer ofte med ferdige moduler, etablerte grensesnitt og en rask første utrulling.

Ulempen viser seg når virksomheten permanent må tilpasse seg verktøyet. Da håndteres spesialtilfeller igjen utenfor systemet, obligatoriske felt omgås, eller ansatte vedlikeholder skyggelister. Dette kan være akseptabelt så lenge disse unntakene forblir sjeldne og håndterbare. Hvis de akkumuleres, blir standardproduktet et ekstra prosessbrudd. Excel forblir også et nyttig verktøy når datamengder er små, bare noen få personer jobber samtidig, og konsekvensene av feilregistrering forblir begrenset. Det er imidlertid ingen god database for parallelle lagerbevegelser, bindende reservasjoner eller en fullstendig frakthistorikk.

En skreddersydd løsning er spesielt verdt bryet når arbeidsflyten er en genuin konkurransefordel, når flere mediebrudd møtes, eller når et eksisterende system inneholder data, men bremser det daglige arbeidet. Den bør ikke forstås som et prestisjeprosjekt. Dens økonomiske verdi ligger i kortere gjennomløpstider, færre feil og mindre avhengighet av enkeltpersoner.

Skreddersydd logistikkprogramvare for SMB-er trenger grenser

Skreddersydd betyr ikke å implementere hver ønskede funksjon umiddelbart. Tvert imot: god skreddersydd utvikling setter tydelige grenser. Ellers oppstår et system som bevarer alle historiske spesialveier, noe som gjør det vanskelig å bruke.

En fornuftig start definerer en kjerneprosess med målbar nytte. For eksempel: varemottak bokføres fullstendig samme dag. Eller: vare, mengde, saksbehandler og fraktstatus dokumenteres tydelig for hver fraktordre. Først når denne arbeidsflyten kjører stabilt, følger ytterligere moduler som ruteplanlegging, kundeportaler eller spesialevalueringer.

Også tekniske beslutninger krever pragmatisme. En webapplikasjon kan bygges på moderne, vedlikeholdbare teknologier som PHP 8.4, moderne JavaScript og MySQL 8. Dette er ikke selviscenesettelse med teknologibegreper; det skaper et sporbart grunnlag for rollerettigheter, databasetransaksjoner, mobile grensesnitt og dokumenterte utrullinger. For skannere på lageret er det ofte avgjørende at applikasjonen reagerer pålitelig på eksisterende enheter og gir tydelig tilbakemelding selv med svakere WiFi.

Ikke hver funksjon krever sanntidskompleksitet. Noen rapporter kan oppdateres om natten, mens lagerbokføringer og reservasjoner må være umiddelbart konsistente. Dette skillet holder arkitektur, kostnader og drift håndterbare.

Innføring: Stabiliser arbeidsflyten først, akselerer deretter

Innføringen mislykkes sjelden på grunn av ett enkelt grensesnitt. Den mislykkes når åpne prosessspørsmål utsettes til utviklingsfasen. Hvem har lov til å korrigere lager? Hva skjer med skadet gods? Når reserveres en ordre bindende? Hvordan håndteres returer? Slike regler må avklares før en bred utrulling.

En pålitelig vei starter med noen få representative arbeidsflyter og reelle data. Ansatte fra lager, disponering og administrasjon sjekker sammen om skjermen snakker virksomhetens språk og om rekkefølgen på arbeidstrinnene stemmer. I denne prosessen er tilbakemeldinger som «Vi trenger ikke dette feltet» eller «Statusen for delleveranse mangler her» mer verdifulle enn abstrakte funksjonsønsker.

Deretter følger en begrenset pilotdrift — ikke med kunstige eksempler, men med utvalgte ordrer i den daglige driften. Feil og uklare tilstander dokumenteres, prioriteres og korrigeres. Først deretter utvides utrullingen til andre områder. Parallelldrift kan gi kortsiktig trygghet, men bør ha en sluttdato. To ledende systemer skaper på sikt nettopp den usikkerheten prosjektet skal fjerne.

Opplæring er også mer enn en engangspresentasjon. Ansatte trenger korte, rollespesifikke instruksjoner: Hva bokfører jeg? Hva kontrollerer jeg? Hva gjør jeg ved et avvik? Dokumentert unntakshåndtering forhindrer at papir og chattegrupper tar over ledelsen så snart den første spesialsituasjonen oppstår.

Vedlikeholdbarhet er en del av løsningen, ikke en ettertanke

Logistikkprosesser endrer seg. Nye lagerplasser kommer til, en logistikktjenesteleverandør endrer krav, kunder krever andre dokumentformater, eller et nytt sted kobles til. Derfor må programvaren ikke bare passe ved oppstart, men også være forståelig videreutviklbar.

Dette inkluderer en ren datastruktur, klart adskilt forretningslogikk, rettighetskonsepter og dokumenterte utrullinger. Like viktig er sikkerhetskopier, logging og regulert feilhåndtering. Hvis en bruker taster feil tilgangsdata flere ganger, trengs for eksempel en sporbar kontosperringsflyt i stedet for stille, usikker improvisasjon.

Tester bør gå foran endringer i kritiske arbeidsflyter. I skreddersydde applikasjoner er automatisert testing spesielt verdifull for tilbakevendende kjerneveier: opprette ordre, reservere lager, generere fraktdokument, endre status. Dette sikrer at en endring i følgeseddelen ikke uoppdaget får konsekvenser et annet sted.
softify.pro satser på denne typen kjedelig pålitelig, testbar teknologi for slike prosjekter fremfor kortsiktige effekter.

Hva nytten bør måles mot etter seks måneder

Ikke hver forbedring kan umiddelbart uttrykkes i kroner, men den bør være synlig. Gode nøkkeltall fokuserer på flaskehalsen: behandlingstid per ordre, antall lagerkorrigeringer, feilfraktandel, andel rettidige varemottaksbokføringer eller tilbakespørsmål mellom lager og kontor.

Viktig er sammenligningen med en realistisk utgangssituasjon. Hvis ingen tidligere har registrert mangler rent, kan den nye gjennomsiktigheten i utgangspunktet se ut som flere problemer. I virkeligheten blir problemer bare synlige og håndterbare for første gang. Denne fasen krever tålmodighet og åpen kommunikasjon.

Den riktige programvaren forsvinner ikke fra hverdagen fordi den er uviktig. Den sørger for at en ordre, en pall eller en tur går sin tydelige vei — også når den mest erfarne personen på lageret ikke er til stede.

Permalenke →

Automatiserte regresjonstester for webapplikasjoner

Automatiserte regresjonstester for webapplikasjoner

En endret rabattkode, en ny rolletillatelse eller en oppdatering av betalingstjenesten kan bryte en webapplikasjon på et sted ingen har rørt på flere måneder. Nettopp der kommer automatiserte regresjonstester for webapplikasjoner inn: de verifiserer gjentatte ganger om utprøvde forretningsprosesser fortsatt fungerer etter endringer. Ikke som et teoretisk kvalitetstiltak, men akkurat der en feil ville blokkert ordrer, lagerbevegelser, fakturaer eller kundekontoer.

For mange team begynner problemet snikende. Utgivelser tar lengre tid fordi avdelinger manuelt klikker seg gjennom de samme kjerneprosessene. Testkunnskap er låst til enkeltpersoner. Og før en oppdatering gjenstår det ubehagelige spørsmålet: Hva har vi oversett? Automatisering erstatter verken faglig ansvar eller meningsfullt utforskende arbeid. Den gjør de tilbakevendende, forretningskritiske kontrollene pålitelige, reproduserbare og sporbare.

Hva automatiserte regresjonstester faktisk sikrer

En regresjonstest svarer på et enkelt spørsmål: Fungerer noe som fungerte tidligere fortsatt etter en endring? I en webapplikasjon handler det sjelden bare om én enkelt knapp. Det som betyr noe er ende-til-ende-arbeidsflyter på tvers av brukergrensesnitt, rettigheter, grensesnitt og database.

Et eksempel fra et operativt system: En ansatt logger inn, registrerer et varemottak, bokfører en lagerbevegelse, oppretter en følgeseddel og overleverer forsendelsen til en kurertjeneste. Hvert enkelt trinn kan se teknisk korrekt ut og likevel feile i samspillet. Kanskje lagres mengden, men oppdateres ikke i lageret. Kanskje genereres etiketten, men referansenummeret mangler. Kanskje fungerer arbeidsflyten bare for administratorer, men ikke for lagerrollen.

Automatiserte tester kan utføre slike reiser med definerte inndata og verifisere resultatene. Dette inkluderer synlige resultater i brukergrensesnittet så vel som statusverdier, genererte dokumenter, e-poster eller API-svar. Nytten øker når kontrollene organiseres tett på operative risikoer — ikke basert på antall teknisk mulige testtilfeller.

Hvilke webarbeidsflyter bør automatiseres først

Ikke hvert klikk fortjener umiddelbart en automatisert test. En sjelden brukt innstillingsside med lavt skadepotensial kan i utgangspunktet sjekkes manuelt. Derimot hører arbeidsflyter med hyppige endringer, høy bruk eller tydelige finansielle og operative konsekvenser hjemme i testsuiten tidlig.

Spesielt verdifulle er tester for pålogging, passordtilbakestilling og kontosperring. De sikrer tilgangen til applikasjonen og påvirkes ofte av endringer i identitetstjenester, øktstyring eller sikkerhetsregler. Like viktige er kjerneprosesser som ordreregistrering, pris- og skatteberegning, godkjenninger, lagerbokføringer, dokumentgenerering og grensesnitt mot forsendelse, ERP eller betalingsleverandører.

Nøktern prioritering hjelper både ledelse og forretningsavdelinger. Ikke spør først hvilken side som er enklest å teste. Spør: Hvilken feil stopper et skift, forårsaker etterarbeid eller fører til feil kundeinformasjon? Fra dette oppstår en testliste som beskytter den reelle driften.

Et testtilfelle trenger et verifiserbart resultat

«Opprett ordre» er ennå ikke et godt testtilfelle. Bedre er: En selger med salgsrollen oppretter en ordre for en eksisterende kunde, legger til en vare med definert mengde, lagrer den og genererer et ordrenummer. Deretter er statusen «åpen», summen samsvarer med reglene, og ordren vises i listen over åpne transaksjoner.

Denne presisjonen er ikke byråkrati. Den forhindrer tester som klikker seg gjennom uten å kunne fastslå om det forretningsmessige resultatet er riktig. Den letter også avstemmingen mellom utvikling, QA og forretningsavdeling. Spesielt i skreddersydde systemer er fagfolkene ofte den eneste pålitelige kilden til hva «korrekt» egentlig betyr i hverdagen.

Testpyramide i stedet for nettleserautomatisering for alt

Nettlesertester er verdifulle, men de er ikke hele teststrategien. De kjører saktere, er mer sårbare for ustabile testdata og kan brytes etter mindre UI-justeringer hvis selektorer er dårlig valgt. Den som sjekker hver regel utelukkende gjennom overflaten, bygger vanligvis en treg og vedlikeholdstung suite.

Forretningslogikk som prisberegninger, mengdesjekker eller statusoverganger bør testes der den er implementert — for eksempel som en enhets- eller integrasjonstest. Grensesnitt kan testes målrettet med kontrollerte svar. Nettleserbaserte ende-til-ende-tester forblir da forbeholdt de få stiene der samspillet mellom alle komponenter er avgjørende.

For PHP 8.4-applikasjoner med MySQL 8 betyr dette for eksempel: Beregnings- og valideringsregler sikres tett på koden, databasetransaksjoner og API-kontrakter testes integrasjonsmessig, mens en nettlesertest sporer den fullstendige ordren helt til det genererte dokumentet. Dette er mindre spektakulært enn en stor samling synlige klikktester. Det gir imidlertid raskere tilbakemelding og lavere vedlikeholdskostnad.

Stabilitet kommer fra testdata og tydelige tekniske grenser

Mange automatiseringsprosjekter mislykkes ikke på grunn av testverktøyet, men på grunn av ukontrollerte forutsetninger. Hvis en testkonto er sperret, en testordre fra dagen før fortsatt eksisterer, eller en ekstern tjeneste svarer sakte, oppstår en falsk alarm. Slike ustabile tester mister raskt teamets tillit.

Testdata må derfor opprettes og ryddes opp med hensikt. Fornuftig er separate leietakere eller klart isolerte datasett, unike identifikatorer per testkjøring og definerte starttilstander. En test skal ikke tilfeldig avhenge av rekkefølgen til andre tester. Der eksterne tjenester er involvert, bør det tas en klar beslutning: Brukes et realistisk testmiljø, eller simuleres grensesnittet for den respektive testen? Begge tilnærmingene kan være riktige.

Selektorer fortjener også oppmerksomhet. Tester bør ikke avhenge av layoutklasser, tekstposisjoner eller tilfeldige HTML-strukturer. Stabile attributter uttrykkelig ment for testing reduserer unødvendig vedlikehold. Dette er en liten teknisk beslutning med stor innvirkning når grensesnittet og designet utvikler seg regelmessig.

Integrere automatiserte regresjonstester i utgivelsesprosessen

Den beste testen hjelper lite hvis den bare startes manuelt før store utgivelser. En gradert utførelse gir mening: Raske kode- og grensesnitttester kjøres ved hver endring. De viktigste nettleserreisene kjøres ved pull requests eller før utrulling til staging-miljøet. Mer omfattende kontroller kan skje om natten eller før en planlagt produksjonsutgivelse.

Tilbakemelding er avgjørende. En mislykket test trenger ikke bare et rødt ikon, men handlingsrettede innsikter: Hvilke data ble brukt? På hvilket trinn oppstod feilen? Hvilket skjermbilde eller hvilken logg beviser det? For team uten en stor egen QA-avdeling er forståelige funn spesielt verdifulle. De må kunne fastslå om en defekt ligger i systemet, i testdataene eller i testmiljøet.

COCO kan brukes her som en selvhostet testinfrastruktur for å utføre testarbeidsflyter, registrere bevis og presentere resultater på klarspråk. Dette er spesielt relevant når skjermbilder, interne grensesnitt eller testdata ikke bør overføres til en ekstern sky. Selvhostet betyr imidlertid ikke vedlikeholdsfritt: tilgangsrettigheter, oppdateringer, kapasitet og oppbevaringsregler må planlegges like nøye som testene selv.

Hva nøkkeltall avslører — og hva de ikke gjør

Et økende antall automatiserte tester er ikke bevis på kvalitet. En suite med 2000 overfladiske tester kan gi mindre beskyttelse enn 40 rent vedlikeholdte tester for kritiske verdistrømmer. Mer innsiktsfulle er spørsmål som: Hvor lang tid tar tilbakemeldingen etter en endring? Hvor mange relevante feil fanges opp før produksjon? Hvor ofte er testfeil egentlig falske alarmer? Og hvilke forretningskritiske prosesser er dokumentert dekket?

Kjøretid er også en praktisk faktor. Hvis en suite bruker fire timer på å levere resultater, vil den bli omgått i den daglige driften. Hvis den leverer et tydelig signal om pålogging, ordre, lager og dokumenter innen 15 minutter, støtter den beslutningstaking før utgivelsen. Nødvendig dybde avhenger av applikasjonen og risikoen. Et internt planleggingsverktøy krever noe annet enn en kundeportal som håndterer betalinger og personopplysninger.

Den riktige starten er mindre enn mange forventer

Start med en prosess hvis svikt ville merkes tydelig, og kartlegg den fullstendig. Definer det forventede resultatet sammen med personene som bruker denne arbeidsflyten daglig. Sørg for kontrollerte testdata, stabile tekniske ankere og sporbart bevis. Først når denne første testen kjører pålitelig, bør neste prosess legges til.

Slik ender du ikke opp med en imponerende, men skjør testkulisse. I stedet skaper du en motstandsdyktig sikkerhetslinje for endringer — steg for steg, akkurat der webapplikasjonen din faktisk bærer den operative virksomheten.

Permalenke →

Digitalt registrere varemottak uten lagerkaos

Digitalt registrere varemottak uten lagerkaos

En følgeseddel ligger på pakkebordet, pallen står allerede i gangen, og sjåføren venter på en signatur. Nettopp i dette øyeblikket avgjøres det om lagernivåene senere stemmer, eller om neste kollega vil lete etter materiale som ifølge systemet skulle være tilgjengelig. Den som vil registrere varemottak digitalt, trenger derfor mer enn bare en innmatingsskjerm. Prosessen må fungere under tidspress, generere entydige data og passe de faktiske arbeidsflytene på lageret.

Papirlister og regneark virker ofte tilstrekkelige lenge. De blir imidlertid skjøre så snart flere personer bokfører, varer har lignende betegnelser, partinumre blir relevante, eller varer går direkte til montasje, plukking eller kundeordrer. En god digital registrering skaper ikke bare mer data. Den skaper en pålitelig, delt sannhetstilstand.

Hva som faktisk bør registreres ved digitalt varemottak

Varemottak er overgangen mellom leveranse og tilgjengelig lager. For at denne overgangen skal forbli kontrollerbar, bør hver registrering minst kunne svare på: Hva ble levert, i hvilken mengde, når, fra hvilken leverandør og hvor ble varen lagret? Avhengig av virksomheten kommer bestillingsnummer, følgeseddelnummer, partinummer, serienummer, best-før-dato eller kvalitetsstatus i tillegg.

Det avgjørende er skillet mellom bestilt og faktisk mottatt vare. En bestilling kan vise 100 stykker, men det som leveres er 96 stykker, to skadde kartonger og to erstatningsposisjoner. Hvis ansatte bare bekrefter bestillingen, havner en feil rett i lageret. Digital registrering må gjøre avvik bevisst enkle å håndtere — ikke straffe dem med omveier.

For et reservedelslager er det ofte nok med vare, mengde, lagerplass og dokumentreferanse. I produksjon kan partigodkjenninger eller inspeksjonsprotokoller være uunnværlige. Flere felt er ikke automatisk bedre. Hvert obligatoriske felt koster tid og øker sannsynligheten for at noen anslår verdier eller legger dem til senere.

Digitalt registrere varemottak: Arbeidsflyten på lagergulvet

En praktisk arbeidsflyt starter ikke ved en kontor-PC, men der varene ankommer. Ansatte åpner det forventede varemottaket på en mobil enhet eller registrerer først følgeseddelen via søk, bestillingsnummer eller strekkode. Deretter skannes, telles eller veies posisjoner og avstemmes mot den forventede leveransen.

Hvis mengden er korrekt, tildeles varen en lagerplass og bokføres. Ved avvik skrives det ikke bare en kommentar i et fritekstfelt. Systemet registrerer om det dreier seg om manglende mengde, overlevering, transportskade, feil vare eller en ennå ukontrollert posisjon. Et bilde kan være nyttig ved synlige skader, men er ikke nødvendig for hver leveranse.

Etter bokføringen bør det være klart hvilken status varen har. Noen varer er umiddelbart tilgjengelige. Andre forblir sperret til en kvalitetskontroll er fullført eller en ansvarlig har avgjort avviket. Denne statuslogikken forhindrer at salg lover ut varer som fysisk har ankommet, men ennå ikke er brukbare.

Riktig registreringspunkt avhenger av driften. På et lite lager kan varemottaket bokføres fullstendig direkte ved porten. Ved store leveranser eller trange rampetider er en totrinns bokføring ofte bedre: Først registreres leveransen som ankommet, deretter kontrolleres og plasseres varene. Fordelen er hastighet ved rampen. Ulempen: Det krever tydelig ansvar slik at åpne kontroller ikke blir liggende.

Skanner, nettbrett eller arbeidsstasjon-PC?

Maskinvaren bør følge bevegelsesflyten. For varer med rent trykte strekkoder er en håndskanner vanligvis det raskeste og minst feilutsatte valget. Mobile skannere eller smarttelefoner med kamera egner seg når ansatte beveger seg mellom varemottak, hyller og sperrede soner. Et nettbrett kan være fornuftig for mer komplekse bokføringer med bilder, flere mengder eller inspeksjonsmerknader.

En fast PC-arbeidsstasjon fungerer derimot godt når én person sentralt kontrollerer følgesedler og varemottaket er romlig konsentrert. Den er mindre egnet hvis teamet må løpe til kontoret for hver bokføring. Den sparte lisensen betales da ofte med gangavstander, avbrudd og forsinkede bokføringer.

Ikke hver vare trenger en strekkode. Spesielt ved individuelle komponenter, råmaterialer eller leverandøretiketter er merkingen uensartet. Da bør systemet tilby et raskt søk via varenummer, leverandørens varenummer eller bestillingsposisjon. Strekkodeskanning er et godt verktøy, men ikke et mål i seg selv.

Datakvalitet oppstår gjennom regler, ikke gjennom appeller

Et lagerbeholdning blir ikke korrekt bare fordi programvare er installert. Korrekthet oppstår når systemet håndhever fornuftige regler og gjør unntak synlige. En negativ mengde uten begrunnet prosess, en ukjent lagerplass eller et gjenbrukt følgeseddelnummer bør ikke passere ubemerket.

Samtidig må kontrollen ikke blokkere driften. Hvis en leverandør gjenbruker følgeseddelnumre eller etiketter er uleselige, trenger ansatte en sporbar alternativ vei. For eksempel kan en bokføring gjøres med en merknad som må kontrolleres senere. Det viktige er at dette blir en åpen oppgave og ikke et usynlig kompromiss.

Spesielt verdifulle er enkle rimelighetskontroller: Stemmer varen med bestillingen? Avviker mengden mer enn en definert toleranse? Er partinummeret til stede for partikrevende varer? Ble en sperrestatus satt når en skademelding ble registrert? Slike regler reduserer etterarbeid uten å overbelaste teamet med kompliserte innmatingsskjermer.

Bygg grensesnitt først når kjerneprosessen er etablert

Mange bedrifter ønsker umiddelbart en tilkobling til ERP, innkjøp, forsendelse og regnskap. Det kan være riktig, men bare hvis datasuvereniteten er tydelig. Et system bør entydig fastsette hvor bestillinger oppstår, hvor det ledende lageret ligger, og hvilke data som overføres i hvilken retning.

Et dårlig grensesnitt mangedobler feil raskere enn et regneark. Hvis for eksempel bestillinger kommer fra ERP, men det faktiske varemottaket opprettes i lagerbokføringssystemet, må det være klart hvilke statuser som rapporteres tilbake: fullstendig levert, delvis levert, sperret eller med avvik. Tidsstempler og entydige dokumentreferanser er her viktigere enn en visuelt imponerende integrasjon.

For mindre virksomheter kan en kontrollert CSV-import være mer fornuftig å starte med enn en dyr sanntidstilkobling. Dette er ingen nødløsning hvis import, kontroll og feillogg er rent implementert. Så snart volumer, frekvens eller etterfølgende prosesser vokser, blir et direkte grensesnitt mer økonomisk.

En meningsfull utrulling starter med reelle leveranser

Før utvikling eller standardprogramvare velges, lønner det seg med en kort prosesskartlegging med reelle tilfeller. Ikke bare idealleveransen hører hjemme på bordet, men også skadet gods, delmengder, feil varer, manglende bestillinger og hastemateriale til verkstedet. Dette avdekker hvilke data og beslutninger som faktisk trengs.

Til å begynne med er det ofte nok med et klart avgrenset område, for eksempel én leverandør, én varegruppe eller ett lagersted. Teamet jobber med den nye arbeidsflyten parallelt med tidligere kontroller til bokføringene stemmer sporbart. Først deretter følger utvidelsen. En big bang sparer tid i prosjektplanen, men skaper ofte hektikk på gulvet.

Viktige aksept-kriterier er konkrete og målbare:

  • En standardleveranse kan bokføres uten tilbakespørsmål på noen minutter.
  • Avvik vises i en åpen, tildelt avklaringsliste.
  • Lageret til en vare kan forklares med dokument og lagerplass.
  • Autoriserte ansatte kan utføre korrigeringer på en sporbar måte.
  • Åpen eller sperret vare disponeres ikke ved en feiltakelse.

Et system skreddersydd for driften kan her oppnå mer enn en overbelastet pakke hvis det respekterer eksisterende arbeidsmåter.
softify.pro utvikler slike logistikkprosesser ikke for digitaliseringens skyld, men rundt bokføringer, ansvar og data som må være robuste i hverdagen.

Nøkkeltall som synliggjør nytten

Etter lansering bør man ikke bare telle hvor mange varemottak som ble bokført digitalt. Mer meningsfullt er tiden mellom leveranse og tilgjengelig vare, antall uavklarte avvik, lagerdifferanser ved varetelling og innsatsen for henvendelser i innkjøp eller salg.

Hvis gjennomløpstiden reduseres, men antallet etterfølgende korrigeringer øker, er prosessen sannsynligvis for rask og for lite kontrollerbar. Hvis hver bokføring tar lang tid til tross for at det knapt oppstår avvik, er det kanskje bygget inn for mange obligatoriske trinn. Gode lagerprosesser søker ikke maksimal kontroll, men passende kontroll.

Det beste neste steget er ofte en rundtur på varemottaket med tre reelle følgesedler. Observer hvilken informasjon som søkes, hvor ansatte improviserer beslutninger, og hvilke data som legges inn på nytt senere. Nettopp der begynner et digitalt varemottak som ikke bare ser mer moderne ut, men faktisk gjør lageret troverdig.

Permalenke →

Selvhostet AI-programvaretesting i drift

Selvhostet AI-programvaretesting i drift

En mislykket regresjonstest er sjelden bare en rød oppføring i en liste. Det kan bety at en lagerarbeider ikke kan skrive ut en følgeseddel, en saksbehandler sitter fast i ordresystemet, eller at en oppdatering har ødelagt en funksjon som har kjørt pålitelig i årevis. Selvhostet AI-programvaretesting trer inn nettopp der: den automatiserer tilbakevendende kontroller uten unødvendig å eksponere sensitive testdata, skjermbilder eller interne applikasjonsflyter for eksterne plattformer.

For team med webapplikasjoner og Windows-skrivebordsprogramvare er dette mer enn et spørsmål om personvern. Det handler om kontroll over testmiljøet, sporbare feillogger og en testoperasjon som passer den egne utgivelsesprosessen. AI kan lette arbeidsbyrden, men den erstatter verken rene testtilfeller eller faglig ansvar.

Når selvhostet AI-programvaretesting gir mening

Klassisk testautomatisering er svært effektiv, men den krever vedlikehold. Selektorer endres, grensesnitt utvikler seg, testdata må være tilgjengelig og feilmeldinger må klassifiseres. Mange team automatiserer derfor bare en liten del av sine kritiske arbeidsflyter — eller stoler fortsatt hovedsakelig på manuell testing før en utgivelse.

AI-støttede systemer kan innsnevre dette gapet. De leser grensesnitt mer kontekstuelt, kjører forhåndsdefinerte arbeidsflyter, gjenkjenner synlige avvik og oppsummerer resultatene på forståelig språk. Dette blir spesielt verdifullt for applikasjoner som ikke bare består av API-kall, men av reelle brukergrensesnitt: innlogginger, innmatingsskjermer, godkjenninger, utskriftsdialoger og Windows-vinduer.

Selvhosting gir mening når testkjøringer berører konfidensiell informasjon. Dette gjelder ikke bare personopplysninger. Interne priser, kundenavn, varebevegelser, skjermbilder av administrative grensesnitt, påloggingsinformasjon for testkontoer eller informasjon om ennå ikke lanserte funksjoner hører også hjemme her. Den som bruker eksterne AI-tjenester bør nøye sjekke hvilke data som forlater eget nettverk, hvor lenge de lagres og hvem som kan få tilgang til dem.

Det finnes imidlertid også tilfeller der en hostet plattform er tilstrekkelig. For en offentlig markedsføringsside uten reelle kundedata, få utgivelser og overkommelig testdybde kan den settes opp raskere. Den riktige beslutningen avhenger av beskyttelsesbehov, applikasjonslandskap, eksisterende kompetanse og endringsfrekvens — ikke av et generelt sky- eller AI-prinsipp.

Hva som forblir i eget miljø

I et selvhostet testmiljø kjører testutførelsen på infrastruktur kontrollert av selskapet: i eget datasenter, i et privat skymiljø, eller på en dedikert server under en avtalt driftsmodell. Serverens plassering er ikke den eneste avgjørende faktoren. Det er hele dataflyten som betyr noe.

Et rent strukturert system behandler teststeg, nettleser- eller skrivebordsøkter, skjermbilder, logger og testrapporter innenfor dette kontrollerte miljøet. Testkontoer kan opprettes med minimale rettigheter. Påloggingsinformasjon kan håndteres separat. Nettverkstilgang kan begrenses til systemene som faktisk trengs. For spesielt sensitive applikasjoner kan en dedikert testleietaker gi mer mening enn testing med produksjonslignende reelle data.

Dette beskytter ikke automatisk mot feil. En lokalt driftet løsning krever oppdateringer, rettighetskonsepter, sikkerhetskopier og tydelig ansvar. Den som installerer en server én gang og deretter glemmer den, har ikke en sikker testinfrastruktur, men en ekstra driftsoppgave. Fordelen ligger i at denne oppgaven forblir planleggbar og verifiserbar.

Testdata fortjener samme beskyttelse som applikasjonen

Sikkerhetsdiskusjoner fokuserer ofte på kildekoden. I praksis avslører testartefakter minst like mye. Et skjermbilde kan vise kundedata, interne betingelser og prosessdetaljer. En video av en testkjøring kan avsløre strukturen til et backoffice-system. En loggfil kan inneholde URL-er, feilmeldinger eller tekniske versjonsnumre.

Derfor bør oppbevaringsperioder defineres. Ikke hver vellykket kjøring trenger å lagres permanent. Omvendt kan en definert historikk være svært nyttig for feilverifisering og utgivelser. Tilgangsrettigheter til rapporter hører hjemme i samme rettighetskonsept som tilgang til selve applikasjonen.

Ikke hver gjennomgang bør drives av AI

De sterkeste testmiljøene kombinerer ulike metoder. En innlogging med kontosperring etter flere mislykkede forsøk kan testes presist og raskt med deterministiske automatiserte tester. Grensesnitt, beregninger, databaseregler og rettigheter drar også nytte av tydelige forventninger: inndata A må gi resultat B.

AI er spesielt nyttig når brukergrensesnittet, arbeidsflyten og brukerens perspektiv er i fokus. En testoppgave kan for eksempel sjekke om en disponent oppretter en ordre, tildeler en rute, genererer et dokument og korrekt får statusen tilbake. AI-en kan navigere gjennom applikasjonen, fange dokumenter og forståelig dokumentere hvor i prosessen den brøt sammen. For en bærekraftig testoperasjon bør fire nivåer samarbeide:

  • Enhets- og integrasjonstester sikrer forretningslogikk, grensesnitt og databehandling tidlig i utviklingsprosessen.
  • UI-tester sjekker repeterbare klikkveier og konkrete forventninger i web- eller skrivebordsapplikasjoner.
  • AI-støttede arbeidsflytkontroller evaluerer reelle brukerveier og synlige resultater fra brukerens perspektiv.
  • Eksplorative fagtester avdekker spesialtilfeller som ingen ennå har beskrevet som en fast regel.

En AI bør ikke avgjøre om en prislogikk er forretningsmessig korrekt hvis reglene er uklart dokumentert. Den kan heller ikke meningsfullt utføre en upresis instruksjon. «Sjekk frakten» er ikke en robust testbeskrivelse. «Opprett en ordre med tre linjeposter, generer en fraktetikett og sjekk om statusen endres til sendt» er en verifiserbar instruksjon.

Fra demo til robust testoperasjon

Den vanligste feilen i AI-testing er å starte for bredt. En imponerende demo med en enkelt pålogging sier lite om hvorvidt systemet vil sikre utgivelser om seks måneder. En smalere inngang med to til fem arbeidsflyter hvis feil forårsaker reelle kostnader eller skaper tilbakevendende manuelt testarbeid er mye mer fornuftig. I et lager- eller logistikksystem kunne dette være varemottak, lageroverføring, ordreplukking og generering av en følgeseddel. I administrativ programvare heller pålogging, rettighetsendring, ordreregistrering og fakturagodkjenning. Gode kandidater er hyppige prosesser med stabile regler og tydelig synlige resultater.

Deretter trenger hver arbeidsflyt et definert startpunkt. Hvilke data må være til stede? Hvilken testkonto brukes? Får testen sende e-post, skrive ut etiketter eller få tilgang til grensesnitt? Hva tilbakestilles etter kjøringen? Uten disse reglene produserer automatisering raskt testdatarot eller blokkerer andre team.

Evalueringen av resultater bør også være gradert. En manglende knapp er vanligvis en klar feil. En litt annerledes formulering i en hjelpetekst trenger ikke automatisk blokkere en utgivelse. Konfidensterskler og en tydelig separasjon mellom automatisk varsling, manuell gjennomgang og faktiske blokkeringskriterier hjelper her. En testrapport bør ikke bare rapportere «mislyktes», men inneholde det utførte trinnet, den synlige tilstanden, tidsstempelet og passende bevis.

Rollen til skjermbilder, videoer og klartekstrapporter

En test som bare gir en teknisk feilmelding, flytter arbeid til utviklingsteamet. Forretningsavdelinger kan ofte ikke gjøre mye med slik informasjon. Godt bevis kombinerer teknisk presisjon med kontekst: Hva skulle skje? Hva skjedde faktisk? Hvor er det synlig? Hvilken versjon ble testet?

Skjermbilder og opptak forkorter koordineringen betraktelig. QA-ansvarlig trenger ikke først prøve å gjenskape feilen, og produkteieren ser umiddelbart om et avbrudd er forretningsmessig relevant. Samtidig bør slike artefakter lagres selektivt. Vellykkede tester krever ofte mindre bevismateriale enn mislykkede eller kritiske utgivelser.

En klartekstrapport er ingen erstatning for logger. Den er broen mellom drift, forretningsavdeling og utvikling. Spesielt i mellomstore team, der de samme personene har ansvar for prosesser og tar beslutninger, forhindrer denne broen unødvendig oversettelsesarbeid.

Drift, vedlikehold og realistiske forventninger

Selvhostet testautomatisering er ikke et produkt som fungerer uten oppmerksomhet etter oppsett. Applikasjoner endrer seg. Nettlesere oppdateres. Testdata mister sin gyldighet. Nye rettighetsnivåer, captchaer, flerfaktorautentisering eller endrede utskriftsdialoger påvirker testkjøringer.

Dette er ikke et argument mot automatisering. Det er et argument for en tydelig vedlikeholdsplan. Testtilfeller bør behandles som produktkode: versjonert, gjennomgått og bevisst justert ved endringer. Hvis en arbeidsflyt mislykkes tre ganger på rad på grunn av en tilsiktet UI-endring, er ikke AI-en problemet. Da mangler koblingen mellom utvikling, utgivelsesplanlegging og testvedlikehold.

Med COCO satser softify.pro på en dedikert, selvhostet AI-server til dette formålet, som tester web- og Windows-applikasjoner, registrerer bevis og kategoriserer resultatene forståelig. Det avgjørende punktet forblir imidlertid integreringen i hverdagens arbeidsprosesser: hvilke prosesser sikres, hvem gjennomgår avvik, og når får en utgivelse lov til å fortsette?

Det beste første steget er derfor ikke å kjøpe eller konfigurere flest mulig tester. Velg arbeidsflyten der en oversett feil i morgen faktisk ville forårsaket arbeid på lageret, i tjenesten eller i regnskapet. Når denne arbeidsflyten testes pålitelig, sporbart og under egen datakontroll, slutter AI å være teknologi for teknologiens skyld og blir merkbar avlastning.

Permalenke →

Erstatte Excel med skreddersydd programvare

Erstatte Excel med skreddersydd programvare

Lagerpresisjon avhenger helt av at noen åpner riktig fil, registrerer siste varemottak og sikrer at ingen kopier er distribuert via e-post. Så lenge transaksjonsvolumene er lave, er Excel et flott verktøy. Å erstatte Excel med skreddersydd programvare gir bare mening når regnearket blir en flaskehals for arbeidsflyter, ansvarlighet og pålitelighet.

Dette gjelder sjelden bare lageret. Ordrer tas imot per telefon, følgesedler genereres fra maler, lagerdata er delt over flere filer, og oppfølgingsspørsmål havner alltid hos akkurat den personen som er utilgjengelig akkurat nå. Problemet er ikke regnearket i seg selv. Det er forsøket på å styre en voksende operativ prosess med et verktøy som ikke håndhever standardiserte rutiner.

Når Excel ikke lenger er det riktige operative verktøyet

Et regneark kan beregne, filtrere og synliggjøre informasjon. Det håndhever imidlertid ikke at et varemottak bokføres fullstendig, at en leveranse kontrolleres før frakt, eller at to ansatte ikke endrer samme post samtidig. Der slike regler blir forretningskritiske, mangler Excel den riktige strukturen.

Typiske varselsignaler er tilbakevendende avstemminger mellom skift, lager og kontor. Ansatte spør om gjeldende status på en ordre, selv om informasjonen egentlig burde være lett tilgjengelig. Lagerlister ryddes manuelt opp før varetelling. Følgeseddelnumre eller varebeskrivelser kopieres og korrigeres senere. Og når avvik oppstår, er det ofte ikke lenger sporbart hvem som endret hvilken verdi og når.

Selve filen blir også en risiko. Versjoner med navn som "Lager_endelig_ny_2" er ikke enkeltstående tilfeller; de er et tegn på at en prosess mangler én sannhetskilde. Makroer kan fremskynde enkelte arbeidstrinn, men de løser verken parallelt samarbeid eller rollebaserte rettigheter, godkjenninger eller pålitelige revisjonsspor.

Overgangen er ikke verdt bryet fordi skreddersydd programvare ser mer moderne ut. Den er verdt bryet når feil, ventetider og kontrollarbeid regelmessig koster mer enn å innføre et tydelig system.

Å erstatte Excel med skreddersydd programvare: Hva som konkret endres

En god forretningsapplikasjon digitaliserer ikke bare et eksisterende regneark. Den kartlegger de faktiske beslutningene og bevegelsene som skjer i driften. For et varemottak betyr dette for eksempel: å velge eller opprette en leveranse, registrere linjeposter, kontrollere mengder, begrunne avvik, tildele en lagerplass og først deretter oppdatere lageret bindende.

Som et resultat blir en liste til en prosess. Ansatte ser bare trinnene som er nødvendige for deres spesifikke oppgave. Kontoret kan se behandlingsstatus uten å måtte følge opp per telefon. Ledelsen kan gjennomgå åpne transaksjoner, avvik eller manglende registreringer. En endring forblir sporbar i stedet for stille å forsvinne inn i en celle.

Forskjellen ligger også i dataarkitekturen. En applikasjon med en rent modellert database, for eksempel basert på MySQL 8, lagrer ikke varer, ordrer, lagerplasser og bevegelser som løse kopier. Relasjoner er tydelig definert. En vare kan ikke ved et uhell opprettes med tre forskjellige numre hvis forretningsregelen krever en unik identifikator.

Dette skaper ingen feilfri virkelighet. Mengder kan fortsatt telles feil, og leveranser kan ankomme skadet. Programvaren sørger imidlertid for at avvik registreres synlig, tilordnes og gjøres tilgjengelig for senere analyse. Operativt er det mye mer verdifullt enn et tilsynelatende rent lager hvis opprinnelse ingen kan forklare.

Ikke bygg om hver prosess umiddelbart

Den vanlige feilen er å starte for stort. Den som prøver å erstatte alle en bedrifts prosesser på én gang, venter lenge på et resultat og tvinger mange åpne spørsmål inn i ett enkelt prosjekt. For små og mellomstore bedrifter er en trinnvis tilnærming vanligvis mer fornuftig.

Det første området bør oppfylle to kriterier: det forårsaker merkbar innsats eller feilkostnader, og det kan avgrenses klart. Dette kan være registrering av innkommende varer, generering av følgesedler, ordremottak eller styring av lagerbevegelser. En konkret flaskehals gir bedre krav enn det abstrakte kravet om en «komplett digital løsning».

Excel kan fortsatt spille en rolle her. For engangsberegninger, analyser eller små planleggingslister er det ofte raskere og billigere enn en skreddersydd applikasjon. Dataeksporter for controlling eller skatterådgivere forblir også nyttige. Det avgjørende er at Excel ikke lenger er den ledende kilden for tidskritiske prosesser.

Videre trenger ikke en skreddersydd løsning å gjenskape alle funksjonene til et stort ERP-system. En bedrift med to lagre og ti ansatte trenger kanskje ikke flerklientlogikk, men den trenger definitivt rene rettigheter, mobil skanning på lagerplassen og pålitelige dokumenter. Overbelastede standardpakker inneholder ofte funksjoner ingen bruker, mens kjernearbeidsflyten likevel må tilpasses.

Observer krav på arbeidsplassen, ikke bare spør om dem

Den beste kravlisten skapes ikke alene på et møterom. Den skapes der varer losses, plukkes, kontrolleres og overleveres. En samtale med lagerledelsen kan beskrive en idealprosess. Å observere et skift avslører hvilken informasjon som mangler, når hansker eller skannere er nødvendige, og på hvilke punkter ansatte bevisst tar snarveier.

Disse snarveiene er ikke automatisk feil atferd. De peker ofte på et systemproblem. Hvis en ansatt skriver ned tall på papir fordi datamaskinen er for langt unna, bør løsningen ikke bare være å gjøre et felt obligatorisk på en skrivebordsskjerm. Kanskje trenger prosessen en mobil registreringsskjerm, etikettutskrift eller et tydeligere overleveringspunkt mellom varemottak og lagring.

Derfor bør konkrete spørsmål besvares under designfasen: Hvem oppretter en ordre? Hvem har lov til å korrigere mengder? Hva skjer ved en delleveranse? Når genereres en følgeseddel? Hvilke data må være synlige hvis nettverket på lageret midlertidig er utilgjengelig? Og hvilke nøkkeltall brukes faktisk i stedet for bare å se bra ut på et dashbord?

Jo tydeligere disse beslutningene er før utviklingen starter, desto mindre spesiallogikk skapes senere. God skreddersydd programvare gjenskaper ikke hvert historiske unntak. Den skiller fornuftige operative regler fra vaner som bare eksisterer fordi det forrige verktøyet satte begrensninger.

Ta hensyn til teknologi, rettigheter og drift fra dag én

En forretningsapplikasjon må forbli vedlikeholdbar i daglig drift. Dette gjelder ikke bare brukergrensesnittet, men også rene datamodeller, dokumentert utrulling, sikkerhetskopier og tydelige ansvarsområder. Moderne webapplikasjoner kan bygges solid med PHP 8.4, oppdatert JavaScript og MySQL 8. Det avgjørende er ikke trendverdien til en teknologistabel, men om den er forståelig, testbar og driftbar over lang tid.

Roller og rettigheter hører hjemme i konseptet fra de tidlige stadiene. Ikke hver bruker bør kunne endre priser, stamdata eller historiske registreringer. For sensitive funksjoner er sporbare godkjenninger, systemlogger og, ved behov, kontosperringer etter mislykkede innloggingsforsøk nyttige. Slike detaljer virker i utgangspunktet tekniske, men de forhindrer uklart ansvar under drift.

Like viktig er datamigrering. Eksisterende Excel-filer inneholder ofte duplikater, inkonsistente enheter eller varer som ikke lenger er i bruk. Å importere disse dataene ukontrollert flytter bare gamle problemer inn i det nye systemet. En kontrollert opprydding med klare regler er mye bedre: Hvilke data migreres, hvilke arkiveres, og hvilke må gjennomgås fra et forretningsperspektiv før lansering?

Innføring uten driftsstans

En lansering må ikke sette fraktoperasjonene i fare. Derfor krever utrullingen en begrenset pilotfase, reelle testtilfeller og ansatte som kjenner arbeidsflyten. Det er ikke nok å bare opprette eksempelordrer. Systemet må kunne håndtere delleveranser, feilaktige mengder, kanselleringer, tidspress og unntakene som forekommer i normal daglig drift.

En kort parallellfase kan være nyttig, men den bør ha en klar sluttdato. Hvis regnearket og den nye applikasjonen vedlikeholdes samtidig for lenge, skaper det dobbelt arbeid og bringer tilbake spørsmålet om hvilken kilde som gjelder. En definert overgangsdato er bedre, sammen med opplærte kontaktpersoner og en rask tilbakemeldingssløyfe for feil eller manglende detaljer.

Etter lansering måles verdien av en skreddersydd løsning ikke av et spesielt utpenslet brukergrensesnitt. Det viser seg når en ordre går videre uten spørsmål, lageret forblir forklarbart, og en ny kollega trygt kan betjene prosessen etter en kort innføring. Det er nettopp der neste beslutning bør begynne: ikke med den neste Excel-filen, men med det konkrete arbeidstrinnet som vil sløse bort tid igjen i morgen.

Permalenke →

Digitalisere lagerprosesser med programvare

Digitalisere lagerprosesser med programvare

En plukker bruker ti minutter på å lete etter en vare som ifølge en Excel-fil skal ligge på hyllen. Samtidig registrerer en kollega innkommende varer på et papirskjema mens en ordre endres per telefon på kontoret. Slike situasjoner er ikke et tegn på dårlig arbeid. De viser at informasjonen ikke lenger følger de fysiske varebevegelsene pålitelig. Den som vil digitalisere lagerprosesser med programvare, bør derfor ikke starte med den lengst mulige funksjonslisten, men med nettopp disse hverdagslige bruddene.

Når det er meningsfullt å digitalisere lagerprosesser med programvare

Et regneark er ikke i seg selv et problem. For et overkommelig lager, få ansatte og sjeldne bevegelser kan det være fornuftig, rimelig og transparent. Et bytte lønner seg først når filen blir en uoffisiell kontrollsentral: flere versjoner sirkulerer, lagernivåer korrigeres i etterkant, eller bare et fåtall personer forstår formlene og filstrukturene.

Typiske utløsere er ikke abstrakte vekstmål, men tilbakevendende operativ friksjon. Lagernivåer stemmer regelmessig ikke etter fysiske tellinger. Varemottak forblir ubokført til stengetid. Leveranser sendes ut uten fullstendig følgeseddel. Ansatte ringer hverandre frem og tilbake for å avklare en vares plassering eller status på en ordre. Eller én person overfører nøyaktig de samme dataene fortløpende til e-post, Excel, en fraktportal og regnskap.

I denne sammenhengen betyr digitalisering: Systemet kartlegger en tydelig tilstand. En vare har ankommet, blitt inspisert, satt på plass, reservert, plukket eller sendt. Hver statusendring har en utløser, et tidsstempel og ideelt sett en ansvarlig person. Dette skaper ikke byråkrati; det forhindrer snarere at beslutninger baseres på gjetning.

Det riktige utgangspunktet: fysiske bevegelser i stedet for programvaremoduler

Mange innføringer starter med spørsmål om funksjoner som skannerintegrasjon, batchhåndtering eller dashbord. Det er forståelig, men fører ofte til et overbelastet kravdokument. Det er mer fornuftig å kartlegge prosesser langs den faktiske varebevegelsen.

Ta en reell ordre og følg den fra mottak til overlevering til fraktleverandøren. Hvor oppstår informasjon? Hvem sjekker den? Hvor blir noe notert på papir, overført senere eller videreformidlet muntlig? Unntakene er spesielt verdifulle: delleveranser, skadet gods, erstatningsvarer, sperret lager og returer. Standardprosessen ser vanligvis ryddig ut på en tavle. Unntakene avgjør om den nye applikasjonen vil bli akseptert i hverdagen.

For en første workshop er ofte tre spørsmål nok: Hvilken informasjon mangler ansatte oftest? Hvilken transaksjon forsinkes eller gjøres dobbelt oftest? Og hvilke feil koster faktisk tid, penger eller kundetillit hver måned? Prioriteringer kan utledes fra dette uten å måtte omorganisere hele lagerorganisasjonen på én gang.

En liten, komplett arbeidsflyt slår en stor systemlansering

I stedet for å digitalisere alle prosesser på én gang, bør ett område fungere sømløst fra start til slutt. Et fornuftig innledende omfang kan for eksempel dekke varemottak, plassering og lagerstyring. En forhåndsvarslet leveranse eller ordre registreres, varer inspiseres, en lagerplass tildeles og lager bokføres umiddelbart. Først når denne arbeidsflyten kjører stabilt, følger plukking, fraktetiketter eller ruteplanlegging.

Dette reduserer prosjektrisiko. Ansatte lærer ikke bare et nytt brukergrensesnitt, men en klart definert arbeidsflyt. Samtidig blir det tydelig hvilke regler som mangler i praksis — for eksempel spørsmålet om uinspiserte varer allerede kan være reserverbare, eller om mangelfulle mengder umiddelbart bør utløse en avklaringssak.

Hvilke lagerfunksjoner som virkelig gjør en forskjell

Den beste lagerapplikasjonen er ikke den med flest menyvalg. Den gjør neste arbeidstrinn utvetydig og dokumenterer bevegelsen uten dobbeltregistrering. I mange virksomheter gir spesielt fire kjernebyggeklosser raskt målbare forbedringer:

  • Sentral lagerstyring med varer, varianter, lagerplasser, minimumslagernivåer og sperret lager forhindrer konkurrerende Excel-versjoner.
  • Mobile transaksjoner via håndholdte skannere eller smarttelefoner kobler plassering, flytting og uttak direkte til varens faktiske plassering.
  • Ordre- og plukklister viser prioritet, status og mangler i stedet for å fordele ordrer via muntlige tilrop eller papirbunker.
  • Automatisk genererte følgesedler, fraktetiketter og bevegelseslogger reduserer manuelle dataoverføringer og gjør sporing enklere.

Om strekkodeskanning er umiddelbart nødvendig, avhenger av lageret. Med få varer og faste hyller kan en oversiktlig innmatingsskjerm være tilstrekkelig i starten. Med mange lignende varer, skiftende lagerplasser eller høy gjennomstrømning er skanning derimot vanligvis ikke en bekvemmelighetsfunksjon, men en feilbrems. Pålitelig Wi-Fi-dekning over hele arealet er også avgjørende. En mobilapp som mister forbindelsen i flere ganger, flytter bare problemet til en kø av utsatte etterregistreringer senere.

Automatisering trenger også klare grenser. Et system kan prioritere fraktordrer basert på cut-off-tider eller forberede en innkjøpsrekvisisjon når lageret når minimumsnivået. Det bør imidlertid ikke utløse ordrer stille når leveringstider, godkjenningsgrenser eller spesielle kundeordrer må tas i betraktning. God programvare foreslår alternativer, flagger avvik og dokumenterer beslutninger. Den fratar ikke team kontrollen over unntakstilfeller.

For små og mellomstore bedrifter er spørsmålet sjelden om et internasjonalt bedriftssystem ville vært teknisk kapabelt. Spørsmålet er om det faktisk forkorter veien fra varemottak til frakt — eller om det skaper nye innmatingsskjermer, godkjenninger og opplæringsbyrde. God digitalisering erstatter ikke hver eneste manuelle oppgave. Den sikrer at hver nødvendige manuelle oppgave fører til riktig informasjon, bokføring og oppfølgende handling.

Datakvalitet er ingen oppgave for senere

Digitalisering mislykkes sjelden på grunn av PHP, databaser eller skannermaskinvare. Den mislykkes oftere fordi varenumre er tvetydige, enheter forstås ulikt, eller historiske lagerdata importeres uten å bli sjekket. Ellers kan en "kartong" plutselig bety ett enkelt stykke, en emballasjeenhet eller en pall, avhengig av personen.

Stamdata bør derfor ryddes opp før import: entydige vareidentifikatorer, tydelige beskrivelser, definerte enheter, sporbare lagerplasser og regler for aktive eller sperrede varer. Ikke hvert gamle datasett trenger å flyttes til det nye systemet. Å dra med seg utdaterte duplikater og lagerplasser som ikke lenger brukes, bevarer bare gammel usikkerhet i et mer moderne grensesnitt.

På et teknisk nivå trenger applikasjonen et robust fundament. En tydelig databasestruktur i MySQL 8 kan lagre lagerbevegelser som individuelle, sporbare hendelser i stedet for bare å vedlikeholde én overskrivbar gjeldende verdi. Dette gjør det mulig å avklare hvorfor et lagernivå avviker: varemottak, uttak, flytting, lagerjustering eller kansellering. Med vedlikeholdbare teknologier som PHP 8.4 og moderne JavaScript forblir en skreddersydd applikasjon også utvidbar uten å bli et stort prosjekt for hver minste justering.

Integrasjon bare der den eliminerer dobbeltarbeid

Et lager opererer sjelden isolert. Ordrer kommer fra en nettbutikk, ERP, e-post eller telefon. Fraktdata går til leverandører, dokumenter til regnskap og nøkkeltall til ledelsen. Likevel trenger ikke hvert tredjepartssystem å kobles til på dag én.

Prioritet gis til grensesnitt som erstatter gjentatt manuell registrering eller eliminerer feilkilder. Hvis ordrer transkriberes fra en nettbutikk hver dag, er en ren overføringsmekanisme verdifull. Hvis en fraktleverandør leverer etiketter og sporingsnumre, kan en integrasjon merkbart øke hastigheten på pakkeprosessen. En sjelden brukt eksportfil kan derimot trygt forbli en kontrollert manuell eksport i starten.

Tydelig ansvar ved feil er essensielt. Hva skjer hvis en ordre opprettes i butikken, men ikke overføres til lagerapplikasjonen? Blir overføringer logget, duplikater gjenkjent, og mislykkede prosesser tydelig merket? Grensesnitt er først virkelig pålitelige når de også tilbyr en forståelig prosedyre for unntakshåndtering.

Innføring i skiftarbeid: aksept opparbeides på lagergulvet

Programvare innføres ikke gjennom en presentasjon, men mellom lasterampen, pakkebordet og hyllen. Derfor bør erfarne lageransatte involveres tidlig. De kjenner snarveier, sikkerhetskrav og de nøyaktige punktene der en teoretisk korrekt arbeidsflyt svikter under tidspress.

Et pilotområde med ekte varer og faktiske ordrer er vanligvis mer meningsfullt enn en lang testfase med eksempeldata. En sikret parallelldrift kan være nyttig i en begrenset periode. Den må imidlertid ikke bli en permanent tilstand, fordi dobbel registrering genererer feil i seg selv. En tydelig omleggingsdag, en utpekt kontaktperson og en enkel måte å rapportere problemer direkte på er avgjørende.

Opplæring bør være prosessorientert: motta varer, registrere et avvik, sette på plass, plukke en ordre og fullføre frakt. Ingen trenger å mestre alle evalueringsverktøy eller administrasjonsfunksjoner i starten. Roller og rettigheter bidrar til å holde skjermen fokusert på den respektive oppgaven. En ordreplukker trenger annen informasjon enn lagerledelsen, og en lagerjustering bør kreve en sporbar godkjenningsprosess.

Å måle suksess med mer enn bare lagernivåer

Etter lansering er det verdt å se på noen få nøkkeltall som teamet faktisk kan påvirke: ledetid fra varemottak til tilgjengelighet, antall lagerjusteringer, plukkfeil, søketider, leveranser i tide og åpne avklaringssaker. Disse målene viser mye raskere enn et generelt digitaliseringsprosjekt om arbeidsflyten forbedres.

softify.pro utvikler slike systemer ikke som en erstatning for fungerende arbeidstrinn, men som et presist supplement der papir, regneark og muntlige tilrop ikke lenger strekker til. Noen ganger er den riktige anbefalingen en liten applikasjon for varemottak og frakt i stedet for et komplett lagerstyringssystem. Noen ganger forblir et regneark den mer fornuftige løsningen for en sjelden spesialanalyse.

Det beste neste steget er derfor ikke produktvalg, men et felles blikk på en konkret ordre fra forrige uke. Når dens vei gjennom lageret blir tydelig, bokførbar og sporbar ved avvik, er grunnlaget lagt for en digitalisering som virkelig sparer tid i hverdagen.

Permalenke →