softify.pro
Cargando …
Servicios Nosotros COCO – nuestro servidor de IA Portafolio Insiders Casos de éxito Curiosidades Contacto Acceso

Curiosidades

Pure fluidity meets ultimate performance: qué hace realmente rápido al software empresarial

Pure fluidity meets ultimate performance: qué hace realmente rápido al software empresarial

Un jefe de almacén no reconoce un mal software por un dibujo de arquitectura. Lo reconoce porque los empleados vuelven a coger el teléfono, registran los albaranes dos veces o, tras un turno, no pueden decir qué mercancía ha llegado realmente. Pure fluidity meets ultimate performance no puede ser, por tanto, una mera aspiración visual. Para el software empresarial significa que una operación se siente natural y, al mismo tiempo, funciona de forma fiable en condiciones reales.

Una interfaz elegante no vale nada si se atasca con un WLAN débil en el almacén. Una aplicación rápida tampoco ayuda mucho si impone una secuencia de trabajo que nadie en la rampa puede seguir. Las buenas herramientas digitales combinan diseño, velocidad y comprensión de procesos. Reducen la fricción sin meter a la empresa en una lógica estándar prefabricada.

Pure fluidity meets ultimate performance es una cuestión operativa

La fluidez se confunde a menudo con animaciones, imágenes grandes y transiciones suaves. Eso puede encajar con una marca moderna. En el día a día de trabajo, sin embargo, se muestra de otro modo: una recepción de mercancías se puede contabilizar sin rodeos. Un empleado encuentra un pedido incluso cuando solo se conoce un número de referencia. Un error se nombra con claridad, en lugar de desaparecer en un mensaje críptico.

El rendimiento es igualmente más que un buen valor en una prueba de navegador. Lo decisivo es el tiempo de respuesta con un pedido de muchas posiciones, la estabilidad a fin de mes y la pregunta de si cinco personas pueden trabajar a la vez sin sobrescribirse mutuamente los estados de datos. También forma parte un manejo limpio de cortes de conexión, permisos y cuentas bloqueadas.

Ambos son inseparables. Si una pantalla reacciona al instante pero tiene campos obligatorios poco claros, sigue siendo agotadora. Si el flujo está modelado con inteligencia pero la página espera dos segundos en cada asiento, se rodea. La fluidez surge donde el sistema apoya la siguiente acción sensata y sigue siendo técnicamente lo bastante rápido para que el hilo del pensamiento no se rompa.

La interfaz sigue el camino de trabajo, no el organigrama

Muchas soluciones estándar estructuran sus menús por módulos: compras, ventas, almacén, informes, administración. Desde la perspectiva del producto es comprensible. En el suelo del almacén, sin embargo, el trabajo suele empezar con una situación: hay un camión esperando, falta un palé, un cliente necesita un comprobante de entrega o un envío debe etiquetarse todavía antes del cierre de recepción.

Una buena aplicación a medida empieza, por tanto, con estas situaciones. ¿Qué información hay? ¿Quién decide? ¿Qué hay que documentar? ¿Qué no debe modificarse después? Solo entonces se decide qué pantalla de entrada, comprobación o automatización hace falta.

Eso no significa volcar cada flujo existente sin cambios en software. Algunas tablas son realmente demasiado propensas a errores, algunas aprobaciones innecesariamente lentas. Pero una lista de Excel que funciona no tiene por qué sustituirse forzosamente por un proyecto. Si solo la mantiene una persona, conoce pocas excepciones y sigue siendo trazable, puede ser la herramienta adecuada. El software vale la pena cuando mejora la coordinación, reduce fuentes de error o pone la información a disposición de varios participantes de forma fiable.

Menos clics no es automáticamente mejor

La exigencia de los menos clics posibles suena razonable, pero puede conducir en la dirección equivocada. Para un asiento de almacén irreversible, una breve confirmación tiene sentido. Para una liberación de envío, una comprobación de plausibilidad visible puede evitar costosos retrabajos. El flujo correcto depende del riesgo.

Lo decisivo es que los pasos adicionales tengan un propósito claro. Una confirmación no debería aparecer solo porque el framework la genera con facilidad. Debería estar exactamente donde las personas deben tomar una decisión de forma consciente. Así la aplicación sigue siendo rápida sin volverse ligera.

El rendimiento surge en la arquitectura, no en el último sprint

Quien acelera un sitio web o una aplicación web solo poco antes del go-live suele tratar síntomas. Las consultas grandes, los modelos de datos poco claros y los casos especiales añadidos después no pueden corregirse de forma duradera con un único día de optimización.

Una base sólida empieza con una base de datos que corresponda a las relaciones reales en la empresa. En MySQL 8, movimientos, documentos, cambios de estado y acciones de usuario necesitan claves trazables e índices sensatos. Una existencia no debe aparecer solo como número si luego hay que aclarar de qué asiento resulta. Al mismo tiempo, no hace falta recalcular cada información histórica en cada carga de página.

En las aplicaciones web modernas también es relevante la separación de responsabilidades. PHP 8.4 puede representar reglas de negocio de forma clara y mantenible, mientras que el JavaScript moderno se emplea de forma selectiva para áreas reactivas. Eso no es una profesión de fe en un stack determinado. Es una cuestión de mantenimiento: ¿pueden implementarse cambios con seguridad dentro de seis meses? ¿Se ve dónde rige una regla? ¿Puede reproducirse un error, en lugar de solo suponerse?

El rendimiento necesita además límites. Los campos de búsqueda necesitan un mínimo sensato de caracteres o una lógica de filtro precisa si son imaginables millones de registros. Las listas grandes necesitan páginas o procesos de carga escalonados. Imágenes y documentos no deberían bloquear el flujo de trabajo crítico. Estas decisiones parecen poco espectaculares. Justo por eso siguen siendo valiosas más tiempo que un efecto de frontend llamativo.

La velocidad visible genera confianza

No todo proceso puede terminar en menos de un segundo. Una impresión de etiquetas, una interfaz con el transportista o una comprobación frente a datos externos requiere a veces tiempo. Lo decisivo es entonces cómo maneja la aplicación la espera.

Un estado claro como «Se está creando la etiqueta de envío» es mejor que un botón congelado. Tras un cierre debería poder verse qué número se generó y si la operación puede volver a lanzarse. Si un servicio externo no está accesible, el equipo necesita una opción de actuación comprensible en lugar de un mensaje de error para desarrolladores.

Es también una cuestión de integridad de datos. Un doble clic no debe generar dos entregas. Un proceso interrumpido no debe dejar en silencio un registro a medias. Los buenos sistemas prevén estos casos, porque ocurrirán en el día a día. Especialmente con turnos cambiantes, presión de tiempo y dispositivos móviles, la excepción no es un tema marginal.

La calidad se hace visible antes del error

Para aplicaciones con muchas variantes de proceso no basta con recorrer manualmente unos cuantos caminos al final. Los cambios en precios, roles, validaciones o interfaces pueden desencadenar consecuencias en un lugar muy alejado. Aquí el testing automatizado se convierte en parte del rendimiento: no solo técnicamente, sino a nivel organizativo.

Un sistema de pruebas debería poder comprobar flujos reales, por ejemplo crear un pedido, modificar una posición, generar un albarán y controlar un permiso. Debería registrar evidencias y formular los resultados de modo que las áreas funcionales puedan interpretarlos. Una frase como «El proceso de envío no se completó tras el cambio de dirección» ayuda más que un stack trace sin comentarios.

Para los equipos preocupados por la seguridad también es relevante el lugar donde se ejecutan estas pruebas. Si capturas de pantalla, credenciales, casos de prueba o pasos internos de la aplicación no deben salir de la empresa, un enfoque autoalojado suele ser más sensato que un servicio cloud externo. Con COCO pueden ejecutarse pruebas automatizadas para aplicaciones web y Windows en un entorno dedicado. Eso no es necesario para todos los equipos. Con datos sensibles, ámbitos regulados o aplicaciones especializadas internas, el control sobre los datos de prueba puede ser, sin embargo, una ventaja decisiva.

El diseño es bueno cuando facilita el trabajo

Una identidad visual fuerte puede generar confianza. Muestra que una empresa se toma en serio su presencia digital. En el sistema operativo, sin embargo, el diseño debe hacer aún más: orientación bajo presión de tiempo. Contraste, tipografía, estados claros y rótulos comprensibles deciden si alguien completa una operación con seguridad o pregunta a un compañero.

La contención suele ser aquí la mejor opción. Un panel con diez indicadores de colores puede parecer impresionante y aun así ocultar la única desviación relevante. Una vista reducida que haga visibles recepciones de mercancías abiertas, escaneos que faltan y plazos de entrega en peligro es más útil. La pregunta no es cuánta interfaz es posible, sino qué información mejora una decisión.

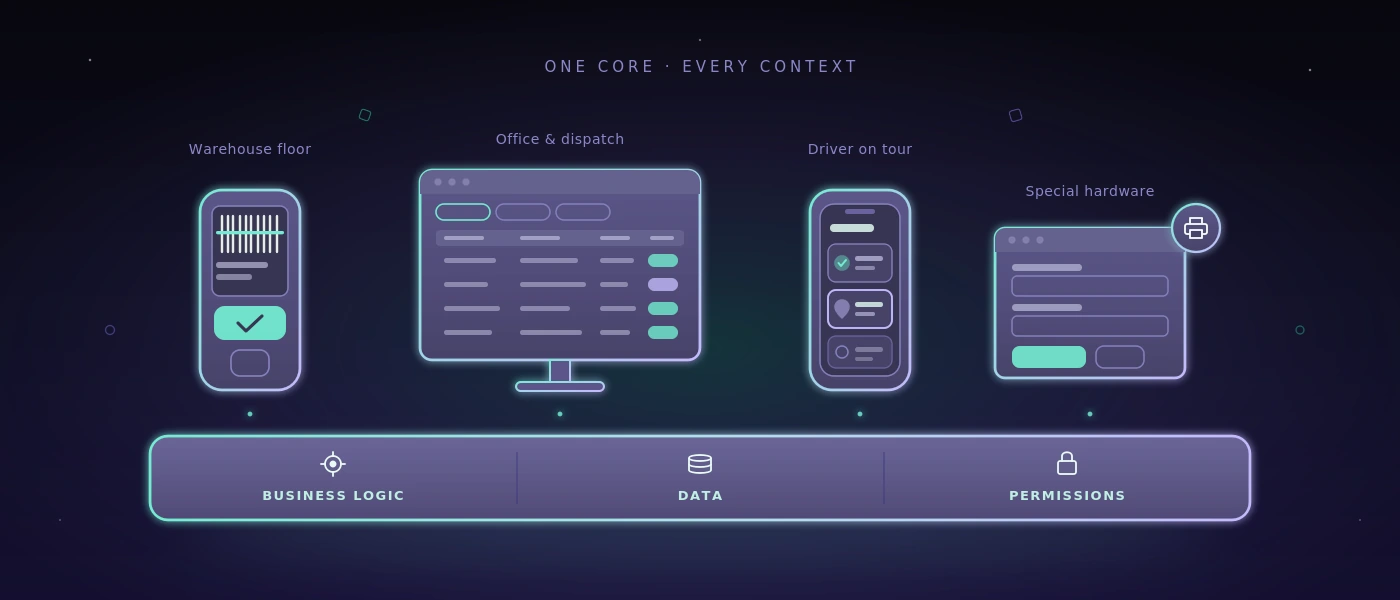
Esto vale también para las aplicaciones responsivas. La capacidad móvil no significa comprimir cada pantalla de escritorio en un formato más pequeño. Un smartphone en la recepción de mercancías quizá solo necesite escaneo, cantidad, ubicación y confirmación. El posprocesamiento detallado pertenece quizá a una pantalla mayor. Dispositivos distintos merecen prioridades distintas, aunque accedan a la misma base de datos fiable.

Una vara de medir sensata para la próxima decisión

Antes de que un equipo decida una nueva plataforma, una automatización o una reconstrucción completa, ayuda una comprobación sencilla: ¿se vuelve el flujo más claro, rápido o seguro para las personas que lo ejecutan a diario? ¿Y sigue pudiendo entenderse la solución cuando cambian requisitos, empleados o interfaces?

Si ambas respuestas son sólidas, una bonita promesa se convierte en un sistema utilizable. Entonces pure fluidity meets ultimate performance se muestra no en una diapositiva, sino en una jornada de trabajo tranquila en la que pedidos, datos y decisiones siguen adelante sin fricción innecesaria.
Enlace permanente →

SaaS Flow Web: implantar workflows con seguridad con la operativa en marcha

SaaS Flow Web: implantar workflows con seguridad con la operativa en marcha

Una recepción de mercancías no se queda parada porque un equipo no conozca otro software más. Se queda parada porque la información se pierde entre correo electrónico, formulario en papel, archivo de Excel y llamada telefónica. Con el SaaS - «Flow Web» en flow.softify.pro - la primera pregunta no debería ser, por tanto, la interfaz. Lo decisivo es si el servicio reproduce de forma fiable un flujo de trabajo concreto - también en días agitados, con responsabilidades cambiantes y cuando una entrega no se ajusta al plan.

Para las pequeñas y medianas empresas, el SaaS suele tener sentido porque no tienen que construir primero sus propios servidores, versiones y funciones básicas. Pero eso no es un cheque en blanco para cualquier proceso. Quien introduce una herramienta que complica el día a día o desplaza datos importantes a listas secundarias poco claras no digitaliza el trabajo. Solo traslada la fricción.

Qué debe ofrecer el SaaS «Flow Web»

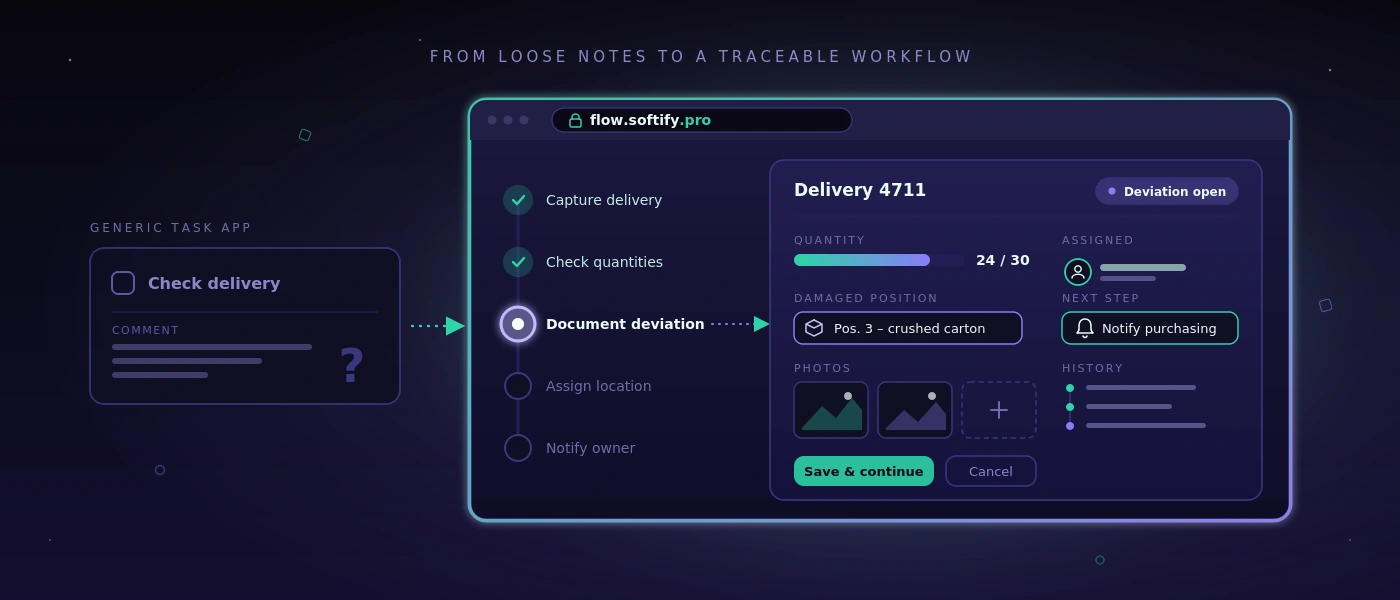
Un workflow web es bueno cuando los empleados saben sin interpretación qué hay que hacer a continuación. En una recepción de mercancías eso puede significar: registrar la entrega, comprobar cantidades frente al pedido, documentar la desviación, asignar una ubicación y, si hace falta, informar a un responsable. El flujo no tiene que ser espectacular. Tiene que ser trazable, rápido y repetible.

Justo aquí está la diferencia entre una aplicación general de tareas y un sistema de procesos especializado. Una aplicación de tareas puede crear un punto llamado «Comprobar entrega». Un workflow especializado puede además anotar de qué entrega se trata, quién la recibió, qué posición estaba dañada, qué fotos hay y si queda pendiente una entrega posterior. Esos datos no están entonces como texto libre en un único comentario, sino donde la siguiente persona los necesita.

Para una solución como Flow Web en flow.softify.pro, la evaluación debería empezar por las operaciones, no por una lista de funciones. Una empresa con cinco movimientos de almacén al día necesita algo distinto a un equipo de envíos con varias horas de corte, diferentes transportistas y gestión regular de entregas parciales. El SaaS no sustituye la comprensión del proceso.

Primero nombrar el cuello de botella, luego configurar

Muchos proyectos de digitalización empiezan demasiado amplios: «Queremos digitalizar el almacén.» Suena plausible, pero lleva rápido a un sistema con demasiadas pantallas, casos especiales y documentos de formación. Mejor una afirmación precisa como: «Las recepciones de mercancías solo se contabilizan al día siguiente, porque los albaranes quedan en el escritorio al final del turno.»

De una frase así puede derivarse un comienzo sensato. La primera versión puede registrar albaranes, confirmar artículos y cantidades, marcar desviaciones y pasar el asiento al área responsable. Cuando este flujo funciona, etiquetas, valoraciones de proveedores o propuestas de pedido automáticas pueden añadirse más tarde. No todo paso de ampliación sensato pertenece al primer despliegue.

También una tabla bien mantenida puede quedarse si cumple su propósito. Por ejemplo, un informe mensual con pocos participantes en un archivo existente puede ser más barato y transparente que un módulo propio. El SaaS compensa donde la información se usa varias veces, los tiempos de tramitación son críticos o los errores surgen de rupturas de soporte.

Las preguntas correctas antes de la implantación

Antes de la configuración, un equipo debería recorrer una operación real de principio a fin. No el proceso ideal, sino el caso que da problemas en el día a día: cantidad errónea, referencia ausente, envío urgente o un pedido con aprobación especial. Así se ven las reglas que un sistema debe reproducir realmente.

Son relevantes, entre otros, estos puntos: ¿quién puede crear, modificar o cerrar una operación? ¿Qué entradas son obligatorias y cuáles solo útiles? ¿Cuándo hay que informar a un responsable? ¿Qué datos se pasan a contabilidad, envíos o atención al cliente? ¿Y qué ocurre si el WLAN del almacén es débil o un empleado ya no tiene sus credenciales?

Las respuestas determinan la calidad de la implantación con más fuerza que un largo catálogo de requisitos visuales. Un proceso de roles limpio, un mensaje de error comprensible y un paso de aprobación documentado evitan en la operación normalmente más esfuerzo que un informe adicional en la página de inicio.

La conservación de datos y los roles no son un detalle

El SaaS se trata a menudo como una mera cuestión de manejo. Para los responsables de operaciones y de TI, sin embargo, es al menos igual de importante qué ocurre con los datos. Eso afecta a datos maestros, información de entrega, datos de empleados, fotos de daños y posiblemente datos de clientes. Antes de la implantación deberían estar claras las responsabilidades, la conservación y las posibilidades de exportación.

En la práctica significa: la empresa debe saber qué datos hay en el sistema, quién tiene acceso administrativo y cómo se ponen a disposición los datos en caso de cambio o fin de contrato. Una exportación disponible solo como archivo PDF difícil de leer rara vez ayuda. Para los datos operativos son decisivos formatos estructurados y utilizables.

También el concepto de permisos merece atención concreta. En el almacén no todas las personas necesitan ver precios, condiciones de clientes o ajustes globales. Al mismo tiempo, una asignación de derechos demasiado estrecha no debe bloquear el flujo. Tienen sentido roles alineados con las actividades reales: recepción, planificación, envíos, jefatura de equipo y administración. Los cambios críticos deberían ser trazables, para que, ante consultas, no haya que adivinar quién modificó un asiento.

El acceso en sí debería protegerse con bases sólidas. Eso incluye políticas de contraseñas seguras, un restablecimiento de contraseña regulado, bloqueo de cuenta tras intentos fallidos repetidos y, donde el perfil de riesgo lo exija, pasos de inicio de sesión adicionales. La seguridad resulta profesional cuando es previsible y no se nota solo cuando alguien ha quedado excluido.

Integración solo donde alivia de forma medible

Un workflow web suele desplegar su valor solo en interacción con sistemas existentes. Puede ser un ERP, una tienda, una solución de envíos, un control horario o una base de datos. Aun así, no toda interfaz es automáticamente sensata. Cada integración crea dependencias, cuadros de error y esfuerzo de mantenimiento.

La pregunta central es: ¿qué paso manual elimina concretamente la conexión? Si una interfaz ahorra cada día 30 minutos de trabajo de traspaso y reduce errores de tecleo, el beneficio es claro. Si solo refleja una información que de todos modos se comprueba una vez por semana, una exportación manual puede ser al principio la solución más razonable.

En las ampliaciones individuales cuenta la base técnica. Interfaces documentadas, campos de datos claramente definidos y registros de errores trazables facilitan la operación posterior. Si un sistema se conecta a una aplicación web a medida, las tecnologías y la estructura de la base de datos deberían elegirse de modo que sigan siendo mantenibles a largo plazo. Una aplicación cuidada basada en PHP 8.4, JavaScript moderno y MySQL 8 vale más que una solución especial impresionante a corto plazo pero sin documentación.

Implantación con la operativa en marcha

El error más frecuente es un arranque brusco sin fase de comparación. Los equipos tienen entonces que trabajar de otro modo ya el lunes por la mañana, mientras las preguntas abiertas solo surgen de problemas reales. Eso aumenta el rechazo, incluso si el software encaja en principio.

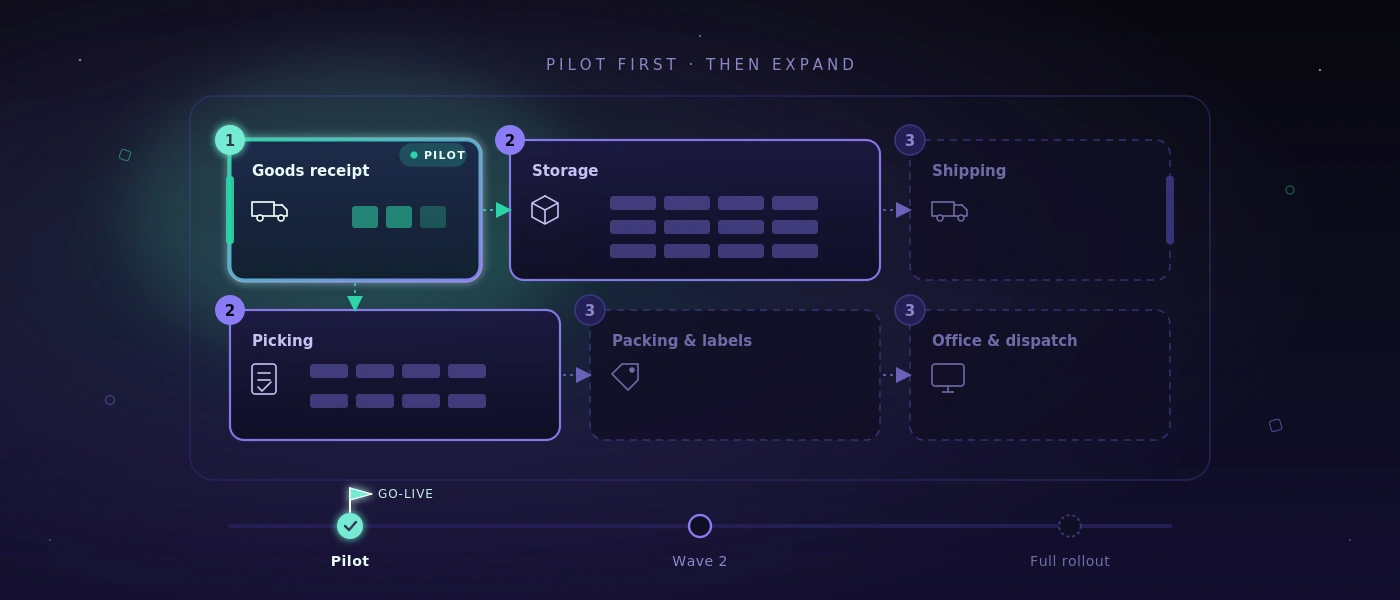
Mejor es un piloto limitado con un equipo, una variante de proceso o un área de sede claramente definida. En ese tiempo se comprueba si el registro y las aprobaciones funcionan, si los términos son comprensibles y si los casos excepcionales terminan limpiamente. Es importante no recoger las respuestas solo como lista de deseos. Cada cambio debería contrastarse con el beneficio para el tiempo de paso, la tasa de errores o la transparencia.

También los indicadores deberían fijarse pronto. Por ejemplo, pueden observarse el tiempo de tramitación por recepción de mercancías, el número de desviaciones abiertas, las consultas sobre el estado de entrega o los asientos de corrección. Sin valor de partida, «parece más rápido» sigue siendo la única valoración. Puede ser cierto, pero no basta para una decisión de inversión sólida.

La operación necesita un responsable claro

El SaaS reduce el esfuerzo técnico, pero no libera a una empresa de la responsabilidad por su propio proceso. Internamente hace falta alguien que gestione roles, reúna respuestas, detecte necesidades de formación y decida qué cambios son realmente necesarios. Esta persona no tiene que saber programar. Pero debería entender el flujo de trabajo y tener acceso a los responsables.

Igual de importante es una documentación operativa breve y sólida. No explica cada pantalla, sino que responde a las preguntas que surgen en el día a día: ¿qué hacer ante un asiento erróneo? ¿Quién aprueba nuevos usuarios? ¿Cómo se comunica una caída? ¿Dónde están los datos exportados? Tal claridad evita que un sistema digital vuelva a depender, tras pocos meses, de avisos personales.

Una buena solución SaaS no se reconoce, por tanto, por cuántas entradas de menú ofrece. Muestra su valor cuando una nueva compañera puede tramitar una operación con seguridad, una desviación no desaparece y un responsable ve el estado sin llamar a tres personas. Flow Web debería medirse precisamente con esta vara: no por promesas, sino por una jornada laboral que transcurre demostrablemente más tranquila y fiable.

Enlace permanente →

Desarrollo web con frameworks actuales: lo que las empresas ganan de verdad

Desarrollo web con frameworks actuales: lo que las empresas ganan de verdad

Si una recepción de mercancías todavía oscila entre formulario en papel, llamada telefónica y tres archivos de Excel, un frontend moderno por sí solo no resuelve el problema. El desarrollo web con frameworks actuales tiene sentido cuando simplifica visiblemente los flujos: los empleados ven el siguiente paso, los datos se registran una sola vez y la aplicación sigue siendo comprensiblemente mantenible incluso después del primer go-live.

Para las pequeñas y medianas empresas, la cuestión del framework no es, por tanto, una cuestión de fe. Lo decisivo no es si una interfaz lleva especialmente muchas palabras técnicas de moda. Lo decisivo es si los movimientos de almacén, pedidos, controles o aprobaciones recorren la jornada laboral de forma fiable - también bajo presión de tiempo, cambios de turno y una conexión de red fluctuante.

Los frameworks son un medio, no un objetivo de proyecto

Un framework ofrece una estructura probada para tareas recurrentes: enrutamiento, formularios, gestión de permisos, acceso a datos, pruebas y la representación de interfaces. Eso no reduce automáticamente todos los riesgos. Pero evita que un proyecto tenga que reinventar una y otra vez las funciones básicas.

En una aplicación web a medida, un framework JavaScript moderno puede, por ejemplo, representar de forma sensata pantallas interactivas: una lista de picking que actualiza continuamente las posiciones, una planificación de rutas con cambios de estado claros o un acta de inspección que asigna fotos y comentarios directamente a una operación. En el backend, frameworks PHP consolidados aportan reglas trazables, responsabilidades claramente separadas e interfaces coherentes con la base de datos.

Esto es especialmente relevante cuando una solución inicialmente pequeña se convierte en un sistema operativo de uso diario para un proceso. Una pantalla de entrada para avisos de entrega puede empezar de forma manejable. En cuanto actualiza existencias, emite etiquetas, tiene en cuenta roles y se comunica con un transportista, necesita una base técnica limpia. Los frameworks ayudan a no renegociar esa base con cada ampliación.

Qué hacen concretamente mejor los frameworks web actuales

El valor de los frameworks modernos rara vez está en efectos espectaculares. Se muestra en las partes invisibles de una aplicación. Los formularios pueden comprobar las entradas directamente, sin que los datos erróneos se noten solo tras el envío. Los permisos pueden definirse de forma central, de modo que un conductor vea otra información que la planificación. Los cambios en un pedido se guardan de forma trazable, en lugar de sobrescribir silenciosamente una celda de tabla.

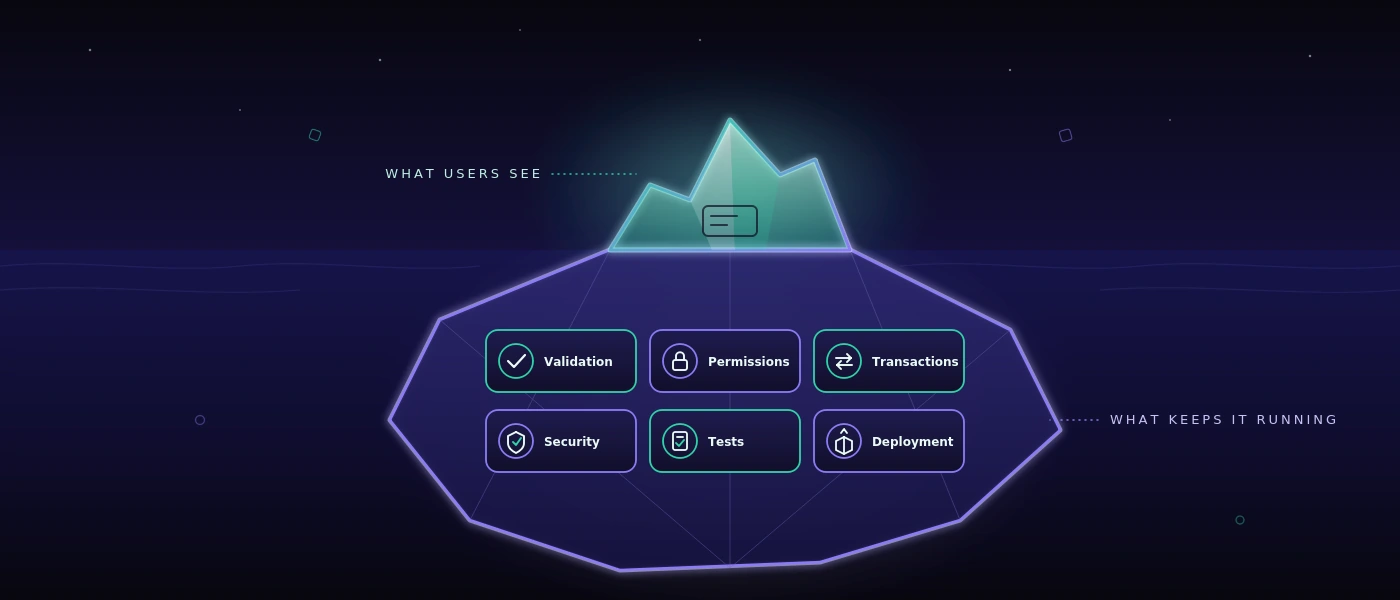
En el lado del servidor, un entorno actual con PHP 8.4 y MySQL 8 crea una base sólida para lógica crítica para el negocio. Las transacciones de base de datos evitan, por ejemplo, que se reduzca una existencia mientras falla el asiento correspondiente. Claves únicas y reglas de validación evitan duplicados. Los procesos en segundo plano pueden generar documentos o consultar interfaces sin que la persona ante la pantalla tenga que esperar.

Tampoco la seguridad es una función que se añada después. Un framework actual admite almacenamiento seguro de contraseñas, protección frente a los ataques típicos por entrada, sesiones trazables y flujos de bloqueo de cuenta definidos. Aun así, la implementación sigue siendo una tarea de proyecto: los permisos deben modelarse correctamente desde el punto de vista funcional y las funciones sensibles requieren comprobaciones adicionales. Un framework ofrece barandillas, pero no sabe quién en la empresa puede conceder qué aprobación.

Decidir bien sobre el desarrollo web con frameworks actuales

La mejor tecnología no surge de una lista de herramientas populares, sino del uso real. Una aplicación interna para diez personas tiene otros requisitos que un portal de clientes con varios miles de accesos simultáneos. Un terminal de almacén con escáner necesita otra lógica de manejo que un informe de dirección en el escritorio.

Por eso una decisión sensata empieza con preguntas concretas: ¿qué operaciones cuestan hoy tiempo de forma medible? ¿Qué datos se transfieren varias veces? ¿Dónde surgen errores porque la información se hace visible demasiado tarde? ¿Qué tabla existente funciona lo bastante bien y debería quedarse por ahora? Precisamente este último punto protege de proyectos de digitalización caros sin beneficio operativo.

Para muchas aplicaciones empresariales a medida, un sistema renderizado en el servidor con componentes interactivos específicos es la elección más razonable. Carga rápido, es manejable de operar y evita complejidad innecesaria. Una aplicación de página única totalmente desacoplada puede, en cambio, ser adecuada cuando la interfaz procesa muchísimos estados dinámicos, tiene que funcionar offline o más adelante debe ofrecer las mismas funciones también a una app móvil.

Ambas pueden ser correctas desde el punto de vista funcional. La pregunta no es: ¿qué framework es el más moderno? Es: ¿qué arquitectura seguirá siendo ampliable con seguridad, comprobable y comprensible para el propio equipo dentro de dos años?

Cuándo menos técnica es la mejor técnica

No todo proceso necesita un frontend complejo. Una pantalla de entrada sencilla para pedidos internos puede ser más rápida, más estable y más barata que una interfaz animada con esmero. Si un archivo de Excel se mantiene solo una vez al mes y no causa errores, quizá siga siendo la herramienta adecuada.

La complejidad solo vale la pena cuando elimina una fricción real. Puede ser el caso cuando los pedidos se vuelven a teclear varias veces, el estado de entrega debe consultarse por teléfono o nadie está seguro de qué versión de un documento es la válida. Entonces una aplicación central crea un beneficio claro: un solo estado de datos, responsabilidades inequívocas y menos consultas.

La mantenibilidad empieza antes de la primera línea de código

Los frameworks suelen verse como aceleradores. Eso solo es cierto si las reglas de negocio están antes suficientemente claras. Un desarrollador puede construir una máquina de estados de forma técnicamente limpia. Pero si la secuencia de estados encaja realmente con el proceso se decide en el levantamiento: ¿cuándo se considera recibida la mercancía? ¿Quién puede cerrar una desviación? ¿Qué ocurre con una entrega parcial?

Estas decisiones deben documentarse, igual que interfaces, campos de datos y excepciones. Eso no hace los proyectos más lentos. Reduce discusiones posteriores, porque se hace visible qué regla se implementó deliberadamente y qué supuesto sigue abierto.

La mantenibilidad se muestra también en pequeñas disciplinas. Los cambios en la base de datos deben versionarse. Los pasos de despliegue deben documentarse. Los mensajes de error deben ser aprovechables para operación y desarrollo sin revelar detalles confidenciales. Las pruebas automatizadas comprueban en cada cambio los flujos centrales, por ejemplo la creación de un pedido, el cálculo de una cantidad o la emisión de un albarán.

En aplicaciones críticas no basta un solo tipo de prueba. Las pruebas unitarias aseguran reglas individuales, las pruebas de integración comprueban la interacción con la base de datos y las interfaces, y las pruebas de extremo a extremo reproducen en el navegador recorridos de uso reales. Para aplicaciones web y Windows, un entorno de pruebas autoalojado puede además aportar capturas de pantalla, registros de ejecución y valoraciones comprensibles, sin entregar innecesariamente datos de prueba internos a servicios cloud externos.

El rendimiento surge de la arquitectura y el modelo de datos

Una interfaz moderna no se vuelve rápida porque use un framework actual. Las consultas lentas a la base de datos, las imágenes sobredimensionadas o las interfaces poco claras siguen siendo lentas, independientemente del frontend. Especialmente con listas de pedidos, artículos o datos de movimiento, es el modelo de datos el que decide la velocidad percibida.

Índices limpios en MySQL 8, consultas paginadas y datos cargados de forma consciente suelen ser más eficaces que una optimización posterior de la interfaz. Igual de importante es un concepto claro de caché. Los datos maestros pueden, en ciertas circunstancias, almacenarse en caché; las existencias actuales o el estado de aprobación, en cambio, no a ciegas. Aquí no hay una regla general, porque el significado funcional de los datos determina cuán actuales deben ser.

El diseño responsive también forma parte de la planificación técnica. En la pantalla de oficina puede tener sentido una tabla ancha. En un escáner de mano o una tableta en el almacén, la misma información necesita grandes áreas táctiles, recorridos cortos y una presentación que siga siendo manejable incluso con guantes o con poca luz. Pure fluidity meets ultimate performance no significa en este contexto el mayor movimiento posible en pantalla. Significa que la aplicación funciona sin fricción en el dispositivo que realmente se usa en el proceso.

El camino sensato de la idea a la operación

Un proyecto web sólido empieza con un núcleo limitado y comprobable. En lugar de automatizar de antemano cada excepción imaginable, se elige un proceso que ocurre con frecuencia y causa un esfuerzo notable. Tras el primer uso, datos y respuestas reales muestran qué ampliación tiene realmente la siguiente prioridad.

La entrega técnica no debería tener lugar solo al final. Las responsabilidades de hosting, copias de seguridad, monitorización, actualizaciones y derechos de acceso deben aclararse pronto. Un sistema es tan fiable como su operación. Quien necesita una aplicación a diario para el envío o la tramitación de pedidos necesita vías de recuperación definidas y una respuesta clara a lo que ocurre en caso de incidencia.

softify.pro apuesta por ello por tecnologías mantenibles, entrega documentada y responsabilidad técnica directa en lugar de modas pasajeras de frameworks. Eso no es un atajo mágico. Crea la condición para que una aplicación siga funcionando tras el lanzamiento, pueda seguir desarrollándose y no se convierta en el siguiente caso especial frágil.

En el mejor de los casos, la aplicación web adecuada no se siente como un nuevo proyecto de TI. Se siente como un flujo que por fin funciona sin rodeos - con suficiente sustancia técnica para acoger con calma también el siguiente cambio en la operativa.

Enlace permanente →

Planificar un despliegue de software: cómo implantarlo con la operativa en marcha

Planificar un despliegue de software: cómo implantarlo con la operativa en marcha

Un sistema nuevo rara vez fracasa porque falte un botón. Fracasa el lunes por la mañana: el turno de mañana no encuentra la recepción de mercancías, un albarán se imprime dos veces o un archivo de Excel se convierte de repente en la verdad no oficial. Quien quiera planificar un despliegue de software debe, por tanto, no solo introducir funciones, sino asegurar la operativa real.

Precisamente en el almacén, el taller, la planificación y la administración, un despliegue no es una cita de TI. Cambia gestos, responsabilidades y vías de información. Una buena implantación mantiene el trabajo en movimiento, hace visibles los errores pronto y da a los empleados una respuesta clara a la pregunta decisiva: ¿qué hago de forma distinta a partir de mañana?

El despliegue comienza antes de la primera formación

Muchos proyectos empiezan con una lista de funciones: registrar pedidos, contabilizar movimientos de almacén, imprimir etiquetas de envío, planificar rutas. Es necesario, pero no basta. Antes del inicio debe estar claro qué procesos deben pasar realmente por el nuevo sistema el primer día productivo - y cuáles deliberadamente todavía no.

Esta delimitación no es señal de incompletitud. Reduce el riesgo. Si una empresa mediana ha coordinado hasta ahora las recepciones de mercancías mediante papel, teléfono y tablas, no tiene por qué digitalizar el primer día también toda la gestión de existencias, la tramitación de devoluciones, la planificación de rutas y la evaluación de proveedores. Un primer alcance sensato podría estar en la recepción de mercancías, movimientos de almacén inequívocos y la impresión de documentos de entrega.

Lo decisivo es describir el proceso objetivo de forma concreta. No: «La recepción de mercancías se vuelve digital.» Sino: «El empleado escanea la entrega, comprueba cantidad y estado, asigna una ubicación y, en caso de desviaciones, crea una operación para compras.» Solo a este nivel se hacen visibles las preguntas abiertas: ¿qué ocurre si falta el pedido? ¿Quién puede corregir cantidades? ¿Puede almacenarse una entrega sin etiqueta?

Planificar un despliegue de software significa: priorizar los flujos críticos

No todos los procesos tienen el mismo peso. Una caída en el mantenimiento de datos maestros puede ser desagradable. Una caída en el envío, el picking o la aprobación de facturas puede bloquear el trabajo de un día entero. Por eso el despliegue necesita una priorización según el riesgo operativo, no según el orden del pliego de condiciones.

Una clasificación sencilla ha dado buen resultado: crítico para el negocio, importante y aplazable. Son críticos todos los flujos que mueven mercancía, dinero o comunicación vinculante con clientes. Son importantes las funciones que aceleran el día a día, pero cuya caída puede amortiguarse manualmente de forma transitoria. Son aplazables las funciones de comodidad, los casos especiales raros o los análisis que al principio pueden seguir procediendo de una fuente existente.

Esta clasificación influye en la profundidad de las pruebas. Para un proceso de envío crítico no basta con recorrer con éxito un solo pedido. También hay que probar entregas parciales, anulaciones, impresoras ausentes, direcciones erróneas, procesamiento paralelo y la entrega al transportista. Para una función estadística poco usada puede ser adecuado un ciclo de pruebas posterior.

Hacer medibles de antemano los criterios de éxito

«La aplicación funciona» no es un criterio de aceptación. Mejor son afirmaciones verificables: una recepción de mercancías de 30 posiciones se puede contabilizar en diez minutos. Las etiquetas de envío se imprimen en el puesto previsto. Los cambios de existencias aparecen de inmediato en la planificación. Una cuenta de usuario bloqueada solo puede reactivarse mediante el proceso de aprobación definido.

Tales criterios conectan el área funcional y el desarrollo. También evitan que la aceptación se convierta en una colección de impresiones vagas. No toda respuesta tiene que resolverse antes del go-live. Pero cada respuesta necesita una clasificación: error crítico, mejora relevante o punto para una fase de ampliación posterior.

Migración de datos: solo los datos limpios merecen confianza

Los datos antiguos suelen subestimarse. En las tablas hay números de artículo duplicados, unidades distintas, direcciones de clientes caducadas y existencias cuyo origen ya nadie sabe explicar. Quien asume estos datos sin comprobarlos traslada la antigua falta de claridad a un sistema nuevo - solo que con mejor interfaz.

Antes de la migración debería determinarse qué datos se necesitan realmente. A menudo tienen sentido artículos actuales, clientes activos, pedidos abiertos, proveedores relevantes y existencias iniciales comprobadas. Los registros históricos no tienen que pasar necesariamente por completo a la nueva aplicación. Puede bastar con archivarlos de forma legible si siguen siendo necesarios para justificantes o consultas.

Especialmente importante es una carga de prueba. Los datos no solo se importan técnicamente, sino que se comprueban funcionalmente: ¿coinciden cantidades, unidades y asignaciones? ¿Están completos los campos obligatorios? ¿Pueden procesarse correctamente pedidos típicos con ellos? Para el go-live se necesita después una fecha límite clara. ¿Desde cuándo se usa qué sistema principal? Sin esta regla surgen mantenimiento duplicado y existencias contradictorias.

Operación piloto en lugar de un gran interruptor

Un big bang puede tener sentido si un equipo pequeño utiliza un proceso claramente delimitado y la solución antigua y la nueva no pueden funcionar en paralelo. En la mayoría de los entornos operativos, sin embargo, una operación piloto es la opción más controlable.

El piloto debería trabajar con casos reales, pero en un marco limitado: una zona de almacén, un turno, un grupo de productos o un equipo seleccionado. Lo decisivo es que el grupo piloto no incluya solo a empleados especialmente aficionados a la tecnología. Debería representar de forma realista el día a día posterior, incluidas las personas que trabajan bajo presión de tiempo y tienen objeciones legítimas.

En la operación piloto se ve si escáneres, impresoras, red y permisos funcionan en el puesto de trabajo real. También se hacen visibles lagunas de proceso que nadie mencionó en las reuniones. Quizá en la práctica la mercancía se deja primero en un lugar intermedio. Quizá los conductores necesitan un albarán distinto al de la administración. Tales hallazgos no son un retroceso. Son la razón para realizar el piloto antes del arranque generalizado.

La formación como situación de trabajo, no como visita guiada del software

Una formación que solo explica elementos de menú genera poca seguridad. Los empleados deben aprender con sus tareas: «Usted recibe una entrega dañada», «Usted prepara un pedido urgente», «Usted corrige una cantidad mal contabilizada». El contexto se queda porque corresponde al día a día laboral.

Las formaciones cortas cercanas al go-live suelen ser más eficaces que una cita larga semanas antes. También ayudan instrucciones de trabajo breves directamente en el puesto. No deberían explicar todo el sistema, sino mostrar las operaciones más frecuentes, responsabilidades claras y el camino en caso de incidencias.

Nombre además personas de contacto por área. Estas personas no tienen que resolver por sí mismas cada problema técnico. Pero deberían poder decidir si se trata de un error de manejo, una ambigüedad funcional o un error real del sistema. Eso protege al equipo del proyecto de avisos no estructurados y acelera la ayuda para el turno.

El go-live necesita un plan operativo

El día del go-live necesita más que una hora. Defina quién decide a nivel funcional, quién es responsable de los cambios técnicos y por qué canal se comunican las incidencias. En flujos críticos debería ser visible si las funciones centrales funcionan: inicio de sesión, permisos, captura de datos, interfaces, impresión y copia de seguridad.

También forma parte un plan de contingencia. Eso no significa volver por completo al viejo mundo ante el menor problema. Significa determinar de antemano qué incidencia justifica una parada, cómo se documentan los pedidos en caso necesario y cómo se vuelven a registrar después de forma limpia. Un formulario en papel durante pocas horas puede ser razonable. Una gestión paralela permanente sin fin no lo es.

Los detalles técnicos cuentan aquí: ¿se han creado los accesos a tiempo? ¿Funcionan correctamente los roles y las reglas de bloqueo de cuenta? ¿Están las impresoras de etiquetas conectadas a las plantillas correctas? ¿Existe una copia de seguridad probada de la base de datos? En aplicaciones desarrolladas a medida, despliegues documentados, versiones trazables y un camino claro para las correcciones son el estándar.

Las primeras semanas deciden la aceptación

Tras el inicio comienza la fase en la que una aplicación se convierte o bien en herramienta de trabajo o bien en un paso adicional detestado. Planifique por ello breves ciclos de retroalimentación diarios. ¿Qué errores se repiten? ¿Dónde surgen rodeos? ¿Qué campos se malinterpretan? ¿Qué análisis le falta realmente a un responsable?

No toda observación exige un cambio inmediato. Algunos problemas se resuelven con reglas de trabajo más precisas o una mejor formación. Otros muestran debilidades reales en el proceso o en la aplicación. El arte consiste en no confundir ambas cosas. Un sistema no debería complicar sin motivo procesos existentes que funcionan. Si una tabla bien mantenida sigue siendo la mejor solución para un caso especial raro, puede quedarse.

Mida el efecto con unos pocos indicadores concretos: tiempo de procesamiento por operación, número de consultas, contabilizaciones erróneas, reimpresiones, pedidos abiertos o discrepancias de inventario. Solo estos valores muestran si el despliegue mejora realmente la operativa - en lugar de limitarse a introducir nuevas pantallas.

Un buen despliegue, tras unas semanas, ya no se siente como un proyecto. Se convierte en una rutina de trabajo fiable: los datos correctos están donde se necesitan, las excepciones son trazables y los equipos tienen que perseguir menos la información por teléfono. Justo a eso debería apuntar la planificación - no a un día de lanzamiento espectacular, sino a un día a día más tranquilo y mejor controlable.

Enlace permanente →

Planificar el Multiplatform Application Development: primero el proceso, después la plataforma

Planificar el Multiplatform Application Development: primero el proceso, después la plataforma

Un jefe de almacén confirma una recepción de mercancías en el escáner de mano. La planificación comprueba la misma operación en el navegador. Un conductor necesita el estado de entrega en ruta en el smartphone. El Multiplatform application development suena en este momento a una cuestión técnica. En realidad, se trata primero de un flujo operativo: ¿qué trabajo debe realizarse en qué lugar, con qué fiabilidad y con qué dispositivo?

Para las pequeñas y medianas empresas, la respuesta correcta rara vez es: lo construimos todo de forma nativa para cada plataforma. Con más frecuencia es: definimos un proceso común, elegimos de forma selectiva las interfaces necesarias y evitamos la lógica duplicada. Eso no solo ahorra presupuesto de desarrollo. También evita que el almacén, la oficina y el servicio externo trabajen con estados de datos distintos.

Qué debe aportar el Multiplatform Application Development

El Multiplatform Application Development designa el desarrollo de una aplicación utilizable en varios entornos, por ejemplo en el navegador web, en iOS y Android o en sistemas de escritorio Windows. El término se reduce a menudo a la pregunta de si una única base de código puede generar varias aplicaciones. Eso es solo una parte de la decisión.

Para los sistemas operativos importa sobre todo si la aplicación funciona en su lugar de uso. Una zona de recepción puede necesitar una cámara para capturar códigos de barras, elementos de control grandes para los guantes y una reacción utilizable con cobertura WLAN inestable. La administración, en cambio, necesita tablas, filtros, conceptos de permisos y registros de cambios trazables. Un conductor necesita una vista reducida, no la misma interfaz que la planificación.

Una base técnica común puede conectar estos requisitos de forma sensata. Pero no debe llevar a atender cada plataforma como un mal compromiso. El mejor código compartido carece de valor si los empleados dan rodeos porque la aplicación no refleja su flujo de trabajo real.

Primero determinar el proceso, luego la plataforma

Antes de hablar de frameworks, los equipos deberían examinar una operación concreta de principio a fin. Tomemos una entrega: entra el pedido, se prepara la mercancía, se genera un albarán, se confirma la entrega y el estado se comunica a ventas o atención al cliente. ¿En qué punto surge hoy la ruptura de soporte? ¿Dónde se anota algo en papel, se teclea más tarde o se pregunta por teléfono?

Esta observación separa los requisitos reales de plataforma de las listas de deseos. Si solo dos empleados de la oficina usan una función, una interfaz web bien hecha suele bastar. Si diez personas en el suelo del almacén realizan contabilizaciones, una interfaz móvil adecuada para el escáner puede marcar la diferencia. Si un programa Windows existente debe trabajar con hardware especial, puede ser necesaria una integración de escritorio.

No toda función pertenece a todo dispositivo. Eso no es un defecto de una solución multiplataforma, sino señal de decisiones de producto limpias. Datos y reglas de negocio comunes no significan necesariamente pantallas idénticas.

Las tres preguntas que aclaran costes y beneficios

La primera pregunta es: ¿qué dispositivos están ya en uso y cuánto tiempo seguirán estándolo? Una empresa con terminales Windows gestionados tiene otros requisitos que un servicio externo con smartphones privados. La segunda es: ¿qué ocurre sin conexión de red? La capacidad offline aumenta considerablemente el esfuerzo, porque los datos deben guardarse localmente, sincronizarse más tarde y tratarse limpiamente en caso de conflicto. Tiene sentido si el proceso se detendría de otro modo - no como equipamiento estándar.

La tercera pregunta se refiere a las consecuencias de un fallo. ¿Puede un empleado registrar una contabilización más tarde, o depende de ello una etiqueta de envío, una existencia o una liberación de seguridad? Cuanto más crítica es la operación, más deben planificarse permisos, reglas de comprobación, repetibilidad y registro.

Una arquitectura que no se desmorona en la segunda plataforma

En una solución sostenible, la lógica de negocio no está dispersa en varias interfaces. Las comprobaciones de existencias, los cambios de estado, los rangos de numeración, los permisos y la generación de documentos necesitan una base central y probada. Navegador, aplicación móvil y cliente de escritorio acceden a ella mediante interfaces claramente definidas.

Para muchos procesos empresariales internos, una aplicación web moderna es el punto de partida más económico. Puede actualizarse de forma central, no necesita instalación en cada puesto y funciona en ordenador, tableta y smartphone. Con PHP 8.4, JavaScript moderno y MySQL 8 se puede construir una base mantenible, siempre que el modelo de datos, los derechos de acceso y el despliegue no se consideren solo poco antes de la puesta en marcha.

Una aplicación móvil o de escritorio instalable se añade cuando aporta una ventaja clara: integración profunda con escáner, impresora o cámara, funcionamiento offline fiable, funciones especiales en segundo plano o requisitos de la gestión de dispositivos. Es una ampliación dirigida, no un fin en sí mismo.

Un error frecuente es la reutilización completa de la interfaz de usuario a toda costa. Técnicamente puede parecer atractivo. En la práctica surgen textos pequeños en monitores grandes, formularios sobrecargados en smartphones o controles que no encajan con la plataforma. Es mejor compartir modelo de datos, reglas y componentes donde tenga sentido, mientras se adapta el manejo al contexto respectivo.

La coherencia de los datos importa más que una base de código común

Varias plataformas aumentan el riesgo de datos contradictorios. Un pedido se modifica en la oficina mientras un conductor aún ve una versión antigua en su dispositivo. Dos empleados contabilizan al mismo tiempo las mismas existencias de un artículo. Un dispositivo offline devuelve sus cambios horas después. Estos casos no son un tema marginal, sino el núcleo de la arquitectura.

El sistema necesita por ello identidades inequívocas, marcas de tiempo, cambios de estado trazables y reglas para los conflictos. Para un estado de entrega puede bastar el último cambio confirmado. Para las existencias suele ser demasiado tosco. Ahí debe estar claro qué movimiento se contabilizó, de qué ubicación procede y si una corrección debe justificarse.

También los permisos deben regularse de forma central. Un empleado puede, quizá, registrar recepciones de mercancías, pero no aprobar correcciones de existencias. Un conductor externo solo debe ver su ruta. Las duraciones de sesión, la autenticación multifactor para roles críticos y los flujos de bloqueo de cuenta no son funciones de seguridad decorativas. Protegen procesos concretos y hacen visibles las responsabilidades.

Probar el Multiplatform Application Development tal como se trabaja

Una aplicación puede arrancar en tres sistemas operativos y aun así fallar en la operativa. Lo decisivo son los flujos en condiciones reales: el escáner reacciona demasiado despacio, una impresora de etiquetas no es accesible, un permiso no se aplica tras un cambio de rol, o una sincronización genera contabilizaciones duplicadas.

Por eso deberían comprobarse automáticamente los procesos críticos. Entre ellos se cuentan el inicio de sesión y el comportamiento de bloqueo, la entrada de pedidos, los movimientos de existencias, la creación de documentos y el tratamiento de entradas erróneas. Para aplicaciones web y Windows, las pruebas recurrentes pueden ejecutarse en una infraestructura autoalojada. Esto es especialmente relevante si las capturas de pantalla, los datos internos de pedidos o los accesos de prueba no deben transmitirse a servicios cloud externos.

La automatización no sustituye la comprobación por personas en el suelo del almacén. Pero garantiza que los flujos conocidos se controlen una y otra vez tras los cambios. Los buenos informes de prueba no nombran solo un error técnico, sino el proceso afectado: no se puede generar el comprobante de entrega, la cuenta de usuario sigue bloqueada tras una aprobación correcta o los datos de ruta no se actualizan.

Cuándo una estrategia de plataforma es demasiado

Algunas empresas no necesitan una app propia. Si basta un acceso estable por navegador, el flujo rara vez es móvil y el número de usuarios sigue siendo manejable, una aplicación web responsiva suele ser la elección más razonable. Reduce el esfuerzo de mantenimiento, los problemas de distribución y el número de posibles fuentes de error.

Tampoco una tabla existente tiene que sustituirse de inmediato. Si solo sirve como evaluación sencilla, la mantiene una persona y no genera traspasos propensos a errores, puede cumplir su propósito. El momento para un sistema llega cuando el conocimiento está en cabezas individuales, las versiones divergen, las consultas aumentan o una operación ya no puede rastrearse de forma fiable.

A la inversa, una estrategia de plataforma ligera se queda pronto pequeña cuando los empleados deben trabajar offline, se conecta hardware o clientes y socios necesitan acceso controlado. Entonces merece la pena financiar conscientemente los requisitos adicionales, en lugar de añadirlos más tarde bajo presión de tiempo.

Empezar con un piloto sólido

Un buen comienzo no es un catálogo de funciones con cien puntos, sino un flujo completo y medible. Por ejemplo: registrar la recepción de mercancías, actualizar las existencias, documentar una desviación y crear una tarea de aclaración. Este piloto muestra pronto si modelo de datos, dispositivos, derechos y manejo encajan.

Después la solución puede crecer en pasos sensatos: picking, envío, planificación de rutas o análisis. Cada ampliación debería superar la misma pregunta: ¿acorta un flujo real, reduce errores o crea transparencia fiable? Si no, puede esperar.

La plataforma más sensata, al final, no es la que tiene más opciones técnicas. Es aquella en la que un equipo empieza su trabajo más rápido por la mañana, pregunta menos durante el turno y puede rastrear por la tarde qué ocurrió realmente.

Enlace permanente →

Evaluar correctamente los Test Automation Results

Evaluar correctamente los Test Automation Results

Una prueba de regresión puede terminar por la mañana con un 98 por ciento de casos exitosos y aun así no ser una buena noticia. Quizá la prueba fallida sea precisamente el inicio de sesión de un gran cliente. Quizá se omitieron 40 pruebas porque el entorno de pruebas no era accesible. O la ejecución salió en verde, pero solo comprobó si existen botones, no si un pedido se guarda realmente, se genera un albarán y las existencias se ajustan correctamente. Los Test automation results no son una afirmación sobre la calidad mientras falte su contexto.

Para la dirección de QA, el desarrollo y las áreas funcionales, el verdadero trabajo no consiste, por tanto, solo en automatizar pruebas. Lo decisivo es preparar los resultados de modo que de ellos surjan decisiones fiables: ¿se puede desplegar una versión? ¿Hay que tratar un error de inmediato? ¿Es el error nuevo, recurrente o solo un problema del entorno de pruebas? ¿Y existen evidencias que también pueda entender un área funcional sin código de pruebas?

Qué dicen realmente los Test Automation Results

El indicador más sencillo es: superado o fallido. Es útil, pero rara vez suficiente. Una tasa alta de éxito puede generar confianza si las pruebas cubren flujos críticos, los datos de prueba son plausibles y el entorno se parece a la operación posterior. Si falta uno de estos factores, la cifra sigue siendo sobre todo una señal de que se ejecutó un proceso automatizado.

En aplicaciones críticas para el negocio pesan más otras preguntas. En una solución de almacén, no todas las pantallas son igual de importantes. Un error de visualización en un texto de aviso interno puede esperar. Un error que contabiliza la cantidad equivocada en la recepción de mercancías o genera una etiqueta de envío sin dirección del destinatario, no. Los buenos resultados de pruebas ponderan, por tanto, los riesgos en lugar de tratar todos los casos por igual.

Una prueba fallida tampoco es automáticamente un defecto del producto. Puede deberse a credenciales caducadas, un rol de prueba bloqueado, interfaces no disponibles, datos de prueba modificados o un entorno lento. Quien no separa estas causas produce ruido. El equipo pierde entonces tiempo con falsas alarmas mientras los errores reales se pierden entre mensajes de estado en rojo.

Cuatro tipos de estado en lugar de una lista roja

En la práctica se ha demostrado útil una clasificación clara: error funcional, error técnico de la prueba, problema de entorno y cambio esperado. Un error funcional significa que la aplicación infringe un requisito definido. Un error técnico de la prueba apunta más bien a la propia prueba, por ejemplo un selector que ya no coincide tras una interfaz modificada deliberadamente.

Existe un problema de entorno cuando, por ejemplo, un sistema de pruebas o una interfaz conectada no está disponible. Los cambios esperados surgen cuando un proceso se ha adaptado deliberadamente, pero la automatización sigue comprobando el antiguo estado objetivo. Estas categorías no evitan toda discusión. Pero hacen que la discusión empiece en el punto correcto.

De las ejecuciones de pruebas a informes aptos para decidir

Un informe útil no responde solo que algo ha fallado, sino qué ha pasado, cuán grave es y si el error parece reproducible. Para ello hace falta más que una lista de nombres de pruebas y marcas de tiempo.

A cada ejecución relevante pertenecen la compilación comprobada, el entorno de pruebas, el rol utilizado, los datos de prueba centrales y la hora de inicio y fin. Especialmente con aplicaciones de escritorio Windows o plataformas web complejas, esta información es necesaria para acotar diferencias. Un error que solo aparece con un rol de almacén restringido es algo distinto de un error que bloquea cada inicio de sesión.

Los resultados con valor informativo contienen además evidencias trazables: capturas de pantalla, pasos grabados, mensajes de error y, si es necesario, registros técnicos. Una captura de pantalla por sí sola, sin embargo, puede engañar. Muestra un momento, no la causa. La combinación de secuencia de pasos, estado visible y reacción esperada es mucho más útil.

Los sistemas asistidos por IA pueden convertir estas evidencias en valoraciones comprensibles. Con COCO, por ejemplo, las pruebas se ejecutan en un servidor de IA propio y autoalojado. La evaluación puede explicar que un pedido se creó pero el cambio de estado esperado no se produjo, y asignar directamente la grabación de la ejecución. Para los equipos preocupados por la seguridad es relevante dónde se procesan las capturas de pantalla, los datos de la aplicación y el tráfico de pruebas. El control local no es automáticamente necesario, pero con aplicaciones internas y datos sensibles puede ser el camino más sensato frente a un servicio cloud externo.

El nivel de detalle adecuado para distintos destinatarios

Los equipos de desarrollo necesitan mensajes de error, pasos técnicos y pistas lo más precisas posible para la reproducción. Un responsable de operaciones, en cambio, necesita primero la función afectada, el riesgo para el negocio y una afirmación clara sobre la capacidad operativa. Ambas perspectivas deben poder surgir de la misma ejecución, sin que nadie tenga que trasladar resultados manualmente a presentaciones.

Un buen informe comienza, por tanto, con un breve nivel de decisión: lanzamiento recomendado, lanzamiento con limitaciones conocidas o detener el lanzamiento. Debajo figuran las desviaciones críticas con prioridad y evidencia. Los detalles técnicos siguen solo después. Eso no es una simplificación a costa de la precisión, sino una separación limpia de las necesidades de información.

Medir la cobertura sin engañarse con una falsa seguridad

La cobertura de pruebas se presenta a menudo como un valor porcentual. Este valor es útil cuando está claro qué mide. La cobertura de código muestra, por ejemplo, qué partes del código del programa se ejecutaron durante las pruebas. Eso no demuestra que un proceso de negocio funcione correctamente. Una prueba puede tocar muchas líneas de código y, aun así, no comprobar nunca si aparece una dirección de entrega errónea en el documento.

Para las áreas funcionales, la cobertura de procesos suele ser más reveladora. Describe qué flujos reales están protegidos: capturar un pedido, reservar existencias, contabilizar una entrega parcial, aceptar una devolución o aprobar una factura. Especialmente valiosos son los traspasos entre sistemas y roles, porque ahí suelen surgir errores: al importar un pedido, al imprimir una etiqueta o al pasar de la oficina al terminal de almacén.

No priorice según el número de pruebas posibles, sino según el impacto del daño y la frecuencia de cambios. Un proceso poco usado con alto riesgo financiero o legal merece a menudo una automatización antes que una vista usada con frecuencia pero inofensiva. A la inversa, un flujo estable y poco crítico puede seguir conformándose con una breve comprobación manual. No toda comprobación tiene que automatizarse solo porque sea automatizable.

Las pruebas inestables son un problema de calidad en sí mismas

Las pruebas que a veces pasan y a veces fallan sin ningún cambio reconocible en el producto suelen llamarse flaky. Dañan la confianza más rápido que una prueba permanentemente en rojo. En cuanto los equipos reinician por reflejo los resultados en rojo, la automatización pierde su función de aviso.

Las causas suelen ser concretas: esperas fijas, datos de prueba compartidos, accesos paralelos, procesamiento asíncrono o un entorno que no se restablece. Una breve pausa de tres segundos en la prueba puede ayudar por casualidad, pero no es una solución. Es mejor esperar a un estado verificable, hacer únicos los datos de prueba y aislar los procesos entre sí.

No toda inestabilidad puede evitarse por completo. Las interfaces externas pueden fluctuar y la infraestructura real sufre caídas. Entonces el informe debería indicar claramente si una prueba no pudo evaluarse por una dependencia externa. Una ejecución repetida puede ser útil para el diagnóstico, pero no debe hacer invisible el primer hallazgo.

Un proceso sensato después de cada ejecución de pruebas

Tras una ejecución automatizada, no todos los resultados deberían tratarse de inmediato por igual. Primero se revisan los errores bloqueantes y las pruebas críticas no evaluables. Después sigue la clasificación de las nuevas desviaciones frente a problemas conocidos y aceptados. Solo entonces una decisión de lanzamiento es sólida.

Son útiles los umbrales definidos, pero deben ajustarse al proceso. Por ejemplo, una prueba fallida en el flujo de pagos o de permisos puede desencadenar una parada inmediata. Ante una desviación puramente cosmética puede ser aceptable una excepción documentada. Tales reglas no deberían surgir solo bajo presión de tiempo antes de un lanzamiento.

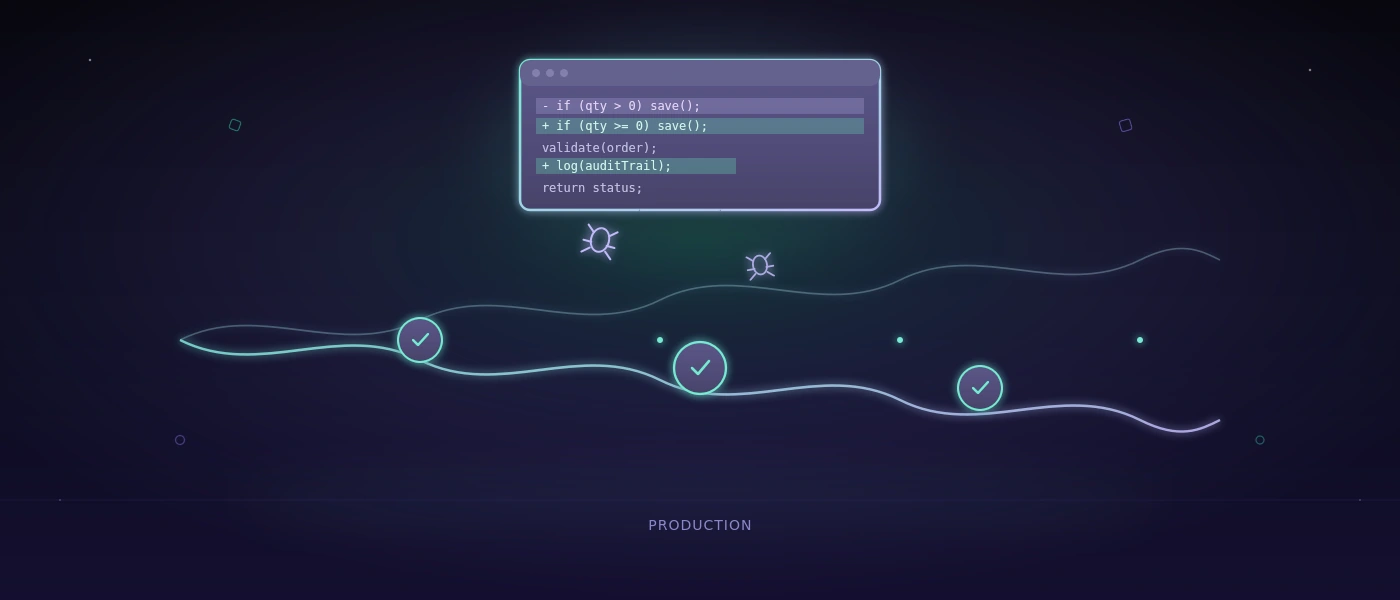
Igual de importante es la retroalimentación: cada error en producción que las pruebas no detectaron es un motivo para comprobar si falta un escenario, una variante de datos de prueba o un punto de control. El objetivo no es acumular tantas pruebas como sea posible. Es construir, a partir de errores reales, una mejor protección de forma dirigida.

Los resultados de prueba más útiles, al final, no son los de la visión general más verde. Son aquellos con los que un responsable puede entender el lunes por la mañana qué se comprobó, qué riesgo permanece y qué acción es ahora razonable.

Enlace permanente →

Inventory Discrepancy Causes: motivos frecuentes de las discrepancias de inventario

Inventory Discrepancy Causes: motivos frecuentes de las discrepancias de inventario

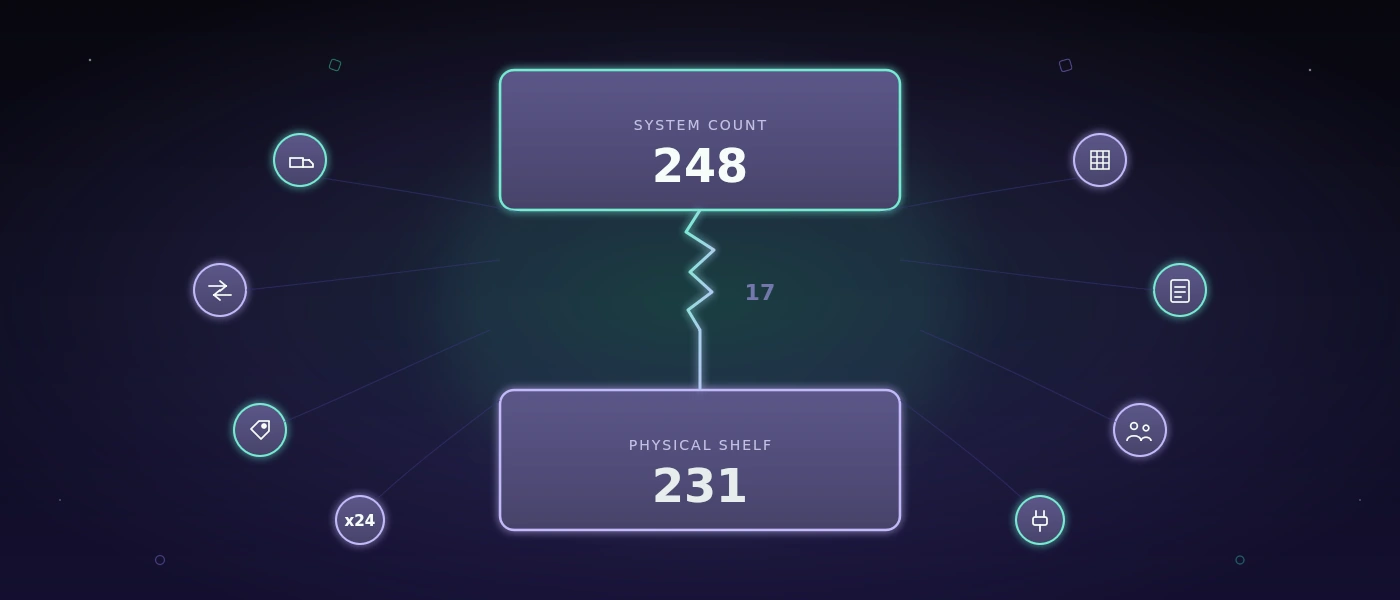
El sistema indica 248 unidades en existencia, en la estantería hay 231. Estas 17 unidades parecen a primera vista un error de conteo. Pero justo ahí es donde a menudo empieza el análisis equivocado. Las inventory discrepancy causes rara vez son, en la práctica, un descuido aislado. La mayoría de las veces surgen donde la recepción de mercancías, el movimiento de almacén, la preparación de pedidos, y la contabilización se desvían en el tiempo o organizativamente.

Para una pequeña o mediana empresa, las discrepancias de inventario no son solo un tema para el inventario físico. Generan pedidos erróneos, entregas urgentes, existencias de seguridad innecesarias, y promesas de entrega que no se pueden cumplir. Quien separa las causas con claridad no tiene que introducir de inmediato un gran ERP. A menudo bastan reglas de contabilización más claras, dispositivos de captura adecuados, y un sistema que refleje los procesos de trabajo reales.

Inventory discrepancy causes: dónde surgen las diferencias

Una discrepancia de inventario es la diferencia entre la existencia teórica en el sistema principal y la existencia realmente presente. Decisiva aquí es la palabra "principal". Si en paralelo se mantienen un archivo Excel, una lista en papel, y un sistema de gestión de mercancías, existen prácticamente varias verdades. Entonces la diferencia no surgió solo en el almacén, sino que ya estaba integrada en la gestión de datos.

La contramedida eficaz depende, por tanto, del tipo de error. Un palé mal contado necesita una solución diferente a una entrega aceptada físicamente pero nunca contabilizada. Antes de reestructurar procesos, los equipos deberían evaluar las diferencias por artículo, ubicación, turno, tipo de movimiento, y momento. Solo este patrón muestra si se trata de un caso aislado o de un error de proceso recurrente.

1. Las recepciones de mercancías se contabilizan tarde o de forma incompleta

La recepción de mercancías es un punto de ruptura clásico. La mercancía llega por la mañana, se aparta para su inspección, y más tarde se traslada directamente a producción o a la estantería. La contabilización se hace por la tarde, al día siguiente, o nunca. Mientras la mercancía esté físicamente presente, la existencia del sistema parece demasiado baja. Si ya se ha consumido o enviado, los errores posteriores se vuelven más probables.

Especialmente propensas son las entregas parciales, los artículos sustitutos, y las entregas en exceso. Si en el albarán figura una cantidad, pero llega una cantidad distinta, nadie debería simplemente contabilizar el documento de forma "más o menos coincidente". La discrepancia debe permanecer visible como excepción, incluyendo motivo, persona responsable, y aprobación. De lo contrario, la desviación desaparece de la operación y solo resurge en el inventario físico.

2. Los movimientos de almacén ocurren sin transacción

Un artículo se coloca de la recepción de mercancías a la estantería alta, se traslada de un hueco a la zona de picking, o se reserva para un pedido. Físicamente, es un movimiento pequeño y rápido. En el sistema puede ser decisivo.

Si el personal reorganiza las ubicaciones solo por intuición, la existencia total quizá todavía sea correcta, pero la disponibilidad en el lugar correcto no. Eso provoca tiempos de búsqueda, errores de picking, y viajes de reabastecimiento innecesarios. Una buena solución de almacén no tiene que complicar cada movimiento. Tiene que registrar los pocos movimientos relevantes para la disponibilidad, la trazabilidad, y el reabastecimiento.

En talleres o almacenes más pequeños, suele ser más sensato mantener pocas zonas inequívocas que una estructura de huecos teóricamente perfecta que nadie mantiene en el día a día. La precisión solo funciona si sigue siendo manejable.

3. El picking y el envío se contabilizan demasiado pronto

Muchos equipos contabilizan un pedido como "dado de baja" en el momento del picking, aunque la mercancía todavía esté en una zona de preparación. Si el pedido luego se modifica, se cancela, o se envía solo parcialmente, la existencia del sistema y la existencia física ya no coinciden.

Mejor es una separación clara entre reservado, preparado, y enviado. No todas las empresas necesitan cadenas de estado complejas para esto. Pero el momento de la reducción de existencias debe ser inequívoco. Para la mercancía de envío, suele estar más cerca de la entrega real al transportista que del primer gesto hacia la estantería.

Las devoluciones también pertenecen a este flujo. Cuando la mercancía vuelve, no está automáticamente disponible de nuevo. Solo la inspección, la decisión de calidad, y el almacenaje deberían determinar si vuelve a la existencia vendible, permanece bloqueada, o se da de baja.

4. Unidades erróneas y errores en los datos maestros

Una caja, un paquete, un rollo, y una pieza individual pueden referirse al mismo artículo. Si la conversión no se mantiene correctamente, surgen diferencias a una velocidad impresionante. Un empleado contabiliza "1", refiriéndose a una caja de 24 piezas. El sistema entiende una pieza.

Los errores en los datos maestros son especialmente insidiosos porque el proceso de contabilización puede parecer técnicamente correcto. Por eso, compruebe las unidades de embalaje, los factores de conversión, las cantidades mínimas, las ubicaciones, y los números de artículo. También se confunden fácilmente las variantes con nombres similares, por ejemplo diferentes longitudes, colores, o lotes.

Aquí no ayuda ninguna regla general como "escanear más". Los códigos de barras solo son tan fiables como la asociación que hay detrás. Para surtidos pequeños, un maestro de artículos bien mantenido con etiquetas bien legibles puede lograr más que un amplio pero mal configurado parque de escáneres.

5. Tablas paralelas y correcciones manuales

La tabla en el escritorio rara vez surge por negligencia. La mayoría de las veces cubre un vacío real: una reserva especial, un valor de evaluación faltante, o un proceso que el software existente no representa. Se vuelve problemática cuando se convierte en el segundo libro de existencias.

Entonces las entradas se contabilizan en el sistema, pero las salidas se anotan en la tabla. O una corrección solo se hace donde precisamente ayuda para el siguiente pedido. Nadie puede explicar después de forma fiable qué valor es el válido.

No toda tabla tiene que eliminarse. Un cálculo para planificación o análisis puede seguir siendo sensato. Sin embargo, las operaciones que modifican existencias deberían tener exactamente un sistema principal. Los ajustes necesitan un código de motivo, una marca temporal, e idealmente una persona que se pueda rastrear. Eso no es burocracia por sí misma, sino el requisito previo para análisis de causas sólidos.

6. Errores de conteo y métodos de inventario inadecuados

Incluso los procesos correctos no protegen contra errores humanos. Los artículos se cuentan dos veces, se pasan por alto palés, se estiman cajas abiertas, o no se bloquean ubicaciones mientras se cuenta. Un inventario completo anual descubre estos problemas tarde y bajo gran presión.

Para muchas empresas, un inventario cíclico es la alternativa más razonable. Los artículos de rotación rápida o de alto valor se comprueban más a menudo, los artículos C estables con menos frecuencia. Lo importante no es producir la mayor cantidad posible de conteos, sino comprobar las desviaciones con prontitud frente a los últimos movimientos. Si un artículo con discrepancia simplemente se corrige sin documentar la causa, el patrón permanece invisible.

Un contracontrol es especialmente sensato para valores altos, números de serie, o lotes. Para tornillos en un almacén de consumibles puede ser económicamente excesivo. La profundidad del control debería ajustarse al riesgo.

7. Responsabilidades poco claras entre turnos y áreas

Los errores de existencias surgen a menudo en las transferencias. El turno de mañana prepara la mercancía, el turno de tarde la envía. La recepción de mercancías acepta una entrega, mientras la planificación modifica el pedido en paralelo. Cada paso individual puede ser trazable, pero nadie es dueño de la operación completa.

Por eso, defina no solo roles, sino puntos de transferencia: ¿quién confirma la recepción de mercancías? ¿Cuándo cambia la responsabilidad de la mercancía preparada? ¿Quién revisa las excepciones abiertas al final del turno? Un tablero digital compartido o una simple lista de excepciones suele ser más eficaz que reuniones adicionales.

El sistema debería hacer visibles las operaciones abiertas, en lugar de obligar al personal a recordar. Por ejemplo, las entregas sin control de cantidad, los pickings sin finalización de envío, o las devoluciones sin decisión de calidad deben destacarse antes de convertirse en errores silenciosos de existencias.

8. Integración de sistemas débil y reglas de control faltantes

Si la tienda, la gestión de pedidos, el almacén, y la contabilidad intercambian datos con desfase temporal o por archivo, pueden surgir contabilizaciones duplicadas o faltantes. Una importación se ejecuta dos veces. Una interfaz falla silenciosamente. Un pedido se modifica después de que su estado de envío ya se haya transferido.

La solución no es necesariamente una sustitución completa. A menudo se necesitan interfaces claramente definidas, números de documento inequívocos, y controles técnicos. Una contabilización de almacén debería guardar de forma trazable cuándo ocurrió, de qué operación proviene, y si se canceló posteriormente. Los procesos críticos necesitan mensajes de error y colas, no solo una entrada silenciosa en el archivo de registro.

Con sistemas logísticos desarrollados a medida, tales reglas se pueden adaptar de forma específica a la operativa: ninguna cantidad negativa sin aprobación, ninguna confirmación de envío sin posición de envío, ningún procesamiento duplicado de la misma referencia externa. La mejor regla aquí no es la más estricta, sino aquella que detiene los errores reales sin bloquear la operativa ante excepciones normales.

Comprobar las discrepancias de inventario sistemáticamente

No empiece con una corrección generalizada. Elija los diez artículos con las diferencias más frecuentes o más costosas, y rastree su último movimiento hacia atrás: recepción de mercancías, traslado, picking, devolución, conteo, y cualquier ajuste manual. Si los casos se concentran en una ubicación, un turno, o un tipo de movimiento, ese es un punto de partida sólido.

Después, cada medida debería ser medible. Si se introducen nuevos escaneos de códigos de barras, observe no solo el número de escaneos, sino la tasa de discrepancia por grupo de artículos. Si se añade un nuevo estado para la preparación, compruebe diariamente las preparaciones abiertas. Los buenos procesos no producen una precisión aparente. Hacen visibles y trazables las excepciones de forma temprana.

El siguiente paso sensato suele ser pequeño: definir un punto de transferencia, limpiar una ubicación, o asegurar técnicamente una corrección manual recurrente. Las existencias fiables no surgen de más software por sospecha, sino de procesos que todavía se pueden ejecutar correctamente un martes ajetreado a las 16:45.

Enlace permanente →

Abordar correctamente la automatización de procesos para pymes

Abordar correctamente la automatización de procesos para pymes

Falta un albarán porque los datos todavía están en un papel. Una recepción de mercancías se registra dos veces porque el almacén y la oficina trabajan con tablas distintas. Una aprobación se retrasa porque la persona responsable no contesta al teléfono en ese momento. Ese tipo de fricción rara vez cuesta mucho dinero de golpe. Pero a lo largo de semanas se acumulan consultas, tiempos de búsqueda, correcciones de errores, y esperas innecesarias. Justo ahí es donde tiene sentido la automatización de procesos para pymes.

No se trata de sustituir el mayor número posible de actividades por software. Una buena automatización hace que los flujos sean trazables, reduce las transferencias evitables, y da al personal tiempo para decisiones que requieren experiencia. Eso es especialmente decisivo en las pequeñas y medianas empresas: los equipos están cerca del negocio diario. Cuando un proceso se atasca, a menudo todo el turno lo nota de inmediato.

No automatizar cada proceso

El error más frecuente es empezar por la molestia más visible. Quizá moleste un archivo de Excel, quizá haga falta un nuevo panel de control. Ambas cosas pueden estar justificadas. Pero un caos digitalizado sigue siendo caos - solo que más rápido y con más datos.

Antes de una decisión técnica, el flujo debería describirse primero tal como ocurre realmente. No como debería figurar en el manual. ¿Quién inicia el proceso? ¿Qué información se necesita? ¿Dónde se transfiere algo manualmente? ¿Quién decide en las excepciones? ¿Y en qué reconoce el equipo que el proceso ha concluido?

Precisamente en el almacén o en la tramitación de pedidos, los puntos críticos suelen estar entre sistemas: un pedido llega por correo electrónico, se copia en una tabla, se coordina por teléfono, y más tarde se introduce en un software de envío. Cada transferencia aumenta la probabilidad de que las cantidades, fechas, o direcciones difieran.

La automatización merece especialmente la pena cuando un proceso ocurre con frecuencia, tiene reglas claras, y los errores provocan consecuencias notables. Eso puede ser la recepción de mercancías, la creación de albaranes, la asignación de movimientos de almacén, o la entrega de pedidos aprobados al envío. Los casos especiales poco frecuentes con muchas decisiones discrecionales, en cambio, suelen ser mejor gestionados manualmente - al menos al principio.

La automatización de procesos para pymes empieza con prioridades

No toda actividad innecesaria merece de inmediato un proyecto. Una priorización sencilla aporta claridad. Evalúe los distintos flujos según frecuencia, tiempo de procesamiento, costes de error, y dependencias. Un proceso que ocurre cincuenta veces al día y ahorra solo dos minutos cada vez puede ser más rentable que un complicado proceso mensual.

La pregunta sobre la consecuencia del error es al menos igual de importante. Un documento interno impreso incorrectamente resulta molesto. Una asignación de lote errónea, una dirección de entrega perdida, o una recepción de mercancías sin documentar puede desencadenar reclamaciones, trabajo de búsqueda, y discrepancias de existencias. Ahí la automatización genera no solo velocidad, sino fiabilidad.

Un primer paso sensato suele ser lo bastante pequeño como para poder verificarse en pocas semanas. Por ejemplo, un empleado puede registrar mercancías mediante un código de barras, el sistema comprueba artículo y cantidad, actualiza las existencias en una base de datos central, y genera directamente un recibo de almacenaje si es necesario. El equipo no tiene después que adivinar qué versión de una tabla es la actual.

Un estado objetivo claro en lugar de una lista de funciones

Muchos proyectos comienzan con una larga lista de funciones deseadas. Mejor es una imagen operativa concreta: ¿qué debe ser visible al final de un proceso sin necesidad de preguntar? En el envío, eso podría significar que un pedido, tras su aprobación, reciba automáticamente una lista de picking, se compruebe la dirección de envío, y pueda generarse una etiqueta. Las excepciones aterrizan de forma visible en una lista de aclaración, en lugar de en una bandeja de correo inabarcable.

Esta imagen objetivo obliga a tomar decisiones útiles. ¿Tiene que procesarse cada pedido de forma completamente automática? ¿O deben los pedidos a partir de cierto valor de mercancía, con dirección de entrega divergente, o con existencias faltantes, someterse deliberadamente a revisión? La automatización no necesita un procesamiento a oscuras del cien por cien para generar un gran beneficio.

La técnica adecuada depende del flujo

No existe un camino técnico estándar para cada pyme. Una solución de tabla puede seguir siendo razonable para una evaluación manejable. Se adapta rápidamente, es familiar, y provoca poco esfuerzo de implantación. Sin embargo, en cuanto varias personas trabajan simultáneamente, las contabilizaciones deben ser trazables, o se intercambian datos con otros sistemas, alcanza sus límites.

Entonces suele ser más sensata una aplicación ligera y específica del flujo que una suite empresarial sobredimensionada. Puede representar exactamente los pasos necesarios en la operativa: registrar pedido, comprobar existencias, mover mercancía, generar documento, registrar envío, e informar del estado. Ni más, pero tampoco menos.

Técnicamente, importa menos si un sistema se anuncia con la última palabra de moda. Lo decisivo son fundamentos sólidos: una base de datos modelada limpiamente, permisos trazables, registros para cambios relevantes, interfaces fiables, y despliegues documentados. Una aplicación basada en PHP 8.4, JavaScript moderno, y MySQL 8 puede ser muy mantenible a largo plazo, si la arquitectura y la operativa se piensan desde el principio.

Las integraciones también merecen atención. Un intercambio automático de datos con la tienda, el ERP, el proveedor de envíos, o la contabilidad solo ahorra tiempo si los errores se tratan de forma visible. ¿Qué ocurre con una dirección inválida? ¿Se reintenta una impresión de etiqueta fallida? ¿Puede el equipo reconocer qué datos se han transferido y cuáles faltan todavía? Los errores silenciosos son más peligrosos que un caso excepcional claramente marcado.

Implantación durante la operativa en curso

Un nuevo sistema debe adaptarse a los cambios de turno, los plazos de entrega, y las rutinas de trabajo existentes. Por eso, una implantación gradual suele ser más segura que una fecha límite rígida para todas las áreas. Empiece con un proceso delimitado, un grupo de productos, o un área de almacén. Eso reduce el riesgo y genera retroalimentación real del día a día.

El funcionamiento en paralelo no es, por tanto, señal de inseguridad, sino una prueba controlada. Durante un tiempo limitado, se pueden comparar el registro antiguo y el nuevo. Las diferencias no solo muestran errores de software, sino a menudo también reglas que hasta ahora solo existían en la cabeza de empleados individuales. Esas reglas deben figurar de forma visible en el proceso - no permanecer de forma duradera en la experiencia personal.

El personal no debería enfrentarse al nuevo flujo solo en la formación. Quien ejecuta el proceso a diario reconoce pronto atajos, casos especiales, y pantallas poco prácticas. Un buen software respeta ese conocimiento, sin incorporar sin cambios cada excepción crecida históricamente. La pregunta correcta es: ¿qué excepción protege un caso de negocio importante, y cuál es solo una solución alternativa para un problema antiguo?

Hacer medible si el esfuerzo merece la pena

Antes del inicio deberían fijarse dos o tres indicadores. Pueden ser el tiempo de tramitación por pedido, el número de correcciones manuales, las discrepancias de existencias, o el tiempo hasta el envío. Sin un valor de partida, toda evaluación posterior se convierte en una mera impresión subjetiva.

No todo efecto se muestra de inmediato en euros. Cuando un equipo de almacén sabe en todo momento dónde se encuentra la mercancía, disminuye el número de interrupciones. Cuando los documentos de entrega surgen de los mismos datos que el pedido, disminuye el riesgo de información contradictoria. Y cuando las responsabilidades son visibles en el sistema, un proceso depende menos de personas individuales.

La automatización necesita mantenimiento y límites

Un flujo automatizado no es un proyecto que se congela tras la puesta en marcha. Las estructuras de artículos cambian, los clientes exigen nuevos documentos, los proveedores de envío adaptan sus interfaces. Por eso las responsabilidades, las actualizaciones, las copias de seguridad, y una gestión regulada de los permisos forman parte del sistema propiamente dicho.

Especialmente en aplicaciones con datos de clientes, pedidos, o existencias, debería estar claro quién obtiene acceso y por qué. Los roles deben ajustarse al día a día laboral: un equipo de almacén necesita funciones distintas a contabilidad o ventas. Los cambios registrados, los flujos de inicio de sesión seguros, y las restauraciones probadas resultan poco espectaculares. En caso de incidencia, son precisamente estos detalles los que deciden si la operativa puede seguir funcionando.

Las pruebas también forman parte de la seguridad operativa. Las verificaciones recurrentes de entrada de pedidos, contabilización de existencias, generación de documentos, y gestión de derechos evitan que un cambio en un punto dañe un flujo funcional en otro. Para aplicaciones web o de escritorio críticas, un entorno de pruebas autoalojado y controlado puede tener sentido si las capturas de pantalla, los datos de prueba, y los procesos internos no deben llegar a servicios cloud externos.

softify.pro acompaña este tipo de proyectos con un principio sencillo: primero comprender el flujo real, luego construir la solución mínima viable. A veces es una aplicación a medida. A veces basta con estructurar de forma más limpia una tabla existente y automatizar un único paso de transferencia.

El mejor siguiente paso no es, por tanto, una comparación de software, sino un recorrido por un proceso real - desde el desencadenante hasta la finalización. Tome un pedido, una recepción de mercancías, o una reclamación y sígalo con las personas implicadas. Allí donde se vuelve a introducir información, nadie conoce el estado, o las decisiones esperan innecesariamente, suele estar el enfoque más sensato para la automatización.

Enlace permanente →

Probar aplicaciones Windows: un plan práctico

Probar aplicaciones Windows: un plan práctico

Una aplicación Windows puede verse impecable en modo demo y aun así ralentizar la operativa el lunes por la mañana. Un albarán no guardado, un usuario bloqueado tras tres intentos fallidos, o un cuadro de diálogo de impresión que reacciona de forma distinta tras una actualización no son errores cosméticos. Quien quiera saber cómo probar aplicaciones Windows no debería, por tanto, empezar por botones individuales, sino por los flujos que cuestan trabajo, dinero, o trazabilidad.

Precisamente en almacén, taller, expedición, y administración, muchos procesos críticos se ejecutan a través de software de escritorio desarrollado a lo largo de los años. Ahí no importa si un caso de prueba está formulado de forma impresionante. Lo decisivo es si el personal puede realizar su trabajo de forma fiable en condiciones realistas - incluso con datos incompletos, permisos cambiantes, redes lentas, e interrupciones no planificadas.

Probar aplicaciones Windows empieza por los flujos críticos

No todas las funciones merecen el mismo esfuerzo de prueba. Una exportación poco usada con retrabajo manual debe evaluarse de forma distinta a la contabilización de una recepción de mercancías, la generación de una etiqueta, o la conciliación diaria de pedidos. Empiece por tanto con una pregunta sencilla: ¿qué ocurre concretamente si este flujo falla?

Tienen alta prioridad los procesos con impacto directo en existencias, entrega, facturación, seguridad, o comunicación con el cliente. Entre ellos se incluyen, por ejemplo, el inicio de sesión y la comprobación de permisos, la creación y modificación de datos maestros, las contabilizaciones de transacciones, la impresión de documentos, las interfaces con servicios ERP o de envío, así como las reanudaciones tras un error. Incluso las funciones usadas solo por un pequeño grupo de personas pueden ser críticas si bloquean un cierre mensual o la liberación de mercancía.

De estos flujos no surgen listas de pruebas abstractas, sino pasos de trabajo trazables. Una prueba de recepción de mercancías podría, por ejemplo, empezar con un pedido existente, registrar una entrega parcial, notificar una cantidad divergente, asignar una ubicación de almacén, y luego comprobar si existencias, registro de contabilizaciones, y documento impreso coinciden. Así prueba el efecto real del software, no solo campos de entrada individuales.

Crear una base de pruebas que refleje la operativa

Muchos errores solo se hacen visibles cuando el entorno de prueba se acerca a la realidad. Una aplicación a menudo se comporta de forma distinta con un tenant de prueba vacío que con varios años de datos de movimientos, artículos bloqueados, información obligatoria faltante, u operaciones ya abiertas.

Por tanto, configure los datos de prueba de forma deliberada. No necesita forzosamente una copia completa de producción. Es más sensato un conjunto de datos controlado con casos típicos, límite, y deliberadamente erróneos: artículos con distintas unidades de medida, clientes con condiciones especiales, pedidos con entregas parciales, usuarios con distintos roles, y operaciones ya en curso. Los datos personales deberían anonimizarse o sustituirse por datos de ejemplo realistas.

A la base de pruebas también pertenece el entorno técnico. Documente la versión de Windows, resolución, escalado, impresoras instaladas, unidades de red, versión de la base de datos, servicios conectados, y permisos. Suena árido, pero ahorra tiempo después. Si un error solo ocurre en puestos de trabajo con escalado al 125% o con un controlador de impresora concreto, eso debe ser reproducible.

No comprobar solo el caso ideal

El caso ideal demuestra sobre todo que la aplicación se construyó para el camino esperado. En la operativa, las situaciones difíciles surgen junto a él. ¿Qué ocurre si un usuario deja un campo obligatorio vacío, dispara la misma contabilización dos veces, o pierde la conexión durante el guardado? ¿Permanece coherente la operación? ¿Recibe la persona un mensaje comprensible? ¿Puede seguir trabajando con seguridad?

En las aplicaciones Windows, además, el manejo y el estado son especialmente relevantes. Las ventanas de diálogo pueden aparecer en segundo plano, los atajos de teclado pueden solaparse, los diálogos de selección de archivos pueden bloquear el flujo. Compruebe si el foco, los mensajes de error, y los bloqueos son inequívocos. Una excepción técnica sin indicación de qué hacer no ayuda al jefe de turno.

Usar pruebas manuales donde se requiere criterio

Las pruebas manuales no son señal de madurez insuficiente. Son imprescindibles cuando surge un flujo nuevo, se reconstruye una interfaz, o el conocimiento especializado determina la calidad. Un jefe de almacén experimentado reconoce más rápido que un script si una pantalla es comprensible bajo alta presión de tiempo, o si un aviso aparece demasiado tarde.

Sin embargo, la prueba manual se vuelve costosa y poco fiable cuando se repiten los mismos flujos estables antes de cada versión. Entonces el lanzamiento depende de personas disponibles, memoria, y notas dispersas. El momento adecuado para pasar a la automatización suele estar donde un proceso se ejecuta con frecuencia, puede causar un daño considerable, y tiene resultados esperados claros.

Un buen caso de prueba manual describe la situación de partida, los pasos, el resultado esperado, y los datos necesarios. Ante un error, añada una captura de pantalla, marca de tiempo, versión de la aplicación y de la build, así como la acción exacta. "La impresión no funciona" no es una descripción de error utilizable. "Tras cambiar la dirección de entrega, el cuadro de diálogo de impresión permanece abierto, el pedido 4711 no recibe un PDF, y no aparece ningún mensaje" sí lo es.

Pruebas de regresión automatizadas para riesgos recurrentes

La automatización no comprueba si un software es fundamentalmente bueno. Comprueba si flujos definidos que antes funcionaban siguen funcionando tras un cambio. Eso es especialmente valioso para software Windows cuyas interfaces, lógica de base de datos, e interfaces externas se siguen desarrollando durante años.

Empiece a pequeña escala. Elija primero de cinco a diez flujos críticos para el negocio que deban comprobarse en cada lanzamiento. Entre ellos pueden estar el inicio de sesión con un flujo de bloqueo de cuenta, la entrada de pedidos, la contabilización de almacén, la impresión de PDF o etiquetas, el cambio de rol, y una importación central. Solo cuando estas pruebas funcionan de forma fiable merece la pena ampliar a casos especiales.

En las aplicaciones de escritorio, las pruebas automatizadas suelen controlar elementos visibles de la interfaz: ventanas, campos de entrada, tablas, botones, y diálogos. Eso funciona, pero es más frágil que una prueba pura de interfaz. Pequeños cambios de diseño, ordenadores más lentos, o elementos con nombres ambiguos pueden romper las pruebas. Por eso desarrolladores, área de negocio, y responsables de pruebas deberían determinar conjuntamente qué elementos son direccionables de forma estable y qué pasos de comprobación se aseguran mejor a través de la base de datos, un registro, o una interfaz.

Una prueba sensata también comprueba algo más que si se pudo hacer clic en un botón. Controla la consecuencia funcional: ¿se guardó la contabilización? ¿Es correcta la existencia? ¿Se generó un documento? ¿No se creó ningún registro duplicado? Interacción visible y resultado verificable van de la mano.

Las evidencias forman parte del resultado de la prueba

Un estado verde por sí solo rara vez basta en aplicaciones críticas. Cuando una prueba falla, los equipos necesitan rápidamente una respuesta a tres preguntas: ¿cuál era la situación de partida? ¿En qué paso falló el flujo? ¿Qué mostraba la aplicación en ese momento?

Las capturas de pantalla, los registros de ejecución, y, en su caso, las grabaciones de pantalla hacen que los errores sean discutibles. Acortan considerablemente el traspaso entre operativa, QA, y desarrollo. Para empresas reguladas o preocupadas por la seguridad, son además una base sólida para rastrear aprobaciones y desviaciones.

En esto, la ubicación de almacenamiento no es un asunto secundario. Las ejecuciones de prueba pueden contener datos internos de clientes, listas de precios, información de pedidos, o vistas de pantalla. Quien automatice pruebas para aplicaciones Windows sensibles debería aclarar si esos datos pueden salir de su propia infraestructura. Un entorno autoalojado como COCO puede ser sensato aquí, porque la ejecución de pruebas, las evidencias, y la evaluación permanecen bajo su propio control. Si eso es necesario depende de los requisitos de protección de datos, la situación contractual, y la necesidad de protección - no todos los equipos necesitan la misma arquitectura para ello.

Integrar las pruebas en el proceso de lanzamiento

El mejor catálogo de pruebas pierde valor si solo se usa después de una puesta en producción precipitada. Defina un momento fijo: las regresiones centrales automatizadas se ejecutan antes de cada lanzamiento, la aceptación manual comprueba flujos nuevos o modificados, y las limitaciones conocidas se documentan abiertamente.

No todas las pruebas fallidas deben detener un lanzamiento. Un error en una vista de administración poco usada puede ser aceptable si existe una solución alternativa segura y el área afectada está claramente informada. Un error que contabiliza existencias incorrectamente o bloquea usuarios sin que se note debe tratarse de forma distinta. Esa decisión debería tomarse según el impacto en el negocio, no según el mero número de pruebas en rojo.

Mantenga las pruebas junto con la aplicación. Cuando un proceso cambia deliberadamente, actualice el caso de prueba, los datos de prueba, y el resultado esperado junto con el requisito. Las pruebas obsoletas generan ruido y acaban ignorándose. Unas pocas comprobaciones fiables valen más que cientos de flujos automatizados cuyos resultados ya nadie se toma en serio.

Al final, no se trata de simular cada entrada imaginable. Se trata de proteger el trabajo que tiene que volver a funcionar a la mañana siguiente. Empiece con un único proceso crítico, haga demostrable su resultado, y construya desde ahí.

Enlace permanente →

Secure test data management sin perder el control

Secure test data management sin perder el control

Una ejecución de prueba fallida es molesta. Una ejecución de prueba exitosa con datos reales de clientes en un entorno insuficientemente protegido puede resultar considerablemente más costosa. El secure test data management no resuelve esta contradicción con una sola herramienta, sino con reglas claras para datos, accesos, entornos de prueba, y evidencias. Para los equipos que prueban de forma automatizada aplicaciones web o Windows, esto forma por tanto parte del trabajo de calidad - no solo del cumplimiento normativo.

Por qué los datos de prueba se convierten en un problema de seguridad

Los datos de producción son tentadores para las pruebas porque contienen casos límite reales: direcciones incompletas, combinaciones de pedidos inusuales, reglas de precios históricas, o entradas erróneas. Pero precisamente estos datos suelen contener nombres, datos de contacto, información contractual, números de personal, datos bancarios, o lógica de negocio interna.

El riesgo rara vez surge de un único error evidente. Normalmente crece paso a paso: se crea una exportación de la base de datos para una prueba, se deposita en un directorio compartido, y más tarde se copia a otro entorno. Un servicio externo recibe capturas de pantalla para el análisis de errores. Una cuenta de prueba conserva permisos amplios porque una limpieza podría interrumpir la siguiente ejecución. Después de unos meses, ya nadie sabe con certeza qué datos están dónde.

En las pequeñas y medianas empresas, el problema a menudo se agrava por la escasa capacidad. El equipo quiere cumplir un plazo de lanzamiento, no gestionar su propio proyecto de protección de datos. Sin embargo, la responsabilidad se mantiene. Quien usa datos para el aseguramiento de la calidad debe poder rastrear qué datos se procesan, quién tiene acceso, y cuándo se eliminan de nuevo.

El secure test data management empieza antes del caso de prueba

La pregunta decisiva no es: "¿Cómo protegemos el conjunto de datos de prueba?" Es: "¿Qué información necesita realmente esta prueba?" Muchas pruebas de regresión no requieren referencias personales reales en absoluto. Un proceso de envío, por ejemplo, debe verificar si las direcciones de entrega, pesos, zonas, etiquetas, y cambios de estado se procesan correctamente. Para eso bastan clientes sintéticos, datos maestros de artículos plausibles, y casos límite definidos deliberadamente.

Esta distinción lleva a una clasificación de datos práctica. No todos los entornos de prueba necesitan la misma profundidad de datos. Para pruebas unitarias y de integración a menudo bastan conjuntos de datos completamente artificiales. Para pruebas de extremo a extremo pueden ser sensatas copias pseudonimizadas, si los patrones de datos reales son relevantes desde el punto de vista funcional. Los datos similares a los de producción deberían ser la excepción - con un propósito documentado, acceso limitado, y una vida útil fija.

Aquí importa la calidad de los datos sustitutos. Los datos ficticios aleatorios ayudan poco si no reflejan dependencias realistas. Un conjunto de datos de prueba para una aplicación de almacén debe, por ejemplo, contener variantes de artículos, ubicaciones de almacén, existencias bloqueadas, entregas parciales, y devoluciones en una combinación coherente. Los buenos datos de prueba no solo protegen información personal. Encuentran errores que nunca aparecerían con tablas vacías y el cliente de muestra "Juan Pérez".

¿Sintetizar, enmascarar, o minimizar?

Los datos sintéticos son la opción más segura cuando las reglas de negocio se pueden modelar de forma limpia. Surgen de manera específica a partir de los requisitos de prueba y no contienen ninguna copia de personas u operaciones reales. El esfuerzo radica en el mantenimiento: si el modelo de datos cambia o se añaden nuevas reglas de proceso, generadores y fixtures deben crecer con ellos.

El enmascaramiento es adecuado cuando el comportamiento de una aplicación depende fuertemente de estructuras de producción. En este caso, los campos sensibles se sustituyen o modifican, mientras se conservan las relaciones. Los nombres se convierten en nombres plausibles pero ficticios; las direcciones de correo electrónico se convierten en direcciones de prueba no entregables; los números de cuenta se convierten en valores con formato correcto sin relación real. Un enmascaramiento solo es sólido si también se tienen en cuenta las deducciones indirectas. Una combinación de un lugar poco común, fecha de nacimiento, y característica contractual puede seguir haciendo identificable a una persona.

La minimización de datos es a menudo el tercer camino infravalorado. En lugar de copiar una exportación completa, solo se proporciona el segmento necesario. Eso reduce la superficie de ataque, la necesidad de almacenamiento, y el esfuerzo de limpieza. Para probar una lógica de descuento nadie necesita todo el historial de un año de clientes.

Los accesos y entornos deben ajustarse al riesgo

Un conjunto de datos protegido pierde su valor si se encuentra en un entorno de prueba libremente accesible. Los sistemas de prueba necesitan por tanto sus propios límites de seguridad - bases de datos separadas, cuentas de servicio propias, accesos de red claramente definidos, y ninguna conexión silenciosa con producción.

Los derechos de acceso deberían basarse en roles, no en cuentas compartidas. Los desarrolladores pueden necesitar derechos distintos a los de QA, soporte, o proveedores externos. Los accesos de administrador a veces son necesarios, pero deberían estar limitados en el tiempo, registrados, y vinculados a una aprobación rastreable. También para las cuentas de prueba rigen reglas de contraseña sensatas, autenticación multifactor donde esté disponible, y flujos de bloqueo de cuenta ante intentos fallidos repetidos.

Las pruebas automatizadas traen consigo otro caso especial: generan evidencias. Las capturas de pantalla, grabaciones de pantalla, registros, y mensajes de error pueden contener contenido sensible, incluso si la base de datos ha sido enmascarada. Una captura de pantalla de una máscara de cliente, un rastro de navegador con información de sesión, o un registro con carga útil de API pertenecen a la misma consideración de protección que la base de datos de prueba.

Por eso los artefactos de prueba necesitan reglas de retención. No todas las ejecuciones exitosas deben almacenarse de forma permanente. Para aprobaciones críticas puede tener sentido una evidencia rastreable, por ejemplo con marca de tiempo, número de compilación, versión de prueba, y resultado. Las ejecuciones fallidas a menudo necesitan una ventana de análisis más larga. Después de eso, los artefactos deberían eliminarse automáticamente. Lo que ya no existe no puede compartirse o comprometerse por accidente.

Automatización sin fugas de datos incontroladas

La automatización de pruebas asistida por IA puede acelerar considerablemente las pruebas, especialmente en aplicaciones web y Windows extensas. Pero cambia la pregunta de seguridad: ¿adónde van las capturas de pantalla, entradas, descripciones de errores, y tráfico de la aplicación? ¿Quién los procesa? ¿Cuánto tiempo permanecen allí?

Para equipos conscientes de la seguridad, la ejecución autoalojada suele ser la mejor arquitectura. Un sistema como COCO puede funcionar dentro de la propia infraestructura, o de una claramente delimitada, ejecutando pasos de prueba, almacenando evidencias, y generando evaluaciones comprensibles. Esto no es obligatorio en todas las situaciones. Para una página de marketing pública con valores de formulario puramente sintéticos, un servicio externo puede ser aceptable. Sin embargo, en aplicaciones empresariales internas, portales de clientes, o software con operaciones personales, el control local es una ventaja concreta.

El autoalojamiento no es un pase libre. La operación exige actualizaciones, conceptos de copia de seguridad, registros de acceso, y una entidad responsable. A cambio, la soberanía de los datos permanece donde debe estar. El enfoque correcto depende de la necesidad de protección, de las capacidades operativas existentes, y del tipo de aplicación probada - no de la moda actual en torno a una herramienta de prueba concreta.

Cómo las reglas se convierten en un proceso funcional

Un proceso práctico no tiene por qué bloquear el lanzamiento. Empiece con un mapa de datos: ¿qué entornos de prueba existen, qué tipos de datos se encuentran allí, y qué sistemas generan artefactos adicionales? Este inventario suele revelar ya exportaciones antiguas, sistemas de staging olvidados, y responsabilidades poco claras.

Después de eso, merece la pena una matriz de decisión sencilla por clase de prueba. Determina si bastan datos sintéticos, se requiere un enmascaramiento, o se necesita un extracto de producción claramente justificado. Se complementa con propietarios, plazos de eliminación, y roles de acceso. Esto no tiene que ser un conjunto de reglas sobrecargado. Una directriz corta y realmente seguida es mejor que un documento de seguridad que nadie encuentra durante un incidente.

Técnicamente, el suministro y la limpieza de datos pertenecen al pipeline de pruebas. Una ejecución crea de forma reproducible los conjuntos de datos que necesita, usa marcadores únicos, y luego los elimina de nuevo. Eso evita que los entornos de prueba se llenen de datos residuales y que los resultados sean cada vez menos fiables con cada sprint. Para procesos críticos, los equipos deberían además comprobar si los accesos a datos y las evidencias de prueba deben registrarse de forma auditable.

Seguridad que acelera las pruebas

El secure test data management se considera a menudo una carga de control adicional. Mal implementado, ciertamente puede serlo. Bien implementado, sin embargo, crea condiciones de partida fiables y repetibles. Los equipos pierden menos tiempo buscando una exportación de datos utilizable, evitan pruebas rotas por datos residuales sin limpiar, y pueden justificar mejor las aprobaciones.

El primer paso más sensato rara vez es un gran proyecto de plataforma. Tome el proceso de prueba con el mayor riesgo o la mayor fricción - por ejemplo, la aprobación de una aplicación interna de pedidos - y haga visibles allí la fuente de datos, los accesos, los artefactos, y la eliminación. De ese trabajo concreto surge una rutina de seguridad que no hace las pruebas más engorrosas, sino más creíbles.

Enlace permanente →

Warehouse Software vs ERP

Warehouse Software vs ERP

Una entrada de mercancías llega al mismo tiempo que una recogida urgente, dos empleados preguntan por la ubicación de un artículo, y un albarán ya ha sido corregido a mano. Es exactamente en esos momentos cuando la pregunta Warehouse Software vs ERP se vuelve práctica. No se trata de la interfaz más moderna ni de la lista de funciones más larga. Se trata de si la información está disponible justo donde hay que tomar una decisión en segundos.

Muchas pequeñas y medianas empresas de la región DACH empiezan con un ERP, una hoja de cálculo y mucha experiencia en el equipo. Eso puede funcionar durante mucho tiempo. Los problemas empiezan cuando las existencias difieren entre sistemas, los tiempos de búsqueda aumentan y cada caso especial hay que resolverlo a voces por el almacén. En ese momento suele plantearse un gran proyecto de ERP, aunque quizá solo haga falta digitalizar un único proceso de almacén claramente delimitado.

Warehouse Software vs ERP: la diferencia en el día a día

Un sistema ERP representa la empresa en toda su amplitud. Normalmente conecta compras, ventas, datos maestros de artículos, contabilidad, producción, facturación y planificación. Su fortaleza está en que los datos comerciales y operativos confluyen en un marco común. Se crea un pedido, se emite una factura, se planifica una necesidad, se valora un stock.

El warehouse software, a menudo llamado WMS o gestión de almacén, trabaja más cerca de los movimientos reales dentro del almacén. Da soporte a la entrada de mercancías, el almacenaje, los traslados, la preparación de pedidos, el inventario, el envío y las devoluciones. Responde a preguntas que el ERP a menudo solo representa de forma general: ¿en qué ubicación está la mercancía? ¿Qué stock está realmente disponible? ¿Qué lote se ha enviado? ¿Qué pedido tiene prioridad? ¿Quién ha confirmado el traslado?

Esta división no es absoluta. Hay ERP con amplias funciones de almacén y productos WMS con conexiones a procesos de pedidos o compras. Lo decisivo, por tanto, no es la etiqueta de la oferta, sino la profundidad operativa. Un ERP puede gestionar diez ubicaciones y seguir siendo poco práctico si el personal tiene que abrir varias pantallas para cada movimiento, o registrar los datos solo más tarde.

El ERP es la fuente comercial

Cuando hay que facturar un pedido, lanzar una orden de compra o crear una valoración de material, eso corresponde al ERP en la mayoría de las empresas. Ahí suele residir la lógica principal de artículos y clientes. Este papel no debería duplicarse a la ligera. Dos sistemas independientes para precios, referencias de artículo o pedidos no generan seguridad, sino trabajo de conciliación.

Un ERP resulta especialmente útil cuando el reto central es transversal: compras y producción deben planificarse juntas, los datos financieros deben mantenerse coherentes, o varias sociedades trabajan con los mismos procesos. Quien todavía no tenga esa base no debería esperar que una solución puramente de almacén sustituya todos los procesos de la empresa.

El warehouse software controla el movimiento

En el almacén, sin embargo, no solo importa lo que teóricamente existe en el sistema. Importa lo que acaba de llegar a la puerta tres, qué hueco está libre y si la mercancía se ha reservado para un pedido confirmado. Una buena solución de almacén reduce la fricción precisamente en esos puntos.

Eso puede empezar con escáneres móviles: la mercancía se escanea en la entrada de mercancías, se asigna a una ubicación y se marca de inmediato como disponible. Durante la preparación de pedidos, el sistema guía en una secuencia lógica, verifica artículo y cantidad, y genera etiquetas de envío o documentos de entrega cuando hace falta. El registro no ocurre horas después en un puesto de oficina, sino dentro del propio proceso.

El beneficio no está solo en la velocidad. Los registros trazables hacen visibles los errores. Si un stock no cuadra, se puede determinar cuándo faltó un movimiento o se confirmó mal. Eso es mucho más fiable que una corrección mensual en una hoja de cálculo.

Cuándo basta con un módulo del ERP

Un módulo del ERP ya existente puede ser la elección correcta cuando la organización del almacén es manejable y el equipo puede trabajar de forma fiable con los procesos actuales. Un único almacén, ubicaciones fijas, pocas líneas de pedido y ningún requisito estricto de lote o número de serie son condiciones típicas. También con poco volumen de envío, un componente de sistema adicional puede exigir más mantenimiento del que aporta.

Antes de adquirir un nuevo sistema, merece la pena una prueba honesta: ¿puede un empleado registrar por completo una entrada de mercancías, un traslado y un envío sin notas en papel? ¿Es visible el stock por ubicación? ¿Se pueden rastrear las diferencias de un inventario? ¿Se generan los documentos sin doble introducción de datos? Si la respuesta es mayoritariamente sí, una ampliación quizá no sea urgente.

La hoja de cálculo también puede quedarse, si cumple limpiamente un propósito limitado, por ejemplo una planificación estacional de capacidad o un análisis puntual. Una buena solución no sustituye toda forma de trabajo conocida. Sustituye aquellos pasos manuales en los que los errores, la espera o la falta de transparencia cuestan dinero de verdad.

Cuándo tiene sentido una solución de almacén especializada

El punto de inflexión suele llegar de forma gradual. Primero, un empleado pregunta más a menudo por un artículo. Luego se mantienen existencias más altas por precaución, porque nadie conoce con certeza el stock realmente disponible. Al final, los envíos se retrasan porque albaranes, etiquetas y correcciones de stock pasan por herramientas distintas.

Un warehouse software especializado resulta especialmente útil cuando confluyen varias de estas condiciones:

  • se gestionan varias zonas de almacén, ubicaciones o almacenes externos
  • las entradas de mercancías, traslados y preparaciones de pedidos ocurren a diario en gran número
  • hay que rastrear lotes, números de serie, caducidades o stock bloqueado
  • transportistas, impresoras de etiquetas o escáneres móviles deben integrarse en el proceso
  • la realidad operativa se desvía cada vez más de lo que muestra el ERP

Esta lista no es una recomendación automática de compra. Una empresa con muchas líneas de pedido puede funcionar bien con un ERP bien configurado. A la inversa, una empresa pequeña puede necesitar pronto una aplicación de almacén ligera si cada pieza debe ser trazable o varios equipos tienen que registrar a la vez.

La cuestión de la integración suele pesar más que las funciones

La pregunta más difícil en Warehouse Software vs ERP pocas veces es: ¿qué sistema puede hacer más? La mejor pregunta es: ¿qué datos tienen que fluir, cuándo, hacia qué sistema?

En muchos casos el ERP sigue siendo la fuente principal para artículos, clientes, pedidos y documentos comerciales. La aplicación de almacén se encarga de la ejecución operativa. Recibe los pedidos liberados, realiza los movimientos de almacén y devuelve estado, cantidades, lotes o números de envío. Así, cada parte tiene una tarea clara.

Esta interfaz necesita reglas concretas. ¿Qué ocurre con un cambio de pedido después de que la preparación ya ha empezado? ¿Puede un stock de almacén volverse negativo? ¿Qué registro vale en caso de caída de red? ¿Cómo se bloquean los artículos que se detectan en el control de calidad? Sin estas decisiones, hasta una API técnicamente limpia se convierte en una nueva fuente de errores.

Para las pequeñas y medianas empresas, una implantación por fases suele ser más razonable que un cambio completo. Primero se puede introducir la entrada de mercancías con escaneo de códigos de barras. Después siguen las ubicaciones y los traslados, más tarde la preparación de pedidos y el envío. Así las excepciones reales salen a la luz pronto, sin apostar toda la operativa a un único día de cambio.

¿Producto estándar, ampliación del ERP o aplicación a medida?

Un WMS estándar merece la pena cuando los procesos propios son en gran medida convencionales y una integración existente encaja con el ERP. Aporta rápidamente funciones probadas a la operativa. El precio puede ser que los equipos tengan que adaptar sus flujos de trabajo a esquemas fijos, o pagar por funciones enterprise que apenas usan.

Ampliar el ERP tiene sentido cuando la profundidad operativa necesaria está realmente disponible y funciona sobre el suelo de la nave. No basta con revisar la demo del producto, sino un flujo real con escáner, guantes, wifi inestable y presión de tiempo antes de la salida.

Una aplicación a medida se vuelve interesante cuando el proceso sostiene la ventaja competitiva de la empresa, o el software estándar fuerza rodeos de forma permanente. Puede ser un proceso de entrada de mercancías particular, una conexión entre taller y almacén, albaranes especiales o una lógica de rutas propia. En ese caso, la solución no debería hacerse artificialmente grande. Un proceso claro, bien modelado y construido sobre una base técnica mantenible, vale más que una plataforma que en teoría puede hacerlo todo.

softify.pro desarrolla estos sistemas a partir de movimientos y responsabilidades concretos: desde la entrada de mercancías hasta los documentos de envío, pasando por los registros de almacén. El modelo de datos, los permisos, los casos de error y el mantenimiento posterior siguen formando parte de la implementación, no tareas para «algún día» después de la puesta en marcha.

Preguntas que deben plantearse antes de decidir

No todo requisito tiene que automatizarse el primer día. Pero sí debe decidirse de forma consciente. Los responsables deberían aclarar con el equipo de almacén, ventas y contabilidad qué datos son de referencia, qué errores se producen hoy con más frecuencia y qué indicadores se necesitarán realmente más adelante. Una bonita vista general de existencias ayuda poco si nadie sabe si las cantidades reservadas, bloqueadas y disponibles se tratan de forma distinta.

Igual de importante es la responsabilidad sobre los datos maestros. Los procesos de almacén rara vez fallan por un botón que falta. Fallan por referencias de artículo incoherentes, unidades de medida mal mantenidas y reglas sin aclarar para artículos sustitutos o conversiones de unidades. El software puede hacer visibles estos problemas. Pero no puede resolverlos sin decisiones tomadas dentro de la empresa.

La elección adecuada, por tanto, no es automáticamente ERP o warehouse software. Surge de la distancia entre su proceso actual y el proceso que su equipo realmente debe ejecutar de forma fiable. Empiece por un movimiento que hoy cueste tiempo o genere errores, y compruebe qué sistema representa ese movimiento de la forma más clara, rápida y trazable.

Enlace permanente →

Automatizar la entrada de mercancías

Automatizar la entrada de mercancías

Un camión está parado en la puerta, dos empleados revisan albaranes y la lista de existencias sigue en el ordenador de la oficina. Justo ahí empieza a hacerse práctica la pregunta how to automate goods receiving. No porque cada almacén necesite una gran implantación de ERP. Sino porque una entrada de mercancías faltante, tardía o registrada de forma incorrecta tiene consecuencias: las existencias no cuadran, los pedidos esperan, las reclamaciones se vuelven difíciles de rastrear y el turno empieza con preguntas pendientes.

Automatizar la entrada de mercancías no significa sustituir a las personas por escáneres. Significa gestionar controles, registros y documentos recurrentes de modo que el equipo en la puerta pueda decidir con rapidez y que el stock quede después siendo fiable. Para las pequeñas y medianas empresas, un flujo de trabajo ligero y adecuado suele valer más que un sistema de gran corporación lleno de funciones que nadie usa.

Qué se pierde realmente con la entrada de mercancías manual

Los albaranes en papel y las hojas de cálculo suelen funcionar el tiempo suficiente como para posponer una inversión. El problema no surge por una caja aislada. Surge cuando se acumulan las desviaciones: una entrega parcial se anota más tarde, un lote no se puede identificar, un palé acaba en la zona equivocada o el registro de entrada solo se hace al final del día.

Entonces conviven varias verdades a la vez. El proveedor informa de que ha entregado. En el almacén hay mercancía físicamente. La planificación aún no ve stock disponible. Contabilidad tiene un documento, pero ninguna confirmación de cantidad o de daños. El personal concilia esta información por teléfono, correo y experiencia. Eso cuesta tiempo y hace que el proceso dependa de personas concretas.

La automatización crea una única fuente compartida y actualizada para la operación. Registra no solo el stock teórico, sino también lo que realmente ha ocurrido en la puerta: quién ha recibido, cuándo, en qué cantidad, con qué desviación y a dónde va la mercancía después.

How to automate goods receiving con un flujo claro

El punto de partida correcto no es elegir un escáner o una aplicación de almacén. Primero hay que hacer visible el proceso real. Recorra una entrada de mercancías típica, desde la fecha de entrega anunciada hasta el almacenaje. Observe también los casos especiales por el camino, porque son los que determinan si una solución aguanta en el día a día.

Un flujo digital suele constar de cinco decisiones consecutivas. La entrega se identifica, se verifica frente al pedido o a la llegada esperada, se registra la cantidad real, se documentan las desviaciones y la mercancía se asigna a una ubicación de almacén o a un paso de control adicional. Cada paso debería pedir solo los datos que realmente hacen falta en ese punto.

1. Poner a disposición con antelación las entregas esperadas

Si existen pedidos de compra, órdenes de producción o avisos de expedición, el almacén debería poder verlos antes de la llegada. Al llegar, la persona responsable elige el proveedor, escanea un número de pedido o busca una entrega abierta. El sistema muestra los artículos esperados, las cantidades y, si procede, lotes o números de serie.

Esto acorta notablemente la recepción. Pero aún más importante es la lógica de control: el equipo no tiene que decidir de memoria si 18 cajas en lugar de 20 son aceptables. La desviación se hace visible y puede indicarse un motivo. Para entregas no anunciadas, el flujo necesita una vía controlada, por ejemplo como entrada provisional con liberación por parte de compras o planificación.

2. Usar códigos de barras donde realmente ahorran tiempo

Un lector de códigos de barras o la cámara de un dispositivo móvil robusto son, para muchos almacenes, el punto de partida más razonable. Un escaneo reduce los errores de tecleo y acelera los movimientos recurrentes. El requisito, eso sí, es que los códigos de artículo, las unidades de embalaje y las etiquetas se mantengan de forma coherente. Un escáner no arregla datos maestros poco claros.

No toda mercancía necesita trazabilidad por número de serie. Para tornillos o consumibles estándar suele bastar con artículo, cantidad y ubicación. Para repuestos en garantía, productos regulados o componentes destinados a producción, el lote, el número de serie, la caducidad y el estado de control pueden ser obligatorios. La profundidad del registro debe ajustarse al riesgo, no a una plantilla de software genérica.

3. Tratar las desviaciones como un proceso normal

Una buena entrada digital de mercancías no intenta evitar todas las desviaciones. Las hace sencillas y demostrablemente gestionables. Faltas, excesos de entrega, daños de transporte, artículos equivocados y lotes bloqueados necesitan estados claros en lugar de notas manuscritas en el albarán.

Ante una entrega dañada, por ejemplo, se puede tomar una foto directamente en el punto de recepción, registrar la cantidad como bloqueada e informar automáticamente a compras. El stock disponible se mantiene correcto mientras la mercancía pasa físicamente a una zona de cuarentena. Esto evita que piezas dañadas se recojan por error o se usen en producción.

La regla no siempre tiene que ser totalmente automática. Para cantidades pequeñas, un exceso de entrega puede aceptarse directamente. Para artículos caros o relevantes para la seguridad debería exigirse una liberación. Estos umbrales forman parte del proceso y deben seguir siendo ajustables más adelante.

4. Disparar el almacenaje de inmediato

Una recepción solo está operativamente completa cuando queda claro dónde está la mercancía o por qué todavía no puede almacenarse. El sistema puede proponer una ubicación fija, dar preferencia a una zona de reposición o determinar una zona de destino en función del grupo de artículos, el rango de temperatura y la capacidad disponible.

Para almacenes de tamaño manejable, a menudo basta con una lógica de ubicación clara con pocas zonas. La optimización compleja de rutas solo tiene sentido si el volumen, los recorridos y la estructura de personal la justifican. Quien recibe diez palés al día no necesita un proyecto de optimización que tarde más de lo que ahorra. Un escaneo fiable de la ubicación suele ser el avance más importante.

Tras el almacenaje, el sistema actualiza el stock y el registro de movimientos. Ventas, planificación o producción ven así el estado sin tener que preguntar al almacén. Si un artículo solo puede quedar disponible tras un control de calidad, el sistema separa el stock físico del stock disponible.

Qué datos necesita realmente la entrada de mercancías

Un proceso digital se vuelve impopular rápido si en la puerta pide demasiados campos. Al mismo tiempo, sin un mínimo de datos faltan las pruebas para aclaraciones posteriores. En la mayoría de las empresas medianas tiene sentido esta información:

  • Proveedor y referencia al pedido o al albarán
  • Artículo, cantidad aceptada y unidad de embalaje
  • Momento de la operación y persona responsable
  • Ubicación o estado como control, bloqueo o cuarentena
  • Motivo de la desviación, fotos y liberación si es necesario

Los campos adicionales solo deberían ser obligatorios cuando permiten una decisión concreta. Cuando el lote es obligatorio, su número no es un añadido, sino información central. Un comentario libre en cada entrega, en cambio, a menudo solo se rellena para que un formulario parezca completo.

La integración decide entre beneficio y esfuerzo

La entrada de mercancías no debe convertirse en una nueva solución aislada junto a compras, producción y contabilidad. Como mínimo, los datos maestros de artículos, los pedidos abiertos y los cambios de stock deben intercambiarse de forma fiable. Que esto ocurra mediante una interfaz ERP existente, importaciones de datos o un proceso intermedio desarrollado a propósito depende del panorama de sistemas ya presente.

Con sistemas ERP más antiguos, una integración completa en tiempo real no siempre es rentable. Una importación verificada a intervalos fijos puede ser del todo suficiente si las cantidades y los plazos lo permiten. Para repuestos que se asignan de inmediato a pedidos urgentes, en cambio, importa más un registro casi inmediato. Aquí la tecnología sigue el ritmo del negocio.

La operatividad también forma parte de la planificación. Los dispositivos necesitan cuentas de usuario, roles claros y un comportamiento definido ante caídas de red. Una entrada de mercancías móvil no tiene por qué funcionar necesariamente sin conexión. Pero si los cortes de Wi-Fi son frecuentes, un búfer local con sincronización trazable no es un lujo, es parte de la fiabilidad del proceso.

Implantación en pequeños pasos en lugar de un big bang

Empiece con un proveedor, un grupo de productos o una zona de almacén claramente delimitada. Mida no solo la duración por registro, sino también el retrabajo, las diferencias sin aclarar y las consultas entre almacén y oficina. Así se ve si la automatización alivia realmente el trabajo.

Forme al personal con albaranes reales del día a día, incluyendo entregas dañadas o incompletas. Un proceso que solo funciona con una entrega perfectamente conforme no es automatización, es una demostración. El personal de entrada de mercancías debería poder ayudar a definir las reglas, porque conoce las excepciones.

softify.pro desarrolla estos flujos de forma deliberadamente específica para cada workflow: desde el escaneo móvil hasta el movimiento de stock documentado y una conexión estable con los sistemas existentes. Lo decisivo no es la lista de funciones más larga, sino un sistema que siga siendo trazable bajo presión de tiempo y que pueda operarse y mantenerse técnicamente.

El mejor siguiente paso no es, por tanto, una comparación de software, sino dedicar una hora a mirar las últimas diez entregas problemáticas. Si puede decir, para cada una de ellas, dónde se perdió tiempo y qué información faltaba, ya existe el primer borrador de una entrada de mercancías mejor.

Enlace permanente →

Ventajas de la preparación de pedidos con código de barras para almacenes pequeños y medianos

Ventajas de la preparación de pedidos con código de barras para almacenes pequeños y medianos

Un artículo equivocado en la caja rara vez cuesta solo el precio de la devolución. Consume tiempo en el almacén, genera consultas en la oficina y, en el peor de los casos, daña la relación con el cliente. Por eso, las ventajas de la preparación de pedidos con código de barras no se aprecian primero en un indicador técnico, sino en una salida de mercancías más tranquila: los empleados saben qué hacer a continuación y las desviaciones se detectan donde se producen.

Para los almacenes pequeños y medianos esto es especialmente relevante. Muchos procesos funcionan al principio con listas en papel, archivos de Excel, indicaciones de viva voz y la experiencia de personas concretas. Eso no es incorrecto en sí. Con un volumen manejable, una hoja de cálculo puede incluso ser la herramienta más sensata. Pero cuando aumentan la variedad de artículos, el número de pedidos, los cambios de turno o las exigencias de trazabilidad, la solución provisional pragmática se convierte rápidamente en una fuente de errores.

Qué cambia la preparación de pedidos con código de barras en el día a día

En la preparación de pedidos con código de barras, un escaneo no confirma solo que alguien ha hecho algo. Vincula pedido, ubicación, artículo y cantidad en un paso de trabajo trazable. El sistema indica el siguiente picking, el empleado escanea la ubicación y el artículo, introduce la cantidad si es necesario y recibe una respuesta inmediata.

El orden de las comprobaciones es decisivo. Si un empleado escanea primero el artículo y después la ubicación, el sistema puede detectar un artículo equivocado, pero no evitar un recorrido desfavorable. En la práctica suele dar buen resultado la secuencia ubicación, artículo, cantidad. En los procesos con lotes, números de serie o fechas de caducidad se añaden comprobaciones adicionales. Cuáles son necesarias depende del riesgo, no de lo que sería técnicamente posible.

Un buen sistema no sustituye una organización sensata del almacén. Pero sí hace visible cuándo esa organización no se respeta en la operativa diaria. Si la mercancía está en una ubicación no prevista, el error no se descubre en el inventario, sino en el escaneo.

Las principales ventajas de la preparación de pedidos con código de barras: menos confusiones justo donde se originan

Las listas en papel exigen una concentración constante: leer la referencia, encontrar el hueco, comparar el embalaje, marcar la cantidad. Bajo presión de tiempo, bastan cajas parecidas, denominaciones casi idénticas o una tarea interrumpida para provocar un error. El código de barras aporta una identificación inequívoca en ese momento.

El escáner no sustituye el razonamiento, pero asume el control que a las personas más les cuesta mantener de forma constante en el trabajo rutinario. Si el artículo no corresponde al pedido, la respuesta debe ser clara: artículo equivocado, artículo esperado, siguiente paso razonable. Una simple señal roja de aviso sirve de poco si no queda claro cómo resolver la desviación.

Los registros hacen que el stock sea más fiable

El stock solo es útil si permite tomar decisiones. Quien planifica reposiciones, confirma plazos de entrega o suministra material a producción necesita algo más que una cifra de la semana pasada. Si las salidas se trasladan desde una lista al final del turno o a posteriori, aparecen intervalos de tiempo con datos poco claros.

Un escaneo puede registrar la salida de inmediato. Así se reduce la diferencia entre el movimiento físico y el stock digital. Eso no significa que cada cifra sea automáticamente correcta. La mercancía mal etiquetada, los traslados no registrados y el stock dañado siguen siendo cuestiones reales. Pero las causas pueden acotarse mucho mejor, porque cada movimiento tiene una hora, un pedido y, en su caso, una referencia de usuario.

Esto resulta especialmente útil en los procesos de reposición. Si un hueco cae por debajo de su stock objetivo, el sistema puede generar una orden de reposición o, al menos, hacerlo visible. Así, los preparadores no tienen que buscar mercancía de sustitución en mitad de un pedido mientras el cliente espera su envío.

Incorporación más rápida sin depender del conocimiento de unos pocos

El personal de almacén con experiencia conoce de memoria los recorridos, los casos especiales y el aspecto de los artículos. Ese conocimiento es valioso, pero arriesgado como único sistema operativo. En vacaciones, bajas o fases de crecimiento, los equipos se ven presionados cuando los nuevos empleados tienen que aprender durante semanas qué fila de estanterías corresponde a una abreviatura interna.

Una buena interfaz móvil guía a través del pedido con un lenguaje comprensible. Muestra la ubicación, el artículo, la cantidad prevista y, si es necesario, una imagen o indicaciones sobre el embalaje. El escaneo confirma el paso. Los nuevos compañeros no se convierten en expertos de inmediato, pero pueden colaborar con seguridad mucho antes.

Lo mismo vale para el personal temporal y los turnos cambiantes. El requisito es que los datos maestros estén bien mantenidos. Un sistema no puede derivar una instrucción clara de una denominación de artículo como «pieza pequeña azul nueva». La digitalización saca a la luz estas debilidades - y precisamente eso suele ser un efecto secundario útil.

Trazabilidad en reclamaciones e inventarios

Cuando un cliente comunica una cantidad faltante, sin datos de proceso suele empezar una búsqueda entre montones de papeles, listas de envío y recuerdos. Con registros basados en código de barras se puede comprobar qué pedido se procesó y cuándo, qué línea se confirmó y si hubo una corrección o una cantidad parcial.

No es una garantía contra las reclamaciones. Pero acorta la aclaración y separa las suposiciones de los hechos. Los inventarios también se benefician: las diferencias no solo pueden contarse, sino también investigarse a partir de los movimientos. Si las correcciones se acumulan en un hueco concreto, en un grupo de artículos o tras un determinado traspaso del proceso, surge un punto de partida concreto para mejorar.

Procesos medibles en lugar de intuición

Muchos almacenes saben que «por la tarde se complica» o que ciertos pedidos tardan de forma inusual. Sin marcas de tiempo ni pasos de proceso, sigue siendo una intuición. Si se registran el inicio del picking, el escaneo, la interrupción, la finalización y la entrega, los cuellos de botella pueden distinguirse con claridad.

Quizá no sea lenta la preparación de pedidos, sino que la mercancía se ubica demasiado tarde. Quizá se producen esperas en el puesto de embalaje o un solo hueco se visita con una frecuencia desproporcionada. Estos datos no deben malinterpretarse como una herramienta de control generalizado del rendimiento. Su valor está ante todo en detectar recorridos innecesarios, reposiciones que faltan y traspasos poco claros.

El beneficio depende del diseño del proceso

La preparación de pedidos con código de barras no es un fin en sí mismo y no todos los almacenes necesitan un software de gestión de almacenes completo. Con pocos pedidos, un surtido reducido y personal fijo, un proceso bien llevado con listas sencillas puede ser más rentable. Un proyecto tiene sentido cuando los costes de errores de picking, tiempos de búsqueda, incertidumbre sobre el stock o repasos manuales se notan con regularidad.

La cuestión del hardware también merece un análisis sereno. Un smartphone con escaneo por cámara puede bastar para los primeros procesos. Con una alta frecuencia de escaneo, guantes, mala iluminación o entornos exigentes, los escáneres de mano especializados suelen ser más rápidos y menos propensos a errores. También es decisiva la cobertura de red. Si el Wi-Fi falla en una zona del almacén, la aplicación necesita una estrategia clara: almacenamiento temporal sin conexión con sincronización posterior o un proceso que no gestione esa zona con dispositivos móviles.

La calidad de las etiquetas es tan importante como el software. Un código de barras en una etiqueta de hueco desgastada o un identificador de artículo asignado dos veces socava todo el proceso. Antes del arranque, las ubicaciones deben estar rotuladas de forma inequívoca, las unidades definidas y los casos especiales críticos aclarados: ¿cómo se trata un envase abierto? ¿Qué ocurre si falta stock? ¿Quién puede corregir una cantidad? ¿Qué pasa con la mercancía sin código legible?

Cómo implantarlo sin interrumpir la operativa

El inicio más fiable rara vez es el cambio completo. Empiece por un área bien delimitada, por ejemplo los pedidos de envío más frecuentes o un grupo de artículos con muchas confusiones. Allí pueden probarse la secuencia de escaneo, los mensajes de error y las etiquetas en la operativa real, sin transformar todo el centro a la vez.

Antes de la implementación técnica, conviene levantar el recorrido real de un pedido - desde la entrada del pedido, pasando por la reserva y el picking, hasta el puesto de embalaje y la etiqueta de envío. Lo que cuenta no es el proceso teórico de un organigrama, sino el flujo que el turno utiliza realmente. Los requisitos más valiosos suelen estar en pequeñas excepciones: pedidos agrupados, artículos sustitutivos, preparaciones parciales o la devolución de mercancía que no se necesita.

Después hacen falta reglas claras para las excepciones. Un empleado debe poder notificar una falta de stock sin eludir el pedido de manera informal. Una persona autorizada debe poder realizar correcciones de forma trazable. Y si existen interfaces con la tienda online, el ERP o el transportista, el estado del pedido y los registros de stock deben estar claramente definidos. El doble mantenimiento de datos es una señal de alarma, no una solución permanente.

En los sistemas a medida, softify.pro parte justo de este punto: no con un paquete enterprise sobrecargado, sino con los pasos de escaneo y registro que el almacén concreto necesita de forma demostrable. Una base de datos mantenible, interfaces claramente documentadas y pantallas comprensibles valen más que una larga lista de funciones que apenas se usan.

Un primer punto de control sensato

Tome diez pedidos típicos y sígalos desde la entrada hasta la entrega para el envío. Anote en qué puntos los empleados tienen que buscar, preguntar, introducir datos más tarde o fiarse de la memoria. Es justo ahí donde se decide si la preparación de pedidos con código de barras aporta ventajas - y qué proceso de escaneo encaja de verdad con el almacén.

Enlace permanente →

Pruebas autoalojadas vs cloud

Pruebas autoalojadas vs cloud

Una prueba de regresión fallida rara vez es solo una entrada roja en un panel. Puede significar que una pantalla de envío en el almacén genera etiquetas incorrectas, un portal de clientes deja de aceptar pedidos, o una aplicación Windows se bloquea durante un cambio de turno. La pregunta de self hosted testing vs cloud no trata, por tanto, de la infraestructura como fin en sí misma. Se trata de qué datos toca un proceso de prueba, quién lo controla, y con qué fiabilidad funciona en condiciones operativas reales.

Las plataformas de pruebas basadas en la nube pueden estar operativas rápidamente. Para muchos equipos eso es sensato, especialmente cuando prueban una aplicación web pública y necesitan capacidad de ejecución adicional a corto plazo. Los entornos de prueba autoalojados, en cambio, exigen una configuración técnica deliberada. Pero devuelven a la empresa el control sobre los datos de prueba, las rutas de red, los derechos de acceso, y la operación. La elección correcta no depende de un principio general, sino de la aplicación, el riesgo, y la capacidad operativa disponible.

Self Hosted Testing vs Cloud: De qué se trata realmente

El debate a menudo se reduce demasiado a los costes iniciales. Una solución en la nube parece más barata porque no hay que adquirir servidores ni configurar un entorno. Un servidor de pruebas propio parece a primera vista más laborioso, porque el sistema operativo, las actualizaciones, el control de acceso, la monitorización, y las copias de seguridad deben planificarse.

Ese cálculo se queda corto. Lo decisivo son los costes continuos de una estrategia de pruebas: tiempos de espera antes de los lanzamientos, búsqueda de errores tras ejecuciones de prueba incompletas, coordinación con protección de datos y seguridad de la información, así como las consecuencias de un despliegue defectuoso. Si un equipo examina regularmente aplicaciones empresariales sensibles, la carga organizativa adicional de servicios externos puede superar la operación de un entorno propio claramente delimitado.

Tampoco "la nube" es un modelo uniforme. Algunos proveedores solo almacenan registros de pruebas, otros procesan capturas de pantalla, grabaciones de vídeo, credenciales, contenido DOM, o tráfico de red. Con las pruebas asistidas por IA, los datos de imagen y texto pueden además llegar a modelos externos o subcontratistas para su evaluación. Quien solo mira la ubicación de un centro de datos a menudo pasa por alto la pregunta más importante: ¿qué datos abandonan realmente la propia zona de control, y qué reglas contractuales y de eliminación se aplican?

Cuándo las pruebas en la nube son la opción sensata

Las pruebas en la nube no son fundamentalmente un problema de seguridad, y el autoalojamiento no es automáticamente la mejor arquitectura. Para una nueva tienda web públicamente accesible o una plataforma de marketing, un entorno en la nube puede ser muy adecuado. El equipo puede cubrir rápidamente variantes de navegador y dispositivo sin mantener sus propias máquinas de ejecución. Con carga de pruebas fluctuante, el escalado elástico también es una ventaja real.

Los equipos de desarrollo pequeños con pocos datos de prueba claramente anonimizados también suelen beneficiarse de un servicio gestionado. No deberían invertir su tiempo en operar una plataforma cuando el cuello de botella está más bien en casos de prueba faltantes, criterios de aceptación poco claros, o datos de prueba inestables. Un servidor propio no resuelve esos problemas.

La nube encaja especialmente bien cuando la aplicación no necesita accesos de red internos, no aparecen datos personales o críticos para el negocio en los flujos de prueba, y el corto tiempo de preparación importa más que un control profundo de la infraestructura. El requisito previo es una configuración cuidadosa: cuentas de prueba separadas, sin datos reales de clientes, tokens limitados, periodos de retención rastreables, y un concepto de derechos claro.

Cuándo las pruebas autoalojadas se vuelven más sensatas

La situación es distinta para aplicaciones que solo son accesibles en la red de la empresa o que representan procesos operativos centrales. Un software de almacén o producción a menudo procesa movimientos de artículos, direcciones de entrega, existencias, números de serie, y lógica de precios. Una ejecución de prueba puede generar capturas de pantalla de pantallas de pedido, descargar documentos, o iniciar sesión con roles de usuario. Tales datos no deberían dispersarse sin ser notados por varios sistemas externos.

Las pruebas autoalojadas permiten colocar la ejecución de pruebas cerca de la aplicación. El servidor de pruebas puede funcionar en el mismo segmento de red o en una DMZ controlada. Las reglas de firewall se establecen de forma específica, las aplicaciones internas no necesitan abrirse a un servicio externo, y los registros permanecen bajo administración propia. Eso suele ser especialmente relevante para aplicaciones de escritorio Windows, ya que rara vez están diseñadas para plataformas de prueba externas.

Para sectores regulados, requisitos de clientes más amplios, o directrices de seguridad internas, esta arquitectura suele ser más fácil de auditar. Eso no significa que cada auditoría se supere automáticamente. Un servidor propio también necesita gestión de parches, cifrado, derechos por roles, copias de seguridad, y procedimientos operativos documentados. La diferencia está en que la empresa toma estas decisiones por sí misma y puede demostrarlas.

En softify.pro, COCO está por eso concebido como un servidor de IA dedicado y autoalojado: las ejecuciones de pruebas para aplicaciones web y Windows se ejecutan localmente, se registran evidencias, y los resultados se evalúan en lenguaje comprensible. Eso no sustituye la aprobación por expertos del dominio. Pero garantiza que el tráfico de pruebas, capturas de pantalla, y evaluaciones puedan permanecer donde la empresa conserva la soberanía de los datos.

Comparar costes correctamente: operación frente a fricción

Una comparación sensata abarca más que el precio de licencia frente al precio del hardware. En la nube surgen tarifas recurrentes por usuario, minuto de prueba, ejecución paralela, o consumo de IA. Estos costes son inicialmente predecibles, pero pueden aumentar considerablemente con la creciente cobertura de pruebas. A eso se suman posibles gastos por contratos empresariales, acuerdos de tratamiento de datos, y auditorías de seguridad.

Con el autoalojamiento surgen inversiones para infraestructura y configuración. Eso puede incluir máquinas virtuales, almacenamiento, acceso de red, monitorización, y el tiempo de un equipo técnicamente responsable. Estos costes permanecen incluso cuando se ejecutan pocas pruebas. Para un proyecto con lanzamientos poco frecuentes, ese es un buen argumento contra una solución propia sobredimensionada.

Con pruebas de regresión regulares, el panorama cambia. Si cada semana deben verificarse los mismos flujos críticos para el negocio, la capacidad interna predecible suele ser más económica que los costes variables de plataforma y los ciclos de aprobación manual. El enfoque se vuelve especialmente valioso cuando los casos de prueba se usan durante años y evolucionan junto con la aplicación empresarial. La mantenibilidad importa entonces más que un inicio rápido pero difícil de controlar.

La calidad no depende del modelo de alojamiento

Un error común dice: las pruebas en la nube serían automáticamente más modernas, las pruebas autoalojadas automáticamente más estables. Ninguna de las dos afirmaciones es cierta. La calidad de las pruebas surge de escenarios sensatos, datos de prueba resilientes, identificadores estables en la interfaz, y expectativas claras sobre el resultado.

Una prueba no debería solo verificar si un botón es pulsable. Para un procesamiento de pedidos puede, por ejemplo, crear un pedido, verificar una cantidad disponible, generar un albarán, y asegurar que el rol correcto pueda aprobar la operación. Para un programa de escritorio puede verificar la importación de un archivo, el manejo de errores, y la salida de un documento. Solo tales flujos de extremo a extremo muestran si un cambio ha dañado el proceso real.

La IA puede ayudar a reconocer cambios de interfaz, documentar pasos de forma comprensible, y priorizar anomalías. Sin embargo, no debería convertirse en una caja negra. Los equipos necesitan capturas de pantalla u otras evidencias, pasos de prueba rastreables, y umbrales definidos para cuándo un resultado cuenta como aprobado, incierto, o fallido. Precisamente en las verificaciones visuales, un umbral de confianza es sensato, para que pequeñas desviaciones de diseño esperadas no bloqueen cada lanzamiento.

Las preguntas operativas antes de la decisión

Antes de que un equipo se comprometa, debería rastrear concretamente el camino de una ejecución de prueba. ¿Dónde se ejecuta la prueba? ¿A qué sistemas inicia sesión? ¿Qué datos ve? ¿Dónde se almacenan capturas de pantalla, registros, e informes? ¿Quién puede leer, eliminar, o exportar resultados? Estas preguntas son más prácticas que una decisión general a favor o en contra de la nube.

Igualmente importante es la responsabilidad tras el lanzamiento. ¿Quién actualiza navegadores y agentes de prueba? ¿Quién reacciona cuando expira un certificado? ¿Cómo se rotan las credenciales? ¿Y cómo se garantiza que una prueba no desencadene accidentalmente un registro de envío real o una notificación al cliente? Una buena automatización de pruebas necesita entornos separados y mecanismos de protección, no solo buenos scripts.

Un modelo híbrido puede tener sentido. Las interfaces públicas y las verificaciones de navegador ampliamente distribuidas se ejecutan en la nube, mientras que los procesos empresariales internos permanecen en un servidor de pruebas propio. Eso reduce la carga operativa, sin ceder en bloque flujos sensibles hacia el exterior. El requisito previo es un límite claro entre ambas áreas, no una operación mixta confusa.

La mejor decisión es la que se ajusta al riesgo real y a la realidad operativa propia. Si una hoja de cálculo todavía sostiene fiablemente un proceso, no necesita convertirse en un gran sistema. Pero si los datos de prueba y las aplicaciones internas pertenecen al núcleo del negocio, el control no es un lujo, sino un requisito objetivo para un software fiable.

Enlace permanente →

Inventory Management en el almacén

Inventory Management en el almacén

Una pieza faltante rara vez se nota al contar en el almacén. Por lo general solo se manifiesta cuando un pedido no puede empaquetarse, un técnico está frente a un estante vacío, o compras busca por teléfono una promesa de entrega. Una buena Inventory Management no previene estas sorpresas con más tablas, sino con una imagen fiable de qué hay disponible, dónde está, y qué sucede a continuación con ello.

Para las pequeñas y medianas empresas, esto no es una cuestión de tener el sistema ERP más grande posible. Lo decisivo es si el personal en la recepción de mercancía, almacén, y envío puede trabajar con pocos pasos claros - incluso bajo presión de tiempo, a través de cambios de turno, y cuando una entrega no resulta como estaba planeado.

Inventory Management comienza con movimientos, no con listas de existencias

Una lista de existencias es una instantánea. Puede ser correcta y aun así ayudar poco si nadie puede rastrear por qué cambió una cantidad. Un sistema resiliente trata, por tanto, las existencias como resultado de movimientos documentados: la mercancía llega, se controla, se almacena, se reserva, se recoge, se traslada, se envía, o se corrige.

Cada movimiento necesita un motivo claro, una marca de tiempo, una persona responsable, y idealmente un vínculo con una transacción concreta. Eso puede ser un pedido de compra, un pedido de cliente, un albarán, o una orden de producción. Eso convierte la cifra "24 unidades disponibles" en una afirmación verificable: se registraron 30 unidades, cuatro están reservadas para dos pedidos, y ningún traslado abierto distorsiona la existencia disponible.

Esta distinción es especialmente relevante con piezas escasas. Físicamente presente, reservado, y libremente disponible son tres estados diferentes. Si se mezclan, ventas promete mercancía que el almacén ya necesita para otro pedido. Si se mantienen limpios, un equipo puede decidir a tiempo: volver a pedir, repriorizar, o dar al cliente una respuesta realista.

Dónde suelen romperse los procesos manuales

Las hojas de cálculo no son fundamentalmente incorrectas. Para un surtido pequeño, una ubicación de almacén, y pocos movimientos por semana, pueden ser más económicas que una aplicación dedicada. Se vuelven problemáticas en cuanto varias personas trabajan simultáneamente o las existencias se actualizan desde varias fuentes.

Entonces surgen las brechas conocidas: la recepción de mercancía se queda en papel sobre el escritorio, el archivo Excel se modificó localmente, un traslado se acordó solo verbalmente, y el envío no registra hasta después del horario laboral. La existencia no necesariamente es errónea, pero está desfasada en el tiempo y su origen no está claro. Precisamente eso la hace inadecuada para decisiones operativas.

La estructura organizativa también juega un papel. Una ubicación central necesita procesos diferentes a una empresa con almacenes externos, vehículos de servicio, o una producción que retira material. Quien representa estas diferencias con una sola columna de texto libre, traslada la lógica a la cabeza de empleados individuales. Eso funciona hasta que esa persona está de vacaciones o el volumen de pedidos aumenta.

Definir el proceso antes del software

Un proyecto sensato no comienza con la pregunta de qué escáner comprar o qué interfaz parece moderna. Primero debe estar claro qué decisiones debe apoyar el sistema. Para eso a menudo bastan observaciones concretas del día a día: ¿cómo se acepta hoy la mercancía? ¿Cuándo se considera controlada? ¿Quién puede corregir existencias? ¿Qué sucede con mercancía dañada? ¿Y en qué punto un pedido queda reservado de forma vinculante?

De estas respuestas surgen pocas reglas vinculantes. Por ejemplo, la recepción de mercancía solo puede registrarse tras un control de cantidad. Los artículos sin ubicación de almacén no deben aparecer como listos para almacenar. Las correcciones de existencias requieren un código de motivo y permanecen visibles en el historial. La mercancía enviada no se elimina silenciosamente, sino que se asigna al pedido mediante una baja documentada.

Eso es menos espectacular que una gran presentación de digitalización, pero mucho más valioso en la operación. Cuando las reglas son inequívocas, el software puede verificarlas de forma fiable. Cuando permanecen poco claras, cada nueva aplicación solo acelera pasos de trabajo contradictorios.

Datos maestros: empezar pequeño, mantener con constancia

No todos los artículos necesitan diez clasificaciones desde el principio. Una base utilizable a menudo consiste en número de artículo, descripción, unidad, estado de almacén activo, y una o varias ubicaciones. Según el negocio, se añaden lotes, números de serie, existencias mínimas, números de artículo del proveedor, o fechas de caducidad.

Lo importante es la consistencia, no la cantidad de campos. Dos números de artículo para el mismo artículo físico, o unidades cambiantes como "caja", "paquete", y "unidad" sin regla de conversión, generan errores posteriores casi automáticamente. Un sistema puede permitir técnicamente tales entradas. Debería limitarlas donde ponen en riesgo el proceso.

Qué funciones realmente ayudan en el almacén

Para muchos almacenes medianos, un núcleo claro es más valioso que un catálogo de funciones sobrecargado. Este núcleo abarca típicamente cuatro áreas:

  • Recepción de mercancía con referencia de pedido, control de cantidad, y almacenamiento
  • Movimientos de almacén entre ubicaciones y áreas definidas
  • Reserva de pedidos, picking, y confirmación de envío
  • Inventario y correcciones de existencias con historial rastreable

Como complemento, la impresión de etiquetas, el escaneo de códigos de barras, albaranes, etiquetas de envío, o una transferencia a contabilidad y sistemas de tienda pueden ahorrar mucho tiempo. Pero deberían basarse en un modelo de movimiento limpio. Una impresión rápida de etiquetas ayuda poco si el escaneo no asigna inequívocamente el artículo a la ubicación o pedido correctos.

En el uso también cuenta el entorno. Un empleado con guantes en la recepción de mercancía necesita acciones grandes e inequívocas y la menor entrada de texto posible. Una despachadora en su puesto de trabajo, en cambio, necesita filtros, funciones de búsqueda, y una vista de las transacciones abiertas. Ambos roles pueden usar los mismos datos, pero no necesitan la misma interfaz.

Tiempo real no significa que cada cifra sea incuestionable

Muchas empresas desean existencias en tiempo real. Eso es sensato, pero el término a menudo se usa de forma demasiado general. Una existencia puede actualizarse inmediatamente después de cada escaneo y aun así ser errónea si un proceso permanece incompleto. Si la mercancía se escanea pero no se controla, la cifra es técnicamente actual y operativamente cuestionable.

Por eso cada sistema necesita un manejo de excepciones. Las diferencias en la recepción de mercancía, embalajes dañados, devoluciones, y artículos no localizables no son casos marginales. Forman parte del día a día. Los buenos procesos los marcan de forma visible, en lugar de forzar al personal a listas paralelas improvisadas.

Los permisos también merecen atención. No toda persona debería poder cambiar los datos maestros de artículos o corregir registros históricos. Un concepto de derechos práctico separa las operaciones rutinarias de las intervenciones de mayor riesgo. Eso no solo protege contra errores, sino que también facilita el análisis de causas cuando una existencia se desvía inesperadamente.

Integración solo donde mejora el proceso

Inventory Management rara vez está solo. Los pedidos pueden provenir de una tienda web, una captura por correo electrónico, una solución sectorial, o directamente de ventas. Los proveedores de envío necesitan datos de dirección y pesos. Contabilidad espera comprobantes en una forma determinada.

Una integración merece la pena cuando elimina la captura duplicada o reduce fuentes de error. No es automáticamente sensata solo porque haya una interfaz disponible. Especialmente en procesos que han crecido orgánicamente, una importación clara con control puede ser más fiable que un acoplamiento permanente en tiempo real que transmite datos erróneos sin ser notado.

Técnicamente, la solución debería permanecer rastreable: interfaces inequívocas, transferencias registradas, mensajes de error comprensibles, y una estructura de base de datos que no oculta los cambios. Con una aplicación bien mantenida basada en PHP 8.4 y MySQL 8, tales procesos pueden implementarse de forma esbelta, sin forzar a los equipos a un sistema corporativo global. Lo decisivo no es la etiqueta tecnológica, sino si el mantenimiento, las extensiones, y las correcciones de datos siguen siendo controlables dentro de tres años también.

Implementación en pasos pequeños y medibles

Un big bang rara vez es la mejor opción en un almacén. Un comienzo limitado es más seguro, por ejemplo con recepción de mercancía y un área de almacén seleccionada. En esta fase se pueden observar tiempos de escaneo, tipos de error, casos especiales abiertos, y la calidad de los datos maestros. Solo después siguen la reserva, el envío, u otras ubicaciones.

El funcionamiento paralelo puede tener sentido, pero solo con un final claro. Dos existencias principales durante un periodo prolongado crean exactamente el problema que la nueva solución debe resolver. Es mejor una transición definida con inventario, datos maestros depurados, y responsabilidades para las primeras semanas.

El éxito no se ve en cuántas funciones se activaron. Se ve en si surgen menos consultas de seguimiento, si los pedidos se empaquetan más completamente, y si un equipo puede explicar sin investigación detectivesca por qué una existencia de artículo se ve como se ve.

Si el proceso actual con una tabla bien mantenida funciona realmente de forma estable, debería poder mantenerse. Pero si la información sigue perdiéndose entre papel, llamadas telefónicas, y varios archivos, el siguiente paso sensato no es una herramienta más grande, sino un proceso claro que hace visible cada movimiento de almacén importante.

Enlace permanente →

¿Son seguras las pruebas autoalojadas?

¿Son seguras las pruebas autoalojadas?

Una prueba de regresión fallida es molesta. Una captura de pantalla de un sistema ERP interno que termina sin control en un servicio externo es un incidente de seguridad. Precisamente por eso los responsables de QA y TI se plantean la pregunta: are self hosted tests secure? La respuesta honesta es: pueden ser claramente más seguras que las alternativas basadas en la nube, pero solo si la operación se toma tan en serio como las propias pruebas.

La automatización de pruebas autoalojada traslada el control sobre la ejecución, los datos de prueba, capturas de pantalla, registros, y derechos de acceso a la propia infraestructura. Eso reduce dependencias y rutas de datos innecesarias. Sin embargo, no sustituye una arquitectura de seguridad. Un servidor de pruebas interno mal mantenido sigue siendo un servidor mal mantenido.

¿Son las pruebas autoalojadas más seguras que las pruebas en la nube?

La diferencia decisiva no está en si una prueba se ejecuta localmente o de forma automatizada. Está en dónde se procesan los datos, quién puede acceder a ellos, y qué límites técnicos se aplican.

Con un servicio de pruebas operado externamente, a menudo salen de la empresa varios artefactos: credenciales para cuentas de prueba, URLs de aplicaciones internas, contenido DOM, capturas de pantalla, vídeos de ejecuciones de prueba, registros de errores, y posiblemente extractos de bases de datos. Incluso si un proveedor cumple altos estándares de seguridad, surge una relación adicional de confianza y contractual. Para aplicaciones con datos de clientes, personal, producción, o financieros, esto puede ser un obstáculo relevante.

Un sistema autoalojado puede operarse dentro de la propia red o de un entorno de la UE claramente delimitado. La instancia de prueba accede directamente a sistemas de staging, aceptación, o pruebas aisladas. Las evidencias de prueba permanecen donde también se encuentran la aplicación y su responsabilidad operativa. Esto es especialmente sensato al probar aplicaciones de escritorio de Windows, portales web internos, o sistemas con datos de proceso sensibles.

Pero el autoalojamiento no es automáticamente más seguro. Quien opera un servidor de pruebas con acceso remoto abierto, cuentas de administrador compartidas, y contraseñas válidas permanentemente, simplemente ha trasladado los riesgos. La pregunta, por tanto, no es solo: ¿nube u on-premises? Sino: ¿el entorno de pruebas está demostrablemente protegido y es mantenible de forma permanente?

Are self hosted tests secure? Depende de estos límites

Una plataforma de pruebas segura necesita límites técnicos y organizativos claros. Para las pequeñas y medianas empresas, esto no tiene que parecer un programa corporativo. Solo tiene que implementarse de forma consistente y documentarse.

Separar el entorno de pruebas de la producción

Las pruebas automatizadas deben encontrar errores, no desencadenar pedidos, modificar albaranes, o registrar movimientos de stock. Por eso las pruebas necesitan un entorno separado con interfaces propias, inquilinos de prueba, y datos de prueba. Donde no es necesaria una copia completa de producción, a menudo es incluso innecesariamente arriesgada.

Para un portal de almacén o pedidos, eso puede significar: los usuarios de prueba pueden registrar recepciones de mercancía y generar etiquetas de envío, pero los documentos generados no van a ninguna impresora real ni ningún transportista real. Las claves API apuntan a puntos finales sandbox. El envío de correos electrónicos se intercepta o se limita a destinatarios internos. Así una prueba sigue siendo significativa sin producir consecuencias operativas.

La separación también debería aplicarse a nivel de red. El servidor de pruebas solo necesita las conexiones que realmente requiere. El acceso general a toda la red interna es cómodo, pero raramente justificable. La segmentación limita el daño si una cuenta de prueba o un componente del sistema se ve comprometido.

Tratar las credenciales como accesos de producción

La automatización de pruebas a menudo necesita datos de acceso. Eso es normal, pero estos datos no pertenecen a scripts de prueba, archivos de configuración en el código fuente, o historiales de chat. Contraseñas, tokens, y certificados deberían cargarse desde una gestión controlada de secretos. Las cuentas de prueba reciben solo los derechos que el flujo concreto requiere.

El acceso a la propia plataforma de pruebas también necesita roles. Un desarrollador quizás necesite iniciar ejecuciones de prueba y leer resultados, pero no cambiar la configuración de red. Un departamento puede consultar informes, pero no necesita acceso a los datos de acceso almacenados. Los derechos de administración deberían estar vinculados a personas, no acoplados a una cuenta compartida.

Además, la autenticación multifactor, reglas de contraseña razonables, y flujos de bloqueo de cuenta pertenecen al estándar mínimo. Precisamente los sistemas de prueba a menudo se tratan como menos críticos. Los atacantes lo ven de otra manera: les gusta usar entornos de prueba como punto de entrada, porque ahí residen accesos, nombres internos, y detalles técnicos.

Minimizar los datos de prueba y enmascararlos de forma selectiva

El error más frecuente no es un método de cifrado faltante, sino demasiada información real en el conjunto de pruebas. Para la mayoría de las pruebas de regresión, nadie necesita nombres reales de clientes, direcciones reales, o expedientes de personal completos. Conjuntos de datos sintéticos, copias enmascaradas, y casos especiales creados deliberadamente a menudo son suficientes.

Hay excepciones. Algunos errores solo aparecen con estructuras de datos reales, secuencias de caracteres inusuales, o constelaciones de permisos complejas. Entonces una copia controlada y seudonimizada puede tener sentido. Lo decisivo es que esta decisión se tome de forma consciente y tenga un plazo de eliminación. Las bases de datos de prueba no deberían seguir funcionando durante años como una copia sombra olvidada de la producción.

Las capturas de pantalla y vídeos merecen la misma atención. Son valiosos para la búsqueda de errores, pero pueden mostrar datos de cuenta, precios internos, o contenido personal. Determine qué artefactos se graban, quién puede verlos, y cuándo se eliminan automáticamente. Un informe de prueba no necesita almacenar cada captura de pantalla para siempre para ser probatorio.

Operar el servidor como un producto

Un servidor de pruebas autoalojado no es un dispositivo que se instala una vez y luego se olvida. La seguridad operativa surge de un mantenimiento repetible: actualizaciones de seguridad oportunas para el sistema operativo, navegador, ejecutor de pruebas, y dependencias; soportes de datos y vías de transporte cifrados; copias de seguridad monitorizadas; registro centralizado; así como un manejo claro de los avisos de seguridad.

Especialmente en las pruebas dirigidas por navegador, el ritmo de actualización es relevante. Motores de navegador obsoletos y bibliotecas de automatización pueden contener vulnerabilidades conocidas o hacer que las pruebas sean poco fiables. Ambas cosas cuestan tiempo. Los despliegues documentados y las ventanas de mantenimiento fijas no son por tanto un añadido burocrático, sino la base para resultados reproducibles.

Para un servidor de pruebas de IA dedicado como COCO, esto también se aplica. La ejecución local no protege el contenido sensible de la aplicación por arte de magia. Crea control sobre dónde se procesan la evaluación asistida por IA, las capturas de pantalla, y los registros de prueba. Ese control debe llenarse con gestión de parches, permisos, separación de red, y reglas de retención claras.

Dónde tiene sus límites el autoalojamiento

Los servicios en la nube no son inseguros por definición. Un proveedor especializado puede ofrecer más personal de seguridad, supervisión más madura, y redundancia más profesional que una empresa con un único rol de TI sobrecargado. Quien no tenga capacidad para operación, actualizaciones, y respuesta a incidentes puede generar un riesgo mayor con un sistema autoalojado mal mantenido.

Por otro lado, muchas plataformas de prueba externas simplemente no son un buen ajuste de proceso para aplicaciones especializadas internas. Si una aplicación solo es accesible dentro de la red de la empresa, si las ejecuciones de prueba muestran pantallas y documentos confidenciales, o si los datos no deberían salir del propio dominio de control, la operación local suele ser la solución más clara.

La decisión razonable depende de la necesidad de protección y de la capacidad operativa. Para un sitio de marketing público sin inicios de sesión sensibles, un servicio de pruebas en la nube puede ser apropiado. Para un software interno de despacho, un portal de clientes con datos personales, o una aplicación Windows en la red de producción, mucho habla a favor de un entorno controlado y autoalojado.

Una comprobación de seguridad práctica antes del lanzamiento

Antes de desplegar pruebas automatizadas, un responsable debería poder responder estas preguntas sin adivinar:

  • ¿A qué sistemas, bases de datos, e interfaces puede acceder el servidor de pruebas?
  • ¿Qué datos aparecen en capturas de pantalla, vídeos, registros, y evaluaciones de IA?
  • ¿Dónde se guardan las credenciales, y cuándo se rotan?
  • ¿Quién puede iniciar ejecuciones de prueba, leer resultados, y administrar sistemas?
  • ¿Con qué rapidez se aplican las actualizaciones críticas, y cómo se verifica eso?
  • ¿Cuándo se eliminan los artefactos de prueba y los datos que ya no se necesitan?

Estas preguntas parecen sobrias. Precisamente ese es su valor. La seguridad rara vez surge de una sola herramienta o de un impresionante diagrama de arquitectura. Surge cuando responsabilidades, flujos de datos, y límites técnicos siguen siendo verificables en el día a día.

Quien construya automatización de pruebas debería primero aclarar la necesidad de protección de la aplicación y luego elegir la arquitectura más pequeña sensata. Un servidor de pruebas claramente delimitado con pocas cuentas autorizadas a menudo es más valioso que una plataforma sobrecargada que nadie puede mantener de forma fiable. Boring, provable reliability también vence en las pruebas a la solución espectacular pero opaca.

Enlace permanente →

Warehouse Management Systems: Lo que realmente importa

Warehouse Management Systems: Lo que realmente importa

Cuando un empleado en la recepción de mercancía anota la misma línea de entrega en papel, la transfiere después a una tabla y luego aclara a viva voz dónde se almacenará, rara vez falta disposición para trabajar. Falta un proceso compartido. Los Warehouse Management Systems crean ese proceso documentando movimientos de mercancía, existencias, y tareas posteriores en un solo lugar. Para las pequeñas y medianas empresas, lo decisivo no es la lista de funciones más larga, sino si el software representa de forma fiable el recorrido de una mercancía por su propio almacén.

Qué deben lograr los Warehouse Management Systems en el día a día

Un Warehouse Management System, o WMS por sus siglas, no es simplemente una mejor lista de existencias. Controla o documenta los procesos físicos en el almacén: recepción de mercancía, control de calidad, almacenamiento, traslado, picking, embalaje, envío, e inventario. Cada registro responde a una pregunta operativa sencilla: ¿qué hay dónde, en qué cantidad, en qué estado, y quién desencadenó el movimiento?

A primera vista esta claridad parece banal. Pero evita cadenas de errores típicas. Un artículo ha sido entregado, pero aún no ha sido controlado. Un palet está en la recepción de mercancía, pero en el sistema ya figura como disponible. Un pedido se prepara aunque la mercancía debería estar reservada para un pedido de cliente más importante. Sin estados y movimientos claramente definidos, una simple incertidumbre se convierte rápidamente en una promesa de entrega errónea.

Para muchos almacenes medianos, el beneficio no empieza con un control totalmente automático. Órdenes de almacenamiento ya rastreadas, ubicaciones inequívocas, y registros móviles pueden reducir notablemente los tiempos de búsqueda. Lo decisivo es que el personal ya no tenga que traducir entre papel, teléfono, correo electrónico, y varias tablas.

No todo almacén necesita una gran suite

El mercado ofrece amplios sistemas empresariales con funciones para redes globales multi-sede, gestión aduanera compleja, tecnología de transporte automatizada, y lógica de optimización muy fina. Eso puede ser correcto si estos requisitos realmente existen. Pero para una empresa con uno o pocos almacenes, prioridades cambiantes, y procesos especiales bien establecidos, tal suite puede generar más fricción que beneficio.

Los costes entonces no están solo en las licencias. Surgen en largos proyectos de implementación, adaptaciones costosas, formación, y dependencia de especialistas externos. Incluso un sistema con cien ajustes no resuelve un problema si los jefes de turno tienen que abrir un ticket para correcciones cotidianas.

La alternativa no significa necesariamente un desarrollo completamente a medida. Un producto estándar puede ser sensato cuando sus flujos de trabajo principales encajan y las adaptaciones permanecen deliberadamente limitadas. Del mismo modo, una tabla existente puede seguir siendo la mejor solución, por ejemplo para una evaluación rara y manejable. Se vuelve crítica solo cuando varias personas trabajan en ella simultáneamente, registran movimientos con retraso, o la tabla debe convertirse en la verdad operativa sobre la mercancía disponible.

La solución adecuada se orienta según el volumen real del proceso y el coste de los errores. Cinco picks incorrectos por semana significan algo diferente en un almacén de repuestos con pedidos de clientes críticos en tiempo que cinco desviaciones en un stock de archivo de rotación lenta.

Capturar primero los procesos, no elegir las pantallas

Muchos proyectos WMS comienzan con una demo de producto. Allí los responsables ven paneles elegantes, vistas de escáner, e indicadores coloridos. Más útil es primero un recorrido por el almacén durante un día de trabajo normal. ¿Dónde llega la mercancía? ¿Quién controla cantidades y daños? ¿Cuándo recibe un artículo su número de lote o serie? ¿Cómo se decide a qué lugar va? ¿Y qué sucede cuando la realidad se desvía del pedido?

Estas preguntas sientan las bases para una solución que se aceptará después. Un proceso objetivo bien documentado no describe solo el caso ideal. También contiene excepciones: entregas parciales, mercancía dañada, llegadas no anunciadas, faltantes de existencias, devoluciones, y existencias bloqueadas. Precisamente estos casos deciden si el personal confía en el sistema o vuelve a tomar notas en papel.

Los estados son más importantes que las interfaces bonitas

Un conjunto de datos limpio distingue por ejemplo "esperado", "llegado", "en control", "almacenado", "reservado", "preparado", y "enviado". Qué estados son necesarios depende de la empresa. Demasiado pocos ocultan diferencias relevantes. Demasiados ralentizan los registros y son eludidos.

La regla debería ser: cada estado debe tener una consecuencia operativa. Si la mercancía está bloqueada, no debe ser preparada. Si está reservada, debe ser visible para qué pedido. Si está almacenada, debe registrarse una ubicación. Así, las reglas de datos se convierten en fiabilidad práctica del proceso.

Los escáneres solo ayudan con registros claros

Los códigos de barras y los dispositivos móviles reducen los errores de tecleo y aceleran los movimientos. Pero no sustituyen una decisión de proceso. Un escaneo debe desencadenar una acción comprensible: verificar artículo, confirmar cantidad, elegir ubicación de destino, o completar pedido. Si un empleado tiene que adivinar después de cada escaneo qué pantalla sigue, el flujo está diseñado de forma demasiado complicada.

La cuestión del hardware también debería resolverse de forma pragmática. Para algunos equipos bastan smartphones con función de escaneo adecuada y funda protectora resistente. Otros necesitan escáneres de mano industriales, porque guantes, refrigeración, caídas, o turnos largos así lo exigen. Un piloto en la superficie real del almacén muestra más que una presentación en el escritorio.


La base técnica decide después del go-live

Un WMS debe funcionar correctamente incluso cuando se registran recepciones de mercancía, se preparan pedidos, y se controlan existencias simultáneamente. De ahí surgen requisitos que a menudo se pierden en las conversaciones iniciales: registros de movimiento inequívocos, permisos basados en roles, correcciones rastreables, interfaces fiables, y copias de seguridad que sean realmente restaurables en caso de emergencia.

Una existencia no debería simplemente sobrescribirse. Mejor es un modelo de movimiento: entrada, salida, traslado, bloqueo, o corrección generan cada uno un registro documentado. Así se puede rastrear después por qué una cantidad se desvía. Esto es tan valioso para los inventarios como para aclarar un caso de reclamación de cliente.

Los permisos deben coincidir con la responsabilidad. Un preparador de pedidos necesita funciones diferentes a un responsable de almacén que aprueba correcciones de existencias. Para cambios críticos son sensatos justificaciones, aprobaciones de cuatro ojos, o al menos un registro de cambios inmutable. El esfuerzo depende del perfil de riesgo, pero la pregunta debería aclararse antes del inicio.

Las interfaces merecen la misma atención. Un almacén rara vez trabaja de forma aislada. Los pedidos vienen de una tienda, un ERP, o mediante importación estructurada. Los datos de envío van a sistemas de transportistas, se generan albaranes y etiquetas, los datos de existencias refluyen. Cada interfaz necesita responsabilidades claras para los casos de error. ¿Qué sucede si se generó una etiqueta de envío pero la confirmación no llega al WMS? Sin lógica de reintento y una cola de errores visible, tales casos quedan atascados en personas individuales.

Para soluciones a medida, las tecnologías mantenibles no son un asunto secundario. Una aplicación rastreable con una estructura de base de datos clara, despliegues documentados, e integraciones probadas se mantiene manejable incluso después de cambios de personal. Una arquitectura de moda no ayuda si nadie puede rastrear una importación defectuosa.

Implementación en pasos pequeños y controlables

Un big bang genera riesgo evitable. A menudo es más sensato digitalizar primero un proceso delimitado, como la recepción de mercancía para un grupo de productos o el picking en un área de almacén. El equipo verifica así no solo funciones, sino también formulaciones, rutas de escaneo, distancias de recorrido, y responsabilidades.

Los datos maestros suelen ser aquí el verdadero foco de trabajo. Los números de artículo deben ser inequívocos, las unidades de medida consistentes, las ubicaciones de almacén estructuradas de forma sensata, y las unidades de embalaje claramente definidas. Un sistema no puede ofrecer existencias fiables si el mismo artículo aparece bajo tres denominaciones diferentes, o una "caja" significa cantidades distintas según el proveedor.

Durante la fase piloto los indicadores deberían mantenerse sencillos: ¿cuánto dura la recepción de mercancía? ¿Cuántos registros deben corregirse? ¿Cuántos picks son erróneos? ¿Con qué frecuencia se busca mercancía? No toda mejora se manifiesta de inmediato en una gran partida de costes. Menos consultas de seguimiento y una información de entrega más fiable ya pueden quitar presión considerable de la operativa diaria.

La formación funciona mejor directamente en el proceso. El personal no necesita un recorrido abstracto por todos los elementos del menú. Necesita saber cómo registrar su próxima entrega, notificar una desviación, o corregir un escaneo erróneo. Para los primeros turnos tras el lanzamiento debería estar disponible una persona responsable que pueda tomar decisiones rápidamente.

La pregunta correcta para la elección

Con los Warehouse Management Systems la pregunta central no es: ¿qué software puede hacer más? Es: ¿qué flujos de trabajo necesitan volverse más rápidos, más claros, y más rastreables cada día para nuestro equipo?

Quien describa primero estos flujos de trabajo de forma limpia puede evaluar objetivamente software estándar, extensiones, o una aplicación a medida. El resultado no tiene que parecer espectacular. Debería asegurar que la mercancía encuentre su camino, la existencia permanezca fiable, y las personas en el almacén pasen menos tiempo buscando, preguntando, y corrigiendo después.

Enlace permanente →

Custom Logistics Software vs Spreadsheets

Custom Logistics Software vs Spreadsheets

Una recepción de mercancía llega antes de lo anunciado, dos empleados modifican en paralelo la misma lista de existencias, y el conductor espera un albarán cuya última versión nadie puede nombrar con certeza. Situaciones como estas deciden la pregunta "custom logistics software vs spreadsheets" no de forma teórica, sino entre la recepción de mercancía, la ubicación de almacén, y la rampa.

Las tablas no son fundamentalmente el problema. Se crean rápidamente, son familiares para todos, y a menudo sorprendentemente eficaces para tareas claramente delimitadas. Se vuelven problemáticas cuando deben servir como sistema operativo de un proceso de almacén o distribución en crecimiento. Entonces un archivo se convierte en un proceso crítico - sin reglas vinculantes, estados rastreables, o un historial sólido.

Cuándo las hojas de cálculo en el almacén son la elección correcta

Una tabla tiene sentido cuando el proceso es manejable, poco frecuente, y controlado por pocas personas. Eso puede ser, por ejemplo, una planificación mensual de necesidades, una preparación puntual de inventario, o una evaluación de precios de proveedores. También puede ser suficiente para un pequeño stock con un responsable, siempre que los cambios no se realicen bajo presión de tiempo y ningún proceso posterior dependa automáticamente de ella.

La ventaja no está solo en los bajos costes de licencia. Los equipos pueden ajustar columnas, verificar cálculos, y configurar un nuevo formulario en cuestión de minutos. Quien aún no ha comprendido un proceso estable no debería apresurarse a convertirlo en software. Una buena tabla puede primero hacer visible qué datos se necesitan realmente y qué campos se mantienen solo por costumbre.

Por tanto, sería erróneo tratar cada archivo de Excel como un atraso. La pregunta decisiva es: ¿es la tabla una herramienta de trabajo para una persona, o una fuente compartida para decisiones operativas? En cuanto varios roles dependen de los mismos datos, el riesgo aumenta notablemente.

Custom Logistics Software vs Spreadsheets: El punto de inflexión

El cambio no suele estar desencadenado por el número de filas. Una tabla con 20.000 posiciones puede funcionar, mientras que un archivo con 200 filas ya provoca errores. Lo decisivo es la concurrencia, los pasos del proceso, y las consecuencias de una información incorrecta.

Una señal de advertencia típica es la cuestión de las versiones. Si las existencias, los pedidos abiertos, o las fechas de entrega están en archivos con nombres como "stock_final_nuevo", "stock_final_nuevo2", y "de_verdad_final", lo que falta no es una mejor estructura de carpetas. Falta un estado de datos vinculante. Lo mismo ocurre cuando los empleados tienen que llamarse por teléfono para averiguar si ha llegado la mercancía, si se ha aprobado un pedido, o si un vehículo ya ha sido cargado.

El punto de inflexión se alcanza cuando una entrada desencadena varias acciones posteriores. Una recepción de mercancía entonces no solo cambia un número en las existencias. Puede iniciar un control de calidad, asignar una ubicación de almacén, marcar un pedido como parcialmente entregado, y mostrar a ventas un artículo disponible. Si estos pasos se coordinan manualmente a través de archivos, papel, y llamadas telefónicas, las desviaciones son difíciles de evitar.

Se vuelve especialmente crítico durante los cambios de turno y las ausencias. Cuando solo una persona experimentada sabe qué marca de color en una lista significa un bloqueo, o qué fórmula calcula una existencia de seguridad, el proceso no es sólido. Funciona solo mientras esa persona esté disponible.

Qué hace realmente mejor el software a medida

El software logístico a medida no es simplemente una tabla con una interfaz bonita. Su valor surge de flujos de trabajo controlados. Cada registro recibe una marca de tiempo inequívoca, una persona responsable, y un estado rastreable. Los empleados no ven solo datos, sino la siguiente acción permitida.

Para una recepción de mercancía, eso puede significar en la práctica: seleccionar la entrega, registrar la cantidad, documentar cualquier desviación, imprimir la etiqueta, y confirmar el almacenamiento. Solo entonces se libera el stock. Para el picking, el sistema puede agrupar pedidos por prioridad, mostrar las ubicaciones de almacén en un orden sensato, y generar un albarán solo cuando las líneas están confirmadas.

No se trata de una complejidad innecesaria. Evita que el mismo artículo se reserve dos veces, que una entrega parcial cuente como completa, o que se imprima un albarán basándose en datos obsoletos. También ayudan reglas sencillas: campos obligatorios para lotes, motivos de bloqueo para mercancía dañada, comprobaciones de plausibilidad en cantidades, y permisos para registros de corrección.

Una aplicación bien planificada no cubre inmediatamente cada caso especial. Se centra en los procesos que cuestan tiempo a diario o producen errores con regularidad. Para una empresa puede ser la gestión de movimientos de contenedores; para otra, la captura rápida de mercancía entrante con dispositivos móviles. El software estándar a menudo solo conoce estas particularidades como un módulo adicional costoso, o directamente no las conoce.

El coste oculto de la tabla

El coste de licencia de una tabla es bajo. El coste de proceso no puede serlo. Surge en consultas de seguimiento, repeticiones de trabajo, tiempos de búsqueda, mantenimiento duplicado, y existencias mal planificadas. Surge también cuando un equipo tiene que comprobar por la tarde qué datos han cambiado desde la mañana.

Estos costes suelen permanecer invisibles porque están repartidos entre muchos roles. El jefe de almacén verifica las existencias, el equipo comercial interno corrige las fechas de entrega, contabilidad busca comprobantes, y la dirección recibe cifras con retraso. Ninguna actividad individual parece dramática. Juntas ralentizan el rendimiento y la previsibilidad.

Una decisión sólida no debería, por tanto, comparar solo precios de software. Mida, durante dos a tres semanas, cuántas transferencias manuales atraviesa un pedido, con qué frecuencia se solicita información, y qué errores se repiten. También son relevantes las consecuencias: ¿un stock incorrecto lleva a una corrección interna o a una entrega perdida?

No todo problema necesita una gran suite

Muchas empresas medianas en la región DACH dudan con razón ante extensos sistemas empresariales. Implementaciones largas, pantallas rígidas, y modelos de licencia para funciones que nunca se usan rara vez resuelven un problema concreto de almacén. Pero la alternativa no tiene por qué significar quedarse con archivos dispersos.

Entre ambos extremos se encuentra una aplicación específica para el flujo de trabajo. Puede, por ejemplo, conectar la recepción de pedidos, la recepción de mercancía, los movimientos de stock, las etiquetas de envío, y los albaranes en un sistema compartido, sin traer de entrada contabilidad financiera completa, lógica corporativa global, y veinte idiomas extranjeros.

La base técnica es decisiva. Una aplicación con una estructura de base de datos clara, interfaces documentadas, y permisos rastreables permanece adaptable. Tecnologías como PHP 8.4, JavaScript moderno, y MySQL 8 no son un fin en sí mismas aquí. Utilizadas correctamente, crean una base mantenible para roles, historiales de registro, documentos impresos, e informes - incluso cuando los procesos cambien dentro de dos años.

Cómo se consigue el cambio sin interrumpir la operación

El mayor peligro no es la técnica, sino un primer paso demasiado grande. Quien intenta limpiar todos los archivos históricos y mapear cada caso excepcional antes del lanzamiento, retrasa el beneficio durante meses. Es mejor un comienzo claro y verificable.

Empiece con un proceso que ocurra con frecuencia y sea bien delimitable, como la recepción de mercancía con registro de stock, o el envío con albarán y etiqueta. Defina con precisión cuándo comienza la operación, qué datos son estrictamente necesarios, quién otorga qué aprobación, y cuándo se considera completada. De ahí surgen no solo pantallas, sino reglas de trabajo sólidas.

La migración de datos también necesita pragmatismo. Los artículos activos, proveedores, ubicaciones de almacén, y pedidos abiertos deben estar limpios. Las existencias antiguas históricas, en cambio, a menudo pueden archivarse, en lugar de importarlas al nuevo sistema con gran esfuerzo. La operación paralela puede tener sentido, pero solo con una fecha final fija. De lo contrario, surgen dos verdades en lugar de una mejor.

El valor de un socio técnico directo se muestra durante la implementación.

softify.pro por eso no trabaja a partir de una lista abstracta de funciones, sino que aclara los flujos donde realmente ocurren: en la recepción, en el pasillo del almacén, durante el embalaje, y en la entrega al envío. El buen software respeta las rutinas que funcionan y solo cambia lo que realmente hace el proceso más fiable.

La decisión se puede verificar con tres preguntas

Primero: ¿varias personas necesitan confiar simultáneamente en datos actuales? Segundo: ¿un registro desencadena procesos posteriores que hoy se aseguran manualmente? Tercero: ¿un error puede llevar a un retraso de entrega, stock incorrecto, factura equivocada, o búsqueda laboriosa? Si estas preguntas se responden predominantemente con sí, la tabla probablemente ya no es el sistema de referencia correcto.

Si la respuesta sigue siendo predominantemente no, puede seguir siendo una solución razonable. Entonces vale más la pena unificar archivos, definir responsabilidades, y documentar fórmulas críticas. La técnica no debería ser más grande que el problema.

El siguiente paso sensato, por tanto, no es un proyecto de digitalización general, sino una mirada compartida a un flujo concreto junto con las personas que lo ejecutan a diario. Allí se hace visible rápidamente si una tabla bien mantenida es suficiente - o si un software fiable debería por fin asumir el trabajo que hoy queda atrapado entre papel, teléfono, y varias versiones del mismo archivo.

Enlace permanente →

Desarrollo web para empresas

Desarrollo web para empresas

Un sitio web puede tener buen aspecto y aun así generar trabajo cada lunes: los datos de producto se mantienen por duplicado, las consultas llegan incompletas a la bandeja de entrada, los cambios necesitan ayuda externa. La búsqueda de una empresa de desarrollo web no debería, por tanto, terminar en colores, frameworks, o un portafolio elegante. Lo que importa es si la solución crea menos fricción en el trabajo diario y sigue siendo comprensible de operar incluso dentro de tres años.

Para las pequeñas y medianas empresas, esto no es una cuestión académica. En talleres, almacenes, y organizaciones de ventas, presupuestos, pedidos, información de entrega, y consultas de clientes a menudo se encuentran con procesos que han crecido orgánicamente. Algunos de ellos merecen software. Otros funcionan mejor todavía con una tabla mantenida limpiamente. Un buen desarrollo web reconoce la diferencia, en lugar de convertir cada problema en un gran proyecto digital.

Lo que el desarrollo web debe ofrecer a las empresas

Un sitio web corporativo suele ser el primer punto de contacto. Tiene que cargar rápido, funcionar en dispositivos móviles, y guiar claramente a los visitantes hacia una consulta, solicitud, o pedido. Pero en cuanto procesa datos, mapea roles internos, o dispara procesos, se convierte en una aplicación web. Entonces cuentan otras preguntas: ¿Quién puede ver qué? ¿De dónde vienen los datos? ¿Qué sucede con una entrada errónea? ¿Cómo se implementa una actualización sin interrumpir la operación?

La diferencia es práctica. Una página de marketing puede arreglárselas con pocas áreas de contenido claramente estructuradas. Un portal de clientes, un proceso de pedidos, o una herramienta interna de almacén, en cambio, necesita permisos rastreables, una estructura de base de datos robusta, y casos especiales definidos. Si una recepción de mercancía se entrega solo parcialmente o un pedido debe modificarse posteriormente, el sistema no debe terminar en un estado indefinido.

El desarrollo web para empresas, por tanto, no significa simplemente programar páginas. Significa implementar reglas de negocio de manera que sigan siendo comprensibles para los usuarios y controlables para la empresa.

Primero verificar el flujo, luego planificar la interfaz

Un proyecto a menudo comienza con un deseo como "Necesitamos un portal". Ese es un comienzo sensato, pero aún no un requisito suficiente. Antes del primer diseño, deberían hacerse visibles los caminos reales de una información: ¿quién la crea, quién la verifica, quién la completa, y quién la necesitará de nuevo más tarde?

Tomemos el procesamiento de pedidos. En muchas empresas, una consulta llega por correo electrónico o teléfono, se anota en una tabla, se transfiere más tarde a otro sistema, y luego se vuelve a procesar para el almacén o el envío. El retraso rara vez se debe a un solo paso. Surge en las transferencias, las preguntas de seguimiento, y los diferentes estados de los datos.

Un buen análisis pregunta, por tanto, concretamente sobre el día a día:

  • ¿Qué información se introduce varias veces hoy?
  • ¿Dónde surgen la mayoría de las preguntas de seguimiento o correcciones?
  • ¿Qué excepciones ocurren regularmente aunque no estén documentadas en ninguna parte?
  • ¿Qué roles necesitan acceso, y qué datos no deben poder modificar?
  • ¿En qué reconoce finalmente el equipo que una operación está realmente completa?

Estas preguntas suenan sobrias. Esa es precisamente su ventaja. Evitan que se construya una aplicación visualmente convincente alrededor de un proceso idealizado que nadie usa realmente en la operación. Especialmente en almacén y logística cuentan las condiciones reales: los escáneres se manejan con guantes, los turnos cambian, el Wi-Fi no es igual de bueno en todas partes, y un albarán no debe surgir solo tras varios clics.

No todo flujo pertenece, sin embargo, a una aplicación. Una pequeña lista con pocas entradas estables puede ser más rápida y económica como tabla. El software merece la pena cuando los datos fluyen entre personas o áreas, cuando falta la trazabilidad, o cuando el trabajo manual genera repetidamente tiempo perdido y errores.

La base técnica determina el esfuerzo posterior

Muchos sistemas parecen similares en la primera demo. La diferencia se muestra con los cambios, el crecimiento, y las interrupciones. Una aplicación debería, por tanto, basarse en tecnologías que el equipo pueda mantener a largo plazo, en lugar de apostar por una moda pasajera.

Para muchas aplicaciones web críticas para el negocio, un stack con PHP 8.4, JavaScript moderno, y MySQL 8 es una elección pragmática. Es capaz, bien comprensible, y adecuado para requisitos típicos como portales, gestión de pedidos, generación de documentos, o herramientas internas. Eso no es un dogma. Para aplicaciones muy interactivas, integraciones especiales, o altas necesidades de tiempo real, otra arquitectura puede tener sentido. La tecnología debería seguir a la tarea, no al revés.

Más importante que el nombre de un framework son las decisiones claras sobre datos y estados. Un pedido, por ejemplo, necesita valores de estado inequívocos en lugar de texto libre. Los cambios deberían ser rastreables. Los datos de clientes, precios, y permisos no deben dispersarse entre tablas desperdigadas e interfaces improvisadas. Quien más tarde necesite saber por qué se creó una etiqueta de envío o se bloqueó un pedido, necesita un historial rastreable.

La seguridad también forma parte de la construcción básica. Eso incluye permisos basados en roles, almacenamiento seguro de contraseñas, flujos de bloqueo de cuenta tras intentos fallidos repetidos, entornos de prueba y producción separados, y actualizaciones regulares. La seguridad no es un único plugin añadido al final del proyecto. Surge de responsabilidades limpias y una arquitectura que contempla los casos de error.

La velocidad es un requisito operativo

Las páginas lentas no solo cuestan visibilidad en los motores de búsqueda. Provocan abandonos en las consultas y tiempo de espera innecesario en el negocio diario. En un sitio web público, el tiempo de carga, la presentación móvil, y una estructura de página clara deciden si los interesados llegan siquiera a contactar. En una aplicación interna, dos o tres segundos de espera por cada registro se suman de forma perceptible a lo largo de la jornada laboral.

El rendimiento no comienza con un proyecto de optimización posterior. Las imágenes, las consultas a la base de datos, la caché, JavaScript, y el hosting deben planificarse adecuadamente desde el principio. Aquí rige: no toda aplicación necesita la máxima complejidad técnica. Una herramienta interna sencilla con pocos usuarios no necesita una arquitectura para millones de llamadas simultáneas. Necesita rutas cortas, copias de seguridad fiables, y un comportamiento que permanezca predecible en el día a día.

El mismo principio se aplica al manejo responsive. "Apto para móviles" no significa que una pantalla de escritorio de alguna manera se encoja en un smartphone. Quien revisa albaranes sobre la marcha, notifica un daño, o corrige un stock, necesita elementos de control grandes, retroalimentación clara, y la menor entrada innecesaria posible.

De la idea a la operación: entregar en pequeños pasos

Los grandes pliegos de requisitos prometen seguridad, pero a menudo llevan a los equipos a esperar meses por una primera versión utilizable. Un camino mejor es un primer paso de expansión claramente delimitado. Debería resolver un problema real, como el registro centralizado de recepciones de mercancía o la generación automática de documentos de entrega. Después, con retroalimentación real se puede decidir qué aporta el mayor beneficio a continuación.

Eso no significa trabajar sin planificación. Al contrario: el modelo de datos, los roles, las interfaces, y el concepto operativo deben aclararse pronto. El alcance funcional puede, sin embargo, crecer paso a paso. Así, las suposiciones se vuelven visibles antes de volverse costosas.

Una entrega profesional incluye más que credenciales de acceso. Pasos de despliegue documentados, copias de seguridad, monitorización, responsabilidades, y una documentación técnica comprensible hacen que un sistema sea independiente de personas individuales. Si solo el desarrollador original sabe cómo se implementa una actualización, la aplicación no está terminada, sino vinculada a una persona.

Cómo reconocer a un socio adecuado

Una empresa de desarrollo web no tiene que ofrecer todas las tecnologías imaginables. Pero debería hacer las preguntas correctas y ser capaz de justificar decisiones. Se recomienda precaución si ya en la primera conversación se promete una plataforma integral sin que nadie haya visto los procesos existentes.

Un socio adecuado habla sobre mantenimiento, calidad de datos, e implementación con la misma apertura que sobre diseño. Explica qué requisitos pueden cubrir las funciones estándar y dónde tiene sentido el desarrollo individual. También menciona el coste de las solicitudes especiales. Una función puede ser técnicamente viable y aun así no tener suficiente beneficio.

Pregunte por detalles operativos concretos: ¿Cómo se prueban los cambios? ¿Cómo funciona un rollback? ¿Dónde residen los datos sensibles? ¿Quién responde ante una caída? ¿Cómo se gestionan los permisos? Las buenas respuestas no tienen por qué ser largas, pero son específicas. "Nos ocuparemos de eso más tarde" no es una estrategia para procesos críticos del negocio.

Para equipos con software existente, la cuestión de la integración también es central. Una nueva aplicación no tiene que sustituirlo todo. Puede inicialmente tomar datos de un sistema existente, generar documentos, o cubrir un proceso ausente. El primer paso más sensato a menudo no es la gran sustitución, sino la eliminación específica de un cuello de botella.

El software debe clarificar el trabajo, no desplazarlo

La mejor aplicación web no destaca en la operación por su sofisticación técnica, sino por menos preguntas de seguimiento, datos fiables, y tiempos de procesamiento más cortos. Respeta las formas de trabajo que funcionan, hace visibles las excepciones, y puede seguir desarrollándose sin miedo a la próxima actualización.

Antes de iniciar un proyecto, tome una operación concreta de su día a día y sígala desde el primer contacto hasta su conclusión. Allí donde la información espera, desaparece, o se captura por duplicado, suele estar el enfoque más sensato para el desarrollo web.

Enlace permanente →

Logistics Automation Software que realmente encaja

Logistics Automation Software que realmente encaja

La entrada de mercancías se apunta en papel, la variación del stock se pasa más tarde a una hoja de cálculo y el envío llama al almacén porque la dirección de entrega está en un correo electrónico. Justo en estos traspasos es donde una empresa pierde tiempo y fiabilidad. Logistics Automation Software no debe tapar esta fricción con un gran mundo nuevo de procesos, sino conectar de forma trazable las tareas diarias.

Para las pequeñas y medianas empresas, esta es una tarea distinta a la de implantar una plataforma de gran corporación. Un jefe de almacén no necesita 200 funciones que solo se entienden tras tres días de formación. Necesita un estado claro: qué ha llegado, dónde está, qué tiene que salir hoy y qué falta todavía. Una buena automatización responde a estas preguntas allí donde se trabaja.

Qué debe aportar en la práctica Logistics Automation Software

El término suena amplio, pero los casos de uso razonables suelen ser muy concretos. Una empresa procesa, por ejemplo, la mercancía entrante, registra movimientos de almacén, emite albaranes, imprime etiquetas de envío y planifica las entregas. Si cada puesto necesita su propio archivo, un acceso aparte o un aviso a voces, se producen retrasos y cadenas de errores.

Un software adecuado reúne la información en un único flujo de trabajo. Un pedido puede generar automáticamente una orden de picking. El escaneo de un artículo confirma la extracción y actualiza el stock. Al terminar se crea un albarán con las posiciones correctas, mientras que el estado del envío se hace visible para ventas o planificación. Suena sencillo. Precisamente por eso es valioso: el software no sustituye una lógica que funciona, sino que evita que tenga que reconstruirse en cada cambio de soporte.

Lo decisivo es el orden. Primero debe estar claro qué datos desencadenan un evento y quién decide sobre ello. Solo entonces merece la pena automatizar reglas. Quien digitaliza un proceso poco claro solo consigue una confusión más rápida.

Elegir primero los procesos adecuados

No todo proceso manual merece de inmediato una aplicación. Una hoja de cálculo pequeña y bien cuidada puede ser mejor para un caso especial poco frecuente que un módulo que hay que mantener de forma permanente. La palanca económica suele estar en los procesos con mucha repetición, muchos traspasos o consecuencias notables en caso de error.

Candidatos típicos son las entradas de mercancías con estado de inspección, los traslados entre zonas, el picking de pedidos recurrentes, los documentos de envío y la planificación de rutas. También la recepción de pedidos es a menudo un buen punto de partida cuando los pedidos que llegan por teléfono, correo y formularios se reúnen primero a mano.

Cuatro preguntas ayudan a elegir:

  • ¿Con qué frecuencia se realiza el proceso cada semana?
  • ¿En qué punto se registran o transfieren los datos más de una vez?
  • ¿Qué errores provocan repeticiones de trabajo, diferencias de stock o entregas tardías?
  • ¿Qué casos excepcionales debe seguir decidiendo el personal por sí mismo?

La última pregunta evita un error muy extendido. Automatizar no tiene por qué significar que cada decisión se tome sin personas. Ante mercancía dañada, entregas incompletas o peticiones de clientes de última hora, el equipo necesita una forma clara de detener una operación, corregirla y continuarla con una justificación. Un sistema sin esas vías parece coherente sobre el papel, pero en el almacén se convierte enseguida en un obstáculo.

De la entrada de mercancías al envío: un flujo continuo

Tomemos un distribuidor mediano con almacén y reparto propio. Hoy la mercancía se cuenta en el muelle, se apunta en un formulario y solo se registra en el sistema hacia el final del turno. Por eso ventas ve el nuevo stock demasiado tarde. En un envío urgente, el albarán se crea aparte y el conductor recibe su información por teléfono.

En un flujo automatizado con criterio, la entrada de mercancías comienza con una operación digital. El personal registra entrega, artículo y cantidad y, opcionalmente, lote o número de serie directamente en el puesto de trabajo o desde el móvil. Las desviaciones no se esconden en una nota al margen, sino que reciben un estado como «Revisión necesaria». Solo tras la liberación queda la mercancía disponible como stock utilizable.

El siguiente paso surge de necesidades reales: se libera un pedido, el almacén recibe una lista de picking o una vista móvil ordenada por ubicación, y cada registro documenta lo que realmente se ha retirado. De ahí salen el albarán y los datos de envío a partir de la misma fuente. Nadie tiene que volver a teclear posiciones ni comprobar qué versión del archivo es la vigente.

Para la planificación, el sistema puede agrupar entregas abiertas por zona, franja de entrega, peso o capacidad del vehículo. La planificación de rutas no es siempre el primer paso razonable. Si las direcciones están incompletas o los pedidos solo se liberan poco antes de la salida, primero conviene mejorar la calidad de los datos y la claridad de los pedidos. Las rutas optimizadas no ayudan si la base no es fiable.

¿Software estándar o solución a medida?

El software estándar tiene sentido cuando la empresa trabaja con procesos habituales y acepta adaptarse a las pantallas, los roles y los procesos previstos. Puede implantarse rápido, sobre todo con requisitos claros como la impresión de etiquetas o una gestión de stock sencilla. El precio suelen ser concesiones en casos especiales, interfaces y adaptaciones posteriores.

Un Logistics Automation Software a medida resulta interesante cuando la particularidad operativa no es un caso marginal, sino que determina el éxito del negocio. Puede ser una lógica de embalaje especial, un proceso de aprobación de varios niveles, la conexión entre taller y almacén o un modelo de entrega propio. Entonces suele ser más sensato reproducir de forma selectiva los pocos procesos centrales, en lugar de implantar una suite completa con muchos módulos sin usar.

A medida, sin embargo, no significa ilimitado. Toda función especial necesita una justificación técnica, pruebas, documentación y mantenimiento. Un buen trabajo de proyecto se pregunta, por tanto, también: ¿se puede simplificar este paso? ¿Basta con una configuración? ¿Sigue siendo una hoja de cálculo la mejor solución para este proceso excepcional? Estas preguntas protegen presupuesto y equipo de una complejidad innecesaria.

Una técnica que aguanta el día a día

La interfaz decide si el personal usa un sistema con gusto. La base técnica decide si puede seguir funcionando de forma fiable años después. Para los procesos críticos del negocio, forman parte del equipamiento básico modelos de datos comprensibles, roles y permisos, registros de los cambios importantes y copias de seguridad periódicas.

En un registro de almacén debe poder verse quién modificó qué stock y cuándo, y de qué operación procede el cambio. Si varios usuarios actúan a la vez, el stock no debe falsearse por entradas contradictorias. Con impresoras, escáneres o interfaces de transportistas hacen falta estados de error claros en lugar de fallos silenciosos. Una etiqueta que no se imprimió debe verse como un paso de trabajo abierto.

El mantenimiento también es un requisito operativo. Una aplicación web sobre una arquitectura comprensible, por ejemplo con PHP 8.4, JavaScript moderno y MySQL 8, puede revisarse y ampliarse mejor a largo plazo que un conjunto de soluciones aisladas difíciles de seguir. Un despliegue documentado, entornos de prueba y de producción separados y pruebas automatizadas no son un lujo. Reducen el riesgo de que un pequeño cambio en el albarán afecte de repente a la liberación de pedidos.

La protección de datos y el control de accesos merecen la misma sobriedad. No todos los usuarios necesitan precios, márgenes o datos maestros de clientes. Sobre todo en equipos distribuidos, los accesos, dispositivos y permisos deberían diseñarse de modo que no frenen innecesariamente el trabajo diario, pero que sigan siendo controlables ante un cambio de empleado o la pérdida de un dispositivo.

Una implantación en etapas razonables

La función más potente ayuda poco si un equipo no puede usarla en el trabajo por turnos. Por eso una implantación gradual suele ser más sólida que una gran fecha de corte. Primero se pone en producción un proceso acotado, por ejemplo la entrada de mercancías de un grupo de productos o la elaboración de documentos de envío. El equipo trabaja con ello en condiciones reales y las dudas se resuelven con casos reales.

Después siguen otros procesos e interfaces. Este orden genera confianza, porque el personal ve que los comentarios se convierten en mejoras concretas. Al mismo tiempo limita el riesgo: si hay que ajustar un nuevo flujo de escaneo, no se detiene toda la logística.

Las métricas deben acordarse antes de empezar. Pueden ser el plazo desde el pedido hasta el envío, el número de correcciones manuales, las diferencias de stock o la duración de las tareas de cierre diario. No toda mejora se refleja enseguida en una cifra espectacular. Menos consultas entre almacén y oficina, un relevo de turno fiable e historiales de operaciones fáciles de encontrar son también un alivio medible.

softify.pro desarrolla estos sistemas a partir del flujo de trabajo, con participación técnica directa en lugar de un traspaso del concepto a la implementación. El criterio sigue siendo deliberadamente pragmático: la solución debe funcionar en el suelo de la nave, no solo en una presentación.

Cómo reconocer una decisión sólida

Una buena decisión no empieza con una lista de funciones, sino con una jornada de trabajo observada. Pida que le muestren dónde nace la información, dónde espera, dónde se pierde o se corrige después. No hable solo con la dirección, sino también con las personas de la entrada de mercancías, del almacén y del envío. Conocen las excepciones que ningún organigrama hace visibles.

Compruebe después si el proveedor hace preguntas concretas sobre datos, roles, dispositivos, interfaces y operación. Quien promete enseguida una solución completa sin entender los procesos existentes vende más volumen de software que solución a un problema. Igual de crítico es un proyecto que no prevé una regulación clara para el mantenimiento, la corrección de errores y las adaptaciones posteriores.

La mejor automatización no se siente como burocracia adicional. Da al equipo tiempo para los casos en los que la experiencia realmente cuenta: valorar correctamente una entrega inesperada, informar a un cliente a tiempo o resolver un cuello de botella antes de que se convierta en problema.

Enlace permanente →

¿Puede la IA probar software de escritorio?

¿Puede la IA probar software de escritorio?

Un empleado registra la recepción de mercancía en una aplicación Windows, imprime un albarán, y entrega los datos a contabilidad. Después de una actualización, un cuadro de diálogo aparece en otro lugar, un campo pierde el foco, la impresión ya no se inicia. La pregunta "can AI test desktop software" es por tanto menos teórica de lo que suena: ¿puede un sistema detectar errores como este antes del próximo turno de mañana?

Sí. La IA puede probar software de escritorio Windows, especialmente donde la automatización clásica falla ante interfaces cambiantes, controles inconsistentes, o scripts costosos de mantener. Sin embargo, no es un sustituto de objetivos de prueba claros, datos de prueba limpios, y responsabilidad de negocio. Su valor surge cuando asume de forma fiable el trabajo repetible y dirige a las personas hacia los casos que requieren criterio.

¿Puede la IA probar software de escritorio - y qué significa eso en la práctica?

Las pruebas de escritorio no solo verifican si se abre una ventana. En una operación real, se trata de flujos de trabajo completos: inicio de sesión con lógica de bloqueo correcta, entrada de pedidos, selección de un artículo, registro de existencias, impresión de etiquetas, mensajes de error para datos inválidos, y la entrega correcta a un sistema conectado.

Un entorno de prueba impulsado por IA puede ejecutar estos flujos en una máquina Windows, evaluar la interfaz visible, y generar evidencia. Puede, por ejemplo, reconocer botones por texto y posición, leer contenido de cuadros de diálogo, y comparar capturas de pantalla con el estado esperado. A diferencia de un script rígido, puede manejar mejor cambios visuales menores - por ejemplo cuando cambia un icono, un espaciado, o el identificador técnico exacto de un elemento de control.

Esto es relevante especialmente para aplicaciones empresariales que han crecido con el tiempo. Muchos de estos programas no tienen una API moderna para cada proceso. Algunos utilizan interfaces propietarias, tablas incrustadas, o componentes difíciles de abordar con la automatización UI convencional. Un agente de IA puede operar la aplicación más como lo haría un usuario capacitado: leer la pantalla, elegir una acción, verificar el resultado.

La palabra "más" se elige deliberadamente. La IA no ve automáticamente el proceso de negocio detrás de un campo de entrada. Puede determinar que se creó un albarán. Si se debía usar la condición de entrega correcta para un cliente determinado requiere una expectativa definida a nivel de negocio.

Dónde tienen sentido las pruebas de IA para aplicaciones Windows

El mejor punto de partida son los flujos de trabajo que ocurren con frecuencia, son críticos para el negocio, y hoy se verifican manualmente. Un equipo no necesita automatizar todo el catálogo de pruebas para esto. Es mejor elegir los pocos procesos cuyo fallo cuesta directamente tiempo, dinero, o confianza.

En almacén, producción, y planificación, esto a menudo incluye la creación y registro de recepciones de mercancía, los procesos de picking y envío, las correcciones de stock autorizadas, la impresión de etiquetas, y los flujos de importación y exportación. En aplicaciones comerciales, el inicio de sesión, el cambio de permisos, la creación de facturas, el mantenimiento de datos maestros, y las transferencias de interfaz son candidatos típicos.

La IA es especialmente útil donde un lanzamiento actualmente desencadena un día de control manual. Un tester entonces hace clic en una larga lista, documenta anomalías, y más tarde intenta reconstruir exactamente qué sucedió. Las ejecuciones automatizadas pueden trasladar esta parte a la noche o a un proceso de lanzamiento fijo. Por la mañana, no solo hay un estado, sino un registro de prueba con capturas de pantalla, marcas de tiempo, y una descripción comprensible de la desviación.

Las pruebas de regresión también se benefician. Cuando se incorpora una nueva función en el cuadro de diálogo de pedidos, los procesos existentes no deberían romperse sin ser notados. La IA repite escenarios definidos tras cada cambio relevante. Eso no elimina todos los riesgos, pero evita que flujos centrales conocidos permanezcan sin verificar simplemente porque falta tiempo.

Qué puede verificar la IA de forma fiable - y qué no

Las pruebas de interfaz basadas en IA son sólidas en expectativas observables. "El número de pedido aparece después de guardar." "Se muestra una advertencia cuando falta un campo obligatorio." "El stock se reduce en cinco." "El cuadro de diálogo de impresión contiene la impresora prevista." Afirmaciones como estas se traducen en pasos de verificación concretos.

Los requisitos formulados de manera imprecisa se vuelven más difíciles. "La interfaz debe parecer profesional" o "el programa debe ser rápido" no son casos de prueba suficientes. Aquí se necesitan criterios: tiempo máximo de espera bajo carga definida, un diseño aprobado, o reglas de aceptación claras para mensajes de error.

Las pruebas humanas también siguen siendo indispensables para casos especiales de negocio complejos. Si una regla de devolución se aplica a un único contrato marco, alguien con conocimiento del proceso tiene que decidir si el resultado es correcto. La IA puede preparar, ejecutar, y documentar el caso. No debería inventar por su cuenta nuevas reglas de negocio.

Otro límite es la estabilidad del entorno. Las pruebas de escritorio dependen de la resolución de pantalla, los permisos de usuario, la conectividad de red, los controladores de impresora, los datos de prueba, y, cuando sea relevante, el hardware conectado. Si una impresora de etiquetas está fuera de línea, una prueba fallida podría ser un defecto genuino - o un problema de entorno. Los buenos sistemas de prueba distinguen estos casos y los informan de forma transparente, en lugar de etiquetar todo genéricamente como error del producto.

La base técnica decide el valor

Una prueba de escritorio utilizable es más que una secuencia de clics de ratón. Necesita una máquina controlada o un entorno Windows virtual, cuentas de usuario definidas, datos de partida reproducibles, y reglas claras para los reinicios. De lo contrario, la prueba verifica un estado diferente el martes que el lunes, produciendo discusiones en lugar de certeza.

La evidencia es igualmente decisiva. Una marca verde sin contexto ayuda poco cuando un departamento de negocio informa un error. Cada ejecución debería, por tanto, venir con los pasos ejecutados, capturas de pantalla en puntos importantes, mensajes de error visibles, y una marca de tiempo. Ante desviaciones, debe quedar claro si la aplicación respondió incorrectamente, un elemento esperado no fue encontrado, o el entorno de prueba estaba bloqueado.

Para aplicaciones sensibles, la pregunta sobre dónde ocurre la ejecución no es un asunto secundario. Las capturas de pantalla, las credenciales, los datos de clientes, y las pantallas de proceso internas pueden contener información confidencial. Cualquiera que ejecute pruebas a través de servicios externos debería verificar cuidadosamente qué datos salen de su propio entorno, cuánto tiempo se almacenan, y quién obtiene acceso.

Para equipos con requisitos correspondientes, un entorno autoalojado puede tener más sentido.

softify.pro opera para este propósito COCO, su propio servidor de IA para pruebas web y de aplicaciones automatizadas. La ejecución, la evidencia de prueba, y la evaluación pueden permanecer dentro del entorno empresarial controlado. Eso no es necesario para cada aplicación, pero para sistemas de negocio internos, datos personales, o requisitos de TI estrictos, suele ser la arquitectura más limpia.

Cómo empieza un equipo sin dejar que un proyecto de automatización de pruebas se descontrole

Un comienzo sensato no empieza con la selección de una herramienta, sino con un proceso. Tome un flujo de trabajo que se verifica al menos semanalmente y cuyas consecuencias de fallo sean rastreables. Un proceso de envío encaja mejor que una colección de veinte pantallas aleatorias.

Describa a continuación el camino de negocio en frases claras: situación inicial, entradas, estados intermedios esperados, resultado final esperado. Añada también el caso negativo. ¿Qué tiene que pasar si falta un número de lote, un usuario no tiene permiso, o el stock no es suficiente? Precisamente estas reglas a menudo se omiten en las pruebas manuales, aunque pueden volverse costosas en el día a día.

Después viene un piloto limitado con datos de prueba estables y un entorno definido. No mida solo si la prueba funciona. Mida cuántos minutos de verificación manual reemplaza, cuántas falsas alarmas ocurren, y si la evidencia es suficiente para el desarrollo y el departamento de negocio. Solo cuando esta base funciona vale la pena expandirse a más procesos.

El mantenimiento forma parte de esto desde el principio. Si una pantalla cambia a nivel de negocio, la expectativa también debe adaptarse. Eso no es un argumento en contra de la automatización. Es mantenimiento normal de software - comparable a actualizar una instrucción de trabajo cuando cambia un proceso de almacén.

No cada clic tiene que automatizarse

Algunos equipos esperan cobertura completa de las pruebas de IA. Eso conduce rápidamente a altos costos para casos excepcionales raros, cuya verificación sería más rápida y fiable hecha manualmente. Una buena estrategia de prueba en cambio prioriza según riesgo, frecuencia, y ritmo de cambio.

Un cuadro de diálogo de administración usado raramente con bajo impacto de error puede seguir verificándose con una breve lista de comprobación manual. Una recepción de mercancía diaria con varios pasos posteriores, en cambio, merece pruebas de regresión automatizadas y evidencia limpia. Boring, provable reliability supera aquí a una colección de pruebas grande pero frágil.

Empiece con el proceso donde un error realmente se sentiría el próximo día laborable. Cuando ese flujo de trabajo se verifica de forma automatizada, rastreable, y repetible en su propio entorno, la automatización de pruebas se convierte en una ventaja operativa fiable - no en otro proyecto de TI con bonitas diapositivas.

Enlace permanente →

¿Cuándo deberían las empresas sustituir las hojas de cálculo?

¿Cuándo deberían las empresas sustituir las hojas de cálculo?

Un responsable de almacén imprime por la mañana una lista de existencias. Dos horas más tarde, el departamento de ventas ha registrado un pedido, se ha corregido la cantidad de una entrada de mercancías y un compañero ha abierto un archivo antiguo desde un adjunto de correo electrónico. Las cifras ya no coinciden. Justo en ese momento surge la pregunta: ¿cuándo deberían las empresas sustituir las hojas de cálculo? No cuando un archivo se vuelve confuso una vez, sino cuando se convierte en el cuello de botella invisible de un proceso en marcha.

Las hojas de cálculo no son señal de mala organización. Para cálculos, análisis puntuales, pequeños volúmenes de datos y decisiones con pocas personas implicadas, suelen ser la herramienta adecuada. Son flexibles, conocidas y están disponibles sin necesidad de poner en marcha un proyecto. Solo se vuelven problemáticas cuando una única hoja debe ser a la vez base de datos, instrucción de trabajo, flujo de aprobación, archivo de documentos y canal de comunicación.

Las hojas de cálculo son buenas - hasta que sostienen un proceso

Muchas empresas en crecimiento se aferran a sus archivos porque se han ido construyendo con esmero durante años. En ellos hay números de artículo, casos especiales, conocimiento sobre proveedores y una lógica de cálculo probada. Eso merece respeto. Un sistema sustituto que ignore esta realidad genera resistencia y, en el peor de los casos, nuevos rodeos.

Por eso, la pregunta decisiva no es «¿Es malo Excel?», sino «¿Puede nuestro equipo trabajar de forma fiable con esta herramienta, incluso cuando cambian el volumen de pedidos, los turnos o los responsables?». Si la respuesta depende con regularidad de una persona concreta, de una unidad compartida o de la disciplina de todos los implicados, a menudo se ha alcanzado el límite.

Esto se nota con especial claridad en el almacén, el taller y la planificación. Un inventario que solo se concilia a posteriori no es un inventario fiable. Un justificante de entrega que se reúne manualmente a partir de varios archivos cuesta algo más que tiempo. Dificulta las consultas posteriores, el seguimiento y un traspaso ordenado entre empleados.

¿Cuándo deberían las empresas sustituir las hojas de cálculo?

No existe un momento universal ni un número mágico de filas. Una empresa con 500 artículos puede trabajar bien con una hoja sencilla, mientras que otra con 50 artículos lleva tiempo necesitando un sistema. Lo determinante es la carga operativa: ¿con qué frecuencia cambian los datos, quién los utiliza y qué consecuencias tiene un error?

Un desencadenante claro es el conflicto de versiones. Cuando los equipos se envían archivos con nombres como «Existencias_final_nuevo2» o los compañeros tienen que preguntar qué columna es la válida en este momento, falta una fuente de datos vinculante. También es una señal el trabajo manual de copiado entre la lista de pedidos, el resumen del almacén, el archivo de envíos y la preparación de facturas. Cada traspaso crea una nueva oportunidad de cifras transpuestas, entradas duplicadas o actualizaciones olvidadas.

Igualmente críticos son los procesos sin responsabilidad trazable. ¿Quién ha cambiado una cantidad? ¿Cuándo se registró una entrada de mercancías? ¿Por qué se puso un pedido en espera? En una hoja de cálculo, los cambios pueden registrarse en parte. Sin embargo, en el día a día rara vez resulta tan claro y utilizable como un proceso que registra de forma deliberada los movimientos, los cambios de estado y las acciones de los usuarios.

Otro punto es la velocidad del trabajo. Si antes de embalar los empleados tienen que buscar en un archivo, comprobar una existencia, volver a teclear datos y después crear una etiqueta de envío en un portal aparte, la hoja de cálculo se convierte en quien marca el ritmo en la nave. Los costes no surgen entonces solo en minutos. Se manifiestan en interrupciones, consultas, envíos erróneos y en un saber que solo está en la cabeza de unas pocas personas.

Los riesgos suelen estar entre dos celdas

Las hojas de cálculo rara vez fallan de forma espectacular. Con frecuencia son pequeñas desviaciones que se propagan: una fórmula arrastrada mal, un filtro que no abarca todas las filas, un número guardado como texto en lugar de como número o una fórmula sobrescrita por descuido. Estos errores permanecen mucho tiempo sin detectarse, precisamente cuando el equipo trabaja bajo presión de tiempo.

En los procesos críticos para el negocio se suma un segundo riesgo: la falta de guía del proceso. Una hoja de cálculo puede mostrar que existe un pedido. Pero no garantiza de forma fiable que todos los pasos necesarios se den en el orden correcto. ¿Debe estar terminado un control de calidad antes del envío? ¿Puede crearse un albarán sin una preparación de pedido confirmada? ¿Debe un pedido pasar automáticamente a revisión cuando falta stock? Estas reglas no pertenecen a recordatorios, celdas de colores ni complicadas fórmulas «si-entonces» cuando deciden cada día si los procesos se desarrollan correctamente.

Los permisos también cobran relevancia a medida que crece el equipo. No todos necesitan poder cambiar precios, mantener datos maestros o corregir operaciones cerradas. Una aplicación a medida puede reflejar los roles con claridad, registrar las acciones sensibles y, por ejemplo, bloquear una cuenta tras varios intentos fallidos. Eso no es tecnología excesiva. Es una respuesta limpia a la cuestión de la responsabilidad.

No todo problema necesita un gran ERP

La alternativa a la hoja de cálculo no es automáticamente una suite empresarial global con largos proyectos de implantación. Para muchas pequeñas y medianas empresas sería el paso equivocado: demasiadas funciones, procesos demasiado rígidos, elevados costes de licencia y un sistema que no se adapta lo suficiente a la empresa.

A menudo resulta más sensata una aplicación enfocada en el cuello de botella concreto. Puede tratarse de un sistema para entradas de mercancías, movimientos de stock y ubicaciones de almacén. Puede registrar de forma estructurada pedidos procedentes de correos electrónicos o formularios, generar albaranes, preparar etiquetas de envío o planificar rutas según reglas claras. Lo decisivo no es implantar la mayor cantidad posible de software. Lo decisivo es que la siguiente acción quede clara para la persona responsable.

Una buena solución puede empezar además junto a las herramientas existentes. La contabilidad, el ERP o los proveedores de envío no tienen por qué sustituirse de inmediato. A menudo, una interfaz fiable o una exportación limpia es el camino más pragmático. El beneficio surge cuando desaparecen las entradas duplicadas y los datos operativos están actualizados allí donde se necesitan.

Cómo comprobar la necesidad real de actuar

En lugar de comparar directamente ofertas de software, merece la pena examinar un proceso concreto. Tome, por ejemplo, el recorrido de un pedido desde su entrada hasta el envío. Anote no solo los pasos oficiales, sino también las llamadas telefónicas, las notas en papelitos, los mensajes privados de chat y los puntos en los que alguien traslada información de un archivo a otro sistema.

Pregúntese a continuación: ¿dónde esperan información los empleados? ¿Dónde se introducen los datos varias veces? ¿Qué decisión depende de la experiencia en lugar de reglas visibles? ¿Y qué errores saldrían caros si el volumen de pedidos se duplicara en seis meses? Este análisis suele mostrar más rápido que cualquier lista de funciones si una hoja de cálculo todavía es suficiente.

No toda anomalía justifica un desarrollo a medida. Si un informe lo elabora una persona una vez al mes y un error es fácil de corregir, la hoja de cálculo suele seguir siendo razonable. Pero si varias personas dependen a diario de datos actualizados, si se mueven mercancías físicas o si se necesitan justificantes frente a los clientes, la cuenta cambia. Entonces la empresa lleva tiempo pagando por los límites de la herramienta, solo que repartido entre horas de trabajo, corrección de errores y retrasos.

Una sustitución debe seguir siendo mantenible

Quien sustituye hojas de cálculo no debería limitarse a comprar una interfaz más bonita. La estructura de datos, las reglas y la operación de la aplicación determinan si la solución sigue funcionando de forma fiable pasados dos años. Para una aplicación web ligera, por ejemplo, PHP 8.4, JavaScript moderno y MySQL 8 pueden ser una base deliberadamente sobria: fácil de mantener, potente y sin dependencia de modas pasajeras.

La implantación es igual de importante. Un sistema debería estabilizar primero los procesos reales, en lugar de cubrir a la vez todos los deseos imaginables. Un primer ámbito claramente delimitado, por ejemplo la entrada de mercancías y el registro de existencias, genera confianza. Después pueden añadirse el envío, los documentos de entrega o los análisis sobre una base de datos coherente.

Las hojas de cálculo antiguas no tienen por qué desaparecer de inmediato. Algunas se mantienen como archivo, para análisis especiales o como exportación controlada. El objetivo no es desterrar las hojas de cálculo. El objetivo es liberarlas de tareas para las que nunca fueron concebidas como sistema operativo permanente.

Si su equipo comprueba con regularidad qué archivo es el correcto, quién fue el último en cambiar algo o si un pedido se ha tramitado realmente por completo, no se trata de un pequeño defecto organizativo. Es una buena ocasión para examinar el proceso conjuntamente en el puesto de trabajo real, antes de que el próximo pico de crecimiento convierta una hoja de cálculo frágil en un cuello de botella diario.

Enlace permanente →

AI testing platforms para pruebas de regresión

AI testing platforms para pruebas de regresión

Un lanzamiento está funcionalmente terminado, pero nadie puede decir con certeza si la nueva importación de precios ha dañado la entrada de pedidos, los permisos de usuario, o el proceso de envío. Precisamente aquí es donde las AI testing platforms se vuelven interesantes. No porque hagan desaparecer por arte de magia el trabajo de calidad humano, sino porque pueden ejecutar de forma fiable verificaciones recurrentes, documentarlas visiblemente, y hacer comprensibles las desviaciones.

Para equipos con aplicaciones web o Windows desarrolladas a lo largo del tiempo, esto es un problema práctico, no un proyecto de innovación. Los procesos críticos a menudo se desarrollan durante años: se crea un pedido, se registra un stock de almacén, se genera un PDF, se notifica a una interfaz. Un pequeño cambio en una pantalla de entrada puede tener consecuencias en un lugar inesperado. Las pruebas de regresión manuales son entonces lentas, dependientes de personas individuales, y especialmente propensas a errores bajo presión de tiempo.

Qué ofrecen realmente las AI testing platforms

La automatización de pruebas clásica sigue pasos escritos de antemano. Eso sigue siendo sensato y necesario para muchas verificaciones. Una plataforma impulsada por IA puede además trabajar con una aplicación a través de su interfaz, reconocer contenido, ejecutar pasos de prueba, y clasificar anomalías en lenguaje natural. Puede, por ejemplo, verificar si un usuario autorizado puede registrar una recepción de mercancía, si una cuenta bloqueada es rechazada correctamente, o si un albarán todavía se genera después de un cambio.

El beneficio decisivo no está solo en hacer clic en un botón. Los buenos sistemas conectan ejecución, observación, y evidencia. Una ejecución de prueba debería, por tanto, incluir pasos trazables, capturas de pantalla o grabaciones, marcas de tiempo, los datos de prueba utilizados, y una evaluación clara. Cuando una prueba falla, el equipo necesita más que el mensaje "assertion failed". Debe poder ver en qué pantalla, en qué estado, y por qué motivo se produjo la desviación.

La IA puede acelerar este trabajo. Sin embargo, no reemplaza la decisión sobre qué es realmente crítico para el negocio. Un modelo puede reconocer que un diálogo se ve diferente. Si ese cambio representa un error, un rediseño deliberado, o simplemente una diferencia inofensiva de renderizado en el navegador, sigue siendo una cuestión de reglas, contexto, y aprobación.

No toda verificación pertenece a la IA

El error más común durante la implementación es apuntar demasiado alto. Una plataforma no debería primero cubrir cada función de un sistema. Debería proteger los procesos cuyo fallo sería costoso, arriesgado, o laborioso. En un software de logística, esto típicamente es la entrada de pedidos, los movimientos de inventario, la impresión de etiquetas o documentos, los roles de usuario, y las transferencias de interfaz. En una aplicación web comercial, el inicio de sesión, la aprobación de facturas, las exportaciones, y el estado de pago pueden ser el foco.

Un comienzo sensato consiste en un pequeño conjunto de pruebas de extremo a extremo estables. Una prueba aquí no cubre solo un único clic, sino un proceso de trabajo completo. Por ejemplo: un usuario inicia sesión, crea un pedido, confirma las líneas, genera un albarán, y verifica si la transacción aparece en la vista general. Verificaciones como estas proporcionan una relevancia empresarial más alta que muchas pruebas aisladas para campos individuales.

Eso no significa que cada tipo de prueba deba pasar por la interfaz de usuario. Los equipos de desarrollo siguen necesitando pruebas unitarias y de integración rápidas, cercanas al código. Estas pruebas detectan errores técnicos temprano y a bajo costo. Las pruebas de IA basadas en UI las complementan donde sea necesario verificar la interacción entre interfaz, permisos, base de datos, documentos, y servicios externos. Quien prueba todo solo a través de la interfaz obtiene ejecuciones de prueba lentas y difíciles de mantener. Quien prueba exclusivamente en el código puede pasar por alto errores que afectan directamente a los usuarios.

La estabilidad surge de buenas condiciones de prueba

Las pruebas automatizadas no siempre fallan debido a un error del producto. Los datos de prueba inestables, los permisos de usuario cambiantes, los sistemas de prueba inaccesibles, o los cambios paralelos pueden ser igualmente la causa. Por eso el entorno de prueba forma parte de la decisión de plataforma.

Las cuentas de prueba deberían ser inequívocas y tener permisos conocidos. Los datos deben ser restablecidos de forma reproducible antes de cada ejecución o recreados de forma específica. Los sistemas externos también requieren una decisión: ¿se verifica una integración de envío o pago contra un entorno de prueba seguro, se simula con un stub controlado, o se excluye deliberadamente del flujo? No existe una respuesta universalmente correcta. Lo que importa es que la afirmación de una prueba permanezca clara.

Para las aprobaciones críticas, también vale la pena tener un nivel de confianza definido. Una diferencia visual con baja confianza no debería bloquear automáticamente un lanzamiento. Un documento de envío faltante después de una entrega registrada con éxito, en cambio, es un fallo grave. Los buenos procesos de prueba distinguen entre indicios a verificar y criterios de aprobación claros.

La soberanía de los datos no es un tema secundario en las pruebas de IA

Tan pronto como una prueba se ejecuta contra una aplicación real, puede ver información confidencial: nombres de clientes, precios, direcciones, números de artículo internos, capturas de pantalla de aplicaciones de negocio, o contenido de documentos. Si tales datos se transmiten a servicios externos junto con grabaciones de pantalla y registros de prueba, esta es una decisión arquitectónica con consecuencias para la protección de datos, la seguridad de la información, y los contratos.

Precisamente para las aplicaciones web y Windows internas, la pregunta "¿funciona la plataforma?" no es suficiente. Los responsables deberían verificar dónde se ejecutan las pruebas, dónde se almacenan las capturas de pantalla y registros, qué datos procesa un modelo de IA, y quién obtiene acceso administrativo. Los períodos de retención y los conceptos de eliminación también forman parte de esto. Un informe de prueba puede ser una evidencia valiosa para un lanzamiento, pero no debería conservar información sensible indefinidamente.

Para organizaciones con requisitos elevados, una ejecución autoalojada puede ser la solución más adecuada. Mantiene el tráfico de pruebas, los datos de prueba, y la evidencia en su propio entorno controlado. Eso aumenta algo el esfuerzo operativo: las actualizaciones, los accesos, la capacidad, y la monitorización necesitan responsabilidad. A cambio, el control técnico y organizativo permanece donde a menudo pertenece. Con COCO, softify.pro apuesta exactamente por este modelo: pruebas automatizadas para aplicaciones web y Windows con retención local de datos y evidencia de prueba trazable.

Cómo reconocer una plataforma adecuada

Una elección convincente comienza con las aplicaciones existentes, no con una demo de producto. Una plataforma puede parecer impresionante en una aplicación de ejemplo limpia y encontrar sus límites en una pantalla de escritorio antigua, un entorno Citrix, o un inicio de sesión complejo. Una breve prueba de concepto con dos o tres flujos de trabajo empresariales reales dice mucho más que una lista de funciones.

Al hacerlo, los equipos deberían prestar especial atención a cuatro puntos:

  • Cobertura de aplicaciones: ¿La solución admite los navegadores web existentes, las aplicaciones de escritorio Windows, y, cuando sea relevante, los escenarios de escritorio remoto o Citrix?
  • Trazabilidad: ¿Cada ejecución proporciona pasos comprensibles, capturas de pantalla, registros, y una justificación de por qué una prueba se considera superada o fallida?
  • Modelo operativo: ¿La nube, un entorno privado, o el autoalojamiento se ajustan a los requisitos de seguridad, los recursos de TI disponibles, y los datos de prueba?
  • Mantenibilidad: ¿Pueden los departamentos de negocio revisar los flujos de prueba mientras los equipos técnicos gestionan de forma limpia el versionado, las aprobaciones, y la ejecución repetible?

A esto se suma la integración en el proceso de lanzamiento. Una prueba que solo se inicia a petición ayuda menos que una ejecución programada antes del despliegue o después de un cambio relevante. Al mismo tiempo, no cada pequeña actualización de estilo debería desencadenar una prueba completa de horas de duración. Los procesos maduros seleccionan las pruebas según el riesgo: una breve prueba de humo después de cada despliegue, regresiones dirigidas para cambios en módulos críticos, y ejecuciones más extensas antes de lanzamientos mayores.

Informes claros en lugar de teatro de pruebas

La automatización de pruebas produce fácilmente actividad sin comprensión. Cientos de comprobaciones verdes suenan bien, pero si nadie puede decir qué procesos de negocio protegen, apenas son manejables. Un informe utilizable responde a preguntas simples: ¿Qué se verificó? ¿Con qué resultado? ¿Qué versión se vio afectada? ¿Qué debe decidir alguien ahora?

Las evaluaciones en lenguaje sencillo pueden ahorrar mucho tiempo aquí, siempre que se basen en datos de ejecución reales. "El usuario pudo iniciar sesión, crear el pedido, y generar el albarán" es más útil para un responsable de negocio que una colección de selectores técnicos. En caso de fallos, la profundidad técnica sigue siendo importante. QA y desarrollo necesitan la captura de pantalla, los datos de registro, y pasos reproducibles, no solo un resumen de IA.

Implementación sin interrumpir la operación diaria

La mejor implementación comienza con un proceso en el que un error tendría un impacto notable y cuyo flujo es lo suficientemente estable. Eso puede ser el cierre de fin de día, la aprobación de pedidos, o una función central en una plataforma de clientes. Junto con el departamento de negocio y el equipo técnico, se define qué cuenta como éxito, qué datos de prueba se utilizan, y quién evalúa un fallo.

Después viene un ritmo controlado: construir pruebas, ejecutarlas repetidamente, reducir las falsas alarmas, y solo entonces vincularlas de forma vinculante en las aprobaciones. Este paso intermedio es importante. Quien despliega pruebas automatizadas inmediatamente como una barrera dura, mientras el entorno y los datos aún están cambiando, genera resistencia en lugar de confianza. Quien, en cambio, conecta visiblemente los resultados con errores reales y lanzamientos estables, construye aceptación.

Las AI testing platforms no son un sustituto de una buena arquitectura de software, la responsabilidad de negocio, o decisiones de lanzamiento limpias. Utilizadas correctamente, sin embargo, devuelven a los equipos algo muy concreto: tiempo para los casos que necesitan criterio, y evidencia sólida para los flujos que simplemente tienen que funcionar. La primera prueba más sensata es, por tanto, raramente la más espectacular - sino el proceso en el que, el lunes por la mañana, ya nadie tiene que preguntarse si el sistema todavía hace lo que la operación espera de él.

Enlace permanente →

Documentar automáticamente la evidencia de las pruebas

Documentar automáticamente la evidencia de las pruebas

Una prueba de regresión fallida es molesta. Una prueba superada sin evidencia utilizable a menudo apenas es mejor. Quien quiere documentar automáticamente la evidencia de las pruebas no resuelve, por tanto, un simple problema de reportes. Se trata de una respuesta sólida a preguntas concretas: ¿Qué se probó? ¿En qué versión? ¿Con qué entradas? ¿Qué ocurrió realmente en pantalla? ¿Y puede un desarrollador, responsable de QA, o auditor reconstruir el resultado más adelante?

Precisamente en aplicaciones web y Windows críticas para el negocio, estas preguntas no surgen solo en la auditoría. Surgen cuando después de un lanzamiento un pedido se procesa incorrectamente, cuando un cliente reporta un error inusual, o cuando un equipo tiene que distinguir entre "parece correcto" y "verificado de forma demostrable" antes de un lanzamiento. Las listas de Excel mantenidas manualmente, las capturas de pantalla en hilos de chat, y las notas de prueba sueltas solo bastan mientras el alcance y la tasa de cambio se mantengan reducidos.

Por qué la evidencia de pruebas manual se vuelve rápidamente poco fiable

En muchos equipos, la documentación empieza con buenas intenciones. Un tester registra el resultado, añade una captura de pantalla, y anota la versión probada. Bajo presión de tiempo, sin embargo, esto rápidamente se convierte en una rutina abreviada: marcar la casilla, pasar el error, siguiente caso de prueba. Esto es comprensible, especialmente para las pruebas de regresión recurrentes - pero no es sólido.

El problema no está en empleados individuales. La documentación manual siempre compite con el trabajo de prueba real. En cuanto hay que verificar diez, cincuenta, o varios cientos de casos por lanzamiento, o falta tiempo para una evidencia limpia, o la evidencia se vuelve tan extensa que ya nadie la evalúa. A eso se suman lagunas típicas: una captura de pantalla muestra un estado, pero no la secuencia previa. Un registro de prueba nombra el caso, pero no el número de build utilizado. Un error fue corregido, pero no es visible cuándo y cómo se volvió a verificar la corrección.

Para aplicaciones que gestionan procesamiento de pedidos, movimientos de almacén, precios, permisos de usuario, o interfaces, esto es más que una cuestión de comodidad. Una prueba no documentada no puede contar de forma fiable como una verificación de riesgo completada. Eso aplica especialmente cuando un cambio aparentemente pequeño en un lugar desencadena efectos secundarios en procesos adyacentes.

Qué debe contener realmente una evidencia de prueba utilizable

Una evidencia de prueba no es simplemente una captura de pantalla con una marca verde. Vincula el caso de prueba con su contexto técnico y de negocio. Como mínimo, debe ser identificable más adelante qué aplicación, qué versión, y qué entorno de prueba se verificaron. Igualmente importantes son la hora de inicio, la hora de fin, el resultado, y una asignación clara al respectivo paso de prueba.

Para las pruebas de UI automatizadas, la evidencia también debería capturar las acciones realizadas y los resultados observados. Ejemplo: una prueba crea un pedido, verifica el total de la línea, genera un albarán, y luego comprueba el estado en el área de envío. Un buen registro no solo consigna "superado". Muestra en qué paso tuvo lugar la verificación, qué valor se esperaba que el sistema devolviera, y qué valor devolvió realmente.

Las capturas de pantalla o las grabaciones de pantalla cortas son valiosas aquí, pero no siempre obligatorias para cada paso exitoso individual. Cuestan espacio de almacenamiento y pueden contener datos sensibles. Suele tener sentido una estrategia escalonada: en verificaciones fallidas, se guarda automáticamente una evidencia visual completa; en casos estándar exitosos, bastan datos de registro estructurados y evidencia seleccionada. Qué profundidad se requiere depende del riesgo, la frecuencia de cambio, y el entorno regulatorio.

La evidencia debe ser legible y técnicamente utilizable

Los desarrolladores necesitan detalles como mensajes de error, valores esperados/reales, marcas de tiempo, y el paso concreto en el flujo de prueba. Los departamentos de negocio y los responsables de lanzamiento, en cambio, necesitan una declaración comprensible: ¿qué procesos de negocio se verificaron, qué pasó, y dónde se necesita acción?

Ambas perspectivas deberían surgir de la misma ejecución de prueba. Si un equipo de QA exporta archivos de registro técnicos y luego escribe manualmente un resumen para la dirección, vuelve a aparecer una ruptura de medios propensa a errores. Mejor es un sistema que capture los datos en bruto de forma estructurada y genere a partir de ellos una evaluación clara, sin ocultar los detalles técnicos.

Documentar automáticamente la evidencia de las pruebas: la secuencia correcta

La automatización funciona mejor cuando está vinculada a riesgos claramente definidos. No cada clic en cada aplicación debe automatizarse y documentarse de inmediato por completo. El punto de partida suele ser flujos de trabajo estables, repetidos con frecuencia, y críticos para el negocio: inicio de sesión y verificación de permisos, entrada de pedidos, cálculo de precios, generación de documentos, registro de almacén, o transferencia de datos a una interfaz.

Para cada flujo de trabajo, primero se define qué cuenta como prueba superada. "La pantalla se ve correcta" es demasiado vago para eso. Mejor son condiciones de verificación concretas: un usuario con el rol de almacén no debe poder cambiar precios. Se genera el número de albarán. La cantidad reduce el stock disponible. Tras cinco intentos fallidos, se activa el bloqueo de cuenta. Criterios como estos hacen que los casos de prueba sean repetibles y las evidencias comparables.

La ejecución de la prueba debería entonces iniciarse automáticamente con datos de contexto. Eso incluye número de build o versión, entorno de destino, navegador o sistema operativo, estado de los datos de prueba, y marca de tiempo. Durante la ejecución, el sistema registra los pasos individuales, los resultados esperados y reales, y cualquier anomalía técnica. Ante desviaciones, genera evidencia, como capturas de pantalla, mensajes de error, o una grabación de la secuencia relevante.

El resultado final no es una carpeta de archivos sin estructurar, sino una ejecución de prueba con un estado. Idealmente, se puede rastrear desde una decisión de lanzamiento hasta el paso individual por qué se evaluó una prueba como superada o fallida. Precisamente esa conexión reduce considerablemente las discusiones después de un incidente.

Dónde ayuda de verdad la IA - y dónde no

La IA puede acelerar notablemente la documentación y la evaluación. Puede evaluar estados de pantalla, marcar desviaciones llamativas, y resumir ejecuciones de prueba en lenguaje comprensible. Para grandes volúmenes de pruebas, esto ayuda a los equipos de QA a no tener que leer manualmente cada ejecución exitosa. Una evaluación con umbral de confianza también puede destacar casos en los que la detección es incierta y sigue siendo necesaria una verificación humana.

Aun así, la IA no debería decidir por sí sola sobre lanzamientos críticos. En áreas como autorización de pagos, permisos, lógica de precios, o documentos legalmente relevantes, se necesitan criterios de verificación deterministas. Un importe esperado está calculado correctamente o no lo está. Un rol tiene acceso o no lo tiene. La IA complementa aquí el análisis de contenido visual y lingüístico, pero no reemplaza una regla de negocio definida de forma limpia.

Cómo se manejan los datos también es una decisión arquitectónica. Las capturas de pantalla de aplicaciones internas pueden mostrar datos de clientes, precios, direcciones, o información de producción. Quien documenta automáticamente la evidencia de las pruebas debería, por tanto, decidir de antemano dónde se almacena esta evidencia, quién puede verla, y cuánto tiempo se conserva. Para equipos conscientes de la seguridad, una infraestructura de pruebas autoalojada como COCO puede tener sentido, porque el tráfico de pruebas, las grabaciones, y la evaluación permanecen en su propio entorno controlado.

Períodos de retención, accesos, y calidad de la evidencia

Más evidencia no es automáticamente mejor evidencia. Un almacén de capturas de pantalla que crece durante años sin modelo de roles ni concepto de retención crea un nuevo riesgo. Tiene sentido establecer períodos de retención escalonados: conservar más tiempo las ejecuciones de prueba fallidas o relevantes para el lanzamiento, condensar o eliminar las pruebas de rutina exitosas tras un período definido, y anonimizar tempranamente los datos de prueba sensibles.

Igual de decisiva es la inmutabilidad. Si los resultados de las pruebas pueden editarse posteriormente sin rastro, pierden valor como evidencia. Los cambios en los casos de prueba, resultados, o estado de lanzamiento deberían, por tanto, registrarse. Eso no significa que cada informe de prueba necesite un software de auditoría complicado. Pero las responsabilidades, marcas de tiempo, e historiales rastreables forman parte del equipamiento básico.

Empezar con un proceso que realmente duela

El primer paso de automatización más sensato raras veces es el más grande. Elija un flujo de trabajo que se verifique en cada lanzamiento, que cueste muchos minutos manuales, y que tenga consecuencias perceptibles en caso de error. Eso puede ser la entrada de pedidos en el portal web, la generación de un documento de envío, o un concepto de permisos en una aplicación Windows.

Defina para este flujo de trabajo criterios de éxito claros, la evidencia requerida, y un destinatario responsable para las pruebas fallidas. Tras algunos lanzamientos, rápidamente queda claro si la evidencia es lo bastante comprensible, si se generan demasiados datos, y qué pruebas deberían seguir a continuación. Así no crece una máquina de documentación por sí misma, sino una cadena de verificación que asegura los lanzamientos más rápido y ofrece respuestas sólidas en caso de problemas.

Enlace permanente →

Documentar digitalmente los movimientos de inventario

Documentar digitalmente los movimientos de inventario

Una diferencia de 24 unidades en el sistema suena manejable al principio. Se convierte en un problema cuando nadie puede decir si la mercancía se almacenó en el lugar equivocado, se retiró para un pedido, se dañó o nunca se registró. Quien quiere documentar digitalmente los movimientos de inventario no crea simplemente más datos. Crea un historial trazable para cada artículo en stock - y con ello una base sólida para compras, producción, envío e inventario.

Para almacenes pequeños y medianos, esto raramente es un caso para una suite empresarial completa. Lo que importa es un sistema que refleje los recorridos reales que hace la mercancía: recepción de mercancía en la puerta, traslado entre estanterías, retirada de material en el taller, preparación de pedidos, devoluciones y correcciones tras el inventario. Cuantas menos veces los equipos tengan que alternar entre papel, Excel y avisos verbales y varios programas, más fiables se vuelven las cifras.

Documentar digitalmente los movimientos de inventario empieza por la transacción

Un nivel de stock actual solo responde a una pregunta: ¿cuánto hay ahora mismo? Para el trabajo operativo, eso a menudo no es suficiente. Cuando surgen preguntas, el equipo también necesita respuestas a otras cuestiones: ¿Cuándo cambió el stock? ¿Quién hizo el registro? ¿De dónde venía la mercancía, adónde fue, y qué operación comercial lo originó?

Aquí es exactamente donde radica la diferencia entre una simple lista de inventario y una documentación digital de movimientos. Cada cambio se guarda como una transacción propia e inmutable. El nivel de stock resulta después de estas transacciones. Si, por ejemplo, un artículo se traslada de la ubicación A-03 a la B-12, el sistema debe vincular de forma trazable un movimiento de salida y uno de entrada. Si se retira material para una orden de producción, el registro pertenece a esa orden - no solo a un cambio de cantidad anónimo.

Este principio no previene completamente los errores. Sin embargo, los hace localizables. Una corrección entonces no sobrescribe el valor antiguo, sino que crea un nuevo asiento de corrección con un motivo. Eso es menos cómodo que modificar directamente una cifra, pero es notablemente mejor para inventarios, reclamaciones y conciliaciones internas.

Qué datos son realmente necesarios por movimiento

Muchos proyectos se vuelven innecesariamente complicados porque desde el principio se prevé cada campo imaginable. Para un funcionamiento fiable, suelen bastar unos pocos datos bien mantenidos. Lo que importa no es la longitud del formulario, sino que cada registro permanezca inequívoco en cuanto al contenido.

Un registro de movimiento debería contener al menos esta información:

  • Artículo o material, incluyendo un número de artículo único
  • Cantidad y unidad, por ejemplo piezas, metros, kilogramos o cajas
  • Tipo de movimiento, por ejemplo entrada, retirada, traslado, devolución o corrección
  • Ubicación de origen y destino, en la medida en que el tipo de movimiento afecte a ambas
  • Fecha y hora, persona que lo ejecuta, y una referencia documental trazable

La referencia documental puede ser un pedido de compra, un albarán, un pedido de cliente, una orden de producción o una posición de inventario. Ahorra tiempo más adelante, porque el registro no tiene que interpretarse primero mediante comentarios. El texto libre sigue siendo útil para excepciones, pero no debería sustituir la información obligatoria.

En artículos sujetos a lote, con número de serie o perecederos, se añaden más características. Entonces debe quedar claro, por ejemplo, de qué lote se retiró o qué fecha de caducidad se ve afectada. No es un detalle para resolver más adelante: si se requiere trazabilidad, debe funcionar directamente dentro del flujo de registro.

Adaptar los tipos de movimiento al flujo real de mercancías

Las categorías más sensatas no surgen en un taller sobre un diagrama de proceso abstracto, sino en un recorrido por el almacén. ¿Dónde se recibe realmente la mercancía? ¿Quién decide sobre el stock bloqueado? ¿Cuándo se da de baja el material: al entregarlo al taller, al iniciar la producción, o solo al consumirlo?

Recepción de mercancía y control de calidad

En la recepción de mercancía, la mercancía debería verificarse primero contra el pedido de compra o el albarán. Un registro digital puede reunir directamente cantidad, proveedor, número de documento, ubicación de almacén y, opcionalmente, lote. Si se requiere una inspección, la mercancía no debería aparecer automáticamente como libremente disponible. Un estado como "en verificación" o "bloqueado" evita que material no verificado sea recogido por error.

Traslado y transferencias internas

Los traslados se olvidan con especial frecuencia porque no generan ningún documento externo visible. El resultado es que el stock total es correcto, pero nadie encuentra la mercancía en la ubicación esperada. Los registros móviles mediante escáner de mano, tableta o un formulario web sencillo ayudan aquí, siempre que requieran pocos datos de entrada. Un formulario en pantalla complicado se termina evitando en la operativa diaria - independientemente de lo bien planificada que esté la base de datos detrás.

Retirada, envío y devolución

En las retiradas, el registro debe corresponder al propósito adecuado. El material para una orden de trabajo, la mercancía para un pedido de cliente y los desechos son, en esencia, operaciones distintas. Pueden reducir el mismo stock de artículo, pero requieren evaluaciones diferentes. Las devoluciones también deberían ser su propio tipo de movimiento. De lo contrario, queda sin resolver si un artículo es reutilizable, debe revisarse o darse de baja.

El registro tiene que funcionar sobre el terreno

La digitalización rara vez fracasa porque un equipo no entienda su utilidad. Fracasa con más frecuencia por cinco clics adicionales, Wi-Fi inestable, números de artículo poco claros, o un registro que solo puede completarse en el PC de la oficina después de terminar el turno.

Por eso vale la pena definir un flujo claro por rol. En la recepción de mercancía, típicamente se selecciona el pedido de compra o el albarán, se escanea el artículo, se confirma la cantidad y se asigna una ubicación de almacén. En la preparación de pedidos, a menudo basta con abrir el pedido, escanear la posición y confirmar la retirada. Los responsables de almacén necesitan además funciones para bloqueos, correcciones y recuentos de inventario, incluida la obligación de indicar el motivo de cualquier corrección.

Los escaneos de código de barras o QR reducen los errores de transcripción cuando los artículos y las ubicaciones de almacén están etiquetados correctamente. Pero no sustituyen el mantenimiento de datos maestros. Si existen cinco grafías distintas para el mismo artículo, o las ubicaciones se nombran de manera informal, un escáner solo acelera el registro erróneo. Antes de la implantación técnica, deberían depurarse los números de artículo, las unidades, las ubicaciones de almacén y las responsabilidades.

La capacidad sin conexión también es una decisión a sopesar. En un almacén pequeño con red estable, una aplicación basada en navegador puede ser suficiente. Para almacenes remotos, naves grandes o conexiones poco fiables, un almacenamiento local intermedio puede tener sentido. En ese caso, debe quedar claramente definido cómo se fusionan los registros duplicados o desfasados en el tiempo.

Una implantación sensata en lugar de un gran día de cambio

Un cambio completo en una fecha límite parece decidido, pero crea un riesgo innecesario. Es mejor empezar con un ámbito delimitado: por ejemplo, recepción de mercancía y traslados para un grupo de artículos o una zona de almacén. Ahí se ve rápidamente qué tipos de movimiento faltan, qué pantallas de entrada son demasiado lentas y qué casos especiales se presentan realmente con regularidad.

Para el inicio, el equipo necesita un saldo inicial verificado. Este puede proceder de un inventario, de una lista de existencias depurada o de una asunción controlada. Es importante documentar claramente la transición: ¿hasta qué momento se aplica el sistema antiguo, y a partir de cuándo es determinante el sistema nuevo? Las listas llevadas en paralelo solo resultan útiles a corto plazo para el control, como mucho. Si permanecen de forma permanente, surgen dos verdades.

Después de dos a cuatro semanas, los responsables no deberían fijarse solo en la precisión del inventario. Igualmente reveladores son el número de correcciones posteriores, las referencias documentales faltantes, los tiempos de búsqueda y los registros realizados fuera de los procesos previstos. Estas observaciones proporcionan mejores requisitos que una larga lista de deseos elaborada antes de que comenzara el proyecto.

Base técnica: trazable y mantenible

Detrás de una pantalla de registro sencilla se necesita una estructura de datos limpia. Artículos, ubicaciones de almacén, movimientos, documentos y permisos de usuario deberían modelarse por separado. Cada registro necesita un ID único, una marca de tiempo y una asignación a una cuenta de usuario. Los cambios en transacciones críticas pertenecen a un registro de auditoría.

Para muchas aplicaciones de tamaño medio, una aplicación web ligera con una base de datos relacional como MySQL 8 es una base adecuada. Puede procesar entradas de escáner, representar permisos basados en roles, generar diarios de movimientos y entregar datos a procesos de envío o pedidos. Lo que importa es menos el framework utilizado que una lógica de datos documentada, reglas de registro probadas y un concepto operativo con copias de seguridad, derechos de acceso y procedimientos de recuperación.

No todos los movimientos necesitan transmitirse inmediatamente a todos los demás sistemas. La sincronización en tiempo real tiene sentido cuando el envío, una tienda online o la producción dependen directamente de las cantidades disponibles. En otros casos, bastan traspasos controlados a intervalos fijos. Más integración también significa más fuentes de error y más responsabilidad en caso de interrupciones.

Cuándo una hoja de cálculo todavía es suficiente

Una hoja de cálculo no es fundamentalmente un problema. Con pocos artículos, una ubicación de almacén fija y una persona que mantiene de forma consistente las entradas y salidas, puede ser económica. El cambio resulta rentable cuando varias personas registran al mismo tiempo, las ubicaciones de almacén se vuelven relevantes, los documentos deben vincularse, o regularmente no está claro por qué difiere un nivel de stock.

El siguiente paso correcto no es entonces el software más grande posible, sino una solución que apoye con precisión el flujo de mercancías existente. Una buena documentación digital no hace que el trabajo sea más espectacular. Se asegura de que un registro ocurra en el momento del movimiento - y de que la respuesta a la siguiente pregunta de inventario ya esté en el sistema.

Enlace permanente →

Ideas de digitalización de almacén que funcionan

Ideas de digitalización de almacén que funcionan

Un albarán que falta justo antes de la salida, un nivel de existencias que se ve diferente en la estantería que en la hoja de cálculo, y tres empleados aclarando simultáneamente la misma pregunta por teléfono: precisamente ahí surgen ideas de digitalización de almacén sensatas. No a partir de la pregunta de qué tecnología parece estar de moda ahora, sino de un proceso concreto que cuesta tiempo, genera errores, o depende del conocimiento de personas concretas.

Para las pequeñas y medianas empresas de almacenamiento, comercio, y fabricación, la digitalización rara vez es un único gran proyecto. Es una secuencia de mejoras claramente delimitadas. El objetivo no tiene que ser un complejo sistema empresarial de gestión de almacenes. A menudo, una herramienta ligera, adaptada al flujo de trabajo real, es mejor que una suite con funciones que nadie usa en el suelo del almacén.

Ideas de digitalización de almacén con valor operativo

El mejor punto de partida es un proceso que ocurre con frecuencia, es fácilmente medible, y mejora perceptiblemente para los empleados. Quien quiera digitalizar inmediatamente todo el almacén inmoviliza presupuesto y atención antes de que una solución se haya demostrado en el día a día. Un primer paso limitado, por el contrario, crea datos sólidos para la siguiente decisión.

1. Recepción de mercancía con captura de datos móvil

En la recepción de mercancía se originan muchos errores en cascada: cantidades contadas incorrectamente, discrepancias sin resolver, registros de existencias retrasados, y documentos en papel que luego no se encuentran. Un formulario de captura móvil en un escáner de mano, una tableta, o un smartphone puede hacer el proceso mucho más estable.

Los empleados escanean el artículo y la referencia de entrega, capturando cantidad, ubicación de almacén, y el motivo de cualquier discrepancia directamente en el muelle de carga. Si un lote, un número de serie, o una foto son relevantes, esa información pertenece exactamente al mismo registro. Las existencias no se añaden retroactivamente a una hoja de cálculo al final del turno; en su lugar, reciben un estado trazable en el momento real de la recepción.

Esto no significa que cada proveedor o artículo requiera estrictamente etiquetas de código de barras. Para entregas pequeñas e irregulares, una búsqueda por código de artículo puede bastar. El factor decisivo es que la captura de datos sea más rápida que el anterior rodeo por papel y transcripción manual.

2. Traslados digitales en lugar de enigmas de inventario

Muchos almacenes saben fundamentalmente qué hay disponible, pero no de forma fiable dónde se encuentra. La mercancía se adelanta para un pedido, se almacena temporalmente, se lleva a montaje, o se coloca en un área libre por falta de espacio. Sin un registro simple, una pregunta de existencias se convierte rápidamente en una operación de búsqueda.

Un proceso de traslado no necesita una interfaz complicada. Escanear la ubicación de origen, escanear la ubicación de destino, confirmar la cantidad — en la mayoría de los casos no hace falta más. El sistema debería verificar si el artículo y la ubicación de almacén son plausibles, y asignar claramente un registro a una persona y una marca de tiempo.

El manejo de excepciones es importante. Una ubicación de almacén puede estar bloqueada, sobrecargada, o aprobada solo para mercancías específicas. Estas reglas deberían mapearse donde previenen un daño real. Para casos especiales poco frecuentes, a menudo basta un paso de aprobación por parte de la dirección de almacén. Demasiados campos obligatorios convierten una aplicación útil en un obstáculo.

3. Picking de pedidos con estados de pedido claros

Las listas de picking en papel funcionan hasta que cambian las prioridades, faltan posiciones, o un pedido se reparte entre varias áreas. Una simple lista de picking digital muestra qué pedido está abierto, qué posiciones ya se han recogido, y dónde se necesita aclaración. Esto reduce las consultas entre almacén, ventas, y expediciones.

Según el tamaño del almacén, la aplicación puede dictar rutas de picking o simplemente ordenar las posiciones por zona de almacén. La optimización completa de rutas merece la pena sobre todo con muchos pedidos diarios y largos recorridos a pie. En un almacén compacto, una indicación de estado fiable a menudo aporta más que una ruta matemáticamente perfecta que nadie sigue en la práctica diaria.

En caso de faltantes, el sistema no debería limitarse a resaltar en rojo. Debería ofrecer un proceso de seguimiento concreto: comprobar existencias, solicitar artículos sustitutos, activar reposición, o pasar el pedido para aclaración. La digitalización es valiosa cuando hace visible la siguiente acción sensata.

4. Documentos de envío y etiquetas a partir de datos de pedido reales

Transferir manualmente direcciones, pesos, y posiciones de artículos a los portales de envío es un candidato ideal para la automatización. Las direcciones de entrega, instrucciones de entrega, métodos de envío, e información del paquete idealmente existen una sola vez y se usan para el albarán, la etiqueta de envío, y la confirmación de envío.

Un sistema adecuado puede generar etiquetas, almacenar documentos de forma inalterable, y establecer automáticamente el pedido en "listo para enviar" o "enviado" tras la impresión. La ventaja operativa no reside solo en los minutos ahorrados. Reside en garantizar que los datos de envío nunca diverjan entre varios sistemas.

Aquí la integración es crucial. Si un transportista no ofrece una interfaz utilizable o implica reglas especiales muy diferentes, un flujo semiautomatizado puede ser más sensato que una integración completa frágil. Una fiabilidad aburrida pero demostrable vence a una automatización que se detiene en cada excepción.

5. Reposición y niveles mínimos de stock con reglas trazables

Los niveles mínimos de stock a menudo se mantienen en hojas de cálculo y luego se ignoran porque nadie está seguro de si las cifras siguen siendo correctas. Una solución digital sensata conecta los registros reales con reglas claras de control de inventario. Puede notificar cuando un artículo cae por debajo de un umbral, tener en cuenta las cantidades reservadas, y preparar una lista de pedido.

El umbral no debería tratarse como una verdad eterna. La demanda estacional, los plazos de entrega, y las cantidades mínimas de pedido cambian. Por eso la persona responsable necesita una forma sencilla de revisar sugerencias y ajustar reglas. Los pedidos totalmente automáticos solo tienen sentido cuando los datos maestros, la lógica de proveedores, y los datos de consumo son suficientemente estables.

6. Trazabilidad para lotes, números de serie, y existencias bloqueadas

Quien trabaja con lotes, dispositivos, repuestos, o productos regulados necesita más que una simple indicación de cantidad. Debe ser trazable qué mercancía llegó cuándo, adónde se movió, y en qué pedido de cliente terminó.

El proyecto puede empezar deliberadamente pequeño: registrar inicialmente solo la recepción y el envío de un grupo de productos crítico. Los movimientos internos y las devoluciones siguen más tarde. Un sistema que impone cada registro pero no comprende el proceso real de reparación o inspección será eludido. La lógica de negocio debe, por tanto, surgir del flujo de trabajo, no de un modelo de datos abstracto.

Seleccionar el proyecto adecuado

La idea más atractiva no es automáticamente la primera idea correcta. Evalúen los proyectos potenciales según frecuencia, coste de errores, tiempo de espera, y dependencia de personas individuales. Un proceso que se ejecuta 50 veces al día y ahorra dos minutos por transacción puede valer más que una función especial poco frecuente con gran elegancia técnica.

La calidad de los datos también forma parte de la decisión. Si los códigos de artículo están duplicados, las ubicaciones de almacén no están nombradas de forma unívoca, o los pedidos llegan de forma contradictoria desde varias fuentes, el proyecto debería limpiar primero estos fundamentos. El software puede hacer visibles las reglas faltantes, pero no puede sustituirlas de forma fiable.

Para la priorización bastan cuatro preguntas:

  • ¿Qué actividad causa demostrablemente más consultas o retrabajos?
  • ¿Qué información se transcribe hoy varias veces o se consulta por teléfono?
  • ¿Qué error tendría las consecuencias más costosas para clientes, existencias, o envío?
  • ¿Qué flujo de trabajo puede probarse en pocas semanas con una medición clara del éxito?

Decisiones técnicas que cuentan en la operativa diaria del almacén

Una aplicación de almacén no necesita parecer espectacular. Debe seguir siendo comprensible con mala cobertura Wi-Fi, llevando guantes, bajo presión de tiempo, y durante los cambios de turno. Botones grandes, retroalimentación clara tras un escaneo, y un manejo visible de errores son más importantes que paneles decorativos.

La arquitectura también debería ajustarse a la realidad operativa. Una aplicación web con una estructura de base de datos limpia puede funcionar en dispositivos existentes y es más fácil de mantener que una solución aislada en un único PC. Con una base estable — como PHP 8.4, JavaScript moderno, y MySQL 8 — los roles, historiales de registro, interfaces, y despliegues documentados pueden operarse de forma trazable a largo plazo.

No toda la información está destinada a cada rol. El personal de almacén necesita tareas abiertas y diálogos de registro claros. El control de inventario necesita alertas y sugerencias de reposición. La dirección necesita evaluaciones sobre tiempos de tránsito, discrepancias, y operaciones abiertas. Los conceptos de acceso basados en roles, los registros, y los bloqueos de cuenta tras intentos fallidos repetidos pertenecen pronto a la planificación, especialmente cuando participan proveedores externos o varias sedes.

Implementación: primero demostrar, luego expandir

Un piloto debería funcionar con pedidos reales, no solo con datos de prueba en una sala de reuniones. Elijan una zona de almacén, un grupo de productos, o un turno, y definan de antemano cómo se reconocerá el éxito: menos registros correctivos, tiempo de procesamiento más corto, menos consultas, o una mayor tasa de finalización de registros el mismo día.

Planifiquen en paralelo un nivel de respaldo. Si la nueva aplicación falla o un proceso no está claro, el equipo debe saber cómo continuar trabajando y cómo se controlarán los registros posteriores. Esto no es señal de falta de confianza en la tecnología, sino de operativa profesional.

Tras dos a cuatro semanas suelen emerger los conocimientos más valiosos. Quizás no falta una función, sino un mejor etiquetado de artículos. Quizás el flujo de trabajo es correcto, pero un perfil de escáner o un permiso está creando un cuello de botella. Estas observaciones deberían fluir hacia ciclos de mejora cortos y controlados, en lugar de desencadenar un nuevo gran proyecto.

La mejor digitalización no hace que el día a día del almacén sea teóricamente más moderno, sino concretamente más tranquilo: menos búsqueda, menos transcripción manual, traspasos más claros, e información fiable precisamente cuando una decisión está pendiente.

Enlace permanente →

Lista de verificación para automatizar flujos de trabajo de almacén

Lista de verificación para automatizar flujos de trabajo de almacén

Cuando una recepción de mercancía se confirma en papel, los niveles de inventario se trasladan más tarde a una hoja de cálculo, y una pregunta de expedición se aclara por teléfono, cada paso individual parece manejable. Juntos, sin embargo, generan consultas, discrepancias de inventario y dependencia de empleados concretos.

Una lista de verificación para automatizar flujos de trabajo de almacén evita que esta situación se convierta prematuramente en un proyecto de software sobredimensionado. Separa los procesos que realmente deberían automatizarse de aquellos para los que una hoja de cálculo bien mantenida sigue siendo suficiente.

La lista de verificación para automatizar flujos de almacén antes de iniciar el proyecto

La automatización no empieza eligiendo un sistema. Empieza con una descripción verificable de lo que realmente ocurre en el almacén, incluso durante excepciones, cambios de turno y presión de tiempo. Repasen los siguientes puntos directamente a nivel de proceso con la dirección de almacén, expediciones, compras y, si corresponde, contabilidad.

1. Registrar movimientos, no solo inventarios

Un inventario actual es el resultado de movimientos. Por eso debe quedar claro qué eventos aumentan, disminuyen, reservan, bloquean o transfieren existencias. Entre ellos están la recepción de mercancía, la ubicación, el picking de pedidos, la expedición, las devoluciones, las mermas, las discrepancias de inventario y los traslados.

Cada movimiento requiere una respuesta definitiva a cuatro preguntas: ¿quién lo ejecuta? ¿Cuándo se registra? ¿Qué ubicación de almacén se ve afectada? ¿Qué documento o pedido lo justifica? Si hoy estas respuestas solo existen en la cabeza de empleados con experiencia, es un candidato perfecto para la automatización. El objetivo no es recopilar más datos, sino construir un historial resiliente a partir del cual pueda explicarse cualquier nivel de existencias.

2. Depurar artículos, variantes y unidades

Muchos proyectos fracasan no por los escáneres o las interfaces web, sino por los datos maestros. Un artículo puede comprarse por cajas, almacenarse por unidad y venderse en sets. Sin conversiones definidas, el software produce cantidades formalmente correctas pero operativamente erróneas.

Revisen los códigos de artículo en busca de duplicados, establezcan descripciones vinculantes y distingan entre unidades de venta, unidades de almacenamiento y unidades de embalaje. Los números de serie, lotes, fechas de caducidad o clasificaciones de materiales peligrosos solo deberían incluirse en la construcción inicial si influyen en decisiones diarias o son legalmente obligatorios. Todo lo demás aumenta inicialmente el esfuerzo de mantenimiento y la superficie de error.

3. Definir las ubicaciones de almacén con la precisión necesaria

"Nave 2" puede bastar para una lista de inventario. Para un picking fiable, suele ser demasiado impreciso. Definan si una ubicación se refiere a una zona, estantería, hueco, slot o área de tránsito. Las zonas de cuarentena, las áreas de recepción, las áreas de devolución y los buffers de expedición también deben ser reconocibles como ubicaciones distintas si puede haber mercancía allí.

El nivel de granularidad adecuado depende del negocio. Un taller con unos pocos cientos de posiciones no necesita estrictamente una gestión por casillero. Sin embargo, con varios operarios de picking por turno, una ubicación de almacén precisa puede reducir significativamente los recorridos y los tiempos de búsqueda. No automaticen un nivel de precisión que nadie pueda mantener.

4. Establecer disparadores, roles responsables y aprobaciones

Un flujo de trabajo necesita un punto de partida claro. En la recepción de mercancía, puede ser la entrega en el muelle, el pedido de compra en aprovisionamiento, o el escaneo de un albarán. Para el reabastecimiento, un stock mínimo puede activar una propuesta, mientras que el pedido final sigue siendo responsabilidad de una persona.

Documenten además qué acciones pueden ocurrir automáticamente y cuáles requieren revisión. Una cantidad faltante debería generar una discrepancia, no alterar silenciosamente la recepción esperada. Los pasos de aprobación son sensatos para artículos valiosos, gestionados por lotes o críticos para la seguridad. Para consumibles, ralentizarían innecesariamente el flujo.

5. Generar documentos donde se necesitan

Los albaranes, listas de ubicación, listas de picking, etiquetas de envío y protocolos de entrega suelen originarse en aplicaciones distintas. Esto provoca rupturas: una dirección se copia, un pedido se marca, y el estado de envío se actualiza más tarde.

Registren la fuente de datos, la marca de tiempo de creación y el destinatario para cada documento. Un flujo de trabajo sensato podría, por ejemplo, generar automáticamente una lista de picking tras la aprobación de un pedido, proporcionar una etiqueta de envío tras el embalaje, y cerrar el pedido con una marca de tiempo tras la entrega. Lo crucial es que los datos ya no necesiten introducirse manualmente varias veces.

Comprobar interfaces y calidad de datos

La mejor lógica de almacén es inútil si los pedidos llegan solo una vez al día como archivo, o si las direcciones de entrega están formateadas de forma inconsistente. Creen por tanto una lista sobria de los sistemas que envían o reciben datos: tienda, ERP, contabilidad, transportista, portal de proveedores, sistema de producción y hojas de cálculo existentes.

Para cada conexión, debería establecerse qué sistema es la fuente autorizada para cada campo de datos. Si los datos maestros de artículos son autorizados en el ERP, el portal de almacén no debe crear silenciosamente sus propios artículos. Si un cambio de pedido viene de la tienda, debe hacerse visible antes de la expedición. Para volúmenes bajos, una importación CSV controlada puede ser el primer paso correcto. Para volumen alto o plazos de entrega cortos, una interfaz directa merece la pena.

El manejo de errores es igual de importante. Una interfaz no debería solo transferir datos, sino también mostrar qué se rechazó y por qué. Los códigos de artículo desconocidos, direcciones no válidas o cantidades faltantes no deben desaparecer en un archivo de registro técnico. Requieren una lista de trabajo con responsabilidad designada y estado.

Diseñar la usabilidad en el suelo del almacén

Un proceso que parece plausible en un escritorio puede fallar en el suelo del almacén. Los empleados llevan guantes, mueven mercancía, comparten dispositivos, o trabajan con cobertura Wi-Fi inestable. Comprueben por tanto desde el principio si escáneres, tabletas, puestos fijos o impresos en papel encajan con cada paso de trabajo.

El escaneo debería dar una retroalimentación clara: artículo correcto, ubicación de almacén equivocada, cantidad ya registrada, o artículo bloqueado. Los colores solos no bastan. Mensajes cortos y comprensibles, junto con un siguiente paso claro, son más valiosos bajo presión de tiempo que una interfaz rica en funciones.

Planifiquen también las excepciones. ¿Qué ocurre con un código de barras dañado, un corte de red, una entrega parcial, o mercancía sin asignar descubierta? Un buen flujo de trabajo ofrece rutas controladas para esto y registra la corrección. No obliga a los equipos a depender de notas adhesivas y registros por lotes posteriores.

Definir métricas antes de construir paneles de control

Un panel de control no es un objetivo. Las métricas relevantes son las que desencadenan una decisión operativa. Esto puede incluir recepciones abiertas que superan una antigüedad definida, pedidos cercanos a su plazo de envío, discrepancias de inventario por zona de almacén, errores de picking, o el tiempo transcurrido entre la recepción del pedido y la entrega.

Definan la fuente de datos, la regla de cálculo y el rol responsable para cada métrica. La "precisión de inventario", por ejemplo, solo tiene sentido cuando queda claro contra qué recuento se mide y cómo se tratan las devoluciones o el stock bloqueado. Unas pocas métricas fiables son mejores que un muro de gráficos en el que nadie confía.

Planificar seguridad, permisos y trazabilidad

La automatización distribuye capacidad de actuación. Quién puede modificar el inventario, crear artículos, generar etiquetas de envío o cancelar pedidos debería establecerse deliberadamente. Los permisos basados en roles suelen ser más sensatos que un inicio de sesión compartido en el PC del almacén. Las correcciones especialmente críticas requieren una marca de tiempo, una asignación de persona y, idealmente, un motivo.

Los fundamentos técnicos también pertenecen a la lista de verificación: copias de seguridad regulares, recuperación probada, credenciales de acceso documentadas, registro de errores de interfaz, y un procedimiento para cuentas de usuario bloqueadas o desactivadas. En una aplicación a medida, tecnologías mantenibles, una estructura de base de datos limpia y pasos de despliegue trazables no son detalles menores. Determinan si las modificaciones siguen siendo manejables después de dos años.

Implementar en pasos pequeños y medibles

No intenten convertir a la vez la recepción de mercancía, la reposición, el recuento de inventario, la expedición y la planificación de rutas. Elijan un flujo de trabajo con fricción perceptible y riesgo manejable, como el registro móvil de recepciones de mercancía o la generación automática de documentos de envío. Antes de empezar, registren el tiempo de procesamiento, las correcciones y los casos abiertos.

Prueben con artículos reales, pedidos reales y los empleados que realmente trabajarán con ellos. Un piloto con una zona de almacén o un grupo de productos muestra más rápido que un taller si las descripciones, los flujos de escaneo y las aprobaciones funcionan. Solo cuando las excepciones estén dominadas debería seguir el siguiente proceso.

La automatización tiene éxito cuando los equipos necesitan hacer menos preguntas, el inventario sigue siendo explicable, y el proceso funciona incluso cuando la persona más experimentada está de vacaciones. Precisamente ahí merece la pena la siguiente mejora: no con la herramienta más ruidosa, sino con la fricción que realmente ralentiza la jornada laboral.

Enlace permanente →

Mejorar los tiempos de carga de sitios web móviles

Mejorar los tiempos de carga de sitios web móviles

Cuando se usa un smartphone de almacén con mala cobertura para acceder a un sitio, no es la animación de la sección hero lo que determina la primera impresión, sino si la página llega a ser interactiva. Si un cliente potencial espera tres, cuatro o cinco segundos por el contenido, la alternativa está a solo un botón de "atrás" de distancia. Mejorar los tiempos de carga de sitios móviles requiere una secuencia técnica trazable, no retoques cosméticos puntuales.

Esto aplica especialmente a los sitios diseñados para generar solicitudes: para un fabricante, un proveedor de logística o una empresa con servicios complejos. Los usuarios móviles acceden con frecuencia a las páginas entre citas, en el almacén, o mediante búsquedas con una intención concreta. El sitio debe entregar información, no provocar un procesamiento pesado en el dispositivo.

Por qué la velocidad de carga móvil es un problema operativo

El rendimiento móvil suele tratarse estrictamente como una disciplina de SEO. Eso se queda corto. Las páginas rápidas ayudan a la visibilidad y a los costes de campaña, pero el efecto inmediato está en el uso real: los formularios se envían con más frecuencia, los números de teléfono se marcan más a menudo y la información de producto se lee con atención. Un sitio lento, en cambio, genera dudas antes incluso de que un interlocutor pueda responder.

"Rápido" no es una única métrica. Una página puede mostrar un fondo pronto y aun así seguir sin responder a los clics durante bastante tiempo. Para los visitantes importan tres cosas: ¿cuándo aparece el contenido más importante? ¿Cuándo puede usarse la página sin demora? ¿Y sigue moviéndose el diseño mientras intentan tocar un botón? Estas preguntas se reflejan en métricas como Largest Contentful Paint, Interaction to Next Paint y Cumulative Layout Shift.

Las mediciones deben hacerse en condiciones realistas. Un potente ordenador de oficina con Wi-Fi enmascara problemas que se vuelven evidentes en un dispositivo Android más antiguo con red móvil. La ubicación, los servicios intermedios y una caché del navegador ya poblada también alteran los resultados. Las mediciones repetidas y los datos de usuarios reales importan mucho más que una única prueba perfecta.

Mejorar los tiempos de carga de sitios móviles: primero medir, después cambiar

El error más común es comprimir imágenes de inmediato o instalar otro plugin de optimización. Ambas cosas pueden ayudar, pero sin un análisis de causa raíz crean rápidamente configuraciones difíciles de mantener. Comprueben primero una selección representativa: la página de inicio, una página típica de servicio o producto, la página de contacto y una landing page de alto tráfico. En estas páginas se vuelven visibles los patrones.

El registro de red revela qué archivos bloquean la inicialización y qué tamaño tienen realmente. Una auditoría de rendimiento muestra si JavaScript retrasa la interacción, si las fuentes llegan tarde o si las imágenes se cargan innecesariamente pronto. Complementen las mediciones de laboratorio con datos de visitantes reales si el tráfico lo permite. Esto evita optimizar para un perfil de prueba que no refleja a su público objetivo real.

Fijen un objetivo claro antes de cada cambio. Por ejemplo: el contenido principal visible debería aparecer en un dispositivo móvil medio en menos de 2,5 segundos, o el formulario de contacto debería ser utilizable sin retraso al escribir. No todas las páginas requieren una puntuación teórica perfecta. Una aplicación compleja con datos autenticados tiene requisitos distintos a los de un sitio corporativo público. Una fiabilidad aburrida pero demostrable vale aquí más que una puntuación a corto plazo lograda con trucos arriesgados.

1. Tratar las imágenes según su propósito

En muchas páginas móviles, las imágenes siguen siendo el mayor bloque de datos. El problema no es la foto en sí, sino una imagen transmitida a 2.500 píxeles de ancho cuando el dispositivo solo requiere 700 píxeles. Proporcionen variantes de imagen responsivas para que el navegador pueda elegir el tamaño adecuado. Formatos modernos como WebP o AVIF suelen reducir significativamente el tamaño de archivo, aunque deben desplegarse con alternativas limpias y calidad de imagen verificada.

La imagen más grande en el viewport inicial visible merece especial atención. Debería estar correctamente recortada, tener una resolución adecuada y cargarse pronto. Las imágenes más abajo en la página pueden cargarse de forma diferida. Esto ahorra datos al entrar, pero no debe hacer que las imágenes aparezcan de forma visible al hacer scroll cuando el usuario ya las espera.

No descarten todas las imágenes por reflejo. Una buena imagen puede explicar una máquina, un equipo o un proceso más rápido que un párrafo de texto. La tarea técnica es entregar información visual relevante de forma eficiente, no reducir el diseño a recuadros grises de relleno.

2. Limitar JavaScript al trabajo necesario

Cada script compite por el tiempo de procesamiento durante la carga y la interacción. Son especialmente problemáticas las bibliotecas integradas de forma genérica, los gestores de etiquetas con muchos scripts de terceros, los widgets de chat, los mapas y las animaciones. En dispositivos de escritorio, estos costes suelen pasar desapercibidos. En móvil, resultan en una página visible pero que reacciona con lentitud a las entradas.

Verifiquen para cada script su propósito, su condición de carga y su valor de negocio. Un mapa interactivo en la página de contacto no necesita cargarse en cada subpágina. Una herramienta de cookies o análisis no debería desencadenar una cadena de archivos adicionales antes de que el visitante siquiera pueda leer el contenido. Las funciones necesarias solo tras la interacción pueden cargarse bajo demanda.

Para los sitios desarrollados a medida, una estructura de componentes clara es una ventaja real. JavaScript se agrupa por función en lugar de entregarse como un paquete global. Esto también facilita el mantenimiento posterior: ampliar un formulario no altera accidentalmente el código de un filtro de productos o de una navegación.

3. Entregar CSS y fuentes sin bloqueos

Un cuello de botella frecuente está en la zona visible inicial. Si para ella deben cargarse varias hojas de estilo, fuentes de iconos y variantes de fuentes externas, el navegador espera innecesariamente mucho. Los estilos críticos para la sección visible deberían ser pequeños y estar disponibles pronto. Las reglas no críticas pueden seguir después.

En las fuentes web, normalmente bastan pocos pesos. Cuatro pesos en normal, cursiva y subconjuntos adicionales parecen completos en un sistema de diseño, pero rara vez son necesarios para un sitio corporativo típico. Definan alternativas de sistema sensatas para que el texto siga siendo legible de inmediato. Una fuente que cambia limpiamente unos milisegundos después es mejor que bloques de texto vacíos.

Los iconos también merecen una revisión. Un pequeño conjunto SVG suele ser más eficiente y controlable con precisión que una fuente de iconos completa. Esta regla admite excepciones: los sistemas existentes no necesitan reconstruirse solo por unos pocos kilobytes. Pero si de todos modos se planean cambios mayores, esta decisión pertenece a la base técnica.

4. Configurar el caché y la respuesta del servidor de forma limpia

Incluso una interfaz ligera se siente lenta si el servidor tarda demasiado en dar la primera respuesta. Las causas van desde consultas de base de datos sin optimizar, pasando por páginas compuestas dinámicamente, hasta la falta de caché. El contenido público que cambia poco debería poder entregarse rápidamente como versión en caché. Los archivos estáticos como imágenes, CSS y JavaScript requieren nombres de versión únicos y reglas de caché sensatas.

En las aplicaciones PHP, esto además implica una ejecución eficiente, una caché de opcode correctamente configurada y accesos controlados a la base de datos. Las consultas MySQL necesitan índices que coincidan con los caminos reales de filtrado y ordenación. Una página de inicio que ejecuta varias consultas de datos redundantes en cada solicitud no mejorará con el crecimiento del tráfico.

Sin embargo, el caché no es un cheque en blanco. Los precios, disponibilidades, secciones personalizadas o contenido tras iniciar sesión nunca deben parecer desactualizados por error. Por eso los límites del caché se definen con precisión: ¿qué puede tener cinco minutos de antigüedad, qué debe estar inmediatamente actualizado, y quién vacía el caché tras una modificación de contenido? De esta precisión surge un buen rendimiento.

5. Tratar a los proveedores externos con espíritu crítico

Los servicios externos suelen ser el lastre invisible de un sitio web. Analítica, gestión de consentimiento, vídeos, mapas, widgets de reseñas y píxeles de marketing cargan scripts adicionales desde servidores externos. Cada dependencia puede causar retrasos, plantear cuestiones de privacidad y perjudicar la representación visual en caso de error.

Esto no significa que haya que eliminar cada herramienta externa. Un vídeo puede apoyar las ventas, una herramienta de análisis puede fundamentar decisiones importantes. Pero se necesita un análisis de coste-beneficio. Carguen los medios incrustados solo tras el consentimiento o la interacción. Usen inicialmente un marcador de posición para los mapas. Y, finalmente, eliminen las etiquetas cuyos datos nadie evalúa desde hace meses.

6. Tener en cuenta los saltos de diseño y la usabilidad móvil

La velocidad de carga y la usabilidad van de la mano. Reserven dimensiones fijas para imágenes, banners y elementos incrustados para que los botones no se muevan bajo el dedo del usuario. Eviten los pop-ups que cubren el contenido visible justo al entrar. Una página rápida que muestra de inmediato una superposición difícil de cerrar no resuelve el problema de fondo.

Prueben los formularios con especial cuidado. Campos de entrada grandes, tipos de teclado adecuados y recorridos obligatorios cortos ayudan más que un efecto visual elaborado. Si una solicitud solo requiere nombre, número de devolución de llamada y motivo, un formulario de doce partes no es señal de minuciosidad: es fricción.

7. Gestionar el rendimiento como un proceso operativo permanente

Un relanzamiento único no mantiene el tiempo de carga bajo de forma permanente. Nuevas imágenes de campaña, requisitos de seguimiento y módulos editoriales se van acumulando con el tiempo. Por eso los presupuestos de rendimiento pertenecen al proceso de desarrollo: un tamaño máximo para las imágenes de entrada, reglas claras para nuevas herramientas de terceros y límites definidos para JavaScript.

Después de cada lanzamiento, deberían reevaluarse los tipos de página principales. Las pruebas automatizadas pueden determinar si las páginas centrales siguen siendo accesibles y si los flujos críticos funcionan correctamente. Sin embargo, para el rendimiento, una prueba puramente funcional no es suficiente. Complétenla con mediciones del tiempo de respuesta, el volumen de datos transferidos y la interactividad móvil.

Un sitio móvil rápido no surge de un único plugin, ni de renunciar a todo a cualquier precio. Surge cuando el diseño, el contenido, la infraestructura y el uso real se consideran juntos. Empiecen por la página que genera solicitudes o contactos operativos, midan en condiciones honestas y eliminen la fricción allí donde los usuarios realmente la sienten.

Enlace permanente →

Software logístico que realmente alivia las operaciones

Software logístico que realmente alivia las operaciones

Cuando una recepción de mercancía se anota primero en papel, luego se traslada a una hoja de cálculo y finalmente se comunica a expediciones de palabra, rara vez es la dedicación de los empleados lo que falta. Lo que falta es una base de trabajo compartida y fiable. Un buen software logístico no sustituye estas fracturas con más trabajo en pantalla, sino con flujos de trabajo claros: qué ha llegado, dónde se encuentra, qué se ha reservado y qué se puede enviar hoy.

Para las pequeñas y medianas empresas, no importa la lista más larga posible de funciones. El factor decisivo es que el software refleje el trabajo real en el suelo del almacén, en la oficina y en expediciones. Una solución pensada para una multinacional con veinte sedes puede resultar innecesariamente lenta, cara y complicada para una operación con un almacén y dos turnos.

Cuándo tiene sentido de verdad un software logístico

Las hojas de cálculo no son fundamentalmente un problema. Para cantidades bajas, una lista maestra de artículos manejable y un único empleado responsable, pueden ser la solución más pragmática. Sería un error sustituir un proceso funcional por un proyecto solo por el gusto de modernizar. El punto de inflexión llega cuando la información debe mantenerse varias veces o nadie puede decir con certeza qué archivo está actualizado. Las señales típicas son la escasez de existencias a pesar de estanterías llenas, consultas sobre el estado de las entregas, albaranes escritos a mano y recuentos de inventario que paralizan la operación durante días. El número creciente de pedidos también hace visible qué pasos se sostenían antes solo por la experiencia de personas concretas.

Entonces no se trata principalmente de digitalización como palabra de moda. Se trata de fuentes de error y tiempos de espera. Un empleado no debería tener que comparar varias listas solo para aprobar un pedido. Expediciones no debería tener que adivinar si un artículo está realmente disponible o ya reservado para otro pedido.

Qué procesos debería conectar el software logístico

Una solución utilizable empieza por el flujo de material, no por un menú estándar. Para muchas empresas, este flujo abarca recepción de mercancía, ubicación, gestión de inventario, picking de pedidos, expedición y retroalimentación. Según el negocio, se añaden lotes, números de serie, devoluciones, órdenes de fabricación o planificación de rutas.

Recepción de mercancía con inventarios trazables

Mucho se decide en la recepción de mercancía. Si una entrega se comprueba directamente contra un pedido o albarán, las discrepancias de cantidad, la mercancía dañada y las posiciones faltantes pueden registrarse justo donde ocurren. La mercancía recibe un estado en lugar de simplemente ser aparcada físicamente en algún lugar.

El software no tiene por qué empezar necesariamente con hardware de escaneo costoso. En algunos almacenes, una tableta o un puesto de trabajo en la zona de recepción de mercancía basta para empezar. Sin embargo, donde muchas posiciones se mueven a diario, los escáneres de código de barras son sensatos porque aceleran los registros y reducen los errores de tecleo. La decisión correcta depende de las cantidades, los trayectos y la estructura de los artículos.

Movimientos de almacén sin un registro histórico

Los inventarios solo son resilientes si las recepciones, reubicaciones, retiradas y correcciones son trazables. Esto no significa que deba evitarse toda excepción. En la operativa diaria hay embalajes dañados, ubicaciones incorrectas y retiradas espontáneas de material. Una buena aplicación hace que estos casos sean registrables, pero también documenta quién cambió qué y cuándo.

Este historial no es un instrumento de control por sí mismo. Ayuda a encontrar causas. Si un artículo acaba repetidamente en la ubicación de almacén equivocada, puede que el etiquetado del almacén no sea claro. Si se producen correcciones regulares, el problema suele estar en el proceso previo al registro.

Pedidos, albaranes y expedición desde un único flujo de trabajo

Muchos equipos pierden tiempo en la interfaz entre el procesamiento de pedidos y la expedición. Los datos del pedido llegan por correo electrónico, teléfono o desde un sistema de tienda independiente. Después, las posiciones se imprimen, se comprueban los inventarios y se registran de nuevo los documentos de envío. Cada traspaso manual crea margen para discrepancias.

El software logístico debería poder generar una lista de picking clara, un albarán y, si es necesario, una etiqueta de envío a partir de un pedido aprobado. Aquí el orden es importante: primero debe estar claro qué es entregable. Después, el pedido debería reservarse para otros procesos. De lo contrario, surge la desagradable situación en la que dos empleados asignan el mismo inventario restante.

Una planificación que se ajusta a la realidad

La planificación de rutas y el control de capacidad pueden ser valiosos, especialmente con reparto propio, franjas horarias fijas o muchas paradas regionales. Sin embargo, no son automáticamente el siguiente paso sensato. Quien todavía no tenga una aprobación de pedidos limpia y datos de inventario fiables debería resolver primero esos fundamentos.

Lo mismo se aplica a las previsiones y a la planificación asistida por IA. Pueden hacer visibles los patrones, pero requieren datos de entrada limpios. Una previsión basada en un inventario incompleto parece técnicamente sofisticada, pero no mejora la capacidad de entrega.

¿Solución estándar o software logístico a medida?

El software estándar es sensato cuando los propios flujos de trabajo son en gran medida convencionales y pueden adaptarse sin gran fricción. Puede implementarse más rápido y aporta funciones básicas ya probadas. Para una operación con procesos de almacén sencillos, roles claros y pocas particularidades, esa suele ser la opción económicamente correcta.

Un software logístico a medida merece la pena cuando el negocio vive de flujos de trabajo especiales o los sistemas existentes solo pueden conectarse mediante rodeos. Esto afecta, por ejemplo, a talleres con incidencias de material en pedidos en curso, distribuidores con reglas de envío específicas por cliente, o fabricantes que deben vincular estrechamente los movimientos de almacén con los pasos de producción.

La diferencia no está en reinventarlo todo. Los buenos sistemas a medida adoptan patrones probados como cambios de estado, reservas y permisos. Sin embargo, adaptan el lenguaje, las pantallas, los documentos y las interfaces al trabajo que realmente se realiza. Así, el equipo no tiene que orientarse permanentemente hacia categorías que solo tienen sentido en el manual del fabricante.

En softify.pro, un proyecto de este tipo comienza, por tanto, con la pregunta de qué flujos de trabajo deben preservarse. No todo papel es un error, y no toda regla especial tiene sentido. Solo cuando está claro dónde se pierde información o dónde las decisiones esperan innecesariamente se puede planificar una solución viable.

Un despliegue sin interrupción operativa

El mayor riesgo rara vez está solo en el código del programa. Está en una implementación que quiere cambiar demasiado de golpe. Un almacén no puede detenerse durante dos semanas para aprender un nuevo sistema. Por eso, un despliegue paso a paso suele ser más sensato que una gran fecha de cambio.

Un buen primer tramo se centra en un flujo de trabajo delimitado, por ejemplo, la recepción de mercancía y los registros de inventario o la creación de albaranes. El equipo trabaja con datos reales, la retroalimentación fluye directamente hacia la adaptación, y el beneficio se vuelve medible. Solo entonces siguen otras áreas, como el picking móvil, las devoluciones o las conexiones con tiendas y transportistas.

La migración de datos merece especial atención aquí. Los números de artículo antiguos, los datos maestros de clientes duplicados y las ubicaciones de almacén incoherentes no desaparecen automáticamente solo porque se introduzca un nuevo sistema. A menudo es mejor limpiar deliberadamente los datos maestros y adoptar solo los historiales relevantes. Esto ahorra búsquedas posteriores y evita que el viejo desorden se conserve técnicamente.

Los permisos también pertenecen pronto a la agenda. No todo empleado necesita acceso a precios, a todas las correcciones de inventario o al mantenimiento de datos maestros. Los roles claros protegen contra modificaciones accidentales y hacen visibles las responsabilidades sin bloquear el flujo de trabajo con aprobaciones innecesarias.

Una tecnología que no se convierte en una carga tras la puesta en marcha

Una aplicación logística debe reaccionar rápido en la operativa diaria, incluso si varios puestos registran simultáneamente. Para ello necesita una arquitectura de datos trazable, transacciones limpias y reglas claras para modificaciones paralelas. Si dos empleados procesan el mismo inventario, el sistema no debe generar registros erróneos silenciosos.

La mantenibilidad es igual de importante. Tecnologías como PHP 8.4, JavaScript moderno y MySQL 8 no son un argumento de venta en sí mismas. Son sensatas cuando la aplicación sigue siendo comprensible a largo plazo, recibe actualizaciones de seguridad y puede ser continuada por desarrolladores cualificados. El aprovisionamiento documentado, las copias de seguridad, el registro y una gestión realista de las actualizaciones forman parte de la capacidad operativa.

Un buen software logístico, por tanto, no se reconoce por una demo especialmente vistosa. Se demuestra en un martes por la mañana normal: la entrega se registra, el inventario es correcto, el pedido es trazable, el albarán coincide y el siguiente turno sabe qué se ha hecho ya. El alivio surge precisamente ahí — no a través de tantas funciones como sea posible, sino a través de flujos de trabajo fiables que encajan con la operación.

Enlace permanente →

Planificar una base de datos MySQL para aplicaciones web

Planificar una base de datos MySQL para aplicaciones web

Cuando tres empleados reservan mercancía en paralelo por la mañana, un cliente comprueba el estado de su entrega y la administración emite una factura, la calidad de una aplicación no se ve en su diseño. Se demuestra en que todos vean exactamente el mismo estado correcto de los datos. Planificar una base de datos MySQL para una aplicación web no significa, por tanto, crear tablas lo más rápido posible. Significa entender los flujos de trabajo reales con suficiente precisión para garantizar que los datos sigan siendo fiables incluso bajo carga, durante errores, y a medida que el negocio crece.

Especialmente en plataformas internas, procesos de almacén y pedidos, o portales orientados al cliente, la base de datos suele abordarse demasiado tarde. Primero se construye la interfaz, luego se añaden campos, seguidos de excepciones. Eso funciona para un prototipo. En producción, esto se traduce en conjuntos de datos duplicados, estados poco claros e informes en los que ya nadie confía del todo.

Planificar una base de datos MySQL para aplicaciones web: empezar por el flujo de trabajo

El primer borrador no debería empezar por los nombres de columna, sino por una situación de trabajo concreta. Tomemos la recepción de mercancía: llega una entrega, se asigna a un proveedor y a un pedido, se comprueban las cantidades, se asigna una ubicación de almacén y el stock cambia. Según la operación, este proceso requiere además fotos, una inspección de calidad, un estado de bloqueo o una corrección trazable. De este flujo de trabajo surgen los objetos funcionales. Ejemplos típicos son artículos, proveedores, pedidos, posiciones, ubicaciones de almacén, movimientos de inventario y usuarios.

La distinción entre un objeto y un evento es crucial. Un artículo describe qué es algo. Un movimiento de inventario documenta que una cantidad cambió en una ubicación específica en un momento específico. Mezclar ambos en una sola tabla lleva rápidamente a una pérdida de trazabilidad.

Algunas preguntas difíciles ayudan para cada objeto: ¿cuál es la identidad única? ¿Qué información puede cambiar? ¿Quién puede modificarla? ¿Qué datos deben conservarse históricamente? ¿Y qué reglas se aplican cuando dos personas trabajan simultáneamente? Estas preguntas previenen la improvisación posterior mejor que una larga lista de campos de base de datos supuestamente completa.

El modelo de datos debe expresar reglas

Una base de datos no es simplemente un almacén para las entradas de formularios. Debería hacer cumplir reglas centrales por sí misma. Si cada movimiento de inventario debe pertenecer exactamente a un artículo y una ubicación de almacén, las claves foráneas tienen su lugar en el modelo. Si un número de pedido externo solo puede aparecer una vez por tenant, se necesita un índice único. Si una posición nunca debería existir sin un pedido de cabecera, esta relación debe modelarse con claridad.

MySQL 8 con InnoDB ofrece bases sólidas para esto: transacciones, claves foráneas, mecanismos de bloqueo y cambios coherentes en múltiples tablas. Al escribir un movimiento, el inventario actual y el registro de inspección durante un registro de recepción de mercancía, esto debería ocurrir como una transacción cohesiva. Si un paso falla, no debe quedar ninguna operación a medio terminar.

Sin embargo, no todas las reglas pertenecen a la base de datos. Las aprobaciones, la lógica de precios compleja o los pasos de proceso dependientes de rol a menudo se ubican mejor en la lógica de la aplicación porque cambian más rápido funcionalmente. El límite es pragmático: las reglas cuya violación daña los datos de forma permanente deberían protegerse lo más cerca posible de los datos. Las reglas que cambian con frecuencia o dependen fuertemente del contexto requieren código de aplicación bien probado.

No confundir el historial con los valores actuales

Un error común es almacenar solo el inventario actual o el estado actual. Eso basta hasta que alguien pregunta por qué cambió la cantidad ayer o quién restableció un pedido. Para los sistemas operativos, un historial de movimientos o eventos suele ser más valioso que un único campo sobrescribible.

Esto no significa registrar permanentemente cada movimiento de clic. Deberían registrarse los cambios relevantes para el negocio: cambios de estado, modificaciones de cantidad, correcciones, aprobaciones y asignaciones. Una buena entrada de auditoría contiene una marca de tiempo, el usuario o proceso del sistema, el valor anterior y el nuevo, y una razón comprensible cuando el flujo de trabajo lo exige. Esto permite aclarar errores sin tener que buscar en correos electrónicos, listas en papel o copias de seguridad de la base de datos.

Elegir con criterio las claves, tipos de datos y convenciones de nomenclatura

Las decisiones técnicas parecen pequeñas, pero condicionan el mantenimiento y las integraciones durante años. Para claves primarias internas, los valores BIGINT con asignación automática suelen ser una opción sobria y fácilmente manejable. Los UUID pueden tener sentido cuando los datos se originan sin conexión, varios sistemas escriben de forma independiente, o las interfaces externas no deberían exponer IDs secuenciales. Sin embargo, cuestan más almacenamiento y requieren algo más de atención con índices y ordenación.

Los importes monetarios deben almacenarse como DECIMAL, no como FLOAT o DOUBLE. Las cantidades también necesitan una precisión funcionalmente adecuada: los recuentos de artículos suelen ser enteros, mientras que los pesos y longitudes no lo son. Las marcas de tiempo deberían gestionarse de forma uniforme, idealmente internamente en UTC, mientras que la interfaz muestra la zona horaria local de la operación. Especialmente durante los cambios de turno y el horario de verano, esto evita discrepancias difíciles de detectar.

Los nombres también deberían ser aburridos e inequívocos. order_items o inventory_movements son más útiles que abreviaturas creativas que solo entiende el equipo de proyecto original. Las formas singular o plural coherentes son menos importantes que la coherencia en sí. Igual de sensatos son campos como created_at, updated_at y, cuando se necesite, deleted_at. Sin embargo, un borrado suave no es una obligación estándar. Para registros relevantes legal u operativamente, una anulación limpia suele ser mejor que un conjunto de datos eliminado de forma invisible.

Los índices siguen las consultas reales, no las suposiciones

Un índice puede acelerar enormemente una búsqueda, pero hace más complejas las operaciones de escritura y consume espacio de almacenamiento. Por eso, "un índice en cada campo" no es una estrategia. Las consultas más importantes deberían establecerse pronto: pedidos abiertos de un cliente, movimientos de un artículo en un período, inventario por ubicación de almacén, o registros modificados recientemente para una interfaz.

El orden de los índices compuestos importa aquí. Si la aplicación busca regularmente por tenant_id, status y created_at, un índice compuesto en este orden exacto suele ser sensato. Si realmente encaja lo muestra el plan de ejecución mediante EXPLAIN, no la intuición. Las bases de datos no se vuelven rápidas por trucos espectaculares, sino por consultas observables, índices adecuados y volúmenes de datos probados de forma realista.

Para las tablas en crecimiento, merece la pena tener una estrategia de retención clara. ¿Necesitan los registros técnicos permanecer en la base de datos de producción principal durante cinco años? No necesariamente. Los registros de negocio, los movimientos y las pruebas de inspección requieren períodos de retención distintos de la información de depuración. Archivar no es señal de un sistema débil, sino una decisión operativa deliberada.

El funcionamiento multiusuario requiere transacciones y estados claros

En una aplicación web, varias solicitudes acceden simultáneamente a los mismos datos. Esto es normal en las operaciones diarias de almacén, no una excepción. Dos empleados pueden reservar el mismo inventario mientras una importación crea nuevos pedidos. Sin transacciones y bloqueo específico, existe el riesgo de modificaciones perdidas o inventarios negativos que solo se hacen evidentes semanas después.

Para las operaciones críticas, debería estar claro qué datos se leen y escriben dentro de una transacción. A veces basta con una actualización atómica, como un inventario que solo cambia si la cantidad disponible es suficiente. En otros casos, un bloqueo de fila es sensato para que una operación pueda comprobar el estado de los datos de forma controlada y modificarlo después. Las transacciones largas, en cambio, son problemáticas: bloquean otro trabajo y aumentan el riesgo de conflictos.

Igual de importante es un conjunto limitado de estados funcionales. Un pedido no debería estar "abierto", "parcialmente entregado" y "procesado manualmente" al mismo tiempo debido al mantenimiento de campos contradictorios. Las transiciones de estado definidas simplifican las interfaces, los informes y las automatizaciones. Se pueden permitir excepciones, pero deberían nombrarse y documentarse.

Planificar seguridad, tenants y operaciones desde el principio

La aplicación debería usar un usuario de base de datos dedicado para MySQL con privilegios mínimos. El acceso de escritura para la aplicación web no significa que este usuario necesite eliminar tablas o modificar privilegios de usuario. Las cuentas administrativas no tienen cabida en los archivos de configuración de producción y nunca en un repositorio.

Cuando varios clientes, ubicaciones o empresas trabajan dentro de una aplicación, el aislamiento de tenants es una decisión arquitectónica, no una condición de filtro retroactiva. Una base de datos compartida con un tenant_id puede ser eficiente y fácil de mantener, pero exige comprobaciones coherentes en cada consulta y reglas claras para los índices. Las bases de datos separadas ofrecen un aislamiento más fuerte, pero aumentan el esfuerzo en actualizaciones, evaluaciones y operaciones. Qué variante encaja depende de los requisitos de privacidad de datos, el volumen de datos y el modelo de negocio.

Las copias de seguridad solo son copias de seguridad una vez que se ha probado una restauración. Se requiere un ritmo definido para copias de seguridad, retención y recuperación. Asimismo, la supervisión del espacio de almacenamiento, las consultas lentas y los trabajos fallidos, junto con actualizaciones documentadas, pertenecen al sistema. MySQL 8, PHP 8.4, y las aplicaciones web modernas pueden operarse bien a largo plazo si las dependencias, las credenciales de acceso y los pasos de despliegue no residen únicamente en la cabeza de un desarrollador.

Un plan sensato antes del primer día en producción

Antes de la implementación debería existir un modelo de datos compacto con flujos de trabajo de ejemplo. Esto incluye tablas y relaciones clave, reglas de estado, permisos, consultas esperadas, interfaces, y un concepto para copias de seguridad y registros de auditoría. Este plan no necesita tener cien páginas. Debe capturar decisiones que después resultarían costosas de corregir.

En softify.pro, la planificación de la base de datos comienza, por tanto, con las personas que reservan, comprueban, recogen o resuelven excepciones. Si una hoja de cálculo existente representa de forma fiable un proceso manejable, puede seguir siendo la solución correcta. Si varias personas trabajan simultáneamente, surgen registros y los errores deben ser trazables, la base de datos merece en cambio el mismo esfuerzo de planificación que la interfaz. La mejor arquitectura, al final, es la que simplifica el día a día laboral y que aún puede modificarse de forma transparente dentro de dos años.

Enlace permanente →

Cómo medir correctamente los Warehouse Automation Results

Cómo medir correctamente los Warehouse Automation Results

Una nueva interfaz de escaneo puede resultar impresionante el primer día. Sin embargo, tras tres semanas se ve con claridad si realmente acelera la recepción de mercancía o si simplemente crea un paso de trabajo adicional. Los Warehouse automation results no son, por tanto, una única métrica ni una captura de pantalla de una demo de producto. Se manifiestan allí donde un equipo de almacén tiene que buscar, preguntar, reintroducir datos y corregir menos, manteniendo o mejorando la calidad.

Para las pequeñas y medianas empresas, esta distinción es especialmente relevante. Las grandes suites empresariales suelen prometer una optimización integral, pero exigen implementaciones largas, procesos rígidos y mucho mantenimiento. Un paso de automatización sensato puede empezar más pequeño: precisamente en el punto donde hoy se pierde información o las decisiones esperan innecesariamente.

Qué Warehouse Automation Results cuentan realmente

Muchos proyectos parten de una pregunta técnica: ¿escáner de códigos de barras, app móvil, interfaz con la tienda o etiquetas automáticas? La mejor pregunta de partida es: ¿qué cuello de botella cuesta sensiblemente tiempo, dinero o fiabilidad por turno?

La respuesta rara vez está en el número de dispositivos desplegados. Los resultados significativos se miden en el trabajo diario. En la recepción de mercancía, por ejemplo, cuenta el tiempo entre la entrega y la disponibilidad del stock registrado. En el picking, es relevante el tiempo desde el pedido hasta estar listo para el envío. En los inventarios, no solo importa la duración, sino sobre todo la diferencia entre el stock del sistema y el stock real.

Igual de importantes son los indicadores que muchas operaciones no registran de forma limpia: ¿cuántas consultas surgen porque una ubicación de almacén no está clara? ¿Con qué frecuencia hay que corregir un albarán? ¿Cuántos pedidos quedan sin procesar porque solo una persona conoce el estado de memoria o en una hoja de cálculo privada? Precisamente este retrabajo silencioso desaparece de los informes clásicos de productividad, pero recae con fuerza sobre jefes de turno, planificación y atención al cliente. Una buena imagen objetivo combina velocidad y control. Si los pedidos se procesan más rápido pero aumentan los registros incorrectos, eso no es progreso. Si los inventarios se vuelven más precisos pero la recepción se satura, el proceso debe rediseñarse. La automatización tiene éxito cuando mejora el flujo de trabajo sin deteriorar la visión operativa de conjunto.

Del alivio percibido a los datos verificables

La experiencia de los empleados es un indicador valioso. Cuando alguien dice, tras dos semanas, que ya no tiene que correr a la oficina por cada ubicación, eso importa. Para las decisiones de inversión, sin embargo, sigue haciendo falta una comparación independiente de la sensación diaria. Antes del lanzamiento conviene, por tanto, registrar algunos valores de referencia: tiempo medio de procesamiento, número de casos de aclaración abiertos, registros de corrección, tiempos de búsqueda, errores de envío y precisión del inventario. No hacen falta veinte indicadores; a menudo bastan de cuatro a seis valores adaptados al problema concreto.

Tras el despliegue, esos mismos valores deben observarse durante varias semanas. Días puntuales de pico inducen fácilmente a error. La estacionalidad, las bajas, los nuevos empleados o un pedido inusualmente grande influyen en los resultados. Solo una comparación a lo largo de turnos normales muestra si el cambio es sólido.

El efecto más importante: un estado de proceso compartido

En muchos almacenes, la verdadera debilidad no es la falta de disposición a trabajar, sino un estado de información fragmentado. Recepción conoce la entrega, planificación conoce el pedido del cliente y expediciones conoce la prioridad, pero no todos trabajan con la misma información actualizada.

Un sistema específico para el flujo de trabajo puede cerrar esta brecha. Una entrega se registra al llegar, las discrepancias se documentan directamente, el inventario recibe un estado claro y el siguiente paso se vuelve visible. Los datos ya no necesitan anotarse en papel, transferirse más tarde y confirmarse después por teléfono.

Esto no solo reduce los desplazamientos. Reduce las decisiones basadas en información obsoleta. Un empleado de expediciones ve si un pedido es realmente preparable. La administración reconoce si la mercancía ha llegado o solo ha sido anunciada. La dirección no recibe una instantánea maquillada, sino una base trazable.

Para equipos con turnos rotativos, este efecto suele ser más valioso que un ahorro de tiempo espectacular. El proceso depende menos de personas concretas. El conocimiento ya no queda atrapado en cuadernos, historiales de chat o la memoria del especialista más experimentado.

Por qué no toda automatización da buenos resultados

La automatización refuerza los procesos. Es útil cuando el flujo es claro. Es problemático cuando un flujo poco claro simplemente se reproduce más rápido.

Un ejemplo típico es el registro obligatorio por escaneo para cada mínima acción. Si los empleados tienen que abrir varias pantallas para una excepción poco frecuente, surgen soluciones alternativas. Los artículos se registran entonces en bloque más tarde, los escáneres se quedan en un cajón, o un empleado vuelve a llevar una lista paralela. El software está presente, pero el proceso real continúa junto a él.

La calidad de los datos también impone límites. Los datos maestros de artículos sin unidades claras, una lógica de ubicaciones poco definida o denominaciones de proveedores incoherentes no se arreglan con una interfaz vistosa. Aquí, un proyecto puede consistir inicialmente en trabajo de limpieza. Eso parece menos visible que una aplicación nueva, pero suele ser el requisito previo para resultados fiables.

Además, hay procesos que deliberadamente no deberían automatizarse por completo. Una inspección experta de mercancía sensible, la aprobación de discrepancias inusuales o la decisión sobre una entrega especial requieren criterio profesional. Los buenos sistemas marcan claramente estos casos y los derivan de forma específica. No fingen que toda excepción pueda resolverse con una regla.

Cuándo una hoja de cálculo sigue siendo la mejor solución

No todo paso manual justifica un desarrollo a medida. Si un proceso ocurre raramente, involucra a pocos participantes y se gestiona de forma trazable, una hoja de cálculo bien mantenida puede seguir siendo razonable. El defecto no está en Excel en sí, sino en gestionar movimientos críticos sin responsabilidad clara, control de versiones o registro oportuno.

En cuanto varias personas modifican en paralelo, los movimientos de inventario se vuelven críticos en el tiempo, o hay que consolidar información de clientes procedente de fuentes distintas, el riesgo aumenta notablemente. Un sistema compartido suele salir entonces más económico que corregir continuamente malentendidos.

Los Warehouse Automation Results requieren un despliegue controlado

El camino más rápido hacia malos resultados es una reforma completa durante la operativa en marcha. Es mejor un ámbito delimitado con beneficio medible: por ejemplo, recepción de mercancía para un grupo de productos, etiquetas de envío para una sede, o un registro móvil para los traslados más frecuentes.

Un piloto debería reflejar pedidos reales y turnos reales. Los datos de prueba ayudan en el desarrollo, pero no muestran si el Wi-Fi fluctúa en la zona trasera del almacén, si los guantes dificultan el manejo del escáner o si un estado está formulado de forma confusa para planificación. Estos detalles determinan la aceptación y la calidad de los datos.

Técnicamente, cuenta más una fiabilidad aburrida y demostrable que una pila tecnológica de moda. Permisos de rol claros, registros de operaciones trazables, indicaciones de error inequívocas, transacciones de base de datos estables y procesos documentados no son cuestiones secundarias. Convierten una aplicación en una herramienta en la que los equipos pueden confiar en el día a día.

Para los sistemas logísticos a medida, esto también significa: la integración debe encajar con la operativa existente. Una aplicación puede recibir pedidos de una tienda, generar albaranes, poner a disposición etiquetas de envío y documentar movimientos de inventario. No necesita sustituir de inmediato todos los sistemas colindantes. Precisamente en las pymes, una sustitución paso a paso suele ser menos arriesgada y más económica.

Cómo un proyecto se convierte en una mejora duradera

Tras la implantación empieza la fase decisiva. ¿Se registran los casos especiales? ¿Las ubicaciones de almacén siguen correspondiendo a la realidad? ¿Los nuevos empleados entienden la lógica de registro sin traducción verbal? ¿Y siguen siendo válidos los valores medidos cuando crece el volumen de pedidos?

Los comentarios cortos y periódicos de almacén, expediciones y administración son más eficaces para esto que un gran taller anual. Cuando se hace visible una excepción recurrente, debería representarse como un paso de proceso claro o eliminarse deliberadamente del flujo estándar. Ambas opciones son mejores que tolerarla en silencio.

El siguiente paso más sensato a menudo no es un gran pliego de condiciones. Tome un proceso con consultas frecuentes y mida durante una semana dónde se pierde tiempo. Si de ahí surge un flujo claro y repetible, la automatización puede combinarse con un resultado tan convincente en el suelo del almacén como en la evaluación mensual.

Enlace permanente →

Desarrollo web moderno que funciona en la operativa: arquitecturas pragmáticas para pequeñas y medianas empresas — con código mantenible, almacenamiento de datos sólido y sin sobrecarga innecesaria de herramientas.

Desarrollo web moderno que funciona en la operativa: arquitecturas pragmáticas para pequeñas y medianas empresas — con código mantenible, almacenamiento de datos sólido y sin sobrecarga innecesaria de herramientas.

Un jefe de almacén imprime albaranes por la mañana mientras una colega corrige el inventario en una hoja de cálculo, y ventas llama para preguntar sobre el estado de un pedido. El problema rara vez es la falta de digitalización. La mayoría de las veces hay demasiadas herramientas desconectadas entre sí. El desarrollo web moderno entonces no crea simplemente una interfaz más bonita, sino una base de trabajo compartida y fiable.

Para las pequeñas y medianas empresas, esto significa: una aplicación web debe funcionar bajo presión de tiempo, en un escáner en el almacén tanto como en una pantalla en la oficina. Debe almacenar datos de forma rastreable, gestionar permisos limpiamente y permitir un mayor desarrollo sin convertirse en un riesgo con cada modificación. La tecnología no es aquí un fin en sí mismo. Es la base para que los procesos funcionen más rápido y permanezcan al mismo tiempo mejor controlables.

El desarrollo web moderno comienza antes del primer código

Quien comienza con un catálogo de funciones predefinido a menudo construye pasando por alto el verdadero cuello de botella. En la práctica, vale la pena un enfoque diferente: ¿qué información falta regularmente hoy? ¿Dónde ocurren entradas duplicadas? ¿En qué punto se aseguran las decisiones por teléfono o verbalmente porque nadie ve de forma fiable el estado actual?

En la recepción de mercancías, esto puede manifestarse por ejemplo como descripciones de artículos inconsistentes, instrucciones de inspección faltantes, o inventarios actualizados con retraso. En el procesamiento de pedidos, a menudo son notas manuscritas, aprobaciones poco claras y datos de envío mantenidos en múltiples sistemas. Una buena aplicación no solo digitaliza estas entregas. Las organiza de manera que las responsabilidades, estados y próximos pasos sean visibles.

Esto también significa no abolir reflexivamente las prácticas existentes. Una hoja de cálculo bien mantenida puede seguir siendo la solución más sensata para una pequeña evaluación. Una aplicación web personalizada vale la pena donde varias personas trabajan simultáneamente, los errores surgen de la transcripción manual, o un proceso necesita documentarse y ser repetible.

Lo que una aplicación web moderna debe lograr en el día a día

Una interfaz de usuario convincente es valiosa, pero es solo una parte del trabajo. En la operativa continua cuentan sobre todo los tiempos de respuesta, los flujos de trabajo comprensibles y los datos resilientes. Cuando un preparador de pedidos completa una tarea, el estado no debe hacerse visible solo después de varias actualizaciones. Cuando se modifica un pedido, debe ser rastreable qué se cambió y qué pasos posteriores se ven afectados. Esto incluye tres capas estrechamente conectadas: la interfaz de usuario, la lógica de aplicación y la base de datos. La interfaz guía a las personas a través del proceso. La lógica verifica, por ejemplo, campos obligatorios, permisos o cantidades disponibles. La base de datos almacena los hechos de manera que las evaluaciones, correcciones y ampliaciones sigan siendo posibles más adelante.

Para muchas aplicaciones empresariales, las tecnologías probadas son una elección más sensata que una tendencia efímera. PHP 8.4 puede ofrecer una lógica de servidor claramente estructurada, JavaScript moderno una experiencia de usuario receptiva, y MySQL 8 una base de datos sólida. El factor decisivo no es que cada proyecto use la misma pila. La clave es que la tecnología elegida se adapte al problema, la operativa y el mantenimiento a largo plazo.

El rendimiento es una cuestión de proceso

El rendimiento se reduce frecuentemente a los tiempos de carga. Eso es insuficiente. Una aplicación también se siente lenta cuando los empleados ejecutan demasiados pasos, buscan información, o tienen que introducir el mismo dato varias veces. Una página rápida con un formulario engorroso sigue siendo un mal proceso.

Una optimización sensata comienza por tanto con las operaciones más frecuentes. ¿Qué pantallas se abren cien veces al día? ¿Qué búsqueda debe permanecer rápida incluso con un volumen de datos creciente? ¿Qué datos deberían guardarse en segundo plano sin que los empleados esperen una confirmación? Solo después siguen detalles técnicos como índices de base de datos específicos, consultas reducidas y una entrega ligera de archivos en el navegador.

Modelo de datos y permisos: la arquitectura invisible

Muchos proyectos web no fallan en la primera versión, sino en adiciones posteriores. Un campo inicialmente simple como "Estado" se convierte de repente en una cadena de aprobación, inspección, procesamiento, cancelación y reprocesamiento. Si estos estados se almacenan solo de forma laxa en formularios, cada extensión se vuelve costosa y propensa a errores.

Un modelo de datos limpio separa por tanto procesos, posiciones, contactos, documentos y cambios de estado de forma rastreable. Previene entradas contradictorias en lugar de tener que limpiarlas laboriosamente después. Precisamente en los movimientos de almacén, albaranes o datos de pedidos, esta precisión no es un ejercicio académico. Determina si la cifra de inventario sirve como base de trabajo.

Los roles y permisos son igualmente importantes. No cada persona necesita acceso a precios, información de personal o configuraciones administrativas. Los buenos conceptos de permisos son concretos: ¿quién puede crear un pedido, aprobarlo o cancelarlo? ¿Quién solo ve su propio departamento? A esto se añaden medidas de protección como almacenamiento seguro de contraseñas, bloqueos de cuenta tras intentos fallidos repetidos, registro de cambios críticos y sesiones claramente reguladas. La seguridad, por tanto, no es un añadido justo antes del lanzamiento. Pertenece a la arquitectura porque las correcciones posteriores a menudo intervienen profundamente en el inicio de sesión, el acceso a datos y el sistema de permisos.

Responsive no significa solo "se adapta al teléfono"

Una aplicación responsive se adapta a diferentes tamaños de pantalla. Para el trabajo diario, esta definición no es suficiente. En una tableta en el almacén se aplican requisitos diferentes que en una pantalla grande en la planificación. Las áreas táctiles deben ser operables de forma segura, los detalles importantes no deben desaparecer bajo información secundaria, y las entradas deben seguir siendo prácticas incluso con guantes, condiciones de iluminación cambiantes o conexión inestable.

En consecuencia, cada vista necesita una prioridad clara. En la recepción de mercancías, el escaneo y la confirmación pueden estar en el centro. En la oficina, los filtros, listas, funciones de exportación y vistas detalladas suelen ser más importantes. Una interfaz que se ve idéntica en todas partes no es automáticamente utilizable en todas partes.

El desarrollo web moderno requiere una operativa controlada

El lanzamiento no es un punto final, sino el comienzo de la prueba real. Solo con datos reales, excepciones y horas punta se revela si las reglas son comprensibles y si las interfaces funcionan de manera fiable. El aprovisionamiento documentado, entornos claramente separados para desarrollo y producción, así como copias de seguridad rastreables forman por tanto parte del proyecto, no una mera administración de TI.

Las pruebas automatizadas también logran mucho aquí. Vuelven a verificar flujos de trabajo recurrentes como inicio de sesión, verificaciones de permisos, entrada de pedidos o generación de documentos después de cada cambio. Para aplicaciones sensibles, un entorno de pruebas autoalojado puede ser sensato porque las capturas de pantalla, datos de prueba y pasos de aplicación internos permanecen dentro de la esfera de control propia de la empresa. La automatización no reemplaza la revisión experta de empleados experimentados. Sin embargo, asegura que los flujos de trabajo conocidos no se dañen silenciosamente.

En softify.pro, esta mentalidad es parte de la implementación: planificar con precisión técnica, tomar en serio los flujos de trabajo reales, y entregar cambios de manera que sigan siendo comprensibles más adelante. Esto es menos espectacular que un despliegue de fuegos artificiales tecnológicos, pero significativamente más valioso en la operativa.

Cuándo el software estándar es suficiente — y cuándo no

El software estándar es sensato cuando tu propio proceso coincide en gran medida con los flujos de trabajo estándar de la industria y la configuración sigue siendo manejable. Puede estar disponible rápidamente y aportar funciones básicas fiables. Se vuelve problemático cuando los equipos se ven obligados a doblar continuamente sus flujos de trabajo funcionales de formas incómodas o cuando información vital termina fuera del sistema.

Una solución personalizada no es automáticamente mejor. Requiere requisitos claros, contactos responsables, y la disposición para tomar decisiones. A cambio, puede mapear exactamente los pasos de trabajo que son críticos para la empresa: una inspección especializada de recepción de mercancías, la impresión de etiquetas de envío correspondientes, una aprobación basada en el grupo de clientes, o la conexión entre taller, almacén y ventas. La pregunta correcta, por tanto, no es: ¿necesitamos una aplicación a medida? Es: ¿qué fricción recurrente nos cuesta hoy tiempo, dinero o fiabilidad — y se puede eliminar permanentemente con un esfuerzo razonable?

Una buena aplicación web no hace que el trabajo sea artificialmente digital. Elimina entregas innecesarias, establece un estado de datos fiable, y da a las personas exactamente la información que necesitan para su próximo paso. Cuando esto tiene éxito, el desarrollo web moderno no se siente como un nuevo proyecto de TI, sino como una operativa que finalmente puede trabajar sin rodeos.

Enlace permanente →

Cómo implementar correctamente la digitalización de los albaranes de entrega

Cómo implementar correctamente la digitalización de los albaranes de entrega

Un conductor no espera porque un archivo Excel esté actualmente abierto por otra persona. Y en la recepción de mercancías, una pila de papel ordenada no sirve de nada si una entrega parcial ya no se puede rastrear después. Quien busca "cómo digitalizar los albaranes de entrega" rara vez quiere solo escanear papel. Lo que se busca es un flujo de trabajo resiliente que registre los movimientos de mercancías, las confirmaciones y las discrepancias justo donde ocurren.

Los albaranes digitales funcionan bien cuando simplifican el trabajo en el almacén, en el taller y con el cliente. Si se implementan solo como un archivo PDF, el esfuerzo permanece — solo en una pantalla en lugar de en papel. La diferencia decisiva radica en datos estructurados, responsabilidades claras y una conexión limpia con pedidos, inventario y facturas.

Cómo digitalizar los albaranes de entrega: revisar primero el flujo de trabajo

El primer paso no es la selección de software, sino una evaluación honesta del inventario. Toma un albarán real y sigue su camino: desde el pedido hasta la preparación, la entrega, la retroalimentación y el archivado. Esto suele revelar rápidamente dónde se añade información retroactivamente, se introduce dos veces, o se aclara por teléfono y chat.

En las pequeñas y medianas empresas, rara vez hay un solo flujo de trabajo. Una entrega estándar a clientes habituales requiere algo diferente a una entrega en obra, una recogida, o una entrega con devolución de embalajes vacíos. No es necesario automatizar todas estas diferencias en la versión uno. Sin embargo, deberían ser conocidas para que el nuevo sistema no falle en el primer caso especial.

Un buen proceso digital responde inequívocamente a tres preguntas para cada estado: ¿Quién movió la mercancía y cuándo? ¿Qué cantidades se entregaron realmente? ¿Y qué pasó en caso de discrepancias? Si falta esta información, un albarán digital es principalmente solo un documento más bonito.

No reproducir simplemente el papel como PDF

Escanear albaranes existentes puede ser útil como transición, por ejemplo para archivar procesos antiguos. Para el negocio operativo, sin embargo, resuelve poco. Una imagen o PDF se puede almacenar, pero cantidades, números de artículo, lotes y observaciones no se pueden reutilizar de forma fiable en él.

Un mejor enfoque es un documento generado a partir de datos de pedido estructurados. Se adoptan artículos, cantidades objetivo, direcciones de entrega y personas de contacto. Los empleados confirman entonces las cantidades reales directamente en un dispositivo móvil o en un puesto de trabajo en el almacén. Solo discrepancias, daños o posiciones adicionales necesitan introducirse manualmente.

Esto no solo ahorra tiempo. También evita una típica ruptura de medios: la contabilidad ya no recibe una firma apenas legible en papel mientras el almacén mantiene por separado el mismo proceso en una hoja de cálculo.

Los datos que realmente necesita un albarán digital

Un sistema no debería forzar cada campo imaginable. Las entradas adicionales ralentizan las entregas y reducen la aceptación. Al mismo tiempo, el nombre del cliente y la firma no son suficientes para muchos flujos de trabajo.

Como base, cada albarán necesita un número único, la referencia al pedido, direcciones de entrega y destinatario, posiciones de artículos con cantidades objetivo y reales, así como marcas de tiempo.

Dependiendo de la industria, se añaden lotes, números de serie, peso, ubicaciones de almacenamiento o contenedores. Para mercancías con control de temperatura, los valores medidos pueden ser relevantes; para entregas en obra, las fotos o indicaciones precisas del lugar de entrega son útiles.

El estado es particularmente importante. "Creado," "preparado," "en tránsito," "entregado," "entregado parcialmente," y "disputado" no son simples etiquetas. Determinan qué persona debe actuar a continuación y si, por ejemplo, se puede generar una factura o programar una entrega posterior.

Usar firmas y fotos con mesura

Una firma digital es útil en muchos procesos de entrega, pero no es automáticamente la mejor confirmación. Para una entrega rápida en la recepción de mercancías, un nombre impreso, una marca de tiempo y la asignación del destinatario pueden ser suficientes. Para mercancías de alto valor o entregas disputadas, una firma combinada con una foto e información de ubicación puede ser más sensata.

El factor decisivo es la cadena de evidencias: la confirmación debe estar vinculada al documento específico y su versión. Si alguien cambia cantidades o posiciones después de firmar, el sistema no debería sobrescribir esto silenciosamente. Requiere una corrección rastreable o una nueva confirmación. Las fotos merecen la misma disciplina. Pueden documentar daños, pero no deberían convertirse en una colección indiscriminada de datos personales. Define cuándo se requiere una foto, quién puede acceder a ella, y cuánto tiempo se almacena.

La captura de datos móvil debe funcionar en condiciones reales

En la oficina, casi cualquier aplicación es operable. En el almacén cuentan los guantes, el mal Wi-Fi, la presión del tiempo y los dispositivos con batería limitada. Un albarán digital debe por tanto arreglárselas con pocos pasos de entrada, pero grandes. Los escaneos de código de barras o código QR suelen ser más rápidos y fiables que buscar números de artículo.

La capacidad sin conexión no es un lujo cuando los conductores trabajan fuera de una cobertura de red estable. La aplicación debería almacenar en caché las operaciones localmente, mostrar claramente lo que aún no se ha sincronizado, y manejar los conflictos de manera controlada. Si dos personas editan la misma entrega, no debe ganar por casualidad el último guardado.

La cuestión del hardware también debe responderse pragmáticamente. Un smartphone existente puede ser suficiente para entregas simples. Para escaneos, fotos y firmas frecuentes en el almacén, los terminales portátiles robustos o tablets suelen ser más económicos. La mejor decisión depende de la duración operativa, el entorno y el rendimiento esperado — no de qué dispositivo parece moderno en una diapositiva de producto.

Definir interfaces antes de la implementación

Un albarán digital desarrolla su valor solo cuando se conecta con las fuentes de datos principales. En muchas empresas, los pedidos residen en el ERP o en el sistema de gestión de inventario, el inventario en una solución de almacén separada, y las facturas en contabilidad. Esto no tiene que convertirse inmediatamente en un gran proyecto de sistema. Pero la soberanía de datos debe ser clara.

Define, por lo tanto, qué sistema mantiene clientes, artículos, precios y pedidos. La solución de albaranes puede adoptar información, pero no debería generar sin darse cuenta un segundo maestro de artículos. Igualmente, debe estar regulado cuándo se reportan de vuelta las cantidades reales confirmadas y quién revisa las discrepancias.

Técnicamente, interfaces fiables son más importantes que funciones espectaculares. IDs únicos, formatos de datos documentados, protocolos para transferencias fallidas, y un mecanismo de reintento evitan que los albaranes desaparezcan entre dos sistemas. Una aplicación ligera sobre una base mantenible, como PHP 8.4, JavaScript moderno y MySQL 8, es más sensata para muchos flujos de trabajo de medianas empresas que una suite sobrecargada con funciones que nadie usa.

La seguridad y el archivado forman parte del proceso

Los albaranes contienen datos comerciales y frecuentemente también datos personales. Los permisos de rol no deberían asignarse por tanto de forma genérica. Los conductores necesitan sus rutas y tareas abiertas, los responsables de almacén necesitan opciones de corrección y revisión, la contabilidad necesita documentos confirmados y exportaciones. El acceso administrativo completo no es un derecho estándar.

Además, se requiere un historial rastreable: creación, modificación, entrega, firma, cancelación y corrección deberían registrarse con hora, usuario y justificación. Esto ayuda con consultas y protege a los empleados cuando más tarde no está claro cuándo se informó un daño o una escasez. Para el archivado, la regla es: el documento debe permanecer legible y el proceso localizable. Si se genera un PDF depende del flujo de trabajo interno y los requisitos de destinatarios externos. El PDF es, sin embargo, la salida de un proceso digital, no su modelo de datos.

Volverse productivo en pequeños pasos

El despliegue más fiable comienza con un proceso claramente delimitado: por ejemplo, entregas estándar desde un almacén o recepciones de mercancías de un departamento. Elige un área con volumen suficiente, pero sin los casos excepcionales más complicados. Esto permite probar el funcionamiento, la calidad de datos y las interfaces en condiciones reales.

No midas solo si la aplicación funciona técnicamente. Verifica cuánto tiempo tarda una entrega, cuántos albaranes requieren retrabajo, con qué frecuencia ocurren discrepancias de inventario, y si la contabilidad puede trabajar más rápido. Si un procedimiento digital genera más consultas que el formulario en papel, no es la plantilla el problema — entonces falta claridad de proceso o la máscara de entrada no se ajusta a la práctica operativa.

Las hojas de cálculo pueden seguir existiendo si son fiables para una evaluación limitada o una lista especial rara. La digitalización no significa abolir cada herramienta conocida. Significa reemplazar deliberadamente las entregas propensas a errores y hacer robusto el proceso central.

softify.pro desarrolla tales flujos de trabajo no como un producto estándar rígido, sino a lo largo de movimientos de mercancías concretos, roles y sistemas existentes. Esto es particularmente útil cuando una empresa busca una solución adecuada entre el caos de papel y un sistema corporativo sobredimensionado.

El primer paso correcto no es, por tanto, un largo catálogo de requisitos. Toma diez albaranes de una semana normal, incluyendo una entrega parcial y una reclamación. Si tu futuro flujo de trabajo procesa estos diez casos rápida, inequívoca y rastreablemente, un albarán digital se convierte en una herramienta en la que el almacén, los conductores y la administración pueden confiar.

Enlace permanente →

Tendencias del testing de software 2026 que realmente cuentan

Tendencias del testing de software 2026 que realmente cuentan

Un lanzamiento fallido rara vez muestra un solo error. A menudo se combinan varias causas: un permiso modificado, un entorno de pruebas poco claro, datos de prueba faltantes o una prueba de regresión que no se ha mantenido durante meses. Precisamente ahí es donde las software testing trends para 2026 se vuelven concretas - no como una colección de nuevas herramientas, sino como la pregunta de cómo las empresas pueden entregar cambios con seguridad verificable, incluso con capacidades de QA limitadas y datos sensibles.

Para los equipos de software en empresas medianas, esto es especialmente relevante. Una aplicación de almacén, un portal de clientes o un software de escritorio de Windows no necesita servir a millones de usuarios. Sin embargo, debe funcionar en operación por turnos, generar documentos correctamente y aplicar los permisos de forma fiable. Por tanto, el testing debe estar más cerca de los flujos operativos reales que de un entorno de demostración impecable.

Tendencias del testing de software: la IA se convierte en ejecutora, no en oráculo

La tendencia más visible es el testing asistido por IA. Esto no significa que un modelo de lenguaje lea un requisito y garantice posteriormente la calidad de la aplicación. Esa expectativa sería peligrosa. Sin embargo, la IA puede reducir significativamente el esfuerzo donde los equipos pierden tiempo hoy: formular casos de prueba, reconocer cambios llamativos en las interfaces de usuario, asignar patrones de error similares y escribir informes de prueba comprensibles.

La IA se vuelve especialmente útil cuando ejecuta pasos de trabajo concretos y aporta pruebas de sus resultados. Un agente de prueba puede, por ejemplo, iniciar sesión, crear una entrada de mercancía, cambiar una dirección de entrega, generar una etiqueta de envío y comprobar si el estado, el movimiento de inventario y el documento coinciden. El factor decisivo no es la afirmación «prueba superada», sino la cadena de evidencias: pasos ejecutados, marcas de tiempo, capturas de pantalla, registros técnicos y una descripción clara de la desviación.

El límite sigue siendo importante. La IA puede sugerir casos de prueba y gestionar flujos recurrentes. No debería decidir por sí sola si un asiento de negocio críticamente sensible es correcto. Para precios, niveles de inventario, aprobaciones de pago o derechos de acceso, siguen siendo necesarias reglas explícitas y expectativas confirmadas por los departamentos de negocio. La automatización acelera las pruebas; no sustituye la responsabilidad.

La automatización de pruebas migra al proceso de negocio

Durante mucho tiempo, la automatización de pruebas de UI se centró en rutas simples: abrir la página, rellenar el formulario, comprobar el mensaje de éxito. Eso sigue siendo útil, pero no basta para sistemas críticos para el negocio. La prueba más valiosa valida toda una cadena de procesos.

Tomemos una función logística típica. Se registra un pedido, se reserva mercancía, se inicia un proceso de picking, se genera un albarán y se notifica el envío. Cada pantalla individual puede parecer limpia mientras el proceso, aun así, falla - por ejemplo, porque una reserva persiste tras una cancelación o una entrega parcial altera incorrectamente el inventario. Las buenas pruebas automatizadas siguen por tanto estados y datos a través de los límites del sistema.

Esto exige una arquitectura de pruebas limpia. Las pruebas de API y base de datos comprueban las reglas de forma rápida y precisa. Las pruebas de UI controlan además si los empleados pueden realmente operar el proceso. Las pruebas de extremo a extremo combinan ambas, pero son más lentas y frágiles. Quien prueba todo exclusivamente a través del navegador suele construir una suite de pruebas cara y frágil. Quien solo prueba interfaces pasa por alto problemas operativos e interfaces de usuario mal conectadas.

La solución pragmática es una pirámide adaptada al riesgo: muchas comprobaciones rápidas cerca de la lógica de negocio, menos comprobaciones de integración y escenarios de extremo a extremo elegidos selectivamente para los flujos más importantes. Suena poco glamuroso. Sin embargo, aporta una fiabilidad aburrida y demostrable en lugar de perseguir tendencias.

La IA de pruebas autoalojada se convierte en una cuestión de arquitectura

Con las herramientas de prueba de IA surge una nueva pregunta: ¿adónde van los datos de prueba, las capturas de pantalla y las grabaciones? En muchas aplicaciones contienen nombres de clientes, precios internos, información de personal o vistas de procesos críticos para el negocio. Incluso un entorno de pruebas aparentemente inofensivo puede contener copias de datos reales o estructuras confidenciales.

Por eso el entorno de ejecución se convierte en un criterio central. Un servicio en la nube externo puede ser apropiado para aplicaciones web públicas y datos de prueba no críticos. Para portales internos, aplicaciones de escritorio o áreas reguladas, un enfoque autoalojado suele ser más sensato. En esta configuración, la ejecución de pruebas, el material de imagen y los registros permanecen dentro de la infraestructura controlada de la empresa o en un entorno de la UE claramente delimitado.

Esto no es un argumento general contra los servicios en la nube. La autogestión conlleva esfuerzo: hay que gestionar actualizaciones, control de acceso, recursos de computación, monitorización y responsabilidades claras. El beneficio surge cuando la protección de datos, la trazabilidad y el control sobre los artefactos de prueba pesan más que la comodidad de una cuenta SaaS disponible al instante. Sistemas como COCO siguen precisamente este enfoque, ejecutando pruebas para aplicaciones web y de Windows mientras mantienen las evidencias controlables localmente.

Las pruebas inestables ya no se aceptan como normales

Una prueba automatizada que a veces pasa y a veces falla sin un cambio de producto no genera seguridad. Genera colas. Los equipos se acostumbran entonces a ignorar las compilaciones en rojo o a repetir las pruebas hasta que aparece el resultado deseado. Esto es una pérdida progresiva de confianza en todo el marco de control de calidad.

En 2026, la estabilidad de la ejecución de pruebas pasa por tanto más a primer plano. Las causas suelen conocerse: tiempos de espera aleatorios, selectores inestables, datos de prueba compartidos, dependencias de servicios externos o bases de datos no reiniciadas. La solución rara vez es otro reintento. Más sensatos son selectores técnicos inequívocos, cuentas de prueba aisladas, estados de datos controlados y condiciones de espera específicas que reaccionan a eventos reales del sistema.

La evaluación también debería diferenciar: ¿es reproducible un error? ¿Ocurre solo en un entorno? ¿Ha fallado un servicio externo o la propia aplicación? La IA puede ayudar a agrupar estas señales. Sin embargo, la decisión técnica debe seguir siendo trazable. Un equipo de QA no necesita una predicción de errores misteriosa, sino una base sólida para la siguiente medida.

La calidad empieza antes, con los requisitos y los datos

Muchos errores surgen antes de escribir la primera línea de código. «El pedido debería poder enviarse» no es un requisito comprobable. ¿Qué ocurre en caso de dirección incompleta, cuenta de cliente bloqueada, mercancía faltante, procesamiento paralelo o sesión caducada? Sin respuestas a estas preguntas, ningún sistema de pruebas puede comprobar de forma fiable si el software funciona correctamente.

Un enfoque de pruebas más maduro complementa por tanto los requisitos con ejemplos verificables. Para una cuenta con intentos de inicio de sesión incorrectos, esto puede significar concretamente: tras cinco intentos fallidos, la cuenta se bloquea durante 15 minutos, el proceso se registra y un administrador autorizado puede rastrear el bloqueo. De ahí surgen directamente comprobaciones automatizables - y menos margen de interpretación entre desarrollo, operaciones y el departamento de negocio.

Los datos de prueba también se convierten en una característica del producto. Deben ser lo suficientemente realistas para reflejar casos límite, pero no deben copiar datos personales innecesarios. Son útiles los conjuntos de datos generados para casos de IVA, cantidades parciales, artículos bloqueados, direcciones no válidas y diversos roles. Precisamente con aplicaciones que usan MySQL 8 o bases de datos relacionales comparables, vale la pena aprovisionar automáticamente estados iniciales definidos y eliminarlos tras la ejecución.

El testing basado en riesgos vence a la cobertura de pruebas a cualquier precio

Una cifra alta de cobertura de código puede resultar tranquilizadora y aun así decir muy poco. Muestra qué líneas se ejecutaron, no si se comprobó la regla correcta. Un sistema puede alcanzar el 90 por ciento de cobertura y aun así generar inventario incorrecto durante la cancelación de una entrega parcial.

La mejor pregunta es: ¿qué errores serían especialmente costosos para la operativa, los clientes o el cumplimiento legal? De ahí surge una priorización. La protección de accesos, el cálculo de precios, los asientos de inventario, la generación de documentos y las interfaces con los proveedores de servicios de envío suelen merecer más profundidad de prueba que las páginas de configuración raramente utilizadas. Esto no significa entregar asuntos secundarios sin comprobar. Significa emplear tiempo limitado donde un fallo detiene trabajo real o genera decisiones equivocadas.

Esta priorización debe poder cambiar. Si se introduce una nueva función de planificación de rutas, su riesgo aumenta. Si una antigua evaluación de Excel va a ser sustituida pronto, un gran esfuerzo de automatización puede que ya no valga la pena. A veces es más sensato mantener una hoja de cálculo funcional unos meses más en lugar de forzar apresuradamente su lógica dentro de un sistema a medio terminar.

Qué deberían hacer los equipos en la práctica ahora

El primer paso sensato no es una comparación de herramientas. Elija un proceso cuyos fallos sean tangibles: de pedido a entrega, de entrada de mercancía a almacenamiento, o de inicio de sesión a aprobación de rol. Describa el flujo objetivo con casos excepcionales, configure datos de prueba fiables y automatice primero las comprobaciones críticas.

A continuación, no mida solo el número de pruebas. Observe con qué rapidez se detecta un error real, con qué frecuencia fallan las pruebas sin motivo, y si un informe explica la causa de forma comprensible a un desarrollador o responsable de negocio. Solo cuando estos fundamentos estén establecidos merece la pena ampliar con agentes de IA, inspección visual o entornos de prueba extensos.

Las tendencias de testing más fuertes son, en definitiva, las que hacen que los lanzamientos sean menos arriesgados y llevan a los equipos a decisiones claras más rápido. No es el panel más moderno lo que cuenta, sino una ejecución de pruebas trazable que muestre que este proceso de negocio funciona - y si no, saber por qué.

Enlace permanente →

Planificación de rutas de reparto: cómo elegir el software adecuado

Planificación de rutas de reparto: cómo elegir el software adecuado

Un conductor espera un albarán mientras el orden de sus paradas vuelve a cambiar. En el almacén todavía no se ha preparado un envío, un cliente llama por una ventana horaria más estrecha, y la lista de rutas está en una hoja de cálculo que solo una persona entiende realmente. Quien busca «software de planificación de rutas de reparto» en esta situación no necesariamente quiere un algoritmo cartográfico complicado. Lo que busca es un flujo de trabajo fiable desde la entrada del pedido hasta la prueba de entrega.

Para las pequeñas y medianas empresas, esta es una diferencia decisiva. Una ruta teóricamente más corta sirve de poco si no tiene en cuenta que la mercancía no está lista hasta las 10 de la mañana, un vehículo necesita refrigeración, o un conductor posee un conocimiento específico del cliente en una ruta determinada. Un buen software para rutas de reparto refleja la realidad operativa - haciéndola utilizable conjuntamente por planificación, almacén y conductores.

Cuándo la planificación de rutas se convierte en un problema operativo

Muchas empresas empiezan de forma razonable con teléfono, papel y una hoja de cálculo. Con cinco paradas al día y un equipo fijo de conductores, esta suele ser la solución más rápida. Solo cuando el volumen de pedidos, las variantes y la presión de tiempo aumentan surgen las fricciones típicas: direcciones introducidas por duplicado, estados de ruta desactualizados, información faltante sobre soportes de carga y consultas que solo pueden responderse llamando a varias personas.

El problema entonces no es solo el trayecto. Es la ruptura de información entre la entrada del pedido, el almacén, la planificación y la entrega. Si se pospone un pedido, hoy este cambio a menudo debe seguirse en varias listas, en una impresión y en la cabeza del conductor. Esto cuesta tiempo y genera errores que los clientes ven de inmediato.

Otra señal de alarma son las decisiones que dependen de empleados individuales. Si solo la planificadora experimentada sabe qué acceso es adecuado para un cliente o cómo ajustar la ruta 3 en caso de recepción tardía de mercancía, el proceso no está documentado de forma sólida. El software no debe sustituir este conocimiento. Debe representarlo de modo que el equipo siga siendo capaz de actuar.

Qué debe saber hacer un software de planificación de rutas de reparto

La función central suena simple: los pedidos se asignan a una ruta, las paradas se ordenan de forma sensata y se entregan a los conductores. Sin embargo, para su utilidad práctica el sistema necesita mucho más contexto. Lo decisivo es qué reglas se aplican en la planificación y cómo se gestionan los cambios.

Los pedidos deben ser planificables, no solo visibles

Una dirección de entrega en un mapa aún no constituye una entrega planificable. A un pedido pertenecen al menos cantidades, peso o volumen, fecha de entrega, ventana horaria deseada, información de contacto y un estado de tramitación claro. Según el negocio se añaden soportes de carga, requisitos de temperatura, marcados de mercancías peligrosas, reglas de aviso o una clase de vehículo determinada.

Estos datos no deberían tener que recopilarse manualmente cada vez de sistemas distintos. Si los pedidos ya proceden de una tienda online, un ERP, una máscara de pedidos o una base de datos existente, un traspaso limpio suele ser más valioso que una vista de mapa especialmente espectacular. De lo contrario, el trabajo solo se desplaza del papel a una nueva interfaz.

Las rutas necesitan reglas, no solo distancia

Un orden automático basado en kilómetros o tiempo de conducción puede ser una buena sugerencia. Sin embargo, no es una decisión para el negocio. La planificación debe poder tener en cuenta restricciones: fechas de entrega fijas, capacidad del vehículo, horarios laborales, tiempos de carga y descarga, así como responsabilidades regionales.

También cuenta la lógica de inicio. Algunos vehículos empiezan y terminan en el almacén, otros van directamente al siguiente lugar de trabajo tras la última entrega. Para rutas recurrentes puede tener sentido una estructura básica fija, que los planificadores solo modifican cuando es necesario. Quien recorre exactamente las mismas paradas cada mañana no necesita necesariamente una reoptimización completa. Aquí una ruta estable y trazable suele ser mejor que un ahorro de tiempo calculado mínimo.

Los cambios deben llegar al conductor de forma controlada

La realidad rara vez se ajusta al plan de la mañana. Los clientes cancelan, falta mercancía, un vehículo se avería o un pedido se vuelve urgente. En tales casos se decide si el software supone un alivio o crea trabajo adicional.

Una solución utilizable muestra claramente qué versión de la ruta es válida actualmente, qué paradas ya se han completado y qué se ha cambiado en concreto. El conductor no debería tener que comparar impresiones contradictorias, capturas de pantalla y mensajes de mensajería. Para muchos equipos, al principio basta con una vista de conductor móvil y basada en navegador con orden de paradas, datos de contacto, indicaciones de entrega y confirmación de estado. Una app dedicada no es automáticamente mejor si la instalación, la gestión de dispositivos y los requisitos sin conexión no aportan un beneficio claro.

No empezar únicamente con la optimización de rutas

El enfoque erróneo más común es comprar primero un servicio de optimización y solo después comprobar si los datos maestros y los procesos son correctos. Direcciones mal escritas, ventanas de entrega poco claras y pedidos sin un estado de disponibilidad fiable no se pueden «optimizar» para que desaparezcan.

Es más razonable hacer un breve inventario a lo largo de la rutina diaria real. ¿Dónde se originan los pedidos? ¿Cuándo confirma el almacén la disponibilidad? ¿Quién planifica las rutas? ¿Cómo recibe el conductor los cambios? ¿Y qué prueba se necesita tras la entrega? Estas preguntas parecen triviales, pero determinan qué campos de datos, roles e interfaces necesita realmente el sistema.

A menudo se descubre que no todos los pasos deben digitalizarse. Una nota manuscrita para una entrega especial poco frecuente puede ser adecuada, si después se traslada correctamente al pedido. Una hoja de cálculo también puede permanecer, si entrega de forma fiable un análisis manejable. El software debería resolver el cuello de botella, no sustituir por la fuerza cada proceso conocido.

¿Build, Buy o ampliación específica?

El software estándar es apropiado cuando la lógica de rutas es general, los procesos varían poco y el equipo puede adaptarse a las máscaras predefinidas. Acorta la implementación y puede ser suficiente para una flota sencilla. La desventaja se hace evidente en cuanto solo representa los casos particulares centrales mediante listas secundarias, texto libre o costosos módulos adicionales.

Una solución individual no merece la pena porque el desarrollo a medida sea superior por principio. Merece la pena cuando el proceso en sí es una ventaja competitiva o una fuente de errores persistente: por ejemplo con unidades de embalaje especiales, rutas combinadas de recogida y entrega, documentos de entrega propios, o una estrecha vinculación entre la entrada de mercancía, la preparación de pedidos y la salida.

Entre ambos extremos suele estar el camino más pragmático. Los sistemas existentes se mantienen para contabilidad o gestión de almacén, mientras una aplicación ligera agrupa pedidos, planifica rutas y cubre el proceso del conductor. Para ello se necesitan interfaces claras, responsabilidades de datos inequívocas y una estructura de base de datos que almacene los cambios de forma trazable. Las aplicaciones web modernas sobre una base mantenible como PHP 8.4 y MySQL 8 no son para esto una decisión de moda, sino una base para una operativa calculable y ajustes futuros.

Implantación en pequeños pasos en lugar de un gran cambio

Un software de planificación de rutas debería probarse primero en una ruta o grupo de vehículos manejable. No porque un proyecto piloto sea libre de riesgo, sino porque las excepciones reales se manifiestan pronto: indicaciones de entrega faltantes, datos de dirección heterogéneos, tiempos de espera en el cliente o traspasos poco claros en el almacén.

Para la primera fase de expansión suelen bastar funciones claramente delimitadas: asumir el pedido, ver el estado de disponibilidad, componer la ruta, aprobar la ruta e informar la entrega. Solo cuando esta cadena funciona en el día a día tienen sentido la optimización automática, la firma electrónica, las pruebas fotográficas, las notificaciones a clientes o indicadores detallados.

El beneficio no se mide solo en kilómetros ahorrados. También son relevantes un menor esfuerzo de planificación, menos consultas, menos entregas erróneas, un tiempo más corto hasta el albarán y una mejor capacidad de respuesta hacia los clientes. Estos indicadores deberían establecerse de forma aproximada antes del lanzamiento. De lo contrario, tras la implementación solo queda la impresión de que la interfaz parece más moderna.

La tecnología debe seguir siendo fiable en segundo plano

La planificación de rutas procesa datos operativos sensibles: direcciones de clientes, asignaciones de conductores, cantidades de entrega y, con frecuencia, pruebas de entrega. Por eso, los permisos por rol, las modificaciones trazables, las copias de seguridad regulares y una operativa documentada forman parte de la solución. Quién puede aprobar, modificar o eliminar una ruta no debería dejarse al azar.

Los datos de mapas y enrutamiento también merecen un examen sobrio. Los servicios externos pueden encajar muy bien, pero conllevan costes continuos, cuestiones de disponibilidad y de protección de datos. Con altos requisitos de conservación de datos o lógicas territoriales especiales, hay que aclarar pronto qué datos abandonan el propio sistema y cómo se amortiguan los fallos. Una ruta perfecta no vale nada si la planificación no puede seguir trabajando durante una interrupción.

softify.pro diseña estos sistemas desde la entrada real del pedido hasta la confirmación desde el vehículo. El criterio no es la lista de funciones más larga, sino un proceso que almacén, planificación y conductores puedan manejar de forma fiable bajo presión de tiempo.

La mejor planificación de rutas resulta sorprendentemente poco espectacular en el día a día: los pedidos están completos, las rutas son comprensibles, los cambios inequívocos y las entregas demostrables. Precisamente esta fiabilidad discreta crea espacio para las excepciones en las que las personas deben decidir.

Enlace permanente →

Automatizar el flujo de trabajo de recepción de pedidos en la empresa

Automatizar el flujo de trabajo de recepción de pedidos en la empresa

Un pedido llega por correo electrónico, otro por teléfono, además un archivo Excel de la cuenta clave. Más tarde falta en el almacén la dirección de entrega, ventas ya no recuerda con exactitud la fecha prometida, y el departamento de envíos imprime el albarán con una posición de artículo desactualizada. Quien quiera automatizar el flujo de trabajo de recepción de pedidos no resuelve un proyecto digital abstracto. Elimina precisamente esa fricción en el punto donde la facturación se convierte en trabajo operativo.

Para las pequeñas y medianas empresas, la recepción de pedidos suele estar subestimada. Mientras lleguen pocos pedidos al día y los empleados con experiencia conozcan cada caso especial, notas telefónicas, buzones de correo y tablas sostienen el proceso. Con un volumen creciente, sin embargo, se convierten en un riesgo: la información existe por duplicado, los traspasos ocurren verbalmente, y nadie puede decir con fiabilidad qué estado tiene realmente el pedido.

Por qué la recepción de pedidos se convierte tan a menudo en un cuello de botella

La causa raramente es falta de compromiso. Normalmente el proceso ha crecido a lo largo de los años. Los clientes piden por vías distintas, los precios y condiciones de entrega solo aplican a ciertos grupos de clientes, los números de artículo se apartan de las denominaciones internas. Los empleados concilian la información por experiencia y llenan los vacíos con consultas.

Esto funciona hasta que alguien está de vacaciones, cambia el turno o llegan varios pedidos urgentes a la vez. Entonces se revela que el conocimiento no reside en el proceso, sino en cabezas individuales y archivos dispersos. Las consecuencias son conocidas: cantidades erróneas, entregas retrasadas, aprobaciones sin resolver y correcciones innecesarias en el almacén.

Automatización aquí no significa que un cliente deba pedir necesariamente a través de un portal. Significa que cada pedido, sea cual sea su canal de entrada, se registra, se verifica, se enriquece y se traspasa según las mismas reglas trazables.

Automatizar el flujo de recepción de pedidos sin forzar la operativa

Un flujo de trabajo utilizable no empieza con una lista de software, sino con un levantamiento sobrio del proceso. Lo decisivo es: ¿qué información debe estar disponible antes de que un pedido pueda pasar a almacén, planificación o producción? ¿Y qué excepciones son legítimas, en lugar de simplemente molestas?

Un flujo típico consta de cuatro etapas claras: registrar el pedido, verificar los datos, aprobar el pedido y desencadenar los procesos siguientes. Entre estas etapas se necesitan responsabilidades y estados inequívocos. Un pedido, por ejemplo, no debería poder figurar simultáneamente como «nuevo», «en aclaración» y «listo para enviar».

1. Reunir los pedidos de todos los canales en un único expediente

Correo electrónico, teléfono, PDF, EDI, formulario web o nota del equipo comercial pueden seguir siendo canales de entrada distintos. Lo decisivo es que todos acaben en un expediente de pedido común. Los empleados no deberían tener que copiar primero información del correo, luego actualizar una tabla y después informar a una segunda persona.

En pedidos estructurados, los datos del cliente, números de artículo, cantidades y fechas deseadas pueden trasladarse directamente. En PDF o correos de texto libre, una captura guiada suele ser más razonable que una lectura totalmente automática. La extracción asistida por IA puede hacer propuestas, pero en cantidades poco claras, números de artículo específicos del cliente o documentos manuscritos hace falta una revisión visible.

El criterio razonable no es «el máximo de automatización», sino «ninguna doble captura innecesaria». Un formulario bien diseñado con campos obligatorios y sugerencias plausibles ahorra, en muchas empresas, más tiempo que una automatización completa propensa a errores.

2. Verificar los datos antes de que los errores se propaguen

La automatización más valiosa ocurre antes de la aprobación. El sistema puede comprobar si el número de cliente existe, si la dirección de entrega está completa, si el artículo está activo, si la cantidad solicitada parece admisible y si existe la aprobación de pago o crédito. También pueden compararse precios específicos del cliente, cantidades mínimas y ventanas de entrega con las reglas almacenadas.

Es importante el tratamiento de las desviaciones. No toda desviación debe bloquear un pedido. Si falta, por ejemplo, un número de referencia, ventas puede recibir una tarea. Si un pedido supera un límite de valor definido o el margen queda fuera del marco acordado, puede requerirse la aprobación del rol competente.

Así no surgen errores silenciosos, sino casos de aclaración visibles. Es una gran diferencia: el almacén no recibe simplemente un pedido incompleto, sino un pedido con un estado claro y una decisión documentada.

3. Vincular las aprobaciones a reglas en lugar de a peticiones verbales

Muchos retrasos surgen de frases como: «¿Puedes aprobarlo rápido?». Estas consultas no son fundamentalmente erróneas. Se vuelven problemáticas cuando ocurren por chat, teléfono o conversación de pasillo y luego no son trazables.

Un flujo de trabajo automatizado guarda las reglas de aprobación directamente en el pedido. Por ejemplo, un pedido puede aprobarse automáticamente si el cliente, el precio, el stock y la dirección de entrega son plausibles. En condiciones especiales, entregas parciales o un pedido por encima de un límite definido, se notifica a la persona responsable. La aprobación se guarda con marca de tiempo y justificación.

Esto genera velocidad sin renunciar al control. Especialmente con turnos rotativos o varias ubicaciones, evita que los pedidos queden atascados en buzones personales.

4. Informar de forma dirigida a almacén, envíos y cliente

Tras la aprobación, el pedido ya no necesita transferirse manualmente de una lista a otra. El flujo de trabajo puede generar una orden de picking, reservar existencias, preparar un albarán o desencadenar un aviso de envío. Qué pasos tienen sentido depende del modelo de negocio.

Un distribuidor de recambios puede necesitar de inmediato una orden de picking y un marcado de prioridad. Un fabricante necesita primero una verificación de disponibilidad y después un impulso de producción. Un mayorista con rutas fijas quiere agrupar pedidos hasta cierta hora. Por eso una solución estándar rígida a menudo no es la mejor opción.

Para el cliente suele bastar una confirmación clara: pedido recibido, verificado o planificado en firme. No todo cambio de estado interno pertenece a un correo. Demasiados mensajes automáticos generan consultas en lugar de confianza.

Qué datos necesita un proceso sólido

Una buena recepción de pedidos se apoya en una base de datos limpia. Esto incluye datos maestros de clientes bien mantenidos, números de artículo únicos, reglas de precios y condiciones válidas, así como direcciones de entrega claramente definidas. Si faltan estas bases, la automatización solo acelera la transmisión de datos poco fiables.

También cuenta la arquitectura técnica. Un sistema central con cambios de estado trazables y una base de datos fiable es, a la larga, mejor que una cadena de macros, archivos locales y reenvíos de correo descontrolados. Esto no significa que cada hoja de Excel deba sustituirse de inmediato. Si una tabla funciona de forma transparente en un subproceso pequeño y estable, puede permanecer por ahora.

En cuanto varias personas trabajen a la vez con pedidos, se necesiten aprobaciones o se transmita información a almacén y envíos, una fuente de datos central debería sin embargo tener prioridad. Los sistemas basados en una arquitectura mantenible, por ejemplo con PHP 8.4, JavaScript moderno y MySQL 8, pueden así conectarse de forma dirigida a los procesos existentes, en lugar de forzar una operativa dentro del esquema de un software corporativo.

Hacer medible si el flujo de trabajo realmente mejora

Un sistema nuevo no es automáticamente un proceso mejor. Antes del lanzamiento deberían por tanto establecerse unos pocos indicadores. Son relevantes, por ejemplo, el tiempo desde la recepción del pedido hasta la aprobación, el número de consultas por pedido, las correcciones tras el traspaso al almacén y la tasa de pedidos procesados a tiempo.

Estos indicadores también muestran dónde no se necesita más automatización. Si el 85 % de los pedidos estándar transcurre rápido y sin errores, pero el 15 % restante son casos verdaderamente especiales, un proceso de aclaración claro es más razonable que intentar forzar algorítmicamente cada excepción.

Los registros ayudan además en el día a día. Quien ve cuándo llegó un pedido, qué comprobación falló, quién lo aprobó y cuándo se generó la orden de envío ya no busca la causa en cinco buzones. Esto reduce no solo los errores, sino también la dependencia de empleados concretos.

Implantación en pequeños pasos en lugar de un Big Bang

La entrada más segura suele ser un tipo de pedido claramente delimitado: por ejemplo, pedidos estándar de un grupo de clientes concreto o pedidos por correo con artículos conocidos. Allí pueden probarse campos de datos, reglas y traspasos en condiciones reales. Solo cuando estado, excepciones y responsabilidades funcionan correctamente, siguen los casos más complejos como precios especiales, entregas parciales o especificaciones de embalaje individuales por cliente.

Los empleados deberían participar en el diseño. No porque cada hábito existente deba permanecer sin cambios, sino porque las personas al teléfono, en ventas y en el almacén conocen las excepciones reales. Una solución que solo se ve bien en un taller se elude rápidamente en la nave.

Para este tipo de proyectos, softify.pro apuesta por sistemas específicos para el flujo de trabajo en lugar de suites estándar sobrecargadas: con traspasos claros, reglas documentadas y suficiente espacio para las formas de trabajo que demostrablemente funcionan en la operativa.

El mejor siguiente paso no es, por tanto, la búsqueda del mayor número posible de funciones. Tome diez pedidos reales de una semana típica y siga su recorrido desde la recepción hasta el envío. Cada doble transferencia manual, cada decisión poco clara y cada consulta recurrente es un punto de partida concreto para un proceso que en el futuro trabajará de forma fiable para el equipo.

Enlace permanente →

Proteger de forma segura los datos de prueba durante las pruebas con IA

Proteger de forma segura los datos de prueba durante las pruebas con IA

Una prueba automatizada fallida suele resolverse rápidamente. Una captura de pantalla del test que contiene datos de clientes, listas de precios o una sesión activa y que acaba en un servicio de IA externo es un problema distinto. Quien quiera proteger los datos de prueba durante las pruebas con IA debe considerar, por tanto, no solo los casos de prueba, sino todo el recorrido de los datos: entradas, tráfico del navegador, registros, imágenes, evaluación por IA y conservación.

Precisamente con aplicaciones web, portales internos y software de Windows surge rápidamente una falsa sensación de seguridad. El entorno se llama «prueba», pero a menudo utiliza copias de bases de datos productivas, roles de usuario reales o interfaces hacia envíos, ERP y archivos documentales. Las pruebas asistidas por IA hacen que estos datos sean especialmente valiosos para el análisis - y por tanto especialmente necesitados de protección.

Por qué las pruebas con IA requieren una perspectiva propia de protección de datos

La automatización de pruebas clásica suele verificar pasos claramente delimitados: iniciar sesión, crear un pedido, generar un albarán, comprobar el cierre de sesión. Las pruebas asistidas por IA amplian este proceso. El sistema puede interpretar interfaces, evaluar anomalías, comparar capturas de pantalla y documentar resultados en un lenguaje comprensible. Esto ahorra tiempo en las pruebas de regresión, pero genera artefactos de datos adicionales.

Estos artefactos suelen ser más reveladores que un registro de prueba habitual. Una captura de pantalla puede mostrar nombres, direcciones, importes contractuales, cantidades de pedido o datos de salud. Un registro de red puede contener tokens de sesión y respuestas de API. Un mensaje de error puede revelar rutas de archivo internas, estructuras de base de datos o versiones. Cuando un modelo trabaja con esta información, debe quedar claro dónde tiene lugar el procesamiento y quién puede acceder a él.

La pregunta decisiva, por tanto, no es: «¿Usamos IA en las pruebas?». Sino más bien: «¿Qué datos abandonan qué zona de seguridad, y por qué?». Para muchas empresas de la región DACH, el procesamiento externo en la nube no está fundamentalmente excluido. Pero debe adecuarse a la necesidad de protección desde el punto de vista contractual, técnico y organizativo. Para datos de desarrollo, producción o clientes, una ejecución controlada localmente suele ser la decisión más pragmática.

Proteger los datos de prueba durante las pruebas con IA empieza antes de la primera ejecución

La protección de datos en las pruebas a menudo solo se discute al elegir una herramienta. Eso es demasiado tarde. Primero se necesita un inventario de datos sencillo y sólido. ¿Qué sistemas se están probando? ¿Qué campos aparecen en las interfaces? ¿Qué adjuntos, exportaciones y respuestas de API pueden aparecer en la prueba? ¿Y qué datos acaban automáticamente en capturas de pantalla, vídeos o mensajes de error?

Aquí conviene una división en tres grupos. Los datos de prueba no críticos pueden generarse libremente y conservarse durante más tiempo. Los datos personales o comercialmente confidenciales requieren enmascaramiento, restricciones de acceso y una conservación breve. Las credenciales de acceso, tokens, claves y valores de configuración productivos no tienen cabida en las evidencias de prueba ni en las solicitudes al modelo, ni siquiera si solo son visibles accidentalmente en una ventana del navegador.

En muchas aplicaciones medianas, la situación de los datos no está claramente separada. El equipo de almacén prueba una nueva entrada de mercancía con un extracto de la base de datos, porque solo ahí están presentes las estructuras de artículos reales, las reglas de proveedores y los casos especiales. Eso puede tener sentido desde el punto de vista técnico. La consecuencia, sin embargo, no debe ser que ese extracto migre sin cambios a todos los entornos de prueba.

Es mejor un proceso reproducible: exportar los datos, seudonimizar de forma dirigida los campos sensibles, eliminar las tablas innecesarias y poner a disposición la base de datos de prueba resultante de forma versionada. Así se conservan los errores de proceso típicos, sin que clientes o empleados reales se vuelvan visibles en las pruebas. Para lógicas de precios o de planificación complejas, los datos totalmente sintéticos a menudo no bastan. En ese caso, una copia cuidadosamente depurada suele ser el mejor compromiso.

El enmascaramiento debe preservar la lógica de negocio

Un enmascaramiento que sustituye cada dirección de correo electrónico por el mismo marcador de posición puede dañar los casos de prueba. Las comprobaciones de duplicados, la lógica de roles, las funciones de búsqueda o los procesos de facturación se comportan de forma distinta a como lo hacen en producción. Un buen enmascaramiento, por tanto, preserva formatos, relaciones y distribuciones. De un número de cliente surge otro número de cliente válido. De una dirección surge una dirección plausible pero ficticia. De una fecha de entrega queda una fecha dentro de un margen de planificación realista.

Esto requiere cierta preparación. A cambio, evita el error clásico en el que las pruebas están técnicamente en verde pero ya no reflejan los procesos reales en el almacén, ventas o atención al cliente. La protección de datos y las pruebas funcionalmente útiles no son opuestos, siempre que la preparación de los datos forme parte de la arquitectura de pruebas.

El lugar de ejecución decide sobre el control

Quien entrega pruebas automatizadas a un servicio externo transmite, según la configuración, más que simples pasos de prueba. El contenido del navegador, las estructuras DOM, las capturas de pantalla, los vídeos, los registros de consola y las evaluaciones pueden procesarse y almacenarse fuera de la propia infraestructura. Que esto sea aceptable depende del caso concreto: categorías de datos, marco contractual, ubicación del almacenamiento, separación de inquilinos, concepto de eliminación y directrices internas actúan en conjunto.

Para aplicaciones con altas necesidades de protección, un entorno de pruebas autoalojado suele ser más fácil de evaluar. El ejecutor de pruebas, el componente de IA y el almacenamiento de evidencias permanecen en la propia red o en una infraestructura europea controlada. Las reglas de red pueden limitar las conexiones externas. Los accesos pueden vincularse a identidades, roles y registros ya existentes. La conservación de imágenes e informes también se convierte en una decisión propia en lugar de una configuración predeterminada de un proveedor de plataforma.

COCO sigue exactamente este enfoque: el servidor de IA ejecuta pruebas para aplicaciones web y de Windows de forma controlada, documenta evidencias y genera evaluaciones comprensibles, sin que los datos de aplicación internos deban entregarse por defecto a una nube de IA externa. Esto no sustituye una auditoría de protección de datos. Sin embargo, crea una base técnica sobre la que TI, seguridad de la información y el área de negocio pueden acordar reglas trazables.

Capturas de pantalla, registros y secretos son las fugas más frecuentes

Muchos equipos protegen la base de datos de prueba, pero pasan por alto los subproductos de las pruebas. Precisamente ahí suelen residir en la práctica los mayores riesgos. Una prueba de inicio de sesión fallida puede mostrar una contraseña en el campo de entrada. Una prueba de API puede mostrar un token de portador en el registro. Una grabación de vídeo automática documenta un pedido completo, incluida la dirección del cliente.

Un concepto sólido regula por tanto al menos cinco puntos:

  • Las capturas de pantalla y los vídeos solo se crean cuando es necesario y se eliminan tras plazos fijos.
  • Los secretos se integran a través de un almacén de secretos o variables de tiempo de ejecución protegidas, nunca almacenados en el código de prueba.
  • Los registros filtran tokens, contraseñas, ID de sesión y campos sensibles antes de guardarse.
  • Las cuentas de prueba solo poseen los permisos necesarios para el proceso correspondiente.
  • Los sistemas de prueba no deben desencadenar correos, etiquetas, pagos o movimientos de inventario productivos, salvo que ello esté explícitamente asegurado.

Estas reglas suenan sobrias. Precisamente esa es su ventaja. Un equipo no tiene que confiar en la atención o en las buenas intenciones, sino que puede limitar técnicamente el mal uso. Son especialmente eficaces las cuentas de servicio separadas para la automatización de pruebas, las vidas útiles cortas de los tokens y un proceso claro para revocar credenciales comprometidas.

La evaluación con IA también necesita límites

Los modelos de IA se utilizan a menudo para explicar desviaciones: «El botón no era visible», «La aplicación reaccionó más despacio de lo esperado» o «El proceso terminó en una comprobación de permisos». Para tales valoraciones, un modelo no necesita necesariamente el conjunto completo de datos del cliente.

Defina, por tanto, qué información puede entrar en la evaluación. ¿Basta con una captura de pantalla anonimizada? ¿Es suficiente una clase de error técnica en lugar de la respuesta completa del servidor? ¿Se pueden ocultar campos antes del análisis? La profundidad adecuada depende del objetivo de la prueba. En una comparación de diseño, un nombre rara vez es relevante. Al comprobar una plantilla de documento personalizada puede serlo - entonces el procesamiento debe asegurarse en consecuencia.

Las medidas de protección deben seguir siendo verificables en producción

Un concepto solo es sólido si puede controlarse en el día a día. Esto incluye comprobaciones aleatorias periódicas de las evidencias de prueba, revisiones de permisos y una mirada a los datos realmente almacenados. ¿Se han colado nuevos campos en las capturas de pantalla? ¿Siguen existiendo cuentas de prueba antiguas? ¿Se conserva un extracto de base de datos más tiempo del previsto? Estas preguntas forman parte de la rutina operativa normal, no solo de una auditoría.

Igual de importante es una responsabilidad clara. QA conoce los procesos de prueba, desarrollo conoce las interfaces técnicas, el área de negocio conoce los procesos críticos y la seguridad informática define el marco. Si nadie une estas perspectivas, se crea un atajo arriesgado o una exigencia de seguridad que impide pruebas reales. Un pequeño proceso de aprobación documentado suele ser más eficaz que un extenso conjunto de normas que nadie aplica.

Al final no se trata de complicar artificialmente cada prueba. Proteger bien los datos de prueba significa eliminar de forma deliberada los riesgos reales de la automatización, preservando al mismo tiempo la validez funcional de las pruebas. Cuando los equipos saben exactamente qué datos puede ver una prueba, dónde se encuentran sus evidencias y cuándo desaparecen, las pruebas con IA se convierten en una herramienta controlable en lugar de una incertidumbre adicional.

Enlace permanente →

Encargar el desarrollo de una aplicación web con PHP

Encargar el desarrollo de una aplicación web con PHP

Cuando las entradas de mercancía acaban en una hoja de cálculo, los datos de envío se transmiten por teléfono y el estado actual de un pedido solo existe en la cabeza de algunos empleados, normalmente no falta otra herramienta estándar más. Falta un sistema que refleje de forma fiable el propio flujo de trabajo. Encargar el desarrollo de una aplicación web con PHP merece la pena precisamente entonces: cuando información, decisiones y documentos deben confluir en un único lugar, sin sobrecargar el negocio con una suite empresarial sobredimensionada.

PHP no es aquí un compromiso nostálgico. Con PHP 8.4, una arquitectura de aplicación clara y MySQL 8 se pueden construir aplicaciones web duraderas, que reaccionan con rapidez, son fáciles de mantener y funcionan de forma fiable en ordenadores de escritorio, tablets o escáneres de mano. Sin embargo, lo decisivo no es solo el lenguaje. Lo decisivo es si la aplicación realmente facilita el trabajo en el suelo del almacén, en la oficina y en movimiento.

Cuándo tiene sentido una aplicación web a medida

No todos los procesos necesitan de inmediato software a medida. Una hoja de cálculo bien mantenida puede seguir siendo la solución más razonable para una lista pequeña que rara vez cambia. Un producto estándar consolidado también resulta útil si ya cubre los flujos esenciales y puede utilizarse sin rodeos permanentes.

El punto de inflexión llega cuando los empleados introducen datos varias veces, reúnen información de distintos archivos o resuelven regularmente casos especiales fuera del sistema propiamente dicho. Señales típicas son la falta de claridad sobre el inventario, los albaranes generados manualmente, responsabilidades poco claras en los pedidos o consultas que cada turno tiene que repetir. En ese momento no solo se pierde tiempo: los errores se vuelven difíciles de rastrear y la dependencia de personas concretas aumenta.

Una aplicación web a medida, en cambio, refleja exactamente las reglas que rigen en el negocio. Puede, por ejemplo, registrar las entradas de mercancía, documentar los movimientos de almacén, generar etiquetas, priorizar pedidos o hacer trazables las entregas entre equipos. No es necesario automatizar cada caso especial desde el primer día. Un inicio razonable se centra en el flujo que hoy genera más fricción.

Encargar el desarrollo de una aplicación web con PHP: qué hay que aclarar antes

Un buen software no empieza con bocetos de pantalla ni con una lista de términos técnicos. Empieza con situaciones concretas: ¿qué ocurre si una entrega llega incompleta? ¿Quién puede corregir un inventario? ¿Qué información necesita el departamento de envíos antes de imprimir una etiqueta? ¿Y qué ocurre cuando un empleado del turno de tarde retoma un pedido creado por la mañana?

De estas preguntas surge una imagen sólida del proceso. Muestra entradas, decisiones, traspasos y excepciones. Precisamente las excepciones son valiosas, porque es ahí donde las soluciones estándar a menudo fallan. Una aplicación de recepción de pedidos, por ejemplo, no solo debe guardar un pedido nuevo. También debe aclarar cómo se gestionan los datos de artículo faltantes, las direcciones de entrega divergentes, las aprobaciones o las cancelaciones.

Antes de la implementación deberían quedar establecidos el objetivo, los grupos de usuarios y la primera fase de desarrollo. Resultan útiles datos de ejemplo reales, formularios existentes, fotos de los puestos de trabajo y conversaciones con las personas que trabajan a diario con ese proceso. Una simple entrevista con la dirección rara vez aporta suficiente detalle. Quien maneja un escáner, almacena mercancía o revisa albaranes suele conocer con más precisión las limitaciones prácticas.

El inicio razonable más pequeño

Una primera versión no tiene que ser una plataforma corporativa terminada. Al contrario: un núcleo limitado pero utilizable en producción reduce el riesgo y aporta valor desde el principio. Podría pensarse en una aplicación que al principio solo registre pedidos de forma centralizada, muestre su estado y cree un albarán fiable. La gestión de inventario, las interfaces o la planificación de rutas pueden llegar en cuanto el núcleo se haya confirmado en el día a día.

Este orden evita que un proyecto trabaje durante meses en funciones cuyo beneficio real aún no está claro. También deja espacio para correcciones. Quizá la lógica de estados prevista es demasiado fina, quizá la entrada de mercancía necesita una pantalla de captura más rápida o una aprobación solo a partir de cierto valor. Estos hallazgos no son un fallo de la planificación, sino parte de una implementación bien hecha.

La base técnica decide sobre los costes posteriores

Una aplicación web no se vuelve mantenible solo porque PHP figure en la propuesta. La mantenibilidad surge de decisiones trazables: una separación clara entre interfaz, lógica de negocio y acceso a datos, modelos de datos inequívocos, pruebas automatizadas para las reglas críticas y un despliegue documentado.

PHP 8.4 se presta muy bien para ello. El lenguaje es maduro, eficiente de operar y una elección pragmática para muchas aplicaciones críticas para el negocio. Junto con JavaScript moderno, la interfaz puede reaccionar de forma rápida y directa, sin construir cada función de manera innecesariamente complicada como una aplicación de página única. MySQL 8 ofrece una base sólida para transacciones, conceptos de permisos y datos coherentes.

Precisamente en los procesos de almacén y de pedidos, una operación no debe guardarse a medias. Si se da salida a un artículo, el inventario, el registro de movimientos y el estado del pedido deben coincidir. Las transacciones de base de datos garantizan que se realicen todos los cambios necesarios o ninguno. Suena a detalle, pero determina si un sistema sigue siendo fiable en los casos excepcionales.

La seguridad también forma parte del núcleo de la arquitectura. Los roles y permisos deben adaptarse al día a día laboral: una persona en la recepción de mercancía necesita permisos distintos a los de contabilidad o a los de un conductor externo. Los hashes de contraseñas seguros, el bloqueo de cuentas tras intentos de acceso fallidos, la gestión de sesiones y los registros de cambios críticos no son extras para más adelante. Forman parte de la primera versión en producción.

Construir interfaces solo donde realmente ahorran trabajo

Muchos proyectos se vuelven innecesariamente grandes porque desde el principio se planifica cualquier integración imaginable. Las interfaces con la tienda, el ERP, los proveedores de envío o la contabilidad pueden ser muy útiles. Pero solo son buenas si sustituyen un paso manual claro o mejoran de forma notable la calidad de los datos.

Un ejemplo: si las etiquetas de envío se generan a diario a partir de los datos del pedido, una conexión directa ahorra tiempo y reduce errores de transmisión. Si, en cambio, los datos de facturación solo se transfieren una vez por semana a un sistema existente y el proceso es estable, una exportación estructurada puede bastar para empezar. La solución técnicamente más elegante no es automáticamente la más económica.

La soberanía de los datos también debería aclararse de antemano. ¿Qué datos se almacenan, cuánto tiempo permanecen disponibles los registros, quién puede exportarlos y cómo funcionan las copias de seguridad y la recuperación? Para las empresas de la región DACH, estas preguntas no son meras formalidades informáticas. Afectan a la protección de datos, la capacidad operativa y la confianza dentro del equipo.

Implementación sin frenar la actividad

La mejor aplicación fracasa si, durante la transición, bloquea el día a día. Por eso la implementación debería prepararse con casos reales: pedidos representativos, artículos reales, direcciones de entrega típicas y casos especiales conocidos. Solo cuando estos flujos funcionen de forma trazable, el sistema debería asumir una tarea central.

Un funcionamiento paralelo puede tener sentido durante un breve periodo, por ejemplo cuando hay que conciliar inventarios o revisar nuevos documentos. Pero no debe convertirse en un estado permanente. Dos fuentes de datos de referencia generan inevitablemente diferencias. Se necesita una fecha límite clara a partir de la cual quede establecido qué sistema es vinculante.

Igual de importante es una breve formación orientada al rol. Un empleado del almacén no necesita una explicación de las funciones de administración. Necesita seguridad en los pocos pasos que hay que realizar bajo presión de tiempo. Las buenas aplicaciones ayudan con denominaciones comprensibles, valores predeterminados plausibles y mensajes de error que explican qué hacer a continuación.

Cómo reconocer a un socio de desarrollo adecuado

Quien encarga una aplicación web no compra simplemente horas de desarrollo. Se busca un socio que se tome en serio las cuestiones de proceso, justifique las decisiones técnicas y también sepa oponerse cuando un requisito resulte innecesariamente caro o arriesgado. El acceso directo a desarrolladores experimentados vale aquí más que un elaborado proceso comercial con traspasos posteriores.

Preste atención a afirmaciones concretas sobre arquitectura, operación y desarrollo futuro. ¿Cómo se documentan los cambios? ¿Cómo se realizan las actualizaciones? ¿Quién responde ante una incidencia? ¿Existe una estrategia de pruebas trazable para las operaciones y permisos críticos? Una interfaz puede resultar convincente en una presentación. Lo decisivo es si puede seguir adaptándose después de dos años sin que cada cambio se convierta en una reconstrucción completa.

softify.pro trabaja por ello con una implementación gradual y cercana al proceso: primero entender el cuello de botella operativo, después entregar un núcleo sólido y construir sobre él. Es menos espectacular que una gran promesa de transformación, pero en el día a día suele ser mucho más valioso.

Una buena aplicación web no necesita contener el mayor número posible de funciones. Debe garantizar que un pedido no se pierda, que un inventario siga siendo trazable y que los empleados puedan realizar su trabajo sin consultas innecesarias. Cuando esto se logra, una inversión técnica se convierte en una herramienta que hace cada jornada de trabajo notablemente más tranquila.

Enlace permanente →

Generar etiquetas de envío automáticamente y reducir errores

Generar etiquetas de envío automáticamente y reducir errores

Un pedido está embalado, la mercancía espera en el muelle — y alguien todavía busca el método de envío correcto, escribe la dirección del destinatario en un portal de transportistas e imprime la etiqueta. Este paso solo cuesta unos minutos por paquete. Con 30, 80 o 300 envíos al día, se convierte en un cuello de botella. Generar etiquetas de envío automáticamente no significa, por tanto, simplemente conectar una impresora. Significa conectar los datos del pedido, las reglas de envío y el proceso de embalaje real de forma que un envío listo se convierta de manera fiable en la etiqueta correspondiente.

Para las pequeñas y medianas empresas, este suele ser el punto de entrada más razonable a la automatización logística. El beneficio se nota de inmediato en el suelo del almacén: menos consultas, menos paquetes mal direccionados y un estado claro para ventas, almacén y atención al cliente. Aun así, merece la pena observar detenidamente el proceso antes de la implementación técnica. Un maestro de artículos mal mantenido o unas reglas de envío poco claras no mejoran con la automatización: solo se procesan más rápido.

Qué ocurre realmente durante la impresión automática de etiquetas

Una etiqueta de envío contiene más que un nombre y una dirección. Según el proveedor, incluye un número de envío, un código legible por máquina, información de enrutamiento, servicios como la verificación de edad o el contrarreembolso, así como datos aduaneros en el caso de envíos internacionales. Para que el transportista pueda generar una etiqueta, esta información debe estar completa y en el formato esperado.

El flujo técnico suele comenzar con un pedido en la tienda, el ERP o una gestión de pedidos propia. En cuanto el pedido está listo para enviarse, el sistema determina, según reglas definidas, el proveedor, el producto y los servicios adicionales. A continuación transfiere los datos a la interfaz del transportista o a una plataforma de envíos. Esta registra el envío, devuelve el número de seguimiento y la etiqueta, y el sistema guarda los datos en PDF o de impresión junto al pedido. Solo entonces se imprime, en el puesto de trabajo, en la mesa de embalaje o directamente a través de una impresora de etiquetas.

Este orden es determinante. Una etiqueta bonita sin un registro de envío exitoso no sirve de nada. A la inversa, un registro exitoso no debe desaparecer en segundo plano si a la impresora se le acaba el material. Los buenos procesos tratan el registro, la salida y la confirmación de estado como una operación conjunta.

Generar etiquetas de envío automáticamente empieza con reglas claras

El error más habitual es pensar que siempre debe elegirse el mismo proveedor para cada pedido. Eso puede funcionar, por ejemplo, en envíos B2C homogéneos dentro de Alemania. Sin embargo, muchas empresas necesitan reglas más diferenciadas. Un envío pesado, un pedido urgente, una recogida en un punto de paquetería o un envío a Suiza plantean requisitos distintos.

Unas reglas razonables pueden tener en cuenta el peso y las dimensiones, el país de destino, la dirección de entrega, el valor de la mercancía, el plazo de entrega deseado, las indicaciones de mercancías peligrosas y las condiciones acordadas con el cliente. Aquí se aplica lo siguiente: no todas las excepciones teóricas deben automatizarse desde el primer día. Si se dan dos casos especiales al mes, un paso manual claramente señalizado suele ser más económico y seguro que un motor de reglas complicado. Los casos recurrentes con un volumen considerable, en cambio, pertenecen al proceso estándar.

La fuente de datos es especialmente importante. Los pesos de un maestro de artículos bien mantenido son útiles para mercancías similares. En pedidos mixtos, embalaje variable o recargos por sobredimensión, el peso final del paquete debería registrarse en el puesto de embalaje. El sistema puede entonces generar la etiqueta solo después del pesaje. Es un paso manual adicional, pero evita correcciones y cargos posteriores costosos.

La calidad de las direcciones se decide antes de imprimir

Muchos problemas de envío surgen antes de la entrega al transportista. Los números de calle acaban en el campo equivocado, los códigos postales no coinciden con la ciudad, o las direcciones de empresa contienen nombres de destinatario poco claros. Por eso, la automatización no debería limitarse a transmitir las direcciones, sino verificarlas de antemano. Los campos obligatorios, los formatos por país, la longitud de los caracteres y los duplicados reconocibles pueden detectarse ya en la entrada del pedido.

Una verificación de direcciones no es una garantía de entrega. Sin embargo, reduce el número de errores evitables. Ante datos llamativos, el sistema debería poner claramente el pedido en espera para su aclaración, en lugar de generar en silencio una etiqueta incompleta. En el almacén debe ser visible por qué un pedido está esperando y quién puede aportar la información.

El puesto de embalaje necesita un manejo sencillo

La mejor interfaz fracasa si el personal tiene que cambiar entre cinco pantallas al embalar. Un diálogo de embalaje práctico solo muestra lo necesario para el envío actual: pedido, artículos, dirección de entrega, estado del embalaje, peso, método de envío elegido y estado de impresión. Un escaneo de código de barras en el albarán o en el documento de picking debería abrir el pedido correcto. Tras el pesaje, en el caso ideal basta una acción de confirmación para crear e imprimir la etiqueta.

Con varios puestos de embalaje, cada puesto necesita una asignación clara a una impresora. El formato de la etiqueta también debe coincidir con el dispositivo y el transportista. El A6 es habitual para muchas etiquetas de paquetes, pero no todos los rollos, impresoras térmicas y archivadores de documentos funcionan igual. Quien empiece emitiendo las etiquetas como PDF en una impresora láser de oficina puede arrancar rápido. Con volúmenes más altos, las impresoras térmicas suelen ser más adecuadas: evitan cortar, pegar y el riesgo de que una etiqueta se desplace al lado equivocado al imprimir.

Un buen proceso comunica los problemas técnicos de forma comprensible. «API Error 403» no ayuda en la mesa de embalaje. Es mejor: «Etiqueta no creada: comprobar el acceso al proveedor de envíos» o «Impresora del puesto de embalaje 2 inaccesible». El pedido no debe considerarse enviado por error mientras tanto. Permanece en un estado de error claro y puede procesarse de nuevo tras resolverse, sin registrar un segundo envío.

Las interfaces necesitan gestión de errores, no solo un camino ideal

Las interfaces de los transportistas son sistemas externos. Pueden quedar temporalmente inaccesibles, rechazar entradas o cambiar su formato de respuesta. Una red local, un servicio de impresión o unas credenciales de acceso caducadas también pueden interrumpir el flujo. Por eso es arriesgado hacer depender el éxito únicamente de que un usuario haya pulsado «Crear etiqueta».

Técnicamente, cada solicitud debería registrarse de forma trazable: momento, pedido, servicio de envío utilizado, resultado, número de seguimiento y mensaje de error comprensible. Los datos sensibles y las claves de acceso no deben aparecer sin protección en los archivos de registro. Un ID de envío interno único evita que un reintento genere etiquetas duplicadas o facturaciones duplicadas.

Las cancelaciones también forman parte de la planificación. Si un paquete finalmente no se recoge o se reembala después de imprimir la etiqueta, debe quedar claro si el envío puede anularse ante el transportista y cómo se documenta esto en el sistema interno. Sin este paso, el estado de envío, el seguimiento y la facturación dejan de coincidir al cabo de unas semanas.

No todas las empresas necesitan de inmediato una gran plataforma de envíos

Las plataformas de envíos pueden agrupar varios transportistas, lógicas de tarifas y devoluciones. Esto tiene sentido cuando los volúmenes de envío, los países de destino y los proveedores son muy variados. Sin embargo, quien tenga un proceso de envío claro y uno o dos transportistas puede trabajar de forma más clara con una conexión directa. Menos sistemas significan menos conciliación de datos, menos cuentas de usuario y menos puntos donde pueden surgir errores.

La decisión no depende solo del volumen de paquetes. También son relevantes las devoluciones, los documentos de exportación, las reglas de envío individuales, las fuentes de pedidos existentes y la cuestión de quién mantendrá los cambios más adelante. Una solución en hoja de cálculo sigue siendo defendible, por ejemplo, si a diario se envían pocos envíos con datos constantes. En cuanto los compañeros transfieren información varias veces o el envío depende de personas concretas, un flujo centralizado suele resultar más rentable.

Para procesos específicos de cada cliente, puede tener sentido una aplicación web ligera que reúna los datos de pedidos, los movimientos de almacén, los albaranes y la impresión de etiquetas.

softify.pro implementa este tipo de sistemas con una estructura de datos trazable, una puesta en producción documentada y tecnologías mantenibles como PHP 8.4 y MySQL 8. Lo decisivo no es el número de funciones, sino que el proceso resulte más comprensible para el equipo en el puesto de embalaje.

Introducir en pequeños pasos y mejorar de forma medible

Un inicio controlado es mejor que un gran cambio un lunes por la mañana. Primero se automatiza un caso estándar claramente delimitado, por ejemplo los paquetes nacionales de un transportista con un formato de etiqueta definido. En paralelo, durante unos días deberían comprobarse los datos generados automáticamente frente al proceso anterior: dirección, peso, producto de envío, número de seguimiento y etiqueta impresa.

Después pueden añadirse las excepciones. Indicadores útiles son el tiempo de procesamiento por envío, el número de correcciones manuales, las etiquetas no impresas o generadas por duplicado, y el tiempo hasta la confirmación de seguimiento al cliente. Estos valores muestran si la automatización realmente quita trabajo o solo reproduce digitalmente un viejo rodeo.

Al final no cuenta un diálogo de envío especialmente complejo. Cuenta que un pedido embalado reciba la etiqueta correcta sin buscar, volver a escribir ni incertidumbre, y que las excepciones se vuelvan visibles precisamente donde una persona debe decidir realmente.

Enlace permanente →

Probar automáticamente el proceso de inicio de sesión con un sistema

Probar automáticamente el proceso de inicio de sesión con un sistema

Un inicio de sesión solo parece trivial cuando funciona. Si falla tras una publicación, los empleados se encuentran bloqueados antes de comenzar su turno, los clientes ante el portal de clientes o los planificadores ante un procesamiento de pedidos detenido. Probar automáticamente el proceso de inicio de sesión no significa, por tanto, simplemente introducir un nombre de usuario y una contraseña en un formulario. Significa comprobar de forma repetible un acceso crítico para el negocio, con sus reglas, excepciones y límites de seguridad.

Para muchos equipos, la automatización comienza con un único caso de prueba positivo: introducir credenciales válidas, confirmar el inicio de sesión, ver la página de inicio. Esto tiene sentido, pero es insuficiente como única prueba. Los errores de inicio de sesión suelen surgir en los márgenes: sesiones caducadas, cuentas bloqueadas, una nueva autenticación multifactor o un permiso que ya no funciona correctamente tras un cambio de rol. Precisamente estos casos deben cubrirse de forma planificada.

Por qué el inicio de sesión exige una disciplina de pruebas especial

El inicio de sesión es al mismo tiempo una función de seguridad, una interfaz técnica y la puerta de entrada al flujo de trabajo. Un error puede ser demasiado permisivo y permitir un acceso no autorizado. Pero también puede ser demasiado estricto y bloquear a personas autorizadas. Ambos casos tienen un coste: el primero genera riesgos para los datos y el cumplimiento normativo; el segundo, paradas, carga de soporte y soluciones improvisadas.

En las aplicaciones web se suman otras dependencias. El inicio de sesión suele comunicarse con un proveedor de identidad, un sistema de correo para restablecer contraseñas, una app de MFA o un servicio de directorio. En las aplicaciones de escritorio de Windows pueden influir los permisos locales, las conexiones de red y las versiones instaladas. Una prueba que solo observa el formulario en el navegador no detecta de forma fiable estos problemas de integración.

Por eso, antes de la primera automatización de pruebas, el equipo debería definir qué significa un inicio de sesión exitoso en el sistema en cuestión. ¿Basta con una página de inicio visible? ¿O hay que comprobar que se cargó la selección de cliente correcta, que el rol de usuario es el adecuado y que la primera acción protegida es realmente posible? Para un portal de almacén, eso podría ser el acceso a la recepción de mercancías. Para un sistema de planificación, la liberación de una ruta.

Probar automáticamente el proceso de inicio de sesión: del modelo de flujo al caso de prueba

Un buen punto de partida no es un script, sino un modelo de flujo. El inicio de sesión puede describirse como una secuencia de estados claros: no autenticado, credenciales enviadas, identidad confirmada, MFA requerido, autenticado, sesión caducada o cuenta bloqueada. Cada estado tiene acciones permitidas y reacciones esperadas del sistema.

De este modelo surgen casos de prueba con valor de negocio. El caso positivo estándar forma parte de ellos, pero también contraseñas inválidas, cuentas de usuario inexistentes y enlaces de restablecimiento caducados. Aquí es clave la respuesta esperada. Ante credenciales erróneas, una aplicación no debería revelar si existe una dirección de correo. La prueba verifica, por tanto, no solo que se muestre un error, sino también que su texto y comportamiento no den pistas innecesarias.

Especialmente relevantes son los mecanismos de protección contra intentos fallidos repetidos. Tras un número definido de introducciones erróneas, una cuenta puede bloquearse temporalmente. La prueba automatizada debe comprobar si el bloqueo realmente se activa, cuánto dura y si el usuario legítimo recupera después un acceso controlado. Aquí se necesita precisión: una prueba que bloquea intencionadamente cuentas de producción crea más problemas de los que resuelve. Estos escenarios deben ubicarse en un entorno de pruebas separado, con cuentas creadas específicamente para ello.

Considerar por separado el MFA, el restablecimiento de contraseña y el Single Sign-On

La autenticación multifactor no es un detalle menor al final del inicio de sesión. Cambia el flujo. Una prueba debe reconocer que tras la contraseña se requiere una confirmación adicional, y debe reflejar tanto la confirmación exitosa como la rechazada. Para los códigos de un solo uso basados en tiempo, el entorno de pruebas necesita un manejo controlado del tiempo y los secretos. En muchos casos, un método de prueba previsto por el proveedor de identidad es más sensato que recrear un teléfono móvil real.

El restablecimiento de contraseña y el Single Sign-On también deberían tener sus propios recorridos de prueba. En el restablecimiento importan el envío del mensaje, la unicidad del enlace, el periodo de validez y el posterior inicio de sesión con la nueva contraseña. En el SSO es decisivo si la aplicación, al volver del proveedor de identidad, crea correctamente la sesión y asume limpiamente los roles.

Los CAPTCHA son un caso especial. Están destinados a frenar ataques automatizados y no deberían eludirse mediante la automatización de pruebas. Es más sensato usar una configuración de prueba, una clave de prueba oficial o una excepción protegida para el entorno de pruebas. Engañar los controles de seguridad solo para que una prueba se ponga en verde no es una estrategia de calidad.

Elegir el nivel técnico de prueba adecuado

No todas las pruebas de inicio de sesión tienen que pasar por un navegador real. Las pruebas de API pueden verificar si los tokens, sesiones, mensajes de error y reglas de bloqueo funcionan correctamente. Son rápidas y ayudan a encontrar errores cerca de la lógica de autenticación. Las pruebas de navegador, en cambio, muestran si campos, redirecciones, cookies, ajustes SameSite y estados visibles encajan en el flujo real del usuario.

Para las aplicaciones críticas, la combinación es sensata. Unas pocas pruebas de extremo a extremo verifican el recorrido completo con el navegador. Por debajo, pruebas de API e integración específicas cubren las variantes. Esto reduce el tiempo de ejecución y las falsas alarmas. Quien prueba cada combinación imaginable exclusivamente en el navegador obtiene a menudo una suite lenta cuyo mantenimiento consume más tiempo del que ahorra.

En el software de escritorio rige un principio similar. Una prueba automatizada no debería limitarse a comprobar si se abre una ventana. Debe determinar si, tras el inicio de sesión, existe la conexión de datos correcta, si los permisos de usuario están activos y si la pantalla de trabajo central es accesible. Esto es especialmente relevante en aplicaciones de almacén o producción, porque los puestos de trabajo pueden tener condiciones de red, conexiones de escáner o configuraciones locales distintas.

Tratar los datos de prueba de forma segura y repetible

Las pruebas de inicio de sesión trabajan necesariamente con credenciales. Sin embargo, las cuentas de empleados en producción, los datos reales de clientes o los secretos de MFA no deben acabar de forma descontrolada en scripts de prueba, registros y capturas de pantalla. Las cuentas de prueba deben estar claramente identificadas, tener permisos mínimos y poder restablecerse automáticamente. Las contraseñas y tokens se proporcionan mediante una gestión segura de secretos, no se almacenan en el código fuente.

Igual de importante es la limpieza tras la ejecución de la prueba. Si una prueba genera nuevas sesiones, entradas de auditoría o cuentas bloqueadas, el entorno de pruebas debe volver a un estado inicial definido. De lo contrario, una prueba falla el lunes solo porque una ejecución del viernes dejó efectos secundarios.

Para empresas con aplicaciones confidenciales, el lugar de ejecución también es decisivo. Las capturas de pantalla de las pantallas de inicio de sesión, los vídeos de prueba y los registros técnicos pueden contener información sensible. Una infraestructura de pruebas autoalojada como COCO puede ser útil aquí, porque los datos de prueba, la ejecución y las evidencias permanecen bajo control propio. Si esto es necesario depende de las necesidades de protección, la situación contractual y las directrices internas. Una infraestructura propia no es automáticamente la opción más económica para cada aplicación.

Generar evidencias, no solo marcas verdes

Un informe de pruebas debería permitir a QA, desarrollo y al área de negocio entender qué se ha verificado. Un estado verde sin contexto ayuda poco si una publicación genera preguntas más adelante. Por eso son útiles las marcas de tiempo, el entorno de prueba utilizado, la cuenta de prueba, los pasos relevantes, capturas de pantalla en caso de error y un mensaje de error claro en lenguaje cotidiano.

En este proceso, la recopilación de evidencias no debe convertirse en un problema de protección de datos. Contraseñas, códigos de un solo uso, identificadores de sesión y datos personales deben enmascararse en los registros. En las capturas de pantalla puede ser necesario ocultar determinadas áreas. Estas reglas deberían formar parte de la arquitectura de pruebas, no un trabajo manual posterior a un incidente.

Qué deberían automatizar primero los equipos

La prioridad se guía por el riesgo y la frecuencia de uso. Primero vienen el inicio de sesión estándar para los roles más importantes, las credenciales erróneas, el cierre de sesión y la caducidad de sesión. Después siguen las reglas de bloqueo, el restablecimiento de contraseña, el MFA y los cambios de rol. El SSO, los clientes especiales o las rutas de excepción poco frecuentes pueden seguir más adelante, siempre que su fallo no detenga de inmediato la operativa.

Las pruebas forman parte del proceso de publicación. Los cambios en formularios de inicio de sesión, cookies, permisos o configuraciones del proveedor de identidad deberían activar la suite de pruebas correspondiente antes de que una versión pase a producción. Además, merece la pena una ejecución planificada en un entorno realista, por ejemplo tras cambios de infraestructura o de certificados. Esto permite encontrar problemas no visibles en un entorno de desarrollo aislado.

La mejor prueba de inicio de sesión no es, al final, la que tiene más clics. Es la que detecta pronto un fallo real, lo documenta de forma comprensible y se puede seguir ejecutando de forma fiable en el siguiente cambio. Quien trata el inicio de sesión como un proceso de negocio claramente modelado no protege solo un formulario. Protege el acceso al trabajo que espera detrás.

Enlace permanente →

Crear albaranes de entrega automáticamente con software

Crear albaranes de entrega automáticamente con software

La búsqueda de "software para crear albaranes automáticamente" normalmente no empieza con un problema de documentos. Empieza en la mesa de embalaje: un pedido está aprobado, la mercancía se ha preparado, pero el albarán todavía existe como plantilla de Word, exportación de Excel o nota manuscrita. Mientras alguien revisa las líneas, cambian cantidades, direcciones de entrega o envíos parciales. Esto cuesta tiempo, y genera precisamente los errores que después provocan consultas, correcciones y coordinación innecesaria.

Un albarán generado automáticamente es, por tanto, más que un PDF con un logotipo. Es la transición documentada entre el pedido, el movimiento de inventario y el envío. Para que esto funcione de forma fiable, el software no necesita ofrecer tantas funciones como sea posible. Debe representar correctamente el flujo real de trabajo en la empresa.

Cuándo merece la pena crear albaranes automáticamente con software

No toda empresa necesita de inmediato una aplicación personalizada. Quien gestiona pocos envíos por semana, vende artículos fijos y trabaja con una plantilla bien mantenida, puede arreglárselas bien con una solución de hoja de cálculo. La automatización se vuelve útil cuando los empleados introducen datos varias veces, los pedidos se dividen regularmente en envíos parciales, o el estado del envío no se puede seguir con claridad.

Las señales de alerta típicas son archivos Excel que se han vuelto frágiles, descripciones de artículos diferentes entre el pedido y el almacén, comprobantes ausentes ante consultas o números de albarán asignados manualmente. Incluso cuando varias personas trabajan entre la oficina, el almacén y el envío, una carpeta compartida a menudo ya no basta. Entonces falta no solo velocidad, sino una fuente fiable de lo que realmente salió de la empresa.

El punto decisivo es este: el albarán debería surgir de un evento, no de un paso de trabajo adicional. Este evento puede ser la liberación para la preparación, la extracción confirmada o la finalización del embalaje. Qué variante encaja depende de su proceso. En un almacén de repuestos, el registro de inventario suele ser el disparador correcto. En la fabricación bajo pedido, la liberación de envío por parte de la preparación del trabajo puede ser decisiva.

Qué datos necesita realmente un albarán automático

Un buen sistema no toma simplemente todos los datos de un pedido. Comprueba qué información es válida en el momento de la entrega. El destinatario puede diferir del destinatario de la factura, un pedido puede entregarse en varios envíos, y la cantidad entregada puede ser menor que la cantidad originalmente pedida.

Como mínimo se requieren un número de albarán único, la fecha de emisión, la dirección de entrega, la referencia del cliente, así como las líneas realmente entregadas con cantidades y unidades. Según el sector se añaden lotes, números de serie, pesos, unidades de embalaje, preparadores de pedidos o instrucciones de recepción de mercancía. Si estos datos se necesitan más adelante para reclamaciones o trazabilidad, no pertenecen a un campo de texto libre, sino a campos de datos claramente definidos.

Pedido, movimiento de inventario y documento deben coincidir

El punto débil más habitual está entre el pedido y el almacén. El pedido quizá prevé diez unidades, pero el almacén solo confirma ocho. Si aun así se imprimen diez unidades en el albarán, se crea un documento problemático. Si se entregan ocho unidades sin ajustar el estado del pedido, la cantidad restante queda invisible.

Un software adecuado mantiene estos estados separados pero conectados: pedido, reservado, preparado, entregado, eventualmente devuelto. El albarán accede a las cantidades de entrega confirmadas. Así, incluso en caso de entregas parciales y posteriores, sigue siendo trazable qué línea estaba incluida en qué envío.

Los rangos de numeración y las versiones no son un detalle menor

Asignar manualmente los números de albarán parece sencillo al principio. A más tardar con varias ubicaciones, distintas cuentas de usuario o correcciones posteriores, se vuelve propenso a errores. La aplicación debería generar los números de forma centralizada e impedir que el mismo número se use dos veces.

Igual de importante es la gestión de los cambios. Un albarán ya enviado no debería sobrescribirse silenciosamente. Es mejor una corrección reconocible, una anulación o una nueva versión con un historial trazable. Técnicamente no es un lujo, sino que protege a los empleados de trabajar con información contradictoria.

Así funciona la creación en el flujo práctico

En un proceso claro, todo comienza con un pedido estructurado. Artículos, cantidades, dirección de entrega y fecha deseada se registran una vez o se importan de un sistema existente. A continuación, se crea una orden de preparación para el almacén, en un dispositivo móvil, como impresión o en un terminal de puesto de trabajo.

Durante el embalaje se confirman las cantidades realmente retiradas. Para flujos simples basta un botón de confirmación. Con muchos artículos, ubicaciones o lotes, los escaneos de código de barras son más adecuados. Solo después de esta confirmación el software crea el albarán en PDF, le asigna un número y lo asocia al proceso de envío. En paralelo, puede preparar una etiqueta de envío, siempre que el respectivo servicio de paquetería esté técnicamente conectado.

El documento generado se almacena de forma centralizada y sigue siendo localizable a través del pedido, la cuenta del cliente o el número de envío. Un empleado de administración ya no tiene que buscar en su bandeja de correo cuando un cliente pregunta qué se entregó en un día concreto. Ve el pedido, las entregas individuales y el estado de cada documento en un solo lugar.

Esto suena sencillo, pero a menudo falla en casos especiales. Por eso, la aplicación debe tratarlos de forma deliberada: ¿qué pasa en caso de faltantes? ¿Quién puede cambiar una dirección de entrega tras la liberación? ¿Se puede generar un albarán sin stock disponible? ¿Cómo se marcan los obsequios gratuitos o las entregas de sustitución? Reglas de este tipo determinan si la automatización se acepta en el suelo del almacén.

¿Software estándar o solución individual?

El software estándar tiene sentido cuando su flujo sigue en gran medida el modelo previsto y ya existen interfaces con la tienda, el ERP o los proveedores de envío. Reduce el esfuerzo de implantación y a menudo ofrece una amplia gama de funciones. El precio a pagar puede ser que los equipos tengan que organizar sus flujos de trabajo funcionales en torno a un sistema rígido.

Una solución individual merece la pena especialmente cuando su lógica es crítica para el negocio: por ejemplo, con reglas de embalaje específicas del cliente, entregas parciales complejas, varias zonas de almacén o una combinación de taller, producción y envío. Puede centrarse en las funciones necesarias a diario, en lugar de hacer pasar a los empleados por módulos que nadie usa.

Entre ambos extremos suele estar el camino más sensato: los sistemas existentes siguen siendo la referencia para los datos maestros de artículos o la contabilidad, mientras que una aplicación web ligera cierra la brecha operativa en el almacén. A través de interfaces claramente documentadas se pueden importar pedidos, informar de existencias y archivar albaranes. Para tales aplicaciones, una estructura de datos trazable, accesos basados en roles y procesos de importación probados son más importantes que una interfaz especialmente espectacular.

En softify.pro, estos procesos se examinan primero según el flujo concreto de mercancías: ¿quién activa, quién confirma, qué excepción ocurre realmente y qué datos deben poder demostrarse después? Solo entonces se decide si basta con una adaptación del sistema existente o si una aplicación propia es económicamente razonable.

Implementación sin frenar la operativa

El inicio más seguro rara vez es la digitalización completa de todos los procesos de almacén en una única fecha. Empiece con una ruta de entrega claramente delimitada, por ejemplo pedidos estándar de una ubicación o una categoría de producto. Esto revela si los datos maestros de artículos, la calidad de las direcciones y la lógica de cantidades son suficientemente limpios.

En el siguiente paso, los pedidos reales deberían probarse en paralelo. El software crea el albarán mientras el flujo anterior sigue disponible como instancia de control. Las desviaciones son valiosas en esta fase: no indican necesariamente un error de software, sino a menudo reglas de proceso no aclaradas. Si, por ejemplo, dos empleados empaquetarían el mismo pedido de forma distinta, primero hay que aclarar la regla de trabajo.

Después vienen los roles y permisos. El personal de almacén necesita vistas distintas a las de ventas o contabilidad. No todo el mundo debería poder modificar posteriormente las cantidades entregadas o anular documentos. Una buena solución hace visibles las responsabilidades sin forzar cada pequeña acción en un proceso de aprobación complicado.

La operación técnica también forma parte de la implementación. Documentos y datos de movimiento necesitan copias de seguridad regulares, reglas de retención claras y vías de recuperación probadas. En una aplicación web con PHP 8.4 y MySQL 8, las transacciones de base de datos limpias son especialmente importantes: un registro de inventario y la creación del albarán correspondiente no deben desincronizarse si una conexión se interrumpe en el momento equivocado.

Tres errores que encarecen innecesariamente la automatización

El primer error es automatizar un problema de PDF cuando los datos previos no están claros. Si los números de artículo, las unidades o las direcciones de clientes no están bien mantenidos, el sistema solo genera documentos erróneos más rápido.

El segundo error es un alcance de proyecto demasiado grande. Rehacer al mismo tiempo albaranes, almacén, envío, compras, producción y contabilidad suele ocupar a los equipos durante meses. Un proceso de entrega pequeño y sólido genera confianza más rápido y ofrece una base para nuevos pasos.

El tercer error es la falta de retroalimentación del almacén. Un albarán no debe crearse únicamente a partir de un pedido planificado si nadie ha confirmado qué se empaquetó realmente. Precisamente esa retroalimentación convierte una plantilla de documento en un proceso sólido.

El mejor software para albaranes casi desaparece de la vista en el día a día. Los empleados registran un pedido una vez, confirman su trabajo donde ocurre y vuelven a encontrar el documento correcto cuando lo necesitan. Cuando esto funciona, no solo surge un envío más rápido, sino un proceso en el que almacén, oficina y clientes pueden confiar por igual.

Enlace permanente →

Probar automáticamente una aplicación Windows: cómo lograrlo

Probar automáticamente una aplicación Windows: cómo lograrlo

Un lanzamiento está listo, pero nadie puede afirmar con certeza si el nuevo cuadro de diálogo de importación, la comprobación de permisos y la impresión de facturas siguen funcionando. Precisamente en este punto resulta valioso poder probar automáticamente una aplicación Windows - no como una demo de tres clics, sino como una parte repetible del proceso de lanzamiento.

El software de escritorio es crítico para el negocio en muchas empresas. Controla movimientos de inventario, órdenes de fabricación, datos maestros de clientes o documentos de envío. Un error no afecta solo a una pantalla: puede bloquear pedidos, generar etiquetas incorrectas u obligar a los empleados del turno de tarde a soluciones manuales de emergencia. Las pruebas automatizadas reducen este riesgo cuando se orientan a flujos de trabajo reales y a un entorno de pruebas técnicamente controlado.

Por qué las pruebas de Windows son diferentes de las pruebas web

Una aplicación web se prueba normalmente a través de elementos claramente direccionables en el navegador. En las aplicaciones de escritorio Windows, el manejo depende más de ventanas, cuadros de diálogo, controles nativos, resolución, permisos y componentes instalados. Una prueba debe determinar, por ejemplo, si un cuadro de diálogo se abrió realmente, si un campo es editable o si un trabajo de impresión se transfirió correctamente.

A esto se suma la realidad acumulada de muchas aplicaciones. Algunas interfaces constan de componentes clásicos WinForms o WPF, otras integran módulos más antiguos, visores de PDF o interfaces hacia impresoras y hardware de escáner. No existe un único procedimiento de automatización que funcione igual de bien para cada aplicación. Quien lo oculta produce pruebas que se ven bien en el laboratorio y fallan en la siguiente actualización.

El punto de partida sensato no es, por tanto, la herramienta, sino la pregunta: ¿qué procesos deben funcionar de forma demostrable en cada lanzamiento? Para un software de almacén o pedidos, eso sería, por ejemplo, el inicio de sesión, la comprobación de permisos, la entrada de pedidos, el registro de inventario, la creación de documentos y la transferencia a una interfaz. Estos procesos generan valor de negocio. Una prueba que solo comprueba si un menú es visible rara vez lo hace.

Probar automáticamente una aplicación Windows: elegir el nivel adecuado

Para la automatización existen fundamentalmente tres niveles. Lo ideal es combinarlos, en lugar de basarse exclusivamente en la interfaz visible.

En el nivel técnico, las pruebas unitarias y de integración verifican la lógica de negocio, el acceso a datos y las interfaces. Se ejecutan rápidamente y muestran pronto si, por ejemplo, un cálculo de precios, un formato de importación o una regla de permisos se ha dañado. Sin embargo, no sustituyen una prueba operativa: si un planificador realmente puede acceder a la función y ejecutarla correctamente sigue siendo una incógnita.

El segundo nivel son las pruebas de interfaz a través de la API de Windows Automation. Aquí las herramientas de prueba se dirigen a los controles mediante propiedades como el ID de automatización, el nombre o el tipo de control. Esto suele ser más estable que las pruebas que simplemente hacen clic en coordenadas de pantalla fijas. Los equipos de desarrollo pueden fomentar activamente esta estabilidad asignando ID únicos y no renombrando los controles relevantes con cada cambio de interfaz.

El tercer nivel funciona visualmente. Aquí un sistema reconoce botones, contenidos de tablas, cuadros de diálogo o estados a partir del contenido de la pantalla. Esto ayuda especialmente con aplicaciones antiguas, componentes propietarios o interfaces que no ofrecen información de automatización útil. Sin embargo, el reconocimiento visual es más sensible a la escala, los temas, las ventanas emergentes inesperadas y los estados de pantalla confusos. Requiere puestos de trabajo definidos, condiciones de espera claras y evidencias trazables.

Un enfoque asistido por IA puede clasificar las señales visuales mejor que un simple clic en coordenadas. Aun así, no debería convertirse en una caja negra. Para los pasos críticos, un equipo necesita capturas de pantalla, registros, resultados esperados y una explicación de por qué una ejecución se evaluó como fallida. Una fiabilidad aburrida pero demostrable, en lugar de perseguir tendencias, se aplica especialmente en las pruebas.

Empezar con un alcance de pruebas pequeño y sólido

El error más común es intentar automatizar de inmediato cada pantalla. Esto consume presupuesto y crea una gran colección de scripts frágiles antes incluso de que quede claro si el enfoque mejora el día a día de los lanzamientos. Es mejor un comienzo reducido con entre cinco y diez flujos críticos que hoy se comprueban regularmente de forma manual.

Un buen primer caso de prueba tiene un inicio claro, una entrada realista y un resultado verificable. Ejemplo: un usuario con el rol de almacén inicia sesión, crea una recepción de mercancía, registra un artículo en una ubicación y imprime el documento. La prueba comprueba entonces no solo el mensaje de éxito, sino también el inventario, el número de documento y el trabajo de impresión registrado. Así, una secuencia de clics se convierte en una prueba de un proceso de negocio.

No todos los flujos son adecuados de inmediato. Las funciones con hardware inestable, servicios de pago externos o sistemas de terceros que cambian con frecuencia suelen requerir un enfoque diferente. Aquí se puede probar la propia aplicación hasta el traspaso y representar el componente externo mediante un simulador controlado. No es un atajo, sino una delimitación clara de responsabilidades.

Los datos de prueba son parte del sistema

La automatización a menudo falla no por la interfaz, sino por datos inutilizables. Una cuenta de prueba está bloqueada, un artículo ya se ha usado, o una ejecución anterior cambió la cantidad de inventario esperada. Por eso el entorno de pruebas necesita datos de partida definidos y una forma fiable de volver a ese estado.

En la práctica, esto significa: base de datos de pruebas separada, roles de usuario fijos, conjuntos conocidos de artículos y clientes, así como una lógica de tiempo y numeración controlada. Con datos sensibles, los datos de producción no deberían copiarse de forma incontrolada. Los conjuntos de datos anonimizados o generados específicamente suelen ser la mejor opción. Son predecibles y reducen el riesgo de protección de datos.

Los flujos de bloqueo de cuenta también merecen especial atención. Si las ejecuciones de prueba fallidas usan repetidamente contraseñas incorrectas, pueden bloquear sus propios accesos. Estos escenarios deberían probarse conscientemente, pero separados de la prueba de regresión normal.

La estabilidad surge de la operación, no de una sola herramienta

Una prueba de interfaz solo es útil si se ejecuta en condiciones reproducibles. Esto incluye una versión fija de Windows, resolución y escala de pantalla definidas, versiones de aplicación conocidas, así como un manejo limpio de actualizaciones, cuadros de diálogo y procesos en segundo plano. Si un servidor de pruebas usa tamaños de fuente diferentes por la mañana que por la noche, eso no es un problema de pruebas, es un problema operativo.

Los tiempos de espera no deberían introducirse ciegamente como valores fijos. Tres segundos de pausa después de cada clic hacen que una prueba sea lenta y no resuelven problemas de sincronización. Es mejor esperar específicamente a un estado: la ventana es visible, la tabla contiene el registro esperado, o el proceso de guardado ha finalizado. Para procesos asíncronos reales se necesitan límites de tiempo razonables y un diagnóstico de errores claro.

Las ejecuciones fallidas pertenecen a una clasificación, no a una carpeta ignorada. ¿Estaba defectuosa la aplicación? ¿Cambió la interfaz de forma funcionalmente correcta? ¿No estaba disponible el entorno de pruebas? Capturas de pantalla, grabaciones de pantalla, registros técnicos y marcas de tiempo acortan considerablemente esta aclaración. Un informe en texto claro también ayuda a los departamentos a entender qué proceso de negocio se ve afectado, sin tener que leer primero un script de prueba.

Planificar la protección de datos y las evidencias desde el principio

En las aplicaciones de escritorio, las capturas de pantalla suelen mostrar nombres de clientes, precios de artículos, direcciones o cifras internas clave. Si las pruebas se ejecutan a través de servicios en la nube externos, los datos de pantalla y el tráfico de la aplicación pueden salir de su propia zona de control. Para los equipos conscientes de la seguridad, esto no es un detalle menor, sino una decisión de arquitectura.

Un servidor de pruebas autoalojado puede mantener la ejecución de pruebas, las imágenes y los informes en su propio entorno. Para ello, softify.pro utiliza COCO, un entorno que ejecuta pruebas automatizadas para aplicaciones web y Windows y genera resultados trazables. Si un servidor propio tiene sentido depende de las necesidades de protección, la infraestructura de TI existente y el número de ejecuciones de prueba. Para una aplicación pequeña y no crítica, un enfoque simple puede ser suficiente; para sistemas especializados internos con datos sensibles, el control local suele ser la opción más razonable.

La conservación de las evidencias también debería estar regulada. No todas las capturas de pantalla necesitan almacenarse de forma permanente. Son útiles los plazos, el acceso basado en roles y una asignación clara entre ejecución de prueba, versión de la aplicación y resultado. Así se pueden reproducir errores sin crear una segunda colección de datos incontrolada.

Qué aporta un despliegue sensato

Después de una primera ejecución, un equipo no debería recibir solo un número de pruebas superadas. Lo decisivo es si las pruebas encuentran errores reales, si funcionan de forma fiable y si el esfuerzo de mantenimiento se corresponde con el beneficio. Una prueba que hay que ajustar cada semana por un cambio de diseño insignificante es demasiado costosa, incluso si técnicamente parece impresionante.

El siguiente paso es la integración en el proceso de lanzamiento. Las pruebas técnicas rápidas pueden ejecutarse en cada build; las pruebas de extremo a extremo seleccionadas se ejecutan antes de una aprobación o por la noche en un entorno estable. Las desviaciones críticas bloquean el lanzamiento, las indicaciones menos críticas se documentan y priorizan. Estos umbrales deberían acordarse con el área de negocio. No toda diferencia visual detiene una entrega, pero una cantidad registrada incorrectamente sí.

Las pruebas automatizadas de Windows no sustituyen el conocimiento especializado. Pero crean tiempo para las comprobaciones que requieren criterio: nuevos procesos, casos especiales inusuales y la pregunta de si una función es realmente comprensible en el día a día laboral. Cuando los procesos estándar son demostrablemente fiables, un lanzamiento ya no tiene que basarse en la esperanza.

Enlace permanente →

Software logístico a medida para pymes

Software logístico a medida para pymes

Cuando la recepción de mercancía se registra en papel, los inventarios están repartidos en varios archivos Excel y las preguntas de envío se resuelven de palabra, rara vez falta disposición. Falta un proceso compartido. El software logístico a medida para pymes actúa precisamente ahí: no con un sistema corporativo sobrecargado, sino con una aplicación que refleja los caminos reales en el almacén, la planificación y la oficina.

Para muchas empresas, esto no es un proyecto de digitalización por sí mismo. Se trata de menos consultas, inventarios fiables, albaranes generados más rápido y un traspaso de turno que no depende del conocimiento de personas individuales. La mejor solución no es automáticamente la que tiene más funciones. Debe hacer el trabajo demostrablemente más sencillo y controlable.

El punto crítico suele estar en los traspasos

En pequeñas y medianas empresas de almacenamiento y fabricación, muchas cosas funcionan sorprendentemente bien durante mucho tiempo con hojas de cálculo, correos electrónicos y experiencia. Esto no es fundamentalmente incorrecto. Una hoja de cálculo bien mantenida puede ser más sensata que un sistema propio para una lista de inventario manejable.

Se vuelve crítico cuando la información se registra varias veces o su fiabilidad ya no está clara. Un pedido se crea en la oficina, se imprime en el almacén, se completa en una hoja de ruta y luego se traslada de nuevo a una hoja de cálculo. Al mismo tiempo, otro empleado reserva stock para un envío urgente. Al final, no solo el inventario es cuestionable, sino que también resulta difícil responder quién realizó qué paso y cuándo.

Esta fricción rara vez se manifiesta como un único error grande. Cuesta minutos cada día: al buscar artículos, al devolver la llamada de un cliente, al rastrear una entrega o en el relevo de turno. A lo largo de las semanas, esto genera faltantes evitables, envíos urgentes y discusiones sobre cifras en las que nadie confía por completo.

Qué debería mapear concretamente un software logístico a medida

Una aplicación a medida no empieza con un catálogo de funciones. Empieza con un análisis del proceso en el suelo de la nave y en el puesto de planificación. ¿Qué datos llegan realmente? ¿Qué decisión toma un empleado? ¿Qué excepción ocurre regularmente? ¿Y qué información debe estar obligatoriamente disponible para el siguiente paso de trabajo?

De ahí surge un flujo claro, por ejemplo desde la entrada del pedido, pasando por la preparación y el envío, hasta el traspaso a contabilidad. Según la empresa, pueden formar parte los siguientes componentes:

  • Registro de recepciones de mercancía, estado de control y ubicaciones de almacén
  • Movimientos de inventario con soporte de código de barras o escáner móvil
  • Aceptación de pedidos, reservas y listas de preparación
  • Albaranes, etiquetas de envío y traspaso a proveedores de transporte
  • Planificación de rutas para vehículos y giras propios
  • Correcciones trazables, permisos basados en roles y análisis

Lo decisivo no es construirlo todo de una vez. Una empresa con traslados frecuentes quizá necesite primero movimientos de inventario fiables. Un mayorista con muchos envíos pequeños se beneficia inicialmente más de una entrada de pedidos limpia y documentos de envío generados automáticamente. Una empresa de fabricación tal vez necesite primero transparencia sobre el suministro de materiales y las existencias bloqueadas.

Un ejemplo del día a día

Supongamos que la recepción de mercancía recibe cinco palés con artículos cuyas cantidades difieren en parte del pedido. En un buen flujo, la entrega se registra, se comprueba y se le asigna un estado. Solo tras la aprobación el inventario queda disponible para la planificación. Las discrepancias no acaban en una nota en el albarán, sino que se asignan de forma visible a compras y almacén.

Cuando más tarde se realiza la preparación, el sistema muestra no solo un inventario total teórico, sino la ubicación correspondiente y la parte reservada. Tras el escaneo o la confirmación de la extracción, el movimiento queda registrado. El albarán se genera a partir de los mismos datos. Esto reduce las entradas duplicadas y crea un rastro fiable sin que los empleados tengan que realizar más trabajo administrativo.

¿Software estándar, Excel o desarrollo a medida?

La respuesta honesta es: depende del proceso. El software estándar tiene sentido cuando los flujos coinciden en gran medida con los patrones previstos, los ajustes son mínimos y los costes de licencia se ajustan al alcance. A menudo aporta módulos ya hechos, interfaces establecidas y una implantación inicial rápida.

La desventaja se hace evidente cuando la empresa tiene que adaptarse permanentemente a la herramienta. En ese caso, los casos especiales se vuelven a gestionar fuera del sistema, se eluden los campos obligatorios o los empleados mantienen listas paralelas. Esto puede ser aceptable mientras estas excepciones sigan siendo raras y manejables. Si se acumulan, el producto estándar se convierte en una ruptura de proceso adicional.

Excel también sigue siendo una herramienta útil cuando los volúmenes de datos son pequeños, solo trabajan pocas personas simultáneamente y las consecuencias de una entrada errónea siguen siendo limitadas. Sin embargo, no es una buena base de datos para movimientos de inventario paralelos, reservas vinculantes o un historial de envíos completo.

Una solución individual merece especialmente la pena cuando el flujo constituye una ventaja competitiva real, cuando se combinan varias rupturas de soporte, o cuando un sistema existente contiene datos pero frena el trabajo diario. No debería entenderse como un proyecto de prestigio. Su valor económico radica en tiempos de ciclo más cortos, menos errores y menor dependencia de personas concretas.

El software logístico a medida para pymes necesita límites

A medida no significa implementar de inmediato cada función deseada. Al contrario: un buen desarrollo a medida establece límites claros. De lo contrario, se crea un sistema que conserva todas las vías especiales históricas y, por ello, se vuelve difícil de usar.

Un inicio sensato define un proceso central con un beneficio medible. Por ejemplo: las recepciones de mercancía se registran completamente el mismo día. O: para cada pedido de envío, el artículo, la cantidad, el responsable y el estado de envío están documentados de forma inequívoca. Solo cuando este proceso funciona de forma estable siguen otros módulos, como la planificación de rutas, los portales de clientes o análisis especiales.

Las decisiones técnicas también requieren pragmatismo. Una aplicación web puede basarse en tecnologías modernas y mantenibles como PHP 8.4, JavaScript moderno y MySQL 8. Esto no es autopromoción con términos técnicos. Crea una base trazable para permisos basados en roles, transacciones de base de datos, interfaces móviles e implementaciones documentadas. Para los escáneres en el almacén, a menudo es decisivo que la aplicación responda de forma fiable en los dispositivos existentes y dé retroalimentación clara incluso con Wi-Fi más débil.

Implantación: primero estabilizar el proceso, luego acelerar

La implantación rara vez fracasa por una única interfaz. Fracasa cuando las cuestiones de proceso pendientes se posponen a la fase de desarrollo. ¿Quién puede corregir el inventario? ¿Qué ocurre con la mercancía dañada? ¿Cuándo se reserva un pedido de forma vinculante? ¿Cómo se gestionan las devoluciones? Estas reglas deben aclararse antes de una implantación amplia.

Un camino sólido comienza con unos pocos flujos representativos y datos reales. Empleados de almacén, planificación y administración comprueban juntos si la pantalla habla el lenguaje de la empresa y si el orden de los pasos de trabajo es correcto. Comentarios como «este campo no lo necesitamos» o «aquí falta el estado para entrega parcial» son más valiosos que deseos de funciones abstractos.

Después sigue una operación piloto limitada. No con ejemplos artificiales, sino con pedidos seleccionados en el día a día. Los errores y estados poco claros se documentan, priorizan y corrigen. Solo después se amplía a otras áreas. La operación en paralelo puede dar seguridad a corto plazo, pero debería tener un final. Dos sistemas líderes generan a la larga precisamente la incertidumbre que el proyecto pretende eliminar.

La formación también es más que una presentación única. Los empleados necesitan instrucciones breves y específicas por rol: ¿qué registro? ¿qué compruebo? ¿qué hago ante una discrepancia? Una gestión documentada de excepciones evita que, ante la primera situación especial, el papel y los grupos de chat vuelvan a tomar el mando.

La mantenibilidad es parte de la solución, no un añadido posterior

Los procesos logísticos cambian. Se añaden nuevas ubicaciones, un proveedor de transporte modifica sus requisitos, los clientes exigen otros formatos de documento o se conecta una nueva sede. Por eso el software no solo debe encajar en el arranque, sino ser desarrollable de forma comprensible.

Esto incluye una estructura de datos limpia, lógica de negocio claramente separada, conceptos de permisos e implementaciones documentadas. Igual de importantes son las copias de seguridad, el registro y una gestión regulada de errores. Si un usuario introduce varias veces credenciales incorrectas, se necesita, por ejemplo, un flujo de bloqueo de cuenta trazable en lugar de una improvisación silenciosa e insegura.

Las pruebas deberían preceder a los cambios en flujos críticos. En aplicaciones a medida, las pruebas automatizadas resultan especialmente útiles para los caminos centrales recurrentes: crear un pedido, reservar inventario, generar un documento de envío, cambiar el estado. Así, una modificación en el albarán no tiene consecuencias inadvertidas en otro lugar. softify.pro apuesta en este tipo de proyectos por esta clase de tecnología aburridamente fiable y verificable, en lugar de por efectos a corto plazo.

Con qué medir el beneficio después de seis meses

No toda mejora se puede expresar de inmediato en euros, pero debería ser visible. Los buenos indicadores se orientan al cuello de botella: tiempo de procesamiento por pedido, número de correcciones de inventario, tasa de envíos erróneos, proporción de registros de recepción puntuales o consultas entre el almacén y la oficina.

Es importante la comparación con una situación de partida realista. Si hasta ahora nadie ha registrado correctamente los faltantes, la nueva transparencia puede parecer al principio más problemas. En realidad, los problemas se hacen visibles y gestionables por primera vez. Esta fase requiere paciencia y una comunicación abierta.

El software adecuado no desaparece del día a día laboral porque sea poco importante. Hace que un pedido, un palé o una ruta sigan su camino claro, incluso cuando la persona más experimentada del almacén no está precisamente en la empresa.

Enlace permanente →

Pruebas de regresión automatizadas para aplicaciones web

Pruebas de regresión automatizadas para aplicaciones web

Un código de descuento modificado, un nuevo derecho de rol o una actualización del servicio de pasarela de pago pueden romper una aplicación web en un punto que nadie ha tocado durante meses. Es precisamente ahí donde entran en juego las pruebas de regresión automatizadas para aplicaciones web: comprueban de forma repetida si los flujos de trabajo empresariales probados siguen funcionando después de los cambios. No como una medida de calidad teórica, sino allí donde un error bloquea pedidos, movimientos de inventario, facturas o cuentas de clientes.

Para muchos equipos, el problema comienza de forma imperceptible. Los lanzamientos se demoran porque los departamentos especializados hacen clic manualmente en los mismos flujos principales. El conocimiento de las pruebas reside en personas individuales. Y antes de una actualización queda la pregunta incómoda: ¿qué hemos pasado por alto? La automatización no sustituye ni la responsabilidad técnica ni una labor de exploración sensata. Hace que las comprobaciones recurrentes y críticas para el negocio sean fiables, reproducibles y trazables.

Lo que las pruebas de regresión automatizadas protegen realmente

Una prueba de regresión responde a una pregunta sencilla: ¿sigue funcionando algo que antes funcionaba después de un cambio? En una aplicación web, rara vez se trata solo de un botón individual. Lo relevante son los flujos completos a través de la interfaz de usuario, los permisos, las interfaces y la base de datos.

Un ejemplo de un sistema operativo: un empleado inicia sesión, registra una entrada de mercancías, contabiliza un movimiento de inventario, crea un albarán y entrega el envío a un servicio de transporte. Cada paso puede parecer técnicamente correcto y aun así fallar en su interacción conjunta. Quizá la cantidad se guarde, pero no se actualice en el inventario. Quizá se genere la etiqueta, pero falte el número de referencia. Quizá el flujo solo funcione para los administradores, pero no para el rol del almacén.

Las pruebas automatizadas pueden ejecutar dichos recorridos con entradas definidas y comprobar los resultados. Esto incluye tanto los resultados visibles en la interfaz de usuario como los valores de estado, los documentos generados, los correos electrónicos o las respuestas de la API. La utilidad aumenta cuando la comprobación se organiza cerca de los riesgos de la operación, y no en función del número de casos de prueba técnicamente posibles.

Qué flujos web se deben automatizar primero

No cualquier clic merece una prueba automatizada inmediata. Una página de configuración apenas utilizada y con bajo potencial de daño se puede comprobar manualmente al principio. Por el contrario, los flujos con cambios frecuentes, alta utilización o consecuencias financieras y operativas claras deben incorporarse pronto a la suite de pruebas.

Son especialmente valiosas las pruebas para el inicio de sesión, el restablecimiento de contraseñas y el bloqueo de cuentas. Aseguran el acceso a la aplicación y a menudo se ven influenciadas por cambios en los servicios de identidad, la gestión de sesiones o las reglas de seguridad. Igualmente importantes son los procesos clave como la captura de pedidos, el cálculo de precios e impuestos, las aprobaciones, los registros de inventario, la generación de documentos y las interfaces con envíos, ERP o proveedores de pagos.

Para los directivos y los departamentos especializados, ayuda una priorización sobria. No pregunte primero qué página es la más fácil de probar. Pregunte: ¿qué error detiene un turno, genera trabajo adicional o conduce a información incorrecta para los clientes? De ahí surge una lista de pruebas que protege la operativa real.

Un caso de prueba necesita un resultado verificable

«Crear pedido» aún no es un buen caso de prueba. Es mejor: un representante de ventas con el rol de ventas crea un pedido para un cliente existente, añade un artículo con una cantidad definida, lo guarda y genera un número de pedido. A continuación, el estado es «abierto», la suma corresponde a las reglas y el pedido aparece en la lista de operaciones abiertas.

Esta precisión no es burocracia. Evita pruebas que hacen clics pero no pueden determinar si el resultado de negocio es correcto. También facilita la coordinación entre el desarrollo, el control de calidad (QA) y el departamento especializado. Especialmente en sistemas desarrollados a medida, los expertos técnicos son a menudo la única fuente fiable de lo que «correcto» significa realmente en el día a día.

La pirámide de pruebas en lugar de la automatización de navegador para todo

Las pruebas de navegador son valiosas, pero no constituyen toda la estrategia de prueba. Se ejecutan más lentamente, son más vulnerables a datos de prueba inestables y pueden fallar tras pequeños ajustes de la interfaz de usuario si los selectores están mal elegidos. Quien comprueba cada regla exclusivamente a través de la interfaz suele construir una suite lenta y difícil de mantener.

La lógica de negocio como los cálculos de precios, las comprobaciones de cantidades o las transiciones de estado debe probarse allí donde está implementada, por ejemplo como prueba unitaria o de integración. Las interfaces se pueden comprobar de forma específica con respuestas controladas. Las pruebas de extremo a extremo (end-to-end) basadas en navegador quedan reservadas entonces para los pocos caminos en los que la interacción de todos los componentes es decisiva.

En aplicaciones PHP 8.4 con MySQL 8, esto significa por ejemplo: las reglas de cálculo y validación se aseguran cerca del código, las transacciones de base de datos y los contratos de API se prueban de manera integrada, mientras que una prueba de navegador sigue el pedido completo hasta el documento generado. Esto es menos espectacular que una gran colección de pruebas de clics visibles. Sin embargo, proporciona respuestas más rápidas y un menor esfuerzo de mantenimiento.

La estabilidad surge de los datos de prueba y de límites técnicos claros

Muchos proyectos de automatización no fracasan por la herramienta de prueba, sino por requisitos previos no controlados. Si una cuenta de prueba está bloqueada, si todavía existe un pedido de prueba del día anterior o si un servicio externo responde lentamente, se produce una falsa alarma. Estas pruebas inestables pierden rápidamente la confianza del equipo.

Por lo tanto, los datos de prueba deben crearse y depurarse conscientemente. Son útiles los inquilinos propios o conjuntos de datos claramente delimitados, identificadores únicos por ejecución de prueba y estados iniciales definidos. Una prueba no debe depender por casualidad del orden de otras pruebas. Donde intervienen servicios externos, se debe decidir claramente: ¿se utiliza un entorno de prueba realista o se simula la interfaz para la prueba respectiva? Ambas opciones pueden ser correctas.

Los selectores también merecen atención. Las pruebas no deben depender de clases de diseño, posiciones de texto o estructuras HTML aleatorias. Unos identificadores estables y previstos expresamente para las pruebas reducen el mantenimiento innecesario. Esta es una pequeña decisión técnica de gran repercusión cuando la interfaz y el diseño evolucionan regularmente.

Integrar las pruebas de regresión automatizadas en el proceso de lanzamiento

La mejor prueba sirve de poco si solo se inicia manualmente antes de los grandes lanzamientos. Es útil una ejecución graduada: las pruebas rápidas de código y de interfaz se ejecutan en cada cambio. Los recorridos de navegador más importantes se ejecutan en las solicitudes de extracción (pull requests) o antes del despliegue en el entorno de ensayo (staging). Las comprobaciones más exhaustivas pueden tener lugar por la noche o antes de un lanzamiento de producción planeado.

La retroalimentación es crucial. Una prueba fallida no solo necesita un icono rojo, sino indicaciones utilizables: ¿qué datos se utilizaron? ¿En qué paso se produjo el error? ¿Qué captura de pantalla o qué registro lo demuestra? Para los equipos sin un gran departamento de QA propio, los informes comprensibles son especialmente valiosos. Deben poder reconocer si un defecto radica en el sistema, en los datos de prueba o en el entorno de prueba.

COCO se puede utilizar aquí como infraestructura de prueba autohospedada para ejecutar flujos de prueba, registrar evidencias y procesar los resultados en un lenguaje claro. Esto es relevante sobre todo cuando las capturas de pantalla, las interfaces internas o los datos de prueba no deben transferirse a una nube externa. No obstante, estar autohospedado no significa estar libre de mantenimiento: los derechos de acceso, las actualizaciones, las capacidades y las reglas de retención deben planificarse con la misma pulcritud que las propias pruebas.

Qué indican las métricas, y qué no

Un número creciente de pruebas automatizadas no es una prueba de calidad. Una suite con 2.000 pruebas superficiales puede ofrecer menos protección que 40 pruebas cuidadas para los flujos de valor críticos. Son más elocuentes preguntas como: ¿cuánto tiempo tarda la respuesta tras un cambio? ¿Cuántos errores relevantes se detectan antes de la producción? ¿Con qué frecuencia los errores de prueba son en realidad falsas alarmas? Y qué flujos críticos para el negocio están cubiertos de forma demostrable.

La duración de la ejecución también es un factor práctico. Si una suite ofrece resultados solo después de cuatro horas, se elude en el trabajo diario. Si proporciona una señal clara sobre inicio de sesión, pedido, inventario y documentos en 15 minutos, apoya las decisiones antes del lanzamiento. Depende de la aplicación y del riesgo qué profundidad sea necesaria. Una herramienta de planificación interna exige algo distinto a un portal de clientes con pagos y datos personales.
El inicio correcto es más pequeño de lo que muchos esperan

Comience con un proceso cuya interrupción se notaría, y modélizalo por completo. Defina el resultado esperado junto con las personas que utilizan este flujo a diario. Asegúrese de contar con datos de prueba controlados, anclajes técnicos estables y evidencias trazables. Solo cuando esta primera prueba funcione de manera fiable se añadirá el siguiente proceso.

Así no se crea un telón de fondo de pruebas impresionante pero frágil. Se crea una línea de seguridad sólida para los cambios, paso a paso, allí donde su aplicación web sostiene realmente la operativa.

Enlace permanente →

Registro digital de la entrada de mercancías sin caos de inventario

Registro digital de la entrada de mercancías sin caos de inventario

Un albarán está sobre la mesa de mercancías, el palé ya se encuentra en el pasillo y el conductor espera una firma. Exactamente en este momento se decide si un inventario será correcto más tarde o si una compañera tendrá que buscar después un material que, según el sistema, debería estar disponible. Quien quiera registrar la entrada de mercancías de forma digital, necesita por lo tanto algo más que una simple máscara de introducción de datos. El proceso debe funcionar bajo presión de tiempo, generar datos inequívocos y adaptarse a los procedimientos reales del almacén.

Las listas en papel y las hojas de cálculo a menudo parecen suficientes durante mucho tiempo. Sin embargo, se vuelven frágiles en cuanto varias personas realizan registros, los artículos tienen denominaciones similares, los lotes cobran relevancia o la mercancía pasa directamente al montaje, a la preparación de pedidos o a los pedidos de clientes. Un buen registro digital no se limita a crear más datos. Crea un estado común y fiable.

Qué se debe registrar realmente en la entrada digital de mercancías

La entrada de mercancías es la transición entre la entrega y el stock disponible. Para que esta transición siga siendo verificable, cada registro debería poder responder al menos a: ¿qué se entregó, en qué cantidad, cuándo, de qué proveedor y dónde se almacenó la mercancía? Según el tipo de negocio, se añaden el número de pedido, el número de albarán, el lote, el número de serie, la fecha de caducidad o el estado de calidad.

Lo decisivo es la distinción entre la mercancía anunciada y la efectivamente recibida. Un pedido puede indicar 100 unidades, pero se entregan 96 unidades, dos cajas dañadas y dos partidas de repuesto. Si los empleados se limitan a confirmar el pedido, el error pasa directamente al inventario. El registro digital debe facilitar de forma consciente la gestión de las desviaciones, en lugar de penalizarla con procedimientos especiales.

Para un almacén de repuestos, a menudo basta con el artículo, la cantidad, la ubicación y la referencia del documento. En la fabricación, las liberaciones de lotes o los protocolos de inspección pueden resultar indispensables. Más campos no significan automáticamente un mejor resultado. Cada campo obligatorio consume tiempo y aumenta la probabilidad de que alguien estime los valores o los introduzca más tarde.

Registro digital de la entrada de mercancías: el flujo de trabajo en la zona de almacenamiento

Un flujo de trabajo práctico no comienza en la pantalla de la oficina, sino allí donde llega la mercancía. Los empleados abren la entrada de mercancías esperada en un dispositivo móvil o registran el albarán inicialmente mediante la búsqueda, el número de pedido o el código de barras. A continuación, se escanean, se cuentan o se pesan las posiciones y se cotejan con la entrega esperada.

Si la cantidad es correcta, la mercancía se asigna a una ubicación de almacenamiento y se registra. En caso de desviaciones, no se escribe simplemente un comentario en un campo de texto libre. El sistema registra si se trata de un faltante, un exceso de entrega, un daño de transporte, un artículo erróneo o una posición aún no verificada. Una fotografía puede resultar útil en caso de daños visibles, pero no es necesaria para cada envío.

Tras el registro, debe quedar claro qué estado tiene la mercancía. Algunos artículos están disponibles de inmediato. Otros permanecen bloqueados hasta que se complete un control de calidad o un responsable decida sobre la desviación. Esta lógica de estados evita que el departamento de ventas prometa mercancía que ha llegado físicamente pero que aún no se puede utilizar.

El punto de registro adecuado depende de la empresa. En un almacén pequeño, la entrada de mercancías se puede registrar por completo directamente en la puerta. En el caso de grandes entregas o tiempos de rampa ajustados, a menudo es mejor un registro en dos etapas: primero se registra la entrega como llegada, y a continuación se verifican las posiciones y se almacenan. La ventaja es la velocidad en la rampa. El inconveniente: se requieren responsabilidades claras para que las revisiones pendientes no queden en el olvido.

¿Escáner, tableta o PC de puesto de trabajo?

El hardware debe seguir el flujo de movimiento. Para los artículos con códigos de barras impresos nítidamente, un escáner manual suele ser la opción más rápida y con menos errores. Los escáneres móviles o los teléfonos inteligentes con cámara son adecuados cuando los empleados se desplazan entre la recepción de mercancías, las estanterías y la zona de bloqueo. Una tableta puede resultar útil para registros más complejos con fotos, múltiples cantidades o notas de inspección.

Por el contrario, un puesto de trabajo con PC fijo funciona bien cuando una persona comprueba los albaranes de forma centralizada y la recepción de mercancías está concentrada espacialmente. Es menos adecuado si el equipo tiene que caminar hasta la oficina por cada registro. La licencia ahorrada suele pagarse entonces con trayectos, interrupciones y registros tardíos.

No todo artículo necesita un código de barras. Especialmente en el caso de componentes individuales, materias primas o etiquetas de proveedores, el etiquetado no es uniforme. En esos casos, el sistema debe ofrecer una búsqueda rápida a través del número de artículo, el número de artículo del proveedor o la posición del pedido. El escaneo de códigos de barras es una buena herramienta, pero no un fin en sí mismo.

La calidad de los datos surge de las reglas, no de los llamamientos

El inventario de un almacén no se vuelve correcto por el simple hecho de instalar un software. La exactitud surge cuando el sistema impone reglas sensatas y hace visibles las excepciones. Una cantidad negativa sin un proceso justificado, una ubicación de almacenamiento desconocida o un número de albarán utilizado por duplicado no deben pasar desapercibidos.

Al mismo tiempo, la comprobación no debe bloquear las operaciones. Si un proveedor reutiliza los números de albarán o las etiquetas son ilegibles, los empleados necesitan una vía alternativa comprensible. Por ejemplo, se puede realizar un registro con una nota que deba comprobarse más tarde. Lo importante es que esto se convierta en una tarea pendiente y no en un compromiso invisible.

Resultan especialmente valiosas las comprobaciones de plausibilidad sencillas: ¿El artículo coincide con el pedido? ¿La cantidad se desvía más allá de una tolerancia definida? ¿El lote está presente en los artículos sujetos a lotes? ¿Se ha establecido un estado de bloqueo cuando se ha registrado un aviso de daños? Tales reglas reducen el trabajo de corrección sin abrumar al equipo con pantallas de entrada de datos complicadas.

Construir las interfaces solo cuando el proceso central esté definido

Muchas empresas desean la conexión inmediata con el ERP, las compras, el envío y la contabilidad. Esto puede ser correcto, pero solo si la soberanía de los datos es clara. Un sistema debe determinar claramente dónde se originan los pedidos, dónde se encuentra el inventario principal y qué datos se transmiten en qué dirección.

Una mala interfaz multiplica los errores más rápido que una hoja de cálculo. Si, por ejemplo, los pedidos provienen del ERP, pero la entrada de mercancías real se genera en el sistema de gestión de almacenes, debe quedar claro qué estados se comunican de vuelta: entregado por completo, entregado parcialmente, bloqueado o con desviación. Las marcas de tiempo y las referencias de documentos inequívocas son en este caso más importantes que una integración visualmente impresionante.

Para las empresas más pequeñas, una importación CSV controlada al principio puede tener más sentido que una conexión en tiempo real costosa. Esto no es una solución de emergencia si la importación, la comprobación y el registro de errores se implementan correctamente. Tan pronto como las cantidades, la frecuencia o los procesos posteriores crecen, una interfaz directa resulta más rentable.

Un despliegue sensato comienza con entregas reales

Antes de seleccionar un desarrollo a medida o un software estándar, vale la pena realizar un breve levantamiento de procesos con casos reales. No solo se debe tener en cuenta la entrega ideal, sino también la mercancía dañada, las cantidades parciales, los artículos erróneos, los pedidos faltantes y el material urgente para el taller. De esto se desprende qué datos y decisiones se necesitan realmente.

Para empezar, a menudo basta con un área claramente delimitada, por ejemplo, un proveedor, un grupo de artículos o una ubicación de almacén. El equipo trabaja con el nuevo flujo de trabajo en paralelo a los controles anteriores hasta que los registros sean correctos y verificables. Solo entonces sigue la expansión. Un cambio radical (Big Bang) ahorra tiempo en el plan de proyecto, pero suele generar agitación en el área de trabajo.

Los criterios de aceptación importantes son concretos y medibles:

  • Una entrega estándar se puede registrar sin consultas en pocos minutos.
  • Las desviaciones aparecen en una lista de aclaraciones abierta y asignada.
  • El inventario de un artículo se puede explicar mediante el documento y la ubicación de almacenamiento.
  • Los empleados autorizados pueden realizar correcciones de forma trazable.
  • La mercancía abierta o bloqueada no se dispone por descuido.

Un sistema adaptado a la empresa puede ofrecer aquí mucho más que un paquete de software recargado, si respeta las formas de trabajar existentes.
softify.pro desarrolla este tipo de procesos logísticos no por el mero hecho de digitalizar, sino en torno a registros, responsabilidades y datos que deben ser fiables en el día a día.

Indicadores clave (KPI) que hacen visible el beneficio

Después del inicio, no solo se debe contar cuántas entradas de mercancías se han registrado digitalmente. Resultan más elocuentes el tiempo transcurrido desde la entrega hasta que la mercancía está disponible, el número de desviaciones sin aclarar, las diferencias de inventario en los recuentos y el esfuerzo dedicado a consultas en compras o ventas.

Si se acorta el tiempo de ciclo pero aumenta el número de correcciones posteriores, es probable que el proceso sea demasiado rápido y carezca de la comprobación suficiente. Si cada registro lleva mucho tiempo a pesar de que apenas se producen desviaciones, es posible que se hayan integrado demasiados pasos obligatorios. Los buenos procesos de almacenamiento no buscan el control máximo, sino el control adecuado.

El mejor paso siguiente suele ser un recorrido por la zona de recepción de mercancías con tres albaranes reales. Observe qué información se busca, dónde improvisan los decisiones los empleados y qué datos se vuelven a introducir más tarde. Exactamente ahí comienza una entrada de mercancías digital que no solo aparenta ser más moderna, sino que hace que el inventario sea realmente fiable.

Enlace permanente →

Pruebas de software de IA autohospedadas en entornos de producción

Pruebas de software de IA autohospedadas en entornos de producción

Una prueba de regresión fallida rara vez es solo una entrada roja en una lista. Puede significar que un operario de preparación de pedidos no puede imprimir un albarán, que un administrativo se queda bloqueado en el sistema de gestión de pedidos o que una actualización ha dañado una función que llevaba años funcionando de manera fiable. Las pruebas de software de IA autohospedadas se centran precisamente en eso: automatizan las comprobaciones recurrentes sin ceder innecesariamente datos de prueba sensibles, capturas de pantalla o flujos de trabajo internos de la aplicación a plataformas externas.

Para los equipos con aplicaciones web y software de escritorio para Windows, esto es más que una cuestión de protección de datos. Se trata de tener el control sobre el entorno de pruebas, pruebas de errores trazables y una operativa de pruebas que se adapte al propio proceso de lanzamiento (release). La IA puede aliviar la carga de trabajo en este sentido. Sin embargo, no sustituye ni a unos casos de prueba limpios ni a la responsabilidad técnica.

Cuándo tienen sentido las pruebas de software de IA autohospedadas

La automatización de pruebas clásica es muy eficaz, pero requiere mantenimiento. Los selectores cambian, las interfaces evolucionan, los datos de prueba deben estar disponibles y los mensajes de error deben clasificarse. Por esta কারণেই, muchos equipos solo automatizan una pequeña parte de sus procesos críticos o siguen probando predominantemente de forma manual antes de un lanzamiento.

Los sistemas basados en IA pueden reducir esta brecha. Leen las interfaces de manera más contextual, ejecutan flujos de trabajo predeterminados, reconocen desviaciones visibles y resumen el resultado en un lenguaje comprensible. Esto resulta especialmente valioso en aplicaciones que no solo consisten en llamadas a API, sino en interfaces de usuario reales: inicios de sesión, formularios de entrada, aprobaciones, diálogos de impresión y ventanas de Windows.

El autohospedaje (self-hosting) tiene sentido cuando las pruebas afectan a información confidencial. Esto no solo se aplica a los datos de carácter personal. Los precios internos, los nombres de clientes, los movimientos de artículos, las capturas de pantalla de interfaces de gestión, las credenciales de cuentas de prueba o la información sobre funciones aún no publicadas también forman parte de ello. Quien utilice servicios de IA externos debe comprobar con precisión qué datos abandonan su propia red, cuánto tiempo se almacenan y quién puede acceder a ellos. Sin embargo, también hay casos en los que una plataforma alojada en la nube es suficiente. En el caso de una página web pública de marketing sin datos reales de clientes, con pocos lanzamientos y una profundidad de prueba manejable, su configuración puede ser más rápida. La decisión correcta depende de la necesidad de protección, del entorno de aplicaciones, de las competencias existentes y de la frecuencia de los cambios, y no de un principio general de la nube o de la IA.

Lo que permanece en el propio entorno

En un entorno de pruebas autohospedado, la ejecución de las pruebas se realiza en una infraestructura que la propia empresa controla: en su propio centro de datos, en un entorno de nube privada o en un servidor dedicado bajo el modelo operativo acordado. Lo decisivo no es solo la ubicación física de un servidor, sino todo el flujo de datos.

Un sistema bien estructurado procesa los pasos de prueba, las sesiones de navegador o de escritorio, las capturas de pantalla, los registros (logs) y los informes de resultados dentro de este entorno controlado. Las cuentas de prueba se pueden configurar con privilegios mínimos. Las credenciales de acceso se pueden gestionar por separado. Los accesos a la red se pueden limitar a los sistemas que realmente se necesitan. Para aplicaciones especialmente sensibles, un inquilino de prueba (tenant) propio puede ser más recomendable que realizar pruebas con datos reales cercanos a la producción.

Esto no protege automáticamente contra errores. Una solución operada localmente requiere actualizaciones, conceptos de autorización, copias de seguridad y responsabilidades claras. Quien instala un servidor una vez y luego se olvida de él no tiene una infraestructura de pruebas segura, sino una carga operativa adicional. La ventaja radica en que esta tarea sigue siendo planificable y verificable.

Los datos de prueba merecen la misma protección que la aplicación

A menudo, el debate sobre la seguridad se concentra en el código fuente. En la práctica, los artefactos de prueba revelan al menos la misma cantidad de información. Una captura de pantalla puede mostrar datos de clientes, condiciones internas y detalles de un proceso. Un video de una ejecución de prueba puede revelar la estructura de un sistema de 'back office'. Un registro (log) puede contener URL, mensajes de error o versiones técnicas.

Por esta razón, se deben establecer plazos de retención. No es necesario almacenar de forma permanente cada ejecución exitosa. En cambio, para la evidencia de errores y los lanzamientos, un historial definido puede ser de gran ayuda. Los derechos de acceso a los informes deben formar parte del mismo concepto de autorización que los accesos a la propia aplicación.

No todas las comprobaciones deben ser controladas por la IA

Los entornos de pruebas más sólidos combinan diferentes métodos. Un inicio de sesión (login) con bloqueo de cuenta tras varios intentos fallidos se puede comprobar de forma precisa y rápida con pruebas automatizadas deterministas. Las interfaces, los cálculos, las reglas de base de datos y los permisos también se benefician de unas expectativas claras: la entrada A debe generar el resultado B.

La IA es especialmente útil cuando la interfaz, el flujo de trabajo y la perspectiva del usuario ocupan el centro de atención. Por ejemplo, una tarea de prueba puede comprobar si un planificador crea un pedido, asigna una ruta, genera un documento y recibe de vuelta el estado correcto. En este proceso, la IA puede navegar por la aplicación, capturar justificantes y documentar de forma comprensible en qué punto se ha interrumpido el proceso.

Para una operativa de pruebas viable, cuatro niveles deben interactuar entre sí:

  • Las pruebas unitarias y de integración aseguran la lógica de negocio, las interfaces y el procesamiento de datos en una fase temprana del proceso de desarrollo.
  • Las pruebas de interfaz de usuario (UI) comprueban rutas de clics repetibles y expectativas concretas en aplicaciones web o de escritorio.
  • Las revisiones de flujos de trabajo impulsadas por IA evalúan las rutas de operación reales y los resultados visibles desde la perspectiva del usuario.
  • Las pruebas funcionales exploratorias descubren casos especiales que nadie ha descrito todavía como una regla fija.

Una IA no debe decidir si una lógica de precios es correcta a nivel funcional si las reglas están documentadas de forma poco clara. Del mismo modo, tampoco puede ejecutar de manera sensata una orden imprecisa. «Comprueba el envío» no es una descripción de prueba fiable. «Crea un pedido con tres posiciones, genera una etiqueta de envío y comprueba si el estado cambia a enviado» es una instrucción verificable.

De la demostración a una operativa de pruebas viable

El error más frecuente en las pruebas con IA es un inicio demasiado amplio. Una demostración impresionante con un único inicio de sesión dice poco sobre si el sistema garantizará la seguridad de las versiones dentro de seis meses. Es más sensato un comienzo acotado con entre dos y cinco flujos de trabajo cuyo fallo provoque costes reales o genere un esfuerzo de comprobación manual recurrente.

En un sistema de almacén o logística, estos podrían ser la entrada de mercancías, el traslado de stock, la preparación de pedidos (picking) y la generación de un albarán. En un software de gestión, más bien el inicio de sesión, el cambio de permisos, el registro de pedidos y la aprobación de facturas. Los buenos candidatos son procesos frecuentes con reglas estables y resultados claramente visibles.

A continuación, cada flujo de trabajo necesita un punto de partida definido. ¿Qué datos deben estar disponibles? ¿Qué cuenta de prueba se utiliza? ¿Puede la prueba enviar correos electrónicos, imprimir etiquetas o interactuar con interfaces? ¿Qué se restablece después de la ejecución? Sin estas reglas, la automatización produce rápidamente basura de datos de prueba o bloquea a otros equipos.

Asimismo, la evaluación de los resultados debe realizarse de forma gradual. Un botón ausente suele ser un error claro. Una formulación ligeramente diferente en un texto informativo no tiene por qué bloquear automáticamente un lanzamiento. Aquí ayudan los umbrales de confianza (confidence thresholds) y una clara separación entre la notificación automática, la revisión manual y el criterio de bloqueo real. Un informe de prueba no solo debe informar de un «fallo», sino contener el paso ejecutado, el estado visible, la marca de tiempo (timestamp) y los justificantes adecuados.

El papel de las capturas de pantalla, los videos y los informes en texto plano

Una prueba que solo emite un mensaje de error técnico traslada el trabajo al equipo de desarrollo. A menudo, los departamentos funcionales no pueden hacer mucho con eso. Las buenas evidencias combinan la precisión técnica con el contexto: ¿Qué debía ocurrir? ¿Qué ocurrió realmente? ¿Dónde es visible? ¿Qué versión se comprobó?

Las capturas de pantalla y las grabaciones acortan considerablemente la coordinación. El responsable de QA no tiene que intentar reproducir el error primero, y el propietario del producto (product owner) ve inmediatamente si una interrupción es relevante a nivel funcional. Al mismo tiempo, dichos artefactos deben almacenarse de forma selectiva. Las pruebas exitosas suelen necesitar menos material probatorio que los fallos o las aprobaciones críticas.

Un informe en texto plano no es un sustituto de los registros (logs). Es el puente entre las operaciones, el departamento funcional y el desarrollo. Precisamente en los equipos medianos, en los que las mismas personas son responsables de los procesos y toman las decisiones, este puente evita un trabajo de traducción innecesario.

Operación, mantenimiento y expectativas realistas

La automatización de pruebas autohospedada no es un producto que funcione sin supervisión tras su configuración. Las aplicaciones cambian. Los navegadores se actualizan. Los datos de prueba pierden su validez. Los nuevos niveles de permisos, los captchas, la autenticación multifactor o los diálogos de impresión modificados influyen en las ejecuciones de las pruebas.

Esto no es un argumento en contra de la automatización, sino un argumento a favor de un ritmo de mantenimiento claro. Los casos de prueba deben tratarse como código de producto: versionados, revisados y adaptados conscientemente cuando haya cambios. Si un flujo de trabajo falla tres veces seguidas debido a un cambio intencionado en la interfaz de usuario, el problema no es la IA. Lo que falta entonces es la conexión entre el desarrollo, la planificación de lanzamientos y el mantenimiento de las pruebas.

Para ello, softify.pro apuesta por COCO, un servidor de IA dedicado y autohospedado que comprueba aplicaciones web y de Windows, registra evidencias e interpreta los resultados de forma comprensible. Sin embargo, el punto decisivo sigue siendo su integración en la rutina de trabajo diaria: ¿qué procesos se aseguran, quién comprueba las desviaciones y cuándo se puede seguir adelante con un lanzamiento?

Por lo tanto, el mejor primer paso no es comprar o configurar la mayor cantidad posible de pruebas. Elija el flujo de trabajo en el que un error pasado por alto provoque mañana un trabajo real en el almacén, en el servicio técnico o en la contabilidad. Cuando este proceso se comprueba de manera fiable, trazable y bajo el control de los datos propios, la IA deja de ser tecnología por la tecnología misma para convertirse en un alivio perceptible.

Enlace permanente →

Sustituir Excel por un software personalizado

Sustituir Excel por un software personalizado

El inventario de un almacén solo es correcto si alguien ha abierto el archivo correcto, ha registrado la última recepción de mercancías y no ha enviado ninguna copia por correo electrónico. Mientras esto funciona para pocas operaciones, Excel es una buena herramienta. Sustituir Excel por un software personalizado solo cobra sentido cuando la hoja de cálculo se convierte en un cuello de botella para los procesos, las responsabilidades y la fiabilidad.

Esto rara vez afecta únicamente al almacén. Los pedidos se anotan por teléfono, los albaranes se generan a partir de plantillas, las existencias se encuentran en varios archivos y las consultas llegan exactamente a la persona que en ese momento no está disponible. El problema no es la hoja de cálculo en sí. Es el intento de gestionar un proceso operativo en crecimiento con una herramienta que no conoce procedimientos obligatorios.

Cuándo Excel deja de ser el medio de trabajo adecuado

"Una hoja de cálculo puede calcular, filtrar y hacer visibles la información. Sin embargo, no obliga a que una entrada de mercancías se registre por completo, a que un envío se compruebe antes de la expedición, o a que dos empleados no modifiquen el mismo registro al mismo tiempo. Cuando tales reglas se vuelven críticas para el negocio, a Excel le falta la estructura adecuada.

Las señales de alarma típicas son las coordinaciones recurrentes entre el turno, el almacén y la oficina. Los empleados preguntan por el estado actual de un pedido, a pesar de que la información debería estar disponible. Las listas de existencias se depuran manualmente antes del inventario. Los números de albarán o las denominaciones de los artículos se copian y se corrigen más tarde. Y en caso de discrepancia, a menudo ya no es posible rastrear quién cambió qué valor y cuándo.

El archivo en sí también se convierte en un riesgo. Las versiones con nombres como «Bestand_final_neu_2» no son un caso aislado, sino un indicio de que un proceso no tiene una fuente de datos única. Las macros pueden acelerar pasos de trabajo individuales, pero no resuelven el trabajo en paralelo, ni los permisos por roles, ni las aprobaciones, ni un seguimiento fiable de los cambios.

El cambio no vale la pena porque un software personalizado parezca más moderno. Vale la pena cuando los errores, los tiempos de espera y el esfuerzo de control cuestan regularmente más que la introducción de un sistema claro.

Sustituir Excel por un software personalizado: qué es lo que cambia concretamente

Una buena aplicación especializada no se limita a digitalizar una tabla existente. Refleja las decisiones y los movimientos que realmente tienen lugar en la empresa. En el caso de una entrada de mercancías, esto significa, por ejemplo: seleccionar o crear la entrega, registrar las posiciones, comprobar las cantidades, justificar las desviaciones, asignar una ubicación de almacenamiento y solo después actualizar el inventario de forma vinculante.

De este modo, una lista se convierte en un proceso. Los empleados solo ven los pasos necesarios para su tarea. La oficina conoce el estado de tramitación sin necesidad de llamar por teléfono. La dirección del almacén puede comprobar las operaciones pendientes, las diferencias o los registros faltantes. Cualquier modificación sigue siendo trazable, en lugar de desaparecer silenciosamente en una celda.

La diferencia también radica en la arquitectura de datos. Una aplicación con una base de datos modelada limpiamente, por ejemplo basada en MySQL 8, no gestiona los artículos, los pedidos, las ubicaciones de almacenamiento y los movimientos como copias sueltas. Las relaciones están claramente definidas. Un artículo no se puede crear por error con tres números diferentes si la regla de negocio exige un número único.

Esto no crea una realidad libre de errores. Las cantidades se pueden seguir contando mal y las entregas pueden llegar dañadas. Sin embargo, el software se encarga de que las desviaciones se registren de forma visible, se asignen y se puedan analizar posteriormente. Operativamente, esto tiene más valor que un inventario aparentemente limpio cuya procedencia nadie puede explicar.

No reconstruir cada proceso inmediatamente

El error común es empezar con algo demasiado grande. Quien quiera sustituir todos los procesos de una empresa al mismo tiempo espera mucho tiempo para obtener un resultado y concentra muchas preguntas abiertas en un único proyecto. Para las pequeñas y medianas empresas, un enfoque gradual suele ser más sensato.

El primer área debe cumplir dos criterios: genera un esfuerzo o unos costes por errores perceptibles y se deja delimitar con claridad. Esto puede ser el registro de mercancías entrantes, la creación de albaranes, la aceptación de pedidos o el control de los movimientos de almacén. Un cuello de botella concreto aporta mejores requisitos que la exigencia abstracta de una «solución digital global».

Excel puede seguir desempeñando un papel en ello. Para cálculos puntuales, análisis o pequeñas listas de planificación, suele ser más rápido y económico que una aplicación propia. Las exportaciones de datos para el control de gestión o la asesoría fiscal también siguen siendo útiles. Lo decisivo es que Excel deje de ser la fuente principal para los procesos críticos en el tiempo.
Además, una solución personalizada no tiene por qué replicar todas las funciones de un gran sistema ERP. Una empresa con dos almacenes y diez empleados posiblemente no necesite una lógica de múltiples mandantes internacional, pero sí requiere permisos limpios, registro móvil en la ubicación de almacenamiento y documentos fiables. Las suites estándar sobrecargadas suelen incluir funciones que nadie utiliza, mientras que el flujo de trabajo central sigue teniendo que adaptarse.

Observar los requisitos en el puesto de trabajo, no limitarse a consultarlos

La mejor lista de requisitos no surge únicamente en la sala de reuniones. Nace allí donde la mercancía se descarga, se prepara, se comprueba y se entrega. Una conversación con la dirección del almacén puede describir un proceso teórico. La observación de un turno muestra qué información falta, cuándo son necesarios los guantes o los escáneres y en qué puntos los empleados toman atajos deliberadamente.
Estos atajos no son automáticamente un mal comportamiento. A menudo apuntan a un problema del sistema. Si un empleado anota números en papel porque el ordenador está demasiado lejos, la solución no debería ser simplemente un campo obligatorio en el escritorio. Tal vez el proceso necesite una máscara de registro móvil, una impresión de etiquetas o un punto de transferencia más claro entre la entrada de mercancías y el almacenamiento.

Por lo tanto, en la fase de concepción se deben responder preguntas concretas: ¿Quién crea un pedido? ¿Quién puede corregir las cantidades? ¿Qué ocurre en caso de entrega parcial? ¿Cuándo se genera un albarán? ¿Qué datos deben ser visibles si la red del almacén no está disponible brevemente? ¿Y qué indicadores clave de rendimiento se utilizan realmente, en lugar de quedar bien solo en un panel de control?

Cuanto más claras estén estas decisiones antes del desarrollo, menos lógica especial surgirá más tarde. Un buen software personalizado no reproduce cada excepción histórica. Separa las reglas operativas sensatas de los hábitos que solo existen porque la herramienta anterior imponía limitaciones.

Pensar desde el principio en la técnica, los permisos y la explotación

Una aplicación profesional debe seguir siendo fácil de mantener en el día a día. Esto no solo afecta a la interfaz, a los modelos de datos claros, al aprovisionamiento documentado, a las copias de seguridad y a las responsabilidades, sino también a la tecnología. Las aplicaciones web modernas se pueden construir de manera sólida con PHP 8.4, JavaScript actual y MySQL 8. Lo decisivo no es el valor de tendencia de una pila tecnológica, sino si a largo plazo es comprensible, comprobable y operable.

Los roles y los permisos deben integrarse pronto en el concepto. No todos los usuarios deberían poder modificar los precios, los datos maestros o los asientos históricos. Para las funciones sensibles, resultan útiles las aprobaciones trazables, los registros y, si es necesario, los bloqueos de cuenta tras intentos de inicio de sesión fallidos. Estos detalles parecen puramente técnicos al principio, pero evitan responsabilidades confusas durante la explotación.

La migración de datos es igual de importante. Los archivos de Excel existentes suelen contener duplicados, unidades incoherentes o artículos que ya no se utilizan. Importar estos datos sin verificar traslada viejos problemas al nuevo sistema. Es preferible una limpieza controlada con reglas claras: qué datos se adoptan, cuáles se archivan y cuáles deben comprobarse técnicamente antes del inicio.

Introducción sin interrupción de las actividades

Una puesta en marcha no debe poner en peligro los envíos. Por eso, la introducción necesita un área piloto limitada, casos de prueba reales y empleados que conozcan el procedimiento. No basta con crear pedidos de ejemplo. El sistema debe ser capaz de gestionar entregas parciales, cantidades erróneas, cancelaciones, presión de tiempo y las excepciones que surgen en el día a día habitual.

Una fase paralela corta puede ser útil, pero debe tener un final claro. Si la tabla y la nueva aplicación se mantienen simultáneamente durante demasiado tiempo, se genera doble trabajo y de nuevo surge la pregunta de qué fuente es la válida. Es mejor una fecha de cambio definida, acompañada de interlocutores formados y un bucle de retroalimentación rápido para errores o detalles faltantes.

Tras el inicio, el valor de una solución personalizada no se demuestra en una interfaz especialmente compleja. Se demuestra cuando un pedido continúa sin consultas, el inventario sigue siendo explicable y una nueva compañera puede utilizar el proceso de forma segura tras una breve instrucción. Exactamente ahí es donde debe empezar la siguiente decisión: no en el siguiente archivo de Excel, sino en el paso de trabajo concreto que mañana volverá a costar tiempo.

Enlace permanente →

Digitalizar los procesos de almacén con software

Digitalizar los procesos de almacén con software

Un preparador de pedidos busca durante diez minutos un artículo que, según el archivo de Excel, debería estar en la estantería. Al mismo tiempo, un compañero registra la entrada de mercancías en un formulario de papel, mientras que en la oficina se modifica un pedido por teléfono. Este tipo de situaciones no son señal de un mal trabajo. Demuestran que la información ya no sigue de forma fiable a los movimientos físicos de las mercancías. Por lo tanto, quien quiera digitalizar los procesos de almacén con software no debe empezar por una lista de funciones lo más larga posible, sino precisamente por estas rupturas en el día a dia.

Para las pequeñas y medianas empresas, la cuestión rara vez es si un sistema empresarial internacional sería técnicamente potente. La pregunta es si realmente acorta el camino desde la recepción de mercancías hasta el envío, o si crea nuevas pantallas, autorizaciones y necesidades de formación. Una buena digitalización no sustituye todos los movimientos manuales. Se encarga de que cada movimiento necesario conduzca a la información, el registro y la acción de seguimiento correctos.

Cuándo tiene sentido digitalizar los procesos de almacén con software

Una hoja de cálculo no es fundamentalmente un problema. Para un inventario manejable, pocos empleados y movimientos poco frecuentes, puede ser razonable, económica y transparente. Un cambio solo vale la pena cuando el archivo se convierte en el centro de control oficioso: circulan varias versiones, los stocks se corrigen a posteriori o solo unas pocas personas entienden las fórmulas y los archivos.

Los desencadenantes típicos no son objetivos de crecimiento abstractos, sino fricciones operativas recurrentes. Los inventarios no suelen coincidir regularmente tras los recuentos. Las entradas de mercancías se quedan sin registrar hasta el final de la jornada. Los envíos salen sin el albarán completo. Los empleados se llaman entre sí para aclarar la ubicación de un artículo o el estado de un pedido. O una persona transfiere los mismos datos sucesivamente al correo electrónico, Excel, el portal de envíos y la contabilidad.

La digitalización en este contexto significa: el sistema refleja un estado claro. Un artículo ha llegado, ha sido comprobado, almacenado, reservado, preparado o enviado. Cada cambio de estado tiene un desencadenante, un momento determinado y, de manera ideal, una persona responsable. Esto no crea burocracia, sino que evita que las decisiones se basen en suposiciones.

El punto de partida correcto: movimientos en lugar de módulos de software

Muchas implantaciones empiezan con la pregunta sobre funciones como la conexión de escáneres, la gestión de lotes o los paneles de control. Esto es comprensible, pero a menudo conduce a un pliego de condiciones sobrecargado. Tiene más sentido realizar un análisis de los procesos a lo largo del movimiento real de la mercancía.

Tome un pedido real y sígalo desde la entrada hasta la entrega al proveedor de servicios de envío. ¿Dónde se genera la información? ¿Quién la comprueba? ¿Dónde se anota algo en papel, se transfiere más tarde o se transmite de forma verbal? Las excepciones son especialmente valiosas: entregas parciales, mercancía dañada, artículos de sustitución, stocks bloqueados y devoluciones. El proceso estándar suele parecer limpio en la pizarra. Las excepciones son las que determinan si la nueva aplicación será aceptada en el día a día.

Para un primer taller, a menudo bastan tres preguntas: ¿Qué información es la que más echan en falta los empleados? ¿Qué registro se realiza más a menudo con retraso o por duplicado? ¿Y qué errores cuestan realmente tiempo, dinero o la confianza de los clientes al mes? A partir de ahí se pueden deducir prioridades sin tener que cambiar toda la organización del almacén al mismo tiempo.

Un flujo pequeño y completo supera a un gran lanzamiento de sistema

En lugar de digitalizar todos los procesos de golpe, un área debe funcionar de principio a fin. Un primer alcance razonable puede cubrir, por ejemplo, la recepción de mercancías, el almacenamiento y la gestión de stocks. El aviso de expedición o el pedido se registran, la mercancía se comprueba, se asigna una ubicación en el almacén y el stock se registra de inmediato. Solo cuando este flujo funciona de forma estable se procede a la preparación de pedidos, las etiquetas de envío o la planificación de rutas.

Esto reduce el riesgo del proyecto. Los empleados no solo aprenden una nueva interfaz, sino un proceso claramente delimitado. Al mismo tiempo, se hace visible qué reglas faltan en la práctica. Por ejemplo, la cuestión de si la mercancía no comprobada ya puede ser reservable o si las faltas de stock deben generar inmediatamente un caso de aclaración.

Qué funciones del almacén muestran realmente resultados

La mejor aplicación de almacén no es la que tiene más opciones de menú. Hace que el siguiente paso de trabajo sea inequívoco y documenta el movimiento sin doble registro. En muchas empresas, son especialmente cuatro componentes los que aportan mejoras rápidamente medibles:

  • Una gestión centralizada del inventario con artículos, variantes, ubicaciones en el almacén, existencias mínimas y stocks bloqueados evita versiones de Excel en competencia.
  • Los registros móviles mediante escáneres manuales o teléfonos inteligentes conectan directamente el almacenamiento, el traslado interno y la extracción con el lugar real de la mercancía.
  • Las listas de pedidos y de preparación de pedidos muestran la prioridad, el estado y las faltas de stock, en lugar de distribuir los pedidos mediante llamadas a voces o pilas de papel.
  • Los albaranes, las etiquetas de envío y los registros de movimientos generados automáticamente reducen las transmisiones manuales y facilitan el seguimiento.

Si el escaneo de códigos de barras es necesario de inmediato depende del almacén. Con pocos artículos y estanterías fijas, una pantalla de introducción clara puede ser suficiente al principio. Sin embargo, con muchos artículos similares, ubicaciones cambiantes o un alto rendimiento, el escaneo suele dejar de ser una función de comodidad para convertirse en un freno de errores. La cobertura de red en el área también es decisiva. Una aplicación móvil que no tenga conexión en varios pasillos de estanterías no hace más que trasladar el problema a una cola de registros posteriores.

La automatización también necesita límites claros. Un sistema puede priorizar los pedidos de envío según la hora límite (cut-off) o preparar una solicitud de pedido en caso de stock mínimo. Sin embargo, no debe activar pedidos de forma silenciosa si hay que tener en cuenta los plazos de entrega, los límites de autorización o los pedidos de clientes especiales. Un buen software propone, marca las desviaciones y documenta las decisiones. No quita a los equipos el control sobre los casos excepcionales.

La calidad de los datos no es una tarea para más tarde

La digitalización rara vez fracasa por PHP, la base de datos o el hardware del escáner. A menudo fracasa porque los números de artículo no son unívocos, las unidades se entienden de forma diferente o las existencias históricas se adoptan sin comprobación. De lo contrario, dependiendo de la persona, un «cartón» se convierte en una pieza, una unidad de embalaje o un palé.

Por lo tanto, antes de la importación, los datos maestros deben depurarse: identificadores de artículos unívocos, denominaciones comprensibles, unidades definidas, ubicaciones de almacén trazables y reglas para los artículos activos o bloqueados. No es necesario transferir todos los antiguos conjuntos de datos al nuevo sistema. Llevarse duplicados obsoletos y ubicaciones de almacén que ya no se utilizan solo sirve para conservar la antigua incertidumbre en una interfaz más moderna.

Desde el punto de vista técnico, la aplicación necesita una base sólida. Una estructura clara de base de datos en MySQL 8 puede almacenar los movimientos de existencias como eventos individuales y trazables, en lugar de mantener únicamente un valor actual sobrescribible. De este (modo), se puede aclarar por qué difieren unas existencias: recepción de mercancías, extracción, traslado, corrección de inventario o anulación. Con tecnologías de fácil mantenimiento como PHP 8.4 y JavaScript moderno, una aplicación individual sigue siendo ampliable al mismo tiempo, sin convertirse en un gran proyecto por cada pequeño ajuste.

Integración solo donde elimina la duplicidad de trabajo

Un almacén rara vez trabaja de forma aislada. Los pedidos proceden de la tienda online, el ERP, el correo electrónico o el teléfono. Los datos de envío se envían a los proveedores de servicios, los documentos a la contabilidad y los indicadores clave a la dirección de la empresa. A pesar de ello, no es necesario conectar todos los sistemas externos desde el primer día.

Tienen prioridad las interfaces que sustituyen a la transmisión manual repetida o eliminan fuentes de errores. Si los pedidos se copian a mano todos los días desde una tienda online, una transferencia clara es valiosa. Si un proveedor de servicios de envío proporciona etiquetas y números de seguimiento, una conexión puede acelerar notablemente el proceso de empaquetado. En cambio, un archivo de exportación que se utiliza raras veces puede seguir siendo una exportación controlada al principio.

Lo importante son unas responsabilidades claras en caso de errores. ¿Qué ocurre cuando un pedido se crea en la tienda, pero no se transfiere a la aplicación de almacén? ¿Se registran las transferencias, se detectan los duplicados y se marcan de forma visible los procesos fallidos? Las interfaces solo son fiables cuando también ofrecen un procedimiento comprensible para los casos excepcionales.

Implementación en régimen de turnos: la aceptación se genera sobre el terreno

El software no se introduce mediante una presentación, sino entre la puerta de recepción de mercancías, la mesa de empaquetado y la estantería. Por ello, los empleados de almacén experimentados deben integrarse desde el principio. Conocen los atajos, los requisitos de seguridad y los puntos en los que un proceso teóricamente correcto fracasa bajo la presión del tiempo.

Un área piloto con mercancía real y pedidos reales suele ser más significativa que una larga fase de prueba con datos de ejemplo. Durante un tiempo limitado, puede ser útil un funcionamiento en paralelo seguro. Sin embargo, este no debe convertirse en un estado permanente, ya que el doble registro genera por sí mismo nuevos errores. Lo decisivo es un día de cambio claro, una persona de contacto responsable y una forma sencilla de reportar los problemas directamente.

La formación debe estar orientada al proceso: aceptar mercancías, registrar desviaciones, almacenar, preparar pedidos y completar el envío. Al principio, nadie necesita dominar todas las evaluaciones o funciones de administración. Los roles y los permisos ayudan a centrar la pantalla en la tarea correspondiente. Un preparador de pedidos necesita información diferente a la de la dirección del almacén, y una corrección de inventario debería poder autorizarse de forma trazable.

El éxito no se mide solo por el stock

Tras el inicio, vale la pena echar un vistazo a unos pocos indicadores clave que el equipo puede influenciar: el tiempo de tránsito desde la recepción de mercancías hasta la disponibilidad, el número de correcciones de inventario, los errores de picking, los tiempos de búsqueda, los pedidos enviados a tiempo y los casos de aclaración pendientes. Estos valores muestran más rápidamente que un proyecto de digitalización general si el proceso está mejorando.

softify.pro no desarrolla este tipo de sistemas como sustituto de los pasos de trabajo que funcionan, sino como un complemento preciso allí donde el papel, las hojas de cálculo y las llamadas a voces ya no son suficientes. A veces, la recomendación correcta es una pequeña aplicación para la recepción de mercancías y el envío en lugar de un sistema completo de gestión de almacenes. A veces, una hoja de cálculo para un análisis especial poco frecuente sigue siendo la solución más sensata.

Por lo tanto, el mejor paso siguiente no es la selección de productos, sino una mirada conjunta a un pedido concreto de la semana pasada. Si su recorrido por el almacén se vuelve claro, registrable y trazable en caso de desviaciones, se habrán sentado las bases para una digitalización que realmente ahorre tiempo en el día a día.

Enlace permanente →