softify.pro
Wird geladen …
Leistungen Über uns COCO – unser KI-Server Portfolio Insiders Case Studies Wissenswertes Kontakt Login

Wissenswertes

Pure fluidity meets ultimate performance: Was betriebliche Software wirklich schnell macht

Pure fluidity meets ultimate performance: Was betriebliche Software wirklich schnell macht

Ein Lagerleiter erkennt schlechte Software nicht an einer Architekturzeichnung. Er erkennt sie daran, dass Mitarbeitende wieder zum Telefon greifen, Lieferscheine doppelt erfassen oder nach einer Schicht nicht sagen können, welche Ware tatsächlich angekommen ist. Pure fluidity meets ultimate performance darf deshalb kein bloßer visueller Anspruch sein. Für betriebliche Software bedeutet es, dass sich ein Vorgang natürlich anfühlt und zugleich unter realen Bedingungen verlässlich funktioniert.

Eine elegante Oberfläche ist wertlos, wenn sie bei schwachem WLAN im Lager stockt. Eine schnelle Anwendung hilft ebenfalls wenig, wenn sie eine Arbeitsfolge erzwingt, die an der Rampe niemand nachvollziehen kann. Gute digitale Werkzeuge verbinden Gestaltung, Geschwindigkeit und Prozessverständnis. Sie reduzieren Reibung, ohne den Betrieb in eine vorgefertigte Standardlogik zu pressen.

Pure fluidity meets ultimate performance ist eine Betriebsfrage

Fluidität wird oft mit Animationen, großen Bildern und glatten Übergängen verwechselt. Das kann zu einer modernen Marke passen. Im Arbeitsalltag zeigt sie sich aber anders: Ein Wareneingang lässt sich ohne Umwege buchen. Ein Mitarbeiter findet einen Auftrag auch dann, wenn nur eine Referenznummer bekannt ist. Ein Fehler wird klar benannt, statt in einer kryptischen Meldung zu verschwinden.

Performance ist ebenso mehr als ein guter Wert in einem Browser-Test. Entscheidend ist die Antwortzeit bei einem Auftrag mit vielen Positionen, die Stabilität am Monatsende und die Frage, ob fünf Personen gleichzeitig arbeiten können, ohne sich gegenseitig Datenstände zu überschreiben. Auch ein sauberer Umgang mit Verbindungsabbrüchen, Berechtigungen und gesperrten Konten gehört dazu.

Beides ist untrennbar. Wenn eine Maske sofort reagiert, aber unklare Pflichtfelder besitzt, bleibt sie anstrengend. Wenn der Ablauf klug modelliert ist, die Seite aber bei jeder Buchung zwei Sekunden wartet, wird er umgangen. Fluidität entsteht dort, wo das System die nächste sinnvolle Handlung unterstützt und technisch schnell genug bleibt, damit der Gedanke nicht abreißt.

Die Oberfläche folgt dem Arbeitsweg, nicht dem Organigramm

Viele Standardlösungen strukturieren ihre Menüs nach Modulen: Einkauf, Verkauf, Lager, Reporting, Administration. Das ist aus Produktsicht verständlich. Auf dem Hallenboden beginnt die Arbeit jedoch häufig mit einer Situation: Ein Lkw steht da, eine Palette fehlt, ein Kunde braucht einen Liefernachweis oder eine Sendung muss noch vor Annahmeschluss etikettiert werden.

Eine gute individuelle Anwendung beginnt deshalb mit diesen Situationen. Welche Information liegt vor? Wer entscheidet? Was muss dokumentiert werden? Was darf später nicht mehr verändert werden? Erst danach wird entschieden, welche Eingabemaske, Prüfung oder Automatisierung erforderlich ist.

Das bedeutet nicht, jeden bestehenden Ablauf unverändert in Software zu gießen. Manche Tabellen sind tatsächlich zu fehleranfällig, manche Freigaben unnötig langsam. Aber eine funktionierende Excel-Liste muss nicht zwangsläufig durch ein Projekt ersetzt werden. Wenn sie nur von einer Person gepflegt wird, wenige Ausnahmen kennt und nachvollziehbar bleibt, kann sie das passende Werkzeug sein. Software lohnt sich, wenn sie Koordination verbessert, Fehlerquellen senkt oder Informationen für mehrere Beteiligte zuverlässig verfügbar macht.

Weniger Klicks sind nicht automatisch besser

Die Forderung nach möglichst wenigen Klicks klingt vernünftig, kann aber in die falsche Richtung führen. Bei einer irreversiblen Lagerbuchung ist eine kurze Bestätigung sinnvoll. Bei einer Versandfreigabe kann eine sichtbare Plausibilitätsprüfung teure Nacharbeit verhindern. Der richtige Ablauf hängt vom Risiko ab.

Entscheidend ist, dass zusätzliche Schritte einen klaren Zweck haben. Eine Bestätigung sollte nicht nur deshalb erscheinen, weil das Framework sie leicht erzeugt. Sie sollte genau dort stehen, wo Menschen eine Entscheidung bewusst treffen müssen. So bleibt die Anwendung schnell, ohne leichtfertig zu werden.

Performance entsteht in der Architektur, nicht im letzten Sprint

Wer eine Website oder Webanwendung erst kurz vor dem Go-live beschleunigt, behandelt meist Symptome. Große Abfragen, unklare Datenmodelle und nachträglich ergänzte Sonderfälle lassen sich nicht durch einen einzelnen Optimierungstag dauerhaft korrigieren.

Eine belastbare Grundlage beginnt mit einer Datenbank, die den tatsächlichen Beziehungen im Betrieb entspricht. In MySQL 8 brauchen Bewegungen, Belege, Statusänderungen und Benutzeraktionen nachvollziehbare Schlüssel und sinnvolle Indizes. Ein Bestand darf nicht nur als Zahl erscheinen, wenn später geklärt werden muss, durch welche Buchung er entstanden ist. Gleichzeitig muss nicht jede historische Information bei jedem Seitenaufruf neu berechnet werden.

Bei modernen Webanwendungen ist auch die Trennung der Verantwortlichkeiten relevant. PHP 8.4 kann Geschäftsregeln klar und wartbar abbilden, während modernes JavaScript gezielt für reaktive Bereiche eingesetzt wird. Das ist kein Glaubensbekenntnis für einen bestimmten Stack. Es ist eine Frage der Wartung: Können Änderungen in sechs Monaten sicher umgesetzt werden? Ist sichtbar, wo eine Regel gilt? Lässt sich ein Fehler reproduzieren, statt nur zu vermuten?

Performance braucht außerdem Grenzen. Suchfelder benötigen sinnvolle Mindestzeichen oder eine präzise Filterlogik, wenn Millionen Datensätze denkbar sind. Große Listen brauchen Seiten oder abgestufte Nachladeprozesse. Bilder und Dokumente sollten nicht den kritischen Arbeitsablauf blockieren. Diese Entscheidungen wirken unspektakulär. Genau deshalb bleiben sie oft länger wertvoll als ein auffälliger Frontend-Effekt.

Sichtbare Geschwindigkeit schafft Vertrauen

Nicht jeder Prozess kann in unter einer Sekunde abgeschlossen sein. Ein Etikettendruck, eine Schnittstelle zum Versanddienstleister oder eine Prüfung gegen externe Daten braucht gelegentlich Zeit. Entscheidend ist dann, wie die Anwendung mit Wartezeit umgeht.

Ein klarer Status wie „Versandlabel wird erstellt“ ist besser als ein eingefrorener Button. Nach einem Abschluss sollte erkennbar sein, welche Nummer erzeugt wurde und ob der Vorgang erneut ausgelöst werden darf. Wenn ein externer Dienst nicht erreichbar ist, braucht das Team eine verständliche Handlungsoption statt einer Fehlermeldung für Entwickler.

Das ist auch eine Frage der Datenintegrität. Ein Doppelklick darf nicht zwei Lieferungen erzeugen. Ein abgebrochener Prozess darf nicht stillschweigend einen halbfertigen Datensatz hinterlassen. Gute Systeme planen solche Fälle ein, weil sie im Alltag eintreten werden. Gerade bei wechselnden Schichten, Zeitdruck und mobilen Geräten ist die Ausnahme kein Randthema.

Qualität wird vor dem Fehler sichtbar

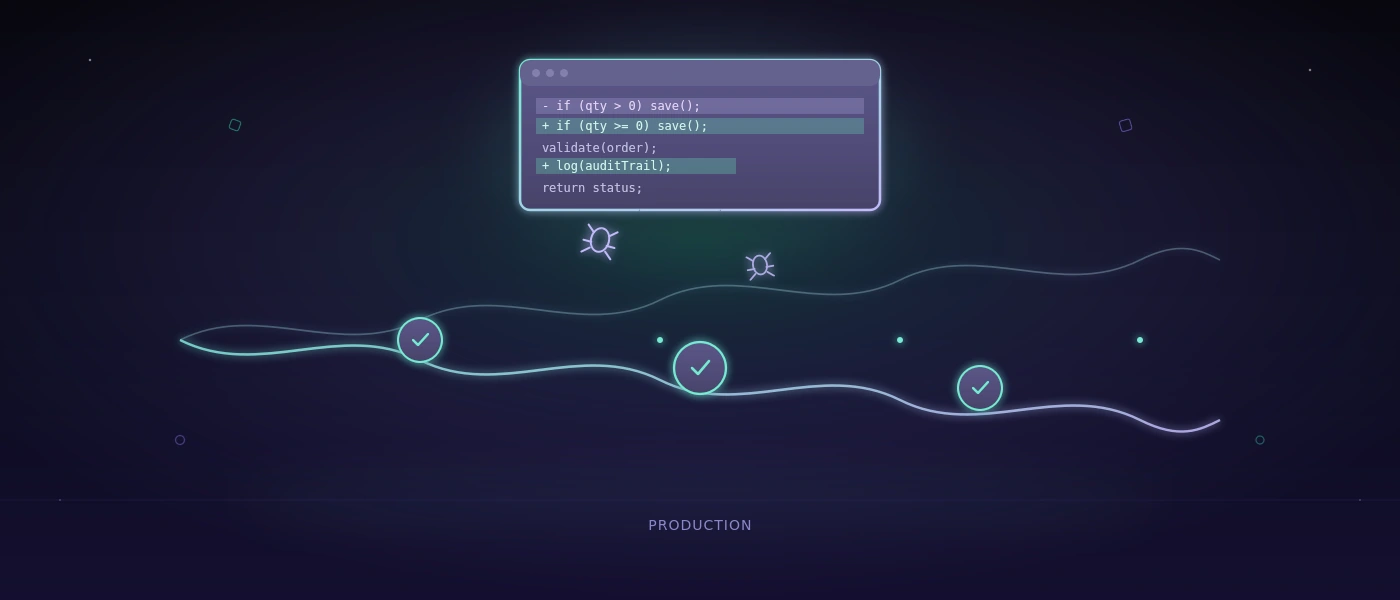
Für Anwendungen mit vielen Prozessvarianten reicht es nicht, am Ende ein paar Wege manuell durchzuklicken. Änderungen an Preisen, Rollen, Validierungen oder Schnittstellen können an einer weit entfernten Stelle Folgen auslösen. Hier wird automatisiertes Testing zu einem Teil der Performance: nicht nur technisch, sondern organisatorisch.

Ein Testsystem sollte reale Abläufe prüfen können, etwa Auftrag anlegen, Position ändern, Lieferschein erzeugen und Berechtigung kontrollieren. Es sollte Belege aufzeichnen und Ergebnisse so formulieren, dass Fachbereiche sie einordnen können. Ein Satz wie „Der Versandprozess wurde nach der Adressänderung nicht abgeschlossen“ hilft mehr als ein unkommentierter Stacktrace.

Für sicherheitsbewusste Teams ist auch der Ort relevant, an dem diese Tests laufen. Wenn Screenshots, Zugangsdaten, Testfälle oder interne Anwendungsschritte das Unternehmen nicht verlassen sollen, ist ein selbst gehosteter Ansatz oft sinnvoller als ein externer Cloud-Dienst. Mit COCO lassen sich automatisierte Tests für Web- und Windows-Anwendungen auf einer dedizierten Umgebung ausführen. Das ist nicht für jedes Team nötig. Bei sensiblen Daten, regulierten Bereichen oder internen Fachanwendungen kann die Kontrolle über Testdaten jedoch ein entscheidender Vorteil sein.

Gestaltung ist dann gut, wenn sie Arbeit erleichtert

Eine starke visuelle Identität kann Vertrauen schaffen. Sie zeigt, dass ein Unternehmen seine digitale Präsenz ernst nimmt. Im operativen System muss Gestaltung jedoch noch mehr leisten: Orientierung unter Zeitdruck. Kontrast, Typografie, klare Zustände und verständliche Beschriftungen entscheiden darüber, ob jemand einen Vorgang sicher abschließt oder beim Kollegen nachfragt.

Dabei ist Zurückhaltung oft die bessere Wahl. Ein Dashboard mit zehn farbigen Kennzahlen kann eindrucksvoll aussehen und dennoch die einzige relevante Abweichung verdecken. Eine reduzierte Ansicht, die offene Wareneingänge, fehlende Scans und gefährdete Liefertermine sichtbar macht, ist nützlicher. Die Frage lautet nicht, wie viel Oberfläche möglich ist, sondern welche Information eine Entscheidung verbessert.

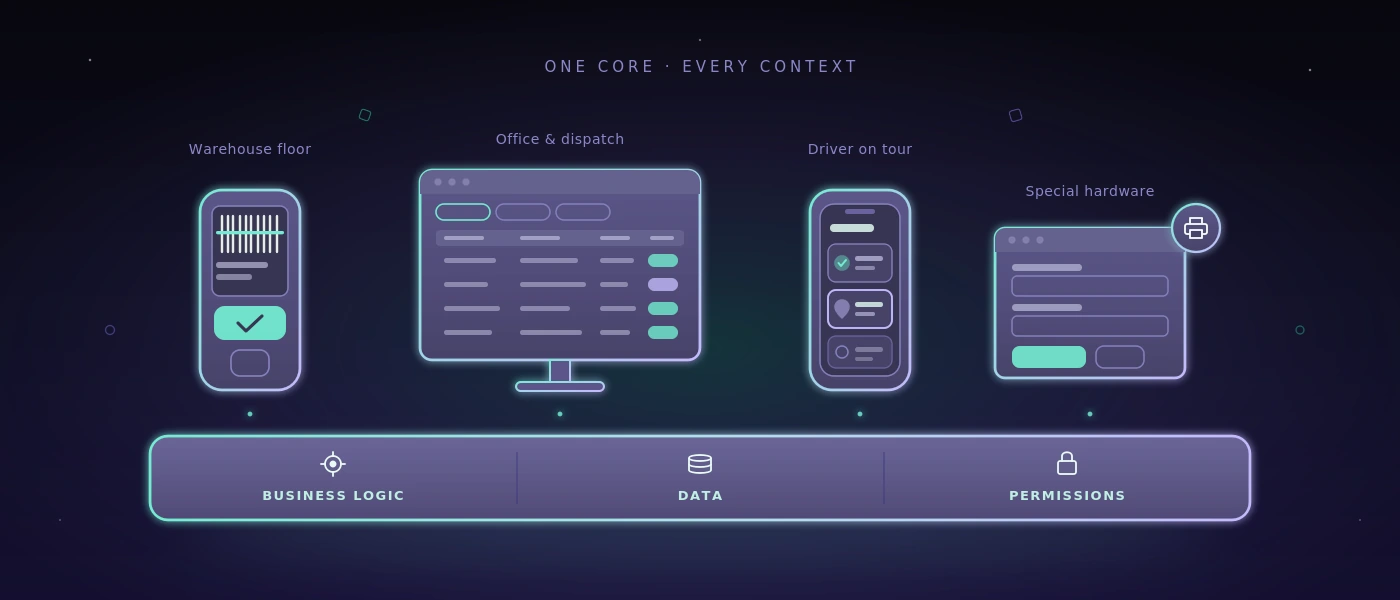
Das gilt auch für responsive Anwendungen. Mobilfähigkeit bedeutet nicht, jeden Desktop-Bildschirm auf ein kleineres Format zu quetschen. Ein Smartphone am Wareneingang braucht vielleicht nur Scan, Menge, Lagerplatz und Bestätigung. Die ausführliche Nachbearbeitung gehört möglicherweise an einen größeren Bildschirm. Unterschiedliche Geräte verdienen unterschiedliche Prioritäten, obwohl sie auf dieselbe verlässliche Datenbasis zugreifen.

Ein sinnvoller Maßstab für die nächste Entscheidung

Bevor ein Team eine neue Plattform, eine Automatisierung oder einen kompletten Neubau beschließt, hilft eine einfache Prüfung: Wird der Ablauf für die Menschen, die ihn täglich ausführen, klarer, schneller oder sicherer? Und lässt sich die Lösung auch noch verstehen, wenn sich Anforderungen, Mitarbeitende oder Schnittstellen ändern?

Wenn beide Antworten belastbar sind, wird aus einem schönen Versprechen ein brauchbares System. Dann zeigt sich pure fluidity meets ultimate performance nicht in einer Folie, sondern an einem ruhigen Arbeitstag, an dem Aufträge, Daten und Entscheidungen ohne unnötige Reibung weiterlaufen.
Permalink →

SaaS Flow Web: Workflows im laufenden Betrieb sicher einführen

SaaS Flow Web: Workflows im laufenden Betrieb sicher einführen

Ein Wareneingang bleibt nicht liegen, weil ein Team keine weitere Software kennt. Er bleibt liegen, weil Informationen zwischen E-Mail, Papierformular, Excel-Datei und Telefonat verloren gehen. Bei SaaS - „Flow Web“ auf flow.softify.pro sollte deshalb nicht die Oberfläche die erste Frage sein. Entscheidend ist, ob der Dienst einen konkreten Arbeitsablauf verlässlich abbildet - auch an hektischen Tagen, bei wechselnden Zuständigkeiten und wenn eine Lieferung nicht dem Plan entspricht.

Für kleine und mittlere Unternehmen ist SaaS oft sinnvoll, weil sie nicht erst eigene Server, Releases und Grundfunktionen aufbauen müssen. Das ist aber kein Freifahrtschein für jeden Prozess. Wer ein Werkzeug einführt, das den Alltag komplizierter macht oder wichtige Daten in unklare Nebenlisten verdrängt, digitalisiert keine Arbeit. Er verlagert nur die Reibung.

Was SaaS „Flow Web“ leisten muss

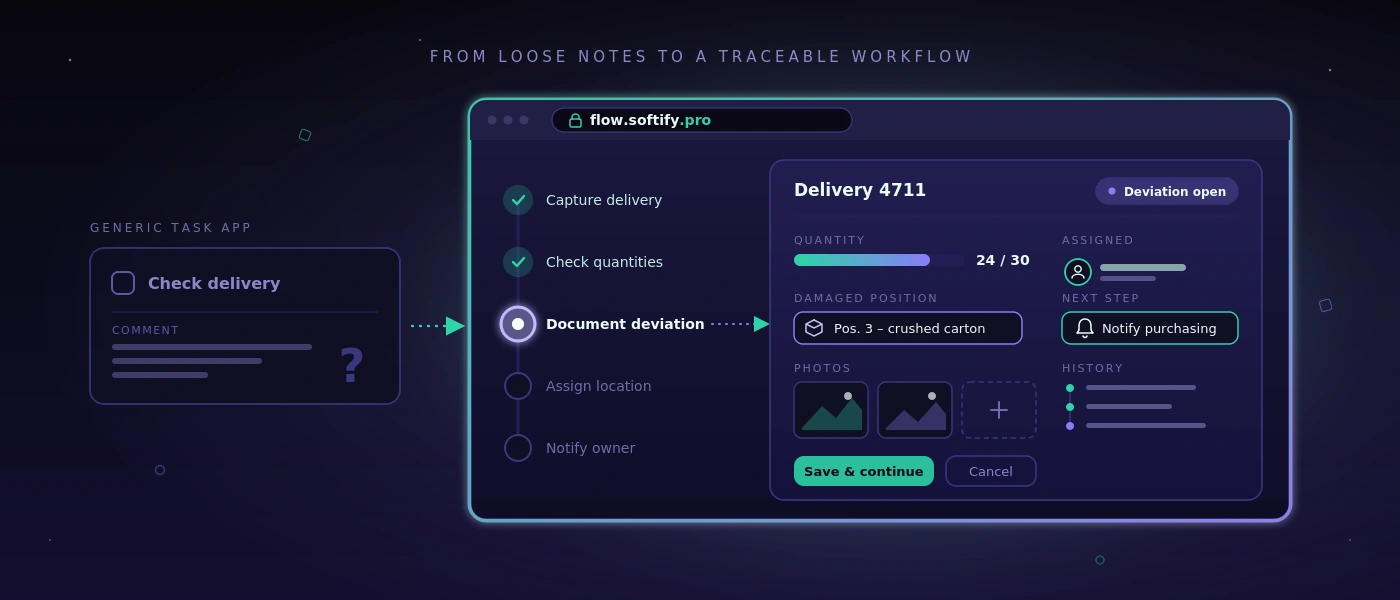
Ein Web-Workflow ist dann gut, wenn Mitarbeitende ohne Interpretation wissen, was als Nächstes zu tun ist. Bei einer Warenannahme kann das bedeuten: Lieferung erfassen, Mengen gegen Bestellung prüfen, Abweichung dokumentieren, Lagerplatz zuordnen und bei Bedarf einen Verantwortlichen informieren. Der Ablauf muss nicht spektakulär sein. Er muss nachvollziehbar, schnell und wiederholbar sein.

Genau hier liegt der Unterschied zwischen einer allgemeinen Aufgaben-App und einem fachlichen Prozesssystem. Eine Aufgaben-App kann einen Punkt namens „Lieferung prüfen“ anlegen. Ein fachlicher Workflow kann zusätzlich festhalten, welche Lieferung gemeint ist, wer sie angenommen hat, welche Position beschädigt war, welche Fotos vorliegen und ob eine Nachlieferung aussteht. Diese Daten stehen dann nicht als Freitext in einem einzelnen Kommentar, sondern dort, wo die nächste Person sie benötigt.

Für eine Lösung wie Flow Web auf flow.softify.pro sollte die Prüfung daher bei den Vorgängen beginnen, nicht bei einer Funktionsliste. Ein Betrieb mit fünf Lagerbewegungen am Tag braucht etwas anderes als ein Versandteam mit mehreren Cut-off-Zeiten, unterschiedlichen Frachtführern und regelmäßigem Teillieferungsmanagement. SaaS ist kein Ersatz für Prozessverständnis.

Erst den Engpass benennen, dann konfigurieren

Viele Digitalisierungsprojekte starten zu breit: „Wir wollen das Lager digitalisieren.“ Das klingt plausibel, führt aber schnell zu einem System mit zu vielen Masken, Sonderfällen und Schulungsunterlagen. Besser ist eine präzise Aussage wie: „Wareneingänge werden erst am nächsten Tag gebucht, weil Lieferscheine am Schichtende auf dem Schreibtisch liegen.“

Aus einem solchen Satz lässt sich ein sinnvoller Start ableiten. Die erste Version kann Lieferscheine erfassen, Artikel und Mengen bestätigen, Abweichungen markieren und die Buchung an die zuständige Stelle weitergeben. Wenn dieser Ablauf funktioniert, lassen sich Etiketten, Lieferantenbewertungen oder automatische Bestellvorschläge später ergänzen. Nicht jeder sinnvolle Ausbauschritt gehört in den ersten Rollout.

Auch eine gut gepflegte Tabelle darf bleiben, wenn sie ihren Zweck erfüllt. Beispielsweise kann eine monatliche Auswertung mit wenigen Beteiligten in einer bestehenden Datei günstiger und transparenter sein als ein eigenes Modul. SaaS lohnt sich dort, wo Informationen mehrfach genutzt werden, Bearbeitungszeiten kritisch sind oder Fehler aus Medienbrüchen entstehen.

Die richtigen Fragen vor der Einführung

Vor der Konfiguration sollte ein Team einen realen Vorgang vom Anfang bis zum Ende durchspielen. Nicht den Idealprozess, sondern den Fall, der im Alltag Probleme macht: falsche Menge, fehlende Referenz, dringender Versand oder ein Auftrag mit Sonderfreigabe. Dabei zeigen sich die Regeln, die ein System tatsächlich abbilden muss.

Relevant sind unter anderem diese Punkte: Wer darf einen Vorgang anlegen, ändern oder abschließen? Welche Eingaben sind Pflicht, welche nur hilfreich? Wann muss eine Führungskraft informiert werden? Welche Daten werden an Buchhaltung, Versand oder Kundenservice übergeben? Und was passiert, wenn das WLAN im Lager schwach ist oder ein Mitarbeitender seine Zugangsdaten nicht mehr hat?

Die Antworten bestimmen die Qualität der Einführung stärker als ein langer Katalog optischer Anforderungen. Ein sauberer Rollenprozess, eine verständliche Fehlermeldung und ein dokumentierter Freigabeschritt verhindern im Betrieb meist mehr Aufwand als ein zusätzlicher Bericht auf der Startseite.

Datenhaltung und Rollen sind keine Nebensache

SaaS wird häufig als reine Bedienfrage behandelt. Für Betriebs- und IT-Verantwortliche ist jedoch mindestens ebenso wichtig, was mit den Daten geschieht. Das betrifft Stammdaten, Lieferinformationen, Mitarbeiterdaten, Fotos von Schäden und möglicherweise Kundendaten. Vor der Einführung sollten Zuständigkeiten, Aufbewahrung und Exportmöglichkeiten klar sein.

Praktisch heißt das: Das Unternehmen muss wissen, welche Daten im System liegen, wer administrativen Zugriff hat und wie Daten bei einem Wechsel oder einer Vertragsbeendigung bereitgestellt werden. Ein Export, der nur als schwer lesbare PDF-Datei verfügbar ist, hilft selten weiter. Für operative Daten sind strukturierte, verwendbare Formate entscheidend.

Auch das Berechtigungskonzept verdient konkrete Aufmerksamkeit. Im Lager muss nicht jede Person Preise, Kundenkonditionen oder globale Einstellungen sehen. Gleichzeitig darf eine zu enge Rechtevergabe den Ablauf nicht blockieren. Sinnvoll sind Rollen, die an tatsächlichen Tätigkeiten ausgerichtet sind: Annahme, Disposition, Versand, Teamleitung und Administration. Kritische Änderungen sollten nachvollziehbar sein, damit bei Rückfragen nicht geraten werden muss, wer eine Buchung geändert hat.

Der Zugang selbst sollte mit soliden Grundlagen geschützt sein. Dazu gehören sichere Passwortrichtlinien, eine geregelte Passwort-Zurücksetzung, Account-Lockout bei wiederholten Fehlversuchen und, wo das Risikoprofil es verlangt, zusätzliche Anmeldungsschritte. Sicherheit wirkt dann professionell, wenn sie vorhersehbar ist und nicht erst dann auffällt, wenn jemand ausgesperrt wurde.

Integration nur dort, wo sie messbar entlastet

Ein Web-Workflow entfaltet seinen Wert oft erst im Zusammenspiel mit bestehenden Systemen. Das kann ein ERP, ein Shop, eine Versandlösung, eine Zeiterfassung oder eine Datenbank sein. Trotzdem ist nicht jede Schnittstelle automatisch sinnvoll. Jede Integration schafft Abhängigkeiten, Fehlerbilder und Wartungsaufwand.

Die zentrale Frage lautet: Welchen manuellen Schritt entfernt die Verbindung konkret? Wenn eine Schnittstelle täglich 30 Minuten Übertragungsarbeit spart und Tippfehler reduziert, ist der Nutzen klar. Wenn sie lediglich eine Information spiegelt, die ohnehin einmal pro Woche geprüft wird, kann ein manueller Export zunächst die vernünftigere Lösung sein.

Bei individuellen Erweiterungen zählt die technische Basis. Dokumentierte Schnittstellen, klar definierte Datenfelder und nachvollziehbare Fehlerprotokolle erleichtern späteren Betrieb. Wenn ein System an eine maßgeschneiderte Webanwendung angebunden wird, sollten Technologien und Datenbankstruktur so gewählt sein, dass sie langfristig wartbar bleiben. Eine gepflegte Anwendung auf Basis von PHP 8.4, modernem JavaScript und MySQL 8 ist wertvoller als eine kurzfristig beeindruckende Sonderlösung ohne Dokumentation.

Einführung im laufenden Betrieb

Der häufigste Fehler ist ein harter Start ohne Vergleichsphase. Teams sollen dann am Montagmorgen sofort anders arbeiten, während offene Fragen erst aus echten Problemen entstehen. Das erhöht die Ablehnung, selbst wenn die Software grundsätzlich passt.

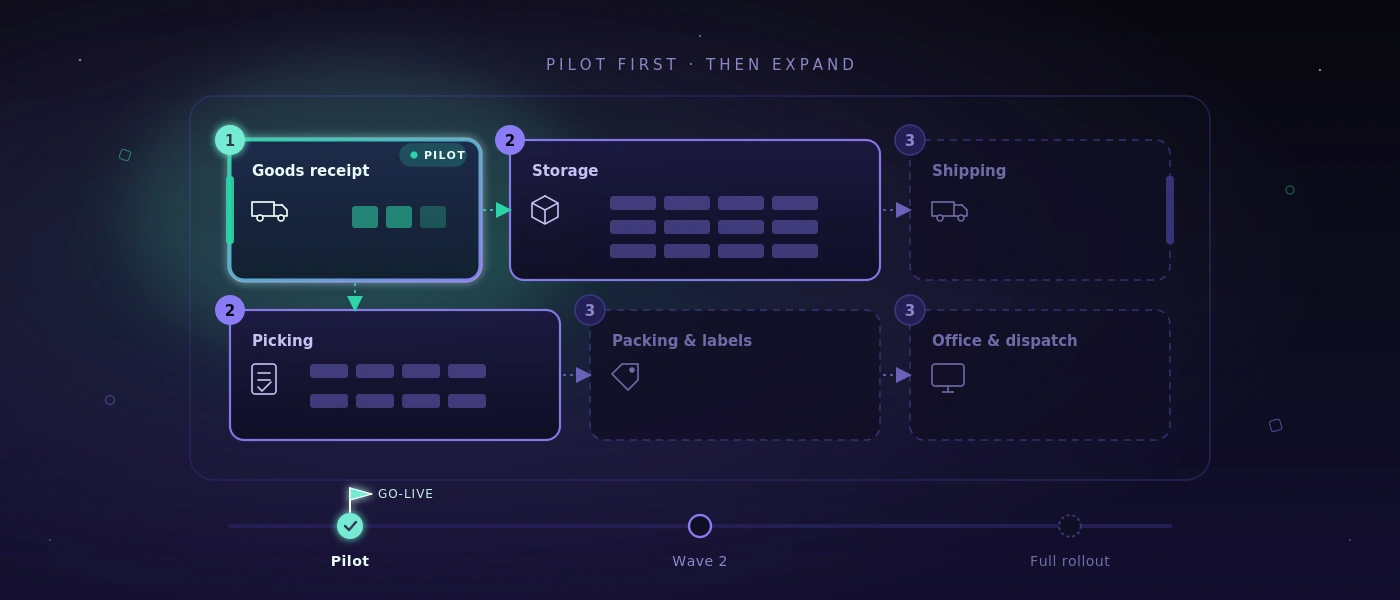
Besser ist ein begrenzter Pilot mit einem Team, einer Prozessvariante oder einem klaren Standortbereich. In dieser Zeit wird überprüft, ob Erfassung und Freigaben funktionieren, ob Begriffe verständlich sind und ob Ausnahmefälle sauber landen. Wichtig ist, Rückmeldungen nicht nur als Wunschliste zu sammeln. Jede Änderung sollte gegen den Nutzen für Durchlaufzeit, Fehlerquote oder Transparenz geprüft werden.

Auch Kennzahlen sollten früh festgelegt werden. Beispielsweise lassen sich Bearbeitungszeit pro Wareneingang, Anzahl offener Abweichungen, Nachfragen zu Lieferstatus oder Korrekturbuchungen beobachten. Ohne Ausgangswert bleibt „fühlt sich schneller an“ die einzige Bewertung. Das kann stimmen, reicht aber nicht für eine belastbare Investitionsentscheidung.

Betrieb braucht einen klaren Eigentümer

SaaS reduziert technischen Aufwand, nimmt einem Unternehmen aber nicht die Verantwortung für den eigenen Prozess ab. Es braucht intern jemanden, der Rollen verwaltet, Rückmeldungen bündelt, Schulungsbedarf erkennt und entscheidet, welche Änderungen wirklich notwendig sind. Diese Person muss nicht programmieren können. Sie sollte den Arbeitsablauf jedoch verstehen und Zugang zu den Verantwortlichen haben.

Ebenso wichtig ist eine kurze, belastbare Betriebsdokumentation. Sie erklärt nicht jede Bildschirmansicht, sondern beantwortet die Fragen, die im Alltag auftreten: Was tun bei einer fehlerhaften Buchung? Wer genehmigt neue Benutzer? Wie wird ein Ausfall kommuniziert? Wo liegen exportierte Daten? Solche Klarheit verhindert, dass ein digitales System nach wenigen Monaten wieder von persönlichen Zurufen abhängig wird.

Eine gute SaaS-Lösung erkennt man deshalb nicht daran, wie viele Menüpunkte sie anbietet. Sie zeigt ihren Wert, wenn eine neue Kollegin einen Vorgang sicher bearbeiten kann, eine Abweichung nicht verschwindet und eine Führungskraft den Status sieht, ohne drei Personen anzurufen. Genau an diesem Maßstab sollte Flow Web gemessen werden: nicht an Versprechen, sondern an einem Arbeitstag, der nachweisbar ruhiger und verlässlicher läuft.

Permalink →

Webentwicklung mit aktuellen Frameworks: Was Unternehmen wirklich davon haben

Webentwicklung mit aktuellen Frameworks: Was Unternehmen wirklich davon haben

Wenn ein Wareneingang noch zwischen Papierformular, Telefonat und drei Excel-Dateien pendelt, löst ein modernes Frontend allein das Problem nicht. Webentwicklung mit aktuellen Frameworks ist dann sinnvoll, wenn sie Abläufe sichtbar vereinfacht: Mitarbeitende sehen den nächsten Schritt, Daten werden nur einmal erfasst, und die Anwendung bleibt auch nach dem ersten Go-live verständlich wartbar.

Für kleine und mittlere Unternehmen ist die Framework-Frage daher keine Glaubensfrage. Entscheidend ist nicht, ob eine Oberfläche besonders viele technische Schlagworte trägt. Entscheidend ist, ob Lagerbewegungen, Aufträge, Prüfungen oder Freigaben zuverlässig durch den Arbeitstag kommen - auch bei Zeitdruck, Schichtwechsel und schwankender Netzverbindung.

Frameworks sind ein Mittel, kein Projektziel

Ein Framework liefert eine bewährte Struktur für wiederkehrende Aufgaben: Routing, Formulare, Rechteverwaltung, Datenzugriffe, Tests und die Darstellung von Oberflächen. Das reduziert nicht automatisch jedes Risiko. Es verhindert aber, dass ein Projekt grundlegende Funktionen immer wieder neu erfinden muss.

Bei einer individuellen Webanwendung kann ein modernes JavaScript-Framework beispielsweise interaktive Masken sinnvoll abbilden: eine Kommissionierliste, die Positionen fortlaufend aktualisiert, eine Routenplanung mit klaren Statuswechseln oder ein Prüfprotokoll, das Fotos und Kommentare direkt einem Vorgang zuordnet. Im Backend sorgen etablierte PHP-Frameworks für nachvollziehbare Regeln, klar getrennte Verantwortlichkeiten und konsistente Schnittstellen zur Datenbank.

Das ist besonders relevant, wenn aus einer zunächst kleinen Lösung ein täglich genutztes Betriebssystem für einen Prozess wird. Eine Eingabemaske für Lieferavis kann überschaubar beginnen. Sobald sie Bestände aktualisiert, Etiketten ausgibt, Rollen berücksichtigt und mit einem Versanddienstleister kommuniziert, braucht sie eine saubere technische Basis. Frameworks helfen dabei, diese Basis nicht bei jeder Erweiterung neu zu verhandeln.

Was aktuelle Webframeworks konkret besser machen

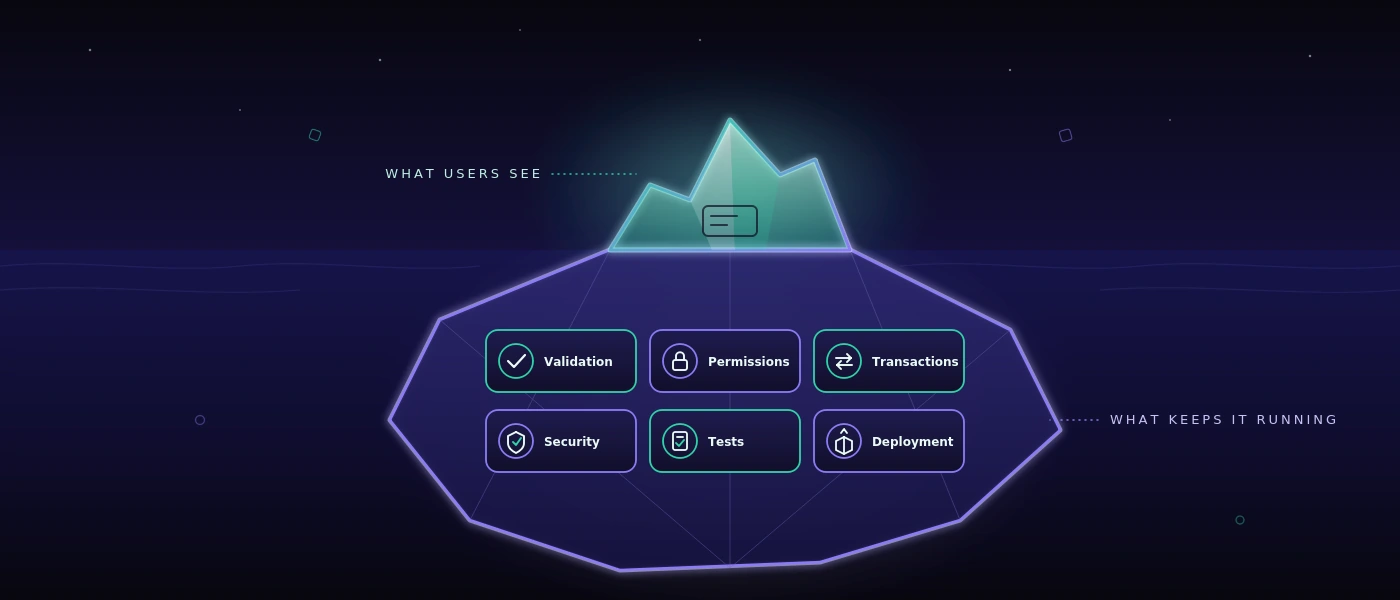
Der Wert moderner Frameworks liegt selten in spektakulären Effekten. Er zeigt sich in den unsichtbaren Teilen einer Anwendung. Formulare können Eingaben direkt prüfen, ohne dass fehlerhafte Daten erst nach dem Absenden auffallen. Berechtigungen lassen sich zentral definieren, sodass ein Fahrer andere Informationen sieht als die Disposition. Änderungen an einer Bestellung werden nachvollziehbar gespeichert, statt still eine Tabellenzelle zu überschreiben.

Auf Serverseite schafft eine aktuelle Umgebung mit PHP 8.4 und MySQL 8 eine belastbare Grundlage für geschäftskritische Logik. Datenbanktransaktionen verhindern beispielsweise, dass ein Bestand reduziert wird, während die zugehörige Buchung fehlschlägt. Eindeutige Schlüssel und Validierungsregeln vermeiden Dubletten. Hintergrundprozesse können Dokumente erzeugen oder Schnittstellen ansprechen, ohne dass die Person am Bildschirm warten muss.

Auch Sicherheit ist keine nachträgliche Funktion. Ein zeitgemäßes Framework unterstützt sichere Passwortspeicherung, Schutz vor typischen Eingabeangriffen, nachvollziehbare Sitzungen und definierte Account-Lockout-Flows. Trotzdem bleibt die Umsetzung eine Projektaufgabe: Rechte müssen fachlich korrekt modelliert werden, und sensible Funktionen benötigen zusätzliche Prüfungen. Ein Framework liefert Leitplanken, aber keine Kenntnis darüber, wer im Betrieb welche Freigabe erteilen darf.

Webentwicklung mit aktuellen Frameworks richtig entscheiden

Die beste Technologie entsteht nicht durch eine Liste beliebter Tools, sondern durch die tatsächliche Nutzung. Eine interne Anwendung für zehn Personen hat andere Anforderungen als ein Kundenportal mit mehreren tausend gleichzeitigen Zugriffen. Ein Lagerterminal mit Scanner braucht eine andere Bedienlogik als eine Management-Auswertung am Desktop.

Deshalb beginnt eine sinnvolle Entscheidung mit konkreten Fragen: Welche Vorgänge kosten heute messbar Zeit? Welche Daten werden mehrfach übertragen? Wo entstehen Fehler, weil Informationen erst zu spät sichtbar sind? Welche bestehende Tabelle funktioniert gut genug und sollte zunächst bleiben? Gerade der letzte Punkt schützt vor teuren Digitalisierungsprojekten ohne operativen Nutzen.

Für viele individuelle Geschäftsanwendungen ist ein serverseitig gerendertes System mit gezielten interaktiven Komponenten die vernünftigste Wahl. Es lädt schnell, ist überschaubar zu betreiben und vermeidet unnötige Komplexität. Eine vollständig entkoppelte Single-Page-Anwendung kann dagegen passend sein, wenn die Oberfläche sehr viele dynamische Zustände verarbeitet, offline arbeiten muss oder dieselben Funktionen später auch einer mobilen App bereitstellen soll.

Beides kann fachlich richtig sein. Die Frage lautet nicht: Welches Framework ist am modernsten? Sie lautet: Welche Architektur ist in zwei Jahren noch sicher erweiterbar, testbar und für das eigene Team nachvollziehbar?

Wann weniger Technik die bessere Technik ist

Nicht jeder Prozess benötigt ein komplexes Frontend. Eine schlanke Eingabemaske für interne Bestellungen kann schneller, stabiler und günstiger sein als eine aufwendig animierte Oberfläche. Wenn eine Excel-Datei lediglich einmal pro Monat gepflegt wird und keine Fehler verursacht, ist sie möglicherweise weiterhin das richtige Werkzeug.

Komplexität lohnt sich erst, wenn sie echte Reibung beseitigt. Das kann der Fall sein, wenn Aufträge mehrfach abgetippt werden, Lieferstatus telefonisch abgefragt werden müssen oder sich niemand sicher ist, welche Version eines Dokuments gilt. Dann schafft eine zentrale Anwendung einen klaren Nutzen: ein Datenstand, eindeutige Verantwortlichkeiten und weniger Rückfragen.

Wartbarkeit beginnt vor der ersten Zeile Code

Frameworks werden oft als Beschleuniger betrachtet. Das stimmt nur, wenn die fachlichen Regeln zuvor ausreichend klar sind. Ein Entwickler kann eine Statusmaschine technisch sauber bauen. Ob die Statusfolge aber wirklich zum Prozess passt, entscheidet sich bei der Aufnahme: Wann gilt Ware als eingegangen? Wer darf eine Abweichung schließen? Was passiert bei einer Teillieferung?

Diese Entscheidungen gehören dokumentiert, ebenso wie Schnittstellen, Datenfelder und Ausnahmen. Das macht Projekte nicht langsamer. Es reduziert spätere Diskussionen, weil sichtbar wird, welche Regel bewusst umgesetzt wurde und welche Annahme noch offen ist.

Wartbarkeit zeigt sich auch in kleinen Disziplinen. Datenbankänderungen müssen versioniert sein. Deployment-Schritte müssen dokumentiert werden. Fehlermeldungen sollen für Betrieb und Entwicklung verwertbar sein, ohne vertrauliche Details preiszugeben. Automatisierte Tests prüfen zentrale Abläufe bei jeder Änderung, etwa das Anlegen eines Auftrags, die Berechnung einer Menge oder die Ausgabe eines Lieferscheins.

Bei kritischen Anwendungen reicht ein einzelner Testtyp nicht aus. Unit-Tests sichern einzelne Regeln ab, Integrationstests prüfen das Zusammenspiel mit Datenbank und Schnittstellen, und End-to-End-Tests spielen reale Bedienwege im Browser nach. Für Web- und Windows-Anwendungen kann eine selbst gehostete Testumgebung zusätzlich Screenshots, Ablaufprotokolle und verständliche Bewertungen liefern, ohne interne Testdaten unnötig in externe Cloud-Dienste zu geben.

Performance entsteht aus Architektur und Datenmodell

Eine moderne Oberfläche wird nicht schnell, weil sie ein aktuelles Framework verwendet. Langsame Datenbankabfragen, übergroße Bilder oder unklare Schnittstellen bleiben langsam, unabhängig vom Frontend. Besonders bei Listen mit Aufträgen, Artikeln oder Bewegungsdaten entscheidet das Datenmodell über die gefühlte Geschwindigkeit.

Saubere Indizes in MySQL 8, paginierte Abfragen und bewusst geladene Daten sind oft wirksamer als spätere Optimierung an der Oberfläche. Ebenso wichtig ist ein klares Caching-Konzept. Stammdaten dürfen unter Umständen zwischengespeichert werden, aktuelle Bestände oder Freigabestatus dagegen nicht blind. Hier gibt es keine pauschale Regel, weil die fachliche Bedeutung der Daten bestimmt, wie aktuell sie sein müssen.

Responsive Gestaltung gehört ebenfalls zur technischen Planung. Auf dem Bürobildschirm kann eine breite Tabelle sinnvoll sein. Auf einem Handscanner oder Tablet im Lager braucht dieselbe Information große Trefferflächen, kurze Wege und eine Darstellung, die auch mit Handschuhen oder bei schlechtem Licht bedienbar bleibt. Pure fluidity meets ultimate performance bedeutet in diesem Kontext nicht möglichst viel Bewegung auf dem Bildschirm. Es bedeutet, dass die Anwendung ohne Reibung auf dem Gerät funktioniert, das im Prozess tatsächlich verwendet wird.

Der sinnvolle Weg von der Idee zum Betrieb

Ein belastbares Webprojekt startet mit einem begrenzten, prüfbaren Kern. Statt jede denkbare Ausnahme vorab zu automatisieren, wird ein Prozess ausgewählt, der häufig vorkommt und spürbar Aufwand verursacht. Nach dem ersten Einsatz zeigen reale Daten und Rückmeldungen, welche Erweiterung als Nächstes wirklich Priorität hat.

Dabei sollte die technische Übergabe nicht erst am Ende stattfinden. Verantwortlichkeiten für Hosting, Backups, Monitoring, Updates und Zugriffsrechte müssen früh geklärt sein. Ein System ist nur so verlässlich wie sein Betrieb. Wer eine Anwendung täglich für Versand oder Auftragsabwicklung benötigt, braucht definierte Wiederherstellungswege und eine klare Antwort darauf, was bei einer Störung passiert.

softify.pro setzt deshalb auf wartbare Technologien, dokumentierte Auslieferung und direkte technische Verantwortung statt auf kurzfristige Framework-Moden. Das schafft keine magische Abkürzung. Es schafft die Voraussetzung, dass eine Anwendung nach dem Launch weiterarbeitet, weiterentwickelt werden kann und nicht zum nächsten fragilen Sonderfall wird.

Die richtige Webanwendung fühlt sich im besten Fall nicht wie ein neues IT-Projekt an. Sie fühlt sich an wie ein Ablauf, der endlich ohne Umwege funktioniert - mit genug technischer Substanz, um auch die nächste Veränderung im Betrieb ruhig aufzunehmen.

Permalink →

Software Rollout planen: So gelingt die Einführung im laufenden Betrieb

Software Rollout planen: So gelingt die Einführung im laufenden Betrieb

Ein neues System scheitert selten daran, dass ein Button fehlt. Es scheitert am Montagmorgen: Die Frühschicht findet den Wareneingang nicht, ein Lieferschein wird doppelt gedruckt oder eine Excel-Datei bleibt plötzlich die inoffizielle Wahrheit. Wer ein Software Rollout planen will, muss deshalb nicht nur Funktionen einführen, sondern den realen Betrieb absichern.

Gerade in Lager, Werkstatt, Disposition und Verwaltung ist ein Rollout kein IT-Termin. Er verändert Handgriffe, Verantwortlichkeiten und Informationswege. Eine gute Einführung hält die Arbeit in Bewegung, macht Fehler früh sichtbar und gibt Mitarbeitenden eine klare Antwort auf die entscheidende Frage: Was mache ich ab morgen anders?

Der Rollout beginnt vor der ersten Schulung

Viele Projekte starten mit einer Funktionsliste: Aufträge erfassen, Lagerbewegungen buchen, Versandetiketten drucken, Routen planen. Das ist notwendig, reicht aber nicht. Vor dem Start muss geklärt sein, welche Prozesse am ersten produktiven Tag tatsächlich über das neue System laufen sollen - und welche bewusst noch nicht.

Diese Abgrenzung ist kein Zeichen von Unvollständigkeit. Sie reduziert Risiko. Wenn ein mittelständischer Betrieb bisher Wareneingänge per Papier, Telefon und Tabellen koordiniert hat, muss nicht am ersten Tag zugleich die komplette Bestandsführung, Retourenabwicklung, Tourenplanung und Lieferantenbewertung digitalisiert werden. Ein sinnvoller erster Umfang könnte bei der Warenannahme, eindeutigen Lagerbewegungen und dem Druck von Lieferdokumenten liegen.

Entscheidend ist, den Sollprozess konkret zu beschreiben. Nicht: „Wareneingang wird digital.“ Sondern: „Der Mitarbeitende scannt die Lieferung, prüft Menge und Zustand, ordnet einen Lagerplatz zu und erzeugt bei Abweichungen einen Vorgang für den Einkauf.“ Erst auf dieser Ebene werden offene Fragen sichtbar: Was passiert bei fehlender Bestellung? Wer darf Mengen korrigieren? Darf eine Lieferung ohne Etikett eingelagert werden?

Software Rollout planen heißt: kritische Abläufe priorisieren

Nicht jeder Prozess hat dieselbe Bedeutung. Ein Ausfall im Bereich Stammdatenpflege kann unangenehm sein. Ein Ausfall bei Versand, Kommissionierung oder Rechnungsfreigabe kann die Arbeit eines ganzen Tages blockieren. Deshalb braucht der Rollout eine Priorisierung nach Betriebsrisiko, nicht nach der Reihenfolge im Pflichtenheft.

Bewährt hat sich eine einfache Einteilung: geschäftskritisch, wichtig und verschiebbar. Geschäftskritisch sind alle Abläufe, die Ware, Geld oder verbindliche Kundenkommunikation bewegen. Wichtig sind Funktionen, die den Alltag beschleunigen, deren Ausfall aber übergangsweise manuell abgefedert werden kann. Verschiebbar sind Komfortfunktionen, seltene Sonderfälle oder Auswertungen, die zunächst noch aus einer bestehenden Quelle kommen dürfen.

Diese Einteilung beeinflusst die Testtiefe. Für einen kritischen Versandprozess genügt es nicht, einen einzelnen Auftrag erfolgreich durchzuklicken. Getestet werden müssen auch Teillieferungen, Stornos, fehlende Drucker, falsche Adressen, parallele Bearbeitung und die Übergabe an den Versanddienstleister. Bei einer selten verwendeten Statistikfunktion kann ein späterer Testzyklus angemessen sein.

Erfolgskriterien vorher messbar machen

„Die Anwendung läuft“ ist kein Abnahmekriterium. Besser sind überprüfbare Aussagen: Ein Wareneingang von 30 Positionen ist innerhalb von zehn Minuten buchbar. Versandetiketten werden am vorgesehenen Arbeitsplatz gedruckt. Bestandsänderungen erscheinen unmittelbar in der Disposition. Ein gesperrtes Benutzerkonto lässt sich nur über den definierten Freigabeprozess wieder aktivieren.

Solche Kriterien verbinden Fachbereich und Entwicklung. Sie verhindern auch, dass die Abnahme zu einer Sammlung vager Eindrücke wird. Nicht jede Rückmeldung muss vor dem Go-live gelöst sein. Aber jede Rückmeldung braucht eine Einordnung: kritischer Fehler, relevante Verbesserung oder Punkt für eine spätere Ausbaustufe.

Datenmigration: Nur saubere Daten verdienen Vertrauen

Alte Daten werden oft unterschätzt. In Tabellen finden sich doppelte Artikelnummern, unterschiedliche Einheiten, abgelaufene Kundenadressen und Lagerbestände, deren Herkunft niemand mehr erklären kann. Wer diese Daten ungeprüft übernimmt, verlagert alte Unklarheit in ein neues System - nur mit besserer Oberfläche.

Vor der Migration sollte festgelegt werden, welche Daten wirklich benötigt werden. Häufig sind aktuelle Artikel, aktive Kunden, offene Aufträge, relevante Lieferanten und geprüfte Startbestände sinnvoll. Historische Datensätze müssen nicht zwangsläufig vollständig in die neue Anwendung wandern. Es kann genügen, sie lesbar zu archivieren, wenn sie für Nachweise oder Rückfragen erforderlich bleiben.

Besonders wichtig ist eine Probeladung. Dabei werden Daten nicht nur technisch importiert, sondern fachlich geprüft: Stimmen Mengen, Einheiten und Zuordnungen? Sind Pflichtfelder vollständig? Lassen sich typische Aufträge damit korrekt bearbeiten? Für den Go-live braucht es anschließend einen klaren Stichtag. Ab wann wird welches führende System verwendet? Ohne diese Regel entstehen Doppelpflege und widersprüchliche Bestände.

Pilotbetrieb statt großer Schalter

Ein Big Bang kann sinnvoll sein, wenn ein kleines Team einen klar abgegrenzten Prozess nutzt und alte sowie neue Lösung nicht parallel funktionieren können. In den meisten operativen Umgebungen ist ein Pilotbetrieb jedoch die kontrollierbarere Wahl.

Der Pilot sollte mit echten Fällen arbeiten, aber in einem begrenzten Rahmen: ein Lagerbereich, eine Schicht, eine Produktgruppe oder ein ausgewähltes Team. Entscheidend ist, dass die Pilotgruppe nicht nur besonders technikaffine Mitarbeitende umfasst. Sie sollte den späteren Alltag realistisch abbilden, einschließlich der Menschen, die unter Zeitdruck arbeiten und berechtigte Einwände haben.

Im Pilotbetrieb zeigt sich, ob Scanner, Drucker, Netzwerk und Berechtigungen am tatsächlichen Arbeitsplatz funktionieren. Ebenso sichtbar werden Prozesslücken, die in Besprechungen niemand genannt hat. Vielleicht wird Ware im Alltag zunächst auf einem Zwischenplatz abgestellt. Vielleicht benötigen Fahrer einen anderen Lieferschein als die Verwaltung. Solche Erkenntnisse sind kein Rückschritt. Sie sind der Grund, den Pilot vor dem flächigen Start durchzuführen.

Schulung als Arbeitssituation, nicht als Softwareführung

Eine Schulung, die nur Menüpunkte erklärt, erzeugt wenig Sicherheit. Mitarbeitende müssen an ihren Aufgaben lernen: „Sie nehmen eine beschädigte Lieferung an“, „Sie kommissionieren einen eiligen Auftrag“, „Sie korrigieren eine falsch gebuchte Menge“. Der Kontext bleibt hängen, weil er dem Arbeitsalltag entspricht.

Kurze Schulungen nahe am Go-live sind meist wirksamer als ein langer Termin Wochen zuvor. Ergänzend helfen knappe Arbeitsanweisungen direkt am Arbeitsplatz. Sie sollten nicht das ganze System erklären, sondern die häufigsten Vorgänge, klare Zuständigkeiten und den Weg bei Störungen zeigen.

Benennen Sie außerdem Ansprechpartner pro Bereich. Diese Personen müssen nicht jedes technische Problem selbst lösen. Sie sollten aber entscheiden können, ob es sich um einen Bedienfehler, eine fachliche Unklarheit oder einen tatsächlichen Systemfehler handelt. Das schützt das Projektteam vor unstrukturierten Zurufen und beschleunigt die Hilfe für die Schicht.

Go-live braucht einen Betriebsplan

Der Go-live-Tag benötigt mehr als eine Uhrzeit. Definieren Sie, wer fachlich entscheidet, wer technische Änderungen verantwortet und über welchen Kanal Störungen gemeldet werden. Bei kritischen Abläufen sollte sichtbar sein, ob zentrale Funktionen funktionieren: Anmeldung, Berechtigungen, Datenerfassung, Schnittstellen, Druck und Sicherung.

Auch ein Rückfallplan gehört dazu. Das bedeutet nicht, beim kleinsten Problem sofort wieder vollständig zur alten Welt zurückzukehren. Es bedeutet, vorab zu bestimmen, welche Störung einen Stopp rechtfertigt, wie Aufträge notfalls dokumentiert werden und wie nachträglich sauber nacherfasst wird. Ein Papierformular für wenige Stunden kann vernünftig sein. Eine dauerhafte Parallelführung ohne Ende ist es nicht.

Technische Details zählen dabei: Sind Zugänge rechtzeitig angelegt? Greifen Rollen und Account-Lockout-Regeln korrekt? Sind Etikettendrucker mit den richtigen Vorlagen verbunden? Existiert eine getestete Sicherung der Datenbank? Bei individuell entwickelten Anwendungen gehören dokumentierte Deployments, nachvollziehbare Versionsstände und ein klarer Weg für Fehlerbehebungen zum Standard.

Die ersten Wochen entscheiden über Akzeptanz

Nach dem Start beginnt die Phase, in der eine Anwendung entweder zum Arbeitsmittel oder zum ungeliebten Zusatzschritt wird. Planen Sie deshalb tägliche kurze Rückmeldeschleifen ein. Welche Fehler treten wiederholt auf? Wo entstehen Umwege? Welche Felder werden falsch verstanden? Welche Auswertung fehlt einer Führungskraft wirklich?

Nicht jede Beobachtung verlangt sofort eine Änderung. Manche Probleme lösen sich durch präzisere Arbeitsregeln oder eine bessere Schulung. Andere zeigen echte Schwächen im Prozess oder in der Anwendung. Die Kunst besteht darin, beides nicht zu verwechseln. Ein System sollte bestehende funktionierende Abläufe nicht ohne Grund komplizierter machen. Wenn eine gut gepflegte Tabelle für einen seltenen Spezialfall weiterhin die bessere Lösung ist, darf sie bleiben.

Messen Sie die Wirkung anhand weniger konkreter Kennzahlen: Bearbeitungszeit pro Vorgang, Zahl der Nachfragen, Fehlbuchungen, Nachdrucke, offene Aufträge oder Bestandsdifferenzen. Erst diese Werte zeigen, ob der Rollout den Betrieb tatsächlich verbessert - statt lediglich neue Masken einzuführen.

Ein guter Rollout fühlt sich nach einigen Wochen nicht wie ein Projekt an. Er wird zur verlässlichen Arbeitsroutine: Die richtigen Daten stehen dort, wo sie gebraucht werden, Ausnahmen sind nachvollziehbar und Teams müssen weniger hinter Informationen hertelefonieren. Genau darauf sollte die Planung zielen - nicht auf einen spektakulären Starttag, sondern auf einen ruhigeren, besser steuerbaren Alltag.

Permalink →

Multiplatform Application Development planen: erst der Prozess, dann die Plattform

Multiplatform Application Development planen: erst der Prozess, dann die Plattform

Ein Lagerleiter bestätigt einen Wareneingang am Handscanner. Die Disposition prüft denselben Vorgang im Browser. Ein Fahrer benötigt den Lieferstatus unterwegs auf dem Smartphone. Multiplatform application development klingt in diesem Moment nach einer technischen Frage. Tatsächlich geht es zuerst um einen Betriebsablauf: Welche Arbeit muss an welchem Ort, mit welcher Verlässlichkeit und mit welchem Gerät erledigt werden?

Für kleine und mittlere Unternehmen ist die richtige Antwort selten: Wir bauen alles nativ für jede Plattform. Häufiger lautet sie: Wir definieren einen gemeinsamen Prozess, wählen gezielt die nötigen Bedienoberflächen und vermeiden doppelte Logik. Das spart nicht nur Entwicklungsbudget. Es verhindert auch, dass Lager, Büro und Außendienst mit unterschiedlichen Datenständen arbeiten.

Was Multiplatform Application Development leisten soll

Multiplatform Application Development bezeichnet die Entwicklung einer Anwendung, die auf mehreren Umgebungen nutzbar ist, etwa im Webbrowser, auf iOS und Android oder auf Windows-Desktop-Systemen. Der Begriff wird oft auf die Frage reduziert, ob ein einzelner Codebestand mehrere Apps erzeugen kann. Das ist nur ein Teil der Entscheidung.

Für operative Systeme zählt vor allem, ob die Anwendung an ihrem Einsatzort funktioniert. Eine Warenannahme braucht vielleicht eine Kamera zum Erfassen von Barcodes, große Bedienelemente für Handschuhe und eine brauchbare Reaktion bei instabiler WLAN-Abdeckung. Die Verwaltung braucht dagegen Tabellen, Filter, Rechtekonzepte und nachvollziehbare Änderungsprotokolle. Ein Fahrer benötigt eine reduzierte Ansicht, nicht dieselbe Oberfläche wie die Disposition.

Eine gemeinsame technische Grundlage kann diese Anforderungen sinnvoll verbinden. Sie darf aber nicht dazu führen, dass jede Plattform wie ein schlechter Kompromiss bedient wird. Der beste gemeinsame Code ist wertlos, wenn Mitarbeitende Umwege gehen, weil die Anwendung ihren tatsächlichen Arbeitsablauf nicht abbildet.

Erst den Prozess, dann die Plattform bestimmen

Bevor Teams über Frameworks sprechen, sollten sie einen konkreten Vorgang von Anfang bis Ende prüfen. Nehmen wir eine Lieferung: Bestellung kommt herein, Ware wird kommissioniert, ein Lieferschein entsteht, die Übergabe wird bestätigt und der Status wird an Vertrieb oder Kundenservice zurückgemeldet. An welcher Stelle entsteht heute Medienbruch? Wo wird etwas auf Papier notiert, später abgetippt oder per Telefon nachgefragt?

Diese Beobachtung trennt echte Plattformanforderungen von Wunschlisten. Wenn nur zwei Mitarbeitende im Büro eine Funktion verwenden, ist eine gut gemachte Weboberfläche meist ausreichend. Wenn zehn Personen auf dem Hallenboden Buchungen vornehmen, kann eine mobile, scannerfreundliche Oberfläche den Unterschied machen. Muss ein bestehendes Windows-Programm mit Spezialhardware arbeiten, kann eine Desktop-Integration notwendig sein.

Nicht jede Funktion gehört auf jedes Gerät. Das ist kein Mangel einer multiplattformfähigen Lösung, sondern ein Zeichen sauberer Produktentscheidung. Gemeinsame Daten und Geschäftsregeln bedeuten nicht zwangsläufig identische Masken.

Die drei Fragen, die Kosten und Nutzen klären

Die erste Frage lautet: Welche Geräte sind bereits im Einsatz und wie lange bleiben sie es? Ein Betrieb mit verwalteten Windows-Terminals hat andere Anforderungen als ein Außendienst mit privaten Smartphones. Die zweite lautet: Was passiert ohne Netzverbindung? Offline-Fähigkeit erhöht den Aufwand erheblich, weil Daten lokal gespeichert, später synchronisiert und bei Konflikten sauber behandelt werden müssen. Sie ist sinnvoll, wenn der Prozess sonst stehen bleibt - nicht als Standardausstattung.

Die dritte Frage betrifft die Ausfallfolgen. Kann ein Mitarbeitender eine Buchung später nachtragen, oder hängt ein Versandlabel, ein Bestand oder eine Sicherheitsfreigabe daran? Je kritischer der Vorgang, desto stärker müssen Berechtigungen, Prüfregeln, Wiederholbarkeit und Protokollierung geplant werden.

Eine Architektur, die nicht bei der zweiten Plattform zerfällt

Bei einer nachhaltigen Lösung liegt die Geschäftslogik nicht verstreut in mehreren Oberflächen. Bestandsprüfungen, Statuswechsel, Nummernkreise, Berechtigungen und Dokumentenerzeugung brauchen eine zentrale, getestete Grundlage. Browser, mobile Anwendung und Desktop-Client greifen über klar definierte Schnittstellen darauf zu.

Für viele interne Geschäftsprozesse ist eine moderne Webanwendung der wirtschaftlichste Ausgangspunkt. Sie lässt sich zentral aktualisieren, benötigt keine Installation auf jedem Arbeitsplatz und funktioniert auf Desktop, Tablet und Smartphone. Mit PHP 8.4, modernem JavaScript und MySQL 8 lässt sich dafür eine wartbare Basis aufbauen, sofern Datenmodell, Zugriffsrechte und Deployment nicht erst kurz vor dem Go-live bedacht werden.

Eine installierbare mobile oder Desktop-Anwendung wird dann ergänzt, wenn sie einen klaren Vorteil bringt: tiefe Integration mit Scanner, Drucker oder Kamera, verlässlicher Offline-Betrieb, spezielle Hintergrundfunktionen oder Anforderungen aus der Geräteverwaltung. Das ist ein gezielter Ausbau, kein Selbstzweck.

Ein häufiger Fehler ist die vollständige Wiederverwendung der Benutzeroberfläche um jeden Preis. Technisch kann das attraktiv aussehen. Praktisch entstehen kleine Texte auf großen Monitoren, überladene Formulare auf Smartphones oder Bedienungen, die nicht zur Plattform passen. Besser ist es, Datenmodell, Regeln und Komponenten dort gemeinsam zu nutzen, wo es sinnvoll ist, während die Bedienung auf den jeweiligen Kontext abgestimmt wird.

Datenkonsistenz ist wichtiger als ein gemeinsamer Codebestand

Mehrere Plattformen erhöhen die Gefahr widersprüchlicher Daten. Ein Auftrag wird im Büro geändert, während ein Fahrer bereits eine alte Version auf seinem Gerät sieht. Zwei Mitarbeitende buchen gleichzeitig denselben Artikelbestand. Ein Offline-Gerät sendet seine Änderungen Stunden später zurück. Diese Fälle sind kein Randthema, sondern Kern der Architektur.

Das System braucht deshalb eindeutige Identitäten, Zeitstempel, nachvollziehbare Zustandswechsel und Regeln für Konflikte. Bei einem Lieferstatus kann die zuletzt bestätigte Änderung ausreichend sein. Bei Beständen ist das oft zu grob. Dort muss klar sein, welche Bewegung gebucht wurde, von welchem Lagerplatz sie stammt und ob eine Korrektur begründet werden muss.

Auch Berechtigungen gehören zentral geregelt. Ein Mitarbeiter darf möglicherweise Wareneingänge erfassen, aber keine Bestandskorrekturen freigeben. Ein externer Fahrer darf nur seine Tour sehen. Sitzungslaufzeiten, Mehrfaktor-Authentifizierung bei kritischen Rollen und Account-Lockout-Flows sind keine dekorativen Sicherheitsfeatures. Sie schützen konkrete Abläufe und machen Verantwortlichkeiten sichtbar.

Multiplatform Application Development testen, wie gearbeitet wird

Eine Anwendung kann auf drei Betriebssystemen starten und trotzdem im Betrieb scheitern. Entscheidend sind die Abläufe unter realen Bedingungen: Scanner reagiert zu langsam, ein Etikettendrucker ist nicht erreichbar, eine Berechtigung greift nach einem Rollenwechsel nicht, oder eine Synchronisierung erzeugt doppelte Buchungen.

Deshalb sollten kritische Prozesse automatisiert geprüft werden. Dazu gehören Anmeldung und Sperrverhalten, Auftragserfassung, Bestandsbewegungen, Dokumentenerstellung und die Verarbeitung fehlerhafter Eingaben. Für Web- und Windows-Anwendungen lassen sich wiederkehrende Tests auf einer selbst gehosteten Infrastruktur ausführen. Das ist besonders relevant, wenn Screenshots, interne Auftragsdaten oder Testzugänge nicht an externe Cloud-Dienste weitergegeben werden sollen.

Automatisierung ersetzt keine Prüfung durch Menschen auf dem Lagerboden. Sie sorgt jedoch dafür, dass bekannte Abläufe nach Änderungen immer wieder kontrolliert werden. Gute Testberichte benennen dabei nicht nur einen technischen Fehler, sondern den betroffenen Prozess: Liefernachweis kann nicht erzeugt werden, Benutzerkonto bleibt nach erfolgreicher Freigabe gesperrt oder Tourdaten werden nicht aktualisiert.

Wann eine Plattformstrategie zu viel ist

Manche Unternehmen brauchen keine eigene App. Wenn ein stabiler Browserzugang genügt, der Ablauf selten mobil ist und die Zahl der Nutzer überschaubar bleibt, ist eine responsive Webanwendung häufig die vernünftigere Wahl. Sie reduziert Pflegeaufwand, Verteilungsprobleme und die Zahl möglicher Fehlerquellen.

Auch eine bestehende Tabelle muss nicht sofort ersetzt werden. Wenn sie nur als einfache Auswertung dient, von einer Person gepflegt wird und keine fehleranfälligen Übergaben erzeugt, kann sie ihren Zweck erfüllen. Der Zeitpunkt für ein System ist erreicht, wenn Wissen in einzelnen Köpfen steckt, Versionen auseinanderlaufen, Nachfragen zunehmen oder ein Vorgang nicht mehr zuverlässig nachvollzogen werden kann.

Umgekehrt wird eine schlanke Plattformstrategie schnell zu klein, wenn Mitarbeitende offline arbeiten müssen, Hardware angebunden wird oder Kunden und Partner kontrollierten Zugriff benötigen. Dann lohnt es sich, die zusätzlichen Anforderungen bewusst zu finanzieren, statt sie später unter Zeitdruck anzubauen.

Mit einem belastbaren Pilot beginnen

Ein guter Start ist kein Funktionskatalog mit hundert Punkten, sondern ein vollständiger, messbarer Ablauf. Beispielsweise: Wareneingang erfassen, Bestand aktualisieren, Abweichung dokumentieren und eine Aufgabe zur Klärung erzeugen. Dieser Pilot zeigt früh, ob Datenmodell, Geräte, Rechte und Bedienung zusammenpassen.

Danach kann die Lösung in sinnvollen Schritten wachsen: Kommissionierung, Versand, Tourenplanung oder Auswertungen. Jede Erweiterung sollte dieselbe Frage bestehen: Verkürzt sie einen echten Ablauf, senkt sie Fehler oder schafft sie verlässliche Transparenz? Wenn nicht, darf sie warten.

Die sinnvollste Plattform ist am Ende nicht die mit den meisten technischen Optionen. Es ist die, auf der ein Team seine Arbeit morgens schneller beginnt, während der Schicht weniger nachfragt und abends nachvollziehen kann, was tatsächlich passiert ist.

Permalink →

Test Automation Results richtig bewerten

Test Automation Results richtig bewerten

Ein Regressionstest kann morgens mit 98 Prozent erfolgreichen Fällen enden und trotzdem keine gute Nachricht sein. Vielleicht ist genau der fehlgeschlagene Test der Login eines Großkunden. Vielleicht wurden 40 Tests übersprungen, weil die Testumgebung nicht erreichbar war. Oder der Lauf war zwar grün, prüfte aber nur, ob Schaltflächen vorhanden sind, nicht ob ein Auftrag tatsächlich gespeichert, eine Liefernote erzeugt und der Bestand korrekt angepasst wird. Test automation results sind keine Qualitätsaussage, solange ihr Kontext fehlt.

Für QA-Leitung, Entwicklung und Fachbereiche liegt die eigentliche Arbeit deshalb nicht allein im Automatisieren von Tests. Entscheidend ist, Ergebnisse so aufzubereiten, dass daraus verlässliche Entscheidungen entstehen: Kann ein Release ausgerollt werden? Muss ein Fehler sofort behandelt werden? Ist der Fehler neu, wieder aufgetreten oder nur ein Problem der Testumgebung? Und gibt es Belege, die auch ein Fachbereich ohne Testcode nachvollziehen kann?

Was Test Automation Results wirklich aussagen

Die einfachste Kennzahl lautet: bestanden oder fehlgeschlagen. Sie ist hilfreich, aber selten ausreichend. Ein hoher Erfolgsanteil kann Vertrauen schaffen, wenn die Tests kritische Abläufe abdecken, die Testdaten plausibel sind und die Umgebung dem späteren Betrieb ähnelt. Fehlt einer dieser Faktoren, bleibt die Zahl vor allem ein Signal dafür, dass ein automatisierter Ablauf ausgeführt wurde.

Bei geschäftskritischen Anwendungen zählen andere Fragen stärker. In einer Lagerlösung ist nicht jede Bildschirmansicht gleich wichtig. Ein Darstellungsfehler im internen Hinweistext kann warten. Ein Fehler, der bei Wareneingang die falsche Menge bucht oder ein Versandlabel ohne Empfängeradresse erzeugt, nicht. Gute Testergebnisse gewichten daher Risiken statt alle Fälle gleich zu behandeln.

Auch ein fehlgeschlagener Test ist nicht automatisch ein Produktfehler. Er kann durch abgelaufene Zugangsdaten, eine gesperrte Testrolle, nicht verfügbare Schnittstellen, geänderte Testdaten oder eine langsame Umgebung ausgelöst werden. Wer diese Ursachen nicht trennt, produziert Lärm. Das Team verbringt dann Zeit mit Fehlalarmen, während echte Fehler zwischen roten Statusmeldungen untergehen.

Vier Statusarten statt einer roten Liste

Praktisch bewährt sich eine klare Einteilung: fachlicher Fehler, technischer Testfehler, Umgebungsproblem und erwartete Änderung. Ein fachlicher Fehler bedeutet, dass die Anwendung gegen eine definierte Anforderung verstößt. Ein technischer Testfehler weist eher auf den Test selbst hin, etwa einen nicht mehr passenden Selektor nach einer absichtlich geänderten Oberfläche.

Ein Umgebungsproblem liegt vor, wenn etwa ein Testsystem oder eine angebundene Schnittstelle nicht verfügbar ist. Erwartete Änderungen entstehen, wenn ein Prozess bewusst angepasst wurde, die Automatisierung aber noch den alten Sollzustand prüft. Diese Kategorien verhindern nicht jede Diskussion. Sie sorgen aber dafür, dass die Diskussion am richtigen Punkt beginnt.

Von Testläufen zu entscheidungsfähigen Berichten

Ein brauchbarer Bericht beantwortet nicht nur, dass etwas fehlgeschlagen ist, sondern was passiert ist, wie gravierend es ist und ob der Fehler reproduzierbar erscheint. Dafür braucht es mehr als eine Liste aus Testnamen und Zeitstempeln.

Zu jedem relevanten Lauf gehören der geprüfte Build, die Testumgebung, die verwendete Rolle, zentrale Testdaten sowie Start- und Endzeit. Gerade bei Windows-Desktop-Anwendungen oder komplexen Webplattformen sind diese Informationen nötig, um Unterschiede einzugrenzen. Ein Fehler, der nur unter einer eingeschränkten Lagerrolle auftritt, ist etwas anderes als ein Fehler, der jede Anmeldung blockiert.

Aussagekräftige Ergebnisse enthalten außerdem nachvollziehbare Belege: Screenshots, aufgezeichnete Schritte, Fehlermeldungen und bei Bedarf technische Protokolle. Ein Screenshot allein kann allerdings täuschen. Er zeigt einen Moment, nicht die Ursache. Die Kombination aus Schrittfolge, sichtbarem Zustand und erwarteter Reaktion ist wesentlich hilfreicher.

KI-gestützte Systeme können diese Belege in verständliche Bewertungen überführen. Bei COCO etwa laufen Tests auf einem eigenen, selbst gehosteten KI-Server. Die Auswertung kann erklären, dass ein Auftrag zwar angelegt wurde, der erwartete Statuswechsel jedoch ausblieb, und die Aufnahme der Ausführung direkt zuordnen. Für sicherheitsbewusste Teams ist dabei relevant, wo Screenshots, Anwendungsdaten und Testverkehr verarbeitet werden. Lokale Kontrolle ist nicht automatisch erforderlich, kann bei internen Anwendungen und sensiblen Daten aber der sinnvollere Weg sein als ein externer Cloud-Dienst.

Die richtige Detailtiefe für verschiedene Empfänger

Entwicklungsteams benötigen Fehlermeldungen, technische Schritte und möglichst präzise Hinweise zur Reproduktion. Ein Operations Manager braucht dagegen zuerst die betroffene Funktion, das Geschäftsrisiko und eine klare Aussage zur Betriebsfähigkeit. Beide Perspektiven müssen aus derselben Ausführung entstehen können, ohne dass jemand Ergebnisse manuell in Präsentationen übertragen muss.

Ein guter Bericht beginnt deshalb mit einer kurzen Entscheidungsebene: Freigabe empfohlen, Freigabe mit bekannten Einschränkungen oder Freigabe stoppen. Darunter stehen die kritischen Abweichungen mit Priorität und Beleg. Die technischen Einzelheiten folgen erst danach. Das ist keine Vereinfachung auf Kosten der Genauigkeit, sondern eine saubere Trennung der Informationsbedürfnisse.

Abdeckung messen, ohne sich Sicherheit vorzutäuschen

Testabdeckung wird häufig als Prozentwert dargestellt. Dieser Wert ist nützlich, wenn klar ist, was er misst. Code-Abdeckung zeigt beispielsweise, welche Teile des Programmcodes während Tests ausgeführt wurden. Das beweist nicht, dass ein Geschäftsprozess korrekt funktioniert. Ein Test kann viele Codezeilen berühren und dennoch nie prüfen, ob eine falsche Lieferadresse auf dem Dokument erscheint.

Für Fachbereiche ist Prozessabdeckung oft aussagekräftiger. Sie beschreibt, welche realen Abläufe geschützt sind: Auftrag erfassen, Bestand reservieren, Teillieferung buchen, Rücksendung annehmen oder Rechnung freigeben. Besonders wertvoll sind Übergänge zwischen Systemen und Rollen, denn dort entstehen häufig Fehler: beim Import einer Bestellung, beim Druck eines Labels oder beim Wechsel von Büro zu Lagerterminal.

Priorisieren Sie nicht nach der Anzahl möglicher Tests, sondern nach Schadenswirkung und Änderungshäufigkeit. Ein selten genutzter Prozess mit hohem finanziellem oder rechtlichem Risiko verdient oft früher eine Automatisierung als eine häufig verwendete, aber harmlose Ansicht. Umgekehrt kann ein stabiler, wenig kritischer Ablauf weiterhin mit einer kurzen manuellen Prüfung auskommen. Nicht jede Prüfung muss automatisiert werden, nur weil sie automatisierbar ist.

Instabile Tests sind ein eigenes Qualitätsproblem

Tests, die ohne erkennbare Produktänderung mal bestehen und mal scheitern, werden oft als flakig bezeichnet. Sie beschädigen Vertrauen schneller als ein dauerhaft roter Test. Sobald Teams rote Ergebnisse reflexartig erneut starten, verliert die Automatisierung ihre Warnfunktion.

Die Ursachen sind meist konkret: harte Wartezeiten, gemeinsam genutzte Testdaten, parallele Zugriffe, asynchrone Verarbeitung oder eine Umgebung, die nicht zurückgesetzt wird. Eine kurze Pause von drei Sekunden im Test kann zufällig helfen, ist aber keine Lösung. Besser ist es, auf einen nachweisbaren Zustand zu warten, Testdaten eindeutig zu machen und Abläufe voneinander zu isolieren.

Nicht jede Instabilität lässt sich vollständig vermeiden. Externe Schnittstellen können schwanken, und reale Infrastruktur hat Ausfälle. Dann sollte der Bericht klar kennzeichnen, ob ein Test wegen einer externen Abhängigkeit nicht bewertbar war. Ein wiederholter Lauf kann zur Diagnose sinnvoll sein, darf aber den ersten Befund nicht unsichtbar machen.

Ein sinnvoller Ablauf nach jedem Testlauf

Nach einem automatisierten Lauf sollte nicht jedes Ergebnis sofort gleich behandelt werden. Zuerst werden blockierende Fehler und nicht bewertbare kritische Tests geprüft. Danach folgt die Einordnung neuer Abweichungen gegenüber bekannten, akzeptierten Problemen. Erst dann ist eine Release-Entscheidung belastbar.

Hilfreich sind festgelegte Schwellenwerte, aber sie müssen zum Prozess passen. Beispielsweise kann ein fehlgeschlagener Test im Zahlungs- oder Berechtigungsfluss einen sofortigen Stopp auslösen. Bei einer rein kosmetischen Abweichung kann eine dokumentierte Ausnahme vertretbar sein. Solche Regeln sollten nicht erst unter Zeitdruck vor einem Release entstehen.

Ebenso wichtig ist die Rückkopplung: Jeder produktive Fehler, der durch die Tests nicht erkannt wurde, ist ein Anlass zu prüfen, ob ein Szenario, eine Testdatenvariante oder ein Kontrollpunkt fehlt. Das Ziel ist nicht, möglichst viele Tests anzuhäufen. Es ist, aus echten Fehlern gezielt bessere Absicherung zu bauen.

Die nützlichsten Testergebnisse sind am Ende nicht die mit der grünsten Übersicht. Es sind jene, bei denen ein Verantwortlicher am Montagmorgen nachvollziehen kann, was geprüft wurde, welches Risiko bleibt und welche Handlung jetzt vernünftig ist.

Permalink →

Inventory Discrepancy Causes: Häufige Gründe für Bestandsdifferenzen

Inventory Discrepancy Causes: Häufige Gründe für Bestandsdifferenzen

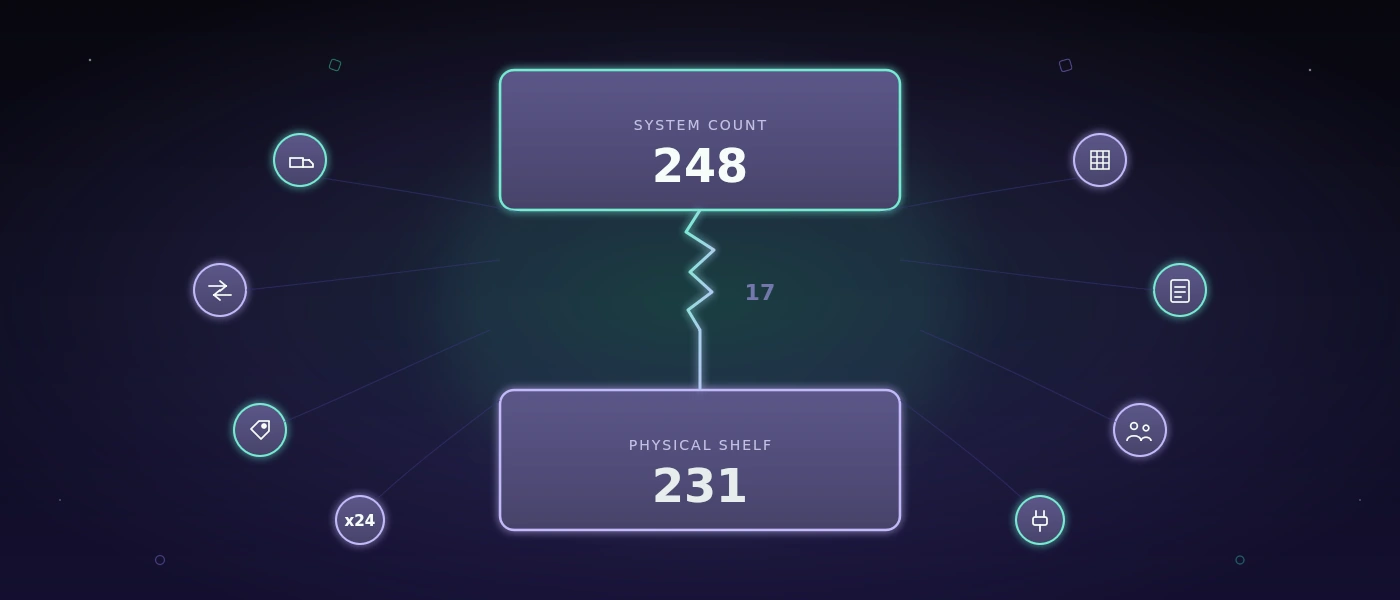
Der Bestand im System sagt 248 Stück, im Regal liegen 231. Diese 17 Einheiten wirken zunächst wie ein Zählfehler. Doch genau hier beginnt häufig die falsche Analyse. Inventory discrepancy causes sind in der Praxis selten ein einzelnes Versehen. Meist entstehen sie dort, wo Wareneingang, Lagerbewegung, Kommissionierung und Buchung zeitlich oder organisatorisch auseinanderlaufen.

Für ein kleines oder mittleres Unternehmen sind Bestandsdifferenzen nicht nur ein Thema für die Inventur. Sie führen zu Fehlbestellungen, Expresslieferungen, unnötigen Sicherheitsbeständen und Lieferzusagen, die sich nicht halten lassen. Wer die Ursachen sauber trennt, muss nicht sofort ein großes ERP einführen. Oft reichen klarere Buchungsregeln, passende Erfassungsgeräte und ein System, das reale Arbeitsabläufe abbildet.

Inventory discrepancy causes: Wo Differenzen entstehen

Eine Bestandsdifferenz ist die Differenz zwischen Sollbestand im führenden System und tatsächlich vorhandenem Bestand. Entscheidend ist dabei das Wort „führend". Wenn parallel eine Excel-Datei, eine Papierliste und ein Warenwirtschaftssystem gepflegt werden, gibt es praktisch mehrere Wahrheiten. Dann ist die Differenz nicht bloß im Lager entstanden, sondern bereits in der Datenführung angelegt.

Die wirksame Gegenmaßnahme hängt deshalb von der Fehlerart ab. Eine falsch gezählte Palette braucht eine andere Lösung als eine Lieferung, die physisch angenommen, aber nie gebucht wurde. Bevor Teams Prozesse umbauen, sollten sie Differenzen nach Artikel, Lagerort, Schicht, Bewegungsart und Zeitpunkt auswerten. Erst dieses Muster zeigt, ob ein Einzelfall oder ein wiederkehrender Prozessfehler vorliegt.

1. Wareneingänge werden verspätet oder unvollständig gebucht

Der Wareneingang ist ein klassischer Bruchpunkt. Ware trifft morgens ein, wird zur Prüfung abgestellt und später direkt in die Produktion oder ins Regal gebracht. Die Buchung erfolgt am Nachmittag, am nächsten Tag oder gar nicht. Solange die Ware physisch vorhanden ist, erscheint der Systembestand zu niedrig. Wird sie bereits verbraucht oder ausgeliefert, werden Folgefehler wahrscheinlicher.

Besonders anfällig sind Teillieferungen, Ersatzartikel und Überlieferungen. Steht auf dem Lieferschein eine Menge, kommt aber eine andere Menge an, darf niemand den Beleg einfach „irgendwie passend" buchen. Der Unterschied muss als Ausnahme sichtbar bleiben, inklusive Grund, verantwortlicher Person und Freigabe. Sonst verschwindet die Abweichung aus dem Vorgang und taucht erst bei der Inventur wieder auf.

2. Lagerbewegungen passieren ohne Transaktion

Ein Artikel wird vom Wareneingang ins Hochregal gestellt, aus einem Fach in die Kommissionierzone umgelagert oder für einen Auftrag reserviert. Physisch ist das eine kleine, schnelle Bewegung. Im System kann sie entscheidend sein.

Wenn Mitarbeitende Lagerorte nur nach Gefühl umsortieren, wird der Gesamtbestand eventuell noch stimmen, die Verfügbarkeit am richtigen Platz aber nicht. Das verursacht Suchzeiten, Fehlkommissionierungen und unnötige Nachschubfahrten. Eine gute Lagerlösung muss nicht jede Bewegung kompliziert machen. Sie muss die wenigen Bewegungen erfassen, die für Verfügbarkeit, Rückverfolgbarkeit und Nachbestellung relevant sind.

In Werkstätten oder kleineren Lagern ist es oft sinnvoller, wenige eindeutige Zonen zu führen als eine theoretisch perfekte Fachstruktur, die im Alltag niemand pflegt. Präzision funktioniert nur, wenn sie arbeitsfähig bleibt.

3. Kommissionierung und Versand werden zu früh gebucht

Viele Teams buchen einen Auftrag beim Picken als „ausgebucht", obwohl die Ware noch auf einem Bereitstellungsplatz liegt. Wird der Auftrag anschließend geändert, storniert oder nur teilweise versendet, stimmen System- und physischer Bestand nicht mehr überein.

Besser ist eine klare Trennung zwischen reserviert, kommissioniert und versendet. Nicht jedes Unternehmen braucht dafür komplexe Statusketten. Aber der Zeitpunkt der Bestandsminderung muss eindeutig sein. Bei Versandware liegt er häufig näher an der tatsächlichen Übergabe an den Transportdienstleister als am ersten Griff ins Regal.

Auch Retouren gehören in diesen Ablauf. Kommt Ware zurück, ist sie nicht automatisch wieder verfügbar. Erst Prüfung, Qualitätsentscheidung und Einlagerung sollten bestimmen, ob sie in den verkaufbaren Bestand zurückkehrt, gesperrt bleibt oder ausgeschieden wird.

4. Falsche Einheiten und Stammdatenfehler

Ein Karton, ein Gebinde, eine Rolle und ein einzelnes Stück können denselben Artikel betreffen. Wenn die Umrechnung nicht sauber gepflegt ist, entstehen Differenzen in beeindruckender Geschwindigkeit. Ein Mitarbeitender bucht „1", meint einen Karton mit 24 Stück. Das System versteht ein Stück.

Stammdatenfehler sind besonders tückisch, weil der Buchungsvorgang technisch korrekt aussehen kann. Prüfen Sie deshalb Verpackungseinheiten, Umrechnungsfaktoren, Mindestmengen, Lagerorte und Artikelnummern. Auch ähnlich benannte Varianten, etwa unterschiedliche Längen, Farben oder Chargen, werden leicht verwechselt.

Hier hilft keine pauschale Regel wie „mehr scannen". Barcodes sind nur so zuverlässig wie die Zuordnung dahinter. Bei kleinen Sortimenten kann ein sauber gepflegter Artikelstamm mit gut lesbaren Etiketten mehr bewirken als eine umfangreiche, aber schlecht konfigurierte Scannerlandschaft.

5. Parallel geführte Tabellen und manuelle Korrekturen

Die Tabelle auf dem Desktop entsteht selten aus Nachlässigkeit. Meist schließt sie eine reale Lücke: eine Sonderreservierung, ein fehlender Auswertungswert oder ein Prozess, den die vorhandene Software nicht abbildet. Problematisch wird sie, wenn sie zum zweiten Bestandsbuch wird.

Dann werden Zugänge im System gebucht, Entnahmen aber in der Tabelle notiert. Oder eine Korrektur erfolgt nur dort, wo sie für den nächsten Auftrag gerade hilft. Niemand kann später verlässlich erklären, welcher Wert gilt.

Nicht jede Tabelle muss abgeschafft werden. Eine Kalkulation für Planung oder Analysen kann sinnvoll bleiben. Bestandsverändernde Vorgänge sollten jedoch genau ein führendes System haben. Anpassungen brauchen einen Grundcode, einen Zeitstempel und idealerweise eine Person, die sie nachvollziehen kann. Das ist keine Bürokratie um der Bürokratie willen, sondern die Voraussetzung für belastbare Ursachenanalysen.

6. Zählfehler und unpassende Inventurmethoden

Auch korrekte Prozesse schützen nicht vor menschlichen Fehlern. Artikel werden doppelt gezählt, Paletten werden übersehen, offene Kartons geschätzt oder Lagerorte nicht gesperrt, während gezählt wird. Eine jährliche Vollinventur entdeckt diese Probleme spät und unter hohem Druck.

Für viele Betriebe ist eine permanente Inventur die vernünftigere Alternative. Schnell drehende oder wertvolle Artikel werden öfter geprüft, stabile C-Artikel seltener. Wichtig ist nicht, möglichst viele Zählungen zu produzieren, sondern Abweichungen zeitnah gegen die letzten Bewegungen zu prüfen. Wird ein Differenzartikel einfach korrigiert, ohne die Ursache zu dokumentieren, bleibt das Muster unsichtbar.

Eine Gegenkontrolle ist besonders sinnvoll bei hohen Werten, Seriennummern oder Chargen. Bei Schrauben im Verbrauchslager kann sie wirtschaftlich überzogen sein. Die Kontrolltiefe sollte zum Risiko passen.

7. Unklare Verantwortlichkeiten zwischen Schichten und Bereichen

Bestandsfehler entstehen häufig an Übergaben. Die Frühschicht stellt Ware bereit, die Spätschicht versendet sie. Der Wareneingang nimmt eine Lieferung an, die Disposition ändert parallel den Auftrag. Jeder einzelne Schritt kann nachvollziehbar sein, doch niemand besitzt den Gesamtvorgang.

Definieren Sie deshalb nicht nur Rollen, sondern Übergabepunkte: Wer bestätigt den Wareneingang? Wann wechselt die Verantwortung für kommissionierte Ware? Wer prüft offene Ausnahmen am Schichtende? Ein gemeinsames digitales Board oder eine einfache Ausnahmeliste ist oft wirksamer als zusätzliche Meetings.

Das System sollte offene Vorgänge sichtbar machen, statt Mitarbeitende zum Erinnern zu zwingen. Beispielsweise müssen Lieferungen ohne Mengenprüfung, Kommissionierungen ohne Versandabschluss oder Rückgaben ohne Qualitätsentscheidung auffallen, bevor sie zu stillen Bestandsfehlern werden.

8. Schwache Systemintegration und fehlende Prüfregeln

Wenn Shop, Auftragsverwaltung, Lager und Buchhaltung Daten zeitversetzt oder per Datei austauschen, können doppelte oder fehlende Buchungen entstehen. Ein Import läuft zweimal. Eine Schnittstelle scheitert still. Ein Auftrag wird geändert, nachdem sein Versandstatus bereits übertragen wurde.

Die Lösung ist nicht zwangsläufig eine Komplettablösung. Häufig braucht es klar definierte Schnittstellen, eindeutige Belegnummern und technische Prüfungen. Eine Lagerbuchung sollte nachvollziehbar speichern, wann sie erfolgte, aus welchem Vorgang sie stammt und ob sie später storniert wurde. Kritische Prozesse benötigen Fehlermeldungen und Warteschlangen, nicht nur einen stillen Eintrag im Logfile.

Bei individuell entwickelten Logistiksystemen lassen sich solche Regeln gezielt an den Betrieb anpassen: keine negative Menge ohne Freigabe, keine Versandbestätigung ohne Versandposition, keine doppelte Verarbeitung derselben externen Referenz. Die beste Regel ist dabei nicht die strengste, sondern jene, die echte Fehler stoppt, ohne den Betrieb bei normalen Ausnahmen zu blockieren.

Bestandsdifferenzen systematisch prüfen

Beginnen Sie nicht mit einer flächendeckenden Korrektur. Wählen Sie die zehn Artikel mit den häufigsten oder teuersten Differenzen und verfolgen Sie ihre letzte Bewegung rückwärts: Wareneingang, Umlagerung, Entnahme, Rückgabe, Zählung und eventuelle manuelle Anpassung. Häufen sich die Fälle an einem Standort, einer Schicht oder einer Bewegungsart, ist das ein belastbarer Ansatzpunkt.

Danach sollte jede Maßnahme messbar sein. Wenn neue Barcode-Scans eingeführt werden, beobachten Sie nicht nur die Zahl der Scans, sondern die Differenzquote je Artikelgruppe. Wenn ein neuer Status für Bereitstellung ergänzt wird, prüfen Sie offene Bereitstellungen täglich. Gute Prozesse erzeugen keine Scheingenauigkeit. Sie machen Ausnahmen früh sichtbar und nachvollziehbar.

Der sinnvolle nächste Schritt ist oft klein: einen Übergabepunkt definieren, einen Lagerort bereinigen oder eine wiederkehrende manuelle Korrektur technisch absichern. Verlässliche Bestände entstehen nicht durch mehr Software auf Verdacht, sondern durch Prozesse, die auch an einem hektischen Dienstag um 16:45 Uhr noch korrekt ausführbar sind.

Permalink →

Prozessautomatisierung für KMU richtig angehen

Prozessautomatisierung für KMU richtig angehen

Ein Lieferschein fehlt, weil die Daten noch auf einem Zettel stehen. Ein Wareneingang wird doppelt erfasst, weil Lager und Büro mit unterschiedlichen Tabellen arbeiten. Eine Freigabe verzögert sich, weil die zuständige Person gerade nicht ans Telefon geht. Solche Reibung kostet selten auf einen Schlag viel Geld. Über Wochen summieren sich jedoch Nachfragen, Suchzeiten, Fehlerkorrekturen und unnötige Wartezeiten. Genau dort setzt Prozessautomatisierung KMU sinnvoll an.

Es geht nicht darum, möglichst viele Tätigkeiten durch Software zu ersetzen. Gute Automatisierung macht Abläufe nachvollziehbar, reduziert vermeidbare Übergaben und gibt Mitarbeitenden Zeit für Entscheidungen, die Erfahrung benötigen. Besonders in kleinen und mittleren Unternehmen ist das entscheidend: Die Teams sind nah am Tagesgeschäft. Wenn ein Prozess hakt, merkt es oft sofort die ganze Schicht.

Nicht jeden Prozess automatisieren

Der häufigste Fehler ist, mit dem sichtbarsten Ärgernis zu beginnen. Vielleicht nervt eine Excel-Datei, vielleicht soll ein neues Dashboard her. Beides kann berechtigt sein. Doch ein digitalisiertes Chaos bleibt Chaos - nur schneller und mit mehr Daten.

Vor einer technischen Entscheidung sollte der Ablauf zunächst so beschrieben werden, wie er tatsächlich stattfindet. Nicht wie er im Handbuch stehen sollte. Wer löst den Vorgang aus? Welche Informationen werden benötigt? Wo wird etwas manuell übertragen? Wer entscheidet bei Ausnahmen? Und woran erkennt das Team, dass der Vorgang abgeschlossen ist?

Gerade im Lager oder in der Auftragsabwicklung liegen die kritischen Stellen oft zwischen Systemen: Ein Auftrag kommt per E-Mail, wird in eine Tabelle kopiert, telefonisch abgestimmt und später in eine Versandsoftware eingegeben. Jede Übergabe erhöht die Wahrscheinlichkeit, dass Mengen, Termine oder Adressen abweichen.

Eine Automatisierung lohnt sich besonders, wenn ein Prozess häufig vorkommt, klare Regeln hat und Fehler spürbare Folgen verursachen. Das kann der Wareneingang sein, die Erstellung von Lieferscheinen, die Zuordnung von Lagerbewegungen oder die Übergabe freigegebener Aufträge an den Versand. Seltene Sonderfälle mit vielen Ermessensentscheidungen bleiben dagegen häufig besser manuell - zumindest zunächst.

Prozessautomatisierung für KMU beginnt mit Prioritäten

Nicht jede unnötige Tätigkeit verdient sofort ein Projekt. Eine einfache Priorisierung schafft Klarheit. Bewerten Sie einzelne Abläufe nach Häufigkeit, Bearbeitungszeit, Fehlerkosten und Abhängigkeiten. Ein Vorgang, der täglich fünfzigmal stattfindet und jeweils nur zwei Minuten spart, kann wirtschaftlicher sein als ein komplizierter Monatsprozess.

Die Frage nach der Fehlerfolge ist mindestens genauso wichtig. Ein falsch gedrucktes internes Dokument ist ärgerlich. Eine falsche Chargenzuordnung, eine verlorene Lieferadresse oder ein nicht dokumentierter Wareneingang kann Reklamationen, Sucharbeit und Bestandsdifferenzen auslösen. Dort erzeugt Automatisierung nicht nur Tempo, sondern Verlässlichkeit.

Ein sinnvoller erster Schritt ist meist klein genug, um innerhalb weniger Wochen überprüfbar zu sein. Beispielsweise kann ein Mitarbeitender Waren über einen Barcode erfassen, das System prüft Artikel und Menge, aktualisiert den Bestand in einer zentralen Datenbank und erzeugt bei Bedarf direkt einen Einlagerungsbeleg. Das Team muss danach nicht raten, welche Version einer Tabelle aktuell ist.

Ein klarer Zielzustand statt einer Funktionsliste

Viele Projekte starten mit einer langen Liste gewünschter Funktionen. Besser ist ein konkretes Betriebsbild: Was soll am Ende eines Vorgangs ohne Nachfragen sichtbar sein? Beim Versand könnte das bedeuten, dass ein Auftrag nach Freigabe automatisch eine Packliste erhält, die Versandadresse geprüft wird und ein Etikett erzeugt werden kann. Ausnahmen landen sichtbar in einer Klärliste, statt in einem unübersehbaren E-Mail-Postfach.

Dieses Zielbild zwingt zu hilfreichen Entscheidungen. Muss jede Bestellung vollständig automatisch verarbeitet werden? Oder sollen Aufträge ab einem bestimmten Warenwert, bei abweichender Lieferadresse oder bei fehlendem Bestand bewusst zur Prüfung vorgelegt werden? Automatisierung braucht keine hundertprozentige Dunkelverarbeitung, um einen großen Nutzen zu schaffen.

Die passende Technik hängt vom Ablauf ab

Es gibt keinen technischen Standardweg für jedes KMU. Eine Tabellenlösung kann für eine überschaubare Auswertung weiterhin vernünftig sein. Sie ist schnell angepasst, vertraut und verursacht wenig Einführungsaufwand. Sobald mehrere Personen gleichzeitig arbeiten, Buchungen nachvollziehbar sein müssen oder Daten mit anderen Systemen ausgetauscht werden, stößt sie jedoch an Grenzen.

Dann ist häufig eine schlanke, workflow-spezifische Anwendung sinnvoller als eine überdimensionierte Enterprise-Suite. Sie kann genau die Schritte abbilden, die im Betrieb benötigt werden: Auftrag erfassen, Bestand prüfen, Ware bewegen, Dokument erzeugen, Versand buchen und Status zurückmelden. Nicht mehr, aber auch nicht weniger.

Technisch zählt dabei weniger, ob ein System mit dem neuesten Schlagwort wirbt. Entscheidend sind belastbare Grundlagen: eine sauber modellierte Datenbank, nachvollziehbare Berechtigungen, Protokolle für relevante Änderungen, verlässliche Schnittstellen und dokumentierte Deployments. Eine Anwendung auf Basis von PHP 8.4, modernem JavaScript und MySQL 8 kann langfristig sehr gut wartbar sein, wenn Architektur und Betrieb von Anfang an mitgedacht werden.

Auch Integrationen verdienen Aufmerksamkeit. Ein automatischer Datenaustausch mit Shop, ERP, Versanddienstleister oder Buchhaltung spart nur dann Zeit, wenn Fehler sichtbar behandelt werden. Was passiert bei einer ungültigen Adresse? Wird ein fehlgeschlagener Etikettendruck erneut versucht? Kann das Team erkennen, welche Daten übertragen wurden und welche noch fehlen? Stille Fehler sind gefährlicher als ein klar markierter Ausnahmefall.

Einführung im laufenden Betrieb

Ein neues System muss sich an Schichtwechsel, Liefertermine und vorhandene Arbeitsroutinen anpassen. Deshalb ist ein schrittweiser Rollout meist sicherer als ein harter Stichtag für alle Bereiche. Starten Sie mit einem abgegrenzten Prozess, einer Produktgruppe oder einem Lagerbereich. Das reduziert Risiko und schafft echtes Feedback aus dem Alltag.

Parallelbetrieb ist dabei kein Zeichen von Unsicherheit, sondern ein kontrollierter Test. Für eine begrenzte Zeit können alte und neue Erfassung verglichen werden. Differenzen zeigen nicht nur Softwarefehler, sondern oft auch Regeln, die bisher nur im Kopf einzelner Mitarbeitender existierten. Diese Regeln gehören sichtbar in den Prozess - nicht dauerhaft in persönliche Erfahrung.

Mitarbeitende sollten nicht erst zur Schulung mit dem neuen Ablauf konfrontiert werden. Wer den Prozess täglich ausführt, erkennt Abkürzungen, Sonderfälle und unpraktische Masken früh. Gute Software respektiert dieses Wissen, ohne jede historisch gewachsene Ausnahme unverändert einzubauen. Die richtige Frage lautet: Welche Ausnahme schützt einen wichtigen Geschäftsfall, und welche ist nur ein Workaround für ein altes Problem?

Messbar machen, ob sich der Aufwand lohnt

Vor dem Start sollten zwei oder drei Kennzahlen festgelegt werden. Das können Durchlaufzeit pro Auftrag, Anzahl manueller Korrekturen, Differenzen im Bestand oder die Zeit bis zum Versand sein. Ohne Ausgangswert wird jede Bewertung später zum Bauchgefühl.

Nicht jede Wirkung zeigt sich sofort in Euro. Wenn ein Lagerteam jederzeit erkennt, wo sich Ware befindet, sinkt die Zahl der Unterbrechungen. Wenn Lieferdokumente aus denselben Daten entstehen wie der Auftrag, sinkt das Risiko widersprüchlicher Angaben. Und wenn Verantwortlichkeiten im System sichtbar sind, hängt ein Vorgang weniger an einzelnen Personen.

Automatisierung braucht Wartung und Grenzen

Ein automatisierter Ablauf ist kein Projekt, das nach dem Go-live einfriert. Artikelstrukturen ändern sich, Kunden verlangen neue Dokumente, Versanddienstleister passen Schnittstellen an. Deshalb gehören Zuständigkeiten, Updates, Backups und ein geregelter Umgang mit Berechtigungen zum eigentlichen System.

Besonders bei Anwendungen mit Kunden-, Auftrags- oder Bestandsdaten sollte klar sein, wer Zugriff erhält und warum. Rollen müssen zum Arbeitsalltag passen: Ein Lagerteam benötigt andere Funktionen als Buchhaltung oder Vertrieb. Protokollierte Änderungen, sichere Anmeldeflüsse und getestete Wiederherstellungen wirken unspektakulär. Im Störungsfall entscheiden genau diese Details darüber, ob der Betrieb weiterarbeiten kann.

Auch Tests sind Teil der Betriebssicherheit. Wiederkehrende Prüfungen für Auftragserfassung, Bestandsbuchung, Dokumentenerzeugung und Rechteverwaltung verhindern, dass eine Anpassung an einer Stelle einen funktionierenden Ablauf an anderer Stelle beschädigt. Bei kritischen Web- oder Desktop-Anwendungen kann eine kontrollierte, selbst gehostete Testumgebung sinnvoll sein, wenn Screenshots, Testdaten und interne Prozesse nicht in externe Cloud-Dienste gelangen sollen.

softify.pro begleitet solche Vorhaben mit einem einfachen Grundsatz: Erst den tatsächlichen Ablauf verstehen, dann die kleinste tragfähige Lösung bauen. Manchmal ist das eine maßgeschneiderte Anwendung. Manchmal genügt es, eine bestehende Tabelle sauberer zu strukturieren und einen einzelnen Übergabeschritt zu automatisieren.

Der beste nächste Schritt ist daher kein Softwarevergleich, sondern ein Gang durch einen echten Vorgang - vom Auslöser bis zum Abschluss. Nehmen Sie einen Auftrag, einen Wareneingang oder eine Reklamation und verfolgen Sie ihn mit den beteiligten Personen. Dort, wo Informationen erneut eingegeben werden, niemand den Status kennt oder Entscheidungen unnötig warten, liegt meist der sinnvollste Ansatz für Automatisierung.

Permalink →

Windows-Anwendungen testen: Ein praxisnaher Plan

Windows-Anwendungen testen: Ein praxisnaher Plan

Eine Windows-Anwendung kann im Demo-Modus sauber aussehen und trotzdem am Montagmorgen den Betrieb bremsen. Ein nicht gespeicherter Lieferschein, ein blockierter Benutzer nach drei Fehlversuchen oder ein Druckdialog, der nach einem Update anders reagiert, sind keine kosmetischen Fehler. Wer wissen will, wie man Windows-Anwendungen testet, sollte deshalb nicht bei einzelnen Buttons anfangen, sondern bei den Abläufen, die Arbeit, Geld oder Nachvollziehbarkeit kosten.

Gerade in Lager, Werkstatt, Disposition und Verwaltung laufen viele kritische Prozesse über gewachsene Desktop-Software. Dort zählt nicht, ob ein Testfall beeindruckend formuliert ist. Entscheidend ist, ob Mitarbeitende ihre Aufgaben unter realistischen Bedingungen zuverlässig erledigen können - auch bei unvollständigen Daten, wechselnden Berechtigungen, langsamen Netzwerken und ungeplanten Unterbrechungen.

Windows-Anwendungen testen beginnt mit den kritischen Abläufen

Nicht jede Funktion verdient den gleichen Testaufwand. Ein selten verwendeter Export mit manueller Nacharbeit ist anders zu bewerten als die Buchung eines Wareneingangs, die Etikettenerstellung oder der tägliche Abgleich von Aufträgen. Starten Sie daher mit einer einfachen Frage: Was passiert konkret, wenn dieser Ablauf fehlschlägt?

Hohe Priorität haben Prozesse mit direkter Auswirkung auf Bestand, Lieferung, Rechnung, Sicherheit oder Kundenkommunikation. Dazu gehören etwa Anmeldung und Rechteprüfung, Anlage und Änderung von Stammdaten, Transaktionsbuchungen, Dokumentendruck, Schnittstellen zu ERP- oder Versanddiensten sowie Wiederanläufe nach einem Fehler. Auch Funktionen, die nur ein kleiner Personenkreis nutzt, können kritisch sein, wenn sie einen Monatsabschluss oder die Freigabe von Waren verhindern.

Aus diesen Abläufen entstehen keine abstrakten Testlisten, sondern nachvollziehbare Arbeitsschritte. Ein Wareneingangstest könnte beispielsweise mit einer bestehenden Bestellung beginnen, eine Teillieferung erfassen, eine abweichende Menge melden, einen Lagerplatz zuweisen und anschließend prüfen, ob Bestand, Buchungsprotokoll und gedrucktes Dokument übereinstimmen. Damit testen Sie die tatsächliche Wirkung der Software, nicht nur einzelne Eingabefelder.

Eine Testbasis schaffen, die den Betrieb abbildet

Viele Fehler werden erst sichtbar, wenn die Testumgebung der Realität nahekommt. Eine Anwendung verhält sich mit einem leeren Testmandanten oft anders als mit mehreren Jahren Bewegungsdaten, gesperrten Artikeln, fehlenden Pflichtinformationen oder bereits geöffneten Vorgängen.

Legen Sie deshalb Testdaten bewusst an. Sie benötigen nicht zwingend eine vollständige Kopie der Produktion. Sinnvoller ist ein kontrollierter Datenbestand mit typischen, grenzwertigen und absichtlich fehlerhaften Fällen: Artikel mit unterschiedlichen Mengeneinheiten, Kunden mit Sonderkonditionen, Aufträge mit Teillieferungen, Benutzer mit verschiedenen Rollen und Vorgänge, die bereits in Bearbeitung sind. Personenbezogene Daten sollten dabei anonymisiert oder durch realistische Beispieldaten ersetzt werden.

Zur Testbasis gehört auch die technische Umgebung. Dokumentieren Sie Windows-Version, Auflösung, Skalierung, installierte Drucker, Netzlaufwerke, Datenbankversion, angebundene Dienste und Berechtigungen. Das klingt nüchtern, spart aber später Zeit. Wenn ein Fehler nur auf Arbeitsplätzen mit 125-Prozent-Skalierung oder bei einem bestimmten Druckertreiber auftritt, muss das reproduzierbar sein.

Nicht nur den Idealfall prüfen

Der Idealfall beweist vor allem, dass die Anwendung für den erwarteten Weg gebaut wurde. Im Betrieb entstehen die schwierigen Situationen daneben. Was geschieht, wenn ein Anwender ein Pflichtfeld leer lässt, dieselbe Buchung zweimal auslöst oder während des Speicherns die Verbindung verliert? Bleibt der Vorgang konsistent? Erhält die Person eine verständliche Meldung? Kann sie sicher weiterarbeiten?

Bei Windows-Anwendungen sind außerdem Bedienung und Zustand besonders relevant. Dialogfenster können im Hintergrund erscheinen, Tastaturkürzel können sich überschneiden, Dateiauswahldialoge können den Ablauf blockieren. Prüfen Sie, ob Fokus, Fehlermeldungen und Sperren eindeutig sind. Eine technische Ausnahme ohne Handlungshinweis hilft dem Schichtleiter nicht weiter.

Manuelle Tests dort einsetzen, wo Urteil gefragt ist

Manuelle Tests sind kein Zeichen mangelnder Reife. Sie sind unverzichtbar, wenn ein neuer Ablauf entsteht, eine Oberfläche umgebaut wird oder Fachwissen über die Qualität entscheidet. Ein erfahrener Lagerleiter erkennt schneller als ein Skript, ob eine Maske bei hohem Zeitdruck verständlich ist oder ob ein Hinweis zu spät erscheint.

Manuelles Testen wird jedoch teuer und unzuverlässig, wenn dieselben stabilen Abläufe vor jeder Version wiederholt werden. Dann hängt die Freigabe an verfügbaren Personen, Erinnerungsvermögen und verstreuten Notizen. Der richtige Übergang zur Automatisierung liegt meist dort, wo ein Prozess häufig ausgeführt wird, einen hohen Schaden verursachen kann und klare erwartete Ergebnisse besitzt.

Ein guter manueller Testfall beschreibt Ausgangslage, Schritte, erwartetes Ergebnis und benötigte Daten. Ergänzen Sie bei einem Fehler einen Screenshot, Zeitstempel, Anwendungs- und Build-Version sowie die genaue Aktion. „Drucken geht nicht" ist keine brauchbare Fehlerbeschreibung. „Nach Änderung der Lieferadresse bleibt der Druckdialog offen, der Auftrag 4711 erhält kein PDF und es erscheint keine Meldung" ist es.

Automatisierte Regressionstests für wiederkehrende Risiken

Automatisierung prüft nicht, ob eine Software grundsätzlich gut ist. Sie prüft, ob zuvor funktionierende, definierte Abläufe nach einer Änderung noch funktionieren. Das ist besonders wertvoll bei Windows-Software, deren Oberflächen, Datenbanklogik und externe Schnittstellen über Jahre weiterentwickelt werden.

Beginnen Sie klein. Wählen Sie zunächst fünf bis zehn geschäftskritische Abläufe, die bei jedem Release geprüft werden sollen. Dazu können Anmeldung mit account-lockout flow, Auftragserfassung, Lagerbuchung, PDF- oder Etikettendruck, Rollenwechsel und ein zentraler Import gehören. Erst wenn diese Tests verlässlich laufen, lohnt sich die Erweiterung auf Sonderfälle.

Bei Desktop-Anwendungen steuern automatisierte Tests häufig sichtbare Oberflächenelemente: Fenster, Eingabefelder, Tabellen, Schaltflächen und Dialoge. Das funktioniert, ist aber empfindlicher als ein reiner Schnittstellentest. Kleine Layoutänderungen, langsamere Rechner oder nicht eindeutig benannte Elemente können Tests brechen. Deshalb sollten Entwickler, Fachbereich und Testverantwortliche gemeinsam festlegen, welche Elemente stabil adressierbar sind und welche Prüfschritte besser über Datenbank, Protokoll oder Schnittstelle abgesichert werden.

Ein sinnvoller Test prüft außerdem nicht nur, dass eine Schaltfläche geklickt werden konnte. Er kontrolliert die fachliche Folge: Wurde die Buchung gespeichert? Ist der Bestand korrekt? Wurde ein Dokument erzeugt? Wurde kein doppelter Datensatz angelegt? Sichtbare Interaktion und überprüfbares Ergebnis gehören zusammen.

Beweise sind Teil des Testergebnisses

Ein grüner Status allein reicht bei kritischen Anwendungen selten aus. Wenn ein Test fehlschlägt, benötigen Teams schnell eine Antwort auf drei Fragen: Was war die Ausgangslage? An welchem Schritt ist der Ablauf gescheitert? Was zeigte die Anwendung zu diesem Zeitpunkt?

Screenshots, Ablaufprotokolle und gegebenenfalls Bildschirmaufzeichnungen machen Fehler besprechbar. Sie verkürzen die Übergabe zwischen Betrieb, QA und Entwicklung erheblich. Für regulierte oder sicherheitsbewusste Unternehmen sind sie zudem eine belastbare Grundlage, um Freigaben und Abweichungen nachzuvollziehen.

Dabei ist der Speicherort keine Nebensache. Testläufe können interne Kundendaten, Preislisten, Auftragsinformationen oder Bildschirmansichten enthalten. Wer sensible Windows-Anwendungen automatisiert testet, sollte klären, ob diese Daten die eigene Infrastruktur verlassen dürfen. Eine selbst gehostete Umgebung wie COCO kann hier sinnvoll sein, weil Testausführung, Evidenz und Auswertung unter der eigenen Kontrolle bleiben. Ob das erforderlich ist, hängt von Datenschutzvorgaben, Vertragslage und Schutzbedarf ab - nicht jedes Team braucht dafür dieselbe Architektur.

Testen in den Release-Prozess einbauen

Der beste Testkatalog verliert Wert, wenn er erst nach einer hektischen Produktivsetzung genutzt wird. Definieren Sie einen festen Zeitpunkt: Automatisierte Kernregressionen laufen vor jeder Freigabe, manuelle Abnahme prüft neue oder veränderte Abläufe, und bekannte Einschränkungen werden offen dokumentiert.

Nicht jeder fehlgeschlagene Test muss ein Release stoppen. Ein Fehler in einer seltenen Verwaltungsansicht kann vertretbar sein, wenn ein sicherer Workaround existiert und der betroffene Bereich klar informiert ist. Ein Fehler, der Bestände falsch bucht oder Benutzer unbemerkt sperrt, ist anders zu behandeln. Diese Entscheidung sollte nach Geschäftsauswirkung getroffen werden, nicht nach der bloßen Anzahl roter Tests.

Pflegen Sie die Tests mit der Anwendung. Wenn sich ein Prozess bewusst verändert, aktualisieren Sie Testfall, Testdaten und erwartetes Ergebnis gemeinsam mit der Anforderung. Veraltete Tests erzeugen Lärm und werden irgendwann ignoriert. Wenige vertrauenswürdige Prüfungen sind wertvoller als Hunderte automatisierte Abläufe, deren Ergebnisse niemand mehr ernst nimmt.

Am Ende geht es nicht darum, jede denkbare Eingabe zu simulieren. Es geht darum, die Arbeit zu schützen, die am nächsten Morgen wieder funktionieren muss. Beginnen Sie mit einem einzigen kritischen Prozess, machen Sie sein Ergebnis beweisbar und bauen Sie von dort aus weiter.

Permalink →

Secure Test Data Management ohne Kontrollverlust

Secure Test Data Management ohne Kontrollverlust

Ein fehlgeschlagener Testlauf ist ärgerlich. Ein erfolgreicher Testlauf mit echten Kundendaten in einer unzureichend geschützten Umgebung kann deutlich teurer werden. Secure Test Data Management löst diesen Widerspruch nicht mit einem einzelnen Tool, sondern mit klaren Regeln für Daten, Zugriffe, Testumgebungen und Nachweise. Für Teams, die Web- oder Windows-Anwendungen automatisiert testen, gehört es damit zur Qualitätsarbeit - nicht nur zur Compliance.

Warum Testdaten ein Sicherheitsproblem werden

Produktivdaten sind für Tests verführerisch, weil sie reale Sonderfälle enthalten: unvollständige Adressen, ungewöhnliche Bestellkonstellationen, historische Preisregeln oder fehlerhafte Eingaben. Genau diese Daten enthalten aber häufig Namen, Kontaktdaten, Vertragsinformationen, Personalnummern, Bankdaten oder interne Geschäftslogik.

Das Risiko entsteht selten durch einen einzelnen groben Fehler. Meist wächst es schrittweise: Ein Datenbankexport wird für einen Test erstellt, in einem gemeinsamen Verzeichnis abgelegt und später in eine weitere Umgebung kopiert. Ein externer Dienst erhält Screenshots zur Fehleranalyse. Ein Testkonto behält weitreichende Rechte, weil eine Bereinigung den nächsten Lauf stören könnte. Nach einigen Monaten weiß niemand mehr verlässlich, welche Daten wo liegen.

Bei kleinen und mittleren Unternehmen verschärft sich das Problem oft durch knappe Kapazitäten. Das Team will eine Release-Frist halten, nicht ein eigenes Datenschutzprojekt betreiben. Trotzdem bleibt die Verantwortung bestehen. Wer Daten für Qualitätssicherung nutzt, muss nachvollziehen können, welche Daten verarbeitet werden, wer Zugriff hat und wann sie wieder entfernt werden.

Secure Test Data Management beginnt vor dem Testfall

Die entscheidende Frage lautet nicht: „Wie schützen wir den Testdatenbestand?" Sie lautet: „Welche Information braucht dieser Test tatsächlich?" Viele Regressionstests benötigen keine echten Personenbezüge. Ein Versandprozess muss beispielsweise prüfen, ob Lieferadressen, Gewichte, Zonen, Etiketten und Statuswechsel korrekt verarbeitet werden. Dafür reichen synthetische Kunden, plausible Artikelstammdaten und bewusst definierte Grenzfälle.

Diese Unterscheidung führt zu einer praktikablen Datenklassifizierung. Nicht jede Testumgebung braucht dieselbe Datentiefe. Für Unit- und Integrationstests genügen oft vollständig künstliche Datensätze. Für End-to-End-Tests können pseudonymisierte Kopien sinnvoll sein, wenn reale Datenmuster fachlich relevant sind. Produktionsähnliche Daten sollten die Ausnahme sein - mit dokumentiertem Zweck, begrenztem Zugriff und einer festen Lebensdauer.

Wichtig ist dabei die Qualität der Ersatzdaten. Zufällige Fantasiedaten helfen wenig, wenn sie keine realistischen Abhängigkeiten abbilden. Ein Testdatensatz für eine Lageranwendung muss etwa Artikelvarianten, Lagerplätze, Sperrbestände, Teillieferungen und Retouren in stimmiger Kombination enthalten. Gute Testdaten schützen nicht nur personenbezogene Informationen. Sie finden Fehler, die mit leeren Tabellen und dem Musterkunden „Max Mustermann" nie sichtbar würden.

Synthetisieren, maskieren oder minimieren?

Synthetische Daten sind die sicherste Wahl, wenn sich die fachlichen Regeln sauber modellieren lassen. Sie entstehen gezielt aus Testanforderungen und enthalten keine Kopie realer Personen oder Vorgänge. Der Aufwand liegt in der Pflege: Ändert sich das Datenmodell oder kommen neue Prozessregeln hinzu, müssen Generatoren und Fixtures mitwachsen.

Maskierung eignet sich, wenn das Verhalten einer Anwendung stark von Produktionsstrukturen abhängt. Dabei werden sensible Felder ersetzt oder verändert, während Beziehungen erhalten bleiben. Aus Namen werden plausible, aber fiktive Namen; aus E-Mail-Adressen werden nicht zustellbare Testadressen; aus Kontonummern werden Werte mit korrektem Format ohne echten Bezug. Eine Maskierung ist nur dann belastbar, wenn auch indirekte Rückschlüsse bedacht werden. Eine Kombination aus seltenem Ort, Geburtsdatum und Vertragsmerkmal kann eine Person weiterhin erkennbar machen.

Datenminimierung ist oft der unterschätzte dritte Weg. Statt einen kompletten Export zu kopieren, wird nur der erforderliche Ausschnitt bereitgestellt. Das reduziert Angriffsfläche, Speicherbedarf und Bereinigungsaufwand. Für einen Test einer Rabattlogik braucht niemand die gesamte Kundenhistorie eines Jahres.

Zugriffe und Umgebungen müssen zum Risiko passen

Ein geschützter Datensatz verliert seinen Wert, wenn er in einer frei erreichbaren Testumgebung liegt. Testsysteme brauchen daher eigene Sicherheitsgrenzen - getrennte Datenbanken, eigene Servicekonten, klar definierte Netzwerkzugänge und keine stillschweigende Verbindung zur Produktion.

Zugriffsrechte sollten auf Rollen beruhen, nicht auf gemeinsam genutzten Konten. Entwickelnde benötigen unter Umständen andere Rechte als QA, Support oder externe Dienstleister. Administratorzugriffe sind manchmal nötig, aber sie sollten zeitlich begrenzt, protokolliert und mit einer nachvollziehbaren Freigabe verbunden sein. Auch für Testkonten gelten sinnvolle Passwortregeln, Multi-Faktor-Authentifizierung, wo sie verfügbar ist, und Account-Lockout-Flows bei wiederholten Fehlversuchen.

Automatisierte Tests bringen einen weiteren Sonderfall mit: Sie erzeugen Beweise. Screenshots, Bildschirmaufzeichnungen, Logs und Fehlermeldungen können sensible Inhalte enthalten, selbst wenn die Datenbank maskiert wurde. Ein Screenshot einer Kundenmaske, ein Browser-Trace mit Session-Informationen oder ein Log mit API-Payload gehört in dieselbe Schutzbetrachtung wie die Testdatenbank.

Deshalb brauchen Testartefakte Aufbewahrungsregeln. Nicht jeder erfolgreiche Lauf muss dauerhaft gespeichert werden. Für kritische Freigaben kann eine nachvollziehbare Evidenz sinnvoll sein, etwa mit Zeitstempel, Build-Nummer, Testversion und Ergebnis. Fehlgeschlagene Läufe benötigen oft eine längere Analysefrist. Danach sollten Artefakte automatisiert gelöscht werden. Was nicht mehr existiert, kann nicht versehentlich geteilt oder kompromittiert werden.

Automatisierung ohne unkontrollierte Datenabflüsse

KI-gestützte Testautomatisierung kann Tests deutlich beschleunigen, besonders bei umfangreichen Web- und Windows-Anwendungen. Sie verändert aber die Sicherheitsfrage: Wohin gehen Screenshots, Eingaben, Fehlerbeschreibungen und Anwendungstraffic? Wer verarbeitet sie? Wie lange bleiben sie dort?

Für sicherheitsbewusste Teams ist eine selbst gehostete Ausführung oft die bessere Architektur. Ein System wie COCO kann innerhalb der eigenen oder einer klar abgegrenzten Infrastruktur laufen, Testschritte ausführen, Nachweise speichern und verständliche Bewertungen erzeugen. Das ist nicht in jeder Situation zwingend. Für eine öffentliche Marketingseite mit rein synthetischen Formularwerten kann ein externer Dienst vertretbar sein. Bei internen Fachanwendungen, Kundenportalen oder Software mit personenbezogenen Vorgängen ist die lokale Kontrolle jedoch ein handfester Vorteil.

Selbsthosting ist kein Freifahrtschein. Der Betrieb verlangt Updates, Backup-Konzepte, Zugriffsprotokolle und eine verantwortliche Stelle. Dafür bleibt die Datenhoheit dort, wo sie hingehört. Der richtige Ansatz hängt vom Schutzbedarf, den vorhandenen Betriebsfähigkeiten und der Art der getesteten Anwendung ab - nicht vom aktuellen Hype um ein bestimmtes Testwerkzeug.

So wird aus Regeln ein arbeitsfähiger Prozess

Ein praktikabler Prozess muss den Release nicht blockieren. Beginnen Sie mit einer Datenlandkarte: Welche Testumgebungen gibt es, welche Datenarten liegen dort und welche Systeme erzeugen zusätzliche Artefakte? Diese Bestandsaufnahme deckt meist schon alte Exporte, vergessene Staging-Systeme und unklare Verantwortlichkeiten auf.

Danach lohnt sich eine einfache Entscheidungsmatrix pro Testklasse. Sie legt fest, ob synthetische Daten genügen, eine Maskierung erforderlich ist oder ein klar begründeter Produktionsauszug gebraucht wird. Ergänzt wird sie durch Eigentümer, Löschfristen und Zugriffsrollen. Das muss kein überladenes Regelwerk sein. Eine kurze, gelebte Vorgabe ist besser als ein Sicherheitsdokument, das während einer Störung niemand findet.

Technisch gehören Datenbereitstellung und Bereinigung in die Testpipeline. Ein Lauf erstellt seine benötigten Datensätze reproduzierbar, nutzt eindeutige Kennzeichnungen und entfernt sie anschließend wieder. Das verhindert, dass sich Testumgebungen mit Restdaten füllen und Ergebnisse mit jedem Sprint weniger vertrauenswürdig werden. Für kritische Prozesse sollten Teams außerdem prüfen, ob Datenzugriffe und Testnachweise revisionsfähig protokolliert werden müssen.

Sicherheit, die den Test schneller macht

Secure Test Data Management wird häufig als zusätzlicher Kontrollaufwand betrachtet. Schlecht umgesetzt kann es das auch sein. Gut umgesetzt schafft es aber verlässliche, wiederholbare Ausgangsbedingungen. Teams verschwenden weniger Zeit mit der Suche nach einem brauchbaren Datenexport, vermeiden defekte Tests durch unbereinigte Altdaten und können Freigaben besser begründen.

Der sinnvollste erste Schritt ist selten ein großes Plattformprojekt. Nehmen Sie den Testprozess mit dem höchsten Risiko oder der größten Reibung - etwa die Freigabe einer internen Auftragsanwendung - und machen Sie Datenquelle, Zugriffe, Artefakte und Löschung dort sichtbar. Aus dieser konkreten Arbeit entsteht eine Sicherheitsroutine, die Tests nicht schwerfälliger macht, sondern glaubwürdiger.

Permalink →

Warehouse Software vs ERP

Warehouse Software vs ERP

Ein Wareneingang kommt gleichzeitig mit einer dringenden Kommissionierung, zwei Mitarbeitende fragen nach dem Lagerplatz eines Artikels, und ein Lieferschein wurde bereits handschriftlich korrigiert. In genau solchen Momenten wird die Frage Warehouse Software vs ERP praktisch. Es geht nicht um die modernste Oberfläche oder die längste Funktionsliste. Es geht darum, ob die Information dort verfügbar ist, wo eine Entscheidung in Sekunden getroffen werden muss.

Viele kleine und mittlere Unternehmen im DACH-Raum starten mit einem ERP, einer Tabellenkalkulation und viel Erfahrung im Team. Das kann lange funktionieren. Problematisch wird es erst, wenn Bestände zwischen Systemen abweichen, Suchwege zunehmen und jeder Sonderfall über Zuruf gelöst werden muss. Dann steht häufig ein großes ERP-Projekt im Raum, obwohl vielleicht nur ein klar abgegrenzter Lagerprozess digitalisiert werden muss.

Warehouse Software vs ERP: Der Unterschied im Arbeitsalltag

Ein ERP-System bildet das Unternehmen in der Breite ab. Es verbindet typischerweise Einkauf, Verkauf, Artikelstammdaten, Buchhaltung, Produktion, Rechnungen und Planung. Seine Stärke liegt darin, dass kaufmännische und operative Daten in einem gemeinsamen Rahmen zusammenlaufen. Ein Auftrag wird angelegt, eine Rechnung erstellt, ein Bedarf geplant und ein Bestand bewertet.

Warehouse Software, häufig als WMS oder Lagerverwaltung bezeichnet, arbeitet näher an den tatsächlichen Bewegungen im Lager. Sie unterstützt den Wareneingang, Einlagerung, Umlagerung, Kommissionierung, Inventur, Versand und Retouren. Sie beantwortet Fragen, die im ERP oft nur grob abgebildet sind: Auf welchem Platz liegt die Ware? Welcher Bestand ist wirklich verfügbar? Welche Charge wurde versendet? Welcher Auftrag hat Vorrang? Wer hat die Umlagerung bestätigt?

Diese Abgrenzung ist nicht absolut. Es gibt ERPs mit umfangreichen Lagerfunktionen und WMS-Produkte mit Anbindungen an Auftrags- oder Einkaufsprozesse. Entscheidend ist daher nicht das Etikett auf dem Angebot, sondern die operative Tiefe. Ein ERP kann zehn Lagerplätze verwalten und trotzdem unpraktisch sein, wenn Mitarbeitende für jede Bewegung mehrere Masken öffnen oder Daten erst später nachtragen müssen.

Das ERP ist die kaufmännische Quelle

Wenn ein Auftrag fakturiert, eine Bestellung ausgelöst oder eine Materialbewertung erstellt werden soll, gehört das in vielen Unternehmen ins ERP. Dort liegt häufig die führende Artikel- und Kundenlogik. Diese Rolle sollte nicht leichtfertig doppelt aufgebaut werden. Zwei voneinander unabhängige Systeme für Preise, Artikelnummern oder Aufträge erzeugen keine Sicherheit, sondern Abstimmungsaufwand.

Ein ERP ist besonders sinnvoll, wenn die zentrale Herausforderung bereichsübergreifend ist: Einkauf und Fertigung müssen geplant werden, Finanzdaten müssen konsistent bleiben oder mehrere Gesellschaften arbeiten mit denselben Prozessen. Wer ein solches Fundament noch nicht hat, sollte nicht erwarten, dass eine reine Lagerlösung alle Unternehmensprozesse ersetzt.

Die Warehouse Software steuert die Bewegung

Im Lager zählt jedoch nicht nur, was theoretisch im System vorhanden ist. Es zählt, was gerade an Tor drei angekommen ist, welches Fach frei ist und ob die Ware für einen bestätigten Auftrag reserviert wurde. Eine gute Lagerlösung reduziert genau an diesen Punkten Reibung.

Das kann mit mobilen Scannern beginnen: Ware wird beim Wareneingang gescannt, einem Lagerplatz zugeordnet und unmittelbar als verfügbar gemeldet. Bei der Kommissionierung führt das System durch eine sinnvolle Reihenfolge, prüft Artikel und Menge und erzeugt bei Bedarf Versandlabel oder Lieferdokumente. Die Buchung passiert nicht Stunden später am Büroarbeitsplatz, sondern im Ablauf selbst.

Der Nutzen liegt nicht nur in Geschwindigkeit. Nachvollziehbare Buchungen machen Fehler sichtbar. Wenn ein Bestand nicht stimmt, lässt sich feststellen, wann eine Bewegung fehlte oder falsch bestätigt wurde. Das ist deutlich belastbarer als eine monatliche Korrektur in einer Tabelle.

Wann ein ERP-Modul genügt

Ein vorhandenes ERP-Modul kann die richtige Wahl sein, wenn die Lagerorganisation überschaubar ist und das Team mit den Abläufen zuverlässig arbeiten kann. Ein einzelnes Lager, feste Plätze, wenige Auftragspositionen und keine strengen Chargen- oder Seriennummernanforderungen sind typische Bedingungen. Auch bei geringem Versandvolumen kann ein zusätzlicher Systembaustein mehr Pflege als Nutzen bringen.

Bevor ein neues System angeschafft wird, lohnt sich ein nüchterner Test: Kann ein Mitarbeitender einen Wareneingang, eine Umlagerung und einen Versand ohne Notizzettel vollständig buchen? Ist der Bestand pro Lagerplatz sichtbar? Lassen sich Differenzen einer Inventur nachvollziehen? Werden Dokumente ohne doppelte Eingabe erstellt? Wenn diese Antworten überwiegend ja lauten, ist ein Ausbau möglicherweise nicht dringend.

Auch die Tabellenkalkulation darf bleiben, wenn sie einen begrenzten Zweck sauber erfüllt, etwa für eine saisonale Kapazitätsplanung oder eine einmalige Auswertung. Eine gute Lösung ersetzt nicht jede bekannte Arbeitsweise. Sie ersetzt jene manuellen Schritte, bei denen Fehler, Wartezeit oder fehlende Transparenz tatsächlich Geld kosten.

Wann eine spezialisierte Lagerlösung sinnvoll wird

Der Wendepunkt kommt meist schrittweise. Erst fragt ein Mitarbeiter häufiger nach einem Artikel. Dann werden Bestände vorsichtshalber höher gehalten, weil niemand den verfügbaren Bestand sicher kennt. Schließlich verzögern sich Sendungen, weil Lieferscheine, Etiketten und Bestandskorrekturen über verschiedene Werkzeuge laufen.

Eine spezialisierte Warehouse Software ist besonders sinnvoll, wenn mehrere dieser Bedingungen zusammenkommen:

  • mehrere Lagerbereiche, Lagerplätze oder Außenlager verwaltet werden
  • Wareneingänge, Umlagerungen und Kommissionierungen täglich in hoher Zahl stattfinden
  • Chargen, Seriennummern, Mindesthaltbarkeiten oder Sperrbestände nachverfolgt werden müssen
  • Versanddienstleister, Etikettendrucker oder mobile Scanner in den Ablauf eingebunden werden sollen
  • die operative Realität häufiger von der Darstellung im ERP abweicht

Die Liste ist keine automatische Kaufempfehlung. Ein Betrieb mit vielen Positionen kann mit einem gut eingerichteten ERP arbeiten. Umgekehrt kann ein kleiner Betrieb früh eine schlanke Lageranwendung brauchen, wenn jedes Teil rückverfolgbar sein muss oder mehrere Teams gleichzeitig buchen.

Das Integrationsproblem entscheidet oft mehr als die Funktionen

Die schwierigste Frage bei Warehouse Software vs ERP lautet selten: Welches System kann mehr? Die bessere Frage lautet: Welche Daten müssen wann in welches System fließen?

In vielen Fällen bleibt das ERP führend für Artikel, Kunden, Aufträge und kaufmännische Belege. Die Lageranwendung übernimmt die operative Ausführung. Sie erhält freigegebene Aufträge, führt die Lagerbewegungen aus und meldet Status, Mengen, Chargen oder Sendungsnummern zurück. Dadurch bekommt jede Seite eine klare Aufgabe.

Diese Schnittstelle braucht konkrete Regeln. Was geschieht bei einer Auftragsänderung, nachdem die Kommissionierung begonnen hat? Darf ein Lagerbestand negativ werden? Welche Buchung gilt bei einem Netzwerkausfall? Wie werden Artikel gesperrt, die bei der Qualitätsprüfung auffallen? Ohne diese Entscheidungen wird auch eine technisch saubere API zur neuen Fehlerquelle.

Für kleine und mittlere Unternehmen ist ein schrittweiser Rollout häufig vernünftiger als ein Komplettwechsel. Zuerst kann der Wareneingang mit Barcode-Scans eingeführt werden. Danach folgen Lagerplätze und Umlagerungen, später Kommissionierung und Versand. So lassen sich reale Ausnahmen früh erkennen, ohne den Betrieb auf einen einzigen Umstellungstag zu setzen.

Standardprodukt, ERP-Ausbau oder passgenaue Anwendung?

Ein Standard-WMS lohnt sich, wenn die eigenen Prozesse weitgehend üblich sind und eine vorhandene Integration zum ERP passt. Es bringt erprobte Funktionen schnell in den Betrieb. Der Preis dafür kann sein, dass Teams ihre Abläufe an feste Vorgaben anpassen müssen oder für selten genutzte Enterprise-Funktionen mitbezahlen.

Ein ERP-Ausbau ist sinnvoll, wenn die notwendige operative Tiefe wirklich verfügbar ist und die Bedienung auf dem Hallenboden funktioniert. Prüfen sollte man nicht nur die Produktdemo, sondern einen echten Ablauf mit Scanner, Handschuhen, schwankendem WLAN und Zeitdruck vor der Abfahrt.

Eine passgenaue Anwendung wird interessant, wenn der Ablauf den Wettbewerbsvorteil des Unternehmens trägt oder Standardsoftware dauerhaft Umwege erzwingt. Das kann ein besonderer Wareneingangsprozess, eine Verbindung aus Werkstatt und Lager, spezielle Lieferscheine oder eine eigene Tourenlogik sein. Dann sollte die Lösung nicht künstlich groß werden. Ein klarer Prozess, sauber modelliert und mit einem wartbaren technischen Fundament umgesetzt, ist wertvoller als eine Plattform, die theoretisch alles kann.

softify.pro entwickelt solche Systeme entlang konkreter Bewegungen und Verantwortlichkeiten: vom Wareneingang über Lagerbuchungen bis zu Versanddokumenten. Dabei bleiben Datenmodell, Berechtigungen, Fehlerfälle und spätere Wartung Teil der Umsetzung - nicht Aufgaben für irgendwann nach dem Go-live.

Fragen, die vor der Entscheidung auf den Tisch gehören

Nicht jede Anforderung muss am ersten Tag automatisiert werden. Aber sie sollte bewusst entschieden sein. Verantwortliche sollten mit Lagerteam, Vertrieb und Buchhaltung klären, welche Daten führend sind, welche Fehler heute am häufigsten auftreten und welche Kennzahlen später wirklich gebraucht werden. Eine schöne Bestandsübersicht hilft wenig, wenn niemand weiß, ob reservierte, gesperrte und verfügbare Mengen unterschiedlich behandelt werden.

Ebenso wichtig ist die Verantwortung für Stammdaten. Lagerprozesse scheitern selten an einem fehlenden Button. Sie scheitern an uneinheitlichen Artikelnummern, nicht gepflegten Maßeinheiten und ungeklärten Regeln für Ersatzartikel oder Mengeneinheiten. Software kann diese Probleme sichtbar machen. Sie kann sie aber nicht ohne Entscheidungen aus dem Unternehmen lösen.

Die passende Wahl ist deshalb nicht automatisch ERP oder Warehouse Software. Sie entsteht aus dem Abstand zwischen Ihrem aktuellen Ablauf und dem Ablauf, den Ihr Team zuverlässig ausführen muss. Beginnen Sie bei einer Bewegung, die heute Zeit kostet oder Fehler erzeugt, und prüfen Sie, welches System diese Bewegung am klarsten, schnellsten und nachvollziehbarsten abbildet.

Permalink →

Wareneingang automatisieren ohne Prozesschaos

Wareneingang automatisieren ohne Prozesschaos

Ein Lkw steht am Tor, zwei Mitarbeitende prüfen Lieferscheine, und die Bestandsliste liegt noch auf dem Rechner im Büro. Genau an dieser Stelle beginnt die Frage, how to automate goods receiving, praktisch zu werden. Nicht, weil jedes Lager eine große ERP-Einführung braucht. Sondern weil ein fehlender, verspäteter oder falsch gebuchter Wareneingang Folgen hat: Bestände stimmen nicht, Aufträge warten, Reklamationen werden schwer nachvollziehbar und die Schicht beginnt mit Rückfragen.

Wareneingang zu automatisieren bedeutet nicht, Menschen durch Scanner zu ersetzen. Es bedeutet, wiederkehrende Prüfungen, Buchungen und Dokumente so zu führen, dass das Team am Tor schnell entscheiden kann und der Bestand danach verlässlich ist. Für kleine und mittlere Unternehmen ist ein schlanker, passender Ablauf meist wertvoller als ein Konzernsystem mit Funktionen, die niemand nutzt.

Was beim manuellen Wareneingang tatsächlich verloren geht

Papierlieferscheine und Excel-Listen funktionieren oft lange genug, um eine Investition aufzuschieben. Das Problem entsteht nicht beim einzelnen Karton. Es entsteht, wenn sich Abweichungen sammeln: Eine Teillieferung wird erst später notiert, eine Charge ist nicht zuordenbar, eine Palette landet im falschen Bereich oder eine Wareneingangsbuchung erfolgt erst am Tagesende.

Dann gibt es mehrere Wahrheiten gleichzeitig. Der Lieferant meldet geliefert. Im Lager steht Ware. Die Disposition sieht noch keinen verfügbaren Bestand. Die Buchhaltung hat einen Beleg, aber keine Bestätigung über Menge oder Schaden. Mitarbeitende gleichen diese Informationen per Telefon, E-Mail und Erfahrung ab. Das kostet Zeit und macht den Ablauf von einzelnen Personen abhängig.

Automatisierung schafft eine gemeinsame, zeitnahe Quelle für den Vorgang. Sie erfasst nicht nur den Sollbestand, sondern auch das, was tatsächlich am Tor passiert ist: wer angenommen hat, wann, in welcher Menge, mit welcher Abweichung und wohin die Ware weitergeht.

How to automate goods receiving mit einem klaren Ablauf

Der richtige Start ist nicht die Auswahl eines Scanners oder einer Lager-App. Zuerst muss der reale Prozess sichtbar werden. Gehen Sie einen typischen Wareneingang vom angekündigten Liefertermin bis zur Einlagerung durch. Beobachten Sie dabei auch Sonderfälle, denn sie bestimmen, ob eine Lösung im Alltag trägt.

Ein digitaler Ablauf besteht meist aus fünf aufeinanderfolgenden Entscheidungen. Die Lieferung wird identifiziert, gegen Bestellung oder erwartete Anlieferung geprüft, die tatsächliche Menge erfasst, Abweichungen dokumentiert und die Ware einem Lagerplatz oder einem weiteren Prüfschritt zugewiesen. Jeder Schritt sollte nur die Daten verlangen, die an diesem Punkt nötig sind.

1. Erwartete Lieferungen vorab bereitstellen

Wenn Einkaufsbestellungen, Produktionsaufträge oder Lieferavis vorhanden sind, sollte das Lager sie vor der Ankunft sehen können. Beim Eintreffen wählt die verantwortliche Person den Lieferanten, scannt eine Bestellnummer oder sucht nach einer offenen Lieferung. Das System zeigt erwartete Artikel, Mengen und gegebenenfalls Chargen- oder Seriennummern.

Das verkürzt die Annahme deutlich. Noch wichtiger ist aber die Prüflogik: Das Team muss nicht aus dem Gedächtnis entscheiden, ob 18 statt 20 Kartons akzeptabel sind. Die Abweichung wird sichtbar und kann mit einem Grund versehen werden. Bei nicht angekündigten Lieferungen braucht der Ablauf einen kontrollierten Weg, etwa als vorläufigen Wareneingang mit Freigabe durch Einkauf oder Disposition.

2. Barcodes dort einsetzen, wo sie Zeit sparen

Barcode-Scanner oder die Kamera eines robusten Mobilgeräts sind für viele Lager der sinnvollste Einstieg. Ein Scan reduziert Tippfehler und beschleunigt wiederkehrende Bewegungen. Voraussetzung ist allerdings, dass Artikelnummern, Verpackungseinheiten und Etiketten konsistent gepflegt sind. Ein Scanner löst keine unklaren Stammdaten.

Nicht jede Ware braucht eine Seriennummernverfolgung. Bei Schrauben oder Standardverbrauchsmaterial genügt oft Artikel, Menge und Lagerplatz. Bei Ersatzteilen mit Garantie, regulierten Produkten oder Komponenten für die Fertigung können Charge, Seriennummer, Mindesthaltbarkeit und Prüfstatus zwingend sein. Die Erfassungstiefe sollte zum Risiko passen, nicht zu einer allgemeinen Software-Vorlage.

3. Abweichungen als normalen Prozess behandeln

Ein guter digitaler Wareneingang versucht nicht, jede Abweichung zu verhindern. Er macht sie einfach und beweisbar behandelbar. Fehlmengen, Überlieferungen, Transportschäden, falsche Artikel und gesperrte Chargen benötigen klare Status statt handschriftlicher Notizen auf dem Lieferschein.

Bei einer beschädigten Lieferung kann beispielsweise ein Foto direkt am Annahmeplatz erfasst, die Menge als gesperrt gebucht und der Einkauf automatisch informiert werden. Der verfügbare Bestand bleibt korrekt, während die Ware physisch in eine Quarantänezone geht. Das verhindert, dass beschädigte Teile versehentlich kommissioniert oder in der Produktion verwendet werden.

Die Regel muss nicht immer vollautomatisch sein. Für geringe Mengen kann eine Überlieferung direkt akzeptiert werden. Bei teuren oder sicherheitsrelevanten Artikeln sollte eine Freigabe erforderlich sein. Diese Schwellenwerte gehören in den Prozess und müssen später anpassbar bleiben.

4. Einlagerung unmittelbar auslösen

Eine Annahme ist erst dann operativ vollständig, wenn klar ist, wo die Ware liegt oder warum sie noch nicht eingelagert werden darf. Das System kann einen festen Lagerplatz vorschlagen, eine Nachschubzone bevorzugen oder anhand von Artikelgruppe, Temperaturbereich und verfügbarer Kapazität einen Zielbereich bestimmen.

Für überschaubare Lager reicht oft eine klare Platzlogik mit wenigen Zonen. Komplexe Wegoptimierung ist nur sinnvoll, wenn Volumen, Laufwege und Personalstruktur sie rechtfertigen. Wer zehn Paletten am Tag empfängt, braucht kein Optimierungsprojekt, das länger dauert als die eingesparte Laufzeit. Ein belastbarer Lagerplatzscan ist häufig der größere Fortschritt.

Nach der Einlagerung aktualisiert das System Bestand und Bewegungsprotokoll. Vertrieb, Disposition oder Produktion sehen dadurch den Status ohne Rückfrage im Lager. Falls der Artikel erst nach einer Qualitätsprüfung verfügbar sein darf, trennt das System physischen Bestand von verfügbarem Bestand.

Welche Daten der Wareneingang wirklich braucht

Ein digitaler Prozess wird schnell unbeliebt, wenn er am Tor zu viele Felder abfragt. Gleichzeitig fehlen ohne Mindestdaten die Nachweise für spätere Klärungen. In den meisten mittelständischen Betrieben sind diese Informationen sinnvoll:

  • Lieferant und Referenz zur Bestellung oder zum Lieferschein
  • Artikel, angenommene Menge und Verpackungseinheit
  • Zeitpunkt sowie verantwortliche Person
  • Lagerplatz oder Status wie Prüfung, Sperrlager oder Quarantäne
  • Abweichungsgrund, Fotos und Freigabe bei Bedarf

Zusätzliche Felder sollten nur dann Pflicht sein, wenn sie eine konkrete Entscheidung ermöglichen. Bei Chargenpflicht ist die Chargennummer kein Zusatz, sondern Kerninformation. Eine freie Bemerkung zu jeder Lieferung dagegen wird häufig nur ausgefüllt, damit ein Formular vollständig wirkt.

Integration entscheidet über Nutzen und Aufwand

Der Wareneingang darf nicht als neue Insellösung neben Einkauf, Produktion und Buchhaltung entstehen. Mindestens Artikelstammdaten, offene Bestellungen und Bestandsänderungen müssen zuverlässig ausgetauscht werden. Ob dies über eine bestehende ERP-Schnittstelle, Datenimporte oder einen gezielt entwickelten Zwischenprozess geschieht, hängt von der vorhandenen Systemlandschaft ab.

Bei älteren ERP-Systemen ist eine vollständige Echtzeitintegration nicht immer wirtschaftlich. Ein geprüfter Import in festen Intervallen kann völlig ausreichend sein, wenn Mengen und Fristen dazu passen. Für Ersatzteile, die sofort für dringende Aufträge disponiert werden, ist dagegen eine zeitnahe Buchung wichtiger. Technik folgt hier dem Geschäftstakt.

Auch die Betriebsfähigkeit gehört zur Planung. Geräte brauchen Benutzerkonten, klare Rollen und einen Ablauf bei Netzwerkausfall. Ein mobiler Wareneingang muss nicht zwangsläufig offline arbeiten können. Wenn WLAN-Ausfälle aber regelmäßig vorkommen, ist ein lokaler Zwischenspeicher mit nachvollziehbarer Synchronisation kein Luxus, sondern Teil der Prozesssicherheit.

Einführung in kleinen Schritten statt Big Bang

Beginnen Sie mit einem Lieferanten, einer Warengruppe oder einem klar abgegrenzten Lagerbereich. Messen Sie nicht nur die Dauer pro Buchung, sondern auch Nacharbeit, ungeklärte Differenzen und Rückfragen zwischen Lager und Büro. Daraus wird sichtbar, ob die Automatisierung wirklich entlastet.

Schulen Sie mit echten Lieferscheinen aus dem Alltag, einschließlich beschädigter oder unvollständiger Lieferungen. Ein Prozess, der nur bei vollständiger Soll-Lieferung funktioniert, ist keine Automatisierung, sondern eine Vorführung. Die Mitarbeitenden am Wareneingang sollten Regeln mitgestalten können, weil sie die Ausnahmefälle kennen.

softify.pro entwickelt solche Abläufe bewusst workflow-spezifisch: vom mobilen Scan bis zur dokumentierten Bestandsbewegung und stabilen Anbindung an bestehende Systeme. Entscheidend ist dabei nicht die größte Funktionsliste, sondern ein System, das unter Zeitdruck nachvollziehbar bleibt und technisch wartbar betrieben werden kann.

Der beste nächste Schritt ist deshalb kein Softwarevergleich, sondern ein einstündiger Blick auf die letzten zehn problematischen Anlieferungen. Wenn Sie für jede davon sagen können, wo Zeit verloren ging und welche Information fehlte, ist der erste Entwurf für einen besseren Wareneingang bereits vorhanden.

Permalink →

Vorteile barcodegestützter Kommissionierung

Vorteile barcodegestützter Kommissionierung

Ein falscher Artikel im Karton kostet selten nur den Preis der Rücksendung. Er bindet Zeit im Lager, erzeugt Rückfragen im Büro und beschädigt im schlechtesten Fall eine Kundenbeziehung. Die Vorteile barcodegestützter Kommissionierung zeigen sich deshalb nicht zuerst in einer technischen Kennzahl, sondern an einem ruhigeren Warenausgang: Mitarbeitende wissen, was als Nächstes zu tun ist, und Abweichungen fallen dort auf, wo sie entstehen.

Für kleine und mittlere Lager ist das besonders relevant. Viele Abläufe funktionieren zunächst mit Papierlisten, Excel-Dateien, Zurufen und Erfahrungswissen einzelner Personen. Das ist nicht grundsätzlich falsch. Bei überschaubarem Volumen kann eine Tabelle sogar das sinnvollere Werkzeug sein. Steigen jedoch Artikelvielfalt, Auftragszahl, Schichtwechsel oder Anforderungen an die Rückverfolgbarkeit, wird aus dem pragmatischen Provisorium schnell eine Fehlerquelle.

Was barcodegestützte Kommissionierung im Alltag verändert

Bei der barcodegestützten Kommissionierung bestätigt ein Scan nicht bloß, dass jemand etwas getan hat. Er verbindet Auftrag, Lagerplatz, Artikel und Menge in einem nachvollziehbaren Arbeitsschritt. Das System gibt den nächsten Pick vor, der Mitarbeitende scannt Lagerplatz und Artikel, trägt bei Bedarf die Menge ein und erhält sofort eine Rückmeldung.

Entscheidend ist die Reihenfolge der Prüfung. Scannt ein Mitarbeiter zuerst einen Artikel und erst danach den Lagerplatz, kann das System zwar einen falschen Artikel erkennen, aber eine ungünstige Wegeführung nicht verhindern. In der Praxis bewährt sich häufig die Abfolge Lagerplatz, Artikel, Menge. Bei Chargen-, Seriennummern- oder Mindesthaltbarkeitsprozessen kommen weitere Prüfungen hinzu. Welche davon erforderlich sind, hängt vom Risiko ab, nicht davon, was technisch möglich wäre.

Ein gutes System ersetzt keine sinnvolle Lagerordnung. Es macht jedoch sichtbar, wenn die Ordnung im Tagesgeschäft nicht eingehalten wird. Liegt Ware auf einem nicht vorgesehenen Platz, wird der Fehler nicht erst bei der Inventur entdeckt, sondern beim Scan.

Die wichtigsten Vorteile barcodegestützter Kommissionierung: Weniger Verwechslungen direkt am Entstehungsort

Papierlisten verlangen dauernde Konzentration: Artikelnummer lesen, Fach finden, Verpackung vergleichen, Menge abhaken. Unter Zeitdruck reichen ähnliche Kartons, fast identische Bezeichnungen oder ein unterbrochener Arbeitsgang, um einen Fehler zu verursachen. Der Barcode bringt eine eindeutige Identifikation in diesen Moment.

Der Scanner ersetzt dabei nicht das Denken, aber er übernimmt die Kontrolle, die Menschen bei Routinearbeit am schwersten dauerhaft leisten können. Passt der Artikel nicht zum Auftrag, sollte die Rückmeldung klar sein: falscher Artikel, erwarteter Artikel, nächster sinnvoller Schritt. Ein bloßes rotes Warnsignal hilft wenig, wenn nicht erkennbar ist, wie die Abweichung behoben wird.

Bestände werden durch Buchungen belastbarer

Bestände sind nur dann nützlich, wenn sie Entscheidungen tragen. Wer Nachbestellungen plant, Liefertermine zusagt oder Produktionsmaterial bereitstellt, braucht mehr als eine Zahl aus der vergangenen Woche. Wenn Entnahmen erst am Schichtende oder nachträglich aus einer Liste übertragen werden, entstehen Zeitfenster mit unklarer Datenlage.

Ein Scan kann die Entnahme unmittelbar buchen. Damit sinkt die Differenz zwischen physischer Bewegung und digitalem Bestand. Das heißt nicht, dass jede Zahl automatisch korrekt ist. Falsch etikettierte Ware, ungebuchte Umlagerungen und beschädigte Bestände bleiben reale Themen. Aber Ursachen lassen sich deutlich besser eingrenzen, weil jede Bewegung einen Zeitpunkt, einen Auftrag und gegebenenfalls einen Nutzerbezug hat.

Besonders hilfreich ist das bei Nachschubprozessen. Unterschreitet ein Fach seinen Sollbestand, kann das System einen Nachschubauftrag erzeugen oder zumindest sichtbar machen. Kommissionierende suchen dann nicht erst während des Auftrags nach Ersatzware, während der Kunde auf seine Sendung wartet.

Schnellere Einarbeitung ohne Abhängigkeit von Einzelwissen

Erfahrene Lagerkräfte kennen Wege, Sonderfälle und Artikelbilder aus dem Kopf. Dieses Wissen ist wertvoll, aber als einziges Betriebssystem riskant. Bei Urlaub, Krankheit oder Wachstum geraten Teams unter Druck, wenn neue Mitarbeitende erst über Wochen lernen müssen, welche Regalreihe mit einer internen Abkürzung gemeint ist.

Eine gute mobile Oberfläche führt durch den Auftrag in einer verständlichen Sprache. Sie zeigt Lagerplatz, Artikel, Sollmenge und bei Bedarf ein Bild oder Hinweise zur Verpackung. Der Scan bestätigt den Schritt. Neue Kolleginnen und Kollegen werden dadurch nicht sofort zu Fachleuten, können aber früher sicher mitarbeiten.

Das gilt auch für Aushilfen und wechselnde Schichten. Voraussetzung ist, dass Stammdaten gepflegt sind. Ein System kann keine klare Anleitung aus einer Artikelbezeichnung wie „Teil klein blau neu“ ableiten. Die Digitalisierung legt solche Schwächen offen - und genau das ist oft ein nützlicher Nebeneffekt.

Nachvollziehbarkeit bei Reklamationen und Inventuren

Wenn ein Kunde eine Fehlmenge meldet, beginnt ohne Prozessdaten oft eine Suche durch Papierstapel, Versandlisten und Erinnerungen. Mit barcodegestützten Buchungen lässt sich prüfen, welcher Auftrag wann bearbeitet wurde, welche Position bestätigt wurde und ob es eine Korrektur oder Teilmenge gab.

Das ist keine Garantie gegen Reklamationen. Es verkürzt aber die Klärung und trennt Vermutungen von Fakten. Auch Inventuren profitieren: Differenzen können nicht nur gezählt, sondern anhand von Bewegungen untersucht werden. Häufen sich Korrekturen an einem bestimmten Fach, einer Artikelgruppe oder nach einer bestimmten Prozessübergabe, entsteht ein konkreter Ansatzpunkt für Verbesserungen.

Messbare Abläufe statt Bauchgefühl

Viele Lager wissen, dass es „am Nachmittag eng wird“ oder dass bestimmte Aufträge ungewöhnlich lange dauern. Ohne Zeitstempel und Prozessschritte bleibt das Bauchgefühl. Werden Pickstart, Scan, Unterbrechung, Abschluss und Übergabe erfasst, lassen sich Engpässe sauber unterscheiden.

Vielleicht ist nicht die Kommissionierung langsam, sondern Ware wird zu spät eingelagert. Vielleicht entstehen Wartezeiten am Packplatz oder ein einzelnes Fach wird überproportional häufig angelaufen. Diese Daten sollten nicht als Werkzeug zur pauschalen Leistungskontrolle missverstanden werden. Ihr Wert liegt zuerst darin, unnötige Wege, fehlende Nachschübe und unklare Übergaben zu erkennen.

Der Nutzen hängt von der Prozessgestaltung ab

Barcodegestützte Kommissionierung ist kein Selbstzweck und nicht jedes Lager braucht eine umfassende Lagerverwaltungssoftware. Bei wenigen Aufträgen, einem kleinen Sortiment und festen Mitarbeitenden kann ein sauber geführter Prozess mit einfachen Listen wirtschaftlicher sein. Ein Projekt ist sinnvoll, wenn die Kosten von Fehlgriffen, Suchzeiten, Bestandsunsicherheit oder manueller Nacharbeit regelmäßig spürbar werden.

Auch die Hardwarefrage verdient eine nüchterne Betrachtung. Ein Smartphone mit Kamerascan kann für erste Prozesse ausreichen. Bei hoher Scanfrequenz, Handschuhen, schlechten Lichtverhältnissen oder rauer Umgebung sind spezialisierte Handscanner meist schneller und weniger fehleranfällig. Entscheidend ist zudem die Netzabdeckung. Fällt WLAN in einer Lagerzone aus, braucht die Anwendung eine klare Strategie: Offline-Pufferung mit späterer Synchronisierung oder einen Prozess, der den Bereich nicht mobil bearbeitet.

Die Etikettenqualität ist ebenso wichtig wie die Software. Ein Barcode auf einem abgeriebenen Fachschild oder eine doppelt vergebene Artikelkennung unterläuft den gesamten Ablauf. Vor dem Start sollten Lagerplätze eindeutig beschriftet, Einheiten definiert und kritische Sonderfälle geklärt werden: Wie wird eine angebrochene Verpackung behandelt? Was passiert bei Fehlbestand? Wer darf eine Menge korrigieren? Was geschieht mit Ware ohne lesbaren Code?

So gelingt die Einführung ohne Betriebsunterbrechung

Der verlässlichste Einstieg ist selten die Komplettumstellung. Beginnen Sie mit einem abgegrenzten Bereich, etwa den häufigsten Versandaufträgen oder einer Artikelgruppe mit vielen Verwechslungen. Dort lassen sich Scanabfolge, Fehlermeldungen und Etiketten im echten Betrieb prüfen, ohne den gesamten Standort gleichzeitig umzubauen.

Vor der technischen Umsetzung sollte der reale Weg eines Auftrags aufgenommen werden - vom Auftragseingang über Reservierung und Pick bis zum Packplatz und Versandlabel. Nicht der Sollprozess aus einem Organigramm zählt, sondern der Ablauf, den die Schicht tatsächlich nutzt. Oft liegen die wertvollsten Anforderungen in kleinen Ausnahmen: Sammelaufträge, Ersatzartikel, Teilkommissionierungen oder die Rückgabe nicht benötigter Ware.

Danach braucht es eindeutige Regeln für Ausnahmen. Ein Mitarbeitender muss einen Fehlbestand melden können, ohne den Auftrag informell zu umgehen. Eine autorisierte Person muss Korrekturen nachvollziehbar durchführen können. Und wenn Schnittstellen zu Shop, ERP oder Versanddienstleister bestehen, sollten Auftragsstatus und Bestandsbuchungen klar definiert sein. Doppelte Datenpflege ist ein Warnsignal, keine dauerhafte Lösung.

Für kundenspezifische Systeme setzt softify.pro an diesem Punkt an: Nicht mit einem überladenen Enterprise-Paket, sondern mit den Scan- und Buchungsschritten, die für den konkreten Lagerbetrieb nachweisbar nötig sind. Eine wartbare Datenbasis, klar dokumentierte Schnittstellen und verständliche Bedienoberflächen sind dabei wertvoller als eine lange Liste selten genutzter Funktionen.

Ein sinnvoller erster Prüfpunkt

Nehmen Sie zehn typische Aufträge und verfolgen Sie sie vom Eingang bis zur Versandübergabe. Notieren Sie, an welchen Stellen Mitarbeitende suchen, nachfragen, Daten später nachtragen oder sich auf Erinnerung verlassen müssen. Genau dort entscheidet sich, ob Barcodegestützte Kommissionierung Vorteile bringt - und welcher Scanprozess wirklich zum Lager passt.

Permalink →

Selbst gehostetes Testing vs Cloud

Selbst gehostetes Testing vs Cloud

Ein fehlgeschlagener Regressionstest ist selten nur ein roter Eintrag im Dashboard. Er kann bedeuten, dass eine Versandmaske im Lager falsche Etiketten erzeugt, ein Kundenportal keine Aufträge annimmt oder eine Windows-Anwendung bei der Schichtübergabe abstürzt. Bei der Frage self hosted testing vs cloud geht es deshalb nicht um Infrastruktur als Selbstzweck. Es geht darum, welche Daten ein Testprozess berührt, wer ihn kontrolliert und wie verlässlich er unter realen Betriebsbedingungen läuft.

Cloudbasierte Testplattformen können schnell einsatzbereit sein. Für viele Teams ist das sinnvoll, besonders wenn sie eine öffentliche Webanwendung testen und kurzfristig zusätzliche Ausführungskapazität brauchen. Selbst gehostete Testumgebungen verlangen dagegen einen bewussten technischen Aufbau. Sie geben aber Kontrolle über Testdaten, Netzwerkwege, Zugriffsrechte und den Betrieb zurück an das Unternehmen. Die richtige Wahl hängt nicht von einem allgemeinen Prinzip ab, sondern von Anwendung, Risiko und vorhandener Betriebsfähigkeit.

Self Hosted Testing vs Cloud: Worum es wirklich geht

Die Debatte wird oft zu stark auf die Anfangskosten reduziert. Eine Cloud-Lösung wirkt günstiger, weil keine Server beschafft und keine Umgebung eingerichtet werden muss. Ein eigener Testserver wirkt auf den ersten Blick aufwendiger, weil Betriebssystem, Aktualisierungen, Zugriffssteuerung, Monitoring und Sicherung geplant werden müssen.

Diese Rechnung greift zu kurz. Entscheidend sind die laufenden Kosten einer Teststrategie: Wartezeiten vor Releases, Fehlersuche nach unvollständigen Testläufen, Abstimmungen mit Datenschutz und Informationssicherheit sowie die Folgen eines fehlerhaften Deployments. Wenn ein Team regelmäßig sensible Fachanwendungen prüft, kann der zusätzliche organisatorische Aufwand externer Dienste größer sein als der Betrieb einer klar abgegrenzten eigenen Umgebung.

Auch „Cloud" ist kein einheitliches Modell. Manche Anbieter speichern lediglich Testprotokolle, andere verarbeiten Screenshots, Videoaufzeichnungen, Zugangsdaten, DOM-Inhalte oder Netzwerkverkehr. Bei KI-gestütztem Testing können zusätzlich Bild- und Textdaten zur Bewertung an externe Modelle oder Unterauftragnehmer gelangen. Wer nur auf den Standort eines Rechenzentrums schaut, übersieht oft die wichtigere Frage: Welche Daten verlassen die eigene Kontrollzone tatsächlich und welche Vertrags- und Löschregeln gelten dafür?

Wenn Cloud-Testing die vernünftige Wahl ist

Cloud-Testing ist nicht grundsätzlich ein Sicherheitsproblem und Selbsthosting nicht automatisch die bessere Architektur. Für einen neuen, öffentlich erreichbaren Webshop oder eine Marketingplattform kann eine Cloud-Umgebung sehr passend sein. Das Team kann Browser- und Gerätevarianten schnell abdecken, ohne eigene Ausführungsmaschinen vorzuhalten. Bei schwankender Testlast ist die elastische Skalierung ebenfalls ein realer Vorteil.

Auch kleine Entwicklungsteams mit wenigen, klar anonymisierten Testdaten profitieren häufig von einem Managed Service. Sie sollten ihre Zeit nicht in den Betrieb einer Plattform investieren, wenn der Engpass vielmehr bei fehlenden Testfällen, unklaren Akzeptanzkriterien oder instabilen Testdaten liegt. Ein eigener Server löst diese Probleme nicht.

Die Cloud passt besonders gut, wenn die Anwendung keine internen Netzwerkzugriffe benötigt, keine personenbezogenen oder geschäftskritischen Daten in den Testabläufen vorkommen und kurze Vorlaufzeit wichtiger ist als tiefe Infrastrukturkontrolle. Voraussetzung ist eine sorgfältige Konfiguration: separate Testkonten, keine echten Kundendaten, eingeschränkte Tokens, nachvollziehbare Aufbewahrungsfristen und ein klares Rechtekonzept.

Wann selbst gehostetes Testing sinnvoller wird

Anders sieht es bei Anwendungen aus, die nur im Unternehmensnetz erreichbar sind oder operative Kernprozesse abbilden. Eine Lager- oder Produktionssoftware verarbeitet häufig Artikelbewegungen, Lieferadressen, Bestände, Seriennummern und Preislogik. Ein Testdurchlauf kann dabei Screenshots von Auftragsmasken erzeugen, Belege herunterladen oder sich mit Benutzerrollen anmelden. Solche Daten sollten nicht unbemerkt über mehrere externe Systeme verteilt werden.

Selbst gehostetes Testing erlaubt, die Testausführung nahe an der Anwendung zu platzieren. Der Testserver kann im gleichen Netzwerksegment oder in einer kontrollierten DMZ laufen. Firewall-Regeln werden gezielt gesetzt, interne Anwendungen müssen nicht für einen externen Dienst geöffnet werden, und Protokolle bleiben unter eigener Verwaltung. Das ist für Windows-Desktop-Anwendungen oft besonders relevant, da diese selten für externe Testplattformen konzipiert sind.

Für regulierte Branchen, größere Kundenanforderungen oder interne Sicherheitsvorgaben ist diese Architektur häufig leichter prüfbar. Das bedeutet nicht, dass jede Prüfung automatisch bestanden ist. Auch ein eigener Server braucht Patch-Management, Verschlüsselung, Rollenrechte, Backups und dokumentierte Betriebsabläufe. Der Unterschied liegt darin, dass das Unternehmen diese Entscheidungen selbst trifft und nachweisen kann.

Bei softify.pro ist COCO deshalb als dedizierter, selbst gehosteter KI-Server gedacht: Testläufe für Web- und Windows-Anwendungen werden lokal ausgeführt, Belege aufgezeichnet und Ergebnisse in verständlicher Sprache bewertet. Das ersetzt keine fachliche Freigabe. Es sorgt aber dafür, dass Testverkehr, Screenshots und Auswertungen dort bleiben können, wo das Unternehmen die Datenhoheit behält.

Kosten richtig vergleichen: Betrieb gegen Reibung

Ein sinnvoller Vergleich umfasst mehr als Lizenzpreis gegen Hardwarepreis. In der Cloud entstehen wiederkehrende Gebühren nach Nutzern, Testminuten, parallelen Ausführungen oder KI-Verbrauch. Diese Kosten sind anfangs planbar, können aber mit wachsender Testabdeckung deutlich steigen. Hinzu kommen mögliche Aufwände für Enterprise-Verträge, Datenverarbeitungsvereinbarungen und Sicherheitsprüfungen.

Beim Selbsthosting fallen Investitionen für Infrastruktur und Einrichtung an. Dazu gehören gegebenenfalls virtuelle Maschinen, Speicher, Netzwerkzugang, Monitoring und die Zeit eines technisch verantwortlichen Teams. Diese Kosten bleiben auch dann bestehen, wenn wenige Tests laufen. Für ein Projekt mit seltenen Releases ist das ein gutes Argument gegen eine überdimensionierte Eigenlösung.

Bei regelmäßigen Regressionstests verschiebt sich das Bild. Wenn jede Woche dieselben geschäftskritischen Abläufe geprüft werden müssen, sind berechenbare interne Kapazitäten oft wirtschaftlicher als variable Plattformkosten und manuelle Freigabeschleifen. Besonders wertvoll wird der Ansatz, wenn Testfälle über Jahre genutzt und mit der Fachanwendung weiterentwickelt werden. Wartbarkeit ist dann wichtiger als ein schneller, aber schwer kontrollierbarer Start.

Qualität hängt nicht am Hosting-Modell

Ein häufiger Irrtum lautet: Cloud-Tests seien automatisch moderner, selbst gehostete Tests automatisch stabiler. Beides stimmt nicht. Testqualität entsteht durch sinnvolle Szenarien, belastbare Testdaten, stabile Identifikatoren in der Oberfläche und klare Erwartungen an das Ergebnis.

Ein Test sollte nicht nur prüfen, ob ein Button anklickbar ist. Für eine Auftragsabwicklung kann er beispielsweise einen Auftrag anlegen, eine verfügbare Menge prüfen, einen Lieferschein erzeugen und sicherstellen, dass die richtige Rolle den Vorgang freigeben darf. Bei einem Desktop-Programm kann er den Import einer Datei, die Fehlerbehandlung und die Ausgabe eines Dokuments nachvollziehen. Erst solche End-to-End-Abläufe zeigen, ob eine Änderung den realen Prozess beschädigt.

KI kann dabei helfen, Oberflächenänderungen zu erkennen, Schritte verständlich zu dokumentieren und Auffälligkeiten zu priorisieren. Sie sollte jedoch nicht zur Black Box werden. Teams brauchen Screenshots oder andere Belege, nachvollziehbare Testschritte und definierte Schwellenwerte dafür, wann ein Ergebnis als bestanden, unsicher oder fehlgeschlagen gilt. Gerade bei visuellen Prüfungen ist ein Confidence-Threshold sinnvoll, damit kleine, erwartete Layoutabweichungen nicht jeden Release blockieren.

Die Betriebsfragen vor der Entscheidung

Bevor ein Team sich festlegt, sollte es den Weg eines Testlaufs konkret aufzeichnen. Wo läuft der Test? Welche Systeme meldet er an? Welche Daten sieht er? Wo werden Screenshots, Logs und Reports gespeichert? Wer darf Ergebnisse lesen, löschen oder exportieren? Diese Fragen sind praktischer als eine pauschale Entscheidung für oder gegen die Cloud.

Ebenso wichtig ist die Verantwortlichkeit nach dem Go-live. Wer aktualisiert Browser und Testagenten? Wer reagiert, wenn ein Zertifikat abläuft? Wie werden Zugangsdaten rotiert? Und wie wird sichergestellt, dass ein Test nicht versehentlich eine echte Versandbuchung oder Kundenbenachrichtigung auslöst? Gute Testautomatisierung benötigt getrennte Umgebungen und Schutzmechanismen, nicht nur gute Skripte.

Ein hybrides Modell kann sinnvoll sein. Öffentliche Oberflächen und breit gestreute Browserprüfungen laufen in der Cloud, während interne Fachprozesse auf einem eigenen Testserver verbleiben. Das reduziert Betriebsaufwand, ohne sensible Abläufe pauschal nach außen zu geben. Voraussetzung ist eine klare Grenze zwischen beiden Bereichen, nicht ein unübersichtlicher Mischbetrieb.

Die beste Entscheidung ist die, die zum tatsächlichen Risiko und zur eigenen Betriebsrealität passt. Wenn ein Spreadsheet einen Prozess noch zuverlässig trägt, muss daraus kein großes System werden. Wenn Testdaten und interne Anwendungen dagegen zum geschäftlichen Kern gehören, ist Kontrolle kein Luxus, sondern eine sachliche Anforderung an verlässliche Software.

Permalink →

Inventory Management im Lager

Inventory Management im Lager

Ein fehlendes Teil fällt selten beim Zählen im Lager auf. Meist zeigt es sich erst, wenn ein Auftrag nicht gepackt werden kann, ein Monteur vor dem leeren Regal steht oder der Einkauf per Telefon nach einer Lieferzusage sucht. Gutes Inventory Management verhindert diese Überraschungen nicht mit mehr Tabellen, sondern mit einem verlässlichen Bild davon, was vorhanden ist, wo es liegt und was als Nächstes damit passiert.

Für kleine und mittlere Unternehmen ist das keine Frage eines möglichst großen ERP-Systems. Entscheidend ist, ob die Mitarbeitenden im Wareneingang, Lager und Versand mit wenigen klaren Schritten arbeiten können - auch unter Zeitdruck, über Schichtwechsel hinweg und dann, wenn eine Lieferung anders ausfällt als geplant.

Inventory Management beginnt mit Bewegungen, nicht mit Bestandslisten

Eine Bestandsliste ist eine Momentaufnahme. Sie kann korrekt sein und dennoch wenig helfen, wenn niemand nachvollziehen kann, warum sich eine Menge verändert hat. Ein belastbares System behandelt Bestände deshalb als Folge dokumentierter Bewegungen: Ware kommt an, wird geprüft, eingelagert, reserviert, kommissioniert, umgelagert, versendet oder korrigiert.

Jede Bewegung braucht einen eindeutigen Anlass, einen Zeitpunkt, eine verantwortliche Person und möglichst einen Bezug zu einem Vorgang. Das kann eine Bestellung, ein Kundenauftrag, ein Lieferschein oder ein Fertigungsauftrag sein. Damit wird aus der Zahl „24 Stück verfügbar" eine prüfbare Aussage: 30 Stück wurden eingebucht, vier sind für zwei Aufträge reserviert, und keine offene Umlagerung verfälscht den verfügbaren Bestand.

Diese Unterscheidung ist gerade bei knappen Teilen relevant. Physisch vorhanden, reserviert und frei verfügbar sind drei unterschiedliche Zustände. Werden sie vermischt, verspricht der Vertrieb Ware, die das Lager bereits für einen anderen Auftrag benötigt. Werden sie sauber geführt, kann ein Team früh entscheiden: nachbestellen, umpriorisieren oder dem Kunden realistisch Auskunft geben.

Wo manuelle Prozesse typischerweise brechen

Spreadsheets sind nicht grundsätzlich falsch. Für ein kleines Sortiment, einen Lagerort und wenige Bewegungen pro Woche können sie wirtschaftlicher sein als eine eigene Anwendung. Problematisch werden sie, sobald mehrere Personen gleichzeitig arbeiten oder Bestände aus mehreren Quellen aktualisiert werden.

Dann entstehen die bekannten Lücken: Der Wareneingang liegt als Papier auf dem Schreibtisch, die Excel-Datei wurde lokal geändert, eine Umlagerung wurde nur mündlich abgesprochen, und der Versand bucht erst nach Feierabend. Der Bestand ist nicht unbedingt falsch, aber er ist zeitlich versetzt und seine Herkunft unklar. Genau das macht ihn für operative Entscheidungen ungeeignet.

Auch die Organisationsstruktur spielt eine Rolle. Ein zentraler Standort braucht andere Abläufe als ein Betrieb mit Außenlagern, Servicefahrzeugen oder einer Produktion, die Material entnimmt. Wer diese Unterschiede mit einer einzigen Freitextspalte abbildet, verlagert die Logik in die Köpfe einzelner Mitarbeitender. Das funktioniert, bis diese Person Urlaub hat oder das Auftragsvolumen steigt.

Den Prozess vor der Software festlegen

Ein sinnvolles Projekt beginnt nicht mit der Frage, welcher Scanner gekauft wird oder welche Oberfläche modern aussieht. Zuerst muss klar sein, welche Entscheidungen das System unterstützen soll. Dafür reichen oft konkrete Beobachtungen aus dem Alltag: Wie wird Ware heute angenommen? Wann gilt sie als geprüft? Wer darf Bestände korrigieren? Was passiert bei beschädigter Ware? Und an welchem Punkt wird ein Auftrag verbindlich reserviert?

Aus diesen Antworten entstehen wenige, verbindliche Regeln. Beispielsweise darf Wareneingang erst nach einer Mengenprüfung eingebucht werden. Artikel ohne Lagerplatz dürfen nicht als einlagerbar erscheinen. Bestandskorrekturen erfordern einen Grundcode und bleiben in der Historie sichtbar. Versandte Ware wird nicht stillschweigend gelöscht, sondern über eine dokumentierte Ausbuchung dem Auftrag zugeordnet.

Das ist weniger spektakulär als eine große Digitalisierungsfolie, aber im Betrieb wesentlich wertvoller. Wenn die Regeln eindeutig sind, kann Software sie zuverlässig prüfen. Wenn sie unklar bleiben, beschleunigt jede neue Anwendung nur widersprüchliche Arbeitsschritte.

Stammdaten: klein anfangen, konsequent pflegen

Nicht jeder Artikel braucht zu Beginn zehn Klassifikationen. Eine brauchbare Grundlage besteht häufig aus Artikelnummer, Bezeichnung, Einheit, aktivem Lagerstatus und einem oder mehreren Lagerplätzen. Je nach Geschäft kommen Chargen, Seriennummern, Mindestbestände, Lieferantenartikelnummern oder Ablaufdaten hinzu.

Wichtig ist die Konsequenz, nicht die Menge der Felder. Zwei Artikelnummern für denselben physischen Artikel oder wechselnde Einheiten wie „Karton", „Packung" und „Stück" ohne Umrechnungsregel erzeugen spätere Fehler fast automatisch. Ein System kann solche Eingaben technisch erlauben. Es sollte sie dort begrenzen, wo sie den Ablauf gefährden.

Welche Funktionen im Lager wirklich helfen

Für viele mittelständische Lager ist ein klarer Kern wertvoller als ein überladener Funktionskatalog. Dieser Kern umfasst in der Regel vier Bereiche:

  • Wareneingang mit Bestellbezug, Mengenprüfung und Einlagerung
  • Lagerbewegungen zwischen definierten Plätzen und Bereichen
  • Auftragsreservierung, Kommissionierung und Versandbuchung
  • Inventur und Bestandskorrekturen mit nachvollziehbarer Historie

Ergänzend können Etikettendruck, Barcode-Scanning, Lieferscheine, Versandlabels oder eine Übergabe an Buchhaltung und Shop-Systeme viel Zeit sparen. Aber sie sollten auf einem sauberen Bewegungsmodell aufbauen. Ein schneller Etikettendruck bringt wenig, wenn der Artikel beim Scannen nicht eindeutig dem richtigen Lagerplatz oder Auftrag zugeordnet wird.

Bei der Bedienung zählt zudem die Umgebung. Ein Mitarbeitender mit Handschuhen am Wareneingang benötigt große, eindeutige Aktionen und möglichst wenig Texteingabe. Eine Disponentin am Arbeitsplatz braucht dagegen Filter, Suchfunktionen und eine Sicht auf offene Vorgänge. Beide Rollen dürfen dieselben Daten verwenden, aber sie brauchen nicht dieselbe Oberfläche.

Echtzeit heißt nicht: jede Zahl ist unkritisch

Viele Unternehmen wünschen sich Echtzeitbestände. Das ist sinnvoll, doch der Begriff wird oft zu grob verwendet. Ein Bestand kann unmittelbar nach jedem Scan aktualisiert werden und trotzdem falsch sein, wenn ein Prozess unvollständig bleibt. Wird Ware zwar gescannt, aber nicht geprüft, ist die Zahl technisch aktuell und operativ fragwürdig.

Deshalb braucht jedes System einen Umgang mit Ausnahmen. Differenzen im Wareneingang, beschädigte Verpackungen, Rücksendungen und nicht auffindbare Artikel sind keine Randfälle. Sie gehören zum Alltag. Gute Prozesse markieren sie sichtbar, statt Mitarbeitende zu improvisierten Nebenlisten zu zwingen.

Auch die Berechtigungen verdienen Aufmerksamkeit. Nicht jede Person sollte Artikelstammdaten ändern oder historische Buchungen korrigieren können. Ein praxistaugliches Rechtekonzept trennt Routinevorgänge von Eingriffen mit höherem Risiko. Das schützt nicht nur vor Fehlern, sondern erleichtert die Ursachenanalyse, wenn ein Bestand unerwartet abweicht.

Integration nur dort, wo sie den Ablauf verbessert

Inventory Management steht selten allein. Aufträge kommen möglicherweise aus einem Webshop, einer E-Mail-Erfassung, einer Branchenlösung oder direkt vom Vertrieb. Versanddienstleister benötigen Adressdaten und Gewichte. Die Buchhaltung erwartet Belege in einer bestimmten Form.

Eine Integration lohnt sich, wenn sie doppelte Erfassung beseitigt oder Fehlerquellen reduziert. Sie ist nicht automatisch sinnvoll, nur weil eine Schnittstelle verfügbar ist. Gerade bei gewachsenen Abläufen kann ein klarer Import mit Prüfung verlässlicher sein als eine dauerhafte Echtzeitkopplung, die unbemerkt fehlerhafte Daten überträgt.

Technisch sollte die Lösung nachvollziehbar bleiben: eindeutige Schnittstellen, protokollierte Übertragungen, verständliche Fehlermeldungen und eine Datenbankstruktur, die Änderungen nicht versteckt. Mit einer gepflegten Anwendung auf Basis von PHP 8.4 und MySQL 8 lassen sich solche Prozesse schlank umsetzen, ohne Teams in ein globales Konzernsystem zu zwingen. Entscheidend ist nicht der Technologiebegriff, sondern ob Wartung, Erweiterungen und Datenkorrekturen auch in drei Jahren noch kontrollierbar sind.

Einführung in kleinen, messbaren Schritten

Ein Big Bang ist im Lager selten die beste Wahl. Sicherer ist ein begrenzter Start, etwa mit Wareneingang und einem ausgewählten Lagerbereich. In dieser Phase lassen sich Scanzeiten, Fehlerarten, offene Sonderfälle und die Qualität der Stammdaten beobachten. Erst danach folgen Reservierung, Versand oder weitere Standorte.

Parallelbetrieb kann dabei sinnvoll sein, aber nur mit einem klaren Ende. Zwei führende Bestände über längere Zeit schaffen genau das Problem, das die neue Lösung beheben soll. Besser ist eine festgelegte Umstellung mit Inventur, bereinigten Stammdaten und Verantwortlichkeiten für die ersten Wochen.

Der Erfolg zeigt sich nicht daran, wie viele Funktionen aktiviert wurden. Er zeigt sich daran, ob weniger Rückfragen entstehen, ob Aufträge vollständiger gepackt werden und ob ein Team ohne detektivische Suche erklären kann, warum ein Artikelbestand so aussieht, wie er aussieht.

Wenn der aktuelle Prozess mit einer gut gepflegten Tabelle tatsächlich stabil funktioniert, sollte er bleiben dürfen. Wenn aber Informationen zwischen Papier, Telefonaten und mehreren Dateien verloren gehen, ist der nächste sinnvolle Schritt kein größeres Werkzeug, sondern ein klarer Ablauf, der jede wichtige Lagerbewegung sichtbar macht.

Permalink →

Sind selbst gehostete Tests sicher?

Sind selbst gehostete Tests sicher?

Ein fehlgeschlagener Regressionstest ist ärgerlich. Ein Screenshot aus einem internen ERP-System, der unkontrolliert bei einem externen Dienst landet, ist ein Sicherheitsvorfall. Genau deshalb stellen sich QA-Leads und IT-Verantwortliche die Frage: are self hosted tests secure? Die ehrliche Antwort lautet: Sie können deutlich sicherer sein als cloudbasierte Alternativen, aber nur, wenn der Betrieb genauso ernst genommen wird wie die Tests selbst.

Selbst gehostete Testautomatisierung verlagert die Kontrolle über Ausführung, Testdaten, Screenshots, Protokolle und Zugriffsrechte in die eigene Infrastruktur. Das reduziert Abhängigkeiten und unnötige Datenwege. Es ersetzt jedoch keine Sicherheitsarchitektur. Ein schlecht gepflegter interner Testserver bleibt ein schlecht gepflegter Server.

Sind self-hosted Tests sicherer als Cloud-Tests?

Der entscheidende Unterschied liegt nicht darin, ob ein Test lokal oder automatisiert läuft. Er liegt darin, wo Daten verarbeitet werden, wer darauf zugreifen kann und welche technischen Grenzen gelten.

Bei einem extern betriebenen Testing-Service verlassen häufig mehrere Artefakte das Unternehmen: Zugangsdaten für Testkonten, URLs interner Anwendungen, DOM-Inhalte, Screenshots, Videos von Testläufen, Fehlerprotokolle und gegebenenfalls Datenbankauszüge. Auch wenn ein Anbieter hohe Sicherheitsstandards erfüllt, entsteht eine zusätzliche Vertrauens- und Vertragsbeziehung. Für Anwendungen mit Kunden-, Personal-, Produktions- oder Finanzdaten kann das eine relevante Hürde sein.

Ein selbst gehostetes System kann innerhalb des eigenen Netzwerks oder einer klar abgegrenzten EU-Umgebung betrieben werden. Die Testinstanz greift direkt auf Staging-, Abnahme- oder isolierte Testsysteme zu. Testbelege bleiben dort, wo auch die Anwendung und ihre Betriebsverantwortung liegen. Das ist besonders sinnvoll, wenn Windows-Desktop-Anwendungen, interne Webportale oder Systeme mit sensiblen Prozessdaten getestet werden.

Sicherer ist Selbsthosting aber nicht automatisch. Wer einen Testserver mit offenem Fernzugang, gemeinsam genutzten Administratorkonten und dauerhaft gültigen Passwörtern betreibt, hat lediglich die Risiken verlagert. Die Frage ist daher nicht nur: Cloud oder On-Premises? Sondern: Ist die Testumgebung nachvollziehbar abgesichert und dauerhaft wartbar?

Are self hosted tests secure? Es kommt auf diese Grenzen an

Eine sichere Testplattform braucht klare technische und organisatorische Grenzen. Für kleine und mittlere Unternehmen muss das nicht nach Konzernprogramm aussehen. Es muss nur konsequent umgesetzt und dokumentiert sein.

Die Testumgebung vom Produktivbetrieb trennen

Automatisierte Tests sollen Fehler finden, nicht Bestellungen auslösen, Lieferscheine verändern oder Lagerbestände buchen. Deshalb benötigen Tests eine getrennte Umgebung mit eigenen Schnittstellen, Testmandanten und Testdaten. Wo eine vollständige Kopie der Produktion nicht nötig ist, ist sie oft sogar unnötig riskant.

Für ein Lager- oder Auftragsportal kann das bedeuten: Testnutzer dürfen Wareneingänge erfassen und Versandlabels erzeugen, aber die erzeugten Dokumente gehen an keinen realen Drucker und keine reale Spedition. API-Schlüssel zeigen auf Sandbox-Endpunkte. E-Mail-Versand wird abgefangen oder auf interne Empfänger begrenzt. So bleibt ein Test aussagekräftig, ohne operative Folgen zu erzeugen.

Die Trennung sollte auch auf Netzwerkebene gelten. Der Testserver braucht nur die Verbindungen, die er tatsächlich benötigt. Pauschaler Zugriff in das gesamte interne Netz ist bequem, aber selten begründbar. Segmentierung begrenzt den Schaden, falls ein Testkonto oder ein Systembestandteil kompromittiert wird.

Zugangsdaten wie Produktionszugänge behandeln

Testautomatisierung benötigt oft Anmeldedaten. Das ist normal, aber diese Daten gehören nicht in Testskripte, Konfigurationsdateien im Quellcode oder Chat-Verläufe. Passwörter, Tokens und Zertifikate sollten aus einer kontrollierten Geheimnisverwaltung geladen werden. Testkonten erhalten nur die Rechte, die der konkrete Ablauf verlangt.

Auch der Zugriff auf die Testplattform selbst braucht Rollen. Ein Entwickler muss vielleicht Testläufe starten und Ergebnisse lesen, aber nicht die Netzwerkkonfiguration ändern. Ein Fachbereich kann Berichte einsehen, benötigt aber keinen Zugriff auf gespeicherte Anmeldedaten. Administrationsrechte sollten personengebunden sein, nicht an ein gemeinsames Konto gekoppelt.

Zusätzlich gehören Mehrfaktor-Anmeldung, angemessene Passwortregeln und Account-Lockout-Flows zum Mindeststandard. Gerade Testsysteme werden oft als weniger kritisch behandelt. Angreifer sehen das anders: Sie nutzen Testumgebungen gern als Einstiegspunkt, weil dort Zugänge, interne Namen und technische Details liegen.

Testdaten minimieren und gezielt maskieren

Der häufigste Fehler ist nicht ein fehlendes Verschlüsselungsverfahren, sondern zu viel echte Information im Testbestand. Für die meisten Regressionstests braucht niemand reale Kundennamen, echte Adressen oder vollständige Personalakten. Synthetische Datensätze, maskierte Kopien und bewusst angelegte Sonderfälle reichen häufig aus.

Es gibt Ausnahmen. Manche Fehler erscheinen nur bei echten Datenstrukturen, ungewöhnlichen Zeichenfolgen oder komplexen Berechtigungskonstellationen. Dann kann eine kontrollierte, pseudonymisierte Kopie sinnvoll sein. Entscheidend ist, dass diese Entscheidung bewusst getroffen wird und eine Löschfrist hat. Testdatenbanken sollten nicht jahrelang als vergessene Schattenkopie der Produktion weiterlaufen.
Screenshots und Videos verdienen dieselbe Aufmerksamkeit. Sie sind für die Fehlersuche wertvoll, können aber Kontodaten, interne Preise oder personenbezogene Inhalte zeigen. Legen Sie fest, welche Artefakte aufgezeichnet werden, wer sie sehen darf und wann sie automatisch gelöscht werden. Ein Testbericht muss nicht jedes Bildschirmbild für immer speichern, um beweiskräftig zu sein.

Den Server wie ein Produkt betreiben

Ein selbst gehosteter Testserver ist kein Gerät, das man einmal installiert und dann vergisst. Betriebssicherheit entsteht durch wiederholbare Pflege: zeitnahe Sicherheitsupdates für Betriebssystem, Browser, Test-Runner und Abhängigkeiten; verschlüsselte Datenträger und Transportwege; überwachte Backups; zentrale Protokollierung; sowie ein klarer Umgang mit Sicherheitsmeldungen.

Besonders bei browsergesteuerten Tests ist der Aktualisierungsrhythmus relevant. Veraltete Browser-Engines und Automatisierungsbibliotheken können bekannte Schwachstellen enthalten oder Tests unzuverlässig machen. Beides kostet Zeit. Dokumentierte Deployments und feste Wartungsfenster sind deshalb kein bürokratischer Zusatz, sondern Grundlage für reproduzierbare Ergebnisse.

Für einen dedizierten KI-Testserver wie COCO gilt das ebenfalls. Die lokale Ausführung schützt sensible Anwendungsinhalte nicht durch Magie. Sie schafft Kontrolle darüber, wo KI-gestützte Auswertung, Screenshots und Testprotokolle verarbeitet werden. Diese Kontrolle muss mit Patch-Management, Berechtigungen, Netztrennung und klaren Aufbewahrungsregeln gefüllt werden.

Wo Selbsthosting seine Grenzen hat

Cloud-Dienste sind nicht per Definition unsicher. Ein spezialisierter Anbieter kann mehr Security-Personal, ausgereiftere Überwachung und professionellere Redundanz bieten als ein Unternehmen mit einer einzelnen überlasteten IT-Rolle. Wer keine Kapazität für Betrieb, Updates und Incident Response hat, kann mit einem schlecht betreuten Self-Hosted-System ein höheres Risiko erzeugen.

Andererseits sind viele externe Testplattformen für interne Fachanwendungen schlicht kein guter Prozessfit. Wenn eine Anwendung nur im Firmennetz erreichbar ist, wenn Testläufe vertrauliche Masken und Belege zeigen oder wenn Daten den eigenen Kontrollbereich nicht verlassen sollen, ist lokaler Betrieb oft die klarere Lösung.

Die vernünftige Entscheidung hängt vom Schutzbedarf und von der Betriebsfähigkeit ab. Für eine öffentliche Marketingseite ohne sensible Logins kann ein Cloud-Testdienst angemessen sein. Für eine interne Dispositionssoftware, ein Kundenportal mit personenbezogenen Daten oder eine Windows-Anwendung im Produktionsnetz spricht viel für eine kontrollierte, selbst gehostete Umgebung.

Ein praxistauglicher Sicherheitscheck vor dem Start

Bevor automatisierte Tests ausgerollt werden, sollte ein Verantwortlicher diese Fragen ohne Rätselraten beantworten können:

  • Welche Systeme, Datenbanken und Schnittstellen darf der Testserver erreichen?
  • Welche Daten erscheinen in Screenshots, Videos, Logs und KI-Auswertungen?
  • Wo liegen Zugangsdaten, und wann werden sie rotiert?
  • Wer darf Testläufe starten, Ergebnisse lesen und Systeme administrieren?
  • Wie schnell werden kritische Updates eingespielt, und wie wird das geprüft?
  • Wann werden Testartefakte und nicht mehr benötigte Daten gelöscht?

Diese Fragen wirken nüchtern. Genau das ist ihr Wert. Sicherheit entsteht selten durch ein einzelnes Tool oder ein beeindruckendes Architekturdiagramm. Sie entsteht, wenn Zuständigkeiten, Datenflüsse und technische Grenzen im Alltag überprüfbar bleiben.

Wer Testautomatisierung aufbaut, sollte zuerst den Schutzbedarf der Anwendung klären und dann die kleinste sinnvolle Architektur wählen. Ein sauber abgegrenzter Testserver mit wenigen berechtigten Konten ist oft wertvoller als eine überladene Plattform, die niemand zuverlässig pflegen kann. Boring, provable reliability schlägt auch beim Testing die spektakuläre, aber undurchsichtige Lösung.

Permalink →

Warehouse Management Systems: Was wirklich zählt

Warehouse Management Systems: Was wirklich zählt

Wenn ein Mitarbeiter im Wareneingang dieselbe Lieferposition auf Papier notiert, später in eine Tabelle überträgt und dann per Zuruf klärt, wo sie eingelagert wird, fehlt selten Einsatzbereitschaft. Es fehlt ein gemeinsamer Ablauf. Warehouse Management Systems schaffen diesen Ablauf, indem sie Warenbewegungen, Bestände und Folgeaufgaben an einer Stelle dokumentieren. Für kleine und mittlere Betriebe ist dabei nicht die größte Funktionsliste entscheidend, sondern ob die Software den Weg einer Ware durch das eigene Lager zuverlässig abbildet.

Was Warehouse Management Systems im Alltag leisten müssen

Ein Warehouse Management System, kurz WMS, ist keine bessere Bestandsliste. Es steuert oder dokumentiert die physischen Prozesse im Lager: Wareneingang, Qualitätsprüfung, Einlagerung, Umbuchung, Kommissionierung, Verpackung, Versand und Inventur. Jede Buchung beantwortet eine einfache operative Frage: Was ist wo, in welcher Menge, in welchem Status und wer hat die Bewegung ausgelöst?

Diese Klarheit wirkt auf den ersten Blick banal. Sie verhindert aber typische Fehlerketten. Ein Artikel wird zwar geliefert, ist jedoch noch nicht geprüft. Eine Palette steht im Wareneingang, wird aber im System bereits als verfügbar geführt. Ein Auftrag wird gepickt, obwohl Ware für einen wichtigeren Kundenauftrag reserviert sein sollte. Ohne sauber definierte Status und Bewegungen entsteht aus einer einzelnen Unklarheit schnell eine falsche Lieferzusage.

Für viele mittelständische Lager beginnt der Nutzen nicht mit vollautomatischer Steuerung. Bereits geführte Einlageraufträge, eindeutige Lagerplätze und mobile Buchungen können Suchzeiten deutlich senken. Entscheidend ist, dass Mitarbeitende nicht zwischen Papier, Telefon, E-Mail und mehreren Tabellen übersetzen müssen.

Nicht jedes Lager braucht eine große Suite

Der Markt bietet umfangreiche Enterprise-Systeme mit Funktionen für globale Multi-Standort-Netzwerke, komplexe Zollabwicklung, automatisierte Fördertechnik und sehr feine Optimierungslogik. Das kann richtig sein, wenn diese Anforderungen tatsächlich bestehen. Für einen Betrieb mit einem oder wenigen Lagern, wechselnden Prioritäten und eingespielten Sonderprozessen kann eine solche Suite jedoch mehr Reibung als Nutzen erzeugen.

Die Kosten liegen dann nicht nur in Lizenzen. Sie entstehen in langen Einführungsprojekten, aufwendigen Anpassungen, Schulungen und Abhängigkeit von externen Spezialisten. Auch ein System mit hundert Einstellungen löst kein Problem, wenn Schichtleiter für alltägliche Korrekturen ein Ticket eröffnen müssen.

Das Gegenstück ist nicht zwangsläufig eine vollständige Individualentwicklung. Ein Standardprodukt kann sinnvoll sein, wenn seine Kernabläufe passen und Anpassungen bewusst begrenzt bleiben. Ebenso kann eine bestehende Tabelle weiterhin die beste Lösung sein, etwa für eine seltene, überschaubare Auswertung. Kritisch wird sie erst, wenn mehrere Personen gleichzeitig damit arbeiten, Bewegungen zeitversetzt nachtragen oder die Tabelle zur operativen Wahrheit über verfügbare Ware werden soll.

Die passende Lösung orientiert sich am tatsächlichen Prozessvolumen und an den Fehlerkosten. Fünf falsche Picks pro Woche sind in einem Ersatzteillager mit zeitkritischen Kundenaufträgen etwas anderes als fünf Abweichungen in einem langsam drehenden Archivbestand.

Die Prozesse zuerst aufnehmen, nicht die Masken auswählen

Viele WMS-Projekte starten mit einer Produktdemo. Dort sehen Verantwortliche schicke Dashboards, Scanner-Ansichten und farbige Kennzahlen. Nützlicher ist zunächst ein Gang durch das Lager während eines normalen Arbeitstags. Wo kommt Ware an? Wer prüft Mengen und Schäden? Wann erhält ein Artikel seine Chargen- oder Seriennummer? Wie wird entschieden, auf welchen Platz er kommt? Und was passiert, wenn die Realität von der Bestellung abweicht?

Diese Fragen legen die Grundlage für eine Lösung, die später akzeptiert wird. Ein gut dokumentierter Sollprozess beschreibt nicht nur den Idealfall. Er enthält auch Ausnahmen: Teillieferungen, beschädigte Ware, nicht angekündigte Anlieferungen, Fehlbestände, Rückläufer und gesperrte Bestände. Gerade diese Fälle entscheiden darüber, ob Mitarbeitende dem System vertrauen oder wieder zu Notizzetteln greifen.

Status sind wichtiger als hübsche Oberflächen

Ein sauberer Datenbestand trennt beispielsweise „erwartet", „eingetroffen", „in Prüfung", „eingelagert", „reserviert", „kommissioniert" und „versendet". Welche Status notwendig sind, hängt vom Betrieb ab. Zu wenige verschleiern relevante Unterschiede. Zu viele machen Buchungen langsam und werden umgangen.

Die Regel sollte sein: Jeder Status muss eine operative Konsequenz haben. Ist Ware gesperrt, darf sie nicht kommissioniert werden. Ist sie reserviert, muss sichtbar sein, für welchen Auftrag. Ist sie eingelagert, muss ein Lagerplatz hinterlegt sein. So werden Datenregeln zu praktischer Prozesssicherheit.

Scanner helfen nur bei klaren Buchungen

Barcodes und mobile Endgeräte reduzieren Tippfehler und beschleunigen Bewegungen. Sie ersetzen aber keine Prozessentscheidung. Ein Scan muss eine verständliche Aktion auslösen: Artikel prüfen, Menge bestätigen, Zielplatz wählen oder Auftrag abschließen. Wenn ein Mitarbeiter nach jedem Scan rätseln muss, welche Maske als Nächstes folgt, ist der Ablauf zu kompliziert gestaltet.

Auch die Hardwarefrage sollte pragmatisch beantwortet werden. Für manche Teams reichen Smartphones mit geeigneter Scan-Funktion und stabiler Schutzhülle. Andere benötigen industrielle Handscanner, weil Handschuhe, Kühlung, Stürze oder lange Schichten dies verlangen. Ein Pilot auf der tatsächlichen Lagerfläche zeigt mehr als eine Präsentation am Schreibtisch.


Die technische Grundlage entscheidet nach dem Go-live

Ein WMS muss auch dann korrekt arbeiten, wenn gleichzeitig Wareneingänge gebucht, Aufträge gepickt und Bestände geprüft werden. Daraus ergeben sich Anforderungen, die in frühen Gesprächen oft untergehen: eindeutige Bewegungsprotokolle, Berechtigungen nach Rolle, nachvollziehbare Korrekturen, zuverlässige Schnittstellen und Sicherungen, die im Ernstfall wiederherstellbar sind.

Ein Bestand sollte nicht einfach überschrieben werden. Besser ist ein Bewegungsmodell: Zugang, Abgang, Umbuchung, Sperrung oder Korrektur erzeugen jeweils einen protokollierten Datensatz. Damit lässt sich später nachvollziehen, warum eine Menge abweicht. Das ist für Inventuren ebenso wertvoll wie für die Klärung eines Kundenreklamationsfalls.

Berechtigungen müssen zur Verantwortung passen. Ein Kommissionierer benötigt andere Funktionen als eine Lagerleitung, die Bestandskorrekturen freigibt. Für kritische Änderungen sind Begründungen, Vier-Augen-Freigaben oder zumindest ein unveränderbares Änderungsprotokoll sinnvoll. Der Aufwand hängt vom Risikoprofil ab, aber die Frage sollte vor dem Start geklärt sein.

Schnittstellen verdienen dieselbe Aufmerksamkeit. Ein Lager arbeitet selten isoliert. Bestellungen kommen aus einem Shop, einem ERP oder per strukturiertem Import. Versanddaten gehen an Carrier-Systeme, Lieferscheine und Labels werden erzeugt, Bestandsdaten fließen zurück. Jede Schnittstelle braucht klare Zuständigkeiten für Fehlerfälle. Was passiert, wenn ein Versandlabel erzeugt wurde, die Rückmeldung aber nicht im WMS ankommt? Ohne Wiederholungslogik und sichtbare Fehlerwarteschlange bleiben solche Fälle an einzelnen Personen hängen.

Für maßgeschneiderte Lösungen sind wartbare Technologien keine Nebensache. Eine nachvollziehbare Anwendung mit klarer Datenbankstruktur, dokumentierten Deployments und getesteten Integrationen bleibt auch nach personellen Wechseln beherrschbar. Trendige Architektur hilft nicht, wenn niemand einen fehlerhaften Import nachvollziehen kann.

Einführung in kleinen, kontrollierbaren Schritten

Ein Big Bang erzeugt vermeidbares Risiko. Sinnvoller ist häufig, zuerst einen abgegrenzten Prozess zu digitalisieren, etwa den Wareneingang für eine Produktgruppe oder die Kommissionierung in einem Lagerbereich. Das Team prüft dabei nicht nur Funktionen, sondern auch Formulierungen, Scanwege, Laufwege und Verantwortlichkeiten.

Stammdaten sind dabei oft die eigentliche Baustelle. Artikelnummern müssen eindeutig sein, Mengeneinheiten konsistent, Lagerplätze sinnvoll strukturiert und Verpackungseinheiten klar definiert. Ein System kann keine verlässlichen Bestände liefern, wenn derselbe Artikel unter drei Bezeichnungen auftaucht oder eine „Kiste" je nach Lieferant unterschiedliche Mengen meint.

Während der Pilotphase sollten Kennzahlen schlicht bleiben: Wie lange dauert der Wareneingang? Wie viele Buchungen müssen korrigiert werden? Wie viele Picks sind fehlerhaft? Wie häufig wird Ware gesucht? Nicht jede Verbesserung zeigt sich sofort in einer großen Kostenposition. Weniger Rückfragen und eine verlässlichere Lieferauskunft können bereits erheblichen Druck aus dem Tagesgeschäft nehmen.

Schulung funktioniert am besten direkt am Prozess. Mitarbeitende brauchen keine abstrakte Führung durch alle Menüpunkte. Sie müssen wissen, wie sie ihre nächste Lieferung buchen, eine Abweichung melden oder einen falschen Scan korrigieren. Für die ersten Schichten nach dem Start sollte eine zuständige Person erreichbar sein, die Entscheidungen zügig treffen kann.

Die richtige Frage für die Auswahl

Bei Warehouse Management Systems lautet die zentrale Frage nicht: Welche Software kann am meisten? Sie lautet: Welche Abläufe müssen für unser Team jeden Tag schneller, eindeutiger und nachvollziehbarer werden?

Wer diese Abläufe zuerst sauber beschreibt, kann Standardsoftware, Erweiterungen oder eine passgenaue Anwendung sachlich bewerten. Das Ergebnis muss nicht spektakulär wirken. Es sollte dafür sorgen, dass die Ware ihren Weg findet, der Bestand belastbar bleibt und die Menschen im Lager weniger Zeit mit Suchen, Nachfragen und Nachtragen verbringen.

Permalink →

Custom Logistics Software vs Spreadsheets

Custom Logistics Software vs Spreadsheets

Ein Wareneingang kommt früher als angekündigt, zwei Mitarbeitende ändern parallel dieselbe Bestandsliste und der Fahrer wartet auf einen Lieferschein, dessen letzte Version niemand sicher benennen kann. Solche Situationen entscheiden die Frage „custom logistics software vs spreadsheets" nicht theoretisch, sondern zwischen Wareneingang, Lagerplatz und Rampe.

Tabellen sind nicht grundsätzlich das Problem. Sie sind schnell erstellt, jedem vertraut und für klar abgegrenzte Aufgaben oft erstaunlich wirksam. Problematisch werden sie, wenn sie das Betriebssystem eines wachsenden Lager- oder Distributionsprozesses ersetzen sollen. Dann wird aus einer Datei ein kritischer Prozess - ohne verbindliche Regeln, nachvollziehbare Zustände oder belastbare Historie.

Wann Spreadsheets im Lager die richtige Wahl sind

Eine Tabelle ist sinnvoll, wenn der Prozess überschaubar, selten und von wenigen Personen gesteuert wird. Das kann etwa eine monatliche Bedarfsplanung, eine einmalige Inventurvorbereitung oder die Auswertung von Lieferantenpreisen sein. Auch für einen kleinen Bestand mit einem Verantwortlichen kann sie reichen, sofern Änderungen nicht unter Zeitdruck erfolgen und keine Folgeprozesse automatisch davon abhängen.

Der Vorteil liegt nicht nur in den geringen Lizenzkosten. Teams können Spalten anpassen, Berechnungen prüfen und ein neues Formular innerhalb weniger Minuten aufsetzen. Wer einen stabilen Prozess noch nicht verstanden hat, sollte ihn nicht vorschnell in Software gießen. Eine gute Tabelle kann zunächst sichtbar machen, welche Daten wirklich gebraucht werden und welche Felder nur aus Gewohnheit gepflegt werden.

Es wäre daher falsch, jede Excel-Datei als Rückstand zu behandeln. Die entscheidende Frage lautet: Ist die Tabelle ein Arbeitsmittel für eine Person oder eine gemeinsame Quelle für operative Entscheidungen? Sobald mehrere Rollen auf dieselben Daten angewiesen sind, steigt das Risiko deutlich.

Custom Logistics Software vs Spreadsheets: Der Kipppunkt

Der Wechsel wird meist nicht durch die Zahl der Zeilen ausgelöst. Eine Tabelle mit 20.000 Positionen kann funktionieren, während eine Datei mit 200 Zeilen bereits zu Fehlern führt. Entscheidend sind Gleichzeitigkeit, Prozessschritte und die Folgen einer falschen Information.

Ein typisches Warnsignal ist die Versionsfrage. Liegen Bestände, offene Aufträge oder Liefertermine in Dateien mit Namen wie „final_neu", „final_neu2" und „wirklich_final", fehlt keine bessere Ordnerstruktur. Es fehlt ein verbindlicher Datenstand. Das Gleiche gilt, wenn Mitarbeitende anrufen müssen, um zu erfahren, ob Ware eingetroffen ist, ein Auftrag freigegeben wurde oder ein Fahrzeug bereits beladen wurde.

Der Kipppunkt ist erreicht, wenn eine Eingabe mehrere Folgehandlungen auslöst. Ein Wareneingang verändert dann nicht nur eine Zahl im Bestand. Er kann eine Qualitätsprüfung starten, einen Lagerplatz zuweisen, eine Bestellung als teilweise geliefert markieren und dem Vertrieb einen verfügbaren Artikel anzeigen. Werden diese Schritte manuell über Dateien, Papier und Telefonate koordiniert, sind Abweichungen kaum zu vermeiden.

Besonders kritisch wird es bei Schichtwechseln und Ausfällen. Wenn nur eine erfahrene Person weiß, welche Farbmarkierung in einer Liste eine Sperrung bedeutet oder welche Formel einen Sicherheitsbestand berechnet, ist der Prozess nicht belastbar. Er funktioniert, solange diese Person verfügbar ist.

Was maßgeschneiderte Software tatsächlich besser macht

Custom Logistics Software ist nicht einfach eine Tabelle mit schöner Oberfläche. Ihr Nutzen entsteht durch kontrollierte Abläufe. Jede Buchung erhält einen eindeutigen Zeitpunkt, eine verantwortliche Person und einen nachvollziehbaren Status. Mitarbeitende sehen nicht nur Daten, sondern die nächste zulässige Handlung.

Bei einem Wareneingang kann das praktisch bedeuten: Lieferung auswählen, Menge erfassen, Abweichung dokumentieren, Etikett drucken und Einlagerung bestätigen. Erst danach wird der Bestand freigegeben. Für die Kommissionierung kann das System Aufträge nach Priorität bündeln, Lagerplätze in sinnvoller Reihenfolge anzeigen und einen Lieferschein erst erzeugen, wenn die Positionen bestätigt sind.

Das ist keine Frage unnötiger Komplexität. Es verhindert, dass derselbe Artikel zweimal reserviert wird, dass eine Teillieferung als vollständig gilt oder dass ein Lieferschein auf Basis veralteter Daten gedruckt wird. Auch einfache Regeln helfen: Pflichtfelder für Chargen, Sperrgründe für beschädigte Ware, Plausibilitätsprüfungen bei Mengen und Berechtigungen für Korrekturbuchungen.

Eine gut geplante Anwendung bildet nicht jeden Sonderfall sofort ab. Sie konzentriert sich auf die Abläufe, die täglich Zeit kosten oder regelmäßig Fehler produzieren. Für einen Betrieb kann das die Verwaltung von Behälterbewegungen sein, für einen anderen die schnelle Erfassung eingehender Ware mit mobilen Geräten. Standardsoftware kennt diese Besonderheiten oft nur als teures Zusatzmodul oder gar nicht.

Die versteckten Kosten der Tabelle

Die Lizenzkosten einer Tabelle sind niedrig. Die Prozesskosten können es nicht sein. Sie entstehen in Rückfragen, Nacharbeiten, Suchzeiten, Doppelpflege und falsch disponierten Beständen. Sie entstehen auch dann, wenn ein Team abends kontrollieren muss, welche Daten seit dem Morgen verändert wurden.

Diese Kosten bleiben häufig unsichtbar, weil sie über viele Rollen verteilt sind. Der Lagerleiter prüft Bestände, der Innendienst korrigiert Liefertermine, die Buchhaltung sucht Belege und die Geschäftsführung bekommt Zahlen mit Verzögerung. Keine einzelne Tätigkeit wirkt dramatisch. Zusammen bremsen sie Durchsatz und Planbarkeit.

Eine belastbare Entscheidung sollte deshalb nicht nur Softwarepreise vergleichen. Messen Sie für zwei bis drei Wochen, wie viele manuelle Übergaben ein Auftrag durchläuft, wie oft Informationen nachgefragt werden und welche Fehler wiederkehren. Relevant sind außerdem die Folgen: Führt ein falscher Bestand zu einer internen Korrektur oder zu einer verpassten Auslieferung?

Nicht jedes Problem braucht eine große Suite

Viele mittelständische Unternehmen im DACH-Raum zögern zu Recht vor umfangreichen Enterprise-Systemen. Lange Einführungen, starre Masken und Lizenzmodelle für Funktionen, die nie genutzt werden, lösen selten ein konkretes Lagerproblem. Die Alternative muss aber nicht heißen, bei verteilten Dateien zu bleiben.

Zwischen beiden Extremen liegt eine workflow-spezifische Anwendung. Sie kann beispielsweise Auftragsannahme, Wareneingang, Lagerbewegungen, Versandetiketten und Lieferscheine in einem gemeinsamen System verbinden, ohne gleich Finanzbuchhaltung, globale Konzernlogik und zwanzig Fremdsprachen mitzubringen.

Entscheidend ist die technische Grundlage. Eine Anwendung mit klarer Datenbankstruktur, dokumentierten Schnittstellen und nachvollziehbaren Berechtigungen bleibt anpassbar. Technologien wie PHP 8.4, modernes JavaScript und MySQL 8 sind dabei kein Selbstzweck. Richtig eingesetzt, schaffen sie eine wartbare Basis für Rollen, Buchungshistorien, Druckdokumente und Auswertungen - auch dann, wenn sich Prozesse in zwei Jahren ändern.

So gelingt die Umstellung ohne Betriebsunterbrechung

Die größte Gefahr ist nicht die Technik, sondern ein zu großer erster Schritt. Wer versucht, sämtliche historischen Dateien zu bereinigen und jeden Ausnahmefall vor dem Start abzubilden, verschiebt den Nutzen monatelang. Besser ist ein klarer, überprüfbarer Anfang.

Starten Sie mit einem Prozess, der häufig vorkommt und gut abgrenzbar ist, etwa Wareneingang mit Bestandsbuchung oder Versand mit Lieferschein und Etikett. Definieren Sie dabei präzise, wann der Vorgang beginnt, welche Daten zwingend nötig sind, wer welche Freigabe erteilt und wann er als abgeschlossen gilt. Daraus entstehen nicht nur Bildschirmmasken, sondern belastbare Arbeitsregeln.

Die Datenübernahme braucht ebenfalls Pragmatismus. Aktive Artikel, Lieferanten, Lagerplätze und offene Aufträge müssen sauber sein. Historische Altbestände können dagegen oft archiviert werden, statt sie mit hohem Aufwand in das neue System zu importieren. Parallelbetrieb kann sinnvoll sein, aber nur mit einem festen Enddatum. Sonst entstehen zwei Wahrheiten statt einer besseren.

In der Einführung zeigt sich der Wert eines direkten technischen Partners. softify.pro arbeitet deshalb nicht von einer abstrakten Funktionsliste aus, sondern klärt Abläufe dort, wo sie stattfinden: an der Annahme, im Lagergang, beim Verpacken und bei der Übergabe an den Versand. Gute Software respektiert funktionierende Routinen und verändert nur, was den Prozess tatsächlich verlässlicher macht.

Die Entscheidung lässt sich an drei Fragen prüfen

Erstens: Müssen mehrere Personen gleichzeitig auf aktuelle Daten vertrauen? Zweitens: Löst eine Buchung Folgeprozesse aus, die heute manuell abgesichert werden? Drittens: Kann ein Fehler zu Lieferverzug, Fehlbestand, falscher Rechnung oder aufwendiger Suche führen? Wenn diese Fragen überwiegend mit Ja beantwortet werden, ist die Tabelle vermutlich nicht mehr das richtige führende System.

Bleibt die Antwort überwiegend Nein, kann sie weiterhin eine vernünftige Lösung sein. Dann lohnt es sich eher, Dateien zu vereinheitlichen, Verantwortlichkeiten festzulegen und kritische Formeln zu dokumentieren. Technik sollte nicht größer sein als das Problem.

Der nächste sinnvolle Schritt ist daher kein pauschales Digitalisierungsprojekt, sondern ein gemeinsamer Blick auf einen konkreten Ablauf mit den Menschen, die ihn täglich ausführen. Dort wird schnell sichtbar, ob eine gut gepflegte Tabelle genügt - oder ob verlässliche Software endlich die Arbeit übernehmen sollte, die heute zwischen Papier, Telefon und mehreren Versionen derselben Datei hängen bleibt.

Permalink →

Webentwicklung für Unternehmen

Webentwicklung für Unternehmen

Eine Website kann gut aussehen und trotzdem jeden Montag Arbeit erzeugen: Produktdaten werden doppelt gepflegt, Anfragen landen unvollständig im Postfach, Änderungen brauchen externe Hilfe. Die Suche nach einem Webentwicklung-Unternehmen sollte deshalb nicht bei Farben, Frameworks oder einem schicken Portfolio enden. Entscheidend ist, ob die Lösung im Arbeitsalltag weniger Reibung schafft und auch in drei Jahren noch verständlich zu betreiben ist.

Für kleine und mittlere Unternehmen ist das keine akademische Frage. In Werkstätten, Lagern und Vertriebsorganisationen treffen Angebote, Bestellungen, Lieferinformationen und Kundenanfragen oft auf gewachsene Abläufe. Manche davon verdienen Software. Andere funktionieren mit einer sauber geführten Tabelle weiterhin besser. Gute Webentwicklung erkennt den Unterschied, statt jedes Problem in ein großes Digitalprojekt zu verwandeln.

Was Webentwicklung für Unternehmen leisten muss

Eine Unternehmenswebsite ist häufig der erste Kontaktpunkt. Sie muss schnell laden, auf mobilen Geräten funktionieren und Besucher klar zu einer Anfrage, Bewerbung oder Bestellung führen. Doch sobald sie Daten verarbeitet, interne Rollen abbildet oder Prozesse auslöst, wird sie zur Webanwendung. Dann zählen andere Fragen: Wer darf was sehen? Woher kommen die Daten? Was passiert bei einer fehlerhaften Eingabe? Wie wird ein Update ausgerollt, ohne den Betrieb zu stören?

Der Unterschied ist praktisch. Eine Marketingseite kann mit wenigen, klar strukturierten Inhaltsbereichen auskommen. Ein Kundenportal, ein Bestellprozess oder ein internes Lagerwerkzeug braucht dagegen nachvollziehbare Berechtigungen, eine belastbare Datenbankstruktur und definierte Sonderfälle. Wenn ein Wareneingang nur teilweise geliefert wird oder ein Auftrag nachträglich geändert werden muss, darf das System nicht in einem undefinierten Zustand enden.

Webentwicklung für Unternehmen heißt daher nicht einfach, Seiten zu programmieren. Sie bedeutet, Geschäftsregeln so umzusetzen, dass sie für Anwender verständlich bleiben und für das Unternehmen kontrollierbar sind.

Erst den Ablauf prüfen, dann die Oberfläche planen

Ein Projekt wird oft mit einem Wunsch wie „Wir brauchen ein Portal" gestartet. Das ist ein sinnvoller Anfang, aber noch keine ausreichende Anforderung. Vor dem ersten Design sollten die tatsächlichen Wege einer Information sichtbar werden: Wer legt sie an, wer prüft sie, wer ergänzt sie und wer braucht sie später wieder?

Nehmen wir die Auftragsabwicklung. In vielen Betrieben kommt eine Anfrage per E-Mail oder Telefon herein, wird in einer Tabelle notiert, später in ein anderes System übertragen und anschließend für Lager oder Versand erneut aufbereitet. Die Verzögerung liegt selten an einem einzelnen Schritt. Sie entsteht an den Übergaben, Rückfragen und unterschiedlichen Datenständen.

Eine gute Analyse fragt deshalb konkret nach dem Alltag:

  • Welche Informationen werden heute mehrfach eingegeben?
  • An welcher Stelle entstehen die meisten Rückfragen oder Korrekturen?
  • Welche Ausnahmen kommen regelmäßig vor, obwohl sie nirgends dokumentiert sind?
  • Welche Rollen benötigen Zugriff, und welche Daten dürfen sie nicht verändern?
  • Woran erkennt das Team am Ende, dass ein Vorgang wirklich abgeschlossen ist?

Diese Fragen klingen nüchtern. Genau das ist ihr Vorteil. Sie verhindern, dass eine optisch überzeugende Anwendung um einen idealisierten Prozess gebaut wird, den im Betrieb niemand nutzt. Besonders in Lager und Logistik zählen reale Bedingungen: Scanner werden mit Handschuhen bedient, Schichten wechseln, WLAN ist nicht überall gleich gut und ein Lieferschein darf nicht erst nach mehreren Klicks entstehen.

Nicht jeder Ablauf gehört allerdings in eine Anwendung. Eine kleine Liste mit wenigen, stabilen Einträgen kann als Tabelle schneller und günstiger sein. Software lohnt sich, wenn Daten zwischen Personen oder Bereichen fließen, wenn Nachvollziehbarkeit fehlt oder wenn manuelle Arbeit wiederkehrend Zeit und Fehler erzeugt.

Die technische Basis entscheidet über den späteren Aufwand

Viele Systeme wirken in der ersten Demo ähnlich. Der Unterschied zeigt sich bei Änderungen, Wachstum und Störungen. Eine Anwendung sollte daher auf Technologien beruhen, die das Team langfristig warten kann, statt auf kurzfristigen Hype zu setzen.

Für viele geschäftskritische Webanwendungen ist ein Stack mit PHP 8.4, modernem JavaScript und MySQL 8 eine pragmatische Wahl. Er ist leistungsfähig, gut verständlich und für typische Anforderungen wie Portale, Auftragsverwaltung, Dokumentenerstellung oder interne Werkzeuge passend. Das ist kein Dogma. Bei sehr interaktiven Anwendungen, speziellen Integrationen oder hohem Echtzeitbedarf kann eine andere Architektur sinnvoll sein. Die Technologie sollte der Aufgabe folgen, nicht umgekehrt.

Wichtiger als der Name eines Frameworks sind klare Entscheidungen bei Daten und Zuständen. Eine Bestellung braucht beispielsweise eindeutige Statuswerte statt Freitext. Änderungen sollten nachvollziehbar sein. Kundendaten, Preise und Berechtigungen dürfen nicht über verstreute Tabellen und improvisierte Schnittstellen auseinanderlaufen. Wer später wissen muss, warum ein Versandlabel erstellt oder ein Auftrag gesperrt wurde, benötigt eine nachvollziehbare Historie.
Auch Sicherheit gehört zur Grundkonstruktion. Dazu zählen rollenbasierte Rechte, sichere Passwortspeicherung, Account-Lockout-Flows bei wiederholten Fehlversuchen, getrennte Test- und Produktionsumgebungen sowie regelmäßige Updates. Sicherheit ist kein einzelnes Plugin am Projektende. Sie entsteht durch saubere Zuständigkeiten und eine Architektur, die Fehlerfälle mitdenkt.

Geschwindigkeit ist eine betriebliche Anforderung

Langsame Seiten kosten nicht nur Sichtbarkeit in Suchmaschinen. Sie erzeugen Abbrüche bei Anfragen und unnötige Wartezeit im Tagesgeschäft. Auf einer öffentlichen Website entscheiden Ladezeit, mobile Darstellung und eine klare Seitenstruktur darüber, ob Interessenten überhaupt Kontakt aufnehmen. In einer internen Anwendung summieren sich zwei oder drei Sekunden Wartezeit bei jeder Buchung über den Arbeitstag hinweg spürbar.

Performance beginnt nicht mit einem späteren Optimierungsprojekt. Bilder, Datenbankabfragen, Caching, JavaScript und Hosting müssen von Beginn an angemessen geplant werden. Dabei gilt: Nicht jede Anwendung braucht maximale technische Komplexität. Ein einfaches internes Werkzeug mit wenigen Nutzern benötigt keine Architektur für Millionen gleichzeitiger Aufrufe. Es braucht kurze Wege, zuverlässige Backups und ein Verhalten, das im Alltag vorhersehbar bleibt.

Das gleiche Prinzip gilt für responsive Bedienung. „Mobilfähig" heißt nicht, dass eine Desktopmaske irgendwie auf ein Smartphone schrumpft. Wer unterwegs Lieferscheine prüft, einen Schaden meldet oder einen Bestand korrigiert, braucht große Bedienelemente, klare Rückmeldungen und möglichst wenig unnötige Eingabe.

Von der Idee zum Betrieb: In kleinen Schritten liefern

Große Lastenhefte versprechen Sicherheit, führen aber häufig dazu, dass Teams Monate auf eine erste nutzbare Version warten. Ein besserer Weg ist ein klar abgegrenzter erster Ausbauschritt. Er soll ein echtes Problem lösen, etwa die zentrale Erfassung von Wareneingängen oder die automatische Erstellung von Lieferdokumenten. Danach lässt sich mit realen Rückmeldungen entscheiden, was als Nächstes den größten Nutzen bringt.

Das bedeutet nicht, ohne Planung zu arbeiten. Im Gegenteil: Datenmodell, Rollen, Schnittstellen und Betriebskonzept müssen früh geklärt sein. Der Funktionsumfang darf trotzdem schrittweise wachsen. So werden Annahmen sichtbar, bevor sie teuer werden.

Zu einer professionellen Übergabe gehören mehr als Zugangsdaten. Dokumentierte Deployment-Schritte, Backups, Monitoring, Zuständigkeiten und eine verständliche technische Dokumentation machen ein System unabhängig von einzelnen Personen. Wenn nur der ursprüngliche Entwickler weiß, wie ein Update eingespielt wird, ist die Anwendung nicht fertig, sondern personengebunden.

Woran Sie einen passenden Partner erkennen

Ein Webentwicklung-Unternehmen muss nicht jede denkbare Technologie anbieten. Es sollte aber die richtigen Rückfragen stellen und Entscheidungen begründen können. Vorsicht ist angebracht, wenn bereits im ersten Gespräch eine umfassende Plattform versprochen wird, ohne dass jemand die bestehenden Abläufe gesehen hat.

Ein passender Partner spricht über Wartung, Datenqualität und Einführung genauso offen wie über Design. Er erklärt, welche Anforderungen Standardfunktionen abdecken können und wo individuelle Entwicklung sinnvoll wird. Er benennt auch die Kosten von Sonderwünschen. Eine Funktion kann technisch machbar sein und dennoch keinen ausreichenden Nutzen haben.

Fragen Sie nach konkreten Betriebsdetails: Wie werden Änderungen getestet? Wie funktioniert ein Rollback? Wo liegen sensible Daten? Wer reagiert bei einem Ausfall? Wie werden Berechtigungen verwaltet? Gute Antworten sind nicht zwingend lang, aber sie sind spezifisch. „Das kümmern wir uns später" ist bei geschäftskritischen Abläufen keine Strategie.

Für Teams mit vorhandener Software ist zudem die Integrationsfrage zentral. Eine neue Anwendung muss nicht alles ersetzen. Sie kann zunächst Daten aus einem bestehenden System übernehmen, Dokumente erzeugen oder einen fehlenden Prozess abbilden. Der sinnvollste erste Schritt ist oft nicht die große Ablösung, sondern die gezielte Beseitigung eines Engpasses.

Software soll Arbeit klären, nicht verlagern

Die beste Webanwendung fällt im Betrieb nicht durch technische Raffinesse auf, sondern durch weniger Rückfragen, verlässliche Daten und kürzere Durchlaufzeiten. Sie respektiert funktionierende Arbeitsweisen, macht Ausnahmen sichtbar und lässt sich ohne Angst vor dem nächsten Update weiterentwickeln.

Bevor Sie ein Projekt starten, nehmen Sie einen konkreten Vorgang aus Ihrem Alltag und verfolgen ihn vom ersten Kontakt bis zum Abschluss. Dort, wo Informationen warten, verschwinden oder doppelt erfasst werden, liegt meist der sinnvollste Ansatz für Webentwicklung.

Permalink →

Logistics Automation Software, die wirklich passt

Logistics Automation Software, die wirklich passt

Ein Wareneingang wird auf Papier notiert, die Bestandsänderung später in eine Tabelle übertragen und der Versand ruft im Lager an, weil die Lieferadresse in einer E-Mail steckt. Genau an diesen Übergaben verliert ein Betrieb Zeit und Verlässlichkeit. Logistics Automation Software soll diese Reibung nicht mit einer großen neuen Prozesswelt überdecken, sondern die täglichen Handgriffe nachvollziehbar verbinden.

Für kleine und mittlere Unternehmen ist das eine andere Aufgabe als die Einführung einer Konzernplattform. Ein Lagerleiter braucht keine 200 Funktionen, die erst nach drei Schulungstagen verständlich werden. Er braucht einen klaren Status: Was ist angekommen, wo liegt es, was muss heute raus, und was fehlt noch? Gute Automatisierung beantwortet diese Fragen dort, wo die Arbeit passiert.

Was Logistics Automation Software praktisch leisten muss

Der Begriff klingt breit, die sinnvollen Anwendungsfälle sind meist sehr konkret. Ein Betrieb verarbeitet zum Beispiel eingehende Ware, bucht Lagerbewegungen, erstellt Lieferscheine, druckt Versandetiketten und plant Auslieferungen. Wenn jede Station eine eigene Datei, einen separaten Zugang oder einen Zuruf benötigt, entstehen Verzögerungen und Fehlerketten.

Eine passende Software führt die Informationen in einem Arbeitsablauf zusammen. Eine Bestellung kann automatisch einen Kommissionierauftrag erzeugen. Der Scan eines Artikels bestätigt die Entnahme und aktualisiert den Bestand. Nach dem Abschluss wird ein Lieferschein mit den richtigen Positionen erstellt, während der Versandstatus für Vertrieb oder Disposition sichtbar wird. Das klingt schlicht. Gerade deshalb ist es wertvoll: Die Software ersetzt keine funktionierende Logik, sondern verhindert, dass sie bei jedem Medienbruch neu rekonstruiert werden muss.

Entscheidend ist die Reihenfolge. Zuerst muss klar sein, welche Daten ein Ereignis auslösen und wer darüber entscheidet. Erst dann lohnt es sich, Regeln zu automatisieren. Wer einen unklaren Ablauf digitalisiert, bekommt lediglich schnellere Unklarheit.

Die richtigen Prozesse zuerst auswählen

Nicht jeder manuelle Vorgang verdient sofort eine Anwendung. Eine kleine, sauber gepflegte Tabelle kann für einen seltenen Sonderfall besser sein als ein Modul, das dauerhaft gewartet werden muss. Der wirtschaftliche Hebel liegt meist bei Abläufen mit hoher Wiederholung, vielen Übergaben oder spürbaren Fehlerfolgen.

Typische Kandidaten sind Wareneingänge mit Prüfstatus, Umlagerungen zwischen Zonen, die Kommissionierung wiederkehrender Aufträge, Versanddokumente und die Tourenplanung. Auch die Auftragsannahme ist häufig ein guter Einstieg, wenn Bestellungen aus Telefonaten, E-Mails und Formularen zunächst manuell zusammengeführt werden.

Bei der Auswahl helfen vier Fragen:

  • Wie oft wird der Ablauf pro Woche durchgeführt?
  • An welcher Stelle werden Daten mehrfach erfasst oder übertragen?
  • Welche Fehler verursachen Nacharbeit, Fehlbestände oder verspätete Lieferungen?
  • Welche Ausnahmefälle müssen Mitarbeitende weiterhin selbst entscheiden?

Die letzte Frage verhindert einen verbreiteten Fehler. Automatisierung muss nicht bedeuten, dass jede Entscheidung ohne Menschen fällt. Bei beschädigter Ware, unvollständigen Lieferungen oder kurzfristigen Kundenwünschen braucht das Team eine klare Möglichkeit, einen Vorgang anzuhalten, zu korrigieren und mit Begründung fortzuführen. Ein System ohne solche Wege wirkt auf dem Papier konsequent, im Lager aber schnell wie ein Hindernis.

Vom Wareneingang bis zum Versand: ein durchgängiger Ablauf

Nehmen wir einen mittelständischen Händler mit Lager und eigener Auslieferung. Heute wird Ware am Tor gezählt, auf einem Formular notiert und erst gegen Ende der Schicht ins System eingetragen. Der Vertrieb sieht den neuen Bestand daher zu spät. Bei einer Eilsendung wird ein Lieferschein separat erstellt, und der Fahrer erhält seine Informationen telefonisch.

In einem zweckmäßig automatisierten Ablauf beginnt der Wareneingang mit einem digitalen Vorgang. Mitarbeitende erfassen Lieferung, Artikel, Menge und optional Charge oder Seriennummer direkt am Arbeitsplatz oder mobil. Abweichungen werden nicht in einer Randnotiz versteckt, sondern erhalten einen Status wie „Prüfung erforderlich“. Erst nach Freigabe steht die Ware als verfügbarer Bestand bereit.

Der nächste Schritt entsteht aus realen Anforderungen: Ein Auftrag wird freigegeben, das Lager erhält eine Pickliste oder eine mobile Ansicht nach Lagerplatz, und jede Buchung dokumentiert, was tatsächlich entnommen wurde. Daraus entstehen Lieferschein und Versanddaten aus derselben Quelle. Niemand muss Positionen nochmals abtippen oder prüfen, welche Dateiversion gerade gilt.

Für die Disposition kann das System offene Auslieferungen nach Gebiet, Lieferfenster, Gewicht oder Fahrzeugkapazität bündeln. Eine Routenplanung ist dabei nicht immer der erste sinnvolle Schritt. Wenn Adressen unvollständig sind oder Aufträge erst kurz vor Abfahrt freigegeben werden, sollte zunächst die Datenqualität und Auftragsklarheit verbessert werden. Optimierte Routen helfen nicht, wenn die Grundlage unzuverlässig ist.

Standardsoftware oder individuelle Lösung?

Standardsoftware ist sinnvoll, wenn der Betrieb mit üblichen Abläufen arbeitet und akzeptiert, sich an die vorgesehenen Masken, Rollen und Prozesse anzupassen. Sie kann schnell eingeführt werden, insbesondere bei klaren Anforderungen wie Etikettendruck oder einer einfachen Bestandsführung. Der Preis dafür sind oft Kompromisse bei Sonderfällen, Schnittstellen und späteren Anpassungen.

Eine individuelle Logistics Automation Software wird interessant, wenn die operative Besonderheit kein Randfall ist, sondern den Geschäftserfolg bestimmt. Das kann eine spezielle Verpackungslogik sein, ein mehrstufiger Freigabeprozess, die Verbindung von Werkstatt und Lager oder ein eigenes Liefermodell. Dann ist es häufig sinnvoller, gezielt die wenigen Kernabläufe abzubilden, statt eine umfassende Suite mit vielen ungenutzten Modulen einzuführen.

Individuell bedeutet allerdings nicht grenzenlos. Jede Sonderfunktion braucht eine fachliche Begründung, Tests, Dokumentation und Pflege. Gute Projektarbeit fragt deshalb auch: Kann dieser Schritt vereinfacht werden? Reicht eine Konfiguration? Bleibt eine Tabelle für diesen Ausnahmeprozess die bessere Lösung? Diese Fragen schützen Budget und Team vor unnötiger Komplexität.

Technik, die im Alltag standhält

Die Oberfläche entscheidet darüber, ob Mitarbeitende ein System gern verwenden. Die technische Basis entscheidet, ob es auch nach Jahren zuverlässig betrieben werden kann. Für geschäftskritische Prozesse gehören nachvollziehbare Datenmodelle, Rollen und Berechtigungen, Protokolle wichtiger Änderungen sowie regelmäßige Sicherungen zur Grundausstattung.

Bei einer Lagerbuchung muss erkennbar sein, wer wann welchen Bestand verändert hat und aus welchem Vorgang die Änderung stammt. Werden mehrere Nutzer gleichzeitig aktiv, darf der Bestand nicht durch widersprüchliche Eingaben verfälscht werden. Bei Druckern, Scannern oder Versanddienstleister-Schnittstellen braucht es klare Fehlerzustände statt stiller Fehlschläge. Ein Etikett, das nicht gedruckt wurde, muss als offener Arbeitsschritt sichtbar sein.

Auch Wartbarkeit ist eine betriebliche Anforderung. Eine Webanwendung auf einer verständlichen Architektur, etwa mit PHP 8.4, modernem JavaScript und MySQL 8, lässt sich langfristig besser prüfen und erweitern als eine Sammlung schwer nachvollziehbarer Einzellösungen. Dokumentierte Bereitstellung, getrennte Test- und Produktionsumgebungen und automatisierte Tests sind kein Luxus. Sie reduzieren das Risiko, dass eine kleine Änderung am Lieferschein plötzlich die Auftragsfreigabe beeinträchtigt.

Datenschutz und Zugriffskontrolle verdienen dieselbe Nüchternheit. Nicht jeder Nutzer benötigt Preise, Margen oder Kundenstammdaten. Besonders in verteilten Teams sollten Zugänge, Geräte und Berechtigungen so gestaltet sein, dass sie den Arbeitsalltag nicht unnötig bremsen, aber bei einem Mitarbeiterwechsel oder verlorenen Gerät kontrollierbar bleiben.

Einführung in sinnvollen Etappen

Die stärkste Funktion hilft wenig, wenn ein Team sie nicht im Schichtbetrieb anwenden kann. Deshalb ist eine schrittweise Einführung oft belastbarer als ein großer Stichtag. Zunächst wird ein abgegrenzter Ablauf produktiv gesetzt, etwa der Wareneingang für eine Produktgruppe oder die Erstellung von Versandpapieren. Das Team arbeitet damit unter echten Bedingungen, und offene Fragen werden an realen Fällen geklärt.

Danach folgen weitere Prozesse und Schnittstellen. Diese Reihenfolge schafft Vertrauen, weil Mitarbeitende sehen, dass Rückmeldungen in konkrete Verbesserungen einfließen. Sie begrenzt zugleich das Risiko: Wenn ein neuer Scanablauf angepasst werden muss, steht nicht die gesamte Logistik still.

Messgrößen sollten vor Beginn vereinbart werden. Das können Durchlaufzeit vom Auftrag bis zum Versand, Anzahl manueller Korrekturen, Fehlbestände oder die Dauer der Tagesabschlussarbeiten sein. Nicht jede Verbesserung zeigt sich sofort in einer spektakulären Kennzahl. Weniger Rückfragen zwischen Lager und Büro, ein verlässlicher Schichtübergang und auffindbare Vorgangshistorien sind ebenfalls messbare Entlastung.

softify.pro entwickelt solche Systeme aus dem Ablauf heraus, mit direkter technischer Beteiligung statt einer Übergabe von Konzept zu Umsetzung. Der Maßstab bleibt dabei bewusst pragmatisch: Die Lösung soll auf dem Hallenboden funktionieren, nicht nur in einer Präsentation.

Woran Sie eine tragfähige Entscheidung erkennen

Eine gute Entscheidung beginnt nicht mit einer Funktionsliste, sondern mit einem beobachteten Arbeitstag. Lassen Sie sich zeigen, wo Informationen entstehen, warten, verloren gehen oder nachträglich korrigiert werden. Sprechen Sie nicht nur mit der Leitung, sondern auch mit den Personen am Wareneingang, im Lager und im Versand. Sie kennen die Ausnahmen, die kein Organigramm sichtbar macht.

Prüfen Sie anschließend, ob der Anbieter konkrete Fragen zu Daten, Rollen, Geräten, Schnittstellen und Betrieb stellt. Wer sofort eine Komplettlösung verspricht, ohne die bestehenden Abläufe zu verstehen, verkauft eher Softwareumfang als Problemlösung. Ebenso kritisch ist ein Projekt, das keine klare Regelung für Wartung, Fehlerbehebung und spätere Anpassungen vorsieht.

Die beste Automatisierung fühlt sich nicht wie zusätzliche Bürokratie an. Sie gibt dem Team Zeit für die Fälle, in denen Erfahrung wirklich zählt: eine unerwartete Lieferung richtig bewerten, einen Kunden rechtzeitig informieren oder einen Engpass lösen, bevor er zum Problem wird.

Permalink →

Kann KI Desktop-Software testen?

Kann KI Desktop-Software testen?

Ein Mitarbeiter bucht Wareneingang in einer Windows-Anwendung, druckt einen Lieferschein und übergibt die Daten an die Buchhaltung. Nach einem Update erscheint ein Dialog an anderer Stelle, ein Feld verliert den Fokus, der Druck startet nicht mehr. Die Frage „can AI test desktop software" ist deshalb weniger theoretisch, als sie klingt: Kann ein System solche Fehler vor der nächsten Frühschicht erkennen?

Ja. KI kann Windows-Desktop-Software testen, besonders dort, wo klassische Automatisierung an wechselnden Oberflächen, uneinheitlichen Steuerelementen oder aufwendig zu pflegenden Skripten scheitert. Sie ist jedoch kein Ersatz für klare Testziele, saubere Testdaten und fachliche Verantwortung. Ihr Wert entsteht, wenn sie wiederholbare Arbeit zuverlässig übernimmt und Menschen auf die Fälle lenkt, die Urteilsvermögen erfordern.

Kann AI Desktop-Software testen - und was bedeutet das praktisch?

Desktop-Tests prüfen nicht nur, ob ein Fenster geöffnet wird. In einem realen Betrieb geht es um vollständige Abläufe: Anmeldung mit korrekter Sperrlogik, Auftragserfassung, Auswahl eines Artikels, Bestandsbuchung, Etikettendruck, Fehlermeldung bei ungültigen Daten und die korrekte Übergabe an ein angeschlossenes System.

Eine KI-gestützte Testumgebung kann diese Abläufe auf einem Windows-Rechner ausführen, die sichtbare Oberfläche bewerten und Belege erzeugen. Sie erkennt beispielsweise Schaltflächen anhand von Text und Position, liest Inhalte aus Dialogen und vergleicht Screenshots mit dem erwarteten Zustand. Anders als ein starres Skript kann sie mit kleineren visuellen Änderungen besser umgehen - etwa wenn sich ein Icon, ein Abstand oder die genaue technische Kennung eines Bedienelements ändert.

Das ist vor allem bei gewachsenen Fachanwendungen relevant. Viele dieser Programme haben keine moderne API für jeden Prozess. Manche verwenden proprietäre Oberflächen, eingebettete Tabellen oder Komponenten, die sich für herkömmliche UI-Automatisierung schlecht ansprechen lassen. Ein KI-Agent kann die Anwendung eher so bedienen, wie es ein geschulter Anwender tut: Bildschirm lesen, Aktion auswählen, Ergebnis prüfen.

Das Wort „eher" ist bewusst gewählt. Eine KI sieht nicht automatisch den Geschäftsprozess hinter einem Eingabefeld. Sie kann feststellen, dass ein Lieferschein erstellt wurde. Ob die richtige Lieferbedingung für einen bestimmten Kunden verwendet werden musste, braucht eine fachlich definierte Erwartung.

Wo KI-Tests für Windows-Anwendungen sinnvoll sind

Der beste Einstieg sind Abläufe, die häufig stattfinden, geschäftskritisch sind und heute manuell geprüft werden. Ein Team muss dafür nicht den gesamten Testkatalog automatisieren. Besser ist es, die wenigen Prozesse zu wählen, deren Ausfall unmittelbar Zeit, Geld oder Vertrauen kostet.

In Lager, Produktion und Disposition gehören dazu oft das Anlegen und Buchen von Wareneingängen, Kommissionier- und Versandprozesse, Bestandskorrekturen mit Berechtigung, der Druck von Etiketten sowie Import- und Exportabläufe. In kaufmännischen Anwendungen sind Anmeldung, Rechtewechsel, Rechnungserstellung, Stammdatenpflege und Schnittstellenübergaben typische Kandidaten.

Besonders nützlich ist die KI dort, wo ein Release bisher einen manuellen Kontrolltag auslöst. Ein Tester klickt dann eine lange Liste ab, dokumentiert Auffälligkeiten und versucht später nachzuvollziehen, was genau passiert ist. Automatisierte Läufe können diesen Teil in die Nacht oder in einen festen Release-Prozess verlagern. Am Morgen liegt nicht nur ein Status vor, sondern ein Testprotokoll mit Screenshots, Zeitstempeln und einer verständlichen Beschreibung der Abweichung.

Auch Regressionstests profitieren. Wenn eine neue Funktion im Auftragsdialog eingebaut wird, sollen bestehende Prozesse nicht unbemerkt brechen. Die KI wiederholt definierte Szenarien nach jeder relevanten Änderung. Das reduziert nicht jedes Risiko, aber es verhindert, dass bekannte Kernabläufe nur deshalb ungeprüft bleiben, weil Zeit fehlt.

Was KI zuverlässig prüfen kann - und was nicht

KI-basierte Oberflächentests sind stark bei beobachtbaren Erwartungen. „Nach dem Speichern erscheint die Auftragsnummer." „Bei fehlender Pflichtangabe wird eine Warnung angezeigt." „Der Bestand reduziert sich um fünf." „Der Druckdialog enthält den vorgesehenen Drucker." Solche Aussagen lassen sich in konkrete Prüfschritte übersetzen.

Schwieriger werden Anforderungen, die unpräzise formuliert sind. „Die Oberfläche soll professionell wirken" oder „das Programm soll schnell sein" sind keine ausreichenden Testfälle. Hier braucht es Kriterien: maximale Wartezeit unter definierter Last, ein freigegebenes Layout oder klare Akzeptanzregeln für Fehlermeldungen.

Auch bei komplexen fachlichen Sonderfällen bleibt menschliches Testen unverzichtbar. Wenn eine Retourenregel für einen einzelnen Rahmenvertrag gilt, muss jemand mit Prozesswissen entscheiden, ob das Ergebnis korrekt ist. KI kann den Fall vorbereiten, ausführen und dokumentieren. Sie sollte nicht eigenmächtig neue Geschäftsregeln erfinden.

Eine weitere Grenze ist die Stabilität der Umgebung. Desktop-Tests hängen von Bildschirmauflösung, Benutzerrechten, Netzverbindung, Druckertreibern, Testdaten und gegebenenfalls angeschlossener Hardware ab. Wenn ein Etikettendrucker offline ist, kann ein fehlgeschlagener Test ein echter Defekt sein - oder ein Umgebungsproblem. Gute Testsysteme unterscheiden diese Fälle und melden sie transparent, statt alles pauschal als Produktfehler zu bewerten.

Die technische Basis entscheidet über den Nutzen

Ein brauchbarer Desktop-Test ist mehr als eine Folge von Mausklicks. Er braucht einen kontrollierten Rechner oder eine virtuelle Windows-Umgebung, definierte Benutzerkonten, reproduzierbare Ausgangsdaten und klare Regeln für Rücksetzungen. Sonst prüft der Test am Dienstag einen anderen Zustand als am Montag und erzeugt Diskussionen statt Sicherheit.

Ebenso entscheidend sind Belege. Ein grünes Häkchen ohne Kontext hilft wenig, wenn ein Fachbereich einen Fehler meldet. Zu jedem Lauf sollten daher die ausgeführten Schritte, Screenshots an wichtigen Stellen, sichtbare Fehlermeldungen und eine Zeitangabe vorliegen. Bei Abweichungen muss erkennbar sein, ob die Anwendung falsch reagiert hat, ein erwartetes Element nicht gefunden wurde oder die Testumgebung blockiert war.

Bei sensiblen Anwendungen ist die Frage nach dem Ausführungsort keine Nebensache. Screenshots, Zugangsdaten, Kundendaten und interne Prozessmasken können vertrauliche Informationen enthalten. Wer Tests über externe Dienste laufen lässt, sollte genau prüfen, welche Daten den eigenen Bereich verlassen, wie lange sie gespeichert werden und wer Zugriff erhält.

Für Teams mit entsprechenden Anforderungen kann eine selbst gehostete Umgebung sinnvoller sein.

softify.pro betreibt dafür COCO, einen eigenen KI-Server für automatisierte Web- und Aplikations-Tests. Die Ausführung, Testbelege und Auswertung können innerhalb der kontrollierten Unternehmensumgebung bleiben. Das ist nicht für jede Anwendung erforderlich, aber bei internen Fachsystemen, personenbezogenen Daten oder strengen IT-Vorgaben oft die sauberere Architektur.

So startet ein Team ohne Testautomatisierungsprojekt ausufern zu lassen

Ein sinnvoller Start beginnt nicht mit einer Tool-Auswahl, sondern mit einem Prozess. Nehmen Sie einen Ablauf, der mindestens wöchentlich geprüft wird und dessen Fehlerfolgen nachvollziehbar sind. Ein Versandprozess eignet sich besser als eine Sammlung von zwanzig zufälligen Bildschirmmasken.

Beschreiben Sie anschließend den fachlichen Weg in klaren Sätzen: Ausgangslage, Eingaben, erwartete Zwischenstände, erwartetes Endergebnis. Ergänzen Sie auch den negativen Fall. Was muss passieren, wenn eine Chargennummer fehlt, ein Benutzer keine Berechtigung besitzt oder der Bestand nicht ausreicht? Gerade diese Regeln werden in manuellen Tests häufig übersprungen, obwohl sie im Alltag teuer werden können.

Danach folgt ein begrenzter Pilot mit stabilen Testdaten und einer definierten Umgebung. Messen Sie nicht nur, ob der Test läuft. Messen Sie, wie viele manuelle Prüfminuten er ersetzt, wie viele Fehlalarme auftreten und ob die Belege für Entwicklung und Fachbereich ausreichen. Erst wenn diese Grundlage funktioniert, lohnt sich die Erweiterung auf weitere Prozesse.

Die Pflege gehört von Anfang an dazu. Wenn sich eine Maske fachlich verändert, muss auch die Erwartung angepasst werden. Das ist kein Argument gegen Automatisierung. Es ist normale Softwarepflege - vergleichbar mit der Aktualisierung einer Arbeitsanweisung, wenn sich ein Lagerprozess ändert.

Nicht jeder Klick muss automatisiert werden

Manche Teams erwarten von KI-Tests vollständige Abdeckung. Das führt schnell zu hohen Kosten für seltene Ausnahmefälle, deren Prüfung manuell schneller und verlässlicher wäre. Eine gute Teststrategie priorisiert stattdessen nach Risiko, Häufigkeit und Änderungstempo.

Ein selten genutzter Administrationsdialog mit niedriger Fehlerfolge kann weiterhin durch eine kurze manuelle Checkliste geprüft werden. Ein täglicher Wareneingang mit mehreren Folgeschritten verdient dagegen automatisierte Regressionstests und saubere Nachweise. Boring, provable reliability schlägt dabei eine große, aber fragile Testsammlung.

Beginnen Sie mit dem Prozess, bei dem ein Fehler am nächsten Arbeitstag wirklich spürbar wäre. Wenn dieser Ablauf automatisiert, nachvollziehbar und in Ihrer eigenen Umgebung wiederholbar geprüft wird, entsteht Testautomatisierung als verlässlicher Betriebsvorteil - nicht als weiteres IT-Projekt mit schönen Folien.

Permalink →

Wann sollten Unternehmen Tabellenkalkulationen ersetzen?

Wann sollten Unternehmen Tabellenkalkulationen ersetzen?

Ein Lagerleiter druckt morgens eine Bestandsliste aus. Zwei Stunden später hat der Vertrieb einen Auftrag erfasst, die Wareneingangsmenge wurde korrigiert und ein Kollege hat eine alte Datei aus dem E-Mail-Anhang geöffnet. Die Zahlen sind nicht mehr dieselben. Genau an diesem Punkt stellt sich die Frage: Wann sollten Unternehmen Tabellenkalkulationen ersetzen? Nicht, wenn eine Datei einmal unübersichtlich wird, sondern wenn sie zum unsichtbaren Engpass für einen laufenden Prozess wird.

Tabellenkalkulationen sind kein Zeichen schlechter Organisation. Für Kalkulationen, einmalige Analysen, kleine Datenmengen und Entscheidungen mit wenigen Beteiligten sind sie oft das richtige Werkzeug. Sie sind flexibel, vertraut und ohne Projektstart verfügbar. Problematisch werden sie erst, wenn eine Tabelle gleichzeitig Datenbank, Arbeitsanweisung, Freigabeworkflow, Dokumentenarchiv und Kommunikationskanal sein soll.

Tabellenkalkulationen sind gut - bis sie einen Prozess tragen

Viele wachsende Betriebe halten an ihren Dateien fest, weil diese über Jahre sorgfältig aufgebaut wurden. Darin stecken Artikelnummern, Sonderfälle, Lieferantenwissen und bewährte Rechenlogik. Das verdient Respekt. Ein Ersatzsystem, das diese Realität ignoriert, produziert Widerstand und im schlimmsten Fall neue Umwege.

Die entscheidende Frage lautet deshalb nicht: „Ist Excel schlecht?“ Sondern: „Kann unser Team mit diesem Werkzeug zuverlässig arbeiten, auch wenn Auftragsvolumen, Schichten oder Verantwortliche wechseln?“ Wenn die Antwort regelmäßig von einer bestimmten Person, einem gemeinsamen Laufwerk oder der Disziplin aller Beteiligten abhängt, ist die Grenze häufig erreicht.

Besonders deutlich wird das in Lager, Werkstatt und Disposition. Ein Bestand, der erst nachträglich abgeglichen wird, ist kein verlässlicher Bestand. Ein Liefernachweis, der manuell aus mehreren Dateien zusammengestellt wird, kostet nicht nur Zeit. Er erschwert Rückfragen, Nachverfolgung und eine saubere Übergabe zwischen Mitarbeitenden.

Wann sollten Unternehmen Tabellenkalkulationen ersetzen?

Es gibt keinen universellen Zeitpunkt und keine magische Zahl von Zeilen. Ein Betrieb mit 500 Positionen kann mit einer einfachen Tabelle gut arbeiten, während ein anderer mit 50 Positionen längst ein System braucht. Ausschlaggebend ist die operative Belastung: Wie oft ändern sich Daten, wer nutzt sie und welche Folgen hat ein Fehler?

Ein klarer Auslöser ist der Versionskonflikt. Wenn Teams Dateien mit Namen wie „Bestand_final_neu2“ versenden oder Kollegen nachfragen müssen, welche Spalte gerade gültig ist, fehlt eine verbindliche Datenquelle. Auch manuelle Kopierarbeit zwischen Auftragsliste, Lagerübersicht, Versanddatei und Rechnungsvorbereitung ist ein Signal. Jeder Transfer schafft eine weitere Gelegenheit für Zahlendreher, doppelte Einträge oder vergessene Aktualisierungen.

Ebenso kritisch sind Prozesse ohne nachvollziehbare Verantwortlichkeit. Wer hat eine Menge geändert? Wann wurde ein Wareneingang gebucht? Warum wurde ein Auftrag zurückgestellt? In einer Tabelle lassen sich Änderungen zwar teilweise protokollieren. Im Alltag ist das jedoch selten so eindeutig und nutzbar wie ein Prozess, der Buchungen, Statuswechsel und Benutzeraktionen gezielt festhält.

Ein weiterer Punkt ist die Geschwindigkeit der Arbeit. Wenn Mitarbeitende vor dem Verpacken erst eine Datei durchsuchen, einen Bestand prüfen, Daten abtippen und anschließend ein Versandlabel in einem separaten Portal erzeugen müssen, wird die Tabelle zum Taktgeber auf dem Hallenboden. Die Kosten entstehen dann nicht nur in Minuten. Sie zeigen sich in Unterbrechungen, Rückfragen, Fehlversand und dem Wissen, das nur in den Köpfen einzelner Personen steckt.

Die Risiken liegen oft zwischen zwei Zellen

Spreadsheets scheitern selten spektakulär. Häufig sind es kleine Abweichungen, die sich fortpflanzen: eine falsch gezogene Formel, ein Filter, der nicht alle Zeilen umfasst, eine Nummer als Text statt als Zahl oder eine versehentlich überschriebene Formel. Solche Fehler bleiben gerade dann lange unentdeckt, wenn das Team unter Zeitdruck arbeitet.

Bei geschäftskritischen Abläufen kommt ein zweites Risiko hinzu: fehlende Prozessführung. Eine Tabelle kann zeigen, dass ein Auftrag existiert. Sie stellt aber nicht zuverlässig sicher, dass alle notwendigen Schritte in der richtigen Reihenfolge erfolgen. Muss vor dem Versand eine Qualitätsprüfung abgeschlossen sein? Darf ein Lieferschein ohne bestätigte Kommissionierung erstellt werden? Soll ein Auftrag bei fehlendem Bestand automatisch in die Klärung gehen? Diese Regeln gehören nicht in Erinnerungen, farbige Zellen oder komplizierte Wenn-Dann-Formeln, wenn sie täglich über korrekte Abläufe entscheiden.

Auch Berechtigungen werden mit zunehmender Teamgröße relevant. Nicht jeder muss Preise ändern, Stammdaten pflegen oder abgeschlossene Vorgänge korrigieren dürfen. Eine maßgeschneiderte Anwendung kann Rollen klar abbilden, sensible Aktionen protokollieren und etwa nach mehreren Fehlversuchen einen Account sperren. Das ist keine übertriebene Technik. Es ist eine saubere Antwort auf Verantwortlichkeit.

Nicht jedes Problem braucht ein großes ERP

Die Alternative zur Tabellenkalkulation ist nicht automatisch eine globale Enterprise-Suite mit langen Einführungsprojekten. Für viele kleine und mittlere Unternehmen wäre das der falsche Schritt: zu viele Funktionen, zu starre Abläufe, hohe Lizenzkosten und ein System, das sich dem Betrieb nicht ausreichend anpasst.

Sinnvoller ist häufig eine fokussierte Anwendung für den konkreten Engpass. Das kann ein System für Wareneingänge, Bestandsbewegungen und Lagerplätze sein. Es kann Aufträge aus E-Mails oder Formularen strukturiert erfassen, Lieferscheine erzeugen, Versandetiketten vorbereiten oder Touren nach klaren Regeln planen. Entscheidend ist nicht, möglichst viel Software einzuführen. Entscheidend ist, dass die nächste Handlung für die zuständige Person eindeutig wird.

Eine gute Lösung darf dabei neben bestehenden Werkzeugen starten. Buchhaltung, ERP oder Versanddienstleister müssen nicht sofort ersetzt werden. Häufig ist eine verlässliche Schnittstelle oder ein sauberer Export der pragmatischere Weg. Der Nutzen entsteht, wenn doppelte Eingaben entfallen und operative Daten dort aktuell sind, wo sie gebraucht werden.

So prüfen Sie den tatsächlichen Handlungsbedarf

Statt direkt Softwareangebote zu vergleichen, lohnt sich ein Blick auf einen konkreten Ablauf. Nehmen Sie zum Beispiel den Weg eines Auftrags vom Eingang bis zum Versand. Notieren Sie nicht nur die offiziellen Schritte, sondern auch Telefonate, Notizzettel, private Chat-Nachrichten und die Stellen, an denen jemand Informationen aus einer Datei in ein anderes System überträgt.

Fragen Sie anschließend: Wo warten Mitarbeitende auf Informationen? Wo werden Daten mehrfach eingegeben? Welche Entscheidung hängt an Erfahrung statt an sichtbaren Regeln? Und welche Fehler wären teuer, wenn sich das Auftragsvolumen in sechs Monaten verdoppelt? Diese Analyse zeigt meist schneller als jede Funktionsliste, ob eine Tabelle noch genügt.

Nicht jede Auffälligkeit rechtfertigt eine Individualentwicklung. Wenn ein Bericht monatlich von einer Person erstellt wird und ein Fehler leicht korrigierbar ist, bleibt die Tabelle oft sinnvoll. Wenn jedoch mehrere Personen täglich auf aktuelle Daten angewiesen sind, wenn physische Waren bewegt werden oder wenn Nachweise gegenüber Kunden benötigt werden, verändert sich die Rechnung. Dann bezahlt der Betrieb längst für die Grenzen des Werkzeugs - nur verteilt über Arbeitszeit, Fehlerkorrekturen und Verzögerungen.

Ein Ersatz muss wartbar bleiben

Wer Spreadsheets ablöst, sollte nicht bloß eine schönere Oberfläche kaufen. Die Datenstruktur, die Regeln und der Betrieb der Anwendung entscheiden darüber, ob die Lösung nach zwei Jahren noch zuverlässig funktioniert. Für eine schlanke Webanwendung können beispielsweise PHP 8.4, modernes JavaScript und MySQL 8 eine bewusst nüchterne Grundlage sein: gut wartbar, leistungsfähig und ohne Abhängigkeit von kurzlebigen Trends.

Genauso wichtig ist die Einführung. Ein System sollte reale Abläufe zuerst stabilisieren, nicht alle denkbaren Wünsche gleichzeitig abdecken. Ein klar abgegrenzter erster Bereich - etwa Wareneingang und Bestandsbuchung - schafft Vertrauen. Danach lassen sich Versand, Lieferdokumente oder Auswertungen auf einer konsistenten Datenbasis ergänzen.

Die alten Tabellen verschwinden dabei nicht zwangsläufig sofort. Manche bleiben als Archiv, für Sonderauswertungen oder als kontrollierter Export bestehen. Das Ziel ist nicht, Tabellenkalkulationen zu verbannen. Das Ziel ist, sie von Aufgaben zu entlasten, für die sie nie als dauerhaftes Betriebssystem gedacht waren.

Wenn Ihr Team regelmäßig prüft, welche Datei stimmt, wer zuletzt etwas geändert hat oder ob ein Auftrag wirklich vollständig bearbeitet wurde, ist das kein kleiner organisatorischer Makel. Es ist ein guter Anlass, den Prozess gemeinsam am tatsächlichen Arbeitsplatz anzusehen - bevor die nächste Wachstumsspitze aus einer fragilen Tabelle einen täglichen Engpass macht.

Permalink →

AI Testing Platforms für Regressionstests

AI Testing Platforms für Regressionstests

Ein Release ist fachlich fertig, aber niemand kann mit Sicherheit sagen, ob der neue Preisimport den Auftragseingang, die Benutzerrechte oder den Versandprozess beschädigt hat. Genau an dieser Stelle werden AI testing platforms interessant. Nicht, weil sie menschliche Qualitätsarbeit wegzaubern, sondern weil sie wiederkehrende Prüfungen zuverlässig ausführen, sichtbar dokumentieren und bei Abweichungen verständlich machen können.

Für Teams mit gewachsenen Web- oder Windows-Anwendungen ist das ein praktisches Problem, kein Innovationsprojekt. Kritische Abläufe entstehen oft über Jahre: ein Auftrag wird angelegt, ein Lagerbestand gebucht, ein PDF erzeugt, eine Schnittstelle informiert. Eine kleine Änderung an einer Eingabemaske kann an unerwarteter Stelle Folgen haben. Manuelle Regressionstests sind dann langsam, abhängig von einzelnen Personen und unter Zeitdruck besonders fehleranfällig.

Was AI Testing Platforms tatsächlich leisten

Klassische Testautomatisierung folgt vorab geschriebenen Schritten. Das bleibt für viele Prüfungen sinnvoll und notwendig. Eine KI-gestützte Plattform kann zusätzlich mit einer Anwendung über ihre Oberfläche arbeiten, Inhalte erkennen, Testschritte ausführen und Auffälligkeiten in natürlicher Sprache einordnen. Sie kann etwa prüfen, ob ein berechtigter Nutzer einen Wareneingang buchen kann, ob ein gesperrter Account korrekt abgewiesen wird oder ob ein Lieferschein nach einer Änderung weiterhin erzeugt wird.

Der entscheidende Nutzen liegt nicht nur im Klick auf einen Button. Gute Systeme verbinden Ausführung, Beobachtung und Nachweis. Zu einem Testlauf gehören daher nachvollziehbare Schritte, Screenshots oder Aufzeichnungen, Zeitpunkte, verwendete Testdaten und eine klare Bewertung. Wenn ein Test fehlschlägt, braucht das Team mehr als die Meldung „Assertion failed". Es muss sehen können, an welchem Bildschirm, mit welchem Zustand und aus welchem Grund die Abweichung aufgetreten ist.

KI kann diese Arbeit beschleunigen. Sie ersetzt jedoch nicht die Entscheidung, was wirklich geschäftskritisch ist. Ein Modell erkennt möglicherweise, dass ein Dialog anders aussieht. Ob diese Änderung einen Fehler darstellt, eine bewusst neue Gestaltung ist oder nur eine harmlose Darstellung im Browser, bleibt eine Frage von Regeln, Kontext und Freigabe.

Nicht jede Prüfung gehört in die KI

Der häufigste Fehler bei der Einführung ist ein zu großer Anspruch. Eine Plattform sollte nicht zuerst jede Funktion eines Systems abdecken. Sie sollte die Abläufe sichern, deren Ausfall teuer, riskant oder arbeitsintensiv wäre. In einer Logistiksoftware sind das typischerweise Auftragserfassung, Bestandsbewegungen, Etiketten- oder Dokumentendruck, Benutzerrollen und Schnittstellenübergaben. In einer kaufmännischen Webanwendung können Anmeldung, Rechnungsfreigabe, Exporte und Zahlungsstatus im Mittelpunkt stehen.

Ein sinnvoller Start besteht aus einem kleinen Satz stabiler End-to-End-Tests. Ein Test bildet dabei nicht nur einen einzelnen Klick ab, sondern einen abgeschlossenen Arbeitsvorgang. Beispielsweise: Nutzer meldet sich an, legt einen Auftrag an, bestätigt die Positionen, erzeugt einen Lieferschein und prüft, ob der Vorgang in der Übersicht erscheint. Solche Prüfungen liefern einen höheren Geschäftsbezug als viele isolierte Tests für einzelne Felder.

Das heißt nicht, dass jede Testart über die Benutzeroberfläche laufen sollte. Entwicklerteams brauchen weiterhin schnelle Unit- und Integrationstests nah am Code. Diese Tests finden technische Fehler früh und günstig. UI-basierte KI-Tests ergänzen sie dort, wo das Zusammenspiel von Oberfläche, Berechtigungen, Datenbank, Dokumenten und externen Diensten geprüft werden muss. Wer alles nur über die Oberfläche testet, bekommt langsame und schwer wartbare Testläufe. Wer ausschließlich im Code testet, übersieht unter Umständen Fehler, die Anwender unmittelbar treffen.

Stabilität entsteht durch gute Testbedingungen

Automatisierte Tests scheitern nicht immer wegen eines Produktfehlers. Instabile Testdaten, wechselnde Benutzerrechte, nicht erreichbare Testsysteme oder parallele Änderungen können ebenso die Ursache sein. Deshalb gehört die Testumgebung zur Plattformentscheidung dazu.

Testkonten sollten eindeutig sein und bekannte Berechtigungen besitzen. Daten müssen entweder vor jedem Lauf reproduzierbar zurückgesetzt oder gezielt neu angelegt werden. Auch externe Systeme verlangen eine Entscheidung: Wird eine Versand- oder Zahlungsintegration gegen eine sichere Testumgebung geprüft, mit einem kontrollierten Stub simuliert oder bewusst aus dem Ablauf herausgenommen? Es gibt keine pauschal richtige Antwort. Entscheidend ist, dass die Aussage eines Tests klar bleibt.

Für kritische Freigaben lohnt sich außerdem ein definiertes Vertrauensniveau. Ein visueller Unterschied mit geringer Sicherheit sollte nicht automatisch ein Release blockieren. Ein fehlender Versandbeleg nach einer erfolgreich gebuchten Lieferung dagegen ist ein harter Fehler. Gute Testprozesse unterscheiden zwischen Hinweisen zur Prüfung und klaren Freigabekriterien.

Datenhoheit ist bei KI-Tests keine Randfrage

Sobald ein Test auf einer echten Anwendung läuft, kann er vertrauliche Informationen sehen: Kundennamen, Preise, Adressen, interne Artikelnummern, Screenshots aus Fachanwendungen oder Inhalte aus Dokumenten. Werden solche Daten zusammen mit Bildschirmaufzeichnungen und Testprotokollen an externe Dienste übertragen, ist das eine Architekturentscheidung mit Folgen für Datenschutz, Informationssicherheit und Verträge.

Gerade bei internen Web- und Windows-Anwendungen reicht die Frage „Funktioniert die Plattform?" nicht aus. Verantwortliche sollten prüfen, wo Testläufe ausgeführt werden, wo Screenshots und Protokolle gespeichert werden, welche Daten ein KI-Modell verarbeitet und wer administrativen Zugriff erhält. Auch Aufbewahrungsfristen und Löschkonzepte gehören dazu. Ein Testbericht kann wertvoller Nachweis für ein Release sein, aber er sollte nicht unbegrenzt sensible Informationen konservieren.

Für Organisationen mit erhöhten Anforderungen kann eine selbst gehostete Ausführung die passendere Lösung sein. Sie hält Testverkehr, Testdaten und Beweise in der eigenen kontrollierten Umgebung. Das erhöht den Betriebsaufwand etwas: Updates, Zugänge, Kapazitäten und Monitoring brauchen Verantwortung. Im Gegenzug bleibt die technische und organisatorische Kontrolle dort, wo sie oft hingehört. Bei COCO setzt softify.pro genau auf dieses Modell: automatisierte Tests für Web- und Windows-Anwendungen mit lokaler Datenhaltung und nachvollziehbaren Testnachweisen.

Woran sich eine passende Plattform erkennen lässt

Eine überzeugende Auswahl beginnt mit den vorhandenen Anwendungen, nicht mit einer Produktdemo. Eine Plattform kann in einer sauberen Beispielanwendung beeindruckend wirken und an einer älteren Desktop-Maske, einer Citrix-Umgebung oder einer komplexen Anmeldung an Grenzen stoßen. Ein kurzer Proof of Concept mit zwei oder drei echten Geschäftsabläufen sagt deutlich mehr aus als eine Funktionsliste.

Dabei sollten Teams besonders auf vier Punkte achten:

  • Anwendungsabdeckung: Unterstützt die Lösung die vorhandenen Webbrowser, Windows-Desktop-Anwendungen und gegebenenfalls Remote-Desktop- oder Citrix-Szenarien?
  • Nachvollziehbarkeit: Liefert jeder Lauf verständliche Schritte, Screenshots, Protokolle und eine Begründung, warum ein Test als bestanden oder fehlgeschlagen gilt?
  • Betriebsmodell: Passt Cloud, private Umgebung oder Self-Hosting zu den Sicherheitsvorgaben, den verfügbaren IT-Ressourcen und den Testdaten?
  • Wartbarkeit: Können Fachbereiche Testabläufe mitprüfen, während technische Teams Versionierung, Freigaben und wiederholbare Ausführung sauber steuern?

Hinzu kommt die Integration in den Releaseprozess. Ein Test, der nur auf Nachfrage gestartet wird, hilft weniger als ein geplanter Lauf vor der Bereitstellung oder nach einer relevanten Änderung. Gleichzeitig sollte nicht jedes kleine Styling-Update einen stundenlangen Gesamttest auslösen. Reife Prozesse wählen Tests nach Risiko: ein kurzer Smoke-Test nach jedem Deployment, gezielte Regressionen bei Änderungen an kritischen Modulen und umfangreichere Läufe vor größeren Releases.

Klare Berichte statt Testtheater

Testautomatisierung produziert leicht Aktivität ohne Erkenntnis. Hunderte grüne Checks klingen gut, wenn niemand sagen kann, welche Geschäftsprozesse sie absichern, sind sie kaum steuerbar. Ein brauchbarer Bericht beantwortet einfache Fragen: Was wurde geprüft? Mit welchem Ergebnis? Welche Version war betroffen? Was muss jetzt jemand entscheiden?

Plain-Language-Bewertungen können hier viel Zeit sparen, sofern sie auf echten Ausführungsdaten beruhen. „Der Benutzer konnte sich anmelden, den Auftrag anlegen und den Lieferschein erzeugen" ist für einen Fachverantwortlichen nützlicher als eine Sammlung technischer Selektoren. Bei Fehlern bleibt die technische Tiefe dennoch wichtig. QA und Entwicklung benötigen den Screenshot, die Protokolldaten und reproduzierbare Schritte, nicht nur eine KI-Zusammenfassung.

Einführung ohne den laufenden Betrieb zu stören

Die beste Einführung beginnt mit einem Prozess, bei dem ein Fehler spürbare Auswirkungen hätte und dessen Ablauf ausreichend stabil ist. Das kann der Tagesabschluss sein, die Auftragsfreigabe oder eine Kernfunktion in einer Kundenplattform. Gemeinsam mit Fachbereich und Technik wird festgelegt, was als erfolgreich gilt, welche Testdaten verwendet werden und wer einen Fehler bewertet.

Danach folgt ein kontrollierter Rhythmus: Tests bauen, wiederholt ausführen, Fehlalarme reduzieren und erst dann verbindlich in Freigaben einbinden. Dieser Zwischenschritt ist wichtig. Wer automatisierte Tests sofort als harte Sperre einsetzt, obwohl Umgebung und Daten noch schwanken, erzeugt Widerstand statt Vertrauen. Wer die Ergebnisse dagegen sichtbar mit echten Fehlern und stabilen Releases verbindet, schafft Akzeptanz.

AI testing platforms sind kein Ersatz für gute Softwarearchitektur, fachliche Verantwortung oder saubere Releaseentscheidungen. Richtig eingesetzt geben sie Teams aber etwas sehr Konkretes zurück: Zeit für die Fälle, die Urteilskraft brauchen, und belastbare Belege für die Abläufe, die einfach funktionieren müssen. Der sinnvollste erste Test ist deshalb selten der spektakulärste - sondern der Prozess, bei dem Montagmorgen niemand mehr rätseln soll, ob das System noch tut, was der Betrieb von ihm erwartet.

Permalink →

Testnachweise automatisch dokumentieren

Testnachweise automatisch dokumentieren

Ein fehlgeschlagener Regressionstest ist ärgerlich. Ein bestandener Test ohne verwertbaren Nachweis ist oft kaum besser. Wer Testnachweise automatisch dokumentieren will, löst deshalb kein reines Reporting-Problem. Es geht um eine belastbare Antwort auf konkrete Fragen: Was wurde getestet? In welcher Version? Mit welchen Eingaben? Was ist tatsächlich auf dem Bildschirm passiert? Und kann ein Entwickler, QA-Verantwortlicher oder Auditor das Ergebnis später nachvollziehen?

Gerade bei geschäftskritischen Web- und Windows-Anwendungen entstehen diese Fragen nicht erst beim Audit. Sie kommen auf, wenn nach einem Release ein Auftrag falsch verarbeitet wird, wenn ein Kunde einen ungewöhnlichen Fehler meldet oder wenn ein Team vor der Freigabe zwischen „sieht gut aus" und „ist nachweislich geprüft" unterscheiden muss. Manuell gepflegte Excel-Listen, Screenshots in Chatverläufen und lose Testnotizen reichen dafür nur, solange Umfang und Änderungsrate klein bleiben.

Warum manuelle Testnachweise schnell unzuverlässig werden

In vielen Teams beginnt die Dokumentation mit guten Absichten. Ein Tester hält das Ergebnis fest, ergänzt einen Screenshot und vermerkt die getestete Version. Unter Zeitdruck wird daraus jedoch schnell eine verkürzte Routine: Häkchen setzen, Fehler weitergeben, nächster Testfall. Besonders bei wiederkehrenden Regressionstests ist das nachvollziehbar - aber nicht belastbar.

Das Problem liegt nicht bei einzelnen Mitarbeitenden. Manuelle Dokumentation konkurriert immer mit der eigentlichen Testarbeit. Sobald zehn, fünfzig oder mehrere hundert Fälle pro Release geprüft werden müssen, fehlt entweder die Zeit für saubere Nachweise oder die Nachweise werden so umfangreich, dass sie niemand mehr auswertet. Dazu kommen typische Lücken: Ein Screenshot zeigt einen Zustand, aber nicht den vorangegangenen Ablauf. Ein Testprotokoll nennt den Fall, aber nicht die eingesetzte Build-Nummer. Ein Fehler wurde korrigiert, doch es ist nicht ersichtlich, wann und wie die Korrektur erneut geprüft wurde.

Für Anwendungen mit Auftragsabwicklung, Lagerbewegungen, Preisen, Benutzerrechten oder Schnittstellen ist das mehr als ein Komfortthema. Ein nicht dokumentierter Test kann nicht zuverlässig als erledigte Risikoprüfung gelten. Das gilt besonders dann, wenn ein vermeintlich kleiner Eingriff an einer Stelle Nebenwirkungen in angrenzenden Prozessen auslöst.

Was ein brauchbarer Testnachweis enthalten muss

Ein Testnachweis ist nicht einfach ein Bildschirmausschnitt mit grünem Haken. Er verbindet den Testfall mit seinem technischen und fachlichen Kontext. Mindestens muss später erkennbar sein, welche Anwendung, welche Version und welche Testumgebung geprüft wurden. Ebenso wichtig sind Startzeit, Endzeit, Ergebnis und eine klare Zuordnung zum jeweiligen Testschritt.

Bei automatisierten UI-Tests sollte der Nachweis außerdem die ausgeführten Aktionen und die beobachteten Resultate abbilden. Beispiel: Ein Test legt einen Auftrag an, prüft die Positionssumme, erzeugt einen Lieferschein und kontrolliert anschließend den Status im Versandbereich. Ein gutes Protokoll hält nicht nur „bestanden" fest. Es zeigt, an welchem Schritt die Prüfung stattfand, welchen erwarteten Wert das System liefern sollte und welchen Wert es geliefert hat.

Screenshots oder kurze Bildschirmaufzeichnungen sind dabei wertvoll, aber nicht immer zwingend für jeden einzelnen Erfolgsschritt. Sie kosten Speicherplatz und können sensible Daten enthalten. Sinnvoll ist meist eine abgestufte Strategie: Bei fehlgeschlagenen Prüfungen wird automatisch ein vollständiger visueller Nachweis gespeichert; bei erfolgreichen Standardfällen genügen strukturierte Protokolldaten und ausgewählte Belege. Welche Tiefe erforderlich ist, hängt von Risiko, Änderungsfrequenz und regulatorischem Umfeld ab.

Der Nachweis muss lesbar und technisch verwertbar sein

Entwickler brauchen Details wie Fehlermeldungen, Prüfwerte, Zeitstempel und den konkreten Schritt im Testablauf. Fachbereiche und Freigabeverantwortliche benötigen dagegen eine verständliche Aussage: Welche Geschäftsprozesse wurden geprüft, was hat bestanden und wo besteht Handlungsbedarf?

Beide Perspektiven sollten aus derselben Testausführung entstehen. Wenn ein QA-Team technische Logdateien exportiert und danach händisch eine Management-Zusammenfassung schreibt, entsteht wieder ein fehleranfälliger Medienbruch. Besser ist ein System, das Rohdaten strukturiert erfasst und daraus eine klare Bewertung erzeugt, ohne technische Details zu verstecken.

Testnachweise automatisch dokumentieren: der richtige Ablauf

Automatisierung funktioniert am besten, wenn sie an klar definierte Risiken gekoppelt wird. Nicht jeder Klick in jeder Anwendung muss sofort automatisiert und vollständig belegt werden. Der Startpunkt sind meist stabile, häufig wiederholte und geschäftskritische Abläufe: Anmeldung und Rechteprüfung, Auftragserfassung, Preisberechnung, Dokumentenerzeugung, Lagerbuchung oder Datenübergabe an eine Schnittstelle.

Für jeden Ablauf wird zunächst festgelegt, was als bestandener Test gilt. „Der Bildschirm sieht korrekt aus" ist dafür zu ungenau. Besser sind konkrete Prüfbedingungen: Der Benutzer mit Rolle Lager darf keine Preise ändern. Die Lieferscheinnummer wird erzeugt. Die Menge reduziert den verfügbaren Bestand. Nach fünf Fehlversuchen greift die Kontosperre. Solche Kriterien machen Testfälle wiederholbar und Nachweise vergleichbar.

Die Testausführung sollte dann automatisch mit Kontextdaten starten. Dazu zählen Build- oder Versionsnummer, Zielumgebung, Browser oder Betriebssystem, Testdatenstand und Zeitpunkt. Während der Ausführung protokolliert das System die einzelnen Schritte, die erwarteten und tatsächlichen Ergebnisse sowie technische Auffälligkeiten. Bei Abweichungen erzeugt es Belege, etwa Screenshots, Fehlermeldungen oder eine Aufzeichnung des relevanten Ablaufs.

Am Ende steht kein unstrukturierter Dateiordner, sondern ein Testlauf mit Status. Idealerweise lässt sich von einer Freigabeentscheidung bis zum einzelnen Schritt zurückverfolgen, warum ein Test als bestanden oder fehlgeschlagen bewertet wurde. Genau diese Verbindung reduziert Diskussionen nach einem Incident erheblich.

Wo KI sinnvoll ergänzt - und wo nicht

KI kann die Dokumentation und Auswertung deutlich beschleunigen. Sie kann Bildschirmzustände bewerten, auffällige Abweichungen markieren und Testläufe in verständlicher Sprache zusammenfassen. Bei großen Testmengen hilft das QA-Teams, nicht jeden erfolgreichen Durchlauf manuell lesen zu müssen. Eine Bewertung mit Konfidenzschwelle kann zudem Fälle hervorheben, bei denen die Erkennung unsicher ist und eine menschliche Prüfung erforderlich bleibt.

Trotzdem sollte KI nicht allein über kritische Freigaben entscheiden. Bei Feldern wie Zahlungsfreigabe, Berechtigungen, Preislogik oder rechtlich relevanten Dokumenten braucht es deterministische Prüfkriterien. Ein erwarteter Betrag ist entweder korrekt berechnet oder nicht. Eine Rolle hat Zugriff oder sie hat ihn nicht. KI ergänzt hier die Analyse visueller und sprachlicher Inhalte, ersetzt aber keine sauber definierte Fachregel.

Auch der Umgang mit Daten ist eine Architekturentscheidung. Screenshots aus internen Anwendungen können Kundendaten, Preise, Adressen oder Produktionsinformationen zeigen. Wer Testnachweise automatisch dokumentiert, sollte daher vorab festlegen, wo diese Belege gespeichert werden, wer sie einsehen darf und wie lange sie aufbewahrt werden. Für sicherheitsbewusste Teams kann eine selbst gehostete Testinfrastruktur wie COCO sinnvoll sein, weil Testverkehr, Aufzeichnungen und Auswertung im eigenen kontrollierten Umfeld bleiben.

Speicherfristen, Zugriffe und Belegqualität

Mehr Nachweise sind nicht automatisch bessere Nachweise. Ein jahrelang wachsender Screenshot-Bestand ohne Rollenmodell und Aufbewahrungskonzept schafft ein neues Risiko. Sinnvoll sind abgestufte Fristen: fehlgeschlagene oder freigaberelevante Testläufe länger vorhalten, erfolgreiche Routinetests nach einem definierten Zeitraum verdichten oder löschen und sensible Testdaten frühzeitig anonymisieren.

Ebenso entscheidend ist die Unveränderbarkeit. Wenn Testresultate nachträglich ohne Spur bearbeitet werden können, verlieren sie als Nachweis an Wert. Änderungen an Testfällen, Ergebnissen oder Freigabestatus sollten deshalb protokolliert werden. Das bedeutet nicht, dass jeder Testbericht komplizierte Audit-Software braucht. Aber Verantwortlichkeiten, Zeitstempel und nachvollziehbare Historien gehören zur Grundausstattung.

Mit einem Prozess beginnen, der wirklich weh tut

Der sinnvollste erste Automatisierungsschritt ist selten der größte. Wählen Sie einen Ablauf, der bei jedem Release geprüft wird, viele manuelle Minuten kostet und bei einem Fehler spürbare Folgen hat. Das kann die Auftragserfassung im Webportal sein, die Erzeugung eines Versanddokuments oder ein Rechtekonzept in einer Windows-Anwendung.

Definieren Sie für diesen Ablauf klare Erfolgskriterien, die erforderlichen Belege und einen verantwortlichen Empfänger für fehlgeschlagene Tests. Nach einigen Releases zeigt sich schnell, ob die Nachweise verständlich genug sind, ob zu viele Daten entstehen und welche Tests als Nächstes folgen sollten. So wächst keine Dokumentationsmaschine um der Dokumentation willen, sondern eine Prüfkette, die Releases schneller absichert und im Problemfall belastbare Antworten liefert.

Permalink →

Bestandsbewegungen digital dokumentieren im Lager

Bestandsbewegungen digital dokumentieren im Lager

Eine Differenz von 24 Stück im System klingt zunächst überschaubar. Problematisch wird sie, wenn niemand sagen kann, ob die Ware falsch eingelagert, für einen Auftrag entnommen, beschädigt oder nie gebucht wurde. Wer Bestandsbewegungen digital dokumentieren will, schafft deshalb nicht einfach mehr Daten. Er schafft eine nachvollziehbare Geschichte zu jedem Bestand - und damit eine belastbare Grundlage für Einkauf, Produktion, Versand und Inventur.

Für kleine und mittlere Lager ist das selten ein Fall für eine umfassende Enterprise-Suite. Entscheidend ist ein System, das die realen Wege der Ware abbildet: Wareneingang am Tor, Umlagerung zwischen Regalen, Materialentnahme in der Werkstatt, Kommissionierung, Rückläufer und Korrekturen nach der Inventur. Je weniger Teams zwischen Papier, Excel, Zuruf und mehreren Programmen wechseln müssen, desto verlässlicher werden die Zahlen.

Bestandsbewegungen digital dokumentieren beginnt beim Vorgang

Ein aktueller Lagerbestand beantwortet nur eine Frage: Wie viel ist gerade vorhanden? Für die operative Arbeit reicht das oft nicht. Bei Rückfragen braucht das Team zusätzlich Antworten auf andere Fragen: Wann hat sich der Bestand verändert? Wer hat die Buchung vorgenommen? Woher kam die Ware, wohin ging sie und welcher geschäftliche Vorgang war der Auslöser?

Genau hier liegt der Unterschied zwischen einer einfachen Bestandsliste und einer digitalen Bewegungsdokumentation. Jede Änderung wird als eigener, unveränderbarer Vorgang gespeichert. Der Bestand entsteht anschließend aus diesen Vorgängen. Wird etwa ein Artikel von Lagerplatz A-03 nach B-12 umgelagert, muss das System eine Abgangs- und eine Zugangsbewegung nachvollziehbar verbinden. Wird Material für einen Fertigungsauftrag entnommen, gehört die Buchung zum Auftrag - nicht nur zu einer anonymen Mengenänderung.

Dieses Prinzip verhindert keine Fehler vollständig. Es macht sie jedoch auffindbar. Eine Korrektur überschreibt dann nicht den alten Wert, sondern erzeugt eine neue Korrekturbuchung mit Grund. Das ist weniger bequem als eine Zahl direkt zu ändern, aber für Inventuren, Reklamationen und interne Abstimmungen deutlich besser.

Welche Daten pro Bewegung wirklich nötig sind

Viele Projekte werden unnötig kompliziert, weil von Anfang an jedes denkbare Feld vorgesehen wird. Für den zuverlässigen Betrieb genügen meist wenige, sauber gepflegte Angaben. Entscheidend ist nicht die Länge des Formulars, sondern dass jede Buchung fachlich eindeutig bleibt.

Eine Bewegungsbuchung sollte mindestens diese Informationen enthalten:

  • Artikel oder Material inklusive eindeutiger Artikelnummer
  • Menge und Einheit, etwa Stück, Meter, Kilogramm oder Karton
  • Bewegungsart, zum Beispiel Zugang, Entnahme, Umlagerung, Rückgabe oder Korrektur
  • Quell- und Zielort, soweit die Bewegungsart beides betrifft
  • Zeitpunkt, ausführende Person und ein nachvollziehbarer Belegbezug

Der Belegbezug kann eine Bestellung, ein Lieferschein, ein Kundenauftrag, ein Fertigungsauftrag oder eine Inventurposition sein. Er spart später Zeit, weil die Buchung nicht erst über Kommentare interpretiert werden muss. Freitext bleibt sinnvoll für Ausnahmen, sollte aber keine Pflichtinformationen ersetzen.

Bei chargenpflichtigen, seriennummerngeführten oder haltbaren Artikeln kommen weitere Merkmale hinzu. Dann muss beispielsweise klar sein, aus welcher Charge entnommen wurde oder welches Mindesthaltbarkeitsdatum betroffen ist. Das ist kein Detail für später: Wenn Rückverfolgbarkeit erforderlich ist, muss sie direkt im Buchungsablauf funktionieren.

Die Bewegungsarten an den realen Warenfluss anpassen

Die sinnvollsten Kategorien entstehen nicht im Workshop auf einer abstrakten Prozessgrafik, sondern bei einem Rundgang durchs Lager. Wo wird Ware tatsächlich angenommen? Wer entscheidet über Sperrbestände? Wann wird Material ausgebucht: bei Übergabe an die Werkstatt, beim Produktionsstart oder erst beim Verbrauch?

Wareneingang und Qualitätsprüfung

Beim Wareneingang sollte die Ware zunächst gegen Bestellung oder Lieferschein geprüft werden. Eine digitale Erfassung kann Menge, Lieferant, Belegnummer, Lagerplatz und optional Charge direkt zusammenführen. Falls eine Prüfung erforderlich ist, sollte die Ware nicht automatisch als frei verfügbar erscheinen. Ein Status wie „in Prüfung“ oder „gesperrt“ verhindert, dass ungeprüftes Material versehentlich kommissioniert wird.

Umlagerung und interne Übergaben

Umlagerungen werden besonders häufig vergessen, weil sie keinen sichtbaren Außenbeleg erzeugen. Im Ergebnis stimmt der Gesamtbestand, aber niemand findet die Ware am erwarteten Platz. Mobile Buchungen per Handscanner, Tablet oder einem einfachen Webformular helfen hier, wenn sie mit wenigen Eingaben auskommen. Ein kompliziertes Bildschirmformular wird im laufenden Betrieb umgangen - unabhängig davon, wie gut die Datenbank dahinter geplant ist.

Entnahme, Versand und Rückgabe

Bei Entnahmen muss die Buchung zum passenden Zweck passen. Material für einen Arbeitsauftrag, Ware für einen Kundenauftrag und Ausschuss sind fachlich unterschiedliche Vorgänge. Sie dürfen zwar denselben Artikelbestand reduzieren, benötigen aber unterschiedliche Auswertungen. Rückgaben sollten ebenfalls eine eigene Bewegungsart sein. Sonst bleibt offen, ob ein Artikel wieder verwendbar, zu prüfen oder auszubuchen ist.

Die Erfassung muss auf dem Hallenboden funktionieren

Digitalisierung scheitert selten daran, dass ein Team den Nutzen nicht versteht. Sie scheitert häufiger an fünf zusätzlichen Klicks, instabilem WLAN, unklaren Artikelnummern oder einer Buchung, die erst nach Schichtende am Büro-PC erledigt werden kann.

Deshalb lohnt es sich, pro Rolle einen klaren Ablauf festzulegen. Im Wareneingang wird typischerweise Bestellung oder Lieferschein gewählt, Artikel gescannt, Menge bestätigt und ein Lagerplatz vergeben. In der Kommissionierung genügt häufig Auftrag öffnen, Position scannen und Entnahme bestätigen. Für Lagerleiter braucht es zusätzlich Funktionen für Sperrungen, Korrekturen und Inventurzählungen, einschließlich einer Pflicht zur Angabe des Korrekturgrundes.

Barcode- oder QR-Scans reduzieren Übertragungsfehler, wenn Artikel und Lagerplätze sauber gekennzeichnet sind. Sie ersetzen aber keine Stammdatenpflege. Existieren fünf Schreibweisen für denselben Artikel oder werden Stellplätze informell benannt, beschleunigt ein Scanner nur die falsche Buchung. Vor dem technischen Rollout sollten Artikelnummern, Einheiten, Lagerorte und Verantwortlichkeiten bereinigt werden.

Auch Offline-Fähigkeit ist eine Abwägung. In einem kleinen Lager mit stabilem Netz kann eine browserbasierte Anwendung ausreichen. Bei Außenlagern, großen Hallen oder unzuverlässiger Verbindung kann eine lokale Zwischenspeicherung sinnvoll sein. Dann muss eindeutig geregelt sein, wie doppelte oder zeitlich versetzte Buchungen zusammengeführt werden.

Ein sinnvoller Rollout statt eines großen Umstellungstags

Ein vollständiger Wechsel an einem Stichtag wirkt entschlossen, erzeugt aber unnötiges Risiko. Besser ist es, mit einem abgegrenzten Bereich zu starten: etwa Wareneingang und Umlagerungen für eine Artikelgruppe oder einen Lagerbereich. Dort zeigt sich schnell, welche Bewegungsarten fehlen, welche Eingabemasken zu langsam sind und welche Sonderfälle tatsächlich regelmäßig auftreten.

Für den Start braucht das Team einen geprüften Anfangsbestand. Dieser kann aus einer Inventur, einer bereinigten Bestandsliste oder einer kontrollierten Übernahme stammen. Wichtig ist, den Übergang klar zu dokumentieren: Bis zu welchem Zeitpunkt gilt das alte System, ab wann ist das neue System führend? Parallel geführte Listen sind höchstens kurzfristig zur Kontrolle sinnvoll. Bleiben sie dauerhaft bestehen, entstehen zwei Wahrheiten.

Nach zwei bis vier Wochen sollten die Verantwortlichen nicht nur auf die Bestandsgenauigkeit schauen. Ebenso aussagekräftig sind die Zahl nachträglicher Korrekturen, fehlende Belegbezüge, Suchzeiten und Buchungen außerhalb der vorgesehenen Prozesse. Diese Beobachtungen liefern bessere Anforderungen als eine lange Wunschliste vor Projektbeginn.

Technische Grundlage: nachvollziehbar und wartbar

Hinter einer einfachen Buchungsmaske braucht es eine saubere Datenstruktur. Artikel, Lagerorte, Bewegungen, Belege und Benutzerrechte sollten getrennt modelliert sein. Jede Buchung benötigt eine eindeutige ID, Zeitstempel und eine Zuordnung zum Benutzerkonto. Änderungen an kritischen Vorgängen gehören in ein Prüfprotokoll.

Für viele mittelständische Anwendungen ist eine schlanke Webanwendung mit einer relationalen Datenbank wie MySQL 8 eine passende Grundlage. Sie kann Scanner-Eingaben verarbeiten, Rollenrechte abbilden, Bewegungsjournale erzeugen und Daten an Versand- oder Auftragsprozesse übergeben. Entscheidend ist weniger das eingesetzte Framework als eine dokumentierte Datenlogik, getestete Buchungsregeln und ein Betriebskonzept mit Backups, Zugriffsrechten und Wiederherstellungsabläufen.

Nicht jede Bewegung muss sofort an jedes andere System übertragen werden. Echtzeit-Synchronisation ist sinnvoll, wenn Versand, Shop oder Produktion direkt auf verfügbare Mengen angewiesen sind. In anderen Fällen reichen kontrollierte Übergaben in festen Intervallen. Mehr Integration bedeutet auch mehr Fehlerquellen und mehr Verantwortung bei Ausfällen.

Wann eine Tabelle noch genügt

Eine Tabelle ist nicht grundsätzlich ein Problem. Bei wenigen Artikeln, einem festen Lagerort und einer Person, die Ein- und Ausgänge konsequent pflegt, kann sie wirtschaftlich sein. Der Wechsel wird sinnvoll, wenn mehrere Personen gleichzeitig buchen, Lagerplätze relevant werden, Belege verknüpft werden müssen oder regelmäßig unklar ist, warum ein Bestand abweicht.

Der richtige nächste Schritt ist dann keine möglichst große Software, sondern eine Lösung, die den vorhandenen Warenfluss präzise unterstützt. Gute digitale Dokumentation macht Arbeit nicht spektakulärer. Sie sorgt dafür, dass eine Buchung im Moment der Bewegung passiert - und dass die Antwort auf die nächste Bestandsfrage bereits im System steht.

Permalink →

Warehouse Digitization Project Ideas, die wirken

Warehouse Digitization Project Ideas, die wirken

Ein fehlender Lieferschein kurz vor der Abfahrt, ein Bestand, der im Regal anders aussieht als in der Tabelle, und drei Mitarbeitende, die gleichzeitig dieselbe Rückfrage per Telefon klären: Genau dort entstehen sinnvolle warehouse digitization project ideas. Nicht bei der Frage, welche Technologie gerade modern wirkt, sondern bei einem konkreten Prozess, der Zeit kostet, Fehler erzeugt oder vom Wissen einzelner Personen abhängt.

Für kleine und mittlere Lager-, Handels- und Produktionsbetriebe ist Digitalisierung selten ein einzelnes Großprojekt. Sie ist eine Folge klar abgegrenzter Verbesserungen. Das Ziel muss nicht ein komplexes Enterprise-Warehouse-Management-System sein. Häufig ist ein schlankes, auf den tatsächlichen Ablauf zugeschnittenes Werkzeug besser als eine Suite mit Funktionen, die niemand auf dem Hallenboden nutzt.

Warehouse Digitization Project Ideas mit operativem Nutzen

Der beste Einstieg ist ein Prozess, der häufig vorkommt, leicht messbar ist und für Mitarbeitende spürbar besser wird. Wer sofort das gesamte Lager digitalisieren will, bindet Budget und Aufmerksamkeit, bevor sich eine Lösung im Alltag bewiesen hat. Ein begrenzter erster Schritt schafft dagegen belastbare Daten für die nächste Entscheidung.

1. Wareneingang mit mobiler Erfassung

Beim Wareneingang entstehen viele Folgefehler: falsch gezählte Mengen, ungeklärte Abweichungen, verzögert gebuchte Bestände und Papierbelege, die später nicht mehr auffindbar sind. Ein mobiles Erfassungsformular auf einem Handscanner, Tablet oder Smartphone kann den Vorgang deutlich stabiler machen.

Mitarbeitende scannen Artikel und Lieferreferenz, erfassen Menge, Lagerplatz und Abweichungsgrund direkt an der Rampe. Falls eine Charge, Seriennummer oder ein Foto relevant ist, gehört auch diese Information an denselben Datensatz. Der Bestand wird nicht erst am Ende der Schicht in einer Tabelle nachgetragen, sondern erhält einen nachvollziehbaren Status beim tatsächlichen Eingang.

Das bedeutet nicht, dass jeder Lieferant oder jeder Artikel zwingend Barcode-Etiketten braucht. Bei kleinen, unregelmäßigen Lieferungen kann eine Suche nach Artikelnummer ausreichen. Entscheidend ist, dass die Datenerfassung schneller ist als der bisherige Umweg über Papier und Nachpflege.

2. Digitale Umlagerungen statt Bestandsrätsel

Viele Lager wissen grundsätzlich, was vorhanden ist, aber nicht zuverlässig, wo es liegt. Ware wird für einen Auftrag vorgezogen, zwischengelagert, in die Montage gebracht oder wegen Platzmangel auf eine freie Fläche gestellt. Ohne einfache Buchung wird aus einer Bestandsfrage schnell eine Suchaktion.

Ein Umlagerungsprozess braucht keine komplizierte Oberfläche. Ausgangsplatz scannen, Zielplatz scannen, Menge bestätigen - mehr ist für viele Fälle nicht nötig. Das System sollte dabei prüfen, ob Artikel und Lagerplatz plausibel sind, und eine Buchung eindeutig einer Person und Uhrzeit zuordnen.

Wichtig ist der Umgang mit Ausnahmen. Ein Lagerplatz kann gesperrt, überfüllt oder nur für bestimmte Waren zugelassen sein. Diese Regeln sollten dort abgebildet werden, wo sie wirklichen Schaden verhindern. Für seltene Sonderfälle genügt oft ein Freigabeschritt durch die Lagerleitung. Zu viele Pflichtfelder machen aus einer hilfreichen Anwendung ein Hindernis.

3. Kommissionierung mit klaren Auftragsstatus

Papier-Picklisten funktionieren, bis Prioritäten wechseln, Positionen fehlen oder ein Auftrag auf mehrere Bereiche verteilt ist. Eine einfache digitale Kommissionierliste zeigt, welcher Auftrag offen ist, welche Positionen bereits gepickt wurden und wo eine Klärung nötig ist. Das reduziert Rückfragen zwischen Lager, Vertrieb und Versand.

Je nach Lagergröße kann die Anwendung Pickwege vorgeben oder lediglich Positionen nach Lagerzone sortieren. Eine vollständige Wegoptimierung lohnt sich vor allem bei vielen täglichen Aufträgen und langen Laufwegen. In einem kompakten Lager bringt eine verlässliche Statusanzeige oft mehr als ein mathematisch perfekter Weg, den im Alltag niemand befolgt.

Bei Fehlmengen sollte das System nicht nur rot markieren. Es sollte einen konkreten Folgeprozess anbieten: Bestand prüfen, Ersatzartikel anfragen, Nachschub auslösen oder Auftrag zur Klärung weitergeben. Digitalisierung ist dann wertvoll, wenn sie die nächste sinnvolle Handlung sichtbar macht.

4. Versanddokumente und Etiketten aus echten Auftragsdaten

Das manuelle Übertragen von Adressen, Gewichten und Artikelpositionen in Versandportale ist ein typischer Kandidat für Automatisierung. Lieferadresse, Lieferhinweise, Versandart und Paketinformationen liegen idealerweise einmal vor und werden für Lieferschein, Versandetikett und Versandbestätigung verwendet.

Ein passendes System kann Etiketten erzeugen, Dokumente revisionssicher ablegen und den Auftrag nach dem Druck automatisch auf versandbereit oder versendet setzen. Der operative Vorteil liegt nicht allein in gesparten Minuten. Er liegt darin, dass Versanddaten nicht an mehreren Stellen voneinander abweichen.

Hier ist die Integration entscheidend. Wenn ein Versanddienstleister keine brauchbare Schnittstelle bietet oder sehr unterschiedliche Sonderregeln gelten, kann ein teilautomatisierter Ablauf vernünftiger sein als eine fragile Vollintegration. Boring, provable reliability schlägt eine Automatisierung, die bei jeder Ausnahme stehen bleibt.

5. Nachschub und Mindestbestände mit nachvollziehbaren Regeln

Mindestbestände werden häufig in Tabellen gepflegt und dann ignoriert, weil niemand sicher ist, ob die Zahlen noch stimmen. Eine sinnvolle digitale Lösung verbindet tatsächliche Buchungen mit klaren Dispositionsregeln. Sie kann melden, wenn ein Artikel unter einen Schwellenwert fällt, reservierte Mengen berücksichtigen und eine Bestellliste vorbereiten.

Die Schwelle sollte nicht als ewige Wahrheit behandelt werden. Saisonale Nachfrage, Lieferzeiten und Mindestbestellmengen verändern sich. Deshalb braucht die verantwortliche Person eine einfache Möglichkeit, Vorschläge zu prüfen und Regeln anzupassen. Vollautomatische Bestellungen sind erst dann sinnvoll, wenn Stammdaten, Lieferantenlogik und Verbrauchsdaten stabil genug sind.

6. Rückverfolgbarkeit für Chargen, Seriennummern und Sperrbestände

Wer mit Chargen, Geräten, Ersatzteilen oder regulierten Produkten arbeitet, braucht mehr als eine Mengenanzeige. Es muss nachvollziehbar sein, welche Ware wann eingegangen ist, wohin sie bewegt wurde und in welchem Kundenauftrag sie gelandet ist.

Das Projekt kann bewusst klein beginnen: Zunächst nur Wareneingang und Versand einer kritischen Warengruppe erfassen. Danach folgen interne Bewegungen und Rückläufer. Ein System, das jede Buchung erzwingt, aber den realen Reparatur- oder Prüfprozess nicht kennt, wird umgangen. Die Fachlogik muss deshalb aus dem Arbeitsablauf entstehen, nicht aus einem abstrakten Datenmodell.

Das richtige Projekt auswählen

Die attraktivste Idee ist nicht automatisch die richtige erste Idee. Bewerten Sie mögliche Vorhaben nach Häufigkeit, Fehlerkosten, Wartezeit und Abhängigkeit von Einzelpersonen. Ein Prozess, der 50-mal täglich läuft und pro Vorgang zwei Minuten spart, kann wertvoller sein als eine seltene Sonderfunktion mit großer technischer Eleganz.

Auch die Datenqualität gehört in die Entscheidung. Wenn Artikelnummern doppelt vergeben sind, Lagerplätze nicht eindeutig benannt werden oder Aufträge aus mehreren Quellen widersprüchlich eintreffen, sollte das Projekt diese Grundlagen zuerst bereinigen. Software kann fehlende Regeln sichtbar machen, aber nicht zuverlässig ersetzen.

Für die Priorisierung reichen vier Fragen:

  • Welche Tätigkeit verursacht nachweislich die meisten Rückfragen oder Nacharbeiten?
  • Welche Information wird heute mehrfach abgeschrieben oder telefonisch abgefragt?
  • Welcher Fehler hätte die teuersten Folgen für Kunden, Bestand oder Versand?
  • Welcher Ablauf lässt sich in wenigen Wochen mit einer klaren Erfolgsmessung testen?

Technische Entscheidungen, die im Lageralltag zählen

Eine Lageranwendung muss nicht spektakulär aussehen. Sie muss bei schlechter WLAN-Abdeckung, im Handschuhbetrieb, unter Zeitdruck und während eines Schichtwechsels verständlich bleiben. Große Schaltflächen, klare Rückmeldungen nach einem Scan und eine sichtbare Fehlerbehandlung sind wichtiger als dekorative Dashboards.

Auch die Architektur sollte zur Betriebsrealität passen. Eine webbasierte Anwendung mit sauberer Datenbankstruktur kann auf vorhandenen Geräten laufen und ist leichter wartbar als eine Insellösung auf einem einzelnen PC. Mit einer stabilen Basis, etwa PHP 8.4, modernem JavaScript und MySQL 8, lassen sich Rollen, Buchungshistorien, Schnittstellen und dokumentierte Deployments langfristig nachvollziehbar betreiben.

Dabei ist nicht jede Information für jede Rolle bestimmt. Lagerkräfte benötigen offene Aufgaben und klare Buchungsdialoge. Die Disposition braucht Warnungen und Bestellvorschläge. Die Leitung braucht Auswertungen zu Durchlaufzeiten, Differenzen und offenen Vorgängen. Rechtekonzepte, Protokolle und Kontensperren bei wiederholten Fehlversuchen gehören früh in die Planung, besonders wenn externe Dienstleister oder mehrere Standorte beteiligt sind.

Einführung: Erst beweisen, dann ausweiten

Ein Pilot sollte mit echten Aufträgen laufen, nicht nur mit Testdaten im Besprechungsraum. Wählen Sie eine Lagerzone, eine Produktgruppe oder eine Schicht und definieren Sie vorab, woran Erfolg erkennbar ist: weniger Korrekturbuchungen, kürzere Bearbeitungszeit, weniger Rückfragen oder höhere Buchungsquote am selben Tag.

Planen Sie parallel eine Rückfallebene. Wenn die neue Anwendung ausfällt oder ein Prozess ungeklärt ist, muss die Mannschaft wissen, wie sie weiterarbeitet und wie nachträgliche Buchungen kontrolliert werden. Das ist kein Zeichen mangelnden Vertrauens in die Technik, sondern professioneller Betrieb.

Nach zwei bis vier Wochen zeigen sich meist die wertvollsten Erkenntnisse. Vielleicht fehlt kein Feature, sondern eine bessere Artikelkennzeichnung. Vielleicht ist der Workflow richtig, aber ein Scannerprofil oder eine Berechtigung bremst. Diese Beobachtungen sollten in kurze, kontrollierte Verbesserungszyklen fließen, statt ein neues Großprojekt auszulösen.

Die beste Digitalisierung macht den Lageralltag nicht theoretisch moderner, sondern konkret ruhiger: weniger Suchen, weniger Nachtragen, klarere Übergaben und belastbare Informationen genau dann, wenn eine Entscheidung ansteht.

Permalink →

Inventory Workflow Automation Checklist fürs Lager

Inventory Workflow Automation Checklist fürs Lager

Ein Wareneingang wird auf Papier bestätigt, Bestände später in eine Tabelle übertragen und eine Versandfrage per Telefon geklärt. Jeder einzelne Schritt wirkt beherrschbar. Zusammen erzeugen sie Rückfragen, Bestandsdifferenzen und Abhängigkeit von einzelnen Mitarbeitenden.

Eine Inventory Workflow Automation Checklist verhindert, dass aus diesem Zustand vorschnell ein überdimensioniertes Softwareprojekt wird. Sie trennt Prozesse, die wirklich automatisiert werden sollten, von solchen, für die ein sauber geführtes Spreadsheet weiterhin genügt.


Die Inventory Workflow Automation Checklist vor dem Projektstart

Automatisierung beginnt nicht mit der Auswahl eines Systems. Sie beginnt mit einer überprüfbaren Beschreibung dessen, was im Lager tatsächlich passiert - auch bei Ausnahmen, Schichtwechseln und Zeitdruck. Gehen Sie die folgenden Punkte mit Lagerleitung, Disposition, Einkauf und gegebenenfalls Buchhaltung direkt am Prozess durch.

1. Bewegungen statt nur Bestände erfassen

Ein aktueller Bestand ist das Ergebnis von Bewegungen. Deshalb sollte klar sein, welche Ereignisse den Bestand erhöhen, verringern, reservieren, sperren oder umbuchen. Dazu gehören Wareneingang, Einlagerung, Kommissionierung, Versand, Retoure, Ausschuss, Inventurdifferenz und Umlagerung.

Für jede Bewegung braucht es eine eindeutige Antwort auf vier Fragen: Wer führt sie aus? Wann wird sie gebucht? Welcher Lagerort ist betroffen? Welcher Beleg oder Auftrag belegt sie? Wenn diese Antworten heute nur im Kopf erfahrener Mitarbeitender existieren, ist das ein guter Automatisierungskandidat. Das Ziel ist nicht mehr Datenerfassung, sondern eine belastbare Historie, aus der sich ein Bestand erklären lässt.

2. Artikel, Varianten und Einheiten bereinigen

Viele Projekte scheitern nicht am Scanner oder an der Weboberfläche, sondern an Stammdaten. Ein Artikel kann als Karton eingekauft, einzeln gelagert und in Sets verkauft werden. Ohne definierte Umrechnungen produziert die Software formal korrekte, operativ aber falsche Mengen.

Prüfen Sie Artikelnummern auf Dubletten, legen Sie verbindliche Bezeichnungen fest und unterscheiden Sie Verkaufseinheit, Lagereinheit und Verpackungseinheit. Seriennummern, Chargen, Mindesthaltbarkeitsdaten oder Gefahrstoffkennzeichnungen gehören nur dann in den ersten Ausbau, wenn sie im Alltag Entscheidungen beeinflussen oder regulatorisch erforderlich sind. Alles andere erhöht zunächst Pflegeaufwand und Fehlerfläche.

3. Lagerorte so genau definieren, wie nötig

„Halle 2“ ist für eine Inventurliste vielleicht ausreichend. Für eine verlässliche Kommissionierung ist es meist zu grob. Definieren Sie, ob ein Lagerort Zone, Regal, Fach, Stellplatz oder Übergabefläche meint. Auch Sperrlager, Wareneingangszone, Retourenbereich und Versandpuffer müssen als eigene Orte erkennbar sein, wenn Waren dort liegen können.

Die richtige Granularität hängt vom Betrieb ab. Ein Workshop mit wenigen hundert Positionen braucht nicht zwingend eine Fachverwaltung. Bei mehreren Kommissionierenden pro Schicht kann ein präziser Stellplatz jedoch Laufwege und Suchzeiten deutlich reduzieren. Automatisieren Sie keine Genauigkeit, die niemand pflegen kann.

4. Auslöser, Verantwortliche und Freigaben festlegen

Ein Workflow braucht einen klaren Startpunkt. Beim Wareneingang kann das die Lieferung am Tor, die Bestellung im Einkauf oder der Scan eines Lieferscheins sein. Für eine Nachbestellung kann ein Mindestbestand den Vorschlag auslösen, während die endgültige Bestellung bei einer verantwortlichen Person bleibt.

Dokumentieren Sie außerdem, welche Aktionen automatisch erfolgen dürfen und welche eine Prüfung brauchen. Eine fehlende Menge sollte etwa eine Abweichung erzeugen, nicht stillschweigend den erwarteten Wareneingang verändern. Bei wertvollen, chargenpflichtigen oder sicherheitskritischen Artikeln sind Freigabeschritte sinnvoll. Bei Verbrauchsmaterial würden sie den Durchsatz unnötig bremsen.

5. Dokumente dort erzeugen, wo sie gebraucht werden

Lieferscheine, Einlagerungslisten, Picklisten, Versandetiketten und Übergabeprotokolle entstehen oft in verschiedenen Anwendungen. Das führt zu Medienbrüchen: Eine Adresse wird kopiert, ein Auftrag abgehakt, ein Versandstatus später nachgetragen.

Notieren Sie pro Dokument die Quelle der Daten, den Zeitpunkt der Erstellung und den Empfänger. Ein sinnvoller Ablauf kann beispielsweise nach der Freigabe eines Auftrags automatisch eine Pickliste erzeugen, nach dem Packen ein Versandlabel bereitstellen und nach der Übergabe den Auftrag mit Zeitstempel abschließen. Entscheidend ist, dass die Daten nicht mehrfach manuell eingegeben werden müssen.

Schnittstellen und Datenqualität prüfen

Die beste Lagerlogik nützt wenig, wenn Aufträge nur einmal täglich als Datei eintreffen oder Lieferadressen unterschiedlich formatiert sind. Erstellen Sie deshalb eine nüchterne Liste der Systeme, die Daten senden oder empfangen: Shop, ERP, Buchhaltung, Versanddienstleister, Lieferantenportal, Produktionssystem und vorhandene Tabellen.

Für jede Verbindung sollte feststehen, welches System bei welchem Datenfeld führend ist. Ist der Artikelstamm im ERP maßgeblich, darf das Lagerportal nicht still eigene Artikel anlegen. Kommt eine Auftragsänderung aus dem Shop, muss sie vor dem Versand sichtbar werden. Bei kleinen Mengen kann ein kontrollierter CSV-Import der richtige erste Schritt sein. Bei hohem Volumen oder kurzen Lieferzusagen lohnt sich eine direkte Schnittstelle.

Ebenso wichtig ist der Umgang mit Fehlern. Eine Schnittstelle sollte nicht nur Daten übertragen, sondern auch zeigen, was abgewiesen wurde und warum. Unbekannte Artikelnummern, ungültige Adressen oder fehlende Mengen dürfen nicht in einer technischen Protokolldatei verschwinden. Sie brauchen eine Arbeitsliste mit Zuständigkeit und Status.

Bedienung auf dem Lagerboden gestalten

Ein Prozess, der am Schreibtisch plausibel aussieht, kann auf dem Lagerboden scheitern. Mitarbeitende tragen Handschuhe, bewegen Waren, teilen Geräte oder arbeiten bei instabiler WLAN-Abdeckung. Prüfen Sie deshalb früh, ob Scanner, Tablet, Desktop oder Ausdruck zum jeweiligen Arbeitsschritt passen.

Der Scan sollte eine eindeutige Rückmeldung geben: richtige Ware, falscher Lagerort, bereits gebuchte Menge oder gesperrter Artikel. Farben allein reichen nicht. Kurze, verständliche Meldungen und ein klarer nächster Schritt sind unter Zeitdruck wertvoller als eine funktionsreiche Oberfläche.

Planen Sie auch den Ausnahmefall. Was passiert bei beschädigtem Barcode, Netzwerkausfall, Teillieferung oder einer gefundenen Ware ohne Zuordnung? Ein guter Ablauf bietet dafür kontrollierte Wege und protokolliert die Korrektur. Er zwingt Teams nicht dazu, sich mit Notizzetteln und späteren Sammelbuchungen zu helfen.

Kennzahlen definieren, bevor Dashboards gebaut werden

Ein Dashboard ist kein Ziel. Relevant sind Kennzahlen, die eine operative Entscheidung auslösen. Das können offene Wareneingänge über einem definierten Alter, Aufträge kurz vor dem Versandtermin, Bestandsdifferenzen je Lagerzone, Kommissionierfehler oder die Zeit zwischen Auftragseingang und Übergabe sein.

Legen Sie für jede Kennzahl Datenquelle, Berechnungsregel und verantwortliche Rolle fest. „Bestandsgenauigkeit“ ist beispielsweise nur aussagekräftig, wenn klar ist, gegen welche Zählung sie gemessen wird und wie Retouren oder Sperrbestände behandelt werden. Wenige verlässliche Kennzahlen sind besser als eine Wand aus Diagrammen, der niemand vertraut.

Sicherheit, Rechte und Nachvollziehbarkeit einplanen

Automatisierung verteilt Handlungsmacht. Wer Bestände ändern, Artikel anlegen, Versandlabels erzeugen oder Aufträge stornieren darf, sollte bewusst festgelegt werden. Rollenbasierte Rechte sind meist sinnvoller als ein gemeinsames Login am Lager-PC. Besonders kritische Korrekturen benötigen einen Zeitstempel, eine Personenzuordnung und idealerweise einen Grund.

Auch technische Grundlagen gehören auf die Checkliste: regelmäßige Backups, getestete Wiederherstellung, dokumentierte Zugänge, Protokollierung von Schnittstellenfehlern und ein Verfahren für gesperrte oder ausgeschiedene Nutzerkonten. Bei einer individuellen Anwendung sind wartbare Technologien, eine klare Datenbankstruktur und nachvollziehbare Deployment-Schritte keine Nebensache. Sie entscheiden darüber, ob Anpassungen nach zwei Jahren noch kalkulierbar bleiben.

In kleinen, messbaren Schritten einführen

Versuchen Sie nicht, Wareneingang, Nachschub, Inventur, Versand und Routenplanung gleichzeitig umzustellen. Wählen Sie einen Ablauf mit spürbarem Schmerz und überschaubarem Risiko, etwa die mobile Buchung von Wareneingängen oder das automatische Erstellen von Versanddokumenten. Erfassen Sie vor dem Start Bearbeitungszeit, Korrekturen und offene Fälle.

Testen Sie mit echten Artikeln, echten Aufträgen und den Mitarbeitenden, die später damit arbeiten. Ein Pilot mit einer Lagerzone oder einer Produktgruppe zeigt schneller als ein Workshop, ob Bezeichnungen, Scannerabläufe und Freigaben funktionieren. Erst wenn die Ausnahmefälle beherrscht sind, sollte der nächste Prozess folgen.

Automatisierung ist gelungen, wenn Teams weniger nachfragen müssen, ein Bestand erklärbar bleibt und der Prozess auch dann funktioniert, wenn die erfahrenste Person im Urlaub ist. Genau dort lohnt sich die nächste Verbesserung: nicht beim lautesten Tool, sondern bei der Reibung, die den Arbeitstag tatsächlich verlangsamt.

Permalink →

Mobile Webseiten-Ladezeit verbessern

Mobile Webseiten-Ladezeit verbessern

Auf einem Lagerhandy mit mäßigem Empfang entscheidet nicht die Animation im Hero-Bereich über den ersten Eindruck, sondern ob die Seite überhaupt bedienbar wird. Wartet ein Interessent drei, vier oder fünf Sekunden auf Inhalte, ist der Vergleich zur Konkurrenz nur einen Zurück-Button entfernt. Wer die mobile Webseite Ladezeit verbessern will, braucht deshalb keine kosmetischen Einzelmaßnahmen, sondern eine nachvollziehbare technische Reihenfolge.

Das gilt besonders für Websites, die Anfragen erzeugen sollen: für einen Hersteller, einen Logistikdienstleister oder einen Betrieb mit erklärungsbedürftigen Leistungen. Mobil kommen Nutzer oft zwischen Terminen, auf der Fläche oder über eine Suchanfrage mit konkreter Absicht auf die Seite. Die Website muss dann Informationen liefern, nicht erst Rechenarbeit auf dem Gerät verursachen.

Warum mobile Ladezeit ein Betriebsproblem ist

Mobile Performance wird häufig als SEO-Disziplin behandelt. Das greift zu kurz. Schnelle Seiten helfen zwar bei Sichtbarkeit und Kampagnenkosten, aber der unmittelbare Effekt liegt in der Nutzung: Formulare werden eher abgeschickt, Telefonnummern eher gewählt und Produktinformationen eher gelesen. Eine langsame Website erzeugt dagegen Zweifel, noch bevor ein Ansprechpartner reagieren kann.

Dabei ist „schnell“ kein einzelner Messwert. Eine Seite kann früh einen Hintergrund anzeigen und dennoch erst deutlich später auf Klicks reagieren. Für Besucher zählen drei Dinge: Wann erscheint der wichtigste Inhalt? Wann lässt sich die Seite ohne Verzögerung bedienen? Und springt das Layout noch, während sie gerade einen Button antippen wollen? Diese Fragen spiegeln sich in Kennzahlen wie Largest Contentful Paint, Interaction to Next Paint und Cumulative Layout Shift wider.

Messungen müssen unter realistischen Bedingungen erfolgen. Ein leistungsstarker Bürorechner im WLAN verschleiert Probleme, die auf einem älteren Android-Gerät im Mobilfunknetz sichtbar werden. Auch der Standort, zwischengeschaltete Dienste und eine bereits gefüllte Browser-Cache verändern Ergebnisse. Entscheidend sind deshalb wiederholte Messungen und echte Nutzungsdaten, nicht ein einzelner perfekter Testlauf.

Mobile Webseiten-Ladezeit verbessern: erst messen, dann ändern

Der häufigste Fehler ist, sofort Bilder zu komprimieren oder ein weiteres Optimierungs-Plugin zu installieren. Beides kann helfen, aber ohne Ursachenanalyse entstehen schnell schwer wartbare Konfigurationen. Prüfen Sie zuerst eine repräsentative Auswahl: Startseite, eine typische Leistungs- oder Produktseite, Kontaktseite und eine stark besuchte Landingpage. Auf diesen Seiten lassen sich Muster erkennen.

Im Netzwerkprotokoll zeigt sich, welche Dateien den Start blockieren und wie groß sie tatsächlich sind. Ein Performance-Audit macht sichtbar, ob JavaScript die Bedienung verzögert, ob Schriften zu spät kommen oder ob Bilder unnötig früh geladen werden. Ergänzen Sie Labormessungen durch Daten echter Besucher, sofern ausreichend Verkehr vorhanden ist. So vermeiden Sie Optimierung für ein Testprofil, das Ihre Zielgruppe nicht abbildet.

Setzen Sie vor jeder Änderung ein klares Ziel. Beispielsweise: Der sichtbare Hauptinhalt soll auf einem durchschnittlichen Mobilgerät in unter 2,5 Sekunden erscheinen, oder das Kontaktformular soll ohne Eingabeverzögerung nutzbar sein. Nicht jede Seite muss eine theoretische Bestnote erreichen. Bei einer komplexen Anwendung mit authentifizierten Daten gelten andere Voraussetzungen als bei einer öffentlichen Unternehmensseite. Boring, provable reliability ist hier wertvoller als ein kurzfristiger Score durch riskante Tricks.

1. Bilder nach ihrer Aufgabe behandeln

Auf vielen mobilen Seiten sind Bilder weiterhin der größte Datenblock. Das Problem ist nicht das Foto selbst, sondern ein Bild, das in 2.500 Pixel Breite übertragen wird, obwohl auf dem Gerät 700 Pixel genügen. Stellen Sie responsive Bildvarianten bereit, damit der Browser die passende Größe auswählen kann. Moderne Formate wie WebP oder AVIF reduzieren die Dateigröße oft deutlich, sollten aber mit sauberen Fallbacks und geprüfter Bildqualität eingesetzt werden.

Das größte Bild im sichtbaren Einstieg verdient besondere Aufmerksamkeit. Es sollte korrekt zugeschnitten sein, eine passende Auflösung haben und früh geladen werden. Bilder weiter unten auf der Seite können verzögert geladen werden. Das spart Daten beim Einstieg, darf aber nicht dazu führen, dass Bilder beim Scrollen sichtbar nachladen, obwohl der Nutzer sie bereits erwartet.

Verzichten Sie nicht reflexhaft auf alle Bilder. Ein gutes Bild kann eine Maschine, ein Team oder einen Prozess schneller erklären als ein Absatz. Die technische Aufgabe lautet: Relevante visuelle Informationen effizient ausliefern, nicht Gestaltung auf einen grauen Platzhalter reduzieren.

2. JavaScript auf notwendige Arbeit begrenzen

Jedes Script konkurriert beim Laden und bei der Bedienung um Rechenzeit. Besonders problematisch sind pauschal eingebundene Bibliotheken, Tag-Manager mit vielen Fremdskripten, Chat-Widgets, Karten und Animationen. Auf Desktop-Geräten bleiben diese Kosten oft unauffällig. Mobil führen sie zu einer Seite, die sichtbar ist, aber auf Eingaben träge reagiert.

Prüfen Sie für jedes Script seinen Zweck, seine Ladebedingung und seinen geschäftlichen Nutzen. Eine interaktive Karte auf der Kontaktseite muss nicht auf jeder Unterseite geladen werden. Ein Cookie- oder Analysewerkzeug sollte keine Kette weiterer Dateien auslösen, bevor der Besucher überhaupt Inhalte lesen kann. Funktionen, die erst nach Interaktion nötig werden, können auch dann geladen werden.

Bei individuell entwickelten Websites ist eine klare Komponentenstruktur ein echter Vorteil. JavaScript wird pro Funktion gebündelt statt als globales Paket ausgeliefert. Das erleichtert auch spätere Pflege: Wer ein Formular erweitert, verändert nicht versehentlich den Code für einen Produktfilter oder eine Navigation.

3. CSS und Schriften ohne Blockaden ausliefern

Ein häufiger Engpass liegt im ersten sichtbaren Bereich. Wenn dafür mehrere Stylesheets, Icon-Fonts und externe Schriftvarianten geladen werden müssen, wartet der Browser unnötig lange. Kritische Styles für den sichtbaren Bereich sollten klein und früh verfügbar sein. Nicht kritische Regeln können später folgen.

Bei Webfonts reichen meist wenige Schriftschnitte. Vier Gewichtungen in normal, kursiv und zusätzlichen Untersets wirken im Designsystem vollständig, sind für eine typische Unternehmenswebsite aber selten erforderlich. Legen Sie sinnvolle System-Fallbacks fest, damit Text sofort lesbar bleibt. Eine Schrift, die einige Millisekunden später sauber wechselt, ist besser als leerer Text.

Auch Icons verdienen eine Prüfung. Ein kleines SVG-Set ist häufig effizienter und präziser steuerbar als eine komplette Icon-Schrift. Das ist keine Regel ohne Ausnahme: Bestehende Systeme müssen nicht allein für ein paar Kilobyte neu gebaut werden. Werden ohnehin größere Änderungen geplant, gehört die Entscheidung aber in die technische Basis.

4. Caching und Serverantwort sauber aufsetzen

Selbst eine schlanke Oberfläche fühlt sich langsam an, wenn der Server lange bis zur ersten Antwort benötigt. Ursachen reichen von ungebremsten Datenbankabfragen über dynamisch zusammengesetzte Seiten bis zu fehlendem Caching. Öffentliche Inhalte, die sich selten ändern, sollten als Cache-Version schnell auslieferbar sein. Statische Dateien wie Bilder, CSS und JavaScript benötigen eindeutige Versionsnamen und sinnvolle Cache-Regeln.

Bei PHP-Anwendungen geht es zusätzlich um effiziente Ausführung, einen korrekt konfigurierten Opcode-Cache und kontrollierte Datenbankzugriffe. MySQL-Abfragen brauchen Indizes, die zu den tatsächlichen Filter- und Sortierwegen passen. Eine Startseite, die für jeden Aufruf mehrere unnötige Datenabfragen ausführt, wird mit wachsendem Traffic nicht besser.

Caching ist jedoch kein Freifahrtschein. Preise, Verfügbarkeiten, personalisierte Bereiche oder Inhalte nach einem Login dürfen nicht versehentlich veraltet erscheinen. Deshalb werden Cache-Grenzen fachlich definiert: Was darf fünf Minuten alt sein, was muss unmittelbar aktuell sein, und wer leert den Cache nach einer Inhaltsänderung? Gute Performance entsteht aus dieser Präzision.

5. Drittanbieter kritisch behandeln

Externe Dienste sind oft der unsichtbare Ballast einer Website. Analyse, Consent-Management, Videos, Karten, Bewertungswidgets und Marketing-Pixel laden weitere Skripte von weiteren Servern. Jede Abhängigkeit kann Verzögerungen erzeugen, Datenschutzfragen aufwerfen und im Fehlerfall die Darstellung beeinträchtigen.

Das heißt nicht, dass jedes externe Tool entfernt werden muss. Ein Video kann Vertrieb unterstützen, ein Analysewerkzeug kann wichtige Entscheidungen fundieren. Es braucht aber eine Kosten-Nutzen-Prüfung. Laden Sie eingebettete Medien erst nach Zustimmung oder Interaktion. Nutzen Sie bei Karten zunächst eine Vorschau. Und entfernen Sie Tags, deren Ergebnisse seit Monaten niemand mehr auswertet.

6. Layoutsprünge und mobile Bedienung mitdenken

Ladezeit und Bedienbarkeit gehören zusammen. Reservieren Sie für Bilder, Banner und eingebettete Elemente feste Flächen, damit Buttons nicht unter dem Finger wegspringen. Vermeiden Sie Pop-ups, die den sichtbaren Inhalt direkt beim Einstieg verdecken. Eine schnelle Seite, die sofort ein schwer schließbares Overlay zeigt, löst das Problem nicht.

Testen Sie Formulare besonders sorgfältig. Große Eingabefelder, passende Tastaturtypen und kurze Pflichtstrecken helfen mehr als ein aufwendiger Effekt. Wenn eine Anfrage nur Name, Rückrufnummer und Anliegen benötigt, ist ein zwölfteiliges Formular kein Zeichen von Gründlichkeit. Es ist Reibung.

7. Performance als festen Betriebsprozess führen

Ein einmaliger Relaunch hält die Ladezeit nicht dauerhaft niedrig. Neue Kampagnenbilder, Tracking-Anforderungen und Redaktionsmodule summieren sich. Deshalb gehören Performance-Budgets in den Entwicklungsprozess: eine maximale Größe für Einstiegsbilder, klare Regeln für neue Drittanbieter und definierte Grenzwerte für JavaScript.

Nach Releases sollten die wichtigsten Seitentypen erneut geprüft werden. Automatisierte Tests können dabei feststellen, ob zentrale Seiten erreichbar sind und kritische Abläufe funktionieren. Für Performance reicht ein reiner Funktionstest allerdings nicht aus. Ergänzen Sie ihn um Messungen der Antwortzeit, der übertragenen Datenmenge und der mobilen Interaktionsfähigkeit. Eine schnelle mobile Website entsteht nicht durch ein einzelnes Plugin und auch nicht durch Verzicht um jeden Preis. Sie entsteht, wenn Design, Inhalte, Infrastruktur und reale Nutzung zusammen betrachtet werden. Beginnen Sie bei der Seite, die Anfragen oder operative Kontakte auslöst, messen Sie unter ehrlichen Bedingungen und beseitigen Sie dort Reibung, wo Nutzer sie tatsächlich spüren.

Permalink →

Logistiksoftware, die den Betrieb wirklich entlastet

Logistiksoftware, die den Betrieb wirklich entlastet

Wenn ein Wareneingang erst auf Papier notiert, später in eine Tabelle übertragen und anschließend per Zuruf an den Versand weitergegeben wird, fehlt meist nicht der Einsatz der Mitarbeitenden. Es fehlt eine gemeinsame, verlässliche Arbeitsgrundlage. Gute Logistiksoftware ersetzt solche Brüche nicht mit mehr Bildschirmarbeit, sondern mit klaren Abläufen: Was ist angekommen, wo liegt es, was wurde reserviert und was kann heute versendet werden?

Für kleine und mittlere Unternehmen ist dabei nicht die größtmögliche Funktionsliste entscheidend. Entscheidend ist, dass die Software die tatsächliche Arbeit auf dem Lagerboden, im Büro und im Versand abbildet. Eine Lösung, die für einen globalen Konzern mit zwanzig Standorten gedacht ist, kann für einen Betrieb mit einem Lager und zwei Schichten unnötig langsam, teuer und kompliziert sein.

Wann Logistiksoftware wirklich sinnvoll wird

Tabellen sind nicht grundsätzlich ein Problem. Für geringe Mengen, einen überschaubaren Artikelstamm und einen einzelnen verantwortlichen Mitarbeiter können sie die pragmatischste Lösung sein. Es wäre falsch, einen funktionierenden Prozess allein aus Modernisierungsgründen durch ein Projekt zu ersetzen.

Der Kipppunkt kommt, wenn Informationen mehrfach gepflegt werden müssen oder niemand mehr sicher sagen kann, welche Datei aktuell ist. Typische Signale sind Fehlbestände trotz voller Regale, Rückfragen zum Status von Lieferungen, manuell geschriebene Lieferscheine und Inventuren, die den Betrieb für Tage ausbremsen. Auch wachsende Auftragszahlen machen sichtbar, welche Schritte bislang nur durch Erfahrung einzelner Personen zusammengehalten wurden.

Dann geht es nicht primär um Digitalisierung als Schlagwort. Es geht um Fehlerquellen und Wartezeiten. Ein Mitarbeiter sollte nicht erst mehrere Listen vergleichen müssen, um eine Bestellung freizugeben. Der Versand sollte nicht raten müssen, ob ein Artikel tatsächlich verfügbar oder bereits für einen anderen Auftrag reserviert ist.

Welche Prozesse Logistiksoftware verbinden sollte

Eine brauchbare Lösung beginnt mit dem Materialfluss, nicht mit einem Standardmenü. Bei vielen Betrieben umfasst dieser Fluss Wareneingang, Einlagerung, Bestandsführung, Kommissionierung, Versand und Rückmeldung. Je nach Geschäft kommen Chargen, Seriennummern, Retouren, Fertigungsaufträge oder Tourenplanung hinzu.

Wareneingang mit nachvollziehbaren Beständen

Im Wareneingang entscheidet sich viel. Wird eine Lieferung direkt gegen Bestellung oder Lieferschein geprüft, lassen sich Mengenabweichungen, beschädigte Ware und fehlende Positionen dort festhalten, wo sie entstehen. Die Ware erhält einen Status, statt nur physisch irgendwo abgestellt zu werden.

Die Software muss dafür nicht zwangsläufig mit teurer Scanner-Hardware beginnen. In manchen Lagern reicht zunächst ein Tablet oder ein Arbeitsplatz am Wareneingang. Wo viele Positionen täglich bewegt werden, sind Barcode-Scanner jedoch sinnvoll, weil sie Buchungen beschleunigen und Tippfehler reduzieren. Die richtige Entscheidung hängt von Mengen, Wegen und Artikelstruktur ab.

Lagerbewegungen ohne Gedächtnisprotokoll

Bestände sind nur dann belastbar, wenn Zugänge, Umlagerungen, Entnahmen und Korrekturen nachvollziehbar sind. Das bedeutet nicht, dass jede Ausnahme verhindert werden muss. Im Alltag gibt es beschädigte Verpackungen, falsche Einlagerungen und spontane Materialentnahmen. Eine gute Anwendung macht diese Fälle buchbar, dokumentiert aber auch, wer was wann geändert hat.

Diese Historie ist kein Kontrollinstrument um ihrer selbst willen. Sie hilft, Ursachen zu finden. Wenn ein Artikel wiederholt auf einem falschen Lagerplatz landet, ist möglicherweise die Lagerkennzeichnung unklar. Wenn regelmäßige Korrekturen auftreten, liegt das Problem oft im Prozess vor der Buchung.

Aufträge, Lieferscheine und Versand aus einem Ablauf

Viele Teams verlieren Zeit an der Schnittstelle zwischen Auftrag und Versand. Auftragsdaten kommen per E-Mail, Telefon oder aus einem separaten Shop-System. Anschließend werden Positionen ausgedruckt, Bestände geprüft und Versandpapiere erneut erfasst. Jede manuelle Übergabe schafft Raum für Abweichungen.

Logistiksoftware sollte aus einem freigegebenen Auftrag eine eindeutige Pickliste, einen Lieferschein und bei Bedarf ein Versandlabel erzeugen können. Wichtig ist dabei die Reihenfolge: Erst muss klar sein, was lieferbar ist. Danach sollte der Auftrag für andere Prozesse reserviert sein. Sonst entsteht die unangenehme Situation, dass zwei Mitarbeiter denselben letzten Bestand verplanen.

Planung, die zur Realität passt

Tourenplanung und Kapazitätssteuerung können wertvoll sein, besonders bei eigenen Auslieferungen, festen Zeitfenstern oder vielen regionalen Stopps. Sie sind aber nicht automatisch der nächste sinnvolle Schritt. Wer noch keine saubere Auftragsfreigabe und keine belastbaren Bestandsdaten hat, sollte zuerst diese Grundlagen lösen.

Dasselbe gilt für Prognosen und KI-gestützte Planung. Sie können Muster sichtbar machen, benötigen aber saubere Eingangsdaten. Eine Prognose auf Basis unvollständiger Bestände wirkt technisch anspruchsvoll, verbessert aber keine Lieferfähigkeit.

Standardlösung oder individuelle Logistiksoftware?

Standardsoftware ist sinnvoll, wenn die eigenen Abläufe weitgehend üblich sind und sich ohne größere Reibung anpassen lassen. Sie kann schneller eingeführt werden und bringt erprobte Grundfunktionen mit. Für einen Betrieb mit einfachen Lagerprozessen, klaren Rollen und wenigen Besonderheiten ist das oft die wirtschaftlich richtige Wahl.

Individuelle Logistiksoftware lohnt sich, wenn das Geschäft von speziellen Abläufen lebt oder bestehende Systeme nur mit Umwegen verbunden werden können. Das betrifft etwa Werkstätten mit Materialausgabe an laufende Aufträge, Händler mit kundenspezifischen Versandregeln oder Hersteller, die Lagerbewegungen eng mit Produktionsschritten verbinden müssen.

Der Unterschied liegt nicht darin, alles neu zu erfinden. Gute individuelle Systeme übernehmen bewährte Muster wie Statuswechsel, Reservierungen und Berechtigungen. Sie passen aber Sprache, Masken, Dokumente und Schnittstellen an die Arbeit an, die tatsächlich erledigt wird. So muss sich das Team nicht dauerhaft an Kategorien orientieren, die nur im Handbuch des Herstellers Sinn ergeben.

Für softify.pro beginnt ein solches Vorhaben deshalb mit der Frage, welche Abläufe erhalten bleiben sollen. Nicht jeder Zettel ist ein Fehler, und nicht jede Sonderregel ist sinnvoll. Erst wenn klar ist, wo Informationen verloren gehen oder Entscheidungen unnötig warten, lässt sich eine tragfähige Lösung planen.

Ein Rollout ohne Betriebsunterbrechung

Das größte Risiko liegt selten im Programmcode allein. Es liegt in einer Einführung, die zu viel auf einmal verändern will. Ein Lager kann nicht zwei Wochen pausieren, um ein neues System zu lernen. Deshalb ist ein schrittweiser Rollout meist vernünftiger als ein großer Umstellungstermin.

Ein guter erster Abschnitt konzentriert sich auf einen abgrenzbaren Ablauf, zum Beispiel Wareneingang und Bestandsbuchungen oder die Erstellung von Lieferscheinen. Das Team arbeitet mit echten Daten, Rückmeldungen fließen direkt in die Anpassung ein, und der Nutzen wird messbar. Erst danach folgen weitere Bereiche wie mobile Kommissionierung, Retouren oder Anbindungen an Shops und Versanddienstleister.

Datenübernahme verdient dabei besondere Aufmerksamkeit. Alte Artikelnummern, doppelte Kundenstammdaten und uneinheitliche Lagerorte verschwinden nicht automatisch, nur weil ein neues System eingeführt wird. Häufig ist es besser, Stammdaten bewusst zu bereinigen und nur relevante Historien zu übernehmen. Das spart spätere Suche und verhindert, dass alte Unordnung technisch konserviert wird.

Auch Berechtigungen gehören früh auf die Agenda. Nicht jeder Mitarbeiter benötigt Zugriff auf Preise, alle Bestandskorrekturen oder die Stammdatenpflege. Klare Rollen schützen vor versehentlichen Änderungen und machen Verantwortlichkeiten sichtbar, ohne den Arbeitsfluss mit unnötigen Freigaben zu blockieren.

Technik, die nach dem Go-live nicht zur Last wird

Eine Logistikanwendung muss im Alltag schnell reagieren, auch wenn mehrere Arbeitsplätze gleichzeitig buchen. Dafür braucht sie eine nachvollziehbare Datenarchitektur, saubere Transaktionen und klare Regeln für parallele Änderungen. Wenn zwei Personen denselben Bestand bearbeiten, darf das System keine stillen Fehlbuchungen erzeugen.

Ebenso wichtig ist die Wartbarkeit. Technologien wie PHP 8.4, modernes JavaScript und MySQL 8 sind kein Verkaufsargument für sich. Sie sind dann sinnvoll, wenn die Anwendung damit langfristig verständlich bleibt, Sicherheitsupdates erhält und von qualifizierten Entwicklern weitergeführt werden kann. Dokumentierte Bereitstellung, Backups, Protokollierung und ein realistischer Umgang mit Updates gehören zur Betriebsfähigkeit dazu.

Eine gute Logistiksoftware erkennt man daher nicht an einer besonders glatten Demo. Sie zeigt sich an einem normalen Dienstagmorgen: Die Lieferung wird gebucht, der Bestand stimmt, der Auftrag ist auffindbar, der Lieferschein passt und die nächste Schicht weiß, was bereits erledigt wurde. Genau dort entsteht Entlastung - nicht durch möglichst viele Funktionen, sondern durch verlässliche Abläufe, die zum Betrieb passen.

Permalink →

MySQL-Datenbank für Webanwendungen planen

MySQL-Datenbank für Webanwendungen planen

Wenn morgens drei Mitarbeitende parallel Waren buchen, ein Kunde den Lieferstatus prüft und das Backoffice eine Rechnung erstellt, zeigt sich die Qualität einer Anwendung nicht im Design. Sie zeigt sich daran, ob alle denselben, korrekten Datenstand sehen. Eine MySQL-Datenbank für eine Webanwendung planen heißt deshalb nicht, Tabellen möglichst schnell anzulegen. Es heißt, reale Abläufe so präzise zu verstehen, dass die Daten auch unter Last, bei Fehlern und mit wachsendem Geschäft verlässlich bleiben.

Gerade bei internen Plattformen, Lager- und Auftragsprozessen oder kundenbezogenen Portalen wird die Datenbank oft zu spät behandelt. Erst entsteht die Oberfläche, dann kommen Felder hinzu, danach Ausnahmen. Das funktioniert für einen Prototypen. Im Betrieb entstehen daraus doppelte Datensätze, unklare Zustände und Auswertungen, denen niemand mehr vollständig vertraut.

MySQL-Datenbank für Webanwendungen planen: beim Ablauf beginnen

Der erste Entwurf sollte nicht mit Spaltennamen beginnen, sondern mit einer konkreten Arbeitssituation. Nehmen wir einen Wareneingang: Eine Lieferung trifft ein, wird einem Lieferanten und einer Bestellung zugeordnet, Mengen werden geprüft, ein Lagerplatz wird vergeben und Bestände ändern sich. Je nach Betrieb braucht dieser Vorgang zusätzlich Fotos, eine Qualitätsprüfung, eine Sperrung oder eine nachvollziehbare Korrektur.

Aus diesem Ablauf ergeben sich die fachlichen Objekte. Typische Beispiele sind Artikel, Lieferanten, Bestellungen, Positionen, Lagerplätze, Bestandsbewegungen und Benutzer. Entscheidend ist die Trennung zwischen einem Objekt und einem Ereignis. Ein Artikel beschreibt, was etwas ist. Eine Bestandsbewegung dokumentiert, dass sich zu einem bestimmten Zeitpunkt an einem Ort eine Menge verändert hat. Wer beides in einer einzelnen Tabelle vermischt, verliert schnell die Nachvollziehbarkeit.

Für jedes Objekt helfen wenige harte Fragen: Was ist die eindeutige Identität? Welche Informationen dürfen sich ändern? Wer darf sie ändern? Welche Daten müssen historisch erhalten bleiben? Und welche Regeln gelten, wenn zwei Personen gleichzeitig arbeiten? Diese Fragen verhindern spätere Improvisation besser als eine lange Liste vermeintlich vollständiger Datenbankfelder.

Das Datenmodell soll Regeln ausdrücken

Eine Datenbank ist nicht nur Speicher für Formulareingaben. Sie sollte zentrale Regeln selbst absichern. Wenn jede Bestandsbewegung genau zu einem Artikel und einem Lagerplatz gehören muss, gehören Fremdschlüssel in das Modell. Wenn eine externe Auftragsnummer pro Mandant nur einmal vorkommen darf, braucht es einen eindeutigen Index. Wenn eine Position nie ohne Kopfauftrag existieren soll, muss diese Beziehung klar modelliert sein.

MySQL 8 mit InnoDB bietet dafür belastbare Grundlagen: Transaktionen, Fremdschlüssel, Sperrmechanismen und konsistente Änderungen über mehrere Tabellen hinweg. Werden beim Buchen eines Wareneingangs Bewegung, aktueller Bestand und Prüfprotokoll geschrieben, sollte das als zusammenhängende Transaktion passieren. Scheitert ein Schritt, darf kein halbfertiger Vorgang zurückbleiben.

Nicht jede Regel gehört allerdings in die Datenbank. Freigaben, komplexe Preislogik oder rollenabhängige Prozessschritte liegen häufig besser in der Anwendungslogik, weil sie sich fachlich schneller ändern. Die Grenze ist pragmatisch: Regeln, deren Verletzung Daten dauerhaft beschädigt, sollten möglichst nah an den Daten abgesichert werden. Regeln, die sich häufig ändern oder stark vom Kontext abhängen, brauchen gut getesteten Anwendungscode.

Historie nicht mit aktuellen Werten verwechseln

Ein häufiger Fehler ist, nur den aktuellen Bestand oder den aktuellen Status zu speichern. Das reicht, bis jemand fragt, warum sich die Menge gestern verändert hat oder wer einen Auftrag zurückgesetzt hat. Für operative Systeme ist eine Bewegungs- oder Ereignishistorie oft wertvoller als ein einzelnes überschreibbares Feld.

Das bedeutet nicht, jede Klickbewegung dauerhaft zu protokollieren. Protokolliert werden sollten geschäftlich relevante Änderungen: Statuswechsel, Mengenänderungen, Korrekturen, Freigaben und Zuordnungen. Ein guter Audit-Eintrag enthält Zeitpunkt, Benutzer oder Systemprozess, vorherigen und neuen Wert sowie einen verständlichen Grund, wenn der Ablauf ihn verlangt. So lassen sich Fehler klären, ohne in E-Mails, Papierlisten oder Datenbank-Backups suchen zu müssen.

Schlüssel, Datentypen und Namensregeln bewusst wählen

Technische Entscheidungen wirken klein, prägen aber Wartung und Integrationen über Jahre. Für interne Primärschlüssel sind häufig BIGINT-Werte mit automatischer Vergabe eine nüchterne, gut handhabbare Wahl. UUIDs können sinnvoll sein, wenn Daten offline entstehen, mehrere Systeme unabhängig schreiben oder externe Schnittstellen keine fortlaufenden IDs offenlegen sollen. Sie kosten jedoch mehr Speicher und verlangen bei Indizes und Sortierung etwas mehr Aufmerksamkeit.

Geldbeträge gehören als DECIMAL gespeichert, nicht als FLOAT oder DOUBLE. Mengen brauchen ebenfalls eine fachlich passende Genauigkeit: Stückzahlen sind oft ganzzahlig, Gewichte und Längen nicht. Zeitstempel sollten einheitlich behandelt werden, idealerweise intern in UTC, während die Oberfläche die lokale Zeitzone des Betriebs darstellt. Besonders bei Schichtwechseln und Sommerzeit verhindert das schwer auffindbare Differenzen.

Auch Namen sollten langweilig und eindeutig sein. order_items oder bestandsbewegungen sind hilfreicher als kreative Abkürzungen, die nur das ursprüngliche Projektteam versteht. Einheitliche Singular- oder Pluralformen sind weniger wichtig als Konsequenz. Ebenso sinnvoll sind Felder wie created_at, updated_at und bei Bedarf deleted_at. Ein Soft Delete ist aber kein Standardzwang. Bei rechtlich oder operativ relevanten Belegen ist eine saubere Stornierung meist besser als ein unsichtbar gelöschter Datensatz.

Indizes folgen echten Abfragen, nicht Vermutungen

Ein Index kann eine Suche massiv beschleunigen, macht Schreibvorgänge aber aufwendiger und benötigt Speicher. Deshalb ist „auf jedes Feld einen Index“ keine Strategie. Die wichtigsten Abfragen sollten früh feststehen: offene Aufträge eines Kunden, Bewegungen eines Artikels in einem Zeitraum, Bestand je Lagerplatz oder zuletzt geänderte Datensätze für eine Schnittstelle.

Dabei zählt die Reihenfolge zusammengesetzter Indizes. Sucht die Anwendung regelmäßig nach tenant_id, status und created_at, ist ein zusammengesetzter Index in dieser Reihenfolge oft sinnvoll. Ob er tatsächlich passt, zeigt der Ausführungsplan mit EXPLAIN, nicht das Bauchgefühl. Datenbanken werden nicht durch spektakuläre Tricks schnell, sondern durch beobachtbare Abfragen, passende Indizes und eine Datenmenge, die realistisch getestet wurde.

Für wachsende Tabellen lohnt eine klare Aufbewahrungsstrategie. Müssen technische Logs fünf Jahre in der produktiven Hauptdatenbank liegen? Nicht unbedingt. Geschäftliche Belege, Bewegungen und Prüfnachweise brauchen andere Fristen als Debug-Informationen. Archivierung ist kein Zeichen eines schwachen Systems, sondern eine bewusste Betriebsentscheidung.

Mehrbenutzerbetrieb braucht Transaktionen und klare Zustände

In einer Webanwendung greifen mehrere Anfragen gleichzeitig auf dieselben Daten zu. Das ist im Lageralltag normal, nicht der Ausnahmefall. Zwei Mitarbeitende können denselben Bestand buchen, während ein Import neue Aufträge anlegt. Ohne Transaktionen und gezielte Sperrung besteht das Risiko verlorener Änderungen oder negativer Bestände, die erst Wochen später auffallen.

Für kritische Vorgänge sollte klar sein, welche Daten innerhalb einer Transaktion gelesen und geschrieben werden. Manchmal genügt eine atomare Aktualisierung, etwa ein Bestand, der nur verändert wird, wenn die verfügbare Menge ausreichend ist. In anderen Fällen ist eine Zeilensperre sinnvoll, damit ein Vorgang den Datenstand kontrolliert prüfen und danach ändern kann. Lange Transaktionen sind hingegen problematisch: Sie blockieren andere Arbeit und erhöhen das Risiko von Konflikten.

Ebenso wichtig ist ein begrenzter Satz fachlicher Zustände. Ein Auftrag sollte nicht gleichzeitig „offen“, „teilgeliefert“ und „manuell bearbeitet“ sein, weil verschiedene Felder widersprüchlich gepflegt werden. Definierte Statusübergänge machen Oberfläche, Berichte und Automatisierungen einfacher. Ausnahmen dürfen möglich sein, sollten aber benannt und dokumentiert sein.

Sicherheit, Mandanten und Betrieb von Anfang an einplanen

Die Anwendung sollte für MySQL einen eigenen Datenbankbenutzer mit minimalen Rechten verwenden. Ein Schreibzugriff für die Webanwendung bedeutet nicht, dass dieser Benutzer Tabellen löschen oder Benutzerrechte ändern muss. Administrative Konten gehören nicht in Konfigurationsdateien des Produktivsystems und niemals in ein Repository.

Wenn mehrere Kunden, Standorte oder Gesellschaften in einer Anwendung arbeiten, ist die Mandantentrennung eine Architekturentscheidung, keine nachträgliche Filterbedingung. Eine gemeinsame Datenbank mit tenant_id kann effizient und gut wartbar sein, verlangt aber konsequente Prüfungen in jeder Abfrage und eindeutige Regeln für Indizes. Getrennte Datenbanken bieten stärkere Isolation, erhöhen jedoch Aufwand bei Updates, Auswertungen und Betrieb. Welche Variante passt, hängt von Datenschutzanforderungen, Datenvolumen und Geschäftsmodell ab.

Backups sind erst dann Backups, wenn eine Wiederherstellung getestet wurde. Benötigt wird ein definierter Rhythmus für Sicherungen, Aufbewahrung und Wiederanlauf. Ebenso gehören Monitoring für Speicherplatz, langsame Abfragen und fehlgeschlagene Jobs sowie dokumentierte Updates zum System. MySQL 8, PHP 8.4 und moderne Webanwendungen lassen sich langfristig gut betreiben, wenn Abhängigkeiten, Zugangsdaten und Deployment-Schritte nicht nur im Kopf eines Entwicklers existieren.

Ein sinnvoller Plan vor dem ersten Produktivtag

Vor der Umsetzung sollte ein kompaktes Datenmodell mit Beispielvorgängen vorliegen. Dazu gehören wichtigste Tabellen und Beziehungen, Statusregeln, Berechtigungen, erwartete Abfragen, Schnittstellen sowie ein Konzept für Backups und Änderungsprotokolle. Dieser Plan muss nicht hundert Seiten lang sein. Er muss die Entscheidungen festhalten, die später teuer zu korrigieren wären.

Bei softify.pro beginnt Datenbankplanung deshalb mit den Menschen, die buchen, prüfen, kommissionieren oder Ausnahmen klären. Wenn ein bestehendes Spreadsheet einen überschaubaren Prozess zuverlässig abbildet, kann es die richtige Lösung bleiben. Wenn mehrere Personen zeitgleich arbeiten, Belege entstehen und Fehler nachvollziehbar sein müssen, verdient die Datenbank dagegen denselben Planungsaufwand wie die Oberfläche. Die beste Architektur ist am Ende jene, die den Arbeitstag vereinfacht und auch in zwei Jahren noch verständlich geändert werden kann.

Permalink →

Warehouse Automation Results richtig messen

Warehouse Automation Results richtig messen

Eine neue Scanmaske kann am ersten Tag beeindruckend wirken. Nach drei Wochen zeigt sich jedoch, ob sie den Wareneingang wirklich beschleunigt oder lediglich einen weiteren Arbeitsschritt erzeugt. Warehouse automation results sind deshalb keine einzelne Kennzahl und auch kein Screenshot aus einer Produktdemo. Sie zeigen sich dort, wo ein Lagerteam weniger suchen, nachfragen, nachbuchen und korrigieren muss - bei gleichbleibender oder besserer Qualität.

Für kleine und mittlere Unternehmen ist diese Unterscheidung besonders relevant. Große Enterprise-Suiten versprechen oft umfassende Optimierung, verlangen aber lange Einführungen, starre Prozesse und viel Pflege. Ein sinnvoller Automatisierungsschritt darf kleiner beginnen: genau an dem Punkt, an dem Informationen heute verloren gehen oder Entscheidungen unnötig warten.

Welche Warehouse Automation Results tatsächlich zählen

Viele Projekte starten mit einer technischen Frage: Barcode-Scanner, mobile App, Schnittstelle zum Shop oder automatische Etiketten? Die bessere Ausgangsfrage lautet: Welcher Engpass kostet pro Schicht spürbar Zeit, Geld oder Verlässlichkeit?

Die Antwort liegt selten bei der Anzahl eingesetzter Geräte. Aussagekräftige Ergebnisse lassen sich an der täglichen Arbeit messen. Im Wareneingang zählt etwa die Zeit zwischen Anlieferung und verfügbar gebuchtem Bestand. In der Kommissionierung ist die Zeit vom Auftrag bis zur Versandbereitschaft relevant. Bei Inventuren ist nicht nur die Dauer entscheidend, sondern vor allem die Differenz zwischen Systembestand und tatsächlichem Bestand.

Ebenso wichtig sind Kennzahlen, die in vielen Betrieben nicht sauber erfasst werden: Wie viele Rückfragen entstehen, weil ein Lagerplatz unklar ist? Wie oft muss ein Lieferschein korrigiert werden? Wie viele Aufträge bleiben liegen, weil eine Person den Status nur im Kopf oder in einer privaten Excel-Datei kennt? Gerade diese stille Nacharbeit verschwindet aus klassischen Produktivitätsberichten, belastet aber Schichtleiter, Disposition und Kundenservice.

Ein gutes Zielbild verbindet Tempo und Kontrolle. Werden Aufträge schneller abgewickelt, während Fehlbuchungen steigen, ist das kein Fortschritt. Werden Bestände genauer, aber der Wareneingang staut sich, muss der Prozess anders gestaltet werden. Automatisierung ist dann gelungen, wenn sie den Arbeitsfluss verbessert, ohne die operative Übersicht zu verschlechtern.

Von gefühlter Entlastung zu belegbaren Daten

Die Erfahrung der Mitarbeitenden ist ein wertvoller Indikator. Wenn jemand nach zwei Wochen sagt, dass er nicht mehr für jede Einlagerung ins Büro laufen muss, ist das relevant. Für Investitionsentscheidungen braucht es trotzdem einen Vergleich, der nicht vom Tagesgefühl abhängt.

Vor dem Start sollten deshalb einige Ausgangswerte festgehalten werden: durchschnittliche Bearbeitungszeit, Anzahl offener Klärfälle, Korrekturbuchungen, Suchzeiten, Versandfehler und Bestandstreue. Es müssen nicht zwanzig Kennzahlen sein. Vier bis sechs Werte, die zum konkreten Problem passen, reichen oft aus.

Nach dem Rollout sollten dieselben Werte über mehrere Wochen beobachtet werden. Einzelne Spitzentage führen leicht in die Irre. Saison, Krankheit, neue Mitarbeitende oder ein ungewöhnlich großer Auftrag beeinflussen Ergebnisse. Erst ein Vergleich über normale Schichten zeigt, ob die Veränderung belastbar ist.

Der wichtigste Effekt: Ein gemeinsamer Prozessstand

In vielen Lagern ist die eigentliche Schwachstelle nicht fehlende Arbeitsbereitschaft, sondern ein zersplitterter Informationsstand. Der Wareneingang kennt die Lieferung, die Disposition kennt den Kundenauftrag und der Versand kennt die Priorität - aber nicht alle arbeiten mit derselben aktuellen Information.

Ein workflow-spezifisches System kann diesen Bruch schließen. Eine Lieferung wird beim Eintreffen erfasst, Abweichungen werden direkt dokumentiert, der Bestand erhält einen klaren Status und der nächste Schritt wird sichtbar. Die Daten müssen nicht erst auf Papier notiert, später übertragen und anschließend telefonisch bestätigt werden.

Das reduziert nicht nur Laufwege. Es reduziert Entscheidungen auf Basis veralteter Informationen. Ein Versandmitarbeiter sieht, ob ein Auftrag wirklich kommissionierbar ist. Die Verwaltung erkennt, ob Waren eingegangen oder lediglich angekündigt sind. Die Geschäftsführung erhält keine geschönte Momentaufnahme, sondern eine nachvollziehbare Grundlage.

Für Teams mit wechselnden Schichten ist dieser Effekt häufig wertvoller als eine spektakuläre Zeitersparnis. Der Prozess wird weniger abhängig von einzelnen Personen. Wissen bleibt nicht in Notizbüchern, Chatverläufen oder dem Gedächtnis der erfahrensten Fachkraft hängen.

Warum nicht jede Automatisierung gute Ergebnisse liefert

Automatisierung verstärkt Prozesse. Das ist nützlich, wenn der Ablauf klar ist. Es ist problematisch, wenn ein unklarer Ablauf nur schneller reproduziert wird.

Ein typisches Beispiel ist die verpflichtende Scan-Buchung für jeden kleinsten Handgriff. Wenn Mitarbeitende für eine seltene Ausnahme mehrere Masken öffnen müssen, entstehen Umgehungslösungen. Dann werden Artikel später gesammelt gebucht, Scanner liegen in der Schublade oder ein Mitarbeiter führt wieder eine Schattenliste. Die Software ist vorhanden, der reale Prozess läuft daneben weiter.

Auch die Datenqualität setzt Grenzen. Artikelstammdaten ohne eindeutige Einheiten, unklare Lagerplatzlogik oder uneinheitliche Lieferantenbezeichnungen lassen sich nicht durch eine schicke Oberfläche heilen. Hier kann ein Projekt zunächst aus Aufräumarbeit bestehen. Das wirkt weniger sichtbar als eine neue Anwendung, ist aber oft die Voraussetzung für verlässliche Resultate.

Es gibt außerdem Prozesse, die bewusst nicht vollautomatisiert werden sollten. Eine erfahrene Prüfung bei empfindlichen Waren, eine Freigabe bei ungewöhnlichen Abweichungen oder die Entscheidung über eine Sonderlieferung brauchen fachliches Urteil. Gute Systeme kennzeichnen solche Fälle klar und leiten sie gezielt weiter. Sie tun nicht so, als ließe sich jede Ausnahme mit einer Regel erschlagen.

Wann eine Tabelle weiterhin die bessere Lösung ist

Nicht jeder manuelle Schritt rechtfertigt eine Individualentwicklung. Wenn ein Prozess selten stattfindet, wenige Beteiligte hat und nachvollziehbar geführt wird, kann eine gut gepflegte Tabelle sinnvoll bleiben. Der Fehler liegt nicht in Excel selbst, sondern darin, kritische Bewegungen ohne klare Verantwortlichkeit, Versionskontrolle oder zeitnahe Buchung zu verwalten.

Sobald mehrere Personen parallel ändern, Lagerbewegungen zeitkritisch werden oder Kundeninformationen aus verschiedenen Quellen zusammengeführt werden müssen, steigt das Risiko deutlich. Dann ist ein gemeinsames System meist günstiger als die fortlaufende Korrektur von Missverständnissen.

Warehouse Automation Results brauchen einen kontrollierten Rollout

Der schnellste Weg zu schlechten Ergebnissen ist ein Komplettumbau während des laufenden Betriebs. Besser ist ein abgegrenzter Bereich mit messbarem Nutzen: zum Beispiel Wareneingang für eine Produktgruppe, Versandetiketten für einen Standort oder eine mobile Buchung für die häufigsten Umlagerungen.

Ein Pilot sollte echte Aufträge und echte Schichten abbilden. Testdaten helfen bei der Entwicklung, zeigen aber nicht, ob WLAN im hinteren Lagerbereich schwankt, ob Handschuhe die Scannerbedienung erschweren oder ob ein Status für die Disposition missverständlich formuliert ist. Diese Details entscheiden über Akzeptanz und Datenqualität.

Technisch zählt dabei langweilige, beweisbare Zuverlässigkeit mehr als ein modischer Stack. Klare Rollenrechte, nachvollziehbare Buchungsprotokolle, eindeutige Fehlerhinweise, stabile Datenbanktransaktionen und dokumentierte Abläufe sind keine Nebensachen. Sie machen aus einer Anwendung ein Werkzeug, dem Teams im Tagesgeschäft vertrauen können.

Für individuelle Logistiksysteme bedeutet das auch: Die Integration muss zum vorhandenen Betrieb passen. Eine Anwendung kann Aufträge aus einem Shop übernehmen, Lieferscheine erzeugen, Versandlabels bereitstellen und Bestandsbewegungen dokumentieren. Sie muss dafür nicht sofort alle angrenzenden Systeme ersetzen. Gerade im Mittelstand ist eine schrittweise Ablösung oft risikoärmer und wirtschaftlicher.

So wird aus einem Projekt eine dauerhafte Verbesserung

Nach der Einführung beginnt die entscheidende Phase. Werden Sonderfälle erfasst? Passen die Lagerplätze noch zur Realität? Verstehen neue Mitarbeitende die Buchungslogik ohne mündliche Übersetzung? Und stimmen die gemessenen Werte noch, wenn das Auftragsvolumen wächst?

Regelmäßige kurze Rückmeldungen aus Lager, Versand und Verwaltung sind dafür wirksamer als ein jährlicher Großworkshop. Wenn eine wiederkehrende Ausnahme sichtbar wird, sollte sie entweder als klarer Prozessschritt abgebildet oder bewusst aus dem Standardfluss herausgenommen werden. Beides ist besser, als sie stillschweigend zu tolerieren.

Der sinnvollste nächste Schritt ist oft kein großes Lastenheft. Nehmen Sie einen Prozess mit häufigen Rückfragen und messen Sie eine Woche lang, wo Zeit verloren geht. Wenn daraus ein klarer, wiederholbarer Ablauf entsteht, lässt sich Automatisierung mit einem Ergebnis verbinden, das auf dem Lagerboden genauso überzeugt wie in der Monatsauswertung.

Permalink →

Moderne Webentwicklung, die im Betrieb funktioniert

Moderne Webentwicklung, die im Betrieb funktioniert

Ein Lagerleiter druckt morgens Lieferscheine aus, während eine Kollegin Bestände in einer Tabellenkalkulation korrigiert und der Vertrieb telefonisch nach dem Status eines Auftrags fragt. Das Problem ist selten fehlende Digitalisierung. Meist gibt es zu viele voneinander getrennte Werkzeuge. Moderne Webentwicklung schafft dann nicht einfach eine schönere Oberfläche, sondern eine verlässliche gemeinsame Arbeitsgrundlage.

Für kleine und mittlere Unternehmen bedeutet das: Eine Webanwendung muss unter Zeitdruck funktionieren, auf dem Scanner im Lager ebenso wie am Bildschirm im Büro. Sie muss Daten nachvollziehbar speichern, Berechtigungen sauber regeln und sich weiterentwickeln lassen, ohne bei jeder Änderung zum Risiko zu werden. Technologie ist dabei kein Selbstzweck. Sie ist die Grundlage dafür, dass Prozesse schneller laufen und gleichzeitig besser kontrollierbar bleiben.

Moderne Webentwicklung beginnt vor dem ersten Code

Wer mit einem vorgefertigten Funktionskatalog startet, baut oft am tatsächlichen Engpass vorbei. In der Praxis lohnt sich ein anderer Einstieg: Welche Information fehlt heute regelmäßig? Wo entstehen doppelte Eingaben? An welcher Stelle werden Entscheidungen telefonisch oder über Zuruf abgesichert, weil niemand den aktuellen Status zuverlässig sieht?

Bei einem Wareneingang können das beispielsweise uneinheitliche Artikelbezeichnungen, fehlende Prüfhinweise oder verspätet aktualisierte Bestände sein. Bei der Auftragsabwicklung sind es oft handschriftliche Notizen, unklare Freigaben und Versanddaten, die in mehreren Systemen gepflegt werden. Eine gute Anwendung macht diese Übergaben nicht nur digital. Sie ordnet sie so, dass Zuständigkeiten, Status und nächste Schritte sichtbar sind.

Das bedeutet auch, Bestehendes nicht reflexhaft abzuschaffen. Eine gut gepflegte Tabelle kann für eine kleine Auswertung weiterhin die sinnvollste Lösung sein. Eine individuelle Webanwendung lohnt sich dort, wo mehrere Personen gleichzeitig arbeiten, Fehler durch manuelle Übertragung entstehen oder ein Prozess dokumentiert und wiederholbar sein muss.

Was eine moderne Webanwendung im Alltag leisten muss

Eine überzeugende Oberfläche ist wertvoll, aber sie ist nur ein Teil der Arbeit. Im laufenden Betrieb zählen vor allem Antwortzeiten, verständliche Abläufe und belastbare Daten. Wenn ein Kommissionierer einen Vorgang abschließt, darf der Status nicht erst nach mehreren Aktualisierungen sichtbar werden. Wenn ein Auftrag geändert wird, muss nachvollziehbar sein, was geändert wurde und welche Folgeschritte betroffen sind.

Dazu gehören drei eng verbundene Ebenen: die Benutzeroberfläche, die Anwendungslogik und die Datenbank. Die Oberfläche führt Menschen durch den Vorgang. Die Logik prüft etwa Pflichtfelder, Berechtigungen oder verfügbare Mengen. Die Datenbank speichert die Fakten so, dass Auswertungen, Korrekturen und Erweiterungen später möglich bleiben.

Für viele Geschäftsanwendungen sind bewährte Technologien die vernünftigere Wahl als ein kurzlebiger Trend. PHP 8.4 kann eine klar strukturierte Serverlogik liefern, modernes JavaScript eine reaktionsfähige Bedienung und MySQL 8 eine solide Datenbasis. Entscheidend ist nicht, dass jedes Projekt denselben Stack nutzt. Entscheidend ist, dass die gewählte Technik zum Problem, zum Betrieb und zur langfristigen Betreuung passt.

Performance ist eine Prozessfrage

Performance wird häufig auf Ladezeiten reduziert. Das greift zu kurz. Eine Anwendung fühlt sich auch dann langsam an, wenn Mitarbeitende zu viele Schritte ausführen, nach Informationen suchen oder dieselbe Angabe mehrfach erfassen müssen. Eine schnelle Seite mit einem umständlichen Formular bleibt ein schlechter Prozess.

Sinnvolle Optimierung beginnt deshalb bei den häufigsten Vorgängen. Welche Masken werden hundertmal am Tag geöffnet? Welche Suche muss auch bei wachsendem Datenbestand schnell bleiben? Welche Daten sollen im Hintergrund gespeichert werden, ohne dass Mitarbeitende auf eine Bestätigung warten? Erst danach folgen technische Details wie gezielte Datenbankindizes, reduzierte Abfragen und eine schlanke Auslieferung von Dateien im Browser.

Datenmodell und Rechte: Die unsichtbare Architektur

Viele Webprojekte scheitern nicht an der ersten Version, sondern an späteren Ergänzungen. Ein zunächst einfaches Feld wie „Status“ wird plötzlich zu einer Kette aus Freigabe, Prüfung, Versand, Storno und Nachbearbeitung. Wenn diese Zustände nur lose in Formularen abgelegt werden, wird jede Erweiterung teuer und fehleranfällig.

Ein sauberes Datenmodell trennt deshalb Vorgänge, Positionen, Ansprechpartner, Dokumente und Statusänderungen nachvollziehbar. Es verhindert widersprüchliche Einträge, statt sie später mühsam zu bereinigen. Gerade bei Lagerbewegungen, Lieferscheinen oder Auftragsdaten ist diese Genauigkeit keine akademische Übung. Sie entscheidet darüber, ob die Bestandszahl als Arbeitsgrundlage taugt.

Ebenso wichtig sind Rollen und Rechte. Nicht jede Person braucht Zugriff auf Preise, Personalinformationen oder administrative Einstellungen. Gute Rechtekonzepte sind konkret: Wer darf einen Auftrag anlegen, wer freigeben, wer stornieren? Wer sieht nur den eigenen Bereich? Hinzu kommen Schutzmaßnahmen wie sichere Passwortspeicherung, Account-Sperren nach wiederholten Fehlversuchen, Protokollierung kritischer Änderungen und klar geregelte Sitzungen.

Sicherheit ist damit kein Zusatz kurz vor dem Go-live. Sie gehört in die Architektur, weil spätere Korrekturen oft tief in Anmeldung, Datenzugriff und Berechtigungssystem eingreifen.

Responsive heißt nicht nur „passt aufs Handy“

Eine responsive Anwendung passt sich verschiedenen Bildschirmgrößen an. Für den Arbeitsalltag reicht diese Definition nicht. Auf einem Tablet im Lager gelten andere Anforderungen als am großen Bildschirm in der Disposition. Touch-Flächen müssen sicher bedienbar sein, wichtige Angaben dürfen nicht unter Nebeninformationen verschwinden, und Eingaben müssen auch mit Handschuhen, wechselnden Lichtverhältnissen oder instabiler Verbindung praktikabel bleiben.

Deshalb braucht jede Ansicht eine klare Priorität. Im Wareneingang kann das Scannen und Bestätigen im Mittelpunkt stehen. Im Büro sind Filter, Listen, Exportfunktionen und Detailansichten oft wichtiger. Eine Oberfläche, die überall gleich aussieht, ist nicht automatisch überall gut nutzbar.

Moderne Webentwicklung braucht einen kontrollierten Betrieb

Der Go-live ist kein Endpunkt, sondern der Beginn des echten Tests. Erst mit realen Daten, Ausnahmen und Stoßzeiten zeigt sich, ob Regeln verständlich sind und ob Schnittstellen zuverlässig arbeiten. Dokumentierte Bereitstellung, klar getrennte Umgebungen für Entwicklung und Produktivbetrieb sowie nachvollziehbare Sicherungen sind deshalb Teil des Projekts, nicht bloße IT-Verwaltung.

Auch automatisierte Tests leisten hier viel. Sie prüfen wiederkehrende Abläufe wie Anmeldung, Rechteprüfung, Auftragserfassung oder Dokumentenerstellung nach jeder Änderung erneut. Für sensible Anwendungen kann eine selbst betriebene Testumgebung sinnvoll sein, weil Screenshots, Testdaten und interne Anwendungsschritte im eigenen Kontrollbereich bleiben. Automatisierung ersetzt keine fachliche Prüfung durch erfahrene Mitarbeitende. Sie sorgt aber dafür, dass bekannte Abläufe nicht still und leise beschädigt werden.

Bei softify.pro gehört diese Denkweise zur Umsetzung: technisch präzise planen, reale Arbeitsabläufe ernst nehmen und Änderungen so liefern, dass sie später verständlich bleiben. Das ist weniger spektakulär als ein Technologiefeuerwerk, im Betrieb aber deutlich wertvoller.

Wann Standardsoftware reicht - und wann nicht

Standardsoftware ist sinnvoll, wenn der eigene Prozess weitgehend dem üblichen Branchenablauf entspricht und die Konfiguration überschaubar bleibt. Sie kann schnell verfügbar sein und verlässliche Grundfunktionen mitbringen. Problematisch wird sie, wenn Teams ihre funktionierenden Abläufe dauerhaft umständlich verbiegen müssen oder wichtige Informationen außerhalb des Systems landen.

Eine individuelle Lösung ist nicht automatisch besser. Sie braucht klare Anforderungen, verantwortliche Ansprechpartner und die Bereitschaft, Entscheidungen zu treffen. Dafür kann sie genau die Arbeitsschritte abbilden, die für das Unternehmen entscheidend sind: eine spezielle Wareneingangsprüfung, den Druck passender Versandlabels, eine Freigabe nach Kundengruppe oder die Verbindung von Werkstatt, Lager und Vertrieb.

Die richtige Frage lautet daher nicht: Brauchen wir eine maßgeschneiderte Anwendung? Sie lautet: Welche wiederkehrende Reibung kostet uns heute Zeit, Geld oder Verlässlichkeit - und lässt sie sich mit vertretbarem Aufwand dauerhaft beseitigen?

Eine gute Webanwendung macht Arbeit nicht künstlich digital. Sie nimmt unnötige Übergaben heraus, schafft einen verlässlichen Datenstand und gibt Menschen genau die Informationen, die sie für ihren nächsten Schritt brauchen. Wenn das gelingt, wirkt moderne Webentwicklung nicht wie ein neues IT-Projekt, sondern wie ein Betrieb, der endlich ohne Umwege arbeiten kann.

Permalink →

Wie man die Digitalisierung von Lieferscheinen richtig umsetzt

Wie man die Digitalisierung von Lieferscheinen richtig umsetzt

Ein Fahrer wartet nicht, weil eine Excel-Datei gerade von jemand anderem geöffnet ist. Und im Wareneingang hilft kein sauberer Papierstapel, wenn eine Teillieferung später nicht mehr nachvollziehbar ist. Wer nach „how to digitize delivery notes“ sucht, will deshalb selten nur Papier scannen. Gesucht ist ein belastbarer Ablauf, der Warenbewegungen, Bestätigungen und Abweichungen dort erfasst, wo sie entstehen.

Digitale Lieferscheine funktionieren dann gut, wenn sie die Arbeit im Lager, in der Werkstatt und beim Kunden vereinfachen. Werden sie lediglich als PDF-Ablage umgesetzt, bleibt der Aufwand bestehen - nur eben auf einem Bildschirm. Der entscheidende Unterschied liegt in strukturierten Daten, klaren Zuständigkeiten und einer sauberen Verbindung zu Auftrag, Bestand und Rechnung.

Wie man die Digitalisierung von Lieferscheinen richtig umsetzt: Erst den Ablauf prüfen

Der erste Schritt ist keine Softwareauswahl, sondern eine ehrliche Bestandsaufnahme. Nehmen Sie einen realen Lieferschein und verfolgen Sie seinen Weg: vom Auftrag über die Kommissionierung bis zur Übergabe, Rückmeldung und Archivierung. Dabei zeigt sich meist schnell, an welchen Stellen Informationen nachgetragen, doppelt erfasst oder über Telefon und Chat geklärt werden.

In kleinen und mittleren Betrieben gibt es selten nur einen Ablauf. Eine Standardlieferung an Stammkunden braucht etwas anderes als eine Baustellenlieferung, eine Abholung oder eine Lieferung mit Rücknahme von Leergut. Diese Unterschiede müssen nicht alle in Version eins automatisiert werden. Sie sollten aber bekannt sein, damit das neue System nicht am ersten Sonderfall scheitert.

Ein guter digitaler Prozess beantwortet für jeden Status eindeutig drei Fragen: Wer hat die Ware wann bewegt? Welche Mengen wurden tatsächlich übergeben? Und was ist bei Abweichungen passiert? Fehlen diese Informationen, ist ein digitaler Lieferschein vor allem ein schöneres Dokument.

Papier nicht einfach als PDF reproduzieren

Das Scannen bestehender Lieferscheine kann als Übergang sinnvoll sein, etwa für die Archivierung alter Vorgänge. Für das operative Geschäft löst es jedoch wenig. Ein Bild oder PDF lässt sich zwar ablegen, aber Mengen, Artikelnummern, Chargen und Bemerkungen sind darin nicht zuverlässig weiterverwendbar.

Besser ist ein Dokument, das aus strukturierten Auftragsdaten entsteht. Artikel, Sollmengen, Lieferadresse und Ansprechpartner werden übernommen. Mitarbeitende bestätigen anschließend die tatsächlichen Mengen direkt auf einem Mobilgerät oder an einem Arbeitsplatz im Lager. Nur Abweichungen, Schäden oder Zusatzpositionen müssen neu eingegeben werden.

Das spart nicht nur Zeit. Es verhindert auch einen typischen Medienbruch: Die Buchhaltung erhält nicht mehr eine kaum lesbare Unterschrift auf Papier, während das Lager denselben Vorgang separat in einer Tabelle nachpflegt.

Die Daten, die ein digitaler Lieferschein wirklich braucht

Ein System sollte nicht jedes denkbare Feld erzwingen. Zusätzliche Eingaben verlangsamen die Übergabe und senken die Akzeptanz. Gleichzeitig reichen Kundenname und Unterschrift für viele Abläufe nicht aus.

Als Grundlage braucht jeder Lieferschein eine eindeutige Nummer, den Bezug zum Auftrag, Liefer- und Empfängeradresse, Artikelpositionen mit Soll- und Istmengen sowie Zeitstempel. Je nach Branche kommen Chargen, Seriennummern, Gewicht, Stellplätze oder Behälter hinzu. Bei temperaturgeführten Waren können Messwerte relevant sein, bei Baustellenlieferungen Fotos oder eine präzise Angabe zum Übergabeort.

Besonders wichtig ist der Status. „Erstellt“, „kommissioniert“, „unterwegs“, „übergeben“, „teilgeliefert“ und „beanstandet“ sind keine bloßen Etiketten. Sie steuern, welche Person als Nächstes handeln muss und ob beispielsweise eine Rechnung erstellt oder eine Nachlieferung geplant werden darf.

Unterschriften und Fotos mit Augenmaß einsetzen

Eine digitale Unterschrift ist bei vielen Lieferprozessen sinnvoll, aber nicht automatisch die beste Bestätigung. Bei einer schnellen Übergabe am Wareneingang kann ein Name in Druckschrift, ein Zeitstempel und die Zuordnung zum Empfänger ausreichend sein. Bei hochwertigen Gütern oder strittigen Übergaben kann eine Unterschrift zusammen mit Foto und Standortinformation dagegen sinnvoll sein.

Entscheidend ist die Beweiskette: Die Bestätigung muss dem konkreten Dokument und dessen Version zugeordnet sein. Ändert jemand nach der Unterschrift Mengen oder Positionen, sollte das System dies nicht still überschreiben. Es braucht eine nachvollziehbare Korrektur oder eine neue Bestätigung.

Fotos verdienen dieselbe Disziplin. Sie können Schäden dokumentieren, sollten aber nicht zur wahllosen Sammlung personenbezogener Daten werden. Legen Sie fest, wann ein Foto erforderlich ist, wer darauf zugreifen darf und wie lange es gespeichert wird.

Mobile Erfassung muss unter realen Bedingungen funktionieren

Im Büro ist fast jede Anwendung bedienbar. Im Lager zählen Handschuhe, schlechtes WLAN, Zeitdruck und Geräte mit begrenzter Akkulaufzeit. Ein digitaler Lieferschein muss deshalb mit wenigen, großen Eingabeschritten auskommen. Barcode- oder QR-Code-Scans sind oft schneller und verlässlicher als die Suche nach Artikelnummern.

Offline-Fähigkeit ist kein Luxus, wenn Fahrer außerhalb stabiler Netzabdeckung arbeiten. Die Anwendung sollte Vorgänge lokal zwischenspeichern, klar anzeigen, was noch nicht synchronisiert wurde, und Konflikte kontrolliert behandeln. Wenn zwei Personen dieselbe Lieferung bearbeiten, darf nicht zufällig die letzte Speicherung gewinnen.

Auch die Gerätefrage ist pragmatisch zu beantworten. Ein vorhandenes Smartphone kann für einfache Zustellungen genügen. Für häufige Scans, Fotos und Unterschriften im Lager sind robuste Handhelds oder Tablets häufig wirtschaftlicher. Die beste Entscheidung hängt von Einsatzdauer, Umgebung und dem erwarteten Durchsatz ab - nicht davon, welches Gerät auf einer Produktfolie modern aussieht.

Schnittstellen vor der Einführung festlegen

Ein digitaler Lieferschein entfaltet seinen Nutzen erst, wenn er an die führenden Daten anschließt. In vielen Betrieben liegen Aufträge im ERP oder in der Warenwirtschaft, Bestände in einer separaten Lagerlösung und Rechnungen in der Buchhaltung. Das muss nicht sofort zu einem großen Systemprojekt werden. Aber die Datenhoheit sollte klar sein.

Definieren Sie daher, welches System Kunden, Artikel, Preise und Aufträge führt. Die Lieferscheinlösung darf Informationen übernehmen, aber sie sollte nicht unbemerkt einen zweiten Artikelstamm erzeugen. Ebenso muss geregelt sein, wann bestätigte Istmengen zurückgemeldet werden und wer Abweichungen prüft.

Technisch sind verlässliche Schnittstellen wichtiger als spektakuläre Funktionen. Eindeutige IDs, dokumentierte Datenformate, Protokolle für fehlgeschlagene Übertragungen und ein Wiederholungsmechanismus verhindern, dass Lieferscheine zwischen zwei Systemen verschwinden. Eine schlanke Anwendung auf einer wartbaren Basis, etwa PHP 8.4, modernem JavaScript und MySQL 8, ist für viele mittelständische Abläufe sinnvoller als eine überladene Suite mit Funktionen, die niemand nutzt.

Sicherheit und Archivierung gehören zum Prozess

Lieferscheine enthalten Geschäfts- und häufig auch personenbezogene Daten. Rollenrechte sollten deshalb nicht pauschal vergeben werden. Fahrer brauchen etwa ihre Touren und offene Vorgänge, Lagerverantwortliche benötigen Korrektur- und Prüfoptionen, die Buchhaltung bestätigte Dokumente und Exporte. Administrativer Vollzugriff ist kein Standardrecht.

Zusätzlich braucht es eine nachvollziehbare Historie: Erstellung, Änderung, Übergabe, Unterschrift, Storno und Korrektur sollten mit Zeit, Benutzer und Begründung erfasst werden. Das hilft bei Rückfragen und schützt Mitarbeitende, wenn später unklar ist, wann ein Schaden oder eine Fehlmenge gemeldet wurde.

Für die Archivierung gilt: Das Dokument muss lesbar bleiben und der Vorgang auffindbar sein. Ob ein PDF erzeugt wird, hängt vom internen Ablauf und den Anforderungen externer Empfänger ab. Das PDF ist jedoch die Ausgabe eines digitalen Vorgangs, nicht dessen Datenmodell.

In kleinen Schritten produktiv werden

Der zuverlässigste Rollout startet mit einem klar abgegrenzten Prozess: beispielsweise Standardauslieferungen eines Lagers oder Wareneingänge einer Abteilung. Wählen Sie einen Bereich mit ausreichendem Volumen, aber ohne die kompliziertesten Ausnahmefälle. So lassen sich Bedienung, Datenqualität und Schnittstellen unter echten Bedingungen prüfen.

Messen Sie nicht nur, ob die Anwendung technisch läuft. Prüfen Sie, wie lange eine Übergabe dauert, wie viele Lieferscheine nachbearbeitet werden müssen, wie häufig Bestandsdifferenzen auftreten und ob die Buchhaltung schneller arbeiten kann. Wenn ein digitales Verfahren mehr Rückfragen erzeugt als das Papierformular, ist nicht die Belegschaft das Problem - dann fehlt Prozessklarheit oder die Eingabemaske passt nicht zur Praxis.

Spreadsheets dürfen dabei weiterleben, wenn sie für eine kleine Auswertung oder eine seltene Sonderliste verlässlich sind. Digitalisierung bedeutet nicht, jedes bekannte Werkzeug abzuschaffen. Sie bedeutet, die fehleranfälligen Übergaben gezielt zu ersetzen und den Kernprozess belastbar zu machen.

softify.pro entwickelt solche Abläufe nicht als starres Standardprodukt, sondern entlang konkreter Warenbewegungen, Rollen und vorhandener Systeme. Das ist besonders dann sinnvoll, wenn ein Unternehmen zwischen Papierchaos und einem überdimensionierten Konzernsystem eine passende Lösung sucht.

Der richtige erste Schritt ist daher kein langer Anforderungskatalog. Nehmen Sie zehn Lieferscheine aus einer normalen Woche, einschließlich einer Teillieferung und einer Reklamation. Wenn Ihr künftiger Ablauf diese zehn Fälle schnell, eindeutig und nachvollziehbar verarbeitet, entsteht aus einem digitalen Lieferschein ein Werkzeug, auf das sich Lager, Fahrer und Verwaltung verlassen können.

Permalink →

Software Testing Trends 2026, die wirklich zählen

Software Testing Trends 2026, die wirklich zählen

Ein fehlgeschlagener Release zeigt selten nur einen einzelnen Fehler. Häufig treffen mehrere Ursachen zusammen: eine geänderte Berechtigung, eine unklare Testumgebung, fehlende Testdaten oder ein Regressionstest, der seit Monaten nicht mehr gepflegt wurde. Genau dort werden die software testing trends 2026 konkret. Nicht als Sammlung neuer Werkzeuge, sondern als Frage, wie Unternehmen Änderungen nachweisbar sicher ausliefern - auch bei knappen QA-Kapazitäten und sensiblen Daten.

Für Softwareteams in mittelständischen Betrieben ist das besonders relevant. Eine Lageranwendung, ein Kundenportal oder eine Windows-Desktop-Software muss nicht Millionen Nutzer bedienen. Sie muss aber im Schichtbetrieb funktionieren, Belege korrekt erzeugen und Berechtigungen zuverlässig durchsetzen. Testing muss deshalb näher an den realen Abläufen liegen als an einer perfekten Demo-Umgebung.

Software Testing Trends: KI wird zum Ausführenden, nicht zum Orakel

Der sichtbarste Trend ist KI-gestütztes Testen. Gemeint ist damit nicht, dass ein Sprachmodell eine Anforderung liest und anschließend die Qualität der Anwendung garantiert. Diese Erwartung wäre gefährlich. KI kann jedoch viel Aufwand dort reduzieren, wo Teams heute Zeit verlieren: beim Formulieren von Testfällen, beim Erkennen auffälliger Änderungen in Oberflächen, beim Zuordnen ähnlicher Fehlerbilder und beim Schreiben verständlicher Testberichte.

Besonders nützlich wird KI, wenn sie konkrete Arbeitsschritte ausführt und ihre Ergebnisse belegt. Ein Testagent kann sich etwa anmelden, einen Wareneingang anlegen, eine Lieferadresse ändern, ein Versandlabel erzeugen und prüfen, ob Status, Bestandsbewegung und Dokument zusammenpassen. Entscheidend ist nicht die Behauptung „Test bestanden“, sondern die Beweiskette: ausgeführte Schritte, Zeitstempel, Screenshots, technische Protokolle und eine klare Beschreibung der Abweichung.

Die Grenze bleibt wichtig. KI darf Testfälle vorschlagen und wiederkehrende Abläufe bedienen. Sie sollte nicht allein entscheiden, ob eine fachlich kritische Buchung korrekt ist. Bei Preisen, Lagerbeständen, Zahlungsfreigaben oder Zugriffsrechten braucht es weiterhin explizite Regeln und von Fachbereichen bestätigte Erwartungen. Automatisierung beschleunigt die Prüfung, sie ersetzt keine Verantwortung.

Testautomatisierung wandert in den Fachprozess

Lange Zeit konzentrierte sich UI-Testautomatisierung auf einfache Wege: Seite öffnen, Formular ausfüllen, Erfolgsmeldung prüfen. Das bleibt sinnvoll, reicht aber für geschäftskritische Systeme nicht aus. Der wertvollere Test prüft eine komplette Prozesskette.

Nehmen wir eine typische Logistikfunktion. Ein Auftrag wird erfasst, Ware reserviert, ein Pickvorgang gestartet, ein Lieferschein erzeugt und der Versand gemeldet. Jeder einzelne Bildschirm kann sauber aussehen, während der Prozess dennoch fehlschlägt - etwa weil eine Reservierung bei einem Abbruch bestehen bleibt oder eine Teillieferung den Bestand falsch verändert. Gute automatisierte Tests verfolgen daher Zustände und Daten über Systemgrenzen hinweg.

Das verlangt eine saubere Testarchitektur. API- und Datenbanktests prüfen Regeln schnell und präzise. UI-Tests kontrollieren zusätzlich, ob Mitarbeitende den Vorgang tatsächlich bedienen können. End-to-End-Tests verbinden beides, sind aber langsamer und anfälliger. Wer alles ausschließlich über den Browser testet, baut meist eine teure und fragile Testsuite. Wer nur Schnittstellen testet, übersieht Bedienungsprobleme und falsch verdrahtete Oberflächen.

Die pragmatische Lösung ist eine Pyramide, die zum Risiko passt: Viele schnelle Prüfungen nah an der Geschäftslogik, weniger Integrationsprüfungen und gezielt ausgewählte End-to-End-Szenarien für die wichtigsten Abläufe. Das klingt wenig spektakulär. Es liefert aber boring, provable reliability statt Trend-Chasing.

Selbst gehostete Test-KI wird zur Architekturfrage

Mit KI-Testwerkzeugen entsteht eine neue Frage: Wohin gehen Testdaten, Screenshots und Aufzeichnungen? In vielen Anwendungen enthalten sie Kundennamen, interne Preise, Personalinformationen oder Ansichten geschäftskritischer Prozesse. Selbst eine scheinbar harmlose Testumgebung kann reale Datenkopien oder vertrauliche Strukturen enthalten.

Deshalb wird die Ausführungsumgebung zu einem zentralen Kriterium. Ein externer Cloud-Dienst kann für öffentliche Webanwendungen und unkritische Testdaten passend sein. Für interne Portale, Desktop-Anwendungen oder regulierte Bereiche ist ein selbst gehosteter Ansatz oft sinnvoller. Dabei bleiben Testausführung, Bildmaterial und Protokolle in der kontrollierten Infrastruktur des Unternehmens oder in einer klar abgegrenzten EU-Umgebung.

Das ist kein pauschales Argument gegen Cloud-Dienste. Selbstbetrieb bringt Aufwand mit: Updates, Zugriffssteuerung, Rechenressourcen, Monitoring und klare Verantwortlichkeiten müssen geregelt sein. Der Nutzen entsteht, wenn Datenschutz, Nachvollziehbarkeit und Kontrolle über Testartefakte schwerer wiegen als der Komfort eines sofort verfügbaren SaaS-Kontos. Systeme wie COCO verfolgen genau diesen Ansatz, indem sie Tests für Web- und Windows-Anwendungen ausführen und Evidenz lokal kontrollierbar halten.

Flaky Tests werden nicht mehr als Normalzustand akzeptiert

Ein automatisierter Test, der ohne Produktänderung mal besteht und mal scheitert, erzeugt keine Sicherheit. Er erzeugt Warteschlangen. Teams gewöhnen sich dann daran, rote Builds zu ignorieren oder Tests erneut auszuführen, bis das gewünschte Ergebnis erscheint. Das ist ein schleichender Verlust an Vertrauen in die gesamte Qualitätskontrolle.

2026 rückt deshalb die Stabilität der Testausführung stärker in den Vordergrund. Die Ursachen sind meist bekannt: zufällige Wartezeiten, instabile Selektoren, gemeinsam genutzte Testdaten, Abhängigkeiten von externen Diensten oder nicht zurückgesetzte Datenbanken. Die Lösung ist selten ein weiterer Retry. Sinnvoller sind eindeutige technische Selektoren, isolierte Testkonten, kontrollierte Datenzustände und gezielte Wartebedingungen, die auf tatsächliche Systemereignisse reagieren.

Auch die Auswertung sollte unterscheiden: Ist ein Fehler reproduzierbar? Tritt er nur in einer Umgebung auf? Ist ein externer Dienst ausgefallen oder die Anwendung selbst? KI kann bei der Bündelung dieser Signale helfen. Die technische Entscheidung muss jedoch nachvollziehbar bleiben. Ein QA-Team braucht keine geheimnisvolle Fehlervorhersage, sondern eine belastbare Grundlage für die nächste Maßnahme.

Qualität beginnt früher bei Anforderungen und Daten

Viele Fehler entstehen, bevor die erste Zeile Code geschrieben wird. „Der Auftrag soll versendet werden können“ ist keine testbare Anforderung. Was geschieht bei unvollständiger Adresse, gesperrtem Kundenkonto, fehlender Ware, paralleler Bearbeitung oder abgelaufener Sitzung? Ohne Antworten darauf kann kein Testsystem zuverlässig prüfen, ob die Software richtig arbeitet.

Ein reiferer Testansatz ergänzt Anforderungen daher um überprüfbare Beispiele. Für ein Konto mit falschen Login-Versuchen kann das konkret bedeuten: Nach fünf Fehlversuchen wird das Konto für 15 Minuten gesperrt, der Vorgang wird protokolliert und ein berechtigter Administrator kann die Sperre nachvollziehen. Daraus entstehen direkt automatisierbare Prüfungen - und weniger Interpretationsspielraum zwischen Entwicklung, Betrieb und Fachbereich.

Testdaten werden ebenfalls zur Produktfunktion. Sie müssen realistisch genug sein, um Sonderfälle abzubilden, dürfen aber keine unnötigen personenbezogenen Daten kopieren. Sinnvoll sind generierte Datensätze für Mehrwertsteuerfälle, Teilmengen, gesperrte Artikel, ungültige Adressen und verschiedene Rollen. Gerade bei Anwendungen mit MySQL 8 oder vergleichbaren relationalen Datenbanken lohnt es sich, definierte Ausgangszustände automatisiert bereitzustellen und nach dem Lauf wieder zu entfernen.

Risikobasiertes Testen schlägt Testabdeckung um jeden Preis

Eine hohe Code-Coverage-Zahl kann beruhigend wirken und trotzdem wenig aussagen. Sie zeigt, welche Zeilen ausgeführt wurden, nicht ob die richtige Regel geprüft wurde. Ein System kann 90 Prozent Abdeckung erreichen und dennoch beim Storno einer Teillieferung falsche Bestände führen.

Die bessere Frage lautet: Welche Fehler wären für Betrieb, Kunden oder Recht besonders teuer? Daraus ergibt sich eine Priorisierung. Zugangsschutz, Preisberechnung, Bestandsbuchungen, Dokumentenerzeugung und Schnittstellen zu Versanddienstleistern verdienen meist mehr Testtiefe als selten genutzte Einstellungsseiten. Das bedeutet nicht, Nebensachen ungeprüft auszuliefern. Es bedeutet, begrenzte Zeit dort einzusetzen, wo ein Ausfall reale Arbeit stoppt oder falsche Entscheidungen erzeugt.

Diese Priorisierung muss sich verändern dürfen. Wird eine neue Route-Planungsfunktion eingeführt, steigt ihr Risiko. Wird eine alte Excel-Auswertung bald ersetzt, lohnt sich möglicherweise kein großer Automatisierungsaufwand mehr. Manchmal ist es vernünftiger, eine funktionierende Tabelle noch einige Monate beizubehalten, statt ihre Logik hastig in ein halbfertiges System zu pressen.

Was Teams jetzt praktisch tun sollten

Der erste sinnvolle Schritt ist kein Toolvergleich. Wählen Sie einen Prozess, dessen Fehler spürbar sind: Auftrag bis Versand, Wareneingang bis Einlagerung oder Anmeldung bis Rollenfreigabe. Beschreiben Sie den Sollablauf mit Ausnahmefällen, legen Sie verlässliche Testdaten an und automatisieren Sie zunächst die kritischen Prüfungen.

Messen Sie anschließend nicht nur die Anzahl der Tests. Beobachten Sie, wie schnell ein echter Fehler erkannt wird, wie oft Tests unbegründet fehlschlagen und ob ein Bericht einem Entwickler oder Fachverantwortlichen die Ursache verständlich erklärt. Erst wenn diese Grundlagen stehen, lohnt sich der Ausbau mit KI-Agenten, visueller Prüfung oder umfangreichen Testumgebungen.

Die stärksten Testing-Trends sind am Ende die, die Freigaben weniger riskant machen und Teams schneller zu klaren Entscheidungen bringen. Nicht das modernste Dashboard zählt, sondern ein nachvollziehbarer Testlauf, der zeigt: Dieser Geschäftsprozess funktioniert - und wenn nicht, wissen wir warum.

Permalink →

Routenplanung für Lieferfahrten: Software richtig wählen

Routenplanung für Lieferfahrten: Software richtig wählen

Ein Fahrer wartet auf einen Lieferschein, während sich die Reihenfolge seiner Stopps schon wieder ändert. Im Lager ist eine Sendung noch nicht kommissioniert, ein Kunde ruft wegen eines engeren Zeitfensters an, und die Tourenliste liegt in einer Tabellenkalkulation, die nur eine Person wirklich versteht. Wer nach „Routenplanung für Lieferfahrten Software“ sucht, will in dieser Situation nicht zwingend einen komplizierten Kartenalgorithmus. Gesucht wird ein verlässlicher Ablauf vom Auftrag bis zum Nachweis der Zustellung.

Für kleine und mittlere Unternehmen ist das ein entscheidender Unterschied. Eine theoretisch kürzere Strecke bringt wenig, wenn sie nicht berücksichtigt, dass Ware erst um 10 Uhr bereitsteht, ein Fahrzeug Kühlung benötigt oder ein Fahrer auf einer bestimmten Tour besondere Kundenkenntnis braucht. Gute Software für Lieferfahrten bildet die Realität des Betriebs ab - und macht sie für Disposition, Lager und Fahrer gemeinsam nutzbar.

Wann Routenplanung zum operativen Problem wird

Viele Betriebe starten sinnvoll mit Telefon, Papier und einer Tabelle. Bei fünf Stopps pro Tag und einem festen Fahrerteam ist das oft die schnellste Lösung. Erst wenn Auftragsmenge, Varianten und Zeitdruck zunehmen, entstehen die typischen Reibungsverluste: doppelt erfasste Adressen, veraltete Tourenstände, fehlende Informationen zu Ladehilfsmitteln und Rückfragen, die nur durch Anrufe an mehrere Personen beantwortet werden können.

Das Problem ist dann nicht allein die Fahrstrecke. Es ist der Informationsbruch zwischen Auftragserfassung, Lager, Disposition und Auslieferung. Wird ein Auftrag verschoben, muss diese Änderung heute häufig in mehreren Listen, auf einem Ausdruck und im Kopf des Fahrers nachgezogen werden. Das kostet Zeit und erzeugt Fehler, die Kunden unmittelbar sehen.

Ein weiteres Warnsignal sind Entscheidungen, die von einzelnen Mitarbeitenden abhängen. Wenn nur die erfahrene Disponentin weiß, welche Zufahrt für einen Kunden geeignet ist oder wie Tour 3 bei spätem Wareneingang angepasst wird, ist der Ablauf nicht belastbar dokumentiert. Software soll dieses Wissen nicht ersetzen. Sie soll es so abbilden, dass das Team handlungsfähig bleibt.

Was Software zur Routenplanung für Lieferfahrten können muss

Die Kernfunktion klingt einfach:
Aufträge werden einer Tour zugeordnet, Stopps sinnvoll sortiert und an Fahrer übergeben. Für den praktischen Nutzen braucht das System jedoch deutlich mehr Kontext. Entscheidend ist, welche Regeln bei der Planung gelten und wie Änderungen behandelt werden.

Aufträge müssen planbar statt nur sichtbar sein

Eine Lieferadresse auf einer Karte ist noch keine planbare Lieferung. Zu einem Auftrag gehören mindestens Mengen, Gewicht oder Volumen, Lieferdatum, gewünschtes Zeitfenster, Kontaktinformationen und ein klarer Bearbeitungsstatus. Je nach Betrieb kommen Ladehilfsmittel, Temperaturvorgaben, Gefahrgutkennzeichnungen, Avisierungsregeln oder eine bestimmte Fahrzeugklasse hinzu.

Diese Daten sollten nicht jedes Mal manuell aus verschiedenen Systemen zusammengesucht werden. Wenn Aufträge bereits aus einem Webshop, ERP, einer Auftragsmaske oder einer bestehenden Datenbank kommen, ist eine saubere Übergabe oft wertvoller als eine besonders spektakuläre Kartenansicht. Andernfalls verlagert sich die Arbeit nur von Papier in eine neue Oberfläche.

Touren brauchen Regeln, nicht nur Entfernung

Eine automatische Reihenfolge nach Kilometern oder Fahrzeit kann ein guter Vorschlag sein. Sie ist aber keine Entscheidung für den Betrieb. Die Planung muss Einschränkungen berücksichtigen können: feste Liefertermine, Kapazität des Fahrzeugs, Arbeitszeiten, Be- und Entladezeiten sowie regionale Zuständigkeiten.

Auch die Startlogik zählt. Manche Fahrzeuge beginnen und enden am Lager, andere fahren nach der letzten Lieferung direkt zum nächsten Einsatzort. Bei wiederkehrenden Touren kann eine feste Grundstruktur sinnvoll sein, die Disponenten nur bei Bedarf verändern. Wer jeden Morgen dieselben Stopps anfährt, braucht nicht zwangsläufig eine vollständige Neuoptimierung. Hier ist eine stabile, nachvollziehbare Tour häufig besser als ein rechnerisch minimaler Zeitgewinn.

Änderungen müssen kontrolliert beim Fahrer ankommen

Die Realität hält sich selten an den Morgenplan. Kunden sagen ab, Ware fehlt, ein Fahrzeug fällt aus oder ein Auftrag wird dringend. In solchen Fällen entscheidet sich, ob die Software Entlastung oder zusätzliche Arbeit schafft.

Eine brauchbare Lösung zeigt eindeutig, welche Tourversion aktuell gilt, welche Stopps bereits erledigt sind und was konkret geändert wurde. Der Fahrer sollte keine widersprüchlichen Ausdrucke, Screenshots und Messenger-Nachrichten vergleichen müssen. Für viele Teams genügt zunächst eine mobile, browserbasierte Fahreransicht mit Stoppreihenfolge, Kontaktdaten, Lieferhinweisen und Statusrückmeldung. Eine eigene App ist nicht automatisch besser, wenn Installation, Geräteverwaltung und Offline-Anforderungen keinen klaren Nutzen bringen.

Nicht mit Routenoptimierung allein anfangen

Der häufigste Fehlansatz ist, zuerst einen Optimierungsdienst einzukaufen und erst danach zu prüfen, ob die Stammdaten und Abläufe stimmen. Falsch geschriebene Adressen, unklare Lieferfenster und Aufträge ohne verlässlichen Bereitstellungsstatus lassen sich nicht wegoptimieren.

Sinnvoller ist eine kurze Bestandsaufnahme entlang des realen Tagesablaufs. Wo entstehen Aufträge? Wann bestätigt das Lager die Bereitstellung? Wer plant Touren? Wie erhält der Fahrer Änderungen? Und welcher Nachweis wird nach der Lieferung benötigt? Diese Fragen wirken banal, legen aber fest, welche Datenfelder, Rollen und Schnittstellen das System tatsächlich braucht.

Oft zeigt sich dabei, dass nicht jeder Schritt digitalisiert werden sollte. Eine handschriftliche Notiz für eine seltene Sonderlieferung kann angemessen sein, wenn sie später sauber in den Auftrag übernommen wird. Eine Tabellenkalkulation darf ebenfalls bleiben, wenn sie eine überschaubare Auswertung zuverlässig liefert. Software sollte den Engpass lösen, nicht jeden bekannten Ablauf zwanghaft ersetzen.

Build, Buy oder gezielte Erweiterung?

Standardsoftware ist passend, wenn die Tourenlogik allgemein ist, Prozesse kaum variieren und sich das Team an vorgegebene Masken anpassen kann. Sie verkürzt die Einführung und kann für einen einfachen Fuhrpark ausreichend sein. Der Nachteil zeigt sich, sobald sie zentrale Sonderfälle nur über Nebenlisten, Freitext oder teure Zusatzmodule abbildet.

Eine individuelle Lösung lohnt sich nicht, weil Individualentwicklung grundsätzlich überlegen wäre. Sie lohnt sich, wenn der Ablauf selbst ein Wettbewerbsvorteil oder eine dauerhafte Fehlerquelle ist: etwa bei speziellen Verpackungseinheiten, kombinierten Abhol- und Liefertouren, eigenen Lieferdokumenten oder einer engen Verbindung von Wareneingang, Kommissionierung und Auslieferung.

Dazwischen liegt oft der pragmatischste Weg. Bestehende Systeme bleiben für Buchhaltung oder Lagerführung bestehen, während eine schlanke Anwendung Aufträge bündelt, Touren plant und den Fahrerprozess abdeckt. Dafür braucht es klare Schnittstellen, eindeutige Verantwortlichkeiten für Daten und eine Datenbankstruktur, die Änderungen nachvollziehbar speichert. Moderne Webanwendungen auf einer wartbaren Basis wie PHP 8.4 und MySQL 8 sind dafür keine Modeentscheidung, sondern eine Grundlage für kalkulierbaren Betrieb und spätere Anpassungen.

Einführung in kleinen Schritten statt großer Umstellung

Eine Routenplanungssoftware sollte zuerst an einer überschaubaren Tour oder Fahrzeuggruppe erprobt werden. Nicht weil ein Pilotprojekt risikolos wäre, sondern weil sich echte Ausnahmen früh zeigen: fehlende Lieferhinweise, uneinheitliche Adressdaten, Wartezeiten beim Kunden oder unklare Übergaben im Lager.

Für die erste Ausbaustufe reichen meist klar abgegrenzte Funktionen: Auftrag übernehmen, Status der Bereitstellung sehen, Tour zusammenstellen, Tour freigeben und Lieferung zurückmelden. Erst wenn diese Kette im Alltag funktioniert, sind automatische Optimierung, elektronische Unterschrift, Foto-Nachweise, Kundenbenachrichtigungen oder detaillierte Kennzahlen sinnvoll.

Messbar wird der Nutzen nicht nur über eingesparte Kilometer. Relevant sind auch weniger Dispositionsaufwand, weniger Rückfragen, geringere Fehlzustellungen, kürzere Zeit bis zum Lieferschein und eine bessere Auskunftsfähigkeit gegenüber Kunden. Diese Kennzahlen sollten vor dem Start grob erfasst werden. Sonst bleibt nach der Einführung nur der Eindruck, dass die Oberfläche moderner aussieht.

Die Technik muss im Hintergrund zuverlässig bleiben

Routenplanung verarbeitet sensible Betriebsdaten: Kundenadressen, Fahrerzuordnungen, Liefermengen und häufig auch Zustellnachweise. Deshalb gehören Rollenrechte, nachvollziehbare Änderungen, regelmäßige Backups und ein dokumentierter Betrieb zur Lösung. Wer eine Tour freigeben, ändern oder löschen darf, sollte nicht dem Zufall überlassen werden.

Auch die Karten- und Routingdaten verdienen eine nüchterne Prüfung. Externe Dienste können sehr gut passen, bringen aber laufende Kosten, Verfügbarkeiten und Datenschutzfragen mit. Bei hohen Anforderungen an Datenhaltung oder speziellen Gebietslogiken muss früh geklärt werden, welche Daten das eigene System verlassen und wie Ausfälle abgefedert werden. Eine perfekte Route ist wertlos, wenn die Disposition bei einer Störung nicht weiterarbeiten kann.

softify.pro plant solche Systeme vom tatsächlichen Auftragseingang bis zur Rückmeldung aus dem Fahrzeug. Der Maßstab ist dabei nicht die längste Funktionsliste, sondern ein Ablauf, den Lager, Disposition und Fahrer unter Zeitdruck zuverlässig bedienen können.

Die beste Routenplanung wirkt im Alltag erstaunlich unspektakulär: Aufträge sind vollständig, Touren verständlich, Änderungen eindeutig und Zustellungen belegbar. Genau diese unaufgeregte Verlässlichkeit schafft Raum für die Ausnahmen, bei denen Menschen entscheiden müssen.

Permalink →

Bestellannahme Workflow automatisieren im Betrieb

Bestellannahme Workflow automatisieren im Betrieb

Ein Auftrag kommt per E-Mail, ein weiterer per Telefon, dazu eine Excel-Datei vom Key Account. Im Lager fehlt später die Lieferadresse, der Vertrieb kennt den zugesagten Termin nicht mehr genau, und die Versandabteilung druckt den Lieferschein mit einer alten Artikelposition. Wer den Bestellannahme Workflow automatisieren will, löst kein abstraktes Digitalprojekt. Er beseitigt genau diese Reibung an der Stelle, an der Umsatz in operative Arbeit übergeht.

Für kleine und mittlere Unternehmen ist die Bestellannahme oft unterschätzt. Solange wenige Aufträge pro Tag eingehen und erfahrene Mitarbeitende jeden Sonderfall kennen, tragen Telefonnotizen, Postfächer und Tabellen den Prozess. Mit wachsendem Volumen werden sie jedoch zu einem Risiko: Informationen liegen doppelt vor, Übergaben passieren mündlich, und niemand kann zuverlässig sagen, welcher Stand der Bestellung gilt.

Warum die Bestellannahme so oft zum Engpass wird

Die Ursache ist selten fehlender Einsatz. Meist ist der Ablauf über Jahre gewachsen. Kunden bestellen auf unterschiedlichen Wegen, Preise und Lieferbedingungen gelten nur für bestimmte Kundengruppen, Artikelnummern weichen von internen Bezeichnungen ab. Mitarbeitende gleichen Informationen aus Erfahrung ab und füllen Lücken mit Rückfragen.

Das funktioniert, bis eine Person im Urlaub ist, die Schicht wechselt oder mehrere dringende Aufträge gleichzeitig eintreffen. Dann zeigt sich, dass Wissen nicht im Prozess steckt, sondern in einzelnen Köpfen und verstreuten Dateien. Die Folgen sind vertraut: falsche Mengen, verspätete Lieferungen, ungeklärte Freigaben und unnötige Korrekturen im Lager.

Automatisierung bedeutet hier nicht, dass ein Kunde zwangsläufig in einem Portal bestellen muss. Sie bedeutet, dass jeder Auftrag unabhängig vom Eingangskanal nach denselben nachvollziehbaren Regeln erfasst, geprüft, angereichert und übergeben wird.

Den Bestellannahme Workflow automatisieren, ohne den Betrieb zu verbiegen

Ein brauchbarer Workflow beginnt nicht mit einer Softwareliste, sondern mit einer nüchternen Prozessaufnahme. Entscheidend ist: Welche Informationen müssen vorliegen, bevor ein Auftrag in Lager, Disposition oder Fertigung gehen darf? Und welche Ausnahmen sind legitim, statt einfach nur störend?

Ein typischer Ablauf besteht aus vier klaren Stationen: Auftrag erfassen, Daten prüfen, Auftrag freigeben und Folgeprozesse auslösen. Zwischen diesen Stationen braucht es eindeutige Verantwortlichkeiten und Status. Ein Auftrag sollte beispielsweise nicht gleichzeitig als „neu“, „in Klärung“ und „versandbereit“ gelten können.

1. Aufträge aus allen Kanälen in einen Vorgang überführen

E-Mail, Telefon, PDF, EDI, Webformular oder Außendienstnotiz können unterschiedliche Eingänge bleiben. Entscheidend ist, dass sie in einem gemeinsamen Auftragsvorgang landen. Mitarbeitende sollten nicht erst Informationen aus dem Postfach kopieren, dann eine Tabelle aktualisieren und anschließend eine zweite Person informieren müssen.

Bei strukturierten Bestellungen lassen sich Kundendaten, Artikelnummern, Mengen und Wunschtermine direkt übernehmen. Bei PDFs oder Freitext-E-Mails ist eine geführte Erfassung oft sinnvoller als eine vollständig automatische Auslesung. KI-gestützte Extraktion kann Vorschläge machen, aber bei unklaren Mengenangaben, kundenspezifischen Artikelnummern oder handschriftlichen Dokumenten braucht es eine sichtbare Prüfung.

Der sinnvolle Maßstab lautet nicht „maximal automatisch“, sondern „keine unnötige doppelte Erfassung“. Ein gut gestaltetes Formular mit Pflichtfeldern und plausiblen Vorschlägen spart in vielen Betrieben mehr Zeit als eine fehleranfällige Vollautomatik.

2. Daten prüfen, bevor Fehler weiterlaufen

Die wertvollste Automatisierung findet vor der Freigabe statt. Das System kann prüfen, ob die Kundennummer existiert, die Lieferadresse vollständig ist, der Artikel aktiv ist, die gewünschte Menge zulässig erscheint und die Zahlungs- oder Kreditfreigabe vorliegt. Auch kundenspezifische Preise, Mindestmengen und Lieferfenster lassen sich gegen hinterlegte Regeln abgleichen.

Wichtig ist die Behandlung von Abweichungen. Nicht jede Abweichung muss einen Auftrag blockieren. Fehlt etwa eine Referenznummer, kann der Vertrieb eine Aufgabe erhalten. Überschreitet ein Auftrag eine definierte Wertgrenze oder liegt die Marge außerhalb des vereinbarten Rahmens, kann eine Freigabe durch die zuständige Rolle erforderlich sein.

So entstehen keine stillen Fehler, sondern sichtbare Klärfälle. Das ist ein großer Unterschied: Das Lager bekommt nicht einfach einen unvollständigen Auftrag, sondern einen Auftrag mit eindeutigem Status und dokumentierter Entscheidung.

3. Freigaben an Regeln statt an Zurufe koppeln

Viele Verzögerungen entstehen durch Sätze wie: „Kannst du das noch kurz freigeben?“ Solche Nachfragen sind nicht grundsätzlich falsch. Problematisch werden sie, wenn sie über Chat, Telefon oder Flurgespräch laufen und später nicht nachvollziehbar sind.

Ein automatisierter Workflow hinterlegt Freigaberegeln direkt am Auftrag. Beispielsweise kann ein Auftrag automatisch freigegeben werden, wenn Kunde, Preis, Bestand und Lieferadresse plausibel sind. Bei Sonderkonditionen, Teillieferungen oder einem Auftrag über einer definierten Grenze wird die zuständige Person benachrichtigt. Die Freigabe wird mit Zeitstempel und Begründung gespeichert.

Das schafft Geschwindigkeit, ohne Kontrolle aufzugeben. Gerade bei wechselnden Schichten oder mehreren Standorten verhindert es, dass Aufträge an persönlichen Postfächern hängen bleiben.

4. Lager, Versand und Kunde gezielt informieren

Nach der Freigabe muss der Auftrag nicht mehr manuell von einer Liste in die nächste übertragen werden. Der Workflow kann einen Kommissionierauftrag erzeugen, Bestände reservieren, einen Lieferschein vorbereiten oder eine Versandmeldung anstoßen. Welche Schritte sinnvoll sind, hängt vom Geschäftsmodell ab.

Ein Ersatzteilhändler benötigt möglicherweise sofort einen Pickauftrag und eine Prioritätskennzeichnung. Ein Hersteller braucht zunächst eine Verfügbarkeitsprüfung und danach einen Produktionsimpuls. Ein Großhändler mit festen Touren möchte Aufträge bis zu einer bestimmten Uhrzeit bündeln. Deshalb ist eine starre Standardlösung oft nicht die beste Wahl.

Für den Kunden reicht häufig eine klare Bestätigung: Auftrag eingegangen, geprüft oder verbindlich eingeplant. Nicht jede interne Statusänderung gehört in eine E-Mail. Zu viele automatische Nachrichten erzeugen Rückfragen statt Vertrauen.

Welche Daten ein belastbarer Prozess braucht

Eine gute Bestellannahme steht auf einer sauberen Datenbasis. Dazu gehören gepflegte Kundenstammdaten, eindeutige Artikelnummern, gültige Preis- und Konditionsregeln sowie klar definierte Lieferadressen. Fehlen diese Grundlagen, beschleunigt Automatisierung nur die Weitergabe unsicherer Daten.

Auch die technische Architektur zählt. Ein zentrales System mit nachvollziehbaren Statuswechseln und einer verlässlichen Datenbank ist dauerhaft besser als eine Kette aus Makros, lokalen Dateien und unkontrollierten E-Mail-Weiterleitungen. Das heißt nicht, dass jede Excel-Tabelle sofort ersetzt werden muss. Wenn eine Tabelle in einem kleinen, stabilen Teilprozess transparent funktioniert, kann sie vorerst bleiben.

Sobald mehrere Personen gleichzeitig mit Aufträgen arbeiten, Freigaben erforderlich sind oder Informationen an Lager und Versand weitergegeben werden, sollte jedoch eine zentrale Datenquelle Vorrang haben. Systeme auf Basis einer wartbaren Architektur, etwa mit PHP 8.4, modernem JavaScript und MySQL 8, lassen sich dabei gezielt an vorhandene Abläufe anbinden, statt einen Betrieb in das Schema einer Konzernsoftware zu pressen.

Messbar machen, ob der Workflow wirklich besser wird

Ein neues System ist nicht automatisch ein besserer Prozess. Vor dem Start sollten deshalb wenige Kennzahlen festgelegt werden. Relevant sind etwa die Zeit vom Auftragseingang bis zur Freigabe, die Zahl der Rückfragen pro Auftrag, Korrekturen nach Übergabe ans Lager und die Quote termingerecht bearbeiteter Bestellungen.

Diese Kennzahlen zeigen auch, wo keine weitere Automatisierung nötig ist. Wenn 85 Prozent der Standardaufträge schnell und fehlerfrei laufen, die übrigen 15 Prozent aber echte Sonderfälle sind, ist ein klarer Klärprozess sinnvoller als der Versuch, jede Ausnahme algorithmisch zu erzwingen.

Protokolle helfen zusätzlich im Tagesgeschäft. Wer sieht, wann ein Auftrag einging, welche Prüfung fehlgeschlagen ist, wer ihn freigegeben hat und wann der Versandauftrag erzeugt wurde, sucht nicht mehr in fünf Postfächern nach der Ursache. Das reduziert nicht nur Fehler, sondern auch die Abhängigkeit von einzelnen Mitarbeitenden.

Einführung in kleinen Schritten statt Big Bang

Der sicherste Einstieg ist meist eine klar abgegrenzte Auftragsart: etwa Standardbestellungen eines bestimmten Kundenkreises oder E-Mail-Aufträge mit bekannten Artikeln. Dort lassen sich Datenfelder, Regeln und Übergaben unter realen Bedingungen testen. Erst wenn Status, Ausnahmen und Verantwortlichkeiten sauber funktionieren, folgen komplexere Fälle wie Sonderpreise, Teillieferungen oder kundenindividuelle Verpackungsvorgaben.

Mitarbeitende sollten an der Gestaltung beteiligt sein. Nicht, weil jede bestehende Gewohnheit unverändert bleiben muss, sondern weil die Personen am Telefon, im Vertrieb und im Lager die tatsächlichen Ausnahmen kennen. Eine Lösung, die nur im Workshop gut aussieht, wird auf dem Hallenboden schnell umgangen.

softify.pro setzt bei solchen Vorhaben auf workflow-spezifische Systeme statt auf überladene Standardsuiten: mit klaren Übergaben, dokumentierten Regeln und genug Raum für die Arbeitsweisen, die im Betrieb nachweislich funktionieren.

Der beste nächste Schritt ist daher nicht die Suche nach möglichst vielen Funktionen. Nehmen Sie zehn reale Bestellungen aus einer typischen Woche und verfolgen Sie ihren Weg vom Eingang bis zum Versand. Jede manuelle Doppelübertragung, jede unklare Entscheidung und jede wiederkehrende Rückfrage ist ein konkreter Ansatzpunkt für einen Prozess, der künftig verlässlich für das Team arbeitet.

Permalink →

Testdaten beim KI Testing sicher schützen

Testdaten beim KI Testing sicher schützen

Ein fehlgeschlagener automatisierter Test ist meist schnell behoben. Ein Screenshot aus dem Testlauf, der Kundendaten, Preislisten oder eine aktive Sitzung enthält und in einen externen KI-Dienst gelangt, ist ein anderes Problem. Wer Testdaten beim KI Testing schützen will, muss deshalb nicht nur die Testfälle betrachten, sondern den gesamten Datenweg: Eingaben, Browserverkehr, Protokolle, Bilder, KI-Auswertung und Aufbewahrung.

Gerade bei Webanwendungen, internen Portalen und Windows-Software entsteht schnell ein falsches Sicherheitsgefühl. Die Umgebung heißt zwar „Test“, doch sie verwendet oft Kopien produktiver Datenbanken, echte Benutzerrollen oder Schnittstellen zu Versand, ERP und Dokumentenarchiven. KI-gestützte Tests machen diese Daten für die Analyse besonders wertvoll - und damit besonders schutzbedürftig.

Warum KI-Testing einen eigenen Datenschutzblick braucht

Klassische Testautomatisierung prüft meist klar abgegrenzte Schritte: anmelden, Auftrag anlegen, Lieferschein erzeugen, Abmeldung prüfen. KI-gestütztes Testing erweitert diesen Ablauf. Das System kann Oberflächen interpretieren, Auffälligkeiten bewerten, Screenshots vergleichen und Ergebnisse in verständlicher Sprache dokumentieren. Das spart Zeit bei Regressionstests, erzeugt aber zusätzliche Datenartefakte.

Diese Artefakte sind oft aussagekräftiger als ein gewöhnliches Testprotokoll. Ein Screenshot kann Namen, Adressen, Vertragswerte, Bestellmengen oder Gesundheitsdaten zeigen. Ein Netzwerk-Log kann Sitzungs-Token und API-Antworten enthalten. Eine Fehlermeldung verrät unter Umständen interne Dateipfade, Datenbankstrukturen oder Versionsstände. Wenn ein Modell mit diesen Informationen arbeitet, muss klar sein, wo die Verarbeitung stattfindet und wer darauf zugreifen kann.

Die entscheidende Frage lautet daher nicht: „Nutzen wir KI im Test?“ Sondern: „Welche Daten verlassen welche Sicherheitszone - und warum?“ Für viele Unternehmen im DACH-Raum ist eine externe Cloud-Verarbeitung nicht grundsätzlich ausgeschlossen. Sie muss aber vertraglich, technisch und organisatorisch zum Schutzbedarf passen. Bei Entwicklungs-, Produktions- oder Kundendaten ist eine lokal kontrollierte Ausführung häufig die sachlichere Entscheidung.

Testdaten beim KI Testing schützen beginnt vor dem ersten Lauf

Datenschutz im Testing wird oft erst bei der Auswahl eines Tools diskutiert. Das ist zu spät. Zuerst braucht es eine einfache, belastbare Dateninventur. Welche Systeme werden getestet? Welche Felder erscheinen in Oberflächen? Welche Anhänge, Exporte und API-Antworten können im Test auftauchen? Und welche Daten landen automatisch in Screenshots, Videos oder Fehlermeldungen?

Dabei lohnt sich eine Einteilung in drei Gruppen. Unkritische Testdaten können frei erzeugt und länger gespeichert werden. Personenbezogene oder geschäftlich vertrauliche Daten brauchen Maskierung, Zugriffsbeschränkungen und kurze Aufbewahrung. Zugangsdaten, Tokens, Schlüssel und produktive Konfigurationswerte gehören nicht in Testnachweise oder Modellanfragen - auch dann nicht, wenn sie nur versehentlich in einem Browserfenster sichtbar sind.

In vielen mittelständischen Anwendungen ist die Datenlage nicht sauber getrennt. Das Lagerteam testet einen neuen Wareneingang mit einem Datenbankabzug, weil nur dort die realen Artikelstrukturen, Lieferantenregeln und Sonderfälle vorhanden sind. Das kann fachlich sinnvoll sein. Die Konsequenz darf aber nicht sein, dass dieser Abzug unverändert in jede Testumgebung wandert.

Besser ist ein reproduzierbarer Prozess: Daten exportieren, sensible Felder gezielt pseudonymisieren, nicht benötigte Tabellen entfernen und die resultierende Testdatenbasis versioniert bereitstellen. So bleiben typische Prozessfehler erhalten, ohne dass echte Kunden oder Mitarbeitende in Testläufen sichtbar werden. Bei komplexen Preis- oder Dispositionslogiken reichen vollständig synthetische Daten oft nicht aus. Dann ist eine sorgfältig bereinigte Kopie meist der bessere Kompromiss.

Maskierung muss die Fachlogik erhalten

Eine Maskierung, die jede E-Mail-Adresse durch denselben Platzhalter ersetzt, kann Testfälle beschädigen. Dublettenprüfungen, Rollenlogik, Suchfunktionen oder Rechnungsabläufe reagieren anders als im Betrieb. Gute Maskierung erhält daher Formate, Beziehungen und Verteilungen. Aus einer Kundennummer wird eine andere gültige Kundennummer. Aus einer Adresse wird eine plausible, aber fiktive Adresse. Aus einem Lieferdatum bleibt ein Datum innerhalb einer realistischen Planungsspanne.

Das kostet etwas Vorbereitung. Dafür verhindert es den klassischen Fehler, bei dem Tests zwar technisch grün sind, aber die tatsächlichen Abläufe im Lager, Vertrieb oder Kundenservice nicht mehr abbilden. Datenschutz und fachlich brauchbare Tests sind keine Gegensätze - sofern die Datenaufbereitung Teil der Testarchitektur ist.

Der Ausführungsort entscheidet über die Kontrolle

Wer automatisierte Tests an einen externen Dienst übergibt, gibt je nach Konfiguration mehr weiter als Testschritte. Browserinhalte, DOM-Strukturen, Screenshots, Videos, Konsolenprotokolle und Auswertungen können außerhalb der eigenen Infrastruktur verarbeitet und gespeichert werden. Ob das akzeptabel ist, hängt vom Einzelfall ab: Datenkategorien, Vertragswerk, Speicherort, Mandantentrennung, Löschkonzept und interne Vorgaben spielen zusammen.

Für Anwendungen mit hohem Schutzbedarf ist eine selbst gehostete Testumgebung oft klarer zu beurteilen. Der Test-Runner, die KI-Komponente und die Evidenzspeicherung bleiben im eigenen Netzwerk oder in einer kontrollierten europäischen Infrastruktur. Netzwerkregeln können externe Verbindungen begrenzen. Zugriffe lassen sich an vorhandene Identitäten, Rollen und Protokollierung anbinden. Auch die Aufbewahrung von Bildern und Berichten wird zur eigenen Entscheidung statt zu einer Standardeinstellung eines Plattformanbieters.

COCO folgt genau diesem Ansatz: Der KI-Server führt Tests für Web- und Windows-Anwendungen kontrolliert aus, dokumentiert Nachweise und erzeugt verständliche Bewertungen, ohne dass interne Anwendungsdaten standardmäßig in eine externe KI-Cloud abgegeben werden müssen. Das ersetzt keine Datenschutzprüfung. Es schafft jedoch eine technische Grundlage, auf der IT, Informationssicherheit und Fachbereich nachvollziehbare Regeln vereinbaren können.

Screenshots, Logs und Secrets sind die häufigsten Lecks

Viele Teams schützen die Testdatenbank, übersehen aber die Nebenprodukte des Testens. Genau dort liegen in der Praxis oft die größeren Risiken. Ein fehlgeschlagener Login-Test kann ein Passwort im Eingabefeld zeigen. Ein API-Test kann einen Bearer-Token im Log ausgeben. Ein automatischer Video-Mitschnitt dokumentiert einen vollständigen Auftrag inklusive Kundenadresse.

Ein belastbares Konzept regelt deshalb mindestens fünf Punkte:

  • Screenshots und Videos werden nur bei Bedarf erstellt und nach festen Fristen gelöscht.
  • Geheimnisse werden über einen Secret-Store oder geschützte Laufzeitvariablen eingebunden, niemals im Testcode abgelegt.
  • Protokolle filtern Token, Passwörter, Session-IDs und sensible Felder, bevor sie gespeichert werden.
  • Testkonten besitzen nur die Rechte, die für den jeweiligen Ablauf nötig sind.
  • Testsysteme dürfen keine produktiven E-Mails, Etiketten, Zahlungen oder Bestandsbewegungen auslösen, sofern das nicht ausdrücklich abgesichert ist.

Diese Regeln klingen nüchtern. Genau das ist ihr Vorteil. Ein Team muss nicht auf Aufmerksamkeit oder gute Absichten hoffen, sondern kann Fehlbedienung technisch begrenzen. Besonders wirksam sind getrennte Servicekonten für Testautomatisierung, kurze Token-Laufzeiten und ein klarer Prozess zum Widerruf kompromittierter Zugangsdaten.

Auch die KI-Auswertung braucht Grenzen

KI-Modelle werden häufig eingesetzt, um Abweichungen zu erklären: „Der Button war nicht sichtbar“, „Die Anwendung reagierte langsamer als erwartet“ oder „Der Prozess endete in einer Berechtigungsprüfung“. Für solche Einschätzungen braucht ein Modell nicht zwangsläufig den vollständigen Kundendatensatz.

Definieren Sie daher, welche Informationen in die Bewertung einfließen dürfen. Reicht ein anonymisierter Screenshot? Genügt eine technische Fehlerklasse statt der kompletten Serverantwort? Können Felder vor der Analyse geschwärzt werden? Die richtige Tiefe hängt vom Testziel ab. Bei einem Layoutvergleich ist ein Name selten relevant. Bei der Prüfung einer personalisierten Dokumentenvorlage kann er relevant sein - dann muss die Verarbeitung entsprechend abgesichert werden.

Schutzmaßnahmen müssen im Betrieb überprüfbar bleiben

Ein Konzept ist nur belastbar, wenn es im Alltag kontrolliert werden kann. Dazu gehören regelmäßige Stichproben der Testnachweise, Prüfungen von Berechtigungen und ein Blick auf tatsächlich gespeicherte Daten. Haben sich neue Felder in Screenshots eingeschlichen? Existieren alte Testkonten noch? Wird ein Datenbankabzug länger aufbewahrt als vorgesehen? Solche Fragen gehören in die normale Betriebsroutine, nicht nur in ein Audit.

Ebenso wichtig ist eine klare Verantwortlichkeit. QA kennt die Testabläufe, Entwicklung kennt die technischen Schnittstellen, der Fachbereich kennt die kritischen Prozesse und IT-Sicherheit definiert den Rahmen. Wenn niemand diese Perspektiven zusammenführt, entsteht entweder ein riskanter Schnellweg oder eine Sicherheitsvorgabe, die reale Tests verhindert. Ein kleiner, dokumentierter Freigabeprozess ist meist wirksamer als ein umfangreiches Regelwerk, das niemand anwendet.

Am Ende geht es nicht darum, jeden Test künstlich kompliziert zu machen. Gute Testdaten schützen heißt, echte Risiken gezielt aus der Automatisierung herauszunehmen und die fachliche Aussagekraft der Tests zu bewahren. Wenn Teams genau wissen, welche Daten ein Test sehen darf, wo seine Nachweise liegen und wann sie verschwinden, wird KI-Testing zu einem kontrollierbaren Werkzeug statt zu einer zusätzlichen Unsicherheit.

Permalink →

Webanwendung mit PHP entwickeln lassen

Webanwendung mit PHP entwickeln lassen

Wenn Wareneingänge in einer Tabelle landen, Versanddaten per Telefon weitergegeben werden und der aktuelle Auftragsstatus nur im Kopf einzelner Mitarbeitender existiert, fehlt meist kein weiteres Standardtool. Es fehlt ein System, das den eigenen Ablauf verbindlich abbildet. Eine Webanwendung mit PHP entwickeln lassen lohnt sich genau dann: wenn Informationen, Entscheidungen und Dokumente an einem Ort zusammenkommen müssen, ohne den Betrieb mit einer überdimensionierten Enterprise-Suite zu belasten.

PHP ist dabei kein nostalgischer Kompromiss. Mit PHP 8.4, einer klaren Anwendungsarchitektur und MySQL 8 lassen sich langlebige Webanwendungen bauen, die schnell reagieren, gut wartbar sind und auf Desktop, Tablet oder Handscanner zuverlässig funktionieren. Entscheidend ist allerdings nicht die Sprache allein. Entscheidend ist, ob die Anwendung die Arbeit auf dem Lagerboden, im Büro und unterwegs tatsächlich einfacher macht.

Wann eine individuelle Webanwendung sinnvoll ist

Nicht jeder Prozess braucht sofort Individualsoftware. Eine sauber gepflegte Tabelle kann für eine kleine, selten veränderte Liste die vernünftigste Lösung bleiben. Auch ein etabliertes Standardprodukt ist sinnvoll, wenn es die wesentlichen Abläufe bereits abdeckt und sich ohne dauerhafte Umwege nutzen lässt.

Der Wendepunkt kommt, wenn Mitarbeitende Daten mehrfach erfassen, Informationen aus verschiedenen Dateien zusammensuchen oder Sonderfälle regelmäßig außerhalb des eigentlichen Systems lösen. Typische Signale sind fehlende Bestandsklarheit, manuell erzeugte Lieferscheine, unklare Zuständigkeiten bei Aufträgen oder Rückfragen, die jede Schicht wiederholen muss. Dann wird nicht nur Zeit verloren. Fehler werden schwer nachvollziehbar, und die Abhängigkeit von einzelnen Personen steigt.

Eine maßgeschneiderte Webanwendung bildet dagegen genau die Regeln ab, die im Betrieb gelten. Sie kann zum Beispiel Wareneingänge erfassen, Lagerbewegungen dokumentieren, Etiketten erzeugen, Aufträge priorisieren oder Übergaben zwischen Teams nachvollziehbar machen. Dabei muss nicht am ersten Tag jeder Sonderfall automatisiert sein. Ein sinnvoller Start konzentriert sich auf den Ablauf, der heute am meisten Reibung erzeugt.

Webanwendung mit PHP entwickeln lassen: Was vorher geklärt sein muss

Gute Software beginnt nicht mit Maskenentwürfen oder einer Liste technischer Schlagworte. Sie beginnt mit konkreten Situationen: Was passiert, wenn eine Lieferung unvollständig eintrifft? Wer darf einen Bestand korrigieren? Welche Information braucht die Versandabteilung, bevor ein Label gedruckt wird? Und was geschieht, wenn ein Mitarbeitender im Spätdienst einen Auftrag übernimmt, der am Vormittag angelegt wurde?

Aus diesen Fragen entsteht ein belastbares Prozessbild. Es zeigt Eingaben, Entscheidungen, Übergaben und Ausnahmen. Gerade die Ausnahmen sind wertvoll, denn dort brechen Standardlösungen oft auf. Eine Anwendung für die Auftragsannahme muss etwa nicht nur einen neuen Auftrag speichern. Sie muss auch klären, wie mit fehlenden Artikeldaten, abweichenden Lieferadressen, Freigaben oder Stornierungen umgegangen wird.

Vor der Umsetzung sollten daher Ziel, Nutzergruppen und die erste Ausbaustufe feststehen. Hilfreich sind echte Beispieldaten, vorhandene Formulare, Fotos von Arbeitsplätzen und Gespräche mit den Menschen, die täglich mit dem Ablauf arbeiten. Ein reines Management-Interview liefert selten genug Details. Wer einen Scanner bedient, Ware einlagert oder Lieferscheine prüft, kennt die praktischen Einschränkungen meist genauer.

Der kleinste sinnvolle Start

Ein erstes Release muss keine fertige Unternehmensplattform sein. Im Gegenteil: Ein begrenzter, produktiv nutzbarer Kern reduziert Risiko und schafft früh Nutzen. Denkbar wäre eine Anwendung, die zunächst nur Aufträge zentral erfasst, ihren Status sichtbar macht und einen verlässlichen Lieferschein erstellt. Bestandsführung, Schnittstellen oder Tourenplanung können folgen, sobald der Kern im Alltag bestätigt ist.

Diese Reihenfolge verhindert, dass ein Projekt monatelang an Funktionen arbeitet, deren tatsächlicher Nutzen noch unklar ist. Sie schafft außerdem Raum für Korrekturen. Vielleicht ist die vorgesehene Statuslogik zu fein, vielleicht braucht der Wareneingang eine schnellere Eingabemaske oder eine Freigabe erst ab einem bestimmten Warenwert. Solche Erkenntnisse sind kein Scheitern der Planung, sondern Teil einer sauberen Einführung.

Die technische Basis entscheidet über die Folgekosten

Eine Webanwendung wird nicht dadurch wartbar, dass PHP im Angebot steht. Wartbarkeit entsteht durch nachvollziehbare Entscheidungen: eine klare Trennung zwischen Oberfläche, Geschäftslogik und Datenzugriff, eindeutige Datenmodelle, automatisierte Tests für kritische Regeln sowie eine dokumentierte Auslieferung.

PHP 8.4 eignet sich dafür sehr gut. Die Sprache ist ausgereift, effizient zu betreiben und für viele geschäftskritische Anwendungen eine sachliche Wahl. In Verbindung mit modernem JavaScript kann die Oberfläche schnell und direkt reagieren, ohne jede Funktion unnötig kompliziert als Einseitenanwendung aufzubauen. MySQL 8 bietet eine solide Grundlage für Transaktionen, Rechtekonzepte und konsistente Datenbestände.

Gerade bei Lager- und Auftragsprozessen darf eine Buchung nicht halb gespeichert werden. Wird ein Artikel ausgebucht, müssen Bestand, Bewegungsprotokoll und Auftragsstatus zusammenpassen. Datenbanktransaktionen sorgen dafür, dass entweder alle nötigen Änderungen erfolgen oder keine. Das klingt nach einem Detail, entscheidet aber darüber, ob ein System im Ausnahmefall verlässlich bleibt.

Sicherheit gehört ebenso in den Kern der Architektur. Rollen und Berechtigungen müssen zum Arbeitsalltag passen: Eine Person im Wareneingang braucht andere Rechte als die Buchhaltung oder ein externer Fahrer. Sichere Passworthashes, Konto-Sperrungen nach fehlgeschlagenen Anmeldeversuchen, Sitzungsverwaltung und Protokolle für kritische Änderungen sind keine Extras für später. Sie gehören in die erste produktive Version.

Schnittstellen nur dort bauen, wo sie Arbeit sparen

Viele Projekte werden unnötig groß, weil von Beginn an jede denkbare Integration geplant wird. Schnittstellen zu Shop, ERP, Versanddienstleister oder Buchhaltung können sehr sinnvoll sein. Sie sind aber nur dann gut, wenn sie einen klaren manuellen Schritt ersetzen oder Datenqualität deutlich verbessern.

Ein Beispiel: Werden Versandlabels täglich aus Auftragsdaten erstellt, spart eine direkte Anbindung Zeit und reduziert Übertragungsfehler. Werden Rechnungsdaten dagegen nur einmal pro Woche in ein bestehendes System übertragen und ist der Prozess stabil, kann ein strukturierter Export für den Start ausreichen. Die technisch elegantere Lösung ist nicht automatisch die wirtschaftlichere.

Auch die Datenhoheit sollte vorab geklärt werden. Welche Daten werden gespeichert, wie lange bleiben Protokolle verfügbar, wer darf sie exportieren und wie funktionieren Sicherungen sowie Wiederherstellung? Für Unternehmen im DACH-Raum sind diese Fragen nicht bloß IT-Formalitäten. Sie betreffen Datenschutz, Betriebsfähigkeit und Vertrauen im Team.

Einführung ohne den Betrieb auszubremsen

Die beste Anwendung scheitert, wenn sie während der Umstellung den Tagesablauf blockiert. Deshalb sollte die Einführung mit echten Fällen vorbereitet werden: repräsentative Aufträge, reale Artikel, typische Lieferadressen und bekannte Sonderfälle. Erst wenn diese Abläufe nachvollziehbar funktionieren, sollte das System eine zentrale Aufgabe übernehmen.

Ein paralleler Betrieb kann für kurze Zeit sinnvoll sein, etwa wenn Bestände abgeglichen oder neue Dokumente geprüft werden müssen. Er darf aber nicht zum Dauerzustand werden. Zwei führende Datenquellen erzeugen zwangsläufig Differenzen. Es braucht einen klaren Stichtag, ab dem feststeht, welches System verbindlich ist.

Ebenso wichtig ist eine kurze, rollenbezogene Einweisung. Ein Mitarbeitender im Lager braucht keine Erklärung der Administrationsfunktionen. Er braucht Sicherheit bei den wenigen Schritten, die unter Zeitdruck sitzen müssen. Gute Anwendungen helfen dabei mit verständlichen Bezeichnungen, plausiblen Vorgaben und Fehlermeldungen, die erklären, was als Nächstes zu tun ist.

Woran Sie einen passenden Entwicklungspartner erkennen

Wer eine Webanwendung beauftragt, kauft nicht einfach Entwicklungsstunden. Gesucht ist ein Partner, der Prozessfragen ernst nimmt, technische Entscheidungen begründet und auch widerspricht, wenn eine Anforderung unnötig teuer oder riskant wird. Direkter Zugang zu erfahrenen Entwicklern ist dabei mehr wert als ein aufwendiger Vertriebsprozess mit späteren Übergaben.

Achten Sie auf konkrete Aussagen zu Architektur, Betrieb und Weiterentwicklung. Wie werden Änderungen dokumentiert? Wie laufen Updates ab? Wer reagiert bei einer Störung? Gibt es eine nachvollziehbare Teststrategie für kritische Buchungen und Rechte? Eine Oberfläche kann bei der Präsentation überzeugend wirken. Entscheidend ist, ob sie auch nach zwei Jahren angepasst werden kann, ohne dass jede Änderung zum Neubau wird.

softify.pro arbeitet deshalb mit einer schrittweisen, prozessnahen Umsetzung: erst die operative Engstelle verstehen, dann einen belastbaren Kern liefern und darauf aufbauen. Das ist weniger spektakulär als ein großes Transformationsversprechen, aber im laufenden Betrieb meist deutlich wertvoller.

Eine gute Webanwendung muss nicht möglichst viele Funktionen enthalten. Sie muss dafür sorgen, dass ein Auftrag nicht verloren geht, ein Bestand nachvollziehbar bleibt und Mitarbeitende ihre Arbeit ohne unnötige Rückfragen erledigen können. Wenn das gelingt, wird aus einer technischen Investition ein Werkzeug, das jeden Arbeitstag messbar ruhiger macht.

Permalink →

Versandetiketten automatisch erzeugen und Fehler senken

Versandetiketten automatisch erzeugen und Fehler senken

Ein Auftrag ist gepackt, die Ware steht an der Rampe - und jemand sucht noch die richtige Versandart, tippt die Empfängeradresse in ein Carrier-Portal und druckt das Etikett aus. Dieser Ablauf kostet pro Paket nur wenige Minuten. Bei 30, 80 oder 300 Sendungen am Tag wird er zum Engpass. Versandetiketten automatisch erzeugen heißt deshalb nicht einfach, einen Drucker anzuschließen. Es heißt, Auftragsdaten, Versandregeln und den tatsächlichen Packprozess so zu verbinden, dass aus einer fertigen Sendung verlässlich ein passendes Label wird.

Für kleine und mittlere Unternehmen ist das oft der sinnvollste Einstieg in die Logistikautomatisierung. Der Nutzen zeigt sich unmittelbar auf dem Hallenboden: weniger Rückfragen, weniger falsch adressierte Pakete und ein klarer Status für Vertrieb, Lager und Kundenservice. Trotzdem lohnt es sich, den Prozess vor der technischen Umsetzung genau anzusehen. Ein schlecht gepflegter Artikelstamm oder unklare Versandregeln werden durch Automatisierung nicht besser - sie werden nur schneller weiterverarbeitet.

Was beim automatischen Etikettendruck tatsächlich passiert

Ein Versandetikett enthält mehr als Name und Adresse. Je nach Dienstleister gehören dazu eine Sendungsnummer, ein maschinenlesbarer Code, Routing-Informationen, Services wie Altersprüfung oder Nachnahme sowie bei Auslandssendungen Zollangaben. Damit der Carrier ein Label erzeugen kann, müssen diese Informationen vollständig und im erwarteten Format vorliegen.

Der technische Ablauf beginnt üblicherweise mit einem Auftrag im Shop, ERP oder einer individuellen Auftragsverwaltung. Sobald der Auftrag versandbereit ist, ermittelt das System anhand definierter Regeln Dienstleister, Produkt und Zusatzleistungen. Anschließend übergibt es die Daten an die Schnittstelle des Carriers oder an eine Versandplattform. Diese registriert die Sendung, liefert Trackingnummer und Etikett zurück, und das System legt die PDF- oder Druckdaten am Auftrag ab. Erst dann wird gedruckt - am Arbeitsplatz, am Packtisch oder direkt über einen Etikettendrucker.

Diese Reihenfolge ist entscheidend. Ein hübsches Etikett ohne erfolgreiche Sendungsanmeldung hilft nicht weiter. Umgekehrt darf eine erfolgreiche Anmeldung nicht im Hintergrund verschwinden, wenn der Drucker kein Material mehr hat. Gute Prozesse behandeln Registrierung, Ausgabe und Statusrückmeldung als zusammenhängenden Vorgang.

Versandetiketten automatisch erzeugen beginnt mit klaren Regeln

Die häufigste Fehlannahme lautet: Für jeden Auftrag soll immer derselbe Dienstleister gewählt werden. Das kann passen, etwa bei homogenen B2C-Sendungen innerhalb Deutschlands. Viele Betriebe brauchen jedoch differenziertere Regeln. Eine schwere Lieferung, eine Expressbestellung, eine Abholung im Paketshop oder eine Sendung in die Schweiz stellen unterschiedliche Anforderungen.

Sinnvolle Regeln können Gewicht und Maße, Zielland, Lieferadresse, Warenwert, gewünschte Laufzeit, Gefahrgutkennzeichen und vereinbarte Kundenkonditionen berücksichtigen. Dabei gilt: Nicht jede theoretische Ausnahme muss vom ersten Tag an automatisiert sein. Wenn zwei Sonderfälle im Monat auftreten, ist ein sichtbar markierter manueller Schritt häufig günstiger und sicherer als eine komplizierte Regelmaschine. Wiederkehrende Fälle mit nennenswertem Volumen gehören dagegen in den Standardprozess.

Besonders wichtig ist die Datenquelle. Gewichte aus einem gepflegten Artikelstamm sind für gleichartige Waren brauchbar. Bei gemischten Aufträgen, variabler Verpackung oder Zuschlägen für Übergrößen sollte das endgültige Paketgewicht am Packplatz erfasst werden. Das System kann das Label dann erst nach dem Wiegen erzeugen. Das ist ein zusätzlicher Handgriff, verhindert aber teure Korrekturen und Nachbelastungen.

Adressqualität entscheidet vor dem Druck

Viele Versandprobleme entstehen vor der Übergabe an den Carrier. Hausnummern landen im falschen Feld, Postleitzahlen passen nicht zum Ort oder Firmenadressen enthalten unklare Empfängernamen. Eine Automatisierung sollte Adressen daher nicht nur weiterreichen, sondern vorab prüfen. Pflichtfelder, Länderformate, Zeichenlängen und erkennbare Dubletten lassen sich direkt beim Auftragseingang abfangen.

Eine Adressprüfung ist keine Garantie für Zustellbarkeit. Sie senkt jedoch die Zahl vermeidbarer Fehler. Bei auffälligen Daten sollte das System den Auftrag klar zur Klärung stellen, statt stillschweigend ein unvollständiges Etikett zu erzeugen. Im Lager muss sichtbar sein, warum ein Auftrag wartet und wer die Information liefern kann.

Der Packplatz braucht eine einfache Bedienung

Die beste Schnittstelle scheitert, wenn Mitarbeitende beim Verpacken zwischen fünf Masken wechseln müssen. Ein praxistauglicher Packdialog zeigt nur, was für die aktuelle Sendung nötig ist: Auftrag, Artikel, Lieferadresse, Verpackungsstatus, Gewicht, gewählte Versandart und Druckstatus. Ein Barcode-Scan auf Lieferschein oder Kommissionierbeleg sollte den richtigen Auftrag öffnen. Nach dem Wiegen reicht im Idealfall eine bestätigende Aktion, um das Etikett zu erstellen und zu drucken.

Bei mehreren Packplätzen braucht jeder Arbeitsplatz eine eindeutige Zuordnung zum Drucker. Auch das Etikettenformat muss zum Gerät und zum Carrier passen. A6 ist für viele Paketlabels üblich, aber nicht jede Rolle, jeder Thermodrucker und jede Dokumentenablage arbeitet gleich. Wer Etiketten zunächst als PDF auf einem Büro-Laserdrucker ausgibt, kann schnell starten. Bei höherem Volumen sind Thermodrucker meist sinnvoller: Sie vermeiden Schneiden, Kleben und das Risiko, dass ein Label beim Ausdrucken auf die falsche Seite rutscht.

Ein guter Prozess meldet technische Probleme verständlich. „API Error 403“ hilft am Packtisch nicht. Besser ist: „Etikett nicht erzeugt: Zugang zum Versanddienstleister prüfen“ oder „Drucker Packplatz 2 nicht erreichbar“. Der Auftrag darf dabei nicht versehentlich als versendet gelten. Er bleibt in einem klaren Fehlerstatus und kann nach der Behebung erneut verarbeitet werden, ohne eine zweite Sendung anzumelden.

Schnittstellen brauchen Fehlerbehandlung, nicht nur einen Happy Path

Carrier-Schnittstellen sind externe Systeme. Sie können zeitweise nicht erreichbar sein, Eingaben ablehnen oder ihr Antwortformat ändern. Auch ein lokales Netzwerk, ein Druckdienst oder abgelaufene Zugangsdaten können den Ablauf unterbrechen. Deshalb ist es riskant, den Erfolg allein daran festzumachen, dass ein Benutzer auf „Label erstellen“ geklickt hat.

Technisch sollte jede Anfrage nachvollziehbar protokolliert werden: Zeitpunkt, Auftrag, verwendeter Versandservice, Ergebnis, Trackingnummer und verständliche Fehlermeldung. Sensible Daten und Zugangsschlüssel gehören dabei nicht ungeschützt in Logdateien. Eine eindeutige interne Sendungs-ID verhindert, dass ein Wiederholungsversuch doppelte Labels oder doppelte Abrechnungen erzeugt.

Auch Stornierungen gehören in die Planung. Wird ein Paket nach dem Etikettendruck doch nicht abgeholt oder neu verpackt, muss klar sein, ob die Sendung beim Carrier annulliert werden kann und wie das im eigenen System dokumentiert wird. Ohne diesen Schritt stimmen Versandstatus, Tracking und Abrechnung nach einigen Wochen nicht mehr überein.

Nicht jedes Unternehmen braucht sofort eine große Versandplattform

Versandplattformen können mehrere Carrier, Tariflogiken und Rücksendungen bündeln. Das ist sinnvoll, wenn Sendungsvolumen, Zielländer und Dienstleister vielfältig sind. Wer jedoch einen klaren Versandprozess und einen oder zwei Carrier hat, kann mit einer direkten Anbindung übersichtlicher fahren. Weniger Systeme bedeuten weniger Datenabgleich, weniger Benutzerkonten und weniger Stellen, an denen Fehler entstehen.

Die Entscheidung hängt nicht nur vom Paketvolumen ab. Relevant sind auch Retouren, Exportdokumente, individuelle Versandregeln, vorhandene Auftragsquellen und die Frage, wer Änderungen später pflegt. Eine Tabellenlösung bleibt beispielsweise vertretbar, wenn täglich wenige Sendungen mit gleichbleibenden Daten verschickt werden. Sobald Kollegen Informationen mehrfach übertragen oder der Versand an einzelne Personen gebunden ist, wird ein zentraler Ablauf meist wirtschaftlicher.

Für kundenspezifische Prozesse kann eine schlanke Webanwendung sinnvoll sein, die Auftragsdaten, Lagerbewegungen, Lieferscheine und Labeldruck zusammenführt.
softify.pro setzt solche Systeme mit nachvollziehbarer Datenstruktur, dokumentierter Bereitstellung und wartbaren Technologien wie PHP 8.4 und MySQL 8 um. Entscheidend ist dabei nicht die Zahl der Funktionen, sondern dass der Ablauf für das Team am Packplatz verständlicher wird.

In kleinen Schritten einführen und messbar verbessern

Ein kontrollierter Start ist besser als ein großer Wechsel an einem Montagmorgen. Zuerst wird ein klar abgegrenzter Standardfall automatisiert, etwa nationale Pakete eines Carriers mit einem definierten Etikettenformat. Parallel sollten einige Tage lang automatisch erzeugte Daten gegen den bisherigen Ablauf geprüft werden: Adresse, Gewicht, Versandprodukt, Trackingnummer und gedrucktes Label.

Danach lassen sich Ausnahmen ergänzen. Hilfreiche Kennzahlen sind die Bearbeitungszeit je Sendung, die Zahl manueller Korrekturen, nicht gedruckte oder doppelt erzeugte Labels und die Zeit bis zur Tracking-Rückmeldung an den Kunden. Diese Werte zeigen, ob die Automatisierung wirklich Arbeit abnimmt oder nur einen alten Umweg digital abbildet.

Am Ende zählt kein besonders komplexer Versanddialog. Es zählt, dass ein gepackter Auftrag ohne Suchen, Nachtippen und Unsicherheit das richtige Etikett erhält - und dass Ausnahmen dort sichtbar werden, wo ein Mensch tatsächlich entscheiden muss.

Permalink →

Login-Prozess automatisiert testen mit System

Login-Prozess automatisiert testen mit System

Ein Login wirkt erst dann banal, wenn er funktioniert. Fällt er nach einem Release aus, stehen Mitarbeitende vor dem Schichtbeginn, Kunden vor dem Kundenportal oder Disponenten vor einer blockierten Auftragsbearbeitung. Den Login-Prozess automatisiert testen heißt deshalb nicht einfach, Benutzername und Passwort in ein Formular einzutragen. Es bedeutet, einen geschäftskritischen Zugang mit seinen Regeln, Ausnahmen und Sicherheitsgrenzen wiederholbar zu prüfen.

Für viele Teams beginnt die Automatisierung mit einem einzelnen positiven Testfall: gültige Zugangsdaten eingeben, Anmeldung bestätigen, Startseite sehen. Das ist sinnvoll, aber als alleiniger Test unzureichend. Login-Fehler entstehen oft an den Rändern: bei abgelaufenen Sessions, gesperrten Konten, einer neuen Mehrfaktor-Authentifizierung oder einer Berechtigung, die nach einem Rollenwechsel nicht mehr korrekt greift. Genau diese Fälle müssen planbar abgedeckt sein.

Warum der Login besondere Testdisziplin verlangt

Der Login ist gleichzeitig Sicherheitsfunktion, technische Schnittstelle und Einstieg in den Arbeitsablauf. Ein Fehler kann zu offen sein und unberechtigten Zugriff erlauben. Er kann aber auch zu streng sein und berechtigte Personen aussperren. Beides kostet: Im ersten Fall entstehen Risiken für Daten und Compliance, im zweiten Stillstand, Supportaufwand und hektische Sonderlösungen.

Bei Webanwendungen kommen weitere Abhängigkeiten hinzu. Der Login kommuniziert häufig mit einem Identity Provider, einem Mail-System für Passwort-Resets, einer MFA-App oder einem Verzeichnisdienst. Bei Windows-Desktop-Anwendungen können lokale Rechte, Netzwerkverbindungen und Versionsstände Einfluss nehmen. Ein Test, der nur das Formular im Browser betrachtet, erkennt solche Integrationsprobleme nicht zuverlässig.

Deshalb sollte das Team vor der ersten Testautomatisierung festlegen, was ein erfolgreicher Login im jeweiligen System bedeutet. Reicht eine sichtbare Startseite? Oder muss geprüft werden, ob die richtige Mandantenauswahl geladen wurde, ob die Benutzerrolle stimmt und ob die erste geschützte Aktion tatsächlich möglich ist? Für ein Lagerportal wäre das beispielsweise der Zugriff auf den Wareneingang. Für ein Dispositionssystem kann es die Freigabe einer Tour sein.

Login-Prozess automatisiert testen: Vom Ablaufmodell zum Testfall

Ein guter Ausgangspunkt ist kein Skript, sondern ein Ablaufmodell. Der Login lässt sich als Folge klarer Zustände beschreiben: nicht angemeldet, Zugangsdaten übermittelt, Identität bestätigt, MFA erforderlich, angemeldet, Session abgelaufen oder Konto gesperrt. Zu jedem Zustand gehören erlaubte Aktionen und erwartete Reaktionen des Systems.

Aus diesem Modell entstehen Testfälle mit fachlichem Wert. Der positive Standardfall gehört dazu, aber ebenso ungültige Passwörter, nicht vorhandene Benutzerkonten und abgelaufene Reset-Links. Wichtig ist dabei die erwartete Rückmeldung. Eine Anwendung sollte bei fehlerhaften Zugangsdaten keine Information preisgeben, ob eine E-Mail-Adresse existiert. Der Test prüft daher nicht nur, dass ein Fehler angezeigt wird, sondern auch, dass dessen Text und Verhalten keine unnötigen Hinweise liefern.

Besonders relevant sind Schutzmechanismen gegen wiederholte Fehlversuche. Nach einer definierten Anzahl falscher Eingaben kann ein Konto zeitweise gesperrt werden. Der automatisierte Test muss prüfen, ob die Sperre wirklich greift, wie lange sie gilt und ob der legitime Nutzer anschließend wieder kontrolliert Zugang erhält. Hier ist Präzision nötig: Ein Test, der produktive Konten absichtlich sperrt, schafft mehr Probleme als er löst. Solche Szenarien gehören in eine getrennte Testumgebung mit eigens dafür angelegten Konten.

MFA, Passwort-Reset und Single Sign-on getrennt betrachten

Mehrfaktor-Authentifizierung ist kein Detail am Ende des Logins. Sie verändert den Ablauf. Ein Test muss erkennen, dass nach dem Passwort eine zusätzliche Bestätigung erforderlich ist, und er muss die erfolgreiche wie die abgelehnte Bestätigung abbilden. Bei zeitbasierten Einmalcodes braucht die Testumgebung einen kontrollierten Umgang mit Zeit und Geheimnissen. In vielen Fällen ist eine vom Identity Provider vorgesehene Testmethode sinnvoller als das Nachbilden eines echten Mobiltelefons.

Auch Passwort-Reset und Single Sign-on sollten eigene Teststrecken erhalten. Beim Reset zählen der Versand der Nachricht, die Einmaligkeit des Links, die Gültigkeitsdauer und die anschließende Anmeldung mit dem neuen Passwort. Beim SSO ist entscheidend, ob die Anwendung nach der Rückkehr vom Identity Provider die Session korrekt anlegt und Rollen sauber übernimmt.

CAPTCHAs bilden einen Sonderfall. Sie sollen automatisierte Angriffe bremsen und sollten nicht durch Testautomatisierung umgangen werden. Sinnvoll ist stattdessen eine Testkonfiguration, ein offizieller Testschlüssel oder eine abgesicherte Ausnahme für die Testumgebung. Sicherheitskontrollen auszutricksen, nur damit ein Test grün wird, ist keine Qualitätsstrategie.

Die passende technische Testebene wählen

Nicht jeder Login-Test muss durch einen echten Browser laufen. API-Tests können prüfen, ob Token, Sessions, Fehlermeldungen und Sperrregeln korrekt funktionieren. Sie sind schnell und helfen, Fehler nahe an der Authentifizierungslogik zu finden. Browser-Tests zeigen dagegen, ob Felder, Weiterleitungen, Cookies, SameSite-Einstellungen und sichtbare Zustände im echten Nutzerablauf zusammenpassen.
Für kritische Anwendungen ist die Kombination sinnvoll. Wenige End-to-End-Tests prüfen den kompletten Weg mit dem Browser. Darunter sichern gezielte API- und Integrationstests die Varianten ab. Das reduziert Laufzeit und Fehlalarme. Wer jede denkbare Kombination ausschließlich im Browser testet, erhält oft eine langsame Suite, deren Pflege mehr Zeit frisst als sie spart.

Bei Desktop-Software gilt ein ähnliches Prinzip. Ein automatisierter Test sollte nicht bloß kontrollieren, ob sich ein Fenster öffnet. Er muss feststellen, ob nach der Anmeldung die korrekte Datenverbindung besteht, die Benutzerrechte aktiv sind und die zentrale Arbeitsmaske erreichbar ist. Gerade bei Anwendungen im Lager oder in der Fertigung ist das relevant, weil Arbeitsplätze unterschiedliche Netzbedingungen, Scanner-Anbindungen oder lokale Konfigurationen haben können.

Testdaten sicher und wiederholbar behandeln

Login-Tests arbeiten zwangsläufig mit Zugangsdaten. Produktive Mitarbeiterkonten, echte Kundendaten oder MFA-Geheimnisse gehören jedoch nicht unkontrolliert in Testskripte, Logs und Screenshots. Testkonten müssen klar gekennzeichnet, minimal berechtigt und automatisch zurücksetzbar sein. Passwörter und Tokens werden über sichere Geheimnisverwaltung bereitgestellt, nicht im Quellcode abgelegt.

Ebenso wichtig ist die Bereinigung nach dem Testlauf. Wenn ein Test neue Sessions, Audit-Einträge oder gesperrte Konten erzeugt, muss die Testumgebung in einen definierten Ausgangszustand zurückkehren. Sonst schlägt ein Test am Montag nur deshalb fehl, weil ein Lauf vom Freitag noch Nebenwirkungen hinterlassen hat.

Für Unternehmen mit vertraulichen Anwendungen entscheidet auch der Ausführungsort. Screenshots von Login-Masken, Testvideos und technische Protokolle können sensible Informationen enthalten. Eine selbst gehostete Testinfrastruktur wie COCO kann hier sinnvoll sein, weil Testdaten, Ausführung und Nachweise unter eigener Kontrolle bleiben. Ob das erforderlich ist, hängt von Schutzbedarf, Vertragslage und internen Vorgaben ab. Für jede Anwendung ist eine eigene Infrastruktur nicht automatisch die wirtschaftlichste Wahl.

Nachweise erzeugen, nicht nur grüne Haken

Ein Testbericht sollte für QA, Entwicklung und Fachbereich verständlich machen, was geprüft wurde. Ein grüner Status ohne Kontext hilft wenig, wenn ein Release später Fragen auslöst. Sinnvoll sind daher Zeitstempel, verwendete Testumgebung, Testkonto, relevante Schritte, Screenshots bei Fehlern und eine klare Fehlermeldung in Alltagssprache.

Dabei darf die Beweissicherung nicht selbst zum Datenschutzproblem werden. Passwörter, Einmalcodes, Session-IDs und personenbezogene Daten müssen in Protokollen maskiert werden. Bei Screenshots kann es nötig sein, bestimmte Bereiche auszublenden. Diese Regeln sollten Teil der Testarchitektur sein, nicht eine manuelle Nacharbeit nach einem Vorfall.

Was Teams zuerst automatisieren sollten

Die Priorität richtet sich nach Risiko und Nutzungshäufigkeit. Zuerst kommen der Standard-Login für die wichtigsten Rollen, fehlerhafte Zugangsdaten, Logout und Session-Ablauf. Danach folgen Sperrregeln, Passwort-Reset, MFA und Rollenwechsel. SSO, Sondermandanten oder seltene Ausnahmewege können später folgen, sofern ihr Ausfall nicht unmittelbar den Betrieb stoppt.

Die Tests gehören in den Release-Prozess. Änderungen an Login-Formularen, Cookies, Berechtigungen oder Identity-Provider-Konfigurationen sollten die relevante Testsuite auslösen, bevor eine Version in die Produktion geht. Zusätzlich lohnt sich ein geplanter Lauf in einer realitätsnahen Umgebung, etwa nach Infrastrukturänderungen oder Zertifikatswechseln. Das findet Probleme, die in einer isolierten Entwicklungsumgebung nicht sichtbar sind.

Der beste Login-Test ist am Ende nicht der mit den meisten Klicks. Er ist der, der einen realen Ausfall früh erkennt, verständlich dokumentiert und sich bei der nächsten Änderung noch verlässlich ausführen lässt. Wer den Login als klar modellierten Geschäftsprozess behandelt, schützt nicht nur ein Formular. Er schützt den Zugang zur Arbeit, die dahinter wartet.

Permalink →

Lieferscheine automatisch erstellen mit Software

Lieferscheine automatisch erstellen mit Software

Die Suche nach „Lieferscheine automatisch erstellen Software“ beginnt meist nicht mit einem Dokumentenproblem. Sie beginnt am Packtisch: Ein Auftrag ist freigegeben, Ware wurde kommissioniert, doch der Lieferschein liegt noch als Word-Vorlage, Excel-Export oder handschriftlicher Zettel vor. Während jemand Positionen kontrolliert, ändern sich Mengen, Lieferadressen oder Teillieferungen. Das kostet Zeit - und erzeugt genau die Fehler, die später Rückfragen, Korrekturen und unnötige Abstimmung auslösen.

Ein automatisch erzeugter Lieferschein ist deshalb mehr als ein PDF mit Logo. Er ist der dokumentierte Übergang zwischen Auftrag, Lagerbewegung und Versand. Damit das zuverlässig funktioniert, muss die Software nicht möglichst viele Funktionen anbieten. Sie muss den tatsächlichen Ablauf im Betrieb korrekt abbilden.

Wann sich Lieferscheine automatisch erstellen mit Software lohnt

Nicht jeder Betrieb braucht sofort eine individuelle Anwendung. Wer wenige Sendungen pro Woche bearbeitet, feste Artikel verkauft und mit einer gepflegten Vorlage arbeitet, kann mit einer Tabellenlösung gut fahren. Eine Automatisierung wird dann sinnvoll, wenn Mitarbeitende Daten mehrfach eingeben, Aufträge regelmäßig in Teillieferungen zerfallen oder der Versandstatus nicht eindeutig nachvollziehbar ist.

Typische Warnsignale sind fragil gewordene Excel-Dateien, unterschiedliche Artikelbezeichnungen in Auftrag und Lager, fehlende Belege bei Rückfragen oder Lieferscheinnummern, die manuell vergeben werden. Auch wenn mehrere Personen zwischen Büro, Lager und Versand arbeiten, reicht eine gemeinsame Ablage oft nicht mehr aus. Dann fehlt nicht nur Geschwindigkeit, sondern eine verlässliche Quelle dafür, was tatsächlich das Haus verlassen hat.

Der entscheidende Punkt lautet: Der Lieferschein sollte durch ein Ereignis entstehen, nicht durch einen zusätzlichen Arbeitsschritt. Dieses Ereignis kann die Freigabe zur Kommissionierung, die bestätigte Entnahme oder der Abschluss des Packvorgangs sein. Welche Variante passt, hängt von Ihrem Prozess ab. In einem Ersatzteillager ist die Lagerbuchung häufig der richtige Auslöser. Bei kundenspezifischer Fertigung kann die Versandfreigabe durch die Arbeitsvorbereitung maßgeblich sein.

Welche Daten ein automatischer Lieferschein wirklich braucht

Ein gutes System übernimmt nicht einfach alle Daten aus einem Auftrag. Es prüft, welche Informationen zum Zeitpunkt der Lieferung gelten. Der Empfänger kann vom Rechnungsempfänger abweichen, eine Bestellung kann in mehreren Sendungen ausgeliefert werden, und die gelieferte Menge kann kleiner sein als die ursprünglich bestellte Menge.

Mindestens erforderlich sind eine eindeutige Lieferscheinnummer, Ausstellungsdatum, Lieferadresse, Kundenreferenz sowie die tatsächlich gelieferten Positionen mit Mengen und Einheiten. Je nach Branche kommen Chargen, Seriennummern, Gewichte, Verpackungseinheiten, Kommissionierer oder Hinweise zur Warenannahme hinzu. Wenn diese Daten später für Reklamationen oder Rückverfolgbarkeit gebraucht werden, gehören sie nicht in ein Freitextfeld, sondern in klar definierte Datenfelder.

Auftrag, Lagerbewegung und Dokument müssen zusammenpassen

Die häufigste Schwachstelle liegt zwischen Auftrag und Lager. Der Auftrag sagt vielleicht zehn Stück voraus, das Lager bestätigt aber nur acht Stück. Werden trotzdem zehn Stück auf den Lieferschein gedruckt, entsteht ein problematischer Beleg. Werden acht Stück geliefert, ohne den Auftragsstatus anzupassen, bleibt die Restmenge unsichtbar.

Eine passende Software führt diese Zustände getrennt, aber verbunden: bestellt, reserviert, kommissioniert, geliefert, gegebenenfalls retourniert. Der Lieferschein greift auf die bestätigten Liefermengen zu. So bleibt auch bei Teil- und Nachlieferungen nachvollziehbar, welche Position in welcher Sendung enthalten war.

Nummernkreise und Versionen sind keine Nebensache

Lieferscheinnummern manuell zu vergeben wirkt zunächst unkompliziert. Spätestens bei mehreren Standorten, verschiedenen Benutzerkonten oder nachträglichen Korrekturen wird es fehleranfällig. Die Anwendung sollte Nummern zentral erzeugen und verhindern, dass dieselbe Nummer doppelt verwendet wird.

Ebenso wichtig ist der Umgang mit Änderungen. Ein bereits versendeter Lieferschein sollte nicht still überschrieben werden. Besser ist eine erkennbare Korrektur, Stornierung oder neue Version mit nachvollziehbarer Historie. Das ist technisch kein Luxus, sondern schützt Mitarbeitende davor, mit widersprüchlichen Informationen zu arbeiten.

So funktioniert die Erstellung im praktischen Ablauf

In einem klaren Prozess startet alles mit einem strukturierten Auftrag. Artikel, Mengen, Lieferadresse und gewünschter Termin werden einmal erfasst oder aus einem vorhandenen System übernommen. Anschließend entsteht ein Kommissionierauftrag für das Lager - auf einem mobilen Gerät, als Ausdruck oder an einem Arbeitsplatzterminal.

Beim Packen werden die tatsächlich entnommenen Mengen bestätigt. Bei einfachen Abläufen genügt ein Bestätigungsbutton. Bei vielen Artikeln, Lagerplätzen oder Chargen sind Barcode-Scans sinnvoller. Erst nach dieser Rückmeldung erstellt die Software den Lieferschein als PDF, weist eine Nummer zu und ordnet ihn dem Versandvorgang zu. Parallel kann sie ein Versandetikett vorbereiten, sofern der jeweilige Paketdienst technisch angebunden ist.

Der erzeugte Beleg wird zentral gespeichert und bleibt über Auftrag, Kundenkonto oder Sendungsnummer auffindbar. Ein Mitarbeiter im Innendienst muss dann nicht mehr im E-Mail-Postfach suchen, wenn ein Kunde nachfragt, was an einem bestimmten Tag geliefert wurde. Er sieht den Auftrag, die einzelnen Lieferungen und den jeweiligen Dokumentstand an einer Stelle.

Das klingt geradlinig, scheitert aber häufig an Sonderfällen. Deshalb muss die Anwendung sie bewusst behandeln: Was passiert bei Fehlmengen? Wer darf eine Lieferadresse nach Freigabe ändern? Kann ein Lieferschein ohne Lagerbestand erzeugt werden? Wie werden kostenlose Beigaben oder Ersatzlieferungen gekennzeichnet? Solche Regeln entscheiden darüber, ob die Automatisierung auf dem Lagerboden akzeptiert wird.

Standardsoftware oder individuelle Lösung?

Standardsoftware ist sinnvoll, wenn Ihr Ablauf weitgehend dem vorgesehenen Modell folgt und Schnittstellen zu Shop, Warenwirtschaft oder Versanddienstleistern bereits vorhanden sind. Sie reduziert den Einführungsaufwand und bietet oft eine breite Funktionspalette. Der Preis dafür kann sein, dass Teams ihre funktionierenden Abläufe um ein starres System herum organisieren müssen.

Eine individuelle Lösung lohnt sich vor allem dann, wenn Ihre Logik geschäftskritisch ist: etwa bei kundenindividuellen Verpackungsregeln, komplexen Teillieferungen, mehreren Lagerbereichen oder einer Verbindung aus Werkstatt, Produktion und Versand. Sie kann sich auf die Funktionen konzentrieren, die täglich gebraucht werden, statt Mitarbeitende durch Module zu schicken, die niemand nutzt.

Dazwischen liegt häufig der sinnvollste Weg: Vorhandene Systeme bleiben führend für Artikelstammdaten oder Buchhaltung, während eine schlanke Webanwendung die operative Lücke im Lager schließt. Über klar dokumentierte Schnittstellen lassen sich Aufträge übernehmen, Bestände zurückmelden und Lieferscheine archivieren. Für solche Anwendungen sind eine nachvollziehbare Datenstruktur, rollenbasierte Zugriffe und getestete Importprozesse wichtiger als ein besonders spektakuläres Interface.

Bei softify.pro werden solche Prozesse zunächst am konkreten Warenfluss geprüft: Wer löst aus, wer bestätigt, welche Ausnahme tritt tatsächlich auf, und welche Daten müssen später belegbar sein? Erst danach wird entschieden, ob eine Anpassung am bestehenden System genügt oder eine eigene Anwendung wirtschaftlich sinnvoll ist.

Einführung ohne den Betrieb auszubremsen

Der sicherste Start ist selten die vollständige Digitalisierung aller Lagerprozesse an einem Stichtag. Beginnen Sie mit einem klar abgegrenzten Lieferweg, etwa Standardaufträgen eines Standorts oder einer Produktgruppe. Dabei wird sichtbar, ob Artikelstammdaten, Adressqualität und Mengenlogik ausreichend sauber sind.

Im nächsten Schritt sollten echte Aufträge parallel geprüft werden. Die Software erstellt den Lieferschein, während der bisherige Ablauf noch als Kontrollinstanz verfügbar bleibt. Abweichungen sind in dieser Phase wertvoll: Sie zeigen nicht zwingend einen Softwarefehler, sondern oft ungeklärte Prozessregeln. Wenn etwa zwei Mitarbeiter denselben Auftrag unterschiedlich packen würden, muss zuerst die Arbeitsregel eindeutig werden.

Danach folgen Rollen und Rechte. Lagerpersonal braucht andere Ansichten als Vertrieb oder Buchhaltung. Nicht jeder sollte Liefermengen nachträglich ändern oder Dokumente stornieren dürfen. Eine gute Lösung macht Zuständigkeiten sichtbar, ohne jede kleine Handlung in ein kompliziertes Freigabeverfahren zu zwingen.
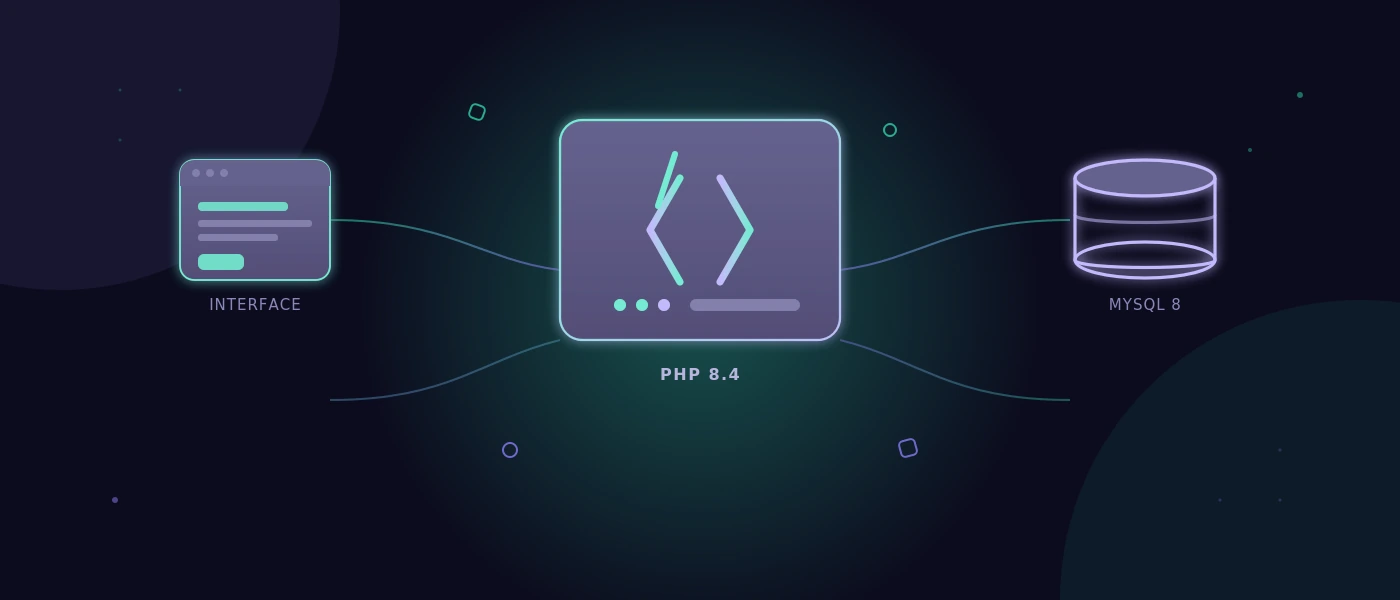
Auch der technische Betrieb gehört zur Einführung. Dokumente und Bewegungsdaten benötigen regelmäßige Sicherungen, eindeutige Aufbewahrungsregeln und getestete Wiederherstellungswege. Bei einer Webanwendung mit PHP 8.4 und MySQL 8 sind saubere Datenbanktransaktionen besonders wichtig: Eine Lagerbuchung und die Erstellung des zugehörigen Lieferscheins dürfen nicht auseinanderfallen, wenn eine Verbindung im falschen Moment abbricht.

Drei Fehler, die Automatisierung unnötig teuer machen

Der erste Fehler ist, ein PDF-Problem zu automatisieren, obwohl die Daten davor unklar sind. Wenn Artikelnummern, Einheiten oder Kundenadressen nicht gepflegt sind, erzeugt das System nur schneller fehlerhafte Dokumente.

Der zweite Fehler ist ein zu großer Projektumfang. Lieferscheine, Lager, Versand, Einkauf, Produktion und Buchhaltung gleichzeitig neu aufzusetzen, bindet Teams oft über Monate. Ein kleiner, belastbarer Lieferprozess schafft schneller Vertrauen und liefert eine Grundlage für weitere Schritte.

Der dritte Fehler ist fehlende Rückmeldung aus dem Lager. Ein Lieferschein darf nicht allein auf Basis eines geplanten Auftrags entstehen, wenn niemand bestätigt hat, was wirklich gepackt wurde. Genau diese Rückmeldung macht aus einer Dokumentvorlage einen belastbaren Prozess.

Die beste Software für Lieferscheine verschwindet im Alltag fast aus dem Blick. Mitarbeitende erfassen einen Auftrag einmal, bestätigen ihre Arbeit dort, wo sie stattfindet, und finden den richtigen Beleg wieder, wenn er gebraucht wird. Wenn das gelingt, entsteht nicht nur ein schnellerer Versand - sondern ein Ablauf, auf den sich Lager, Büro und Kunden gleichermaßen verlassen können.
Permalink →

Windows Anwendung automatisch testen: So gelingt es

Windows Anwendung automatisch testen: So gelingt es

Ein Release steht bereit, doch niemand kann mit Sicherheit sagen, ob der neue Importdialog, die Rechteprüfung und der Rechnungsdruck noch funktionieren. Genau an diesem Punkt wird es teuer, eine Windows Anwendung automatisch testen zu können - nicht als Demo mit drei Klicks, sondern als wiederholbaren Teil des Release-Prozesses.
Desktop-Software ist in vielen Betrieben geschäftskritisch. Sie steuert Lagerbewegungen, Fertigungsaufträge, Kundenstammdaten oder Versanddokumente. Ein Fehler wirkt nicht nur auf einem Bildschirm: Er kann Aufträge blockieren, falsche Etiketten erzeugen oder Mitarbeitende in der Spätschicht zu manuellen Notlösungen zwingen. Automatisierte Tests reduzieren dieses Risiko, wenn sie auf reale Arbeitsabläufe und eine technisch kontrollierte Testumgebung ausgerichtet sind.

Warum Windows-Tests anders sind als Webtests

Eine Webanwendung testet man meist über klar ansprechbare Elemente im Browser. Bei Windows-Desktop-Anwendungen hängt die Bedienung stärker von Fenstern, Dialogen, nativen Controls, Auflösung, Berechtigungen und installierten Komponenten ab. Ein Test muss etwa erkennen, ob ein Dialog wirklich geöffnet wurde, ein Feld editierbar ist oder ein Druckauftrag korrekt übergeben wurde.

Hinzu kommt die gewachsene Realität vieler Anwendungen. Manche Oberflächen bestehen aus klassischen WinForms- oder WPF-Komponenten, andere binden ältere Module, PDF-Viewer oder Schnittstellen zu Druckern und Scanner-Hardware ein. Es gibt nicht das eine Automatisierungsverfahren, das für jede Anwendung gleich gut funktioniert. Wer das verschweigt, produziert Tests, die im Labor gut aussehen und beim nächsten Update ausfallen.

Der sinnvolle Startpunkt ist deshalb nicht das Tool, sondern die Frage: Welche Abläufe müssen bei jedem Release nachweisbar funktionieren? Für eine Lager- oder Auftragssoftware wären das beispielsweise Anmeldung, Rechteprüfung, Auftragserfassung, Bestandsbuchung, Belegerstellung und die Übergabe an eine Schnittstelle. Diese Prozesse liefern Geschäftswert. Ein Test, der nur prüft, ob ein Menü sichtbar ist, liefert ihn selten.

Windows Anwendung automatisch testen: Die passende Ebene wählen

Für die Automatisierung stehen grundsätzlich drei Ebenen zur Verfügung. Idealerweise werden sie kombiniert, statt ausschließlich auf die sichtbare Oberfläche zu setzen.

Auf der technischen Ebene prüfen Unit- und Integrationstests Geschäftslogik, Datenzugriffe und Schnittstellen. Sie laufen schnell und zeigen früh, ob etwa eine Preisberechnung, ein Importformat oder eine Berechtigungsregel beschädigt wurde. Sie ersetzen jedoch keinen Bedienungstest: Ob ein Disponent die Funktion tatsächlich erreichen und korrekt ausführen kann, bleibt offen. Die zweite Ebene sind UI-Tests über die Windows-Automation-API. Dabei sprechen Testwerkzeuge Steuerelemente über Eigenschaften wie Automation-ID, Name oder Control-Type an. Das ist meist stabiler als Tests, die bloß an feste Bildschirmkoordinaten klicken. Entwickelnde Teams können diese Stabilität gezielt fördern, indem sie eindeutige IDs vergeben und relevante Controls nicht bei jeder Oberflächenänderung umbenennen.

Die dritte Ebene arbeitet visuell. Hier erkennt ein System Buttons, Tabelleninhalte, Dialoge oder Zustände anhand des Bildschirminhalts. Das hilft besonders bei älteren Anwendungen, proprietären Komponenten oder Oberflächen, die keine brauchbaren Automation-Informationen liefern. Visuelle Erkennung ist allerdings empfindlicher gegenüber Skalierung, Themes, unerwarteten Pop-ups und unklaren Bildschirmzuständen. Sie braucht definierte Arbeitsplätze, klare Wartebedingungen und nachvollziehbare Nachweise.

Ein KI-gestützter Ansatz kann visuelle Signale besser einordnen als ein reiner Koordinatenklick. Er sollte trotzdem nicht zur Black Box werden. Für kritische Schritte braucht ein Team Screenshots, Protokolle, erwartete Ergebnisse und eine Aussage, weshalb ein Lauf als fehlgeschlagen bewertet wurde. Boring, provable reliability over trend-chasing gilt gerade beim Testen.

Mit einem kleinen, belastbaren Testumfang beginnen

Der häufigste Fehler ist der Versuch, sofort jede Maske zu automatisieren. Das bindet Budget und erzeugt eine große Sammlung fragiler Skripte, bevor überhaupt klar ist, ob der Ansatz den Release-Alltag verbessert. Besser ist ein enger Start mit fünf bis zehn kritischen Abläufen, die heute regelmäßig manuell geprüft werden.

Ein guter erster Testfall hat einen klaren Anfang, eine realistische Eingabe und ein überprüfbares Ergebnis. Beispiel: Ein Benutzer mit der Rolle Lager prüft sich an, legt einen Wareneingang an, bucht einen Artikel auf einen Lagerplatz und druckt den Beleg. Der Test kontrolliert anschließend nicht nur die Erfolgsmeldung, sondern auch Bestand, Belegnummer und den protokollierten Druckauftrag. So wird aus einer Klickfolge ein Nachweis für einen Geschäftsprozess.

Nicht jeder Ablauf eignet sich sofort. Funktionen mit instabiler Hardware, externen Zahlungsdiensten oder häufig wechselnden Drittsystemen benötigen oft einen anderen Zuschnitt. Hier kann man die eigene Anwendung bis zur Übergabe prüfen und die Fremdkomponente über einen kontrollierten Simulator abbilden. Das ist keine Abkürzung, sondern eine saubere Abgrenzung von Verantwortlichkeiten.

Testdaten sind Teil des Systems

Automatisierung scheitert oft nicht an der Oberfläche, sondern an unbrauchbaren Daten. Ein Testkonto ist gesperrt, ein Artikel wurde schon verwendet oder ein vorheriger Lauf hat die erwartete Bestandsmenge verändert. Deshalb braucht die Testumgebung definierte Ausgangsdaten und einen verlässlichen Weg zurück in diesen Zustand.

In der Praxis bedeutet das: getrennte Testdatenbank, festgelegte Benutzerrollen, bekannte Artikel- und Kundensätze sowie kontrollierte Zeit- und Nummernlogik. Bei sensiblen Daten sollten keine Produktionsdaten unkontrolliert kopiert werden. Anonymisierte oder gezielt erzeugte Datensätze sind meist die bessere Wahl. Sie sind berechenbar und senken das Datenschutzrisiko.

Auch Account-Lockout-Flows verdienen besondere Aufmerksamkeit. Wenn fehlgeschlagene Testläufe wiederholt falsche Kennwörter einsetzen, können sie ihre eigenen Zugänge sperren. Solche Szenarien sollten bewusst getestet, aber vom normalen Regressionstest getrennt werden.

Stabilität entsteht durch Betrieb, nicht durch ein einzelnes Tool

Ein UI-Test ist nur dann nützlich, wenn er unter wiederholbaren Bedingungen läuft. Dazu gehören eine feste Windows-Version, definierte Bildschirmauflösung und Skalierung, bekannte Anwendungsversionen sowie ein sauberer Umgang mit Updates, Dialogen und Hintergrundprozessen. Wenn ein Testserver morgens andere Schriftgrößen nutzt als nachts, ist das kein Testproblem - es ist ein Betriebsproblem.

Wartezeiten sollten nicht blind fest eingetragen werden. Drei Sekunden Pause nach jedem Klick machen einen Test langsam und lösen keine Timing-Probleme. Besser ist es, gezielt auf einen Zustand zu warten: Das Fenster ist sichtbar, die Tabelle enthält den erwarteten Datensatz oder der Speichervorgang ist abgeschlossen. Für echte asynchrone Vorgänge braucht es sinnvolle Zeitlimits und eine eindeutige Fehlerdiagnose.

Fehlgeschlagene Läufe gehören in eine Triage, nicht in einen ignorierten Ordner. War die Anwendung defekt? Hat sich die Oberfläche fachlich korrekt verändert? War die Testumgebung nicht verfügbar? Screenshots, Bildschirmaufzeichnungen, technische Logs und Zeitstempel verkürzen diese Klärung erheblich. Ein Bericht in Klartext hilft zudem Fachbereichen zu verstehen, welcher Geschäftsablauf betroffen ist, ohne erst ein Testskript lesen zu müssen.

Datenschutz und Nachweise von Anfang an einplanen

Bei Desktop-Anwendungen zeigen Screenshots häufig Kundennamen, Artikelpreise, Adressen oder interne Kennzahlen. Werden Tests über externe Cloud-Dienste ausgeführt, verlassen Bildschirmdaten und Anwendungsverkehr möglicherweise die eigene Kontrollzone. Für sicherheitsbewusste Teams ist das kein Nebendetail, sondern eine Architekturentscheidung.

Ein selbst gehosteter Testserver kann Testausführung, Bilder und Berichte im eigenen Umfeld halten.
softify.pro setzt dafür mit COCO auf eine Umgebung, die automatisierte Tests für Web- und Windows-Anwendungen ausführt und nachvollziehbare Ergebnisse erzeugt. Ob ein eigener Server sinnvoll ist, hängt vom Schutzbedarf, der vorhandenen IT und der Zahl der Testläufe ab. Für eine kleine, unkritische Anwendung kann ein einfacher Ansatz genügen; bei internen Fachsystemen mit sensiblen Daten ist lokale Kontrolle oft die vernünftigere Option.

Die Aufbewahrung der Nachweise sollte ebenfalls geregelt sein. Nicht jeder Screenshot muss dauerhaft gespeichert werden. Sinnvoll sind Fristen, rollenbasierter Zugriff und eine klare Zuordnung zwischen Testlauf, Anwendungsversion und Ergebnis. So lassen sich Fehler nachstellen, ohne eine zweite unkontrollierte Datensammlung aufzubauen.

Was ein sinnvoller Rollout liefert

Nach einem ersten Durchlauf sollte ein Team nicht nur eine Zahl über bestandene Tests erhalten. Entscheidend ist, ob die Tests reale Fehler finden, ob sie zuverlässig laufen und ob der Pflegeaufwand zum Nutzen passt. Ein Test, der jede Woche wegen einer belanglosen Layoutänderung angepasst werden muss, ist zu teuer - selbst wenn er technisch beeindruckend wirkt.

Der nächste Schritt ist die Einbindung in den Release-Ablauf. Schnelle technische Tests können bei jedem Build starten; ausgewählte End-to-End-Tests laufen vor einer Freigabe oder nachts in einer stabilen Umgebung. Kritische Abweichungen blockieren das Release, weniger kritische Hinweise werden dokumentiert und priorisiert. Diese Schwellen sollten fachlich abgestimmt sein. Nicht jeder Darstellungsunterschied ist ein Auslieferungsstopp, eine falsch gebuchte Menge hingegen schon.

Automatisierte Windows-Tests ersetzen keine Fachkenntnis. Sie schaffen aber Zeit für die Prüfungen, die Urteilsvermögen brauchen: neue Prozesse, ungewöhnliche Sonderfälle und die Frage, ob eine Funktion im Arbeitsalltag wirklich verständlich ist. Wenn die Standardabläufe verlässlich nachweisbar sind, muss ein Release nicht mehr auf Hoffnung beruhen.

Permalink →

Individuelle Logistiksoftware für den Mittelstand

Individuelle Logistiksoftware für den Mittelstand

Wenn der Wareneingang auf Papier erfasst wird, Bestände in mehreren Excel-Dateien stehen und Versandfragen per Zuruf geklärt werden, fehlt selten Einsatzbereitschaft. Es fehlt ein gemeinsamer Prozess. Individuelle Logistiksoftware für Mittelstand setzt genau dort an: nicht mit einem überladenen Konzernsystem, sondern mit einer Anwendung, die die tatsächlichen Wege im Lager, in der Disposition und im Büro abbildet.

Für viele Unternehmen ist das kein Projekt zur Digitalisierung um ihrer selbst willen. Es geht um weniger Rückfragen, verlässliche Bestände, schneller erzeugte Lieferscheine und eine Übergabe zwischen Schichten, die nicht vom Wissen einzelner Personen abhängt. Die beste Lösung ist dabei nicht automatisch die mit den meisten Funktionen. Sie muss die Arbeit nachweisbar einfacher und kontrollierbarer machen.

Der kritische Punkt sind meist die Übergaben

In kleinen und mittleren Lager- und Fertigungsbetrieben funktioniert vieles erstaunlich lange mit Tabellen, E-Mails und Erfahrung. Das ist nicht grundsätzlich falsch. Eine gepflegte Tabelle kann für eine überschaubare Inventurliste sinnvoller sein als ein eigenes System.

Kritisch wird es, wenn Informationen mehrfach erfasst werden oder ihre Verlässlichkeit nicht mehr klar ist. Ein Auftrag wird im Büro angelegt, im Lager ausgedruckt, auf einem Laufzettel ergänzt und später wieder in eine Tabelle übertragen. Gleichzeitig reserviert ein anderer Mitarbeiter Bestand für einen dringenden Versand. Am Ende ist nicht nur der Bestand fraglich. Auch die Frage, wer welchen Schritt wann ausgeführt hat, lässt sich kaum beantworten.

Diese Reibung zeigt sich selten als einzelner großer Fehler. Sie kostet täglich Minuten: bei der Artikelsuche, beim Rückruf eines Kunden, bei der Nachverfolgung einer Lieferung oder bei der Schichtübergabe. Über Wochen entstehen daraus vermeidbare Fehlmengen, Expresssendungen und Diskussionen über Zahlen, denen niemand vollständig vertraut.

Was individuelle Logistiksoftware konkret abbilden sollte

Eine maßgeschneiderte Anwendung beginnt nicht mit einem Funktionskatalog. Sie beginnt mit einer Prozessaufnahme auf dem Hallenboden und am Arbeitsplatz der Disposition. Welche Daten kommen tatsächlich an? Welche Entscheidung trifft ein Mitarbeiter? Welche Ausnahme tritt regelmäßig auf? Und welche Informationen müssen für den nächsten Arbeitsschritt zwingend vorhanden sein?

Daraus entsteht ein klarer Ablauf, beispielsweise vom Auftragseingang über Kommissionierung und Versand bis zur Übergabe an die Buchhaltung. Je nach Betrieb können folgende Bausteine dazugehören:


  • Erfassung von Wareneingängen, Prüfstatus und Lagerplätzen
  • Bestandsbewegungen mit Barcode- oder mobiler Scanner-Unterstützung
  • Auftragsannahme, Reservierungen und Picklisten
  • Lieferscheine, Versandetiketten und Übergabe an Versanddienstleister
  • Routenplanung für eigene Fahrzeuge und Touren
  • Nachvollziehbare Korrekturen, Rollenrechte und Auswertungen

Entscheidend ist nicht, alles auf einmal zu bauen. Ein Betrieb mit häufigen Umlagerungen braucht womöglich zuerst verlässliche Lagerbewegungen. Ein Großhändler mit vielen kleinen Sendungen profitiert zunächst stärker von einem sauberen Auftragseingang und automatisch erzeugten Versanddokumenten. Ein produzierendes Unternehmen benötigt vielleicht zuerst Transparenz über Materialbereitstellung und Sperrbestände.

Ein Beispiel aus dem Tagesgeschäft

Angenommen, der Wareneingang erhält fünf Paletten mit Artikeln, deren Mengen teilweise von der Bestellung abweichen. In einem guten Ablauf wird die Lieferung erfasst, geprüft und einem Status zugeordnet. Erst nach Freigabe wird der Bestand für die Disposition verfügbar. Abweichungen landen nicht in einer Notiz auf dem Lieferschein, sondern sind dem Einkauf und Lager sichtbar zugeordnet.

Wird später kommissioniert, zeigt das System nicht nur einen theoretischen Gesamtbestand, sondern den passenden Lagerplatz und den reservierten Anteil. Nach dem Scan oder der Bestätigung der Entnahme wird die Bewegung protokolliert. Der Lieferschein entsteht aus denselben Daten. Das reduziert doppelte Eingaben und schafft eine belastbare Spur, ohne dass Mitarbeitende mehr Verwaltungsarbeit erledigen müssen.

Standardsoftware, Excel oder Individualentwicklung?

Die ehrliche Antwort lautet: Es kommt auf den Prozess an. Standardsoftware ist sinnvoll, wenn Abläufe weitgehend den vorgesehenen Mustern entsprechen, Anpassungen gering bleiben und die Lizenzkosten zum Umfang passen. Sie bringt oft fertige Module, etablierte Schnittstellen und eine schnelle erste Einführung mit.

Der Nachteil zeigt sich, wenn sich der Betrieb dauerhaft nach dem Werkzeug richten muss. Dann werden Sonderfälle wieder außerhalb des Systems geführt, Pflichtfelder umgangen oder Mitarbeiter pflegen Schattenlisten. Das kann akzeptabel sein, solange diese Ausnahmen selten und beherrschbar bleiben. Häufen sie sich, wird das Standardprodukt zum zusätzlichen Prozessbruch. Excel bleibt ebenfalls ein brauchbares Werkzeug, wenn Datenmengen klein sind, nur wenige Personen gleichzeitig arbeiten und die Folgen einer fehlerhaften Eingabe begrenzt bleiben. Es ist jedoch keine gute Datenbasis für parallel laufende Lagerbewegungen, verbindliche Reservierungen oder eine lückenlose Versandhistorie.

Eine individuelle Lösung lohnt sich besonders, wenn der Ablauf ein echter Wettbewerbsvorteil ist, wenn mehrere Medienbrüche zusammenkommen oder wenn ein vorhandenes System zwar Daten enthält, aber die tägliche Arbeit ausbremst. Sie sollte nicht als Prestigeprojekt verstanden werden. Ihr wirtschaftlicher Wert liegt in kürzeren Durchlaufzeiten, weniger Fehlern und weniger Abhängigkeit von einzelnen Köpfen.

Individuelle Logistiksoftware für den Mittelstand braucht Grenzen

Maßgeschneidert bedeutet nicht, jede Wunschfunktion sofort umzusetzen. Im Gegenteil: Gute Individualentwicklung setzt klare Grenzen. Sonst entsteht ein System, das alle historischen Sonderwege konserviert und dadurch schwer bedienbar wird.

Ein sinnvoller Start definiert einen Kernprozess mit messbarem Nutzen. Etwa: Wareneingänge werden am selben Tag vollständig gebucht. Oder: Für jeden Versandauftrag sind Artikel, Menge, Bearbeiter und Versandstatus eindeutig dokumentiert. Erst wenn dieser Ablauf stabil läuft, folgen weitere Module wie Tourenplanung, Kundenportale oder spezielle Auswertungen.

Auch technische Entscheidungen brauchen Pragmatismus. Eine Webanwendung kann auf modernen, wartbaren Technologien wie PHP 8.4, modernem JavaScript und MySQL 8 aufbauen. Das ist keine Selbstinszenierung mit Technologiebegriffen. Es schafft eine nachvollziehbare Basis für Rollenrechte, Datenbanktransaktionen, mobile Oberflächen und dokumentierte Bereitstellungen. Für Scanner im Lager ist oft entscheidend, dass die Anwendung auf vorhandenen Geräten zuverlässig reagiert und auch bei schwächerem WLAN klare Rückmeldungen gibt.

Nicht jede Funktion benötigt Echtzeit-Komplexität. Manche Auswertungen dürfen nachts aktualisiert werden. Bestandsbuchungen und Reservierungen hingegen müssen unmittelbar konsistent sein. Diese Unterscheidung hält Architektur, Kosten und Betrieb beherrschbar.

Einführung: Erst den Ablauf stabilisieren, dann beschleunigen

Die Einführung scheitert selten an einer einzelnen Oberfläche. Sie scheitert, wenn offene Prozessfragen in die Entwicklungsphase verschoben werden. Wer darf Bestände korrigieren? Was geschieht bei beschädigter Ware? Wann wird ein Auftrag verbindlich reserviert? Wie werden Retouren behandelt? Solche Regeln müssen vor dem breiten Rollout geklärt sein.

Ein belastbarer Weg beginnt mit wenigen repräsentativen Abläufen und echten Daten. Mitarbeitende aus Lager, Disposition und Verwaltung prüfen gemeinsam, ob der Bildschirm die Sprache des Betriebs spricht und ob die Reihenfolge der Arbeitsschritte stimmt. Dabei sind Hinweise wie „Das Feld brauchen wir nicht“ oder „Hier fehlt der Status für Teillieferung“ wertvoller als abstrakte Funktionswünsche.

Danach folgt ein begrenzter Pilotbetrieb. Nicht mit künstlichen Beispielen, sondern mit ausgewählten Aufträgen im Tagesgeschäft. Fehler und unklare Zustände werden dokumentiert, priorisiert und korrigiert. Erst anschließend wird auf weitere Bereiche ausgerollt. Parallelbetrieb kann kurzfristig Sicherheit geben, sollte aber ein Ende haben. Zwei führende Systeme erzeugen auf Dauer genau die Unsicherheit, die das Projekt beseitigen soll.

Schulung ist ebenfalls mehr als eine einmalige Präsentation. Mitarbeitende brauchen kurze, rollenbezogene Anleitungen: Was buche ich? Was prüfe ich? Was tue ich bei einer Abweichung? Eine dokumentierte Ausnahmebehandlung verhindert, dass bei der ersten Sonderlage wieder Papier und Chatgruppen die Führung übernehmen.

Wartbarkeit ist Teil der Lösung, nicht der Nachtrag

Logistikprozesse verändern sich. Neue Lagerplätze kommen hinzu, ein Versanddienstleister ändert Anforderungen, Kunden verlangen andere Belegformate oder ein neuer Standort wird angebunden. Deshalb muss die Software nicht nur beim Start passen, sondern verständlich weiterentwickelbar sein.

Dazu gehören eine saubere Datenstruktur, klar getrennte Fachlogik, Rechtekonzepte und dokumentierte Bereitstellungen. Ebenso wichtig sind Sicherungen, Protokollierung und ein geregelter Umgang mit Fehlern. Wenn ein Nutzer mehrfach falsche Zugangsdaten eingibt, braucht es etwa einen nachvollziehbaren Account-Lockout-Flow statt stiller, unsicherer Improvisation.

Vor Änderungen an kritischen Abläufen sollten Tests stehen. Bei individuellen Anwendungen lohnt sich automatisierte Prüfung besonders für wiederkehrende Kernwege: Auftrag anlegen, Bestand reservieren, Versanddokument erzeugen, Status ändern. So bleibt eine Anpassung am Lieferschein nicht unbemerkt an einer anderen Stelle folgenreich.
softify.pro setzt bei solchen Projekten auf diese Art von langweilig verlässlicher, prüfbarer Technik statt auf kurzfristige Effekte.

Woran sich der Nutzen nach sechs Monaten messen lässt

Nicht jede Verbesserung lässt sich sofort in Euro ausdrücken, aber sie sollte sichtbar sein. Gute Kennzahlen orientieren sich am Engpass: Bearbeitungszeit pro Auftrag, Zahl der Bestandskorrekturen, Fehlversandquote, Anteil termingerechter Wareneingangsbuchungen oder Rückfragen zwischen Lager und Büro.

Wichtig ist der Vergleich mit einer realistischen Ausgangslage. Wenn bisher niemand die Fehlmengen sauber erfasst hat, kann die neue Transparenz zunächst nach mehr Problemen aussehen. Tatsächlich werden Probleme dann erstmals sichtbar und steuerbar. Diese Phase braucht Geduld und eine offene Kommunikation.

Die passende Software verschwindet nicht aus dem Arbeitsalltag, weil sie unwichtig wäre. Sie sorgt dafür, dass ein Auftrag, eine Palette oder eine Tour ihren klaren Weg nimmt - auch dann, wenn die erfahrenste Person im Lager gerade nicht im Haus ist.

Permalink →

Automatisierte Regressionstests für Webanwendungen

Automatisierte Regressionstests für Webanwendungen

Ein geänderter Rabattcode, ein neues Rollenrecht oder ein Update des Zahlungsdienstes kann eine Webanwendung an einer Stelle brechen, die seit Monaten niemand angefasst hat. Genau dort setzen automatisierte Regressionstests für Webanwendungen an: Sie prüfen wiederholt, ob bewährte Geschäftsabläufe nach Änderungen weiterhin funktionieren. Nicht als theoretische Qualitätsmaßnahme, sondern dort, wo ein Fehler Aufträge, Lagerbewegungen, Rechnungen oder Kundenkonten blockiert.

Für viele Teams beginnt das Problem schleichend. Releases dauern länger, weil Fachbereiche dieselben Kernabläufe manuell durchklicken. Testwissen steckt bei einzelnen Personen. Und vor einem Update bleibt die unangenehme Frage: Was haben wir übersehen? Automatisierung ersetzt dabei weder fachliche Verantwortung noch sinnvolle Explorationsarbeit. Sie macht die wiederkehrenden, geschäftskritischen Prüfungen verlässlich, reproduzierbar und nachvollziehbar.

Was automatisierte Regressionstests tatsächlich absichern

Ein Regressionstest beantwortet eine einfache Frage: Funktioniert etwas, das vorher funktioniert hat, nach einer Änderung noch immer? Bei einer Webanwendung geht es dabei selten nur um eine einzelne Schaltfläche. Relevant sind vollständige Abläufe über Oberfläche, Berechtigungen, Schnittstellen und Datenbank hinweg.

Ein Beispiel aus einem operativen System: Ein Mitarbeiter meldet sich an, erfasst einen Wareneingang, bucht eine Bestandsbewegung, erstellt einen Lieferschein und übergibt die Sendung an einen Versanddienst. Jeder Schritt kann technisch korrekt aussehen und dennoch im Zusammenspiel scheitern. Vielleicht wird die Menge gespeichert, aber nicht im Bestand aktualisiert. Vielleicht wird das Etikett erzeugt, aber die Referenznummer fehlt. Vielleicht klappt der Ablauf nur für Administratoren, nicht jedoch für die Rolle im Lager.

Automatisierte Tests können solche Journeys mit definierten Eingaben ausführen und die Ergebnisse prüfen. Dazu gehören sichtbare Ergebnisse in der Benutzeroberfläche ebenso wie Statuswerte, erzeugte Dokumente, E-Mails oder API-Antworten. Der Nutzen steigt, wenn die Prüfung nahe an den Risiken des Betriebs organisiert wird - nicht nach der Anzahl technisch möglicher Testfälle.

Welche Webabläufe zuerst automatisiert werden sollten

Nicht jeder Klick verdient sofort einen automatisierten Test. Eine kaum genutzte Einstellungsseite mit geringem Schadenpotenzial kann zunächst manuell geprüft werden. Dagegen gehören Abläufe mit häufigen Änderungen, hoher Nutzung oder klaren finanziellen und operativen Folgen früh in die Testsuite.

Besonders wertvoll sind Tests für Anmeldung, Passwort-Reset und Account-Lockout. Sie sichern den Zugang zur Anwendung und werden oft durch Änderungen an Identitätsdiensten, Session-Verwaltung oder Sicherheitsregeln beeinflusst. Ebenso wichtig sind Kernprozesse wie Auftragserfassung, Preis- und Steuerberechnung, Freigaben, Bestandsbuchungen, Dokumentenerzeugung und Schnittstellen zu Versand, ERP oder Zahlungsanbietern.

Für Führungskräfte und Fachbereiche hilft eine nüchterne Priorisierung. Fragen Sie nicht zuerst, welche Seite am einfachsten zu testen ist. Fragen Sie: Welcher Fehler stoppt eine Schicht, erzeugt Nacharbeit oder führt zu falschen Kundeninformationen? Daraus entsteht eine Testliste, die den realen Betrieb schützt.

Ein Testfall braucht ein überprüfbares Ergebnis

„Bestellung anlegen“ ist noch kein guter Testfall. Besser ist: Ein Vertriebsmitarbeiter legt mit der Rolle Verkauf einen Auftrag für einen bestehenden Kunden an, fügt einen Artikel mit definierter Menge hinzu, speichert ihn und erzeugt eine Auftragsnummer. Anschließend ist der Status „offen“, die Summe entspricht den Regeln und der Auftrag erscheint in der Liste der offenen Vorgänge.

Diese Präzision ist keine Bürokratie. Sie verhindert Tests, die zwar klicken, aber nicht feststellen können, ob das fachliche Ergebnis stimmt. Sie erleichtert außerdem die Abstimmung zwischen Entwicklung, QA und Fachbereich. Gerade bei individuell entwickelten Systemen sind die Fachleute oft die einzige verlässliche Quelle dafür, was „korrekt“ im Alltag wirklich bedeutet.

Testpyramide statt Browser-Automatisierung für alles

Browser-Tests sind wertvoll, aber sie sind nicht die gesamte Teststrategie. Sie laufen langsamer, sind anfälliger für instabile Testdaten und können bei schlecht gewählten Selektoren nach kleinen UI-Anpassungen brechen. Wer jede Regel ausschließlich über die Oberfläche prüft, baut meist eine langsame und wartungsintensive Suite.

Geschäftslogik wie Preisberechnungen, Mengenprüfungen oder Statusübergänge sollte dort getestet werden, wo sie implementiert ist - etwa als Unit- oder Integrationstest. Schnittstellen lassen sich gezielt mit kontrollierten Antworten prüfen. Browserbasierte End-to-End-Tests bleiben dann für die wenigen Wege reserviert, bei denen das Zusammenspiel aller Komponenten entscheidend ist.

Bei PHP-8.4-Anwendungen mit MySQL 8 bedeutet das beispielsweise: Rechen- und Validierungsregeln werden nah am Code abgesichert, Datenbanktransaktionen und API-Verträge werden integriert getestet, während ein Browser-Test den vollständigen Auftrag bis zum erzeugten Beleg nachvollzieht. Das ist weniger spektakulär als eine große Sammlung sichtbarer Klicktests. Es liefert jedoch schnellere Rückmeldungen und geringeren Pflegeaufwand.

Stabilität entsteht durch Testdaten und klare technische Grenzen

Viele Automatisierungsprojekte scheitern nicht am Testwerkzeug, sondern an unkontrollierten Voraussetzungen. Wenn ein Testkonto gesperrt ist, eine Testbestellung vom Vortag noch existiert oder ein externer Dienst gerade langsam antwortet, entsteht ein Fehlalarm. Solche instabilen Tests verlieren schnell das Vertrauen des Teams.

Testdaten müssen deshalb bewusst angelegt und bereinigt werden. Sinnvoll sind eigene Mandanten oder klar abgegrenzte Datensätze, eindeutige Kennungen pro Testlauf und definierte Startzustände. Ein Test darf nicht zufällig von der Reihenfolge anderer Tests abhängen. Wo externe Dienste beteiligt sind, sollte klar entschieden werden: Wird eine realistische Testumgebung verwendet oder wird die Schnittstelle für den jeweiligen Test simuliert? Beides kann richtig sein.

Auch Selektoren verdienen Aufmerksamkeit. Tests sollten nicht an Layout-Klassen, Textpositionen oder zufälligen HTML-Strukturen hängen. Stabile, ausdrücklich für Tests vorgesehene Kennzeichnungen reduzieren unnötige Wartung. Das ist eine kleine technische Entscheidung mit großer Wirkung, wenn sich Oberfläche und Design regelmäßig weiterentwickeln.

Automatisierte Regressionstests für Webanwendungen in den Release-Prozess einbauen

Der beste Test hilft wenig, wenn er nur vor großen Releases manuell gestartet wird. Sinnvoll ist eine abgestufte Ausführung: Schnelle Code- und Schnittstellentests laufen bei jeder Änderung. Die wichtigsten Browser-Journeys laufen bei Pull Requests oder vor der Bereitstellung in die Staging-Umgebung. Umfangreichere Prüfungen können nachts oder vor einem geplanten Produktivrelease stattfinden.

Entscheidend ist die Rückmeldung. Ein fehlgeschlagener Test braucht nicht nur ein rotes Symbol, sondern verwertbare Hinweise: Welche Daten wurden verwendet? An welchem Schritt trat der Fehler auf? Welcher Screenshot oder welches Protokoll belegt ihn? Für Teams ohne eigene große QA-Abteilung sind verständliche Befunde besonders wertvoll. Sie müssen erkennen können, ob ein Defekt im System, in den Testdaten oder in der Testumgebung liegt.

COCO kann hier als selbst gehostete Testinfrastruktur eingesetzt werden, um Testabläufe auszuführen, Nachweise aufzuzeichnen und Ergebnisse in klarer Sprache aufzubereiten. Das ist vor allem dann relevant, wenn Screenshots, interne Oberflächen oder Testdaten nicht in eine externe Cloud übertragen werden sollen. Selbst gehostet bedeutet allerdings nicht wartungsfrei: Zugriffsrechte, Updates, Kapazitäten und Aufbewahrungsregeln müssen ebenso sauber geplant werden wie die Tests selbst.

Was Kennzahlen aussagen - und was nicht

Eine wachsende Zahl automatisierter Tests ist kein Qualitätsbeweis. Eine Suite mit 2.000 oberflächlichen Tests kann weniger Schutz bieten als 40 sauber gepflegte Tests für die kritischen Wertströme. Aussagekräftiger sind Fragen wie: Wie lange dauert die Rückmeldung nach einer Änderung? Wie viele relevante Fehler werden vor der Produktion gefunden? Wie oft sind Testfehler tatsächlich Fehlalarme? Und welche geschäftskritischen Abläufe sind nachweislich abgedeckt?

Auch die Laufzeit ist ein praktischer Faktor. Wenn eine Suite erst nach vier Stunden Ergebnisse liefert, wird sie im Tagesgeschäft umgangen. Wenn sie in 15 Minuten ein klares Signal zu Anmeldung, Auftrag, Bestand und Dokumenten liefert, unterstützt sie Entscheidungen vor dem Release. Es hängt von Anwendung und Risiko ab, welche Tiefe notwendig ist. Ein internes Planungstool verlangt etwas anderes als ein Kundenportal mit Zahlungen und personenbezogenen Daten.

Der richtige Start ist kleiner als viele erwarten

Beginnen Sie mit einem Prozess, dessen Ausfall spürbar wäre, und bilden Sie ihn vollständig ab. Definieren Sie das erwartete Ergebnis gemeinsam mit den Personen, die diesen Ablauf täglich nutzen. Sorgen Sie für kontrollierte Testdaten, stabile technische Anker und nachvollziehbare Nachweise. Erst wenn dieser erste Test zuverlässig läuft, wird der nächste Prozess ergänzt.

So entsteht keine beeindruckende, aber fragile Testkulisse. Es entsteht eine belastbare Sicherheitslinie für Änderungen - Schritt für Schritt, dort, wo Ihre Webanwendung den Betrieb tatsächlich trägt.

Permalink →

Wareneingang digital erfassen ohne Bestandschaos

Wareneingang digital erfassen ohne Bestandschaos

Ein Lieferschein liegt auf dem Warentisch, die Palette steht bereits im Gang und der Fahrer wartet auf eine Unterschrift. Genau in diesem Moment entscheidet sich, ob ein Bestand später stimmt oder ob die nächste Kollegin nach Material sucht, das laut System vorhanden sein müsste. Wer den Wareneingang digital erfassen will, braucht deshalb mehr als eine Eingabemaske. Der Prozess muss unter Zeitdruck funktionieren, eindeutige Daten erzeugen und zu den tatsächlichen Abläufen im Lager passen.

Papierlisten und Tabellen wirken oft lange ausreichend. Sie werden aber fragil, sobald mehrere Personen buchen, Artikel ähnliche Bezeichnungen haben, Chargen relevant werden oder Ware direkt an Montage, Kommissionierung oder Kundenaufträge weitergeht. Eine gute digitale Erfassung schafft nicht einfach mehr Daten. Sie schafft einen verlässlichen gemeinsamen Stand.

Was beim digitalen Wareneingang wirklich erfasst werden sollte

Der Wareneingang ist der Übergang zwischen Anlieferung und verfügbarem Bestand. Damit dieser Übergang prüfbar bleibt, sollte jede Buchung mindestens beantworten können: Was wurde geliefert, in welcher Menge, wann, von welchem Lieferanten und wohin wurde die Ware eingelagert? Je nach Geschäft kommen Bestellnummer, Lieferscheinnummer, Charge, Seriennummer, Mindesthaltbarkeitsdatum oder Qualitätsstatus hinzu.

Entscheidend ist die Unterscheidung zwischen angekündigter und tatsächlich angenommener Ware. Eine Bestellung kann 100 Stück ausweisen, geliefert werden aber 96 Stück, zwei beschädigte Kartons und zwei Ersatzpositionen. Wenn Mitarbeitende nur die Bestellung bestätigen, wandert ein Fehler direkt in den Bestand. Die digitale Erfassung muss Abweichungen bewusst einfach machen - nicht durch Sonderwege bestrafen.

Für ein Ersatzteillager reicht häufig Artikel, Menge, Lagerplatz und Belegreferenz. In der Fertigung können Chargenfreigaben oder Prüfprotokolle unverzichtbar sein. Mehr Felder sind nicht automatisch besser. Jedes Pflichtfeld kostet Zeit und erhöht die Wahrscheinlichkeit, dass jemand Werte schätzt oder später nachträgt.

Wareneingang digital erfassen: Der Ablauf auf der Lagerfläche

Ein praxistauglicher Ablauf beginnt nicht am Bildschirm im Büro, sondern dort, wo die Ware ankommt. Mitarbeitende öffnen den erwarteten Wareneingang auf einem mobilen Gerät oder erfassen den Lieferschein zunächst über Suche, Bestellnummer oder Barcode. Danach werden Positionen gescannt, gezählt oder gewogen und mit der erwarteten Lieferung abgeglichen.

Ist die Menge korrekt, wird die Ware einem Lagerplatz zugeordnet und gebucht. Bei Abweichungen wird nicht einfach ein Kommentar in ein Freitextfeld geschrieben. Das System hält fest, ob es sich um Fehlmenge, Überlieferung, Transportschaden, falschen Artikel oder eine noch ungeprüfte Position handelt. Ein Foto kann bei sichtbaren Schäden sinnvoll sein, ist aber nicht für jede Anlieferung nötig.

Nach der Buchung sollte klar sein, welchen Status die Ware hat. Manche Artikel sind sofort verfügbar. Andere bleiben gesperrt, bis eine Qualitätsprüfung abgeschlossen ist oder ein Verantwortlicher die Abweichung entschieden hat. Diese Statuslogik verhindert, dass der Vertrieb Ware zusagt, die physisch zwar angekommen, aber noch nicht verwendbar ist.

Der richtige Erfassungspunkt hängt vom Betrieb ab. In einem kleinen Lager kann der Wareneingang direkt am Tor komplett gebucht werden. Bei großen Anlieferungen oder engen Rampenzeiten ist oft eine zweistufige Buchung besser: Erst wird die Lieferung als eingetroffen registriert, anschließend werden Positionen geprüft und eingelagert. Der Vorteil ist Geschwindigkeit an der Rampe. Der Nachteil: Es braucht klare Verantwortlichkeiten, damit offene Prüfungen nicht liegen bleiben.

Scanner, Tablet oder Arbeitsplatz-PC?

Die Hardware sollte dem Bewegungsablauf folgen. Für Artikel mit sauber gedruckten Barcodes ist ein Handscanner meist die schnellste und fehlerärmste Wahl. Mobile Scanner oder Smartphones mit Kamera eignen sich, wenn Mitarbeitende zwischen Wareneingang, Regalen und Sperrfläche unterwegs sind. Ein Tablet kann für komplexere Buchungen mit Fotos, mehreren Mengen oder Prüfhinweisen sinnvoll sein.

Ein fester PC-Arbeitsplatz funktioniert dagegen gut, wenn eine Person Lieferscheine zentral prüft und die Warenannahme räumlich konzentriert ist. Er ist weniger passend, wenn das Team für jede Buchung zum Büro laufen muss. Die eingesparte Lizenz wird dann oft durch Laufwege, Unterbrechungen und verspätete Buchungen bezahlt.

Nicht jeder Artikel braucht einen Barcode. Gerade bei individuellen Bauteilen, Rohmaterialien oder Lieferantenetiketten ist die Kennzeichnung uneinheitlich. Dann sollte das System eine schnelle Suche über Artikelnummer, Lieferantenartikelnummer oder Bestellposition anbieten. Barcode-Scanning ist ein gutes Werkzeug, aber kein Selbstzweck.

Datenqualität entsteht durch Regeln, nicht durch Appelle

Ein Lagerbestand wird nicht dadurch korrekt, dass eine Software installiert ist. Korrektheit entsteht, wenn das System sinnvolle Regeln erzwingt und Ausnahmen sichtbar macht. Eine negative Menge ohne begründeten Vorgang, ein unbekannter Lagerplatz oder eine doppelt verwendete Lieferscheinnummer sollten nicht unbemerkt durchgehen.

Gleichzeitig darf die Prüfung den Betrieb nicht blockieren. Wenn ein Lieferant Lieferscheinnummern wiederverwendet oder Etiketten unleserlich sind, brauchen Mitarbeitende einen nachvollziehbaren Ausweichweg. Beispielsweise kann eine Buchung mit einem Hinweis erfolgen, der später geprüft werden muss. Wichtig ist, dass daraus eine offene Aufgabe wird und kein unsichtbarer Kompromiss.

Besonders wertvoll sind einfache Plausibilitätsprüfungen: Passt der Artikel zur Bestellung? Weicht die Menge über eine definierte Toleranz ab? Ist die Charge bei chargepflichtigen Artikeln vorhanden? Wurde ein Sperrstatus gesetzt, wenn eine Schadensmeldung erfasst wurde? Solche Regeln reduzieren Nacharbeit, ohne das Team mit komplizierten Masken zu überfordern.

Schnittstellen erst bauen, wenn der Kernprozess steht

Viele Unternehmen wünschen sich sofort die Verbindung zu ERP, Einkauf, Versand und Buchhaltung. Das kann richtig sein, aber nur wenn die Datenhoheit klar ist. Ein System sollte eindeutig festlegen, wo Bestellungen entstehen, wo der führende Lagerbestand liegt und welche Daten in welcher Richtung übertragen werden.

Eine schlechte Schnittstelle vervielfacht Fehler schneller als eine Tabelle. Wenn etwa Bestellungen aus dem ERP kommen, der tatsächliche Wareneingang aber im Lagerbuchungssystem entsteht, muss klar sein, welche Status zurückgemeldet werden: vollständig geliefert, teilweise geliefert, gesperrt oder mit Abweichung. Zeitstempel und eindeutige Belegreferenzen sind dabei wichtiger als eine optisch beeindruckende Integration.

Für kleinere Betriebe kann ein kontrollierter CSV-Import zum Start sinnvoller sein als eine teure Echtzeit-Anbindung. Das ist keine Notlösung, wenn Import, Prüfung und Fehlerprotokoll sauber umgesetzt sind. Sobald Mengen, Frequenz oder Folgeprozesse wachsen, wird eine direkte Schnittstelle wirtschaftlicher.

Ein sinnvoller Rollout beginnt mit echten Lieferungen

Bevor Entwicklung oder Standardsoftware ausgewählt wird, lohnt sich eine kurze Prozessaufnahme mit realen Fällen. Nicht nur die Ideallieferung gehört auf den Tisch, sondern auch beschädigte Ware, Teilmengen, falsche Artikel, fehlende Bestellungen und Eilmaterial für die Werkstatt. Daraus ergibt sich, welche Daten und Entscheidungen tatsächlich benötigt werden.

Für den Start reichen häufig ein klar abgegrenzter Bereich, etwa ein Lieferant, eine Warengruppe oder ein Lagerstandort. Das Team arbeitet mit dem neuen Ablauf parallel zu den bisherigen Kontrollen, bis die Buchungen nachvollziehbar stimmen. Erst dann folgt die Ausweitung. Ein Big Bang spart auf dem Projektplan Zeit, erzeugt aber häufig Hektik auf der Fläche.

Wichtige Akzeptanzkriterien sind konkret und messbar:

  • Eine Standardlieferung ist ohne Rückfrage in wenigen Minuten buchbar.
  • Abweichungen erscheinen in einer offenen, zugeordneten Klärliste.
  • Der Bestand eines Artikels lässt sich mit Beleg und Lagerplatz erklären.
  • Berechtigte Mitarbeitende können Korrekturen nachvollziehbar durchführen.
  • Offene oder gesperrte Ware wird nicht versehentlich disponiert.

Ein auf den Betrieb zugeschnittenes System kann hier mehr leisten als eine überladene Suite, wenn es die vorhandenen Arbeitsweisen respektiert.
softify.pro entwickelt solche Logistikprozesse nicht um einer Digitalisierung willen, sondern rund um Buchungen, Verantwortlichkeiten und Daten, die im Alltag belastbar sein müssen.

Kennzahlen, die den Nutzen sichtbar machen

Nach dem Start sollte nicht nur gezählt werden, wie viele Wareneingänge digital gebucht wurden. Aussagekräftiger sind die Zeit zwischen Anlieferung und verfügbarer Ware, die Anzahl ungeklärter Abweichungen, Bestandsdifferenzen bei Inventuren und der Aufwand für Rückfragen im Einkauf oder Vertrieb.

Wenn sich Durchlaufzeit verkürzt, aber die Anzahl nachträglicher Korrekturen steigt, ist der Prozess vermutlich zu schnell und zu wenig prüfbar. Wenn jede Buchung lange dauert, obwohl kaum Abweichungen auftreten, sind womöglich zu viele Pflichtschritte eingebaut. Gute Lagerprozesse suchen nicht die maximale Kontrolle, sondern die passende Kontrolle.

Der beste nächste Schritt ist oft ein Rundgang an der Warenannahme mit drei echten Lieferscheinen. Beobachten Sie, welche Informationen gesucht werden, wo Mitarbeitende Entscheidungen improvisieren und welche Daten später erneut eingegeben werden. Genau dort beginnt ein digitaler Wareneingang, der nicht nur moderner aussieht, sondern den Bestand tatsächlich glaubwürdig macht.

Permalink →

Selbstgehostete KI-Softwaretests im Betrieb

Selbstgehostete KI-Softwaretests im Betrieb

Ein fehlgeschlagener Regressionstest ist selten nur ein roter Eintrag in einer Liste. Er kann bedeuten, dass ein Kommissionierer keinen Lieferschein drucken kann, ein Sachbearbeiter im Auftragssystem festhängt oder ein Update eine Funktion beschädigt, die seit Jahren zuverlässig lief. Selbstgehostete KI Softwaretests setzen genau dort an: Sie automatisieren wiederkehrende Prüfungen, ohne sensible Testdaten, Screenshots oder interne Anwendungsabläufe unnötig an externe Plattformen abzugeben.

Für Teams mit Webanwendungen und Windows-Desktopsoftware ist das mehr als eine Datenschutzfrage. Es geht um Kontrolle über die Testumgebung, nachvollziehbare Fehlernachweise und einen Testbetrieb, der zum eigenen Release-Prozess passt. KI kann dabei Arbeit abnehmen. Sie ersetzt jedoch weder saubere Testfälle noch fachliche Verantwortung.

Wann selbstgehostete KI-Softwaretests sinnvoll sind

Klassische Testautomatisierung ist sehr wirksam, aber sie verlangt Pflege. Selektoren ändern sich, Oberflächen entwickeln sich weiter, Testdaten müssen bereitstehen und Fehlermeldungen wollen eingeordnet werden. Viele Teams automatisieren deshalb nur einen kleinen Teil ihrer kritischen Abläufe - oder testen vor einem Release weiterhin überwiegend von Hand.

KI-gestützte Systeme können diese Lücke verkleinern. Sie lesen Oberflächen kontextbezogener, führen vorgegebene Arbeitsabläufe aus, erkennen sichtbare Abweichungen und fassen das Ergebnis in verständlicher Sprache zusammen. Besonders wertvoll wird das bei Anwendungen, die nicht nur aus API-Aufrufen bestehen, sondern aus realen Benutzeroberflächen: Logins, Eingabemasken, Freigaben, Druckdialogen und Windows-Fenstern.

Selbsthosting ist sinnvoll, wenn die Testläufe vertrauliche Informationen berühren. Das betrifft nicht nur personenbezogene Daten. Auch interne Preise, Kundennamen, Artikelbewegungen, Screenshots von Verwaltungsoberflächen, Zugangsdaten für Testkonten oder Informationen über noch nicht veröffentlichte Funktionen gehören dazu. Wer externe KI-Dienste einsetzt, sollte genau prüfen, welche Daten das eigene Netzwerk verlassen, wie lange sie gespeichert werden und wer darauf zugreifen kann.

Es gibt aber auch Fälle, in denen eine gehostete Plattform ausreicht. Bei einer öffentlichen Marketingseite ohne echte Kundendaten, wenigen Releases und überschaubarer Testtiefe kann sie schneller eingerichtet sein. Die richtige Entscheidung hängt vom Schutzbedarf, der Anwendungslandschaft, den vorhandenen Kompetenzen und der Häufigkeit von Änderungen ab - nicht von einem allgemeinen Cloud- oder KI-Prinzip.

Was im eigenen Umfeld bleibt

Bei einer selbstgehosteten Testumgebung läuft die Testausführung auf Infrastruktur, die das Unternehmen kontrolliert: im eigenen Rechenzentrum, in einer privaten Cloud-Umgebung oder auf einem dedizierten Server im vereinbarten Betriebsmodell. Entscheidend ist nicht allein der Standort eines Servers. Entscheidend ist der gesamte Datenfluss.

Ein sauber aufgebautes System verarbeitet Testschritte, Browser- oder Desktop-Sitzungen, Screenshots, Protokolle und Ergebnisberichte innerhalb dieses kontrollierten Umfelds. Testkonten lassen sich mit minimalen Berechtigungen anlegen. Zugangsdaten können getrennt verwaltet werden. Netzwerkzugriffe lassen sich auf die tatsächlich benötigten Systeme begrenzen. Für besonders sensible Anwendungen kann ein eigener Testmandant sinnvoller sein als Tests mit produktionsnahen Echtdaten.

Das schützt nicht automatisch vor Fehlern. Eine lokal betriebene Lösung braucht Updates, Berechtigungskonzepte, Backups und klare Verantwortlichkeiten. Wer einen Server einmal installiert und dann vergisst, hat keine sichere Testinfrastruktur, sondern eine zusätzliche Betriebsaufgabe. Der Vorteil liegt darin, dass diese Aufgabe planbar und prüfbar bleibt.

Die Testdaten verdienen denselben Schutz wie die Anwendung

Oft konzentriert sich die Sicherheitsdiskussion auf den Quellcode. In der Praxis verraten Testartefakte mindestens genauso viel. Ein Screenshot kann Kundendaten, interne Konditionen und Prozessdetails zeigen. Ein Video eines Testlaufs kann die Struktur eines Backoffice-Systems offenlegen. Ein Protokoll kann URLs, Fehlermeldungen oder technische Versionsstände enthalten.

Deshalb sollten Aufbewahrungsfristen festgelegt werden. Nicht jeder erfolgreiche Lauf muss dauerhaft gespeichert bleiben. Für Fehlernachweise und Releases kann eine definierte Historie dagegen sehr hilfreich sein. Zugriffsrechte auf Berichte gehören in das gleiche Berechtigungskonzept wie Zugriffe auf die Anwendung selbst.

Nicht jede Prüfung sollte von KI gesteuert werden

Die stärksten Testumgebungen kombinieren unterschiedliche Verfahren. Ein Login mit Account-Lockout nach mehreren Fehlversuchen lässt sich präzise und schnell mit deterministischen automatisierten Tests prüfen. Auch Schnittstellen, Berechnungen, Datenbankregeln und Berechtigungen profitieren von klaren Erwartungen: Eingabe A muss Ergebnis B liefern.

KI ist besonders nützlich, wenn die Oberfläche, der Ablauf und die Sicht des Anwenders im Mittelpunkt stehen. Ein Testauftrag kann beispielsweise prüfen, ob ein Disponent einen Auftrag anlegt, eine Route zuweist, ein Dokument erzeugt und den Status korrekt zurückerhält. Die KI kann dabei durch die Anwendung navigieren, Belege erfassen und verständlich dokumentieren, an welcher Stelle der Prozess abgebrochen ist. Für einen tragfähigen Testbetrieb sollten vier Ebenen zusammenspielen:

  • Unit- und Integrationstests sichern Geschäftslogik, Schnittstellen und Datenverarbeitung früh im Entwicklungsprozess ab.
  • UI-Tests prüfen wiederholbare Klickpfade und konkrete Erwartungen in Web- oder Desktopanwendungen.
  • KI-gestützte Ablaufprüfungen bewerten reale Bedienwege und sichtbare Ergebnisse aus Anwendersicht.
  • Explorative Fachtests decken Sonderfälle auf, die noch niemand als feste Regel beschrieben hat.

Eine KI sollte nicht entscheiden, ob eine Preislogik fachlich korrekt ist, wenn die Regeln unklar dokumentiert sind. Ebenso wenig kann sie einen unpräzisen Auftrag sinnvoll ausführen. „Prüfe den Versand“ ist keine belastbare Testbeschreibung. „Lege einen Auftrag mit drei Positionen an, erzeuge ein Versandetikett und prüfe, ob der Status auf versendet wechselt“ ist eine prüfbare Anweisung.

Von der Demo zum belastbaren Testbetrieb

Der häufigste Fehler bei KI-Tests ist ein zu breiter Start. Eine beeindruckende Demo mit einem einzelnen Login sagt wenig darüber aus, ob das System in sechs Monaten Releases absichert. Sinnvoller ist ein enger Einstieg mit zwei bis fünf Abläufen, deren Ausfall echte Kosten verursacht oder wiederkehrend manuellen Prüfaufwand erzeugt.

In einem Lager- oder Logistiksystem könnten das Wareneingang, Umbuchung, Kommissionierung und das Erzeugen eines Lieferscheins sein. In einer Verwaltungssoftware eher Anmeldung, Rechtewechsel, Auftragserfassung und Rechnungsfreigabe. Gute Kandidaten sind häufige Prozesse mit stabilen Regeln und klar sichtbaren Ergebnissen.

Danach braucht jeder Ablauf einen definierten Ausgangspunkt. Welche Daten müssen vorliegen? Welches Testkonto wird verwendet? Darf der Test E-Mails versenden, Etiketten drucken oder Schnittstellen ansprechen? Was wird nach dem Lauf zurückgesetzt? Ohne diese Regeln produziert Automatisierung schnell Testdatenmüll oder blockiert andere Teams.

Auch die Bewertung von Ergebnissen sollte abgestuft erfolgen. Ein fehlender Button ist meist ein klarer Fehler. Eine geringfügig andere Formulierung in einem Hinweistext muss nicht automatisch ein Release blockieren. Hier helfen Confidence Thresholds und eine klare Trennung zwischen automatischer Meldung, manueller Prüfung und tatsächlichem Sperrkriterium. Ein Testbericht sollte nicht nur „fehlgeschlagen“ melden, sondern den ausgeführten Schritt, den sichtbaren Zustand, den Zeitstempel und passende Belege enthalten.

Die Rolle von Screenshots, Videos und Klartext-Berichten

Ein Test, der nur eine technische Fehlermeldung ausgibt, verschiebt Arbeit in das Entwicklungsteam. Fachbereiche können damit oft wenig anfangen. Gute Nachweise verbinden technische Präzision mit Kontext: Was sollte passieren? Was ist tatsächlich passiert? Wo ist es sichtbar? Welche Version wurde geprüft?

Screenshots und Aufzeichnungen verkürzen die Abstimmung erheblich. Der QA-Verantwortliche muss nicht erst versuchen, den Fehler nachzustellen, und der Product Owner sieht sofort, ob ein Abbruch fachlich relevant ist. Gleichzeitig sollten solche Artefakte gezielt gespeichert werden. Erfolgreiche Tests brauchen häufig weniger Beweismaterial als fehlgeschlagene oder kritische Freigaben.

Ein Klartext-Bericht ist kein Ersatz für Logs. Er ist die Brücke zwischen Betrieb, Fachbereich und Entwicklung. Gerade bei mittelständischen Teams, in denen dieselben Personen Prozesse verantworten und Entscheidungen treffen, verhindert diese Brücke unnötige Übersetzungsarbeit.

Betrieb, Wartung und realistische Erwartungen

Selbstgehostete Testautomatisierung ist kein Produkt, das nach der Einrichtung ohne Aufmerksamkeit arbeitet. Anwendungen ändern sich. Browser aktualisieren sich. Testdaten verlieren ihre Gültigkeit. Neue Berechtigungsstufen, Captchas, Mehrfaktor-Anmeldung oder veränderte Druckdialoge beeinflussen Testläufe.

Das ist kein Argument gegen Automatisierung. Es ist ein Argument für einen klaren Wartungsrhythmus. Testfälle sollten wie Produktcode behandelt werden: versioniert, überprüft und bei Änderungen bewusst angepasst. Wenn ein Ablauf dreimal hintereinander aufgrund einer absichtlichen UI-Änderung scheitert, ist nicht die KI das Problem. Dann fehlt die Verbindung zwischen Entwicklung, Release-Planung und Testpflege.

softify.pro setzt dafür mit COCO auf einen dedizierten, selbstgehosteten KI-Server, der Web- und Windows-Anwendungen prüft, Nachweise aufzeichnet und die Ergebnisse verständlich einordnet. Der entscheidende Punkt bleibt jedoch die Einbettung in den Arbeitsalltag: Welche Prozesse werden abgesichert, wer prüft Abweichungen und wann darf ein Release weiterlaufen?

Der beste erste Schritt ist daher nicht, möglichst viele Tests zu kaufen oder zu konfigurieren. Wählen Sie den Ablauf, bei dem ein übersehener Fehler morgen tatsächlich Arbeit im Lager, im Service oder in der Buchhaltung verursacht. Wenn dieser Ablauf verlässlich, nachvollziehbar und unter eigener Datenkontrolle geprüft wird, entsteht aus KI nicht mehr Technik um der Technik willen, sondern spürbare Entlastung.

Permalink →

Excel durch individuelle Software ersetzen

Excel durch individuelle Software ersetzen

Ein Lagerbestand stimmt nur, wenn jemand die richtige Datei geöffnet, den letzten Wareneingang eingetragen und keine Kopie per E-Mail weitergegeben hat. Solange das bei wenigen Vorgängen funktioniert, ist Excel ein gutes Werkzeug. Excel durch individuelle Software zu ersetzen wird erst dann sinnvoll, wenn die Tabelle zum Engpass für Abläufe, Verantwortung und Verlässlichkeit wird.

Das betrifft selten nur das Lager. Aufträge werden per Telefon notiert, Lieferscheine entstehen aus Vorlagen, Bestände liegen in mehreren Dateien, und Rückfragen landen bei genau der Person, die gerade nicht erreichbar ist. Das Problem ist nicht die Tabellenkalkulation selbst. Es ist der Versuch, einen wachsenden operativen Prozess mit einem Werkzeug zu steuern, das keine verbindlichen Abläufe kennt.

Wann Excel nicht mehr das richtige Betriebsmittel ist

Eine Tabelle kann rechnen, filtern und Informationen sichtbar machen. Sie erzwingt aber nicht, dass ein Wareneingang vollständig gebucht wird, dass eine Lieferung vor dem Versand geprüft wurde oder dass zwei Mitarbeitende nicht gleichzeitig denselben Datensatz verändern. Wo solche Regeln geschäftskritisch werden, fehlt Excel die passende Struktur.

Typische Warnsignale sind wiederkehrende Abstimmungen zwischen Schicht, Lager und Büro. Mitarbeitende fragen nach dem aktuellen Stand eines Auftrags, obwohl die Information eigentlich verfügbar sein müsste. Bestandslisten werden vor der Inventur manuell bereinigt. Lieferscheinnummern oder Artikelbezeichnungen werden kopiert und später korrigiert. Und bei einer Abweichung lässt sich oft nicht mehr nachvollziehen, wer wann welchen Wert geändert hat.

Auch die Datei selbst wird zum Risiko. Versionen mit Namen wie „Bestand_final_neu_2“ sind kein Einzelfall, sondern ein Hinweis darauf, dass ein Prozess keine eindeutige Datenquelle hat. Makros können einzelne Arbeitsschritte beschleunigen, lösen aber weder paralleles Arbeiten noch Rollenrechte, Freigaben oder eine belastbare Änderungsverfolgung.

Der Wechsel lohnt sich nicht, weil individuelle Software moderner wirkt. Er lohnt sich, wenn Fehler, Wartezeiten und Kontrollaufwand regelmäßig mehr kosten als die Einführung eines klaren Systems.

Excel durch individuelle Software ersetzen: Was sich konkret ändert

Eine gute Fachanwendung digitalisiert nicht einfach eine bestehende Tabelle. Sie bildet die Entscheidungen und Bewegungen ab, die im Betrieb tatsächlich stattfinden. Bei einem Wareneingang bedeutet das beispielsweise: Lieferung auswählen oder anlegen, Positionen erfassen, Mengen prüfen, Abweichungen begründen, Lagerplatz zuordnen und den Bestand erst danach verbindlich aktualisieren.

Dadurch wird aus einer Liste ein Prozess. Mitarbeitende sehen nur die Schritte, die für ihre Aufgabe nötig sind. Das Büro erkennt den Bearbeitungsstand, ohne telefonisch nachzufassen. Die Lagerleitung kann offene Vorgänge, Differenzen oder fehlende Buchungen prüfen. Eine Änderung bleibt nachvollziehbar, statt still in einer Zelle zu verschwinden.

Der Unterschied liegt auch in der Datenarchitektur. Eine Anwendung mit einer sauber modellierten Datenbank, etwa auf Basis von MySQL 8, führt Artikel, Aufträge, Lagerorte und Bewegungen nicht als lose Kopien. Beziehungen sind eindeutig definiert. Ein Artikel kann nicht versehentlich mit drei unterschiedlichen Nummern angelegt werden, wenn die Geschäftsregel eine eindeutige Nummer verlangt.

Das schafft keine fehlerfreie Realität. Mengen können weiterhin falsch gezählt werden, Lieferungen können beschädigt eintreffen. Die Software sorgt jedoch dafür, dass Abweichungen sichtbar erfasst, zugeordnet und später ausgewertet werden können. Das ist operativ wertvoller als ein scheinbar sauberer Bestand, dessen Entstehung niemand erklären kann.

Nicht jeden Prozess sofort neu bauen

Der verbreitete Fehler ist ein zu großer Start. Wer sämtliche Abläufe eines Unternehmens gleichzeitig ersetzen will, wartet lange auf ein Ergebnis und zwingt viele offene Fragen in ein einzelnes Projekt. Für kleine und mittlere Unternehmen ist ein schrittweises Vorgehen meist sinnvoller.

Der erste Bereich sollte zwei Kriterien erfüllen: Er verursacht spürbaren Aufwand oder Fehlerkosten und lässt sich klar eingrenzen. Das kann die Erfassung eingehender Waren sein, die Erstellung von Lieferscheinen, die Auftragsannahme oder die Steuerung von Lagerbewegungen. Ein konkreter Engpass liefert bessere Anforderungen als die abstrakte Forderung nach einer „digitalen Gesamtlösung“.

Excel darf dabei weiterhin eine Rolle spielen. Für einmalige Kalkulationen, Auswertungen oder kleine Planungslisten ist es oft schneller und günstiger als eine eigene Anwendung. Auch Datenexporte für Controlling oder Steuerberatung bleiben sinnvoll. Entscheidend ist, dass Excel nicht mehr die führende Quelle für zeitkritische Prozesse ist.

Eine individuelle Lösung muss außerdem nicht alle Funktionen eines großen ERP-Systems nachbilden. Ein Betrieb mit zwei Lagern und zehn Mitarbeitenden braucht möglicherweise keine internationale Mandantenlogik, aber sehr wohl saubere Rechte, mobile Erfassung am Lagerplatz und verlässliche Dokumente. Überladene Standardsuiten bringen häufig Funktionen mit, die niemand nutzt, während der zentrale Ablauf dennoch angepasst werden muss.

Anforderungen am Arbeitsplatz beobachten, nicht nur abfragen

Die beste Anforderungsliste entsteht nicht allein im Besprechungsraum. Sie entsteht dort, wo Ware abgeladen, kommissioniert, geprüft und übergeben wird. Ein Gespräch mit der Lagerleitung kann einen Soll-Prozess beschreiben. Die Beobachtung einer Schicht zeigt, welche Informationen fehlen, wann Handschuhe oder Scanner nötig sind und an welchen Stellen Mitarbeitende bewusst Abkürzungen nehmen.

Diese Abkürzungen sind nicht automatisch Fehlverhalten. Sie weisen oft auf ein Systemproblem hin. Wenn ein Mitarbeiter Nummern auf Papier notiert, weil der Rechner zu weit entfernt ist, sollte die Lösung nicht lediglich ein Pflichtfeld am Desktop sein. Vielleicht braucht der Prozess eine mobile Erfassungsmaske, einen Etikettendruck oder einen klareren Übergabepunkt zwischen Wareneingang und Einlagerung.

In der Konzeption sollten daher konkrete Fragen beantwortet werden: Wer legt einen Auftrag an? Wer darf Mengen korrigieren? Was passiert bei einer Teillieferung? Wann wird ein Lieferschein erzeugt? Welche Daten müssen sichtbar sein, wenn das Netzwerk im Lager kurzzeitig nicht verfügbar ist? Und welche Kennzahlen werden tatsächlich genutzt, statt nur in einem Dashboard gut auszusehen?

Je klarer diese Entscheidungen vor der Entwicklung sind, desto weniger Sonderlogik entsteht später. Gute Individualsoftware bildet nicht jede historische Ausnahme nach. Sie trennt sinnvolle betriebliche Regeln von Gewohnheiten, die nur deshalb bestehen, weil das bisherige Werkzeug Grenzen gesetzt hat.

Technik, Rechte und Betrieb von Anfang an mitdenken

Eine Fachanwendung muss im Alltag wartbar bleiben. Das betrifft nicht nur die Oberfläche, sondern auch klare Datenmodelle, dokumentierte Bereitstellung, Backups und Zuständigkeiten. Moderne Webanwendungen können mit PHP 8.4, aktuellem JavaScript und MySQL 8 solide aufgebaut werden. Entscheidend ist nicht der Trendwert eines Technologie-Stacks, sondern ob er langfristig verständlich, testbar und betreibbar ist.

Rollen und Rechte gehören früh in das Konzept. Nicht jeder Nutzer sollte Preise, Stammdaten oder historische Buchungen ändern können. Für sensible Funktionen sind nachvollziehbare Freigaben, Protokolle und bei Bedarf Kontosperren nach fehlgeschlagenen Anmeldeversuchen sinnvoll. Solche Details wirken zunächst technisch, vermeiden aber im Betrieb unklare Verantwortung.

Ebenso wichtig ist die Datenübernahme. Bestehende Excel-Dateien enthalten häufig Dubletten, uneinheitliche Einheiten oder nicht mehr verwendete Artikel. Diese Daten ungeprüft zu importieren, verlagert alte Probleme in das neue System. Besser ist eine kontrollierte Bereinigung mit klaren Regeln: Welche Daten werden übernommen, welche archiviert und welche müssen vor dem Start fachlich geprüft werden?

Einführung ohne Stillstand im Betrieb

Ein Go-live darf den Versand nicht gefährden. Deshalb braucht die Einführung einen begrenzten Pilotbereich, echte Testfälle und Mitarbeitende, die den Ablauf kennen. Es reicht nicht, Beispielaufträge anzulegen. Das System muss mit Teillieferungen, falschen Mengen, Stornos, Zeitdruck und den Ausnahmen umgehen, die im normalen Tagesgeschäft auftreten.

Eine kurze Parallelphase kann sinnvoll sein, sollte aber ein klares Ende haben. Werden Tabelle und neue Anwendung zu lange gleichzeitig gepflegt, entsteht doppelte Arbeit und erneut die Frage, welche Quelle gilt. Besser ist ein definierter Umstellungstermin, begleitet durch geschulte Ansprechpartner und eine schnelle Rückmeldungsschleife für Fehler oder fehlende Details.

Nach dem Start zeigt sich der Wert einer individuellen Lösung nicht an einer besonders aufwendigen Oberfläche. Er zeigt sich, wenn ein Auftrag ohne Rückfrage weiterläuft, der Bestand erklärbar bleibt und eine neue Kollegin den Prozess nach kurzer Einweisung sicher bedienen kann. Genau dort sollte die nächste Entscheidung ansetzen: nicht bei der nächsten Excel-Datei, sondern bei dem konkreten Arbeitsschritt, der morgen wieder Zeit kostet.

Permalink →

Lagerprozesse mit Software digitalisieren

Lagerprozesse mit Software digitalisieren

Ein Kommissionierer sucht zehn Minuten nach einem Artikel, der laut Excel-Datei im Regal liegen soll. Gleichzeitig bucht ein Kollege Wareneingang auf einem Papierformular, während im Büro eine Bestellung telefonisch geändert wird. Solche Situationen sind kein Zeichen schlechter Arbeit. Sie zeigen, dass Informationen den physischen Warenbewegungen nicht mehr zuverlässig folgen.
Wer Lagerprozesse mit Software digitalisieren will, sollte deshalb nicht bei einer möglichst langen Funktionsliste anfangen, sondern bei genau diesen Brüchen im Alltag.

Für kleine und mittelständische Unternehmen ist die Frage selten, ob ein internationales Enterprise-System technisch leistungsfähig wäre. Die Frage ist, ob es den Weg vom Wareneingang bis zum Versand tatsächlich verkürzt - oder ob es neue Masken, Freigaben und Schulungsaufwand schafft. Gute Digitalisierung ersetzt nicht jeden Handgriff. Sie sorgt dafür, dass jeder notwendige Handgriff zur richtigen Information, Buchung und Folgeaktion führt.

Wann Lagerprozesse mit Software digitalisieren sinnvoll ist

Eine Tabellenkalkulation ist nicht grundsätzlich ein Problem. Für einen überschaubaren Bestand, wenige Mitarbeitende und seltene Bewegungen kann sie vernünftig, günstig und transparent sein. Ein Wechsel lohnt sich erst, wenn die Datei zur inoffiziellen Schaltzentrale wird: mehrere Versionen kursieren, Bestände werden nachträglich korrigiert oder nur einzelne Personen verstehen die Formeln und Ablagen.

Typische Auslöser sind nicht abstrakte Wachstumsziele, sondern wiederkehrende operative Reibung. Bestände stimmen nach Inventuren regelmäßig nicht. Wareneingänge bleiben bis zum Feierabend ungebucht. Lieferungen gehen ohne vollständigen Lieferschein raus. Mitarbeitende rufen sich gegenseitig an, um den Standort eines Artikels oder den Status eines Auftrags zu klären. Oder eine Person überträgt dieselben Daten nacheinander in E-Mail, Excel, Versandportal und Buchhaltung.

Digitalisierung bedeutet in diesem Kontext: Das System bildet einen klaren Zustand ab. Ein Artikel ist eingetroffen, geprüft, eingelagert, reserviert, kommissioniert oder versendet. Jede Statusänderung hat einen Auslöser, einen Zeitpunkt und idealerweise eine verantwortliche Person. Das schafft keine Bürokratie, sondern verhindert, dass sich Entscheidungen auf Vermutungen stützen.

Der richtige Startpunkt: Bewegungen statt Softwaremodule

Viele Einführungen beginnen mit der Frage nach Funktionen wie Scanner-Anbindung, Chargenverwaltung oder Dashboards. Das ist verständlich, führt aber oft zu einem überladenen Pflichtenheft. Sinnvoller ist eine Prozessaufnahme entlang der tatsächlichen Warenbewegung.

Nehmen Sie einen realen Auftrag und verfolgen Sie ihn vom Eingang bis zur Übergabe an den Versanddienstleister. Wo entstehen Informationen? Wer prüft sie? Wo wird etwas auf Papier notiert, später übertragen oder mündlich weitergegeben? Besonders wertvoll sind die Ausnahmen: Teillieferungen, beschädigte Ware, Ersatzartikel, gesperrte Bestände und Rücksendungen. Der Standardprozess sieht auf dem Whiteboard meist sauber aus. Die Ausnahmen bestimmen, ob die neue Anwendung im Alltag akzeptiert wird.

Für einen ersten Workshop reichen oft drei Fragen: Welche Information fehlt Mitarbeitenden am häufigsten? Welche Buchung wird am häufigsten verspätet oder doppelt erledigt? Und welche Fehler kosten im Monat tatsächlich Zeit, Geld oder Kundenvertrauen? Daraus lassen sich Prioritäten ableiten, ohne die gesamte Lagerorganisation gleichzeitig umzustellen.

Ein kleiner, vollständiger Ablauf schlägt einen großen Systemstart

Statt alle Prozesse auf einmal zu digitalisieren, sollte ein Bereich durchgängig funktionieren. Ein sinnvoller erster Umfang kann beispielsweise Wareneingang, Einlagerung und Bestandsführung abdecken. Lieferavis oder Bestellung werden erfasst, Ware wird geprüft, ein Lagerplatz zugewiesen und der Bestand unmittelbar gebucht. Erst wenn dieser Ablauf stabil läuft, folgen Kommissionierung, Versandetiketten oder Tourenplanung.

Das reduziert Projektrisiko. Mitarbeitende lernen nicht nur eine neue Oberfläche, sondern einen klar abgegrenzten Ablauf. Gleichzeitig wird sichtbar, welche Regeln in der Praxis fehlen. Etwa die Frage, ob ungeprüfte Ware bereits reservierbar sein darf oder ob Fehlmengen sofort einen Klärfall erzeugen sollen.

Welche Funktionen im Lager wirklich Wirkung zeigen

Die beste Lageranwendung ist nicht die mit den meisten Menüpunkten. Sie macht den nächsten Arbeitsschritt eindeutig und dokumentiert die Bewegung ohne doppelte Erfassung. In vielen Betrieben liefern vor allem vier Bausteine schnell messbare Verbesserungen:

  • Eine zentrale Bestandsführung mit Artikeln, Varianten, Lagerorten, Mindestbeständen und Sperrbeständen verhindert konkurrierende Excel-Versionen.
  • Mobile Buchungen per Handscanner oder Smartphone verbinden Einlagerung, Umlagerung und Entnahme direkt mit dem tatsächlichen Ort der Ware.
  • Auftrags- und Kommissionierlisten zeigen Priorität, Status und Fehlmengen, statt Aufträge über Zurufe oder Papierstapel zu verteilen.
  • Automatisch erzeugte Lieferscheine, Versandlabels und Bewegungsprotokolle reduzieren manuelle Übertragungen und erleichtern die Nachverfolgung.

Ob Barcode-Scanning sofort nötig ist, hängt vom Lager ab. Bei wenigen Artikeln und festen Regalen kann eine übersichtliche Eingabemaske zunächst ausreichen. Bei vielen ähnlichen Artikeln, wechselnden Lagerplätzen oder hohem Durchsatz ist Scannen dagegen meist keine Komfortfunktion, sondern eine Fehlerbremse. Entscheidend ist auch die Funkabdeckung auf der Fläche. Eine mobile Anwendung, die an mehreren Regalgängen keine Verbindung hat, verlagert das Problem nur in eine Warteschlange späterer Nachbuchungen.

Auch Automatisierung braucht klare Grenzen. Ein System kann Versandaufträge nach Cut-off-Zeit priorisieren oder bei Mindestbestand eine Bestellanforderung vorbereiten. Es sollte aber nicht stillschweigend Bestellungen auslösen, wenn Lieferzeiten, Freigabelimits oder Sonderkundenaufträge berücksichtigt werden müssen. Gute Software schlägt vor, markiert Abweichungen und dokumentiert Entscheidungen. Sie nimmt Teams nicht die Kontrolle über Ausnahmefälle.

Datenqualität ist keine Aufgabe für später

Die Digitalisierung scheitert selten an PHP, Datenbank oder Scanner-Hardware. Sie scheitert häufiger daran, dass Artikelnummern nicht eindeutig sind, Einheiten unterschiedlich verstanden werden oder historische Bestände ohne Prüfung übernommen werden. Aus „Karton“ wird sonst je nach Person ein Stück, eine Verpackungseinheit oder eine Palette.

Vor dem Import sollten Stammdaten daher bereinigt werden: eindeutige Artikelkennungen, verständliche Bezeichnungen, definierte Einheiten, nachvollziehbare Lagerorte und Regeln für aktive oder gesperrte Artikel. Nicht jeder alte Datensatz muss in das neue System. Veraltete Dubletten und nicht mehr verwendete Lagerplätze mitzunehmen, konserviert nur alte Unsicherheit in einer moderneren Oberfläche.

Technisch braucht die Anwendung eine belastbare Grundlage. Eine klare Datenbankstruktur in MySQL 8 kann Bestandsbewegungen als einzelne, nachvollziehbare Ereignisse speichern, statt nur einen überschreibbaren aktuellen Wert zu führen. So lässt sich klären, warum ein Bestand abweicht: Wareneingang, Entnahme, Umlagerung, Inventurkorrektur oder Stornierung. Mit wartbaren Technologien wie PHP 8.4 und modernem JavaScript bleibt eine individuelle Anwendung zugleich erweiterbar, ohne für jede kleine Anpassung zum Großprojekt zu werden.

Integration nur dort, wo sie Doppelarbeit beseitigt

Ein Lager arbeitet selten isoliert. Aufträge kommen aus Shop, ERP, E-Mail oder Telefon. Versanddaten gehen an Dienstleister, Belege an Buchhaltung und Kennzahlen an die Geschäftsleitung. Trotzdem muss nicht am ersten Tag jedes Fremdsystem angebunden sein.

Priorität haben Schnittstellen, die wiederholte manuelle Übertragung ersetzen oder Fehlerquellen beseitigen. Wenn Bestellungen täglich aus einem Webshop abgeschrieben werden, ist eine klare Übergabe wertvoll. Wenn ein Versanddienstleister Etiketten und Sendungsnummern bereitstellt, kann eine Anbindung den Packprozess spürbar beschleunigen. Eine selten genutzte Exportdatei darf dagegen zunächst ein kontrollierter Export bleiben.

Wichtig sind eindeutige Zuständigkeiten bei Fehlern. Was passiert, wenn ein Auftrag im Shop angelegt, aber nicht in die Lageranwendung übertragen wurde? Werden Übertragungen protokolliert, Dubletten erkannt und fehlgeschlagene Vorgänge sichtbar markiert? Schnittstellen sind erst dann zuverlässig, wenn sie auch für den Ausnahmefall ein verständliches Verfahren bieten.

Einführung im Schichtbetrieb: Akzeptanz entsteht auf der Fläche

Software wird nicht durch eine Präsentation eingeführt, sondern zwischen Wareneingangstor, Packtisch und Regal. Deshalb sollten erfahrene Lagermitarbeitende früh eingebunden sein. Sie kennen Abkürzungen, Sicherheitsanforderungen und die Stellen, an denen ein theoretisch korrekter Ablauf unter Zeitdruck scheitert.

Ein Pilotbereich mit echter Ware und echten Aufträgen ist meist aussagekräftiger als eine lange Testphase mit Musterdaten. Für eine begrenzte Zeit kann ein abgesicherter Parallelbetrieb sinnvoll sein. Er darf jedoch nicht zum Dauerzustand werden, denn doppelte Buchung erzeugt selbst wieder Fehler. Entscheidend ist ein klarer Umschalttag, eine verantwortliche Ansprechperson und ein einfacher Weg, Probleme direkt zu melden.

Schulungen sollten am Prozess orientiert sein: Ware annehmen, Abweichung erfassen, einlagern, Auftrag kommissionieren, Versand abschließen. Niemand muss zu Beginn sämtliche Auswertungen oder Administrationsfunktionen beherrschen. Rollen und Rechte helfen dabei, den Bildschirm auf die jeweilige Aufgabe zu konzentrieren. Ein Kommissionierer braucht andere Informationen als die Lagerleitung, und eine Inventurkorrektur sollte nachvollziehbar freigegeben werden können.

Erfolg nicht nur am Bestand messen

Nach dem Start lohnt sich ein Blick auf wenige Kennzahlen, die das Team beeinflussen kann: Durchlaufzeit vom Wareneingang bis zur Verfügbarkeit, Anzahl der Bestandskorrekturen, Pickfehler, Suchzeiten, pünktlich versendete Aufträge und offene Klärfälle. Diese Werte zeigen schneller als ein allgemeines Digitalisierungsprojekt, ob sich der Ablauf verbessert.

softify.pro entwickelt solche Systeme nicht als Ersatz für funktionierende Arbeitsschritte, sondern als präzise Ergänzung dort, wo Papier, Tabellen und Zurufe nicht mehr tragen. Manchmal ist die richtige Empfehlung eine kleine Anwendung für Wareneingang und Versand statt eines vollständigen Lagerverwaltungssystems. Manchmal bleibt eine Tabelle für eine seltene Sonderauswertung die vernünftigere Lösung.

Der beste nächste Schritt ist deshalb nicht die Produktauswahl, sondern ein gemeinsamer Blick auf einen konkreten Auftrag aus der letzten Woche. Wenn dessen Weg durch das Lager klar, buchbar und bei Abweichungen nachvollziehbar wird, ist die Grundlage für eine Digitalisierung gelegt, die im Alltag wirklich Zeit spart.

Permalink →