softify.pro
Načítání …
Služby O nás COCO – náš AI server Portfolio Insiders Case Studies Stojí za to vědět Kontakt Přihlášení

Stojí za to vědět

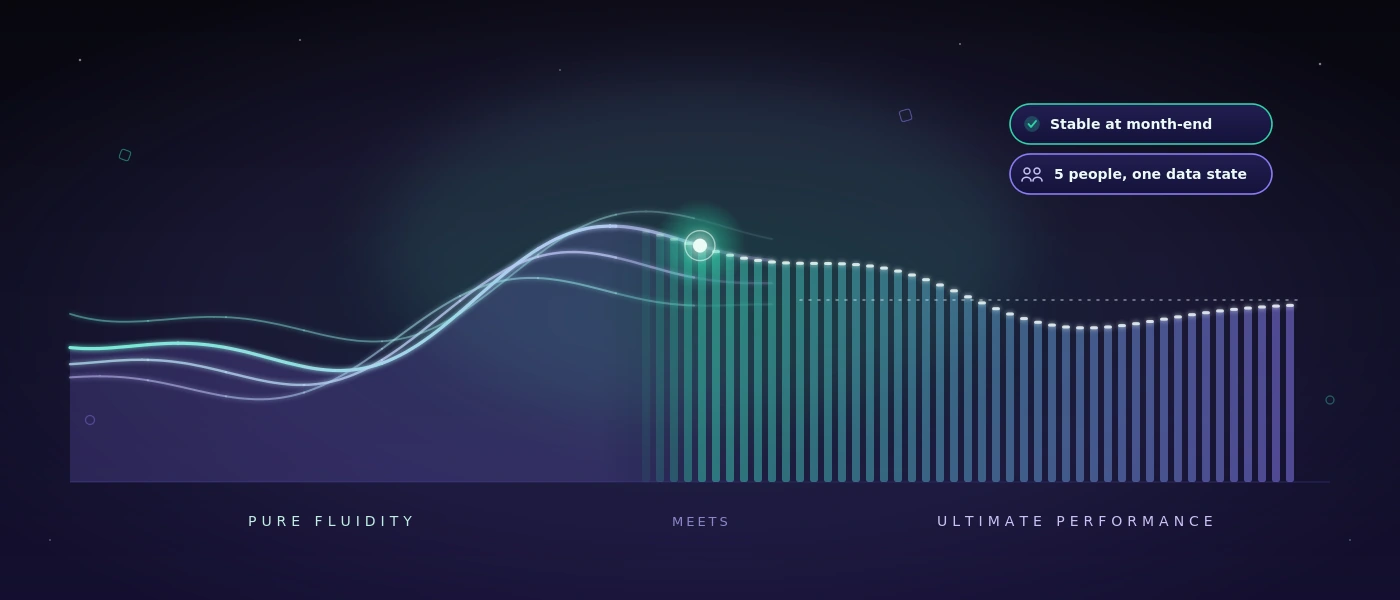
Pure fluidity meets ultimate performance: co skutečně zrychluje podnikový software

Pure fluidity meets ultimate performance: co skutečně zrychluje podnikový software

Vedoucí skladu nepozná špatný software podle výkresu architektury. Pozná ho podle toho, že zaměstnanci opět sahají po telefonu, zaevidují dodací listy dvakrát nebo po směně neumějí říct, jaké zboží skutečně dorazilo. Pure fluidity meets ultimate performance proto nesmí být pouhým vizuálním nárokem. Pro podnikový software to znamená, že operace působí přirozeně a zároveň spolehlivě funguje v reálných podmínkách.

Elegantní rozhraní je bezcenné, pokud se seká při slabé WLAN ve skladu. Rychlá aplikace také málo pomáhá, pokud vynucuje pracovní pořadí, které na rampě nikdo nedokáže sledovat. Dobré digitální nástroje spojují design, rychlost a porozumění procesům. Snižují tření, aniž by podnik tlačily do předem připravené standardní logiky.

Pure fluidity meets ultimate performance je provozní otázka

Plynulost se často zaměňuje s animacemi, velkými obrázky a hladkými přechody. To může pasovat k moderní značce. V pracovní každodennosti se však ukazuje jinak: příjem zboží lze zaúčtovat bez oklik. Zaměstnanec najde objednávku i tehdy, když je známo jen referenční číslo. Chyba se jasně pojmenuje, místo aby zmizela v kryptickém hlášení.

Výkon je stejně tak víc než dobrá hodnota v testu prohlížeče. Rozhodující jsou doba odezvy u objednávky s mnoha položkami, stabilita na konci měsíce a otázka, zda může pět osob pracovat současně, aniž by si navzájem přepisovaly stavy dat. Patří k tomu i čisté zacházení s přerušeními spojení, oprávněními a zablokovanými účty.

Obojí je neoddělitelné. Pokud obrazovka reaguje okamžitě, ale má nejasná povinná pole, zůstává namáhavá. Pokud je postup chytře namodelován, ale stránka při každém zaúčtování čeká dvě sekundy, obchází se. Plynulost vzniká tam, kde systém podporuje další smysluplnou činnost a technicky zůstává dost rychlý, aby se myšlenka nepřerušila.

Rozhraní sleduje pracovní cestu, ne organizační schéma

Mnohá standardní řešení strukturují svá menu podle modulů: nákup, prodej, sklad, reporting, administrace. Z pohledu produktu je to srozumitelné. Na podlaze haly se však práce často začíná situací: stojí kamion, chybí paleta, zákazník potřebuje doklad o dodání nebo zásilku je třeba ještě před uzávěrkou příjmu označit štítkem.

Dobrá individuální aplikace proto začíná těmito situacemi. Jaká informace je k dispozici? Kdo rozhoduje? Co je třeba zdokumentovat? Co se později už nesmí měnit? Teprve poté se rozhodne, jaká vstupní obrazovka, kontrola nebo automatizace je potřebná.

To neznamená odlít každý existující postup beze změny do softwaru. Některé tabulky jsou skutečně příliš náchylné k chybám, některá schválení zbytečně pomalá. Ale fungující seznam Excel nemusí být nutně nahrazen projektem. Pokud ho udržuje jen jedna osoba, zná málo výjimek a zůstává sledovatelný, může být vhodným nástrojem. Software se vyplatí, když zlepšuje koordinaci, snižuje zdroje chyb nebo spolehlivě zpřístupňuje informace více zúčastněným.

Méně kliků není automaticky lepší

Požadavek na co nejméně kliků zní rozumně, ale může vést špatným směrem. U nevratného skladového zaúčtování je krátké potvrzení smysluplné. U uvolnění expedice může viditelná kontrola věrohodnosti zabránit drahému dodatečnému opravování. Správný postup závisí na riziku.

Rozhodující je, aby další kroky měly jasný účel. Potvrzení by se nemělo objevit jen proto, že ho framework snadno vytvoří. Mělo by stát přesně tam, kde musí lidé vědomě učinit rozhodnutí. Tak aplikace zůstane rychlá, aniž by se stala lehkomyslnou.

Výkon vzniká v architektuře, ne v posledním šprintu

Kdo zrychluje webovou stránku nebo webovou aplikaci až těsně před go-live, léčí obvykle symptomy. Velké dotazy, nejasné datové modely a dodatečně přidané zvláštní případy nelze trvale opravit jediným optimalizačním dnem.

Spolehlivý základ začíná databází, která odpovídá skutečným vztahům v podniku. V MySQL 8 potřebují pohyby, doklady, změny stavů a akce uživatelů sledovatelné klíče a smysluplné indexy. Zásoba se nesmí jevit jen jako číslo, pokud se později musí objasnit, z kterého zaúčtování vznikla. Zároveň se nemusí každá historická informace přepočítávat při každém načtení stránky.

U moderních webových aplikací je relevantní i oddělení odpovědností. PHP 8.4 dokáže obchodní pravidla zobrazit jasně a udržitelně, zatímco moderní JavaScript se používá cíleně pro reaktivní oblasti. To není vyznání víry pro určitý stack. Je to otázka údržby: dají se změny za šest měsíců bezpečně zrealizovat? Je viditelné, kde pravidlo platí? Dá se chyba reprodukovat, místo aby se jen předpokládala?

Výkon navíc potřebuje hranice. Vyhledávací pole potřebují smysluplný minimální počet znaků nebo přesnou logiku filtrování, pokud jsou představitelné miliony záznamů. Velké seznamy potřebují stránky nebo odstupňované procesy dodatečného načítání. Obrázky a dokumenty by neměly blokovat kritický pracovní postup. Tato rozhodnutí působí nenápadně. Právě proto zůstávají často hodnotná déle než nápadný frontendový efekt.

Viditelná rychlost vytváří důvěru

Ne každý proces se může skončit za méně než sekundu. Tisk štítků, rozhraní k přepravci nebo kontrola vůči externím datům si občas vyžaduje čas. Rozhodující je pak, jak aplikace zachází s čekací dobou.

Jasný stav jako „Expediční štítek se vytváří“ je lepší než zamrzlé tlačítko. Po ukončení by mělo být viditelné, jaké číslo bylo vygenerováno a zda se operace smí spustit znovu. Pokud externí služba není dostupná, tým potřebuje srozumitelnou možnost jednání místo chybového hlášení pro vývojáře.

Je to i otázka integrity dat. Dvojklik nesmí vytvořit dvě dodávky. Přerušený proces nesmí tiše zanechat polotovarový záznam. Dobré systémy plánují takové případy, protože v každodennosti nastanou. Zejména při měnících se směnách, časovém tlaku a mobilních zařízeních není výjimka okrajovým tématem.

Kvalita se stává viditelnou před chybou

Pro aplikace s mnoha variantami procesů nestačí na konci ručně proklikat několik cest. Změny cen, rolí, validací nebo rozhraní mohou vyvolat následky na velmi vzdáleném místě. Zde se automatizované testování stává součástí výkonu: nejen technicky, ale organizačně.

Testovací systém by měl umět ověřovat reálné postupy, například vytvořit objednávku, změnit položku, vygenerovat dodací list a zkontrolovat oprávnění. Měl by zaznamenávat důkazy a formulovat výsledky tak, aby je odborné útvary dokázaly zařadit. Věta jako „Expediční proces nebyl po změně adresy dokončen“ pomůže víc než nekomentovaný stack trace.

Pro bezpečnostně uvědomělé týmy je relevantní i místo, na kterém tyto testy běží. Pokud snímky obrazovky, přístupové údaje, testovací případy nebo interní kroky aplikace nemají opustit podnik, je samostatně hostovaný přístup často rozumnější než externí cloudová služba. S COCO lze automatizované testy pro webové aplikace a aplikace Windows spouštět v dedikovaném prostředí. Není to potřeba pro každý tým. U citlivých dat, regulovaných oblastí nebo interních odborných aplikací však může být kontrola nad testovacími daty rozhodující výhodou.

Design je dobrý, když usnadňuje práci

Silná vizuální identita může vytvářet důvěru. Ukazuje, že podnik bere svou digitální přítomnost vážně. V provozním systému však musí design dosáhnout ještě víc: orientaci pod časovým tlakem. Kontrast, typografie, jasné stavy a srozumitelné popisky rozhodují o tom, zda někdo operaci s jistotou dokončí, nebo se zeptá kolegy.

Zdrženlivost je zde často lepší volbou. Přehledový panel s deseti barevnými ukazateli může vypadat působivě a přesto zakrýt jedinou relevantní odchylku. Redukované zobrazení, které zviditelňuje otevřené příjmy zboží, chybějící skeny a ohrožené termíny dodání, je užitečnější. Otázka nezní, kolik rozhraní je možné, ale jaká informace zlepšuje rozhodnutí.

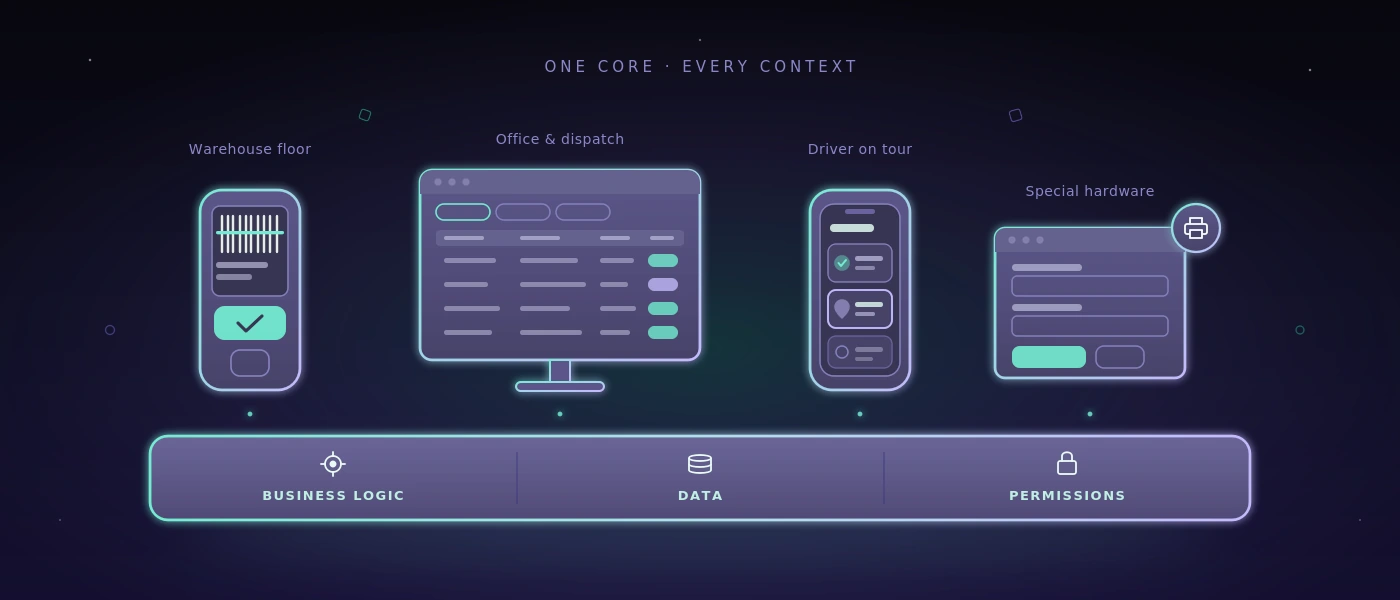
To platí i pro responzivní aplikace. Mobilní schopnost neznamená stlačit každou obrazovku počítače do menšího formátu. Smartphone při příjmu zboží potřebuje možná jen sken, množství, skladové místo a potvrzení. Rozsáhlé dodatečné zpracování patří případně na větší obrazovku. Různá zařízení si zaslouží různé priority, i když přistupují ke stejné spolehlivé datové základně.

Smysluplné měřítko pro další rozhodnutí

Než tým rozhodne o nové platformě, automatizaci nebo úplné novostavbě, pomáhá jednoduchá kontrola: stává se postup pro lidi, kteří ho denně provádějí, jasnějším, rychlejším nebo bezpečnějším? A dá se řešení ještě porozumět, když se změní požadavky, zaměstnanci nebo rozhraní?

Pokud jsou obě odpovědi spolehlivé, z krásného příslibu se stane použitelný systém. Tehdy se pure fluidity meets ultimate performance neukáže na snímku, ale v klidném pracovním dni, v němž objednávky, data a rozhodnutí plynou dál bez zbytečného tření.
Permalink →

SaaS Flow Web: bezpečné zavedení workflow během běžného provozu

SaaS Flow Web: bezpečné zavedení workflow během běžného provozu

Příjem zboží nezůstane ležet proto, že tým nezná další software. Zůstane ležet proto, že se informace ztrácejí mezi e-mailem, papírovým formulářem, souborem Excel a telefonátem. U SaaS - „Flow Web“ na flow.softify.pro - by proto první otázkou nemělo být rozhraní. Rozhodující je, zda služba spolehlivě zobrazuje konkrétní pracovní postup - i v hektických dnech, při měnících se odpovědnostech a když dodávka neodpovídá plánu.

Pro malé a střední podniky je SaaS často smysluplný, protože nemusejí nejprve budovat vlastní servery, vydání a základní funkce. Není to však volná vstupenka pro každý proces. Kdo zavede nástroj, který dělá každodennost složitější nebo vytlačuje důležitá data do nejasných vedlejších seznamů, nedigitalizuje práci. Jen přesouvá tření.

Co musí SaaS „Flow Web“ poskytovat

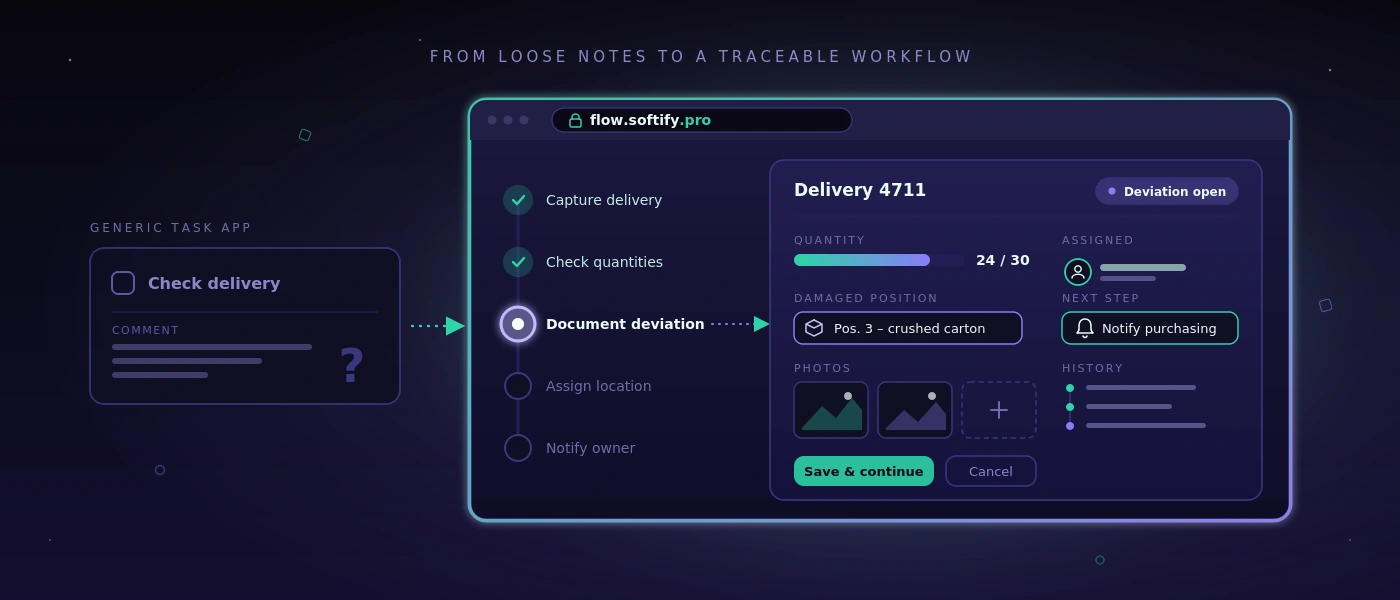
Webový workflow je dobrý, když zaměstnanci bez výkladu vědí, co mají udělat dál. Při převzetí zboží to může znamenat: zaevidovat dodávku, zkontrolovat množství vůči objednávce, zdokumentovat odchylku, přiřadit skladové místo a v případě potřeby informovat odpovědnou osobu. Postup nemusí být efektní. Musí být sledovatelný, rychlý a opakovatelný.

Právě zde leží rozdíl mezi obecnou aplikací na úkoly a odborným procesním systémem. Aplikace na úkoly může vytvořit položku s názvem „Zkontrolovat dodávku“. Odborný workflow může navíc zaznamenat, o kterou dodávku jde, kdo ji převzal, která položka byla poškozená, jaké fotografie existují a zda čeká dodatečná dodávka. Tato data pak nestojí jako volný text v jednom komentáři, ale tam, kde je potřebuje další osoba.

U řešení jako Flow Web na flow.softify.pro by proto posuzování mělo začít u operací, ne u seznamu funkcí. Podnik s pěti skladovými pohyby denně potřebuje něco jiného než expediční tým s několika uzávěrkovými časy, různými přepravci a pravidelným řízením částečných dodávek. SaaS nenahrazuje porozumění procesu.

Nejprve pojmenovat úzké místo, poté konfigurovat

Mnohé digitalizační projekty začínají příliš široce: „Chceme zdigitalizovat sklad.“ Zní to uvěřitelně, ale rychle to vede k systému s příliš mnoha obrazovkami, zvláštními případy a školicími materiály. Lepší je přesné vyjádření jako: „Příjmy zboží se zaúčtují až následující den, protože dodací listy na konci směny leží na stole.“

Z takové věty lze odvodit smysluplný začátek. První verze může evidovat dodací listy, potvrzovat artikly a množství, označovat odchylky a předat zaúčtování příslušnému místu. Když tento postup funguje, štítky, hodnocení dodavatelů nebo automatické návrhy objednávek lze doplnit později. Ne každý smysluplný krok rozšíření patří do prvního nasazení.

I dobře udržovaná tabulka může zůstat, pokud plní svůj účel. Například měsíční vyhodnocení s několika účastníky v existujícím souboru může být levnější a transparentnější než vlastní modul. SaaS se vyplatí tam, kde se informace používají vícekrát, doby zpracování jsou kritické nebo chyby vznikají z přerušení médií.

Správné otázky před zavedením

Před konfigurací by měl tým projít skutečnou operaci od začátku do konce. Ne ideální proces, ale případ, který dělá v každodennosti problémy: nesprávné množství, chybějící reference, naléhavá expedice nebo objednávka se zvláštním schválením. Přitom se ukážou pravidla, která musí systém skutečně zobrazit.

Relevantní jsou mimo jiné tyto body: kdo smí operaci vytvořit, změnit nebo uzavřít? Které vstupy jsou povinné, které jen užitečné? Kdy musí být informován vedoucí? Která data se předávají účetnictví, expedici nebo zákaznickému servisu? A co se stane, pokud je WLAN ve skladu slabá nebo zaměstnanec už nemá své přístupové údaje?

Odpovědi určují kvalitu zavedení silněji než dlouhý katalog vizuálních požadavků. Čistý proces rolí, srozumitelné chybové hlášení a zdokumentovaný krok schválení zabraňují v provozu obvykle většímu úsilí než další přehled na úvodní stránce.

Uchovávání dat a role nejsou vedlejší věc

SaaS se často bere jako čistě obslužná otázka. Pro provozní a IT odpovědné je však přinejmenším stejně důležité, co se děje s daty. Týká se to kmenových dat, informací o dodávkách, dat zaměstnanců, fotografií škod a případně dat zákazníků. Před zavedením by měly být jasné odpovědnosti, uchovávání a možnosti exportu.

Prakticky to znamená: podnik musí vědět, která data jsou v systému, kdo má administrátorský přístup a jak se data poskytují při změně nebo ukončení smlouvy. Export dostupný jen jako obtížně čitelný soubor PDF jen zřídka pomůže. Pro provozní data jsou rozhodující strukturované, použitelné formáty.

I koncept oprávnění si zaslouží konkrétní pozornost. Ve skladu nemusí každá osoba vidět ceny, zákaznické podmínky nebo globální nastavení. Zároveň příliš úzké přidělování práv nesmí blokovat postup. Smysluplné jsou role zaměřené na skutečné činnosti: převzetí, dispozice, expedice, vedení týmu a administrace. Kritické změny by měly být sledovatelné, aby se při dotazech nemuselo hádat, kdo změnil zaúčtování.

Samotný přístup by měl být chráněn pevnými základy. Patří sem bezpečné politiky hesel, upravený reset hesla, zablokování účtu při opakovaných neúspěšných pokusech a, kde to profil rizika vyžaduje, dodatečné kroky přihlášení. Bezpečnost působí profesionálně, když je předvídatelná a nepozná se až tehdy, když byl někdo vyloučen.

Integrace jen tam, kde měřitelně odlehčuje

Webový workflow často rozvine svou hodnotu až v souhře s existujícími systémy. Může to být ERP, e-shop, expediční řešení, evidence pracovní doby nebo databáze. Přesto není každé rozhraní automaticky smysluplné. Každá integrace vytváří závislosti, obrazy chyb a náklady na údržbu.

Ústřední otázka zní: jaký ruční krok spojení konkrétně odstraní? Pokud rozhraní denně ušetří 30 minut přenosové práce a sníží překlepy, přínos je jasný. Pokud jen zrcadlí informaci, která se stejně jednou týdně kontroluje, může být zpočátku rozumnějším řešením ruční export.

U individuálních rozšíření rozhoduje technický základ. Zdokumentovaná rozhraní, jasně definovaná datová pole a sledovatelné protokoly chyb usnadňují pozdější provoz. Pokud se systém připojuje k webové aplikaci na míru, technologie a struktura databáze by se měly zvolit tak, aby zůstaly dlouhodobě udržovatelné. Udržovaná aplikace na bázi PHP 8.4, moderního JavaScriptu a MySQL 8 je cennější než krátkodobě působivé zvláštní řešení bez dokumentace.

Zavedení během běžného provozu

Nejčastější chybou je tvrdý start bez srovnávací fáze. Týmy mají pak v pondělí ráno hned pracovat jinak, zatímco otevřené otázky vznikají až ze skutečných problémů. To zvyšuje odmítání, i když software v zásadě vyhovuje.

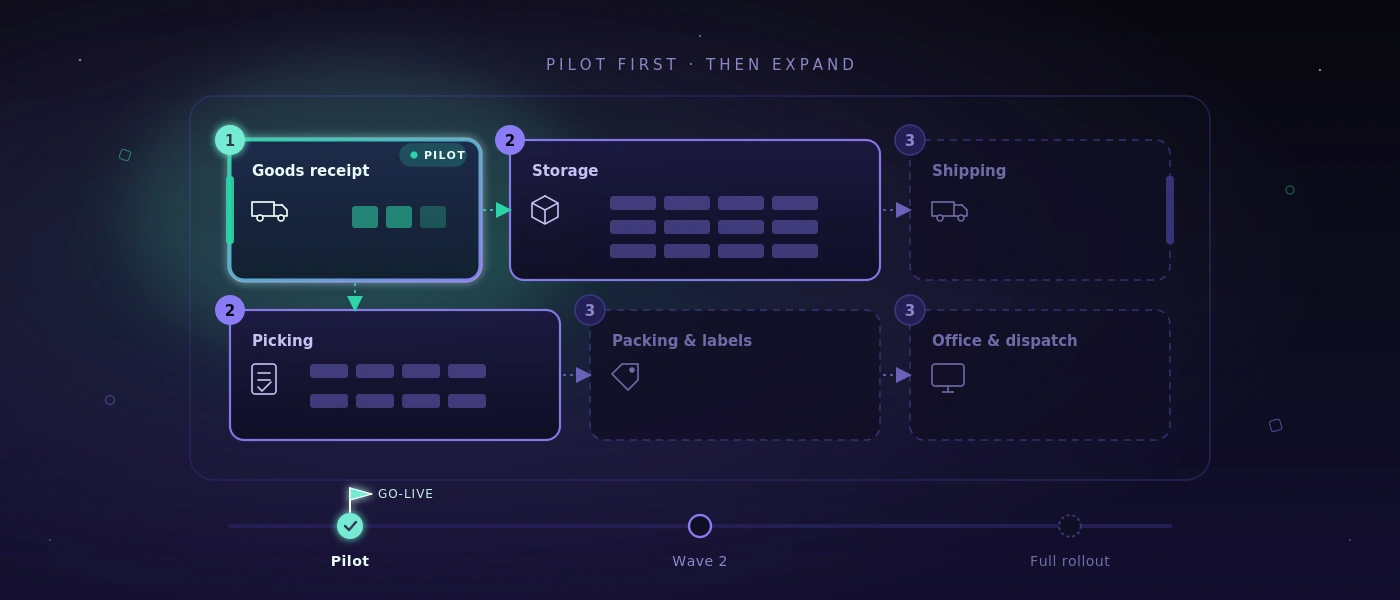
Lepší je omezený pilot s jedním týmem, jednou variantou procesu nebo jasně vymezenou oblastí lokality. V této době se ověřuje, zda evidence a schválení fungují, zda jsou pojmy srozumitelné a zda výjimečné případy přistanou čistě. Důležité je nesbírat zpětnou vazbu jen jako seznam přání. Každá změna by se měla posoudit vůči přínosu pro dobu průběhu, míru chyb nebo transparentnost.

I ukazatele by se měly stanovit včas. Například lze sledovat dobu zpracování na převzetí zboží, počet otevřených odchylek, dotazy ke stavu dodávky nebo opravná zaúčtování. Bez výchozí hodnoty zůstává „působí rychleji“ jediným hodnocením. To může být pravda, ale na spolehlivé investiční rozhodnutí to nestačí.

Provoz potřebuje jasného vlastníka

SaaS snižuje technickou námahu, ale nezbavuje podnik odpovědnosti za vlastní proces. Interně je potřeba někdo, kdo spravuje role, shromažďuje zpětnou vazbu, rozpoznává potřebu školení a rozhoduje, které změny jsou skutečně nezbytné. Tato osoba nemusí umět programovat. Měla by však rozumět pracovnímu postupu a mít přístup k odpovědným.

Stejně důležitá je krátká, spolehlivá provozní dokumentace. Nevysvětluje každou obrazovku, ale odpovídá na otázky, které se vyskytují v každodennosti: co dělat při chybném zaúčtování? Kdo schvaluje nové uživatele? Jak se komunikuje výpadek? Kde jsou exportovaná data? Taková jasnost brání tomu, aby se digitální systém po několika měsících opět stal závislým na osobních zvoláních.

Dobré řešení SaaS se proto nepozná podle toho, kolik položek menu nabízí. Svou hodnotu ukazuje, když nová kolegyně dokáže operaci zpracovat s jistotou, odchylka nezmizí a vedoucí vidí stav bez telefonátu třem osobám. Přesně tímto měřítkem by se měl měřit Flow Web: ne sliby, ale pracovním dnem, který prokazatelně probíhá klidněji a spolehlivěji.

Permalink →

Webový vývoj s aktuálními frameworky: co z toho firmy skutečně mají

Webový vývoj s aktuálními frameworky: co z toho firmy skutečně mají

Pokud příjem zboží stále kolísá mezi papírovým formulářem, telefonátem a třemi soubory Excel, moderní frontend sám problém nevyřeší. Webový vývoj s aktuálními frameworky dává smysl tehdy, když viditelně zjednodušuje postupy: zaměstnanci vidí další krok, data se zadávají jen jednou a aplikace zůstává srozumitelně udržovatelná i po prvním go-live.

Pro malé a střední podniky proto otázka frameworku není otázkou víry. Rozhodující není, zda rozhraní nese obzvlášť mnoho technických módních slov. Rozhodující je, zda skladové pohyby, objednávky, kontroly nebo schválení procházejí spolehlivě pracovním dnem - i pod časovým tlakem, při střídání směn a kolísavém síťovém připojení.

Frameworky jsou prostředek, ne cíl projektu

Framework poskytuje osvědčenou strukturu pro opakující se úlohy: routing, formuláře, správu oprávnění, přístup k datům, testy a zobrazení rozhraní. To automaticky nesníží každé riziko. Zabrání to však tomu, aby musel projekt základní funkce vymýšlet stále znovu.

U individuální webové aplikace může moderní framework JavaScript například smysluplně zobrazit interaktivní obrazovky: seznam komisionování, který průběžně aktualizuje položky, plánování tras s jasnými změnami stavů nebo kontrolní protokol, který přiřazuje fotografie a komentáře přímo k operaci. V backendu zajišťují etablované frameworky PHP sledovatelná pravidla, jasně oddělené odpovědnosti a konzistentní rozhraní k databázi.

To je obzvlášť důležité, když se z původně malého řešení stane denně používaný provozní systém pro nějaký proces. Vstupní obrazovka pro avíza dodávek může začít přehledně. Jakmile aktualizuje zásoby, tiskne štítky, zohledňuje role a komunikuje s přepravcem, potřebuje čistý technický základ. Frameworky pomáhají tento základ při každém rozšíření znovu nevyjednávat.

Co aktuální webové frameworky konkrétně dělají lépe

Hodnota moderních frameworků jen zřídka spočívá v efektních efektech. Ukazuje se v neviditelných částech aplikace. Formuláře mohou kontrolovat vstupy přímo, aniž by chybná data vyšla najevo až po odeslání. Oprávnění lze definovat centrálně, takže řidič vidí jiné informace než dispozice. Změny objednávky se ukládají sledovatelně, místo aby tiše přepsaly buňku tabulky.

Na straně serveru vytváří aktuální prostředí s PHP 8.4 a MySQL 8 spolehlivý základ pro obchodně kritickou logiku. Databázové transakce zabraňují například tomu, aby se zásoba snížila, zatímco příslušné zaúčtování selže. Jedinečné klíče a validační pravidla předcházejí duplicitám. Procesy na pozadí mohou vytvářet dokumenty nebo volat rozhraní, aniž by musela osoba u obrazovky čekat.

Ani bezpečnost není dodatečná funkce. Moderní framework podporuje bezpečné ukládání hesel, ochranu před typickými útoky přes vstupy, sledovatelné relace a definované postupy zablokování účtu. Přesto zůstává realizace projektovou úlohou: oprávnění se musí odborně správně modelovat a citlivé funkce vyžadují dodatečné kontroly. Framework poskytuje ochranná zábradlí, ale neví, kdo v podniku smí udělit jaké schválení.

Správně rozhodnout o webovém vývoji s aktuálními frameworky

Nejlepší technologie nevzniká ze seznamu oblíbených nástrojů, ale ze skutečného používání. Interní aplikace pro deset osob má jiné požadavky než zákaznický portál s několika tisíci souběžných přístupů. Skladový terminál se skenerem potřebuje jinou logiku obsluhy než manažerská analýza na počítači.

Proto smysluplné rozhodnutí začíná konkrétními otázkami: které postupy dnes měřitelně stojí čas? Která data se přenášejí vícekrát? Kde vznikají chyby, protože informace jsou viditelné příliš pozdě? Která existující tabulka funguje dost dobře a měla by zpočátku zůstat? Právě poslední bod chrání před drahými digitalizačními projekty bez provozního přínosu.

Pro mnohé individuální obchodní aplikace je nejrozumnější volbou systém renderovaný na straně serveru s cílenými interaktivními komponentami. Rychle se načte, je přehledný na provoz a vyhýbá se zbytečné složitosti. Zcela oddělená jednostránková aplikace může být naopak vhodná, když rozhraní zpracovává velmi mnoho dynamických stavů, musí fungovat offline nebo mají stejné funkce později poskytovat i mobilní aplikaci.

Obojí může být odborně správné. Otázka nezní: který framework je nejmodernější? Zní: která architektura bude za dva roky stále bezpečně rozšiřitelná, testovatelná a srozumitelná pro vlastní tým?

Kdy je méně techniky lepší technikou

Ne každý proces potřebuje složitý frontend. Štíhlá vstupní obrazovka pro interní objednávky může být rychlejší, stabilnější a levnější než pracně animované rozhraní. Pokud se soubor Excel udržuje jen jednou měsíčně a nezpůsobuje chyby, je možná nadále správným nástrojem.

Složitost se vyplatí až tehdy, když odstraňuje skutečné tření. Může to být tak, když se objednávky vícekrát přepisují, stav dodávky se musí zjišťovat telefonicky nebo si nikdo není jistý, která verze dokumentu platí. Tehdy vytváří centrální aplikace jasný přínos: jeden stav dat, jednoznačné odpovědnosti a méně dotazů.

Udržovatelnost začíná před prvním řádkem kódu

Frameworky se často považují za urychlovače. To platí jen tehdy, pokud jsou odborná pravidla předtím dostatečně jasná. Vývojář může stavový automat postavit technicky čistě. Zda však posloupnost stavů skutečně sedí na proces, rozhoduje se při zjištění: kdy se zboží považuje za přijaté? Kdo smí uzavřít odchylku? Co se stane při částečné dodávce?

Tato rozhodnutí patří zdokumentovat, stejně jako rozhraní, datová pole a výjimky. To projekty nezpomaluje. Snižuje to pozdější diskuse, protože se stane viditelným, které pravidlo bylo vědomě implementováno a který předpoklad je ještě otevřený.

Udržovatelnost se ukazuje i v malých disciplínách. Změny databáze musí být verzované. Kroky nasazení musí být zdokumentované. Chybová hlášení mají být použitelná pro provoz a vývoj bez prozrazování důvěrných podrobností. Automatizované testy při každé změně kontrolují centrální postupy, například vytvoření objednávky, výpočet množství nebo vystavení dodacího listu.

U kritických aplikací jeden typ testu nestačí. Jednotkové testy zajišťují jednotlivá pravidla, integrační testy kontrolují souhru s databází a rozhraními a end-to-end testy přehrávají v prohlížeči skutečné obslužné cesty. Pro webové aplikace a aplikace Windows může samostatně hostované testovací prostředí navíc poskytovat snímky obrazovky, protokoly provedení a srozumitelná hodnocení, bez zbytečného předávání interních testovacích dat externím cloudovým službám.

Výkon vzniká z architektury a datového modelu

Moderní rozhraní se nestane rychlým tím, že používá aktuální framework. Pomalé databázové dotazy, nadměrné obrázky nebo nejasná rozhraní zůstávají pomalé, nezávisle na frontendu. Zejména u seznamů objednávek, artiklů nebo pohybových dat rozhoduje datový model o pocitové rychlosti.

Čisté indexy v MySQL 8, stránkované dotazy a vědomě načtená data jsou často účinnější než pozdější optimalizace na rozhraní. Stejně důležitý je jasný koncept cachování. Kmenová data se mohou za určitých okolností ukládat do vyrovnávací paměti, aktuální zásoby nebo stav schválení však ne naslepo. Zde neexistuje paušální pravidlo, protože odborný význam dat určuje, jak aktuální musí být.

Responzivní design patří také k technickému plánování. Na kancelářské obrazovce může být široká tabulka smysluplná. Na ručním skeneru nebo tabletu ve skladu potřebuje stejná informace velké dotykové plochy, krátké cesty a zobrazení, které zůstane použitelné i s rukavicemi nebo při špatném světle. Pure fluidity meets ultimate performance neznamená v tomto kontextu co nejvíce pohybu na obrazovce. Znamená, že aplikace funguje bez tření na zařízení, které se v procesu skutečně používá.

Smysluplná cesta od nápadu k provozu

Spolehlivý webový projekt začíná omezeným, ověřitelným jádrem. Místo toho, aby se předem automatizovala každá myslitelná výjimka, vybere se proces, který se vyskytuje často a způsobuje citelnou námahu. Po prvním nasazení ukážou skutečná data a zpětné vazby, které rozšíření má skutečně další prioritu.

Technické předání by nemělo proběhnout až na konci. Odpovědnosti za hosting, zálohy, monitoring, aktualizace a přístupová práva se musí objasnit včas. Systém je tak spolehlivý, jaký je jeho provoz. Kdo potřebuje aplikaci denně pro expedici nebo zpracování objednávek, potřebuje definované cesty obnovy a jasnou odpověď na to, co se stane při poruše.

softify.pro proto sází na udržovatelné technologie, zdokumentované dodání a přímou technickou odpovědnost namísto krátkodobých frameworkových módních vln. Není to kouzelná zkratka. Vytváří to předpoklad, aby aplikace po spuštění fungovala dál, dala se rozvíjet a nestala se dalším křehkým zvláštním případem.

Správná webová aplikace se v nejlepším případě nejeví jako nový IT projekt. Jeví se jako postup, který konečně funguje bez obchůzek - s dostatkem technické podstaty k tomu, aby klidně přijala i další změnu v provozu.

Permalink →

Plánování nasazení softwaru: jak uspět během běžného provozu

Plánování nasazení softwaru: jak uspět během běžného provozu

Nový systém málokdy selže proto, že chybí tlačítko. Selže v pondělí ráno: ranní směna nenajde příjem zboží, dodací list se vytiskne dvakrát nebo se soubor Excel najednou stane neoficiální pravdou. Kdo chce naplánovat nasazení softwaru, proto nemusí jen zavést funkce, ale zabezpečit skutečný provoz.

Právě ve skladu, dílně, dispozici a administrativě není nasazení IT termínem. Mění pohyby rukou, odpovědnosti a cesty informací. Dobré zavedení udržuje práci v pohybu, včas činí chyby viditelnými a dává zaměstnancům jasnou odpověď na rozhodující otázku: co dělám od zítřka jinak?

Nasazení začíná před prvním školením

Mnohé projekty začínají seznamem funkcí: evidovat objednávky, zaúčtovat skladové pohyby, tisknout expediční štítky, plánovat trasy. To je nezbytné, ale nestačí. Před startem musí být jasné, které procesy mají v první produktivní den skutečně běžet přes nový systém - a které vědomě ještě ne.

Toto vymezení není znakem neúplnosti. Snižuje riziko. Pokud středně velký podnik dosud koordinoval příjmy zboží papírem, telefonem a tabulkami, nemusí první den současně digitalizovat celé řízení zásob, vyřizování vratek, plánování tras a hodnocení dodavatelů. Smysluplný první rozsah by mohl ležet v převzetí zboží, jednoznačných skladových pohybech a tisku dodacích dokumentů.

Rozhodující je konkrétně popsat cílový proces. Ne: „Příjem zboží se stane digitálním.“ Ale: „Zaměstnanec naskenuje dodávku, zkontroluje množství a stav, přiřadí skladové místo a při odchylkách vytvoří případ pro nákup.“ Teprve na této úrovni se stanou viditelnými otevřené otázky: co se stane při chybějící objednávce? Kdo smí opravovat množství? Smí se dodávka bez štítku uskladnit?

Plánovat nasazení softwaru znamená: upřednostnit kritické procesy

Ne každý proces má stejný význam. Výpadek v oblasti údržby kmenových dat může být nepříjemný. Výpadek při expedici, komisionování nebo schvalování faktur může zablokovat práci celého dne. Proto nasazení potřebuje prioritizaci podle provozního rizika, ne podle pořadí ve specifikaci požadavků.

Osvědčilo se jednoduché rozdělení: obchodně kritické, důležité a odložitelné. Obchodně kritické jsou všechny procesy, které pohybují zbožím, penězi nebo závaznou komunikací se zákazníky. Důležité jsou funkce, které urychlují každodennost, ale jejichž výpadek lze dočasně zmírnit ručně. Odložitelné jsou komfortní funkce, vzácné zvláštní případy nebo vyhodnocení, která zpočátku ještě mohou pocházet z existujícího zdroje.

Toto rozdělení ovlivňuje hloubku testování. Pro kritický expediční proces nestačí úspěšně proklikat jednu objednávku. Testovat se musí i částečné dodávky, storna, chybějící tiskárny, nesprávné adresy, paralelní zpracování a předání přepravci. U zřídka používané statistické funkce může být vhodný pozdější testovací cyklus.

Udělat kritéria úspěchu měřitelnými předem

„Aplikace běží“ není kritériem přejímky. Lepší jsou ověřitelná tvrzení: příjem zboží s 30 položkami je zaúčtovatelný do deseti minut. Expediční štítky se tisknou na určeném pracovišti. Změny zásob se okamžitě zobrazují v dispozici. Zablokovaný uživatelský účet lze znovu aktivovat pouze přes definovaný proces schválení.

Taková kritéria spojují odborný útvar a vývoj. Zabraňují také tomu, aby se přejímka stala sbírkou nejasných dojmů. Ne každá zpětná vazba musí být vyřešena před go-live. Ale každá potřebuje zařazení: kritická chyba, relevantní zlepšení nebo bod pro pozdější fázi rozšíření.

Migrace dat: důvěru si zaslouží jen čistá data

Stará data se často podceňují. V tabulkách se nacházejí duplicitní čísla artiklů, různé jednotky, prošlé adresy zákazníků a stavy zásob, jejichž původ už nikdo nedokáže vysvětlit. Kdo tato data převezme bez kontroly, přesouvá starou nejasnost do nového systému - jen s lepším rozhraním.

Před migrací by se mělo stanovit, která data jsou skutečně potřeba. Často jsou smysluplné aktuální artikly, aktivní zákazníci, otevřené objednávky, relevantní dodavatelé a ověřené počáteční stavy. Historické záznamy nemusí nutně přejít celé do nové aplikace. Může stačit archivovat je čitelně, pokud zůstávají potřebné pro důkazy nebo dotazy.

Obzvlášť důležité je zkušební nahrání. Data se přitom nejen technicky importují, ale i odborně kontrolují: sedí množství, jednotky a přiřazení? Jsou povinná pole úplná? Dají se s nimi správně zpracovat typické objednávky? Pro go-live je poté potřeba jasný rozhodný den. Od kdy se používá který vedoucí systém? Bez tohoto pravidla vzniká dvojí vedení a protichůdné stavy.

Pilotní provoz místo velkého spínače

Big bang může být smysluplný, pokud malý tým používá jasně vymezený proces a staré i nové řešení nemohou fungovat paralelně. Ve většině operativních prostředí je však pilotní provoz lépe kontrolovatelnou volbou.

Pilot by měl pracovat se skutečnými případy, ale v omezeném rámci: jedna skladová oblast, jedna směna, jedna skupina produktů nebo vybraný tým. Rozhodující je, aby pilotní skupina nezahrnovala jen obzvlášť technicky zdatné zaměstnance. Měla by realisticky zobrazovat pozdější každodennost, včetně lidí, kteří pracují pod časovým tlakem a mají oprávněné námitky.

V pilotním provozu se ukáže, zda skenery, tiskárny, síť a oprávnění fungují na skutečném pracovišti. Stejně se stanou viditelnými procesní mezery, které nikdo na poradách nezmínil. Možná se zboží v každodennosti nejprve odkládá na mezimísto. Možná řidiči potřebují jiný dodací list než administrativa. Taková poznání nejsou krokem zpět. Jsou důvodem, proč pilot provést před plošným startem.

Školení jako pracovní situace, ne jako prohlídka softwaru

Školení, které jen vysvětluje položky menu, vytváří málo jistoty. Zaměstnanci se musí učit na svých úkolech: „Přebíráte poškozenou dodávku“, „Komisionujete naléhavou objednávku“, „Opravujete nesprávně zaúčtované množství“. Kontext zůstane v paměti, protože odpovídá pracovní každodennosti.

Krátká školení blízko go-live jsou obvykle účinnější než jeden dlouhý termín týdny předem. Pomáhají i stručné pracovní pokyny přímo na pracovišti. Neměly by vysvětlovat celý systém, ale ukázat nejčastější postupy, jasné odpovědnosti a cestu při poruchách.

Určete navíc kontaktní osoby pro jednotlivé oblasti. Tyto osoby nemusí samy řešit každý technický problém. Měly by však umět rozhodnout, zda jde o chybu obsluhy, odbornou nejasnost nebo skutečnou chybu systému. To chrání projektový tým před nestrukturovanými zvoláními a urychluje pomoc pro směnu.

Go-live potřebuje provozní plán

Den go-live potřebuje víc než čas. Definujte, kdo rozhoduje odborně, kdo odpovídá za technické změny a přes který kanál se hlásí poruchy. U kritických procesů by mělo být viditelné, zda fungují centrální funkce: přihlášení, oprávnění, sběr dat, rozhraní, tisk a zálohování.

K tomu patří i plán návratu. To neznamená při nejmenším problému se hned úplně vrátit do starého světa. Znamená to předem určit, která porucha ospravedlňuje zastavení, jak se objednávky v nouzi dokumentují a jak se dodatečně čistě zaevidují. Papírový formulář na několik hodin může být rozumný. Trvalé paralelní vedení bez konce není.

Technické detaily zde počítají: byly přístupy založeny včas? Fungují role a pravidla zablokování účtu správně? Jsou tiskárny štítků propojeny se správnými šablonami? Existuje otestovaná záloha databáze? U individuálně vyvinutých aplikací patří ke standardu zdokumentovaná nasazení, sledovatelné stavy verzí a jasná cesta pro opravy chyb.

První týdny rozhodují o akceptaci

Po startu se začíná fáze, v níž se aplikace stane buď pracovním nástrojem, nebo neoblíbeným dodatečným krokem. Plánujte proto denní krátké smyčky zpětné vazby. Jaké chyby se opakují? Kde vznikají obchůzky? Která pole se chápou nesprávně? Jaké vyhodnocení vedoucí osobě skutečně chybí?

Ne každé pozorování vyžaduje okamžitou změnu. Některé problémy se vyřeší přesnějšími pracovními pravidly nebo lepším školením. Jiné ukazují skutečné slabiny v procesu nebo v aplikaci. Umění spočívá v tom, nezaměňovat jedno s druhým. Systém by neměl bez důvodu komplikovat existující fungující postupy. Pokud je dobře udržovaná tabulka pro vzácný zvláštní případ nadále lepším řešením, může zůstat.

Měřte účinek pomocí několika konkrétních ukazatelů: doba zpracování na postup, počet dotazů, chybná zaúčtování, opakované tisky, otevřené objednávky nebo rozdíly v zásobách. Teprve tyto hodnoty ukážou, zda nasazení skutečně zlepšuje provoz - místo toho, aby jen zavedlo nové masky.

Dobré nasazení se po několika týdnech nejeví jako projekt. Stane se spolehlivou pracovní rutinou: správná data jsou tam, kde jsou potřeba, výjimky jsou sledovatelné a týmy musí méně telefonovat za informacemi. Přesně na to by mělo plánování mířit - ne na působivý den startu, ale na klidnější, lépe řiditelnou každodennost.

Permalink →

Plánování Multiplatform Application Development: nejprve proces, potom platforma

Plánování Multiplatform Application Development: nejprve proces, potom platforma

Vedoucí skladu potvrzuje příjem zboží na ručním skeneru. Dispozice kontroluje stejný proces v prohlížeči. Řidič potřebuje stav dodávky na cestě na chytrém telefonu. Multiplatform application development zní v tuto chvíli jako technická otázka. Ve skutečnosti jde nejprve o provozní postup: jaká práce se musí vykonat kde, s jakou spolehlivostí a na jakém zařízení?

Pro malé a střední podniky je správná odpověď zřídka: vše postavíme nativně pro každou platformu. Častěji zní: definujeme společný proces, cíleně vybereme potřebná uživatelská rozhraní a vyhneme se dvojí logice. To neušetří jen vývojový rozpočet. Zabrání to také tomu, aby sklad, kancelář a externí služba pracovaly s různými stavy dat.

Co má Multiplatform Application Development přinést

Multiplatform Application Development označuje vývoj aplikace, kterou lze používat ve více prostředích, například ve webovém prohlížeči, na iOS a Androidu nebo na desktopových systémech Windows. Pojem se často redukuje na otázku, zda jedna kódová základna dokáže vytvořit více aplikací. To je jen část rozhodnutí.

U provozních systémů záleží především na tom, zda aplikace funguje na místě použití. Příjem zboží může potřebovat kameru k snímání čárových kódů, velké ovládací prvky pro rukavice a použitelnou reakci při nestabilním pokrytí WLAN. Administrativa naopak potřebuje tabulky, filtry, koncepty oprávnění a sledovatelné protokoly změn. Řidič potřebuje zredukované zobrazení, ne stejné rozhraní jako dispozice.

Společný technický základ může tyto požadavky smysluplně propojit. Nesmí však vést k tomu, že každá platforma se obsluhuje jako špatný kompromis. Nejlepší společný kód je bezcenný, pokud zaměstnanci chodí oklikami, protože aplikace nezobrazuje jejich skutečný pracovní postup.

Nejprve určit proces, poté platformu

Než týmy mluví o frameworcích, měly by prověřit jednu konkrétní operaci od začátku do konce. Vezměme dodávku: objednávka přijde, zboží se komisionuje, vznikne dodací list, předání se potvrdí a stav se nahlásí zpět obchodu nebo zákaznickému servisu. Na kterém místě vzniká dnes přerušení médií? Kde se něco zapisuje na papír, později přepisuje nebo ptá telefonicky?

Toto pozorování odděluje skutečné požadavky na platformu od seznamů přání. Pokud funkci používají jen dva zaměstnanci v kanceláři, dobře udělané webové rozhraní obvykle stačí. Pokud zaúčtování provádí deset lidí na podlaze haly, mobilní rozhraní vhodné pro skener může způsobit rozdíl. Pokud musí existující program Windows pracovat se speciálním hardwarem, může být nutná desktopová integrace.

Ne každá funkce patří na každé zařízení. To není nedostatek multiplatformního řešení, ale znak čistých produktových rozhodnutí. Společná data a obchodní pravidla nemusí znamenat identické obrazovky.

Tři otázky, které objasní náklady a přínos

První otázka zní: jaká zařízení jsou již v používání a jak dlouho v něm zůstanou? Podnik se spravovanými terminály Windows má jiné požadavky než externí služba se soukromými chytrými telefony. Druhá zní: co se stane bez síťového připojení? Offline schopnost výrazně zvyšuje náklady, protože data se musí lokálně ukládat, později synchronizovat a při konfliktech čistě zpracovat. Je smysluplná, pokud by se jinak proces zastavil - ne jako standardní výbava.

Třetí otázka se týká následků výpadku. Může zaměstnanec zaúčtování doplnit později, nebo na něm závisí expediční štítek, zásoba či bezpečnostní uvolnění? Čím kritičtější je proces, tím silněji se musí plánovat oprávnění, kontrolní pravidla, opakovatelnost a zaznamenávání.

Architektura, která se nerozpadne u druhé platformy

U udržitelného řešení není obchodní logika roztroušena ve více rozhraních. Kontroly zásob, změny stavů, číselné řady, oprávnění a tvorba dokumentů potřebují centrální, otestovaný základ. Prohlížeč, mobilní aplikace a desktopový klient k němu přistupují přes jasně definovaná rozhraní.

Pro mnohé interní obchodní procesy je moderní webová aplikace nejhospodárnějším východiskem. Dá se centrálně aktualizovat, nevyžaduje instalaci na každém pracovišti a funguje na počítači, tabletu a chytrém telefonu. S PHP 8.4, moderním JavaScriptem a MySQL 8 lze vybudovat udržitelný základ, pokud se datový model, přístupová práva a nasazení nezvažují až těsně před spuštěním.

Instalovatelná mobilní nebo desktopová aplikace se přidá tehdy, když přináší jasnou výhodu: hlubokou integraci se skenerem, tiskárnou nebo kamerou, spolehlivý offline provoz, speciální funkce na pozadí nebo požadavky správy zařízení. Je to cílené rozšíření, ne samoúčel.

Častou chybou je úplné opětovné použití uživatelského rozhraní za každou cenu. Technicky to může vypadat atraktivně. V praxi vznikají malé texty na velkých monitorech, přetížené formuláře na chytrých telefonech nebo ovládání, které neodpovídá platformě. Lepší je sdílet datový model, pravidla a komponenty tam, kde to dává smysl, a ovládání přizpůsobit příslušnému kontextu.

Konzistence dat je důležitější než společná kódová základna

Více platforem zvyšuje nebezpečí protichůdných dat. Objednávka se změní v kanceláři, zatímco řidič na svém zařízení ještě vidí starou verzi. Dva zaměstnanci zaúčtují současně stejnou zásobu artiklu. Offline zařízení odešle své změny zpět až o hodiny později. Tyto případy nejsou okrajovým tématem, ale jádrem architektury.

Systém proto potřebuje jednoznačné identity, časová razítka, sledovatelné změny stavů a pravidla pro konflikty. U stavu dodávky může stačit poslední potvrzená změna. U zásob je to často příliš hrubé. Tam musí být jasné, který pohyb se zaúčtoval, ze kterého skladového místa pochází a zda se musí oprava zdůvodnit.

I oprávnění patří upravit centrálně. Zaměstnanec smí možná evidovat příjmy zboží, ale ne schvalovat opravy zásob. Externí řidič smí vidět jen svou trasu. Délky relací, vícefaktorové ověření u kritických rolí a postupy zablokování účtu nejsou dekorativní bezpečnostní funkce. Chrání konkrétní procesy a činí odpovědnosti viditelnými.

Testovat Multiplatform Application Development tak, jak se pracuje

Aplikace se může spustit na třech operačních systémech a přesto selhat v provozu. Rozhodující jsou průběhy v reálných podmínkách: skener reaguje příliš pomalu, tiskárna štítků není dostupná, oprávnění nezabere po změně role nebo synchronizace vytvoří dvojitá zaúčtování.

Proto by se měly kritické procesy ověřovat automatizovaně. Patří sem přihlášení a chování při zablokování, zadávání objednávek, pohyby zásob, tvorba dokumentů a zpracování chybných vstupů. Pro webové aplikace a aplikace Windows lze opakující se testy spouštět na samostatně hostované infrastruktuře. To je obzvlášť důležité, pokud se snímky obrazovky, interní data objednávek nebo testovací přístupy nemají předávat externím cloudovým službám.

Automatizace nenahrazuje kontrolu lidmi na podlaze skladu. Zajišťuje však, že známé průběhy se po změnách kontrolují znovu a znovu. Dobré testovací zprávy nepojmenovávají jen technickou chybu, ale dotčený proces: doklad o dodávce nelze vytvořit, uživatelský účet zůstává po úspěšném uvolnění zablokovaný nebo se data trasy neaktualizují.

Kdy je strategie platformy příliš

Některé podniky nepotřebují vlastní aplikaci. Pokud stačí stabilní přístup přes prohlížeč, postup je zřídka mobilní a počet uživatelů zůstává přehledný, je responzivní webová aplikace často rozumnější volbou. Snižuje náklady na údržbu, problémy s distribucí a počet možných zdrojů chyb.

Ani existující tabulku není třeba hned nahradit. Pokud slouží jen jako jednoduché vyhodnocení, udržuje ji jedna osoba a nevytváří chybově náchylná předání, může splnit svůj účel. Čas na systém nastává, když znalosti sedí v jednotlivých hlavách, verze se rozcházejí, dotazy přibývají nebo se operace už nedá spolehlivě sledovat.

Naopak, štíhlá strategie platformy se rychle stane příliš malou, když zaměstnanci musí pracovat offline, připojuje se hardware nebo zákazníci a partneři potřebují kontrolovaný přístup. Tehdy se vyplatí dodatečné požadavky vědomě financovat, místo aby se později dostavovaly pod časovým tlakem.

Začít spolehlivým pilotem

Dobrý začátek není katalog funkcí se sto body, ale úplný, měřitelný postup. Například: zaevidovat příjem zboží, aktualizovat zásobu, zdokumentovat odchylku a vytvořit úkol k objasnění. Tento pilot včas ukáže, zda k sobě pasuje datový model, zařízení, práva a ovládání.

Poté může řešení růst ve smysluplných krocích: komisionování, expedice, plánování tras nebo vyhodnocení. Každé rozšíření by mělo obstát u stejné otázky: zkracuje skutečný postup, snižuje chyby nebo vytváří spolehlivou transparentnost? Pokud ne, může počkat.

Nejsmysluplnější platforma nakonec není ta s nejvíce technickými možnostmi. Je to ta, na které tým ráno rychleji začne pracovat, během směny méně ptá a večer může sledovat, co se skutečně stalo.

Permalink →

Jak správně hodnotit Test Automation Results

Jak správně hodnotit Test Automation Results

Regresní test může ráno skončit s 98 procenty úspěšných případů a přesto nebýt dobrou zprávou. Možná je neúspěšný test právě přihlášení velkého zákazníka. Možná se 40 testů přeskočilo, protože testovací prostředí nebylo dostupné. Nebo byl běh zelený, ale kontroloval jen to, zda tlačítka existují, ne zda se objednávka skutečně uloží, vytvoří se dodací list a zásoba se správně upraví. Test automation results nejsou výrokem o kvalitě, dokud chybí jejich kontext.

Pro vedení QA, vývoj a odborné útvary proto skutečná práce nespočívá jen v automatizaci testů. Rozhodující je připravit výsledky tak, aby z nich vznikala spolehlivá rozhodnutí: dá se vydání nasadit? Musí se chyba řešit okamžitě? Je chyba nová, opakovaná, nebo jen problém testovacího prostředí? A existují důkazy, kterým porozumí i odborný útvar bez testovacího kódu?

Co Test Automation Results skutečně vypovídají

Nejjednodušší ukazatel zní: prošel nebo neprošel. Je užitečný, ale zřídka dostačující. Vysoký podíl úspěšnosti může vytvářet důvěru, pokud testy pokrývají kritické procesy, testovací data jsou věrohodná a prostředí se podobá pozdějšímu provozu. Pokud chybí jeden z těchto faktorů, číslo zůstává především signálem, že se provedl automatizovaný průběh.

U obchodně kritických aplikací mají větší váhu jiné otázky. Ve skladovém řešení není každá obrazovka stejně důležitá. Chyba zobrazení ve vnitřním textu upozornění může počkat. Chyba, která při příjmu zboží zaúčtuje nesprávné množství nebo vytvoří expediční štítek bez adresy příjemce, ne. Dobré výsledky testů proto váží rizika místo toho, aby všechny případy braly stejně.

Ani neúspěšný test není automaticky chybou produktu. Může ho vyvolat prošlá platnost přístupových údajů, zablokovaná testovací role, nedostupná rozhraní, změněná testovací data nebo pomalé prostředí. Kdo tyto příčiny neodliší, vytváří šum. Tým pak tráví čas falešnými poplachy, zatímco skutečné chyby zanikají mezi červenými stavovými hlášeními.

Čtyři typy stavu místo jednoho červeného seznamu

V praxi se osvědčuje jasné rozdělení: odborná chyba, technická chyba testu, problém prostředí a očekávaná změna. Odborná chyba znamená, že aplikace porušuje definovaný požadavek. Technická chyba testu poukazuje spíše na samotný test, například selektor, který už nesedí po záměrně změněném rozhraní.

Problém prostředí nastává, když například testovací systém nebo připojené rozhraní není dostupné. Očekávané změny vznikají, když se proces záměrně upravil, ale automatizace ještě kontroluje starý cílový stav. Tyto kategorie nezabraňují každé diskusi. Ale zaručují, že diskuse začne na správném místě.

Od testovacích běhů ke zprávám připraveným k rozhodnutí

Použitelná zpráva neodpovídá jen na to, že něco selhalo, ale co se stalo, jak je to závažné a zda se chyba jeví jako reprodukovatelná. Je k tomu potřeba víc než seznam názvů testů a časových razítek.

Ke každému relevantnímu běhu patří ověřovaný build, testovací prostředí, použitá role, klíčová testovací data a čas začátku a konce. Zejména u desktopových aplikací Windows nebo složitých webových platforem jsou tyto informace potřebné ke zúžení rozdílů. Chyba, která se vyskytuje jen pod omezenou skladovou rolí, je něco jiného než chyba, která blokuje každé přihlášení.

Významné výsledky obsahují navíc sledovatelné důkazy: snímky obrazovky, zaznamenané kroky, chybová hlášení a v případě potřeby technické protokoly. Samotný snímek obrazovky však může klamat. Ukazuje okamžik, ne příčinu. Kombinace pořadí kroků, viditelného stavu a očekávané reakce je podstatně užitečnější.

Systémy podporované umělou inteligencí mohou tyto důkazy převést na srozumitelná hodnocení. U COCO například testy běží na vlastním, samostatně hostovaném AI serveru. Vyhodnocení může vysvětlit, že objednávka byla sice vytvořena, ale očekávaná změna stavu nenastala, a přímo přiřadit záznam provedení. Pro bezpečnostně uvědomělé týmy je relevantní, kde se zpracovávají snímky obrazovky, data aplikace a testovací provoz. Lokální kontrola není automaticky nezbytná, ale u interních aplikací a citlivých dat může být rozumnější cestou než externí cloudová služba.

Správná úroveň detailu pro různé příjemce

Vývojové týmy potřebují chybová hlášení, technické kroky a co nejpřesnější pokyny k reprodukci. Provozní manažer naopak potřebuje nejprve dotčenou funkci, obchodní riziko a jasné vyjádření k provozuschopnosti. Obě perspektivy musí moci vzniknout ze stejného provedení, aniž by někdo musel ručně přenášet výsledky do prezentací.

Dobrá zpráva proto začíná krátkou rozhodovací úrovní: vydání doporučeno, vydání se známými omezeními nebo zastavit vydání. Pod tím stojí kritické odchylky s prioritou a důkazem. Technické podrobnosti následují až poté. To není zjednodušení na úkor přesnosti, ale čisté oddělení informačních potřeb.

Měřit pokrytí bez klamání se o jistotě

Pokrytí testy se často znázorňuje jako procentuální hodnota. Tato hodnota je užitečná, když je jasné, co měří. Pokrytí kódu ukazuje například, které části programového kódu se provedly během testů. To nedokazuje, že obchodní proces funguje správně. Test se může dotknout mnoha řádků kódu a přesto nikdy neověřit, zda se na dokumentu objeví nesprávná dodací adresa.

Pro odborné útvary je pokrytí procesů často výpovědnější. Popisuje, které skutečné průběhy jsou chráněny: zaevidovat objednávku, rezervovat zásobu, zaúčtovat částečnou dodávku, přijmout vratku nebo schválit fakturu. Obzvlášť cenné jsou přechody mezi systémy a rolemi, protože tam často vznikají chyby: při importu objednávky, tisku štítku nebo při přechodu z kanceláře na skladový terminál.

Neurčujte priority podle počtu možných testů, ale podle dosahu škody a frekvence změn. Zřídka používaný proces s vysokým finančním nebo právním rizikem si často zaslouží automatizaci dříve než často používané, ale neškodné zobrazení. Naopak, stabilní, málo kritický průběh může nadále vystačit s krátkou ruční kontrolou. Ne každou kontrolu je třeba automatizovat jen proto, že se dá automatizovat.

Nestabilní testy jsou samostatný problém kvality

Testy, které bez rozpoznatelné změny produktu jednou projdou a jednou selžou, se často označují jako flaky. Poškozují důvěru rychleji než trvale červený test. Jakmile týmy reflexivně znovu spouštějí červené výsledky, automatizace ztrácí svou varovnou funkci.

Příčiny jsou obvykle konkrétní: pevné čekací doby, společně používaná testovací data, paralelní přístupy, asynchronní zpracování nebo prostředí, které se neobnovuje. Krátká tříslekundová pauza v testu může náhodou pomoci, ale není řešením. Lepší je čekat na prokazatelný stav, učinit testovací data jednoznačnými a izolovat průběhy od sebe.

Ne každou nestabilitu lze zcela vyloučit. Externí rozhraní mohou kolísat a skutečná infrastruktura má výpadky. Zpráva by pak měla jasně označit, zda se test kvůli externí závislosti nedal vyhodnotit. Opakovaný běh může být pro diagnostiku smysluplný, ale nesmí učinit první zjištění neviditelným.

Smysluplný postup po každém testovacím běhu

Po automatizovaném běhu by se neměl každý výsledek hned brát stejně. Nejprve se zkontrolují blokující chyby a kritické testy, které se nedaly vyhodnotit. Poté následuje zařazení nových odchylek vůči známým, akceptovaným problémům. Teprve potom je rozhodnutí o vydání spolehlivé.

Užitečné jsou stanovené prahové hodnoty, ale musí odpovídat procesu. Například neúspěšný test v platebním nebo autorizačním toku může spustit okamžité zastavení. U čistě kosmetické odchylky může být zdokumentovaná výjimka obhajitelná. Taková pravidla by neměla vznikat až pod časovým tlakem před vydáním.

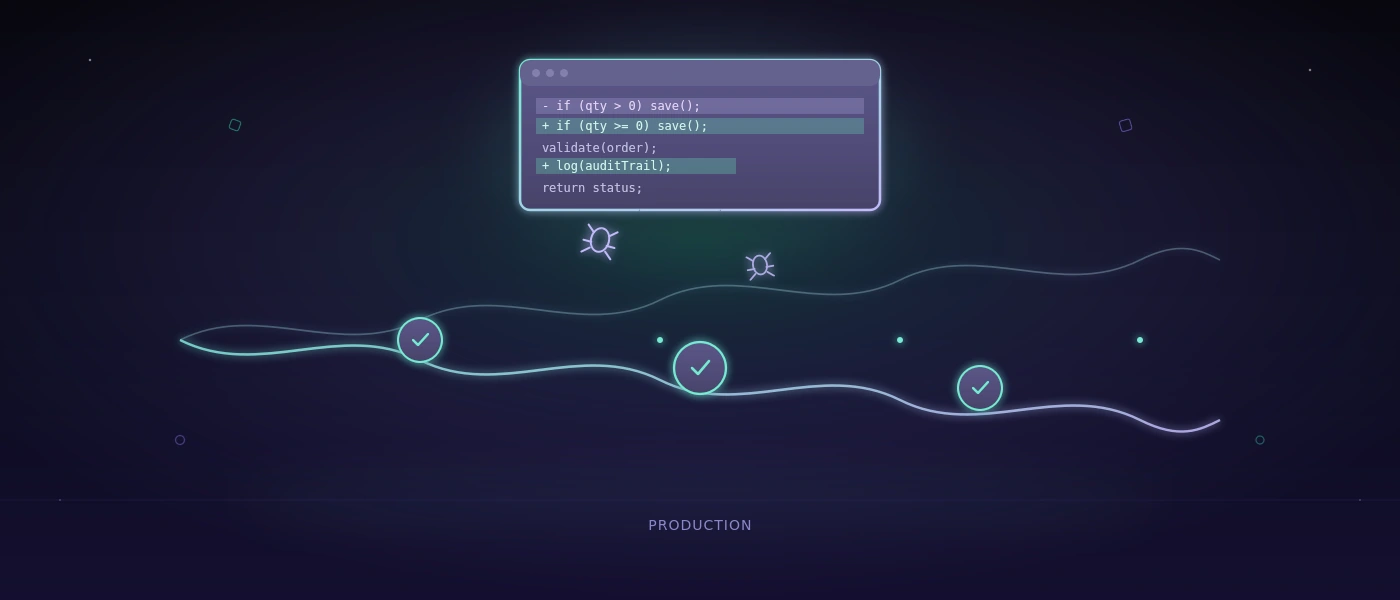
Stejně důležitá je zpětná vazba: každá produkční chyba, kterou testy nezachytily, je důvodem zkontrolovat, zda nechybí scénář, varianta testovacích dat nebo kontrolní bod. Cílem není nahromadit co nejvíce testů. Je jím budovat ze skutečných chyb cíleně lepší zabezpečení.

Nejužitečnější výsledky testů nejsou nakonec ty s nejzelenějším přehledem. Jsou to ty, u kterých může odpovědná osoba v pondělí ráno pochopit, co se ověřilo, jaké riziko zůstává a jaký krok je nyní rozumný.

Permalink →

Inventory Discrepancy Causes: časté příčiny rozdílů v zásobách

Inventory Discrepancy Causes: časté příčiny rozdílů v zásobách

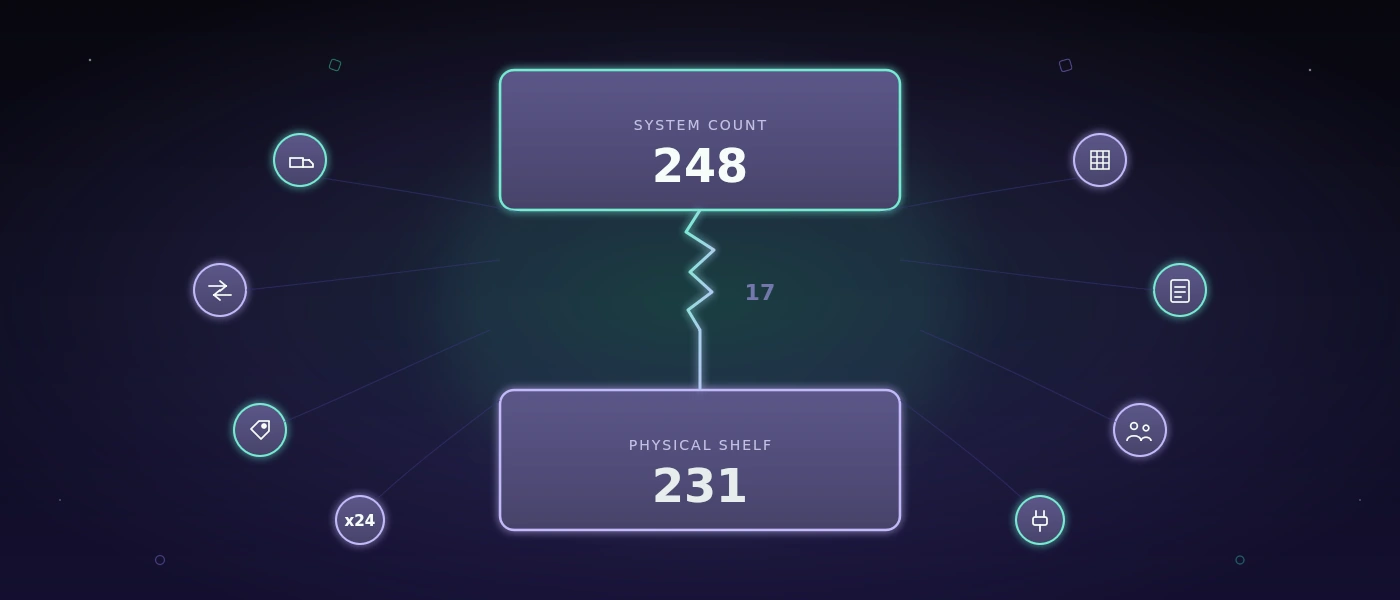
Zásoba v systému říká 248 kusů, na regálu leží 231. Těchto 17 jednotek působí nejprve jako chyba počítání. Ale přesně tam často začíná nesprávná analýza. Inventory discrepancy causes jsou v praxi zřídka jediné přehlédnutí. Většinou vznikají tam, kde se příjem zboží, skladový pohyb, komisionování, a zaúčtování časově nebo organizačně rozcházejí.

Pro malý nebo střední podnik nejsou rozdíly v zásobách jen tématem pro inventuru. Vedou k chybným objednávkám, expresním dodávkám, zbytečným bezpečnostním zásobám, a dodacím příslibům, které nelze dodržet. Kdo čistě oddělí příčiny, nemusí hned zavést velký ERP. Často stačí jasnější pravidla zaúčtování, vhodná zařízení pro evidenci, a systém, který odráží reálné pracovní procesy.

Inventory discrepancy causes: kde vznikají rozdíly

Rozdíl v zásobách je rozdíl mezi cílovou zásobou ve vedoucím systému a skutečně přítomnou zásobou. Rozhodující je zde slovo "vedoucí". Pokud se paralelně vedou Excel soubor, papírový seznam, a systém řízení zboží, prakticky existuje více pravd. Tehdy rozdíl nevznikl jen ve skladu, ale byl již zabudován do řízení dat.

Účinné protiopatření proto závisí na typu chyby. Nesprávně spočítaná paleta potřebuje jiné řešení než dodávka, která byla fyzicky přijata, ale nikdy zaúčtována. Než týmy přestaví procesy, měly by vyhodnotit rozdíly podle artiklu, skladové lokality, směny, typu pohybu, a okamžiku. Až tento vzor ukáže, zda jde o jednotlivý případ nebo opakující se procesní chybu.

1. Příjmy zboží se zaúčtují opožděně nebo neúplně

Příjem zboží je klasický bod zlomu. Zboží přijde ráno, odloží se ke kontrole, a později se přenese přímo do výroby nebo na regál. Zaúčtování se děje odpoledne, druhý den, nebo vůbec. Dokud je zboží fyzicky přítomno, zásoba systému se jeví příliš nízká. Pokud je již spotřebováno nebo vyexpedováno, následné chyby se stávají pravděpodobnějšími.

Obzvlášť náchylné jsou částečné dodávky, náhradní artikly, a nadměrné dodávky. Pokud je na dodacím listu uvedeno jedno množství, ale přijde jiné množství, nikdo by neměl jednoduše zaúčtovat doklad "nějak odpovídajícím způsobem". Rozdíl musí zůstat viditelný jako výjimka, včetně důvodu, odpovědné osoby, a schválení. Jinak odchylka zmizí z procesu a znovu se objeví až při inventuře.

2. Skladové pohyby se dějí bez transakce

Artikl se přemístí z příjmu zboží do vysokoregálového skladu, přemístí se z přihrádky do komisionační zóny, nebo se rezervuje pro objednávku. Fyzicky je to malý, rychlý pohyb. V systému může být rozhodující.

Pokud zaměstnanci přeuspořádávají skladové lokality jen podle pocitu, celková zásoba možná ještě bude sedět, ale dostupnost na správném místě ne. To způsobuje čas hledání, chybné komisionování, a zbytečné doplňovací jízdy. Dobré skladové řešení nemusí složitě zpracovávat každý pohyb. Musí zaznamenávat těch několik pohybů, které jsou relevantní pro dostupnost, sledovatelnost, a doobjednávání.

V dílnách nebo menších skladech je často smysluplnější udržovat několik jednoznačných zón než teoreticky dokonalou strukturu přihrádek, kterou nikdo v každodennosti neudržuje. Přesnost funguje jen tehdy, pokud zůstává proveditelná.

3. Komisionování a expedice se zaúčtují příliš brzy

Mnohé týmy zaúčtují objednávku při pickingu jako "vyskladněnou", ačkoli zboží ještě leží na přípravném místě. Pokud se objednávka následně změní, stornuje, nebo jen částečně vyexpeduje, systémová a fyzická zásoba se už neshodují.

Lepší je jasné oddělení mezi rezervované, komisionované, a vyexpedované. Ne každý podnik k tomu potřebuje složité stavové řetězce. Ale okamžik snížení zásoby musí být jednoznačný. U expedičního zboží je často blíže skutečnému předání přepravci než prvnímu sáhnutí na regál.

I vratky patří do tohoto procesu. Pokud se zboží vrátí, není automaticky opět dostupné. Až kontrola, rozhodnutí o kvalitě, a uskladnění by měly určit, zda se vrátí do prodejní zásoby, zůstane blokované, nebo bude vyřazeno.

4. Nesprávné jednotky a chyby kmenových dat

Karton, balení, role, a jednotlivý kus se mohou týkat stejného artiklu. Pokud přepočet není čistě udržován, vznikají rozdíly ohromující rychlostí. Zaměstnanec zaúčtuje "1", přičemž myslí karton s 24 kusy. Systém rozumí jednomu kusu.

Chyby kmenových dat jsou obzvlášť záludné, protože proces zaúčtování může vypadat technicky správně. Proto zkontrolujte balicí jednotky, přepočítací faktory, minimální množství, skladové lokality, a čísla artiklů. I podobně pojmenované varianty, například různé délky, barvy, nebo šarže, se snadno zamění.

Zde nepomůže paušální pravidlo jako "více skenovat". Čárové kódy jsou jen tak spolehlivé jako přiřazení za nimi. Při malých sortimentech může čistě udržovaný kmen artiklů s dobře čitelnými štítky dosáhnout více než rozsáhlá, ale špatně nakonfigurovaná krajina skenerů.

5. Paralelně vedené tabulky a ruční korekce

Tabulka na pracovní ploše vzniká zřídka z nedbalosti. Většinou vyplňuje reálnou mezeru: speciální rezervaci, chybějící hodnotu vyhodnocení, nebo proces, který stávající software nezobrazuje. Problematickou se stává, když se stane druhou knihou zásob.

Tehdy se přírůstky zaúčtují v systému, ale úbytky zaznamenají v tabulce. Nebo korekce probíhá jen tam, kde zrovna pomáhá další objednávce. Nikdo později nedokáže spolehlivě vysvětlit, která hodnota platí.

Ne každá tabulka se musí zrušit. Kalkulace pro plánování nebo analýzy může zůstat smysluplná. Ale procesy měnící zásobu by měly mít přesně jeden vedoucí systém. Úpravy potřebují kód důvodu, časové razítko, a ideálně osobu, kterou lze vysledovat. To není byrokracie pro byrokracii, ale předpoklad pro spolehlivé analýzy příčin.

6. Chyby počítání a nevhodné metody inventury

Ani správné procesy nechrání před lidskými chybami. Artikly se počítají dvakrát, palety se přehlédnou, otevřené kartony se odhadují, nebo se skladové lokality neblokují během počítání. Roční plná inventura odhalí tyto problémy pozdě a pod vysokým tlakem.

Pro mnohé provozy je průběžná inventura rozumnější alternativou. Rychle obrátkové nebo hodnotné artikly se kontrolují častěji, stabilní C-artikly méně často. Důležité není produkovat co nejvíce počítání, ale včas kontrolovat odchylky vůči posledním pohybům. Pokud se rozdílový artikl jednoduše opraví bez dokumentace příčiny, vzor zůstává neviditelný.

Protikontrola je obzvlášť smysluplná u vysokých hodnot, sériových čísel, nebo šarží. U šroubů ve spotřebním skladu může být ekonomicky přehnaná. Hloubka kontroly by měla odpovídat riziku.

7. Nejasné odpovědnosti mezi směnami a oblastmi

Chyby zásob vznikají často při předávkách. Ranní směna připraví zboží, odpolední směna ho vyexpeduje. Příjem zboží přijme dodávku, dispozice paralelně změní objednávku. Každý jednotlivý krok může být sledovatelný, ale nikdo nevlastní celý proces.

Proto definujte nejen role, ale i předávací body: kdo potvrzuje příjem zboží? Kdy se mění odpovědnost za komisionované zboží? Kdo kontroluje otevřené výjimky na konci směny? Společná digitální tabule nebo jednoduchý seznam výjimek je často účinnější než další schůzky.

Systém by měl zviditelnit otevřené procesy místo toho, aby nutil zaměstnance si pamatovat. Například dodávky bez kontroly množství, komisionování bez ukončení expedice, nebo vratky bez rozhodnutí o kvalitě musí upoutat pozornost dříve, než se stanou tichými chybami zásob.

8. Slabá integrace systémů a chybějící kontrolní pravidla

Pokud obchod, správa objednávek, sklad, a účetnictví vyměňují data s časovým posunem nebo přes soubor, mohou vzniknout dvojí nebo chybějící zaúčtování. Import se spustí dvakrát. Rozhraní tiše selže. Objednávka se změní poté, co už byl přenesen její stav expedice.

Řešení není nutně úplná náhrada. Často jsou potřeba jasně definovaná rozhraní, jednoznačná čísla dokladů, a technické kontroly. Skladové zaúčtování by mělo sledovatelně ukládat, kdy nastalo, z jakého procesu pochází, a zda bylo později stornováno. Kritické procesy potřebují chybová hlášení a fronty, nejen tichý záznam v log souboru.

U individuálně vyvinutých logistických systémů lze taková pravidla cíleně přizpůsobit provozu: žádné záporné množství bez schválení, žádné potvrzení expedice bez expediční pozice, žádné dvojí zpracování stejné externí reference. Nejlepší pravidlo zde není nejpřísnější, ale to, které zastaví skutečné chyby, aniž by blokovalo provoz při běžných výjimkách.

Systematicky kontrolovat rozdíly v zásobách

Nezačínejte s plošnou korekcí. Vyberte deset artiklů s nejčastějšími nebo nejdražšími rozdíly, a sledujte jejich poslední pohyb zpětně: příjem zboží, přemístění, úbytek, vratka, počítání, a případná ruční úprava. Pokud se případy shlukují na jednom místě, jedné směně, nebo jednom typu pohybu, je to pevný výchozí bod.

Poté by mělo být každé opatření měřitelné. Pokud se zavedou nová skenování čárových kódů, nesledujte jen počet skenování, ale míru rozdílů podle skupiny artiklů. Pokud se doplní nový stav pro přípravu, denně kontrolujte otevřené přípravy. Dobré procesy nevytvářejí zdánlivou přesnost. Dělají výjimky brzy viditelnými a sledovatelnými.

Smysluplný další krok je často malý: definovat předávací bod, vyčistit skladovou lokalitu, nebo technicky zajistit opakující se ruční korekci. Spolehlivé zásoby nevznikají z více softwaru na podezření, ale z procesů, které jsou i v hektické úterý v 16:45 stále správně proveditelné.

Permalink →

Jak správně přistupovat k automatizaci procesů pro MSP

Jak správně přistupovat k automatizaci procesů pro MSP

Dodací list chybí, protože údaje jsou stále na papírku. Příjem zboží je zaznamenán dvakrát, protože sklad a kancelář pracují s různými tabulkami. Schválení se opožďuje, protože odpovědná osoba právě nezvedá telefon. Takové tření zřídka stojí hodně peněz najednou. Ale během týdnů se sčítají dotazy, čas hledání, opravy chyb, a zbytečné čekání. Přesně tam má smysl automatizace procesů pro MSP.

Nejde o to nahradit co nejvíce činností softwarem. Dobrá automatizace dělá postupy sledovatelnými, snižuje zbytečná předávání, a dává zaměstnancům čas na rozhodnutí, která vyžadují zkušenosti. To je obzvlášť rozhodující v malých a středních podnicích: týmy jsou blízko každodennímu provozu. Když se proces zasekne, celá směna si to často všimne okamžitě.

Neautomatizovat každý proces

Nejčastější chybou je začít s nejviditelnější nepříjemností. Možná vadí soubor Excel, možná je potřeba nový dashboard. Obojí může být oprávněné. Ale digitalizovaný chaos zůstává chaosem - jen rychlejším a s více daty.

Před technickým rozhodnutím by měl být postup nejprve popsán tak, jak skutečně probíhá. Ne jak by měl být napsán v příručce. Kdo spouští postup? Jaké informace jsou potřeba? Kde se něco ručně přenáší? Kdo rozhoduje při výjimkách? A podle čeho tým pozná, že postup je dokončen?

Právě ve skladu nebo při zpracování objednávek se kritická místa často nacházejí mezi systémy: objednávka přijde e-mailem, zkopíruje se do tabulky, telefonicky se odsouhlasí, a později se zadá do přepravního softwaru. Každé předání zvyšuje pravděpodobnost, že se množství, termíny, nebo adresy budou lišit.

Automatizace se vyplatí obzvlášť tehdy, když se proces vyskytuje často, má jasná pravidla, a chyby způsobují citelné následky. Může to být příjem zboží, vytváření dodacích listů, přiřazování skladových pohybů, nebo předávání schválených objednávek expedici. Vzácné zvláštní případy s mnoha diskrečními rozhodnutími naopak často zůstávají lépe řízeny ručně - alespoň zpočátku.

Automatizace procesů pro MSP začíná prioritami

Ne každá zbytečná činnost si okamžitě zaslouží projekt. Jednoduché stanovení priorit přináší jasnost. Zhodnoťte jednotlivé postupy podle frekvence, doby zpracování, nákladů na chyby, a závislostí. Postup, který se děje padesátkrát denně a pokaždé ušetří jen dvě minuty, může být ekonomičtější než komplikovaný měsíční proces.

Otázka důsledku chyby je minimálně stejně důležitá. Nesprávně vytištěný interní dokument je nepříjemný. Nesprávné přiřazení šarže, ztracená dodací adresa, nebo nezdokumentovaný příjem zboží může vyvolat reklamace, práci s hledáním, a rozdíly v zásobách. Tam automatizace vytváří nejen tempo, ale i spolehlivost.

Smysluplný první krok je obvykle dostatečně malý na to, aby byl ověřitelný během několika týdnů. Například zaměstnanec může evidovat zboží přes čárový kód, systém ověří artikl a množství, aktualizuje zásobu v centrální databázi, a podle potřeby přímo vytvoří skladový doklad. Tým pak nemusí hádat, která verze tabulky je aktuální.

Jasný cílový stav místo seznamu funkcí

Mnohé projekty začínají dlouhým seznamem požadovaných funkcí. Lepší je konkrétní provozní obraz: co by mělo být na konci postupu viditelné bez dalších dotazů? Při expedici by to mohlo znamenat, že objednávka po schválení automaticky dostane sběrný seznam, dodací adresa se ověří, a může se vytvořit štítek. Výjimky viditelně skončí v seznamu k objasnění, místo v nepřehledné e-mailové schránce.

Tento cílový obraz nutí k užitečným rozhodnutím. Musí se každá objednávka zpracovat zcela automaticky? Nebo by se objednávky nad určitou hodnotu zboží, s odchylnou dodací adresou, nebo s chybějící zásobou měly vědomě předložit ke kontrole? Automatizace nepotřebuje stoprocentní zpracování naslepo, aby vytvořila velký užitek.

Vhodná technika závisí na postupu

Neexistuje standardní technická cesta pro každé MSP. Tabulkové řešení může nadále zůstat rozumné pro přehledné vyhodnocení. Je rychle přizpůsobené, důvěrně známé, a způsobuje malé zaváděcí úsilí. Jakmile ale pracuje více osob současně, zaúčtování musí být sledovatelná, nebo se data vyměňují s jinými systémy, naráží na své hranice.

Tehdy je často smysluplnější štíhlá, workflow-specifická aplikace než předimenzovaná enterprise sada. Může přesně zobrazit kroky, které jsou v provozu potřeba: zaevidovat objednávku, ověřit zásobu, přesunout zboží, vytvořit dokument, zaúčtovat expedici, a nahlásit stav zpět. Ne více, ale ani méně.

Technicky přitom méně záleží na tom, zda systém propaguje nejnovější módní slovo. Rozhodující jsou pevné základy: čistě modelovaná databáze, sledovatelná oprávnění, protokoly pro relevantní změny, spolehlivá rozhraní, a dokumentovaná nasazení. Aplikace na bázi PHP 8.4, moderního JavaScriptu, a MySQL 8 může být dlouhodobě velmi dobře udržovatelná, pokud jsou architektura a provoz promyšleny od začátku.

I integrace si zaslouží pozornost. Automatická výměna dat s obchodem, ERP, přepravním poskytovatelem, nebo účetnictvím šetří čas jen tehdy, pokud jsou chyby řešeny viditelně. Co se stane u neplatné adresy? Zkouší se neúspěšný tisk štítku znovu? Vidí tým, která data byla přenesena a která ještě chybí? Tiché chyby jsou nebezpečnější než jasně označený výjimečný případ.

Zavedení během běžného provozu

Nový systém se musí přizpůsobit střídání směn, dodacím termínům, a existujícím pracovním rutinám. Proto je postupné zavádění obvykle bezpečnější než tvrdý termín pro všechny oblasti. Začněte ohraničeným procesem, produktovou skupinou, nebo skladovou oblastí. To snižuje riziko a vytváří skutečnou zpětnou vazbu z každodennosti.

Paralelní provoz přitom není znakem nejistoty, ale kontrolovaným testem. Po omezenou dobu lze porovnat starou a novou evidenci. Rozdíly neukazují jen softwarové chyby, ale často i pravidla, která dosud existovala jen v hlavách jednotlivých zaměstnanců. Tato pravidla viditelně patří do procesu - ne trvale do osobní zkušenosti.

Zaměstnanci by neměli být konfrontováni s novým postupem až při školení. Kdo proces provádí denně, brzy rozpozná zkratky, zvláštní případy, a nepraktické masky. Dobrý software respektuje tyto znalosti, aniž by neměnně zabudoval každou historicky vzniklou výjimku. Správná otázka zní: která výjimka chrání důležitý obchodní případ, a která je jen obchvatem pro starý problém?

Učinit měřitelným, zda se námaha vyplatí

Před startem by měly být stanoveny dva nebo tři ukazatele. Může to být průběžná doba na objednávku, počet ručních korekcí, rozdíly v zásobách, nebo čas do expedice. Bez výchozí hodnoty se každé pozdější hodnocení stane pocitem.

Ne každý efekt se okamžitě projeví v korunách. Když skladový tým vždy ví, kde se zboží nachází, klesá počet přerušení. Když dodací dokumenty vznikají ze stejných dat jako objednávka, klesá riziko protichůdných údajů. A když jsou odpovědnosti viditelné v systému, postup méně závisí na jednotlivých osobách.

Automatizace potřebuje údržbu a hranice

Automatizovaný postup není projekt, který zamrzne po nasazení. Struktury artiklů se mění, zákazníci vyžadují nové dokumenty, přepravní poskytovatelé přizpůsobují rozhraní. Proto odpovědnosti, aktualizace, zálohy, a regulované zacházení s oprávněními patří k samotnému systému.

Obzvlášť u aplikací s daty zákazníků, objednávek, nebo zásob by mělo být jasné, kdo získá přístup a proč. Role musí odpovídat pracovní každodennosti: skladový tým potřebuje jiné funkce než účetnictví nebo prodej. Zaznamenané změny, bezpečné přihlašovací toky, a testované obnovy působí neefektně. V případě poruchy právě tyto detaily rozhodují, zda může provoz pokračovat v práci.

I testy jsou součástí provozní bezpečnosti. Opakované kontroly pro zadávání objednávek, skladové zaúčtování, tvorbu dokumentů, a správu práv zabraňují tomu, aby úprava na jednom místě poškodila fungující postup na jiném místě. U kritických webových nebo desktopových aplikací může být smysluplné kontrolované, samostatně hostované testovací prostředí, pokud snímky obrazovky, testovací data, a interní procesy nemají dosáhnout externích cloudových služeb.

softify.pro doprovází takové projekty jednoduchou zásadou: nejprve pochopit skutečný postup, poté postavit nejmenší udržitelné řešení. Někdy je to aplikace na míru. Někdy stačí existující tabulku strukturovat čistěji a automatizovat jeden jediný krok předání.

Nejlepším dalším krokem proto není srovnání softwaru, ale průchod skutečným postupem - od spouštěče po dokončení. Vezměte objednávku, příjem zboží, nebo reklamaci a sledujte ji se zúčastněnými osobami. Tam, kde se informace zadávají znovu, nikdo nezná stav, nebo rozhodnutí zbytečně čekají, se obvykle nachází nejsmysluplnější přístup k automatizaci.

Permalink →

Testování Windows aplikací: praktický plán

Testování Windows aplikací: praktický plán

Windows aplikace může v demo režimu vypadat upraveně a přesto v pondělí ráno zpomalit provoz. Neuložený dodací list, uživatel zablokovaný po třech neúspěšných pokusech, nebo dialog tisku, který po aktualizaci reaguje jinak, nejsou kosmetické chyby. Kdo chce vědět, jak testovat Windows aplikace, by proto neměl začínat jednotlivými tlačítky, ale procesy, které stojí práci, peníze, nebo sledovatelnost.

Právě ve skladu, dílně, dispozici, a administrativě probíhá mnoho kritických procesů přes desktopový software vyvíjený v průběhu let. Tam nezáleží na tom, zda je testovací případ působivě formulován. Rozhodující je, zda zaměstnanci spolehlivě dokážou vykonávat své úkoly za realistických podmínek - i při neúplných datech, měnících se oprávněních, pomalých sítích, a neplánovaných přerušeních.

Testování Windows aplikací začíná kritickými procesy

Nezaslouží si každá funkce stejné úsilí při testování. Zřídka používaný export s manuálním dopracováním je třeba hodnotit jinak než zaúčtování příjmu zboží, vytvoření štítku, nebo denní odsouhlasení objednávek. Začněte proto jednoduchou otázkou: co se konkrétně stane, pokud tento proces selže?

Vysokou prioritu mají procesy s přímým vlivem na zásoby, dodávku, fakturaci, bezpečnost, nebo komunikaci se zákazníkem. Sem patří například přihlášení a kontrola práv, vytvoření a změna kmenových dat, zaúčtování transakcí, tisk dokumentů, rozhraní na ERP nebo přepravní služby, jakož i obnovení po chybě. I funkce, které používá jen malá skupina lidí, mohou být kritické, pokud blokují měsíční uzávěrku nebo uvolnění zboží.

Z těchto procesů nevznikají abstraktní seznamy testů, ale sledovatelné pracovní kroky. Test příjmu zboží by mohl například začít existující objednávkou, zaznamenat částečnou dodávku, nahlásit odchylné množství, přiřadit skladové místo, a poté ověřit, zda se shodují zásoby, protokol zaúčtování, a vytištěný dokument. Tak testujete skutečný účinek softwaru, nejen jednotlivá vstupní pole.

Vytvořit testovací základnu, která odráží provoz

Mnohé chyby se stanou viditelnými až tehdy, když se testovací prostředí přiblíží realitě. Aplikace se s prázdným testovacím nájemcem často chová jinak než s víceletými pohybovými daty, blokovanými artikly, chybějícími povinnými informacemi, nebo již otevřenými transakcemi.

Proto vědomě vytvořte testovací data. Nemusíte nutně potřebovat úplnou kopii produkce. Smysluplnější je kontrolovaný soubor dat s typickými, hraničními, a záměrně chybnými případy: artikly s různými měrnými jednotkami, zákazníci se speciálními podmínkami, objednávky s částečnými dodávkami, uživatelé s různými rolemi, a transakce, které jsou již ve zpracování. Osobní údaje by měly být přitom anonymizovány nebo nahrazeny realistickými vzorovými daty.

K testovací základně patří i technické prostředí. Dokumentujte verzi Windows, rozlišení, škálování, nainstalované tiskárny, síťové disky, verzi databáze, připojené služby, a oprávnění. Zní to suchopárně, ale později to šetří čas. Pokud se chyba vyskytuje jen na pracovištích se škálováním 125% nebo s určitým ovladačem tiskárny, musí to být reprodukovatelné.

Neověřovat jen ideální případ

Ideální případ především dokazuje, že aplikace byla postavena pro očekávanou cestu. V provozu vznikají obtížné situace vedle toho. Co se stane, pokud uživatel nechá povinné pole prázdné, spustí stejné zaúčtování dvakrát, nebo ztratí spojení během ukládání? Zůstává transakce konzistentní? Dostane osoba srozumitelnou zprávu? Může bezpečně pokračovat v práci?

U Windows aplikací jsou kromě toho obzvlášť relevantní obsluha a stav. Dialogová okna se mohou objevit na pozadí, klávesové zkratky se mohou překrývat, dialogy výběru souborů mohou blokovat průběh. Ověřte, zda jsou fokus, chybová hlášení, a blokování jednoznačné. Technická výjimka bez pokynu k jednání nepomůže vedoucímu směny.

Manuální testy nasadit tam, kde je potřeba úsudek

Manuální testy nejsou znakem nedostatečné vyspělosti. Jsou nepostradatelné, když vzniká nový proces, přestavuje se rozhraní, nebo o kvalitě rozhoduje odborné poznání. Zkušený vedoucí skladu rozpozná rychleji než skript, zda je maska srozumitelná pod vysokým časovým tlakem, nebo zda se upozornění objeví příliš pozdě.

Manuální testování se však stává nákladným a nespolehlivým, když se stejné stabilní procesy opakují před každou verzí. Pak uvolnění závisí na dostupných osobách, paměti, a roztroušených poznámkách. Správný přechod na automatizaci se obvykle nachází tam, kde se proces vykonává často, může způsobit velkou škodu, a má jasné očekávané výsledky.

Dobrý manuální testovací případ popisuje výchozí situaci, kroky, očekávaný výsledek, a potřebná data. Při chybě doplňte snímek obrazovky, časové razítko, verzi aplikace a buildu, jakož i přesnou akci. "Tisk nefunguje" není použitelný popis chyby. "Po změně dodací adresy zůstává dialog tisku otevřený, objednávka 4711 nedostane PDF, a nezobrazí se žádná zpráva" je.

Automatizované regresní testy pro opakující se rizika

Automatizace neověřuje, zda je software zásadně dobrý. Ověřuje, zda dříve fungující, definované procesy fungují i po změně. To je obzvlášť cenné u Windows softwaru, jehož rozhraní, logika databáze, a externí rozhraní se vyvíjejí po léta.

Začněte malým krokem. Vyberte si nejprve pět až deset obchodně kritických procesů, které by se měly ověřovat při každém vydání. Sem mohou patřit přihlášení s account-lockout postupem, zadávání objednávek, skladové zaúčtování, tisk PDF nebo štítků, změna role, a centrální import. Až když tyto testy běží spolehlivě, vyplatí se rozšíření na speciální případy.

U desktopových aplikací automatizované testy často řídí viditelné prvky rozhraní: okna, vstupní pole, tabulky, tlačítka, a dialogy. To funguje, ale je citlivější než čistý test rozhraní. Malé změny rozvržení, pomalejší počítače, nebo nejednoznačně pojmenované prvky mohou testy pokazit. Proto by vývojáři, odborný útvar, a odpovědní za testování měli společně určit, které prvky jsou stabilně adresovatelné a které kontrolní kroky je lepší zajistit přes databázi, protokol, nebo rozhraní.

Smysluplný test navíc neověřuje jen to, že se dalo kliknout na tlačítko. Kontroluje odborný důsledek: bylo zaúčtování uloženo? Je zásoba správná? Byl vytvořen dokument? Nebyl vytvořen duplicitní záznam? Viditelná interakce a ověřitelný výsledek patří k sobě.

Důkazy jsou součástí výsledku testu

Samotný zelený stav u kritických aplikací málokdy stačí. Když test selže, týmy rychle potřebují odpověď na tři otázky: jaká byla výchozí situace? Na jakém kroku proces selhal? Co aplikace v tom momentě zobrazovala?

Snímky obrazovky, protokoly průběhu, a případně záznamy obrazovky dělají chyby předmětem diskuse. Výrazně zkracují předání mezi provozem, QA, a vývojem. Pro regulované nebo bezpečnostně uvědomělé společnosti jsou navíc spolehlivým základem pro sledování schválení a odchylek.

Přitom místo uložení není vedlejší záležitostí. Testovací běhy mohou obsahovat interní zákaznická data, ceníky, informace o objednávkách, nebo pohledy na obrazovku. Kdo automatizovaně testuje citlivé Windows aplikace, by měl objasnit, zda tato data smí opustit vlastní infrastrukturu. Samostatně hostované prostředí jako COCO zde může být smysluplné, protože provádění testů, důkazy, a hodnocení zůstávají pod vlastní kontrolou. Zda je to nutné, závisí na požadavcích na ochranu údajů, smluvní situaci, a potřebě ochrany - ne každý tým potřebuje k tomu stejnou architekturu.

Zabudovat testování do procesu vydávání

Nejlepší katalog testů ztrácí hodnotu, pokud se použije až po hektickém nasazení do produkce. Definujte pevný okamžik: automatizované jádrové regrese běží před každým vydáním, manuální akceptace ověřuje nové nebo změněné procesy, a známá omezení se otevřeně dokumentují.

Nemusí každý neúspěšný test zastavit vydání. Chyba ve zřídka používaném administrativním zobrazení může být přijatelná, pokud existuje bezpečné řešení a dotčená oblast je jasně informována. Chyba, která nesprávně zaúčtuje zásoby nebo nepozorovaně zablokuje uživatele, se musí řešit jinak. Toto rozhodnutí by se mělo přijmout podle obchodního dopadu, ne podle pouhého počtu červených testů.

Udržujte testy společně s aplikací. Když se proces záměrně mění, aktualizujte testovací případ, testovací data, a očekávaný výsledek společně s požadavkem. Zastaralé testy vytvářejí šum a nakonec se ignorují. Několik důvěryhodných kontrol je cennějších než stovky automatizovaných procesů, jejichž výsledky už nikdo nebere vážně.

Nakonec nejde o simulaci každého myslitelného vstupu. Jde o ochranu práce, která musí opět fungovat další ráno. Začněte jediným kritickým procesem, učiňte jeho výsledek prokazatelným, a stavějte odtud dál.

Permalink →

Secure test data management bez ztráty kontroly

Secure test data management bez ztráty kontroly

Neúspěšný testovací běh je nepříjemný. Úspěšný testovací běh se skutečnými zákaznickými daty v nedostatečně chráněném prostředí může být výrazně dražší. Secure test data management neřeší tento rozpor jediným nástrojem, ale jasnými pravidly pro data, přístupy, testovací prostředí, a důkazy. Pro týmy, které automatizovaně testují webové nebo Windows aplikace, to proto patří ke kvalitativní práci - nejen k souladu s předpisy.

Proč se testovací data stávají bezpečnostním problémem

Produkční data jsou pro testy lákavá, protože obsahují skutečné okrajové případy: neúplné adresy, neobvyklé kombinace objednávek, historická cenová pravidla, nebo chybné vstupy. Právě tato data však často obsahují jména, kontaktní údaje, smluvní informace, personální čísla, bankovní údaje, nebo interní obchodní logiku.

Riziko zřídka vzniká jednou hrubou chybou. Většinou roste postupně: export databáze se vytvoří pro test, uloží se do sdíleného adresáře, a později se zkopíruje do dalšího prostředí. Externí služba dostane snímky obrazovky pro analýzu chyb. Testovací účet si zachová rozsáhlá práva, protože vyčištění by mohlo narušit další běh. Po několika měsících už nikdo spolehlivě neví, která data se kde nacházejí.

V malých a středních podnicích se problém často vyostřuje kvůli omezeným kapacitám. Tým chce dodržet termín vydání, ne provozovat vlastní projekt ochrany údajů. Odpovědnost přesto zůstává. Kdo používá data k zajištění kvality, musí být schopen sledovat, jaká data se zpracovávají, kdo k nim má přístup, a kdy se znovu odstraní.

Secure test data management začíná před testovacím případem

Rozhodující otázka nezní: "Jak chráníme testovací datový fond?" Zní: "Jakou informaci tento test skutečně potřebuje?" Mnohé regresní testy nepotřebují vůbec skutečné osobní reference. Zásilkový proces musí například ověřit, zda se dodací adresy, hmotnosti, zóny, štítky, a změny stavu zpracovávají správně. K tomu stačí syntetičtí zákazníci, věrohodná kmenová data artiklů, a vědomě definované hraniční případy.

Toto rozlišení vede k praktické klasifikaci dat. Ne každé testovací prostředí potřebuje stejnou hloubku dat. Pro jednotkové a integrační testy často stačí zcela umělé datové sady. Pro end-to-end testy mohou být smysluplné pseudonymizované kopie, pokud jsou skutečné datové vzory odborně relevantní. Data podobná produkčním by měla být výjimkou - s dokumentovaným účelem, omezeným přístupem, a pevnou dobou životnosti.

Důležitá je přitom kvalita náhradních dat. Náhodná fantazijní data pomáhají málo, pokud nezobrazují realistické závislosti. Testovací datová sada pro skladovou aplikaci musí například obsahovat varianty artiklů, skladová místa, blokované zásoby, částečné dodávky, a vrácení zboží v souladné kombinaci. Dobrá testovací data nechrání jen osobní informace. Nacházejí chyby, které by s prázdnými tabulkami a vzorovým zákazníkem "Jan Novák" nikdy nebyly viditelné.

Syntetizovat, maskovat, nebo minimalizovat?

Syntetická data jsou nejbezpečnější volbou, když se odborná pravidla dají čistě modelovat. Vznikají cíleně z testovacích požadavků a neobsahují žádnou kopii skutečných osob ani transakcí. Úsilí spočívá v údržbě: pokud se změní datový model nebo přibudou nová procesní pravidla, generátory a fixtures musí růst spolu s nimi.

Maskování se hodí, když chování aplikace silně závisí na produkčních strukturách. Přitom se citlivá pole nahrazují nebo mění, zatímco vztahy zůstávají zachovány. Ze jmen se stávají věrohodná, ale fiktivní jména; z e-mailových adres se stávají nedoručitelné testovací adresy; z čísel účtů se stávají hodnoty se správným formátem bez skutečné vazby. Maskování je odolné jen tehdy, pokud se zohlední i nepřímé závěry. Kombinace vzácného místa, data narození, a smluvní vlastnosti může osobu stále identifikovat.

Minimalizace dat je často podceňovanou třetí cestou. Místo kopírování úplného exportu se poskytuje jen potřebný výsek. To snižuje útočnou plochu, potřeby úložiště, a náročnost čištění. Na test slevové logiky nikdo nepotřebuje celou roční historii zákazníka.

Přístupy a prostředí musí odpovídat riziku

Chráněná datová sada ztrácí svou hodnotu, pokud se nachází ve volně dostupném testovacím prostředí. Testovací systémy proto potřebují vlastní bezpečnostní hranice - oddělené databáze, vlastní servisní účty, jasně definované síťové přístupy, a žádné tiché propojení s produkcí.

Přístupová práva by měla být založena na rolích, ne na sdílených účtech. Vývojáři mohou potřebovat jiná práva než QA, podpora, nebo externí poskytovatelé služeb. Administrátorské přístupy jsou někdy nutné, ale měly by být časově omezené, zaznamenávané, a spojené s prokazatelným schválením. I pro testovací účty platí smysluplná pravidla hesel, vícefaktorová autentizace tam, kde je dostupná, a postupy blokování účtu při opakovaných neúspěšných pokusech.

Automatizované testy přinášejí další zvláštní případ: generují důkazy. Snímky obrazovky, záznamy obrazovky, protokoly, a chybová hlášení mohou obsahovat citlivý obsah, i když byla databáze maskována. Snímek obrazovky zákaznické masky, prohlížečová stopa s informacemi o relaci, nebo protokol s API payloadem patří do stejné úvahy o ochraně jako testovací databáze.

Proto testovací artefakty potřebují pravidla uchovávání. Ne každý úspěšný běh se musí trvale ukládat. Pro kritická schválení může být smysluplný sledovatelný důkaz, například s časovým razítkem, číslem buildu, verzí testu, a výsledkem. Neúspěšné běhy často potřebují delší období na analýzu. Poté by artefakty měly být automaticky odstraňovány. Co už neexistuje, nemůže být náhodně sdíleno nebo kompromitováno.

Automatizace bez nekontrolovaných úniků dat

AI podporovaná testovací automatizace může výrazně urychlit testy, zejména u rozsáhlých webových a Windows aplikací. Mění však bezpečnostní otázku: kam jdou snímky obrazovky, vstupy, popisy chyb, a aplikační provoz? Kdo je zpracovává? Jak dlouho tam zůstávají?

Pro bezpečnostně uvědomělé týmy je samostatně hostované provádění často lepší architekturou. Systém jako COCO může běžet v rámci vlastní nebo jasně ohraničené infrastruktury, provádět testovací kroky, ukládat důkazy, a generovat srozumitelná hodnocení. To není v každé situaci povinné. Pro veřejnou marketingovou stránku s čistě syntetickými hodnotami formulářů může být externí služba opodstatněná. U interních odborných aplikací, zákaznických portálů, nebo softwaru s osobními procesy je však lokální kontrola konkrétní výhodou.

Samostatné hostování není volný průkaz. Provoz vyžaduje aktualizace, koncepty zálohování, protokoly přístupu, a odpovědný subjekt. Na oplátku suverenita dat zůstává tam, kam patří. Správný přístup závisí na potřebě ochrany, existujících provozních schopnostech, a typu testované aplikace - ne na aktuálním hypu kolem konkrétního testovacího nástroje.

Jak se z pravidel stává funkční proces

Praktický proces nemusí blokovat vydání. Začněte s mapou dat: jaká testovací prostředí existují, jaké typy dat se tam nacházejí, a jaké systémy generují další artefakty? Tato inventarizace obvykle už odhalí staré exporty, zapomenuté staging systémy, a nejasné odpovědnosti.

Poté se vyplatí jednoduchá rozhodovací matice pro každou třídu testu. Určuje, zda stačí syntetická data, je nutné maskování, nebo je potřeba jasně odůvodněný produkční výtah. Doplní se vlastníky, lhůtami smazání, a přístupovými rolemi. Nemusí to být přetížený soubor pravidel. Krátká, skutečně dodržovaná směrnice je lepší než bezpečnostní dokument, který nikdo nenajde během výpadku.

Technicky patří poskytování dat a čištění do testovací pipeline. Běh reprodukovatelně vytváří potřebné datové sady, používá jedinečná označení, a poté je znovu odstraňuje. To zabraňuje tomu, aby se testovací prostředí plnila zbytkovými daty a výsledky byly s každým sprintem méně důvěryhodné. Pro kritické procesy by týmy měly navíc ověřit, zda přístupy k datům a testovací důkazy musí být zaznamenávány způsobem vhodným pro audit.

Bezpečnost, která zrychluje testování

Secure test data management je často považován za dodatečnou kontrolní zátěž. Špatně implementovaný to skutečně může být. Dobře implementovaný však vytváří spolehlivé, opakovatelné výchozí podmínky. Týmy ztrácejí méně času hledáním použitelného exportu dat, vyhýbají se poškozeným testům kvůli nevyčištěným starým datům, a mohou lépe odůvodnit schválení.

Nejsmysluplnějším prvním krokem je jen zřídka velký platformový projekt. Vezměte testovací proces s nejvyšším rizikem nebo největším třením - například schválení interní objednávkové aplikace - a udělejte tam viditelnými zdroj dat, přístupy, artefakty, a mazání. Z této konkrétní práce vzniká bezpečnostní rutina, která testy nedělá těžkopádnějšími, ale důvěryhodnějšími.

Permalink →

Warehouse Software vs ERP

Warehouse Software vs ERP

Příjem zboží přichází současně s naléhavým kompletováním zakázky, dva zaměstnanci se ptají na skladové místo artiklu, a dodací list už byl ručně opraven. Přesně v takových okamžicích se otázka Warehouse Software vs ERP stává praktickou. Nejde o nejmodernější rozhraní ani nejdelší seznam funkcí. Jde o to, zda je informace dostupná přesně tam, kde je třeba rozhodnout během vteřin.

Mnoho malých a středních podniků v regionu DACH začíná s ERP, tabulkovým procesorem a velkými zkušenostmi v týmu. To může dlouho fungovat. Problémy nastávají teprve tehdy, když se zásoby mezi systémy začnou rozcházet, časy hledání rostou a každý zvláštní případ se musí řešit křikem přes sklad. V tu chvíli se na stole často objeví velký projekt ERP, přestože možná stačí digitalizovat jediný jasně vymezený skladový proces.

Warehouse Software vs ERP: rozdíl v každodenní praxi

Systém ERP zobrazuje podnik do šířky. Typicky propojuje nákup, prodej, kmenová data artiklů, účetnictví, výrobu, fakturaci a plánování. Jeho síla spočívá v tom, že obchodní a provozní data se sbíhají ve společném rámci. Zakázka se vytvoří, faktura vystaví, potřeba naplánuje, zásoba ocení.

Warehouse software, často nazývaný WMS nebo správa skladu, pracuje blíže ke skutečným pohybům uvnitř skladu. Podporuje příjem zboží, uskladnění, přesuny, kompletaci, inventuru, expedici a vrácení zboží. Odpovídá na otázky, které ERP často zobrazuje jen hrubě: na jakém místě zboží leží? Jaká zásoba je skutečně dostupná? Která šarže byla odeslána? Která zakázka má přednost? Kdo potvrdil přesun?

Toto rozhraní není absolutní. Existují ERP s rozsáhlými skladovými funkcemi a WMS produkty napojené na objednávkové nebo nákupní procesy. Rozhodující tedy není označení na nabídce, nýbrž provozní hloubka. ERP může spravovat deset skladových míst, a přesto být nepraktický, pokud zaměstnanci musí při každém pohybu otevírat několik obrazovek nebo data zapisovat až později.

ERP je obchodní zdroj

Když je třeba zakázku vyfakturovat, spustit nákupní objednávku nebo vytvořit ocenění materiálu, patří to ve většině podniků do ERP. Tam se obvykle nachází vedoucí logika artiklů a zákazníků. Tuto roli by se nemělo lehkovážně zdvojovat. Dva na sobě nezávislé systémy pro ceny, čísla artiklů nebo objednávky nevytvářejí jistotu, ale práci na sladění.

ERP je obzvláště užitečný, když je centrální výzva meziresortní: nákup a výrobu je třeba plánovat společně, finanční data musí zůstat konzistentní, nebo více společností pracuje se stejnými procesy. Kdo takový základ ještě nemá, neměl by očekávat, že čistě skladové řešení nahradí všechny podnikové procesy.

Warehouse software řídí pohyb

Ve skladu ale nezáleží jen na tom, co teoreticky existuje v systému. Záleží na tom, co právě dorazilo k bráně tři, které místo je volné a zda bylo zboží rezervováno pro potvrzenou zakázku. Dobré skladové řešení snižuje tření přesně v těchto bodech.

To může začít mobilními skenery: zboží se skenuje při příjmu zboží, přiřadí se ke skladovému místu a okamžitě se hlásí jako dostupné. Při kompletaci systém vede smysluplným pořadím, kontroluje artikl a množství a podle potřeby generuje přepravní štítky nebo dodací dokumenty. Zaúčtování neprobíhá o hodiny později na kancelářském pracovišti, ale přímo v rámci procesu.

Přínos nespočívá jen v rychlosti. Vysledovatelná zaúčtování zviditelňují chyby. Pokud zásoba nesedí, lze zjistit, kdy pohyb chyběl nebo byl nesprávně potvrzen. To je mnohem spolehlivější než měsíční oprava v tabulce.

Kdy stačí modul ERP

Existující modul ERP může být správnou volbou, když je organizace skladu přehledná a tým dokáže spolehlivě pracovat se stávajícími procesy. Jeden sklad, pevná místa, málo položek zakázky a žádné přísné požadavky na šarži či sériové číslo jsou typické podmínky. I při nízkém objemu expedice může dodatečná systémová součást přinést více údržby než užitku.

Před pořízením nového systému se vyplatí střízlivý test: dokáže zaměstnanec plně zaúčtovat příjem zboží, přesun a expedici bez papírku? Je zásoba viditelná podle skladového místa? Dají se vysledovat rozdíly z inventury? Vznikají dokumenty bez dvojího zadávání? Pokud jsou tyto odpovědi převážně ano, rozšíření možná není naléhavé.

I tabulkový procesor může zůstat, pokud čistě plní omezený účel, například sezónní plánování kapacit nebo jednorázové vyhodnocení. Dobré řešení nenahrazuje každý známý způsob práce. Nahrazuje ty ruční kroky, u kterých chyby, čekací doba nebo chybějící transparentnost skutečně stojí peníze.

Kdy dává smysl specializované skladové řešení

Zlomový bod přichází většinou postupně. Nejprve se zaměstnanec stále častěji ptá na artikl. Pak se zásoby pro jistotu udržují vyšší, protože nikdo s jistotou nezná skutečně dostupnou zásobu. Nakonec se zásilky opožďují, protože dodací listy, štítky a opravy zásob procházejí přes různé nástroje.

Specializovaný warehouse software dává obzvlášť smysl, když se sejde více z těchto podmínek:

  • spravuje se více skladových oblastí, skladových míst nebo externích skladů
  • příjmy zboží, přesuny a kompletace probíhají denně ve vysokém počtu
  • je třeba sledovat šarže, sériová čísla, data spotřeby nebo blokované zásoby
  • do procesu je třeba zapojit přepravce, tiskárny štítků nebo mobilní skenery
  • provozní realita se stále častěji odchyluje od zobrazení v ERP

Seznam není automatickým doporučením ke koupi. Podnik s mnoha položkami může dobře fungovat s dobře nastaveným ERP. Naopak malý podnik může brzy potřebovat štíhlou skladovou aplikaci, pokud musí být vysledovatelná každá součástka nebo musí současně zaúčtovávat více týmů.

Otázka integrace často rozhoduje více než funkce

Nejtěžší otázka u Warehouse Software vs ERP zřídka zní: který systém umí víc? Lepší otázka zní: která data musí kdy proudit do kterého systému?

V mnoha případech zůstává ERP vedoucím pro artikly, zákazníky, zakázky a obchodní doklady. Skladová aplikace přebírá provozní realizaci. Přijímá uvolněné zakázky, provádí skladové pohyby a zpětně hlásí stav, množství, šarže nebo čísla zásilek. Tím dostane každá strana jasný úkol.

Toto rozhraní potřebuje konkrétní pravidla. Co se stane se změnou zakázky poté, co kompletace už začala? Smí skladová zásoba klesnout do záporu? Které zaúčtování platí při výpadku sítě? Jak se blokují artikly, které upoutají pozornost při kontrole kvality? Bez těchto rozhodnutí se i technicky čisté API stává novým zdrojem chyb.

Pro malé a střední podniky je postupné zavádění často rozumnější než úplná výměna. Nejprve lze zavést příjem zboží se skenováním čárových kódů. Pak následují skladová místa a přesuny, později kompletace a expedice. Tak se skutečné výjimky rozpoznají včas, aniž by celý provoz závisel na jediném dni přechodu.

Standardní produkt, rozšíření ERP, nebo řešení na míru?

Standardní WMS se vyplatí, když jsou vlastní procesy z velké části běžné a existující integrace sedí s ERP. Rychle přináší do provozu osvědčené funkce. Cenou za to může být, že týmy musí přizpůsobit své postupy pevným šablonám, nebo doplácet za zřídka využívané enterprise funkce.

Rozšíření ERP dává smysl, když je potřebná provozní hloubka skutečně dostupná a obsluha funguje na podlaze haly. Ověřit by se neměla jen demoverze produktu, ale skutečný postup se skenerem, rukavicemi, kolísavým wifi a časovým tlakem před odjezdem.

Řešení na míru se stává zajímavým, když proces nese konkurenční výhodu podniku, nebo standardní software trvale vynucuje oklikami. Může jít o zvláštní proces příjmu zboží, propojení dílny a skladu, speciální dodací listy nebo vlastní logiku tras. Pak by se řešení nemělo uměle zvětšovat. Jasný proces, čistě namodelovaný a postavený na udržovatelném technickém základu, má větší hodnotu než platforma, která teoreticky umí vše.

softify.pro vyvíjí takové systémy podél konkrétních pohybů a odpovědností: od příjmu zboží přes skladová zaúčtování až po expediční dokumenty. Datový model, oprávnění, chybové stavy a pozdější údržba přitom zůstávají součástí realizace, nikoli úkoly na někdy po spuštění do ostrého provozu.

Otázky, které patří na stůl před rozhodnutím

Ne každý požadavek je třeba automatizovat první den. Měl by být ale vědomě rozhodnut. Odpovědní by si měli se skladovým týmem, obchodem a účetnictvím vyjasnit, která data jsou vedoucí, jaké chyby dnes vznikají nejčastěji a jaké ukazatele budou později skutečně potřeba. Hezký přehled zásob pomůže málo, pokud nikdo neví, zda se rezervované, blokované a dostupné množství zpracovává odlišně.

Stejně důležitá je odpovědnost za kmenová data. Skladové procesy zřídka selhávají kvůli chybějícímu tlačítku. Selhávají kvůli nejednotným číslům artiklů, neudržovaným měrným jednotkám a nevyjasněným pravidlům pro náhradní artikly nebo přepočty jednotek. Software může tyto problémy zviditelnit. Nemůže je ale vyřešit bez rozhodnutí zevnitř podniku.

Správná volba tedy není automaticky ERP nebo warehouse software. Vzniká z odstupu mezi vaším současným procesem a procesem, který váš tým skutečně musí spolehlivě vykonávat. Začněte u jednoho pohybu, který dnes stojí čas nebo vytváří chyby, a ověřte, který systém tento pohyb zobrazuje nejjasněji, nejrychleji a nejvysledovatelněji.

Permalink →

Automatizace příjmu zboží

Automatizace příjmu zboží

Nákladní auto stojí u brány, dva zaměstnanci kontrolují dodací listy a seznam zásob stále leží na počítači v kanceláři. Přesně tady se otázka how to automate goods receiving začíná stávat praktickou. Ne proto, že by každý sklad potřeboval velké zavedení ERP. Ale proto, že chybějící, opožděný nebo špatně zaúčtovaný příjem zboží má následky: stavy nesedí, objednávky čekají, reklamace se těžko dohledávají a směna začíná otázkami, které je třeba vyjasnit.

Automatizovat příjem zboží neznamená nahradit lidi skenery. Znamená to vést opakující se kontroly, zaúčtování a dokumenty tak, aby se tým u brány mohl rychle rozhodovat a aby byl stav zásob poté spolehlivý. Pro malé a střední podniky je štíhlý, vhodně přizpůsobený proces obvykle hodnotnější než koncernový systém plný funkcí, které nikdo nepoužívá.

Co se při ručním příjmu zboží skutečně ztrácí

Papírové dodací listy a tabulky Excel často fungují dostatečně dlouho na to, aby se investice odložila. Problém nevzniká u jednotlivého kartonu. Vzniká, když se hromadí odchylky: dílčí dodávka se zapíše až později, šarži nelze přiřadit, paleta skončí ve špatné zóně, nebo se zaúčtování příjmu provede až na konci dne.

Pak existuje několik pravd zároveň. Dodavatel hlásí dodáno. Ve skladu zboží fyzicky stojí. Dispozice ještě nevidí dostupný stav. Účetnictví má doklad, ale žádné potvrzení o množství či poškození. Zaměstnanci tyto informace slaďují telefonicky, e-mailem a na základě zkušenosti. To stojí čas a činí proces závislým na jednotlivých osobách.

Automatizace vytváří jeden společný, aktuální zdroj pro danou operaci. Zaznamenává nejen plánovaný stav, ale i to, co se skutečně stalo u brány: kdo převzal, kdy, v jakém množství, s jakou odchylkou a kam zboží dál směřuje.

How to automate goods receiving s jasným postupem

Správným začátkem není výběr skeneru nebo skladové aplikace. Nejprve musí být viditelný reálný proces. Projděte si typický příjem zboží od ohlášeného termínu dodání až po uskladnění. Sledujte přitom i zvláštní případy, protože právě ty rozhodují, zda řešení obstojí v běžném provozu.

Digitální postup se obvykle skládá z pěti na sebe navazujících rozhodnutí. Dodávka se identifikuje, zkontroluje se proti objednávce nebo očekávanému dodání, zaznamená se skutečné množství, zdokumentují se odchylky a zboží se přiřadí ke skladovému místu nebo dalšímu kontrolnímu kroku. Každý krok by měl vyžadovat pouze ta data, která jsou v daném bodě skutečně potřeba.

1. Předem zpřístupnit očekávané dodávky

Pokud existují nákupní objednávky, výrobní příkazy nebo avíza o dodání, sklad by je měl vidět ještě před příjezdem. Při příjezdu odpovědná osoba vybere dodavatele, naskenuje číslo objednávky nebo vyhledá otevřenou dodávku. Systém zobrazí očekávané položky, množství a případně čísla šarží nebo sériová čísla.

To výrazně zkracuje přejímku. Ještě důležitější je ale kontrolní logika: tým se nemusí rozhodovat zpaměti, zda je 18 místo 20 kartonů přijatelných. Odchylka se stane viditelnou a lze ji doplnit důvodem. U neohlášených dodávek potřebuje proces kontrolovanou cestu, například jako předběžný příjem zboží se schválením nákupu nebo dispozice.

2. Používat čárové kódy tam, kde skutečně šetří čas

Čtečka čárových kódů nebo fotoaparát robustního mobilního zařízení je pro mnoho skladů nejsmysluplnějším začátkem. Sken snižuje překlepy a zrychluje opakující se pohyby. Předpokladem však je, že čísla položek, balicí jednotky a štítky jsou vedeny konzistentně. Skener neřeší nejasná kmenová data.

Ne každé zboží potřebuje sledování podle sériového čísla. U šroubů nebo standardního spotřebního materiálu často stačí položka, množství a skladové místo. U náhradních dílů v záruce, regulovaných produktů nebo komponentů pro výrobu mohou být šarže, sériové číslo, datum minimální trvanlivosti a stav kontroly povinné. Hloubka zaznamenávání by měla odpovídat riziku, ne obecné softwarové šabloně.

3. Zacházet s odchylkami jako s normálním procesem

Dobrý digitální příjem zboží se nesnaží zabránit každé odchylce. Dělá ji jednoduchou a prokazatelně zvládnutelnou. Chybějící množství, nadměrné dodávky, přepravní škody, špatné položky a blokované šarže potřebují jasné stavy místo ručně psaných poznámek na dodacím listu.

U poškozené dodávky lze například pořídit fotografii přímo na místě přejímky, množství zaúčtovat jako blokované a automaticky informovat nákup. Dostupný stav zůstává správný, zatímco zboží fyzicky putuje do karanténní zóny. To zabraňuje, aby se poškozené díly omylem zkompletovaly nebo použily ve výrobě.

Pravidlo nemusí být vždy plně automatické. U malých množství lze nadměrnou dodávku přijmout přímo. U drahých nebo bezpečnostně relevantních položek by mělo být vyžadováno schválení. Tyto prahové hodnoty patří do procesu a musí zůstat později upravitelné.

4. Okamžitě spustit uskladnění

Přejímka je provozně kompletní až tehdy, když je jasné, kde se zboží nachází nebo proč je ještě nelze uskladnit. Systém může navrhnout pevné skladové místo, upřednostnit doplňovací zónu nebo na základě skupiny položek, teplotního rozsahu a dostupné kapacity určit cílovou oblast.

Pro přehledné sklady často stačí jasná logika míst s několika zónami. Složitá optimalizace tras má smysl jen tehdy, když ji odůvodňuje objem, přepravní vzdálenosti a personální struktura. Kdo přijímá deset palet denně, nepotřebuje optimalizační projekt, který trvá déle než ušetřený čas. Spolehlivý sken skladového místa je často větším pokrokem.

Po uskladnění systém aktualizuje stav a protokol pohybů. Prodej, dispozice nebo výroba tak vidí stav, aniž by se museli ptát skladu. Pokud smí být položka dostupná až po kontrole kvality, systém odděluje fyzický stav od dostupného stavu.

Jaká data příjem zboží skutečně potřebuje

Digitální proces se rychle stává neoblíbeným, pokud u brány vyžaduje příliš mnoho polí. Zároveň bez minima dat chybí důkazy pro pozdější vyjasnění. Ve většině středně velkých podniků jsou tyto informace smysluplné:

  • Dodavatel a odkaz na objednávku nebo dodací list
  • Položka, přijaté množství a balicí jednotka
  • Časový okamžik a odpovědná osoba
  • Skladové místo nebo stav jako kontrola, blokovaný sklad nebo karanténa
  • Důvod odchylky, fotografie a schválení dle potřeby

Další pole by měla být povinná pouze tehdy, umožňují-li konkrétní rozhodnutí. Je-li šarže povinná, číslo šarže není doplňkem, nýbrž klíčovou informací. Naproti tomu volná poznámka u každé dodávky se často vyplňuje jen proto, aby formulář působil kompletně.

Integrace rozhoduje o poměru přínosu a nákladů

Příjem zboží nesmí vzniknout jako nové izolované řešení vedle nákupu, výroby a účetnictví. Přinejmenším kmenová data položek, otevřené objednávky a změny stavů musí být spolehlivě vyměňovány. Zda se to děje přes existující rozhraní ERP, importy dat nebo cíleně vyvinutý mezikrok, závisí na stávající systémové krajině.

U starších ERP systémů není plná integrace v reálném čase vždy ekonomická. Ověřený import v pevných intervalech může zcela postačovat, pokud to množství a termíny umožňují. U náhradních dílů, které jsou okamžitě dispozičně přiřazeny naléhavým objednávkám, je naopak důležitější téměř okamžité zaúčtování. Technika zde následuje tempo byznysu.

K plánování patří i provozní spolehlivost. Zařízení potřebují uživatelské účty, jasné role a definované chování při výpadku sítě. Mobilní příjem zboží nemusí nutně fungovat offline. Pokud však výpadky Wi-Fi nastávají pravidelně, lokální vyrovnávací paměť s dohledatelnou synchronizací není luxus, ale součást spolehlivosti procesu.

Zavádění v malých krocích místo velkého třesku

Začněte s jedním dodavatelem, jednou skupinou zboží nebo jasně vymezenou skladovou oblastí. Měřte nejen dobu na zaúčtování, ale i dopracování, nevyjasněné rozdíly a dotazy mezi skladem a kanceláří. Z toho se ukáže, zda automatizace skutečně ulehčuje.

Školte na skutečných, každodenních dodacích listech včetně poškozených nebo neúplných dodávek. Proces, který funguje jen při dokonale odpovídající dodávce, není automatizace, ale předvádění. Zaměstnanci na příjmu zboží by se měli podílet na tvorbě pravidel, protože znají výjimečné případy.

softify.pro vyvíjí takové postupy záměrně specificky podle daného workflow: od mobilního skenu přes zdokumentovaný pohyb zásob až po stabilní připojení ke stávajícím systémům. Rozhodující není nejdelší seznam funkcí, ale systém, který zůstává přehledný pod časovým tlakem a lze jej technicky provozovat a udržovat.

Nejlepším dalším krokem proto není srovnávání softwaru, ale hodinový pohled na posledních deset problematických dodávek. Pokud u každé z nich dokážete říct, kde se ztratil čas a jaká informace chyběla, první návrh lepšího příjmu zboží už existuje.

Permalink →

Výhody vychystávání s podporou čárových kódů pro malé a střední sklady

Výhody vychystávání s podporou čárových kódů pro malé a střední sklady

Chybný artikl v krabici málokdy stojí jen cenu vratky. Váže čas ve skladu, vyvolává dotazy v kanceláři a v nejhorším případě poškodí vztah se zákazníkem. Výhody vychystávání s podporou čárových kódů se proto neprojeví nejprve v technickém ukazateli, ale v klidnější expedici: zaměstnanci vědí, co mají udělat dál, a odchylky se odhalí tam, kde vznikají.

Pro malé a střední sklady je to obzvlášť důležité. Mnoho procesů zpočátku funguje s papírovými seznamy, soubory Excel, pokyny volanými přes sklad a zkušenostmi jednotlivců. To samo o sobě není špatně. Při přehledném objemu může být tabulka dokonce rozumnějším nástrojem. Jakmile však roste počet položek, objednávek, střídání směn nebo požadavky na dohledatelnost, stává se z pragmatického provizoria rychle zdroj chyb.

Co vychystávání s podporou čárových kódů mění v každodenní práci

Při vychystávání s podporou čárových kódů sken nepotvrzuje jen to, že někdo něco udělal. Propojuje zakázku, skladové místo, artikl a množství v jeden dohledatelný pracovní krok. Systém určí další pick, zaměstnanec naskenuje skladové místo a artikl, v případě potřeby zadá množství a okamžitě dostane zpětnou vazbu.

Rozhodující je pořadí kontroly. Pokud zaměstnanec naskenuje nejprve artikl a teprve potom skladové místo, systém sice rozpozná chybný artikl, ale nezabrání nevýhodné trase. V praxi se často osvědčuje pořadí skladové místo, artikl, množství. U procesů se šaržemi, sériovými čísly nebo datem minimální trvanlivosti přibývají další kontroly. Které z nich jsou nutné, závisí na riziku, nikoli na tom, co by bylo technicky možné.

Dobrý systém nenahradí smysluplné uspořádání skladu. Ukáže však, kdy se toto uspořádání v běžném provozu nedodržuje. Leží-li zboží na místě, které pro ně není určeno, chyba se neodhalí až při inventuře, ale už při skenování.

Nejdůležitější výhody vychystávání s podporou čárových kódů: méně záměn přímo tam, kde vznikají

Papírové seznamy vyžadují neustálou koncentraci: přečíst číslo artiklu, najít přihrádku, porovnat obal, odškrtnout množství. Pod časovým tlakem stačí podobné krabice, téměř totožné názvy nebo přerušený úkon a chyba je na světě. Čárový kód přináší v tomto okamžiku jednoznačnou identifikaci.

Skener přitom nenahrazuje myšlení, ale přebírá kontrolu, kterou lidé při rutinní práci nejhůře dlouhodobě udrží. Pokud artikl neodpovídá zakázce, zpětná vazba by měla být jasná: chybný artikl, očekávaný artikl, další smysluplný krok. Pouhý červený varovný signál příliš nepomůže, pokud není zřejmé, jak odchylku odstranit.

Díky zaúčtování jsou zásoby spolehlivější

Stavy zásob jsou užitečné jen tehdy, když se o ně lze opřít při rozhodování. Kdo plánuje doobjednávky, slibuje termíny dodání nebo připravuje materiál pro výrobu, potřebuje víc než číslo z minulého týdne. Pokud se výdeje přepisují ze seznamu až na konci směny nebo dodatečně, vznikají časová okna s nejasným stavem dat.

Sken může výdej zaúčtovat okamžitě. Tím se zmenšuje rozdíl mezi fyzickým pohybem a digitálním stavem zásob. Neznamená to, že každé číslo je automaticky správné. Chybně označené zboží, nezaúčtované přesuny a poškozené zásoby zůstávají reálnými tématy. Příčiny však lze výrazně lépe zúžit, protože každý pohyb má čas, zakázku a případně vazbu na uživatele.

Zvlášť užitečné je to u doplňování. Pokud stav v přihrádce klesne pod cílovou zásobu, systém může vytvořit příkaz k doplnění nebo to alespoň zviditelnit. Vychystávači pak nemusejí hledat náhradní zboží uprostřed zakázky, zatímco zákazník čeká na zásilku.

Rychlejší zaučení bez závislosti na znalostech jednotlivců

Zkušení skladníci znají trasy, zvláštní případy a vzhled artiklů zpaměti. Tyto znalosti jsou cenné, ale jako jediný provozní systém riskantní. Při dovolených, nemocech nebo růstu se týmy dostávají pod tlak, když se noví zaměstnanci musí týdny učit, kterou řadu regálů znamená interní zkratka.

Dobré mobilní rozhraní provádí zakázkou srozumitelným jazykem. Zobrazuje skladové místo, artikl, požadované množství a v případě potřeby obrázek nebo pokyny k balení. Sken krok potvrdí. Z nových kolegyň a kolegů se tím nestanou okamžitě odborníci, ale mohou mnohem dříve bezpečně pracovat.

Totéž platí pro brigádníky a střídající se směny. Předpokladem je, že kmenová data jsou udržovaná. Systém nedokáže odvodit jasný pokyn z názvu artiklu typu „díl malý modrý nový“. Digitalizace takové slabiny odhalí - a právě to bývá užitečným vedlejším efektem.

Dohledatelnost při reklamacích a inventurách

Když zákazník nahlásí chybějící množství, bez procesních dat často začíná hledání v hromadách papírů, expedičních seznamech a vzpomínkách. Díky zaúčtování pomocí čárových kódů lze ověřit, která zakázka byla kdy zpracována, která položka byla potvrzena a zda došlo ke korekci nebo dílčímu množství.

Není to záruka proti reklamacím. Zkracuje to však objasňování a odděluje domněnky od faktů. Přínos mají i inventury: rozdíly lze nejen spočítat, ale také prošetřit na základě pohybů. Pokud se korekce hromadí u určité přihrádky, skupiny artiklů nebo po určitém předání v procesu, vzniká konkrétní výchozí bod pro zlepšení.

Měřitelné procesy místo pocitů

Mnoho skladů ví, že „odpoledne je to na hraně“ nebo že některé zakázky trvají neobvykle dlouho. Bez časových razítek a procesních kroků zůstává jen pocit. Pokud se zaznamenává začátek picku, sken, přerušení, dokončení a předání, lze úzká místa jasně rozlišit.

Možná není pomalé vychystávání, ale zboží se zaskladňuje příliš pozdě. Možná vznikají čekací doby na balicím pracovišti nebo je jedna přihrádka navštěvována nepřiměřeně často. Tato data by se neměla chápat jako nástroj plošné kontroly výkonu. Jejich hodnota spočívá především v odhalení zbytečných tras, chybějícího doplňování a nejasných předání.

Přínos závisí na návrhu procesu

Vychystávání s podporou čárových kódů není samoúčelné a ne každý sklad potřebuje rozsáhlý systém řízení skladu. Při malém počtu zakázek, malém sortimentu a stálých zaměstnancích může být pečlivě vedený proces s jednoduchými seznamy hospodárnější. Projekt dává smysl tehdy, když jsou náklady na chybné picky, hledání, nejistotu stavů nebo ruční dodělávky pravidelně znatelné.

I otázka hardwaru si zaslouží střízlivý pohled. Pro první procesy může stačit chytrý telefon se skenováním kamerou. Při vysoké frekvenci skenování, práci v rukavicích, špatném osvětlení nebo drsném prostředí jsou specializované ruční skenery obvykle rychlejší a méně náchylné k chybám. Rozhodující je také pokrytí sítí. Pokud v některé zóně skladu vypadne Wi-Fi, potřebuje aplikace jasnou strategii: offline ukládání s pozdější synchronizací, nebo proces, v němž se tato oblast mobilně nezpracovává.

Kvalita etiket je stejně důležitá jako software. Čárový kód na ošoupaném štítku přihrádky nebo dvakrát přidělený identifikátor artiklu podkopává celý proces. Před spuštěním by měla být skladová místa jednoznačně označena, jednotky definovány a kritické zvláštní případy vyjasněny: Jak se zachází s načatým balením? Co se stane při chybějící zásobě? Kdo smí opravit množství? Co se děje se zbožím bez čitelného kódu?

Jak zavést systém bez přerušení provozu

Nejspolehlivějším začátkem je málokdy úplný přechod. Začněte s jasně vymezenou oblastí, například s nejčastějšími expedičními zakázkami nebo se skupinou artiklů, u níž dochází k mnoha záměnám. Tam lze pořadí skenování, chybová hlášení a etikety ověřit v reálném provozu, aniž by se najednou přestavoval celý provoz.

Před technickou realizací by se měla zmapovat skutečná cesta zakázky - od přijetí přes rezervaci a pick až po balicí pracoviště a přepravní štítek. Nerozhoduje cílový proces z organigramu, ale postup, který směna skutečně používá. Nejcennější požadavky se často skrývají v drobných výjimkách: souhrnných zakázkách, náhradních artiklech, částečném vychystání nebo vracení nepotřebného zboží.

Poté jsou potřeba jednoznačná pravidla pro výjimky. Zaměstnanec musí mít možnost nahlásit chybějící zásobu, aniž by zakázku neformálně obešel. Oprávněná osoba musí mít možnost provádět opravy dohledatelným způsobem. A pokud existují rozhraní na e-shop, ERP nebo přepravce, měly by být stav zakázky a skladová zaúčtování jasně definovány. Dvojí správa dat je varovný signál, nikoli trvalé řešení.

U systémů na míru začíná softify.pro právě v tomto bodě: ne přetíženým enterprise balíkem, ale kroky skenování a zaúčtování, které jsou pro konkrétní skladový provoz prokazatelně nutné. Udržovatelná datová základna, jasně zdokumentovaná rozhraní a srozumitelné uživatelské obrazovky mají přitom větší hodnotu než dlouhý seznam málo používaných funkcí.

Smysluplný první kontrolní bod

Vezměte deset typických zakázek a sledujte je od přijetí až po předání do expedice. Poznamenejte si, na kterých místech musí zaměstnanci hledat, doptávat se, dodatečně doplňovat data nebo spoléhat na paměť. Právě tam se rozhoduje, zda vychystávání s podporou čárových kódů přinese výhody - a jaký proces skenování skutečně sedí danému skladu.

Permalink →

Samostatně hostované testování vs cloud

Samostatně hostované testování vs cloud

Neúspěšný regresní test je zřídka jen červený záznam v přehledu. Může znamenat, že obrazovka expedice ve skladu generuje nesprávné štítky, zákaznický portál přestane přijímat objednávky, nebo aplikace Windows spadne při předání směny. Otázka self hosted testing vs cloud se proto netýká infrastruktury jako samoúčelu. Jde o to, jakých dat se testovací proces dotýká, kdo ho kontroluje, a jak spolehlivě funguje v reálných provozních podmínkách.

Cloudové testovací platformy mohou být rychle připraveny k použití. Pro mnohé týmy je to smysluplné, zejména když testují veřejně dostupnou webovou aplikaci a krátkodobě potřebují dodatečnou vykonávací kapacitu. Samostatně hostovaná testovací prostředí naopak vyžadují uvědomělé technické sestavení. Vracejí však kontrolu nad testovacími daty, síťovými cestami, přístupovými právy, a provozem zpět podniku. Správná volba nezávisí na obecné zásadě, ale na aplikaci, riziku, a dostupné provozní schopnosti.

Self Hosted Testing vs Cloud: O co skutečně jde

Debata se často příliš zužuje na počáteční náklady. Cloudové řešení působí levněji, protože není třeba pořizovat servery ani nastavovat prostředí. Vlastní testovací server působí na první pohled náročněji, protože je třeba plánovat operační systém, aktualizace, řízení přístupu, monitorování, a zálohování.

Tento výpočet je nedostatečný. Rozhodující jsou průběžné náklady testovací strategie: čekací doby před vydáními, hledání chyb po neúplných testovacích bězích, koordinace s ochranou dat a informační bezpečností, jakož i důsledky chybného nasazení. Pokud tým pravidelně zkoumá citlivé podnikové aplikace, dodatečná organizační zátěž externích služeb může být větší než provoz jasně ohraničeného vlastního prostředí.

Ani "cloud" není jednotný model. Někteří poskytovatelé ukládají jen testovací protokoly, jiní zpracovávají snímky obrazovky, videozáznamy, přístupové údaje, DOM obsah, nebo síťový provoz. Při AI podporovaném testování se navíc mohou obrazová a textová data dostat k externím modelům nebo subdodavatelům k vyhodnocení. Kdo se dívá jen na lokalitu datového centra, často přehlíží důležitější otázku: která data skutečně opouštějí vlastní kontrolní zónu, a jaká smluvní a mazací pravidla pro ně platí?

Kdy je cloudové testování rozumnou volbou

Cloudové testování není v zásadě bezpečnostní problém, a samostatné hostování není automaticky lepší architektura. Pro nový, veřejně dostupný webový obchod nebo marketingovou platformu může být cloudové prostředí velmi vhodné. Tým může rychle pokrýt varianty prohlížeče a zařízení bez udržování vlastních vykonávacích strojů. Při kolísavé testovací zátěži je elastické škálování rovněž reálnou výhodou.

I malé vývojářské týmy s malým množstvím jasně anonymizovaných testovacích dat často profitují ze spravované služby. Neměly by investovat svůj čas do provozu platformy, když úzké hrdlo spočívá spíše v chybějících testovacích případech, nejasných akceptačních kritériích, nebo nestabilních testovacích datech. Vlastní server tyto problémy neřeší.

Cloud se hodí obzvlášť dobře, když aplikace nepotřebuje interní síťový přístup, v testovacích tocích se nevyskytují žádná osobní ani obchodně kritická data, a krátká doba přípravy je důležitější než hluboká kontrola infrastruktury. Předpokladem je pečlivá konfigurace: oddělené testovací účty, žádná skutečná zákaznická data, omezené tokeny, sledovatelné doby uchovávání, a jasný koncept práv.

Kdy se samostatně hostované testování stává smysluplnějším

Jinak je tomu u aplikací, které jsou dostupné jen v podnikové síti nebo zobrazují operativní klíčové procesy. Skladový nebo výrobní software často zpracovává pohyby artiklů, dodací adresy, zásoby, sériová čísla, a cenovou logiku. Testovací běh může přitom generovat snímky obrazovky objednávkových masek, stahovat doklady, nebo se přihlašovat s uživatelskými rolemi. Taková data by neměla být nepozorovaně rozptylována přes několik externích systémů.

Samostatně hostované testování umožňuje umístit vykonávání testů blízko aplikace. Testovací server může běžet ve stejném síťovém segmentu nebo v kontrolované DMZ. Pravidla firewallu se nastavují cíleně, interní aplikace se nemusí otevírat pro externí službu, a protokoly zůstávají pod vlastní správou. To je často obzvlášť relevantní pro desktopové aplikace Windows, jelikož ty jsou zřídka navrženy pro externí testovací platformy.

Pro regulovaná odvětví, větší zákaznické požadavky, nebo interní bezpečnostní směrnice je tato architektura často snáze prověřitelná. To neznamená, že každá prověrka automaticky projde. I vlastní server potřebuje správu oprav, šifrování, práva podle rolí, zálohy, a zdokumentované provozní postupy. Rozdíl spočívá v tom, že podnik tato rozhodnutí dělá sám a umí je prokázat.

V softify.pro je proto COCO koncipován jako dedikovaný, samostatně hostovaný AI server: testovací běhy pro webové a Windows aplikace se vykonávají lokálně, důkazy se zaznamenávají, a výsledky se hodnotí ve srozumitelném jazyce. To nenahrazuje odborné schválení. Ale zajišťuje, aby testovací provoz, snímky obrazovky, a vyhodnocení mohly zůstat tam, kde si podnik ponechává suverenitu nad daty.

Správné porovnávání nákladů: provoz proti tření

Smysluplné porovnání zahrnuje více než cenu licence proti ceně hardwaru. V cloudu vznikají opakující se poplatky podle uživatelů, testovacích minut, paralelních vykonání, nebo spotřeby AI. Tyto náklady jsou zpočátku plánovatelné, ale mohou s rostoucím pokrytím testů výrazně stoupat. K tomu se přidávají možné náklady na enterprise smlouvy, smlouvy o zpracování údajů, a bezpečnostní prověrky.

Při samostatném hostování vznikají investice do infrastruktury a nastavení. To může zahrnovat virtuální stroje, úložiště, síťový přístup, monitorování, a čas technicky odpovědného týmu. Tyto náklady zůstávají i tehdy, když běží málo testů. Pro projekt se vzácnými vydáními je to dobrý argument proti předimenzovanému vlastnímu řešení.

Při pravidelném regresním testování se obraz mění. Pokud se každý týden musí kontrolovat stejné obchodně kritické pracovní postupy, vypočitatelné interní kapacity jsou často ekonomičtější než variabilní náklady platformy a manuální schvalovací smyčky. Přístup se stává obzvlášť hodnotným, když se testovací případy používají roky a dále se vyvíjejí spolu s odbornou aplikací. Udržovatelnost je tehdy důležitější než rychlý, ale těžko kontrolovatelný začátek.

Kvalita nezávisí na modelu hostování

Častý omyl říká: cloudové testy jsou automaticky modernější, samostatně hostované testy automaticky stabilnější. Ani jedno není pravda. Kvalita testů vzniká ze smysluplných scénářů, odolných testovacích dat, stabilních identifikátorů v rozhraní, a jasných očekávání výsledku.

Test by neměl jen kontrolovat, zda je tlačítko klikatelné. Pro zpracování objednávky může například vytvořit objednávku, zkontrolovat dostupné množství, vygenerovat dodací list, a zajistit, aby správná role směla schválit operaci. U desktopového programu může ověřit import souboru, zpracování chyb, a výstup dokumentu. Až takové end-to-end toky ukazují, zda změna poškodila reálný proces.

AI může přitom pomoci rozpoznávat změny rozhraní, srozumitelně dokumentovat kroky, a prioritizovat anomálie. Neměla by se však stát černou skříňkou. Týmy potřebují snímky obrazovky nebo jiné důkazy, sledovatelné testovací kroky, a definované prahové hodnoty pro to, kdy se výsledek počítá jako úspěšný, nejistý, nebo neúspěšný. Právě u vizuálních kontrol je práh spolehlivosti smysluplný, aby malé, očekávané odchylky rozvržení neblokovaly každé vydání.

Provozní otázky před rozhodnutím

Předtím, než se tým rozhodne, měl by konkrétně zaznamenat cestu testovacího běhu. Kde běží test? Do kterých systémů se přihlašuje? Jaká data vidí? Kde se ukládají snímky obrazovky, protokoly, a zprávy? Kdo smí číst, mazat, nebo exportovat výsledky? Tyto otázky jsou praktičtější než paušální rozhodnutí pro nebo proti cloudu.

Stejně důležitá je odpovědnost po spuštění. Kdo aktualizuje prohlížeče a testovací agenty? Kdo reaguje, když certifikát vyprší? Jak se rotují přístupové údaje? A jak se zajišťuje, aby test náhodou nespustil skutečné zaúčtování expedice nebo zákaznické oznámení? Dobrá automatizace testů potřebuje oddělená prostředí a ochranné mechanismy, nejen dobré skripty.

Hybridní model může být smysluplný. Veřejná rozhraní a široce rozšířené kontroly prohlížeče běží v cloudu, zatímco interní odborné procesy zůstávají na vlastním testovacím serveru. To snižuje provozní zátěž, bez paušálního odevzdání citlivých toků navenek. Předpokladem je jasná hranice mezi oběma oblastmi, ne nepřehledný smíšený provoz.

Nejlepší rozhodnutí je to, které odpovídá skutečnému riziku a vlastní provozní realitě. Pokud tabulka ještě stále spolehlivě nese proces, nemusí se z ní stát velký systém. Pokud však testovací data a interní aplikace patří k obchodnímu jádru, kontrola není luxus, ale věcný požadavek na spolehlivý software.

Permalink →

Inventory Management ve skladu

Inventory Management ve skladu

Chybějící díl se při počítání ve skladu zřídka zpozoruje. Většinou se ukáže až tehdy, když objednávku nelze zabalit, montér stojí před prázdným regálem, nebo nákup telefonicky hledá potvrzení dodání. Dobrý Inventory Management nezabraňuje těmto překvapením více tabulkami, ale spolehlivým obrazem toho, co je k dispozici, kde se to nachází, a co se s tím dále děje.

Pro malé a střední podniky to není otázka co největšího ERP systému. Rozhodující je, zda zaměstnanci při příjmu zboží, ve skladu, a při expedici mohou pracovat s několika jasnými kroky - i pod časovým tlakem, přes změny směn, a když dodávka dopadne jinak, než bylo plánováno.

Inventory Management začíná pohyby, ne seznamy zásob

Seznam zásob je okamžitý snímek. Může být správný a přesto málo pomoct, pokud nikdo nedokáže vysledovat, proč se množství změnilo. Odolný systém proto považuje zásoby za důsledek zdokumentovaných pohybů: zboží přichází, kontroluje se, uskladňuje, rezervuje, kompletuje, přesouvá, expeduje, nebo opravuje.

Každý pohyb potřebuje jasný důvod, časový údaj, odpovědnou osobu, a podle možnosti souvislost s konkrétní transakcí. To může být objednávka nákupu, objednávka zákazníka, dodací list, nebo výrobní příkaz. Díky tomu se z čísla "24 kusů dostupných" stává ověřitelné tvrzení: 30 kusů bylo zaúčtováno, čtyři jsou rezervovány pro dvě objednávky, a žádný otevřený přesun nezkresluje dostupnou zásobu.

Toto rozlišení je obzvlášť relevantní u nedostatkových dílů. Fyzicky přítomné, rezervované, a volně dostupné jsou tři různé stavy. Pokud se smíchají, prodej slibuje zboží, které sklad již potřebuje pro jinou objednávku. Pokud se vedou čistě, tým se může včas rozhodnout: doobjednat, přeprioritizovat, nebo dát zákazníkovi realistickou odpověď.

Kde se manuální procesy typicky lámou

Tabulky nejsou zásadně nesprávné. Pro malý sortiment, jedno skladové místo, a málo pohybů týdně mohou být ekonomičtější než vlastní aplikace. Stávají se problematickými, jakmile současně pracuje více osob nebo se zásoby aktualizují z více zdrojů.

Tehdy vznikají známé mezery: příjem zboží leží jako papír na stole, Excel soubor byl lokálně změněn, přesun byl dohodnut jen ústně, a expedice zaúčtuje až po pracovní době. Zásoba není nutně nesprávná, ale je časově posunutá a její původ je nejasný. Právě to ji činí nevhodnou pro operativní rozhodnutí.

Také organizační struktura hraje roli. Centrální místo potřebuje jiné procesy než podnik s externími sklady, servisními vozidly, nebo výrobou, která odebírá materiál. Kdo tyto rozdíly zobrazuje jedním sloupcem volného textu, přesouvá logiku do hlav jednotlivých zaměstnanců. To funguje, dokud ta osoba nemá dovolenou nebo se objem objednávek nezvýší.

Určit proces před softwarem

Smysluplný projekt nezačíná otázkou, který skener se koupí nebo které rozhraní vypadá moderně. Nejprve musí být jasné, které rozhodnutí má systém podporovat. K tomu často stačí konkrétní pozorování z každodenní praxe: jak se dnes přijímá zboží? Kdy se považuje za zkontrolované? Kdo smí opravovat zásoby? Co se děje s poškozeným zbožím? A v kterém bodě se objednávka závazně rezervuje?

Z těchto odpovědí vzniká několik závazných pravidel. Například příjem zboží smí být zaúčtován až po kontrole množství. Artikly bez skladového místa se nesmí zobrazovat jako připravené k uskladnění. Opravy zásob vyžadují kód důvodu a zůstávají viditelné v historii. Expedované zboží se nemaže tichým způsobem, ale přiřazuje se objednávce prostřednictvím zdokumentovaného odpisu.

To je méně efektní než velká prezentace digitalizace, ale v provozu podstatně cennější. Když jsou pravidla jednoznačná, software je může spolehlivě kontrolovat. Když zůstávají nejasná, každá nová aplikace jen urychluje protichůdné pracovní kroky.

Kmenová data: začít malým, důsledně udržovat

Ne každý artikl potřebuje na začátku deset klasifikací. Použitelný základ tvoří často číslo artiklu, označení, jednotka, aktivní skladový stav, a jedno nebo více skladových míst. V závislosti na podnikání přibývají šarže, sériová čísla, minimální zásoby, čísla artiklů dodavatele, nebo data expirace.

Důležitá je důslednost, ne množství polí. Dvě čísla artiklu pro tentýž fyzický artikl, nebo měnící se jednotky jako "karton", "balení", a "kus" bez pravidla přepočtu, generují pozdější chyby téměř automaticky. Systém může technicky povolit taková zadání. Měl by je omezit tam, kde ohrožují průběh.

Které funkce skutečně pomáhají ve skladu

Pro mnohé středně velké sklady je jasné jádro cennější než přetížený katalog funkcí. Toto jádro obvykle zahrnuje čtyři oblasti:

  • Příjem zboží s referencí objednávky, kontrolou množství, a uskladněním
  • Skladové pohyby mezi definovanými místy a oblastmi
  • Rezervaci objednávky, kompletaci, a potvrzení expedice
  • Inventuru a opravy zásob se sledovatelnou historií

Doplňkově může tisk štítků, skenování čárových kódů, dodací listy, přepravní štítky, nebo předání účetnictví a systémům obchodu ušetřit hodně času. Ale měly by stavět na čistém pohybovém modelu. Rychlý tisk štítků málo pomůže, pokud skenování nepřiřadí artikl jednoznačně správnému skladovému místu nebo objednávce.

Při obsluze je důležité i prostředí. Zaměstnanec s rukavicemi při příjmu zboží potřebuje velké, jednoznačné akce a co nejméně textového vstupu. Dispečerka na pracovišti naopak potřebuje filtry, vyhledávací funkce, a přehled otevřených transakcí. Obě role smí používat stejná data, ale nepotřebují stejné rozhraní.

Reálný čas neznamená, že každé číslo je nezpochybnitelné

Mnohé podniky si přejí zásoby v reálném čase. To je smysluplné, ale pojem se často používá příliš hrubě. Zásoba se může aktualizovat bezprostředně po každém skenování a přesto být nesprávná, pokud proces zůstává neúplný. Pokud se zboží skenuje, ale nekontroluje, číslo je technicky aktuální a operativně sporné.

Proto každý systém potřebuje zacházení s výjimkami. Rozdíly při příjmu zboží, poškozené obaly, vratky, a nenajitelné artikly nejsou okrajové případy. Patří do každodennosti. Dobré procesy je viditelně označují, místo aby nutily zaměstnance k improvizovaným vedlejším seznamům.

I oprávnění si zaslouží pozornost. Ne každá osoba by měla umět měnit kmenová data artiklů nebo opravovat historická zaúčtování. Praktický koncept práv odděluje rutinní operace od zásahů s vyšším rizikem. To chrání nejen před chybami, ale usnadňuje i analýzu příčin, když zásoba neočekávaně odchýlí.

Integrace jen tam, kde zlepšuje průběh

Inventory Management zřídka stojí sám. Objednávky mohou přicházet z internetového obchodu, e-mailového zaznamenávání, odvětvového řešení, nebo přímo z prodeje. Přepravci potřebují adresní údaje a hmotnosti. Účetnictví očekává doklady v určité formě.

Integrace se vyplatí, když eliminuje dvojité zadávání nebo snižuje zdroje chyb. Není automaticky smysluplná jen proto, že je k dispozici rozhraní. Zejména u organicky vyrostlých procesů může být jasný import s kontrolou spolehlivější než trvalé propojení v reálném čase, které nepozorovaně přenáší chybná data.

Technicky by řešení mělo zůstat sledovatelné: jednoznačná rozhraní, zaznamenávané přenosy, srozumitelné chybové zprávy, a struktura databáze, která neskrývá změny. S dobře udržovanou aplikací na základě PHP 8.4 a MySQL 8 se takové procesy dají realizovat úsporně, aniž by se týmy nutily do globálního koncernového systému. Rozhodující není technologické označení, ale zda zůstanou údržba, rozšíření, a opravy dat kontrolovatelné i za tři roky.

Zavedení v malých, měřitelných krocích

Big bang je ve skladu zřídka nejlepší volbou. Bezpečnější je ohraničený start, například s příjmem zboží a jednou vybranou skladovou oblastí. V této fázi lze pozorovat skenovací časy, typy chyb, otevřené speciální případy, a kvalitu kmenových dat. Až poté následuje rezervace, expedice, nebo další lokality.

Paralelní provoz může být přitom smysluplný, ale jen s jasným koncem. Dvě vedoucí zásoby po delší dobu vytvářejí přesně ten problém, který má nové řešení odstranit. Lepší je stanovený přechod s inventurou, vyčištěnými kmenovými daty, a odpovědnostmi pro první týdny.

Úspěch se neprojevuje v tom, kolik funkcí bylo aktivováno. Projevuje se v tom, zda vzniká méně zpětných dotazů, zda se objednávky balí kompletněji, a zda tým dokáže bez detektivního pátrání vysvětlit, proč zásoba artiklu vypadá tak, jak vypadá.

Pokud aktuální proces s dobře udržovanou tabulkou skutečně funguje stabilně, měl by smět zůstat. Ale pokud se informace nadále ztrácejí mezi papírem, telefonáty, a několika soubory, dalším smysluplným krokem není větší nástroj, ale jasný průběh, který zviditelňuje každý důležitý skladový pohyb.

Permalink →

Jsou samostatně hostované testy bezpečné?

Jsou samostatně hostované testy bezpečné?

Neúspěšný regresní test je otravný. Snímek obrazovky z interního ERP systému, který nekontrolovaně skončí u externí služby, je bezpečnostní incident. Právě proto si QA vedoucí a IT odpovědní kladou otázku: are self hosted tests secure? Upřímná odpověď zní: mohou být výrazně bezpečnější než cloudové alternativy, ale jen pokud se provoz bere stejně vážně jako samotné testy.

Samostatně hostovaná automatizace testů přesouvá kontrolu nad prováděním, testovacími daty, snímky obrazovky, protokoly, a přístupovými právy do vlastní infrastruktury. To snižuje závislosti a zbytečné datové cesty. Nenahrazuje to však bezpečnostní architekturu. Špatně udržovaný interní testovací server zůstává špatně udržovaným serverem.

Jsou self-hosted testy bezpečnější než cloudové testy?

Rozhodující rozdíl není v tom, zda test běží lokálně nebo automatizovaně. Je v tom, kde jsou data zpracovávána, kdo k nim může přistupovat, a jaké technické hranice platí.

U externě provozované testovací služby firmu často opouští několik artefaktů: přístupové údaje pro testovací účty, URL adresy interních aplikací, DOM obsah, snímky obrazovky, videa z testovacích běhů, chybové protokoly, a případně výpisy z databází. I když poskytovatel splňuje vysoké bezpečnostní standardy, vzniká dodatečný vztah důvěry a smluvní vztah. Pro aplikace se zákaznickými, personálními, produkčními, nebo finančními daty to může být relevantní překážka.

Samostatně hostovaný systém lze provozovat v rámci vlastní sítě nebo jasně ohraničeného prostředí EU. Testovací instance přistupuje přímo ke staging, akceptačním, nebo izolovaným testovacím systémům. Testovací důkazy zůstávají tam, kde se nachází i aplikace a její provozní odpovědnost. To je obzvlášť smysluplné při testování desktopových Windows aplikací, interních webových portálů, nebo systémů s citlivými procesními daty.

Ale samostatné hostování není automaticky bezpečnější. Kdo provozuje testovací server s otevřeným vzdáleným přístupem, společně používanými administrátorskými účty, a trvale platnými hesly, pouze přesunul rizika. Otázka tedy nezní jen: cloud nebo on-premises? Ale: je testovací prostředí prokazatelně zabezpečeno a trvale udržovatelné?

Are self hosted tests secure? Záleží na těchto hranicích

Bezpečná testovací platforma potřebuje jasné technické a organizační hranice. Pro malé a střední podniky to nemusí vypadat jako koncernový program. Musí to být jen důsledně implementováno a zdokumentováno.

Oddělit testovací prostředí od produkčního provozu

Automatizované testy mají nacházet chyby, ne spouštět objednávky, měnit dodací listy, nebo knihovat skladové pohyby. Proto testy potřebují oddělené prostředí s vlastními rozhraními, testovacími nájemci, a testovacími daty. Kde není potřeba úplná kopie produkce, je to často dokonce zbytečně rizikové.

Pro skladový nebo objednávkový portál to může znamenat: testovací uživatelé smí zaznamenávat příjmy zboží a generovat přepravní štítky, ale vygenerované dokumenty nejdou k žádné skutečné tiskárně ani žádnému skutečnému spedičnímu partnerovi. API klíče ukazují na sandbox koncové body. Odesílání e-mailů je zachycováno nebo omezeno na interní příjemce. Tak zůstává test smysluplný bez vytváření provozních důsledků.

Oddělení by mělo platit i na úrovni sítě. Testovací server potřebuje jen ta spojení, která skutečně vyžaduje. Paušální přístup do celé interní sítě je pohodlný, ale zřídka odůvodnitelný. Segmentace omezuje škodu, pokud je testovací účet nebo komponenta systému kompromitována.

Zacházet s přístupovými údaji jako s produkčními přístupy

Automatizace testů často potřebuje přihlašovací údaje. To je normální, ale tato data nepatří do testovacích skriptů, konfiguračních souborů ve zdrojovém kódu, nebo historií chatů. Hesla, tokeny, a certifikáty by se měly načítat z kontrolované správy tajemství. Testovací účty dostávají jen práva, která konkrétní proces vyžaduje.

I přístup k samotné testovací platformě potřebuje role. Vývojář možná musí spouštět testovací běhy a číst výsledky, ale neměnit síťovou konfiguraci. Odborný útvar může prohlížet zprávy, ale nepotřebuje přístup k uloženým přihlašovacím údajům. Administrátorská práva by měla být vázána na osoby, ne navázána na sdílený účet.

Navíc k minimálnímu standardu patří vícefaktorové přihlášení, přiměřená pravidla hesel, a toky uzamčení účtu. Právě testovací systémy jsou často považovány za méně kritické. Útočníci to vidí jinak: rádi využívají testovací prostředí jako vstupní bod, protože se tam nacházejí přístupy, interní názvy, a technické detaily.

Minimalizovat testovací data a cíleně maskovat

Nejčastější chybou není chybějící metoda šifrování, ale příliš mnoho skutečných informací v testovacím fondu. Pro většinu regresních testů nikdo nepotřebuje skutečná jména zákazníků, skutečné adresy, nebo úplné personální spisy. Syntetické datové sady, maskované kopie, a vědomě vytvořené speciální případy často stačí.

Existují výjimky. Některé chyby se objevují jen u skutečných datových struktur, neobvyklých řetězců znaků, nebo složitých konstelací oprávnění. Tehdy může být smysluplná kontrolovaná, pseudonymizovaná kopie. Rozhodující je, že toto rozhodnutí je učiněno vědomě a má lhůtu smazání. Testovací databáze by neměly běžet roky jako zapomenutá stínová kopie produkce.

Snímky obrazovky a videa si zaslouží stejnou pozornost. Jsou cenné pro hledání chyb, ale mohou zobrazovat údaje o účtu, interní ceny, nebo osobní obsahy. Stanovte, které artefakty se zaznamenávají, kdo je smí vidět, a kdy se automaticky smažou. Testovací zpráva nemusí ukládat každý snímek obrazovky navždy, aby byla důkazní.

Provozovat server jako produkt

Samostatně hostovaný testovací server není zařízení, které se jednou nainstaluje a pak zapomene. Provozní bezpečnost vzniká opakovatelnou péčí: včasné bezpečnostní aktualizace pro operační systém, prohlížeč, testovací runner, a závislosti; šifrovaná datová média a přenosové cesty; monitorované zálohy; centrální protokolování; jakož i jasné zacházení s bezpečnostními upozorněními.

Obzvlášť u testů řízených prohlížečem je relevantní rytmus aktualizací. Zastaralé prohlížečové jádra a automatizační knihovny mohou obsahovat známé zranitelnosti nebo činit testy nespolehlivými. Obojí stojí čas. Zdokumentovaná nasazení a pevná servisní okna proto nejsou byrokratický doplněk, nýbrž základ pro reprodukovatelné výsledky.

Pro dedikovaný AI testovací server jako COCO platí totéž. Lokální provádění nechrání citlivý obsah aplikace magií. Vytváří kontrolu nad tím, kde se zpracovává AI podporované vyhodnocení, snímky obrazovky, a testovací protokoly. Tato kontrola musí být naplněna správou oprav, oprávněními, síťovým oddělením, a jasnými pravidly uchovávání.

Kde má samostatné hostování své hranice

Cloudové služby nejsou z definice nebezpečné. Specializovaný poskytovatel může nabídnout více bezpečnostního personálu, vyspělejší dohled, a profesionálnější redundanci než podnik s jedinou přetíženou IT rolí. Kdo nemá kapacitu pro provoz, aktualizace, a reakci na incidenty, může se špatně udržovaným samostatně hostovaným systémem vytvořit vyšší riziko.

Na druhou stranu mnohé externí testovací platformy jednoduše nejsou dobrým procesním přizpůsobením pro interní odborné aplikace. Pokud je aplikace dostupná jen ve firemní síti, pokud testovací běhy zobrazují důvěrné masky a doklady, nebo pokud data nemají opustit vlastní kontrolní oblast, lokální provoz je často jasnějším řešením.

Rozumné rozhodnutí závisí na potřebě ochrany a na provozní schopnosti. Pro veřejnou marketingovou stránku bez citlivých přihlášení může být cloudová testovací služba přiměřená. Pro interní dispoziční software, zákaznický portál s osobními údaji, nebo Windows aplikaci v produkční síti mluví hodně ve prospěch kontrolovaného, samostatně hostovaného prostředí.

Praktická bezpečnostní kontrola před startem

Předtím, než se zavedou automatizované testy, by měl odpovědný pracovník umět odpovědět na tyto otázky bez hádání:

  • Ke kterým systémům, databázím, a rozhraním smí testovací server přistupovat?
  • Jaká data se objevují ve snímcích obrazovky, videích, protokolech, a AI vyhodnoceních?
  • Kde se nacházejí přístupové údaje, a kdy se rotují?
  • Kdo smí spouštět testovací běhy, číst výsledky, a administrovat systémy?
  • Jak rychle se nasazují kritické aktualizace, a jak se to kontroluje?
  • Kdy se smažou testovací artefakty a již nepotřebná data?

Tyto otázky působí věcně. Přesně to je jejich hodnota. Bezpečnost vzniká zřídka díky jedinému nástroji nebo působivému architektonickému diagramu. Vzniká, když odpovědnosti, datové toky, a technické hranice zůstávají ověřitelné v každodenní praxi.

Kdo buduje automatizaci testů, měl by nejprve objasnit potřebu ochrany aplikace a poté zvolit nejmenší smysluplnou architekturu. Čistě ohraničený testovací server s málo oprávněnými účty je často hodnotnější než přetížená platforma, kterou nikdo nedokáže spolehlivě udržovat. Boring, provable reliability porazí i v testování spektakulární, ale neprůhledné řešení.

Permalink →

Warehouse Management Systems: Co skutečně záleží

Warehouse Management Systems: Co skutečně záleží

Když zaměstnanec při příjmu zboží zapíše stejnou dodací položku na papír, později ji přenese do tabulky, a pak vykřičí přes uličku, kam se uskladní, málokdy chybí ochota pracovat. Chybí společný proces. Warehouse Management Systems vytvářejí tento proces tím, že dokumentují pohyby zboží, zásoby, a navazující úkoly na jednom místě. Pro malé a střední firmy není rozhodující nejdelší seznam funkcí, ale to, zda software spolehlivě zobrazuje cestu zboží vlastním skladem.

Co musí Warehouse Management Systems dosahovat v každodenním provozu

Warehouse Management System, zkráceně WMS, není jednoduše lepší seznam zásob. Řídí nebo dokumentuje fyzické procesy ve skladu: příjem zboží, kontrolu kvality, uskladnění, přesun, kompletaci, balení, expedici, a inventuru. Každé zaúčtování odpovídá na jednoduchou operativní otázku: co je kde, v jakém množství, v jakém stavu, a kdo vyvolal pohyb?

Tato jasnost působí na první pohled banálně. Ale zabraňuje typickým řetězcům chyb. Artikl je sice dodán, ale ještě není zkontrolován. Paleta stojí při příjmu zboží, ale v systému je již vedena jako dostupná. Objednávka se kompletuje, ačkoli zboží by mělo být rezervováno pro důležitější zákaznickou objednávku. Bez jasně definovaných stavů a pohybů z jedné jediné nejasnosti rychle vznikne nesprávný příslib dodání.

Pro mnohé středně velké sklady přínos nezačíná plně automatizovaným řízením. Již sledované úkoly uskladnění, jednoznačná skladová místa, a mobilní zaúčtování mohou výrazně zkrátit časy hledání. Rozhodující je, aby zaměstnanci už nemuseli překládat mezi papírem, telefonem, e-mailem, a několika tabulkami.

Ne každý sklad potřebuje velkou sadu

Trh nabízí rozsáhlé podnikové systémy s funkcemi pro globální sítě s více lokalitami, komplexní celní odbavování, automatizovanou dopravníkovou techniku, a velmi jemnou optimalizační logiku. To může být správné, pokud tyto požadavky skutečně existují. Ale pro podnik s jedním nebo několika sklady, měnícími se prioritami, a zaběhnutými zvláštními procesy může taková sada vytvořit více tření než užitku.

Náklady pak nespočívají jen v licencích. Vznikají v dlouhých projektech zavádění, rozsáhlých úpravách, školeních, a závislosti na externích specialistech. Ani systém se sto nastaveními neřeší problém, pokud vedoucí směn musí pro běžné opravy otevřít tiket.

Alternativa nemusí nutně znamenat úplný individuální vývoj. Standardní produkt může být smysluplný, když jeho základní procesy vyhovují a úpravy zůstávají vědomě omezené. Stejně tak existující tabulka může nadále být nejlepším řešením, například pro vzácné, přehledné vyhodnocení. Kritickou se stává až tehdy, když s ní současně pracuje více osob, zaznamenává pohyby se zpožděním, nebo má tabulka být provozní pravdou o dostupném zboží.

Správné řešení se řídí skutečným objemem procesů a náklady na chyby. Pět nesprávných kompletací týdně znamená něco jiného ve skladu náhradních dílů s časově kritickými zákaznickými objednávkami než pět odchylek v pomalu rotujícím archivním zásobě.

Nejprve zaznamenat procesy, ne vybírat obrazovky

Mnohé WMS projekty začínají produktovou ukázkou. Tam odpovědní vidí elegantní přehledové panely, pohledy skeneru, a barevné ukazatele. Užitečnější je nejprve procházka skladem během běžného pracovního dne. Kde přichází zboží? Kdo kontroluje množství a poškození? Kdy artikl dostane své číslo šarže nebo sériové číslo? Jak se rozhoduje, na které místo jde? A co se stane, když realita odchyluje se od objednávky?

Tyto otázky kladou základ pro řešení, které bude později akceptováno. Dobře zdokumentovaný cílový proces nepopisuje jen ideální případ. Obsahuje i výjimky: částečné dodávky, poškozené zboží, neohlášené dodávky, nedostatky zásob, vratky, a blokované zásoby. Právě tyto případy rozhodují o tom, zda zaměstnanci důvěřují systému, nebo sáhnou znovu po lístečcích.

Stavy jsou důležitější než hezká rozhraní

Čistá datová sada rozlišuje například "očekávaný", "přišlý", "v kontrole", "uskladněný", "rezervovaný", "kompletovaný", a "expedovaný". Které stavy jsou potřeba, závisí na podniku. Příliš málo zakrývá relevantní rozdíly. Příliš mnoho zpomaluje zaúčtování a obchází se.

Pravidlo by mělo znít: každý stav musí mít operativní důsledek. Pokud je zboží blokované, nesmí být kompletováno. Pokud je rezervované, musí být viditelné, pro kterou objednávku. Pokud je uskladněné, musí být zaznamenáno skladové místo. Tak se datová pravidla stávají praktickou spolehlivostí procesu.

Skenery pomáhají jen při jasných zaúčtováních

Čárové kódy a mobilní zařízení snižují překlepy a urychlují pohyby. Ale nenahrazují rozhodnutí o procesu. Skenování musí vyvolat srozumitelnou akci: zkontrolovat artikl, potvrdit množství, vybrat cílové místo, nebo dokončit objednávku. Pokud zaměstnanec musí po každém skenování hádat, jaká obrazovka následuje, tok je navržen příliš komplikovaně.

I otázka hardwaru by měla být zodpovězena pragmaticky. Pro některé týmy postačují smartphony s vhodnou funkcí skenování a pevným ochranným pouzdrem. Jiné potřebují průmyslové ruční skenery, protože rukavice, chlazení, pády, nebo dlouhé směny to vyžadují. Pilotní projekt na skutečné skladové ploše ukáže více než prezentace za stolem.


Technický základ rozhoduje po spuštění

WMS musí fungovat správně i tehdy, když se současně zaúčtovávají příjmy zboží, kompletují objednávky, a kontrolují zásoby. Z toho vyplývají požadavky, které se v raných rozhovorech často ztrácejí: jednoznačné záznamy pohybů, oprávnění podle rolí, sledovatelné opravy, spolehlivá rozhraní, a zálohy, které jsou v nouzové situaci skutečně obnovitelné.

Zásoba by neměla být jednoduše přepsána. Lepší je model pohybu: příjem, výdej, přesun, blokace, nebo oprava generují každá zaznamenaný záznam. Tím se dá později sledovat, proč se množství odchyluje. To je stejně cenné pro inventury jako pro objasnění případu zákaznické reklamace.

Oprávnění musí odpovídat odpovědnosti. Kompletátor potřebuje jiné funkce než vedoucí skladu, který schvaluje opravy zásob. Pro kritické změny jsou smysluplná zdůvodnění, schválení na čtyři oči, nebo alespoň neměnný protokol změn. Úsilí závisí na rizikovém profilu, ale otázka by měla být objasněna před začátkem.

Rozhraní si zaslouží stejnou pozornost. Sklad pracuje zřídka izolovaně. Objednávky přicházejí z obchodu, ERP, nebo strukturovaného importu. Údaje o přepravě jdou do systémů dopravců, generují se dodací listy a štítky, údaje o zásobách se vrací zpět. Každé rozhraní potřebuje jasné odpovědnosti pro případy chyb. Co se stane, pokud byl vygenerován přepravní štítek, ale potvrzení se nedostane do WMS? Bez logiky opakování a viditelné fronty chyb zůstávají takové případy zaseklé u jednotlivých osob.

Pro řešení na míru nejsou udržovatelné technologie vedlejší věcí. Sledovatelná aplikace s jasnou strukturou databáze, zdokumentovanými nasazeními, a testovanými integracemi zůstává zvládnutelná i po personálních změnách. Trendová architektura nepomůže, pokud nikdo nedokáže vysledovat chybný import.

Zavádění v malých, kontrolovatelných krocích

Big bang vytváří vyhnutelné riziko. Často je smysluplnější nejprve digitalizovat ohraničený proces, například příjem zboží pro jednu produktovou skupinu nebo kompletaci v jedné skladové oblasti. Tým přitom ověřuje nejen funkce, ale i formulace, cesty skenování, chodby, a odpovědnosti.

Kmenová data jsou zde často skutečným staveništěm. Čísla artiklů musí být jednoznačná, měrné jednotky konzistentní, skladová místa smysluplně strukturovaná, a balicí jednotky jasně definované. Systém nemůže dodávat spolehlivé zásoby, pokud se stejný artikl objevuje pod třemi různými označeními, nebo "bedna" znamená různá množství podle dodavatele.

Během pilotní fáze by měly ukazatele zůstat jednoduché: jak dlouho trvá příjem zboží? Kolik zaúčtování je třeba opravit? Kolik kompletací je chybných? Jak často se zboží hledá? Ne každé zlepšení se okamžitě projeví jako velká nákladová položka. Méně zpětných dotazů a spolehlivější informace o dodání mohou už odlehčit podstatný tlak z každodenního provozu.

Školení funguje nejlépe přímo u procesu. Zaměstnanci nepotřebují abstraktní provedení přes všechny položky menu. Musí vědět, jak zaúčtovat svou další dodávku, nahlásit odchylku, nebo opravit nesprávné skenování. Pro první směny po spuštění by měla být dostupná odpovědná osoba, která dokáže rychle přijímat rozhodnutí.

Správná otázka pro výběr

U Warehouse Management Systems ústřední otázka nezní: který software umí nejvíc? Zní: které pracovní postupy musí být pro náš tým každý den rychlejší, jednoznačnější, a sledovatelnější?

Kdo tyto pracovní postupy nejprve jasně popíše, může věcně zhodnotit standardní software, rozšíření, nebo aplikaci na míru. Výsledek nemusí působit spektakulárně. Měl by zajistit, aby zboží našlo svou cestu, zásoba zůstala důvěryhodná, a lidé ve skladu trávili méně času hledáním, dotazováním, a dodatečnou opravou.

Permalink →

Custom Logistics Software vs Spreadsheets

Custom Logistics Software vs Spreadsheets

Příjem zboží přichází dříve, než bylo ohlášeno, dva zaměstnanci souběžně mění stejný seznam zásob, a řidič čeká na dodací list, jehož poslední verzi nikdo neumí s jistotou pojmenovat. Takové situace rozhodují otázku "custom logistics software vs spreadsheets" ne teoreticky, ale mezi příjmem zboží, skladovou pozicí, a rampou.

Tabulky nejsou zásadně problém. Rychle se vytvářejí, jsou všem známé, a často překvapivě účinné pro jasně ohraničené úkoly. Stávají se problematickými, když mají sloužit jako operační systém rostoucího skladového nebo distribučního procesu. Tehdy se ze souboru stává kritický proces - bez závazných pravidel, dohledatelných stavů, nebo pevné historie.

Kdy jsou tabulkové kalkulace ve skladu správnou volbou

Tabulka má smysl, když je proces přehledný, vzácný, a řízený malým počtem osob. To může být například měsíční plánování potřeb, jednorázová příprava inventury, nebo hodnocení cen dodavatelů. Může stačit i pro malou zásobu s jedním odpovědným, pokud se změny nedějí pod časovým tlakem a žádné navazující procesy na ní automaticky nezávisí.

Výhoda není jen v nízkých licenčních nákladech. Týmy mohou přizpůsobit sloupce, kontrolovat výpočty, a nastavit nový formulář během několika minut. Kdo ještě nepochopil stabilní proces, neměl by se ukvapovat s jeho přeléváním do softwaru. Dobrá tabulka může nejprve zviditelnit, která data jsou skutečně potřeba a která pole se udržují jen ze zvyku.

Bylo by proto chybou zacházet s každým Excel souborem jako s resty. Rozhodující otázka zní: je tabulka pracovním nástrojem pro jednu osobu nebo sdíleným zdrojem pro provozní rozhodnutí? Jakmile na stejných datech závisí více rolí, riziko výrazně stoupá.

Custom Logistics Software vs Spreadsheets: Bod zlomu

Změnu obvykle nespouští počet řádků. Tabulka s 20 000 položkami může fungovat, zatímco soubor s 200 řádky už vede k chybám. Rozhodující je souběžnost, kroky procesu, a důsledky nesprávné informace.

Typickým varovným signálem je otázka verzí. Pokud se zásoby, otevřené objednávky, nebo termíny dodání nacházejí v souborech s názvy jako "finální_nová", "finální_nová2", a "opravdu_finální", nechybí lepší struktura složek. Chybí závazný stav dat. Totéž platí, když si zaměstnanci musí telefonovat, aby zjistili, zda zboží dorazilo, zda byla objednávka uvolněna, nebo zda bylo vozidlo již naloženo.

Bod zlomu je dosažen, když jeden vstup spouští více navazujících akcí. Příjem zboží pak nemění jen číslo v zásobě. Může spustit kontrolu kvality, přiřadit skladovou pozici, označit objednávku jako částečně dodanou, a zobrazit prodeji dostupný artikl. Pokud jsou tyto kroky koordinovány manuálně přes soubory, papír, a telefonáty, odchylkám se lze těžko vyhnout.

Obzvlášť kritické se to stává při směnných výměnách a absencích. Když jen jedna zkušená osoba ví, které barevné označení v seznamu znamená blokaci, nebo který vzorec počítá bezpečnostní zásobu, proces není robustní. Funguje jen dokud je tato osoba k dispozici.

Co software na míru skutečně dělá lépe

Logistický software na míru není jednoduše tabulka s pěkným rozhraním. Jeho hodnota vzniká z kontrolovaných pracovních postupů. Každé zaúčtování dostane jednoznačný časový údaj, odpovědnou osobu, a dohledatelný stav. Zaměstnanci nevidí jen data, ale další povolenou akci.

Při příjmu zboží to může v praxi znamenat: výběr dodávky, zaznamenání množství, zdokumentování odchylky, vytištění štítku, a potvrzení uskladnění. Teprve poté se zásoba uvolní. Pro kompletaci může systém seskupit objednávky podle priority, zobrazit skladové pozice ve smysluplném pořadí, a vytvořit dodací list až, když jsou položky potvrzeny.

Nejde o zbytečnou složitost. Zabraňuje to tomu, aby byl stejný artikl rezervován dvakrát, aby se částečná dodávka počítala jako kompletní, nebo aby se dodací list vytiskl na základě zastaralých dat. Pomáhají i jednoduchá pravidla: povinná pole pro šarže, důvody blokace pro poškozené zboží, kontroly věrohodnosti u množství, a oprávnění pro opravná zaúčtování.

Dobře naplánovaná aplikace nepokrývá hned každý zvláštní případ. Soustředí se na procesy, které denně stojí čas nebo pravidelně produkují chyby. Pro jednu firmu to může být správa pohybů kontejnerů, pro jinou rychlé zaznamenávání příchozího zboží mobilními zařízeními. Standardní software tyto zvláštnosti často zná jen jako drahý doplňkový modul, nebo vůbec.

Skryté náklady tabulky

Licenční náklady tabulky jsou nízké. Náklady procesu nemohou být. Vznikají ve zpětných dotazech, přepracování, čase hledání, dvojí údržbě, a nesprávně naplánovaných zásobách. Vznikají i tehdy, když tým musí večer zkontrolovat, která data se od rána změnila.

Tyto náklady často zůstávají neviditelné, protože jsou rozděleny mezi mnoho rolí. Vedoucí skladu kontroluje zásoby, vnitřní obchod opravuje termíny dodání, účetnictví hledá doklady, a vedení dostává čísla se zpožděním. Žádná jednotlivá činnost nepůsobí dramaticky. Dohromady zpomalují průtok a plánovatelnost.

Solidní rozhodnutí by proto nemělo srovnávat jen ceny softwaru. Měřte po dobu dvou až tří týdnů, kolik manuálních předání objednávka projde, jak často jsou vyžadovány informace, a které chyby se opakují. Relevantní jsou i důsledky: vede nesprávná zásoba k interní korekci nebo k zmeškané dodávce?

Ne každý problém potřebuje velkou sadu

Mnoho středních firem v regionu DACH právem váhá před rozsáhlými enterprise systémy. Dlouhá zavádění, rigidní masky, a licenční modely pro funkce, které se nikdy nepoužijí, zřídka řeší konkrétní skladový problém. Alternativa však nemusí znamenat zůstat u roztroušených souborů.

Mezi oběma extrémy leží aplikace specifická pro pracovní postup. Může například propojit přijímání objednávek, příjem zboží, skladové pohyby, expediční štítky, a dodací listy v jednom společném systému, aniž by hned přinesla kompletní finanční účetnictví, globální koncernovou logiku, a dvacet cizích jazyků.

Rozhodující je technický základ. Aplikace s jasnou strukturou databáze, zdokumentovanými rozhraními, a dohledatelnými oprávněními zůstává přizpůsobitelná. Technologie jako PHP 8.4, moderní JavaScript, a MySQL 8 zde nejsou samoúčelné. Správně použité vytvářejí udržovatelný základ pro role, historie zaúčtování, tiskové dokumenty, a vyhodnocení - i když se procesy za dva roky změní.

Jak se podaří přechod bez narušení provozu

Největším nebezpečím není technika, ale příliš velký první krok. Kdo se pokouší vyčistit všechny historické soubory a před startem zmapovat každý výjimečný případ, odsouvá přínos o měsíce. Lepší je jasný, ověřitelný začátek.

Začněte s procesem, který se vyskytuje často a je dobře ohraničitelný, například příjem zboží se skladovým zaúčtováním, nebo expedice s dodacím listem a štítkem. Přesně přitom definujte, kdy operace začíná, která data jsou nezbytně nutná, kdo uděluje jaké schválení, a kdy se považuje za dokončenou. Z toho vznikají nejen obrazovky, ale pevná pracovní pravidla.

Převzetí dat rovněž vyžaduje pragmatismus. Aktivní artikly, dodavatelé, skladové pozice, a otevřené objednávky musí být čisté. Historické staré zásoby naopak lze často archivovat, místo aby se s velkým úsilím importovaly do nového systému. Paralelní provoz může být smysluplný, ale jen s pevným koncovým datem. Jinak vzniknou dvě pravdy místo jedné lepší.

Při zavádění se ukazuje hodnota přímého technického partnera.

softify.pro proto nepracuje z abstraktního seznamu funkcí, ale objasňuje pracovní postupy tam, kde skutečně probíhají: při převzetí, ve skladové uličce, při balení, a při předání expedici. Dobrý software respektuje fungující rutiny a mění jen to, co proces skutečně dělá spolehlivějším.

Rozhodnutí lze prověřit na třech otázkách

Za prvé: musí více osob současně důvěřovat aktuálním datům? Za druhé: spouští zaúčtování navazující procesy, které se dnes zajišťují manuálně? Za třetí: může chyba vést ke zpoždění dodávky, nesprávné zásobě, nesprávné faktuře, nebo zdlouhavému hledání? Pokud se na tyto otázky převážně odpovídá ano, tabulka pravděpodobně už není správným vedoucím systémem.

Pokud odpověď zůstává převážně ne, může nadále být rozumným řešením. Pak se více vyplatí sjednotit soubory, stanovit odpovědnosti, a zdokumentovat kritické vzorce. Technika by neměla být větší než problém.

Dalším smysluplným krokem tedy není paušální projekt digitalizace, ale společný pohled na konkrétní pracovní postup společně s lidmi, kteří ho denně vykonávají. Tam se rychle ukáže, zda dobře vedená tabulka postačuje - nebo zda by spolehlivý software měl konečně převzít práci, která dnes zůstává uvíznutá mezi papírem, telefonem, a několika verzemi téhož souboru.

Permalink →

Webový vývoj pro firmy

Webový vývoj pro firmy

Webová stránka může vypadat dobře a přesto vytvářet práci každé pondělí: údaje o produktech se udržují dvojmo, dotazy přicházejí neúplné do schránky, změny vyžadují externí pomoc. Hledání firmy pro webový vývoj by proto nemělo končit u barev, frameworků, nebo elegantního portfolia. Rozhodující je, zda řešení vytváří méně tření v každodenní práci a zůstává srozumitelné pro provoz i za tři roky.

Pro malé a střední firmy to není akademická otázka. V dílnách, skladech, a prodejních organizacích se nabídky, objednávky, informace o dodávce, a zákaznické dotazy často setkávají s organicky vyrostlými procesy. Některé z nich si zaslouží software. Jiné nadále lépe fungují s čistě vedenou tabulkou. Dobrý webový vývoj rozpoznává rozdíl, místo aby každý problém měnil na velký digitální projekt.

Co musí webový vývoj přinést firmám

Firemní webová stránka je často prvním kontaktním bodem. Musí se rychle načítat, fungovat na mobilních zařízeních, a jasně vést návštěvníky k dotazu, přihlášce, nebo objednávce. Ale jakmile zpracovává data, mapuje interní role, nebo spouští procesy, stává se webovou aplikací. Tehdy se počítají jiné otázky: Kdo smí vidět co? Odkud pocházejí data? Co se stane při chybném zadání? Jak se nasazuje aktualizace bez narušení provozu?

Rozdíl je praktický. Marketingová stránka si vystačí s několika jasně strukturovanými obsahovými oblastmi. Zákaznický portál, objednávkový proces, nebo interní skladový nástroj naopak potřebuje dohledatelná oprávnění, spolehlivou strukturu databáze, a definované zvláštní případy. Pokud se příjem zboží dodá jen částečně nebo se musí objednávka dodatečně změnit, systém se nesmí skončit v nedefinovaném stavu.

Webový vývoj pro firmy tedy neznamená jen programování stránek. Znamená implementaci obchodních pravidel tak, aby zůstala srozumitelná pro uživatele a kontrolovatelná pro firmu.

Nejprve zkontrolovat proces, poté naplánovat rozhraní

Projekt často začíná přáním jako "Potřebujeme portál". To je smysluplný začátek, ale ještě ne dostatečný požadavek. Před prvním designem by se měly stát viditelnými skutečné cesty informace: kdo ji vytváří, kdo ji kontroluje, kdo ji doplňuje, a kdo ji bude později znovu potřebovat?

Vezměme zpracování objednávek. V mnoha firmách přijde dotaz e-mailem nebo telefonicky, zapíše se do tabulky, později se přenese do jiného systému, a poté se znovu zpracuje pro sklad nebo expedici. Zpoždění zřídka spočívá v jednom jediném kroku. Vzniká při předáváních, zpětných dotazech, a různých stavech dat.

Dobrá analýza se proto konkrétně ptá na každodennost:

  • Které informace se dnes zadávají vícekrát?
  • Na kterém místě vzniká nejvíce zpětných dotazů nebo korekcí?
  • Které výjimky se vyskytují pravidelně, ačkoli nikde nejsou zdokumentovány?
  • Které role potřebují přístup, a která data nesmí moci měnit?
  • Podle čeho tým nakonec pozná, že proces je opravdu dokončen?

Tyto otázky znějí střízlivě. Přesně to je jejich výhoda. Zabraňují tomu, aby se vizuálně přesvědčivá aplikace postavila kolem idealizovaného procesu, který v provozu nikdo nepoužívá. Zvlášť ve skladu a logistice se počítají reálné podmínky: skenery se obsluhují v rukavicích, směny se střídají, WiFi není všude stejně dobré, a dodací list nesmí vzniknout až po několika kliknutích.

Ne každý proces však patří do aplikace. Malý seznam s několika stabilními záznamy může být rychlejší a levnější jako tabulka. Software se vyplatí, když data proudí mezi osobami nebo oblastmi, když chybí dohledatelnost, nebo když manuální práce opakovaně vytváří ztrátu času a chyby.

Technický základ rozhoduje o pozdějším úsilí

Mnohé systémy působí podobně v první demo verzi. Rozdíl se ukáže při změnách, růstu, a poruchách. Aplikace by se proto měla zakládat na technologiích, které tým dokáže dlouhodobě udržovat, místo aby sázela na krátkodobý hype.

Pro mnohé obchodně kritické webové aplikace je stack s PHP 8.4, moderním JavaScriptem, a MySQL 8 pragmatickou volbou. Je výkonný, dobře srozumitelný, a vhodný pro typické požadavky jako portály, správa objednávek, generování dokumentů, nebo interní nástroje. To není dogma. Při velmi interaktivních aplikacích, speciálních integracích, nebo vysokých potřebách reálného času může být smysluplná jiná architektura. Technologie by měla následovat úkol, ne naopak.

Důležitější než název frameworku jsou jasná rozhodnutí o datech a stavech. Objednávka například potřebuje jednoznačné hodnoty stavu místo volného textu. Změny by měly být dohledatelné. Zákaznická data, ceny, a oprávnění se nesmí rozcházet přes roztroušené tabulky a improvizovaná rozhraní. Kdo později musí vědět, proč byl vytvořen expediční štítek nebo byla zablokována objednávka, potřebuje dohledatelnou historii.

I bezpečnost patří k základní konstrukci. Sem patří práva založená na rolích, bezpečné ukládání hesel, tok blokování účtu při opakovaných neúspěšných pokusech, oddělená testovací a produkční prostředí, jakož i pravidelné aktualizace. Bezpečnost není jednotlivý plugin na konci projektu. Vzniká čistými odpovědnostmi a architekturou, která myslí na chybové případy.

Rychlost je provozní požadavek

Pomalé stránky stojí nejen viditelnost ve vyhledávačích. Vytvářejí odchody při dotazech a zbytečný čas čekání v každodenním provozu. Na veřejné webové stránce rozhoduje doba načítání, mobilní zobrazení, a jasná struktura stránky o tom, zda se zájemci vůbec spojí. V interní aplikaci se dvě nebo tři sekundy čekání při každém zaúčtování citelně sčítají během pracovního dne.

Výkon nezačíná pozdějším optimalizačním projektem. Obrázky, databázové dotazy, cachování, JavaScript, a hosting musí být přiměřeně naplánovány od začátku. Přitom platí: ne každá aplikace potřebuje maximální technickou složitost. Jednoduchý interní nástroj s málo uživateli nepotřebuje architekturu pro miliony současných volání. Potřebuje krátké cesty, spolehlivé zálohy, a chování, které zůstává předvídatelné v každodennosti.

Stejný princip platí pro responzivní ovládání. "Mobilně kompatibilní" neznamená, že se desktopová maska nějak zmenší na smartphone. Kdo na cestách kontroluje dodací listy, hlásí škodu, nebo opravuje zásobu, potřebuje velké ovládací prvky, jasné zpětné vazby, a co nejméně zbytečného zadávání.

Od nápadu k provozu: dodávat v malých krocích

Velké zadání slibují jistotu, ale často vedou k tomu, že týmy čekají měsíce na první použitelnou verzi. Lepší cestou je jasně vymezený první krok rozšíření. Měl by vyřešit skutečný problém, například centrální zaznamenávání příjmů zboží nebo automatické vytváření dodacích dokumentů. Poté se dá s reálnou zpětnou vazbou rozhodnout, co přinese dál největší přínos.

To neznamená pracovat bez plánování. Naopak: datový model, role, rozhraní, a provozní koncept musí být objasněny brzy. Rozsah funkcí může přesto růst postupně. Tak se předpoklady stávají viditelnými dříve, než se stanou nákladnými.

K profesionálnímu předání patří více než přístupové údaje. Zdokumentované kroky nasazení, zálohy, monitoring, odpovědnosti, a srozumitelná technická dokumentace dělají systém nezávislým na jednotlivých osobách. Pokud jen původní vývojář ví, jak se nasazuje aktualizace, aplikace není dokončena, ale vázaná na osobu.

Podle čeho poznáte vhodného partnera

Firma pro webový vývoj nemusí nabízet každou představitelnou technologii. Měla by však klást správné zpětné otázky a umět zdůvodnit rozhodnutí. Opatrnost je namístě, pokud se již v prvním rozhovoru slibuje komplexní platforma, aniž by někdo viděl existující procesy.

Vhodný partner mluví o údržbě, kvalitě dat, a zavedení stejně otevřeně jako o designu. Vysvětluje, které požadavky mohou pokrýt standardní funkce a kde se individuální vývoj stává smysluplným. Uvádí i náklady zvláštních přání. Funkce může být technicky proveditelná a přesto nemá dostatečný přínos.

Zeptejte se na konkrétní provozní detaily: Jak se testují změny? Jak funguje rollback? Kde se nacházejí citlivá data? Kdo reaguje při výpadku? Jak se spravují oprávnění? Dobré odpovědi nemusí být nutně dlouhé, ale jsou konkrétní. "O to se postaráme později" není strategie při obchodně kritických procesech.

Pro týmy s existujícím softwarem je kromě toho centrální otázka integrace. Nová aplikace nemusí vše nahradit. Může nejprve převzít data z existujícího systému, generovat dokumenty, nebo zmapovat chybějící proces. Nejsmysluplnějším prvním krokem často není velká náhrada, ale cílené odstranění úzkého hrdla.

Software má objasnit práci, ne ji přesunout

Nejlepší webová aplikace se v provozu neodlišuje technickou rafinovaností, ale méně zpětnými dotazy, spolehlivými daty, a kratšími průběžnými časy. Respektuje fungující způsoby práce, dělá výjimky viditelnými, a nechá se dále rozvíjet bez strachu z další aktualizace.

Než začnete projekt, vezměte si konkrétní proces ze své každodennosti a sledujte ho od prvního kontaktu až po dokončení. Tam, kde informace čekají, mizí, nebo se zadávají dvojmo, se obvykle nachází nejsmysluplnější přístup k webovému vývoji.

Permalink →

Logistics Automation Software, který opravdu sedí

Logistics Automation Software, který opravdu sedí

Příjem zboží se zapíše na papír, změna zásob se později přepíše do tabulky a expedice volá do skladu, protože adresa doručení uvízla v e-mailu. Právě při těchto předáních firma ztrácí čas a spolehlivost. Logistics Automation Software nemá toto tření zakrývat velkým novým světem procesů, ale srozumitelně propojovat každodenní úkony.

Pro malé a střední podniky je to jiný úkol než zavedení koncernové platformy. Vedoucí skladu nepotřebuje 200 funkcí, které se stanou srozumitelnými až po třech dnech školení. Potřebuje jasný stav: co dorazilo, kde to leží, co musí dnes ven a co ještě chybí? Dobrá automatizace odpovídá na tyto otázky tam, kde se pracuje.

Co musí Logistics Automation Software v praxi zvládat

Pojem zní široce, ale smysluplné případy použití bývají velmi konkrétní. Podnik například zpracovává příchozí zboží, účtuje skladové pohyby, vystavuje dodací listy, tiskne přepravní štítky a plánuje dodávky. Pokud každé pracoviště potřebuje vlastní soubor, samostatný přístup nebo zavolání přes halu, vznikají zpoždění a řetězce chyb.

Vhodný software slučuje informace do jednoho pracovního postupu. Objednávka může automaticky vytvořit příkaz ke kompletaci. Naskenování položky potvrdí výdej a aktualizuje stav zásob. Po dokončení se vytvoří dodací list se správnými položkami, zatímco stav expedice se zviditelní prodeji nebo dispečinku. Zní to jednoduše. Právě proto je to cenné: software nenahrazuje fungující logiku, ale brání tomu, aby se musela při každém přerušení nosiče znovu rekonstruovat.

Rozhodující je pořadí. Nejprve musí být jasné, které údaje spouštějí událost a kdo o ní rozhoduje. Teprve poté se vyplatí automatizovat pravidla. Kdo digitalizuje nejasný postup, získá pouze rychlejší nejasnost.

Nejprve vybrat správné procesy

Ne každý ruční úkon si hned zaslouží aplikaci. Malá, pečlivě vedená tabulka může být pro vzácný zvláštní případ lepší než modul, který je třeba trvale udržovat. Ekonomická páka bývá u postupů s vysokou opakovaností, mnoha předáními nebo citelnými následky chyb.

Typickými kandidáty jsou příjmy zboží se stavem kontroly, přesuny mezi zónami, kompletace opakujících se objednávek, přepravní dokumenty a plánování tras. I přijímání objednávek bývá dobrým začátkem, když se objednávky z telefonátů, e-mailů a formulářů nejprve slučují ručně.

Při výběru pomáhají čtyři otázky:

  • Jak často se postup provádí týdně?
  • Na kterém místě se údaje opakovaně zadávají nebo přenášejí?
  • Které chyby způsobují dopracování, manka na zásobách nebo zpožděné dodávky?
  • Které výjimečné případy musí zaměstnanci i nadále rozhodovat sami?

Poslední otázka brání rozšířené chybě. Automatizace nemusí znamenat, že každé rozhodnutí padne bez lidí. U poškozeného zboží, neúplných dodávek nebo krátkodobých přání zákazníků potřebuje tým jasnou možnost zastavit operaci, opravit ji a pokračovat s odůvodněním. Systém bez takových cest působí na papíře důsledně, ve skladu se ale rychle stane překážkou.

Od příjmu zboží po expedici: ucelený postup

Vezměme středně velkého obchodníka se skladem a vlastním rozvozem. Dnes se zboží počítá u brány, zapíše na formulář a do systému se zadá až ke konci směny. Prodej proto vidí nové zásoby příliš pozdě. U expresní zásilky se dodací list vytváří zvlášť a řidič dostane informace telefonicky.

Ve smysluplně automatizovaném postupu začíná příjem zboží digitální operací. Zaměstnanci zaznamenávají dodávku, položku, množství a volitelně šarži nebo sériové číslo přímo na pracovišti nebo mobilně. Odchylky se neschovávají do poznámky na okraji, ale dostanou stav jako „Nutná kontrola“. Teprve po uvolnění je zboží k dispozici jako využitelná zásoba.

Další krok vychází ze skutečných požadavků: objednávka se uvolní, sklad dostane seznam ke kompletaci nebo mobilní zobrazení podle skladového místa a každé zaúčtování zdokumentuje, co se skutečně odebralo. Ze stejného zdroje pak vzniknou dodací list a expediční údaje. Nikdo nemusí položky znovu přepisovat ani kontrolovat, která verze souboru právě platí.

Pro dispečink může systém seskupovat otevřené dodávky podle oblasti, časového okna doručení, hmotnosti nebo kapacity vozidla. Plánování tras přitom není vždy prvním smysluplným krokem. Pokud jsou adresy neúplné nebo se objednávky uvolňují až krátce před odjezdem, je třeba nejprve zlepšit kvalitu údajů a jasnost objednávek. Optimalizované trasy nepomohou, pokud je základ nespolehlivý.

Standardní software, nebo individuální řešení?

Standardní software je smysluplný, když podnik pracuje s běžnými postupy a akceptuje přizpůsobení předpokládaným obrazovkám, rolím a procesům. Lze jej zavést rychle, zejména při jasných požadavcích, jako je tisk štítků nebo jednoduchá evidence zásob. Cenou bývají kompromisy u zvláštních případů, rozhraní a pozdějších úprav.

Individuální Logistics Automation Software se stává zajímavým, když provozní zvláštnost není okrajovým případem, ale rozhoduje o obchodním úspěchu. Může jít o speciální logiku balení, vícestupňový schvalovací proces, propojení dílny a skladu nebo vlastní model dodávek. Pak je často rozumnější cíleně zobrazit několik klíčových procesů, než zavádět rozsáhlý balík s mnoha nevyužitými moduly.

Individuální však neznamená bezbřehé. Každá zvláštní funkce potřebuje odborné odůvodnění, testy, dokumentaci a údržbu. Dobrá projektová práce se proto ptá i na to: dá se tento krok zjednodušit? Stačí konfigurace? Zůstane tabulka pro tento výjimečný proces lepším řešením? Tyto otázky chrání rozpočet a tým před zbytečnou složitostí.

Technika, která obstojí v každodenním provozu

Rozhraní rozhoduje o tom, zda zaměstnanci systém rádi používají. Technický základ rozhoduje o tom, zda jej lze spolehlivě provozovat i po letech. U procesů kritických pro podnikání patří k základní výbavě srozumitelné datové modely, role a oprávnění, záznamy o důležitých změnách a pravidelné zálohy.

U skladového zaúčtování musí být poznat, kdo kdy změnil který stav a z které operace změna pochází. Pokud je současně aktivních více uživatelů, nesmí se stav zkreslit protichůdnými zadáními. U tiskáren, skenerů nebo rozhraní dopravců jsou potřeba jasné chybové stavy místo tichých selhání. Štítek, který se nevytiskl, musí být viditelný jako otevřený pracovní krok.

I udržovatelnost je provozní požadavek. Webovou aplikaci na srozumitelné architektuře, například s PHP 8.4, moderním JavaScriptem a MySQL 8, lze z dlouhodobého hlediska lépe kontrolovat a rozšiřovat než soubor obtížně pochopitelných jednotlivých řešení. Zdokumentované nasazení, oddělená testovací a produkční prostředí a automatizované testy nejsou luxus. Snižují riziko, že malá změna na dodacím listu náhle ovlivní uvolňování objednávek.

Ochrana údajů a kontrola přístupu si zaslouží stejnou střízlivost. Ne každý uživatel potřebuje ceny, marže nebo kmenová data zákazníků. Zejména v rozptýlených týmech by měly být přístupy, zařízení a oprávnění navrženy tak, aby zbytečně nebrzdily každodenní práci, ale zůstaly kontrolovatelné při výměně zaměstnance nebo ztrátě zařízení.

Zavedení v rozumných etapách

Nejsilnější funkce mnoho nepomůže, pokud ji tým nedokáže využívat ve směnném provozu. Proto je postupné zavádění často odolnější než jeden velký rozhodný termín. Nejprve se do ostrého provozu uvede vymezený postup, například příjem zboží pro jednu skupinu výrobků nebo tvorba přepravních dokladů. Tým s ním pracuje ve skutečných podmínkách a otevřené otázky se řeší na skutečných případech.

Poté následují další procesy a rozhraní. Toto pořadí vytváří důvěru, protože zaměstnanci vidí, že zpětná vazba se mění v konkrétní zlepšení. Zároveň omezuje riziko: pokud je třeba upravit nový postup skenování, nezastaví se celá logistika.

Měřené veličiny je třeba dohodnout před začátkem. Může jít o průběžnou dobu od objednávky po expedici, počet ručních oprav, manka na zásobách nebo délku prací při denní uzávěrce. Ne každé zlepšení se hned projeví v efektním ukazateli. Méně doplňujících dotazů mezi skladem a kanceláří, spolehlivé předání směny a dohledatelné historie operací jsou také měřitelnou úlevou.

softify.pro vyvíjí takové systémy z pracovního postupu, s přímou technickou účastí místo předání od konceptu k realizaci. Měřítko zůstává záměrně pragmatické: řešení má fungovat na podlaze skladu, ne jen v prezentaci.

Podle čeho poznáte udržitelné rozhodnutí

Dobré rozhodnutí nezačíná seznamem funkcí, ale pozorovaným pracovním dnem. Nechte si ukázat, kde informace vznikají, čekají, ztrácejí se nebo se dodatečně opravují. Nemluvte jen s vedením, ale i s lidmi na příjmu zboží, ve skladu a v expedici. Znají výjimky, které žádné organizační schéma nezviditelní.

Poté zkontrolujte, zda poskytovatel klade konkrétní otázky k údajům, rolím, zařízením, rozhraním a provozu. Kdo hned slibuje kompletní řešení, aniž by chápal stávající procesy, prodává spíše rozsah softwaru než řešení problému. Stejně kritický je projekt, který nepočítá s jasnou úpravou údržby, odstraňování chyb a pozdějších úprav.

Nejlepší automatizace nepůsobí jako další byrokracie. Dává týmu čas na případy, v nichž zkušenost opravdu rozhoduje: správně posoudit neočekávanou dodávku, včas informovat zákazníka nebo vyřešit úzké místo dříve, než se stane problémem.

Permalink →

Dokáže AI testovat desktopový software?

Dokáže AI testovat desktopový software?

Zaměstnanec zaúčtuje příjem zboží ve Windows aplikaci, vytiskne dodací list, a předá údaje účetnictví. Po aktualizaci se dialogové okno objeví na jiném místě, pole ztratí zaměření, tisk se už nespustí. Otázka "can AI test desktop software" je proto méně teoretická, než zní: dokáže systém rozpoznat takové chyby před další ranní směnou?

Ano. AI dokáže testovat Windows desktopový software, zejména tam, kde klasická automatizace selhává na měnících se rozhraních, nekonzistentních ovládacích prvcích, nebo skriptech, které jsou nákladné na údržbu. Není však náhradou za jasné testovací cíle, čistá testovací data, a obchodní odpovědnost. Její hodnota vzniká, když spolehlivě přebírá opakovatelnou práci a směruje lidi k případům, které vyžadují úsudek.

Dokáže AI testovat desktopový software - a co to znamená v praxi?

Desktopové testy nekontrolují jen to, zda se otevře okno. V reálném provozu jde o kompletní pracovní postupy: přihlášení se správnou logikou blokování, zadání objednávky, výběr artiklu, zaúčtování zásob, tisk štítků, chybová hlášení při neplatných údajích, a správné předání připojenému systému.

Testovací prostředí poháněné AI dokáže provádět tyto pracovní postupy na Windows počítači, hodnotit viditelné rozhraní, a generovat důkazy. Může například rozpoznávat tlačítka podle textu a pozice, číst obsah z dialogových oken, a porovnávat screenshoty s očekávaným stavem. Na rozdíl od rigidního skriptu lépe zvládá menší vizuální změny - například když se změní ikona, mezera, nebo přesný technický identifikátor ovládacího prvku.

To je obzvlášť relevantní u obchodních aplikací, které rostly v průběhu času. Mnohé z těchto programů nemají moderní API pro každý proces. Některé využívají proprietární rozhraní, vložené tabulky, nebo komponenty, které se dají konvenční UI automatizací obtížně oslovovat. AI agent může aplikaci ovládat spíše tak, jak to dělá vyškolený uživatel: číst obrazovku, vybírat akci, kontrolovat výsledek.

Slovo "spíše" je zvoleno záměrně. AI automaticky nevidí obchodní proces za vstupním polem. Dokáže zjistit, že byl vytvořen dodací list. Zda byla potřebná správná dodací podmínka pro konkrétního zákazníka, vyžaduje obchodně definované očekávání.

Kde mají AI testy smysl pro Windows aplikace

Nejlepším výchozím bodem jsou pracovní postupy, které se vyskytují často, jsou obchodně kritické, a dnes se kontrolují ručně. Tým k tomu nemusí automatizovat celý katalog testů. Lepší je vybrat těch několik procesů, jejichž selhání přímo stojí čas, peníze, nebo důvěru.

Ve skladu, výrobě, a plánování sem často patří vytváření a zaúčtování příjmů zboží, procesy kompletace a expedice, autorizované korekce zásob, tisk štítků, jakož i procesy importu a exportu. V komerčních aplikacích jsou přihlášení, změna práv, tvorba faktur, údržba kmenových dat, a předávání rozhraní typickými kandidáty.

AI je obzvlášť užitečná tam, kde vydání v současnosti spouští ruční kontrolní den. Tester pak klikne přes dlouhý seznam, dokumentuje nesrovnalosti, a později se snaží rekonstruovat, co přesně se stalo. Automatizované běhy mohou tuto část přesunout do noci nebo do pevného procesu vydání. Ráno je k dispozici nejen stav, ale testovací záznam se screenshoty, časovými značkami, a srozumitelným popisem odchylky.

Také regresní testy z toho těží. Když se do dialogu objednávky zabuduje nová funkce, existující procesy by se neměly nepovšimnuto pokazit. AI opakuje definované scénáře po každé relevantní změně. To neeliminuje každé riziko, ale zabraňuje tomu, aby známé klíčové pracovní postupy zůstaly nekontrolované jen proto, že chybí čas.

Co AI dokáže spolehlivě zkontrolovat - a co ne

AI založené testy rozhraní jsou silné u pozorovatelných očekávání. "Po uložení se zobrazí číslo objednávky." "Při chybějícím povinném údaji se zobrazí upozornění." "Zásoba se sníží o pět." "Dialog tisku obsahuje zamýšlenou tiskárnu." Taková tvrzení se dají přeložit do konkrétních kontrolních kroků.

Těžší jsou požadavky, které jsou nepřesně formulované. "Rozhraní by mělo vypadat profesionálně" nebo "program by měl být rychlý" nejsou dostatečné testovací případy. Zde je třeba kritéria: maximální doba čekání pod definovanou zátěží, schválené rozložení, nebo jasná pravidla akceptace pro chybová hlášení.

I u složitých obchodních zvláštních případů zůstává lidské testování nepostradatelné. Pokud se pravidlo vrácení vztahuje na jednu rámcovou smlouvu, musí někdo se znalostí procesu rozhodnout, zda je výsledek správný. AI dokáže případ připravit, provést, a zdokumentovat. Neměla by svévolně vymýšlet nová obchodní pravidla.

Další hranicí je stabilita prostředí. Desktopové testy závisí na rozlišení obrazovky, uživatelských právech, síťovém připojení, ovladačích tiskárny, testovacích datech, a případně připojeném hardwaru. Pokud je tiskárna štítků offline, neúspěšný test může být skutečná chyba - nebo problém prostředí. Dobré testovací systémy tyto případy rozlišují a nahlašují je transparentně, namísto toho, aby vše paušálně hodnotily jako chybu produktu.

Technický základ rozhoduje o přínosu

Použitelný desktopový test je více než posloupnost kliknutí myší. Potřebuje kontrolovaný počítač nebo virtuální Windows prostředí, definované uživatelské účty, reprodukovatelná výchozí data, a jasná pravidla pro resetování. Jinak test v úterý kontroluje jiný stav než v pondělí a vytváří diskuse místo jistoty.

Stejně rozhodující jsou důkazy. Zelená fajfka bez kontextu pomůže málo, když obchodní oddělení nahlásí chybu. Ke každému běhu by proto měly existovat vykonané kroky, screenshoty na důležitých místech, viditelná chybová hlášení, a časový údaj. Při odchylkách musí být rozpoznatelné, zda aplikace reagovala nesprávně, očekávaný prvek nebyl nalezen, nebo bylo testovací prostředí blokováno.

U citlivých aplikací není otázka místa provádění vedlejší záležitostí. Screenshoty, přístupové údaje, zákaznická data, a interní procesní obrazovky mohou obsahovat důvěrné informace. Kdo nechává testy běžet přes externí služby, měl by přesně zkontrolovat, jaká data opouštějí vlastní prostředí, jak dlouho se uchovávají, a kdo získává přístup.

Pro týmy s odpovídajícími požadavky může být samostatně hostované prostředí smysluplnější.

softify.pro k tomu provozuje COCO, vlastní AI server pro automatizované webové a aplikační testování. Provádění, testovací důkazy, a hodnocení mohou zůstat v rámci kontrolovaného firemního prostředí. To není nutné pro každou aplikaci, ale u interních obchodních systémů, osobních údajů, nebo přísných IT požadavků je to často čistší architektura.

Jak tým začíná, aniž by se projekt automatizace testování rozbujněl

Smysluplný začátek nezačíná výběrem nástroje, ale procesem. Vezměte pracovní postup, který se kontroluje alespoň týdně a jehož důsledky chyb jsou dohledatelné. Expediční proces se hodí lépe než sbírka dvaceti náhodných obrazovek.

Následně popište obchodní cestu v jasných větách: výchozí situace, vstupy, očekávané mezistavy, očekávaný konečný výsledek. Doplňte i negativní případ. Co se musí stát, pokud chybí číslo šarže, uživatel nemá oprávnění, nebo zásoba nedostačuje? Právě tato pravidla se v ručních testech často vynechávají, ačkoli se v každodenním provozu mohou stát nákladnými.

Poté následuje omezený pilot se stabilními testovacími daty a definovaným prostředím. Neměřte jen, zda test běží. Měřte, kolik manuálních kontrolních minut nahrazuje, kolik falešných poplachů se vyskytuje, a zda důkazy postačují pro vývoj a obchodní oddělení. Teprve až tento základ funguje, vyplatí se rozšíření na další procesy.

Údržba k tomu patří od samého začátku. Pokud se obrazovka obchodně změní, musí se přizpůsobit i očekávání. To není argument proti automatizaci. Je to běžná softwarová údržba - srovnatelná s aktualizací pracovního pokynu, když se změní skladový proces.

Nemusí se automatizovat každé kliknutí

Některé týmy očekávají od AI testů úplné pokrytí. To rychle vede k vysokým nákladům pro vzácné výjimečné případy, jejichž kontrola by byla ručně rychlejší a spolehlivější. Dobrá testovací strategie místo toho upřednostňuje podle rizika, frekvence, a tempa změn.

Zřídka používaný administrativní dialog s nízkým důsledkem chyby může nadále být kontrolován krátkým ručním kontrolním seznamem. Denní příjem zboží s více následujícími kroky si naopak zaslouží automatizované regresní testy a čisté důkazy. Boring, provable reliability zde vítězí nad velkou, ale křehkou sbírkou testů.

Začněte s procesem, při kterém by chyba následující pracovní den byla skutečně citelná. Když je tento pracovní postup kontrolován automatizovaně, dohledatelně, a opakovatelně ve vašem vlastním prostředí, automatizace testování se stává spolehlivou provozní výhodou - ne dalším IT projektem s pěknými snímky.

Permalink →

Kdy by firmy měly nahradit tabulkové procesory?

Kdy by firmy měly nahradit tabulkové procesory?

Vedoucí skladu ráno vytiskne seznam zásob. O dvě hodiny později zadal obchod zakázku, množství při příjmu zboží bylo opraveno a jeden z kolegů otevřel starý soubor z přílohy e-mailu. Čísla už nesedí. Právě v tomto okamžiku vzniká otázka: Kdy by firmy měly nahradit tabulkové procesory? Ne když se soubor jednou stane nepřehledným, ale když se stane neviditelným úzkým hrdlem probíhajícího procesu.

Tabulkové procesory nejsou známkou špatné organizace. Pro kalkulace, jednorázové analýzy, malé objemy dat a rozhodnutí s málo zúčastněnými bývají často správným nástrojem. Jsou flexibilní, známé a dostupné bez zahájení projektu. Problematické se stávají teprve tehdy, když má jedna tabulka současně sloužit jako databáze, pracovní pokyn, schvalovací workflow, archiv dokumentů a komunikační kanál.

Tabulky jsou dobré - dokud nemají nést proces

Mnoho rostoucích podniků se drží svých souborů, protože je léta pečlivě budovaly. Nacházejí se v nich čísla artiklů, zvláštní případy, znalosti o dodavatelích a osvědčená výpočetní logika. To si zaslouží respekt. Náhradní systém, který tuto realitu ignoruje, vyvolává odpor a v nejhorším případě další provizoria.

Rozhodující otázka proto nezní: „Je Excel špatný?“, ale: „Dokáže náš tým s tímto nástrojem spolehlivě pracovat, i když se mění objem zakázek, směny nebo odpovědné osoby?“ Pokud odpověď pravidelně závisí na konkrétní osobě, sdíleném disku nebo disciplíně všech zúčastněných, je hranice často dosažena.

Zvlášť zřetelně je to vidět ve skladu, v dílně a v plánování. Stav zásob, který se sladí až dodatečně, není spolehlivý stav zásob. Doklad o dodání, který se ručně sestavuje z několika souborů, stojí víc než jen čas. Ztěžuje doplňující dotazy, dohledatelnost a čisté předání mezi zaměstnanci.

Kdy by firmy měly nahradit tabulkové procesory?

Neexistuje univerzální okamžik ani kouzelný počet řádků. Podnik s 500 položkami může s jednoduchou tabulkou pracovat dobře, zatímco jiný s 50 položkami už dávno potřebuje systém. Rozhodující je provozní zátěž: jak často se data mění, kdo je používá a jaké následky má chyba?

Jasným spouštěčem je konflikt verzí. Když si týmy posílají soubory s názvy jako „Zásoby_final_nové2“ nebo se kolegové musejí ptát, který sloupec právě platí, chybí závazný zdroj dat. Signálem je i ruční kopírování mezi seznamem zakázek, přehledem skladu, expedičním souborem a přípravou faktur. Každý přenos vytváří další příležitost pro přehozené číslice, duplicitní záznamy nebo zapomenuté aktualizace.

Stejně kritické jsou procesy bez dohledatelné odpovědnosti. Kdo změnil množství? Kdy byl zaúčtován příjem zboží? Proč byla zakázka pozastavena? V tabulce lze změny sice částečně protokolovat. V každodenním provozu to však málokdy bývá tak jednoznačné a použitelné jako u procesu, který cíleně zaznamenává zaúčtování, změny stavů a akce uživatelů.

Dalším bodem je rychlost práce. Musí-li zaměstnanci před balením nejprve prohledávat soubor, kontrolovat stav zásob, opisovat data a poté v samostatném portálu vytvářet expediční štítek, stává se tabulka tím, kdo udává tempo na hale. Náklady pak nevznikají jen v minutách. Projevují se v přerušeních, doplňujících dotazech, chybných zásilkách a znalostech, které jsou jen v hlavách jednotlivců.

Rizika se často skrývají mezi dvěma buňkami

Tabulky selhávají jen zřídka spektakulárně. Často jde o malé odchylky, které se šíří dál: špatně přetažený vzorec, filtr, který nezahrnuje všechny řádky, číslo uložené jako text místo čísla nebo omylem přepsaný vzorec. Takové chyby zůstávají dlouho neodhaleny právě tehdy, když tým pracuje pod časovým tlakem.

U obchodně kritických procesů přibývá druhé riziko: chybějící řízení procesu. Tabulka umí ukázat, že zakázka existuje. Nezajistí ale spolehlivě, že všechny potřebné kroky proběhnou ve správném pořadí. Musí být před expedicí dokončena kontrola kvality? Smí se vystavit dodací list bez potvrzené kompletace? Má zakázka při chybějících zásobách automaticky přejít do řešení? Tato pravidla nepatří do připomínek, barevných buněk ani složitých vzorců „když-pak“, pokud denně rozhodují o správném průběhu procesů.

Také oprávnění nabývají na významu s rostoucí velikostí týmu. Ne každý musí smět měnit ceny, spravovat kmenová data nebo opravovat uzavřené operace. Aplikace na míru dokáže jasně zobrazit role, protokolovat citlivé akce a například po několika neúspěšných pokusech zablokovat účet. To není přehnaná technika. Je to čistá odpověď na otázku odpovědnosti.

Ne každý problém potřebuje velký ERP

Alternativou k tabulce není automaticky globální podniková sada s dlouhými implementačními projekty. Pro mnoho malých a středních podniků by to byl špatný krok: příliš mnoho funkcí, příliš pevné procesy, vysoké licenční náklady a systém, který se firmě dostatečně nepřizpůsobí.

Smysluplnější je často cílená aplikace pro konkrétní úzké hrdlo. Může jít o systém pro příjem zboží, pohyby zásob a skladová místa. Může strukturovaně zachycovat zakázky z e-mailů nebo formulářů, vytvářet dodací listy, připravovat expediční štítky nebo plánovat trasy podle jasných pravidel. Rozhodující není zavést co nejvíce softwaru. Rozhodující je, aby byl další krok pro odpovědnou osobu jednoznačný.

Dobré řešení může navíc začít vedle stávajících nástrojů. Účetnictví, ERP nebo dopravce není třeba nahrazovat hned. Často je pragmatičtější cestou spolehlivé rozhraní nebo čistý export. Přínos vzniká tehdy, když odpadne dvojí zadávání a provozní data jsou aktuální tam, kde jsou potřeba.

Jak zjistit skutečnou potřebu jednat

Místo okamžitého srovnávání nabídek softwaru se vyplatí podívat se na jeden konkrétní postup. Vezměte například cestu zakázky od přijetí až po expedici. Zapište si nejen oficiální kroky, ale také telefonáty, poznámkové lístky, soukromé zprávy v chatu a místa, kde někdo přenáší informace z jednoho souboru do jiného systému.

Poté se zeptejte: Kde zaměstnanci čekají na informace? Kde se data zadávají opakovaně? Které rozhodnutí závisí na zkušenostech místo na viditelných pravidlech? A které chyby by byly drahé, kdyby se objem zakázek za šest měsíců zdvojnásobil? Tato analýza obvykle ukáže rychleji než jakýkoli seznam funkcí, zda tabulka ještě stačí.

Ne každá odchylka ospravedlňuje vývoj na míru. Pokud zprávu vypracovává jedna osoba měsíčně a chybu lze snadno opravit, zůstává tabulka často smysluplná. Pokud ale na aktuálních datech denně závisí více lidí, pokud se přemisťuje fyzické zboží nebo pokud jsou zapotřebí doklady vůči zákazníkům, kalkulace se mění. Pak už firma dávno platí za hranice nástroje - jen rozložené do pracovní doby, oprav chyb a zpoždění.

Náhrada musí zůstat udržovatelná

Kdo nahrazuje tabulky, neměl by kupovat jen hezčí rozhraní. Datová struktura, pravidla a provoz aplikace rozhodují o tom, zda řešení bude i po dvou letech spolehlivě fungovat. Pro štíhlou webovou aplikaci mohou být například PHP 8.4, moderní JavaScript a MySQL 8 záměrně střízlivým základem: dobře udržovatelným, výkonným a bez závislosti na krátkodobých trendech.

Stejně důležité je zavedení. Systém by měl nejprve stabilizovat skutečné procesy, nikoli pokrývat všechna myslitelná přání najednou. Jasně vymezená první oblast - například příjem zboží a skladové účtování - vytváří důvěru. Poté lze na konzistentním datovém základě doplnit expedici, dodací doklady nebo analýzy.

Staré tabulky přitom nemusejí okamžitě zmizet. Některé zůstanou jako archiv, pro speciální analýzy nebo jako kontrolovaný export. Cílem není tabulky vypovědět. Cílem je odlehčit jim od úkolů, pro které nikdy nebyly myšleny jako trvalý operační systém.

Pokud váš tým pravidelně kontroluje, který soubor platí, kdo naposledy něco změnil nebo zda byla zakázka skutečně zpracována celá, nejde o malou organizační vadu. Je to dobrý důvod podívat se na proces společně na skutečném pracovišti - dřív než další růstová špička udělá z křehké tabulky každodenní úzké hrdlo.

Permalink →

AI testing platforms pro regresní testy

AI testing platforms pro regresní testy

Vydání je funkčně hotové, ale nikdo nedokáže s jistotou říct, zda nový import cen poškodil vstup objednávek, uživatelská práva, nebo proces expedice. Přesně zde se AI testing platforms stávají zajímavými. Ne proto, že by kouzelně odstranily lidskou práci na kvalitě, ale proto, že dokážou spolehlivě provádět opakující se kontroly, viditelně je dokumentovat, a při odchylkách je učinit srozumitelnými.

Pro týmy s webovými nebo Windows aplikacemi, které rostly v průběhu času, je to praktický problém, ne inovační projekt. Kritické pracovní postupy často vznikají v průběhu let: objednávka se vytvoří, skladová zásoba se zaúčtuje, PDF se vygeneruje, rozhraní se informuje. Malá změna ve vstupním formuláři může mít důsledky na neočekávaném místě. Manuální regresní testy jsou pak pomalé, závislé na jednotlivých osobách, a obzvlášť náchylné k chybám pod časovým tlakem.

Co AI testing platforms skutečně přinášejí

Klasická automatizace testů následuje předem napsané kroky. To zůstává smysluplné a potřebné pro mnoho kontrol. Platforma poháněná AI může navíc pracovat s aplikací prostřednictvím jejího rozhraní, rozpoznávat obsah, vykonávat testovací kroky, a klasifikovat anomálie v přirozeném jazyce. Může například zkontrolovat, zda oprávněný uživatel dokáže zaúčtovat příjem zboží, zda je zablokovaný účet správně odmítnut, nebo zda se dodací list stále generuje po změně.

Rozhodující přínos nespočívá jen v kliknutí na tlačítko. Dobré systémy spojují provedení, pozorování, a důkaz. Běh testu by proto měl zahrnovat dohledatelné kroky, screenshoty nebo nahrávky, časová razítka, použitá testovací data, a jasné hodnocení. Když test selže, tým potřebuje víc než zprávu "assertion failed". Musí vidět, na které obrazovce, v jakém stavu, a z jakého důvodu k odchylce došlo.

AI dokáže tuto práci urychlit. Nenahrazuje však rozhodnutí o tom, co je skutečně obchodně kritické. Model možná rozpozná, že dialog vypadá jinak. Zda tato změna představuje chybu, záměrně nový design, nebo jen neškodný rozdíl ve vykreslování prohlížeče, zůstává otázkou pravidel, kontextu, a schválení.

Ne každá kontrola patří do AI

Nejčastější chybou při zavádění je mířit příliš vysoko. Platforma by neměla nejprve pokrýt každou funkci systému. Měla by zabezpečovat pracovní postupy, jejichž selhání by bylo nákladné, rizikové, nebo pracovně náročné. V logistickém softwaru jsou to typicky zadávání objednávek, skladové pohyby, tisk štítků nebo dokumentů, uživatelské role, a předávání rozhraní. V komerční webové aplikaci mohou být ve středu přihlášení, schvalování faktur, exporty, a stav plateb.

Smysluplný začátek se skládá z malé sady stabilních end-to-end testů. Test zde nepokrývá jen jediné kliknutí, ale kompletní pracovní proces. Například: uživatel se přihlásí, vytvoří objednávku, potvrdí položky, vygeneruje dodací list, a zkontroluje, zda se transakce zobrazuje v přehledu. Takové kontroly poskytují vyšší obchodní relevanci než mnoho izolovaných testů pro jednotlivá pole.

To neznamená, že každý typ testu by měl probíhat přes uživatelské rozhraní. Vývojové týmy stále potřebují rychlé jednotkové a integrační testy blízko kódu. Tyto testy nacházejí technické chyby brzy a levně. AI testy založené na UI je doplňují tam, kde je třeba zkontrolovat souhru rozhraní, oprávnění, databáze, dokumentů, a externích služeb. Kdo testuje vše jen přes rozhraní, dostává pomalé a těžko udržovatelné běhy testů. Kdo testuje výhradně v kódu, může přehlédnout chyby, které přímo zasahují uživatele.

Stabilita vzniká z dobrých testovacích podmínek

Automatizované testy neselhávají vždy kvůli chybě produktu. Nestabilní testovací data, měnící se uživatelská práva, nedostupné testovací systémy, nebo paralelní změny mohou být stejně tak příčinou. Proto testovací prostředí patří k rozhodnutí o platformě.

Testovací účty by měly být jednoznačné a mít známá oprávnění. Data musí být buď reprodukovatelně resetována před každým během, nebo cíleně znovu vytvořena. Externí systémy také vyžadují rozhodnutí: kontroluje se integrace expedice nebo plateb vůči bezpečnému testovacímu prostředí, simuluje se kontrolovaným stubem, nebo je záměrně vyloučena z toku? Neexistuje univerzálně správná odpověď. Rozhodující je, aby výrok testu zůstal jasný.

Pro kritická schválení se navíc vyplatí mít definovanou úroveň důvěry. Vizuální rozdíl s nízkou důvěrou by neměl automaticky blokovat vydání. Chybějící expediční doklad po úspěšně zaúčtované dodávce je naopak vážné selhání. Dobré testovací procesy rozlišují mezi indiciemi ke kontrole a jasnými kritérii schválení.

Datová suverenita není vedlejší otázkou při AI testech

Jakmile test běží na skutečné aplikaci, může vidět důvěrné informace: jména zákazníků, ceny, adresy, interní čísla artiklů, screenshoty z obchodních aplikací, nebo obsah z dokumentů. Pokud se taková data přenášejí do externích služeb spolu s nahrávkami obrazovky a testovacími záznamy, jde o architektonické rozhodnutí s důsledky pro ochranu údajů, informační bezpečnost, a smlouvy.

Právě u interních webových a Windows aplikací otázka "funguje platforma?" nestačí. Odpovědní by měli zkontrolovat, kde se provádí běhy testů, kde se ukládají screenshoty a záznamy, jaká data zpracovává AI model, a kdo získává administrativní přístup. Doby uchovávání a koncepce mazání sem také patří. Testovací zpráva může být cenným důkazem pro vydání, ale neměla by neomezeně uchovávat citlivé informace.

Pro organizace se zvýšenými požadavky může být samostatně hostované provádění vhodnějším řešením. Udržuje testovací provoz, testovací data, a důkazy ve vlastním kontrolovaném prostředí. To poněkud zvyšuje provozní úsilí: aktualizace, přístupy, kapacity, a monitorování vyžadují odpovědnost. Na oplátku technická a organizační kontrola zůstává tam, kam často patří. U COCO se softify.pro spoléhá přesně na tento model: automatizované testy pro webové a Windows aplikace s lokálním uchováváním dat a dohledatelnými testovacími důkazy.

Podle čeho poznat vhodnou platformu

Přesvědčivý výběr začíná existujícími aplikacemi, ne produktovou demonstrací. Platforma může působit impozantně v čisté vzorové aplikaci a narazit na hranice u starší desktopové masky, Citrix prostředí, nebo složitého přihlášení. Krátký proof of concept se dvěma nebo třemi reálnými obchodními postupy vypovídá mnohem více než seznam funkcí.

Týmy by přitom měly věnovat zvláštní pozornost čtyřem bodům:

  • Pokrytí aplikací: Podporuje řešení existující webové prohlížeče, Windows desktopové aplikace, a, kde je to relevantní, scénáře vzdálené plochy nebo Citrix?
  • Dohledatelnost: Poskytuje každý běh srozumitelné kroky, screenshoty, záznamy, a zdůvodnění, proč je test považován za úspěšný nebo neúspěšný?
  • Provozní model: Odpovídá cloud, soukromé prostředí, nebo samostatné hostování bezpečnostním požadavkům, dostupným IT zdrojům, a testovacím datům?
  • Udržovatelnost: Mohou obchodní oddělení kontrolovat testovací postupy, zatímco technické týmy čistě řídí verzování, schválení, a opakovatelné provádění?

K tomu se přidává integrace do procesu vydání. Test, který se spouští jen na vyžádání, pomáhá méně než naplánovaný běh před nasazením nebo po relevantní změně. Zároveň by neměla každá malá stylistická aktualizace spustit hodiny trvající úplný test. Zralé procesy vybírají testy podle rizika: krátký smoke test po každém nasazení, cílené regrese při změnách kritických modulů, a rozsáhlejší běhy před většími vydáními.

Jasné zprávy místo testovacího divadla

Automatizace testů snadno produkuje aktivitu bez poznání. Stovky zelených fajfek znějí dobře, ale pokud nikdo nedokáže říct, které obchodní procesy zabezpečují, jsou sotva řiditelné. Použitelná zpráva odpovídá na jednoduché otázky: Co bylo zkontrolováno? S jakým výsledkem? Která verze byla dotčena? Co musí někdo teď rozhodnout?

Hodnocení v jednoduchém jazyce zde mohou ušetřit hodně času, pokud jsou založena na skutečných datech z provádění. "Uživatel se dokázal přihlásit, vytvořit objednávku, a vygenerovat dodací list" je užitečnější pro obchodně odpovědnou osobu než sbírka technických selektorů. Při chybách zůstává technická hloubka přesto důležitá. QA a vývoj potřebují screenshot, data záznamu, a reprodukovatelné kroky, ne jen AI shrnutí.

Zavedení bez narušení běžného provozu

Nejlepší zavedení začíná procesem, při kterém by chyba měla citelný dopad a jehož průběh je dostatečně stabilní. To může být denní uzávěrka, schvalování objednávek, nebo klíčová funkce v zákaznické platformě. Společně s obchodním oddělením a technickým týmem se stanoví, co se počítá jako úspěch, jaká testovací data se používají, a kdo hodnotí selhání.

Poté následuje kontrolovaný rytmus: budovat testy, opakovaně je vykonávat, snižovat falešné poplachy, a až poté je závazně zahrnout do schválení. Tento mezikrok je důležitý. Kdo nasadí automatizované testy okamžitě jako tvrdou překážku, zatímco prostředí a data ještě kolísají, vytváří odpor místo důvěry. Kdo naopak viditelně spojuje výsledky se skutečnými chybami a stabilními vydáními, buduje akceptaci.

AI testing platforms nejsou náhradou za dobrou softwarovou architekturu, obchodní odpovědnost, nebo čistá rozhodnutí o vydání. Správně použité však týmům vrací něco velmi konkrétního: čas na případy, které vyžadují úsudek, a pevné důkazy pro pracovní postupy, které jednoduše musí fungovat. Nejsmysluplnější první test je proto zřídka nejspektakulárnější - ale proces, při kterém si v pondělí ráno už nikdo nemusí lámat hlavu, zda systém stále dělá to, co od něj provoz očekává.

Permalink →

Automatická dokumentace testovacích důkazů

Automatická dokumentace testovacích důkazů

Neúspěšný regresní test je otravný. Prošlý test bez využitelného důkazu je často sotva lepší. Kdo chce automaticky dokumentovat testovací důkazy, tím neřeší čistě problém reportování. Jde o pevnou odpověď na konkrétní otázky: Co bylo testováno? V které verzi? S jakými vstupy? Co se skutečně stalo na obrazovce? A dokáže vývojář, vedoucí QA, nebo auditor později rekonstruovat výsledek?

Právě u obchodně kritických webových a Windows aplikací se tyto otázky neobjevují až při auditu. Objevují se, když je po vydání objednávka zpracována nesprávně, když zákazník nahlásí neobvyklou chybu, nebo když tým musí před vydáním rozlišit mezi "vypadá dobře" a "prokazatelně ověřeno". Ručně udržované Excel seznamy, screenshoty v chatových vláknech, a volné testovací poznámky postačují jen tak dlouho, dokud rozsah a míra změn zůstávají malé.

Proč manuální testovací důkazy rychle ztrácí spolehlivost

V mnoha týmech dokumentace začíná s dobrými úmysly. Tester zaznamená výsledek, přidá screenshot, a poznamená si testovanou verzi. Pod časovým tlakem se to však rychle změní na zkrácenou rutinu: zaškrtnout, předat chybu, další testovací případ. To je pochopitelné, zejména u opakujících se regresních testů - ale není to pevné.

Problém není v jednotlivých zaměstnancích. Manuální dokumentace vždy soupeří se samotnou testovací prací. Jakmile je třeba zkontrolovat deset, padesát, nebo několik stovek případů na vydání, buď chybí čas na čisté důkazy, nebo se důkazy stanou tak rozsáhlými, že je už nikdo nevyhodnocuje. K tomu se přidávají typické mezery: screenshot ukazuje stav, ale ne předchozí průběh. Testovací záznam pojmenovává případ, ale ne použité číslo buildu. Chyba byla opravena, ale není vidět, kdy a jak byla oprava znovu ověřena.

Pro aplikace se zpracováním objednávek, skladovými pohyby, cenami, uživatelskými právy, nebo rozhraními je to víc než otázka pohodlí. Nedokumentovaný test nemůže spolehlivě platit jako dokončená kontrola rizika. To platí zejména tehdy, když zdánlivě malá změna na jednom místě vyvolá vedlejší účinky v sousedních procesech.

Co musí skutečně obsahovat použitelný testovací důkaz

Testovací důkaz není jednoduše záběr obrazovky se zelenou fajfkou. Spojuje testovací případ s jeho technickým a obchodním kontextem. Alespoň musí být později rozpoznatelné, která aplikace, která verze, a které testovací prostředí byly zkontrolovány. Stejně důležité jsou čas zahájení, čas ukončení, výsledek, a jasné přiřazení k příslušnému testovacímu kroku.

Při automatizovaných UI testech by měl důkaz navíc zachycovat provedené akce a pozorované výsledky. Příklad: test vytvoří objednávku, zkontroluje součet řádku, vygeneruje dodací list, a následně zkontroluje stav v oblasti expedice. Dobrý záznam nezaznamenává jen "prošel". Ukazuje, ve kterém kroku se kontrola uskutečnila, jakou očekávanou hodnotu měl systém vrátit, a jakou hodnotu skutečně vrátil.

Screenshoty nebo krátké nahrávky obrazovky jsou zde cenné, ale ne vždy povinné pro každý jednotlivý úspěšný krok. Stojí úložný prostor a mohou obsahovat citlivá data. Obvykle dává smysl stupňovaná strategie: při neúspěšných kontrolách se automaticky uloží úplný vizuální důkaz; u úspěšných standardních případů postačují strukturovaná záznamová data a vybrané důkazy. Jaká hloubka je potřebná, závisí na riziku, frekvenci změn, a regulačním prostředí.

Důkaz musí být čitelný a technicky využitelný

Vývojáři potřebují detaily jako chybové zprávy, očekávané/skutečné hodnoty, časové značky, a konkrétní krok v průběhu testu. Obchodní oddělení a odpovědní za vydání naopak potřebují srozumitelné vyjádření: které obchodní procesy byly zkontrolovány, co prošlo, a kde je potřeba akce?

Obě perspektivy by měly vznikat ze stejného běhu testu. Pokud QA tým exportuje technické log soubory a poté ručně napíše manažerské shrnutí, opět vzniká na chyby náchylné médiové zlomení. Lepší je systém, který strukturovaně zachycuje surová data a z nich generuje jasné hodnocení bez skrývání technických detailů.

Automatická dokumentace testovacích důkazů: správný průběh

Automatizace funguje nejlépe, když je vázaná na jasně definovaná rizika. Ne každé kliknutí v každé aplikaci musí být okamžitě automatizováno a plně zdokumentováno. Výchozím bodem jsou obvykle stabilní, často opakované, a obchodně kritické pracovní postupy: přihlášení a kontrola práv, zadání objednávky, výpočet ceny, generování dokumentů, skladové zaúčtování, nebo předání dat rozhraní.

Pro každý pracovní postup se nejprve stanoví, co se počítá jako prošlý test. "Obrazovka vypadá správně" je na to příliš nepřesné. Lepší jsou konkrétní testovací podmínky: uživatel s rolí sklad nesmí moci měnit ceny. Číslo dodacího listu se vygeneruje. Množství snižuje dostupnou zásobu. Po pěti neúspěšných pokusech se aktivuje blokování účtu. Taková kritéria dělají testovací případy opakovatelnými a důkazy srovnatelnými.

Běh testu by měl pak automaticky startovat s kontextovými daty. Sem patří číslo buildu nebo verze, cílové prostředí, prohlížeč nebo operační systém, stav testovacích dat, a časová značka. Během provádění systém zaznamenává jednotlivé kroky, očekávané a skutečné výsledky, jakož i technické anomálie. Při odchylkách generuje důkazy, jako screenshoty, chybové zprávy, nebo nahrávku relevantního průběhu.

Na konci nestojí nestrukturovaná složka souborů, ale běh testu se stavem. Ideálně lze zpětně vysledovat od rozhodnutí o vydání až po jednotlivý krok, proč byl test hodnocen jako prošlý nebo neúspěšný. Právě toto propojení výrazně snižuje diskuse po incidentu.

Kde AI opravdu pomáhá - a kde ne

AI dokáže výrazně urychlit dokumentaci a hodnocení. Dokáže vyhodnocovat stavy obrazovky, označovat nápadné odchylky, a shrnovat běhy testů ve srozumitelném jazyce. Při velkých objemech testů to pomáhá QA týmům, aby nemusely ručně číst každý úspěšný běh. Hodnocení s prahem důvěry může navíc zdůraznit případy, kde je detekce nejistá a lidská kontrola zůstává potřebná.

Přesto by AI neměla sama rozhodovat o kritických vydáních. U oblastí jako autorizace plateb, práva, cenová logika, nebo právně relevantní dokumenty jsou potřebná deterministická testovací kritéria. Očekávaná částka je buď správně vypočtená, nebo ne. Role má přístup nebo nemá. AI zde doplňuje analýzu vizuálního a jazykového obsahu, ale nenahrazuje čistě definované obchodní pravidlo.

I zacházení s daty je architektonické rozhodnutí. Screenshoty z interních aplikací mohou zobrazovat zákaznická data, ceny, adresy, nebo výrobní informace. Kdo automaticky dokumentuje testovací důkazy, měl by proto předem určit, kde se tyto důkazy ukládají, kdo je smí prohlížet, a jak dlouho se uchovávají. Pro bezpečnostně uvědomělé týmy může dávat smysl samostatně hostovaná testovací infrastruktura jako COCO, protože testovací provoz, nahrávky, a hodnocení zůstávají ve vlastním kontrolovaném prostředí.

Doby uchovávání, přístupy, a kvalita důkazů

Více důkazů automaticky neznamená lepší důkazy. Roky rostoucí archiv screenshotů bez rolového modelu a konceptu uchovávání vytváří nové riziko. Smysluplné jsou stupňované doby uchovávání: neúspěšné nebo pro vydání relevantní běhy testů uchovávat déle, úspěšné rutinní testy po definovaném období zhušťovat nebo mazat, a citlivá testovací data včas anonymizovat.

Stejně rozhodující je neměnnost. Pokud se výsledky testů dají dodatečně upravovat bez stopy, ztrácí hodnotu jako důkaz. Změny v testovacích případech, výsledcích, nebo stavu vydání by proto měly být zaznamenávány. To neznamená, že každý testovací report potřebuje komplikovaný auditorský software. Ale odpovědnosti, časové značky, a dohledatelné historie patří do základní výbavy.

Začněte procesem, který opravdu bolí

Nejsmysluplnější první krok automatizace je zřídka největší. Vyberte pracovní postup, který se kontroluje při každém vydání, stojí mnoho ručních minut, a má citelné následky v případě chyby. Může to být zadání objednávky ve webovém portálu, generování expedičního dokumentu, nebo koncept práv v Windows aplikaci.

Definujte pro tento pracovní postup jasná kritéria úspěchu, potřebné důkazy, a odpovědného příjemce pro neúspěšné testy. Po několika vydáních se rychle ukáže, zda jsou důkazy dostatečně srozumitelné, zda vzniká příliš mnoho dat, a které testy by měly následovat dál. Tak neroste dokumentační stroj sám pro sebe, ale ověřovací řetězec, který rychleji zabezpečuje vydání a v případě problémů poskytuje pevné odpovědi.

Permalink →

Digitální dokumentace skladových pohybů

Digitální dokumentace skladových pohybů

Rozdíl 24 kusů v systému zní na první pohled zvládnutelně. Problematickým se stává, když nikdo nedokáže říct, zda bylo zboží nesprávně uskladněno, vyskladněno pro zakázku, poškozeno, nebo nikdy nezaúčtováno. Kdo chce digitálně dokumentovat skladové pohyby, tedy nevytváří jednoduše více dat. Vytváří dohledatelnou historii pro každou zásobu - a tím i pevný základ pro nákup, výrobu, expedici a inventuru.

Pro malé a střední sklady to zřídka představuje případ pro rozsáhlý enterprise balík. Rozhodující je systém, který zobrazuje reálné cesty zboží: příjem zboží u brány, přemístění mezi regály, výdej materiálu v dílně, kompletaci, vratky a korekce po inventuře. Čím méně krát musí týmy přepínat mezi papírem, Excelem a ústními dohodami a více programy, tím spolehlivější se čísla stávají.

Digitální dokumentace skladových pohybů začíná transakcí

Aktuální stav zásob odpovídá jen na jednu otázku: kolik je právě k dispozici? Pro provozní práci to často nestačí. Při dotazech potřebuje tým i odpovědi na jiné otázky: Kdy se zásoba změnila? Kdo provedl zaúčtování? Odkud zboží přišlo, kam směřovalo, a která obchodní transakce to způsobila?

Přesně zde leží rozdíl mezi jednoduchým seznamem zásob a digitální dokumentací pohybů. Každá změna se ukládá jako vlastní, neměnná transakce. Zásoba pak vzniká z těchto transakcí. Pokud se například položka přemístí z místa A-03 na B-12, systém musí dohledatelně propojit odcházející a přicházející pohyb. Pokud se materiál vyskladní pro výrobní zakázku, zaúčtování patří k této zakázce - ne jen k anonymní změně množství.

Tento princip zcela nezabraňuje chybám. Činí je však dohledatelnými. Korekce pak nepřepíše starou hodnotu, ale vytvoří nový korekční zápis s důvodem. To je méně pohodlné než přímo změnit číslo, ale výrazně lepší pro inventury, reklamace a interní odsouhlasení.

Jaká data jsou skutečně potřebná pro každý pohyb

Mnoho projektů se stává zbytečně komplikovanými, protože od začátku se počítá s každým představitelným polem. Pro spolehlivý provoz obvykle postačuje několik, důsledně udržovaných údajů. Rozhodující není délka formuláře, ale to, že každé zaúčtování zůstává věcně jednoznačné.

Zaúčtování pohybu by mělo obsahovat alespoň tyto informace:

  • Položku nebo materiál, včetně jedinečného čísla položky
  • Množství a jednotku, například kus, metr, kilogram nebo krabici
  • Typ pohybu, například příjem, výdej, přemístění, vratku, nebo korekci
  • Zdrojové a cílové místo, pokud se typ pohybu týká obou
  • Časový okamžik, vykonávající osobu, a dohledatelnou referenci na doklad

Reference na doklad může být objednávka, dodací list, zákaznická objednávka, výrobní zakázka, nebo inventurní položka. Později šetří čas, protože zaúčtování se nemusí nejprve interpretovat přes komentáře. Volný text zůstává užitečný pro výjimky, ale neměl by nahrazovat povinné informace.

U položek podléhajících šarži, sériovému číslu, nebo trvanlivosti přibývají další vlastnosti. Pak musí být například jasné, ze které šarže se vyskladnilo, nebo které datum minimální trvanlivosti je dotčeno. Toto není detail na později: pokud je vyžadována dohledatelnost, musí fungovat přímo v procesu zaúčtování.

Přizpůsobení typů pohybů reálnému toku zboží

Nejsmysluplnější kategorie nevznikají na workshopu u abstraktního procesního diagramu, ale při obchůzce po skladu. Kde je zboží skutečně přijímáno? Kdo rozhoduje o blokovaných zásobách? Kdy se materiál vyskladní: při předání dílně, při zahájení výroby, nebo až při spotřebě?

Příjem zboží a kontrola kvality

Při příjmu zboží by mělo být zboží nejprve zkontrolováno vůči objednávce nebo dodacímu listu. Digitální zaznamenání může přímo spojit množství, dodavatele, číslo dokladu, skladové místo, a volitelně šarži. Pokud je nutná kontrola, zboží by se nemělo automaticky jevit jako volně dostupné. Status jako "v kontrole" nebo "blokováno" zabraňuje, aby se nezkontrolovaný materiál omylem zkompletoval.

Přemístění a interní předání

Přemístění se obzvlášť často zapomínají, protože nevytvářejí žádný viditelný externí doklad. Výsledkem je, že celková zásoba souhlasí, ale nikdo nenajde zboží na očekávaném místě. Mobilní zaúčtování přes ruční skener, tablet, nebo jednoduchý webový formulář zde pomáhají, pokud vyžadují málo vstupů. Komplikovaný obrazovkový formulář se v běžném provozu obchází - bez ohledu na to, jak dobře je naplánována databáze za ním.

Výdej, expedice a vratka

Při výdejích musí zaúčtování odpovídat vhodnému účelu. Materiál pro pracovní zakázku, zboží pro zákaznickou objednávku, a zmetek jsou věcně odlišné transakce. Mohou sice snížit stejnou zásobu položky, ale vyžadují odlišná vyhodnocení. Vratky by měly být také vlastním typem pohybu. Jinak zůstává nejasné, zda je položka znovu použitelná, je třeba ji zkontrolovat, nebo vyskladnit.

Zaznamenávání musí fungovat na skladové podlaze

Digitalizace selhává zřídka proto, že tým nerozumí přínosu. Selhává častěji kvůli pěti dodatečným kliknutím, nestabilnímu WiFi, nejasným číslům položek, nebo zaúčtování, které lze dokončit až po skončení směny na kancelářském PC.

Proto se vyplatí definovat jasný postup pro každou roli. Při příjmu zboží se typicky vybírá objednávka nebo dodací list, položka se skenuje, množství se potvrzuje, a přiděluje se skladové místo. Při kompletaci často stačí otevřít zakázku, naskenovat pozici, a potvrdit výdej. Vedoucí skladu potřebují navíc funkce pro blokace, korekce, a inventurní počítání, včetně povinnosti uvést důvod korekce.

Skenování čárového kódu nebo QR kódu snižuje chyby při přenosu, když jsou položky a skladová místa přehledně označeny. Nenahrazují však údržbu kmenových dat. Pokud existuje pět různých způsobů zápisu téže položky, nebo se místa pojmenovávají neformálně, skener jen urychluje nesprávné zaúčtování. Před technickým nasazením by měla být vyčištěna čísla položek, jednotky, skladová místa, a odpovědnosti.

I offline schopnost je otázkou zvážení. V malém skladu se stabilní sítí může postačovat aplikace založená na prohlížeči. Pro vzdálené sklady, velké haly, nebo nespolehlivá připojení může mít smysl lokální dočasné ukládání. Pak musí být jasně upraveno, jak se slučují duplicitní nebo časově posunutá zaúčtování.

Smysluplné nasazení místo jednoho velkého dne přechodu

Úplná změna k jednomu rozhodnému datu působí rozhodně, ale vytváří zbytečné riziko. Lepší je začít s ohraničenou oblastí: například příjem zboží a přemístění pro jednu skupinu položek, nebo jednu skladovou oblast. Tam se rychle ukáže, které typy pohybů chybí, které vstupní obrazovky jsou příliš pomalé, a které zvláštní případy se skutečně pravidelně vyskytují.

Pro start tým potřebuje ověřený počáteční stav zásob. Ten může pocházet z inventury, vyčištěného seznamu zásob, nebo kontrolovaného převzetí. Důležité je jasně zdokumentovat přechod: do kterého okamžiku platí starý systém, od kdy je směrodatný nový systém? Paralelně vedené seznamy jsou užitečné maximálně krátkodobě pro kontrolu. Pokud zůstanou trvale, vznikají dvě pravdy.

Po dvou až čtyřech týdnech by se odpovědní neměli dívat jen na přesnost zásob. Stejně výmluvné jsou počet dodatečných korekcí, chybějící reference na doklady, časy hledání, a zaúčtování mimo předpokládané procesy. Tato pozorování poskytují lepší požadavky než dlouhý seznam přání sestavený před zahájením projektu.

Technický základ: dohledatelný a udržovatelný

Za jednoduchou obrazovkou pro zaúčtování je potřeba čistá datová struktura. Položky, skladová místa, pohyby, doklady, a uživatelská práva by měly být modelovány odděleně. Každé zaúčtování potřebuje jedinečné ID, časové razítko, a přiřazení k uživatelskému účtu. Změny kritických transakcí patří do kontrolního protokolu.

Pro mnoho středně velkých aplikací je štíhlá webová aplikace s relační databází jako MySQL 8 vhodným základem. Dokáže zpracovávat skenerové vstupy, zobrazovat práva založená na rolích, generovat pohybové deníky, a předávat data expedičním nebo objednávkovým procesům. Rozhodující je méně použitý framework, než zdokumentovaná datová logika, testovaná pravidla zaúčtování, a provozní koncept se zálohami, přístupovými právy, a postupy obnovy.

Nemusí se každý pohyb okamžitě přenášet do každého jiného systému. Synchronizace v reálném čase má smysl, když expedice, e-shop, nebo výroba přímo závisí na dostupných množstvích. V jiných případech postačují kontrolovaná předání v pevných intervalech. Více integrace znamená i více zdrojů chyb a více odpovědnosti při výpadcích.

Kdy ještě postačuje tabulka

Tabulka není zásadně problémem. Při malém počtu položek, pevném skladovém místě, a jedné osobě, která důsledně udržuje příjmy a výdeje, může být ekonomická. Změna se stává smysluplnou, když více lidí zaúčtuje současně, skladová místa se stanou relevantními, doklady je třeba propojit, nebo je pravidelně nejasné, proč se zásoba odchyluje.

Správným dalším krokem tehdy není co největší software, ale řešení, které přesně podporuje existující tok zboží. Dobrá digitální dokumentace nedělá práci efektnější. Zajišťuje, že zaúčtování proběhne v okamžiku pohybu - a že odpověď na další otázku o zásobách je již v systému.

Permalink →

Nápady na projekty digitalizace skladu

Nápady na projekty digitalizace skladu

Chybějící dodací list těsně před odjezdem, úroveň zásoby, která vypadá jinak na regálu než v tabulce, a tři zaměstnanci současně vyjasňující stejnou otázku telefonicky: přesně zde vznikají smysluplné nápady na projekty digitalizace skladu. Ne z otázky, která technologie momentálně vypadá módně, ale z konkrétního procesu, který stojí čas, generuje chyby, nebo závisí na znalostech jednotlivých lidí.

Pro malé a střední skladové, obchodní, a výrobní firmy je digitalizace zřídka jediným velkým projektem. Je sekvencí jasně definovaných zlepšení. Cílem nemusí být komplexní podnikový systém řízení skladu. Často je štíhlý nástroj přizpůsobený skutečnému pracovnímu postupu lepší než sada s funkcemi, které nikdo na skladu nepoužívá.

Nápady na projekty digitalizace skladu s provozní hodnotou

Nejlepším vstupním bodem je proces, který se vyskytuje často, je snadno měřitelný, a citelně se zlepšuje pro zaměstnance. Každý, kdo chce digitalizovat celý sklad najednou, okamžitě váže rozpočet a pozornost dříve, než se řešení osvědčí v každodenním provozu. Omezený první krok naopak vytváří odolná data pro další rozhodnutí.

1. Příjem zboží s mobilním zachycováním dat

Při příjmu zboží vzniká mnoho navazujících chyb: nesprávně spočítaná množství, nevyřešené rozdíly, opožděná knihování zásob, a papírové dokumenty, které už později nelze najít. Mobilní formulář zachycování na ručním skeneru, tabletu, nebo smartphonu může výrazně stabilizovat proces.

Zaměstnanci skenují artikl a referenci dodávky, zachycujíce množství, skladové místo, a důvod jakéhokoli rozdílu přímo u nakládací rampy. Pokud je šarže, sériové číslo, nebo fotografie relevantní, tato informace patří k přesně stejnému datovému záznamu. Zásoba není retroaktivně přidávána do tabulky na konci směny; místo toho dostává sledovatelný status při skutečném přijetí.

Toto neznamená, že každý dodavatel nebo artikl striktně vyžaduje čárové kódy. Pro malé, nepravidelné dodávky může postačovat vyhledávání podle čísla artiklu. Rozhodujícím faktorem je, že zachycování dat je rychlejší než předchozí obcházení papírem a ručním přepisováním.

2. Digitální přemístění místo zásobových hádanek

Mnoho skladů zásadně ví, co je dostupné, ale spolehlivě neví, kde se to nachází. Zboží je vytahováno dopředu pro objednávku, dočasně skladováno, přinášeno na montáž, nebo umístěno v otevřené oblasti kvůli prostorovým omezením. Bez jednoduchého knihování se zásobová otázka rychle mění na pátrací operaci.

Proces přemístění nepotřebuje komplikované rozhraní. Naskenujte zdrojové místo, naskenujte cílové místo, potvrďte množství — ve většině případů není potřeba nic víc. Systém by měl ověřit, zda jsou artikl a skladové místo věrohodné, a jasně přiřadit knihování k osobě a časové značce.

Zacházení s výjimkami je důležité. Skladové místo může být zablokováno, přeplněno, nebo schváleno jen pro specifické zboží. Tato pravidla by měla být zobrazena tam, kde předcházejí skutečné škodě. Pro vzácné speciální případy často postačuje schvalovací krok vedením skladu. Příliš mnoho povinných polí mění užitečnou aplikaci na překážku.

3. Vychystávání objednávek s jasným statusem objednávky

Papírové vychystávací seznamy fungují, dokud se nezmění priority, nechybí pozice, nebo se objednávka nerozdělí napříč více oblastmi. Jednoduchý digitální vychystávací seznam ukazuje, která objednávka je otevřená, které pozice už byly vychystány, a kde je potřeba vyjasnění. Toto snižuje dotazy mezi skladem, prodejem, a expedičními odděleními.

V závislosti na velikosti skladu může aplikace diktovat vychystávací trasy nebo jednoduše třídit pozice podle skladové zóny. Plná optimalizace trasy se vyplatí především při mnoha denních objednávkách a dlouhých pochozích trasách. V kompaktním skladu často přinese spolehlivé zobrazení statusu více než matematicky dokonalá trasa, kterou nikdo v každodenní praxi nedodržuje.

V případě nedostatků by systém neměl jen zvýrazňovat věci červeně. Měl by nabízet konkrétní navazující proces: zkontrolovat zásobu, požádat o náhradní artikly, spustit doplnění, nebo předat objednávku k vyjasnění. Digitalizace je hodnotná, když zviditelní další smysluplnou akci.

4. Expediční dokumenty a štítky ze skutečných dat objednávky

Ruční přenášení adres, hmotností, a pozic artiklů do expedičních portálů je hlavním kandidátem na automatizaci. Dodací adresy, dodací instrukce, metody přepravy, a informace o balíku ideálně existují jednou a jsou používány pro dodací list, přepravní štítek, a potvrzení expedice.

Vhodný systém může generovat štítky, ukládat dokumenty způsobem odolným vůči auditu, a automaticky nastavit objednávku na „připraveno k expedici" nebo „expedováno" po vytištění. Provozní výhoda spočívá nejen v ušetřených minutách. Spočívá v zajištění, že se expediční data nikdy nerozcházejí napříč více systémy.

Integrace je zde klíčová. Pokud poskytovatel expedičních služeb nenabízí použitelné rozhraní nebo zahrnuje velmi odlišná speciální pravidla, částečně automatizovaný pracovní postup může být smysluplnější než křehká plná integrace. Nudná, prokazatelná spolehlivost poráží automatizaci, která se zastavuje při každé výjimce.

5. Doplňování a minimální úrovně zásob se sledovatelnými pravidly

Minimální úrovně zásob jsou často udržovány v tabulkách a poté ignorovány, protože nikdo si není jistý, zda jsou čísla stále přesná. Smysluplné digitální řešení propojuje skutečná knihování s jasnými pravidly kontroly zásob. Může upozornit, když artikl klesne pod práh, zohlednit rezervovaná množství, a připravit seznam nákupních objednávek.

Práh by neměl být považován za věčnou pravdu. Sezónní poptávka, dodací doby, a minimální množství objednávek se mění. Proto zodpovědná osoba potřebuje jednoduchý způsob, jak přezkoumat návrhy a upravit pravidla. Plně automatizované objednávky jsou smysluplné až tehdy, když jsou kmenová data, logika dodavatelů, a data spotřeby dostatečně stabilní.

6. Sledovatelnost pro šarže, sériová čísla, a blokovanou zásobu

Každý, kdo pracuje se šaržemi, zařízeními, náhradními díly, nebo regulovanými produkty, potřebuje více než zobrazení množství. Musí být sledovatelné, jaké zboží přišlo kdy, kam bylo přemístěno, a v jaké zákaznické objednávce skončilo.

Projekt může záměrně začít malý: zpočátku zaznamenávaje jen příjem a expedici kritické produktové skupiny. Interní pohyby a vrácení následují později. Systém, který vynucuje každé knihování, ale nerozumí skutečnému procesu opravy nebo kontroly, bude obcházen. Obchodní logika musí proto vycházet z pracovního postupu, ne z abstraktního datového modelu.

Výběr správného projektu

Nejatraktivnější nápad není automaticky správným prvním nápadem. Vyhodnoťte potenciální projekty na základě frekvence, nákladů na chyby, čekací doby, a závislosti na jednotlivcích. Proces, který probíhá 50krát denně a šetří dvě minuty na transakci, může být hodnotnější než vzácná speciální funkce s velkou technickou elegancí. Kvalita dat také patří do rozhodovacího procesu. Pokud jsou čísla artiklů duplicitní, skladová místa nejsou pojmenována jednoznačně, nebo objednávky přicházejí protichůdně z více zdrojů, projekt by měl nejprve vyčistit tyto základy. Software může udělat chybějící pravidla viditelnými, ale nemůže je spolehlivě nahradit. Na prioritizaci stačí čtyři otázky:

  • Která aktivita prokazatelně způsobuje nejvíce dotazů nebo dodatečné práce?
  • Která informace je momentálně přepisována vícekrát nebo dotazována telefonicky?
  • Která chyba by měla nejnákladnější důsledky pro zákazníky, zásobu, nebo expedici?
  • Který pracovní postup lze otestovat za několik týdnů s jasným měřením úspěchu?

Technická rozhodnutí, která záleží v každodenním provozu skladu

Skladová aplikace nemusí vypadat působivě. Musí zůstat srozumitelná při slabém pokrytí Wi-Fi, v rukavicích, pod časovým tlakem, a během změn směn. Velká tlačítka, jasná zpětná vazba po skenu, a viditelné zacházení s chybami jsou důležitější než dekorativní dashboardy.

Architektura by měla také odpovídat provozní realitě. Webová aplikace s čistou databází může běžet na existujících zařízeních a je snadněji udržovatelná než izolované řešení na jednom PC. Se stabilním základem — jako PHP 8.4, modern JavaScript, and MySQL 8 — mohou být role, historie knihování, rozhraní, a zdokumentovaná nasazení provozovány transparentně dlouhodobě.

Ne každá informace je určena pro každou roli. Skladový personál potřebuje otevřené úkoly a jasné dialogy knihování. Kontrola zásob potřebuje upozornění a návrhy na doobjednání. Management potřebuje vyhodnocení týkající se propustných časů, rozdílů, a otevřených transakcí. Koncepty přístupu založené na rolích, deníky, a blokování účtů po opakovaných neúspěšných pokusech patří brzy do fáze plánování, obzvlášť když jsou zapojeni externí poskytovatelé služeb nebo více lokalit.

Implementace: nejprve dokažte, poté rozšiřte

Pilot by měl běžet se skutečnými objednávkami, ne jen s testovacími daty v zasedací místnosti. Vyberte skladovou zónu, produktovou skupinu, nebo směnu a předem definujte, jak bude rozpoznán úspěch: méně korekčních knihování, kratší čas zpracování, méně dotazů, nebo vyšší míra dokončení knihování ve stejný den.

Naplánujte paralelně záložní úroveň. Pokud nová aplikace selže nebo je proces nejasný, tým musí vědět, jak pokračovat v práci a jak budou kontrolována následná knihování. Toto není znak nedostatku důvěry v technologii, ale profesionálního provozu. Po dvou až čtyřech týdnech se obvykle objeví nejhodnotnější poznatky. Možná chybí ne funkce, ale spíše lepší označování artiklů. Možná je pracovní postup správný, ale skenerový profil nebo oprávnění způsobuje úzké hrdlo. Tato pozorování by měla plynout do krátkých, kontrolovaných cyklů zlepšování místo spouštění nového velkého projektu.

Nejlepší digitalizace nedělá každodenní skladovou práci teoreticky modernější, ale konkrétně klidnější: méně hledání, méně ručního přepisování, jasnější předání, a spolehlivá informace přesně tehdy, když čeká na rozhodnutí.

Permalink →

Kontrolní seznam automatizace pracovního postupu skladu

Kontrolní seznam automatizace pracovního postupu skladu

Když je příjem zboží potvrzen na papíře, úrovně zásob jsou později přeneseny do tabulky, a otázka expedice je vyjasněna telefonicky, každý jednotlivý krok se zdá zvládnutelný. Společně vytvářejí dotazy, rozdíly v zásobách, a závislost na jednotlivých zaměstnancích.

Kontrolní seznam automatizace pracovního postupu skladu zabraňuje tomu, aby se tento stav předčasně změnil na předimenzovaný softwarový projekt. Odděluje procesy, které by skutečně měly být automatizovány, od těch, pro které čistě udržovaná tabulka zůstává postačující.

Kontrolní seznam automatizace pracovního postupu skladu před spuštěním projektu

Automatizace nezačíná výběrem systému. Začíná ověřitelným popisem toho, co se skutečně děje ve skladu — i během výjimek, změny směn, a časového tlaku. Projděte následující body přímo na úrovni procesu s vedením skladu, dispečinkem, nákupem, a, pokud je to relevantní, účetnictvím.

1. Zaznamenávejte pohyby, ne jen zásoby

Aktuální zásoba je výsledkem pohybů. Proto by mělo být jasné, které události zvyšují, snižují, rezervují, blokují, nebo přesouvají zásobu. Toto zahrnuje příjem zboží, uložení, vychystávání objednávek, expedici, vrácení, šrot, rozdíly zásob, a přemístění.

Každý pohyb vyžaduje definitivní odpověď na čtyři otázky: kdo jej vykonává? Kdy je zaúčtován? Které skladové místo je dotčeno? Který dokument nebo objednávka jej potvrzuje? Pokud tyto odpovědi momentálně existují jen v hlavách zkušených zaměstnanců, to je hlavní kandidát na automatizaci. Cílem není více sběru dat, ale odolná historie, z níž lze vysvětlit jakoukoli úroveň zásob.

2. Vyčistěte artikly, varianty, a jednotky

Mnoho projektů selhává ne kvůli skenerům nebo webovým rozhraním, ale kvůli kmenovým datům. Artikl může být nakoupen jako karton, uložen individuálně, a prodáván v sadách. Bez definovaných přepočtů software produkuje formálně správná, ale provozně nesprávná množství.

Zkontrolujte čísla artiklů na duplicity, ustanovte závazné popisy, a rozlišujte mezi prodejními jednotkami, skladovými jednotkami, a balicími jednotkami. Sériová čísla, šarže, data expirace, nebo klasifikace nebezpečných materiálů by měly být zahrnuty v počáteční stavbě jen tehdy, pokud ovlivňují každodenní rozhodnutí nebo jsou právně vyžadovány. Vše ostatní zpočátku zvyšuje nároky na údržbu a plochu chyb.

3. Definujte skladová místa tak precizně, jak je potřeba

„Hala 2" může stačit pro inventární seznam. Pro spolehlivé vychystávání objednávek je to obvykle příliš hrubé. Definujte, zda se místo vztahuje na zónu, regál, sekci, přihrádku, nebo přepravní oblast. Karanténní oblasti, zóny příjmu zboží, oblasti vrácení, a expediční buffery musí být také rozpoznatelné jako odlišná místa, pokud se tam zboží může nacházet.

Správná granularita závisí na provozu. Dílna s několika stovkami pozic striktně nevyžaduje správu přihrádek. Avšak s více vychystávači na směnu může přesné skladové místo výrazně snížit cesty pohybu a časy hledání. Neautomatizujte úroveň přesnosti, kterou nikdo nemůže udržovat.

4. Ustanovte spouštěče, zodpovědné role, a schválení

Pracovní postup potřebuje jasný počáteční bod. Při příjmu zboží to může být dodávka při rampě, objednávka nákupu v obstarávání, nebo sken dodacího listu. Pro doobjednávání, minimální úroveň zásob může spustit návrh, zatímco konečná objednávka zůstává u zodpovědné osoby.

Dále zdokumentujte, které akce se mohou dít automaticky a které vyžadují kontrolu. Chybějící množství by mělo vytvořit rozdíl, ne tiše změnit očekávaný příjem zboží. Schvalovací kroky jsou smysluplné pro hodnotné, šaržově spravované, nebo bezpečnostně kritické artikly. Pro spotřební materiál by zbytečně zpomalily propustnost.

5. Generujte dokumenty tam, kde jsou potřeba

Dodací listy, seznamy uložení, vychystávací seznamy, přepravní štítky, a předávací protokoly často vznikají v různých aplikacích. Toto vede k mediálním zlomům: adresa je zkopírována, objednávka je odškrtnuta, a status expedice je aktualizován později.

Poznamenejte si zdroj dat, časovou značku vytvoření, a příjemce pro každý dokument. Smysluplný pracovní postup by mohl, například, automaticky generovat vychystávací seznam po schválení objednávky, poskytnout přepravní štítek po balení, a uzavřít objednávku s časovou značkou po předání. Rozhodujícím bodem je, že data už nemusí být ručně zadávána vícekrát.

Zkontrolujte rozhraní a kvalitu dat

Nejlepší skladová logika je zbytečná, pokud objednávky přicházejí jen jednou denně jako soubor nebo pokud jsou dodací adresy formátovány nekonzistentně. Proto vytvořte střízlivý seznam systémů, které posílají nebo přijímají data: obchod, ERP, účetnictví, poskytovatel expedičních služeb, dodavatelský portál, výrobní systém, a existující tabulky.

Pro každé propojení by mělo být stanoveno, který systém je autoritativní pro každé datové pole. Pokud jsou kmenová data artiklů autoritativní v ERP, skladový portál nesmí tiše vytvářet vlastní artikly. Pokud změna objednávky přichází z obchodu, musí se stát viditelnou před expedicí. Pro nízké objemy může být kontrolovaný CSV import správným prvním krokem. Pro vysoký objem nebo krátké dodací sliby se vyplatí přímé rozhraní.

Zacházení s chybami je stejně důležité. Rozhraní by nemělo jen přenášet data, ale také ukazovat, co bylo odmítnuto a proč. Neznámá čísla artiklů, neplatné adresy, nebo chybějící množství nesmí zmizet do technického deníkového souboru. Vyžadují pracovní seznam s určenou zodpovědností a statusem.

Navrhněte použitelnost na skladu

Proces, který vypadá věrohodně u stolu, může selhat na skladu. Zaměstnanci nosí rukavice, přesouvají zboží, sdílejí zařízení, nebo pracují s nestabilním pokrytím Wi-Fi. Proto zkontrolujte brzy, zda skenery, tablety, desktopy, nebo výtisky sedí k danému pracovnímu kroku.

Skenování by mělo poskytovat jasnou zpětnou vazbu: správný artikl, nesprávné skladové místo, už zaúčtované množství, nebo zablokovaný artikl. Samotné barvy nestačí. Krátké, srozumitelné zprávy a jasný další krok jsou hodnotnější pod časovým tlakem než rozhraní bohaté na funkce.

Naplánujte také výjimky. Co se děje při poškozeném čárovém kódu, výpadku sítě, částečné dodávce, nebo objeveném nepřiřazeném zboží? Dobrý pracovní postup nabízí pro toto kontrolované cesty a zaznamenává opravu. Nenutí týmy spoléhat na lepicí lístky a pozdější hromadná knihování.

Definujte ukazatele před budováním dashboardů

Dashboard není cíl. Relevantní ukazatele jsou ty, které spouštějí provozní rozhodnutí. Tyto mohou zahrnovat otevřené příjmy zboží překračující definovaný věk, objednávky blízké jejich expedičnímu termínu, rozdíly zásob na skladovou zónu, chyby vychystávání, nebo čas, který uplynul mezi přijetím objednávky a předáním.

Definujte zdroj dat, výpočetní pravidlo, a zodpovědnou roli pro každý ukazatel. „Přesnost zásob", například, má smysl jen tehdy, když je jasné, oproti jakému počtu se měří a jak se zachází s vráceními nebo zablokovanou zásobou. Několik spolehlivých ukazatelů je lepších než stěna grafů, kterým nikdo nedůvěřuje.

Naplánujte bezpečnost, oprávnění, a sledovatelnost

Automatizace distribuuje působnost. Kdo smí upravovat zásobu, vytvářet artikly, generovat přepravní štítky, nebo stornovat objednávky, by mělo být záměrně ustanoveno. Oprávnění založená na rolích jsou obvykle smysluplnější než sdílené přihlášení na skladovém PC. Obzvlášť kritické opravy vyžadují časovou značku, přiřazení personálu, a ideálně důvod.

Technické základy také patří na kontrolní seznam: pravidelné zálohy, otestované obnovení, zdokumentované přístupové údaje, logování chyb rozhraní, a postup pro zablokované nebo deaktivované uživatelské účty. V individuální aplikaci nejsou udržovatelné technologie, čistá databázová struktura, a sledovatelné kroky nasazení menšími detaily. Určují, zda zůstávají úpravy vypočitatelné po dvou letech.

Implementujte v malých, měřitelných krocích

Nepokoušejte se najednou konvertovat příjem zboží, doplňování, počítání inventáře, expedici, a plánování tras. Vyberte si pracovní postup s citelným třením a zvládnutelným rizikem, jako mobilní knihování příjmů zboží nebo automatizované generování expedičních dokumentů. Před zahájením zaznamenejte čas zpracování, opravy, a otevřené případy.

Testujte se skutečnými artikly, skutečnými objednávkami, a zaměstnanci, kteří s nimi budou skutečně pracovat. Pilot s jednou skladovou zónou nebo produktovou skupinou ukáže rychleji než workshop, zda popisy, pracovní postupy skeneru, a schválení fungují. Až když jsou výjimky zvládnuty, měl by následovat další proces.

Automatizace je úspěšná, když týmy potřebují klást méně otázek, zásoba zůstává vysvětlitelná, a proces funguje i tehdy, když je nejzkušenější osoba na dovolené. Přesně tam se vyplatí další zlepšení: ne s nejhlučnějším nástrojem, ale s třením, které skutečně zpomaluje pracovní den.

Permalink →

Zlepšení doby načítání mobilní stránky

Zlepšení doby načítání mobilní stránky

Když se skladový smartphone se slabým signálem používá ke vstupu na stránku, není to animace hero sekce, která určuje první dojem, ale to, zda se stránka vůbec stane interaktivní. Pokud potenciální klient čeká tři, čtyři, nebo pět sekund na obsah, alternativa je jen jedno tlačítko zpět. Zlepšení doby načítání mobilní stránky vyžaduje sledovatelnou technickou sekvenci, ne kosmetické rychlé opravy.

Toto platí obzvlášť pro webové stránky navržené k generování dotazů: pro výrobce, poskytovatele logistických služeb, nebo firmu nabízející komplexní služby. Mobilní uživatelé často vstupují na stránky mezi schůzkami, na skladě, nebo přes vyhledávací dotazy s konkrétním záměrem. Stránka musí poskytovat informace, ne způsobovat náročné zpracování na zařízení.

Proč je mobilní rychlost načítání provozním problémem

Mobilní výkon je často striktně považován za SEO disciplínu. To je nedostatečné. Rychlé stránky pomáhají s viditelností a náklady kampaní, ale okamžitý efekt leží ve skutečném používání: formuláře jsou odesílány častěji, telefonní čísla jsou vytáčena častěji, a informace o produktu jsou důkladně čteny. Pomalá webová stránka naopak vytváří pochybnosti dříve, než kontaktní osoba vůbec může odpovědět.

„Rychlý" není jediný ukazatel. Stránka může zobrazit pozadí brzy, a přesto zůstat nereagující na kliknutí po značnou dobu. Pro návštěvníky záleží tři faktory: kdy se objeví nejdůležitější obsah? Kdy může být stránka ovládána bez zpoždění? A posouvá se rozložení ještě, když se snaží stisknout tlačítko? Tyto otázky se odrážejí v ukazatelích jako Largest Contentful Paint, Interaction to Next Paint, a Cumulative Layout Shift.

Měření musí probíhat za realistických podmínek. Výkonný kancelářský počítač na Wi-Fi maskuje problémy, které se stávají zjevnými na starším Android zařízení na mobilní síti. Poloha, zprostředkovatelské služby, a předem naplněná vyrovnávací paměť prohlížeče také mění výsledky. Opakovaná měření a skutečná uživatelská data záleží mnohem více než jediný dokonalý testovací běh.

Zlepšení doby načítání mobilní stránky: nejprve měřte, poté měňte

Nejčastější chybou je okamžité komprimování obrázků nebo instalování dalšího optimalizačního pluginu. Obojí může pomoci, ale bez analýzy hlavní příčiny rychle vytváří těžko udržovatelné konfigurace. Nejprve zkontrolujte reprezentativní výběr: domovskou stránku, typickou stránku služby nebo produktu, kontaktní stránku, a landing page s vysokou návštěvností. Vzory se stávají viditelnými napříč těmito stránkami.

Síťový deník odhaluje, které soubory blokují inicializaci a jak velké skutečně jsou. Audit výkonu ukazuje, zda JavaScript zpožďuje provoz, zda fonty přicházejí pozdě, nebo zda se obrázky načítají zbytečně brzy. Doplňte laboratorní měření daty od skutečných návštěvníků, pokud to návštěvnost dovoluje. Toto zabraňuje optimalizaci pro testovací profil, který neodráží vaši skutečnou cílovou skupinu.

Stanovte jasný cíl před každou změnou. Například: viditelný hlavní obsah by se měl objevit na průměrném mobilním zařízení pod 2,5 sekundy, nebo kontaktní formulář by měl být použitelný bez zpoždění vstupu. Ne každá stránka vyžaduje teoretické nejvyšší skóre. Komplexní aplikace s autentizovanými daty mají jiné předpoklady než veřejné podnikové webové stránky. Nudná, prokazatelná spolehlivost je zde hodnotnější než krátkodobé skóre poháněné rizikovými triky.

1. Zacházejte s obrázky podle jejich účelu

Na mnoha mobilních stránkách zůstávají obrázky největším datovým blokem. Problémem není samotná fotografie, ale obrázek přenášený při šířce 2 500 pixelů, když zařízení vyžaduje jen 700 pixelů. Poskytněte responzivní varianty obrázků, aby si prohlížeč mohl vybrat vhodnou velikost. Moderní formáty jako WebP nebo AVIF často výrazně snižují velikosti souborů, ačkoli by měly být nasazeny s čistými záložními řešeními a ověřenou kvalitou obrázku.

Největší obrázek ve viditelné počáteční oblasti zobrazení si zaslouží zvláštní pozornost. Měl by být správně ořezán, používat vhodné rozlišení, a načítat se brzy. Obrázky dále dole na stránce se mohou načítat líně. Toto šetří data při vstupu, ačkoli to nesmí způsobit, že se obrázky viditelně objeví během scrollování, když je uživatel už očekává.

Neodstraňujte reflexivně všechny obrázky. Dobrý obrázek může vysvětlit stroj, tým, nebo proces rychleji než odstavec textu. Technickým úkolem je efektivně poskytovat relevantní vizuální informaci, ne redukovat design na šedá zástupná pole.

2. Omezte JavaScript na potřebnou práci

Každý skript soutěží o čas zpracování během načítání a interakce. Jednotně integrované knihovny, správci tagů s více skripty třetích stran, chatovací widgety, mapy, a animace jsou obzvlášť problematické. Na desktopových zařízeních tyto náklady často zůstávají nepovšimnuty. Na mobilu výsledkem je stránka, která je viditelná, ale reaguje pomalu na vstupy.

Ověřte účel, podmínku načítání, a obchodní hodnotu každého skriptu. Interaktivní mapa na kontaktní stránce se nemusí načítat na každé podstránce. Cookie nebo analytický nástroj by neměl spouštět řetěz dalších souborů dříve, než návštěvník vůbec může číst obsah. Funkce potřebné jen po interakci mohou být načteny na vyžádání.

Pro individuálně vyvinuté webové stránky je jasná struktura komponent skutečným aktivem. JavaScript je balený podle funkce místo toho, aby byl odesílán jako globální monolit. Toto také zjednodušuje pozdější údržbu: rozšíření formuláře náhodou nezmění kód pro produktový filtr nebo navigaci.

3. Doručujte CSS a fonty bez blokád

Časté úzké hrdlo leží v rámci počáteční viditelné oblasti zobrazení. Pokud se pro ni musí načíst více stylopisů, ikonových fontů, a externích variant fontů, prohlížeč čeká zbytečně dlouho. Kritické styly pro viditelnou sekci by měly být malé a brzy dostupné. Nekritická pravidla mohou následovat později.

Pro webové fonty obvykle stačí několik tlouštěk. Čtyři tloušťky v normální, kurzívě, a dodatečné podskupiny se cítí kompletní v designovém systému, ale jsou zřídka potřeba pro typickou podnikovou webovou stránku. Definujte rozumná systémová záložní řešení, aby text zůstal okamžitě čitelný. Font, který se čistě přepne o několik milisekund později, je lepší než prázdné textové bloky.

Ikony si také zaslouží přezkoumání. Malá sada SVG je často efektivnější a přesněji kontrolovatelná než kompletní ikonový font. Toto pravidlo připouští výjimky: existující systémy nemusí být přebudovány výhradně kvůli pár kilobajtům. Pokud jsou však větší změny už plánovány, toto rozhodnutí patří do technického základu.

4. Nastavte cachování a odpověď serveru čistě

I štíhlé rozhraní působí pomalu, pokud server potřebuje příliš dlouho na doručení počáteční odpovědi. Příčiny sahají od neoptimalizovaných databázových dotazů a dynamicky kompilovaných stránek po chybějící cachování. Veřejný obsah, který se mění zřídka, by měl být rychle doručitelný jako cachovaná verze. Statické soubory jako obrázky, CSS, a JavaScript vyžadují odlišné názvy verzí a rozumná pravidla cache.

Pro PHP aplikace to dodatečně zahrnuje efektivní vykonávání, správně nakonfigurovanou opcode cache, a kontrolovaný přístup k databázi. MySQL dotazy potřebují indexy, které odpovídají skutečným cestám filtrování a třídění. Domovská stránka, která provádí více redundantních datových dotazů při každém požadavku, se nezlepší s rostoucí návštěvností.

Cachování však není bianko šek. Ceny, dostupnosti, personalizované sekce, nebo obsah po přihlášení se nikdy nesmí jevit zastaralé omylem. Hranice cache jsou proto přesně definovány: co může být staré pět minut, co musí být okamžitě aktuální, a kdo čistí cache po modifikacích obsahu? Dobrý výkon vyplývá z této přesnosti.

5. Zacházejte s poskytovateli třetích stran kriticky

Externí služby často tvoří neviditelnou zátěž webové stránky. Analytika, správa souhlasu, videa, mapy, recenzní widgety, a marketingové pixely načítají dodatečné skripty z externích serverů. Každá závislost může způsobit zpoždění, vyvolat otázky ochrany soukromí, a zhoršit vykreslování, pokud dojde k chybám.

Toto neznamená, že každý externí nástroj musí být odstraněn. Video může podporovat prodej, a analytický nástroj může podložit klíčová rozhodnutí. Vyžaduje se však analýza nákladů a přínosů. Načítejte vložená média až po souhlasu nebo interakci. Používejte zástupné symboly pro mapy zpočátku. Nakonec odstraňte tagy, jejichž data nikdo nevyhodnotil měsíce.

6. Zohledněte posuny rozložení a mobilní použitelnost

Rychlost načítání a použitelnost jdou ruku v ruce. Rezervujte pevné rozměry pro obrázky, bannery, a vložené prvky, aby se tlačítka neposouvala zpod prstu uživatele. Vyhýbejte se pop-up oknům, která překrývají viditelný obsah hned při vstupu. Rychlá stránka, která okamžitě zobrazí těžko zavíratelný překryv, neřeší základní problém.

Testujte formuláře se zvláštní péčí. Velká vstupní pole, vhodné typy klávesnice, a krátké povinné cesty pomáhají více než propracované vizuální efekty. Pokud dotaz vyžaduje jen jméno, číslo pro zpětné zavolání, a žádost, dvanáctičlenný formulář není znakem důkladnosti — je to tření.

7. Řiďte výkon jako trvalý provozní proces

Jednorázový relaunch neudržuje nízké doby načítání trvale. Nové obrázky kampaní, požadavky sledování, a redakční moduly se časem hromadí. Rozpočty výkonu proto patří do vývojového procesu: maximální velikost souboru pro počáteční obrázky, jasná pravidla pro nové nástroje třetích stran, a definované limity pro JavaScript.

Po vydáních by měly být klíčové typy stránek znovu vyhodnoceny. Automatizované testy mohou určit, zda centrální stránky zůstávají dosažitelné a zda kritické pracovní postupy fungují správně. Pro výkon je však samotný funkční test nedostatečný. Doplňte ho měřeními doby odezvy, přeneseného objemu dat, a mobilní interaktivity.

Rychlá mobilní webová stránka není vytvořena jediným pluginem, ani skrze odpírání za každou cenu. Vzniká, když design, obsah, infrastruktura, a skutečné používání jsou zvažovány společně. Začněte se stránkou, která generuje dotazy nebo provozní kontakty, měřte za čestných podmínek, a eliminujte tření všude tam, kde ho uživatelé skutečně cítí.

Permalink →

Logistický software, který skutečně odlehčuje provoz

Logistický software, který skutečně odlehčuje provoz

Když je příjem zboží nejprve poznamenán na papíře, později přenesen do tabulky, a poté předán do expedice ústně, zřídka chybí nasazení zaměstnanců. Chybí sdílený, spolehlivý pracovní základ. Dobrý logistický software nenahrazuje takové trhliny více prací na obrazovce, ale jasnými pracovními postupy: co přišlo, kde se to nachází, co bylo rezervováno, a co lze dnes expedovat?

Pro malé a střední podniky nezáleží na co nejdelším seznamu funkcí. Rozhodujícím faktorem je, že software odráží skutečnou práci na skladě, v kanceláři, a v expedici. Řešení určené pro globální korporaci s dvaceti lokalitami může být zbytečně pomalé, drahé, a komplikované pro provoz s jedním skladem a dvěma směnami.

Kdy má logistický software skutečně smysl

Tabulky nejsou zásadně problémem. Při nízkých množstvích, zvládnutelném seznamu základních artiklů, a jediném odpovědném zaměstnanci, mohou být nejpragmatičtějším řešením. Bylo by chybou nahradit fungující proces projektem výhradně kvůli modernizaci. Zlomový bod přichází, když se informace musí udržovat vícekrát nebo nikdo nemůže s jistotou říct, který soubor je aktuální. Typickými signály jsou nedostatky zásob navzdory plným regálům, dotazy na status dodávek, ručně psané dodací listy, a inventury, které zastaví provoz na dny. Rostoucí počet objednávek také zviditelňuje, které kroky byly dříve udržovány pohromadě jen zkušeností jednotlivých osob.

Tehdy nejde především o digitalizaci jako módní slovo. Jde o zdroje chyb a čekací doby. Zaměstnanec by neměl muset nejprve porovnávat více seznamů jen proto, aby schválil objednávku. Dispečink by neměl muset hádat, zda je artikl skutečně dostupný, nebo už rezervovaný pro jinou objednávku.

Které procesy by měl logistický software propojovat

Použitelné řešení začíná materiálovým tokem, ne standardním menu. Pro mnoho firem tento tok zahrnuje příjem zboží, uložení, správu zásob, vychystávání objednávek, expedici, a zpětnou vazbu. V závislosti na firmě se přidávají šarže, sériová čísla, vrácení, výrobní zakázky, nebo plánování tras.

Příjem zboží se sledovatelnými zásobami

Hodně se rozhoduje při příjmu zboží. Pokud je dodávka zkontrolována přímo oproti objednávce nebo dodacímu listu, rozdíly v množství, poškozené zboží, a chybějící pozice mohou být zaznamenány přesně tam, kde vznikají. Zboží dostává status místo toho, aby bylo jednoduše fyzicky někde odloženo.

Software nemusí nutně začínat drahým skenerovým hardwarem. V některých skladech tablet nebo pracoviště v oblasti příjmu zboží stačí na začátek. Tam, kde je denně přemísťováno mnoho pozic, jsou však skenery čárových kódů smysluplné, protože zrychlují knihování a snižují chyby psaní. Správné rozhodnutí závisí na množstvích, trasách, a struktuře artiklů.

Skladové pohyby bez paměťového deníku

Zásoby jsou odolné jen tehdy, když jsou příjmy, přemístění, výdeje, a opravy sledovatelné. Toto neznamená, že každé výjimce musí být zabráněno. V každodenním provozu se vyskytují poškozené obaly, nesprávná uložení, a spontánní výdeje materiálu. Dobrá aplikace dělá tyto případy knihovatelnými, ale také dokumentuje, kdo co změnil a kdy.

Tato historie není kontrolním nástrojem sama o sobě. Pomáhá najít příčiny. Pokud artikl opakovaně skončí na nesprávném skladovém místě, označení skladu může být nejasné. Pokud se vyskytují pravidelné opravy, problém často leží v procesu před knihováním.

Objednávky, dodací listy, a expedice z jednoho pracovního postupu

Mnoho týmů ztrácí čas na rozhraní mezi zpracováním objednávek a expedicí. Data objednávky přicházejí e-mailem, telefonicky, nebo ze samostatného obchodního systému. Následně jsou pozice tištěny, zásoby jsou kontrolovány, a expediční dokumenty jsou znovu zaznamenány. Každé ruční předání vytváří prostor pro rozdíly.

Logistický software by měl umět vygenerovat jasný vychystávací seznam, dodací list, a, pokud je potřeba, přepravní štítek ze schválené objednávky. Pořadí je zde důležité: nejprve musí být jasné, co je dodatelné. Poté by objednávka měla být rezervována pro jiné procesy. Jinak vzniká nepříjemná situace, kdy dva zaměstnanci přidělují stejnou zbývající zásobu.

Plánování, které odpovídá realitě

Plánování tras a kontrola kapacity mohou být hodnotné, obzvlášť při vlastních dodávkách, pevných časových oknech, nebo mnoha regionálních zastávkách. Nejsou však automaticky dalším smysluplným krokem. Každý, kdo ještě nemá čisté schvalování objednávek a spolehlivá data zásob, by měl nejprve vyřešit tyto základy.

Totéž platí pro prognózy a AI podporované plánování. Mohou udělat vzory viditelnými, ale vyžadují čistá vstupní data. Prognóza založená na neúplné zásobě vypadá technicky sofistikovaně, ale nezlepšuje schopnost dodávky.

Standardní řešení nebo individuální logistický software?

Standardní software je smysluplný, když jsou vlastní pracovní postupy do velké míry konvenční a mohou být přizpůsobeny bez většího tření. Může být zaveden rychleji a přináší osvědčené základní funkce. Pro provoz s jednoduchými skladovými procesy, jasnými rolemi, a málo zvláštnostmi, je to často ekonomicky správná volba.
Individuální logistický software se vyplatí, když firma žije ze speciálních pracovních postupů nebo existující systémy mohou být propojeny jen oklikami. Toto se týká například dílen s výdeji materiálu pro probíhající zakázky, prodejců s pravidly expedice specifickými pro zákazníka, nebo výrobců, kteří musí těsně propojovat skladové pohyby s výrobními kroky.

Rozdíl neleží ve vymýšlení všeho znovu. Dobré individuální systémy přebírají osvědčené vzory, jako změny statusu, rezervace, a oprávnění. Přizpůsobují však jazyk, masky, dokumenty, a rozhraní práci, která je skutečně vykonávána. Díky tomu se tým nemusí trvale orientovat na kategorie, které dávají smysl jen v příručce výrobce.

Pro softify.pro proto takový projekt začíná otázkou, které pracovní postupy by měly být zachovány. Ne každý útržek papíru je chyba, a ne každé speciální pravidlo dává smysl. Až když je jasné, kde se informace ztrácí nebo rozhodnutí zbytečně čekají, lze naplánovat schůdné řešení.

Zavedení bez přerušení provozu

Největší riziko zřídka leží jen v programovém kódu. Leží v implementaci, která chce změnit příliš mnoho najednou. Sklad se nemůže zastavit na dva týdny, aby se naučil nový systém. Proto je zavedení krok za krokem obvykle smysluplnější než velké datum přechodu.

Dobrá první sekce se zaměřuje na vymezený pracovní postup, například příjem zboží a knihování zásob nebo vytváření dodacích listů. Tým pracuje se skutečnými daty, zpětná vazba proudí přímo do adaptace, a přínos se stává měřitelným. Až poté následují další oblasti, jako mobilní vychystávání, vrácení, nebo propojení s obchody a poskytovateli expedičních služeb.

Migrace dat si zde zaslouží zvláštní pozornost. Stará čísla artiklů, duplicitní kmenová data zákazníků, a nekonzistentní skladová místa automaticky nezmizí jen proto, že se zavádí nový systém. Často je lepší záměrně vyčistit kmenová data a převzít jen relevantní historie. Toto šetří pozdější hledání a zabraňuje technickému konzervování starého nepořádku.

Oprávnění také patří brzy na program. Ne každý zaměstnanec potřebuje přístup k cenám, všem opravám zásob, nebo udržování kmenových dat. Jasné role chrání před náhodnými úpravami a dělají odpovědnosti viditelnými bez blokování pracovního postupu zbytečnými schváleními.

Technologie, která se nestává zátěží po spuštění

Logistická aplikace musí rychle reagovat v každodenním provozu, i když více pracovišť knihuje současně. K tomu potřebuje sledovatelnou datovou architekturu, čisté transakce, a jasná pravidla pro paralelní úpravy. Pokud dva zaměstnanci zpracovávají stejnou zásobu, systém nesmí generovat tiché chybné knihování.

Udržitelnost je stejně důležitá. Technologie jako PHP 8.4, moderní JavaScript, a MySQL 8 nejsou prodejním argumentem samy o sobě. Jsou smysluplné, když aplikace zůstává dlouhodobě srozumitelná, dostává bezpečnostní aktualizace, a může být pokračována kvalifikovanými vývojáři. Zdokumentované poskytování, zálohy, logování, a realistické zacházení s aktualizacemi jsou součástí provozní způsobilosti.

Dobrý logistický software proto není rozpoznatelný podle obzvlášť elegantního dema. Ukazuje se v normální úterní ráno: dodávka je zaúčtována, zásoba je správná, objednávka je sledovatelná, dodací list sedí, a další směna ví, co už bylo uděláno. Úleva vzniká přesně tam — ne co nejvíce funkcemi, ale spolehlivými pracovními postupy, které sedí k provozu.

Permalink →

Plánování databáze MySQL pro webové aplikace

Plánování databáze MySQL pro webové aplikace

Když tři zaměstnanci ráno paralelně knihují zboží, zákazník kontroluje status dodávky, a back office vytváří fakturu, kvalita aplikace se neprojevuje v jejím designu. Projevuje se v tom, zda všichni vidí přesně stejný, správný stav dat. Plánování databáze MySQL pro webovou aplikaci proto neznamená vytváření tabulek co nejrychleji. Znamená to pochopení skutečných pracovních postupů dostatečně přesně, aby se zajistilo, že data zůstanou spolehlivá i pod zátěží, během chyb, a s růstem firmy.

Obzvlášť v interních platformách, skladových a objednávkových procesech, nebo zákaznických portálech, se databáze často řeší příliš pozdě. Nejprve se vybuduje rozhraní, poté se přidají pole, následované výjimkami. To funguje pro prototyp. V provozu to vede k duplicitním datovým sadám, nejasným stavům, a zprávám, kterým už nikdo plně nedůvěřuje.

Plánování databáze MySQL pro webové aplikace: začněte pracovním postupem

První návrh by neměl začínat názvy sloupců, ale konkrétní pracovní situací. Vezměte příjem zboží: dodávka přichází, je přiřazena k dodavateli a objednávce, množství jsou zkontrolována, je přiřazeno skladové místo, a zásoba se mění. V závislosti na provozu tento proces dodatečně vyžaduje fotografie, kontrolu kvality, status pozastavení, nebo sledovatelnou opravu. Z tohoto pracovního postupu vznikají funkční objekty. Typickými příklady jsou artikly, dodavatelé, objednávky, pozice, skladová místa, pohyby zásob, a uživatelé.

Rozlišení mezi objektem a událostí je klíčové. Artikl popisuje, čím něco je. Pohyb zásoby dokumentuje, že se množství změnilo na konkrétním místě v konkrétním čase. Míchání obojího v jedné tabulce rychle vede ke ztrátě sledovatelnosti.

Několik těžkých otázek pomáhá pro každý objekt: jaká je jedinečná identita? Která informace se smí měnit? Kdo ji smí měnit? Která data musí být uchovávána historicky? A jaká pravidla platí, když dva lidé pracují současně? Tyto otázky zabraňují pozdější improvizaci lépe než dlouhý seznam údajně kompletních databázových polí.

Datový model by měl vyjadřovat pravidla

Databáze není jen úložiště pro vstupy formulářů. Měla by sama vynucovat centrální pravidla. Pokud každý pohyb zásoby musí patřit právě k jednomu artiklu a jednomu skladovému místu, cizí klíče patří do modelu. Pokud se externí číslo objednávky smí vyskytnout jen jednou na nájemce, vyžaduje se jedinečný index. Pokud by pozice nikdy neměla existovat bez hlavičkové objednávky, tento vztah musí být jasně modelován.

MySQL 8 s InnoDB poskytuje pro toto robustní základy: transakce, cizí klíče, mechanismy uzamykání, a konzistentní změny napříč více tabulkami. Při zapisování pohybu, aktuální zásoby, a kontrolního deníku během knihování příjmu zboží by se to mělo dít jako jednotná transakce. Pokud jeden krok selže, nesmí zůstat žádná napůl dokončená operace.

Ne každé pravidlo však patří do databáze. Schválení, komplexní cenová logika, nebo procesní kroky závislé na roli jsou často lépe umístěny v logice aplikace, protože se funkčně mění rychleji. Hranice je pragmatická: pravidla, jejichž porušení trvale poškozuje data, by měla být zabezpečena co nejblíže k datům. Pravidla, která se mění často nebo silně závisí na kontextu, vyžadují dobře otestovaný kód aplikace.

Nezaměňujte historii se současnými hodnotami

Běžnou chybou je ukládání jen aktuální zásoby nebo aktuálního statusu. To stačí, dokud se někdo nezeptá, proč se množství změnilo včera nebo kdo resetoval objednávku. Pro provozní systémy je historie pohybů nebo událostí často hodnotnější než jediné přepisovatelné pole.

Toto neznamená trvalé zaznamenávání každého kliknutí. Měly by být zaznamenávány obchodně relevantní změny: změny statusu, úpravy množství, opravy, schválení, a přiřazení. Dobrý auditní záznam obsahuje časovou značku, uživatele nebo systémový proces, předchozí a novou hodnotu, a srozumitelný důvod, když to pracovní postup vyžaduje. Toto umožňuje vyjasnit chyby, aniž by bylo potřeba prohledávat e-maily, papírové seznamy, nebo zálohy databáze.

Vědomě zvolte klíče, datové typy, a konvence pojmenování

Technická rozhodnutí se zdají malá, ale formují údržbu a integrace po celé roky. Pro interní primární klíče jsou hodnoty BIGINT s automatickým přiřazením často střízlivou, snadno zvládnutelnou volbou. UUID mohou být smysluplné, když data pocházejí offline, více systémů zapisuje nezávisle, nebo externí rozhraní by neměla vystavovat sekvenční ID. Avšak stojí více úložného prostoru a vyžadují o něco více pozornosti u indexů a třídění.

Peněžní částky by měly být uloženy jako DECIMAL, ne FLOAT nebo DOUBLE. Množství také potřebují funkčně přiměřenou přesnost: počty kusů jsou často celá čísla, zatímco hmotnosti a délky nejsou. Časové značky by měly být zpracovávány jednotně, ideálně interně v UTC, zatímco rozhraní zobrazuje místní časové pásmo provozu. Obzvlášť během změn směn a letního času toto zabraňuje těžko nalezitelným nesrovnalostem.

Názvy by měly být také nudné a jednoznačné. order_items nebo inventory_movements jsou užitečnější než kreativní zkratky, kterým rozumí jen původní projektový tým. Konzistentní jednotné nebo množné formy jsou méně důležité než konzistentnost. Stejně smysluplná jsou pole jako created_at, updated_at, a, když je potřeba, deleted_at. Měkké mazání nicméně není standardní povinností. Pro právně nebo provozně relevantní záznamy je čisté stornování obvykle lepší než neviditelně smazaná datová sada.

Indexy sledují skutečné dotazy, ne hádání

Index může masivně zrychlit vyhledávání, ale činí zápisové operace komplexnějšími a spotřebovává úložný prostor. Proto „index na každém poli" není strategie. Nejdůležitější dotazy by měly být stanoveny brzy: otevřené objednávky zákazníka, pohyby artiklu v rámci období, zásoba na skladové místo, nebo nedávno upravené záznamy pro rozhraní.

Pořadí složených indexů zde záleží. Pokud aplikace pravidelně vyhledává podle tenant_id, status, a created_at, složený index v tomto přesném pořadí je často smysluplný. Zda to skutečně sedí, ukazuje prováděcí plán pomocí EXPLAIN, ne pocit. Databáze se nestávají rychlými díky působivým trikům, ale díky pozorovatelným dotazům, odpovídajícím indexům, a realisticky testovaným objemům dat.

Pro rostoucí tabulky je hodnotná jasná strategie uchovávání. Musí technické deníky sedět v primární produkční databázi pět let? Ne nutně. Obchodní záznamy, pohyby, a důkazy kontroly vyžadují jiné doby uchovávání než ladicí informace. Archivace není znakem slabého systému, ale promyšleným provozním rozhodnutím.

Provoz více uživatelů vyžaduje transakce a jasné stavy

Ve webové aplikaci přistupuje více požadavků ke stejným datům současně. Toto je normální v každodenním skladovém provozu, ne výjimka. Dva zaměstnanci mohou knihovat stejnou zásobu, zatímco import vytváří nové objednávky. Bez transakcí a cíleného uzamykání existuje riziko ztracených úprav nebo záporných zásob, které se stanou zjevnými až o týdny později.

Pro kritické operace by mělo být jasné, která data jsou čtena a zapisována v rámci transakce. Někdy stačí atomická aktualizace, jako zásoba, která se mění jen tehdy, když je dostupné množství dostatečné. V jiných případech je smysluplný zámek řádku, aby operace mohla zkontrolovat stav dat kontrolovaným způsobem a upravit ho poté. Dlouhé transakce jsou naopak problematické: blokují jinou práci a zvyšují riziko konfliktů.

Stejně důležitá je omezená sada funkčních stavů. Objednávka by neměla být současně „otevřená", „částečně dodaná", a „ručně zpracovaná" kvůli udržovaným protichůdným polím. Definované přechody statusu činí rozhraní, zprávy, a automatizace jednoduššími. Výjimky mohou být povoleny, ale měly by být pojmenovány a zdokumentovány.

Naplánujte bezpečnost, nájemce, a provoz od začátku

Aplikace by měla používat vyhrazeného databázového uživatele pro MySQL s minimálními oprávněními. Přístup k zápisu pro webovou aplikaci neznamená, že tento uživatel potřebuje mazat tabulky nebo měnit oprávnění uživatelů. Administrativní účty nepatří do produkčních konfiguračních souborů a nikdy do repozitáře.

Když v rámci aplikace pracuje více zákazníků, lokalit, nebo firem, izolace nájemců je architektonické rozhodnutí, ne retroaktivní filtrovací podmínka. Sdílená databáze s tenant_id může být efektivní a snadno udržitelná, ale vyžaduje konzistentní kontroly v každém dotazu a jasná pravidla pro indexy. Oddělené databáze nabízejí silnější izolaci, avšak zvyšují námahu při aktualizacích, vyhodnoceních, a provozu. Která varianta sedí, závisí na požadavcích ochrany dat, objemu dat, a obchodním modelu.

Zálohy jsou zálohami až tehdy, když bylo obnovení otestováno. Vyžaduje se definovaný rytmus pro zálohy, uchovávání, a obnovu. Podobně, monitorování úložného prostoru, pomalých dotazů, a selhaných úloh, spolu se zdokumentovanými aktualizacemi, patří k systému. MySQL 8, PHP 8.4, a moderní webové aplikace mohou být dlouhodobě dobře provozovány, pokud závislosti, přístupové údaje, a kroky nasazení nesídlí výhradně v hlavě vývojáře.

Smysluplný plán před prvním dnem v produkci

Před implementací by měl existovat kompaktní datový model s příkladovými pracovními postupy. Toto zahrnuje klíčové tabulky a vztahy, pravidla statusu, oprávnění, očekávané dotazy, rozhraní, a koncept pro zálohy a auditní deníky. Tento plán nemusí mít sto stran. Musí zachytit rozhodnutí, jejichž pozdější oprava by byla nákladná.

Ve softify.pro proto plánování databáze začíná lidmi, kteří knihují, kontrolují, vychystávají, nebo řeší výjimky. Pokud existující tabulka spolehlivě zobrazuje zvládnutelný proces, může zůstat správným řešením. Pokud pracuje více lidí současně, vznikají záznamy, a chyby musí být sledovatelné, databáze si naopak zaslouží stejné plánovací úsilí jako rozhraní. Nejlepší architektura je nakonec ta, která zjednodušuje pracovní den a stále může být transparentně změněna za dva roky.

Permalink →

Správné měření výsledků automatizace skladu

Správné měření výsledků automatizace skladu

Nové skenovací rozhraní může vypadat působivě první den. Po třech týdnech se však ukáže, zda skutečně zrychluje příjem zboží, nebo jen vytváří dodatečný pracovní krok. Výsledky automatizace skladu proto nejsou jediný ukazatel, ani snímek obrazovky z produktového dema. Projevují se tam, kde skladový tým musí méně hledat, ptát se, přeúčtovávat, a opravovat — při zachování nebo zlepšení kvality.

Pro malé a střední podniky je toto rozlišení obzvlášť relevantní. Velké podnikové balíky často slibují komplexní optimalizaci, avšak vyžadují dlouhé implementace, rigidní procesy, a náročnou údržbu. Smysluplný krok automatizace může začít menší: přesně v bodě, kde se informace momentálně ztrácí nebo rozhodnutí zbytečně čekají.

Které výsledky automatizace skladu skutečně záleží

Mnoho projektů začíná technickou otázkou: skener čárových kódů, mobilní aplikace, obchodní rozhraní, nebo automatické štítky? Lepší úvodní otázkou je: které úzké hrdlo citelně stojí čas, peníze, nebo spolehlivost na směnu?

Odpověď zřídka leží v počtu nasazených zařízení. Smysluplné výsledky lze měřit v každodenní práci. Při příjmu zboží, například, se počítá čas mezi dodávkou a zásobou zaúčtovanou jako dostupná. Při vychystávání je relevantní čas od objednávky po připravenost k expedici. Během inventury není trvání jediným rozhodujícím faktorem; nejvíce záleží na rozdílu mezi systémovou a skutečnou zásobou.

Stejně důležité jsou ukazatele, které mnoho provozů čistě nezaznamenává: kolik dotazů vzniká, protože skladové místo je nejasné? Jak často se musí opravovat dodací list? Kolik objednávek zůstává nezpracováno, protože jen jedna osoba zná status ve své hlavě nebo v soukromé tabulce? Přesně tato tichá dodatečná práce mizí z klasických zpráv o produktivitě, a přesto těžce zatěžuje vedoucí směn, dispečery, a zákaznický servis. Dobrý cílový obraz kombinuje rychlost a kontrolu. Pokud jsou objednávky zpracovány rychleji, zatímco nesprávná zaúčtování rostou, to není pokrok. Pokud se zásoby stanou přesnějšími, ale příjmy zboží se hromadí, proces musí být překonstruován. Automatizace je úspěšná, když zlepšuje pracovní postup bez zhoršení provozního přehledu.

Od vnímané úlevy k ověřitelným datům

Zkušenost zaměstnanců je hodnotným indikátorem. Když někdo po dvou týdnech řekne, že už nemusí běhat do kanceláře při každém uskladnění, na tom záleží. Pro investiční rozhodnutí je však stále potřeba srovnání nezávislé na každodenních pocitech. Před spuštěním by proto měly být zaznamenány základní hodnoty: průměrný čas zpracování, počet otevřených případů vyjasnění, opravné záznamy, časy vyhledávání, chyby při expedici, a přesnost zásob. Dvacet ukazatelů není potřeba; čtyři až šest hodnot odpovídajících konkrétnímu problému často stačí.

Po zavedení by měly být tyto stejné hodnoty sledovány několik týdnů. Jednotlivé špičkové dny snadno zavádějí. Sezónnost, nemoc, noví zaměstnanci, nebo neobvykle velká objednávka ovlivňují výsledky. Jen srovnání napříč normálními směnami ukazuje, zda je změna robustní.

Nejdůležitější efekt: společný stav procesu

V mnoha skladech není skutečnou zranitelností nedostatek ochoty pracovat, ale rozdrobený stav informací. Příjem zboží zná dodávku, dispečink zná zákaznickou objednávku, a expedice zná prioritu — ale ne každý pracuje se stejnou aktuální informací.

Systém specifický pro pracovní postup dokáže uzavřít tuto mezeru. Dodávka je zaznamenána při příchodu, rozdíly jsou dokumentovány přímo, zásoba dostává jasný status, a další krok se stává viditelným. Data už nemusí být poznamenána na papíře, přenesena později, a poté potvrzena telefonicky.

Toto nesnižuje jen chodecké trasy. Snižuje rozhodnutí založená na zastaralých informacích. Zaměstnanec expedice vidí, zda je objednávka skutečně vychystatelná. Management rozpoznává, zda zboží přišlo, nebo je jen ohlášeno. Výkonné vedení nedostává přikrášlený snímek, ale sledovatelný základ.

Pro týmy s rotujícími směnami je tento efekt často hodnotnější než spektakulární úspora času. Proces se stává méně závislým na jednotlivých osobách. Znalosti už neuvíznou v sešitech, chatových historiích, nebo paměti nejzkušenějšího specialisty.

Proč ne každá automatizace přináší dobré výsledky

Automatizace posiluje procesy. Toto je užitečné, když je pracovní postup jasný. Je problematické, když je nejasný pracovní postup jen rychleji reprodukován.

Typickým příkladem je povinné skenovací zaúčtování pro každou jednotlivou mikro-akci. Pokud zaměstnanci musí otevírat více obrazovek pro vzácnou výjimku, vznikají obchvaty. Artikly jsou pak později zaúčtovány hromadně, skenery leží v zásuvce, nebo zaměstnanec znovu udržuje stínový seznam. Software je přítomen, ale skutečný proces pokračuje vedle něj.

Kvalita dat také stanovuje hranice. Kmenová data artiklů bez jasných jednotek, nejasná logika skladových míst, nebo nekonzistentní označení dodavatelů nemohou být vyléčena elegantním rozhraním. Zde může projekt zpočátku sestávat z čisticích prací. To vypadá méně viditelně než nová aplikace, ale je to často předpokladem pro spolehlivé výsledky.

Kromě toho existují procesy, které by záměrně neměly být plně automatizovány. Zkušená kontrola u citlivého zboží, schválení neobvyklých rozdílů, nebo rozhodování o speciální dodávce vyžadují profesionální úsudek. Dobré systémy jasně označují takové případy a účelně je směrují. Nepředstírají, že každá výjimka může být vyřešena pravidlem.

Kdy tabulka zůstává lepším řešením

Ne každý ruční krok ospravedlňuje individuální vývoj. Pokud se proces vyskytuje zřídka, zahrnuje málo účastníků, a je zacházeno sledovatelně, dobře udržovaná tabulka může zůstat smysluplná. Nedostatek leží ne v samotném Excelu, ale ve spravování kritických pohybů bez jasné odpovědnosti, kontroly verzí, nebo včasného zaúčtování.

Jakmile více osob upravuje paralelně, pohyby zásob se stanou časově kritické, nebo zákaznické informace z různých zdrojů musí být konsolidovány, riziko výrazně roste. Sdílený systém je pak obvykle levnější než neustálé opravování nedorozumění.

Výsledky automatizace skladu vyžadují kontrolované zavedení

Nejrychlejší cestou ke slabým výsledkům je kompletní přestavba během běžného provozu. Lepší je ohraničená oblast s měřitelným přínosem: například příjem zboží pro jednu produktovou skupinu, přepravní štítky pro jednu lokalitu, nebo mobilní zaúčtování pro nejčastější přemístění.

Pilotní projekt by měl zobrazit skutečné objednávky a skutečné směny. Testovací data pomáhají při vývoji, ale neukazují, zda Wi-Fi kolísá v zadní části skladu, zda rukavice ztěžují obsluhu skeneru, nebo zda je status formulován matoucím způsobem pro dispečink. Tyto detaily určují akceptaci a kvalitu dat.

Technicky se nudná, prokazatelná spolehlivost počítá více než módní stack. Jasná rolová oprávnění, sledovatelné deníky zaúčtování, jednoznačné indikace chyb, stabilní databázové transakce, a zdokumentované pracovní postupy nejsou vedlejší záležitosti. Mění aplikaci na nástroj, kterému týmy mohou důvěřovat v každodenním byznysu.

Pro individuální logistické systémy, toto také znamená: integrace musí sedět ke stávajícímu provozu. Aplikace může převzít objednávky z obchodu, generovat dodací listy, poskytovat přepravní štítky, a dokumentovat pohyby zásob. Nemusí okamžitě nahradit všechny sousedící systémy. Obzvlášť v malých a středních podnicích je nahrazování krok za krokem často méně rizikové a ekonomičtější.

Jak se projekt stává trvalým zlepšením

Rozhodující fáze začíná po implementaci. Jsou výjimky zachyceny? Odpovídají skladová místa stále realitě? Rozumí noví zaměstnanci zaúčtovací logice bez ústního překladu? A drží se naměřené hodnoty i tehdy, když objem objednávek roste?

Pravidelné krátké smyčky zpětné vazby ze skladu, expedice, a administrativy jsou pro toto účinnější než roční velký workshop. Když se opakující výjimka stane viditelnou, měla by být buď zobrazena jako jasný krok procesu, nebo vědomě odstraněna ze standardního toku. Obojí je lepší než ji tiše tolerovat.

Nejsmysluplnějším dalším krokem často není zdlouhavý dokument specifikace. Vezměte proces s častými dotazy a měřte jeden týden, kde se ztrácí čas. Pokud z toho vyplyne jasný, opakovatelný pracovní postup, automatizace může být kombinována s výsledkem, který přesvědčí na skladě stejně jako v měsíčním vyhodnocení.

Permalink →

Moderní vývoj webových aplikací v provozu

Moderní vývoj webových aplikací v provozu

Vedoucí skladu ráno tiskne dodací listy, zatímco kolega opravuje zásobu v tabulce, a prodej telefonuje, aby se zeptal na status objednávky. Problémem je zřídka nedostatek digitalizace. Většinou existuje jednoduše příliš mnoho nepropojených nástrojů. Moderní vývoj webových aplikací pak vytváří nejen hezčí rozhraní, ale spolehlivý společný pracovní základ.

Pro malé a střední podniky to znamená: webová aplikace musí fungovat pod časovým tlakem, na skeneru ve skladu stejně jako na obrazovce v kanceláři. Musí ukládat data sledovatelně, čistě spravovat oprávnění, a umožňovat další vývoj, aniž by se stala rizikem při každé úpravě. Technologie není cílem samo o sobě. Je základem pro to, aby procesy probíhaly rychleji a zároveň zůstaly lépe kontrolovatelné.

Moderní vývoj webových aplikací začíná před prvním kódem

Každý, kdo začíná s předem definovaným katalogem funkcí, často buduje mimo skutečné úzké hrdlo. V praxi je hodnotný jiný vstupní bod: jaká informace momentálně pravidelně chybí? Kde vznikají duplicitní záznamy? V kterém bodě jsou rozhodnutí zabezpečena telefonicky nebo ústní dohodou, protože nikdo spolehlivě nevidí aktuální status?

Při příjmu zboží se to může projevit jako nekonzistentní popisy artiklů, chybějící instrukce kontroly, nebo opožděně aktualizované zásoby. Při zpracování objednávek jsou to často ručně psané poznámky, nejasná schválení, a expediční data udržovaná napříč více systémy. Dobrá aplikace tato předání nejen digitalizuje. Uspořádává je tak, aby odpovědnosti, statusy, a další kroky byly viditelné.

Toto také znamená nereflexivní rušení existujících praktik. Dobře udržovaná tabulka může nadále zůstat nejsmysluplnějším řešením pro malé vyhodnocení. Individuální webová aplikace se vyplatí tam, kde pracuje více lidí současně, chyby vznikají z ručního přepisování, nebo proces musí být zdokumentován a opakovatelný.

Co musí moderní webová aplikace poskytovat v každodenním provozu

Přesvědčivé uživatelské rozhraní je hodnotné, ale je to jen část práce. V běžném provozu se počítají především doby odezvy, srozumitelné pracovní postupy, a odolná data. Když vychystávač objednávky dokončí úkol, status se nesmí stát viditelným až po více obnoveních. Když je objednávka změněna, musí být sledovatelné, co bylo změněno a které následující kroky jsou dotčeny. Toto zahrnuje tři úzce propojené vrstvy: uživatelské rozhraní, logiku aplikace, a databázi. Rozhraní vede lidi procesem. Logika kontroluje věci jako povinná pole, oprávnění, nebo dostupná množství. Databáze ukládá fakta způsobem, který umožňuje, aby vyhodnocení, opravy, a rozšíření zůstaly možné později.

Pro mnoho obchodních aplikací jsou osvědčené technologie smysluplnější volbou než krátkodobý trend. PHP 8.4 dokáže poskytnout jasně strukturovanou serverovou logiku, moderní JavaScript poskytuje responzivní uživatelský zážitek, a MySQL 8 nabízí solidní datový základ. Rozhodujícím faktorem není to, že každý projekt používá stejný stack. Klíčové je, aby zvolená technologie odpovídala problému, provozu, a dlouhodobé údržbě.

Výkon je procesní otázka

Výkon se často redukuje na doby načítání. To je nedostatečné. Aplikace působí pomalu i tehdy, když zaměstnanci provádějí příliš mnoho kroků, hledají informace, nebo musí zadat stejný detail vícekrát. Rychlá stránka s těžkopádným formulářem zůstává špatným procesem.

Smysluplná optimalizace proto začíná nejčastějšími operacemi. Které obrazovky se otevírají stokrát denně? Které vyhledávání musí zůstat rychlé i s rostoucím objemem dat? Která data by měla být uložena na pozadí, aniž by zaměstnanci čekali na potvrzení? Až poté následují technické detaily, jako cílené databázové indexy, snížené dotazy, a štíhlé doručování souborů v prohlížeči.

Datový model a oprávnění: neviditelná architektura

Mnoho webových projektů selhává ne na první verzi, ale při pozdějších doplněních. Zpočátku jednoduché pole jako „Status" se náhle změní v řetězec schválení, kontroly, zpracování, stornování, a navazujících kroků. Pokud jsou tyto stavy uloženy jen volně ve formulářích, každé rozšíření se stává nákladným a chybově náchylným.

Čistý datový model proto odděluje procesy, pozice, kontakty, dokumenty, a změny statusu sledovatelně. Zabraňuje protichůdným záznamům namísto jejich pracného čištění později. Obzvlášť u skladových pohybů, dodacích listů, nebo dat objednávek, tato přesnost není akademickým cvičením. Určuje, zda jsou čísla zásob spolehlivá jako pracovní základ.

Role a oprávnění jsou stejně důležité. Ne každá osoba potřebuje přístup k cenám, personálním informacím, nebo administrativním nastavením. Dobré koncepce oprávnění jsou konkrétní: kdo smí vytvořit objednávku, schválit ji, nebo stornovat? Kdo vidí jen své vlastní oddělení? Další ochranná opatření zahrnují bezpečné ukládání hesel, zablokování účtu po opakovaných neúspěšných pokusech, zaznamenávání kritických změn, a jasně regulované relace. Bezpečnost tedy není doplňkem těsně před spuštěním. Patří do architektury, protože následné opravy často hluboce zasahují do autentizace, přístupu k datům, a systému oprávnění.

Responzivní neznamená jen „vejde se na telefon"

Responzivní aplikace se přizpůsobuje různým velikostem obrazovky. Pro každodenní práci tato definice nestačí. Na tabletu ve skladu platí jiné požadavky než na velké obrazovce v expedici. Dotykové oblasti musí být bezpečně ovladatelné, důležité detaily nesmí zmizet pod vedlejšími informacemi, a vstupy musí zůstat praktické i v rukavicích, při měnících se světelných podmínkách, nebo při nestabilním připojení.

V důsledku toho každé zobrazení vyžaduje jasnou prioritu. Při příjmu zboží mohou skenování a potvrzení zaujímat centrální místo. V kanceláři jsou filtry, seznamy, exportní funkce, a detailní zobrazení často důležitější. Rozhraní, které vypadá všude stejně, není automaticky použitelné všude.

Moderní vývoj webových aplikací vyžaduje kontrolovaný provoz

Spuštění není koncovým bodem, ale začátkem skutečného testu. Až se skutečnými daty, výjimkami, a špičkovými časy se ukáže, zda jsou pravidla srozumitelná a zda rozhraní fungují spolehlivě. Zdokumentované poskytování, jasně oddělená prostředí pro vývoj a produkci, a sledovatelné zálohy jsou proto součástí projektu, ne jen IT administrace.

Automatizované testy zde také dosahují mnoho. Opětovně kontrolují opakující se pracovní postupy, jako přihlášení, kontroly oprávnění, zadávání objednávek, nebo generování dokumentů po každé změně. Pro citlivé aplikace může být samostatně hostované testovací prostředí smysluplné, protože snímky obrazovky, testovací data, a interní kroky aplikace zůstávají ve sféře vlastní kontroly firmy. Automatizace nenahrazuje odborný přehled zkušenými zaměstnanci. Zajišťuje však, že známé pracovní postupy nejsou tiše porušeny.

Ve softify.pro je toto smýšlení součástí implementace: plánování s technickou přesností, brání skutečných pracovních postupů vážně, a dodávání změn způsobem, který zachovává jejich srozumitelnost později. Toto je méně spektakulární než technologický ohňostroj, ale výrazně hodnotnější v provozu.

Kdy standardní software stačí — a kdy ne

Standardní software je smysluplný, když vlastní proces do velké míry odpovídá standardním pracovním postupům odvětví a konfigurace zůstává zvládnutelná. Může být rychle dostupný a přinést spolehlivé základní funkce. Stává se problematickým, když jsou týmy nuceny neustále deformovat své fungující pracovní postupy nepraktickým způsobem, nebo když důležité informace skončí mimo systém.

Individuální řešení není automaticky lepší. Vyžaduje jasné požadavky, odpovědné kontaktní osoby, a ochotu dělat rozhodnutí. Výměnou za to může odrážet přesné pracovní kroky, které jsou kritické pro firmu: specializovanou kontrolu příjmu zboží, tisk odpovídajících přepravních štítků, schválení založené na skupině zákazníků, nebo propojení dílny, skladu, a prodeje. Správnou otázkou tedy není: potřebujeme přizpůsobenou aplikaci? Je to: jaké opakující se tření nás momentálně stojí čas, peníze, nebo spolehlivost — a dá se to trvale odstranit s rozumným úsilím?

Dobrá webová aplikace nedělá práci uměle digitální. Odstraňuje zbytečná předání, ustanovuje spolehlivý stav dat, a dává lidem přesně tu informaci, kterou potřebují pro svůj další krok. Když se to podaří, moderní vývoj webových aplikací nepůsobí jako nový IT projekt, ale jako provoz, který může konečně fungovat bez oklik.

Permalink →

Jak správně zavést digitalizaci dodacích listů

Jak správně zavést digitalizaci dodacích listů

Řidič nečeká proto, že Excel soubor je právě otevřen někým jiným. A v příjmu zboží nepomůže úhledná hromada papíru, pokud částečná dodávka nemůže být později sledována. Každý, kdo hledá „jak digitalizovat dodací listy", proto zřídka hledá jen skenování papíru. Hledaný je odolný pracovní postup, který zaznamenává pohyby zboží, potvrzení, a rozdíly přesně tam, kde vznikají.

Digitální dodací listy fungují dobře, když zjednodušují práci ve skladu, v dílně, a u zákazníka. Pokud jsou implementovány jen jako PDF archiv, námaha zůstává — jen na obrazovce. Rozhodující rozdíl spočívá ve strukturovaných datech, jasných odpovědnostech, a čistém propojení s objednávkami, zásobou, a fakturami.

Jak digitalizovat dodací listy: nejprve zkontrolujte pracovní postup

Prvním krokem není výběr softwaru, ale čestné posouzení stavu. Vezměte skutečný dodací list a sledujte jeho cestu: od objednávky přes vychystávání po předání, zpětnou vazbu, a archivaci. Toto obvykle rychle odhalí, kde jsou informace dodatečně přidávány, zadávány dvakrát, nebo vyjasňovány telefonicky a přes chat.

V malých a středních podnicích zřídka existuje jen jeden pracovní postup. Standardní dodávka stálým zákazníkům vyžaduje něco jiného než dodávka na staveniště, vyzvednutí, nebo dodávka zahrnující vrácení prázdných obalů. Ne všechny tyto rozdíly musí být automatizovány ve verzi jedna. Měly by však být známé, aby nový systém neselhal při prvním speciálním případu.

Dobrý digitální proces jednoznačně odpovídá na tři otázky pro každý status: Kdo přesunul zboží a kdy? Jaká množství byla skutečně předána? A co se stalo v případě rozdílů? Pokud tyto informace chybí, digitální dodací list je především jen hezčí dokument.

Nereprodukujte jednoduše papír jako PDF

Skenování existujících dodacích listů může být užitečné jako přechod, například pro archivaci starých procesů. Pro operativní provoz to však málo řeší. Obrázek nebo PDF lze uložit, ale množství, čísla položek, šarže, a poznámky v něm nelze spolehlivě opětovně použít.

Lepším přístupem je dokument generovaný ze strukturovaných dat objednávky. Artikly, cílová množství, dodací adresy, a kontaktní osoby jsou převzaty. Zaměstnanci následně potvrzují skutečná množství přímo na mobilním zařízení nebo na pracovišti ve skladu. Jen rozdíly, škody, nebo dodatečné pozice musí být zadány ručně.

Toto nejenže šetří čas. Zabraňuje to také typickému mediálnímu zlomu: účetnictví už nedostává sotva čitelný podpis na papíře, zatímco sklad samostatně udržuje stejný proces v tabulce.

Data, která digitální dodací list skutečně potřebuje

Systém by neměl vynucovat každé představitelné pole. Dodatečné vstupy zpomalují předání a snižují akceptaci. Zároveň jsou jméno zákazníka a podpis nedostatečné pro mnoho pracovních postupů.

Jako základ, každý dodací list vyžaduje jedinečné číslo, referenci na objednávku, dodací a příjemcovu adresu, pozice artiklů s cílovými a skutečnými množstvími, a časové značky.

V závislosti na odvětví se přidávají šarže, sériová čísla, hmotnost, skladová místa, nebo kontejnery. Pro teplotně kontrolované zboží mohou být relevantní naměřené hodnoty; pro dodávky na staveniště jsou užitečné fotografie nebo přesné údaje o místě dodání.

Status je obzvlášť důležitý. „Vytvořeno", „vychystáno", „na cestě", „předáno", „částečně dodáno", a „reklamováno" nejsou pouhé štítky. Určují, která osoba musí jednat dál a zda, například, může být vygenerována faktura nebo naplánována opětovná dodávka.

Nasazení podpisů a fotografií s rozumnou mírou

Digitální podpis je užitečný v mnoha dodacích procesech, ale není automaticky nejlepším potvrzením. Pro rychlé předání při příjmu zboží může postačovat vytištěné jméno, časová značka, a přiřazení příjemce. Pro vysoce hodnotné zboží nebo sporná předání může mít místo toho smysl podpis kombinovaný s fotografií a informací o poloze.

Rozhodujícím faktorem je řetězec důkazů: potvrzení musí být namapováno na konkrétní dokument a jeho verzi. Pokud někdo změní množství nebo pozice po podpisu, systém by to neměl tiše přepsat. Vyžaduje si to sledovatelnou opravu nebo nové potvrzení. Fotografie si zaslouží stejnou disciplínu. Mohou dokumentovat škody, ale neměly by se změnit v nerozlišující sbírku osobních údajů. Definujte, kdy je fotografie potřeba, kdo k ní může přistupovat, a jak dlouho je uchovávána.

Mobilní zadávání dat musí fungovat za skutečných podmínek

V kanceláři je téměř každá aplikace ovladatelná. Ve skladu záleží na rukavicích, špatném Wi-Fi, časovém tlaku, a zařízeních s omezenou výdrží baterie. Digitální dodací list proto musí vystačit s několika velkými kroky zadávání. Skenování čárových nebo QR kódů je často rychlejší a spolehlivější než hledání čísel artiklů.

Offline schopnost není luxus, když řidiči pracují mimo stabilní pokrytí sítě. Aplikace by měla lokálně ukládat operace do vyrovnávací paměti, jasně ukazovat, co ještě nebylo synchronizováno, a kontrolovaně řešit konflikty. Pokud dva lidé upravují stejnou dodávku, poslední uložení nesmí zvítězit náhodou.

Otázka hardwaru musí být také zodpovězena pragmaticky. Existující smartphone může postačovat pro jednoduché dodávky. Pro časté skeny, fotografie, a podpisy ve skladu jsou odolná ruční zařízení nebo tablety často ekonomičtější. Nejlepší rozhodnutí závisí na délce provozu, prostředí, a očekávané propustnosti — ne na tom, které zařízení vypadá moderně na produktovém slajdu.

Definování rozhraní před implementací

Digitální dodací list rozvíjí svou hodnotu až tehdy, když se napojí na vedoucí zdroje dat. V mnoha firmách sídlí objednávky v ERP nebo systému správy zásob, zásoby v samostatném skladovém řešení, a faktury v účetnictví. Toto se nemusí okamžitě stát velkým systémovým projektem. Ale suverenita dat musí být jasná.

Proto definujte, který systém udržuje zákazníky, artikly, ceny, a objednávky. Řešení dodacího listu může převzít informace, ale nemělo by nepozorovaně vytvářet druhý kmenový soubor artiklů. Podobně musí být regulováno, kdy jsou potvrzená skutečná množství hlášena zpět a kdo kontroluje rozdíly.

Technicky jsou spolehlivá rozhraní důležitější než působivé funkce. Jedinečná ID, zdokumentované datové formáty, protokoly pro neúspěšné přenosy, a mechanismus opakování zabraňují mizení dodacích listů mezi dvěma systémy. Štíhlá aplikace na udržitelném základě, jako PHP 8.4, moderní JavaScript, a MySQL 8, je smysluplnější pro mnoho středně velkých pracovních postupů než přetížená sada s funkcemi, které nikdo nepoužívá.

Bezpečnost a archivace patří k procesu

Dodací listy obsahují obchodní a často i osobní data. Rolová oprávnění by proto neměla být přidělena globálně. Řidiči potřebují své trasy a otevřené úkoly, vedoucí skladu vyžadují opravné a kontrolní možnosti, a účetnictví potřebuje potvrzené dokumenty a exporty. Administrativní plný přístup není standardním právem.

Navíc je potřeba sledovatelná historie: vytvoření, úprava, předání, podpis, stornování, a oprava by měly být zaznamenány s časem, uživatelem, a odůvodněním. Toto pomáhá při dotazech a chrání zaměstnance, když je později nejasné, kdy byla škoda nebo manko nahlášeno. Pro archivaci platí pravidlo: dokument musí zůstat čitelný a proces musí být lokalizovatelný. Zda je vygenerován PDF, závisí na interních pracovních postupech a požadavcích externích příjemců. PDF je však výstupem digitálního procesu, ne jeho datovým modelem.

Stávání se produktivním v malých krocích

Nejspolehlivější zavedení začíná jasně vymezeným procesem: například standardními zásilkami ze skladu nebo příjmy zboží oddělení. Vyberte oblast s dostatečným objemem, ale bez nejkomplikovanějších výjimečných případů. Toto umožňuje testovat obsluhu, kvalitu dat, a rozhraní za skutečných podmínek.

Neměřte jen to, zda aplikace běží technicky. Zkontrolujte, jak dlouho trvá předání, kolik dodacích listů vyžaduje dodatečnou práci, jak často se vyskytují rozdíly v zásobách, a zda může účetnictví pracovat rychleji. Pokud digitální postup generuje více dotazů než papírový formulář, problémem není pracovní síla — chybí jasnost procesu, nebo vstupní maska nesedí k provozní praxi.

Tabulky mohou nadále existovat, pokud jsou spolehlivé pro omezené vyhodnocení nebo vzácný speciální seznam. Digitalizace neznamená zrušení každého známého nástroje. Znamená to záměrné nahrazení chybově náchylných předání a dělání základního procesu odolným.

softify.pro vyvíjí takové pracovní postupy ne jako rigidní standardní produkty, ale kolem konkrétních pohybů zboží, rolí, a existujících systémů. Toto je obzvlášť užitečné, když firma hledá vhodné řešení mezi papírovým chaosem a předimenzovaným podnikovým systémem.

Správným prvním krokem proto není dlouhý katalog požadavků. Vezměte deset dodacích listů z běžného týdne, včetně částečné dodávky a reklamace. Pokud váš budoucí pracovní postup zpracovává těchto deset případů rychle, jasně, a sledovatelně, digitální dodací list se transformuje na nástroj, na který se sklad, řidiči, a administrativa mohou spolehnout.

Permalink →

Trendy v testování softwaru 2026, na kterých skutečně záleží

Trendy v testování softwaru 2026, na kterých skutečně záleží

Neúspěšné vydání zřídka ukazuje jen jednu chybu. Často se spojuje více příčin: změněné oprávnění, nejasné testovací prostředí, chybějící testovací data, nebo regresní test, který nebyl udržován měsíce. Přesně tam se trendy v testování softwaru pro rok 2026 stávají konkrétními — ne jako sbírka nových nástrojů, ale jako otázka, jak mohou firmy dodávat změny s ověřitelnou bezpečností, i při omezených QA kapacitách a citlivých datech.

Pro vývojářské týmy ve středních firmách je toto obzvlášť relevantní. Skladová aplikace, zákaznický portál, nebo desktopový software Windows nemusí obsluhovat miliony uživatelů. Musí však fungovat ve směnném provozu, správně generovat dokumenty, a spolehlivě prosazovat oprávnění. Testování proto musí být blíže skutečným provozním postupům než neposkvrněnému demo prostředí.

Trendy v testování softwaru: AI se stává vykonavatelem, ne věštcem

Nejviditelnějším trendem je testování podporované AI. Toto neznamená, že jazykový model čte požadavek a následně garantuje kvalitu aplikace. Toto očekávání by bylo nebezpečné. AI však může výrazně snížit námahu tam, kde týmy dnes ztrácejí čas: formulování testovacích případů, rozpoznávání nápadných změn v uživatelských rozhraních, přiřazování podobných chybových vzorů, a psaní srozumitelných testovacích zpráv.

AI se stává obzvlášť užitečnou, když provádí konkrétní pracovní kroky a poskytuje důkazy pro své výsledky. Testovací agent se může například přihlásit, vytvořit příjem zboží, změnit dodací adresu, vygenerovat přepravní štítek, a zkontrolovat, zda status, skladový pohyb, a dokument souhlasí. Rozhodujícím faktorem není tvrzení „test úspěšný", ale řetězec důkazů: provedené kroky, časové značky, snímky obrazovky, technické deníky, a jasný popis odchylky.

Hranice zůstává důležitá. AI může navrhovat testovací případy a zpracovávat opakující se pracovní postupy. Neměla by samostatně rozhodovat, zda je kriticky citlivé obchodní zaúčtování správné. Pro ceny, úrovně zásob, schválení plateb, nebo přístupová práva, jsou nadále potřeba explicitní pravidla a očekávání potvrzená obchodními odděleními. Automatizace zrychluje testování; nenahrazuje odpovědnost.

Automatizace testů se přesouvá do obchodního procesu

Dlouhou dobu se automatizace UI testů soustředila na jednoduché cesty: otevřít stránku, vyplnit formulář, zkontrolovat zprávu o úspěchu. To zůstává užitečné, ale nestačí pro mission-critical systémy. Hodnotnější test ověřuje celý řetězec procesu.

Vezměme typickou logistickou funkci. Objednávka je zaznamenána, zboží je rezervováno, proces vychystávání je spuštěn, dodací list je vygenerován, a expedice je nahlášena. Každá jednotlivá obrazovka může vypadat čistě, zatímco proces stále selhává — například proto, že rezervace přetrvává po přerušení nebo částečná dodávka nesprávně mění zásobu. Dobré automatizované testy proto sledují stavy a data napříč hranicemi systémů.

Toto vyžaduje čistou testovací architekturu. API a databázové testy kontrolují pravidla rychle a přesně. UI testy dodatečně kontrolují, zda zaměstnanci mohou proces skutečně obsluhovat. End-to-end testy kombinují obojí, ale jsou pomalejší a křehčí. Každý, kdo testuje vše výhradně přes prohlížeč, obvykle buduje drahou a křehkou testovací sadu. Každý, kdo testuje jen rozhraní, přehlíží provozní problémy a nesprávně propojená uživatelská rozhraní.

Pragmatickým řešením je pyramida, která odpovídá riziku: mnoho rychlých kontrol blízko obchodní logiky, méně integračních kontrol, a selektivně vybrané end-to-end scénáře pro nejdůležitější pracovní postupy. Toto zní málo působivě. Přináší však nudnou, prokazatelnou spolehlivost místo honby za trendy.

Samostatně hostovaná testovací AI se stává architektonickou otázkou

S nástroji na AI testování vzniká nová otázka: kam jdou testovací data, snímky obrazovky, a záznamy? V mnoha aplikacích obsahují jména zákazníků, interní ceny, personální informace, nebo pohledy na obchodně kritické procesy. I zdánlivě neškodné testovací prostředí může obsahovat skutečné kopie dat nebo důvěrné struktury.

Proto se prostředí provedení stává ústředním kritériem. Externí cloudová služba může být vhodná pro veřejné webové aplikace a nekritická testovací data. Pro interní portály, desktopové aplikace, nebo regulované oblasti je samostatně hostovaný přístup často smysluplnější. V tomto nastavení zůstávají provedení testů, obrazový materiál, a deníky v rámci kontrolované infrastruktury firmy nebo jasně vymezeného EU prostředí.

Toto není paušální argument proti cloudovým službám. Samostatný provoz přináší námahu: aktualizace, kontrola přístupu, výpočetní zdroje, monitorování, a jasné odpovědnosti musí být řízeny. Přínos vzniká, když ochrana dat, sledovatelnost, a kontrola nad testovacími artefakty převažují nad pohodlím okamžitě dostupného SaaS účtu. Systémy jako COCO následují přesně tento přístup prováděním testů pro webové a Windows aplikace, přičemž udržují důkazy lokálně kontrolovatelné.

Nestabilní testy už nejsou akceptovány jako norma

Automatizovaný test, který někdy projde a někdy selže bez změny produktu, nevytváří bezpečnost. Vytváří fronty. Týmy si pak zvyknou ignorovat červené buildy nebo opakovaně spouštět testy, dokud se neobjeví žádaný výsledek. Toto je plíživá ztráta důvěry v celý rámec kontroly kvality.

V roce 2026 se stabilita provedení testů posouvá více do popředí. Příčiny jsou obvykle známé: náhodné čekací doby, nestabilní selektory, společně používaná testovací data, závislosti na externích službách, nebo neresetované databáze. Řešením je zřídka další pokus. Smysluplnější jsou jednoznačné technické selektory, izolované testovací účty, kontrolované datové stavy, a cílené podmínky čekání, které reagují na skutečné systémové události.

Vyhodnocení by mělo také rozlišovat: je chyba reprodukovatelná? Vyskytuje se jen v jednom prostředí? Selhala externí služba nebo samotná aplikace? AI může pomoci při seskupování těchto signálů. Technické rozhodnutí však musí zůstat sledovatelné. QA tým nepotřebuje záhadnou predikci chyb, ale odolný základ pro další opatření.

Kvalita začíná dříve u požadavků a dat

Mnoho chyb vzniká předtím, než je napsán první řádek kódu. „Objednávka by měla být schopna být odeslána" není testovatelný požadavek. Co se stane v případě neúplné adresy, zablokovaného zákaznického účtu, chybějícího zboží, paralelního zpracování, nebo vypršelé relace? Bez odpovědí na tyto otázky nemůže žádný testovací systém spolehlivě zkontrolovat, zda software funguje správně.

Vyzrálejší testovací přístup proto doplňuje požadavky o ověřitelné příklady. Pro účet s nesprávnými pokusy o přihlášení to může konkrétně znamenat: po pěti neúspěšných pokusech je účet zablokován na 15 minut, proces je zaznamenán, a oprávněný administrátor může vysledovat zablokování. Toto přímo vytváří automatizovatelné kontroly — a méně prostoru pro interpretaci mezi vývojem, provozem, a obchodním oddělením.

Testovací data se také stávají produktovou funkcí. Musí být dostatečně realistická, aby zobrazovala hraniční případy, ale nesmí kopírovat zbytečné osobní údaje. Užitečné jsou vygenerované datasety pro DPH případy, částečná množství, blokované položky, neplatné adresy, a různé role. Obzvlášť u aplikací používajících MySQL 8 nebo srovnatelné relační databáze se vyplatí automaticky poskytovat definované počáteční stavy a odstraňovat je po běhu.

Testování založené na riziku poráží testovací pokrytí za každou cenu

Vysoké číslo pokrytí kódu může uklidňovat, přitom ale říkat velmi málo. Ukazuje, které řádky byly provedeny, ne zda bylo testováno správné pravidlo. Systém může dosáhnout 90 procent pokrytí a přesto vést k nesprávné zásobě během storna částečné dodávky.

Lepší otázkou je: které chyby by byly obzvlášť nákladné pro provoz, zákazníky, nebo právní soulad? Z toho vyplývá prioritizace. Ochrana přístupu, výpočet cen, zaúčtování zásob, generování dokumentů, a rozhraní k poskytovatelům přepravních služeb si obvykle zaslouží větší hloubku testování než zřídka používané stránky nastavení. To neznamená dodávat vedlejší záležitosti nezkontrolované. Znamená to nasadit omezený čas tam, kde selhání zastavuje skutečnou práci nebo generuje nesprávná rozhodnutí.

Tato prioritizace se musí moci měnit. Pokud je zavedena nová funkce plánování tras, její riziko se zvyšuje. Pokud má být brzy nahrazeno staré Excel vyhodnocení, velké automatizační úsilí se už nemusí vyplatit. Někdy je smysluplnější ponechat fungující tabulku ještě několik měsíců, namísto uspěchaného vtlačování její logiky do polodokončeného systému.

Co by týmy měly nyní prakticky dělat

Prvním smysluplným krokem není porovnání nástrojů. Vyberte proces, jehož selhání jsou citelná: od objednávky po dodání, od příjmu zboží po uložení, nebo od přihlášení po schválení role. Popište cílový pracovní postup s výjimečnými případy, nastavte spolehlivá testovací data, a nejprve automatizujte kritické kontroly. Následně měřte nejen počet testů. Sledujte, jak rychle je odhalena skutečná chyba, jak často testy selhávají bez důvodu, a zda zpráva vysvětluje příčinu srozumitelně vývojáři nebo obchodnímu vlastníkovi. Až když jsou tyto základy na místě, vyplatí se rozšíření o AI agenty, vizuální kontrolu, nebo rozsáhlá testovací prostředí. Nejsilnější testovací trendy jsou nakonec ty, které dělají vydání méně rizikovými a přivádějí týmy k jasným rozhodnutím rychleji. Nepočítá se nejmodernější dashboard, ale sledovatelný testovací běh ukazující, že tento obchodní proces funguje — a pokud ne, vědět proč.

Permalink →

Plánování tras pro dodávkové jízdy: výběr správného softwaru

Plánování tras pro dodávkové jízdy: výběr správného softwaru

Řidič čeká na dodací list, zatímco pořadí jeho zastávek se opět mění. Ve skladu ještě nebyla vychystána zásilka, zákazník volá kvůli užšímu časovému oknu, a seznam tras sedí v tabulce, které skutečně rozumí jen jedna osoba. Každý, kdo v této situaci hledá „software pro plánování tras pro dodávkové jízdy", nehledá nutně komplikovaný mapový algoritmus. Hledá spolehlivý pracovní postup od zadání objednávky po potvrzení dodání.

Pro malé a střední podniky je toto rozhodující rozdíl. Teoreticky kratší trasa málo pomůže, pokud nezohledňuje fakt, že zboží není připraveno do 10 hodiny, vozidlo vyžaduje chlazení, nebo řidič má na dané trase specifické znalosti o zákazníkovi. Dobrý software pro dodávkové jízdy odráží realitu provozu — čímž ho činí společně použitelným pro dispečink, sklad, a řidiče.

Kdy se plánování tras stává provozním problémem

Mnoho firem začíná smysluplně pomocí telefonátů, papíru, a tabulky. Při pěti zastávkách denně a pevném týmu řidičů je to často nejrychlejší řešení. Až když roste objem objednávek, varianty, a časový tlak, dochází k typickým třecím ztrátám: duplicitně zadávané adresy, zastaralé statusy tras, chybějící informace o nosičích nákladu, a dotazy, na které lze odpovědět jen telefonátem více osobám.

Problémem tehdy není jen jízdní vzdálenost. Je to informační mezera mezi přijetím objednávky, skladem, dispečinkem, a dodáním. Pokud je objednávka odložena, tato změna se v současnosti často musí sledovat napříč více seznamy, na výtisku, a v hlavě řidiče. To stojí čas a vytváří chyby, které zákazníci vidí okamžitě.

Dalším varovným signálem jsou rozhodnutí závislá na jednotlivých zaměstnancích. Pokud jen zkušený dispečer ví, která příjezdová cesta je vhodná pro konkrétního zákazníka, nebo jak by měla být trasa 3 upravena v případě pozdního příjmu zboží, pracovní postup není robustně zdokumentován. Software by neměl nahrazovat tuto znalost. Měl by ji zobrazit tak, aby tým zůstal schopen jednat.

Co musí umět software pro plánování tras pro dodávkové jízdy

Základní funkce zní jednoduše: objednávky jsou přiřazeny k trase, zastávky jsou smysluplně seřazeny, a předány řidičům. Pro praktickou užitečnost však systém vyžaduje výrazně více kontextu. Rozhodujícími faktory jsou, která pravidla platí během plánování a jak se zachází se změnami.

Objednávky musí být plánovatelné, ne jen viditelné

Dodací adresa na mapě ještě nepředstavuje plánovatelnou dodávku. Objednávka vyžaduje minimálně množství, hmotnost nebo objem, datum dodání, požadované časové okno, kontaktní informace, a jasný status zpracování. V závislosti na firmě mohou být také přidány nosiče nákladu, teplotní požadavky, označení nebezpečného zboží, pravidla upozornění, nebo konkrétní třída vozidla.

Tato data by neměla muset být pokaždé ručně shromažďována z různých systémů. Pokud objednávky již pocházejí z internetového obchodu, ERP, masky zadávání objednávek, nebo existující databáze, čisté předání je často hodnotnější než obzvlášť působivý pohled na mapu. Jinak se práce jednoduše přesouvá z papíru na nové uživatelské rozhraní.

Trasy potřebují pravidla, nejen vzdálenost

Automatické pořadí založené na kilometrech nebo čase jízdy může být dobrým návrhem. Není to však rozhodnutí za firmu. Plánování musí umět zohlednit omezení: pevná data dodání, kapacitu vozidla, pracovní hodiny, časy nakládky a vykládky, jakož i regionální odpovědnosti.

Na startovací logice také záleží. Některá vozidla začínají a končí ve skladu, zatímco jiná jedou přímo na své další provozní místo po poslední dodávce. Pro opakující se trasy může být užitečná pevná základní struktura, kterou dispečeři upravují jen v případě potřeby. Každý, kdo jezdí přesně stejné zastávky každé ráno, nevyhnutelně nepotřebuje kompletní reoptimalizaci. Zde je stabilní, sledovatelná trasa často lepší než matematicky minimální úspora času.

Změny musí dosáhnout řidiče kontrolovaným způsobem

Realita se zřídka drží ranního plánu. Zákazníci ruší, zboží chybí, vozidlo se porouchá, nebo se objednávka stane naléhavou. V takových případech se rozhoduje, zda software poskytuje úlevu nebo vytváří dodatečnou práci.

Použitelné řešení jasně ukazuje, která verze trasy je aktuálně platná, které zastávky již byly dokončeny, a co konkrétně bylo změněno. Řidič by neměl muset porovnávat protichůdné výtisky, snímky obrazovky, a zprávy z messengeru. Pro mnoho týmů je mobilní, na prohlížeči založený pohled řidiče s pořadím zastávek, kontaktními daty, dodacími listy, a zpětnou vazbou o statusu zpočátku dostatečný. Vyhrazená aplikace není automaticky lepší, pokud instalace, správa zařízení, a offline požadavky nepřinášejí jasný přínos.

Nezačínejte jen samotnou optimalizací tras

Nejčastějším chybným přístupem je nejprve zakoupit optimalizační službu a až poté zkontrolovat, zda jsou základní data a pracovní postupy správné. Nesprávně napsané adresy, nejasná dodací okna, a objednávky bez spolehlivého statusu zajištění nelze optimalizovat pryč. Krátká inventarizace podél skutečné denní rutiny je smysluplnější. Odkud pocházejí objednávky? Kdy sklad potvrzuje dostupnost? Kdo plánuje trasy? Jak řidič dostává změny? A jaký důkaz je potřeba po dodání? Tyto otázky se mohou zdát banální, ale rozhodují o tom, jaká datová pole, role, a rozhraní systém skutečně potřebuje.

Často se ukáže, že ne každý krok by měl být digitalizován. Ručně psaná poznámka pro vzácnou speciální dodávku může být vhodná, pokud je později čistě přenesena do objednávky. Tabulka může také zůstat, pokud spolehlivě poskytuje zvládnutelné vyhodnocení. Software by měl řešit úzké hrdlo, místo násilného nahrazování každého známého pracovního postupu.

Postavit, koupit, nebo cílené rozšíření?

Standardní software je vhodný, když je logika tras obecná, procesy se zřídka liší, a tým se dokáže přizpůsobit daným maskám. Zkracuje implementaci a může být postačující pro jednoduchou flotilu vozidel. Nevýhoda se projeví, jakmile mapuje centrální speciální případy jen prostřednictvím vedlejších seznamů, volného textu, nebo drahých doplňkových modulů.

Individuální řešení se nevyplatí proto, že vývoj na míru je vnitřně nadřazený. Vyplatí se, když je samotný pracovní postup konkurenční výhodou nebo trvalým zdrojem chyb: například se speciálními balicími jednotkami, kombinovanými trasami vyzvednutí a dodání, vlastními dodacími dokumenty, nebo těsnou integrací příjmu zboží, vychystávání, a dispečinku.

Nejpragmatičtější cesta často leží někde uprostřed. Existující systémy zůstávají na místě pro účetnictví nebo správu skladu, zatímco štíhlá aplikace slučuje objednávky, plánuje trasy, a pokrývá pracovní postup řidiče. Toto vyžaduje jasná rozhraní, jednoznačné odpovědnosti za data, a databázovou strukturu, která sledovatelně ukládá změny. Moderní webové aplikace postavené na udržitelném základě, jako PHP 8.4 a MySQL 8, nejsou pro toto módním rozhodnutím, ale spíše základem pro předvídatelný provoz a budoucí úpravy.

Zavedení v malých krocích místo velké přestavby

Software pro plánování tras by měl být nejprve otestován na zvládnutelné trase nebo skupině vozidel. Ne proto, že pilotní projekt je bez rizika, ale proto, že skutečné výjimky se objeví brzy: chybějící dodací pokyny, nekonzistentní adresní data, čekací doby u zákazníka, nebo nejasná předání ve skladu.

Pro počáteční fázi rozšíření obvykle stačí jasně definované funkce: převzetí objednávky, zobrazení statusu zajištění, sestavení trasy, schválení trasy, a zpětné hlášení dodání. Automatická optimalizace, elektronické podpisy, fotografický důkaz, upozornění zákazníků, nebo podrobné klíčové ukazatele se stávají smysluplnými až když tento řetězec spolehlivě funguje v každodenním provozu.

Přínos se měří nejen ušetřenými kilometry. Snížená dispečerská námaha, méně dotazů, méně chybných dodávek, kratší časy k dodacímu listu, a lepší responzivita vůči zákazníkům jsou stejně relevantní. Tyto ukazatele by měly být přibližně zachyceny před spuštěním. Jinak jediným dojmem po implementaci zůstává, že uživatelské rozhraní vypadá modernější.

Technologie musí zůstat spolehlivá v pozadí

Plánování tras zpracovává citlivá provozní data: adresy zákazníků, přiřazení řidičů, dodací množství, a často důkazy o dodání. Proto jsou součástí řešení rolová oprávnění, sledovatelné úpravy, pravidelné zálohy, a zdokumentované operace. Kdo smí schvalovat, upravovat, nebo mazat trasu, by nemělo být ponecháno na náhodě.

Mapová a směrovací data si také zaslouží střízlivou analýzu. Externí služby mohou velmi dobře sedět, ale přinášejí průběžné náklady, otázky dostupnosti, a otázky ochrany dat. Když jsou ve hře vysoké požadavky na uchovávání dat nebo speciální regionální logistika, musí se brzy vyjasnit, jaká data opouštějí vlastní systém firmy a jak jsou tlumeny výpadky. Perfektní trasa je bezcenná, pokud dispečink nemůže pokračovat v práci během narušení.

softify.pro plánuje takové systémy od skutečného přijetí objednávky až po zpětnou vazbu z vozidla. Měřítkem zde není nejdelší seznam funkcí, ale pracovní postup, který sklad, dispečink, a řidiči mohou spolehlivě obsluhovat pod časovým tlakem. Nejlepší plánování tras vypadá v každodenním provozu překvapivě nespektakulárně: objednávky jsou kompletní, trasy jsou srozumitelné, změny jsou jednoznačné, a dodávky jsou ověřitelné. Přesně tato nevzrušující spolehlivost vytváří prostor pro výjimky, kde musí rozhodovat člověk.

Permalink →

Automatizace procesu přijímání objednávek

Automatizace procesu přijímání objednávek

Jedna objednávka přijde e-mailem, další telefonicky, plus Excel soubor od klíčového zákazníka. Později na skladu chybí dodací adresa, prodej už nezná přesné slíbené datum dodání, a expediční oddělení vytiskne dodací list se zastaralou pozicí položky. Každý, kdo chce automatizovat proces přijímání objednávek, neřeší abstraktní digitální projekt. Eliminuje přesně toto tření v momentě, kdy se výnos mění na provozní práci.

Pro malé a střední podniky je přijímání objednávek často podceňováno. Pokud denně přichází málo objednávek a zkušení zaměstnanci znají každý speciální případ, telefonické poznámky, poštovní schránky, a tabulky nesou proces. S rostoucím objemem se však stávají rizikem: informace je přítomna duplicitně, předání se dějí ústně, a nikdo nemůže spolehlivě říct, jaký status objednávky platí.

Proč se přijímání objednávek tak často stává úzkým hrdlem

Příčinou je zřídka nedostatek úsilí. Obvykle pracovní postup narostl během let. Zákazníci objednávají přes různé kanály, ceny a dodací podmínky platí jen pro určité skupiny zákazníků, a čísla položek se liší od interních označení. Zaměstnanci sesouhlasují informace ze zkušenosti a vyplňují mezery dotazy.

Toto funguje, dokud někdo není na dovolené, směny se nemění, nebo nepřichází současně několik naléhavých objednávek. Tehdy se ukáže, že znalosti nesídlí v procesu, ale v jednotlivých myslích a roztroušených souborech. Důsledky jsou známé: nesprávná množství, opožděné dodávky, nevyřešená schválení, a zbytečné opravy ve skladu. Automatizace zde neznamená, že zákazník musí nutně objednávat přes portál. Znamená to, že každá objednávka, bez ohledu na svůj vstupní kanál, je zaznamenána, zkontrolována, obohacena, a předána podle stejných sledovatelných pravidel.

Automatizace procesu přijímání objednávek bez deformace provozu

Použitelný pracovní postup nezačíná seznamem softwaru, ale střízlivou analýzou procesu. Klíčové otázky jsou: jaká informace musí být k dispozici předtím, než objednávka může jít do skladu, expedice, nebo výroby? A které výjimky jsou legitimní spíše než jednoduše rušivé? Typický pracovní postup se skládá ze čtyř jasných etap: zaznamenání objednávky, kontrola dat, schválení objednávky, a spuštění navazujících procesů. Mezi těmito etapami jsou potřebné jasné odpovědnosti a statusy. Například objednávka by neměla být současně považována za „novou", „ve vyjasňování", a „připravenou k expedici".

1. Konsolidace objednávek ze všech kanálů do jednoho procesu

E-mail, telefon, PDF, EDI, webový formulář, nebo poznámky terénní služby mohou zůstat různými vstupními body. Rozhodujícím faktorem je, že přistanou ve sdíleném procesu objednávek. Zaměstnanci by neměli nejprve muset kopírovat informace z poštovní schránky, poté aktualizovat tabulku, a následně informovat druhou osobu.

Pro strukturované objednávky lze přímo převzít zákaznická data, čísla položek, množství, a požadovaná data. Pro PDF soubory nebo e-maily s volným textem je řízené zadávání často smysluplnější než plně automatická extrakce. AI podporovaná extrakce může dávat návrhy, ale pro nejasná množství, zákaznicky specifická čísla položek, nebo ručně psané dokumenty, je potřeba viditelná kontrola. Smysluplným měřítkem není „maximální automatizace", ale „žádné zbytečné duplicitní zadávání". Dobře navržený formulář s povinnými poli a věrohodnými návrhy šetří v mnoha provozech více času než chybová plná automatizace.

2. Kontrola dat předtím, než se chyby rozšíří

Nejhodnotnější automatizace se odehrává před schválením. Systém může zkontrolovat, zda číslo zákazníka existuje, dodací adresa je kompletní, položka je aktivní, požadované množství se jeví přípustné, a je přítomno schválení platby nebo kreditu. Zákaznicky specifické ceny, minimální množství, a dodací okna lze také porovnat s uloženými pravidly.

Zacházení s odchylkami je důležité. Ne každá odchylka musí blokovat objednávku. Pokud například chybí referenční číslo, prodej může dostat úkol. Pokud objednávka překračuje definovaný limit hodnoty nebo marže se nachází mimo dohodnutý rámec, může být potřeba schválení odpovědnou rolí. Toto zabraňuje tichým chybám a vytváří viditelné případy k vyjasnění. To je velký rozdíl: sklad nedostává jednoduše neúplnou objednávku, ale objednávku s jasným statusem a zdokumentovaným rozhodnutím.

3. Vázání schválení na pravidla místo ústních žádostí

Mnohá zpoždění vznikají z frází jako: „můžeš to rychle schválit?" Takové dotazy nejsou zásadně špatné. Stávají se problematickými, když probíhají přes chat, telefon, nebo chodbový rozhovor a jsou později nesledovatelné.

Automatizovaný pracovní postup ukládá schvalovací pravidla přímo na úrovni objednávky. Například objednávka může být schválena automaticky, pokud jsou zákazník, cena, zásoba, a dodací adresa věrohodné. Pro speciální podmínky, částečné dodávky, nebo objednávku překračující definovaný limit, je informována odpovědná osoba. Schválení se ukládá s časovou značkou a odůvodněním.

Toto vytváří rychlost bez vzdání se kontroly. Obzvlášť v případě rotujících směn nebo více lokalit to zabraňuje uvíznutí objednávek v osobních poštovních schránkách.

4. Cílené informování skladu, expedice, a zákazníků

Po schválení už objednávka nemusí být ručně přenášena z jednoho seznamu do druhého. Pracovní postup může generovat vychystávací příkaz, rezervovat zásobu, připravovat dodací list, nebo spouštět oznámení o expedici. Které kroky mají smysl, závisí na obchodním modelu.

Prodejce náhradních dílů může okamžitě potřebovat vychystávací příkaz a označení priority. Výrobce potřebuje nejprve kontrolu dostupnosti a poté výrobní impuls. Velkoobchodník s pevnými dodacími trasami chce slučovat objednávky do určitého času. Proto rigidní standardní řešení často není nejlepší volbou.

Pro zákazníka často stačí jasné potvrzení: objednávka přijata, zkontrolována, nebo závazně naplánována. Ne každá interní změna statusu patří do e-mailu. Příliš mnoho automatizovaných zpráv generuje dotazy místo důvěry.

Jaká data vyžaduje robustní proces

Dobré přijímání objednávek stojí na čistém datovém základě. To zahrnuje udržovaná základní data zákazníků, jedinečná čísla položek, platná cenová a podmínková pravidla, a jasně definované dodací adresy. Pokud tyto základy chybí, automatizace jen urychluje přenos nespolehlivých dat. Technická architektura se také počítá. Centrální systém se sledovatelnými změnami statusu a spolehlivou databází je trvale lepší než řetěz makrů, lokálních souborů, a nekontrolovaného přeposílání e-mailů. Toto neznamená, že každý Excel list musí být okamžitě nahrazen.

Pokud tabulka funguje transparentně v malém, stabilním subprocesu, může zatím zůstat. Avšak jakmile více lidí pracuje s objednávkami současně, jsou potřeba schválení, nebo je informace předávána skladu a expedici, centrální zdroj dat by měl mít přednost. Systémy založené na udržitelné architektuře, jako s PHP 8.4, moderním JavaScriptem, a MySQL 8, mohou být přesně integrovány do existujících pracovních postupů namísto vtlačování provozu do schématu enterprise softwarového balíku.

Měřitelnost toho, zda se pracovní postup skutečně zlepšuje

Nový systém není automaticky lepším procesem. Před spuštěním by proto mělo být stanoveno několik klíčových ukazatelů. Relevantní ukazatele zahrnují čas od přijetí objednávky po schválení, počet dotazů na objednávku, opravy po předání skladu, a míru objednávek zpracovaných včas.

Tyto ukazatele také ukazují, kde není potřeba další automatizace. Pokud 85 procent standardních objednávek probíhá rychle a bezchybně, ale zbývajících 15 procent jsou skutečné speciální případy, jasný proces vyjasnění je smysluplnější než pokus algoritmicky vynutit každou výjimku. Deníky také pomáhají v každodenním provozu. Každý, kdo vidí, kdy objednávka přišla, která kontrola selhala, kdo ji schválil, a kdy byl vygenerován expediční příkaz, už nehledá příčinu v pěti poštovních schránkách. Toto snižuje nejen chyby, ale i závislost na jednotlivých zaměstnancích.

Zavedení v malých krocích místo velkého třesku

Nejbezpečnějším vstupem je obvykle jasně definovaný typ objednávky: například standardní objednávky od určité skupiny zákazníků nebo e-mailové objednávky se známými položkami. Datová pole, pravidla, a předání lze tam testovat za skutečných podmínek. Až když statusy, výjimky, a odpovědnosti fungují čistě, následují komplexnější případy, jako speciální ceny, částečné dodávky, nebo zákaznicky individuální specifikace balení.

Zaměstnanci by měli být zapojeni do návrhu. Ne proto, že každý existující zvyk musí zůstat nezměněn, ale proto, že lidé u telefonu, v prodeji, a ve skladu znají skutečné výjimky. Řešení, které vypadá dobře jen na workshopu, je rychle obcházeno na skladu.

Pro takové projekty se softify.pro spoléhá na systémy specifické pro pracovní postup namísto přetížených standardních balíků: s jasnými předáními, zdokumentovanými pravidly, a dostatečným prostorem pro pracovní metody, které prokazatelně fungují ve firmě.

Nejlepším dalším krokem tedy není hledání co nejvíce funkcí. Vezměte deset skutečných objednávek z typického týdne a sledujte jejich cestu od přijetí po expedici. Každý ruční duplicitní přenos, každé nejasné rozhodnutí, a každý opakující se dotaz je konkrétním výchozím bodem pro proces, který bude spolehlivě fungovat pro tým v budoucnosti.

Permalink →

Ochrana testovacích dat při AI testování

Ochrana testovacích dat při AI testování

Neúspěšný automatizovaný test se obvykle rychle opraví. Snímek obrazovky z testovacího běhu, který obsahuje zákaznická data, ceníky nebo aktivní relaci a skončí u externí AI služby, je jiný problém. Kdo chce chránit testovací data při AI testování, musí proto zohlednit nejen testovací případy, ale celou cestu dat: vstupy, provoz prohlížeče, logy, obrázky, AI vyhodnocení a dobu uchovávání.

Zejména u webových aplikací, interních portálů a softwaru pro Windows rychle vzniká falešný pocit bezpečí. Prostředí se sice může jmenovat „testovací“, ale často používá kopie produkčních databází, skutečné uživatelské role nebo rozhraní na expedici, ERP a dokumentové archivy. AI testování dělá tato data obzvlášť cennými pro analýzu — a tedy obzvlášť potřebnými ochrany.

Proč AI testování vyžaduje vlastní perspektivu ochrany dat

Klasická automatizace testů obvykle ověřuje jasně definované kroky: přihlásit se, vytvořit objednávku, vygenerovat dodací list, zkontrolovat odhlášení. AI testování tento postup rozšiřuje. Systém dokáže interpretovat uživatelská rozhraní, vyhodnocovat anomálie, porovnávat snímky obrazovky a dokumentovat výsledky srozumitelným jazykem. To šetří čas při regresních testech, ale generuje další datové artefakty.

Tyto artefakty jsou často výmluvnější než běžný testovací log. Snímek obrazovky může zobrazovat jména, adresy, hodnoty smluv, množství objednávek nebo zdravotní údaje. Síťový log může obsahovat tokeny relace a odpovědi API. Chybové hlášení může odhalit interní cesty k souborům, struktury databází nebo verze. Když model pracuje s těmito informacemi, musí být jasné, kde zpracování probíhá a kdo k němu má přístup.

Rozhodující otázka tedy nezní: „Používáme v testování AI?“ Ale spíše: „Jaká data opouštějí jakou bezpečnostní zónu — a proč?“ Pro mnoho firem v regionu DACH není externí cloudové zpracování zásadně vyloučeno. Musí však odpovídat požadavkům na ochranu smluvně, technicky i organizačně. U vývojářských, produkčních nebo zákaznických dat je lokálně kontrolované spuštění často pragmatičtějším řešením.

Ochrana testovacích dat při AI testování začíná před prvním během

O ochraně dat v testování se často mluví až při výběru nástroje. To je příliš pozdě. Nejprve je potřeba jednoduchá, spolehlivá inventura dat. Které systémy se testují? Jaká pole se objevují v uživatelských rozhraních? Jaké přílohy, exporty a odpovědi API se mohou v testu objevit? A jaká data automaticky skončí ve snímcích obrazovky, videích nebo chybových hlášeních?

Zde se vyplatí rozdělení do tří skupin. Nekritická testovací data lze volně generovat a uchovávat déle. Osobní nebo obchodně citlivá data vyžadují maskování, omezení přístupu a krátké doby uchovávání. Přístupové údaje, tokeny, klíče a produkční konfigurační hodnoty nepatří do testovacích důkazů ani do požadavků na model — ani když jsou náhodně viditelné jen v okně prohlížeče.

V mnoha středně velkých aplikacích není situace s daty čistě oddělená. Skladový tým testuje nový příjem zboží na výtahu z databáze, protože jen tam jsou skutečné struktury položek, dodavatelská pravidla a zvláštní případy. To může mít technicky smysl. Důsledkem však nesmí být, že tento výtah se nezměněný přesune do každého testovacího prostředí.

Lepší je reprodukovatelný proces: exportovat data, cíleně pseudonymizovat citlivá pole, odstranit nepotřebné tabulky a poskytnout výslednou testovací datovou základnu ve verzované podobě. Takto se zachovají typické procesní chyby, aniž by se v testovacích bězích objevili skuteční zákazníci či zaměstnanci. U složité cenové nebo dispoziční logiky jsou zcela syntetická data často nedostatečná. Pak je obvykle lepším kompromisem pečlivě očištěná kopie.

Maskování musí zachovat obchodní logiku

Maskování, které nahradí každou e-mailovou adresu stejným zástupným symbolem, může poškodit testovací případy. Kontroly duplicit, logika rolí, vyhledávací funkce nebo fakturační procesy se chovají jinak než v provozu. Dobré maskování proto zachovává formáty, vztahy a rozložení. Zákaznické číslo se stane jiným platným zákaznickým číslem. Adresa se stane věrohodnou, ale fiktivní adresou. Datum dodání zůstává datem v realistickém plánovacím horizontu.

To vyžaduje jistou přípravu. Na oplátku to brání klasické chybě, kdy jsou testy technicky zelené, ale už nemapují skutečné pracovní postupy ve skladu, prodeji či zákaznickém servisu. Ochrana dat a funkčně užitečné testy nejsou protiklady — za předpokladu, že příprava dat je součástí testovací architektury.

Místo provedení rozhoduje o kontrole

Kdo předá automatizované testy externí službě, předá — v závislosti na konfiguraci — víc než jen testovací kroky. Obsah prohlížeče, struktury DOM, snímky obrazovky, videa, konzolové logy a vyhodnocení mohou být zpracovávány a uchovávány mimo vlastní infrastrukturu. Zda je to přijatelné, závisí na konkrétním případu: kategoriích dat, smluvním rámci, místě uložení, oddělení nájemců, koncepci mazání a interních směrnicích.

U aplikací s vysokými nároky na ochranu je často jasněji hodnotitelné samostatně hostované testovací prostředí. Spouštěč testů, AI komponenta a úložiště důkazů zůstávají ve vlastní síti firmy nebo v kontrolované evropské infrastruktuře. Síťová pravidla mohou omezit externí připojení. Přístup lze navázat na existující identity, role a logování. Uchovávání snímků a reportů se tak stává vlastním rozhodnutím, nikoli výchozím nastavením poskytovatele platformy.

COCO přesně takový přístup sleduje: AI server provádí testy pro webové a Windows aplikace kontrolovaným způsobem, dokumentuje důkazy a generuje srozumitelná vyhodnocení, aniž by interní data aplikace musela být standardně předávána externímu AI cloudu. To nenahrazuje audit ochrany dat. Vytváří to však technický základ, na kterém se IT, bezpečnost informací a obchodní oddělení mohou shodnout na sledovatelných pravidlech.

Snímky obrazovky, logy a tajemství jsou nejčastější úniky

Mnoho týmů chrání testovací databázi, ale přehlíží vedlejší produkty testování. V praxi právě tam číhají větší rizika. Neúspěšný test přihlášení může zobrazit heslo ve vstupním poli. API test může vypsat bearer token do logu. Automatický videozáznam zdokumentuje celou objednávku včetně adresy zákazníka. Robustní koncepce proto upravuje minimálně pět bodů:

  • Snímky obrazovky a videa se vytvářejí pouze v případě potřeby a mažou se po pevných termínech.
  • Tajemství se integrují přes úložiště tajemství nebo chráněné runtime proměnné, nikdy se neukládají do testovacího kódu.
  • Logy filtrují tokeny, hesla, ID relací a citlivá pole ještě před uložením.
  • Testovací účty mají jen práva potřebná pro daný pracovní postup.
  • Testovací systémy nesmí spouštět produkční e-maily, štítky, platby ani skladové pohyby, pokud to není výslovně zabezpečeno.

Tato pravidla znějí věcně. Právě v tom je jejich výhoda. Tým se nemusí spoléhat na pozornost či dobré úmysly, ale může technicky omezit zneužití. Obzvlášť účinné jsou samostatné servisní účty pro automatizaci testů, krátká životnost tokenů a jasný proces pro odvolání kompromitovaných přístupových údajů.

I AI vyhodnocení potřebuje hranice

AI modely se často používají k vysvětlení odchylek: „Tlačítko nebylo viditelné,“ „Aplikace reagovala pomaleji, než se očekávalo,“ nebo „Proces skončil u kontroly oprávnění.“ Pro taková hodnocení model nemusí nutně potřebovat kompletní soubor zákaznických dat.

Proto je třeba definovat, jaké informace smí vstoupit do vyhodnocení. Stačí anonymizovaný snímek obrazovky? Stačí místo kompletní odpovědi serveru technická třída chyby? Lze pole před analýzou začernit? Správná hloubka závisí na cíli testu. Při porovnání rozložení je jméno málokdy relevantní. Při kontrole personalizované šablony dokumentu může být relevantní — pak musí být zpracování odpovídajícím způsobem zabezpečeno.

Ochranná opatření musí zůstat ověřitelná v provozu

Koncepce je robustní pouze tehdy, pokud ji lze kontrolovat v běžném provozu. Patří sem pravidelné namátkové kontroly testovacích důkazů, revize oprávnění a pohled na skutečně uložená data. Vplížila se do snímků obrazovky nová pole? Existují ještě staré testovací účty? Uchovává se výtah z databáze déle, než bylo zamýšleno? Taková otázky patří do běžné provozní rutiny, nejen do auditu. Stejně důležitá je jasná odpovědnost. QA zná testovací postupy, vývoj zná technická rozhraní, obchodní oddělení zná kritické procesy a IT bezpečnost definuje rámec. Pokud tyto perspektivy nikdo nespojí, vznikne buď riskantní zkratka, nebo bezpečnostní specifikace, která znemožňuje skutečné testy. Malý, zdokumentovaný schvalovací proces je obvykle účinnější než rozsáhlý soubor pravidel, který nikdo nepoužívá.

Nakonec nejde o to, aby byl každý test uměle zkomplikován. Dobrá ochrana testovacích dat znamená vědomě odstranit z automatizace skutečná rizika při zachování funkční platnosti testů. Když týmy přesně vědí, jaká data smí test vidět, kde se nacházejí jeho důkazy a kdy zmizí, stává se AI testování kontrolovatelným nástrojem místo dodatečné nejistoty.

Permalink →

Nechat si vyvinout webovou aplikaci v PHP

Nechat si vyvinout webovou aplikaci v PHP

Když příjem zboží skončí v tabulkovém procesoru, přepravní údaje se předávají telefonicky a aktuální stav objednávky existuje jen v hlavách jednotlivých zaměstnanců, obvykle nechybí další standardní nástroj. Chybí systém, který spolehlivě zobrazuje vlastní pracovní postup. Nechat si vyvinout webovou aplikaci v PHP se vyplatí právě tehdy: když se informace, rozhodnutí a dokumenty musí scházet na jednom místě, aniž by provoz zatěžoval předimenzovaný podnikový balík.

PHP tu není nostalgický kompromis. S PHP 8.4, přehlednou architekturou aplikace a MySQL 8 lze budovat dlouhodobě fungující webové aplikace, které reagují rychle, jsou snadno udržovatelné a spolehlivě fungují na počítačích, tabletech nebo ručních skenerech. Rozhodující však není samotný jazyk. Rozhodující je, zda aplikace skutečně usnadňuje práci ve skladu, v kanceláři i v terénu.

Kdy dává smysl webová aplikace na míru

Ne každý proces si hned vyžaduje software na míru. Přehledně vedený tabulkový procesor může zůstat nejrozumnějším řešením pro malý, málo se měnící seznam. Zavedený standardní produkt je také užitečný, pokud už pokrývá podstatné pracovní postupy a lze jej používat bez trvalých obcházení.

Zlomový bod nastává, když zaměstnanci zadávají data vícekrát, shromažďují informace z různých souborů, nebo pravidelně řeší zvláštní případy mimo skutečný systém. Typickými signály jsou nejasné stavy zásob, ručně vytvářené dodací listy, nejednoznačná odpovědnost za objednávky nebo dotazy, které musí opakovat každá směna. Pak se neztrácí jen čas; chyby se obtížně dohledávají a závislost na jednotlivých lidech roste.

Webová aplikace na míru naopak přesně zobrazuje pravidla platná ve firmě. Může například zaznamenávat příjem zboží, dokumentovat pohyby zásob, generovat štítky, prioritizovat objednávky nebo činit předávání mezi týmy sledovatelnými. Ne každý zvláštní případ je třeba automatizovat hned první den. Rozumný začátek se soustředí na pracovní postup, který momentálně vytváří nejvíce tření.
Nechat si vyvinout webovou aplikaci v PHP: co je třeba objasnit předem

Dobrý software nezačíná makětami obrazovek ani seznamem technických hesel. Začíná konkrétními situacemi: co se stane, když dodávka přijde neúplná? Kdo smí opravit stav zásob? Jaké informace potřebuje oddělení expedice, než se vytiskne štítek? A co se stane, když zaměstnanec na pozdní směně převezme objednávku vytvořenou ráno?

Z těchto otázek vzniká pevný obraz procesu. Ukazuje vstupy, rozhodnutí, předávání a výjimky. Právě výjimky jsou cenné, protože právě tam standardní řešení často selhávají. Aplikace pro příjem objednávek například nemusí jen uložit novou objednávku. Musí také objasnit, jak se řeší chybějící údaje o položkách, odlišné dodací adresy, schválení nebo storna.

Před implementací by se tedy měl stanovit cíl, skupiny uživatelů a první fáze vydání. Užitečnými podklady jsou reálná vzorová data, existující formuláře, fotografie pracovišť a rozhovory s lidmi, kteří s daným postupem pracují denně. Čistě manažerský rozhovor jen zřídka poskytne dostatek detailů. Kdo obsluhuje skener, skladuje zboží nebo kontroluje dodací listy, obvykle přesněji zná praktická omezení.
Nejmenší smysluplný začátek

První vydání nemusí být hotová podniková platforma. Naopak: omezené, produktivně využitelné jádro snižuje riziko a brzy vytváří hodnotu. Představitelnou možností je aplikace, která zpočátku jen centrálně zaznamenává objednávky, zviditelňuje jejich stav a vytváří spolehlivý dodací list. Správa zásob, rozhraní nebo plánování tras mohou následovat, jakmile se jádro potvrdí v běžném provozu.

Tento postup brání tomu, aby projekt měsíce pracoval na funkcích, jejichž skutečný přínos je ještě nejasný. Vytváří také prostor pro korekce. Možná je plánovaná logika stavů příliš jemná, možná příjem zboží potřebuje rychlejší vstupní masku nebo schválení až nad určitou hodnotu. Taková zjištění nejsou selháními plánování, ale součástí čisté implementace.

Technický základ určuje následné náklady

Webová aplikace se nestane udržovatelnou jen proto, že se v nabídce zmiňuje PHP. Udržovatelnost vzniká ze sledovatelných rozhodnutí: jasného oddělení rozhraní, obchodní logiky a přístupu k datům, jednoznačných datových modelů, automatizovaných testů pro kritická pravidla a zdokumentovaného nasazování.
PHP 8.4 se pro to velmi dobře hodí. Jazyk je vyzrálý, efektivní na provoz a pragmatická volba pro mnoho klíčových aplikací. V kombinaci s moderním JavaScriptem může rozhraní reagovat rychle a přímo, aniž by se každá funkce zbytečně komplikovaně budovala jako jednostránková aplikace. MySQL 8 poskytuje pevný základ pro transakce, koncepty oprávnění a konzistentní datové sady.
Zejména ve skladových a objednávkových procesech se rezervace nesmí uložit napůl. Pokud je položka vyskladněna, musí se shodovat zásoby, záznamy pohybů a stav objednávky. Databázové transakce zajišťují, že buď nastanou všechny potřebné změny, nebo žádná. Zní to jako detail, ale rozhoduje to o tom, zda systém zůstává spolehlivý i ve výjimečných případech.

Bezpečnost také patří do jádra architektury. Role a oprávnění musí sedět s každodenní rutinou: osoba na příjmu zboží potřebuje jiná práva než účetnictví nebo externí řidič. Bezpečné hashování hesel, blokování účtů po neúspěšných pokusech o přihlášení, správa relací a logy kritických změn nejsou doplňky na později. Patří do první produkční verze.

Rozhraní budovat jen tam, kde šetří práci

Mnoho projektů se zbytečně rozroste, protože se od začátku plánuje každá myslitelná integrace. Rozhraní na obchody, ERP, poskytovatele přepravních služeb nebo účetnictví mohou být velmi užitečná. Jsou však dobrá jen tehdy, pokud nahrazují jasný manuální krok nebo výrazně zlepšují kvalitu dat.

Příklad: pokud se denně vytvářejí přepravní štítky z objednávkových dat, přímá integrace šetří čas a snižuje chyby při přenosu. Pokud se naopak fakturační data přenášejí do existujícího systému jen jednou týdně a proces je stabilní, na začátek může stačit strukturovaný export. Technicky elegantnější řešení není automaticky to nejekonomičtější.

Předem by měla být objasněna i suverenita dat. Jaká data se ukládají, jak dlouho jsou logy dostupné, kdo je smí exportovat a jak fungují zálohy a obnova? Pro firmy v regionu DACH tyto otázky nejsou jen IT formality. Týkají se ochrany dat, provozní schopnosti a důvěry v týmu.

Nasazení bez zpomalení provozu

I nejlepší aplikace selže, pokud během přechodu blokuje běžný provoz. Proto by mělo být nasazení připraveno na reálných případech: reprezentativních objednávkách, skutečných položkách, typických dodacích adresách a známých zvláštních případech. Až když tyto procesy fungují sledovatelně, měl by systém převzít centrální úlohu.

Paralelní provoz může být krátce užitečný, například když je třeba sladit zásoby nebo zkontrolovat nové dokumenty. Nesmí se však stát trvalým stavem. Dva vedoucí zdroje dat nevyhnutelně vytvářejí rozdíly. Je zapotřebí jasné cílové datum, od kterého je stanoveno, který systém je závazný.

Stejně důležité je krátké zaškolení podle role. Zaměstnanec ve skladu nepotřebuje vysvětlení administrativních funkcí. Potřebuje jistotu v několika krocích, které je třeba udělat pod časovým tlakem. Dobré aplikace pomáhají srozumitelnými pojmy, rozumnými výchozími hodnotami a chybovými hláškami, které vysvětlují, co dělat dál.

Jak poznat vhodného vývojového partnera

Kdo zadává webovou aplikaci, nekupuje pouze hodiny programování. Je zapotřebí partner, který bere procesní otázky vážně, zdůvodňuje technická rozhodnutí a dokonce se postaví proti, když se požadavek stává zbytečně nákladným nebo riskantním. Přímý přístup ke zkušeným vývojářům má zde větší hodnotu než propracovaný prodejní proces s následnými předáváními.

Všímejte si konkrétních vyjádření k architektuře, provozu a dalšímu vývoji. Jak se dokumentují změny? Jak probíhají aktualizace? Kdo reaguje během výpadku? Existuje sledovatelná testovací strategie pro kritické rezervace a oprávnění? Rozhraní může působit přesvědčivě během prezentace. Rozhodující je, zda se dá po dvou letech ještě přizpůsobit, aniž by se každá změna proměnila v kompletní přestavbu.

softify.pro proto pracuje krok za krokem, procesně orientovaným způsobem: nejprve pochopit provozní úzké místo, poté dodat robustní jádro a na něm dále stavět. Je to méně efektní než velký slib transformace, ale v běžném provozu obvykle výrazně cennější. Dobrá webová aplikace nemusí obsahovat co nejvíce funkcí. Musí zajistit, aby se objednávka neztratila, zásoby zůstaly sledovatelné a zaměstnanci mohli dokončit svou práci bez zbytečných dotazů. Když se to podaří, technická investice se stane nástrojem, který dělá každý pracovní den měřitelně klidnějším.

Permalink →

Automatické generování přepravních štítků a snižování chyb

Automatické generování přepravních štítků a snižování chyb

Objednávka je zabalená, zboží stojí na rampě — a někdo ještě stále hledá správný způsob přepravy, zadává adresu příjemce do portálu dopravce a tiskne štítek. Tento pracovní postup trvá jen několik minut na balík. Při 30, 80 nebo 300 zásilkách denně se stává úzkým hrdlem. Automatické generování přepravních štítků tedy neznamená jen připojení tiskárny. Znamená to propojení údajů o objednávce, přepravních pravidel a skutečného procesu balení tak, aby se hotová zásilka spolehlivě proměnila v odpovídající štítek.

Pro malé a střední podniky je to často nejrozumnější vstupní bod do automatizace logistiky. Přínosy se okamžitě projeví na skladě: méně dotazů, méně nesprávně adresovaných balíků a jasný stav pro prodej, sklad a zákaznický servis. Přesto se vyplatí před technickou implementací důkladně se podívat na proces. Špatně udržovaný soubor kmenových dat položek nebo nejasná přepravní pravidla automatizace nezlepší — pouze je rychleji zpracuje.

Co se skutečně děje při automatickém tisku štítků

Přepravní štítek obsahuje více než jen jméno a adresu. V závislosti na poskytovateli služby to zahrnuje sledovací číslo, strojově čitelný kód, směrovací informace, služby jako ověření věku nebo dobírka, a celní informace pro mezinárodní zásilky. Aby dopravce mohl vygenerovat štítek, tyto informace musí být kompletní a v očekávaném formátu. Technický pracovní postup obvykle začíná objednávkou v internetovém obchodě, ERP nebo vlastním systému správy objednávek. Jakmile je objednávka připravena k odeslání, systém na základě definovaných pravidel určí poskytovatele služby, produkt a doplňkové služby.

Následně předá data rozhraní dopravce nebo přepravní platformě. Ta zásilku zaregistruje, vrátí sledovací číslo a štítek, a systém uloží PDF nebo tisková data k objednávce. Teprve poté se vytiskne — na pracovní stanici, baličském stole nebo přímo přes tiskárnu štítků.

Toto pořadí je klíčové. Pěkný štítek bez úspěšné registrace zásilky nepomůže. Naopak, úspěšná registrace nesmí zmizet v pozadí, pokud tiskárně dojde materiál. Dobré procesy zacházejí s registrací, výstupem a zpětnou vazbou o stavu jako s jednotnou operací.

Automatické generování přepravních štítků začíná jasnými pravidly

Nejčastějším omylem je: pro každou objednávku by měl být vždy vybrán přesně stejný poskytovatel služby. To může fungovat například u homogenních B2C zásilek v rámci Německa. Mnoho firem však potřebuje diferencovanější pravidla. Těžká dodávka, expresní objednávka, vyzvednutí na výdejním místě nebo zásilka do Švýcarska kladou odlišné požadavky.

Rozumná pravidla mohou zohledňovat hmotnost a rozměry, cílovou zemi, dodací adresu, hodnotu zboží, požadovaný čas dodání, označení nebezpečného zboží a dohodnuté podmínky zákazníka. Praktickým pravidlem je: ne každou teoretickou výjimku je třeba automatizovat od prvního dne. Pokud se měsíčně vyskytnou dva zvláštní případy, viditelně označený manuální krok je často levnější a bezpečnější než komplikovaný systém pravidel. Naopak opakující se případy s významným objemem patří do standardního procesu.

Zvlášť důležitý je zdroj dat. Hmotnosti z dobře udržovaného souboru kmenových dat položek jsou použitelné pro podobné zboží. U smíšených objednávek, variabilního balení nebo příplatků za nadměrné položky by se měla konečná hmotnost balíku zaznamenat na balicí stanici. Systém pak může vygenerovat štítek až po zvážení. Jde o dodatečný manuální krok, ale zabraňuje nákladným opravám a doúčtování.

Kvalita adres rozhoduje před tiskem

Mnoho přepravních problémů vzniká ještě před předáním dopravci. Čísla domů skončí ve špatném poli, PSČ nesedí s městem, nebo firemní adresy obsahují nejasná jména příjemců. Automatizace by proto neměla jen předávat adresy, ale i předem je kontrolovat. Povinná pole, formáty pro jednotlivé země, délky znaků a rozpoznatelné duplicity lze zachytit přímo při zadávání objednávky.

Ověření adresy není zárukou doručitelnosti. Snižuje však počet chyb, kterým se dá předejít. U nápadných údajů by měl systém jasně pozastavit objednávku k objasnění, místo aby tiše vygeneroval neúplný štítek. Ve skladu musí být viditelné, proč objednávka čeká a kdo může poskytnout potřebné informace.

Balicí stanice potřebuje jednoduchou obsluhu

Nejlepší rozhraní selže, pokud musí zaměstnanci během balení přepínat mezi pěti obrazovkami. Praktický balicí dialog zobrazuje pouze to, co je pro aktuální zásilku potřeba: objednávku, položky, dodací adresu, stav balení, hmotnost, zvolený způsob přepravy a stav tisku. Naskenování čárového kódu na dodacím listu nebo sběracím lístku by mělo otevřít správnou objednávku. Po zvážení ideálně stačí jedna potvrzující akce k vytvoření a vytisknutí štítku.

U více balicích stanic potřebuje každé pracoviště jasné přiřazení k tiskárně. Formát štítku musí odpovídat i zařízení a dopravci. A6 je běžný pro mnoho balíkových štítků, ale ne každá role, tepelná tiskárna a podavač dokumentů fungují stejně. Kdo začíná výstupem štítků jako PDF na kancelářské laserové tiskárně, může začít rychle. Při vyšších objemech jsou obvykle rozumnější tepelné tiskárny: vyhýbají se stříhání, lepení a riziku, že se štítek během tisku posune na nesprávnou stranu.

Dobrý proces srozumitelně hlásí technické problémy. „Chyba API 403“ u balicího stolu nepomůže. Lepší je: „Štítek nevytvořen: zkontrolujte přístup k poskytovateli přepravních služeb“ nebo „Tiskárna balicí stanice 2 nedostupná.“ Objednávka přitom nesmí být mylně považována za odeslanou. Zůstává v jasném chybovém stavu a po vyřešení se dá znovu zpracovat, aniž by se registrovala druhá zásilka.

Rozhraní potřebují ošetření chyb, nejen ideální scénář

Rozhraní dopravců jsou externí systémy. Mohou být dočasně nedostupná, odmítat vstupy nebo měnit formát odpovědi. Místní síť, tisková služba nebo vypršelé přístupové údaje mohou také přerušit proces. Proto je riskantní vázat úspěch výhradně na to, že uživatel kliknul na „Vytvořit štítek“.

Technicky by se měl každý požadavek logovat sledovatelným způsobem: časové razítko, objednávka, použitá přepravní služba, výsledek, sledovací číslo a srozumitelná chybová zpráva. Citlivá data a přístupové klíče nepatří nechráněné do log souborů. Jedinečné interní ID zásilky zabraňuje tomu, aby opakovaný pokus vygeneroval duplicitní štítky nebo duplicitní fakturace.

Do plánování patří i storna. Pokud balík nakonec není vyzvednut nebo je po vytištění štítku přebalen, musí být jasné, zda lze zásilku u dopravce zrušit a jak je to dokumentováno ve vnitřním systému. Bez tohoto kroku se po několika týdnech stav přepravy, sledování a fakturace přestanou shodovat.

Ne každá firma hned potřebuje velkou přepravní platformu

Přepravní platformy mohou slučovat více dopravců, tarifní logiky a vrácení zboží. To dává smysl, pokud jsou objemy zásilek, cílové země a poskytovatelé služeb rozmanití. Kdo však má jasný přepravní proces a jednoho nebo dva dopravce, může pracovat transparentněji s přímým napojením. Méně systémů znamená méně slaďování dat, méně uživatelských účtů a méně míst, kde mohou vznikat chyby.

Rozhodnutí nezávisí jen na objemu balíků. Relevantní jsou i vrácení zboží, exportní dokumenty, individuální přepravní pravidla, existující zdroje objednávek a otázka, kdo později udržuje změny. Řešení s tabulkovým procesorem zůstává obhajitelné například tehdy, pokud se denně posílá málo zásilek s konzistentními daty. Jakmile kolegové předávají informace vícekrát nebo je přeprava vázána na jednotlivé osoby, centralizovaný pracovní postup se obvykle stává ekonomičtějším.

Pro procesy přizpůsobené zákazníkovi může dávat smysl štíhlá webová aplikace, která spojuje data objednávek, pohyby zásob, dodací listy a tisk štítků.
softify.pro implementuje takové systémy se sledovatelnou datovou strukturou, zdokumentovaným nasazením a udržovatelnými technologiemi, jako jsou PHP 8.4 a MySQL 8. Rozhodující není počet funkcí, ale to, že proces se stává srozumitelnějším pro tým u balicího stolu.

Zaveďte v malých krocích a měřitelně zlepšujte

Kontrolovaný začátek je lepší než velká změna v pondělí ráno. Nejprve se automatizuje jasně definovaný standardní případ, například vnitrostátní balíky jednoho dopravce s definovaným formátem štítku. Souběžně by se měla automaticky vygenerovaná data po několik dní porovnávat s předchozím procesem: adresa, hmotnost, přepravní produkt, sledovací číslo a vytištěný štítek.

Výjimky lze poté přidat dodatečně. Užitečné metriky jsou doba zpracování na zásilku, počet manuálních oprav, nevytištěné nebo duplicitní štítky a doba do poskytnutí sledovací zpětné vazby zákazníkovi. Tyto hodnoty ukazují, zda automatizace skutečně přebírá práci, nebo jen digitálně mapuje starou oklikou.

Nakonec nezáleží na obzvlášť složitém přepravním dialogu. Záleží na tom, že zabalená objednávka dostane správný štítek bez hledání, opětovného zadávání a nejistoty — a že výjimky se stanou viditelné tam, kde skutečně musí rozhodnout člověk.

Permalink →

Automatizované testování přihlašovacího procesu

Automatizované testování přihlašovacího procesu

Automatické testování přihlašovacího procesu se stává banální záležitostí jen tehdy, když funguje. Pokud selže po vydání, zaměstnanci čelí začátku směny, zákazníci se ocitnou zablokovaní mimo zákaznický portál, nebo dispečeři řeší blokované zpracování objednávek. Automatické testování přihlašovacího procesu proto neznamená jen zadání uživatelského jména a hesla do formuláře. Znamená to opakovanou kontrolu mission-critical přístupového bodu se všemi jeho pravidly, výjimkami, a bezpečnostními hranicemi.

Pro mnoho týmů automatizace začíná jediným pozitivním testovacím případem: zadáním platných přihlašovacích údajů, potvrzením přihlášení, a zobrazením domovské stránky. To má smysl, ale samo o sobě je nedostatečné jako jediný test. Chyby přihlášení se často vyskytují na okrajích: při vypršelých relacích, zablokovaných účtech, nové metodě vícefaktorové autentizace, nebo oprávněních, která po změně role už správně neplatí. Přesně tyto scénáře je třeba pokrýt plánovaným způsobem.

Proč přihlášení vyžaduje zvláštní testovací disciplínu

Přihlášení je současně bezpečnostní funkcí, technickým rozhraním, a vstupním bodem do pracovního postupu. Chyba může být příliš shovívavá, umožňující neoprávněný přístup. Naopak může být i příliš přísná, blokující oprávněné osoby. Obojí je nákladné: první případ vytváří rizika pro data a soulad, zatímco druhý způsobuje výpadky, zátěž podpory, a horečnatá nouzová řešení.

Pro webové aplikace přicházejí do hry další závislosti. Přihlášení často komunikuje s poskytovatelem identity, poštovním systémem pro obnovení hesla, MFA aplikací, nebo adresářovou službou. U desktopových aplikací Windows mohou mít vliv lokální práva, síťová připojení, a statusy verzí. Test, který se dívá jen na formulář v prohlížeči, nedokáže spolehlivě odhalit takové integrační problémy.

Proto by měl tým před zahájením jakékoli automatizace testů definovat, co znamená úspěšné přihlášení v daném systému. Stačí viditelná domovská stránka? Nebo je třeba zkontrolovat, zda byl načten správný výběr nájemce, zda je role uživatele správná, a zda je skutečně možná první chráněná akce? Pro skladový portál by to byl například přístup k příjmu zboží. Pro dispečerský systém by to mohlo být uvolnění trasy.

Automatické testování přihlašovacího procesu: od modelu pracovního postupu k testovacímu případu

Dobrým výchozím bodem není skript, ale model pracovního postupu. Přihlášení lze popsat jako sekvenci jasných stavů: odhlášen, přihlašovací údaje odeslány, identita potvrzena, vyžadována MFA, přihlášen, relace vypršela, nebo účet zablokován. Každý stav zahrnuje povolené akce a očekávané odpovědi systému.

Z tohoto modelu vznikají testovací případy s obchodní hodnotou. Standardní pozitivní případ sem patří, ale i nesprávná hesla, neexistující uživatelské účty, a vypršelé resetovací odkazy. Důležitá je zde očekávaná zpětná vazba. V případě chybných přihlašovacích údajů by aplikace neměla prozrazovat, zda e-mailová adresa existuje. Test proto kontroluje nejen to, zda se zobrazí chyba, ale i to, zda její text a chování neposkytují zbytečné náznaky.

Ochranné mechanismy proti opakovaným neúspěšným pokusům jsou obzvlášť relevantní. Po definovaném počtu nesprávných zadání může být účet dočasně zablokován. Automatizovaný test musí zkontrolovat, zda zablokování skutečně nastoupí, jak dlouho trvá, a zda legitimní uživatel následně získá zpět kontrolovaný přístup. Zde je potřeba přesnost: test, který záměrně blokuje produkční účty, vytváří více problémů, než řeší. Takové scénáře patří do samostatného testovacího prostředí se speciálně vytvořenými účty.

Samostatné zvážení MFA, obnovení hesla, a Single Sign-On

Vícefaktorová autentizace není drobný detail na konci přihlášení. Mění pracovní postup. Test musí rozpoznat, že po heslu se vyžaduje další potvrzení, a musí zmapovat úspěšné i odmítnuté potvrzení. U časově založených jednorázových kódů testovací prostředí vyžaduje kontrolované zacházení s časem a tajemstvími. V mnoha případech je testovací metoda poskytovaná poskytovatelem identity smysluplnější než rekonstrukce skutečného mobilního telefonu.

Obnovení hesla a Single Sign-On by měly také dostat vlastní testovací trasy. Při obnovení záleží na přenosu zprávy, jedinečnosti odkazu, době platnosti, a následném přihlášení s novým heslem. U SSO je rozhodující, zda aplikace správně vytvoří relaci a čistě převezme role po návratu od poskytovatele identity.

CAPTCHA tvoří zvláštní případ. Mají za cíl zpomalit automatizované útoky a neměly by být obcházeny prostřednictvím automatizace testů. Místo toho je smysluplná testovací konfigurace, oficiální testovací klíč, nebo zabezpečená výjimka pro testovací prostředí. Oklamávání bezpečnostních kontrol jen proto, aby test zobrazil zelený výsledek, není strategií kvality.

Výběr vhodné technické vrstvy testu

Ne každý test přihlášení musí probíhat přes skutečný prohlížeč. API testy mohou ověřit, zda tokeny, relace, chybová hlášení, a pravidla zablokování fungují správně. Jsou rychlé a pomáhají najít chyby blízko autentizační logiky. Prohlížečové testy naopak ukazují, zda pole, přesměrování, cookies, SameSite nastavení, a viditelné stavy do sebe zapadají ve skutečném pracovním postupu uživatele.

Pro kritické aplikace je smysluplná kombinace. Několik end-to-end testů kontroluje kompletní cestu pomocí prohlížeče. Pod tím cílené API a integrační testy zajišťují varianty. Toto snižuje dobu běhu a falešné poplachy. Kdo testuje každou představitelnou kombinaci výhradně v prohlížeči, často skončí s pomalou testovací sadou, jejíž údržba spotřebuje více času, než ušetří.

Pro desktopový software platí podobný princip. Automatizovaný test by neměl jen kontrolovat, zda se okno otevře. Musí určit, zda po přihlášení existuje správné datové spojení, zda jsou práva uživatele aktivní, a zda je přístupná centrální pracovní maska. Toto je obzvlášť relevantní pro aplikace ve skladu nebo výrobě, protože pracoviště mohou mít různé síťové podmínky, připojení skenerů, nebo lokální konfigurace.

Bezpečné a opakovatelné zacházení s testovacími daty

Testy přihlášení nevyhnutelně pracují s přihlašovacími údaji. Produkční účty zaměstnanců, skutečná zákaznická data, nebo MFA tajemství však nekontrolovaně nepatří do testovacích skriptů, deníků, a snímků obrazovky. Testovací účty musí být jasně označené, minimálně privilegované, a automaticky obnovitelné. Hesla a tokeny jsou poskytovány prostřednictvím bezpečné správy tajemství namísto uložení ve zdrojovém kódu.

Stejně důležité je čištění po testovacím běhu. Pokud test vytvoří nové relace, auditní záznamy, nebo zablokované účty, testovací prostředí se musí vrátit do definovaného počátečního stavu. Jinak test v pondělí selže jednoduše proto, že běh z pátku zanechal vedlejší účinky.

Pro firmy s důvěrnými aplikacemi je rozhodující i místo provedení. Snímky obrazovky přihlašovacích masek, testovací videa, a technické deníky mohou obsahovat citlivé informace. Samostatně hostovaná testovací infrastruktura jako COCO zde může mít smysl, protože testovací data, provedení, a důkazy zůstávají pod vlastní kontrolou. Zda je to nutné, závisí na potřebách ochrany, smluvních situacích, a interních směrnicích. Samostatná infrastruktura není automaticky nejekonomičtější volbou pro každou aplikaci.

Generování důkazů, nejen zelených značek

Testovací zpráva by měla pro QA, vývoj, a obchodní oddělení učinit srozumitelným, co bylo testováno. Zelený status bez kontextu moc nepomůže, pokud vydání později vyvolá otázky. Užitečné jsou proto časové značky, použité testovací prostředí, testovací účet, relevantní kroky, snímky obrazovky v případě chyb, a jasná chybová zpráva v běžném jazyce.

V tomto kontextu se samotné sbírání důkazů nesmí stát problémem ochrany dat. Hesla, jednorázové kódy, ID relací, a osobní údaje musí být v denících maskovány. U snímků obrazovky může být nutné rozmazat určité oblasti. Tato pravidla by měla být součástí testovací architektury, ne ruční dodatečnou úpravou po incidentu.

Co by měly týmy automatizovat jako první

Priorita se řídí rizikem a frekvencí používání. Nejprve přichází standardní přihlášení pro nejdůležitější role, chybné přihlašovací údaje, odhlášení, a vypršení relace. Poté následují pravidla zablokování, obnovení hesla, MFA, a změny rolí. SSO, speciální nájemci, nebo vzácné cesty výjimek mohou následovat později, pokud jejich selhání okamžitě nezastaví provoz.

Testy patří do procesu vydávání. Změny v přihlašovacích formulářích, cookies, oprávněních, nebo konfiguraci poskytovatele identity by měly spustit příslušnou testovací sadu předtím, než verze přejde do produkce. Kromě toho se vyplatí plánovaný běh v realistickém prostředí, například po změnách infrastruktury nebo obnovení certifikátů. Toto najde problémy, které nejsou viditelné v izolovaném vývojovém prostředí.

Nakonec nejlepší test přihlášení není ten s nejvíce kliknutími. Je to ten, který včas odhalí skutečné selhání, srozumitelně ho zdokumentuje, a stále může být spolehlivě proveden při další změně. Kdo zachází s přihlášením jako s jasně modelovaným obchodním procesem, chrání víc než jen formulář. Chrání přístup k práci, která za ním čeká.

Permalink →