softify.pro
Laddar …
Tjänster Om oss COCO – vår AI-server Portfolio Insiders Fallstudier Bra att veta Kontakt Logga in

Bra att veta

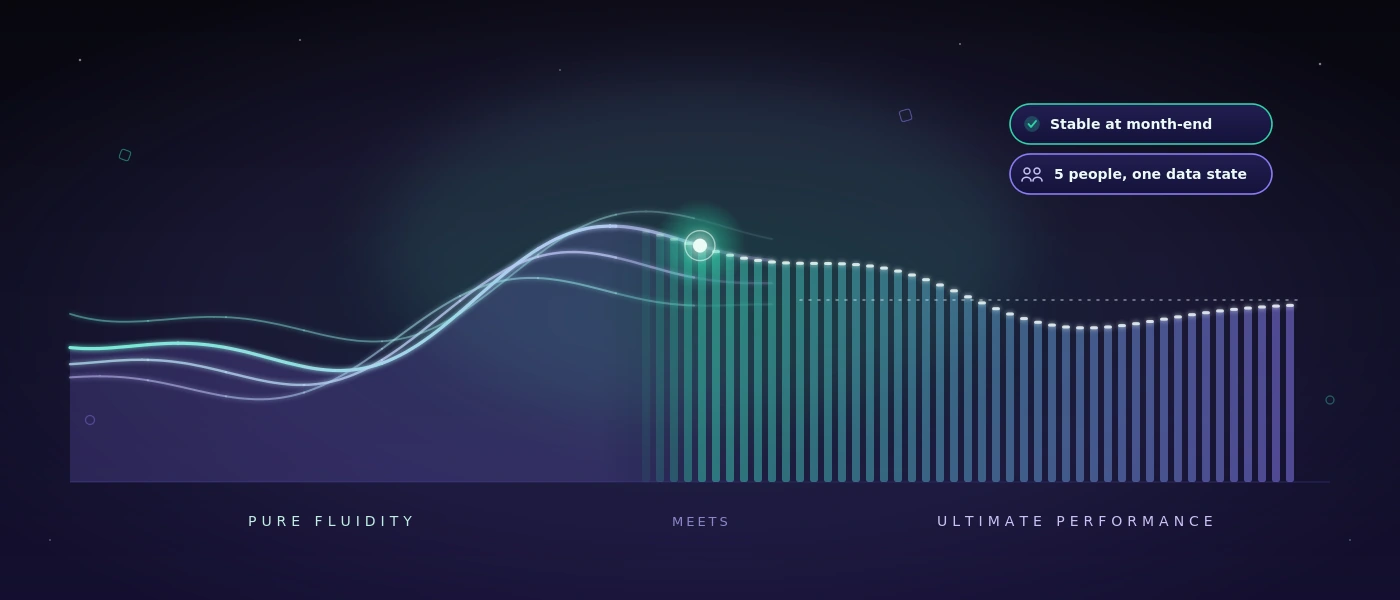
Pure fluidity meets ultimate performance: vad som verkligen gör affärsprogramvara snabb

Pure fluidity meets ultimate performance: vad som verkligen gör affärsprogramvara snabb

En lagerchef känner inte igen dålig programvara på en arkitekturritning. Hen känner igen den på att medarbetare åter griper efter telefonen, registrerar följesedlar dubbelt eller efter ett skift inte kan säga vilket gods som faktiskt har kommit. Pure fluidity meets ultimate performance får därför inte vara ett blott visuellt anspråk. För affärsprogramvara betyder det att ett förlopp känns naturligt och samtidigt fungerar tillförlitligt under verkliga förhållanden.

Ett elegant gränssnitt är värdelöst om det hackar vid svagt WLAN i lagret. En snabb applikation hjälper likaså föga om den tvingar fram en arbetsföljd som ingen vid rampen kan följa. Bra digitala verktyg förenar utformning, hastighet och processförståelse. De minskar friktion utan att pressa in verksamheten i en förfabricerad standardlogik.

Pure fluidity meets ultimate performance är en driftfråga

Flytande känsla förväxlas ofta med animationer, stora bilder och mjuka övergångar. Det kan passa ett modernt varumärke. I arbetsvardagen visar den sig dock annorlunda: en godsmottagning kan bokas utan omvägar. En medarbetare hittar en order även när bara ett referensnummer är känt. Ett fel benämns tydligt, istället för att försvinna i ett kryptiskt meddelande.

Prestanda är likaså mer än ett bra värde i ett webbläsartest. Avgörande är svarstiden vid en order med många positioner, stabiliteten vid månadsskiftet och frågan om fem personer kan arbeta samtidigt utan att skriva över varandras dataunderlag. Även en ren hantering av anslutningsavbrott, behörigheter och spärrade konton hör dit.

Båda är oskiljaktiga. Om en vy reagerar direkt men har oklara obligatoriska fält förblir den ansträngande. Om förloppet är klokt modellerat men sidan väntar två sekunder vid varje bokning, kringgås det. Flytande känsla uppstår där systemet stöder nästa förnuftiga handling och tekniskt förblir tillräckligt snabbt för att tankegången inte ska brytas.

Gränssnittet följer arbetsvägen, inte organisationsschemat

Många standardlösningar strukturerar sina menyer efter moduler: inköp, försäljning, lager, rapportering, administration. Ur produktsynpunkt är det begripligt. På lagergolvet börjar arbetet dock ofta med en situation: en lastbil står där, en pall saknas, en kund behöver ett leveransbevis eller en sändning måste märkas innan mottagningen stänger.

En bra individuell applikation börjar därför med dessa situationer. Vilken information finns? Vem beslutar? Vad måste dokumenteras? Vad får inte ändras senare? Först därefter avgörs vilken inmatningsvy, kontroll eller automatisering som krävs.

Det betyder inte att varje befintligt förlopp ska gjutas oförändrat i programvara. Vissa tabeller är verkligen för felbenägna, vissa godkännanden onödigt långsamma. Men en fungerande Excel-lista behöver inte nödvändigtvis ersättas av ett projekt. Om den bara sköts av en person, känner få undantag och förblir spårbar kan den vara rätt verktyg. Programvara lönar sig när den förbättrar samordningen, minskar felkällor eller gör information tillförlitligt tillgänglig för flera inblandade.

Färre klick är inte automatiskt bättre

Kravet på så få klick som möjligt låter förnuftigt, men kan leda åt fel håll. Vid en oåterkallelig lagerbokning är en kort bekräftelse meningsfull. Vid ett fraktgodkännande kan en synlig rimlighetskontroll förhindra dyr efterbearbetning. Rätt förlopp beror på risken.

Avgörande är att ytterligare steg har ett tydligt syfte. En bekräftelse bör inte visas bara för att ramverket lätt skapar den. Den bör stå exakt där människor medvetet måste fatta ett beslut. Så förblir applikationen snabb utan att bli lättsinnig.

Prestanda uppstår i arkitekturen, inte i sista sprinten

Den som snabbar upp en webbplats eller webbapplikation först strax före go-live behandlar oftast symptom. Stora frågor, oklara datamodeller och i efterhand tillagda specialfall går inte att bestående korrigera med en enda optimeringsdag.

En hållbar grund börjar med en databas som motsvarar de faktiska sambanden i verksamheten. I MySQL 8 behöver rörelser, underlag, statusändringar och användaråtgärder spårbara nycklar och förnuftiga index. Ett lagersaldo får inte bara framstå som ett tal om det senare måste klargöras genom vilken bokning det uppstod. Samtidigt behöver inte varje historisk information räknas om vid varje sidanrop.

Vid moderna webbapplikationer är också ansvarsfördelningen relevant. PHP 8.4 kan avbilda affärsregler tydligt och underhållbart, medan modern JavaScript används riktat för reaktiva områden. Det är ingen trosbekännelse för en viss stack. Det är en underhållsfråga: kan ändringar genomföras säkert om sex månader? Syns det var en regel gäller? Går ett fel att reproducera, istället för att bara misstänkas?

Prestanda behöver dessutom gränser. Sökfält behöver förnuftiga minimitecken eller en precis filterlogik om miljontals poster är tänkbara. Stora listor behöver sidor eller graderade efterladdningsprocesser. Bilder och dokument bör inte blockera det kritiska arbetsflödet. Dessa beslut verkar ospektakulära. Just därför förblir de ofta värdefulla längre än en iögonfallande frontend-effekt.

Synlig hastighet skapar förtroende

Inte varje process kan vara klar på under en sekund. En etikettutskrift, ett gränssnitt mot fraktleverantören eller en kontroll mot externa data tar ibland tid. Avgörande är då hur applikationen hanterar väntetid.

En tydlig status som ”Fraktetikett skapas” är bättre än en frusen knapp. Efter ett avslut bör det synas vilket nummer som skapades och om förloppet får utlösas igen. Om en extern tjänst inte är nåbar behöver teamet ett begripligt handlingsalternativ istället för ett felmeddelande för utvecklare.

Det är också en fråga om dataintegritet. Ett dubbelklick får inte skapa två leveranser. En avbruten process får inte tyst lämna kvar en halvfärdig post. Bra system planerar för sådana fall eftersom de kommer att inträffa i vardagen. Särskilt vid växlande skift, tidspress och mobila enheter är undantaget inget randämne.

Kvalitet blir synlig före felet

För applikationer med många processvarianter räcker det inte att i slutet manuellt klicka igenom några vägar. Ändringar av priser, roller, valideringar eller gränssnitt kan utlösa följder på en långt avlägsen plats. Här blir automatiserad testning en del av prestandan: inte bara tekniskt, utan organisatoriskt.

Ett testsystem bör kunna kontrollera verkliga förlopp, till exempel skapa en order, ändra en position, generera en följesedel och kontrollera en behörighet. Det bör spela in belägg och formulera resultat så att verksamhetsavdelningar kan placera in dem. En mening som ”Fraktprocessen slutfördes inte efter adressändringen” hjälper mer än en okommenterad stacktrace.

För säkerhetsmedvetna team är också platsen relevant där dessa tester körs. Om skärmdumpar, inloggningsuppgifter, testfall eller interna applikationssteg inte ska lämna företaget är ett självhostat angreppssätt ofta förnuftigare än en extern molntjänst. Med COCO kan automatiserade tester för webb- och Windows-applikationer köras i en dedikerad miljö. Det är inte nödvändigt för varje team. Vid känsliga data, reglerade områden eller interna fackapplikationer kan kontrollen över testdata dock vara en avgörande fördel.

Utformning är bra när den underlättar arbetet

En stark visuell identitet kan skapa förtroende. Den visar att ett företag tar sin digitala närvaro på allvar. I det operativa systemet måste utformningen dock åstadkomma ännu mer: orientering under tidspress. Kontrast, typografi, tydliga tillstånd och begripliga beteckningar avgör om någon avslutar ett förlopp tryggt eller frågar kollegan.

Återhållsamhet är här ofta det bättre valet. En instrumentpanel med tio färgade nyckeltal kan se imponerande ut och ändå dölja den enda relevanta avvikelsen. En reducerad vy som gör öppna godsmottagningar, saknade skanningar och hotade leveranstider synliga är mer användbar. Frågan lyder inte hur mycket gränssnitt som är möjligt, utan vilken information som förbättrar ett beslut.

Det gäller också responsiva applikationer. Mobilanpassning betyder inte att pressa in varje skrivbordsvy i ett mindre format. En smartphone vid godsmottagningen behöver kanske bara skanning, mängd, lagerplats och bekräftelse. Den utförliga efterbearbetningen hör möjligen hemma på en större skärm. Olika enheter förtjänar olika prioriteringar, trots att de använder samma tillförlitliga databas.

Ett förnuftigt mått för nästa beslut

Innan ett team beslutar om en ny plattform, en automatisering eller en komplett nybyggnation hjälper en enkel kontroll: blir förloppet tydligare, snabbare eller säkrare för de människor som utför det dagligen? Och går lösningen fortfarande att förstå när krav, medarbetare eller gränssnitt ändras?

Om båda svaren håller blir ett vackert löfte ett användbart system. Då visar sig pure fluidity meets ultimate performance inte på en bild, utan på en lugn arbetsdag där ordrar, data och beslut fortsätter utan onödig friktion.
Permalänk →

SaaS Flow Web: införa arbetsflöden tryggt under pågående drift

SaaS Flow Web: införa arbetsflöden tryggt under pågående drift

En godsmottagning blir inte liggande för att ett team inte känner till ännu en programvara. Den blir liggande för att information går förlorad mellan e-post, pappersformulär, Excel-fil och telefonsamtal. Vid SaaS - ”Flow Web” på flow.softify.pro - bör därför inte gränssnittet vara den första frågan. Avgörande är om tjänsten tillförlitligt avbildar ett konkret arbetsflöde - även under hektiska dagar, vid växlande ansvar och när en leverans inte motsvarar planen.

För små och medelstora företag är SaaS ofta meningsfullt, eftersom de inte först måste bygga egna servrar, releaser och grundfunktioner. Men det är inget frikort för varje process. Den som inför ett verktyg som gör vardagen mer komplicerad eller tränger undan viktiga data i oklara sidolistor digitaliserar inget arbete. Hen flyttar bara friktionen.

Vad SaaS ”Flow Web” måste prestera

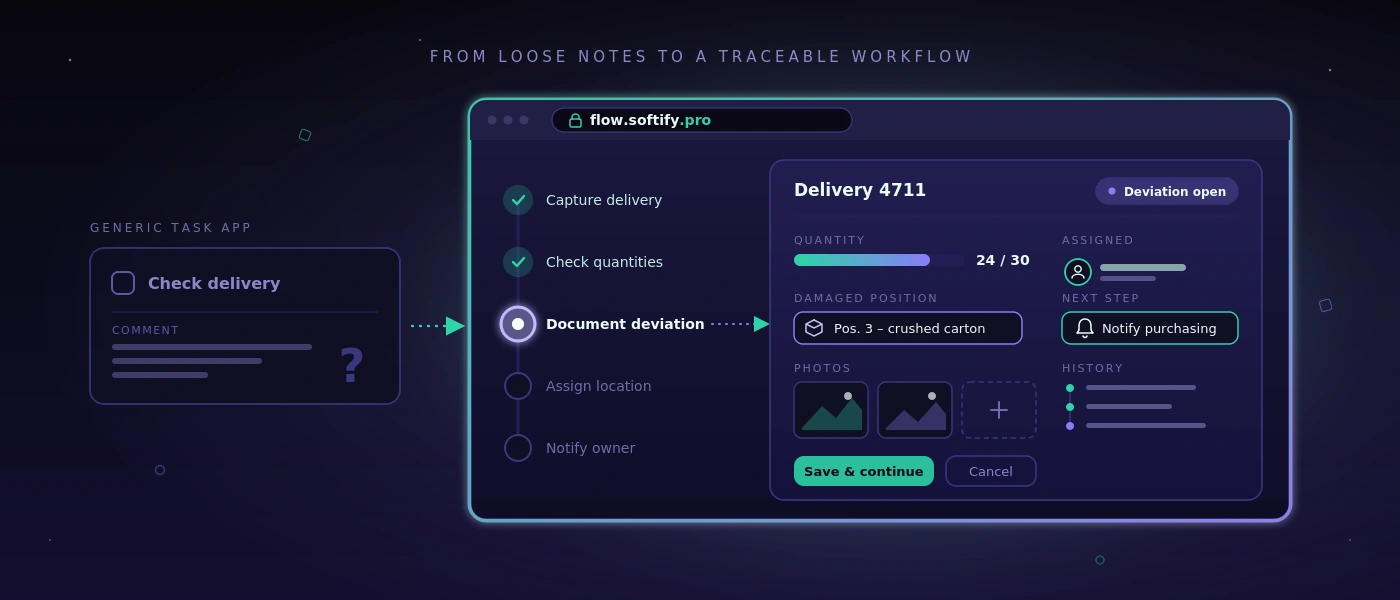
Ett webbaserat arbetsflöde är bra när medarbetare utan tolkning vet vad som ska göras härnäst. Vid en godsmottagning kan det betyda: registrera leveransen, kontrollera mängder mot beställningen, dokumentera avvikelse, tilldela lagerplats och vid behov informera en ansvarig. Förloppet behöver inte vara spektakulärt. Det måste vara spårbart, snabbt och upprepbart.

Just här ligger skillnaden mellan en allmän uppgiftsapp och ett sakligt processsystem. En uppgiftsapp kan skapa en punkt som heter ”Kontrollera leverans”. Ett sakligt arbetsflöde kan dessutom registrera vilken leverans som avses, vem som tog emot den, vilken position som var skadad, vilka foton som finns och om en efterleverans är utestående. Dessa data står då inte som fri text i en enskild kommentar, utan där nästa person behöver dem.

För en lösning som Flow Web på flow.softify.pro bör granskningen därför börja vid förloppen, inte vid en funktionslista. Ett företag med fem lagerrörelser per dag behöver något annat än ett fraktteam med flera cut-off-tider, olika transportörer och regelbunden hantering av delleveranser. SaaS är ingen ersättning för processförståelse.

Först namnge flaskhalsen, sedan konfigurera

Många digitaliseringsprojekt startar för brett: ”Vi vill digitalisera lagret.” Det låter rimligt, men leder snabbt till ett system med för många vyer, specialfall och utbildningsmaterial. Bättre är ett precist påstående som: ”Godsmottagningar bokas först nästa dag, eftersom följesedlar vid skiftets slut ligger på skrivbordet.”

Av en sådan mening kan en förnuftig start härledas. Den första versionen kan registrera följesedlar, bekräfta artiklar och mängder, markera avvikelser och föra bokningen vidare till ansvarig enhet. När detta förlopp fungerar kan etiketter, leverantörsbedömningar eller automatiska beställningsförslag läggas till senare. Inte varje förnuftigt utbyggnadssteg hör hemma i den första utrullningen.

Även en välskött tabell får vara kvar om den fyller sitt syfte. Till exempel kan en månatlig utvärdering med få inblandade i en befintlig fil vara billigare och mer transparent än en egen modul. SaaS lönar sig där information används flera gånger, handläggningstider är kritiska eller fel uppstår ur mediebrott.

De rätta frågorna före införandet

Före konfigurationen bör ett team spela igenom ett verkligt förlopp från början till slut. Inte idealprocessen, utan det fall som ställer till problem i vardagen: fel mängd, saknad referens, brådskande frakt eller en order med särskilt godkännande. Därvid visar sig de regler ett system faktiskt måste avbilda.

Relevanta är bland annat dessa punkter: vem får skapa, ändra eller avsluta ett förlopp? Vilka inmatningar är obligatoriska, vilka bara hjälpsamma? När måste en chef informeras? Vilka data överlämnas till bokföring, frakt eller kundtjänst? Och vad händer om WLAN i lagret är svagt eller en medarbetare inte längre har sina inloggningsuppgifter?

Svaren bestämmer införandets kvalitet starkare än en lång katalog med visuella krav. En ren rollprocess, ett begripligt felmeddelande och ett dokumenterat godkännandesteg förhindrar i drift oftast mer arbete än en extra rapport på startsidan.

Datalagring och roller är ingen bisak

SaaS behandlas ofta som en ren hanteringsfråga. För drifts- och IT-ansvariga är det dock minst lika viktigt vad som händer med data. Det gäller stamdata, leveransinformation, medarbetardata, foton av skador och eventuellt kunddata. Före införandet bör ansvar, lagring och exportmöjligheter vara klara.

Praktiskt betyder det: företaget måste veta vilka data som ligger i systemet, vem som har administrativ åtkomst och hur data tillhandahålls vid byte eller avslutat avtal. En export som bara finns som svårläst PDF-fil hjälper sällan. För operativa data är strukturerade, användbara format avgörande.

Även behörighetskonceptet förtjänar konkret uppmärksamhet. I lagret behöver inte varje person se priser, kundvillkor eller globala inställningar. Samtidigt får en för snäv rättighetstilldelning inte blockera flödet. Förnuftiga är roller som är inriktade på faktiska arbetsuppgifter: mottagning, disposition, frakt, teamledning och administration. Kritiska ändringar bör vara spårbara, så att man vid frågor inte behöver gissa vem som ändrat en bokning.

Själva åtkomsten bör skyddas med solida grunder. Dit hör säkra lösenordspolicyer, en reglerad lösenordsåterställning, kontolåsning vid upprepade misslyckade försök och, där riskprofilen kräver det, ytterligare inloggningssteg. Säkerhet verkar professionell när den är förutsägbar och inte märks först när någon har blivit utelåst.

Integration bara där den mätbart avlastar

Ett webbaserat arbetsflöde utvecklar ofta sitt värde först i samspel med befintliga system. Det kan vara ett ERP, en webbutik, en fraktlösning, en tidrapportering eller en databas. Ändå är inte varje gränssnitt automatiskt meningsfullt. Varje integration skapar beroenden, felbilder och underhållsarbete.

Den centrala frågan lyder: vilket manuellt steg tar kopplingen konkret bort? Om ett gränssnitt varje dag sparar 30 minuters överföringsarbete och minskar skrivfel är nyttan klar. Om det bara speglar en information som ändå kontrolleras en gång i veckan kan en manuell export till att börja med vara den förnuftigare lösningen.

Vid individuella utbyggnader räknas den tekniska basen. Dokumenterade gränssnitt, tydligt definierade datafält och spårbara felprotokoll underlättar senare drift. Om ett system kopplas till en skräddarsydd webbapplikation bör teknologier och databasstruktur väljas så att de förblir underhållbara på lång sikt. En väl underhållen applikation baserad på PHP 8.4, modern JavaScript och MySQL 8 är värdefullare än en kortsiktigt imponerande specialkonstruktion utan dokumentation.

Införande under pågående drift

Det vanligaste felet är en hård start utan jämförelsefas. Team ska då på måndagsmorgonen genast arbeta annorlunda, medan öppna frågor först uppstår ur verkliga problem. Det ökar avvisandet, även om programvaran i grunden passar.

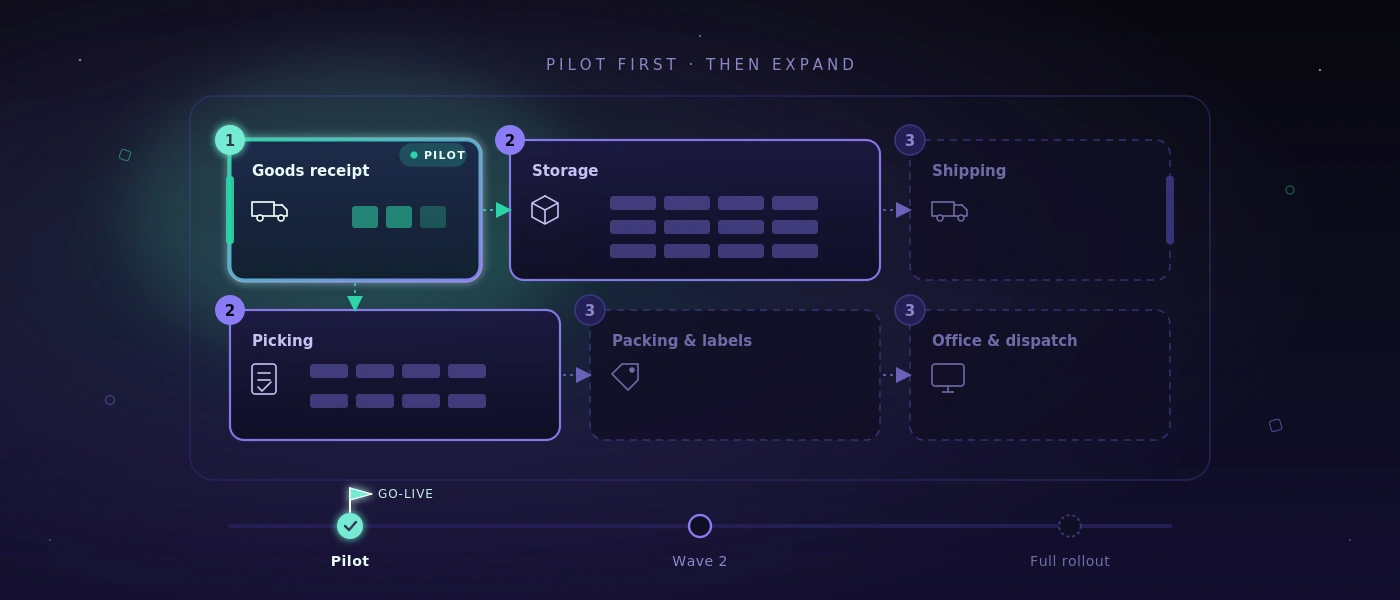
Bättre är en begränsad pilot med ett team, en processvariant eller ett tydligt avgränsat platsområde. Under den tiden kontrolleras om registrering och godkännanden fungerar, om begrepp är begripliga och om undantagsfall landar rent. Viktigt är att inte bara samla återkoppling som en önskelista. Varje ändring bör prövas mot nyttan för genomloppstid, felfrekvens eller transparens.

Även nyckeltal bör fastställas tidigt. Till exempel kan handläggningstid per godsmottagning, antal öppna avvikelser, förfrågningar om leveransstatus eller korrigeringsbokningar följas. Utan utgångsvärde förblir ”känns snabbare” den enda bedömningen. Det kan stämma, men räcker inte för ett hållbart investeringsbeslut.

Drift behöver en tydlig ägare

SaaS minskar det tekniska arbetet, men tar inte ifrån ett företag ansvaret för den egna processen. Internt behövs någon som hanterar roller, samlar återkoppling, upptäcker utbildningsbehov och avgör vilka ändringar som verkligen är nödvändiga. Denna person behöver inte kunna programmera. Hen bör dock förstå arbetsflödet och ha tillgång till de ansvariga.

Lika viktig är en kort, hållbar driftdokumentation. Den förklarar inte varje skärmvy, utan besvarar de frågor som uppstår i vardagen: vad göra vid en felaktig bokning? Vem godkänner nya användare? Hur kommuniceras ett avbrott? Var ligger exporterade data? Sådan klarhet förhindrar att ett digitalt system efter några månader åter blir beroende av personliga tillrop.

En bra SaaS-lösning känner man därför inte igen på hur många menyalternativ den erbjuder. Den visar sitt värde när en ny kollega säkert kan hantera ett förlopp, en avvikelse inte försvinner och en chef ser statusen utan att ringa tre personer. Just efter detta mått bör Flow Web mätas: inte efter löften, utan efter en arbetsdag som påvisbart går lugnare och tillförlitligare.

Permalänk →

Webbutveckling med aktuella ramverk: vad företag verkligen får ut av det

Webbutveckling med aktuella ramverk: vad företag verkligen får ut av det

Om en godsmottagning fortfarande pendlar mellan pappersformulär, telefonsamtal och tre Excel-filer löser ett modernt frontend inte problemet ensamt. Webbutveckling med aktuella ramverk är meningsfull när den synligt förenklar förlopp: medarbetare ser nästa steg, data registreras bara en gång och applikationen förblir begripligt underhållbar även efter den första go-live.

För små och medelstora företag är ramverksfrågan därför ingen trosfråga. Avgörande är inte om ett gränssnitt bär särskilt många tekniska modeord. Avgörande är om lagerrörelser, ordrar, kontroller eller godkännanden tar sig tillförlitligt genom arbetsdagen - även under tidspress, skiftbyten och växlande nätverksanslutning.

Ramverk är ett medel, inget projektmål

Ett ramverk levererar en beprövad struktur för återkommande uppgifter: routing, formulär, behörighetshantering, dataåtkomst, tester och visning av gränssnitt. Det minskar inte automatiskt varje risk. Men det förhindrar att ett projekt om och om igen måste uppfinna grundläggande funktioner.

Vid en individuell webbapplikation kan ett modernt JavaScript-ramverk till exempel förnuftigt avbilda interaktiva vyer: en plocklista som löpande uppdaterar positioner, en ruttplanering med tydliga statusbyten eller ett kontrollprotokoll som kopplar foton och kommentarer direkt till ett ärende. I backend ger etablerade PHP-ramverk spårbara regler, tydligt åtskilda ansvarsområden och konsekventa gränssnitt mot databasen.

Det är särskilt relevant när en från början liten lösning blir ett dagligen använt driftsystem för en process. En inmatningsvy för leveransaviseringar kan börja överskådligt. Så fort den uppdaterar lagersaldon, skriver ut etiketter, beaktar roller och kommunicerar med en fraktleverantör behöver den en ren teknisk bas. Ramverk hjälper till att inte förhandla om den basen vid varje utbyggnad.

Vad aktuella webbramverk konkret gör bättre

Värdet hos moderna ramverk ligger sällan i spektakulära effekter. Det visar sig i en applikations osynliga delar. Formulär kan kontrollera inmatningar direkt, utan att felaktiga data märks först efter att de skickats. Behörigheter kan definieras centralt, så att en förare ser annan information än dispositionen. Ändringar i en beställning sparas spårbart, istället för att tyst skriva över en tabellcell.

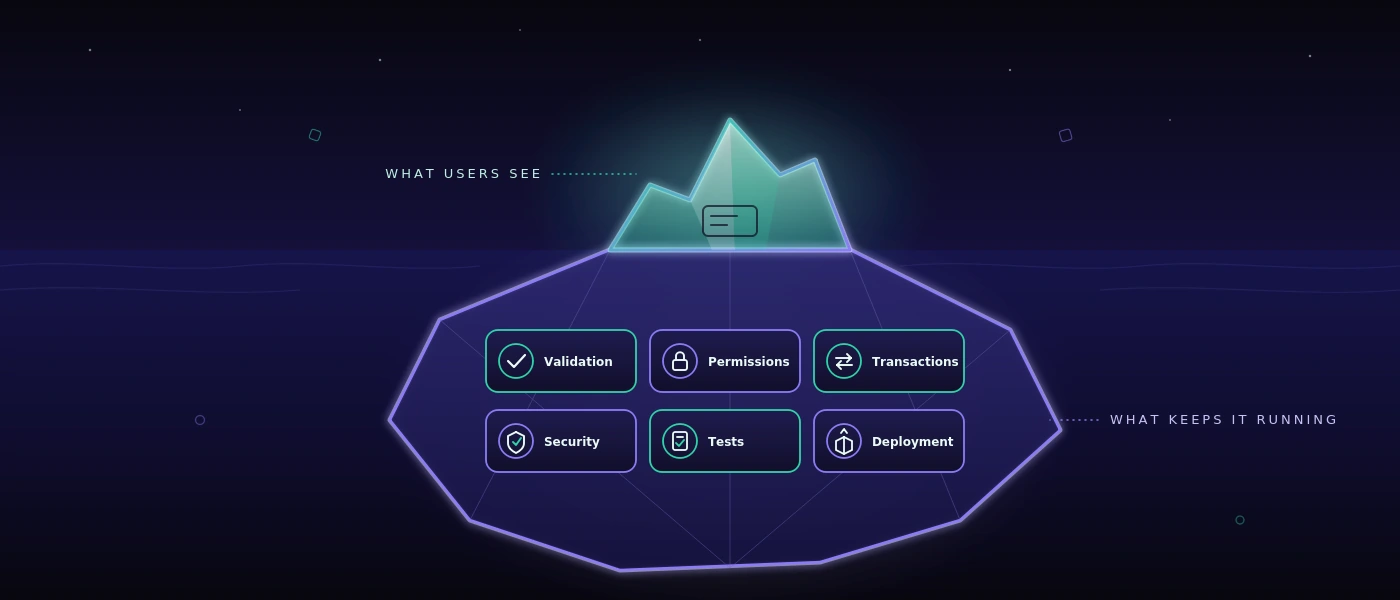
På serversidan skapar en aktuell miljö med PHP 8.4 och MySQL 8 en bärkraftig grund för affärskritisk logik. Databastransaktioner förhindrar till exempel att ett lagersaldo minskas medan den tillhörande bokningen misslyckas. Unika nycklar och valideringsregler undviker dubbletter. Bakgrundsprocesser kan skapa dokument eller anropa gränssnitt utan att personen vid skärmen behöver vänta.

Inte heller säkerhet är en funktion i efterhand. Ett tidsenligt ramverk stöder säker lösenordslagring, skydd mot typiska inmatningsattacker, spårbara sessioner och definierade kontolåsningsflöden. Ändå förblir genomförandet en projektuppgift: behörigheter måste modelleras sakligt korrekt och känsliga funktioner kräver extra kontroller. Ett ramverk ger skyddsräcken, men ingen kunskap om vem i verksamheten som får ge vilket godkännande.

Att avgöra webbutveckling med aktuella ramverk rätt

Den bästa tekniken uppstår inte genom en lista över populära verktyg, utan genom den faktiska användningen. En intern applikation för tio personer har andra krav än en kundportal med flera tusen samtidiga åtkomster. En lagerterminal med skanner behöver en annan hanteringslogik än en ledningsanalys på skrivbordet.

Därför börjar ett förnuftigt beslut med konkreta frågor: vilka förlopp kostar idag mätbart tid? Vilka data överförs flera gånger? Var uppstår fel för att information blir synlig för sent? Vilken befintlig tabell fungerar tillräckligt bra och bör till att börja med vara kvar? Just den sista punkten skyddar mot dyra digitaliseringsprojekt utan operativ nytta.

För många individuella affärsapplikationer är ett serverrenderat system med riktade interaktiva komponenter det förnuftigaste valet. Det laddar snabbt, är överskådligt att driva och undviker onödig komplexitet. En helt frikopplad single-page-applikation kan däremot vara lämplig när gränssnittet hanterar mycket många dynamiska tillstånd, måste fungera offline eller senare ska tillhandahålla samma funktioner även åt en mobilapp.

Båda kan vara sakligt rätt. Frågan lyder inte: vilket ramverk är modernast? Den lyder: vilken arkitektur går om två år fortfarande att bygga ut säkert, testa och förstå för det egna teamet?

När mindre teknik är bättre teknik

Inte varje process behöver ett komplext frontend. En slimmad inmatningsvy för interna beställningar kan vara snabbare, stabilare och billigare än ett omsorgsfullt animerat gränssnitt. Om en Excel-fil bara underhålls en gång i månaden och inte orsakar fel är den möjligen fortfarande rätt verktyg.

Komplexitet lönar sig först när den undanröjer verklig friktion. Det kan vara fallet när ordrar knappas in flera gånger, leveransstatus måste efterfrågas per telefon eller ingen är säker på vilken version av ett dokument som gäller. Då skapar en central applikation en tydlig nytta: ett dataunderlag, entydiga ansvarsområden och färre förfrågningar.
Underhållbarhet börjar före första kodraden

Ramverk ses ofta som accelererare. Det stämmer bara om de sakliga reglerna dessförinnan är tillräckligt klara. En utvecklare kan bygga en tillståndsmaskin tekniskt rent. Men om statusföljden verkligen passar processen avgörs vid kartläggningen: när gäller gods som mottaget? Vem får stänga en avvikelse? Vad händer vid en delleverans?

Dessa beslut bör dokumenteras, liksom gränssnitt, datafält och undantag. Det gör inte projekt långsammare. Det minskar senare diskussioner, eftersom det blir synligt vilken regel som medvetet genomfördes och vilket antagande som ännu är öppet.

Underhållbarhet visar sig också i små discipliner. Databasändringar måste versioneras. Driftsättningssteg måste dokumenteras. Felmeddelanden ska vara användbara för drift och utveckling utan att avslöja konfidentiella detaljer. Automatiserade tester kontrollerar vid varje ändring centrala förlopp, till exempel skapandet av en order, beräkningen av en mängd eller utskriften av en följesedel.

Vid kritiska applikationer räcker inte en enda testtyp. Enhetstester säkrar enskilda regler, integrationstester kontrollerar samspelet med databas och gränssnitt, och end-to-end-tester spelar upp verkliga användningsvägar i webbläsaren. För webb- och Windows-applikationer kan en självhostad testmiljö dessutom leverera skärmdumpar, körningsprotokoll och begripliga bedömningar, utan att i onödan lämna ut interna testdata till externa molntjänster.

Prestanda uppstår ur arkitektur och datamodell

Ett modernt gränssnitt blir inte snabbt för att det använder ett aktuellt ramverk. Långsamma databasfrågor, överdimensionerade bilder eller oklara gränssnitt förblir långsamma, oberoende av frontend. Särskilt vid listor med ordrar, artiklar eller rörelsedata avgör datamodellen den upplevda hastigheten.

Rena index i MySQL 8, paginerade frågor och medvetet laddade data är ofta effektivare än senare optimering i gränssnittet. Lika viktigt är ett tydligt cachingkoncept. Stamdata får under vissa omständigheter cachas, aktuella lagersaldon eller godkännandestatus däremot inte blint. Här finns ingen generell regel, eftersom datans sakliga betydelse avgör hur aktuell den måste vara.

Responsiv utformning hör också till den tekniska planeringen. På kontorsskärmen kan en bred tabell vara förnuftig. På en handskanner eller surfplatta i lagret behöver samma information stora träffytor, korta vägar och en visning som förblir användbar även med handskar eller vid dåligt ljus. Pure fluidity meets ultimate performance betyder i detta sammanhang inte så mycket rörelse som möjligt på skärmen. Det betyder att applikationen fungerar utan friktion på den enhet som faktiskt används i processen.

Den förnuftiga vägen från idé till drift

Ett hållbart webbprojekt startar med en begränsad, kontrollerbar kärna. Istället för att i förväg automatisera varje tänkbart undantag väljs en process som förekommer ofta och orsakar märkbar insats. Efter den första användningen visar verkliga data och återkoppling vilken utökning som verkligen har nästa prioritet.

Den tekniska överlämningen bör inte ske först i slutet. Ansvar för hosting, säkerhetskopior, övervakning, uppdateringar och åtkomsträttigheter måste klarläggas tidigt. Ett system är bara så tillförlitligt som dess drift. Den som dagligen behöver en applikation för frakt eller orderhantering behöver definierade återställningsvägar och ett tydligt svar på vad som händer vid en störning.

softify.pro satsar därför på underhållbara teknologier, dokumenterad leverans och direkt tekniskt ansvar istället för kortlivade ramverksmoden. Det är ingen magisk genväg. Det skapar förutsättningen att en applikation efter lanseringen fortsätter att fungera, kan vidareutvecklas och inte blir nästa sköra specialfall.

Den rätta webbapplikationen känns i bästa fall inte som ett nytt IT-projekt. Den känns som ett förlopp som äntligen fungerar utan omvägar - med tillräckligt teknisk substans för att lugnt ta emot även nästa förändring i driften.

Permalänk →

Planera en programvaruutrullning: så lyckas införandet under pågående drift

Planera en programvaruutrullning: så lyckas införandet under pågående drift

Ett nytt system misslyckas sällan för att en knapp saknas. Det misslyckas på måndagsmorgonen: morgonskiftet hittar inte godsmottagningen, en följesedel skrivs ut två gånger eller en Excel-fil förblir plötsligt den inofficiella sanningen. Den som vill planera en programvaruutrullning måste därför inte bara införa funktioner, utan säkra den verkliga verksamheten.

Just i lager, verkstad, disposition och administration är en utrullning inget IT-möte. Den förändrar handgrepp, ansvar och informationsvägar. Ett bra införande håller arbetet i rörelse, gör fel synliga tidigt och ger medarbetare ett tydligt svar på den avgörande frågan: vad gör jag annorlunda från i morgon?

Utrullningen börjar före den första utbildningen

Många projekt startar med en funktionslista: registrera ordrar, boka lagerrörelser, skriva ut fraktetiketter, planera rutter. Det är nödvändigt men räcker inte. Före starten måste det vara klarlagt vilka processer som faktiskt ska löpa via det nya systemet den första produktiva dagen - och vilka som medvetet ännu inte ska göra det.

Denna avgränsning är inget tecken på ofullständighet. Den minskar risken. Om ett medelstort företag hittills har samordnat godsmottagningar via papper, telefon och tabeller, behöver man inte första dagen samtidigt digitalisera hela lagerhanteringen, returhanteringen, turplaneringen och leverantörsbedömningen. Ett förnuftigt första omfång kan ligga i godsmottagningen, entydiga lagerrörelser och utskrift av leveransdokument.

Avgörande är att beskriva målprocessen konkret. Inte: ”Godsmottagningen blir digital.” Utan: ”Medarbetaren skannar leveransen, kontrollerar mängd och skick, tilldelar en lagerplats och skapar vid avvikelser ett ärende för inköp.” Först på denna nivå blir öppna frågor synliga: vad händer vid saknad beställning? Vem får korrigera mängder? Får en leverans utan etikett lagras in?

Att planera en programvaruutrullning innebär: prioritera kritiska flöden

Inte varje process har samma betydelse. Ett avbrott inom stamdataunderhåll kan vara obehagligt. Ett avbrott vid frakt, plockning eller fakturagodkännande kan blockera en hel dags arbete. Därför behöver utrullningen en prioritering efter driftrisk, inte efter ordningen i kravspecifikationen.

En enkel indelning har visat sig fungera: affärskritisk, viktig och uppskjutbar. Affärskritiska är alla flöden som rör varor, pengar eller bindande kundkommunikation. Viktiga är funktioner som snabbar upp vardagen, men vars bortfall tillfälligt kan mildras manuellt. Uppskjutbara är bekvämlighetsfunktioner, sällsynta specialfall eller utvärderingar som till en början fortfarande får komma från en befintlig källa.

Denna indelning påverkar testdjupet. För en kritisk fraktprocess räcker det inte att klicka sig igenom en enskild order framgångsrikt. Testas måste också delleveranser, makuleringar, saknade skrivare, felaktiga adresser, parallell hantering och överlämningen till transportören. För en sällan använd statistikfunktion kan en senare testcykel vara lämplig.

Gör framgångskriterier mätbara i förväg

”Applikationen kör” är inget godkännandekriterium. Bättre är kontrollerbara påståenden: en godsmottagning på 30 positioner kan bokas inom tio minuter. Fraktetiketter skrivs ut vid den avsedda arbetsplatsen. Lagerförändringar syns omedelbart i dispositionen. Ett spärrat användarkonto kan endast återaktiveras via den definierade godkännandeprocessen.

Sådana kriterier förenar verksamhetsavdelning och utveckling. De förhindrar också att godkännandet blir en samling vaga intryck. Inte varje återkoppling måste vara löst före go-live. Men varje återkoppling behöver en klassificering: kritiskt fel, relevant förbättring eller punkt för ett senare utbyggnadssteg.

Datamigrering: bara rena data förtjänar förtroende

Gamla data underskattas ofta. I tabeller finns dubbla artikelnummer, olika enheter, utgångna kundadresser och lagersaldon vars ursprung ingen längre kan förklara. Den som tar över dessa data ogranskade flyttar gammal oklarhet in i ett nytt system - bara med ett bättre gränssnitt.

Före migreringen bör det fastställas vilka data som verkligen behövs. Ofta är aktuella artiklar, aktiva kunder, öppna ordrar, relevanta leverantörer och kontrollerade ingångssaldon förnuftiga. Historiska poster behöver inte nödvändigtvis flytta över helt till den nya applikationen. Det kan räcka att arkivera dem läsbart, om de förblir nödvändiga för belägg eller förfrågningar.

Särskilt viktig är en provladdning. Därvid importeras data inte bara tekniskt, utan kontrolleras sakligt: stämmer mängder, enheter och tilldelningar? Är obligatoriska fält kompletta? Går typiska ordrar att hantera korrekt med dem? För go-live behövs därefter ett tydligt stoppdatum. Från när används vilket ledande system? Utan denna regel uppstår dubbelunderhåll och motstridiga saldon.

Pilotdrift istället för en stor strömbrytare

En big bang kan vara förnuftig om ett litet team använder en tydligt avgränsad process och den gamla och den nya lösningen inte kan fungera parallellt. I de flesta operativa miljöer är pilotdrift dock det mer kontrollerbara valet.

Piloten bör arbeta med verkliga fall, men inom en begränsad ram: ett lagerområde, ett skift, en produktgrupp eller ett utvalt team. Avgörande är att pilotgruppen inte bara omfattar särskilt teknikintresserade medarbetare. Den bör återge den senare vardagen realistiskt, inklusive de människor som arbetar under tidspress och har befogade invändningar.

I pilotdriften visar sig om skannrar, skrivare, nätverk och behörigheter fungerar vid den faktiska arbetsplatsen. Likaså blir processluckor synliga som ingen nämnt i möten. Kanske ställs varor i vardagen först på en mellanplats. Kanske behöver förare en annan följesedel än administrationen. Sådana insikter är inget bakslag. De är skälet att genomföra piloten före den breda starten.

Utbildning som arbetssituation, inte som programvarurundtur

En utbildning som bara förklarar menyalternativ skapar liten trygghet. Medarbetare måste lära sig på sina uppgifter: ”Ni tar emot en skadad leverans”, ”Ni plockar en brådskande order”, ”Ni korrigerar en felbokad mängd”. Sammanhanget fastnar eftersom det motsvarar arbetsvardagen.

Korta utbildningar nära go-live är oftast mer effektiva än ett långt tillfälle veckor tidigare. Dessutom hjälper kortfattade arbetsinstruktioner direkt vid arbetsplatsen. De bör inte förklara hela systemet, utan visa de vanligaste förloppen, tydliga ansvarsområden och vägen vid störningar.

Utse dessutom kontaktpersoner per område. Dessa personer behöver inte själva lösa varje tekniskt problem. Men de bör kunna avgöra om det rör sig om ett handhavandefel, en sakmässig oklarhet eller ett faktiskt systemfel. Det skyddar projektteamet från ostrukturerade tillrop och påskyndar hjälpen för skiftet.

Go-live behöver en driftplan

Go-live-dagen behöver mer än en tidpunkt. Definiera vem som beslutar sakligt, vem som ansvarar för tekniska ändringar och via vilken kanal störningar rapporteras. Vid kritiska flöden bör det vara synligt om centrala funktioner fungerar: inloggning, behörigheter, datainmatning, gränssnitt, utskrift och säkerhetskopiering.

Även en reservplan hör dit. Det betyder inte att man vid minsta problem genast helt återvänder till den gamla världen. Det betyder att i förväg bestämma vilken störning som motiverar ett stopp, hur ordrar vid behov dokumenteras och hur man i efterhand rent registrerar. Ett pappersformulär några timmar kan vara förnuftigt. En permanent parallellhantering utan slut är det inte.

Tekniska detaljer räknas här: har åtkomster skapats i tid? Fungerar roller och kontolåsningsregler korrekt? Är etikettskrivare kopplade till rätt mallar? Finns det en testad säkerhetskopia av databasen? Vid individuellt utvecklade applikationer hör dokumenterade driftsättningar, spårbara versionsstatusar och en tydlig väg för felrättningar till standarden.

De första veckorna avgör acceptansen

Efter starten börjar fasen där en applikation antingen blir ett arbetsmedel eller ett ogillat extra steg. Planera därför korta dagliga återkopplingsrundor. Vilka fel uppträder upprepat? Var uppstår omvägar? Vilka fält missförstås? Vilken utvärdering saknar en chef egentligen?

Inte varje iakttagelse kräver en omedelbar ändring. Vissa problem löser sig genom mer precisa arbetsregler eller bättre utbildning. Andra visar verkliga svagheter i processen eller applikationen. Konsten är att inte blanda ihop de två. Ett system bör inte utan skäl göra befintliga fungerande förlopp mer komplicerade. Om en välskött tabell för ett sällsynt specialfall fortfarande är den bättre lösningen, får den vara kvar.

Mät effekten med hjälp av några få konkreta nyckeltal: handläggningstid per förlopp, antal förfrågningar, felbokningar, omutskrifter, öppna ordrar eller lagerdifferenser. Först dessa värden visar om utrullningen faktiskt förbättrar verksamheten - istället för att bara införa nya masker.

En bra utrullning känns efter några veckor inte som ett projekt. Den blir en pålitlig arbetsrutin: rätt data finns där de behövs, undantag är spårbara och team behöver ringa mindre efter information. Just det bör planeringen sikta på - inte en spektakulär startdag, utan en lugnare, bättre styrbar vardag.

Permalänk →

Planera Multiplatform Application Development: först processen, sedan plattformen

Planera Multiplatform Application Development: först processen, sedan plattformen

En lagerchef bekräftar en godsmottagning på handskannern. Dispositionen kontrollerar samma process i webbläsaren. En förare behöver leveransstatusen på vägen i smartphonen. Multiplatform application development låter i detta ögonblick som en teknisk fråga. I själva verket handlar det först om ett verksamhetsflöde: vilket arbete måste utföras var, med vilken tillförlitlighet och med vilken enhet?

För små och medelstora företag är det rätta svaret sällan: vi bygger allt nativt för varje plattform. Oftare lyder det: vi definierar en gemensam process, väljer målinriktat de nödvändiga användargränssnitten och undviker dubbel logik. Det sparar inte bara utvecklingsbudget. Det förhindrar också att lager, kontor och fältservice arbetar med olika dataunderlag.

Vad Multiplatform Application Development ska åstadkomma

Multiplatform Application Development avser utveckling av en applikation som kan användas i flera miljöer, till exempel i webbläsaren, på iOS och Android eller på Windows-skrivbordssystem. Begreppet reduceras ofta till frågan om en enda kodbas kan skapa flera appar. Det är bara en del av beslutet.

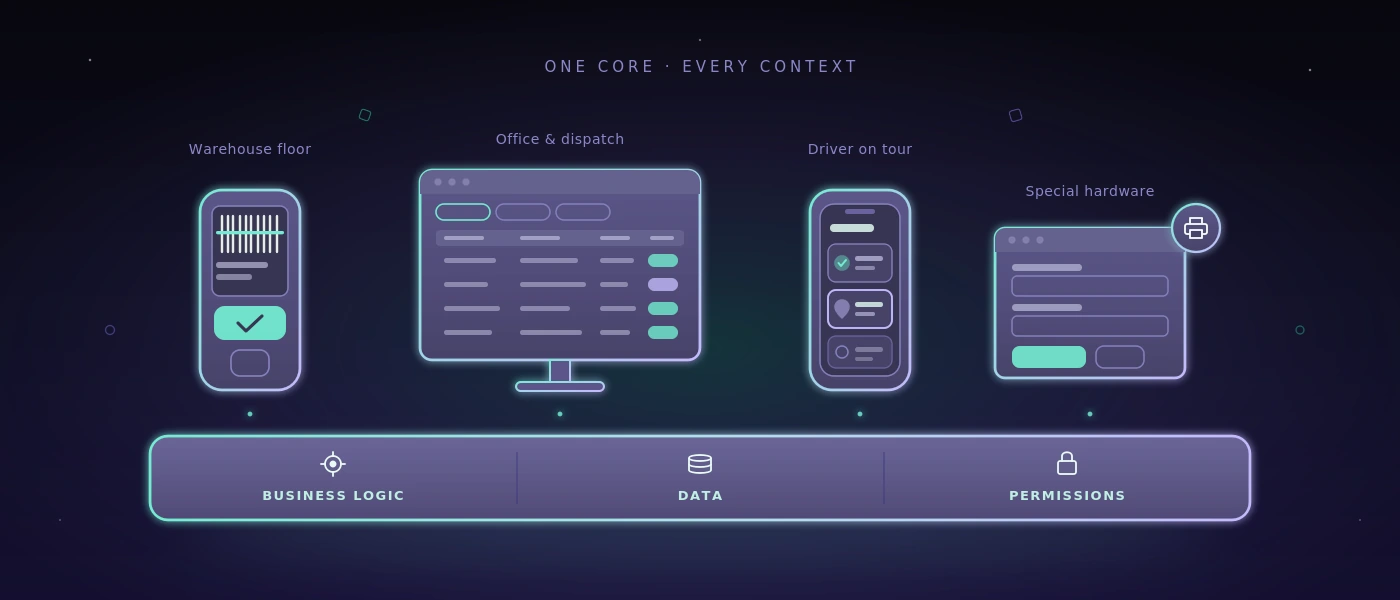
För operativa system räknas framför allt om applikationen fungerar där den används. En godsmottagning kan behöva en kamera för att läsa streckkoder, stora manöverelement för handskar och en användbar reaktion vid instabil WLAN-täckning. Administrationen behöver däremot tabeller, filter, behörighetskoncept och spårbara ändringsloggar. En förare behöver en reducerad vy, inte samma gränssnitt som dispositionen.

En gemensam teknisk grund kan förena dessa krav på ett förnuftigt sätt. Men den får inte leda till att varje plattform betjänas som en dålig kompromiss. Den bästa gemensamma koden är värdelös om medarbetare tar omvägar eftersom applikationen inte avspeglar deras faktiska arbetsflöde.

Först bestämma processen, sedan plattformen

Innan team pratar om ramverk bör de granska ett konkret förlopp från början till slut. Ta en leverans: ordern kommer in, varor plockas, en följesedel skapas, överlämningen bekräftas och statusen rapporteras tillbaka till försäljning eller kundtjänst. Var uppstår mediebrottet idag? Var antecknas något på papper, knappas in senare eller frågas efter per telefon?

Denna iakttagelse skiljer verkliga plattformskrav från önskelistor. Om bara två medarbetare på kontoret använder en funktion räcker ett välgjort webbgränssnitt oftast. Om tio personer på lagergolvet gör bokningar kan ett mobilt, skannervänligt gränssnitt göra skillnaden. Måste ett befintligt Windows-program arbeta med specialhårdvara kan en skrivbordsintegration vara nödvändig.

Inte varje funktion hör hemma på varje enhet. Det är ingen brist hos en multiplattformslösning, utan ett tecken på rena produktbeslut. Gemensamma data och affärsregler innebär inte nödvändigtvis identiska vyer.

De tre frågorna som klargör kostnad och nytta

Den första frågan lyder: vilka enheter används redan och hur länge förblir de i bruk? Ett företag med hanterade Windows-terminaler har andra krav än en fältservice med privata smartphones. Den andra lyder: vad händer utan nätverksanslutning? Offlineförmåga ökar insatsen avsevärt, eftersom data måste sparas lokalt, synkroniseras senare och hanteras rent vid konflikter. Den är förnuftig om processen annars står still - inte som standardutrustning.

Den tredje frågan gäller följderna av ett avbrott. Kan en medarbetare lägga in en bokning i efterhand, eller hänger en fraktetikett, ett lager eller ett säkerhetsgodkännande på den? Ju mer kritisk processen är, desto starkare måste behörigheter, kontrollregler, upprepbarhet och loggning planeras.

En arkitektur som inte faller sönder vid den andra plattformen

Vid en hållbar lösning ligger affärslogiken inte utspridd i flera gränssnitt. Lagerkontroller, statusbyten, nummerserier, behörigheter och dokumentgenerering behöver en central, testad grund. Webbläsare, mobilapplikation och skrivbordsklient når den via tydligt definierade gränssnitt.

För många interna affärsprocesser är en modern webbapplikation den mest ekonomiska utgångspunkten. Den kan uppdateras centralt, kräver ingen installation på varje arbetsplats och fungerar på dator, surfplatta och smartphone. Med PHP 8.4, modern JavaScript och MySQL 8 kan en underhållbar bas byggas, förutsatt att datamodell, åtkomsträttigheter och driftsättning inte beaktas först strax före go-live.

En installerbar mobil- eller skrivbordsapplikation läggs till när den ger en tydlig fördel: djup integration med skanner, skrivare eller kamera, tillförlitlig offlinedrift, speciella bakgrundsfunktioner eller krav från enhetshanteringen. Det är en målinriktad utbyggnad, inget självändamål.

Ett vanligt misstag är fullständig återanvändning av användargränssnittet till varje pris. Tekniskt kan det se attraktivt ut. I praktiken uppstår små texter på stora skärmar, överlastade formulär på smartphones eller manövrering som inte passar plattformen. Bättre är att dela datamodell, regler och komponenter där det är förnuftigt, medan hanteringen anpassas till respektive sammanhang.

Datakonsistens är viktigare än en gemensam kodbas

Flera plattformar ökar risken för motstridiga data. En order ändras på kontoret medan en förare fortfarande ser en gammal version på sin enhet. Två medarbetare bokar samtidigt samma artikellager. En offlineenhet skickar tillbaka sina ändringar timmar senare. Dessa fall är inget randämne, utan arkitekturens kärna.

Systemet behöver därför entydiga identiteter, tidsstämplar, spårbara tillståndsbyten och regler för konflikter. Vid en leveransstatus kan den senast bekräftade ändringen räcka. Vid lagersaldon är det ofta för grovt. Där måste det vara klart vilken rörelse som bokades, från vilken lagerplats den kommer och om en korrigering måste motiveras.

Även behörigheter bör regleras centralt. En medarbetare får kanske registrera godsmottagningar men inte godkänna lagerkorrigeringar. En extern förare får bara se sin tur. Sessionslängder, flerfaktorsautentisering för kritiska roller och kontolåsningsflöden är inga dekorativa säkerhetsfunktioner. De skyddar konkreta förlopp och gör ansvar synligt.

Testa Multiplatform Application Development så som man arbetar

En applikation kan starta på tre operativsystem och ändå misslyckas i drift. Avgörande är förloppen under verkliga förhållanden: skannern reagerar för långsamt, en etikettskrivare är inte nåbar, en behörighet gäller inte efter ett rollbyte, eller en synkronisering skapar dubbla bokningar.

Därför bör kritiska processer kontrolleras automatiserat. Dit hör inloggning och spärrbeteende, orderregistrering, lagerrörelser, dokumentskapande och hanteringen av felaktiga inmatningar. För webb- och Windows-applikationer kan återkommande tester köras på en självhostad infrastruktur. Det är särskilt relevant om skärmdumpar, interna orderdata eller testkonton inte ska lämnas vidare till externa molntjänster.

Automatisering ersätter inte kontroll av människor på lagergolvet. Men den ser till att kända förlopp kontrolleras om och om igen efter ändringar. Bra testrapporter anger inte bara ett tekniskt fel, utan den berörda processen: leveransbevis kan inte skapas, användarkonto förblir spärrat efter lyckat godkännande eller turdata uppdateras inte.

När en plattformsstrategi är för mycket

Vissa företag behöver ingen egen app. Om en stabil webbläsaråtkomst räcker, förloppet sällan är mobilt och antalet användare förblir överskådligt är en responsiv webbapplikation ofta det förnuftigare valet. Den minskar underhållsinsats, distributionsproblem och antalet möjliga felkällor.

Inte heller en befintlig tabell behöver ersättas omedelbart. Om den bara fungerar som enkel utvärdering, sköts av en person och inte skapar felkänsliga överlämningar kan den fylla sitt syfte. Tidpunkten för ett system är nådd när kunskap finns i enskilda huvuden, versioner glider isär, återfrågor ökar eller ett förlopp inte längre kan spåras tillförlitligt.

Omvänt blir en slimmad plattformsstrategi snabbt för liten när medarbetare måste arbeta offline, hårdvara kopplas in eller kunder och partner behöver kontrollerad åtkomst. Då lönar det sig att medvetet finansiera de tillkommande kraven, istället för att bygga på dem senare under tidspress.

Börja med en hållbar pilot

En bra start är ingen funktionskatalog med hundra punkter, utan ett fullständigt, mätbart förlopp. Till exempel: registrera godsmottagning, uppdatera lager, dokumentera avvikelse och skapa en uppgift för klargörande. Denna pilot visar tidigt om datamodell, enheter, rättigheter och hantering passar ihop.

Därefter kan lösningen växa i förnuftiga steg: plockning, frakt, turplanering eller utvärderingar. Varje utökning bör klara samma fråga: förkortar den ett verkligt förlopp, minskar den fel eller skapar den tillförlitlig transparens? Om inte, kan den vänta.

Den mest förnuftiga plattformen är till sist inte den med flest tekniska alternativ. Det är den där ett team börjar sitt arbete snabbare på morgonen, frågar mindre under skiftet och på kvällen kan spåra vad som faktiskt hände.

Permalänk →

Att bedöma Test Automation Results på rätt sätt

Att bedöma Test Automation Results på rätt sätt

Ett regressionstest kan på morgonen sluta med 98 procent lyckade fall och ändå inte vara goda nyheter. Kanske är det misslyckade testet just inloggningen för en storkund. Kanske hoppades 40 tester över eftersom testmiljön inte gick att nå. Eller så var körningen grön, men kontrollerade bara om knappar finns, inte om en order faktiskt sparas, en följesedel skapas och lagret justeras korrekt. Test automation results är inget kvalitetsutlåtande så länge deras sammanhang saknas.

För QA-ledning, utveckling och verksamhetsavdelningar ligger det egentliga arbetet därför inte bara i att automatisera tester. Avgörande är att bereda resultaten så att tillförlitliga beslut uppstår: kan en release rullas ut? Måste ett fel hanteras direkt? Är felet nytt, återkommande eller bara ett problem i testmiljön? Och finns det belägg som även en verksamhetsavdelning utan testkod kan följa?

Vad Test Automation Results egentligen säger

Det enklaste nyckeltalet lyder: godkänt eller underkänt. Det är till hjälp, men sällan tillräckligt. En hög andel lyckade tester kan skapa förtroende om testerna täcker kritiska flöden, testdatan är trovärdig och miljön liknar den senare driften. Saknas en av dessa faktorer förblir siffran framför allt en signal om att ett automatiserat flöde kördes.

Vid affärskritiska applikationer väger andra frågor tyngre. I en lagerlösning är inte varje bildskärmsvy lika viktig. Ett visningsfel i en intern infotext kan vänta. Ett fel som bokar fel mängd vid godsmottagning eller skapar en fraktetikett utan mottagaradress kan det inte. Bra testresultat väger därför risker istället för att behandla alla fall lika.

Inte heller ett misslyckat test är automatiskt ett produktfel. Det kan utlösas av utgångna inloggningsuppgifter, en spärrad testroll, otillgängliga gränssnitt, ändrad testdata eller en långsam miljö. Den som inte skiljer dessa orsaker åt producerar brus. Teamet lägger då tid på falsklarm medan verkliga fel försvinner bland röda statusmeddelanden.

Fyra statustyper istället för en röd lista

I praktiken har en tydlig indelning visat sig fungera: funktionellt fel, tekniskt testfel, miljöproblem och förväntad ändring. Ett funktionellt fel innebär att applikationen bryter mot ett definierat krav. Ett tekniskt testfel pekar snarare på själva testet, till exempel en selektor som inte längre stämmer efter ett avsiktligt ändrat gränssnitt.

Ett miljöproblem föreligger när till exempel ett testsystem eller ett anslutet gränssnitt inte är tillgängligt. Förväntade ändringar uppstår när en process medvetet anpassats, men automatiseringen fortfarande kontrollerar det gamla börläget. Dessa kategorier förhindrar inte varje diskussion. Men de ser till att diskussionen börjar på rätt punkt.

Från testkörningar till beslutsklara rapporter

En användbar rapport besvarar inte bara att något misslyckades, utan vad som hände, hur allvarligt det är och om felet verkar reproducerbart. Det kräver mer än en lista med testnamn och tidsstämplar.

Till varje relevant körning hör den kontrollerade builden, testmiljön, den använda rollen, centrala testdata samt start- och sluttid. Särskilt vid Windows-skrivbordsapplikationer eller komplexa webbplattformar behövs den informationen för att avgränsa skillnader. Ett fel som bara uppstår under en begränsad lagerroll är något annat än ett fel som blockerar varje inloggning.

Meningsfulla resultat innehåller dessutom spårbara belägg: skärmdumpar, inspelade steg, felmeddelanden och vid behov tekniska loggar. En skärmdump ensam kan dock vilseleda. Den visar ett ögonblick, inte orsaken. Kombinationen av stegföljd, synligt tillstånd och förväntad reaktion är betydligt mer användbar.

AI-stödda system kan omvandla dessa belägg till begripliga bedömningar. Hos COCO exempelvis körs tester på en egen, självhostad AI-server. Utvärderingen kan förklara att en order visserligen skapades men att den förväntade statusändringen uteblev, och direkt koppla ihop inspelningen av körningen. För säkerhetsmedvetna team är det relevant var skärmdumpar, applikationsdata och testtrafik bearbetas. Lokal kontroll är inte automatiskt nödvändig, men kan vid interna applikationer och känsliga data vara den förnuftigare vägen än en extern molntjänst.

Rätt detaljnivå för olika mottagare

Utvecklingsteam behöver felmeddelanden, tekniska steg och så precisa anvisningar som möjligt för reproduktion. En operations manager behöver däremot först den berörda funktionen, affärsrisken och ett tydligt besked om driftdugligheten. Båda perspektiven måste kunna uppstå ur samma körning, utan att någon manuellt behöver föra över resultat till presentationer.

En bra rapport börjar därför med en kort beslutsnivå: release rekommenderas, release med kända begränsningar eller stoppa releasen. Därunder står de kritiska avvikelserna med prioritet och belägg. De tekniska detaljerna följer först därefter. Det är ingen förenkling på bekostnad av noggrannheten, utan en ren separation av informationsbehov.

Mäta täckning utan att inbilla sig säkerhet

Testtäckning presenteras ofta som ett procentvärde. Det värdet är användbart när det är klart vad det mäter. Kodtäckning visar till exempel vilka delar av programkoden som kördes under tester. Det bevisar inte att en affärsprocess fungerar korrekt. Ett test kan beröra många kodrader och ändå aldrig kontrollera om en felaktig leveransadress dyker upp på dokumentet.

För verksamhetsavdelningar är processtäckning ofta mer talande. Den beskriver vilka verkliga flöden som är skyddade: registrera en order, reservera lager, boka en delleverans, ta emot en retur eller godkänna en faktura. Särskilt värdefulla är övergångarna mellan system och roller, eftersom fel ofta uppstår där: vid import av en beställning, vid utskrift av en etikett eller vid byte från kontor till lagerterminal.

Prioritera inte efter antalet möjliga tester, utan efter skadeverkan och förändringsfrekvens. En sällan använd process med hög ekonomisk eller juridisk risk förtjänar ofta automatisering tidigare än en ofta använd men ofarlig vy. Omvänt kan ett stabilt, föga kritiskt flöde fortfarande klara sig med en kort manuell kontroll. Inte varje kontroll behöver automatiseras bara för att den går att automatisera.

Instabila tester är ett eget kvalitetsproblem

Tester som utan igenkännbar produktändring ibland lyckas och ibland misslyckas kallas ofta flaky. De skadar förtroendet snabbare än ett permanent rött test. Så fort team reflexmässigt startar om röda resultat förlorar automatiseringen sin varningsfunktion.

Orsakerna är oftast konkreta: hårda väntetider, gemensamt använd testdata, parallella åtkomster, asynkron bearbetning eller en miljö som inte återställs. En kort paus på tre sekunder i testet kan av en slump hjälpa, men är ingen lösning. Bättre är att vänta på ett påvisbart tillstånd, göra testdata entydig och isolera flöden från varandra.

Inte varje instabilitet går att undvika helt. Externa gränssnitt kan variera och verklig infrastruktur har avbrott. Då bör rapporten tydligt markera om ett test inte gick att bedöma på grund av ett externt beroende. En upprepad körning kan vara meningsfull för diagnos, men får inte göra det första fyndet osynligt.

Ett förnuftigt flöde efter varje testkörning

Efter en automatiserad körning bör inte varje resultat omedelbart behandlas lika. Först kontrolleras blockerande fel och kritiska tester som inte gick att bedöma. Därefter följer inordningen av nya avvikelser mot kända, accepterade problem. Först då är ett releasebeslut hållbart.

Fastställda tröskelvärden är till hjälp, men de måste passa processen. Till exempel kan ett misslyckat test i betalnings- eller behörighetsflödet utlösa ett omedelbart stopp. Vid en rent kosmetisk avvikelse kan ett dokumenterat undantag vara försvarbart. Sådana regler bör inte först uppstå under tidspress före en release.

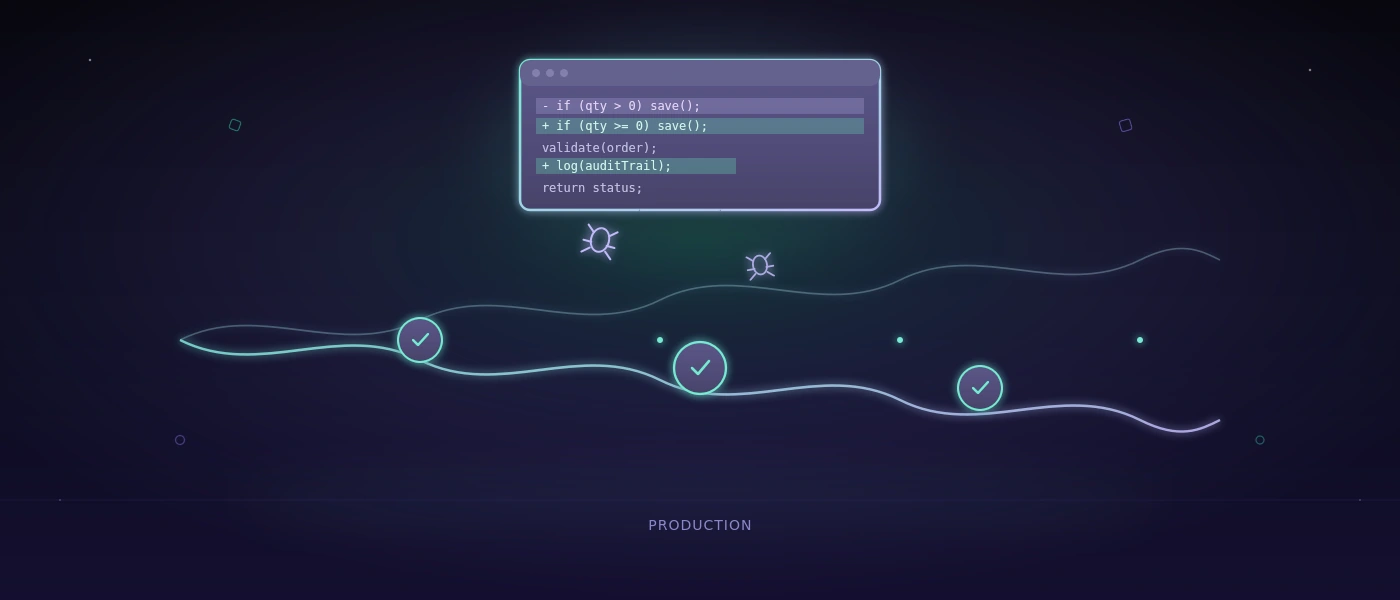
Lika viktig är återkopplingen: varje produktionsfel som testerna inte upptäckte är en anledning att kontrollera om ett scenario, en testdatavariant eller en kontrollpunkt saknas. Målet är inte att samla på sig så många tester som möjligt. Det är att av verkliga fel målinriktat bygga bättre säkring.

De mest användbara testresultaten är till sist inte de med den grönaste överblicken. Det är de där en ansvarig på måndagsmorgonen kan förstå vad som kontrollerats, vilken risk som kvarstår och vilken åtgärd som nu är förnuftig.

Permalänk →

Inventory Discrepancy Causes: vanliga orsaker till lagerdifferenser

Inventory Discrepancy Causes: vanliga orsaker till lagerdifferenser

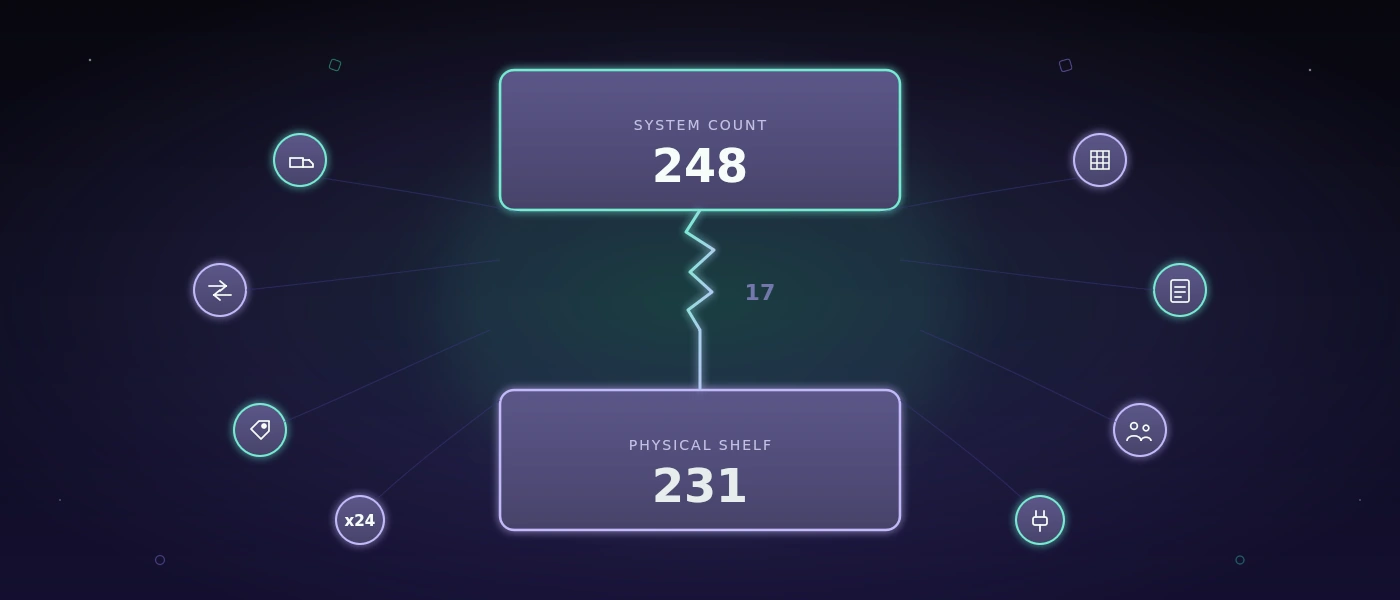
Lagret i systemet säger 248 stycken, på hyllan ligger 231. Dessa 17 enheter ser först ut som ett räknefel. Men det är precis där den felaktiga analysen ofta börjar. Inventory discrepancy causes är i praktiken sällan ett enskilt misstag. Oftast uppstår de där godsmottagning, lagerrörelse, plockning, och bokföring glider isär tidsmässigt eller organisatoriskt.

För ett litet eller medelstort företag är lagerdifferenser inte bara ett ämne för inventeringen. De leder till felaktiga beställningar, expressleveranser, onödiga säkerhetslager, och leveranslöften som inte kan hållas. Den som renodlar orsakerna behöver inte omedelbart införa ett stort ERP. Ofta räcker tydligare bokföringsregler, lämpliga registreringsenheter, och ett system som avspeglar verkliga arbetsprocesser.

Inventory discrepancy causes: var differenser uppstår

En lagerdifferens är skillnaden mellan börvärdet i det ledande systemet och det faktiskt befintliga lagret. Avgörande här är ordet "ledande". Om en Excel-fil, en papperslista, och ett varuhanteringssystem underhålls parallellt, finns det praktiskt sett flera sanningar. Då har differensen inte bara uppstått i lagret, utan var redan inbyggd i datahanteringen.

Den effektiva motåtgärden beror därför på feltypen. En felräknad pall behöver en annan lösning än en leverans som fysiskt mottagits men aldrig bokförts. Innan team omstrukturerar processer bör de utvärdera differenser efter artikel, lagerplats, skift, rörelsetyp, och tidpunkt. Först detta mönster visar om det rör sig om ett enstaka fall eller ett återkommande processfel.

1. Godsmottagningar bokförs sent eller ofullständigt

Godsmottagning är en klassisk brytpunkt. Varor anländer på morgonen, ställs åt sidan för kontroll, och flyttas senare direkt till produktion eller hyllan. Bokföringen sker på eftermiddagen, nästa dag, eller inte alls. Så länge varorna fysiskt finns, framstår systemlagret som för lågt. Är de redan förbrukade eller utlevererade, blir följdfel mer sannolika.

Särskilt känsliga är delleveranser, ersättningsartiklar, och överleveranser. Står det en mängd på följesedeln, men en annan mängd anländer, bör ingen bara bokföra dokumentet "ungefär matchande". Skillnaden måste förbli synlig som undantag, inklusive orsak, ansvarig person, och godkännande. Annars försvinner avvikelsen ur processen och dyker först upp igen vid inventeringen.

2. Lagerrörelser sker utan transaktion

En artikel flyttas från godsmottagning till höglager, omlagras från ett fack till plockzonen, eller reserveras för en order. Fysiskt är det en liten, snabb rörelse. I systemet kan den vara avgörande.

Om medarbetare omorganiserar lagerplatser enbart på känsla, kan det totala lagret fortfarande stämma, men tillgängligheten på rätt plats inte. Det orsakar söktider, felplock, och onödiga påfyllningskörningar. En bra lagerlösning behöver inte göra varje rörelse komplicerad. Den måste registrera de få rörelser som är relevanta för tillgänglighet, spårbarhet, och återbeställning.

I verkstäder eller mindre lager är det ofta förnuftigare att hålla några entydiga zoner än en teoretiskt perfekt fackstruktur som ingen underhåller i vardagen. Precision fungerar bara om den förblir hanterbar.

3. Plockning och leverans bokförs för tidigt

Många team bokför en order som "utbokad" vid plockningen, trots att varan fortfarande ligger på en tillredningsplats. Ändras ordern därefter, avbokas, eller skickas endast delvis, stämmer system- och fysiskt lager inte längre överens.

Bättre är en tydlig separation mellan reserverad, plockad, och levererad. Inte alla företag behöver komplexa statuskedjor för detta. Men tidpunkten för lagerreduktion måste vara entydig. För leveransvaror ligger den ofta närmare den faktiska överlämningen till transportören än det första greppet mot hyllan.

Även returer hör till detta flöde. Kommer varor tillbaka är de inte automatiskt tillgängliga igen. Först kontroll, kvalitetsbeslut, och inlagring bör avgöra om de återgår till säljbart lager, förblir spärrade, eller skrotas.

4. Fel enheter och stamdatafel

En kartong, en förpackning, en rulle, och ett enstaka stycke kan alla avse samma artikel. Om omräkningen inte underhålls rent, uppstår differenser med imponerande hastighet. En medarbetare bokför "1", menar en kartong med 24 stycken. Systemet förstår ett stycke.

Stamdatafel är särskilt lömska eftersom bokföringsprocessen kan se tekniskt korrekt ut. Kontrollera därför förpackningsenheter, omräkningsfaktorer, minimikvantiteter, lagerplatser, och artikelnummer. Även liknande namngivna varianter, till exempel olika längder, färger, eller partier, förväxlas lätt.

Här hjälper ingen schablonregel som "skanna mer". Streckkoder är bara så pålitliga som kopplingen bakom. Vid litet sortiment kan en rent underhållen artikelstam med tydligt läsbara etiketter åstadkomma mer än ett omfattande men dåligt konfigurerat skannerlandskap.

5. Parallella tabeller och manuella korrigeringar

Den tabellen på skrivbordet uppstår sällan av slarv. Oftast fyller den en verklig lucka: en specialreservation, ett saknat utvärderingsvärde, eller en process som den befintliga programvaran inte avspeglar. Den blir problematisk när den blir den andra lagerboken.

Då bokförs intag i systemet, men uttag antecknas i tabellen. Eller en korrigering sker bara där den just hjälper nästa order. Ingen kan senare på ett tillförlitligt sätt förklara vilket värde som gäller.

Inte varje tabell behöver avskaffas. En kalkyl för planering eller analyser kan förbli förnuftig. Lagerförändrande processer bör dock ha exakt ett ledande system. Justeringar behöver en orsakskod, en tidsstämpel, och helst en person som kan spåras. Det är inte byråkrati för dess egen skull, utan förutsättningen för gedigna orsaksanalyser.

6. Räknefel och olämpliga inventeringsmetoder

Även korrekta processer skyddar inte mot mänskliga fel. Artiklar räknas dubbelt, pallar förbises, öppna kartonger uppskattas, eller lagerplatser spärras inte medan man räknar. En årlig fullständig inventering upptäcker dessa problem sent och under högt tryck.

För många verksamheter är en rullande inventering det förnuftigare alternativet. Snabbrörliga eller värdefulla artiklar kontrolleras oftare, stabila C-artiklar mer sällan. Viktigt är inte att producera så många räkningar som möjligt, utan att kontrollera avvikelser i tid mot de senaste rörelserna. Korrigeras en differensartikel bara utan att dokumentera orsaken, förblir mönstret osynligt.

En motkontroll är särskilt förnuftig vid höga värden, serienummer, eller partier. För skruvar i ett förbrukningslager kan den vara ekonomiskt överdriven. Kontrolldjupet bör matcha risken.

7. Otydliga ansvarsområden mellan skift och avdelningar

Lagerfel uppstår ofta vid överlämningar. Tidigt skift ställer fram varor, sent skift levererar dem. Godsmottagningen tar emot en leverans, dispositionen ändrar parallellt ordern. Varje enskilt steg kan vara spårbart, men ingen äger hela processen.

Definiera därför inte bara roller, utan överlämningspunkter: vem bekräftar godsmottagningen? När växlar ansvaret för plockad vara? Vem kontrollerar öppna undantag vid skiftets slut? En gemensam digital tavla eller en enkel undantagslista är ofta effektivare än ytterligare möten.

Systemet bör göra öppna processer synliga, istället för att tvinga medarbetare att komma ihåg. Till exempel måste leveranser utan kvantitetskontroll, plockningar utan leveransavslut, eller returer utan kvalitetsbeslut märkas innan de blir tysta lagerfel.

8. Svag systemintegration och saknade kontrollregler

Om butik, orderhantering, lager, och bokföring utbyter data med fördröjning eller via fil, kan dubbla eller saknade bokföringar uppstå. En import körs två gånger. Ett gränssnitt misslyckas tyst. En order ändras efter att dess leveransstatus redan överförts.

Lösningen är inte nödvändigtvis en fullständig ersättning. Ofta behövs tydligt definierade gränssnitt, entydiga dokumentnummer, och tekniska kontroller. En lagerbokföring bör spårbart lagra när den skedde, från vilken process den härstammar, och om den senare avbokats. Kritiska processer behöver felmeddelanden och köer, inte bara en tyst post i loggfilen.

Med skräddarsytt utvecklade logistiksystem kan sådana regler anpassas målinriktat till verksamheten: ingen negativ kvantitet utan godkännande, ingen leveransbekräftelse utan leveransposition, ingen dubbel bearbetning av samma externa referens. Den bästa regeln här är inte den strängaste, utan den som stoppar riktiga fel utan att blockera verksamheten vid normala undantag.

Kontrollera lagerdifferenser systematiskt

Börja inte med en övergripande korrigering. Välj de tio artiklarna med de vanligaste eller dyraste differenserna, och spåra deras senaste rörelse bakåt: godsmottagning, omlagring, uttag, retur, räkning, och eventuell manuell justering. Klustrar sig fallen till en plats, ett skift, eller en rörelsetyp, är det en solid utgångspunkt.

Därefter bör varje åtgärd vara mätbar. Införs nya streckkodsskanningar, observera inte bara antalet skanningar, utan differenskvoten per artikelgrupp. Läggs en ny status för tillredning till, kontrollera öppna tillredningar dagligen. Bra processer skapar ingen skenbar precision. De gör undantag synliga och spårbara tidigt.

Det förnuftiga nästa steget är ofta litet: definiera en överlämningspunkt, rensa en lagerplats, eller tekniskt säkra en återkommande manuell korrigering. Pålitliga lager uppstår inte av mer programvara på misstanke, utan av processer som fortfarande är korrekt genomförbara en hektisk tisdag klockan 16:45.

Permalänk →

Att göra processautomatisering rätt för små och medelstora företag

Att göra processautomatisering rätt för små och medelstora företag

En följesedel saknas, eftersom uppgifterna fortfarande står på en lapp. En godsmottagning registreras dubbelt, eftersom lager och kontor arbetar med olika tabeller. Ett godkännande försenas, eftersom den ansvariga personen just nu inte svarar i telefon. Sådan friktion kostar sällan mycket pengar på en gång. Men över veckor summeras förfrågningar, söktider, felrättningar, och onödiga väntetider. Precis där är processautomatisering för små och medelstora företag meningsfull.

Det handlar inte om att ersätta så många aktiviteter som möjligt med programvara. Bra automatisering gör flöden spårbara, minskar undvikbara överlämningar, och ger medarbetare tid för beslut som kräver erfarenhet. Det är särskilt avgörande i små och medelstora företag: teamen står nära den dagliga verksamheten. När en process hakar upp sig märker ofta hela skiftet det direkt.

Automatisera inte varje process

Det vanligaste misstaget är att börja med den mest synliga irritationen. Kanske stör en Excel-fil, kanske behövs en ny instrumentpanel. Båda kan vara berättigade. Men ett digitaliserat kaos förblir kaos - bara snabbare och med mer data.

Före ett tekniskt beslut bör flödet först beskrivas som det faktiskt sker. Inte som det borde stå i manualen. Vem utlöser processen? Vilken information behövs? Var förs något över manuellt? Vem beslutar vid undantag? Och hur märker teamet att processen är avslutad?

Just i lagret eller vid orderhanteringen ligger de kritiska punkterna ofta mellan system: en order kommer via e-post, kopieras till en tabell, stäms av per telefon, och matas senare in i en fraktprogramvara. Varje överlämning ökar sannolikheten för att kvantiteter, datum, eller adresser avviker.

En automatisering lönar sig särskilt när en process förekommer ofta, har tydliga regler, och fel orsakar märkbara konsekvenser. Det kan vara godsmottagning, skapande av följesedlar, tilldelning av lagerrörelser, eller överlämning av godkända order till frakt. Sällsynta specialfall med många skönsmässiga beslut förblir däremot ofta bättre hanterade manuellt - åtminstone till en början.

Processautomatisering för små och medelstora företag börjar med prioriteringar

Inte varje onödig aktivitet förtjänar omedelbart ett projekt. En enkel prioritering skapar tydlighet. Bedöm enskilda flöden efter frekvens, bearbetningstid, felkostnader, och beroenden. En process som sker femtio gånger dagligen och sparar bara två minuter varje gång kan vara mer ekonomisk än en komplicerad månadsprocess.

Frågan om felföljden är minst lika viktig. Ett felaktigt utskrivet internt dokument är irriterande. En felaktig chargetilldelning, en förlorad leveransadress, eller en odokumenterad godsmottagning kan utlösa reklamationer, sökarbete, och lagerdifferenser. Där skapar automatisering inte bara tempo, utan pålitlighet.

Ett förnuftigt första steg är oftast tillräckligt litet för att vara verifierbart inom några veckor. Till exempel kan en medarbetare registrera varor via en streckkod, systemet kontrollerar artikel och mängd, uppdaterar lagret i en central databas, och genererar vid behov direkt ett lagringskvitto. Teamet behöver då inte gissa vilken version av en tabell som är aktuell.

Ett tydligt måltillstånd istället för en funktionslista

Många projekt startar med en lång lista önskade funktioner. Bättre är en konkret operativ bild: vad ska vara synligt i slutet av en process utan att någon behöver fråga? Vid frakt skulle det kunna innebära att en order efter godkännande automatiskt får en plocklista, leveransadressen kontrolleras, och en etikett kan genereras. Undantag hamnar synligt i en klarläggningslista, istället för i en oöverskådlig e-postinkorg.

Denna målbild tvingar fram nyttiga beslut. Måste varje beställning behandlas helt automatiskt? Eller ska order över ett visst varuvärde, med avvikande leveransadress, eller med saknat lager medvetet lämnas för kontroll? Automatisering behöver ingen hundraprocentig mörkbehandling för att skapa stor nytta.

Den lämpliga tekniken beror på flödet

Det finns ingen teknisk standardväg för varje litet eller medelstort företag. En tabellösning kan fortfarande vara förnuftig för en överskådlig utvärdering. Den är snabbt anpassad, förtrogen, och orsakar lite införandeinsats. Så snart flera personer arbetar samtidigt, bokningar måste vara spårbara, eller data utbyts med andra system, stöter den dock på gränser.

Då är ofta en smal, flödesspecifik applikation mer förnuftig än en överdimensionerad enterprise-svit. Den kan avbilda exakt de steg som behövs i verksamheten: registrera order, kontrollera lager, flytta varor, generera dokument, boka frakt, och rapportera tillbaka status. Inte mer, men inte heller mindre.

Tekniskt spelar det mindre roll om ett system annonserar det senaste modeordet. Avgörande är solida grunder: en rent modellerad databas, spårbara behörigheter, loggar för relevanta ändringar, pålitliga gränssnitt, och dokumenterade driftsättningar. En applikation baserad på PHP 8.4, modern JavaScript, och MySQL 8 kan vara mycket väl underhållbar på lång sikt, om arkitektur och drift beaktas från början.

Även integrationer förtjänar uppmärksamhet. Ett automatiskt datautbyte med butik, ERP, fraktleverantör, eller bokföring sparar bara tid om fel hanteras synligt. Vad händer vid en ogiltig adress? Görs ett nytt försök vid misslyckad etikettutskrift? Kan teamet se vilken data som har överförts och vilken som fortfarande saknas? Tysta fel är farligare än ett tydligt markerat undantagsfall.

Införande under pågående drift

Ett nytt system måste anpassa sig till skiftbyten, leveranstider, och befintliga arbetsrutiner. Därför är en stegvis utrullning oftast säkrare än ett hårt stoppdatum för alla områden. Börja med en avgränsad process, en produktgrupp, eller ett lagerområde. Det minskar risken och skapar verklig feedback från vardagen.

Parallelldrift är därvid inget tecken på osäkerhet, utan ett kontrollerat test. Under en begränsad tid kan gammal och ny registrering jämföras. Skillnader visar inte bara programvarufel, utan ofta också regler som hittills bara funnits i enskilda medarbetares huvuden. Dessa regler hör synligt hemma i processen - inte permanent i personlig erfarenhet.

Medarbetare bör inte konfronteras med det nya flödet först vid utbildningen. Den som kör processen dagligen upptäcker genvägar, specialfall, och opraktiska vyer tidigt. Bra programvara respekterar denna kunskap, utan att bygga in varje historiskt vuxet undantag oförändrat. Rätt fråga är: vilket undantag skyddar ett viktigt affärsfall, och vilket är bara en workaround för ett gammalt problem?

Göra det mätbart om insatsen lönar sig

Före starten bör två eller tre nyckeltal fastställas. Det kan vara genomloppstid per order, antal manuella korrigeringar, lagerdifferenser, eller tiden till frakt. Utan ett utgångsvärde blir varje senare utvärdering en magkänsla.

Inte varje effekt visar sig omedelbart i euro. När ett lagerteam alltid vet var varor befinner sig, minskar antalet avbrott. När leveransdokument uppstår ur samma data som ordern, minskar risken för motstridiga uppgifter. Och när ansvar är synligt i systemet, beror en process mindre på enskilda personer.

Automatisering behöver underhåll och gränser

Ett automatiserat flöde är inget projekt som fryser efter go-live. Artikelstrukturer förändras, kunder kräver nya dokument, fraktleverantörer anpassar gränssnitt. Därför hör ansvar, uppdateringar, säkerhetskopior, och en reglerad hantering av behörigheter till själva systemet.

Särskilt för applikationer med kund-, order-, eller lagerdata bör det vara tydligt vem som får åtkomst och varför. Roller måste passa arbetsvardagen: ett lagerteam behöver andra funktioner än bokföring eller försäljning. Loggade ändringar, säkra inloggningsflöden, och testade återställningar verkar osensationella. Vid en störning avgör exakt dessa detaljer om verksamheten kan fortsätta arbeta.

Även tester är en del av driftsäkerheten. Återkommande kontroller för orderregistrering, lagerbokning, dokumentgenerering, och rättighetshantering förhindrar att en ändring på ett ställe skadar ett fungerande flöde på ett annat. För kritiska webb- eller skrivbordsapplikationer kan en kontrollerad, självhostad testmiljö vara meningsfull, om skärmdumpar, testdata, och interna processer inte ska nå externa molntjänster.

softify.pro följer sådana projekt med en enkel princip: först förstå det faktiska flödet, sedan bygga den minsta bärkraftiga lösningen. Ibland är det en skräddarsydd applikation. Ibland räcker det att strukturera en befintlig tabell renare och automatisera ett enda överlämningssteg.

Det bästa nästa steget är därför ingen mjukvarujämförelse, utan en genomgång av en verklig process - från utlösare till avslutning. Ta en order, en godsmottagning, eller ett klagomål och följ det med de inblandade personerna. Där information matas in på nytt, ingen känner till statusen, eller beslut väntar i onödan, ligger oftast det mest förnuftiga tillvägagångssättet för automatisering.

Permalänk →

Testa Windows-applikationer: en praktisk plan

Testa Windows-applikationer: en praktisk plan

En Windows-applikation kan se ren ut i demoläge och ändå bromsa verksamheten på måndagsmorgonen. En osparad följesedel, en användare som blockeras efter tre misslyckade försök, eller en utskriftsdialog som reagerar annorlunda efter en uppdatering är inga kosmetiska buggar. Den som vill veta hur man testar Windows-applikationer bör därför inte börja med enskilda knappar, utan med de flöden som kostar arbete, pengar, eller spårbarhet.

Just i lager, verkstad, disposition, och administration löper många kritiska processer genom skrivbordsprogram som vuxit fram över åren. Där räknas inte om ett testfall är imponerande formulerat. Avgörande är om medarbetare tillförlitligt kan utföra sina uppgifter under realistiska förhållanden - även med ofullständig data, växlande behörigheter, långsamma nätverk, och oplanerade avbrott.

Att testa Windows-applikationer börjar med de kritiska flödena

Inte varje funktion förtjänar samma testinsats. En sällan använd export med manuellt efterarbete ska bedömas annorlunda än bokning av en godsmottagning, etikettskapande, eller den dagliga orderavstämningen. Börja därför med en enkel fråga: vad händer konkret om detta flöde misslyckas?

Hög prioritet har processer med direkt påverkan på lager, leverans, fakturering, säkerhet, eller kundkommunikation. Dit hör till exempel inloggning och rättighetskontroll, skapande och ändring av stamdata, transaktionsbokningar, dokumentutskrift, gränssnitt mot ERP- eller fraktjänster, samt återhämtning efter ett fel. Även funktioner som bara en liten grupp använder kan vara kritiska om de blockerar en månadsavslutning eller frisläppandet av gods.

Ur dessa flöden skapas inga abstrakta testlistor, utan spårbara arbetssteg. Ett godsmottagningstest skulle till exempel kunna börja med en befintlig order, registrera en delleverans, rapportera en avvikande kvantitet, tilldela en lagerplats, och sedan kontrollera om lager, bokföringslogg, och utskrivet dokument stämmer överens. Så testar du programvarans faktiska effekt, inte bara enskilda inmatningsfält.

Skapa en testbas som avspeglar verksamheten

Många fel blir synliga först när testmiljön närmar sig verkligheten. En applikation beter sig ofta annorlunda med en tom testklient än med flera års transaktionsdata, spärrade artiklar, saknad obligatorisk information, eller redan öppnade transaktioner.

Skapa därför testdata medvetet. Du behöver inte nödvändigtvis en fullständig kopia av produktionen. Mer meningsfullt är en kontrollerad datamängd med typiska, gränsfalls-, och medvetet felaktiga fall: artiklar med olika måttenheter, kunder med specialvillkor, ordrar med delleveranser, användare med olika roller, och transaktioner som redan bearbetas. Personuppgifter bör anonymiseras eller ersättas med realistisk exempeldata.

Till testbasen hör också den tekniska miljön. Dokumentera Windows-version, upplösning, skalning, installerade skrivare, nätverksenheter, databasversion, anslutna tjänster, och behörigheter. Det låter torrt, men sparar tid senare. Om ett fel bara uppstår på arbetsstationer med 125-procentig skalning eller med en viss skrivardrivrutin, måste det vara reproducerbart.

Kontrollera inte bara idealfallet

Idealfallet bevisar framför allt att applikationen är byggd för den förväntade vägen. I verksamheten uppstår de svåra situationerna vid sidan om. Vad händer om en användare lämnar ett obligatoriskt fält tomt, utlöser samma bokning två gånger, eller förlorar anslutningen under sparandet? Förblir transaktionen konsekvent? Får personen ett begripligt meddelande? Kan hen fortsätta arbeta säkert?

Vid Windows-applikationer är dessutom hantering och tillstånd särskilt relevanta. Dialogfönster kan dyka upp i bakgrunden, kortkommandon kan överlappa, filväljardialoger kan blockera flödet. Kontrollera om fokus, felmeddelanden, och spärrar är entydiga. Ett tekniskt undantag utan handlingsanvisning hjälper inte skiftledaren.

Använd manuella tester där omdöme krävs

Manuella tester är inget tecken på bristande mognad. De är oumbärliga när ett nytt flöde uppstår, ett gränssnitt byggs om, eller sakkunskap avgör kvaliteten. En erfaren lagerchef märker snabbare än ett skript om en vy är begriplig under hög tidspress, eller om en varning kommer för sent.

Manuell testning blir dock dyr och opålitlig när samma stabila flöden upprepas före varje version. Då beror releasen på tillgängliga personer, minne, och spridda anteckningar. Den rätta övergången till automation ligger oftast där en process körs ofta, kan orsaka stor skada, och har tydliga förväntade resultat.

Ett bra manuellt testfall beskriver utgångsläge, steg, förväntat resultat, och nödvändig data. Vid ett fel, lägg till en skärmdump, tidsstämpel, applikations- och byggversion, samt den exakta åtgärden. "Utskrift fungerar inte" är ingen användbar felbeskrivning. "Efter ändring av leveransadressen förblir utskriftsdialogen öppen, order 4711 får ingen PDF, och inget meddelande visas" är det.

Automatiserade regressionstester för återkommande risker

Automation kontrollerar inte om programvara i grunden är bra. Den kontrollerar om tidigare fungerande, definierade flöden fortfarande fungerar efter en ändring. Det är särskilt värdefullt för Windows-programvara vars gränssnitt, databaslogik, och externa gränssnitt vidareutvecklas under åren.

Börja litet. Välj först fem till tio affärskritiska flöden som ska kontrolleras vid varje release. Dit kan höra inloggning med ett account-lockout-flöde, orderregistrering, lagerbokning, PDF- eller etikettutskrift, rollbyte, och en central import. Först när dessa tester körs tillförlitligt lönar sig utökningen till specialfall.

För skrivbordsapplikationer styr automatiserade tester ofta synliga gränssnittselement: fönster, inmatningsfält, tabeller, knappar, och dialoger. Det fungerar, men är känsligare än ett rent gränssnittstest. Små layoutändringar, långsammare datorer, eller tvetydigt namngivna element kan bryta tester. Därför bör utvecklare, verksamhet, och testansvariga gemensamt fastställa vilka element som är stabilt adresserbara och vilka kontrollsteg som bättre säkras via databas, logg, eller gränssnitt.

Ett vettigt test kontrollerar dessutom inte bara att en knapp gick att klicka på. Det kontrollerar den affärsmässiga konsekvensen: sparades bokningen? Är lagret korrekt? Genererades ett dokument? Skapades ingen dubblettpost? Synlig interaktion och verifierbart resultat hör ihop.

Bevis är en del av testresultatet

En grön status ensam räcker sällan för kritiska applikationer. När ett test misslyckas behöver team snabbt svar på tre frågor: vad var utgångsläget? Vid vilket steg misslyckades flödet? Vad visade applikationen vid den tidpunkten?

Skärmdumpar, körningsloggar, och eventuellt skärminspelningar gör fel diskuterbara. De förkortar avsevärt överlämningen mellan drift, QA, och utveckling. För reglerade eller säkerhetsmedvetna företag är de dessutom en solid grund för att spåra godkännanden och avvikelser.

Lagringsplatsen är därvid ingen bisak. Testkörningar kan innehålla interna kunddata, prislistor, orderinformation, eller skärmvyer. Den som automatiserat testar känsliga Windows-applikationer bör klargöra om denna data får lämna den egna infrastrukturen. En självhostad miljö som COCO kan vara meningsfull här, eftersom testexekvering, bevis, och utvärdering förblir under egen kontroll. Om det är nödvändigt beror på dataskyddskrav, avtalssituation, och skyddsbehov - inte alla team behöver samma arkitektur för det.

Bygg in testning i releaseprocessen

Den bästa testkatalogen förlorar värde om den bara används efter en hektisk produktionssättning. Definiera en fast tidpunkt: automatiserade kärnregressioner körs före varje release, manuell acceptans kontrollerar nya eller ändrade flöden, och kända begränsningar dokumenteras öppet.

Inte varje misslyckat test behöver stoppa en release. Ett fel i en sällan använd administrationsvy kan vara acceptabelt om en säker lösning finns och det berörda området är tydligt informerat. Ett fel som bokför lager felaktigt eller obemärkt blockerar användare måste behandlas annorlunda. Det beslutet bör fattas utifrån affärspåverkan, inte enbart antalet röda tester.

Underhåll testerna tillsammans med applikationen. När en process medvetet förändras, uppdatera testfall, testdata, och förväntat resultat tillsammans med kravet. Föråldrade tester skapar brus och ignoreras så småningom. Ett fåtal pålitliga kontroller är mer värda än hundratals automatiserade flöden vars resultat ingen längre tar på allvar.

I slutändan handlar det inte om att simulera varje tänkbar inmatning. Det handlar om att skydda det arbete som måste fungera igen nästa morgon. Börja med en enda kritisk process, gör dess resultat bevisbart, och bygg vidare därifrån.

Permalänk →

Secure test data management utan att förlora kontrollen

Secure test data management utan att förlora kontrollen

En misslyckad testkörning är irriterande. En lyckad testkörning med riktiga kunddata i en otillräckligt skyddad miljö kan visa sig betydligt dyrare. Secure test data management löser inte den motsättningen med ett enda verktyg, utan med tydliga regler för data, åtkomst, testmiljöer, och bevis. För team som automatiserat testar webb- eller Windows-applikationer hör det därför till kvalitetsarbetet - inte bara till efterlevnad.

Varför testdata blir ett säkerhetsproblem

Produktionsdata är lockande för tester eftersom det innehåller riktiga specialfall: ofullständiga adresser, ovanliga orderkombinationer, historiska prisregler, eller felaktiga inmatningar. Men just den datan innehåller ofta namn, kontaktuppgifter, avtalsinformation, personalnummer, bankuppgifter, eller intern affärslogik.

Risken uppstår sällan genom ett enda grovt misstag. Den växer oftast steg för steg: en databasexport skapas för ett test, läggs i en delad katalog, och kopieras senare till en annan miljö. En extern tjänst får skärmdumpar för felanalys. Ett testkonto behåller omfattande rättigheter eftersom en sanering skulle kunna störa nästa körning. Efter några månader vet ingen längre tillförlitligt vilken data som finns var.

Hos små och medelstora företag förvärras problemet ofta av knapp kapacitet. Teamet vill hålla en releasedeadline, inte driva ett eget dataskyddsprojekt. Ansvaret kvarstår ändå. Den som använder data för kvalitetssäkring måste kunna spåra vilken data som behandlas, vem som har åtkomst, och när den tas bort igen.

Secure test data management börjar före testfallet

Den avgörande frågan är inte: "Hur skyddar vi testdatabeståndet?" Den är: "Vilken information behöver det här testet egentligen?" Många regressionstester behöver inga riktiga personreferenser alls. En fraktprocess måste till exempel kontrollera att leveransadresser, vikter, zoner, etiketter, och statusändringar behandlas korrekt. Syntetiska kunder, rimliga artikelstamdata, och medvetet definierade gränsfall räcker för det.

Denna åtskillnad leder till en praktisk dataklassificering. Inte varje testmiljö behöver samma datadjup. För enhets- och integrationstester räcker ofta helt konstgjorda datamängder. För end-to-end-tester kan pseudonymiserade kopior vara meningsfulla, om verkliga datamönster är sakligt relevanta. Produktionsliknande data bör vara undantaget - med dokumenterat syfte, begränsad åtkomst, och en fast livslängd.

Viktigt här är kvaliteten på ersättningsdatan. Slumpmässig påhittad data hjälper föga om den inte återspeglar realistiska beroenden. En testdatamängd för en lagerapplikation måste till exempel innehålla artikelvarianter, lagerplatser, spärrat lager, delleveranser, och returer i en samstämmig kombination. Bra testdata skyddar inte bara personuppgifter. De hittar buggar som aldrig skulle synas med tomma tabeller och exempelkunden "Sven Svensson".

Syntetisera, maskera, eller minimera?

Syntetisk data är det säkraste valet när de sakliga reglerna kan modelleras rent. Den uppstår riktat ur testkrav och innehåller ingen kopia av verkliga personer eller transaktioner. Ansträngningen ligger i underhållet: ändras datamodellen eller tillkommer nya processregler måste generatorer och fixtures växa med.

Maskering passar när en applikations beteende är starkt beroende av produktionsstrukturer. Därvid ersätts eller ändras känsliga fält, medan relationer behålls. Namn blir rimliga men fiktiva namn; e-postadresser blir icke-levererbara testadresser; kontonummer blir värden med korrekt format utan verklig koppling. En maskering är bara hållbar om även indirekta slutsatser beaktas. En kombination av en sällsynt plats, födelsedatum, och avtalsegenskap kan fortfarande göra en person identifierbar.

Dataminimering är ofta den underskattade tredje vägen. Istället för att kopiera en fullständig export tillhandahålls endast det nödvändiga utsnittet. Det minskar attackytan, lagringsbehovet, och saneringsinsatsen. För att testa en rabattlogik behöver ingen en hel kunds hela årshistorik.

Åtkomst och miljöer måste matcha risken

En skyddad datamängd förlorar sitt värde om den ligger i en fritt tillgänglig testmiljö. Testsystem behöver därför egna säkerhetsgränser - separata databaser, egna tjänstekonton, tydligt definierad nätverksåtkomst, och ingen tyst anslutning till produktion.

Åtkomsträttigheter bör baseras på roller, inte på delade konton. Utvecklare kan behöva andra rättigheter än QA, support, eller externa tjänsteleverantörer. Administratörsåtkomst är ibland nödvändig, men bör vara tidsbegränsad, loggad, och kopplad till ett spårbart godkännande. Även för testkonton gäller förnuftiga lösenordsregler, multifaktorautentisering där den finns tillgänglig, och kontospärrflöden vid upprepade misslyckade försök.

Automatiserade tester medför ytterligare ett specialfall: de genererar bevis. Skärmdumpar, skärminspelningar, loggar, och felmeddelanden kan innehålla känsligt innehåll, även när databasen har maskerats. En skärmdump av en kundvy, ett webbläsarspår med sessionsinformation, eller en logg med API-nyttolast hör till samma skyddsöverväganden som testdatabasen.

Därför behöver testartefakter bevaranderegler. Inte varje lyckad körning behöver lagras permanent. För kritiska godkännanden kan spårbar bevisning vara meningsfull, till exempel med tidsstämpel, byggnummer, testversion, och resultat. Misslyckade körningar behöver ofta ett längre analysfönster. Efter det bör artefakter raderas automatiskt. Det som inte längre finns kan inte oavsiktligt delas eller komprometteras.

Automatisering utan okontrollerade dataläckor

AI-stödd testautomatisering kan avsevärt påskynda tester, särskilt för omfattande webb- och Windows-applikationer. Men den förändrar säkerhetsfrågan: vart tar skärmdumpar, inmatningar, felbeskrivningar, och applikationstrafik vägen? Vem behandlar dem? Hur länge stannar de där?

För säkerhetsmedvetna team är självhostad exekvering ofta den bättre arkitekturen. Ett system som COCO kan köras inom den egna eller en tydligt avgränsad infrastruktur, exekvera teststeg, lagra bevis, och generera begripliga bedömningar. Det är inte obligatoriskt i varje situation. För en offentlig marknadsföringssida med rent syntetiska formulärvärden kan en extern tjänst vara försvarbar. Vid interna verksamhetsapplikationer, kundportaler, eller mjukvara med personrelaterade processer är dock lokal kontroll en konkret fördel.

Självhostning är inget frikort. Driften kräver uppdateringar, backupkoncept, åtkomstloggar, och en ansvarig instans. I gengäld förblir datasuveräniteten där den hör hemma. Rätt tillvägagångssätt beror på skyddsbehov, befintlig driftsförmåga, och typen av testad applikation - inte på den aktuella hypen kring ett visst testverktyg.

Så blir regler en arbetsduglig process

En genomförbar process behöver inte blockera releasen. Börja med en datakarta: vilka testmiljöer finns, vilka datatyper finns där, och vilka system genererar ytterligare artefakter? Denna inventering avslöjar oftast redan gamla exporter, glömda staging-system, och oklara ansvarsområden.

Därefter lönar sig en enkel beslutsmatris per testklass. Den avgör om syntetisk data räcker, en maskering krävs, eller ett tydligt motiverat produktionsutdrag behövs. Den kompletteras med ägare, raderingsfrister, och åtkomstroller. Det behöver inte vara ett överlastat regelverk. En kort, faktiskt efterlevd riktlinje är bättre än ett säkerhetsdokument som ingen hittar under en störning.

Tekniskt hör datatillhandahållande och sanering hemma i testpipelinen. En körning skapar reproducerbart de datamängder den behöver, använder unika markörer, och tar sedan bort dem igen. Det förhindrar att testmiljöer fylls med restdata och resultat blir mindre trovärdiga med varje sprint. För kritiska processer bör team dessutom kontrollera om dataåtkomst och testbevis behöver loggas på ett revisionssäkert sätt.

Säkerhet som gör testandet snabbare

Secure test data management ses ofta som ytterligare kontrollbörda. Dåligt implementerat kan det verkligen vara det. Väl implementerat skapar det dock tillförlitliga, repeterbara utgångsvillkor. Team slösar mindre tid på att leta efter en användbar dataexport, undviker trasiga tester på grund av osanerad kvarvarande data, och kan bättre motivera godkännanden.

Det mest förnuftiga första steget är sällan ett stort plattformsprojekt. Ta testprocessen med högst risk eller störst friktion - till exempel godkännandet av en intern orderapplikation - och gör datakälla, åtkomst, artefakter, och radering synliga där. Ur det konkreta arbetet växer en säkerhetsrutin som inte gör testerna tyngre, utan mer trovärdiga.

Permalänk →

Warehouse Software vs ERP

Warehouse Software vs ERP

En varumottagning kommer in samtidigt som ett brådskande plock, två medarbetare frågar efter lagerplatsen för en artikel, och en följesedel har redan rättats för hand. Det är precis i sådana ögonblick som frågan Warehouse Software vs ERP blir praktisk. Det handlar inte om det modernaste gränssnittet eller den längsta funktionslistan. Det handlar om huruvida informationen finns tillgänglig just där ett beslut måste fattas på sekunder.

Många små och medelstora företag i DACH-regionen börjar med ett ERP, ett kalkylblad och mycket erfarenhet i teamet. Det kan fungera länge. Problemen börjar först när saldon avviker mellan system, söktiderna ökar och varje specialfall måste lösas genom att ropa genom lagret. Då dyker ofta ett stort ERP-projekt upp, trots att kanske bara en tydligt avgränsad lagerprocess behöver digitaliseras.

Warehouse Software vs ERP: skillnaden i vardagen

Ett ERP-system avbildar verksamheten på bredden. Det kopplar vanligtvis samman inköp, försäljning, artikelstamdata, ekonomi, produktion, fakturering och planering. Dess styrka är att kommersiella och operativa data flyter samman i ett gemensamt ramverk. En order skapas, en faktura ställs ut, ett behov planeras, ett saldo värderas.

Warehouse software, ofta kallat WMS eller lagerhanteringssystem, arbetar närmare de faktiska rörelserna inne i lagret. Det stödjer varumottagning, inlagring, omflyttningar, plockning, inventering, leverans och returer. Det besvarar frågor som ERP:et ofta bara avbildar grovt: vilken plats ligger varan på? Vilket saldo är faktiskt tillgängligt? Vilket parti skickades? Vilken order har prioritet? Vem bekräftade omflyttningen?

Den här gränsen är inte absolut. Det finns ERP med omfattande lagerfunktioner och WMS-produkter med kopplingar till order- eller inköpsprocesser. Avgörande är alltså inte etiketten på erbjudandet, utan den operativa djupet. Ett ERP kan hantera tio lagerplatser och ändå vara opraktiskt om medarbetarna måste öppna flera skärmar för varje rörelse eller registrera data först i efterhand.

ERP:et är den kommersiella källan

När en order ska faktureras, en inköpsorder utlösas eller en materialvärdering skapas, hör det i de flesta företag hemma i ERP:et. Där finns oftast den ledande artikel- och kundlogiken. Den rollen bör inte lättvindigt byggas upp dubbelt. Två oberoende system för priser, artikelnummer eller order skapar ingen säkerhet, utan avstämningsarbete.

Ett ERP är särskilt värdefullt när den centrala utmaningen är avdelningsövergripande: inköp och produktion måste planeras tillsammans, ekonomidata måste förbli konsekventa, eller flera bolag arbetar med samma processer. Den som ännu inte har en sådan grund bör inte förvänta sig att en ren lagerlösning ersätter alla verksamhetsprocesser.

Warehouse software styr rörelsen

På lagret räknas dock inte bara det som teoretiskt finns i systemet. Det som räknas är vad som just anlänt till port tre, vilken plats som är ledig och om varan har reserverats för en bekräftad order. En bra lagerlösning minskar friktionen precis på dessa punkter.

Det kan börja med mobila skannrar: varor skannas vid varumottagningen, tilldelas en lagerplats och rapporteras direkt som tillgängliga. Vid plockning guidar systemet genom en ändamålsenlig ordning, kontrollerar artikel och kvantitet och genererar vid behov fraktetiketter eller leveransdokument. Bokningen sker inte timmar senare vid en kontorsplats, utan inne i själva processen.

Nyttan ligger inte bara i hastighet. Spårbara bokningar gör fel synliga. Om ett saldo inte stämmer går det att fastställa när en rörelse saknades eller bekräftades fel. Det är betydligt mer tillförlitligt än en månatlig korrigering i ett kalkylblad.

När en ERP-modul räcker

En befintlig ERP-modul kan vara rätt val när lagerorganisationen är överskådlig och teamet kan arbeta tillförlitligt med processerna. Ett enda lager, fasta platser, få orderrader och inga strikta krav på parti eller serienummer är typiska förutsättningar. Även vid låg leveransvolym kan en extra systemkomponent innebära mer underhåll än nytta.

Innan ett nytt system anskaffas lönar sig ett nyktert test: kan en medarbetare fullständigt boka en varumottagning, en omflyttning och en leverans utan lapp? Syns saldot per lagerplats? Går differenser från en inventering att spåra? Skapas dokument utan dubbel inmatning? Om svaren övervägande är ja är en utbyggnad kanske inte akut.

Även kalkylbladet får finnas kvar, om det städat fyller ett begränsat syfte, till exempel säsongsbetonad kapacitetsplanering eller en engångsanalys. En bra lösning ersätter inte varje känt arbetssätt. Den ersätter de manuella steg där fel, väntetid eller bristande transparens faktiskt kostar pengar.

När en specialiserad lagerlösning blir motiverad

Vändpunkten kommer oftast stegvis. Först frågar en medarbetare oftare efter en artikel. Sedan hålls saldon högre av försiktighet, eftersom ingen säkert känner till det tillgängliga saldot. Till slut försenas sändningar eftersom följesedlar, etiketter och saldokorrigeringar går via olika verktyg.

En specialiserad warehouse software blir särskilt motiverad när flera av dessa förhållanden sammanfaller:

  • flera lagerområden, lagerplatser eller externa lager förvaltas
  • varumottagningar, omflyttningar och plockning sker dagligen i stort antal
  • partier, serienummer, hållbarhetsdatum eller spärrat saldo måste spåras
  • fraktbolag, etikettskrivare eller mobila skannrar behöver byggas in i processen
  • den operativa verkligheten allt oftare avviker från det ERP:et visar

Listan är ingen automatisk köprekommendation. Ett företag med många orderrader kan fungera bra med ett välinrättat ERP. Omvänt kan ett litet företag tidigt behöva en smal lagerapplikation om varje del måste vara spårbar eller flera team behöver bokföra samtidigt.

Integrationsfrågan väger ofta tyngre än funktionerna

Den svåraste frågan i Warehouse Software vs ERP är sällan: vilket system kan mer? Den bättre frågan är: vilka data måste flöda när till vilket system?

I många fall förblir ERP:et ledande för artiklar, kunder, order och kommersiella underlag. Lagerapplikationen tar över den operativa exekveringen. Den tar emot frisläppta order, utför lagerrörelserna och rapporterar tillbaka status, kvantiteter, partier eller sändningsnummer. Därigenom får varje sida en tydlig uppgift.

Det här gränssnittet behöver konkreta regler. Vad händer vid en orderändring efter att plockningen redan påbörjats? Får ett lagersaldo bli negativt? Vilken bokning gäller vid ett nätverksavbrott? Hur spärras artiklar som noteras vid kvalitetskontroll? Utan dessa beslut blir även ett tekniskt rent API en ny felkälla.

För små och medelstora företag är en stegvis utrullning ofta klokare än ett fullständigt byte. Först kan varumottagningen införas med streckkodsskanning. Sedan följer lagerplatser och omflyttningar, senare plockning och leverans. På så sätt upptäcks verkliga undantag tidigt, utan att satsa hela verksamheten på en enda omställningsdag.

Standardprodukt, ERP-utbyggnad eller skräddarsydd applikation?

Ett standard-WMS lönar sig när de egna processerna till stor del är konventionella och en befintlig integration passar ERP:et. Det ger snabbt beprövade funktioner i drift. Priset för det kan vara att team måste anpassa sina arbetssätt efter fasta mallar, eller betala för enterprise-funktioner som sällan används.

En ERP-utbyggnad är motiverad när det nödvändiga operativa djupet faktiskt finns tillgängligt och användningen fungerar på lagergolvet. Man bör inte bara granska produktdemot, utan ett riktigt förlopp med skanner, handskar, ostadigt wifi och tidspress före avgång.

En skräddarsydd applikation blir intressant när processen bär företagets konkurrensfördel, eller standardprogramvara permanent tvingar fram omvägar. Det kan vara en särskild varumottagningsprocess, en koppling mellan verkstad och lager, speciella följesedlar eller en egen ruttlogik. Då bör lösningen inte göras konstlat stor. En tydlig process, städat modellerad och byggd på en underhållbar teknisk grund, är mer värd än en plattform som teoretiskt kan allt.

softify.pro utvecklar sådana system utifrån konkreta rörelser och ansvarsområden: från varumottagning via lagerbokningar till fraktdokument. Datamodell, behörigheter, felfall och senare underhåll förblir en del av genomförandet, inte uppgifter för någon gång efter driftsättningen.

Frågor som bör upp på bordet innan beslutet

Inte varje krav behöver automatiseras på dag ett. Men det bör beslutas medvetet. Ansvariga bör tillsammans med lagerteamet, försäljning och ekonomi klargöra vilka data som är ledande, vilka fel som förekommer oftast i dag och vilka nyckeltal som verkligen kommer att behövas senare. En fin saldoöversikt hjälper lite om ingen vet om reserverade, spärrade och tillgängliga kvantiteter behandlas olika.

Lika viktigt är ansvaret för stamdata. Lagerprocesser misslyckas sällan på grund av en saknad knapp. De misslyckas på grund av inkonsekventa artikelnummer, dåligt underhållna måttenheter och oklara regler för ersättningsartiklar eller enhetsomräkningar. Programvara kan göra dessa problem synliga. Den kan inte lösa dem utan beslut inifrån verksamheten.

Det rätta valet är alltså inte automatiskt ERP eller warehouse software. Det uppstår ur avståndet mellan er nuvarande process och den process ert team faktiskt måste utföra tillförlitligt. Börja med en rörelse som kostar tid eller skapar fel i dag, och undersök vilket system som avbildar den rörelsen tydligast, snabbast och mest spårbart.

Permalänk →

Automatisera varumottagning

Automatisera varumottagning

En lastbil står vid porten, två medarbetare kontrollerar följesedlar, och lagerlistan ligger fortfarande på datorn inne på kontoret. Det är precis här som frågan how to automate goods receiving börjar bli praktisk. Inte för att varje lager behöver en stor ERP-införing. Utan för att en varumottagning som saknas, kommer sent eller bokförs fel får konsekvenser: saldon stämmer inte, ordrar väntar, reklamationer blir svåra att spåra, och skiftet börjar med frågor som måste redas ut.

Att automatisera varumottagning betyder inte att ersätta människor med skannrar. Det betyder att sköta återkommande kontroller, bokningar och dokument på ett sätt som gör att teamet vid porten snabbt kan besluta, och att saldot därefter är tillförlitligt. För små och medelstora företag är ett smalt, anpassat flöde oftast värt mer än ett koncernsystem fullt av funktioner som ingen använder.

Vad som verkligen går förlorat med manuell varumottagning

Pappersföljesedlar och kalkylblad fungerar ofta tillräckligt länge för att skjuta upp en investering. Problemet uppstår inte vid en enskild kartong. Det uppstår när avvikelser hopar sig: en delleverans antecknas först senare, ett parti går inte att härleda, en pall hamnar i fel zon, eller en varumottagning bokförs först i slutet av dagen.

Då finns flera sanningar samtidigt. Leverantören meddelar levererat. I lagret finns varan fysiskt. Planeringen ser ännu inget tillgängligt saldo. Ekonomiavdelningen har ett underlag men ingen bekräftelse på kvantitet eller skada. Medarbetare stämmer av denna information via telefon, e-post och erfarenhet. Det kostar tid och gör processen beroende av enskilda personer.

Automatisering skapar en gemensam, aktuell källa för händelsen. Den fångar inte bara det förväntade saldot, utan också det som faktiskt hände vid porten: vem som tog emot, när, i vilken kvantitet, med vilken avvikelse och vart varan sedan tar vägen.

How to automate goods receiving med ett tydligt flöde

Rätt startpunkt är inte valet av en skanner eller en lagerapp. Först måste den verkliga processen bli synlig. Gå igenom en typisk varumottagning från den aviserade leveransdagen till inlagringen. Observera också specialfallen längs vägen, eftersom de avgör om en lösning håller i vardagen.

Ett digitalt flöde består oftast av fem på varandra följande beslut. Leveransen identifieras, kontrolleras mot ordern eller den förväntade ankomsten, den faktiska kvantiteten registreras, avvikelser dokumenteras och varan tilldelas en lagerplats eller ett ytterligare kontrollsteg. Varje steg bör bara efterfråga de data som faktiskt behövs just där.

1. Gör förväntade leveranser tillgängliga i förväg

Om inköpsordrar, tillverkningsordrar eller avisering om leverans finns, bör lagret kunna se dem innan ankomst. Vid ankomst väljer den ansvariga personen leverantören, skannar ett ordernummer eller söker efter en öppen leverans. Systemet visar förväntade artiklar, kvantiteter och i förekommande fall parti- eller serienummer.

Det förkortar mottagningen betydligt. Ännu viktigare är dock kontrollogiken: teamet behöver inte avgöra ur minnet om 18 kartonger i stället för 20 är godtagbart. Avvikelsen blir synlig och kan förses med en orsak. Vid oaviserade leveranser behöver flödet en kontrollerad väg, till exempel som en preliminär varumottagning som frisläpps av inköp eller planering.

2. Använd streckkoder där de verkligen sparar tid

En streckkodsläsare eller kameran på en robust mobil enhet är för många lager den mest ändamålsenliga ingången. En skanning minskar skrivfel och snabbar upp återkommande rörelser. Förutsättningen är dock att artikelnummer, förpackningsenheter och etiketter underhålls konsekvent. En skanner löser inte oklara stamdata.

Inte all vara behöver serienummerspårning. För skruv eller standardförbrukningsmaterial räcker ofta artikel, kvantitet och lagerplats. För reservdelar med garanti, reglerade produkter eller komponenter till produktionen kan parti, serienummer, hållbarhetsdatum och kontrollstatus vara obligatoriska. Registreringsdjupet bör motsvara risken, inte en generell mjukvarumall.

3. Behandla avvikelser som en normal process

En bra digital varumottagning försöker inte förhindra varje avvikelse. Den gör dem enkla och bevisligen hanterbara. Bristande mängd, överleverans, transportskador, fel artiklar och spärrade partier behöver tydliga statusar i stället för handskrivna anteckningar på följesedeln.

Vid en skadad leverans kan till exempel ett foto tas direkt vid mottagningsplatsen, kvantiteten bokföras som spärrad, och inköp informeras automatiskt. Tillgängligt saldo förblir korrekt medan varan fysiskt går till en karantänzon. Det förhindrar att skadade delar av misstag plockas eller används i produktionen.

Regeln behöver inte alltid vara helt automatisk. Vid små kvantiteter kan en överleverans accepteras direkt. Vid dyra eller säkerhetsrelevanta artiklar bör en frisläppning krävas. Dessa tröskelvärden hör hemma i processen och måste förbli justerbara senare.

4. Utlös inlagring omedelbart

En mottagning är operativt komplett först när det är klart var varan finns, eller varför den ännu inte får läggas in i lager. Systemet kan föreslå en fast lagerplats, prioritera en påfyllnadszon, eller utifrån artikelgrupp, temperaturintervall och tillgänglig kapacitet bestämma ett målområde.

För överskådliga lager räcker ofta en tydlig platslogik med få zoner. Komplex ruttoptimering är bara meningsfull om volym, gångvägar och personalstruktur motiverar den. Den som tar emot tio pallar om dagen behöver inget optimeringsprojekt som tar längre tid än den tid det sparar. En pålitlig lagerplatsskanning är ofta det större framsteget.

Efter inlagringen uppdaterar systemet saldo och rörelselogg. Försäljning, planering eller produktion ser därigenom statusen utan att behöva fråga lagret. Om en artikel först får bli tillgänglig efter en kvalitetskontroll separerar systemet fysiskt saldo från tillgängligt saldo.

Vilka data varumottagning verkligen behöver

En digital process blir snabbt impopulär om den efterfrågar för många fält vid porten. Samtidigt saknas, utan ett minimum av data, underlaget för senare klargöranden. I de flesta medelstora företag är denna information meningsfull:

  • Leverantör och referens till order eller följesedel
  • Artikel, mottagen kvantitet och förpackningsenhet
  • Tidpunkt samt ansvarig person
  • Lagerplats eller status såsom kontroll, spärrlager eller karantän
  • Avvikelseorsak, foton och frisläppning vid behov

Ytterligare fält bör bara vara obligatoriska när de möjliggör ett konkret beslut. Vid partikrav är partinumret inget tillägg, utan kärninformation. En fri kommentar till varje leverans, däremot, fylls ofta i bara för att ett formulär ska se fullständigt ut.

Integration avgör förhållandet mellan nytta och insats

Varumottagning får inte uppstå som en ny öisolerad lösning vid sidan av inköp, produktion och ekonomi. Åtminstone artikelstamdata, öppna ordrar och saldoförändringar måste utbytas tillförlitligt. Om detta sker via ett befintligt ERP-gränssnitt, dataimporter eller en särskilt utvecklad mellanprocess beror på den befintliga systemlandskapet.

Med äldre ERP-system är fullständig realtidsintegration inte alltid lönsam. En kontrollerad import med fasta intervall kan vara fullt tillräcklig om kvantiteter och tidsfrister tillåter det. För reservdelar som omedelbart disponeras för brådskande ordrar väger däremot en näst intill omedelbar bokning tyngre. Tekniken följer här verksamhetens takt.

Även driftberedskap hör till planeringen. Enheter behöver användarkonton, tydliga roller och ett definierat beteende vid nätverksavbrott. En mobil varumottagning måste inte nödvändigtvis kunna arbeta offline. Men om wifi-avbrott sker regelbundet är en lokal buffert med spårbar synkronisering ingen lyx, utan en del av processens tillförlitlighet.

Införande i små steg i stället för en big bang

Börja med en leverantör, en produktgrupp eller ett tydligt avgränsat lagerområde. Mät inte bara tiden per bokning, utan också efterarbete, oklara differenser och frågor mellan lager och kontor. Det visar om automatiseringen verkligen avlastar.

Utbilda med verkliga följesedlar från vardagen, inklusive skadade eller ofullständiga leveranser. En process som bara fungerar vid en perfekt matchande leverans är ingen automatisering, utan en demonstration. Medarbetare vid varumottagning bör kunna vara med och utforma reglerna, eftersom de känner till undantagsfallen.

softify.pro utvecklar medvetet sådana flöden arbetsflödesspecifikt: från den mobila skanningen till den dokumenterade lagerrörelsen och en stabil koppling till befintliga system. Det avgörande är inte den längsta funktionslistan, utan ett system som förblir spårbart under tidspress och som kan drivas och underhållas tekniskt.

Det bästa nästa steget är därför ingen programvarujämförelse, utan en timme där ni tittar på de tio senaste problematiska leveranserna. Om ni för var och en av dem kan säga var tid gick förlorad och vilken information som saknades, finns redan det första utkastet till en bättre varumottagning.

Permalänk →

Fördelar med streckkodsbaserad plockning för små och medelstora lager

Fördelar med streckkodsbaserad plockning för små och medelstora lager

En felaktig artikel i kartongen kostar sällan bara priset för returen. Den binder tid i lagret, skapar frågor på kontoret och skadar i värsta fall en kundrelation. Fördelarna med streckkodsbaserad plockning märks därför inte först i ett tekniskt nyckeltal, utan i en lugnare utleverans: medarbetarna vet vad nästa steg är, och avvikelser upptäcks där de uppstår.

För små och medelstora lager är detta särskilt relevant. Många flöden fungerar till en början med papperslistor, Excel-filer, tillrop och enskilda personers erfarenhet. Det är inte i grunden fel. Vid en överskådlig volym kan ett kalkylark till och med vara det mer förnuftiga verktyget. Men när artikelbredden, antalet order, skiftbytena eller kraven på spårbarhet ökar blir den pragmatiska nödlösningen snabbt en felkälla.

Vad streckkodsbaserad plockning förändrar i vardagen

Vid streckkodsbaserad plockning bekräftar en skanning inte bara att någon har gjort något. Den kopplar samman order, lagerplats, artikel och kvantitet i ett spårbart arbetssteg. Systemet anger nästa plock, medarbetaren skannar lagerplats och artikel, anger kvantiteten vid behov och får omedelbar återkoppling.

Ordningen på kontrollerna är avgörande. Skannar en medarbetare först artikeln och sedan lagerplatsen kan systemet visserligen upptäcka fel artikel, men inte förhindra en ogynnsam gångväg. I praktiken fungerar ordningen lagerplats, artikel, kvantitet ofta bra. I processer med batch, serienummer eller bäst före-datum tillkommer ytterligare kontroller. Vilka som behövs beror på risken, inte på vad som vore tekniskt möjligt.

Ett bra system ersätter inte en genomtänkt lagerordning. Men det gör det synligt när ordningen inte följs i det dagliga arbetet. Ligger varor på en plats som inte är avsedd för dem upptäcks felet inte först vid inventeringen, utan vid skanningen.

De viktigaste fördelarna med streckkodsbaserad plockning: färre förväxlingar där de uppstår

Papperslistor kräver ständig koncentration: läsa artikelnumret, hitta facket, jämföra förpackningen, bocka av kvantiteten. Under tidspress räcker liknande kartonger, nästan identiska benämningar eller ett avbrutet arbetsmoment för att orsaka ett fel. Streckkoden ger en entydig identifiering i just det ögonblicket.

Skannern ersätter inte tänkandet, men den tar över den kontroll som människor har svårast att upprätthålla varaktigt i rutinarbete. Om artikeln inte stämmer med ordern ska återkopplingen vara tydlig: fel artikel, förväntad artikel, nästa rimliga steg. En enkel röd varningssignal hjälper föga om det inte framgår hur avvikelsen ska åtgärdas.

Bokningar gör lagersaldon mer tillförlitliga

Lagersaldon är bara användbara om de kan bära beslut. Den som planerar nybeställningar, lovar leveransdatum eller tillhandahåller produktionsmaterial behöver mer än en siffra från förra veckan. Om uttag först förs över från en lista i slutet av skiftet eller i efterhand uppstår tidsfönster med oklart dataläge.

En skanning kan boka uttaget direkt. Därmed minskar skillnaden mellan fysisk rörelse och digitalt lagersaldo. Det betyder inte att varje siffra automatiskt är korrekt. Felmärkta varor, obokade omflyttningar och skadat lager förblir verkliga frågor. Men orsakerna kan ringas in betydligt bättre, eftersom varje rörelse har en tidpunkt, en order och i förekommande fall en användarkoppling.

Det är särskilt värdefullt i påfyllnadsprocesser. Om ett fack understiger sitt börsaldo kan systemet skapa en påfyllnadsorder eller åtminstone synliggöra behovet. Plockarna behöver då inte leta efter ersättningsvaror mitt i en order medan kunden väntar på sin försändelse.

Snabbare introduktion utan beroende av enskildas kunskap

Erfarna lagermedarbetare kan gångvägar, specialfall och artiklarnas utseende utantill. Den kunskapen är värdefull, men riskabel som enda operativsystem. Vid semester, sjukdom eller tillväxt hamnar teamen under press när nya medarbetare först måste lära sig i veckor vilken hyllrad en intern förkortning syftar på.

Ett bra mobilt gränssnitt guidar genom ordern på ett begripligt språk. Det visar lagerplats, artikel, beordrad kvantitet och vid behov en bild eller anvisningar om förpackningen. Skanningen bekräftar steget. Nya kollegor blir därmed inte experter direkt, men kan arbeta säkert mycket tidigare.

Detsamma gäller för extrapersonal och växlande skift. En förutsättning är att grunddata hålls uppdaterade. Ett system kan inte härleda en tydlig instruktion från en artikelbenämning som ”del liten blå ny”. Digitaliseringen blottlägger sådana svagheter - och just det är ofta en nyttig bieffekt.

Spårbarhet vid reklamationer och inventeringar

När en kund anmäler en saknad kvantitet börjar det utan processdata ofta ett sökande genom pappershögar, sändningslistor och minnen. Med streckkodsbaserade bokningar kan man kontrollera vilken order som hanterades när, vilken rad som bekräftades och om det förekom en korrigering eller en dellevererad kvantitet.

Det är ingen garanti mot reklamationer. Men det förkortar utredningen och skiljer antaganden från fakta. Även inventeringar gynnas: differenser kan inte bara räknas, utan också undersökas utifrån rörelserna. Om korrigeringarna hopar sig vid ett visst fack, i en artikelgrupp eller efter en viss överlämning i processen uppstår en konkret utgångspunkt för förbättringar.

Mätbara flöden i stället för magkänsla

Många lager vet att ”det blir trångt på eftermiddagen” eller att vissa order tar ovanligt lång tid. Utan tidsstämplar och processteg förblir det en magkänsla. Om plockstart, skanning, avbrott, avslut och överlämning registreras kan flaskhalsar urskiljas tydligt.

Kanske är det inte plockningen som går långsamt, utan varorna som lagras in för sent. Kanske uppstår väntetider vid packstationen eller besöks ett enskilt fack oproportionerligt ofta. Dessa data bör inte missförstås som ett verktyg för generell prestationskontroll. Värdet ligger först och främst i att upptäcka onödiga gångvägar, uteblivna påfyllningar och otydliga överlämningar.

Nyttan beror på hur processen utformas

Streckkodsbaserad plockning är inget självändamål, och alla lager behöver inte ett omfattande lagerhanteringssystem. Med få order, ett litet sortiment och fast personal kan en välskött process med enkla listor vara mer ekonomisk. Ett projekt är motiverat när kostnaderna för felplock, söktider, osäkra saldon eller manuellt efterarbete regelbundet märks.

Även hårdvarufrågan förtjänar en nykter bedömning. En smartphone med kameraskanning kan räcka för de första processerna. Vid hög skanningsfrekvens, handskar, dåliga ljusförhållanden eller tuff miljö är specialiserade handskannrar oftast snabbare och mindre felbenägna. Avgörande är dessutom nätverkstäckningen. Om wifi faller bort i en lagerzon behöver applikationen en tydlig strategi: offline-buffring med senare synkronisering eller en process där det området inte hanteras mobilt.

Etikettkvaliteten är lika viktig som programvaran. En streckkod på en sliten facketikett eller en dubbelt tilldelad artikelidentitet undergräver hela flödet. Före start bör lagerplatser märkas entydigt, enheter definieras och kritiska specialfall klargöras: Hur hanteras en bruten förpackning? Vad händer vid brist? Vem får korrigera en kvantitet? Vad händer med varor utan läsbar kod?

Så lyckas införandet utan driftavbrott

Den mest tillförlitliga starten är sällan en total omställning. Börja med ett avgränsat område, till exempel de vanligaste leveransordrarna eller en artikelgrupp med många förväxlingar. Där kan skanningsordning, felmeddelanden och etiketter prövas i verklig drift utan att hela anläggningen byggs om samtidigt.

Före den tekniska implementeringen bör en orders verkliga väg kartläggas - från orderingång via reservation och plock till packstation och fraktetikett. Det som räknas är inte börprocessen i ett organisationsschema, utan det flöde som skiftet faktiskt använder. De mest värdefulla kraven finns ofta i små undantag: samlingsorder, ersättningsartiklar, delplockning eller återlämning av varor som inte behövs.

Därefter krävs entydiga regler för undantag. En medarbetare måste kunna rapportera en brist utan att informellt kringgå ordern. En behörig person måste kunna göra korrigeringar på ett spårbart sätt. Och om det finns integrationer mot webbutik, ERP eller transportör bör orderstatus och lagerbokningar vara tydligt definierade. Dubbel datahantering är en varningssignal, inte en varaktig lösning.

För kundanpassade system tar softify.pro avstamp just här: inte med ett överlastat enterprisepaket, utan med de skannings- och bokningssteg som bevisligen behövs för den konkreta lagerdriften. En underhållsbar databas, tydligt dokumenterade gränssnitt och begripliga användargränssnitt är mer värda än en lång lista med sällan använda funktioner.

En förnuftig första kontrollpunkt

Ta tio typiska order och följ dem från ingång till överlämning för leverans. Anteckna var medarbetarna måste leta, fråga, registrera data i efterhand eller förlita sig på minnet. Det är precis där det avgörs om streckkodsbaserad plockning ger fördelar - och vilken skanningsprocess som verkligen passar lagret.

Permalänk →

Självhostad testning vs moln

Självhostad testning vs moln

Ett misslyckat regressionstest är sällan bara en röd post i en instrumentpanel. Det kan betyda att en fraktskärm i lagret genererar felaktiga etiketter, en kundportal slutar acceptera beställningar, eller en Windows-applikation kraschar under ett skiftbyte. Frågan om self hosted testing vs cloud handlar därför inte om infrastruktur som ett mål i sig. Det handlar om vilken data en testprocess rör, vem som kontrollerar den, och hur tillförlitligt den fungerar under verkliga driftsförhållanden.

Molnbaserade testplattformar kan vara igång snabbt. För många team är det förnuftigt, särskilt när de testar en offentlig webbapplikation och behöver extra exekveringskapacitet på kort varsel. Självhostade testmiljöer kräver däremot en medveten teknisk uppsättning. Men de ger tillbaka kontrollen över testdata, nätverksvägar, åtkomsträttigheter, och drift till företaget. Det rätta valet beror inte på en generell princip, utan på applikationen, risken, och den tillgängliga driftsförmågan.

Self Hosted Testing vs Cloud: Vad det egentligen handlar om

Debatten reduceras ofta för mycket till initiala kostnader. En molnlösning ser billigare ut eftersom inga servrar behöver anskaffas och ingen miljö behöver ställas in. En egen testserver ser vid första anblicken mer omfattande ut, eftersom operativsystem, uppdateringar, åtkomstkontroll, övervakning, och säkerhetskopiering alla måste planeras.

Den kalkylen räcker inte till. Avgörande är de löpande kostnaderna för en teststrategi: väntetider före releaser, felsökning efter ofullständiga testkörningar, samordning med dataskydd och informationssäkerhet, samt konsekvenserna av en felaktig driftsättning. Om ett team regelbundet granskar känsliga verksamhetskritiska applikationer, kan den extra organisatoriska bördan från externa tjänster överstiga driften av en tydligt avgränsad egen miljö.

Inte heller "moln" är en enhetlig modell. Vissa leverantörer lagrar bara testloggar, andra bearbetar skärmdumpar, videoinspelningar, inloggningsuppgifter, DOM-innehåll, eller nätverkstrafik. Med AI-stödd testning kan dessutom bild- och textdata nå externa modeller eller underleverantörer för utvärdering. Den som bara tittar på ett datacenters plats missar ofta den viktigare frågan: vilken data lämnar faktiskt den egna kontrollzonen, och vilka avtals- och raderingsregler gäller för den?

När molntestning är det förnuftiga valet

Molntestning är inte i grunden ett säkerhetsproblem, och självhostning är inte automatiskt den bättre arkitekturen. För en ny, offentligt tillgänglig webbutik eller en marknadsföringsplattform kan en molnmiljö vara mycket lämplig. Teamet kan snabbt täcka webbläsar- och enhetsvarianter utan att underhålla egna exekveringsmaskiner. Vid fluktuerande testbelastning är elastisk skalning också en verklig fördel.

Små utvecklingsteam med få, tydligt anonymiserade testdata drar också ofta nytta av en managed service. De bör inte investera sin tid i att driva en plattform när flaskhalsen snarare ligger i saknade testfall, otydliga acceptanskriterier, eller instabila testdata. En egen server löser inte dessa problem.

Molnet passar särskilt bra när applikationen inte behöver intern nätverksåtkomst, inga personuppgifter eller verksamhetskritiska data förekommer i testflödena, och kort ledtid är viktigare än djup infrastrukturkontroll. Förutsättningen är en noggrann konfiguration: separata testkonton, inga riktiga kunddata, begränsade token, spårbara lagringsperioder, och ett tydligt behörighetskoncept.

När självhostad testning blir mer förnuftig

Annorlunda ser det ut för applikationer som bara är nåbara i företagsnätverket eller som representerar centrala operativa processer. Lager- eller produktionsmjukvara bearbetar ofta artikelrörelser, leveransadresser, lagersaldon, serienummer, och prislogik. En testkörning kan därvid generera skärmdumpar av orderskärmar, ladda ner dokument, eller logga in med användarroller. Sådan data bör inte spridas obemärkt över flera externa system.

Självhostad testning gör det möjligt att placera testexekveringen nära applikationen. Testservern kan köras i samma nätverkssegment eller i en kontrollerad DMZ. Brandväggsregler ställs in riktat, interna applikationer behöver inte öppnas för en extern tjänst, och loggar förblir under egen förvaltning. Det är ofta särskilt relevant för Windows-skrivbordsapplikationer, eftersom dessa sällan är utformade för externa testplattformar.

För reglerade branscher, större kundkrav, eller interna säkerhetsriktlinjer är denna arkitektur ofta lättare att granska. Det betyder inte att varje granskning automatiskt godkänns. Även en egen server behöver patchhantering, kryptering, rollbaserade rättigheter, säkerhetskopior, och dokumenterade driftrutiner. Skillnaden ligger i att företaget själv fattar dessa beslut och kan visa upp dem.

Hos softify.pro är COCO därför tänkt som en dedikerad, självhostad AI-server: testkörningar för webb- och Windows-applikationer exekveras lokalt, bevis registreras, och resultat utvärderas i begripligt språk. Det ersätter inte fackmässigt godkännande. Men det säkerställer att testtrafik, skärmdumpar, och utvärderingar kan stanna där företaget behåller datasuveräniteten.

Jämföra kostnader korrekt: drift mot friktion

En förnuftig jämförelse omfattar mer än licenspris mot hårdvarupris. I molnet uppstår återkommande avgifter per användare, testminut, parallell exekvering, eller AI-förbrukning. Dessa kostnader är initialt förutsägbara, men kan öka betydligt med växande testtäckning. Till detta kommer eventuella utgifter för enterprise-avtal, personuppgiftsbiträdesavtal, och säkerhetsgranskningar.

Vid självhostning uppstår investeringar för infrastruktur och installation. Det kan inkludera virtuella maskiner, lagring, nätverksåtkomst, övervakning, och tiden för ett tekniskt ansvarigt team. Dessa kostnader kvarstår även när få tester körs. För ett projekt med sällsynta releaser är det ett bra argument mot en överdimensionerad egen lösning.

Vid regelbunden regressionstestning skiftar bilden. Om samma verksamhetskritiska arbetsflöden måste kontrolleras varje vecka, är förutsägbar intern kapacitet ofta mer ekonomisk än varierande plattformskostnader och manuella godkännandeslingor. Metoden blir särskilt värdefull när testfall används i flera år och vidareutvecklas tillsammans med verksamhetsapplikationen. Underhållbarhet väger då tyngre än en snabb men svårkontrollerad start.

Kvalitet beror inte på hostingmodellen

Ett vanligt missförstånd säger: molntester skulle automatiskt vara modernare, självhostade tester automatiskt stabilare. Ingetdera stämmer. Testkvalitet uppstår genom förnuftiga scenarier, motståndskraftiga testdata, stabila identifierare i gränssnittet, och tydliga förväntningar på resultatet.

Ett test bör inte bara kontrollera om en knapp är klickbar. För en orderhantering kan det till exempel skapa en order, kontrollera en tillgänglig mängd, generera en följesedel, och säkerställa att rätt roll får godkänna processen. Vid ett skrivbordsprogram kan det verifiera importen av en fil, felhanteringen, och utmatningen av ett dokument. Först sådana end-to-end-flöden visar om en ändring har skadat den verkliga processen.

AI kan hjälpa till att upptäcka gränssnittsändringar, dokumentera steg begripligt, och prioritera avvikelser. Den bör dock inte bli en svart låda. Team behöver skärmdumpar eller andra bevis, spårbara teststeg, och definierade tröskelvärden för när ett resultat räknas som godkänt, osäkert, eller misslyckat. Särskilt vid visuella kontroller är en konfidenströskel förnuftig, så att små, förväntade layoutavvikelser inte blockerar varje release.

Driftfrågorna före beslutet

Innan ett team binder sig bör det konkret spåra vägen för en testkörning. Var körs testet? Vilka system loggar det in på? Vilken data ser det? Var lagras skärmdumpar, loggar, och rapporter? Vem får läsa, radera, eller exportera resultat? Dessa frågor är mer praktiska än ett generellt beslut för eller mot molnet.

Lika viktigt är ansvaret efter driftsättning. Vem uppdaterar webbläsare och testagenter? Vem reagerar när ett certifikat löper ut? Hur roteras inloggningsuppgifter? Och hur säkerställs det att ett test inte av misstag utlöser en riktig fraktbokning eller kundnotifiering? Bra testautomatisering kräver separata miljöer och skyddsmekanismer, inte bara bra skript.

En hybridmodell kan vara förnuftig. Offentliga gränssnitt och brett spridda webbläsarkontroller körs i molnet, medan interna verksamhetsprocesser stannar på en egen testserver. Det minskar driftsbördan, utan att ge bort känsliga arbetsflöden till utsidan i klump. Förutsättningen är en tydlig gräns mellan de båda områdena, inte en oöverskådlig blandad drift.

Det bästa beslutet är det som passar den faktiska risken och den egna driftsverkligheten. Om ett kalkylblad fortfarande bär en process tillförlitligt, behöver det inte bli ett stort system av det. Men om testdata och interna applikationer istället tillhör verksamhetens kärna, är kontroll ingen lyx, utan ett sakligt krav för tillförlitlig mjukvara.

Permalänk →

Inventory Management i lagret

Inventory Management i lagret

En saknad del märks sällan vid räkning i lagret. Oftast visar den sig först när en order inte kan packas, en tekniker står framför en tom hylla, eller inköp letar per telefon efter ett leveranslöfte. Bra Inventory Management förhindrar inte dessa överraskningar med fler tabeller, utan med en tillförlitlig bild av vad som finns, var det ligger, och vad som händer med det härnäst.

För små och medelstora företag handlar det inte om att ha det största möjliga ERP-systemet. Avgörande är om medarbetare vid godsmottagning, lager, och frakt kan arbeta med några få tydliga steg - även under tidspress, över skiftbyten, och när en leverans blir annorlunda än planerat.

Inventory Management börjar med rörelser, inte lagerlistor

En lagerlista är en ögonblicksbild. Den kan vara korrekt och ändå hjälpa lite om ingen kan spåra varför en mängd har förändrats. Ett motståndskraftigt system behandlar därför lagersaldon som resultatet av dokumenterade rörelser: gods anländer, kontrolleras, läggs in i lager, reserveras, plockas, flyttas, skickas, eller korrigeras.

Varje rörelse behöver en tydlig orsak, en tidsstämpel, en ansvarig person, och helst en koppling till en specifik transaktion. Det kan vara en inköpsorder, en kundorder, en följesedel, eller en tillverkningsorder. Det förvandlar siffran "24 stycken tillgängliga" till ett verifierbart påstående: 30 enheter bokades in, fyra är reserverade för två order, och ingen öppen omflyttning förvränger det tillgängliga lagret.

Denna åtskillnad är särskilt relevant vid knappa delar. Fysiskt närvarande, reserverat, och fritt tillgängligt är tre olika tillstånd. Om de blandas ihop lovar försäljning gods som lagret redan behöver för en annan order. Om de hålls rena kan ett team tidigt besluta: beställa på nytt, ompriorisera, eller ge kunden ett realistiskt svar.

Var manuella processer typiskt går sönder

Kalkylblad är inte fundamentalt fel. För ett litet sortiment, en lagerplats, och få rörelser per vecka kan de vara mer ekonomiska än en egen applikation. De blir problematiska så snart flera personer arbetar samtidigt eller lagersaldon uppdateras från flera källor.

Då uppstår de kända luckorna: godsmottagningen ligger som papper på skrivbordet, Excel-filen har ändrats lokalt, en omflyttning har bara avtalats muntligt, och frakten bokar inte förrän efter arbetstid. Lagersaldot är inte nödvändigtvis fel, men det är tidsförskjutet och dess ursprung är oklart. Precis det gör det olämpligt för operativa beslut.

Organisationsstrukturen spelar också en roll. En central plats behöver andra arbetsflöden än ett företag med satellitlager, servicefordon, eller en produktion som tar ut material. Den som kartlägger dessa skillnader med en enda fritextkolumn flyttar logiken till enskilda medarbetares huvuden. Det fungerar tills den personen har semester eller ordervolymen ökar.

Definiera processen före mjukvaran

Ett förnuftigt projekt börjar inte med frågan om vilken skanner som ska köpas eller vilket gränssnitt som ser modernt ut. Först måste det vara klart vilka beslut systemet ska stödja. Konkreta observationer från vardagen räcker ofta för det: hur tas gods emot idag? När räknas det som kontrollerat? Vem får korrigera lagersaldon? Vad händer med skadat gods? Och vid vilken tidpunkt blir en order bindande reserverad?

Från dessa svar uppstår några bindande regler. Till exempel får godsmottagning bara bokas in efter en mängdkontroll. Artiklar utan lagerplats får inte visas som redo att läggas in i lager. Lagerkorrigeringar kräver en orsakskod och förblir synliga i historiken. Skickat gods raderas inte tyst, utan tilldelas ordern via en dokumenterad avbokning.

Det är mindre spektakulärt än en stor digitaliseringspresentation, men betydligt mer värdefullt i drift. När reglerna är entydiga kan mjukvaran tillförlitligt kontrollera dem. När de förblir oklara påskyndar varje ny applikation bara motstridiga arbetssteg.

Stamdata: börja litet, underhåll konsekvent

Inte varje artikel behöver tio klassificeringar från början. En användbar grund består ofta av artikelnummer, beskrivning, enhet, aktiv lagerstatus, och en eller flera lagerplatser. Beroende på verksamheten tillkommer partier, serienummer, minimilager, leverantörsartikelnummer, eller utgångsdatum.

Viktigt är konsekvens, inte antalet fält. Två artikelnummer för samma fysiska artikel, eller varierande enheter som "kartong", "förpackning", och "styck" utan omräkningsregel, genererar senare fel nästan automatiskt. Ett system kan tekniskt tillåta sådana inmatningar. Det bör begränsa dem där de äventyrar arbetsflödet.

Vilka funktioner som verkligen hjälper i lagret

För många medelstora lager är en tydlig kärna mer värdefull än en överlastad funktionskatalog. Denna kärna omfattar vanligtvis fyra områden:

  • Godsmottagning med orderreferens, mängdkontroll, och inlagring
  • Lagerrörelser mellan definierade platser och zoner
  • Orderreservation, plockning, och fraktbekräftelse
  • Inventering och lagerkorrigeringar med spårbar historik

Som komplement kan etikettutskrift, streckkodsskanning, följesedlar, fraktetiketter, eller en överlämning till bokföring och butikssystem spara mycket tid. Men de bör bygga på en ren rörelsemodell. Snabb etikettutskrift hjälper föga om skanningen inte entydigt tilldelar artikeln till rätt lagerplats eller order.

Vid användningen räknas också miljön. En medarbetare med handskar vid godsmottagning behöver stora, entydiga åtgärder och så lite textinmatning som möjligt. En disponent vid arbetsplatsen behöver däremot filter, sökfunktioner, och en översikt över öppna transaktioner. Båda rollerna får använda samma data, men behöver inte samma gränssnitt.

Realtid betyder inte att varje siffra är obestridlig

Många företag önskar realtidslager. Det är förnuftigt, men begreppet används ofta för grovt. Ett lagersaldo kan uppdateras omedelbart efter varje scanning och ändå vara fel om en process förblir ofullständig. Skannas gods men kontrolleras inte, är siffran tekniskt aktuell och operativt tveksam.

Därför behöver varje system en hantering av undantag. Avvikelser vid godsmottagning, skadade förpackningar, returer, och artiklar som inte kan hittas är inga gränsfall. De hör till vardagen. Bra processer markerar dem synligt, istället för att tvinga medarbetare till improviserade sidolistor.

Även behörigheter förtjänar uppmärksamhet. Inte varje person bör kunna ändra artikelstamdata eller korrigera historiska bokningar. Ett praktiskt behörighetskoncept skiljer rutintransaktioner från ingrepp med högre risk. Det skyddar inte bara mot fel, utan underlättar också orsaksanalys när ett lagersaldo avviker oväntat.

Integration endast där den förbättrar arbetsflödet

Inventory Management står sällan ensamt. Order kan komma från en webbutik, en e-postregistrering, en branschlösning, eller direkt från försäljning. Fraktleverantörer behöver adressdata och vikter. Bokföringen förväntar sig verifikat i en viss form.

En integration lönar sig när den eliminerar dubbel registrering eller minskar felkällor. Den är inte automatiskt förnuftig bara för att ett gränssnitt är tillgängligt. Särskilt vid organiskt växta processer kan en tydlig import med kontroll vara mer tillförlitlig än en permanent realtidskoppling som obemärkt överför felaktig data.

Tekniskt bör lösningen förbli spårbar: entydiga gränssnitt, loggade överföringar, begripliga felmeddelanden, och en databasstruktur som inte döljer ändringar. Med en väl underhållen applikation baserad på PHP 8.4 och MySQL 8 kan sådana processer implementeras slimmat, utan att tvinga team in i ett globalt koncernsystem. Avgörande är inte teknikbeteckningen, utan om underhåll, utökningar, och datakorrigeringar förblir kontrollerbara även om tre år.

Införande i små, mätbara steg

En big bang är sällan det bästa valet i ett lager. Säkrare är en begränsad start, till exempel med godsmottagning och ett utvalt lagerområde. I denna fas kan skanntider, feltyper, öppna specialfall, och kvaliteten på stamdata observeras. Först därefter följer reservation, frakt, eller ytterligare platser.

Parallell drift kan vara förnuftig, men bara med ett tydligt slut. Två ledande lagersaldon under en längre period skapar precis det problem som den nya lösningen ska åtgärda. Bättre är en fastställd omställning med inventering, uppstädad stamdata, och ansvar för de första veckorna.

Framgången syns inte i hur många funktioner som aktiverades. Den syns i om färre uppföljningsfrågor uppstår, om order packas mer fullständigt, och om ett team kan förklara utan detektivarbete varför ett artikellager ser ut som det gör.

Om den nuvarande processen med ett väl underhållet kalkylblad faktiskt fungerar stabilt, bör den få finnas kvar. Men om information fortsätter att gå förlorad mellan papper, telefonsamtal, och flera filer, är nästa förnuftiga steg inte ett större verktyg, utan en tydlig process som gör varje viktig lagerrörelse synlig.

Permalänk →

Är självhostade tester säkra?

Är självhostade tester säkra?

Ett misslyckat regressionstest är irriterande. En skärmdump från ett internt ERP-system som hamnar okontrollerat hos en extern tjänst är en säkerhetsincident. Precis därför ställer sig QA-ledare och IT-ansvariga frågan: are self hosted tests secure? Det ärliga svaret är: de kan vara betydligt säkrare än molnbaserade alternativ, men bara om driften tas lika seriöst som testerna själva.

Självhostad testautomatisering flyttar kontrollen över exekvering, testdata, skärmdumpar, loggar, och åtkomsträttigheter till den egna infrastrukturen. Det minskar beroenden och onödiga datavägar. Det ersätter dock ingen säkerhetsarkitektur. En dåligt underhållen intern testserver förblir en dåligt underhållen server.

Är self-hosted-tester säkrare än molntester?

Den avgörande skillnaden ligger inte i om ett test körs lokalt eller automatiserat. Den ligger i var data behandlas, vem som kan komma åt den, och vilka tekniska gränser som gäller.

Med en externt driven testtjänst lämnar ofta flera artefakter företaget: inloggningsuppgifter för testkonton, URL:er till interna applikationer, DOM-innehåll, skärmdumpar, videor av testkörningar, felloggar, och eventuellt databasutdrag. Även om en leverantör uppfyller höga säkerhetsstandarder uppstår en ytterligare förtroende- och avtalsrelation. För applikationer med kund-, personal-, produktions-, eller finansdata kan detta vara ett relevant hinder.

Ett självhostat system kan drivas inom det egna nätverket eller en tydligt avgränsad EU-miljö. Testinstansen kommer åt staging-, acceptans-, eller isolerade testsystem direkt. Testbevis stannar där även applikationen och dess driftansvar finns. Det är särskilt förnuftigt när Windows-skrivbordsapplikationer, interna webbportaler, eller system med känsliga processdata testas.

Men självhosting är inte automatiskt säkrare. Den som driver en testserver med öppen fjärråtkomst, delade administratörskonton, och permanent giltiga lösenord har bara flyttat riskerna. Frågan är därför inte bara: moln eller on-premises? Utan: är testmiljön bevisligen säkrad och varaktigt underhållbar?

Are self hosted tests secure? Det handlar om dessa gränser

En säker testplattform behöver tydliga tekniska och organisatoriska gränser. För små och medelstora företag behöver detta inte se ut som ett koncernprogram. Det behöver bara implementeras konsekvent och dokumenteras.

Separera testmiljön från produktion

Automatiserade tester ska hitta fel, inte utlösa beställningar, ändra följesedlar, eller bokföra lagerrörelser. Därför behöver tester en separat miljö med egna gränssnitt, testklienter, och testdata. Där en fullständig kopia av produktionen inte behövs är det ofta till och med onödigt riskabelt.

För en lager- eller orderportal kan det betyda: testanvändare får registrera godsmottagningar och generera fraktetiketter, men de genererade dokumenten går inte till någon riktig skrivare eller riktig speditör. API-nycklar pekar mot sandlådändpunkter. E-postsändning avlyssnas eller begränsas till interna mottagare. På så sätt förblir ett test meningsfullt utan att producera operativa konsekvenser.

Separationen bör också gälla på nätverksnivå. Testservern behöver bara de anslutningar den faktiskt kräver. Generell åtkomst till hela det interna nätverket är bekvämt men sällan motiverbart. Segmentering begränsar skadan om ett testkonto eller en systemkomponent komprometteras.

Behandla inloggningsuppgifter som produktionsåtkomster

Testautomatisering behöver ofta inloggningsdata. Det är normalt, men denna data hör inte hemma i testskript, konfigurationsfiler i källkoden, eller chatthistorik. Lösenord, token, och certifikat bör laddas från en kontrollerad hemlighetshantering. Testkonton får bara de rättigheter som det konkreta flödet kräver.

Även åtkomst till själva testplattformen behöver roller. En utvecklare kanske behöver starta testkörningar och läsa resultat, men inte ändra nätverkskonfigurationen. En avdelning kan se rapporter, men behöver ingen åtkomst till lagrade inloggningsuppgifter. Administrationsrättigheter bör vara knutna till individer, inte kopplade till ett delat konto.

Dessutom hör flerfaktorsautentisering, rimliga lösenordsregler, och kontolåsningsflöden till miniminstandarden. Just testsystem behandlas ofta som mindre kritiska. Angripare ser det annorlunda: de använder gärna testmiljöer som ingångspunkt, eftersom åtkomster, interna namn, och tekniska detaljer finns där.

Minimera testdata och maskera målinriktat

Det vanligaste misstaget är inte en saknad krypteringsmetod, utan för mycket verklig information i testbeståndet. För de flesta regressionstester behöver ingen riktiga kundnamn, riktiga adresser, eller fullständiga personalakter. Syntetiska dataset, maskerade kopior, och medvetet skapade specialfall räcker ofta.

Det finns undantag. Vissa fel dyker bara upp med verkliga datastrukturer, ovanliga teckensekvenser, eller komplexa behörighetskonstellationer. Då kan en kontrollerad, pseudonymiserad kopia vara förnuftig. Avgörande är att detta beslut fattas medvetet och har en raderingsfrist. Testdatabaser bör inte fortsätta köra i åratal som en glömd skuggkopia av produktionen.

Skärmdumpar och videor förtjänar samma uppmärksamhet. De är värdefulla för felsökning, men kan visa kontodata, interna priser, eller personuppgifter. Fastställ vilka artefakter som spelas in, vem som får se dem, och när de automatiskt raderas. En testrapport behöver inte lagra varje skärmbild för alltid för att vara bevisande.

Driva servern som en produkt

En självhostad testserver är inte en enhet man installerar en gång och sedan glömmer. Driftsäkerhet uppstår genom upprepningsbart underhåll: tidiga säkerhetsuppdateringar för operativsystem, webbläsare, testkörare, och beroenden; krypterade datamedier och transportvägar; övervakade säkerhetskopior; centraliserad loggning; samt tydlig hantering av säkerhetsmeddelanden.

Särskilt vid webbläsarstyrda tester är uppdateringsrytmen relevant. Föråldrade webbläsarmotorer och automatiseringsbibliotek kan innehålla kända sårbarheter eller göra tester opålitliga. Båda kostar tid. Dokumenterade driftsättningar och fasta underhållsfönster är därför inget byråkratiskt tillägg, utan grunden för reproducerbara resultat.

För en dedikerad AI-testserver som COCO gäller detsamma. Den lokala exekveringen skyddar inte känsligt applikationsinnehåll genom magi. Den skapar kontroll över var AI-stödd utvärdering, skärmdumpar, och testloggar behandlas. Den kontrollen måste fyllas med patchhantering, behörigheter, nätverksseparering, och tydliga bevarandregler.

Var självhosting har sina gränser

Molntjänster är inte osäkra per definition. En specialiserad leverantör kan erbjuda mer säkerhetspersonal, mognare övervakning, och mer professionell redundans än ett företag med en enda överbelastad IT-roll. Den som saknar kapacitet för drift, uppdateringar, och incidenthantering kan skapa högre risk med ett dåligt underhållet självhostat system.

Å andra sidan är många externa testplattformar helt enkelt inte en bra processpassform för interna fackapplikationer. Om en applikation bara är nåbar inom företagsnätverket, om testkörningar visar konfidentiella skärmar och dokument, eller om data inte bör lämna det egna kontrollområdet, är lokal drift ofta den tydligare lösningen.

Det förnuftiga beslutet beror på skyddsbehov och driftförmåga. För en offentlig marknadsföringssida utan känsliga inloggningar kan en molntesttjänst vara lämplig. För intern dispositionsprogramvara, en kundportal med personuppgifter, eller en Windows-applikation i produktionsnätverket talar mycket för en kontrollerad, självhostad miljö.

En praktisk säkerhetskontroll före start

Innan automatiserade tester rullas ut bör en ansvarig kunna besvara dessa frågor utan att gissa:

  • Vilka system, databaser, och gränssnitt får testservern nå?
  • Vilken data visas i skärmdumpar, videor, loggar, och AI-utvärderingar?
  • Var finns inloggningsuppgifter, och när roteras de?
  • Vem får starta testkörningar, läsa resultat, och administrera system?
  • Hur snabbt tillämpas kritiska uppdateringar, och hur kontrolleras det?
  • När raderas testartefakter och data som inte längre behövs?

Dessa frågor känns nyktra. Precis det är deras värde. Säkerhet uppstår sällan genom ett enda verktyg eller ett imponerande arkitekturdiagram. Den uppstår när ansvar, dataflöden, och tekniska gränser förblir verifierbara i vardagen.

Den som bygger testautomatisering bör först klargöra applikationens skyddsbehov och sedan välja den minsta förnuftiga arkitekturen. En rent avgränsad testserver med få behöriga konton är ofta mer värdefull än en överbelastad plattform som ingen kan underhålla pålitligt. Boring, provable reliability slår även inom testning den spektakulära men ogenomskinliga lösningen.

Permalänk →

Warehouse Management Systems: Vad som verkligen betyder något

Warehouse Management Systems: Vad som verkligen betyder något

När en medarbetare vid godsmottagningen antecknar samma leveransrad på papper, senare för över den till en tabell, och sedan förtydligar genom att ropa över gången var den ska lagras, saknas sällan arbetsvilja. Det som saknas är en gemensam process. Warehouse Management Systems skapar denna process genom att dokumentera godsrörelser, lagersaldon, och uppföljande uppgifter på ett ställe. För små och medelstora företag är det inte den längsta funktionslistan som är avgörande, utan om mjukvaran tillförlitligt kartlägger en varas väg genom det egna lagret.

Vad Warehouse Management Systems måste prestera dagligen

Ett Warehouse Management System, förkortat WMS, är inte helt enkelt en bättre lagerlista. Det styr eller dokumenterar de fysiska processerna i lagret: godsmottagning, kvalitetskontroll, inlagring, omflyttning, plockning, packning, frakt, och inventering. Varje bokning besvarar en enkel operativ fråga: vad finns var, i vilken mängd, i vilken status, och vem har utlöst rörelsen?

Denna tydlighet verkar vid första anblicken banal. Men den förhindrar typiska felkedjor. En artikel har visserligen levererats, men är ännu inte kontrollerad. En pall står vid godsmottagningen, men visas redan som tillgänglig i systemet. En order plockas trots att godset borde vara reserverat för en viktigare kundorder. Utan tydligt definierade statusar och rörelser blir en enda oklarhet snabbt ett felaktigt leveranslöfte.

För många medelstora lager börjar nyttan inte med fullständigt automatiserad styrning. Redan spårade inlagringsorder, entydiga lagerplatser, och mobila bokningar kan märkbart minska söktider. Avgörande är att medarbetare inte längre behöver översätta mellan papper, telefon, e-post, och flera tabeller.

Inte varje lager behöver en stor svit

Marknaden erbjuder omfattande enterprise-system med funktioner för globala multi-plats-nätverk, komplex tullhantering, automatiserad transportteknik, och mycket finfördelad optimeringslogik. Det kan vara rätt val om dessa krav faktiskt finns. Men för ett företag med ett eller få lager, skiftande prioriteringar, och inarbetade specialprocesser kan en sådan svit skapa mer friktion än nytta.

Kostnaderna ligger då inte bara i licenser. De uppstår i långa implementeringsprojekt, omfattande anpassningar, utbildning, och beroende av externa specialister. Även ett system med hundra inställningar löser inte ett problem om skiftledare måste öppna en ärendebiljett för vardagliga korrigeringar.

Alternativet behöver inte nödvändigtvis innebära fullständig egenutveckling. En standardprodukt kan vara förnuftig när dess kärnprocesser passar och anpassningar medvetet förblir begränsade. På samma sätt kan en befintlig tabell fortfarande vara den bästa lösningen, till exempel för en sällsynt, överskådlig utvärdering. Den blir kritisk först när flera personer arbetar med den samtidigt, för in rörelser med fördröjning, eller tabellen ska bli den operativa sanningen om tillgängligt gods.

Den rätta lösningen styrs av den faktiska processvolymen och felkostnaderna. Fem felaktiga plock per vecka betyder något annat i ett reservdelslager med tidskritiska kundorder än fem avvikelser i ett långsamt roterande arkivlager.

Fånga processerna först, inte välja skärmarna

Många WMS-projekt börjar med en produktdemo. Där ser ansvariga snygga dashboards, skannervyer, och färgglada nyckeltal. Mer användbart är först en rundvandring genom lagret under en normal arbetsdag. Var kommer godset in? Vem kontrollerar mängder och skador? När får en artikel sitt sats- eller serienummer? Hur bestäms vilken plats den ska ha? Och vad händer när verkligheten avviker från beställningen?

Dessa frågor lägger grunden för en lösning som senare accepteras. En väl dokumenterad målprocess beskriver inte bara idealfallet. Den innehåller också undantag: delleveranser, skadat gods, oanmälda leveranser, bristande lagersaldon, returer, och spärrat lager. Just dessa fall avgör om medarbetare litar på systemet eller griper efter lappar igen.

Statusar är viktigare än snygga gränssnitt

En ren datamängd skiljer till exempel mellan "förväntad", "ankommen", "under kontroll", "inlagrad", "reserverad", "plockad", och "skickad". Vilka statusar som behövs beror på verksamheten. För få döljer relevanta skillnader. För många saktar ner bokningar och kringgås.

Regeln bör vara: varje status måste ha en operativ konsekvens. Är godset spärrat får det inte plockas. Är det reserverat måste det synas för vilken order. Är det inlagrat måste en lagerplats vara registrerad. På så sätt blir dataregler praktisk processäkerhet.

Skannrar hjälper bara vid tydliga bokningar

Streckkoder och mobila enheter minskar skrivfel och påskyndar rörelser. Men de ersätter inte ett processbeslut. En scanning måste utlösa en begriplig åtgärd: kontrollera artikel, bekräfta mängd, välja destinationsplats, eller slutföra order. Om en medarbetare efter varje scanning måste gissa vilken skärm som kommer härnäst, är arbetsflödet för komplicerat utformat.

Även hårdvarufrågan bör besvaras pragmatiskt. För vissa team räcker smartphones med lämplig skannfunktion och robust skyddsfodral. Andra behöver industriella handskannrar, eftersom handskar, kyla, fall, eller långa skift kräver det. En pilot på den faktiska lagerytan visar mer än en presentation vid skrivbordet.


Den tekniska grunden avgör efter driftsättning

Ett WMS måste fungera korrekt även när godsmottagningar bokas, order plockas, och lagersaldon kontrolleras samtidigt. Ur det uppstår krav som ofta går förlorade i tidiga samtal: entydiga rörelselogg, rollbaserade behörigheter, spårbara korrigeringar, tillförlitliga gränssnitt, och säkerhetskopior som faktiskt kan återställas i en nödsituation.

Ett lagersaldo bör inte helt enkelt skrivas över. Bättre är en rörelsemodell: ingång, utgång, omflyttning, spärr, eller korrigering genererar var och en en loggad post. Så kan man senare spåra varför en mängd avviker. Detta är lika värdefullt för inventeringar som för att klara upp ett kundreklamationsärende.

Behörigheter måste matcha ansvar. En plockare behöver andra funktioner än en lagerchef som godkänner lagerkorrigeringar. För kritiska ändringar är motiveringar, fyraögonsgodkännanden, eller åtminstone en oföränderlig ändringslogg förnuftiga. Insatsen beror på riskprofilen, men frågan bör vara klarlagd före start.

Gränssnitt förtjänar samma uppmärksamhet. Ett lager arbetar sällan isolerat. Beställningar kommer från en butik, ett ERP, eller strukturerad import. Fraktdata går till transportörssystem, följesedlar och etiketter genereras, lagerdata flödar tillbaka. Varje gränssnitt behöver tydliga ansvar för felfall. Vad händer om en frakt­etikett har genererats men bekräftelsen inte når WMS:et? Utan repetitionslogik och synlig felkö blir sådana fall hängande hos enskilda personer.

För skräddarsydda lösningar är underhållbara teknologier ingen bisak. En spårbar applikation med tydlig databasstruktur, dokumenterade driftsättningar, och testade integrationer förblir hanterbar även efter personalomsättning. Trendig arkitektur hjälper inte om ingen kan spåra en felaktig import.

Utrullning i små, kontrollerbara steg

En big bang skapar undvikbar risk. Ofta är det mer förnuftigt att först digitalisera en avgränsad process, till exempel godsmottagningen för en produktgrupp eller plockningen i ett lagerområde. Teamet kontrollerar då inte bara funktioner, utan också formuleringar, skannvägar, gångvägar, och ansvarsområden.

Stamdata är här ofta den egentliga byggarbetsplatsen. Artikelnummer måste vara entydiga, måttenheter konsekventa, lagerplatser förnuftigt strukturerade, och förpackningsenheter tydligt definierade. Ett system kan inte leverera tillförlitliga lagersaldon om samma artikel dyker upp under tre olika beteckningar, eller en "låda" betyder olika mängder beroende på leverantör.

Under pilotfasen bör nyckeltalen förbli enkla: hur lång tid tar godsmottagningen? Hur många bokningar måste korrigeras? Hur många plock är felaktiga? Hur ofta letas gods? Inte varje förbättring visar sig omedelbart som en stor kostnadspost. Färre uppföljningsfrågor och mer tillförlitlig leveransinformation kan redan ta bort betydande press från den dagliga verksamheten.

Utbildning fungerar bäst direkt vid processen. Medarbetare behöver ingen abstrakt genomgång av alla menyalternativ. De måste veta hur de bokar sin nästa leverans, rapporterar en avvikelse, eller korrigerar en felaktig scanning. För de första skiften efter starten bör en ansvarig person vara nåbar som snabbt kan fatta beslut.

Den rätta frågan för valet

För Warehouse Management Systems är den centrala frågan inte: vilken mjukvara kan mest? Den är: vilka arbetsflöden behöver bli snabbare, tydligare, och mer spårbara varje dag för vårt team?

Den som först tydligt beskriver dessa arbetsflöden kan objektivt utvärdera standardmjukvara, tillägg, eller en skräddarsydd applikation. Resultatet behöver inte se spektakulärt ut. Det bör säkerställa att godset hittar sin väg, lagersaldot förblir tillförlitligt, och människorna i lagret ägnar mindre tid åt att söka, fråga, och korrigera i efterhand.

Permalänk →

Custom Logistics Software vs Spreadsheets

Custom Logistics Software vs Spreadsheets

En godsmottagning anländer tidigare än aviserat, två medarbetare ändrar samma lagerlista parallellt, och föraren väntar på en följesedel vars senaste version ingen med säkerhet kan namnge. Sådana situationer avgör frågan "custom logistics software vs spreadsheets" inte teoretiskt, utan mellan godsmottagning, lagerplats, och lastramp.

Tabeller är inte grundläggande problemet. De är snabba att skapa, bekanta för alla, och ofta förvånansvärt effektiva för tydligt avgränsade uppgifter. De blir problematiska när de ska fungera som operativsystem för en växande lager- eller distributionsprocess. Då förvandlas en fil till en kritisk process - utan bindande regler, spårbara tillstånd, eller en solid historik.

När kalkylblad i lagret är rätt val

En tabell är meningsfull när processen är överskådlig, sällsynt, och styrs av få personer. Det kan till exempel vara en månatlig behovsplanering, en enstaka inventeringsförberedelse, eller en utvärdering av leverantörspriser. Den kan också räcka för ett litet lager med en ansvarig, förutsatt att ändringar inte görs under tidspress och inga efterföljande processer automatiskt beror på den.

Fördelen ligger inte bara i de låga licenskostnaderna. Team kan anpassa kolumner, kontrollera beräkningar, och sätta upp ett nytt formulär på några minuter. Den som ännu inte förstått en stabil process bör inte rusa att gjuta den i mjukvara. En bra tabell kan först synliggöra vilka data som verkligen behövs och vilka fält som bara underhålls av vana.

Det vore därför fel att behandla varje Excel-fil som en eftersläpning. Den avgörande frågan är: är tabellen ett arbetsverktyg för en person, eller en delad källa för operativa beslut? Så snart flera roller är beroende av samma data ökar risken märkbart.

Custom Logistics Software vs Spreadsheets: Vändpunkten

Bytet utlöses vanligtvis inte av antalet rader. En tabell med 20 000 poster kan fungera, medan en fil med 200 rader redan leder till fel. Avgörande är samtidighet, processteg, och konsekvenserna av felaktig information.

En typisk varningssignal är versionsfrågan. Om lagersaldon, öppna order, eller leveransdatum finns i filer med namn som "slutlig_ny", "slutlig_ny2", och "verkligen_slutlig", saknas inte en bättre mappstruktur. Det som saknas är ett bindande datatillstånd. Detsamma gäller när medarbetare måste ringa varandra för att ta reda på om varor har anlänt, en order har frisläppts, eller ett fordon redan har lastats.

Vändpunkten nås när en registrering utlöser flera efterföljande åtgärder. En godsmottagning ändrar då inte bara ett tal i lagret. Den kan starta en kvalitetskontroll, tilldela en lagerplats, markera en order som delvis levererad, och visa säljarna en tillgänglig artikel. Om dessa steg samordnas manuellt via filer, papper, och telefonsamtal, är avvikelser svåra att undvika.

Det blir särskilt kritiskt vid skiftbyten och frånvaro. När bara en erfaren person vet vilken färgmarkering i en lista som betyder en spärr, eller vilken formel som beräknar ett säkerhetslager, är processen inte robust. Den fungerar bara så länge den personen är tillgänglig.

Vad skräddarsydd mjukvara faktiskt gör bättre

Skräddarsydd logistikmjukvara är inte helt enkelt en tabell med ett snyggt gränssnitt. Dess värde uppstår genom kontrollerade arbetsflöden. Varje bokning får en entydig tidsstämpel, en ansvarig person, och en spårbar status. Medarbetare ser inte bara data, utan nästa tillåtna åtgärd.

Vid en godsmottagning kan det praktiskt innebära: välja leverans, registrera kvantitet, dokumentera avvikelse, skriva ut etikett, och bekräfta lagring. Först därefter frisläpps lagret. För plockning kan systemet gruppera order efter prioritet, visa lagerplatser i en meningsfull ordning, och endast generera en följesedel när posterna är bekräftade.

Det handlar inte om onödig komplexitet. Det förhindrar att samma artikel reserveras två gånger, att en delleverans räknas som fullständig, eller att en följesedel skrivs ut baserat på föråldrade data. Även enkla regler hjälper: obligatoriska fält för partier, spärrskäl för skadade varor, rimlighetskontroller på kvantiteter, och behörigheter för korrigeringsbokningar.

En väl planerad applikation täcker inte varje specialfall direkt. Den fokuserar på de processer som dagligen kostar tid eller regelbundet ger upphov till fel. För ett företag kan det vara hantering av containerrörelser, för ett annat den snabba registreringen av inkommande varor med mobila enheter. Standardmjukvara känner ofta till dessa särdrag bara som en dyr tilläggsmodul, eller inte alls.

Tabellens dolda kostnader

Licenskostnaden för en tabell är låg. Processkostnaden kan inte vara det. Den uppstår i uppföljningsfrågor, omarbetningar, söktider, dubbelt underhåll, och felplanerade lagersaldon. Den uppstår också när ett team på kvällen måste kontrollera vilka data som förändrats sedan morgonen.

Dessa kostnader förblir ofta osynliga eftersom de är utspridda på många roller. Lagerchefen kontrollerar lagersaldon, innesäljaren korrigerar leveransdatum, bokföringen letar efter verifikat, och ledningen får siffror med fördröjning. Ingen enskild aktivitet verkar dramatisk. Tillsammans bromsar de genomströmning och planeringssäkerhet.

Ett solitt beslut bör därför inte bara jämföra mjukvarupriser. Mät under två till tre veckor hur många manuella överlämningar en order går igenom, hur ofta information efterfrågas, och vilka fel som återkommer. Relevanta är också konsekvenserna: leder ett felaktigt lagersaldo till en intern korrigering eller en missad leverans?

Inte varje problem behöver en stor svit

Många medelstora företag i DACH-regionen tvekar med rätta inför omfattande enterprise-system. Långa driftsättningar, stela masker, och licensmodeller för funktioner som aldrig används löser sällan ett konkret lagerproblem. Men alternativet behöver inte innebära att stanna kvar vid spridda filer.

Mellan de båda ytterligheterna finns en arbetsflödesspecifik applikation. Den kan till exempel koppla samman orderintag, godsmottagning, lagerrörelser, fraktetiketter, och följesedlar i ett gemensamt system, utan att direkt föra med sig fullständig bokföring, global koncernlogik, och tjugo främmande språk.

Den tekniska grunden är avgörande. En applikation med en tydlig databasstruktur, dokumenterade gränssnitt, och spårbara behörigheter förblir anpassningsbar. Teknologier som PHP 8.4, modern JavaScript, och MySQL 8 är inget självändamål här. Rätt använda skapar de en underhållbar grund för roller, bokningshistorik, utskriftsdokument, och rapporter - även när processer förändras om två år.

Så lyckas övergången utan att störa verksamheten

Den största faran är inte tekniken, utan ett för stort första steg. Den som försöker städa upp alla historiska filer och kartlägga varje undantagsfall före start skjuter upp nyttan i flera månader. Bättre är en tydlig, verifierbar start.

Börja med en process som förekommer ofta och är väl avgränsningsbar, till exempel godsmottagning med lagerbokföring, eller frakt med följesedel och etikett. Definiera därvid exakt när processen börjar, vilka data som strikt behövs, vem som ger vilket godkännande, och när den räknas som avslutad. Ur det uppstår inte bara skärmmasker, utan solida arbetsregler.

Dataöverföringen kräver också pragmatism. Aktiva artiklar, leverantörer, lagerplatser, och öppna order måste vara rena. Historiska gamla lagersaldon kan däremot ofta arkiveras, istället för att importeras till det nya systemet med stor ansträngning. Parallell drift kan vara meningsfull, men bara med ett fast slutdatum. Annars uppstår två sanningar istället för en bättre.

Vid införandet visar sig värdet av en direkt teknisk partner.

softify.pro arbetar därför inte utifrån en abstrakt funktionslista, utan klargör arbetsflöden där de faktiskt sker: vid mottagning, i lagergången, vid packning, och vid överlämning till frakt. Bra mjukvara respekterar fungerande rutiner och ändrar bara det som faktiskt gör processen mer pålitlig.

Beslutet kan prövas mot tre frågor

För det första: måste flera personer samtidigt lita på aktuella data? För det andra: utlöser en bokning efterföljande processer som idag säkras manuellt? För det tredje: kan ett fel leda till leveransförsening, felaktigt lagersaldo, fel faktura, eller tidskrävande sökning? Om dessa frågor mestadels besvaras med ja, är tabellen förmodligen inte längre rätt ledande system.

Förblir svaret mestadels nej kan den fortfarande vara en förnuftig lösning. Då lönar det sig mer att enhetliggöra filer, definiera ansvar, och dokumentera kritiska formler. Tekniken bör inte vara större än problemet.

Nästa förnuftiga steg är därför inte ett generellt digitaliseringsprojekt, utan en gemensam titt på ett konkret arbetsflöde tillsammans med de människor som utför det dagligen. Där blir det snabbt synligt om en väl underhållen tabell räcker - eller om pålitlig mjukvara äntligen bör ta över arbetet som idag fastnar mellan papper, telefon, och flera versioner av samma fil.

Permalänk →

Webbutveckling för företag

Webbutveckling för företag

En webbplats kan se bra ut och ändå skapa arbete varje måndag: produktdata underhålls dubbelt, förfrågningar landar ofullständiga i inkorgen, ändringar kräver extern hjälp. Sökandet efter ett webbutvecklingsföretag bör därför inte sluta vid färger, ramverk, eller en snygg portfolio. Det avgörande är om lösningen skapar mindre friktion i det dagliga arbetet och fortfarande går att förstå och driva om tre år.

För små och medelstora företag är detta ingen akademisk fråga. I verkstäder, lager, och säljorganisationer möter offerter, beställningar, leveransinformation, och kundförfrågningar ofta processer som vuxit fram organiskt. Vissa av dem förtjänar mjukvara. Andra fungerar fortfarande bättre med en prydligt förd tabell. Bra webbutveckling känner igen skillnaden, istället för att förvandla varje problem till ett stort digitalt projekt.

Vad webbutveckling måste leverera för företag

En företagswebbplats är ofta den första kontaktpunkten. Den måste laddas snabbt, fungera på mobila enheter, och tydligt leda besökare mot en förfrågan, ansökan, eller beställning. Men så snart den behandlar data, avbildar interna roller, eller utlöser processer, blir den en webbapplikation. Då räknas andra frågor: Vem får se vad? Varifrån kommer data? Vad händer vid en felaktig inmatning? Hur rullas en uppdatering ut utan att störa verksamheten?

Skillnaden är praktisk. En marknadsföringssida kan klara sig med några få, tydligt strukturerade innehållsområden. En kundportal, en beställningsprocess, eller ett internt lagerverktyg behöver däremot spårbara behörigheter, en robust databasstruktur, och definierade specialfall. Om en godsmottagning bara levereras delvis eller en order behöver ändras i efterhand, får systemet inte hamna i ett odefinierat tillstånd.

Webbutveckling för företag betyder därför inte bara att programmera sidor. Det betyder att implementera affärsregler på ett sätt som förblir begripligt för användare och kontrollerbart för företaget.

Kontrollera först flödet, planera sedan gränssnittet

Ett projekt börjar ofta med en önskan som "Vi behöver en portal". Det är en meningsfull start, men ännu inte ett tillräckligt krav. Före den första designen bör de faktiska vägarna för en information bli synliga: vem skapar den, vem kontrollerar den, vem kompletterar den, och vem behöver den igen senare?

Ta orderhanteringen. I många företag kommer en förfrågan in via e-post eller telefon, antecknas i en tabell, överförs senare till ett annat system, och bearbetas sedan igen för lager eller frakt. Fördröjningen beror sällan på ett enda steg. Den uppstår vid överlämningarna, uppföljningsfrågorna, och de olika datatillstånden.

En bra analys frågar därför konkret om vardagen:

  • Vilken information matas in flera gånger idag?
  • Var uppstår de flesta uppföljningsfrågor eller korrigeringar?
  • Vilka undantag inträffar regelbundet trots att de inte är dokumenterade någonstans?
  • Vilka roller behöver åtkomst, och vilka data får de inte ändra?
  • På vad känner teamet till slut igen att en transaktion verkligen är avslutad?

Dessa frågor låter nyktra. Det är precis deras fördel. De förhindrar att en visuellt övertygande applikation byggs kring en idealiserad process som ingen faktiskt använder i verksamheten. Särskilt i lager och logistik räknas verkliga förhållanden: skannrar hanteras med handskar, skift växlar, wifi är inte lika bra överallt, och en följesedel får inte bara uppstå efter flera klick.

Inte varje flöde hör dock hemma i en applikation. En liten lista med få, stabila poster kan vara snabbare och billigare som tabell. Mjukvara lönar sig när data flödar mellan personer eller områden, när spårbarhet saknas, eller när manuellt arbete återkommande skapar tidsspill och fel.

Den tekniska grunden avgör den senare insatsen

Många system ser liknande ut i den första demon. Skillnaden visar sig vid ändringar, tillväxt, och störningar. En applikation bör därför baseras på teknologier som teamet kan underhålla långsiktigt, istället för att satsa på kortlivad hype.

För många affärskritiska webbapplikationer är en stack med PHP 8.4, modern JavaScript, och MySQL 8 ett pragmatiskt val. Den är kapabel, väl begriplig, och lämplig för typiska krav som portaler, orderhantering, dokumentgenerering, eller interna verktyg. Det är ingen dogm. Vid mycket interaktiva applikationer, speciella integrationer, eller höga realtidsbehov kan en annan arkitektur vara meningsfull. Teknologin bör följa uppgiften, inte tvärtom.

Viktigare än namnet på ett ramverk är tydliga beslut kring data och tillstånd. En order behöver till exempel entydiga statusvärden istället för fritext. Ändringar bör vara spårbara. Kunddata, priser, och behörigheter får inte driva isär över spridda tabeller och improviserade gränssnitt. Den som senare behöver veta varför en fraktetikett skapades eller en order spärrades behöver en spårbar historik.

Även säkerhet hör till grundkonstruktionen. Dit hör rollbaserade rättigheter, säker lösenordslagring, kontospärrflöden vid upprepade misslyckade försök, separata test- och produktionsmiljöer, samt regelbundna uppdateringar. Säkerhet är inte en enskild plugin i slutet av projektet. Den uppstår genom rena ansvarsområden och en arkitektur som tar hänsyn till felfall.

Hastighet är ett operativt krav

Långsamma sidor kostar inte bara synlighet i sökmotorer. De skapar avhopp vid förfrågningar och onödig väntetid i den dagliga verksamheten. På en offentlig webbplats avgör laddningstid, mobil presentation, och en tydlig sidstruktur om intressenter alls tar kontakt. I en intern applikation summeras två eller tre sekunders väntetid vid varje bokning märkbart över arbetsdagen.

Prestanda börjar inte med ett senare optimeringsprojekt. Bilder, databasfrågor, caching, JavaScript, och hosting måste planeras lämpligt från början. Här gäller: inte varje applikation behöver maximal teknisk komplexitet. Ett enkelt internt verktyg med få användare behöver ingen arkitektur för miljontals samtidiga anrop. Det behöver korta vägar, pålitliga säkerhetskopior, och ett beteende som förblir förutsägbart i vardagen.

Samma princip gäller för responsiv hantering. "Mobilanpassad" betyder inte att en skrivbordsskärm på något sätt krymper till en smartphone. Den som kontrollerar följesedlar på språng, rapporterar en skada, eller korrigerar ett lagersaldo, behöver stora kontrollelement, tydlig återkoppling, och så lite onödig inmatning som möjligt.

Från idé till drift: leverera i små steg

Stora kravspecifikationer lovar säkerhet, men leder ofta till att team väntar månader på en första användbar version. En bättre väg är ett tydligt avgränsat första utökningssteg. Det bör lösa ett verkligt problem, till exempel den centrala registreringen av godsmottagningar eller den automatiska genereringen av leveransdokument. Därefter kan man med verklig återkoppling avgöra vad som ger störst nytta härnäst.

Det betyder inte att arbeta utan planering. Tvärtom: datamodell, roller, gränssnitt, och driftskoncept måste klargöras tidigt. Funktionsomfånget kan ändå växa steg för steg. På så sätt blir antaganden synliga innan de blir dyra.

En professionell överlämning omfattar mer än åtkomstuppgifter. Dokumenterade driftsättningssteg, säkerhetskopior, övervakning, ansvarsområden, och begriplig teknisk dokumentation gör ett system oberoende av enskilda personer. Om bara den ursprungliga utvecklaren vet hur en uppdatering driftsätts, är applikationen inte färdig, utan personbunden.

Hur du känner igen en lämplig partner

Ett webbutvecklingsföretag behöver inte erbjuda varje tänkbar teknologi. Men det bör ställa rätt frågor och kunna motivera beslut. Försiktighet är på sin plats om en omfattande plattform redan utlovas i det första samtalet, utan att någon har sett de befintliga processerna.

En lämplig partner pratar om underhåll, datakvalitet, och införande lika öppet som om design. Den förklarar vilka krav standardfunktioner kan täcka och var individuell utveckling blir meningsfull. Den anger också kostnaden för specialönskemål. En funktion kan vara tekniskt genomförbar och ändå inte ha tillräcklig nytta.

Fråga efter konkreta driftsdetaljer: Hur testas ändringar? Hur fungerar en rollback? Var finns känsliga data? Vem reagerar vid ett avbrott? Hur hanteras behörigheter? Bra svar behöver inte vara långa, men de är specifika. "Det tar vi hand om senare" är ingen strategi för affärskritiska processer.

För team med befintlig mjukvara är dessutom integrationsfrågan central. En ny applikation behöver inte ersätta allt. Den kan inledningsvis ta över data från ett befintligt system, generera dokument, eller fylla i en saknad process. Det mest meningsfulla första steget är ofta inte det stora utbytet, utan den riktade undanröjningen av en flaskhals.

Mjukvara ska klargöra arbete, inte flytta det

Den bästa webbapplikationen sticker inte ut i drift genom teknisk finess, utan genom färre uppföljningsfrågor, pålitliga data, och kortare genomloppstider. Den respekterar fungerande arbetssätt, gör undantag synliga, och kan vidareutvecklas utan rädsla för nästa uppdatering.

Innan du startar ett projekt, ta en konkret transaktion från din vardag och följ den från första kontakt till avslut. Där information väntar, försvinner, eller registreras dubbelt, finns oftast den mest meningsfulla ansatsen för webbutveckling.

Permalänk →

Logistics Automation Software som verkligen passar

Logistics Automation Software som verkligen passar

En varumottagning antecknas på papper, lagerförändringen förs över till ett kalkylblad senare, och expeditionen ringer till lagret eftersom leveransadressen ligger i ett mejl. Det är precis vid dessa överlämningar som ett företag förlorar tid och tillförlitlighet. Logistics Automation Software ska inte dölja den friktionen med en stor ny processvärld, utan koppla ihop de dagliga handgreppen på ett spårbart sätt.

För små och medelstora företag är detta en annan uppgift än att införa en koncernplattform. En lagerchef behöver inte 200 funktioner som blir begripliga först efter tre utbildningsdagar. Lagerchefen behöver en tydlig status: vad har kommit in, var ligger det, vad ska ut i dag och vad saknas fortfarande? God automatisering svarar på de frågorna där arbetet sker.

Vad Logistics Automation Software praktiskt måste leverera

Begreppet låter brett, men de meningsfulla användningsfallen är oftast mycket konkreta. Ett företag hanterar till exempel inkommande varor, bokför lagerrörelser, skapar följesedlar, skriver ut fraktetiketter och planerar leveranser. Om varje station behöver en egen fil, en separat inloggning eller ett tillrop uppstår förseningar och felkedjor.

En lämplig programvara för samman informationen i ett enda arbetsflöde. En order kan automatiskt skapa ett plockuppdrag. Skanningen av en artikel bekräftar uttaget och uppdaterar saldot. Efter avslut skapas en följesedel med rätt orderrader, medan leveransstatusen blir synlig för försäljning eller planering. Det låter enkelt. Just därför är det värdefullt: programvaran ersätter ingen fungerande logik, utan förhindrar att den måste byggas om vid varje mediebrott.

Ordningsföljden är avgörande. Först måste det vara klart vilka data som utlöser en händelse och vem som beslutar om den. Först därefter lönar det sig att automatisera regler. Den som digitaliserar ett oklart förlopp får bara snabbare oklarhet.

Välj rätt processer först

Inte varje manuellt moment förtjänar en applikation direkt. Ett litet, välskött kalkylblad kan vara bättre för ett sällsynt specialfall än en modul som måste underhållas permanent. Den ekonomiska hävstången ligger oftast hos förlopp med hög repetition, många överlämningar eller kännbara följder av fel.

Typiska kandidater är varumottagningar med kontrollstatus, omflyttningar mellan zoner, plockning av återkommande ordrar, fraktdokument och ruttplanering. Även ordermottagningen är ofta en bra startpunkt när beställningar från telefonsamtal, mejl och formulär först förs samman manuellt.

Vid urvalet hjälper fyra frågor:

  • Hur ofta genomförs förloppet per vecka?
  • På vilket ställe registreras eller överförs data flera gånger?
  • Vilka fel orsakar efterarbete, saldodifferenser eller försenade leveranser?
  • Vilka undantagsfall måste medarbetarna fortsatt avgöra själva?

Den sista frågan förhindrar ett vanligt misstag. Automatisering behöver inte betyda att varje beslut fattas utan människor. Vid skadade varor, ofullständiga leveranser eller kundönskemål med kort varsel behöver teamet ett tydligt sätt att stoppa en transaktion, rätta den och fortsätta med en motivering. Ett system utan sådana vägar verkar konsekvent på papperet, men blir snabbt ett hinder på lagret.

Från varumottagning till leverans: ett genomgående förlopp

Ta en medelstor handlare med lager och egen utleverans. I dag räknas varorna vid porten, antecknas på ett formulär och registreras i systemet först mot slutet av skiftet. Försäljningen ser därför det nya saldot för sent. Vid en expressleverans skapas en följesedel separat, och chauffören får sin information per telefon.

I ett ändamålsenligt automatiserat förlopp börjar varumottagningen med en digital transaktion. Medarbetarna registrerar leverans, artikel och kvantitet samt eventuellt batch eller serienummer direkt vid arbetsplatsen eller mobilt. Avvikelser göms inte i en marginalanteckning, utan får en status som ”Kontroll krävs”. Först efter frisläppning står varan till förfogande som tillgängligt saldo.

Nästa steg växer fram ur verkliga krav: en order frisläpps, lagret får en plocklista eller en mobil vy sorterad efter lagerplats, och varje bokning dokumenterar vad som faktiskt plockades. Därifrån uppstår följesedel och fraktdata ur samma källa. Ingen behöver knappa in orderrader på nytt eller kontrollera vilken filversion som gäller just nu.

För planeringen kan systemet gruppera öppna leveranser efter område, leveransfönster, vikt eller fordonskapacitet. Ruttplanering är då inte alltid det första meningsfulla steget. Om adresser är ofullständiga eller ordrar frisläpps först strax före avfärd bör först datakvaliteten och orderklarheten förbättras. Optimerade rutter hjälper inte om grunden är opålitlig.

Standardprogramvara eller individuell lösning?

Standardprogramvara är rimlig när företaget arbetar med vanliga förlopp och accepterar att anpassa sig till de förutsedda vyerna, rollerna och processerna. Den kan införas snabbt, i synnerhet vid tydliga krav som etikettutskrift eller enkel lagerstyrning. Priset är ofta kompromisser vid specialfall, gränssnitt och senare anpassningar.

En individuell Logistics Automation Software blir intressant när den operativa särarten inte är ett randfall utan avgör affärsframgången. Det kan vara en särskild förpackningslogik, en flerstegsprocess för godkännande, kopplingen mellan verkstad och lager eller en egen leveransmodell. Då är det ofta klokare att målinriktat avbilda de få kärnförloppen än att införa en omfattande svit med många oanvända moduler.

Individuell betyder dock inte gränslös. Varje specialfunktion kräver en sakmässig motivering, tester, dokumentation och underhåll. Bra projektarbete frågar därför också: kan det här steget förenklas? Räcker en konfiguration? Förblir ett kalkylblad den bättre lösningen för just detta undantagsförlopp? Dessa frågor skyddar budget och team från onödig komplexitet.

Teknik som håller i vardagen

Gränssnittet avgör om medarbetarna gärna använder ett system. Den tekniska grunden avgör om det kan drivas tillförlitligt även efter år. För affärskritiska processer hör spårbara datamodeller, roller och behörigheter, loggar över viktiga ändringar samt regelbundna säkerhetskopior till grundutrustningen.

Vid en lagerbokning måste det framgå vem som har ändrat vilket saldo och när, och från vilken transaktion ändringen härrör. När flera användare är aktiva samtidigt får saldot inte förvanskas av motstridiga inmatningar. Vid skrivare, skannrar eller gränssnitt mot fraktbolag behövs tydliga felstatusar i stället för tysta misslyckanden. En etikett som inte skrivits ut måste synas som ett öppet arbetssteg.

Även underhållbarhet är ett driftskrav. En webbapplikation på en begriplig arkitektur, till exempel med PHP 8.4, modern JavaScript och MySQL 8, går att granska och utöka bättre på lång sikt än en samling svårgenomskådade enskilda lösningar. Dokumenterad driftsättning, åtskilda test- och produktionsmiljöer och automatiserade tester är ingen lyx. De minskar risken att en liten ändring av följesedeln plötsligt påverkar orderfrisläppningen.

Dataskydd och åtkomstkontroll förtjänar samma nykterhet. Inte varje användare behöver priser, marginaler eller kundstamdata. Särskilt i distribuerade team bör åtkomst, enheter och behörigheter utformas så att de inte bromsar vardagsarbetet i onödan, men ändå förblir kontrollerbara vid personalbyte eller en förlorad enhet.

Införande i rimliga etapper

Den starkaste funktionen hjälper föga om ett team inte kan använda den i skiftdrift. Därför är ett stegvis införande ofta mer hållbart än ett stort stickdatum. Först sätts ett avgränsat förlopp i produktion, till exempel varumottagningen för en produktgrupp eller framtagningen av fraktpapper. Teamet arbetar med det under verkliga förhållanden, och öppna frågor klaras ut på verkliga fall.

Därefter följer fler processer och gränssnitt. Den ordningen skapar förtroende, eftersom medarbetarna ser att återkoppling leder till konkreta förbättringar. Samtidigt begränsar den risken: om ett nytt skanningsflöde måste justeras står inte hela logistiken still.

Mätvärden bör överenskommas innan start. Det kan vara ledtid från order till leverans, antal manuella rättelser, saldodifferenser eller hur lång tid dagsavslutet tar. Inte varje förbättring syns direkt i ett spektakulärt nyckeltal. Färre följdfrågor mellan lager och kontor, en tillförlitlig skiftöverlämning och sökbara transaktionshistoriker är också mätbar avlastning.

softify.pro utvecklar sådana system utifrån arbetsflödet, med direkt teknisk medverkan i stället för en överlämning från koncept till genomförande. Måttstocken förblir medvetet pragmatisk: lösningen ska fungera på lagergolvet, inte bara i en presentation.

Så känner du igen ett hållbart beslut

Ett bra beslut börjar inte med en funktionslista, utan med en observerad arbetsdag. Låt dig visas var information uppstår, väntar, försvinner eller rättas i efterhand. Prata inte bara med ledningen, utan också med personerna vid varumottagningen, i lagret och i leveransen. De känner de undantag som inget organisationsschema synliggör.

Kontrollera därefter om leverantören ställer konkreta frågor om data, roller, enheter, gränssnitt och drift. Den som genast lovar en totallösning utan att förstå de befintliga förloppen säljer snarare programvaruomfång än problemlösning. Lika kritiskt är ett projekt som saknar tydlig reglering av underhåll, felavhjälpning och senare anpassningar.

Den bästa automatiseringen känns inte som extra byråkrati. Den ger teamet tid för de fall där erfarenhet verkligen räknas: bedöma en oväntad leverans rätt, informera en kund i tid eller lösa en flaskhals innan den blir ett problem.

Permalänk →

Kan AI testa skrivbordsprogram?

Kan AI testa skrivbordsprogram?

En medarbetare bokför godsmottagning i en Windows-applikation, skriver ut en följesedel, och lämnar över uppgifterna till bokföringen. Efter en uppdatering visas en dialogruta på en annan plats, ett fält förlorar fokus, utskriften startar inte längre. Frågan "can AI test desktop software" är därför mindre teoretisk än den låter: kan ett system upptäcka sådana fel innan nästa förmiddagsskift?

Ja. AI kan testa Windows-skrivbordsprogram, särskilt där klassisk automatisering misslyckas med skiftande gränssnitt, inkonsekventa kontroller, eller skript som är dyra att underhålla. Den är dock inget substitut för tydliga testmål, rena testdata, och affärsansvar. Dess värde uppstår när den pålitligt tar över repeterbart arbete och riktar människor mot fallen som kräver omdöme.

Kan AI testa skrivbordsprogram - och vad betyder det i praktiken?

Skrivbordstester kontrollerar inte bara om ett fönster öppnas. I verklig drift handlar det om fullständiga arbetsflöden: inloggning med korrekt spärrlogik, orderregistrering, val av en artikel, lagerbokning, etikettutskrift, felmeddelanden för ogiltiga data, och den korrekta överlämningen till ett anslutet system.

En AI-driven testmiljö kan köra dessa arbetsflöden på en Windows-maskin, bedöma det synliga gränssnittet, och generera bevis. Den kan till exempel känna igen knappar utifrån text och position, läsa innehåll från dialogrutor, och jämföra skärmbilder med det förväntade tillståndet. Till skillnad från ett stelt skript kan den bättre hantera mindre visuella ändringar - till exempel när en ikon, ett avstånd, eller den exakta tekniska identifieraren för ett kontrollelement ändras.

Detta är särskilt relevant för affärsapplikationer som vuxit över tid. Många av dessa program har inget modernt API för varje process. Vissa använder proprietära gränssnitt, inbäddade tabeller, eller komponenter som är svåra att adressera med konventionell UI-automatisering. En AI-agent kan använda applikationen mer som en utbildad användare gör: läsa skärmen, välja en åtgärd, kontrollera resultatet.

Ordet "mer" är medvetet valt. AI ser inte automatiskt affärsprocessen bakom ett inmatningsfält. Den kan fastställa att en följesedel skapades. Om den korrekta leveransvillkoret behövde användas för en viss kund kräver en affärsmässigt definierad förväntning.

Var AI-tester är meningsfulla för Windows-applikationer

Den bästa startpunkten är arbetsflöden som sker ofta, är affärskritiska, och idag kontrolleras manuellt. Ett team behöver inte automatisera hela testkatalogen för detta. Bättre är att välja de få processer vars fel direkt kostar tid, pengar, eller förtroende.

I lager, produktion, och planering hör hit ofta skapandet och bokföringen av godsmottagningar, plocknings- och leveransprocesser, auktoriserade lagerkorrigeringar, utskrift av etiketter, samt import- och exportprocesser. I kommersiella applikationer är inloggning, rättighetsbyte, fakturaskapande, stamdataunderhåll, och gränssnittsöverföringar typiska kandidater.

AI är särskilt användbar där en release för närvarande utlöser en manuell kontrolldag. En testare klickar då igenom en lång lista, dokumenterar avvikelser, och försöker senare rekonstruera exakt vad som hände. Automatiserade körningar kan flytta denna del till natten eller till en fast releaseprocess. På morgonen finns det inte bara en status, utan en testlogg med skärmbilder, tidsstämplar, och en begriplig beskrivning av avvikelsen.

Regressionstester drar också nytta. När en ny funktion byggs in i orderdialogen ska befintliga processer inte gå sönder obemärkt. AI:n upprepar definierade scenarier efter varje relevant ändring. Det eliminerar inte varje risk, men det förhindrar att kända kärnprocesser förblir okontrollerade bara för att tiden inte räcker till.

Vad AI pålitligt kan kontrollera - och vad den inte kan

AI-baserade gränssnittstester är starka på observerbara förväntningar. "Ordernumret visas efter sparande." "En varning visas om ett obligatoriskt fält saknas." "Lagersaldot minskar med fem." "Utskriftsdialogen innehåller den avsedda skrivaren." Sådana uttalanden översätts till konkreta kontrollsteg.

Svårare blir krav som är oprecist formulerade. "Gränssnittet ska se professionellt ut" eller "programmet ska vara snabbt" är inte tillräckliga testfall. Här behövs kriterier: maximal väntetid under definierad belastning, en godkänd layout, eller tydliga acceptansregler för felmeddelanden.

Även vid komplexa affärsmässiga specialfall förblir mänsklig testning oumbärlig. Om en returregel gäller för ett enda ramavtal måste någon med processkunskap avgöra om resultatet är korrekt. AI kan förbereda, utföra, och dokumentera fallet. Den bör inte egenmäktigt hitta på nya affärsregler.

En annan gräns är miljöns stabilitet. Skrivbordstester beror på skärmupplösning, användarrättigheter, nätverksanslutning, skrivardrivrutiner, testdata, och, i förekommande fall, ansluten hårdvara. Om en etikettskrivare är offline kan ett misslyckat test vara ett verkligt fel - eller ett miljöproblem. Bra testsystem särskiljer dessa fall och rapporterar dem transparent, istället för att generellt bedöma allt som en produktbugg.

Den tekniska grunden avgör nyttan

Ett användbart skrivbordstest är mer än en rad musklick. Det behöver en kontrollerad maskin eller en virtuell Windows-miljö, definierade användarkonton, reproducerbara utgångsdata, och tydliga regler för återställningar. Annars kontrollerar testet ett annat tillstånd på tisdag än på måndag och skapar diskussioner istället för säkerhet.

Lika avgörande är bevis. En grön bock utan kontext hjälper lite när en affärsavdelning rapporterar en bugg. Varje körning bör därför åtföljas av de utförda stegen, skärmbilder vid viktiga punkter, synliga felmeddelanden, och en tidsangivelse. Vid avvikelser måste det vara tydligt om applikationen reagerade felaktigt, ett förväntat element inte hittades, eller testmiljön var blockerad.

Vid känsliga applikationer är frågan om var utförandet sker ingen bisak. Skärmbilder, åtkomstuppgifter, kunddata, och interna processkärmar kan innehålla konfidentiell information. Den som kör tester via externa tjänster bör noggrant kontrollera vilka data som lämnar den egna miljön, hur länge de lagras, och vem som får åtkomst.

För team med motsvarande krav kan en självhostad miljö vara mer meningsfull.

softify.pro driver för detta ändamål COCO, en egen AI-server för automatiserad webb- och applikationstestning. Utförande, testbevis, och utvärdering kan förbli inom den kontrollerade företagsmiljön. Det är inte nödvändigt för varje applikation, men för interna affärssystem, personuppgifter, eller strikta IT-krav är det ofta den renare arkitekturen.

Så startar ett team utan att låta ett testautomationsprojekt spåra ur

En meningsfull start börjar inte med ett verktygsval, utan med en process. Ta ett arbetsflöde som kontrolleras minst varje vecka och vars felkonsekvenser är spårbara. En leveransprocess passar bättre än en samling av tjugo slumpmässiga skärmar.

Beskriv sedan den affärsmässiga vägen i tydliga meningar: utgångsläge, indata, förväntade mellantillstånd, förväntat slutresultat. Lägg också till det negativa fallet. Vad måste hända om ett satsnummer saknas, en användare saknar behörighet, eller lagret inte räcker? Just dessa regler hoppas ofta över i manuella tester, även om de kan bli dyra i vardagen.

Sedan följer en begränsad pilot med stabila testdata och en definierad miljö. Mät inte bara om testet fungerar. Mät hur många manuella kontrollminuter det ersätter, hur många falsklarm som uppstår, och om beviset räcker för utveckling och affärsavdelningen. Först när denna grund fungerar lönar sig utökningen till fler processer.

Underhåll hör till från början. Om en skärm ändras affärsmässigt måste även förväntningen anpassas. Det är inget argument mot automatisering. Det är normalt mjukvaruunderhåll - jämförbart med att uppdatera en arbetsinstruktion när en lagerprocess ändras.

Inte varje klick behöver automatiseras

Vissa team förväntar sig fullständig täckning från AI-tester. Det leder snabbt till höga kostnader för sällsynta undantagsfall, vars kontroll manuellt skulle vara snabbare och mer tillförlitlig. En bra teststrategi prioriterar istället efter risk, frekvens, och förändringstakt.

En sällan använd administrationsdialog med låg felkonsekvens kan fortsätta kontrolleras med en kort manuell checklista. En daglig godsmottagning med flera efterföljande steg förtjänar däremot automatiserade regressionstester och rent bevis. Boring, provable reliability vinner här över en stor men skör testsamling.

Börja med processen där en bugg verkligen skulle kännas nästa arbetsdag. När detta arbetsflöde kontrolleras automatiserat, spårbart, och repeterbart i din egen miljö, blir testautomatisering en pålitlig operativ fördel - inte ytterligare ett IT-projekt med fina bilder.

Permalänk →

När bör företag ersätta kalkylblad?

När bör företag ersätta kalkylblad?

En lagerchef skriver ut en lagerlista på morgonen. Två timmar senare har försäljningen lagt in en order, mängden på en inleverans har korrigerats och en kollega har öppnat en gammal fil från en e-postbilaga. Siffrorna stämmer inte längre. Just då uppstår frågan: När bör företag ersätta kalkylblad? Inte när en fil någon gång blir rörig, utan när den blir den osynliga flaskhalsen i en pågående process.

Kalkylblad är inget tecken på dålig organisation. För kalkyler, engångsanalyser, små datamängder och beslut med få inblandade är de ofta rätt verktyg. De är flexibla, välkända och tillgängliga utan att något projekt behöver startas. Problematiska blir de först när ett enda kalkylblad ska vara databas, arbetsinstruktion, godkännandeflöde, dokumentarkiv och kommunikationskanal på samma gång.

Kalkylblad är bra - tills de ska bära en process

Många växande företag håller fast vid sina filer eftersom de har byggts upp med omsorg under många år. I dem finns artikelnummer, specialfall, leverantörskunskap och beprövad beräkningslogik. Det förtjänar respekt. Ett ersättningssystem som ignorerar den verkligheten skapar motstånd och, i värsta fall, nya omvägar.

Den avgörande frågan är därför inte: ”Är Excel dåligt?” Utan: ”Kan vårt team arbeta tillförlitligt med det här verktyget, även när ordervolym, skift eller ansvariga förändras?” Om svaret regelbundet beror på en viss person, en delad enhet eller allas disciplin är gränsen ofta nådd.

Det blir särskilt tydligt i lagret, verkstaden och planeringen. Ett lagersaldo som först stäms av i efterhand är inget tillförlitligt saldo. Ett leveransunderlag som sammanställs manuellt ur flera filer kostar inte bara tid. Det försvårar följdfrågor, spårbarhet och en ren överlämning mellan medarbetare.

När bör företag ersätta kalkylblad?

Det finns ingen universell tidpunkt och inget magiskt antal rader. Ett företag med 500 artiklar kan fungera bra med ett enkelt kalkylblad, medan ett annat med 50 artiklar sedan länge behöver ett system. Avgörande är den operativa belastningen: hur ofta ändras data, vem använder den och vilka följder får ett fel?

En tydlig utlösare är versionskonflikten. När team skickar filer med namn som ”Lager_final_ny2” eller kollegor måste fråga vilken kolumn som just nu gäller saknas en bindande datakälla. Även manuellt kopieringsarbete mellan orderlista, lageröversikt, fraktfil och fakturaförberedelse är en signal. Varje överföring skapar ytterligare ett tillfälle för omkastade siffror, dubbletter eller bortglömda uppdateringar.

Lika kritiska är processer utan spårbart ansvar. Vem har ändrat en mängd? När bokfördes en inleverans? Varför sattes en order i vänteläge? I ett kalkylblad går det visserligen att delvis logga ändringar. I vardagen är det dock sällan lika entydigt och användbart som i en process som medvetet registrerar bokningar, statusbyten och användaråtgärder.

En annan punkt är arbetets hastighet. Om medarbetare före packningen först måste söka igenom en fil, kontrollera ett saldo, skriva av data och därefter skapa en fraktetikett i en separat portal, blir kalkylbladet den som anger takten på lagergolvet. Kostnaderna uppstår då inte bara i minuter. De visar sig i avbrott, följdfrågor, felleveranser och kunskap som bara finns i några enskilda personers huvuden.

Riskerna ligger ofta mellan två celler

Kalkylblad havererar sällan spektakulärt. Ofta är det små avvikelser som fortplantar sig: en felaktigt dragen formel, ett filter som inte omfattar alla rader, ett nummer som lagrats som text i stället för som tal eller en formel som skrivits över av misstag. Sådana fel förblir länge oupptäckta just när teamet arbetar under tidspress.

I affärskritiska flöden tillkommer en andra risk: bristande processtyrning. Ett kalkylblad kan visa att en order finns. Men det säkerställer inte tillförlitligt att alla nödvändiga steg sker i rätt ordning. Måste en kvalitetskontroll vara avslutad före leverans? Får en följesedel skapas utan bekräftad plockning? Ska en order automatiskt gå till utredning när lagersaldot inte räcker? Dessa regler hör inte hemma i påminnelser, färgade celler eller komplicerade om-så-formler när de dagligen avgör om flödena går rätt till.

Även behörigheter blir relevanta när teamet växer. Inte alla behöver få ändra priser, underhålla artikelregister eller korrigera avslutade transaktioner. En skräddarsydd applikation kan tydligt avbilda roller, logga känsliga åtgärder och till exempel spärra ett konto efter flera misslyckade försök. Det är ingen överdriven teknik. Det är ett rent svar på ansvarsfrågan.

Inte varje problem behöver ett stort ERP

Alternativet till kalkylbladet är inte automatiskt en global enterprise-svit med långa införandeprojekt. För många små och medelstora företag vore det fel steg: för många funktioner, för stela processer, höga licenskostnader och ett system som inte anpassar sig tillräckligt till verksamheten.

Mer meningsfullt är ofta en fokuserad applikation för den konkreta flaskhalsen. Det kan vara ett system för godsmottagning, lagerrörelser och lagerplatser. Det kan fånga upp ordrar från e-post eller formulär på ett strukturerat sätt, skapa följesedlar, förbereda fraktetiketter eller planera rutter enligt tydliga regler. Det avgörande är inte att införa så mycket programvara som möjligt. Det avgörande är att nästa handling blir entydig för den ansvariga personen.

En bra lösning får dessutom starta vid sidan av befintliga verktyg. Bokföring, ERP eller fraktleverantörer behöver inte ersättas direkt. Ofta är ett tillförlitligt gränssnitt eller en ren export den mer pragmatiska vägen. Nyttan uppstår när dubbelregistreringen försvinner och operativa data är aktuella där de behövs.

Så prövar ni det faktiska behovet av åtgärder

I stället för att direkt jämföra programvaruofferter lönar det sig att titta på ett konkret flöde. Ta till exempel en orders väg från ankomst till leverans. Anteckna inte bara de officiella stegen, utan också telefonsamtal, lappar, privata chattmeddelanden och de ställen där någon för över information från en fil till ett annat system.

Fråga er sedan: var väntar medarbetare på information? Var matas data in flera gånger? Vilket beslut hänger på erfarenhet i stället för synliga regler? Och vilka fel skulle bli dyra om ordervolymen fördubblades på sex månader? Den analysen visar oftast snabbare än någon funktionslista om ett kalkylblad fortfarande räcker.

Inte varje avvikelse motiverar en egenutveckling. Om en rapport upprättas varje månad av en person och ett fel är lätt att rätta till, förblir kalkylbladet ofta lämpligt. Men om flera personer dagligen är beroende av aktuella data, om fysiska varor flyttas eller om bevis behövs gentemot kunder, förändras kalkylen. Då har verksamheten för länge sedan betalat för verktygets gränser - bara utspritt över arbetstid, felrättningar och förseningar.

En ersättning måste förbli underhållbar

Den som ersätter kalkylblad bör inte bara köpa ett snyggare gränssnitt. Datastrukturen, reglerna och driften av applikationen avgör om lösningen fortfarande fungerar tillförlitligt efter två år. För en smal webbapplikation kan till exempel PHP 8.4, modern JavaScript och MySQL 8 utgöra en medvetet nykter grund: lätt att underhålla, kraftfull och utan beroende av kortlivade trender.

Lika viktigt är införandet. Ett system bör först stabilisera verkliga flöden, inte täcka alla tänkbara önskemål samtidigt. Ett tydligt avgränsat första område - till exempel godsmottagning och lagerbokning - skapar förtroende. Därefter kan frakt, leveransdokument eller analyser läggas till på en konsekvent databas.

De gamla kalkylbladen försvinner inte nödvändigtvis direkt. Vissa finns kvar som arkiv, för särskilda analyser eller som kontrollerad export. Målet är inte att förvisa kalkylblad. Målet är att avlasta dem från uppgifter som de aldrig var avsedda att sköta som permanent operativsystem.

Om ert team regelbundet kontrollerar vilken fil som stämmer, vem som senast ändrade något eller om en order verkligen har behandlats fullständigt, är det ingen liten organisatorisk skavank. Det är ett bra tillfälle att gemensamt granska processen på den faktiska arbetsplatsen - innan nästa tillväxttopp gör ett skört kalkylblad till en daglig flaskhals.

Permalänk →

AI testing platforms för regressionstester

AI testing platforms för regressionstester

En release är funktionellt klar, men ingen kan med säkerhet säga om den nya prisimporten har skadat orderregistreringen, användarrättigheterna, eller leveransprocessen. Precis här blir AI testing platforms intressanta. Inte för att de trollar bort mänskligt kvalitetsarbete, utan för att de tillförlitligt kan köra återkommande kontroller, dokumentera dem synligt, och göra avvikelser begripliga.

För team med webb- eller Windows-applikationer som vuxit över tid är detta ett praktiskt problem, inte ett innovationsprojekt. Kritiska arbetsflöden uppstår ofta över flera år: en order skapas, ett lagersaldo bokförs, en PDF genereras, ett gränssnitt informeras. En liten ändring i en inmatningsskärm kan få konsekvenser på ett oväntat ställe. Manuella regressionstester är då långsamma, beroende av enskilda personer, och särskilt felbenägna under tidspress.

Vad AI testing platforms faktiskt levererar

Klassisk testautomatisering följer i förväg skrivna steg. Det förblir meningsfullt och nödvändigt för många kontroller. En AI-driven plattform kan dessutom arbeta med en applikation genom dess gränssnitt, känna igen innehåll, utföra teststeg, och klassificera avvikelser på naturligt språk. Den kan till exempel kontrollera om en behörig användare kan bokföra en godsmottagning, om ett spärrat konto korrekt avvisas, eller om en följesedel fortfarande genereras efter en ändring.

Den avgörande nyttan ligger inte bara i att klicka på en knapp. Bra system kopplar samman utförande, observation, och bevis. En testkörning bör därför inkludera spårbara steg, skärmbilder eller inspelningar, tidsstämplar, använda testdata, och en tydlig bedömning. När ett test misslyckas behöver teamet mer än meddelandet "assertion failed". Det måste kunna se på vilken skärm, i vilket tillstånd, och av vilken anledning avvikelsen inträffade.

AI kan snabba upp detta arbete. Den ersätter dock inte beslutet om vad som verkligen är affärskritiskt. En modell kan känna igen att en dialogruta ser annorlunda ut. Om den ändringen utgör en bugg, en medveten ny design, eller bara en ofarlig renderingsskillnad i webbläsaren, förblir en fråga om regler, sammanhang, och godkännande.

Inte varje kontroll hör hemma i AI

Det vanligaste misstaget vid införandet är att sikta för högt. En plattform bör inte först täcka varje funktion i ett system. Den bör säkra de arbetsflöden vars fel skulle vara kostsamma, riskabla, eller arbetsintensiva. I logistikmjukvara är det typiskt orderregistrering, lagerrörelser, etikett- eller dokumentutskrift, användarroller, och gränssnittsöverföringar. I en kommersiell webbapplikation kan inloggning, fakturagodkännande, exporter, och betalstatus stå i fokus.

En meningsfull start består av en liten uppsättning stabila end-to-end-tester. Ett test täcker här inte bara ett enda klick, utan en fullständig arbetsprocess. Till exempel: en användare loggar in, skapar en order, bekräftar positionerna, genererar en följesedel, och kontrollerar om transaktionen visas i översikten. Sådana kontroller ger en högre affärsrelevans än många isolerade tester för enskilda fält.

Det betyder inte att varje typ av test bör köras genom användargränssnittet. Utvecklingsteam behöver fortfarande snabba enhets- och integrationstester nära koden. Dessa tester hittar tekniska buggar tidigt och billigt. UI-baserade AI-tester kompletterar dem där samspelet mellan gränssnitt, behörigheter, databas, dokument, och externa tjänster behöver kontrolleras. Den som testar allt bara genom gränssnittet får långsamma och svårunderhållna testkörningar. Den som testar uteslutande i koden kan missa buggar som direkt drabbar användare.

Stabilitet uppstår genom goda testvillkor

Automatiserade tester misslyckas inte alltid på grund av en produktbugg. Instabila testdata, förändrade användarrättigheter, oåtkomliga testsystem, eller parallella ändringar kan lika gärna vara orsaken. Därför hör testmiljön till plattformsbeslutet.

Testkonton bör vara entydiga och ha kända rättigheter. Data måste antingen återställas reproducerbart före varje körning eller riktat återskapas. Externa system kräver också ett beslut: kontrolleras en frakt- eller betalningsintegration mot en säker testmiljö, simuleras den med en kontrollerad stub, eller utesluts den medvetet från flödet? Det finns inget universellt korrekt svar. Det avgörande är att ett tests utsaga förblir tydlig.

För kritiska godkännanden lönar det sig dessutom att ha en definierad konfidensnivå. En visuell skillnad med låg konfidens bör inte automatiskt blockera en release. Ett saknat fraktdokument efter en framgångsrikt bokförd leverans är däremot ett allvarligt fel. Bra testprocesser skiljer mellan ledtrådar att kontrollera och tydliga godkännandekriterier.

Datasuveränitet är ingen sidofråga i AI-tester

Så snart ett test körs mot en verklig applikation kan det se konfidentiell information: kundnamn, priser, adresser, interna artikelnummer, skärmbilder från affärsapplikationer, eller innehåll från dokument. Om sådan data överförs till externa tjänster tillsammans med skärminspelningar och testloggar är det ett arkitekturbeslut med konsekvenser för dataskydd, informationssäkerhet, och avtal.

Just för interna webb- och Windows-applikationer räcker inte frågan "fungerar plattformen?". Ansvariga bör kontrollera var testkörningar utförs, var skärmbilder och loggar lagras, vilka data en AI-modell bearbetar, och vem som får administrativ åtkomst. Lagringstider och raderingskoncept hör också hit. En testrapport kan vara värdefullt bevis för en release, men bör inte bevara känslig information på obestämd tid.

För organisationer med höjda krav kan en självhostad körning vara den lämpligare lösningen. Den håller testtrafik, testdata, och bevis inom den egna kontrollerade miljön. Det ökar driftsansträngningen något: uppdateringar, åtkomster, kapaciteter, och övervakning kräver ansvar. I gengäld förblir den tekniska och organisatoriska kontrollen där den ofta hör hemma. Med COCO satsar softify.pro precis på denna modell: automatiserade tester för webb- och Windows-applikationer med lokal datalagring och spårbara testbevis.

Hur man känner igen en lämplig plattform

Ett övertygande val börjar med de befintliga applikationerna, inte med en produktdemo. En plattform kan verka imponerande i en ren exempelapplikation och stöta på gränser vid en äldre desktopskärm, en Citrix-miljö, eller en komplex inloggning. Ett kort proof of concept med två eller tre verkliga affärsflöden säger mycket mer än en funktionslista.

Team bör därvid särskilt uppmärksamma fyra punkter:

  • Applikationstäckning: Stödjer lösningen de befintliga webbläsarna, Windows-skrivbordsapplikationerna, och, där relevant, fjärrskrivbords- eller Citrix-scenarier?
  • Spårbarhet: Levererar varje körning begripliga steg, skärmbilder, loggar, och en motivering till varför ett test anses godkänt eller misslyckat?
  • Driftsmodell: Passar moln, en privat miljö, eller self-hosting till säkerhetskraven, de tillgängliga IT-resurserna, och testdata?
  • Underhållbarhet: Kan affärsavdelningar granska testflöden medan tekniska team rent hanterar versionshantering, godkännanden, och repeterbart utförande?

Därtill kommer integrationen i releaseprocessen. Ett test som bara startas på begäran hjälper mindre än en schemalagd körning före driftsättning eller efter en relevant ändring. Samtidigt bör inte varje liten styling-uppdatering utlösa ett timslångt fullständigt test. Mogna processer väljer tester efter risk: ett kort smoke-test efter varje driftsättning, riktade regressioner vid ändringar av kritiska moduler, och mer omfattande körningar före större releaser.

Tydliga rapporter istället för testteater

Testautomatisering producerar lätt aktivitet utan insikt. Hundratals gröna bockar låter bra, men om ingen kan säga vilka affärsprocesser de säkrar är de knappt styrbara. En användbar rapport besvarar enkla frågor: Vad kontrollerades? Med vilket resultat? Vilken version berördes? Vad behöver någon besluta nu?

Bedömningar på klarspråk kan spara mycket tid här, förutsatt att de bygger på verkliga körningsdata. "Användaren kunde logga in, skapa ordern, och generera följesedeln" är mer användbart för en affärsansvarig än en samling tekniska selektorer. Vid fel förblir den tekniska djupet ändå viktig. QA och utveckling behöver skärmbilden, loggdata, och reproducerbara steg, inte bara en AI-sammanfattning.

Införande utan att störa den löpande driften

Det bästa införandet börjar med en process där en bugg skulle ha en märkbar påverkan och vars förlopp är tillräckligt stabilt. Det kan vara dagsavslutet, orderngodkännandet, eller en kärnfunktion i en kundplattform. Tillsammans med affärsavdelningen och det tekniska teamet fastställs vad som räknas som framgång, vilka testdata som används, och vem som bedömer ett fel.

Därefter följer en kontrollerad rytm: bygga tester, köra dem upprepade gånger, minska falsklarm, och först då binda in dem bindande i godkännanden. Detta mellansteg är viktigt. Den som sätter in automatiserade tester omedelbart som en hård spärr, medan miljö och data fortfarande svänger, skapar motstånd istället för förtroende. Den som istället synligt kopplar resultaten till verkliga buggar och stabila releaser bygger acceptans.

AI testing platforms är ingen ersättning för god mjukvaruarkitektur, affärsansvar, eller rena releasebeslut. Rätt använda ger de dock teamen något mycket konkret tillbaka: tid för de fall som kräver omdöme, och solida bevis för de arbetsflöden som helt enkelt måste fungera. Det mest meningsfulla första testet är därför sällan det mest spektakulära - utan processen där ingen på måndagsmorgonen längre behöver undra om systemet fortfarande gör vad verksamheten förväntar sig av det.

Permalänk →

Dokumentera testbevis automatiskt

Dokumentera testbevis automatiskt

Ett misslyckat regressionstest är irriterande. Ett godkänt test utan användbart bevis är ofta knappt bättre. Den som vill dokumentera testbevis automatiskt löser därför inte ett rent rapporteringsproblem. Det handlar om ett solitt svar på konkreta frågor: Vad testades? I vilken version? Med vilka indata? Vad hände egentligen på skärmen? Och kan en utvecklare, QA-ansvarig, eller revisor rekonstruera resultatet senare?

Just för affärskritiska webb- och Windows-applikationer uppstår dessa frågor inte först vid revision. De uppstår när en order behandlas felaktigt efter en release, när en kund rapporterar ett ovanligt fel, eller när ett team måste skilja mellan "ser bra ut" och "bevisligen verifierat" före en release. Manuellt underhållna Excel-listor, skärmbilder i chattrådar, och lösa testanteckningar räcker bara så länge omfattning och ändringstakt förblir små.

Varför manuellt testbevis snabbt blir opålitligt

I många team börjar dokumentationen med goda avsikter. En testare noterar resultatet, lägger till en skärmbild, och antecknar den testade versionen. Under tidspress förvandlas detta dock snabbt till en förkortad rutin: bocka av, lämna över felet, nästa testfall. Detta är förståeligt, särskilt för återkommande regressionstester - men det är inte solitt.

Problemet ligger inte hos enskilda medarbetare. Manuell dokumentation konkurrerar alltid med det egentliga testarbetet. Så snart tio, femtio, eller flera hundra fall måste kontrolleras per release, saknas antingen tid för rena bevis, eller så blir bevisen så omfattande att ingen längre utvärderar dem. Till detta kommer typiska luckor: en skärmbild visar ett tillstånd, men inte det föregående förloppet. En testlogg namnger fallet, men inte det använda build-numret. Ett fel har korrigerats, men det syns inte när och hur korrigeringen verifierades på nytt.

För applikationer med orderhantering, lagerrörelser, priser, användarrättigheter, eller gränssnitt är detta mer än en bekvämlighetsfråga. Ett odokumenterat test kan inte tillförlitligt räknas som en avslutad riskkontroll. Det gäller särskilt när en till synes liten ändring på ett ställe utlöser sidoeffekter i angränsande processer.

Vad ett användbart testbevis faktiskt måste innehålla

Ett testbevis är inte bara en skärmbild med en grön bock. Det kopplar testfallet till dess tekniska och affärsmässiga sammanhang. Åtminstone måste det senare gå att identifiera vilken applikation, vilken version, och vilken testmiljö som kontrollerades. Lika viktiga är starttid, sluttid, resultat, och en tydlig koppling till respektive teststeg.

Vid automatiserade UI-tester bör beviset dessutom fånga de utförda åtgärderna och de observerade resultaten. Exempel: ett test skapar en order, kontrollerar radsumman, genererar en följesedel, och kontrollerar sedan statusen i leveransområdet. En bra logg registrerar inte bara "godkänd". Den visar vid vilket steg kontrollen ägde rum, vilket förväntat värde systemet skulle leverera, och vilket värde det faktiskt levererade.

Skärmbilder eller korta skärminspelningar är värdefulla här, men inte alltid obligatoriska för varje enskilt lyckat steg. De kostar lagringsutrymme och kan innehålla känsliga data. Vanligtvis är en stegvis strategi meningsfull: vid misslyckade kontroller sparas automatiskt ett fullständigt visuellt bevis; vid lyckade standardfall räcker strukturerad loggdata och utvalda bevis. Hur mycket djup som krävs beror på risk, ändringsfrekvens, och regulatorisk miljö.

Beviset måste vara läsbart och tekniskt användbart

Utvecklare behöver detaljer såsom felmeddelanden, förväntade/faktiska värden, tidsstämplar, och det konkreta steget i testflödet. Affärsavdelningar och release-ansvariga behöver däremot ett begripligt uttalande: vilka affärsprocesser kontrollerades, vad godkändes, och var behövs åtgärder?

Båda perspektiven bör komma från samma testkörning. Om ett QA-team exporterar tekniska loggfiler och sedan manuellt skriver en ledningssammanfattning, uppstår återigen ett felbenäget mediebrott. Bättre är ett system som fångar rådata strukturerat och genererar en tydlig bedömning från det, utan att dölja tekniska detaljer.

Dokumentera testbevis automatiskt: rätt förlopp

Automatisering fungerar bäst när den är kopplad till tydligt definierade risker. Inte varje klick i varje applikation behöver omedelbart automatiseras och fullständigt dokumenteras. Startpunkten är oftast stabila, ofta upprepade, och affärskritiska arbetsflöden: inloggning och rättighetskontroll, orderregistrering, prisberäkning, dokumentgenerering, lagerbokning, eller dataöverföring till ett gränssnitt.

För varje arbetsflöde fastställs först vad som räknas som ett godkänt test. "Skärmen ser korrekt ut" är för vagt för det. Bättre är konkreta testvillkor: en användare med rollen lager får inte kunna ändra priser. Följesedelnumret genereras. Kvantiteten minskar tillgängligt lager. Efter fem misslyckade försök aktiveras kontospärren. Sådana kriterier gör testfall repeterbara och bevis jämförbara.

Testkörningen bör då starta automatiskt med kontextdata. Det inkluderar build- eller versionsnummer, målmiljö, webbläsare eller operativsystem, testdatastatus, och tidsstämpel. Under körningen loggar systemet de enskilda stegen, de förväntade och faktiska resultaten, samt tekniska avvikelser. Vid avvikelser genererar det bevis, såsom skärmbilder, felmeddelanden, eller en inspelning av det relevanta förloppet.

Slutresultatet är inte en ostrukturerad filmapp, utan en testkörning med en status. Idealiskt kan man spåra bakåt från ett release-beslut till det enskilda steget varför ett test bedömdes som godkänt eller misslyckat. Just den kopplingen minskar diskussioner efter en incident avsevärt.

Var AI verkligen hjälper - och var inte

AI kan märkbart snabba upp dokumentation och utvärdering. Den kan bedöma skärmtillstånd, markera iögonfallande avvikelser, och sammanfatta testkörningar i begripligt språk. Vid stora testvolymer hjälper detta QA-team att slippa läsa varje lyckad körning manuellt. En bedömning med konfidensgräns kan dessutom lyfta fram fall där detekteringen är osäker och en mänsklig kontroll fortfarande krävs.

Ändå bör AI inte ensamt besluta om kritiska releaser. För områden som betalningsauktorisering, rättigheter, prislogik, eller juridiskt relevanta dokument behövs deterministiska testkriterier. Ett förväntat belopp är antingen korrekt beräknat eller inte. En roll har åtkomst eller inte. AI kompletterar här analysen av visuellt och språkligt innehåll, men ersätter inte en tydligt definierad affärsregel.

Hur data hanteras är också ett arkitekturbeslut. Skärmbilder från interna applikationer kan visa kunddata, priser, adresser, eller produktionsinformation. Den som dokumenterar testbevis automatiskt bör därför i förväg bestämma var dessa bevis lagras, vem som får se dem, och hur länge de sparas. För säkerhetsmedvetna team kan en självhostad testinfrastruktur som COCO vara meningsfull, eftersom testtrafik, inspelningar, och utvärdering förblir i den egna kontrollerade miljön.

Lagringstider, åtkomst, och bevisets kvalitet

Mer bevis är inte automatiskt bättre bevis. Ett skärmbildslager som växer i åratal utan rollmodell och lagringskoncept skapar en ny risk. Stegvisa lagringstider är meningsfulla: behåll misslyckade eller release-relevanta testkörningar längre, komprimera eller ta bort lyckade rutintester efter en definierad period, och anonymisera känslig testdata tidigt.

Lika avgörande är oföränderligheten. Om testresultat kan redigeras i efterhand utan spår, förlorar de värde som bevis. Ändringar av testfall, resultat, eller releasestatus bör därför loggas. Det betyder inte att varje testrapport behöver komplicerad revisionsprogramvara. Men ansvar, tidsstämplar, och spårbara historik hör till grundutrustningen.

Börja med en process som verkligen gör ont

Det mest meningsfulla första automatiseringssteget är sällan det största. Välj ett arbetsflöde som kontrolleras vid varje release, kostar många manuella minuter, och har märkbara konsekvenser vid ett fel. Det kan vara orderregistrering i webbportalen, generering av ett fraktdokument, eller ett rättighetskoncept i en Windows-applikation.

Definiera tydliga framgångskriterier för detta arbetsflöde, det nödvändiga beviset, och en ansvarig mottagare för misslyckade tester. Efter några releaser blir det snabbt tydligt om bevisen är begripliga nog, om för mycket data uppstår, och vilka tester som bör följa härnäst. På så sätt växer ingen dokumentationsmaskin för sin egen skull, utan en verifieringskedja som säkrar releaser snabbare och levererar solida svar vid problem.

Permalänk →

Dokumentera lagerrörelser digitalt

Dokumentera lagerrörelser digitalt

En differens på 24 enheter i systemet låter till en början hanterbar. Den blir problematisk när ingen kan säga om varan lagrades fel, plockades för en order, skadades, eller aldrig bokfördes. Den som vill dokumentera lagerrörelser digitalt skapar därför inte bara mer data. Den skapar en spårbar historik för varje lagerpost - och därmed en solid grund för inköp, produktion, leverans och inventering.

För små och medelstora lager är detta sällan ett fall för en omfattande enterprise-svit. Avgörande är ett system som avbildar varornas verkliga väg: godsmottagning vid porten, omflyttning mellan hyllor, materialuttag i verkstaden, plockning, returer och korrigeringar efter inventering. Ju färre gånger team behöver växla mellan papper, Excel och muntliga besked och flera program, desto pålitligare blir siffrorna.

Att dokumentera lagerrörelser digitalt börjar med transaktionen

Ett aktuellt lagersaldo besvarar bara en fråga: hur mycket finns just nu? För det operativa arbetet räcker det ofta inte. Vid frågor behöver teamet även svar på andra frågor: När ändrades lagersaldot? Vem gjorde bokningen? Varifrån kom varan, vart tog den vägen, och vilken affärstransaktion utlöste det?

Precis här ligger skillnaden mellan en enkel lagerlista och digital rörelsedokumentation. Varje förändring lagras som en egen, oföränderlig transaktion. Lagersaldot uppstår därefter ur dessa transaktioner. Om till exempel en artikel flyttas från plats A-03 till B-12, måste systemet spårbart koppla samman en utgående och en ingående rörelse. Om material tas ut för en tillverkningsorder, tillhör bokningen den ordern - inte bara en anonym kvantitetsförändring.

Denna princip förhindrar inte fel helt och hållet. Den gör dem dock möjliga att spåra. En korrigering skriver då inte över det gamla värdet, utan skapar en ny korrigeringspost med en orsak. Det är mindre bekvämt än att direkt ändra en siffra, men betydligt bättre för inventeringar, reklamationer och interna avstämningar.

Vilken data som verkligen behövs per rörelse

Många projekt blir onödigt komplicerade eftersom varje tänkbart fält planeras in från början. För tillförlitlig drift räcker vanligtvis några få, noggrant underhållna uppgifter. Avgörande är inte formulärets längd, utan att varje bokning förblir entydig i sak.

En rörelsebokning bör åtminstone innehålla denna information:

  • Artikel eller material, inklusive ett unikt artikelnummer
  • Kvantitet och enhet, till exempel styck, meter, kilogram eller kartong
  • Rörelsetyp, till exempel mottagning, uttag, omflyttning, retur eller korrigering
  • Käll- och destinationsplats, i den mån rörelsetypen berör båda
  • Tidpunkt, utförande person, och en spårbar dokumentreferens

Dokumentreferensen kan vara en beställning, en följesedel, en kundorder, en tillverkningsorder eller en inventeringspost. Den sparar tid senare, eftersom bokningen inte först behöver tolkas via kommentarer. Fritext förblir användbar för undantag, men bör inte ersätta obligatorisk information.

För satsstyrda, serienummerhanterade eller hållbarhetsbegränsade artiklar tillkommer ytterligare egenskaper. Då måste det till exempel vara tydligt vilken sats som togs ut från, eller vilket bäst-före-datum som berörs. Det är inte en detalj att lösa senare: om spårbarhet krävs, måste den fungera direkt i bokningsflödet.

Anpassa rörelsetyperna till det verkliga varuflödet

De mest ändamålsenliga kategorierna uppstår inte i en workshop kring ett abstrakt processdiagram, utan under en rundvandring genom lagret. Var tas varorna faktiskt emot? Vem beslutar om spärrat lager? När bokas material ut: vid överlämning till verkstaden, vid produktionsstart, eller först vid förbrukning?

Godsmottagning och kvalitetskontroll

Vid godsmottagning bör varan först kontrolleras mot beställning eller följesedel. En digital registrering kan direkt sammanföra kvantitet, leverantör, dokumentnummer, lagerplats och eventuellt sats. Om en kontroll krävs bör varan inte automatiskt visas som fritt tillgänglig. En status som "under kontroll" eller "spärrad" förhindrar att okontrollerat material av misstag plockas.

Omflyttning och interna överlämningar

Omflyttningar glöms bort särskilt ofta eftersom de inte genererar något synligt externt dokument. Resultatet blir att det totala lagersaldot stämmer, men ingen hittar varan på den förväntade platsen. Mobila bokningar via handscanner, surfplatta eller ett enkelt webbformulär hjälper här, förutsatt att de kräver få inmatningar. Ett komplicerat skärmformulär kringgås i den löpande driften - oavsett hur väl databasen bakom är planerad.

Uttag, leverans och retur

Vid uttag måste bokningen matcha rätt syfte. Material för en arbetsorder, varor för en kundorder och kassation är i sak olika transaktioner. De får visserligen minska samma artikellager, men kräver olika utvärderingar. Returer bör också vara en egen rörelsetyp. Annars förblir det oklart om en artikel är återanvändbar, behöver kontrolleras, eller ska bokas bort.

Registreringen måste fungera på lagergolvet

Digitalisering misslyckas sällan för att ett team inte förstår nyttan. Den misslyckas oftare på grund av fem extra klick, instabilt wifi, otydliga artikelnummer, eller en bokning som först kan slutföras vid kontorsdatorn efter skiftets slut.

Därför är det värt att definiera ett tydligt arbetsflöde per roll. Vid godsmottagning väljs typiskt beställning eller följesedel, artikeln skannas, kvantiteten bekräftas och en lagerplats tilldelas. Vid plockning räcker det ofta att öppna ordern, skanna positionen och bekräfta uttaget. Lagerchefer behöver dessutom funktioner för spärrar, korrigeringar och inventeringsräkningar, inklusive ett krav på att ange orsak till korrigeringen.

Streckkods- eller QR-skanningar minskar överföringsfel när artiklar och lagerplatser är tydligt märkta. Men de ersätter inte stamdataunderhåll. Finns det fem olika stavningar för samma artikel, eller namnges platser informellt, påskyndar en skanner bara den felaktiga bokningen. Före den tekniska utrullningen bör artikelnummer, enheter, lagerplatser och ansvar städas upp.

Även offline-förmåga är en avvägning. I ett litet lager med stabilt nätverk kan en webbläsarbaserad applikation räcka. För fjärrlager, stora hallar eller opålitliga anslutningar kan lokal mellanlagring vara meningsfull. Då måste det vara tydligt reglerat hur dubbla eller tidsförskjutna bokningar slås samman.

En genomtänkt utrullning istället för en stor omställningsdag

Ett fullständigt byte vid ett bestämt stoppdatum verkar beslutsamt, men skapar onödig risk. Bättre är att starta med ett avgränsat område: till exempel godsmottagning och omflyttningar för en artikelgrupp eller ett lagerområde. Där visar det sig snabbt vilka rörelsetyper som saknas, vilka inmatningsskärmar som är för långsamma, och vilka specialfall som faktiskt förekommer regelbundet.

För starten behöver teamet ett verifierat ingående saldo. Detta kan komma från en inventering, en uppstädad lagerlista, eller en kontrollerad övertagning. Viktigt är att dokumentera övergången tydligt: fram till vilken tidpunkt gäller det gamla systemet, från när är det nya systemet styrande? Parallellt förda listor är endast kortsiktigt användbara för kontroll. Om de finns kvar permanent uppstår två sanningar.

Efter två till fyra veckor bör de ansvariga inte bara titta på lagernoggrannheten. Lika talande är antalet efterföljande korrigeringar, saknade dokumentreferenser, söktider, och bokningar utanför de avsedda processerna. Dessa observationer ger bättre krav än en lång önskelista upprättad före projektstart.

Teknisk grund: spårbar och underhållbar

Bakom en enkel bokningsskärm behövs en ren datastruktur. Artiklar, lagerplatser, rörelser, dokument och användarrättigheter bör modelleras separat. Varje bokning behöver ett unikt ID, en tidsstämpel och en koppling till användarkontot. Ändringar av kritiska transaktioner hör hemma i en granskningslogg.

För många medelstora tillämpningar är en slimmad webbapplikation med en relationsdatabas som MySQL 8 en lämplig grund. Den kan bearbeta skannerinmatningar, avbilda rollbaserade rättigheter, generera rörelsejournaler och överlämna data till leverans- eller orderprocesser. Avgörande är mindre det använda ramverket än en dokumenterad datalogik, testade bokningsregler, och ett driftkoncept med säkerhetskopior, åtkomsträttigheter och återställningsrutiner.

Inte varje rörelse behöver omedelbart överföras till varje annat system. Realtidssynkronisering är meningsfull när leverans, en webbutik eller produktion är direkt beroende av tillgängliga kvantiteter. I andra fall räcker kontrollerade överlämningar med fasta intervall. Mer integration innebär också fler felkällor och mer ansvar vid driftstopp.

När ett kalkylblad fortfarande räcker

Ett kalkylblad är inte i grunden ett problem. Med få artiklar, en fast lagerplats, och en person som konsekvent underhåller in- och utgående poster, kan det vara ekonomiskt. Bytet blir meningsfullt när flera personer bokar samtidigt, lagerplatser blir relevanta, dokument behöver länkas, eller det regelbundet är oklart varför ett lagersaldo avviker.

Rätt nästa steg är då inte den störst möjliga programvaran, utan en lösning som exakt stödjer det befintliga varuflödet. Bra digital dokumentation gör inte arbetet mer spektakulärt. Den ser till att en bokning sker i rörelsens ögonblick - och att svaret på nästa lagerfråga redan finns i systemet.

Permalänk →

Idéer för lagerdigitalisering som fungerar

Idéer för lagerdigitalisering som fungerar

En saknad följesedel precis före avgång, ett lagersaldo som ser annorlunda ut på hyllan än i kalkylbladet, och tre medarbetare som samtidigt klargör samma fråga per telefon: precis där uppstår förnuftiga idéer för lagerdigitalisering. Inte från frågan om vilken teknik som just nu verkar trendig, utan från en konkret process som kostar tid, skapar fel, eller beror på enskilda personers kunskap.

För små och medelstora lager-, handels-, och tillverkningsföretag är digitalisering sällan ett enda stort projekt. Det är en sekvens av tydligt avgränsade förbättringar. Målet behöver inte vara ett komplext enterprise-lagerhanteringssystem. Ofta är ett slimmat verktyg, skräddarsytt för det faktiska arbetsflödet, bättre än en svit med funktioner som ingen på lagergolvet använder.

Idéer för lagerdigitalisering med operativt värde

Den bästa ingångspunkten är en process som förekommer ofta, är lätt att mäta, och märkbart förbättras för medarbetarna. Den som vill digitalisera hela lagret direkt binder budget och uppmärksamhet innan en lösning har bevisat sig i vardagen. Ett begränsat första steg skapar istället solid data för nästa beslut.

1. Godsmottagning med mobil datainsamling

Vid godsmottagning uppstår många följdfel: felräknade kvantiteter, olösta avvikelser, försenat bokförda lager, och pappersdokument som senare inte går att hitta. Ett mobilt insamlingsformulär på en handskanner, surfplatta, eller smartphone kan göra processen betydligt stabilare.

Medarbetare skannar artikeln och leveransreferensen, och registrerar kvantitet, lagerplats, och orsaken till eventuella avvikelser direkt vid lastkajen. Om ett parti, serienummer, eller foto är relevant, hör den informationen till exakt samma post. Lagret läggs inte till i efterhand i ett kalkylblad vid skiftets slut; det får istället en spårbar status vid den faktiska mottagningen.

Det betyder inte att varje leverantör eller artikel strikt behöver streckkodsetiketter. För små, oregelbundna leveranser kan en sökning på artikelnummer räcka. Den avgörande faktorn är att datainsamlingen är snabbare än den tidigare omvägen via papper och manuell avskrift.

2. Digitala omflyttningar istället för lagergåtor

Många lager vet i grunden vad som finns tillgängligt, men inte tillförlitligt var det befinner sig. Gods hämtas i förväg för en order, mellanlagras, tas till montering, eller placeras på en ledig yta på grund av platsbrist. Utan enkel bokföring blir en lagerfråga snabbt en sökoperation.

En omflyttningsprocess behöver inget komplicerat gränssnitt. Skanna ursprungsplats, skanna destinationsplats, bekräfta kvantitet — mer behövs oftast inte. Systemet bör kontrollera om artikel och lagerplats är rimliga, och tydligt tilldela en bokning till en person och en tidsstämpel.

Hanteringen av undantag är viktig. En lagerplats kan vara blockerad, överfull, eller godkänd endast för specifika varor. Dessa regler bör kartläggas där de förhindrar verklig skada. För sällsynta specialfall räcker det ofta med ett godkännandesteg från lagerledningen. För många obligatoriska fält gör en hjälpsam applikation till ett hinder.

3. Orderplock med tydliga orderstatusar

Pappersplocklistor fungerar tills prioriteringar ändras, positioner saknas, eller en order delas upp över flera områden. En enkel digital plocklista visar vilken order som är öppen, vilka positioner som redan plockats, och var förtydligande behövs. Det minskar förfrågningar mellan lager, försäljning, och utleverans.

Beroende på lagrets storlek kan applikationen diktera plockvägar eller helt enkelt sortera positioner efter lagerzon. Full vägoptimering lönar sig främst vid många dagliga order och långa gångsträckor. I ett kompakt lager ger en pålitlig statusvisning ofta mer än en matematiskt perfekt väg som ingen följer i vardagen.

Vid bristande kvantiteter bör systemet inte bara markera rött. Det bör erbjuda en konkret uppföljningsprocess: kontrollera lager, begära ersättningsartiklar, utlösa påfyllning, eller skicka ordern vidare för förtydligande. Digitalisering är värdefull när den gör nästa förnuftiga åtgärd synlig.

4. Fraktdokument och etiketter från verklig orderdata

Att manuellt föra över adresser, vikter, och artikelpositioner till fraktportaler är en utmärkt kandidat för automatisering. Leveransadresser, leveransinstruktioner, fraktmetoder, och paketinformation finns idealiskt bara en gång och används för följesedeln, fraktetiketten, och fraktbekräftelsen.

Ett lämpligt system kan generera etiketter, lagra dokument på ett spårsäkert sätt, och automatiskt sätta ordern till "redo för frakt" eller "skickad" efter utskrift. Den operativa fördelen ligger inte bara i sparade minuter. Den ligger i att säkerställa att fraktdata aldrig avviker mellan flera system.

Här är integrationen avgörande. Om en fraktleverantör inte erbjuder ett användbart gränssnitt eller involverar mycket olika specialregler, kan ett halvautomatiserat arbetsflöde vara mer förnuftigt än en skör fullständig integration. Tråkig, bevisbar tillförlitlighet slår automatisering som stannar vid varje undantag.

5. Påfyllning och minimilagernivåer med spårbara regler

Minimilagernivåer underhålls ofta i kalkylblad och ignoreras sedan eftersom ingen är säker på om siffrorna fortfarande stämmer. En förnuftig digital lösning kopplar samman faktiska bokningar med tydliga lagerstyrningsregler. Den kan meddela när en artikel faller under en tröskel, ta hänsyn till reserverade kvantiteter, och förbereda en beställningslista.

Tröskeln bör inte behandlas som en evig sanning. Säsongsefterfrågan, leveranstider, och minsta beställningskvantiteter förändras. Därför behöver den ansvariga personen ett enkelt sätt att granska förslag och justera regler. Helautomatiska beställningar är först förnuftiga när stamdata, leverantörslogik, och förbrukningsdata är tillräckligt stabila.

6. Spårbarhet för partier, serienummer, och blockerat lager

Den som arbetar med partier, enheter, reservdelar, eller reglerade produkter behöver mer än bara en kvantitetsvisning. Det måste vara spårbart vilket gods som anlände när, vart det flyttades, och i vilken kundorder det hamnade.

Projektet kan medvetet börja litet: registrera inledningsvis bara mottagning och utleverans av en kritisk produktgrupp. Interna rörelser och returer följer senare. Ett system som tvingar fram varje bokning men inte förstår den verkliga reparations- eller inspektionsprocessen kommer att kringgås. Affärslogiken måste därför härröra från arbetsflödet, inte från en abstrakt datamodell.

Välja rätt projekt

Den mest attraktiva idén är inte automatiskt den rätta första idén. Utvärdera potentiella projekt utifrån frekvens, felkostnader, väntetid, och beroende av individer. En process som körs 50 gånger om dagen och sparar två minuter per transaktion kan vara mer värdefull än en sällsynt specialfunktion med stor teknisk elegans.

Datakvalitet hör också hemma i beslutet. Om artikelnummer är dubblerade, lagerplatser inte namnges entydigt, eller order kommer motstridigt från flera källor, bör projektet först städa upp dessa grunder. Programvara kan göra saknade regler synliga, men kan inte tillförlitligt ersätta dem.

Fyra frågor räcker för prioritering:

  • Vilken aktivitet orsakar bevisligen flest förfrågningar eller omarbetningar?
  • Vilken information skrivs idag av flera gånger eller efterfrågas per telefon?
  • Vilket fel skulle få de dyraste konsekvenserna för kunder, lager, eller frakt?
  • Vilket arbetsflöde kan testas på några veckor med tydlig framgångsmätning?

Tekniska beslut som räknas i den dagliga lagerverksamheten

En lagerapplikation behöver inte se spektakulär ut. Den måste förbli begriplig vid dålig Wi-Fi-täckning, med handskar på, under tidspress, och under skiftbyten. Stora knappar, tydlig återkoppling efter en skanning, och synlig felhantering är viktigare än dekorativa dashboards.

Arkitekturen bör också matcha den operativa verkligheten. En webbaserad applikation med en ren databasstruktur kan köras på befintliga enheter och är lättare att underhålla än en isolerad lösning på en enda dator. Med en stabil grund — som PHP 8.4, modern JavaScript, och MySQL 8 — kan roller, bokningshistorik, gränssnitt, och dokumenterade driftsättningar drivas spårbart på lång sikt.

Inte all information är avsedd för varje roll. Lagerpersonal behöver öppna uppgifter och tydliga bokningsdialoger. Lagerstyrning behöver varningar och påfyllnadsförslag. Ledningen behöver utvärderingar av genomloppstider, avvikelser, och öppna transaktioner. Rollbaserade åtkomstkoncept, loggar, och kontospärrar efter upprepade misslyckade försök hör tidigt hemma i planeringen, särskilt när externa leverantörer eller flera platser är inblandade.

Implementering: bevisa först, expandera sedan

En pilot bör köras med verkliga order, inte bara testdata i ett mötesrum. Välj en lagerzon, en produktgrupp, eller ett skift, och definiera i förväg hur framgång ska kännas igen: färre korrigeringsbokningar, kortare bearbetningstid, färre förfrågningar, eller en högre andel slutförda bokningar samma dag.

Planera parallellt en reservnivå. Om den nya applikationen fallerar eller en process är oklar, måste teamet veta hur man fortsätter arbeta och hur senare bokningar kontrolleras. Det är inte ett tecken på bristande förtroende för tekniken, utan för professionell drift.

Efter två till fyra veckor framträder oftast de mest värdefulla insikterna. Kanske saknas inte en funktion, utan bättre artikelmärkning. Kanske är arbetsflödet korrekt, men en skannerprofil eller behörighet skapar en flaskhals. Dessa observationer bör flöda in i korta, kontrollerade förbättringscykler, istället för att utlösa ett nytt stort projekt.

Den bästa digitaliseringen gör inte lagrets vardag teoretiskt modernare, utan konkret lugnare: mindre sökande, mindre manuell avskrift, tydligare överlämningar, och tillförlitlig information precis när ett beslut väntar.

Permalänk →

Checklista för att automatisera lagerarbetsflöden

Checklista för att automatisera lagerarbetsflöden

När en godsmottagning bekräftas på papper, lagernivåer senare förs över till ett kalkylblad, och en fråga om utleverans klaras upp per telefon, känns varje enskilt steg hanterbart. Tillsammans skapar de dock förfrågningar, lagerdifferenser, och beroende av enskilda medarbetare.

En checklista för att automatisera lagerarbetsflöden förhindrar att detta läge i förtid växer till ett överdimensionerat mjukvaruprojekt. Den skiljer processer som verkligen bör automatiseras från de där ett städat kalkylblad fortfarande räcker.

Checklistan för lagerautomatisering före projektstart

Automatisering börjar inte med att välja ett system. Den börjar med en verifierbar beskrivning av vad som faktiskt händer i lagret — även under undantag, skiftbyten och tidspress. Gå igenom följande punkter direkt på processnivå tillsammans med lagerledning, utleverans, inköp, och vid behov redovisning.

1. Registrera rörelser, inte bara lagersaldon

Ett aktuellt lagersaldo är resultatet av rörelser. Därför bör det vara tydligt vilka händelser ökar, minskar, reserverar, blockerar, eller överför lager. Hit hör godsmottagning, inlagring, orderplock, utleverans, returer, kassation, lagerdifferenser, och omflyttningar.

Varje rörelse kräver ett definitivt svar på fyra frågor: vem utför den? När bokförs den? Vilken lagerplats berörs? Vilket dokument eller vilken order styrker den? Om dessa svar idag bara finns i huvudet på erfarna medarbetare är det en utmärkt kandidat för automatisering. Målet är inte mer datainsamling, utan en motståndskraftig historik varifrån varje lagernivå kan förklaras.

2. Städa upp artiklar, varianter, och enheter

Många projekt misslyckas inte på grund av skannrar eller webbgränssnitt, utan på grund av stamdata. En artikel kan köpas per kartong, lagras styckvis, och säljas i set. Utan definierade omräkningar producerar programvaran formellt korrekta men operativt felaktiga kvantiteter.

Kontrollera artikelnummer för dubbletter, upprätta bindande beskrivningar, och skilj mellan säljenheter, lagerenheter, och förpackningsenheter. Serienummer, partier, utgångsdatum, eller farligt gods-klassificeringar bör bara ingå i den första uppbyggnaden om de påverkar dagliga beslut eller är lagstadgade. Allt annat ökar inledningsvis underhållsbördan och felytan.

3. Definiera lagerplatser så exakt som nödvändigt

"Hall 2" kan räcka för en lagerlista. För tillförlitligt orderplock är det oftast för grovt. Definiera om en plats syftar på en zon, hylla, fack, slot, eller genomgångsyta. Karantänområden, godsmottagningszoner, returområden, och utleveransbuffertar måste också vara igenkännliga som distinkta platser om gods kan finnas där.

Rätt detaljnivå beror på verksamheten. En verkstad med några hundra positioner behöver inte strikt fackhantering. Men med flera plockare per skift kan en exakt lagerplats avsevärt minska gångvägar och söktider. Automatisera inte en precisionsnivå som ingen kan underhålla.

4. Etablera utlösare, ansvariga roller, och godkännanden

Ett arbetsflöde behöver en tydlig startpunkt. Vid godsmottagning kan det vara leveransen vid lastkajen, inköpsordern i inköp, eller skanningen av en följesedel. För påfyllning kan en minimilagernivå utlösa ett förslag, medan den slutliga ordern förblir hos en ansvarig person.

Dokumentera dessutom vilka åtgärder som får ske automatiskt och vilka som kräver granskning. En saknad kvantitet bör skapa en differens, inte tyst ändra den förväntade godsmottagningen. Godkännandesteg är förnuftiga för värdefulla, partihanterade, eller säkerhetskritiska artiklar. För förbrukningsvaror skulle de i onödan sakta ner flödet.

5. Skapa dokument där de behövs

Följesedlar, inlagringslistor, plocklistor, fraktetiketter, och överlämningsprotokoll uppstår ofta i olika applikationer. Det leder till mediebrott: en adress kopieras, en order bockas av, och leveransstatus uppdateras senare.

Notera datakälla, skapelsetidsstämpel, och mottagare för varje dokument. Ett förnuftigt arbetsflöde kan till exempel automatiskt generera en plocklista efter att en order godkänts, tillhandahålla en fraktetikett efter packning, och stänga ordern med en tidsstämpel efter överlämning. Den avgörande poängen är att data inte längre behöver matas in manuellt flera gånger.

Kontrollera gränssnitt och datakvalitet

Den bästa lagerlogiken är värdelös om order bara kommer en gång om dagen som en fil, eller om leveransadresser är inkonsekvent formaterade. Skapa därför en nykter lista över systemen som skickar eller tar emot data: butik, affärssystem, redovisning, fraktleverantör, leverantörsportal, produktionssystem, och befintliga kalkylblad.

För varje koppling bör det fastställas vilket system som är auktoritativt för varje datafält. Om artikelstamdata är auktoritativ i affärssystemet får inte lagerportalen tyst skapa egna artiklar. Om en orderändring kommer från butiken måste den bli synlig före utleverans. För låga volymer kan en kontrollerad CSV-import vara det rätta första steget. För hög volym eller korta leveranslöften lönar sig en direkt koppling.

Felhantering är lika viktigt. En koppling bör inte bara överföra data, utan också visa vad som avvisats och varför. Okända artikelnummer, ogiltiga adresser, eller saknade kvantiteter får inte försvinna i en teknisk loggfil. De kräver en arbetslista med utsedd ansvarig och status.

Utforma användbarhet på lagergolvet

En process som ser rimlig ut vid ett skrivbord kan misslyckas på lagergolvet. Medarbetare bär handskar, flyttar gods, delar enheter, eller arbetar med instabil Wi-Fi-täckning. Kontrollera därför tidigt om skannrar, surfplattor, fasta arbetsstationer, eller pappersutskrifter passar respektive arbetssteg.

Skanning bör ge tydlig återkoppling: korrekt artikel, fel lagerplats, redan bokförd kvantitet, eller blockerad artikel. Enbart färger räcker inte. Korta, begripliga meddelanden och ett tydligt nästa steg är mer värdefullt under tidspress än ett funktionsrikt gränssnitt.

Planera också för undantag. Vad händer vid en skadad streckkod, nätverksavbrott, delleverans, eller upptäckt otilldelat gods? Ett bra arbetsflöde erbjuder kontrollerade vägar för detta och loggar korrigeringen. Det tvingar inte team att förlita sig på post-it-lappar och senare batchbokningar.

Definiera mätvärden innan ni bygger dashboards

En dashboard är inget mål. Relevanta mätvärden är de som utlöser ett operativt beslut. Det kan omfatta öppna godsmottagningar som överskrider en definierad ålder, order nära sin utleveransdeadline, lagerdifferenser per lagerzon, plockfel, eller tiden mellan orderottagande och överlämning.

Definiera datakälla, beräkningsregel, och ansvarig roll för varje mätvärde. "Lagernoggrannhet" är till exempel bara meningsfullt när det är tydligt mot vilken räkning den mäts och hur returer eller blockerat lager hanteras. Några få tillförlitliga mätvärden är bättre än en vägg av diagram som ingen litar på.

Planera säkerhet, behörigheter, och spårbarhet

Automatisering fördelar handlingskraft. Vem som får ändra lager, skapa artiklar, generera fraktetiketter, eller avbryta order bör medvetet fastställas. Rollbaserade behörigheter är oftast förnuftigare än en delad inloggning på lagerdatorn. Särskilt kritiska korrigeringar kräver en tidsstämpel, en persontilldelning, och helst en orsak.

Tekniska grunder hör också hemma på checklistan: regelbundna säkerhetskopior, testad återställning, dokumenterade åtkomstuppgifter, loggning av gränssnittsfel, och en rutin för blockerade eller inaktiverade användarkonton. I en skräddarsydd applikation är underhållbara teknologier, en ren databasstruktur, och spårbara driftsättningssteg inga småsaker. De avgör om ändringar förblir hanterbara efter två år.

Genomför i små, mätbara steg

Försök inte omvandla godsmottagning, påfyllning, lagerräkning, utleverans, och ruttplanering samtidigt. Välj ett arbetsflöde med märkbar friktion och hanterbar risk, som mobil bokning av godsmottagningar eller automatisk generering av fraktdokument. Registrera bearbetningstid, korrigeringar, och öppna ärenden innan ni börjar.

Testa med riktiga artiklar, riktiga order, och de medarbetare som faktiskt kommer att arbeta med dem. En pilot med en lagerzon eller produktgrupp visar snabbare än en workshop om beskrivningar, skanningsflöden, och godkännanden fungerar. Först när undantagen bemästras bör nästa process följa.

Automatisering lyckas när team behöver ställa färre frågor, lager förblir förklarbart, och processen fungerar även när den mest erfarna personen är på semester. Just där lönar sig nästa förbättring: inte med det högljuddaste verktyget, utan med friktionen som verkligen saktar ner arbetsdagen.

Permalänk →

Förbättra laddningstiden för mobila webbplatser

Förbättra laddningstiden för mobila webbplatser

När en lagermobil med dålig täckning används för att besöka en webbplats är det inte animationen i hero-sektionen som avgör första intrycket, utan om sidan över huvud taget blir interaktiv. Om en presumtiv kund väntar tre, fyra eller fem sekunder på innehåll är alternativet bara en bakåtknapp bort. Att förbättra mobila webbplatsers laddningstider kräver en spårbar teknisk ordning, inte kosmetiska engångsåtgärder.

Detta gäller särskilt webbplatser som ska generera förfrågningar: för en tillverkare, en logistikleverantör eller ett företag med förklaringskrävande tjänster. Mobila användare besöker ofta sidor mellan möten, på lagergolvet, eller via en sökning med konkret avsikt. Webbplatsen måste då leverera information, inte först orsaka tung bearbetning på enheten.

Varför mobil laddningshastighet är ett driftsproblem

Mobil prestanda behandlas ofta strikt som en SEO-disciplin. Det är otillräckligt. Snabba sidor hjälper visserligen synlighet och kampanjkostnader, men den omedelbara effekten ligger i den faktiska användningen: formulär skickas oftare, telefonnummer knappas in oftare, och produktinformation läses noggrannare. En långsam webbplats skapar däremot tvivel redan innan en kontaktperson hinner svara.

"Snabb" är inte ett enda mätvärde. En sida kan visa en bakgrund tidigt men ändå förbli oreagerande på klick under lång tid. För besökare räknas tre saker: när visas det viktigaste innehållet? När kan sidan användas utan fördröjning? Och hoppar layouten fortfarande medan de försöker trycka på en knapp? Dessa frågor speglas i mätvärden som Largest Contentful Paint, Interaction to Next Paint och Cumulative Layout Shift.

Mätningar måste ske under realistiska förhållanden. En kraftfull kontorsdator på Wi-Fi döljer problem som blir uppenbara på en äldre Android-enhet på mobilnät. Plats, mellanliggande tjänster och en redan fylld webbläsarcache förändrar också resultaten. Upprepade mätningar och riktig användardata väger därför mycket tyngre än en enda perfekt testkörning.

Förbättra mobila webbplatsers laddningstider: mät först, ändra sedan

Det vanligaste felet är att omedelbart komprimera bilder eller installera ytterligare ett optimeringsplugin. Båda kan hjälpa, men utan grundorsaksanalys uppstår snabbt svårunderhållna konfigurationer. Kontrollera först ett representativt urval: startsidan, en typisk tjänste- eller produktsida, kontaktsidan och en högtrafikerad landningssida. På dessa sidor blir mönster synliga.

Nätverksloggen visar vilka filer som blockerar starten och hur stora de faktiskt är. En prestandagranskning visar om JavaScript fördröjer användningen, om typsnitt kommer för sent, eller om bilder laddas i onödan tidigt. Komplettera labbmätningar med data från riktiga besökare om trafiken tillåter det. Så undviker du att optimera för en testprofil som inte speglar din faktiska målgrupp.

Sätt ett tydligt mål inför varje ändring. Till exempel: det synliga huvudinnehållet ska visas på en genomsnittlig mobil enhet på under 2,5 sekunder, eller kontaktformuläret ska kunna användas utan inmatningsfördröjning. Inte varje sida behöver ett teoretiskt toppbetyg. En komplex applikation med autentiserad data har andra förutsättningar än en offentlig företagswebbplats. Tråkig, bevisbar tillförlitlighet är här mer värdefull än ett kortsiktigt betyg uppnått genom riskabla knep.

1. Behandla bilder efter deras uppgift

På många mobila sidor förblir bilder det största datablocket. Problemet är inte fotot i sig, utan en bild som överförs i 2 500 pixlars bredd när enheten bara behöver 700 pixlar. Erbjud responsiva bildvarianter så att webbläsaren kan välja rätt storlek. Moderna format som WebP eller AVIF minskar ofta filstorleken avsevärt, men bör införas med rena reservlösningar och kontrollerad bildkvalitet.

Den största bilden i det synliga startfönstret förtjänar särskild uppmärksamhet. Den bör vara korrekt beskuren, ha en lämplig upplösning och ladda tidigt. Bilder längre ner på sidan kan laddas fördröjt. Det sparar data vid inträdet, men får inte leda till att bilder synligt efterladdas vid scrollning när användaren redan förväntar sig dem.

Ta inte bort alla bilder reflexmässigt. En bra bild kan förklara en maskin, ett team eller en process snabbare än ett textstycke. Den tekniska uppgiften är: leverera relevant visuell information effektivt, inte reducera design till grå platshållarrutor.

2. Begränsa JavaScript till nödvändigt arbete

Varje skript konkurrerar om bearbetningstid vid laddning och interaktion. Särskilt problematiska är schablonmässigt inbundna bibliotek, tagghanterare med många tredjepartsskript, chattwidgetar, kartor och animationer. På stationära enheter förblir dessa kostnader ofta obemärkta. På mobilen resulterar de i en sida som är synlig men reagerar trögt på inmatning.

Kontrollera för varje skript dess syfte, laddningsvillkor och affärsvärde. En interaktiv karta på kontaktsidan behöver inte laddas på varje undersida. Ett cookie- eller analysverktyg bör inte utlösa en kedja av ytterligare filer innan besökaren ens kan läsa innehållet. Funktioner som bara behövs efter interaktion kan också laddas då.

För skräddarsydda webbplatser är en tydlig komponentstruktur en verklig fördel. JavaScript grupperas per funktion i stället för att levereras som ett globalt paket. Det underlättar även senare underhåll: den som utökar ett formulär ändrar inte av misstag koden för ett produktfilter eller en navigering.

3. Leverera CSS och typsnitt utan blockeringar

En vanlig flaskhals finns i det första synliga området. Om flera stilmallar, ikonteckensnitt och externa typsnittsvarianter måste laddas för det väntar webbläsaren i onödan länge. Kritiska stilar för det synliga området bör vara små och tillgängliga tidigt. Icke-kritiska regler kan följa senare.

För webbtypsnitt räcker det oftast med några få vikter. Fyra vikter i normal, kursiv och ytterligare delmängder känns kompletta i ett designsystem, men behövs sällan för en typisk företagswebbplats. Definiera sensibla systemreservlösningar så att text förblir läsbar omedelbart. Ett typsnitt som växlar rent några millisekunder senare är bättre än tomma textblock.

Även ikoner förtjänar en granskning. En liten SVG-uppsättning är ofta effektivare och mer precist styrbar än ett komplett ikonteckensnitt. Denna regel medger undantag: befintliga system behöver inte byggas om enbart för några kilobyte. Om större ändringar ändå är planerade hör dock detta beslut hemma i den tekniska grunden.

4. Sätt upp cachning och serversvar korrekt

Även ett smalt gränssnitt känns långsamt om servern tar för lång tid på sig för det första svaret. Orsaker sträcker sig från obromsade databasfrågor, via dynamiskt sammansatta sidor, till saknad cachning. Offentligt innehåll som sällan ändras bör snabbt kunna levereras som en cachad version. Statiska filer som bilder, CSS och JavaScript behöver unika versionsnamn och sensibla cache-regler.

För PHP-applikationer handlar det dessutom om effektiv körning, en korrekt konfigurerad opcode-cache och kontrollerad databasåtkomst. MySQL-frågor behöver index som matchar de faktiska filtrerings- och sorteringsvägarna. En startsida som utför flera onödiga datafrågor vid varje anrop blir inte bättre med växande trafik.

Cachning är dock inte en frikort. Priser, tillgänglighet, personaliserade avsnitt eller innehåll efter inloggning får aldrig av misstag verka inaktuella. Därför definieras cachegränser precist: vad får vara fem minuter gammalt, vad måste vara omedelbart aktuellt, och vem tömmer cachen efter en innehållsändring? Bra prestanda uppstår ur denna precision.

5. Behandla tredjepartsleverantörer kritiskt

Externa tjänster är ofta den osynliga barlasten på en webbplats. Analys, samtyckeshantering, videor, kartor, recensionswidgetar och marknadsföringspixlar laddar ytterligare skript från ytterligare servrar. Varje beroende kan orsaka fördröjningar, väcka integritetsfrågor och försämra renderingen vid fel.

Det betyder inte att varje externt verktyg måste tas bort. En video kan stödja försäljning, ett analysverktyg kan underbygga viktiga beslut. Men en kostnads-nyttoanalys behövs. Ladda inbäddade medier först efter samtycke eller interaktion. Använd inledningsvis en platshållare för kartor. Och ta till sist bort taggar vars resultat ingen har utvärderat på månader.

6. Ta hänsyn till layoutförskjutningar och mobil användbarhet

Laddningstid och användbarhet hör ihop. Reservera fasta dimensioner för bilder, banners och inbäddade element så att knappar inte hoppar undan från användarens finger. Undvik popup-fönster som täcker synligt innehåll direkt vid inträdet. En snabb sida som omedelbart visar en svårstängd overlay löser inte grundproblemet.

Testa formulär extra noggrant. Stora inmatningsfält, lämpliga tangentbordstyper och korta obligatoriska sträckor hjälper mer än en genomarbetad visuell effekt. Om en förfrågan bara behöver namn, återuppringningsnummer och ärende är ett formulär i tolv delar inte ett tecken på noggrannhet — det är friktion.

7. Hantera prestanda som en permanent driftsprocess

En engångslansering håller inte laddningstiden låg permanent. Nya kampanjbilder, spårningskrav och redaktionella moduler summeras med tiden. Därför hör prestandabudgetar hemma i utvecklingsprocessen: en maximal storlek för ingångsbilder, tydliga regler för nya tredjepartsverktyg och definierade gränsvärden för JavaScript.

Efter releaser bör de viktigaste sidtyperna utvärderas på nytt. Automatiserade tester kan då fastställa om centrala sidor förblir nåbara och kritiska flöden fungerar. För prestanda räcker dock inte ett rent funktionstest. Komplettera det med mätningar av svarstid, överförd datamängd och mobil interaktivitet.

En snabb mobil webbplats uppstår inte genom ett enda plugin, och inte heller genom avstående till varje pris. Den uppstår när design, innehåll, infrastruktur och verklig användning betraktas tillsammans. Börja med den sida som genererar förfrågningar eller operativa kontakter, mät under ärliga förhållanden, och eliminera friktion exakt där användarna faktiskt känner av den.

Permalänk →

Logistikprogramvara som verkligen avlastar verksamheten

Logistikprogramvara som verkligen avlastar verksamheten

När en godsmottagning först antecknas på papper, senare förs över till ett kalkylblad, och slutligen förmedlas till utleverans muntligt, är det sällan medarbetarnas engagemang som saknas. Det som saknas är en delad, tillförlitlig arbetsgrund. Bra logistikprogramvara ersätter inte dessa sprickor med mer skärmarbete, utan med tydliga arbetsflöden: vad har anlänt, var finns det, vad är reserverat, och vad kan skickas idag?

För små och medelstora företag spelar den längsta möjliga funktionslistan ingen roll. Det avgörande är att programvaran avspeglar det verkliga arbetet på lagergolvet, på kontoret och vid utleverans. En lösning avsedd för en global koncern med tjugo platser kan vara onödigt långsam, dyr, och komplicerad för en verksamhet med ett lager och två skift.

När logistikprogramvara verkligen är meningsfull

Kalkylblad är i grunden inget problem. Vid låga volymer, en hanterbar artikelstamlista, och en enda ansvarig medarbetare kan de vara den mest pragmatiska lösningen. Det vore fel att ersätta en fungerande process med ett projekt enbart för moderniseringens skull. Vändpunkten kommer när information måste underhållas flera gånger eller ingen med säkerhet kan säga vilken fil som är aktuell. Typiska signaler är lagerbrist trots fulla hyllor, förfrågningar om leveransstatus, handskrivna följesedlar, och inventeringar som stannar upp verksamheten i flera dagar. Ökande antal order gör också synligt vilka steg som tidigare hölls samman enbart av enskilda personers erfarenhet.

Då handlar det inte främst om digitalisering som modeord. Det handlar om felkällor och väntetider. En medarbetare bör inte behöva jämföra flera listor bara för att godkänna en order. Utleverans bör inte behöva gissa om en artikel verkligen är tillgänglig eller redan reserverad för en annan order.

Vilka processer logistikprogramvara bör koppla samman

En användbar lösning börjar med materialflödet, inte med en standardmeny. För många verksamheter omfattar detta flöde godsmottagning, inlagring, lagerhantering, orderplock, utleverans, och återkoppling. Beroende på verksamheten tillkommer partier, serienummer, returer, tillverkningsorder, eller ruttplanering.

Godsmottagning med spårbara lager

Mycket avgörs vid godsmottagningen. Om en leverans kontrolleras direkt mot en order eller följesedel kan kvantitetsavvikelser, skadat gods, och saknade positioner registreras exakt där de uppstår. Godset får en status istället för att bara fysiskt ställas någonstans.

Programvaran behöver inte nödvändigtvis börja med dyr skannerhårdvara. På vissa lager räcker en surfplatta eller en arbetsstation vid godsmottagningen för att komma igång. Där många positioner flyttas dagligen är streckkodsläsare dock förnuftiga eftersom de påskyndar bokningar och minskar inmatningsfel. Rätt beslut beror på volymer, vägar, och artikelstruktur.

Lagerrörelser utan minneslogg

Lager är bara motståndskraftiga om mottagningar, omflyttningar, uttag, och korrigeringar är spårbara. Det betyder inte att varje undantag måste förhindras. I den dagliga verksamheten finns skadad förpackning, felaktig inlagring, och spontana materialuttag. En bra applikation gör dessa fall bokningsbara, men dokumenterar också vem som ändrade vad och när.

Denna historik är inget kontrollinstrument för sin egen skull. Den hjälper till att hitta orsaker. Om en artikel upprepade gånger hamnar på fel lagerplats kan lagermärkningen vara otydlig. Om regelbundna korrigeringar sker ligger problemet ofta i processen före bokningen.

Order, följesedlar, och utleverans från ett enda arbetsflöde

Många team förlorar tid vid gränssnittet mellan orderhantering och utleverans. Orderdata kommer via e-post, telefon, eller från ett separat butikssystem. Därefter skrivs positioner ut, lager kontrolleras, och fraktdokument registreras igen. Varje manuell överlämning skapar utrymme för avvikelser.

Logistikprogramvara bör kunna generera en tydlig plocklista, en följesedel, och vid behov en fraktetikett från en godkänd order. Ordningen är viktig här: först måste det vara tydligt vad som är leveransbart. Därefter bör ordern reserveras för andra processer. Annars uppstår den obekväma situationen där två medarbetare tilldelar samma återstående lager.

Planering som matchar verkligheten

Ruttplanering och kapacitetskontroll kan vara värdefulla, särskilt med egna leveranser, fasta tidsfönster, eller många regionala stopp. De är dock inte automatiskt nästa förnuftiga steg. Den som ännu inte har rent ordergodkännande och tillförlitliga lagerdata bör lösa dessa grunder först.

Detsamma gäller prognoser och AI-stödd planering. De kan göra mönster synliga, men kräver ren indata. En prognos baserad på ofullständigt lager ser tekniskt sofistikerad ut, men förbättrar inte leveransförmågan.

Standardlösning eller skräddarsydd logistikprogramvara?

Standardprogramvara är förnuftig när de egna arbetsflödena i stort sett är konventionella och kan anpassas utan större friktion. Den kan införas snabbare och ger beprövade kärnfunktioner. För en verksamhet med enkla lagerprocesser, tydliga roller, och få särdrag är det ofta det ekonomiskt riktiga valet.

Skräddarsydd logistikprogramvara är värt det när verksamheten lever av speciella arbetsflöden eller befintliga system bara kan anslutas via omvägar. Detta gäller till exempel verkstäder med materialproblem för pågående order, återförsäljare med kundspecifika fraktregler, eller tillverkare som måste koppla lagerrörelser tätt till produktionssteg.

Skillnaden ligger inte i att uppfinna allt på nytt. Bra skräddarsydda system tar över beprövade mönster som statusändringar, reservationer, och behörigheter. De anpassar dock språk, masker, dokument, och gränssnitt till det arbete som faktiskt utförs. Så behöver teamet inte permanent orientera sig mot kategorier som bara är meningsfulla i tillverkarens manual.

Hos softify.pro börjar ett sådant projekt därför med frågan om vilka arbetsflöden som bör bevaras. Inte varje papperslapp är ett fel, och inte varje specialregel är meningsfull. Först när det är tydligt var information går förlorad eller beslut väntar i onödan kan en genomförbar lösning planeras.

En utrullning utan driftavbrott

Den största risken ligger sällan enbart i programkoden. Den ligger i en implementation som vill förändra för mycket på en gång. Ett lager kan inte pausa i två veckor för att lära sig ett nytt system. Därför är en stegvis utrullning oftast mer förnuftig än ett stort omställningsdatum.

Ett bra första avsnitt fokuserar på ett avgränsat arbetsflöde, till exempel godsmottagning och lagerbokningar eller skapande av följesedlar. Teamet arbetar med verklig data, återkoppling flödar direkt in i anpassningen, och nyttan blir mätbar. Först därefter följer ytterligare områden, som mobilt plock, returer, eller kopplingar till butiker och fraktbolag.

Datamigrering förtjänar särskild uppmärksamhet här. Gamla artikelnummer, dubblerade kundstamdata, och inkonsekventa lagerplatser försvinner inte automatiskt bara för att ett nytt system införs. Det är ofta bättre att medvetet städa upp stamdata och bara ta över relevant historik. Det sparar senare sökande och förhindrar att gammal oreda tekniskt bevaras.

Behörigheter hör också tidigt hemma på agendan. Inte varje medarbetare behöver tillgång till priser, alla lagerkorrigeringar, eller stamdataunderhåll. Tydliga roller skyddar mot oavsiktliga ändringar och gör ansvar synligt utan att blockera arbetsflödet med onödiga godkännanden.

Teknik som inte blir en börda efter driftsättning

En logistikapplikation måste reagera snabbt i den dagliga verksamheten, även om flera arbetsstationer bokar samtidigt. Det kräver en spårbar dataarkitektur, rena transaktioner, och tydliga regler för parallella ändringar. Om två medarbetare bearbetar samma lager får systemet inte generera tysta felaktiga bokningar.

Underhållbarhet är lika viktigt. Teknologier som PHP 8.4, modern JavaScript, och MySQL 8 är inte ett säljargument i sig. De är förnuftiga när applikationen förblir begriplig på lång sikt, får säkerhetsuppdateringar, och kan vidareutvecklas av kvalificerade utvecklare. Dokumenterad provisionering, säkerhetskopior, loggning, och en realistisk hantering av uppdateringar är del av den operativa förmågan.

Bra logistikprogramvara känns därför inte igen på en särskilt polerad demo. Den visar sig en vanlig tisdagsmorgon: leveransen bokas, lagret stämmer, ordern är spårbar, följesedeln matchar, och nästa skift vet vad som redan gjorts. Avlastningen skapas precis där — inte genom så många funktioner som möjligt, utan genom tillförlitliga arbetsflöden som passar verksamheten.

Permalänk →

Planera en MySQL-databas för webbapplikationer

Planera en MySQL-databas för webbapplikationer

När tre medarbetare bokar varor parallellt på morgonen, en kund kontrollerar leveransstatus, och ekonomiavdelningen skapar en faktura, syns inte kvaliteten hos en applikation i designen. Den visar sig i om alla ser exakt samma, korrekta datastatus. Att planera en MySQL-databas för en webbapplikation betyder därför inte att skapa tabeller så snabbt som möjligt. Det betyder att förstå verkliga arbetsflöden tillräckligt exakt för att säkerställa att data förblir tillförlitliga även under belastning, vid fel, och när verksamheten växer.

Särskilt i interna plattformar, lager- och orderprocesser, eller kundvända portaler behandlas databasen ofta för sent. Först byggs gränssnittet, sedan läggs fält till, följt av undantag. Det fungerar för en prototyp. I drift resulterar detta i dubblerade dataset, otydliga tillstånd, och rapporter som ingen längre riktigt litar på.

Planera en MySQL-databas för webbapplikationer: börja med arbetsflödet

Det första utkastet bör inte börja med kolumnnamn, utan med en konkret arbetssituation. Ta godsmottagning: en leverans anländer, tilldelas en leverantör och en order, kvantiteter kontrolleras, en lagerplats tilldelas, och lagret ändras. Beroende på verksamheten kräver denna process dessutom foton, en kvalitetskontroll, en spärrstatus, eller en spårbar korrigering. Ur detta arbetsflöde växer de funktionella objekten fram. Typiska exempel är artiklar, leverantörer, order, rader, lagerplatser, lagerrörelser, och användare.

Skillnaden mellan ett objekt och en händelse är avgörande. En artikel beskriver vad något är. En lagerrörelse dokumenterar att en kvantitet ändrades på en specifik plats vid en specifik tidpunkt. Att blanda båda i en enda tabell leder snabbt till förlorad spårbarhet.

Några svåra frågor hjälper för varje objekt: vad är den unika identiteten? Vilken information får ändras? Vem får ändra den? Vilka data måste bevaras historiskt? Och vilka regler gäller när två personer arbetar samtidigt? Dessa frågor förebygger senare improvisation bättre än en lång lista av påstått kompletta databasfält.

Datamodellen bör uttrycka regler

En databas är inte bara lagring för formulärinmatning. Den bör själv upprätthålla centrala regler. Om varje lagerrörelse måste tillhöra exakt en artikel och en lagerplats hör främmande nycklar hemma i modellen. Om ett externt ordernummer bara får förekomma en gång per tenant krävs ett unikt index. Om en rad aldrig bör existera utan en huvudorder måste denna relation modelleras tydligt.

MySQL 8 med InnoDB ger en solid grund för detta: transaktioner, främmande nycklar, låsmekanismer, och konsekventa ändringar över flera tabeller. Vid skrivning av en rörelse, aktuellt lager, och inspektionslogg under en godsmottagningsbokning bör detta ske som en sammanhållen transaktion. Om ett steg misslyckas får ingen halvfärdig åtgärd kvarstå.

Men inte varje regel hör hemma i databasen. Godkännanden, komplex prislogik, eller rollberoende processteg placeras ofta bättre i applikationslogiken eftersom de förändras snabbare funktionellt. Gränsen är pragmatisk: regler vars överträdelse permanent skadar data bör säkras så nära datan som möjligt. Regler som ändras ofta eller starkt beror på sammanhanget kräver väl testad applikationskod.

Blanda inte ihop historik med aktuella värden

Ett vanligt misstag är att bara lagra aktuellt lager eller aktuell status. Det räcker tills någon frågar varför kvantiteten ändrades i går eller vem som återställde en order. För operativa system är en historik av rörelser eller händelser ofta mer värdefull än ett enda överskrivbart fält.

Detta betyder inte att varje klickrörelse måste loggas permanent. Affärsrelevanta ändringar bör loggas: statusändringar, kvantitetsjusteringar, korrigeringar, godkännanden, och tilldelningar. En bra granskningspost innehåller en tidsstämpel, användaren eller systemprocessen, det tidigare och nya värdet, och en begriplig anledning när arbetsflödet kräver det. Detta gör det möjligt att klargöra fel utan att behöva leta igenom e-post, papperslistor, eller databasbackuper.

Välj nycklar, datatyper, och namngivningskonventioner medvetet

Tekniska beslut verkar små, men formar underhåll och integrationer under flera år. För interna primärnycklar är BIGINT-värden med automatisk tilldelning ofta ett nyktert, lätthanterligt val. UUID:er kan vara meningsfulla när data uppstår offline, flera system skriver oberoende, eller externa gränssnitt inte bör exponera sekventiella ID:n. De kostar dock mer lagringsutrymme och kräver lite mer uppmärksamhet vid index och sortering.

Penningbelopp bör lagras som DECIMAL, inte FLOAT eller DOUBLE. Kvantiteter behöver också en funktionellt lämplig precision: artikelantal är ofta heltal, medan vikter och längder inte är det. Tidsstämplar bör hanteras enhetligt, helst internt i UTC, medan gränssnittet visar den lokala tidszonen för verksamheten. Särskilt vid skiftbyten och sommartid förhindrar detta svårupptäckta avvikelser.

Namn bör också vara tråkiga och entydiga. order_items eller inventory_movements är mer hjälpsamma än kreativa förkortningar som bara det ursprungliga projektteamet förstår. Konsekventa singular- eller pluralformer är mindre viktiga än konsekvens i sig. Lika förnuftiga är fält som created_at, updated_at, och, vid behov, deleted_at. En mjuk radering är dock ingen standardförpliktelse. För juridiskt eller operativt relevanta poster är en ren avbokning vanligtvis bättre än en osynligt raderad datamängd.

Index följer faktiska frågor, inte gissningar

Ett index kan kraftigt påskynda en sökning, men gör skrivoperationer mer komplexa och förbrukar lagringsutrymme. Därför är "ett index på varje fält" ingen strategi. De viktigaste frågorna bör fastställas tidigt: öppna order från en kund, rörelser för en artikel inom en period, lager per lagerplats, eller nyligen ändrade poster för ett gränssnitt.

Ordningen på sammansatta index spelar roll här. Om applikationen regelbundet söker på tenant_id, status, och created_at är ett sammansatt index i exakt denna ordning ofta förnuftigt. Om det verkligen passar visar exekveringsplanen via EXPLAIN, inte magkänslan. Databaser görs inte snabba genom spektakulära knep, utan genom observerbara frågor, matchande index, och realistiskt testade datavolymer.

För växande tabeller lönar sig en tydlig bevarandestrategi. Behöver tekniska loggar ligga kvar i den primära produktionsdatabasen i fem år? Inte nödvändigtvis. Affärsposter, rörelser, och inspektionsbevis kräver andra bevarandeperioder än felsökningsinformation. Arkivering är inte ett tecken på ett svagt system, utan ett medvetet driftbeslut.

Flera samtidiga användare kräver transaktioner och tydliga tillstånd

I en webbapplikation kommer flera förfrågningar åt samma data samtidigt. Det är normalt i daglig lagerverksamhet, inte ett undantag. Två medarbetare kan boka samma lager medan en import skapar nya order. Utan transaktioner och riktad låsning finns risken för förlorade ändringar eller negativa lagernivåer som bara blir synliga veckor senare.

För kritiska åtgärder bör det vara tydligt vilka data som läses och skrivs inom en transaktion. Ibland räcker en atomär uppdatering, till exempel lager som bara ändras om den tillgängliga kvantiteten är tillräcklig. I andra fall är ett radlås förnuftigt så att en åtgärd kan kontrollera datatillståndet på ett kontrollerat sätt och sedan ändra det. Långa transaktioner är däremot problematiska: de blockerar annat arbete och ökar risken för konflikter.

Lika viktigt är en begränsad uppsättning funktionella tillstånd. En order bör inte vara "öppen", "delvis levererad", och "manuellt hanterad" samtidigt på grund av att motstridiga fält underhålls. Definierade statusövergångar förenklar gränssnitt, rapporter, och automatiseringar. Undantag kan tillåtas, men bör namnges och dokumenteras.

Planera säkerhet, tenants, och drift från början

Applikationen bör använda en dedikerad databasanvändare för MySQL med minimala privilegier. Skrivåtkomst för webbapplikationen betyder inte att denna användare behöver kunna ta bort tabeller eller ändra användarrättigheter. Administrativa konton hör inte hemma i produktionskonfigurationsfiler och aldrig i ett repository.

När flera kunder, platser, eller företag arbetar inom en applikation är tenant-isolering ett arkitektoniskt beslut, inte ett efterhandskonstruerat filtervillkor. En delad databas med en tenant_id kan vara effektiv och lätt att underhålla, men kräver konsekventa kontroller i varje fråga och tydliga regler för index. Separata databaser ger starkare isolering, men ökar arbetsinsatsen vid uppdateringar, utvärderingar, och drift. Vilken variant som passar beror på dataskyddskrav, datavolym, och affärsmodell.

Backuper är bara backuper när en återställning har testats. En fastställd rytm för backuper, bevarande, och återställning krävs. Likaså hör övervakning av lagringsutrymme, långsamma frågor, och misslyckade jobb, tillsammans med dokumenterade uppdateringar, till systemet. MySQL 8, PHP 8.4, och moderna webbapplikationer kan drivas väl på lång sikt om beroenden, åtkomstuppgifter, och driftsättningssteg inte enbart finns i en utvecklares huvud.

En förnuftig plan före den första dagen i drift

Innan implementeringen bör en kompakt datamodell med exempelarbetsflöden finnas. Detta inkluderar nyckeltabeller och relationer, statusregler, behörigheter, förväntade frågor, gränssnitt, och ett koncept för backuper och granskningsloggar. Denna plan behöver inte vara hundra sidor lång. Den måste fånga beslut som senare skulle vara kostsamma att korrigera.

Hos softify.pro börjar databasplanering därför med de personer som bokar, kontrollerar, plockar, eller löser undantag. Om ett befintligt kalkylblad tillförlitligt avbildar en hanterbar process kan det förbli den korrekta lösningen. Om flera personer arbetar samtidigt, poster uppstår, och fel måste vara spårbara, förtjänar databasen istället samma planeringsinsats som gränssnittet. Den bästa arkitekturen i slutändan är den som förenklar arbetsdagen och som fortfarande kan ändras transparent om två år.

Permalänk →