softify.pro
Laden …
Diensten Over ons COCO – onze AI-server Portfolio Insiders Case Studies Wetenswaardigheden Contact Aanmelden

Wetenswaardigheden

Pure fluidity meets ultimate performance: wat bedrijfssoftware echt snel maakt

Pure fluidity meets ultimate performance: wat bedrijfssoftware echt snel maakt

Een magazijnleider herkent slechte software niet aan een architectuurtekening. Hij herkent haar eraan dat medewerkers weer naar de telefoon grijpen, leveringsbonnen dubbel registreren of na een ploeg niet kunnen zeggen welke goederen er werkelijk zijn aangekomen. Pure fluidity meets ultimate performance mag daarom geen louter visuele pretentie zijn. Voor bedrijfssoftware betekent het dat een proces natuurlijk aanvoelt en tegelijk onder reële omstandigheden betrouwbaar functioneert.

Een elegante interface is waardeloos als ze hapert bij zwakke wifi in het magazijn. Een snelle toepassing helpt evenmin veel als ze een werkvolgorde afdwingt die niemand bij de laadperron kan volgen. Goede digitale hulpmiddelen verbinden ontwerp, snelheid en procesbegrip. Ze verminderen wrijving zonder het bedrijf in een voorgefabriceerde standaardlogica te persen.

Pure fluidity meets ultimate performance is een bedrijfsvraag

Vloeiendheid wordt vaak verward met animaties, grote afbeeldingen en gladde overgangen. Dat kan bij een modern merk passen. In het dagelijks werk toont ze zich echter anders: een goederenontvangst kan zonder omwegen worden geboekt. Een medewerker vindt een order ook wanneer alleen een referentienummer bekend is. Een fout wordt duidelijk benoemd, in plaats van te verdwijnen in een cryptische melding.

Prestaties zijn evenzeer meer dan een goede waarde in een browsertest. Doorslaggevend zijn de responstijd bij een order met veel posities, de stabiliteit aan het einde van de maand en de vraag of vijf personen tegelijk kunnen werken zonder elkaars gegevensstanden te overschrijven. Ook een nette omgang met verbindingsonderbrekingen, rechten en geblokkeerde accounts hoort erbij.

Beide zijn onlosmakelijk. Als een scherm direct reageert maar onduidelijke verplichte velden heeft, blijft het vermoeiend. Als het proces slim is gemodelleerd maar de pagina bij elke boeking twee seconden wacht, wordt het omzeild. Vloeiendheid ontstaat waar het systeem de volgende zinvolle handeling ondersteunt en technisch snel genoeg blijft, zodat de gedachtegang niet afbreekt.

De interface volgt het werkpad, niet het organigram

Veel standaardoplossingen structureren hun menu's naar modules: inkoop, verkoop, magazijn, rapportage, beheer. Vanuit productperspectief is dat begrijpelijk. Op de magazijnvloer begint het werk echter vaak met een situatie: een vrachtwagen staat er, een pallet ontbreekt, een klant heeft een leveringsbewijs nodig of een zending moet nog vóór de acceptatiesluiting worden geëtiketteerd.

Een goede individuele toepassing begint daarom met deze situaties. Welke informatie ligt er? Wie beslist? Wat moet worden gedocumenteerd? Wat mag later niet meer worden gewijzigd? Pas daarna wordt beslist welk invoerscherm, welke controle of automatisering nodig is.

Dat betekent niet dat elk bestaand proces ongewijzigd in software wordt gegoten. Sommige tabellen zijn werkelijk te foutgevoelig, sommige vrijgaven onnodig traag. Maar een werkende Excel-lijst hoeft niet noodzakelijk door een project te worden vervangen. Als ze slechts door één persoon wordt bijgehouden, weinig uitzonderingen kent en navolgbaar blijft, kan ze het passende hulpmiddel zijn. Software loont wanneer ze de coördinatie verbetert, foutbronnen verlaagt of informatie voor meerdere betrokkenen betrouwbaar beschikbaar maakt.

Minder klikken is niet automatisch beter

De eis van zo weinig mogelijk klikken klinkt redelijk, maar kan in de verkeerde richting leiden. Bij een onomkeerbare magazijnboeking is een korte bevestiging zinvol. Bij een verzendvrijgave kan een zichtbare plausibiliteitscontrole dure nabewerking voorkomen. Het juiste proces hangt af van het risico.

Doorslaggevend is dat extra stappen een duidelijk doel hebben. Een bevestiging mag niet alleen verschijnen omdat het framework ze gemakkelijk genereert. Ze moet precies staan waar mensen bewust een beslissing moeten nemen. Zo blijft de toepassing snel zonder lichtzinnig te worden.

Prestaties ontstaan in de architectuur, niet in de laatste sprint

Wie een website of webtoepassing pas kort vóór de go-live versnelt, behandelt meestal symptomen. Grote query's, onduidelijke datamodellen en achteraf aangevulde bijzondere gevallen laten zich niet door één enkele optimalisatiedag blijvend corrigeren.

Een deugdelijke basis begint met een database die overeenkomt met de werkelijke relaties in het bedrijf. In MySQL 8 hebben bewegingen, documenten, statuswijzigingen en gebruikersacties navolgbare sleutels en zinvolle indexen nodig. Een voorraad mag niet alleen als getal verschijnen als later moet worden opgehelderd door welke boeking ze is ontstaan. Tegelijk hoeft niet elke historische informatie bij elke paginaweergave opnieuw te worden berekend.

Bij moderne webtoepassingen is ook de scheiding van verantwoordelijkheden relevant. PHP 8.4 kan bedrijfsregels helder en onderhoudbaar afbeelden, terwijl moderne JavaScript gericht wordt ingezet voor reactieve gebieden. Dat is geen geloofsbelijdenis voor een bepaalde stack. Het is een kwestie van onderhoud: kunnen wijzigingen over zes maanden veilig worden doorgevoerd? Is zichtbaar waar een regel geldt? Kan een fout worden gereproduceerd, in plaats van alleen vermoed?

Prestaties hebben bovendien grenzen nodig. Zoekvelden hebben zinvolle minimumtekens of een precieze filterlogica nodig als miljoenen records denkbaar zijn. Grote lijsten hebben pagina's of getrapte naladingsprocessen nodig. Afbeeldingen en documenten mogen het kritieke werkproces niet blokkeren. Deze beslissingen lijken onspectaculair. Juist daarom blijven ze vaak langer waardevol dan een opvallend frontendeffect.

Zichtbare snelheid schept vertrouwen

Niet elk proces kan in minder dan een seconde zijn afgerond. Een etiketprint, een interface naar de transporteur of een controle tegen externe gegevens kost af en toe tijd. Doorslaggevend is dan hoe de toepassing met wachttijd omgaat.

Een duidelijke status zoals “Verzendlabel wordt aangemaakt” is beter dan een bevroren knop. Na afronding moet herkenbaar zijn welk nummer is aangemaakt en of het proces opnieuw mag worden gestart. Als een externe dienst niet bereikbaar is, heeft het team een begrijpelijke handelingsoptie nodig in plaats van een foutmelding voor ontwikkelaars.

Dat is ook een kwestie van gegevensintegriteit. Een dubbelklik mag geen twee leveringen aanmaken. Een afgebroken proces mag niet stilzwijgend een half afgemaakt record achterlaten. Goede systemen plannen zulke gevallen in, omdat ze in het dagelijks werk zullen optreden. Juist bij wisselende ploegen, tijdsdruk en mobiele apparaten is de uitzondering geen randthema.

Kwaliteit wordt zichtbaar vóór de fout

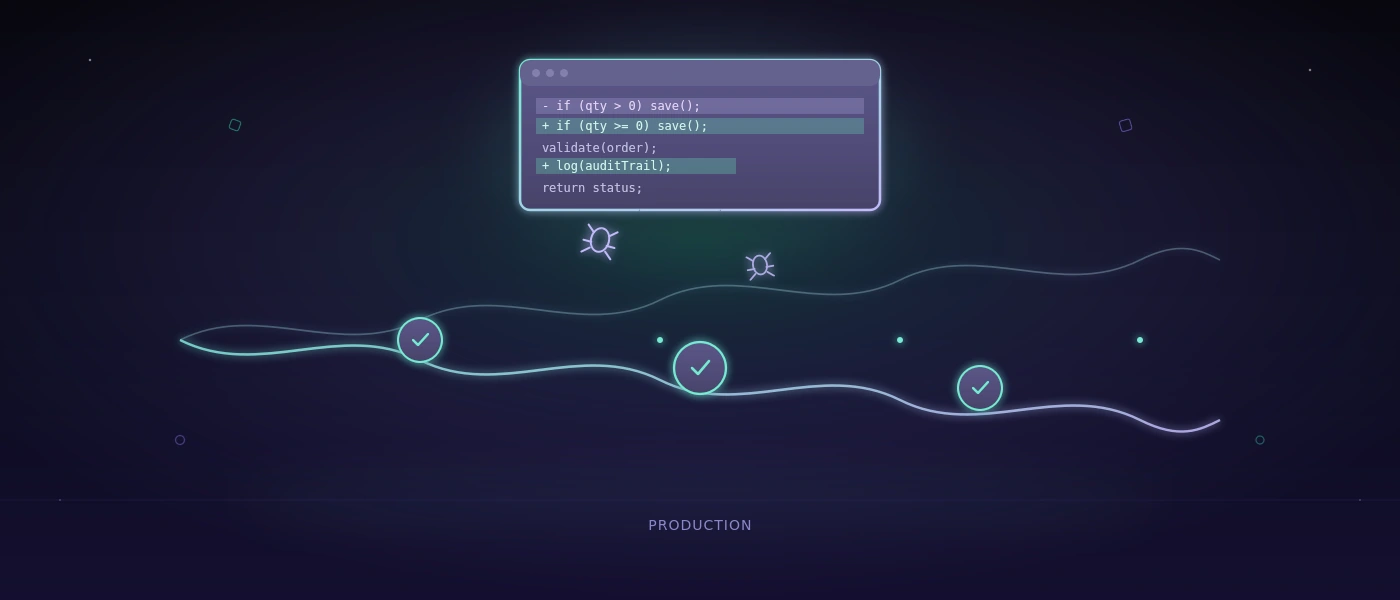
Voor toepassingen met veel procesvarianten volstaat het niet om aan het einde een paar paden handmatig door te klikken. Wijzigingen aan prijzen, rollen, validaties of interfaces kunnen op een ver verwijderde plek gevolgen veroorzaken. Hier wordt geautomatiseerd testen een onderdeel van de prestaties: niet alleen technisch, maar organisatorisch.

Een testsysteem zou echte processen moeten kunnen controleren, zoals een order aanmaken, een positie wijzigen, een leveringsbon genereren en een recht controleren. Het zou bewijzen moeten vastleggen en resultaten zo formuleren dat vakafdelingen ze kunnen plaatsen. Een zin als “Het verzendproces werd na de adreswijziging niet afgerond” helpt meer dan een ongecommentarieerde stacktrace.

Voor veiligheidsbewuste teams is ook de plek relevant waar deze tests draaien. Als screenshots, toegangsgegevens, testgevallen of interne toepassingsstappen het bedrijf niet mogen verlaten, is een zelfgehoste aanpak vaak zinvoller dan een externe clouddienst. Met COCO kunnen geautomatiseerde tests voor web- en Windows-toepassingen op een speciale omgeving worden uitgevoerd. Dat is niet voor elk team nodig. Bij gevoelige gegevens, gereguleerde gebieden of interne vaktoepassingen kan de controle over testgegevens echter een beslissend voordeel zijn.

Ontwerp is goed wanneer het werk vergemakkelijkt

Een sterke visuele identiteit kan vertrouwen scheppen. Ze toont dat een bedrijf zijn digitale aanwezigheid serieus neemt. In het operationele systeem moet ontwerp echter nog meer leveren: oriëntatie onder tijdsdruk. Contrast, typografie, duidelijke toestanden en begrijpelijke labels bepalen of iemand een proces zeker afrondt of bij de collega navraagt.

Terughoudendheid is hierbij vaak de betere keuze. Een dashboard met tien gekleurde kengetallen kan indrukwekkend ogen en toch de enige relevante afwijking verbergen. Een beperkte weergave die openstaande goederenontvangsten, ontbrekende scans en bedreigde leverdata zichtbaar maakt, is nuttiger. De vraag luidt niet hoeveel interface mogelijk is, maar welke informatie een beslissing verbetert.

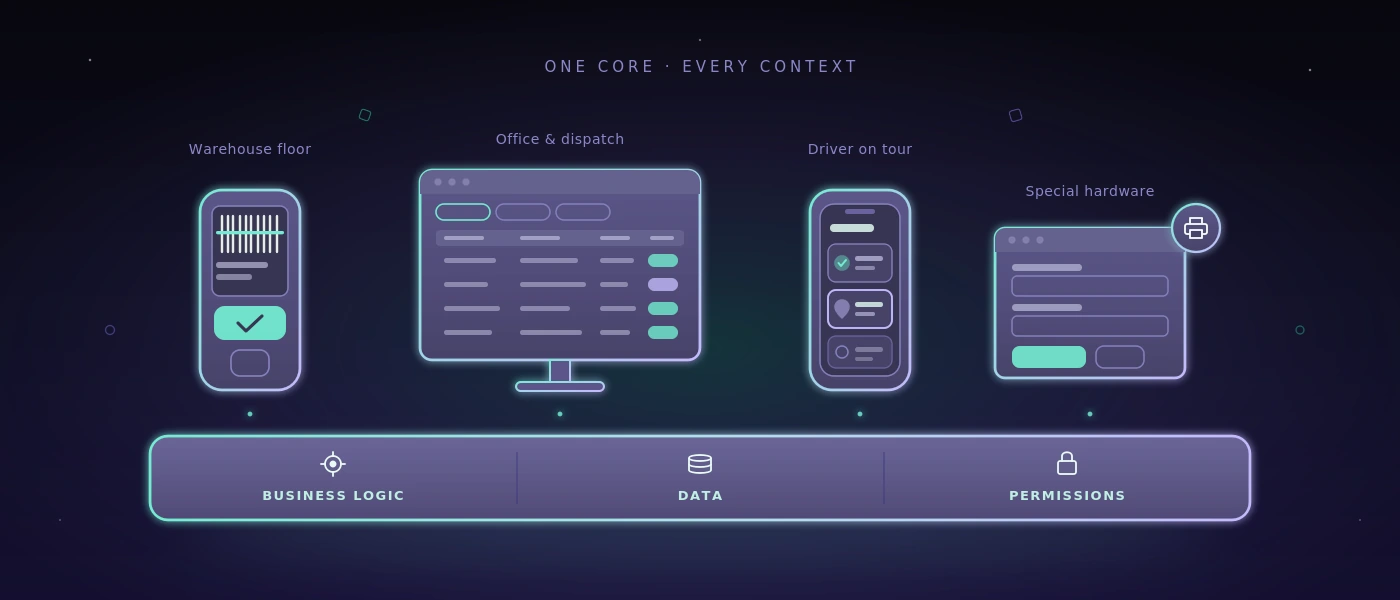
Dat geldt ook voor responsieve toepassingen. Mobiele geschiktheid betekent niet elk desktopscherm in een kleiner formaat te persen. Een smartphone bij de goederenontvangst heeft misschien alleen scan, hoeveelheid, opslaglocatie en bevestiging nodig. De uitgebreide nabewerking hoort mogelijk op een groter scherm. Verschillende apparaten verdienen verschillende prioriteiten, hoewel ze dezelfde betrouwbare gegevensbasis gebruiken.

Een zinvolle maatstaf voor de volgende beslissing

Voordat een team een nieuw platform, een automatisering of een complete nieuwbouw besluit, helpt een eenvoudige toets: wordt het proces voor de mensen die het dagelijks uitvoeren duidelijker, sneller of veiliger? En is de oplossing nog te begrijpen wanneer eisen, medewerkers of interfaces veranderen?

Als beide antwoorden deugdelijk zijn, wordt uit een mooie belofte een bruikbaar systeem. Dan toont pure fluidity meets ultimate performance zich niet in een dia, maar op een rustige werkdag waarop orders, gegevens en beslissingen zonder onnodige wrijving doorlopen.
Permalink →

SaaS Flow Web: workflows veilig invoeren tijdens de lopende bedrijfsvoering

SaaS Flow Web: workflows veilig invoeren tijdens de lopende bedrijfsvoering

Een goederenontvangst blijft niet liggen omdat een team nog een stuk software niet kent. Ze blijft liggen omdat informatie verloren gaat tussen e-mail, papieren formulier, Excel-bestand en telefoongesprek. Bij SaaS - “Flow Web” op flow.softify.pro - hoort daarom niet de interface de eerste vraag te zijn. Doorslaggevend is of de dienst een concreet werkproces betrouwbaar afbeeldt - ook op hectische dagen, bij wisselende verantwoordelijkheden en wanneer een levering niet met het plan overeenkomt.

Voor kleine en middelgrote bedrijven is SaaS vaak zinvol, omdat ze niet eerst eigen servers, releases en basisfuncties hoeven op te bouwen. Maar dat is geen vrijbrief voor elk proces. Wie een hulpmiddel invoert dat het dagelijks werk ingewikkelder maakt of belangrijke gegevens verdringt naar onduidelijke zijlijsten, digitaliseert geen werk. Hij verplaatst alleen de wrijving.

Wat SaaS “Flow Web” moet leveren

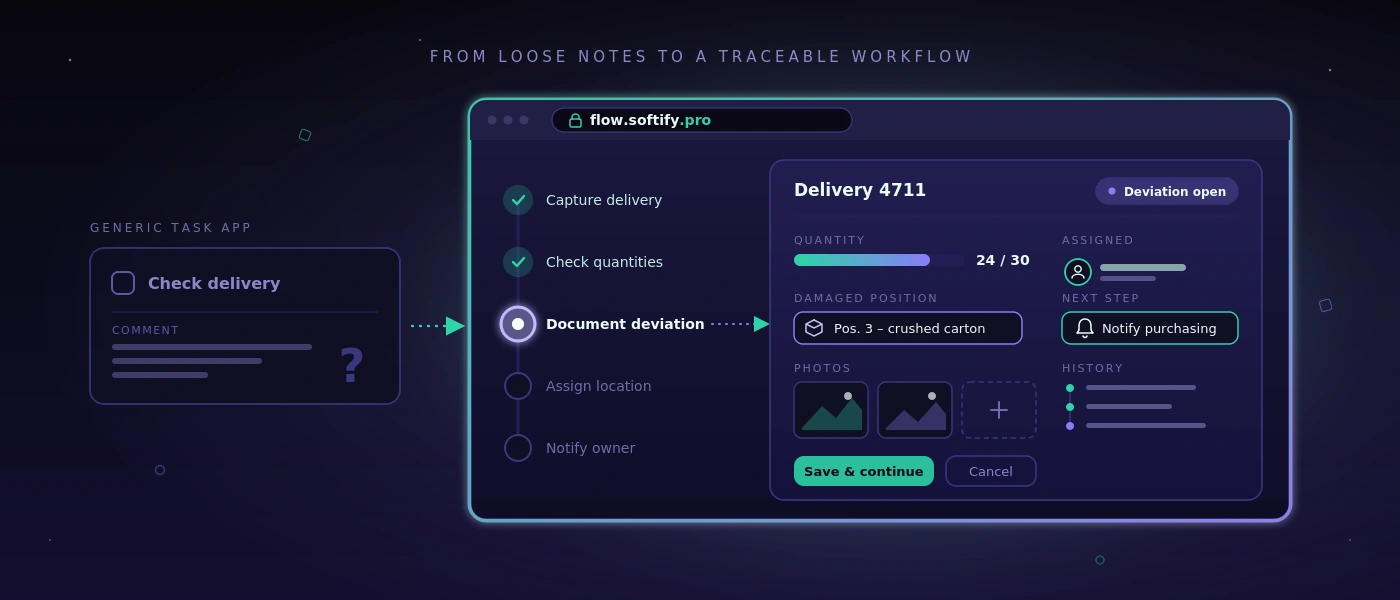
Een webworkflow is goed wanneer medewerkers zonder interpretatie weten wat de volgende stap is. Bij een goederenontvangst kan dat betekenen: levering registreren, hoeveelheden tegen de bestelling controleren, afwijking documenteren, opslaglocatie toewijzen en zo nodig een verantwoordelijke informeren. Het proces hoeft niet spectaculair te zijn. Het moet navolgbaar, snel en herhaalbaar zijn.

Precies hier ligt het verschil tussen een algemene taken-app en een vakinhoudelijk processysteem. Een taken-app kan een punt aanmaken met de naam “Levering controleren”. Een vakinhoudelijke workflow kan bovendien vastleggen welke levering bedoeld is, wie haar heeft aangenomen, welke positie beschadigd was, welke foto's er zijn en of een nalevering openstaat. Deze gegevens staan dan niet als vrije tekst in één enkele opmerking, maar waar de volgende persoon ze nodig heeft.

Voor een oplossing als Flow Web op flow.softify.pro zou de toetsing daarom bij de processen moeten beginnen, niet bij een functielijst. Een bedrijf met vijf magazijnbewegingen per dag heeft iets anders nodig dan een verzendteam met meerdere cut-off-tijden, verschillende vervoerders en regelmatig deelleveringsbeheer. SaaS is geen vervanging voor procesbegrip.

Eerst het knelpunt benoemen, dan configureren

Veel digitaliseringsprojecten starten te breed: “We willen het magazijn digitaliseren.” Dat klinkt aannemelijk, maar leidt snel tot een systeem met te veel schermen, bijzondere gevallen en trainingsdocumenten. Beter is een precieze uitspraak zoals: “Goederenontvangsten worden pas de volgende dag geboekt, omdat leveringsbonnen aan het einde van de ploeg op het bureau liggen.”

Uit zo'n zin laat zich een zinvolle start afleiden. De eerste versie kan leveringsbonnen registreren, artikelen en hoeveelheden bevestigen, afwijkingen markeren en de boeking doorgeven aan de bevoegde afdeling. Als dit proces werkt, kunnen etiketten, leveranciersbeoordelingen of automatische bestelvoorstellen later worden toegevoegd. Niet elke zinvolle uitbreidingsstap hoort in de eerste uitrol.

Ook een goed onderhouden tabel mag blijven als ze haar doel vervult. Een maandelijkse evaluatie met weinig betrokkenen in een bestaand bestand kan bijvoorbeeld goedkoper en transparanter zijn dan een eigen module. SaaS loont waar informatie meermaals wordt gebruikt, verwerkingstijden kritiek zijn of fouten ontstaan door mediabreuken.

De juiste vragen vóór de invoering

Vóór de configuratie zou een team een echt proces van begin tot einde moeten doorspelen. Niet het ideale proces, maar het geval dat in het dagelijks werk problemen geeft: verkeerde hoeveelheid, ontbrekende referentie, dringende verzending of een order met bijzondere vrijgave. Daarbij komen de regels naar voren die een systeem werkelijk moet afbeelden.

Relevant zijn onder meer deze punten: wie mag een proces aanmaken, wijzigen of afsluiten? Welke invoer is verplicht, welke alleen nuttig? Wanneer moet een leidinggevende worden geïnformeerd? Welke gegevens gaan naar boekhouding, verzending of klantenservice? En wat gebeurt er als de wifi in het magazijn zwak is of een medewerker zijn inloggegevens niet meer heeft?

De antwoorden bepalen de kwaliteit van de invoering sterker dan een lange catalogus van visuele eisen. Een schoon rollenproces, een begrijpelijke foutmelding en een gedocumenteerde vrijgavestap voorkomen in de praktijk meestal meer inspanning dan een extra rapport op de startpagina.

Gegevensbewaring en rollen zijn geen bijzaak

SaaS wordt vaak behandeld als een louter bedieningsvraag. Voor bedrijfs- en IT-verantwoordelijken is echter minstens even belangrijk wat er met de gegevens gebeurt. Dat betreft stamgegevens, leveringsinformatie, medewerkersgegevens, foto's van schade en mogelijk klantgegevens. Vóór de invoering moeten verantwoordelijkheden, bewaring en exportmogelijkheden duidelijk zijn.

In de praktijk betekent dat: het bedrijf moet weten welke gegevens in het systeem staan, wie beheerderstoegang heeft en hoe gegevens worden aangeleverd bij een wissel of beëindiging van het contract. Een export die alleen als moeilijk leesbaar PDF-bestand beschikbaar is, helpt zelden verder. Voor operationele gegevens zijn gestructureerde, bruikbare formaten doorslaggevend.

Ook het rechtenconcept verdient concrete aandacht. In het magazijn hoeft niet iedereen prijzen, klantvoorwaarden of globale instellingen te zien. Tegelijk mag een te strakke rechtentoewijzing het proces niet blokkeren. Zinvol zijn rollen die aansluiten bij werkelijke taken: ontvangst, planning, verzending, teamleiding en beheer. Kritieke wijzigingen moeten navolgbaar zijn, zodat bij vragen niet hoeft te worden geraden wie een boeking heeft gewijzigd.

De toegang zelf moet met solide basisprincipes worden beschermd. Daartoe behoren veilige wachtwoordrichtlijnen, een geregelde wachtwoordherstelprocedure, account-lockout bij herhaalde mislukte pogingen en, waar het risicoprofiel dat vraagt, extra aanmeldstappen. Beveiliging werkt professioneel wanneer ze voorspelbaar is en niet pas opvalt wanneer iemand buitengesloten werd.

Integratie alleen waar ze meetbaar ontlast

Een webworkflow ontplooit haar waarde vaak pas in samenspel met bestaande systemen. Dat kan een ERP zijn, een webwinkel, een verzendoplossing, een tijdregistratie of een database. Toch is niet elke interface automatisch zinvol. Elke integratie schept afhankelijkheden, foutbeelden en onderhoudsinspanning.

De centrale vraag luidt: welke handmatige stap verwijdert de koppeling concreet? Als een interface dagelijks 30 minuten overdrachtswerk bespaart en typefouten vermindert, is het nut duidelijk. Als ze slechts een informatie spiegelt die toch eens per week wordt gecontroleerd, kan een handmatige export aanvankelijk de verstandigere oplossing zijn.

Bij individuele uitbreidingen telt de technische basis. Gedocumenteerde interfaces, duidelijk gedefinieerde gegevensvelden en navolgbare foutenlogboeken vergemakkelijken het latere beheer. Als een systeem aan een maatwerk-webtoepassing wordt gekoppeld, moeten technologieën en databasestructuur zo worden gekozen dat ze op lange termijn onderhoudbaar blijven. Een verzorgde toepassing op basis van PHP 8.4, moderne JavaScript en MySQL 8 is waardevoller dan een op korte termijn indrukwekkende speciale oplossing zonder documentatie.

Invoering tijdens de lopende bedrijfsvoering

De meest voorkomende fout is een harde start zonder vergelijkingsfase. Teams moeten dan op maandagochtend meteen anders werken, terwijl open vragen pas uit echte problemen ontstaan. Dat verhoogt de afwijzing, zelfs als de software in principe past.

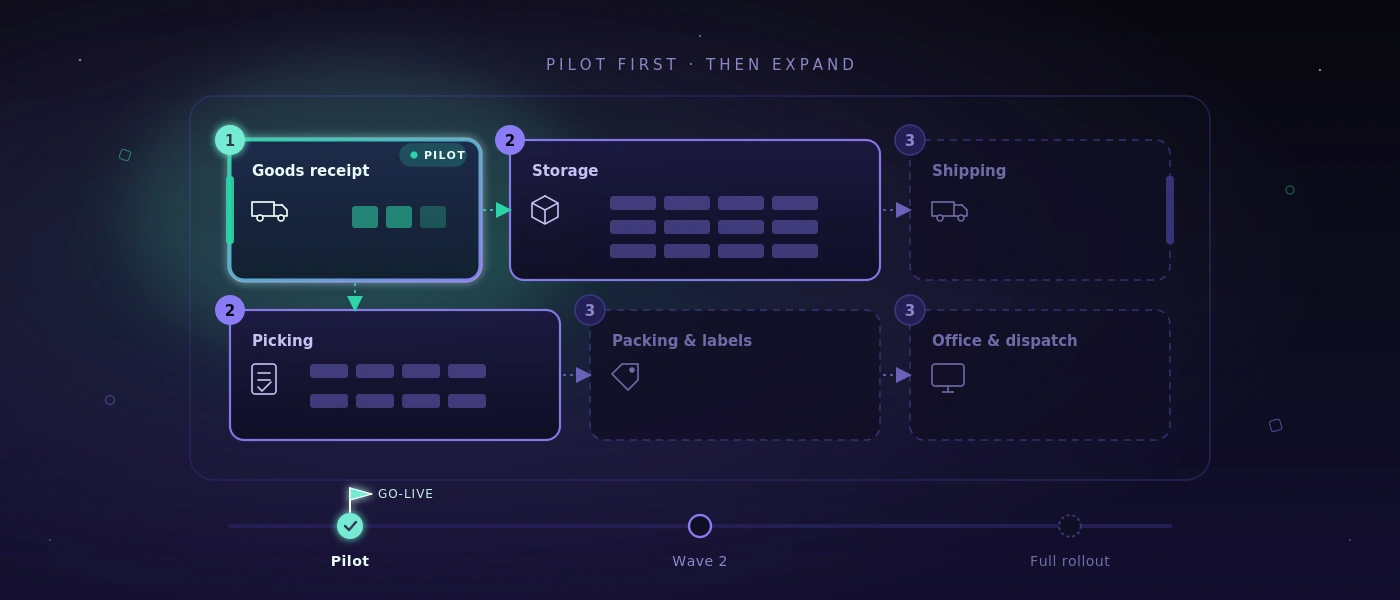
Beter is een beperkte pilot met één team, één procesvariant of een duidelijk afgebakend vestigingsgebied. In die tijd wordt gecontroleerd of registratie en vrijgaven werken, of begrippen begrijpelijk zijn en of uitzonderingsgevallen netjes terechtkomen. Belangrijk is terugkoppeling niet alleen als wensenlijst te verzamelen. Elke wijziging moet worden getoetst aan het nut voor doorlooptijd, foutenpercentage of transparantie.

Ook kengetallen moeten vroeg worden vastgelegd. Zo kunnen bijvoorbeeld de verwerkingstijd per goederenontvangst, het aantal openstaande afwijkingen, navragen over leveringsstatus of correctieboekingen worden gevolgd. Zonder uitgangswaarde blijft “voelt sneller” de enige beoordeling. Dat kan kloppen, maar volstaat niet voor een deugdelijke investeringsbeslissing.

Beheer heeft een duidelijke eigenaar nodig

SaaS vermindert de technische inspanning, maar ontslaat een bedrijf niet van de verantwoordelijkheid voor het eigen proces. Er is intern iemand nodig die rollen beheert, terugkoppeling bundelt, trainingsbehoefte herkent en beslist welke wijzigingen werkelijk nodig zijn. Deze persoon hoeft niet te kunnen programmeren. Ze moet het werkproces echter begrijpen en toegang hebben tot de verantwoordelijken.

Even belangrijk is een korte, solide beheerdocumentatie. Ze legt niet elk scherm uit, maar beantwoordt de vragen die in het dagelijks werk opkomen: wat te doen bij een foutieve boeking? Wie keurt nieuwe gebruikers goed? Hoe wordt een storing gecommuniceerd? Waar staan geëxporteerde gegevens? Zulke duidelijkheid voorkomt dat een digitaal systeem na enkele maanden weer afhankelijk wordt van persoonlijke tussenkomsten.

Een goede SaaS-oplossing herkent men daarom niet aan hoeveel menupunten ze biedt. Ze toont haar waarde wanneer een nieuwe collega een proces zeker kan afhandelen, een afwijking niet verdwijnt en een leidinggevende de status ziet zonder drie mensen te bellen. Precies aan deze maatstaf zou Flow Web moeten worden gemeten: niet aan beloften, maar aan een werkdag die aantoonbaar rustiger en betrouwbaarder verloopt.

Permalink →

Webontwikkeling met actuele frameworks: wat bedrijven er echt aan hebben

Webontwikkeling met actuele frameworks: wat bedrijven er echt aan hebben

Als een goederenontvangst nog heen en weer pendelt tussen papieren formulier, telefoongesprek en drie Excel-bestanden, lost een modern frontend het probleem alleen niet op. Webontwikkeling met actuele frameworks is zinvol wanneer ze processen zichtbaar vereenvoudigt: medewerkers zien de volgende stap, gegevens worden slechts één keer vastgelegd en de toepassing blijft ook na de eerste go-live begrijpelijk onderhoudbaar.

Voor kleine en middelgrote bedrijven is de frameworkvraag daarom geen geloofskwestie. Doorslaggevend is niet of een interface bijzonder veel technische modewoorden draagt. Doorslaggevend is of magazijnbewegingen, orders, controles of vrijgaves betrouwbaar door de werkdag komen - ook onder tijdsdruk, bij ploegwissels en wisselende netwerkverbinding.

Frameworks zijn een middel, geen projectdoel

Een framework levert een beproefde structuur voor terugkerende taken: routing, formulieren, rechtenbeheer, gegevenstoegang, tests en de weergave van interfaces. Dat vermindert niet automatisch elk risico. Maar het voorkomt dat een project basisfuncties steeds opnieuw moet uitvinden.

Bij een individuele webtoepassing kan een modern JavaScript-framework bijvoorbeeld interactieve schermen zinvol weergeven: een verzamellijst die posities voortdurend bijwerkt, een routeplanning met duidelijke statuswisselingen of een controleprotocol dat foto's en opmerkingen direct aan een proces koppelt. In de backend zorgen gevestigde PHP-frameworks voor navolgbare regels, duidelijk gescheiden verantwoordelijkheden en consistente interfaces naar de database.

Dat is vooral relevant wanneer uit een aanvankelijk kleine oplossing een dagelijks gebruikt bedrijfssysteem voor een proces wordt. Een invoerscherm voor leveringsberichten kan overzichtelijk beginnen. Zodra het voorraden bijwerkt, etiketten uitvoert, rollen in aanmerking neemt en met een transporteur communiceert, heeft het een schone technische basis nodig. Frameworks helpen die basis niet bij elke uitbreiding opnieuw te hoeven bespreken.

Wat actuele webframeworks concreet beter doen

De waarde van moderne frameworks ligt zelden in spectaculaire effecten. Ze blijkt in de onzichtbare delen van een toepassing. Formulieren kunnen invoer direct controleren, zonder dat foutieve gegevens pas na het verzenden opvallen. Rechten kunnen centraal worden gedefinieerd, zodat een chauffeur andere informatie ziet dan de planning. Wijzigingen aan een bestelling worden navolgbaar opgeslagen, in plaats van stilletjes een tabelcel te overschrijven.

Aan serverzijde schept een actuele omgeving met PHP 8.4 en MySQL 8 een robuuste basis voor bedrijfskritieke logica. Databasetransacties voorkomen bijvoorbeeld dat een voorraad wordt verlaagd terwijl de bijbehorende boeking mislukt. Unieke sleutels en validatieregels vermijden dubbele records. Achtergrondprocessen kunnen documenten genereren of interfaces aanspreken zonder dat de persoon aan het scherm hoeft te wachten.

Ook beveiliging is geen achteraf toegevoegde functie. Een eigentijds framework ondersteunt veilige wachtwoordopslag, bescherming tegen typische invoeraanvallen, navolgbare sessies en gedefinieerde account-lockout-processen. Toch blijft de uitvoering een projecttaak: rechten moeten inhoudelijk correct worden gemodelleerd en gevoelige functies vragen extra controles. Een framework levert vangrails, maar geen kennis over wie in het bedrijf welke vrijgave mag verlenen.

Webontwikkeling met actuele frameworks juist beslissen

De beste technologie ontstaat niet uit een lijst populaire tools, maar uit het werkelijke gebruik. Een interne toepassing voor tien personen heeft andere eisen dan een klantenportaal met enkele duizenden gelijktijdige toegangen. Een magazijnterminal met scanner heeft een andere bedieningslogica nodig dan een managementanalyse op de desktop.

Daarom begint een zinvolle beslissing met concrete vragen: welke processen kosten vandaag meetbaar tijd? Welke gegevens worden meermaals overgedragen? Waar ontstaan fouten omdat informatie pas te laat zichtbaar wordt? Welke bestaande tabel werkt goed genoeg en zou voorlopig moeten blijven? Juist het laatste punt beschermt tegen dure digitaliseringsprojecten zonder operationeel nut.

Voor veel individuele bedrijfstoepassingen is een server-side gerenderd systeem met gerichte interactieve componenten de verstandigste keuze. Het laadt snel, is overzichtelijk te beheren en vermijdt onnodige complexiteit. Een volledig ontkoppelde single-page-toepassing kan daarentegen passend zijn wanneer de interface zeer veel dynamische toestanden verwerkt, offline moet werken of dezelfde functies later ook aan een mobiele app moet leveren.

Beide kunnen inhoudelijk juist zijn. De vraag luidt niet: welk framework is het modernst? Ze luidt: welke architectuur is over twee jaar nog veilig uitbreidbaar, testbaar en begrijpelijk voor het eigen team?

Wanneer minder techniek de betere techniek is

Niet elk proces heeft een complex frontend nodig. Een slank invoerscherm voor interne bestellingen kan sneller, stabieler en goedkoper zijn dan een uitgebreid geanimeerde interface. Als een Excel-bestand slechts eens per maand wordt bijgehouden en geen fouten veroorzaakt, is het mogelijk nog steeds het juiste hulpmiddel.

Complexiteit loont pas wanneer ze echte wrijving wegneemt. Dat kan het geval zijn wanneer orders meermaals worden overgetypt, de leveringsstatus telefonisch moet worden nagevraagd of niemand zeker weet welke versie van een document geldt. Dan schept een centrale toepassing duidelijk nut: één gegevensstand, eenduidige verantwoordelijkheden en minder navragen.

Onderhoudbaarheid begint vóór de eerste regel code

Frameworks worden vaak als versneller gezien. Dat klopt alleen als de inhoudelijke regels vooraf voldoende duidelijk zijn. Een ontwikkelaar kan een toestandsmachine technisch netjes bouwen. Of de statusvolgorde echt bij het proces past, wordt echter beslist bij de opname: wanneer geldt goederen als ontvangen? Wie mag een afwijking afsluiten? Wat gebeurt er bij een deellevering?

Deze beslissingen horen gedocumenteerd, evenals interfaces, gegevensvelden en uitzonderingen. Dat maakt projecten niet trager. Het vermindert latere discussies, omdat zichtbaar wordt welke regel bewust is geïmplementeerd en welke aanname nog openstaat.

Onderhoudbaarheid blijkt ook uit kleine disciplines. Databasewijzigingen moeten worden geversioneerd. Deploymentstappen moeten worden gedocumenteerd. Foutmeldingen moeten bruikbaar zijn voor beheer en ontwikkeling, zonder vertrouwelijke details prijs te geven. Geautomatiseerde tests controleren bij elke wijziging centrale processen, zoals het aanmaken van een order, de berekening van een hoeveelheid of de uitvoer van een leveringsbon.

Bij kritieke toepassingen volstaat een enkel testtype niet. Unit-tests borgen afzonderlijke regels, integratietests controleren het samenspel met database en interfaces, en end-to-end-tests spelen echte bedieningspaden in de browser na. Voor web- en Windows-toepassingen kan een zelfgehoste testomgeving bovendien screenshots, uitvoeringsprotocollen en begrijpelijke beoordelingen leveren, zonder interne testgegevens onnodig aan externe clouddiensten te geven.

Prestaties ontstaan uit architectuur en datamodel

Een moderne interface wordt niet snel doordat ze een actueel framework gebruikt. Trage databasequery's, te grote afbeeldingen of onduidelijke interfaces blijven traag, ongeacht het frontend. Vooral bij lijsten met orders, artikelen of bewegingsgegevens bepaalt het datamodel de gevoelde snelheid.

Schone indexen in MySQL 8, gepagineerde query's en bewust geladen gegevens zijn vaak effectiever dan latere optimalisatie aan de interface. Even belangrijk is een duidelijk cachingconcept. Stamgegevens mogen onder omstandigheden worden gecachet, actuele voorraden of vrijgavestatus daarentegen niet blindelings. Hier is geen algemene regel, omdat de inhoudelijke betekenis van de gegevens bepaalt hoe actueel ze moeten zijn.

Responsief ontwerp hoort eveneens bij de technische planning. Op het kantoorscherm kan een brede tabel zinvol zijn. Op een handscanner of tablet in het magazijn heeft dezelfde informatie grote tikvlakken, korte wegen en een weergave nodig die ook met handschoenen of bij slecht licht bedienbaar blijft. Pure fluidity meets ultimate performance betekent in deze context niet zo veel mogelijk beweging op het scherm. Het betekent dat de toepassing zonder wrijving werkt op het apparaat dat in het proces daadwerkelijk wordt gebruikt.

De zinvolle weg van idee naar bedrijf

Een robuust webproject start met een beperkte, controleerbare kern. In plaats van elke denkbare uitzondering vooraf te automatiseren, wordt een proces gekozen dat vaak voorkomt en merkbaar inspanning veroorzaakt. Na de eerste inzet tonen echte gegevens en terugkoppeling welke uitbreiding als volgende werkelijk prioriteit heeft.

De technische overdracht zou niet pas aan het einde moeten plaatsvinden. Verantwoordelijkheden voor hosting, back-ups, monitoring, updates en toegangsrechten moeten vroeg worden verduidelijkt. Een systeem is slechts zo betrouwbaar als zijn beheer. Wie een toepassing dagelijks voor verzending of orderafhandeling nodig heeft, heeft gedefinieerde herstelwegen nodig en een duidelijk antwoord op wat er bij een storing gebeurt.

softify.pro zet daarom in op onderhoudbare technologieën, gedocumenteerde oplevering en directe technische verantwoordelijkheid in plaats van op kortstondige frameworkmodes. Dat is geen magische sluiproute. Het schept de voorwaarde dat een toepassing na de lancering blijft werken, verder kan worden ontwikkeld en niet het volgende fragiele bijzondere geval wordt.

De juiste webtoepassing voelt in het beste geval niet als een nieuw IT-project. Ze voelt als een proces dat eindelijk zonder omwegen werkt - met genoeg technische substantie om ook de volgende verandering in de bedrijfsvoering rustig op te vangen.

Permalink →

Een software-uitrol plannen: zo slaagt de invoering tijdens de lopende bedrijfsvoering

Een software-uitrol plannen: zo slaagt de invoering tijdens de lopende bedrijfsvoering

Een nieuw systeem faalt zelden omdat er een knop ontbreekt. Het faalt op maandagochtend: de vroege ploeg vindt de goederenontvangst niet, een leveringsbon wordt dubbel afgedrukt of een Excel-bestand blijft plotseling de onofficiële waarheid. Wie een software-uitrol wil plannen, moet daarom niet alleen functies invoeren, maar de werkelijke bedrijfsvoering borgen.

Juist in magazijn, werkplaats, planning en administratie is een uitrol geen IT-afspraak. Ze verandert handelingen, verantwoordelijkheden en informatiewegen. Een goede invoering houdt het werk in beweging, maakt fouten vroeg zichtbaar en geeft medewerkers een duidelijk antwoord op de beslissende vraag: wat doe ik vanaf morgen anders?

De uitrol begint vóór de eerste training

Veel projecten starten met een functielijst: orders registreren, magazijnbewegingen boeken, verzendlabels afdrukken, routes plannen. Dat is nodig, maar niet genoeg. Vóór de start moet duidelijk zijn welke processen op de eerste productieve dag daadwerkelijk via het nieuwe systeem moeten lopen - en welke bewust nog niet.

Deze afbakening is geen teken van onvolledigheid. Ze vermindert risico. Als een middelgroot bedrijf goederenontvangsten tot nu toe via papier, telefoon en tabellen coördineerde, hoeft op de eerste dag niet tegelijk het volledige voorraadbeheer, de retourafhandeling, de routeplanning en de leveranciersbeoordeling gedigitaliseerd te worden. Een zinvolle eerste omvang zou kunnen liggen bij de goederenontvangst, eenduidige magazijnbewegingen en het afdrukken van leveringsdocumenten.

Doorslaggevend is het streefproces concreet te beschrijven. Niet: "Goederenontvangst wordt digitaal." Maar: "De medewerker scant de levering, controleert hoeveelheid en toestand, wijst een opslaglocatie toe en maakt bij afwijkingen een proces voor inkoop aan." Pas op dit niveau worden open vragen zichtbaar: wat gebeurt er bij een ontbrekende bestelling? Wie mag hoeveelheden corrigeren? Mag een levering zonder label worden opgeslagen?

Een software-uitrol plannen betekent: kritieke processen prioriteren

Niet elk proces heeft dezelfde betekenis. Een storing bij stamgegevensbeheer kan vervelend zijn. Een storing bij verzending, orderverzameling of factuurvrijgave kan het werk van een hele dag blokkeren. Daarom heeft de uitrol een prioritering naar bedrijfsrisico nodig, niet naar de volgorde in het pakket van eisen.

Een eenvoudige indeling heeft zich bewezen: bedrijfskritiek, belangrijk en uitstelbaar. Bedrijfskritiek zijn alle processen die goederen, geld of bindende klantcommunicatie in beweging brengen. Belangrijk zijn functies die de dagelijkse gang van zaken versnellen, maar waarvan de uitval tijdelijk handmatig kan worden opgevangen. Uitstelbaar zijn comfortfuncties, zeldzame bijzondere gevallen of analyses die aanvankelijk nog uit een bestaande bron mogen komen.

Deze indeling beïnvloedt de testdiepte. Voor een kritiek verzendproces volstaat het niet één enkele order succesvol door te klikken. Getest moeten ook deelleveringen, annuleringen, ontbrekende printers, verkeerde adressen, parallelle verwerking en de overdracht aan de transporteur. Bij een zelden gebruikte statistiekfunctie kan een latere testcyclus passend zijn.

Succescriteria vooraf meetbaar maken

"De toepassing draait" is geen acceptatiecriterium. Beter zijn controleerbare uitspraken: een goederenontvangst van 30 posities is binnen tien minuten boekbaar. Verzendlabels worden op de beoogde werkplek afgedrukt. Voorraadwijzigingen verschijnen direct in de planning. Een geblokkeerd gebruikersaccount kan alleen via het gedefinieerde vrijgaveproces weer worden geactiveerd.

Zulke criteria verbinden vakafdeling en ontwikkeling. Ze voorkomen ook dat de acceptatie een verzameling vage indrukken wordt. Niet elke terugkoppeling hoeft vóór de go-live opgelost te zijn. Maar elke terugkoppeling heeft een indeling nodig: kritieke fout, relevante verbetering of punt voor een latere uitbreidingsfase.

Datamigratie: alleen schone gegevens verdienen vertrouwen

Oude gegevens worden vaak onderschat. In tabellen vindt men dubbele artikelnummers, verschillende eenheden, verlopen klantadressen en voorraden waarvan niemand de herkomst meer kan verklaren. Wie deze gegevens ongecontroleerd overneemt, verplaatst oude onduidelijkheid naar een nieuw systeem - alleen met een betere interface.

Vóór de migratie moet worden vastgelegd welke gegevens echt nodig zijn. Vaak zijn actuele artikelen, actieve klanten, openstaande orders, relevante leveranciers en gecontroleerde beginvoorraden zinvol. Historische gegevens hoeven niet noodzakelijk volledig naar de nieuwe toepassing te verhuizen. Het kan volstaan ze leesbaar te archiveren als ze nodig blijven voor bewijs of navragen.

Bijzonder belangrijk is een proefinlading. Daarbij worden gegevens niet alleen technisch geïmporteerd, maar inhoudelijk gecontroleerd: kloppen hoeveelheden, eenheden en toewijzingen? Zijn verplichte velden volledig? Kunnen typische orders er correct mee worden verwerkt? Voor de go-live is daarna een duidelijke stopdatum nodig. Vanaf wanneer wordt welk leidend systeem gebruikt? Zonder deze regel ontstaan dubbel onderhoud en tegenstrijdige voorraden.

Pilotbedrijf in plaats van één grote schakelaar

Een big bang kan zinvol zijn als een klein team een duidelijk afgebakend proces gebruikt en oude en nieuwe oplossing niet parallel kunnen functioneren. In de meeste operationele omgevingen is een pilot echter de beter beheersbare keuze.

De pilot zou met echte gevallen moeten werken, maar binnen een beperkt kader: een magazijngebied, een ploeg, een productgroep of een geselecteerd team. Doorslaggevend is dat de pilotgroep niet alleen bijzonder technisch aangelegde medewerkers omvat. Ze moet het latere dagelijks werk realistisch weergeven, inclusief de mensen die onder tijdsdruk werken en terechte bezwaren hebben.

In de pilot blijkt of scanners, printers, netwerk en rechten op de feitelijke werkplek functioneren. Even zichtbaar worden proceslacunes die niemand in overleggen heeft genoemd. Misschien wordt goederen in de praktijk eerst op een tussenplek neergezet. Misschien hebben chauffeurs een andere leveringsbon nodig dan de administratie. Zulke inzichten zijn geen stap terug. Ze zijn de reden om de pilot vóór de brede start uit te voeren.

Training als werksituatie, niet als softwarerondleiding

Een training die alleen menu-items uitlegt, schept weinig zekerheid. Medewerkers moeten leren aan de hand van hun taken: "U neemt een beschadigde levering aan", "U verzamelt een spoedorder", "U corrigeert een verkeerd geboekte hoeveelheid". De context blijft hangen omdat ze overeenkomt met het dagelijks werk.

Korte trainingen dicht bij de go-live zijn meestal effectiever dan één lange afspraak weken eerder. Aanvullend helpen beknopte werkinstructies direct op de werkplek. Ze moeten niet het hele systeem uitleggen, maar de meest voorkomende handelingen, duidelijke verantwoordelijkheden en de weg bij storingen tonen.

Benoem bovendien aanspreekpunten per afdeling. Deze personen hoeven niet elk technisch probleem zelf op te lossen. Ze moeten echter kunnen beslissen of het gaat om een bedieningsfout, een inhoudelijke onduidelijkheid of een daadwerkelijke systeemfout. Dat beschermt het projectteam tegen ongestructureerde tussenkomsten en versnelt de hulp voor de ploeg.

De go-live heeft een bedrijfsplan nodig

De go-live-dag heeft meer nodig dan een tijdstip. Definieer wie inhoudelijk beslist, wie technische wijzigingen verantwoordt en via welk kanaal storingen worden gemeld. Bij kritieke processen moet zichtbaar zijn of centrale functies werken: aanmelding, rechten, gegevensregistratie, interfaces, afdrukken en back-up.

Ook een terugvalplan hoort erbij. Dat betekent niet bij het kleinste probleem meteen volledig terug te keren naar de oude wereld. Het betekent vooraf te bepalen welke storing een stop rechtvaardigt, hoe orders desnoods worden gedocumenteerd en hoe achteraf netjes wordt nageregistreerd. Een papieren formulier voor enkele uren kan verstandig zijn. Een permanente parallelle werkwijze zonder einde is het niet.

Technische details tellen daarbij: zijn toegangen op tijd aangemaakt? Werken rollen en account-lockout-regels correct? Zijn etikettenprinters verbonden met de juiste sjablonen? Bestaat er een geteste back-up van de database? Bij op maat ontwikkelde toepassingen horen gedocumenteerde deployments, navolgbare versiestanden en een duidelijke weg voor foutherstel tot de standaard.

De eerste weken bepalen de acceptatie

Na de start begint de fase waarin een toepassing ofwel een werkmiddel ofwel een ongeliefde extra stap wordt. Plan daarom dagelijkse korte terugkoppelrondes in. Welke fouten treden herhaaldelijk op? Waar ontstaan omwegen? Welke velden worden verkeerd begrepen? Welke evaluatie mist een leidinggevende werkelijk?

Niet elke waarneming vraagt meteen een wijziging. Sommige problemen lossen zich op door nauwkeurigere werkregels of een betere training. Andere tonen echte zwakten in het proces of de toepassing. De kunst bestaat erin beide niet te verwarren. Een systeem moet bestaande werkende processen niet zonder reden ingewikkelder maken. Als een goed onderhouden tabel voor een zeldzaam bijzonder geval nog steeds de betere oplossing is, mag ze blijven.

Meet het effect aan de hand van enkele concrete kengetallen: verwerkingstijd per proces, aantal navragen, foutboekingen, herafdrukken, openstaande orders of voorraadverschillen. Pas deze waarden tonen of de uitrol de bedrijfsvoering daadwerkelijk verbetert - in plaats van louter nieuwe schermen in te voeren.

Een goede uitrol voelt na enkele weken niet meer als een project. Ze wordt een betrouwbare werkroutine: de juiste gegevens staan waar ze nodig zijn, uitzonderingen zijn navolgbaar en teams hoeven minder achter informatie aan te bellen. Precies daarop moet de planning mikken - niet op een spectaculaire startdag, maar op een rustiger, beter stuurbaar dagelijks werk.

Permalink →

Multiplatform Application Development plannen: eerst het proces, dan het platform

Multiplatform Application Development plannen: eerst het proces, dan het platform

Een magazijnleider bevestigt een goederenontvangst op de handscanner. De planning controleert dezelfde transactie in de browser. Een chauffeur heeft onderweg de leveringsstatus nodig op de smartphone. Multiplatform application development klinkt op dit moment als een technische vraag. In werkelijkheid gaat het eerst om een bedrijfsproces: welk werk moet op welke plek, met welke betrouwbaarheid en met welk apparaat worden uitgevoerd?

Voor kleine en middelgrote bedrijven is het juiste antwoord zelden: we bouwen alles native voor elk platform. Vaker luidt het: we definiëren een gemeenschappelijk proces, kiezen gericht de noodzakelijke gebruikersinterfaces en vermijden dubbele logica. Dat bespaart niet alleen ontwikkelbudget. Het voorkomt ook dat magazijn, kantoor en buitendienst met verschillende gegevensstanden werken.

Wat Multiplatform Application Development moet leveren

Multiplatform Application Development duidt op de ontwikkeling van een toepassing die in meerdere omgevingen bruikbaar is, bijvoorbeeld in de webbrowser, op iOS en Android of op Windows-desktopsystemen. De term wordt vaak teruggebracht tot de vraag of één enkele codebasis meerdere apps kan opleveren. Dat is slechts een deel van de beslissing.

Voor operationele systemen telt vooral of de toepassing werkt op de plek waar ze wordt gebruikt. Een goederenontvangst heeft misschien een camera nodig om barcodes vast te leggen, grote bedieningselementen voor handschoenen en een bruikbare reactie bij onstabiele wifidekking. De administratie heeft daarentegen tabellen, filters, rechtenconcepten en navolgbare wijzigingslogboeken nodig. Een chauffeur heeft een beperkte weergave nodig, niet dezelfde interface als de planning.

Een gemeenschappelijke technische basis kan deze eisen zinvol verbinden. Maar ze mag er niet toe leiden dat elk platform als slecht compromis wordt bediend. De beste gedeelde code is waardeloos als medewerkers omwegen nemen omdat de toepassing hun werkelijke werkproces niet weergeeft.

Eerst het proces bepalen, dan het platform

Voordat teams over frameworks praten, zouden ze één concrete transactie van begin tot eind moeten onderzoeken. Neem een levering: de bestelling komt binnen, goederen worden verzameld, een leveringsbon ontstaat, de overdracht wordt bevestigd en de status wordt teruggemeld aan verkoop of klantenservice. Op welke plek ontstaat vandaag de mediabreuk? Waar wordt iets op papier genoteerd, later overgetypt of telefonisch nagevraagd?

Deze waarneming scheidt echte platformeisen van wensenlijstjes. Als maar twee medewerkers op kantoor een functie gebruiken, is een goed gemaakte webinterface meestal voldoende. Als tien mensen op de magazijnvloer boekingen uitvoeren, kan een mobiele, scannervriendelijke interface het verschil maken. Moet een bestaand Windows-programma met speciale hardware werken, dan kan een desktopintegratie nodig zijn.

Niet elke functie hoort op elk apparaat. Dat is geen gebrek van een multiplatformoplossing, maar een teken van nette productbeslissingen. Gedeelde gegevens en bedrijfsregels betekenen niet noodzakelijk identieke schermen.

De drie vragen die kosten en baten verduidelijken

De eerste vraag luidt: welke apparaten zijn al in gebruik en hoe lang blijven ze dat? Een bedrijf met beheerde Windows-terminals heeft andere eisen dan een buitendienst met privésmartphones. De tweede luidt: wat gebeurt er zonder netwerkverbinding? Offlinecapaciteit verhoogt de inspanning aanzienlijk, omdat gegevens lokaal moeten worden opgeslagen, later gesynchroniseerd en bij conflicten netjes afgehandeld. Ze is zinvol als het proces anders stilvalt - niet als standaarduitrusting.

De derde vraag betreft de gevolgen van een storing. Kan een medewerker een boeking later nabrengen, of hangt er een verzendlabel, een voorraad of een veiligheidsvrijgave aan? Hoe kritieker het proces, hoe sterker rechten, controleregels, herhaalbaarheid en logging moeten worden gepland.

Een architectuur die niet bij het tweede platform uiteenvalt

Bij een duurzame oplossing ligt de bedrijfslogica niet verspreid over meerdere interfaces. Voorraadcontroles, statuswisselingen, nummerreeksen, rechten en documentgeneratie hebben een centrale, geteste basis nodig. Browser, mobiele toepassing en desktopclient benaderen die via duidelijk gedefinieerde interfaces.

Voor veel interne bedrijfsprocessen is een moderne webtoepassing het meest economische vertrekpunt. Ze kan centraal worden bijgewerkt, vereist geen installatie op elke werkplek en werkt op desktop, tablet en smartphone. Met PHP 8.4, moderne JavaScript en MySQL 8 kan een onderhoudbare basis worden opgebouwd, mits datamodel, toegangsrechten en uitrol niet pas kort voor de go-live worden bedacht.

Een installeerbare mobiele of desktoptoepassing wordt aangevuld wanneer ze een duidelijk voordeel biedt: diepe integratie met scanner, printer of camera, betrouwbare offlinewerking, speciale achtergrondfuncties of eisen vanuit het apparaatbeheer. Dat is een gerichte uitbreiding, geen doel op zich.

Een veelvoorkomende fout is de volledige hergebruik van de gebruikersinterface tegen elke prijs. Technisch kan dat aantrekkelijk lijken. In de praktijk ontstaan kleine teksten op grote monitoren, overladen formulieren op smartphones of bedieningen die niet bij het platform passen. Beter is het datamodel, regels en componenten te delen waar dat zinvol is, terwijl de bediening op de betreffende context wordt afgestemd.

Gegevensconsistentie is belangrijker dan een gedeelde codebasis

Meerdere platforms vergroten het risico op tegenstrijdige gegevens. Een order wordt op kantoor gewijzigd terwijl een chauffeur op zijn apparaat nog een oude versie ziet. Twee medewerkers boeken tegelijk dezelfde artikelvoorraad. Een offlineapparaat stuurt zijn wijzigingen uren later terug. Deze gevallen zijn geen randthema, maar de kern van de architectuur.

Het systeem heeft daarom eenduidige identiteiten, tijdstempels, navolgbare toestandswisselingen en regels voor conflicten nodig. Bij een leveringsstatus kan de laatst bevestigde wijziging volstaan. Bij voorraden is dat vaak te grof. Daar moet duidelijk zijn welke beweging is geboekt, van welke opslaglocatie ze afkomstig is en of een correctie moet worden gemotiveerd.

Ook rechten horen centraal geregeld. Een medewerker mag mogelijk goederenontvangsten registreren, maar geen voorraadcorrecties vrijgeven. Een externe chauffeur mag alleen zijn route zien. Sessieduur, meervoudige authenticatie bij kritieke rollen en account-lockout-processen zijn geen decoratieve beveiligingsfuncties. Ze beschermen concrete processen en maken verantwoordelijkheden zichtbaar.

Multiplatform Application Development testen zoals er gewerkt wordt

Een toepassing kan op drie besturingssystemen starten en toch in de praktijk falen. Doorslaggevend zijn de processen onder reële omstandigheden: de scanner reageert te traag, een etikettenprinter is niet bereikbaar, een recht werkt na een rolwisseling niet, of een synchronisatie genereert dubbele boekingen.

Daarom zouden kritieke processen geautomatiseerd gecontroleerd moeten worden. Daartoe behoren aanmelding en blokkeergedrag, orderregistratie, voorraadbewegingen, documentgeneratie en de verwerking van foutieve invoer. Voor web- en Windows-toepassingen kunnen terugkerende tests op een zelfgehoste infrastructuur worden uitgevoerd. Dat is vooral relevant als screenshots, interne ordergegevens of testtoegangen niet aan externe clouddiensten mogen worden doorgegeven.

Automatisering vervangt geen controle door mensen op de magazijnvloer. Ze zorgt er wel voor dat bekende processen na wijzigingen telkens opnieuw worden gecontroleerd. Goede testrapporten noemen daarbij niet alleen een technische fout, maar het getroffen proces: leveringsbewijs kan niet worden gegenereerd, gebruikersaccount blijft na succesvolle vrijgave geblokkeerd of routegegevens worden niet bijgewerkt.

Wanneer een platformstrategie te veel is

Sommige bedrijven hebben geen eigen app nodig. Als een stabiele browsertoegang volstaat, het proces zelden mobiel is en het aantal gebruikers overzichtelijk blijft, is een responsieve webtoepassing vaak de verstandigere keuze. Ze vermindert onderhoudsinspanning, distributieproblemen en het aantal mogelijke foutbronnen.

Ook een bestaande tabel hoeft niet meteen te worden vervangen. Als ze slechts als eenvoudige evaluatie dient, door één persoon wordt bijgehouden en geen foutgevoelige overdrachten veroorzaakt, kan ze haar doel vervullen. Het moment voor een systeem is bereikt wanneer kennis in individuele hoofden zit, versies uit elkaar lopen, navragen toenemen of een proces niet meer betrouwbaar kan worden nagegaan.

Omgekeerd wordt een slanke platformstrategie snel te klein wanneer medewerkers offline moeten werken, hardware wordt gekoppeld of klanten en partners gecontroleerde toegang nodig hebben. Dan loont het de extra eisen bewust te financieren, in plaats van ze later onder tijdsdruk aan te bouwen.

Beginnen met een solide pilot

Een goede start is geen functiecatalogus met honderd punten, maar een compleet, meetbaar proces. Bijvoorbeeld: goederenontvangst registreren, voorraad bijwerken, afwijking documenteren en een taak ter verheldering aanmaken. Deze pilot toont vroeg of datamodel, apparaten, rechten en bediening bij elkaar passen.

Daarna kan de oplossing in zinvolle stappen groeien: orderverzameling, verzending, routeplanning of analyses. Elke uitbreiding zou dezelfde vraag moeten doorstaan: verkort ze een echt proces, verlaagt ze fouten of creëert ze betrouwbare transparantie? Zo niet, dan mag ze wachten.

Het zinvolste platform is uiteindelijk niet dat met de meeste technische opties. Het is het platform waarop een team 's ochtends sneller met het werk begint, tijdens de ploeg minder navraagt en 's avonds kan nagaan wat er daadwerkelijk is gebeurd.

Permalink →

Test Automation Results juist beoordelen

Test Automation Results juist beoordelen

Een regressietest kan 's ochtends eindigen met 98 procent geslaagde gevallen en toch geen goed nieuws zijn. Misschien is precies de mislukte test de login van een grote klant. Misschien zijn 40 tests overgeslagen omdat de testomgeving niet bereikbaar was. Of de run was weliswaar groen, maar controleerde alleen of knoppen aanwezig zijn, niet of een order daadwerkelijk wordt opgeslagen, een leveringsbon wordt gegenereerd en de voorraad correct wordt aangepast. Test automation results zijn geen uitspraak over kwaliteit zolang hun context ontbreekt.

Voor QA-leiding, ontwikkeling en vakafdelingen ligt het eigenlijke werk daarom niet alleen in het automatiseren van tests. Doorslaggevend is om resultaten zo op te bereiden dat er betrouwbare beslissingen uit voortkomen: kan een release worden uitgerold? Moet een fout direct worden behandeld? Is de fout nieuw, teruggekeerd of slechts een probleem van de testomgeving? En zijn er bewijzen die ook een vakafdeling zonder testcode kan volgen?

Wat Test Automation Results echt zeggen

De eenvoudigste kengetal luidt: geslaagd of mislukt. Het is nuttig, maar zelden voldoende. Een hoog slagingspercentage kan vertrouwen scheppen als de tests kritieke processen afdekken, de testdata plausibel zijn en de omgeving op de latere productie lijkt. Ontbreekt een van deze factoren, dan blijft het getal vooral een signaal dat een geautomatiseerde run is uitgevoerd.

Bij bedrijfskritieke toepassingen tellen andere vragen zwaarder. In een magazijnoplossing is niet elk scherm even belangrijk. Een weergavefout in een interne hinttekst kan wachten. Een fout die bij goederenontvangst de verkeerde hoeveelheid boekt of een verzendlabel zonder afleveradres genereert, niet. Goede testresultaten wegen daarom risico's in plaats van alle gevallen gelijk te behandelen.

Ook een mislukte test is niet automatisch een productfout. Hij kan veroorzaakt worden door verlopen inloggegevens, een geblokkeerde testrol, niet-beschikbare interfaces, gewijzigde testdata of een trage omgeving. Wie deze oorzaken niet scheidt, produceert ruis. Het team besteedt dan tijd aan valse alarmen terwijl echte fouten verdwijnen tussen rode statusmeldingen.

Vier statustypen in plaats van één rode lijst

In de praktijk bewijst een duidelijke indeling haar waarde: functionele fout, technische testfout, omgevingsprobleem en verwachte wijziging. Een functionele fout betekent dat de toepassing een gedefinieerde eis schendt. Een technische testfout wijst eerder op de test zelf, bijvoorbeeld een selector die niet meer past na een bewust gewijzigde interface.

Een omgevingsprobleem doet zich voor wanneer bijvoorbeeld een testsysteem of een gekoppelde interface niet beschikbaar is. Verwachte wijzigingen ontstaan wanneer een proces bewust is aangepast, maar de automatisering nog de oude streeftoestand controleert. Deze categorieën voorkomen niet elke discussie. Maar ze zorgen ervoor dat de discussie op het juiste punt begint.

Van testruns naar beslissingsklare rapporten

Een bruikbaar rapport beantwoordt niet alleen dat iets is mislukt, maar wat er is gebeurd, hoe ernstig het is en of de fout reproduceerbaar lijkt. Daarvoor is meer nodig dan een lijst van testnamen en tijdstempels.

Bij elke relevante run horen de gecontroleerde build, de testomgeving, de gebruikte rol, centrale testdata en begin- en eindtijd. Juist bij Windows-desktoptoepassingen of complexe webplatforms is deze informatie nodig om verschillen af te bakenen. Een fout die alleen optreedt onder een beperkte magazijnrol is iets anders dan een fout die elke aanmelding blokkeert.

Betekenisvolle resultaten bevatten bovendien navolgbaar bewijs: screenshots, opgenomen stappen, foutmeldingen en zo nodig technische logboeken. Een screenshot alleen kan echter bedriegen. Het toont een moment, niet de oorzaak. De combinatie van stappenvolgorde, zichtbare toestand en verwachte reactie is veel behulpzamer.

AI-ondersteunde systemen kunnen dit bewijs omzetten in begrijpelijke beoordelingen. Bij COCO bijvoorbeeld draaien tests op een eigen, zelfgehoste AI-server. De evaluatie kan uitleggen dat een order wel is aangemaakt maar de verwachte statuswijziging uitbleef, en de opname van de uitvoering direct toewijzen. Voor veiligheidsbewuste teams is relevant waar screenshots, toepassingsgegevens en testverkeer worden verwerkt. Lokale controle is niet automatisch vereist, maar kan bij interne toepassingen en gevoelige gegevens de verstandigere weg zijn dan een externe clouddienst.

De juiste detailgraad voor verschillende ontvangers

Ontwikkelteams hebben foutmeldingen, technische stappen en zo precies mogelijke aanwijzingen voor reproductie nodig. Een operations manager heeft daarentegen eerst de getroffen functie, het bedrijfsrisico en een duidelijke uitspraak over de bedrijfsvaardigheid nodig. Beide perspectieven moeten uit dezelfde uitvoering kunnen ontstaan, zonder dat iemand resultaten handmatig in presentaties hoeft over te zetten.

Een goed rapport begint daarom met een korte beslissingslaag: vrijgave aanbevolen, vrijgave met bekende beperkingen of vrijgave stoppen. Daaronder staan de kritieke afwijkingen met prioriteit en bewijs. De technische details volgen pas daarna. Dat is geen vereenvoudiging ten koste van nauwkeurigheid, maar een nette scheiding van informatiebehoeften.

Dekking meten zonder jezelf veiligheid voor te spiegelen

Testdekking wordt vaak als percentage weergegeven. Deze waarde is nuttig wanneer duidelijk is wat ze meet. Codedekking toont bijvoorbeeld welke delen van de programmacode tijdens tests zijn uitgevoerd. Dat bewijst niet dat een bedrijfsproces correct werkt. Een test kan veel coderegels raken en toch nooit controleren of een verkeerd afleveradres op het document verschijnt.

Voor vakafdelingen is procesdekking vaak veelzeggender. Ze beschrijft welke echte processen beschermd zijn: order registreren, voorraad reserveren, deellevering boeken, retour aannemen of factuur vrijgeven. Bijzonder waardevol zijn overgangen tussen systemen en rollen, want daar ontstaan vaak fouten: bij het importeren van een bestelling, het afdrukken van een label of de wissel van kantoor naar magazijnterminal.

Prioriteer niet naar het aantal mogelijke tests, maar naar schadeimpact en wijzigingsfrequentie. Een zelden gebruikt proces met hoog financieel of juridisch risico verdient vaak eerder een automatisering dan een veelgebruikte, maar onschuldige weergave. Omgekeerd kan een stabiel, weinig kritiek proces nog steeds volstaan met een korte handmatige controle. Niet elke controle hoeft geautomatiseerd te worden alleen omdat het kan.

Instabiele tests zijn een eigen kwaliteitsprobleem

Tests die zonder herkenbare productwijziging soms slagen en soms mislukken, worden vaak flaky genoemd. Ze beschadigen vertrouwen sneller dan een permanent rode test. Zodra teams rode resultaten reflexmatig opnieuw starten, verliest de automatisering haar waarschuwingsfunctie.

De oorzaken zijn meestal concreet: vaste wachttijden, gedeelde testdata, parallelle toegang, asynchrone verwerking of een omgeving die niet wordt teruggezet. Een korte pauze van drie seconden in de test kan toevallig helpen, maar is geen oplossing. Beter is te wachten op een aantoonbare toestand, testdata uniek te maken en processen van elkaar te isoleren.

Niet elke instabiliteit is volledig te vermijden. Externe interfaces kunnen schommelen en echte infrastructuur kent storingen. Dan moet het rapport duidelijk aangeven of een test vanwege een externe afhankelijkheid niet beoordeelbaar was. Een herhaalde run kan voor diagnose zinvol zijn, maar mag de eerste bevinding niet onzichtbaar maken.

Een zinvol verloop na elke testrun

Na een geautomatiseerde run moet niet elk resultaat meteen gelijk worden behandeld. Eerst worden blokkerende fouten en niet-beoordeelbare kritieke tests gecontroleerd. Daarna volgt de indeling van nieuwe afwijkingen tegenover bekende, geaccepteerde problemen. Pas dan is een releasebeslissing deugdelijk.

Vastgelegde drempelwaarden helpen, maar ze moeten bij het proces passen. Zo kan een mislukte test in de betalings- of autorisatiestroom een onmiddellijke stop uitlokken. Bij een puur cosmetische afwijking kan een gedocumenteerde uitzondering verdedigbaar zijn. Zulke regels mogen niet pas onder tijdsdruk vóór een release ontstaan.

Even belangrijk is de terugkoppeling: elke productiefout die door de tests niet werd herkend, is een aanleiding om te controleren of een scenario, een testdatavariant of een controlepunt ontbreekt. Het doel is niet zoveel mogelijk tests op te stapelen. Het is om uit echte fouten gericht betere borging te bouwen.

De nuttigste testresultaten zijn uiteindelijk niet die met het groenste overzicht. Het zijn die waarbij een verantwoordelijke op maandagochtend kan nagaan wat gecontroleerd is, welk risico blijft en welke handeling nu verstandig is.

Permalink →

Inventory Discrepancy Causes: veelvoorkomende oorzaken van voorraadverschillen

Inventory Discrepancy Causes: veelvoorkomende oorzaken van voorraadverschillen

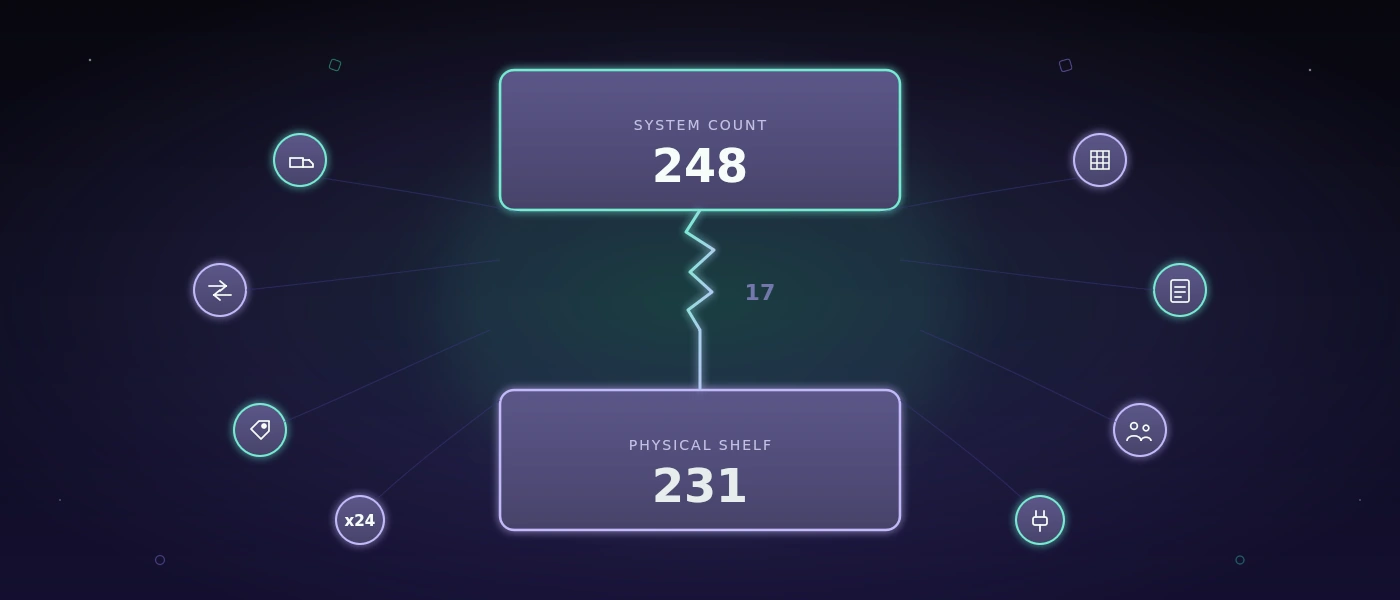
De voorraad in het systeem zegt 248 stuks, op het schap liggen er 231. Deze 17 eenheden lijken in eerste instantie op een telfout. Maar precies daar begint vaak de verkeerde analyse. Inventory discrepancy causes zijn in de praktijk zelden één enkele vergissing. Meestal ontstaan ze daar waar goederenontvangst, magazijnbeweging, orderverzameling, en boeking in de tijd of organisatorisch uiteenlopen.

Voor een klein of middelgroot bedrijf zijn voorraadverschillen niet alleen een onderwerp voor de inventarisatie. Ze leiden tot foutieve bestellingen, spoedleveringen, onnodige veiligheidsvoorraden, en leverbeloften die niet kunnen worden nagekomen. Wie de oorzaken netjes scheidt, hoeft niet meteen een groot ERP in te voeren. Vaak volstaan duidelijkere boekingsregels, passende registratieapparatuur, en een systeem dat reële werkprocessen weerspiegelt.

Inventory discrepancy causes: waar ontstaan verschillen

Een voorraadverschil is het verschil tussen de theoretische voorraad in het leidende systeem en de daadwerkelijk aanwezige voorraad. Doorslaggevend hierbij is het woord "leidend". Als er parallel een Excel-bestand, een papieren lijst, en een voorraadbeheersysteem worden bijgehouden, bestaan er praktisch meerdere waarheden. Dan is het verschil niet alleen in het magazijn ontstaan, maar al ingebouwd in het databeheer.

De effectieve tegenmaatregel hangt dus af van het type fout. Een verkeerd geteld pallet heeft een andere oplossing nodig dan een levering die fysiek is ontvangen maar nooit geboekt. Voordat teams processen herstructureren, zouden ze verschillen moeten evalueren naar artikel, opslaglocatie, ploeg, bewegingstype, en tijdstip. Pas dit patroon toont of het om een eenmalig geval of een terugkerende procesfout gaat.

1. Goederenontvangsten worden te laat of onvolledig geboekt

De goederenontvangst is een klassiek breekpunt. Goederen komen 's ochtends binnen, worden apart gezet voor controle, en later rechtstreeks naar productie of het schap gebracht. De boeking gebeurt 's middags, de volgende dag, of helemaal niet. Zolang de goederen fysiek aanwezig zijn, lijkt de systeemvoorraad te laag. Zijn ze al verbruikt of verzonden, dan worden vervolgfouten waarschijnlijker.

Bijzonder gevoelig zijn deelleveringen, vervangende artikelen, en overleveringen. Staat op de leveringsbon een hoeveelheid, maar komt er een andere hoeveelheid binnen, dan mag niemand het document gewoon "ongeveer passend" boeken. Het verschil moet zichtbaar blijven als uitzondering, inclusief reden, verantwoordelijke persoon, en goedkeuring. Anders verdwijnt de afwijking uit het proces en duikt pas bij de inventarisatie weer op.

2. Magazijnbewegingen gebeuren zonder transactie

Een artikel wordt van de goederenontvangst naar het hoogbouwmagazijn gebracht, van een vak naar de orderverzamelzone verplaatst, of voor een order gereserveerd. Fysiek is dat een kleine, snelle beweging. In het systeem kan het doorslaggevend zijn.

Als medewerkers opslaglocaties alleen op gevoel herschikken, klopt de totale voorraad misschien nog wel, maar de beschikbaarheid op de juiste plek niet. Dat veroorzaakt zoektijd, foutieve orderverzameling, en onnodige aanvulritten. Een goede magazijnoplossing hoeft niet elke beweging ingewikkeld te maken. Ze moet de enkele bewegingen vastleggen die relevant zijn voor beschikbaarheid, traceerbaarheid, en nabestelling.

In werkplaatsen of kleinere magazijnen is het vaak zinvoller om een paar eenduidige zones te hanteren dan een theoretisch perfecte vakstructuur die niemand dagelijks bijhoudt. Precisie werkt alleen als ze werkbaar blijft.

3. Orderverzameling en verzending worden te vroeg geboekt

Veel teams boeken een order bij het picken als "uitgeboekt", terwijl de goederen nog op een gereedzetplek liggen. Wordt de order vervolgens gewijzigd, geannuleerd, of slechts gedeeltelijk verzonden, dan komen systeem- en fysieke voorraad niet meer overeen.

Beter is een duidelijke scheiding tussen gereserveerd, verzameld, en verzonden. Niet elk bedrijf heeft daarvoor complexe statusketens nodig. Maar het moment van voorraadvermindering moet eenduidig zijn. Bij verzendgoederen ligt dat vaak dichter bij de daadwerkelijke overdracht aan de transportdienstverlener dan bij de eerste greep naar het schap.

Ook retouren horen bij dit proces. Komt goederen terug, dan is het niet automatisch weer beschikbaar. Pas controle, kwaliteitsbeslissing, en opslag zouden moeten bepalen of het terugkeert naar de verkoopbare voorraad, geblokkeerd blijft, of wordt afgevoerd.

4. Verkeerde eenheden en stamgegevensfouten

Een doos, een verpakkingseenheid, een rol, en een los stuk kunnen allemaal hetzelfde artikel betreffen. Als de omrekening niet netjes wordt bijgehouden, ontstaan verschillen met indrukwekkende snelheid. Een medewerker boekt "1", bedoelt een doos met 24 stuks. Het systeem verstaat één stuk.

Stamgegevensfouten zijn bijzonder verraderlijk, omdat het boekingsproces technisch correct kan lijken. Controleer daarom verpakkingseenheden, omrekenfactoren, minimumhoeveelheden, opslaglocaties, en artikelnummers. Ook soortgelijk benoemde varianten, bijvoorbeeld verschillende lengtes, kleuren, of partijen, worden gemakkelijk verward.

Hier helpt geen algemene regel als "meer scannen". Barcodes zijn alleen zo betrouwbaar als de koppeling erachter. Bij kleine assortimenten kan een netjes bijgehouden artikelstam met goed leesbare labels meer uitrichten dan een omvangrijk, maar slecht geconfigureerd scannerlandschap.

5. Parallelle tabellen en handmatige correcties

De tabel op het bureaublad ontstaat zelden uit nalatigheid. Meestal vult ze een reëel gat: een speciale reservering, een ontbrekende evaluatiewaarde, of een proces dat de bestaande software niet weergeeft. Problematisch wordt ze als ze het tweede voorraadboek wordt.

Dan worden ontvangsten in het systeem geboekt, maar onttrekkingen in de tabel genoteerd. Of een correctie vindt alleen plaats waar ze net helpt voor de volgende order. Niemand kan later betrouwbaar verklaren welke waarde geldt.

Niet elke tabel hoeft te worden afgeschaft. Een berekening voor planning of analyses kan zinvol blijven. Voorraadwijzigende processen zouden echter precies één leidend systeem moeten hebben. Aanpassingen hebben een reden-code nodig, een tijdstempel, en idealiter een persoon die ernaar herleid kan worden. Dat is geen bureaucratie om de bureaucratie zelf, maar de voorwaarde voor betrouwbare oorzaakanalyses.

6. Telfouten en ongeschikte inventarisatiemethoden

Ook correcte processen beschermen niet tegen menselijke fouten. Artikelen worden dubbel geteld, pallets worden over het hoofd gezien, open dozen geschat, of opslaglocaties niet geblokkeerd tijdens het tellen. Een jaarlijkse volledige inventarisatie ontdekt deze problemen laat en onder hoge druk.

Voor veel bedrijven is een permanente inventarisatie het verstandigere alternatief. Snel draaiende of waardevolle artikelen worden vaker gecontroleerd, stabiele C-artikelen minder vaak. Belangrijk is niet zoveel mogelijk tellingen te produceren, maar afwijkingen tijdig tegen de laatste bewegingen te controleren. Wordt een verschilartikel gewoon gecorrigeerd zonder de oorzaak te documenteren, dan blijft het patroon onzichtbaar.

Een tegencontrole is vooral zinvol bij hoge waarden, serienummers, of partijen. Bij schroeven in een verbruiksmagazijn kan ze economisch overdreven zijn. De controlediepte zou bij het risico moeten passen.

7. Onduidelijke verantwoordelijkheden tussen ploegen en afdelingen

Voorraadfouten ontstaan vaak bij overdrachten. De vroege ploeg zet goederen klaar, de late ploeg verzendt ze. De goederenontvangst neemt een levering aan, de planning wijzigt parallel de order. Elke afzonderlijke stap kan navolgbaar zijn, maar niemand bezit het hele proces.

Definieer daarom niet alleen rollen, maar overdrachtspunten: wie bevestigt de goederenontvangst? Wanneer wisselt de verantwoordelijkheid voor verzamelde goederen? Wie controleert openstaande uitzonderingen aan het einde van de ploeg? Een gedeeld digitaal bord of een eenvoudige uitzonderingslijst is vaak effectiever dan extra vergaderingen.

Het systeem zou openstaande processen zichtbaar moeten maken, in plaats van medewerkers te dwingen te onthouden. Bijvoorbeeld moeten leveringen zonder hoeveelheidscontrole, orderverzamelingen zonder verzendafsluiting, of retouren zonder kwaliteitsbeslissing opvallen voordat ze tot stille voorraadfouten worden.

8. Zwakke systeemintegratie en ontbrekende controleregels

Als winkel, orderbeheer, magazijn, en boekhouding gegevens met vertraging of via bestand uitwisselen, kunnen dubbele of ontbrekende boekingen ontstaan. Een import loopt twee keer. Een interface faalt stil. Een order wordt gewijzigd nadat de verzendstatus al is overgedragen.

De oplossing is niet noodzakelijk een volledige vervanging. Vaak zijn duidelijk gedefinieerde interfaces, eenduidige documentnummers, en technische controles nodig. Een magazijnboeking zou navolgbaar moeten vastleggen wanneer ze plaatsvond, uit welk proces ze voortkomt, en of ze later werd geannuleerd. Kritieke processen hebben foutmeldingen en wachtrijen nodig, niet alleen een stille vermelding in het logbestand.

Bij op maat ontwikkelde logistieke systemen kunnen zulke regels gericht op het bedrijf worden afgestemd: geen negatieve hoeveelheid zonder goedkeuring, geen verzendbevestiging zonder verzendpositie, geen dubbele verwerking van dezelfde externe referentie. De beste regel is hierbij niet de strengste, maar degene die echte fouten stopt zonder het bedrijf bij normale uitzonderingen te blokkeren.

Voorraadverschillen systematisch controleren

Begin niet met een landelijke correctie. Kies de tien artikelen met de meest frequente of duurste verschillen, en volg hun laatste beweging achterwaarts: goederenontvangst, verplaatsing, onttrekking, retour, telling, en eventuele handmatige aanpassing. Hopen de gevallen zich op bij één locatie, één ploeg, of één bewegingstype, dan is dat een solide aanknopingspunt.

Daarna zou elke maatregel meetbaar moeten zijn. Worden nieuwe barcode-scans ingevoerd, observeer dan niet alleen het aantal scans, maar het verschilpercentage per artikelgroep. Wordt een nieuwe status voor gereedzetting toegevoegd, controleer dan dagelijks openstaande gereedzettingen. Goede processen produceren geen schijnprecisie. Ze maken uitzonderingen vroeg zichtbaar en navolgbaar.

De zinvolle volgende stap is vaak klein: een overdrachtspunt definiëren, een opslaglocatie opschonen, of een terugkerende handmatige correctie technisch afdichten. Betrouwbare voorraden ontstaan niet door meer software op vermoeden, maar door processen die ook op een hectische dinsdag om 16:45 uur nog correct uitvoerbaar zijn.

Permalink →

Procesautomatisering voor kmo's goed aanpakken

Procesautomatisering voor kmo's goed aanpakken

Een leveringsbon ontbreekt, omdat de gegevens nog op een briefje staan. Een goederenontvangst wordt dubbel geregistreerd, omdat magazijn en kantoor met verschillende tabellen werken. Een vrijgave loopt vertraging op, omdat de verantwoordelijke persoon net niet opneemt. Dergelijke wrijving kost zelden in één klap veel geld. Maar over weken tellen navragen, zoektijden, foutcorrecties, en onnodige wachttijden op. Precies daar is procesautomatisering voor kmo's zinvol.

Het gaat er niet om zoveel mogelijk activiteiten door software te vervangen. Goede automatisering maakt processen navolgbaar, vermindert vermijdbare overdrachten, en geeft medewerkers tijd voor beslissingen die ervaring vereisen. Vooral in kleine en middelgrote bedrijven is dat doorslaggevend: de teams staan dicht bij de dagelijkse bedrijfsvoering. Als een proces hapert, merkt vaak de hele ploeg dat meteen.

Niet elk proces automatiseren

De meest voorkomende fout is beginnen bij het meest zichtbare ergernis. Misschien irriteert een Excel-bestand, misschien moet er een nieuw dashboard komen. Beide kunnen gerechtvaardigd zijn. Maar een gedigitaliseerde chaos blijft chaos - alleen sneller en met meer data.

Vóór een technische beslissing moet het proces eerst beschreven worden zoals het werkelijk verloopt. Niet zoals het in het handboek zou moeten staan. Wie start het proces? Welke informatie is nodig? Waar wordt iets handmatig overgedragen? Wie beslist bij uitzonderingen? En waaraan herkent het team dat het proces is afgerond?

Juist in het magazijn of bij de orderafhandeling liggen de kritieke punten vaak tussen systemen: een order komt binnen per e-mail, wordt gekopieerd naar een tabel, telefonisch afgestemd, en later ingevoerd in verzendsoftware. Elke overdracht vergroot de kans dat hoeveelheden, termijnen, of adressen afwijken.

Een automatisering loont vooral wanneer een proces vaak voorkomt, duidelijke regels heeft, en fouten merkbare gevolgen hebben. Dat kan de goederenontvangst zijn, het aanmaken van leveringsbonnen, de toewijzing van magazijnbewegingen, of de overdracht van vrijgegeven orders aan de verzending. Zeldzame bijzondere gevallen met veel beoordelingsvrijheid blijven daarentegen vaak beter handmatig - althans in eerste instantie.

Procesautomatisering voor kmo's begint met prioriteiten

Niet elke onnodige activiteit verdient meteen een project. Een eenvoudige prioritering schept duidelijkheid. Beoordeel afzonderlijke processen naar frequentie, verwerkingstijd, foutkosten, en afhankelijkheden. Een proces dat dagelijks vijftig keer plaatsvindt en telkens maar twee minuten bespaart, kan economischer zijn dan een gecompliceerd maandelijks proces.

De vraag naar het foutgevolg is minstens even belangrijk. Een verkeerd afgedrukt intern document is vervelend. Een verkeerde chargetoewijzing, een verloren afleveradres, of een niet-gedocumenteerde goederenontvangst kan klachten, zoekwerk, en voorraadverschillen veroorzaken. Daar zorgt automatisering niet alleen voor snelheid, maar voor betrouwbaarheid.

Een zinvolle eerste stap is meestal klein genoeg om binnen enkele weken controleerbaar te zijn. Bijvoorbeeld kan een medewerker goederen via een barcode registreren, controleert het systeem artikel en hoeveelheid, werkt de voorraad in een centrale database bij, en genereert desgewenst direct een opslagbon. Het team hoeft daarna niet te raden welke versie van een tabel actueel is.

Een duidelijk streefbeeld in plaats van een functielijst

Veel projecten beginnen met een lange lijst gewenste functies. Beter is een concreet operationeel beeld: wat moet aan het einde van een proces zichtbaar zijn zonder navragen? Bij verzending zou dat kunnen betekenen dat een order na vrijgave automatisch een picklijst krijgt, het verzendadres gecontroleerd wordt, en een label gegenereerd kan worden. Uitzonderingen komen zichtbaar in een verhelderingslijst terecht, in plaats van in een onoverzichtelijke e-mailinbox.

Dit streefbeeld dwingt tot nuttige beslissingen. Moet elke bestelling volledig automatisch verwerkt worden? Of moeten orders vanaf een bepaalde goederenwaarde, bij afwijkend afleveradres, of bij ontbrekende voorraad bewust ter controle worden voorgelegd? Automatisering heeft geen honderd procent donkere verwerking nodig om groot nut te scheppen.

De passende techniek hangt af van het proces

Er is geen technische standaardweg voor elk kmo. Een tabeloplossing kan voor een overzichtelijke evaluatie nog steeds verstandig zijn. Ze is snel aangepast, vertrouwd, en veroorzaakt weinig invoeringsinspanning. Zodra echter meerdere personen tegelijk werken, boekingen navolgbaar moeten zijn, of gegevens met andere systemen worden uitgewisseld, stuit ze op grenzen.

Dan is vaak een slanke, workflow-specifieke toepassing zinvoller dan een overgedimensioneerde enterprise-suite. Ze kan precies de stappen weergeven die in de bedrijfsvoering nodig zijn: order registreren, voorraad controleren, goederen verplaatsen, document genereren, verzending boeken, en status terugmelden. Niet meer, maar ook niet minder.

Technisch telt daarbij minder of een systeem met het nieuwste modewoord adverteert. Doorslaggevend zijn solide fundamenten: een netjes gemodelleerde database, navolgbare rechten, logboeken voor relevante wijzigingen, betrouwbare interfaces, en gedocumenteerde deployments. Een toepassing op basis van PHP 8.4, moderne JavaScript, en MySQL 8 kan op lange termijn zeer goed onderhoudbaar zijn, als architectuur en beheer vanaf het begin worden meegenomen.

Ook integraties verdienen aandacht. Een automatische gegevensuitwisseling met winkel, ERP, verzenddienstverlener, of boekhouding bespaart alleen tijd als fouten zichtbaar worden behandeld. Wat gebeurt er bij een ongeldig adres? Wordt een mislukte labelafdruk opnieuw geprobeerd? Kan het team zien welke gegevens zijn overgedragen en welke nog ontbreken? Stille fouten zijn gevaarlijker dan een duidelijk gemarkeerd uitzonderingsgeval.

Invoering tijdens de lopende bedrijfsvoering

Een nieuw systeem moet zich aanpassen aan ploegwisselingen, leveringstermijnen, en bestaande werkroutines. Daarom is een gefaseerde uitrol meestal veiliger dan een harde stopdatum voor alle gebieden. Begin met een afgebakend proces, een productgroep, of een magazijngebied. Dat vermindert risico en levert echte feedback uit de dagelijkse praktijk op.

Parallel draaien is daarbij geen teken van onzekerheid, maar een gecontroleerde test. Gedurende een beperkte tijd kunnen oude en nieuwe registratie vergeleken worden. Verschillen tonen niet alleen softwarefouten, maar vaak ook regels die tot nu toe alleen in het hoofd van individuele medewerkers bestonden. Die regels horen zichtbaar in het proces - niet permanent in persoonlijke ervaring.

Medewerkers zouden niet pas bij de training met het nieuwe proces geconfronteerd moeten worden. Wie het proces dagelijks uitvoert, herkent snelkoppelingen, bijzondere gevallen, en onpraktische schermen vroegtijdig. Goede software respecteert deze kennis, zonder elke historisch gegroeide uitzondering ongewijzigd in te bouwen. De juiste vraag luidt: welke uitzondering beschermt een belangrijk bedrijfsgeval, en welke is slechts een workaround voor een oud probleem?

Meetbaar maken of de inspanning loont

Vóór de start zouden twee of drie kengetallen vastgelegd moeten worden. Dat kunnen doorlooptijd per order, aantal handmatige correcties, voorraadverschillen, of de tijd tot verzending zijn. Zonder uitgangswaarde wordt elke latere beoordeling een onderbuikgevoel.

Niet elk effect toont zich meteen in euro's. Als een magazijnteam op elk moment weet waar goederen zich bevinden, daalt het aantal onderbrekingen. Als leveringsdocumenten uit dezelfde gegevens ontstaan als de order, daalt het risico op tegenstrijdige gegevens. En als verantwoordelijkheden zichtbaar zijn in het systeem, hangt een proces minder af van individuele personen.

Automatisering vereist onderhoud en grenzen

Een geautomatiseerd proces is geen project dat na de go-live bevriest. Artikelstructuren veranderen, klanten eisen nieuwe documenten, verzenddienstverleners passen interfaces aan. Daarom horen verantwoordelijkheden, updates, back-ups, en een geregelde omgang met rechten bij het eigenlijke systeem.

Vooral bij toepassingen met klant-, order-, of voorraadgegevens moet duidelijk zijn wie toegang krijgt en waarom. Rollen moeten passen bij de dagelijkse werkpraktijk: een magazijnteam heeft andere functies nodig dan boekhouding of verkoop. Gelogde wijzigingen, veilige aanmeldstromen, en geteste herstelacties ogen onspectaculair. Bij een storing bepalen juist deze details of de bedrijfsvoering kan doorwerken.

Ook tests zijn onderdeel van de operationele veiligheid. Terugkerende controles voor orderregistratie, voorraadboeking, documentgeneratie, en rechtenbeheer voorkomen dat een aanpassing op de ene plek een werkend proces op een andere plek beschadigt. Bij kritieke web- of desktoptoepassingen kan een gecontroleerde, self-hosted testomgeving zinvol zijn, als screenshots, testdata, en interne processen niet bij externe clouddiensten mogen terechtkomen.

softify.pro begeleidt dergelijke trajecten met een eenvoudig uitgangspunt: eerst het werkelijke proces begrijpen, dan de kleinste haalbare oplossing bouwen. Soms is dat een maatwerktoepassing. Soms volstaat het om een bestaande tabel netter te structureren en één enkele overdrachtsstap te automatiseren.

De beste volgende stap is daarom geen softwarevergelijking, maar een gang door een echt proces - van trigger tot afronding. Neem een order, een goederenontvangst, of een klacht en volg deze met de betrokken personen. Daar waar informatie opnieuw wordt ingevoerd, niemand de status kent, of beslissingen onnodig wachten, ligt meestal de zinvolste aanpak voor automatisering.

Permalink →

Windows-toepassingen testen: een praktisch plan

Windows-toepassingen testen: een praktisch plan

Een Windows-toepassing kan er in demomodus netjes uitzien en toch op maandagochtend het bedrijf vertragen. Een niet-opgeslagen leveringsbon, een gebruiker die na drie mislukte pogingen geblokkeerd wordt, of een afdrukdialoog die na een update anders reageert, zijn geen cosmetische bugs. Wie wil weten hoe je Windows-toepassingen test, moet daarom niet beginnen bij afzonderlijke knoppen, maar bij de processen die werk, geld, of navolgbaarheid kosten.

Juist in magazijn, werkplaats, planning, en administratie lopen veel kritieke processen via desktopsoftware die in de loop der jaren is gegroeid. Daar telt niet of een testcase indrukwekkend geformuleerd is. Doorslaggevend is of medewerkers hun taken onder realistische omstandigheden betrouwbaar kunnen uitvoeren - ook bij onvolledige gegevens, wisselende rechten, trage netwerken, en ongeplande onderbrekingen.

Windows-toepassingen testen begint bij de kritieke processen

Niet elke functie verdient dezelfde testinspanning. Een zelden gebruikte export met handmatig nawerk moet anders beoordeeld worden dan het boeken van een goederenontvangst, het aanmaken van een label, of de dagelijkse afstemming van orders. Begin daarom met een eenvoudige vraag: wat gebeurt er concreet als dit proces mislukt?

Hoge prioriteit hebben processen met directe invloed op voorraad, levering, facturatie, beveiliging, of klantcommunicatie. Daartoe behoren bijvoorbeeld aanmelding en rechtencontrole, aanmaak en wijziging van stamgegevens, transactieboekingen, documentafdruk, koppelingen met ERP- of verzenddiensten, en herstart na een fout. Ook functies die maar een kleine groep mensen gebruikt, kunnen kritiek zijn als ze een maandafsluiting of de vrijgave van goederen blokkeren.

Uit deze processen ontstaan geen abstracte testlijsten, maar navolgbare werkstappen. Een goederenontvangsttest zou bijvoorbeeld kunnen beginnen met een bestaande bestelling, een deellevering registreren, een afwijkende hoeveelheid melden, een magazijnlocatie toewijzen, en vervolgens controleren of voorraad, boekingslogboek, en afgedrukt document overeenkomen. Zo test u het werkelijke effect van de software, niet alleen afzonderlijke invoervelden.

Een testbasis opbouwen die de praktijk weerspiegelt

Veel fouten worden pas zichtbaar wanneer de testomgeving de werkelijkheid benadert. Een toepassing gedraagt zich met een lege testomgeving vaak anders dan met meerdere jaren aan mutatiegegevens, geblokkeerde artikelen, ontbrekende verplichte informatie, of al geopende transacties.

Leg daarom testdata bewust aan. U heeft niet per se een volledige kopie van de productie nodig. Zinvoller is een gecontroleerd databestand met typische, grens-, en bewust foutieve gevallen: artikelen met verschillende maateenheden, klanten met speciale voorwaarden, orders met deelleveringen, gebruikers met verschillende rollen, en transacties die al in behandeling zijn. Persoonsgegevens zouden daarbij geanonimiseerd of vervangen moeten worden door realistische voorbeelddata.

Bij de testbasis hoort ook de technische omgeving. Documenteer Windows-versie, resolutie, schaling, geïnstalleerde printers, netwerkschijven, databaseversie, gekoppelde diensten, en rechten. Dat klinkt nuchter, maar bespaart later tijd. Als een fout alleen optreedt op werkplekken met 125%-schaling of bij een bepaald printerstuurprogramma, moet dat reproduceerbaar zijn.

Niet alleen het ideale geval controleren

Het ideale geval bewijst vooral dat de toepassing gebouwd is voor het verwachte pad. In de praktijk ontstaan de lastige situaties ernaast. Wat gebeurt er als een gebruiker een verplicht veld leeg laat, dezelfde boeking twee keer uitvoert, of tijdens het opslaan de verbinding verliest? Blijft de transactie consistent? Krijgt de persoon een begrijpelijke melding? Kan hij veilig verder werken?

Bij Windows-toepassingen zijn bediening en toestand bovendien bijzonder relevant. Dialoogvensters kunnen op de achtergrond verschijnen, sneltoetsen kunnen overlappen, bestandskeuzedialogen kunnen het verloop blokkeren. Controleer of focus, foutmeldingen, en blokkades eenduidig zijn. Een technische uitzondering zonder handelingsaanwijzing helpt de ploegleider niet verder.

Handmatige tests inzetten waar oordeel gevraagd is

Handmatige tests zijn geen teken van onvoldoende volwassenheid. Ze zijn onmisbaar wanneer een nieuw proces ontstaat, een interface wordt herbouwd, of vakkennis over de kwaliteit beslist. Een ervaren magazijnleider herkent sneller dan een script of een scherm bij hoge tijdsdruk begrijpelijk is, of dat een melding te laat verschijnt.

Handmatig testen wordt echter duur en onbetrouwbaar wanneer dezelfde stabiele processen voor elke versie herhaald worden. Dan hangt de vrijgave af van beschikbare mensen, geheugen, en verspreide notities. De juiste overgang naar automatisering ligt meestal daar waar een proces vaak wordt uitgevoerd, veel schade kan veroorzaken, en duidelijke verwachte resultaten heeft.

Een goede handmatige testcase beschrijft uitgangssituatie, stappen, verwacht resultaat, en benodigde data. Voeg bij een fout een screenshot, tijdstempel, toepassings- en buildversie, en de exacte actie toe. "Afdrukken werkt niet" is geen bruikbare foutbeschrijving. "Na wijziging van het afleveradres blijft het afdrukdialoog open, order 4711 krijgt geen PDF, en er verschijnt geen melding" is dat wel.

Geautomatiseerde regressietests voor terugkerende risico's

Automatisering controleert niet of software fundamenteel goed is. Ze controleert of eerder werkende, gedefinieerde processen na een wijziging nog werken. Dat is bijzonder waardevol bij Windows-software waarvan interfaces, databaselogica, en externe koppelingen jarenlang doorontwikkeld worden.

Begin klein. Kies eerst vijf tot tien bedrijfskritieke processen die bij elke release gecontroleerd moeten worden. Daartoe kunnen aanmelding met account-lockout flow, orderregistratie, magazijnboeking, PDF- of labelafdruk, rolwisseling, en een centrale import behoren. Pas als deze tests betrouwbaar lopen, loont uitbreiding naar bijzondere gevallen.

Bij desktoptoepassingen sturen geautomatiseerde tests vaak zichtbare interface-elementen aan: vensters, invoervelden, tabellen, knoppen, en dialoogvensters. Dat werkt, maar is gevoeliger dan een pure interfacetest. Kleine lay-outwijzigingen, tragere computers, of niet eenduidig benoemde elementen kunnen tests breken. Daarom zouden ontwikkelaars, vakafdeling, en testverantwoordelijken gezamenlijk moeten vastleggen welke elementen stabiel aanspreekbaar zijn en welke controlestappen beter via database, logboek, of interface geborgd worden.

Een zinvolle test controleert bovendien niet alleen dat op een knop geklikt kon worden. Ze controleert het vakinhoudelijke gevolg: is de boeking opgeslagen? Klopt de voorraad? Is er een document gegenereerd? Is er geen dubbel record aangemaakt? Zichtbare interactie en controleerbaar resultaat horen bij elkaar.

Bewijs is onderdeel van het testresultaat

Een groene status alleen volstaat bij kritieke toepassingen zelden. Wanneer een test mislukt, hebben teams snel een antwoord nodig op drie vragen: wat was de uitgangssituatie? Bij welke stap is het proces mislukt? Wat toonde de toepassing op dat moment?

Screenshots, uitvoeringslogboeken, en eventueel schermopnamen maken fouten bespreekbaar. Ze verkorten de overdracht tussen bedrijfsvoering, QA, en ontwikkeling aanzienlijk. Voor gereguleerde of veiligheidsbewuste bedrijven zijn ze bovendien een solide basis om goedkeuringen en afwijkingen te navolgen.

Daarbij is de opslaglocatie geen bijzaak. Testruns kunnen interne klantgegevens, prijslijsten, orderinformatie, of schermweergaven bevatten. Wie geautomatiseerd test voor gevoelige Windows-toepassingen, zou moeten verduidelijken of die data de eigen infrastructuur mogen verlaten. Een self-hosted omgeving zoals COCO kan hierbij zinvol zijn, omdat testuitvoering, bewijs, en beoordeling onder eigen controle blijven. Of dat nodig is, hangt af van gegevensbeschermingsvereisten, contractuele situatie, en beschermingsbehoefte - niet elk team heeft daarvoor dezelfde architectuur nodig.

Testen inbouwen in het releaseproces

De beste testcatalogus verliest waarde als hij pas na een hectische productieoverzetting gebruikt wordt. Definieer een vast moment: geautomatiseerde kernregressies lopen vóór elke vrijgave, handmatige acceptatie controleert nieuwe of gewijzigde processen, en bekende beperkingen worden openlijk gedocumenteerd.

Niet elke mislukte test hoeft een release te stoppen. Een fout in een zelden gebruikte beheerweergave kan aanvaardbaar zijn als er een veilige workaround bestaat en het betrokken gebied duidelijk geïnformeerd is. Een fout die voorraden onjuist boekt of gebruikers ongemerkt blokkeert, moet anders behandeld worden. Die beslissing zou genomen moeten worden op basis van bedrijfsimpact, niet op basis van het aantal rode tests alleen.

Onderhoud de tests samen met de toepassing. Wanneer een proces bewust verandert, werk dan testcase, testdata, en verwacht resultaat samen met de eis bij. Verouderde tests veroorzaken ruis en worden ooit genegeerd. Een paar betrouwbare controles zijn waardevoller dan honderden geautomatiseerde processen waarvan niemand de resultaten nog serieus neemt.

Uiteindelijk gaat het er niet om elke denkbare invoer te simuleren. Het gaat erom het werk te beschermen dat de volgende ochtend weer moet functioneren. Begin met één enkel kritiek proces, maak het resultaat bewijsbaar, en bouw van daaruit verder.

Permalink →

Secure test data management zonder controleverlies

Secure test data management zonder controleverlies

Een mislukte testrun is vervelend. Een geslaagde testrun met echte klantgegevens in een onvoldoende beveiligde omgeving kan aanzienlijk duurder uitpakken. Secure test data management lost die tegenstelling niet op met één enkele tool, maar met duidelijke regels voor data, toegang, testomgevingen, en bewijsstukken. Voor teams die web- of Windows-toepassingen geautomatiseerd testen, hoort dit dus bij kwaliteitswerk - niet alleen bij compliance.

Waarom testdata een beveiligingsprobleem wordt

Productiedata is verleidelijk voor tests omdat het echte randgevallen bevat: onvolledige adressen, ongewone bestelcombinaties, historische prijsregels, of foutieve invoer. Maar juist die data bevat vaak namen, contactgegevens, contractinformatie, personeelsnummers, bankgegevens, of interne bedrijfslogica.

Het risico ontstaat zelden door één enkele grove fout. Meestal groeit het stapsgewijs: een databaseexport wordt aangemaakt voor een test, in een gedeelde map geplaatst, en later gekopieerd naar een andere omgeving. Een externe dienst ontvangt screenshots voor foutanalyse. Een testaccount behoudt uitgebreide rechten omdat opschoning de volgende run zou kunnen verstoren. Na een paar maanden weet niemand meer betrouwbaar welke data waar staat.

Bij kleine en middelgrote bedrijven verscherpt het probleem zich vaak door krappe capaciteit. Het team wil een releasedeadline halen, niet een eigen gegevensbeschermingsproject runnen. Toch blijft de verantwoordelijkheid bestaan. Wie data gebruikt voor kwaliteitsborging moet kunnen navolgen welke data worden verwerkt, wie er toegang toe heeft, en wanneer ze weer worden verwijderd.

Secure test data management begint vóór het testgeval

De beslissende vraag luidt niet: "Hoe beschermen we het testdatabestand?" Ze luidt: "Welke informatie heeft deze test werkelijk nodig?" Veel regressietests hebben geen echte persoonsverwijzingen nodig. Een verzendproces moet bijvoorbeeld controleren of afleveradressen, gewichten, zones, labels, en statuswijzigingen correct worden verwerkt. Daarvoor volstaan synthetische klanten, plausibele artikelstamdata, en bewust gedefinieerde randgevallen.

Dit onderscheid leidt tot een praktische dataclassificatie. Niet elke testomgeving heeft dezelfde datadiepte nodig. Voor unit- en integratietests volstaan vaak volledig kunstmatige datasets. Voor end-to-end-tests kunnen gepseudonimiseerde kopieën zinvol zijn, als reële datapatronen vakinhoudelijk relevant zijn. Productiegelijke data zou de uitzondering moeten zijn - met gedocumenteerd doel, beperkte toegang, en een vaste levensduur.

Belangrijk hierbij is de kwaliteit van de vervangende data. Willekeurige fantasiedata helpt weinig als het geen realistische afhankelijkheden weergeeft. Een testdataset voor een magazijntoepassing moet bijvoorbeeld artikelvarianten, magazijnlocaties, geblokkeerde voorraad, deelleveringen, en retouren in een kloppende combinatie bevatten. Goede testdata beschermt niet alleen persoonsgebonden informatie. Ze vindt fouten die met lege tabellen en de standaardklant "Jan Janssen" nooit zichtbaar zouden worden.

Synthetiseren, maskeren, of minimaliseren?

Synthetische data is de veiligste keuze wanneer de vakinhoudelijke regels zich netjes laten modelleren. Ze ontstaat gericht uit testvereisten en bevat geen kopie van reële personen of transacties. De inspanning zit in het onderhoud: verandert het datamodel of komen er nieuwe procesregels bij, dan moeten generators en fixtures meegroeien.

Maskeren is geschikt wanneer het gedrag van een toepassing sterk afhangt van productiestructuren. Daarbij worden gevoelige velden vervangen of gewijzigd, terwijl relaties behouden blijven. Van namen worden plausibele maar fictieve namen; van e-mailadressen worden onbestelbare testadressen; van rekeningnummers worden waarden met correct formaat zonder echte verwijzing. Een maskering is alleen betrouwbaar als ook indirecte conclusies worden meegewogen. Een combinatie van een zeldzame plaats, geboortedatum, en contractkenmerk kan een persoon nog steeds herkenbaar maken.

Dataminimalisatie is vaak de onderschatte derde weg. In plaats van een volledige export te kopiëren, wordt alleen het benodigde deel beschikbaar gesteld. Dat vermindert het aanvalsoppervlak, de opslagbehoefte, en de opschoningsinspanning. Voor een test van een kortingslogica heeft niemand de volledige klantgeschiedenis van een jaar nodig.

Toegang en omgevingen moeten bij het risico passen

Een beschermde dataset verliest zijn waarde als hij zich in een vrij bereikbare testomgeving bevindt. Testsystemen hebben daarom eigen beveiligingsgrenzen nodig - gescheiden databases, eigen serviceaccounts, duidelijk gedefinieerde netwerktoegang, en geen stilzwijgende verbinding met productie.

Toegangsrechten zouden op rollen moeten berusten, niet op gedeelde accounts. Ontwikkelaars hebben mogelijk andere rechten nodig dan QA, support, of externe dienstverleners. Beheerderstoegang is soms nodig, maar zou tijdelijk moeten zijn, gelogd, en gekoppeld aan een navolgbare goedkeuring. Ook voor testaccounts gelden zinvolle wachtwoordregels, multi-factor-authenticatie waar beschikbaar, en account-lockout-flows bij herhaalde mislukte pogingen.

Geautomatiseerde tests brengen nog een bijzonder geval met zich mee: ze genereren bewijs. Screenshots, schermopnamen, logs, en foutmeldingen kunnen gevoelige inhoud bevatten, zelfs als de database is gemaskeerd. Een screenshot van een klantscherm, een browsertrace met sessie-informatie, of een log met API-payload horen tot dezelfde beschermingsafweging als de testdatabase.

Daarom hebben testartefacten bewaarregels nodig. Niet elke geslaagde run hoeft permanent te worden opgeslagen. Voor kritieke goedkeuringen kan navolgbaar bewijs zinvol zijn, bijvoorbeeld met tijdstempel, buildnummer, testversie, en resultaat. Mislukte runs hebben vaak een langere analysetermijn nodig. Daarna zouden artefacten automatisch verwijderd moeten worden. Wat niet meer bestaat, kan niet per ongeluk worden gedeeld of gecompromitteerd.

Automatisering zonder ongecontroleerde datalekken

AI-ondersteunde testautomatisering kan tests aanzienlijk versnellen, vooral bij omvangrijke web- en Windows-toepassingen. Maar ze verandert de beveiligingsvraag: waar gaan screenshots, invoer, foutbeschrijvingen, en applicatieverkeer naartoe? Wie verwerkt ze? Hoe lang blijven ze daar?

Voor veiligheidsbewuste teams is self-hosted uitvoering vaak de betere architectuur. Een systeem als COCO kan binnen de eigen of een duidelijk afgebakende infrastructuur draaien, teststappen uitvoeren, bewijsstukken opslaan, en begrijpelijke beoordelingen genereren. Dat is niet in elke situatie noodzakelijk. Voor een publieke marketingpagina met puur synthetische formulierwaarden kan een externe dienst verdedigbaar zijn. Bij interne vakapplicaties, klantportalen, of software met persoonsgebonden processen is lokale controle echter een tastbaar voordeel.

Zelfhosting is geen vrijbrief. De exploitatie vereist updates, back-upconcepten, toegangslogs, en een verantwoordelijke instantie. Daar staat tegenover dat de datasoevereiniteit blijft waar ze hoort. De juiste aanpak hangt af van de beschermingsbehoefte, de aanwezige operationele capaciteiten, en het type geteste toepassing - niet van de actuele hype rond een bepaald testinstrument.

Zo worden regels een werkbaar proces

Een praktisch proces hoeft de release niet te blokkeren. Begin met een datalandkaart: welke testomgevingen zijn er, welke soorten data bevinden zich daar, en welke systemen genereren extra artefacten? Deze inventarisatie legt meestal al oude exports, vergeten staging-systemen, en onduidelijke verantwoordelijkheden bloot.

Daarna loont een eenvoudige beslissingsmatrix per testklasse. Ze bepaalt of synthetische data volstaat, een maskering vereist is, of een duidelijk onderbouwd productie-uittreksel nodig is. Ze wordt aangevuld met eigenaren, verwijderingstermijnen, en toegangsrollen. Dat hoeft geen overladen regelwerk te zijn. Een korte, daadwerkelijk gehanteerde richtlijn is beter dan een beveiligingsdocument dat niemand tijdens een storing terugvindt.

Technisch horen databeschikbaarstelling en opschoning thuis in de testpijplijn. Een run maakt zijn benodigde datasets reproduceerbaar aan, gebruikt unieke kenmerken, en verwijdert ze daarna weer. Dat voorkomt dat testomgevingen zich vullen met restdata en resultaten met elke sprint minder betrouwbaar worden. Voor kritieke processen zouden teams bovendien moeten nagaan of datatoegang en testbewijs auditklaar gelogd moeten worden.

Beveiliging die het testen sneller maakt

Secure test data management wordt vaak gezien als extra controle-inspanning. Slecht uitgevoerd kan dat ook zo zijn. Goed uitgevoerd schept het echter betrouwbare, herhaalbare uitgangscondities. Teams verspillen minder tijd aan het zoeken naar een bruikbare data-export, vermijden kapotte tests door niet-opgeschoonde oude data, en kunnen goedkeuringen beter onderbouwen.

De zinvolste eerste stap is zelden een groot platformproject. Neem het testproces met het hoogste risico of de grootste wrijving - bijvoorbeeld de vrijgave van een interne orderapplicatie - en maak daar databron, toegang, artefacten, en verwijdering zichtbaar. Uit dit concrete werk ontstaat een beveiligingsroutine die tests niet omslachtiger maakt, maar geloofwaardiger.

Permalink →

Warehouse Software vs ERP

Warehouse Software vs ERP

Een goederenontvangst komt tegelijk binnen met een dringende orderpicking, twee medewerkers vragen naar de opslaglocatie van een artikel, en een leveringsbon is al met de hand gecorrigeerd. Precies in zulke momenten wordt de vraag Warehouse Software vs ERP praktisch. Het gaat niet om de modernste interface of de langste functielijst. Het gaat erom of de informatie beschikbaar is precies daar waar binnen enkele seconden een beslissing moet vallen.

Veel kleine en middelgrote bedrijven in de DACH-regio beginnen met een ERP, een spreadsheet en veel ervaring in het team. Dat kan lang goed werken. Problemen ontstaan pas wanneer voorraden tussen systemen gaan afwijken, zoektijden toenemen en elk bijzonder geval via geroep door het magazijn moet worden opgelost. Op dat moment ligt vaak een groot ERP-project op tafel, terwijl misschien maar één duidelijk afgebakend magazijnproces gedigitaliseerd hoeft te worden.

Warehouse Software vs ERP: het verschil in de dagelijkse praktijk

Een ERP-systeem beeldt het bedrijf in de breedte af. Het verbindt doorgaans inkoop, verkoop, artikelstamgegevens, boekhouding, productie, facturering en planning. De kracht ervan zit erin dat commerciële en operationele gegevens samenkomen in één gedeeld kader. Een order wordt aangemaakt, een factuur opgesteld, een behoefte gepland, een voorraad gewaardeerd.

Warehouse software, vaak WMS of magazijnbeheer genoemd, werkt dichter bij de werkelijke bewegingen binnen het magazijn. Het ondersteunt goederenontvangst, opslag, verplaatsingen, orderpicking, inventarisatie, verzending en retouren. Het beantwoordt vragen die in het ERP vaak maar grofweg worden weergegeven: op welke locatie ligt de goederen? Welke voorraad is echt beschikbaar? Welke batch is verzonden? Welke order heeft voorrang? Wie heeft de verplaatsing bevestigd?

Dit onderscheid is niet absoluut. Er bestaan ERP's met uitgebreide magazijnfuncties en WMS-producten met koppelingen naar order- of inkoopprocessen. Doorslaggevend is dus niet het label op de offerte, maar de operationele diepgang. Een ERP kan tien opslaglocaties beheren en toch onpraktisch zijn als medewerkers voor elke beweging meerdere schermen moeten openen of gegevens pas later kunnen invoeren.

Het ERP is de commerciële bron

Wanneer een order gefactureerd moet worden, een inkooporder wordt aangemaakt of een materiaalwaardering wordt opgesteld, hoort dat bij de meeste bedrijven thuis in het ERP. Daar zit doorgaans de leidende artikel- en klantlogica. Deze rol mag niet lichtvaardig dubbel worden opgebouwd. Twee onafhankelijke systemen voor prijzen, artikelnummers of orders creëren geen zekerheid, maar afstemmingswerk.

Een ERP is vooral zinvol wanneer de centrale uitdaging afdelingsoverstijgend is: inkoop en productie moeten samen gepland worden, financiële gegevens moeten consistent blijven, of meerdere bedrijfsonderdelen werken met dezelfde processen. Wie zo'n fundament nog niet heeft, moet niet verwachten dat een pure magazijnoplossing alle bedrijfsprocessen vervangt.

Warehouse software stuurt de beweging

In het magazijn telt echter niet alleen wat theoretisch in het systeem staat. Het telt wat er zojuist bij poort drie is aangekomen, welk vak vrij is, en of de goederen zijn gereserveerd voor een bevestigde order. Een goede magazijnoplossing vermindert wrijving precies op deze punten.

Dat kan beginnen met mobiele scanners: goederen worden gescand bij de goederenontvangst, toegewezen aan een opslaglocatie en direct als beschikbaar gemeld. Bij het orderpicken leidt het systeem door een logische volgorde, controleert artikel en hoeveelheid en genereert waar nodig verzendlabels of leveringsdocumenten. De boeking gebeurt niet uren later op een bureau, maar binnen het proces zelf.

Het voordeel zit niet alleen in snelheid. Navolgbare boekingen maken fouten zichtbaar. Als een voorraad niet klopt, is vast te stellen wanneer een beweging ontbrak of verkeerd werd bevestigd. Dat is veel betrouwbaarder dan een maandelijkse correctie in een spreadsheet.

Wanneer een ERP-module volstaat

Een bestaande ERP-module kan de juiste keuze zijn wanneer de magazijnorganisatie overzichtelijk is en het team betrouwbaar met de processen kan werken. Eén magazijn, vaste locaties, weinig orderregels en geen strenge batch- of serienummervereisten zijn typische voorwaarden. Ook bij een laag verzendvolume kan een extra systeemonderdeel meer onderhoud dan nut opleveren.

Voordat een nieuw systeem wordt aangeschaft, loont een nuchtere test: kan een medewerker een goederenontvangst, een verplaatsing en een verzending volledig boeken zonder briefje? Is de voorraad per opslaglocatie zichtbaar? Zijn verschillen uit een inventarisatie te herleiden? Worden documenten gemaakt zonder dubbele invoer? Als deze antwoorden overwegend ja zijn, is een uitbreiding wellicht niet dringend.

Ook de spreadsheet mag blijven, als die een beperkt doel netjes vervult, bijvoorbeeld een seizoensgebonden capaciteitsplanning of een eenmalige analyse. Een goede oplossing vervangt niet elke bekende werkwijze. Ze vervangt die handmatige stappen waarbij fouten, wachttijd of gebrek aan transparantie echt geld kosten.

Wanneer een gespecialiseerde magazijnoplossing zinvol wordt

Het omslagpunt komt meestal geleidelijk. Eerst vraagt een medewerker vaker naar een artikel. Dan wordt voorraad voor de zekerheid hoger aangehouden, omdat niemand de werkelijk beschikbare voorraad zeker weet. Uiteindelijk lopen zendingen vertraging op, omdat leveringsbonnen, etiketten en voorraadcorrecties via verschillende hulpmiddelen lopen.

Een gespecialiseerde warehouse software wordt vooral zinvol wanneer meerdere van deze voorwaarden samenkomen:

  • meerdere magazijngebieden, opslaglocaties of externe magazijnen beheerd worden
  • goederenontvangsten, verplaatsingen en orderpicking dagelijks in groot aantal plaatsvinden
  • batches, serienummers, houdbaarheidsdata of geblokkeerde voorraad gevolgd moeten worden
  • verzenddienstverleners, labelprinters of mobiele scanners in het proces moeten worden ingebouwd
  • de operationele realiteit steeds vaker afwijkt van wat het ERP toont

Deze lijst is geen automatische koopaanbeveling. Een bedrijf met veel orderregels kan prima werken met een goed ingericht ERP. Omgekeerd kan een klein bedrijf al vroeg een lichte magazijntoepassing nodig hebben, als elk onderdeel traceerbaar moet zijn of meerdere teams tegelijk moeten boeken.

Het integratievraagstuk weegt vaak zwaarder dan de functies

De lastigste vraag bij Warehouse Software vs ERP is zelden: welk systeem kan meer? De betere vraag is: welke gegevens moeten wanneer naar welk systeem stromen?

In veel gevallen blijft het ERP leidend voor artikelen, klanten, orders en commerciële documenten. De magazijntoepassing neemt de operationele uitvoering voor haar rekening. Ze ontvangt vrijgegeven orders, voert de magazijnbewegingen uit en meldt status, hoeveelheden, batches of zendingsnummers terug. Zo krijgt elke kant een duidelijke taak.

Deze koppeling heeft concrete regels nodig. Wat gebeurt er bij een orderwijziging nadat het picken al begonnen is? Mag een magazijnvoorraad negatief worden? Welke boeking geldt bij een netwerkstoring? Hoe worden artikelen geblokkeerd die tijdens de kwaliteitscontrole opvallen? Zonder deze beslissingen wordt zelfs een technisch nette API een nieuwe foutenbron.

Voor kleine en middelgrote bedrijven is een gefaseerde uitrol vaak verstandiger dan een volledige overstap. Eerst kan de goederenontvangst met barcodescans worden ingevoerd. Daarna volgen opslaglocaties en verplaatsingen, later orderpicking en verzending. Zo komen echte uitzonderingen vroeg aan het licht, zonder het hele bedrijf op één omschakeldag te zetten.

Standaardproduct, ERP-uitbreiding of maatwerktoepassing?

Een standaard-WMS loont wanneer de eigen processen grotendeels gangbaar zijn en een bestaande koppeling bij het ERP past. Het brengt beproefde functies snel in de praktijk. De prijs daarvoor kan zijn dat teams hun werkwijzen aan vaste schema's moeten aanpassen, of meebetalen aan zelden gebruikte enterprise-functies.

Een ERP-uitbreiding is zinvol wanneer de benodigde operationele diepgang echt beschikbaar is en de bediening op de werkvloer werkt. Beoordeel niet alleen de productdemo, maar een echt proces met scanner, handschoenen, wisselvallige wifi en tijdsdruk vlak voor vertrek.

Een maatwerktoepassing wordt interessant wanneer het proces het concurrentievoordeel van het bedrijf draagt, of standaardsoftware blijvend omwegen afdwingt. Dat kan een bijzonder goederenontvangstproces zijn, een koppeling tussen werkplaats en magazijn, speciale leveringsbonnen of een eigen routelogica. In dat geval hoeft de oplossing niet kunstmatig groot te worden. Een helder proces, netjes gemodelleerd en gebouwd op een onderhoudbaar technisch fundament, is meer waard dan een platform dat in theorie alles kan.

softify.pro ontwikkelt zulke systemen vanuit concrete bewegingen en verantwoordelijkheden: van goederenontvangst via magazijnboekingen tot verzenddocumenten. Datamodel, rechten, foutgevallen en later onderhoud blijven daarbij onderdeel van de uitvoering, niet taken voor ooit na de go-live.

Vragen die vóór de beslissing op tafel horen

Niet elke eis hoeft op dag één geautomatiseerd te worden. Maar ze moet bewust worden beslist. Verantwoordelijken moeten met het magazijnteam, verkoop en boekhouding verhelderen welke gegevens leidend zijn, welke fouten vandaag het vaakst voorkomen en welke kengetallen later echt nodig zijn. Een mooi voorraadoverzicht helpt weinig als niemand weet of gereserveerde, geblokkeerde en beschikbare hoeveelheden verschillend worden behandeld.

Even belangrijk is de verantwoordelijkheid voor stamgegevens. Magazijnprocessen mislukken zelden door een ontbrekende knop. Ze mislukken door inconsistente artikelnummers, slecht bijgehouden maateenheden en onopgehelderde regels voor vervangende artikelen of eenheidsomrekeningen. Software kan deze problemen zichtbaar maken. Ze kan ze niet oplossen zonder beslissingen vanuit het bedrijf zelf.

De juiste keuze is dus niet automatisch ERP of warehouse software. Ze ontstaat uit de afstand tussen uw huidige proces en het proces dat uw team betrouwbaar moet uitvoeren. Begin bij één beweging die vandaag tijd kost of fouten oplevert, en ga na welk systeem die beweging het duidelijkst, snelst en meest navolgbaar afbeeldt.

Permalink →

Goederenontvangst automatiseren

Goederenontvangst automatiseren

Er staat een vrachtwagen aan de poort, twee medewerkers controleren leveringsbonnen, en de voorraadlijst staat nog op de computer op kantoor. Precies hier begint de vraag how to automate goods receiving praktisch te worden. Niet omdat elk magazijn een grote ERP-invoering nodig heeft. Maar omdat een ontbrekende, te late of verkeerd geboekte goederenontvangst gevolgen heeft: voorraden kloppen niet, orders wachten, klachten worden lastig te herleiden en de ploeg begint met vragen die eerst uitgezocht moeten worden.

Goederenontvangst automatiseren betekent niet mensen door scanners vervangen. Het betekent terugkerende controles, boekingen en documenten zo inrichten dat het team aan de poort snel kan beslissen en de voorraad daarna betrouwbaar is. Voor kleine en middelgrote bedrijven is een slank, passend proces meestal waardevoller dan een concernsysteem vol functies die niemand gebruikt.

Wat er bij handmatige goederenontvangst echt verloren gaat

Papieren leveringsbonnen en Excel-lijsten werken vaak lang genoeg om een investering uit te stellen. Het probleem ontstaat niet bij één losse doos. Het ontstaat wanneer afwijkingen zich opstapelen: een deelleverantie wordt pas later genoteerd, een batch is niet te herleiden, een pallet komt in het verkeerde vak terecht, of een goederenontvangst wordt pas aan het einde van de dag geboekt.

Dan bestaan er meerdere waarheden tegelijk. De leverancier meldt geleverd. In het magazijn staat de goederen fysiek. De planning ziet nog geen beschikbare voorraad. De boekhouding heeft een document, maar geen bevestiging van hoeveelheid of schade. Medewerkers stemmen deze informatie af via telefoon, e-mail en ervaring. Dat kost tijd en maakt het proces afhankelijk van individuele personen.

Automatisering creëert één gedeelde, actuele bron voor de transactie. Ze legt niet alleen de verwachte voorraad vast, maar ook wat er daadwerkelijk aan de poort is gebeurd: wie heeft aangenomen, wanneer, in welke hoeveelheid, met welke afwijking en waar de goederen daarna naartoe gaan.

How to automate goods receiving met een duidelijk proces

Het juiste startpunt is niet de keuze voor een scanner of een magazijn-app. Eerst moet het echte proces zichtbaar worden. Loop een typische goederenontvangst na, van de aangekondigde leverdatum tot de opslag. Let daarbij ook op de bijzondere gevallen, want die bepalen of een oplossing in de praktijk standhoudt.

Een digitaal proces bestaat meestal uit vijf opeenvolgende beslissingen. De levering wordt geïdentificeerd, gecontroleerd tegen de bestelling of de verwachte aanvoer, de werkelijke hoeveelheid wordt vastgelegd, afwijkingen worden gedocumenteerd en de goederen worden toegewezen aan een opslaglocatie of een extra controlestap. Elke stap zou alleen de gegevens moeten vragen die op dat punt echt nodig zijn.

1. Verwachte leveringen vooraf beschikbaar stellen

Als inkooporders, productieorders of vooraankondigingen van levering aanwezig zijn, zou het magazijn ze vóór aankomst moeten kunnen zien. Bij aankomst kiest de verantwoordelijke persoon de leverancier, scant een bestelnummer of zoekt naar een openstaande levering. Het systeem toont de verwachte artikelen, hoeveelheden en eventueel batch- of serienummers.

Dat verkort de aanname aanzienlijk. Nog belangrijker is echter de controlelogica: het team hoeft niet uit het hoofd te beslissen of 18 in plaats van 20 dozen aanvaardbaar zijn. De afwijking wordt zichtbaar en kan van een reden worden voorzien. Bij niet-aangekondigde leveringen heeft het proces een gecontroleerde weg nodig, bijvoorbeeld als voorlopige goederenontvangst met vrijgave door inkoop of planning.

2. Barcodes inzetten waar ze echt tijd besparen

Een barcodescanner of de camera van een robuust mobiel apparaat is voor veel magazijnen het meest zinvolle startpunt. Een scan vermindert typefouten en versnelt terugkerende bewegingen. Voorwaarde is wel dat artikelnummers, verpakkingseenheden en etiketten consistent worden bijgehouden. Een scanner lost geen onduidelijke stamgegevens op.

Niet elke goederen hoeft serienummertraceerbaarheid te hebben. Bij schroeven of standaard verbruiksmateriaal volstaan vaak artikel, hoeveelheid en opslaglocatie. Bij reserveonderdelen met garantie, gereguleerde producten of componenten voor de productie kunnen batch, serienummer, houdbaarheidsdatum en controlestatus verplicht zijn. De registratiediepte moet passen bij het risico, niet bij een algemene softwaresjabloon.

3. Afwijkingen als normaal proces behandelen

Een goede digitale goederenontvangst probeert niet elke afwijking te voorkomen. Ze maakt afwijkingen eenvoudig en aantoonbaar behandelbaar. Tekorten, overleveringen, transportschade, verkeerde artikelen en geblokkeerde batches hebben duidelijke statussen nodig in plaats van handgeschreven notities op de leveringsbon.

Bij een beschadigde levering kan bijvoorbeeld direct bij de ontvangstplek een foto worden vastgelegd, de hoeveelheid als geblokkeerd worden geboekt en inkoop automatisch worden geïnformeerd. De beschikbare voorraad blijft correct, terwijl de goederen fysiek naar een quarantainezone gaan. Dat voorkomt dat beschadigde onderdelen per ongeluk worden gepickt of in de productie worden gebruikt.

De regel hoeft niet altijd volledig automatisch te zijn. Voor kleine hoeveelheden kan een overlevering direct worden geaccepteerd. Bij dure of veiligheidsrelevante artikelen zou een vrijgave vereist moeten zijn. Deze drempelwaarden horen thuis in het proces en moeten later aanpasbaar blijven.

4. Opslag direct in gang zetten

Een aanname is pas operationeel compleet wanneer duidelijk is waar de goederen liggen, of waarom ze nog niet opgeslagen mogen worden. Het systeem kan een vaste opslaglocatie voorstellen, een aanvulzone laten prevaleren, of op basis van artikelgroep, temperatuurbereik en beschikbare capaciteit een doelgebied bepalen.

Voor overzichtelijke magazijnen volstaat vaak een duidelijke locatielogica met weinig zones. Complexe routeoptimalisatie is alleen zinvol als volume, looproutes en personeelsstructuur dat rechtvaardigen. Wie tien pallets per dag ontvangt, heeft geen optimalisatieproject nodig dat langer duurt dan de tijd die het bespaart. Een betrouwbare opslaglocatiescan is vaak de grotere stap vooruit.

Na de opslag werkt het systeem voorraad en bewegingslogboek bij. Verkoop, planning of productie zien zo de status zonder navraag bij het magazijn. Als een artikel pas na een kwaliteitscontrole beschikbaar mag zijn, scheidt het systeem fysieke voorraad van beschikbare voorraad.

Welke gegevens goederenontvangst echt nodig heeft

Een digitaal proces wordt snel onpopulair als er aan de poort te veel velden worden gevraagd. Tegelijk ontbreken zonder minimale gegevens de bewijzen voor latere opheldering. In de meeste middelgrote bedrijven zijn deze gegevens zinvol:

  • Leverancier en referentie naar de bestelling of leveringsbon
  • Artikel, aangenomen hoeveelheid en verpakkingseenheid
  • Tijdstip en verantwoordelijke persoon
  • Opslaglocatie of status zoals controle, sperrmagazijn of quarantaine
  • Reden van afwijking, foto's en vrijgave indien nodig

Extra velden zouden alleen verplicht moeten zijn als ze een concrete beslissing mogelijk maken. Bij batchplicht is het batchnummer geen extra, maar kerninformatie. Een vrij commentaarveld bij elke levering wordt daarentegen vaak alleen ingevuld om een formulier compleet te laten lijken.

Integratie bepaalt de verhouding tussen nut en inspanning

Goederenontvangst mag niet als nieuwe eilandoplossing naast inkoop, productie en boekhouding ontstaan. Ten minste artikelstamgegevens, openstaande bestellingen en voorraadwijzigingen moeten betrouwbaar worden uitgewisseld. Of dit via een bestaande ERP-koppeling, data-imports of een gericht ontwikkeld tussenproces gebeurt, hangt af van het aanwezige systeemlandschap.

Bij oudere ERP-systemen is een volledige realtime-integratie niet altijd rendabel. Een gecontroleerde import op vaste intervallen kan volstaan als hoeveelheden en termijnen dat toelaten. Voor reserveonderdelen die direct voor urgente orders worden ingezet, telt daarentegen een tijdige boeking zwaarder. Techniek volgt hier het tempo van het bedrijf.

Ook bedrijfszekerheid hoort bij de planning. Apparaten hebben gebruikersaccounts, duidelijke rollen en een gedefinieerd gedrag bij netwerkuitval nodig. Een mobiele goederenontvangst hoeft niet per se offline te kunnen werken. Maar als wifi-uitval regelmatig voorkomt, is een lokale buffer met navolgbare synchronisatie geen luxe, maar onderdeel van de procesbetrouwbaarheid.

Invoering in kleine stappen in plaats van een big bang

Begin met één leverancier, één productgroep of één duidelijk afgebakend magazijngebied. Meet niet alleen de duur per boeking, maar ook herstelwerk, onopgehelderde verschillen en navraag tussen magazijn en kantoor. Daaruit blijkt of de automatisering echt ontlast.

Train met echte leveringsbonnen uit de dagelijkse praktijk, inclusief beschadigde of onvolledige leveringen. Een proces dat alleen werkt bij een perfect kloppende levering is geen automatisering, maar een demonstratie. Medewerkers bij goederenontvangst zouden mee moeten kunnen bepalen aan de regels, omdat zij de uitzonderingsgevallen kennen.

softify.pro ontwikkelt zulke processen bewust workflow-specifiek: van de mobiele scan tot de gedocumenteerde voorraadbeweging en een stabiele koppeling met bestaande systemen. Doorslaggevend is daarbij niet de langste functielijst, maar een systeem dat onder tijdsdruk navolgbaar blijft en technisch onderhoudbaar kan worden gebruikt.

De beste volgende stap is dan ook geen softwarevergelijking, maar een uur kijken naar de laatste tien problematische leveringen. Als u voor elk daarvan kunt zeggen waar tijd verloren ging en welke informatie ontbrak, ligt het eerste concept voor een betere goederenontvangst er al.

Permalink →

Voordelen van orderpicking met barcodes voor kleine en middelgrote magazijnen

Voordelen van orderpicking met barcodes voor kleine en middelgrote magazijnen

Een verkeerd artikel in de doos kost zelden alleen de prijs van de retourzending. Het kost tijd in het magazijn, zorgt voor vragen op kantoor en beschadigt in het ergste geval een klantrelatie. De voordelen van orderpicking met barcodes blijken daarom niet eerst uit een technisch kengetal, maar uit een rustigere goederenuitgifte: medewerkers weten wat de volgende stap is en afwijkingen vallen op waar ze ontstaan.

Voor kleine en middelgrote magazijnen is dat bijzonder relevant. Veel processen werken aanvankelijk met papieren lijsten, Excel-bestanden, geroepen instructies en de ervaring van individuele personen. Dat is niet principieel fout. Bij een overzichtelijk volume kan een spreadsheet zelfs het verstandigere hulpmiddel zijn. Maar zodra het aantal artikelen, het aantal orders, de ploegwissels of de eisen aan traceerbaarheid toenemen, wordt de pragmatische noodoplossing al snel een bron van fouten.

Wat orderpicking met barcodes in de dagelijkse praktijk verandert

Bij orderpicking met barcodes bevestigt een scan niet alleen dat iemand iets heeft gedaan. Hij verbindt order, locatie, artikel en hoeveelheid in één traceerbare werkstap. Het systeem geeft de volgende pick aan, de medewerker scant locatie en artikel, voert indien nodig de hoeveelheid in en krijgt direct feedback.

De volgorde van de controle is doorslaggevend. Scant een medewerker eerst een artikel en pas daarna de locatie, dan kan het systeem wel een verkeerd artikel herkennen, maar geen ongunstige looproute voorkomen. In de praktijk werkt de volgorde locatie, artikel, hoeveelheid vaak goed. Bij processen met batches, serienummers of houdbaarheidsdatum komen er extra controles bij. Welke daarvan nodig zijn, hangt af van het risico, niet van wat technisch mogelijk zou zijn.

Een goed systeem vervangt geen doordachte magazijnindeling. Het maakt wel zichtbaar wanneer die indeling in de dagelijkse praktijk niet wordt nageleefd. Ligt een product op een niet bedoelde locatie, dan wordt de fout niet pas bij de inventarisatie ontdekt, maar al bij de scan.

De belangrijkste voordelen van orderpicking met barcodes: minder verwisselingen precies waar ze ontstaan

Papieren lijsten vragen voortdurend concentratie: artikelnummer lezen, vak vinden, verpakking vergelijken, hoeveelheid afvinken. Onder tijdsdruk zijn vergelijkbare dozen, bijna identieke omschrijvingen of een onderbroken handeling genoeg om een fout te veroorzaken. De barcode brengt op dat moment een eenduidige identificatie.

De scanner vervangt het nadenken niet, maar neemt de controle over die mensen bij routinewerk het moeilijkst langdurig volhouden. Past het artikel niet bij de order, dan moet de feedback duidelijk zijn: verkeerd artikel, verwacht artikel, volgende zinvolle stap. Een simpel rood waarschuwingssignaal helpt weinig als niet duidelijk is hoe de afwijking moet worden opgelost.

Boekingen maken voorraden betrouwbaarder

Voorraden zijn alleen nuttig als er beslissingen op kunnen worden gebaseerd. Wie nabestellingen plant, levertijden toezegt of productiemateriaal klaarzet, heeft meer nodig dan een getal van vorige week. Als uitnames pas aan het einde van de ploeg of achteraf vanuit een lijst worden overgenomen, ontstaan er periodes met een onduidelijke datasituatie.

Een scan kan de uitname direct boeken. Daardoor wordt het verschil tussen fysieke beweging en digitale voorraad kleiner. Dat betekent niet dat elk getal automatisch klopt. Verkeerd geëtiketteerde goederen, ongeboekte verplaatsingen en beschadigde voorraad blijven echte aandachtspunten. Maar oorzaken zijn veel beter af te bakenen, omdat elke beweging een tijdstip, een order en eventueel een gebruikerskoppeling heeft.

Dat is vooral handig bij aanvulprocessen. Zakt een vak onder de streefvoorraad, dan kan het systeem een aanvulopdracht aanmaken of dat op zijn minst zichtbaar maken. Orderpickers hoeven dan niet midden in een order naar vervangende goederen te zoeken terwijl de klant op zijn zending wacht.

Sneller inwerken zonder afhankelijkheid van individuele kennis

Ervaren magazijnmedewerkers kennen routes, uitzonderingen en het uiterlijk van artikelen uit hun hoofd. Die kennis is waardevol, maar als enig besturingssysteem riskant. Bij vakanties, ziekte of groei komen teams onder druk te staan wanneer nieuwe medewerkers eerst wekenlang moeten leren welke stellingrij met een interne afkorting wordt bedoeld.

Een goede mobiele interface leidt in begrijpelijke taal door de order. Ze toont locatie, artikel, gevraagde hoeveelheid en indien nodig een afbeelding of aanwijzingen over de verpakking. De scan bevestigt de stap. Nieuwe collega's worden daardoor niet meteen experts, maar kunnen wel eerder veilig meewerken.

Dat geldt ook voor uitzendkrachten en wisselende ploegen. Voorwaarde is dat de stamgegevens goed worden bijgehouden. Een systeem kan geen duidelijke instructie afleiden uit een artikelomschrijving als „onderdeel klein blauw nieuw“. Digitalisering legt zulke zwakke plekken bloot - en juist dat is vaak een nuttig neveneffect.

Traceerbaarheid bij klachten en inventarisaties

Als een klant een tekort meldt, begint zonder procesgegevens vaak een zoektocht door stapels papier, verzendlijsten en herinneringen. Met boekingen op basis van barcodes is na te gaan welke order wanneer is verwerkt, welke regel is bevestigd en of er een correctie of deelhoeveelheid was.

Dat is geen garantie tegen klachten. Maar het verkort de opheldering en scheidt vermoedens van feiten. Ook inventarisaties profiteren: verschillen kunnen niet alleen worden geteld, maar ook aan de hand van bewegingen worden onderzocht. Stapelen correcties zich op bij een bepaald vak, een artikelgroep of na een bepaalde overdracht in het proces, dan ontstaat een concreet aanknopingspunt voor verbeteringen.

Meetbare processen in plaats van onderbuikgevoel

Veel magazijnen weten dat het „in de middag krap wordt“ of dat bepaalde orders ongewoon lang duren. Zonder tijdstempels en processtappen blijft het een onderbuikgevoel. Als start van de pick, scan, onderbreking, afronding en overdracht worden vastgelegd, zijn knelpunten nauwkeurig van elkaar te onderscheiden.

Misschien is niet het picken traag, maar worden goederen te laat opgeslagen. Misschien ontstaan er wachttijden bij de inpakplek of wordt één vak onevenredig vaak bezocht. Deze gegevens moeten niet worden verward met een instrument voor algemene prestatiecontrole. Hun waarde ligt in de eerste plaats in het herkennen van onnodige looproutes, ontbrekende aanvullingen en onduidelijke overdrachten.

Het nut hangt af van het procesontwerp

Orderpicking met barcodes is geen doel op zich en niet elk magazijn heeft een uitgebreid magazijnbeheersysteem nodig. Bij weinig orders, een klein assortiment en vaste medewerkers kan een goed georganiseerd proces met eenvoudige lijsten voordeliger zijn. Een project is zinvol wanneer de kosten van mispicks, zoektijden, onzekerheid over de voorraad of handmatig herstelwerk regelmatig voelbaar worden.

Ook de hardwarevraag verdient een nuchtere blik. Een smartphone met camerascan kan voor de eerste processen volstaan. Bij een hoge scanfrequentie, handschoenen, slechte verlichting of een ruwe omgeving zijn gespecialiseerde handscanners meestal sneller en minder foutgevoelig. Daarnaast is de netwerkdekking doorslaggevend. Valt de wifi in een magazijnzone uit, dan heeft de applicatie een duidelijke strategie nodig: offline buffering met latere synchronisatie of een proces waarbij dat gebied niet mobiel wordt bewerkt.

De kwaliteit van de etiketten is net zo belangrijk als de software. Een barcode op een versleten vaklabel of een dubbel toegekende artikelcode ondermijnt het hele proces. Voor de start moeten locaties eenduidig worden gelabeld, eenheden worden gedefinieerd en kritieke uitzonderingen worden verduidelijkt: hoe wordt een aangebroken verpakking behandeld? Wat gebeurt er bij een tekort? Wie mag een hoeveelheid corrigeren? Wat gebeurt er met goederen zonder leesbare code?

Zo verloopt de invoering zonder bedrijfsonderbreking

De betrouwbaarste start is zelden een volledige omschakeling. Begin met een afgebakend gebied, bijvoorbeeld de meest voorkomende verzendorders of een artikelgroep met veel verwisselingen. Daar kunnen scanvolgorde, foutmeldingen en etiketten in de echte praktijk worden getest, zonder de hele locatie tegelijk om te bouwen.

Vóór de technische uitvoering moet de werkelijke route van een order in kaart worden gebracht - van orderontvangst via reservering en pick tot aan de inpakplek en het verzendlabel. Niet het gewenste proces uit een organigram telt, maar de werkwijze die de ploeg daadwerkelijk gebruikt. De waardevolste eisen zitten vaak in kleine uitzonderingen: verzamelorders, vervangende artikelen, deelpicks of het terugbrengen van goederen die niet nodig zijn.

Daarna zijn duidelijke regels voor uitzonderingen nodig. Een medewerker moet een tekort kunnen melden zonder de order informeel te omzeilen. Een bevoegde persoon moet correcties traceerbaar kunnen uitvoeren. En als er koppelingen zijn met een webshop, ERP of vervoerder, moeten orderstatus en voorraadboekingen duidelijk zijn gedefinieerd. Dubbel gegevensbeheer is een waarschuwingssignaal, geen blijvende oplossing.

Bij maatwerksystemen begint softify.pro precies op dit punt: niet met een overladen enterprisepakket, maar met de scan- en boekingsstappen die voor het concrete magazijn aantoonbaar nodig zijn. Een onderhoudbare databasis, duidelijk gedocumenteerde koppelingen en begrijpelijke gebruikersinterfaces zijn daarbij waardevoller dan een lange lijst zelden gebruikte functies.

Een zinvol eerste toetspunt

Neem tien typische orders en volg ze van ontvangst tot aan de overdracht aan verzending. Noteer op welke plekken medewerkers moeten zoeken, navragen, gegevens later invoeren of op hun geheugen moeten vertrouwen. Precies daar wordt beslist of orderpicking met barcodes voordelen oplevert - en welk scanproces echt bij het magazijn past.

Permalink →

Self-hosted testen vs cloud

Self-hosted testen vs cloud

Een mislukte regressietest is zelden slechts een rode regel in een dashboard. Het kan betekenen dat een verzendscherm in het magazijn verkeerde labels genereert, een klantenportaal geen bestellingen meer accepteert, of een Windows-toepassing crasht tijdens een ploegoverdracht. De vraag self hosted testing vs cloud gaat daarom niet over infrastructuur als doel op zich. Het gaat erom welke gegevens een testproces raakt, wie het controleert, en hoe betrouwbaar het onder werkelijke bedrijfsomstandigheden draait.

Cloudgebaseerde testplatforms kunnen snel operationeel zijn. Voor veel teams is dat zinvol, vooral wanneer ze een publieke webapplicatie testen en op korte termijn extra uitvoeringscapaciteit nodig hebben. Zelf gehoste testomgevingen vereisen daarentegen een bewuste technische opzet. Maar ze geven de controle over testdata, netwerkpaden, toegangsrechten, en exploitatie terug aan het bedrijf. De juiste keuze hangt niet af van een algemeen principe, maar van de toepassing, het risico, en de beschikbare operationele capaciteit.

Self Hosted Testing vs Cloud: Waar het echt om gaat

Het debat wordt vaak te sterk gereduceerd tot de initiële kosten. Een cloudoplossing oogt goedkoper omdat geen servers hoeven te worden aangeschaft en geen omgeving hoeft te worden ingericht. Een eigen testserver oogt op het eerste gezicht omslachtiger, omdat besturingssysteem, updates, toegangscontrole, monitoring, en back-ups gepland moeten worden.

Die berekening schiet tekort. Doorslaggevend zijn de lopende kosten van een teststrategie: wachttijden vóór releases, foutopsporing na onvolledige testruns, afstemming met gegevensbescherming en informatiebeveiliging, en de gevolgen van een gebrekkige deployment. Als een team regelmatig gevoelige vakapplicaties onderzoekt, kan de extra organisatorische last van externe diensten groter zijn dan de exploitatie van een duidelijk afgebakende eigen omgeving.

Ook "cloud" is geen uniform model. Sommige aanbieders slaan alleen testlogs op, andere verwerken screenshots, video-opnamen, toegangsgegevens, DOM-inhoud, of netwerkverkeer. Bij AI-ondersteund testen kunnen bovendien beeld- en tekstgegevens voor evaluatie bij externe modellen of onderaannemers terechtkomen. Wie alleen naar de locatie van een datacenter kijkt, mist vaak de belangrijkere vraag: welke gegevens verlaten daadwerkelijk de eigen controlezone, en welke contract- en verwijderingsregels gelden daarvoor?

Wanneer cloudtesten de verstandige keuze is

Cloudtesten is niet fundamenteel een beveiligingsprobleem, en zelfhosting is niet automatisch de betere architectuur. Voor een nieuwe, publiek bereikbare webshop of een marketingplatform kan een cloudomgeving zeer passend zijn. Het team kan browser- en apparaatvarianten snel dekken zonder eigen uitvoeringsmachines te onderhouden. Bij wisselende testbelasting is elastische schaalbaarheid eveneens een reëel voordeel.

Ook kleine ontwikkelteams met weinig, duidelijk geanonimiseerde testdata profiteren vaak van een managed service. Ze zouden hun tijd niet moeten investeren in de exploitatie van een platform als het knelpunt eerder ligt bij ontbrekende testcases, onduidelijke acceptatiecriteria, of instabiele testdata. Een eigen server lost die problemen niet op.

De cloud past bijzonder goed wanneer de applicatie geen interne netwerktoegang nodig heeft, geen persoonsgebonden of bedrijfskritieke gegevens in de testprocessen voorkomen, en een korte doorlooptijd belangrijker is dan diepgaande infrastructuurcontrole. Vereiste is een zorgvuldige configuratie: gescheiden testaccounts, geen echte klantgegevens, beperkte tokens, navolgbare bewaartermijnen, en een duidelijk rechtenconcept.

Wanneer self-hosted testen zinvoller wordt

Anders ligt het bij applicaties die alleen binnen het bedrijfsnetwerk bereikbaar zijn of operationele kernprocessen weergeven. Magazijn- of productiesoftware verwerkt vaak artikelbewegingen, afleveradressen, voorraden, serienummers, en prijslogica. Een testrun kan daarbij screenshots van orderschermen genereren, documenten downloaden, of inloggen met gebruikersrollen. Zulke gegevens zouden niet ongemerkt over meerdere externe systemen verspreid moeten worden.

Self-hosted testen maakt het mogelijk de testuitvoering dicht bij de applicatie te plaatsen. De testserver kan in hetzelfde netwerksegment of in een gecontroleerde DMZ draaien. Firewallregels worden gericht ingesteld, interne applicaties hoeven niet voor een externe dienst opengesteld te worden, en logs blijven onder eigen beheer. Dat is vaak bijzonder relevant voor Windows-desktoptoepassingen, aangezien deze zelden ontworpen zijn voor externe testplatforms.

Voor gereguleerde sectoren, grotere klanteisen, of interne beveiligingsrichtlijnen is deze architectuur vaak eenvoudiger te toetsen. Dat betekent niet dat elke toetsing automatisch wordt doorstaan. Ook een eigen server heeft patchbeheer, versleuteling, rolgebonden rechten, back-ups, en gedocumenteerde operationele procedures nodig. Het verschil is dat het bedrijf deze beslissingen zelf neemt en kan aantonen.

Bij softify.pro is COCO daarom bedoeld als toegewijde, self-hosted AI-server: testruns voor web- en Windows-toepassingen worden lokaal uitgevoerd, bewijsstukken vastgelegd, en resultaten in begrijpelijke taal beoordeeld. Dat vervangt geen vakkundige goedkeuring. Het zorgt er wel voor dat testverkeer, screenshots, en evaluaties kunnen blijven waar het bedrijf de datasoevereiniteit behoudt.

Kosten correct vergelijken: exploitatie tegen wrijving

Een zinvolle vergelijking omvat meer dan licentieprijs tegen hardwareprijs. In de cloud ontstaan terugkerende kosten per gebruiker, testminuut, parallelle uitvoering, of AI-verbruik. Deze kosten zijn aanvankelijk voorspelbaar, maar kunnen aanzienlijk stijgen naarmate de testdekking groeit. Daar komen mogelijke uitgaven bij voor enterprise-contracten, verwerkersovereenkomsten, en beveiligingsaudits.

Bij zelfhosting ontstaan investeringen voor infrastructuur en inrichting. Dat kan virtuele machines, opslag, netwerktoegang, monitoring, en de tijd van een technisch verantwoordelijk team omvatten. Deze kosten blijven ook bestaan wanneer weinig tests draaien. Voor een project met zeldzame releases is dat een goed argument tegen een overgedimensioneerde eigen oplossing.

Bij regelmatige regressietests verschuift het beeld. Als elke week dezelfde bedrijfskritieke processen moeten worden gecontroleerd, zijn berekenbare interne capaciteiten vaak economischer dan variabele platformkosten en handmatige goedkeuringslussen. De aanpak wordt bijzonder waardevol wanneer testgevallen jarenlang worden gebruikt en samen met de vakapplicatie doorontwikkeld worden. Onderhoudbaarheid weegt dan zwaarder dan een snelle maar moeilijk beheersbare start.

Kwaliteit hangt niet af van het hostingmodel

Een veelvoorkomend misverstand luidt: cloudtests zouden automatisch moderner zijn, self-hosted tests automatisch stabieler. Beide kloppen niet. Testkwaliteit ontstaat door zinvolle scenario's, robuuste testdata, stabiele identificatoren in de interface, en duidelijke verwachtingen ten aanzien van het resultaat.

Een test zou niet alleen moeten controleren of een knop klikbaar is. Voor een orderafhandeling kan hij bijvoorbeeld een order aanmaken, een beschikbare hoeveelheid controleren, een leveringsbon genereren, en waarborgen dat de juiste rol het proces mag vrijgeven. Bij een desktopprogramma kan hij het importeren van een bestand, de foutafhandeling, en de uitvoer van een document natrekken. Pas zulke end-to-end-processen tonen of een wijziging het werkelijke proces heeft beschadigd.

AI kan hierbij helpen om interfacewijzigingen te herkennen, stappen begrijpelijk te documenteren, en opvallendheden te prioriteren. Ze zou echter geen black box moeten worden. Teams hebben screenshots of andere bewijsstukken nodig, navolgbare teststappen, en gedefinieerde drempelwaarden voor wanneer een resultaat als geslaagd, onzeker, of mislukt geldt. Juist bij visuele controles is een betrouwbaarheidsdrempel zinvol, zodat kleine, verwachte layout-afwijkingen niet elke release blokkeren.

De operationele vragen vóór de beslissing

Voordat een team zich vastlegt, zou het het traject van een testrun concreet moeten vastleggen. Waar draait de test? Bij welke systemen meldt hij zich aan? Welke gegevens ziet hij? Waar worden screenshots, logs, en rapporten opgeslagen? Wie mag resultaten lezen, verwijderen, of exporteren? Deze vragen zijn praktischer dan een algemene beslissing voor of tegen de cloud.

Even belangrijk is de verantwoordelijkheid na de go-live. Wie werkt browsers en testagenten bij? Wie reageert wanneer een certificaat verloopt? Hoe worden toegangsgegevens geroteerd? En hoe wordt gewaarborgd dat een test niet per ongeluk een echte verzendboeking of klantnotificatie uitlokt? Goede testautomatisering vereist gescheiden omgevingen en beschermingsmechanismen, niet alleen goede scripts.

Een hybride model kan zinvol zijn. Publieke interfaces en breed verspreide browsercontroles draaien in de cloud, terwijl interne vakprocessen op een eigen testserver blijven. Dat vermindert de operationele last, zonder gevoelige processen en masse naar buiten te geven. Vereiste is een duidelijke grens tussen beide gebieden, geen onoverzichtelijke gemengde exploitatie.

De beste beslissing is degene die past bij het werkelijke risico en de eigen operationele realiteit. Als een spreadsheet een proces nog betrouwbaar draagt, hoeft daar geen groot systeem van te worden gemaakt. Als testdata en interne toepassingen daarentegen tot de bedrijfskern behoren, is controle geen luxe, maar een zakelijke eis voor betrouwbare software.

Permalink →

Inventory Management in het magazijn

Inventory Management in het magazijn

Een ontbrekend onderdeel valt zelden op tijdens het tellen in het magazijn. Meestal blijkt het pas wanneer een order niet kan worden ingepakt, een technieker voor een leeg schap staat, of aankoop telefonisch op zoek gaat naar een leveringsbelofte. Goed Inventory Management voorkomt deze verrassingen niet met meer tabellen, maar met een betrouwbaar beeld van wat aanwezig is, waar het ligt, en wat er vervolgens mee gebeurt.

Voor kleine en middelgrote bedrijven is dat geen kwestie van een zo groot mogelijk ERP-systeem. Doorslaggevend is of medewerkers bij goederenontvangst, magazijn, en verzending met enkele duidelijke stappen kunnen werken - ook onder tijdsdruk, over ploegwisselingen heen, en wanneer een levering anders uitpakt dan gepland.

Inventory Management begint met bewegingen, niet met voorraadlijsten

Een voorraadlijst is een momentopname. Ze kan correct zijn en toch weinig helpen als niemand kan achterhalen waarom een hoeveelheid is veranderd. Een robuust systeem behandelt voorraden daarom als het gevolg van gedocumenteerde bewegingen: goederen komen aan, worden gecontroleerd, opgeslagen, gereserveerd, gepickt, verplaatst, verzonden, of gecorrigeerd.

Elke beweging heeft een duidelijke reden, een tijdstip, een verantwoordelijke persoon, en idealiter een koppeling naar een specifieke transactie nodig. Dat kan een aankooporder, een klantorder, een leveringsbon, of een productieorder zijn. Zo wordt van het getal "24 stuks beschikbaar" een controleerbare uitspraak: 30 stuks zijn ingeboekt, vier zijn gereserveerd voor twee orders, en geen openstaande verplaatsing vertekent de beschikbare voorraad.

Dit onderscheid is vooral relevant bij schaarse onderdelen. Fysiek aanwezig, gereserveerd, en vrij beschikbaar zijn drie verschillende toestanden. Worden ze vermengd, dan belooft de verkoop goederen die het magazijn al nodig heeft voor een andere order. Worden ze netjes bijgehouden, dan kan een team vroeg beslissen: bijbestellen, herprioriteren, of de klant een realistisch antwoord geven.

Waar manuele processen typisch breken

Spreadsheets zijn niet fundamenteel verkeerd. Voor een klein assortiment, één opslaglocatie, en weinig bewegingen per week kunnen ze economischer zijn dan een eigen toepassing. Ze worden problematisch zodra meerdere personen tegelijk werken of voorraden vanuit meerdere bronnen worden bijgewerkt.

Dan ontstaan de bekende lacunes: de goederenontvangst ligt als papier op het bureau, het Excel-bestand is lokaal gewijzigd, een verplaatsing is alleen mondeling afgesproken, en verzending boekt pas na werktijd. De voorraad is niet per se onjuist, maar hij is tijdsverschoven en zijn herkomst onduidelijk. Precies dat maakt hem ongeschikt voor operationele beslissingen.

Ook de organisatiestructuur speelt een rol. Een centrale locatie heeft andere processen nodig dan een bedrijf met buitenmagazijnen, servicevoertuigen, of een productie die materiaal onttrekt. Wie deze verschillen met één vrije-tekstkolom in kaart brengt, verschuift de logica naar de hoofden van individuele medewerkers. Dat werkt totdat die persoon vakantie heeft of het ordervolume stijgt.

Het proces vaststellen vóór de software

Een zinvol project begint niet met de vraag welke scanner wordt gekocht of welke interface modern oogt. Eerst moet duidelijk zijn welke beslissingen het systeem moet ondersteunen. Daarvoor volstaan vaak concrete observaties uit de dagelijkse praktijk: hoe wordt goederen vandaag aangenomen? Wanneer geldt het als gecontroleerd? Wie mag voorraden corrigeren? Wat gebeurt er bij beschadigde goederen? En op welk punt wordt een order bindend gereserveerd?

Uit deze antwoorden ontstaan enkele bindende regels. Bijvoorbeeld: goederenontvangst mag pas na een hoeveelheidscontrole worden ingeboekt. Artikelen zonder opslaglocatie mogen niet als opslaanbaar verschijnen. Voorraadcorrecties vereisen een redencode en blijven zichtbaar in de historie. Verzonden goederen worden niet stilzwijgend verwijderd, maar via een gedocumenteerde afboeking aan de order toegewezen.

Dat is minder spectaculair dan een grote digitaliseringsslide, maar in de praktijk veel waardevoller. Als de regels eenduidig zijn, kan software ze betrouwbaar toetsen. Blijven ze onduidelijk, dan versnelt elke nieuwe toepassing alleen tegenstrijdige werkstappen.

Stamgegevens: klein beginnen, consequent onderhouden

Niet elk artikel heeft bij aanvang tien classificaties nodig. Een bruikbare basis bestaat vaak uit artikelnummer, omschrijving, eenheid, actieve voorraadstatus, en een of meer opslaglocaties. Afhankelijk van het bedrijf komen daar charges, serienummers, minimale voorraden, leveranciersartikelnummers, of vervaldatums bij.

Belangrijk is de consequentie, niet de hoeveelheid velden. Twee artikelnummers voor hetzelfde fysieke artikel, of wisselende eenheden zoals "doos", "verpakking", en "stuk" zonder omrekeningsregel, veroorzaken later bijna automatisch fouten. Een systeem kan zulke invoer technisch toestaan. Het zou ze moeten begrenzen waar ze het proces in gevaar brengen.

Welke functies in het magazijn echt helpen

Voor veel middelgrote magazijnen is een duidelijke kern waardevoller dan een overladen functiecatalogus. Deze kern omvat doorgaans vier gebieden:

  • Goederenontvangst met bestelreferentie, hoeveelheidscontrole, en opslag
  • Magazijnbewegingen tussen gedefinieerde locaties en zones
  • Orderreservering, picking, en verzendbevestiging
  • Inventarisatie en voorraadcorrecties met navolgbare historie

Aanvullend kunnen etikettendruk, barcodescannen, leveringsbonnen, verzendlabels, of een overdracht aan boekhouding en shopsystemen veel tijd besparen. Maar ze zouden moeten voortbouwen op een schoon bewegingsmodel. Een snelle etikettendruk levert weinig op als het artikel bij het scannen niet eenduidig aan de juiste opslaglocatie of order wordt toegewezen.

Bij het gebruik telt ook de omgeving. Een medewerker met handschoenen bij goederenontvangst heeft grote, eenduidige acties nodig en zo weinig mogelijk tekstinvoer. Een planner op de werkplek heeft daarentegen filters, zoekfuncties, en een overzicht van openstaande transacties nodig. Beide rollen mogen dezelfde gegevens gebruiken, maar hebben niet dezelfde interface nodig.

Real-time betekent niet: elk getal is onbetwistbaar

Veel bedrijven wensen real-time voorraden. Dat is zinvol, maar het begrip wordt vaak te grof gebruikt. Een voorraad kan direct na elke scan worden bijgewerkt en toch onjuist zijn als een proces onvolledig blijft. Wordt goederen wel gescand maar niet gecontroleerd, dan is het getal technisch actueel en operationeel twijfelachtig.

Daarom heeft elk systeem een omgang met uitzonderingen nodig. Verschillen bij goederenontvangst, beschadigde verpakkingen, retours, en niet-vindbare artikelen zijn geen randgevallen. Ze horen bij de dagelijkse praktijk. Goede processen markeren ze zichtbaar, in plaats van medewerkers te dwingen tot geïmproviseerde nevenlijsten.

Ook de bevoegdheden verdienen aandacht. Niet iedereen zou artikelstamgegevens moeten kunnen wijzigen of historische boekingen moeten kunnen corrigeren. Een praktisch rechtenconcept scheidt routinehandelingen van ingrepen met hoger risico. Dat beschermt niet alleen tegen fouten, maar vergemakkelijkt ook de oorzaakanalyse wanneer een voorraad onverwacht afwijkt.

Integratie alleen waar het het proces verbetert

Inventory Management staat zelden alleen. Orders komen mogelijk uit een webshop, een e-mailregistratie, een branchespecifieke oplossing, of rechtstreeks van verkoop. Verzenddienstverleners hebben adresgegevens en gewichten nodig. De boekhouding verwacht belegstukken in een bepaalde vorm.

Een integratie loont wanneer het dubbele invoer elimineert of foutbronnen vermindert. Ze is niet automatisch zinvol alleen omdat een interface beschikbaar is. Vooral bij organisch gegroeide processen kan een duidelijke import met controle betrouwbaarder zijn dan een permanente real-time koppeling die ongemerkt foutieve gegevens overdraagt.

Technisch zou de oplossing navolgbaar moeten blijven: eenduidige interfaces, geregistreerde overdrachten, begrijpelijke foutmeldingen, en een databasestructuur die wijzigingen niet verbergt. Met een goed onderhouden toepassing op basis van PHP 8.4 en MySQL 8 kunnen zulke processen slank worden gerealiseerd, zonder teams in een wereldwijd concernsysteem te dwingen. Doorslaggevend is niet het technologielabel, maar of onderhoud, uitbreidingen, en gegevenscorrecties ook over drie jaar nog beheersbaar zijn.

Invoering in kleine, meetbare stappen

Een big bang is in het magazijn zelden de beste keuze. Veiliger is een beperkte start, bijvoorbeeld met goederenontvangst en één geselecteerd magazijngebied. In deze fase kunnen scantijden, soorten fouten, openstaande bijzondere gevallen, en de kwaliteit van de stamgegevens worden geobserveerd. Pas daarna volgen reservering, verzending, of extra locaties.

Parallel draaien kan daarbij zinvol zijn, maar alleen met een duidelijk einde. Twee leidende voorraden over een langere periode creëren precies het probleem dat de nieuwe oplossing zou moeten verhelpen. Beter is een vastgestelde overgang met inventarisatie, opgeschoonde stamgegevens, en verantwoordelijkheden voor de eerste weken.

Het succes blijkt niet uit hoeveel functies geactiveerd zijn. Het blijkt uit of er minder navragen ontstaan, of orders vollediger worden ingepakt, en of een team zonder detectivewerk kan verklaren waarom een artikelvoorraad eruitziet zoals hij eruitziet.

Als het huidige proces met een goed bijgehouden tabel daadwerkelijk stabiel functioneert, mag het blijven bestaan. Maar als informatie tussen papier, telefoongesprekken, en meerdere bestanden verloren blijft gaan, is de volgende zinvolle stap geen groter gereedschap, maar een duidelijk proces dat elke belangrijke magazijnbeweging zichtbaar maakt.

Permalink →

Zijn self-hosted tests veilig?

Zijn self-hosted tests veilig?

Een mislukte regressietest is vervelend. Een screenshot uit een intern ERP-systeem dat ongecontroleerd bij een externe dienst terechtkomt, is een beveiligingsincident. Precies daarom stellen QA-leads en IT-verantwoordelijken zich de vraag: are self hosted tests secure? Het eerlijke antwoord luidt: ze kunnen aanzienlijk veiliger zijn dan cloudgebaseerde alternatieven, maar alleen als de exploitatie net zo serieus wordt genomen als de tests zelf.

Zelf gehoste testautomatisering verplaatst de controle over uitvoering, testdata, screenshots, logs, en toegangsrechten naar de eigen infrastructuur. Dat vermindert afhankelijkheden en onnodige datatrajecten. Het vervangt echter geen beveiligingsarchitectuur. Een slecht onderhouden interne testserver blijft een slecht onderhouden server.

Zijn self-hosted tests veiliger dan cloudtests?

Het beslissende verschil ligt niet in of een test lokaal of geautomatiseerd draait. Het ligt in waar data wordt verwerkt, wie er toegang toe heeft, en welke technische grenzen gelden.

Bij een extern beheerde testservice verlaten vaak meerdere artefacten het bedrijf: toegangsgegevens voor testaccounts, URL's van interne applicaties, DOM-inhoud, screenshots, video's van testruns, foutlogboeken, en eventueel databankuittreksels. Zelfs als een aanbieder hoge beveiligingsnormen naleeft, ontstaat er een extra vertrouwens- en contractuele relatie. Voor applicaties met klant-, personeels-, productie-, of financiële gegevens kan dat een relevante drempel zijn.

Een zelf gehost systeem kan binnen het eigen netwerk of een duidelijk afgebakende EU-omgeving worden geëxploiteerd. De testinstantie heeft rechtstreeks toegang tot staging-, acceptatie-, of geïsoleerde testsystemen. Testbewijzen blijven waar ook de applicatie en haar operationele verantwoordelijkheid zich bevinden. Dat is bijzonder zinvol bij het testen van Windows-desktopapplicaties, interne webportalen, of systemen met gevoelige procesgegevens.

Maar zelfhosting is niet automatisch veiliger. Wie een testserver met open externe toegang, gedeelde beheerdersaccounts, en permanent geldige wachtwoorden exploiteert, heeft de risico's gewoon verplaatst. De vraag is dus niet alleen: cloud of on-premises? Maar: is de testomgeving aantoonbaar beveiligd en duurzaam onderhoudbaar?

Are self hosted tests secure? Het komt aan op deze grenzen

Een veilig testplatform heeft duidelijke technische en organisatorische grenzen nodig. Voor kleine en middelgrote bedrijven hoeft dat er niet uit te zien als een concernprogramma. Het moet alleen consequent worden geïmplementeerd en gedocumenteerd.

De testomgeving scheiden van de productieomgeving

Geautomatiseerde tests moeten fouten vinden, geen bestellingen uitlokken, leveringsbonnen wijzigen, of voorraadbewegingen boeken. Daarom hebben tests een gescheiden omgeving nodig met eigen interfaces, testtenants, en testdata. Waar een volledige kopie van de productie niet nodig is, is dat vaak zelfs onnodig risicovol.

Voor een magazijn- of orderportaal kan dat betekenen: testgebruikers mogen goederenontvangsten registreren en verzendlabels genereren, maar de gegenereerde documenten gaan naar geen echte printer en geen echte vervoerder. API-sleutels wijzen naar sandbox-eindpunten. E-mailverzending wordt onderschept of beperkt tot interne ontvangers. Zo blijft een test betekenisvol zonder operationele gevolgen te produceren.

De scheiding zou ook op netwerkniveau moeten gelden. De testserver heeft alleen de verbindingen nodig die hij daadwerkelijk vereist. Algemene toegang tot het gehele interne netwerk is comfortabel, maar zelden te rechtvaardigen. Segmentatie beperkt de schade als een testaccount of een systeemonderdeel wordt gecompromitteerd.

Toegangsgegevens behandelen als productietoegangen

Testautomatisering heeft vaak inloggegevens nodig. Dat is normaal, maar deze gegevens horen niet thuis in testscripts, configuratiebestanden in de broncode, of chatgeschiedenissen. Wachtwoorden, tokens, en certificaten zouden geladen moeten worden vanuit een gecontroleerd geheimenbeheer. Testaccounts krijgen alleen de rechten die het concrete proces vereist.

Ook de toegang tot het testplatform zelf heeft rollen nodig. Een ontwikkelaar moet misschien testruns starten en resultaten lezen, maar niet de netwerkconfiguratie wijzigen. Een vakafdeling kan rapporten inzien, maar heeft geen toegang nodig tot opgeslagen inloggegevens. Beheerrechten zouden aan personen gebonden moeten zijn, niet gekoppeld aan een gedeeld account.

Bovendien horen multifactorauthenticatie, redelijke wachtwoordregels, en account-lockout-flows bij de minimumstandaard. Vooral testsystemen worden vaak als minder kritiek behandeld. Aanvallers zien dat anders: zij gebruiken testomgevingen graag als toegangspunt, omdat daar toegangsgegevens, interne namen, en technische details liggen.

Testdata minimaliseren en gericht maskeren

De meest voorkomende fout is niet een ontbrekende versleutelingsmethode, maar te veel echte informatie in het testbestand. Voor de meeste regressietests heeft niemand echte klantnamen, echte adressen, of volledige personeelsdossiers nodig. Synthetische datasets, gemaskeerde kopieën, en bewust aangelegde bijzondere gevallen zijn vaak voldoende.

Er zijn uitzonderingen. Sommige fouten verschijnen alleen bij echte datastructuren, ongebruikelijke tekenreeksen, of complexe rechtenconstellaties. Dan kan een gecontroleerde, gepseudonimiseerde kopie zinvol zijn. Doorslaggevend is dat deze beslissing bewust wordt genomen en een verwijderingstermijn heeft. Testdatabases zouden niet jarenlang moeten doordraaien als vergeten schaduwkopie van de productie.

Screenshots en video's verdienen dezelfde aandacht. Ze zijn waardevol voor foutopsporing, maar kunnen accountgegevens, interne prijzen, of persoonsgebonden inhoud tonen. Leg vast welke artefacten worden vastgelegd, wie ze mag zien, en wanneer ze automatisch worden verwijderd. Een testrapport hoeft niet elk schermbeeld voor altijd op te slaan om bewijskrachtig te zijn.

De server als een product exploiteren

Een zelf gehoste testserver is geen toestel dat je eenmaal installeert en dan vergeet. Operationele veiligheid ontstaat door herhaalbaar onderhoud: tijdige beveiligingsupdates voor besturingssysteem, browser, testrunner, en afhankelijkheden; versleutelde gegevensdragers en transportroutes; bewaakte back-ups; centrale logging; alsook een duidelijke omgang met beveiligingsmeldingen.

Vooral bij browsergestuurde tests is het updateritme relevant. Verouderde browser-engines en automatiseringsbibliotheken kunnen bekende kwetsbaarheden bevatten of tests onbetrouwbaar maken. Beide kosten tijd. Gedocumenteerde deployments en vaste onderhoudsvensters zijn daarom geen bureaucratische toevoeging, maar de basis voor reproduceerbare resultaten.

Voor een toegewijde AI-testserver zoals COCO geldt dit eveneens. De lokale uitvoering beschermt gevoelige applicatie-inhoud niet door magie. Ze schept controle over waar AI-ondersteunde evaluatie, screenshots, en testlogboeken worden verwerkt. Die controle moet worden ingevuld met patchmanagement, rechten, netwerkscheiding, en duidelijke bewaarregels.

Waar zelfhosting zijn grenzen heeft

Clouddiensten zijn niet per definitie onveilig. Een gespecialiseerde aanbieder kan meer beveiligingspersoneel, volwassener monitoring, en professionelere redundantie bieden dan een bedrijf met één overbelaste IT-rol. Wie geen capaciteit heeft voor exploitatie, updates, en incident response, kan met een slecht onderhouden self-hosted systeem een hoger risico creëren.

Anderzijds zijn veel externe testplatformen gewoon geen goede procesfit voor interne vakapplicaties. Als een applicatie alleen bereikbaar is binnen het bedrijfsnetwerk, als testruns vertrouwelijke schermen en documenten tonen, of als data het eigen controlegebied niet mag verlaten, is lokale exploitatie vaak de duidelijkere oplossing.

De verstandige beslissing hangt af van de beschermingsbehoefte en van het exploitatievermogen. Voor een openbare marketingpagina zonder gevoelige logins kan een cloudtestdienst passend zijn. Voor interne dispositiesoftware, een klantportaal met persoonsgegevens, of een Windows-applicatie in het productienetwerk pleit veel voor een gecontroleerde, zelf gehoste omgeving.

Een praktijktaugelijke beveiligingscheck vóór de start

Voordat geautomatiseerde tests worden uitgerold, zou een verantwoordelijke deze vragen zonder giswerk moeten kunnen beantwoorden:

  • Welke systemen, databanken, en interfaces mag de testserver bereiken?
  • Welke gegevens verschijnen in screenshots, video's, logs, en AI-evaluaties?
  • Waar bevinden toegangsgegevens zich, en wanneer worden ze geroteerd?
  • Wie mag testruns starten, resultaten lezen, en systemen beheren?
  • Hoe snel worden kritieke updates ingevoerd, en hoe wordt dat gecontroleerd?
  • Wanneer worden testartefacten en niet meer benodigde gegevens verwijderd?

Deze vragen ogen nuchter. Precies dat is hun waarde. Veiligheid ontstaat zelden door één enkele tool of een indrukwekkend architectuurdiagram. Ze ontstaat wanneer verantwoordelijkheden, datastromen, en technische grenzen in het dagelijkse gebruik controleerbaar blijven.

Wie testautomatisering opbouwt, zou eerst de beschermingsbehoefte van de applicatie moeten verhelderen en dan de kleinste zinvolle architectuur kiezen. Een netjes afgebakende testserver met weinig bevoegde accounts is vaak waardevoller dan een overladen platform dat niemand betrouwbaar kan onderhouden. Boring, provable reliability wint ook bij testen van de spectaculaire maar ondoorzichtige oplossing.

Permalink →

Warehouse Management Systems: Wat er echt toe doet

Warehouse Management Systems: Wat er echt toe doet

Wanneer een medewerker bij de goederenontvangst dezelfde leverpositie op papier noteert, later in een tabel overzet, en dan roepend door het gangpad verduidelijkt waar het wordt opgeslagen, ontbreekt het zelden aan werkbereidheid. Wat ontbreekt is een gedeeld proces. Warehouse Management Systems creëren dat proces door goederenbewegingen, voorraden, en vervolgtaken op één plek te documenteren. Voor kleine en middelgrote bedrijven is niet de langste functielijst doorslaggevend, maar of de software het traject van een goed door het eigen magazijn betrouwbaar weergeeft.

Wat Warehouse Management Systems dagelijks moeten presteren

Een Warehouse Management System, kort WMS, is niet simpelweg een betere voorraadlijst. Het stuurt of documenteert de fysieke processen in het magazijn: goederenontvangst, kwaliteitscontrole, opslag, verplaatsing, picking, verpakking, verzending, en inventarisatie. Elke boeking beantwoordt een eenvoudige operationele vraag: wat is waar, in welke hoeveelheid, in welke status, en wie heeft de beweging veroorzaakt?

Deze duidelijkheid oogt op het eerste gezicht banaal. Maar ze voorkomt typische foutenketens. Een artikel is wel geleverd, maar nog niet gecontroleerd. Een palet staat bij de goederenontvangst, maar wordt in het systeem al als beschikbaar getoond. Een order wordt gepickt, terwijl de goederen gereserveerd zouden moeten zijn voor een belangrijkere klantorder. Zonder duidelijk gedefinieerde statussen en bewegingen wordt uit één enkele onduidelijkheid snel een verkeerde leverbelofte.

Voor veel middelgrote magazijnen begint het voordeel niet met volledig geautomatiseerde sturing. Reeds gevolgde opslagopdrachten, eenduidige opslaglocaties, en mobiele boekingen kunnen zoektijden aanzienlijk verlagen. Doorslaggevend is dat medewerkers niet meer hoeven te vertalen tussen papier, telefoon, e-mail, en meerdere tabellen.

Niet elk magazijn heeft een grote suite nodig

De markt biedt uitgebreide enterprise-systemen met functies voor wereldwijde multi-locatienetwerken, complexe douaneafhandeling, geautomatiseerde transporttechniek, en zeer fijne optimalisatielogica. Dat kan juist zijn als deze vereisten daadwerkelijk bestaan. Maar voor een bedrijf met één of enkele magazijnen, wisselende prioriteiten, en ingesleten bijzondere processen kan zo'n suite meer wrijving dan voordeel opleveren.

De kosten liggen dan niet alleen in licenties. Ze ontstaan in lange implementatieprojecten, omvangrijke aanpassingen, opleiding, en afhankelijkheid van externe specialisten. Ook een systeem met honderd instellingen lost geen probleem op als ploegleiders voor alledaagse correcties een ticket moeten openen.

Het alternatief betekent niet noodzakelijk een volledig maatwerktraject. Een standaardproduct kan zinvol zijn wanneer de kernprocessen passen en aanpassingen bewust beperkt blijven. Evenzo kan een bestaande tabel nog steeds de beste oplossing zijn, bijvoorbeeld voor een zeldzame, overzichtelijke evaluatie. Ze wordt pas kritiek wanneer meerdere personen er gelijktijdig mee werken, bewegingen met vertraging bijhouden, of de tabel de operationele waarheid over beschikbare goederen moet worden.

De juiste oplossing richt zich naar het werkelijke procesvolume en de foutkosten. Vijf verkeerde picks per week betekenen iets anders in een reserveonderdelenmagazijn met tijdkritische klantorders dan vijf afwijkingen in een langzaam draaiende archiefvoorraad.

Eerst de processen vastleggen, niet de schermen kiezen

Veel WMS-projecten beginnen met een productdemo. Daar zien verantwoordelijken strakke dashboards, scannerweergaves, en kleurrijke kengetallen. Nuttiger is eerst een rondgang door het magazijn tijdens een normale werkdag. Waar komt de goederen aan? Wie controleert hoeveelheden en schade? Wanneer krijgt een artikel zijn charge- of serienummer? Hoe wordt beslist op welke plek het komt? En wat gebeurt er wanneer de realiteit afwijkt van de bestelling?

Deze vragen leggen de basis voor een oplossing die later geaccepteerd wordt. Een goed gedocumenteerd doelproces beschrijft niet alleen het ideale geval. Het bevat ook uitzonderingen: deelleveringen, beschadigde goederen, niet-aangekondigde aanleveringen, tekorten, retouren, en geblokkeerde voorraden. Juist deze gevallen bepalen of medewerkers het systeem vertrouwen of weer naar briefjes grijpen.

Statussen zijn belangrijker dan mooie interfaces

Een schoon gegevensbestand onderscheidt bijvoorbeeld "verwacht", "aangekomen", "in controle", "opgeslagen", "gereserveerd", "gepickt", en "verzonden". Welke statussen noodzakelijk zijn, hangt af van het bedrijf. Te weinig verhullen relevante verschillen. Te veel vertragen boekingen en worden omzeild.

De regel zou moeten zijn: elke status moet een operationeel gevolg hebben. Is goederen geblokkeerd, dan mag het niet gepickt worden. Is het gereserveerd, dan moet zichtbaar zijn voor welke order. Is het opgeslagen, dan moet een opslaglocatie geregistreerd zijn. Zo worden gegevensregels tot praktische procesbetrouwbaarheid.

Scanners helpen alleen bij duidelijke boekingen

Barcodes en mobiele toestellen verminderen tikfouten en versnellen bewegingen. Maar ze vervangen geen procesbeslissing. Een scan moet een begrijpelijke actie uitlokken: artikel controleren, hoeveelheid bevestigen, doellocatie kiezen, of order afronden. Als een medewerker na elke scan moet raden welk scherm volgt, is het proces te ingewikkeld vormgegeven.

Ook de hardwarevraag zou pragmatisch beantwoord moeten worden. Voor sommige teams volstaan smartphones met geschikte scanfunctie en stevige beschermhoes. Anderen hebben industriële handscanners nodig, omdat handschoenen, koeling, valpartijen, of lange diensten dit vereisen. Een pilot op de daadwerkelijke magazijnvloer laat meer zien dan een presentatie op kantoor.


De technische basis beslist na de go-live

Een WMS moet ook dan correct werken wanneer gelijktijdig goederenontvangsten geboekt, orders gepickt, en voorraden gecontroleerd worden. Daaruit ontstaan vereisten die in vroege gesprekken vaak verloren gaan: eenduidige bewegingslogs, rolgebaseerde rechten, navolgbare correcties, betrouwbare interfaces, en back-ups die in noodgevallen daadwerkelijk herstelbaar zijn.

Een voorraad zou niet simpelweg overschreven moeten worden. Beter is een bewegingsmodel: ontvangst, afgifte, verplaatsing, blokkering, of correctie genereren elk een vastgelegd record. Zo kan later worden nagegaan waarom een hoeveelheid afwijkt. Dat is voor inventarisaties net zo waardevol als voor het ophelderen van een klantenklacht.

Rechten moeten passen bij de verantwoordelijkheid. Een picker heeft andere functies nodig dan een magazijnleider die voorraadcorrecties vrijgeeft. Voor kritieke wijzigingen zijn motivaties, vier-ogen-goedkeuringen, of minstens een onwijzigbaar wijzigingslogboek zinvol. De inspanning hangt af van het risicoprofiel, maar de vraag zou vóór de start opgehelderd moeten zijn.

Interfaces verdienen dezelfde aandacht. Een magazijn werkt zelden geïsoleerd. Bestellingen komen van een shop, een ERP, of via gestructureerde import. Verzendgegevens gaan naar carriersystemen, leveringsbonnen en labels worden gegenereerd, voorraadgegevens vloeien terug. Elke interface heeft duidelijke verantwoordelijkheden nodig voor foutgevallen. Wat gebeurt er als een verzendlabel is gegenereerd maar de bevestiging niet in het WMS aankomt? Zonder herhaallogica en zichtbare foutwachtrij blijven zulke gevallen aan individuele personen hangen.

Voor maatwerkoplossingen zijn onderhoudbare technologieën geen bijzaak. Een navolgbare toepassing met een duidelijke databasestructuur, gedocumenteerde deployments, en geteste integraties blijft ook na personeelswisselingen beheersbaar. Trendy architectuur helpt niet als niemand een foutieve import kan natrekken.

Invoering in kleine, beheersbare stappen

Een big bang creëert vermijdbaar risico. Vaak is het zinvoller om eerst een afgebakend proces te digitaliseren, zoals de goederenontvangst voor een productgroep of het picken in één magazijngebied. Het team toetst daarbij niet alleen functies, maar ook formuleringen, scanroutes, looproutes, en verantwoordelijkheden.

Stamgegevens zijn hierbij vaak de eigenlijke bouwplaats. Artikelnummers moeten eenduidig zijn, meeteenheden consistent, opslaglocaties zinvol gestructureerd, en verpakkingseenheden duidelijk gedefinieerd. Een systeem kan geen betrouwbare voorraden leveren als hetzelfde artikel onder drie benamingen opduikt, of een "krat" per leverancier verschillende hoeveelheden betekent.

Tijdens de pilotfase zouden kengetallen eenvoudig moeten blijven: hoe lang duurt de goederenontvangst? Hoeveel boekingen moeten gecorrigeerd worden? Hoeveel picks zijn foutief? Hoe vaak wordt goederen gezocht? Niet elke verbetering toont zich meteen in een grote kostenpost. Minder navragen en betrouwbaardere leverinformatie kunnen al aanzienlijke druk van de dagelijkse operatie halen.

Opleiding werkt het beste direct bij het proces. Medewerkers hebben geen abstracte rondleiding door alle menu-items nodig. Ze moeten weten hoe ze hun volgende levering boeken, een afwijking melden, of een verkeerde scan corrigeren. Voor de eerste diensten na de start zou een verantwoordelijke persoon bereikbaar moeten zijn die snel beslissingen kan nemen.

De juiste vraag voor de keuze

Bij Warehouse Management Systems luidt de centrale vraag niet: welke software kan het meeste? Ze luidt: welke processen moeten voor ons team elke dag sneller, eenduidiger, en navolgbaarder worden?

Wie deze processen eerst helder beschrijft, kan standaardsoftware, uitbreidingen, of een maatwerktoepassing objectief beoordelen. Het resultaat hoeft niet spectaculair over te komen. Het zou ervoor moeten zorgen dat de goederen hun weg vinden, de voorraad betrouwbaar blijft, en de mensen in het magazijn minder tijd besteden aan zoeken, navragen, en achteraf corrigeren.

Permalink →

Custom Logistics Software vs Spreadsheets

Custom Logistics Software vs Spreadsheets

Een goederenontvangst komt vroeger aan dan aangekondigd, twee medewerkers wijzigen parallel dezelfde voorraadlijst, en de chauffeur wacht op een leveringsbon waarvan niemand met zekerheid kan benoemen welke de laatste versie is. Dergelijke situaties beslissen de vraag "custom logistics software vs spreadsheets" niet theoretisch, maar tussen goederenontvangst, opslaglocatie, en de laadperron.

Tabellen zijn niet fundamenteel het probleem. Ze zijn snel opgezet, iedereen vertrouwd, en vaak verrassend effectief voor duidelijk afgebakende taken. Ze worden problematisch wanneer ze moeten dienen als besturingssysteem van een groeiend magazijn- of distributieproces. Dan wordt van een bestand een kritiek proces - zonder bindende regels, navolgbare toestanden, of solide geschiedenis.

Wanneer spreadsheets in het magazijn de juiste keuze zijn

Een tabel is zinvol wanneer het proces overzichtelijk, zeldzaam, en door weinig personen aangestuurd is. Dat kan bijvoorbeeld een maandelijkse behoefteplanning, een eenmalige inventarisatievoorbereiding, of een evaluatie van leveranciersprijzen zijn. Ook voor een kleine voorraad met één verantwoordelijke kan het volstaan, mits wijzigingen niet onder tijdsdruk gebeuren en geen vervolgprocessen er automatisch van afhangen.

Het voordeel zit niet enkel in de lage licentiekosten. Teams kunnen kolommen aanpassen, berekeningen controleren, en binnen enkele minuten een nieuw formulier opzetten. Wie een stabiel proces nog niet heeft begrepen, zou het niet overhaast in software moeten gieten. Een goede tabel kan eerst zichtbaar maken welke gegevens echt nodig zijn en welke velden enkel uit gewoonte worden bijgehouden.

Het zou daarom onjuist zijn elk Excel-bestand als achterstand te behandelen. De beslissende vraag is: is de tabel een werkmiddel voor één persoon of een gedeelde bron voor operationele beslissingen? Zodra meerdere rollen op dezelfde gegevens vertrouwen, stijgt het risico aanzienlijk.

Custom Logistics Software vs Spreadsheets: Het kantelpunt

De overstap wordt meestal niet veroorzaakt door het aantal rijen. Een tabel met 20.000 posities kan functioneren, terwijl een bestand met 200 rijen al tot fouten leidt. Doorslaggevend zijn gelijktijdigheid, processtappen, en de gevolgen van foutieve informatie.

Een typisch waarschuwingssignaal is de versievraag. Staan voorraden, openstaande bestellingen, of leverdata in bestanden met namen zoals "voorraad_definitief_nieuw", "voorraad_definitief_nieuw2", en "echt_definitief", dan ontbreekt geen betere mapstructuur. Er ontbreekt een bindende gegevensstand. Hetzelfde geldt wanneer medewerkers moeten bellen om te weten te komen of goederen zijn aangekomen, een bestelling is vrijgegeven, of een voertuig al geladen is.

Het kantelpunt is bereikt wanneer één invoer meerdere vervolghandelingen uitlokt. Een goederenontvangst verandert dan niet enkel een getal in de voorraad. Het kan een kwaliteitscontrole starten, een opslaglocatie toewijzen, een bestelling als gedeeltelijk geleverd markeren, en de verkoop een beschikbaar artikel tonen. Worden deze stappen manueel gecoördineerd via bestanden, papier, en telefoontjes, dan zijn afwijkingen nauwelijks te vermijden.

Het wordt bijzonder kritiek bij ploegenwissels en uitval. Als enkel een ervaren persoon weet welke kleurmarkering in een lijst een blokkering betekent, of welke formule een veiligheidsvoorraad berekent, is het proces niet robuust. Het functioneert enkel zolang die persoon beschikbaar is.

Wat maatwerksoftware daadwerkelijk beter doet

Op maat gemaakte logistieke software is niet simpelweg een tabel met een mooie interface. De waarde ervan ontstaat door gecontroleerde workflows. Elke boeking krijgt een eenduidig tijdstip, een verantwoordelijke persoon, en een navolgbare status. Medewerkers zien niet enkel gegevens, maar de volgende toegestane handeling.

Bij een goederenontvangst kan dat praktisch betekenen: levering selecteren, hoeveelheid registreren, afwijking documenteren, etiket afdrukken, en opslag bevestigen. Pas daarna wordt de voorraad vrijgegeven. Voor het picken kan het systeem bestellingen naar prioriteit bundelen, opslaglocaties in een zinvolle volgorde tonen, en pas een leveringsbon genereren zodra de posities bevestigd zijn.

Dat is geen kwestie van onnodige complexiteit. Het voorkomt dat hetzelfde artikel twee keer wordt gereserveerd, dat een deellevering als volledig geldt, of dat een leveringsbon wordt afgedrukt op basis van verouderde gegevens. Ook eenvoudige regels helpen: verplichte velden voor charges, blokkeringsredenen voor beschadigde goederen, plausibiliteitscontroles bij hoeveelheden, en rechten voor correctieboekingen.

Een goed geplande toepassing dekt niet meteen elk bijzonder geval af. Ze richt zich op de processen die dagelijks tijd kosten of regelmatig fouten produceren. Voor het ene bedrijf kan dat het beheer van containerbewegingen zijn, voor het andere de snelle registratie van binnenkomende goederen met mobiele toestellen. Standaardsoftware kent deze bijzonderheden vaak enkel als een dure extra module, of helemaal niet.

De verborgen kosten van de tabel

De licentiekosten van een tabel zijn laag. De proceskosten kunnen dat niet zijn. Ze ontstaan in navragen, herbewerkingen, zoektijden, dubbel onderhoud, en verkeerd geplande voorraden. Ze ontstaan ook wanneer een team 's avonds moet controleren welke gegevens sinds de ochtend zijn veranderd.

Deze kosten blijven vaak onzichtbaar omdat ze over veel rollen verdeeld zijn. De magazijnverantwoordelijke controleert voorraden, de binnendienst corrigeert leverdata, de boekhouding zoekt bewijsstukken, en de directie krijgt cijfers met vertraging. Geen enkele individuele activiteit lijkt dramatisch. Samen vertragen ze de doorstroom en de planbaarheid.

Een gedegen beslissing zou daarom niet enkel softwareprijzen moeten vergelijken. Meet gedurende twee tot drie weken hoeveel manuele overdrachten een bestelling doorloopt, hoe vaak informatie wordt nagevraagd, en welke fouten terugkeren. Relevant zijn ook de gevolgen: leidt een verkeerde voorraad tot een interne correctie of tot een gemiste levering?

Niet elk probleem heeft een grote suite nodig

Veel middelgrote bedrijven in het DACH-gebied aarzelen terecht voor uitgebreide enterprise-systemen. Lange implementaties, starre schermen, en licentiemodellen voor functies die nooit worden gebruikt, lossen zelden een concreet magazijnprobleem op. Het alternatief hoeft echter niet te betekenen dat men bij verspreide bestanden blijft.

Tussen beide uitersten ligt een workflow-specifieke toepassing. Ze kan bijvoorbeeld orderacceptatie, goederenontvangst, voorraadbewegingen, verzendlabels, en leveringsbonnen in één gedeeld systeem verbinden, zonder meteen volledige financiële boekhouding, wereldwijde concernlogica, en twintig vreemde talen mee te brengen.

Doorslaggevend is de technische basis. Een toepassing met een duidelijke databasestructuur, gedocumenteerde interfaces, en navolgbare rechten blijft aanpasbaar. Technologieën zoals PHP 8.4, moderne JavaScript, en MySQL 8 zijn hierbij geen doel op zich. Correct toegepast, creëren ze een onderhoudbare basis voor rollen, boekingsgeschiedenissen, printdocumenten, en rapportages - ook wanneer processen over twee jaar veranderen.

Zo lukt de overstap zonder de bedrijfsvoering te verstoren

Het grootste gevaar is niet de techniek, maar een te grote eerste stap. Wie probeert alle historische bestanden op te schonen en elk uitzonderingsgeval vóór de start in kaart te brengen, stelt het voordeel maandenlang uit. Beter is een duidelijk, controleerbaar begin.

Start met een proces dat vaak voorkomt en goed afbakenbaar is, bijvoorbeeld goederenontvangst met voorraadboeking of verzending met leveringsbon en label. Definieer daarbij precies wanneer het proces begint, welke gegevens strikt noodzakelijk zijn, wie welke goedkeuring verleent, en wanneer het als afgerond geldt. Daaruit ontstaan niet enkel schermmaskers, maar solide werkregels.

De gegevensoverdracht vereist eveneens pragmatisme. Actieve artikelen, leveranciers, opslaglocaties, en openstaande bestellingen moeten proper zijn. Historische oude voorraden kunnen daarentegen vaak worden gearchiveerd, in plaats van ze met veel inspanning in het nieuwe systeem te importeren. Parallel draaien kan zinvol zijn, maar enkel met een vaste einddatum. Anders ontstaan twee waarheden in plaats van één betere.

Bij de invoering blijkt de waarde van een directe technische partner.

softify.pro werkt daarom niet vanuit een abstracte functielijst, maar verheldert processen daar waar ze plaatsvinden: bij de aanname, in het magazijnpad, bij het inpakken, en bij de overdracht aan de verzending. Goede software respecteert werkende routines en verandert enkel wat het proces daadwerkelijk betrouwbaarder maakt.

De beslissing is te toetsen aan drie vragen

Ten eerste: moeten meerdere personen gelijktijdig op actuele gegevens vertrouwen? Ten tweede: leidt een boeking tot vervolgprocessen die vandaag manueel worden geborgd? Ten derde: kan een fout leiden tot leververtraging, foutieve voorraad, verkeerde factuur, of tijdrovend zoeken? Als deze vragen overwegend met ja worden beantwoord, is de tabel vermoedelijk niet meer het juiste leidende systeem.

Blijft het antwoord overwegend nee, dan kan ze nog steeds een verstandige oplossing zijn. Dan loont het meer om bestanden te uniformeren, verantwoordelijkheden vast te leggen, en kritieke formules te documenteren. Techniek zou niet groter moeten zijn dan het probleem.

De volgende zinvolle stap is daarom geen alomvattend digitaliseringsproject, maar een gezamenlijke blik op een concreet proces samen met de mensen die het dagelijks uitvoeren. Daar wordt snel zichtbaar of een goed bijgehouden tabel volstaat - of dat betrouwbare software eindelijk het werk zou moeten overnemen dat vandaag blijft steken tussen papier, telefoon, en meerdere versies van hetzelfde bestand.

Permalink →

Webontwikkeling voor bedrijven

Webontwikkeling voor bedrijven

Een website kan er goed uitzien en toch elke maandag werk veroorzaken: productgegevens worden dubbel bijgehouden, aanvragen komen onvolledig in de inbox terecht, wijzigingen vereisen externe hulp. De zoektocht naar een webontwikkelingsbedrijf zou daarom niet moeten eindigen bij kleuren, frameworks, of een chic portfolio. Doorslaggevend is of de oplossing minder wrijving creëert in het dagelijkse werk en ook over drie jaar nog begrijpelijk te exploiteren is.

Voor kleine en middelgrote bedrijven is dat geen academische vraag. In ateliers, magazijnen, en verkooporganisaties komen offertes, bestellingen, leveringsinformatie, en klantvragen vaak terecht bij organisch gegroeide processen. Sommige daarvan verdienen software. Andere functioneren nog steeds beter met een netjes bijgehouden tabel. Goede webontwikkeling herkent het verschil, in plaats van elk probleem in een groot digitaal project te veranderen.

Wat webontwikkeling voor bedrijven moet presteren

Een bedrijfswebsite is vaak het eerste contactpunt. Ze moet snel laden, op mobiele toestellen werken, en bezoekers duidelijk naar een aanvraag, sollicitatie, of bestelling leiden. Maar zodra ze gegevens verwerkt, interne rollen weergeeft, of processen activeert, wordt ze een webtoepassing. Dan tellen andere vragen: Wie mag wat zien? Waar komen de gegevens vandaan? Wat gebeurt er bij een foutieve invoer? Hoe wordt een update uitgerold zonder de bedrijfsvoering te verstoren?

Het verschil is praktisch. Een marketingpagina kan het stellen met enkele, duidelijk gestructureerde inhoudsgebieden. Een klantenportaal, een bestelproces, of een intern magazijnhulpmiddel heeft daarentegen navolgbare rechten, een robuuste databasestructuur, en gedefinieerde bijzondere gevallen nodig. Als een goederenontvangst slechts gedeeltelijk geleverd wordt of een bestelling achteraf gewijzigd moet worden, mag het systeem niet in een ongedefinieerde toestand eindigen.

Webontwikkeling voor bedrijven betekent daarom niet gewoon pagina's programmeren. Het betekent bedrijfsregels zo implementeren dat ze begrijpelijk blijven voor gebruikers en beheersbaar voor het bedrijf.

Eerst het proces controleren, dan de interface plannen

Een project begint vaak met een wens zoals "We hebben een portaal nodig". Dat is een zinvol begin, maar nog geen voldoende vereiste. Vóór het eerste ontwerp zouden de daadwerkelijke wegen van een informatie zichtbaar moeten worden: wie legt het aan, wie controleert het, wie vult het aan, en wie heeft het later weer nodig?

Neem de orderafhandeling. In veel bedrijven komt een aanvraag binnen per e-mail of telefoon, wordt in een tabel genoteerd, later overgedragen naar een ander systeem, en vervolgens opnieuw verwerkt voor magazijn of verzending. De vertraging ligt zelden aan één enkele stap. Ze ontstaat bij de overdrachten, de navragen, en de verschillende gegevensstanden.

Een goede analyse vraagt daarom concreet naar de dagelijkse praktijk:

  • Welke informatie wordt vandaag meerdere keren ingevoerd?
  • Op welke plek ontstaan de meeste navragen of correcties?
  • Welke uitzonderingen komen regelmatig voor, hoewel ze nergens gedocumenteerd zijn?
  • Welke rollen hebben toegang nodig, en welke gegevens mogen ze niet wijzigen?
  • Waaraan herkent het team uiteindelijk dat een transactie echt afgerond is?

Deze vragen klinken nuchter. Precies dat is hun voordeel. Ze voorkomen dat een visueel overtuigende toepassing wordt gebouwd rond een geïdealiseerd proces dat in de praktijk niemand gebruikt. Vooral in magazijn en logistiek tellen reële omstandigheden: scanners worden met handschoenen bediend, shiften wisselen, wifi is niet overal even goed, en een leveringsbon mag niet pas na meerdere klikken ontstaan.

Niet elk proces hoort echter thuis in een toepassing. Een kleine lijst met weinig, stabiele items kan als tabel sneller en goedkoper zijn. Software loont wanneer gegevens tussen personen of gebieden stromen, wanneer navolgbaarheid ontbreekt, of wanneer manueel werk terugkerend tijd en fouten veroorzaakt.

De technische basis bepaalt de latere inspanning

Veel systemen lijken op elkaar in de eerste demo. Het verschil toont zich bij wijzigingen, groei, en storingen. Een toepassing zou daarom moeten berusten op technologieën die het team op lange termijn kan onderhouden, in plaats van op kortstondige hype te vertrouwen.

Voor veel bedrijfskritische webtoepassingen is een stack met PHP 8.4, moderne JavaScript, en MySQL 8 een pragmatische keuze. Ze is performant, goed begrijpelijk, en geschikt voor typische vereisten zoals portalen, orderbeheer, documentgeneratie, of interne hulpmiddelen. Dat is geen dogma. Bij zeer interactieve toepassingen, speciale integraties, of hoge realtimebehoeften kan een andere architectuur zinvol zijn. De technologie zou de taak moeten volgen, niet omgekeerd.

Belangrijker dan de naam van een framework zijn duidelijke beslissingen over gegevens en toestanden. Een bestelling heeft bijvoorbeeld eenduidige statuswaarden nodig in plaats van vrije tekst. Wijzigingen zouden navolgbaar moeten zijn. Klantgegevens, prijzen, en rechten mogen niet uiteenlopen over verspreide tabellen en geïmproviseerde interfaces. Wie later moet weten waarom een verzendlabel aangemaakt is of een bestelling geblokkeerd is, heeft een navolgbare geschiedenis nodig.

Ook beveiliging hoort bij de basisconstructie. Daartoe behoren rolgebaseerde rechten, veilige wachtwoordopslag, account-vergrendelingsflows bij herhaalde mislukte pogingen, gescheiden test- en productieomgevingen, en regelmatige updates. Beveiliging is geen losse plugin aan het einde van het project. Ze ontstaat door nette verantwoordelijkheden en een architectuur die foutscenario's meeneemt.

Snelheid is een operationele vereiste

Trage pagina's kosten niet alleen zichtbaarheid in zoekmachines. Ze veroorzaken afhakers bij aanvragen en onnodige wachttijd in de dagelijkse bedrijfsvoering. Op een openbare website bepalen laadtijd, mobiele weergave, en een duidelijke paginastructuur of geïnteresseerden überhaupt contact opnemen. In een interne toepassing tellen twee of drie seconden wachttijd bij elke boeking merkbaar op over de werkdag heen.

Performance begint niet bij een later optimalisatieproject. Afbeeldingen, databasequery's, caching, JavaScript, en hosting moeten vanaf het begin adequaat gepland worden. Daarbij geldt: niet elke toepassing heeft maximale technische complexiteit nodig. Een eenvoudig intern hulpmiddel met weinig gebruikers heeft geen architectuur voor miljoenen gelijktijdige aanroepen nodig. Het heeft korte wegen, betrouwbare back-ups, en gedrag nodig dat in de dagelijkse praktijk voorspelbaar blijft.

Hetzelfde principe geldt voor responsieve bediening. "Mobielvriendelijk" betekent niet dat een desktopscherm op een of andere manier krimpt naar een smartphone. Wie onderweg leveringsbonnen controleert, een schade meldt, of een voorraad corrigeert, heeft grote bedieningselementen, duidelijke terugkoppelingen, en zo weinig mogelijk onnodige invoer nodig.

Van idee naar bedrijfsvoering: in kleine stappen leveren

Grote lastenboeken beloven zekerheid, maar leiden er vaak toe dat teams maanden wachten op een eerste bruikbare versie. Een betere weg is een duidelijk afgebakende eerste uitbreidingsstap. Ze zou een echt probleem moeten oplossen, zoals de centrale registratie van goederenontvangsten of het automatisch aanmaken van leveringsdocumenten. Daarna kan met reële terugkoppeling beslist worden wat vervolgens het grootste voordeel oplevert.

Dat betekent niet zonder planning te werken. Integendeel: gegevensmodel, rollen, interfaces, en exploitatieconcept moeten vroeg verduidelijkt worden. De functieomvang mag desondanks stapsgewijs groeien. Zo worden aannames zichtbaar voordat ze duur worden.

Bij een professionele overdracht hoort meer dan toegangsgegevens. Gedocumenteerde deploymentstappen, back-ups, monitoring, verantwoordelijkheden, en begrijpelijke technische documentatie maken een systeem onafhankelijk van individuele personen. Als enkel de oorspronkelijke ontwikkelaar weet hoe een update ingespeeld wordt, is de toepassing niet af, maar persoonsgebonden.

Waaraan u een geschikte partner herkent

Een webontwikkelingsbedrijf hoeft niet elke denkbare technologie aan te bieden. Het zou echter de juiste vragen moeten stellen en beslissingen moeten kunnen onderbouwen. Voorzichtigheid is geboden wanneer al in het eerste gesprek een omvangrijk platform beloofd wordt, zonder dat iemand de bestaande processen gezien heeft.

Een geschikte partner spreekt even open over onderhoud, gegevenskwaliteit, en invoering als over ontwerp. Hij legt uit welke vereisten standaardfuncties kunnen dekken en waar individuele ontwikkeling zinvol wordt. Hij noemt ook de kosten van speciale wensen. Een functie kan technisch haalbaar zijn en toch onvoldoende nut hebben.

Vraag naar concrete operationele details: Hoe worden wijzigingen getest? Hoe werkt een rollback? Waar bevinden zich gevoelige gegevens? Wie reageert bij een uitval? Hoe worden rechten beheerd? Goede antwoorden hoeven niet lang te zijn, maar zijn wel specifiek. "Daar zorgen we later voor" is bij bedrijfskritische processen geen strategie.

Voor teams met bestaande software is bovendien de integratievraag centraal. Een nieuwe toepassing hoeft niet alles te vervangen. Ze kan aanvankelijk gegevens uit een bestaand systeem overnemen, documenten aanmaken, of een ontbrekend proces weergeven. De zinvolste eerste stap is vaak niet de grote vervanging, maar het gericht wegnemen van één knelpunt.

Software moet werk verduidelijken, niet verplaatsen

De beste webtoepassing valt in de bedrijfsvoering niet op door technische verfijning, maar door minder navragen, betrouwbare gegevens, en kortere doorlooptijden. Ze respecteert werkzame werkwijzen, maakt uitzonderingen zichtbaar, en laat zich zonder angst voor de volgende update verder ontwikkelen.

Neem, voordat u een project start, een concrete handeling uit uw dagelijkse praktijk en volg deze van het eerste contact tot de afronding. Daar waar informatie wacht, verdwijnt, of dubbel vastgelegd wordt, ligt meestal de zinvolste aanpak voor webontwikkeling.

Permalink →

Logistics Automation Software die echt past

Logistics Automation Software die echt past

Een goederenontvangst wordt op papier genoteerd, de voorraadwijziging later in een spreadsheet overgetypt en de verzending belt het magazijn omdat het afleveradres in een e-mail staat. Juist bij deze overdrachtsmomenten verliest een bedrijf tijd en betrouwbaarheid. Logistics Automation Software moet die wrijving niet toedekken met een grote nieuwe proceswereld, maar de dagelijkse handelingen op een navolgbare manier met elkaar verbinden.

Voor kleine en middelgrote bedrijven is dit een andere opgave dan de invoering van een concernplatform. Een magazijnverantwoordelijke heeft geen 200 functies nodig die pas na drie trainingsdagen begrijpelijk worden. Hij heeft een duidelijke status nodig: wat is er binnengekomen, waar ligt het, wat moet er vandaag weg en wat ontbreekt er nog? Goede automatisering beantwoordt deze vragen op de plek waar het werk gebeurt.

Wat Logistics Automation Software in de praktijk moet kunnen

De term klinkt breed, maar de zinvolle toepassingen zijn meestal heel concreet. Een bedrijf verwerkt bijvoorbeeld binnenkomende goederen, boekt magazijnbewegingen, maakt leveringsbonnen, drukt verzendetiketten af en plant leveringen. Als elk werkstation een eigen bestand, een aparte toegang of een verbale oproep nodig heeft, ontstaan vertragingen en foutketens.

Passende software brengt de informatie samen in één werkproces. Een bestelling kan automatisch een pickopdracht genereren. Het scannen van een artikel bevestigt de uitgifte en werkt de voorraad bij. Na afronding wordt een leveringsbon met de juiste regels aangemaakt, terwijl de verzendstatus zichtbaar wordt voor verkoop of planning. Dat klinkt eenvoudig. Juist daarom is het waardevol: de software vervangt geen logica die werkt, maar voorkomt dat die bij elke overgang tussen media opnieuw moet worden gereconstrueerd.

De volgorde is doorslaggevend. Eerst moet duidelijk zijn welke gegevens een gebeurtenis in gang zetten en wie erover beslist. Pas dan loont het om regels te automatiseren. Wie een onduidelijk proces digitaliseert, krijgt alleen snellere onduidelijkheid.

Eerst de juiste processen kiezen

Niet elke handmatige handeling verdient meteen een applicatie. Een kleine, netjes bijgehouden spreadsheet kan voor een zeldzaam speciaal geval beter zijn dan een module die permanent onderhouden moet worden. De economische hefboom ligt meestal bij processen met veel herhaling, veel overdrachten of merkbare gevolgen bij fouten.

Typische kandidaten zijn goederenontvangsten met controlestatus, verplaatsingen tussen zones, het picken van terugkerende orders, verzenddocumenten en routeplanning. Ook de orderintake is vaak een goed startpunt wanneer bestellingen uit telefoongesprekken, e-mails en formulieren eerst handmatig worden samengevoegd.

Bij de keuze helpen vier vragen:

  • Hoe vaak wordt het proces per week uitgevoerd?
  • Op welk punt worden gegevens meermaals vastgelegd of overgedragen?
  • Welke fouten veroorzaken herstelwerk, voorraadverschillen of te late leveringen?
  • Welke uitzonderingen moeten medewerkers zelf blijven beslissen?

De laatste vraag voorkomt een veelgemaakte fout. Automatisering hoeft niet te betekenen dat elke beslissing zonder mensen wordt genomen. Bij beschadigde goederen, onvolledige leveringen of kortetermijnwensen van klanten heeft het team een duidelijke mogelijkheid nodig om een transactie stop te zetten, te corrigeren en met motivering voort te zetten. Een systeem zonder zulke wegen oogt op papier consequent, maar wordt in het magazijn snel een obstakel.

Van goederenontvangst tot verzending: een doorlopend proces

Neem een middelgrote handelaar met magazijn en eigen bezorging. Nu worden goederen bij de laaddeur geteld, op een formulier genoteerd en pas tegen het einde van de dienst in het systeem ingevoerd. Verkoop ziet de nieuwe voorraad daardoor te laat. Bij een spoedzending wordt een leveringsbon apart aangemaakt en krijgt de chauffeur zijn informatie telefonisch.

In een zinvol geautomatiseerd proces begint de goederenontvangst met een digitale transactie. Medewerkers registreren levering, artikel en hoeveelheid en optioneel batch of serienummer direct aan de werkplek of mobiel. Afwijkingen worden niet verstopt in een kanttekening, maar krijgen een status zoals „Controle vereist”. Pas na vrijgave staan de goederen beschikbaar als bruikbare voorraad.

De volgende stap komt voort uit echte eisen: een order wordt vrijgegeven, het magazijn krijgt een picklijst of een mobiele weergave per locatie, en elke boeking legt vast wat er daadwerkelijk is genomen. Daaruit ontstaan leveringsbon en verzendgegevens uit dezelfde bron. Niemand hoeft regels opnieuw over te typen of na te gaan welke bestandsversie op dat moment geldt.

Voor de planning kan het systeem openstaande leveringen bundelen op gebied, levervenster, gewicht of voertuigcapaciteit. Routeplanning is daarbij niet altijd de eerste zinvolle stap. Als adressen onvolledig zijn of orders pas kort voor vertrek worden vrijgegeven, moeten eerst de datakwaliteit en de duidelijkheid van orders worden verbeterd. Geoptimaliseerde routes helpen niet als de basis onbetrouwbaar is.

Standaardsoftware of maatwerk?

Standaardsoftware is zinvol wanneer het bedrijf met gangbare processen werkt en accepteert zich aan te passen aan de voorziene schermen, rollen en processen. Ze kan snel worden ingevoerd, vooral bij duidelijke eisen zoals etiketten printen of eenvoudig voorraadbeheer. De prijs daarvoor zijn vaak compromissen bij bijzondere gevallen, koppelingen en latere aanpassingen.

Een maatwerk Logistics Automation Software wordt interessant wanneer de operationele bijzonderheid geen randgeval is, maar het bedrijfssucces bepaalt. Dat kan een speciale verpakkingslogica zijn, een meertraps goedkeuringsproces, de koppeling van werkplaats en magazijn of een eigen leveringsmodel. Dan is het vaak zinvoller om gericht de weinige kernprocessen af te beelden, in plaats van een uitgebreide suite met veel ongebruikte modules in te voeren.

Maatwerk betekent echter niet grenzeloos. Elke speciale functie heeft een inhoudelijke rechtvaardiging, tests, documentatie en onderhoud nodig. Goed projectwerk vraagt daarom ook: kan deze stap worden vereenvoudigd? Volstaat een configuratie? Blijft een spreadsheet voor dit uitzonderingsproces de betere oplossing? Deze vragen beschermen budget en team tegen onnodige complexiteit.

Techniek die in de dagelijkse praktijk standhoudt

De gebruikersinterface bepaalt of medewerkers graag met een systeem werken. De technische basis bepaalt of het ook na jaren betrouwbaar kan worden beheerd. Voor bedrijfskritische processen horen navolgbare datamodellen, rollen en bevoegdheden, logboeken van belangrijke wijzigingen en regelmatige back-ups tot de basisuitrusting.

Bij een magazijnboeking moet zichtbaar zijn wie wanneer welke voorraad heeft gewijzigd en uit welke transactie de wijziging voortkomt. Als meerdere gebruikers tegelijk actief zijn, mag de voorraad niet worden vervalst door tegenstrijdige invoer. Bij printers, scanners of koppelingen met vervoerders zijn duidelijke foutstatussen nodig in plaats van stille mislukkingen. Een etiket dat niet is geprint, moet zichtbaar zijn als openstaande werkstap.

Ook onderhoudbaarheid is een operationele eis. Een webapplicatie op een begrijpelijke architectuur, bijvoorbeeld met PHP 8.4, moderne JavaScript en MySQL 8, is op lange termijn beter te controleren en uit te breiden dan een verzameling moeilijk te doorgronden losse oplossingen. Gedocumenteerde uitrol, gescheiden test- en productieomgevingen en geautomatiseerde tests zijn geen luxe. Ze verkleinen het risico dat een kleine wijziging aan de leveringsbon plotseling de orderdoorgifte beïnvloedt.

Gegevensbescherming en toegangscontrole verdienen dezelfde nuchterheid. Niet elke gebruiker heeft prijzen, marges of klantstamgegevens nodig. Vooral in verspreide teams moeten toegang, apparaten en bevoegdheden zo worden ingericht dat ze het dagelijkse werk niet onnodig afremmen, maar wel beheersbaar blijven bij een personeelswissel of een verloren apparaat.

Invoering in zinvolle etappes

De sterkste functie helpt weinig als een team ze niet in ploegendienst kan gebruiken. Daarom is een stapsgewijze invoering vaak robuuster dan één grote startdatum. Eerst wordt een afgebakend proces in productie genomen, bijvoorbeeld de goederenontvangst voor een productgroep of het aanmaken van verzendpapieren. Het team werkt daarmee onder echte omstandigheden en openstaande vragen worden aan de hand van echte gevallen opgelost.

Daarna volgen verdere processen en koppelingen. Deze volgorde schept vertrouwen, omdat medewerkers zien dat feedback in concrete verbeteringen terechtkomt. Tegelijk beperkt ze het risico: als een nieuw scanproces moet worden aangepast, ligt niet de hele logistiek stil.

Meetwaarden moeten vóór de start worden afgesproken. Dat kunnen doorlooptijd van order tot verzending, aantal handmatige correcties, voorraadverschillen of de duur van de dagafsluiting zijn. Niet elke verbetering verschijnt meteen in een spectaculair kengetal. Minder vragen heen en weer tussen magazijn en kantoor, een betrouwbare ploegoverdracht en vindbare transactiehistorieken zijn eveneens meetbare ontlasting.

softify.pro ontwikkelt zulke systemen vanuit het werkproces, met directe technische betrokkenheid in plaats van een overdracht van concept naar uitvoering. De maatstaf blijft daarbij bewust pragmatisch: de oplossing moet op de werkvloer functioneren, niet alleen in een presentatie.

Waaraan u een duurzame beslissing herkent

Een goede beslissing begint niet met een functielijst, maar met een geobserveerde werkdag. Laat u tonen waar informatie ontstaat, wacht, verloren gaat of achteraf wordt gecorrigeerd. Praat niet alleen met de directie, maar ook met de mensen bij de goederenontvangst, in het magazijn en bij de verzending. Zij kennen de uitzonderingen die geen organigram zichtbaar maakt.

Controleer vervolgens of de aanbieder concrete vragen stelt over gegevens, rollen, apparaten, koppelingen en beheer. Wie meteen een totaaloplossing belooft zonder de bestaande processen te begrijpen, verkoopt eerder software-omvang dan probleemoplossing. Even kritisch is een project dat geen duidelijke regeling bevat voor onderhoud, foutherstel en latere aanpassingen.

De beste automatisering voelt niet als extra bureaucratie. Ze geeft het team tijd voor de gevallen waarin ervaring echt telt: een onverwachte levering juist beoordelen, een klant tijdig informeren of een knelpunt oplossen voordat het een probleem wordt.

Permalink →

Kan AI desktopsoftware testen?

Kan AI desktopsoftware testen?

Een medewerker boekt goederenontvangst in een Windows-toepassing, drukt een leveringsbon af, en geeft de gegevens door aan de boekhouding. Na een update verschijnt een dialoogvenster op een andere plek, een veld verliest de focus, het afdrukken start niet meer. De vraag "can AI test desktop software" is daarom minder theoretisch dan ze klinkt: kan een systeem zulke fouten opsporen vóór de volgende vroege shift?

Ja. AI kan Windows-desktopsoftware testen, vooral daar waar klassieke automatisering faalt bij wisselende interfaces, inconsistente bedieningselementen, of scripts die duur zijn om te onderhouden. Ze is echter geen vervanging voor duidelijke testdoelen, propere testgegevens, en zakelijke verantwoordelijkheid. Haar waarde ontstaat wanneer ze betrouwbaar herhaalbaar werk overneemt en mensen richt op de gevallen die beoordelingsvermogen vereisen.

Kan AI desktopsoftware testen - en wat betekent dat in de praktijk?

Desktoptests controleren niet alleen of een venster opent. In een reële werking gaat het om volledige workflows: aanmelding met correcte blokkeringslogica, orderinvoer, selectie van een artikel, voorraadboeking, etikettenafdruk, foutmelding bij ongeldige gegevens, en de correcte overdracht naar een verbonden systeem.

Een AI-gedreven testomgeving kan deze workflows op een Windows-machine uitvoeren, de zichtbare interface beoordelen, en bewijs genereren. Ze herkent bijvoorbeeld knoppen aan de hand van tekst en positie, leest inhoud uit dialoogvensters, en vergelijkt screenshots met de verwachte toestand. Anders dan een star script kan ze beter omgaan met kleinere visuele wijzigingen - bijvoorbeeld wanneer een icoon, een afstand, of de exacte technische identificatie van een bedieningselement verandert.

Dit is vooral relevant bij bedrijfstoepassingen die doorheen de tijd gegroeid zijn. Veel van deze programma's hebben geen moderne API voor elk proces. Sommige gebruiken eigen interfaces, ingebedde tabellen, of componenten die zich slecht laten aanspreken met conventionele UI-automatisering. Een AI-agent kan de toepassing eerder bedienen zoals een geschoolde gebruiker dat doet: scherm lezen, actie kiezen, resultaat controleren.

Het woord "eerder" is bewust gekozen. AI ziet niet automatisch het zakelijke proces achter een invoerveld. Ze kan vaststellen dat een leveringsbon werd aangemaakt. Of de juiste leveringsvoorwaarde voor een bepaalde klant gebruikt moest worden, vereist een zakelijk gedefinieerde verwachting.

Waar AI-tests zinvol zijn voor Windows-toepassingen

Het beste startpunt zijn workflows die vaak voorkomen, bedrijfskritisch zijn, en vandaag manueel worden gecontroleerd. Een team moet hiervoor niet de hele testcatalogus automatiseren. Beter is het de weinige processen te kiezen waarvan het uitvallen rechtstreeks tijd, geld, of vertrouwen kost.

In magazijn, productie, en planning behoren hiertoe vaak het aanmaken en boeken van goederenontvangsten, picking- en verzendprocessen, geautoriseerde voorraadcorrecties, het afdrukken van etiketten, en import- en exportprocessen. In commerciële toepassingen zijn aanmelding, rechtenwissel, factuuraanmaak, stamgegevensonderhoud, en interfaceoverdrachten typische kandidaten.

AI is bijzonder nuttig daar waar een release tot nu toe een manuele controledag veroorzaakt. Een tester klikt dan een lange lijst af, documenteert bijzonderheden, en probeert later na te gaan wat er precies gebeurd is. Geautomatiseerde runs kunnen dit deel naar de nacht of naar een vast releaseproces verplaatsen. 's Ochtends ligt er niet enkel een status, maar een testlog met screenshots, tijdstempels, en een begrijpelijke beschrijving van de afwijking.

Ook regressietests profiteren. Wanneer een nieuwe functie in het orderdialoogvenster wordt ingebouwd, mogen bestaande processen niet onopgemerkt breken. De AI herhaalt gedefinieerde scenario's na elke relevante wijziging. Dat elimineert niet elk risico, maar het voorkomt dat gekende kernprocessen enkel ongecontroleerd blijven omdat de tijd ontbreekt.

Wat AI betrouwbaar kan controleren - en wat niet

AI-gebaseerde interfacetests zijn sterk bij observeerbare verwachtingen. "Na het opslaan verschijnt het ordernummer." "Bij een ontbrekende verplichte opgave wordt een waarschuwing getoond." "De voorraad vermindert met vijf." "Het afdrukdialoogvenster bevat de bedoelde printer." Zulke uitspraken vertalen zich naar concrete controlestappen.

Moeilijker worden vereisten die onnauwkeurig geformuleerd zijn. "De interface moet er professioneel uitzien" of "het programma moet snel zijn" zijn geen voldoende testgevallen. Hier zijn criteria nodig: maximale wachttijd onder gedefinieerde belasting, een goedgekeurde lay-out, of duidelijke acceptatieregels voor foutmeldingen.

Ook bij complexe zakelijke bijzondere gevallen blijft menselijk testen onmisbaar. Als een retourregel voor één raamcontract geldt, moet iemand met proceskennis beslissen of het resultaat correct is. AI kan het geval voorbereiden, uitvoeren, en documenteren. Ze zou niet eigenmachtig nieuwe bedrijfsregels moeten verzinnen.

Een andere grens is de stabiliteit van de omgeving. Desktoptests hangen af van schermresolutie, gebruikersrechten, netwerkverbinding, printerdrivers, testgegevens, en eventueel aangesloten hardware. Als een etikettenprinter offline is, kan een mislukte test een echt defect zijn - of een omgevingsprobleem. Goede testsystemen onderscheiden deze gevallen en melden ze transparant, in plaats van alles generiek als productfout te beoordelen.

De technische basis bepaalt het nut

Een bruikbare desktoptest is meer dan een reeks muisklikken. Ze heeft een gecontroleerde machine of een virtuele Windows-omgeving nodig, gedefinieerde gebruikersaccounts, reproduceerbare uitgangsgegevens, en duidelijke regels voor terugzettingen. Anders controleert de test op dinsdag een andere toestand dan op maandag en levert het discussies op in plaats van zekerheid.

Even beslissend zijn bewijzen. Een groen vinkje zonder context helpt weinig wanneer een bedrijfsafdeling een fout meldt. Bij elke run zouden daarom de uitgevoerde stappen, screenshots op belangrijke punten, zichtbare foutmeldingen, en een tijdsaanduiding aanwezig moeten zijn. Bij afwijkingen moet herkenbaar zijn of de toepassing verkeerd gereageerd heeft, een verwacht element niet gevonden werd, of de testomgeving geblokkeerd was.

Bij gevoelige toepassingen is de vraag naar de uitvoeringsplek geen bijzaak. Screenshots, toegangsgegevens, klantgegevens, en interne processchermen kunnen vertrouwelijke informatie bevatten. Wie tests via externe diensten laat lopen, zou precies moeten controleren welke gegevens het eigen domein verlaten, hoe lang ze opgeslagen worden, en wie toegang krijgt.

Voor teams met overeenkomstige vereisten kan een zelf gehoste omgeving zinvoller zijn.

softify.pro exploiteert hiervoor COCO, een eigen AI-server voor geautomatiseerde web- en applicatietests. De uitvoering, testbewijzen, en evaluatie kunnen binnen de gecontroleerde bedrijfsomgeving blijven. Dat is niet voor elke toepassing nodig, maar bij interne bedrijfssystemen, persoonsgegevens, of strenge IT-vereisten is het vaak de propere architectuur.

Hoe een team start zonder een testautomatiseringsproject te laten uitdeinen

Een zinvolle start begint niet met een toolkeuze, maar met een proces. Neem een workflow die minstens wekelijks gecontroleerd wordt en waarvan de foutgevolgen navolgbaar zijn. Een verzendproces past beter dan een verzameling van twintig willekeurige schermmaskers.

Beschrijf vervolgens het zakelijke pad in duidelijke zinnen: uitgangssituatie, invoer, verwachte tussentoestanden, verwacht eindresultaat. Voeg ook het negatieve geval toe. Wat moet er gebeuren als een chargenummer ontbreekt, een gebruiker geen bevoegdheid heeft, of de voorraad niet toereikend is? Juist deze regels worden bij manuele tests vaak overgeslagen, ook al kunnen ze in de dagelijkse praktijk duur worden.

Daarna volgt een beperkte piloot met stabiele testgegevens en een gedefinieerde omgeving. Meet niet enkel of de test loopt. Meet hoeveel manuele controleminuten ze vervangt, hoeveel valse alarmen optreden, en of het bewijs voldoende is voor ontwikkeling en de bedrijfsafdeling. Pas wanneer deze basis werkt, loont uitbreiding naar meer processen.

Onderhoud hoort er vanaf het begin bij. Als een scherm zakelijk verandert, moet ook de verwachting aangepast worden. Dat is geen argument tegen automatisering. Het is normaal software-onderhoud - vergelijkbaar met het bijwerken van een werkinstructie wanneer een magazijnproces verandert.

Niet elke klik moet geautomatiseerd worden

Sommige teams verwachten van AI-tests volledige dekking. Dat leidt snel tot hoge kosten voor zeldzame uitzonderingsgevallen, waarvan de controle manueel sneller en betrouwbaarder zou zijn. Een goede teststrategie prioriteert in plaats daarvan op risico, frequentie, en wijzigingstempo.

Een zelden gebruikt beheerdersdialoogvenster met laag foutgevolg kan verder gecontroleerd worden met een korte manuele checklist. Een dagelijkse goederenontvangst met meerdere vervolgstappen verdient daarentegen geautomatiseerde regressietests en propere bewijzen. Boring, provable reliability wint het hier van een grote maar kwetsbare testverzameling.

Begin met het proces waarbij een fout de volgende werkdag echt merkbaar zou zijn. Wanneer dit proces geautomatiseerd, navolgbaar, en herhaalbaar in uw eigen omgeving gecontroleerd wordt, ontstaat testautomatisering als betrouwbaar operationeel voordeel - niet als nog een IT-project met mooie slides.

Permalink →

Wanneer moeten bedrijven spreadsheets vervangen?

Wanneer moeten bedrijven spreadsheets vervangen?

Een magazijnverantwoordelijke print 's ochtends een voorraadlijst af. Twee uur later heeft de verkoop een bestelling ingevoerd, is de hoeveelheid van een goederenontvangst gecorrigeerd en heeft een collega een oud bestand geopend uit een e-mailbijlage. De cijfers kloppen niet meer. Precies op dat moment rijst de vraag: wanneer moeten bedrijven spreadsheets vervangen? Niet wanneer een bestand eens onoverzichtelijk wordt, maar wanneer het het onzichtbare knelpunt van een lopend proces wordt.

Spreadsheets zijn geen teken van slechte organisatie. Voor berekeningen, eenmalige analyses, kleine hoeveelheden gegevens en beslissingen met weinig betrokkenen zijn ze vaak het juiste hulpmiddel. Ze zijn flexibel, vertrouwd en beschikbaar zonder dat er een project moet starten. Problematisch worden ze pas wanneer één spreadsheet tegelijk database, werkinstructie, goedkeuringsworkflow, documentenarchief en communicatiekanaal moet zijn.

Spreadsheets zijn goed - tot ze een proces moeten dragen

Veel groeiende bedrijven houden vast aan hun bestanden, omdat die in de loop der jaren zorgvuldig zijn opgebouwd. Er zitten artikelnummers, uitzonderingsgevallen, leveranciersknowhow en beproefde rekenlogica in. Dat verdient respect. Een vervangend systeem dat deze realiteit negeert, wekt weerstand op en zorgt in het slechtste geval voor nieuwe omwegen.

De beslissende vraag luidt daarom niet: “Is Excel slecht?” Maar wel: “Kan ons team betrouwbaar met dit hulpmiddel werken, ook wanneer het bestelvolume, de ploegen of de verantwoordelijken wisselen?” Als het antwoord geregeld afhangt van één bepaalde persoon, een gedeelde schijf of de discipline van alle betrokkenen, is de grens vaak bereikt.

Dat wordt bijzonder duidelijk in het magazijn, de werkplaats en de planning. Een voorraad die pas achteraf wordt afgestemd, is geen betrouwbare voorraad. Een leveringsbewijs dat handmatig uit meerdere bestanden wordt samengesteld, kost niet alleen tijd. Het bemoeilijkt navragen achteraf, opvolging en een nette overdracht tussen medewerkers.

Wanneer moeten bedrijven spreadsheets vervangen?

Er is geen universeel moment en geen magisch aantal rijen. Een bedrijf met 500 posities kan prima werken met een eenvoudige tabel, terwijl een ander met 50 posities al lang een systeem nodig heeft. Doorslaggevend is de operationele belasting: hoe vaak veranderen gegevens, wie gebruikt ze en welke gevolgen heeft een fout?

Een duidelijke aanleiding is het versieconflict. Wanneer teams bestanden met namen als “Voorraad_definitief_nieuw2” rondsturen of collega's moeten navragen welke kolom op dit moment geldt, ontbreekt een bindende gegevensbron. Ook handmatig kopieerwerk tussen bestellijst, magazijnoverzicht, verzendbestand en factuurvoorbereiding is een signaal. Elke overdracht schept opnieuw de kans op omgewisselde cijfers, dubbele ingaves of vergeten updates.

Even kritiek zijn processen zonder traceerbare verantwoordelijkheid. Wie heeft een hoeveelheid gewijzigd? Wanneer is een goederenontvangst geboekt? Waarom is een bestelling in de wacht gezet? In een spreadsheet kunnen wijzigingen weliswaar gedeeltelijk worden bijgehouden. In de praktijk is dat echter zelden zo eenduidig en bruikbaar als bij een proces dat boekingen, statuswijzigingen en gebruikersacties gericht vastlegt.

Een ander punt is de snelheid van het werk. Als medewerkers vóór het inpakken eerst een bestand moeten doorzoeken, een voorraad moeten controleren, gegevens moeten overtypen en daarna een verzendetiket in een apart portaal moeten aanmaken, wordt de spreadsheet de tempobepaler op de werkvloer. De kosten ontstaan dan niet alleen in minuten. Ze komen tot uiting in onderbrekingen, vragen achteraf, foute verzendingen en kennis die alleen in de hoofden van enkele personen zit.

De risico's zitten vaak tussen twee cellen

Spreadsheets falen zelden spectaculair. Vaak zijn het kleine afwijkingen die zich voortplanten: een verkeerd doorgetrokken formule, een filter dat niet alle rijen omvat, een getal dat als tekst is opgeslagen in plaats van als getal of een per ongeluk overschreven formule. Zulke fouten blijven net lang onopgemerkt wanneer het team onder tijdsdruk werkt.

Bij bedrijfskritieke processen komt er een tweede risico bij: ontbrekende processturing. Een spreadsheet kan tonen dat een bestelling bestaat. Maar ze garandeert niet betrouwbaar dat alle noodzakelijke stappen in de juiste volgorde gebeuren. Moet vóór de verzending een kwaliteitscontrole zijn afgerond? Mag een leveringsbon worden aangemaakt zonder bevestigde orderpicking? Moet een bestelling bij ontbrekende voorraad automatisch naar verduidelijking gaan? Deze regels horen niet thuis in geheugensteuntjes, ingekleurde cellen of ingewikkelde als-dan-formules, wanneer ze dagelijks bepalen of processen correct verlopen.

Ook toegangsrechten worden relevant naarmate het team groeit. Niet iedereen moet prijzen mogen wijzigen, stamgegevens mogen onderhouden of afgesloten transacties mogen corrigeren. Een toepassing op maat kan rollen duidelijk weergeven, gevoelige acties loggen en bijvoorbeeld na meerdere mislukte pogingen een account blokkeren. Dat is geen overdreven techniek. Het is een nette oplossing voor verantwoordelijkheid.

Niet elk probleem heeft een groot ERP nodig

Het alternatief voor de spreadsheet is niet automatisch een wereldwijde enterprise-suite met langdurige implementatietrajecten. Voor veel kleine en middelgrote bedrijven zou dat de verkeerde stap zijn: te veel functies, te starre processen, hoge licentiekosten en een systeem dat zich onvoldoende aanpast aan het bedrijf.

Zinvoller is vaak een gerichte toepassing voor het concrete knelpunt. Dat kan een systeem voor goederenontvangsten, voorraadbewegingen en magazijnlocaties zijn. Het kan bestellingen uit e-mails of formulieren gestructureerd registreren, leveringsbonnen genereren, verzendetiketten voorbereiden of routes volgens duidelijke regels plannen. Beslissend is niet om zoveel mogelijk software in te voeren. Beslissend is dat de volgende handeling voor de verantwoordelijke persoon eenduidig wordt.

Een goede oplossing mag daarbij naast bestaande hulpmiddelen starten. Boekhouding, ERP of verzenddiensten moeten niet meteen worden vervangen. Vaak is een betrouwbare koppeling of een nette export de pragmatischere weg. Het nut ontstaat wanneer dubbele ingaves wegvallen en operationele gegevens up-to-date zijn waar ze nodig zijn.

Zo toetst u de daadwerkelijke nood aan actie

In plaats van meteen softwareaanbiedingen te vergelijken, loont het de moeite om naar één concreet proces te kijken. Neem bijvoorbeeld het traject van een bestelling van ontvangst tot verzending. Noteer niet alleen de officiële stappen, maar ook telefoongesprekken, briefjes, privé-chatberichten en de plekken waar iemand informatie uit het ene bestand naar een ander systeem overzet.

Vraag u vervolgens af: waar wachten medewerkers op informatie? Waar worden gegevens meermaals ingevoerd? Welke beslissing hangt af van ervaring in plaats van van zichtbare regels? En welke fouten zouden duur uitvallen als het bestelvolume over zes maanden verdubbelt? Deze analyse toont meestal sneller dan eender welke functielijst of een spreadsheet nog volstaat.

Niet elke afwijking rechtvaardigt een ontwikkeling op maat. Als een rapport maandelijks door één persoon wordt opgesteld en een fout eenvoudig te corrigeren is, blijft de spreadsheet vaak zinvol. Maar wanneer meerdere mensen dagelijks afhankelijk zijn van actuele gegevens, wanneer er fysieke goederen worden verplaatst of wanneer bewijzen tegenover klanten nodig zijn, verandert de rekensom. Dan betaalt het bedrijf al lang voor de grenzen van het hulpmiddel - alleen verspreid over arbeidstijd, foutcorrecties en vertragingen.

Een vervanging moet onderhoudbaar blijven

Wie spreadsheets vervangt, moet niet zomaar een mooiere gebruikersinterface kopen. De datastructuur, de regels en het beheer van de toepassing bepalen of de oplossing na twee jaar nog betrouwbaar werkt. Voor een slanke webtoepassing kunnen bijvoorbeeld PHP 8.4, modern JavaScript en MySQL 8 een bewust nuchtere basis zijn: goed onderhoudbaar, krachtig en zonder afhankelijkheid van kortstondige trends.

Even belangrijk is de invoering. Een systeem moet eerst de echte processen stabiliseren en niet alle denkbare wensen tegelijk afdekken. Een duidelijk afgebakend eerste domein - bijvoorbeeld goederenontvangst en voorraadboeking - schept vertrouwen. Daarna kunnen verzending, leveringsdocumenten of analyses op een consistente gegevensbasis worden aangevuld.

De oude spreadsheets verdwijnen daarbij niet per se meteen. Sommige blijven bestaan als archief, voor bijzondere analyses of als gecontroleerde export. Het doel is niet om spreadsheets te verbannen. Het doel is om ze te ontlasten van taken waarvoor ze nooit als permanent besturingssysteem bedoeld waren.

Als uw team geregeld nagaat welk bestand klopt, wie als laatste iets heeft gewijzigd of een bestelling echt volledig is afgehandeld, is dat geen klein organisatorisch smetje. Het is een goede aanleiding om het proces samen op de echte werkplek te bekijken - voordat de volgende groeipiek van een fragiele spreadsheet een dagelijks knelpunt maakt.

Permalink →

AI testing platforms voor regressietests

AI testing platforms voor regressietests

Een release is functioneel klaar, maar niemand kan met zekerheid zeggen of de nieuwe prijsimport de orderinvoer, gebruikersrechten, of het verzendproces heeft beschadigd. Precies hier worden AI testing platforms interessant. Niet omdat ze menselijk kwaliteitswerk wegtoveren, maar omdat ze terugkerende controles betrouwbaar kunnen uitvoeren, zichtbaar documenteren, en bij afwijkingen begrijpelijk maken.

Voor teams met web- of Windows-toepassingen die doorheen de tijd gegroeid zijn, is dit een praktisch probleem, geen innovatieproject. Kritieke workflows ontstaan vaak over jaren: een bestelling wordt aangemaakt, een voorraad wordt geboekt, een PDF wordt gegenereerd, een interface wordt geïnformeerd. Een kleine wijziging aan een invoerscherm kan gevolgen hebben op een onverwachte plek. Manuele regressietests zijn dan traag, afhankelijk van individuele personen, en bijzonder foutgevoelig onder tijdsdruk.

Wat AI testing platforms werkelijk opleveren

Klassieke testautomatisering volgt vooraf geschreven stappen. Dat blijft voor veel controles zinvol en noodzakelijk. Een AI-gedreven platform kan bovendien met een toepassing via de gebruikersinterface werken, inhoud herkennen, teststappen uitvoeren, en afwijkingen in natuurlijke taal indelen. Het kan bijvoorbeeld controleren of een bevoegde gebruiker een goederenontvangst kan boeken, of een geblokkeerd account correct geweigerd wordt, of een leveringsbon na een wijziging nog steeds gegenereerd wordt.

Het beslissende voordeel zit niet alleen in het klikken op een knop. Goede systemen verbinden uitvoering, observatie, en bewijs. Een testrun moet daarom navolgbare stappen, screenshots of opnames, tijdstempels, gebruikte testgegevens, en een duidelijke beoordeling omvatten. Wanneer een test faalt, heeft het team meer nodig dan het bericht "assertion failed". Het moet kunnen zien op welk scherm, in welke toestand, en om welke reden de afwijking optrad.

AI kan dit werk versnellen. Ze vervangt echter niet de beslissing over wat werkelijk bedrijfskritisch is. Een model herkent mogelijk dat een dialoogvenster er anders uitziet. Of die wijziging een fout vormt, een bewust nieuw ontwerp is, of slechts een onschuldig weergaveverschil in de browser, blijft een kwestie van regels, context, en goedkeuring.

Niet elke controle hoort thuis in de AI

De meest voorkomende fout bij de invoering is te groot mikken. Een platform zou niet eerst elke functie van een systeem moeten dekken. Het zou de workflows moeten beveiligen waarvan het uitvallen duur, risicovol, of arbeidsintensief zou zijn. In logistieke software is dat typisch orderinvoer, voorraadbewegingen, label- of documentafdruk, gebruikersrollen, en interfaceoverdrachten. In een commerciële webtoepassing kunnen aanmelding, factuurgoedkeuring, exports, en betaalstatus centraal staan.

Een zinvolle start bestaat uit een kleine set stabiele end-to-end-tests. Een test dekt hierbij niet slechts één enkele klik, maar een volledig werkproces. Bijvoorbeeld: een gebruiker meldt zich aan, maakt een bestelling aan, bevestigt de posities, genereert een leveringsbon, en controleert of de transactie in het overzicht verschijnt. Zulke controles leveren een hogere zakelijke relevantie op dan veel geïsoleerde tests voor afzonderlijke velden.

Dat betekent niet dat elk type test via de gebruikersinterface zou moeten lopen. Ontwikkelteams hebben nog steeds snelle unit- en integratietests dicht bij de code nodig. Deze tests vinden technische fouten vroeg en goedkoop. UI-gebaseerde AI-tests vullen ze aan waar de wisselwerking tussen interface, permissies, database, documenten, en externe diensten gecontroleerd moet worden. Wie alles enkel via de interface test, krijgt trage en moeilijk te onderhouden testruns. Wie uitsluitend in de code test, ziet mogelijk fouten over het hoofd die gebruikers rechtstreeks treffen.

Stabiliteit ontstaat door goede testomstandigheden

Geautomatiseerde tests falen niet altijd door een productfout. Instabiele testgegevens, wisselende gebruikersrechten, onbereikbare testsystemen, of parallelle wijzigingen kunnen evengoed de oorzaak zijn. Daarom hoort de testomgeving bij de platformbeslissing.

Testaccounts zouden ondubbelzinnig moeten zijn en gekende rechten moeten hebben. Gegevens moeten ofwel reproduceerbaar gereset worden voor elke run, ofwel gericht opnieuw aangemaakt worden. Ook externe systemen vereisen een beslissing: wordt een verzend- of betaalintegratie gecontroleerd tegen een veilige testomgeving, gesimuleerd met een gecontroleerde stub, of bewust uit de flow gehaald? Er bestaat geen universeel juist antwoord. Doorslaggevend is dat de uitspraak van een test duidelijk blijft.

Voor kritieke goedkeuringen loont het ook om een gedefinieerd betrouwbaarheidsniveau te hebben. Een visueel verschil met lage betrouwbaarheid zou niet automatisch een release moeten blokkeren. Een ontbrekend verzenddocument na een succesvol geboekte levering is daarentegen een harde fout. Goede testprocessen onderscheiden tussen aanwijzingen om te controleren en duidelijke goedkeuringscriteria.

Datasoevereiniteit is bij AI-tests geen bijzaak

Zodra een test tegen een echte toepassing loopt, kan hij vertrouwelijke informatie zien: klantnamen, prijzen, adressen, interne artikelnummers, screenshots uit bedrijfstoepassingen, of inhoud uit documenten. Als zulke gegevens samen met schermopnames en testlogs naar externe diensten overgedragen worden, is dat een architectuurbeslissing met gevolgen voor gegevensbescherming, informatiebeveiliging, en contracten.

Juist bij interne web- en Windows-toepassingen volstaat de vraag "werkt het platform?" niet. Verantwoordelijken zouden moeten controleren waar testruns uitgevoerd worden, waar screenshots en logs opgeslagen worden, welke gegevens een AI-model verwerkt, en wie administratieve toegang krijgt. Ook bewaartermijnen en verwijderconcepten horen hierbij. Een testrapport kan waardevol bewijs zijn voor een release, maar zou gevoelige informatie niet onbeperkt moeten bewaren.

Voor organisaties met verhoogde eisen kan een zelf gehoste uitvoering de meer geschikte oplossing zijn. Ze houdt testverkeer, testgegevens, en bewijs in de eigen gecontroleerde omgeving. Dat verhoogt de operationele inspanning enigszins: updates, toegangen, capaciteiten, en monitoring vereisen verantwoordelijkheid. In ruil daarvoor blijft de technische en organisatorische controle waar ze vaak thuishoort. Bij COCO zet softify.pro precies op dit model in: geautomatiseerde tests voor web- en Windows-toepassingen met lokale gegevensopslag en navolgbaar testbewijs.

Waaraan een geschikt platform te herkennen is

Een overtuigende keuze begint met de bestaande toepassingen, niet met een productdemo. Een platform kan indrukwekkend overkomen in een propere voorbeeldtoepassing en tegen grenzen aanlopen bij een oudere desktopscherm, een Citrix-omgeving, of een complexe aanmelding. Een korte proof of concept met twee of drie echte bedrijfsprocessen zegt veel meer dan een functielijst.

Daarbij zouden teams bijzonder moeten letten op vier punten:

  • Toepassingsdekking: Ondersteunt de oplossing de bestaande webbrowsers, Windows-desktoptoepassingen, en, indien relevant, remote-desktop- of Citrix-scenario's?
  • Navolgbaarheid: Levert elke run begrijpelijke stappen, screenshots, logs, en een verantwoording waarom een test als geslaagd of mislukt geldt?
  • Bedrijfsmodel: Past cloud, een private omgeving, of self-hosting bij de beveiligingseisen, de beschikbare IT-middelen, en de testgegevens?
  • Onderhoudbaarheid: Kunnen bedrijfsafdelingen testflows mee controleren terwijl technische teams versiebeheer, goedkeuringen, en herhaalbare uitvoering netjes aansturen?

Daarbij komt de integratie in het releaseproces. Een test die enkel op verzoek gestart wordt, helpt minder dan een geplande run vóór de implementatie of na een relevante wijziging. Tegelijkertijd zou niet elke kleine styling-update een urenlange volledige test moeten uitlokken. Volwassen processen selecteren tests op risico: een korte smoke-test na elke deployment, gerichte regressies bij wijzigingen aan kritieke modules, en uitgebreidere runs vóór grotere releases.

Duidelijke rapporten in plaats van testtheater

Testautomatisering produceert gemakkelijk activiteit zonder inzicht. Honderden groene vinkjes klinken goed, maar als niemand kan zeggen welke bedrijfsprocessen ze beveiligen, zijn ze amper stuurbaar. Een bruikbaar rapport beantwoordt eenvoudige vragen: Wat werd gecontroleerd? Met welk resultaat? Welke versie was betrokken? Wat moet iemand nu beslissen?

Plain-language-beoordelingen kunnen hier veel tijd besparen, op voorwaarde dat ze op echte uitvoeringsgegevens berusten. "De gebruiker kon zich aanmelden, de bestelling aanmaken, en de leveringsbon genereren" is nuttiger voor een bedrijfsverantwoordelijke dan een verzameling technische selectors. Bij fouten blijft de technische diepgang niettemin belangrijk. QA en ontwikkeling hebben de screenshot, de logdata, en reproduceerbare stappen nodig, niet enkel een AI-samenvatting.

Invoering zonder de lopende bedrijfsvoering te verstoren

De beste invoering begint met een proces waarbij een fout een merkbare impact zou hebben en waarvan het verloop voldoende stabiel is. Dat kan de dagafsluiting zijn, de bestellingsgoedkeuring, of een kernfunctie in een klantplatform. Samen met de bedrijfsafdeling en het technische team wordt vastgelegd wat als succesvol geldt, welke testgegevens gebruikt worden, en wie een fout beoordeelt.

Daarna volgt een gecontroleerd ritme: tests bouwen, herhaaldelijk uitvoeren, valse alarmen verminderen, en pas dan bindend in goedkeuringen opnemen. Deze tussenstap is belangrijk. Wie geautomatiseerde tests onmiddellijk als harde blokkade inzet, terwijl omgeving en gegevens nog schommelen, creëert weerstand in plaats van vertrouwen. Wie de resultaten daarentegen zichtbaar verbindt met echte fouten en stabiele releases, bouwt aanvaarding op.

AI testing platforms zijn geen vervanging voor goede software-architectuur, bedrijfsverantwoordelijkheid, of nette releasebeslissingen. Correct ingezet geven ze teams echter iets heel concreets terug: tijd voor de gevallen die beoordelingsvermogen vereisen, en solide bewijs voor de workflows die eenvoudigweg moeten werken. De zinvolste eerste test is daarom zelden de meest spectaculaire - maar het proces waarbij op maandagochtend niemand meer moet afvragen of het systeem nog doet wat de bedrijfsvoering ervan verwacht.

Permalink →

Testbewijs automatisch documenteren

Testbewijs automatisch documenteren

Een mislukte regressietest is vervelend. Een geslaagde test zonder bruikbaar bewijs is vaak nauwelijks beter. Wie testbewijs automatisch wil documenteren, lost daarom geen louter rapportageprobleem op. Het gaat om een solide antwoord op concrete vragen: Wat werd getest? In welke versie? Met welke invoer? Wat is er werkelijk op het scherm gebeurd? En kan een ontwikkelaar, QA-verantwoordelijke, of auditor het resultaat later reconstrueren?

Net bij bedrijfskritische web- en Windows-toepassingen komen deze vragen niet pas bij een audit naar boven. Ze duiken op wanneer na een release een bestelling verkeerd verwerkt wordt, wanneer een klant een ongewone fout meldt, of wanneer een team vóór de release onderscheid moet maken tussen "ziet er goed uit" en "aantoonbaar geverifieerd". Handmatig bijgehouden Excel-lijsten, screenshots in chatgesprekken, en losse testnota's volstaan enkel zolang de omvang en de wijzigingssnelheid beperkt blijven.

Waarom manueel testbewijs snel onbetrouwbaar wordt

In veel teams begint de documentatie met goede bedoelingen. Een tester legt het resultaat vast, voegt een screenshot toe, en noteert de geteste versie. Onder tijdsdruk verandert dit echter snel in een verkorte routine: vinkje zetten, bug doorgeven, volgend testgeval. Dat is begrijpelijk, vooral bij terugkerende regressietests - maar het is niet solide.

Het probleem ligt niet bij individuele medewerkers. Manuele documentatie concurreert altijd met het eigenlijke testwerk. Van zodra tien, vijftig, of meerdere honderden gevallen per release gecontroleerd moeten worden, ontbreekt ofwel de tijd voor nette bewijzen, of wordt het bewijs zo omvangrijk dat niemand het nog beoordeelt. Daarbij komen typische hiaten: een screenshot toont een toestand, maar niet het voorafgaande verloop. Een testlog vermeldt het geval, maar niet het gebruikte buildnummer. Een fout werd gecorrigeerd, maar het is niet zichtbaar wanneer en hoe de correctie opnieuw geverifieerd werd.

Voor toepassingen met bestellingsverwerking, magazijnbewegingen, prijzen, gebruikersrechten, of interfaces is dit meer dan een gemakskwestie. Een niet-gedocumenteerde test kan niet betrouwbaar gelden als voltooide risicocontrole. Dat geldt vooral wanneer een ogenschijnlijk kleine wijziging op één plek neveneffecten veroorzaakt in aangrenzende processen.

Wat bruikbaar testbewijs echt moet bevatten

Testbewijs is niet zomaar een schermafbeelding met een groen vinkje. Het verbindt het testgeval met zijn technische en zakelijke context. Op zijn minst moet later herkenbaar zijn welke toepassing, welke versie, en welke testomgeving gecontroleerd werden. Even belangrijk zijn starttijd, eindtijd, resultaat, en een duidelijke toewijzing aan de betreffende teststap.

Bij geautomatiseerde UI-tests zou het bewijs bovendien de uitgevoerde acties en de waargenomen resultaten moeten vastleggen. Voorbeeld: een test maakt een bestelling aan, controleert het positietotaal, genereert een leveringsbon, en controleert vervolgens de status in de verzendzone. Een goed logboek legt niet enkel "geslaagd" vast. Het toont bij welke stap de controle plaatsvond, welke verwachte waarde het systeem zou moeten leveren, en welke waarde het effectief geleverd heeft.

Screenshots of korte schermopnames zijn hierbij waardevol, maar niet altijd verplicht voor elke afzonderlijke succesvolle stap. Ze kosten opslagruimte en kunnen gevoelige gegevens bevatten. Meestal is een gefaseerde strategie zinvol: bij mislukte controles wordt automatisch een volledig visueel bewijs opgeslagen; bij succesvolle standaardgevallen volstaan gestructureerde loggegevens en geselecteerd bewijs. Welke diepgang vereist is, hangt af van risico, wijzigingsfrequentie, en regelgevende omgeving.

Het bewijs moet leesbaar en technisch bruikbaar zijn

Ontwikkelaars hebben details nodig zoals foutmeldingen, verwachte/werkelijke waarden, tijdstempels, en de concrete stap in het testverloop. Bedrijfsafdelingen en release-verantwoordelijken hebben daarentegen een begrijpelijke verklaring nodig: welke bedrijfsprocessen werden gecontroleerd, wat is geslaagd, en waar is actie nodig?

Beide perspectieven zouden uit dezelfde testuitvoering moeten voortkomen. Als een QA-team technische logbestanden exporteert en daarna manueel een managementsamenvatting schrijft, ontstaat opnieuw een foutgevoelige mediumbreuk. Beter is een systeem dat ruwe gegevens gestructureerd vastlegt en daaruit een duidelijke beoordeling genereert, zonder technische details te verbergen.

Testbewijs automatisch documenteren: het juiste verloop

Automatisering werkt het best wanneer ze gekoppeld is aan duidelijk gedefinieerde risico's. Niet elke klik in elke toepassing moet onmiddellijk geautomatiseerd en volledig gedocumenteerd worden. Het startpunt zijn meestal stabiele, veel herhaalde, en bedrijfskritische workflows: aanmelding en rechtencontrole, bestellingsinvoer, prijsberekening, documentgeneratie, magazijnboeking, of gegevensoverdracht naar een interface.

Voor elke workflow wordt eerst vastgelegd wat als geslaagde test geldt. "Het scherm ziet er correct uit" is daarvoor te vaag. Beter zijn concrete testvoorwaarden: een gebruiker met de rol magazijn mag geen prijzen wijzigen. Het leveringsbonnummer wordt gegenereerd. De hoeveelheid vermindert de beschikbare voorraad. Na vijf mislukte pogingen wordt de accountvergrendeling geactiveerd. Zulke criteria maken testgevallen herhaalbaar en bewijzen vergelijkbaar.

De testuitvoering zou dan automatisch moeten starten met contextgegevens. Daartoe behoren build- of versienummer, doelomgeving, browser of besturingssysteem, teststatus, en tijdstip. Tijdens de uitvoering legt het systeem de afzonderlijke stappen vast, de verwachte en werkelijke resultaten, alsook technische bijzonderheden. Bij afwijkingen genereert het bewijs, zoals screenshots, foutmeldingen, of een opname van het relevante verloop.

Het eindresultaat is geen ongestructureerde bestandsmap, maar een testrun met een status. Idealiter kan van een release-beslissing tot de afzonderlijke stap teruggeleid worden waarom een test als geslaagd of mislukt beoordeeld werd. Precies die koppeling vermindert discussies na een incident aanzienlijk.

Waar AI echt helpt - en waar niet

AI kan de documentatie en beoordeling merkbaar versnellen. Ze kan schermtoestanden beoordelen, opvallende afwijkingen markeren, en testruns in begrijpelijke taal samenvatten. Bij grote hoeveelheden tests helpt dit QA-teams om niet elke geslaagde run manueel te moeten lezen. Een beoordeling met betrouwbaarheidsdrempel kan bovendien gevallen benadrukken waarbij de detectie onzeker is en een menselijke controle noodzakelijk blijft.

Toch zou AI niet alleen over kritieke releases mogen beslissen. Bij gebieden zoals betalingsautorisatie, rechten, prijslogica, of juridisch relevante documenten zijn deterministische testcriteria nodig. Een verwacht bedrag is ofwel correct berekend, ofwel niet. Een rol heeft toegang of niet. AI vult hier de analyse van visuele en talige inhoud aan, maar vervangt geen netjes gedefinieerde bedrijfsregel.

Ook de omgang met gegevens is een architectuurbeslissing. Screenshots uit interne toepassingen kunnen klantgegevens, prijzen, adressen, of productie-informatie tonen. Wie testbewijs automatisch documenteert, zou daarom vooraf moeten vastleggen waar dit bewijs opgeslagen wordt, wie het mag inzien, en hoe lang het bewaard wordt. Voor veiligheidsbewuste teams kan een zelf gehoste testinfrastructuur zoals COCO zinvol zijn, omdat testverkeer, opnames, en beoordeling binnen de eigen gecontroleerde omgeving blijven.

Bewaartermijnen, toegang, en bewijskwaliteit

Meer bewijs is niet automatisch beter bewijs. Een jarenlang groeiend screenshotbestand zonder rolmodel en bewaarconcept creëert een nieuw risico. Gefaseerde termijnen zijn zinvol: mislukte of release-relevante testruns langer bewaren, geslaagde routinetests na een gedefinieerde periode verdichten of verwijderen, en gevoelige testgegevens vroegtijdig anonimiseren.

Even beslissend is de onveranderlijkheid. Als testresultaten achteraf zonder spoor bewerkt kunnen worden, verliezen ze waarde als bewijs. Wijzigingen aan testgevallen, resultaten, of releasestatus zouden daarom gelogd moeten worden. Dat betekent niet dat elk testrapport gecompliceerde auditsoftware nodig heeft. Maar verantwoordelijkheden, tijdstempels, en navolgbare geschiedenissen horen bij de basisuitrusting.

Beginnen met een proces dat echt pijn doet

De zinvolste eerste automatiseringsstap is zelden de grootste. Kies een workflow die bij elke release gecontroleerd wordt, veel manuele minuten kost, en bij een fout merkbare gevolgen heeft. Dat kan de bestellingsinvoer in het webportaal zijn, het genereren van een verzenddocument, of een rechtenconcept in een Windows-toepassing.

Definieer voor deze workflow duidelijke succescriteria, het vereiste bewijs, en een verantwoordelijke ontvanger voor mislukte tests. Na enkele releases blijkt snel of het bewijs begrijpelijk genoeg is, of er te veel gegevens ontstaan, en welke tests hierna zouden moeten volgen. Zo groeit er geen documentatiemachine omwille van zichzelf, maar een verificatieketen die releases sneller beveiligt en bij problemen solide antwoorden levert.

Permalink →

Voorraadbewegingen digitaal documenteren

Voorraadbewegingen digitaal documenteren

Een verschil van 24 stuks in het systeem klinkt aanvankelijk overzichtelijk. Problematisch wordt het wanneer niemand kan zeggen of de goederen verkeerd opgeslagen, voor een order uitgenomen, beschadigd of nooit geboekt werden. Wie voorraadbewegingen digitaal wil documenteren, creëert daarom niet gewoon meer data. Hij creëert een navolgbare geschiedenis voor elke voorraad - en daarmee een solide basis voor aankoop, productie, verzending en inventarisatie.

Voor kleine en middelgrote magazijnen is dit zelden een geval voor een uitgebreide enterprise-suite. Doorslaggevend is een systeem dat de werkelijke routes van de goederen weergeeft: goederenontvangst aan de poort, verplaatsing tussen stellingen, materiaalonttrekking in het atelier, orderverzameling, retours en correcties na de inventarisatie. Hoe minder vaak teams tussen papier, Excel en mondelinge afstemming en meerdere programma's moeten wisselen, hoe betrouwbaarder de cijfers worden.

Voorraadbewegingen digitaal documenteren begint bij de transactie

Een actuele voorraadstand beantwoordt slechts één vraag: hoeveel is er nu voorhanden? Voor het operationele werk is dat vaak niet voldoende. Bij vragen heeft het team ook antwoorden op andere vragen nodig: Wanneer is de voorraad veranderd? Wie heeft de boeking uitgevoerd? Waar kwamen de goederen vandaan, waar gingen ze naartoe, en welke zakelijke transactie was de aanleiding?

Precies hier ligt het verschil tussen een eenvoudige voorraadlijst en een digitale bewegingsdocumentatie. Elke wijziging wordt opgeslagen als een eigen, onveranderlijke transactie. De voorraad ontstaat vervolgens uit deze transacties. Wordt bijvoorbeeld een artikel van locatie A-03 naar B-12 verplaatst, dan moet het systeem een uitgaande en een inkomende beweging navolgbaar met elkaar verbinden. Wordt materiaal onttrokken voor een productieorder, dan hoort de boeking bij die order - niet enkel bij een anonieme hoeveelheidswijziging.

Dit principe voorkomt fouten niet volledig. Het maakt ze echter wel vindbaar. Een correctie overschrijft dan niet de oude waarde, maar creëert een nieuwe correctieboeking met een reden. Dat is minder gemakkelijk dan een cijfer rechtstreeks te wijzigen, maar aanzienlijk beter voor inventarisaties, klachten en interne afstemmingen.

Welke gegevens per beweging echt nodig zijn

Veel projecten worden onnodig ingewikkeld omdat van bij het begin elk denkbaar veld voorzien wordt. Voor een betrouwbare werking volstaan meestal enkele, netjes bijgehouden gegevens. Doorslaggevend is niet de lengte van het formulier, maar dat elke boeking inhoudelijk eenduidig blijft.

Een bewegingsboeking zou minstens deze informatie moeten bevatten:

  • Artikel of materiaal, inclusief een uniek artikelnummer
  • Hoeveelheid en eenheid, bijvoorbeeld stuks, meter, kilogram of doos
  • Bewegingssoort, bijvoorbeeld ontvangst, onttrekking, verplaatsing, retour of correctie
  • Bron- en bestemmingslocatie, voor zover de bewegingssoort beide betreft
  • Tijdstip, uitvoerende persoon en een navolgbare documentreferentie

De documentreferentie kan een aankooporder, een leveringsbon, een klantorder, een productieorder of een inventarisatiepositie zijn. Het bespaart later tijd, omdat de boeking niet eerst via opmerkingen geïnterpreteerd moet worden. Vrije tekst blijft nuttig voor uitzonderingen, maar zou geen verplichte informatie moeten vervangen.

Bij artikelen met chargeplicht, serienummerbeheer of houdbaarheid komen bijkomende kenmerken bij. Dan moet bijvoorbeeld duidelijk zijn uit welke charge werd onttrokken of welke houdbaarheidsdatum betrokken is. Dat is geen detail voor later: als traceerbaarheid vereist is, moet die rechtstreeks in het boekingsproces functioneren.

De bewegingssoorten aan de werkelijke goederenstroom aanpassen

De zinvolste categorieën ontstaan niet in een workshop op een abstract processchema, maar tijdens een rondgang door het magazijn. Waar wordt goederen effectief ontvangen? Wie beslist over geblokkeerde voorraad? Wanneer wordt materiaal afgeboekt: bij overdracht aan het atelier, bij productiestart, of pas bij verbruik?

Goederenontvangst en kwaliteitscontrole

Bij goederenontvangst zouden de goederen eerst tegen de aankooporder of leveringsbon gecontroleerd moeten worden. Een digitale registratie kan hoeveelheid, leverancier, documentnummer, opslaglocatie en optioneel charge rechtstreeks samenbrengen. Als een controle vereist is, zouden de goederen niet automatisch als vrij beschikbaar mogen verschijnen. Een status zoals "in controle" of "geblokkeerd" voorkomt dat ongecontroleerd materiaal per vergissing wordt verzameld.

Verplaatsing en interne overdrachten

Verplaatsingen worden bijzonder vaak vergeten, omdat ze geen zichtbaar extern document opleveren. Het resultaat is dat de totale voorraad klopt, maar niemand de goederen op de verwachte plek terugvindt. Mobiele boekingen via handscanner, tablet of een eenvoudig webformulier helpen hierbij, als ze met weinig invoer toekunnen. Een ingewikkeld schermformulier wordt in de dagelijkse praktijk omzeild - ongeacht hoe goed de database erachter opgezet is.

Onttrekking, verzending en retour

Bij onttrekkingen moet de boeking bij het passende doel aansluiten. Materiaal voor een werkorder, goederen voor een klantorder en uitval zijn inhoudelijk verschillende transacties. Ze mogen weliswaar dezelfde artikelvoorraad verminderen, maar vereisen verschillende analyses. Retours zouden eveneens een eigen bewegingssoort moeten zijn. Anders blijft onduidelijk of een artikel opnieuw bruikbaar is, gecontroleerd moet worden, of afgeboekt moet worden.

De registratie moet op de werkvloer functioneren

Digitalisering mislukt zelden omdat een team het nut niet begrijpt. Ze mislukt vaker door vijf bijkomende klikken, instabiele wifi, onduidelijke artikelnummers, of een boeking die pas na het einde van de shift op de kantoor-pc afgehandeld kan worden.

Daarom loont het om per rol een duidelijk verloop vast te leggen. Bij goederenontvangst wordt doorgaans de aankooporder of leveringsbon gekozen, het artikel gescand, de hoeveelheid bevestigd en een opslaglocatie toegewezen. Bij orderverzameling volstaat vaak: order openen, positie scannen en onttrekking bevestigen. Magazijnverantwoordelijken hebben daarnaast functies nodig voor blokkeringen, correcties en inventaristellingen, inclusief een verplichting om de correctiereden op te geven.

Barcode- of QR-scans verminderen overdrachtsfouten wanneer artikelen en opslaglocaties netjes gelabeld zijn. Ze vervangen echter geen stamgegevensbeheer. Bestaan er vijf schrijfwijzen voor hetzelfde artikel, of worden vakken informeel benoemd, dan versnelt een scanner enkel de verkeerde boeking. Vóór de technische uitrol zouden artikelnummers, eenheden, opslaglocaties en verantwoordelijkheden opgeschoond moeten worden.

Ook offline-capaciteit is een afweging. In een klein magazijn met een stabiel netwerk kan een browsergebaseerde applicatie volstaan. Bij externe magazijnen, grote hallen of onbetrouwbare verbindingen kan lokale tussentijdse opslag zinvol zijn. Dan moet duidelijk geregeld zijn hoe dubbele of in tijd verschoven boekingen samengevoegd worden.

Een verstandige uitrol in plaats van één grote omschakeldag

Een volledige overstap op één peildatum oogt besluitvaardig, maar creëert onnodig risico. Beter is het om met een afgebakend gebied te starten: bijvoorbeeld goederenontvangst en verplaatsingen voor één artikelgroep of één magazijngebied. Daar blijkt snel welke bewegingssoorten ontbreken, welke invoerschermen te traag zijn en welke bijzondere gevallen effectief regelmatig voorkomen.

Voor de start heeft het team een gecontroleerde beginvoorraad nodig. Deze kan afkomstig zijn van een inventarisatie, een opgeschoonde voorraadlijst of een gecontroleerde overname. Belangrijk is de overgang duidelijk te documenteren: tot welk tijdstip geldt het oude systeem, vanaf wanneer is het nieuwe systeem leidend? Parallel bijgehouden lijsten zijn hoogstens kortstondig nuttig ter controle. Blijven ze permanent bestaan, dan ontstaan twee waarheden.

Na twee tot vier weken zouden de verantwoordelijken niet enkel naar de voorraadnauwkeurigheid moeten kijken. Even veelzeggend zijn het aantal achteraf uitgevoerde correcties, ontbrekende documentreferenties, zoektijden en boekingen buiten de bedoelde processen. Deze vaststellingen leveren betere vereisten op dan een lange verlanglijst opgesteld vóór de projectstart.

Technische basis: navolgbaar en onderhoudbaar

Achter een eenvoudig boekingsscherm is een propere datastructuur nodig. Artikelen, opslaglocaties, bewegingen, documenten en gebruikersrechten zouden gescheiden gemodelleerd moeten zijn. Elke boeking heeft een uniek ID, een tijdstempel en een koppeling aan het gebruikersaccount nodig. Wijzigingen aan kritieke transacties horen thuis in een controlelogboek.

Voor veel toepassingen in het middensegment is een slanke webapplicatie met een relationele database zoals MySQL 8 een geschikte basis. Ze kan scannerinvoer verwerken, rolgebaseerde rechten weergeven, bewegingsjournalen genereren en gegevens overdragen aan verzend- of orderprocessen. Doorslaggevend is minder het gebruikte framework dan een gedocumenteerde datalogica, geteste boekingsregels en een exploitatieconcept met back-ups, toegangsrechten en herstelprocedures.

Niet elke beweging moet onmiddellijk naar elk ander systeem overgedragen worden. Realtime synchronisatie is zinvol wanneer verzending, een webshop of productie rechtstreeks afhankelijk zijn van beschikbare hoeveelheden. In andere gevallen volstaan gecontroleerde overdrachten met vaste intervallen. Meer integratie betekent ook meer foutbronnen en meer verantwoordelijkheid bij uitval.

Wanneer een spreadsheet nog volstaat

Een spreadsheet is niet principieel een probleem. Bij weinig artikelen, een vaste opslaglocatie en één persoon die in- en uitgaande posten consequent bijhoudt, kan het economisch zijn. De overstap wordt zinvol wanneer meerdere personen tegelijk boeken, opslaglocaties relevant worden, documenten gekoppeld moeten worden, of regelmatig onduidelijk is waarom een voorraad afwijkt.

De juiste volgende stap is dan niet de zo groot mogelijke software, maar een oplossing die de bestaande goederenstroom precies ondersteunt. Goede digitale documentatie maakt werk niet spectaculairder. Ze zorgt ervoor dat een boeking op het moment van de beweging plaatsvindt - en dat het antwoord op de volgende voorraadvraag al in het systeem staat.

Permalink →

Ideeën voor magazijndigitalisering die werken

Ideeën voor magazijndigitalisering die werken

Een ontbrekende pakbon vlak voor vertrek, een voorraadstand die op het schap anders lijkt dan in het spreadsheet, en drie medewerkers die tegelijk dezelfde vraag telefonisch ophelderen: precies daar ontstaan zinvolle ideeën voor magazijndigitalisering. Niet bij de vraag welke technologie momenteel trendy oogt, maar bij een concreet proces dat tijd kost, fouten veroorzaakt, of afhankelijk is van de kennis van individuele personen.

Voor kleine en middelgrote magazijn-, handels-, en productiebedrijven is digitalisering zelden één groot project. Het is een reeks duidelijk afgebakende verbeteringen. Het doel hoeft geen complex enterprise-warehouse-managementsysteem te zijn. Vaak is een slank hulpmiddel, toegesneden op het werkelijke proces, beter dan een suite met functies die niemand op de magazijnvloer gebruikt.

Ideeën voor magazijndigitalisering met operationele waarde

Het beste startpunt is een proces dat vaak voorkomt, gemakkelijk meetbaar is, en merkbaar verbetert voor medewerkers. Wie meteen het hele magazijn wil digitaliseren, bindt budget en aandacht voordat een oplossing zich in de dagelijkse praktijk heeft bewezen. Een beperkte eerste stap levert daarentegen solide data op voor de volgende beslissing.

1. Goederenontvangst met mobiele registratie

Bij de goederenontvangst ontstaan veel vervolgfouten: verkeerd geteld aantal, onopgeloste afwijkingen, vertraagd geboekte voorraden, en papieren documenten die later niet meer te vinden zijn. Een mobiel registratieformulier op een handscanner, tablet, of smartphone kan het proces aanzienlijk stabieler maken.

Medewerkers scannen het artikel en de leverreferentie, en leggen hoeveelheid, opslaglocatie, en de reden van eventuele afwijkingen rechtstreeks aan het laadperron vast. Als een batch, serienummer, of foto relevant is, hoort deze informatie bij exact hetzelfde record. De voorraad wordt niet pas aan het einde van de dienst in een spreadsheet nagevoerd; ze krijgt in plaats daarvan een navolgbare status bij daadwerkelijke ontvangst.

Dat betekent niet dat elke leverancier of elk artikel per se streepjescode-etiketten nodig heeft. Bij kleine, onregelmatige leveringen kan een zoekopdracht op artikelnummer volstaan. Doorslaggevend is dat de gegevensregistratie sneller verloopt dan de vorige omweg via papier en handmatig overtypen.

2. Digitale verplaatsingen in plaats van voorraadraadsels

Veel magazijnen weten in principe wat beschikbaar is, maar niet betrouwbaar waar het ligt. Goederen worden vooraf gehaald voor een order, tussentijds opgeslagen, naar montage gebracht, of bij plaatsgebrek op een vrije plek gezet. Zonder eenvoudige boeking wordt een voorraadvraag al snel een zoekactie.

Een verplaatsingsproces heeft geen ingewikkelde interface nodig. Bronlocatie scannen, doellocatie scannen, hoeveelheid bevestigen — meer is in de meeste gevallen niet nodig. Het systeem zou moeten controleren of artikel en opslaglocatie plausibel zijn, en een boeking eenduidig aan een persoon en tijdstip toewijzen.

De omgang met uitzonderingen is belangrijk. Een opslaglocatie kan geblokkeerd, overvol, of alleen voor bepaalde goederen toegestaan zijn. Deze regels zouden vastgelegd moeten worden waar ze echte schade voorkomen. Voor zeldzame bijzondere gevallen volstaat vaak een goedkeuringsstap door de magazijnleiding. Te veel verplichte velden maken van een nuttige applicatie een obstakel.

3. Orderpicking met duidelijke orderstatussen

Papieren picklijsten werken totdat prioriteiten wijzigen, posities ontbreken, of een order over meerdere gebieden verdeeld wordt. Een eenvoudige digitale picklijst toont welke order open is, welke posities al zijn gepickt, en waar verduidelijking nodig is. Dat vermindert vragen tussen magazijn, verkoop, en verzending.

Afhankelijk van de magazijngrootte kan de applicatie pickroutes voorschrijven of posities simpelweg per magazijnzone sorteren. Volledige routeoptimalisatie loont vooral bij veel dagelijkse orders en lange looproutes. In een compact magazijn levert een betrouwbare statusweergave vaak meer op dan een wiskundig perfecte route die niemand in de dagelijkse praktijk volgt.

Bij tekorten zou het systeem niet alleen rood moeten markeren. Het zou een concreet vervolgproces moeten aanbieden: voorraad controleren, vervangend artikel aanvragen, aanvulling triggeren, of order doorsturen ter verduidelijking. Digitalisering is waardevol wanneer ze de volgende zinvolle actie zichtbaar maakt.

4. Verzenddocumenten en labels uit echte ordergegevens

Het handmatig overzetten van adressen, gewichten, en artikelposities naar verzendportalen is een uitstekende kandidaat voor automatisering. Afleveradressen, afleverinstructies, verzendmethoden, en pakketinformatie bestaan idealiter één keer en worden gebruikt voor de pakbon, het verzendlabel, en de verzendbevestiging.

Een geschikt systeem kan labels genereren, documenten controleerbaar opslaan, en de order na het afdrukken automatisch op "verzendklaar" of "verzonden" zetten. Het operationele voordeel zit niet alleen in bespaarde minuten. Het zit erin dat verzendgegevens nooit tussen meerdere systemen uiteenlopen.

Hier is de koppeling doorslaggevend. Als een vervoerder geen bruikbare koppeling biedt of zeer uiteenlopende speciale regels hanteert, kan een halfgeautomatiseerd proces zinvoller zijn dan een kwetsbare volledige integratie. Saaie, bewijsbare betrouwbaarheid verslaat automatisering die bij elke uitzondering vastloopt.

5. Aanvulling en minimumvoorraden met navolgbare regels

Minimumvoorraden worden vaak in spreadsheets bijgehouden en dan genegeerd omdat niemand zeker weet of de cijfers nog kloppen. Een zinvolle digitale oplossing koppelt daadwerkelijke boekingen aan duidelijke voorraadregels. Ze kan melden wanneer een artikel onder een drempel zakt, gereserveerde hoeveelheden meenemen, en een bestellijst voorbereiden.

De drempel zou niet als eeuwige waarheid behandeld moeten worden. Seizoensvraag, levertijden, en minimale bestelhoeveelheden veranderen. Daarom heeft de verantwoordelijke persoon een eenvoudige manier nodig om voorstellen te beoordelen en regels aan te passen. Volledig automatische bestellingen zijn pas zinvol wanneer stamgegevens, leverancierslogica, en verbruiksgegevens stabiel genoeg zijn.

6. Traceerbaarheid voor batches, serienummers, en geblokkeerde voorraad

Wie met batches, apparaten, reserveonderdelen, of gereguleerde producten werkt, heeft meer nodig dan alleen een hoeveelheidsweergave. Het moet navolgbaar zijn welke goederen wanneer zijn binnengekomen, waarheen ze zijn verplaatst, en in welke klantorder ze terecht zijn gekomen.

Het project kan bewust klein beginnen: aanvankelijk alleen ontvangst en verzending van een kritieke productgroep vastleggen. Interne bewegingen en retouren volgen later. Een systeem dat elke boeking afdwingt maar het werkelijke reparatie- of inspectieproces niet kent, wordt omzeild. De vaklogica moet daarom voortkomen uit de werkwijze, niet uit een abstract datamodel.

Het juiste project kiezen

Het aantrekkelijkste idee is niet automatisch het juiste eerste idee. Beoordeel potentiële projecten op frequentie, foutkosten, wachttijd, en afhankelijkheid van individuele personen. Een proces dat 50 keer per dag draait en twee minuten per transactie bespaart, kan waardevoller zijn dan een zeldzame speciale functie met grote technische elegantie.

Ook datakwaliteit hoort bij de beslissing. Als artikelnummers dubbel voorkomen, opslaglocaties niet eenduidig benoemd zijn, of orders tegenstrijdig uit meerdere bronnen binnenkomen, zou het project deze basis eerst moeten opschonen. Software kan ontbrekende regels zichtbaar maken, maar kan ze niet betrouwbaar vervangen.

Voor prioritering volstaan vier vragen:

  • Welke activiteit veroorzaakt aantoonbaar de meeste vragen of herstelwerk?
  • Welke informatie wordt vandaag meerdere keren overgeschreven of telefonisch opgevraagd?
  • Welke fout zou de duurste gevolgen hebben voor klanten, voorraad, of verzending?
  • Welk proces kan in enkele weken worden getest met een duidelijke succesmeting?

Technische beslissingen die tellen in de dagelijkse magazijnpraktijk

Een magazijnapplicatie hoeft er niet spectaculair uit te zien. Ze moet begrijpelijk blijven bij slechte wifi-dekking, met handschoenen aan, onder tijdsdruk, en tijdens ploegwisselingen. Grote knoppen, duidelijke terugkoppeling na een scan, en zichtbare foutafhandeling zijn belangrijker dan decoratieve dashboards.

Ook de architectuur zou bij de operationele realiteit moeten passen. Een webgebaseerde applicatie met een schone databasestructuur kan op bestaande apparaten draaien en is makkelijker te onderhouden dan een geïsoleerde oplossing op één pc. Met een stabiele basis — zoals PHP 8.4, moderne JavaScript, en MySQL 8 — kunnen rollen, boekingsgeschiedenissen, koppelingen, en gedocumenteerde implementaties op lange termijn navolgbaar beheerd worden.

Niet elke informatie is voor elke rol bedoeld. Magazijnpersoneel heeft open taken en duidelijke boekingsdialogen nodig. Voorraadbeheer heeft waarschuwingen en bestelvoorstellen nodig. Het management heeft evaluaties nodig over doorlooptijden, verschillen, en openstaande transacties. Rolgebaseerde toegangsconcepten, logs, en accountvergrendelingen na herhaalde mislukte pogingen horen vroeg bij de planning, vooral wanneer externe dienstverleners of meerdere locaties betrokken zijn.

Invoering: eerst bewijzen, dan uitbreiden

Een pilot zou met echte orders moeten draaien, niet alleen met testdata in een vergaderruimte. Kies een magazijnzone, een productgroep, of een ploeg, en bepaal vooraf hoe succes herkenbaar is: minder correctieboekingen, kortere verwerkingstijd, minder vragen, of een hoger percentage voltooide boekingen op dezelfde dag.

Plan tegelijkertijd een terugvalniveau. Als de nieuwe applicatie uitvalt of een proces onduidelijk is, moet het team weten hoe verder te werken en hoe latere boekingen worden gecontroleerd. Dat is geen teken van gebrek aan vertrouwen in de techniek, maar van professionele bedrijfsvoering.

Na twee tot vier weken komen meestal de waardevolste inzichten naar boven. Misschien ontbreekt geen functie, maar een betere artikelmarkering. Misschien klopt de workflow, maar remt een scannerprofiel of een rechtenniveau. Deze observaties zouden in korte, gecontroleerde verbetercycli moeten stromen, in plaats van een nieuw groot project op te starten.

De beste digitalisering maakt de dagelijkse magazijnpraktijk niet theoretisch moderner, maar concreet rustiger: minder zoeken, minder handmatig overtypen, duidelijkere overdrachten, en betrouwbare informatie precies op het moment dat een beslissing aanstaande is.

Permalink →

Checklist voor het automatiseren van magazijnworkflows

Checklist voor het automatiseren van magazijnworkflows

Wanneer een goederenontvangst op papier wordt bevestigd, voorraadniveaus later in een spreadsheet worden overgezet, en een verzendvraag telefonisch wordt opgehelderd, voelt elke afzonderlijke stap beheersbaar aan. Samen leiden ze echter tot vragen, voorraadverschillen, en afhankelijkheid van individuele medewerkers.

Een checklist voor het automatiseren van magazijnworkflows voorkomt dat deze situatie voortijdig uitgroeit tot een te groot softwareproject. Ze scheidt processen die écht geautomatiseerd zouden moeten worden van die waarvoor een netjes bijgehouden spreadsheet voldoende blijft.

De checklist voor magazijnautomatisering vóór projectstart

Automatisering begint niet met het kiezen van een systeem. Ze begint met een verifieerbare beschrijving van wat er werkelijk in het magazijn gebeurt — ook tijdens uitzonderingen, ploegwisselingen en tijdsdruk. Loop de volgende punten rechtstreeks op procesniveau door met magazijnleiding, verzending, inkoop, en indien van toepassing de boekhouding.

1. Leg mutaties vast, niet alleen voorraden

Een actuele voorraad is het resultaat van mutaties. Daarom moet duidelijk zijn welke gebeurtenissen voorraad verhogen, verlagen, reserveren, blokkeren of overboeken. Hieronder vallen goederenontvangst, opslag, orderpicking, verzending, retouren, afkeur, voorraadverschillen en verplaatsingen.

Elke mutatie vraagt om een definitief antwoord op vier vragen: wie voert ze uit? Wanneer wordt ze geboekt? Welke opslaglocatie is betrokken? Welk document of welke order onderbouwt ze? Als deze antwoorden nu alleen in het hoofd van ervaren medewerkers bestaan, is dat een uitstekende kandidaat voor automatisering. Het doel is niet meer gegevens verzamelen, maar een robuuste geschiedenis waaruit elke voorraadstand te verklaren is.

2. Maak artikelen, varianten en eenheden schoon

Veel projecten mislukken niet door scanners of webinterfaces, maar door stamgegevens. Een artikel kan per doos worden ingekocht, per stuk worden opgeslagen, en in sets worden verkocht. Zonder vastgelegde omrekeningen levert de software formeel correcte maar operationeel foutieve hoeveelheden.

Controleer artikelnummers op duplicaten, stel bindende omschrijvingen vast, en onderscheid verkoopeenheden, opslageenheden en verpakkingseenheden. Serienummers, batches, houdbaarheidsdata of gevaarlijkestoffenclassificaties horen alleen in de eerste bouwfase thuis als ze dagelijkse beslissingen beïnvloeden of wettelijk verplicht zijn. Al het overige verhoogt vooral onderhoudslast en foutgevoeligheid.

3. Definieer opslaglocaties zo precies als nodig

"Hal 2" kan volstaan voor een voorraadlijst. Voor betrouwbaar orderpicken is dat meestal te grof. Bepaal of een locatie een zone, stelling, vak, slot of doorvoerruimte aanduidt. Quarantainegebieden, ontvangstzones, retourgebieden en verzendbuffers moeten ook als aparte locaties herkenbaar zijn als daar goederen kunnen staan.

De juiste mate van detail hangt af van het bedrijf. Een werkplaats met een paar honderd posities heeft niet per se bakbeheer nodig. Maar met meerdere pickers per ploeg kan een nauwkeurige opslagplek looppaden en zoektijden flink verkorten. Automatiseer geen precisieniveau dat niemand kan onderhouden.

4. Leg triggers, verantwoordelijke rollen, en goedkeuringen vast

Een workflow heeft een duidelijk startpunt nodig. Bij goederenontvangst kan dat de levering aan de dock zijn, de inkooporder bij inkoop, of het scannen van een pakbon. Voor bijbestellen kan een minimumvoorraad een voorstel triggeren, terwijl de definitieve bestelling bij een verantwoordelijke persoon blijft.

Documenteer verder welke acties automatisch mogen verlopen en welke controle vereisen. Een ontbrekende hoeveelheid zou een verschil moeten aanmaken, niet stilzwijgend de verwachte goederenontvangst wijzigen. Goedkeuringsstappen zijn zinvol voor waardevolle, batchbeheerde, of veiligheidskritische artikelen. Voor verbruiksartikelen zouden ze de doorstroom onnodig vertragen.

5. Genereer documenten waar ze nodig zijn

Pakbonnen, opslaglijsten, picklijsten, verzendlabels en overdrachtsprotocollen ontstaan vaak in verschillende applicaties. Dat leidt tot mediabreuken: een adres wordt gekopieerd, een order wordt afgevinkt, en de verzendstatus wordt later bijgewerkt.

Leg voor elk document de gegevensbron, het aanmaaktijdstip en de ontvanger vast. Een zinvolle workflow kan bijvoorbeeld automatisch een picklijst genereren na goedkeuring van een order, na het inpakken een verzendlabel aanleveren, en de order na overdracht met een tijdstempel sluiten. Het cruciale punt is dat gegevens niet meer meerdere keren handmatig hoeven te worden ingevoerd.

Controleer interfaces en datakwaliteit

De beste magazijnlogica heeft geen zin als orders maar eens per dag als bestand binnenkomen, of als bezorgadressen inconsistent zijn opgemaakt. Maak daarom een nuchtere lijst van systemen die gegevens versturen of ontvangen: webshop, ERP, boekhouding, vervoerder, leveranciersportaal, productiesysteem en bestaande spreadsheets.

Voor elke koppeling moet vaststaan welk systeem leidend is voor elk gegevensveld. Als artikelstamgegevens leidend zijn in het ERP, mag het magazijnportaal niet stilzwijgend eigen artikelen aanmaken. Als een orderwijziging uit de webshop komt, moet ze zichtbaar worden vóór verzending. Bij lage volumes kan een gecontroleerde CSV-import de juiste eerste stap zijn. Bij hoog volume of korte levertijden loont een directe koppeling.

Foutafhandeling is even belangrijk. Een koppeling zou niet alleen gegevens moeten overdragen, maar ook tonen wat is afgewezen en waarom. Onbekende artikelnummers, ongeldige adressen, of ontbrekende hoeveelheden mogen niet verdwijnen in een technisch logbestand. Ze vragen om een werklijst met aangewezen verantwoordelijkheid en status.

Ontwerp bruikbaarheid op de magazijnvloer

Een proces dat achter een bureau plausibel oogt, kan op de magazijnvloer falen. Medewerkers dragen handschoenen, verplaatsen goederen, delen apparaten, of werken met onstabiele wifi-dekking. Controleer daarom vroeg of scanners, tablets, vaste werkplekken, of afdrukken bij de betreffende werkstap passen.

Scannen zou duidelijke feedback moeten geven: correct artikel, verkeerde opslaglocatie, al geboekte hoeveelheid, of geblokkeerd artikel. Kleuren alleen zijn niet genoeg. Korte, begrijpelijke meldingen en een duidelijke volgende stap zijn onder tijdsdruk waardevoller dan een functierijke interface.

Plan ook voor uitzonderingen. Wat gebeurt er bij een beschadigde streepjescode, netwerkuitval, deellevering, of ontdekte niet-toegewezen goederen? Een goede workflow biedt hiervoor gecontroleerde paden en legt de correctie vast. Ze dwingt teams niet om te vertrouwen op post-its en latere batchboekingen.

Bepaal kengetallen vóór u dashboards bouwt

Een dashboard is geen doel. Relevante kengetallen zijn die welke een operationele beslissing uitlokken. Denk aan open goederenontvangsten die een vastgestelde ouderdom overschrijden, orders dicht bij hun verzenddeadline, voorraadverschillen per magazijnzone, pickfouten, of de tijd tussen orderontvangst en overdracht.

Leg voor elk kengetal de gegevensbron, de berekeningsregel, en de verantwoordelijke rol vast. "Voorraadnauwkeurigheid" is bijvoorbeeld pas zinvol als duidelijk is tegen welke telling ze wordt gemeten en hoe retouren of geblokkeerde voorraad worden behandeld. Enkele betrouwbare kengetallen zijn beter dan een muur vol grafieken die niemand vertrouwt.

Plan beveiliging, rechten, en traceerbaarheid

Automatisering verdeelt handelingsbevoegdheid. Wie voorraad mag wijzigen, artikelen mag aanmaken, verzendlabels mag genereren, of orders mag annuleren, zou bewust vastgesteld moeten worden. Rolgebaseerde rechten zijn meestal zinvoller dan een gedeelde login op de magazijn-pc. Bijzonder kritieke correcties vragen om een tijdstempel, een persoonstoewijzing, en idealiter een reden.

Technische basiszaken horen ook op de checklist: regelmatige back-ups, geteste hersteltests, gedocumenteerde toegangsgegevens, logging van koppelingsfouten, en een procedure voor geblokkeerde of gedeactiveerde gebruikersaccounts. Bij een maatwerktoepassing zijn onderhoudbare technologieën, een schone databasestructuur, en traceerbare implementatiestappen geen bijzaak. Ze bepalen of wijzigingen na twee jaar nog beheersbaar blijven.

Voer in met kleine, meetbare stappen

Probeer niet goederenontvangst, aanvulling, voorraadtelling, verzending en routeplanning tegelijk om te zetten. Kies een workflow met merkbare wrijving en beheersbaar risico, zoals het mobiel boeken van goederenontvangsten of het automatisch genereren van verzenddocumenten. Leg vóór de start de verwerkingstijd, correcties, en openstaande gevallen vast.

Test met echte artikelen, echte orders, en de medewerkers die er daadwerkelijk mee gaan werken. Een pilot met één magazijnzone of productgroep laat sneller dan een workshop zien of omschrijvingen, scanworkflows, en goedkeuringen werken. Pas als uitzonderingen beheerst worden, zou het volgende proces moeten volgen.

Automatisering slaagt wanneer teams minder vragen hoeven te stellen, voorraad verklaarbaar blijft, en het proces ook werkt wanneer de meest ervaren persoon met vakantie is. Precies daar loont de volgende verbetering: niet met het luidruchtigste hulpmiddel, maar met de wrijving die de werkdag écht vertraagt.

Permalink →

Mobiele website-laadtijd verbeteren

Mobiele website-laadtijd verbeteren

Wanneer een magazijn-smartphone met matige ontvangst wordt gebruikt om een site te openen, bepaalt niet de animatie in de hero-sectie de eerste indruk, maar of de pagina überhaupt interactief wordt. Als een potentiële klant drie, vier of vijf seconden op content wacht, is het alternatief maar één terug-knop verwijderd. De mobiele laadtijd verbeteren vraagt daarom geen cosmetische losse maatregelen, maar een navolgbare technische volgorde.

Dat geldt vooral voor websites die aanvragen moeten opleveren: voor een fabrikant, een logistiek dienstverlener of een bedrijf met uitlegbehoevende diensten. Mobiele gebruikers komen vaak tussen afspraken door, op de werkvloer, of via een zoekopdracht met een concrete intentie op de site. De website moet dan informatie leveren, niet eerst rekenwerk op het apparaat veroorzaken.

Waarom mobiele laadsnelheid een operationeel probleem is

Mobiele performance wordt vaak strikt als SEO-discipline behandeld. Dat is te kort door de bocht. Snelle pagina's helpen weliswaar bij vindbaarheid en campagnekosten, maar het directe effect zit in het gebruik: formulieren worden vaker verzonden, telefoonnummers vaker gebeld en productinformatie vaker grondig gelezen. Een trage website wekt daarentegen twijfel op nog voordat een aanspreekpunt kan reageren.

Daarbij is "snel" geen enkele meetwaarde. Een pagina kan vroeg een achtergrond tonen en toch pas veel later op klikken reageren. Voor bezoekers tellen drie dingen: wanneer verschijnt de belangrijkste content? Wanneer is de pagina zonder vertraging bedienbaar? En springt de layout nog terwijl ze net een knop willen aantikken? Deze vragen weerspiegelen zich in kengetallen zoals Largest Contentful Paint, Interaction to Next Paint en Cumulative Layout Shift.

Metingen moeten onder realistische omstandigheden plaatsvinden. Een krachtige kantoorcomputer op wifi verhult problemen die op een ouder Android-toestel op mobiel netwerk zichtbaar worden. Ook locatie, tussengeschakelde diensten en een al gevulde browsercache veranderen resultaten. Herhaalde metingen en echte gebruiksdata tellen daarom veel zwaarder dan één perfecte testrun.

Mobiele website-laadtijd verbeteren: eerst meten, dan wijzigen

De meest voorkomende fout is meteen afbeeldingen comprimeren of nog een optimalisatieplugin installeren. Beide kunnen helpen, maar zonder oorzaakanalyse ontstaan snel moeilijk te onderhouden configuraties. Controleer eerst een representatieve selectie: de homepage, een typische dienst- of productpagina, de contactpagina en een druk bezochte landingpagina. Op deze pagina's worden patronen zichtbaar.

Het netwerklog laat zien welke bestanden de start blokkeren en hoe groot ze daadwerkelijk zijn. Een performance-audit maakt zichtbaar of JavaScript de bediening vertraagt, of lettertypen te laat komen of afbeeldingen onnodig vroeg laden. Vul labmetingen aan met data van echte bezoekers, mits er voldoende verkeer is. Zo voorkomt u optimalisatie voor een testprofiel dat uw doelgroep niet weerspiegelt.

Stel vóór elke wijziging een duidelijk doel. Bijvoorbeeld: de zichtbare hoofdinhoud moet op een gemiddeld mobiel toestel binnen 2,5 seconden verschijnen, of het contactformulier moet zonder invoervertraging bruikbaar zijn. Niet elke pagina hoeft een theoretisch perfecte score te halen. Bij een complexe applicatie met geauthenticeerde gegevens gelden andere voorwaarden dan bij een publieke bedrijfswebsite. Saaie, bewijsbare betrouwbaarheid is hier waardevoller dan een kortetermijnscore via riskante trucs.

1. Afbeeldingen behandelen naar hun taak

Op veel mobiele pagina's blijven afbeeldingen het grootste databestand. Het probleem is niet de foto zelf, maar een afbeelding die in 2.500 pixels breedte wordt verzonden terwijl het toestel maar 700 pixels nodig heeft. Bied responsieve beeldvarianten aan zodat de browser de juiste maat kan kiezen. Moderne formaten zoals WebP of AVIF verkleinen bestandsgroottes vaak flink, maar moeten wel met schone fallbacks en gecontroleerde beeldkwaliteit worden ingezet.

De grootste afbeelding in het zichtbare startvenster verdient bijzondere aandacht. Ze moet correct bijgesneden zijn, een passende resolutie hebben en vroeg laden. Afbeeldingen verder naar beneden op de pagina kunnen vertraagd laden. Dat bespaart data bij binnenkomst, maar mag er niet toe leiden dat afbeeldingen zichtbaar bijladen tijdens het scrollen terwijl de gebruiker ze al verwacht.

Schrap niet reflexmatig alle afbeeldingen. Een goede afbeelding kan een machine, een team of een proces sneller uitleggen dan een alinea tekst. De technische taak is: relevante visuele informatie efficiënt aanleveren, geen vormgeving reduceren tot een grijs placeholder-blok.

2. JavaScript beperken tot noodzakelijk werk

Elk script concurreert bij het laden en bedienen om rekentijd. Bijzonder problematisch zijn generiek ingebonden bibliotheken, tagmanagers met veel externe scripts, chatwidgets, kaarten en animaties. Op desktopapparaten blijven deze kosten vaak onopgemerkt. Mobiel resulteren ze in een pagina die zichtbaar is maar traag reageert op invoer.

Controleer voor elk script het doel, de laadvoorwaarde en de zakelijke waarde. Een interactieve kaart op de contactpagina hoeft niet op elke subpagina te laden. Een cookie- of analysetool zou geen keten van extra bestanden moeten activeren voordat de bezoeker de content überhaupt kan lezen. Functies die pas na interactie nodig zijn, kunnen ook dan pas geladen worden.

Bij maatwerk-ontwikkelde websites is een duidelijke componentstructuur een echt voordeel. JavaScript wordt per functie gebundeld in plaats van als globaal pakket uitgeleverd. Dat vereenvoudigt ook later onderhoud: wie een formulier uitbreidt, wijzigt niet per ongeluk de code voor een productfilter of navigatie.

3. CSS en lettertypen zonder blokkades leveren

Een veelvoorkomend knelpunt zit in het eerste zichtbare gebied. Als daarvoor meerdere stylesheets, icon-fonts en externe lettertypevarianten moeten laden, wacht de browser onnodig lang. Kritieke stijlen voor het zichtbare gebied moeten klein en vroeg beschikbaar zijn. Niet-kritieke regels kunnen later volgen.

Bij webfonts volstaan meestal enkele letterdiktes. Vier gewichten in normaal, cursief en extra subsets ogen compleet in een designsysteem, maar zijn voor een typische bedrijfswebsite zelden nodig. Leg zinvolle systeem-fallbacks vast zodat tekst direct leesbaar blijft. Een lettertype dat enkele milliseconden later netjes wisselt, is beter dan lege tekstblokken.

Ook iconen verdienen een controle. Een kleine SVG-set is vaak efficiënter en preciezer aan te sturen dan een compleet icon-font. Dat is geen regel zonder uitzondering: bestaande systemen hoeven niet enkel voor een paar kilobyte opnieuw gebouwd te worden. Als er toch al grotere wijzigingen gepland staan, hoort deze beslissing wel bij de technische basis.

4. Caching en serverrespons netjes opzetten

Zelfs een slanke interface voelt traag aan als de server lang nodig heeft voor de eerste reactie. Oorzaken lopen uiteen van ongeremde databasequery's tot dynamisch samengestelde pagina's tot ontbrekende caching. Publieke content die zelden verandert, zou snel als cache-versie leverbaar moeten zijn. Statische bestanden zoals afbeeldingen, CSS en JavaScript hebben eenduidige versienamen en zinvolle cache-regels nodig.

Bij PHP-applicaties gaat het bovendien om efficiënte uitvoering, een correct geconfigureerde opcode-cache en gecontroleerde databasetoegang. MySQL-query's hebben indexen nodig die passen bij de daadwerkelijke filter- en sorteerpaden. Een homepage die bij elke aanroep meerdere onnodige dataquery's uitvoert, wordt niet beter naarmate het verkeer groeit.

Caching is echter geen vrijbrief. Prijzen, beschikbaarheid, gepersonaliseerde secties of content na een login mogen nooit per ongeluk verouderd lijken. Daarom worden cachegrenzen inhoudelijk gedefinieerd: wat mag vijf minuten oud zijn, wat moet direct actueel zijn, en wie leegt de cache na een contentwijziging? Goede performance ontstaat uit die precisie.

5. Derde partijen kritisch behandelen

Externe diensten zijn vaak de onzichtbare ballast van een website. Analytics, consent-beheer, video's, kaarten, reviewwidgets en marketingpixels laden extra scripts van extra servers. Elke afhankelijkheid kan vertragingen veroorzaken, privacyvragen oproepen en bij fouten de weergave beïnvloeden.

Dat betekent niet dat elke externe tool verwijderd moet worden. Een video kan verkoop ondersteunen, een analysetool kan belangrijke beslissingen onderbouwen. Maar er is een kosten-batenanalyse nodig. Laad ingesloten media pas na toestemming of interactie. Gebruik voor kaarten eerst een voorbeeldweergave. En verwijder ten slotte tags waarvan niemand al maanden de resultaten evalueert.

6. Layoutsprongen en mobiele bediening meenemen

Laadtijd en bedienbaarheid horen bij elkaar. Reserveer voor afbeeldingen, banners en ingesloten elementen vaste afmetingen zodat knoppen niet onder de vinger van de gebruiker wegspringen. Vermijd pop-ups die de zichtbare content direct bij binnenkomst afdekken. Een snelle pagina die meteen een lastig te sluiten overlay toont, lost het onderliggende probleem niet op.

Test formulieren extra zorgvuldig. Grote invoervelden, passende toetsenbordtypes en korte verplichte trajecten helpen meer dan een bewerkelijk visueel effect. Als een aanvraag alleen naam, terugbelnummer en onderwerp nodig heeft, is een formulier in twaalf delen geen teken van grondigheid — het is wrijving.

7. Performance als vast operationeel proces voeren

Eén relaunch houdt de laadtijd niet blijvend laag. Nieuwe campagnebeelden, trackingvereisten en redactionele modules tellen na verloop van tijd op. Daarom horen performance-budgetten in het ontwikkelproces: een maximale grootte voor entreebeelden, duidelijke regels voor nieuwe derde-partij-tools en gedefinieerde grenswaarden voor JavaScript.

Na releases moeten de belangrijkste paginatypes opnieuw gecontroleerd worden. Geautomatiseerde tests kunnen daarbij vaststellen of centrale pagina's bereikbaar blijven en kritieke workflows functioneren. Voor performance volstaat een pure functionele test echter niet. Vul die aan met metingen van reactietijd, overgedragen datavolume en mobiele interactiviteit.

Een snelle mobiele website ontstaat niet door één plugin, en ook niet door verzaking tegen elke prijs. Ze ontstaat wanneer design, content, infrastructuur en werkelijk gebruik samen worden beschouwd. Begin bij de pagina die aanvragen of operationele contacten oplevert, meet onder eerlijke omstandigheden en verwijder wrijving precies waar gebruikers die daadwerkelijk voelen.

Permalink →

Logistieke software die de operatie écht verlicht

Logistieke software die de operatie écht verlicht

Wanneer een goederenontvangst eerst op papier wordt genoteerd, later naar een spreadsheet wordt overgezet en vervolgens mondeling aan verzending wordt doorgegeven, ontbreekt zelden de inzet van de medewerkers. Wat ontbreekt is een gedeelde, betrouwbare werkbasis. Goede logistieke software vervangt deze breuken niet door meer schermwerk, maar door duidelijke workflows: wat is er binnengekomen, waar ligt het, wat is gereserveerd, en wat kan er vandaag verzonden worden?

Voor kleine en middelgrote ondernemingen telt niet de langst mogelijke lijst met functies. Doorslaggevend is dat de software het werkelijke werk op de magazijnvloer, op kantoor en bij verzending weergeeft. Een oplossing bedoeld voor een wereldwijd concern met twintig locaties kan onnodig traag, duur en gecompliceerd zijn voor een bedrijf met één magazijn en twee ploegen.

Wanneer logistieke software écht zinvol is

Spreadsheets zijn op zichzelf geen probleem. Bij lage aantallen, een overzichtelijke artikelstamlijst, en één verantwoordelijke medewerker, kunnen ze de meest pragmatische oplossing zijn. Het zou verkeerd zijn een goed functionerend proces te vervangen door een project puur om het moderniseren zelf. Het kantelpunt komt wanneer informatie meerdere keren moet worden bijgehouden of niemand met zekerheid kan zeggen welk bestand actueel is. Typische signalen zijn voorraadtekorten ondanks volle schappen, vragen over de status van leveringen, handgeschreven pakbonnen, en inventarisaties die het bedrijf dagenlang platleggen. Groeiende ordernummers maken ook zichtbaar welke stappen voorheen alleen bijeen werden gehouden door de ervaring van individuele medewerkers.

Dan gaat het niet primair om digitalisering als modewoord. Het gaat om foutbronnen en wachttijden. Een medewerker zou niet eerst meerdere lijsten moeten vergelijken alleen om een order goed te keuren. Verzending zou niet moeten hoeven raden of een artikel daadwerkelijk beschikbaar is of al gereserveerd voor een andere order.

Welke processen logistieke software zou moeten verbinden

Een bruikbare oplossing begint bij de materiaalstroom, niet bij een standaardmenu. Voor veel bedrijven omvat deze stroom goederenontvangst, opslag, voorraadbeheer, orderpicking, verzending, en terugkoppeling. Afhankelijk van het bedrijf komen daar batches, serienummers, retouren, productieorders, of routeplanning bij.

Goederenontvangst met traceerbare voorraden

Veel wordt beslist bij de goederenontvangst. Als een levering direct tegen een order of pakbon wordt gecontroleerd, kunnen hoeveelheidsverschillen, beschadigde goederen, en ontbrekende posities precies daar worden vastgelegd waar ze zich voordoen. De goederen krijgen een status in plaats van gewoon ergens fysiek te worden neergezet.

De software hoeft niet per se te beginnen met dure scannerhardware. In sommige magazijnen volstaat een tablet of een werkplek bij de goederenontvangst om te beginnen. Waar dagelijks veel posities worden verplaatst, zijn barcodescanners echter zinvol omdat ze boekingen versnellen en typefouten verminderen. De juiste keuze hangt af van hoeveelheden, routes, en artikelstructuur.

Magazijnmutaties zonder geheugenlog

Voorraden zijn alleen weerbaar als ontvangsten, verplaatsingen, verwijderingen, en correcties traceerbaar zijn. Dat betekent niet dat elke uitzondering voorkomen moet worden. In de dagelijkse praktijk zijn er beschadigde verpakkingen, foutieve opslag, en spontane materiaalonttrekkingen. Een goede applicatie maakt deze gevallen boekbaar, maar documenteert ook wie wat wanneer heeft veranderd.

Deze geschiedenis is geen controle-instrument om zichzelf. Het helpt oorzaken te vinden. Als een artikel herhaaldelijk op de verkeerde magazijnlocatie belandt, is de magazijnetikettering mogelijk onduidelijk. Als er regelmatig correcties plaatsvinden, ligt het probleem vaak in het proces vóór de boeking.

Orders, pakbonnen, en verzending vanuit één workflow

Veel teams verliezen tijd op het raakvlak tussen orderverwerking en verzending. Orderdata komt binnen via e-mail, telefoon, of vanuit een apart webshopsysteem. Vervolgens worden posities afgedrukt, voorraden gecontroleerd, en verzenddocumenten opnieuw geregistreerd. Elke handmatige overdracht creëert ruimte voor afwijkingen.

Logistieke software zou een duidelijke picklijst, een pakbon, en, indien nodig, een verzendlabel moeten kunnen genereren vanuit een goedgekeurde order. De volgorde is hier belangrijk: eerst moet duidelijk zijn wat leverbaar is. Daarna zou de order voor andere processen gereserveerd moeten worden. Anders ontstaat de vervelende situatie waarin twee medewerkers dezelfde resterende voorraad toewijzen.

Planning die bij de werkelijkheid past

Routeplanning en capaciteitscontrole kunnen waardevol zijn, vooral bij eigen bezorging, vaste tijdvensters, of veel regionale stops. Ze zijn echter niet automatisch de volgende zinvolle stap. Wie nog geen schone ordergoedkeuring en betrouwbare voorraadgegevens heeft, zou eerst die fundamenten moeten oplossen.

Hetzelfde geldt voor prognoses en AI-ondersteunde planning. Ze kunnen patronen zichtbaar maken, maar vereisen schone invoergegevens. Een prognose gebaseerd op onvolledige voorraad oogt technisch geavanceerd, maar verbetert de leverbetrouwbaarheid niet.

Standaardoplossing of logistieke software op maat?

Standaardsoftware is zinvol wanneer de eigen workflows grotendeels conventioneel zijn en zonder grote wrijving kunnen worden aangepast. Ze kan sneller worden ingevoerd en brengt beproefde kernfuncties mee. Voor een bedrijf met eenvoudige magazijnprocessen, duidelijke rollen, en weinig bijzonderheden is dat vaak de economisch juiste keuze.

Maatwerk logistieke software is de moeite waard wanneer het bedrijf leeft van bijzondere workflows of bestaande systemen alleen via omwegen gekoppeld kunnen worden. Dit betreft bijvoorbeeld werkplaatsen met materiaalproblemen bij lopende orders, dealers met klantspecifieke verzendregels, of fabrikanten die magazijnmutaties strak moeten koppelen aan productiestappen.

Het verschil zit niet in alles opnieuw uitvinden. Goede maatwerksystemen nemen beproefde patronen over, zoals statuswijzigingen, reserveringen, en rechten. Ze passen echter taal, schermen, documenten, en interfaces aan het werk aan dat daadwerkelijk wordt uitgevoerd. Zo hoeft het team zich niet permanent te oriënteren op categorieën die alleen zinvol zijn in het handboek van de leverancier.

Bij softify.pro begint zo'n traject daarom met de vraag welke workflows behouden moeten blijven. Niet elk briefje is een fout, en niet elke bijzondere regel is zinvol. Pas als duidelijk is waar informatie verloren gaat of beslissingen onnodig wachten, kan een haalbare oplossing worden gepland.

Een uitrol zonder operationele onderbreking

Het grootste risico zit zelden alleen in de programmacode. Het zit in een implementatie die te veel tegelijk wil veranderen. Een magazijn kan niet twee weken pauzeren om een nieuw systeem te leren. Daarom is een stapsgewijze uitrol meestal zinvoller dan één grote overstapdatum.

Een goed eerste onderdeel richt zich op een afgebakende workflow, bijvoorbeeld goederenontvangst en voorraadboekingen of het aanmaken van pakbonnen. Het team werkt met echte gegevens, feedback stroomt direct terug in de aanpassing, en het voordeel wordt meetbaar. Pas daarna volgen verdere gebieden, zoals mobiel picken, retouren, of koppelingen met webshops en vervoerders.

Datamigratie verdient hier speciale aandacht. Oude artikelnummers, dubbele klantstamgegevens, en inconsistente opslaglocaties verdwijnen niet automatisch alleen omdat een nieuw systeem wordt ingevoerd. Het is vaak beter om bewust de stamgegevens op te schonen en alleen relevante geschiedenissen over te nemen. Dat bespaart later zoekwerk en voorkomt dat oude wanorde technisch behouden blijft.

Rechten horen ook vroeg op de agenda. Niet elke medewerker heeft toegang nodig tot prijzen, alle voorraadcorrecties, of stamgegevensbeheer. Duidelijke rollen beschermen tegen onbedoelde wijzigingen en maken verantwoordelijkheden zichtbaar zonder de workflow te blokkeren met onnodige goedkeuringen.

Technologie die na go-live geen last wordt

Een logistieke applicatie moet snel reageren in de dagelijkse praktijk, ook als meerdere werkplekken tegelijk boeken. Daarvoor is een traceerbare data-architectuur nodig, schone transacties, en duidelijke regels voor parallelle wijzigingen. Als twee medewerkers dezelfde voorraad verwerken, mag het systeem geen stille foutieve boekingen genereren.

Onderhoudbaarheid is even belangrijk. Technologieën zoals PHP 8.4, moderne JavaScript, en MySQL 8 zijn op zichzelf geen verkoopargument. Ze zijn zinvol wanneer de applicatie op lange termijn begrijpelijk blijft, beveiligingsupdates ontvangt, en door gekwalificeerde ontwikkelaars kan worden voortgezet. Gedocumenteerde provisioning, back-ups, logging, en een realistische omgang met updates horen bij operationele capaciteit.

Goede logistieke software wordt daarom niet herkend aan een bijzonder gladde demo. Ze bewijst zichzelf op een gewone dinsdagochtend: de levering wordt geboekt, de voorraad klopt, de order is traceerbaar, de pakbon komt overeen, en de volgende ploeg weet wat al gedaan is. Verlichting ontstaat precies daar — niet door zoveel mogelijk functies, maar door betrouwbare workflows die bij het bedrijf passen.

Permalink →

Een MySQL-database plannen voor webapplicaties

Een MySQL-database plannen voor webapplicaties

Wanneer drie medewerkers 's ochtends parallel goederen boeken, een klant de leveringsstatus controleert en de administratie een factuur opstelt, zie je de kwaliteit van een applicatie niet aan het ontwerp. Ze blijkt uit het feit dat iedereen precies dezelfde, correcte gegevensstatus ziet. Een MySQL-database plannen voor een webapplicatie betekent daarom niet zo snel mogelijk tabellen aanmaken. Het betekent echte workflows precies genoeg begrijpen om te garanderen dat gegevens betrouwbaar blijven, zelfs onder belasting, tijdens fouten, en naarmate het bedrijf groeit.

Vooral bij interne platforms, magazijn- en orderprocessen, of klantgerichte portals wordt de database vaak te laat aangepakt. Eerst wordt de interface gebouwd, dan worden velden toegevoegd, gevolgd door uitzonderingen. Dat werkt voor een prototype. In de praktijk resulteert dit in dubbele datasets, onduidelijke statussen, en rapporten die niemand meer volledig vertrouwt.

Een MySQL-database plannen voor webapplicaties: begin bij de workflow

Het eerste ontwerp zou niet moeten beginnen met kolomnamen, maar met een concrete werksituatie. Neem de goederenontvangst: een levering komt aan, wordt toegewezen aan een leverancier en een order, hoeveelheden worden gecontroleerd, een magazijnlocatie wordt toegewezen, en de voorraad verandert. Afhankelijk van de bewerking vraagt dit proces bovendien om foto's, een kwaliteitscontrole, een blokkeerstatus, of een traceerbare correctie. Uit deze workflow ontstaan de functionele objecten. Typische voorbeelden zijn artikelen, leveranciers, orders, posities, magazijnlocaties, voorraadmutaties, en gebruikers.

Het onderscheid tussen een object en een gebeurtenis is cruciaal. Een artikel beschrijft wat iets is. Een voorraadmutatie documenteert dat een hoeveelheid op een specifieke locatie op een specifiek moment is veranderd. Beide mengen in één tabel leidt snel tot verlies van traceerbaarheid.

Een paar lastige vragen helpen voor elk object: wat is de unieke identiteit? Welke informatie mag veranderen? Wie mag die wijzigen? Welke gegevens moeten historisch bewaard blijven? En welke regels gelden wanneer twee personen gelijktijdig werken? Deze vragen voorkomen latere improvisatie beter dan een lange lijst van zogenaamd complete databasevelden.

Het datamodel moet regels tot uitdrukking brengen

Een database is niet slechts opslag voor formulierinvoer. Ze zou zelf centrale regels moeten afdwingen. Als elke voorraadmutatie precies bij één artikel en één magazijnlocatie moet horen, horen foreign keys in het model thuis. Als een extern ordernummer maar één keer per tenant mag voorkomen, is een unieke index vereist. Als een positie nooit zonder een hoofdorder mag bestaan, moet deze relatie duidelijk gemodelleerd worden.

MySQL 8 met InnoDB biedt hiervoor een stevige basis: transacties, foreign keys, vergrendelingsmechanismen, en consistente wijzigingen over meerdere tabellen. Bij het schrijven van een mutatie, actuele voorraad, en inspectielog tijdens een goederenontvangstboeking zou dit als één samenhangende transactie moeten gebeuren. Als één stap mislukt, mag er geen halfvoltooide bewerking overblijven.

Toch hoort niet elke regel in de database. Goedkeuringen, complexe prijslogica, of roladhankelijke processtappen zijn vaak beter geplaatst in applicatielogica, omdat ze functioneel sneller veranderen. De grens is pragmatisch: regels waarvan overtreding blijvende schade aan gegevens toebrengt, zouden zo dicht mogelijk bij de gegevens beveiligd moeten worden. Regels die vaak veranderen of sterk contextafhankelijk zijn, vereisen goed geteste applicatiecode.

Verwar geschiedenis niet met huidige waarden

Een veelgemaakte fout is alleen de huidige voorraad of huidige status op te slaan. Dat volstaat totdat iemand vraagt waarom de hoeveelheid gisteren is veranderd of wie een order heeft teruggezet. Voor operationele systemen is een geschiedenis van mutaties of gebeurtenissen vaak waardevoller dan één overschrijfbaar veld.

Dit betekent niet dat elke klikbeweging permanent gelogd moet worden. Bedrijfsrelevante wijzigingen zouden gelogd moeten worden: statuswijzigingen, hoeveelheidsaanpassingen, correcties, goedkeuringen, en toewijzingen. Een goede auditregel bevat een tijdstempel, de gebruiker of het systeemproces, de vorige en nieuwe waarde, en een begrijpelijke reden wanneer de workflow dat vereist. Dit maakt het mogelijk fouten te verhelderen zonder door e-mails, papieren lijsten, of databaseback-ups te hoeven zoeken.

Kies bewust sleutels, datatypes, en naamgevingsconventies

Technische beslissingen lijken klein, maar bepalen jarenlang onderhoud en integraties. Voor interne primaire sleutels zijn BIGINT-waarden met automatische toewijzing vaak een nuchtere, goed beheersbare keuze. UUID's kunnen zinvol zijn wanneer gegevens offline ontstaan, meerdere systemen onafhankelijk schrijven, of externe interfaces geen opeenvolgende ID's zouden mogen tonen. Ze kosten echter meer opslag en vragen wat meer aandacht bij indexen en sorteren.

Geldbedragen horen opgeslagen te worden als DECIMAL, niet als FLOAT of DOUBLE. Hoeveelheden hebben ook een functioneel passende precisie nodig: artikelaantallen zijn vaak gehele getallen, terwijl gewichten en lengtes dat niet zijn. Tijdstempels zouden uniform behandeld moeten worden, idealiter intern in UTC, terwijl de interface de lokale tijdzone van de bewerking toont. Vooral bij ploegwisselingen en zomertijd voorkomt dit lastig te vinden discrepanties.

Namen zouden ook saai en ondubbelzinnig moeten zijn. order_items of inventory_movements zijn nuttiger dan creatieve afkortingen die alleen het oorspronkelijke projectteam begrijpt. Consistente enkelvouds- of meervoudsvormen zijn minder belangrijk dan consistentie zelf. Even zinvol zijn velden zoals created_at, updated_at, en, indien nodig, deleted_at. Een soft delete is echter geen standaardverplichting. Voor juridisch of operationeel relevante records is een nette annulering meestal beter dan een onzichtbaar verwijderde dataset.

Indexen volgen echte queries, geen giswerk

Een index kan een zoekopdracht enorm versnellen, maar maakt schrijfbewerkingen complexer en verbruikt opslagruimte. Daarom is "een index op elk veld" geen strategie. De belangrijkste queries zouden vroeg vastgesteld moeten worden: openstaande orders van een klant, mutaties van een artikel binnen een periode, voorraad per magazijnlocatie, of recent gewijzigde records voor een interface.

De volgorde van samengestelde indexen is hier van belang. Als de applicatie regelmatig zoekt op tenant_id, status, en created_at, is een samengestelde index in precies deze volgorde vaak zinvol. Of hij echt past, blijkt uit het uitvoeringsplan via EXPLAIN, niet uit een onderbuikgevoel. Databases worden niet snel gemaakt door spectaculaire trucs, maar door observeerbare queries, passende indexen, en realistisch geteste datavolumes.

Voor groeiende tabellen loont een duidelijke retentiestrategie. Moeten technische logs vijf jaar in de primaire productiedatabase blijven staan? Niet per se. Zakelijke records, mutaties, en inspectiebewijzen vragen om andere bewaartermijnen dan debuginformatie. Archiveren is geen teken van een zwak systeem, maar een bewuste operationele beslissing.

Multi-user gebruik vraagt om transacties en duidelijke statussen

In een webapplicatie benaderen meerdere verzoeken tegelijk dezelfde gegevens. Dat is normaal in de dagelijkse magazijnpraktijk, geen uitzondering. Twee medewerkers kunnen dezelfde voorraad boeken terwijl een import nieuwe orders aanmaakt. Zonder transacties en gerichte vergrendeling bestaat het risico op verloren wijzigingen of negatieve voorraden die pas weken later aan het licht komen.

Voor kritieke bewerkingen zou duidelijk moeten zijn welke gegevens binnen een transactie gelezen en geschreven worden. Soms volstaat een atomaire update, zoals voorraad die alleen wijzigt als de beschikbare hoeveelheid toereikend is. In andere gevallen is een rijvergrendeling zinvol, zodat een bewerking de gegevensstatus gecontroleerd kan controleren en daarna kan aanpassen. Lange transacties zijn daarentegen problematisch: ze blokkeren ander werk en verhogen het risico op conflicten.

Even belangrijk is een beperkte set functionele statussen. Een order zou niet tegelijk "open", "gedeeltelijk geleverd", en "handmatig verwerkt" moeten zijn door het onderhouden van tegenstrijdige velden. Gedefinieerde statusovergangen maken interfaces, rapportages, en automatiseringen eenvoudiger. Uitzonderingen mogen toegestaan zijn, maar zouden benoemd en gedocumenteerd moeten worden.

Plan beveiliging, tenants, en beheer vanaf het begin

De applicatie zou een dedicated databasegebruiker voor MySQL met minimale rechten moeten gebruiken. Schrijftoegang voor de webapplicatie betekent niet dat deze gebruiker tabellen mag verwijderen of gebruikersrechten mag wijzigen. Administratieve accounts horen niet thuis in productieconfiguratiebestanden en nooit in een repository.

Wanneer meerdere klanten, locaties, of bedrijven binnen één applicatie werken, is tenant-isolatie een architecturale beslissing, geen achteraf toegevoegde filtervoorwaarde. Een gedeelde database met een tenant_id kan efficiënt en goed onderhoudbaar zijn, maar vereist consistente controles in elke query en duidelijke regels voor indexen. Aparte databases bieden sterkere isolatie, maar verhogen de inspanning bij updates, evaluaties, en beheer. Welke variant past, hangt af van privacyvereisten, datavolume, en bedrijfsmodel.

Back-ups zijn pas back-ups zodra een herstel getest is. Een vastgesteld ritme voor back-ups, retentie, en herstel is vereist. Ook monitoring van opslagruimte, trage queries, en mislukte taken, samen met gedocumenteerde updates, horen bij het systeem. MySQL 8, PHP 8.4, en moderne webapplicaties kunnen goed op de lange termijn beheerd worden als afhankelijkheden, toegangsgegevens, en implementatiestappen niet enkel in het hoofd van één ontwikkelaar zitten.

Een zinvol plan vóór de eerste productiedag

Vóór de implementatie zou een compact datamodel met voorbeeldworkflows moeten bestaan. Dit omvat kerntabellen en relaties, statusregels, rechten, verwachte queries, interfaces, en een concept voor back-ups en auditlogs. Dit plan hoeft geen honderd pagina's lang te zijn. Het moet beslissingen vastleggen die later duur zouden zijn om te corrigeren.

Bij softify.pro begint databaseplanning daarom bij de mensen die boeken, controleren, picken, of uitzonderingen oplossen. Als een bestaande spreadsheet een beheersbaar proces betrouwbaar in kaart brengt, kan die de juiste oplossing blijven. Als meerdere mensen tegelijk werken, records ontstaan, en fouten traceerbaar moeten zijn, verdient de database daarentegen dezelfde planningsinspanning als de interface. De beste architectuur is uiteindelijk die welke de werkdag vereenvoudigt en die over twee jaar nog steeds transparant aangepast kan worden.

Permalink →