softify.pro
Caricamento …
Servizi Chi siamo COCO – il nostro server IA Portfolio Insiders Case Study Da Sapere Contatti Accesso

Da Sapere

Pure fluidity meets ultimate performance: cosa rende davvero veloce il software aziendale

Pure fluidity meets ultimate performance: cosa rende davvero veloce il software aziendale

Un responsabile di magazzino non riconosce un software scadente da un disegno di architettura. Lo riconosce dal fatto che i dipendenti tornano a prendere il telefono, registrano due volte le bolle di consegna o dopo un turno non sanno dire quale merce sia effettivamente arrivata. Pure fluidity meets ultimate performance non deve quindi essere una mera pretesa visiva. Per il software aziendale significa che un'operazione risulta naturale e allo stesso tempo funziona in modo affidabile in condizioni reali.

Un'interfaccia elegante è inutile se si blocca con un WLAN debole in magazzino. Anche un'applicazione veloce aiuta poco se impone una sequenza di lavoro che alla rampa nessuno riesce a seguire. I buoni strumenti digitali uniscono design, velocità e comprensione dei processi. Riducono l'attrito senza costringere l'azienda in una logica standard precostituita.

Pure fluidity meets ultimate performance è una questione operativa

La fluidità viene spesso confusa con animazioni, grandi immagini e transizioni morbide. Può andare bene per un marchio moderno. Nella quotidianità lavorativa si mostra però in altro modo: un'entrata merci si registra senza deviazioni. Un dipendente trova un ordine anche quando è noto solo un numero di riferimento. Un errore viene indicato chiaramente, invece di sparire in un messaggio criptico.

Anche le prestazioni sono più di un buon valore in un test del browser. Decisivi sono il tempo di risposta con un ordine con molte posizioni, la stabilità a fine mese e la domanda se cinque persone possano lavorare contemporaneamente senza sovrascriversi a vicenda gli stati dei dati. Ne fa parte anche una gestione pulita di interruzioni di connessione, autorizzazioni e account bloccati.

Le due cose sono inscindibili. Se una maschera risponde subito ma ha campi obbligatori poco chiari, resta faticosa. Se il flusso è modellato con intelligenza ma la pagina a ogni registrazione attende due secondi, viene aggirato. La fluidità nasce dove il sistema supporta la successiva azione sensata e resta tecnicamente abbastanza veloce da non far interrompere il filo del pensiero.

L'interfaccia segue il percorso di lavoro, non l'organigramma

Molte soluzioni standard strutturano i loro menu per moduli: acquisti, vendite, magazzino, reporting, amministrazione. Dal punto di vista del prodotto è comprensibile. Sul piano del magazzino, però, il lavoro inizia spesso con una situazione: un camion è lì, manca un bancale, un cliente ha bisogno di una prova di consegna o una spedizione deve essere ancora etichettata prima della chiusura accettazione.

Una buona applicazione su misura inizia quindi con queste situazioni. Quale informazione è disponibile? Chi decide? Cosa va documentato? Cosa non deve più essere modificato in seguito? Solo dopo si decide quale maschera di inserimento, controllo o automazione sia necessaria.

Ciò non significa gettare ogni flusso esistente invariato nel software. Alcune tabelle sono davvero troppo soggette a errori, alcune approvazioni inutilmente lente. Ma un elenco Excel funzionante non deve necessariamente essere sostituito da un progetto. Se è mantenuto da una sola persona, conosce poche eccezioni e resta tracciabile, può essere lo strumento adatto. Il software vale la pena quando migliora il coordinamento, riduce le fonti di errore o rende le informazioni disponibili in modo affidabile a più partecipanti.

Meno clic non è automaticamente meglio

La richiesta di pochissimi clic suona ragionevole, ma può portare nella direzione sbagliata. Per una registrazione di magazzino irreversibile una breve conferma ha senso. Per un'autorizzazione di spedizione un controllo di plausibilità visibile può evitare costosi rifacimenti. Il flusso giusto dipende dal rischio.

Decisivo è che i passaggi aggiuntivi abbiano uno scopo chiaro. Una conferma non dovrebbe comparire solo perché il framework la genera facilmente. Dovrebbe trovarsi proprio dove le persone devono prendere consapevolmente una decisione. Così l'applicazione resta veloce senza diventare avventata.

Le prestazioni nascono nell'architettura, non nell'ultimo sprint

Chi velocizza un sito web o un'applicazione web solo poco prima del go-live di solito tratta sintomi. Query grandi, modelli di dati poco chiari e casi speciali aggiunti in seguito non si correggono in modo duraturo con un singolo giorno di ottimizzazione.

Una base solida inizia con un database che corrisponda alle relazioni effettive nell'azienda. In MySQL 8 movimenti, documenti, cambi di stato e azioni degli utenti necessitano di chiavi tracciabili e indici sensati. Una scorta non deve apparire solo come numero se in seguito occorre chiarire da quale registrazione sia derivata. Allo stesso tempo non ogni informazione storica deve essere ricalcolata a ogni apertura di pagina.

Con le applicazioni web moderne è rilevante anche la separazione delle responsabilità. PHP 8.4 può rappresentare le regole di business in modo chiaro e manutenibile, mentre JavaScript moderno viene impiegato in modo mirato per le aree reattive. Non è una professione di fede per un determinato stack. È una questione di manutenzione: le modifiche si possono realizzare in sicurezza tra sei mesi? È visibile dove vale una regola? Un errore si può riprodurre, invece di essere solo supposto?

Le prestazioni necessitano inoltre di limiti. I campi di ricerca richiedono un numero minimo sensato di caratteri o una logica di filtro precisa, se sono immaginabili milioni di record. Le liste grandi necessitano di pagine o processi di caricamento graduali. Immagini e documenti non dovrebbero bloccare il flusso di lavoro critico. Queste decisioni appaiono poco spettacolari. Proprio per questo restano spesso preziose più a lungo di un vistoso effetto frontend.

La velocità visibile crea fiducia

Non ogni processo può concludersi in meno di un secondo. Una stampa di etichette, un'interfaccia verso il corriere o una verifica rispetto a dati esterni richiedono talvolta tempo. Decisivo è allora come l'applicazione gestisce l'attesa.

Uno stato chiaro come «Etichetta di spedizione in creazione» è meglio di un pulsante congelato. Dopo una conclusione dovrebbe essere riconoscibile quale numero è stato generato e se l'operazione può essere avviata di nuovo. Se un servizio esterno non è raggiungibile, il team ha bisogno di un'opzione d'azione comprensibile invece di un messaggio di errore per sviluppatori.

Anche questa è una questione di integrità dei dati. Un doppio clic non deve generare due consegne. Un processo interrotto non deve lasciare in silenzio un record a metà. I buoni sistemi prevedono tali casi, perché nella quotidianità si verificheranno. Proprio con turni che cambiano, pressione di tempo e dispositivi mobili l'eccezione non è un tema marginale.

La qualità diventa visibile prima dell'errore

Per applicazioni con molte varianti di processo non basta far passare manualmente alcuni percorsi alla fine. Modifiche a prezzi, ruoli, validazioni o interfacce possono scatenare conseguenze in un punto molto lontano. Qui il testing automatizzato diventa parte delle prestazioni: non solo sul piano tecnico, ma organizzativo.

Un sistema di test dovrebbe poter verificare flussi reali, ad esempio creare un ordine, modificare una posizione, generare una bolla di consegna e controllare un'autorizzazione. Dovrebbe registrare prove e formulare i risultati in modo che i reparti specialistici possano inquadrarli. Una frase come «Il processo di spedizione non è stato completato dopo la modifica dell'indirizzo» aiuta più di uno stack trace senza commento.

Per i team attenti alla sicurezza è rilevante anche il luogo in cui questi test girano. Se screenshot, credenziali, casi di test o passaggi applicativi interni non devono lasciare l'azienda, un approccio self-hosted è spesso più sensato di un servizio cloud esterno. Con COCO si possono eseguire test automatizzati per applicazioni web e Windows su un ambiente dedicato. Ciò non è necessario per ogni team. Con dati sensibili, ambiti regolamentati o applicazioni specialistiche interne il controllo sui dati di test può tuttavia essere un vantaggio decisivo.

Il design è buono quando facilita il lavoro

Una forte identità visiva può creare fiducia. Mostra che un'azienda prende sul serio la propria presenza digitale. Nel sistema operativo il design deve però fare ancora di più: orientamento sotto pressione di tempo. Contrasto, tipografia, stati chiari ed etichette comprensibili decidono se qualcuno conclude un'operazione con sicurezza o chiede al collega.

Qui la sobrietà è spesso la scelta migliore. Una dashboard con dieci indicatori colorati può sembrare impressionante e nascondere comunque l'unica deviazione rilevante. Una vista ridotta che rende visibili entrate merci aperte, scansioni mancanti e termini di consegna a rischio è più utile. La domanda non è quanta interfaccia sia possibile, ma quale informazione migliori una decisione.

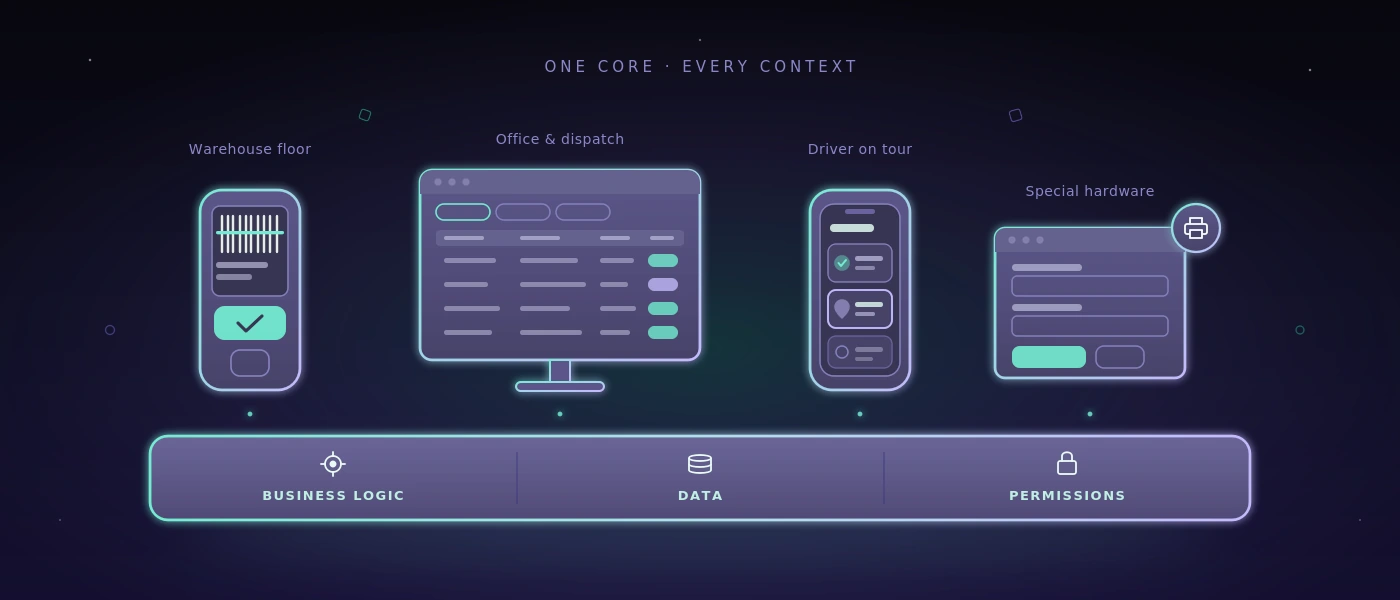
Ciò vale anche per le applicazioni responsive. La compatibilità mobile non significa comprimere ogni schermata desktop in un formato più piccolo. Uno smartphone all'entrata merci ha forse bisogno solo di scansione, quantità, ubicazione e conferma. L'elaborazione successiva dettagliata appartiene forse a uno schermo più grande. Dispositivi diversi meritano priorità diverse, pur accedendo alla stessa base di dati affidabile.

Un metro sensato per la prossima decisione

Prima che un team decida una nuova piattaforma, un'automazione o una ricostruzione completa, aiuta una semplice verifica: il flusso diventa più chiaro, più veloce o più sicuro per le persone che lo eseguono ogni giorno? E la soluzione si può ancora comprendere quando cambiano requisiti, dipendenti o interfacce?

Se entrambe le risposte sono solide, una bella promessa diventa un sistema utilizzabile. Allora pure fluidity meets ultimate performance si mostra non in una slide, ma in una giornata di lavoro tranquilla in cui ordini, dati e decisioni procedono senza attrito inutile.
Link permanente →

SaaS Flow Web: introdurre i workflow in sicurezza durante l'attività in corso

SaaS Flow Web: introdurre i workflow in sicurezza durante l'attività in corso

Un'entrata merci non resta ferma perché un team non conosce un altro software. Resta ferma perché le informazioni si perdono tra e-mail, modulo cartaceo, file Excel e telefonata. Con il SaaS - «Flow Web» su flow.softify.pro - la prima domanda non dovrebbe quindi essere l'interfaccia. Decisivo è se il servizio rappresenta in modo affidabile un flusso di lavoro concreto - anche nei giorni frenetici, con competenze che cambiano e quando una consegna non corrisponde al piano.

Per le piccole e medie imprese il SaaS ha spesso senso perché non devono prima costruire server, rilasci e funzioni di base propri. Ma non è un lasciapassare per ogni processo. Chi introduce uno strumento che rende più complicata la quotidianità o spinge dati importanti in liste secondarie poco chiare non digitalizza il lavoro. Sposta soltanto l'attrito.

Cosa deve offrire il SaaS «Flow Web»

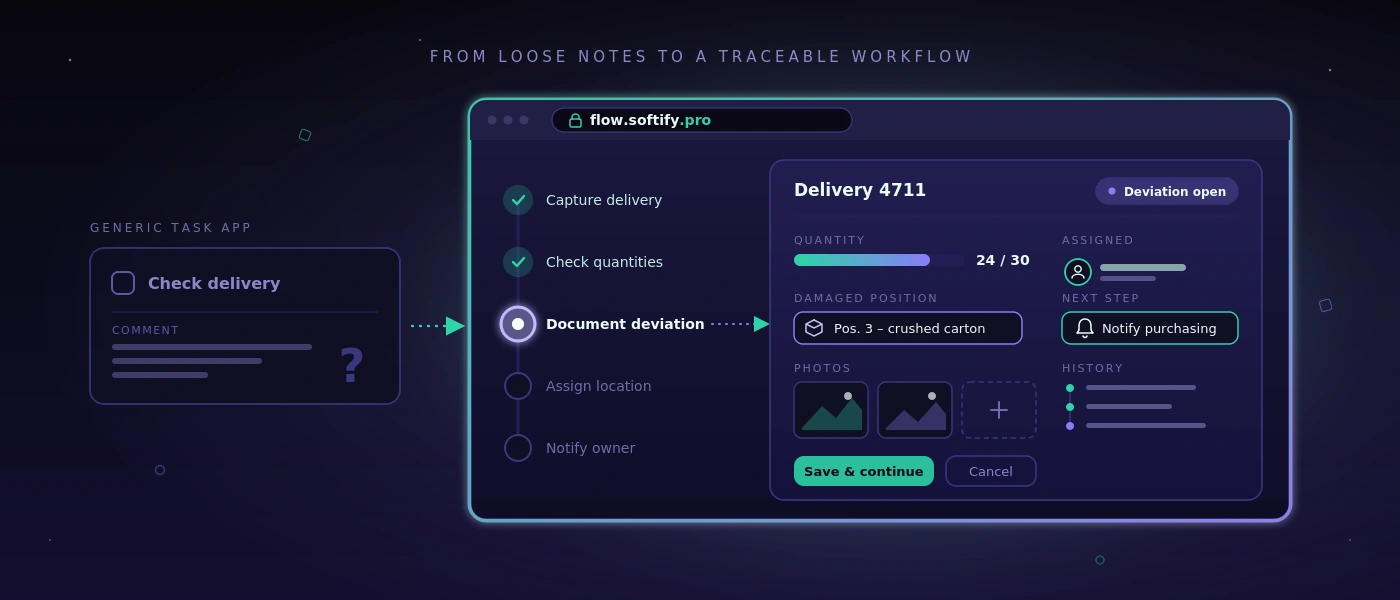
Un workflow web è buono quando i dipendenti sanno senza interpretazione cosa fare successivamente. In un ricevimento merci ciò può significare: registrare la consegna, verificare le quantità rispetto all'ordine, documentare la deviazione, assegnare un'ubicazione e, se necessario, informare un responsabile. Il flusso non deve essere spettacolare. Deve essere tracciabile, rapido e ripetibile.

Proprio qui sta la differenza tra una generica app di attività e un sistema di processo specialistico. Un'app di attività può creare una voce chiamata «Verificare consegna». Un workflow specialistico può inoltre annotare di quale consegna si tratta, chi l'ha accettata, quale posizione era danneggiata, quali foto sono disponibili e se è in sospeso una consegna successiva. Questi dati non stanno allora come testo libero in un singolo commento, ma dove la persona successiva ne ha bisogno.

Per una soluzione come Flow Web su flow.softify.pro la valutazione dovrebbe quindi iniziare dalle operazioni, non da un elenco di funzioni. Un'azienda con cinque movimenti di magazzino al giorno ha bisogno di qualcosa di diverso da un team di spedizione con più orari di cut-off, corrieri diversi e gestione regolare di consegne parziali. Il SaaS non sostituisce la comprensione del processo.

Prima nominare il collo di bottiglia, poi configurare

Molti progetti di digitalizzazione partono troppo ampi: «Vogliamo digitalizzare il magazzino.» Suona plausibile, ma porta presto a un sistema con troppe maschere, casi speciali e documenti di formazione. Meglio un'affermazione precisa come: «Le entrate merci vengono registrate solo il giorno dopo, perché le bolle di consegna restano sulla scrivania a fine turno.»

Da una frase simile si può ricavare un inizio sensato. La prima versione può rilevare le bolle di consegna, confermare articoli e quantità, segnalare deviazioni e inoltrare la registrazione all'ufficio competente. Quando questo flusso funziona, etichette, valutazioni dei fornitori o proposte d'ordine automatiche si possono aggiungere in seguito. Non ogni passo di sviluppo sensato appartiene al primo rollout.

Anche una tabella ben mantenuta può restare, se assolve al suo scopo. Ad esempio un'analisi mensile con pochi partecipanti in un file esistente può essere più economica e trasparente di un modulo dedicato. Il SaaS vale la pena dove le informazioni vengono usate più volte, i tempi di elaborazione sono critici o gli errori nascono da rotture di supporto.

Le domande giuste prima dell'introduzione

Prima della configurazione un team dovrebbe simulare un'operazione reale dall'inizio alla fine. Non il processo ideale, ma il caso che crea problemi nella quotidianità: quantità errata, riferimento mancante, spedizione urgente o un ordine con approvazione speciale. In questo modo emergono le regole che un sistema deve effettivamente rappresentare.

Sono rilevanti tra l'altro questi punti: chi può creare, modificare o chiudere un'operazione? Quali inserimenti sono obbligatori, quali solo utili? Quando va informato un responsabile? Quali dati vengono passati a contabilità, spedizione o assistenza clienti? E cosa succede se il WLAN in magazzino è debole o un dipendente non ha più le sue credenziali?

Le risposte determinano la qualità dell'introduzione più di un lungo catalogo di requisiti estetici. Un processo di ruoli pulito, un messaggio di errore comprensibile e un passaggio di approvazione documentato evitano in esercizio di solito più lavoro di un ulteriore report sulla pagina iniziale.

Conservazione dei dati e ruoli non sono una questione secondaria

Il SaaS viene spesso trattato come una pura questione di utilizzo. Per i responsabili operativi e IT è tuttavia almeno altrettanto importante cosa succede ai dati. Ciò riguarda anagrafiche, informazioni di consegna, dati dei dipendenti, foto di danni e possibilmente dati dei clienti. Prima dell'introduzione dovrebbero essere chiari responsabilità, conservazione e possibilità di esportazione.

In pratica significa: l'azienda deve sapere quali dati sono nel sistema, chi ha accesso amministrativo e come i dati vengono messi a disposizione in caso di cambio o cessazione del contratto. Un'esportazione disponibile solo come file PDF difficilmente leggibile aiuta di rado. Per i dati operativi sono decisivi formati strutturati e utilizzabili.

Anche il concetto di autorizzazioni merita attenzione concreta. In magazzino non ogni persona deve vedere prezzi, condizioni cliente o impostazioni globali. Allo stesso tempo un'assegnazione dei diritti troppo stretta non deve bloccare il flusso. Hanno senso ruoli allineati alle attività effettive: ricezione, pianificazione, spedizione, responsabile di team e amministrazione. Le modifiche critiche dovrebbero essere tracciabili, affinché in caso di domande non si debba indovinare chi abbia modificato una registrazione.

L'accesso stesso dovrebbe essere protetto con basi solide. Ne fanno parte policy di password sicure, un ripristino password regolato, il blocco account dopo ripetuti tentativi falliti e, dove il profilo di rischio lo richiede, ulteriori passaggi di accesso. La sicurezza appare professionale quando è prevedibile e non si nota solo quando qualcuno è stato escluso.

Integrazione solo dove alleggerisce in modo misurabile

Un workflow web spesso sviluppa il suo valore solo nell'interazione con i sistemi esistenti. Può essere un ERP, uno shop, una soluzione di spedizione, una rilevazione presenze o un database. Ciononostante non ogni interfaccia è automaticamente sensata. Ogni integrazione crea dipendenze, quadri di errore e oneri di manutenzione.

La domanda centrale è: quale passaggio manuale elimina concretamente il collegamento? Se un'interfaccia risparmia ogni giorno 30 minuti di lavoro di trasferimento e riduce gli errori di digitazione, il beneficio è chiaro. Se rispecchia soltanto un'informazione che comunque viene verificata una volta alla settimana, un'esportazione manuale può inizialmente essere la soluzione più ragionevole.

Per le estensioni individuali conta la base tecnica. Interfacce documentate, campi dati chiaramente definiti e protocolli di errore tracciabili facilitano l'esercizio successivo. Se un sistema viene collegato a un'applicazione web su misura, tecnologie e struttura del database dovrebbero essere scelte in modo da restare manutenibili a lungo termine. Un'applicazione curata basata su PHP 8.4, JavaScript moderno e MySQL 8 vale più di una soluzione speciale impressionante a breve termine ma senza documentazione.

Introduzione durante l'attività in corso

L'errore più frequente è un avvio brusco senza fase di confronto. I team dovrebbero allora lavorare in modo diverso già il lunedì mattina, mentre le domande aperte nascono solo da problemi reali. Ciò aumenta il rifiuto, anche se il software in fondo è adatto.

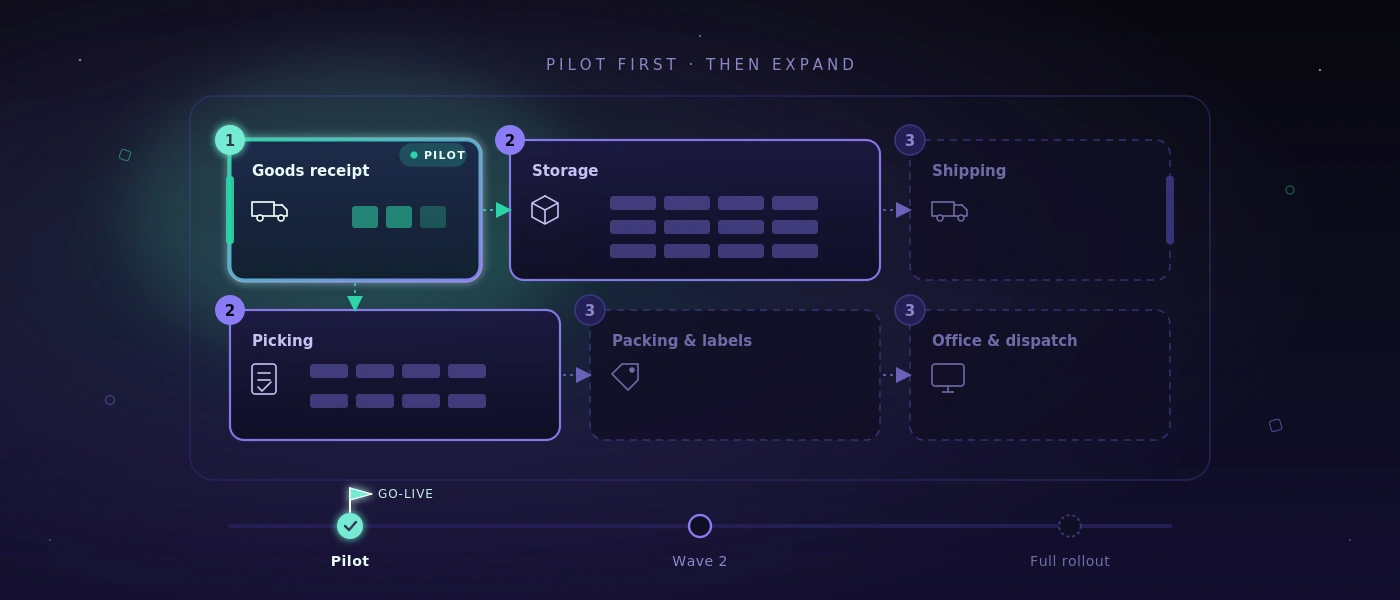
Meglio un pilota limitato con un team, una variante di processo o un'area di sede chiaramente definita. In questo periodo si verifica se registrazione e approvazioni funzionano, se i termini sono comprensibili e se i casi eccezionali finiscono in modo pulito. È importante non raccogliere i riscontri solo come lista dei desideri. Ogni modifica dovrebbe essere verificata rispetto al beneficio per tempo di attraversamento, tasso di errori o trasparenza.

Anche gli indicatori dovrebbero essere definiti presto. Ad esempio si possono osservare il tempo di elaborazione per entrata merci, il numero di deviazioni aperte, le richieste sullo stato di consegna o le registrazioni di correzione. Senza valore iniziale «sembra più veloce» resta l'unica valutazione. Può essere vero, ma non basta per una decisione d'investimento solida.

L'esercizio ha bisogno di un titolare chiaro

Il SaaS riduce lo sforzo tecnico, ma non toglie a un'azienda la responsabilità del proprio processo. Serve internamente qualcuno che gestisca i ruoli, raccolga i riscontri, riconosca il fabbisogno formativo e decida quali modifiche siano davvero necessarie. Questa persona non deve saper programmare. Dovrebbe però comprendere il flusso di lavoro e avere accesso ai responsabili.

Altrettanto importante è una documentazione operativa breve e solida. Non spiega ogni schermata, ma risponde alle domande che sorgono nella quotidianità: cosa fare con una registrazione errata? Chi approva nuovi utenti? Come viene comunicato un guasto? Dove si trovano i dati esportati? Tale chiarezza impedisce che un sistema digitale dopo pochi mesi torni a dipendere da richiami personali.

Una buona soluzione SaaS non si riconosce quindi da quante voci di menu offre. Mostra il suo valore quando una nuova collega può elaborare un'operazione con sicurezza, una deviazione non scompare e un responsabile vede lo stato senza telefonare a tre persone. Flow Web dovrebbe essere misurato proprio con questo metro: non sulle promesse, ma su una giornata di lavoro che procede dimostrabilmente più tranquilla e affidabile.

Link permanente →

Sviluppo web con framework attuali: cosa ne ricavano davvero le aziende

Sviluppo web con framework attuali: cosa ne ricavano davvero le aziende

Se un'entrata merci oscilla ancora tra modulo cartaceo, telefonata e tre file Excel, un frontend moderno da solo non risolve il problema. Lo sviluppo web con framework attuali ha senso quando semplifica visibilmente i flussi: i dipendenti vedono il passo successivo, i dati vengono registrati una sola volta e l'applicazione resta comprensibilmente manutenibile anche dopo il primo go-live.

Per le piccole e medie imprese la questione dei framework non è quindi una questione di fede. Decisivo non è se un'interfaccia porti con sé particolarmente tante parole d'ordine tecniche. Decisivo è se movimenti di magazzino, ordini, controlli o approvazioni attraversino in modo affidabile la giornata lavorativa - anche sotto pressione di tempo, cambi turno e connessione di rete instabile.

I framework sono un mezzo, non un obiettivo di progetto

Un framework offre una struttura collaudata per compiti ricorrenti: routing, moduli, gestione dei permessi, accesso ai dati, test e rappresentazione delle interfacce. Questo non riduce automaticamente ogni rischio. Ma impedisce a un progetto di dover reinventare ogni volta le funzioni di base.

In un'applicazione web su misura un moderno framework JavaScript può ad esempio rappresentare in modo sensato maschere interattive: una lista di prelievo che aggiorna continuamente le posizioni, una pianificazione di percorsi con chiari cambi di stato o un verbale di controllo che assegna foto e commenti direttamente a un'operazione. Nel backend framework PHP consolidati garantiscono regole tracciabili, responsabilità chiaramente separate e interfacce coerenti verso il database.

Ciò è particolarmente rilevante quando una soluzione inizialmente piccola diventa un sistema operativo usato quotidianamente per un processo. Una maschera di inserimento per gli avvisi di consegna può iniziare in modo contenuto. Non appena aggiorna scorte, emette etichette, tiene conto dei ruoli e comunica con un corriere, necessita di una base tecnica pulita. I framework aiutano a non rinegoziare questa base a ogni estensione.

Cosa fanno concretamente meglio gli attuali framework web

Il valore dei framework moderni raramente sta in effetti spettacolari. Si mostra nelle parti invisibili di un'applicazione. I moduli possono controllare subito i dati inseriti, senza che dati errati emergano solo dopo l'invio. I permessi si possono definire centralmente, così che un autista veda informazioni diverse dalla pianificazione. Le modifiche a un ordine vengono salvate in modo tracciabile, invece di sovrascrivere silenziosamente una cella di tabella.

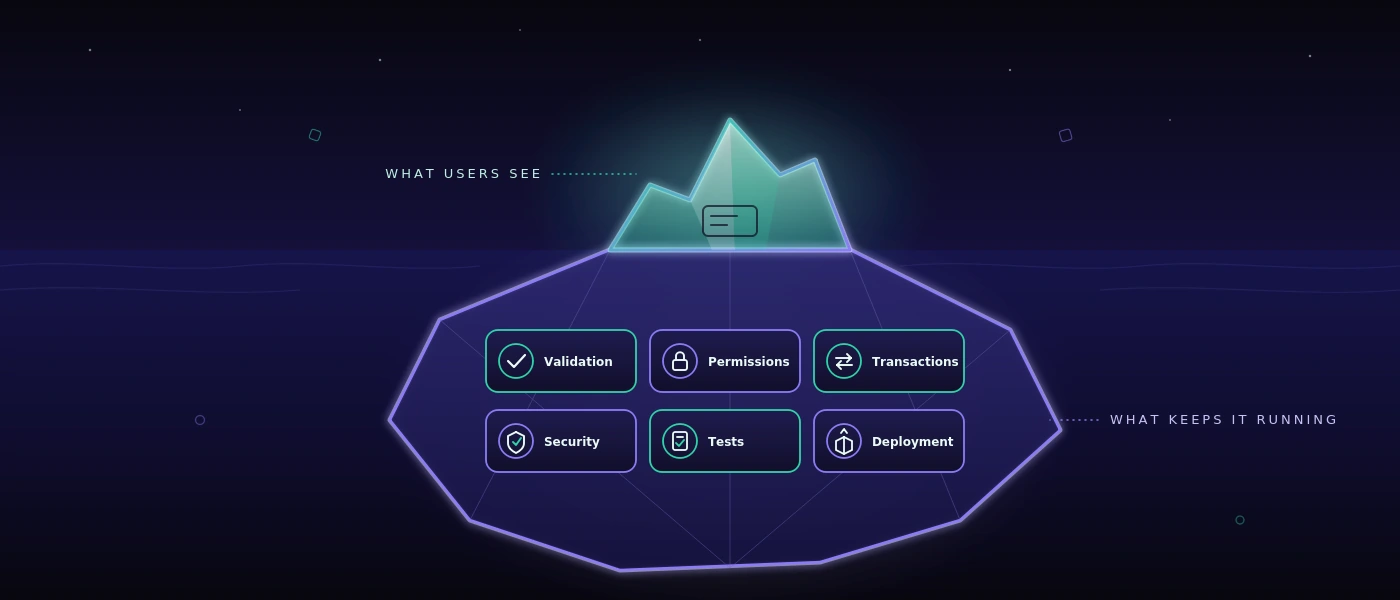
Lato server un ambiente attuale con PHP 8.4 e MySQL 8 crea una base solida per logiche critiche per il business. Le transazioni di database impediscono ad esempio che una scorta venga ridotta mentre la relativa registrazione fallisce. Chiavi univoche e regole di validazione evitano i duplicati. I processi in background possono generare documenti o interrogare interfacce senza che la persona davanti allo schermo debba attendere.

Anche la sicurezza non è una funzione da aggiungere dopo. Un framework moderno supporta la memorizzazione sicura delle password, la protezione dai tipici attacchi tramite input, sessioni tracciabili e flussi di blocco account definiti. Ciononostante l'implementazione resta un compito di progetto: i permessi devono essere modellati correttamente sul piano funzionale e le funzioni sensibili richiedono controlli aggiuntivi. Un framework fornisce guard rail, ma non conosce chi in azienda possa concedere quale approvazione.

Decidere correttamente sullo sviluppo web con framework attuali

La migliore tecnologia non nasce da una lista di strumenti popolari, ma dall'uso effettivo. Un'applicazione interna per dieci persone ha requisiti diversi da un portale clienti con molte migliaia di accessi simultanei. Un terminale di magazzino con scanner richiede una logica di utilizzo diversa da un'analisi per il management sul desktop.

Per questo una decisione sensata inizia con domande concrete: quali operazioni costano oggi tempo in modo misurabile? Quali dati vengono trasferiti più volte? Dove nascono errori perché le informazioni diventano visibili troppo tardi? Quale tabella esistente funziona abbastanza bene e dovrebbe per ora restare? Proprio l'ultimo punto protegge da costosi progetti di digitalizzazione senza beneficio operativo.

Per molte applicazioni aziendali su misura un sistema renderizzato lato server con componenti interattivi mirati è la scelta più ragionevole. Si carica velocemente, è gestibile da operare ed evita complessità inutile. Un'applicazione single-page completamente disaccoppiata può invece essere adatta quando l'interfaccia elabora moltissimi stati dinamici, deve lavorare offline o in seguito dovrà mettere le stesse funzioni a disposizione anche di un'app mobile.

Entrambe possono essere giuste sul piano funzionale. La domanda non è: quale framework è il più moderno? È: quale architettura è ancora estendibile in sicurezza, testabile e comprensibile per il proprio team tra due anni?

Quando meno tecnica è la tecnica migliore

Non ogni processo richiede un frontend complesso. Una snella maschera di inserimento per ordini interni può essere più veloce, più stabile e più economica di un'interfaccia animata in modo elaborato. Se un file Excel viene aggiornato solo una volta al mese e non causa errori, può darsi che resti lo strumento giusto.

La complessità vale la pena solo quando elimina un reale attrito. Può essere il caso quando gli ordini vengono digitati più volte, lo stato di consegna deve essere chiesto per telefono o nessuno è sicuro di quale versione di un documento sia valida. Allora un'applicazione centrale crea un chiaro beneficio: un unico stato dei dati, responsabilità chiare e meno richieste.

La manutenibilità inizia prima della prima riga di codice

I framework sono spesso visti come acceleratori. Ciò è vero solo se le regole di business sono prima sufficientemente chiare. Uno sviluppatore può costruire una macchina a stati in modo tecnicamente pulito. Ma se la sequenza di stati si adatti davvero al processo si decide in fase di rilevazione: quando la merce si considera entrata? Chi può chiudere una deviazione? Cosa succede con una consegna parziale?

Queste decisioni vanno documentate, così come interfacce, campi dati ed eccezioni. Ciò non rende i progetti più lenti. Riduce le discussioni successive, perché diventa visibile quale regola è stata implementata consapevolmente e quale ipotesi è ancora aperta.

La manutenibilità si vede anche nelle piccole discipline. Le modifiche al database devono essere versionate. I passaggi di deployment devono essere documentati. I messaggi di errore devono essere utilizzabili per esercizio e sviluppo senza rivelare dettagli riservati. I test automatici verificano a ogni modifica i flussi centrali, ad esempio la creazione di un ordine, il calcolo di una quantità o l'emissione di una bolla di consegna.

Per le applicazioni critiche un singolo tipo di test non basta. Gli unit test proteggono singole regole, i test di integrazione verificano l'interazione con database e interfacce e i test end-to-end riproducono nel browser percorsi di utilizzo reali. Per applicazioni web e Windows un ambiente di test self-hosted può inoltre fornire screenshot, protocolli di esecuzione e valutazioni comprensibili, senza cedere inutilmente dati di test interni a servizi cloud esterni.

Le prestazioni nascono da architettura e modello dati

Un'interfaccia moderna non diventa veloce perché usa un framework attuale. Query lente al database, immagini sovradimensionate o interfacce poco chiare restano lente, indipendentemente dal frontend. Soprattutto con liste di ordini, articoli o dati di movimento è il modello dati a decidere la velocità percepita.

Indici puliti in MySQL 8, query paginate e dati caricati consapevolmente sono spesso più efficaci di una successiva ottimizzazione dell'interfaccia. Altrettanto importante è un chiaro concetto di caching. I dati anagrafici possono in certi casi essere messi in cache, le scorte attuali o lo stato di approvazione invece non alla cieca. Qui non esiste una regola generale, perché è il significato funzionale dei dati a determinare quanto devono essere aggiornati.

Anche il design responsive fa parte della pianificazione tecnica. Sullo schermo dell'ufficio una tabella ampia può avere senso. Su uno scanner portatile o un tablet in magazzino la stessa informazione richiede grandi aree di tocco, percorsi brevi e una presentazione utilizzabile anche con i guanti o con luce scarsa. Pure fluidity meets ultimate performance in questo contesto non significa il maggior movimento possibile sullo schermo. Significa che l'applicazione funziona senza attrito sul dispositivo effettivamente usato nel processo.

Il percorso sensato dall'idea all'esercizio

Un progetto web solido parte da un nucleo limitato e verificabile. Invece di automatizzare in anticipo ogni eccezione immaginabile, si sceglie un processo che ricorre spesso e causa un onere percepibile. Dopo il primo impiego dati reali e riscontri mostrano quale estensione abbia davvero priorità successiva.

La consegna tecnica non dovrebbe avvenire solo alla fine. Le responsabilità per hosting, backup, monitoraggio, aggiornamenti e diritti di accesso devono essere chiarite presto. Un sistema è affidabile quanto il suo esercizio. Chi ha bisogno di un'applicazione ogni giorno per la spedizione o la gestione degli ordini necessita di vie di ripristino definite e di una risposta chiara su cosa accada in caso di guasto.

softify.pro punta quindi su tecnologie manutenibili, rilascio documentato e responsabilità tecnica diretta invece che su mode passeggere dei framework. Non è una scorciatoia magica. Crea il presupposto affinché un'applicazione continui a funzionare dopo il lancio, possa essere sviluppata ulteriormente e non diventi il prossimo fragile caso speciale.

Nel migliore dei casi la giusta applicazione web non sembra un nuovo progetto IT. Sembra un flusso che finalmente funziona senza deviazioni - con abbastanza sostanza tecnica da accogliere con calma anche il prossimo cambiamento nell'operatività.

Link permanente →

Pianificare un rollout software: come introdurlo durante l'attività in corso

Pianificare un rollout software: come introdurlo durante l'attività in corso

Un nuovo sistema raramente fallisce perché manca un pulsante. Fallisce il lunedì mattina: il turno del mattino non trova l'entrata merci, una bolla di consegna viene stampata due volte o un file Excel diventa all'improvviso la verità non ufficiale. Chi vuole pianificare un rollout software deve quindi non solo introdurre funzioni, ma mettere in sicurezza l'operatività reale.

Proprio in magazzino, officina, pianificazione e amministrazione un rollout non è un appuntamento IT. Cambia gesti, responsabilità e canali informativi. Una buona introduzione mantiene il lavoro in movimento, rende visibili presto gli errori e dà ai dipendenti una risposta chiara alla domanda decisiva: cosa faccio di diverso da domani?

Il rollout inizia prima della prima formazione

Molti progetti partono con un elenco di funzioni: registrare ordini, contabilizzare movimenti di magazzino, stampare etichette di spedizione, pianificare percorsi. È necessario, ma non basta. Prima dell'avvio deve essere chiaro quali processi devono effettivamente passare dal nuovo sistema il primo giorno produttivo - e quali deliberatamente non ancora.

Questa delimitazione non è un segno di incompletezza. Riduce il rischio. Se un'impresa di medie dimensioni finora ha coordinato le entrate merci con carta, telefono e tabelle, non deve digitalizzare il primo giorno anche l'intera gestione scorte, la gestione resi, la pianificazione dei giri e la valutazione dei fornitori. Un primo ambito sensato potrebbe essere la ricezione merci, i movimenti di magazzino inequivocabili e la stampa dei documenti di consegna.

Decisivo è descrivere concretamente il processo target. Non: "L'entrata merci diventa digitale." Ma: "Il dipendente scansiona la consegna, verifica quantità e stato, assegna un'ubicazione e in caso di deviazioni genera un'operazione per gli acquisti." Solo a questo livello diventano visibili le domande aperte: cosa succede se manca l'ordine? Chi può correggere le quantità? Si può stoccare una consegna senza etichetta?

Pianificare un rollout software significa: dare priorità ai flussi critici

Non ogni processo ha lo stesso peso. Un'interruzione nella manutenzione delle anagrafiche può essere sgradevole. Un'interruzione nella spedizione, nel prelievo o nell'approvazione fatture può bloccare il lavoro di un'intera giornata. Per questo il rollout necessita di una priorità in base al rischio operativo, non in base all'ordine nel capitolato.

Una semplice suddivisione si è dimostrata valida: critico per il business, importante e rinviabile. Sono critici tutti i flussi che muovono merci, denaro o comunicazione vincolante con i clienti. Sono importanti le funzioni che accelerano la quotidianità, ma la cui interruzione può essere attutita manualmente in via transitoria. Sono rinviabili le funzioni di comfort, i rari casi speciali o le analisi che inizialmente possono ancora provenire da una fonte esistente.

Questa suddivisione influenza la profondità dei test. Per un processo di spedizione critico non basta far passare con successo un singolo ordine. Vanno testate anche consegne parziali, storni, stampanti mancanti, indirizzi errati, elaborazione parallela e consegna al corriere. Per una funzione statistica usata raramente può essere adeguato un ciclo di test successivo.

Rendere misurabili in anticipo i criteri di successo

"L'applicazione funziona" non è un criterio di collaudo. Meglio affermazioni verificabili: un'entrata merci di 30 posizioni è registrabile entro dieci minuti. Le etichette di spedizione vengono stampate alla postazione prevista. Le modifiche di scorta compaiono immediatamente nella pianificazione. Un account utente bloccato si può riattivare solo tramite il processo di approvazione definito.

Tali criteri collegano reparto specialistico e sviluppo. Impediscono anche che il collaudo diventi una raccolta di impressioni vaghe. Non ogni riscontro deve essere risolto prima del go-live. Ma ogni riscontro necessita di una classificazione: errore critico, miglioramento rilevante o punto per una fase di sviluppo successiva.

Migrazione dei dati: solo dati puliti meritano fiducia

I vecchi dati vengono spesso sottovalutati. Nelle tabelle si trovano codici articolo duplicati, unità diverse, indirizzi cliente scaduti e scorte la cui origine nessuno sa più spiegare. Chi prende questi dati senza verificarli sposta la vecchia ambiguità in un nuovo sistema - solo con un'interfaccia migliore.

Prima della migrazione si dovrebbe stabilire quali dati servono davvero. Spesso hanno senso articoli attuali, clienti attivi, ordini aperti, fornitori rilevanti e scorte iniziali verificate. I dati storici non devono necessariamente passare per intero nella nuova applicazione. Può bastare archiviarli in forma leggibile, se restano necessari per prove o richieste.

Particolarmente importante è un caricamento di prova. I dati non vengono solo importati tecnicamente, ma verificati sul piano funzionale: quantità, unità e assegnazioni sono corrette? I campi obbligatori sono completi? Si possono elaborare correttamente ordini tipici? Per il go-live serve poi una data limite chiara. Da quando si usa quale sistema principale? Senza questa regola nascono doppia gestione e scorte contraddittorie.

Esercizio pilota invece di un grande interruttore

Un big bang può avere senso se un piccolo team usa un processo ben delimitato e la vecchia e la nuova soluzione non possono funzionare in parallelo. Nella maggior parte degli ambienti operativi, tuttavia, un esercizio pilota è la scelta più controllabile.

Il pilota dovrebbe lavorare con casi reali, ma in un ambito limitato: un'area di magazzino, un turno, un gruppo di prodotti o un team selezionato. Decisivo è che il gruppo pilota non comprenda solo dipendenti particolarmente esperti di tecnologia. Dovrebbe rappresentare in modo realistico la quotidianità futura, comprese le persone che lavorano sotto pressione di tempo e hanno obiezioni fondate.

Nell'esercizio pilota si vede se scanner, stampanti, rete e autorizzazioni funzionano alla postazione effettiva. Diventano visibili anche lacune di processo che nessuno aveva citato nelle riunioni. Forse nella pratica la merce viene prima appoggiata in un posto intermedio. Forse gli autisti hanno bisogno di una bolla di consegna diversa dall'amministrazione. Tali scoperte non sono un passo indietro. Sono il motivo per cui il pilota va fatto prima dell'avvio generale.

La formazione come situazione di lavoro, non come visita al software

Una formazione che spiega solo le voci di menu genera poca sicurezza. I dipendenti devono imparare sui propri compiti: "Accettate una consegna danneggiata", "Prelevate un ordine urgente", "Correggete una quantità registrata male". Il contesto resta impresso perché corrisponde alla quotidianità lavorativa.

Formazioni brevi vicino al go-live sono di solito più efficaci di un lungo appuntamento settimane prima. Aiutano anche istruzioni di lavoro concise direttamente alla postazione. Non dovrebbero spiegare l'intero sistema, ma mostrare le operazioni più frequenti, le responsabilità chiare e la via in caso di guasti.

Nominate inoltre referenti per ogni area. Queste persone non devono risolvere da sole ogni problema tecnico. Ma dovrebbero poter decidere se si tratta di un errore di utilizzo, di un'ambiguità funzionale o di un vero errore di sistema. Ciò protegge il team di progetto da richieste non strutturate e accelera l'aiuto per il turno.

Il go-live ha bisogno di un piano operativo

Il giorno del go-live richiede più di un orario. Definite chi decide sul piano funzionale, chi è responsabile delle modifiche tecniche e attraverso quale canale vengono segnalati i guasti. Nei flussi critici dovrebbe essere visibile se le funzioni centrali funzionano: accesso, autorizzazioni, acquisizione dati, interfacce, stampa e backup.

Anche un piano di ripiego fa parte del quadro. Non significa tornare completamente al vecchio mondo al minimo problema. Significa stabilire in anticipo quale guasto giustifichi un arresto, come vengono documentati gli ordini in caso di necessità e come si recuperano in seguito in modo pulito. Un modulo cartaceo per poche ore può essere ragionevole. Una gestione parallela permanente senza fine no.

I dettagli tecnici contano: gli accessi sono stati creati in tempo? Ruoli e regole di blocco account funzionano correttamente? Le stampanti di etichette sono collegate ai modelli giusti? Esiste un backup del database testato? Per le applicazioni sviluppate su misura, deployment documentati, versioni tracciabili e una via chiara per le correzioni sono lo standard.

Le prime settimane decidono l'accettazione

Dopo l'avvio inizia la fase in cui un'applicazione diventa o uno strumento di lavoro o un passaggio aggiuntivo sgradito. Pianificate quindi brevi cicli di feedback quotidiani. Quali errori si ripetono? Dove nascono deviazioni? Quali campi vengono fraintesi? Quale analisi manca davvero a un responsabile?

Non ogni osservazione richiede subito una modifica. Alcuni problemi si risolvono con regole di lavoro più precise o con una formazione migliore. Altri mostrano reali debolezze nel processo o nell'applicazione. L'arte consiste nel non confondere le due cose. Un sistema non dovrebbe rendere più complicati senza motivo flussi esistenti che funzionano. Se una tabella ben mantenuta per un raro caso speciale resta la soluzione migliore, può restare.

Misurate l'effetto con pochi indicatori concreti: tempo di elaborazione per operazione, numero di richieste, registrazioni errate, ristampe, ordini aperti o differenze di scorte. Solo questi valori mostrano se il rollout migliora davvero l'operatività - invece di introdurre semplicemente nuove maschere.

Un buon rollout dopo qualche settimana non sembra più un progetto. Diventa una routine di lavoro affidabile: i dati giusti sono dove servono, le eccezioni sono tracciabili e i team devono telefonare meno per rincorrere informazioni. È esattamente a questo che la pianificazione dovrebbe mirare - non a un giorno di avvio spettacolare, ma a una quotidianità più tranquilla e meglio governabile.

Link permanente →

Pianificare il Multiplatform Application Development: prima il processo, poi la piattaforma

Pianificare il Multiplatform Application Development: prima il processo, poi la piattaforma

Un responsabile di magazzino conferma un'entrata merci sullo scanner portatile. La pianificazione verifica la stessa operazione nel browser. Un autista ha bisogno dello stato di consegna in viaggio sullo smartphone. Multiplatform application development in questo momento suona come una questione tecnica. In realtà si tratta prima di tutto di un flusso operativo: quale lavoro deve essere svolto in quale luogo, con quale affidabilità e con quale dispositivo?

Per le piccole e medie imprese la risposta giusta è raramente: costruiamo tutto in modo nativo per ogni piattaforma. Più spesso è: definiamo un processo comune, scegliamo in modo mirato le interfacce necessarie ed evitiamo logiche duplicate. Questo non fa risparmiare solo budget di sviluppo. Impedisce anche che magazzino, ufficio e servizio esterno lavorino con stati di dati diversi.

Cosa deve offrire il Multiplatform Application Development

Multiplatform Application Development indica lo sviluppo di un'applicazione utilizzabile in più ambienti, ad esempio nel browser web, su iOS e Android o su sistemi desktop Windows. Il termine viene spesso ridotto alla domanda se un'unica base di codice possa generare più app. Questa è solo una parte della decisione.

Per i sistemi operativi conta soprattutto se l'applicazione funziona nel luogo d'uso. Un'area di ricevimento merci può avere bisogno di una fotocamera per acquisire codici a barre, di elementi di comando grandi per i guanti e di una reazione utilizzabile quando la copertura WLAN è instabile. L'amministrazione ha invece bisogno di tabelle, filtri, concetti di autorizzazione e registri delle modifiche tracciabili. Un autista ha bisogno di una vista ridotta, non della stessa interfaccia della pianificazione.

Una base tecnica comune può collegare in modo sensato questi requisiti. Ma non deve portare a servire ogni piattaforma come un cattivo compromesso. Il miglior codice comune è inutile se i dipendenti fanno deviazioni perché l'applicazione non rispecchia il loro flusso di lavoro effettivo.

Prima definire il processo, poi la piattaforma

Prima di parlare di framework, i team dovrebbero esaminare un'operazione concreta dall'inizio alla fine. Prendiamo una consegna: arriva l'ordine, la merce viene prelevata, nasce una bolla di consegna, la consegna viene confermata e lo stato viene comunicato a vendite o assistenza clienti. In quale punto nasce oggi la rottura di supporto? Dove si annota qualcosa su carta, lo si ridigita più tardi o lo si chiede per telefono?

Questa osservazione separa i veri requisiti di piattaforma dalle liste dei desideri. Se solo due dipendenti in ufficio usano una funzione, di solito basta un'interfaccia web ben fatta. Se dieci persone sul piano del magazzino fanno registrazioni, un'interfaccia mobile adatta allo scanner può fare la differenza. Se un programma Windows esistente deve lavorare con hardware speciale, può essere necessaria un'integrazione desktop.

Non ogni funzione appartiene a ogni dispositivo. Non è un difetto di una soluzione multipiattaforma, ma il segno di decisioni di prodotto pulite. Dati e regole di business comuni non significano necessariamente maschere identiche.

Le tre domande che chiariscono costi e benefici

La prima domanda è: quali dispositivi sono già in uso e per quanto tempo lo resteranno? Un'azienda con terminali Windows gestiti ha requisiti diversi da un servizio esterno con smartphone privati. La seconda è: cosa succede senza connessione di rete? La capacità offline aumenta notevolmente lo sforzo, perché i dati devono essere salvati localmente, sincronizzati in seguito e gestiti correttamente in caso di conflitti. Ha senso se altrimenti il processo si ferma - non come dotazione standard.

La terza domanda riguarda le conseguenze di un guasto. Un dipendente può registrare un'operazione in un secondo momento, oppure da essa dipendono un'etichetta di spedizione, una scorta o un'autorizzazione di sicurezza? Quanto più critica è l'operazione, tanto più devono essere pianificati autorizzazioni, regole di controllo, ripetibilità e registrazione.

Un'architettura che non si sgretola alla seconda piattaforma

In una soluzione sostenibile la logica di business non è sparpagliata in più interfacce. Controlli di scorta, cambi di stato, intervalli di numerazione, autorizzazioni e generazione di documenti richiedono una base centrale e testata. Browser, applicazione mobile e client desktop vi accedono tramite interfacce chiaramente definite.

Per molti processi aziendali interni un'applicazione web moderna è il punto di partenza più economico. Può essere aggiornata centralmente, non richiede installazione su ogni postazione e funziona su desktop, tablet e smartphone. Con PHP 8.4, JavaScript moderno e MySQL 8 si può costruire una base manutenibile, a condizione che modello dati, diritti di accesso e deployment non vengano considerati solo poco prima del go-live.

Un'applicazione mobile o desktop installabile viene aggiunta quando porta un chiaro vantaggio: integrazione profonda con scanner, stampante o fotocamera, funzionamento offline affidabile, funzioni speciali in background o requisiti della gestione dei dispositivi. È un'espansione mirata, non fine a sé stessa.

Un errore frequente è il riutilizzo completo dell'interfaccia utente a ogni costo. Tecnicamente può sembrare attraente. In pratica nascono testi piccoli su monitor grandi, moduli sovraccarichi su smartphone o comandi che non si adattano alla piattaforma. È meglio condividere modello dati, regole e componenti dove ha senso, adattando l'uso al rispettivo contesto.

La coerenza dei dati conta più di una base di codice comune

Più piattaforme aumentano il rischio di dati contraddittori. Un ordine viene modificato in ufficio mentre un autista vede ancora una vecchia versione sul suo dispositivo. Due dipendenti registrano contemporaneamente la stessa scorta di un articolo. Un dispositivo offline rimanda le sue modifiche ore dopo. Questi casi non sono un tema marginale, ma il nucleo dell'architettura.

Il sistema ha quindi bisogno di identità univoche, marche temporali, cambi di stato tracciabili e regole per i conflitti. Per uno stato di consegna può bastare l'ultima modifica confermata. Per le scorte spesso è troppo grossolano. Lì deve essere chiaro quale movimento è stato registrato, da quale ubicazione proviene e se una correzione deve essere motivata.

Anche le autorizzazioni vanno regolate centralmente. Un dipendente può forse registrare entrate merci, ma non approvare correzioni di scorta. Un autista esterno può vedere solo il suo giro. Durate di sessione, autenticazione a più fattori per ruoli critici e flussi di blocco account non sono funzioni di sicurezza decorative. Proteggono flussi concreti e rendono visibili le responsabilità.

Testare il Multiplatform Application Development come si lavora davvero

Un'applicazione può avviarsi su tre sistemi operativi e fallire comunque nell'esercizio. Decisivi sono i flussi in condizioni reali: lo scanner reagisce troppo lentamente, una stampante di etichette non è raggiungibile, un'autorizzazione non si applica dopo un cambio di ruolo, oppure una sincronizzazione genera registrazioni doppie.

Per questo i processi critici dovrebbero essere verificati automaticamente. Ne fanno parte accesso e comportamento di blocco, registrazione ordini, movimenti di scorta, creazione di documenti ed elaborazione di input errati. Per applicazioni web e Windows i test ricorrenti possono essere eseguiti su un'infrastruttura self-hosted. Ciò è particolarmente rilevante se screenshot, dati interni degli ordini o accessi di test non devono essere ceduti a servizi cloud esterni.

L'automazione non sostituisce il controllo da parte delle persone sul piano del magazzino. Garantisce però che i flussi noti vengano verificati ripetutamente dopo le modifiche. I buoni report di test non nominano solo un errore tecnico, ma il processo interessato: la prova di consegna non può essere generata, l'account utente resta bloccato dopo l'approvazione riuscita oppure i dati del giro non vengono aggiornati.

Quando una strategia di piattaforma è troppo

Alcune aziende non hanno bisogno di una propria app. Se basta un accesso stabile dal browser, il flusso è raramente mobile e il numero di utenti resta contenuto, un'applicazione web responsive è spesso la scelta più ragionevole. Riduce l'onere di manutenzione, i problemi di distribuzione e il numero di possibili fonti di errore.

Anche una tabella esistente non deve essere sostituita subito. Se serve solo come semplice valutazione, è mantenuta da una persona e non crea passaggi soggetti a errori, può assolvere al suo scopo. Il momento per un sistema è arrivato quando la conoscenza sta in singole teste, le versioni divergono, le richieste aumentano o un'operazione non può più essere ricostruita in modo affidabile.

Al contrario, una strategia di piattaforma snella diventa presto troppo piccola quando i dipendenti devono lavorare offline, si collega hardware o clienti e partner necessitano di accesso controllato. Allora conviene finanziare consapevolmente i requisiti aggiuntivi, invece di aggiungerli più tardi sotto pressione di tempo.

Iniziare con un pilota solido

Un buon inizio non è un catalogo di funzioni con cento punti, ma un flusso completo e misurabile. Ad esempio: registrare l'entrata merci, aggiornare la scorta, documentare una deviazione e creare un compito di chiarimento. Questo pilota mostra presto se modello dati, dispositivi, diritti e uso si adattano tra loro.

Dopodiché la soluzione può crescere in passi sensati: prelievo, spedizione, pianificazione dei giri o analisi. Ogni estensione dovrebbe superare la stessa domanda: accorcia un flusso reale, riduce gli errori o crea trasparenza affidabile? Se no, può aspettare.

La piattaforma più sensata alla fine non è quella con più opzioni tecniche. È quella su cui un team inizia il lavoro più velocemente al mattino, fa meno domande durante il turno e la sera può ricostruire cosa è effettivamente accaduto.

Link permanente →

Valutare correttamente i Test Automation Results

Valutare correttamente i Test Automation Results

Un test di regressione può concludersi al mattino con il 98 per cento di casi riusciti e non essere comunque una buona notizia. Forse il test fallito è proprio il login di un grande cliente. Forse 40 test sono stati saltati perché l'ambiente di test non era raggiungibile. Oppure l'esecuzione era verde, ma verificava solo se i pulsanti esistono, non se un ordine viene effettivamente salvato, una bolla di consegna generata e la scorta aggiornata correttamente. I Test automation results non sono un'affermazione sulla qualità finché ne manca il contesto.

Per la direzione QA, lo sviluppo e i reparti specialistici, il vero lavoro non sta quindi solo nell'automatizzare i test. Decisivo è preparare i risultati in modo che ne derivino decisioni affidabili: si può rilasciare? Un errore va gestito subito? L'errore è nuovo, ricorrente o solo un problema dell'ambiente di test? E ci sono prove che anche un reparto senza codice di test possa comprendere?

Cosa dicono davvero i Test Automation Results

L'indicatore più semplice è: superato o fallito. È utile, ma raramente sufficiente. Un'alta percentuale di successo può creare fiducia se i test coprono flussi critici, i dati di test sono plausibili e l'ambiente somiglia all'esercizio successivo. Se manca uno di questi fattori, il numero resta soprattutto un segnale che un'esecuzione automatica è stata eseguita.

Per applicazioni critiche per il business contano di più altre domande. In una soluzione di magazzino non ogni schermata è ugualmente importante. Un errore di visualizzazione in un testo di avviso interno può aspettare. Un errore che registra la quantità sbagliata all'entrata merci o genera un'etichetta di spedizione senza indirizzo del destinatario, no. Buoni risultati di test ponderano quindi i rischi invece di trattare tutti i casi allo stesso modo.

Anche un test fallito non è automaticamente un difetto del prodotto. Può essere causato da credenziali scadute, un ruolo di test bloccato, interfacce non disponibili, dati di test modificati o un ambiente lento. Chi non separa queste cause produce rumore. Il team passa allora tempo con falsi allarmi mentre errori reali si perdono tra segnalazioni di stato rosse.

Quattro tipi di stato invece di un'unica lista rossa

Nella pratica si dimostra valida una classificazione chiara: errore funzionale, errore tecnico del test, problema dell'ambiente e modifica attesa. Un errore funzionale significa che l'applicazione viola un requisito definito. Un errore tecnico del test indica piuttosto il test stesso, ad esempio un selettore non più adatto dopo un'interfaccia modificata deliberatamente.

Un problema dell'ambiente sussiste quando, ad esempio, un sistema di test o un'interfaccia collegata non è disponibile. Le modifiche attese nascono quando un processo è stato adattato deliberatamente, ma l'automazione verifica ancora il vecchio stato obiettivo. Queste categorie non evitano ogni discussione. Fanno però in modo che la discussione inizi dal punto giusto.

Dai test eseguiti a report utili alle decisioni

Un report utilizzabile non risponde solo che qualcosa è fallito, ma cosa è successo, quanto è grave e se l'errore appare riproducibile. Serve più di un elenco di nomi di test e marche temporali.

A ogni esecuzione rilevante appartengono la build verificata, l'ambiente di test, il ruolo utilizzato, i dati di test principali nonché ora di inizio e fine. Soprattutto con applicazioni desktop Windows o piattaforme web complesse queste informazioni servono per circoscrivere le differenze. Un errore che compare solo con un ruolo di magazzino limitato è qualcosa di diverso da un errore che blocca ogni accesso.

Risultati significativi contengono inoltre prove tracciabili: screenshot, passaggi registrati, messaggi di errore e, se necessario, log tecnici. Uno screenshot da solo può però ingannare. Mostra un momento, non la causa. La combinazione di sequenza di passaggi, stato visibile e reazione attesa è molto più utile.

I sistemi assistiti da IA possono trasformare queste prove in valutazioni comprensibili. Con COCO, ad esempio, i test girano su un server IA dedicato e self-hosted. La valutazione può spiegare che un ordine è stato creato ma il cambio di stato atteso non è avvenuto, e collegare direttamente la registrazione dell'esecuzione. Per i team attenti alla sicurezza è rilevante dove vengono elaborati screenshot, dati applicativi e traffico di test. Il controllo locale non è automaticamente necessario, ma con applicazioni interne e dati sensibili può essere la strada più sensata rispetto a un servizio cloud esterno.

Il giusto livello di dettaglio per destinatari diversi

I team di sviluppo necessitano di messaggi di errore, passaggi tecnici e indicazioni il più possibile precise per la riproduzione. Un operations manager ha invece bisogno prima della funzione interessata, del rischio per il business e di un'affermazione chiara sull'operatività. Entrambe le prospettive devono poter nascere dalla stessa esecuzione, senza che qualcuno debba trasferire manualmente risultati in presentazioni.

Un buon report inizia quindi con un breve livello decisionale: rilascio raccomandato, rilascio con limitazioni note o rilascio da fermare. Sotto compaiono le deviazioni critiche con priorità e prova. I dettagli tecnici seguono solo dopo. Non è una semplificazione a scapito della precisione, ma una netta separazione dei bisogni informativi.

Misurare la copertura senza illudersi di sicurezza

La copertura dei test viene spesso presentata come valore percentuale. Questo valore è utile quando è chiaro cosa misura. La copertura del codice mostra ad esempio quali parti del codice del programma sono state eseguite durante i test. Ciò non dimostra che un processo di business funzioni correttamente. Un test può toccare molte righe di codice e non verificare mai se un indirizzo di consegna errato compare sul documento.

Per i reparti specialistici la copertura dei processi è spesso più significativa. Descrive quali flussi reali sono protetti: registrare un ordine, riservare scorte, registrare una consegna parziale, accettare un reso o approvare una fattura. Particolarmente preziosi sono i passaggi tra sistemi e ruoli, perché lì nascono spesso errori: nell'importazione di un ordine, nella stampa di un'etichetta o nel passaggio dall'ufficio al terminale di magazzino.

Non date priorità in base al numero di test possibili, ma in base all'impatto del danno e alla frequenza delle modifiche. Un processo usato raramente con alto rischio finanziario o legale merita spesso un'automazione prima di una vista usata frequentemente ma innocua. Al contrario, un flusso stabile e poco critico può continuare ad accontentarsi di un breve controllo manuale. Non ogni verifica deve essere automatizzata solo perché è automatizzabile.

I test instabili sono un problema di qualità a sé

I test che a volte riescono e a volte falliscono senza una modifica riconoscibile del prodotto vengono spesso chiamati flaky. Danneggiano la fiducia più rapidamente di un test permanentemente rosso. Non appena i team riavviano per riflesso i risultati rossi, l'automazione perde la sua funzione di allarme.

Le cause sono di solito concrete: attese fisse, dati di test condivisi, accessi paralleli, elaborazione asincrona o un ambiente che non viene ripristinato. Una breve pausa di tre secondi nel test può aiutare per caso, ma non è una soluzione. Meglio attendere uno stato verificabile, rendere i dati di test univoci e isolare i flussi l'uno dall'altro.

Non ogni instabilità si può evitare del tutto. Le interfacce esterne possono oscillare e l'infrastruttura reale ha interruzioni. Allora il report dovrebbe indicare chiaramente se un test non era valutabile a causa di una dipendenza esterna. Un'esecuzione ripetuta può essere utile per la diagnosi, ma non deve rendere invisibile il primo esito.

Un processo sensato dopo ogni esecuzione di test

Dopo un'esecuzione automatica non ogni risultato dovrebbe essere trattato subito allo stesso modo. Prima si verificano gli errori bloccanti e i test critici non valutabili. Poi segue la classificazione delle nuove deviazioni rispetto a problemi noti e accettati. Solo allora una decisione di rilascio è affidabile.

Sono utili soglie definite, ma devono adattarsi al processo. Ad esempio, un test fallito nel flusso di pagamento o di autorizzazione può far scattare un arresto immediato. In caso di deviazione puramente estetica può essere accettabile un'eccezione documentata. Tali regole non dovrebbero nascere solo sotto pressione di tempo prima di un rilascio.

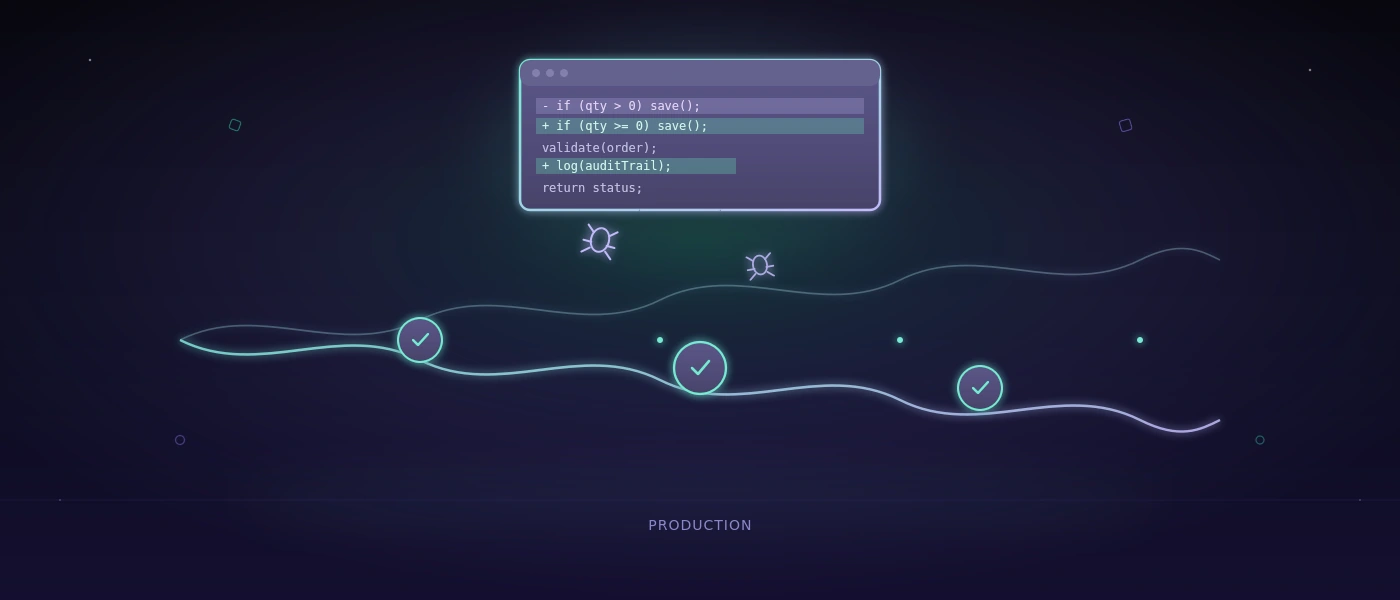
Altrettanto importante è il feedback: ogni errore in produzione non riconosciuto dai test è un motivo per verificare se manca uno scenario, una variante di dati di test o un punto di controllo. L'obiettivo non è accumulare il maggior numero possibile di test. È costruire, dagli errori reali, una protezione migliore e mirata.

I risultati di test più utili, alla fine, non sono quelli con il quadro più verde. Sono quelli in cui un responsabile può capire il lunedì mattina cosa è stato verificato, quale rischio rimane e quale azione è ora ragionevole.

Link permanente →

Inventory Discrepancy Causes: motivi comuni delle differenze di inventario

Inventory Discrepancy Causes: motivi comuni delle differenze di inventario

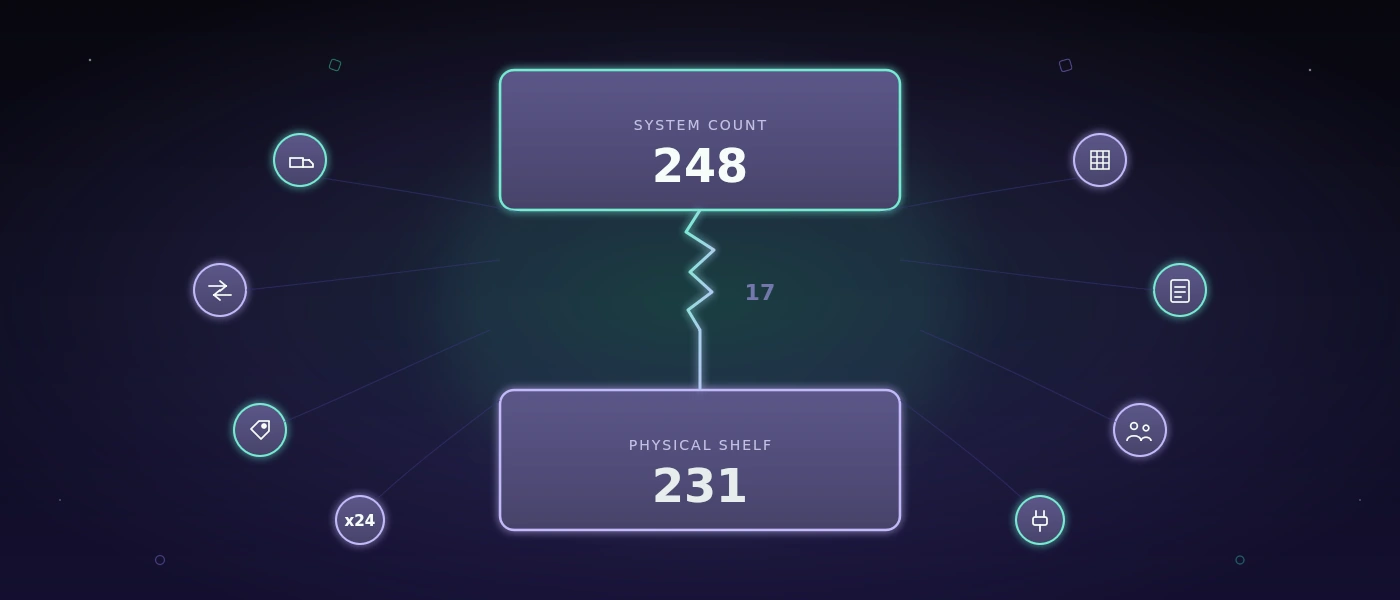
Il sistema dice 248 pezzi in giacenza, sullo scaffale ce ne sono 231. Queste 17 unità sembrano inizialmente un errore di conteggio. Ma è proprio qui che spesso inizia l'analisi sbagliata. Le inventory discrepancy causes sono raramente nella pratica una svista isolata. Per lo più nascono dove entrata merci, movimentazione di magazzino, prelievo, e registrazione divergono nel tempo o organizzativamente.

Per una piccola o media impresa, le differenze di scorte non sono solo un tema per l'inventario. Portano a ordini errati, consegne espresse, scorte di sicurezza inutili, e promesse di consegna che non si possono mantenere. Chi separa le cause in modo pulito non deve introdurre subito un grande ERP. Spesso bastano regole di registrazione più chiare, dispositivi di acquisizione adeguati, e un sistema che rispecchia i processi di lavoro reali.

Inventory discrepancy causes: dove nascono le differenze

Una differenza di scorte è la differenza tra la scorta teorica nel sistema principale e la scorta effettivamente presente. Decisiva qui è la parola "principale". Se parallelamente vengono mantenuti un file Excel, una lista cartacea, e un sistema di gestione merci, esistono praticamente più verità. Allora la differenza non è nata solo in magazzino, ma era già insita nella gestione dei dati.

La contromisura efficace dipende quindi dal tipo di errore. Un bancale contato male richiede una soluzione diversa da una consegna accettata fisicamente ma mai registrata. Prima di ristrutturare i processi, i team dovrebbero valutare le differenze per articolo, ubicazione, turno, tipo di movimento, e momento. Solo questo schema mostra se si tratta di un caso isolato o di un errore di processo ricorrente.

1. Gli ingressi merci vengono registrati in ritardo o in modo incompleto

L'entrata merci è un classico punto di rottura. La merce arriva al mattino, viene messa da parte per il controllo, e in seguito portata direttamente in produzione o sullo scaffale. La registrazione avviene nel pomeriggio, il giorno dopo, o mai. Finché la merce è fisicamente presente, la scorta di sistema appare troppo bassa. Se viene già consumata o spedita, diventano più probabili errori conseguenti.

Particolarmente soggette a problemi sono le consegne parziali, gli articoli sostitutivi, e le sovra-consegne. Se sulla bolla c'è scritta una quantità, ma ne arriva una diversa, nessuno dovrebbe semplicemente registrare il documento "in modo più o meno corrispondente". La differenza deve rimanere visibile come eccezione, incluso motivo, persona responsabile, e approvazione. Altrimenti lo scostamento scompare dall'operazione e riaffiora solo all'inventario.

2. I movimenti di magazzino avvengono senza transazione

Un articolo viene posizionato dall'entrata merci nello scaffale alto, spostato da un vano alla zona di prelievo, o riservato per un ordine. Fisicamente è un movimento piccolo e veloce. Nel sistema può essere decisivo.

Se il personale riorganizza le ubicazioni solo a sensazione, la scorta totale potrebbe ancora essere corretta, ma la disponibilità nel posto giusto no. Ciò causa tempi di ricerca, prelievi errati, e viaggi di rifornimento inutili. Una buona soluzione di magazzino non deve rendere complicato ogni movimento. Deve registrare i pochi movimenti rilevanti per disponibilità, tracciabilità, e riordino.

In officine o magazzini più piccoli è spesso più sensato mantenere poche zone inequivocabili piuttosto che una struttura di vani teoricamente perfetta che nessuno mantiene nella quotidianità. La precisione funziona solo se resta praticabile.

3. Prelievo e spedizione vengono registrati troppo presto

Molti team registrano un ordine come "evaso" al momento del prelievo, anche se la merce si trova ancora in un'area di preparazione. Se l'ordine viene poi modificato, annullato, o spedito solo parzialmente, scorta di sistema e scorta fisica non coincidono più.

Meglio è una chiara separazione tra riservato, prelevato, e spedito. Non ogni azienda necessita di catene di stato complesse per questo. Ma il momento della riduzione della scorta deve essere inequivocabile. Per la merce in spedizione, spesso è più vicino alla effettiva consegna al corriere che al primo prelievo dallo scaffale.

Anche i resi appartengono a questo flusso. Se la merce ritorna, non è automaticamente di nuovo disponibile. Solo controllo, decisione sulla qualità, e stoccaggio dovrebbero determinare se torna nella scorta vendibile, resta bloccata, o viene scartata.

4. Unità sbagliate ed errori anagrafici

Una scatola, una confezione, un rotolo, e un singolo pezzo possono riguardare lo stesso articolo. Se la conversione non è mantenuta in modo pulito, nascono differenze a velocità impressionante. Un dipendente registra "1", intendendo una scatola con 24 pezzi. Il sistema intende un pezzo.

Gli errori anagrafici sono particolarmente insidiosi perché il processo di registrazione può apparire tecnicamente corretto. Verificate quindi unità di imballaggio, fattori di conversione, quantità minime, ubicazioni, e codici articolo. Anche varianti denominate in modo simile, ad esempio lunghezze, colori, o lotti diversi, vengono facilmente confuse.

Qui non aiuta nessuna regola generica come "scansionare di più". I codici a barre sono affidabili solo quanto l'associazione che sta dietro. Per assortimenti piccoli, un'anagrafica articoli ben mantenuta con etichette leggibili può ottenere più risultati di un vasto, ma mal configurato, parco scanner.

5. Tabelle parallele e correzioni manuali

La tabella sul desktop raramente nasce da negligenza. Per lo più colma una lacuna reale: una riserva speciale, un valore di analisi mancante, o un processo che il software esistente non rappresenta. Diventa problematica quando diventa il secondo libro di magazzino.

Allora gli ingressi vengono registrati nel sistema, ma i prelievi annotati nella tabella. Oppure una correzione avviene solo dove serve proprio per il prossimo ordine. Nessuno può più spiegare in modo affidabile quale valore sia valido.

Non ogni tabella deve essere abolita. Un calcolo per pianificazione o analisi può restare sensato. Le operazioni che modificano la scorta dovrebbero però avere esattamente un sistema principale. Le modifiche necessitano di un codice motivo, una marca temporale, e idealmente una persona che le possa ricondurre. Non è burocrazia fine a se stessa, ma il presupposto per analisi delle cause affidabili.

6. Errori di conteggio e metodi di inventario non adeguati

Anche processi corretti non proteggono dagli errori umani. Gli articoli vengono contati due volte, i bancali vengono trascurati, le scatole aperte stimate, o le ubicazioni non bloccate mentre si conta. Un inventario completo annuale scopre questi problemi tardi e sotto forte pressione.

Per molte aziende, un inventario permanente è l'alternativa più ragionevole. Gli articoli a rotazione rapida o di valore vengono controllati più spesso, i C-articoli stabili meno spesso. Importante non è produrre il maggior numero possibile di conteggi, ma verificare tempestivamente gli scostamenti rispetto agli ultimi movimenti. Se un articolo con differenza viene semplicemente corretto senza documentare la causa, lo schema resta invisibile.

Un controllo incrociato è particolarmente sensato per valori elevati, numeri di serie, o lotti. Per le viti in un magazzino di consumo può essere economicamente eccessivo. La profondità del controllo dovrebbe adattarsi al rischio.

7. Responsabilità poco chiare tra turni e aree

Gli errori di scorte nascono spesso ai passaggi di consegne. Il turno mattutino prepara la merce, il turno serale la spedisce. L'entrata merci accetta una consegna, la pianificazione modifica parallelamente l'ordine. Ogni singolo passo può essere tracciabile, ma nessuno possiede l'operazione complessiva.

Definite quindi non solo ruoli, ma punti di passaggio: chi conferma l'entrata merci? Quando passa la responsabilità per la merce prelevata? Chi verifica le eccezioni aperte a fine turno? Una bacheca digitale condivisa o una semplice lista di eccezioni è spesso più efficace di riunioni aggiuntive.

Il sistema dovrebbe rendere visibili le operazioni aperte, invece di costringere il personale a ricordare. Ad esempio, consegne senza controllo quantità, prelievi senza conclusione spedizione, o resi senza decisione sulla qualità devono risultare evidenti prima di diventare errori silenziosi di scorte.

8. Integrazione di sistema debole e regole di controllo mancanti

Se negozio, gestione ordini, magazzino, e contabilità scambiano dati con ritardo temporale o tramite file, possono nascere registrazioni doppie o mancanti. Un'importazione viene eseguita due volte. Un'interfaccia fallisce silenziosamente. Un ordine viene modificato dopo che il suo stato di spedizione è già stato trasferito.

La soluzione non è necessariamente una sostituzione completa. Spesso servono interfacce chiaramente definite, numeri di documento univoci, e controlli tecnici. Una registrazione di magazzino dovrebbe memorizzare in modo tracciabile quando è avvenuta, da quale operazione deriva, e se è stata successivamente annullata. I processi critici necessitano di messaggi di errore e code, non solo di una voce silenziosa nel file di log.

Con sistemi logistici sviluppati su misura, tali regole possono essere adattate mirate all'attività: nessuna quantità negativa senza approvazione, nessuna conferma di spedizione senza posizione di spedizione, nessuna elaborazione doppia dello stesso riferimento esterno. La regola migliore qui non è la più severa, ma quella che ferma gli errori reali senza bloccare l'attività per le eccezioni normali.

Verificare sistematicamente le differenze di scorte

Non iniziate con una correzione generalizzata. Scegliete i dieci articoli con le differenze più frequenti o più costose, e tracciate il loro ultimo movimento a ritroso: entrata merci, trasferimento, prelievo, reso, conteggio, ed eventuale correzione manuale. Se i casi si concentrano in una sede, un turno, o un tipo di movimento, è un punto di partenza solido.

Dopodiché ogni misura dovrebbe essere misurabile. Se vengono introdotte nuove scansioni di codici a barre, osservate non solo il numero di scansioni, ma il tasso di differenza per gruppo di articoli. Se viene aggiunto un nuovo stato per la preparazione, verificate quotidianamente le preparazioni aperte. I buoni processi non producono una precisione apparente. Rendono le eccezioni visibili e tracciabili precocemente.

Il prossimo passo sensato è spesso piccolo: definire un punto di passaggio, ripulire un'ubicazione, o assicurare tecnicamente una correzione manuale ricorrente. Scorte affidabili non nascono da più software per sospetto, ma da processi ancora correttamente eseguibili anche in un martedì frenetico alle 16:45.

Link permanente →

Affrontare correttamente l'automazione dei processi per le PMI

Affrontare correttamente l'automazione dei processi per le PMI

Manca una bolla di consegna perché i dati sono ancora su un foglietto. Un carico merci viene registrato due volte perché magazzino e ufficio lavorano con tabelle diverse. Un'approvazione si ritarda perché la persona responsabile non risponde al telefono in quel momento. Questo tipo di attrito raramente costa molto denaro in un colpo solo. Ma nel corso di settimane si accumulano richieste, tempi di ricerca, correzioni di errori, e attese inutili. È proprio lì che l'automazione dei processi per le PMI trova senso.

Non si tratta di sostituire quante più attività possibile con il software. Una buona automazione rende i flussi tracciabili, riduce i passaggi di consegna evitabili, e dà al personale tempo per decisioni che richiedono esperienza. Ciò è particolarmente decisivo nelle piccole e medie imprese: i team sono vicini al business quotidiano. Quando un processo si inceppa, spesso l'intero turno se ne accorge subito.

Non automatizzare ogni processo

L'errore più comune è iniziare dal fastidio più visibile. Forse infastidisce un file Excel, forse serve un nuovo dashboard. Entrambe le cose possono essere giustificate. Ma un caos digitalizzato resta caos - solo più veloce e con più dati.

Prima di una decisione tecnica, il flusso dovrebbe essere descritto per come avviene realmente. Non come dovrebbe stare scritto nel manuale. Chi avvia il processo? Quali informazioni sono necessarie? Dove qualcosa viene trasferito manualmente? Chi decide nelle eccezioni? E come riconosce il team che il processo è completato?

Proprio in magazzino o nell'evasione ordini, i punti critici si trovano spesso tra i sistemi: un ordine arriva via e-mail, viene copiato in una tabella, concordato telefonicamente, e in seguito inserito in un software di spedizione. Ogni passaggio aumenta la probabilità che quantità, date, o indirizzi divergano.

L'automazione conviene particolarmente quando un processo ricorre frequentemente, ha regole chiare, e gli errori causano conseguenze percettibili. Può trattarsi del carico merci, della creazione di bolle di consegna, dell'assegnazione dei movimenti di magazzino, o del passaggio di ordini approvati alla spedizione. I casi speciali rari con molte decisioni discrezionali restano invece spesso meglio gestiti manualmente - almeno all'inizio.

L'automazione dei processi per le PMI inizia con le priorità

Non ogni attività superflua merita subito un progetto. Una semplice definizione delle priorità crea chiarezza. Valutate i singoli flussi per frequenza, tempo di elaborazione, costi di errore, e dipendenze. Un processo che avviene cinquanta volte al giorno e risparmia solo due minuti ogni volta può essere più economico di un complicato processo mensile.

La domanda sulla conseguenza dell'errore è almeno altrettanto importante. Un documento interno stampato erroneamente è fastidioso. Un'assegnazione errata di lotto, un indirizzo di consegna perso, o un carico merci non documentato può scatenare reclami, ricerche, e differenze di scorte. Lì l'automazione genera non solo velocità, ma affidabilità.

Un primo passo sensato è di solito abbastanza piccolo da poter essere verificato entro poche settimane. Ad esempio, un dipendente può registrare merci tramite un codice a barre, il sistema verifica articolo e quantità, aggiorna la scorta in un database centrale, e genera direttamente una ricevuta di stoccaggio se necessario. Il team non deve poi indovinare quale versione di una tabella sia attuale.

Uno stato obiettivo chiaro invece di una lista di funzioni

Molti progetti iniziano con una lunga lista di funzioni desiderate. Meglio un quadro operativo concreto: cosa deve essere visibile alla fine di un processo senza richieste ulteriori? Nella spedizione, ciò potrebbe significare che un ordine, dopo l'approvazione, riceva automaticamente una lista di prelievo, l'indirizzo di spedizione venga verificato, e possa essere generata un'etichetta. Le eccezioni finiscono visibilmente in una lista di chiarimento, invece che in una casella e-mail ingestibile.

Questo quadro obiettivo obbliga a decisioni utili. Ogni ordine deve essere elaborato completamente in automatico? O gli ordini oltre un certo valore merce, con indirizzo di consegna divergente, o con scorta mancante devono essere deliberatamente sottoposti a verifica? L'automazione non ha bisogno di un'elaborazione al buio al cento per cento per creare un grande beneficio.

La tecnica giusta dipende dal flusso

Non esiste un percorso tecnico standard per ogni PMI. Una soluzione a tabella può restare ragionevole per una valutazione gestibile. È rapidamente adattabile, familiare, e causa poco sforzo di introduzione. Non appena però più persone lavorano contemporaneamente, le registrazioni devono essere tracciabili, o i dati vengono scambiati con altri sistemi, raggiunge i suoi limiti.

Allora è spesso più sensata un'applicazione snella, specifica per il flusso, piuttosto che una suite enterprise sovradimensionata. Può rappresentare esattamente i passaggi necessari nell'operatività: registrare ordine, verificare scorta, muovere merce, generare documento, registrare spedizione, e riportare lo stato. Non di più, ma anche non di meno.

Tecnicamente conta meno se un sistema pubblicizza l'ultima parola d'ordine. Decisivi sono fondamenti solidi: un database modellato in modo pulito, permessi tracciabili, protocolli per modifiche rilevanti, interfacce affidabili, e deployment documentati. Un'applicazione basata su PHP 8.4, JavaScript moderno, e MySQL 8 può essere molto ben manutenibile a lungo termine, se architettura e gestione vengono pensate fin dall'inizio.

Anche le integrazioni meritano attenzione. Uno scambio automatico di dati con negozio, ERP, corriere, o contabilità fa risparmiare tempo solo se gli errori vengono gestiti in modo visibile. Cosa succede con un indirizzo non valido? Una stampa di etichetta fallita viene ritentata? Il team può riconoscere quali dati sono stati trasferiti e quali mancano ancora? Gli errori silenziosi sono più pericolosi di un caso eccezionale chiaramente segnalato.

Introduzione durante l'operatività corrente

Un nuovo sistema deve adattarsi ai cambi turno, alle scadenze di consegna, e alle routine di lavoro esistenti. Per questo un rollout graduale è di solito più sicuro di una data limite rigida per tutte le aree. Iniziate con un processo delimitato, un gruppo di prodotti, o un'area di magazzino. Ciò riduce il rischio e crea feedback reale dalla quotidianità.

L'esercizio parallelo non è quindi segno di incertezza, ma un test controllato. Per un tempo limitato, vecchia e nuova registrazione possono essere confrontate. Le differenze mostrano non solo errori software, ma spesso anche regole che finora esistevano solo nella testa di singoli dipendenti. Queste regole appartengono visibilmente al processo - non permanentemente all'esperienza personale.

I dipendenti non dovrebbero essere confrontati con il nuovo flusso solo alla formazione. Chi esegue il processo quotidianamente riconosce presto scorciatoie, casi speciali, e maschere impraticabili. Un buon software rispetta questa conoscenza, senza integrare invariata ogni eccezione storicamente cresciuta. La domanda giusta è: quale eccezione protegge un caso di business importante, e quale è solo un workaround per un vecchio problema?

Rendere misurabile se lo sforzo vale la pena

Prima dell'avvio dovrebbero essere fissati due o tre indicatori. Possono essere il tempo di attraversamento per ordine, il numero di correzioni manuali, le differenze di scorta, o il tempo fino alla spedizione. Senza un valore di partenza, ogni valutazione successiva diventa una sensazione di pancia.

Non ogni effetto si manifesta subito in euro. Se un team di magazzino riconosce in ogni momento dove si trova la merce, diminuisce il numero di interruzioni. Se i documenti di consegna nascono dagli stessi dati dell'ordine, diminuisce il rischio di indicazioni contraddittorie. E se le responsabilità sono visibili nel sistema, un processo dipende meno da singole persone.

L'automazione richiede manutenzione e limiti

Un flusso automatizzato non è un progetto che si congela dopo il go-live. Le strutture articolo cambiano, i clienti richiedono nuovi documenti, i corrieri adattano le interfacce. Per questo responsabilità, aggiornamenti, backup, e una gestione regolamentata dei permessi appartengono al sistema vero e proprio.

Specialmente per applicazioni con dati clienti, ordini, o scorte, dovrebbe essere chiaro chi ottiene l'accesso e perché. I ruoli devono adattarsi alla quotidianità lavorativa: un team di magazzino necessita funzioni diverse da contabilità o vendite. Modifiche protocollate, flussi di accesso sicuri, e ripristini testati appaiono poco spettacolari. In caso di guasto, sono proprio questi dettagli a decidere se l'operatività può continuare.

Anche i test sono parte della sicurezza operativa. Verifiche ricorrenti per registrazione ordini, contabilizzazione scorte, generazione documenti, e gestione diritti impediscono che una modifica in un punto danneggi un flusso funzionante in un altro. Per applicazioni web o desktop critiche, un ambiente di test self-hosted controllato può essere sensato, se screenshot, dati di test, e processi interni non devono raggiungere servizi cloud esterni.

softify.pro accompagna tali progetti con un principio semplice: prima comprendere il flusso reale, poi costruire la soluzione minima sostenibile. A volte è un'applicazione su misura. A volte basta strutturare più pulitamente una tabella esistente e automatizzare un singolo passaggio di consegna.

Il miglior prossimo passo non è quindi un confronto tra software, ma un percorso attraverso un processo reale - dall'innesco al completamento. Prendete un ordine, un carico merci, o un reclamo e seguitelo con le persone coinvolte. Lì dove le informazioni vengono inserite di nuovo, nessuno conosce lo stato, o le decisioni attendono inutilmente, si trova di solito l'approccio più sensato per l'automazione.

Link permanente →

Testare applicazioni Windows: un piano pratico

Testare applicazioni Windows: un piano pratico

Un'applicazione Windows può sembrare pulita in modalità demo e comunque rallentare l'operatività il lunedì mattina. Una bolla di consegna non salvata, un utente bloccato dopo tre tentativi falliti, o una finestra di stampa che si comporta diversamente dopo un aggiornamento non sono bug cosmetici. Chi vuole sapere come testare applicazioni Windows non dovrebbe quindi iniziare dai singoli pulsanti, ma dai flussi che costano lavoro, denaro, o tracciabilità.

Proprio in magazzino, officina, spedizione, e amministrazione, molti processi critici passano attraverso software desktop cresciuto negli anni. Lì non conta se un caso di test è formulato in modo impressionante. Ciò che conta è se il personale può portare a termine il proprio lavoro in modo affidabile in condizioni realistiche - anche con dati incompleti, permessi mutevoli, reti lente, e interruzioni non pianificate.

Testare applicazioni Windows inizia con i flussi critici

Non ogni funzione merita lo stesso sforzo di test. Un export usato raramente con rilavorazione manuale va valutato diversamente rispetto alla registrazione di un carico merci, la creazione di un'etichetta, o la riconciliazione giornaliera degli ordini. Iniziate quindi con una domanda semplice: cosa succede concretamente se questo flusso fallisce?

Hanno priorità alta i processi con impatto diretto su scorte, consegna, fatturazione, sicurezza, o comunicazione col cliente. Tra questi rientrano ad esempio l'accesso e il controllo dei diritti, la creazione e modifica di anagrafiche, le registrazioni delle transazioni, la stampa dei documenti, le interfacce verso servizi ERP o di spedizione, nonché i riavvii dopo un errore. Anche le funzioni usate solo da un piccolo gruppo di persone possono essere critiche se bloccano una chiusura mensile o il rilascio di merce.

Da questi flussi non nascono liste astratte di test, ma passaggi di lavoro tracciabili. Un test del carico merci potrebbe, ad esempio, iniziare con un ordine esistente, registrare una consegna parziale, segnalare una quantità difforme, assegnare un'ubicazione di magazzino, e poi verificare se scorte, registro delle registrazioni, e documento stampato corrispondono. Così si testa l'effetto reale del software, non solo singoli campi di input.

Creare una base di test che rispecchi l'operatività

Molti errori diventano visibili solo quando l'ambiente di test si avvicina alla realtà. Un'applicazione si comporta spesso diversamente con un tenant di test vuoto rispetto a diversi anni di dati di movimento, articoli bloccati, informazioni obbligatorie mancanti, o operazioni già aperte.

Predisponete quindi dati di test in modo consapevole. Non è necessariamente richiesta una copia completa della produzione. È più sensato un patrimonio dati controllato con casi tipici, limite, e volutamente errati: articoli con diverse unità di misura, clienti con condizioni speciali, ordini con consegne parziali, utenti con ruoli diversi, e operazioni già in lavorazione. I dati personali dovrebbero essere anonimizzati o sostituiti con dati di esempio realistici.

Alla base di test appartiene anche l'ambiente tecnico. Documentate versione di Windows, risoluzione, scalatura, stampanti installate, unità di rete, versione del database, servizi collegati, e permessi. Suona arido, ma fa risparmiare tempo in seguito. Se un errore si presenta solo su postazioni con scalatura al 125% o con un determinato driver di stampante, ciò deve essere riproducibile.

Non verificare solo il caso ideale

Il caso ideale dimostra soprattutto che l'applicazione è stata costruita per il percorso atteso. Nell'operatività, le situazioni difficili sorgono accanto a esso. Cosa succede se un utente lascia vuoto un campo obbligatorio, avvia la stessa registrazione due volte, o perde la connessione durante il salvataggio? L'operazione rimane coerente? La persona riceve un messaggio comprensibile? Può continuare a lavorare in sicurezza?

Nelle applicazioni Windows sono inoltre particolarmente rilevanti l'uso e lo stato. Le finestre di dialogo possono apparire in secondo piano, le scorciatoie da tastiera possono sovrapporsi, le finestre di selezione file possono bloccare il flusso. Verificate se focus, messaggi di errore, e blocchi sono inequivocabili. Un'eccezione tecnica senza indicazione operativa non aiuta il capoturno.

Usare i test manuali dove serve giudizio

I test manuali non sono segno di scarsa maturità. Sono indispensabili quando nasce un nuovo flusso, un'interfaccia viene ricostruita, o la competenza specialistica determina la qualità. Un capomagazzino esperto riconosce più rapidamente di uno script se una maschera è comprensibile sotto forte pressione di tempo, o se un avviso appare troppo tardi.

Il test manuale diventa però costoso e inaffidabile quando gli stessi flussi stabili vengono ripetuti prima di ogni versione. Allora il rilascio dipende da persone disponibili, capacità di memoria, e appunti sparsi. Il momento giusto per passare all'automazione si trova solitamente dove un processo viene eseguito frequentemente, può causare danni elevati, e possiede risultati attesi chiari.

Un buon caso di test manuale descrive situazione di partenza, passaggi, risultato atteso, e dati necessari. In caso di errore, aggiungete uno screenshot, timestamp, versione dell'applicazione e della build, e l'azione esatta. "La stampa non funziona" non è una descrizione di errore utilizzabile. "Dopo la modifica dell'indirizzo di consegna, la finestra di stampa resta aperta, l'ordine 4711 non riceve un PDF, e non appare alcun messaggio" lo è.

Test di regressione automatizzati per rischi ricorrenti

L'automazione non verifica se un software è fondamentalmente buono. Verifica se flussi definiti che prima funzionavano continuano a funzionare dopo una modifica. Ciò è particolarmente prezioso per il software Windows le cui interfacce, logica di database, e interfacce esterne vengono sviluppate ulteriormente nel corso degli anni.

Iniziate in piccolo. Scegliete inizialmente cinque-dieci flussi critici per il business che dovrebbero essere verificati a ogni rilascio. Tra questi possono rientrare accesso con account-lockout flow, inserimento ordini, registrazione di magazzino, stampa PDF o etichette, cambio di ruolo, e un import centrale. Solo quando questi test funzionano in modo affidabile conviene l'estensione ai casi particolari.

Nelle applicazioni desktop, i test automatizzati spesso governano elementi visibili dell'interfaccia: finestre, campi di input, tabelle, pulsanti, e finestre di dialogo. Ciò funziona, ma è più delicato di un puro test di interfaccia. Piccole modifiche di layout, computer più lenti, o elementi non nominati in modo univoco possono rompere i test. Per questo sviluppatori, reparto specialistico, e responsabili dei test dovrebbero stabilire insieme quali elementi sono indirizzabili in modo stabile e quali passaggi di verifica sono meglio garantiti tramite database, protocollo, o interfaccia.

Un test sensato verifica inoltre non solo che un pulsante potesse essere cliccato. Controlla la conseguenza sul piano funzionale: la registrazione è stata salvata? La scorta è corretta? È stato generato un documento? Non è stato creato alcun record duplicato? Interazione visibile e risultato verificabile vanno insieme.

Le prove sono parte del risultato del test

Uno stato verde da solo raramente è sufficiente per applicazioni critiche. Quando un test fallisce, i team hanno rapidamente bisogno di una risposta a tre domande: qual era la situazione di partenza? A quale passaggio il flusso è fallito? Cosa mostrava l'applicazione in quel momento?

Screenshot, log di esecuzione, ed eventualmente registrazioni schermo rendono gli errori discutibili. Accorciano notevolmente il passaggio di consegne tra operatività, QA, e sviluppo. Per aziende regolamentate o attente alla sicurezza, sono inoltre una base solida per tracciare approvazioni e deviazioni.

In ciò la posizione di memorizzazione non è una questione secondaria. Le esecuzioni di test possono contenere dati clienti interni, listini prezzi, informazioni sugli ordini, o viste schermo. Chi automatizza test per applicazioni Windows sensibili dovrebbe chiarire se questi dati possono lasciare la propria infrastruttura. Un ambiente self-hosted come COCO può essere sensato in questo caso, perché esecuzione dei test, evidenza, e valutazione rimangono sotto il proprio controllo. Se ciò sia necessario dipende da requisiti di protezione dati, situazione contrattuale, e fabbisogno di protezione - non ogni team ha bisogno della stessa architettura per questo.

Integrare il testing nel processo di rilascio

Il miglior catalogo di test perde valore se viene usato solo dopo una messa in produzione frenetica. Definite un momento fisso: le regressioni core automatizzate vengono eseguite prima di ogni rilascio, il collaudo manuale verifica flussi nuovi o modificati, e le limitazioni note vengono documentate apertamente.

Non ogni test fallito deve fermare un rilascio. Un errore in una vista amministrativa raramente usata può essere accettabile se esiste un workaround sicuro e l'area interessata è chiaramente informata. Un errore che registra scorte in modo scorretto o blocca utenti inosservato va trattato diversamente. Questa decisione dovrebbe essere presa in base all'impatto sul business, non al mero numero di test rossi.

Mantenete i test insieme all'applicazione. Se un processo cambia deliberatamente, aggiornate caso di test, dati di test, e risultato atteso insieme al requisito. I test obsoleti generano rumore e prima o poi vengono ignorati. Poche verifiche affidabili valgono più di centinaia di flussi automatizzati i cui risultati nessuno prende più sul serio.

Alla fine non si tratta di simulare ogni input immaginabile. Si tratta di proteggere il lavoro che deve funzionare di nuovo la mattina successiva. Iniziate con un singolo processo critico, rendete dimostrabile il suo risultato, e costruite da lì in avanti.

Link permanente →

Secure test data management senza perdere il controllo

Secure test data management senza perdere il controllo

Un'esecuzione di test fallita è fastidiosa. Un'esecuzione di test riuscita con dati clienti reali in un ambiente insufficientemente protetto può rivelarsi decisamente più costosa. Il secure test data management non risolve questa contraddizione con un singolo strumento, ma con regole chiare per dati, accessi, ambienti di test, ed evidenze. Per i team che testano in modo automatizzato applicazioni web o Windows, questo fa quindi parte del lavoro di qualità - non solo della conformità.

Perché i dati di test diventano un problema di sicurezza

I dati di produzione sono allettanti per i test perché contengono casi limite reali: indirizzi incompleti, combinazioni di ordini insolite, regole di prezzo storiche, o input errati. Ma proprio questi dati contengono spesso nomi, dati di contatto, informazioni contrattuali, numeri del personale, dati bancari, o logica di business interna.

Il rischio nasce raramente da un singolo errore evidente. Di solito cresce passo dopo passo: un export del database viene creato per un test, depositato in una directory condivisa, e in seguito copiato in un altro ambiente. Un servizio esterno riceve screenshot per l'analisi degli errori. Un account di test mantiene ampi permessi perché una pulizia potrebbe disturbare l'esecuzione successiva. Dopo qualche mese, nessuno sa più con certezza quali dati si trovino dove.

Nelle piccole e medie imprese, il problema si aggrava spesso a causa di capacità limitate. Il team vuole rispettare una scadenza di rilascio, non gestire un proprio progetto di protezione dati. La responsabilità però rimane. Chi usa dati per l'assicurazione qualità deve poter tracciare quali dati vengono elaborati, chi vi ha accesso, e quando vengono rimossi.

Il secure test data management inizia prima del caso di test

La domanda decisiva non è: "Come proteggiamo il patrimonio di dati di test?" È: "Di quale informazione ha davvero bisogno questo test?" Molti test di regressione non necessitano di riferimenti personali reali. Un processo di spedizione, per esempio, deve verificare se indirizzi di consegna, pesi, zone, etichette, e cambi di stato vengono elaborati correttamente. Per questo bastano clienti sintetici, anagrafiche articoli plausibili, e casi limite definiti consapevolmente.

Questa distinzione porta a una classificazione pratica dei dati. Non ogni ambiente di test ha bisogno della stessa profondità di dati. Per test unitari e di integrazione spesso bastano set di dati completamente artificiali. Per i test end-to-end possono essere sensate copie pseudonimizzate, se pattern di dati reali sono rilevanti dal punto di vista funzionale. I dati simili alla produzione dovrebbero essere l'eccezione - con scopo documentato, accesso limitato, e durata di vita fissa.

Importante qui è la qualità dei dati sostitutivi. Dati fantasiosi casuali aiutano poco se non riflettono dipendenze realistiche. Un set di dati di test per un'applicazione di magazzino deve, ad esempio, contenere varianti articolo, ubicazioni magazzino, scorte bloccate, consegne parziali, e resi in una combinazione coerente. Buoni dati di test non proteggono solo le informazioni personali. Trovano errori che non emergerebbero mai con tabelle vuote e il cliente campione "Mario Rossi".

Sintetizzare, mascherare, o minimizzare?

I dati sintetici sono la scelta più sicura quando le regole di business si possono modellare in modo pulito. Nascono in modo mirato dai requisiti di test e non contengono alcuna copia di persone o operazioni reali. Lo sforzo sta nella manutenzione: se il modello dati cambia o si aggiungono nuove regole di processo, generatori e fixture devono crescere di conseguenza.

Il mascheramento è adatto quando il comportamento di un'applicazione dipende fortemente dalle strutture di produzione. In questo caso i campi sensibili vengono sostituiti o modificati, mentre le relazioni vengono mantenute. I nomi diventano nomi plausibili ma fittizi; gli indirizzi e-mail diventano indirizzi di test non recapitabili; i numeri di conto diventano valori con formato corretto senza alcun riferimento reale. Un mascheramento è affidabile solo se si considerano anche le deduzioni indirette. Una combinazione di luogo raro, data di nascita, e caratteristica contrattuale può comunque rendere riconoscibile una persona.

La minimizzazione dei dati è spesso la terza via sottovalutata. Invece di copiare un export completo, viene fornito solo il segmento necessario. Ciò riduce la superficie di attacco, il fabbisogno di storage, e lo sforzo di pulizia. Per un test di una logica di sconto nessuno ha bisogno dell'intera cronologia clienti di un anno.

Accessi e ambienti devono corrispondere al rischio

Un set di dati protetto perde il suo valore se si trova in un ambiente di test liberamente raggiungibile. I sistemi di test necessitano quindi di confini di sicurezza propri - database separati, account di servizio propri, accessi di rete chiaramente definiti, e nessuna connessione silenziosa alla produzione.

I diritti di accesso dovrebbero basarsi su ruoli, non su account condivisi. Gli sviluppatori possono necessitare di diritti diversi rispetto a QA, supporto, o fornitori esterni. Gli accessi amministratore sono talvolta necessari, ma dovrebbero essere limitati nel tempo, registrati, e collegati a un'approvazione tracciabile. Anche per gli account di test valgono regole di password sensate, autenticazione a più fattori dove disponibile, e flussi di blocco account in caso di tentativi falliti ripetuti.

I test automatizzati portano un ulteriore caso particolare: generano prove. Screenshot, registrazioni schermo, log, e messaggi di errore possono contenere contenuti sensibili, anche se il database è stato mascherato. Uno screenshot di una maschera cliente, una traccia browser con informazioni di sessione, o un log con payload API appartengono alla stessa considerazione di protezione del database di test.

Per questo gli artefatti di test necessitano di regole di conservazione. Non ogni esecuzione riuscita deve essere memorizzata permanentemente. Per approvazioni critiche può essere sensata un'evidenza tracciabile, ad esempio con timestamp, numero di build, versione test, e risultato. Le esecuzioni fallite necessitano spesso di una finestra di analisi più lunga. Dopo di che, gli artefatti dovrebbero essere eliminati automaticamente. Ciò che non esiste più non può essere condiviso o compromesso per errore.

Automazione senza fughe di dati incontrollate

Il testing automatizzato assistito da IA può accelerare notevolmente i test, specialmente per applicazioni web e Windows estese. Ma cambia la domanda sulla sicurezza: dove vanno screenshot, input, descrizioni degli errori, e traffico applicativo? Chi li elabora? Per quanto tempo rimangono lì?

Per i team attenti alla sicurezza, l'esecuzione self-hosted è spesso l'architettura migliore. Un sistema come COCO può funzionare all'interno della propria infrastruttura, o di una chiaramente delimitata, eseguendo passaggi di test, memorizzando prove, e generando valutazioni comprensibili. Ciò non è obbligatorio in ogni situazione. Per una pagina di marketing pubblica con valori di modulo puramente sintetici, un servizio esterno può essere accettabile. Per applicazioni aziendali interne, portali clienti, o software con operazioni personali, però, il controllo locale è un vantaggio concreto.

L'autohosting non è una scorciatoia senza obblighi. La gestione richiede aggiornamenti, concetti di backup, log di accesso, e un responsabile. In cambio, la sovranità dei dati resta dove appartiene. L'approccio giusto dipende dal fabbisogno di protezione, dalle capacità operative esistenti, e dal tipo di applicazione testata - non dall'hype attuale attorno a un determinato strumento di test.

Come le regole diventano un processo funzionante

Un processo praticabile non deve bloccare il rilascio. Iniziate con una mappa dei dati: quali ambienti di test esistono, quali tipi di dati vi si trovano, e quali sistemi generano ulteriori artefatti? Questa ricognizione scopre di solito già export vecchi, sistemi di staging dimenticati, e responsabilità poco chiare.

Dopodiché conviene una semplice matrice decisionale per classe di test. Stabilisce se bastano dati sintetici, è necessario un mascheramento, o serve un estratto di produzione chiaramente motivato. Viene completata da proprietari, scadenze di cancellazione, e ruoli di accesso. Non deve essere un regolamento appesantito. Una direttiva breve e realmente vissuta è meglio di un documento di sicurezza che nessuno trova durante un'interruzione.

Tecnicamente, la fornitura e la pulizia dei dati appartengono alla pipeline di test. Un'esecuzione crea i propri set di dati necessari in modo riproducibile, usa identificatori univoci, e li rimuove poi di nuovo. Questo impedisce che gli ambienti di test si riempiano di dati residui e che i risultati diventino meno affidabili a ogni sprint. Per i processi critici, i team dovrebbero inoltre verificare se gli accessi ai dati e le prove di test devono essere registrati in modo verificabile.

Sicurezza che rende il test più veloce

Il secure test data management viene spesso considerato un onere di controllo aggiuntivo. Implementato male, può effettivamente esserlo. Implementato bene, però, crea condizioni di partenza affidabili e ripetibili. I team perdono meno tempo a cercare un export di dati utilizzabile, evitano test rotti a causa di dati residui non puliti, e possono giustificare meglio le approvazioni.

Il primo passo più sensato è raramente un grande progetto di piattaforma. Prendete il processo di test con il rischio più alto o l'attrito maggiore - ad esempio l'approvazione di un'applicazione interna per gli ordini - e rendete visibili lì fonte dati, accessi, artefatti, e cancellazione. Da questo lavoro concreto nasce una routine di sicurezza che non rende i test più macchinosi, ma più credibili.

Link permanente →

Warehouse Software vs ERP

Warehouse Software vs ERP

Un'entrata merci arriva contemporaneamente a un prelievo urgente, due dipendenti chiedono l'ubicazione di un articolo, e un documento di trasporto è già stato corretto a mano. È esattamente in momenti così che la domanda Warehouse Software vs ERP diventa concreta. Non si tratta dell'interfaccia più moderna o dell'elenco di funzioni più lungo. Si tratta di sapere se l'informazione è disponibile proprio dove una decisione va presa in pochi secondi.

Molte piccole e medie imprese nell'area DACH iniziano con un ERP, un foglio di calcolo e molta esperienza nel team. Questo può funzionare a lungo. I problemi arrivano quando le giacenze tra i sistemi divergono, i tempi di ricerca aumentano e ogni caso particolare va risolto urlando da un capo all'altro del magazzino. A quel punto si affaccia spesso un grande progetto ERP, anche se magari basterebbe digitalizzare un unico processo di magazzino ben delimitato.

Warehouse Software vs ERP: la differenza nel lavoro quotidiano

Un sistema ERP rappresenta l'azienda nella sua ampiezza. Collega tipicamente acquisti, vendite, anagrafiche articolo, contabilità, produzione, fatturazione e pianificazione. Il suo punto di forza è che i dati commerciali e operativi confluiscono in un'unica cornice condivisa. Un ordine viene creato, una fattura emessa, un fabbisogno pianificato, una giacenza valorizzata.

Il warehouse software, spesso chiamato WMS o gestione di magazzino, lavora più vicino ai movimenti reali all'interno del magazzino. Supporta l'entrata merci, lo stoccaggio, i trasferimenti, il picking, l'inventario, la spedizione e i resi. Risponde a domande che nell'ERP sono spesso rappresentate solo in modo grezzo: in quale ubicazione si trova la merce? Quale giacenza è davvero disponibile? Quale lotto è stato spedito? Quale ordine ha priorità? Chi ha confermato il trasferimento?

Questa distinzione non è assoluta. Esistono ERP con ampie funzioni di magazzino e prodotti WMS collegati a processi d'ordine o di acquisto. Ciò che conta, dunque, non è l'etichetta sull'offerta, ma la profondità operativa. Un ERP può gestire dieci ubicazioni e restare comunque poco pratico se il personale deve aprire più schermate per ogni movimento o registrare i dati solo in seguito.

L'ERP è la fonte commerciale

Quando un ordine va fatturato, un ordine d'acquisto avviato o una valorizzazione dei materiali creata, in molte aziende questo appartiene all'ERP. Lì risiede di solito la logica principale su articoli e clienti. Questo ruolo non andrebbe duplicato con leggerezza. Due sistemi indipendenti per prezzi, codici articolo o ordini non creano sicurezza, ma lavoro di riconciliazione.

Un ERP è particolarmente utile quando la sfida centrale è trasversale ai reparti: acquisti e produzione vanno pianificati insieme, i dati finanziari devono restare coerenti, oppure più società operano con gli stessi processi. Chi non dispone ancora di una base del genere non dovrebbe aspettarsi che una soluzione di solo magazzino sostituisca tutti i processi aziendali.

Il warehouse software governa il movimento

In magazzino, però, non conta solo ciò che teoricamente risulta nel sistema. Conta ciò che è appena arrivato al cancello tre, quale scaffale è libero e se la merce è stata riservata per un ordine confermato. Una buona soluzione di magazzino riduce l'attrito esattamente in questi punti.

Può iniziare con scanner mobili: la merce viene scansionata all'entrata merci, assegnata a un'ubicazione e segnalata subito come disponibile. Durante il picking, il sistema guida attraverso una sequenza sensata, verifica articolo e quantità e genera, se necessario, etichette di spedizione o documenti di consegna. La registrazione non avviene ore dopo a una scrivania d'ufficio, ma all'interno del processo stesso.

Il vantaggio non sta solo nella velocità. Le registrazioni tracciabili rendono visibili gli errori. Se una giacenza non torna, si può stabilire quando è mancato un movimento o quando è stato confermato in modo errato. È molto più solido di una correzione mensile su un foglio di calcolo.

Quando basta un modulo ERP

Un modulo ERP già presente può essere la scelta giusta quando l'organizzazione del magazzino è contenuta e il team riesce a lavorare in modo affidabile con i processi esistenti. Un unico magazzino, ubicazioni fisse, poche righe d'ordine e nessun requisito rigido di lotto o numero di serie sono condizioni tipiche. Anche con volumi di spedizione ridotti, un componente di sistema aggiuntivo può richiedere più manutenzione di quanto renda.

Prima di acquistare un nuovo sistema, conviene un test onesto: un dipendente riesce a registrare completamente un'entrata merci, un trasferimento e una spedizione senza foglietti di appunti? La giacenza per ubicazione è visibile? Le differenze di un inventario sono ricostruibili? I documenti vengono generati senza doppia digitazione? Se la risposta è per lo più sì, un ampliamento potrebbe non essere urgente.

Anche il foglio di calcolo può restare, se assolve in modo pulito a uno scopo limitato, ad esempio una pianificazione stagionale della capacità o un'analisi una tantum. Una buona soluzione non sostituisce ogni modo di lavorare consolidato. Sostituisce quei passaggi manuali in cui errori, tempi di attesa o mancanza di trasparenza costano davvero denaro.

Quando una soluzione di magazzino specializzata diventa sensata

Il punto di svolta arriva quasi sempre per gradi. Prima un dipendente chiede più spesso di un articolo. Poi le giacenze vengono tenute più alte per precauzione, perché nessuno conosce con certezza la disponibilità reale. Infine le spedizioni si ritardano, perché documenti di trasporto, etichette e correzioni di giacenza passano per strumenti diversi.

Un warehouse software specializzato diventa particolarmente sensato quando più di queste condizioni si presentano insieme:

  • si gestiscono più aree di magazzino, ubicazioni o magazzini esterni
  • entrate merci, trasferimenti e picking avvengono ogni giorno in numero elevato
  • occorre tracciare lotti, numeri di serie, scadenze o giacenze bloccate
  • corrieri, stampanti di etichette o scanner mobili vanno integrati nel processo
  • la realtà operativa si discosta sempre più spesso da ciò che mostra l'ERP

L'elenco non è una raccomandazione d'acquisto automatica. Un'azienda con molte righe d'ordine può lavorare bene con un ERP ben configurato. Al contrario, una piccola azienda può avere presto bisogno di un'applicazione di magazzino snella se ogni pezzo deve essere tracciabile o più team devono registrare contemporaneamente.

Il problema dell'integrazione conta spesso più delle funzioni

La domanda più difficile in Warehouse Software vs ERP raramente è: quale sistema sa fare di più? La domanda migliore è: quali dati devono fluire, quando, verso quale sistema?

In molti casi l'ERP resta la fonte principale per articoli, clienti, ordini e documenti commerciali. L'applicazione di magazzino si occupa dell'esecuzione operativa. Riceve gli ordini rilasciati, esegue i movimenti di magazzino e restituisce stato, quantità, lotti o numeri di spedizione. In questo modo ogni parte ha un compito chiaro.

Questa interfaccia ha bisogno di regole concrete. Cosa succede a una modifica d'ordine dopo che il picking è già iniziato? Una giacenza può diventare negativa? Quale registrazione vale in caso di interruzione di rete? Come vengono bloccati gli articoli che risultano non conformi al controllo qualità? Senza queste decisioni, anche un'API tecnicamente pulita diventa una nuova fonte di errori.

Per le piccole e medie imprese, un rollout graduale è spesso più ragionevole di un cambio completo. Si può introdurre prima l'entrata merci con scansioni barcode. Seguono poi ubicazioni e trasferimenti, in seguito picking e spedizione. Così le eccezioni reali emergono presto, senza scommettere l'intera operatività su un unico giorno di passaggio.

Prodotto standard, ampliamento dell'ERP o applicazione su misura?

Un WMS standard conviene quando i propri processi sono in gran parte convenzionali e un'integrazione esistente si adatta all'ERP. Porta rapidamente in azienda funzioni collaudate. Il prezzo può essere che i team debbano adattare i propri flussi a schemi fissi, o pagare per funzioni enterprise usate di rado.

Ampliare l'ERP ha senso quando la profondità operativa necessaria è davvero disponibile e l'uso funziona sul pavimento del magazzino. Non va valutata solo la demo del prodotto, ma un flusso reale con scanner, guanti, Wi-Fi incostante e pressione del tempo prima della partenza.

Un'applicazione su misura diventa interessante quando il processo sostiene il vantaggio competitivo dell'azienda, oppure il software standard impone deviazioni permanenti. Può trattarsi di un processo di entrata merci particolare, di un collegamento tra officina e magazzino, di documenti di trasporto speciali o di una logica di giri propria. In quel caso la soluzione non dovrebbe essere resa artificialmente grande. Un processo chiaro, modellato con cura e realizzato su una base tecnica manutenibile, vale più di una piattaforma che teoricamente può fare tutto.

softify.pro sviluppa sistemi di questo tipo lungo movimenti e responsabilità concrete: dall'entrata merci alle registrazioni di magazzino fino ai documenti di spedizione. Modello dati, permessi, casi di errore e manutenzione successiva restano parte della realizzazione, non compiti da affrontare prima o poi dopo il go-live.

Domande da mettere sul tavolo prima della decisione

Non ogni esigenza va automatizzata il primo giorno. Ma va decisa consapevolmente. I responsabili dovrebbero chiarire con il team di magazzino, le vendite e la contabilità quali dati sono principali, quali errori si presentano oggi più spesso e quali indicatori serviranno davvero in seguito. Una bella panoramica delle giacenze aiuta poco se nessuno sa se le quantità riservate, bloccate e disponibili vengono trattate in modo diverso.

Altrettanto importante è la responsabilità sulle anagrafiche. I processi di magazzino raramente falliscono per un pulsante mancante. Falliscono per codici articolo incoerenti, unità di misura non curate e regole non chiarite per articoli sostitutivi o conversioni di unità. Il software può rendere visibili questi problemi. Ma non può risolverli senza decisioni prese all'interno dell'azienda.

La scelta giusta non è quindi automaticamente ERP o warehouse software. Nasce dalla distanza tra il vostro processo attuale e quello che il team deve effettivamente eseguire in modo affidabile. Iniziate da un movimento che oggi costa tempo o genera errori, e verificate quale sistema rappresenta quel movimento nel modo più chiaro, veloce e tracciabile.

Link permanente →

Automatizzare l'entrata merci

Automatizzare l'entrata merci

Un camion è fermo al cancello, due dipendenti controllano i documenti di trasporto, e l'elenco delle giacenze si trova ancora sul computer in ufficio. È esattamente qui che la domanda how to automate goods receiving comincia a diventare concreta. Non perché ogni magazzino abbia bisogno di una grande implementazione ERP. Ma perché un'entrata merci mancante, in ritardo o registrata in modo errato ha conseguenze: le giacenze non tornano, gli ordini aspettano, i reclami diventano difficili da ricostruire e il turno inizia con richieste di chiarimento.

Automatizzare l'entrata merci non significa sostituire le persone con degli scanner. Significa gestire controlli, registrazioni e documenti ricorrenti in modo che il team al cancello possa decidere rapidamente e che la giacenza risulti poi affidabile. Per le piccole e medie imprese, un flusso snello e adatto è di solito più prezioso di un sistema per grandi gruppi pieno di funzioni che nessuno usa.

Cosa si perde davvero con l'entrata merci manuale

I documenti di trasporto cartacei e i fogli Excel funzionano spesso abbastanza a lungo da far rimandare un investimento. Il problema non nasce dal singolo cartone. Nasce quando le difformità si accumulano: una consegna parziale viene annotata solo più tardi, un lotto non è riconducibile, un pallet finisce nell'area sbagliata oppure la registrazione dell'entrata merci avviene solo a fine giornata.

A quel punto esistono più verità contemporaneamente. Il fornitore segnala la consegna. In magazzino la merce c'è fisicamente. La pianificazione non vede ancora giacenza disponibile. La contabilità ha un documento, ma nessuna conferma su quantità o danni. I collaboratori riconciliano queste informazioni per telefono, e-mail ed esperienza. Questo costa tempo e rende il processo dipendente da singole persone.

L'automazione crea un'unica fonte condivisa e tempestiva per l'operazione. Registra non solo la giacenza teorica, ma anche ciò che è realmente accaduto al cancello: chi ha ricevuto, quando, in che quantità, con quale difformità e dove va poi la merce.

How to automate goods receiving con un flusso chiaro

Il punto di partenza giusto non è la scelta di uno scanner o di un'app di magazzino. Prima di tutto deve diventare visibile il processo reale. Percorrete un'entrata merci tipica, dalla data di consegna annunciata fino allo stoccaggio. Osservate anche i casi particolari, perché sono loro a determinare se una soluzione regge nella quotidianità.

Un flusso digitale è composto solitamente da cinque decisioni consecutive. La consegna viene identificata, verificata rispetto all'ordine o all'arrivo atteso, la quantità effettiva viene registrata, le difformità vengono documentate e la merce viene assegnata a un'ubicazione o a un ulteriore controllo. Ogni passaggio dovrebbe richiedere solo i dati necessari in quel punto.

1. Predisporre in anticipo le consegne attese

Se esistono ordini d'acquisto, ordini di produzione o avvisi di spedizione, il magazzino dovrebbe poterli vedere prima dell'arrivo. All'arrivo, la persona responsabile sceglie il fornitore, scansiona un numero d'ordine o cerca una consegna aperta. Il sistema mostra gli articoli attesi, le quantità ed eventualmente lotti o numeri di serie.

Questo accorcia notevolmente l'accettazione. Ma ancora più importante è la logica di controllo: il team non deve decidere a memoria se 18 cartoni invece di 20 siano accettabili. La difformità diventa visibile e può essere motivata. Per le consegne non annunciate, il flusso ha bisogno di un percorso controllato, per esempio come entrata merci provvisoria con sblocco da parte degli acquisti o della pianificazione.

2. Usare i codici a barre dove fanno risparmiare tempo

Uno scanner di codici a barre o la fotocamera di un dispositivo mobile robusto sono per molti magazzini il punto di partenza più sensato. Una scansione riduce gli errori di digitazione e accelera i movimenti ricorrenti. La condizione, però, è che codici articolo, unità di imballaggio ed etichette siano gestiti in modo coerente. Uno scanner non risolve anagrafiche poco chiare.

Non ogni merce ha bisogno del tracciamento per numero di serie. Per viti o materiale di consumo standard bastano spesso articolo, quantità e ubicazione. Per ricambi in garanzia, prodotti regolamentati o componenti destinati alla produzione, lotto, numero di serie, scadenza e stato di controllo possono essere obbligatori. La profondità di rilevazione dovrebbe corrispondere al rischio, non a un modello software generico.

3. Trattare le difformità come processo normale

Una buona entrata merci digitale non cerca di impedire ogni difformità. La rende semplice e dimostrabile da gestire. Ammanchi, sovraconsegne, danni da trasporto, articoli sbagliati e lotti bloccati hanno bisogno di stati chiari invece di note scritte a mano sul documento di trasporto.

In caso di consegna danneggiata, per esempio, si può scattare una foto direttamente al punto di accettazione, registrare la quantità come bloccata e informare automaticamente l'ufficio acquisti. La giacenza disponibile resta corretta, mentre la merce entra fisicamente in una zona di quarantena. Questo evita che parti danneggiate vengano prelevate per errore o usate in produzione.

La regola non deve essere sempre completamente automatica. Per piccole quantità, una sovraconsegna può essere accettata direttamente. Per articoli costosi o rilevanti per la sicurezza dovrebbe essere richiesto uno sblocco. Queste soglie appartengono al processo e devono restare modificabili in seguito.

4. Avviare subito lo stoccaggio

Un'accettazione è operativamente completa solo quando è chiaro dove si trova la merce o perché non può ancora essere stoccata. Il sistema può proporre un'ubicazione fissa, privilegiare una zona di riassortimento oppure determinare un'area di destinazione in base a gruppo merceologico, intervallo di temperatura e capacità disponibile.

Per magazzini di dimensioni gestibili spesso basta una logica di ubicazione chiara con poche zone. Un'ottimizzazione complessa dei percorsi ha senso solo se volumi, percorsi e struttura del personale la giustificano. Chi riceve dieci pallet al giorno non ha bisogno di un progetto di ottimizzazione che duri più del tempo che fa risparmiare. Una scansione affidabile dell'ubicazione è spesso il progresso maggiore.

Dopo lo stoccaggio il sistema aggiorna giacenza e registro dei movimenti. Vendite, pianificazione o produzione vedono così lo stato senza dover chiedere al magazzino. Se un articolo può diventare disponibile solo dopo un controllo qualità, il sistema separa la giacenza fisica da quella disponibile.

Quali dati servono davvero all'entrata merci

Un processo digitale diventa rapidamente sgradito se al cancello richiede troppi campi. Allo stesso tempo, senza un minimo di dati mancano le prove per i chiarimenti successivi. Nella maggior parte delle aziende di medie dimensioni sono utili queste informazioni:

  • Fornitore e riferimento all'ordine o al documento di trasporto
  • Articolo, quantità accettata e unità di imballaggio
  • Data e ora, nonché persona responsabile
  • Ubicazione o stato come controllo, giacenza bloccata o quarantena
  • Motivo della difformità, foto e sblocco se necessario

Campi aggiuntivi dovrebbero essere obbligatori solo se consentono una decisione concreta. Se il lotto è obbligatorio, il suo numero non è un'aggiunta, ma un'informazione centrale. Un commento libero per ogni consegna, al contrario, viene spesso compilato solo per far sembrare completo un modulo.

L'integrazione decide su beneficio e impegno

L'entrata merci non deve diventare una nuova soluzione isolata accanto ad acquisti, produzione e contabilità. Almeno le anagrafiche articolo, gli ordini aperti e le variazioni di giacenza devono essere scambiati in modo affidabile. Se questo avviene tramite un'interfaccia ERP esistente, importazioni dati o un processo intermedio sviluppato appositamente, dipende dal panorama di sistemi già presente.

Con sistemi ERP più datati, un'integrazione completa in tempo reale non è sempre economicamente vantaggiosa. Un import verificato a intervalli fissi può essere del tutto sufficiente se quantità e scadenze lo consentono. Per i ricambi destinati subito a ordini urgenti, invece, conta di più una registrazione tempestiva. Qui la tecnica segue il ritmo del business.

Anche l'operatività rientra nella pianificazione. I dispositivi hanno bisogno di account utente, ruoli chiari e un comportamento definito in caso di interruzione di rete. Un'entrata merci mobile non deve necessariamente funzionare offline. Ma se le interruzioni Wi-Fi sono frequenti, un buffer locale con sincronizzazione tracciabile non è un lusso, è parte dell'affidabilità del processo.

Introduzione a piccoli passi invece del big bang

Iniziate con un fornitore, un gruppo merceologico o un'area di magazzino chiaramente delimitata. Misurate non solo la durata per registrazione, ma anche le rilavorazioni, le differenze non chiarite e le richieste tra magazzino e ufficio. Da qui emerge se l'automazione alleggerisce davvero il lavoro.

Formate con documenti di trasporto reali di tutti i giorni, comprese consegne danneggiate o incomplete. Un processo che funziona solo con una consegna perfettamente conforme non è automazione, è una dimostrazione. I collaboratori dell'entrata merci dovrebbero poter contribuire a definire le regole, perché conoscono le eccezioni.

softify.pro sviluppa questi flussi in modo deliberatamente specifico per il workflow: dalla scansione mobile al movimento di magazzino documentato, fino a un collegamento stabile con i sistemi esistenti. Ciò che conta non è l'elenco di funzioni più lungo, ma un sistema che resta tracciabile sotto pressione di tempo e che può essere gestito e mantenuto tecnicamente.

Il passo successivo migliore non è quindi un confronto tra software, ma un'ora dedicata a osservare le ultime dieci consegne problematiche. Se per ciascuna di esse riuscite a dire dove si è perso tempo e quale informazione mancava, la prima bozza per un'entrata merci migliore è già pronta.

Link permanente →

Vantaggi del picking con codice a barre per magazzini piccoli e medi

Vantaggi del picking con codice a barre per magazzini piccoli e medi

Un articolo sbagliato nella scatola raramente costa solo il prezzo del reso. Occupa tempo in magazzino, genera richieste di chiarimento in ufficio e, nel peggiore dei casi, danneggia il rapporto con il cliente. Per questo i vantaggi del picking con codice a barre non emergono prima in un indicatore tecnico, ma in un'area spedizioni più tranquilla: i collaboratori sanno qual è il passo successivo e le anomalie vengono notate là dove nascono.

Per i magazzini di piccole e medie dimensioni questo è particolarmente rilevante. Molti processi funzionano inizialmente con liste cartacee, file Excel, indicazioni a voce e l'esperienza di singole persone. Non è sbagliato di per sé. Con volumi contenuti, un foglio di calcolo può essere persino lo strumento più sensato. Ma quando crescono la varietà di articoli, il numero di ordini, i cambi turno o i requisiti di tracciabilità, la soluzione provvisoria pragmatica diventa rapidamente una fonte di errori.

Cosa cambia il picking con codice a barre nel lavoro quotidiano

Nel picking con codice a barre una scansione non conferma soltanto che qualcuno ha fatto qualcosa. Collega ordine, ubicazione, articolo e quantità in un passaggio di lavoro tracciabile. Il sistema indica il prelievo successivo, il collaboratore scansiona ubicazione e articolo, inserisce la quantità se necessario e riceve subito un riscontro.

L'ordine dei controlli è decisivo. Se un collaboratore scansiona prima l'articolo e solo dopo l'ubicazione, il sistema può sì riconoscere un articolo sbagliato, ma non può evitare un percorso sfavorevole. Nella pratica si rivela spesso efficace la sequenza ubicazione, articolo, quantità. Nei processi con lotti, numeri di serie o data di scadenza si aggiungono ulteriori controlli. Quali siano necessari dipende dal rischio, non da ciò che sarebbe tecnicamente possibile.

Un buon sistema non sostituisce un'organizzazione sensata del magazzino. Rende però visibile quando questa organizzazione non viene rispettata nell'operatività quotidiana. Se la merce si trova in un'ubicazione non prevista, l'errore non viene scoperto solo all'inventario, ma al momento della scansione.

I principali vantaggi del picking con codice a barre: meno scambi proprio dove nascono

Le liste cartacee richiedono concentrazione costante: leggere il codice articolo, trovare il vano, confrontare la confezione, spuntare la quantità. Sotto pressione bastano scatole simili, descrizioni quasi identiche o un'attività interrotta per causare un errore. Il codice a barre porta un'identificazione univoca proprio in quel momento.

Lo scanner non sostituisce il ragionamento, ma si fa carico del controllo che le persone faticano di più a mantenere costante nel lavoro di routine. Se l'articolo non corrisponde all'ordine, il riscontro deve essere chiaro: articolo sbagliato, articolo atteso, prossimo passo sensato. Un semplice segnale rosso serve a poco se non è chiaro come risolvere l'anomalia.

Le registrazioni rendono le giacenze più affidabili

Le giacenze sono utili solo se possono sostenere decisioni. Chi pianifica i riordini, conferma date di consegna o mette a disposizione materiale per la produzione ha bisogno di più di un numero della settimana scorsa. Se i prelievi vengono trascritti da una lista solo a fine turno o a posteriori, si creano finestre temporali con dati poco chiari.

Una scansione può registrare subito il prelievo. In questo modo si riduce la differenza tra movimento fisico e giacenza digitale. Ciò non significa che ogni numero sia automaticamente corretto. Merce etichettata male, trasferimenti non registrati e scorte danneggiate restano temi reali. Ma le cause si possono circoscrivere molto meglio, perché ogni movimento ha un orario, un ordine ed eventualmente un riferimento all'utente.

Questo è particolarmente utile nei processi di rifornimento. Se un vano scende sotto la scorta prevista, il sistema può generare un ordine di rifornimento o almeno renderlo visibile. Gli addetti al picking non devono così cercare merce sostitutiva nel mezzo di un ordine, mentre il cliente attende la sua spedizione.

Formazione più rapida senza dipendere dal sapere di singoli

Il personale di magazzino esperto conosce a memoria percorsi, casi particolari e aspetto degli articoli. Questo sapere è prezioso, ma rischioso se è l'unico sistema operativo. Con ferie, malattie o crescita, i team vanno sotto pressione quando i nuovi collaboratori devono prima imparare per settimane quale fila di scaffali corrisponde a una sigla interna.

Una buona interfaccia mobile guida attraverso l'ordine con un linguaggio comprensibile. Mostra ubicazione, articolo, quantità prevista e, se necessario, un'immagine o indicazioni sulla confezione. La scansione conferma il passaggio. I nuovi colleghi non diventano subito esperti, ma possono collaborare in sicurezza molto prima.

Lo stesso vale per il personale temporaneo e i turni variabili. Il presupposto è che i dati anagrafici siano curati. Un sistema non può ricavare istruzioni chiare da una descrizione articolo come «pezzo piccolo blu nuovo». La digitalizzazione mette in luce queste debolezze - ed è spesso proprio questo un utile effetto collaterale.

Tracciabilità in caso di reclami e inventari

Quando un cliente segnala una quantità mancante, senza dati di processo inizia spesso una ricerca tra pile di carta, liste di spedizione e ricordi. Con le registrazioni tramite codice a barre è possibile verificare quale ordine è stato evaso e quando, quale riga è stata confermata e se c'è stata una correzione o una quantità parziale.

Non è una garanzia contro i reclami. Ma accorcia i chiarimenti e separa le supposizioni dai fatti. Ne beneficiano anche gli inventari: le differenze non si possono solo contare, ma anche analizzare sulla base dei movimenti. Se le correzioni si accumulano in un determinato vano, in un gruppo di articoli o dopo un determinato passaggio di consegne nel processo, emerge un punto di partenza concreto per i miglioramenti.

Processi misurabili invece di sensazioni

Molti magazzini sanno che «il pomeriggio si fa stretto» o che certi ordini richiedono un tempo insolitamente lungo. Senza marcature temporali e fasi di processo resta una sensazione. Se vengono registrati inizio del prelievo, scansione, interruzione, completamento e consegna, i colli di bottiglia si possono distinguere con precisione.

Forse non è lento il picking, ma la merce viene stoccata troppo tardi. Forse si creano tempi di attesa alla postazione di imballaggio o un singolo vano viene raggiunto in modo sproporzionato. Questi dati non vanno fraintesi come strumento di controllo generalizzato delle prestazioni. Il loro valore sta anzitutto nel riconoscere percorsi inutili, rifornimenti mancanti e passaggi di consegne poco chiari.

Il beneficio dipende dalla progettazione del processo

Il picking con codice a barre non è fine a se stesso e non ogni magazzino ha bisogno di un software di gestione magazzino completo. Con pochi ordini, un assortimento ridotto e personale fisso, un processo ben gestito con liste semplici può essere più economico. Un progetto ha senso quando i costi di prelievi errati, tempi di ricerca, incertezza sulle giacenze o rilavorazioni manuali si fanno sentire regolarmente.

Anche la questione hardware merita una valutazione lucida. Uno smartphone con scansione tramite fotocamera può bastare per i primi processi. Con un'alta frequenza di scansione, guanti, scarsa illuminazione o ambienti difficili, gli scanner portatili dedicati sono di solito più veloci e meno soggetti a errori. Decisiva è inoltre la copertura di rete. Se il Wi-Fi viene meno in una zona del magazzino, l'applicazione ha bisogno di una strategia chiara: buffer offline con sincronizzazione successiva oppure un processo che non gestisca quell'area da dispositivo mobile.

La qualità delle etichette è importante quanto il software. Un codice a barre su un cartellino di vano consumato o un identificativo articolo assegnato due volte compromette l'intero processo. Prima dell'avvio occorre etichettare le ubicazioni in modo univoco, definire le unità e chiarire i casi particolari critici: come si gestisce una confezione aperta? Cosa succede in caso di mancanza a magazzino? Chi può correggere una quantità? Cosa succede alla merce senza codice leggibile?

Come introdurlo senza interrompere l'operatività

L'ingresso più affidabile raramente è il passaggio completo. Iniziate con un'area ben delimitata, ad esempio gli ordini di spedizione più frequenti o un gruppo di articoli con molti scambi. Lì sequenza di scansione, messaggi di errore ed etichette si possono verificare nell'operatività reale, senza trasformare contemporaneamente l'intero sito.

Prima dell'implementazione tecnica va rilevato il percorso reale di un ordine - dall'acquisizione dell'ordine attraverso la prenotazione e il prelievo fino alla postazione di imballaggio e all'etichetta di spedizione. Non conta il processo ideale di un organigramma, ma il flusso che il turno utilizza davvero. Spesso i requisiti più preziosi si trovano nelle piccole eccezioni: ordini cumulativi, articoli sostitutivi, prelievi parziali o la restituzione di merce non necessaria.

Servono poi regole chiare per le eccezioni. Un collaboratore deve poter segnalare una mancanza a magazzino senza aggirare informalmente l'ordine. Una persona autorizzata deve poter effettuare correzioni in modo tracciabile. E se esistono interfacce verso shop, ERP o corriere, stato dell'ordine e registrazioni di magazzino devono essere definiti con chiarezza. La doppia gestione dei dati è un segnale d'allarme, non una soluzione permanente.

Per i sistemi su misura softify.pro parte proprio da questo punto: non con un pacchetto enterprise sovraccarico, ma con le fasi di scansione e registrazione dimostrabilmente necessarie per quel concreto magazzino. Una base dati manutenibile, interfacce chiaramente documentate e schermate comprensibili valgono più di un lungo elenco di funzioni usate di rado.

Un primo punto di verifica sensato

Prendete dieci ordini tipici e seguiteli dall'arrivo fino alla consegna alla spedizione. Annotate in quali punti i collaboratori devono cercare, chiedere, inserire dati in un secondo momento o affidarsi alla memoria. È proprio lì che si decide se il picking con codice a barre porta vantaggi - e quale processo di scansione si adatta davvero al magazzino.

Link permanente →

Testing self-hosted vs cloud

Testing self-hosted vs cloud

Un test di regressione fallito raramente è solo una voce rossa nella dashboard. Può significare che una maschera di spedizione nel magazzino genera etichette errate, un portale clienti smette di accettare ordini, o un'applicazione Windows si blocca durante il passaggio di turno. La domanda self hosted testing vs cloud non riguarda quindi l'infrastruttura come fine a sé stessa. Riguarda quali dati un processo di test tocca, chi lo controlla, e quanto affidabilmente funziona in condizioni operative reali.

Le piattaforme di test basate su cloud possono essere operative rapidamente. Per molti team è sensato, specialmente quando testano un'applicazione web pubblica e necessitano capacità di esecuzione aggiuntiva a breve termine. Gli ambienti di test self-hosted, al contrario, richiedono una configurazione tecnica consapevole. Ma restituiscono all'azienda il controllo su dati di test, percorsi di rete, diritti di accesso, e gestione operativa. La scelta giusta non dipende da un principio generale, ma dall'applicazione, dal rischio, e dalla capacità operativa disponibile.

Self Hosted Testing vs Cloud: Di cosa si tratta davvero

Il dibattito viene spesso ridotto troppo ai costi iniziali. Una soluzione cloud sembra più economica perché non serve procurare server né allestire un ambiente. Un server di test dedicato sembra a prima vista più impegnativo, perché sistema operativo, aggiornamenti, controllo degli accessi, monitoraggio, e backup devono essere pianificati.

Questo calcolo è insufficiente. Decisivi sono i costi correnti di una strategia di test: tempi di attesa prima dei rilasci, ricerca di errori dopo esecuzioni di test incomplete, coordinamento con protezione dati e sicurezza informatica, nonché le conseguenze di un deployment difettoso. Se un team esamina regolarmente applicazioni aziendali sensibili, il carico organizzativo aggiuntivo di servizi esterni può superare la gestione di un ambiente proprio chiaramente delimitato.

Anche "cloud" non è un modello uniforme. Alcuni fornitori memorizzano solo log di test, altri elaborano screenshot, registrazioni video, credenziali, contenuti DOM, o traffico di rete. Con il testing assistito da IA, dati immagine e testo possono inoltre raggiungere modelli esterni o subappaltatori per la valutazione. Chi guarda solo alla posizione di un data center spesso trascura la domanda più importante: quali dati lasciano davvero la propria zona di controllo, e quali regole contrattuali e di cancellazione si applicano?

Quando il testing in cloud è la scelta sensata

Il testing in cloud non è fondamentalmente un problema di sicurezza, e il self-hosting non è automaticamente l'architettura migliore. Per un nuovo negozio online pubblicamente raggiungibile o una piattaforma di marketing, un ambiente cloud può essere molto adatto. Il team può coprire rapidamente varianti di browser e dispositivo senza mantenere proprie macchine di esecuzione. In caso di carico di test fluttuante, anche la scalabilità elastica è un vantaggio reale.

Anche piccoli team di sviluppo con pochi dati di test chiaramente anonimizzati beneficiano spesso di un servizio gestito. Non dovrebbero investire il loro tempo nella gestione di una piattaforma quando il collo di bottiglia sta piuttosto in casi di test mancanti, criteri di accettazione poco chiari, o dati di test instabili. Un server proprio non risolve questi problemi.

Il cloud si adatta particolarmente bene quando l'applicazione non necessita accessi di rete interni, nessun dato personale o critico per il business compare nei flussi di test, e un breve tempo di avvio è più importante di un controllo profondo dell'infrastruttura. Il presupposto è una configurazione accurata: account di test separati, nessun dato cliente reale, token limitati, periodi di conservazione tracciabili, e un chiaro concetto di diritti.

Quando il testing self-hosted diventa più sensato

Diversa è la situazione per applicazioni raggiungibili solo nella rete aziendale o che rappresentano processi operativi centrali. Un software di magazzino o produzione elabora spesso movimenti articoli, indirizzi di consegna, giacenze, numeri seriali, e logica dei prezzi. Un'esecuzione di test può generare screenshot di maschere d'ordine, scaricare documenti, o accedere con ruoli utente. Tali dati non dovrebbero essere distribuiti inosservatamente su più sistemi esterni.

Il testing self-hosted consente di posizionare l'esecuzione dei test vicino all'applicazione. Il server di test può funzionare nello stesso segmento di rete o in una DMZ controllata. Le regole del firewall vengono impostate mirate, le applicazioni interne non devono essere aperte per un servizio esterno, e i log rimangono sotto la propria amministrazione. Ciò è spesso particolarmente rilevante per le applicazioni desktop Windows, poiché raramente sono progettate per piattaforme di test esterne.

Per settori regolamentati, requisiti clienti più ampi, o direttive di sicurezza interne, questa architettura è spesso più facilmente verificabile. Ciò non significa che ogni verifica venga automaticamente superata. Anche un server proprio necessita gestione delle patch, crittografia, diritti dei ruoli, backup, e procedure operative documentate. La differenza sta nel fatto che l'azienda prende queste decisioni autonomamente e può dimostrarle.

Presso softify.pro, COCO è quindi concepito come server IA dedicato e self-hosted: le esecuzioni di test per applicazioni web e Windows vengono eseguite localmente, i riscontri registrati, e i risultati valutati in linguaggio comprensibile. Ciò non sostituisce l'approvazione da esperti di dominio. Ma garantisce che traffico di test, screenshot, e valutazioni possano rimanere dove l'azienda mantiene la sovranità sui dati.

Confrontare correttamente i costi: gestione contro attrito

Un confronto sensato comprende più del prezzo di licenza contro prezzo hardware. Nel cloud sorgono canoni ricorrenti per utenti, minuti di test, esecuzioni parallele, o consumo IA. Questi costi sono inizialmente pianificabili, ma possono aumentare notevolmente con la crescente copertura dei test. A ciò si aggiungono possibili spese per contratti enterprise, accordi sul trattamento dati, e verifiche di sicurezza.

Con il self-hosting sorgono investimenti per infrastruttura e allestimento. Ciò include eventualmente macchine virtuali, storage, accesso di rete, monitoraggio, e il tempo di un team tecnicamente responsabile. Questi costi rimangono anche quando pochi test sono in esecuzione. Per un progetto con rilasci rari, questo è un buon argomento contro una soluzione propria sovradimensionata.

Con test di regressione regolari, il quadro cambia. Se ogni settimana devono essere verificati gli stessi flussi critici per il business, capacità interne calcolabili sono spesso più economiche di costi variabili della piattaforma e cicli di approvazione manuali. L'approccio diventa particolarmente prezioso quando i casi di test vengono utilizzati per anni e sviluppati insieme all'applicazione aziendale. La manutenibilità diventa allora più importante di un avvio rapido ma difficilmente controllabile.

La qualità non dipende dal modello di hosting

Un equivoco comune afferma: i test in cloud sarebbero automaticamente più moderni, i test self-hosted automaticamente più stabili. Nessuno dei due è vero. La qualità dei test nasce da scenari sensati, dati di test robusti, identificatori stabili nell'interfaccia, e aspettative chiare sul risultato.

Un test non dovrebbe solo verificare se un pulsante è cliccabile. Per un'elaborazione ordini può, ad esempio, creare un ordine, verificare una quantità disponibile, generare un documento di trasporto, e assicurare che il ruolo corretto possa approvare l'operazione. Per un programma desktop può verificare l'importazione di un file, la gestione degli errori, e l'output di un documento. Solo tali flussi end-to-end mostrano se una modifica ha danneggiato il processo reale.

L'IA può aiutare a riconoscere cambiamenti dell'interfaccia, documentare i passaggi in modo comprensibile, e priorizzare le anomalie. Non dovrebbe però diventare una black box. I team necessitano screenshot o altri riscontri, passaggi di test tracciabili, e soglie definite per quando un risultato conta come superato, incerto, o fallito. Proprio nelle verifiche visive una soglia di confidenza è sensata, affinché piccole deviazioni di layout attese non blocchino ogni rilascio.

Le domande operative prima della decisione

Prima che un team si impegni, dovrebbe tracciare concretamente il percorso di un'esecuzione di test. Dove viene eseguito il test? A quali sistemi si autentica? Quali dati vede? Dove vengono memorizzati screenshot, log, e report? Chi può leggere, cancellare, o esportare i risultati? Queste domande sono più pratiche di una decisione generale a favore o contro il cloud.

Altrettanto importante è la responsabilità dopo il go-live. Chi aggiorna browser e agenti di test? Chi reagisce quando un certificato scade? Come vengono ruotate le credenziali? E come si garantisce che un test non inneschi accidentalmente una vera registrazione di spedizione o notifica cliente? Una buona automazione dei test necessita ambienti separati e meccanismi di protezione, non solo buoni script.

Un modello ibrido può essere sensato. Interfacce pubbliche e verifiche browser ampiamente distribuite girano nel cloud, mentre i processi aziendali interni rimangono su un server di test proprio. Ciò riduce l'onere operativo, senza cedere all'esterno in blocco flussi sensibili. Il presupposto è un confine chiaro tra i due ambiti, non una gestione mista confusa.

La decisione migliore è quella che si adatta al rischio effettivo e alla realtà operativa propria. Se un foglio di calcolo sostiene ancora affidabilmente un processo, non deve diventarne un grande sistema. Se invece dati di test e applicazioni interne appartengono al nucleo aziendale, il controllo non è un lusso, ma un requisito oggettivo per un software affidabile.

Link permanente →

Inventory Management in magazzino

Inventory Management in magazzino

Un pezzo mancante raramente emerge durante il conteggio in magazzino. Di solito si manifesta solo quando un ordine non può essere imballato, un tecnico si trova davanti a uno scaffale vuoto, o l'ufficio acquisti cerca per telefono una conferma di consegna. Un buon Inventory Management non previene queste sorprese con più tabelle, ma con un'immagine affidabile di ciò che è disponibile, dove si trova, e cosa succede dopo.

Per le piccole e medie imprese non si tratta di avere il sistema ERP più grande possibile. Ciò che conta è se il personale nel ricevimento merci, magazzino, e spedizione può lavorare con pochi passaggi chiari - anche sotto pressione di tempo, durante i cambi turno, e quando una consegna non va come previsto.

L'Inventory Management inizia con i movimenti, non con gli elenchi di giacenze

Un elenco di giacenze è una fotografia istantanea. Può essere corretto e comunque essere poco utile se nessuno riesce a capire perché una quantità è cambiata. Un sistema resiliente tratta quindi le giacenze come conseguenza di movimenti documentati: la merce arriva, viene controllata, stoccata, riservata, prelevata, spostata, spedita, o corretta.

Ogni movimento necessita di un motivo chiaro, un momento temporale, una persona responsabile, e idealmente un collegamento a una transazione specifica. Può trattarsi di un ordine d'acquisto, un ordine cliente, un documento di trasporto, o un ordine di produzione. Ciò trasforma la cifra "24 pezzi disponibili" in un'affermazione verificabile: 30 unità sono state registrate, quattro sono riservate per due ordini, e nessuno spostamento aperto altera la giacenza disponibile.

Questa distinzione è particolarmente rilevante per pezzi scarsi. Fisicamente presente, riservato, e liberamente disponibile sono tre stati diversi. Se vengono mescolati, le vendite promettono merce che il magazzino necessita già per un altro ordine. Se vengono tenuti separati, un team può decidere presto: riordinare, ripriorizzare, o dare al cliente una risposta realistica.

Dove i processi manuali tipicamente si rompono

I fogli di calcolo non sono fondamentalmente sbagliati. Per un piccolo assortimento, un'ubicazione di magazzino, e pochi movimenti a settimana, possono essere più economici di un'applicazione dedicata. Diventano problematici non appena più persone lavorano contemporaneamente o le giacenze vengono aggiornate da più fonti.

Allora si creano le lacune conosciute: il ricevimento merci giace come carta sulla scrivania, il file Excel è stato modificato localmente, uno spostamento è stato concordato solo verbalmente, e la spedizione registra solo dopo l'orario di lavoro. La giacenza non è necessariamente sbagliata, ma è sfasata nel tempo e la sua origine non è chiara. Proprio questo la rende inadatta per decisioni operative.

Anche la struttura organizzativa gioca un ruolo. Una sede centrale necessita di flussi diversi rispetto a un'azienda con magazzini esterni, veicoli di servizio, o una produzione che preleva materiale. Chi rappresenta queste differenze con un'unica colonna di testo libero, sposta la logica nella testa dei singoli dipendenti. Funziona finché quella persona è in vacanza o il volume degli ordini aumenta.

Definire il processo prima del software

Un progetto sensato non inizia con la domanda su quale scanner acquistare o quale interfaccia sembri moderna. Prima deve essere chiaro quali decisioni il sistema debba supportare. Per questo bastano spesso osservazioni concrete dalla quotidianità: come viene accettata oggi la merce? Quando è considerata controllata? Chi può correggere le giacenze? Cosa succede con merce danneggiata? E a quale punto un ordine viene riservato in modo vincolante?

Da queste risposte nascono poche regole vincolanti. Ad esempio, il ricevimento merci può essere registrato solo dopo un controllo quantitativo. Gli articoli senza ubicazione di magazzino non devono apparire come stoccabili. Le correzioni di giacenza richiedono un codice motivo e rimangono visibili nella cronologia. La merce spedita non viene cancellata silenziosamente, ma assegnata all'ordine tramite uno scarico documentato.

Ciò è meno spettacolare di una grande presentazione di digitalizzazione, ma nell'operatività molto più prezioso. Quando le regole sono inequivocabili, il software può verificarle in modo affidabile. Quando rimangono poco chiare, ogni nuova applicazione accelera solo passi di lavoro contraddittori.

Anagrafiche: iniziare in piccolo, mantenere con costanza

Non ogni articolo necessita all'inizio di dieci classificazioni. Una base utilizzabile consiste spesso in codice articolo, descrizione, unità, stato di magazzino attivo, e una o più ubicazioni. A seconda dell'attività si aggiungono lotti, numeri seriali, giacenze minime, codici articolo del fornitore, o date di scadenza.

Importante è la coerenza, non la quantità di campi. Due codici articolo per lo stesso articolo fisico, o unità variabili come "cartone", "confezione", e "pezzo" senza regola di conversione, generano errori successivi quasi automaticamente. Un sistema può tecnicamente consentire tali immissioni. Dovrebbe limitarle dove mettono a rischio il flusso.

Quali funzioni aiutano realmente in magazzino

Per molti magazzini di medie dimensioni, un nucleo chiaro è più prezioso di un catalogo di funzioni sovraccarico. Questo nucleo comprende tipicamente quattro aree:

  • Ricevimento merci con riferimento all'ordine, controllo quantità, e stoccaggio
  • Movimenti di magazzino tra ubicazioni e aree definite
  • Riserva ordini, prelievo, e conferma di spedizione
  • Inventario e correzioni di giacenza con cronologia tracciabile

In aggiunta, la stampa di etichette, la scansione codici a barre, documenti di trasporto, etichette di spedizione, o un passaggio a contabilità e sistemi di negozio possono far risparmiare molto tempo. Ma dovrebbero basarsi su un modello di movimento pulito. Una stampa rapida di etichette è poco utile se la scansione non assegna in modo inequivocabile l'articolo alla corretta ubicazione o ordine.

Nell'utilizzo conta anche l'ambiente. Un dipendente con guanti al ricevimento merci necessita azioni grandi e inequivocabili e il minor input testuale possibile. Una addetta alla pianificazione alla scrivania necessita invece filtri, funzioni di ricerca, e una vista sulle transazioni aperte. Entrambi i ruoli possono usare gli stessi dati, ma non necessitano della stessa interfaccia.

Tempo reale non significa che ogni cifra è indiscutibile

Molte aziende desiderano giacenze in tempo reale. Ciò è sensato, ma il termine viene spesso usato in modo troppo generico. Una giacenza può essere aggiornata immediatamente dopo ogni scansione e comunque essere errata se un processo rimane incompleto. Se la merce viene scansionata ma non controllata, la cifra è tecnicamente attuale e operativamente discutibile.

Per questo ogni sistema necessita di una gestione delle eccezioni. Differenze nel ricevimento merci, imballaggi danneggiati, resi, e articoli non rintracciabili non sono casi marginali. Fanno parte della quotidianità. I buoni processi li segnalano visibilmente, invece di costringere il personale a elenchi collaterali improvvisati.

Anche i permessi meritano attenzione. Non ogni persona dovrebbe poter modificare le anagrafiche degli articoli o correggere registrazioni storiche. Un concetto di diritti praticabile separa le operazioni di routine dagli interventi a rischio più elevato. Ciò non protegge solo dagli errori, ma facilita anche l'analisi delle cause quando una giacenza devia inaspettatamente.

Integrazione solo dove migliora il flusso

L'Inventory Management raramente sta da solo. Gli ordini possono provenire da un negozio online, una registrazione e-mail, una soluzione di settore, o direttamente dalle vendite. I fornitori di spedizione necessitano di dati di indirizzo e pesi. La contabilità si aspetta documenti in una forma specifica.

Un'integrazione vale la pena quando elimina la registrazione doppia o riduce le fonti di errore. Non è automaticamente sensata solo perché un'interfaccia è disponibile. Specialmente con processi cresciuti organicamente, un'importazione chiara con controllo può essere più affidabile di un accoppiamento permanente in tempo reale che trasmette dati errati inosservati.

Tecnicamente la soluzione dovrebbe rimanere tracciabile: interfacce inequivocabili, trasferimenti registrati, messaggi di errore comprensibili, e una struttura di database che non nasconde le modifiche. Con un'applicazione ben mantenuta basata su PHP 8.4 e MySQL 8 tali processi possono essere realizzati in modo snello, senza costringere i team in un sistema aziendale globale. Decisivo non è l'etichetta tecnologica, ma se manutenzione, estensioni, e correzioni dati rimangono controllabili anche tra tre anni.

Implementazione in passi piccoli e misurabili

Un big bang raramente è la scelta migliore in magazzino. Più sicuro è un inizio limitato, ad esempio con il ricevimento merci e un'area di magazzino selezionata. In questa fase si possono osservare tempi di scansione, tipi di errore, casi speciali aperti, e la qualità delle anagrafiche. Solo dopo seguono riserva, spedizione, o ulteriori sedi.

Il funzionamento parallelo può essere sensato, ma solo con una fine chiara. Due giacenze guida per un periodo prolungato creano esattamente il problema che la nuova soluzione dovrebbe risolvere. Meglio è una transizione definita con inventario, anagrafiche ripulite, e responsabilità per le prime settimane.

Il successo non si vede da quante funzioni sono state attivate. Si vede se sorgono meno richieste di chiarimento, se gli ordini vengono imballati in modo più completo, e se un team può spiegare senza ricerca investigativa perché una giacenza articolo appare come appare.

Se il processo attuale con una tabella ben mantenuta funziona davvero in modo stabile, dovrebbe poter rimanere. Ma se le informazioni continuano a perdersi tra carta, telefonate, e più file, il prossimo passo sensato non è uno strumento più grande, ma un flusso chiaro che rende visibile ogni movimento di magazzino importante.

Link permanente →

I test self-hosted sono sicuri?

I test self-hosted sono sicuri?

Un test di regressione fallito è fastidioso. Uno screenshot di un sistema ERP interno che finisce senza controllo presso un servizio esterno è un incidente di sicurezza. Proprio per questo i QA lead e i responsabili IT si pongono la domanda: are self hosted tests secure? La risposta onesta è: possono essere nettamente più sicuri delle alternative basate su cloud, ma solo se la gestione operativa viene presa sul serio quanto i test stessi.

L'automazione dei test self-hosted sposta il controllo su esecuzione, dati di test, screenshot, log, e diritti di accesso nella propria infrastruttura. Ciò riduce le dipendenze e i percorsi di dati non necessari. Tuttavia non sostituisce un'architettura di sicurezza. Un server di test interno mal gestito rimane un server mal gestito.

I test self-hosted sono più sicuri dei test in cloud?

La differenza decisiva non sta nel fatto che un test giri localmente o in modo automatizzato. Sta in dove i dati vengono elaborati, chi può accedervi, e quali confini tecnici si applicano.

Con un servizio di testing gestito esternamente, spesso lasciano l'azienda diversi artefatti: credenziali per account di test, URL di applicazioni interne, contenuti DOM, screenshot, video delle sessioni di test, log di errore, ed eventualmente estratti di database. Anche se un fornitore soddisfa elevati standard di sicurezza, si crea una relazione aggiuntiva di fiducia e contrattuale. Per applicazioni con dati di clienti, personale, produzione, o finanziari, ciò può essere un ostacolo rilevante.

Un sistema self-hosted può essere gestito all'interno della propria rete o di un ambiente UE chiaramente delimitato. L'istanza di test accede direttamente a sistemi di staging, collaudo, o test isolati. I riscontri dei test rimangono dove si trova anche l'applicazione e la sua responsabilità operativa. Ciò è particolarmente sensato quando si testano applicazioni desktop Windows, portali web interni, o sistemi con dati di processo sensibili.

Ma il self-hosting non è automaticamente più sicuro. Chi gestisce un server di test con accesso remoto aperto, account amministratore condivisi, e password permanentemente valide ha semplicemente spostato i rischi. La domanda quindi non è solo: cloud o on-premises? Ma: l'ambiente di test è dimostrabilmente protetto e manutenibile in modo permanente?

Are self hosted tests secure? Dipende da questi confini

Una piattaforma di test sicura ha bisogno di confini tecnici e organizzativi chiari. Per le piccole e medie imprese, ciò non deve assomigliare a un programma aziendale. Deve solo essere implementato con coerenza e documentato.

Separare l'ambiente di test dall'esercizio produttivo

I test automatizzati devono trovare errori, non innescare ordini, modificare documenti di trasporto, o registrare movimenti di magazzino. Per questo i test necessitano di un ambiente separato con interfacce proprie, tenant di test, e dati di test. Dove non è necessaria una copia completa della produzione, è spesso addirittura inutilmente rischiosa.

Per un portale di magazzino o ordini, ciò può significare: gli utenti di test possono registrare ricevimenti merci e generare etichette di spedizione, ma i documenti generati non vanno a nessuna stampante reale né a nessuno spedizioniere reale. Le chiavi API puntano a endpoint sandbox. L'invio di e-mail viene intercettato o limitato a destinatari interni. Così un test rimane significativo senza produrre conseguenze operative.

La separazione dovrebbe valere anche a livello di rete. Il server di test necessita solo delle connessioni che effettivamente richiede. L'accesso generalizzato all'intera rete interna è comodo, ma raramente giustificabile. La segmentazione limita il danno se un account di test o un componente di sistema viene compromesso.

Trattare le credenziali come accessi di produzione

L'automazione dei test spesso necessita di dati di accesso. Ciò è normale, ma questi dati non appartengono a script di test, file di configurazione nel codice sorgente, o cronologie di chat. Password, token, e certificati dovrebbero essere caricati da una gestione controllata dei segreti. Gli account di test ricevono solo i diritti richiesti dal processo concreto.

Anche l'accesso alla piattaforma di test stessa necessita di ruoli. Uno sviluppatore potrebbe dover avviare sessioni di test e leggere risultati, ma non modificare la configurazione di rete. Un reparto può visualizzare report, ma non necessita accesso ai dati di accesso memorizzati. I diritti amministrativi dovrebbero essere legati a singole persone, non accoppiati a un account condiviso.

Inoltre, l'autenticazione a più fattori, regole di password ragionevoli, e flussi di blocco account appartengono allo standard minimo. Proprio i sistemi di test vengono spesso trattati come meno critici. Gli aggressori la vedono diversamente: amano usare gli ambienti di test come punto di ingresso, perché lì si trovano accessi, nomi interni, e dettagli tecnici.

Ridurre al minimo i dati di test e mascherarli in modo mirato

L'errore più comune non è un metodo di crittografia mancante, ma troppa informazione reale nel patrimonio di test. Per la maggior parte dei test di regressione, nessuno ha bisogno di nomi reali di clienti, indirizzi reali, o fascicoli personali completi. Set di dati sintetici, copie mascherate, e casi speciali creati deliberatamente spesso bastano.

Esistono eccezioni. Alcuni errori appaiono solo con strutture di dati reali, sequenze di caratteri insolite, o costellazioni di permessi complesse. Allora una copia controllata e pseudonimizzata può essere sensata. Decisivo è che questa decisione venga presa consapevolmente e abbia una scadenza di cancellazione. I database di test non dovrebbero continuare per anni come copia ombra dimenticata della produzione.

Screenshot e video meritano la stessa attenzione. Sono preziosi per la ricerca degli errori, ma possono mostrare dati account, prezzi interni, o contenuti personali. Stabilite quali artefatti vengono registrati, chi può vederli, e quando vengono automaticamente cancellati. Un rapporto di test non deve memorizzare per sempre ogni schermata per essere probante.

Gestire il server come un prodotto

Un server di test self-hosted non è un dispositivo che si installa una volta e poi si dimentica. La sicurezza operativa nasce da manutenzione ripetibile: aggiornamenti di sicurezza tempestivi per sistema operativo, browser, test runner, e dipendenze; supporti dati e percorsi di trasporto crittografati; backup monitorati; logging centralizzato; nonché una gestione chiara degli avvisi di sicurezza.

Specialmente nei test guidati dal browser, il ritmo di aggiornamento è rilevante. Motori browser obsoleti e librerie di automazione possono contenere vulnerabilità note o rendere inaffidabili i test. Entrambi costano tempo. Deployment documentati e finestre di manutenzione fisse non sono quindi un'aggiunta burocratica, bensì il fondamento per risultati riproducibili.

Per un server di test IA dedicato come COCO, vale lo stesso. L'esecuzione locale non protegge magicamente i contenuti applicativi sensibili. Crea controllo su dove vengono elaborati la valutazione assistita da IA, gli screenshot, e i log di test. Questo controllo deve essere riempito con gestione delle patch, permessi, separazione di rete, e regole di conservazione chiare.

Dove il self-hosting ha i suoi limiti

I servizi cloud non sono per definizione insicuri. Un fornitore specializzato può offrire più personale di sicurezza, monitoraggio più maturo, e ridondanza più professionale di un'azienda con un singolo ruolo IT sovraccarico. Chi non ha capacità per gestione operativa, aggiornamenti, e risposta agli incidenti può generare un rischio maggiore con un sistema self-hosted mal gestito.

D'altra parte, molte piattaforme di test esterne semplicemente non sono un buon fit di processo per applicazioni interne specialistiche. Se un'applicazione è raggiungibile solo nella rete aziendale, se le sessioni di test mostrano maschere e documenti riservati, o se i dati non devono lasciare il proprio dominio di controllo, la gestione locale è spesso la soluzione più chiara.

La decisione ragionevole dipende dal fabbisogno di protezione e dalla capacità operativa. Per un sito di marketing pubblico senza login sensibili, un servizio di test cloud può essere appropriato. Per un software interno di disposizione, un portale clienti con dati personali, o un'applicazione Windows nella rete di produzione, molto depone a favore di un ambiente controllato e self-hosted.

Un controllo di sicurezza praticabile prima dell'avvio

Prima che i test automatizzati vengano distribuiti, un responsabile dovrebbe poter rispondere a queste domande senza indovinare:

  • A quali sistemi, database, e interfacce può accedere il server di test?
  • Quali dati appaiono in screenshot, video, log, e valutazioni IA?
  • Dove si trovano le credenziali, e quando vengono ruotate?
  • Chi può avviare sessioni di test, leggere risultati, e amministrare sistemi?
  • Quanto rapidamente vengono applicati gli aggiornamenti critici, e come viene verificato?
  • Quando vengono cancellati gli artefatti di test e i dati non più necessari?

Queste domande sembrano sobrie. Proprio questo è il loro valore. La sicurezza nasce raramente da un singolo strumento o da un impressionante diagramma architetturale. Nasce quando responsabilità, flussi di dati, e confini tecnici rimangono verificabili nella quotidianità.

Chi costruisce l'automazione dei test dovrebbe prima chiarire il fabbisogno di protezione dell'applicazione e poi scegliere l'architettura più piccola sensata. Un server di test ben delimitato con pochi account autorizzati è spesso più prezioso di una piattaforma sovraccarica che nessuno può mantenere in modo affidabile. Boring, provable reliability batte anche nel testing la soluzione spettacolare ma opaca.

Link permanente →

Warehouse Management Systems: Ciò che conta davvero

Warehouse Management Systems: Ciò che conta davvero

Quando un dipendente nel ricevimento merci annota la stessa posizione di consegna su carta, la trasferisce poi in una tabella e chiarisce a voce dove verrà stoccata, raramente manca la volontà di lavorare bene. Manca un processo condiviso. I Warehouse Management System creano questo processo documentando movimenti di merce, giacenze e attività successive in un unico punto. Per le piccole e medie imprese non è decisivo l'elenco di funzioni più lungo, ma se il software rappresenta in modo affidabile il percorso di una merce attraverso il proprio magazzino.

Cosa devono offrire i Warehouse Management System nella quotidianità

Un Warehouse Management System, o WMS in breve, non è semplicemente un migliore elenco di giacenze. Controlla o documenta i processi fisici nel magazzino: ricevimento merci, controllo qualità, stoccaggio, spostamento, prelievo, imballaggio, spedizione, e inventario. Ogni registrazione risponde a una semplice domanda operativa: cosa si trova dove, in quale quantità, in quale stato, e chi ha innescato il movimento?

A prima vista questa chiarezza sembra banale. Ma previene tipiche catene di errori. Un articolo viene consegnato ma non è ancora controllato. Un pallet si trova nel ricevimento merci ma nel sistema è già indicato come disponibile. Un ordine viene prelevato benché la merce dovrebbe essere riservata a un ordine cliente più importante. Senza stati e movimenti chiaramente definiti, una singola incertezza diventa rapidamente una promessa di consegna errata.

Per molti magazzini di medie dimensioni il beneficio non inizia con un controllo completamente automatico. Ordini di stoccaggio già tracciati, ubicazioni univoche, e registrazioni mobili possono ridurre notevolmente i tempi di ricerca. Ciò che conta è che il personale non debba più tradurre tra carta, telefono, e-mail, e più tabelle.

Non ogni magazzino ha bisogno di una grande suite

Il mercato offre estesi sistemi enterprise con funzioni per reti globali multi-sede, gestione doganale complessa, tecnologia di trasporto automatizzata, e logica di ottimizzazione molto fine. Ciò può essere corretto se questi requisiti esistono realmente. Ma per un'azienda con uno o pochi magazzini, priorità mutevoli, e processi speciali consolidati, una tale suite può generare più attrito che beneficio.

I costi allora non stanno solo nelle licenze. Nascono in lunghi progetti di implementazione, adattamenti onerosi, formazione, e dipendenza da specialisti esterni. Anche un sistema con cento impostazioni non risolve un problema se i capiturno devono aprire un ticket per correzioni quotidiane.

L'alternativa non significa necessariamente uno sviluppo completamente individuale. Un prodotto standard può essere sensato quando i suoi flussi principali si adattano e gli adattamenti restano deliberatamente limitati. Allo stesso modo, una tabella esistente può rimanere la soluzione migliore, ad esempio per una valutazione rara e gestibile. Diventa critica solo quando più persone vi lavorano contemporaneamente, inseriscono movimenti con ritardo, o la tabella deve diventare la verità operativa sulla merce disponibile.

La soluzione giusta si orienta al volume di processo effettivo e ai costi degli errori. Cinque prelievi errati a settimana significano qualcosa di diverso in un magazzino di ricambi con ordini clienti critici nei tempi rispetto a cinque scostamenti in una giacenza di archivio a rotazione lenta.

Rilevare prima i processi, non scegliere le maschere

Molti progetti WMS iniziano con una demo del prodotto. Lì i responsabili vedono dashboard eleganti, viste scanner, e indicatori colorati. Più utile è prima un giro nel magazzino durante una normale giornata lavorativa. Dove arriva la merce? Chi controlla quantità e danni? Quando un articolo riceve il suo numero di lotto o seriale? Come si decide su quale posto va? E cosa succede quando la realtà si discosta dall'ordine?

Queste domande pongono le basi per una soluzione che verrà poi accettata. Un processo target ben documentato non descrive solo il caso ideale. Contiene anche eccezioni: consegne parziali, merce danneggiata, arrivi non annunciati, carenze di scorte, resi, e giacenze bloccate. Proprio questi casi decidono se il personale si fida del sistema o torna a prendere in mano i foglietti.

Gli stati sono più importanti delle belle interfacce

Un set di dati pulito distingue ad esempio "atteso", "arrivato", "in controllo", "stoccato", "riservato", "prelevato", e "spedito". Quali stati siano necessari dipende dall'azienda. Troppo pochi nascondono differenze rilevanti. Troppi rallentano le registrazioni e vengono aggirati.

La regola dovrebbe essere: ogni stato deve avere una conseguenza operativa. Se la merce è bloccata, non deve essere prelevata. Se è riservata, deve essere visibile per quale ordine. Se è stoccata, deve essere registrata un'ubicazione. Così le regole sui dati diventano affidabilità pratica del processo.

Gli scanner aiutano solo con registrazioni chiare

I codici a barre e i dispositivi mobili riducono gli errori di digitazione e accelerano i movimenti. Ma non sostituiscono una decisione di processo. Una scansione deve innescare un'azione comprensibile: controllare l'articolo, confermare la quantità, scegliere l'ubicazione di destinazione, o completare l'ordine. Se un dipendente deve indovinare dopo ogni scansione quale schermata segue, il flusso è progettato in modo troppo complicato.

Anche la questione dell'hardware dovrebbe essere risolta in modo pragmatico. Per alcuni team bastano smartphone con funzione di scansione adeguata e custodia protettiva robusta. Altri necessitano di scanner palmari industriali, perché guanti, refrigerazione, cadute, o turni lunghi lo richiedono. Un pilota sulla superficie di magazzino effettiva mostra più di una presentazione alla scrivania.


La base tecnica decide dopo il go-live

Un WMS deve funzionare correttamente anche quando ricevimenti merci vengono registrati, ordini vengono prelevati, e giacenze vengono controllate contemporaneamente. Da ciò derivano requisiti che spesso si perdono nelle conversazioni iniziali: registri di movimento univoci, permessi basati su ruolo, correzioni tracciabili, interfacce affidabili, e backup che in caso di emergenza siano effettivamente ripristinabili.

Una giacenza non dovrebbe essere semplicemente sovrascritta. Meglio è un modello di movimento: entrata, uscita, spostamento, blocco, o correzione generano ciascuno un record registrato. Così in seguito si può tracciare perché una quantità si discosta. Questo è prezioso tanto per gli inventari quanto per chiarire un caso di reclamo cliente.

I permessi devono adattarsi alla responsabilità. Un addetto al prelievo necessita di funzioni diverse rispetto a un responsabile di magazzino che approva correzioni di giacenza. Per modifiche critiche hanno senso motivazioni, approvazioni a quattro occhi, o almeno un registro modifiche immutabile. L'impegno dipende dal profilo di rischio, ma la domanda dovrebbe essere chiarita prima dell'avvio.

Le interfacce meritano la stessa attenzione. Un magazzino lavora raramente isolato. Gli ordini arrivano da uno shop, un ERP, o tramite import strutturato. I dati di spedizione vanno a sistemi carrier, documenti di trasporto ed etichette vengono generati, i dati di giacenza rifluiscono. Ogni interfaccia necessita di responsabilità chiare per i casi di errore. Cosa succede se un'etichetta di spedizione è stata generata ma la conferma non arriva nel WMS? Senza logica di ripetizione e coda errori visibile, tali casi restano bloccati su singole persone.

Per soluzioni su misura, le tecnologie manutenibili non sono un dettaglio secondario. Un'applicazione tracciabile con una struttura di database chiara, deployment documentati, e integrazioni testate rimane gestibile anche dopo cambi di personale. Un'architettura di tendenza non aiuta se nessuno riesce a tracciare un import errato.

Implementazione in passi piccoli e controllabili

Un big bang genera rischi evitabili. Spesso è più sensato digitalizzare prima un processo ben delimitato, ad esempio il ricevimento merci per un gruppo di prodotti o il prelievo in un'area di magazzino. Il team verifica così non solo le funzioni, ma anche le formulazioni, i percorsi di scansione, i percorsi a piedi, e le responsabilità.

I dati anagrafici sono spesso il vero cantiere. I codici articolo devono essere univoci, le unità di misura coerenti, le ubicazioni di magazzino strutturate in modo sensato, e le unità di imballaggio chiaramente definite. Un sistema non può fornire giacenze affidabili se lo stesso articolo compare sotto tre denominazioni diverse, o una "cassa" significa quantità diverse a seconda del fornitore.

Durante la fase pilota gli indicatori dovrebbero restare semplici: quanto dura il ricevimento merci? Quante registrazioni devono essere corrette? Quanti prelievi sono errati? Quanto spesso si cerca la merce? Non ogni miglioramento si manifesta subito in una grande voce di costo. Meno richieste di chiarimento e informazioni di consegna più affidabili possono già togliere pressione considerevole dall'operatività quotidiana.

La formazione funziona meglio direttamente sul processo. Il personale non ha bisogno di una guida astratta attraverso tutte le voci di menu. Deve sapere come registrare la prossima consegna, segnalare uno scostamento, o correggere una scansione errata. Per i primi turni dopo l'avvio dovrebbe essere raggiungibile una persona responsabile che possa prendere decisioni rapidamente.

La domanda giusta per la scelta

Per i Warehouse Management System la domanda centrale non è: quale software sa fare di più? È: quali flussi devono diventare più veloci, più chiari, e più tracciabili ogni giorno per il nostro team?

Chi descrive prima questi flussi in modo pulito può valutare oggettivamente software standard, estensioni, o un'applicazione su misura. Il risultato non deve sembrare spettacolare. Dovrebbe assicurare che la merce trovi la sua strada, la giacenza rimanga affidabile, e le persone in magazzino trascorrano meno tempo a cercare, chiedere, e correggere successivamente.

Link permanente →

Custom Logistics Software vs Spreadsheets

Custom Logistics Software vs Spreadsheets

Un ricevimento merci arriva prima del previsto, due dipendenti modificano contemporaneamente lo stesso elenco di giacenze, e l'autista attende un documento di trasporto la cui ultima versione nessuno sa indicare con certezza. Situazioni del genere decidono la domanda "custom logistics software vs spreadsheets" non in teoria, ma tra ricevimento merci, ubicazione di magazzino, e rampa.

Le tabelle non sono fondamentalmente il problema. Sono rapide da creare, familiari a tutti, e spesso sorprendentemente efficaci per compiti chiaramente delimitati. Diventano problematiche quando devono fungere da sistema operativo di un processo di magazzino o distribuzione in crescita. Allora un file diventa un processo critico - senza regole vincolanti, stati tracciabili, o una cronologia affidabile.

Quando i fogli di calcolo in magazzino sono la scelta giusta

Una tabella ha senso quando il processo è gestibile, raro, e controllato da poche persone. Può trattarsi, ad esempio, di una pianificazione mensile del fabbisogno, di una preparazione una tantum per l'inventario, o di una valutazione dei prezzi dei fornitori. Può bastare anche per una piccola giacenza con un responsabile, purché le modifiche non avvengano sotto pressione temporale e nessun processo successivo dipenda automaticamente da essa.

Il vantaggio non sta solo nei bassi costi di licenza. I team possono adattare colonne, verificare calcoli, e configurare un nuovo modulo in pochi minuti. Chi non ha ancora compreso un processo stabile non dovrebbe affrettarsi a trasformarlo in software. Una buona tabella può prima rendere visibile quali dati siano davvero necessari e quali campi vengano mantenuti solo per abitudine.

Sarebbe quindi sbagliato trattare ogni file Excel come un arretrato. La domanda decisiva è: la tabella è uno strumento di lavoro per una persona o una fonte condivisa per decisioni operative? Non appena più ruoli dipendono dagli stessi dati, il rischio aumenta notevolmente.

Custom Logistics Software vs Spreadsheets: Il punto di svolta

Il passaggio non è generalmente innescato dal numero di righe. Una tabella con 20.000 posizioni può funzionare, mentre un file con 200 righe porta già a errori. Ciò che conta è la contemporaneità, i passaggi di processo, e le conseguenze di un'informazione errata.

Un segnale d'allarme tipico è la questione delle versioni. Se le giacenze, gli ordini aperti, o le date di consegna si trovano in file con nomi come "finale_nuovo", "finale_nuovo2", e "veramente_finale", ciò che manca non è una struttura di cartelle migliore. Manca uno stato dei dati vincolante. Lo stesso vale quando i dipendenti devono telefonare per sapere se la merce è arrivata, se un ordine è stato approvato, o se un veicolo è già stato caricato.

Il punto di svolta viene raggiunto quando un inserimento innesca più azioni successive. Un ricevimento merci allora non modifica solo un numero nella giacenza. Può avviare un controllo qualità, assegnare un'ubicazione di magazzino, contrassegnare un ordine come parzialmente consegnato, e mostrare alle vendite un articolo disponibile. Se questi passaggi vengono coordinati manualmente tramite file, carta, e telefonate, gli scostamenti sono difficilmente evitabili.

Diventa particolarmente critico durante i cambi turno e le assenze. Quando solo una persona esperta sa quale contrassegno colorato in un elenco significhi un blocco, o quale formula calcoli una scorta di sicurezza, il processo non è solido. Funziona solo finché quella persona è disponibile.

Cosa fa realmente meglio il software su misura

Il software logistico su misura non è semplicemente una tabella con un'interfaccia bella. Il suo valore nasce da flussi controllati. Ogni registrazione riceve un orario univoco, una persona responsabile, e uno stato tracciabile. I dipendenti non vedono solo dati, ma la prossima azione consentita.

Per un ricevimento merci, ciò può significare in pratica: selezionare la consegna, registrare la quantità, documentare eventuali scostamenti, stampare l'etichetta, e confermare lo stoccaggio. Solo dopo la giacenza viene resa disponibile. Per il prelievo, il sistema può raggruppare gli ordini per priorità, mostrare le ubicazioni di magazzino in un ordine sensato, e generare un documento di trasporto solo quando le posizioni sono confermate.

Non è una questione di complessità superflua. Impedisce che lo stesso articolo venga riservato due volte, che una consegna parziale conti come completa, o che un documento di trasporto venga stampato sulla base di dati obsoleti. Aiutano anche regole semplici: campi obbligatori per i lotti, motivi di blocco per merce danneggiata, controlli di plausibilità sulle quantità, e permessi per le registrazioni di correzione.

Un'applicazione ben pianificata non copre subito ogni caso speciale. Si concentra sui flussi che costano tempo quotidianamente o producono errori regolarmente. Per un'azienda può trattarsi della gestione dei movimenti di contenitori, per un'altra della rapida registrazione della merce in arrivo con dispositivi mobili. Il software standard spesso conosce queste particolarità solo come costoso modulo aggiuntivo, o affatto.

I costi nascosti della tabella

I costi di licenza di una tabella sono bassi. I costi di processo non possono esserlo. Nascono in richieste di chiarimento, rilavorazioni, tempi di ricerca, manutenzione doppia, e giacenze mal pianificate. Nascono anche quando un team deve controllare la sera quali dati sono cambiati dal mattino.

Questi costi rimangono spesso invisibili perché distribuiti su molti ruoli. Il responsabile di magazzino verifica le giacenze, l'ufficio commerciale interno corregge le date di consegna, la contabilità cerca documenti, e la direzione riceve numeri con ritardo. Nessuna singola attività appare drammatica. Insieme rallentano il throughput e la pianificabilità.

Una decisione solida non dovrebbe quindi confrontare solo i prezzi del software. Misurate per due o tre settimane quanti passaggi manuali attraversa un ordine, quante volte vengono richieste informazioni, e quali errori si ripetono. Sono rilevanti anche le conseguenze: una giacenza errata porta a una correzione interna o a una consegna mancata?

Non ogni problema ha bisogno di una grande suite

Molte aziende di medie dimensioni nell'area DACH esitano giustamente davanti a sistemi enterprise estesi. Implementazioni lunghe, maschere rigide, e modelli di licenza per funzioni mai utilizzate raramente risolvono un problema concreto di magazzino. L'alternativa però non deve significare rimanere con file distribuiti.

Tra i due estremi si trova un'applicazione specifica per flusso di lavoro. Può, ad esempio, collegare accettazione ordini, ricevimento merci, movimenti di magazzino, etichette di spedizione, e documenti di trasporto in un sistema condiviso, senza portare con sé contabilità finanziaria completa, logica aziendale globale, e venti lingue straniere.

Decisiva è la base tecnica. Un'applicazione con una struttura di database chiara, interfacce documentate, e permessi tracciabili rimane adattabile. Tecnologie come PHP 8.4, JavaScript moderno, e MySQL 8 non sono qui fini a se stesse. Utilizzate correttamente, creano una base manutenibile per ruoli, cronologie di registrazione, documenti di stampa, e valutazioni - anche quando i processi cambiano tra due anni.

Come riesce il passaggio senza interrompere le operazioni

Il pericolo maggiore non è la tecnica, ma un primo passo troppo grande. Chi cerca di ripulire tutti i file storici e mappare ogni caso eccezionale prima dell'avvio, rimanda il beneficio per mesi. Meglio è un inizio chiaro e verificabile.

Iniziate con un processo che si presenta frequentemente ed è ben delimitabile, ad esempio ricevimento merci con registrazione di giacenza o spedizione con documento di trasporto ed etichetta. Definite con precisione quando inizia l'operazione, quali dati sono strettamente necessari, chi concede quale approvazione, e quando è considerata conclusa. Da questo nascono non solo schermate, ma regole di lavoro solide.

Anche l'acquisizione dei dati richiede pragmatismo. Articoli attivi, fornitori, ubicazioni di magazzino, e ordini aperti devono essere puliti. Le giacenze storiche possono invece spesso essere archiviate, invece di importarle nel nuovo sistema con grande sforzo. Il funzionamento parallelo può avere senso, ma solo con una data di fine fissa. Altrimenti nascono due verità invece di una migliore.

Nell'implementazione emerge il valore di un partner tecnico diretto.

softify.pro non lavora quindi partendo da un elenco astratto di funzioni, ma chiarisce i flussi dove effettivamente avvengono: all'accettazione, nel corridoio di magazzino, durante l'imballaggio, e alla consegna alla spedizione. Il buon software rispetta le routine funzionanti e cambia solo ciò che rende il processo effettivamente più affidabile.

La decisione si può verificare con tre domande

Primo: più persone devono fidarsi contemporaneamente di dati aggiornati? Secondo: una registrazione innesca processi successivi che oggi vengono garantiti manualmente? Terzo: un errore può portare a ritardo di consegna, giacenza errata, fattura sbagliata, o ricerca dispendiosa? Se queste domande sono prevalentemente risposte con sì, la tabella probabilmente non è più il sistema guida corretto.

Se la risposta rimane prevalentemente no, può continuare a essere una soluzione ragionevole. Allora conviene piuttosto unificare i file, definire responsabilità, e documentare formule critiche. La tecnica non dovrebbe essere più grande del problema.

Il prossimo passo sensato non è quindi un progetto generico di digitalizzazione, ma uno sguardo condiviso su un flusso concreto insieme alle persone che lo eseguono quotidianamente. Lì diventa rapidamente visibile se una tabella ben tenuta è sufficiente - o se un software affidabile dovrebbe finalmente assumere il lavoro che oggi resta bloccato tra carta, telefono, e diverse versioni dello stesso file.

Link permanente →

Sviluppo web per le aziende

Sviluppo web per le aziende

Un sito web può avere un bell'aspetto e comunque generare lavoro ogni lunedì: i dati prodotto vengono gestiti doppiamente, le richieste arrivano incomplete nella casella di posta, le modifiche richiedono aiuto esterno. La ricerca di un'azienda di sviluppo web non dovrebbe quindi fermarsi a colori, framework, o un portfolio accattivante. Ciò che conta è se la soluzione crea meno attrito nel lavoro quotidiano e resta comprensibile da gestire anche tra tre anni.

Per le piccole e medie imprese, questa non è una domanda accademica. In officine, magazzini, e organizzazioni di vendita, preventivi, ordini, informazioni di consegna, e richieste dei clienti incontrano spesso processi cresciuti organicamente. Alcuni di essi meritano software. Altri funzionano ancora meglio con una tabella tenuta in modo pulito. Un buon sviluppo web riconosce la differenza, invece di trasformare ogni problema in un grande progetto digitale.

Cosa deve offrire lo sviluppo web alle aziende

Un sito web aziendale è spesso il primo punto di contatto. Deve caricarsi velocemente, funzionare su dispositivi mobili, e guidare chiaramente i visitatori verso una richiesta, una candidatura, o un ordine. Ma non appena elabora dati, mappa ruoli interni, o innesca processi, diventa un'applicazione web. Allora contano altre domande: Chi può vedere cosa? Da dove provengono i dati? Cosa succede con un input errato? Come viene distribuito un aggiornamento senza interrompere l'attività?

La differenza è pratica. Una pagina di marketing può cavarsela con poche aree di contenuto chiaramente strutturate. Un portale clienti, un processo di ordinazione, o uno strumento interno di magazzino, invece, ha bisogno di permessi tracciabili, una struttura di database robusta, e casi speciali definiti. Se un ricevimento merci viene consegnato solo parzialmente o un ordine deve essere modificato successivamente, il sistema non deve finire in uno stato indefinito.

Lo sviluppo web per le aziende quindi non significa semplicemente programmare pagine. Significa implementare regole aziendali in modo che rimangano comprensibili per gli utenti e controllabili per l'azienda.

Verificare prima il flusso, poi pianificare l'interfaccia

Un progetto inizia spesso con un desiderio come "Abbiamo bisogno di un portale". Questo è un inizio sensato, ma non ancora un requisito sufficiente. Prima del primo design, dovrebbero diventare visibili i percorsi reali di un'informazione: chi la crea, chi la verifica, chi la integra, e chi ne avrà bisogno di nuovo in seguito?

Prendiamo l'elaborazione degli ordini. In molte aziende, una richiesta arriva via email o telefono, viene annotata in una tabella, successivamente trasferita in un altro sistema, e poi rielaborata nuovamente per il magazzino o la spedizione. Il ritardo raramente dipende da un singolo passaggio. Si genera nei passaggi di consegna, nelle richieste di chiarimento, e nei diversi stati dei dati.

Una buona analisi quindi chiede concretamente della quotidianità:

  • Quali informazioni vengono inserite più volte oggi?
  • In quale punto sorgono la maggior parte delle richieste di chiarimento o correzioni?
  • Quali eccezioni si presentano regolarmente pur non essendo documentate da nessuna parte?
  • Quali ruoli necessitano di accesso, e quali dati non devono poter modificare?
  • Da cosa riconosce alla fine il team che un'operazione è davvero conclusa?

Queste domande suonano sobrie. È proprio questo il loro vantaggio. Impediscono che un'applicazione visivamente convincente venga costruita attorno a un processo idealizzato che nessuno usa realmente nell'operatività. Soprattutto nel magazzino e nella logistica contano le condizioni reali: gli scanner vengono utilizzati con i guanti, i turni cambiano, il WiFi non è ovunque ugualmente buono, e un documento di trasporto non deve nascere solo dopo diversi clic.

Non ogni flusso appartiene tuttavia a un'applicazione. Un piccolo elenco con poche voci stabili può essere più veloce ed economico come tabella. Il software conviene quando i dati fluiscono tra persone o aree, quando manca la tracciabilità, o quando il lavoro manuale genera ripetutamente tempo perso ed errori.

La base tecnica decide sullo sforzo successivo

Molti sistemi appaiono simili nella prima demo. La differenza si mostra con modifiche, crescita, e interruzioni. Un'applicazione dovrebbe quindi basarsi su tecnologie che il team può mantenere a lungo termine, invece di puntare su hype a breve termine.

Per molte applicazioni web critiche per il business, uno stack con PHP 8.4, JavaScript moderno, e MySQL 8 è una scelta pragmatica. È performante, ben comprensibile, e adatto a requisiti tipici come portali, gestione ordini, generazione di documenti, o strumenti interni. Questo non è un dogma. Per applicazioni molto interattive, integrazioni speciali, o elevate esigenze in tempo reale, un'architettura diversa può avere senso. La tecnologia dovrebbe seguire il compito, non il contrario.

Più importante del nome di un framework sono decisioni chiare su dati e stati. Un ordine, ad esempio, ha bisogno di valori di stato inequivocabili invece di testo libero. Le modifiche dovrebbero essere tracciabili. Dati clienti, prezzi, e permessi non devono divergere tra tabelle sparse e interfacce improvvisate. Chi in seguito deve sapere perché è stata creata un'etichetta di spedizione o è stato bloccato un ordine, necessita di una cronologia tracciabile.

Anche la sicurezza appartiene alla costruzione di base. Vi rientrano diritti basati sui ruoli, archiviazione sicura delle password, flussi di blocco account per tentativi falliti ripetuti, ambienti di test e produzione separati, e aggiornamenti regolari. La sicurezza non è un singolo plugin aggiunto alla fine del progetto. Nasce da responsabilità pulite e un'architettura che tiene conto dei casi di errore.

La velocità è un requisito operativo

Le pagine lente non costano solo visibilità nei motori di ricerca. Generano abbandoni nelle richieste e tempi di attesa inutili nell'attività quotidiana. Su un sito web pubblico, il tempo di caricamento, la presentazione mobile, e una struttura di pagina chiara decidono se gli interessati si mettono affatto in contatto. In un'applicazione interna, due o tre secondi di attesa per ogni registrazione si sommano in modo percepibile lungo la giornata lavorativa.

Le prestazioni non iniziano con un successivo progetto di ottimizzazione. Immagini, query al database, caching, JavaScript, e hosting devono essere pianificati adeguatamente fin dall'inizio. Vale il principio: non ogni applicazione ha bisogno della massima complessità tecnica. Uno strumento interno semplice con pochi utenti non necessita di un'architettura per milioni di chiamate simultanee. Ha bisogno di percorsi brevi, backup affidabili, e un comportamento che rimanga prevedibile nella quotidianità.

Lo stesso principio vale per l'uso responsive. "Compatibile con i dispositivi mobili" non significa che una maschera desktop si restringa in qualche modo su uno smartphone. Chi in movimento controlla documenti di trasporto, segnala un danno, o corregge una giacenza, ha bisogno di elementi di comando grandi, feedback chiari, e il minor input inutile possibile.

Dall'idea all'operatività: consegnare in piccoli passi

I grandi capitolati promettono sicurezza, ma spesso portano i team ad aspettare mesi per una prima versione utilizzabile. Un percorso migliore è un primo passo di ampliamento chiaramente delimitato. Dovrebbe risolvere un problema reale, come la registrazione centralizzata dei ricevimenti merci o la generazione automatica di documenti di consegna. Successivamente, con feedback reali, si può decidere cosa porta il maggiore beneficio come prossimo passo.

Questo non significa lavorare senza pianificazione. Al contrario: modello dati, ruoli, interfacce, e concetto operativo devono essere chiariti presto. L'ambito funzionale può comunque crescere passo dopo passo. Così le assunzioni diventano visibili prima che diventino costose.

Una consegna professionale comprende più delle credenziali di accesso. Passaggi di deployment documentati, backup, monitoraggio, responsabilità, e una documentazione tecnica comprensibile rendono un sistema indipendente da singole persone. Se solo lo sviluppatore originale sa come viene installato un aggiornamento, l'applicazione non è finita, ma legata a una persona.

Come riconoscere un partner adatto

Un'azienda di sviluppo web non deve offrire ogni tecnologia immaginabile. Dovrebbe però porre le domande giuste ed essere in grado di motivare le decisioni. È opportuna cautela se già nella prima conversazione viene promessa una piattaforma completa senza che nessuno abbia visto i processi esistenti.

Un partner adatto parla di manutenzione, qualità dei dati, e implementazione tanto apertamente quanto di design. Spiega quali requisiti possono essere coperti da funzioni standard e dove lo sviluppo individuale diventa sensato. Indica anche i costi di richieste speciali. Una funzione può essere tecnicamente realizzabile e comunque non avere benefici sufficienti.

Chiedete dettagli operativi concreti: Come vengono testate le modifiche? Come funziona un rollback? Dove si trovano i dati sensibili? Chi reagisce in caso di interruzione? Come vengono gestiti i permessi? Le buone risposte non devono necessariamente essere lunghe, ma sono specifiche. "Ce ne occuperemo più tardi" non è una strategia per processi critici per il business.

Per i team con software esistente, la questione dell'integrazione è inoltre centrale. Una nuova applicazione non deve sostituire tutto. Può inizialmente acquisire dati da un sistema esistente, generare documenti, o mappare un processo mancante. Il primo passo più sensato spesso non è la grande sostituzione, ma l'eliminazione mirata di un collo di bottiglia.

Il software deve chiarire il lavoro, non spostarlo

La migliore applicazione web non si distingue nell'operatività per raffinatezza tecnica, ma per meno richieste di chiarimento, dati affidabili, e tempi di elaborazione più brevi. Rispetta i modi di lavorare funzionanti, rende visibili le eccezioni, e si lascia sviluppare ulteriormente senza paura del prossimo aggiornamento.

Prima di avviare un progetto, prendete un'operazione concreta dalla vostra quotidianità e seguitela dal primo contatto fino alla conclusione. Dove le informazioni attendono, scompaiono, o vengono raccolte doppiamente, si trova solitamente l'approccio più sensato per lo sviluppo web.

Link permanente →

Logistics Automation Software che si adatta davvero

Logistics Automation Software che si adatta davvero

L'entrata merci viene annotata su carta, la variazione di giacenza viene riportata più tardi in un foglio di calcolo e la spedizione telefona al magazzino perché l'indirizzo di consegna è finito in una e-mail. È proprio in questi passaggi di consegne che un'azienda perde tempo e affidabilità. Logistics Automation Software non deve coprire questo attrito con un grande e nuovo universo di processi, ma collegare in modo tracciabile le operazioni quotidiane.

Per le piccole e medie imprese è un compito diverso dall'introduzione di una piattaforma per grandi gruppi. Un responsabile di magazzino non ha bisogno di 200 funzioni che diventano comprensibili solo dopo tre giorni di formazione. Ha bisogno di uno stato chiaro: che cosa è arrivato, dove si trova, che cosa deve partire oggi e che cosa manca ancora? Una buona automazione risponde a queste domande dove il lavoro accade davvero.

Che cosa deve offrire in pratica Logistics Automation Software

Il termine suona ampio, ma i casi d'uso sensati sono in genere molto concreti. Un'azienda, per esempio, elabora la merce in entrata, registra i movimenti di magazzino, emette i documenti di trasporto, stampa le etichette di spedizione e pianifica le consegne. Se ogni postazione richiede un proprio file, un accesso separato o una richiesta a voce, si creano ritardi e catene di errori.

Un software adatto riunisce le informazioni in un unico flusso di lavoro. Un ordine può generare automaticamente un incarico di picking. La scansione di un articolo conferma il prelievo e aggiorna la giacenza. A lavoro concluso viene creato un documento di trasporto con le righe corrette, mentre lo stato della spedizione diventa visibile a vendite o pianificazione. Sembra semplice. Ed è proprio per questo che ha valore: il software non sostituisce una logica che funziona, ma evita che debba essere ricostruita a ogni cambio di supporto.

Decisivo è l'ordine. Prima deve essere chiaro quali dati fanno scattare un evento e chi decide in merito. Solo allora vale la pena automatizzare le regole. Chi digitalizza un processo poco chiaro ottiene soltanto confusione più veloce.

Scegliere prima i processi giusti

Non ogni operazione manuale merita subito un'applicazione. Un piccolo foglio di calcolo ben tenuto può essere meglio, per un caso particolare raro, di un modulo che va mantenuto in modo permanente. La leva economica sta di solito nei processi con molte ripetizioni, molti passaggi di consegne o conseguenze evidenti in caso di errore.

Candidati tipici sono le entrate merci con stato di controllo, i trasferimenti tra zone, il picking di ordini ricorrenti, i documenti di spedizione e la pianificazione dei giri. Anche l'acquisizione degli ordini è spesso un buon punto di partenza, quando gli ordini che arrivano da telefonate, e-mail e moduli vengono prima riuniti a mano.

Nella scelta aiutano quattro domande:

  • Quante volte a settimana viene eseguito il processo?
  • In quale punto i dati vengono inseriti o trasferiti più volte?
  • Quali errori causano rilavorazioni, ammanchi di giacenza o consegne in ritardo?
  • Quali eccezioni devono continuare a essere decise dai collaboratori?

L'ultima domanda evita un errore molto diffuso. Automazione non deve significare che ogni decisione viene presa senza persone. In caso di merce danneggiata, consegne incomplete o richieste dei clienti all'ultimo momento, il team ha bisogno di un modo chiaro per fermare un'operazione, correggerla e proseguire con una motivazione. Un sistema privo di queste vie sembra coerente sulla carta, ma in magazzino diventa presto un ostacolo.

Dall'entrata merci alla spedizione: un flusso continuo

Prendiamo un commerciante di medie dimensioni con magazzino e consegne proprie. Oggi la merce viene contata al portone, annotata su un modulo e inserita nel sistema solo verso la fine del turno. Le vendite vedono quindi la nuova giacenza troppo tardi. Per una spedizione urgente il documento di trasporto viene creato a parte e l'autista riceve le sue informazioni per telefono.

In un flusso automatizzato in modo appropriato, l'entrata merci inizia con un'operazione digitale. I collaboratori registrano consegna, articolo, quantità e, se serve, lotto o numero di serie direttamente alla postazione o da mobile. Le difformità non vengono nascoste in una nota a margine, ma ricevono uno stato come «Controllo necessario». Solo dopo lo sblocco la merce è disponibile come giacenza utilizzabile.

Il passo successivo nasce da esigenze reali: un ordine viene rilasciato, il magazzino riceve una lista di prelievo o una vista mobile ordinata per ubicazione, e ogni registrazione documenta che cosa è stato effettivamente prelevato. Da qui nascono documento di trasporto e dati di spedizione dalla stessa fonte. Nessuno deve ribattere le righe o verificare quale versione del file sia quella in vigore.

Per la pianificazione, il sistema può raggruppare le consegne aperte per zona, finestra di consegna, peso o capacità del veicolo. La pianificazione dei percorsi non è sempre il primo passo sensato. Se gli indirizzi sono incompleti o gli ordini vengono rilasciati solo poco prima della partenza, occorre migliorare prima la qualità dei dati e la chiarezza degli ordini. I percorsi ottimizzati non servono se la base è inaffidabile.

Software standard o soluzione su misura?

Il software standard ha senso quando l'azienda lavora con processi consueti e accetta di adattarsi alle maschere, ai ruoli e ai processi previsti. Può essere introdotto rapidamente, soprattutto con requisiti chiari come la stampa delle etichette o una semplice gestione delle giacenze. Il prezzo da pagare sono spesso compromessi su casi particolari, interfacce e adattamenti successivi.

Una Logistics Automation Software su misura diventa interessante quando la particolarità operativa non è un caso marginale, ma determina il successo dell'azienda. Può trattarsi di una logica di imballaggio speciale, di un processo di approvazione a più livelli, del collegamento tra officina e magazzino o di un modello di consegna proprio. In tal caso è spesso più sensato riprodurre in modo mirato i pochi processi centrali, invece di introdurre una suite completa con molti moduli inutilizzati.

Su misura, però, non significa senza limiti. Ogni funzione speciale richiede una motivazione tecnica, test, documentazione e manutenzione. Un buon lavoro di progetto si chiede quindi anche: questo passaggio si può semplificare? Basta una configurazione? Per questo processo eccezionale un foglio di calcolo resta la soluzione migliore? Queste domande proteggono budget e team da una complessità inutile.

Una tecnica che regge nella quotidianità

L'interfaccia decide se i collaboratori usano volentieri un sistema. La base tecnica decide se può essere gestito in modo affidabile anche dopo anni. Per i processi critici per l'attività fanno parte della dotazione di base modelli di dati comprensibili, ruoli e autorizzazioni, registri delle modifiche importanti e backup regolari.

In una registrazione di magazzino deve essere riconoscibile chi ha modificato quale giacenza e quando, e da quale operazione deriva la modifica. Se più utenti sono attivi contemporaneamente, la giacenza non deve essere falsata da inserimenti contraddittori. Con stampanti, scanner o interfacce dei corrieri servono stati di errore chiari invece di fallimenti silenziosi. Un'etichetta che non è stata stampata deve essere visibile come fase di lavoro aperta.

Anche la manutenibilità è un requisito operativo. Un'applicazione web su un'architettura comprensibile, ad esempio con PHP 8.4, JavaScript moderno e MySQL 8, può essere verificata ed estesa meglio nel lungo periodo di una raccolta di soluzioni isolate difficili da seguire. Rilascio documentato, ambienti di test e di produzione separati e test automatizzati non sono un lusso. Riducono il rischio che una piccola modifica al documento di trasporto comprometta improvvisamente il rilascio degli ordini.

Protezione dei dati e controllo degli accessi meritano la stessa sobrietà. Non ogni utente ha bisogno di prezzi, margini o anagrafiche clienti. Soprattutto nei team distribuiti, accessi, dispositivi e autorizzazioni dovrebbero essere organizzati in modo da non rallentare inutilmente il lavoro quotidiano, ma da restare controllabili in caso di cambio di collaboratore o di dispositivo smarrito.

Un'introduzione per tappe sensate

La funzione più potente serve a poco se un team non riesce a usarla nel lavoro a turni. Per questo un'introduzione graduale è spesso più solida di un'unica grande data di avvio. Dapprima viene messo in produzione un processo delimitato, ad esempio l'entrata merci per un gruppo di prodotti o la creazione dei documenti di spedizione. Il team ci lavora in condizioni reali e le questioni aperte vengono chiarite su casi concreti.

Poi seguono altri processi e interfacce. Questa sequenza crea fiducia, perché i collaboratori vedono che i riscontri si traducono in miglioramenti concreti. Allo stesso tempo limita il rischio: se un nuovo flusso di scansione deve essere adattato, non si ferma l'intera logistica.

Le metriche vanno concordate prima dell'avvio. Possono essere il tempo di attraversamento dall'ordine alla spedizione, il numero di correzioni manuali, gli ammanchi di giacenza o la durata delle attività di chiusura giornaliera. Non ogni miglioramento si vede subito in un indicatore spettacolare. Meno richieste di chiarimento tra magazzino e ufficio, un passaggio di turno affidabile e storici delle operazioni facili da ritrovare sono anch'essi un sollievo misurabile.

softify.pro sviluppa questi sistemi partendo dal flusso di lavoro, con un coinvolgimento tecnico diretto invece di un passaggio di consegne dal concetto alla realizzazione. Il metro di giudizio resta volutamente pragmatico: la soluzione deve funzionare sul pavimento del magazzino, non solo in una presentazione.

Come riconoscere una decisione solida

Una buona decisione non inizia con un elenco di funzioni, ma con una giornata di lavoro osservata. Fatevi mostrare dove le informazioni nascono, aspettano, si perdono o vengono corrette in un secondo momento. Non parlate solo con la direzione, ma anche con le persone all'entrata merci, in magazzino e in spedizione. Conoscono le eccezioni che nessun organigramma rende visibili.

Verificate poi se il fornitore pone domande concrete su dati, ruoli, dispositivi, interfacce ed esercizio. Chi promette subito una soluzione completa senza capire i processi esistenti vende più volume di software che soluzione di un problema. Altrettanto critico è un progetto che non prevede una regolamentazione chiara per manutenzione, correzione degli errori e adattamenti successivi.

La migliore automazione non dà la sensazione di burocrazia aggiuntiva. Dà al team tempo per i casi in cui l'esperienza conta davvero: valutare correttamente una consegna inattesa, informare un cliente in tempo o risolvere un collo di bottiglia prima che diventi un problema.

Link permanente →