softify.pro
Chargement …
Services À propos COCO – notre serveur IA Portfolio Insiders Études de cas À Savoir Contact Connexion

À Savoir

Pure fluidity meets ultimate performance : ce qui rend vraiment rapide un logiciel d'entreprise

Pure fluidity meets ultimate performance : ce qui rend vraiment rapide un logiciel d'entreprise

Un responsable d'entrepôt ne reconnaît pas un mauvais logiciel à un schéma d'architecture. Il le reconnaît au fait que les collaborateurs reprennent le téléphone, saisissent les bons de livraison en double ou ne peuvent pas dire, après une équipe, quelle marchandise est réellement arrivée. Pure fluidity meets ultimate performance ne doit donc pas être une simple ambition visuelle. Pour un logiciel d'entreprise, cela signifie qu'une opération paraît naturelle et fonctionne en même temps de façon fiable dans des conditions réelles.

Une interface élégante ne vaut rien si elle saccade avec un WLAN faible dans l'entrepôt. Une application rapide n'aide guère non plus si elle impose un enchaînement de travail que personne ne peut suivre à la rampe. Les bons outils numériques allient conception, vitesse et compréhension des processus. Ils réduisent la friction sans enfermer l'entreprise dans une logique standard préfabriquée.

Pure fluidity meets ultimate performance est une question d'exploitation

La fluidité est souvent confondue avec des animations, de grandes images et des transitions lisses. Cela peut convenir à une marque moderne. Dans le quotidien de travail, elle se montre pourtant autrement : une réception de marchandises peut être enregistrée sans détour. Un collaborateur retrouve une commande même lorsque seul un numéro de référence est connu. Une erreur est nommée clairement, au lieu de disparaître dans un message cryptique.

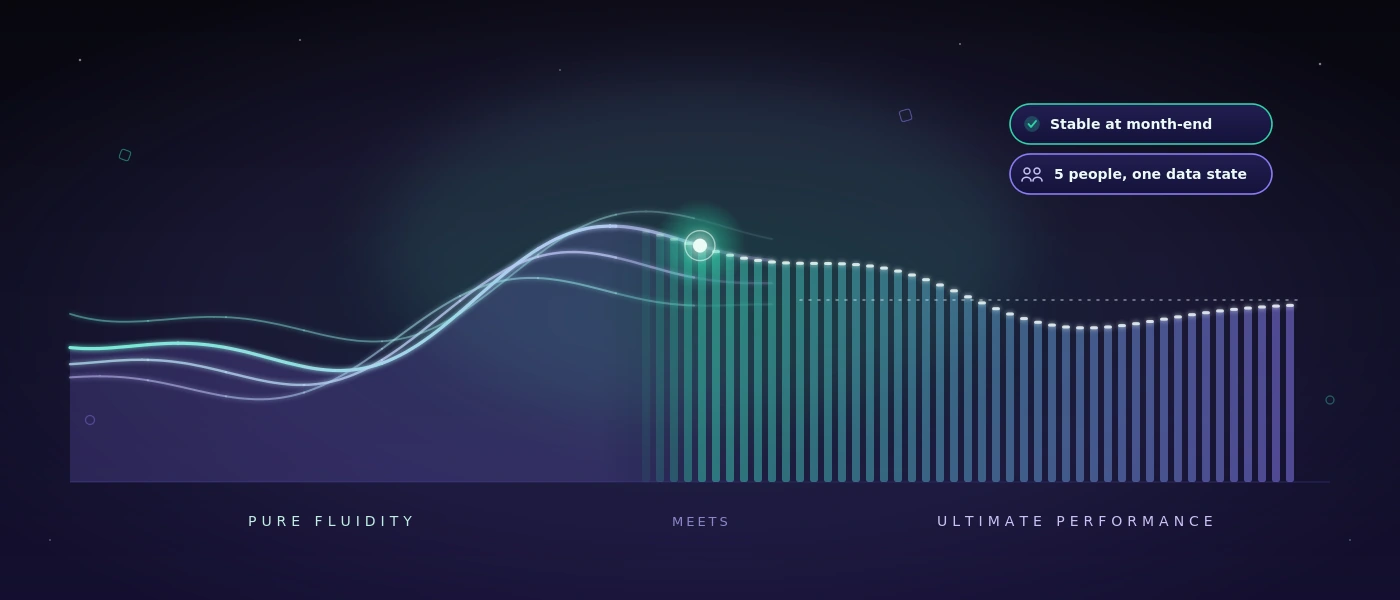
La performance est de même plus qu'une bonne valeur dans un test de navigateur. Ce qui compte, c'est le temps de réponse pour une commande comportant de nombreuses positions, la stabilité en fin de mois et la question de savoir si cinq personnes peuvent travailler en même temps sans s'écraser mutuellement leurs états de données. Une gestion propre des coupures de connexion, des droits et des comptes verrouillés en fait aussi partie.

Les deux sont indissociables. Si un écran réagit immédiatement mais comporte des champs obligatoires peu clairs, il reste pénible. Si le déroulement est intelligemment modélisé mais que la page attend deux secondes à chaque enregistrement, il est contourné. La fluidité naît là où le système soutient la prochaine action sensée et reste techniquement assez rapide pour que le fil de la pensée ne se rompe pas.

L'interface suit le parcours de travail, pas l'organigramme

De nombreuses solutions standard structurent leurs menus par modules : achats, ventes, entrepôt, reporting, administration. C'est compréhensible du point de vue du produit. Sur le sol de l'entrepôt, le travail commence pourtant souvent par une situation : un camion est là, une palette manque, un client a besoin d'une preuve de livraison ou un envoi doit encore être étiqueté avant la clôture de réception.

Une bonne application sur mesure commence donc par ces situations. Quelle information est disponible ? Qui décide ? Que faut-il documenter ? Que ne doit-on plus modifier ensuite ? Ce n'est qu'après qu'on décide quel écran de saisie, quel contrôle ou quelle automatisation est nécessaire.

Cela ne signifie pas couler chaque déroulement existant tel quel dans un logiciel. Certains tableaux sont réellement trop sujets aux erreurs, certaines validations inutilement lentes. Mais une liste Excel qui fonctionne ne doit pas forcément être remplacée par un projet. Si elle n'est tenue que par une personne, connaît peu d'exceptions et reste traçable, elle peut être l'outil adapté. Un logiciel vaut la peine lorsqu'il améliore la coordination, réduit les sources d'erreur ou rend les informations disponibles de façon fiable pour plusieurs intervenants.

Moins de clics ne veut pas automatiquement dire mieux

L'exigence d'un minimum de clics semble raisonnable, mais peut mener dans la mauvaise direction. Pour un enregistrement de stock irréversible, une brève confirmation a du sens. Pour une validation d'expédition, un contrôle de plausibilité visible peut éviter de coûteuses reprises. Le bon déroulement dépend du risque.

L'essentiel est que les étapes supplémentaires aient un but clair. Une confirmation ne devrait pas apparaître simplement parce que le framework la génère facilement. Elle devrait se trouver exactement là où les gens doivent prendre une décision en toute conscience. Ainsi l'application reste rapide sans devenir irréfléchie.

La performance naît dans l'architecture, pas dans le dernier sprint

Qui n'accélère un site web ou une application web que peu avant la mise en production traite généralement des symptômes. Des requêtes volumineuses, des modèles de données peu clairs et des cas particuliers ajoutés après coup ne se corrigent pas durablement en une seule journée d'optimisation.

Une base solide commence par une base de données qui correspond aux relations réelles dans l'entreprise. Dans MySQL 8, mouvements, pièces, changements de statut et actions des utilisateurs ont besoin de clés traçables et d'index judicieux. Un stock ne doit pas apparaître seulement comme un chiffre s'il faut ensuite clarifier de quelle écriture il résulte. En même temps, il n'est pas nécessaire de recalculer chaque information historique à chaque appel de page.

Avec les applications web modernes, la séparation des responsabilités est également pertinente. PHP 8.4 peut représenter les règles métier de façon claire et maintenable, tandis que JavaScript moderne est employé de façon ciblée pour les zones réactives. Ce n'est pas une profession de foi pour une stack donnée. C'est une question de maintenance : des modifications pourront-elles être réalisées en sécurité dans six mois ? Voit-on où une règle s'applique ? Une erreur peut-elle être reproduite, au lieu d'être seulement supposée ?

La performance a en outre besoin de limites. Les champs de recherche nécessitent un nombre minimal de caractères judicieux ou une logique de filtre précise lorsque des millions d'enregistrements sont envisageables. Les grandes listes ont besoin de pages ou de processus de chargement progressifs. Images et documents ne devraient pas bloquer le déroulement critique. Ces décisions semblent peu spectaculaires. C'est précisément pourquoi elles restent souvent précieuses plus longtemps qu'un effet frontend voyant.

La vitesse visible crée la confiance

Tous les processus ne peuvent pas se terminer en moins d'une seconde. Une impression d'étiquettes, une interface avec le transporteur ou un contrôle par rapport à des données externes prend parfois du temps. Ce qui compte alors, c'est la façon dont l'application gère l'attente.

Un statut clair comme « Étiquette d'expédition en cours de création » vaut mieux qu'un bouton figé. Après une clôture, on devrait pouvoir voir quel numéro a été généré et si l'opération peut être redéclenchée. Si un service externe est injoignable, l'équipe a besoin d'une option d'action compréhensible au lieu d'un message d'erreur pour développeurs.

C'est aussi une question d'intégrité des données. Un double clic ne doit pas générer deux livraisons. Un processus interrompu ne doit pas laisser silencieusement un enregistrement à moitié terminé. Les bons systèmes prévoient de tels cas, parce qu'ils surviendront au quotidien. Surtout avec des équipes qui changent, la pression du temps et des appareils mobiles, l'exception n'est pas un sujet marginal.

La qualité devient visible avant l'erreur

Pour des applications avec de nombreuses variantes de processus, il ne suffit pas de parcourir manuellement quelques chemins à la fin. Des modifications de prix, de rôles, de validations ou d'interfaces peuvent déclencher des conséquences à un endroit très éloigné. Ici, le testing automatisé devient une partie de la performance : non seulement sur le plan technique, mais organisationnel.

Un système de test devrait pouvoir vérifier des déroulements réels, par exemple créer une commande, modifier une position, générer un bon de livraison et contrôler un droit. Il devrait enregistrer des preuves et formuler les résultats de manière que les services métier puissent les situer. Une phrase comme « Le processus d'expédition n'a pas été terminé après la modification d'adresse » aide davantage qu'une stack trace sans commentaire.

Pour les équipes soucieuses de sécurité, le lieu où ces tests s'exécutent est aussi pertinent. Si captures d'écran, identifiants, cas de test ou étapes internes de l'application ne doivent pas quitter l'entreprise, une approche auto-hébergée est souvent plus judicieuse qu'un service cloud externe. Avec COCO, on peut exécuter des tests automatisés pour applications web et Windows sur un environnement dédié. Cela n'est pas nécessaire pour chaque équipe. Pour des données sensibles, des domaines réglementés ou des applications métier internes, le contrôle des données de test peut toutefois être un avantage décisif.

Le design est bon quand il facilite le travail

Une identité visuelle forte peut créer la confiance. Elle montre qu'une entreprise prend sa présence numérique au sérieux. Dans le système opérationnel, le design doit pourtant faire encore plus : l'orientation sous pression de temps. Contraste, typographie, états clairs et libellés compréhensibles décident si quelqu'un termine une opération avec assurance ou demande à un collègue.

La retenue est ici souvent le meilleur choix. Un tableau de bord avec dix indicateurs colorés peut paraître impressionnant et pourtant masquer le seul écart pertinent. Une vue réduite qui rend visibles les réceptions de marchandises ouvertes, les scans manquants et les délais de livraison menacés est plus utile. La question n'est pas de savoir combien d'interface est possible, mais quelle information améliore une décision.

Cela vaut aussi pour les applications responsives. La compatibilité mobile ne signifie pas comprimer chaque écran de bureau dans un format plus petit. Un smartphone à la réception de marchandises n'a peut-être besoin que du scan, de la quantité, de l'emplacement et de la confirmation. Le traitement ultérieur détaillé appartient peut-être à un écran plus grand. Des appareils différents méritent des priorités différentes, même s'ils accèdent à la même base de données fiable.

Une mesure judicieuse pour la prochaine décision

Avant qu'une équipe ne décide d'une nouvelle plateforme, d'une automatisation ou d'une refonte complète, un contrôle simple aide : le déroulement devient-il plus clair, plus rapide ou plus sûr pour les personnes qui l'exécutent chaque jour ? Et la solution reste-t-elle compréhensible lorsque les exigences, les collaborateurs ou les interfaces changent ?

Si les deux réponses sont solides, une belle promesse devient un système utilisable. Alors pure fluidity meets ultimate performance se montre non dans une diapositive, mais lors d'une journée de travail calme où commandes, données et décisions continuent sans friction inutile.
Lien permanent →

SaaS Flow Web : introduire des workflows en toute sécurité en cours d'activité

SaaS Flow Web : introduire des workflows en toute sécurité en cours d'activité

Une réception de marchandises ne reste pas en plan parce qu'une équipe ne connaît pas encore un logiciel de plus. Elle reste en plan parce que les informations se perdent entre e-mail, formulaire papier, fichier Excel et appel téléphonique. Avec le SaaS - « Flow Web » sur flow.softify.pro - l'interface ne devrait donc pas être la première question. L'essentiel est de savoir si le service reproduit de façon fiable un déroulement de travail concret - même les jours agités, avec des responsabilités changeantes et lorsqu'une livraison ne correspond pas au plan.

Pour les petites et moyennes entreprises, le SaaS a souvent du sens parce qu'elles n'ont pas à construire d'abord leurs propres serveurs, versions et fonctions de base. Mais ce n'est pas un passe-droit pour chaque processus. Qui introduit un outil qui complique le quotidien ou repousse des données importantes dans des listes annexes peu claires ne numérise pas le travail. Il ne fait que déplacer la friction.

Ce que le SaaS « Flow Web » doit apporter

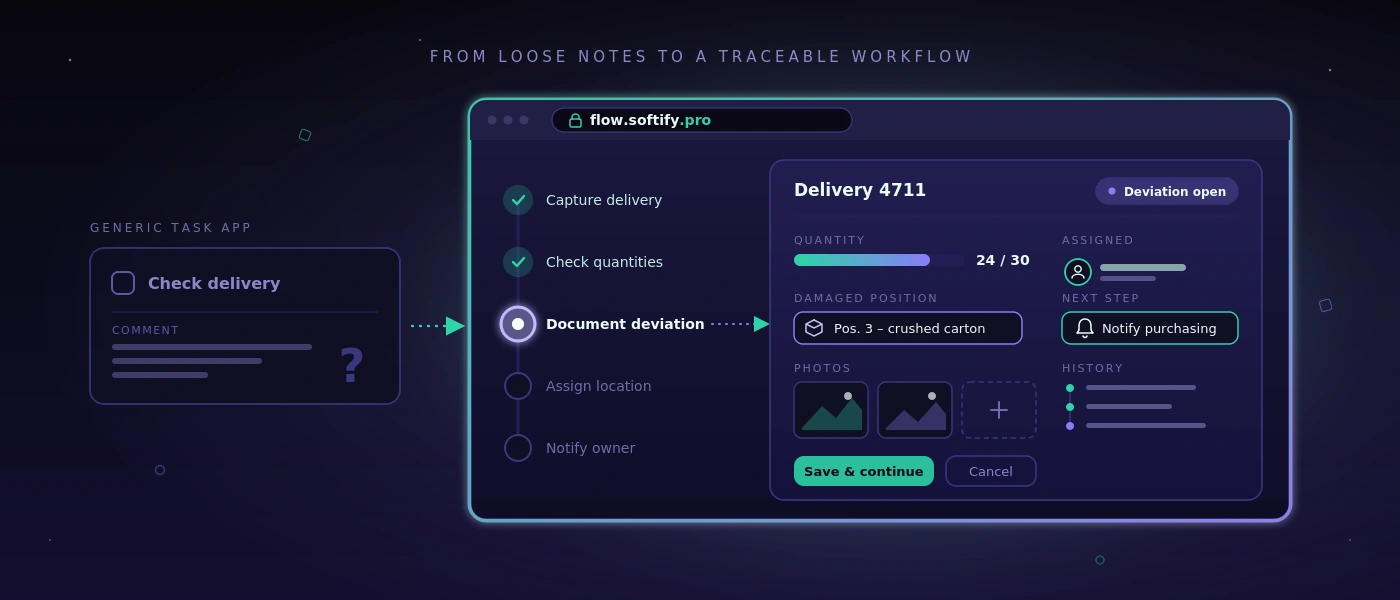
Un workflow web est bon quand les collaborateurs savent sans interprétation ce qu'il faut faire ensuite. Pour une réception de marchandises, cela peut signifier : saisir la livraison, vérifier les quantités par rapport à la commande, documenter l'écart, attribuer un emplacement et, au besoin, informer un responsable. Le déroulement n'a pas à être spectaculaire. Il doit être traçable, rapide et reproductible.

C'est précisément là que se situe la différence entre une application de tâches générale et un système de processus métier. Une application de tâches peut créer un point intitulé « Vérifier la livraison ». Un workflow métier peut en plus consigner de quelle livraison il s'agit, qui l'a réceptionnée, quelle position était endommagée, quelles photos existent et si une livraison complémentaire est en attente. Ces données ne figurent alors pas en texte libre dans un seul commentaire, mais là où la personne suivante en a besoin.

Pour une solution comme Flow Web sur flow.softify.pro, l'examen devrait donc commencer par les opérations, pas par une liste de fonctions. Une entreprise avec cinq mouvements de stock par jour a besoin d'autre chose qu'une équipe d'expédition avec plusieurs heures limites, différents transporteurs et une gestion régulière de livraisons partielles. Le SaaS ne remplace pas la compréhension du processus.

D'abord nommer le goulot d'étranglement, ensuite configurer

Beaucoup de projets de numérisation démarrent trop large : « Nous voulons numériser l'entrepôt. » Cela semble plausible, mais mène vite à un système avec trop d'écrans, de cas particuliers et de documents de formation. Mieux vaut une affirmation précise comme : « Les réceptions de marchandises ne sont enregistrées que le lendemain, parce que les bons de livraison restent sur le bureau en fin d'équipe. »

D'une telle phrase on peut déduire un départ judicieux. La première version peut saisir les bons de livraison, confirmer articles et quantités, signaler les écarts et transmettre l'écriture au service compétent. Lorsque ce déroulement fonctionne, étiquettes, évaluations de fournisseurs ou propositions de commande automatiques pourront être ajoutées plus tard. Toute étape d'évolution judicieuse n'a pas sa place dans le premier déploiement.

Un tableau bien tenu peut lui aussi rester s'il remplit son rôle. Par exemple, une évaluation mensuelle avec peu de participants dans un fichier existant peut être moins chère et plus transparente qu'un module dédié. Le SaaS vaut la peine là où les informations sont utilisées plusieurs fois, où les délais de traitement sont critiques ou où des erreurs naissent de ruptures de support.

Les bonnes questions avant l'introduction

Avant la configuration, une équipe devrait faire jouer une opération réelle du début à la fin. Pas le processus idéal, mais le cas qui pose problème au quotidien : mauvaise quantité, référence manquante, expédition urgente ou commande avec validation spéciale. On voit alors apparaître les règles qu'un système doit réellement reproduire.

Sont notamment pertinents ces points : qui peut créer, modifier ou clôturer une opération ? Quelles saisies sont obligatoires, lesquelles seulement utiles ? Quand un responsable doit-il être informé ? Quelles données sont transmises à la comptabilité, à l'expédition ou au service client ? Et que se passe-t-il si le WLAN de l'entrepôt est faible ou si un collaborateur n'a plus ses identifiants ?

Les réponses déterminent la qualité de l'introduction plus fortement qu'un long catalogue d'exigences visuelles. Un processus de rôles propre, un message d'erreur compréhensible et une étape de validation documentée évitent en exploitation généralement plus d'effort qu'un rapport supplémentaire sur la page d'accueil.

Conservation des données et rôles ne sont pas un détail

Le SaaS est souvent traité comme une pure question d'utilisation. Pour les responsables d'exploitation et informatiques, ce qu'il advient des données est pourtant au moins aussi important. Cela concerne les données de base, les informations de livraison, les données des collaborateurs, les photos de dommages et éventuellement des données clients. Avant l'introduction, les responsabilités, la conservation et les possibilités d'export devraient être claires.

Concrètement : l'entreprise doit savoir quelles données se trouvent dans le système, qui a un accès administratif et comment les données sont mises à disposition en cas de changement ou de fin de contrat. Un export disponible seulement sous forme de fichier PDF difficile à lire aide rarement. Pour les données opérationnelles, des formats structurés et exploitables sont déterminants.

Le concept de droits mérite lui aussi une attention concrète. Dans l'entrepôt, chaque personne n'a pas à voir prix, conditions clients ou paramètres globaux. En même temps, une attribution de droits trop étroite ne doit pas bloquer le déroulement. Des rôles alignés sur les activités réelles ont du sens : réception, planification, expédition, responsable d'équipe et administration. Les modifications critiques devraient être traçables, afin qu'en cas de question on n'ait pas à deviner qui a modifié une écriture.

L'accès lui-même devrait être protégé par des bases solides. Cela comprend des politiques de mots de passe sûres, une réinitialisation de mot de passe encadrée, le verrouillage de compte après des tentatives échouées répétées et, là où le profil de risque l'exige, des étapes de connexion supplémentaires. La sécurité paraît professionnelle lorsqu'elle est prévisible et ne se remarque pas seulement quand quelqu'un a été exclu.

Intégration seulement là où elle soulage de façon mesurable

Un workflow web ne déploie souvent sa valeur qu'en interaction avec les systèmes existants. Cela peut être un ERP, une boutique, une solution d'expédition, une gestion des temps ou une base de données. Pourtant, toute interface n'est pas automatiquement judicieuse. Chaque intégration crée des dépendances, des types de pannes et une charge de maintenance.

La question centrale est : quelle étape manuelle la connexion supprime-t-elle concrètement ? Si une interface économise chaque jour 30 minutes de travail de transfert et réduit les fautes de frappe, l'utilité est claire. Si elle ne fait que refléter une information de toute façon vérifiée une fois par semaine, un export manuel peut d'abord être la solution la plus raisonnable.

Pour les extensions individuelles, la base technique compte. Interfaces documentées, champs de données clairement définis et journaux d'erreurs traçables facilitent l'exploitation ultérieure. Si un système est connecté à une application web sur mesure, technologies et structure de base de données devraient être choisies de façon à rester maintenables à long terme. Une application soignée reposant sur PHP 8.4, JavaScript moderne et MySQL 8 vaut plus qu'une solution spécifique impressionnante à court terme mais sans documentation.

Introduction en cours d'activité

L'erreur la plus fréquente est un démarrage brutal sans phase de comparaison. Les équipes doivent alors travailler différemment dès le lundi matin, alors que les questions ouvertes ne naissent que de vrais problèmes. Cela augmente le rejet, même si le logiciel convient en principe.

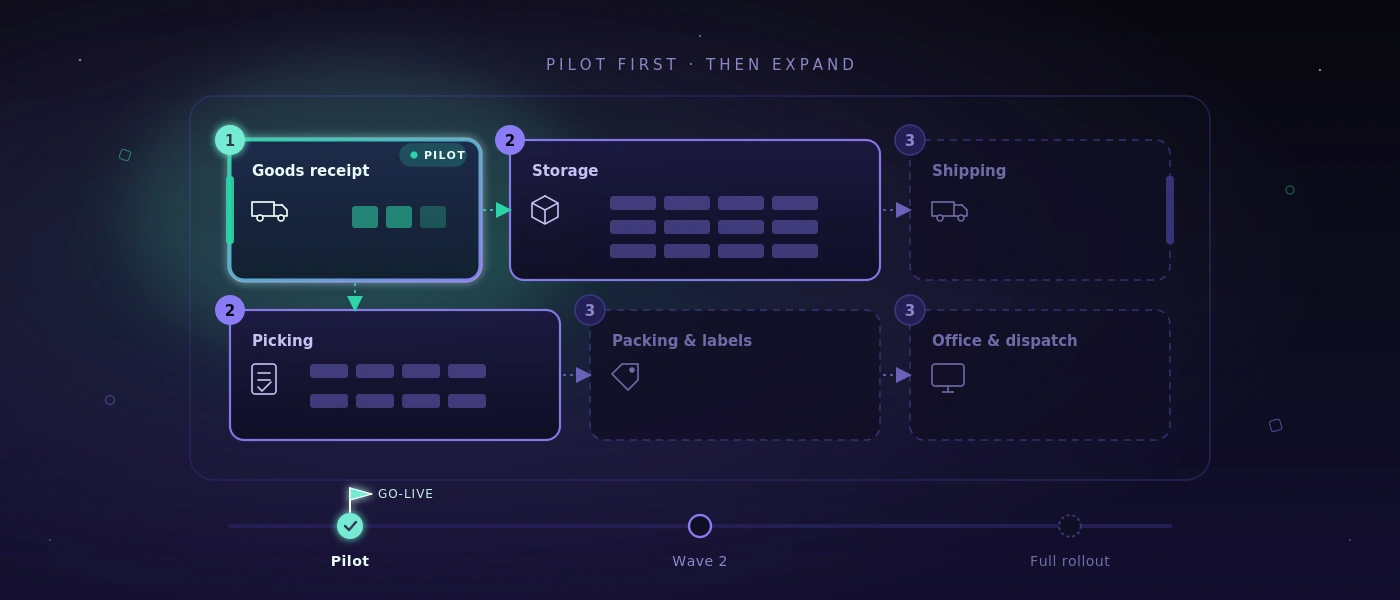
Mieux vaut un pilote limité avec une équipe, une variante de processus ou une zone de site clairement délimitée. Pendant ce temps, on vérifie si la saisie et les validations fonctionnent, si les termes sont compréhensibles et si les cas d'exception atterrissent proprement. Il est important de ne pas collecter les retours seulement comme une liste de souhaits. Chaque modification devrait être testée par rapport à l'utilité pour le délai de traitement, le taux d'erreurs ou la transparence.

Les indicateurs devraient eux aussi être fixés tôt. On peut par exemple observer le temps de traitement par réception de marchandises, le nombre d'écarts ouverts, les demandes sur le statut de livraison ou les écritures de correction. Sans valeur de départ, « ça semble plus rapide » reste la seule évaluation. Cela peut être vrai, mais ne suffit pas pour une décision d'investissement solide.

L'exploitation a besoin d'un propriétaire clair

Le SaaS réduit l'effort technique, mais ne décharge pas une entreprise de la responsabilité de son propre processus. Il faut en interne quelqu'un qui gère les rôles, regroupe les retours, repère les besoins de formation et décide quelles modifications sont vraiment nécessaires. Cette personne n'a pas besoin de savoir programmer. Elle devrait toutefois comprendre le déroulement du travail et avoir accès aux responsables.

Tout aussi importante est une documentation d'exploitation courte et solide. Elle n'explique pas chaque écran, mais répond aux questions qui se posent au quotidien : que faire en cas d'écriture erronée ? Qui approuve les nouveaux utilisateurs ? Comment une panne est-elle communiquée ? Où se trouvent les données exportées ? Une telle clarté évite qu'un système numérique ne redevienne, après quelques mois, dépendant d'appels personnels.

Une bonne solution SaaS ne se reconnaît donc pas au nombre d'entrées de menu qu'elle propose. Elle montre sa valeur quand une nouvelle collègue peut traiter une opération en toute sécurité, qu'un écart ne disparaît pas et qu'un responsable voit le statut sans appeler trois personnes. C'est précisément à cette aune que Flow Web devrait être mesuré : non pas à des promesses, mais à une journée de travail qui se déroule de façon démontrablement plus calme et plus fiable.

Lien permanent →

Développement web avec des frameworks actuels : ce que les entreprises en retirent vraiment

Développement web avec des frameworks actuels : ce que les entreprises en retirent vraiment

Quand une réception de marchandises navigue encore entre formulaire papier, appel téléphonique et trois fichiers Excel, un frontend moderne ne résout pas le problème à lui seul. Le développement web avec des frameworks actuels a du sens lorsqu'il simplifie visiblement les processus : les collaborateurs voient l'étape suivante, les données ne sont saisies qu'une fois, et l'application reste maintenable de façon compréhensible même après la première mise en production.

Pour les petites et moyennes entreprises, la question du framework n'est donc pas une question de foi. L'essentiel n'est pas de savoir si une interface porte particulièrement beaucoup de mots-clés techniques. L'essentiel est de savoir si les mouvements de stock, commandes, contrôles ou validations traversent la journée de travail de façon fiable - même sous pression temporelle, lors de changements d'équipe et avec une connexion réseau fluctuante.

Les frameworks sont un moyen, pas un objectif de projet

Un framework fournit une structure éprouvée pour des tâches récurrentes : routage, formulaires, gestion des droits, accès aux données, tests et affichage des interfaces. Cela ne réduit pas automatiquement tous les risques. Mais cela évite à un projet de devoir réinventer sans cesse les fonctions de base.

Dans une application web sur mesure, un framework JavaScript moderne peut par exemple représenter judicieusement des écrans interactifs : une liste de préparation qui met à jour les positions en continu, une planification de tournées avec des changements de statut clairs ou un procès-verbal de contrôle qui rattache photos et commentaires directement à une opération. Côté backend, des frameworks PHP établis assurent des règles traçables, des responsabilités clairement séparées et des interfaces cohérentes vers la base de données.

C'est particulièrement pertinent quand une solution d'abord petite devient un système d'exploitation utilisé quotidiennement pour un processus. Un écran de saisie pour les avis de livraison peut commencer de façon modeste. Dès qu'il met à jour les stocks, édite des étiquettes, tient compte des rôles et communique avec un transporteur, il a besoin d'une base technique propre. Les frameworks aident à ne pas renégocier cette base à chaque extension.

Ce que les frameworks web actuels font concrètement mieux

La valeur des frameworks modernes réside rarement dans des effets spectaculaires. Elle se montre dans les parties invisibles d'une application. Les formulaires peuvent contrôler directement les saisies, sans que des données erronées ne se remarquent qu'après l'envoi. Les droits peuvent être définis de façon centrale, de sorte qu'un chauffeur voie d'autres informations que la planification. Les modifications d'une commande sont enregistrées de façon traçable, au lieu d'écraser silencieusement une cellule de tableau.

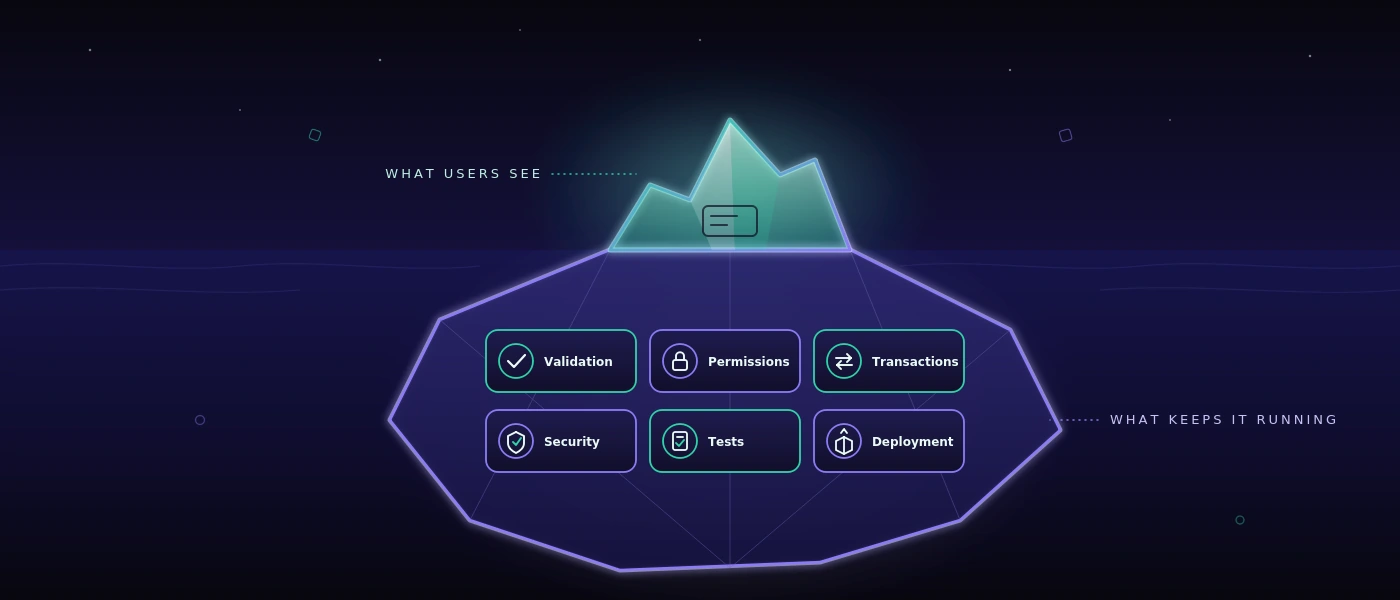
Côté serveur, un environnement actuel avec PHP 8.4 et MySQL 8 crée une base solide pour une logique critique pour l'activité. Les transactions de base de données empêchent par exemple qu'un stock soit réduit pendant que l'écriture correspondante échoue. Des clés uniques et des règles de validation évitent les doublons. Des processus d'arrière-plan peuvent générer des documents ou interroger des interfaces sans que la personne devant l'écran ait à attendre.

La sécurité n'est pas non plus une fonction après coup. Un framework moderne prend en charge le stockage sécurisé des mots de passe, la protection contre les attaques typiques par saisie, des sessions traçables et des flux de verrouillage de compte définis. Malgré cela, la mise en œuvre reste une tâche de projet : les droits doivent être modélisés correctement sur le plan métier et les fonctions sensibles nécessitent des contrôles supplémentaires. Un framework fournit des garde-fous, mais ne sait pas qui, dans l'entreprise, peut accorder quelle validation.

Bien décider du développement web avec des frameworks actuels

La meilleure technologie ne naît pas d'une liste d'outils populaires, mais de l'usage réel. Une application interne pour dix personnes a d'autres exigences qu'un portail client avec plusieurs milliers d'accès simultanés. Un terminal d'entrepôt avec scanner a besoin d'une autre logique d'utilisation qu'une analyse de direction sur ordinateur.

C'est pourquoi une décision judicieuse commence par des questions concrètes : quelles opérations coûtent aujourd'hui du temps de façon mesurable ? Quelles données sont transférées plusieurs fois ? Où naissent des erreurs parce que les informations ne deviennent visibles que trop tard ? Quel tableau existant fonctionne assez bien et devrait d'abord rester ? Précisément ce dernier point protège de projets de numérisation coûteux sans utilité opérationnelle.

Pour de nombreuses applications métier sur mesure, un système rendu côté serveur avec des composants interactifs ciblés est le choix le plus raisonnable. Il se charge vite, est gérable à exploiter et évite une complexité inutile. Une application single-page entièrement découplée peut en revanche convenir quand l'interface traite de très nombreux états dynamiques, doit fonctionner hors ligne ou doit plus tard fournir les mêmes fonctions à une application mobile.

Les deux peuvent être justes sur le plan métier. La question n'est pas : quel framework est le plus moderne ? Elle est : quelle architecture sera encore extensible en sécurité, testable et compréhensible pour sa propre équipe dans deux ans ?

Quand moins de technique est la meilleure technique

Tous les processus n'ont pas besoin d'un frontend complexe. Un écran de saisie épuré pour les commandes internes peut être plus rapide, plus stable et moins cher qu'une interface animée avec sophistication. Si un fichier Excel n'est tenu qu'une fois par mois et ne cause pas d'erreurs, il reste peut-être le bon outil.

La complexité ne vaut la peine que lorsqu'elle supprime une vraie friction. Cela peut être le cas lorsque des commandes sont ressaisies plusieurs fois, que le statut de livraison doit être demandé par téléphone ou que personne n'est sûr de la version d'un document qui fait foi. Une application centrale crée alors un bénéfice clair : un état des données, des responsabilités univoques et moins de demandes.

La maintenabilité commence avant la première ligne de code

Les frameworks sont souvent considérés comme des accélérateurs. Cela n'est vrai que si les règles métier sont auparavant suffisamment claires. Un développeur peut construire une machine à états proprement sur le plan technique. Mais savoir si la suite des statuts correspond vraiment au processus se décide lors du recueil : quand la marchandise est-elle considérée comme reçue ? Qui peut clôturer un écart ? Que se passe-t-il en cas de livraison partielle ?

Ces décisions doivent être documentées, tout comme les interfaces, champs de données et exceptions. Cela ne ralentit pas les projets. Cela réduit les discussions ultérieures, car on voit quelle règle a été mise en œuvre délibérément et quelle hypothèse reste ouverte.

La maintenabilité se montre aussi dans de petites disciplines. Les modifications de base de données doivent être versionnées. Les étapes de déploiement doivent être documentées. Les messages d'erreur doivent être exploitables pour l'exploitation et le développement sans révéler de détails confidentiels. Des tests automatisés vérifient à chaque modification les processus centraux, par exemple la création d'une commande, le calcul d'une quantité ou l'édition d'un bon de livraison.

Pour les applications critiques, un seul type de test ne suffit pas. Les tests unitaires sécurisent des règles individuelles, les tests d'intégration vérifient l'interaction avec la base de données et les interfaces, et les tests de bout en bout rejouent dans le navigateur des parcours d'utilisation réels. Pour les applications web et Windows, un environnement de test auto-hébergé peut en outre fournir des captures d'écran, des journaux d'exécution et des évaluations compréhensibles, sans confier inutilement de données de test internes à des services cloud externes.

La performance naît de l'architecture et du modèle de données

Une interface moderne ne devient pas rapide parce qu'elle utilise un framework actuel. Des requêtes de base de données lentes, des images surdimensionnées ou des interfaces peu claires restent lentes, indépendamment du frontend. Surtout avec des listes de commandes, d'articles ou de données de mouvement, c'est le modèle de données qui décide de la vitesse perçue.

Des index propres dans MySQL 8, des requêtes paginées et des données chargées de façon réfléchie sont souvent plus efficaces qu'une optimisation ultérieure de l'interface. Un concept de cache clair est tout aussi important. Les données de référence peuvent éventuellement être mises en cache, les stocks actuels ou le statut de validation en revanche pas aveuglément. Il n'existe pas de règle générale ici, car c'est la signification métier des données qui détermine leur degré d'actualité requis.

La conception responsive fait aussi partie de la planification technique. Sur l'écran de bureau, un grand tableau peut être pertinent. Sur un scanner portable ou une tablette en entrepôt, la même information requiert de grandes zones tactiles, des parcours courts et une présentation qui reste utilisable même avec des gants ou par mauvaise lumière. Pure fluidity meets ultimate performance ne signifie dans ce contexte pas le plus de mouvement possible à l'écran. Cela signifie que l'application fonctionne sans friction sur l'appareil réellement utilisé dans le processus.

Le chemin judicieux de l'idée à l'exploitation

Un projet web solide démarre avec un noyau limité et vérifiable. Au lieu d'automatiser d'emblée chaque exception imaginable, on choisit un processus qui revient souvent et cause un effort sensible. Après la première utilisation, des données et retours réels montrent quelle extension a vraiment la priorité suivante.

La remise technique ne devrait pas n'avoir lieu qu'à la fin. Les responsabilités pour l'hébergement, les sauvegardes, la supervision, les mises à jour et les droits d'accès doivent être clarifiées tôt. Un système n'est aussi fiable que son exploitation. Qui a besoin d'une application au quotidien pour l'expédition ou le traitement des commandes a besoin de voies de restauration définies et d'une réponse claire à ce qui se passe en cas de panne.

softify.pro mise donc sur des technologies maintenables, une livraison documentée et une responsabilité technique directe plutôt que sur des modes passagères de frameworks. Ce n'est pas un raccourci magique. Cela crée la condition pour qu'une application continue de fonctionner après le lancement, puisse évoluer et ne devienne pas le prochain cas particulier fragile.

Dans le meilleur des cas, la bonne application web ne ressemble pas à un nouveau projet informatique. Elle ressemble à un déroulement qui fonctionne enfin sans détours - avec assez de substance technique pour absorber calmement aussi le prochain changement en exploitation.

Lien permanent →

Planifier un déploiement logiciel : comment l'introduire en cours d'activité

Planifier un déploiement logiciel : comment l'introduire en cours d'activité

Un nouveau système échoue rarement parce qu'un bouton manque. Il échoue le lundi matin : l'équipe du matin ne trouve pas la réception de marchandises, un bon de livraison est imprimé deux fois ou un fichier Excel devient soudain la vérité non officielle. Qui veut planifier un déploiement logiciel doit donc non seulement introduire des fonctions, mais sécuriser l'exploitation réelle.

Précisément dans l'entrepôt, l'atelier, la planification et l'administration, un déploiement n'est pas un rendez-vous informatique. Il modifie les gestes, les responsabilités et les circuits d'information. Une bonne introduction maintient le travail en mouvement, rend les erreurs visibles tôt et donne aux collaborateurs une réponse claire à la question décisive : qu'est-ce que je fais différemment à partir de demain ?

Le déploiement commence avant la première formation

De nombreux projets démarrent avec une liste de fonctions : saisir des commandes, enregistrer des mouvements d'entrepôt, imprimer des étiquettes d'expédition, planifier des tournées. C'est nécessaire, mais insuffisant. Avant le démarrage, il faut clarifier quels processus doivent effectivement passer par le nouveau système le premier jour productif - et lesquels volontairement pas encore.

Cette délimitation n'est pas un signe d'incomplétude. Elle réduit le risque. Si une entreprise de taille moyenne a jusqu'ici coordonné les réceptions de marchandises par papier, téléphone et tableaux, elle n'a pas à numériser le premier jour en même temps toute la gestion des stocks, le traitement des retours, la planification des tournées et l'évaluation des fournisseurs. Un premier périmètre judicieux pourrait porter sur la réception de marchandises, des mouvements d'entrepôt sans ambiguïté et l'impression des documents de livraison.

L'essentiel est de décrire concrètement le processus cible. Pas : « La réception de marchandises devient numérique. » Mais : « Le collaborateur scanne la livraison, vérifie quantité et état, attribue un emplacement et crée, en cas d'écart, une opération pour les achats. » Ce n'est qu'à ce niveau que les questions ouvertes deviennent visibles : que se passe-t-il en cas de commande manquante ? Qui peut corriger les quantités ? Une livraison sans étiquette peut-elle être stockée ?

Planifier un déploiement logiciel signifie : prioriser les processus critiques

Tous les processus n'ont pas la même importance. Une panne dans la maintenance des données de base peut être désagréable. Une panne dans l'expédition, la préparation de commandes ou la validation des factures peut bloquer le travail d'une journée entière. C'est pourquoi le déploiement nécessite une priorisation selon le risque opérationnel, et non selon l'ordre du cahier des charges.

Une classification simple a fait ses preuves : critique pour l'activité, important et reportable. Sont critiques tous les processus qui font circuler marchandises, argent ou communication client engageante. Sont importantes les fonctions qui accélèrent le quotidien, mais dont la panne peut être amortie manuellement de façon transitoire. Sont reportables les fonctions de confort, les cas particuliers rares ou les analyses qui peuvent d'abord provenir encore d'une source existante.

Cette classification influence la profondeur des tests. Pour un processus d'expédition critique, il ne suffit pas de parcourir avec succès une seule commande. Il faut aussi tester les livraisons partielles, les annulations, les imprimantes manquantes, les mauvaises adresses, le traitement parallèle et la transmission au transporteur. Pour une fonction statistique rarement utilisée, un cycle de test ultérieur peut être approprié.

Rendre les critères de réussite mesurables à l'avance

« L'application fonctionne » n'est pas un critère de recette. Mieux vaut des énoncés vérifiables : une réception de marchandises de 30 positions est enregistrable en dix minutes. Les étiquettes d'expédition sont imprimées au poste prévu. Les modifications de stock apparaissent immédiatement dans la planification. Un compte utilisateur verrouillé ne peut être réactivé que via le processus de validation défini.

De tels critères relient service métier et développement. Ils évitent aussi que la recette ne devienne une collection d'impressions vagues. Tous les retours n'ont pas à être résolus avant la mise en production. Mais chaque retour nécessite un classement : erreur critique, amélioration pertinente ou point pour une étape d'évolution ultérieure.

Migration des données : seules des données propres méritent la confiance

Les anciennes données sont souvent sous-estimées. Dans les tableaux se trouvent des numéros d'article en double, des unités différentes, des adresses clients périmées et des stocks dont personne ne sait plus expliquer l'origine. Qui reprend ces données sans les vérifier déplace l'ancienne ambiguïté dans un nouveau système - simplement avec une meilleure interface.

Avant la migration, il faudrait déterminer quelles données sont réellement nécessaires. Des articles actuels, des clients actifs, des commandes ouvertes, des fournisseurs pertinents et des stocks de départ vérifiés sont souvent judicieux. Les données historiques ne doivent pas forcément migrer intégralement vers la nouvelle application. Il peut suffire de les archiver de façon lisible si elles restent nécessaires pour des justificatifs ou des demandes.

Un chargement d'essai est particulièrement important. Les données ne sont pas seulement importées techniquement, mais vérifiées sur le fond : les quantités, unités et affectations sont-elles correctes ? Les champs obligatoires sont-ils complets ? Peut-on traiter correctement des commandes typiques ? Pour la mise en production, il faut ensuite une date butoir claire. À partir de quand quel système fait-il référence ? Sans cette règle naissent double saisie et stocks contradictoires.

Exploitation pilote plutôt qu'un grand interrupteur

Un big bang peut être judicieux si une petite équipe utilise un processus clairement délimité et que l'ancienne et la nouvelle solution ne peuvent pas fonctionner en parallèle. Dans la plupart des environnements opérationnels, une exploitation pilote est toutefois le choix le plus maîtrisable.

Le pilote devrait travailler avec des cas réels, mais dans un cadre limité : une zone d'entrepôt, une équipe, un groupe de produits ou une équipe sélectionnée. L'essentiel est que le groupe pilote ne comprenne pas uniquement des collaborateurs particulièrement à l'aise avec la technique. Il devrait représenter de façon réaliste le quotidien futur, y compris les personnes qui travaillent sous pression temporelle et ont des objections légitimes.

En exploitation pilote, on voit si scanners, imprimantes, réseau et droits fonctionnent au poste de travail réel. Des lacunes de processus que personne n'avait mentionnées en réunion deviennent aussi visibles. Peut-être que la marchandise est d'abord déposée sur un emplacement intermédiaire au quotidien. Peut-être que les chauffeurs ont besoin d'un autre bon de livraison que l'administration. De telles découvertes ne sont pas un recul. Elles sont la raison de mener le pilote avant le démarrage généralisé.

La formation comme situation de travail, pas comme visite du logiciel

Une formation qui n'explique que les entrées de menu génère peu de sécurité. Les collaborateurs doivent apprendre sur leurs tâches : « Vous réceptionnez une livraison endommagée », « Vous préparez une commande urgente », « Vous corrigez une quantité mal enregistrée ». Le contexte reste en mémoire parce qu'il correspond au quotidien de travail.

De courtes formations proches de la mise en production sont généralement plus efficaces qu'un long rendez-vous des semaines auparavant. De brèves consignes de travail directement au poste aident aussi. Elles ne devraient pas expliquer tout le système, mais montrer les opérations les plus fréquentes, les responsabilités claires et la marche à suivre en cas de panne.

Nommez en outre des interlocuteurs par secteur. Ces personnes n'ont pas à résoudre elles-mêmes chaque problème technique. Mais elles devraient pouvoir décider s'il s'agit d'une erreur de manipulation, d'une ambiguïté métier ou d'une véritable erreur système. Cela protège l'équipe projet des sollicitations non structurées et accélère l'aide pour l'équipe de poste.

La mise en production a besoin d'un plan d'exploitation

Le jour de la mise en production exige plus qu'une heure. Définissez qui décide sur le plan métier, qui est responsable des modifications techniques et par quel canal les pannes sont signalées. Pour les processus critiques, il devrait être visible si les fonctions centrales fonctionnent : connexion, droits, saisie des données, interfaces, impression et sauvegarde.

Un plan de repli en fait aussi partie. Cela ne signifie pas revenir complètement à l'ancien monde au moindre problème. Cela signifie déterminer à l'avance quelle panne justifie un arrêt, comment les commandes sont documentées en cas de besoin et comment elles sont ressaisies proprement ensuite. Un formulaire papier pour quelques heures peut être raisonnable. Un fonctionnement parallèle permanent sans fin ne l'est pas.

Les détails techniques comptent ici : les accès ont-ils été créés à temps ? Les rôles et les règles de verrouillage de compte s'appliquent-ils correctement ? Les imprimantes d'étiquettes sont-elles reliées aux bons modèles ? Existe-t-il une sauvegarde testée de la base de données ? Pour les applications développées sur mesure, des déploiements documentés, des versions traçables et une voie claire pour les corrections sont la norme.

Les premières semaines décident de l'acceptation

Après le démarrage commence la phase où une application devient soit un outil de travail, soit une étape supplémentaire détestée. Prévoyez donc de courtes boucles de retour quotidiennes. Quelles erreurs se répètent ? Où naissent des détours ? Quels champs sont mal compris ? Quelle analyse manque réellement à un responsable ?

Toute observation n'exige pas une modification immédiate. Certains problèmes se résolvent par des règles de travail plus précises ou une meilleure formation. D'autres révèlent de véritables faiblesses du processus ou de l'application. L'art consiste à ne pas confondre les deux. Un système ne devrait pas compliquer sans raison des processus existants qui fonctionnent. Si un tableau bien tenu reste la meilleure solution pour un cas particulier rare, il peut rester.

Mesurez l'effet à l'aide de quelques indicateurs concrets : temps de traitement par opération, nombre de demandes, écritures erronées, réimpressions, commandes ouvertes ou écarts de stock. Seules ces valeurs montrent si le déploiement améliore réellement l'exploitation - au lieu de simplement introduire de nouveaux écrans.

Un bon déploiement ne ressemble plus à un projet après quelques semaines. Il devient une routine de travail fiable : les bonnes données sont là où elles sont nécessaires, les exceptions sont traçables et les équipes ont moins à courir après l'information par téléphone. C'est exactement ce que la planification devrait viser - non un jour de lancement spectaculaire, mais un quotidien plus calme et mieux pilotable.

Lien permanent →

Planifier le Multiplatform Application Development : d'abord le processus, ensuite la plateforme

Planifier le Multiplatform Application Development : d'abord le processus, ensuite la plateforme

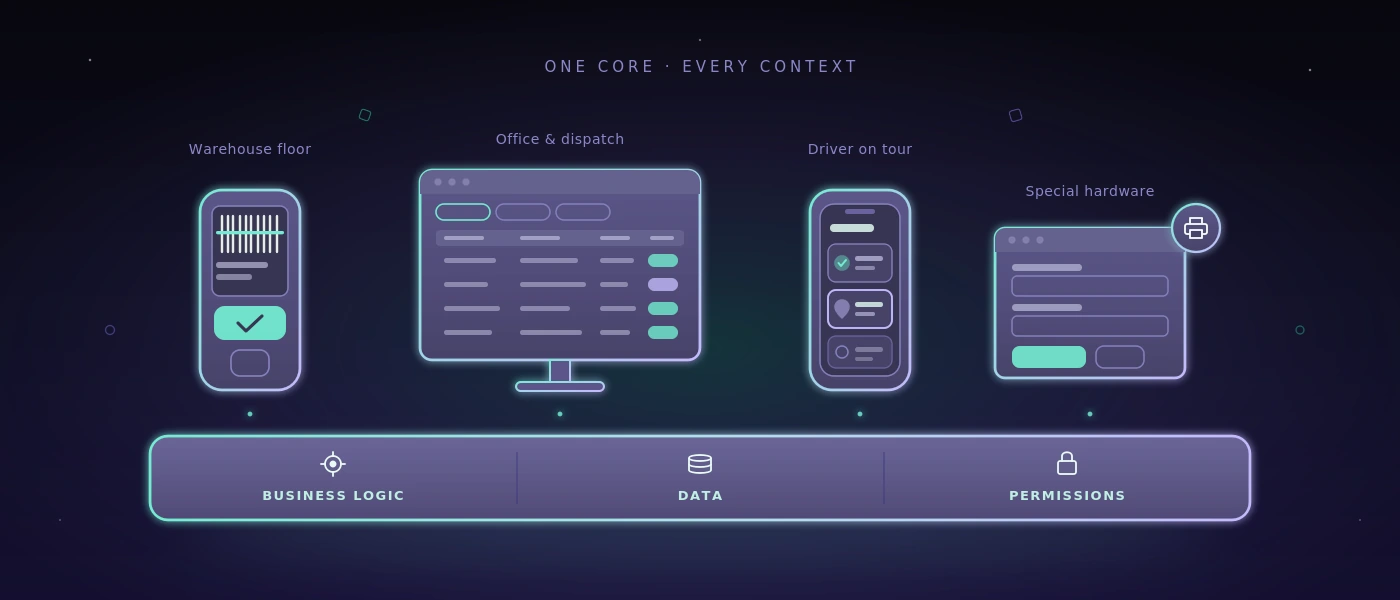
Un responsable d'entrepôt confirme une réception de marchandises sur un scanner portable. La planification vérifie la même opération dans le navigateur. Un chauffeur a besoin du statut de livraison en déplacement sur son smartphone. Le Multiplatform application development ressemble, à ce moment, à une question technique. En réalité, il s'agit d'abord d'un déroulement opérationnel : quel travail doit être accompli à quel endroit, avec quelle fiabilité et sur quel appareil ?

Pour les petites et moyennes entreprises, la bonne réponse est rarement : nous construisons tout en natif pour chaque plateforme. Plus souvent, c'est : nous définissons un processus commun, choisissons de façon ciblée les interfaces nécessaires et évitons la logique en double. Cela n'économise pas seulement du budget de développement. Cela empêche aussi que l'entrepôt, le bureau et le service extérieur travaillent avec des états de données différents.

Ce que le Multiplatform Application Development doit apporter

Le Multiplatform Application Development désigne le développement d'une application utilisable dans plusieurs environnements, par exemple dans le navigateur web, sur iOS et Android ou sur des systèmes de bureau Windows. Le terme est souvent réduit à la question de savoir si une seule base de code peut produire plusieurs applications. Ce n'est qu'une partie de la décision.

Pour les systèmes opérationnels, ce qui compte avant tout est de savoir si l'application fonctionne sur son lieu d'utilisation. Une zone de réception peut avoir besoin d'une caméra pour saisir des codes-barres, de grands éléments de commande pour les gants et d'une réaction utilisable en cas de couverture WLAN instable. L'administration a en revanche besoin de tableaux, de filtres, de concepts de droits et de journaux de modifications traçables. Un chauffeur a besoin d'une vue réduite, pas de la même interface que la planification.

Une base technique commune peut relier ces exigences de façon sensée. Mais elle ne doit pas conduire à servir chaque plateforme comme un mauvais compromis. Le meilleur code commun est sans valeur si les collaborateurs font des détours parce que l'application ne reflète pas leur déroulement de travail réel.

D'abord déterminer le processus, ensuite la plateforme

Avant de parler de frameworks, les équipes devraient examiner une opération concrète du début à la fin. Prenons une livraison : la commande arrive, la marchandise est préparée, un bon de livraison est créé, la remise est confirmée et le statut est remonté aux ventes ou au service client. À quel endroit naît aujourd'hui la rupture de support ? Où note-t-on quelque chose sur papier, le ressaisit-on plus tard ou le demande-t-on par téléphone ?

Cette observation sépare les vraies exigences de plateforme des listes de souhaits. Si seuls deux collaborateurs au bureau utilisent une fonction, une interface web bien faite suffit généralement. Si dix personnes sur le sol de l'entrepôt effectuent des saisies, une interface mobile adaptée au scanner peut faire la différence. Si un programme Windows existant doit travailler avec du matériel spécial, une intégration de bureau peut être nécessaire.

Toute fonction n'appartient pas à tout appareil. Ce n'est pas un défaut d'une solution multiplateforme, mais le signe de décisions de produit propres. Des données et des règles métier communes ne signifient pas forcément des écrans identiques.

Les trois questions qui clarifient coûts et bénéfices

La première question est : quels appareils sont déjà utilisés et pendant combien de temps le resteront-ils ? Une entreprise avec des terminaux Windows gérés a d'autres exigences qu'un service extérieur avec des smartphones privés. La deuxième est : que se passe-t-il sans connexion réseau ? La capacité hors ligne augmente considérablement l'effort, car les données doivent être stockées localement, synchronisées plus tard et traitées proprement en cas de conflit. Elle est judicieuse si le processus s'arrête sinon - pas comme équipement standard.

La troisième question concerne les conséquences d'une panne. Un collaborateur peut-il saisir une écriture plus tard, ou une étiquette d'expédition, un stock ou une validation de sécurité en dépendent-ils ? Plus l'opération est critique, plus les droits, les règles de contrôle, la répétabilité et la journalisation doivent être planifiés.

Une architecture qui ne s'effondre pas à la deuxième plateforme

Dans une solution durable, la logique métier n'est pas dispersée dans plusieurs interfaces. Les contrôles de stock, les changements de statut, les plages de numérotation, les droits et la génération de documents nécessitent une base centrale et testée. Navigateur, application mobile et client de bureau y accèdent par des interfaces clairement définies.

Pour de nombreux processus métier internes, une application web moderne est le point de départ le plus économique. Elle peut être mise à jour de manière centralisée, ne nécessite aucune installation sur chaque poste et fonctionne sur ordinateur, tablette et smartphone. Avec PHP 8.4, JavaScript moderne et MySQL 8, on peut construire une base maintenable, à condition que le modèle de données, les droits d'accès et le déploiement ne soient pas envisagés seulement peu avant la mise en production.

Une application mobile ou de bureau installable est ajoutée lorsqu'elle apporte un avantage clair : intégration profonde avec scanner, imprimante ou caméra, fonctionnement hors ligne fiable, fonctions spéciales en arrière-plan ou exigences de la gestion des appareils. C'est un développement ciblé, pas une fin en soi.

Une erreur fréquente est la réutilisation complète de l'interface utilisateur à tout prix. Techniquement, cela peut sembler attrayant. En pratique, cela donne de petits textes sur de grands écrans, des formulaires surchargés sur smartphone ou des commandes qui ne conviennent pas à la plateforme. Il vaut mieux partager modèle de données, règles et composants là où c'est judicieux, tout en adaptant l'utilisation au contexte respectif.

La cohérence des données compte plus qu'une base de code commune

Plusieurs plateformes augmentent le risque de données contradictoires. Une commande est modifiée au bureau alors qu'un chauffeur voit encore une ancienne version sur son appareil. Deux collaborateurs saisissent en même temps le même stock d'article. Un appareil hors ligne renvoie ses modifications des heures plus tard. Ces cas ne sont pas un sujet marginal, mais le cœur de l'architecture.

Le système a donc besoin d'identités univoques, d'horodatages, de changements d'état traçables et de règles pour les conflits. Pour un statut de livraison, la dernière modification confirmée peut suffire. Pour les stocks, c'est souvent trop grossier. Là, il doit être clair quel mouvement a été enregistré, de quel emplacement il provient et si une correction doit être justifiée.

Les droits doivent eux aussi être réglés de manière centrale. Un collaborateur peut éventuellement saisir des réceptions de marchandises, mais pas valider des corrections de stock. Un chauffeur externe ne doit voir que sa tournée. Les durées de session, l'authentification multifacteur pour les rôles critiques et les flux de verrouillage de compte ne sont pas des fonctions de sécurité décoratives. Ils protègent des processus concrets et rendent les responsabilités visibles.

Tester le Multiplatform Application Development comme on travaille réellement

Une application peut démarrer sur trois systèmes d'exploitation et échouer malgré tout en exploitation. Ce qui compte, ce sont les déroulements en conditions réelles : le scanner réagit trop lentement, une imprimante d'étiquettes n'est pas joignable, un droit ne s'applique pas après un changement de rôle, ou une synchronisation génère des écritures en double.

C'est pourquoi les processus critiques devraient être vérifiés automatiquement. Cela comprend la connexion et le comportement de verrouillage, la saisie des commandes, les mouvements de stock, la création de documents et le traitement des saisies erronées. Pour les applications web et Windows, des tests récurrents peuvent être exécutés sur une infrastructure auto-hébergée. C'est particulièrement pertinent si les captures d'écran, les données internes de commande ou les accès de test ne doivent pas être transmis à des services cloud externes.

L'automatisation ne remplace pas le contrôle par des personnes sur le sol de l'entrepôt. Mais elle garantit que les déroulements connus soient vérifiés encore et encore après les modifications. De bons rapports de test ne nomment pas seulement une erreur technique, mais le processus concerné : la preuve de livraison ne peut pas être générée, le compte utilisateur reste verrouillé après une validation réussie ou les données de tournée ne sont pas mises à jour.

Quand une stratégie de plateforme est de trop

Certaines entreprises n'ont pas besoin de leur propre application. Si un accès navigateur stable suffit, que le déroulement est rarement mobile et que le nombre d'utilisateurs reste raisonnable, une application web responsive est souvent le choix le plus raisonnable. Elle réduit l'effort de maintenance, les problèmes de distribution et le nombre de sources d'erreur possibles.

Un tableau existant n'a pas non plus besoin d'être remplacé immédiatement. S'il ne sert que d'évaluation simple, est tenu par une personne et ne crée pas de transmissions sujettes aux erreurs, il peut remplir son rôle. Le moment d'un système est atteint quand le savoir réside dans des têtes isolées, que les versions divergent, que les questions augmentent ou qu'une opération ne peut plus être retracée de façon fiable.

À l'inverse, une stratégie de plateforme légère devient vite trop petite quand les collaborateurs doivent travailler hors ligne, que du matériel est connecté ou que clients et partenaires ont besoin d'un accès contrôlé. Il vaut alors la peine de financer consciemment les exigences supplémentaires, au lieu de les ajouter plus tard sous pression de temps.

Commencer par un pilote solide

Un bon départ n'est pas un catalogue de fonctions de cent points, mais un déroulement complet et mesurable. Par exemple : saisir la réception de marchandises, mettre à jour le stock, documenter un écart et créer une tâche de clarification. Ce pilote montre tôt si modèle de données, appareils, droits et utilisation s'accordent.

Ensuite, la solution peut grandir par étapes sensées : préparation de commandes, expédition, planification de tournées ou analyses. Chaque extension devrait passer la même question : raccourcit-elle un vrai déroulement, réduit-elle les erreurs ou crée-t-elle une transparence fiable ? Sinon, elle peut attendre.

La plateforme la plus judicieuse n'est finalement pas celle qui a le plus d'options techniques. C'est celle sur laquelle une équipe commence son travail plus vite le matin, pose moins de questions pendant le poste et peut retracer le soir ce qui s'est réellement passé.

Lien permanent →

Bien évaluer les Test Automation Results

Bien évaluer les Test Automation Results

Un test de régression peut se terminer le matin avec 98 pour cent de cas réussis et ne pas être pour autant une bonne nouvelle. Peut-être que le test échoué est justement la connexion d'un grand client. Peut-être que 40 tests ont été ignorés parce que l'environnement de test n'était pas joignable. Ou bien l'exécution était verte, mais ne vérifiait que l'existence des boutons, pas si une commande est réellement enregistrée, un bon de livraison généré et le stock correctement ajusté. Les Test automation results ne sont pas une affirmation sur la qualité tant que leur contexte manque.

Pour la direction QA, le développement et les services métier, le vrai travail ne réside donc pas seulement dans l'automatisation des tests. L'essentiel est de préparer les résultats de manière à en tirer des décisions fiables : une version peut-elle être déployée ? Une erreur doit-elle être traitée immédiatement ? L'erreur est-elle nouvelle, récurrente ou seulement un problème de l'environnement de test ? Et existe-t-il des preuves qu'un service métier sans code de test peut aussi comprendre ?

Ce que disent vraiment les Test Automation Results

L'indicateur le plus simple est : réussi ou échoué. Il est utile, mais rarement suffisant. Un taux de réussite élevé peut créer la confiance si les tests couvrent des processus critiques, si les données de test sont plausibles et si l'environnement ressemble à l'exploitation future. Si l'un de ces facteurs manque, le chiffre reste surtout un signal indiquant qu'une exécution automatisée a eu lieu.

Pour les applications critiques pour l'activité, d'autres questions comptent davantage. Dans une solution d'entrepôt, tous les écrans ne sont pas aussi importants. Une erreur d'affichage dans un texte d'aide interne peut attendre. Une erreur qui enregistre la mauvaise quantité à la réception de marchandises ou génère une étiquette d'expédition sans adresse de destinataire, non. De bons résultats de test pondèrent donc les risques au lieu de traiter tous les cas de la même façon.

Un test échoué n'est pas non plus automatiquement un défaut du produit. Il peut être déclenché par des identifiants expirés, un rôle de test verrouillé, des interfaces indisponibles, des données de test modifiées ou un environnement lent. Qui ne sépare pas ces causes produit du bruit. L'équipe passe alors du temps sur de fausses alertes pendant que de vraies erreurs se perdent parmi les messages de statut rouges.

Quatre types de statut au lieu d'une liste rouge

Une classification claire a fait ses preuves en pratique : erreur fonctionnelle, erreur technique du test, problème d'environnement et changement attendu. Une erreur fonctionnelle signifie que l'application enfreint une exigence définie. Une erreur technique du test renvoie plutôt au test lui-même, par exemple un sélecteur qui ne correspond plus après une interface délibérément modifiée.

Un problème d'environnement existe lorsque, par exemple, un système de test ou une interface connectée n'est pas disponible. Les changements attendus surviennent quand un processus a été délibérément adapté, mais que l'automatisation vérifie encore l'ancien état cible. Ces catégories n'évitent pas toute discussion. Mais elles font en sorte que la discussion commence au bon endroit.

Des exécutions de tests aux rapports prêts à la décision

Un rapport utilisable ne répond pas seulement qu'une chose a échoué, mais ce qui s'est passé, quelle en est la gravité et si l'erreur paraît reproductible. Cela demande plus qu'une liste de noms de tests et d'horodatages.

À chaque exécution pertinente appartiennent la build vérifiée, l'environnement de test, le rôle utilisé, les principales données de test ainsi que l'heure de début et de fin. Surtout avec des applications de bureau Windows ou des plateformes web complexes, ces informations sont nécessaires pour cerner les différences. Une erreur qui n'apparaît que sous un rôle d'entrepôt restreint est autre chose qu'une erreur qui bloque chaque connexion.

Des résultats significatifs contiennent en outre des preuves traçables : captures d'écran, étapes enregistrées, messages d'erreur et, si nécessaire, journaux techniques. Une capture d'écran seule peut toutefois tromper. Elle montre un instant, pas la cause. La combinaison de la séquence d'étapes, de l'état visible et de la réaction attendue est bien plus utile.

Les systèmes assistés par IA peuvent transformer ces preuves en évaluations compréhensibles. Avec COCO, par exemple, les tests s'exécutent sur un serveur IA dédié et auto-hébergé. L'évaluation peut expliquer qu'une commande a bien été créée mais que le changement de statut attendu n'a pas eu lieu, et rattacher directement l'enregistrement de l'exécution. Pour les équipes soucieuses de sécurité, il importe de savoir où sont traités les captures d'écran, les données applicatives et le trafic de test. Le contrôle local n'est pas automatiquement nécessaire, mais pour des applications internes et des données sensibles, il peut être la voie la plus judicieuse par rapport à un service cloud externe.

Le bon niveau de détail pour différents destinataires

Les équipes de développement ont besoin de messages d'erreur, d'étapes techniques et d'indications aussi précises que possible pour la reproduction. Un responsable des opérations a en revanche besoin d'abord de la fonction concernée, du risque métier et d'une affirmation claire sur la capacité d'exploitation. Les deux perspectives doivent pouvoir découler de la même exécution, sans que personne n'ait à transférer manuellement des résultats dans des présentations.

Un bon rapport commence donc par un court niveau décisionnel : mise en production recommandée, mise en production avec limitations connues ou arrêt de la mise en production. En dessous figurent les écarts critiques avec priorité et preuve. Les détails techniques ne suivent qu'ensuite. Ce n'est pas une simplification au détriment de la précision, mais une séparation nette des besoins d'information.

Mesurer la couverture sans se bercer d'illusions

La couverture de test est souvent présentée sous forme de pourcentage. Cette valeur est utile quand on sait ce qu'elle mesure. La couverture de code montre par exemple quelles parties du code du programme ont été exécutées pendant les tests. Cela ne prouve pas qu'un processus métier fonctionne correctement. Un test peut toucher beaucoup de lignes de code et ne jamais vérifier si une mauvaise adresse de livraison apparaît sur le document.

Pour les services métier, la couverture des processus est souvent plus parlante. Elle décrit quels flux réels sont protégés : saisir une commande, réserver du stock, enregistrer une livraison partielle, accepter un retour ou valider une facture. Les passages entre systèmes et rôles sont particulièrement précieux, car c'est là que les erreurs surviennent souvent : à l'import d'une commande, à l'impression d'une étiquette ou lors du passage du bureau au terminal d'entrepôt.

Ne priorisez pas selon le nombre de tests possibles, mais selon l'impact des dommages et la fréquence des modifications. Un processus rarement utilisé avec un risque financier ou juridique élevé mérite souvent une automatisation plus tôt qu'une vue fréquemment utilisée mais inoffensive. Inversement, un processus stable et peu critique peut continuer à se contenter d'un bref contrôle manuel. Tout contrôle n'a pas à être automatisé simplement parce qu'il est automatisable.

Les tests instables sont un problème de qualité à part entière

Les tests qui réussissent parfois et échouent parfois sans changement identifiable du produit sont souvent qualifiés de flaky. Ils abîment la confiance plus vite qu'un test durablement rouge. Dès que les équipes relancent par réflexe les résultats rouges, l'automatisation perd sa fonction d'alerte.

Les causes sont généralement concrètes : attentes fixes, données de test partagées, accès parallèles, traitement asynchrone ou un environnement qui n'est pas réinitialisé. Une courte pause de trois secondes dans le test peut aider par hasard, mais ce n'est pas une solution. Il vaut mieux attendre un état vérifiable, rendre les données de test uniques et isoler les processus les uns des autres.

Toute instabilité ne peut pas être évitée complètement. Les interfaces externes peuvent fluctuer et l'infrastructure réelle connaît des pannes. Le rapport devrait alors indiquer clairement si un test n'était pas évaluable en raison d'une dépendance externe. Une exécution répétée peut être utile pour le diagnostic, mais elle ne doit pas rendre invisible le premier constat.

Un déroulement judicieux après chaque exécution de tests

Après une exécution automatisée, tous les résultats ne devraient pas être traités immédiatement de la même façon. On examine d'abord les erreurs bloquantes et les tests critiques non évaluables. Vient ensuite le classement des nouveaux écarts par rapport aux problèmes connus et acceptés. Ce n'est qu'alors qu'une décision de mise en production est solide.

Des seuils définis sont utiles, mais ils doivent correspondre au processus. Par exemple, un test échoué dans le flux de paiement ou d'autorisation peut déclencher un arrêt immédiat. Pour un écart purement cosmétique, une exception documentée peut être acceptable. De telles règles ne devraient pas n'apparaître que sous la pression du temps avant une mise en production.

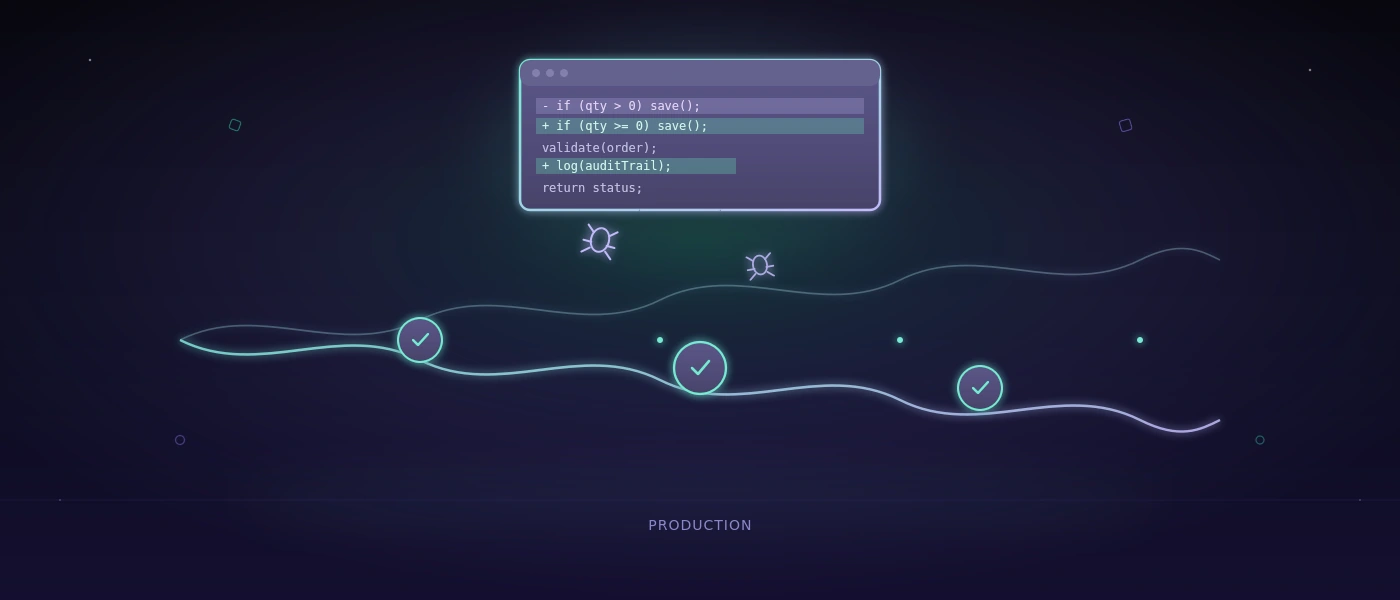
Le retour d'expérience est tout aussi important : chaque erreur en production que les tests n'ont pas détectée est une occasion de vérifier s'il manque un scénario, une variante de données de test ou un point de contrôle. L'objectif n'est pas d'accumuler un maximum de tests. C'est de construire, à partir d'erreurs réelles, une meilleure protection ciblée.

Les résultats de test les plus utiles ne sont finalement pas ceux dont la vue d'ensemble est la plus verte. Ce sont ceux pour lesquels un responsable peut comprendre, le lundi matin, ce qui a été vérifié, quel risque subsiste et quelle action est maintenant raisonnable.

Lien permanent →

Inventory Discrepancy Causes : raisons courantes des écarts de stock

Inventory Discrepancy Causes : raisons courantes des écarts de stock

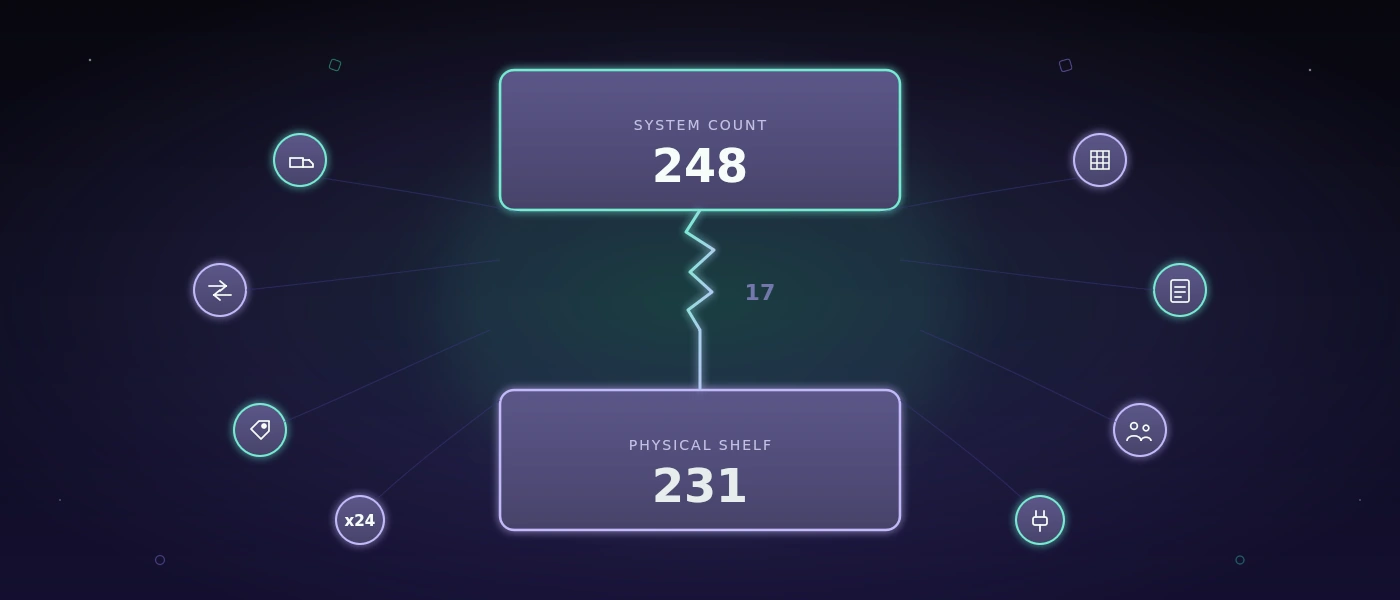
Le système indique 248 pièces en stock, l'étagère en contient 231. Ces 17 unités ressemblent d'abord à une erreur de comptage. Mais c'est précisément là que commence souvent la mauvaise analyse. Les inventory discrepancy causes sont rarement, en pratique, un simple oubli isolé. La plupart du temps, elles naissent là où réception de marchandises, mouvement d'entrepôt, préparation de commande, et comptabilisation divergent dans le temps ou sur le plan organisationnel.

Pour une petite ou moyenne entreprise, les écarts de stock ne sont pas seulement un sujet pour l'inventaire. Ils entraînent des commandes erronées, des livraisons express, des stocks de sécurité inutiles, et des promesses de livraison intenables. Qui sépare proprement les causes n'a pas besoin d'introduire immédiatement un grand ERP. Souvent, des règles de comptabilisation plus claires, des appareils de saisie adaptés, et un système qui reflète les processus de travail réels suffisent.

Inventory discrepancy causes : où naissent les écarts

Un écart de stock est la différence entre le stock théorique dans le système de référence et le stock réellement présent. Le mot « de référence » est ici déterminant. Si un fichier Excel, une liste papier, et un système de gestion des stocks sont tenus en parallèle, il existe pratiquement plusieurs vérités. L'écart n'est alors pas seulement né dans l'entrepôt, mais déjà inscrit dans la gestion des données.

La contre-mesure efficace dépend donc du type d'erreur. Une palette mal comptée nécessite une solution différente d'une livraison acceptée physiquement mais jamais comptabilisée. Avant de restructurer les processus, les équipes devraient évaluer les écarts par article, emplacement, équipe, type de mouvement, et moment. Seul ce schéma montre s'il s'agit d'un cas isolé ou d'une erreur de processus récurrente.

1. Les réceptions de marchandises sont comptabilisées tardivement ou de façon incomplète

La réception de marchandises est un point de rupture classique. La marchandise arrive le matin, est mise de côté pour contrôle, et plus tard déplacée directement vers la production ou sur l'étagère. La comptabilisation a lieu l'après-midi, le lendemain, ou jamais. Tant que la marchandise est physiquement présente, le stock système paraît trop bas. Si elle est déjà consommée ou expédiée, des erreurs ultérieures deviennent plus probables.

Les livraisons partielles, les articles de remplacement, et les sur-livraisons y sont particulièrement sujets. Si le bon de livraison indique une quantité, mais qu'une quantité différente arrive, personne ne devrait simplement comptabiliser le document « à peu près correspondant ». L'écart doit rester visible comme exception, avec motif, personne responsable, et approbation. Sinon, la déviation disparaît de l'opération et ne réapparaît qu'à l'inventaire.

2. Les mouvements d'entrepôt se produisent sans transaction

Un article est placé de la réception vers le stockage en hauteur, déplacé d'un casier vers la zone de préparation, ou réservé pour une commande. Physiquement, c'est un mouvement petit et rapide. Dans le système, il peut être déterminant.

Si le personnel réorganise les emplacements de stockage uniquement au feeling, le stock total pourrait encore être correct, mais la disponibilité au bon endroit non. Cela entraîne des temps de recherche, des erreurs de préparation, et des trajets de réapprovisionnement inutiles. Une bonne solution d'entrepôt n'a pas besoin de compliquer chaque mouvement. Elle doit saisir les quelques mouvements pertinents pour la disponibilité, la traçabilité, et le réapprovisionnement.

Dans les ateliers ou les petits entrepôts, il est souvent plus judicieux de maintenir quelques zones sans ambiguïté qu'une structure de casiers théoriquement parfaite que personne n'entretient au quotidien. La précision ne fonctionne que si elle reste praticable.

3. La préparation de commande et l'expédition sont comptabilisées trop tôt

De nombreuses équipes comptabilisent une commande comme « sortie » au moment du picking, alors que la marchandise se trouve encore sur un emplacement de mise à disposition. Si la commande est ensuite modifiée, annulée, ou seulement partiellement expédiée, le stock système et le stock physique ne correspondent plus.

Une séparation claire entre réservé, préparé, et expédié est préférable. Toutes les entreprises n'ont pas besoin de chaînes de statut complexes pour cela. Mais le moment de la diminution du stock doit être sans ambiguïté. Pour la marchandise expédiée, il se situe souvent plus près de la remise effective au transporteur que du premier geste vers l'étagère.

Les retours font aussi partie de ce flux. Quand une marchandise revient, elle n'est pas automatiquement à nouveau disponible. Seuls le contrôle, la décision qualité, et le stockage devraient déterminer si elle retourne au stock vendable, reste bloquée, ou est mise au rebut.

4. Mauvaises unités et erreurs de données de base

Un carton, un conditionnement, un rouleau, et une pièce unique peuvent tous concerner le même article. Si la conversion n'est pas maintenue proprement, des écarts apparaissent à une vitesse impressionnante. Un employé comptabilise « 1 », voulant dire un carton de 24 pièces. Le système comprend une pièce.

Les erreurs de données de base sont particulièrement insidieuses, car le processus de comptabilisation peut paraître techniquement correct. Vérifiez donc les unités d'emballage, les facteurs de conversion, les quantités minimales, les emplacements, et les numéros d'article. Les variantes nommées de façon similaire, par exemple différentes longueurs, couleurs, ou lots, sont aussi facilement confondues.

Aucune règle générale comme « scanner davantage » n'aide ici. Les codes-barres ne sont fiables qu'à hauteur de l'association qui se trouve derrière. Pour les petits assortiments, une base d'articles proprement tenue avec des étiquettes bien lisibles peut produire plus d'effet qu'un vaste parc de scanners mal configuré.

5. Tableaux parallèles et corrections manuelles

Le tableau sur le bureau naît rarement de la négligence. Il comble le plus souvent une lacune réelle : une réservation spéciale, une valeur d'analyse manquante, ou un processus que le logiciel existant ne représente pas. Il devient problématique quand il devient le deuxième registre de stock.

Les entrées sont alors comptabilisées dans le système, mais les sorties notées dans le tableau. Ou une correction n'a lieu que là où elle aide justement pour la prochaine commande. Personne ne peut plus expliquer de façon fiable plus tard quelle valeur fait foi.

Tous les tableaux n'ont pas besoin d'être supprimés. Un calcul pour la planification ou l'analyse peut rester judicieux. Mais les opérations modifiant le stock devraient avoir exactement un système de référence. Les ajustements nécessitent un code motif, un horodatage, et idéalement une personne qui puisse être retracée. Ce n'est pas de la bureaucratie pour elle-même, mais la condition préalable à des analyses de causes fiables.

6. Erreurs de comptage et méthodes d'inventaire inadaptées

Même des processus corrects ne protègent pas des erreurs humaines. Des articles sont comptés deux fois, des palettes sont oubliées, des cartons ouverts estimés, ou des emplacements non bloqués pendant le comptage. Un inventaire complet annuel découvre ces problèmes tard et sous forte pression.

Pour de nombreuses entreprises, un inventaire tournant est l'alternative la plus raisonnable. Les articles à rotation rapide ou de valeur sont contrôlés plus souvent, les articles C stables moins souvent. Ce qui compte n'est pas de produire le plus grand nombre possible de comptages, mais de vérifier les écarts rapidement par rapport aux derniers mouvements. Si un article en écart est simplement corrigé sans documenter la cause, le schéma reste invisible.

Un contre-contrôle est particulièrement judicieux pour les valeurs élevées, les numéros de série, ou les lots. Pour des vis dans un stock de consommables, il peut être économiquement excessif. La profondeur du contrôle devrait correspondre au risque.

7. Responsabilités floues entre équipes et secteurs

Les erreurs de stock naissent souvent aux transmissions. L'équipe du matin prépare la marchandise, l'équipe du soir l'expédie. La réception de marchandises accepte une livraison, la planification modifie la commande en parallèle. Chaque étape individuelle peut être traçable, mais personne ne possède l'opération dans son ensemble.

Définissez donc non seulement des rôles, mais des points de transmission : qui confirme la réception de marchandises ? Quand la responsabilité de la marchandise préparée change-t-elle de main ? Qui vérifie les exceptions ouvertes en fin d'équipe ? Un tableau numérique partagé ou une simple liste d'exceptions est souvent plus efficace que des réunions supplémentaires.

Le système devrait rendre les opérations ouvertes visibles, plutôt que de forcer le personnel à s'en souvenir. Par exemple, les livraisons sans contrôle de quantité, les préparations sans finalisation d'expédition, ou les retours sans décision qualité doivent se démarquer avant de devenir des erreurs de stock silencieuses.

8. Intégration système faible et règles de contrôle manquantes

Si la boutique, la gestion des commandes, l'entrepôt, et la comptabilité échangent des données avec un décalage temporel ou par fichier, des comptabilisations doubles ou manquantes peuvent survenir. Un import s'exécute deux fois. Une interface échoue silencieusement. Une commande est modifiée après que son statut d'expédition a déjà été transféré.

La solution n'est pas forcément un remplacement complet. Souvent, il faut des interfaces clairement définies, des numéros de document sans ambiguïté, et des contrôles techniques. Une comptabilisation d'entrepôt devrait stocker de façon traçable quand elle a eu lieu, de quelle opération elle provient, et si elle a été annulée par la suite. Les processus critiques nécessitent des messages d'erreur et des files d'attente, pas seulement une entrée silencieuse dans le fichier journal.

Avec des systèmes logistiques développés sur mesure, de telles règles peuvent être adaptées de façon ciblée à l'activité : aucune quantité négative sans approbation, aucune confirmation d'expédition sans position d'expédition, aucun traitement en double de la même référence externe. La meilleure règle n'est pas ici la plus stricte, mais celle qui arrête les véritables erreurs sans bloquer l'activité pour des exceptions normales.

Vérifier les écarts de stock systématiquement

Ne commencez pas par une correction généralisée. Choisissez les dix articles avec les écarts les plus fréquents ou les plus coûteux, et retracez leur dernier mouvement en remontant : réception de marchandises, transfert, prélèvement, retour, comptage, et éventuel ajustement manuel. Si les cas se concentrent sur un site, une équipe, ou un type de mouvement, c'est un point de départ solide.

Ensuite, chaque mesure devrait être mesurable. Si de nouveaux scans de codes-barres sont introduits, observez non seulement le nombre de scans, mais le taux d'écart par groupe d'articles. Si un nouveau statut pour la mise à disposition est ajouté, vérifiez quotidiennement les mises à disposition ouvertes. Les bons processus ne produisent pas une fausse précision. Ils rendent les exceptions visibles et traçables tôt.

L'étape suivante judicieuse est souvent petite : définir un point de transmission, nettoyer un emplacement, ou sécuriser techniquement une correction manuelle récurrente. Des stocks fiables ne naissent pas de plus de logiciels par intuition, mais de processus encore correctement exécutables un mardi mouvementé à 16h45.

Lien permanent →

Bien aborder l'automatisation des processus pour les PME

Bien aborder l'automatisation des processus pour les PME

Un bon de livraison manque parce que les données sont encore sur un bout de papier. Une réception de marchandises est saisie deux fois parce que l'entrepôt et le bureau travaillent avec des tableaux différents. Une validation est retardée parce que la personne responsable ne répond pas au téléphone en ce moment. Ce type de friction coûte rarement beaucoup d'argent d'un coup. Mais sur plusieurs semaines, les demandes, les temps de recherche, les corrections d'erreurs, et les attentes inutiles s'accumulent. C'est exactement là que l'automatisation des processus pour les PME trouve tout son sens.

Il ne s'agit pas de remplacer le plus d'activités possible par des logiciels. Une bonne automatisation rend les processus traçables, réduit les transmissions évitables, et donne au personnel du temps pour des décisions qui nécessitent de l'expérience. C'est particulièrement décisif dans les petites et moyennes entreprises : les équipes sont proches de l'activité quotidienne. Quand un processus coince, c'est souvent toute l'équipe qui s'en rend compte immédiatement.

Ne pas automatiser chaque processus

L'erreur la plus fréquente est de commencer par l'agacement le plus visible. Peut-être qu'un fichier Excel agace, peut-être qu'il faut un nouveau tableau de bord. Les deux peuvent être justifiés. Mais un chaos numérisé reste un chaos - juste plus rapide et avec plus de données.

Avant toute décision technique, le processus devrait d'abord être décrit tel qu'il se déroule réellement. Pas tel qu'il devrait figurer dans le manuel. Qui déclenche l'opération ? Quelles informations sont nécessaires ? Où quelque chose est-il transféré manuellement ? Qui décide en cas d'exception ? Et à quoi l'équipe reconnaît-elle que l'opération est terminée ?

Précisément dans l'entrepôt ou le traitement des commandes, les points critiques se situent souvent entre les systèmes : une commande arrive par e-mail, est copiée dans un tableau, coordonnée par téléphone, et saisie plus tard dans un logiciel d'expédition. Chaque transmission augmente la probabilité que les quantités, les dates, ou les adresses divergent.

Une automatisation est particulièrement rentable lorsqu'un processus revient fréquemment, a des règles claires, et que les erreurs entraînent des conséquences sensibles. Cela peut être la réception de marchandises, la création de bons de livraison, l'attribution de mouvements d'entrepôt, ou la transmission des commandes validées à l'expédition. Les cas particuliers rares nécessitant de nombreuses décisions discrétionnaires restent en revanche souvent mieux traités manuellement - au moins dans un premier temps.

L'automatisation des processus pour les PME commence par les priorités

Toute activité inutile ne mérite pas immédiatement un projet. Une priorisation simple apporte de la clarté. Évaluez les différents processus selon leur fréquence, leur temps de traitement, le coût des erreurs, et les dépendances. Une opération qui se produit cinquante fois par jour et n'économise que deux minutes à chaque fois peut être plus rentable qu'un processus mensuel compliqué.

La question de la conséquence de l'erreur est au moins aussi importante. Un document interne mal imprimé est agaçant. Une attribution de lot erronée, une adresse de livraison perdue, ou une réception de marchandises non documentée peut déclencher des réclamations, un travail de recherche, et des écarts de stock. Là, l'automatisation crée non seulement de la vitesse, mais aussi de la fiabilité.

Une première étape sensée est généralement assez petite pour être vérifiable en quelques semaines. Par exemple, un employé peut saisir des marchandises via un code-barres, le système vérifie l'article et la quantité, met à jour le stock dans une base de données centrale, et génère directement un bon de stockage si nécessaire. L'équipe n'a alors pas à deviner quelle version d'un tableau est à jour.

Un état cible clair plutôt qu'une liste de fonctionnalités

De nombreux projets démarrent avec une longue liste de fonctionnalités souhaitées. Une image opérationnelle concrète est préférable : que doit-on voir à la fin d'un processus sans avoir à demander ? Pour l'expédition, cela pourrait signifier qu'une commande, une fois validée, reçoit automatiquement une liste de préparation, que l'adresse d'expédition est vérifiée, et qu'une étiquette peut être générée. Les exceptions atterrissent visiblement dans une liste de clarification, au lieu d'une boîte e-mail ingérable.

Cette image cible oblige à prendre des décisions utiles. Chaque commande doit-elle être traitée entièrement de manière automatique ? Ou les commandes au-delà d'une certaine valeur marchande, avec une adresse de livraison divergente, ou avec un stock manquant, doivent-elles être délibérément soumises à vérification ? L'automatisation n'a pas besoin d'un traitement à cent pour cent sans intervention pour créer une grande valeur.

La technique adaptée dépend du processus

Il n'existe pas de voie technique standard pour chaque PME. Une solution en tableau peut rester raisonnable pour une évaluation gérable. Elle est rapidement adaptée, familière, et engendre peu d'efforts de mise en place. Dès que plusieurs personnes travaillent simultanément, que les écritures doivent être traçables, ou que des données sont échangées avec d'autres systèmes, elle atteint cependant ses limites.

Alors une application légère, spécifique au processus, est souvent plus judicieuse qu'une suite d'entreprise surdimensionnée. Elle peut représenter exactement les étapes nécessaires dans l'activité : saisir la commande, vérifier le stock, déplacer la marchandise, générer le document, enregistrer l'expédition, et rapporter le statut. Ni plus, ni moins.

Techniquement, ce qui compte moins, c'est si un système fait la publicité du dernier mot à la mode. Ce qui compte, ce sont des fondations solides : une base de données proprement modélisée, des permissions traçables, des journaux pour les modifications pertinentes, des interfaces fiables, et des déploiements documentés. Une application basée sur PHP 8.4, du JavaScript moderne, et MySQL 8 peut être très bien maintenable à long terme, si l'architecture et l'exploitation sont pensées dès le départ.

Les intégrations méritent aussi de l'attention. Un échange automatique de données avec une boutique, un ERP, un prestataire d'expédition, ou la comptabilité ne fait gagner du temps que si les erreurs sont traitées de manière visible. Que se passe-t-il en cas d'adresse invalide ? Une impression d'étiquette échouée est-elle retentée ? L'équipe peut-elle voir quelles données ont été transférées et lesquelles manquent encore ? Les erreurs silencieuses sont plus dangereuses qu'un cas exceptionnel clairement signalé.

Mise en place en cours d'activité

Un nouveau système doit s'adapter aux changements d'équipe, aux délais de livraison, et aux routines de travail existantes. C'est pourquoi un déploiement progressif est généralement plus sûr qu'une date butoir stricte pour tous les domaines. Commencez par un processus délimité, un groupe de produits, ou une zone d'entrepôt. Cela réduit le risque et génère de vrais retours du quotidien.

Le fonctionnement en parallèle n'est donc pas un signe d'incertitude, mais un test contrôlé. Pendant un temps limité, l'ancienne et la nouvelle saisie peuvent être comparées. Les écarts révèlent non seulement des bugs logiciels, mais aussi souvent des règles qui, jusqu'à présent, n'existaient que dans la tête de certains employés. Ces règles doivent figurer visiblement dans le processus - pas rester durablement dans l'expérience personnelle.

Le personnel ne devrait pas être confronté au nouveau processus seulement lors de la formation. Celui qui exécute le processus quotidiennement repère tôt les raccourcis, les cas particuliers, et les écrans peu pratiques. Un bon logiciel respecte ce savoir, sans intégrer inchangée chaque exception née historiquement. La bonne question est : quelle exception protège un cas métier important, et laquelle n'est qu'un contournement pour un vieux problème ?

Rendre mesurable si l'effort en vaut la peine

Deux ou trois indicateurs devraient être définis avant le démarrage. Cela peut être le délai de traitement par commande, le nombre de corrections manuelles, les écarts de stock, ou le délai jusqu'à l'expédition. Sans valeur de départ, toute évaluation ultérieure se réduit à une impression subjective.

Tout effet ne se traduit pas immédiatement en euros. Lorsqu'une équipe d'entrepôt sait à tout moment où se trouve la marchandise, le nombre d'interruptions diminue. Lorsque les documents de livraison proviennent des mêmes données que la commande, le risque d'informations contradictoires diminue. Et lorsque les responsabilités sont visibles dans le système, une opération dépend moins de personnes individuelles.

L'automatisation nécessite maintenance et limites

Un processus automatisé n'est pas un projet qui se fige après la mise en production. Les structures d'articles changent, les clients exigent de nouveaux documents, les prestataires d'expédition adaptent leurs interfaces. C'est pourquoi les responsabilités, les mises à jour, les sauvegardes, et une gestion réglementée des permissions font partie du système en tant que tel.

Notamment pour les applications avec des données clients, de commande, ou de stock, il devrait être clair qui obtient l'accès et pourquoi. Les rôles doivent correspondre au quotidien de travail : une équipe d'entrepôt a besoin de fonctions différentes de la comptabilité ou des ventes. Les modifications journalisées, les flux de connexion sécurisés, et les restaurations testées paraissent peu spectaculaires. En cas d'incident, ce sont précisément ces détails qui décident si l'activité peut continuer.

Les tests font aussi partie de la sécurité opérationnelle. Des vérifications récurrentes pour la saisie des commandes, l'enregistrement des stocks, la génération de documents, et la gestion des droits empêchent qu'une modification à un endroit n'endommage un processus fonctionnel ailleurs. Pour les applications web ou de bureau critiques, un environnement de test auto-hébergé et contrôlé peut être judicieux si les captures d'écran, les données de test, et les processus internes ne doivent pas rejoindre des services cloud externes.

softify.pro accompagne ce type de projets avec un principe simple : d'abord comprendre le processus réel, puis construire la plus petite solution viable. Parfois, c'est une application sur mesure. Parfois, il suffit de structurer plus proprement un tableau existant et d'automatiser une seule étape de transmission.

La meilleure prochaine étape n'est donc pas une comparaison de logiciels, mais un parcours à travers un processus réel - du déclencheur à l'achèvement. Prenez une commande, une réception de marchandises, ou une réclamation, et suivez-la avec les personnes impliquées. Là où des informations sont ressaisies, où personne ne connaît le statut, ou où des décisions attendent inutilement, se trouve généralement l'approche la plus sensée pour l'automatisation.

Lien permanent →

Tester des applications Windows : un plan pratique

Tester des applications Windows : un plan pratique

Une application Windows peut sembler propre en mode démo et tout de même ralentir l'activité le lundi matin. Un bon de livraison non enregistré, un utilisateur bloqué après trois tentatives échouées, ou une boîte de dialogue d'impression qui réagit différemment après une mise à jour ne sont pas des bugs cosmétiques. Quiconque veut savoir comment tester des applications Windows ne devrait donc pas commencer par des boutons isolés, mais par les processus qui coûtent du travail, de l'argent, ou de la traçabilité.

Précisément en entrepôt, atelier, expédition, et administration, de nombreux processus critiques passent par des logiciels de bureau développés au fil des ans. Là, ce qui compte n'est pas si un cas de test est formulé de façon impressionnante. Ce qui compte, c'est si le personnel peut accomplir son travail de manière fiable dans des conditions réalistes - y compris avec des données incomplètes, des permissions changeantes, des réseaux lents, et des interruptions non planifiées.

Tester des applications Windows commence par les processus critiques

Toutes les fonctions ne méritent pas le même effort de test. Un export rarement utilisé avec retraitement manuel doit être évalué différemment de l'enregistrement d'une réception de marchandises, la création d'étiquettes, ou le rapprochement quotidien des commandes. Commencez donc par une question simple : que se passe-t-il concrètement si ce processus échoue ?

Sont prioritaires les processus ayant un impact direct sur le stock, la livraison, la facturation, la sécurité, ou la communication client. Cela inclut par exemple la connexion et la vérification des droits, la création et la modification des données de base, les enregistrements de transactions, l'impression de documents, les interfaces vers les services ERP ou d'expédition, ainsi que les reprises après une erreur. Même les fonctions utilisées par un petit groupe de personnes seulement peuvent être critiques si elles bloquent une clôture mensuelle ou la libération de marchandises.

De ces processus naissent non pas des listes de tests abstraites, mais des étapes de travail traçables. Un test de réception de marchandises pourrait, par exemple, commencer avec une commande existante, saisir une livraison partielle, signaler une quantité divergente, attribuer un emplacement de stockage, puis vérifier si le stock, le journal des écritures, et le document imprimé concordent. Vous testez ainsi l'effet réel du logiciel, pas seulement des champs de saisie isolés.

Créer une base de test qui reflète l'activité

De nombreuses erreurs ne deviennent visibles que lorsque l'environnement de test se rapproche de la réalité. Une application se comporte souvent différemment avec un environnement de test vide qu'avec plusieurs années de données de mouvement, d'articles bloqués, d'informations obligatoires manquantes, ou d'opérations déjà ouvertes.

Préparez donc des données de test de manière délibérée. Vous n'avez pas nécessairement besoin d'une copie complète de la production. Un patrimoine de données contrôlé avec des cas typiques, limites, et délibérément erronés est plus judicieux : articles avec différentes unités de mesure, clients avec des conditions spéciales, commandes avec livraisons partielles, utilisateurs avec différents rôles, et opérations déjà en cours de traitement. Les données personnelles devraient être anonymisées ou remplacées par des données d'exemple réalistes.

La base de test comprend aussi l'environnement technique. Documentez la version de Windows, la résolution, la mise à l'échelle, les imprimantes installées, les lecteurs réseau, la version de la base de données, les services connectés, et les permissions. Cela paraît austère, mais cela fait gagner du temps par la suite. Si une erreur ne se produit que sur des postes de travail avec une mise à l'échelle de 125 %, ou avec un pilote d'imprimante particulier, cela doit être reproductible.

Ne pas vérifier seulement le cas idéal

Le cas idéal prouve surtout que l'application a été construite pour le chemin attendu. Dans l'activité, les situations difficiles surgissent à côté. Que se passe-t-il si un utilisateur laisse un champ obligatoire vide, déclenche deux fois la même écriture, ou perd la connexion pendant l'enregistrement ? L'opération reste-t-elle cohérente ? La personne reçoit-elle un message compréhensible ? Peut-elle continuer à travailler en toute sécurité ?

Dans les applications Windows, l'utilisation et l'état sont en outre particulièrement pertinents. Les fenêtres de dialogue peuvent apparaître en arrière-plan, les raccourcis clavier peuvent se chevaucher, les boîtes de dialogue de sélection de fichiers peuvent bloquer le déroulement. Vérifiez si le focus, les messages d'erreur, et les verrous sont sans ambiguïté. Une exception technique sans indication d'action n'aide pas le chef d'équipe.

Utiliser les tests manuels là où le jugement est requis

Les tests manuels ne sont pas un signe de maturité insuffisante. Ils sont indispensables lorsqu'un nouveau processus émerge, qu'une interface est reconstruite, ou que l'expertise métier détermine la qualité. Un chef d'entrepôt expérimenté reconnaîtra plus vite qu'un script si un écran est compréhensible sous forte pression temporelle, ou si un avertissement apparaît trop tard.

Le test manuel devient toutefois coûteux et peu fiable lorsque les mêmes processus stables sont répétés avant chaque version. La mise en production dépend alors des personnes disponibles, de la mémoire, et de notes éparpillées. Le bon moment pour passer à l'automatisation se trouve généralement là où un processus est exécuté fréquemment, peut causer un dommage important, et possède des résultats attendus clairs.

Un bon cas de test manuel décrit la situation de départ, les étapes, le résultat attendu, et les données nécessaires. En cas d'erreur, ajoutez une capture d'écran, un horodatage, la version de l'application et de la build, ainsi que l'action exacte. « L'impression ne fonctionne pas » n'est pas une description d'erreur utilisable. « Après modification de l'adresse de livraison, la boîte de dialogue d'impression reste ouverte, la commande 4711 ne reçoit pas de PDF, et aucun message n'apparaît » l'est.

Tests de régression automatisés pour les risques récurrents

L'automatisation ne vérifie pas si un logiciel est fondamentalement bon. Elle vérifie si des processus définis qui fonctionnaient auparavant fonctionnent encore après une modification. C'est particulièrement précieux pour les logiciels Windows dont les interfaces, la logique de base de données, et les interfaces externes sont développées au fil des ans.

Commencez petit. Choisissez d'abord cinq à dix processus critiques pour l'entreprise qui devraient être vérifiés à chaque version. Cela peut inclure la connexion avec un flux de verrouillage de compte, la saisie de commandes, l'enregistrement d'entrepôt, l'impression PDF ou d'étiquettes, le changement de rôle, et un import central. Ce n'est que lorsque ces tests fonctionnent de manière fiable que l'extension aux cas particuliers en vaut la peine.

Pour les applications de bureau, les tests automatisés pilotent souvent des éléments d'interface visibles : fenêtres, champs de saisie, tableaux, boutons, et boîtes de dialogue. Cela fonctionne, mais c'est plus fragile qu'un test d'interface pur. De petits changements de mise en page, des ordinateurs plus lents, ou des éléments nommés de façon ambiguë peuvent casser les tests. C'est pourquoi les développeurs, le métier, et les responsables des tests devraient déterminer ensemble quels éléments sont adressables de manière stable et quelles étapes de vérification sont mieux sécurisées via la base de données, un journal, ou une interface.

Un test sensé vérifie en outre pas seulement qu'un bouton a pu être cliqué. Il contrôle la conséquence métier : l'écriture a-t-elle été enregistrée ? Le stock est-il correct ? Un document a-t-il été généré ? Aucun enregistrement en double n'a-t-il été créé ? Interaction visible et résultat vérifiable vont de pair.

Les preuves font partie du résultat du test

Un statut vert seul suffit rarement pour les applications critiques. Quand un test échoue, les équipes ont rapidement besoin d'une réponse à trois questions : quelle était la situation de départ ? À quelle étape le processus a-t-il échoué ? Que montrait l'application à ce moment-là ?

Les captures d'écran, les journaux d'exécution, et le cas échéant des enregistrements d'écran rendent les erreurs discutables. Ils raccourcissent considérablement la transmission entre l'exploitation, l'AQ, et le développement. Pour les entreprises réglementées ou soucieuses de sécurité, ils constituent en outre une base solide pour retracer les validations et les écarts.

Le lieu de stockage n'est pas une question secondaire ici. Les exécutions de tests peuvent contenir des données clients internes, des listes de prix, des informations de commande, ou des vues d'écran. Quiconque automatise des tests pour des applications Windows sensibles devrait clarifier si ces données sont autorisées à quitter sa propre infrastructure. Un environnement auto-hébergé comme COCO peut être judicieux ici, car l'exécution des tests, les preuves, et l'évaluation restent sous votre propre contrôle. Si cela est nécessaire dépend des exigences de protection des données, de la situation contractuelle, et du besoin de protection - toutes les équipes n'ont pas besoin de la même architecture pour cela.

Intégrer les tests dans le processus de mise en production

Le meilleur catalogue de tests perd de sa valeur s'il n'est utilisé qu'après une mise en production précipitée. Définissez un moment fixe : les régressions centrales automatisées s'exécutent avant chaque version, la recette manuelle vérifie les processus nouveaux ou modifiés, et les limitations connues sont documentées ouvertement.

Chaque test échoué ne doit pas arrêter une version. Une erreur dans une vue d'administration rarement utilisée peut être acceptable si une solution de contournement sûre existe et que la zone concernée est clairement informée. Une erreur qui enregistre incorrectement les stocks ou bloque des utilisateurs sans qu'on s'en aperçoive doit être traitée différemment. Cette décision devrait être prise en fonction de l'impact métier, pas du simple nombre de tests en rouge.

Maintenez les tests avec l'application. Lorsqu'un processus change délibérément, mettez à jour le cas de test, les données de test, et le résultat attendu en même temps que l'exigence. Les tests obsolètes créent du bruit et finissent par être ignorés. Quelques vérifications dignes de confiance valent mieux que des centaines de processus automatisés dont plus personne ne prend les résultats au sérieux.

Au final, il ne s'agit pas de simuler chaque saisie imaginable. Il s'agit de protéger le travail qui doit à nouveau fonctionner le lendemain matin. Commencez par un seul processus critique, rendez son résultat démontrable, et construisez à partir de là.

Lien permanent →

Secure test data management sans perdre le contrôle

Secure test data management sans perdre le contrôle

Une exécution de test échouée est agaçante. Une exécution de test réussie avec de vraies données clients dans un environnement insuffisamment protégé peut s'avérer nettement plus coûteuse. Le secure test data management ne résout pas cette contradiction avec un seul outil, mais avec des règles claires pour les données, les accès, les environnements de test, et les preuves. Pour les équipes qui testent de manière automatisée des applications web ou Windows, cela fait donc partie du travail de qualité - pas seulement de la conformité.

Pourquoi les données de test deviennent un problème de sécurité

Les données de production sont séduisantes pour les tests car elles contiennent des cas limites réels : adresses incomplètes, combinaisons de commandes inhabituelles, règles de prix historiques, ou saisies erronées. Mais ces mêmes données contiennent souvent des noms, des coordonnées, des informations contractuelles, des numéros de personnel, des données bancaires, ou de la logique métier interne.

Le risque naît rarement d'une seule erreur flagrante. Il grandit généralement étape par étape : un export de base de données est créé pour un test, déposé dans un répertoire partagé, puis copié plus tard dans un autre environnement. Un service externe reçoit des captures d'écran pour l'analyse des erreurs. Un compte de test conserve des droits étendus parce qu'un nettoyage pourrait perturber la prochaine exécution. Après quelques mois, plus personne ne sait de manière fiable quelles données se trouvent où.

Dans les petites et moyennes entreprises, le problème s'aggrave souvent à cause de capacités limitées. L'équipe veut tenir un délai de mise en production, pas gérer son propre projet de protection des données. La responsabilité demeure malgré tout. Quiconque utilise des données pour l'assurance qualité doit pouvoir retracer quelles données sont traitées, qui y a accès, et quand elles sont à nouveau supprimées.

Le secure test data management commence avant le cas de test

La question décisive n'est pas : « Comment protégeons-nous le jeu de données de test ? » C'est : « De quelle information ce test a-t-il vraiment besoin ? » De nombreux tests de régression ne nécessitent aucune référence personnelle réelle. Un processus d'expédition, par exemple, doit vérifier si les adresses de livraison, les poids, les zones, les étiquettes, et les changements de statut sont traités correctement. Des clients synthétiques, des données de référence articles plausibles, et des cas limites définis délibérément suffisent pour cela.

Cette distinction mène à une classification des données praticable. Chaque environnement de test n'a pas besoin de la même profondeur de données. Pour les tests unitaires et d'intégration, des jeux de données entièrement artificiels suffisent souvent. Pour les tests de bout en bout, des copies pseudonymisées peuvent avoir du sens si des motifs de données réels sont pertinents sur le plan métier. Les données proches de la production devraient être l'exception - avec un objectif documenté, un accès limité, et une durée de vie fixe.

La qualité des données de substitution est importante ici. Des données fantaisistes aléatoires aident peu si elles ne reflètent pas des dépendances réalistes. Un jeu de données de test pour une application d'entrepôt doit, par exemple, contenir des variantes d'articles, des emplacements de stockage, des stocks bloqués, des livraisons partielles, et des retours dans une combinaison cohérente. De bonnes données de test ne protègent pas seulement les informations personnelles. Elles trouvent des bugs qui ne se manifesteraient jamais avec des tables vides et le client type « Jean Dupont ».

Synthétiser, masquer, ou minimiser ?

Les données synthétiques sont le choix le plus sûr lorsque les règles métier peuvent être modélisées proprement. Elles naissent spécifiquement des exigences de test et ne contiennent aucune copie de personnes ou d'opérations réelles. L'effort réside dans la maintenance : si le modèle de données change ou que de nouvelles règles de processus s'ajoutent, générateurs et fixtures doivent évoluer en conséquence.

Le masquage convient lorsque le comportement d'une application dépend fortement des structures de production. Les champs sensibles y sont remplacés ou modifiés, tandis que les relations sont préservées. Les noms deviennent des noms plausibles mais fictifs ; les adresses e-mail deviennent des adresses de test non distribuables ; les numéros de compte deviennent des valeurs au format correct sans lien réel. Un masquage n'est solide que si les déductions indirectes sont également prises en compte. Une combinaison d'un lieu rare, d'une date de naissance, et d'une caractéristique contractuelle peut encore rendre une personne identifiable.

La minimisation des données est souvent la troisième voie sous-estimée. Au lieu de copier un export complet, seule la portion nécessaire est fournie. Cela réduit la surface d'attaque, les besoins de stockage, et l'effort de nettoyage. Pour tester une logique de remise, personne n'a besoin de tout l'historique client d'une année.

Les accès et environnements doivent correspondre au risque

Un jeu de données protégé perd sa valeur s'il se trouve dans un environnement de test librement accessible. Les systèmes de test ont donc besoin de leurs propres frontières de sécurité - bases de données séparées, comptes de service dédiés, accès réseau clairement définis, et aucune connexion silencieuse à la production.

Les droits d'accès devraient reposer sur des rôles, pas sur des comptes partagés. Les développeurs peuvent avoir besoin de droits différents de ceux de l'AQ, du support, ou des prestataires externes. Les accès administrateur sont parfois nécessaires, mais ils devraient être limités dans le temps, journalisés, et liés à une approbation traçable. Des règles de mot de passe sensées, une authentification multifacteur là où elle est disponible, et des flux de blocage de compte en cas de tentatives échouées répétées s'appliquent aussi aux comptes de test.

Les tests automatisés apportent un autre cas particulier : ils génèrent des preuves. Captures d'écran, enregistrements d'écran, journaux, et messages d'erreur peuvent contenir un contenu sensible, même lorsque la base de données a été masquée. Une capture d'écran d'un masque client, une trace navigateur avec des informations de session, ou un journal avec une charge utile d'API relèvent de la même considération de protection que la base de données de test.

C'est pourquoi les artefacts de test ont besoin de règles de conservation. Chaque exécution réussie n'a pas besoin d'être stockée durablement. Pour les validations critiques, une preuve traçable peut avoir du sens, par exemple avec un horodatage, un numéro de build, une version de test, et un résultat. Les exécutions échouées nécessitent souvent une fenêtre d'analyse plus longue. Après quoi, les artefacts devraient être supprimés automatiquement. Ce qui n'existe plus ne peut pas être partagé ou compromis par accident.

Automatisation sans fuites de données incontrôlées

L'automatisation des tests assistée par IA peut accélérer considérablement les tests, en particulier pour des applications web et Windows étendues. Mais elle change la question de sécurité : où vont les captures d'écran, les saisies, les descriptions d'erreurs, et le trafic applicatif ? Qui les traite ? Combien de temps y restent-ils ?

Pour les équipes soucieuses de sécurité, l'exécution auto-hébergée est souvent la meilleure architecture. Un système comme COCO peut fonctionner au sein de sa propre infrastructure, ou d'une infrastructure clairement délimitée, exécutant les étapes de test, stockant les preuves, et générant des évaluations compréhensibles. Ce n'est pas obligatoire dans toutes les situations. Pour une page marketing publique avec des valeurs de formulaire purement synthétiques, un service externe peut être acceptable. Pour des applications métier internes, des portails clients, ou des logiciels traitant des opérations personnelles, en revanche, le contrôle local est un avantage concret.

L'auto-hébergement n'est pas un passe-droit. L'exploitation exige des mises à jour, des concepts de sauvegarde, des journaux d'accès, et une entité responsable. En contrepartie, la souveraineté des données reste là où elle doit être. La bonne approche dépend du besoin de protection, des capacités opérationnelles existantes, et du type d'application testée - pas de l'engouement actuel pour un outil de test particulier.

Comment les règles deviennent un processus opérationnel

Un processus praticable n'a pas besoin de bloquer la mise en production. Commencez par une carte des données : quels environnements de test existent, quels types de données s'y trouvent, et quels systèmes génèrent des artefacts supplémentaires ? Cet inventaire révèle généralement déjà d'anciens exports, des systèmes de staging oubliés, et des responsabilités peu claires.

Ensuite, une simple matrice de décision par classe de test se révèle payante. Elle détermine si des données synthétiques suffisent, si un masquage est requis, ou si un extrait de production clairement justifié est nécessaire. Elle est complétée par des propriétaires, des délais de suppression, et des rôles d'accès. Cela n'a pas besoin d'être un corpus de règles surchargé. Une consigne courte et réellement suivie vaut mieux qu'un document de sécurité que personne ne trouve pendant un incident.

Techniquement, la mise à disposition et le nettoyage des données relèvent du pipeline de test. Une exécution crée les jeux de données dont elle a besoin de manière reproductible, utilise des marqueurs uniques, et les supprime ensuite à nouveau. Cela empêche les environnements de test de se remplir de données résiduelles et les résultats de devenir moins fiables à chaque sprint. Pour les processus critiques, les équipes devraient en outre vérifier si les accès aux données et les preuves de test doivent être journalisés de manière auditable.

Une sécurité qui accélère les tests

Le secure test data management est souvent considéré comme une charge de contrôle supplémentaire. Mal mis en œuvre, il peut effectivement l'être. Bien mis en œuvre, en revanche, il crée des conditions de départ fiables et reproductibles. Les équipes perdent moins de temps à chercher un export de données utilisable, évitent les tests cassés à cause de données résiduelles non nettoyées, et peuvent mieux justifier les validations.

La première étape la plus sensée est rarement un grand projet de plateforme. Prenez le processus de test présentant le risque le plus élevé ou la plus grande friction - par exemple la validation d'une application de commandes interne - et rendez-y visibles la source des données, les accès, les artefacts, et la suppression. De ce travail concret naît une routine de sécurité qui ne rend pas les tests plus lourds, mais plus crédibles.

Lien permanent →

Warehouse Software vs ERP

Warehouse Software vs ERP

Une réception de marchandises arrive en même temps qu'un prélèvement urgent, deux collaborateurs demandent l'emplacement d'un article, et un bon de livraison a déjà été corrigé à la main. C'est exactement dans ces moments-là que la question Warehouse Software vs ERP devient concrète. Il ne s'agit pas de l'interface la plus moderne ou de la plus longue liste de fonctionnalités. Il s'agit de savoir si l'information est disponible précisément là où une décision doit être prise en quelques secondes.

De nombreuses petites et moyennes entreprises de la région DACH démarrent avec un ERP, un tableur et beaucoup d'expérience dans l'équipe. Cela peut fonctionner longtemps. Les problèmes commencent quand les stocks divergent entre systèmes, quand les temps de recherche augmentent et que chaque cas particulier doit se résoudre en criant à travers l'entrepôt. À ce moment-là, un grand projet ERP est souvent évoqué, alors qu'il suffirait peut-être de numériser un seul processus d'entrepôt clairement délimité.

Warehouse Software vs ERP : la différence au quotidien

Un système ERP représente l'entreprise dans sa largeur. Il relie typiquement les achats, les ventes, les données de base articles, la comptabilité, la production, la facturation et la planification. Sa force est de faire converger les données commerciales et opérationnelles dans un cadre commun. Une commande est créée, une facture émise, un besoin planifié, un stock valorisé.

Le warehouse software, souvent appelé WMS ou gestion d'entrepôt, travaille plus près des mouvements réels à l'intérieur de l'entrepôt. Il prend en charge la réception, la mise en stock, les transferts, la préparation de commandes, l'inventaire, l'expédition et les retours. Il répond à des questions que l'ERP ne représente souvent que grossièrement : à quel emplacement se trouve la marchandise ? Quel stock est réellement disponible ? Quel lot a été expédié ? Quelle commande est prioritaire ? Qui a confirmé le transfert ?

Cette distinction n'est pas absolue. Il existe des ERP dotés de fonctions d'entrepôt étendues et des produits WMS connectés aux processus de commande ou d'achat. Ce qui compte, alors, ce n'est pas l'étiquette sur l'offre, mais la profondeur opérationnelle. Un ERP peut gérer dix emplacements et rester malgré tout peu pratique si le personnel doit ouvrir plusieurs écrans pour chaque mouvement, ou ne saisir les données que plus tard.

L'ERP est la source commerciale

Lorsqu'une commande doit être facturée, un bon d'achat déclenché ou une valorisation matière créée, cela relève de l'ERP dans la plupart des entreprises. C'est généralement là que se trouve la logique articles et clients de référence. Ce rôle ne devrait pas être dupliqué à la légère. Deux systèmes indépendants pour les prix, les références articles ou les commandes ne créent pas de la sécurité, mais du travail de réconciliation.

Un ERP est particulièrement pertinent lorsque le défi central est transversal : achats et production doivent être planifiés ensemble, les données financières doivent rester cohérentes, ou plusieurs sociétés travaillent avec les mêmes processus. Qui ne dispose pas encore d'un tel socle ne devrait pas s'attendre à ce qu'une solution purement dédiée à l'entrepôt remplace tous les processus de l'entreprise.

Le warehouse software pilote le mouvement

Dans l'entrepôt, cependant, ce qui compte n'est pas seulement ce qui existe théoriquement dans le système. Ce qui compte, c'est ce qui vient d'arriver à la porte trois, quel emplacement est libre, et si la marchandise a été réservée pour une commande confirmée. Une bonne solution d'entrepôt réduit les frictions précisément à ces endroits.

Cela peut commencer avec des scanners mobiles : la marchandise est scannée à la réception, affectée à un emplacement et signalée immédiatement comme disponible. Lors de la préparation de commandes, le système guide selon un ordre pertinent, vérifie l'article et la quantité, et génère si besoin des étiquettes d'expédition ou des documents de livraison. L'enregistrement ne se fait pas des heures plus tard à un poste de bureau, mais au sein même du processus.

Le bénéfice ne se limite pas à la vitesse. Des enregistrements traçables rendent les erreurs visibles. Si un stock est faux, on peut déterminer quand un mouvement a manqué ou a été confirmé à tort. C'est nettement plus fiable qu'une correction mensuelle dans un tableur.

Quand un module ERP suffit

Un module ERP existant peut être le bon choix lorsque l'organisation de l'entrepôt est maîtrisable et que l'équipe peut travailler de façon fiable avec les processus en place. Un seul entrepôt, des emplacements fixes, peu de lignes de commande et aucune exigence stricte de lot ou de numéro de série sont des conditions typiques. Même avec un faible volume d'expédition, un composant système supplémentaire peut demander plus d'entretien qu'il n'apporte de bénéfice.

Avant d'acquérir un nouveau système, un test sobre vaut la peine : un collaborateur peut-il enregistrer intégralement une réception, un transfert et une expédition sans bout de papier ? Le stock est-il visible par emplacement ? Les écarts d'inventaire sont-ils traçables ? Les documents sont-ils générés sans double saisie ? Si la réponse est majoritairement oui, une extension n'est peut-être pas urgente.

Le tableur a également le droit de rester, s'il remplit proprement un objectif limité, par exemple une planification saisonnière des capacités ou une analyse ponctuelle. Une bonne solution ne remplace pas chaque habitude de travail connue. Elle remplace les étapes manuelles où les erreurs, les temps d'attente ou le manque de transparence coûtent réellement de l'argent.

Quand une solution d'entrepôt spécialisée devient pertinente

Le point de bascule arrive généralement par étapes. D'abord, un collaborateur pose plus souvent des questions sur un article. Puis les stocks sont maintenus plus haut par précaution, car personne ne connaît avec certitude la quantité réellement disponible. Finalement, les expéditions prennent du retard parce que bons de livraison, étiquettes et corrections de stock passent par des outils différents.

Un warehouse software spécialisé devient particulièrement pertinent lorsque plusieurs de ces conditions se combinent :

  • plusieurs zones d'entrepôt, emplacements ou entrepôts externes doivent être gérés
  • réceptions, transferts et préparations de commandes se produisent chaque jour en grand nombre
  • lots, numéros de série, dates limites ou stocks bloqués doivent être suivis
  • transporteurs, imprimantes d'étiquettes ou scanners mobiles doivent être intégrés au processus
  • la réalité opérationnelle s'écarte de plus en plus souvent de ce que montre l'ERP

Cette liste n'est pas une recommandation d'achat automatique. Une entreprise avec de nombreuses lignes de commande peut très bien fonctionner avec un ERP bien configuré. Inversement, une petite entreprise peut avoir besoin tôt d'une application d'entrepôt légère si chaque pièce doit être traçable ou si plusieurs équipes doivent enregistrer en même temps.

La question de l'intégration compte souvent plus que les fonctionnalités

La question la plus difficile dans Warehouse Software vs ERP est rarement : quel système peut faire le plus ? La meilleure question est : quelles données doivent circuler, quand, vers quel système ?

Dans de nombreux cas, l'ERP reste la référence pour les articles, les clients, les commandes et les documents commerciaux. L'application d'entrepôt prend en charge l'exécution opérationnelle. Elle reçoit les commandes libérées, effectue les mouvements d'entrepôt, et renvoie statut, quantités, lots ou numéros d'expédition. Ainsi, chaque côté a une tâche claire.

Cette interface a besoin de règles concrètes. Que se passe-t-il en cas de modification de commande après le début de la préparation ? Un stock d'entrepôt peut-il devenir négatif ? Quel enregistrement fait foi en cas de coupure réseau ? Comment bloque-t-on les articles signalés lors du contrôle qualité ? Sans ces décisions, même une API techniquement propre devient une nouvelle source d'erreurs.

Pour les petites et moyennes entreprises, un déploiement progressif est souvent plus raisonnable qu'un basculement complet. On peut d'abord introduire la réception avec scans de codes-barres. Suivent ensuite les emplacements et les transferts, puis la préparation de commandes et l'expédition. Cela permet de repérer tôt les exceptions réelles, sans faire reposer toute l'exploitation sur une seule journée de bascule.

Produit standard, extension de l'ERP ou application sur mesure ?

Un WMS standard est rentable lorsque vos propres processus sont largement conventionnels et qu'une intégration existante correspond à l'ERP. Il apporte rapidement des fonctionnalités éprouvées dans l'exploitation. Le prix à payer peut être que les équipes doivent adapter leurs façons de faire à des schémas fixes, ou payer pour des fonctions entreprise rarement utilisées.

Étendre l'ERP a du sens lorsque la profondeur opérationnelle nécessaire est réellement disponible et utilisable sur le terrain. Il ne faut pas se contenter d'examiner la démo produit, mais un déroulement réel avec scanner, gants, Wi-Fi instable et pression du temps avant le départ.

Une application sur mesure devient intéressante lorsque le processus porte l'avantage concurrentiel de l'entreprise, ou lorsque le logiciel standard impose durablement des détours. Cela peut être un processus de réception particulier, un lien entre atelier et entrepôt, des bons de livraison spéciaux ou une logique de tournées propre. Dans ce cas, la solution ne devrait pas être artificiellement gonflée. Un processus clair, modélisé proprement et construit sur une base technique maintenable, vaut plus qu'une plateforme théoriquement capable de tout faire.

softify.pro développe ce type de systèmes à partir de mouvements et de responsabilités concrets : de la réception aux documents d'expédition, en passant par les enregistrements d'entrepôt. Le modèle de données, les droits, les cas d'erreur et la maintenance ultérieure restent partie intégrante de la réalisation, et non des tâches pour « un jour, après la mise en production ».

Les questions à poser avant de décider

Tous les besoins ne doivent pas être automatisés dès le premier jour. Mais ils doivent être tranchés délibérément. Les responsables devraient clarifier avec l'équipe entrepôt, les ventes et la comptabilité quelles données font référence, quelles erreurs surviennent le plus souvent aujourd'hui, et quels indicateurs seront réellement nécessaires plus tard. Une belle vue d'ensemble des stocks aide peu si personne ne sait si les quantités réservées, bloquées et disponibles sont traitées différemment.

La responsabilité des données de base compte tout autant. Les processus d'entrepôt échouent rarement à cause d'un bouton manquant. Ils échouent à cause de références articles incohérentes, d'unités de mesure mal tenues et de règles non clarifiées pour les articles de substitution ou les conversions d'unités. Le logiciel peut rendre ces problèmes visibles. Il ne peut pas les résoudre sans des décisions prises au sein de l'entreprise.

Le bon choix n'est donc pas automatiquement ERP ou warehouse software. Il naît de l'écart entre votre processus actuel et celui que votre équipe doit réellement exécuter de façon fiable. Commencez par un mouvement qui coûte du temps ou génère des erreurs aujourd'hui, et vérifiez quel système représente ce mouvement le plus clairement, le plus rapidement et de la façon la plus traçable.

Lien permanent →

Automatiser la réception de marchandises

Automatiser la réception de marchandises

Un camion attend au portail, deux collaborateurs vérifient des bons de livraison, et la liste des stocks se trouve encore sur l'ordinateur du bureau. C'est exactement là que la question how to automate goods receiving commence à devenir concrète. Non pas parce que chaque entrepôt aurait besoin d'un grand déploiement ERP. Mais parce qu'une réception de marchandises manquante, tardive ou mal enregistrée a des conséquences : les stocks ne correspondent plus, les commandes attendent, les réclamations deviennent difficiles à retracer, et l'équipe commence son poste avec des questions à clarifier.

Automatiser la réception de marchandises ne signifie pas remplacer des personnes par des scanners. Cela signifie gérer les contrôles, enregistrements et documents récurrents de façon à ce que l'équipe au portail puisse décider rapidement, et que le stock soit ensuite fiable. Pour les petites et moyennes entreprises, un flux de travail sobre et adapté vaut généralement plus qu'un système de grand groupe rempli de fonctions que personne n'utilise.

Ce qui se perd vraiment avec une réception de marchandises manuelle

Les bons de livraison papier et les tableurs Excel fonctionnent souvent assez longtemps pour repousser un investissement. Le problème ne vient pas d'un carton isolé. Il apparaît quand les écarts s'accumulent : une livraison partielle n'est notée que plus tard, un lot ne peut pas être rattaché, une palette finit dans la mauvaise zone, ou un enregistrement de réception n'a lieu qu'en fin de journée.

Il existe alors plusieurs vérités en même temps. Le fournisseur signale la livraison. La marchandise est physiquement dans l'entrepôt. La planification ne voit encore aucun stock disponible. La comptabilité a un document, mais aucune confirmation de quantité ou de dommage. Les collaborateurs recoupent ces informations par téléphone, e-mail et expérience. Cela coûte du temps et rend le processus dépendant de personnes en particulier.

L'automatisation crée une source unique, partagée et à jour pour l'opération. Elle enregistre non seulement le stock théorique, mais aussi ce qui s'est réellement passé au portail : qui a réceptionné, quand, en quelle quantité, avec quel écart, et où va ensuite la marchandise.

How to automate goods receiving avec un déroulement clair

Le bon point de départ n'est pas le choix d'un scanner ou d'une application d'entrepôt. Il faut d'abord rendre visible le processus réel. Parcourez une réception de marchandises typique, depuis la date de livraison annoncée jusqu'à la mise en stock. Observez aussi les cas particuliers en chemin, car ce sont eux qui déterminent si une solution tient dans le quotidien.

Un flux numérique se compose généralement de cinq décisions successives. La livraison est identifiée, vérifiée par rapport à la commande ou à l'arrivage attendu, la quantité réelle est enregistrée, les écarts sont documentés, et la marchandise est affectée à un emplacement de stockage ou à une étape de contrôle supplémentaire. Chaque étape ne devrait demander que les données réellement nécessaires à ce moment-là.

1. Mettre à disposition les livraisons attendues à l'avance

Si des commandes d'achat, des ordres de fabrication ou des avis d'expédition existent, l'entrepôt devrait pouvoir les voir avant l'arrivée. À l'arrivée, la personne responsable choisit le fournisseur, scanne un numéro de commande ou recherche une livraison ouverte. Le système affiche les articles attendus, les quantités et, le cas échéant, les numéros de lot ou de série.

Cela raccourcit nettement la réception. Mais la logique de contrôle est encore plus importante : l'équipe n'a pas à décider de mémoire si 18 cartons au lieu de 20 sont acceptables. L'écart devient visible et peut être assorti d'un motif. Pour les livraisons non annoncées, le flux a besoin d'une voie contrôlée, par exemple sous forme de réception provisoire libérée par les achats ou la planification.

2. Utiliser les codes-barres là où ils font vraiment gagner du temps

Un lecteur de codes-barres ou l'appareil photo d'un terminal mobile robuste constitue pour beaucoup d'entrepôts le point d'entrée le plus judicieux. Un scan réduit les erreurs de saisie et accélère les mouvements récurrents. La condition, toutefois, est que les références articles, les unités d'emballage et les étiquettes soient tenues à jour de façon cohérente. Un scanner ne résout pas des données de base peu claires.

Toute marchandise n'a pas besoin d'un suivi par numéro de série. Pour des vis ou des consommables standards, article, quantité et emplacement suffisent souvent. Pour des pièces détachées sous garantie, des produits réglementés ou des composants destinés à la production, le lot, le numéro de série, la date limite et le statut de contrôle peuvent être obligatoires. La profondeur de saisie doit correspondre au risque, pas à un modèle logiciel générique.

3. Traiter les écarts comme un processus normal

Une bonne réception numérique de marchandises ne cherche pas à empêcher tout écart. Elle le rend simple et gérable de façon démontrable. Manquants, surlivraisons, dommages de transport, mauvais articles et lots bloqués ont besoin de statuts clairs plutôt que de notes manuscrites sur le bon de livraison.

En cas de livraison endommagée, par exemple, une photo peut être prise directement au poste de réception, la quantité enregistrée comme bloquée, et les achats informés automatiquement. Le stock disponible reste correct tandis que la marchandise part physiquement vers une zone de quarantaine. Cela évite que des pièces endommagées soient prélevées par erreur ou utilisées en production.

La règle n'a pas toujours besoin d'être entièrement automatique. Pour de petites quantités, une surlivraison peut être acceptée directement. Pour des articles coûteux ou sensibles pour la sécurité, une validation devrait être requise. Ces seuils font partie du processus et doivent rester ajustables par la suite.

4. Déclencher immédiatement la mise en stock

Une réception n'est opérationnellement complète que lorsqu'on sait clairement où se trouve la marchandise, ou pourquoi elle ne peut pas encore être mise en stock. Le système peut proposer un emplacement fixe, privilégier une zone de réapprovisionnement, ou déterminer une zone cible en fonction de la famille d'articles, de la plage de température et de la capacité disponible.

Pour des entrepôts de taille maîtrisable, une logique d'emplacement claire avec peu de zones suffit souvent. Une optimisation complexe des trajets n'a de sens que si le volume, les distances parcourues et la structure du personnel la justifient. Qui reçoit dix palettes par jour n'a pas besoin d'un projet d'optimisation qui prend plus de temps que celui qu'il fait gagner. Un scan fiable de l'emplacement est souvent le progrès le plus important.

Après la mise en stock, le système met à jour le stock et le journal des mouvements. Les ventes, la planification ou la production voient ainsi le statut sans avoir à interroger l'entrepôt. Si un article ne peut devenir disponible qu'après un contrôle qualité, le système sépare le stock physique du stock disponible.

Quelles données la réception de marchandises exige-t-elle vraiment

Un processus numérique devient vite impopulaire s'il demande trop de champs au portail. En même temps, sans un minimum de données, les preuves manquent pour les clarifications ultérieures. Dans la plupart des entreprises de taille moyenne, ces informations ont du sens :

  • Fournisseur et référence à la commande ou au bon de livraison
  • Article, quantité acceptée et unité d'emballage
  • Horodatage ainsi que personne responsable
  • Emplacement ou statut tel que contrôle, blocage ou quarantaine
  • Motif de l'écart, photos et validation si nécessaire

Des champs supplémentaires ne devraient être obligatoires que s'ils permettent une décision concrète. Lorsque le suivi de lot est obligatoire, le numéro de lot n'est pas un ajout, c'est une information centrale. À l'inverse, une remarque libre pour chaque livraison n'est souvent renseignée que pour donner l'impression qu'un formulaire est complet.

L'intégration détermine le rapport bénéfice-effort

La réception de marchandises ne doit pas devenir une nouvelle solution isolée à côté des achats, de la production et de la comptabilité. Au minimum, les données de base des articles, les commandes ouvertes et les variations de stock doivent être échangées de façon fiable. Que cela passe par une interface ERP existante, des imports de données ou un processus intermédiaire développé spécifiquement dépend du paysage applicatif déjà en place.

Avec des systèmes ERP plus anciens, une intégration complète en temps réel n'est pas toujours économique. Un import vérifié à intervalles fixes peut être largement suffisant si les quantités et les délais le permettent. Pour des pièces détachées immédiatement affectées à des commandes urgentes, en revanche, un enregistrement quasi immédiat compte davantage. La technique suit ici le rythme de l'activité.

La capacité opérationnelle fait aussi partie de la planification. Les appareils ont besoin de comptes utilisateurs, de rôles clairs et d'un comportement défini en cas de coupure réseau. Une réception mobile n'a pas nécessairement besoin de fonctionner hors ligne. Mais si les coupures Wi-Fi surviennent régulièrement, une mémoire tampon locale avec une synchronisation traçable n'est pas un luxe, c'est un élément de la fiabilité du processus.

Un déploiement par petites étapes plutôt qu'un big bang

Commencez avec un fournisseur, une famille de produits ou une zone d'entrepôt clairement délimitée. Mesurez non seulement la durée par enregistrement, mais aussi les reprises, les écarts non résolus et les allers-retours entre l'entrepôt et le bureau. Cela révèle si l'automatisation allège vraiment le travail.

Formez avec de vrais bons de livraison du quotidien, y compris des livraisons endommagées ou incomplètes. Un processus qui ne fonctionne que pour une livraison parfaitement conforme n'est pas une automatisation, c'est une démonstration. Les collaborateurs à la réception de marchandises devraient pouvoir contribuer à définir les règles, car ils connaissent les cas exceptionnels.

softify.pro développe délibérément ce type de flux de manière spécifique au workflow : du scan mobile au mouvement de stock documenté, jusqu'à une connexion stable avec les systèmes existants. Ce qui compte ici, ce n'est pas la plus longue liste de fonctionnalités, mais un système qui reste traçable sous pression temporelle et qui peut être exploité et maintenu techniquement.

La meilleure prochaine étape n'est donc pas une comparaison de logiciels, mais une heure passée à examiner les dix dernières livraisons problématiques. Si vous pouvez dire, pour chacune d'elles, où du temps a été perdu et quelle information manquait, la première ébauche d'une meilleure réception de marchandises existe déjà.

Lien permanent →

Avantages du picking par code-barres pour les petits et moyens entrepôts

Avantages du picking par code-barres pour les petits et moyens entrepôts

Un mauvais article dans le carton coûte rarement le seul prix du retour. Il mobilise du temps à l'entrepôt, génère des questions au bureau et, dans le pire des cas, abîme une relation client. C'est pourquoi les avantages du picking par code-barres ne se voient pas d'abord dans un indicateur technique, mais dans une zone d'expédition plus sereine : les collaborateurs savent ce qu'ils doivent faire ensuite, et les écarts sont repérés là où ils apparaissent.

Pour les petits et moyens entrepôts, c'est particulièrement important. De nombreux processus fonctionnent d'abord avec des listes papier, des fichiers Excel, des consignes lancées à la volée et l'expérience de quelques personnes. Ce n'est pas faux en soi. Avec un volume limité, un tableur peut même être l'outil le plus judicieux. Mais lorsque la diversité des articles, le nombre de commandes, les changements d'équipe ou les exigences de traçabilité augmentent, la solution provisoire pragmatique devient vite une source d'erreurs.

Ce que le picking par code-barres change au quotidien

Avec le picking par code-barres, un scan ne confirme pas simplement que quelqu'un a fait quelque chose. Il relie commande, emplacement, article et quantité en une étape de travail traçable. Le système indique le prélèvement suivant, le collaborateur scanne l'emplacement et l'article, saisit la quantité si nécessaire et reçoit immédiatement un retour.

L'ordre des contrôles est déterminant. Si un collaborateur scanne d'abord l'article puis seulement l'emplacement, le système peut certes détecter un mauvais article, mais pas empêcher un parcours défavorable. Dans la pratique, la séquence emplacement, article, quantité fait souvent ses preuves. Pour les processus liés aux lots, aux numéros de série ou aux dates de péremption, d'autres contrôles s'ajoutent. Lesquels sont nécessaires dépend du risque, et non de ce qui serait techniquement possible.

Un bon système ne remplace pas une organisation d'entrepôt cohérente. Il rend toutefois visible le moment où cette organisation n'est pas respectée au quotidien. Si une marchandise se trouve à un emplacement non prévu, l'erreur n'est pas découverte lors de l'inventaire, mais au moment du scan.

Les principaux avantages du picking par code-barres : moins de confusions, là où elles naissent

Les listes papier exigent une concentration permanente : lire la référence, trouver le casier, comparer l'emballage, cocher la quantité. Sous la pression du temps, des cartons semblables, des désignations presque identiques ou une tâche interrompue suffisent à provoquer une erreur. Le code-barres apporte une identification univoque à ce moment précis.

Le scanner ne remplace pas la réflexion, mais il prend en charge le contrôle que les humains ont le plus de mal à maintenir durablement dans un travail routinier. Si l'article ne correspond pas à la commande, le retour doit être clair : mauvais article, article attendu, prochaine étape pertinente. Un simple signal rouge aide peu s'il n'indique pas comment corriger l'écart.

Des stocks plus fiables grâce aux enregistrements

Les stocks ne sont utiles que s'ils permettent de prendre des décisions. Celui qui planifie des réapprovisionnements, confirme des dates de livraison ou met à disposition des matières pour la production a besoin de plus qu'un chiffre de la semaine dernière. Si les prélèvements ne sont reportés depuis une liste qu'en fin de poste ou a posteriori, il se crée des périodes où les données sont incertaines.

Un scan peut enregistrer le prélèvement immédiatement. L'écart entre le mouvement physique et le stock numérique diminue ainsi. Cela ne signifie pas que chaque chiffre est automatiquement juste. Les marchandises mal étiquetées, les transferts non enregistrés et les stocks endommagés restent des sujets bien réels. Mais les causes se cernent beaucoup mieux, car chaque mouvement possède un horodatage, une commande et, le cas échéant, un lien avec un utilisateur.

C'est particulièrement utile pour les processus de réapprovisionnement. Si un casier passe sous son stock cible, le système peut créer un ordre de réapprovisionnement ou au moins le rendre visible. Les préparateurs ne cherchent alors plus de marchandise de remplacement en pleine commande, pendant que le client attend son colis.

Une prise en main plus rapide, sans dépendre du savoir de quelques-uns

Les magasiniers expérimentés connaissent par cœur les parcours, les cas particuliers et l'aspect des articles. Ce savoir est précieux, mais risqué s'il est le seul système d'exploitation. En période de congés, de maladie ou de croissance, les équipes se retrouvent sous pression lorsque les nouveaux collaborateurs doivent d'abord apprendre pendant des semaines quelle rangée d'étagères correspond à une abréviation interne.

Une bonne interface mobile guide à travers la commande dans un langage compréhensible. Elle affiche l'emplacement, l'article, la quantité attendue et, si nécessaire, une image ou des indications sur l'emballage. Le scan valide l'étape. Les nouveaux collègues ne deviennent pas immédiatement des experts, mais peuvent travailler en toute sécurité bien plus tôt.

Cela vaut aussi pour les intérimaires et les équipes tournantes. La condition est que les données de base soient bien tenues. Un système ne peut pas déduire une consigne claire d'une désignation telle que « pièce petite bleue neuve ». La digitalisation révèle ces faiblesses - et c'est souvent un effet secondaire utile.

Traçabilité lors des réclamations et des inventaires

Lorsqu'un client signale une quantité manquante, l'absence de données de processus déclenche souvent une recherche dans des piles de papiers, des listes d'expédition et des souvenirs. Avec des enregistrements par code-barres, on peut vérifier quelle commande a été traitée et quand, quelle ligne a été confirmée et s'il y a eu une correction ou une quantité partielle.

Ce n'est pas une garantie contre les réclamations. Mais cela raccourcit la clarification et sépare les suppositions des faits. Les inventaires en profitent aussi : les écarts peuvent non seulement être comptés, mais aussi analysés à partir des mouvements. Si les corrections s'accumulent sur un casier donné, un groupe d'articles ou après une étape de transmission précise, on obtient un point de départ concret pour s'améliorer.

Des processus mesurables plutôt que des impressions

Beaucoup d'entrepôts savent que « ça se complique l'après-midi » ou que certaines commandes prennent un temps inhabituel. Sans horodatages ni étapes de processus, cela reste une impression. Si le début du prélèvement, le scan, l'interruption, la finalisation et la remise sont enregistrés, les goulets d'étranglement peuvent être clairement distingués.

Peut-être que ce n'est pas le picking qui est lent, mais le rangement des marchandises qui intervient trop tard. Peut-être que des temps d'attente apparaissent au poste d'emballage, ou qu'un seul casier est sollicité de manière disproportionnée. Ces données ne doivent pas être prises pour un outil de contrôle global des performances. Leur valeur réside d'abord dans l'identification des déplacements inutiles, des réapprovisionnements manquants et des transmissions floues.

Le bénéfice dépend de la conception du processus

Le picking par code-barres n'est pas une fin en soi, et tout entrepôt n'a pas besoin d'un logiciel de gestion d'entrepôt complet. Avec peu de commandes, un petit assortiment et une équipe stable, un processus bien mené avec de simples listes peut être plus économique. Un projet se justifie lorsque le coût des erreurs de prélèvement, des temps de recherche, de l'incertitude sur les stocks ou des reprises manuelles se fait régulièrement sentir.

La question du matériel mérite elle aussi un regard lucide. Un smartphone avec scan par caméra peut suffire pour les premiers processus. En cas de fréquence de scan élevée, de port de gants, de mauvais éclairage ou d'environnement rude, des scanners portables dédiés sont généralement plus rapides et moins sujets aux erreurs. La couverture réseau est également déterminante. Si le Wi-Fi tombe dans une zone de l'entrepôt, l'application a besoin d'une stratégie claire : mise en mémoire hors ligne avec synchronisation ultérieure, ou un processus qui ne traite pas cette zone en mobilité.

La qualité des étiquettes compte autant que le logiciel. Un code-barres sur une étiquette de casier usée ou un identifiant d'article attribué deux fois compromet tout le processus. Avant le lancement, il faut étiqueter clairement les emplacements, définir les unités et clarifier les cas particuliers critiques : comment traiter un emballage entamé ? Que se passe-t-il en cas de rupture ? Qui peut corriger une quantité ? Que devient la marchandise sans code lisible ?

Réussir le déploiement sans interrompre l'activité

Le point d'entrée le plus fiable est rarement une bascule complète. Commencez par un périmètre bien délimité, par exemple les commandes d'expédition les plus fréquentes ou un groupe d'articles souvent confondus. Là, la séquence de scan, les messages d'erreur et les étiquettes peuvent être testés en conditions réelles, sans transformer tout le site en même temps.

Avant la mise en œuvre technique, il faut relever le parcours réel d'une commande - de sa réception à l'étiquette d'expédition, en passant par la réservation, le prélèvement et le poste d'emballage. Ce qui compte n'est pas le processus théorique d'un organigramme, mais le déroulement que l'équipe utilise réellement. Les exigences les plus précieuses se cachent souvent dans de petites exceptions : commandes groupées, articles de substitution, prélèvements partiels ou retour de marchandises non utilisées.

Il faut ensuite des règles claires pour les exceptions. Un collaborateur doit pouvoir signaler une rupture sans contourner la commande de manière informelle. Une personne habilitée doit pouvoir effectuer des corrections de façon traçable. Et s'il existe des interfaces avec une boutique en ligne, un ERP ou un transporteur, le statut des commandes et les mouvements de stock doivent être clairement définis. La double saisie des données est un signal d'alerte, pas une solution durable.

Pour les systèmes sur mesure, softify.pro intervient précisément à ce stade : non pas avec un progiciel enterprise surchargé, mais avec les étapes de scan et d'enregistrement dont l'entrepôt concerné a démontrablement besoin. Une base de données maintenable, des interfaces clairement documentées et des écrans compréhensibles valent davantage qu'une longue liste de fonctions rarement utilisées.

Un premier point de contrôle pertinent

Prenez dix commandes typiques et suivez-les de leur réception jusqu'à la remise à l'expédition. Notez à quels endroits les collaborateurs doivent chercher, poser des questions, saisir des données après coup ou s'en remettre à leur mémoire. C'est précisément là que se décide si le picking par code-barres apporte des avantages - et quel processus de scan convient vraiment à l'entrepôt.

Lien permanent →

Tests auto-hébergés vs cloud

Tests auto-hébergés vs cloud

Un test de régression échoué est rarement juste une entrée rouge dans un tableau de bord. Il peut signifier qu'un écran d'expédition dans l'entrepôt génère de mauvaises étiquettes, qu'un portail client cesse d'accepter des commandes, ou qu'une application Windows plante lors d'un changement d'équipe. La question self hosted testing vs cloud ne concerne donc pas l'infrastructure comme une fin en soi. Il s'agit de savoir quelles données un processus de test touche, qui le contrôle, et à quel point il fonctionne de manière fiable dans des conditions d'exploitation réelles.

Les plateformes de test basées sur le cloud peuvent être opérationnelles rapidement. Pour de nombreuses équipes, c'est judicieux, particulièrement lorsqu'elles testent une application web publique et ont besoin de capacité d'exécution supplémentaire à court terme. Les environnements de test auto-hébergés, en revanche, exigent une mise en place technique délibérée. Mais ils redonnent à l'entreprise le contrôle sur les données de test, les chemins réseau, les droits d'accès, et l'exploitation. Le bon choix ne dépend pas d'un principe général, mais de l'application, du risque, et de la capacité opérationnelle disponible.

Self Hosted Testing vs Cloud : De quoi il s'agit vraiment

Le débat est souvent trop réduit aux coûts initiaux. Une solution cloud paraît moins chère parce qu'aucun serveur n'a besoin d'être acquis et aucun environnement n'a besoin d'être mis en place. Un serveur de test dédié paraît à première vue plus coûteux, parce que le système d'exploitation, les mises à jour, le contrôle d'accès, la surveillance, et les sauvegardes doivent tous être planifiés.

Ce calcul est insuffisant. Ce qui compte, ce sont les coûts courants d'une stratégie de test : temps d'attente avant les versions, recherche d'erreurs après des exécutions de test incomplètes, coordination avec la protection des données et la sécurité de l'information, ainsi que les conséquences d'un déploiement défectueux. Si une équipe examine régulièrement des applications métier sensibles, la charge organisationnelle supplémentaire des services externes peut dépasser l'exploitation d'un environnement propre clairement délimité.

« Cloud » n'est pas non plus un modèle uniforme. Certains fournisseurs stockent seulement des journaux de test, d'autres traitent des captures d'écran, des enregistrements vidéo, des identifiants, des contenus DOM, ou du trafic réseau. Avec les tests assistés par IA, des données image et texte peuvent en outre atteindre des modèles externes ou des sous-traitants pour évaluation. Celui qui ne regarde que l'emplacement d'un centre de données manque souvent la question plus importante : quelles données quittent réellement sa propre zone de contrôle, et quelles règles contractuelles et de suppression s'appliquent ?

Quand les tests cloud sont le choix judicieux

Les tests cloud ne sont pas fondamentalement un problème de sécurité, et l'auto-hébergement n'est pas automatiquement la meilleure architecture. Pour une nouvelle boutique en ligne publiquement accessible ou une plateforme marketing, un environnement cloud peut être très approprié. L'équipe peut couvrir rapidement les variantes de navigateur et d'appareil sans maintenir ses propres machines d'exécution. Avec une charge de test fluctuante, la mise à l'échelle élastique est également un avantage réel.

Les petites équipes de développement avec peu de données de test clairement anonymisées bénéficient aussi souvent d'un service géré. Elles ne devraient pas investir leur temps dans l'exploitation d'une plateforme lorsque le goulot d'étranglement se situe plutôt dans des cas de test manquants, des critères d'acceptation flous, ou des données de test instables. Un serveur propre ne résout pas ces problèmes.

Le cloud convient particulièrement bien lorsque l'application n'a pas besoin d'accès réseau interne, qu'aucune donnée personnelle ou critique pour l'entreprise n'apparaît dans les flux de test, et qu'un délai de mise en œuvre court importe plus qu'un contrôle profond de l'infrastructure. La condition préalable est une configuration soignée : comptes de test séparés, pas de vraies données client, jetons limités, périodes de conservation traçables, et un concept de droits clair.

Quand les tests auto-hébergés deviennent plus judicieux

La situation est différente pour les applications uniquement accessibles sur le réseau de l'entreprise ou qui représentent des processus opérationnels centraux. Un logiciel d'entrepôt ou de production traite souvent des mouvements d'articles, des adresses de livraison, des stocks, des numéros de série, et une logique de prix. Une exécution de test peut générer des captures d'écran d'écrans de commande, télécharger des documents, ou se connecter avec des rôles utilisateur. De telles données ne devraient pas être dispersées sans être remarquées sur plusieurs systèmes externes.

Les tests auto-hébergés permettent de placer l'exécution des tests près de l'application. Le serveur de test peut fonctionner dans le même segment réseau ou dans une DMZ contrôlée. Les règles de pare-feu sont définies de manière ciblée, les applications internes n'ont pas besoin d'être ouvertes pour un service externe, et les journaux restent sous administration propre. C'est souvent particulièrement pertinent pour les applications de bureau Windows, car celles-ci sont rarement conçues pour des plateformes de test externes.

Pour les secteurs réglementés, des exigences client plus importantes, ou des directives de sécurité internes, cette architecture est souvent plus facile à auditer. Cela ne signifie pas que chaque audit est automatiquement réussi. Un serveur propre a lui aussi besoin de gestion des correctifs, chiffrement, droits basés sur les rôles, sauvegardes, et procédures d'exploitation documentées. La différence réside dans le fait que l'entreprise prend elle-même ces décisions et peut les démontrer.

Chez softify.pro, COCO est donc conçu comme un serveur IA dédié et auto-hébergé : les exécutions de test pour applications web et Windows s'exécutent localement, les preuves sont enregistrées, et les résultats sont évalués en langage clair. Cela ne remplace pas la validation par des experts métier. Mais cela garantit que le trafic de test, les captures d'écran, et les évaluations peuvent rester là où l'entreprise conserve la souveraineté des données.

Comparer correctement les coûts : exploitation contre friction

Une comparaison judicieuse comprend plus que le prix de licence contre le prix du matériel. Dans le cloud, des frais récurrents surgissent par utilisateur, minute de test, exécution parallèle, ou consommation IA. Ces coûts sont initialement prévisibles, mais peuvent augmenter significativement avec la croissance de la couverture de test. S'y ajoutent des dépenses possibles pour des contrats entreprise, des accords de traitement de données, et des audits de sécurité.

Avec l'auto-hébergement, des investissements surgissent pour l'infrastructure et la mise en place. Cela peut inclure des machines virtuelles, du stockage, un accès réseau, une surveillance, et le temps d'une équipe techniquement responsable. Ces coûts subsistent même lorsque peu de tests sont en cours. Pour un projet avec des versions rares, c'est un bon argument contre une solution maison surdimensionnée.

Avec des tests de régression réguliers, le tableau change. Si les mêmes flux de travail critiques pour l'entreprise doivent être vérifiés chaque semaine, une capacité interne prévisible est souvent plus économique que des coûts de plateforme variables et des boucles d'approbation manuelles. L'approche devient particulièrement précieuse lorsque les cas de test sont utilisés pendant des années et évoluent avec l'application métier. La maintenabilité importe alors plus qu'un démarrage rapide mais difficile à contrôler.

La qualité ne dépend pas du modèle d'hébergement

Une idée fausse courante dit que les tests cloud seraient automatiquement plus modernes, les tests auto-hébergés automatiquement plus stables. Aucun des deux n'est vrai. La qualité des tests naît de scénarios judicieux, de données de test résilientes, d'identifiants stables dans l'interface, et d'attentes claires sur le résultat.

Un test ne devrait pas seulement vérifier si un bouton est cliquable. Pour un traitement de commande, il peut par exemple créer une commande, vérifier une quantité disponible, générer un bon de livraison, et s'assurer que le bon rôle est autorisé à approuver l'opération. Pour un programme de bureau, il peut vérifier l'importation d'un fichier, la gestion des erreurs, et la sortie d'un document. Seuls de tels flux de bout en bout montrent si une modification a endommagé le processus réel.

L'IA peut aider à détecter les changements d'interface, documenter les étapes de manière compréhensible, et prioriser les anomalies. Elle ne devrait cependant pas devenir une boîte noire. Les équipes ont besoin de captures d'écran ou d'autres preuves, d'étapes de test traçables, et de seuils définis pour déterminer quand un résultat compte comme réussi, incertain, ou échoué. Particulièrement pour les vérifications visuelles, un seuil de confiance est judicieux, afin que de petites déviations de mise en page attendues ne bloquent pas chaque version.

Les questions opérationnelles avant la décision

Avant qu'une équipe ne s'engage, elle devrait retracer concrètement le parcours d'une exécution de test. Où le test s'exécute-t-il ? À quels systèmes se connecte-t-il ? Quelles données voit-il ? Où sont stockés les captures d'écran, journaux, et rapports ? Qui est autorisé à lire, supprimer, ou exporter les résultats ? Ces questions sont plus pratiques qu'une décision générale pour ou contre le cloud.

Tout aussi important est la responsabilité après la mise en service. Qui met à jour les navigateurs et agents de test ? Qui réagit lorsqu'un certificat expire ? Comment les identifiants sont-ils renouvelés ? Et comment s'assure-t-on qu'un test ne déclenche pas accidentellement un véritable enregistrement d'expédition ou une notification client ? Une bonne automatisation de tests nécessite des environnements séparés et des mécanismes de protection, pas seulement de bons scripts.

Un modèle hybride peut être judicieux. Les interfaces publiques et les vérifications de navigateur largement distribuées s'exécutent dans le cloud, tandis que les processus métier internes restent sur un serveur de test propre. Cela réduit la charge opérationnelle, sans céder en bloc des flux de travail sensibles vers l'extérieur. La condition préalable est une frontière claire entre les deux domaines, pas une exploitation mixte confuse.

La meilleure décision est celle qui correspond au risque réel et à la réalité opérationnelle propre. Si un tableur porte encore fiablement un processus, il n'a pas besoin d'en devenir un grand système. Mais si des données de test et des applications internes appartiennent au cœur de l'entreprise, le contrôle n'est pas un luxe, mais une exigence factuelle pour un logiciel fiable.

Lien permanent →

Inventory Management en entrepôt

Inventory Management en entrepôt

Une pièce manquante se remarque rarement lors du comptage dans l'entrepôt. Le plus souvent, elle ne se révèle que lorsqu'une commande ne peut pas être emballée, qu'un technicien se trouve devant une étagère vide, ou que les achats cherchent par téléphone une promesse de livraison. Une bonne Inventory Management ne prévient pas ces surprises avec plus de tableaux, mais avec une image fiable de ce qui est disponible, où cela se trouve, et ce qui se passe ensuite.

Pour les petites et moyennes entreprises, il ne s'agit pas d'avoir le plus grand système ERP possible. Ce qui compte, c'est que le personnel de la réception des marchandises, de l'entrepôt, et de l'expédition puisse travailler avec quelques étapes claires - même sous pression temporelle, à travers les changements d'équipe, et lorsqu'une livraison ne se déroule pas comme prévu.

L'Inventory Management commence par les mouvements, pas par les listes de stock

Une liste de stock est un instantané. Elle peut être correcte et pourtant peu utile si personne ne peut retracer pourquoi une quantité a changé. Un système résilient traite donc les stocks comme le résultat de mouvements documentés : la marchandise arrive, est contrôlée, mise en stock, réservée, préparée, transférée, expédiée, ou corrigée.

Chaque mouvement nécessite une raison claire, un horodatage, une personne responsable, et idéalement un lien vers une transaction spécifique. Cela peut être une commande d'achat, une commande client, un bon de livraison, ou un ordre de fabrication. Cela transforme le chiffre « 24 pièces disponibles » en une affirmation vérifiable : 30 unités ont été enregistrées, quatre sont réservées pour deux commandes, et aucun transfert ouvert ne fausse le stock disponible.

Cette distinction est particulièrement pertinente pour les pièces rares. Physiquement présent, réservé, et librement disponible sont trois états différents. S'ils sont mélangés, les ventes promettent une marchandise dont l'entrepôt a déjà besoin pour une autre commande. S'ils sont tenus proprement, une équipe peut décider tôt : recommander, reprioriser, ou donner au client une réponse réaliste.

Où les processus manuels se brisent typiquement

Les tableurs ne sont pas fondamentalement erronés. Pour un petit assortiment, un emplacement de stockage, et peu de mouvements par semaine, ils peuvent être plus économiques qu'une application dédiée. Ils deviennent problématiques dès que plusieurs personnes travaillent simultanément ou que les stocks sont mis à jour depuis plusieurs sources.

C'est alors que les lacunes connues apparaissent : la réception des marchandises traîne sous forme papier sur le bureau, le fichier Excel a été modifié localement, un transfert n'a été convenu que verbalement, et l'expédition n'enregistre qu'après les heures de travail. Le stock n'est pas nécessairement faux, mais il est décalé dans le temps et son origine est floue. C'est précisément ce qui le rend inadapté aux décisions opérationnelles.

La structure organisationnelle joue également un rôle. Un site central nécessite des processus différents d'une entreprise avec des entrepôts satellites, des véhicules de service, ou une production qui prélève du matériel. Celui qui cartographie ces différences avec une seule colonne de texte libre déplace la logique dans la tête des employés individuels. Cela fonctionne jusqu'à ce que cette personne parte en congé ou que le volume de commandes augmente.

Définir le processus avant le logiciel

Un projet judicieux ne commence pas par la question de savoir quel scanner acheter ou quelle interface semble moderne. Il faut d'abord clarifier quelles décisions le système est censé soutenir. Des observations concrètes du quotidien suffisent souvent pour cela : comment la marchandise est-elle acceptée aujourd'hui ? Quand est-elle considérée comme contrôlée ? Qui a le droit de corriger les stocks ? Que se passe-t-il en cas de marchandise endommagée ? Et à quel moment une commande devient-elle définitivement réservée ?

De ces réponses naissent quelques règles contraignantes. Par exemple, la réception de marchandises ne peut être enregistrée qu'après un contrôle des quantités. Les articles sans emplacement de stockage ne doivent pas apparaître comme pouvant être mis en stock. Les corrections de stock nécessitent un code motif et restent visibles dans l'historique. La marchandise expédiée n'est pas supprimée silencieusement, mais attribuée à la commande via une sortie documentée.

C'est moins spectaculaire qu'une grande présentation de numérisation, mais bien plus précieux en exploitation. Lorsque les règles sont claires, le logiciel peut les vérifier de manière fiable. Lorsqu'elles restent floues, chaque nouvelle application ne fait qu'accélérer des étapes de travail contradictoires.

Données de base : commencer petit, entretenir avec constance

Tous les articles n'ont pas besoin de dix classifications au départ. Une base utilisable se compose souvent d'un numéro d'article, d'une désignation, d'une unité, d'un statut de stock actif, et d'un ou plusieurs emplacements de stockage. Selon l'activité, s'ajoutent des lots, numéros de série, stocks minimums, numéros d'articles fournisseur, ou dates de péremption.

L'important est la cohérence, pas la quantité de champs. Deux numéros d'article pour le même article physique, ou des unités changeantes comme « carton », « emballage », et « pièce » sans règle de conversion, génèrent des erreurs ultérieures presque automatiquement. Un système peut techniquement autoriser de telles saisies. Il devrait les limiter là où elles compromettent le déroulement.

Quelles fonctionnalités aident réellement dans l'entrepôt

Pour de nombreux entrepôts de taille moyenne, un noyau clair est plus précieux qu'un catalogue de fonctionnalités surchargé. Ce noyau couvre généralement quatre domaines :

  • Réception des marchandises avec référence de commande, contrôle des quantités, et mise en stock
  • Mouvements d'entrepôt entre emplacements et zones définis
  • Réservation de commande, préparation, et confirmation d'expédition
  • Inventaire et corrections de stock avec historique traçable

En complément, l'impression d'étiquettes, la lecture de codes-barres, les bons de livraison, les étiquettes d'expédition, ou une transmission à la comptabilité et aux systèmes de boutique peuvent faire gagner beaucoup de temps. Mais ils devraient s'appuyer sur un modèle de mouvement propre. Une impression rapide d'étiquettes n'apporte pas grand-chose si le scan n'attribue pas sans équivoque l'article au bon emplacement ou à la bonne commande.

Dans l'utilisation, l'environnement compte également. Un employé avec des gants à la réception des marchandises a besoin d'actions grandes et sans équivoque, et d'aussi peu de saisie de texte que possible. Une répartitrice à son poste de travail a en revanche besoin de filtres, de fonctions de recherche, et d'une vue sur les transactions ouvertes. Les deux rôles peuvent utiliser les mêmes données, mais n'ont pas besoin de la même interface.

Temps réel ne veut pas dire que chaque chiffre est incontestable

De nombreuses entreprises souhaitent des stocks en temps réel. C'est judicieux, mais le terme est souvent utilisé de manière trop générale. Un stock peut être mis à jour immédiatement après chaque scan et être quand même faux si un processus reste incomplet. Si la marchandise est scannée mais non contrôlée, le chiffre est techniquement à jour et opérationnellement discutable.

C'est pourquoi tout système a besoin d'une gestion des exceptions. Les écarts à la réception des marchandises, les emballages endommagés, les retours, et les articles introuvables ne sont pas des cas marginaux. Ils font partie du quotidien. Les bons processus les signalent visiblement, au lieu de forcer le personnel à des listes annexes improvisées.

Les droits d'accès méritent également de l'attention. Toute personne ne devrait pas pouvoir modifier les données de base des articles ou corriger des enregistrements historiques. Un concept de droits pratique sépare les opérations de routine des interventions à risque plus élevé. Cela protège non seulement contre les erreurs, mais facilite aussi l'analyse des causes lorsqu'un stock s'écarte de manière inattendue.

Intégration uniquement là où elle améliore le déroulement

L'Inventory Management se retrouve rarement seul. Les commandes peuvent provenir d'une boutique en ligne, d'une saisie par e-mail, d'une solution sectorielle, ou directement des ventes. Les transporteurs ont besoin de données d'adresse et de poids. La comptabilité attend des documents sous une forme spécifique.

Une intégration vaut la peine lorsqu'elle élimine la double saisie ou réduit les sources d'erreur. Elle n'est pas automatiquement judicieuse simplement parce qu'une interface est disponible. Surtout avec des processus qui ont évolué organiquement, un import clair avec contrôle peut être plus fiable qu'un couplage permanent en temps réel qui transmet des données erronées sans être remarqué.

Techniquement, la solution devrait rester traçable : interfaces sans équivoque, transferts journalisés, messages d'erreur compréhensibles, et une structure de base de données qui ne cache pas les modifications. Avec une application bien entretenue basée sur PHP 8.4 et MySQL 8, de tels processus peuvent être mis en œuvre de manière sobre, sans forcer les équipes dans un système d'entreprise mondial. Ce qui compte n'est pas l'étiquette technologique, mais si la maintenance, les extensions, et les corrections de données restent contrôlables même dans trois ans.

Déploiement par petites étapes mesurables

Un big bang est rarement le meilleur choix dans un entrepôt. Un début limité est plus sûr, par exemple avec la réception des marchandises et une zone d'entrepôt sélectionnée. Dans cette phase, les temps de scan, les types d'erreurs, les cas particuliers ouverts, et la qualité des données de base peuvent être observés. Ce n'est qu'ensuite que suivent la réservation, l'expédition, ou d'autres sites.

Le fonctionnement parallèle peut être judicieux, mais seulement avec une fin claire. Deux stocks principaux sur une période prolongée créent exactement le problème que la nouvelle solution est censée résoudre. Une transition définie avec inventaire, données de base nettoyées, et responsabilités pour les premières semaines est préférable.

Le succès ne se voit pas au nombre de fonctionnalités activées. Il se voit à si moins de questions de suivi surviennent, si les commandes sont emballées plus complètement, et si une équipe peut expliquer sans travail de détective pourquoi un stock d'article ressemble à ce qu'il est.

Si le processus actuel avec un tableau bien entretenu fonctionne réellement de manière stable, il devrait pouvoir rester. Mais si les informations continuent de se perdre entre papier, appels téléphoniques, et plusieurs fichiers, la prochaine étape judicieuse n'est pas un outil plus grand, mais un processus clair qui rend visible chaque mouvement d'entrepôt important.

Lien permanent →

Les tests auto-hébergés sont-ils sécurisés ?

Les tests auto-hébergés sont-ils sécurisés ?

Un test de régression échoué est agaçant. Une capture d'écran d'un système ERP interne qui atterrit sans contrôle chez un service externe est un incident de sécurité. C'est exactement pourquoi les responsables QA et IT se posent la question : are self hosted tests secure ? La réponse honnête est : ils peuvent être nettement plus sûrs que les alternatives basées sur le cloud, mais seulement si l'exploitation est prise aussi au sérieux que les tests eux-mêmes.

L'automatisation de tests auto-hébergée déplace le contrôle sur l'exécution, les données de test, les captures d'écran, les journaux, et les droits d'accès vers sa propre infrastructure. Cela réduit les dépendances et les trajets de données inutiles. Cela ne remplace cependant pas une architecture de sécurité. Un serveur de test interne mal entretenu reste un serveur mal entretenu.

Les tests auto-hébergés sont-ils plus sûrs que les tests cloud ?

La différence décisive ne réside pas dans le fait qu'un test s'exécute localement ou de manière automatisée. Elle réside dans où les données sont traitées, qui peut y accéder, et quelles limites techniques s'appliquent.

Avec un service de test exploité en externe, plusieurs artefacts quittent souvent l'entreprise : identifiants pour comptes de test, URL d'applications internes, contenus DOM, captures d'écran, vidéos d'exécutions de test, journaux d'erreurs, et éventuellement extraits de base de données. Même si un fournisseur respecte des normes de sécurité élevées, une relation de confiance et contractuelle supplémentaire se crée. Pour des applications avec des données clients, personnel, production, ou financières, cela peut constituer un obstacle pertinent.

Un système auto-hébergé peut être exploité au sein de son propre réseau ou d'un environnement UE clairement délimité. L'instance de test accède directement aux systèmes de staging, de recette, ou de test isolés. Les preuves de test restent là où se trouvent aussi l'application et sa responsabilité opérationnelle. C'est particulièrement judicieux lors du test d'applications de bureau Windows, de portails web internes, ou de systèmes avec des données de processus sensibles.

Mais l'auto-hébergement n'est pas automatiquement plus sûr. Celui qui exploite un serveur de test avec accès distant ouvert, comptes administrateur partagés, et mots de passe valides en permanence n'a fait que déplacer les risques. La question n'est donc pas seulement : cloud ou sur site ? Mais : l'environnement de test est-il démontrablement sécurisé et durablement maintenable ?

Are self hosted tests secure ? Tout dépend de ces limites

Une plateforme de test sécurisée a besoin de limites techniques et organisationnelles claires. Pour les petites et moyennes entreprises, cela ne doit pas ressembler à un programme d'entreprise. Il faut juste que ce soit mis en œuvre de manière cohérente et documenté.

Séparer l'environnement de test de la production

Les tests automatisés doivent trouver des erreurs, pas déclencher des commandes, modifier des bons de livraison, ou enregistrer des mouvements de stock. C'est pourquoi les tests ont besoin d'un environnement séparé avec ses propres interfaces, locataires de test, et données de test. Là où une copie complète de la production n'est pas nécessaire, elle est souvent même inutilement risquée.

Pour un portail d'entrepôt ou de commandes, cela peut signifier : les utilisateurs de test sont autorisés à enregistrer des réceptions de marchandises et générer des étiquettes d'expédition, mais les documents générés ne vont à aucune imprimante réelle ni aucun transporteur réel. Les clés API pointent vers des points de terminaison sandbox. L'envoi d'e-mails est intercepté ou limité aux destinataires internes. Ainsi un test reste pertinent sans produire de conséquences opérationnelles.

La séparation devrait aussi s'appliquer au niveau réseau. Le serveur de test n'a besoin que des connexions dont il a réellement besoin. Un accès général à l'ensemble du réseau interne est pratique, mais rarement justifiable. La segmentation limite les dégâts si un compte de test ou un composant système est compromis.

Traiter les identifiants comme des accès de production

L'automatisation de tests nécessite souvent des données de connexion. C'est normal, mais ces données n'ont pas leur place dans des scripts de test, des fichiers de configuration dans le code source, ou des historiques de chat. Mots de passe, jetons, et certificats devraient être chargés depuis une gestion des secrets contrôlée. Les comptes de test reçoivent uniquement les droits que le flux de travail concret exige.

L'accès à la plateforme de test elle-même a aussi besoin de rôles. Un développeur pourrait avoir besoin de démarrer des exécutions de test et de lire les résultats, mais pas de modifier la configuration réseau. Un service métier peut consulter des rapports, mais n'a pas besoin d'accès aux données de connexion stockées. Les droits d'administration devraient être liés à des personnes, pas couplés à un compte partagé.

De plus, l'authentification multifacteur, des règles de mot de passe raisonnables, et des flux de verrouillage de compte font partie du standard minimum. Les systèmes de test en particulier sont souvent traités comme moins critiques. Les attaquants voient les choses différemment : ils aiment utiliser les environnements de test comme point d'entrée, car c'est là que se trouvent identifiants, noms internes, et détails techniques.

Minimiser les données de test et les masquer de manière ciblée

L'erreur la plus fréquente n'est pas une méthode de chiffrement manquante, mais trop d'informations réelles dans le jeu de test. Pour la plupart des tests de régression, personne n'a besoin de vrais noms de clients, de vraies adresses, ou de dossiers du personnel complets. Des ensembles de données synthétiques, des copies masquées, et des cas particuliers délibérément créés suffisent souvent.

Il y a des exceptions. Certaines erreurs n'apparaissent qu'avec des structures de données réelles, des séquences de caractères inhabituelles, ou des constellations de permissions complexes. Alors une copie contrôlée et pseudonymisée peut être judicieuse. Ce qui compte, c'est que cette décision soit prise délibérément et ait un délai de suppression. Les bases de données de test ne devraient pas continuer pendant des années comme une copie fantôme oubliée de la production.

Les captures d'écran et vidéos méritent la même attention. Elles sont précieuses pour la recherche d'erreurs, mais peuvent montrer des données de compte, des prix internes, ou des contenus personnels. Définissez quels artefacts sont enregistrés, qui a le droit de les voir, et quand ils sont automatiquement supprimés. Un rapport de test n'a pas besoin de stocker éternellement chaque capture d'écran pour être probant.

Exploiter le serveur comme un produit

Un serveur de test auto-hébergé n'est pas un appareil qu'on installe une fois puis oublie. La sécurité opérationnelle naît d'une maintenance répétable : mises à jour de sécurité rapides pour le système d'exploitation, le navigateur, l'exécuteur de tests, et les dépendances ; supports de données et voies de transport chiffrés ; sauvegardes surveillées ; journalisation centralisée ; ainsi qu'une gestion claire des avis de sécurité.

Particulièrement pour les tests pilotés par navigateur, le rythme de mise à jour est pertinent. Des moteurs de navigateur obsolètes et des bibliothèques d'automatisation peuvent contenir des vulnérabilités connues ou rendre les tests peu fiables. Les deux coûtent du temps. Des déploiements documentés et des fenêtres de maintenance fixes ne sont donc pas un ajout bureaucratique, mais un fondement pour des résultats reproductibles.

Pour un serveur de test IA dédié comme COCO, cela s'applique également. L'exécution locale ne protège pas par magie les contenus applicatifs sensibles. Elle crée un contrôle sur l'endroit où l'évaluation assistée par IA, les captures d'écran, et les journaux de test sont traités. Ce contrôle doit être rempli avec gestion des correctifs, permissions, séparation réseau, et règles de conservation claires.

Où l'auto-hébergement a ses limites

Les services cloud ne sont pas par définition non sécurisés. Un fournisseur spécialisé peut offrir plus de personnel de sécurité, une surveillance plus mature, et une redondance plus professionnelle qu'une entreprise avec un seul rôle IT surchargé. Celui qui n'a pas de capacité pour l'exploitation, les mises à jour, et la réponse aux incidents peut créer un risque plus élevé avec un système auto-hébergé mal entretenu.

D'autre part, de nombreuses plateformes de test externes ne sont tout simplement pas un bon fit de processus pour des applications métier internes. Si une application n'est accessible que sur le réseau de l'entreprise, si les exécutions de test montrent des écrans et documents confidentiels, ou si les données ne devraient pas quitter son propre domaine de contrôle, l'exploitation locale est souvent la solution la plus claire.

La décision raisonnable dépend du besoin de protection et de la capacité opérationnelle. Pour un site marketing public sans identifiants sensibles, un service de test cloud peut être approprié. Pour un logiciel de répartition interne, un portail client avec des données personnelles, ou une application Windows dans le réseau de production, beaucoup plaide en faveur d'un environnement contrôlé et auto-hébergé.

Une vérification de sécurité pratique avant le lancement

Avant que des tests automatisés soient déployés, un responsable devrait pouvoir répondre à ces questions sans deviner :

  • Quels systèmes, bases de données, et interfaces le serveur de test peut-il atteindre ?
  • Quelles données apparaissent dans les captures d'écran, vidéos, journaux, et évaluations IA ?
  • Où se trouvent les identifiants, et quand sont-ils renouvelés ?
  • Qui est autorisé à démarrer des exécutions de test, lire des résultats, et administrer des systèmes ?
  • À quelle vitesse les mises à jour critiques sont-elles appliquées, et comment cela est-il vérifié ?
  • Quand les artefacts de test et les données qui ne sont plus nécessaires sont-ils supprimés ?

Ces questions semblent sobres. C'est exactement leur valeur. La sécurité naît rarement d'un seul outil ou d'un diagramme d'architecture impressionnant. Elle naît quand responsabilités, flux de données, et limites techniques restent vérifiables au quotidien.

Celui qui construit une automatisation de tests devrait d'abord clarifier le besoin de protection de l'application, puis choisir l'architecture la plus petite qui soit judicieuse. Un serveur de test proprement délimité avec peu de comptes autorisés est souvent plus précieux qu'une plateforme surchargée que personne ne peut entretenir de manière fiable. Boring, provable reliability bat aussi dans le testing la solution spectaculaire mais opaque.

Lien permanent →

Warehouse Management Systems : Ce qui compte vraiment

Warehouse Management Systems : Ce qui compte vraiment

Quand un employé de la réception des marchandises note la même ligne de livraison sur papier, la transfère plus tard dans un tableau, puis clarifie à voix haute où elle sera stockée, ce n'est rarement pas la bonne volonté qui manque. C'est un processus commun qui manque. Les Warehouse Management Systems créent ce processus en documentant les mouvements de marchandises, les stocks, et les tâches consécutives en un seul endroit. Pour les petites et moyennes entreprises, ce n'est pas la plus longue liste de fonctions qui est décisive, mais le fait que le logiciel représente de manière fiable le parcours d'une marchandise à travers son propre entrepôt.

Ce que les Warehouse Management Systems doivent accomplir au quotidien

Un Warehouse Management System, ou WMS en abrégé, n'est pas simplement une meilleure liste de stocks. Il contrôle ou documente les processus physiques dans l'entrepôt : réception des marchandises, contrôle qualité, mise en stock, transfert, préparation de commandes, emballage, expédition, et inventaire. Chaque enregistrement répond à une question opérationnelle simple : qu'est-ce qui se trouve où, en quelle quantité, dans quel état, et qui a déclenché le mouvement ?

À première vue, cette clarté semble banale. Mais elle empêche des chaînes d'erreurs typiques. Un article est bien livré, mais n'a pas encore été contrôlé. Une palette se trouve en réception mais est déjà affichée comme disponible dans le système. Une commande est préparée bien que la marchandise devrait être réservée pour une commande client plus importante. Sans statuts et mouvements clairement définis, une simple incertitude se transforme rapidement en une promesse de livraison erronée.

Pour de nombreux entrepôts de taille moyenne, le bénéfice ne commence pas avec un contrôle entièrement automatisé. Des ordres de mise en stock déjà suivis, des emplacements de stockage univoques, et des enregistrements mobiles peuvent réduire nettement les temps de recherche. Ce qui compte, c'est que le personnel n'ait plus à traduire entre papier, téléphone, e-mail, et plusieurs tableaux.

Tout entrepôt n'a pas besoin d'une grande suite

Le marché propose de vastes systèmes d'entreprise avec des fonctions pour des réseaux multi-sites mondiaux, une gestion douanière complexe, une technologie de convoyage automatisée, et une logique d'optimisation très fine. Cela peut être le bon choix si ces exigences existent réellement. Mais pour une entreprise avec un ou quelques entrepôts, des priorités changeantes, et des processus spéciaux bien rodés, une telle suite peut créer plus de friction que de bénéfice.

Les coûts ne résident alors pas seulement dans les licences. Ils naissent de longs projets de mise en œuvre, d'adaptations coûteuses, de formations, et d'une dépendance à des spécialistes externes. Même un système avec cent réglages ne résout pas un problème si les chefs d'équipe doivent ouvrir un ticket pour des corrections quotidiennes.

L'alternative ne signifie pas nécessairement un développement entièrement sur mesure. Un produit standard peut être judicieux lorsque ses flux de travail principaux correspondent et que les adaptations restent délibérément limitées. De même, un tableau existant peut rester la meilleure solution, par exemple pour une évaluation rare et gérable. Il devient critique seulement lorsque plusieurs personnes y travaillent simultanément, saisissent les mouvements avec un décalage, ou que le tableau est censé devenir la vérité opérationnelle sur la marchandise disponible.

La bonne solution s'oriente selon le volume de processus réel et le coût des erreurs. Cinq mauvais prélèvements par semaine signifient quelque chose de différent dans un entrepôt de pièces détachées avec des commandes clients critiques en termes de délais que cinq écarts dans un stock d'archives à rotation lente.

Saisir d'abord les processus, pas choisir les écrans

De nombreux projets WMS commencent par une démo produit. Là, les décideurs voient des tableaux de bord élégants, des vues scanner, et des indicateurs colorés. Il est plus utile, d'abord, de faire un tour de l'entrepôt pendant une journée de travail normale. Où arrive la marchandise ? Qui contrôle les quantités et les dommages ? Quand un article reçoit-il son numéro de lot ou de série ? Comment décide-t-on sur quel emplacement il va ? Et que se passe-t-il quand la réalité s'écarte de la commande ?

Ces questions posent les bases d'une solution qui sera acceptée plus tard. Un processus cible bien documenté ne décrit pas seulement le cas idéal. Il contient aussi des exceptions : livraisons partielles, marchandises endommagées, arrivages non annoncés, ruptures de stock, retours, et stocks bloqués. Ce sont précisément ces cas qui décident si le personnel fait confiance au système ou reprend des bouts de papier.

Les statuts comptent plus que de jolies interfaces

Un ensemble de données propre distingue par exemple « attendu », « arrivé », « en contrôle », « mis en stock », « réservé », « préparé », et « expédié ». Les statuts nécessaires dépendent de l'entreprise. Trop peu masquent des différences pertinentes. Trop nombreux ralentissent les enregistrements et sont contournés.

La règle devrait être : chaque statut doit avoir une conséquence opérationnelle. Si la marchandise est bloquée, elle ne doit pas être préparée. Si elle est réservée, il doit être visible pour quelle commande. Si elle est mise en stock, un emplacement de stockage doit être enregistré. Ainsi, les règles de données deviennent une fiabilité pratique du processus.

Les scanners n'aident qu'avec des enregistrements clairs

Les codes-barres et les appareils mobiles réduisent les erreurs de frappe et accélèrent les mouvements. Mais ils ne remplacent pas une décision de processus. Un scan doit déclencher une action compréhensible : vérifier l'article, confirmer la quantité, choisir l'emplacement de destination, ou terminer la commande. Si un employé doit deviner après chaque scan quel écran suit, le flux est conçu de manière trop compliquée.

La question du matériel devrait également être résolue de manière pragmatique. Pour certaines équipes, des smartphones avec une fonction de scan adaptée et une coque de protection robuste suffisent. D'autres ont besoin de scanners portables industriels, car des gants, la réfrigération, des chutes, ou de longs quarts de travail l'exigent. Un pilote sur la surface d'entrepôt réelle montre plus qu'une présentation au bureau.


La base technique décide après la mise en service

Un WMS doit fonctionner correctement même lorsque des réceptions de marchandises sont enregistrées, des commandes préparées, et des stocks contrôlés simultanément. Cela génère des exigences qui se perdent souvent dans les conversations précoces : journaux de mouvement univoques, autorisations basées sur les rôles, corrections traçables, interfaces fiables, et sauvegardes réellement restaurables en cas d'urgence.

Un stock ne devrait pas être simplement écrasé. Mieux vaut un modèle de mouvement : entrée, sortie, transfert, blocage, ou correction génèrent chacun un enregistrement journalisé. Cela permet plus tard de retracer pourquoi une quantité diverge. C'est tout aussi précieux pour les inventaires que pour résoudre un cas de réclamation client.

Les autorisations doivent correspondre à la responsabilité. Un préparateur de commandes a besoin de fonctions différentes d'un responsable d'entrepôt qui approuve des corrections de stock. Pour les modifications critiques, des justifications, des approbations à quatre yeux, ou au moins un journal de modifications immuable sont judicieux. L'effort dépend du profil de risque, mais la question devrait être clarifiée avant le début.

Les interfaces méritent la même attention. Un entrepôt travaille rarement de manière isolée. Les commandes proviennent d'une boutique, d'un ERP, ou d'un import structuré. Les données d'expédition vont vers des systèmes de transporteurs, des bons de livraison et des étiquettes sont générés, les données de stock refluent. Chaque interface a besoin de responsabilités claires pour les cas d'erreur. Que se passe-t-il si une étiquette d'expédition a été générée mais que la confirmation n'arrive pas dans le WMS ? Sans logique de nouvelle tentative et file d'attente d'erreurs visible, de tels cas restent bloqués auprès de personnes individuelles.

Pour les solutions sur mesure, les technologies maintenables ne sont pas un détail secondaire. Une application traçable avec une structure de base de données claire, des déploiements documentés, et des intégrations testées reste gérable même après des changements de personnel. Une architecture à la mode n'aide pas si personne ne peut retracer un import défectueux.

Déploiement par petites étapes contrôlables

Un big bang crée un risque évitable. Il est souvent plus judicieux de d'abord numériser un processus délimité, comme la réception des marchandises pour un groupe de produits ou la préparation de commandes dans une zone d'entrepôt. L'équipe vérifie ainsi non seulement les fonctions, mais aussi les formulations, les parcours de scan, les distances de marche, et les responsabilités.

Les données de base sont souvent le véritable chantier ici. Les numéros d'article doivent être univoques, les unités de mesure cohérentes, les emplacements de stockage structurés de manière sensée, et les unités d'emballage clairement définies. Un système ne peut pas fournir des stocks fiables si le même article apparaît sous trois désignations différentes, ou si une « caisse » signifie des quantités différentes selon le fournisseur.

Pendant la phase pilote, les indicateurs devraient rester simples : combien de temps dure la réception des marchandises ? Combien d'enregistrements doivent être corrigés ? Combien de préparations sont erronées ? À quelle fréquence cherche-t-on la marchandise ? Toute amélioration ne se manifeste pas immédiatement par un poste de coût important. Moins de questions de suivi et des informations de livraison plus fiables peuvent déjà retirer une pression considérable des opérations quotidiennes.

La formation fonctionne mieux directement au niveau du processus. Le personnel n'a pas besoin d'une visite guidée abstraite de tous les éléments de menu. Il doit savoir comment enregistrer sa prochaine livraison, signaler un écart, ou corriger un scan erroné. Pour les premières équipes après le lancement, une personne responsable devrait être joignable et capable de prendre des décisions rapidement.

La bonne question pour le choix

Pour les Warehouse Management Systems, la question centrale n'est pas : quel logiciel peut faire le plus ? C'est : quels flux de travail doivent devenir plus rapides, plus clairs, et plus traçables chaque jour pour notre équipe ?

Celui qui décrit d'abord ces flux de travail proprement peut évaluer objectivement un logiciel standard, des extensions, ou une application sur mesure. Le résultat n'a pas besoin de paraître spectaculaire. Il devrait faire en sorte que la marchandise trouve son chemin, que le stock reste fiable, et que les personnes dans l'entrepôt passent moins de temps à chercher, demander, et corriger après coup.

Lien permanent →

Custom Logistics Software vs Spreadsheets

Custom Logistics Software vs Spreadsheets

Une réception de marchandises arrive plus tôt que prévu, deux employés modifient en parallèle la même liste de stock, et le chauffeur attend un bon de livraison dont personne ne peut nommer avec certitude la dernière version. De telles situations tranchent la question « custom logistics software vs spreadsheets » non pas de manière théorique, mais entre la réception des marchandises, l'emplacement de stockage, et la rampe.

Les tableaux ne sont pas fondamentalement le problème. Ils sont rapides à créer, familiers à tous, et souvent étonnamment efficaces pour des tâches clairement délimitées. Ils deviennent problématiques lorsqu'ils doivent servir de système d'exploitation à un processus d'entrepôt ou de distribution en croissance. Un fichier se transforme alors en processus critique - sans règles contraignantes, états traçables, ou historique solide.

Quand les tableurs dans l'entrepôt sont le bon choix

Un tableau est judicieux lorsque le processus est gérable, peu fréquent, et contrôlé par peu de personnes. Cela peut être, par exemple, une planification mensuelle des besoins, une préparation d'inventaire ponctuelle, ou une évaluation des prix des fournisseurs. Il peut également suffire pour un petit stock avec un responsable, à condition que les modifications ne se fassent pas sous pression temporelle et qu'aucun processus en aval n'en dépende automatiquement.

L'avantage ne réside pas seulement dans les faibles coûts de licence. Les équipes peuvent adapter des colonnes, vérifier des calculs, et mettre en place un nouveau formulaire en quelques minutes. Celui qui n'a pas encore compris un processus stable ne devrait pas se précipiter à le couler dans un logiciel. Un bon tableau peut d'abord rendre visible quelles données sont réellement nécessaires et quels champs ne sont maintenus que par habitude.

Il serait donc erroné de traiter chaque fichier Excel comme un retard. La question décisive est : le tableau est-il un outil de travail pour une personne, ou une source partagée pour des décisions opérationnelles ? Dès que plusieurs rôles dépendent des mêmes données, le risque augmente nettement.

Custom Logistics Software vs Spreadsheets : Le point de bascule

Le changement n'est généralement pas déclenché par le nombre de lignes. Un tableau de 20 000 positions peut fonctionner, tandis qu'un fichier de 200 lignes entraîne déjà des erreurs. Ce qui compte, c'est la simultanéité, les étapes du processus, et les conséquences d'une information incorrecte.

Un signal d'alerte typique est la question des versions. Si les stocks, les commandes ouvertes, ou les dates de livraison se trouvent dans des fichiers nommés « final_nouveau », « final_nouveau2 », et « vraiment_final », ce qui manque n'est pas une meilleure structure de dossiers. Ce qui manque, c'est un état de données faisant autorité. Il en va de même lorsque les employés doivent se téléphoner pour savoir si la marchandise est arrivée, si une commande a été approuvée, ou si un véhicule a déjà été chargé.

Le point de bascule est atteint lorsqu'une saisie déclenche plusieurs actions consécutives. Une réception de marchandises ne modifie alors pas seulement un chiffre dans le stock. Elle peut déclencher un contrôle qualité, attribuer un emplacement de stockage, marquer une commande comme partiellement livrée, et afficher aux ventes un article disponible. Si ces étapes sont coordonnées manuellement via des fichiers, du papier, et des appels téléphoniques, les écarts sont difficilement évitables.

Cela devient particulièrement critique lors des changements d'équipe et des absences. Lorsque seule une personne expérimentée sait quel marquage de couleur dans une liste signifie un blocage, ou quelle formule calcule un stock de sécurité, le processus n'est pas solide. Il ne fonctionne que tant que cette personne est disponible.

Ce qu'un logiciel sur mesure fait réellement mieux

Un logiciel logistique sur mesure n'est pas simplement un tableau avec une belle interface. Sa valeur naît de flux de travail contrôlés. Chaque enregistrement reçoit un horodatage univoque, une personne responsable, et un statut traçable. Les employés ne voient pas seulement des données, mais la prochaine action autorisée.

Pour une réception de marchandises, cela peut signifier concrètement : sélectionner la livraison, saisir la quantité, documenter tout écart, imprimer l'étiquette, et confirmer le rangement. Ce n'est qu'ensuite que le stock est libéré. Pour la préparation de commandes, le système peut regrouper les commandes par priorité, afficher les emplacements de stockage dans un ordre judicieux, et ne générer un bon de livraison qu'une fois les lignes confirmées.

Ce n'est pas une question de complexité inutile. Cela empêche que le même article soit réservé deux fois, qu'une livraison partielle compte comme complète, ou qu'un bon de livraison soit imprimé sur la base de données obsolètes. Des règles simples aident aussi : champs obligatoires pour les lots, motifs de blocage pour marchandises endommagées, contrôles de plausibilité sur les quantités, et droits pour les écritures de correction.

Une application bien planifiée ne couvre pas immédiatement chaque cas particulier. Elle se concentre sur les processus qui coûtent du temps au quotidien ou produisent régulièrement des erreurs. Pour une entreprise, cela peut être la gestion des mouvements de conteneurs ; pour une autre, la saisie rapide des marchandises entrantes avec des appareils mobiles. Le logiciel standard ne connaît souvent ces particularités que comme un module complémentaire coûteux, voire pas du tout.

Le coût caché du tableau

Le coût de licence d'un tableau est faible. Le coût de processus ne peut pas l'être. Il naît des questions de suivi, des reprises, des temps de recherche, de la double maintenance, et des stocks mal planifiés. Il naît aussi lorsqu'une équipe doit vérifier le soir quelles données ont changé depuis le matin.

Ces coûts restent souvent invisibles car répartis sur de nombreux rôles. Le chef d'entrepôt vérifie les stocks, le service commercial interne corrige les dates de livraison, la comptabilité recherche des justificatifs, et la direction reçoit des chiffres avec retard. Aucune activité individuelle ne paraît dramatique. Ensemble, elles ralentissent le débit et la prévisibilité.

Une décision solide ne devrait donc pas seulement comparer les prix des logiciels. Mesurez, pendant deux à trois semaines, combien de transmissions manuelles une commande traverse, à quelle fréquence les informations sont redemandées, et quelles erreurs reviennent. Les conséquences sont également pertinentes : un stock erroné entraîne-t-il une correction interne ou une livraison manquée ?

Tout problème n'a pas besoin d'une grande suite

De nombreuses entreprises de taille moyenne dans la région DACH hésitent à juste titre devant des systèmes d'entreprise étendus. Des déploiements longs, des écrans rigides, et des modèles de licence pour des fonctions jamais utilisées résolvent rarement un problème concret d'entrepôt. Mais l'alternative ne doit pas nécessairement signifier rester avec des fichiers dispersés.

Entre ces deux extrêmes se trouve une application spécifique au flux de travail. Elle peut, par exemple, relier la réception des commandes, la réception des marchandises, les mouvements de stock, les étiquettes d'expédition, et les bons de livraison dans un système partagé, sans apporter d'emblée comptabilité financière complète, logique de groupe mondiale, et vingt langues étrangères.

La base technique est décisive. Une application avec une structure de base de données claire, des interfaces documentées, et des droits traçables reste adaptable. Des technologies comme PHP 8.4, un JavaScript moderne, et MySQL 8 ne sont pas une fin en soi ici. Utilisées correctement, elles créent une base maintenable pour les rôles, les historiques d'enregistrement, les documents imprimés, et les rapports - même lorsque les processus changent dans deux ans.

Comment la transition réussit sans interrompre l'activité

Le plus grand danger n'est pas la technique, mais un premier pas trop grand. Celui qui tente de nettoyer tous les fichiers historiques et de cartographier chaque cas exceptionnel avant le lancement repousse le bénéfice de plusieurs mois. Un début clair et vérifiable est préférable.

Commencez par un processus qui se produit fréquemment et est bien délimitable, comme la réception des marchandises avec enregistrement du stock, ou l'expédition avec bon de livraison et étiquette. Définissez avec précision quand l'opération commence, quelles données sont strictement nécessaires, qui accorde quelle approbation, et quand elle est considérée comme terminée. Cela produit non seulement des écrans, mais des règles de travail solides.

La reprise des données nécessite également du pragmatisme. Les articles actifs, les fournisseurs, les emplacements de stockage, et les commandes ouvertes doivent être propres. Les anciens stocks historiques peuvent en revanche souvent être archivés, plutôt que d'être importés dans le nouveau système à grand effort. Un fonctionnement parallèle peut avoir du sens, mais uniquement avec une date de fin fixe. Sinon, deux vérités naissent au lieu d'une meilleure.

La valeur d'un partenaire technique direct se manifeste lors du déploiement.

softify.pro ne travaille donc pas à partir d'une liste abstraite de fonctionnalités, mais clarifie les processus là où ils se déroulent réellement : à la réception, dans l'allée de l'entrepôt, lors de l'emballage, et lors de la remise à l'expédition. Un bon logiciel respecte les routines fonctionnelles et ne change que ce qui rend réellement le processus plus fiable.

La décision peut être vérifiée à travers trois questions

Premièrement : plusieurs personnes doivent-elles faire confiance simultanément à des données actuelles ? Deuxièmement : un enregistrement déclenche-t-il des processus consécutifs qui sont aujourd'hui sécurisés manuellement ? Troisièmement : une erreur peut-elle entraîner un retard de livraison, un stock incorrect, une facture erronée, ou une recherche fastidieuse ? Si ces questions reçoivent majoritairement une réponse positive, le tableau n'est probablement plus le bon système de référence.

Si la réponse reste majoritairement négative, il peut continuer à être une solution raisonnable. Il vaut alors mieux unifier les fichiers, définir des responsabilités, et documenter les formules critiques. La technique ne devrait pas être plus grande que le problème.

La prochaine étape judicieuse n'est donc pas un projet de numérisation généralisé, mais un regard partagé sur un processus concret avec les personnes qui l'exécutent quotidiennement. On y voit rapidement si un tableau bien tenu suffit - ou si un logiciel fiable devrait enfin prendre en charge le travail qui reste aujourd'hui coincé entre papier, téléphone, et plusieurs versions du même fichier.

Lien permanent →

Développement web pour les entreprises

Développement web pour les entreprises

Un site web peut avoir belle allure et pourtant générer du travail chaque lundi : les données produit sont maintenues en double, les demandes arrivent incomplètes dans la boîte de réception, les modifications nécessitent une aide extérieure. La recherche d'une entreprise de développement web ne devrait donc pas s'arrêter aux couleurs, aux frameworks, ou à un portfolio élégant. Ce qui compte, c'est si la solution crée moins de friction dans le travail quotidien et reste compréhensible à exploiter même dans trois ans.

Pour les petites et moyennes entreprises, ce n'est pas une question académique. Dans les ateliers, les entrepôts, et les organisations commerciales, devis, commandes, informations de livraison, et demandes de clients rencontrent souvent des processus qui se sont développés organiquement. Certains d'entre eux méritent un logiciel. D'autres fonctionnent encore mieux avec un tableau proprement tenu. Un bon développement web reconnaît la différence, au lieu de transformer chaque problème en grand projet numérique.

Ce que le développement web doit apporter aux entreprises

Un site web d'entreprise est souvent le premier point de contact. Il doit se charger rapidement, fonctionner sur les appareils mobiles, et guider clairement les visiteurs vers une demande, une candidature, ou une commande. Mais dès qu'il traite des données, cartographie des rôles internes, ou déclenche des processus, il devient une application web. Alors d'autres questions comptent : Qui a le droit de voir quoi ? D'où viennent les données ? Que se passe-t-il en cas de saisie erronée ? Comment une mise à jour est-elle déployée sans perturber l'activité ?

La différence est pratique. Une page marketing peut se contenter de quelques zones de contenu clairement structurées. Un portail client, un processus de commande, ou un outil interne d'entrepôt, en revanche, nécessite des droits traçables, une structure de base de données robuste, et des cas particuliers définis. Si une réception de marchandises n'est livrée que partiellement ou si une commande doit être modifiée ultérieurement, le système ne doit pas se retrouver dans un état indéfini.

Le développement web pour les entreprises ne signifie donc pas simplement programmer des pages. Cela signifie mettre en œuvre des règles métier de manière à ce qu'elles restent compréhensibles pour les utilisateurs et contrôlables pour l'entreprise.

Vérifier d'abord le processus, puis planifier l'interface

Un projet démarre souvent avec un souhait comme « Nous avons besoin d'un portail ». C'est un début judicieux, mais pas encore une exigence suffisante. Avant la première conception, les trajets réels d'une information devraient devenir visibles : qui la crée, qui la vérifie, qui la complète, et qui en aura besoin plus tard ?

Prenons le traitement des commandes. Dans de nombreuses entreprises, une demande arrive par e-mail ou par téléphone, est notée dans un tableau, transférée plus tard dans un autre système, puis retraitée pour l'entrepôt ou l'expédition. Le retard tient rarement à une seule étape. Il naît des transmissions, des questions de suivi, et des états de données divergents.

Une bonne analyse pose donc des questions concrètes sur le quotidien :

  • Quelles informations sont saisies plusieurs fois aujourd'hui ?
  • À quel endroit surviennent la plupart des questions de suivi ou des corrections ?
  • Quelles exceptions se produisent régulièrement bien qu'elles ne soient documentées nulle part ?
  • Quels rôles ont besoin d'un accès, et quelles données ne doivent-ils pas pouvoir modifier ?
  • À quoi l'équipe reconnaît-elle finalement qu'une opération est vraiment terminée ?

Ces questions paraissent sobres. C'est précisément leur avantage. Elles empêchent qu'une application visuellement convaincante soit construite autour d'un processus idéalisé que personne n'utilise réellement dans l'exploitation. Particulièrement dans l'entrepôt et la logistique, les conditions réelles comptent : les scanners sont utilisés avec des gants, les équipes changent, le Wi-Fi n'est pas partout aussi bon, et un bon de livraison ne doit pas naître seulement après plusieurs clics.

Tout processus n'a cependant pas sa place dans une application. Une petite liste avec peu d'entrées stables peut être plus rapide et plus économique sous forme de tableau. Le logiciel vaut la peine lorsque les données circulent entre personnes ou services, lorsque la traçabilité fait défaut, ou lorsque le travail manuel gaspille du temps et génère des erreurs de manière récurrente.

La base technique détermine l'effort ultérieur

De nombreux systèmes se ressemblent lors de la première démo. La différence se manifeste lors des modifications, de la croissance, et des perturbations. Une application devrait donc reposer sur des technologies que l'équipe peut maintenir à long terme, plutôt que de miser sur un effet de mode éphémère.

Pour de nombreuses applications web critiques pour l'entreprise, une pile avec PHP 8.4, un JavaScript moderne, et MySQL 8 est un choix pragmatique. Elle est performante, bien compréhensible, et adaptée à des exigences typiques comme les portails, la gestion des commandes, la génération de documents, ou les outils internes. Ce n'est pas un dogme. Pour des applications très interactives, des intégrations spéciales, ou des besoins élevés en temps réel, une autre architecture peut être judicieuse. La technologie devrait suivre la tâche, pas l'inverse.

Plus important que le nom d'un framework sont des décisions claires concernant les données et les états. Une commande, par exemple, nécessite des valeurs de statut univoques plutôt que du texte libre. Les modifications devraient être traçables. Les données clients, les prix, et les droits ne doivent pas diverger entre des tableaux dispersés et des interfaces improvisées. Quiconque doit savoir plus tard pourquoi une étiquette d'expédition a été créée ou une commande bloquée a besoin d'un historique traçable.

La sécurité fait également partie de la construction de base. Cela inclut des droits basés sur les rôles, un stockage sécurisé des mots de passe, des mécanismes de verrouillage de compte en cas de tentatives échouées répétées, des environnements de test et de production séparés, ainsi que des mises à jour régulières. La sécurité n'est pas un plugin unique ajouté à la fin du projet. Elle naît de responsabilités propres et d'une architecture qui anticipe les cas d'erreur.

La vitesse est une exigence opérationnelle

Les pages lentes ne coûtent pas seulement de la visibilité dans les moteurs de recherche. Elles provoquent des abandons de demandes et un temps d'attente inutile dans l'activité quotidienne. Sur un site web public, le temps de chargement, la présentation mobile, et une structure de page claire déterminent si les prospects prennent même contact. Dans une application interne, deux ou trois secondes d'attente par enregistrement s'additionnent de manière perceptible tout au long de la journée de travail.

La performance ne commence pas par un projet d'optimisation ultérieur. Les images, les requêtes de base de données, la mise en cache, le JavaScript, et l'hébergement doivent être planifiés de manière appropriée dès le départ. Le principe est le suivant : toute application n'a pas besoin d'une complexité technique maximale. Un simple outil interne avec peu d'utilisateurs n'a pas besoin d'une architecture pour des millions d'appels simultanés. Il a besoin de chemins courts, de sauvegardes fiables, et d'un comportement qui reste prévisible au quotidien.

Le même principe s'applique à l'utilisation responsive. « Compatible mobile » ne signifie pas qu'un écran de bureau se rétrécit d'une manière ou d'une autre sur un smartphone. Quiconque vérifie des bons de livraison en déplacement, signale un dommage, ou corrige un stock, a besoin de grands éléments de commande, de retours clairs, et d'aussi peu de saisie inutile que possible.

De l'idée à l'exploitation : livrer par petites étapes

Les grands cahiers des charges promettent de la sécurité, mais conduisent souvent les équipes à attendre des mois avant une première version utilisable. Une meilleure voie consiste en une première étape d'extension clairement délimitée. Elle doit résoudre un problème réel, comme la saisie centralisée des réceptions de marchandises ou la génération automatique de documents de livraison. Ensuite, de vrais retours permettent de décider ce qui apporte le plus grand bénéfice ensuite.

Cela ne signifie pas travailler sans planification. Au contraire : le modèle de données, les rôles, les interfaces, et le concept d'exploitation doivent être clarifiés tôt. Le périmètre fonctionnel peut néanmoins croître progressivement. Ainsi, les hypothèses deviennent visibles avant de devenir coûteuses.

Une remise professionnelle comprend plus que des identifiants d'accès. Des étapes de déploiement documentées, des sauvegardes, une surveillance, des responsabilités, et une documentation technique compréhensible rendent un système indépendant des personnes individuelles. Si seul le développeur d'origine sait comment une mise à jour est déployée, l'application n'est pas terminée - elle est liée à une personne.

Comment reconnaître un partenaire adapté

Une entreprise de développement web n'a pas à proposer toutes les technologies imaginables. Elle devrait cependant poser les bonnes questions et être capable de justifier ses décisions. La prudence est de mise si une plateforme complète est déjà promise dès le premier entretien, sans que personne n'ait vu les processus existants.

Un partenaire adapté parle de maintenance, de qualité des données, et de déploiement aussi ouvertement que de design. Il explique quelles exigences les fonctions standard peuvent couvrir et où un développement individuel devient judicieux. Il indique également le coût des demandes spéciales. Une fonctionnalité peut être techniquement réalisable et pourtant n'avoir aucun bénéfice suffisant.

Demandez des détails opérationnels concrets : Comment les modifications sont-elles testées ? Comment fonctionne un rollback ? Où se trouvent les données sensibles ? Qui réagit en cas de panne ? Comment les droits sont-ils gérés ? Les bonnes réponses ne doivent pas nécessairement être longues, mais elles sont spécifiques. « Nous nous en occuperons plus tard » n'est pas une stratégie pour des processus critiques pour l'entreprise.

Pour les équipes disposant déjà de logiciels, la question de l'intégration est également centrale. Une nouvelle application ne doit pas tout remplacer. Elle peut d'abord récupérer des données d'un système existant, générer des documents, ou combler un processus manquant. La première étape la plus judicieuse n'est souvent pas le grand remplacement, mais la suppression ciblée d'un goulot d'étranglement.

Le logiciel doit clarifier le travail, pas le déplacer

La meilleure application web ne se distingue pas dans l'exploitation par une sophistication technique, mais par moins de questions de suivi, des données fiables, et des délais plus courts. Elle respecte les modes de travail fonctionnels, rend les exceptions visibles, et peut être développée davantage sans crainte de la prochaine mise à jour.

Avant de démarrer un projet, prenez une opération concrète de votre quotidien et suivez-la depuis le premier contact jusqu'à l'achèvement. Là où les informations attendent, disparaissent, ou sont saisies en double, se trouve généralement l'approche la plus judicieuse pour le développement web.

Lien permanent →

Logistics Automation Software : trouver la solution qui convient vraiment

Logistics Automation Software : trouver la solution qui convient vraiment

Une réception de marchandises est notée sur papier, la variation de stock est reportée plus tard dans un tableur, et l'expédition appelle l'entrepôt parce que l'adresse de livraison se trouve dans un e-mail. C'est précisément à ces passages de relais qu'une entreprise perd du temps et de la fiabilité. Logistics Automation Software ne doit pas masquer cette friction par un grand univers de processus tout neuf, mais relier de façon traçable les gestes du quotidien.

Pour les petites et moyennes entreprises, c'est une tâche différente de l'introduction d'une plateforme de grand groupe. Un responsable d'entrepôt n'a pas besoin de 200 fonctions qui ne deviennent compréhensibles qu'après trois jours de formation. Il a besoin d'un statut clair : qu'est-ce qui est arrivé, où est-ce rangé, qu'est-ce qui doit partir aujourd'hui, et que manque-t-il encore ? Une bonne automatisation répond à ces questions là où le travail se fait.

Ce que Logistics Automation Software doit apporter concrètement

Le terme paraît large, mais les cas d'usage pertinents sont généralement très concrets. Une entreprise traite par exemple les marchandises entrantes, enregistre les mouvements de stock, établit des bons de livraison, imprime des étiquettes d'expédition et planifie les livraisons. Lorsque chaque poste a besoin de son propre fichier, d'un accès distinct ou d'une demande orale, il en résulte des retards et des chaînes d'erreurs.

Un logiciel adapté rassemble les informations dans un seul flux de travail. Une commande peut générer automatiquement un ordre de préparation. Le scan d'un article confirme le prélèvement et met à jour le stock. Une fois l'opération terminée, un bon de livraison avec les bonnes lignes est établi, tandis que le statut d'expédition devient visible pour les ventes ou l'ordonnancement. Cela paraît simple. C'est justement ce qui en fait la valeur : le logiciel ne remplace pas une logique qui fonctionne, il évite qu'elle doive être reconstruite à chaque rupture de support.

L'ordre est déterminant. Il faut d'abord savoir quelles données déclenchent un événement et qui en décide. C'est seulement ensuite qu'il vaut la peine d'automatiser des règles. Qui numérise un processus flou n'obtient qu'une confusion plus rapide.

Choisir d'abord les bons processus

Toute opération manuelle ne mérite pas immédiatement une application. Un petit tableur bien tenu peut valoir mieux, pour un cas particulier rare, qu'un module à maintenir en permanence. Le levier économique se situe généralement dans les processus très répétitifs, comportant beaucoup de passages de relais ou des conséquences d'erreur sensibles.

Les candidats typiques sont les réceptions avec statut de contrôle, les transferts entre zones, la préparation de commandes récurrentes, les documents d'expédition et la planification des tournées. La prise de commande constitue elle aussi souvent un bon point de départ, lorsque les commandes issues d'appels téléphoniques, d'e-mails et de formulaires sont d'abord rassemblées à la main.

Quatre questions aident à faire le choix :

  • À quelle fréquence le processus est-il exécuté chaque semaine ?
  • À quel endroit les données sont-elles saisies ou transférées plusieurs fois ?
  • Quelles erreurs entraînent des reprises, des écarts de stock ou des retards de livraison ?
  • Quelles exceptions les collaborateurs doivent-ils continuer à trancher eux-mêmes ?

La dernière question évite une erreur répandue. Automatiser ne doit pas signifier que chaque décision se prend sans personne. En cas de marchandise endommagée, de livraisons incomplètes ou de demandes clients de dernière minute, l'équipe a besoin d'un moyen clair de suspendre une opération, de la corriger et de la poursuivre avec une justification. Un système dépourvu de telles issues paraît cohérent sur le papier, mais devient vite un obstacle dans l'entrepôt.

De la réception à l'expédition : un déroulement continu

Prenons un négociant de taille moyenne, avec entrepôt et livraison en propre. Aujourd'hui, la marchandise est comptée au quai, notée sur un formulaire et saisie dans le système seulement vers la fin du poste. Les ventes voient donc le nouveau stock trop tard. Pour un envoi urgent, un bon de livraison est établi séparément, et le chauffeur reçoit ses informations par téléphone.

Dans un déroulement automatisé à bon escient, la réception commence par une opération numérique. Les collaborateurs saisissent livraison, article, quantité et, si besoin, lot ou numéro de série directement au poste de travail ou sur mobile. Les écarts ne sont pas cachés dans une note en marge, mais reçoivent un statut tel que « Contrôle requis ». Ce n'est qu'après validation que la marchandise devient un stock disponible.

L'étape suivante découle de besoins réels : une commande est libérée, l'entrepôt reçoit une liste de prélèvement ou une vue mobile triée par emplacement, et chaque enregistrement documente ce qui a réellement été prélevé. Le bon de livraison et les données d'expédition en découlent, issus de la même source. Personne n'a à ressaisir des lignes ni à vérifier quelle version du fichier fait foi.

Pour l'ordonnancement, le système peut regrouper les livraisons ouvertes par zone, créneau de livraison, poids ou capacité du véhicule. La planification d'itinéraires n'est pas toujours la première étape pertinente. Si les adresses sont incomplètes ou si les commandes ne sont libérées que peu avant le départ, il faut d'abord améliorer la qualité des données et la clarté des commandes. Des itinéraires optimisés ne servent à rien si la base n'est pas fiable.

Logiciel standard ou solution sur mesure ?

Un logiciel standard est judicieux lorsque l'entreprise travaille avec des processus courants et accepte de s'adapter aux écrans, rôles et processus prévus. Il peut être introduit rapidement, en particulier pour des besoins clairs comme l'impression d'étiquettes ou une gestion de stock simple. Le prix à payer, ce sont souvent des compromis sur les cas particuliers, les interfaces et les adaptations ultérieures.

Une Logistics Automation Software sur mesure devient intéressante lorsque la particularité opérationnelle n'est pas un cas marginal, mais détermine la réussite de l'entreprise. Cela peut être une logique d'emballage spécifique, un processus de validation à plusieurs niveaux, la liaison entre atelier et entrepôt ou un modèle de livraison propre. Il est alors souvent plus pertinent de reproduire de façon ciblée les quelques processus essentiels, plutôt que d'introduire une suite complète avec de nombreux modules inutilisés.

Sur mesure ne signifie toutefois pas sans limites. Chaque fonction spéciale exige une justification métier, des tests, une documentation et de la maintenance. Un bon travail de projet se demande donc aussi : cette étape peut-elle être simplifiée ? Une configuration suffit-elle ? Un tableur reste-t-il la meilleure solution pour ce processus d'exception ? Ces questions protègent le budget et l'équipe d'une complexité inutile.

Une technique qui tient au quotidien

L'interface détermine si les collaborateurs utilisent volontiers un système. La base technique détermine s'il peut encore être exploité de façon fiable des années plus tard. Pour les processus critiques, des modèles de données compréhensibles, des rôles et des droits, des journaux des modifications importantes ainsi que des sauvegardes régulières font partie de l'équipement de base.

Lors d'un enregistrement de stock, on doit pouvoir voir qui a modifié quel stock et quand, et de quelle opération provient la modification. Lorsque plusieurs utilisateurs sont actifs en même temps, le stock ne doit pas être faussé par des saisies contradictoires. Pour les imprimantes, les scanners ou les interfaces de transporteurs, il faut des états d'erreur clairs plutôt que des échecs silencieux. Une étiquette qui n'a pas été imprimée doit apparaître comme une étape de travail ouverte.

La maintenabilité est elle aussi une exigence opérationnelle. Une application web reposant sur une architecture compréhensible, par exemple avec PHP 8.4, JavaScript moderne et MySQL 8, se contrôle et s'étend mieux à long terme qu'un ensemble de solutions isolées difficiles à suivre. Un déploiement documenté, des environnements de test et de production séparés et des tests automatisés ne sont pas un luxe. Ils réduisent le risque qu'une petite modification du bon de livraison perturbe soudain la libération des commandes.

La protection des données et le contrôle des accès méritent la même sobriété. Tous les utilisateurs n'ont pas besoin des prix, des marges ou des données de base clients. Surtout dans les équipes réparties, les accès, les appareils et les droits devraient être conçus de manière à ne pas freiner inutilement le travail quotidien, tout en restant maîtrisables lors d'un changement de collaborateur ou de la perte d'un appareil.

Un déploiement par étapes pertinentes

La fonction la plus puissante sert peu si une équipe ne peut pas l'utiliser en travail posté. C'est pourquoi une introduction progressive est souvent plus solide qu'une grande date de bascule. On met d'abord en production un processus bien délimité, par exemple la réception pour un groupe de produits ou l'établissement des documents d'expédition. L'équipe travaille ainsi dans des conditions réelles, et les questions ouvertes sont tranchées sur des cas concrets.

D'autres processus et interfaces suivent ensuite. Cet ordre crée de la confiance, car les collaborateurs voient que leurs retours se traduisent en améliorations concrètes. Il limite en même temps le risque : si un nouveau processus de scan doit être ajusté, toute la logistique ne s'arrête pas.

Les indicateurs doivent être convenus avant le début. Il peut s'agir du délai de traitement de la commande à l'expédition, du nombre de corrections manuelles, des écarts de stock ou de la durée des travaux de clôture quotidienne. Toute amélioration ne se traduit pas immédiatement par un chiffre spectaculaire. Moins de demandes d'éclaircissement entre entrepôt et bureau, une passation de poste fiable et des historiques d'opérations faciles à retrouver sont aussi un allègement mesurable.

softify.pro développe de tels systèmes à partir du déroulement du travail, avec une implication technique directe plutôt qu'une transmission du concept à la réalisation. La mesure reste volontairement pragmatique : la solution doit fonctionner sur le sol de l'entrepôt, pas seulement dans une présentation.

À quoi reconnaît-on une décision solide

Une bonne décision ne commence pas par une liste de fonctions, mais par une journée de travail observée. Faites-vous montrer où les informations naissent, attendent, se perdent ou sont corrigées après coup. Ne parlez pas seulement à la direction, mais aussi aux personnes de la réception, de l'entrepôt et de l'expédition. Elles connaissent les exceptions qu'aucun organigramme ne rend visibles.

Vérifiez ensuite si le prestataire pose des questions concrètes sur les données, les rôles, les appareils, les interfaces et l'exploitation. Celui qui promet d'emblée une solution complète sans comprendre les processus existants vend davantage du volume logiciel qu'une solution à un problème. Un projet qui ne prévoit aucune règle claire pour la maintenance, la correction des défauts et les adaptations ultérieures est tout aussi critique.

La meilleure automatisation ne donne pas l'impression d'une bureaucratie supplémentaire. Elle donne à l'équipe du temps pour les cas où l'expérience compte vraiment : évaluer correctement une livraison inattendue, informer un client à temps ou résoudre un goulot d'étranglement avant qu'il ne devienne un problème.

Lien permanent →