Jämförelse av testautomatisering: vilket angreppssätt passar din applikation?
När månadsavslutet, leveransgodkännandet eller en ny kundportal stannar på grund av ett fel hjälper ingen verktygsdemo med imponerande dashboards. En jämförelse av testautomatisering måste därför börja vid den faktiska applikationen: vilka flöden får inte falla bort, hur ofta förändras de och vilka bevis behöver teamet när ett test misslyckas?
För många företag är flaskhalsen inte avsaknaden av ett enskilt testverktyg. Det är manuella regressionstester, oklara ansvarsområden, testdata i produktionsnära system och resultat som ingen kan förklara på ett tillförlitligt sätt. Rätt lösning minskar den risken. Den automatiserar inte så många klick som möjligt till varje pris.
Testautomatisering jämförd: fyra angreppssätt
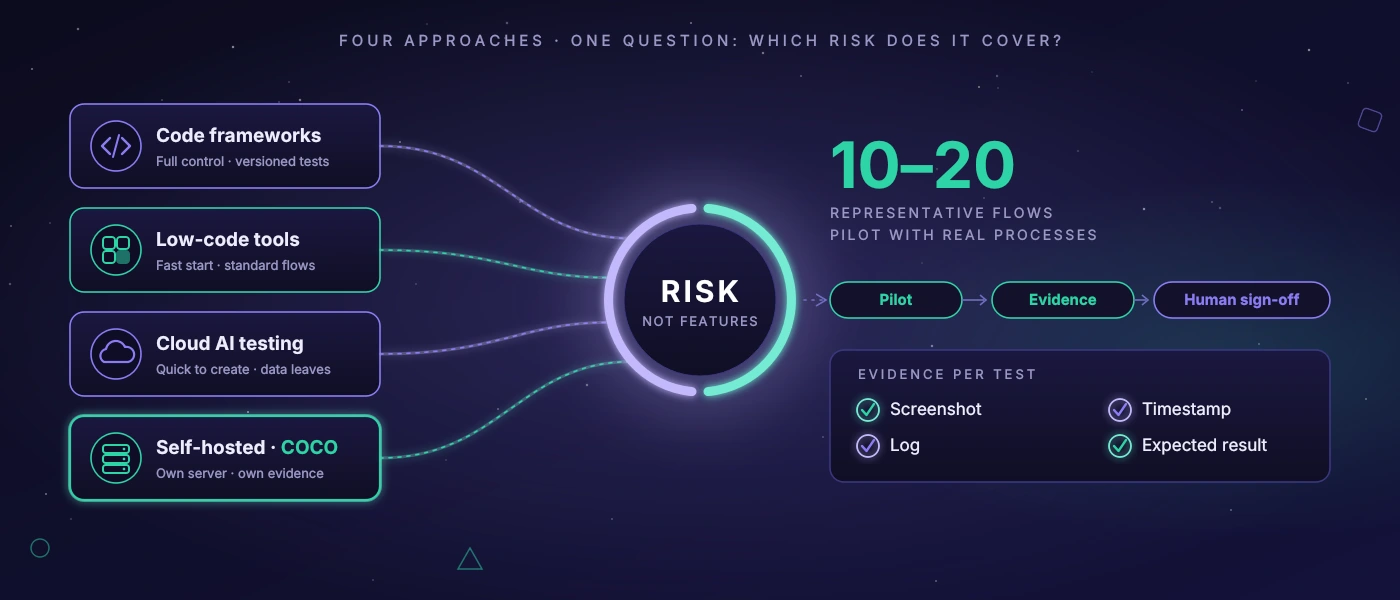
På marknaden möts oftast fyra angreppssätt: klassiska kodbaserade testramverk, low-code- eller no-code-plattformar, molnbaserade AI-verktyg och egen driven testinfrastruktur. Inget av dem är i grunden överlägset. Skillnaden ligger i applikationstyperna, säkerhetskraven och teamets förmåga att underhålla testerna långsiktigt.
Kodbaserade ramverk ger utvecklingsteam mycket kontroll. De kan byggas in i befintliga bygg- och driftsättningsprocesser, versionshantera testlogiken i källkoden och passar särskilt bra för webbapplikationer med en stabil teknisk arkitektur. Priset är tydligt: tester är programvara. De behöver granskningar, rena selektorer, vettiga testdata och utvecklarkapacitet. En dåligt strukturerad testuppsättning blir lika underhållskrävande som dåligt strukturerad produktionskod.
Low-code-verktyg lovar en snabbare start. Fackavdelningar eller QA-team kan sätta ihop teststeg via gränssnitt utan att programmera varje kontroll själva. Det kan vara vettigt för tydligt avgränsade standardflöden, till exempel i en webbapplikation med några få återkommande godkännandeprocesser. Så snart många specialfall, dynamiska gränssnitt eller komplexa behörigheter tillkommer förskjuts dock arbetet ofta bara: bort från koden, mot underhåll av inspelningar, variabler och undantagsregler.
Molnbaserade AI-testerbjudanden kompletterar dessa angreppssätt med bildigenkänning, självläkande löften eller testbeskrivningar på naturligt språk. Det kan påskynda skapandet. De ansvariga bör dock fråga exakt vilka data som lämnar verksamheten. Skärmbilder, användargränssnitt, felmeddelanden och testdata kan innehålla affärshemligheter, personuppgifter eller insyn i interna processer. För en offentlig webbutiks frontend är den avvägningen en annan än för en intern dispositionsprogramvara eller en Windows-applikation i tillverkningen.
En egen eller egenhostad testinfrastruktur är oftast ingen snabbstart med kreditkort. Den kräver uppsättning, övervakning och ett tydligt driftansvar. I gengäld stannar testtrafik, skärmbilder och bevis under egen kontroll. Det är särskilt relevant när webb- och skrivbordsapplikationer, känsliga data eller branschspecifika efterlevnadskrav möts. Hos softify.pro är COCO utformad för just det fallet: en egen AI-server som kör tester, spelar in bevis och skapar begripliga bedömningar utan att som standard skicka interna testdata vidare till en extern molntjänst.
Jämför inte funktioner utan felrisker
En lång funktionslista ser objektiv ut men är sällan rätt beslutsunderlag. Det avgörande är vilken typ av fel ett system ska täcka. Ett inloggningsfel efter en ändring i kontospärren är kritiskt om medarbetarna inte kan börja arbeta. Ett felräknat lagersaldo kan leda till plockfel. En flyttad knapp i en sällan använd vy har kanske en betydligt lägre prioritet.
Ett hållbart urval börjar därför med tio till tjugo representativa flöden. Dit hör inte bara idealfall. Kontrollera till exempel vad som händer vid saknade obligatoriska fält, hur olika roller beter sig, om en leverans skrivs ut igen efter rättelse eller hur systemet reagerar på timeouter. Just på dessa punkter syns skillnaderna mellan en övertygande demonstration och en användbar testdrift.
Även testfrekvensen bör följa risken. Att efter varje commit starta ett fullständigt end-to-end-test av alla flöden låter grundligt men kan blockera utvecklingen. Snabba tekniska kontroller kan köras vid varje ändring. Affärskritiska end-to-end-scenarier körs vid en release, på natten eller före ett produktivt godkännande. En bra uppbyggnad gör det synligt varför ett test körs i vilket steg.
Underhållbarhet avgör efter första kvartalet
Automatiserade tester har dåligt rykte när de blir röda efter varje liten ändring i gränssnittet. Ofta beror det inte på den valda produkten utan på hur testerna är konstruerade. Ett test som förlitar sig på position, färg eller slumpmässigt genererat innehåll är skört. Bättre är entydiga tekniska markeringar, stabila testdata och återanvändbara steg för inloggning, rollval eller orderskapande.
I en jämförelse av testautomatisering lönar det sig därför att titta på det dagliga underhållet. Kan teamet snabbt spåra misslyckade steg? Sparas skärmbild, tidsstämpel, logg och förväntat resultat tillsammans? Kan enskilda tester upprepas riktat? Och är det klart vem som bedömer ett misslyckat test ur affärssynpunkt och vem som åtgärdar den tekniska orsaken?
Särskilt för långlivade applikationer räknas dessutom kompatibiliteten med den egna arkitekturen. Moderna JavaScript-gränssnitt beter sig annorlunda än serverrenderade PHP-applikationer. Windows-skrivbordsprogram kräver andra styr- och observationsmöjligheter än en webbläsare. Den som testar båda bör inte välja en lösning som bara hanterar ett område via omvägar.
AI som testhjälp, inte som godkännandeinstans
AI kan avlasta testteam på ett meningsfullt sätt. Den kan prioritera avvikelser, upptäcka förändringar i skärmbilder, beskriva teststeg på begripligt språk eller utifrån många loggar härleda återkommande felmönster. Det sparar tid vid triagen, alltså när man avgör vilket rött meddelande som verkligen måste undersökas.
Den ersätter dock inte ett affärsmässigt godkännande. En modell kan känna igen ett ovanligt gränssnitt men inte på ett tillförlitligt sätt avgöra om ett prisgodkännande är juridiskt korrekt eller om en lageravvikelse förblir tillåten i den konkreta processen. För sådana fall behövs uttryckliga regler, definierade förväntade värden och en ansvarig människa.
Fråga vid AI-funktioner efter konfidenströsklar och eskaleringslogik. Om ett system bara rapporterar en avvikelse med hög säkerhet kan subtila fel förbli oupptäckta. Om det klassar varje liten bildskillnad som ett fel uppstår larmtrötthet. Rätt tröskel beror på processen och bör ställas in utifrån verkliga testkörningar, inte utifrån allmänna marknadsföringslöften.
Bedöm data, drift och kostnader ärligt
Licensen är bara en del av kostnaden. Räkna också med tid för urval av testfall, skötsel av testdata, anpassningar efter releaser, infrastruktur och utvärdering. Ett billigt verktyg kan bli dyrt om tre personer varje vecka sorterar falsklarm. Omvänt kan en individuellt uppsatt testserver vara lönsam om den på ett tillförlitligt sätt fångar kritiska regressioner och förkortar manuella acceptansdagar.
Med testdata är återhållsamhet klokt. Där det är möjligt bör anonymiserade eller riktat genererade data användas. Produktionskopior innehåller ofta mer information än ett test kräver. Lagras data lokalt eller i det egna nätverket måste ändå åtkomsträttigheter, lagringstider och loggning regleras. Egenhostat betyder inte automatiskt säkert drivet.
Planera också för att testsystemet kan falla bort. Om en nattlig körning misslyckas ska det tydligt gå att se om applikationen är felaktig, testmiljön var oåtkomlig eller ett beroende som en e-postserver saknades. Den åtskillnaden sparar mycket tid på morgonen och förhindrar felaktiga godkännandebeslut.
Börja med en begränsad pilot
Den mest meningsfulla jämförelsen uppstår sällan i en presentation utan i en pilot med verkliga flöden. Välj en process med påtagligt affärsvärde men överskådlig komplexitet. En inloggning med rollkontroll, skapandet av en order och utskriften av en följesedel kan vara lämpligare än att direkt avbilda hela systemlandskapet.
Definiera i förväg vad framgång innebär: till exempel en viss körtid, spårbara felbevis, ingen överföring av känsliga data utåt och ett underhåll som det befintliga teamet klarar. Efter några releasecykler syns om den valda metoden bara ser bra ut eller verkligen tar bort arbete.
Den bästa testautomatiseringen är inte den med flest automatiseringar. Det är den vars resultat ett team förstår, litar på vid godkännanden och som går att driva förnuftigt även efter nästa processförändring.