Comparação de automação de testes: que abordagem se adequa à sua aplicação?
Quando o fecho do mês, a aprovação de uma expedição ou um novo portal de clientes ficam parados por causa de um erro, não ajuda uma demonstração de ferramenta com dashboards impressionantes. Uma comparação de automação de testes tem, por isso, de começar na aplicação real: que fluxos não podem falhar, com que frequência mudam e que provas precisa a equipa quando um teste falha?
Para muitas empresas, o estrangulamento não é a falta de uma única ferramenta de teste. São os testes de regressão manuais, as responsabilidades pouco claras, os dados de teste em sistemas próximos da produção e os resultados que ninguém consegue explicar de forma fiável. A solução adequada reduz esse risco. Não automatiza o maior número possível de cliques a qualquer preço.
Automação de testes em comparação: quatro abordagens
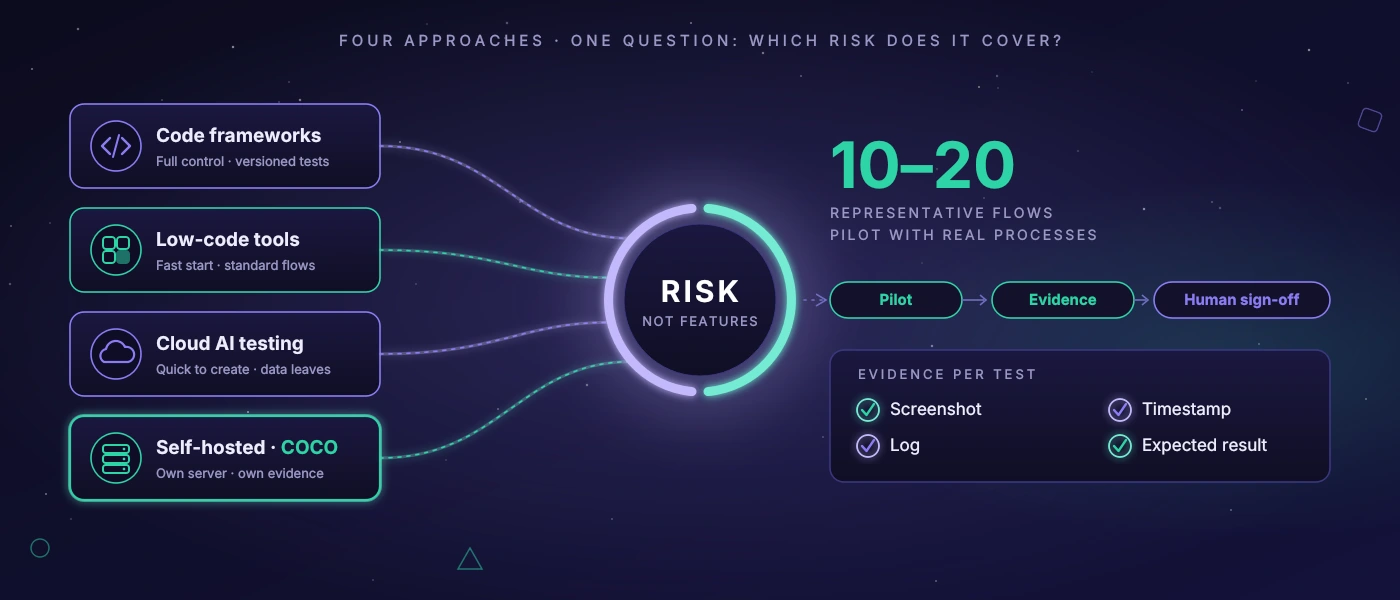
No mercado encontram-se, na maioria das vezes, quatro abordagens: frameworks de teste clássicos baseados em código, plataformas low-code ou no-code, ferramentas de IA na nuvem e infraestrutura de teste operada de forma individual. Nenhuma é, por princípio, superior. A diferença está nos tipos de aplicação, nos requisitos de segurança e na capacidade da equipa de manter os testes a longo prazo.
Os frameworks baseados em código dão muito controlo às equipas de desenvolvimento. Integram-se nos processos de build e de deployment existentes, versionam a lógica de teste no código-fonte e são particularmente adequados para aplicações web com uma arquitetura técnica estável. O preço é claro: os testes são software. Precisam de revisões, seletores limpos, dados de teste com sentido e capacidade de desenvolvimento. Um conjunto de testes mal estruturado dá tanto trabalho de manutenção como um código de produto mal estruturado.
As ferramentas low-code prometem uma entrada mais rápida. Os departamentos especializados ou as equipas de QA podem montar passos de teste através de interfaces, sem programar cada verificação. Isso pode fazer sentido para fluxos padrão bem delimitados, por exemplo numa aplicação web com poucos processos de aprovação recorrentes. Assim que se juntam muitos casos especiais, interfaces dinâmicas ou permissões complexas, o trabalho acaba muitas vezes por apenas se deslocar: do código para a manutenção de gravações, variáveis e regras de exceção.
As ofertas de testes com IA na nuvem complementam estas abordagens com reconhecimento de imagem, promessas de autocorreção ou descrições de testes em linguagem natural. Isso pode acelerar a criação. Os responsáveis devem, no entanto, perguntar com precisão que dados saem da própria empresa. Capturas de ecrã, interfaces de utilizador, mensagens de erro e dados de teste podem conter segredos comerciais, dados pessoais ou informações sobre processos internos. Para o front-end público de uma loja, esta ponderação é diferente da de um software interno de planeamento ou de uma aplicação Windows na produção.
Uma infraestrutura de teste própria ou alojada por si mesmo não costuma ser um arranque rápido com cartão de crédito. Exige configuração, monitorização e uma responsabilidade de operação clara. Em contrapartida, o tráfego de teste, as capturas de ecrã e as evidências ficam sob controlo próprio. Isto é particularmente relevante quando se juntam aplicações web e desktop, dados sensíveis ou requisitos de conformidade específicos do setor. Na softify.pro, o COCO foi concebido exatamente para este caso: um servidor de IA próprio que executa testes, regista provas e gera avaliações compreensíveis, sem transmitir por defeito dados de teste internos a um serviço externo na nuvem.
Não compare funcionalidades, compare riscos de erro
Uma longa lista de funcionalidades parece objetiva, mas raramente é a base de decisão certa. O que é decisivo é a classe de erros que um sistema deve cobrir. Um erro de início de sessão depois de uma alteração ao bloqueio de contas é crítico se os colaboradores não conseguem começar a trabalhar. Um stock mal calculado pode levar a erros de preparação de encomendas. Um botão deslocado numa vista pouco utilizada tem possivelmente uma prioridade bastante inferior.
Uma seleção sólida começa, por isso, com dez a vinte fluxos representativos. Não se incluem apenas os casos ideais. Verifique, por exemplo, o que acontece com campos obrigatórios em falta, como se comportam os diferentes perfis, se uma entrega é impressa de novo após correção ou como o sistema reage a limites de tempo excedidos. É precisamente nestes pontos que se notam as diferenças entre uma demonstração convincente e uma operação de testes utilizável.
A frequência dos testes também deve seguir o risco. Lançar após cada commit um teste end-to-end completo de todos os fluxos parece rigoroso, mas pode bloquear o desenvolvimento. As verificações técnicas rápidas podem correr a cada alteração. Os cenários end-to-end críticos para o negócio correm numa release, de noite ou antes de uma aprovação em produção. Uma boa estrutura torna visível porque é que um teste é executado em que fase.
A manutenção decide depois do primeiro trimestre
Os testes automatizados têm má fama quando ficam vermelhos após cada pequena alteração da interface. Muitas vezes isso não se deve ao produto escolhido, mas à construção dos testes. Um teste que depende da posição, da cor ou de conteúdos gerados aleatoriamente é frágil. São melhores identificadores técnicos inequívocos, dados de teste estáveis e passos reutilizáveis para o início de sessão, a escolha de perfil ou a criação de encomendas.
Numa comparação de automação de testes, vale por isso a pena olhar para o dia a dia da manutenção. Consegue a equipa rastrear depressa os passos falhados? São guardados em conjunto captura de ecrã, carimbo de data/hora, registo e resultado esperado? Podem repetir-se testes individuais de forma direcionada? E está claro quem avalia tecnicamente um teste falhado e quem resolve a causa técnica?
Em aplicações de longa duração conta ainda a compatibilidade com a arquitetura própria. As interfaces JavaScript modernas comportam-se de forma diferente das aplicações PHP renderizadas no servidor. O software desktop para Windows precisa de outras possibilidades de controlo e observação do que um navegador. Quem testa ambos não deve escolher uma solução que trata uma das áreas apenas com desvios.
A IA como auxiliar de verificação, não como instância de aprovação
A IA pode aliviar de forma útil as equipas de teste. Pode priorizar anomalias, reconhecer alterações em capturas de ecrã, descrever passos de teste em linguagem compreensível ou deduzir de muitos registos padrões de erro recorrentes. Isso poupa tempo na triagem, ou seja, na questão de saber que alerta vermelho deve realmente ser investigado.
No entanto, não substitui uma aprovação especializada. Um modelo consegue reconhecer uma interface invulgar, mas não decide de forma fiável se uma aprovação de preço é juridicamente correta ou se um desvio de stock continua admissível no processo concreto. Para esses casos são necessárias regras explícitas, valores esperados definidos e uma pessoa responsável.
Nas funcionalidades de IA, pergunte pelos limiares de confiança e pela lógica de escalonamento. Se um sistema só comunica um desvio com elevada certeza, erros subtis podem passar despercebidos. Se classifica como erro qualquer pequena diferença de imagem, surge fadiga de alarmes. O limiar adequado depende do processo e deve ser ajustado com base em execuções de teste reais, e não em promessas de marketing genéricas.
Avaliar dados, operação e custos com honestidade
A licença é apenas uma parte dos custos. Inclua também o tempo para a seleção de casos de teste, a manutenção dos dados de teste, os ajustes após releases, a infraestrutura e a avaliação. Uma ferramenta barata pode tornar-se cara se três pessoas triarem alarmes falsos todas as semanas. Inversamente, um servidor de testes configurado à medida pode ser rentável se apanhar de forma fiável regressões críticas e encurtar os dias de aceitação manual.
Com os dados de teste, a contenção faz sentido. Sempre que possível, devem usar-se dados anonimizados ou gerados de forma direcionada. As cópias de produção contêm frequentemente mais informação do que um teste exige. Se os dados forem guardados localmente ou na própria rede, é mesmo assim necessário regular direitos de acesso, prazos de conservação e registo. Alojado por si mesmo não significa automaticamente operado em segurança.
Planeie também a falha do sistema de testes. Se uma execução noturna falhar, deve ser claramente identificável se a aplicação tem defeito, se o ambiente de teste estava inacessível ou se faltou uma dependência como um servidor de correio. Esta separação poupa muito tempo de manhã e evita decisões de aprovação erradas.
Começar com um piloto limitado
A comparação mais útil raramente nasce numa apresentação, mas sim num piloto com fluxos reais. Escolha um processo com valor de negócio percetível, mas complexidade controlável. Um início de sessão com verificação de perfis, a criação de uma encomenda e a emissão de uma guia de remessa podem ser mais adequados do que reproduzir logo todo o panorama de sistemas.
Defina previamente o que significa sucesso: por exemplo, uma determinada duração de execução, provas de erro rastreáveis, nenhuma transmissão de dados sensíveis para o exterior e uma manutenção que a equipa existente consiga assegurar. Após alguns ciclos de release, torna-se visível se o método escolhido apenas parece bom ou se realmente tira trabalho das mãos.
A melhor automação de testes não é a que tem mais automatismos. É aquela cujos resultados a equipa compreende, em que confia nas aprovações e que continua a poder ser operada de forma sensata depois da próxima alteração de processo.