Porównanie automatyzacji testów: które podejście pasuje do Twojej aplikacji?
Gdy zamknięcie miesiąca, zatwierdzenie wysyłki albo nowy portal klienta zatrzymuje się z powodu błędu, nie pomoże demonstracja narzędzia z imponującymi pulpitami. Porównanie automatyzacji testów musi więc zaczynać się od rzeczywistej aplikacji: które przebiegi nie mogą zawieść, jak często się zmieniają i jakich dowodów potrzebuje zespół, gdy test się nie powiedzie?
Dla wielu firm wąskim gardłem nie jest brak pojedynczego narzędzia testowego. To ręczne testy regresji, niejasne odpowiedzialności, dane testowe w systemach zbliżonych do produkcji i wyniki, których nikt nie potrafi wiarygodnie wyjaśnić. Odpowiednie rozwiązanie zmniejsza to ryzyko. Nie automatyzuje jak największej liczby kliknięć za wszelką cenę.
Automatyzacja testów w porównaniu: cztery podejścia
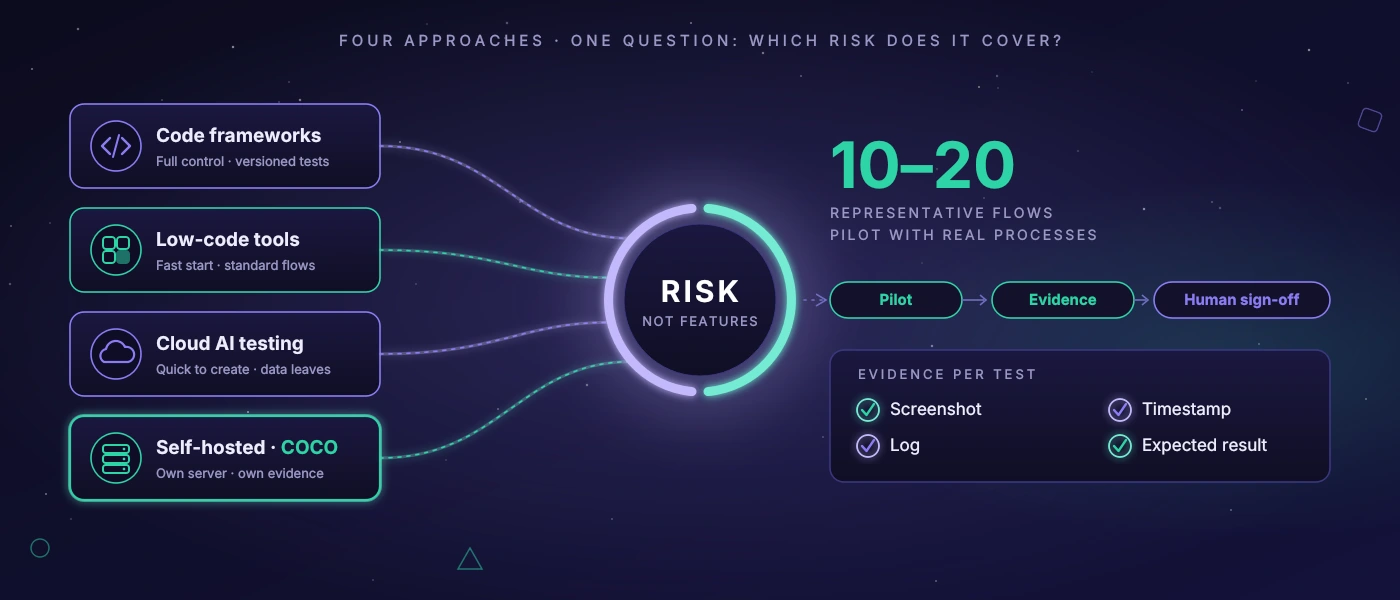
Na rynku zwykle spotykają się cztery podejścia: klasyczne frameworki testowe oparte na kodzie, platformy low-code lub no-code, narzędzia AI działające w chmurze oraz indywidualnie prowadzona infrastruktura testowa. Żadne z nich nie jest z zasady lepsze. Różnica leży w typach aplikacji, wymogach bezpieczeństwa i zdolności zespołu do trwałego utrzymywania testów.
Frameworki oparte na kodzie dają zespołom programistycznym dużo kontroli. Można je wbudować w istniejące procesy budowania i wdrażania, wersjonują logikę testów w kodzie źródłowym i szczególnie dobrze nadają się do aplikacji webowych o stabilnej architekturze technicznej. Cena jest jasna: testy są oprogramowaniem. Wymagają przeglądów, czystych selektorów, sensownych danych testowych i mocy przerobowych programistów. Źle ustrukturyzowany zestaw testów staje się tak samo pracochłonny w utrzymaniu jak źle ustrukturyzowany kod produkcyjny.
Narzędzia low-code obiecują szybszy start. Działy merytoryczne lub zespoły QA mogą składać kroki testowe przez interfejsy, bez samodzielnego programowania każdej kontroli. Może to mieć sens w przypadku wyraźnie wydzielonych standardowych przebiegów, na przykład w aplikacji webowej z kilkoma powtarzalnymi procesami zatwierdzania. Gdy jednak dochodzą liczne przypadki szczególne, dynamiczne interfejsy lub złożone uprawnienia, praca często tylko się przesuwa: od kodu do utrzymywania nagrań, zmiennych i reguł wyjątków.
Oferty testowania z AI w chmurze uzupełniają te podejścia o rozpoznawanie obrazu, obietnice samonaprawy lub opisy testów w języku naturalnym. Może to przyspieszyć tworzenie testów. Osoby odpowiedzialne powinny jednak dokładnie pytać, jakie dane opuszczają firmę. Zrzuty ekranu, interfejsy użytkownika, komunikaty o błędach i dane testowe mogą zawierać tajemnice handlowe, dane osobowe lub wgląd w procesy wewnętrzne. W przypadku publicznego front-endu sklepu ta ocena wygląda inaczej niż dla wewnętrznego oprogramowania dyspozytorskiego czy aplikacji Windows w produkcji.
Własna lub samodzielnie hostowana infrastruktura testowa zazwyczaj nie jest szybkim startem kartą kredytową. Wymaga konfiguracji, monitoringu i jasnej odpowiedzialności za eksploatację. W zamian ruch testowy, zrzuty ekranu i dowody pozostają pod własną kontrolą. Ma to szczególne znaczenie, gdy spotykają się aplikacje webowe i desktopowe, dane wrażliwe lub branżowe wymogi zgodności. W softify.pro COCO został zaprojektowany właśnie z myślą o takim przypadku: własny serwer AI, który wykonuje testy, rejestruje dowody i tworzy zrozumiałe oceny, nie przekazując domyślnie wewnętrznych danych testowych zewnętrznej usłudze w chmurze.
Nie porównuj funkcji, tylko ryzyka błędów
Długa lista funkcji sprawia wrażenie obiektywnej, ale rzadko jest właściwą podstawą decyzji. Liczy się, jaką klasę błędów system ma pokrywać. Błąd logowania po zmianie blokady konta jest krytyczny, jeśli pracownicy nie mogą zacząć pracy. Błędnie obliczony stan magazynowy może prowadzić do błędów w kompletacji. Przesunięty przycisk w rzadko używanym widoku ma być może wyraźnie niższy priorytet.
Rzetelny wybór zaczyna się więc od dziesięciu do dwudziestu reprezentatywnych przebiegów. Nie należą do nich tylko przypadki idealne. Sprawdź na przykład, co dzieje się przy brakujących polach obowiązkowych, jak zachowują się różne role, czy dostawa jest drukowana ponownie po korekcie lub jak system reaguje na przekroczenie czasu. To właśnie w tych miejscach widać różnice między przekonującą prezentacją a użyteczną eksploatacją testów.
Także częstotliwość testów powinna podążać za ryzykiem. Uruchamianie po każdym commicie pełnego testu end-to-end wszystkich przebiegów brzmi dokładnie, ale może blokować rozwój. Szybkie kontrole techniczne mogą działać przy każdej zmianie. Krytyczne dla biznesu scenariusze end-to-end działają przy wydaniu, w nocy lub przed zatwierdzeniem produkcyjnym. Dobra konstrukcja pokazuje, dlaczego dany test działa na danym etapie.
Łatwość utrzymania rozstrzyga po pierwszym kwartale
Testy automatyczne mają złą opinię, gdy czerwienieją po każdej drobnej zmianie interfejsu. Często nie wynika to z wybranego produktu, lecz z konstrukcji testów. Test, który opiera się na położeniu, kolorze lub losowo generowanych treściach, jest kruchy. Lepsze są jednoznaczne oznaczenia techniczne, stabilne dane testowe i wielokrotnie używane kroki logowania, wyboru roli lub tworzenia zamówienia.
W porównaniu automatyzacji testów warto więc spojrzeć na codzienność utrzymania. Czy zespół potrafi szybko prześledzić nieudane kroki? Czy zrzut ekranu, znacznik czasu, dziennik i oczekiwany wynik są zapisywane razem? Czy pojedyncze testy można powtarzać w sposób celowany? I czy jest jasne, kto merytorycznie ocenia nieudany test, a kto usuwa przyczynę techniczną?
Zwłaszcza w aplikacjach o długim czasie życia liczy się też zgodność z własną architekturą. Nowoczesne interfejsy JavaScript zachowują się inaczej niż aplikacje PHP renderowane po stronie serwera. Oprogramowanie desktopowe dla Windows wymaga innych możliwości sterowania i obserwacji niż przeglądarka. Kto testuje jedno i drugie, nie powinien wybierać rozwiązania, które jeden obszar obsługuje tylko okrężną drogą.
AI jako pomoc w testowaniu, a nie instancja zatwierdzająca
AI może sensownie odciążyć zespoły testowe. Potrafi priorytetyzować nieprawidłowości, rozpoznawać zmiany na zrzutach ekranu, opisywać kroki testowe zrozumiałym językiem lub wyprowadzać z wielu dzienników powtarzające się wzorce błędów. Oszczędza to czas przy triażu, czyli przy pytaniu, którym czerwonym komunikatem naprawdę trzeba się zająć.
Nie zastępuje jednak zatwierdzenia merytorycznego. Model może rozpoznać nietypowy interfejs, ale nie potrafi wiarygodnie rozstrzygnąć, czy zatwierdzenie ceny jest prawnie poprawne albo czy odchylenie stanu magazynowego pozostaje dopuszczalne w konkretnym procesie. W takich przypadkach potrzebne są jawne reguły, zdefiniowane wartości oczekiwane i odpowiedzialny człowiek.
W przypadku funkcji AI pytaj o progi pewności i logikę eskalacji. Jeśli system zgłasza odchylenie tylko przy wysokiej pewności, subtelne błędy mogą pozostać niewykryte. Jeśli każdą drobną różnicę obrazu klasyfikuje jako błąd, pojawia się zmęczenie alarmami. Odpowiedni próg zależy od procesu i powinien być ustawiony na podstawie rzeczywistych przebiegów testowych, a nie ogólnych obietnic marketingowych.
Uczciwie ocenić dane, eksploatację i koszty
Licencja to tylko część kosztów. Wlicz także czas na wybór przypadków testowych, pielęgnację danych testowych, dostosowania po wydaniach, infrastrukturę i ocenę wyników. Tanie narzędzie może stać się drogie, jeśli trzy osoby co tydzień sortują fałszywe alarmy. Z kolei indywidualnie skonfigurowany serwer testowy może być opłacalny, jeśli niezawodnie wyłapuje krytyczne regresje i skraca dni ręcznego odbioru.
W przypadku danych testowych rozsądna jest wstrzemięźliwość. Tam, gdzie to możliwe, należy używać danych zanonimizowanych lub celowo wygenerowanych. Kopie produkcyjne zawierają często więcej informacji, niż wymaga test. Jeśli dane są przechowywane lokalnie lub we własnej sieci, i tak trzeba uregulować prawa dostępu, okresy przechowywania i rejestrowanie. Samodzielne hostowanie nie oznacza automatycznie bezpiecznej eksploatacji.
Zaplanuj też awarię systemu testowego. Jeśli nocny przebieg się nie powiedzie, powinno być jasno widoczne, czy aplikacja jest wadliwa, środowisko testowe było niedostępne, czy zabrakło zależności, takiej jak serwer pocztowy. To rozdzielenie oszczędza rano mnóstwo czasu i zapobiega błędnym decyzjom o zatwierdzeniu.
Zacząć od ograniczonego pilotażu
Najrozsądniejsze porównanie rzadko powstaje podczas prezentacji, a częściej w pilotażu z prawdziwymi przebiegami. Wybierz proces o namacalnej wartości biznesowej, ale przejrzystej złożoności. Logowanie ze sprawdzeniem ról, utworzenie zamówienia i wydruk dokumentu dostawy mogą być lepsze niż natychmiastowe odwzorowanie całego krajobrazu systemów.
Z góry zdefiniuj, co oznacza sukces: na przykład określony czas wykonania, możliwe do prześledzenia dowody błędów, brak przesyłania danych wrażliwych na zewnątrz oraz utrzymanie, które istniejący zespół jest w stanie zapewnić. Po kilku cyklach wydań widać, czy wybrana metoda tylko dobrze wygląda, czy rzeczywiście zdejmuje pracę.
Najlepsza automatyzacja testów to nie ta z największą liczbą automatyzacji. To ta, której wyniki zespół rozumie, której ufa przy zatwierdzeniach i którą można rozsądnie prowadzić także po kolejnej zmianie procesu.