Sammenligning av testautomatisering: Hvilken tilnærming passer din applikasjon?
Når månedsavslutningen, forsendelsesgodkjenningen eller et nytt kundeportal stopper opp på grunn av en feil, hjelper ingen verktøydemo med imponerende dashbord. En sammenligning av testautomatisering må derfor begynne ved selve applikasjonen: Hvilke forløp må ikke svikte, hvor ofte endrer de seg, og hvilke bevis trenger teamet når en test mislykkes?
For mange virksomheter er flaskehalsen ikke mangelen på ett enkelt testverktøy. Det er manuelle regresjonstester, uklare ansvarsforhold, testdata i produksjonsnære system og resultater ingen kan forklare pålitelig. Den passende løsningen reduserer denne risikoen. Den automatiserer ikke flest mulig klikk for enhver pris.
Testautomatisering sammenlignet: fire tilnærminger
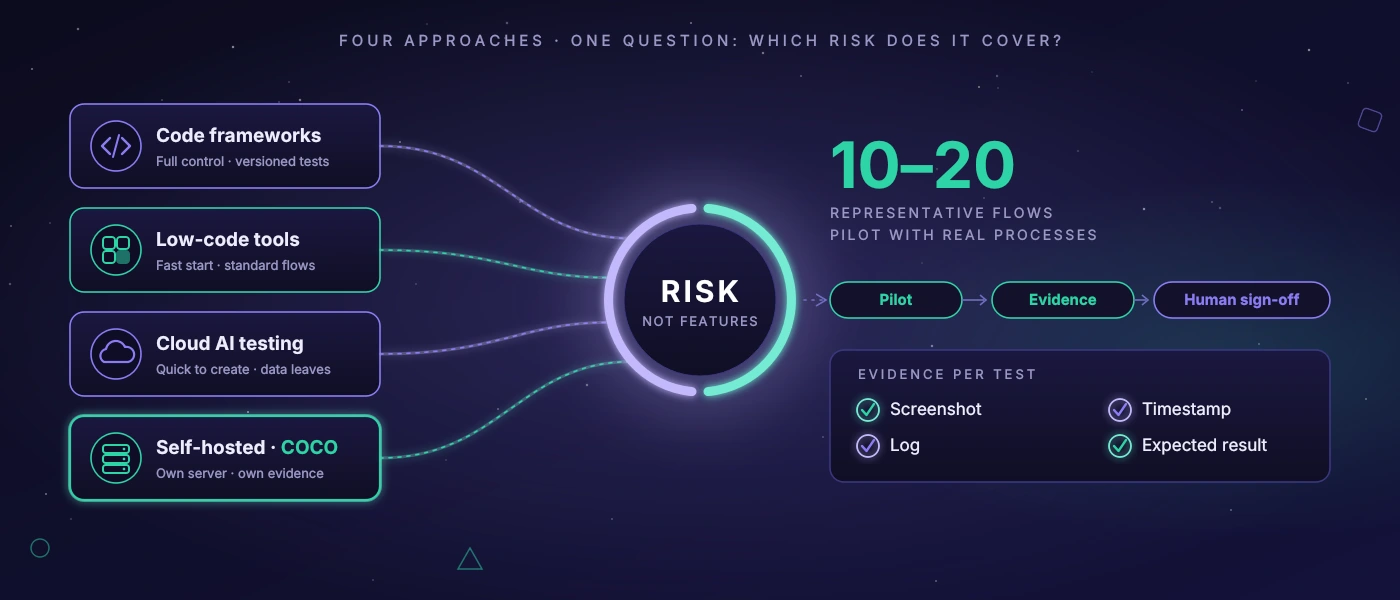
I markedet møtes som regel fire tilnærminger: klassiske kodebaserte testrammeverk, low-code- eller no-code-plattformer, skybaserte KI-verktøy og egendrevet testinfrastruktur. Ingen av dem er i prinsippet overlegen. Forskjellen ligger i applikasjonstypene, sikkerhetskravene og teamets evne til å vedlikeholde testene over tid.
Kodebaserte rammeverk gir utviklingsteam mye kontroll. De kan bygges inn i eksisterende bygge- og utrullingsprosesser, versjonerer testlogikken i kildekoden og egner seg særlig godt for webapplikasjoner med en stabil teknisk arkitektur. Prisen er tydelig: tester er programvare. De trenger gjennomganger, rene selektorer, fornuftige testdata og utviklerkapasitet. Et dårlig strukturert testsett blir like vedlikeholdskrevende som dårlig strukturert produksjonskode.
Low-code-verktøy lover en raskere start. Fagavdelinger eller QA-team kan sette sammen testtrinn via grensesnitt uten å programmere hver kontroll selv. Det kan være fornuftig for tydelig avgrensede standardforløp, for eksempel i en webapplikasjon med noen få gjentakende godkjenningsprosesser. Så snart mange spesialtilfeller, dynamiske grensesnitt eller komplekse tilganger kommer til, forskyves arbeidet imidlertid ofte bare: bort fra koden og mot vedlikehold av opptak, variabler og unntaksregler.
Skybaserte KI-testtilbud utfyller disse tilnærmingene med bildegjenkjenning, selvhelbredende løfter eller testbeskrivelser på naturlig språk. Det kan fremskynde opprettingen. De ansvarlige bør likevel spørre presist om hvilke data som forlater virksomheten. Skjermbilder, brukergrensesnitt, feilmeldinger og testdata kan inneholde forretningshemmeligheter, personopplysninger eller innsyn i interne prosesser. For en offentlig nettbutikkfrontend er denne avveiningen en annen enn for intern disponeringsprogramvare eller en Windows-applikasjon i produksjonen.
En egen eller selvhostet testinfrastruktur er som regel ikke en hurtigstart med kredittkort. Den krever oppsett, overvåking og et klart driftsansvar. Til gjengjeld blir testtrafikk, skjermbilder og bevis værende under egen kontroll. Det er særlig relevant når web- og skrivebordsapplikasjoner, sensitive data eller bransjespesifikke compliance-krav kommer sammen. Hos softify.pro er COCO utformet for akkurat dette tilfellet: en egen KI-server som kjører tester, tar opp bevis og lager forståelige vurderinger uten å sende interne testdata videre til en ekstern skytjeneste som standard.
Sammenlign ikke funksjoner, men feilrisikoer
En lang funksjonsliste virker objektiv, men er sjelden riktig beslutningsgrunnlag. Det avgjørende er hvilken feilklasse et system skal dekke. En innloggingsfeil etter en endring i kontosperringen er kritisk hvis de ansatte ikke kan begynne å jobbe. En feilberegnet lagerbeholdning kan føre til plukkfeil. En flyttet knapp i en sjelden brukt visning har kanskje en betydelig lavere prioritet.
Et solid utvalg starter derfor med ti til tjue representative forløp. Der inngår ikke bare idealtilfeller. Kontroller for eksempel hva som skjer ved manglende obligatoriske felt, hvordan ulike roller oppfører seg, om en levering skrives ut på nytt etter retting eller hvordan systemet reagerer på tidsavbrudd. Nettopp på disse punktene viser forskjellene seg mellom en overbevisende demonstrasjon og en brukbar testdrift.
Også testfrekvensen bør følge risikoen. Å starte en fullstendig ende-til-ende-test av alle forløp etter hver commit høres grundig ut, men kan blokkere utviklingen. Raske tekniske kontroller kan kjøre ved hver endring. Forretningskritiske ende-til-ende-scenarier kjøres ved en utgivelse, om natten eller før en produktiv godkjenning. Et godt oppsett gjør det synlig hvorfor en test kjøres i hvilket trinn.
Vedlikeholdbarhet avgjør etter første kvartal
Automatiserte tester har dårlig rykte når de blir røde etter hver lille endring i grensesnittet. Ofte skyldes ikke det det valgte produktet, men hvordan testene er konstruert. En test som støtter seg på posisjon, farge eller tilfeldig generert innhold, er skjør. Bedre er entydige tekniske merker, stabile testdata og gjenbrukbare trinn for innlogging, rollevalg eller ordreopprettelse.
I en sammenligning av testautomatisering lønner det seg derfor å se på hverdagen i vedlikeholdet. Kan teamet raskt spore mislykkede trinn? Lagres skjermbilde, tidsstempel, logg og forventet resultat sammen? Kan enkelttester gjentas målrettet? Og er det klart hvem som vurderer en mislykket test faglig, og hvem som utbedrer den tekniske årsaken?
Særlig for langlevde applikasjoner teller dessuten kompatibiliteten med egen arkitektur. Moderne JavaScript-grensesnitt oppfører seg annerledes enn serverrendrede PHP-applikasjoner. Windows-skrivebordsprogramvare trenger andre styrings- og observasjonsmuligheter enn en nettleser. Den som tester begge, bør ikke velge en løsning som bare håndterer ett område via omveier.
KI som testhjelp, ikke som godkjenningsinstans
KI kan avlaste testteam på en meningsfull måte. Den kan prioritere avvik, oppdage endringer i skjermbilder, beskrive testtrinn på forståelig språk eller utlede tilbakevendende feilmønstre fra mange logger. Det sparer tid i triagen, altså i spørsmålet om hvilken rød melding som virkelig må undersøkes.
Den erstatter imidlertid ikke en faglig godkjenning. En modell kan kjenne igjen et uvanlig grensesnitt, men ikke pålitelig avgjøre om en prisgodkjenning er juridisk riktig eller om et lageravvik fortsatt er tillatt i den konkrete prosessen. For slike tilfeller trengs eksplisitte regler, definerte forventningsverdier og et ansvarlig menneske.
Spør ved KI-funksjoner etter konfidensterskler og eskaleringslogikk. Hvis et system bare melder et avvik med høy sikkerhet, kan subtile feil forbli uoppdaget. Hvis det klassifiserer hver lille bildeforskjell som en feil, oppstår alarmtretthet. Riktig terskel avhenger av prosessen og bør settes ut fra reelle testkjøringer, ikke ut fra generelle markedsføringsløfter.
Vurder data, drift og kostnader ærlig
Lisensen er bare en del av kostnadene. Regn også inn tid til valg av testtilfeller, vedlikehold av testdata, tilpasninger etter utgivelser, infrastruktur og evaluering. Et billig verktøy kan bli dyrt hvis tre personer hver uke sorterer falske alarmer. Omvendt kan en individuelt satt opp testserver være lønnsom hvis den pålitelig fanger kritiske regresjoner og forkorter manuelle akseptansedager.
Med testdata er tilbakeholdenhet fornuftig. Der det er mulig, bør anonymiserte eller målrettet genererte data brukes. Produksjonskopier inneholder ofte mer informasjon enn en test krever. Lagres data lokalt eller i eget nettverk, må likevel tilgangsrettigheter, oppbevaringstider og logging reguleres. Selvhostet betyr ikke automatisk sikkert drevet.
Planlegg også for at testsystemet kan falle ut. Hvis en nattlig kjøring mislykkes, bør det tydelig kunne ses om applikasjonen er feil, testmiljøet var utilgjengelig eller en avhengighet som en e-postserver manglet. Dette skillet sparer mye tid om morgenen og forhindrer gale godkjenningsbeslutninger.
Start med en begrenset pilot
Den mest fornuftige sammenligningen oppstår sjelden i en presentasjon, men i en pilot med virkelige forløp. Velg en prosess med merkbar forretningsverdi, men oversiktlig kompleksitet. En innlogging med rollesjekk, opprettelse av en ordre og utskrift av en følgeseddel kan være mer egnet enn å avbilde hele systemlandskapet med en gang.
Definer på forhånd hva suksess betyr: for eksempel en bestemt kjøretid, sporbare feilbevis, ingen overføring av sensitive data utad og et vedlikehold det eksisterende teamet kan klare. Etter noen utgivelsessykluser blir det synlig om den valgte metoden bare ser bra ut eller faktisk tar arbeid av hendene.
Den beste testautomatiseringen er ikke den med flest automatiseringer. Det er den hvis resultater et team forstår, stoler på ved godkjenninger og som fortsatt kan drives fornuftig etter neste prosessendring.