Testautomatisering vergelijken: welke aanpak past bij uw toepassing?
Als de maandafsluiting, de verzendgoedkeuring of een nieuw klantenportaal door een fout stokt, helpt geen tooldemo met indrukwekkende dashboards. Een vergelijking van testautomatisering moet daarom beginnen bij de feitelijke toepassing: welke processen mogen niet uitvallen, hoe vaak veranderen ze en welk bewijs heeft het team nodig als een test mislukt?
Voor veel bedrijven is het knelpunt niet het ontbreken van één testtool. Het zijn handmatige regressietests, onduidelijke verantwoordelijkheden, testgegevens in productieachtige systemen en resultaten die niemand betrouwbaar kan uitleggen. De passende oplossing verkleint dat risico. Ze automatiseert niet zoveel mogelijk klikken tegen elke prijs.
Testautomatisering vergeleken: vier aanpakken
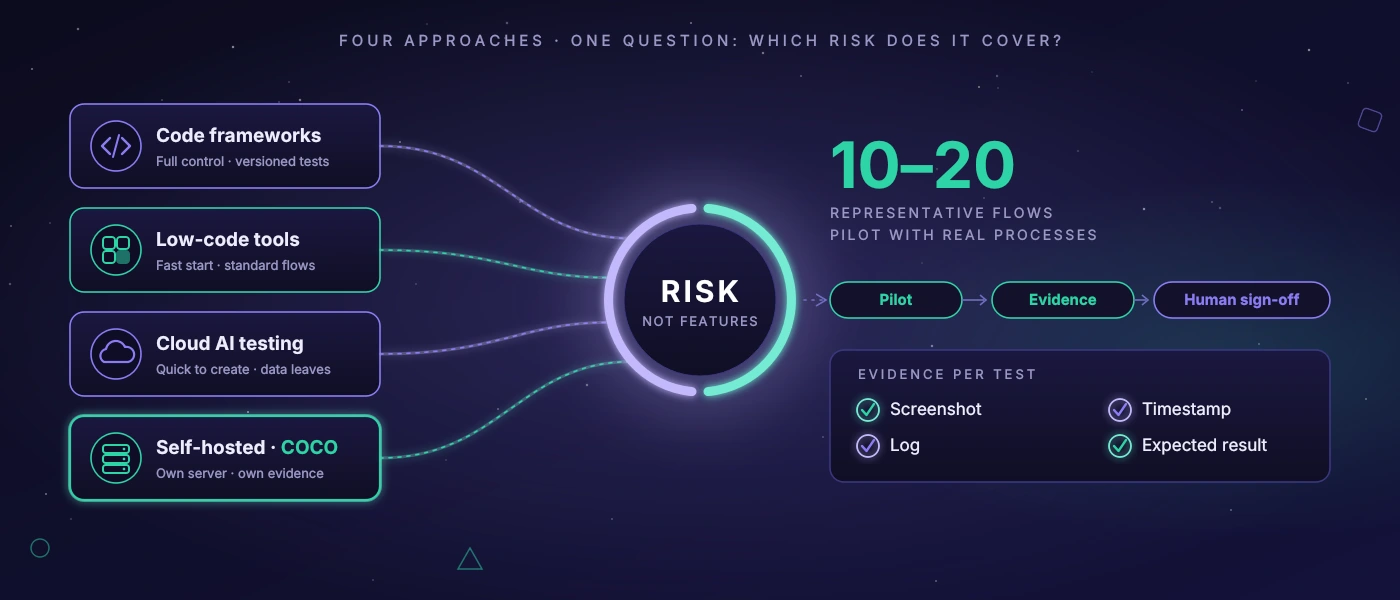
Op de markt komen meestal vier aanpakken samen: klassieke codegebaseerde testframeworks, low-code- of no-codeplatforms, cloudgebaseerde AI-tools en zelf beheerde testinfrastructuur. Geen van deze is principieel superieur. Het verschil zit in de soorten toepassingen, de beveiligingseisen en het vermogen van het team om de tests duurzaam te onderhouden.
Codegebaseerde frameworks geven ontwikkelteams veel controle. Ze zijn in te passen in bestaande build- en deploymentprocessen, leggen de testlogica vast in de broncode en zijn bijzonder geschikt voor webtoepassingen met een stabiele technische architectuur. De prijs is duidelijk: tests zijn software. Ze hebben reviews nodig, nette selectors, zinnige testgegevens en ontwikkelcapaciteit. Een slecht gestructureerde testset wordt even onderhoudsintensief als slecht gestructureerde productiecode.
Low-codetools beloven een snellere start. Vakafdelingen of QA-teams kunnen teststappen via schermen samenstellen zonder elke controle zelf te programmeren. Dat kan zinvol zijn voor duidelijk afgebakende standaardprocessen, bijvoorbeeld bij een webtoepassing met enkele terugkerende goedkeuringsprocessen. Zodra er veel bijzondere gevallen, dynamische schermen of complexe autorisaties bijkomen, verschuift het werk echter vaak alleen: weg van de code, naar het onderhoud van opnames, variabelen en uitzonderingsregels.
Cloudgebaseerde AI-testaanbiedingen vullen deze aanpakken aan met beeldherkenning, zelfherstellende beloften of testbeschrijvingen in natuurlijke taal. Dat kan het opstellen versnellen. Verantwoordelijken moeten echter precies vragen welke gegevens het bedrijf verlaten. Screenshots, gebruikersinterfaces, foutmeldingen en testgegevens kunnen bedrijfsgeheimen, persoonsgegevens of inzicht in interne processen bevatten. Voor een openbare shopfrontend is die afweging anders dan voor interne planningssoftware of een Windows-toepassing in de productie.
Een eigen of zelf gehoste testinfrastructuur is meestal geen snelle start met een creditcard. Ze vraagt om inrichting, monitoring en een duidelijke beheersverantwoordelijkheid. In ruil daarvoor blijven testverkeer, screenshots en bewijsmateriaal onder eigen controle. Dat is vooral relevant wanneer web- en desktoptoepassingen, gevoelige gegevens of branchespecifieke compliance-eisen samenkomen. Bij softify.pro is COCO precies voor dit geval ontworpen: een eigen AI-server die tests uitvoert, bewijs vastlegt en begrijpelijke beoordelingen opstelt, zonder interne testgegevens standaard door te geven aan een externe clouddienst.
Vergelijk geen functies, maar foutrisico's
Een lange functielijst lijkt objectief, maar is zelden de juiste beslisbasis. Doorslaggevend is welke foutklasse een systeem moet afdekken. Een inlogfout na een wijziging aan de accountblokkering is kritiek als medewerkers hun werk niet kunnen beginnen. Een verkeerd berekende voorraad kan tot foutieve orderpicks leiden. Een verschoven knop in een zelden gebruikt scherm heeft mogelijk een duidelijk lagere prioriteit.
Een degelijke selectie begint daarom met tien tot twintig representatieve processen. Daartoe horen niet alleen ideale gevallen. Controleer bijvoorbeeld wat er gebeurt bij ontbrekende verplichte velden, hoe verschillende rollen zich gedragen, of een levering na correctie opnieuw wordt afgedrukt of hoe het systeem op time-outs reageert. Juist op deze punten tonen zich de verschillen tussen een overtuigende demonstratie en een bruikbaar testbeheer.
Ook de testfrequentie moet het risico volgen. Na elke commit een volledige end-to-endtest van alle processen starten klinkt grondig, maar kan de ontwikkeling blokkeren. Snelle technische controles kunnen bij elke wijziging lopen. Bedrijfskritische end-to-endscenario's lopen bij een release, 's nachts of vóór een productieve vrijgave. Een goede opzet maakt zichtbaar waarom een test in welke fase wordt uitgevoerd.
Onderhoudbaarheid beslist na het eerste kwartaal
Geautomatiseerde tests hebben een slechte reputatie als ze na elke kleine wijziging aan het scherm rood worden. Vaak ligt dat niet aan het gekozen product, maar aan de constructie van de tests. Een test die steunt op positie, kleur of willekeurig gegenereerde inhoud is fragiel. Beter zijn eenduidige technische kenmerken, stabiele testgegevens en herbruikbare stappen voor inloggen, rolkeuze of het aanmaken van een order.
Bij een vergelijking van testautomatisering loont het daarom om naar het dagelijkse onderhoud te kijken. Kan het team mislukte stappen snel naspeuren? Worden screenshot, tijdstempel, logboek en verwacht resultaat samen opgeslagen? Kunnen afzonderlijke tests gericht worden herhaald? En is duidelijk wie een mislukte test inhoudelijk beoordeelt en wie de technische oorzaak oplost?
Vooral bij toepassingen met een lange levensduur telt ook de compatibiliteit met de eigen architectuur. Moderne JavaScript-schermen gedragen zich anders dan server-side gerenderde PHP-toepassingen. Windows-desktopsoftware vraagt andere besturings- en observatiemogelijkheden dan een browser. Wie beide test, moet geen oplossing kiezen die één gebied alleen met omwegen behandelt.
AI als testhulp, niet als goedkeuringsinstantie
AI kan testteams op zinvolle wijze ontlasten. Ze kan afwijkingen prioriteren, wijzigingen in screenshots herkennen, teststappen in begrijpelijke taal beschrijven of uit veel logboeken terugkerende foutpatronen afleiden. Dat bespaart tijd bij de triage, dus bij de vraag welke rode melding echt onderzocht moet worden.
Ze vervangt echter geen inhoudelijke goedkeuring. Een model kan een ongebruikelijk scherm herkennen, maar niet betrouwbaar beslissen of een prijsgoedkeuring juridisch correct is of of een voorraadafwijking in het concrete proces toelaatbaar blijft. Voor zulke gevallen zijn expliciete regels, vastgelegde verwachte waarden en een verantwoordelijk mens nodig.
Vraag bij AI-functies naar betrouwbaarheidsdrempels en escalatielogica. Als een systeem alleen met grote zekerheid een afwijking meldt, kunnen subtiele fouten onopgemerkt blijven. Als het elk klein beeldverschil als fout aanmerkt, ontstaat alarmmoeheid. De passende drempel hangt af van het proces en moet worden ingesteld op basis van echte testruns, niet op basis van algemene marketingbeloften.
Gegevens, beheer en kosten eerlijk beoordelen
De licentie is slechts een deel van de kosten. Reken ook tijd mee voor de keuze van testgevallen, het onderhoud van testgegevens, aanpassingen na releases, infrastructuur en analyse. Een goedkope tool kan duur worden als drie mensen elke week valse alarmen sorteren. Omgekeerd kan een op maat ingerichte testserver rendabel zijn als hij kritieke regressies betrouwbaar opvangt en handmatige acceptatiedagen verkort.
Bij testgegevens is terughoudendheid verstandig. Waar mogelijk moeten geanonimiseerde of gericht aangemaakte gegevens worden gebruikt. Productiekopieën bevatten vaak meer informatie dan een test nodig heeft. Worden gegevens lokaal of in het eigen netwerk opgeslagen, dan moeten toegangsrechten, bewaartermijnen en logging toch geregeld zijn. Zelf gehost betekent niet automatisch veilig beheerd.
Houd ook rekening met het uitvallen van het testsysteem. Als een nachtelijke run mislukt, moet duidelijk te zien zijn of de toepassing foutief is, de testomgeving onbereikbaar was of een afhankelijkheid zoals een mailserver ontbrak. Deze scheiding bespaart 's ochtends veel tijd en voorkomt verkeerde vrijgavebeslissingen.
Beginnen met een beperkte pilot
De zinvolste vergelijking ontstaat zelden in een presentatie, maar in een pilot met echte processen. Kies een proces met tastbare bedrijfswaarde maar overzichtelijke complexiteit. Een aanmelding met rolcontrole, het aanmaken van een order en de uitgifte van een leveringsbon kunnen geschikter zijn dan meteen het hele systeemlandschap na te bouwen.
Leg vooraf vast wat succes betekent: bijvoorbeeld een bepaalde uitvoeringsduur, naspeurbaar foutbewijs, geen overdracht van gevoelige gegevens naar buiten en een onderhoud dat het bestaande team aankan. Na een paar releasecycli wordt zichtbaar of de gekozen methode alleen goed oogt of daadwerkelijk werk uit handen neemt.
De beste testautomatisering is niet die met de meeste automatiseringen. Het is die waarvan een team de resultaten begrijpt, die het bij goedkeuringen vertrouwt en die ook na de volgende procesverandering nog verstandig te beheren is.