Confronto tra soluzioni di test automation: quale approccio è adatto alla tua applicazione?
Quando la chiusura mensile, l'approvazione della spedizione o un nuovo portale clienti si bloccano a causa di un errore, non serve a nulla la demo di uno strumento con dashboard impressionanti. Un confronto tra soluzioni di test automation deve quindi partire dall'applicazione reale: quali flussi non devono fermarsi, con che frequenza cambiano e quali evidenze servono al team quando un test fallisce?
Per molte aziende il collo di bottiglia non è la mancanza di un singolo strumento di test. Sono i test di regressione manuali, le responsabilità poco chiare, i dati di test in sistemi simili alla produzione e i risultati che nessuno sa spiegare in modo affidabile. La soluzione giusta riduce questo rischio. Non automatizza il maggior numero possibile di clic a ogni costo.
Confronto tra soluzioni di test automation: quattro approcci
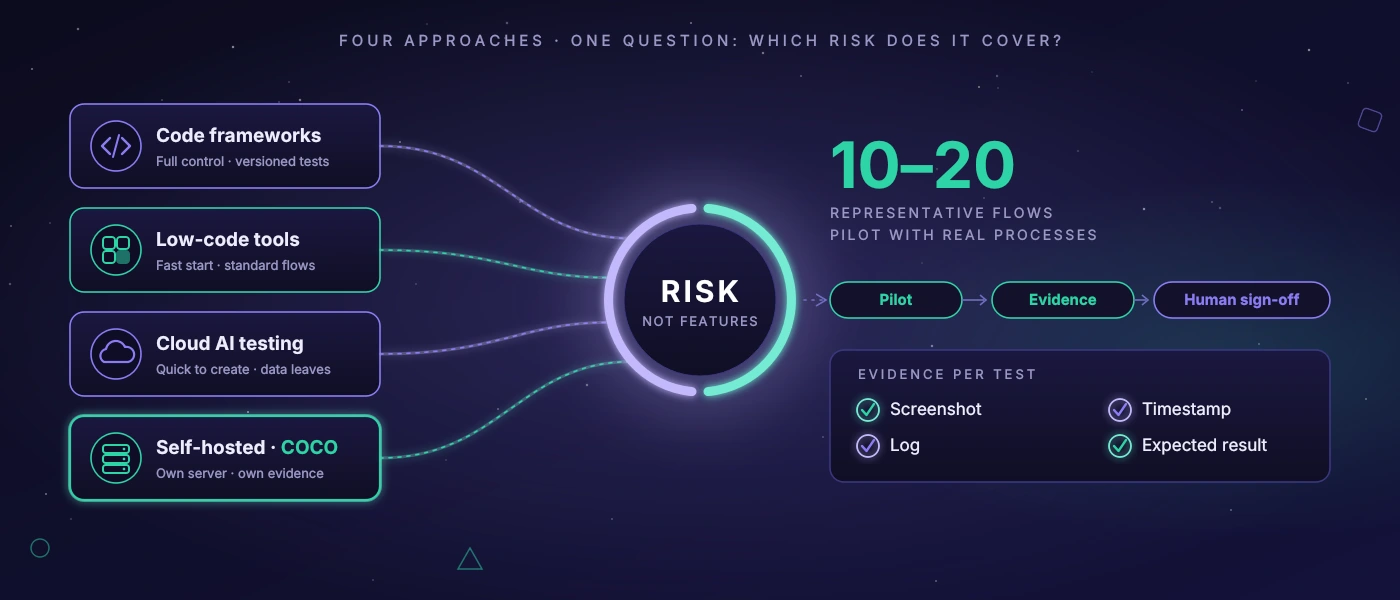
Sul mercato si incontrano di solito quattro approcci: i classici framework di test basati su codice, le piattaforme low-code o no-code, gli strumenti di IA basati su cloud e l'infrastruttura di test gestita in proprio. Nessuno è per principio superiore. La differenza sta nei tipi di applicazione, nei requisiti di sicurezza e nella capacità del team di mantenere i test nel tempo.
I framework basati su codice danno ai team di sviluppo molto controllo. Si integrano nei processi di build e deployment esistenti, versionano la logica di test nel codice sorgente e sono particolarmente adatti ad applicazioni web con un'architettura tecnica stabile. Il prezzo è chiaro: i test sono software. Richiedono review, selettori puliti, dati di test sensati e capacità degli sviluppatori. Un insieme di test mal strutturato diventa oneroso da mantenere quanto un codice di produzione mal strutturato.
Gli strumenti low-code promettono un avvio più rapido. Reparti specialistici o team QA possono comporre i passi di test tramite interfacce, senza programmare di persona ogni verifica. Può avere senso per flussi standard ben delimitati, ad esempio in un'applicazione web con pochi processi di approvazione ricorrenti. Non appena si aggiungono molti casi particolari, interfacce dinamiche o autorizzazioni complesse, però, il lavoro spesso si limita a spostarsi: dal codice alla manutenzione di registrazioni, variabili e regole di eccezione.
Le offerte di test con IA basate su cloud integrano questi approcci con riconoscimento di immagini, promesse di autoriparazione o descrizioni dei test in linguaggio naturale. Questo può accelerare la creazione. I responsabili dovrebbero però chiedere con precisione quali dati lasciano l'azienda. Screenshot, interfacce utente, messaggi di errore e dati di test possono contenere segreti aziendali, dati personali o informazioni su processi interni. Per un front end pubblico di un negozio online la valutazione è diversa rispetto a un software interno di pianificazione o a un'applicazione Windows in produzione.
Un'infrastruttura di test propria o self-hosted di solito non è un avvio rapido con carta di credito. Richiede configurazione, monitoraggio e una chiara responsabilità operativa. In cambio, traffico di test, screenshot ed evidenze restano sotto il proprio controllo. Questo è particolarmente rilevante quando si combinano applicazioni web e desktop, dati sensibili o requisiti di compliance specifici del settore. In softify.pro COCO è pensato proprio per questo caso: un server IA dedicato che esegue i test, registra le prove e produce valutazioni comprensibili, senza trasmettere per impostazione predefinita i dati di test interni a un servizio cloud esterno.
Non confrontare le funzioni, ma i rischi di errore
Un lungo elenco di funzioni sembra oggettivo, ma raramente è la base giusta per decidere. Conta quale classe di errori un sistema deve coprire. Un errore di accesso dopo una modifica al blocco dell'account è critico se i collaboratori non riescono a iniziare a lavorare. Una giacenza calcolata in modo errato può portare a errori di prelievo. Un pulsante spostato in una schermata usata di rado può avere una priorità decisamente inferiore.
Una scelta solida parte quindi da dieci-venti flussi rappresentativi. Tra questi non ci sono solo i casi ideali. Verificate, ad esempio, che cosa accade con campi obbligatori mancanti, come si comportano i diversi ruoli, se una consegna viene stampata di nuovo dopo la correzione o come reagisce il sistema ai timeout. Proprio in questi punti emergono le differenze tra una dimostrazione convincente e un esercizio di test utilizzabile.
Anche la frequenza dei test dovrebbe seguire il rischio. Avviare dopo ogni commit un test end-to-end completo di tutti i flussi suona accurato, ma può bloccare lo sviluppo. Le verifiche tecniche rapide possono girare a ogni modifica. Gli scenari end-to-end critici per il business girano a ogni release, di notte o prima di un rilascio in produzione. Una buona impostazione rende visibile perché un test viene eseguito in una determinata fase.
La manutenibilità decide dopo il primo trimestre
I test automatizzati hanno cattiva fama quando diventano rossi dopo ogni piccola modifica dell'interfaccia. Spesso la causa non è il prodotto scelto, ma la costruzione del test. Un test che si basa su posizione, colore o contenuti generati casualmente è fragile. Meglio usare identificatori tecnici univoci, dati di test stabili e passi riutilizzabili per accesso, scelta del ruolo o creazione di un ordine.
In un confronto tra soluzioni di test automation vale quindi la pena guardare alla manutenzione quotidiana. Il team riesce a ricostruire in fretta i passi falliti? Screenshot, timestamp, log e risultato atteso vengono salvati insieme? È possibile ripetere singoli test in modo mirato? Ed è chiaro chi valuta dal punto di vista funzionale un test fallito e chi risolve la causa tecnica?
Soprattutto per le applicazioni di lunga durata conta anche la compatibilità con la propria architettura. Le interfacce JavaScript moderne si comportano diversamente dalle applicazioni PHP renderizzate lato server. Il software desktop Windows richiede possibilità di controllo e osservazione diverse da quelle di un browser. Chi testa entrambi non dovrebbe scegliere una soluzione che tratta un'area solo con giri tortuosi.
L'IA come aiuto ai test, non come istanza di approvazione
L'IA può alleggerire in modo sensato il lavoro dei team di test. Può dare priorità alle anomalie, riconoscere modifiche negli screenshot, descrivere i passi di test in un linguaggio comprensibile o ricavare da molti log schemi di errore ricorrenti. Questo fa risparmiare tempo nel triage, cioè nel decidere quale segnalazione rossa debba davvero essere esaminata.
Non sostituisce però l'approvazione funzionale. Un modello può riconoscere un'interfaccia insolita, ma non decidere in modo affidabile se l'approvazione di un prezzo sia giuridicamente corretta o se uno scostamento di giacenza resti ammissibile nello specifico processo. Per questi casi servono regole esplicite, valori attesi definiti e una persona responsabile.
Per le funzioni di IA chiedete delle soglie di confidenza e della logica di escalation. Se un sistema segnala uno scostamento solo con alta certezza, errori sottili possono passare inosservati. Se classifica come errore ogni minima differenza d'immagine, nasce l'affaticamento da allarmi. La soglia adatta dipende dal processo e va impostata sulla base di test reali, non di promesse di marketing generiche.
Valutare con onestà dati, esercizio e costi
La licenza è solo una parte dei costi. Considerate anche il tempo per la scelta dei casi di test, la cura dei dati di test, gli adeguamenti dopo le release, l'infrastruttura e la valutazione. Uno strumento economico può diventare costoso se tre persone ogni settimana smistano falsi allarmi. Al contrario, un server di test configurato su misura può essere conveniente se intercetta in modo affidabile le regressioni critiche e accorcia le giornate di collaudo manuale.
Con i dati di test è sensato essere prudenti. Dove possibile, vanno usati dati anonimizzati o generati appositamente. Le copie della produzione contengono spesso più informazioni di quante ne richieda un test. Se i dati sono conservati in locale o nella propria rete, diritti di accesso, termini di conservazione e registrazione devono comunque essere regolati. Self-hosted non significa automaticamente gestito in sicurezza.
Pianificate anche il guasto del sistema di test. Se un'esecuzione notturna fallisce, deve essere chiaro se l'applicazione è difettosa, se l'ambiente di test non era raggiungibile o se mancava una dipendenza come un server di posta. Questa separazione fa risparmiare molto tempo al mattino e impedisce decisioni di rilascio sbagliate.
Partire con un pilota limitato
Il confronto più sensato nasce raramente in una presentazione, ma in un pilota con flussi reali. Scegliete un processo con valore di business tangibile ma complessità gestibile. Un accesso con verifica del ruolo, la creazione di un ordine e l'emissione di una bolla di consegna possono essere più adatti che riprodurre subito l'intero panorama dei sistemi.
Definite in anticipo che cosa significa successo: ad esempio una determinata durata di esecuzione, prove degli errori tracciabili, nessuna trasmissione di dati sensibili all'esterno e una manutenzione che il team esistente sia in grado di sostenere. Dopo alcuni cicli di release si vede se il metodo scelto ha solo un bell'aspetto o se toglie davvero lavoro.
La migliore test automation non è quella con più automazioni. È quella i cui risultati un team comprende, di cui si fida nelle approvazioni e che si può gestire con ragionevolezza anche dopo la prossima modifica di processo.