Comparatif d'automatisation des tests : quelle approche convient à votre application ?
Lorsque la clôture mensuelle, la validation d'expédition ou un nouveau portail client se bloque à cause d'une erreur, aucune démonstration d'outil avec des tableaux de bord impressionnants n'aide. Un comparatif d'automatisation des tests doit donc partir de l'application réelle : quels déroulements ne doivent pas tomber en panne, à quelle fréquence changent-ils et de quelles preuves l'équipe a-t-elle besoin lorsqu'un test échoue ?
Pour beaucoup d'entreprises, le goulot d'étranglement n'est pas l'absence d'un outil de test isolé. Ce sont les tests de régression manuels, les responsabilités floues, les données de test dans des systèmes proches de la production et des résultats que personne ne sait expliquer de façon fiable. La bonne solution réduit ce risque. Elle n'automatise pas à tout prix le plus grand nombre possible de clics.
Automatisation des tests comparée : quatre approches
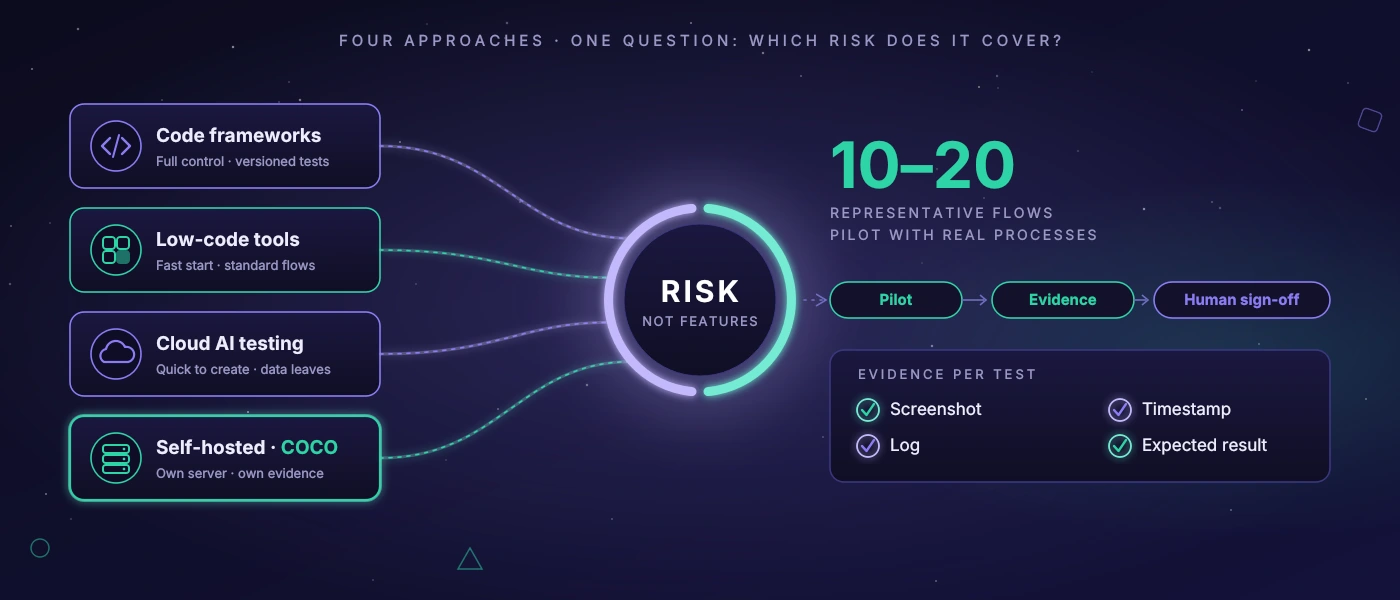
Sur le marché, quatre approches se côtoient en général : les frameworks de test classiques basés sur le code, les plateformes low-code ou no-code, les outils d'IA basés sur le cloud et l'infrastructure de test exploitée en propre. Aucune n'est supérieure par principe. La différence tient aux types d'applications, aux exigences de sécurité et à la capacité de l'équipe à maintenir durablement les tests.
Les frameworks basés sur le code donnent beaucoup de contrôle aux équipes de développement. Ils s'intègrent aux processus de build et de déploiement existants, versionnent la logique de test dans le code source et conviennent particulièrement bien aux applications web dotées d'une architecture technique stable. Le prix est clair : les tests sont du logiciel. Ils exigent des revues, des sélecteurs propres, des données de test pertinentes et de la capacité de développement. Un ensemble de tests mal structuré devient aussi coûteux à maintenir qu'un code de production mal structuré.
Les outils low-code promettent un démarrage plus rapide. Les métiers ou les équipes QA peuvent composer des étapes de test via des interfaces, sans programmer chaque contrôle eux-mêmes. Cela peut avoir du sens pour des déroulements standard clairement délimités, par exemple une application web comportant quelques processus de validation récurrents. Dès que s'ajoutent de nombreux cas particuliers, des interfaces dynamiques ou des droits complexes, le travail se déplace pourtant souvent seulement : du code vers la maintenance d'enregistrements, de variables et de règles d'exception.
Les offres de test par IA basées sur le cloud complètent ces approches avec de la reconnaissance d'images, des promesses d'auto-réparation ou des descriptions de test en langage naturel. Cela peut accélérer la création. Les responsables devraient toutefois demander précisément quelles données quittent l'entreprise. Captures d'écran, interfaces utilisateur, messages d'erreur et données de test peuvent contenir des secrets d'affaires, des données personnelles ou des aperçus de processus internes. Pour un front-end de boutique public, la pesée est différente que pour un logiciel interne de dispatching ou une application Windows en production.
Une infrastructure de test propre ou auto-hébergée n'est en général pas un démarrage rapide par carte bancaire. Elle exige une mise en place, une supervision et une responsabilité d'exploitation claire. En contrepartie, le trafic de test, les captures d'écran et les preuves restent sous votre propre contrôle. C'est particulièrement pertinent lorsque se rencontrent applications web et de bureau, données sensibles ou exigences de conformité propres au secteur. Chez softify.pro, COCO est conçu précisément pour ce cas : un serveur d'IA dédié qui exécute les tests, enregistre les preuves et produit des évaluations compréhensibles, sans transmettre par défaut les données de test internes à un service cloud externe.
Ne pas comparer des fonctions, mais des risques d'erreur
Une longue liste de fonctionnalités paraît objective, mais constitue rarement la bonne base de décision. Ce qui compte, c'est la classe d'erreurs qu'un système doit couvrir. Un échec de connexion après une modification du verrouillage de compte est critique si les collaborateurs ne peuvent pas commencer à travailler. Un stock mal calculé peut entraîner des erreurs de préparation. Un bouton déplacé dans une vue rarement utilisée a peut-être une priorité nettement plus faible.
Une sélection solide commence donc par dix à vingt déroulements représentatifs. Ils ne comprennent pas que des cas idéaux. Vérifiez par exemple ce qui se passe lorsque des champs obligatoires manquent, comment se comportent les différents rôles, si une livraison est réimprimée après correction ou comment le système réagit aux dépassements de délai. C'est justement sur ces points que se révèlent les différences entre une démonstration convaincante et une exploitation de test utilisable.
La fréquence des tests devrait elle aussi suivre le risque. Lancer après chaque commit un test de bout en bout complet de tous les déroulements semble rigoureux, mais peut bloquer le développement. Les contrôles techniques rapides peuvent tourner à chaque modification. Les scénarios de bout en bout critiques pour l'activité tournent lors d'une version, la nuit ou avant une mise en production. Une bonne architecture rend visible pourquoi un test est exécuté à quelle étape.
La maintenabilité décide après le premier trimestre
Les tests automatisés ont mauvaise réputation lorsqu'ils passent au rouge après chaque petite modification de l'interface. Souvent, cela ne tient pas au produit choisi, mais à la construction des tests. Un test qui s'appuie sur la position, la couleur ou des contenus générés aléatoirement est fragile. Mieux vaut recourir à des identifiants techniques univoques, à des données de test stables et à des étapes réutilisables pour la connexion, le choix du rôle ou la création de commande.
Dans un comparatif d'automatisation des tests, il vaut donc la peine de regarder le quotidien de la maintenance. L'équipe peut-elle retracer rapidement les étapes échouées ? Capture d'écran, horodatage, journal et résultat attendu sont-ils enregistrés ensemble ? Peut-on répéter des tests isolés de façon ciblée ? Et est-il clair qui évalue sur le fond un test échoué et qui corrige la cause technique ?
Pour les applications de longue durée, la compatibilité avec sa propre architecture compte en outre. Les interfaces JavaScript modernes se comportent autrement que les applications PHP rendues côté serveur. Un logiciel de bureau Windows exige d'autres possibilités de pilotage et d'observation qu'un navigateur. Qui teste les deux ne devrait pas choisir une solution qui ne traite un domaine que par des détours.
L'IA comme aide au test, pas comme instance de validation
L'IA peut soulager utilement les équipes de test. Elle peut prioriser les anomalies, repérer des changements dans les captures d'écran, décrire les étapes de test en langage compréhensible ou dégager de nombreux journaux des profils d'erreurs récurrents. Cela fait gagner du temps lors du tri, c'est-à-dire pour décider quelle alerte rouge doit vraiment être examinée.
Elle ne remplace toutefois pas la validation métier. Un modèle peut reconnaître une interface inhabituelle, mais pas décider de façon fiable si une validation de prix est juridiquement correcte ou si un écart de stock reste admissible dans le processus concret. Pour de tels cas, il faut des règles explicites, des valeurs attendues définies et une personne responsable.
Pour les fonctions d'IA, interrogez-vous sur les seuils de confiance et la logique d'escalade. Si un système ne signale un écart qu'avec une grande certitude, des erreurs subtiles peuvent passer inaperçues. S'il classe chaque légère différence d'image comme une erreur, il en résulte une lassitude face aux alertes. Le bon seuil dépend du processus et devrait être réglé à partir d'exécutions de test réelles, non de promesses marketing générales.
Évaluer honnêtement données, exploitation et coûts
La licence n'est qu'une partie des coûts. Comptez aussi le temps de sélection des cas de test, d'entretien des données de test, d'adaptation après les versions, l'infrastructure et l'analyse. Un outil bon marché peut devenir cher si trois personnes trient chaque semaine de fausses alertes. À l'inverse, un serveur de test configuré sur mesure peut être rentable s'il intercepte de façon fiable les régressions critiques et raccourcit les journées de recette manuelle.
Pour les données de test, la retenue est de mise. Dans la mesure du possible, il faut utiliser des données anonymisées ou générées de manière ciblée. Les copies de production contiennent souvent plus d'informations qu'un test n'en exige. Si les données sont stockées localement ou dans son propre réseau, les droits d'accès, les durées de conservation et la journalisation doivent néanmoins être réglés. Auto-hébergé ne signifie pas automatiquement exploité en sécurité.
Prévoyez aussi la panne du système de test. Si une exécution nocturne échoue, il doit être clairement identifiable si l'application est défectueuse, si l'environnement de test était inaccessible ou si une dépendance comme un serveur de messagerie manquait. Cette séparation fait gagner beaucoup de temps le matin et évite de mauvaises décisions de validation.
Démarrer avec un pilote limité
Le comparatif le plus judicieux naît rarement lors d'une présentation, mais dans un pilote avec des déroulements réels. Choisissez un processus à valeur métier tangible mais de complexité maîtrisable. Une connexion avec contrôle des rôles, la création d'une commande et l'édition d'un bon de livraison peuvent convenir mieux que de reproduire immédiatement tout le paysage des systèmes.
Définissez à l'avance ce que signifie le succès : par exemple une certaine durée d'exécution, des preuves d'erreurs traçables, aucune transmission de données sensibles vers l'extérieur et une maintenance que l'équipe en place peut assumer. Après quelques cycles de versions, on voit si la méthode choisie n'a que l'air bonne ou si elle décharge réellement du travail.
La meilleure automatisation des tests n'est pas celle qui compte le plus d'automatisations. C'est celle dont une équipe comprend les résultats, à laquelle elle se fie pour les validations et qui reste raisonnablement exploitable après le prochain changement de processus.