Comparativa de automatización de pruebas: ¿qué enfoque encaja con su aplicación?
Cuando el cierre mensual, la aprobación de envíos o un nuevo portal de clientes se atasca por un error, no sirve de nada la demo de una herramienta con paneles impresionantes. Una comparativa de automatización de pruebas debe por tanto empezar por la aplicación real: ¿qué flujos no pueden fallar, con qué frecuencia cambian y qué evidencias necesita el equipo cuando una prueba falla?
Para muchas empresas el cuello de botella no es la falta de una herramienta de pruebas concreta. Son las pruebas de regresión manuales, las responsabilidades poco claras, los datos de prueba en sistemas cercanos a producción y los resultados que nadie sabe explicar con fiabilidad. La solución adecuada reduce ese riesgo. No automatiza a toda costa el mayor número posible de clics.
Automatización de pruebas comparada: cuatro enfoques
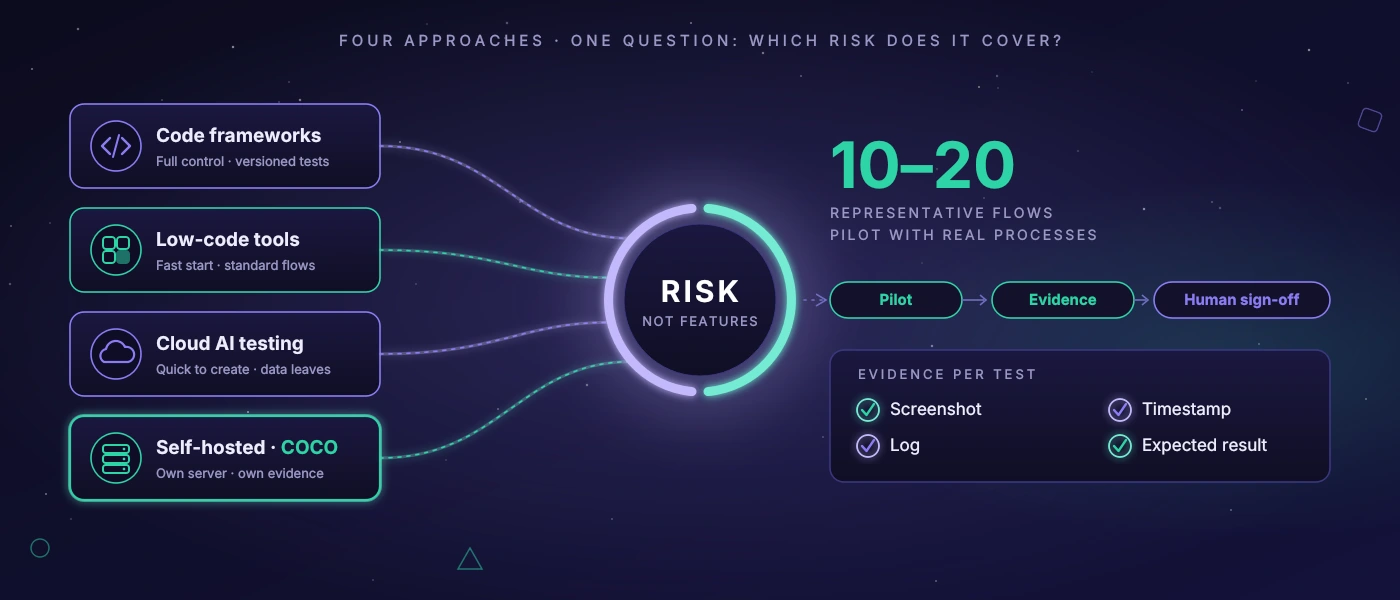
En el mercado suelen coincidir cuatro enfoques: los frameworks de pruebas clásicos basados en código, las plataformas low-code o no-code, las herramientas de IA basadas en la nube y la infraestructura de pruebas operada por cuenta propia. Ninguno es superior por principio. La diferencia está en los tipos de aplicación, los requisitos de seguridad y la capacidad del equipo para mantener las pruebas a largo plazo.
Los frameworks basados en código dan mucho control a los equipos de desarrollo. Se integran en los procesos de build y despliegue existentes, versionan la lógica de pruebas en el código fuente y son especialmente adecuados para aplicaciones web con una arquitectura técnica estable. El precio está claro: las pruebas son software. Necesitan revisiones, selectores limpios, datos de prueba razonables y capacidad de desarrollo. Un conjunto de pruebas mal estructurado exige tanto mantenimiento como un código de producción mal estructurado.
Las herramientas low-code prometen un inicio más rápido. Las áreas funcionales o los equipos de QA pueden componer pasos de prueba mediante interfaces, sin programar ellos mismos cada comprobación. Eso puede tener sentido para flujos estándar claramente delimitados, por ejemplo en una aplicación web con pocos procesos de aprobación recurrentes. En cuanto se suman muchos casos especiales, interfaces dinámicas o permisos complejos, el trabajo suele limitarse a desplazarse: del código al mantenimiento de grabaciones, variables y reglas de excepción.
Las ofertas de pruebas con IA basadas en la nube complementan estos enfoques con reconocimiento de imágenes, promesas de autorreparación o descripciones de pruebas en lenguaje natural. Eso puede acelerar la creación. Los responsables deberían preguntar con precisión qué datos salen de la empresa. Las capturas de pantalla, las interfaces de usuario, los mensajes de error y los datos de prueba pueden contener secretos empresariales, datos personales o información sobre procesos internos. Para un front end público de tienda la ponderación es distinta que para un software interno de disposición o una aplicación Windows en fabricación.
Una infraestructura de pruebas propia o autoalojada normalmente no es un inicio rápido con tarjeta de crédito. Exige configuración, monitorización y una responsabilidad operativa clara. A cambio, el tráfico de pruebas, las capturas de pantalla y las evidencias permanecen bajo control propio. Esto es especialmente relevante cuando coinciden aplicaciones web y de escritorio, datos sensibles o requisitos de cumplimiento específicos del sector. En softify.pro, COCO está concebido justo para este caso: un servidor de IA propio que ejecuta pruebas, registra evidencias y genera valoraciones comprensibles, sin transmitir por defecto los datos de prueba internos a un servicio externo en la nube.
No comparar funciones, sino riesgos de error
Una larga lista de características parece objetiva, pero rara vez es la base correcta para decidir. Lo decisivo es qué clase de errores debe cubrir un sistema. Un fallo de inicio de sesión tras un cambio en el bloqueo de cuentas es crítico si el personal no puede empezar a trabajar. Un stock mal calculado puede provocar errores de preparación de pedidos. Un botón desplazado en una vista que casi no se usa puede tener una prioridad mucho menor.
Una selección sólida empieza por eso con entre diez y veinte flujos representativos. No solo se incluyen casos ideales. Compruebe, por ejemplo, qué ocurre con campos obligatorios vacíos, cómo se comportan los distintos roles, si una entrega se vuelve a imprimir tras una corrección o cómo reacciona el sistema ante los tiempos de espera agotados. Justo en esos puntos se ven las diferencias entre una demostración convincente y una operación de pruebas utilizable.
La frecuencia de las pruebas también debería seguir el riesgo. Lanzar tras cada commit una prueba completa de extremo a extremo de todos los flujos suena minucioso, pero puede bloquear el desarrollo. Las comprobaciones técnicas rápidas pueden ejecutarse con cada cambio. Los escenarios de extremo a extremo críticos para el negocio se ejecutan en una versión, por la noche o antes de una puesta en producción. Una buena estructura hace visible por qué una prueba se ejecuta en qué fase.
La mantenibilidad decide tras el primer trimestre
Las pruebas automatizadas tienen mala fama cuando se ponen en rojo tras cada pequeño cambio de la interfaz. A menudo la causa no es el producto elegido, sino la construcción de las pruebas. Una prueba que se apoya en la posición, el color o contenidos generados al azar es frágil. Mejor son los identificadores técnicos inequívocos, los datos de prueba estables y los pasos reutilizables para el inicio de sesión, la selección de rol o la creación de pedidos.
En una comparativa de automatización de pruebas merece por eso la pena mirar el día a día del mantenimiento. ¿Puede el equipo seguir rápidamente los pasos fallidos? ¿Se guardan juntos la captura de pantalla, la marca de tiempo, el registro y el resultado esperado? ¿Pueden repetirse pruebas concretas de forma selectiva? ¿Y está claro quién valora desde el punto de vista funcional una prueba fallida y quién corrige la causa técnica?
Sobre todo en aplicaciones de larga vida cuenta también la compatibilidad con la propia arquitectura. Las interfaces JavaScript modernas se comportan de forma distinta a las aplicaciones PHP renderizadas en el servidor. El software de escritorio de Windows necesita otras posibilidades de control y observación que un navegador. Quien prueba ambos no debería elegir una solución que solo trata un ámbito con rodeos.
La IA como ayuda a las pruebas, no como instancia de aprobación
La IA puede aliviar de forma útil a los equipos de pruebas. Puede priorizar anomalías, detectar cambios en capturas de pantalla, describir pasos de prueba en un lenguaje comprensible o deducir de muchos registros patrones de error recurrentes. Eso ahorra tiempo en el triaje, es decir, al decidir qué aviso rojo debe investigarse de verdad.
Sin embargo, no sustituye a la aprobación funcional. Un modelo puede reconocer una interfaz inusual, pero no decidir con fiabilidad si una aprobación de precios es legalmente correcta o si una desviación de stock sigue siendo admisible en el proceso concreto. Para esos casos se necesitan reglas explícitas, valores esperados definidos y una persona responsable.
En las funciones de IA, pregunte por los umbrales de confianza y la lógica de escalado. Si un sistema solo notifica una desviación con mucha certeza, pueden pasar desapercibidos errores sutiles. Si clasifica como error cada pequeña diferencia de imagen, surge la fatiga de alarmas. El umbral adecuado depende del proceso y debería ajustarse con ejecuciones de prueba reales, no con promesas de marketing generales.
Evaluar con honestidad datos, operación y costes
La licencia es solo una parte de los costes. Cuente también el tiempo para seleccionar casos de prueba, mantener los datos de prueba, adaptar tras las versiones, la infraestructura y la evaluación. Una herramienta barata puede salir cara si tres personas clasifican falsas alarmas cada semana. A la inversa, un servidor de pruebas configurado a medida puede ser rentable si detecta con fiabilidad regresiones críticas y acorta los días de aceptación manual.
Con los datos de prueba tiene sentido la contención. Siempre que sea posible, deben usarse datos anonimizados o generados a propósito. Las copias de producción suelen contener más información de la que necesita una prueba. Si los datos se guardan en local o en la propia red, aun así hay que regular los derechos de acceso, los plazos de conservación y el registro. Autoalojado no significa automáticamente operado con seguridad.
Planifique también el fallo del sistema de pruebas. Si falla una ejecución nocturna, debe poder verse con claridad si la aplicación es defectuosa, si el entorno de pruebas no estaba accesible o si faltaba una dependencia como un servidor de correo. Esta separación ahorra mucho tiempo por la mañana y evita decisiones de aprobación erróneas.
Empezar con un piloto acotado
La comparación más sensata rara vez surge en una presentación, sino en un piloto con flujos reales. Elija un proceso con valor de negocio palpable pero complejidad manejable. Un inicio de sesión con comprobación de roles, la creación de un pedido y la emisión de un albarán pueden ser más adecuados que reproducir de inmediato todo el panorama de sistemas.
Defina de antemano qué significa éxito: por ejemplo, una determinada duración de ejecución, evidencias de error trazables, ninguna transmisión de datos sensibles al exterior y un mantenimiento que el equipo existente pueda asumir. Tras algunos ciclos de versiones se ve si el método elegido solo tiene buen aspecto o si de verdad quita trabajo.
La mejor automatización de pruebas no es la que tiene más automatizaciones. Es aquella cuyos resultados entiende un equipo, en la que confía a la hora de aprobar y que sigue pudiendo operarse con sensatez tras el próximo cambio de proceso.