Testautomatisierung Vergleich: Welcher Ansatz passt zu Ihrer Anwendung?
Wenn der Monatsabschluss, die Versandfreigabe oder ein neues Kundenportal wegen eines Fehlers stockt, hilft keine Tool-Demo mit beeindruckenden Dashboards. Ein Testautomatisierung Vergleich muss deshalb bei der tatsächlichen Anwendung beginnen: Welche Abläufe dürfen nicht ausfallen, wie oft ändern sie sich und welche Nachweise braucht das Team, wenn ein Test fehlschlägt?
Für viele Unternehmen ist der Engpass nicht das Fehlen eines einzelnen Testwerkzeugs. Es sind manuelle Regressionstests, unklare Verantwortlichkeiten, Testdaten in produktionsnahen Systemen und Ergebnisse, die niemand zuverlässig erklären kann. Die passende Lösung reduziert dieses Risiko. Sie automatisiert nicht möglichst viele Klicks um jeden Preis.
Testautomatisierung im Vergleich: Vier Ansätze
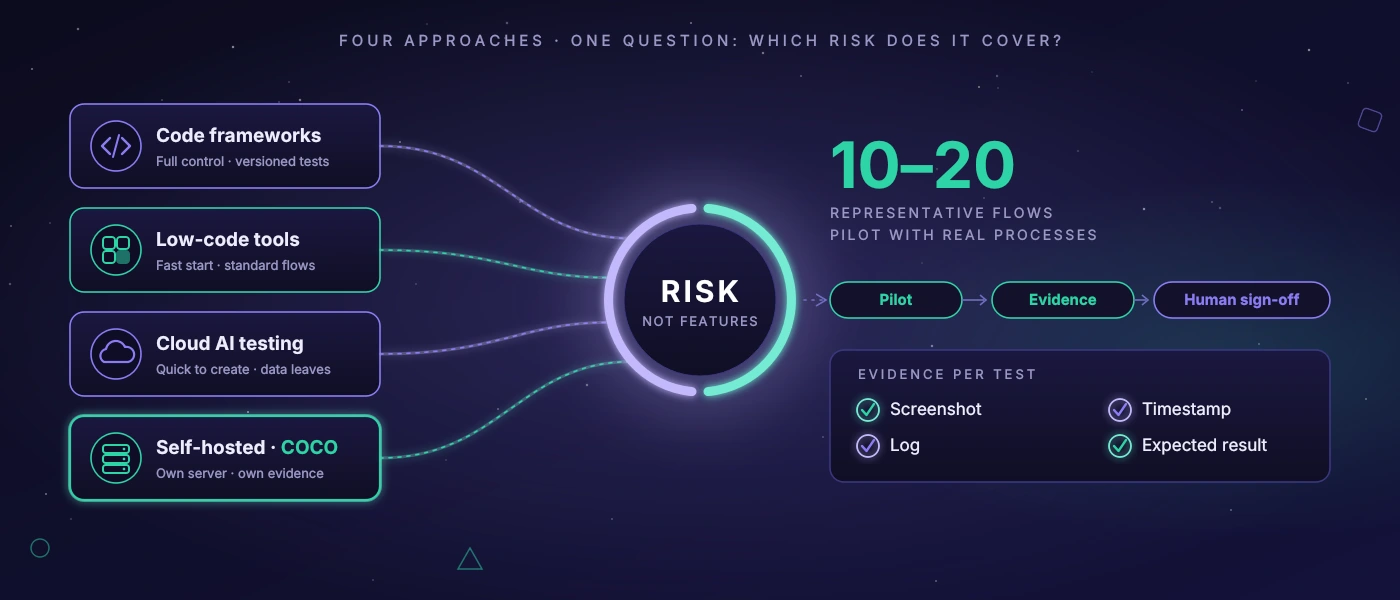
Im Markt treffen meist vier Ansätze aufeinander: klassische Code-basierte Testframeworks, Low-Code- oder No-Code-Plattformen, cloudbasierte KI-Tools und individuell betriebene Testinfrastruktur. Keiner davon ist grundsätzlich überlegen. Der Unterschied liegt in den Anwendungstypen, Sicherheitsvorgaben und der Fähigkeit des Teams, die Tests dauerhaft zu pflegen.
Code-basierte Frameworks geben Entwicklungsteams viel Kontrolle. Sie lassen sich in bestehende Build- und Deployment-Prozesse einbauen, versionieren Testlogik im Quellcode und eignen sich besonders gut für Webanwendungen mit einer stabilen technischen Architektur. Der Preis dafür ist klar: Tests sind Software. Sie brauchen Reviews, saubere Selektoren, sinnvolle Testdaten und Entwicklerkapazität. Ein schlecht strukturierter Testbestand wird genauso wartungsintensiv wie schlecht strukturierter Produktcode.
Low-Code-Werkzeuge versprechen einen schnelleren Einstieg. Fachbereiche oder QA-Teams können Testschritte über Oberflächen zusammenstellen, ohne jede Prüfung selbst zu programmieren. Das kann für klar abgegrenzte Standardabläufe sinnvoll sein, etwa bei einer Webanwendung mit wenigen, wiederkehrenden Freigabeprozessen. Sobald viele Sonderfälle, dynamische Oberflächen oder komplexe Berechtigungen hinzukommen, verschiebt sich die Arbeit jedoch oft nur: weg vom Code, hin zur Pflege von Aufzeichnungen, Variablen und Ausnahmeregeln.
Cloudbasierte KI-Testing-Angebote ergänzen diese Ansätze mit Bilderkennung, Selbstheilungsversprechen oder natürlichsprachlichen Testbeschreibungen. Das kann die Erstellung beschleunigen. Verantwortliche sollten aber präzise fragen, welche Daten den eigenen Betrieb verlassen. Screenshots, Benutzeroberflächen, Fehlermeldungen und Testdaten können Geschäftsgeheimnisse, personenbezogene Daten oder Einblicke in interne Prozesse enthalten. Für ein öffentliches Shop-Frontend ist diese Abwägung anders als für eine interne Dispositionssoftware oder eine Windows-Anwendung in der Fertigung.
Eigene oder selbst gehostete Testinfrastruktur ist meist kein Schnellstart per Kreditkarte. Sie verlangt Einrichtung, Monitoring und eine klare Betriebsverantwortung. Dafür bleiben Testverkehr, Screenshots und Evidenzen unter eigener Kontrolle. Das ist besonders relevant, wenn Web- und Desktop-Anwendungen, sensible Daten oder branchenspezifische Compliance-Vorgaben zusammenkommen. Bei softify.pro ist COCO für genau diesen Fall ausgelegt: ein eigener KI-Server, der Tests ausführt, Belege aufzeichnet und verständliche Bewertungen erzeugt, ohne interne Testdaten standardmäßig an einen externen Cloud-Dienst weiterzugeben.
Nicht Funktionen vergleichen, sondern Fehlerrisiken
Eine lange Featureliste wirkt objektiv, ist aber selten die richtige Entscheidungsgrundlage. Entscheidend ist, welche Fehlerklasse ein System abdecken soll. Ein Anmeldefehler nach einer Änderung am Account-Lockout ist kritisch, wenn Mitarbeitende ihre Arbeit nicht beginnen können. Ein falsch berechneter Bestand kann zu Fehlkommissionierungen führen. Ein verschobener Button in einer selten genutzten Ansicht hat möglicherweise eine deutlich geringere Priorität.
Eine belastbare Auswahl startet daher mit zehn bis zwanzig repräsentativen Abläufen. Dazu gehören nicht nur Idealfälle. Prüfen Sie beispielsweise, was bei fehlenden Pflichtfeldern geschieht, wie sich unterschiedliche Rollen verhalten, ob eine Lieferung nach Korrektur erneut gedruckt wird oder wie das System auf Zeitüberschreitungen reagiert. Gerade an diesen Stellen zeigen sich Unterschiede zwischen einer überzeugenden Vorführung und einem brauchbaren Testbetrieb.
Auch die Testrate sollte dem Risiko folgen. Nach jedem Commit einen kompletten End-to-End-Test aller Abläufe zu starten, klingt gründlich, blockiert aber unter Umständen die Entwicklung. Schnelle technische Prüfungen können bei jeder Änderung laufen. Geschäftskritische End-to-End-Szenarien laufen bei einem Release, nachts oder vor einer produktiven Freigabe. Ein guter Aufbau macht sichtbar, warum ein Test in welcher Stufe ausgeführt wird.
Wartbarkeit entscheidet nach dem ersten Quartal
Automatisierte Tests haben einen schlechten Ruf, wenn sie nach jeder kleinen Oberflächenänderung rot werden. Häufig liegt das nicht am gewählten Produkt, sondern an der Testkonstruktion. Ein Test, der sich auf Position, Farbe oder zufällig generierte Inhalte verlässt, ist fragil. Besser sind eindeutige technische Kennzeichnungen, stabile Testdaten und wiederverwendbare Schritte für Anmeldung, Rollenauswahl oder Auftragsanlage.
Im Testautomatisierung Vergleich lohnt sich deshalb ein Blick auf den Alltag der Pflege. Kann das Team fehlgeschlagene Schritte schnell nachvollziehen? Werden Screenshot, Zeitstempel, Protokoll und erwartetes Ergebnis gemeinsam gespeichert? Lassen sich einzelne Tests gezielt wiederholen? Und ist klar, wer einen fehlgeschlagenen Test fachlich bewertet und wer die technische Ursache behebt?
Besonders bei Anwendungen mit langer Laufzeit zählt zudem die Kompatibilität zur eigenen Architektur. Moderne JavaScript-Oberflächen verhalten sich anders als serverseitig gerenderte PHP-Anwendungen. Windows-Desktop-Software benötigt andere Steuerungs- und Beobachtungsmöglichkeiten als ein Browser. Wer beides testet, sollte keine Lösung wählen, die einen Bereich nur mit Umwegen behandelt.
KI als Prüfhilfe, nicht als Freigabeinstanz
KI kann Testteams sinnvoll entlasten. Sie kann Auffälligkeiten priorisieren, Änderungen in Screenshots erkennen, Testschritte in verständlicher Sprache beschreiben oder aus vielen Protokollen wiederkehrende Fehlerbilder ableiten. Das spart Zeit bei der Triage, also bei der Frage, welche rote Meldung wirklich untersucht werden muss.
Sie ersetzt jedoch keine fachliche Freigabe. Ein Modell kann eine ungewöhnliche Oberfläche erkennen, aber nicht zuverlässig entscheiden, ob eine Preisfreigabe rechtlich korrekt ist oder ob eine Bestandsabweichung im konkreten Prozess zulässig bleibt. Für solche Fälle braucht es explizite Regeln, definierte Erwartungswerte und einen verantwortlichen Menschen.
Fragen Sie bei KI-Funktionen nach Konfidenzschwellen und Eskalationslogik. Wenn ein System nur mit hoher Sicherheit eine Abweichung meldet, können subtile Fehler unentdeckt bleiben. Wenn es jede geringe Bilddifferenz als Fehler einstuft, entsteht Alarmmüdigkeit. Die passende Schwelle hängt vom Prozess ab und sollte anhand realer Testläufe eingestellt werden, nicht anhand allgemeiner Marketingversprechen.
Daten, Betrieb und Kosten ehrlich bewerten
Die Lizenz ist nur ein Teil der Kosten. Rechnen Sie auch Zeit für Testfallauswahl, Testdatenpflege, Anpassungen nach Releases, Infrastruktur und Auswertung ein. Ein günstiges Tool kann teuer werden, wenn drei Personen jede Woche Fehlalarme sortieren. Umgekehrt kann ein individuell eingerichteter Testserver wirtschaftlich sein, wenn er kritische Regressionen verlässlich auffängt und manuelle Abnahmetage verkürzt.
Bei Testdaten ist Zurückhaltung sinnvoll. Wo möglich, sollten anonymisierte oder gezielt erzeugte Daten verwendet werden. Produktionskopien enthalten oft mehr Informationen als für einen Test erforderlich ist. Werden Daten lokal oder im eigenen Netzwerk gespeichert, müssen dennoch Zugriffsrechte, Aufbewahrungsfristen und Protokollierung geregelt sein. Selbst gehostet bedeutet nicht automatisch sicher betrieben.
Planen Sie außerdem den Ausfall des Testsystems mit ein. Wenn ein nächtlicher Lauf scheitert, sollte eindeutig erkennbar sein, ob die Anwendung fehlerhaft ist, die Testumgebung nicht erreichbar war oder eine Abhängigkeit wie ein Mailserver fehlte. Diese Trennung spart morgens viel Zeit und verhindert falsche Freigabeentscheidungen.
Mit einem begrenzten Pilot starten
Der sinnvollste Vergleich entsteht selten in einer Präsentation, sondern in einem Pilot mit echten Abläufen. Wählen Sie einen Prozess mit spürbarem Geschäftswert, aber überschaubarer Komplexität. Eine Anmeldung mit Rollenprüfung, die Anlage eines Auftrags und die Ausgabe eines Lieferscheins können dafür geeigneter sein als sofort die gesamte Systemlandschaft abzubilden.
Definieren Sie vorab, was Erfolg bedeutet: etwa eine bestimmte Ausführungsdauer, nachvollziehbare Fehlerbelege, keine Übertragung sensibler Daten nach außen und eine Pflege, die das vorhandene Team leisten kann. Nach einigen Release-Zyklen wird sichtbar, ob das gewählte Verfahren nur gut aussieht oder tatsächlich Arbeit abnimmt.
Die beste Testautomatisierung ist nicht die mit den meisten Automatisierungen. Sie ist die, deren Ergebnisse ein Team versteht, der es bei Freigaben vertraut und die sich auch nach der nächsten Prozessänderung noch vernünftig betreiben lässt.