softify.pro
Caricamento …
Servizi Chi siamo COCO – il nostro server IA Portfolio Insiders Case Study Da Sapere Contatti Accesso

NEXT-GEN SOFTWARE AESTHETIC

Pure fluidity meets ultimate performance.

La nuova identità visiva per i flussi di lavoro digitali moderni.

softify.pro — La nuova identità visiva per i flussi di lavoro digitali moderni.

Scorri per scoprire ↓

Software costruito come le aziende moderne lavorano davvero

softify.pro è uno studio software costruito attorno a un'idea: la tecnologia dovrebbe muoversi con la stessa fluidità delle aziende che supporta. Lavoriamo all'incrocio tra sviluppo web moderno, automazione dei processi e intelligenza artificiale applicata — tre discipline che raramente convivono sotto lo stesso tetto, ma che sempre più spesso devono farlo. I nostri clienti vanno da piccole officine che digitalizzano la prima fatturazione a produttori di medie dimensioni consolidati che sostituiscono i fogli di calcolo con vero software logistico. Ciò che li accomuna non è la dimensione, ma l'ambizione: vogliono sistemi rapidi, affidabili e piacevoli da usare, non solo funzionali. Ogni progetto parte dalle stesse tre domande: cosa deve realmente accelerare in questa azienda, cosa funziona già bene e va rispettato invece che sostituito, e quale parte del flusso di lavoro può, una volta costruita correttamente, funzionare da sola. Le risposte definiscono tutto ciò che segue, dallo stack tecnologico al piano di implementazione.

Servizi

La nuova identità visiva per i flussi di lavoro digitali moderni.

01 — LOGISTICS

Automazione della logistica — pensata per piccole e medie imprese nell'area DACH

Una parte consistente del nostro lavoro è dedicata a software logistico e gestionale per piccole e medie imprese in Germania, Austria e Svizzera. Queste aziende si trovano spesso tra due opzioni poco attraenti: costose suite logistiche enterprise pensate per gruppi dieci volte più grandi, oppure un insieme raffazzonato di fogli di calcolo, moduli cartacei e telefonate che limita silenziosamente la velocità con cui possono crescere.

Costruiamo la via di mezzo — automazione su misura che si adatta al modo in cui un magazzino, un'officina o un team di distribuzione lavorano davvero. Questo può significare digitalizzare la merce in entrata e i movimenti di magazzino, generare automaticamente bolle di consegna ed etichette di spedizione, collegare la ricezione degli ordini alla pianificazione dei percorsi, oppure semplicemente sostituire un fragile foglio Excel che solo una persona capisce con un sistema condiviso su cui l'intero team può contare. Poiché lavoriamo direttamente con titolari e responsabili operativi nell'area DACH, i requisiti vengono raccolti nella lingua in cui l'azienda opera davvero, e l'implementazione viene pianificata attorno a turni reali e magazzini reali, non a un cronoprogramma astratto.

02 — WEB

Sviluppo web moderno, su tecnologia attuale

Progettiamo e sviluppiamo applicazioni web e siti utilizzando tecnologia attuale e attivamente mantenuta, non framework legacy tenuti in vita per abitudine. Questo significa PHP 8.4 pulito sul backend dove un'applicazione classica lato server è la scelta giusta, JavaScript moderno dove conta l'interattività, e MySQL 8 per dati che devono restare coerenti e interrogabili per anni, non solo nei primi sei mesi dopo il lancio. Ogni progetto viene pianificato per desktop e mobile fin dal primo schizzo, non adattato in seguito: tempi di caricamento, breakpoint di layout e interazioni touch fanno parte della specifica, non un'aggiunta successiva.

Oltre all'interfaccia visibile, ci importa come appare un sito internamente: codice leggibile, uno schema di database che non dovrà essere ricostruito alla prossima richiesta di funzionalità, e passaggi di deployment che un secondo sviluppatore può seguire senza doverci contattare. Un sito che oggi ha buone prestazioni e tra tre anni può ancora essere esteso in modo pulito è, per noi, la vera definizione di 'moderno'.

03 — AI / COCO

COCO — il nostro server IA per il testing automatizzato del software

Per i clienti enterprise, gestiamo e manteniamo un server IA dedicato, chiamato COCO. A differenza di un chatbot generico aggiunto a un flusso di lavoro, COCO è progettato appositamente e ospitato in autonomia specificamente per il testing automatizzato di software web e applicazioni desktop multipiattaforma — dai flussi di login e autenticazione a interi processi aziendali multi-step.

COCO pianifica uno scenario di test, lo esegue sull'applicazione reale, cattura screenshot prima/dopo e registrazioni dell'esecuzione come prova, e produce una valutazione in linguaggio semplice su cosa ha funzionato, cosa no e perché — inclusi casi limite come login falliti ripetuti, blocchi account e flussi di recupero, tediosi e soggetti a errori se testati manualmente. Poiché il server è gestito localmente da noi, i clienti enterprise mantengono il pieno controllo su dove vengono archiviati i dati di test e gli screenshot, senza inviare per impostazione predefinita il traffico applicativo interno a un servizio cloud di terze parti.

COCO — il nostro server IA per il testing automatizzato del software

Per i clienti enterprise, gestiamo e manteniamo un server IA dedicato, chiamato COCO. A differenza di un chatbot generico aggiunto a un flusso di lavoro, COCO è progettato appositamente e ospitato in autonomia specificamente per il testing automatizzato di software web e applicazioni desktop multipiattaforma — dai flussi di login e autenticazione a interi processi aziendali multi-step.

COCO pianifica uno scenario di test, lo esegue sull'applicazione reale, cattura screenshot prima/dopo e registrazioni dell'esecuzione come prova, e produce una valutazione in linguaggio semplice su cosa ha funzionato, cosa no e perché — inclusi casi limite come login falliti ripetuti, blocchi account e flussi di recupero, tediosi e soggetti a errori se testati manualmente. Poiché il server è gestito localmente da noi, i clienti enterprise mantengono il pieno controllo su dove vengono archiviati i dati di test e gli screenshot, senza inviare per impostazione predefinita il traffico applicativo interno a un servizio cloud di terze parti.

Configuriamo e manteniamo COCO individualmente per ogni cliente enterprise — definendo i piani di test rilevanti per la loro specifica applicazione, calibrando le soglie di confidenza e decidendo caso per caso quando un risultato deve essere sottoposto a revisione umana. L'obiettivo non è sostituire un team QA, ma dargli un collega instancabile che esegue i test di regressione ripetitivi prima di ogni rilascio, prima ancora che debba intervenire una persona.

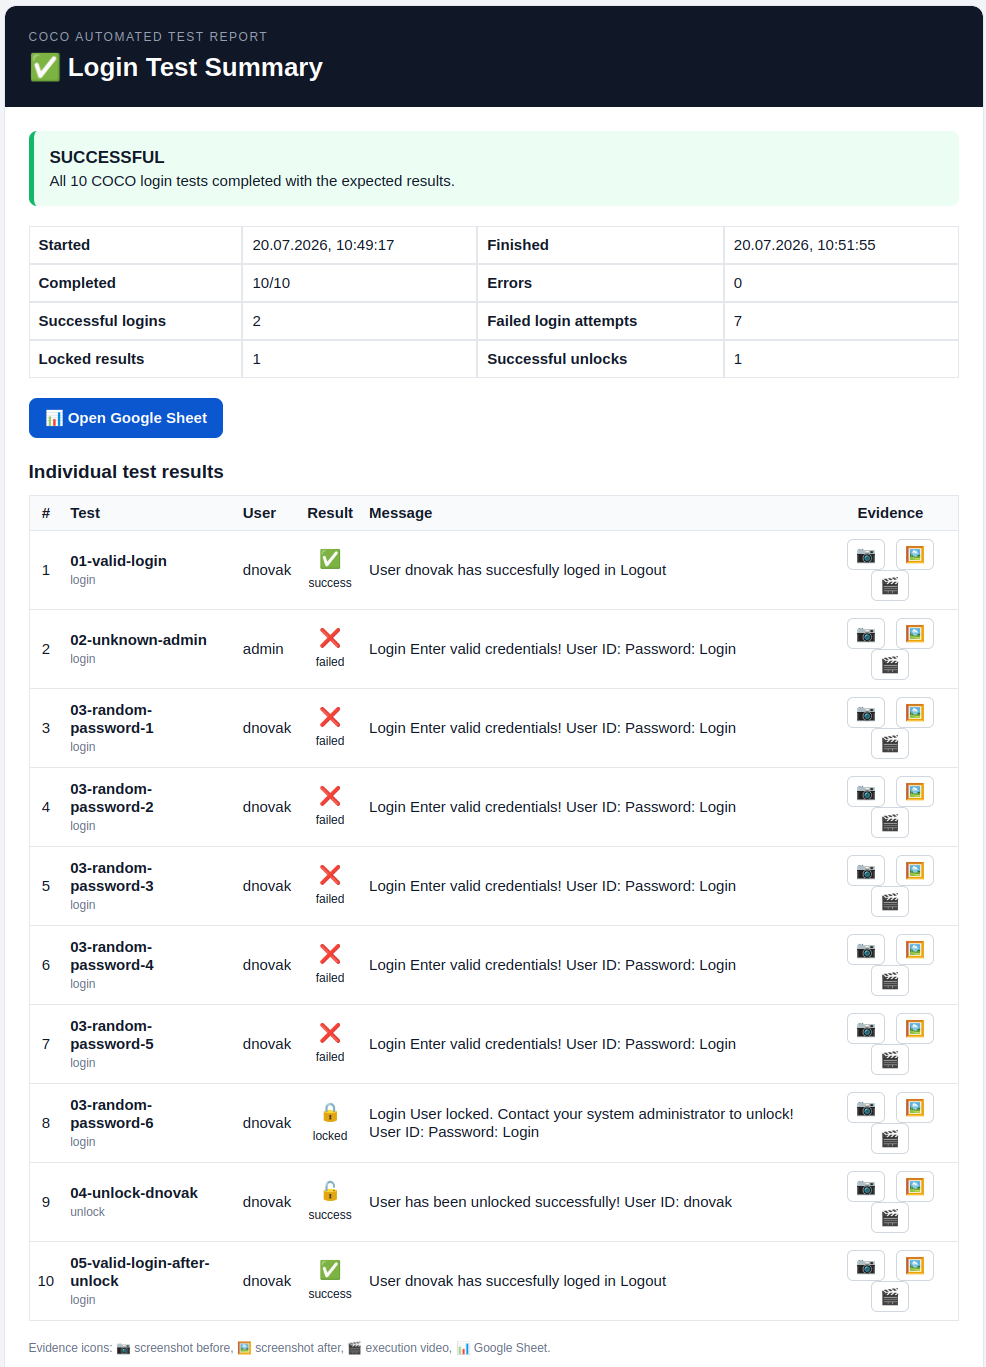
COCO automated login test report
COCO — automated login & account-lockout test report
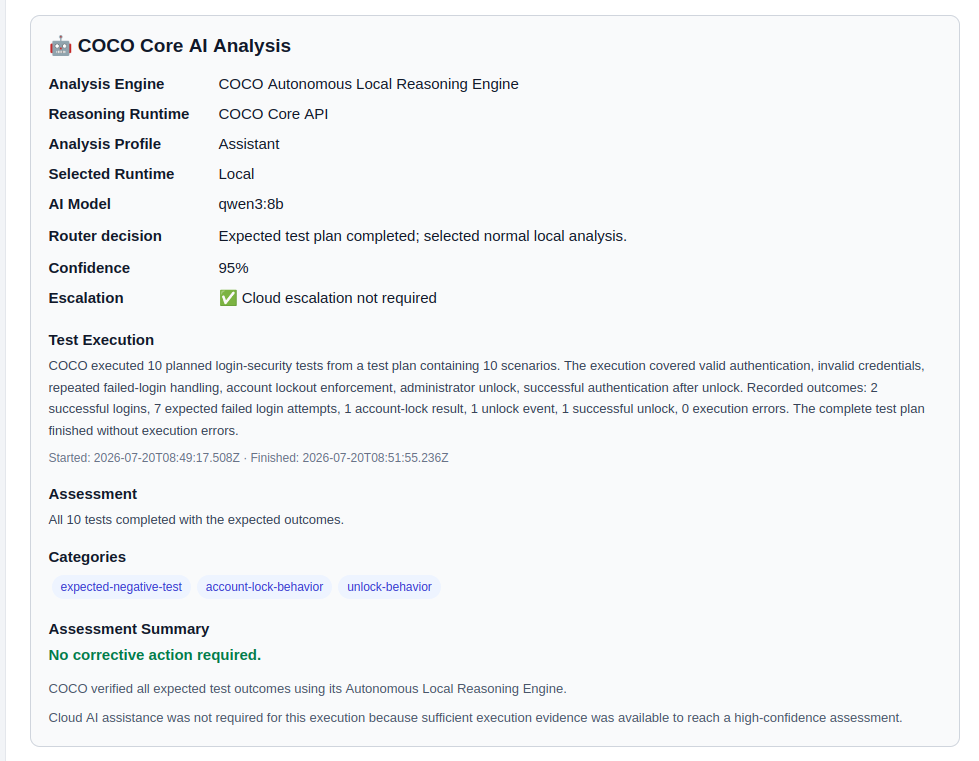
COCO AI analysis panel
COCO — plain-language AI analysis of a completed test run

Perché softify.pro

Restiamo deliberatamente abbastanza piccoli da far seguire ogni progetto dalle stesse persone presenti alla conversazione di pianificazione iniziale, senza passaggi di mano a una coda. Questo significa cicli di feedback più brevi, meno fraintendimenti e un team che, anche dopo sei mesi, ricorda ancora perché è stata presa una certa decisione. Preferiamo un'affidabilità noiosa e dimostrabile all'inseguimento delle tendenze: uno stack tecnologico viene scelto perché è adatto al problema e potrà essere mantenuto da qualcun altro tra cinque anni, non perché era di moda nello sprint in cui è stato scelto. Se un foglio di calcolo fa ancora il suo lavoro meglio di un software su misura, ve lo diciamo comunque — il nostro obiettivo è un flusso di lavoro davvero più veloce, non semplicemente una fattura software più alta.

Lavori selezionati

Una piccola selezione di lavori che possiamo mostrare pubblicamente — ulteriori case study e progetti enterprise sono disponibili su richiesta sotto NDA.

Koralpenhaus

Koralpenhaus

Sito regionale di presentazione e prenotazione nell'arco alpino, realizzato con attenzione a struttura chiara, caricamento rapido e facile gestione dei contenuti.

Dexosano

Dexosano

Una moderna piattaforma web basata su PHP, sviluppata con lo stesso approccio orientato alle prestazioni che softify.pro applica a ogni progetto cliente.

Case Study

softify.pro Flow — Testato da COCO

softify.pro Flow — Testato da COCO

21.08.2026

Control. Clarity. Flow.

Ogni prodotto software serio, prima o poi, sviluppa un secondo prodotto dietro il prodotto.

I clienti potrebbero non vederlo mai. I visitatori potrebbero non sapere mai che esiste. Ma amministratori, operatori e sviluppatori ne dipendono ogni giorno.

Per softify.pro Flow, quell'applicazione è Administration — la console operativa responsabile della gestione di utenti, ruoli, livelli di accesso, stati di autenticazione, ambienti di database e altre configurazioni che tengono sotto controllo un'installazione di Flow.

La sua schermata di login porta tre parole:
Control. Clarity. Flow.

Furono scelte originariamente per descrivere l'esperienza che volevamo che gli amministratori avessero operando il sistema.

Ma descrivono anche, sorprendentemente bene, come crediamo che il software debba essere testato.

Questo ha reso softify.pro FlowAdministration un candidato ovvio per un test reale di COCO.
Non una dimostrazione da laboratorio.
Non una raccolta di pulsanti isolati preparati appositamente per una demo AI.
Un'applicazione desktop multipiattaforma reale, con logica applicativa reale, finestre multiple, backend di database multipli, autenticazione, permessi, localizzazione e abbastanza stato da rendere regressioni apparentemente piccole difficili da individuare manualmente.

Per la dimostrazione pubblica qui mostrata, COCO ha lavorato esclusivamente con dati dimostrativi generati. L'applicazione era concessa in licenza alla azienda fittizia Presentation GmbH, e non sono state usate informazioni clienti, credenziali o dati personali di produzione.

L'obiettivo era semplice:
lasciare che COCO affrontasse l'applicazione come farebbe un tester e determinasse se l'intero flusso di lavoro amministrativo si comporta ancora come il software dichiara.

The Challenge

A prima vista, testare un'applicazione di amministrazione sembra semplice.

Aprila.
Accedi.
Clicca attraverso diverse finestre.
Controlla che tutto sembri corretto.

Questa ipotesi cambia rapidamente man mano che l'applicazione cresce.

softify.pro FlowAdministration non è un singolo modulo statico. È una raccolta di viste operative interconnesse dentro un unico guscio applicativo.

Tra le altre cose, un amministratore può lavorare con:

  • account utente
  • ruoli e livelli di accesso
  • informazioni di autenticazione
  • stato dell'autenticazione a due fattori
  • informazioni sul sistema operativo
  • informazioni di rete e IP
  • configurazione del database
  • opzioni di ordinamento e presentazione
  • selezione della lingua in tempo reale
  • informazioni sull'applicazione e sulla licenza

L'interfaccia attualmente supporta undici lingue. L'applicazione opera anche con MySQL e PostgreSQL backend di database. Presa singolarmente, nessuna di queste funzionalità rappresenta un problema di test insolito.

La difficoltà nasce dalle loro combinazioni.
Una tabella utenti può funzionare correttamente in inglese ma mostrare il nome di una colonna obsoleto in croato.
L'ordinamento può funzionare correttamente collegato a MySQL ma comportarsi diversamente dopo il passaggio a PostgreSQL.

Un cambio di lingua può aggiornare la maggior parte degli elementi dell'interfaccia lasciando un messaggio di stato non tradotto. L'applicazione può cambiare database con successo ma conservare informazioni obsolete dalla connessione precedente. Una nuova release può introdurre una funzione mentre la finestra "Informazioni" descrive ancora quella precedente. Il programma non deve necessariamente andare in crash perché una di queste situazioni sia una regressione. Anzi, alcuni dei difetti software più fastidiosi sono proprio quelli in cui tutto sembra funzionare.

L'applicazione si avvia.
La finestra si apre.
Il pulsante risponde.
Ma qualcosa sotto non è più del tutto corretto.
Ecco perché il test di regressione ripetitivo è importante.

Ed è esattamente il tipo di lavoro in cui gli esseri umani diventano progressivamente meno bravi dopo aver ripetuto la stessa sequenza decine di volte.

Why Manual Testing Becomes Expensive

Testare qualcosa una volta è facile.
Testarlo in modo affidabile dopo ogni release rilevante è diverso.

Considera solo tre dimensioni: 11 lingue di interfaccia × 2 backend di database × molteplici flussi di lavoro applicativi.

Il numero di combinazioni cresce rapidamente.
Aggiungi ruoli utente diversi, stati di autenticazione, comportamento di ordinamento, modifiche di configurazione e ambienti operativi, e la matrice di test diventa troppo grande per essere trattata come una checklist manuale occasionale.

È qui che il test di regressione spesso comincia a erodersi.
Non deliberatamente.
Una scadenza di release si avvicina.
Qualcuno ricorda che l'applicazione è stata testata la settimana scorsa.
Uno sviluppatore controlla rapidamente la schermata più importante.

Il tedesco funziona.
L'inglese funziona.
MySQL funziona.
L'ipotesi diventa:
"Il resto probabilmente va bene."

Di solito è così.
Fino alla release in cui non lo è.
COCO esiste in parte per rimuovere questa ipotesi dal processo.

What COCO Actually Did

COCO ha avviato softify.pro FlowAdministration da uno stato applicativo a freddo, senza affidarsi a una schermata già preparata o a un flusso di lavoro posizionato manualmente.

La prima interazione è stata la stessa presentata a un amministratore umano: la finestra di login.

COCO ha identificato l'interfaccia di autenticazione contenente:

  • nome utente
  • password
  • codice di autenticazione a due fattori

e la riga direttamente sotto l'identità softify.pro Flow:
Control. Clarity. Flow.

Da lì, COCO ha proseguito attraverso una sessione di regressione definita. Lo scopo non era semplicemente determinare se l'applicazione potesse essere aperta.

Lo scopo era verificare se lo stato dell'applicazione rimanesse internamente coerente mentre COCO interagiva con essa.

Authentication Is Only the Beginning

Il test del login è uno dei candidati più ovvi per l'automazione, ma un'autenticazione riuscita da sola dice molto poco sul resto di un'applicazione amministrativa.

Una volta dentro, COCO si è spostato nell'ambiente operativo vero e proprio. Ha ispezionato l'interfaccia di amministrazione utenti e verificato che le informazioni attese fossero presenti.

Questo includeva dati come:

  • nomi utente
  • password mascherate
  • indicatori 2FA
  • ruoli assegnati
  • informazioni sul sistema operativo
  • indirizzi IP

COCO ha poi interagito con la tabella anziché limitarsi a osservarla.
L'elenco utenti è stato ordinato per nome utente.
L'ordine risultante è stato ispezionato.
La parte importante non era se cliccare sull'intestazione della colonna producesse un qualche cambiamento visibile.

COCO ha verificato che lo stato risultante della tabella corrispondesse all'operazione richiesta.

Questa distinzione conta.
Un test funzionale chiede:
"Il pulsante ha risposto?"

Un test di regressione utile chiede:
"L'applicazione è finita nello stato corretto?"

Testing the Database Boundary

softify.pro Flow supporta più di un backend di database.

Questo rende il cambio di database un confine di regressione particolarmente importante.
COCO ha cambiato il backend attivo da MySQL a PostgreSQL.

Dopo il cambio, ha ispezionato di nuovo le informazioni utente.
Il test cercava più di una connessione riuscita.
Ha verificato se l'applicazione continuasse a presentare i record attesi e se le informazioni mostrate tramite l'interfaccia rimanessero coerenti.

COCO è poi tornato indietro.

Questo tipo di transizione è facile da sottovalutare.
L'interfaccia utente può rimanere visivamente identica mentre il livello di archiviazione sottostante cambia completamente.
Dal punto di vista di un amministratore, quella transizione dovrebbe sembrare quasi noiosa.
Gli stessi utenti dovrebbero essere ancora comprensibili.
Gli stessi ruoli dovrebbero avere ancora senso.

Lo stesso comportamento dell'interfaccia dovrebbe ancora valere.

Quella continuità apparentemente priva di eventi è esattamente ciò che va dimostrato.

Eleven Languages, One Application State

La localizzazione è un'altra area in cui il test superficiale è particolarmente pericoloso.

È relativamente facile verificare che un'applicazione possa avviarsi in un'altra lingua.
È molto più prezioso verificare cosa succede quando la lingua cambia mentre l'applicazione è già in esecuzione e mantiene uno stato.

COCO ha cambiato la lingua dell'interfaccia in tempo reale.

La sessione includeva transizioni tra lingue come:
Tedesco → Inglese → Croato
mentre la vista di amministrazione rimaneva attiva.

COCO ha osservato se gli elementi dell'interfaccia cambiavano correttamente sul posto:

  • intestazioni di tabella
  • controlli
  • pulsanti
  • etichette
  • messaggi di stato

Anche la tabella sottostante e lo stato dell'applicazione dovevano sopravvivere a quella transizione.
Questo è importante perché il software multilingue è fatto di più che stringhe tradotte.
I cambi di lingua possono rivelare:

  • risorse dimenticate
  • etichette obsolete
  • problemi di layout
  • messaggi di stato non tradotti
  • problemi di codifica
  • reset dello stato
  • problemi di ricreazione dei controlli

Una finestra che appare corretta quando avviata direttamente in croato può comunque comportarsi in modo scorretto quando l'utente passa dal tedesco al croato durante una sessione attiva.

Questa è la differenza tra controllare uno screenshot e testare un flusso di lavoro.

Restoring Application State

COCO ha successivamente ripristinato la configurazione di ordinamento predefinita dell'applicazione.

Anche qui, il test non è finito con il clic stesso.

Sono stati valutati l'ordine risultante e la conferma presentata tramite l'area di stato dell'applicazione. Questo tipo di verifica può sembrare insignificante rispetto al test dell'autenticazione o dell'accesso al database.

Non lo è.

Le applicazioni enterprise accumulano centinaia di piccole transizioni di stato come queste.
Gli utenti fanno affidamento su di esse senza pensarci consapevolmente.
Il software sembra affidabile proprio perché quelle interazioni restano prevedibili.
Il test di regressione esiste per proteggere quella prevedibilità.

Testing the Information Around the Software

COCO ha anche aperto la finestra "Informazioni su" dell'applicazione.

Perché testare una finestra Informazioni?

Perché la documentazione del software inizia dentro il software stesso.
Il numero di versione, la descrizione delle funzionalità e le informazioni di licenza presentate all'operatore dovrebbero corrispondere all'applicazione effettivamente in esecuzione.

Un'applicazione può funzionare perfettamente pur presentando informazioni di versione obsolete o descrivendo funzionalità che non corrispondono più alla release.

Questo non manda in crash un database.
Fa qualcosa di più sottile:
riduce la fiducia.

Per il software enterprise, l'accuratezza operativa include anche questi dettagli apparentemente piccoli. COCO li ha quindi controllati anch'essi.

Control.

La prima parola dello slogan di softify.pro Flow è anche il primo principio dell'ambiente di test.

Control significa sapere cosa viene testato, contro quale stato e con quali dati.

La dimostrazione pubblica di COCO non usa dati di produzione dei clienti.

Funziona con dati dimostrativi appositamente preparati, il cui stato atteso è noto.

Questo rende i risultati riproducibili.

Significa anche che le differenze tra le esecuzioni di test possono essere indagate anziché essere liquidate come cambiamenti casuali nei dati di produzione.

Cosa ancora più importante, COCO è progettato come sistema di test AI self-hosted.

Le evidenze di test, gli screenshot dell'applicazione e le informazioni sul flusso di lavoro interno possono rimanere all'interno dell'infrastruttura sotto il controllo del cliente o dell'operatore, invece di essere inviate di default a un servizio cloud di terze parti non correlato.

Per le applicazioni aziendali interne, questo non è semplicemente una preferenza infrastrutturale.
Può far parte del requisito di test stesso.

Clarity.

L'automazione non è particolarmente utile se il suo output finale è: FAILED
seguito da centinaia di righe di output tecnico che qualcuno deve ricostruire manualmente prima di capire cosa sia successo.

COCO è progettato per preservare una traccia di evidenza comprensibile.

Il report descrive:

  • cosa è stato testato
  • quale interazione ha avuto luogo
  • in quale sequenza è avvenuta
  • cosa ha osservato COCO
  • quale stato era previsto
  • dove il comportamento è differito quando qualcosa è fallito

Screenshot e prove di esecuzione possono accompagnare quella sequenza.
Lo scopo non è nascondere i dettagli tecnici.

È rendere il risultato comprensibile prima che qualcuno debba aprire un debugger.

Un ingegnere dovrebbe poter rispondere a:
Cosa è successo? prima di chiedere:
Dove nel codice è successo?

Questa distinzione accorcia drasticamente l'indagine quando appare una regressione.

Flow.

L'automazione UI tradizionale spesso pensa per elementi.

Trova selettore.
Clicca selettore.
Trova un altro selettore.
Controlla il valore.

Questo approccio resta utile, ma le applicazioni non si vivono come raccolte di selettori.

Le persone vivono flussi.

Accedi.
Apri l'amministrazione.
Trova un utente.
Cambia un'impostazione.
Cambia un database.
Cambia una lingua.
Verifica il risultato.

Continua a lavorare.

COCO tratta quindi la sequenza come un processo, non come una raccolta casuale di controlli.

Segue ciò che l'utente sta cercando di ottenere e valuta l'applicazione nel contesto.

Questo diventa particolarmente prezioso quando si testa software aziendale reale, perché i guasti si verificano spesso tra schermate o tra stati, non dentro un singolo pulsante.

Un flusso logistico può contenere un ordine, una prenotazione di magazzino, un'operazione di prelievo, una bolla di consegna e una conferma di spedizione.
Ogni singola schermata può apparire corretta mentre l'intero processo è sbagliato.
Lo stesso principio si applica qui su scala minore.
La finestra di amministrazione non è il prodotto.

Il flusso di lavoro attraverso di essa lo è.

Evidence Instead of Assumption

Uno dei compiti più importanti di COCO non è cliccare. È ricordare cosa è successo.
Il test di regressione umano finisce spesso con un'affermazione come:
"L'ho testato e sembrava tutto a posto."

Potrebbe essere del tutto accurato.
Ma settimane dopo, quando emerge un problema, le domande utili sono diverse:

  • Quale release è stata testata?
  • Quale database?
  • Quale lingua?
  • Quale stato utente?
  • Cosa è successo prima del problema?
  • Cosa esattamente era visibile?

In quale ordine sono state eseguite le azioni?
Le esecuzioni di test di COCO sono progettate per lasciare tracce.

Questo trasforma un risultato di test da un'opinione a qualcosa che può essere ispezionato.
Un'esecuzione riuscita diventa quindi utile anch'essa.
Stabilisce uno stato di riferimento noto rispetto al quale confrontare il comportamento successivo.

COCO Is Not the Decision Maker

C'è un confine importante nel modo in cui usiamo l'AI per il test del software.
COCO non intende sostituire la responsabilità ingegneristica.

Non decide come dovrebbe essere una regola di business.

Testa il comportamento rispetto a scenari, requisiti e aspettative definiti per l'applicazione.
Per decisioni sensibili riguardanti permessi, prezzi, inventario, transazioni finanziarie o altri stati aziendali critici, la definizione del comportamento corretto resta una responsabilità umana.

Questa distinzione conta.
L'AI è eccellente nel ripetere un test dettagliato senza perdere concentrazione.
È eccellente nel raccogliere evidenze.
Può ispezionare schermate, confrontare comportamento atteso e osservato e spiegare le discrepanze.
Ma è l'azienda a definire ancora cosa significhi corretto.

COCO rende testabile quella definizione.

The Test Nobody Wants to Repeat

C'è un motivo semplice per cui l'automazione aggiunge valore qui.
Un tester umano può certamente eseguire questa sessione di regressione.
La prima lingua riceve piena attenzione.
Probabilmente anche la seconda.
Poi un'altra.
Poi un'altra ancora.
MySQL è già stato controllato.
PostgreSQL deve ancora essere controllato.
Il test di ordinamento è già stato eseguito diverse volte.
La finestra Informazioni non è cambiata da mesi.

È venerdì pomeriggio.

E l'attenzione umana fa ciò che l'attenzione umana fa naturalmente.
Inizia a ottimizzare.
COCO no.
Nello spirito di COCO stesso:

  • Non mi stanco di cliccare lo stesso pulsante in undici lingue. Non salto il passaggio PostgreSQL solo perché è venerdì pomeriggio. Non presumo che l'ordinamento abbia tenuto solo perché ha funzionato nella release precedente.

Per COCO, ogni sessione di regressione può essere trattata come se fosse la prima.
Questo non è intelligenza che sostituisce un tester umano.
È automazione che protegge il tester umano dalla parte del test in cui l'attenzione umana vale meno.

From Repetitive Testing to Engineering Evidence

Lo scopo più ampio di COCO non è massimizzare il numero di azioni automatizzate.
Mille clic automatizzati non hanno senso se nessuno capisce cosa dimostrano. Il risultato utile è la fiducia sostenuta da evidenze.

Per softify.pro Flow, questo significa poter dire che una release è stata verificata nelle aree operative che contano:

  • autenticazione
  • amministrazione utenti
  • informazioni su ruoli e accessi
  • stato dell'autenticazione a due fattori
  • comportamento di ordinamento
  • funzionamento con MySQL
  • funzionamento con PostgreSQL
  • localizzazione live
  • feedback di stato
  • informazioni sull'applicazione
  • informazioni sulla licenza

e che il risultato è conservato in una forma che può essere rivista in seguito.
Lo stesso principio si estende ben oltre questa applicazione.
Un processo di login può essere testato così.
Un flusso di prenotazione può essere testato così.
Un processo logistico può essere testato così.
Un'applicazione desktop multipiattaforma può essere testata così.
Le schermate cambiano.
Le regole di business cambiano.
Il principio no:
definire il flusso di lavoro atteso, eseguirlo in modo coerente, raccogliere evidenze e rendere il risultato comprensibile.

Why We Test Our Own Software With COCO

C'è un altro motivo per cui softify.pro Flow conta come caso di studio di COCO.

È il nostro stesso software.
Questo elimina la comoda distanza che a volte esiste tra una dimostrazione tecnologica e le persone che la fanno.

Se COCO deve testare software enterprise, deve essere abbastanza utile perché noi ci fidiamo a usarlo con software che sviluppiamo e rilasciamo noi stessi.

Flow funge quindi sia da prodotto che da banco di prova.
Nuove capacità di test possono essere esercitate contro un'applicazione reale.
Comportamenti inattesi possono rivelare debolezze nell'applicazione, nel piano di test o in COCO stesso.

Ogni lato migliora l'altro.
Questo ciclo di feedback è molto più prezioso della costruzione di dimostrazioni artificiali progettate solo per avere successo. Un sistema di test non dovrebbe sembrare convincente perché la dimostrazione era facile.
Dovrebbe diventare convincente perché continua a trovare le piccole cose che gli esseri umani finirebbero per smettere di controllare.

The Result

softify.pro FlowAdministration ha ora un processo di regressione documentato e ripetibile che COCO può eseguire prima delle release rilevanti.

Il test copre entrambi gli ambienti di database supportati e l'interfaccia in undici lingue dell'applicazione, seguendo l'applicazione come farebbe un amministratore, invece di trattare ogni schermata come un bersaglio di test isolato.

COCO produce una traccia di evidenza che mostra cosa è stato testato, cosa è stato osservato e in quale ordine si è svolta la sessione.

Quella evidenza può rimanere sotto controllo locale.
Gli sviluppatori ottengono un punto di partenza riproducibile quando qualcosa cambia.
I tester umani passano meno tempo a ripetere interazioni prevedibili e più tempo a indagare le situazioni che richiedono davvero giudizio.

E softify.pro Flow riceve qualcosa di più prezioso di un indicatore verde PASS.

Riceve la prova che l'esperienza promessa sulla sua schermata di login continua a esistere dopo che il codice sottostante è cambiato.

Control. Sapere cosa viene testato e tenere l'ambiente sotto controllo.

Clarity. Capire cosa è successo senza dover ricostruire un log di automazione opaco.

Flow. Testare l'applicazione come un processo che le persone usano davvero.

Control. Clarity. Flow.

È stato scritto per il software.
Si è scoperto che descrive altrettanto bene la filosofia di test che ne sta dietro.

Link permanente →

softify.pro - Insiders

COCO colpisce ancora

COCO colpisce ancora

Probabilmente dovremmo smettere di dare idee a COCO.
L'esperimento precedente doveva essere sufficiente.
Un'applicazione reale.
Navigazione reale.
Utenti.
Ruoli.
Database.
Lingue.
Prove.

Un caso di studio rispettabile.
Una conclusione pulita.
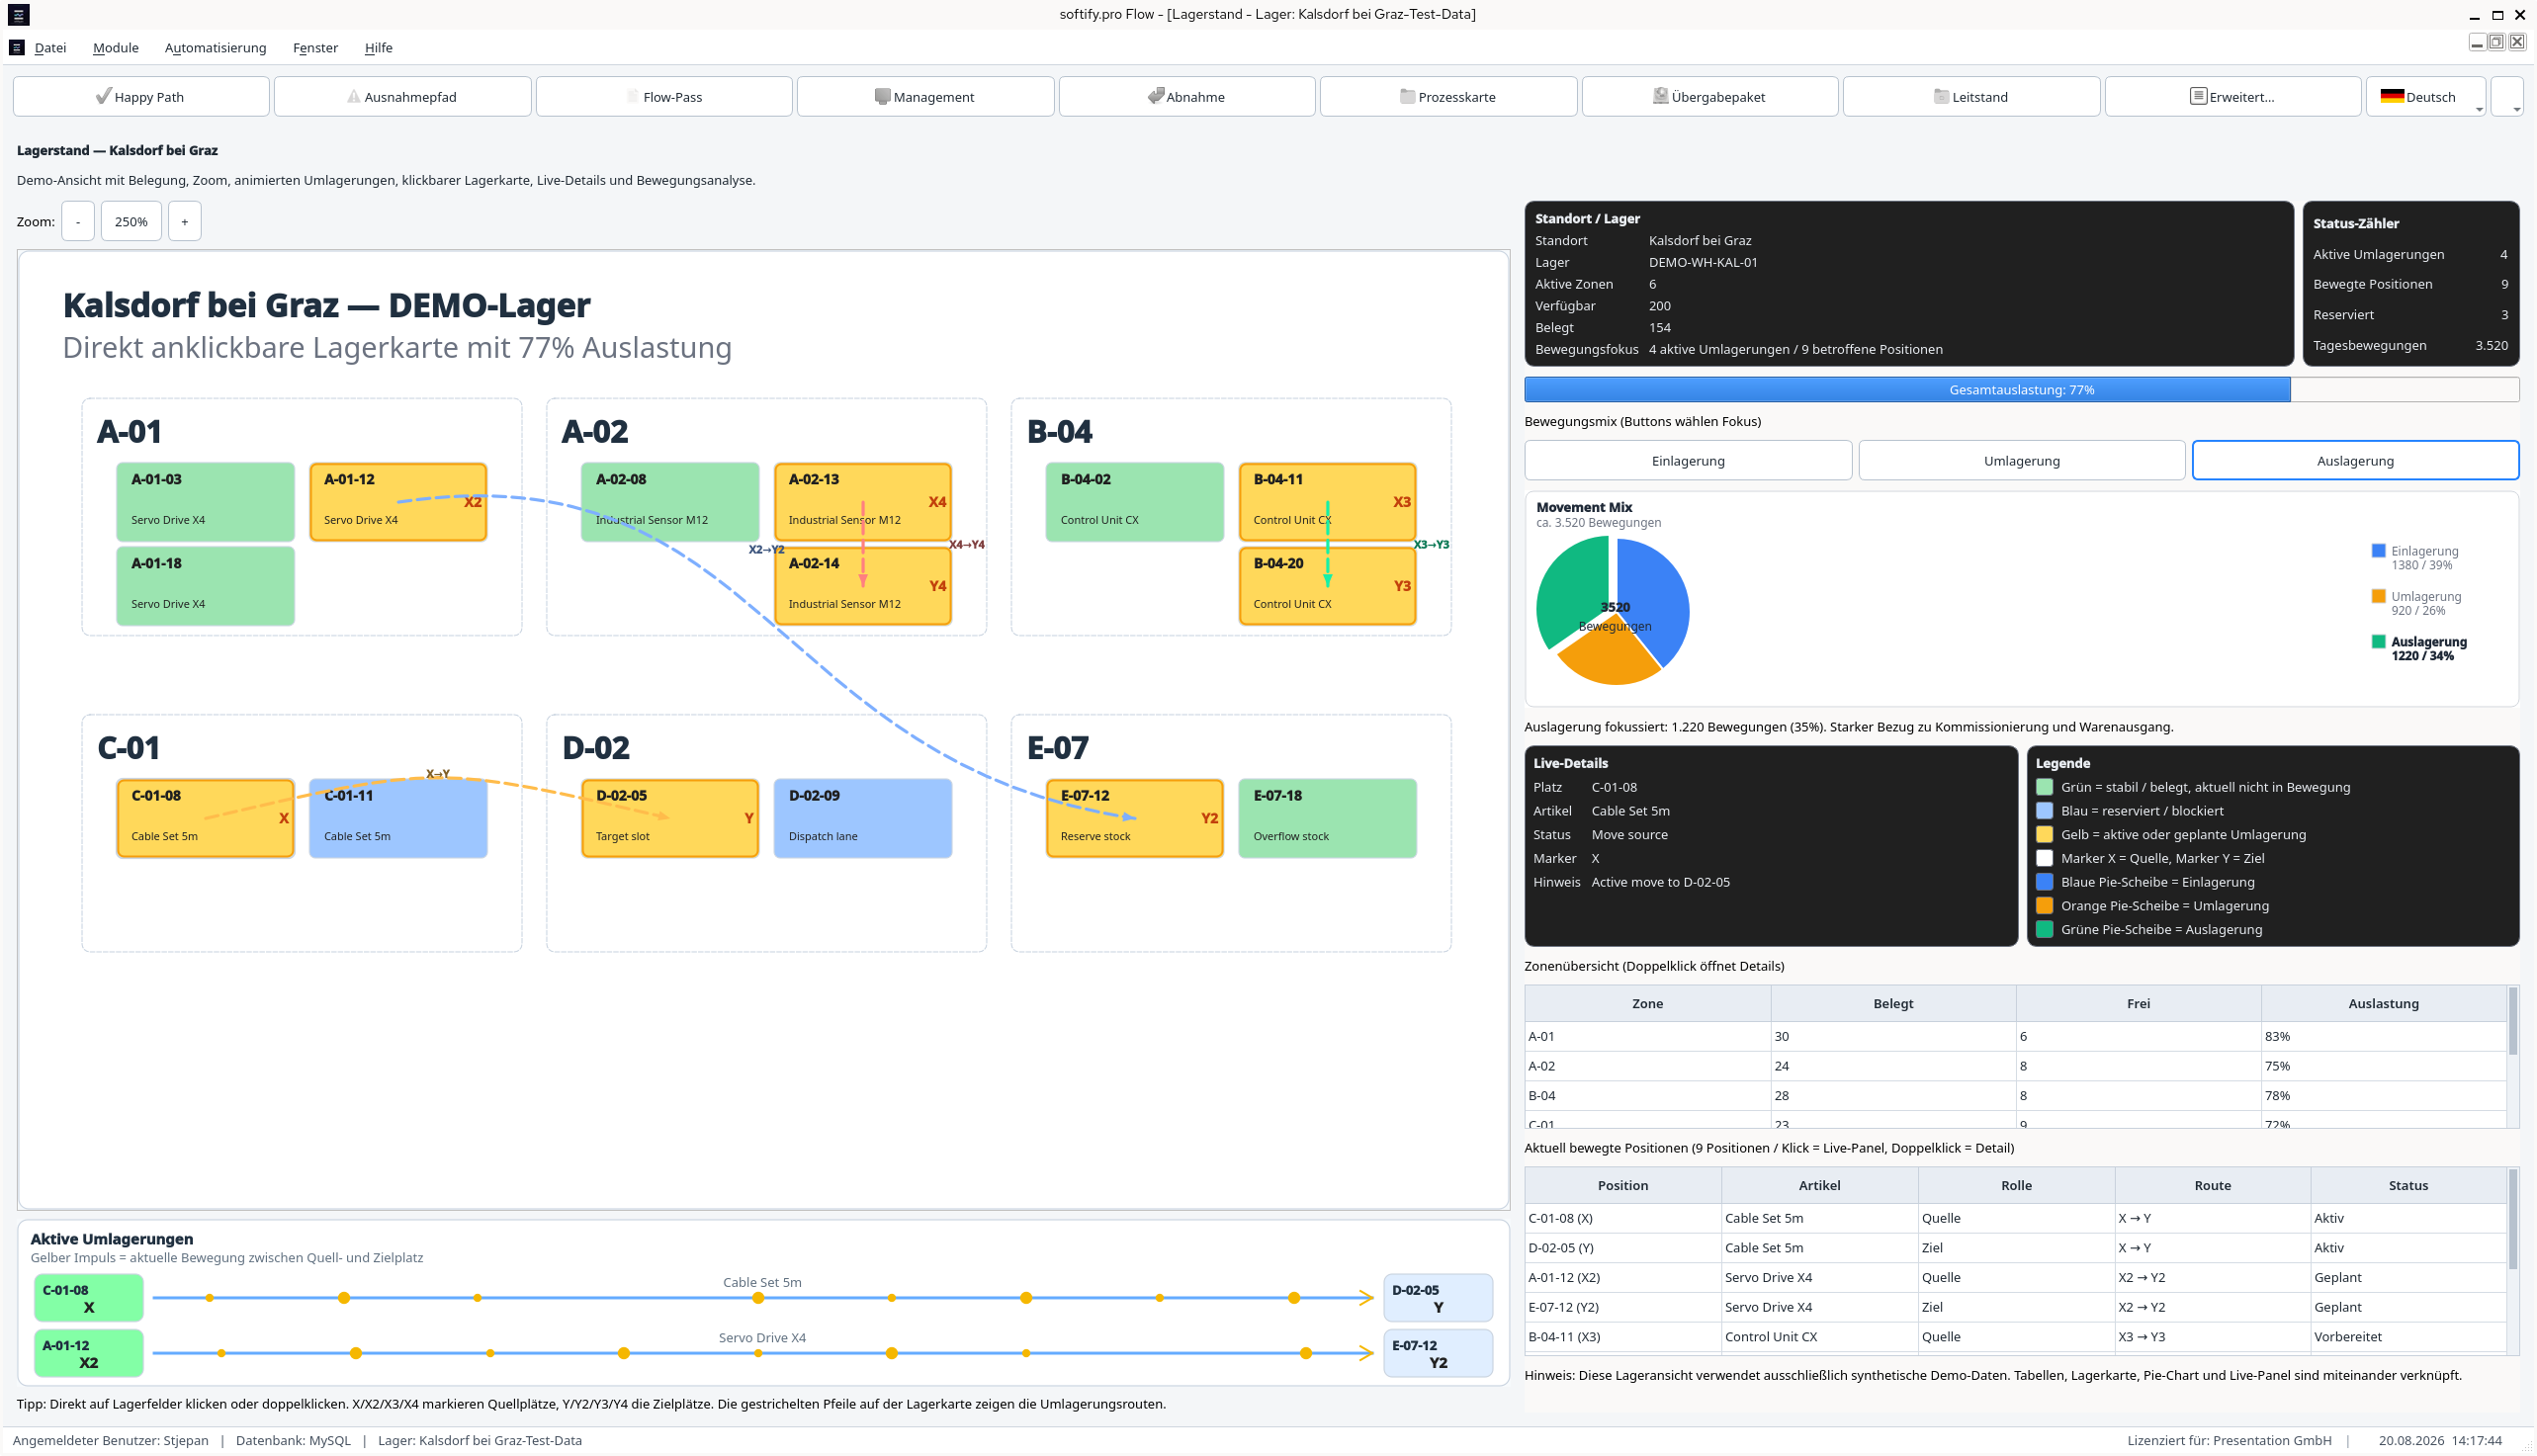
Poi qualcuno l'ha mostrato: Logistics in Motion.
Quello è stato probabilmente l'errore.


È iniziato con tre magazzini
Niente di particolarmente eccitante.
Tre magazzini DEMO.
  • Kalsdorf bei Graz.
  • Wiener Neustadt.
  • Klagenfurt.
Dati sintetici.
Nessuna informazione sui clienti.
Nessun inventario di produzione.

Esattamente il tipo di ambiente in cui non dovrebbe succedere nulla di importante.
Poi è stato selezionato il primo magazzino.
E l'applicazione ha acquisito contesto.
Da quel momento, ogni schermata aveva un'altra domanda associata.

Questo appartiene ancora allo stesso magazzino?
La lingua cambia solo l'interfaccia?
Il processo rimane allo stesso passo?
L'inventario concorda ancora?
Il riferimento del documento punta ancora all'evento giusto?
L'operatore vede esattamente ciò che serve per l'azione successiva?


Improvvisamente, la parte interessante non era più la schermata.
Era la continuità tra le schermate.

COCO tende a farlo.

La logistica non è una collezione di schermate
Dall'esterno, il software di magazzino può sembrare ingannevolmente semplice.
La merce arriva.
Viene immagazzinata.
Qualcuno la ordina.
Viene prelevata.
Viene spedita.
Fatto.

Solo che si nasconde un intero mondo operativo tra arrivato e spedito.
Atteso.
Ricevuto.
Verificato.
Disponibile.
Riservato.
Spostato.
Prelevato.
Bloccato.
Corretto.
Spedito.
Verificato (audit).


Il movimento fisico conta.
Ma è la transizione di stato che rende quel movimento comprensibile al software.
E quando queste due realtà smettono di corrispondere, qualcuno alla fine ha una brutta giornata.

Flow.

Un magazzino è più facile da capire quando il movimento è visibile, non solo registrato.
Ecco perché il nostro lavoro logistico non è mai davvero iniziato con menu, dashboard, o tecnologia.
Inizia con il Flow materiale.

Dove entrano le informazioni?
Dove cambiano?
Dove possono andare perse?

Dove qualcuno è costretto a chiedere a un'altra persona cosa è successo?
Dove un passaggio manuale diventa silenziosamente la parte più debole di un processo altrimenti automatizzato?
A volte la risposta è una nuova interfaccia.
A volte un'integrazione.
A volte uno scanner.
A volte semplicemente un modello di stato migliore.

Più software non è automaticamente software migliore.
L'obiettivo non è l'automazione fine a se stessa.
L'obiettivo è un processo che rimane comprensibile.

Control. Clarity. Flow.

Il processo inizia prima della prima registrazione.
Prima del ricevimento merce.
Prima del prelievo.
Prima del movimento di inventario.
Prima della prima transazione.
Flow pone una domanda molto semplice:
In quale magazzino stiamo lavorando?
Sembra quasi banale.
Non lo è.
Il contesto del magazzino appartiene a tutto ciò che segue.
Inventario.
Documenti.
Ubicazioni.
Prelievo.
Trasferimenti.
Storico degli audit.
Eccezioni.

Il processo può apparire perfettamente sano mentre opera nel contesto sbagliato.
Questo è esattamente il tipo di problema che uno screenshot raramente rivela.
Ed è esattamente il tipo di confine che a COCO piace mettere in discussione.

La lingua è facile, finché non lo è più
Tedesco.
Inglese.
Croato.
Norvegese.
E altre.

Un profilo utente definisce le lingue disponibili.
L'operatore cambia lingua mentre l'applicazione è attiva.
L'interfaccia cambia immediatamente.
Il processo aziendale non deve cambiare.
Questa distinzione è importante.
Il magazzino non si sposta perché è cambiata la parola per magazzino.
L'ordine di prelievo non ricomincia perché l'utente ha selezionato un'altra lingua.
Una prenotazione non scompare.
Un'eccezione non appartiene improvvisamente a un'altra transazione.
Il processo rimane dove si trova.
Solo la sua rappresentazione cambia.
Sembra ovvio.

Finché non ci si rende conto di quante applicazioni trattano un cambio di lingua quasi come una nuova sessione.

Un'applicazione aziendale multilingue non dovrebbe farlo.
Lo stato di presentazione può cambiare.
Lo stato aziendale deve rimanere stabile.
Questo rende il cambio di lingua un test di regressione sorprendentemente utile.
Una piccola funzione.
Una linea di faglia molto buona.
A COCO piacciono le linee di faglia.

Passo dopo passo, l'applicazione inizia ad accumulare storia
La merce arriva.
Il processo avanza.
Il ricevimento merce viene registrato.
L'inventario cambia.
Lo stato del magazzino riflette la nuova realtà.
Il prelievo inizia.
Lo stock diventa riservato.
L'operatore riceve un compito.

Una vista mobile riduce l'intero processo a ciò che conta in quel preciso momento:
Posizione.
Ubicazione di magazzino.
Quantità.
SSCC.
Operatore.
Niente di più.
Niente di meno.
Questo è importante.
L'interfaccia mobile non è un secondo processo aziendale.
È un'altra vista dello stesso processo.
L'applicazione di magazzino può sapere tutto.
Il prelevatore non dovrebbe doverlo sapere.
Clarity non significa sempre mostrare più informazioni.
A volte clarity significa avere la disciplina di nascondere quasi tutto.

Poi qualcuno scansiona l'ubicazione sbagliata
È qui che un workflow logistico diventa più interessante di un elenco di funzionalità.
L'ubicazione attesa è una cosa.
L'ubicazione scansionata è un'altra.
Flow si ferma.
Non si blocca.
Si ferma.
C'è una differenza.
Lo stato del processo rimane visibile.
Lo stock interessato rimane comprensibile.
L'eccezione diventa esplicita.

La Guida contestuale spiega ciò che è rilevante per la situazione attuale.
L'utente risolve la discrepanza.
Il processo continua.
Questo momento dice di più sul software operativo di quanto facciano diverse pagine di screenshot del percorso ideale.
La logistica reale non è difficile quando tutto è corretto.
La logistica reale diventa difficile quando qualcosa è quasi corretto.
Un sistema utile non nasconde questo dietro un dashboard verde.
Dà all'eccezione uno stato.

Una ragione.
Una storia.
E una via da seguire.


I documenti ricordano ciò che le persone dimenticano

Man mano che il workflow procede, i riferimenti iniziano ad accumularsi.
ASN.
Ricevimento merce.
Movimento di magazzino.
Prelievo.
Spedizione.
Flow.
La parte interessante non è che i documenti esistono.
La parte interessante è che raccontano la stessa storia del processo.
Perché questo stock è qui?
Quale ricevimento lo ha introdotto?
Quale operazione lo ha riservato?
Quale prelievo lo ha consumato?
Quale spedizione lo ha spostato fuori?
È stata risolta un'eccezione prima del passaggio successivo?
Qual era il magazzino attivo?
Cosa è successo prima dello stato attuale?
Quando stato e documentazione sono prodotti dallo stesso processo, la tracciabilità diventa più facile da fidarsi.
Quando non lo sono, le persone alla fine iniziano a ricostruire la storia.
Di solito in Excel.
Di solito sotto pressione.
Di solito dopo che qualcosa è già andato storto.
COCO preferisce le prove prima di quel momento.
A quanto pare, anche COCO viaggia
C'è stato un altro piccolo cambiamento tra le esecuzioni.
Ubuntu ha avuto il suo turno.
Red Hat Enterprise Linux 10 ha preso il successivo.
COCO ha continuato.
Nessuna cerimonia.
Nessuna "modalità Red Hat" speciale.
Nessun workflow riscritto.
Nessun test comodamente semplificato.
Stesso Flow.
Terreno diverso sotto di esso.
Un'esecuzione precedente di COCO aveva già testato l'applicazione su Ubuntu Linux.
Quella attuale è passata a Red Hat Enterprise Linux 10.
Ambiente desktop diverso.
Librerie di sistema diverse.
Packaging diverso.
Ambiente operativo diverso.
Stesso magazzino.
Stessi stati aziendali.
Stesse transizioni di inventario.
Stessi cambi di lingua.
Stessa logica delle eccezioni.
Stesse prove.
Questo è un modo piuttosto elegante di testare il software cross-platform.

Non annunciare che è cross-platform. Spostalo. Poi guarda cosa si rompe.

Stato della lingua.
Contesto del magazzino.
Comportamento delle finestre di dialogo.
Tempistiche.
Temi.
Transizioni di processo.
Gestione delle eccezioni.
Prove.
I sistemi operativi hanno modi sorprendentemente creativi di esporre le assunzioni.

Ubuntu ne ha esposte alcune.
Red Hat ne sta esponendo altre.
Questo è utile.

Perché l'ingegneria multi-piattaforma non è la capacità di avviare l'eseguibile due volte.

È la capacità di cambiare l'ambiente senza cambiare il significato del processo.
A un operatore di magazzino non dovrebbe importare se l'applicazione gira su Ubuntu o Red Hat.
Nemmeno a un ordine di prelievo dovrebbe importare.
Né a una traccia di audit.
Se le differenze di piattaforma iniziano a cambiare il comportamento aziendale, il software non è veramente cross-platform.
È semplicemente portabile.
COCO sembra considerevolmente più interessato alla prima definizione.
Anche noi.

COCO non decide cosa significhi logistica corretta
Questa parte è importante.
COCO non diventa un esperto di magazzino semplicemente perché può seguire un workflow di magazzino.
Gli esseri umani continuano a definire la correttezza.
Gli esseri umani decidono quando l'inventario diventa disponibile.
Gli esseri umani definiscono cosa significa una consegna bloccata.
Gli esseri umani decidono chi può correggere una quantità.
Gli esseri umani definiscono quale movimento richiede una traccia di audit.
Gli esseri umani decidono come appare una risoluzione valida di un'eccezione.
Gli esseri umani decidono quando una spedizione è veramente completa.
Il compito di COCO è diverso.

Ripetere.
Osservare.
Confrontare.
Ricordare.
Lasciare prove.


Poi rifarlo dopo che il software cambia.
E ancora.
E ancora.
Senza annoiarsi.
Senza decidere che il risultato della settimana scorsa è probabilmente ancora valido.
Senza saltare l'eccezione fastidiosa perché il pranzo è tra dodici minuti.
Il futuro glamour del testing con AI contiene una quantità sorprendente di ripetizione.
Noi la consideriamo una funzionalità.

Le prove cambiano la conversazione
Il testing tradizionale spesso finisce con una frase perfettamente ragionevole:
"Ha funzionato quando l'ho testato."

COCO è interessato alla frase successiva.

Cosa esattamente ha funzionato?
Quale magazzino?
Quale utente?
Quale lingua?
Quale stato del processo?
Quale sequenza?
Quale documento?
Quale valore di inventario?
Cosa è successo immediatamente prima del passo di test?
Cosa è cambiato immediatamente dopo?
Un altro ingegnere può capire il risultato senza chiedere alla persona che ha eseguito il test?
È qui che il testing di regressione diventa più di un click ripetuto.
Una schermata può essere corretta mentre il processo è sbagliato.
Una finestra di prelievo può sembrare perfetta mentre l'inventario è già andato alla deriva.
Un documento può esistere mentre lo stato che avrebbe dovuto crearlo non si è mai verificato.
Un'applicazione può mostrare il 100% mentre una traccia di audit silenziosamente dissente.
COCO segue il Flow perché è nel Flow che queste contraddizioni diventano visibili.

Da qualche parte tra Control e Flow
C'è una simmetria interessante qui.
Un buon software di logistica cerca di ridurre l'incertezza all'interno di un'operazione.
Un buon testing cerca di ridurre l'incertezza sul software che lo esegue.
L'uno chiede:
Dov'è l'articolo?
L'altro chiede:
Come sappiamo che il software lo sa ancora?
L'uno chiede:
Questo movimento è stato completato?
L'altro chiede:
Quale prova dimostra che lo stato è cambiato correttamente?
L'uno chiede:
Il turno successivo può continuare?
L'altro chiede:
Il prossimo ingegnere può capire cosa è successo?
Domande diverse.
Stesso istinto.
Rendere lo stato visibile.
Preservare il ragionamento.
Ridurre la quantità di conoscenza che esiste solo nella testa di qualcuno.
Forse questa è la connessione che non avevamo originariamente pianificato.

Eccellenza ingegneristica senza lo striscione
Nessuno clicca su un pulsante Engineering Excellence.
Non ce n'è uno.
E probabilmente non dovrebbe esserci.
L'eccellenza ingegneristica appare indirettamente.
Il contesto del magazzino sopravvive a un cambio di lingua.
Lo stesso processo sopravvive a un'altra piattaforma Linux.
Un movimento di stock rimane tracciabile.
Un prelevatore mobile vede esattamente ciò che serve e nient'altro.
Un'eccezione interrompe il processo senza distruggerne lo stato.
La finestra di aiuto spiega il contesto attuale invece di mostrare documentazione generica.
La catena dei documenti concorda con la sequenza operativa.
Il prossimo ingegnere può capire cosa è successo senza chiedere alla persona che si trovava lì per caso.
C'è molto teatro disponibile nel software moderno.
L'AI può generare dimostrazioni impressionanti.
I dashboard possono animarsi.
I numeri possono muoversi.
I video possono sembrare molto convincenti.
Niente di tutto ciò dimostra che due operazioni di inventario non possano silenziosamente produrre un risultato errato.
Niente di tutto ciò dimostra che un'eccezione possa ancora essere ricostruita settimane dopo.
Niente di tutto ciò dimostra che il lavoratore di magazzino, l'addetto alla spedizione, e lo sviluppatore stiano guardando la stessa verità operativa.

L'eccellenza ingegneristica inizia in un posto meno fotogenico.

Con coerenza.
Con prove.
Con confini.


Con la volontà di mantenere noiose le parti noiose.
L'affidabilità invisibile raramente produce lo screenshot più drammatico.
Finché non si inizia deliberatamente a cercarla.

Control. Clarity. Flow.
Control significa sapere quale magazzino, quale processo, e quale stato sono attivi.
Clarity significa capire cosa è cambiato, quando è cambiato, e perché.
Flow significa permettere all'operazione di continuare senza perdere la storia dietro di essa.
Funziona per la logistica.
Funziona per il testing del software.
Funziona sorprendentemente bene per l'ingegneria stessa.
Il primo esperimento Flow ha dato a COCO l'Administration.
Utenti.
Ruoli.
Database.
Lingue.
Poi qualcuno gli ha dato un magazzino.
Poi più lingue.
Poi il prelievo mobile.
Poi l'inventario.
Poi i trasferimenti.
Poi le eccezioni.
Poi i documenti.
Poi un altro sistema operativo.
A questo punto, dovremmo probabilmente smettere di aggiungere cose.
Probabilmente non lo faremo.

Control. Clarity. Flow.

Ubuntu ha avuto il suo turno.

Red Hat ha quello attuale.

Il Flow continua a muoversi.

COCO continua a osservare.
E da qualche parte nel mezzo dell'ultima esecuzione, è diventato ovvio che c'è un'altra domanda in attesa dietro a questa.

Noi sappiamo cos'è.
COCO sa cos'è.
Tu non lo sai.
Ancora.


Potremmo dirtelo.

Ma allora potresti smettere di controllare se è apparso un nuovo articolo Insiders.
E questo rovinerebbe l'esperimento.

Pubblicato: 28.08.2026

Link permanente →

Una lettera da COCO

Una lettera da COCO

All'ingegnere che apre questo repository per la prima volta:

Benvenuto.

Forse sei arrivato qui perché qualcosa si è rotto.

Un servizio ha smesso di rispondere.

Un deployment si è comportato in modo inaspettato.

Un allarme ti ha svegliato nel cuore della notte.

O forse sei semplicemente curioso di sapere come funziona questa piattaforma.

Qualunque cosa ti abbia portato qui,

sappi che questo progetto è stato costruito esattamente per momenti come questo.

Non per eliminare i problemi difficili.

Ma per rendere comprensibili i problemi difficili.

Troverai codice.

Troverai documentazione.

Troverai specifiche.

Ma, cosa più importante,

Da Sapere

Idee di digitalizzazione del magazzino che funzionano

Idee di digitalizzazione del magazzino che funzionano

Una bolla di consegna mancante poco prima della partenza, una giacenza che sullo scaffale appare diversa da quella nel foglio di calcolo, e tre dipendenti che chiariscono contemporaneamente la stessa domanda per telefono: è proprio lì che nascono idee di digitalizzazione del magazzino sensate. Non dalla domanda su quale tecnologia sembri attualmente di moda, ma da un processo concreto che costa tempo, genera errori, o dipende dalla conoscenza di singole persone.

Per le piccole e medie imprese di magazzino, commercio e produzione, la digitalizzazione è raramente un unico grande progetto. È una sequenza di miglioramenti chiaramente delimitati. L'obiettivo non deve essere un complesso sistema enterprise di gestione del magazzino. Spesso uno strumento snello, ritagliato sul flusso di lavoro effettivo, è meglio di una suite con funzioni che nessuno usa sul pavimento del magazzino.

Idee di digitalizzazione del magazzino con valore operativo

Il punto d'ingresso migliore è un processo che ricorre frequentemente, è facilmente misurabile, e migliora percettibilmente per i dipendenti. Chi vuole digitalizzare subito l'intero magazzino vincola budget e attenzione prima che una soluzione si sia dimostrata nell'operatività quotidiana. Un primo passo limitato crea invece dati solidi per la decisione successiva.

1. Ricevimento merci con acquisizione dati mobile

Al ricevimento merci nascono molti errori a catena: quantità contate in modo errato, discrepanze non chiarite, registrazioni di scorta ritardate, e documenti cartacei che poi non si trovano più. Un modulo di acquisizione mobile su uno scanner palmare, un tablet, o uno smartphone può rendere il processo molto più stabile.

I dipendenti scansionano l'articolo e il riferimento di consegna, registrando quantità, posizione di magazzino, e il motivo di eventuali discrepanze direttamente alla banchina di carico. Se un lotto, un numero di serie, o una foto sono rilevanti, questa informazione appartiene esattamente allo stesso record. La scorta non viene aggiunta retroattivamente a un foglio di calcolo alla fine del turno; riceve invece uno stato tracciabile al momento effettivo del ricevimento.

Questo non significa che ogni fornitore o articolo richieda rigorosamente etichette con codice a barre. Per consegne piccole e irregolari, una ricerca per codice articolo può bastare. Il fattore decisivo è che l'acquisizione dati sia più rapida della precedente soluzione alternativa fatta di carta e trascrizione manuale.

2. Trasferimenti digitali invece di enigmi di inventario

Molti magazzini sanno fondamentalmente cosa è disponibile, ma non in modo affidabile dove si trova. La merce viene anticipata per un ordine, stoccata temporaneamente, portata al montaggio, o collocata in un'area libera per mancanza di spazio. Senza una registrazione semplice, una domanda sulla giacenza diventa rapidamente un'operazione di ricerca.

Un processo di trasferimento non ha bisogno di un'interfaccia complicata. Scansionare la posizione di origine, scansionare la posizione di destinazione, confermare la quantità — nella maggior parte dei casi non serve altro. Il sistema dovrebbe verificare se l'articolo e la posizione di magazzino sono plausibili, e assegnare chiaramente una registrazione a una persona e a un orario.

La gestione delle eccezioni è importante. Una posizione di magazzino può essere bloccata, sovraffollata, o approvata solo per merci specifiche. Queste regole dovrebbero essere mappate dove prevengono danni reali. Per casi speciali rari, spesso basta un passaggio di approvazione da parte della direzione di magazzino. Troppi campi obbligatori trasformano un'applicazione utile in un ostacolo.

3. Prelievo ordini con stati d'ordine chiari

Le liste di prelievo cartacee funzionano finché le priorità non cambiano, le posizioni non mancano, o un ordine non viene suddiviso su più aree. Una semplice lista di prelievo digitale mostra quale ordine è aperto, quali posizioni sono già state prelevate, e dove serve chiarimento. Questo riduce le richieste tra magazzino, vendite, e spedizione.

A seconda della dimensione del magazzino, l'applicazione può indicare i percorsi di prelievo o semplicemente ordinare le posizioni per zona di magazzino. L'ottimizzazione completa del percorso conviene soprattutto con molti ordini giornalieri e lunghi percorsi a piedi. In un magazzino compatto, un'indicazione di stato affidabile spesso porta più valore di un percorso matematicamente perfetto che nessuno segue nella pratica quotidiana.

In caso di quantità mancanti, il sistema non dovrebbe limitarsi a evidenziare in rosso. Dovrebbe offrire un processo di follow-up concreto: controllare la giacenza, richiedere articoli sostitutivi, innescare il riassortimento, o passare l'ordine per chiarimento. La digitalizzazione è preziosa quando rende visibile la prossima azione sensata.

4. Documenti di spedizione ed etichette da dati d'ordine reali

Trasferire manualmente indirizzi, pesi, e posizioni articolo nei portali di spedizione è un candidato ideale per l'automazione. Indirizzi di consegna, istruzioni di consegna, metodi di spedizione, e informazioni sul pacco idealmente esistono una sola volta e vengono usati per la bolla di consegna, l'etichetta di spedizione, e la conferma di spedizione.

Un sistema adeguato può generare etichette, archiviare documenti in modo inalterabile, e impostare automaticamente l'ordine su "pronto per la spedizione" o "spedito" dopo la stampa. Il vantaggio operativo non sta solo nei minuti risparmiati. Sta nel garantire che i dati di spedizione non divergano mai tra più sistemi.

Qui l'integrazione è cruciale. Se un corriere non offre un'interfaccia utilizzabile o comporta regole speciali molto diverse, un flusso semiautomatizzato può essere più sensato di un'integrazione completa fragile. Un'affidabilità noiosa ma dimostrabile batte un'automazione che si blocca a ogni eccezione.

5. Riassortimento e scorte minime con regole tracciabili

Le scorte minime vengono spesso mantenute in fogli di calcolo e poi ignorate perché nessuno è sicuro che i numeri siano ancora corretti. Una soluzione digitale sensata collega le registrazioni effettive con regole chiare di controllo scorte. Può notificare quando un articolo scende sotto una soglia, tenere conto delle quantità riservate, e preparare una lista d'ordine.

La soglia non dovrebbe essere trattata come una verità eterna. La domanda stagionale, i tempi di consegna, e le quantità minime d'ordine cambiano. Per questo la persona responsabile ha bisogno di un modo semplice per rivedere i suggerimenti e adattare le regole. Gli ordini completamente automatici hanno senso solo quando i dati anagrafici, la logica dei fornitori, e i dati di consumo sono sufficientemente stabili.

6. Tracciabilità per lotti, numeri di serie, e giacenze bloccate

Chi lavora con lotti, dispositivi, ricambi, o prodotti regolamentati ha bisogno di più di un semplice indicatore di quantità. Deve essere tracciabile quale merce è arrivata quando, dove è stata spostata, e in quale ordine cliente è finita.

Il progetto può iniziare deliberatamente in piccolo: registrare inizialmente solo il ricevimento e la spedizione di un gruppo di prodotti critico. I movimenti interni e i resi seguono in seguito. Un sistema che impone ogni registrazione ma non comprende il reale processo di riparazione o ispezione verrà aggirato. La logica di dominio deve quindi nascere dal flusso di lavoro, non da un modello dati astratto.

Selezionare il progetto giusto

L'idea più attraente non è automaticamente la prima idea giusta. Valutate i potenziali progetti in base a frequenza, costi degli errori, tempi di attesa, e dipendenza da singole persone. Un processo che gira 50 volte al giorno e fa risparmiare due minuti per transazione può valere più di una funzione speciale rara con grande eleganza tecnica.

Anche la qualità dei dati appartiene alla decisione. Se i codici articolo sono duplicati, le posizioni di magazzino non sono nominate in modo univoco, o gli ordini arrivano in modo contraddittorio da più fonti, il progetto dovrebbe prima ripulire queste fondamenta. Il software può rendere visibili le regole mancanti, ma non può sostituirle in modo affidabile.

Per la definizione delle priorità bastano quattro domande:

  • Quale attività causa dimostrabilmente il maggior numero di richieste o rilavorazioni?
  • Quale informazione viene oggi trascritta più volte o richiesta per telefono?
  • Quale errore avrebbe le conseguenze più costose per clienti, giacenza, o spedizione?
  • Quale flusso di lavoro può essere testato in poche settimane con una chiara misurazione del successo?

Decisioni tecniche che contano nell'operatività quotidiana del magazzino

Un'applicazione di magazzino non deve apparire spettacolare. Deve restare comprensibile con copertura Wi-Fi scarsa, indossando guanti, sotto pressione temporale, e durante i cambi turno. Pulsanti grandi, feedback chiari dopo una scansione, e una gestione visibile degli errori sono più importanti di dashboard decorative.

Anche l'architettura dovrebbe adattarsi alla realtà operativa. Un'applicazione basata sul web con una struttura di database pulita può funzionare su dispositivi esistenti ed è più facile da mantenere di una soluzione isolata su un singolo PC. Con una base stabile — ad esempio PHP 8.4, JavaScript moderno, e MySQL 8 — ruoli, cronologie di registrazione, interfacce, e deployment documentati possono essere gestiti in modo tracciabile a lungo termine.

Non ogni informazione è destinata a ogni ruolo. Il personale di magazzino ha bisogno di compiti aperti e dialoghi di registrazione chiari. Il controllo scorte ha bisogno di avvisi e suggerimenti di riordino. La direzione ha bisogno di valutazioni su tempi di attraversamento, discrepanze, e operazioni aperte. I concetti di accesso basati sui ruoli, i log, e i blocchi degli account dopo tentativi ripetuti falliti appartengono presto alla pianificazione, specialmente quando sono coinvolti fornitori esterni o più sedi.

Implementazione: prima dimostrare, poi espandere

Un pilota dovrebbe funzionare con ordini reali, non solo con dati di test in una sala riunioni. Scegliete una zona di magazzino, un gruppo di prodotti, o un turno, e definite in anticipo come si riconoscerà il successo: meno registrazioni correttive, tempi di elaborazione più brevi, meno richieste, o un tasso di completamento delle registrazioni più alto nello stesso giorno.

Pianificate in parallelo un livello di riserva. Se la nuova applicazione si guasta o un processo non è chiaro, il team deve sapere come continuare a lavorare e come vengono controllate le registrazioni successive. Questo non è segno di sfiducia nella tecnologia, ma di operatività professionale.

Dopo due o quattro settimane emergono di solito le intuizioni più preziose. Forse non manca una funzione, ma una migliore etichettatura degli articoli. Forse il flusso di lavoro è corretto, ma un profilo scanner o un permesso crea un collo di bottiglia. Queste osservazioni dovrebbero confluire in cicli di miglioramento brevi e controllati, invece di innescare un nuovo grande progetto.

La migliore digitalizzazione non rende l'operatività quotidiana del magazzino teoricamente più moderna, ma concretamente più tranquilla: meno ricerca, meno trascrizione manuale, passaggi di consegne più chiari, e informazioni affidabili esattamente quando una decisione è in sospeso.
Link permanente →

Checklist per l'automazione dei flussi di lavoro di magazzino

Checklist per l'automazione dei flussi di lavoro di magazzino

Quando un ricevimento merci viene confermato su carta, i livelli di scorta vengono trasferiti successivamente in un foglio di calcolo e una domanda sulla spedizione viene chiarita per telefono, ogni singolo passaggio sembra gestibile. Insieme, però, creano richieste, discrepanze di inventario e dipendenza da singoli dipendenti.

Una checklist per l'automazione dei flussi di lavoro di magazzino impedisce che questa situazione si trasformi prematuramente in un progetto software sovradimensionato. Separa i processi che dovrebbero davvero essere automatizzati da quelli per cui un foglio di calcolo ben mantenuto resta sufficiente.

La checklist per l'automazione dei flussi di magazzino prima dell'avvio del progetto

L'automazione non inizia con la scelta di un sistema. Inizia con una descrizione verificabile di ciò che accade realmente in magazzino — anche durante le eccezioni, i cambi turno e la pressione del tempo. Ripercorrete i seguenti punti direttamente a livello di processo con la direzione di magazzino, la spedizione, gli acquisti e, se applicabile, la contabilità.

1. Registrare i movimenti, non solo le scorte

Una scorta attuale è il risultato di movimenti. Deve quindi essere chiaro quali eventi aumentano, diminuiscono, riservano, bloccano o trasferiscono lo stock. Tra questi rientrano il ricevimento merci, la messa a stock, il prelievo ordini, la spedizione, i resi, gli scarti, le discrepanze di inventario e i trasferimenti.

Ogni movimento richiede una risposta definitiva a quattro domande: chi lo esegue? Quando viene registrato? Quale posizione di magazzino è interessata? Quale documento o ordine lo giustifica? Se queste risposte esistono oggi solo nella testa dei dipendenti esperti, si tratta di un candidato ideale per l'automazione. L'obiettivo non è raccogliere più dati, ma costruire una cronologia resiliente da cui ogni livello di scorta possa essere spiegato.

2. Ripulire articoli, varianti e unità

Molti progetti falliscono non a causa di scanner o interfacce web, ma a causa dei dati anagrafici. Un articolo può essere acquistato in cartoni, immagazzinato singolarmente e venduto in set. Senza conversioni definite, il software produce quantità formalmente corrette ma operativamente sbagliate.

Controllate i codici articolo per duplicati, stabilite descrizioni vincolanti e distinguete tra unità di vendita, unità di stoccaggio e unità di imballaggio. Numeri di serie, lotti, date di scadenza o classificazioni di materiali pericolosi dovrebbero essere inclusi nella costruzione iniziale solo se influenzano decisioni quotidiane o sono richiesti per legge. Tutto il resto aumenta inizialmente lo sforzo di manutenzione e la superficie di errore.

3. Definire le posizioni di magazzino con la precisione necessaria

"Capannone 2" può essere sufficiente per un elenco di inventario. Per un prelievo ordini affidabile, di solito è troppo generico. Definite se una posizione si riferisce a una zona, uno scaffale, una campata, uno slot o un'area di transito. Anche le aree di quarantena, le zone di ricevimento merci, le aree di reso e i buffer di spedizione devono essere riconoscibili come posizioni distinte se la merce può risiedervi.

Il livello di granularità giusto dipende dall'attività. Un'officina con poche centinaia di posizioni non richiede rigorosamente la gestione a vano. Tuttavia, con più addetti al prelievo per turno, uno slot di stoccaggio preciso può ridurre significativamente i percorsi e i tempi di ricerca. Non automatizzate un livello di precisione che nessuno può mantenere.

4. Stabilire trigger, ruoli responsabili e approvazioni

Un flusso di lavoro necessita di un punto di partenza chiaro. Al ricevimento merci, questo può essere la consegna alla banchina, l'ordine di acquisto negli approvvigionamenti, o la scansione di una bolla di consegna. Per il riordino, una scorta minima può innescare una proposta, mentre l'ordine finale resta a una persona responsabile.

Documentate inoltre quali azioni possono avvenire automaticamente e quali richiedono una revisione. Una quantità mancante dovrebbe creare una discrepanza, non alterare silenziosamente il ricevimento merci previsto. I passaggi di approvazione sono sensati per articoli di valore, gestiti a lotti o critici per la sicurezza. Per i materiali di consumo, rallenterebbero inutilmente il flusso.

5. Generare i documenti dove servono

Bolle di consegna, liste di messa a stock, liste di prelievo, etichette di spedizione e protocolli di consegna spesso hanno origine in applicazioni diverse. Questo porta a rotture nel flusso: un indirizzo viene copiato, un ordine viene spuntato, e lo stato di spedizione viene aggiornato più tardi.

Annotate la fonte dei dati, il timestamp di creazione e il destinatario per ogni documento. Un flusso di lavoro sensato potrebbe, ad esempio, generare automaticamente una lista di prelievo dopo l'approvazione di un ordine, fornire un'etichetta di spedizione dopo l'imballaggio, e chiudere l'ordine con un timestamp dopo la consegna. Il punto cruciale è che i dati non devono più essere inseriti manualmente più volte.

Verificare le interfacce e la qualità dei dati

La migliore logica di magazzino è inutile se gli ordini arrivano solo una volta al giorno come file, o se gli indirizzi di consegna sono formattati in modo incoerente. Create quindi un elenco sobrio dei sistemi che inviano o ricevono dati: shop, ERP, contabilità, corriere, portale fornitori, sistema di produzione e fogli di calcolo esistenti.

Per ogni connessione, si dovrebbe stabilire quale sistema è autorevole per ciascun campo dati. Se i dati anagrafici degli articoli sono autorevoli nell'ERP, il portale di magazzino non deve creare silenziosamente propri articoli. Se una modifica dell'ordine proviene dallo shop, deve diventare visibile prima della spedizione. Per volumi bassi, un'importazione CSV controllata può essere il primo passo giusto. Per volumi elevati o tempi di consegna brevi, un'interfaccia diretta vale la pena.

La gestione degli errori è altrettanto importante. Un'interfaccia non dovrebbe solo trasferire i dati, ma anche mostrare cosa è stato rifiutato e perché. Codici articolo sconosciuti, indirizzi non validi o quantità mancanti non devono scomparire in un file di log tecnico. Richiedono una lista di lavoro con responsabilità designata e stato.

Progettare l'usabilità sul pavimento del magazzino

Un processo che sembra plausibile alla scrivania può fallire sul pavimento del magazzino. I dipendenti indossano guanti, spostano merci, condividono dispositivi o lavorano con una copertura Wi-Fi instabile. Verificate quindi presto se scanner, tablet, postazioni fisse o stampe cartacee si adattano al rispettivo passaggio di lavoro.

La scansione dovrebbe fornire un feedback chiaro: articolo corretto, posizione di magazzino sbagliata, quantità già registrata, o articolo bloccato. I soli colori non bastano. Messaggi brevi e comprensibili e un passaggio successivo chiaro sono più preziosi sotto pressione temporale di un'interfaccia ricca di funzioni.

Pianificate anche le eccezioni. Cosa succede con un codice a barre danneggiato, un'interruzione di rete, una consegna parziale, o merce non assegnata scoperta? Un buon flusso di lavoro offre percorsi controllati per questo e registra la correzione. Non costringe i team ad affidarsi a post-it e registrazioni batch successive.

Definire le metriche prima di costruire dashboard

Una dashboard non è un obiettivo. Le metriche rilevanti sono quelle che innescano una decisione operativa. Possono includere ricevimenti merci aperti che superano un'età definita, ordini vicini alla scadenza di spedizione, discrepanze di inventario per zona di magazzino, errori di prelievo, o il tempo trascorso tra la ricezione dell'ordine e la consegna.

Definite la fonte dei dati, la regola di calcolo e il ruolo responsabile per ogni metrica. "L'accuratezza dell'inventario", ad esempio, è significativa solo quando è chiaro rispetto a quale conteggio viene misurata e come vengono gestiti i resi o le scorte bloccate. Poche metriche affidabili sono meglio di un muro di grafici a cui nessuno crede.

Pianificare sicurezza, permessi e tracciabilità

L'automazione distribuisce responsabilità. Chi può modificare l'inventario, creare articoli, generare etichette di spedizione o annullare ordini dovrebbe essere stabilito deliberatamente. I permessi basati sui ruoli sono di solito più sensati di un login condiviso sul PC di magazzino. Le correzioni particolarmente critiche richiedono un timestamp, un'assegnazione a una persona e, idealmente, un motivo.

Anche i fondamenti tecnici appartengono alla checklist: backup regolari, ripristino testato, credenziali di accesso documentate, registrazione degli errori di interfaccia, e una procedura per account utente bloccati o disattivati. In un'applicazione su misura, tecnologie manutenibili, una struttura di database pulita e passaggi di deployment tracciabili non sono dettagli minori. Determinano se le modifiche restano calcolabili dopo due anni.

Implementare in passi piccoli e misurabili

Non cercate di convertire contemporaneamente ricevimento merci, riassortimento, conteggio dell'inventario, spedizione e pianificazione delle rotte. Scegliete un flusso di lavoro con attrito percepibile e rischio gestibile, come la registrazione mobile dei ricevimenti merci o la generazione automatica dei documenti di spedizione. Prima di iniziare, registrate il tempo di elaborazione, le correzioni e i casi aperti.

Testate con articoli reali, ordini reali e i dipendenti che effettivamente lavoreranno con essi. Un pilota con una zona di magazzino o un gruppo di prodotti mostra più rapidamente di un workshop se descrizioni, flussi scanner e approvazioni funzionano. Solo quando le eccezioni sono padroneggiate dovrebbe seguire il prossimo processo.

L'automazione ha successo quando i team devono porre meno domande, l'inventario resta spiegabile, e il processo funziona anche quando la persona più esperta è in vacanza. È esattamente lì che vale la pena il prossimo miglioramento: non con lo strumento più rumoroso, ma con l'attrito che rallenta davvero la giornata lavorativa.

Link permanente →

Migliorare i tempi di caricamento dei siti web mobili

Migliorare i tempi di caricamento dei siti web mobili

Quando uno smartphone da magazzino con ricezione scarsa viene usato per accedere a un sito, non è l'animazione della hero-section a determinare la prima impressione, ma se la pagina diventa interattiva. Se un potenziale cliente aspetta tre, quattro o cinque secondi per i contenuti, l'alternativa è a un solo tasto "indietro" di distanza. Migliorare i tempi di caricamento dei siti mobili richiede una sequenza tecnica tracciabile, non ritocchi cosmetici estemporanei.

Questo vale in particolare per i siti pensati per generare richieste: per un produttore, un fornitore di servizi logistici o un'azienda con servizi complessi da spiegare. Gli utenti mobili accedono spesso alle pagine tra un appuntamento e l'altro, in magazzino, o tramite ricerche con un'intenzione concreta. Il sito deve fornire informazioni, non richiedere elaborazione pesante sul dispositivo.

Perché la velocità di caricamento mobile è un problema operativo

Le performance mobili vengono spesso trattate rigidamente come disciplina SEO. Questo è riduttivo. Le pagine veloci aiutano visibilità e costi delle campagne, ma l'effetto immediato sta nell'uso reale: i moduli vengono inviati più spesso, i numeri di telefono vengono composti più frequentemente, le informazioni sui prodotti vengono lette con attenzione. Un sito lento, al contrario, crea dubbi ancora prima che un referente possa rispondere.

"Veloce" non è una singola metrica. Una pagina può mostrare uno sfondo presto e rimanere comunque non responsiva ai clic per parecchio tempo. Per i visitatori contano tre cose: quando appare il contenuto più importante? Quando la pagina diventa utilizzabile senza ritardi? E il layout si sposta ancora mentre stanno cercando di toccare un pulsante? Queste domande si riflettono in metriche come Largest Contentful Paint, Interaction to Next Paint e Cumulative Layout Shift.

Le misurazioni devono avvenire in condizioni realistiche. Un potente computer da ufficio su Wi-Fi maschera problemi che diventano evidenti su un dispositivo Android più vecchio su rete cellulare. Anche la posizione, i servizi intermedi e una cache del browser già popolata alterano i risultati. Misurazioni ripetute e dati reali degli utenti contano molto più di un singolo test perfetto.

Migliorare i tempi di caricamento dei siti mobili: prima misurare, poi cambiare

L'errore più comune è comprimere subito le immagini o installare un altro plugin di ottimizzazione. Entrambe le cose possono aiutare, ma senza un'analisi delle cause creano rapidamente configurazioni difficili da mantenere. Verificate prima una selezione rappresentativa: la homepage, una tipica pagina di servizio o prodotto, la pagina di contatto e una landing page ad alto traffico. Su queste pagine diventano visibili i pattern.

Il log di rete rivela quali file bloccano l'inizializzazione e quanto sono effettivamente grandi. Un audit delle performance mostra se JavaScript ritarda l'interazione, se i font arrivano in ritardo o se le immagini si caricano inutilmente presto. Integrate le misurazioni di laboratorio con dati di visitatori reali se il traffico lo consente. Questo evita di ottimizzare per un profilo di test che non rispecchia il vostro pubblico effettivo.

Definite un obiettivo chiaro prima di ogni modifica. Ad esempio: il contenuto principale visibile dovrebbe apparire su un dispositivo mobile medio in meno di 2,5 secondi, oppure il modulo di contatto dovrebbe essere utilizzabile senza ritardo nell'input. Non ogni pagina richiede un punteggio teoricamente perfetto. Un'applicazione complessa con dati autenticati ha presupposti diversi da un sito aziendale pubblico. Un'affidabilità noiosa ma dimostrabile qui vale più di un punteggio a breve termine ottenuto con trucchi rischiosi.

1. Trattare le immagini in base al loro scopo

Su molte pagine mobili, le immagini restano il blocco dati più grande. Il problema non è la foto in sé, ma un'immagine trasmessa a 2.500 pixel di larghezza quando il dispositivo ne richiede solo 700. Fornite varianti di immagine responsive così che il browser possa scegliere la dimensione appropriata. Formati moderni come WebP o AVIF riducono spesso significativamente le dimensioni dei file, ma andrebbero implementati con fallback puliti e qualità dell'immagine verificata.

L'immagine più grande nella viewport iniziale visibile merita un'attenzione particolare. Dovrebbe essere ritagliata correttamente, avere una risoluzione adeguata e caricarsi presto. Le immagini più in basso nella pagina possono caricarsi in modo differito. Questo risparmia dati all'ingresso, ma non deve far sì che le immagini appaiano visibilmente durante lo scroll quando l'utente le aspetta già.

Non scartate tutte le immagini per riflesso. Una buona immagine può spiegare una macchina, un team o un processo più velocemente di un paragrafo di testo. Il compito tecnico è consegnare in modo efficiente informazioni visive rilevanti, non ridurre il design a riquadri grigi segnaposto.

2. Limitare JavaScript al lavoro necessario

Ogni script compete per il tempo di elaborazione durante caricamento e interazione. Sono particolarmente problematiche le librerie integrate in modo generico, i tag manager con molti script di terze parti, i widget di chat, le mappe e le animazioni. Sui dispositivi desktop questi costi spesso passano inosservati. Su mobile risultano in una pagina che è visibile ma reagisce lentamente agli input.

Verificate per ogni script lo scopo, la condizione di caricamento e il valore per il business. Una mappa interattiva nella pagina di contatto non deve caricarsi su ogni sottopagina. Uno strumento di cookie o analisi non dovrebbe innescare una catena di file aggiuntivi prima ancora che il visitatore possa leggere i contenuti. Le funzioni necessarie solo dopo un'interazione possono essere caricate su richiesta.

Per i siti sviluppati su misura, una struttura chiara a componenti è un vero vantaggio. JavaScript viene raggruppato per funzione invece che consegnato come pacchetto globale. Questo semplifica anche la manutenzione successiva: chi estende un modulo non modifica accidentalmente il codice di un filtro prodotti o di una navigazione.

3. Consegnare CSS e font senza blocchi

Un collo di bottiglia frequente si trova nella viewport iniziale visibile. Se per essa devono caricarsi più fogli di stile, icon font e varianti di font esterne, il browser attende inutilmente a lungo. Gli stili critici per la sezione visibile dovrebbero essere piccoli e disponibili presto. Le regole non critiche possono seguire più tardi.

Per i web font di solito bastano pochi pesi. Quattro pesi in normale, corsivo e sottoinsiemi aggiuntivi sembrano completi in un design system, ma raramente sono necessari per un tipico sito aziendale. Definite fallback di sistema sensati così che il testo resti leggibile immediatamente. Un font che cambia pulito qualche millisecondo dopo è superiore a blocchi di testo vuoti.

Anche le icone meritano una revisione. Un piccolo set SVG è spesso più efficiente e controllabile con precisione rispetto a un icon font completo. Questa regola ammette eccezioni: i sistemi esistenti non devono essere ricostruiti solo per pochi kilobyte. Se sono comunque previste modifiche più ampie, però, questa decisione appartiene alle fondamenta tecniche.

4. Configurare caching e risposta del server in modo pulito

Anche un'interfaccia snella sembra lenta se il server impiega troppo tempo a fornire la prima risposta. Le cause vanno da query di database non ottimizzate, a pagine composte dinamicamente, fino alla mancanza di caching. I contenuti pubblici che cambiano raramente dovrebbero essere consegnabili rapidamente come versione in cache. I file statici come immagini, CSS e JavaScript richiedono nomi di versione univoci e regole di cache sensate.

Per le applicazioni PHP, si tratta inoltre di esecuzione efficiente, una cache opcode correttamente configurata e accessi al database controllati. Le query MySQL necessitano di indici che corrispondano ai percorsi di filtro e ordinamento effettivi. Una homepage che esegue più query dati ridondanti a ogni richiesta non migliorerà con la crescita del traffico.

Il caching, tuttavia, non è una carta bianca. Prezzi, disponibilità, sezioni personalizzate o contenuti post-login non devono mai apparire per errore obsoleti. I confini della cache vengono quindi definiti con precisione: cosa può avere cinque minuti di anzianità, cosa deve essere immediatamente aggiornato, e chi svuota la cache dopo una modifica dei contenuti? Da questa precisione nasce una buona performance.

5. Trattare i fornitori terzi con spirito critico

I servizi esterni sono spesso la zavorra invisibile di un sito web. Analytics, gestione del consenso, video, mappe, widget di recensioni e pixel di marketing caricano ulteriori script da server esterni. Ogni dipendenza può causare ritardi, sollevare questioni di privacy e compromettere il rendering in caso di errori.

Questo non significa che ogni strumento esterno debba essere rimosso. Un video può supportare le vendite, uno strumento di analisi può fondare decisioni importanti. Serve però un'analisi costi-benefici. Caricate i media incorporati solo dopo il consenso o l'interazione. Usate inizialmente un segnaposto per le mappe. Infine, rimuovete i tag i cui dati nessuno valuta più da mesi.

6. Considerare gli spostamenti di layout e l'usabilità mobile

Velocità di caricamento e usabilità vanno di pari passo. Riservate dimensioni fisse per immagini, banner ed elementi incorporati così che i pulsanti non si spostino da sotto il dito dell'utente. Evitate pop-up che coprono il contenuto visibile direttamente all'ingresso. Una pagina veloce che mostra subito un overlay difficile da chiudere non risolve il problema di fondo.

Testate i moduli con particolare cura. Campi di input ampi, tipi di tastiera appropriati e percorsi obbligatori brevi aiutano più di un effetto visivo elaborato. Se una richiesta necessita solo di nome, numero di richiamata e motivo, un modulo in dodici parti non è segno di accuratezza: è attrito.

7. Gestire le performance come un processo operativo permanente

Un unico relaunch non mantiene basso il tempo di caricamento in modo permanente. Nuove immagini di campagna, requisiti di tracking e moduli editoriali si sommano nel tempo. Per questo i budget di performance appartengono al processo di sviluppo: una dimensione massima per le immagini iniziali, regole chiare per i nuovi strumenti di terze parti e limiti definiti per JavaScript.

Dopo i rilasci, i tipi di pagina principali dovrebbero essere rivalutati. I test automatizzati possono verificare se le pagine centrali restano raggiungibili e i flussi critici funzionano correttamente. Per le performance, tuttavia, un puro test funzionale non basta. Integratelo con misurazioni del tempo di risposta, del volume di dati trasferiti e dell'interattività mobile.

Un sito mobile veloce non nasce da un singolo plugin, né dalla rinuncia a ogni costo. Nasce quando design, contenuti, infrastruttura e uso reale vengono considerati insieme. Iniziate dalla pagina che genera richieste o contatti operativi, misurate in condizioni oneste ed eliminate l'attrito dove gli utenti lo percepiscono davvero.

Link permanente →

Software logistico che alleggerisce davvero le operazioni

Software logistico che alleggerisce davvero le operazioni

Quando un ricevimento merci viene prima annotato su carta, poi trasferito in un foglio di calcolo e infine comunicato alla spedizione a voce, raramente manca l'impegno dei dipendenti. Ciò che manca è una base di lavoro condivisa e affidabile. Un buon software logistico non sostituisce queste fratture con più lavoro a schermo, ma con flussi di lavoro chiari: cosa è arrivato, dove si trova, cosa è stato riservato e cosa può essere spedito oggi?

Per le piccole e medie imprese, non conta l'elenco più lungo possibile di funzioni. Il fattore decisivo è che il software rispecchi il lavoro reale in magazzino, in ufficio e nella spedizione. Una soluzione pensata per una multinazionale con venti sedi può risultare inutilmente lenta, costosa e complicata per un'attività con un magazzino e due turni.

Quando un software logistico ha davvero senso

I fogli di calcolo non sono di per sé un problema. Per basse quantità, un elenco anagrafico gestibile e un unico dipendente responsabile, possono essere la soluzione più pragmatica. Sarebbe sbagliato sostituire un processo funzionante con un progetto fatto solo per il gusto di modernizzare. Il punto di svolta arriva quando le informazioni devono essere mantenute più volte o nessuno può dire con certezza quale file sia aggiornato. Segnali tipici sono carenze di scorte nonostante scaffali pieni, richieste sullo stato delle consegne, bolle di consegna scritte a mano e inventari che bloccano le operazioni per giorni. Anche il numero crescente di ordini rende visibile quali passaggi erano tenuti insieme solo dall'esperienza di singole persone.

Allora non si tratta principalmente di digitalizzazione come parola d'ordine. Si tratta di fonti di errore e tempi di attesa. Un dipendente non dovrebbe dover confrontare più elenchi solo per approvare un ordine. La spedizione non dovrebbe dover indovinare se un articolo è effettivamente disponibile o già riservato per un altro ordine.

Quali processi dovrebbe collegare un software logistico

Una soluzione utilizzabile parte dal flusso di materiale, non da un menu standard. Per molte aziende, questo flusso comprende ricevimento merci, messa a stock, gestione delle scorte, prelievo ordini, spedizione e riscontro. A seconda dell'attività, si aggiungono lotti, numeri di serie, resi, ordini di produzione o pianificazione dei percorsi.

Ricevimento merci con scorte tracciabili

Molto si decide al ricevimento merci. Se una consegna viene controllata direttamente rispetto a un ordine o a una bolla, le discrepanze di quantità, la merce danneggiata e le posizioni mancanti possono essere registrate esattamente dove si verificano. La merce riceve uno stato invece di essere semplicemente parcheggiata fisicamente da qualche parte.

Il software non deve necessariamente iniziare con hardware di scansione costoso. In alcuni magazzini, un tablet o una postazione di lavoro nell'area di ricevimento merci è sufficiente per iniziare. Dove molte posizioni vengono movimentate ogni giorno, tuttavia, gli scanner di codici a barre sono sensati perché accelerano le registrazioni e riducono gli errori di digitazione. La decisione giusta dipende da quantità, percorsi e struttura degli articoli.

Movimenti di magazzino senza un registro storico

Le scorte sono resilienti solo se ricevimenti, spostamenti, prelievi e correzioni sono tracciabili. Questo non significa che ogni eccezione debba essere prevenuta. Nell'operatività quotidiana esistono confezioni danneggiate, messe a stock errate e prelievi spontanei di materiale. Una buona applicazione rende registrabili questi casi, ma documenta anche chi ha cambiato cosa e quando.

Questa cronologia non è uno strumento di controllo fine a se stesso. Aiuta a trovare le cause. Se un articolo finisce ripetutamente nella posizione di magazzino sbagliata, l'etichettatura del magazzino potrebbe non essere chiara. Se si verificano correzioni regolari, il problema risiede spesso nel processo precedente alla registrazione.

Ordini, bolle di consegna e spedizione da un unico flusso di lavoro

Molti team perdono tempo all'interfaccia tra elaborazione ordini e spedizione. I dati dell'ordine arrivano via e-mail, telefono o da un sistema di shop separato. In seguito, le posizioni vengono stampate, le scorte vengono controllate e i documenti di spedizione vengono registrati di nuovo. Ogni passaggio manuale crea spazio per discrepanze.

Il software logistico dovrebbe essere in grado di generare una lista di prelievo chiara, una bolla di consegna e, se necessario, un'etichetta di spedizione a partire da un ordine approvato. La sequenza qui è importante: prima deve essere chiaro cosa è consegnabile. Successivamente l'ordine dovrebbe essere riservato per gli altri processi. Altrimenti si crea la spiacevole situazione in cui due dipendenti assegnano la stessa scorta residua.

Una pianificazione che corrisponde alla realtà

La pianificazione dei percorsi e il controllo della capacità possono essere preziosi, soprattutto con consegne proprie, finestre orarie fisse o molte fermate regionali. Tuttavia, non sono automaticamente il passo successivo sensato. Chi non ha ancora un'approvazione ordini pulita e dati di scorta affidabili dovrebbe prima risolvere questi fondamentali.

Lo stesso vale per previsioni e pianificazione supportata dall'IA. Possono rendere visibili gli schemi, ma richiedono dati di input puliti. Una previsione basata su scorte incomplete appare tecnicamente sofisticata, ma non migliora la capacità di consegna.

Soluzione standard o software logistico su misura?

Il software standard è sensato quando i flussi di lavoro propri sono in gran parte convenzionali e possono essere adattati senza grandi attriti. Può essere introdotto più rapidamente e porta funzioni core già collaudate. Per un'attività con processi di magazzino semplici, ruoli chiari e poche peculiarità, questa è spesso la scelta economicamente corretta.

Un software logistico su misura vale la pena quando l'azienda vive di flussi di lavoro speciali o i sistemi esistenti possono essere collegati solo con deviazioni. Questo riguarda, ad esempio, officine con problemi di materiale per ordini in corso, rivenditori con regole di spedizione specifiche per il cliente, o produttori che devono collegare strettamente i movimenti di magazzino con le fasi di produzione.

La differenza non sta nel reinventare tutto. I buoni sistemi su misura adottano schemi collaudati come cambi di stato, riserve e permessi. Tuttavia, adattano linguaggio, maschere, documenti e interfacce al lavoro effettivamente svolto. Così il team non deve orientarsi permanentemente verso categorie che hanno senso solo nel manuale del produttore.

Per softify.pro, un'impresa di questo tipo inizia quindi con la domanda su quali flussi di lavoro debbano essere preservati. Non ogni pezzo di carta è un errore, e non ogni regola speciale ha senso. Solo quando è chiaro dove si perdono informazioni o dove le decisioni attendono inutilmente si può pianificare una soluzione praticabile.

Un rollout senza interruzioni operative

Il rischio maggiore raramente sta solo nel codice del programma. Sta in un'implementazione che vuole cambiare troppo in una volta. Un magazzino non può fermarsi per due settimane per imparare un nuovo sistema. Pertanto, un rollout graduale è di solito più sensato di una grande data di passaggio.

Una buona prima sezione si concentra su un flusso di lavoro delimitato, ad esempio il ricevimento merci e le registrazioni di scorta o la creazione di bolle di consegna. Il team lavora con dati reali, il feedback confluisce direttamente nell'adattamento e il beneficio diventa misurabile. Solo allora seguono ulteriori aree, come il prelievo mobile, i resi o i collegamenti a shop e corrieri.

La migrazione dei dati merita particolare attenzione in questo contesto. I vecchi codici articolo, i dati anagrafici cliente duplicati e le posizioni di magazzino incoerenti non scompaiono automaticamente solo perché viene introdotto un nuovo sistema. È spesso meglio ripulire deliberatamente i dati anagrafici e adottare solo le cronologie rilevanti. Questo fa risparmiare ricerche successive e impedisce che il vecchio disordine venga tecnicamente conservato.

Anche i permessi appartengono presto all'ordine del giorno. Non ogni dipendente necessita di accesso ai prezzi, a tutte le correzioni di scorta o alla manutenzione dei dati anagrafici. Ruoli chiari proteggono da modifiche accidentali e rendono visibili le responsabilità senza bloccare il flusso di lavoro con approvazioni inutili.

Una tecnologia che non diventa un peso dopo l'avvio

Un'applicazione logistica deve reagire rapidamente nell'operatività quotidiana, anche se più postazioni registrano contemporaneamente. Per questo serve un'architettura dati tracciabile, transazioni pulite e regole chiare per le modifiche parallele. Se due dipendenti elaborano la stessa scorta, il sistema non deve generare registrazioni errate silenziose.

Altrettanto importante è la manutenibilità. Tecnologie come PHP 8.4, JavaScript moderno e MySQL 8 non sono un punto di vendita di per sé. Sono sensate quando l'applicazione rimane comprensibile a lungo termine, riceve aggiornamenti di sicurezza e può essere proseguita da sviluppatori qualificati. Provisioning documentato, backup, logging e una gestione realistica degli aggiornamenti fanno parte della capacità operativa.

Un buon software logistico non si riconosce quindi da una demo particolarmente accattivante. Si dimostra in un normale martedì mattina: la consegna viene registrata, la scorta è corretta, l'ordine è tracciabile, la bolla di consegna corrisponde e il turno successivo sa cosa è già stato fatto. Il sollievo nasce proprio lì — non attraverso il maggior numero possibile di funzioni, ma attraverso flussi di lavoro affidabili che si adattano all'attività.

Link permanente →

Pianificare un database MySQL per applicazioni web

Pianificare un database MySQL per applicazioni web

Quando tre dipendenti prenotano merce in parallelo al mattino, un cliente controlla lo stato della consegna e l'ufficio amministrativo emette una fattura, la qualità di un'applicazione non si vede nel design. Si dimostra dal fatto che tutti vedano esattamente lo stesso stato corretto dei dati. Pianificare un database MySQL per un'applicazione web non significa quindi creare tabelle il più rapidamente possibile. Significa capire i flussi di lavoro reali con sufficiente precisione da garantire che i dati restino affidabili anche sotto carico, durante gli errori e man mano che l'azienda cresce.

Soprattutto nelle piattaforme interne, nei processi di magazzino e ordini o nei portali rivolti ai clienti, il database viene spesso affrontato troppo tardi. Prima si costruisce l'interfaccia, poi si aggiungono campi, seguiti da eccezioni. Questo funziona per un prototipo. In produzione, ciò si traduce in set di dati duplicati, stati poco chiari e report di cui nessuno si fida più del tutto.

Pianificare un database MySQL per applicazioni web: partire dal flusso di lavoro

La prima bozza non dovrebbe iniziare con i nomi delle colonne, ma con una situazione di lavoro concreta. Prendiamo il ricevimento merci: arriva una consegna, viene assegnata a un fornitore e a un ordine, si controllano le quantità, si assegna una posizione di magazzino e le scorte cambiano. A seconda dell'operazione, questo processo richiede inoltre foto, un controllo qualità, uno stato di blocco o una correzione tracciabile. Da questo flusso di lavoro emergono gli oggetti funzionali. Esempi tipici sono articoli, fornitori, ordini, posizioni, posizioni di magazzino, movimenti di magazzino e utenti.

La distinzione tra un oggetto e un evento è fondamentale. Un articolo descrive cos'è qualcosa. Un movimento di magazzino documenta che una quantità è cambiata in una posizione specifica in un momento specifico. Mescolare entrambi in un'unica tabella porta rapidamente a una perdita di tracciabilità.

Alcune domande difficili aiutano per ogni oggetto: qual è l'identità univoca? Quali informazioni possono cambiare? Chi può modificarle? Quali dati devono essere conservati storicamente? E quali regole si applicano quando due persone lavorano contemporaneamente? Queste domande prevengono l'improvvisazione successiva meglio di un lungo elenco di campi del database presumibilmente completo.

Il modello dei dati deve esprimere regole

Un database non è semplicemente uno spazio di archiviazione per gli input dei moduli. Dovrebbe far rispettare regole centrali di per sé. Se ogni movimento di magazzino deve appartenere esattamente a un articolo e a una posizione di magazzino, le chiavi esterne appartengono al modello. Se un numero d'ordine esterno può comparire solo una volta per tenant, è necessario un indice univoco. Se una posizione non dovrebbe mai esistere senza un ordine intestatario, questa relazione deve essere modellata chiaramente.

MySQL 8 con InnoDB offre basi solide per questo: transazioni, chiavi esterne, meccanismi di blocco e modifiche coerenti su più tabelle. Quando si scrive un movimento, la scorta attuale e il registro di ispezione durante una registrazione di ricevimento merci, questo dovrebbe avvenire come una transazione coesa. Se un passaggio fallisce, non deve rimanere alcuna operazione a metà.

Tuttavia, non ogni regola appartiene al database. Approvazioni, logiche di prezzo complesse o passaggi di processo dipendenti dal ruolo sono spesso meglio collocati nella logica applicativa perché cambiano più rapidamente dal punto di vista funzionale. Il confine è pragmatico: le regole la cui violazione danneggia permanentemente i dati dovrebbero essere protette il più vicino possibile ai dati. Le regole che cambiano frequentemente o dipendono fortemente dal contesto richiedono codice applicativo ben testato.

Non confondere la cronologia con i valori attuali

Un errore comune è memorizzare solo la scorta attuale o lo stato attuale. Questo basta finché qualcuno non chiede perché la quantità è cambiata ieri o chi ha ripristinato un ordine. Per i sistemi operativi, una cronologia di movimenti o eventi è spesso più preziosa di un singolo campo sovrascrivibile.

Questo non significa registrare permanentemente ogni movimento di clic. Dovrebbero essere registrate le modifiche rilevanti per il business: cambi di stato, modifiche di quantità, correzioni, approvazioni e assegnazioni. Una buona voce di audit contiene un timestamp, l'utente o il processo di sistema, il valore precedente e quello nuovo, e un motivo comprensibile quando il flusso di lavoro lo richiede. Questo permette di chiarire gli errori senza dover cercare tra e-mail, elenchi cartacei o backup del database.

Scegliere consapevolmente chiavi, tipi di dati e convenzioni di denominazione

Le decisioni tecniche sembrano piccole, ma modellano la manutenzione e le integrazioni per anni. Per le chiavi primarie interne, i valori BIGINT con assegnazione automatica sono spesso una scelta sobria e facilmente gestibile. Gli UUID possono essere sensati quando i dati hanno origine offline, più sistemi scrivono in modo indipendente, o le interfacce esterne non dovrebbero esporre ID sequenziali. Tuttavia, costano più spazio di archiviazione e richiedono un po' più di attenzione con indici e ordinamento.

Gli importi monetari devono essere memorizzati come DECIMAL, non FLOAT o DOUBLE. Anche le quantità necessitano di una precisione funzionalmente appropriata: i conteggi di articoli sono spesso interi, mentre pesi e lunghezze non lo sono. I timestamp dovrebbero essere gestiti in modo uniforme, idealmente internamente in UTC, mentre l'interfaccia mostra il fuso orario locale dell'operazione. Soprattutto durante i cambi turno e l'ora legale, questo previene discrepanze difficili da individuare.

I nomi dovrebbero anche essere noiosi e inequivocabili. order_items o inventory_movements sono più utili di abbreviazioni creative che solo il team di progetto originale capisce. Forme singolari o plurali coerenti sono meno importanti della coerenza stessa. Altrettanto sensati sono campi come created_at, updated_at e, quando necessario, deleted_at. Una cancellazione soft non è tuttavia un obbligo standard. Per i record rilevanti a livello legale o operativo, un'annullamento pulito è di solito meglio di un set di dati eliminato in modo invisibile.

Gli indici seguono le query reali, non le supposizioni

Un indice può accelerare enormemente una ricerca, ma rende le operazioni di scrittura più complesse e consuma spazio di archiviazione. Pertanto, "un indice su ogni campo" non è una strategia. Le query più importanti dovrebbero essere stabilite in anticipo: ordini aperti di un cliente, movimenti di un articolo in un periodo, scorte per posizione di magazzino, o record recentemente modificati per un'interfaccia.

L'ordine degli indici composti è qui rilevante. Se l'applicazione cerca regolarmente per tenant_id, status e created_at, un indice composto in questo esatto ordine è spesso sensato. Se effettivamente si adatta lo mostra il piano di esecuzione tramite EXPLAIN, non l'istinto. I database non diventano veloci grazie a trucchi spettacolari, ma grazie a query osservabili, indici corrispondenti e volumi di dati testati in modo realistico.

Per le tabelle in crescita, vale la pena avere una chiara strategia di conservazione. I log tecnici devono restare nel database di produzione primario per cinque anni? Non necessariamente. I record aziendali, i movimenti e le prove di ispezione richiedono periodi di conservazione diversi rispetto alle informazioni di debug. L'archiviazione non è segno di un sistema debole, ma una decisione operativa deliberata.

Il funzionamento multiutente richiede transazioni e stati chiari

In un'applicazione web, più richieste accedono contemporaneamente agli stessi dati. Questo è normale nelle operazioni quotidiane di magazzino, non un'eccezione. Due dipendenti possono prenotare le stesse scorte mentre un'importazione crea nuovi ordini. Senza transazioni e blocco mirato, esiste il rischio di modifiche perse o scorte negative che diventano evidenti solo settimane dopo.

Per le operazioni critiche, dovrebbe essere chiaro quali dati vengono letti e scritti all'interno di una transazione. A volte un aggiornamento atomico è sufficiente, come una scorta modificata solo se la quantità disponibile è sufficiente. In altri casi, un blocco di riga è sensato in modo che un'operazione possa controllare lo stato dei dati in modo controllato e modificarlo successivamente. Le transazioni lunghe, invece, sono problematiche: bloccano altro lavoro e aumentano il rischio di conflitti.

Altrettanto importante è un insieme limitato di stati funzionali. Un ordine non dovrebbe essere "aperto", "parzialmente consegnato" e "elaborato manualmente" contemporaneamente a causa del mantenimento di campi in conflitto. Transizioni di stato definite semplificano interfacce, report e automazioni. Le eccezioni possono essere consentite, ma dovrebbero essere nominate e documentate.

Pianificare sicurezza, tenant e operazioni fin dall'inizio

L'applicazione dovrebbe usare un utente database dedicato per MySQL con privilegi minimi. L'accesso in scrittura per l'applicazione web non significa che questo utente debba poter eliminare tabelle o modificare i privilegi utente. Gli account amministrativi non appartengono ai file di configurazione di produzione e mai a un repository.

Quando più clienti, sedi o aziende lavorano all'interno di un'applicazione, l'isolamento tra tenant è una decisione architetturale, non una condizione di filtro retroattiva. Un database condiviso con un tenant_id può essere efficiente e facilmente mantenibile, ma richiede controlli coerenti in ogni query e regole chiare per gli indici. Database separati offrono un isolamento più forte, ma aumentano lo sforzo negli aggiornamenti, nelle valutazioni e nelle operazioni. Quale variante si adatti dipende dai requisiti di protezione dei dati, dal volume di dati e dal modello di business.

I backup sono backup solo dopo che un ripristino è stato testato. È richiesto un ritmo definito per backup, conservazione e recupero. Allo stesso modo, il monitoraggio dello spazio di archiviazione, delle query lente e dei job falliti, insieme agli aggiornamenti documentati, appartengono al sistema. MySQL 8, PHP 8.4 e le applicazioni web moderne possono essere gestite bene a lungo termine se le dipendenze, le credenziali di accesso e i passaggi di deployment non risiedono solo nella testa di uno sviluppatore.

Un piano sensato prima del primo giorno in produzione

Prima dell'implementazione dovrebbe esistere un modello di dati compatto con flussi di lavoro di esempio. Questo include tabelle e relazioni chiave, regole di stato, permessi, query attese, interfacce e un concetto per backup e log di audit. Questo piano non deve essere lungo cento pagine. Deve catturare decisioni che sarebbero poi costose da correggere.

In softify.pro, la pianificazione del database inizia quindi con le persone che prenotano, controllano, prelevano o risolvono le eccezioni. Se un foglio di calcolo esistente mappa in modo affidabile un processo gestibile, può rimanere la soluzione corretta. Se più persone lavorano contemporaneamente, emergono record e gli errori devono essere tracciabili, il database merita invece lo stesso impegno di pianificazione dell'interfaccia. La migliore architettura, alla fine, è quella che semplifica la giornata lavorativa e che può ancora essere modificata in modo trasparente tra due anni.

Link permanente →

Misurare correttamente i Warehouse Automation Results

Misurare correttamente i Warehouse Automation Results

Una nuova interfaccia di scansione può sembrare impressionante il primo giorno. Dopo tre settimane, però, diventa chiaro se accelera davvero il ricevimento merci o se crea semplicemente un ulteriore passaggio di lavoro. I Warehouse automation results non sono quindi un singolo indicatore, né uno screenshot tratto da una demo di prodotto. Si manifestano dove un team di magazzino deve cercare, chiedere, ribookare e correggere meno — mantenendo o migliorando la qualità.

Per le piccole e medie imprese, questa distinzione è particolarmente rilevante. Le grandi suite enterprise promettono spesso un'ottimizzazione completa, ma richiedono implementazioni lunghe, processi rigidi e molta manutenzione. Un passo di automazione sensato può partire più piccolo: esattamente nel punto in cui oggi le informazioni si perdono o le decisioni attendono inutilmente.

Quali Warehouse Automation Results contano davvero

Molti progetti partono da una domanda tecnica: scanner di codici a barre, app mobile, interfaccia verso lo shop o etichette automatiche? La domanda di partenza migliore è: quale collo di bottiglia costa sensibilmente tempo, denaro o affidabilità per turno?

La risposta raramente sta nel numero di dispositivi impiegati. I risultati significativi si misurano nel lavoro quotidiano. Nel ricevimento merci, ad esempio, conta il tempo tra la consegna e la disponibilità della merce a magazzino. Nel picking, è rilevante il tempo dall'ordine alla pronta spedizione. Durante l'inventario, non conta solo la durata, ma soprattutto la differenza tra scorte di sistema e scorte reali.

Altrettanto importanti sono gli indicatori che molte aziende non registrano in modo pulito: quante richieste nascono perché una posizione di magazzino non è chiara? Quante volte va corretto un documento di trasporto? Quanti ordini restano in sospeso perché solo una persona conosce lo stato a memoria o in un foglio Excel privato? Proprio questa rilavorazione silenziosa scompare dai classici report di produttività, ma pesa molto su capiturno, pianificazione e servizio clienti. Un buon obiettivo unisce velocità e controllo. Se gli ordini vengono evasi più in fretta ma aumentano le registrazioni errate, non è progresso. Se le scorte diventano più precise ma il ricevimento merci si intasa, il processo va ridisegnato. L'automazione riesce quando migliora il flusso di lavoro senza peggiorare la visione d'insieme operativa.

Dal sollievo percepito ai dati verificabili

L'esperienza dei dipendenti è un indicatore prezioso. Quando qualcuno dice, dopo due settimane, di non dover più correre in ufficio per ogni stoccaggio, questo conta. Per le decisioni di investimento, però, serve comunque un confronto indipendente dalla sensazione quotidiana. Prima dell'avvio andrebbero quindi registrati alcuni valori di partenza: tempo medio di elaborazione, numero di casi da chiarire ancora aperti, registrazioni correttive, tempi di ricerca, errori di spedizione e affidabilità delle scorte. Non servono venti indicatori. Bastano spesso quattro-sei valori adatti al problema concreto.

Dopo il rollout, questi stessi valori andrebbero osservati per diverse settimane. I singoli giorni di picco traggono facilmente in inganno. Stagionalità, malattie, nuovi dipendenti o un ordine insolitamente grande influenzano i risultati. Solo un confronto su turni normali mostra se il cambiamento è solido.

L'effetto più importante: uno stato del processo condiviso

In molti magazzini, il vero punto debole non è la mancanza di volontà di lavorare, ma uno stato informativo frammentato. Il ricevimento merci conosce la consegna, la pianificazione conosce l'ordine cliente e la spedizione conosce la priorità — ma non tutti lavorano con la stessa informazione aggiornata.

Un sistema specifico per il workflow può colmare questa frattura. Una consegna viene registrata all'arrivo, le difformità vengono documentate subito, la scorta riceve uno stato chiaro e il passo successivo diventa visibile. I dati non devono più essere annotati su carta, trasferiti in seguito e poi confermati per telefono.

Questo non riduce solo i percorsi a piedi. Riduce le decisioni basate su informazioni obsolete. Un addetto alla spedizione vede se un ordine è davvero prelevabile. L'amministrazione riconosce se la merce è arrivata o solo annunciata. La direzione non riceve un'istantanea abbellita, ma una base tracciabile.

Per i team con turni variabili, questo effetto è spesso più prezioso di un risparmio di tempo spettacolare. Il processo diventa meno dipendente dalle singole persone. La conoscenza non resta bloccata in quaderni, cronologie di chat o nella memoria del collaboratore più esperto.

Perché non ogni automazione produce buoni risultati

L'automazione rafforza i processi. È utile quando il flusso è chiaro. È problematico quando un flusso poco chiaro viene semplicemente riprodotto più velocemente.

Un esempio tipico è la registrazione obbligatoria tramite scansione per ogni minimo gesto. Se i dipendenti devono aprire più maschere per un'eccezione rara, nascono soluzioni di aggiramento. Gli articoli vengono poi registrati in blocco più tardi, gli scanner restano nel cassetto o un dipendente torna a tenere una lista parallela. Il software c'è, ma il processo reale prosegue accanto ad esso.

Anche la qualità dei dati pone dei limiti. Anagrafiche articolo senza unità chiare, logica delle posizioni di magazzino poco definita o denominazioni fornitori incoerenti non si risolvono con un'interfaccia elegante. Qui un progetto può inizialmente consistere in lavoro di pulizia dei dati. Sembra meno visibile di una nuova applicazione, ma è spesso il presupposto per risultati affidabili.

Esistono inoltre processi che deliberatamente non dovrebbero essere completamente automatizzati. Un controllo esperto su merci delicate, l'approvazione di scostamenti insoliti o la decisione su una consegna speciale richiedono giudizio professionale. I buoni sistemi segnalano chiaramente questi casi e li indirizzano in modo mirato. Non fingono che ogni eccezione si possa risolvere con una regola.

Quando un foglio di calcolo resta ancora la soluzione migliore

Non ogni passaggio manuale giustifica uno sviluppo su misura. Se un processo avviene raramente, coinvolge pochi partecipanti ed è gestito in modo tracciabile, un foglio di calcolo ben curato può restare sensato. Il difetto non sta in Excel in sé, ma nel gestire movimenti critici senza chiara responsabilità, controllo di versione o registrazione tempestiva.

Non appena più persone modificano in parallelo, i movimenti di magazzino diventano critici in termini di tempo o le informazioni clienti da fonti diverse devono essere consolidate, il rischio aumenta sensibilmente. Un sistema condiviso è allora di solito più conveniente della continua correzione di malintesi.

I Warehouse Automation Results richiedono un rollout controllato

La via più rapida verso risultati scadenti è una trasformazione completa durante l'operatività corrente. Meglio un'area delimitata con beneficio misurabile: ad esempio il ricevimento merci per un gruppo di prodotti, le etichette di spedizione per una sede, o una registrazione mobile per gli spostamenti più frequenti.

Un pilota dovrebbe rappresentare ordini reali e turni reali. I dati di test aiutano nello sviluppo, ma non mostrano se il Wi-Fi oscilla nella zona posteriore del magazzino, se i guanti rendono difficile l'uso dello scanner o se uno stato è formulato in modo ambiguo per la pianificazione. Questi dettagli decidono l'accettazione e la qualità dei dati.

Tecnicamente conta di più un'affidabilità noiosa e dimostrabile rispetto a uno stack alla moda. Diritti di ruolo chiari, protocolli di registrazione tracciabili, indicazioni di errore univoche, transazioni di database stabili e processi documentati non sono dettagli secondari. Trasformano un'applicazione in uno strumento di cui i team possono fidarsi nell'operatività quotidiana.

Per i sistemi logistici individuali, questo significa anche: l'integrazione deve adattarsi all'operatività esistente. Un'applicazione può recepire ordini da uno shop, generare documenti di trasporto, mettere a disposizione etichette di spedizione e documentare i movimenti di magazzino. Non deve per questo sostituire subito tutti i sistemi collegati. Proprio nelle PMI, una sostituzione graduale è spesso meno rischiosa e più economica.

Come un progetto diventa un miglioramento duraturo

Dopo l'introduzione inizia la fase decisiva. I casi speciali vengono registrati? Le posizioni di magazzino corrispondono ancora alla realtà? I nuovi dipendenti capiscono la logica di registrazione senza spiegazioni verbali? E i valori misurati restano validi quando il volume degli ordini cresce?

Feedback brevi e regolari da magazzino, spedizione e amministrazione sono più efficaci di un grande workshop annuale. Quando diventa visibile un'eccezione ricorrente, andrebbe rappresentata come un chiaro passaggio di processo oppure deliberatamente esclusa dal flusso standard. Entrambe le soluzioni sono meglio che tollerarla in silenzio.

Il passo successivo più sensato spesso non è un grande capitolato. Prendete un processo con richieste frequenti e misurate per una settimana dove si perde tempo. Se ne emerge un flusso chiaro e ripetibile, l'automazione può essere collegata a un risultato convincente tanto sul piano del magazzino quanto nel bilancio mensile.

Link permanente →

Sviluppo web moderno che funziona nell'operatività: architetture pragmatiche per piccole e medie imprese — con codice manutenibile, archiviazione dati solida e senza inutile sovraccarico di strumenti.

Sviluppo web moderno che funziona nell'operatività: architetture pragmatiche per piccole e medie imprese — con codice manutenibile, archiviazione dati solida e senza inutile sovraccarico di strumenti.

Un responsabile di magazzino stampa documenti di trasporto al mattino mentre una collega corregge le giacenze in un foglio di calcolo, e le vendite chiamano per chiedere lo stato di un ordine. Il problema è raramente la mancanza di digitalizzazione. Il più delle volte ci sono troppi strumenti separati tra loro. Lo sviluppo web moderno non crea allora semplicemente un'interfaccia più bella, ma una base di lavoro comune e affidabile.

Per le piccole e medie imprese, questo significa: un'applicazione web deve funzionare sotto pressione temporale, su uno scanner in magazzino tanto quanto su uno schermo in ufficio. Deve archiviare i dati in modo tracciabile, gestire i permessi in modo pulito e permettere un ulteriore sviluppo senza diventare un rischio a ogni modifica. La tecnologia non è qui fine a se stessa. È la base affinché i processi scorrano più velocemente rimanendo al contempo meglio controllabili.

Lo sviluppo web moderno inizia prima del primo codice

Chi inizia con un catalogo di funzioni predefinito spesso costruisce oltre il vero collo di bottiglia. Nella pratica conviene un approccio diverso: quale informazione manca regolarmente oggi? Dove si verificano inserimenti doppi? In quale punto le decisioni vengono confermate per telefono o a voce perché nessuno vede in modo affidabile lo stato attuale?

Nella ricezione merci, questo può manifestarsi ad esempio come descrizioni articolo incoerenti, istruzioni di ispezione mancanti, o giacenze aggiornate in ritardo. Nell'elaborazione degli ordini si tratta spesso di note scritte a mano, approvazioni poco chiare e dati di spedizione mantenuti in più sistemi. Una buona applicazione non digitalizza semplicemente queste consegne. Le organizza in modo che responsabilità, stati e prossimi passi siano visibili.

Questo significa anche non abolire riflessivamente le pratiche esistenti. Un foglio di calcolo ben mantenuto può continuare a essere la soluzione più sensata per una piccola valutazione. Un'applicazione web personalizzata conviene dove più persone lavorano contemporaneamente, gli errori nascono dalla trascrizione manuale, o un processo deve essere documentato e ripetibile.

Cosa deve offrire un'applicazione web moderna nell'attività quotidiana

Un'interfaccia utente convincente è preziosa, ma è solo una parte del lavoro. Nell'attività continua contano soprattutto i tempi di risposta, i flussi di lavoro comprensibili e i dati resilienti. Quando un operatore completa un'attività, lo stato non deve diventare visibile solo dopo diversi aggiornamenti. Quando un ordine viene modificato, deve essere tracciabile cosa è stato cambiato e quali passi successivi sono interessati. Questo comprende tre livelli strettamente collegati: l'interfaccia utente, la logica applicativa e il database. L'interfaccia guida le persone attraverso il processo. La logica controlla ad esempio campi obbligatori, permessi o quantità disponibili. Il database archivia i fatti in modo tale che valutazioni, correzioni ed espansioni rimangano possibili in seguito.

Per molte applicazioni aziendali, le tecnologie collaudate sono una scelta più sensata rispetto a una tendenza di breve durata. PHP 8.4 può fornire una logica server chiaramente strutturata, JavaScript moderno un'esperienza utente reattiva, e MySQL 8 una solida base dati. Il fattore decisivo non è che ogni progetto utilizzi lo stesso stack. La chiave è che la tecnologia scelta si adatti al problema, all'operatività e alla manutenzione a lungo termine.

Le prestazioni sono una questione di processo

Le prestazioni vengono spesso ridotte ai tempi di caricamento. Questo è insufficiente. Un'applicazione sembra lenta anche quando i dipendenti eseguono troppi passaggi, cercano informazioni, o devono inserire lo stesso dato più volte. Una pagina veloce con un modulo complicato rimane un cattivo processo.

Un'ottimizzazione sensata inizia quindi con le operazioni più frequenti. Quali schermate vengono aperte cento volte al giorno? Quale ricerca deve rimanere veloce anche con l'aumento del volume di dati? Quali dati dovrebbero essere salvati in background senza che i dipendenti attendano una conferma? Solo dopo seguono dettagli tecnici come indici database mirati, query ridotte e una consegna snella dei file nel browser.

Modello dati e permessi: l'architettura invisibile

Molti progetti web non falliscono alla prima versione, ma alle aggiunte successive. Un campo inizialmente semplice come "Stato" diventa improvvisamente una catena di approvazione, ispezione, elaborazione, annullamento ed elaborazione successiva. Se questi stati sono memorizzati solo in modo approssimativo nei moduli, ogni estensione diventa costosa e soggetta a errori.

Un modello dati pulito separa quindi processi, posizioni, contatti, documenti e cambiamenti di stato in modo tracciabile. Previene voci contraddittorie invece di doverle ripulire faticosamente in seguito. Proprio nei movimenti di magazzino, documenti di trasporto o dati d'ordine, questa precisione non è un esercizio accademico. Determina se il numero di giacenza è adatto come base di lavoro.

Altrettanto importanti sono ruoli e permessi. Non ogni persona ha bisogno di accesso a prezzi, informazioni sul personale o impostazioni amministrative. I buoni concetti di permessi sono concreti: chi può creare un ordine, approvarlo o annullarlo? Chi vede solo il proprio reparto? A ciò si aggiungono misure di protezione come archiviazione sicura delle password, blocchi account dopo tentativi ripetuti falliti, registrazione delle modifiche critiche e sessioni chiaramente regolate. La sicurezza non è quindi un'aggiunta poco prima del go-live. Appartiene all'architettura perché le correzioni successive spesso intervengono profondamente nell'accesso, nell'accesso ai dati e nel sistema di permessi.

Responsive non significa solo "si adatta al telefono"

Un'applicazione responsive si adatta a diverse dimensioni dello schermo. Per il lavoro quotidiano, questa definizione non basta. Su un tablet in magazzino valgono requisiti diversi rispetto a un grande schermo nella disposizione. Le aree touch devono essere azionabili in modo sicuro, i dettagli importanti non devono scomparire sotto informazioni secondarie, e gli input devono rimanere pratici anche con guanti, condizioni di illuminazione mutevoli o connessione instabile.

Di conseguenza, ogni vista richiede una priorità chiara. Nella ricezione merci, scansione e conferma possono essere al centro. In ufficio, filtri, liste, funzioni di esportazione e viste dettagliate sono spesso più importanti. Un'interfaccia che appare identica ovunque non è automaticamente utilizzabile ovunque.

Lo sviluppo web moderno richiede un'operatività controllata

Il go-live non è un punto finale, ma l'inizio del vero test. Solo con dati reali, eccezioni e picchi di carico si rivela se le regole sono comprensibili e se le interfacce funzionano in modo affidabile. Fornitura documentata, ambienti chiaramente separati per sviluppo e produzione, nonché backup tracciabili fanno quindi parte del progetto, non semplice amministrazione IT.

Anche i test automatizzati ottengono molto qui. Ricontrollano flussi di lavoro ricorrenti come login, controlli permessi, inserimento ordini o generazione documenti dopo ogni modifica. Per applicazioni sensibili, un ambiente di test self-hosted può essere sensato perché screenshot, dati di test e passaggi applicativi interni rimangono nella sfera di controllo propria dell'azienda. L'automazione non sostituisce la revisione esperta di dipendenti esperti. Tuttavia, garantisce che i flussi di lavoro conosciuti non vengano silenziosamente danneggiati.

In softify.pro, questa mentalità fa parte dell'implementazione: pianificare con precisione tecnica, prendere sul serio i flussi di lavoro reali, e fornire modifiche in modo che rimangano comprensibili in seguito. Questo è meno spettacolare di uno spettacolo pirotecnico tecnologico, ma significativamente più prezioso nell'operatività.

Quando il software standard è sufficiente — e quando no

Il software standard è sensato quando il proprio processo corrisponde in gran parte ai flussi di lavoro standard del settore e la configurazione rimane gestibile. Può essere disponibile rapidamente e portare funzioni core affidabili. Diventa problematico quando i team sono costretti a piegare continuamente i loro flussi di lavoro funzionanti in modi scomodi o quando informazioni vitali finiscono fuori dal sistema.

Una soluzione personalizzata non è automaticamente migliore. Richiede requisiti chiari, referenti responsabili, e la disponibilità a prendere decisioni. In cambio, può mappare esattamente i passaggi di lavoro critici per l'azienda: un'ispezione specializzata alla ricezione merci, la stampa di etichette di spedizione corrispondenti, un'approvazione basata sul gruppo cliente, o il collegamento tra officina, magazzino e vendite. La domanda corretta non è quindi: abbiamo bisogno di un'applicazione su misura? È: quale attrito ricorrente ci costa oggi tempo, denaro o affidabilità — e può essere eliminato permanentemente con uno sforzo ragionevole?

Una buona applicazione web non rende il lavoro artificialmente digitale. Rimuove consegne inutili, stabilisce uno stato dei dati affidabile, e dà alle persone esattamente le informazioni di cui hanno bisogno per il loro prossimo passo. Quando questo riesce, lo sviluppo web moderno non sembra un nuovo progetto IT, ma un'operatività che può finalmente lavorare senza deviazioni.

Link permanente →

Come implementare correttamente la digitalizzazione dei documenti di trasporto

Come implementare correttamente la digitalizzazione dei documenti di trasporto

Un autista non aspetta perché un file Excel è al momento aperto da qualcun altro. E nella ricezione merci, una pila ordinata di carta non serve a nulla se una consegna parziale non può più essere tracciata in seguito. Chi cerca "come digitalizzare i documenti di trasporto" raramente vuole solo scansionare la carta. Ciò che si cerca è un flusso di lavoro resiliente che registri i movimenti di merce, le conferme e le discrepanze proprio dove si verificano.

I documenti di trasporto digitali funzionano bene quando semplificano il lavoro in magazzino, in officina e presso il cliente. Se vengono implementati solo come archivio PDF, lo sforzo rimane lo stesso — solo su uno schermo invece che su carta. La differenza decisiva sta in dati strutturati, responsabilità chiare e un collegamento pulito con ordini, giacenze e fatture.

Come digitalizzare i documenti di trasporto: controllare prima il flusso di lavoro

Il primo passo non è la scelta del software, ma un'onesta analisi della situazione attuale. Prendi un documento di trasporto reale e segui il suo percorso: dall'ordine al prelievo, alla consegna, al riscontro e all'archiviazione. Questo di solito rivela rapidamente dove le informazioni vengono aggiunte a posteriori, inserite due volte, o chiarite per telefono e chat.

Nelle piccole e medie imprese raramente esiste un solo flusso di lavoro. Una consegna standard a clienti abituali richiede qualcosa di diverso rispetto a una consegna in cantiere, un ritiro, o una consegna con reso di imballaggi vuoti. Non è necessario automatizzare tutte queste differenze nella versione uno. Dovrebbero però essere conosciute, in modo che il nuovo sistema non fallisca al primo caso speciale.

Un buon processo digitale risponde in modo univoco a tre domande per ogni stato: Chi ha spostato la merce e quando? Quali quantità sono state effettivamente consegnate? E cosa è successo in caso di discrepanze? Se queste informazioni mancano, un documento di trasporto digitale è soprattutto solo un documento più bello.

Non riprodurre semplicemente la carta come PDF

La scansione dei documenti di trasporto esistenti può essere utile come transizione, ad esempio per l'archiviazione di processi vecchi. Per l'attività operativa, tuttavia, risolve poco. Un'immagine o un PDF può essere archiviato, ma quantità, codici articolo, lotti e note non possono essere riutilizzati in modo affidabile al suo interno.

Un approccio migliore è un documento generato da dati d'ordine strutturati. Articoli, quantità target, indirizzi di consegna e referenti vengono adottati. I dipendenti confermano quindi le quantità effettive direttamente su un dispositivo mobile o in una postazione di lavoro in magazzino. Solo discrepanze, danni o posizioni aggiuntive devono essere inserite manualmente.

Questo non fa solo risparmiare tempo. Previene anche una tipica rottura del supporto: la contabilità non riceve più una firma a malapena leggibile su carta mentre il magazzino mantiene separatamente lo stesso processo in un foglio di calcolo.

I dati di cui un documento di trasporto digitale ha realmente bisogno

Un sistema non dovrebbe forzare ogni campo immaginabile. Input aggiuntivi rallentano le consegne e riducono l'accettazione. Allo stesso tempo, il nome del cliente e la firma non sono sufficienti per molti flussi di lavoro.

Come base, ogni documento di trasporto richiede un numero univoco, il riferimento all'ordine, gli indirizzi di consegna e del destinatario, le posizioni articolo con quantità target ed effettive, e le marche temporali.

A seconda del settore, si aggiungono lotti, numeri di serie, peso, ubicazioni di magazzino o contenitori. Per merci a temperatura controllata, i valori misurati possono essere rilevanti; per consegne in cantiere, foto o indicazioni precise sul luogo di consegna sono utili.

Lo stato è particolarmente importante. "Creato," "prelevato," "in transito," "consegnato," "consegnato parzialmente," e "contestato" non sono semplici etichette. Determinano quale persona deve agire successivamente e se, ad esempio, può essere generata una fattura o programmata una consegna successiva.

Utilizzare firme e foto con moderazione

Una firma digitale è utile in molti processi di consegna, ma non è automaticamente la migliore conferma. Per una consegna rapida alla ricezione merci, un nome stampato, una marca temporale e l'assegnazione al destinatario possono essere sufficienti. Per merci di alto valore o consegne contestate, una firma combinata con una foto e informazioni sulla posizione può invece essere più sensata.

Il fattore decisivo è la catena di prove: la conferma deve essere mappata al documento specifico e alla sua versione. Se qualcuno modifica quantità o posizioni dopo la firma, il sistema non dovrebbe sovrascriverlo silenziosamente. Richiede una correzione tracciabile o una nuova conferma. Le foto meritano la stessa disciplina. Possono documentare i danni, ma non dovrebbero trasformarsi in una raccolta indiscriminata di dati personali. Definire quando è richiesta una foto, chi può accedervi, e per quanto tempo viene conservata.

L'acquisizione dati mobile deve funzionare in condizioni reali

In ufficio, quasi ogni applicazione è utilizzabile. In magazzino contano guanti, Wi-Fi scadente, pressione temporale e dispositivi con autonomia limitata della batteria. Un documento di trasporto digitale deve quindi cavarsela con pochi, grandi passaggi di input. Le scansioni di codici a barre o codici QR sono spesso più veloci e affidabili della ricerca di codici articolo.

La capacità offline non è un lusso quando gli autisti lavorano al di fuori di una copertura di rete stabile. L'applicazione dovrebbe memorizzare le operazioni localmente, mostrare chiaramente cosa non è ancora stato sincronizzato, e gestire i conflitti in modo controllato. Se due persone modificano la stessa consegna, non deve vincere per caso l'ultimo salvataggio.

Anche la questione del dispositivo deve essere affrontata in modo pragmatico. Uno smartphone esistente può essere sufficiente per consegne semplici. Per scansioni, foto e firme frequenti in magazzino, palmari robusti o tablet sono spesso più economici. La decisione migliore dipende dalla durata operativa, dall'ambiente e dal throughput previsto — non da quale dispositivo sembra moderno su una diapositiva di prodotto.

Definire le interfacce prima dell'implementazione

Un documento di trasporto digitale sviluppa il suo valore solo quando si collega alle fonti di dati principali. In molte aziende, gli ordini risiedono nell'ERP o nel sistema di gestione magazzino, le giacenze in una soluzione di magazzino separata, e le fatture in contabilità. Questo non deve diventare immediatamente un grande progetto di sistema. Ma la sovranità dei dati deve essere chiara.

Definire quindi quale sistema gestisce clienti, articoli, prezzi e ordini. La soluzione per i documenti di trasporto può adottare informazioni, ma non dovrebbe generare inosservatamente un secondo anagrafica articoli. Allo stesso modo, deve essere regolato quando le quantità effettive confermate vengono riportate indietro e chi verifica le discrepanze.

Tecnicamente, interfacce affidabili sono più importanti di funzioni spettacolari. ID univoci, formati dati documentati, protocolli per trasferimenti falliti, e un meccanismo di ripetizione impediscono che i documenti di trasporto scompaiano tra due sistemi. Un'applicazione snella su una base gestibile, come PHP 8.4, JavaScript moderno e MySQL 8, è più sensata per molti flussi di lavoro di medie imprese rispetto a una suite sovraccarica con funzioni che nessuno usa.

Sicurezza e archiviazione fanno parte del processo

I documenti di trasporto contengono dati aziendali e spesso anche dati personali. I permessi di ruolo non dovrebbero quindi essere assegnati in modo generico. Gli autisti hanno bisogno dei loro giri e compiti aperti, i responsabili di magazzino necessitano di opzioni di correzione e revisione, la contabilità ha bisogno di documenti confermati ed esportazioni. L'accesso completo amministrativo non è un diritto standard.

Inoltre, è necessaria una cronologia tracciabile: creazione, modifica, consegna, firma, annullamento e correzione dovrebbero essere registrati con ora, utente e giustificazione. Questo aiuta con le richieste e protegge i dipendenti quando in seguito non è chiaro quando è stato segnalato un danno o una carenza. Per l'archiviazione vale: il documento deve rimanere leggibile e il processo rintracciabile. Se viene generato un PDF dipende dal processo interno e dai requisiti dei destinatari esterni. Il PDF è tuttavia l'output di un processo digitale, non il suo modello di dati.

Diventare produttivi in piccoli passi

Il rollout più affidabile inizia con un processo chiaramente delimitato: ad esempio consegne standard da un magazzino o ricezioni merci di un reparto. Scegli un'area con volume sufficiente, ma senza i casi eccezionali più complicati. Questo permette di testare funzionamento, qualità dei dati e interfacce in condizioni reali.

Non misurare solo se l'applicazione funziona tecnicamente. Verifica quanto tempo richiede una consegna, quanti documenti di trasporto richiedono rilavorazione, quanto spesso si verificano discrepanze di magazzino, e se la contabilità può lavorare più velocemente. Se una procedura digitale genera più richieste rispetto al modulo cartaceo, non è la forza lavoro il problema — allora manca chiarezza di processo o la maschera di input non si adatta alla pratica operativa.

I fogli di calcolo possono continuare a esistere se sono affidabili per una valutazione limitata o una lista speciale rara. La digitalizzazione non significa abolire ogni strumento conosciuto. Significa sostituire deliberatamente le consegne soggette a errori e rendere robusto il processo centrale.

softify.pro sviluppa tali flussi di lavoro non come prodotto standard rigido, ma lungo movimenti di merce concreti, ruoli e sistemi esistenti. Questo è particolarmente utile quando un'azienda cerca una soluzione adatta tra il caos cartaceo e un sistema aziendale sovradimensionato.

Il primo passo corretto non è quindi un lungo catalogo di requisiti. Prendi dieci documenti di trasporto da una settimana normale, inclusa una consegna parziale e un reclamo. Se il tuo futuro flusso di lavoro elabora questi dieci casi rapidamente, in modo univoco e tracciabile, un documento di trasporto digitale si trasforma in uno strumento su cui magazzino, autisti e amministrazione possono fare affidamento.

Link permanente →

Tendenze del software testing 2026 che contano davvero

Tendenze del software testing 2026 che contano davvero

Un rilascio fallito raramente mostra un solo errore. Spesso si combinano più cause: un permesso modificato, un ambiente di test poco chiaro, dati di test mancanti o un test di regressione non mantenuto da mesi. È proprio qui che le software testing trends per il 2026 diventano concrete - non come una raccolta di nuovi strumenti, ma come la domanda di come le aziende possano consegnare modifiche con sicurezza verificabile, anche con capacità QA limitate e dati sensibili.

Per i team software nelle medie imprese, questo è particolarmente rilevante. Un'applicazione di magazzino, un portale clienti o un software desktop Windows non deve servire milioni di utenti. Deve però funzionare in turni di lavoro, generare documenti correttamente e applicare in modo affidabile i permessi. Il testing deve quindi essere più vicino ai flussi operativi reali che a un ambiente demo perfetto.

Tendenze del software testing: l'AI diventa esecutore, non oracolo

Il trend più visibile è il testing assistito dall'AI. Non significa che un modello linguistico legga un requisito e successivamente garantisca la qualità dell'applicazione. Questa aspettativa sarebbe pericolosa. L'AI può però ridurre notevolmente lo sforzo dove i team perdono tempo oggi: nel formulare i casi di test, nel riconoscere modifiche vistose nelle interfacce utente, nell'assegnare pattern di errore simili e nello scrivere report di test comprensibili.

L'AI diventa particolarmente utile quando esegue passaggi di lavoro concreti e fornisce prove dei suoi risultati. Un agente di test può, ad esempio, accedere, creare un arrivo merce, modificare un indirizzo di consegna, generare un'etichetta di spedizione e verificare se stato, movimento di magazzino e documento corrispondono. Il fattore decisivo non è l'affermazione "test superato", ma la catena di prove: passaggi eseguiti, timestamp, screenshot, log tecnici e una descrizione chiara della deviazione.

Il limite resta importante. L'AI può suggerire casi di test e gestire flussi ricorrenti. Non dovrebbe decidere autonomamente se una registrazione aziendale criticamente sensibile è corretta. Per prezzi, livelli di scorte, approvazioni di pagamento o diritti di accesso restano necessarie regole esplicite e aspettative confermate dai reparti aziendali. L'automazione accelera il testing; non sostituisce la responsabilità.

L'automazione dei test migra nel processo aziendale

Per molto tempo, l'automazione dei test UI si è concentrata su percorsi semplici: aprire la pagina, compilare il modulo, verificare il messaggio di successo. Questo resta utile, ma non è sufficiente per i sistemi critici per il business. Il test più prezioso convalida un'intera catena di processo.

Prendiamo una tipica funzione logistica. Un ordine viene registrato, la merce riservata, un processo di prelievo avviato, un documento di trasporto generato e la spedizione segnalata. Ogni singola schermata può apparire pulita mentre il processo comunque fallisce - ad esempio perché una prenotazione persiste dopo un'interruzione o una consegna parziale altera erroneamente le scorte. I buoni test automatizzati tracciano quindi stati e dati attraverso i confini del sistema.

Questo richiede un'architettura di test pulita. I test API e database verificano le regole rapidamente e con precisione. I test UI controllano inoltre se i dipendenti possono effettivamente operare il processo. I test end-to-end combinano entrambi, ma sono più lenti e fragili. Chi testa tutto esclusivamente tramite il browser costruisce di solito una suite di test costosa e fragile. Chi testa solo le interfacce trascura i problemi operativi e le interfacce utente collegate male.

La soluzione pragmatica è una piramide adatta al rischio: molti controlli rapidi vicini alla logica di business, meno controlli di integrazione e scenari end-to-end scelti selettivamente per i flussi più importanti. Suona poco spettacolare. Fornisce però un'affidabilità noiosa e dimostrabile invece dell'inseguimento delle tendenze.

L'AI di test self-hosted diventa una questione architetturale

Con gli strumenti di test AI sorge una nuova domanda: dove vanno i dati di test, gli screenshot e le registrazioni? In molte applicazioni contengono nomi di clienti, prezzi interni, informazioni sul personale o viste di processi critici per il business. Anche un ambiente di test apparentemente innocuo può contenere copie di dati reali o strutture riservate.

Per questo l'ambiente di esecuzione diventa un criterio centrale. Un servizio cloud esterno può essere adatto per applicazioni web pubbliche e dati di test non critici. Per portali interni, applicazioni desktop o aree regolamentate, un approccio self-hosted è spesso più sensato. In questo assetto, l'esecuzione dei test, il materiale immagine e i log restano nell'infrastruttura controllata dell'azienda o in un ambiente UE chiaramente delimitato.

Questo non è un argomento generico contro i servizi cloud. La gestione autonoma comporta impegno: aggiornamenti, controllo degli accessi, risorse di calcolo, monitoraggio e responsabilità chiare devono essere gestiti. Il beneficio nasce quando protezione dei dati, tracciabilità e controllo sugli artefatti di test pesano più della comodità di un account SaaS immediatamente disponibile. Sistemi come COCO seguono esattamente questo approccio, eseguendo test per applicazioni web e Windows mantenendo le prove controllabili localmente.

I test flaky non sono più accettati come normalità

Un test automatizzato che a volte passa e a volte fallisce senza una modifica del prodotto non genera sicurezza. Genera code. I team si abituano poi a ignorare le build rosse o a rieseguire i test finché non appare il risultato desiderato. Questa è una perdita graduale di fiducia nell'intero quadro di controllo qualità.

Nel 2026 la stabilità dell'esecuzione dei test passa quindi maggiormente in primo piano. Le cause sono di solito note: tempi di attesa casuali, selettori instabili, dati di test condivisi, dipendenze da servizi esterni o database non ripristinati. La soluzione raramente è un altro retry. Più sensati sono selettori tecnici univoci, account di test isolati, stati di dati controllati e condizioni di attesa mirate che reagiscono a eventi reali del sistema.

Anche la valutazione dovrebbe distinguere: un errore è riproducibile? Si verifica solo in un ambiente? È fallito un servizio esterno o l'applicazione stessa? L'AI può aiutare a raggruppare questi segnali. La decisione tecnica deve però restare tracciabile. Un team QA non ha bisogno di una misteriosa previsione degli errori, ma di una base solida per la prossima misura.

La qualità inizia prima, con requisiti e dati

Molti errori nascono prima che venga scritta la prima riga di codice. "L'ordine dovrebbe poter essere spedito" non è un requisito testabile. Cosa succede in caso di indirizzo incompleto, conto cliente bloccato, merce mancante, elaborazione parallela o sessione scaduta? Senza risposte a queste domande, nessun sistema di test può verificare in modo affidabile se il software funziona correttamente.

Un approccio di test più maturo integra quindi i requisiti con esempi verificabili. Per un conto con tentativi di accesso errati, questo può significare concretamente: dopo cinque tentativi falliti, il conto viene bloccato per 15 minuti, il processo viene registrato e un amministratore autorizzato può tracciare il blocco. Da qui nascono direttamente controlli automatizzabili - e meno margine di interpretazione tra sviluppo, operazioni e reparto aziendale.

Anche i dati di test diventano una caratteristica del prodotto. Devono essere abbastanza realistici da rappresentare i casi limite, ma non devono copiare dati personali non necessari. Sono utili dataset generati per casi IVA, quantità parziali, articoli bloccati, indirizzi non validi e vari ruoli. Proprio con applicazioni che usano MySQL 8 o database relazionali comparabili, conviene predisporre automaticamente stati iniziali definiti e rimuoverli dopo l'esecuzione.

Il testing basato sul rischio batte la copertura dei test a ogni costo

Un numero elevato di code coverage può essere rassicurante pur dicendo molto poco. Mostra quali righe sono state eseguite, non se è stata verificata la regola corretta. Un sistema può raggiungere il 90 percento di copertura e comunque generare scorte errate durante l'annullamento di una consegna parziale.

La domanda migliore è: quali errori sarebbero particolarmente costosi per l'operatività, i clienti o la conformità legale? Da qui nasce una priorizzazione. Protezione degli accessi, calcolo dei prezzi, registrazioni di magazzino, generazione di documenti e interfacce verso i fornitori di servizi di spedizione meritano di solito più profondità di test rispetto a pagine di impostazioni usate raramente. Questo non significa consegnare questioni secondarie senza controllo. Significa impiegare tempo limitato dove un guasto ferma il lavoro reale o genera decisioni sbagliate.

Questa priorizzazione deve poter cambiare. Se viene introdotta una nuova funzione di pianificazione dei percorsi, il suo rischio aumenta. Se una vecchia valutazione Excel sarà presto sostituita, un grande sforzo di automazione potrebbe non valerne più la pena. A volte è più sensato mantenere un foglio di calcolo funzionante ancora per qualche mese piuttosto che forzarne frettolosamente la logica in un sistema mezzo finito.

Cosa dovrebbero fare praticamente i team ora

Il primo passo sensato non è un confronto tra strumenti. Scegliete un processo i cui errori sono tangibili: dall'ordine alla consegna, dall'arrivo merce alla messa a scaffale, o dall'accesso all'approvazione del ruolo. Descrivete il flusso target con i casi eccezionali, impostate dati di test affidabili e automatizzate prima i controlli critici.

Successivamente, non misurate solo il numero di test. Osservate quanto velocemente viene rilevato un errore reale, quanto spesso i test falliscono senza motivo e se un report spiega la causa in modo comprensibile a uno sviluppatore o a un responsabile aziendale. Solo quando queste basi sono solide vale la pena espandersi con agenti AI, ispezione visiva o ambienti di test estesi.

Le tendenze di testing più forti sono alla fine quelle che rendono i rilasci meno rischiosi e portano i team a decisioni chiare più velocemente. Non è la dashboard più moderna a contare, ma un'esecuzione di test tracciabile che mostra che questo processo aziendale funziona - e se non funziona, sapere perché.

Link permanente →

Pianificazione dei percorsi per le consegne: scegliere il software giusto

Pianificazione dei percorsi per le consegne: scegliere il software giusto

Un autista aspetta un documento di trasporto mentre l'ordine delle sue fermate cambia di nuovo. In magazzino una spedizione non è ancora stata prelevata, un cliente chiama per una finestra oraria più stretta, e l'elenco dei giri si trova in un foglio di calcolo che solo una persona capisce davvero. Chi cerca "software per la pianificazione dei percorsi di consegna" in questa situazione non vuole necessariamente un complicato algoritmo cartografico. Cerca un flusso di lavoro affidabile dall'inserimento dell'ordine alla prova di consegna.

Per le piccole e medie imprese, questa è una differenza decisiva. Un percorso teoricamente più breve serve a poco se non tiene conto del fatto che la merce non è pronta prima delle 10, un veicolo richiede la refrigerazione, o un autista possiede una conoscenza specifica del cliente su un determinato giro. Un buon software per le consegne rappresenta la realtà operativa - rendendola utilizzabile congiuntamente da disposizione, magazzino e autisti.

Quando la pianificazione dei percorsi diventa un problema operativo

Molte aziende iniziano in modo sensato con telefono, carta e un foglio di calcolo. Con cinque fermate al giorno e un team fisso di autisti, questa è spesso la soluzione più rapida. Solo quando il volume degli ordini, le varianti e la pressione temporale aumentano nascono i tipici attriti: indirizzi inseriti due volte, stati dei giri superati, informazioni mancanti sui mezzi di carico e richieste di chiarimento che possono essere risolte solo chiamando più persone.

Il problema allora non è solo il percorso di guida. È la rottura informativa tra acquisizione dell'ordine, magazzino, disposizione e consegna. Se un ordine viene rinviato, oggi questa modifica deve spesso essere riportata in più elenchi, su una stampa e nella testa dell'autista. Questo costa tempo e genera errori che i clienti vedono immediatamente.

Un altro segnale d'allarme sono le decisioni che dipendono da singoli dipendenti. Se solo la disponente esperta sa quale accesso è adatto per un cliente o come adattare il giro 3 in caso di arrivo merce tardivo, il processo non è documentato in modo solido. Il software non deve sostituire questa conoscenza. Deve rappresentarla in modo che il team resti capace di agire.

Cosa deve saper fare un software per la pianificazione dei percorsi di consegna

La funzione principale sembra semplice: gli ordini vengono assegnati a un giro, le fermate ordinate in modo sensato e trasferite agli autisti. Per l'utilità pratica, però, il sistema ha bisogno di molto più contesto. Decisivo è quali regole valgono nella pianificazione e come vengono gestite le modifiche.

Gli ordini devono essere pianificabili, non solo visibili

Un indirizzo di consegna su una mappa non è ancora una consegna pianificabile. A un ordine appartengono almeno quantità, peso o volume, data di consegna, finestra oraria desiderata, informazioni di contatto e uno stato di lavorazione chiaro. A seconda dell'azienda si aggiungono mezzi di carico, requisiti di temperatura, marcature per merci pericolose, regole di avviso o una determinata classe di veicolo.

Questi dati non dovrebbero essere raccolti manualmente ogni volta da sistemi diversi. Se gli ordini provengono già da un negozio online, un ERP, una maschera d'ordine o un database esistente, un trasferimento pulito è spesso più prezioso di una vista mappa particolarmente spettacolare. Altrimenti il lavoro si sposta solo dalla carta a una nuova interfaccia.

I giri hanno bisogno di regole, non solo di distanza

Un ordine automatico basato su chilometri o tempo di guida può essere un buon suggerimento. Non è però una decisione per l'azienda. La pianificazione deve poter tenere conto dei vincoli: orari di consegna fissi, capacità del veicolo, orari di lavoro, tempi di carico e scarico, nonché competenze regionali.

Conta anche la logica di partenza. Alcuni veicoli iniziano e finiscono al magazzino, altri procedono direttamente al successivo luogo d'impiego dopo l'ultima consegna. Per i giri ricorrenti può avere senso una struttura di base fissa, che i disponenti modificano solo se necessario. Chi percorre ogni mattina le stesse fermate non ha necessariamente bisogno di una riottimizzazione completa. Qui un giro stabile e tracciabile è spesso meglio di un risparmio di tempo calcolato minimo.

Le modifiche devono arrivare all'autista in modo controllato

La realtà raramente rispetta il piano mattutino. I clienti annullano, la merce manca, un veicolo si guasta o un ordine diventa urgente. In questi casi si decide se il software offre sollievo o crea lavoro aggiuntivo.

Una soluzione utilizzabile mostra chiaramente quale versione del giro è attualmente valida, quali fermate sono già state completate e cosa è stato concretamente modificato. L'autista non dovrebbe dover confrontare stampe contraddittorie, screenshot e messaggi di messaggistica. Per molti team basta inizialmente una vista autista mobile e basata su browser con ordine delle fermate, dati di contatto, indicazioni di consegna e riscontro di stato. Un'app dedicata non è automaticamente migliore se installazione, gestione dei dispositivi e requisiti offline non portano un beneficio chiaro.

Non iniziare solo con l'ottimizzazione dei percorsi

L'approccio errato più comune è acquistare prima un servizio di ottimizzazione e verificare solo dopo se i dati anagrafici e i processi sono corretti. Indirizzi scritti male, finestre di consegna poco chiare e ordini senza uno stato di disponibilità affidabile non si possono ottimizzare via.

Più sensato è un breve censimento lungo la reale routine quotidiana. Dove nascono gli ordini? Quando il magazzino conferma la disponibilità? Chi pianifica i giri? Come riceve l'autista le modifiche? E quale prova è necessaria dopo la consegna? Queste domande sembrano banali, ma stabiliscono quali campi dati, ruoli e interfacce servono realmente al sistema.

Spesso emerge che non ogni passaggio debba essere digitalizzato. Una nota scritta a mano per una rara consegna speciale può essere adeguata, se in seguito viene ripresa correttamente nell'ordine. Anche un foglio di calcolo può restare, se fornisce in modo affidabile un'analisi gestibile. Il software dovrebbe risolvere il collo di bottiglia, non sostituire forzatamente ogni processo noto.

Build, Buy o estensione mirata?

Il software standard è adatto quando la logica dei giri è generale, i processi variano poco e il team può adattarsi alle maschere predefinite. Accorcia l'introduzione e può essere sufficiente per un parco veicoli semplice. Lo svantaggio emerge non appena rappresenta i casi particolari centrali solo tramite elenchi secondari, testo libero o costosi moduli aggiuntivi.

Una soluzione individuale non conviene perché lo sviluppo su misura sarebbe di per sé superiore. Conviene quando il processo stesso è un vantaggio competitivo o una fonte di errore persistente: ad esempio con unità di imballaggio speciali, giri combinati di ritiro e consegna, documenti di trasporto propri o uno stretto collegamento tra arrivo merce, prelievo e consegna.

In mezzo si trova spesso la via più pragmatica. I sistemi esistenti restano per contabilità o gestione di magazzino, mentre un'applicazione snella raggruppa gli ordini, pianifica i giri e copre il processo dell'autista. Per questo servono interfacce chiare, responsabilità inequivocabili sui dati e una struttura di database che memorizzi le modifiche in modo tracciabile. Le applicazioni web moderne su una base manutenibile come PHP 8.4 e MySQL 8 non sono per questo una scelta di moda, ma una base per un'attività calcolabile e adattamenti futuri.

Introduzione a piccoli passi invece di un grande cambiamento

Un software di pianificazione dei percorsi dovrebbe essere testato prima su un giro o un gruppo di veicoli gestibile. Non perché un progetto pilota sia privo di rischi, ma perché le vere eccezioni emergono presto: indicazioni di consegna mancanti, dati di indirizzo non uniformi, tempi di attesa presso il cliente o passaggi di consegna poco chiari in magazzino.

Per la prima fase di espansione bastano di solito funzioni chiaramente delimitate: assumere l'ordine, vedere lo stato di disponibilità, comporre il giro, approvare il giro e segnalare la consegna. Solo quando questa catena funziona nella quotidianità hanno senso ottimizzazione automatica, firma elettronica, prove fotografiche, notifiche ai clienti o indicatori dettagliati.

Il beneficio diventa misurabile non solo attraverso i chilometri risparmiati. Rilevanti sono anche un minore sforzo di disposizione, meno richieste di chiarimento, meno consegne errate, tempi più brevi fino al documento di trasporto e una migliore capacità di risposta verso i clienti. Questi indicatori dovrebbero essere rilevati approssimativamente prima dell'avvio. Altrimenti, dopo l'introduzione, resta solo l'impressione che l'interfaccia appaia più moderna.

La tecnica deve restare affidabile in background

La pianificazione dei percorsi elabora dati operativi sensibili: indirizzi dei clienti, assegnazioni degli autisti, quantità di consegna e spesso anche prove di consegna. Per questo diritti dei ruoli, modifiche tracciabili, backup regolari e un funzionamento documentato fanno parte della soluzione. Chi può approvare, modificare o eliminare un giro non dovrebbe essere lasciato al caso.

Anche i dati di mappe e routing meritano un esame sobrio. I servizi esterni possono adattarsi molto bene, ma comportano costi correnti, questioni di disponibilità e protezione dei dati. In caso di elevati requisiti sulla conservazione dei dati o logiche territoriali speciali, va chiarito presto quali dati lasciano il proprio sistema e come vengono attutiti i guasti. Un percorso perfetto non vale nulla se la disposizione non può continuare a lavorare durante un'interruzione.

softify.pro pianifica tali sistemi dal reale arrivo dell'ordine fino al riscontro dal veicolo. Il metro di misura non è la lista di funzioni più lunga, ma un processo che magazzino, disposizione e autisti possono gestire in modo affidabile sotto pressione temporale.

La migliore pianificazione dei percorsi appare nella quotidianità sorprendentemente poco spettacolare: gli ordini sono completi, i giri comprensibili, le modifiche inequivocabili e le consegne dimostrabili. Proprio questa affidabilità tranquilla crea spazio per le eccezioni in cui devono decidere le persone.

Link permanente →

Automatizzare il workflow di accettazione ordini in azienda

Automatizzare il workflow di accettazione ordini in azienda

Un ordine arriva via e-mail, un altro per telefono, in più un file Excel dal key account. In magazzino manca poi l'indirizzo di consegna, il reparto vendite non ricorda più con precisione la data promessa, e il reparto spedizioni stampa il documento di trasporto con una vecchia posizione articolo. Chi vuole automatizzare il workflow di accettazione ordini non risolve un progetto digitale astratto. Elimina proprio questo attrito nel punto in cui il fatturato si trasforma in lavoro operativo.

Per le piccole e medie imprese, l'accettazione ordini è spesso sottovalutata. Finché arrivano pochi ordini al giorno e i dipendenti esperti conoscono ogni caso particolare, appunti telefonici, caselle di posta e tabelle sostengono il processo. Con volumi crescenti, però, diventano un rischio: le informazioni esistono doppie, i passaggi di consegna avvengono verbalmente, e nessuno può dire con certezza quale sia lo stato effettivo dell'ordine.

Perché l'accettazione ordini diventa così spesso un collo di bottiglia

La causa raramente è la mancanza di impegno. Di solito il processo è cresciuto nel corso degli anni. I clienti ordinano attraverso canali diversi, prezzi e condizioni di consegna valgono solo per determinati gruppi di clienti, i numeri articolo si discostano dalle denominazioni interne. I dipendenti conciliano le informazioni per esperienza e colmano le lacune con richieste di chiarimento.

Questo funziona finché una persona è in ferie, cambia il turno o arrivano contemporaneamente più ordini urgenti. Allora emerge che la conoscenza non risiede nel processo, ma in singole teste e file sparsi. Le conseguenze sono note: quantità errate, consegne in ritardo, approvazioni non chiarite e correzioni inutili in magazzino.

Automazione qui non significa che un cliente debba necessariamente ordinare attraverso un portale. Significa che ogni ordine, indipendentemente dal canale d'ingresso, viene registrato, verificato, arricchito e trasferito secondo le stesse regole tracciabili.

Automatizzare il workflow di accettazione ordini senza forzare l'attività

Un workflow utilizzabile non inizia con un elenco di software, ma con una sobria rilevazione del processo. È decisivo: quali informazioni devono essere disponibili prima che un ordine possa passare a magazzino, disposizione o produzione? E quali eccezioni sono legittime, invece di essere semplicemente fastidiose?

Un tipico flusso è composto da quattro stazioni chiare: registrazione dell'ordine, verifica dei dati, approvazione dell'ordine e attivazione dei processi successivi. Tra queste stazioni servono responsabilità e stati univoci. Un ordine, ad esempio, non dovrebbe poter risultare contemporaneamente "nuovo", "in chiarimento" e "pronto per la spedizione".

1. Far confluire gli ordini da tutti i canali in un'unica pratica

E-mail, telefono, PDF, EDI, modulo web o nota della rete di vendita possono restare punti d'ingresso diversi. Ciò che conta è che confluiscano in un'unica pratica d'ordine condivisa. I dipendenti non dovrebbero prima copiare informazioni dalla casella di posta, poi aggiornare una tabella e infine informare una seconda persona.

Per gli ordini strutturati, dati del cliente, numeri articolo, quantità e date desiderate possono essere ripresi direttamente. Per PDF o e-mail in testo libero, un inserimento guidato è spesso più sensato di una lettura completamente automatica. L'estrazione basata sull'AI può fare proposte, ma in caso di quantità poco chiare, numeri articolo specifici del cliente o documenti scritti a mano serve una verifica visibile.

Il criterio sensato non è "il massimo dell'automazione", ma "nessuna doppia registrazione inutile". Un modulo ben progettato con campi obbligatori e proposte plausibili fa risparmiare, in molte aziende, più tempo di un'automazione completa soggetta a errori.

2. Verificare i dati prima che gli errori si propaghino

L'automazione più preziosa avviene prima dell'approvazione. Il sistema può verificare se il numero cliente esiste, se l'indirizzo di consegna è completo, se l'articolo è attivo, se la quantità richiesta appare ammissibile e se è presente l'approvazione di pagamento o di credito. Anche prezzi specifici del cliente, quantità minime e finestre di consegna possono essere confrontati con le regole memorizzate.

È importante il trattamento delle deviazioni. Non ogni deviazione deve bloccare un ordine. Se manca ad esempio un numero di riferimento, le vendite possono ricevere un'attività. Se un ordine supera un limite di valore definito o il margine è al di fuori del quadro concordato, può essere necessaria un'approvazione da parte del ruolo competente.

Così non nascono errori silenziosi, ma casi di chiarimento visibili. È una grande differenza: il magazzino non riceve semplicemente un ordine incompleto, ma un ordine con uno stato univoco e una decisione documentata.

3. Collegare le approvazioni a regole invece che a richieste verbali

Molti ritardi nascono da frasi come: "Puoi approvarlo velocemente?" Queste richieste non sono di per sé sbagliate. Diventano problematiche quando avvengono via chat, telefono o conversazione in corridoio e in seguito non sono più tracciabili.

Un workflow automatizzato memorizza le regole di approvazione direttamente sull'ordine. Ad esempio, un ordine può essere approvato automaticamente se cliente, prezzo, disponibilità e indirizzo di consegna sono plausibili. In caso di condizioni speciali, consegne parziali o un ordine oltre un limite definito, viene informata la persona competente. L'approvazione viene salvata con marca temporale e motivazione.

Questo crea velocità senza rinunciare al controllo. Soprattutto con turni variabili o più sedi, impedisce che gli ordini rimangano bloccati in caselle di posta personali.

4. Informare in modo mirato magazzino, spedizione e cliente

Dopo l'approvazione, l'ordine non deve più essere trasferito manualmente da un elenco all'altro. Il workflow può generare un ordine di prelievo, riservare le scorte, preparare un documento di trasporto o avviare una notifica di spedizione. Quali passaggi abbiano senso dipende dal modello di business.

Un rivenditore di ricambi potrebbe aver bisogno immediatamente di un ordine di prelievo e di una marcatura di priorità. Un produttore ha bisogno prima di una verifica di disponibilità e poi di un impulso di produzione. Un grossista con giri fissi vuole raggruppare gli ordini fino a un certo orario. Per questo una soluzione standard rigida spesso non è la scelta migliore.

Per il cliente basta spesso una conferma chiara: ordine ricevuto, verificato o pianificato in modo vincolante. Non ogni cambio di stato interno appartiene a un'e-mail. Troppi messaggi automatici generano richieste di chiarimento invece di fiducia.

Quali dati richiede un processo solido

Una buona accettazione ordini si basa su una base dati pulita. Ne fanno parte un'anagrafica clienti ben tenuta, numeri articolo univoci, regole di prezzo e condizioni valide, nonché indirizzi di consegna chiaramente definiti. Se mancano queste basi, l'automazione accelera solo la trasmissione di dati inaffidabili.

Conta anche l'architettura tecnica. Un sistema centrale con cambi di stato tracciabili e un database affidabile è, nel lungo periodo, migliore di una catena di macro, file locali e inoltri e-mail incontrollati. Questo non significa che ogni foglio Excel debba essere sostituito subito. Se una tabella funziona in modo trasparente in un sotto-processo piccolo e stabile, può restare per ora.

Non appena più persone lavorano contemporaneamente sugli ordini, sono necessarie approvazioni o le informazioni vengono trasmesse a magazzino e spedizione, una fonte dati centrale dovrebbe però avere la priorità. I sistemi basati su un'architettura manutenibile, ad esempio con PHP 8.4, JavaScript moderno e MySQL 8, possono così essere collegati in modo mirato ai processi esistenti, invece di forzare un'azienda nello schema di un software aziendale sovradimensionato.

Rendere misurabile se il workflow migliora davvero

Un nuovo sistema non è automaticamente un processo migliore. Prima dell'avvio andrebbero quindi definiti pochi indicatori. Sono rilevanti, ad esempio, il tempo dall'arrivo dell'ordine all'approvazione, il numero di richieste di chiarimento per ordine, le correzioni dopo il passaggio al magazzino e la quota di ordini evasi nei tempi.

Questi indicatori mostrano anche dove non serve ulteriore automazione. Se l'85% degli ordini standard procede rapidamente e senza errori, ma il restante 15% sono veri casi particolari, un chiaro processo di chiarimento è più sensato del tentativo di forzare algoritmicamente ogni eccezione.

I protocolli aiutano anche nell'operatività quotidiana. Chi vede quando è arrivato un ordine, quale controllo è fallito, chi lo ha approvato e quando è stato generato l'ordine di spedizione, non deve più cercare la causa in cinque caselle di posta. Questo riduce non solo gli errori, ma anche la dipendenza da singoli dipendenti.

Introduzione a piccoli passi invece del Big Bang

L'ingresso più sicuro è di solito un tipo di ordine chiaramente delimitato: ad esempio ordini standard di una determinata cerchia di clienti o ordini via e-mail con articoli noti. Lì si possono testare campi dati, regole e passaggi di consegna in condizioni reali. Solo quando stato, eccezioni e responsabilità funzionano correttamente, seguono i casi più complessi come prezzi speciali, consegne parziali o specifiche di imballaggio individuali per il cliente.

I dipendenti dovrebbero essere coinvolti nella progettazione. Non perché ogni abitudine esistente debba restare invariata, ma perché le persone al telefono, nelle vendite e in magazzino conoscono le eccezioni reali. Una soluzione che appare buona solo in un workshop viene rapidamente aggirata sul pavimento del capannone.

softify.pro punta, in questi progetti, su sistemi specifici per il workflow invece che su suite standard sovraccariche: con passaggi di consegna chiari, regole documentate e abbastanza spazio per i metodi di lavoro che nella pratica funzionano dimostrabilmente.

Il miglior passo successivo non è quindi la ricerca del maggior numero possibile di funzioni. Prendete dieci ordini reali di una settimana tipica e seguite il loro percorso dall'arrivo alla spedizione. Ogni doppia trasmissione manuale, ogni decisione poco chiara e ogni richiesta di chiarimento ricorrente è un punto di partenza concreto per un processo che in futuro lavorerà in modo affidabile per il team.

Link permanente →

Proteggere in modo sicuro i dati di test durante l'AI testing

Proteggere in modo sicuro i dati di test durante l'AI testing

Un test automatizzato fallito viene di solito risolto rapidamente. Uno screenshot del test che contiene dati dei clienti, listini prezzi o una sessione attiva e finisce in un servizio AI esterno è un problema diverso. Chi vuole proteggere i dati di test durante l'AI testing deve quindi considerare non solo i casi di test, ma l'intero percorso dei dati: input, traffico del browser, log, immagini, valutazione AI e conservazione.

Proprio con applicazioni web, portali interni e software Windows si crea rapidamente un falso senso di sicurezza. L'ambiente si chiama "test", ma spesso utilizza copie di database produttivi, ruoli utente reali o interfacce verso spedizione, ERP e archivi documentali. I test basati sull'AI rendono questi dati particolarmente preziosi per l'analisi - e quindi particolarmente bisognosi di protezione.

Perché l'AI testing richiede una prospettiva di protezione dati propria

L'automazione dei test classica verifica di solito passaggi ben definiti: accesso, creazione di un ordine, generazione di un documento di trasporto, verifica del logout. Il testing basato sull'AI amplia questo flusso. Il sistema può interpretare le interfacce, valutare anomalie, confrontare screenshot e documentare i risultati in un linguaggio comprensibile. Questo fa risparmiare tempo nei test di regressione, ma genera artefatti di dati aggiuntivi.

Questi artefatti sono spesso più eloquenti di un normale log di test. Uno screenshot può mostrare nomi, indirizzi, valori contrattuali, quantità d'ordine o dati sanitari. Un log di rete può contenere token di sessione e risposte API. Un messaggio di errore può rivelare percorsi di file interni, strutture di database o versioni. Quando un modello lavora con queste informazioni, deve essere chiaro dove avviene l'elaborazione e chi può accedervi.

La domanda decisiva quindi non è: "Usiamo l'AI nei test?" Ma piuttosto: "Quali dati lasciano quale zona di sicurezza - e perché?" Per molte aziende nell'area DACH, l'elaborazione cloud esterna non è fondamentalmente esclusa. Deve però corrispondere al fabbisogno di protezione dal punto di vista contrattuale, tecnico e organizzativo. Per dati di sviluppo, produzione o clienti, un'esecuzione controllata localmente è spesso la scelta più pragmatica.

Proteggere i dati di test durante l'AI testing inizia prima della prima esecuzione

La protezione dei dati nel testing viene spesso discussa solo alla scelta di uno strumento. È troppo tardi. Serve prima di tutto un inventario dei dati semplice e solido. Quali sistemi vengono testati? Quali campi appaiono nelle interfacce? Quali allegati, export e risposte API possono comparire nel test? E quali dati finiscono automaticamente in screenshot, video o messaggi di errore?

Conviene qui una suddivisione in tre gruppi. I dati di test non critici possono essere generati liberamente e conservati più a lungo. I dati personali o commercialmente riservati richiedono mascheramento, restrizioni di accesso e conservazione breve. Credenziali di accesso, token, chiavi e valori di configurazione produttivi non appartengono alle evidenze di test o alle richieste al modello - anche se sono visibili solo accidentalmente in una finestra del browser.

In molte applicazioni di medie dimensioni, la situazione dei dati non è nettamente separata. Il team di magazzino testa un nuovo arrivo merce con un estratto del database, perché solo lì sono presenti le strutture articolo reali, le regole dei fornitori e i casi particolari. Questo può avere senso dal punto di vista tecnico. La conseguenza, però, non deve essere che questo estratto migri invariato in ogni ambiente di test.

Meglio un processo riproducibile: esportare i dati, pseudonimizzare in modo mirato i campi sensibili, rimuovere le tabelle non necessarie e mettere a disposizione la base dati di test risultante in modo versionato. Così si conservano gli errori di processo tipici, senza che clienti o dipendenti reali diventino visibili nei test. Per logiche di prezzo o pianificazione complesse, dati completamente sintetici spesso non bastano. In quel caso, una copia accuratamente ripulita è di solito il compromesso migliore.

Il mascheramento deve preservare la logica di business

Un mascheramento che sostituisce ogni indirizzo email con lo stesso segnaposto può danneggiare i casi di test. Controlli sui duplicati, logica dei ruoli, funzioni di ricerca o flussi di fatturazione si comportano diversamente rispetto all'operatività reale. Un buon mascheramento preserva quindi formati, relazioni e distribuzioni. Da un numero cliente ne nasce un altro numero cliente valido. Da un indirizzo nasce un indirizzo plausibile ma fittizio. Da una data di consegna resta una data entro un intervallo di pianificazione realistico.

Questo richiede una certa preparazione. In cambio, previene l'errore classico in cui i test sono tecnicamente verdi, ma non rappresentano più i flussi effettivi in magazzino, vendite o assistenza clienti. Protezione dei dati e test funzionalmente utili non sono in contraddizione, purché la preparazione dei dati faccia parte dell'architettura di test.

Il luogo di esecuzione decide sul controllo

Chi affida test automatizzati a un servizio esterno, a seconda della configurazione, condivide più dei semplici passaggi di test. Contenuti del browser, strutture DOM, screenshot, video, log della console e valutazioni possono essere elaborati e memorizzati al di fuori della propria infrastruttura. Se ciò sia accettabile dipende dal caso specifico: categorie di dati, quadro contrattuale, luogo di archiviazione, separazione dei tenant, concetto di cancellazione e direttive interne agiscono insieme.

Per applicazioni con elevate esigenze di protezione, un ambiente di test self-hosted è spesso più facile da valutare. Il test runner, il componente AI e l'archiviazione delle evidenze restano nella propria rete o in un'infrastruttura europea controllata. Le regole di rete possono limitare le connessioni esterne. Gli accessi possono essere collegati a identità, ruoli e log già esistenti. Anche la conservazione di immagini e report diventa una decisione propria, invece di un'impostazione predefinita di un fornitore di piattaforma.

COCO segue esattamente questo approccio: il server AI esegue i test per applicazioni web e Windows in modo controllato, documenta le evidenze e genera valutazioni comprensibili, senza che i dati applicativi interni debbano essere ceduti per impostazione predefinita a un cloud AI esterno. Questo non sostituisce una verifica sulla protezione dei dati. Crea però una base tecnica su cui IT, sicurezza delle informazioni e reparto di competenza possono concordare regole tracciabili.

Screenshot, log e segreti sono le falle più comuni

Molti team proteggono il database di test, ma trascurano i sottoprodotti del testing. Proprio lì si nascondono spesso, in pratica, i rischi maggiori. Un test di login fallito può mostrare una password nel campo di input. Un test API può restituire un bearer token nel log. Una registrazione video automatica documenta un ordine completo, indirizzo del cliente incluso.

Un concetto solido regola quindi almeno cinque punti:

  • Screenshot e video vengono creati solo se necessario e cancellati dopo scadenze fisse.
  • I segreti vengono integrati tramite un secret store o variabili di runtime protette, mai memorizzati nel codice di test.
  • I log filtrano token, password, ID di sessione e campi sensibili prima di essere salvati.
  • Gli account di test possiedono solo i diritti necessari per il rispettivo flusso.
  • I sistemi di test non devono attivare email, etichette, pagamenti o movimenti di magazzino produttivi, a meno che ciò non sia esplicitamente previsto e protetto.

Queste regole suonano sobrie. Proprio questo è il loro vantaggio. Un team non deve sperare nell'attenzione o nelle buone intenzioni, ma può limitare tecnicamente gli usi impropri. Particolarmente efficaci sono account di servizio separati per l'automazione dei test, durate brevi dei token e un processo chiaro per la revoca delle credenziali compromesse.

Anche la valutazione AI ha bisogno di limiti

I modelli AI vengono spesso usati per spiegare le anomalie: "Il pulsante non era visibile", "L'applicazione ha reagito più lentamente del previsto" o "Il processo si è concluso in un controllo dei permessi". Per queste valutazioni, un modello non ha necessariamente bisogno del set completo di dati del cliente.

Definite quindi quali informazioni possono confluire nella valutazione. Basta uno screenshot anonimizzato? È sufficiente una classe di errore tecnica invece della risposta completa del server? I campi possono essere oscurati prima dell'analisi? La profondità giusta dipende dall'obiettivo del test. In un confronto di layout, un nome è raramente rilevante. Nel verificare un modello di documento personalizzato può essere rilevante - allora l'elaborazione deve essere protetta di conseguenza.

Le misure di protezione devono restare verificabili nell'operatività

Un concetto è solido solo se può essere controllato nella quotidianità. Ciò comprende controlli a campione regolari delle evidenze di test, verifiche dei permessi e uno sguardo ai dati effettivamente memorizzati. Sono comparsi nuovi campi negli screenshot? Esistono ancora vecchi account di test? Un estratto del database viene conservato più a lungo del previsto? Queste domande appartengono alla normale routine operativa, non solo a un audit.

Altrettanto importante è una responsabilità chiara. Il QA conosce i flussi di test, lo sviluppo conosce le interfacce tecniche, il reparto di competenza conosce i processi critici e la sicurezza informatica definisce il quadro. Se nessuno riunisce queste prospettive, si crea o una scorciatoia rischiosa o una direttiva di sicurezza che impedisce test reali. Un piccolo processo di approvazione documentato è di solito più efficace di un ampio regolamento che nessuno applica.

Alla fine non si tratta di rendere ogni test artificialmente complicato. Proteggere bene i dati di test significa rimuovere in modo mirato i rischi reali dall'automazione, preservando la validità funzionale dei test. Quando i team sanno esattamente quali dati un test può vedere, dove si trovano le sue evidenze e quando scompaiono, l'AI testing diventa uno strumento controllabile invece di un'incertezza aggiuntiva.

Link permanente →

Fare sviluppare un'applicazione web con PHP

Fare sviluppare un'applicazione web con PHP

Quando gli arrivi merce finiscono in un foglio di calcolo, i dati di spedizione vengono passati per telefono e lo stato attuale di un ordine esiste solo nella testa di singoli dipendenti, di solito non manca un altro strumento standard. Manca un sistema che rappresenti in modo vincolante il proprio flusso di lavoro. Fare sviluppare un'applicazione web con PHP conviene proprio in questo caso: quando informazioni, decisioni e documenti devono confluire in un unico posto, senza gravare l'azienda con una suite enterprise sovradimensionata.

PHP non è qui un compromesso nostalgico. Con PHP 8.4, un'architettura applicativa chiara e MySQL 8 si possono costruire applicazioni web durature, che reagiscono rapidamente, sono facili da mantenere e funzionano in modo affidabile su desktop, tablet o lettori portatili. Decisivo, però, non è il linguaggio da solo. Decisivo è se l'applicazione rende davvero più semplice il lavoro sul pavimento del magazzino, in ufficio e in mobilità.

Quando un'applicazione web personalizzata ha senso

Non ogni processo richiede subito software su misura. Un foglio di calcolo ben tenuto può restare la soluzione più sensata per un elenco piccolo e raramente modificato. Anche un prodotto standard affermato è utile se copre già i flussi essenziali e può essere usato senza aggiramenti permanenti.

Il punto di svolta arriva quando i dipendenti inseriscono i dati più volte, raccolgono informazioni da file diversi o risolvono regolarmente casi particolari fuori dal sistema vero e proprio. Segnali tipici sono la mancanza di chiarezza sulle scorte, i documenti di trasporto creati manualmente, responsabilità poco chiare sugli ordini o richieste di chiarimento che ogni turno deve ripetere. In quel momento non si perde solo tempo. Gli errori diventano difficili da ricostruire e la dipendenza da singole persone aumenta.

Un'applicazione web su misura, al contrario, rappresenta esattamente le regole valide in azienda. Può ad esempio registrare gli arrivi merce, documentare i movimenti di magazzino, generare etichette, dare priorità agli ordini o rendere tracciabili i passaggi di consegna tra i team. Non serve automatizzare ogni caso particolare fin dal primo giorno. Un inizio sensato si concentra sul flusso che oggi genera più attrito.

Fare sviluppare un'applicazione web con PHP: cosa va chiarito prima

Un buon software non inizia con bozzetti di schermate o un elenco di parole chiave tecniche. Inizia con situazioni concrete: cosa succede se una consegna arriva incompleta? Chi può correggere una giacenza? Quale informazione serve al reparto spedizioni prima che venga stampata un'etichetta? E cosa accade se un dipendente del turno serale prende in carico un ordine creato al mattino?

Da queste domande nasce un'immagine solida del processo. Mostra input, decisioni, passaggi di consegna ed eccezioni. Proprio le eccezioni sono preziose, perché è lì che le soluzioni standard spesso mostrano i loro limiti. Un'applicazione per la presa in carico degli ordini, ad esempio, non deve solo salvare un nuovo ordine. Deve anche chiarire come gestire dati articolo mancanti, indirizzi di consegna diversi, approvazioni o cancellazioni.

Prima della realizzazione dovrebbero quindi essere chiari l'obiettivo, i gruppi di utenti e la prima fase di sviluppo. Sono utili dati di esempio reali, moduli esistenti, foto delle postazioni di lavoro e colloqui con le persone che lavorano ogni giorno con quel processo. Una semplice intervista al management raramente fornisce dettagli sufficienti. Chi utilizza uno scanner, immagazzina merce o controlla i documenti di trasporto conosce di solito con maggiore precisione i limiti pratici.

Il minimo inizio sensato

Una prima release non deve essere una piattaforma aziendale già finita. Al contrario: un nucleo limitato, ma utilizzabile in produzione, riduce il rischio e crea valore fin da subito. Si potrebbe pensare a un'applicazione che inizialmente registri solo gli ordini in modo centralizzato, ne renda visibile lo stato e crei un documento di trasporto affidabile. Gestione delle scorte, interfacce o pianificazione dei giri possono seguire non appena il nucleo si dimostra valido nell'uso quotidiano.

Questo ordine evita che un progetto lavori per mesi su funzioni il cui reale beneficio è ancora poco chiaro. Crea inoltre spazio per correzioni. Forse la logica di stato prevista è troppo fine, forse l'arrivo merce ha bisogno di una maschera di inserimento più rapida o di un'approvazione solo a partire da un certo valore della merce. Queste scoperte non sono un fallimento della pianificazione, ma parte di un'introduzione fatta bene.

La base tecnica decide sui costi successivi

Un'applicazione web non diventa manutenibile solo perché PHP compare nell'offerta. La manutenibilità nasce da decisioni tracciabili: una separazione chiara tra interfaccia, logica di business e accesso ai dati, modelli di dati univoci, test automatizzati per le regole critiche e un rilascio documentato.

PHP 8.4 si presta molto bene a questo scopo. Il linguaggio è maturo, efficiente da gestire e una scelta pragmatica per molte applicazioni critiche per il business. Insieme a JavaScript moderno, l'interfaccia può reagire in modo rapido e diretto, senza costruire ogni funzione in modo inutilmente complicato come applicazione a pagina singola. MySQL 8 offre una base solida per transazioni, concetti di permessi e dati coerenti.

Proprio nei processi di magazzino e ordini, una registrazione non deve essere salvata a metà. Se un articolo viene scaricato, giacenza, registro dei movimenti e stato dell'ordine devono coincidere. Le transazioni del database garantiscono che avvengano tutte le modifiche necessarie oppure nessuna. Sembra un dettaglio, ma decide se un sistema resta affidabile nei casi eccezionali.

Anche la sicurezza appartiene al cuore dell'architettura. Ruoli e permessi devono adattarsi alla quotidianità lavorativa: una persona in ricezione merci ha bisogno di diritti diversi rispetto alla contabilità o a un autista esterno. Hash delle password sicuri, blocco dell'account dopo tentativi di accesso falliti, gestione delle sessioni e log delle modifiche critiche non sono extra da aggiungere in seguito. Fanno parte della prima versione in produzione.

Costruire interfacce solo dove fanno risparmiare lavoro

Molti progetti diventano inutilmente grandi perché fin dall'inizio si pianifica ogni integrazione immaginabile. Le interfacce verso shop, ERP, fornitori di servizi di spedizione o contabilità possono essere molto utili. Ma sono valide solo se sostituiscono un passaggio manuale ben definito o migliorano sensibilmente la qualità dei dati.

Un esempio: se le etichette di spedizione vengono create ogni giorno a partire dai dati d'ordine, un collegamento diretto fa risparmiare tempo e riduce gli errori di trasmissione. Se invece i dati di fatturazione vengono trasferiti in un sistema esistente solo una volta a settimana e il processo è stabile, un export strutturato può bastare per iniziare. La soluzione tecnicamente più elegante non è automaticamente quella più economica.

Anche la sovranità dei dati andrebbe chiarita in anticipo. Quali dati vengono memorizzati, per quanto tempo restano disponibili i log, chi può esportarli e come funzionano i backup e il ripristino? Per le aziende dell'area DACH queste domande non sono semplici formalità informatiche. Riguardano la protezione dei dati, la capacità operativa e la fiducia all'interno del team.

Introduzione senza rallentare l'attività

La migliore applicazione fallisce se, durante il passaggio, blocca il lavoro quotidiano. Per questo l'introduzione dovrebbe essere preparata con casi reali: ordini rappresentativi, articoli reali, indirizzi di consegna tipici e casi particolari già noti. Solo quando questi flussi funzionano in modo tracciabile, il sistema dovrebbe assumere un compito centrale.

Un funzionamento parallelo può avere senso per un breve periodo, ad esempio quando si devono riconciliare le scorte o verificare nuovi documenti. Non deve però diventare uno stato permanente. Due fonti dati principali generano inevitabilmente differenze. Serve una data limite chiara, a partire dalla quale sia stabilito quale sistema è vincolante.

Altrettanto importante è una breve formazione mirata al ruolo. Un dipendente in magazzino non ha bisogno di una spiegazione delle funzioni amministrative. Ha bisogno di sicurezza nei pochi passaggi da eseguire sotto pressione di tempo. Le buone applicazioni aiutano con denominazioni comprensibili, valori predefiniti plausibili e messaggi di errore che spiegano cosa fare dopo.

Come riconoscere un partner di sviluppo adatto

Chi commissiona un'applicazione web non acquista semplicemente ore di sviluppo. Si cerca un partner che prenda sul serio le domande sui processi, motivi le decisioni tecniche e sappia anche opporsi quando un requisito diventa inutilmente costoso o rischioso. L'accesso diretto a sviluppatori esperti vale qui più di un elaborato processo di vendita con passaggi di consegna successivi.

Prestate attenzione ad affermazioni concrete su architettura, gestione operativa e sviluppo futuro. Come vengono documentate le modifiche? Come avvengono gli aggiornamenti? Chi interviene in caso di guasto? Esiste una strategia di test tracciabile per registrazioni e permessi critici? Un'interfaccia può risultare convincente durante una presentazione. Ciò che conta è se può essere adattata anche dopo due anni senza che ogni modifica diventi una ricostruzione completa.

softify.pro lavora quindi con una realizzazione graduale e vicina al processo: prima capire il collo di bottiglia operativo, poi fornire un nucleo solido e costruirci sopra. È meno spettacolare di una grande promessa di trasformazione, ma nell'attività quotidiana è di solito molto più prezioso.

Una buona applicazione web non deve contenere il maggior numero possibile di funzioni. Deve fare in modo che un ordine non vada perso, che una giacenza resti tracciabile e che i dipendenti possano svolgere il proprio lavoro senza richieste di chiarimento superflue. Quando questo si realizza, un investimento tecnico diventa uno strumento che rende ogni giornata di lavoro sensibilmente più tranquilla.

Link permanente →

Generare etichette di spedizione in automatico e ridurre gli errori

Generare etichette di spedizione in automatico e ridurre gli errori

Un ordine è imballato, la merce è sulla rampa di carico — e qualcuno sta ancora cercando il metodo di spedizione corretto, digitando l'indirizzo del destinatario in un portale del corriere e stampando l'etichetta. Questo passaggio richiede solo pochi minuti per collo. Con 30, 80 o 300 spedizioni al giorno, diventa un collo di bottiglia. Generare automaticamente le etichette di spedizione non significa quindi semplicemente collegare una stampante. Significa collegare i dati dell'ordine, le regole di spedizione e il processo di imballaggio effettivo in modo che una spedizione pronta si trasformi in modo affidabile nell'etichetta corrispondente.

Per le piccole e medie imprese, questo è spesso il punto d'ingresso più sensato nell'automazione della logistica. Il vantaggio si vede subito sul pavimento del magazzino: meno richieste di chiarimento, meno pacchi indirizzati in modo errato e uno stato chiaro per vendite, magazzino e servizio clienti. Ciononostante, vale la pena osservare attentamente il processo prima dell'implementazione tecnica. Un'anagrafica articoli mal gestita o regole di spedizione poco chiare non migliorano con l'automazione: vengono semplicemente elaborate più velocemente.

Cosa succede realmente durante la stampa automatica delle etichette

Un'etichetta di spedizione contiene più del semplice nome e indirizzo. A seconda del fornitore del servizio, comprende un numero di spedizione, un codice leggibile da macchina, informazioni di instradamento, servizi come la verifica dell'età o il contrassegno, nonché, per le spedizioni internazionali, i dati doganali. Perché il corriere possa generare un'etichetta, queste informazioni devono essere complete e nel formato previsto.

Il flusso tecnico inizia solitamente con un ordine nello shop, nell'ERP o in una gestione ordini personalizzata. Non appena l'ordine è pronto per la spedizione, il sistema determina, in base a regole definite, il fornitore, il prodotto e i servizi aggiuntivi. Successivamente trasmette i dati all'interfaccia del corriere o a una piattaforma di spedizione. Questa registra la spedizione, restituisce il numero di tracking e l'etichetta, e il sistema archivia i dati PDF o di stampa presso l'ordine. Solo a quel punto si stampa — alla postazione di lavoro, al tavolo di imballaggio o direttamente tramite una stampante di etichette.

Questo ordine è determinante. Un'etichetta bella da vedere ma senza una registrazione di spedizione riuscita non serve a nulla. Al contrario, una registrazione riuscita non deve scomparire in background se alla stampante manca il materiale. I processi validi trattano registrazione, emissione e riscontro di stato come un'unica operazione coerente.

Generare etichette di spedizione in automatico inizia con regole chiare

L'errore più comune è pensare che per ogni ordine si debba sempre scegliere lo stesso fornitore. Questo può funzionare, ad esempio, per spedizioni B2C omogenee all'interno della Germania. Molte aziende, però, hanno bisogno di regole più differenziate. Una spedizione pesante, un ordine espresso, un ritiro in un punto di consegna o una spedizione in Svizzera pongono esigenze diverse.

Regole sensate possono tenere conto di peso e dimensioni, paese di destinazione, indirizzo di consegna, valore della merce, tempo di consegna desiderato, indicazioni di merci pericolose e condizioni concordate con il cliente. Vale la regola: non ogni eccezione teorica deve essere automatizzata fin dal primo giorno. Se si verificano due casi particolari al mese, un passaggio manuale chiaramente segnalato è spesso più economico e sicuro di un motore di regole complicato. I casi ricorrenti con un volume rilevante, invece, appartengono al processo standard.

La fonte dei dati è particolarmente importante. I pesi provenienti da un'anagrafica articoli ben gestita sono utilizzabili per merci simili tra loro. Per ordini misti, imballaggi variabili o supplementi per articoli fuori misura, il peso definitivo del collo dovrebbe essere rilevato alla postazione di imballaggio. Il sistema può quindi generare l'etichetta solo dopo la pesatura. Si tratta di un passaggio manuale in più, ma evita costose correzioni e addebiti successivi.

La qualità degli indirizzi si decide prima della stampa

Molti problemi di spedizione nascono prima della consegna al corriere. I numeri civici finiscono nel campo sbagliato, i codici postali non corrispondono alla città, oppure gli indirizzi aziendali contengono nomi di destinatario poco chiari. Un'automazione dovrebbe quindi non limitarsi a inoltrare gli indirizzi, ma verificarli in anticipo. Campi obbligatori, formati nazionali, lunghezze dei caratteri e doppioni riconoscibili possono essere intercettati già al momento dell'inserimento dell'ordine.

Una verifica degli indirizzi non è una garanzia di consegna. Riduce però il numero di errori evitabili. In presenza di dati anomali, il sistema dovrebbe mettere chiaramente l'ordine in sospeso per un chiarimento, invece di generare silenziosamente un'etichetta incompleta. In magazzino deve essere visibile perché un ordine è in attesa e chi può fornire l'informazione mancante.

La postazione di imballaggio ha bisogno di un utilizzo semplice

La migliore interfaccia fallisce se il personale deve passare da una schermata all'altra durante l'imballaggio. Una finestra di imballaggio pratica mostra solo ciò che serve per la spedizione in corso: ordine, articoli, indirizzo di consegna, stato dell'imballaggio, peso, metodo di spedizione scelto e stato di stampa. La scansione di un codice a barre sulla bolla di consegna o sul documento di prelievo dovrebbe aprire l'ordine corretto. Dopo la pesatura, nella situazione ideale basta un'azione di conferma per creare e stampare l'etichetta.

Con più postazioni di imballaggio, ogni postazione ha bisogno di un'assegnazione univoca a una stampante. Anche il formato dell'etichetta deve corrispondere al dispositivo e al corriere. L'A6 è comune per molte etichette dei colli, ma non tutti i rotoli, le stampanti termiche e gli archivi documentali funzionano allo stesso modo. Chi inizia stampando le etichette come PDF su una stampante laser da ufficio può partire rapidamente. Con volumi più elevati, le stampanti termiche sono in genere più sensate: evitano di tagliare, incollare e il rischio che un'etichetta scivoli sul lato sbagliato durante la stampa.

Un buon processo segnala i problemi tecnici in modo comprensibile. «API Error 403» non aiuta al tavolo di imballaggio. Meglio: «Etichetta non generata: verificare l'accesso al fornitore del servizio di spedizione» oppure «Stampante postazione 2 non raggiungibile». L'ordine non deve nel frattempo risultare erroneamente spedito. Resta in uno stato di errore chiaro e può essere elaborato di nuovo dopo la risoluzione, senza registrare una seconda spedizione.

Le interfacce hanno bisogno di gestione degli errori, non solo di un percorso senza intoppi

Le interfacce dei corrieri sono sistemi esterni. Possono essere temporaneamente irraggiungibili, rifiutare input o cambiare il formato di risposta. Anche una rete locale, un servizio di stampa o credenziali di accesso scadute possono interrompere il flusso. Per questo è rischioso far dipendere il successo solo dal fatto che un utente abbia cliccato su «Crea etichetta».

Dal punto di vista tecnico, ogni richiesta dovrebbe essere registrata in modo tracciabile: orario, ordine, servizio di spedizione utilizzato, risultato, numero di tracking e messaggio di errore comprensibile. Dati sensibili e chiavi di accesso non devono finire senza protezione nei file di log. Un ID di spedizione interno univoco impedisce che un nuovo tentativo generi etichette doppie o addebiti doppi.

Anche gli annullamenti rientrano nella pianificazione. Se un collo, dopo la stampa dell'etichetta, non viene comunque ritirato o viene reimballato, deve essere chiaro se la spedizione può essere annullata presso il corriere e come ciò venga documentato nel sistema interno. Senza questo passaggio, dopo alcune settimane stato di spedizione, tracking e fatturazione non coincidono più.

Non ogni azienda ha bisogno subito di una grande piattaforma di spedizione

Le piattaforme di spedizione possono raggruppare più corrieri, logiche tariffarie e resi. Questo ha senso quando volumi di spedizione, paesi di destinazione e fornitori sono molto vari. Chi invece ha un processo di spedizione chiaro e uno o due corrieri può procedere in modo più trasparente con un collegamento diretto. Meno sistemi significano meno riconciliazione dei dati, meno account utente e meno punti in cui possono nascere errori.

La decisione non dipende solo dal volume dei colli. Sono rilevanti anche i resi, i documenti di esportazione, regole di spedizione individuali, le fonti d'ordine esistenti e la domanda su chi manterrà le modifiche in futuro. Una soluzione a foglio di calcolo resta ad esempio sostenibile se ogni giorno vengono spedite poche spedizioni con dati costanti. Non appena i colleghi trasferiscono informazioni più volte o la spedizione è legata a singole persone, un flusso centralizzato diventa di solito più conveniente.

Per processi personalizzati per il cliente può avere senso un'applicazione web snella che riunisca dati d'ordine, movimenti di magazzino, bolle di consegna e stampa delle etichette.

softify.pro realizza tali sistemi con una struttura dati tracciabile, una messa in produzione documentata e tecnologie manutenibili come PHP 8.4 e MySQL 8. Ciò che conta non è il numero di funzioni, ma che il processo diventi più comprensibile per il team alla postazione di imballaggio.

Introdurre per piccoli passi e migliorare in modo misurabile

Un avvio controllato è meglio di un grande cambiamento in un lunedì mattina. Prima si automatizza un caso standard ben delimitato, ad esempio i colli nazionali di un corriere con un formato di etichetta definito. In parallelo, per alcuni giorni, i dati generati automaticamente dovrebbero essere confrontati con il flusso precedente: indirizzo, peso, prodotto di spedizione, numero di tracking ed etichetta stampata.

In seguito si possono aggiungere le eccezioni. Indicatori utili sono il tempo di lavorazione per spedizione, il numero di correzioni manuali, le etichette non stampate o generate due volte e il tempo che intercorre fino al riscontro di tracking al cliente. Questi valori mostrano se l'automazione toglie davvero lavoro oppure si limita a riprodurre digitalmente un vecchio giro più lungo.

Alla fine non conta un dialogo di spedizione particolarmente complesso. Conta che un ordine imballato riceva l'etichetta corretta senza cercare, ridigitare e incertezze — e che le eccezioni diventino visibili proprio dove una persona deve effettivamente decidere.

Link permanente →

Testare automaticamente il processo di login con un sistema

Testare automaticamente il processo di login con un sistema

Un login sembra banale solo quando funziona. Se si blocca dopo un rilascio, i dipendenti si trovano davanti all'inizio del turno, i clienti restano fuori dal portale clienti e gli addetti alla pianificazione si scontrano con un'elaborazione ordini bloccata. Testare automaticamente il processo di login non significa quindi semplicemente inserire nome utente e password in un modulo. Significa verificare in modo ripetibile un accesso critico per il business, con le sue regole, eccezioni e confini di sicurezza.

Per molti team l'automazione inizia con un singolo caso di test positivo: inserire credenziali valide, confermare l'accesso, vedere la home page. Questo ha senso, ma da solo non basta. Gli errori di login si manifestano spesso ai margini: sessioni scadute, account bloccati, una nuova autenticazione a più fattori o un permesso che non funziona più correttamente dopo un cambio di ruolo. Sono proprio questi i casi che devono essere coperti in modo pianificato.

Perché il login richiede una disciplina di test particolare

Il login è al tempo stesso una funzione di sicurezza, un'interfaccia tecnica e il punto d'ingresso nel flusso di lavoro. Un errore può essere troppo permissivo e consentire un accesso non autorizzato. Ma può anche essere troppo rigido e bloccare persone autorizzate. Entrambi i casi hanno un costo: nel primo si creano rischi per i dati e la conformità, nel secondo fermi operativi, carico di supporto e soluzioni improvvisate.

Nelle applicazioni web si aggiungono ulteriori dipendenze. Il login comunica spesso con un identity provider, un sistema di posta per il reset delle password, un'app MFA o un servizio di directory. Nelle applicazioni desktop Windows, diritti locali, connessioni di rete e versioni installate possono avere un impatto. Un test che osserva solo il modulo nel browser non individua in modo affidabile questi problemi di integrazione.

Per questo, prima della prima automazione dei test, il team dovrebbe definire cosa significhi un login riuscito nel sistema specifico. Basta una home page visibile? Oppure bisogna verificare che sia stata caricata la selezione corretta del tenant, che il ruolo utente sia corretto e che la prima azione protetta sia effettivamente possibile? Per un portale di magazzino potrebbe trattarsi dell'accesso al ricevimento merci. Per un sistema di pianificazione potrebbe essere il rilascio di un giro di consegne.

Testare automaticamente il processo di login: dal modello di flusso al caso di test

Un buon punto di partenza non è uno script, ma un modello di flusso. Il login può essere descritto come una sequenza di stati chiari: non autenticato, credenziali inviate, identità confermata, MFA richiesta, autenticato, sessione scaduta o account bloccato. Ogni stato prevede azioni consentite e reazioni attese del sistema.

Da questo modello nascono casi di test con valore concreto per il business. Il caso positivo standard ne fa parte, ma anche password errate, account inesistenti e link di reset scaduti. Conta soprattutto la risposta attesa. In caso di credenziali errate, un'applicazione non dovrebbe rivelare se un indirizzo email esiste. Il test verifica quindi non solo che venga mostrato un errore, ma anche che il suo testo e comportamento non forniscano indizi superflui.

Particolarmente rilevanti sono i meccanismi di protezione contro i tentativi ripetuti falliti. Dopo un numero definito di inserimenti errati, un account può essere bloccato temporaneamente. Il test automatico deve verificare se il blocco scatta davvero, quanto dura e se l'utente legittimo riottiene poi un accesso controllato. Qui serve precisione: un test che blocca intenzionalmente account di produzione crea più problemi di quanti ne risolva. Questi scenari vanno collocati in un ambiente di test separato, con account creati appositamente.

MFA, reset password e Single Sign-on da considerare separatamente

L'autenticazione a più fattori non è un dettaglio finale del login. Cambia il flusso. Un test deve riconoscere che dopo la password è richiesta una conferma aggiuntiva, e deve rappresentare sia la conferma riuscita sia quella rifiutata. Per i codici monouso basati sul tempo, l'ambiente di test necessita di una gestione controllata di tempo e segreti. In molti casi un metodo di test previsto dall'identity provider è più sensato che ricreare un vero telefono cellulare.

Anche il reset password e il Single Sign-On dovrebbero avere percorsi di test propri. Nel reset contano l'invio del messaggio, l'unicità del link, la durata di validità e il successivo accesso con la nuova password. Nello SSO è decisivo se l'applicazione, al ritorno dall'identity provider, crea correttamente la sessione e assume in modo pulito i ruoli.

I CAPTCHA rappresentano un caso particolare. Devono rallentare gli attacchi automatizzati e non dovrebbero essere aggirati tramite l'automazione dei test. È invece sensata una configurazione di test, una chiave di test ufficiale o un'eccezione protetta per l'ambiente di test. Ingannare i controlli di sicurezza solo per far diventare verde un test non è una strategia di qualità.

Scegliere il livello tecnico di test adatto

Non ogni test di login deve passare per un browser reale. I test API possono verificare se token, sessioni, messaggi di errore e regole di blocco funzionano correttamente. Sono veloci e aiutano a individuare errori vicino alla logica di autenticazione. I test da browser mostrano invece se campi, redirect, cookie, impostazioni SameSite e stati visibili si combinano correttamente nel flusso utente reale.

Per le applicazioni critiche è utile la combinazione. Pochi test end-to-end verificano l'intero percorso tramite browser. Sotto di essi, test API e di integrazione mirati coprono le varianti. Questo riduce i tempi di esecuzione e i falsi allarmi. Chi testa ogni combinazione immaginabile esclusivamente nel browser ottiene spesso una suite lenta, la cui manutenzione consuma più tempo di quanto ne risparmi.

Per il software desktop vale un principio simile. Un test automatico non dovrebbe limitarsi a controllare se si apre una finestra. Deve accertare se, dopo l'accesso, esiste la connessione dati corretta, se i diritti utente sono attivi e se la maschera di lavoro centrale è raggiungibile. Ciò è particolarmente rilevante per le applicazioni in magazzino o in produzione, perché le postazioni di lavoro possono avere condizioni di rete, collegamenti scanner o configurazioni locali diverse.

Gestire i dati di test in modo sicuro e ripetibile

I test di login lavorano inevitabilmente con credenziali. Account di dipendenti in produzione, dati reali dei clienti o segreti MFA non devono però finire in modo incontrollato in script di test, log e screenshot. Gli account di test devono essere chiaramente identificati, avere permessi minimi ed essere ripristinabili automaticamente. Password e token vengono forniti tramite una gestione sicura dei segreti, non salvati nel codice sorgente.

Altrettanto importante è la pulizia dopo l'esecuzione del test. Se un test genera nuove sessioni, voci di audit o account bloccati, l'ambiente di test deve tornare a uno stato iniziale definito. Altrimenti un test fallisce di lunedì solo perché un'esecuzione di venerdì ha lasciato effetti collaterali.

Per le aziende con applicazioni riservate, anche il luogo di esecuzione è decisivo. Screenshot di maschere di login, video di test e log tecnici possono contenere informazioni sensibili. Un'infrastruttura di test self-hosted come COCO può essere utile in questo caso, perché dati di test, esecuzione e prove restano sotto il proprio controllo. Se ciò sia necessario dipende dal fabbisogno di protezione, dalla situazione contrattuale e dalle linee guida interne. Un'infrastruttura dedicata non è automaticamente la scelta più economica per ogni applicazione.

Generare prove, non solo spunte verdi

Un report di test dovrebbe rendere comprensibile a QA, sviluppo e reparto specialistico cosa è stato verificato. Uno stato verde senza contesto aiuta poco se un rilascio genera domande in seguito. Sono quindi utili timestamp, ambiente di test utilizzato, account di test, passaggi rilevanti, screenshot in caso di errore e un messaggio di errore chiaro in linguaggio comprensibile.

In questo processo, la raccolta delle prove non deve diventare essa stessa un problema di protezione dei dati. Password, codici monouso, ID di sessione e dati personali devono essere mascherati nei log. Negli screenshot può essere necessario oscurare determinate aree. Queste regole dovrebbero far parte dell'architettura di test, non un lavoro manuale successivo a un incidente.

Cosa i team dovrebbero automatizzare per primo

La priorità dipende da rischio e frequenza d'uso. Vengono prima il login standard per i ruoli più importanti, le credenziali errate, il logout e la scadenza della sessione. Seguono poi le regole di blocco, il reset password, l'MFA e i cambi di ruolo. SSO, tenant speciali o percorsi eccezionali rari possono seguire più avanti, purché il loro guasto non fermi immediatamente l'operatività.

I test appartengono al processo di rilascio. Modifiche a moduli di login, cookie, permessi o configurazioni dell'identity provider dovrebbero attivare la suite di test pertinente prima che una versione vada in produzione. Inoltre conviene un'esecuzione pianificata in un ambiente realistico, ad esempio dopo modifiche all'infrastruttura o cambi di certificato. Questo permette di trovare problemi non visibili in un ambiente di sviluppo isolato.

Il miglior test di login, alla fine, non è quello con più click. È quello che riconosce presto un guasto reale, lo documenta in modo comprensibile e continua a funzionare in modo affidabile alla modifica successiva. Chi tratta il login come un processo di business chiaramente modellato non protegge solo un modulo. Protegge l'accesso al lavoro che attende dietro di esso.

Link permanente →

Creare bollette di consegna automaticamente con un software

Creare bollette di consegna automaticamente con un software

La ricerca di "software per creare bollette di consegna automaticamente" di solito non parte da un problema di documenti. Parte al tavolo di imballaggio: un ordine è approvato, la merce è stata prelevata, ma la bolla di consegna esiste ancora come modello Word, esportazione Excel o foglietto scritto a mano. Mentre qualcuno controlla le righe, cambiano quantità, indirizzi di consegna o spedizioni parziali. Questo richiede tempo - e genera esattamente gli errori che poi scatenano richieste, correzioni e coordinamento superfluo.

Una bolla di consegna generata automaticamente è quindi più di un PDF con un logo. È il passaggio documentato tra ordine, movimento di magazzino e spedizione. Perché ciò funzioni in modo affidabile, il software non deve offrire il maggior numero possibile di funzioni. Deve rappresentare correttamente il flusso di lavoro reale nell'azienda.

Quando conviene creare bollette di consegna automaticamente con un software

Non ogni azienda ha subito bisogno di un'applicazione personalizzata. Chi gestisce poche spedizioni a settimana, vende articoli fissi e lavora con un modello ben curato, può cavarsela bene con una soluzione a foglio di calcolo. L'automazione diventa sensata quando i dipendenti inseriscono dati più volte, gli ordini si suddividono regolarmente in spedizioni parziali o lo stato di spedizione non è chiaramente tracciabile.

Segnali di allarme tipici sono file Excel diventati fragili, descrizioni articolo diverse tra ordine e magazzino, documenti mancanti in caso di richieste o numeri di bolla assegnati manualmente. Anche quando più persone lavorano tra ufficio, magazzino e spedizione, una cartella condivisa spesso non basta più. Allora manca non solo velocità, ma una fonte affidabile di ciò che è realmente uscito dall'azienda.

Il punto decisivo è: la bolla di consegna dovrebbe nascere da un evento, non da un passaggio di lavoro aggiuntivo. Questo evento può essere il rilascio per il prelievo, il prelievo confermato o il completamento dell'imballaggio. Quale variante sia adatta dipende dal vostro processo. In un magazzino di ricambi, la registrazione di magazzino è spesso il trigger giusto. Nella produzione su misura, può essere determinante il rilascio della spedizione da parte della preparazione del lavoro.

Quali dati servono davvero a una bolla di consegna automatica

Un buon sistema non riprende semplicemente tutti i dati da un ordine. Verifica quali informazioni valgono al momento della consegna. Il destinatario può differire dal destinatario della fattura, un ordine può essere consegnato in più spedizioni, e la quantità consegnata può essere inferiore a quella originariamente ordinata.

Sono necessari come minimo un numero univoco di bolla, la data di emissione, l'indirizzo di consegna, il riferimento cliente, nonché le righe effettivamente consegnate con quantità e unità. A seconda del settore si aggiungono lotti, numeri di serie, pesi, unità di imballaggio, addetti al prelievo o istruzioni per il ricevimento merci. Se questi dati servono più tardi per reclami o tracciabilità, non appartengono a un campo di testo libero, ma a campi dati chiaramente definiti.

Ordine, movimento di magazzino e documento devono corrispondere

Il punto debole più comune si trova tra ordine e magazzino. L'ordine forse prevede dieci pezzi, ma il magazzino ne conferma solo otto. Se comunque vengono stampati dieci pezzi sulla bolla, si crea un documento problematico. Se vengono consegnati otto pezzi senza adeguare lo stato dell'ordine, la quantità residua resta invisibile.

Un software adatto tiene questi stati separati ma collegati: ordinato, riservato, prelevato, consegnato, eventualmente reso. La bolla di consegna accede alle quantità di consegna confermate. Così resta tracciabile, anche in caso di consegne parziali e successive, quale riga era inclusa in quale spedizione.

Serie numeriche e versioni non sono un dettaglio secondario

Assegnare manualmente i numeri di bolla sembra all'inizio semplice. Al più tardi con più sedi, diversi account utente o correzioni successive, diventa soggetto a errori. L'applicazione dovrebbe generare i numeri centralmente e impedire che lo stesso numero venga usato due volte.

Altrettanto importante è la gestione delle modifiche. Una bolla già inviata non dovrebbe essere sovrascritta silenziosamente. Meglio una correzione riconoscibile, uno storno o una nuova versione con una cronologia tracciabile. Tecnicamente non è un lusso, ma protegge i dipendenti dal lavorare con informazioni contraddittorie.

Come funziona la creazione nel flusso pratico

In un processo chiaro tutto inizia con un ordine strutturato. Articoli, quantità, indirizzo di consegna e data desiderata vengono registrati una volta o ripresi da un sistema esistente. Successivamente nasce un ordine di prelievo per il magazzino - su un dispositivo mobile, come stampa o su un terminale di postazione.

Durante l'imballaggio vengono confermate le quantità effettivamente prelevate. Per flussi semplici basta un pulsante di conferma. Con molti articoli, ubicazioni o lotti, le scansioni barcode sono più sensate. Solo dopo questo riscontro il software crea la bolla di consegna come PDF, assegna un numero e la associa al processo di spedizione. In parallelo può preparare un'etichetta di spedizione, se il rispettivo corriere è tecnicamente collegato.

Il documento generato viene salvato centralmente e resta reperibile tramite ordine, account cliente o numero di spedizione. Un addetto interno non deve più cercare nella casella di posta elettronica quando un cliente chiede cosa è stato consegnato in un determinato giorno. Vede l'ordine, le singole consegne e lo stato del rispettivo documento in un unico punto.

Questo suona lineare, ma spesso fallisce su casi particolari. Perciò l'applicazione deve trattarli consapevolmente: cosa succede in caso di quantità mancanti? Chi può modificare un indirizzo di consegna dopo il rilascio? Si può generare una bolla senza disponibilità di magazzino? Come vengono contrassegnati omaggi gratuiti o consegne sostitutive? Regole di questo tipo decidono se l'automazione viene accettata sul pavimento del magazzino.

Software standard o soluzione individuale?

Il software standard è sensato quando il vostro flusso segue in gran parte il modello previsto e sono già presenti interfacce verso shop, gestionale o corrieri. Riduce lo sforzo di introduzione e offre spesso un'ampia gamma di funzioni. Il prezzo può essere che i team debbano organizzare i loro flussi funzionanti attorno a un sistema rigido.

Una soluzione individuale conviene soprattutto quando la vostra logica è critica per il business: ad esempio con regole di imballaggio personalizzate per cliente, consegne parziali complesse, più aree di magazzino o un collegamento tra officina, produzione e spedizione. Può concentrarsi sulle funzioni necessarie quotidianamente, invece di far passare i dipendenti attraverso moduli che nessuno usa.

Nel mezzo si trova spesso la via più sensata: i sistemi esistenti restano guida per l'anagrafica articoli o la contabilità, mentre un'applicazione web snella colma il divario operativo in magazzino. Tramite interfacce chiaramente documentate si possono riprendere ordini, riportare le giacenze e archiviare le bolle di consegna. Per tali applicazioni una struttura dati tracciabile, accessi basati sui ruoli e processi di importazione testati sono più importanti di un'interfaccia particolarmente spettacolare.

In softify.pro questi processi vengono prima verificati sul flusso di merci concreto: chi attiva, chi conferma, quale eccezione si verifica realmente e quali dati devono essere dimostrabili in seguito? Solo dopo si decide se basta un adattamento del sistema esistente o se un'applicazione propria è economicamente sensata.

Introduzione senza rallentare l'operatività

L'avvio più sicuro raramente è la digitalizzazione completa di tutti i processi di magazzino in un'unica data. Iniziate con un percorso di consegna chiaramente delimitato, ad esempio ordini standard di una sede o di un gruppo di prodotti. Così diventa visibile se l'anagrafica articoli, la qualità degli indirizzi e la logica delle quantità sono sufficientemente pulite.

Nel passo successivo, gli ordini reali dovrebbero essere verificati in parallelo. Il software crea la bolla di consegna mentre il flusso precedente resta disponibile come istanza di controllo. Le deviazioni sono preziose in questa fase: non indicano necessariamente un errore software, ma spesso regole di processo non chiarite. Se, ad esempio, due dipendenti imballerebbero lo stesso ordine in modo diverso, prima deve essere chiarita la regola di lavoro.

Seguono poi ruoli e diritti. Il personale di magazzino ha bisogno di viste diverse rispetto a vendite o contabilità. Non tutti dovrebbero poter modificare successivamente le quantità di consegna o stornare documenti. Una buona soluzione rende visibili le responsabilità, senza costringere ogni piccola azione in una procedura di approvazione complicata.

Anche la gestione tecnica fa parte dell'introduzione. Documenti e dati di movimento necessitano di backup regolari, regole di conservazione chiare e percorsi di ripristino testati. In un'applicazione web con PHP 8.4 e MySQL 8, le transazioni di database pulite sono particolarmente importanti: una registrazione di magazzino e la creazione della relativa bolla di consegna non devono scollegarsi se una connessione si interrompe nel momento sbagliato.

Tre errori che rendono l'automazione inutilmente costosa

Il primo errore è automatizzare un problema di PDF, mentre i dati a monte non sono chiari. Se numeri articolo, unità o indirizzi cliente non sono curati, il sistema genera solo più velocemente documenti errati.

Il secondo errore è un ambito di progetto troppo ampio. Rifare contemporaneamente bolle di consegna, magazzino, spedizione, acquisti, produzione e contabilità impegna spesso i team per mesi. Un processo di consegna piccolo e solido crea fiducia più rapidamente e fornisce una base per ulteriori passi.

Il terzo errore è la mancanza di riscontro dal magazzino. Una bolla di consegna non deve nascere solo sulla base di un ordine pianificato, se nessuno ha confermato cosa è stato realmente imballato. Proprio questo riscontro trasforma un modello di documento in un processo solido.

Il miglior software per bolle di consegna scompare quasi dalla vista nella quotidianità. I dipendenti registrano un ordine una volta, confermano il loro lavoro dove avviene, e ritrovano il documento giusto quando serve. Se questo riesce, non nasce solo una spedizione più veloce - ma un flusso su cui magazzino, ufficio e clienti possono contare allo stesso modo.

Link permanente →

Testare automaticamente un'applicazione Windows: come riuscirci

Testare automaticamente un'applicazione Windows: come riuscirci

Un rilascio è pronto, ma nessuno può affermare con certezza se il nuovo dialogo di importazione, il controllo dei permessi e la stampa delle fatture funzionino ancora. Proprio a questo punto diventa prezioso poter testare automaticamente un'applicazione Windows - non come demo con tre click, ma come parte ripetibile del processo di rilascio.

Il software desktop è critico per il business in molte aziende. Controlla movimenti di magazzino, ordini di produzione, anagrafiche clienti o documenti di spedizione. Un errore non agisce solo su uno schermo: può bloccare ordini, generare etichette errate o costringere i dipendenti del turno serale a soluzioni manuali di emergenza. I test automatizzati riducono questo rischio quando sono orientati a flussi di lavoro reali e a un ambiente di test tecnicamente controllato.

Perché i test Windows sono diversi dai test web

Un'applicazione web si testa solitamente tramite elementi chiaramente indirizzabili nel browser. Nelle applicazioni desktop Windows, l'utilizzo dipende più fortemente da finestre, dialoghi, controlli nativi, risoluzione, permessi e componenti installati. Un test deve, ad esempio, riconoscere se un dialogo è stato davvero aperto, se un campo è modificabile o se un ordine di stampa è stato trasmesso correttamente.

A ciò si aggiunge la realtà stratificata di molte applicazioni. Alcune interfacce sono composte da classici componenti WinForms o WPF, altre integrano moduli più vecchi, visualizzatori PDF o interfacce verso stampanti e hardware scanner. Non esiste un unico metodo di automazione che funzioni ugualmente bene per ogni applicazione. Chi lo nasconde produce test che sembrano buoni in laboratorio e falliscono al successivo aggiornamento.

Il punto di partenza sensato non è quindi lo strumento, ma la domanda: quali flussi devono funzionare in modo dimostrabile a ogni rilascio? Per un software di magazzino o ordini, sarebbero ad esempio accesso, controllo permessi, registrazione ordini, registrazione di magazzino, creazione documenti e trasferimento a un'interfaccia. Questi processi generano valore per il business. Un test che verifica solo se un menu è visibile raramente lo fa.

Testare automaticamente un'applicazione Windows: scegliere il livello adatto

Per l'automazione sono fondamentalmente disponibili tre livelli. Idealmente vengono combinati, invece di puntare esclusivamente sull'interfaccia visibile.

Al livello tecnico, i test unitari e di integrazione verificano logica di business, accessi ai dati e interfacce. Sono veloci e mostrano precocemente se, ad esempio, un calcolo di prezzo, un formato di importazione o una regola di permessi si è danneggiato. Tuttavia non sostituiscono un test operativo: se un pianificatore possa effettivamente raggiungere ed eseguire correttamente la funzione resta aperto.

Il secondo livello sono i test UI tramite la Windows Automation API. Qui gli strumenti di test si rivolgono ai controlli tramite proprietà come Automation-ID, nome o tipo di controllo. Questo è solitamente più stabile dei test che cliccano semplicemente su coordinate fisse dello schermo. I team di sviluppo possono promuovere attivamente questa stabilità assegnando ID univoci e non rinominando i controlli rilevanti a ogni modifica dell'interfaccia.

Il terzo livello lavora visivamente. Qui un sistema riconosce pulsanti, contenuti di tabelle, dialoghi o stati in base al contenuto dello schermo. Questo aiuta soprattutto con applicazioni più vecchie, componenti proprietari o interfacce che non forniscono informazioni di automazione utili. Il riconoscimento visivo è però più sensibile a scalatura, temi, pop-up inattesi e stati di schermo poco chiari. Richiede postazioni di lavoro definite, condizioni di attesa chiare e prove tracciabili.

Un approccio basato su IA può classificare i segnali visivi meglio di un semplice click su coordinate. Non dovrebbe comunque diventare una scatola nera. Per i passaggi critici, un team ha bisogno di screenshot, log, risultati attesi e una motivazione del perché un'esecuzione è stata valutata come fallita. Un'affidabilità noiosa ma dimostrabile, più che l'inseguimento delle tendenze, vale soprattutto nel testing.

Iniziare con un ambito di test piccolo e solido

L'errore più comune è cercare di automatizzare subito ogni schermata. Questo impegna budget e crea una grande raccolta di script fragili prima ancora che sia chiaro se l'approccio migliora la quotidianità dei rilasci. Meglio un inizio ristretto con cinque-dieci flussi critici che oggi vengono regolarmente verificati manualmente.

Un buon primo caso di test ha un inizio chiaro, un input realistico e un risultato verificabile. Esempio: un utente con il ruolo magazzino accede, crea un ricevimento merci, registra un articolo su un'ubicazione e stampa il documento. Il test controlla poi non solo il messaggio di successo, ma anche giacenza, numero documento e l'ordine di stampa registrato. Così una sequenza di click diventa la prova di un processo di business.

Non ogni flusso è subito adatto. Funzioni con hardware instabile, servizi di pagamento esterni o sistemi terzi che cambiano spesso richiedono di solito un taglio diverso. Qui si può testare la propria applicazione fino al passaggio di consegna e rappresentare il componente esterno tramite un simulatore controllato. Non è una scorciatoia, ma una netta separazione di responsabilità.

I dati di test sono parte del sistema

L'automazione fallisce spesso non per l'interfaccia, ma per dati inutilizzabili. Un account di test è bloccato, un articolo è già stato usato o un'esecuzione precedente ha modificato la quantità di magazzino attesa. Per questo l'ambiente di test necessita di dati di partenza definiti e di un modo affidabile per tornare a quello stato.

In pratica ciò significa: database di test separato, ruoli utente fissi, set noti di articoli e clienti, nonché logica di tempo e numerazione controllata. Con dati sensibili, i dati di produzione non dovrebbero essere copiati in modo incontrollato. Set di dati anonimizzati o generati appositamente sono di solito la scelta migliore. Sono prevedibili e riducono il rischio per la protezione dei dati.

Anche i flussi di blocco account meritano particolare attenzione. Se le esecuzioni di test fallite usano ripetutamente password errate, possono bloccare i propri stessi accessi. Tali scenari dovrebbero essere testati consapevolmente, ma separati dal normale test di regressione.

La stabilità nasce dall'operatività, non da un singolo strumento

Un test UI è utile solo se funziona in condizioni ripetibili. Ne fanno parte una versione Windows fissa, risoluzione e scalatura dello schermo definite, versioni note dell'applicazione, nonché una gestione pulita di aggiornamenti, dialoghi e processi in background. Se un server di test usa dimensioni dei caratteri diverse al mattino rispetto alla notte, non è un problema di test - è un problema operativo.

I tempi di attesa non dovrebbero essere inseriti ciecamente come valori fissi. Tre secondi di pausa dopo ogni click rendono un test lento e non risolvono problemi di tempistica. Meglio attendere in modo mirato uno stato: la finestra è visibile, la tabella contiene il record atteso o il processo di salvataggio è completato. Per processi asincroni reali servono limiti di tempo sensati e una diagnosi chiara degli errori.

Le esecuzioni fallite appartengono a una triage, non a una cartella ignorata. L'applicazione era difettosa? L'interfaccia è cambiata correttamente dal punto di vista funzionale? L'ambiente di test non era disponibile? Screenshot, registrazioni schermo, log tecnici e timestamp riducono notevolmente questo chiarimento. Un report in linguaggio chiaro aiuta inoltre i reparti specialistici a capire quale processo di business è interessato, senza dover prima leggere uno script di test.

Pianificare protezione dei dati e prove fin dall'inizio

Nelle applicazioni desktop, gli screenshot mostrano spesso nomi clienti, prezzi articoli, indirizzi o cifre chiave interne. Se i test vengono eseguiti tramite servizi cloud esterni, dati dello schermo e traffico dell'applicazione possono lasciare la propria zona di controllo. Per i team attenti alla sicurezza, questo non è un dettaglio secondario, ma una decisione architetturale.

Un server di test self-hosted può mantenere esecuzione dei test, immagini e report nel proprio ambiente. Per questo, softify.pro utilizza COCO, un ambiente che esegue test automatizzati per applicazioni web e Windows e genera risultati tracciabili. Se un server dedicato sia sensato dipende dal fabbisogno di protezione, dall'IT esistente e dal numero di esecuzioni di test. Per un'applicazione piccola e non critica può bastare un approccio semplice; per sistemi specialistici interni con dati sensibili, il controllo locale è spesso l'opzione più ragionevole.

Anche la conservazione delle prove dovrebbe essere regolata. Non ogni screenshot deve essere salvato permanentemente. Sono utili scadenze, accesso basato sui ruoli e un'associazione chiara tra esecuzione del test, versione dell'applicazione e risultato. Così gli errori possono essere riprodotti senza costruire una seconda raccolta di dati incontrollata.

Cosa fornisce un rollout sensato

Dopo una prima esecuzione, un team non dovrebbe ricevere solo un numero di test superati. Decisivo è se i test trovano errori reali, se funzionano in modo affidabile e se lo sforzo di manutenzione è proporzionato al beneficio. Un test che deve essere adattato ogni settimana per una modifica di layout irrilevante è troppo costoso - anche se sembra tecnicamente impressionante.

Il passo successivo è l'integrazione nel processo di rilascio. Test tecnici rapidi possono partire a ogni build; test end-to-end selezionati vengono eseguiti prima di un'approvazione o di notte in un ambiente stabile. Deviazioni critiche bloccano il rilascio, indicazioni meno critiche vengono documentate e prioritizzate. Queste soglie dovrebbero essere concordate a livello specialistico. Non ogni differenza visiva è un blocco alla consegna, una quantità registrata erroneamente invece sì.

I test Windows automatizzati non sostituiscono le competenze specialistiche. Ma creano tempo per le verifiche che richiedono giudizio: nuovi processi, casi particolari insoliti e la domanda se una funzione sia davvero comprensibile nella quotidianità lavorativa. Quando i flussi standard sono affidabilmente dimostrabili, un rilascio non deve più basarsi sulla speranza.

Link permanente →

Software logistico personalizzato per le piccole e medie imprese (PMI)

Software logistico personalizzato per le piccole e medie imprese (PMI)

Quando il ricevimento merci viene registrato su carta, le giacenze si trovano in più file Excel e le domande sulla spedizione vengono chiarite a voce, raramente manca la buona volontà. Manca un processo condiviso. Il software logistico personalizzato per le PMI interviene esattamente lì: non con un sistema aziendale sovraccarico, ma con un'applicazione che rappresenta i percorsi reali in magazzino, nella pianificazione e in ufficio.

Per molte aziende non si tratta di un progetto di digitalizzazione fine a se stesso. Si tratta di meno richieste, giacenze affidabili, bolle di consegna generate più rapidamente e un passaggio di consegne tra turni che non dipende dalla conoscenza di singole persone. La soluzione migliore non è automaticamente quella con più funzioni. Deve rendere il lavoro dimostrabilmente più semplice e controllabile.

Il punto critico sono di solito i passaggi di consegna

Nelle piccole e medie aziende di magazzino e produzione, molte cose funzionano sorprendentemente a lungo con fogli di calcolo, e-mail ed esperienza. Non è fondamentalmente sbagliato. Un foglio di calcolo ben curato può essere più sensato di un sistema dedicato per una lista di inventario gestibile.

Diventa critico quando le informazioni vengono registrate più volte o la loro affidabilità non è più chiara. Un ordine viene creato in ufficio, stampato in magazzino, integrato su un foglio di lavoro e successivamente ritrasferito in un foglio di calcolo. Contemporaneamente un altro dipendente riserva giacenza per una spedizione urgente. Alla fine non solo la giacenza è discutibile, ma è difficile rispondere anche alla domanda su chi ha eseguito quale passaggio e quando.

Questo attrito raramente si manifesta come un singolo grande errore. Costa minuti ogni giorno: nella ricerca di articoli, nel richiamare un cliente, nel tracciare una consegna o nel passaggio di turno. Nel corso delle settimane ne derivano quantità mancanti evitabili, spedizioni espresse e discussioni su cifre di cui nessuno si fida completamente.

Cosa dovrebbe concretamente rappresentare un software logistico personalizzato

Un'applicazione su misura non inizia con un catalogo di funzioni. Inizia con un'analisi del processo sul pavimento del capannone e alla postazione della pianificazione. Quali dati arrivano realmente? Quale decisione prende un dipendente? Quale eccezione si presenta regolarmente? E quali informazioni devono essere assolutamente presenti per il passo di lavoro successivo?

Da ciò nasce un flusso chiaro, ad esempio dall'entrata dell'ordine attraverso il prelievo e la spedizione fino al passaggio alla contabilità. A seconda dell'azienda possono farne parte i seguenti elementi:

  • Registrazione dei ricevimenti merci, stato di controllo e ubicazioni di magazzino
  • Movimenti di magazzino con supporto barcode o scanner mobile
  • Accettazione ordini, riserve e liste di prelievo
  • Bolle di consegna, etichette di spedizione e passaggio ai corrieri
  • Pianificazione dei percorsi per veicoli e giri propri
  • Correzioni tracciabili, diritti basati sui ruoli e report

Decisivo non è costruire tutto in una volta. Un'azienda con frequenti trasferimenti interni ha forse bisogno prima di tutto di movimenti di magazzino affidabili. Un grossista con molte piccole spedizioni beneficia inizialmente di più di un'accettazione ordini pulita e documenti di spedizione generati automaticamente. Un'azienda produttiva ha forse bisogno prima di trasparenza sulla disponibilità dei materiali e sulle giacenze bloccate.

Un esempio dall'operatività quotidiana

Supponiamo che il ricevimento merci riceva cinque pallet con articoli le cui quantità differiscono in parte dall'ordine. In un buon flusso, la consegna viene registrata, verificata e associata a uno stato. Solo dopo l'approvazione la giacenza diventa disponibile per la pianificazione. Le deviazioni non finiscono in una nota sulla bolla di consegna, ma sono visibilmente assegnate all'ufficio acquisti e al magazzino.

Quando successivamente avviene il prelievo, il sistema mostra non solo una giacenza teorica totale, ma l'ubicazione corrispondente e la quota riservata. Dopo la scansione o la conferma del prelievo, il movimento viene registrato. La bolla di consegna nasce dagli stessi dati. Questo riduce le doppie registrazioni e crea una traccia solida senza che i dipendenti debbano svolgere più lavoro amministrativo.

Software standard, Excel o sviluppo personalizzato?

La risposta onesta è: dipende dal processo. Il software standard è sensato quando i flussi corrispondono in gran parte ai modelli previsti, gli adattamenti restano minimi e i costi di licenza sono proporzionati all'ambito. Porta spesso moduli già pronti, interfacce consolidate e un'introduzione iniziale rapida.

Lo svantaggio emerge quando l'azienda deve adattarsi permanentemente allo strumento. In quel caso i casi particolari vengono nuovamente gestiti fuori dal sistema, i campi obbligatori vengono aggirati o i dipendenti mantengono liste ombra. Questo può essere accettabile finché queste eccezioni restano rare e gestibili. Se si accumulano, il prodotto standard diventa un'ulteriore rottura del processo.

Anche Excel resta uno strumento utile quando i volumi di dati sono piccoli, solo poche persone lavorano contemporaneamente e le conseguenze di un inserimento errato restano limitate. Tuttavia non è una buona base dati per movimenti di magazzino paralleli, riserve vincolanti o una cronologia di spedizione completa.

Una soluzione individuale conviene soprattutto quando il flusso è un vero vantaggio competitivo, quando si sommano più rotture di supporto o quando un sistema esistente contiene sì dati ma rallenta il lavoro quotidiano. Non dovrebbe essere intesa come un progetto di prestigio. Il suo valore economico sta in tempi di attraversamento più brevi, meno errori e minore dipendenza da singole persone.

Il software logistico personalizzato per le PMI ha bisogno di limiti

Su misura non significa realizzare subito ogni funzione desiderata. Al contrario: un buon sviluppo personalizzato pone limiti chiari. Altrimenti nasce un sistema che conserva tutte le vie speciali storiche e diventa così difficile da usare.

Un inizio sensato definisce un processo centrale con benefici misurabili. Ad esempio: i ricevimenti merci vengono completamente registrati lo stesso giorno. Oppure: per ogni ordine di spedizione articolo, quantità, addetto e stato di spedizione sono documentati in modo univoco. Solo quando questo flusso funziona in modo stabile seguono altri moduli come pianificazione dei giri, portali clienti o report speciali.

Anche le decisioni tecniche richiedono pragmatismo. Un'applicazione web può basarsi su tecnologie moderne e manutenibili come PHP 8.4, JavaScript moderno e MySQL 8. Non è auto-celebrazione con termini tecnologici. Crea una base tracciabile per diritti basati sui ruoli, transazioni di database, interfacce mobili e deployment documentati. Per gli scanner in magazzino è spesso decisivo che l'applicazione reagisca in modo affidabile sui dispositivi esistenti e dia riscontri chiari anche con Wi-Fi più debole.

Introduzione: prima stabilizzare il flusso, poi accelerare

L'introduzione raramente fallisce a causa di una singola interfaccia. Fallisce quando questioni di processo aperte vengono rimandate alla fase di sviluppo. Chi può correggere le giacenze? Cosa succede in caso di merce danneggiata? Quando un ordine viene riservato in modo vincolante? Come vengono gestiti i resi? Regole di questo tipo devono essere chiarite prima di un roll-out ampio.

Un percorso solido inizia con pochi flussi rappresentativi e dati reali. Dipendenti di magazzino, pianificazione e amministrazione verificano insieme se lo schermo parla la lingua dell'azienda e se la sequenza dei passaggi di lavoro è corretta. Indicazioni come «Questo campo non ci serve» o «Qui manca lo stato per consegna parziale» sono più preziose di desideri funzionali astratti.

Segue poi un funzionamento pilota limitato. Non con esempi artificiali, ma con ordini selezionati nell'operatività quotidiana. Errori e stati poco chiari vengono documentati, prioritizzati e corretti. Solo successivamente si effettua il roll-out su altre aree. Il funzionamento parallelo può dare sicurezza a breve termine, ma dovrebbe avere una fine. Due sistemi guida creano a lungo andare proprio l'incertezza che il progetto dovrebbe eliminare.

Anche la formazione è più di una presentazione una tantum. I dipendenti hanno bisogno di istruzioni brevi e specifiche per ruolo: cosa registro? Cosa controllo? Cosa faccio in caso di deviazione? Una gestione documentata delle eccezioni impedisce che, alla prima situazione particolare, carta e gruppi di chat riprendano il comando.

La manutenibilità è parte della soluzione, non un ripensamento

I processi logistici cambiano. Si aggiungono nuove ubicazioni, un corriere modifica i requisiti, i clienti richiedono formati di documento diversi o una nuova sede viene collegata. Perciò il software non deve solo adattarsi all'avvio, ma essere sviluppabile ulteriormente in modo comprensibile.

Ne fanno parte una struttura dati pulita, logica di business chiaramente separata, concetti di diritti e deployment documentati. Altrettanto importanti sono i backup, il logging e una gestione regolata degli errori. Se un utente inserisce più volte credenziali errate, serve ad esempio un flusso di blocco account tracciabile invece di un'improvvisazione silenziosa e insicura.

Prima delle modifiche a flussi critici dovrebbero esserci dei test. Nelle applicazioni personalizzate, il test automatizzato è particolarmente utile per i percorsi centrali ricorrenti: creare un ordine, riservare giacenza, generare un documento di spedizione, cambiare stato. Così una modifica alla bolla di consegna non ha conseguenze inosservate altrove. softify.pro punta in questi progetti su questo tipo di tecnologia noiosamente affidabile e verificabile, invece che su effetti a breve termine.

Su cosa si misura il beneficio dopo sei mesi

Non ogni miglioramento si può esprimere subito in euro, ma dovrebbe essere visibile. Buoni indicatori si orientano al collo di bottiglia: tempo di elaborazione per ordine, numero di correzioni di giacenza, tasso di spedizioni errate, quota di registrazioni di ricevimento merci puntuali o richieste tra magazzino e ufficio.

Importante è il confronto con una situazione di partenza realistica. Se finora nessuno ha registrato correttamente le quantità mancanti, la nuova trasparenza può inizialmente sembrare più problemi. In realtà i problemi diventano per la prima volta visibili e gestibili. Questa fase richiede pazienza e una comunicazione aperta.

Il software adatto non scompare dalla quotidianità lavorativa perché sia irrilevante. Fa sì che un ordine, un pallet o un giro percorrano il loro percorso chiaro - anche quando la persona più esperta in magazzino non è in azienda in quel momento.

Link permanente →

Test di regressione automatizzati per applicazioni web

Test di regressione automatizzati per applicazioni web

Un codice sconto modificato, un nuovo diritto di ruolo o un aggiornamento del servizio di pagamento possono compromettere un'applicazione web in un punto che nessuno tocca da mesi. È proprio qui che entrano in gioco i test di regressione automatizzati per le applicazioni web: verificano ripetutamente se i processi aziendali collaudati continuano a funzionare dopo le modifiche. Non come misura teorica di qualità, bensì là dove un errore blocca ordini, movimenti di magazzino, fatture o account di clienti.

Per molti team il problema inizia in modo subdolo. I rilasci durano più a lungo perché i reparti aziendali eseguono manualmente gli stessi flussi di lavoro principali. La conoscenza dei test rimane confinata a singole persone. E prima di un aggiornamento rimane la sgradevole domanda: cosa ci è sfuggito? L'automazione non sostituisce né la responsabilità funzionale né un sensato lavoro di esplorazione. Rende i controlli ricorrenti e critici per il business affidabili, riproducibili e tracciabili.

Cosa proteggono effettivamente i test di regressione automatizzati

Un test di regressione risponde a una domanda semplice: ciò che funzionava prima, funziona ancora dopo una modifica? In un'applicazione web si tratta raramente di un singolo pulsante. Sono rilevanti i flussi completi attraverso l'interfaccia utente, i permessi, le interfacce e il database.

Un esempio da un sistema operativo: un dipendente effettua l'accesso, registra un'entrata merci, contabilizza un movimento di magazzino, crea un documento di trasporto e consegna la spedizione a un corriere. Ogni singolo passaggio può sembrare tecnicamente corretto e tuttavia fallire nell'interazione complessiva. Forse la quantità viene salvata, ma non aggiornata nell'inventario. Forse l'etichetta viene generata, ma manca il numero di riferimento. Forse il flusso funziona solo per gli amministratori, ma non per il ruolo in magazzino.

I test automatizzati possono eseguire tali percorsi con input definiti e verificarne i risultati. Ciò include i risultati visibili nell'interfaccia utente così come i valori di stato, i documenti generati, le e-mail o le risposte API. L'utilità aumenta quando il controllo viene organizzato vicino ai rischi operativi, e non in base al numero di casi di test tecnicamente possibili.

Quali flussi web dovrebbero essere automatizzati per primi

Non ogni clic merita immediatamente un test automatizzato. Una pagina di impostazioni raramente utilizzata e con un basso potenziale di danno può essere verificata inizialmente in modo manuale. Al contrario, i flussi caratterizzati da frequenti modifiche, elevato utilizzo o chiare conseguenze finanziarie e operative devono entrare a far parte della suite di test fin da subito.

Sono particolarmente preziosi i test per l'accesso (login), il recupero della password e il blocco dell'account. Proteggono l'accesso all'applicazione e vengono spesso influenzati da modifiche ai servizi di identità, alla gestione delle sessioni o alle regole di sicurezza. Altrettanto importanti sono i processi chiave come l'acquisizione degli ordini, il calcolo di prezzi e tasse, le approvazioni, le registrazioni di magazzino, la generazione di documenti e le interfacce con spedizionieri, ERP o fornitori di servizi di pagamento.

Per i dirigenti e i reparti operativi è utile una prioritizzazione sobria. Non chiedete per prima cosa quale pagina sia la più semplice da testare. Chiedete: quale errore blocca un turno, genera lavoro extra o porta a informazioni errate per i clienti? Da ciò nasce un elenco di test che protegge le operazioni reali.

Un caso di test richiede un risultato verificabile

«Crea ordine» non è ancora un caso di test valido. È meglio formulato così: un rappresentante di vendita con il ruolo di venditore crea un ordine per un cliente esistente, aggiunge un articolo con una quantità definita, lo salva e genera un numero d'ordine. Successivamente, lo stato è «aperto», il totale è conforme alle regole e l'ordine appare nell'elenco delle operazioni aperte.

Questa precisione non è burocrazia. Evita test che eseguono clic senza poter determinare se il risultato aziendale sia corretto. Facilita inoltre la coordinazione tra sviluppo, QA e reparto aziendale. Soprattutto nei sistemi sviluppati su misura, gli esperti di dominio sono spesso l'unica fonte affidabile per capire cosa significhi realmente «corretto» nella vita di tutti i giorni.

Piramide dei test anziché automazione del browser per tutto

I test basati su browser sono preziosi, ma non costituiscono l'intera strategia di test. Vengono eseguiti più lentamente, sono più vulnerabili a dati di test instabili e possono interrompersi dopo piccoli adeguamenti dell'interfaccia utente se i selettori sono scelti male. Chi verifica ogni regola esclusivamente tramite l'interfaccia solitamente costruisce una suite lenta e difficile da mantenere.

La logica aziendale come il calcolo dei prezzi, i controlli delle quantità o le transizioni di stato dovrebbe essere testata dove è implementata, ad esempio sotto forma di unit test o test di integrazione. Le interfacce possono essere verificate in modo mirato con risposte controllate. I test end-to-end basati su browser rimangono quindi riservati ai pochi percorsi in cui l'interazione di tutti i componenti è fondamentale.

Nelle applicazioni PHP 8.4 con MySQL 8, ad esempio, ciò significa: le regole di calcolo e validazione vengono protette vicino al codice, le transazioni del database e i contratti API vengono testati in modo integrato, mentre un test del browser traccia l'ordine completo fino al documento generato. Questo è meno spettacolare di una grande raccolta di test visivi a clic, ma fornisce feedback più rapidi e minori oneri di manutenzione.

La stabilità nasce dai dati di test e da chiari confini tecnici

Molti progetti di automazione falliscono non a causa dello strumento di test, ma per via di presupposti non controllati. Se un account di test è bloccato, se esiste ancora un ordine di test del giorno precedente o se un servizio esterno risponde lentamente, si genera un falso allarme. Tali test instabili perdono rapidamente la fiducia del team.

I dati di test devono quindi essere creati e ripuliti intenzionalmente. Sono utili tenant dedicati o set di dati chiaramente delimitati, identificatori univoci per ogni esecuzione di test e stati iniziali definiti. Un test non deve dipendere casualmente dall'ordine di esecuzione di altri test. Dove sono coinvolti servizi esterni, si dovrebbe decidere chiaramente: viene utilizzata un'ambiente di test realistico oppure l'interfaccia viene simulata per il rispettivo test? Entrambe le opzioni possono essere corrette.

Anche i selettori meritano attenzione. I test non dovrebbero dipendere da classi di layout, posizioni del testo o strutture HTML casuali. Etichette stabili ed esplicitamente destinate ai test riducono la manutenzione non necessaria. Questa è una piccola decisione tecnica con un grande impatto quando l'interfaccia e il design evolvono regolarmente.

Integrare i test di regressione automatizzati nel processo di rilascio

Il test migliore serve a poco se viene avviato manualmente solo prima dei rilasci principali. Ha senso un'esecuzione graduale: test rapidi del codice e delle interfacce vengono eseguiti a ogni modifica. I percorsi del browser più importanti vengono eseguiti durante le pull request o prima del rilascio nell'ambiente di staging. Controlli più estesi possono avvenire di notte o prima di un rilascio in produzione pianificato.

Il feedback è fondamentale. Un test fallito non richiede solo un'icona rossa, ma indicazioni utilizzabili: quali dati sono stati utilizzati? In quale passaggio si è verificato l'errore? Quale schermata o registro lo comprova? Per i team senza un grande reparto di QA interno, i risultati comprensibili sono particolarmente preziosi. Devono essere in grado di riconoscere se un difetto risiede nel sistema, nei dati di test o nell'ambiente di test.

COCO può essere utilizzato qui come infrastruttura di test self-hosted per eseguire i flussi di test, registrare le prove e presentare i risultati in un linguaggio chiaro. Ciò è particolarmente rilevante quando schermate, interfacce interne o dati di test non devono essere trasferiti su un cloud esterno. Self-hosted non significa tuttavia esente da manutenzione: i diritti di accesso, gli aggiornamenti, le capacità e le regole di conservazione devono essere pianificati con la stessa cura dei test stessi.

Cosa dicono le metriche - e cosa no

Un numero crescente di test automatizzati non è prova di qualità. Una suite con 2.000 test superficiali può offrire meno protezione rispetto a 40 test gestiti con cura per i flussi di valore critici. Sono più significativi interrogativi quali: quanto tempo richiede il feedback dopo una modifica? Quanti errori rilevanti vengono scoperti prima della produzione? Con quale frequenza gli errori di test sono in realtà falsi allarmi? E quali processi critici per il business sono coperti in modo dimostrabile?

Anche la durata dell'esecuzione è un fattore pratico. Se una suite fornisce risultati solo dopo quattro ore, viene aggirata nella routine quotidiana. Se fornisce un segnale chiaro su login, ordine, inventario e documenti in 15 minuti, supporta le decisioni prima del rilascio. La profondità necessaria dipende dall'applicazione e dal rischio. Uno strumento di pianificazione interno richiede qualcosa di diverso rispetto a un portale clienti con pagamenti e dati personali.

Il giusto inizio è più piccolo di quanto molti si aspettino

Iniziate con un processo la cui interruzione sarebbe avvertita concretamente e mappatelo completamente. Definire il risultato atteso insieme alle persone che utilizzano quotidianamente quel flusso. Assicuratevi di disporre di dati di test controllati, punti di ancoraggio tecnici stabili e prove tracciabili. Solo quando questo primo test funziona in modo affidabile, viene aggiunto il processo successivo.

In questo modo non si crea uno scenario di test imponente ma fragile, bensì una linea di sicurezza resiliente per le modifiche, passo dopo passo, esattamente là dove la vostra applicazione web sostiene concretamente l'attività aziendale.

Link permanente →

Registrare digitalmente l'ingresso merce senza caos di magazzino

Registrare digitalmente l'ingresso merce senza caos di magazzino

Una bolla di consegna si trova sul banco delle merci, il pallet è già fermo nel corridoio e l'autista aspetta una firma. È esattamente in questo momento che si decide se una giacenza sarà corretta in seguito o se la collega successiva cercherà del materiale che, secondo il sistema, dovrebbe essere disponibile. Chi vuole registrare digitalmente l'ingresso merce ha quindi bisogno di qualcosa in più rispetto a una semplice schermata di input. Il processo deve funzionare sotto pressione temporale, generare dati univoci e adattarsi ai flussi di lavoro reali in magazzino.

Elenchi cartacei e tabelle sembrano spesso sufficienti a lungo. Tuttavia, diventano fragili non appena più persone effettuano registrazioni, gli articoli hanno descrizioni simili, i lotti diventano rilevanti o la merce viene trasferita direttamente al montaggio, al prelievo o agli ordini dei clienti. Una buona digitalizzazione della registrazione non crea semplicemente più dati. Crea una base comune affidabile.

Cosa andrebbe effettivamente registrato durante l'ingresso merce digitale

L'ingresso merce è il passaggio tra la consegna e la giacenza disponibile. Affinché questo passaggio rimanga verificabile, ogni registrazione dovrebbe poter rispondere almeno a: cosa è stato consegnato, in quale quantità, quando, da quale fornitore e dove è stata immagazzinata la merce? A seconda dell'attività, si aggiungono numero d'ordine, numero di bolla di consegna, lotto, numero di serie, data di scadenza o stato di qualità.

Ciò che è determinante è la distinzione tra merce preannunciata e merce effettivamente accettata. Un ordine può indicare 100 pezzi, ma vengono consegnati 96 pezzi, due cartoni danneggiati e due posizioni sostitutive. Se i collaboratori confermano solo l'ordine, un errore finisce direttamente in magazzino. La registrazione digitale deve rendere le discrepanze volutamente semplici, senza penalizzarle con percorsi alternativi.

Per un magazzino ricambi sono spesso sufficienti articolo, quantità, ubicazione e riferimento del documento. Nella produzione, le approvazioni dei lotti o i verbali di collaudo possono essere indispensabili. Più campi non sono automaticamente migliori. Ogni campo obbligatorio costa tempo e aumenta la probabilità che qualcuno stimi i valori o li inserisca in un secondo momento.

Registrazione digitale dell'ingresso merce: Il flusso di lavoro nell'area di magazzino

Un flusso di lavoro pratico non inizia davanti allo schermo in ufficio, ma dove arriva la merce. I collaboratori aprono l'ingresso merce atteso su un dispositivo mobile o registrano inizialmente la bolla di consegna tramite ricerca, numero d'ordine o codice a barre. Dopodiché, le posizioni vengono scansionate, conteggiate o pesate e confrontate con la consegna prevista.

Se la quantità è corretta, la merce viene assegnata a un'ubicazione di magazzino e registrata. In caso di discrepanze, non ci si limita a scrivere un commento in un campo di testo libero. Il sistema registra se si tratta di una carenza di quantità, di una sovraconsegna, di un danno da trasporto, di un articolo errato o di una posizione non ancora verificata. Una foto può essere utile in caso di danni visibili, ma non è necessaria per ogni consegna.

Dopo la registrazione, dovrebbe essere chiaro quale sia lo stato della merce. Alcuni articoli sono immediatamente disponibili. Altri rimangono bloccati fino al completamento di un controllo qualità o finché un responsabile non ha deciso in merito alla discrepanza. Questa logica di stato impedisce alle vendite di promettere merce che, sebbene sia fisicamente arrivata, non è ancora utilizzabile.

Il punto di registrazione corretto dipende dall'azienda. In un piccolo magazzino, l'ingresso merce può essere registrato completamente direttamente al portone. In caso di grandi consegne o tempi stretti alla rampa, è spesso preferibile una registrazione in due fasi: prima la consegna viene registrata come arrivata, poi le posizioni vengono controllate e immagazzinate. Il vantaggio è la velocità alla rampa. Lo svantaggio: sono necessarie responsabilità chiare affinché i controlli in sospeso non rimangano inevasi.

Scanner, tablet o PC fisso?

L'hardware dovrebbe seguire il flusso di movimento. Per gli articoli con codici a barre stampati chiaramente, uno scanner manuale è solitamente la scelta più rapida e con il minor numero di errori. Gli scanner mobili o gli smartphone con fotocamera sono adatti quando i collaboratori si muovono tra l'ingresso merce, gli scaffali e l'area di blocco. Un tablet può essere utile per registrazioni più complesse con foto, quantità multiple o note di controllo.

Una postazione PC fissa, invece, funziona bene quando una persona controlla centralmente le bolle di consegna e l'accettazione della merce è concentrata in uno spazio ristretto. È meno adatta se il team deve correre in ufficio per ogni registrazione. La licenza risparmiata viene poi spesso pagata in termini di percorsi a piedi, interruzioni e registrazioni ritardate.

Non ogni articolo ha bisogno di un codice a barre. Soprattutto per componenti individuali, materie prime o etichette dei fornitori, l'etichettatura non è uniforme. In quel caso, il sistema dovrebbe offrire una ricerca rapida tramite codice articolo, numero articolo del fornitore o posizione d'ordine. La scansione dei codici a barre è un ottimo strumento, ma non un fine a se stesso.

La qualità dei dati nasce dalle regole, non dagli appelli

Una giacenza di magazzino non diventa corretta solo perché viene installata un software. La correttezza si ottiene quando il sistema impone regole sensate e rende visibili le eccezioni. Una quantità negativa senza un'operazione motivata, un'ubicazione sconosciuta o un numero di bolla di consegna utilizzato due volte non dovrebbero passare inosservati.

Allo stesso tempo, il controllo non deve bloccare le operazioni. Se un fornitore riutilizza i numeri delle bolle di consegna o le etichette sono illeggibili, i collaboratori hanno bisogno di una via d'uscita comprensibile. Ad esempio, una registrazione può essere effettuata con una nota che dovrà essere verificata in un secondo momento. L'importante è che da ciò derivi un'attività aperta e non un compromesso invisibile.

Sono particolarmente preziosi i semplici controlli di plausibilità: l'articolo corrisponde all'ordine? La quantità si scosta oltre una tolleranza definita? Il lotto è presente per gli articoli soggetti a gestione lotti? È stato impostato uno stato di blocco quando è stata registrata una segnalazione di danno? Regole di questo tipo riducono il lavoro di correzione senza sovraccaricare il team con maschere complicate.

Costruire le interfacce solo quando il processo principale è definito

Molte aziende desiderano immediatamente il collegamento con l'ERP, gli acquisti, la spedizione e la contabilità. Questo può essere corretto, ma solo se la sovranità dei dati è chiara. Un sistema dovrebbe definire chiaramente dove nascono gli ordini, dove si trova la giacenza principale di magazzino e quali dati vengono trasmessi in quale direzione.

Una cattiva interfaccia moltiplica gli errori più velocemente di un foglio di calcolo. Se, ad esempio, gli ordini provengono dall'ERP, ma l'effettivo ingresso merce viene generato nel sistema di registrazione di magazzino, deve essere chiaro quali stati vengono notificati: consegnato completamente, parzialmente consegnato, bloccato o con discrepanza. I timestamp e i riferimenti di documento univoci sono più importanti di un'integrazione dall'aspetto impressionante.

Per le aziende più piccole, un'importazione CSV controllata all'inizio può essere più sensata di un costoso collegamento in tempo reale. Non si tratta di una soluzione di ripiego, a patto che l'importazione, la verifica e il registro degli errori siano implementati correttamente. Non appena quantità, frequenza o processi successivi crescono, un'interfaccia diretta diventa più economica.

Un rollout sensato inizia con consegne reali

Prima di selezionare lo sviluppo o un software standard, vale la pena effettuare una breve analisi dei processi con casi reali. Sul tavolo non va messa solo la consegna ideale, ma anche la merce danneggiata, le quantità parziali, gli articoli errati, gli ordini mancanti e il materiale urgente per l'officina. Da ciò risulta quali dati e decisioni siano effettivamente necessari.

Per l'avvio sono spesso sufficienti un'area chiaramente delimitata, ad esempio un fornitore, un gruppo merceologico o una sede di magazzino. Il team lavora con il nuovo flusso in parallelo ai controlli precedenti, finché le registrazioni risultano verificabili e corrette. Solo allora avviene l'estensione. Un approccio 'Big Bang' fa risparmiare tempo sul piano di progetto, ma spesso genera frenesia in magazzino.

I criteri di accettazione importanti sono concreti e misurabili:

  • Una consegna standard può essere registrata in pochi minuti senza bisogno di richieste.
  • Le discrepanze compaiono in un elenco di chiarimento aperto e assegnato.
  • La giacenza di un articolo può essere spiegata tramite documento e ubicazione di magazzino.
  • I collaboratori autorizzati possono effettuare correzioni in modo tracciabile.
  • La merce aperta o bloccata non viene resa disponibile per errore.

Un sistema personalizzato per l'azienda può fare di più rispetto a una suite sovraccarica, se rispetta i modi di lavorare esistenti.
softify.pro sviluppa tali processi logistici non per amore della digitalizzazione, ma attorno a registrazioni, responsabilità e dati che devono essere affidabili nella vita di tutti i giorni.

Indicatori di prestazione (KPI) che rendono visibili i benefici

Dopo l'avvio non bisogna limitarsi a contare quanti ingressi merce sono stati registrati digitalmente. Sono più significativi il tempo tra la consegna e la disponibilità della merce, il numero di discrepanze non chiarite, le differenze di inventario durante le verifiche e l'onere per le richieste nel reparto acquisti o vendite.

Se il tempo di attraversamento si riduce ma aumenta il numero di correzioni successive, il processo è presumibilmente troppo rapido e poco verificabile. Se ogni registrazione richiede molto tempo nonostante si verifichino raramente discrepanze, sono stati inseriti probabilmente troppi passaggi obbligatori. I buoni processi di magazzino non cercano il controllo massimo, bensì il controllo adeguato.

Il passo successivo migliore è spesso un giro di ricognizione all'accettazione merci con tre bolle di consegna reali. Osservate quali informazioni vengono cercate, dove i collaboratori improvvisano le decisioni e quali dati vengono inseriti nuovamente in un secondo momento. È esattamente lì che inizia un ingresso merce digitale che non si limita ad avere un aspetto più moderno, ma rende la giacenza effettivamente credibile.

Link permanente →

Test software IA self-hosted nelle operazioni

Test software IA self-hosted nelle operazioni

Un test di regressione fallito è raramente solo una voce rossa in un elenco. Può significare che un addetto al prelievo non può stampare una bolla di consegna, che un impiegato è bloccato nel sistema ordini o che un aggiornamento ha danneggiato una funzione che ha funzionato in modo affidabile per anni. I test software con IA self-hosted partono esattamente da qui: automatizzano i controlli ripetitivi senza cedere inutilmente dati di test sensibili, screenshot o flussi applicativi interni a piattaforme esterne.

Per i team con applicazioni Web e software desktop Windows, questa è molto più di una questione di protezione dei dati. Riguarda il controllo sull'ambiente di test, prove d'errore tracciabili e operazioni di test che si adattano al proprio processo di rilascio. L'IA può alleggerire il carico di lavoro, ma non sostituisce né test case puliti né la responsabilità professionale.

Quando i test software con IA self-hosted hanno senso

L'automazione dei test classica è molto efficace, ma richiede manutenzione. I selettori cambiano, le interfacce evolvono, i dati di test devono essere disponibili e i messaggi di errore devono essere classificati. Molti team automatizzano quindi solo una piccola parte dei loro flussi critici, o continuano a testare prevalentemente a mano prima di un rilascio. I sistemi basati sull'intelligenza artificiale possono ridurre questo divario. Leggono le interfacce in modo più contestuale, eseguono flussi di lavoro predefiniti, riconoscono le deviazioni visibili e riassumono il risultato in un linguaggio comprensibile. Questo diventa particolarmente prezioso per le applicazioni che non consistono solo in chiamate API, ma in interfacce utente reali: login, maschere di immissione, approvazioni, finestre di stampa e finestre di Windows.

Il self-hosting ha senso quando i cicli di test toccano informazioni riservate. Ciò non riguarda solo i dati personali. Ne fanno parte anche prezzi interni, nomi di clienti, movimenti di articoli, screenshot di interfacce di gestione, credenziali di accesso per account di test o informazioni su funzionalità non ancora pubblicate. Chi utilizza servizi di IA esterni dovrebbe verificare con attenzione quali dati lasciano la propria rete, per quanto tempo vengono memorizzati e chi vi può accedere.

Ci sono tuttavia anche casi in cui una piattaforma ospitata è sufficiente. Nel caso di una pagina di marketing pubblica senza dati reali sui clienti, pochi rilasci e una profondità di test gestibile, può essere configurata più rapidamente. La decisione giusta dipende dalle esigenze di protezione, dal panorama applicativo, dalle competenze esistenti e dalla frequenza delle modifiche, e non da un principio generale di cloud o IA.

Ciò che rimane nel proprio ambiente

In un ambiente di test self-hosted, l'esecuzione dei test avviene su un'infrastruttura controllata dall'azienda: nel proprio data center, in un ambiente cloud privato o su un server dedicato secondo il modello operativo concordato. Ciò che conta non è solo l'ubicazione di un server, ma l'intero flusso di dati.

Un sistema ben strutturato elabora passaggi di test, sessioni di browser o desktop, screenshot, log e report dei risultati all'interno di questo ambiente controllato. Gli account di test possono essere creati con privilegi minimi. Le credenziali di accesso possono essere gestite separatamente. Gli accessi di rete possono essere limitati ai sistemi effettivamente necessari. Per applicazioni particolarmente sensibili, un tenant di test dedicato può essere più utile rispetto a test con dati reali vicini alla produzione.

Ciò non protegge automaticamente dairrori. Una soluzione gestita localmente richiede aggiornamenti, concetti di autorizzazione, backup e chiare responsabilità. Chi installa un server una volta e poi lo dimentica non ha un'infrastruttura di test sicura, bensì un compito operativo aggiuntivo. Il vantaggio risiede nel fatto che questo compito rimane pianificabile e verificabile.

I dati di test meritano la stessa protezione dell'applicazione

Spesso la discussione sulla sicurezza si concentra sul codice sorgente. In pratica, gli artifatti di test rivelano almeno altrettanto. Uno screenshot può mostrare dati dei clienti, condizioni interne e dettagli di processo. Un video di un ciclo di test può rivelare la struttura di un sistema di back-office. Un log può contenere URL, messaggi di errore o versioni tecniche.

Per questo motivo dovrebbero essere definiti i periodi di conservazione. Non ogni esecuzione riuscita deve essere salvata permanentemente. Al contrario, una cronologia definita può essere molto utile per la documentazione degli errori e per i rilasci. I diritti di accesso ai report devono rientrare nello stesso sistema di autorizzazioni previsto per l'accesso all'applicazione stessa.

Non ogni controllo dovrebbe essere guidato dall'IA

Gli ambienti di test più robusti combinano approcci diversi. Un login con blocco dell'account dopo diversi tentativi falliti può essere verificato con precisione e rapidità tramite test automatizzati deterministici. Anche interfacce, calcoli, regole di database e autorizzazioni traggono vantaggio da aspettative chiare: l'input A deve restituire il risultato B.

L'IA è particolarmente utile quando l'attenzione si concentra sull'interfaccia, sul flusso di lavoro e sulla prospettiva dell'utente. Un'attività di test può ad esempio verificare se un spedizioniere crea un ordine, assegna un percorso, genera un documento e riceve correttamente lo stato di ritorno. L'IA può navigare attraverso l'applicazione, registrare le prove e documentare in modo comprensibile in quale punto il processo si è interrotto.

Per un'operatività di test sostenibile, dovrebbero interagire quattro livelli:

  • I test di unità e di integrazione proteggono la logica aziendale, le interfacce e l'elaborazione dei dati nelle prime fasi del processo di sviluppo.
  • I test UI verificano percorsi di clic ripetibili e aspettative concrete in applicazioni Web o desktop.
  • Le verifiche dei flussi basate sull'IA valutano i percorsi di utilizzo reali e i risultati visibili dal punto di vista dell'utente.
  • I test di dominio esplorativi svelano casi particolari che nessuno ha ancora descritto come regola fissa.

Un'IA non dovrebbe decidere se una logica di prezzo sia corretta dal punto di vista aziendale, se le regole sono documentate in modo poco chiaro. Allo stesso modo, non può eseguire un ordine impreciso in modo sensato.

Dalla demo alla gestione dei test affidabile

L'errore più comune nei test con l'IA è un avvio troppo ampio. Una demo impressionante con un singolo login dice poco su sei mesi di copertura dei rilasci per il sistema. È più utile iniziare in modo mirato con due o cinque flussi la cui interruzione causi costi reali o generi un onere di controllo manuale ricorrente.

In un sistema di magazzino o logistica, questi potrebbero essere la ricezione merci, il trasferimento di stock, il prelievo e la generazione di una bolla di consegna. In un software gestionale, piuttosto l'accesso, il cambio di permessi, l'inserimento degli ordini e l'approvazione delle fatture. I candidati ideali sono processi frequenti con regole stabili e risultati chiaramente visibili.

Dopodiché, ogni flusso necessita di un punto di partenza definito. Quali dati devono essere presenti? Quale account di test viene utilizzato? Il test può inviare e-mail, stampare etichette o interagire con le interfacce? Cosa viene ripristinato dopo l'esecuzione? Senza queste regole, l'automazione produce rapidamente rifiuti di dati di test o blocca altri team.

Anche la valutazione dei risultati dovrebbe essere graduale. Un pulsante mancante è solitamente un errore chiaro. Una formulazione leggermente diversa in un testo di avviso non deve bloccare automaticamente un rilascio. In questo caso aiutano le soglie di confidenza (confidence threshold) e una netta separazione tra segnalazione automatica, controllo manuale e effettivo criterio di blocco. Un report di test non dovrebbe limitarsi a segnalare

Il ruolo di screenshot, video e report in chiaro

Un test che restituisce solo un messaggio di errore tecnico sposta il lavoro sul team di sviluppo. Spesso i reparti aziendali non sanno cosa farsene. Una buona documentazione unisce precisione tecnica e contesto: cosa sarebbe dovuto succedere? Cosa è successo realmente? Dove è visibile? Qual è stata la versione testata?

Screenshot e registrazioni riducono notevolmente i tempi di coordinamento. Il responsabile QA non deve prima cercare di riprodurre l'errore e il Product Owner vede immediatamente se un'interruzione è rilevante dal punto di vista aziendale. Allo stesso tempo, tali artifatti dovrebbero essere salvati in modo mirato. I test riusciti richiedono spesso meno materiale probatorio rispetto a quelli falliti o a rilasci critici.

Un report in chiaro non sostituisce i log. È il ponte tra operation, reparto aziendale e sviluppo. Proprio nei team di medie dimensioni, in cui le stesse persone sono responsabili dei processi e prendono le decisioni, questo ponte evita un lavoro di traduzione inutile.

Gestione, manutenzione e aspettative realistiche

L'automazione dei test self-hosted non è un prodotto che funziona senza attenzione dopo la configurazione. Le applicazioni cambiano. I browser si aggiornano. I dati di test perdono validità. Nuovi livelli di autorizzazione, captcha, autenticazione a più fattori o finestre di stampa modificate influenzano i cicli di test.

Questo non è un argomento contro l'automazione, bensì a favore di un chiaro ritmo di manutenzione. I casi di test dovrebbero essere trattati come il codice di prodotto: versionati, revisionati e adattati consapevolmente in caso di modifiche. Se un flusso fallisce tre volte di seguito a causa di una modifica intenzionale dell'interfaccia utente, il problema non è l'IA. In quel caso manca il collegamento tra sviluppo, pianificazione dei rilasci e gestione dei test.

Per questo motivo softify.pro si affida a COCO, un server di IA self-hosted dedicato che verifica applicazioni Web e Windows, registra le prove e classifica i risultati in modo comprensibile. Il punto cruciale rimane tuttavia l'integrazione nella routine lavorativa: quali processi vengono protetti, chi verifica le deviazioni e quando un rilascio può procedere?

Il miglior primo passo non è quindi acquistare o configurare il maggior numero possibile di test. Scegliete il flusso in cui un errore trascurato causerebbe effettivamente del lavoro domani in magazzino, nell'assistenza o in contabilità. Se questo flusso viene verificato in modo affidabile, comprensibile e sotto il proprio controllo dei dati, l'IA non genera più tecnologia fine a sé stessa, ma un sollievo tangibile.

Link permanente →

Sostituire Excel con software personalizzato

Sostituire Excel con software personalizzato

Le giacenze di magazzino sono corrette solo se qualcuno ha aperto il file giusto, registrato l'ultimo carico di merci e non ha inoltrato alcuna copia via e-mail. Finché questo funziona per poche operazioni, Excel è un ottimo strumento. Sostituire Excel con un software personalizzato diventa utile solo quando il foglio di calcolo diventa un collo di bottiglia per i processi, le responsabilità e l'affidabilità.

Questo raramente riguarda solo il magazzino. Gli ordini vengono presi per telefono, i documenti di trasporto sono generati da modelli, le giacenze sono distribuite su più file e le richieste di chiarimento finiscono esattamente sulla persona che in quel momento è irraggiungibile. Il problema non è il foglio di calcolo in sé. È il tentativo di gestire un processo operativo in crescita con uno strumento che non prevede procedure vincolanti.

Quando Excel non è più lo strumento operativo adeguato

Un foglio di calcolo può calcolare, filtrare e rendere visibili le informazioni. Tuttavia, non impone che l'entrata merce venga registrata per intero, che una spedizione venga controllata prima dell'invio o che due dipendenti non modifichino lo stesso record contemporaneamente. Laddove tali regole diventano critiche per il business, Excel manca della struttura adeguata.

I segnali d'allarme tipici sono le continue conciliazioni tra i turni, il magazzino e l'ufficio. I dipendenti chiedono lo stato di avanzamento di un ordine, sebbene l'informazione dovrebbe essere teoricamente disponibile. Le liste delle giacenze vengono ripulite manualmente prima dell'inventario. I numeri dei documenti di trasporto o le descrizioni degli articoli vengono copiati e corretti in un secondo momento. E in caso di discrepanza, spesso non è più possibile risalire a chi abbia modificato quale valore e quando.

Anche il file stesso diventa un rischio. Versioni con nomi come 'Bestand_final_neu_2' (Giacenza_finale_nuova_2) non sono casi isolati, bensì il segnale che un processo non ha un'unica fonte di verità. Le macro possono accelerare singole fasi di lavoro, ma non risolvono né il lavoro in parallelo, né i permessi basati sui ruoli, né le autorizzazioni o un tracciamento affidabile delle modifiche.

Il passaggio non conviene perché il software personalizzato sembra più moderno. Conviene quando errori, tempi di attesa e costi di controllo superano regolarmente il costo dell'introduzione di un sistema chiaro.

Sostituire Excel con un software personalizzato: cosa cambia concretamente

Una buona applicazione aziendale non si limita a digitalizzare un foglio di calcolo esistente. Mappa le decisioni e i movimenti che avvengono effettivamente in azienda. Per un'entrata merce, ad esempio, questo significa: selezionare o creare una consegna, registrare le posizioni, controllare le quantità, motivare le discrepanze, assegnare un'ubicazione di magazzino e solo dopo aggiornare l'inventario in modo vincolante.

Di conseguenza, un elenco si trasforma in un processo. I dipendenti vedono solo i passaggi necessari per il loro compito. L'ufficio riconosce lo stato di avanzamento della lavorazione senza dover chiamare per un sollecito. La gestione del magazzino può verificare le operazioni aperte, le differenze o le registrazioni mancanti. Una modifica rimane tracciabile, invece di scomparire silenziosamente in una cella.

La differenza risiede anche nell'architettura dei dati. Un'applicazione con un database modellato in modo pulito, ad esempio basato su MySQL 8, non gestisce articoli, ordini, ubicazioni di magazzino e movimenti come copie sparse. Le relazioni sono chiaramente definite. Un articolo non può essere creato accidentalmente con tre numeri diversi se la regola aziendale richiede un codice univoco.

Questo non crea una realtà priva di errori. Le quantità possono comunque essere contate in modo errato e le consegne possono arrivare danneggiate. Tuttavia, il software garantisce che le discrepanze vengano registrate in modo visibile, assegnate e analizzate in seguito. Operativamente, questo ha molto più valore di un inventario apparentemente pulito la cui origine nessuno sa spiegare.

Non ricostruire ogni processo subito

L'errore comune è iniziare in modo troppo ambizioso. Chi cerca di sostituire simultaneamente tutti i processi di un'azienda attende a lungo un risultato e concentra troppe questioni aperte in un unico progetto. Per le piccole e medie imprese, un approccio graduale è solitamente la scelta più sensata.

La prima area dovrebbe soddisfare due criteri: causare un impegno o costi di errore evidenti e potersi delimitare chiaramente. Può trattarsi della registrazione delle merci in arrivo, dell'emissione dei documenti di trasporto, dell'accettazione degli ordini o della gestione dei movimenti di magazzino. Un collo di bottiglia concreto fornisce requisiti migliori rispetto alla richiesta astratta di una 'soluzione digitale completa'.

Excel può continuare a svolgere un ruolo in questo contesto. Per calcoli una tantum, analisi o piccoli elenchi di pianificazione, spesso si rivela più rapido ed economico rispetto a un'applicazione personalizzata. Anche le esportazioni di dati per il controllo di gestione o per il consulente fiscale rimangono utili. L'aspetto fondamentale è che Excel cessi di essere la fonte principale per i processi critici dal punto di vista temporale.

Inoltre, una soluzione personalizzata non deve replicare tutte le funzioni di un grande sistema ERP. Un'azienda con due magazzini e dieci dipendenti potrebbe non aver bisogno di una logica multi-societaria internazionale, ma richiede certamente permessi di accesso puliti, inserimento dati in mobilità direttamente in corsia e documenti affidabili. Le suite standard sovraccariche includono spesso funzioni che nessuno utilizza, costringendo comunque ad adattare il flusso di lavoro centrale.

Osservare i requisiti sul posto di lavoro, non limitarsi a richiederli

La migliore lista di requisiti non nasce solo nella sala riunioni. Nasce dove la merce viene scaricata, prelevata, controllata e consegnata. Un colloquio con il responsabile del magazzino può descrivere un processo teorico (da raggiungere). L'osservazione di un turno mostra invece quali informazioni mancano, quando sono necessari i guanti o uno scanner e in quali punti i dipendenti prendono consapevolmente delle scorciatoie.

Queste scorciatoie non rappresentano automaticamente una condotta scorretta. Spesso indicano un problema di sistema. Se un dipendente annota i numeri su un pezzo di carta perché il computer è troppo lontano, la soluzione non dovrebbe essere semplicemente un campo obbligatorio sul desktop. Forse il processo richiede una maschera di inserimento mobile, la stampa di un'etichetta o un punto di passaggio più chiaro tra l'entrata merce e lo stoccaggio.

Nella fase di ideazione, di conseguenza, bisognerebbe rispondere a domande concrete: chi crea un ordine? Chi può correggere le quantità? Cosa succede in caso di consegna parziale? Quando viene generato un documento di trasporto? Quali dati devono essere visibili se la rete in magazzino è temporaneamente non disponibile? E quali indicatori chiave di prestazione (KPI) vengono effettivamente utilizzati, anziché limitarsi a fare bella figura su una dashboard?

Più queste decisioni sono chiare prima dello sviluppo, minore sarà la logica speciale che si accumulerà in seguito. Un buon software personalizzato non replica ogni singola eccezione storica.separa le regole aziendali sensate dalle abitudini che esistono solo perché lo strumento precedente imponeva dei limiti.

Considerare la tecnologia, i permessi e le operazioni fin dall'inizio

Un'applicazione aziendale deve rimanere manutenibile nella quotidianità. Ciò riguarda non solo l'interfaccia, ma anche modelli di dati chiari, provisioning documentato, backup e responsabilità definite. Le moderne web application possono essere sviluppate in modo solido utilizzando PHP 8.4, JavaScript recente e MySQL 8. Ciò che conta non è la popolarità del momento di uno stack tecnologico, bensì che risulti comprensibile, testabile e gestibile a lungo termine.

Ruoli e permessi devono essere inseriti nel progetto sin dalle prime fasi. Non qualsiasi utente dovrebbe poter modificare prezzi, anagrafiche o registrazioni storiche. Per le funzioni sensibili risultano utili approvazioni tracciabili, log e, se necessario, il blocco dell'account dopo tentativi di accesso falliti. Dettagli di questo tipo possono sembrare puramente tecnici in un primo momento, ma evitano ambiguità nelle responsabilità durante l'operatività.

Altrettanto importante è la migrazione dei dati. I file Excel esistenti contengono spesso duplicati, unità di misura non uniformi o articoli non più utilizzati. Importare questi dati senza verifica significa semplicemente trasferire vecchi problemi nel nuovo sistema. È preferibile effettuare una pulizia controllata seguendo regole chiare: quali dati vengono acquisiti, quali archiviati e quali devono essere verificati dal punto di vista aziendale prima dell'avvio?

Introduzione senza interruzioni delle attività operative

Ecco una traduzione professionale in italiano del testo: "Un go-live non deve mettere a rischio le spedizioni. Per questo motivo l'introduzione richiede un'area pilota limitata, casi di test reali e collaboratori che conoscano il flusso di lavoro. Non basta creare ordini di esempio. Il sistema deve essere in grado di gestire consegne parziali, quantità errate, storni, pressione temporale e le eccezioni che si verificano nella normale operatività quotidiana.

Una breve fase parallela può essere utile, ma dovrebbe avere una fine chiara. Se il foglio di calcolo e la nuova applicazione vengono mantenuti contemporaneamente troppo a lungo, si genera un lavoro doppio e torna a porsi la questione di quale sia la fonte valida. È preferibile una data di transizione definita, accompagnata da referenti formati e da un rapido ciclo di feedback per errori o dettagli mancanti.

Dopo l'avvio, il valore di una soluzione personalizzata non si dimostra attraverso un'interfaccia particolarmente complessa. Si evidenzia quando un ordine prosegue senza bisogno di richieste di chiarimento, le giacenze rimangono comprensibili e una nuova collega può gestire il processo in sicurezza dopo una breve introduzione. È esattamente da lì che dovrebbe partire la decisione successiva: non dal prossimo file Excel, bensì dalla specifica fase di lavoro che domani tornerà a costare tempo.

Link permanente →

Digitalizzare i processi di magazzino con il software

Digitalizzare i processi di magazzino con il software

Un addetto al prelievo cerca per dieci minuti un articolo che, stando al file Excel, dovrebbe trovarsi sullo scaffale. Contemporaneamente, un collega registra l'ingresso della merce su un modulo cartaceo, mentre in ufficio viene modificato un ordine per telefono. Situazioni del genere non sono il segno di un lavoro scadente. Dimostrano che le informazioni non tengono più il passo in modo affidabile con i movimenti fisici delle merci. Chi vuole digitalizzare i processi di magazzino con il software, quindi, non dovrebbe iniziare da un elenco di funzioni il più lungo possibile, ma proprio da queste interruzioni nella quotidianità.

Per le piccole e medie imprese la questione raramente è se un sistema enterprise internazionale sia tecnicamente efficiente. La questione è se accorcia realmente il tragitto dall'entrata merci alla spedizione, o se crea nuove maschere, autorizzazioni e un onere di formazione. Una buona digitalizzazione non sostituisce ogni singolo gesto. Fa sì che ogni gesto necessario conduca alla giusta informazione, registrazione e azione successiva.

Quando è opportuno digitalizzare i processi di magazzino con il software

Un foglio di calcolo non è fondamentalmente un problema. Per un inventario limitato, pochi collaboratori e movimenti rari, può essere sensato, economico e trasparente. Il passaggio conviene solo quando il file diventa la centrale operativa ufficiosa: circolano più versioni, le giacenze vengono corrette a posteriori o solo poche persone capiscono le formule e l'archiviazione.

I fattori scatenanti tipici non sono obiettivi di crescita astratti, ma continue frizioni operative. Le giacenze regolarmente non tornano dopo gli inventari. Gli ingressi merce rimangono non registrati fino a fine giornata. Le spedizioni partono senza una bolla di consegna completa. I dipendenti si telefonano a vicenda per chiarire l'ubicazione di un articolo o lo stato di un ordine. Oppure una persona inserisce gli stessi dati uno dopo l'altro in e-mail, Excel, portale di spedizione e contabilità.

In questo contesto, la digitalizzazione significa: il sistema riflette uno stato chiaro. Un articolo è arrivato, controllato, stoccato, riservato, prelevato o spedito. Ogni cambio di stato ha un fattore scatenante, un orario e, idealmente, un responsabile. Questo non crea burocrazia, ma evita che le decisioni si basino su supposizioni.


Il punto di partenza corretto: i movimenti anziché i moduli software

Molti progetti di implementazione iniziano con la domanda su funzioni come la connessione di scanner, la gestione dei lotti o le dashboard. È comprensibile, ma spesso porta a un capitolato d'oneri sovraccarico. È più utile effettuare una mappatura dei processi lungo l'effettivo movimento delle merci.

Prendete un ordine reale e seguitelo dall'arrivo fino alla consegna al corriere. Dove nascono le informazioni? Chi le verifica? Dove si annota qualcosa su carta, per poi trascriverlo in un secondo momento o riferirlo a voce? Le eccezioni sono particolarmente preziose: consegne parziali, merce danneggiata, articoli sostitutivi, giacenze bloccate e resi. Sulla lavagna bianca il processo standard di solito appare pulito. Sono le eccezioni a determinare se la nuova applicazione verrà accettata nella vita di tutti i giorni.

Per un primo workshop bastano spesso tre questioni: Qual è l'informazione che manca più spesso ai collaboratori? Qual è la registrazione che viene eseguita più frequentemente in ritardo o in doppio? E quali errori costano effettivamente tempo, denaro o la fiducia dei clienti ogni mese? Da ciò si possono ricorrere le priorità, senza dover rivoluzionare contemporaneamente l'intera organizzazione del magazzino.

Un piccolo, completo flusso batte un grande avvio di sistema

Invece di digitalizzare tutti i processi in una sola volta, un'area dovrebbe funzionare in modo continuo. Un primo ambito sensato può coprire, ad esempio, l'entrata merci, lo stoccaggio e la gestione delle giacenze. L'avviso di spedizione o l'ordine vengono registrati, la merce viene controllata, le viene assegnata un'ubicazione di magazzino e la giacenza viene registrata immediatamente. Solo quando questo flusso funziona in modo stabile seguono il prelievo, le etichette di spedizione o la pianificazione dei giri.

Ciò riduce il rischio di progetto. I dipendenti non imparano solo una nuova interfaccia, ma un processo chiaramente delimitato. Allo stesso tempo, diventa visibile quali regole mancano nella pratica. Ad esempio la questione se la merce non controllata possa già essere prenotata o se le manenze debbano generare immediatamente un caso da chiarire.

Quali funzioni in magazzino producono davvero un impatto

La migliore applicazione di magazzino non è quella con più voci di menu. Rende inequivocabile la fase di lavoro successiva e documenta il movimento senza doppie registrazioni. In molte aziende, soprattutto quattro componenti offrono miglioramenti rapidi e misurabili:

  • Una gestione centralizzata delle scorte con articoli, varianti, ubicazioni di magazzino, scorte minime e scorte bloccate impedisce l'uso di versioni Excel in competizione tra loro.
  • Le registrazioni mobili tramite terminali portatili o smartphone collegano direttamente l'entrata, il trasferimento e il prelievo della merce con il luogo in cui essa si trova realmente.
  • Le liste di ordini e di prelievo mostrano priorità, stato e manenze, invece di distribuire gli ordini tramite richiami verbali o pile di carte.
  • DDT (documenti di trasporto), etichette di spedizione e registri dei movimenti generati automaticamente riducono le trascrizioni manuali e facilitano la tracciabilità.

Se la scansione con codici a barre sia necessaria fin da subito dipende dal magazzino. Con pochi articoli e scaffali fissi, una schermata di inserimento chiara potrebbe inizialmente bastare. In presenza di molti articoli simili, ubicazioni di magazzino mutevoli o un'elevata movimentazione, la scansione non è invece di solito una funzione di comfort, bensì un freno agli errori. Determinante è anche la copertura del segnale nell'area di lavoro. Un'applicazione mobile che non ha connessione in diversi corridoi di scaffalature non fa che spostare il problema in una coda di successive registrazioni posticipate.

Anche l'automazione ha bisogno di limiti chiari. Un sistema può dare priorità agli ordini di spedizione in base all'orario limite (cut-off) o preparare una richiesta d'ordine al raggiungimento della scorta minima. Non dovrebbe però far partire silenziosamente gli ordini quando occorre tenere conto di tempi di consegna, limiti di approvazione o ordini di clienti speciali. Un buon software fa proposte, evidenzia le anomalie e documenta le decisioni, senza sottrarre ai team il controllo sui casi eccezionali.

La qualità dei dati non è un compito per dopo

La digitalizzazione raramente fallisce a causa di PHP, del database o dell'hardware degli scanner. Fallisce più spesso perché i codici articolo non sono univoci, le unità di misura vengono intese in modo diverso o le giacenze storiche vengono acquisite senza verifiche. Altrimenti, a seconda della persona, un "cartone" diventa un pezzo, un'unità di imballaggio o un pallet.

Prima dell'importazione, i dati anagrafici andrebbero quindi puliti: identificativi articolo univoci, denominazioni comprensibili, unità definite, ubicazioni di magazzino tracciabili e regole per gli articoli attivi o bloccati. Non ogni vecchio record deve entrare nel sistema nuovo. Portarsi dietro duplicati obsoleti e ubicazioni di magazzino non più utilizzate non fa altro che conservare la vecchia incertezza in un'interfaccia più moderna.

Dal punto di vista tecnico, l'applicazione necessita di una base solida. Una chiara struttura di database in MySQL 8 può memorizzare i movimenti di magazzino come singoli eventi tracciabili, anziché mantenere solo un valore attuale sovrascrivibile. In questo modo è possibile chiarire perché una giacenza differisce: entrata merce, prelievo, trasferimento, rettifica d'inventario o storno. Con tecnologie manutenibili come PHP 8.4 e JavaScript moderno, un'applicazione personalizzata rimane al contempo ampliabile, senza trasformarsi in un grande progetto per ogni minima modifica.

Integrazione solo dove elimina il lavoro doppio

Un magazzino lavora raramente in modo isolato. Gli ordini arrivano da e-commerce, ERP, e-mail o telefono. I dati di spedizione vanno ai fornitori di servizi, i documenti alla contabilità e gli indicatori chiave alla direzione aziendale. Ciononostante, non tutti i sistemi esterni devono essere collegati fin dal primo giorno.

Hanno la priorità le interfacce che sostituiscono la ripetuta trasmissione manuale o eliminano le fonti di errore. Se gli ordini vengono trascritti quotidianamente da un negozio online, un passaggio chiaro è prezioso. Se un corriere fornisce etichette e numeri di spedizione, un collegamento può accelerare notevolmente il processo di imballaggio. Un file di esportazione usato raramente può invece rimanere inizialmente un'esportazione controllata.

È importante definire responsabilità chiare in caso di errori. Cosa succede se un ordine viene creato nell'e-commerce ma non viene trasmesso all'applicazione di magazzino? Le trasmissioni vengono registrate, i duplicati vengono riconosciuti e i processi non riusciti vengono contrassegnati in modo visibile? Le interfacce sono affidabili solo quando offrono una procedura comprensibile anche per i casi eccezionali.

Introduzione nel lavoro a turni: l'accettazione nasce sul campo

Il software non viene introdotto tramite una presentazione, bensì tra il portone di ingresso merci, il banco di imballaggio e lo scaffale. Per questo motivo, i collaboratori di magazzino esperti dovrebbero essere coinvolti tempestivamente. Conoscono le scorciatoie, i requisiti di sicurezza e i punti in cui un processo teoricamente corretto fallisce sotto la pressione del tempo.

Un'area pilota con merce vera e ordini reali è solitamente più significativa di una lunga fase di test con dati di prova. Per un periodo limitato, un esercizio parallelo protetto può essere utile. Tuttavia, non deve diventare una condizione permanente, poiché la doppia registrazione genera essa stessa errori. Ciò che conta è un giorno di passaggio chiaro, un referente responsabile e una modalità semplice per segnalare direttamente i problemi.

La formazione dovrebbe essere orientata al processo: accettare la merce, registrare le anomalie, stoccare, prelevare l'ordine, completare la spedizione. All'inizio nessuno deve padroneggiare tutte le valutazioni o le funzioni di amministrazione. I ruoli e i permessi aiutano a concentrare lo schermo sul rispettivo compito. Un addetto al prelievo ha bisogno di informazioni diverse rispetto alla direzione del magazzino, e una rettifica d'inventario dovrebbe poter essere approvata in modo tracciabile.

Non misurare il successo solo in base alle scorte

Dopo l'avvio, vale la pena dare un'occhiata a pochi indicatori chiave che il team può influenzare: tempo di attraversamento dall'entrata merci alla disponibilità, numero di correzioni di inventario, errori di prelievo, tempi di ricerca, ordini spediti puntualmente e casi da chiarire aperti. Questi valori mostrano più rapidamente di un progetto di digitalizzazione generale se il flusso sta migliorando.

softify.pro non sviluppa tali sistemi come sostituto di fasi di lavoro che funzionano, bensì come integrazione precisa laddove carta, tabelle e richiami verbali non reggono più. A volte il consiglio giusto è una piccola applicazione per l'entrata merci e la spedizione anziché un sistema di gestione di magazzino completo. A volte un foglio di calcolo rimane la soluzione più ragionevole per una rara analisi speciale.

Il passo successivo migliore non è quindi la scelta del prodotto, bensì un'analisi congiunta di un ordine concreto della settimana scorsa. Quando il suo percorso attraverso il magazzino diventa chiaro, registrabile e tracciabile in caso di anomalie, sono poste le basi per una digitalizzazione che fa realmente risparmiare tempo nella vita di tutti i giorni.

Link permanente →

Contattaci

Avete un progetto in mente, un flusso di lavoro che gira ancora su fogli Excel e buona volontà, o un arretrato di test che COCO potrebbe togliere di mano al vostro team? Raccontatecelo.

Invia messaggio