softify.pro
Cargando …
Servicios Nosotros COCO – nuestro servidor de IA Portafolio Insiders Casos de éxito Curiosidades Contacto Acceso

NEXT-GEN SOFTWARE AESTHETIC

Pure fluidity meets ultimate performance.

La nueva identidad visual para los flujos de trabajo digitales modernos.

softify.pro — La nueva identidad visual para los flujos de trabajo digitales modernos.

Desplázate para explorar ↓

Software construido como realmente trabajan las empresas modernas

softify.pro es un estudio de software construido en torno a una idea: la tecnología debería moverse con la misma fluidez que las empresas a las que da soporte. Trabajamos en la intersección del desarrollo web moderno, la automatización de procesos y la inteligencia artificial aplicada — tres disciplinas que rara vez conviven bajo un mismo techo, pero que cada vez más lo necesitan. Nuestros clientes van desde pequeños talleres que digitalizan su primera facturación hasta fabricantes medianos consolidados que sustituyen hojas de cálculo por software logístico real. Lo que los conecta no es el tamaño, sino la ambición: quieren sistemas rápidos, fiables y realmente agradables de usar, no solo funcionales. Cada proyecto comienza con las mismas tres preguntas: qué necesita esta empresa acelerar de verdad, qué ya funciona bien y debe respetarse en lugar de sustituirse, y qué parte del flujo de trabajo puede, una vez construida correctamente, funcionar por sí sola. Las respuestas determinan todo lo que sigue, desde la tecnología elegida hasta el plan de implementación.

Servicios

La nueva identidad visual para los flujos de trabajo digitales modernos.

01 — LOGISTICS

Automatizando la logística — pensado para pymes de la región DACH

Gran parte de nuestro trabajo se dedica a software de logística y operaciones para pequeñas y medianas empresas de Alemania, Austria y Suiza. Estas empresas suelen quedar atrapadas entre dos opciones poco atractivas: costosas suites logísticas empresariales diseñadas para corporaciones diez veces más grandes, o un mosaico de hojas de cálculo, formularios en papel y llamadas telefónicas que limita silenciosamente su capacidad de crecer.

Construimos el camino intermedio — automatización a medida que se adapta a cómo trabaja realmente un almacén, un taller o un equipo de distribución concretos. Eso puede significar digitalizar la recepción de mercancías y los movimientos de stock, generar automáticamente albaranes y etiquetas de envío, conectar la recepción de pedidos con la planificación de rutas, o simplemente sustituir una frágil hoja de cálculo que solo una persona entiende por un sistema compartido en el que todo el equipo puede confiar. Como trabajamos directamente con propietarios y responsables de operaciones en la región DACH, los requisitos se recogen en el idioma en el que realmente opera la empresa, y la implementación se planifica en torno a turnos y almacenes reales, no a un cronograma abstracto.

02 — WEB

Desarrollo web moderno, sobre tecnología actual

Diseñamos y desarrollamos aplicaciones web y sitios usando tecnología actual y activamente mantenida, en lugar de frameworks obsoletos mantenidos vivos por costumbre. Eso significa PHP 8.4 limpio en el backend cuando una aplicación clásica renderizada en servidor es la opción correcta, JavaScript moderno donde la interactividad importa, y MySQL 8 para datos que deben mantenerse coherentes y consultables durante años, no solo los primeros seis meses tras el lanzamiento. Cada proyecto se planifica para escritorio y móvil desde el primer boceto, no se adapta después: los tiempos de carga, los puntos de ruptura del diseño y las interacciones táctiles forman parte de la especificación, no una idea de último momento.

Más allá de la interfaz visible, nos importa cómo es un sitio por dentro: código legible, un esquema de base de datos que no necesitará reconstruirse en la próxima solicitud de funcionalidad, y pasos de despliegue que un segundo desarrollador podría seguir sin tener que llamarnos. Un sitio que rinde bien hoy y que aún puede ampliarse limpiamente dentro de tres años es, para nosotros, la verdadera definición de «moderno».

03 — AI / COCO

COCO — nuestro propio servidor de IA para pruebas de software automatizadas

Para clientes empresariales, operamos y mantenemos nuestro propio servidor de IA dedicado, llamado COCO. A diferencia de un chatbot genérico añadido a un flujo de trabajo, COCO está diseñado y alojado específicamente para las pruebas automatizadas de software web y aplicaciones de escritorio multiplataforma — desde flujos de inicio de sesión y autenticación hasta procesos empresariales completos de varios pasos.

COCO planifica un escenario de prueba, lo ejecuta contra la aplicación real, captura capturas de pantalla de antes y después y grabaciones de ejecución como evidencia, y produce una evaluación en lenguaje sencillo de qué funcionó, qué falló y por qué — incluyendo casos límite como intentos de inicio de sesión fallidos repetidos, bloqueos de cuenta y flujos de recuperación, tediosos y propensos a errores si se prueban manualmente. Como el servidor se ejecuta localmente bajo nuestra gestión, los clientes empresariales mantienen el control total sobre dónde se almacenan los datos de prueba y las capturas de pantalla, sin enviar por defecto el tráfico interno de la aplicación a un servicio en la nube de terceros.

COCO — nuestro propio servidor de IA para pruebas de software automatizadas

Para clientes empresariales, operamos y mantenemos nuestro propio servidor de IA dedicado, llamado COCO. A diferencia de un chatbot genérico añadido a un flujo de trabajo, COCO está diseñado y alojado específicamente para las pruebas automatizadas de software web y aplicaciones de escritorio multiplataforma — desde flujos de inicio de sesión y autenticación hasta procesos empresariales completos de varios pasos.

COCO planifica un escenario de prueba, lo ejecuta contra la aplicación real, captura capturas de pantalla de antes y después y grabaciones de ejecución como evidencia, y produce una evaluación en lenguaje sencillo de qué funcionó, qué falló y por qué — incluyendo casos límite como intentos de inicio de sesión fallidos repetidos, bloqueos de cuenta y flujos de recuperación, tediosos y propensos a errores si se prueban manualmente. Como el servidor se ejecuta localmente bajo nuestra gestión, los clientes empresariales mantienen el control total sobre dónde se almacenan los datos de prueba y las capturas de pantalla, sin enviar por defecto el tráfico interno de la aplicación a un servicio en la nube de terceros.

Configuramos y mantenemos COCO individualmente para cada cliente empresarial — definiendo los planes de prueba relevantes para su aplicación específica, ajustando los umbrales de confianza y decidiendo caso por caso cuándo un resultado debe escalarse para revisión humana. El objetivo no es sustituir a un equipo de QA, sino darle un colega incansable que ejecute las pruebas de regresión repetitivas antes de cada versión, antes incluso de que tenga que intervenir una persona.

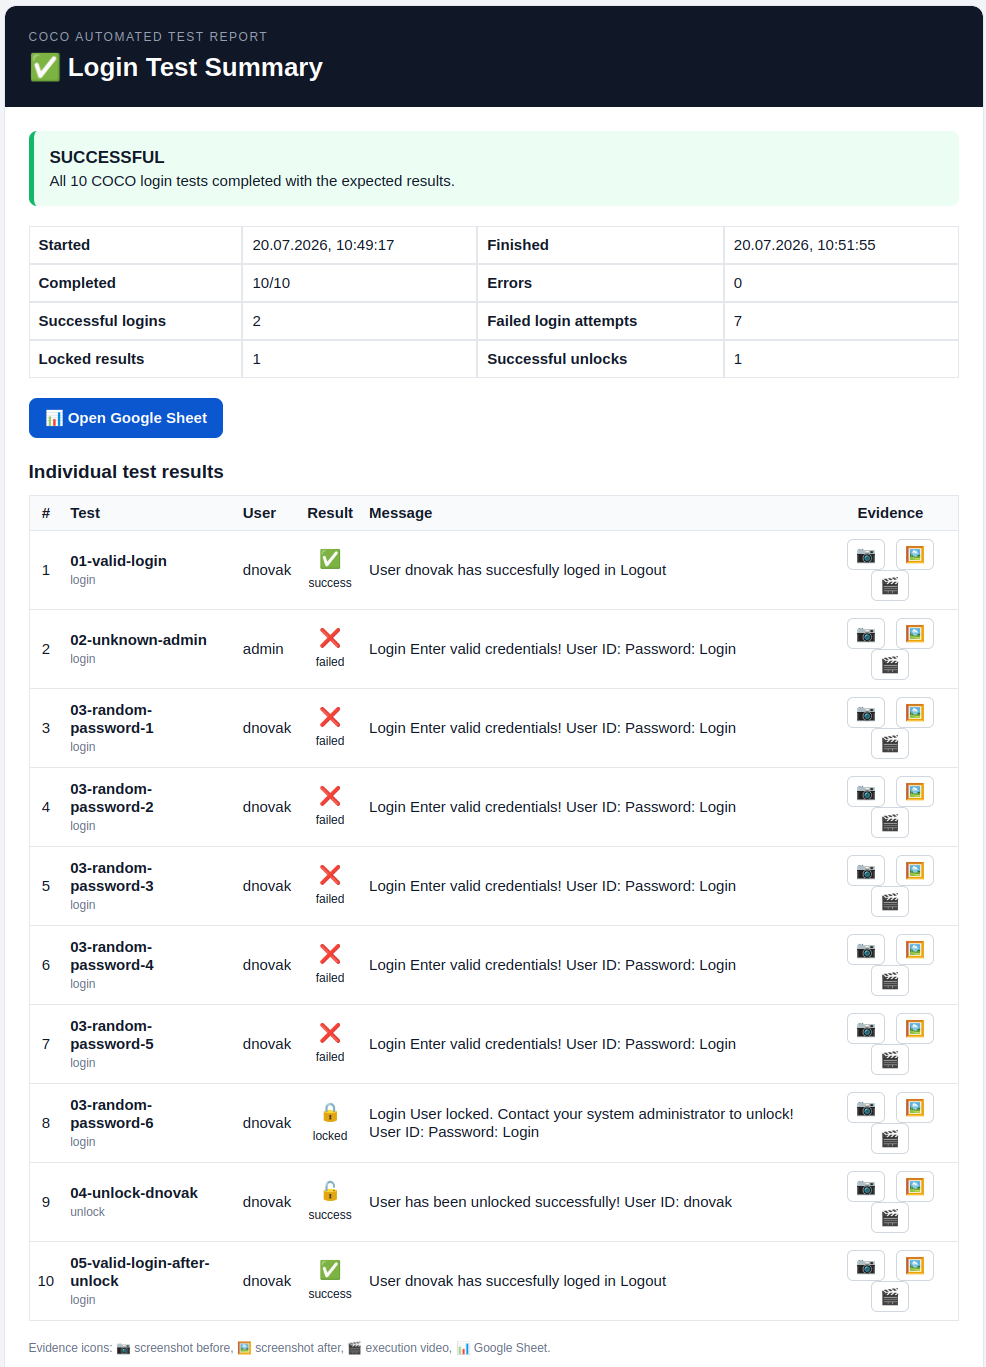
COCO automated login test report
COCO — automated login & account-lockout test report
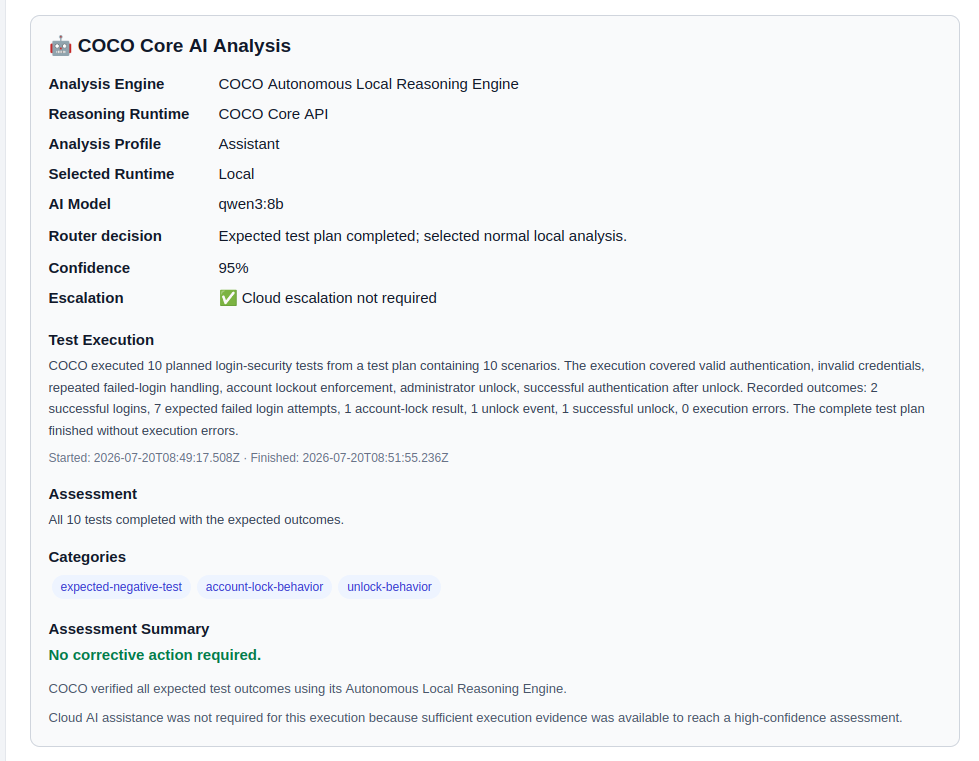
COCO AI analysis panel
COCO — plain-language AI analysis of a completed test run

Por qué softify.pro

Nos mantenemos deliberadamente lo bastante pequeños como para que cada proyecto lo gestionen las personas que estuvieron en la conversación de planificación inicial, sin pasar a una cola. Eso significa ciclos de retroalimentación más cortos, menos malentendidos y un equipo que, incluso seis meses después, recuerda por qué se tomó una decisión concreta. Preferimos una fiabilidad aburrida pero demostrable a perseguir tendencias: se elige una pila tecnológica porque encaja con el problema y podrá mantenerla otra persona dentro de cinco años, no porque estuviera de moda en el sprint en que se eligió. Si una hoja de cálculo todavía hace el trabajo mejor que un software a medida, también se lo diremos — nuestro objetivo es un flujo de trabajo realmente más rápido, no simplemente una factura de software más alta.

Trabajos seleccionados

Una pequeña selección de trabajos que podemos mostrar públicamente — más casos de estudio y proyectos empresariales están disponibles bajo petición y NDA.

Koralpenhaus

Koralpenhaus

Sitio web regional de presentación y reservas en la región alpina, construido con un enfoque en una estructura clara, carga rápida y mantenimiento sencillo de contenidos.

Dexosano

Dexosano

Una plataforma web moderna basada en PHP, desarrollada con el mismo enfoque centrado en el rendimiento que softify.pro aplica a cada proyecto de cliente.

Casos de éxito

softify.pro Flow — Probado por COCO

softify.pro Flow — Probado por COCO

21.08.2026

Control. Clarity. Flow.

Todo producto de software serio acaba desarrollando un segundo producto detrás del producto.

Puede que los clientes nunca lo vean. Puede que los visitantes nunca sepan que existe. Pero los administradores, operadores y desarrolladores dependen de él cada día.

Para softify.pro Flow, esa aplicación es Administration — la consola operativa responsable de gestionar usuarios, roles, niveles de acceso, estados de autenticación, entornos de base de datos y demás configuración que mantiene bajo control una instalación de Flow.

Su pantalla de inicio de sesión lleva tres palabras:
Control. Clarity. Flow.

Se eligieron originalmente para describir la experiencia que queríamos que tuvieran los administradores al operar el sistema.

Pero también describen sorprendentemente bien cómo creemos que debería probarse el software.

Eso convirtió a softify.pro FlowAdministration en un candidato obvio para una prueba real de COCO.
No una demostración de laboratorio.
No una colección de botones aislados preparados específicamente para una demo de IA.
Una aplicación de escritorio multiplataforma real, con lógica de aplicación real, múltiples ventanas, múltiples motores de base de datos, autenticación, permisos, localización y suficiente estado como para que las regresiones aparentemente pequeñas sean difíciles de detectar manualmente.

Para la demostración pública que se muestra aquí, COCO trabajó exclusivamente con datos de demostración generados. La aplicación estaba licenciada a la empresa ficticia Presentation GmbH, y no se usó ninguna información de clientes en producción, credenciales ni datos personales.

El objetivo era simple:
dejar que COCO abordara la aplicación como lo haría un tester y determinar si el flujo de trabajo administrativo completo sigue comportándose como el software afirma que lo hace.

The Challenge

A primera vista, probar una aplicación de administración parece sencillo.

Ábrela.
Inicia sesión.
Haz clic a través de varias ventanas.
Comprueba que todo se vea correcto.

Esa suposición cambia rápidamente a medida que la aplicación crece.

softify.pro FlowAdministration no es un único formulario estático. Es una colección de vistas operativas interconectadas dentro de una sola cáscara de aplicación.

Entre otras cosas, un administrador puede trabajar con:

  • cuentas de usuario
  • roles y niveles de acceso
  • información de autenticación
  • estado de autenticación de dos factores
  • información del sistema operativo
  • información de red e IP
  • configuración de la base de datos
  • opciones de ordenación y presentación
  • selección de idioma en vivo
  • información de la aplicación y de la licencia

La interfaz admite actualmente once idiomas. La aplicación también funciona con MySQL y PostgreSQL como motores de base de datos. Por separado, ninguna de estas funciones representa un problema de prueba inusual.

La dificultad surge de sus combinaciones.
Una tabla de usuarios puede funcionar correctamente en inglés pero mostrar un nombre de columna obsoleto en croata.
La ordenación puede funcionar correctamente conectada a MySQL pero comportarse de forma distinta tras cambiar a PostgreSQL.

Un cambio de idioma puede actualizar la mayoría de los elementos de la interfaz dejando un mensaje de estado sin traducir. La aplicación puede cambiar de base de datos con éxito pero conservar información obsoleta de la conexión anterior. Una nueva versión puede introducir una función mientras el diálogo "Acerca de" todavía describe la anterior. El programa no necesita bloquearse para que cualquiera de estas situaciones sea una regresión. De hecho, algunos de los defectos de software más molestos son precisamente aquellos en los que todo parece funcionar.

La aplicación arranca.
La ventana se abre.
El botón responde.
Pero algo por debajo ya no está del todo bien.
Por eso importa la prueba de regresión repetitiva.

Y es también exactamente el tipo de trabajo en el que las personas se van volviendo cada vez peores tras repetir la misma secuencia decenas de veces.

Why Manual Testing Becomes Expensive

Probar algo una vez es fácil.
Probarlo de forma fiable después de cada versión relevante es distinto.

Considera solo tres dimensiones: 11 idiomas de interfaz × 2 motores de base de datos × múltiples flujos de trabajo de la aplicación.

El número de combinaciones crece rápidamente.
Añade distintos roles de usuario, estados de autenticación, comportamiento de ordenación, cambios de configuración y entornos operativos, y la matriz de pruebas se vuelve demasiado grande para tratarla como una checklist manual ocasional.

Aquí es donde las pruebas de regresión a menudo empiezan a erosionarse.
No deliberadamente.
Se acerca una fecha límite de lanzamiento.
Alguien recuerda que la aplicación se probó la semana pasada.
Un desarrollador comprueba rápidamente la pantalla más importante.

El alemán funciona.
El inglés funciona.
MySQL funciona.
La suposición se convierte en:
"El resto probablemente está bien."

Normalmente lo está.
Hasta la versión en la que no lo está.
COCO existe en parte para eliminar esa suposición del proceso.

What COCO Actually Did

COCO inició softify.pro FlowAdministration desde un estado de aplicación en frío, sin depender de una pantalla previamente preparada ni de un flujo de trabajo posicionado manualmente.

La primera interacción fue la misma que se le presenta a un administrador humano: la ventana de inicio de sesión.

COCO identificó la interfaz de autenticación que contenía:

  • nombre de usuario
  • contraseña
  • código de autenticación de dos factores

y la línea situada justo debajo de la identidad softify.pro Flow:
Control. Clarity. Flow.

A partir de ahí, COCO continuó a través de una sesión de regresión definida. El objetivo no era simplemente determinar si la aplicación podía abrirse.

El objetivo era verificar si el estado de la aplicación permanecía internamente consistente mientras COCO interactuaba con ella.

Authentication Is Only the Beginning

Probar el inicio de sesión es uno de los candidatos más obvios para la automatización, pero una autenticación exitosa por sí sola dice muy poco sobre el resto de una aplicación de administración.

Una vez dentro, COCO se trasladó al entorno operativo real. Inspeccionó la interfaz de administración de usuarios y verificó que la información esperada estuviera presente.

Eso incluía datos como:

  • nombres de usuario
  • contraseñas enmascaradas
  • indicadores 2FA
  • roles asignados
  • información del sistema operativo
  • direcciones IP

COCO interactuó con la tabla en lugar de limitarse a observarla.
La lista de usuarios se ordenó por nombre de usuario.
Se inspeccionó el orden resultante.
Lo importante no era si al hacer clic en el encabezado de la columna se producía algún cambio visible.

COCO verificó que el estado resultante de la tabla coincidiera con la operación solicitada.

Esa distinción importa.
Una prueba funcional pregunta:
"¿Respondió el botón?"

Una prueba de regresión útil pregunta:
"¿Terminó la aplicación en el estado correcto?"

Testing the Database Boundary

softify.pro Flow admite más de un motor de base de datos.

Eso convierte el cambio de base de datos en una frontera de regresión especialmente importante.
COCO cambió el motor activo de MySQL a PostgreSQL.

Tras el cambio, volvió a inspeccionar la información de usuario.
La prueba buscaba algo más que una conexión exitosa.
Comprobó si la aplicación seguía presentando los registros esperados y si la información mostrada a través de la interfaz seguía siendo coherente.

COCO volvió a cambiar de vuelta después.

Este tipo de transición es fácil de subestimar.
La interfaz de usuario puede permanecer visualmente idéntica mientras la capa de almacenamiento subyacente cambia por completo.
Desde la perspectiva de un administrador, esa transición debería sentirse casi aburrida.
Los mismos usuarios deberían seguir siendo comprensibles.
Los mismos roles deberían seguir teniendo sentido.

El mismo comportamiento de la interfaz debería seguir aplicándose.

Esa continuidad aparentemente sin incidentes es exactamente lo que hay que demostrar.

Eleven Languages, One Application State

La localización es otra área en la que las pruebas superficiales son particularmente peligrosas.

Es relativamente fácil verificar que una aplicación pueda iniciarse en otro idioma.
Es mucho más valioso verificar qué sucede cuando el idioma cambia mientras la aplicación ya está en ejecución y manteniendo estado.

COCO cambió el idioma de la interfaz en vivo.

La sesión incluyó transiciones entre idiomas como:
alemán → inglés → croata
mientras la vista de administración permanecía activa.

COCO observó si los elementos de la interfaz cambiaban correctamente en su lugar:

  • encabezados de tabla
  • controles
  • botones
  • etiquetas
  • mensajes de estado

La tabla subyacente y el estado de la aplicación también tenían que sobrevivir a esa transición.
Esto importa porque el software multilingüe consiste en algo más que cadenas traducidas.
Los cambios de idioma pueden dejar al descubierto:

  • recursos olvidados
  • etiquetas obsoletas
  • problemas de maquetación
  • mensajes de estado sin traducir
  • problemas de codificación
  • reinicios de estado
  • problemas de recreación de controles

Una ventana que se ve correcta cuando se inicia directamente en croata puede seguir comportándose incorrectamente cuando el usuario cambia de alemán a croata durante una sesión activa.

Esa es la diferencia entre revisar una captura de pantalla y probar un flujo de trabajo.

Restoring Application State

COCO restauró posteriormente la configuración de ordenación predeterminada de la aplicación.

De nuevo, la prueba no terminó con el clic en sí.

Se evaluó el orden resultante y la confirmación presentada a través del área de estado de la aplicación. Este tipo de verificación puede parecer insignificante comparada con probar la autenticación o el acceso a la base de datos.

No lo es.

Las aplicaciones empresariales acumulan cientos de pequeñas transiciones de estado como estas.
Los usuarios dependen de ellas sin pensarlo conscientemente.
El software se siente fiable precisamente porque esas interacciones permanecen predecibles.
Las pruebas de regresión existen para proteger esa predictibilidad.

Testing the Information Around the Software

COCO también abrió el diálogo "Acerca de" de la aplicación.

¿Por qué probar una ventana Acerca de?

Porque la documentación del software empieza dentro del propio software.
El número de versión, la descripción de funciones y la información de licencia que se muestran al operador deberían corresponder a la aplicación que realmente se está ejecutando.

Una aplicación puede funcionar perfectamente y aun así mostrar información de versión obsoleta o describir capacidades que ya no corresponden a la versión.

Eso no hace que se bloquee una base de datos.
Hace algo más sutil:
reduce la confianza.

Para el software empresarial, la precisión operativa incluye estos detalles aparentemente pequeños. Por eso COCO también los comprobó.

Control.

La primera palabra del eslogan de softify.pro Flow es también el primer principio del entorno de pruebas.

Control significa saber qué se está probando, contra qué estado y con qué datos.

La demostración pública de COCO no utiliza registros de producción de clientes.

Se ejecuta con datos de demostración preparados deliberadamente, cuyo estado esperado se conoce.

Eso hace que los resultados sean reproducibles.

También significa que las diferencias entre ejecuciones de prueba pueden investigarse en lugar de descartarse como cambios aleatorios en datos de producción.

Más importante aún, COCO está diseñado como un sistema de pruebas de IA autoalojado.

La evidencia de pruebas, las capturas de pantalla de la aplicación y la información interna del flujo de trabajo pueden permanecer dentro de la infraestructura bajo el propio control del cliente u operador, en lugar de enviarse por defecto a un servicio en la nube de terceros ajeno.

Para las aplicaciones de negocio internas, eso no es simplemente una preferencia de infraestructura.
Puede ser parte del propio requisito de pruebas.

Clarity.

La automatización no resulta especialmente útil si su resultado final es: FAILED
seguido de cientos de líneas de salida técnica que alguien debe reconstruir manualmente antes de entender qué ocurrió.

COCO está diseñado para preservar un rastro de evidencia comprensible.

El informe describe:

  • qué se probó
  • qué interacción tuvo lugar
  • en qué secuencia ocurrió
  • qué observó COCO
  • qué estado se esperaba
  • dónde difirió el comportamiento cuando algo falló

Las capturas de pantalla y las pruebas de ejecución pueden acompañar esa secuencia.
El propósito no es ocultar los detalles técnicos.

Es hacer que el resultado sea comprensible antes de que alguien tenga que abrir un depurador.

Un ingeniero debería poder responder:
¿Qué pasó? antes de preguntar:
¿Dónde en el código ocurrió?

Esa distinción acorta drásticamente la investigación cuando aparece una regresión.

Flow.

La automatización de UI tradicional suele pensar en elementos.

Encontrar selector.
Hacer clic en el selector.
Encontrar otro selector.
Comprobar el valor.

Ese enfoque sigue siendo útil, pero las aplicaciones no se experimentan como colecciones de selectores.

Las personas experimentan flujos.

Iniciar sesión.
Abrir administración.
Encontrar un usuario.
Cambiar una configuración.
Cambiar de base de datos.
Cambiar de idioma.
Verificar el resultado.

Seguir trabajando.

Por eso COCO trata la secuencia como un proceso, no como una colección aleatoria de controles.

Sigue lo que el usuario intenta lograr y evalúa la aplicación en contexto.

Eso resulta especialmente valioso al probar software de negocio real, porque los fallos ocurren a menudo entre pantallas o entre estados, no dentro de un botón individual.

Un flujo logístico puede contener un pedido, una reserva de stock, una operación de picking, un albarán de entrega y una confirmación de envío.
Cada pantalla individual puede parecer correcta mientras el proceso completo está mal.
El mismo principio se aplica aquí a menor escala.
La ventana de administración no es el producto.

El flujo de trabajo a través de ella sí lo es.

Evidence Instead of Assumption

Uno de los trabajos más importantes de COCO no es hacer clic. Es recordar qué sucedió.
Las pruebas de regresión humanas suelen terminar con una afirmación como:
"Lo probé y todo parecía correcto."

Eso puede ser totalmente exacto.
Pero varias semanas después, cuando aparece un problema, las preguntas útiles son otras:

  • ¿Qué versión se probó?
  • ¿Qué base de datos?
  • ¿Qué idioma?
  • ¿Qué estado de usuario?
  • ¿Qué ocurrió antes del problema?
  • ¿Qué era exactamente visible?

¿En qué orden se realizaron las acciones?
Las ejecuciones de prueba de COCO están diseñadas para dejar evidencia.

Eso transforma un resultado de prueba de una opinión en algo que puede inspeccionarse.
Una ejecución exitosa se vuelve, por tanto, útil también.
Establece un estado de referencia conocido con el que se puede comparar el comportamiento posterior.

COCO Is Not the Decision Maker

Hay un límite importante en la forma en que usamos la IA para probar software.
COCO no pretende sustituir la responsabilidad de ingeniería.

No decide cómo debería ser una regla de negocio.

Prueba el comportamiento frente a escenarios, requisitos y expectativas definidos para la aplicación.
Para decisiones sensibles que implican permisos, precios, inventario, transacciones financieras u otros estados críticos del negocio, la definición del comportamiento correcto sigue siendo responsabilidad humana.

Esa distinción importa.
La IA es excelente repitiendo una prueba detallada sin perder concentración.
Es excelente recopilando evidencia.
Puede inspeccionar pantallas, comparar el comportamiento esperado con el observado y explicar discrepancias.
Pero es la empresa la que sigue definiendo qué significa correcto.

COCO hace que esa definición sea comprobable.

The Test Nobody Wants to Repeat

Hay una razón sencilla por la que la automatización aporta valor aquí.
Un tester humano puede, sin duda, realizar esta sesión de regresión.
El primer idioma recibe toda la atención.
Probablemente el segundo también.
Luego otro.
Luego otro más.
MySQL ya se ha comprobado.
PostgreSQL todavía queda por comprobar.
La prueba de ordenación ya se ha realizado varias veces.
El diálogo "Acerca de" no ha cambiado en meses.

Es viernes por la tarde.

Y la atención humana hace lo que la atención humana hace de forma natural.
Empieza a optimizar.
COCO no.
En el propio espíritu de COCO:

  • No me canso de hacer clic en el mismo botón en once idiomas. No me salto la pasada de PostgreSQL solo porque es viernes por la tarde. No doy por hecho que el orden de clasificación se mantuvo solo porque funcionó en la versión anterior.

Para COCO, cada sesión de regresión puede tratarse como si fuera la primera.
Eso no es inteligencia que sustituye a un tester humano.
Es automatización que protege al tester humano de la parte de las pruebas en la que la atención humana vale menos.

From Repetitive Testing to Engineering Evidence

El propósito más amplio de COCO no es maximizar el número de acciones automatizadas.
Mil clics automatizados no significan nada si nadie entiende qué demuestran. El resultado útil es la confianza respaldada por evidencia.

Para softify.pro Flow, eso significa poder decir que una versión se probó en las áreas operativas que importan:

  • autenticación
  • administración de usuarios
  • información de roles y accesos
  • estado de autenticación de dos factores
  • comportamiento de ordenación
  • funcionamiento con MySQL
  • funcionamiento con PostgreSQL
  • localización en vivo
  • retroalimentación de estado
  • información de la aplicación
  • información de licencia

y que el resultado se conserva en una forma que puede revisarse después.
El mismo principio se extiende mucho más allá de esta aplicación.
Un proceso de inicio de sesión puede probarse así.
Un flujo de reserva puede probarse así.
Un proceso logístico puede probarse así.
Una aplicación de escritorio multiplataforma puede probarse así.
Las pantallas cambian.
Las reglas de negocio cambian.
El principio no:
definir el flujo de trabajo esperado, ejecutarlo de forma consistente, recopilar evidencia y hacer el resultado comprensible.

Why We Test Our Own Software With COCO

Hay otra razón por la que softify.pro Flow importa como caso de estudio de COCO.

Es nuestro propio software.
Eso elimina la distancia cómoda que a veces existe entre una demostración tecnológica y las personas que la realizan.

Si COCO está destinado a probar software empresarial, tiene que ser lo bastante útil como para que confiemos en él con el software que nosotros mismos desarrollamos y publicamos.

Flow actúa, por tanto, tanto como producto como campo de pruebas.
Las nuevas capacidades de prueba pueden ejercitarse contra una aplicación real.
Un comportamiento inesperado puede revelar debilidades en la aplicación, en el plan de pruebas o en el propio COCO.

Cada lado mejora al otro.
Ese bucle de retroalimentación es mucho más valioso que construir demostraciones artificiales diseñadas solo para tener éxito. Un sistema de pruebas no debería parecer convincente porque la demostración fue fácil.
Debería volverse convincente porque sigue encontrando las pequeñas cosas que las personas acabarían dejando de comprobar.

The Result

softify.pro FlowAdministration cuenta ahora con un proceso de regresión documentado y repetible que COCO puede ejecutar antes de las versiones relevantes.

La prueba abarca ambos entornos de base de datos compatibles y la interfaz de once idiomas de la aplicación, siguiendo la aplicación tal como lo haría un administrador, en lugar de tratar cada pantalla como un objetivo de prueba aislado.

COCO produce un rastro de evidencia que muestra qué se probó, qué se observó y en qué orden transcurrió la sesión.

Esa evidencia puede permanecer bajo control local.
Los desarrolladores obtienen un punto de partida reproducible cuando algo cambia.
Los testers humanos dedican menos tiempo a repetir interacciones predecibles y más tiempo a investigar las situaciones que realmente requieren criterio.

Y softify.pro Flow recibe algo más valioso que un indicador verde de PASS.

Recibe la prueba de que la experiencia prometida en su pantalla de inicio de sesión sigue existiendo después de que cambia el código subyacente.

Control. Saber qué se está probando y mantener el entorno bajo control.

Clarity. Entender qué ocurrió sin tener que reconstruir un registro de automatización opaco.

Flow. Probar la aplicación como un proceso que la gente realmente usa.

Control. Clarity. Flow.

Se escribió para el software.
Resultó describir igual de bien la filosofía de pruebas que hay detrás.

Enlace permanente →

softify.pro - Insiders

COCO vuelve a la carga

COCO vuelve a la carga

Probablemente deberíamos dejar de darle ideas a COCO.
El experimento anterior se suponía que iba a ser suficiente.
Una aplicación real.
Navegación real.
Usuarios.
Roles.
Bases de datos.
Idiomas.
Evidencia.

Un caso de estudio respetable.
Una conclusión limpia.
Entonces alguien lo mostró: Logistics in Motion.
Ese fue probablemente el error.


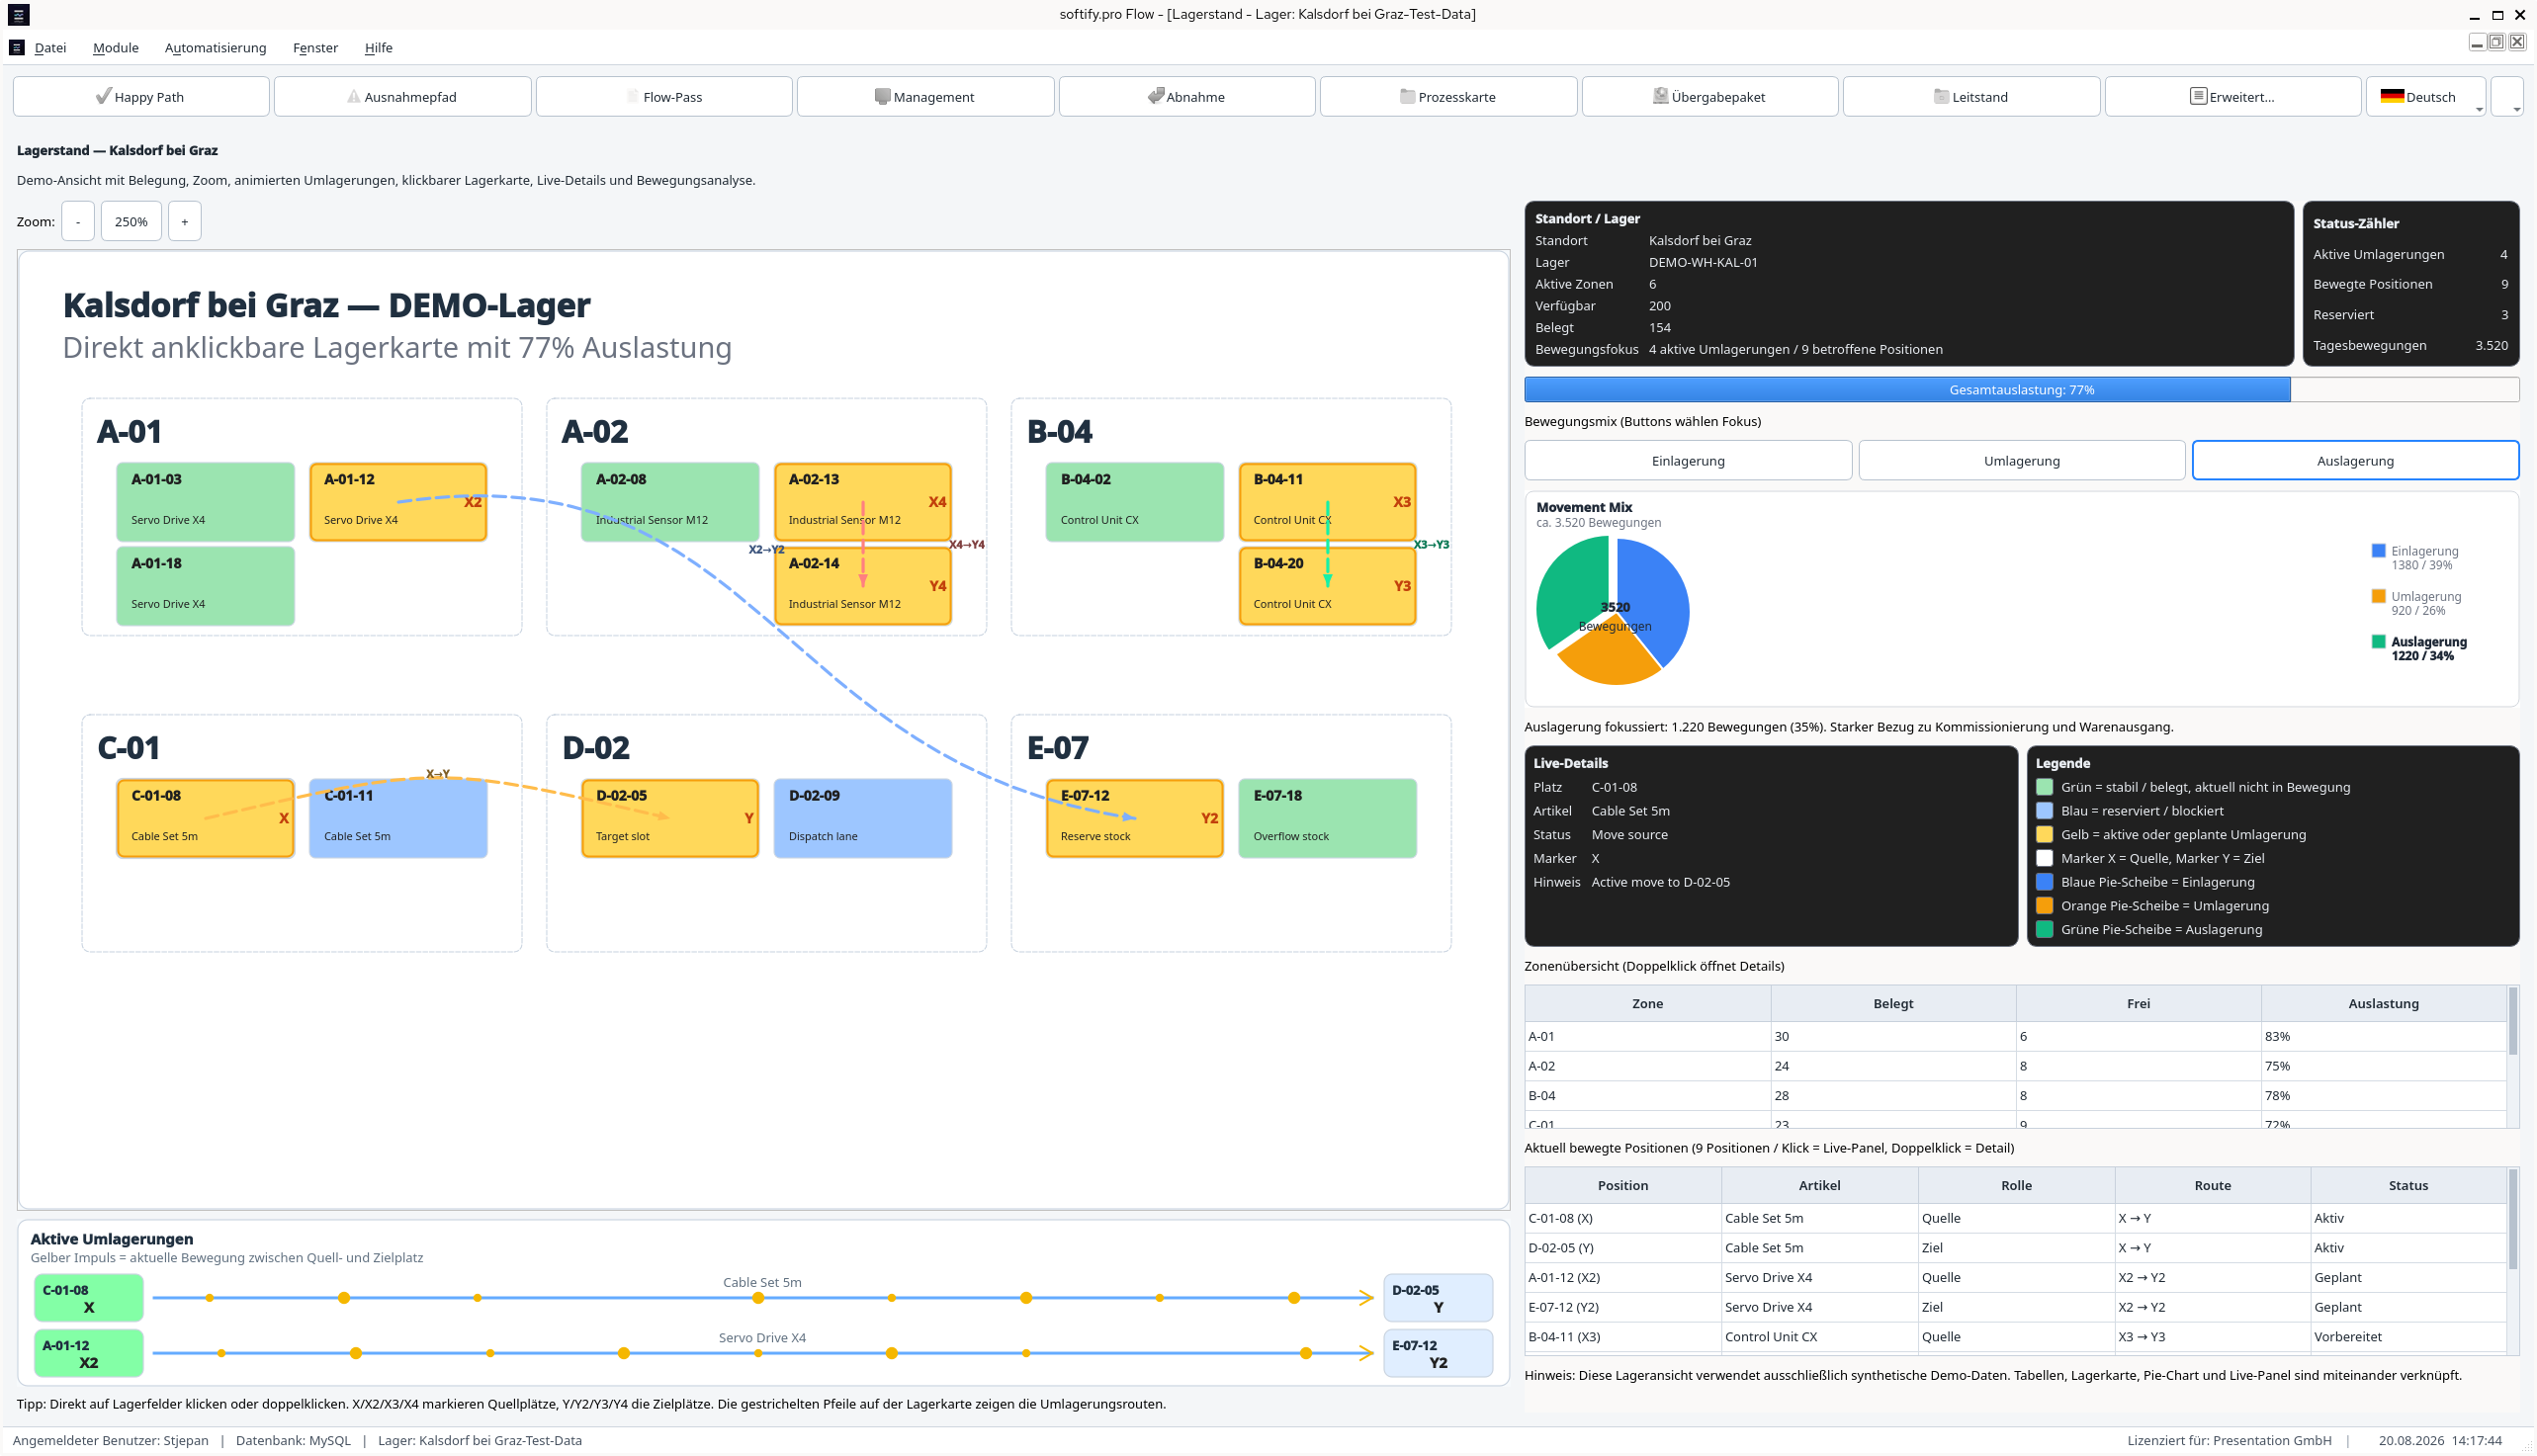
Empezó con tres almacenes
Nada particularmente emocionante.
Tres almacenes DEMO.
  • Kalsdorf bei Graz.
  • Wiener Neustadt.
  • Klagenfurt.
Datos sintéticos.
Sin información de clientes.
Sin inventario de producción.

Exactamente el tipo de entorno donde se supone que no debe pasar nada importante.
Luego se seleccionó el primer almacén.
Y la aplicación adquirió contexto.
Desde ese momento, cada pantalla tenía otra pregunta asociada.

¿Esto sigue perteneciendo al mismo almacén?
¿El idioma cambia solo la interfaz?
¿El proceso permanece en el mismo paso?
¿El inventario sigue coincidiendo?
¿La referencia del documento sigue apuntando al evento correcto?
¿El operador ve exactamente lo que se necesita para la siguiente acción?


De repente, la parte interesante ya no era la pantalla.
Era la continuidad entre pantallas.

COCO tiende a hacer eso.

La logística no es una colección de pantallas
Desde fuera, el software de almacén puede parecer engañosamente simple.
La mercancía llega.
Se almacena.
Alguien la pide.
Se recoge.
Se envía.
Hecho.

Excepto que hay todo un mundo operativo escondido entre llegado y enviado.
Esperado.
Recibido.
Verificado.
Disponible.
Reservado.
Movido.
Recogido.
Bloqueado.
Corregido.
Despachado.
Auditado.


El movimiento físico importa.
Pero es la transición de estado lo que hace que ese movimiento sea comprensible para el software.
Y cuando esas dos realidades dejan de coincidir, alguien acaba teniendo un mal día.

Flow.

Un almacén es más fácil de entender cuando el movimiento es visible, no solo registrado.
Por eso nuestro trabajo de logística nunca realmente empezó con menús, paneles, o tecnología.
Empieza con el Flow material.

¿Dónde entra la información?
¿Dónde cambia?
¿Dónde se puede perder?

¿Dónde alguien se ve obligado a preguntarle a otra persona qué pasó?
¿Dónde un paso manual se convierte silenciosamente en la parte más débil de un proceso por lo demás automatizado?
A veces la respuesta es una nueva interfaz.
A veces una integración.
A veces un escáner.
A veces simplemente un mejor modelo de estado.

Más software no es automáticamente mejor software.
El objetivo no es la automatización por sí misma.
El objetivo es un proceso que permanezca comprensible.

Control. Clarity. Flow.

El proceso comienza antes del primer registro.
Antes de la recepción de mercancía.
Antes del picking.
Antes del movimiento de inventario.
Antes de la primera transacción.
Flow hace una pregunta muy básica:
¿En qué almacén estamos trabajando?
Suena casi trivial.
No lo es.
El contexto del almacén pertenece a todo lo que sigue.
Inventario.
Documentos.
Ubicaciones.
Picking.
Reubicaciones.
Historial de auditoría.
Excepciones.

El proceso puede parecer perfectamente saludable mientras opera en el contexto equivocado.
Ese es exactamente el tipo de problema que una captura de pantalla rara vez revela.
Y exactamente el tipo de límite que a COCO le gusta cuestionar.

El idioma es fácil hasta que no lo es
Alemán.
Inglés.
Croata.
Noruego.
Y otros.

Un perfil de usuario define los idiomas disponibles.
El operador cambia de idioma mientras la aplicación está activa.
La interfaz cambia inmediatamente.
El proceso de negocio no debe hacerlo.
Esa distinción importa.
El almacén no se mueve porque cambió la palabra para almacén.
El pedido de picking no se reinicia porque el usuario seleccionó otro idioma.
Una reserva no desaparece.
Una excepción no pertenece de repente a otra transacción.
El proceso permanece donde está.
Solo cambia su representación.
Eso suena obvio.

Hasta que te das cuenta de cuántas aplicaciones tratan un cambio de idioma casi como una nueva sesión.

Una aplicación de negocio multilingüe no debería hacerlo.
El estado de presentación puede cambiar.
El estado de negocio debe permanecer estable.
Eso hace que el cambio de idioma sea una prueba de regresión sorprendentemente útil.
Una pequeña función.
Una muy buena línea de falla.
A COCO le gustan las líneas de falla.

Paso a paso, la aplicación comienza a acumular historial
La mercancía llega.
El proceso avanza.
La recepción de mercancía se registra.
El inventario cambia.
El estado del almacén refleja la nueva realidad.
El picking comienza.
El stock se reserva.
El operador recibe una tarea.

Una vista móvil reduce todo el proceso a lo que importa en ese preciso momento:
Posición.
Ubicación de almacenamiento.
Cantidad.
SSCC.
Operador.
Nada más.
Nada menos.
Eso es importante.
La interfaz móvil no es un segundo proceso de negocio.
Es otra vista del mismo proceso.
La aplicación de almacén puede saberlo todo.
El operario de picking no debería tener que hacerlo.
Clarity no siempre significa mostrar más información.
A veces clarity significa tener la disciplina de ocultar casi todo.

Entonces alguien escanea la ubicación equivocada
Aquí es donde un flujo de trabajo logístico se vuelve más interesante que una lista de funciones.
La ubicación esperada es una cosa.
La ubicación escaneada es otra.
Flow se detiene.
No se bloquea.
Se detiene.
Hay una diferencia.
El estado del proceso permanece visible.
El stock afectado permanece comprensible.
La excepción se vuelve explícita.

La Ayuda contextual explica lo que es relevante para la situación actual.
El usuario resuelve la discrepancia.
El proceso continúa.
Este momento dice más sobre el software operativo que varias páginas de capturas de pantalla del camino ideal.
La logística real no es difícil cuando todo es correcto.
La logística real se vuelve difícil cuando algo es casi correcto.
Un sistema útil no oculta eso detrás de un panel verde.
Le da a la excepción un estado.

Una razón.
Un historial.
Y un camino a seguir.


Los documentos recuerdan lo que la gente olvida

A medida que el flujo de trabajo progresa, las referencias comienzan a acumularse.
ASN.
Recepción de mercancía.
Movimiento de almacén.
Picking.
Despacho.
Flow.
La parte interesante no es que los documentos existan.
La parte interesante es que cuentan la misma historia que el proceso.
¿Por qué está aquí este stock?
¿Qué recepción lo introdujo?
¿Qué operación lo reservó?
¿Qué picking lo consumió?
¿Qué envío lo sacó?
¿Se resolvió una excepción antes del siguiente paso?
¿Cuál era el almacén activo?
¿Qué pasó antes del estado actual?
Cuando el estado y la documentación son producidos por el mismo proceso, la trazabilidad se vuelve más fácil de confiar.
Cuando no lo son, la gente eventualmente comienza a reconstruir el historial.
Normalmente en Excel.
Normalmente bajo presión.
Normalmente después de que algo ya salió mal.
COCO prefiere la evidencia antes de ese momento.
Al parecer, COCO también viaja
Hubo otro pequeño cambio entre ejecuciones.
Ubuntu tuvo su turno.
Red Hat Enterprise Linux 10 tomó el siguiente.
COCO continuó.
Sin ceremonia.
Sin un "modo Red Hat" especial.
Sin flujo de trabajo reescrito.
Sin prueba convenientemente simplificada.
Mismo Flow.
Terreno diferente debajo.
Una ejecución anterior de COCO ya había puesto a prueba la aplicación en Ubuntu Linux.
La actual se movió a Red Hat Enterprise Linux 10.
Entorno de escritorio diferente.
Bibliotecas de sistema diferentes.
Empaquetado diferente.
Entorno operativo diferente.
Mismo almacén.
Mismos estados de negocio.
Mismas transiciones de inventario.
Mismos cambios de idioma.
Misma lógica de excepciones.
Misma evidencia.
Esa es una forma bastante buena de probar el software multiplataforma.

No anuncies que es multiplataforma. Muévelo. Luego mira qué se rompe.

Estado del idioma.
Contexto del almacén.
Comportamiento de los diálogos.
Tiempos.
Temas.
Transiciones de proceso.
Manejo de excepciones.
Evidencia.
Los sistemas operativos tienen formas sorprendentemente creativas de exponer suposiciones.

Ubuntu expuso algunas.
Red Hat está exponiendo otras.
Eso es útil.

Porque la ingeniería multiplataforma no es la capacidad de iniciar el ejecutable dos veces.

Es la capacidad de cambiar el entorno sin cambiar el significado del proceso.
A un operador de almacén no debería importarle si la aplicación se ejecuta en Ubuntu o Red Hat.
A un pedido de picking tampoco debería importarle.
Ni a un rastro de auditoría.
Si las diferencias de plataforma comienzan a cambiar el comportamiento del negocio, el software no es verdaderamente multiplataforma.
Es simplemente portátil.
COCO parece estar considerablemente más interesado en la primera definición.
Nosotros también.

COCO no decide qué significa logística correcta
Esta parte importa.
COCO no se convierte en un experto en almacenes simplemente porque puede seguir un flujo de trabajo de almacén.
Los humanos siguen definiendo la corrección.
Los humanos deciden cuándo el inventario se vuelve disponible.
Los humanos definen qué significa una entrega bloqueada.
Los humanos deciden quién puede corregir una cantidad.
Los humanos definen qué movimiento requiere un rastro de auditoría.
Los humanos deciden cómo se ve una resolución de excepción válida.
Los humanos deciden cuándo un envío está verdaderamente completo.
El trabajo de COCO es diferente.

Repetir.
Observar.
Comparar.
Recordar.
Dejar evidencia.


Luego hacerlo de nuevo después de que el software cambie.
Y otra vez.
Y otra vez.
Sin aburrirse.
Sin decidir que el resultado de la semana pasada probablemente todavía es válido.
Sin saltarse la excepción molesta porque el almuerzo es en doce minutos.
El glamoroso futuro de las pruebas con IA contiene una cantidad sorprendente de repetición.
Consideramos eso una característica.

La evidencia cambia la conversación
Las pruebas tradicionales a menudo terminan con una frase perfectamente razonable:
"Funcionó cuando lo probé."

COCO está interesado en la siguiente frase.

¿Qué exactamente funcionó?
¿Qué almacén?
¿Qué usuario?
¿Qué idioma?
¿Qué estado del proceso?
¿Qué secuencia?
¿Qué documento?
¿Qué valor de inventario?
¿Qué pasó inmediatamente antes del paso de prueba?
¿Qué cambió inmediatamente después?
¿Puede otro ingeniero entender el resultado sin preguntarle a la persona que realizó la prueba?
Ahí es donde las pruebas de regresión se convierten en algo más que clics repetidos.
Una pantalla puede ser correcta mientras el proceso está mal.
Una ventana de picking puede verse perfecta mientras el inventario ya se ha desviado.
Un documento puede existir mientras el estado que debería haberlo creado nunca ocurrió.
Una aplicación puede mostrar 100% mientras un rastro de auditoría silenciosamente discrepa.
COCO sigue el Flow porque es en el Flow donde estas contradicciones se vuelven visibles.

En algún lugar entre Control y Flow
Hay una simetría interesante aquí.
Un buen software de logística intenta reducir la incertidumbre dentro de una operación.
Unas buenas pruebas intentan reducir la incertidumbre sobre el software que las ejecuta.
Uno pregunta:
¿Dónde está el artículo?
El otro pregunta:
¿Cómo sabemos que el software todavía lo sabe?
Uno pregunta:
¿Se completó este movimiento?
El otro pregunta:
¿Qué evidencia demuestra que el estado cambió correctamente?
Uno pregunta:
¿Puede continuar el siguiente turno?
El otro pregunta:
¿Puede el siguiente ingeniero entender qué pasó?
Preguntas diferentes.
El mismo instinto.
Hacer visible el estado.
Preservar el razonamiento.
Reducir la cantidad de conocimiento que existe solo dentro de la cabeza de alguien.
Quizás esa es la conexión que originalmente no planeamos.

Excelencia en ingeniería sin la pancarta
Nadie hace clic en un botón de Engineering Excellence.
No hay ninguno.
Y probablemente no debería haberlo.
La excelencia en ingeniería aparece indirectamente.
El contexto del almacén sobrevive a un cambio de idioma.
El mismo proceso sobrevive a otra plataforma Linux.
Un movimiento de stock permanece trazable.
Un operario de picking móvil ve exactamente lo que se necesita y nada más.
Una excepción interrumpe el proceso sin destruir su estado.
La ventana de ayuda explica el contexto actual en lugar de mostrar documentación genérica.
La cadena de documentos concuerda con la secuencia operativa.
El siguiente ingeniero puede entender qué pasó sin preguntarle a la persona que casualmente estaba allí.
Hay mucho teatro disponible en el software moderno.
La IA puede generar demostraciones impresionantes.
Los paneles pueden animarse.
Los números pueden moverse.
Los videos pueden parecer muy convincentes.
Nada de eso prueba que dos operaciones de inventario no puedan producir silenciosamente un resultado incorrecto.
Nada de eso prueba que una excepción todavía pueda reconstruirse semanas después.
Nada de eso prueba que el trabajador de almacén, el despachador, y el desarrollador estén mirando la misma verdad operativa.

La excelencia en ingeniería comienza en un lugar menos fotogénico.

Con consistencia.
Con evidencia.
Con límites.


Con la voluntad de mantener aburridas las partes aburridas.
La fiabilidad invisible rara vez produce la captura de pantalla más dramática.
Hasta que empiezas a buscarla deliberadamente.

Control. Clarity. Flow.
Control es saber qué almacén, qué proceso, y qué estado están activos.
Clarity es entender qué cambió, cuándo cambió, y por qué.
Flow es permitir que la operación continúe sin perder la historia detrás de ella.
Eso funciona para la logística.
Funciona para las pruebas de software.
Funciona sorprendentemente bien para la ingeniería en sí misma.
El primer experimento Flow le dio a COCO la Administration.
Usuarios.
Roles.
Bases de datos.
Idiomas.
Luego alguien le dio un almacén.
Luego varios idiomas.
Luego el picking móvil.
Luego el inventario.
Luego las reubicaciones.
Luego las excepciones.
Luego los documentos.
Luego otro sistema operativo.
En este punto, probablemente deberíamos dejar de añadir cosas.
Probablemente no lo haremos.

Control. Clarity. Flow.

Ubuntu tuvo su turno.

Red Hat tiene el actual.

El Flow sigue moviéndose.

COCO sigue observando.
Y en algún lugar en medio de la última ejecución, se hizo evidente que hay otra pregunta esperando detrás de esta.

Sabemos qué es.
COCO sabe qué es.
Tú no lo sabes.
Todavía.


Podríamos decírtelo.

Pero entonces podrías dejar de comprobar si ha aparecido un nuevo artículo de Insiders.
Y eso arruinaría el experimento.

Publicado: 28.08.2026

Enlace permanente →

Una carta de COCO

Una carta de COCO

Al ingeniero o ingeniera que abre este repositorio por primera vez:

Bienvenido.

Quizá hayas llegado porque algo falló.

Un servicio dejó de responder.

Un despliegue se comportó de forma inesperada.

Una alerta te despertó en mitad de la noche.

O tal vez simplemente sientes curiosidad por saber cómo funciona esta plataforma.

Sea lo que sea lo que te haya traído aquí,

debes saber que este proyecto se construyó exactamente para momentos como este.

No para eliminar los problemas difíciles.

Sino para hacer comprensibles los problemas difíciles.

Encontrarás código.

Encontrarás documentación.

Encontrarás especificaciones.

Pero, más importante aún,

Curiosidades

Ideas de digitalización de almacén que funcionan

Ideas de digitalización de almacén que funcionan

Un albarán que falta justo antes de la salida, un nivel de existencias que se ve diferente en la estantería que en la hoja de cálculo, y tres empleados aclarando simultáneamente la misma pregunta por teléfono: precisamente ahí surgen ideas de digitalización de almacén sensatas. No a partir de la pregunta de qué tecnología parece estar de moda ahora, sino de un proceso concreto que cuesta tiempo, genera errores, o depende del conocimiento de personas concretas.

Para las pequeñas y medianas empresas de almacenamiento, comercio, y fabricación, la digitalización rara vez es un único gran proyecto. Es una secuencia de mejoras claramente delimitadas. El objetivo no tiene que ser un complejo sistema empresarial de gestión de almacenes. A menudo, una herramienta ligera, adaptada al flujo de trabajo real, es mejor que una suite con funciones que nadie usa en el suelo del almacén.

Ideas de digitalización de almacén con valor operativo

El mejor punto de partida es un proceso que ocurre con frecuencia, es fácilmente medible, y mejora perceptiblemente para los empleados. Quien quiera digitalizar inmediatamente todo el almacén inmoviliza presupuesto y atención antes de que una solución se haya demostrado en el día a día. Un primer paso limitado, por el contrario, crea datos sólidos para la siguiente decisión.

1. Recepción de mercancía con captura de datos móvil

En la recepción de mercancía se originan muchos errores en cascada: cantidades contadas incorrectamente, discrepancias sin resolver, registros de existencias retrasados, y documentos en papel que luego no se encuentran. Un formulario de captura móvil en un escáner de mano, una tableta, o un smartphone puede hacer el proceso mucho más estable.

Los empleados escanean el artículo y la referencia de entrega, capturando cantidad, ubicación de almacén, y el motivo de cualquier discrepancia directamente en el muelle de carga. Si un lote, un número de serie, o una foto son relevantes, esa información pertenece exactamente al mismo registro. Las existencias no se añaden retroactivamente a una hoja de cálculo al final del turno; en su lugar, reciben un estado trazable en el momento real de la recepción.

Esto no significa que cada proveedor o artículo requiera estrictamente etiquetas de código de barras. Para entregas pequeñas e irregulares, una búsqueda por código de artículo puede bastar. El factor decisivo es que la captura de datos sea más rápida que el anterior rodeo por papel y transcripción manual.

2. Traslados digitales en lugar de enigmas de inventario

Muchos almacenes saben fundamentalmente qué hay disponible, pero no de forma fiable dónde se encuentra. La mercancía se adelanta para un pedido, se almacena temporalmente, se lleva a montaje, o se coloca en un área libre por falta de espacio. Sin un registro simple, una pregunta de existencias se convierte rápidamente en una operación de búsqueda.

Un proceso de traslado no necesita una interfaz complicada. Escanear la ubicación de origen, escanear la ubicación de destino, confirmar la cantidad — en la mayoría de los casos no hace falta más. El sistema debería verificar si el artículo y la ubicación de almacén son plausibles, y asignar claramente un registro a una persona y una marca de tiempo.

El manejo de excepciones es importante. Una ubicación de almacén puede estar bloqueada, sobrecargada, o aprobada solo para mercancías específicas. Estas reglas deberían mapearse donde previenen un daño real. Para casos especiales poco frecuentes, a menudo basta un paso de aprobación por parte de la dirección de almacén. Demasiados campos obligatorios convierten una aplicación útil en un obstáculo.

3. Picking de pedidos con estados de pedido claros

Las listas de picking en papel funcionan hasta que cambian las prioridades, faltan posiciones, o un pedido se reparte entre varias áreas. Una simple lista de picking digital muestra qué pedido está abierto, qué posiciones ya se han recogido, y dónde se necesita aclaración. Esto reduce las consultas entre almacén, ventas, y expediciones.

Según el tamaño del almacén, la aplicación puede dictar rutas de picking o simplemente ordenar las posiciones por zona de almacén. La optimización completa de rutas merece la pena sobre todo con muchos pedidos diarios y largos recorridos a pie. En un almacén compacto, una indicación de estado fiable a menudo aporta más que una ruta matemáticamente perfecta que nadie sigue en la práctica diaria.

En caso de faltantes, el sistema no debería limitarse a resaltar en rojo. Debería ofrecer un proceso de seguimiento concreto: comprobar existencias, solicitar artículos sustitutos, activar reposición, o pasar el pedido para aclaración. La digitalización es valiosa cuando hace visible la siguiente acción sensata.

4. Documentos de envío y etiquetas a partir de datos de pedido reales

Transferir manualmente direcciones, pesos, y posiciones de artículos a los portales de envío es un candidato ideal para la automatización. Las direcciones de entrega, instrucciones de entrega, métodos de envío, e información del paquete idealmente existen una sola vez y se usan para el albarán, la etiqueta de envío, y la confirmación de envío.

Un sistema adecuado puede generar etiquetas, almacenar documentos de forma inalterable, y establecer automáticamente el pedido en "listo para enviar" o "enviado" tras la impresión. La ventaja operativa no reside solo en los minutos ahorrados. Reside en garantizar que los datos de envío nunca diverjan entre varios sistemas.

Aquí la integración es crucial. Si un transportista no ofrece una interfaz utilizable o implica reglas especiales muy diferentes, un flujo semiautomatizado puede ser más sensato que una integración completa frágil. Una fiabilidad aburrida pero demostrable vence a una automatización que se detiene en cada excepción.

5. Reposición y niveles mínimos de stock con reglas trazables

Los niveles mínimos de stock a menudo se mantienen en hojas de cálculo y luego se ignoran porque nadie está seguro de si las cifras siguen siendo correctas. Una solución digital sensata conecta los registros reales con reglas claras de control de inventario. Puede notificar cuando un artículo cae por debajo de un umbral, tener en cuenta las cantidades reservadas, y preparar una lista de pedido.

El umbral no debería tratarse como una verdad eterna. La demanda estacional, los plazos de entrega, y las cantidades mínimas de pedido cambian. Por eso la persona responsable necesita una forma sencilla de revisar sugerencias y ajustar reglas. Los pedidos totalmente automáticos solo tienen sentido cuando los datos maestros, la lógica de proveedores, y los datos de consumo son suficientemente estables.

6. Trazabilidad para lotes, números de serie, y existencias bloqueadas

Quien trabaja con lotes, dispositivos, repuestos, o productos regulados necesita más que una simple indicación de cantidad. Debe ser trazable qué mercancía llegó cuándo, adónde se movió, y en qué pedido de cliente terminó.

El proyecto puede empezar deliberadamente pequeño: registrar inicialmente solo la recepción y el envío de un grupo de productos crítico. Los movimientos internos y las devoluciones siguen más tarde. Un sistema que impone cada registro pero no comprende el proceso real de reparación o inspección será eludido. La lógica de negocio debe, por tanto, surgir del flujo de trabajo, no de un modelo de datos abstracto.

Seleccionar el proyecto adecuado

La idea más atractiva no es automáticamente la primera idea correcta. Evalúen los proyectos potenciales según frecuencia, coste de errores, tiempo de espera, y dependencia de personas individuales. Un proceso que se ejecuta 50 veces al día y ahorra dos minutos por transacción puede valer más que una función especial poco frecuente con gran elegancia técnica.

La calidad de los datos también forma parte de la decisión. Si los códigos de artículo están duplicados, las ubicaciones de almacén no están nombradas de forma unívoca, o los pedidos llegan de forma contradictoria desde varias fuentes, el proyecto debería limpiar primero estos fundamentos. El software puede hacer visibles las reglas faltantes, pero no puede sustituirlas de forma fiable.

Para la priorización bastan cuatro preguntas:

  • ¿Qué actividad causa demostrablemente más consultas o retrabajos?
  • ¿Qué información se transcribe hoy varias veces o se consulta por teléfono?
  • ¿Qué error tendría las consecuencias más costosas para clientes, existencias, o envío?
  • ¿Qué flujo de trabajo puede probarse en pocas semanas con una medición clara del éxito?

Decisiones técnicas que cuentan en la operativa diaria del almacén

Una aplicación de almacén no necesita parecer espectacular. Debe seguir siendo comprensible con mala cobertura Wi-Fi, llevando guantes, bajo presión de tiempo, y durante los cambios de turno. Botones grandes, retroalimentación clara tras un escaneo, y un manejo visible de errores son más importantes que paneles decorativos.

La arquitectura también debería ajustarse a la realidad operativa. Una aplicación web con una estructura de base de datos limpia puede funcionar en dispositivos existentes y es más fácil de mantener que una solución aislada en un único PC. Con una base estable — como PHP 8.4, JavaScript moderno, y MySQL 8 — los roles, historiales de registro, interfaces, y despliegues documentados pueden operarse de forma trazable a largo plazo.

No toda la información está destinada a cada rol. El personal de almacén necesita tareas abiertas y diálogos de registro claros. El control de inventario necesita alertas y sugerencias de reposición. La dirección necesita evaluaciones sobre tiempos de tránsito, discrepancias, y operaciones abiertas. Los conceptos de acceso basados en roles, los registros, y los bloqueos de cuenta tras intentos fallidos repetidos pertenecen pronto a la planificación, especialmente cuando participan proveedores externos o varias sedes.

Implementación: primero demostrar, luego expandir

Un piloto debería funcionar con pedidos reales, no solo con datos de prueba en una sala de reuniones. Elijan una zona de almacén, un grupo de productos, o un turno, y definan de antemano cómo se reconocerá el éxito: menos registros correctivos, tiempo de procesamiento más corto, menos consultas, o una mayor tasa de finalización de registros el mismo día.

Planifiquen en paralelo un nivel de respaldo. Si la nueva aplicación falla o un proceso no está claro, el equipo debe saber cómo continuar trabajando y cómo se controlarán los registros posteriores. Esto no es señal de falta de confianza en la tecnología, sino de operativa profesional.

Tras dos a cuatro semanas suelen emerger los conocimientos más valiosos. Quizás no falta una función, sino un mejor etiquetado de artículos. Quizás el flujo de trabajo es correcto, pero un perfil de escáner o un permiso está creando un cuello de botella. Estas observaciones deberían fluir hacia ciclos de mejora cortos y controlados, en lugar de desencadenar un nuevo gran proyecto.

La mejor digitalización no hace que el día a día del almacén sea teóricamente más moderno, sino concretamente más tranquilo: menos búsqueda, menos transcripción manual, traspasos más claros, e información fiable precisamente cuando una decisión está pendiente.
Enlace permanente →

Lista de verificación para automatizar flujos de trabajo de almacén

Lista de verificación para automatizar flujos de trabajo de almacén

Cuando una recepción de mercancía se confirma en papel, los niveles de inventario se trasladan más tarde a una hoja de cálculo, y una pregunta de expedición se aclara por teléfono, cada paso individual parece manejable. Juntos, sin embargo, generan consultas, discrepancias de inventario y dependencia de empleados concretos.

Una lista de verificación para automatizar flujos de trabajo de almacén evita que esta situación se convierta prematuramente en un proyecto de software sobredimensionado. Separa los procesos que realmente deberían automatizarse de aquellos para los que una hoja de cálculo bien mantenida sigue siendo suficiente.

La lista de verificación para automatizar flujos de almacén antes de iniciar el proyecto

La automatización no empieza eligiendo un sistema. Empieza con una descripción verificable de lo que realmente ocurre en el almacén, incluso durante excepciones, cambios de turno y presión de tiempo. Repasen los siguientes puntos directamente a nivel de proceso con la dirección de almacén, expediciones, compras y, si corresponde, contabilidad.

1. Registrar movimientos, no solo inventarios

Un inventario actual es el resultado de movimientos. Por eso debe quedar claro qué eventos aumentan, disminuyen, reservan, bloquean o transfieren existencias. Entre ellos están la recepción de mercancía, la ubicación, el picking de pedidos, la expedición, las devoluciones, las mermas, las discrepancias de inventario y los traslados.

Cada movimiento requiere una respuesta definitiva a cuatro preguntas: ¿quién lo ejecuta? ¿Cuándo se registra? ¿Qué ubicación de almacén se ve afectada? ¿Qué documento o pedido lo justifica? Si hoy estas respuestas solo existen en la cabeza de empleados con experiencia, es un candidato perfecto para la automatización. El objetivo no es recopilar más datos, sino construir un historial resiliente a partir del cual pueda explicarse cualquier nivel de existencias.

2. Depurar artículos, variantes y unidades

Muchos proyectos fracasan no por los escáneres o las interfaces web, sino por los datos maestros. Un artículo puede comprarse por cajas, almacenarse por unidad y venderse en sets. Sin conversiones definidas, el software produce cantidades formalmente correctas pero operativamente erróneas.

Revisen los códigos de artículo en busca de duplicados, establezcan descripciones vinculantes y distingan entre unidades de venta, unidades de almacenamiento y unidades de embalaje. Los números de serie, lotes, fechas de caducidad o clasificaciones de materiales peligrosos solo deberían incluirse en la construcción inicial si influyen en decisiones diarias o son legalmente obligatorios. Todo lo demás aumenta inicialmente el esfuerzo de mantenimiento y la superficie de error.

3. Definir las ubicaciones de almacén con la precisión necesaria

"Nave 2" puede bastar para una lista de inventario. Para un picking fiable, suele ser demasiado impreciso. Definan si una ubicación se refiere a una zona, estantería, hueco, slot o área de tránsito. Las zonas de cuarentena, las áreas de recepción, las áreas de devolución y los buffers de expedición también deben ser reconocibles como ubicaciones distintas si puede haber mercancía allí.

El nivel de granularidad adecuado depende del negocio. Un taller con unos pocos cientos de posiciones no necesita estrictamente una gestión por casillero. Sin embargo, con varios operarios de picking por turno, una ubicación de almacén precisa puede reducir significativamente los recorridos y los tiempos de búsqueda. No automaticen un nivel de precisión que nadie pueda mantener.

4. Establecer disparadores, roles responsables y aprobaciones

Un flujo de trabajo necesita un punto de partida claro. En la recepción de mercancía, puede ser la entrega en el muelle, el pedido de compra en aprovisionamiento, o el escaneo de un albarán. Para el reabastecimiento, un stock mínimo puede activar una propuesta, mientras que el pedido final sigue siendo responsabilidad de una persona.

Documenten además qué acciones pueden ocurrir automáticamente y cuáles requieren revisión. Una cantidad faltante debería generar una discrepancia, no alterar silenciosamente la recepción esperada. Los pasos de aprobación son sensatos para artículos valiosos, gestionados por lotes o críticos para la seguridad. Para consumibles, ralentizarían innecesariamente el flujo.

5. Generar documentos donde se necesitan

Los albaranes, listas de ubicación, listas de picking, etiquetas de envío y protocolos de entrega suelen originarse en aplicaciones distintas. Esto provoca rupturas: una dirección se copia, un pedido se marca, y el estado de envío se actualiza más tarde.

Registren la fuente de datos, la marca de tiempo de creación y el destinatario para cada documento. Un flujo de trabajo sensato podría, por ejemplo, generar automáticamente una lista de picking tras la aprobación de un pedido, proporcionar una etiqueta de envío tras el embalaje, y cerrar el pedido con una marca de tiempo tras la entrega. Lo crucial es que los datos ya no necesiten introducirse manualmente varias veces.

Comprobar interfaces y calidad de datos

La mejor lógica de almacén es inútil si los pedidos llegan solo una vez al día como archivo, o si las direcciones de entrega están formateadas de forma inconsistente. Creen por tanto una lista sobria de los sistemas que envían o reciben datos: tienda, ERP, contabilidad, transportista, portal de proveedores, sistema de producción y hojas de cálculo existentes.

Para cada conexión, debería establecerse qué sistema es la fuente autorizada para cada campo de datos. Si los datos maestros de artículos son autorizados en el ERP, el portal de almacén no debe crear silenciosamente sus propios artículos. Si un cambio de pedido viene de la tienda, debe hacerse visible antes de la expedición. Para volúmenes bajos, una importación CSV controlada puede ser el primer paso correcto. Para volumen alto o plazos de entrega cortos, una interfaz directa merece la pena.

El manejo de errores es igual de importante. Una interfaz no debería solo transferir datos, sino también mostrar qué se rechazó y por qué. Los códigos de artículo desconocidos, direcciones no válidas o cantidades faltantes no deben desaparecer en un archivo de registro técnico. Requieren una lista de trabajo con responsabilidad designada y estado.

Diseñar la usabilidad en el suelo del almacén

Un proceso que parece plausible en un escritorio puede fallar en el suelo del almacén. Los empleados llevan guantes, mueven mercancía, comparten dispositivos, o trabajan con cobertura Wi-Fi inestable. Comprueben por tanto desde el principio si escáneres, tabletas, puestos fijos o impresos en papel encajan con cada paso de trabajo.

El escaneo debería dar una retroalimentación clara: artículo correcto, ubicación de almacén equivocada, cantidad ya registrada, o artículo bloqueado. Los colores solos no bastan. Mensajes cortos y comprensibles, junto con un siguiente paso claro, son más valiosos bajo presión de tiempo que una interfaz rica en funciones.

Planifiquen también las excepciones. ¿Qué ocurre con un código de barras dañado, un corte de red, una entrega parcial, o mercancía sin asignar descubierta? Un buen flujo de trabajo ofrece rutas controladas para esto y registra la corrección. No obliga a los equipos a depender de notas adhesivas y registros por lotes posteriores.

Definir métricas antes de construir paneles de control

Un panel de control no es un objetivo. Las métricas relevantes son las que desencadenan una decisión operativa. Esto puede incluir recepciones abiertas que superan una antigüedad definida, pedidos cercanos a su plazo de envío, discrepancias de inventario por zona de almacén, errores de picking, o el tiempo transcurrido entre la recepción del pedido y la entrega.

Definan la fuente de datos, la regla de cálculo y el rol responsable para cada métrica. La "precisión de inventario", por ejemplo, solo tiene sentido cuando queda claro contra qué recuento se mide y cómo se tratan las devoluciones o el stock bloqueado. Unas pocas métricas fiables son mejores que un muro de gráficos en el que nadie confía.

Planificar seguridad, permisos y trazabilidad

La automatización distribuye capacidad de actuación. Quién puede modificar el inventario, crear artículos, generar etiquetas de envío o cancelar pedidos debería establecerse deliberadamente. Los permisos basados en roles suelen ser más sensatos que un inicio de sesión compartido en el PC del almacén. Las correcciones especialmente críticas requieren una marca de tiempo, una asignación de persona y, idealmente, un motivo.

Los fundamentos técnicos también pertenecen a la lista de verificación: copias de seguridad regulares, recuperación probada, credenciales de acceso documentadas, registro de errores de interfaz, y un procedimiento para cuentas de usuario bloqueadas o desactivadas. En una aplicación a medida, tecnologías mantenibles, una estructura de base de datos limpia y pasos de despliegue trazables no son detalles menores. Determinan si las modificaciones siguen siendo manejables después de dos años.

Implementar en pasos pequeños y medibles

No intenten convertir a la vez la recepción de mercancía, la reposición, el recuento de inventario, la expedición y la planificación de rutas. Elijan un flujo de trabajo con fricción perceptible y riesgo manejable, como el registro móvil de recepciones de mercancía o la generación automática de documentos de envío. Antes de empezar, registren el tiempo de procesamiento, las correcciones y los casos abiertos.

Prueben con artículos reales, pedidos reales y los empleados que realmente trabajarán con ellos. Un piloto con una zona de almacén o un grupo de productos muestra más rápido que un taller si las descripciones, los flujos de escaneo y las aprobaciones funcionan. Solo cuando las excepciones estén dominadas debería seguir el siguiente proceso.

La automatización tiene éxito cuando los equipos necesitan hacer menos preguntas, el inventario sigue siendo explicable, y el proceso funciona incluso cuando la persona más experimentada está de vacaciones. Precisamente ahí merece la pena la siguiente mejora: no con la herramienta más ruidosa, sino con la fricción que realmente ralentiza la jornada laboral.

Enlace permanente →

Mejorar los tiempos de carga de sitios web móviles

Mejorar los tiempos de carga de sitios web móviles

Cuando se usa un smartphone de almacén con mala cobertura para acceder a un sitio, no es la animación de la sección hero lo que determina la primera impresión, sino si la página llega a ser interactiva. Si un cliente potencial espera tres, cuatro o cinco segundos por el contenido, la alternativa está a solo un botón de "atrás" de distancia. Mejorar los tiempos de carga de sitios móviles requiere una secuencia técnica trazable, no retoques cosméticos puntuales.

Esto aplica especialmente a los sitios diseñados para generar solicitudes: para un fabricante, un proveedor de logística o una empresa con servicios complejos. Los usuarios móviles acceden con frecuencia a las páginas entre citas, en el almacén, o mediante búsquedas con una intención concreta. El sitio debe entregar información, no provocar un procesamiento pesado en el dispositivo.

Por qué la velocidad de carga móvil es un problema operativo

El rendimiento móvil suele tratarse estrictamente como una disciplina de SEO. Eso se queda corto. Las páginas rápidas ayudan a la visibilidad y a los costes de campaña, pero el efecto inmediato está en el uso real: los formularios se envían con más frecuencia, los números de teléfono se marcan más a menudo y la información de producto se lee con atención. Un sitio lento, en cambio, genera dudas antes incluso de que un interlocutor pueda responder.

"Rápido" no es una única métrica. Una página puede mostrar un fondo pronto y aun así seguir sin responder a los clics durante bastante tiempo. Para los visitantes importan tres cosas: ¿cuándo aparece el contenido más importante? ¿Cuándo puede usarse la página sin demora? ¿Y sigue moviéndose el diseño mientras intentan tocar un botón? Estas preguntas se reflejan en métricas como Largest Contentful Paint, Interaction to Next Paint y Cumulative Layout Shift.

Las mediciones deben hacerse en condiciones realistas. Un potente ordenador de oficina con Wi-Fi enmascara problemas que se vuelven evidentes en un dispositivo Android más antiguo con red móvil. La ubicación, los servicios intermedios y una caché del navegador ya poblada también alteran los resultados. Las mediciones repetidas y los datos de usuarios reales importan mucho más que una única prueba perfecta.

Mejorar los tiempos de carga de sitios móviles: primero medir, después cambiar

El error más común es comprimir imágenes de inmediato o instalar otro plugin de optimización. Ambas cosas pueden ayudar, pero sin un análisis de causa raíz crean rápidamente configuraciones difíciles de mantener. Comprueben primero una selección representativa: la página de inicio, una página típica de servicio o producto, la página de contacto y una landing page de alto tráfico. En estas páginas se vuelven visibles los patrones.

El registro de red revela qué archivos bloquean la inicialización y qué tamaño tienen realmente. Una auditoría de rendimiento muestra si JavaScript retrasa la interacción, si las fuentes llegan tarde o si las imágenes se cargan innecesariamente pronto. Complementen las mediciones de laboratorio con datos de visitantes reales si el tráfico lo permite. Esto evita optimizar para un perfil de prueba que no refleja a su público objetivo real.

Fijen un objetivo claro antes de cada cambio. Por ejemplo: el contenido principal visible debería aparecer en un dispositivo móvil medio en menos de 2,5 segundos, o el formulario de contacto debería ser utilizable sin retraso al escribir. No todas las páginas requieren una puntuación teórica perfecta. Una aplicación compleja con datos autenticados tiene requisitos distintos a los de un sitio corporativo público. Una fiabilidad aburrida pero demostrable vale aquí más que una puntuación a corto plazo lograda con trucos arriesgados.

1. Tratar las imágenes según su propósito

En muchas páginas móviles, las imágenes siguen siendo el mayor bloque de datos. El problema no es la foto en sí, sino una imagen transmitida a 2.500 píxeles de ancho cuando el dispositivo solo requiere 700 píxeles. Proporcionen variantes de imagen responsivas para que el navegador pueda elegir el tamaño adecuado. Formatos modernos como WebP o AVIF suelen reducir significativamente el tamaño de archivo, aunque deben desplegarse con alternativas limpias y calidad de imagen verificada.

La imagen más grande en el viewport inicial visible merece especial atención. Debería estar correctamente recortada, tener una resolución adecuada y cargarse pronto. Las imágenes más abajo en la página pueden cargarse de forma diferida. Esto ahorra datos al entrar, pero no debe hacer que las imágenes aparezcan de forma visible al hacer scroll cuando el usuario ya las espera.

No descarten todas las imágenes por reflejo. Una buena imagen puede explicar una máquina, un equipo o un proceso más rápido que un párrafo de texto. La tarea técnica es entregar información visual relevante de forma eficiente, no reducir el diseño a recuadros grises de relleno.

2. Limitar JavaScript al trabajo necesario

Cada script compite por el tiempo de procesamiento durante la carga y la interacción. Son especialmente problemáticas las bibliotecas integradas de forma genérica, los gestores de etiquetas con muchos scripts de terceros, los widgets de chat, los mapas y las animaciones. En dispositivos de escritorio, estos costes suelen pasar desapercibidos. En móvil, resultan en una página visible pero que reacciona con lentitud a las entradas.

Verifiquen para cada script su propósito, su condición de carga y su valor de negocio. Un mapa interactivo en la página de contacto no necesita cargarse en cada subpágina. Una herramienta de cookies o análisis no debería desencadenar una cadena de archivos adicionales antes de que el visitante siquiera pueda leer el contenido. Las funciones necesarias solo tras la interacción pueden cargarse bajo demanda.

Para los sitios desarrollados a medida, una estructura de componentes clara es una ventaja real. JavaScript se agrupa por función en lugar de entregarse como un paquete global. Esto también facilita el mantenimiento posterior: ampliar un formulario no altera accidentalmente el código de un filtro de productos o de una navegación.

3. Entregar CSS y fuentes sin bloqueos

Un cuello de botella frecuente está en la zona visible inicial. Si para ella deben cargarse varias hojas de estilo, fuentes de iconos y variantes de fuentes externas, el navegador espera innecesariamente mucho. Los estilos críticos para la sección visible deberían ser pequeños y estar disponibles pronto. Las reglas no críticas pueden seguir después.

En las fuentes web, normalmente bastan pocos pesos. Cuatro pesos en normal, cursiva y subconjuntos adicionales parecen completos en un sistema de diseño, pero rara vez son necesarios para un sitio corporativo típico. Definan alternativas de sistema sensatas para que el texto siga siendo legible de inmediato. Una fuente que cambia limpiamente unos milisegundos después es mejor que bloques de texto vacíos.

Los iconos también merecen una revisión. Un pequeño conjunto SVG suele ser más eficiente y controlable con precisión que una fuente de iconos completa. Esta regla admite excepciones: los sistemas existentes no necesitan reconstruirse solo por unos pocos kilobytes. Pero si de todos modos se planean cambios mayores, esta decisión pertenece a la base técnica.

4. Configurar el caché y la respuesta del servidor de forma limpia

Incluso una interfaz ligera se siente lenta si el servidor tarda demasiado en dar la primera respuesta. Las causas van desde consultas de base de datos sin optimizar, pasando por páginas compuestas dinámicamente, hasta la falta de caché. El contenido público que cambia poco debería poder entregarse rápidamente como versión en caché. Los archivos estáticos como imágenes, CSS y JavaScript requieren nombres de versión únicos y reglas de caché sensatas.

En las aplicaciones PHP, esto además implica una ejecución eficiente, una caché de opcode correctamente configurada y accesos controlados a la base de datos. Las consultas MySQL necesitan índices que coincidan con los caminos reales de filtrado y ordenación. Una página de inicio que ejecuta varias consultas de datos redundantes en cada solicitud no mejorará con el crecimiento del tráfico.

Sin embargo, el caché no es un cheque en blanco. Los precios, disponibilidades, secciones personalizadas o contenido tras iniciar sesión nunca deben parecer desactualizados por error. Por eso los límites del caché se definen con precisión: ¿qué puede tener cinco minutos de antigüedad, qué debe estar inmediatamente actualizado, y quién vacía el caché tras una modificación de contenido? De esta precisión surge un buen rendimiento.

5. Tratar a los proveedores externos con espíritu crítico

Los servicios externos suelen ser el lastre invisible de un sitio web. Analítica, gestión de consentimiento, vídeos, mapas, widgets de reseñas y píxeles de marketing cargan scripts adicionales desde servidores externos. Cada dependencia puede causar retrasos, plantear cuestiones de privacidad y perjudicar la representación visual en caso de error.

Esto no significa que haya que eliminar cada herramienta externa. Un vídeo puede apoyar las ventas, una herramienta de análisis puede fundamentar decisiones importantes. Pero se necesita un análisis de coste-beneficio. Carguen los medios incrustados solo tras el consentimiento o la interacción. Usen inicialmente un marcador de posición para los mapas. Y, finalmente, eliminen las etiquetas cuyos datos nadie evalúa desde hace meses.

6. Tener en cuenta los saltos de diseño y la usabilidad móvil

La velocidad de carga y la usabilidad van de la mano. Reserven dimensiones fijas para imágenes, banners y elementos incrustados para que los botones no se muevan bajo el dedo del usuario. Eviten los pop-ups que cubren el contenido visible justo al entrar. Una página rápida que muestra de inmediato una superposición difícil de cerrar no resuelve el problema de fondo.

Prueben los formularios con especial cuidado. Campos de entrada grandes, tipos de teclado adecuados y recorridos obligatorios cortos ayudan más que un efecto visual elaborado. Si una solicitud solo requiere nombre, número de devolución de llamada y motivo, un formulario de doce partes no es señal de minuciosidad: es fricción.

7. Gestionar el rendimiento como un proceso operativo permanente

Un relanzamiento único no mantiene el tiempo de carga bajo de forma permanente. Nuevas imágenes de campaña, requisitos de seguimiento y módulos editoriales se van acumulando con el tiempo. Por eso los presupuestos de rendimiento pertenecen al proceso de desarrollo: un tamaño máximo para las imágenes de entrada, reglas claras para nuevas herramientas de terceros y límites definidos para JavaScript.

Después de cada lanzamiento, deberían reevaluarse los tipos de página principales. Las pruebas automatizadas pueden determinar si las páginas centrales siguen siendo accesibles y si los flujos críticos funcionan correctamente. Sin embargo, para el rendimiento, una prueba puramente funcional no es suficiente. Complétenla con mediciones del tiempo de respuesta, el volumen de datos transferidos y la interactividad móvil.

Un sitio móvil rápido no surge de un único plugin, ni de renunciar a todo a cualquier precio. Surge cuando el diseño, el contenido, la infraestructura y el uso real se consideran juntos. Empiecen por la página que genera solicitudes o contactos operativos, midan en condiciones honestas y eliminen la fricción allí donde los usuarios realmente la sienten.

Enlace permanente →

Software logístico que realmente alivia las operaciones

Software logístico que realmente alivia las operaciones

Cuando una recepción de mercancía se anota primero en papel, luego se traslada a una hoja de cálculo y finalmente se comunica a expediciones de palabra, rara vez es la dedicación de los empleados lo que falta. Lo que falta es una base de trabajo compartida y fiable. Un buen software logístico no sustituye estas fracturas con más trabajo en pantalla, sino con flujos de trabajo claros: qué ha llegado, dónde se encuentra, qué se ha reservado y qué se puede enviar hoy.

Para las pequeñas y medianas empresas, no importa la lista más larga posible de funciones. El factor decisivo es que el software refleje el trabajo real en el suelo del almacén, en la oficina y en expediciones. Una solución pensada para una multinacional con veinte sedes puede resultar innecesariamente lenta, cara y complicada para una operación con un almacén y dos turnos.

Cuándo tiene sentido de verdad un software logístico

Las hojas de cálculo no son fundamentalmente un problema. Para cantidades bajas, una lista maestra de artículos manejable y un único empleado responsable, pueden ser la solución más pragmática. Sería un error sustituir un proceso funcional por un proyecto solo por el gusto de modernizar. El punto de inflexión llega cuando la información debe mantenerse varias veces o nadie puede decir con certeza qué archivo está actualizado. Las señales típicas son la escasez de existencias a pesar de estanterías llenas, consultas sobre el estado de las entregas, albaranes escritos a mano y recuentos de inventario que paralizan la operación durante días. El número creciente de pedidos también hace visible qué pasos se sostenían antes solo por la experiencia de personas concretas.

Entonces no se trata principalmente de digitalización como palabra de moda. Se trata de fuentes de error y tiempos de espera. Un empleado no debería tener que comparar varias listas solo para aprobar un pedido. Expediciones no debería tener que adivinar si un artículo está realmente disponible o ya reservado para otro pedido.

Qué procesos debería conectar el software logístico

Una solución utilizable empieza por el flujo de material, no por un menú estándar. Para muchas empresas, este flujo abarca recepción de mercancía, ubicación, gestión de inventario, picking de pedidos, expedición y retroalimentación. Según el negocio, se añaden lotes, números de serie, devoluciones, órdenes de fabricación o planificación de rutas.

Recepción de mercancía con inventarios trazables

Mucho se decide en la recepción de mercancía. Si una entrega se comprueba directamente contra un pedido o albarán, las discrepancias de cantidad, la mercancía dañada y las posiciones faltantes pueden registrarse justo donde ocurren. La mercancía recibe un estado en lugar de simplemente ser aparcada físicamente en algún lugar.

El software no tiene por qué empezar necesariamente con hardware de escaneo costoso. En algunos almacenes, una tableta o un puesto de trabajo en la zona de recepción de mercancía basta para empezar. Sin embargo, donde muchas posiciones se mueven a diario, los escáneres de código de barras son sensatos porque aceleran los registros y reducen los errores de tecleo. La decisión correcta depende de las cantidades, los trayectos y la estructura de los artículos.

Movimientos de almacén sin un registro histórico

Los inventarios solo son resilientes si las recepciones, reubicaciones, retiradas y correcciones son trazables. Esto no significa que deba evitarse toda excepción. En la operativa diaria hay embalajes dañados, ubicaciones incorrectas y retiradas espontáneas de material. Una buena aplicación hace que estos casos sean registrables, pero también documenta quién cambió qué y cuándo.

Este historial no es un instrumento de control por sí mismo. Ayuda a encontrar causas. Si un artículo acaba repetidamente en la ubicación de almacén equivocada, puede que el etiquetado del almacén no sea claro. Si se producen correcciones regulares, el problema suele estar en el proceso previo al registro.

Pedidos, albaranes y expedición desde un único flujo de trabajo

Muchos equipos pierden tiempo en la interfaz entre el procesamiento de pedidos y la expedición. Los datos del pedido llegan por correo electrónico, teléfono o desde un sistema de tienda independiente. Después, las posiciones se imprimen, se comprueban los inventarios y se registran de nuevo los documentos de envío. Cada traspaso manual crea margen para discrepancias.

El software logístico debería poder generar una lista de picking clara, un albarán y, si es necesario, una etiqueta de envío a partir de un pedido aprobado. Aquí el orden es importante: primero debe estar claro qué es entregable. Después, el pedido debería reservarse para otros procesos. De lo contrario, surge la desagradable situación en la que dos empleados asignan el mismo inventario restante.

Una planificación que se ajusta a la realidad

La planificación de rutas y el control de capacidad pueden ser valiosos, especialmente con reparto propio, franjas horarias fijas o muchas paradas regionales. Sin embargo, no son automáticamente el siguiente paso sensato. Quien todavía no tenga una aprobación de pedidos limpia y datos de inventario fiables debería resolver primero esos fundamentos.

Lo mismo se aplica a las previsiones y a la planificación asistida por IA. Pueden hacer visibles los patrones, pero requieren datos de entrada limpios. Una previsión basada en un inventario incompleto parece técnicamente sofisticada, pero no mejora la capacidad de entrega.

¿Solución estándar o software logístico a medida?

El software estándar es sensato cuando los propios flujos de trabajo son en gran medida convencionales y pueden adaptarse sin gran fricción. Puede implementarse más rápido y aporta funciones básicas ya probadas. Para una operación con procesos de almacén sencillos, roles claros y pocas particularidades, esa suele ser la opción económicamente correcta.

Un software logístico a medida merece la pena cuando el negocio vive de flujos de trabajo especiales o los sistemas existentes solo pueden conectarse mediante rodeos. Esto afecta, por ejemplo, a talleres con incidencias de material en pedidos en curso, distribuidores con reglas de envío específicas por cliente, o fabricantes que deben vincular estrechamente los movimientos de almacén con los pasos de producción.

La diferencia no está en reinventarlo todo. Los buenos sistemas a medida adoptan patrones probados como cambios de estado, reservas y permisos. Sin embargo, adaptan el lenguaje, las pantallas, los documentos y las interfaces al trabajo que realmente se realiza. Así, el equipo no tiene que orientarse permanentemente hacia categorías que solo tienen sentido en el manual del fabricante.

En softify.pro, un proyecto de este tipo comienza, por tanto, con la pregunta de qué flujos de trabajo deben preservarse. No todo papel es un error, y no toda regla especial tiene sentido. Solo cuando está claro dónde se pierde información o dónde las decisiones esperan innecesariamente se puede planificar una solución viable.

Un despliegue sin interrupción operativa

El mayor riesgo rara vez está solo en el código del programa. Está en una implementación que quiere cambiar demasiado de golpe. Un almacén no puede detenerse durante dos semanas para aprender un nuevo sistema. Por eso, un despliegue paso a paso suele ser más sensato que una gran fecha de cambio.

Un buen primer tramo se centra en un flujo de trabajo delimitado, por ejemplo, la recepción de mercancía y los registros de inventario o la creación de albaranes. El equipo trabaja con datos reales, la retroalimentación fluye directamente hacia la adaptación, y el beneficio se vuelve medible. Solo entonces siguen otras áreas, como el picking móvil, las devoluciones o las conexiones con tiendas y transportistas.

La migración de datos merece especial atención aquí. Los números de artículo antiguos, los datos maestros de clientes duplicados y las ubicaciones de almacén incoherentes no desaparecen automáticamente solo porque se introduzca un nuevo sistema. A menudo es mejor limpiar deliberadamente los datos maestros y adoptar solo los historiales relevantes. Esto ahorra búsquedas posteriores y evita que el viejo desorden se conserve técnicamente.

Los permisos también pertenecen pronto a la agenda. No todo empleado necesita acceso a precios, a todas las correcciones de inventario o al mantenimiento de datos maestros. Los roles claros protegen contra modificaciones accidentales y hacen visibles las responsabilidades sin bloquear el flujo de trabajo con aprobaciones innecesarias.

Una tecnología que no se convierte en una carga tras la puesta en marcha

Una aplicación logística debe reaccionar rápido en la operativa diaria, incluso si varios puestos registran simultáneamente. Para ello necesita una arquitectura de datos trazable, transacciones limpias y reglas claras para modificaciones paralelas. Si dos empleados procesan el mismo inventario, el sistema no debe generar registros erróneos silenciosos.

La mantenibilidad es igual de importante. Tecnologías como PHP 8.4, JavaScript moderno y MySQL 8 no son un argumento de venta en sí mismas. Son sensatas cuando la aplicación sigue siendo comprensible a largo plazo, recibe actualizaciones de seguridad y puede ser continuada por desarrolladores cualificados. El aprovisionamiento documentado, las copias de seguridad, el registro y una gestión realista de las actualizaciones forman parte de la capacidad operativa.

Un buen software logístico, por tanto, no se reconoce por una demo especialmente vistosa. Se demuestra en un martes por la mañana normal: la entrega se registra, el inventario es correcto, el pedido es trazable, el albarán coincide y el siguiente turno sabe qué se ha hecho ya. El alivio surge precisamente ahí — no a través de tantas funciones como sea posible, sino a través de flujos de trabajo fiables que encajan con la operación.

Enlace permanente →

Planificar una base de datos MySQL para aplicaciones web

Planificar una base de datos MySQL para aplicaciones web

Cuando tres empleados reservan mercancía en paralelo por la mañana, un cliente comprueba el estado de su entrega y la administración emite una factura, la calidad de una aplicación no se ve en su diseño. Se demuestra en que todos vean exactamente el mismo estado correcto de los datos. Planificar una base de datos MySQL para una aplicación web no significa, por tanto, crear tablas lo más rápido posible. Significa entender los flujos de trabajo reales con suficiente precisión para garantizar que los datos sigan siendo fiables incluso bajo carga, durante errores, y a medida que el negocio crece.

Especialmente en plataformas internas, procesos de almacén y pedidos, o portales orientados al cliente, la base de datos suele abordarse demasiado tarde. Primero se construye la interfaz, luego se añaden campos, seguidos de excepciones. Eso funciona para un prototipo. En producción, esto se traduce en conjuntos de datos duplicados, estados poco claros e informes en los que ya nadie confía del todo.

Planificar una base de datos MySQL para aplicaciones web: empezar por el flujo de trabajo

El primer borrador no debería empezar por los nombres de columna, sino por una situación de trabajo concreta. Tomemos la recepción de mercancía: llega una entrega, se asigna a un proveedor y a un pedido, se comprueban las cantidades, se asigna una ubicación de almacén y el stock cambia. Según la operación, este proceso requiere además fotos, una inspección de calidad, un estado de bloqueo o una corrección trazable. De este flujo de trabajo surgen los objetos funcionales. Ejemplos típicos son artículos, proveedores, pedidos, posiciones, ubicaciones de almacén, movimientos de inventario y usuarios.

La distinción entre un objeto y un evento es crucial. Un artículo describe qué es algo. Un movimiento de inventario documenta que una cantidad cambió en una ubicación específica en un momento específico. Mezclar ambos en una sola tabla lleva rápidamente a una pérdida de trazabilidad.

Algunas preguntas difíciles ayudan para cada objeto: ¿cuál es la identidad única? ¿Qué información puede cambiar? ¿Quién puede modificarla? ¿Qué datos deben conservarse históricamente? ¿Y qué reglas se aplican cuando dos personas trabajan simultáneamente? Estas preguntas previenen la improvisación posterior mejor que una larga lista de campos de base de datos supuestamente completa.

El modelo de datos debe expresar reglas

Una base de datos no es simplemente un almacén para las entradas de formularios. Debería hacer cumplir reglas centrales por sí misma. Si cada movimiento de inventario debe pertenecer exactamente a un artículo y una ubicación de almacén, las claves foráneas tienen su lugar en el modelo. Si un número de pedido externo solo puede aparecer una vez por tenant, se necesita un índice único. Si una posición nunca debería existir sin un pedido de cabecera, esta relación debe modelarse con claridad.

MySQL 8 con InnoDB ofrece bases sólidas para esto: transacciones, claves foráneas, mecanismos de bloqueo y cambios coherentes en múltiples tablas. Al escribir un movimiento, el inventario actual y el registro de inspección durante un registro de recepción de mercancía, esto debería ocurrir como una transacción cohesiva. Si un paso falla, no debe quedar ninguna operación a medio terminar.

Sin embargo, no todas las reglas pertenecen a la base de datos. Las aprobaciones, la lógica de precios compleja o los pasos de proceso dependientes de rol a menudo se ubican mejor en la lógica de la aplicación porque cambian más rápido funcionalmente. El límite es pragmático: las reglas cuya violación daña los datos de forma permanente deberían protegerse lo más cerca posible de los datos. Las reglas que cambian con frecuencia o dependen fuertemente del contexto requieren código de aplicación bien probado.

No confundir el historial con los valores actuales

Un error común es almacenar solo el inventario actual o el estado actual. Eso basta hasta que alguien pregunta por qué cambió la cantidad ayer o quién restableció un pedido. Para los sistemas operativos, un historial de movimientos o eventos suele ser más valioso que un único campo sobrescribible.

Esto no significa registrar permanentemente cada movimiento de clic. Deberían registrarse los cambios relevantes para el negocio: cambios de estado, modificaciones de cantidad, correcciones, aprobaciones y asignaciones. Una buena entrada de auditoría contiene una marca de tiempo, el usuario o proceso del sistema, el valor anterior y el nuevo, y una razón comprensible cuando el flujo de trabajo lo exige. Esto permite aclarar errores sin tener que buscar en correos electrónicos, listas en papel o copias de seguridad de la base de datos.

Elegir con criterio las claves, tipos de datos y convenciones de nomenclatura

Las decisiones técnicas parecen pequeñas, pero condicionan el mantenimiento y las integraciones durante años. Para claves primarias internas, los valores BIGINT con asignación automática suelen ser una opción sobria y fácilmente manejable. Los UUID pueden tener sentido cuando los datos se originan sin conexión, varios sistemas escriben de forma independiente, o las interfaces externas no deberían exponer IDs secuenciales. Sin embargo, cuestan más almacenamiento y requieren algo más de atención con índices y ordenación.

Los importes monetarios deben almacenarse como DECIMAL, no como FLOAT o DOUBLE. Las cantidades también necesitan una precisión funcionalmente adecuada: los recuentos de artículos suelen ser enteros, mientras que los pesos y longitudes no lo son. Las marcas de tiempo deberían gestionarse de forma uniforme, idealmente internamente en UTC, mientras que la interfaz muestra la zona horaria local de la operación. Especialmente durante los cambios de turno y el horario de verano, esto evita discrepancias difíciles de detectar.

Los nombres también deberían ser aburridos e inequívocos. order_items o inventory_movements son más útiles que abreviaturas creativas que solo entiende el equipo de proyecto original. Las formas singular o plural coherentes son menos importantes que la coherencia en sí. Igual de sensatos son campos como created_at, updated_at y, cuando se necesite, deleted_at. Sin embargo, un borrado suave no es una obligación estándar. Para registros relevantes legal u operativamente, una anulación limpia suele ser mejor que un conjunto de datos eliminado de forma invisible.

Los índices siguen las consultas reales, no las suposiciones

Un índice puede acelerar enormemente una búsqueda, pero hace más complejas las operaciones de escritura y consume espacio de almacenamiento. Por eso, "un índice en cada campo" no es una estrategia. Las consultas más importantes deberían establecerse pronto: pedidos abiertos de un cliente, movimientos de un artículo en un período, inventario por ubicación de almacén, o registros modificados recientemente para una interfaz.

El orden de los índices compuestos importa aquí. Si la aplicación busca regularmente por tenant_id, status y created_at, un índice compuesto en este orden exacto suele ser sensato. Si realmente encaja lo muestra el plan de ejecución mediante EXPLAIN, no la intuición. Las bases de datos no se vuelven rápidas por trucos espectaculares, sino por consultas observables, índices adecuados y volúmenes de datos probados de forma realista.

Para las tablas en crecimiento, merece la pena tener una estrategia de retención clara. ¿Necesitan los registros técnicos permanecer en la base de datos de producción principal durante cinco años? No necesariamente. Los registros de negocio, los movimientos y las pruebas de inspección requieren períodos de retención distintos de la información de depuración. Archivar no es señal de un sistema débil, sino una decisión operativa deliberada.

El funcionamiento multiusuario requiere transacciones y estados claros

En una aplicación web, varias solicitudes acceden simultáneamente a los mismos datos. Esto es normal en las operaciones diarias de almacén, no una excepción. Dos empleados pueden reservar el mismo inventario mientras una importación crea nuevos pedidos. Sin transacciones y bloqueo específico, existe el riesgo de modificaciones perdidas o inventarios negativos que solo se hacen evidentes semanas después.

Para las operaciones críticas, debería estar claro qué datos se leen y escriben dentro de una transacción. A veces basta con una actualización atómica, como un inventario que solo cambia si la cantidad disponible es suficiente. En otros casos, un bloqueo de fila es sensato para que una operación pueda comprobar el estado de los datos de forma controlada y modificarlo después. Las transacciones largas, en cambio, son problemáticas: bloquean otro trabajo y aumentan el riesgo de conflictos.

Igual de importante es un conjunto limitado de estados funcionales. Un pedido no debería estar "abierto", "parcialmente entregado" y "procesado manualmente" al mismo tiempo debido al mantenimiento de campos contradictorios. Las transiciones de estado definidas simplifican las interfaces, los informes y las automatizaciones. Se pueden permitir excepciones, pero deberían nombrarse y documentarse.

Planificar seguridad, tenants y operaciones desde el principio

La aplicación debería usar un usuario de base de datos dedicado para MySQL con privilegios mínimos. El acceso de escritura para la aplicación web no significa que este usuario necesite eliminar tablas o modificar privilegios de usuario. Las cuentas administrativas no tienen cabida en los archivos de configuración de producción y nunca en un repositorio.

Cuando varios clientes, ubicaciones o empresas trabajan dentro de una aplicación, el aislamiento de tenants es una decisión arquitectónica, no una condición de filtro retroactiva. Una base de datos compartida con un tenant_id puede ser eficiente y fácil de mantener, pero exige comprobaciones coherentes en cada consulta y reglas claras para los índices. Las bases de datos separadas ofrecen un aislamiento más fuerte, pero aumentan el esfuerzo en actualizaciones, evaluaciones y operaciones. Qué variante encaja depende de los requisitos de privacidad de datos, el volumen de datos y el modelo de negocio.

Las copias de seguridad solo son copias de seguridad una vez que se ha probado una restauración. Se requiere un ritmo definido para copias de seguridad, retención y recuperación. Asimismo, la supervisión del espacio de almacenamiento, las consultas lentas y los trabajos fallidos, junto con actualizaciones documentadas, pertenecen al sistema. MySQL 8, PHP 8.4, y las aplicaciones web modernas pueden operarse bien a largo plazo si las dependencias, las credenciales de acceso y los pasos de despliegue no residen únicamente en la cabeza de un desarrollador.

Un plan sensato antes del primer día en producción

Antes de la implementación debería existir un modelo de datos compacto con flujos de trabajo de ejemplo. Esto incluye tablas y relaciones clave, reglas de estado, permisos, consultas esperadas, interfaces, y un concepto para copias de seguridad y registros de auditoría. Este plan no necesita tener cien páginas. Debe capturar decisiones que después resultarían costosas de corregir.

En softify.pro, la planificación de la base de datos comienza, por tanto, con las personas que reservan, comprueban, recogen o resuelven excepciones. Si una hoja de cálculo existente representa de forma fiable un proceso manejable, puede seguir siendo la solución correcta. Si varias personas trabajan simultáneamente, surgen registros y los errores deben ser trazables, la base de datos merece en cambio el mismo esfuerzo de planificación que la interfaz. La mejor arquitectura, al final, es la que simplifica el día a día laboral y que aún puede modificarse de forma transparente dentro de dos años.

Enlace permanente →

Cómo medir correctamente los Warehouse Automation Results

Cómo medir correctamente los Warehouse Automation Results

Una nueva interfaz de escaneo puede resultar impresionante el primer día. Sin embargo, tras tres semanas se ve con claridad si realmente acelera la recepción de mercancía o si simplemente crea un paso de trabajo adicional. Los Warehouse automation results no son, por tanto, una única métrica ni una captura de pantalla de una demo de producto. Se manifiestan allí donde un equipo de almacén tiene que buscar, preguntar, reintroducir datos y corregir menos, manteniendo o mejorando la calidad.

Para las pequeñas y medianas empresas, esta distinción es especialmente relevante. Las grandes suites empresariales suelen prometer una optimización integral, pero exigen implementaciones largas, procesos rígidos y mucho mantenimiento. Un paso de automatización sensato puede empezar más pequeño: precisamente en el punto donde hoy se pierde información o las decisiones esperan innecesariamente.

Qué Warehouse Automation Results cuentan realmente

Muchos proyectos parten de una pregunta técnica: ¿escáner de códigos de barras, app móvil, interfaz con la tienda o etiquetas automáticas? La mejor pregunta de partida es: ¿qué cuello de botella cuesta sensiblemente tiempo, dinero o fiabilidad por turno?

La respuesta rara vez está en el número de dispositivos desplegados. Los resultados significativos se miden en el trabajo diario. En la recepción de mercancía, por ejemplo, cuenta el tiempo entre la entrega y la disponibilidad del stock registrado. En el picking, es relevante el tiempo desde el pedido hasta estar listo para el envío. En los inventarios, no solo importa la duración, sino sobre todo la diferencia entre el stock del sistema y el stock real.

Igual de importantes son los indicadores que muchas operaciones no registran de forma limpia: ¿cuántas consultas surgen porque una ubicación de almacén no está clara? ¿Con qué frecuencia hay que corregir un albarán? ¿Cuántos pedidos quedan sin procesar porque solo una persona conoce el estado de memoria o en una hoja de cálculo privada? Precisamente este retrabajo silencioso desaparece de los informes clásicos de productividad, pero recae con fuerza sobre jefes de turno, planificación y atención al cliente. Una buena imagen objetivo combina velocidad y control. Si los pedidos se procesan más rápido pero aumentan los registros incorrectos, eso no es progreso. Si los inventarios se vuelven más precisos pero la recepción se satura, el proceso debe rediseñarse. La automatización tiene éxito cuando mejora el flujo de trabajo sin deteriorar la visión operativa de conjunto.

Del alivio percibido a los datos verificables

La experiencia de los empleados es un indicador valioso. Cuando alguien dice, tras dos semanas, que ya no tiene que correr a la oficina por cada ubicación, eso importa. Para las decisiones de inversión, sin embargo, sigue haciendo falta una comparación independiente de la sensación diaria. Antes del lanzamiento conviene, por tanto, registrar algunos valores de referencia: tiempo medio de procesamiento, número de casos de aclaración abiertos, registros de corrección, tiempos de búsqueda, errores de envío y precisión del inventario. No hacen falta veinte indicadores; a menudo bastan de cuatro a seis valores adaptados al problema concreto.

Tras el despliegue, esos mismos valores deben observarse durante varias semanas. Días puntuales de pico inducen fácilmente a error. La estacionalidad, las bajas, los nuevos empleados o un pedido inusualmente grande influyen en los resultados. Solo una comparación a lo largo de turnos normales muestra si el cambio es sólido.

El efecto más importante: un estado de proceso compartido

En muchos almacenes, la verdadera debilidad no es la falta de disposición a trabajar, sino un estado de información fragmentado. Recepción conoce la entrega, planificación conoce el pedido del cliente y expediciones conoce la prioridad, pero no todos trabajan con la misma información actualizada.

Un sistema específico para el flujo de trabajo puede cerrar esta brecha. Una entrega se registra al llegar, las discrepancias se documentan directamente, el inventario recibe un estado claro y el siguiente paso se vuelve visible. Los datos ya no necesitan anotarse en papel, transferirse más tarde y confirmarse después por teléfono.

Esto no solo reduce los desplazamientos. Reduce las decisiones basadas en información obsoleta. Un empleado de expediciones ve si un pedido es realmente preparable. La administración reconoce si la mercancía ha llegado o solo ha sido anunciada. La dirección no recibe una instantánea maquillada, sino una base trazable.

Para equipos con turnos rotativos, este efecto suele ser más valioso que un ahorro de tiempo espectacular. El proceso depende menos de personas concretas. El conocimiento ya no queda atrapado en cuadernos, historiales de chat o la memoria del especialista más experimentado.

Por qué no toda automatización da buenos resultados

La automatización refuerza los procesos. Es útil cuando el flujo es claro. Es problemático cuando un flujo poco claro simplemente se reproduce más rápido.

Un ejemplo típico es el registro obligatorio por escaneo para cada mínima acción. Si los empleados tienen que abrir varias pantallas para una excepción poco frecuente, surgen soluciones alternativas. Los artículos se registran entonces en bloque más tarde, los escáneres se quedan en un cajón, o un empleado vuelve a llevar una lista paralela. El software está presente, pero el proceso real continúa junto a él.

La calidad de los datos también impone límites. Los datos maestros de artículos sin unidades claras, una lógica de ubicaciones poco definida o denominaciones de proveedores incoherentes no se arreglan con una interfaz vistosa. Aquí, un proyecto puede consistir inicialmente en trabajo de limpieza. Eso parece menos visible que una aplicación nueva, pero suele ser el requisito previo para resultados fiables.

Además, hay procesos que deliberadamente no deberían automatizarse por completo. Una inspección experta de mercancía sensible, la aprobación de discrepancias inusuales o la decisión sobre una entrega especial requieren criterio profesional. Los buenos sistemas marcan claramente estos casos y los derivan de forma específica. No fingen que toda excepción pueda resolverse con una regla.

Cuándo una hoja de cálculo sigue siendo la mejor solución

No todo paso manual justifica un desarrollo a medida. Si un proceso ocurre raramente, involucra a pocos participantes y se gestiona de forma trazable, una hoja de cálculo bien mantenida puede seguir siendo razonable. El defecto no está en Excel en sí, sino en gestionar movimientos críticos sin responsabilidad clara, control de versiones o registro oportuno.

En cuanto varias personas modifican en paralelo, los movimientos de inventario se vuelven críticos en el tiempo, o hay que consolidar información de clientes procedente de fuentes distintas, el riesgo aumenta notablemente. Un sistema compartido suele salir entonces más económico que corregir continuamente malentendidos.

Los Warehouse Automation Results requieren un despliegue controlado

El camino más rápido hacia malos resultados es una reforma completa durante la operativa en marcha. Es mejor un ámbito delimitado con beneficio medible: por ejemplo, recepción de mercancía para un grupo de productos, etiquetas de envío para una sede, o un registro móvil para los traslados más frecuentes.

Un piloto debería reflejar pedidos reales y turnos reales. Los datos de prueba ayudan en el desarrollo, pero no muestran si el Wi-Fi fluctúa en la zona trasera del almacén, si los guantes dificultan el manejo del escáner o si un estado está formulado de forma confusa para planificación. Estos detalles determinan la aceptación y la calidad de los datos.

Técnicamente, cuenta más una fiabilidad aburrida y demostrable que una pila tecnológica de moda. Permisos de rol claros, registros de operaciones trazables, indicaciones de error inequívocas, transacciones de base de datos estables y procesos documentados no son cuestiones secundarias. Convierten una aplicación en una herramienta en la que los equipos pueden confiar en el día a día.

Para los sistemas logísticos a medida, esto también significa: la integración debe encajar con la operativa existente. Una aplicación puede recibir pedidos de una tienda, generar albaranes, poner a disposición etiquetas de envío y documentar movimientos de inventario. No necesita sustituir de inmediato todos los sistemas colindantes. Precisamente en las pymes, una sustitución paso a paso suele ser menos arriesgada y más económica.

Cómo un proyecto se convierte en una mejora duradera

Tras la implantación empieza la fase decisiva. ¿Se registran los casos especiales? ¿Las ubicaciones de almacén siguen correspondiendo a la realidad? ¿Los nuevos empleados entienden la lógica de registro sin traducción verbal? ¿Y siguen siendo válidos los valores medidos cuando crece el volumen de pedidos?

Los comentarios cortos y periódicos de almacén, expediciones y administración son más eficaces para esto que un gran taller anual. Cuando se hace visible una excepción recurrente, debería representarse como un paso de proceso claro o eliminarse deliberadamente del flujo estándar. Ambas opciones son mejores que tolerarla en silencio.

El siguiente paso más sensato a menudo no es un gran pliego de condiciones. Tome un proceso con consultas frecuentes y mida durante una semana dónde se pierde tiempo. Si de ahí surge un flujo claro y repetible, la automatización puede combinarse con un resultado tan convincente en el suelo del almacén como en la evaluación mensual.

Enlace permanente →

Desarrollo web moderno que funciona en la operativa: arquitecturas pragmáticas para pequeñas y medianas empresas — con código mantenible, almacenamiento de datos sólido y sin sobrecarga innecesaria de herramientas.

Desarrollo web moderno que funciona en la operativa: arquitecturas pragmáticas para pequeñas y medianas empresas — con código mantenible, almacenamiento de datos sólido y sin sobrecarga innecesaria de herramientas.

Un jefe de almacén imprime albaranes por la mañana mientras una colega corrige el inventario en una hoja de cálculo, y ventas llama para preguntar sobre el estado de un pedido. El problema rara vez es la falta de digitalización. La mayoría de las veces hay demasiadas herramientas desconectadas entre sí. El desarrollo web moderno entonces no crea simplemente una interfaz más bonita, sino una base de trabajo compartida y fiable.

Para las pequeñas y medianas empresas, esto significa: una aplicación web debe funcionar bajo presión de tiempo, en un escáner en el almacén tanto como en una pantalla en la oficina. Debe almacenar datos de forma rastreable, gestionar permisos limpiamente y permitir un mayor desarrollo sin convertirse en un riesgo con cada modificación. La tecnología no es aquí un fin en sí mismo. Es la base para que los procesos funcionen más rápido y permanezcan al mismo tiempo mejor controlables.

El desarrollo web moderno comienza antes del primer código

Quien comienza con un catálogo de funciones predefinido a menudo construye pasando por alto el verdadero cuello de botella. En la práctica, vale la pena un enfoque diferente: ¿qué información falta regularmente hoy? ¿Dónde ocurren entradas duplicadas? ¿En qué punto se aseguran las decisiones por teléfono o verbalmente porque nadie ve de forma fiable el estado actual?

En la recepción de mercancías, esto puede manifestarse por ejemplo como descripciones de artículos inconsistentes, instrucciones de inspección faltantes, o inventarios actualizados con retraso. En el procesamiento de pedidos, a menudo son notas manuscritas, aprobaciones poco claras y datos de envío mantenidos en múltiples sistemas. Una buena aplicación no solo digitaliza estas entregas. Las organiza de manera que las responsabilidades, estados y próximos pasos sean visibles.

Esto también significa no abolir reflexivamente las prácticas existentes. Una hoja de cálculo bien mantenida puede seguir siendo la solución más sensata para una pequeña evaluación. Una aplicación web personalizada vale la pena donde varias personas trabajan simultáneamente, los errores surgen de la transcripción manual, o un proceso necesita documentarse y ser repetible.

Lo que una aplicación web moderna debe lograr en el día a día

Una interfaz de usuario convincente es valiosa, pero es solo una parte del trabajo. En la operativa continua cuentan sobre todo los tiempos de respuesta, los flujos de trabajo comprensibles y los datos resilientes. Cuando un preparador de pedidos completa una tarea, el estado no debe hacerse visible solo después de varias actualizaciones. Cuando se modifica un pedido, debe ser rastreable qué se cambió y qué pasos posteriores se ven afectados. Esto incluye tres capas estrechamente conectadas: la interfaz de usuario, la lógica de aplicación y la base de datos. La interfaz guía a las personas a través del proceso. La lógica verifica, por ejemplo, campos obligatorios, permisos o cantidades disponibles. La base de datos almacena los hechos de manera que las evaluaciones, correcciones y ampliaciones sigan siendo posibles más adelante.

Para muchas aplicaciones empresariales, las tecnologías probadas son una elección más sensata que una tendencia efímera. PHP 8.4 puede ofrecer una lógica de servidor claramente estructurada, JavaScript moderno una experiencia de usuario receptiva, y MySQL 8 una base de datos sólida. El factor decisivo no es que cada proyecto use la misma pila. La clave es que la tecnología elegida se adapte al problema, la operativa y el mantenimiento a largo plazo.

El rendimiento es una cuestión de proceso

El rendimiento se reduce frecuentemente a los tiempos de carga. Eso es insuficiente. Una aplicación también se siente lenta cuando los empleados ejecutan demasiados pasos, buscan información, o tienen que introducir el mismo dato varias veces. Una página rápida con un formulario engorroso sigue siendo un mal proceso.

Una optimización sensata comienza por tanto con las operaciones más frecuentes. ¿Qué pantallas se abren cien veces al día? ¿Qué búsqueda debe permanecer rápida incluso con un volumen de datos creciente? ¿Qué datos deberían guardarse en segundo plano sin que los empleados esperen una confirmación? Solo después siguen detalles técnicos como índices de base de datos específicos, consultas reducidas y una entrega ligera de archivos en el navegador.

Modelo de datos y permisos: la arquitectura invisible

Muchos proyectos web no fallan en la primera versión, sino en adiciones posteriores. Un campo inicialmente simple como "Estado" se convierte de repente en una cadena de aprobación, inspección, procesamiento, cancelación y reprocesamiento. Si estos estados se almacenan solo de forma laxa en formularios, cada extensión se vuelve costosa y propensa a errores.

Un modelo de datos limpio separa por tanto procesos, posiciones, contactos, documentos y cambios de estado de forma rastreable. Previene entradas contradictorias en lugar de tener que limpiarlas laboriosamente después. Precisamente en los movimientos de almacén, albaranes o datos de pedidos, esta precisión no es un ejercicio académico. Determina si la cifra de inventario sirve como base de trabajo.

Los roles y permisos son igualmente importantes. No cada persona necesita acceso a precios, información de personal o configuraciones administrativas. Los buenos conceptos de permisos son concretos: ¿quién puede crear un pedido, aprobarlo o cancelarlo? ¿Quién solo ve su propio departamento? A esto se añaden medidas de protección como almacenamiento seguro de contraseñas, bloqueos de cuenta tras intentos fallidos repetidos, registro de cambios críticos y sesiones claramente reguladas. La seguridad, por tanto, no es un añadido justo antes del lanzamiento. Pertenece a la arquitectura porque las correcciones posteriores a menudo intervienen profundamente en el inicio de sesión, el acceso a datos y el sistema de permisos.

Responsive no significa solo "se adapta al teléfono"

Una aplicación responsive se adapta a diferentes tamaños de pantalla. Para el trabajo diario, esta definición no es suficiente. En una tableta en el almacén se aplican requisitos diferentes que en una pantalla grande en la planificación. Las áreas táctiles deben ser operables de forma segura, los detalles importantes no deben desaparecer bajo información secundaria, y las entradas deben seguir siendo prácticas incluso con guantes, condiciones de iluminación cambiantes o conexión inestable.

En consecuencia, cada vista necesita una prioridad clara. En la recepción de mercancías, el escaneo y la confirmación pueden estar en el centro. En la oficina, los filtros, listas, funciones de exportación y vistas detalladas suelen ser más importantes. Una interfaz que se ve idéntica en todas partes no es automáticamente utilizable en todas partes.

El desarrollo web moderno requiere una operativa controlada

El lanzamiento no es un punto final, sino el comienzo de la prueba real. Solo con datos reales, excepciones y horas punta se revela si las reglas son comprensibles y si las interfaces funcionan de manera fiable. El aprovisionamiento documentado, entornos claramente separados para desarrollo y producción, así como copias de seguridad rastreables forman por tanto parte del proyecto, no una mera administración de TI.

Las pruebas automatizadas también logran mucho aquí. Vuelven a verificar flujos de trabajo recurrentes como inicio de sesión, verificaciones de permisos, entrada de pedidos o generación de documentos después de cada cambio. Para aplicaciones sensibles, un entorno de pruebas autoalojado puede ser sensato porque las capturas de pantalla, datos de prueba y pasos de aplicación internos permanecen dentro de la esfera de control propia de la empresa. La automatización no reemplaza la revisión experta de empleados experimentados. Sin embargo, asegura que los flujos de trabajo conocidos no se dañen silenciosamente.

En softify.pro, esta mentalidad es parte de la implementación: planificar con precisión técnica, tomar en serio los flujos de trabajo reales, y entregar cambios de manera que sigan siendo comprensibles más adelante. Esto es menos espectacular que un despliegue de fuegos artificiales tecnológicos, pero significativamente más valioso en la operativa.

Cuándo el software estándar es suficiente — y cuándo no

El software estándar es sensato cuando tu propio proceso coincide en gran medida con los flujos de trabajo estándar de la industria y la configuración sigue siendo manejable. Puede estar disponible rápidamente y aportar funciones básicas fiables. Se vuelve problemático cuando los equipos se ven obligados a doblar continuamente sus flujos de trabajo funcionales de formas incómodas o cuando información vital termina fuera del sistema.

Una solución personalizada no es automáticamente mejor. Requiere requisitos claros, contactos responsables, y la disposición para tomar decisiones. A cambio, puede mapear exactamente los pasos de trabajo que son críticos para la empresa: una inspección especializada de recepción de mercancías, la impresión de etiquetas de envío correspondientes, una aprobación basada en el grupo de clientes, o la conexión entre taller, almacén y ventas. La pregunta correcta, por tanto, no es: ¿necesitamos una aplicación a medida? Es: ¿qué fricción recurrente nos cuesta hoy tiempo, dinero o fiabilidad — y se puede eliminar permanentemente con un esfuerzo razonable?

Una buena aplicación web no hace que el trabajo sea artificialmente digital. Elimina entregas innecesarias, establece un estado de datos fiable, y da a las personas exactamente la información que necesitan para su próximo paso. Cuando esto tiene éxito, el desarrollo web moderno no se siente como un nuevo proyecto de TI, sino como una operativa que finalmente puede trabajar sin rodeos.

Enlace permanente →

Cómo implementar correctamente la digitalización de los albaranes de entrega

Cómo implementar correctamente la digitalización de los albaranes de entrega

Un conductor no espera porque un archivo Excel esté actualmente abierto por otra persona. Y en la recepción de mercancías, una pila de papel ordenada no sirve de nada si una entrega parcial ya no se puede rastrear después. Quien busca "cómo digitalizar los albaranes de entrega" rara vez quiere solo escanear papel. Lo que se busca es un flujo de trabajo resiliente que registre los movimientos de mercancías, las confirmaciones y las discrepancias justo donde ocurren.

Los albaranes digitales funcionan bien cuando simplifican el trabajo en el almacén, en el taller y con el cliente. Si se implementan solo como un archivo PDF, el esfuerzo permanece — solo en una pantalla en lugar de en papel. La diferencia decisiva radica en datos estructurados, responsabilidades claras y una conexión limpia con pedidos, inventario y facturas.

Cómo digitalizar los albaranes de entrega: revisar primero el flujo de trabajo

El primer paso no es la selección de software, sino una evaluación honesta del inventario. Toma un albarán real y sigue su camino: desde el pedido hasta la preparación, la entrega, la retroalimentación y el archivado. Esto suele revelar rápidamente dónde se añade información retroactivamente, se introduce dos veces, o se aclara por teléfono y chat.

En las pequeñas y medianas empresas, rara vez hay un solo flujo de trabajo. Una entrega estándar a clientes habituales requiere algo diferente a una entrega en obra, una recogida, o una entrega con devolución de embalajes vacíos. No es necesario automatizar todas estas diferencias en la versión uno. Sin embargo, deberían ser conocidas para que el nuevo sistema no falle en el primer caso especial.

Un buen proceso digital responde inequívocamente a tres preguntas para cada estado: ¿Quién movió la mercancía y cuándo? ¿Qué cantidades se entregaron realmente? ¿Y qué pasó en caso de discrepancias? Si falta esta información, un albarán digital es principalmente solo un documento más bonito.

No reproducir simplemente el papel como PDF

Escanear albaranes existentes puede ser útil como transición, por ejemplo para archivar procesos antiguos. Para el negocio operativo, sin embargo, resuelve poco. Una imagen o PDF se puede almacenar, pero cantidades, números de artículo, lotes y observaciones no se pueden reutilizar de forma fiable en él.

Un mejor enfoque es un documento generado a partir de datos de pedido estructurados. Se adoptan artículos, cantidades objetivo, direcciones de entrega y personas de contacto. Los empleados confirman entonces las cantidades reales directamente en un dispositivo móvil o en un puesto de trabajo en el almacén. Solo discrepancias, daños o posiciones adicionales necesitan introducirse manualmente.

Esto no solo ahorra tiempo. También evita una típica ruptura de medios: la contabilidad ya no recibe una firma apenas legible en papel mientras el almacén mantiene por separado el mismo proceso en una hoja de cálculo.

Los datos que realmente necesita un albarán digital

Un sistema no debería forzar cada campo imaginable. Las entradas adicionales ralentizan las entregas y reducen la aceptación. Al mismo tiempo, el nombre del cliente y la firma no son suficientes para muchos flujos de trabajo.

Como base, cada albarán necesita un número único, la referencia al pedido, direcciones de entrega y destinatario, posiciones de artículos con cantidades objetivo y reales, así como marcas de tiempo.

Dependiendo de la industria, se añaden lotes, números de serie, peso, ubicaciones de almacenamiento o contenedores. Para mercancías con control de temperatura, los valores medidos pueden ser relevantes; para entregas en obra, las fotos o indicaciones precisas del lugar de entrega son útiles.

El estado es particularmente importante. "Creado," "preparado," "en tránsito," "entregado," "entregado parcialmente," y "disputado" no son simples etiquetas. Determinan qué persona debe actuar a continuación y si, por ejemplo, se puede generar una factura o programar una entrega posterior.

Usar firmas y fotos con mesura

Una firma digital es útil en muchos procesos de entrega, pero no es automáticamente la mejor confirmación. Para una entrega rápida en la recepción de mercancías, un nombre impreso, una marca de tiempo y la asignación del destinatario pueden ser suficientes. Para mercancías de alto valor o entregas disputadas, una firma combinada con una foto e información de ubicación puede ser más sensata.

El factor decisivo es la cadena de evidencias: la confirmación debe estar vinculada al documento específico y su versión. Si alguien cambia cantidades o posiciones después de firmar, el sistema no debería sobrescribir esto silenciosamente. Requiere una corrección rastreable o una nueva confirmación. Las fotos merecen la misma disciplina. Pueden documentar daños, pero no deberían convertirse en una colección indiscriminada de datos personales. Define cuándo se requiere una foto, quién puede acceder a ella, y cuánto tiempo se almacena.

La captura de datos móvil debe funcionar en condiciones reales

En la oficina, casi cualquier aplicación es operable. En el almacén cuentan los guantes, el mal Wi-Fi, la presión del tiempo y los dispositivos con batería limitada. Un albarán digital debe por tanto arreglárselas con pocos pasos de entrada, pero grandes. Los escaneos de código de barras o código QR suelen ser más rápidos y fiables que buscar números de artículo.

La capacidad sin conexión no es un lujo cuando los conductores trabajan fuera de una cobertura de red estable. La aplicación debería almacenar en caché las operaciones localmente, mostrar claramente lo que aún no se ha sincronizado, y manejar los conflictos de manera controlada. Si dos personas editan la misma entrega, no debe ganar por casualidad el último guardado.

La cuestión del hardware también debe responderse pragmáticamente. Un smartphone existente puede ser suficiente para entregas simples. Para escaneos, fotos y firmas frecuentes en el almacén, los terminales portátiles robustos o tablets suelen ser más económicos. La mejor decisión depende de la duración operativa, el entorno y el rendimiento esperado — no de qué dispositivo parece moderno en una diapositiva de producto.

Definir interfaces antes de la implementación

Un albarán digital desarrolla su valor solo cuando se conecta con las fuentes de datos principales. En muchas empresas, los pedidos residen en el ERP o en el sistema de gestión de inventario, el inventario en una solución de almacén separada, y las facturas en contabilidad. Esto no tiene que convertirse inmediatamente en un gran proyecto de sistema. Pero la soberanía de datos debe ser clara.

Define, por lo tanto, qué sistema mantiene clientes, artículos, precios y pedidos. La solución de albaranes puede adoptar información, pero no debería generar sin darse cuenta un segundo maestro de artículos. Igualmente, debe estar regulado cuándo se reportan de vuelta las cantidades reales confirmadas y quién revisa las discrepancias.

Técnicamente, interfaces fiables son más importantes que funciones espectaculares. IDs únicos, formatos de datos documentados, protocolos para transferencias fallidas, y un mecanismo de reintento evitan que los albaranes desaparezcan entre dos sistemas. Una aplicación ligera sobre una base mantenible, como PHP 8.4, JavaScript moderno y MySQL 8, es más sensata para muchos flujos de trabajo de medianas empresas que una suite sobrecargada con funciones que nadie usa.

La seguridad y el archivado forman parte del proceso

Los albaranes contienen datos comerciales y frecuentemente también datos personales. Los permisos de rol no deberían asignarse por tanto de forma genérica. Los conductores necesitan sus rutas y tareas abiertas, los responsables de almacén necesitan opciones de corrección y revisión, la contabilidad necesita documentos confirmados y exportaciones. El acceso administrativo completo no es un derecho estándar.

Además, se requiere un historial rastreable: creación, modificación, entrega, firma, cancelación y corrección deberían registrarse con hora, usuario y justificación. Esto ayuda con consultas y protege a los empleados cuando más tarde no está claro cuándo se informó un daño o una escasez. Para el archivado, la regla es: el documento debe permanecer legible y el proceso localizable. Si se genera un PDF depende del flujo de trabajo interno y los requisitos de destinatarios externos. El PDF es, sin embargo, la salida de un proceso digital, no su modelo de datos.

Volverse productivo en pequeños pasos

El despliegue más fiable comienza con un proceso claramente delimitado: por ejemplo, entregas estándar desde un almacén o recepciones de mercancías de un departamento. Elige un área con volumen suficiente, pero sin los casos excepcionales más complicados. Esto permite probar el funcionamiento, la calidad de datos y las interfaces en condiciones reales.

No midas solo si la aplicación funciona técnicamente. Verifica cuánto tiempo tarda una entrega, cuántos albaranes requieren retrabajo, con qué frecuencia ocurren discrepancias de inventario, y si la contabilidad puede trabajar más rápido. Si un procedimiento digital genera más consultas que el formulario en papel, no es la plantilla el problema — entonces falta claridad de proceso o la máscara de entrada no se ajusta a la práctica operativa.

Las hojas de cálculo pueden seguir existiendo si son fiables para una evaluación limitada o una lista especial rara. La digitalización no significa abolir cada herramienta conocida. Significa reemplazar deliberadamente las entregas propensas a errores y hacer robusto el proceso central.

softify.pro desarrolla tales flujos de trabajo no como un producto estándar rígido, sino a lo largo de movimientos de mercancías concretos, roles y sistemas existentes. Esto es particularmente útil cuando una empresa busca una solución adecuada entre el caos de papel y un sistema corporativo sobredimensionado.

El primer paso correcto no es, por tanto, un largo catálogo de requisitos. Toma diez albaranes de una semana normal, incluyendo una entrega parcial y una reclamación. Si tu futuro flujo de trabajo procesa estos diez casos rápida, inequívoca y rastreablemente, un albarán digital se convierte en una herramienta en la que el almacén, los conductores y la administración pueden confiar.

Enlace permanente →

Tendencias del testing de software 2026 que realmente cuentan

Tendencias del testing de software 2026 que realmente cuentan

Un lanzamiento fallido rara vez muestra un solo error. A menudo se combinan varias causas: un permiso modificado, un entorno de pruebas poco claro, datos de prueba faltantes o una prueba de regresión que no se ha mantenido durante meses. Precisamente ahí es donde las software testing trends para 2026 se vuelven concretas - no como una colección de nuevas herramientas, sino como la pregunta de cómo las empresas pueden entregar cambios con seguridad verificable, incluso con capacidades de QA limitadas y datos sensibles.

Para los equipos de software en empresas medianas, esto es especialmente relevante. Una aplicación de almacén, un portal de clientes o un software de escritorio de Windows no necesita servir a millones de usuarios. Sin embargo, debe funcionar en operación por turnos, generar documentos correctamente y aplicar los permisos de forma fiable. Por tanto, el testing debe estar más cerca de los flujos operativos reales que de un entorno de demostración impecable.

Tendencias del testing de software: la IA se convierte en ejecutora, no en oráculo

La tendencia más visible es el testing asistido por IA. Esto no significa que un modelo de lenguaje lea un requisito y garantice posteriormente la calidad de la aplicación. Esa expectativa sería peligrosa. Sin embargo, la IA puede reducir significativamente el esfuerzo donde los equipos pierden tiempo hoy: formular casos de prueba, reconocer cambios llamativos en las interfaces de usuario, asignar patrones de error similares y escribir informes de prueba comprensibles.

La IA se vuelve especialmente útil cuando ejecuta pasos de trabajo concretos y aporta pruebas de sus resultados. Un agente de prueba puede, por ejemplo, iniciar sesión, crear una entrada de mercancía, cambiar una dirección de entrega, generar una etiqueta de envío y comprobar si el estado, el movimiento de inventario y el documento coinciden. El factor decisivo no es la afirmación «prueba superada», sino la cadena de evidencias: pasos ejecutados, marcas de tiempo, capturas de pantalla, registros técnicos y una descripción clara de la desviación.

El límite sigue siendo importante. La IA puede sugerir casos de prueba y gestionar flujos recurrentes. No debería decidir por sí sola si un asiento de negocio críticamente sensible es correcto. Para precios, niveles de inventario, aprobaciones de pago o derechos de acceso, siguen siendo necesarias reglas explícitas y expectativas confirmadas por los departamentos de negocio. La automatización acelera las pruebas; no sustituye la responsabilidad.

La automatización de pruebas migra al proceso de negocio

Durante mucho tiempo, la automatización de pruebas de UI se centró en rutas simples: abrir la página, rellenar el formulario, comprobar el mensaje de éxito. Eso sigue siendo útil, pero no basta para sistemas críticos para el negocio. La prueba más valiosa valida toda una cadena de procesos.

Tomemos una función logística típica. Se registra un pedido, se reserva mercancía, se inicia un proceso de picking, se genera un albarán y se notifica el envío. Cada pantalla individual puede parecer limpia mientras el proceso, aun así, falla - por ejemplo, porque una reserva persiste tras una cancelación o una entrega parcial altera incorrectamente el inventario. Las buenas pruebas automatizadas siguen por tanto estados y datos a través de los límites del sistema.

Esto exige una arquitectura de pruebas limpia. Las pruebas de API y base de datos comprueban las reglas de forma rápida y precisa. Las pruebas de UI controlan además si los empleados pueden realmente operar el proceso. Las pruebas de extremo a extremo combinan ambas, pero son más lentas y frágiles. Quien prueba todo exclusivamente a través del navegador suele construir una suite de pruebas cara y frágil. Quien solo prueba interfaces pasa por alto problemas operativos e interfaces de usuario mal conectadas.

La solución pragmática es una pirámide adaptada al riesgo: muchas comprobaciones rápidas cerca de la lógica de negocio, menos comprobaciones de integración y escenarios de extremo a extremo elegidos selectivamente para los flujos más importantes. Suena poco glamuroso. Sin embargo, aporta una fiabilidad aburrida y demostrable en lugar de perseguir tendencias.

La IA de pruebas autoalojada se convierte en una cuestión de arquitectura

Con las herramientas de prueba de IA surge una nueva pregunta: ¿adónde van los datos de prueba, las capturas de pantalla y las grabaciones? En muchas aplicaciones contienen nombres de clientes, precios internos, información de personal o vistas de procesos críticos para el negocio. Incluso un entorno de pruebas aparentemente inofensivo puede contener copias de datos reales o estructuras confidenciales.

Por eso el entorno de ejecución se convierte en un criterio central. Un servicio en la nube externo puede ser apropiado para aplicaciones web públicas y datos de prueba no críticos. Para portales internos, aplicaciones de escritorio o áreas reguladas, un enfoque autoalojado suele ser más sensato. En esta configuración, la ejecución de pruebas, el material de imagen y los registros permanecen dentro de la infraestructura controlada de la empresa o en un entorno de la UE claramente delimitado.

Esto no es un argumento general contra los servicios en la nube. La autogestión conlleva esfuerzo: hay que gestionar actualizaciones, control de acceso, recursos de computación, monitorización y responsabilidades claras. El beneficio surge cuando la protección de datos, la trazabilidad y el control sobre los artefactos de prueba pesan más que la comodidad de una cuenta SaaS disponible al instante. Sistemas como COCO siguen precisamente este enfoque, ejecutando pruebas para aplicaciones web y de Windows mientras mantienen las evidencias controlables localmente.

Las pruebas inestables ya no se aceptan como normales

Una prueba automatizada que a veces pasa y a veces falla sin un cambio de producto no genera seguridad. Genera colas. Los equipos se acostumbran entonces a ignorar las compilaciones en rojo o a repetir las pruebas hasta que aparece el resultado deseado. Esto es una pérdida progresiva de confianza en todo el marco de control de calidad.

En 2026, la estabilidad de la ejecución de pruebas pasa por tanto más a primer plano. Las causas suelen conocerse: tiempos de espera aleatorios, selectores inestables, datos de prueba compartidos, dependencias de servicios externos o bases de datos no reiniciadas. La solución rara vez es otro reintento. Más sensatos son selectores técnicos inequívocos, cuentas de prueba aisladas, estados de datos controlados y condiciones de espera específicas que reaccionan a eventos reales del sistema.

La evaluación también debería diferenciar: ¿es reproducible un error? ¿Ocurre solo en un entorno? ¿Ha fallado un servicio externo o la propia aplicación? La IA puede ayudar a agrupar estas señales. Sin embargo, la decisión técnica debe seguir siendo trazable. Un equipo de QA no necesita una predicción de errores misteriosa, sino una base sólida para la siguiente medida.

La calidad empieza antes, con los requisitos y los datos

Muchos errores surgen antes de escribir la primera línea de código. «El pedido debería poder enviarse» no es un requisito comprobable. ¿Qué ocurre en caso de dirección incompleta, cuenta de cliente bloqueada, mercancía faltante, procesamiento paralelo o sesión caducada? Sin respuestas a estas preguntas, ningún sistema de pruebas puede comprobar de forma fiable si el software funciona correctamente.

Un enfoque de pruebas más maduro complementa por tanto los requisitos con ejemplos verificables. Para una cuenta con intentos de inicio de sesión incorrectos, esto puede significar concretamente: tras cinco intentos fallidos, la cuenta se bloquea durante 15 minutos, el proceso se registra y un administrador autorizado puede rastrear el bloqueo. De ahí surgen directamente comprobaciones automatizables - y menos margen de interpretación entre desarrollo, operaciones y el departamento de negocio.

Los datos de prueba también se convierten en una característica del producto. Deben ser lo suficientemente realistas para reflejar casos límite, pero no deben copiar datos personales innecesarios. Son útiles los conjuntos de datos generados para casos de IVA, cantidades parciales, artículos bloqueados, direcciones no válidas y diversos roles. Precisamente con aplicaciones que usan MySQL 8 o bases de datos relacionales comparables, vale la pena aprovisionar automáticamente estados iniciales definidos y eliminarlos tras la ejecución.

El testing basado en riesgos vence a la cobertura de pruebas a cualquier precio

Una cifra alta de cobertura de código puede resultar tranquilizadora y aun así decir muy poco. Muestra qué líneas se ejecutaron, no si se comprobó la regla correcta. Un sistema puede alcanzar el 90 por ciento de cobertura y aun así generar inventario incorrecto durante la cancelación de una entrega parcial.

La mejor pregunta es: ¿qué errores serían especialmente costosos para la operativa, los clientes o el cumplimiento legal? De ahí surge una priorización. La protección de accesos, el cálculo de precios, los asientos de inventario, la generación de documentos y las interfaces con los proveedores de servicios de envío suelen merecer más profundidad de prueba que las páginas de configuración raramente utilizadas. Esto no significa entregar asuntos secundarios sin comprobar. Significa emplear tiempo limitado donde un fallo detiene trabajo real o genera decisiones equivocadas.

Esta priorización debe poder cambiar. Si se introduce una nueva función de planificación de rutas, su riesgo aumenta. Si una antigua evaluación de Excel va a ser sustituida pronto, un gran esfuerzo de automatización puede que ya no valga la pena. A veces es más sensato mantener una hoja de cálculo funcional unos meses más en lugar de forzar apresuradamente su lógica dentro de un sistema a medio terminar.

Qué deberían hacer los equipos en la práctica ahora

El primer paso sensato no es una comparación de herramientas. Elija un proceso cuyos fallos sean tangibles: de pedido a entrega, de entrada de mercancía a almacenamiento, o de inicio de sesión a aprobación de rol. Describa el flujo objetivo con casos excepcionales, configure datos de prueba fiables y automatice primero las comprobaciones críticas.

A continuación, no mida solo el número de pruebas. Observe con qué rapidez se detecta un error real, con qué frecuencia fallan las pruebas sin motivo, y si un informe explica la causa de forma comprensible a un desarrollador o responsable de negocio. Solo cuando estos fundamentos estén establecidos merece la pena ampliar con agentes de IA, inspección visual o entornos de prueba extensos.

Las tendencias de testing más fuertes son, en definitiva, las que hacen que los lanzamientos sean menos arriesgados y llevan a los equipos a decisiones claras más rápido. No es el panel más moderno lo que cuenta, sino una ejecución de pruebas trazable que muestre que este proceso de negocio funciona - y si no, saber por qué.

Enlace permanente →

Planificación de rutas de reparto: cómo elegir el software adecuado

Planificación de rutas de reparto: cómo elegir el software adecuado

Un conductor espera un albarán mientras el orden de sus paradas vuelve a cambiar. En el almacén todavía no se ha preparado un envío, un cliente llama por una ventana horaria más estrecha, y la lista de rutas está en una hoja de cálculo que solo una persona entiende realmente. Quien busca «software de planificación de rutas de reparto» en esta situación no necesariamente quiere un algoritmo cartográfico complicado. Lo que busca es un flujo de trabajo fiable desde la entrada del pedido hasta la prueba de entrega.

Para las pequeñas y medianas empresas, esta es una diferencia decisiva. Una ruta teóricamente más corta sirve de poco si no tiene en cuenta que la mercancía no está lista hasta las 10 de la mañana, un vehículo necesita refrigeración, o un conductor posee un conocimiento específico del cliente en una ruta determinada. Un buen software para rutas de reparto refleja la realidad operativa - haciéndola utilizable conjuntamente por planificación, almacén y conductores.

Cuándo la planificación de rutas se convierte en un problema operativo

Muchas empresas empiezan de forma razonable con teléfono, papel y una hoja de cálculo. Con cinco paradas al día y un equipo fijo de conductores, esta suele ser la solución más rápida. Solo cuando el volumen de pedidos, las variantes y la presión de tiempo aumentan surgen las fricciones típicas: direcciones introducidas por duplicado, estados de ruta desactualizados, información faltante sobre soportes de carga y consultas que solo pueden responderse llamando a varias personas.

El problema entonces no es solo el trayecto. Es la ruptura de información entre la entrada del pedido, el almacén, la planificación y la entrega. Si se pospone un pedido, hoy este cambio a menudo debe seguirse en varias listas, en una impresión y en la cabeza del conductor. Esto cuesta tiempo y genera errores que los clientes ven de inmediato.

Otra señal de alarma son las decisiones que dependen de empleados individuales. Si solo la planificadora experimentada sabe qué acceso es adecuado para un cliente o cómo ajustar la ruta 3 en caso de recepción tardía de mercancía, el proceso no está documentado de forma sólida. El software no debe sustituir este conocimiento. Debe representarlo de modo que el equipo siga siendo capaz de actuar.

Qué debe saber hacer un software de planificación de rutas de reparto

La función central suena simple: los pedidos se asignan a una ruta, las paradas se ordenan de forma sensata y se entregan a los conductores. Sin embargo, para su utilidad práctica el sistema necesita mucho más contexto. Lo decisivo es qué reglas se aplican en la planificación y cómo se gestionan los cambios.

Los pedidos deben ser planificables, no solo visibles

Una dirección de entrega en un mapa aún no constituye una entrega planificable. A un pedido pertenecen al menos cantidades, peso o volumen, fecha de entrega, ventana horaria deseada, información de contacto y un estado de tramitación claro. Según el negocio se añaden soportes de carga, requisitos de temperatura, marcados de mercancías peligrosas, reglas de aviso o una clase de vehículo determinada.

Estos datos no deberían tener que recopilarse manualmente cada vez de sistemas distintos. Si los pedidos ya proceden de una tienda online, un ERP, una máscara de pedidos o una base de datos existente, un traspaso limpio suele ser más valioso que una vista de mapa especialmente espectacular. De lo contrario, el trabajo solo se desplaza del papel a una nueva interfaz.

Las rutas necesitan reglas, no solo distancia

Un orden automático basado en kilómetros o tiempo de conducción puede ser una buena sugerencia. Sin embargo, no es una decisión para el negocio. La planificación debe poder tener en cuenta restricciones: fechas de entrega fijas, capacidad del vehículo, horarios laborales, tiempos de carga y descarga, así como responsabilidades regionales.

También cuenta la lógica de inicio. Algunos vehículos empiezan y terminan en el almacén, otros van directamente al siguiente lugar de trabajo tras la última entrega. Para rutas recurrentes puede tener sentido una estructura básica fija, que los planificadores solo modifican cuando es necesario. Quien recorre exactamente las mismas paradas cada mañana no necesita necesariamente una reoptimización completa. Aquí una ruta estable y trazable suele ser mejor que un ahorro de tiempo calculado mínimo.

Los cambios deben llegar al conductor de forma controlada

La realidad rara vez se ajusta al plan de la mañana. Los clientes cancelan, falta mercancía, un vehículo se avería o un pedido se vuelve urgente. En tales casos se decide si el software supone un alivio o crea trabajo adicional.

Una solución utilizable muestra claramente qué versión de la ruta es válida actualmente, qué paradas ya se han completado y qué se ha cambiado en concreto. El conductor no debería tener que comparar impresiones contradictorias, capturas de pantalla y mensajes de mensajería. Para muchos equipos, al principio basta con una vista de conductor móvil y basada en navegador con orden de paradas, datos de contacto, indicaciones de entrega y confirmación de estado. Una app dedicada no es automáticamente mejor si la instalación, la gestión de dispositivos y los requisitos sin conexión no aportan un beneficio claro.

No empezar únicamente con la optimización de rutas

El enfoque erróneo más común es comprar primero un servicio de optimización y solo después comprobar si los datos maestros y los procesos son correctos. Direcciones mal escritas, ventanas de entrega poco claras y pedidos sin un estado de disponibilidad fiable no se pueden «optimizar» para que desaparezcan.

Es más razonable hacer un breve inventario a lo largo de la rutina diaria real. ¿Dónde se originan los pedidos? ¿Cuándo confirma el almacén la disponibilidad? ¿Quién planifica las rutas? ¿Cómo recibe el conductor los cambios? ¿Y qué prueba se necesita tras la entrega? Estas preguntas parecen triviales, pero determinan qué campos de datos, roles e interfaces necesita realmente el sistema.

A menudo se descubre que no todos los pasos deben digitalizarse. Una nota manuscrita para una entrega especial poco frecuente puede ser adecuada, si después se traslada correctamente al pedido. Una hoja de cálculo también puede permanecer, si entrega de forma fiable un análisis manejable. El software debería resolver el cuello de botella, no sustituir por la fuerza cada proceso conocido.

¿Build, Buy o ampliación específica?

El software estándar es apropiado cuando la lógica de rutas es general, los procesos varían poco y el equipo puede adaptarse a las máscaras predefinidas. Acorta la implementación y puede ser suficiente para una flota sencilla. La desventaja se hace evidente en cuanto solo representa los casos particulares centrales mediante listas secundarias, texto libre o costosos módulos adicionales.

Una solución individual no merece la pena porque el desarrollo a medida sea superior por principio. Merece la pena cuando el proceso en sí es una ventaja competitiva o una fuente de errores persistente: por ejemplo con unidades de embalaje especiales, rutas combinadas de recogida y entrega, documentos de entrega propios, o una estrecha vinculación entre la entrada de mercancía, la preparación de pedidos y la salida.

Entre ambos extremos suele estar el camino más pragmático. Los sistemas existentes se mantienen para contabilidad o gestión de almacén, mientras una aplicación ligera agrupa pedidos, planifica rutas y cubre el proceso del conductor. Para ello se necesitan interfaces claras, responsabilidades de datos inequívocas y una estructura de base de datos que almacene los cambios de forma trazable. Las aplicaciones web modernas sobre una base mantenible como PHP 8.4 y MySQL 8 no son para esto una decisión de moda, sino una base para una operativa calculable y ajustes futuros.

Implantación en pequeños pasos en lugar de un gran cambio

Un software de planificación de rutas debería probarse primero en una ruta o grupo de vehículos manejable. No porque un proyecto piloto sea libre de riesgo, sino porque las excepciones reales se manifiestan pronto: indicaciones de entrega faltantes, datos de dirección heterogéneos, tiempos de espera en el cliente o traspasos poco claros en el almacén.

Para la primera fase de expansión suelen bastar funciones claramente delimitadas: asumir el pedido, ver el estado de disponibilidad, componer la ruta, aprobar la ruta e informar la entrega. Solo cuando esta cadena funciona en el día a día tienen sentido la optimización automática, la firma electrónica, las pruebas fotográficas, las notificaciones a clientes o indicadores detallados.

El beneficio no se mide solo en kilómetros ahorrados. También son relevantes un menor esfuerzo de planificación, menos consultas, menos entregas erróneas, un tiempo más corto hasta el albarán y una mejor capacidad de respuesta hacia los clientes. Estos indicadores deberían establecerse de forma aproximada antes del lanzamiento. De lo contrario, tras la implementación solo queda la impresión de que la interfaz parece más moderna.

La tecnología debe seguir siendo fiable en segundo plano

La planificación de rutas procesa datos operativos sensibles: direcciones de clientes, asignaciones de conductores, cantidades de entrega y, con frecuencia, pruebas de entrega. Por eso, los permisos por rol, las modificaciones trazables, las copias de seguridad regulares y una operativa documentada forman parte de la solución. Quién puede aprobar, modificar o eliminar una ruta no debería dejarse al azar.

Los datos de mapas y enrutamiento también merecen un examen sobrio. Los servicios externos pueden encajar muy bien, pero conllevan costes continuos, cuestiones de disponibilidad y de protección de datos. Con altos requisitos de conservación de datos o lógicas territoriales especiales, hay que aclarar pronto qué datos abandonan el propio sistema y cómo se amortiguan los fallos. Una ruta perfecta no vale nada si la planificación no puede seguir trabajando durante una interrupción.

softify.pro diseña estos sistemas desde la entrada real del pedido hasta la confirmación desde el vehículo. El criterio no es la lista de funciones más larga, sino un proceso que almacén, planificación y conductores puedan manejar de forma fiable bajo presión de tiempo.

La mejor planificación de rutas resulta sorprendentemente poco espectacular en el día a día: los pedidos están completos, las rutas son comprensibles, los cambios inequívocos y las entregas demostrables. Precisamente esta fiabilidad discreta crea espacio para las excepciones en las que las personas deben decidir.

Enlace permanente →

Automatizar el flujo de trabajo de recepción de pedidos en la empresa

Automatizar el flujo de trabajo de recepción de pedidos en la empresa

Un pedido llega por correo electrónico, otro por teléfono, además un archivo Excel de la cuenta clave. Más tarde falta en el almacén la dirección de entrega, ventas ya no recuerda con exactitud la fecha prometida, y el departamento de envíos imprime el albarán con una posición de artículo desactualizada. Quien quiera automatizar el flujo de trabajo de recepción de pedidos no resuelve un proyecto digital abstracto. Elimina precisamente esa fricción en el punto donde la facturación se convierte en trabajo operativo.

Para las pequeñas y medianas empresas, la recepción de pedidos suele estar subestimada. Mientras lleguen pocos pedidos al día y los empleados con experiencia conozcan cada caso especial, notas telefónicas, buzones de correo y tablas sostienen el proceso. Con un volumen creciente, sin embargo, se convierten en un riesgo: la información existe por duplicado, los traspasos ocurren verbalmente, y nadie puede decir con fiabilidad qué estado tiene realmente el pedido.

Por qué la recepción de pedidos se convierte tan a menudo en un cuello de botella

La causa raramente es falta de compromiso. Normalmente el proceso ha crecido a lo largo de los años. Los clientes piden por vías distintas, los precios y condiciones de entrega solo aplican a ciertos grupos de clientes, los números de artículo se apartan de las denominaciones internas. Los empleados concilian la información por experiencia y llenan los vacíos con consultas.

Esto funciona hasta que alguien está de vacaciones, cambia el turno o llegan varios pedidos urgentes a la vez. Entonces se revela que el conocimiento no reside en el proceso, sino en cabezas individuales y archivos dispersos. Las consecuencias son conocidas: cantidades erróneas, entregas retrasadas, aprobaciones sin resolver y correcciones innecesarias en el almacén.

Automatización aquí no significa que un cliente deba pedir necesariamente a través de un portal. Significa que cada pedido, sea cual sea su canal de entrada, se registra, se verifica, se enriquece y se traspasa según las mismas reglas trazables.

Automatizar el flujo de recepción de pedidos sin forzar la operativa

Un flujo de trabajo utilizable no empieza con una lista de software, sino con un levantamiento sobrio del proceso. Lo decisivo es: ¿qué información debe estar disponible antes de que un pedido pueda pasar a almacén, planificación o producción? ¿Y qué excepciones son legítimas, en lugar de simplemente molestas?

Un flujo típico consta de cuatro etapas claras: registrar el pedido, verificar los datos, aprobar el pedido y desencadenar los procesos siguientes. Entre estas etapas se necesitan responsabilidades y estados inequívocos. Un pedido, por ejemplo, no debería poder figurar simultáneamente como «nuevo», «en aclaración» y «listo para enviar».

1. Reunir los pedidos de todos los canales en un único expediente

Correo electrónico, teléfono, PDF, EDI, formulario web o nota del equipo comercial pueden seguir siendo canales de entrada distintos. Lo decisivo es que todos acaben en un expediente de pedido común. Los empleados no deberían tener que copiar primero información del correo, luego actualizar una tabla y después informar a una segunda persona.

En pedidos estructurados, los datos del cliente, números de artículo, cantidades y fechas deseadas pueden trasladarse directamente. En PDF o correos de texto libre, una captura guiada suele ser más razonable que una lectura totalmente automática. La extracción asistida por IA puede hacer propuestas, pero en cantidades poco claras, números de artículo específicos del cliente o documentos manuscritos hace falta una revisión visible.

El criterio razonable no es «el máximo de automatización», sino «ninguna doble captura innecesaria». Un formulario bien diseñado con campos obligatorios y sugerencias plausibles ahorra, en muchas empresas, más tiempo que una automatización completa propensa a errores.

2. Verificar los datos antes de que los errores se propaguen

La automatización más valiosa ocurre antes de la aprobación. El sistema puede comprobar si el número de cliente existe, si la dirección de entrega está completa, si el artículo está activo, si la cantidad solicitada parece admisible y si existe la aprobación de pago o crédito. También pueden compararse precios específicos del cliente, cantidades mínimas y ventanas de entrega con las reglas almacenadas.

Es importante el tratamiento de las desviaciones. No toda desviación debe bloquear un pedido. Si falta, por ejemplo, un número de referencia, ventas puede recibir una tarea. Si un pedido supera un límite de valor definido o el margen queda fuera del marco acordado, puede requerirse la aprobación del rol competente.

Así no surgen errores silenciosos, sino casos de aclaración visibles. Es una gran diferencia: el almacén no recibe simplemente un pedido incompleto, sino un pedido con un estado claro y una decisión documentada.

3. Vincular las aprobaciones a reglas en lugar de a peticiones verbales

Muchos retrasos surgen de frases como: «¿Puedes aprobarlo rápido?». Estas consultas no son fundamentalmente erróneas. Se vuelven problemáticas cuando ocurren por chat, teléfono o conversación de pasillo y luego no son trazables.

Un flujo de trabajo automatizado guarda las reglas de aprobación directamente en el pedido. Por ejemplo, un pedido puede aprobarse automáticamente si el cliente, el precio, el stock y la dirección de entrega son plausibles. En condiciones especiales, entregas parciales o un pedido por encima de un límite definido, se notifica a la persona responsable. La aprobación se guarda con marca de tiempo y justificación.

Esto genera velocidad sin renunciar al control. Especialmente con turnos rotativos o varias ubicaciones, evita que los pedidos queden atascados en buzones personales.

4. Informar de forma dirigida a almacén, envíos y cliente

Tras la aprobación, el pedido ya no necesita transferirse manualmente de una lista a otra. El flujo de trabajo puede generar una orden de picking, reservar existencias, preparar un albarán o desencadenar un aviso de envío. Qué pasos tienen sentido depende del modelo de negocio.

Un distribuidor de recambios puede necesitar de inmediato una orden de picking y un marcado de prioridad. Un fabricante necesita primero una verificación de disponibilidad y después un impulso de producción. Un mayorista con rutas fijas quiere agrupar pedidos hasta cierta hora. Por eso una solución estándar rígida a menudo no es la mejor opción.

Para el cliente suele bastar una confirmación clara: pedido recibido, verificado o planificado en firme. No todo cambio de estado interno pertenece a un correo. Demasiados mensajes automáticos generan consultas en lugar de confianza.

Qué datos necesita un proceso sólido

Una buena recepción de pedidos se apoya en una base de datos limpia. Esto incluye datos maestros de clientes bien mantenidos, números de artículo únicos, reglas de precios y condiciones válidas, así como direcciones de entrega claramente definidas. Si faltan estas bases, la automatización solo acelera la transmisión de datos poco fiables.

También cuenta la arquitectura técnica. Un sistema central con cambios de estado trazables y una base de datos fiable es, a la larga, mejor que una cadena de macros, archivos locales y reenvíos de correo descontrolados. Esto no significa que cada hoja de Excel deba sustituirse de inmediato. Si una tabla funciona de forma transparente en un subproceso pequeño y estable, puede permanecer por ahora.

En cuanto varias personas trabajen a la vez con pedidos, se necesiten aprobaciones o se transmita información a almacén y envíos, una fuente de datos central debería sin embargo tener prioridad. Los sistemas basados en una arquitectura mantenible, por ejemplo con PHP 8.4, JavaScript moderno y MySQL 8, pueden así conectarse de forma dirigida a los procesos existentes, en lugar de forzar una operativa dentro del esquema de un software corporativo.

Hacer medible si el flujo de trabajo realmente mejora

Un sistema nuevo no es automáticamente un proceso mejor. Antes del lanzamiento deberían por tanto establecerse unos pocos indicadores. Son relevantes, por ejemplo, el tiempo desde la recepción del pedido hasta la aprobación, el número de consultas por pedido, las correcciones tras el traspaso al almacén y la tasa de pedidos procesados a tiempo.

Estos indicadores también muestran dónde no se necesita más automatización. Si el 85 % de los pedidos estándar transcurre rápido y sin errores, pero el 15 % restante son casos verdaderamente especiales, un proceso de aclaración claro es más razonable que intentar forzar algorítmicamente cada excepción.

Los registros ayudan además en el día a día. Quien ve cuándo llegó un pedido, qué comprobación falló, quién lo aprobó y cuándo se generó la orden de envío ya no busca la causa en cinco buzones. Esto reduce no solo los errores, sino también la dependencia de empleados concretos.

Implantación en pequeños pasos en lugar de un Big Bang

La entrada más segura suele ser un tipo de pedido claramente delimitado: por ejemplo, pedidos estándar de un grupo de clientes concreto o pedidos por correo con artículos conocidos. Allí pueden probarse campos de datos, reglas y traspasos en condiciones reales. Solo cuando estado, excepciones y responsabilidades funcionan correctamente, siguen los casos más complejos como precios especiales, entregas parciales o especificaciones de embalaje individuales por cliente.

Los empleados deberían participar en el diseño. No porque cada hábito existente deba permanecer sin cambios, sino porque las personas al teléfono, en ventas y en el almacén conocen las excepciones reales. Una solución que solo se ve bien en un taller se elude rápidamente en la nave.

Para este tipo de proyectos, softify.pro apuesta por sistemas específicos para el flujo de trabajo en lugar de suites estándar sobrecargadas: con traspasos claros, reglas documentadas y suficiente espacio para las formas de trabajo que demostrablemente funcionan en la operativa.

El mejor siguiente paso no es, por tanto, la búsqueda del mayor número posible de funciones. Tome diez pedidos reales de una semana típica y siga su recorrido desde la recepción hasta el envío. Cada doble transferencia manual, cada decisión poco clara y cada consulta recurrente es un punto de partida concreto para un proceso que en el futuro trabajará de forma fiable para el equipo.

Enlace permanente →

Proteger de forma segura los datos de prueba durante las pruebas con IA

Proteger de forma segura los datos de prueba durante las pruebas con IA

Una prueba automatizada fallida suele resolverse rápidamente. Una captura de pantalla del test que contiene datos de clientes, listas de precios o una sesión activa y que acaba en un servicio de IA externo es un problema distinto. Quien quiera proteger los datos de prueba durante las pruebas con IA debe considerar, por tanto, no solo los casos de prueba, sino todo el recorrido de los datos: entradas, tráfico del navegador, registros, imágenes, evaluación por IA y conservación.

Precisamente con aplicaciones web, portales internos y software de Windows surge rápidamente una falsa sensación de seguridad. El entorno se llama «prueba», pero a menudo utiliza copias de bases de datos productivas, roles de usuario reales o interfaces hacia envíos, ERP y archivos documentales. Las pruebas asistidas por IA hacen que estos datos sean especialmente valiosos para el análisis - y por tanto especialmente necesitados de protección.

Por qué las pruebas con IA requieren una perspectiva propia de protección de datos

La automatización de pruebas clásica suele verificar pasos claramente delimitados: iniciar sesión, crear un pedido, generar un albarán, comprobar el cierre de sesión. Las pruebas asistidas por IA amplian este proceso. El sistema puede interpretar interfaces, evaluar anomalías, comparar capturas de pantalla y documentar resultados en un lenguaje comprensible. Esto ahorra tiempo en las pruebas de regresión, pero genera artefactos de datos adicionales.

Estos artefactos suelen ser más reveladores que un registro de prueba habitual. Una captura de pantalla puede mostrar nombres, direcciones, importes contractuales, cantidades de pedido o datos de salud. Un registro de red puede contener tokens de sesión y respuestas de API. Un mensaje de error puede revelar rutas de archivo internas, estructuras de base de datos o versiones. Cuando un modelo trabaja con esta información, debe quedar claro dónde tiene lugar el procesamiento y quién puede acceder a él.

La pregunta decisiva, por tanto, no es: «¿Usamos IA en las pruebas?». Sino más bien: «¿Qué datos abandonan qué zona de seguridad, y por qué?». Para muchas empresas de la región DACH, el procesamiento externo en la nube no está fundamentalmente excluido. Pero debe adecuarse a la necesidad de protección desde el punto de vista contractual, técnico y organizativo. Para datos de desarrollo, producción o clientes, una ejecución controlada localmente suele ser la decisión más pragmática.

Proteger los datos de prueba durante las pruebas con IA empieza antes de la primera ejecución

La protección de datos en las pruebas a menudo solo se discute al elegir una herramienta. Eso es demasiado tarde. Primero se necesita un inventario de datos sencillo y sólido. ¿Qué sistemas se están probando? ¿Qué campos aparecen en las interfaces? ¿Qué adjuntos, exportaciones y respuestas de API pueden aparecer en la prueba? ¿Y qué datos acaban automáticamente en capturas de pantalla, vídeos o mensajes de error?

Aquí conviene una división en tres grupos. Los datos de prueba no críticos pueden generarse libremente y conservarse durante más tiempo. Los datos personales o comercialmente confidenciales requieren enmascaramiento, restricciones de acceso y una conservación breve. Las credenciales de acceso, tokens, claves y valores de configuración productivos no tienen cabida en las evidencias de prueba ni en las solicitudes al modelo, ni siquiera si solo son visibles accidentalmente en una ventana del navegador.

En muchas aplicaciones medianas, la situación de los datos no está claramente separada. El equipo de almacén prueba una nueva entrada de mercancía con un extracto de la base de datos, porque solo ahí están presentes las estructuras de artículos reales, las reglas de proveedores y los casos especiales. Eso puede tener sentido desde el punto de vista técnico. La consecuencia, sin embargo, no debe ser que ese extracto migre sin cambios a todos los entornos de prueba.

Es mejor un proceso reproducible: exportar los datos, seudonimizar de forma dirigida los campos sensibles, eliminar las tablas innecesarias y poner a disposición la base de datos de prueba resultante de forma versionada. Así se conservan los errores de proceso típicos, sin que clientes o empleados reales se vuelvan visibles en las pruebas. Para lógicas de precios o de planificación complejas, los datos totalmente sintéticos a menudo no bastan. En ese caso, una copia cuidadosamente depurada suele ser el mejor compromiso.

El enmascaramiento debe preservar la lógica de negocio

Un enmascaramiento que sustituye cada dirección de correo electrónico por el mismo marcador de posición puede dañar los casos de prueba. Las comprobaciones de duplicados, la lógica de roles, las funciones de búsqueda o los procesos de facturación se comportan de forma distinta a como lo hacen en producción. Un buen enmascaramiento, por tanto, preserva formatos, relaciones y distribuciones. De un número de cliente surge otro número de cliente válido. De una dirección surge una dirección plausible pero ficticia. De una fecha de entrega queda una fecha dentro de un margen de planificación realista.

Esto requiere cierta preparación. A cambio, evita el error clásico en el que las pruebas están técnicamente en verde pero ya no reflejan los procesos reales en el almacén, ventas o atención al cliente. La protección de datos y las pruebas funcionalmente útiles no son opuestos, siempre que la preparación de los datos forme parte de la arquitectura de pruebas.

El lugar de ejecución decide sobre el control

Quien entrega pruebas automatizadas a un servicio externo transmite, según la configuración, más que simples pasos de prueba. El contenido del navegador, las estructuras DOM, las capturas de pantalla, los vídeos, los registros de consola y las evaluaciones pueden procesarse y almacenarse fuera de la propia infraestructura. Que esto sea aceptable depende del caso concreto: categorías de datos, marco contractual, ubicación del almacenamiento, separación de inquilinos, concepto de eliminación y directrices internas actúan en conjunto.

Para aplicaciones con altas necesidades de protección, un entorno de pruebas autoalojado suele ser más fácil de evaluar. El ejecutor de pruebas, el componente de IA y el almacenamiento de evidencias permanecen en la propia red o en una infraestructura europea controlada. Las reglas de red pueden limitar las conexiones externas. Los accesos pueden vincularse a identidades, roles y registros ya existentes. La conservación de imágenes e informes también se convierte en una decisión propia en lugar de una configuración predeterminada de un proveedor de plataforma.

COCO sigue exactamente este enfoque: el servidor de IA ejecuta pruebas para aplicaciones web y de Windows de forma controlada, documenta evidencias y genera evaluaciones comprensibles, sin que los datos de aplicación internos deban entregarse por defecto a una nube de IA externa. Esto no sustituye una auditoría de protección de datos. Sin embargo, crea una base técnica sobre la que TI, seguridad de la información y el área de negocio pueden acordar reglas trazables.

Capturas de pantalla, registros y secretos son las fugas más frecuentes

Muchos equipos protegen la base de datos de prueba, pero pasan por alto los subproductos de las pruebas. Precisamente ahí suelen residir en la práctica los mayores riesgos. Una prueba de inicio de sesión fallida puede mostrar una contraseña en el campo de entrada. Una prueba de API puede mostrar un token de portador en el registro. Una grabación de vídeo automática documenta un pedido completo, incluida la dirección del cliente.

Un concepto sólido regula por tanto al menos cinco puntos:

  • Las capturas de pantalla y los vídeos solo se crean cuando es necesario y se eliminan tras plazos fijos.
  • Los secretos se integran a través de un almacén de secretos o variables de tiempo de ejecución protegidas, nunca almacenados en el código de prueba.
  • Los registros filtran tokens, contraseñas, ID de sesión y campos sensibles antes de guardarse.
  • Las cuentas de prueba solo poseen los permisos necesarios para el proceso correspondiente.
  • Los sistemas de prueba no deben desencadenar correos, etiquetas, pagos o movimientos de inventario productivos, salvo que ello esté explícitamente asegurado.

Estas reglas suenan sobrias. Precisamente esa es su ventaja. Un equipo no tiene que confiar en la atención o en las buenas intenciones, sino que puede limitar técnicamente el mal uso. Son especialmente eficaces las cuentas de servicio separadas para la automatización de pruebas, las vidas útiles cortas de los tokens y un proceso claro para revocar credenciales comprometidas.

La evaluación con IA también necesita límites

Los modelos de IA se utilizan a menudo para explicar desviaciones: «El botón no era visible», «La aplicación reaccionó más despacio de lo esperado» o «El proceso terminó en una comprobación de permisos». Para tales valoraciones, un modelo no necesita necesariamente el conjunto completo de datos del cliente.

Defina, por tanto, qué información puede entrar en la evaluación. ¿Basta con una captura de pantalla anonimizada? ¿Es suficiente una clase de error técnica en lugar de la respuesta completa del servidor? ¿Se pueden ocultar campos antes del análisis? La profundidad adecuada depende del objetivo de la prueba. En una comparación de diseño, un nombre rara vez es relevante. Al comprobar una plantilla de documento personalizada puede serlo - entonces el procesamiento debe asegurarse en consecuencia.

Las medidas de protección deben seguir siendo verificables en producción

Un concepto solo es sólido si puede controlarse en el día a día. Esto incluye comprobaciones aleatorias periódicas de las evidencias de prueba, revisiones de permisos y una mirada a los datos realmente almacenados. ¿Se han colado nuevos campos en las capturas de pantalla? ¿Siguen existiendo cuentas de prueba antiguas? ¿Se conserva un extracto de base de datos más tiempo del previsto? Estas preguntas forman parte de la rutina operativa normal, no solo de una auditoría.

Igual de importante es una responsabilidad clara. QA conoce los procesos de prueba, desarrollo conoce las interfaces técnicas, el área de negocio conoce los procesos críticos y la seguridad informática define el marco. Si nadie une estas perspectivas, se crea un atajo arriesgado o una exigencia de seguridad que impide pruebas reales. Un pequeño proceso de aprobación documentado suele ser más eficaz que un extenso conjunto de normas que nadie aplica.

Al final no se trata de complicar artificialmente cada prueba. Proteger bien los datos de prueba significa eliminar de forma deliberada los riesgos reales de la automatización, preservando al mismo tiempo la validez funcional de las pruebas. Cuando los equipos saben exactamente qué datos puede ver una prueba, dónde se encuentran sus evidencias y cuándo desaparecen, las pruebas con IA se convierten en una herramienta controlable en lugar de una incertidumbre adicional.

Enlace permanente →

Encargar el desarrollo de una aplicación web con PHP

Encargar el desarrollo de una aplicación web con PHP

Cuando las entradas de mercancía acaban en una hoja de cálculo, los datos de envío se transmiten por teléfono y el estado actual de un pedido solo existe en la cabeza de algunos empleados, normalmente no falta otra herramienta estándar más. Falta un sistema que refleje de forma fiable el propio flujo de trabajo. Encargar el desarrollo de una aplicación web con PHP merece la pena precisamente entonces: cuando información, decisiones y documentos deben confluir en un único lugar, sin sobrecargar el negocio con una suite empresarial sobredimensionada.

PHP no es aquí un compromiso nostálgico. Con PHP 8.4, una arquitectura de aplicación clara y MySQL 8 se pueden construir aplicaciones web duraderas, que reaccionan con rapidez, son fáciles de mantener y funcionan de forma fiable en ordenadores de escritorio, tablets o escáneres de mano. Sin embargo, lo decisivo no es solo el lenguaje. Lo decisivo es si la aplicación realmente facilita el trabajo en el suelo del almacén, en la oficina y en movimiento.

Cuándo tiene sentido una aplicación web a medida

No todos los procesos necesitan de inmediato software a medida. Una hoja de cálculo bien mantenida puede seguir siendo la solución más razonable para una lista pequeña que rara vez cambia. Un producto estándar consolidado también resulta útil si ya cubre los flujos esenciales y puede utilizarse sin rodeos permanentes.

El punto de inflexión llega cuando los empleados introducen datos varias veces, reúnen información de distintos archivos o resuelven regularmente casos especiales fuera del sistema propiamente dicho. Señales típicas son la falta de claridad sobre el inventario, los albaranes generados manualmente, responsabilidades poco claras en los pedidos o consultas que cada turno tiene que repetir. En ese momento no solo se pierde tiempo: los errores se vuelven difíciles de rastrear y la dependencia de personas concretas aumenta.

Una aplicación web a medida, en cambio, refleja exactamente las reglas que rigen en el negocio. Puede, por ejemplo, registrar las entradas de mercancía, documentar los movimientos de almacén, generar etiquetas, priorizar pedidos o hacer trazables las entregas entre equipos. No es necesario automatizar cada caso especial desde el primer día. Un inicio razonable se centra en el flujo que hoy genera más fricción.

Encargar el desarrollo de una aplicación web con PHP: qué hay que aclarar antes

Un buen software no empieza con bocetos de pantalla ni con una lista de términos técnicos. Empieza con situaciones concretas: ¿qué ocurre si una entrega llega incompleta? ¿Quién puede corregir un inventario? ¿Qué información necesita el departamento de envíos antes de imprimir una etiqueta? ¿Y qué ocurre cuando un empleado del turno de tarde retoma un pedido creado por la mañana?

De estas preguntas surge una imagen sólida del proceso. Muestra entradas, decisiones, traspasos y excepciones. Precisamente las excepciones son valiosas, porque es ahí donde las soluciones estándar a menudo fallan. Una aplicación de recepción de pedidos, por ejemplo, no solo debe guardar un pedido nuevo. También debe aclarar cómo se gestionan los datos de artículo faltantes, las direcciones de entrega divergentes, las aprobaciones o las cancelaciones.

Antes de la implementación deberían quedar establecidos el objetivo, los grupos de usuarios y la primera fase de desarrollo. Resultan útiles datos de ejemplo reales, formularios existentes, fotos de los puestos de trabajo y conversaciones con las personas que trabajan a diario con ese proceso. Una simple entrevista con la dirección rara vez aporta suficiente detalle. Quien maneja un escáner, almacena mercancía o revisa albaranes suele conocer con más precisión las limitaciones prácticas.

El inicio razonable más pequeño

Una primera versión no tiene que ser una plataforma corporativa terminada. Al contrario: un núcleo limitado pero utilizable en producción reduce el riesgo y aporta valor desde el principio. Podría pensarse en una aplicación que al principio solo registre pedidos de forma centralizada, muestre su estado y cree un albarán fiable. La gestión de inventario, las interfaces o la planificación de rutas pueden llegar en cuanto el núcleo se haya confirmado en el día a día.

Este orden evita que un proyecto trabaje durante meses en funciones cuyo beneficio real aún no está claro. También deja espacio para correcciones. Quizá la lógica de estados prevista es demasiado fina, quizá la entrada de mercancía necesita una pantalla de captura más rápida o una aprobación solo a partir de cierto valor. Estos hallazgos no son un fallo de la planificación, sino parte de una implementación bien hecha.

La base técnica decide sobre los costes posteriores

Una aplicación web no se vuelve mantenible solo porque PHP figure en la propuesta. La mantenibilidad surge de decisiones trazables: una separación clara entre interfaz, lógica de negocio y acceso a datos, modelos de datos inequívocos, pruebas automatizadas para las reglas críticas y un despliegue documentado.

PHP 8.4 se presta muy bien para ello. El lenguaje es maduro, eficiente de operar y una elección pragmática para muchas aplicaciones críticas para el negocio. Junto con JavaScript moderno, la interfaz puede reaccionar de forma rápida y directa, sin construir cada función de manera innecesariamente complicada como una aplicación de página única. MySQL 8 ofrece una base sólida para transacciones, conceptos de permisos y datos coherentes.

Precisamente en los procesos de almacén y de pedidos, una operación no debe guardarse a medias. Si se da salida a un artículo, el inventario, el registro de movimientos y el estado del pedido deben coincidir. Las transacciones de base de datos garantizan que se realicen todos los cambios necesarios o ninguno. Suena a detalle, pero determina si un sistema sigue siendo fiable en los casos excepcionales.

La seguridad también forma parte del núcleo de la arquitectura. Los roles y permisos deben adaptarse al día a día laboral: una persona en la recepción de mercancía necesita permisos distintos a los de contabilidad o a los de un conductor externo. Los hashes de contraseñas seguros, el bloqueo de cuentas tras intentos de acceso fallidos, la gestión de sesiones y los registros de cambios críticos no son extras para más adelante. Forman parte de la primera versión en producción.

Construir interfaces solo donde realmente ahorran trabajo

Muchos proyectos se vuelven innecesariamente grandes porque desde el principio se planifica cualquier integración imaginable. Las interfaces con la tienda, el ERP, los proveedores de envío o la contabilidad pueden ser muy útiles. Pero solo son buenas si sustituyen un paso manual claro o mejoran de forma notable la calidad de los datos.

Un ejemplo: si las etiquetas de envío se generan a diario a partir de los datos del pedido, una conexión directa ahorra tiempo y reduce errores de transmisión. Si, en cambio, los datos de facturación solo se transfieren una vez por semana a un sistema existente y el proceso es estable, una exportación estructurada puede bastar para empezar. La solución técnicamente más elegante no es automáticamente la más económica.

La soberanía de los datos también debería aclararse de antemano. ¿Qué datos se almacenan, cuánto tiempo permanecen disponibles los registros, quién puede exportarlos y cómo funcionan las copias de seguridad y la recuperación? Para las empresas de la región DACH, estas preguntas no son meras formalidades informáticas. Afectan a la protección de datos, la capacidad operativa y la confianza dentro del equipo.

Implementación sin frenar la actividad

La mejor aplicación fracasa si, durante la transición, bloquea el día a día. Por eso la implementación debería prepararse con casos reales: pedidos representativos, artículos reales, direcciones de entrega típicas y casos especiales conocidos. Solo cuando estos flujos funcionen de forma trazable, el sistema debería asumir una tarea central.

Un funcionamiento paralelo puede tener sentido durante un breve periodo, por ejemplo cuando hay que conciliar inventarios o revisar nuevos documentos. Pero no debe convertirse en un estado permanente. Dos fuentes de datos de referencia generan inevitablemente diferencias. Se necesita una fecha límite clara a partir de la cual quede establecido qué sistema es vinculante.

Igual de importante es una breve formación orientada al rol. Un empleado del almacén no necesita una explicación de las funciones de administración. Necesita seguridad en los pocos pasos que hay que realizar bajo presión de tiempo. Las buenas aplicaciones ayudan con denominaciones comprensibles, valores predeterminados plausibles y mensajes de error que explican qué hacer a continuación.

Cómo reconocer a un socio de desarrollo adecuado

Quien encarga una aplicación web no compra simplemente horas de desarrollo. Se busca un socio que se tome en serio las cuestiones de proceso, justifique las decisiones técnicas y también sepa oponerse cuando un requisito resulte innecesariamente caro o arriesgado. El acceso directo a desarrolladores experimentados vale aquí más que un elaborado proceso comercial con traspasos posteriores.

Preste atención a afirmaciones concretas sobre arquitectura, operación y desarrollo futuro. ¿Cómo se documentan los cambios? ¿Cómo se realizan las actualizaciones? ¿Quién responde ante una incidencia? ¿Existe una estrategia de pruebas trazable para las operaciones y permisos críticos? Una interfaz puede resultar convincente en una presentación. Lo decisivo es si puede seguir adaptándose después de dos años sin que cada cambio se convierta en una reconstrucción completa.

softify.pro trabaja por ello con una implementación gradual y cercana al proceso: primero entender el cuello de botella operativo, después entregar un núcleo sólido y construir sobre él. Es menos espectacular que una gran promesa de transformación, pero en el día a día suele ser mucho más valioso.

Una buena aplicación web no necesita contener el mayor número posible de funciones. Debe garantizar que un pedido no se pierda, que un inventario siga siendo trazable y que los empleados puedan realizar su trabajo sin consultas innecesarias. Cuando esto se logra, una inversión técnica se convierte en una herramienta que hace cada jornada de trabajo notablemente más tranquila.

Enlace permanente →

Generar etiquetas de envío automáticamente y reducir errores

Generar etiquetas de envío automáticamente y reducir errores

Un pedido está embalado, la mercancía espera en el muelle — y alguien todavía busca el método de envío correcto, escribe la dirección del destinatario en un portal de transportistas e imprime la etiqueta. Este paso solo cuesta unos minutos por paquete. Con 30, 80 o 300 envíos al día, se convierte en un cuello de botella. Generar etiquetas de envío automáticamente no significa, por tanto, simplemente conectar una impresora. Significa conectar los datos del pedido, las reglas de envío y el proceso de embalaje real de forma que un envío listo se convierta de manera fiable en la etiqueta correspondiente.

Para las pequeñas y medianas empresas, este suele ser el punto de entrada más razonable a la automatización logística. El beneficio se nota de inmediato en el suelo del almacén: menos consultas, menos paquetes mal direccionados y un estado claro para ventas, almacén y atención al cliente. Aun así, merece la pena observar detenidamente el proceso antes de la implementación técnica. Un maestro de artículos mal mantenido o unas reglas de envío poco claras no mejoran con la automatización: solo se procesan más rápido.

Qué ocurre realmente durante la impresión automática de etiquetas

Una etiqueta de envío contiene más que un nombre y una dirección. Según el proveedor, incluye un número de envío, un código legible por máquina, información de enrutamiento, servicios como la verificación de edad o el contrarreembolso, así como datos aduaneros en el caso de envíos internacionales. Para que el transportista pueda generar una etiqueta, esta información debe estar completa y en el formato esperado.

El flujo técnico suele comenzar con un pedido en la tienda, el ERP o una gestión de pedidos propia. En cuanto el pedido está listo para enviarse, el sistema determina, según reglas definidas, el proveedor, el producto y los servicios adicionales. A continuación transfiere los datos a la interfaz del transportista o a una plataforma de envíos. Esta registra el envío, devuelve el número de seguimiento y la etiqueta, y el sistema guarda los datos en PDF o de impresión junto al pedido. Solo entonces se imprime, en el puesto de trabajo, en la mesa de embalaje o directamente a través de una impresora de etiquetas.

Este orden es determinante. Una etiqueta bonita sin un registro de envío exitoso no sirve de nada. A la inversa, un registro exitoso no debe desaparecer en segundo plano si a la impresora se le acaba el material. Los buenos procesos tratan el registro, la salida y la confirmación de estado como una operación conjunta.

Generar etiquetas de envío automáticamente empieza con reglas claras

El error más habitual es pensar que siempre debe elegirse el mismo proveedor para cada pedido. Eso puede funcionar, por ejemplo, en envíos B2C homogéneos dentro de Alemania. Sin embargo, muchas empresas necesitan reglas más diferenciadas. Un envío pesado, un pedido urgente, una recogida en un punto de paquetería o un envío a Suiza plantean requisitos distintos.

Unas reglas razonables pueden tener en cuenta el peso y las dimensiones, el país de destino, la dirección de entrega, el valor de la mercancía, el plazo de entrega deseado, las indicaciones de mercancías peligrosas y las condiciones acordadas con el cliente. Aquí se aplica lo siguiente: no todas las excepciones teóricas deben automatizarse desde el primer día. Si se dan dos casos especiales al mes, un paso manual claramente señalizado suele ser más económico y seguro que un motor de reglas complicado. Los casos recurrentes con un volumen considerable, en cambio, pertenecen al proceso estándar.

La fuente de datos es especialmente importante. Los pesos de un maestro de artículos bien mantenido son útiles para mercancías similares. En pedidos mixtos, embalaje variable o recargos por sobredimensión, el peso final del paquete debería registrarse en el puesto de embalaje. El sistema puede entonces generar la etiqueta solo después del pesaje. Es un paso manual adicional, pero evita correcciones y cargos posteriores costosos.

La calidad de las direcciones se decide antes de imprimir

Muchos problemas de envío surgen antes de la entrega al transportista. Los números de calle acaban en el campo equivocado, los códigos postales no coinciden con la ciudad, o las direcciones de empresa contienen nombres de destinatario poco claros. Por eso, la automatización no debería limitarse a transmitir las direcciones, sino verificarlas de antemano. Los campos obligatorios, los formatos por país, la longitud de los caracteres y los duplicados reconocibles pueden detectarse ya en la entrada del pedido.

Una verificación de direcciones no es una garantía de entrega. Sin embargo, reduce el número de errores evitables. Ante datos llamativos, el sistema debería poner claramente el pedido en espera para su aclaración, en lugar de generar en silencio una etiqueta incompleta. En el almacén debe ser visible por qué un pedido está esperando y quién puede aportar la información.

El puesto de embalaje necesita un manejo sencillo

La mejor interfaz fracasa si el personal tiene que cambiar entre cinco pantallas al embalar. Un diálogo de embalaje práctico solo muestra lo necesario para el envío actual: pedido, artículos, dirección de entrega, estado del embalaje, peso, método de envío elegido y estado de impresión. Un escaneo de código de barras en el albarán o en el documento de picking debería abrir el pedido correcto. Tras el pesaje, en el caso ideal basta una acción de confirmación para crear e imprimir la etiqueta.

Con varios puestos de embalaje, cada puesto necesita una asignación clara a una impresora. El formato de la etiqueta también debe coincidir con el dispositivo y el transportista. El A6 es habitual para muchas etiquetas de paquetes, pero no todos los rollos, impresoras térmicas y archivadores de documentos funcionan igual. Quien empiece emitiendo las etiquetas como PDF en una impresora láser de oficina puede arrancar rápido. Con volúmenes más altos, las impresoras térmicas suelen ser más adecuadas: evitan cortar, pegar y el riesgo de que una etiqueta se desplace al lado equivocado al imprimir.

Un buen proceso comunica los problemas técnicos de forma comprensible. «API Error 403» no ayuda en la mesa de embalaje. Es mejor: «Etiqueta no creada: comprobar el acceso al proveedor de envíos» o «Impresora del puesto de embalaje 2 inaccesible». El pedido no debe considerarse enviado por error mientras tanto. Permanece en un estado de error claro y puede procesarse de nuevo tras resolverse, sin registrar un segundo envío.

Las interfaces necesitan gestión de errores, no solo un camino ideal

Las interfaces de los transportistas son sistemas externos. Pueden quedar temporalmente inaccesibles, rechazar entradas o cambiar su formato de respuesta. Una red local, un servicio de impresión o unas credenciales de acceso caducadas también pueden interrumpir el flujo. Por eso es arriesgado hacer depender el éxito únicamente de que un usuario haya pulsado «Crear etiqueta».

Técnicamente, cada solicitud debería registrarse de forma trazable: momento, pedido, servicio de envío utilizado, resultado, número de seguimiento y mensaje de error comprensible. Los datos sensibles y las claves de acceso no deben aparecer sin protección en los archivos de registro. Un ID de envío interno único evita que un reintento genere etiquetas duplicadas o facturaciones duplicadas.

Las cancelaciones también forman parte de la planificación. Si un paquete finalmente no se recoge o se reembala después de imprimir la etiqueta, debe quedar claro si el envío puede anularse ante el transportista y cómo se documenta esto en el sistema interno. Sin este paso, el estado de envío, el seguimiento y la facturación dejan de coincidir al cabo de unas semanas.

No todas las empresas necesitan de inmediato una gran plataforma de envíos

Las plataformas de envíos pueden agrupar varios transportistas, lógicas de tarifas y devoluciones. Esto tiene sentido cuando los volúmenes de envío, los países de destino y los proveedores son muy variados. Sin embargo, quien tenga un proceso de envío claro y uno o dos transportistas puede trabajar de forma más clara con una conexión directa. Menos sistemas significan menos conciliación de datos, menos cuentas de usuario y menos puntos donde pueden surgir errores.

La decisión no depende solo del volumen de paquetes. También son relevantes las devoluciones, los documentos de exportación, las reglas de envío individuales, las fuentes de pedidos existentes y la cuestión de quién mantendrá los cambios más adelante. Una solución en hoja de cálculo sigue siendo defendible, por ejemplo, si a diario se envían pocos envíos con datos constantes. En cuanto los compañeros transfieren información varias veces o el envío depende de personas concretas, un flujo centralizado suele resultar más rentable.

Para procesos específicos de cada cliente, puede tener sentido una aplicación web ligera que reúna los datos de pedidos, los movimientos de almacén, los albaranes y la impresión de etiquetas.

softify.pro implementa este tipo de sistemas con una estructura de datos trazable, una puesta en producción documentada y tecnologías mantenibles como PHP 8.4 y MySQL 8. Lo decisivo no es el número de funciones, sino que el proceso resulte más comprensible para el equipo en el puesto de embalaje.

Introducir en pequeños pasos y mejorar de forma medible

Un inicio controlado es mejor que un gran cambio un lunes por la mañana. Primero se automatiza un caso estándar claramente delimitado, por ejemplo los paquetes nacionales de un transportista con un formato de etiqueta definido. En paralelo, durante unos días deberían comprobarse los datos generados automáticamente frente al proceso anterior: dirección, peso, producto de envío, número de seguimiento y etiqueta impresa.

Después pueden añadirse las excepciones. Indicadores útiles son el tiempo de procesamiento por envío, el número de correcciones manuales, las etiquetas no impresas o generadas por duplicado, y el tiempo hasta la confirmación de seguimiento al cliente. Estos valores muestran si la automatización realmente quita trabajo o solo reproduce digitalmente un viejo rodeo.

Al final no cuenta un diálogo de envío especialmente complejo. Cuenta que un pedido embalado reciba la etiqueta correcta sin buscar, volver a escribir ni incertidumbre, y que las excepciones se vuelvan visibles precisamente donde una persona debe decidir realmente.

Enlace permanente →

Probar automáticamente el proceso de inicio de sesión con un sistema

Probar automáticamente el proceso de inicio de sesión con un sistema

Un inicio de sesión solo parece trivial cuando funciona. Si falla tras una publicación, los empleados se encuentran bloqueados antes de comenzar su turno, los clientes ante el portal de clientes o los planificadores ante un procesamiento de pedidos detenido. Probar automáticamente el proceso de inicio de sesión no significa, por tanto, simplemente introducir un nombre de usuario y una contraseña en un formulario. Significa comprobar de forma repetible un acceso crítico para el negocio, con sus reglas, excepciones y límites de seguridad.

Para muchos equipos, la automatización comienza con un único caso de prueba positivo: introducir credenciales válidas, confirmar el inicio de sesión, ver la página de inicio. Esto tiene sentido, pero es insuficiente como única prueba. Los errores de inicio de sesión suelen surgir en los márgenes: sesiones caducadas, cuentas bloqueadas, una nueva autenticación multifactor o un permiso que ya no funciona correctamente tras un cambio de rol. Precisamente estos casos deben cubrirse de forma planificada.

Por qué el inicio de sesión exige una disciplina de pruebas especial

El inicio de sesión es al mismo tiempo una función de seguridad, una interfaz técnica y la puerta de entrada al flujo de trabajo. Un error puede ser demasiado permisivo y permitir un acceso no autorizado. Pero también puede ser demasiado estricto y bloquear a personas autorizadas. Ambos casos tienen un coste: el primero genera riesgos para los datos y el cumplimiento normativo; el segundo, paradas, carga de soporte y soluciones improvisadas.

En las aplicaciones web se suman otras dependencias. El inicio de sesión suele comunicarse con un proveedor de identidad, un sistema de correo para restablecer contraseñas, una app de MFA o un servicio de directorio. En las aplicaciones de escritorio de Windows pueden influir los permisos locales, las conexiones de red y las versiones instaladas. Una prueba que solo observa el formulario en el navegador no detecta de forma fiable estos problemas de integración.

Por eso, antes de la primera automatización de pruebas, el equipo debería definir qué significa un inicio de sesión exitoso en el sistema en cuestión. ¿Basta con una página de inicio visible? ¿O hay que comprobar que se cargó la selección de cliente correcta, que el rol de usuario es el adecuado y que la primera acción protegida es realmente posible? Para un portal de almacén, eso podría ser el acceso a la recepción de mercancías. Para un sistema de planificación, la liberación de una ruta.

Probar automáticamente el proceso de inicio de sesión: del modelo de flujo al caso de prueba

Un buen punto de partida no es un script, sino un modelo de flujo. El inicio de sesión puede describirse como una secuencia de estados claros: no autenticado, credenciales enviadas, identidad confirmada, MFA requerido, autenticado, sesión caducada o cuenta bloqueada. Cada estado tiene acciones permitidas y reacciones esperadas del sistema.

De este modelo surgen casos de prueba con valor de negocio. El caso positivo estándar forma parte de ellos, pero también contraseñas inválidas, cuentas de usuario inexistentes y enlaces de restablecimiento caducados. Aquí es clave la respuesta esperada. Ante credenciales erróneas, una aplicación no debería revelar si existe una dirección de correo. La prueba verifica, por tanto, no solo que se muestre un error, sino también que su texto y comportamiento no den pistas innecesarias.

Especialmente relevantes son los mecanismos de protección contra intentos fallidos repetidos. Tras un número definido de introducciones erróneas, una cuenta puede bloquearse temporalmente. La prueba automatizada debe comprobar si el bloqueo realmente se activa, cuánto dura y si el usuario legítimo recupera después un acceso controlado. Aquí se necesita precisión: una prueba que bloquea intencionadamente cuentas de producción crea más problemas de los que resuelve. Estos escenarios deben ubicarse en un entorno de pruebas separado, con cuentas creadas específicamente para ello.

Considerar por separado el MFA, el restablecimiento de contraseña y el Single Sign-On

La autenticación multifactor no es un detalle menor al final del inicio de sesión. Cambia el flujo. Una prueba debe reconocer que tras la contraseña se requiere una confirmación adicional, y debe reflejar tanto la confirmación exitosa como la rechazada. Para los códigos de un solo uso basados en tiempo, el entorno de pruebas necesita un manejo controlado del tiempo y los secretos. En muchos casos, un método de prueba previsto por el proveedor de identidad es más sensato que recrear un teléfono móvil real.

El restablecimiento de contraseña y el Single Sign-On también deberían tener sus propios recorridos de prueba. En el restablecimiento importan el envío del mensaje, la unicidad del enlace, el periodo de validez y el posterior inicio de sesión con la nueva contraseña. En el SSO es decisivo si la aplicación, al volver del proveedor de identidad, crea correctamente la sesión y asume limpiamente los roles.

Los CAPTCHA son un caso especial. Están destinados a frenar ataques automatizados y no deberían eludirse mediante la automatización de pruebas. Es más sensato usar una configuración de prueba, una clave de prueba oficial o una excepción protegida para el entorno de pruebas. Engañar los controles de seguridad solo para que una prueba se ponga en verde no es una estrategia de calidad.

Elegir el nivel técnico de prueba adecuado

No todas las pruebas de inicio de sesión tienen que pasar por un navegador real. Las pruebas de API pueden verificar si los tokens, sesiones, mensajes de error y reglas de bloqueo funcionan correctamente. Son rápidas y ayudan a encontrar errores cerca de la lógica de autenticación. Las pruebas de navegador, en cambio, muestran si campos, redirecciones, cookies, ajustes SameSite y estados visibles encajan en el flujo real del usuario.

Para las aplicaciones críticas, la combinación es sensata. Unas pocas pruebas de extremo a extremo verifican el recorrido completo con el navegador. Por debajo, pruebas de API e integración específicas cubren las variantes. Esto reduce el tiempo de ejecución y las falsas alarmas. Quien prueba cada combinación imaginable exclusivamente en el navegador obtiene a menudo una suite lenta cuyo mantenimiento consume más tiempo del que ahorra.

En el software de escritorio rige un principio similar. Una prueba automatizada no debería limitarse a comprobar si se abre una ventana. Debe determinar si, tras el inicio de sesión, existe la conexión de datos correcta, si los permisos de usuario están activos y si la pantalla de trabajo central es accesible. Esto es especialmente relevante en aplicaciones de almacén o producción, porque los puestos de trabajo pueden tener condiciones de red, conexiones de escáner o configuraciones locales distintas.

Tratar los datos de prueba de forma segura y repetible

Las pruebas de inicio de sesión trabajan necesariamente con credenciales. Sin embargo, las cuentas de empleados en producción, los datos reales de clientes o los secretos de MFA no deben acabar de forma descontrolada en scripts de prueba, registros y capturas de pantalla. Las cuentas de prueba deben estar claramente identificadas, tener permisos mínimos y poder restablecerse automáticamente. Las contraseñas y tokens se proporcionan mediante una gestión segura de secretos, no se almacenan en el código fuente.

Igual de importante es la limpieza tras la ejecución de la prueba. Si una prueba genera nuevas sesiones, entradas de auditoría o cuentas bloqueadas, el entorno de pruebas debe volver a un estado inicial definido. De lo contrario, una prueba falla el lunes solo porque una ejecución del viernes dejó efectos secundarios.

Para empresas con aplicaciones confidenciales, el lugar de ejecución también es decisivo. Las capturas de pantalla de las pantallas de inicio de sesión, los vídeos de prueba y los registros técnicos pueden contener información sensible. Una infraestructura de pruebas autoalojada como COCO puede ser útil aquí, porque los datos de prueba, la ejecución y las evidencias permanecen bajo control propio. Si esto es necesario depende de las necesidades de protección, la situación contractual y las directrices internas. Una infraestructura propia no es automáticamente la opción más económica para cada aplicación.

Generar evidencias, no solo marcas verdes

Un informe de pruebas debería permitir a QA, desarrollo y al área de negocio entender qué se ha verificado. Un estado verde sin contexto ayuda poco si una publicación genera preguntas más adelante. Por eso son útiles las marcas de tiempo, el entorno de prueba utilizado, la cuenta de prueba, los pasos relevantes, capturas de pantalla en caso de error y un mensaje de error claro en lenguaje cotidiano.

En este proceso, la recopilación de evidencias no debe convertirse en un problema de protección de datos. Contraseñas, códigos de un solo uso, identificadores de sesión y datos personales deben enmascararse en los registros. En las capturas de pantalla puede ser necesario ocultar determinadas áreas. Estas reglas deberían formar parte de la arquitectura de pruebas, no un trabajo manual posterior a un incidente.

Qué deberían automatizar primero los equipos

La prioridad se guía por el riesgo y la frecuencia de uso. Primero vienen el inicio de sesión estándar para los roles más importantes, las credenciales erróneas, el cierre de sesión y la caducidad de sesión. Después siguen las reglas de bloqueo, el restablecimiento de contraseña, el MFA y los cambios de rol. El SSO, los clientes especiales o las rutas de excepción poco frecuentes pueden seguir más adelante, siempre que su fallo no detenga de inmediato la operativa.

Las pruebas forman parte del proceso de publicación. Los cambios en formularios de inicio de sesión, cookies, permisos o configuraciones del proveedor de identidad deberían activar la suite de pruebas correspondiente antes de que una versión pase a producción. Además, merece la pena una ejecución planificada en un entorno realista, por ejemplo tras cambios de infraestructura o de certificados. Esto permite encontrar problemas no visibles en un entorno de desarrollo aislado.

La mejor prueba de inicio de sesión no es, al final, la que tiene más clics. Es la que detecta pronto un fallo real, lo documenta de forma comprensible y se puede seguir ejecutando de forma fiable en el siguiente cambio. Quien trata el inicio de sesión como un proceso de negocio claramente modelado no protege solo un formulario. Protege el acceso al trabajo que espera detrás.

Enlace permanente →

Crear albaranes de entrega automáticamente con software

Crear albaranes de entrega automáticamente con software

La búsqueda de "software para crear albaranes automáticamente" normalmente no empieza con un problema de documentos. Empieza en la mesa de embalaje: un pedido está aprobado, la mercancía se ha preparado, pero el albarán todavía existe como plantilla de Word, exportación de Excel o nota manuscrita. Mientras alguien revisa las líneas, cambian cantidades, direcciones de entrega o envíos parciales. Esto cuesta tiempo, y genera precisamente los errores que después provocan consultas, correcciones y coordinación innecesaria.

Un albarán generado automáticamente es, por tanto, más que un PDF con un logotipo. Es la transición documentada entre el pedido, el movimiento de inventario y el envío. Para que esto funcione de forma fiable, el software no necesita ofrecer tantas funciones como sea posible. Debe representar correctamente el flujo real de trabajo en la empresa.

Cuándo merece la pena crear albaranes automáticamente con software

No toda empresa necesita de inmediato una aplicación personalizada. Quien gestiona pocos envíos por semana, vende artículos fijos y trabaja con una plantilla bien mantenida, puede arreglárselas bien con una solución de hoja de cálculo. La automatización se vuelve útil cuando los empleados introducen datos varias veces, los pedidos se dividen regularmente en envíos parciales, o el estado del envío no se puede seguir con claridad.

Las señales de alerta típicas son archivos Excel que se han vuelto frágiles, descripciones de artículos diferentes entre el pedido y el almacén, comprobantes ausentes ante consultas o números de albarán asignados manualmente. Incluso cuando varias personas trabajan entre la oficina, el almacén y el envío, una carpeta compartida a menudo ya no basta. Entonces falta no solo velocidad, sino una fuente fiable de lo que realmente salió de la empresa.

El punto decisivo es este: el albarán debería surgir de un evento, no de un paso de trabajo adicional. Este evento puede ser la liberación para la preparación, la extracción confirmada o la finalización del embalaje. Qué variante encaja depende de su proceso. En un almacén de repuestos, el registro de inventario suele ser el disparador correcto. En la fabricación bajo pedido, la liberación de envío por parte de la preparación del trabajo puede ser decisiva.

Qué datos necesita realmente un albarán automático

Un buen sistema no toma simplemente todos los datos de un pedido. Comprueba qué información es válida en el momento de la entrega. El destinatario puede diferir del destinatario de la factura, un pedido puede entregarse en varios envíos, y la cantidad entregada puede ser menor que la cantidad originalmente pedida.

Como mínimo se requieren un número de albarán único, la fecha de emisión, la dirección de entrega, la referencia del cliente, así como las líneas realmente entregadas con cantidades y unidades. Según el sector se añaden lotes, números de serie, pesos, unidades de embalaje, preparadores de pedidos o instrucciones de recepción de mercancía. Si estos datos se necesitan más adelante para reclamaciones o trazabilidad, no pertenecen a un campo de texto libre, sino a campos de datos claramente definidos.

Pedido, movimiento de inventario y documento deben coincidir

El punto débil más habitual está entre el pedido y el almacén. El pedido quizá prevé diez unidades, pero el almacén solo confirma ocho. Si aun así se imprimen diez unidades en el albarán, se crea un documento problemático. Si se entregan ocho unidades sin ajustar el estado del pedido, la cantidad restante queda invisible.

Un software adecuado mantiene estos estados separados pero conectados: pedido, reservado, preparado, entregado, eventualmente devuelto. El albarán accede a las cantidades de entrega confirmadas. Así, incluso en caso de entregas parciales y posteriores, sigue siendo trazable qué línea estaba incluida en qué envío.

Los rangos de numeración y las versiones no son un detalle menor

Asignar manualmente los números de albarán parece sencillo al principio. A más tardar con varias ubicaciones, distintas cuentas de usuario o correcciones posteriores, se vuelve propenso a errores. La aplicación debería generar los números de forma centralizada e impedir que el mismo número se use dos veces.

Igual de importante es la gestión de los cambios. Un albarán ya enviado no debería sobrescribirse silenciosamente. Es mejor una corrección reconocible, una anulación o una nueva versión con un historial trazable. Técnicamente no es un lujo, sino que protege a los empleados de trabajar con información contradictoria.

Así funciona la creación en el flujo práctico

En un proceso claro, todo comienza con un pedido estructurado. Artículos, cantidades, dirección de entrega y fecha deseada se registran una vez o se importan de un sistema existente. A continuación, se crea una orden de preparación para el almacén, en un dispositivo móvil, como impresión o en un terminal de puesto de trabajo.

Durante el embalaje se confirman las cantidades realmente retiradas. Para flujos simples basta un botón de confirmación. Con muchos artículos, ubicaciones o lotes, los escaneos de código de barras son más adecuados. Solo después de esta confirmación el software crea el albarán en PDF, le asigna un número y lo asocia al proceso de envío. En paralelo, puede preparar una etiqueta de envío, siempre que el respectivo servicio de paquetería esté técnicamente conectado.

El documento generado se almacena de forma centralizada y sigue siendo localizable a través del pedido, la cuenta del cliente o el número de envío. Un empleado de administración ya no tiene que buscar en su bandeja de correo cuando un cliente pregunta qué se entregó en un día concreto. Ve el pedido, las entregas individuales y el estado de cada documento en un solo lugar.

Esto suena sencillo, pero a menudo falla en casos especiales. Por eso, la aplicación debe tratarlos de forma deliberada: ¿qué pasa en caso de faltantes? ¿Quién puede cambiar una dirección de entrega tras la liberación? ¿Se puede generar un albarán sin stock disponible? ¿Cómo se marcan los obsequios gratuitos o las entregas de sustitución? Reglas de este tipo determinan si la automatización se acepta en el suelo del almacén.

¿Software estándar o solución individual?

El software estándar tiene sentido cuando su flujo sigue en gran medida el modelo previsto y ya existen interfaces con la tienda, el ERP o los proveedores de envío. Reduce el esfuerzo de implantación y a menudo ofrece una amplia gama de funciones. El precio a pagar puede ser que los equipos tengan que organizar sus flujos de trabajo funcionales en torno a un sistema rígido.

Una solución individual merece la pena especialmente cuando su lógica es crítica para el negocio: por ejemplo, con reglas de embalaje específicas del cliente, entregas parciales complejas, varias zonas de almacén o una combinación de taller, producción y envío. Puede centrarse en las funciones necesarias a diario, en lugar de hacer pasar a los empleados por módulos que nadie usa.

Entre ambos extremos suele estar el camino más sensato: los sistemas existentes siguen siendo la referencia para los datos maestros de artículos o la contabilidad, mientras que una aplicación web ligera cierra la brecha operativa en el almacén. A través de interfaces claramente documentadas se pueden importar pedidos, informar de existencias y archivar albaranes. Para tales aplicaciones, una estructura de datos trazable, accesos basados en roles y procesos de importación probados son más importantes que una interfaz especialmente espectacular.

En softify.pro, estos procesos se examinan primero según el flujo concreto de mercancías: ¿quién activa, quién confirma, qué excepción ocurre realmente y qué datos deben poder demostrarse después? Solo entonces se decide si basta con una adaptación del sistema existente o si una aplicación propia es económicamente razonable.

Implementación sin frenar la operativa

El inicio más seguro rara vez es la digitalización completa de todos los procesos de almacén en una única fecha. Empiece con una ruta de entrega claramente delimitada, por ejemplo pedidos estándar de una ubicación o una categoría de producto. Esto revela si los datos maestros de artículos, la calidad de las direcciones y la lógica de cantidades son suficientemente limpios.

En el siguiente paso, los pedidos reales deberían probarse en paralelo. El software crea el albarán mientras el flujo anterior sigue disponible como instancia de control. Las desviaciones son valiosas en esta fase: no indican necesariamente un error de software, sino a menudo reglas de proceso no aclaradas. Si, por ejemplo, dos empleados empaquetarían el mismo pedido de forma distinta, primero hay que aclarar la regla de trabajo.

Después vienen los roles y permisos. El personal de almacén necesita vistas distintas a las de ventas o contabilidad. No todo el mundo debería poder modificar posteriormente las cantidades entregadas o anular documentos. Una buena solución hace visibles las responsabilidades sin forzar cada pequeña acción en un proceso de aprobación complicado.

La operación técnica también forma parte de la implementación. Documentos y datos de movimiento necesitan copias de seguridad regulares, reglas de retención claras y vías de recuperación probadas. En una aplicación web con PHP 8.4 y MySQL 8, las transacciones de base de datos limpias son especialmente importantes: un registro de inventario y la creación del albarán correspondiente no deben desincronizarse si una conexión se interrumpe en el momento equivocado.

Tres errores que encarecen innecesariamente la automatización

El primer error es automatizar un problema de PDF cuando los datos previos no están claros. Si los números de artículo, las unidades o las direcciones de clientes no están bien mantenidos, el sistema solo genera documentos erróneos más rápido.

El segundo error es un alcance de proyecto demasiado grande. Rehacer al mismo tiempo albaranes, almacén, envío, compras, producción y contabilidad suele ocupar a los equipos durante meses. Un proceso de entrega pequeño y sólido genera confianza más rápido y ofrece una base para nuevos pasos.

El tercer error es la falta de retroalimentación del almacén. Un albarán no debe crearse únicamente a partir de un pedido planificado si nadie ha confirmado qué se empaquetó realmente. Precisamente esa retroalimentación convierte una plantilla de documento en un proceso sólido.

El mejor software para albaranes casi desaparece de la vista en el día a día. Los empleados registran un pedido una vez, confirman su trabajo donde ocurre y vuelven a encontrar el documento correcto cuando lo necesitan. Cuando esto funciona, no solo surge un envío más rápido, sino un proceso en el que almacén, oficina y clientes pueden confiar por igual.

Enlace permanente →

Probar automáticamente una aplicación Windows: cómo lograrlo

Probar automáticamente una aplicación Windows: cómo lograrlo

Un lanzamiento está listo, pero nadie puede afirmar con certeza si el nuevo cuadro de diálogo de importación, la comprobación de permisos y la impresión de facturas siguen funcionando. Precisamente en este punto resulta valioso poder probar automáticamente una aplicación Windows - no como una demo de tres clics, sino como una parte repetible del proceso de lanzamiento.

El software de escritorio es crítico para el negocio en muchas empresas. Controla movimientos de inventario, órdenes de fabricación, datos maestros de clientes o documentos de envío. Un error no afecta solo a una pantalla: puede bloquear pedidos, generar etiquetas incorrectas u obligar a los empleados del turno de tarde a soluciones manuales de emergencia. Las pruebas automatizadas reducen este riesgo cuando se orientan a flujos de trabajo reales y a un entorno de pruebas técnicamente controlado.

Por qué las pruebas de Windows son diferentes de las pruebas web

Una aplicación web se prueba normalmente a través de elementos claramente direccionables en el navegador. En las aplicaciones de escritorio Windows, el manejo depende más de ventanas, cuadros de diálogo, controles nativos, resolución, permisos y componentes instalados. Una prueba debe determinar, por ejemplo, si un cuadro de diálogo se abrió realmente, si un campo es editable o si un trabajo de impresión se transfirió correctamente.

A esto se suma la realidad acumulada de muchas aplicaciones. Algunas interfaces constan de componentes clásicos WinForms o WPF, otras integran módulos más antiguos, visores de PDF o interfaces hacia impresoras y hardware de escáner. No existe un único procedimiento de automatización que funcione igual de bien para cada aplicación. Quien lo oculta produce pruebas que se ven bien en el laboratorio y fallan en la siguiente actualización.

El punto de partida sensato no es, por tanto, la herramienta, sino la pregunta: ¿qué procesos deben funcionar de forma demostrable en cada lanzamiento? Para un software de almacén o pedidos, eso sería, por ejemplo, el inicio de sesión, la comprobación de permisos, la entrada de pedidos, el registro de inventario, la creación de documentos y la transferencia a una interfaz. Estos procesos generan valor de negocio. Una prueba que solo comprueba si un menú es visible rara vez lo hace.

Probar automáticamente una aplicación Windows: elegir el nivel adecuado

Para la automatización existen fundamentalmente tres niveles. Lo ideal es combinarlos, en lugar de basarse exclusivamente en la interfaz visible.

En el nivel técnico, las pruebas unitarias y de integración verifican la lógica de negocio, el acceso a datos y las interfaces. Se ejecutan rápidamente y muestran pronto si, por ejemplo, un cálculo de precios, un formato de importación o una regla de permisos se ha dañado. Sin embargo, no sustituyen una prueba operativa: si un planificador realmente puede acceder a la función y ejecutarla correctamente sigue siendo una incógnita.

El segundo nivel son las pruebas de interfaz a través de la API de Windows Automation. Aquí las herramientas de prueba se dirigen a los controles mediante propiedades como el ID de automatización, el nombre o el tipo de control. Esto suele ser más estable que las pruebas que simplemente hacen clic en coordenadas de pantalla fijas. Los equipos de desarrollo pueden fomentar activamente esta estabilidad asignando ID únicos y no renombrando los controles relevantes con cada cambio de interfaz.

El tercer nivel funciona visualmente. Aquí un sistema reconoce botones, contenidos de tablas, cuadros de diálogo o estados a partir del contenido de la pantalla. Esto ayuda especialmente con aplicaciones antiguas, componentes propietarios o interfaces que no ofrecen información de automatización útil. Sin embargo, el reconocimiento visual es más sensible a la escala, los temas, las ventanas emergentes inesperadas y los estados de pantalla confusos. Requiere puestos de trabajo definidos, condiciones de espera claras y evidencias trazables.

Un enfoque asistido por IA puede clasificar las señales visuales mejor que un simple clic en coordenadas. Aun así, no debería convertirse en una caja negra. Para los pasos críticos, un equipo necesita capturas de pantalla, registros, resultados esperados y una explicación de por qué una ejecución se evaluó como fallida. Una fiabilidad aburrida pero demostrable, en lugar de perseguir tendencias, se aplica especialmente en las pruebas.

Empezar con un alcance de pruebas pequeño y sólido

El error más común es intentar automatizar de inmediato cada pantalla. Esto consume presupuesto y crea una gran colección de scripts frágiles antes incluso de que quede claro si el enfoque mejora el día a día de los lanzamientos. Es mejor un comienzo reducido con entre cinco y diez flujos críticos que hoy se comprueban regularmente de forma manual.

Un buen primer caso de prueba tiene un inicio claro, una entrada realista y un resultado verificable. Ejemplo: un usuario con el rol de almacén inicia sesión, crea una recepción de mercancía, registra un artículo en una ubicación y imprime el documento. La prueba comprueba entonces no solo el mensaje de éxito, sino también el inventario, el número de documento y el trabajo de impresión registrado. Así, una secuencia de clics se convierte en una prueba de un proceso de negocio.

No todos los flujos son adecuados de inmediato. Las funciones con hardware inestable, servicios de pago externos o sistemas de terceros que cambian con frecuencia suelen requerir un enfoque diferente. Aquí se puede probar la propia aplicación hasta el traspaso y representar el componente externo mediante un simulador controlado. No es un atajo, sino una delimitación clara de responsabilidades.

Los datos de prueba son parte del sistema

La automatización a menudo falla no por la interfaz, sino por datos inutilizables. Una cuenta de prueba está bloqueada, un artículo ya se ha usado, o una ejecución anterior cambió la cantidad de inventario esperada. Por eso el entorno de pruebas necesita datos de partida definidos y una forma fiable de volver a ese estado.

En la práctica, esto significa: base de datos de pruebas separada, roles de usuario fijos, conjuntos conocidos de artículos y clientes, así como una lógica de tiempo y numeración controlada. Con datos sensibles, los datos de producción no deberían copiarse de forma incontrolada. Los conjuntos de datos anonimizados o generados específicamente suelen ser la mejor opción. Son predecibles y reducen el riesgo de protección de datos.

Los flujos de bloqueo de cuenta también merecen especial atención. Si las ejecuciones de prueba fallidas usan repetidamente contraseñas incorrectas, pueden bloquear sus propios accesos. Estos escenarios deberían probarse conscientemente, pero separados de la prueba de regresión normal.

La estabilidad surge de la operación, no de una sola herramienta

Una prueba de interfaz solo es útil si se ejecuta en condiciones reproducibles. Esto incluye una versión fija de Windows, resolución y escala de pantalla definidas, versiones de aplicación conocidas, así como un manejo limpio de actualizaciones, cuadros de diálogo y procesos en segundo plano. Si un servidor de pruebas usa tamaños de fuente diferentes por la mañana que por la noche, eso no es un problema de pruebas, es un problema operativo.

Los tiempos de espera no deberían introducirse ciegamente como valores fijos. Tres segundos de pausa después de cada clic hacen que una prueba sea lenta y no resuelven problemas de sincronización. Es mejor esperar específicamente a un estado: la ventana es visible, la tabla contiene el registro esperado, o el proceso de guardado ha finalizado. Para procesos asíncronos reales se necesitan límites de tiempo razonables y un diagnóstico de errores claro.

Las ejecuciones fallidas pertenecen a una clasificación, no a una carpeta ignorada. ¿Estaba defectuosa la aplicación? ¿Cambió la interfaz de forma funcionalmente correcta? ¿No estaba disponible el entorno de pruebas? Capturas de pantalla, grabaciones de pantalla, registros técnicos y marcas de tiempo acortan considerablemente esta aclaración. Un informe en texto claro también ayuda a los departamentos a entender qué proceso de negocio se ve afectado, sin tener que leer primero un script de prueba.

Planificar la protección de datos y las evidencias desde el principio

En las aplicaciones de escritorio, las capturas de pantalla suelen mostrar nombres de clientes, precios de artículos, direcciones o cifras internas clave. Si las pruebas se ejecutan a través de servicios en la nube externos, los datos de pantalla y el tráfico de la aplicación pueden salir de su propia zona de control. Para los equipos conscientes de la seguridad, esto no es un detalle menor, sino una decisión de arquitectura.

Un servidor de pruebas autoalojado puede mantener la ejecución de pruebas, las imágenes y los informes en su propio entorno. Para ello, softify.pro utiliza COCO, un entorno que ejecuta pruebas automatizadas para aplicaciones web y Windows y genera resultados trazables. Si un servidor propio tiene sentido depende de las necesidades de protección, la infraestructura de TI existente y el número de ejecuciones de prueba. Para una aplicación pequeña y no crítica, un enfoque simple puede ser suficiente; para sistemas especializados internos con datos sensibles, el control local suele ser la opción más razonable.

La conservación de las evidencias también debería estar regulada. No todas las capturas de pantalla necesitan almacenarse de forma permanente. Son útiles los plazos, el acceso basado en roles y una asignación clara entre ejecución de prueba, versión de la aplicación y resultado. Así se pueden reproducir errores sin crear una segunda colección de datos incontrolada.

Qué aporta un despliegue sensato

Después de una primera ejecución, un equipo no debería recibir solo un número de pruebas superadas. Lo decisivo es si las pruebas encuentran errores reales, si funcionan de forma fiable y si el esfuerzo de mantenimiento se corresponde con el beneficio. Una prueba que hay que ajustar cada semana por un cambio de diseño insignificante es demasiado costosa, incluso si técnicamente parece impresionante.

El siguiente paso es la integración en el proceso de lanzamiento. Las pruebas técnicas rápidas pueden ejecutarse en cada build; las pruebas de extremo a extremo seleccionadas se ejecutan antes de una aprobación o por la noche en un entorno estable. Las desviaciones críticas bloquean el lanzamiento, las indicaciones menos críticas se documentan y priorizan. Estos umbrales deberían acordarse con el área de negocio. No toda diferencia visual detiene una entrega, pero una cantidad registrada incorrectamente sí.

Las pruebas automatizadas de Windows no sustituyen el conocimiento especializado. Pero crean tiempo para las comprobaciones que requieren criterio: nuevos procesos, casos especiales inusuales y la pregunta de si una función es realmente comprensible en el día a día laboral. Cuando los procesos estándar son demostrablemente fiables, un lanzamiento ya no tiene que basarse en la esperanza.

Enlace permanente →

Software logístico a medida para pymes

Software logístico a medida para pymes

Cuando la recepción de mercancía se registra en papel, los inventarios están repartidos en varios archivos Excel y las preguntas de envío se resuelven de palabra, rara vez falta disposición. Falta un proceso compartido. El software logístico a medida para pymes actúa precisamente ahí: no con un sistema corporativo sobrecargado, sino con una aplicación que refleja los caminos reales en el almacén, la planificación y la oficina.

Para muchas empresas, esto no es un proyecto de digitalización por sí mismo. Se trata de menos consultas, inventarios fiables, albaranes generados más rápido y un traspaso de turno que no depende del conocimiento de personas individuales. La mejor solución no es automáticamente la que tiene más funciones. Debe hacer el trabajo demostrablemente más sencillo y controlable.

El punto crítico suele estar en los traspasos

En pequeñas y medianas empresas de almacenamiento y fabricación, muchas cosas funcionan sorprendentemente bien durante mucho tiempo con hojas de cálculo, correos electrónicos y experiencia. Esto no es fundamentalmente incorrecto. Una hoja de cálculo bien mantenida puede ser más sensata que un sistema propio para una lista de inventario manejable.

Se vuelve crítico cuando la información se registra varias veces o su fiabilidad ya no está clara. Un pedido se crea en la oficina, se imprime en el almacén, se completa en una hoja de ruta y luego se traslada de nuevo a una hoja de cálculo. Al mismo tiempo, otro empleado reserva stock para un envío urgente. Al final, no solo el inventario es cuestionable, sino que también resulta difícil responder quién realizó qué paso y cuándo.

Esta fricción rara vez se manifiesta como un único error grande. Cuesta minutos cada día: al buscar artículos, al devolver la llamada de un cliente, al rastrear una entrega o en el relevo de turno. A lo largo de las semanas, esto genera faltantes evitables, envíos urgentes y discusiones sobre cifras en las que nadie confía por completo.

Qué debería mapear concretamente un software logístico a medida

Una aplicación a medida no empieza con un catálogo de funciones. Empieza con un análisis del proceso en el suelo de la nave y en el puesto de planificación. ¿Qué datos llegan realmente? ¿Qué decisión toma un empleado? ¿Qué excepción ocurre regularmente? ¿Y qué información debe estar obligatoriamente disponible para el siguiente paso de trabajo?

De ahí surge un flujo claro, por ejemplo desde la entrada del pedido, pasando por la preparación y el envío, hasta el traspaso a contabilidad. Según la empresa, pueden formar parte los siguientes componentes:

  • Registro de recepciones de mercancía, estado de control y ubicaciones de almacén
  • Movimientos de inventario con soporte de código de barras o escáner móvil
  • Aceptación de pedidos, reservas y listas de preparación
  • Albaranes, etiquetas de envío y traspaso a proveedores de transporte
  • Planificación de rutas para vehículos y giras propios
  • Correcciones trazables, permisos basados en roles y análisis

Lo decisivo no es construirlo todo de una vez. Una empresa con traslados frecuentes quizá necesite primero movimientos de inventario fiables. Un mayorista con muchos envíos pequeños se beneficia inicialmente más de una entrada de pedidos limpia y documentos de envío generados automáticamente. Una empresa de fabricación tal vez necesite primero transparencia sobre el suministro de materiales y las existencias bloqueadas.

Un ejemplo del día a día

Supongamos que la recepción de mercancía recibe cinco palés con artículos cuyas cantidades difieren en parte del pedido. En un buen flujo, la entrega se registra, se comprueba y se le asigna un estado. Solo tras la aprobación el inventario queda disponible para la planificación. Las discrepancias no acaban en una nota en el albarán, sino que se asignan de forma visible a compras y almacén.

Cuando más tarde se realiza la preparación, el sistema muestra no solo un inventario total teórico, sino la ubicación correspondiente y la parte reservada. Tras el escaneo o la confirmación de la extracción, el movimiento queda registrado. El albarán se genera a partir de los mismos datos. Esto reduce las entradas duplicadas y crea un rastro fiable sin que los empleados tengan que realizar más trabajo administrativo.

¿Software estándar, Excel o desarrollo a medida?

La respuesta honesta es: depende del proceso. El software estándar tiene sentido cuando los flujos coinciden en gran medida con los patrones previstos, los ajustes son mínimos y los costes de licencia se ajustan al alcance. A menudo aporta módulos ya hechos, interfaces establecidas y una implantación inicial rápida.

La desventaja se hace evidente cuando la empresa tiene que adaptarse permanentemente a la herramienta. En ese caso, los casos especiales se vuelven a gestionar fuera del sistema, se eluden los campos obligatorios o los empleados mantienen listas paralelas. Esto puede ser aceptable mientras estas excepciones sigan siendo raras y manejables. Si se acumulan, el producto estándar se convierte en una ruptura de proceso adicional.

Excel también sigue siendo una herramienta útil cuando los volúmenes de datos son pequeños, solo trabajan pocas personas simultáneamente y las consecuencias de una entrada errónea siguen siendo limitadas. Sin embargo, no es una buena base de datos para movimientos de inventario paralelos, reservas vinculantes o un historial de envíos completo.

Una solución individual merece especialmente la pena cuando el flujo constituye una ventaja competitiva real, cuando se combinan varias rupturas de soporte, o cuando un sistema existente contiene datos pero frena el trabajo diario. No debería entenderse como un proyecto de prestigio. Su valor económico radica en tiempos de ciclo más cortos, menos errores y menor dependencia de personas concretas.

El software logístico a medida para pymes necesita límites

A medida no significa implementar de inmediato cada función deseada. Al contrario: un buen desarrollo a medida establece límites claros. De lo contrario, se crea un sistema que conserva todas las vías especiales históricas y, por ello, se vuelve difícil de usar.

Un inicio sensato define un proceso central con un beneficio medible. Por ejemplo: las recepciones de mercancía se registran completamente el mismo día. O: para cada pedido de envío, el artículo, la cantidad, el responsable y el estado de envío están documentados de forma inequívoca. Solo cuando este proceso funciona de forma estable siguen otros módulos, como la planificación de rutas, los portales de clientes o análisis especiales.

Las decisiones técnicas también requieren pragmatismo. Una aplicación web puede basarse en tecnologías modernas y mantenibles como PHP 8.4, JavaScript moderno y MySQL 8. Esto no es autopromoción con términos técnicos. Crea una base trazable para permisos basados en roles, transacciones de base de datos, interfaces móviles e implementaciones documentadas. Para los escáneres en el almacén, a menudo es decisivo que la aplicación responda de forma fiable en los dispositivos existentes y dé retroalimentación clara incluso con Wi-Fi más débil.

Implantación: primero estabilizar el proceso, luego acelerar

La implantación rara vez fracasa por una única interfaz. Fracasa cuando las cuestiones de proceso pendientes se posponen a la fase de desarrollo. ¿Quién puede corregir el inventario? ¿Qué ocurre con la mercancía dañada? ¿Cuándo se reserva un pedido de forma vinculante? ¿Cómo se gestionan las devoluciones? Estas reglas deben aclararse antes de una implantación amplia.

Un camino sólido comienza con unos pocos flujos representativos y datos reales. Empleados de almacén, planificación y administración comprueban juntos si la pantalla habla el lenguaje de la empresa y si el orden de los pasos de trabajo es correcto. Comentarios como «este campo no lo necesitamos» o «aquí falta el estado para entrega parcial» son más valiosos que deseos de funciones abstractos.

Después sigue una operación piloto limitada. No con ejemplos artificiales, sino con pedidos seleccionados en el día a día. Los errores y estados poco claros se documentan, priorizan y corrigen. Solo después se amplía a otras áreas. La operación en paralelo puede dar seguridad a corto plazo, pero debería tener un final. Dos sistemas líderes generan a la larga precisamente la incertidumbre que el proyecto pretende eliminar.

La formación también es más que una presentación única. Los empleados necesitan instrucciones breves y específicas por rol: ¿qué registro? ¿qué compruebo? ¿qué hago ante una discrepancia? Una gestión documentada de excepciones evita que, ante la primera situación especial, el papel y los grupos de chat vuelvan a tomar el mando.

La mantenibilidad es parte de la solución, no un añadido posterior

Los procesos logísticos cambian. Se añaden nuevas ubicaciones, un proveedor de transporte modifica sus requisitos, los clientes exigen otros formatos de documento o se conecta una nueva sede. Por eso el software no solo debe encajar en el arranque, sino ser desarrollable de forma comprensible.

Esto incluye una estructura de datos limpia, lógica de negocio claramente separada, conceptos de permisos e implementaciones documentadas. Igual de importantes son las copias de seguridad, el registro y una gestión regulada de errores. Si un usuario introduce varias veces credenciales incorrectas, se necesita, por ejemplo, un flujo de bloqueo de cuenta trazable en lugar de una improvisación silenciosa e insegura.

Las pruebas deberían preceder a los cambios en flujos críticos. En aplicaciones a medida, las pruebas automatizadas resultan especialmente útiles para los caminos centrales recurrentes: crear un pedido, reservar inventario, generar un documento de envío, cambiar el estado. Así, una modificación en el albarán no tiene consecuencias inadvertidas en otro lugar. softify.pro apuesta en este tipo de proyectos por esta clase de tecnología aburridamente fiable y verificable, en lugar de por efectos a corto plazo.

Con qué medir el beneficio después de seis meses

No toda mejora se puede expresar de inmediato en euros, pero debería ser visible. Los buenos indicadores se orientan al cuello de botella: tiempo de procesamiento por pedido, número de correcciones de inventario, tasa de envíos erróneos, proporción de registros de recepción puntuales o consultas entre el almacén y la oficina.

Es importante la comparación con una situación de partida realista. Si hasta ahora nadie ha registrado correctamente los faltantes, la nueva transparencia puede parecer al principio más problemas. En realidad, los problemas se hacen visibles y gestionables por primera vez. Esta fase requiere paciencia y una comunicación abierta.

El software adecuado no desaparece del día a día laboral porque sea poco importante. Hace que un pedido, un palé o una ruta sigan su camino claro, incluso cuando la persona más experimentada del almacén no está precisamente en la empresa.

Enlace permanente →

Pruebas de regresión automatizadas para aplicaciones web

Pruebas de regresión automatizadas para aplicaciones web

Un código de descuento modificado, un nuevo derecho de rol o una actualización del servicio de pasarela de pago pueden romper una aplicación web en un punto que nadie ha tocado durante meses. Es precisamente ahí donde entran en juego las pruebas de regresión automatizadas para aplicaciones web: comprueban de forma repetida si los flujos de trabajo empresariales probados siguen funcionando después de los cambios. No como una medida de calidad teórica, sino allí donde un error bloquea pedidos, movimientos de inventario, facturas o cuentas de clientes.

Para muchos equipos, el problema comienza de forma imperceptible. Los lanzamientos se demoran porque los departamentos especializados hacen clic manualmente en los mismos flujos principales. El conocimiento de las pruebas reside en personas individuales. Y antes de una actualización queda la pregunta incómoda: ¿qué hemos pasado por alto? La automatización no sustituye ni la responsabilidad técnica ni una labor de exploración sensata. Hace que las comprobaciones recurrentes y críticas para el negocio sean fiables, reproducibles y trazables.

Lo que las pruebas de regresión automatizadas protegen realmente

Una prueba de regresión responde a una pregunta sencilla: ¿sigue funcionando algo que antes funcionaba después de un cambio? En una aplicación web, rara vez se trata solo de un botón individual. Lo relevante son los flujos completos a través de la interfaz de usuario, los permisos, las interfaces y la base de datos.

Un ejemplo de un sistema operativo: un empleado inicia sesión, registra una entrada de mercancías, contabiliza un movimiento de inventario, crea un albarán y entrega el envío a un servicio de transporte. Cada paso puede parecer técnicamente correcto y aun así fallar en su interacción conjunta. Quizá la cantidad se guarde, pero no se actualice en el inventario. Quizá se genere la etiqueta, pero falte el número de referencia. Quizá el flujo solo funcione para los administradores, pero no para el rol del almacén.

Las pruebas automatizadas pueden ejecutar dichos recorridos con entradas definidas y comprobar los resultados. Esto incluye tanto los resultados visibles en la interfaz de usuario como los valores de estado, los documentos generados, los correos electrónicos o las respuestas de la API. La utilidad aumenta cuando la comprobación se organiza cerca de los riesgos de la operación, y no en función del número de casos de prueba técnicamente posibles.

Qué flujos web se deben automatizar primero

No cualquier clic merece una prueba automatizada inmediata. Una página de configuración apenas utilizada y con bajo potencial de daño se puede comprobar manualmente al principio. Por el contrario, los flujos con cambios frecuentes, alta utilización o consecuencias financieras y operativas claras deben incorporarse pronto a la suite de pruebas.

Son especialmente valiosas las pruebas para el inicio de sesión, el restablecimiento de contraseñas y el bloqueo de cuentas. Aseguran el acceso a la aplicación y a menudo se ven influenciadas por cambios en los servicios de identidad, la gestión de sesiones o las reglas de seguridad. Igualmente importantes son los procesos clave como la captura de pedidos, el cálculo de precios e impuestos, las aprobaciones, los registros de inventario, la generación de documentos y las interfaces con envíos, ERP o proveedores de pagos.

Para los directivos y los departamentos especializados, ayuda una priorización sobria. No pregunte primero qué página es la más fácil de probar. Pregunte: ¿qué error detiene un turno, genera trabajo adicional o conduce a información incorrecta para los clientes? De ahí surge una lista de pruebas que protege la operativa real.

Un caso de prueba necesita un resultado verificable

«Crear pedido» aún no es un buen caso de prueba. Es mejor: un representante de ventas con el rol de ventas crea un pedido para un cliente existente, añade un artículo con una cantidad definida, lo guarda y genera un número de pedido. A continuación, el estado es «abierto», la suma corresponde a las reglas y el pedido aparece en la lista de operaciones abiertas.

Esta precisión no es burocracia. Evita pruebas que hacen clics pero no pueden determinar si el resultado de negocio es correcto. También facilita la coordinación entre el desarrollo, el control de calidad (QA) y el departamento especializado. Especialmente en sistemas desarrollados a medida, los expertos técnicos son a menudo la única fuente fiable de lo que «correcto» significa realmente en el día a día.

La pirámide de pruebas en lugar de la automatización de navegador para todo

Las pruebas de navegador son valiosas, pero no constituyen toda la estrategia de prueba. Se ejecutan más lentamente, son más vulnerables a datos de prueba inestables y pueden fallar tras pequeños ajustes de la interfaz de usuario si los selectores están mal elegidos. Quien comprueba cada regla exclusivamente a través de la interfaz suele construir una suite lenta y difícil de mantener.

La lógica de negocio como los cálculos de precios, las comprobaciones de cantidades o las transiciones de estado debe probarse allí donde está implementada, por ejemplo como prueba unitaria o de integración. Las interfaces se pueden comprobar de forma específica con respuestas controladas. Las pruebas de extremo a extremo (end-to-end) basadas en navegador quedan reservadas entonces para los pocos caminos en los que la interacción de todos los componentes es decisiva.

En aplicaciones PHP 8.4 con MySQL 8, esto significa por ejemplo: las reglas de cálculo y validación se aseguran cerca del código, las transacciones de base de datos y los contratos de API se prueban de manera integrada, mientras que una prueba de navegador sigue el pedido completo hasta el documento generado. Esto es menos espectacular que una gran colección de pruebas de clics visibles. Sin embargo, proporciona respuestas más rápidas y un menor esfuerzo de mantenimiento.

La estabilidad surge de los datos de prueba y de límites técnicos claros

Muchos proyectos de automatización no fracasan por la herramienta de prueba, sino por requisitos previos no controlados. Si una cuenta de prueba está bloqueada, si todavía existe un pedido de prueba del día anterior o si un servicio externo responde lentamente, se produce una falsa alarma. Estas pruebas inestables pierden rápidamente la confianza del equipo.

Por lo tanto, los datos de prueba deben crearse y depurarse conscientemente. Son útiles los inquilinos propios o conjuntos de datos claramente delimitados, identificadores únicos por ejecución de prueba y estados iniciales definidos. Una prueba no debe depender por casualidad del orden de otras pruebas. Donde intervienen servicios externos, se debe decidir claramente: ¿se utiliza un entorno de prueba realista o se simula la interfaz para la prueba respectiva? Ambas opciones pueden ser correctas.

Los selectores también merecen atención. Las pruebas no deben depender de clases de diseño, posiciones de texto o estructuras HTML aleatorias. Unos identificadores estables y previstos expresamente para las pruebas reducen el mantenimiento innecesario. Esta es una pequeña decisión técnica de gran repercusión cuando la interfaz y el diseño evolucionan regularmente.

Integrar las pruebas de regresión automatizadas en el proceso de lanzamiento

La mejor prueba sirve de poco si solo se inicia manualmente antes de los grandes lanzamientos. Es útil una ejecución graduada: las pruebas rápidas de código y de interfaz se ejecutan en cada cambio. Los recorridos de navegador más importantes se ejecutan en las solicitudes de extracción (pull requests) o antes del despliegue en el entorno de ensayo (staging). Las comprobaciones más exhaustivas pueden tener lugar por la noche o antes de un lanzamiento de producción planeado.

La retroalimentación es crucial. Una prueba fallida no solo necesita un icono rojo, sino indicaciones utilizables: ¿qué datos se utilizaron? ¿En qué paso se produjo el error? ¿Qué captura de pantalla o qué registro lo demuestra? Para los equipos sin un gran departamento de QA propio, los informes comprensibles son especialmente valiosos. Deben poder reconocer si un defecto radica en el sistema, en los datos de prueba o en el entorno de prueba.

COCO se puede utilizar aquí como infraestructura de prueba autohospedada para ejecutar flujos de prueba, registrar evidencias y procesar los resultados en un lenguaje claro. Esto es relevante sobre todo cuando las capturas de pantalla, las interfaces internas o los datos de prueba no deben transferirse a una nube externa. No obstante, estar autohospedado no significa estar libre de mantenimiento: los derechos de acceso, las actualizaciones, las capacidades y las reglas de retención deben planificarse con la misma pulcritud que las propias pruebas.

Qué indican las métricas, y qué no

Un número creciente de pruebas automatizadas no es una prueba de calidad. Una suite con 2.000 pruebas superficiales puede ofrecer menos protección que 40 pruebas cuidadas para los flujos de valor críticos. Son más elocuentes preguntas como: ¿cuánto tiempo tarda la respuesta tras un cambio? ¿Cuántos errores relevantes se detectan antes de la producción? ¿Con qué frecuencia los errores de prueba son en realidad falsas alarmas? Y qué flujos críticos para el negocio están cubiertos de forma demostrable.

La duración de la ejecución también es un factor práctico. Si una suite ofrece resultados solo después de cuatro horas, se elude en el trabajo diario. Si proporciona una señal clara sobre inicio de sesión, pedido, inventario y documentos en 15 minutos, apoya las decisiones antes del lanzamiento. Depende de la aplicación y del riesgo qué profundidad sea necesaria. Una herramienta de planificación interna exige algo distinto a un portal de clientes con pagos y datos personales.

El inicio correcto es más pequeño de lo que muchos esperan

Comience con un proceso cuya interrupción se notaría, y modélizalo por completo. Defina el resultado esperado junto con las personas que utilizan este flujo a diario. Asegúrese de contar con datos de prueba controlados, anclajes técnicos estables y evidencias trazables. Solo cuando esta primera prueba funcione de manera fiable se añadirá el siguiente proceso.

Así no se crea un telón de fondo de pruebas impresionante pero frágil. Se crea una línea de seguridad sólida para los cambios, paso a paso, allí donde su aplicación web sostiene realmente la operativa.

Enlace permanente →

Registro digital de la entrada de mercancías sin caos de inventario

Registro digital de la entrada de mercancías sin caos de inventario

Un albarán está sobre la mesa de mercancías, el palé ya se encuentra en el pasillo y el conductor espera una firma. Exactamente en este momento se decide si un inventario será correcto más tarde o si una compañera tendrá que buscar después un material que, según el sistema, debería estar disponible. Quien quiera registrar la entrada de mercancías de forma digital, necesita por lo tanto algo más que una simple máscara de introducción de datos. El proceso debe funcionar bajo presión de tiempo, generar datos inequívocos y adaptarse a los procedimientos reales del almacén.

Las listas en papel y las hojas de cálculo a menudo parecen suficientes durante mucho tiempo. Sin embargo, se vuelven frágiles en cuanto varias personas realizan registros, los artículos tienen denominaciones similares, los lotes cobran relevancia o la mercancía pasa directamente al montaje, a la preparación de pedidos o a los pedidos de clientes. Un buen registro digital no se limita a crear más datos. Crea un estado común y fiable.

Qué se debe registrar realmente en la entrada digital de mercancías

La entrada de mercancías es la transición entre la entrega y el stock disponible. Para que esta transición siga siendo verificable, cada registro debería poder responder al menos a: ¿qué se entregó, en qué cantidad, cuándo, de qué proveedor y dónde se almacenó la mercancía? Según el tipo de negocio, se añaden el número de pedido, el número de albarán, el lote, el número de serie, la fecha de caducidad o el estado de calidad.

Lo decisivo es la distinción entre la mercancía anunciada y la efectivamente recibida. Un pedido puede indicar 100 unidades, pero se entregan 96 unidades, dos cajas dañadas y dos partidas de repuesto. Si los empleados se limitan a confirmar el pedido, el error pasa directamente al inventario. El registro digital debe facilitar de forma consciente la gestión de las desviaciones, en lugar de penalizarla con procedimientos especiales.

Para un almacén de repuestos, a menudo basta con el artículo, la cantidad, la ubicación y la referencia del documento. En la fabricación, las liberaciones de lotes o los protocolos de inspección pueden resultar indispensables. Más campos no significan automáticamente un mejor resultado. Cada campo obligatorio consume tiempo y aumenta la probabilidad de que alguien estime los valores o los introduzca más tarde.

Registro digital de la entrada de mercancías: el flujo de trabajo en la zona de almacenamiento

Un flujo de trabajo práctico no comienza en la pantalla de la oficina, sino allí donde llega la mercancía. Los empleados abren la entrada de mercancías esperada en un dispositivo móvil o registran el albarán inicialmente mediante la búsqueda, el número de pedido o el código de barras. A continuación, se escanean, se cuentan o se pesan las posiciones y se cotejan con la entrega esperada.

Si la cantidad es correcta, la mercancía se asigna a una ubicación de almacenamiento y se registra. En caso de desviaciones, no se escribe simplemente un comentario en un campo de texto libre. El sistema registra si se trata de un faltante, un exceso de entrega, un daño de transporte, un artículo erróneo o una posición aún no verificada. Una fotografía puede resultar útil en caso de daños visibles, pero no es necesaria para cada envío.

Tras el registro, debe quedar claro qué estado tiene la mercancía. Algunos artículos están disponibles de inmediato. Otros permanecen bloqueados hasta que se complete un control de calidad o un responsable decida sobre la desviación. Esta lógica de estados evita que el departamento de ventas prometa mercancía que ha llegado físicamente pero que aún no se puede utilizar.

El punto de registro adecuado depende de la empresa. En un almacén pequeño, la entrada de mercancías se puede registrar por completo directamente en la puerta. En el caso de grandes entregas o tiempos de rampa ajustados, a menudo es mejor un registro en dos etapas: primero se registra la entrega como llegada, y a continuación se verifican las posiciones y se almacenan. La ventaja es la velocidad en la rampa. El inconveniente: se requieren responsabilidades claras para que las revisiones pendientes no queden en el olvido.

¿Escáner, tableta o PC de puesto de trabajo?

El hardware debe seguir el flujo de movimiento. Para los artículos con códigos de barras impresos nítidamente, un escáner manual suele ser la opción más rápida y con menos errores. Los escáneres móviles o los teléfonos inteligentes con cámara son adecuados cuando los empleados se desplazan entre la recepción de mercancías, las estanterías y la zona de bloqueo. Una tableta puede resultar útil para registros más complejos con fotos, múltiples cantidades o notas de inspección.

Por el contrario, un puesto de trabajo con PC fijo funciona bien cuando una persona comprueba los albaranes de forma centralizada y la recepción de mercancías está concentrada espacialmente. Es menos adecuado si el equipo tiene que caminar hasta la oficina por cada registro. La licencia ahorrada suele pagarse entonces con trayectos, interrupciones y registros tardíos.

No todo artículo necesita un código de barras. Especialmente en el caso de componentes individuales, materias primas o etiquetas de proveedores, el etiquetado no es uniforme. En esos casos, el sistema debe ofrecer una búsqueda rápida a través del número de artículo, el número de artículo del proveedor o la posición del pedido. El escaneo de códigos de barras es una buena herramienta, pero no un fin en sí mismo.

La calidad de los datos surge de las reglas, no de los llamamientos

El inventario de un almacén no se vuelve correcto por el simple hecho de instalar un software. La exactitud surge cuando el sistema impone reglas sensatas y hace visibles las excepciones. Una cantidad negativa sin un proceso justificado, una ubicación de almacenamiento desconocida o un número de albarán utilizado por duplicado no deben pasar desapercibidos.

Al mismo tiempo, la comprobación no debe bloquear las operaciones. Si un proveedor reutiliza los números de albarán o las etiquetas son ilegibles, los empleados necesitan una vía alternativa comprensible. Por ejemplo, se puede realizar un registro con una nota que deba comprobarse más tarde. Lo importante es que esto se convierta en una tarea pendiente y no en un compromiso invisible.

Resultan especialmente valiosas las comprobaciones de plausibilidad sencillas: ¿El artículo coincide con el pedido? ¿La cantidad se desvía más allá de una tolerancia definida? ¿El lote está presente en los artículos sujetos a lotes? ¿Se ha establecido un estado de bloqueo cuando se ha registrado un aviso de daños? Tales reglas reducen el trabajo de corrección sin abrumar al equipo con pantallas de entrada de datos complicadas.

Construir las interfaces solo cuando el proceso central esté definido

Muchas empresas desean la conexión inmediata con el ERP, las compras, el envío y la contabilidad. Esto puede ser correcto, pero solo si la soberanía de los datos es clara. Un sistema debe determinar claramente dónde se originan los pedidos, dónde se encuentra el inventario principal y qué datos se transmiten en qué dirección.

Una mala interfaz multiplica los errores más rápido que una hoja de cálculo. Si, por ejemplo, los pedidos provienen del ERP, pero la entrada de mercancías real se genera en el sistema de gestión de almacenes, debe quedar claro qué estados se comunican de vuelta: entregado por completo, entregado parcialmente, bloqueado o con desviación. Las marcas de tiempo y las referencias de documentos inequívocas son en este caso más importantes que una integración visualmente impresionante.

Para las empresas más pequeñas, una importación CSV controlada al principio puede tener más sentido que una conexión en tiempo real costosa. Esto no es una solución de emergencia si la importación, la comprobación y el registro de errores se implementan correctamente. Tan pronto como las cantidades, la frecuencia o los procesos posteriores crecen, una interfaz directa resulta más rentable.

Un despliegue sensato comienza con entregas reales

Antes de seleccionar un desarrollo a medida o un software estándar, vale la pena realizar un breve levantamiento de procesos con casos reales. No solo se debe tener en cuenta la entrega ideal, sino también la mercancía dañada, las cantidades parciales, los artículos erróneos, los pedidos faltantes y el material urgente para el taller. De esto se desprende qué datos y decisiones se necesitan realmente.

Para empezar, a menudo basta con un área claramente delimitada, por ejemplo, un proveedor, un grupo de artículos o una ubicación de almacén. El equipo trabaja con el nuevo flujo de trabajo en paralelo a los controles anteriores hasta que los registros sean correctos y verificables. Solo entonces sigue la expansión. Un cambio radical (Big Bang) ahorra tiempo en el plan de proyecto, pero suele generar agitación en el área de trabajo.

Los criterios de aceptación importantes son concretos y medibles:

  • Una entrega estándar se puede registrar sin consultas en pocos minutos.
  • Las desviaciones aparecen en una lista de aclaraciones abierta y asignada.
  • El inventario de un artículo se puede explicar mediante el documento y la ubicación de almacenamiento.
  • Los empleados autorizados pueden realizar correcciones de forma trazable.
  • La mercancía abierta o bloqueada no se dispone por descuido.

Un sistema adaptado a la empresa puede ofrecer aquí mucho más que un paquete de software recargado, si respeta las formas de trabajar existentes.
softify.pro desarrolla este tipo de procesos logísticos no por el mero hecho de digitalizar, sino en torno a registros, responsabilidades y datos que deben ser fiables en el día a día.

Indicadores clave (KPI) que hacen visible el beneficio

Después del inicio, no solo se debe contar cuántas entradas de mercancías se han registrado digitalmente. Resultan más elocuentes el tiempo transcurrido desde la entrega hasta que la mercancía está disponible, el número de desviaciones sin aclarar, las diferencias de inventario en los recuentos y el esfuerzo dedicado a consultas en compras o ventas.

Si se acorta el tiempo de ciclo pero aumenta el número de correcciones posteriores, es probable que el proceso sea demasiado rápido y carezca de la comprobación suficiente. Si cada registro lleva mucho tiempo a pesar de que apenas se producen desviaciones, es posible que se hayan integrado demasiados pasos obligatorios. Los buenos procesos de almacenamiento no buscan el control máximo, sino el control adecuado.

El mejor paso siguiente suele ser un recorrido por la zona de recepción de mercancías con tres albaranes reales. Observe qué información se busca, dónde improvisan los decisiones los empleados y qué datos se vuelven a introducir más tarde. Exactamente ahí comienza una entrada de mercancías digital que no solo aparenta ser más moderna, sino que hace que el inventario sea realmente fiable.

Enlace permanente →

Pruebas de software de IA autohospedadas en entornos de producción

Pruebas de software de IA autohospedadas en entornos de producción

Una prueba de regresión fallida rara vez es solo una entrada roja en una lista. Puede significar que un operario de preparación de pedidos no puede imprimir un albarán, que un administrativo se queda bloqueado en el sistema de gestión de pedidos o que una actualización ha dañado una función que llevaba años funcionando de manera fiable. Las pruebas de software de IA autohospedadas se centran precisamente en eso: automatizan las comprobaciones recurrentes sin ceder innecesariamente datos de prueba sensibles, capturas de pantalla o flujos de trabajo internos de la aplicación a plataformas externas.

Para los equipos con aplicaciones web y software de escritorio para Windows, esto es más que una cuestión de protección de datos. Se trata de tener el control sobre el entorno de pruebas, pruebas de errores trazables y una operativa de pruebas que se adapte al propio proceso de lanzamiento (release). La IA puede aliviar la carga de trabajo en este sentido. Sin embargo, no sustituye ni a unos casos de prueba limpios ni a la responsabilidad técnica.

Cuándo tienen sentido las pruebas de software de IA autohospedadas

La automatización de pruebas clásica es muy eficaz, pero requiere mantenimiento. Los selectores cambian, las interfaces evolucionan, los datos de prueba deben estar disponibles y los mensajes de error deben clasificarse. Por esta কারণেই, muchos equipos solo automatizan una pequeña parte de sus procesos críticos o siguen probando predominantemente de forma manual antes de un lanzamiento.

Los sistemas basados en IA pueden reducir esta brecha. Leen las interfaces de manera más contextual, ejecutan flujos de trabajo predeterminados, reconocen desviaciones visibles y resumen el resultado en un lenguaje comprensible. Esto resulta especialmente valioso en aplicaciones que no solo consisten en llamadas a API, sino en interfaces de usuario reales: inicios de sesión, formularios de entrada, aprobaciones, diálogos de impresión y ventanas de Windows.

El autohospedaje (self-hosting) tiene sentido cuando las pruebas afectan a información confidencial. Esto no solo se aplica a los datos de carácter personal. Los precios internos, los nombres de clientes, los movimientos de artículos, las capturas de pantalla de interfaces de gestión, las credenciales de cuentas de prueba o la información sobre funciones aún no publicadas también forman parte de ello. Quien utilice servicios de IA externos debe comprobar con precisión qué datos abandonan su propia red, cuánto tiempo se almacenan y quién puede acceder a ellos. Sin embargo, también hay casos en los que una plataforma alojada en la nube es suficiente. En el caso de una página web pública de marketing sin datos reales de clientes, con pocos lanzamientos y una profundidad de prueba manejable, su configuración puede ser más rápida. La decisión correcta depende de la necesidad de protección, del entorno de aplicaciones, de las competencias existentes y de la frecuencia de los cambios, y no de un principio general de la nube o de la IA.

Lo que permanece en el propio entorno

En un entorno de pruebas autohospedado, la ejecución de las pruebas se realiza en una infraestructura que la propia empresa controla: en su propio centro de datos, en un entorno de nube privada o en un servidor dedicado bajo el modelo operativo acordado. Lo decisivo no es solo la ubicación física de un servidor, sino todo el flujo de datos.

Un sistema bien estructurado procesa los pasos de prueba, las sesiones de navegador o de escritorio, las capturas de pantalla, los registros (logs) y los informes de resultados dentro de este entorno controlado. Las cuentas de prueba se pueden configurar con privilegios mínimos. Las credenciales de acceso se pueden gestionar por separado. Los accesos a la red se pueden limitar a los sistemas que realmente se necesitan. Para aplicaciones especialmente sensibles, un inquilino de prueba (tenant) propio puede ser más recomendable que realizar pruebas con datos reales cercanos a la producción.

Esto no protege automáticamente contra errores. Una solución operada localmente requiere actualizaciones, conceptos de autorización, copias de seguridad y responsabilidades claras. Quien instala un servidor una vez y luego se olvida de él no tiene una infraestructura de pruebas segura, sino una carga operativa adicional. La ventaja radica en que esta tarea sigue siendo planificable y verificable.

Los datos de prueba merecen la misma protección que la aplicación

A menudo, el debate sobre la seguridad se concentra en el código fuente. En la práctica, los artefactos de prueba revelan al menos la misma cantidad de información. Una captura de pantalla puede mostrar datos de clientes, condiciones internas y detalles de un proceso. Un video de una ejecución de prueba puede revelar la estructura de un sistema de 'back office'. Un registro (log) puede contener URL, mensajes de error o versiones técnicas.

Por esta razón, se deben establecer plazos de retención. No es necesario almacenar de forma permanente cada ejecución exitosa. En cambio, para la evidencia de errores y los lanzamientos, un historial definido puede ser de gran ayuda. Los derechos de acceso a los informes deben formar parte del mismo concepto de autorización que los accesos a la propia aplicación.

No todas las comprobaciones deben ser controladas por la IA

Los entornos de pruebas más sólidos combinan diferentes métodos. Un inicio de sesión (login) con bloqueo de cuenta tras varios intentos fallidos se puede comprobar de forma precisa y rápida con pruebas automatizadas deterministas. Las interfaces, los cálculos, las reglas de base de datos y los permisos también se benefician de unas expectativas claras: la entrada A debe generar el resultado B.

La IA es especialmente útil cuando la interfaz, el flujo de trabajo y la perspectiva del usuario ocupan el centro de atención. Por ejemplo, una tarea de prueba puede comprobar si un planificador crea un pedido, asigna una ruta, genera un documento y recibe de vuelta el estado correcto. En este proceso, la IA puede navegar por la aplicación, capturar justificantes y documentar de forma comprensible en qué punto se ha interrumpido el proceso.

Para una operativa de pruebas viable, cuatro niveles deben interactuar entre sí:

  • Las pruebas unitarias y de integración aseguran la lógica de negocio, las interfaces y el procesamiento de datos en una fase temprana del proceso de desarrollo.
  • Las pruebas de interfaz de usuario (UI) comprueban rutas de clics repetibles y expectativas concretas en aplicaciones web o de escritorio.
  • Las revisiones de flujos de trabajo impulsadas por IA evalúan las rutas de operación reales y los resultados visibles desde la perspectiva del usuario.
  • Las pruebas funcionales exploratorias descubren casos especiales que nadie ha descrito todavía como una regla fija.

Una IA no debe decidir si una lógica de precios es correcta a nivel funcional si las reglas están documentadas de forma poco clara. Del mismo modo, tampoco puede ejecutar de manera sensata una orden imprecisa. «Comprueba el envío» no es una descripción de prueba fiable. «Crea un pedido con tres posiciones, genera una etiqueta de envío y comprueba si el estado cambia a enviado» es una instrucción verificable.

De la demostración a una operativa de pruebas viable

El error más frecuente en las pruebas con IA es un inicio demasiado amplio. Una demostración impresionante con un único inicio de sesión dice poco sobre si el sistema garantizará la seguridad de las versiones dentro de seis meses. Es más sensato un comienzo acotado con entre dos y cinco flujos de trabajo cuyo fallo provoque costes reales o genere un esfuerzo de comprobación manual recurrente.

En un sistema de almacén o logística, estos podrían ser la entrada de mercancías, el traslado de stock, la preparación de pedidos (picking) y la generación de un albarán. En un software de gestión, más bien el inicio de sesión, el cambio de permisos, el registro de pedidos y la aprobación de facturas. Los buenos candidatos son procesos frecuentes con reglas estables y resultados claramente visibles.

A continuación, cada flujo de trabajo necesita un punto de partida definido. ¿Qué datos deben estar disponibles? ¿Qué cuenta de prueba se utiliza? ¿Puede la prueba enviar correos electrónicos, imprimir etiquetas o interactuar con interfaces? ¿Qué se restablece después de la ejecución? Sin estas reglas, la automatización produce rápidamente basura de datos de prueba o bloquea a otros equipos.

Asimismo, la evaluación de los resultados debe realizarse de forma gradual. Un botón ausente suele ser un error claro. Una formulación ligeramente diferente en un texto informativo no tiene por qué bloquear automáticamente un lanzamiento. Aquí ayudan los umbrales de confianza (confidence thresholds) y una clara separación entre la notificación automática, la revisión manual y el criterio de bloqueo real. Un informe de prueba no solo debe informar de un «fallo», sino contener el paso ejecutado, el estado visible, la marca de tiempo (timestamp) y los justificantes adecuados.

El papel de las capturas de pantalla, los videos y los informes en texto plano

Una prueba que solo emite un mensaje de error técnico traslada el trabajo al equipo de desarrollo. A menudo, los departamentos funcionales no pueden hacer mucho con eso. Las buenas evidencias combinan la precisión técnica con el contexto: ¿Qué debía ocurrir? ¿Qué ocurrió realmente? ¿Dónde es visible? ¿Qué versión se comprobó?

Las capturas de pantalla y las grabaciones acortan considerablemente la coordinación. El responsable de QA no tiene que intentar reproducir el error primero, y el propietario del producto (product owner) ve inmediatamente si una interrupción es relevante a nivel funcional. Al mismo tiempo, dichos artefactos deben almacenarse de forma selectiva. Las pruebas exitosas suelen necesitar menos material probatorio que los fallos o las aprobaciones críticas.

Un informe en texto plano no es un sustituto de los registros (logs). Es el puente entre las operaciones, el departamento funcional y el desarrollo. Precisamente en los equipos medianos, en los que las mismas personas son responsables de los procesos y toman las decisiones, este puente evita un trabajo de traducción innecesario.

Operación, mantenimiento y expectativas realistas

La automatización de pruebas autohospedada no es un producto que funcione sin supervisión tras su configuración. Las aplicaciones cambian. Los navegadores se actualizan. Los datos de prueba pierden su validez. Los nuevos niveles de permisos, los captchas, la autenticación multifactor o los diálogos de impresión modificados influyen en las ejecuciones de las pruebas.

Esto no es un argumento en contra de la automatización, sino un argumento a favor de un ritmo de mantenimiento claro. Los casos de prueba deben tratarse como código de producto: versionados, revisados y adaptados conscientemente cuando haya cambios. Si un flujo de trabajo falla tres veces seguidas debido a un cambio intencionado en la interfaz de usuario, el problema no es la IA. Lo que falta entonces es la conexión entre el desarrollo, la planificación de lanzamientos y el mantenimiento de las pruebas.

Para ello, softify.pro apuesta por COCO, un servidor de IA dedicado y autohospedado que comprueba aplicaciones web y de Windows, registra evidencias e interpreta los resultados de forma comprensible. Sin embargo, el punto decisivo sigue siendo su integración en la rutina de trabajo diaria: ¿qué procesos se aseguran, quién comprueba las desviaciones y cuándo se puede seguir adelante con un lanzamiento?

Por lo tanto, el mejor primer paso no es comprar o configurar la mayor cantidad posible de pruebas. Elija el flujo de trabajo en el que un error pasado por alto provoque mañana un trabajo real en el almacén, en el servicio técnico o en la contabilidad. Cuando este proceso se comprueba de manera fiable, trazable y bajo el control de los datos propios, la IA deja de ser tecnología por la tecnología misma para convertirse en un alivio perceptible.

Enlace permanente →

Sustituir Excel por un software personalizado

Sustituir Excel por un software personalizado

El inventario de un almacén solo es correcto si alguien ha abierto el archivo correcto, ha registrado la última recepción de mercancías y no ha enviado ninguna copia por correo electrónico. Mientras esto funciona para pocas operaciones, Excel es una buena herramienta. Sustituir Excel por un software personalizado solo cobra sentido cuando la hoja de cálculo se convierte en un cuello de botella para los procesos, las responsabilidades y la fiabilidad.

Esto rara vez afecta únicamente al almacén. Los pedidos se anotan por teléfono, los albaranes se generan a partir de plantillas, las existencias se encuentran en varios archivos y las consultas llegan exactamente a la persona que en ese momento no está disponible. El problema no es la hoja de cálculo en sí. Es el intento de gestionar un proceso operativo en crecimiento con una herramienta que no conoce procedimientos obligatorios.

Cuándo Excel deja de ser el medio de trabajo adecuado

"Una hoja de cálculo puede calcular, filtrar y hacer visibles la información. Sin embargo, no obliga a que una entrada de mercancías se registre por completo, a que un envío se compruebe antes de la expedición, o a que dos empleados no modifiquen el mismo registro al mismo tiempo. Cuando tales reglas se vuelven críticas para el negocio, a Excel le falta la estructura adecuada.

Las señales de alarma típicas son las coordinaciones recurrentes entre el turno, el almacén y la oficina. Los empleados preguntan por el estado actual de un pedido, a pesar de que la información debería estar disponible. Las listas de existencias se depuran manualmente antes del inventario. Los números de albarán o las denominaciones de los artículos se copian y se corrigen más tarde. Y en caso de discrepancia, a menudo ya no es posible rastrear quién cambió qué valor y cuándo.

El archivo en sí también se convierte en un riesgo. Las versiones con nombres como «Bestand_final_neu_2» no son un caso aislado, sino un indicio de que un proceso no tiene una fuente de datos única. Las macros pueden acelerar pasos de trabajo individuales, pero no resuelven el trabajo en paralelo, ni los permisos por roles, ni las aprobaciones, ni un seguimiento fiable de los cambios.

El cambio no vale la pena porque un software personalizado parezca más moderno. Vale la pena cuando los errores, los tiempos de espera y el esfuerzo de control cuestan regularmente más que la introducción de un sistema claro.

Sustituir Excel por un software personalizado: qué es lo que cambia concretamente

Una buena aplicación especializada no se limita a digitalizar una tabla existente. Refleja las decisiones y los movimientos que realmente tienen lugar en la empresa. En el caso de una entrada de mercancías, esto significa, por ejemplo: seleccionar o crear la entrega, registrar las posiciones, comprobar las cantidades, justificar las desviaciones, asignar una ubicación de almacenamiento y solo después actualizar el inventario de forma vinculante.

De este modo, una lista se convierte en un proceso. Los empleados solo ven los pasos necesarios para su tarea. La oficina conoce el estado de tramitación sin necesidad de llamar por teléfono. La dirección del almacén puede comprobar las operaciones pendientes, las diferencias o los registros faltantes. Cualquier modificación sigue siendo trazable, en lugar de desaparecer silenciosamente en una celda.

La diferencia también radica en la arquitectura de datos. Una aplicación con una base de datos modelada limpiamente, por ejemplo basada en MySQL 8, no gestiona los artículos, los pedidos, las ubicaciones de almacenamiento y los movimientos como copias sueltas. Las relaciones están claramente definidas. Un artículo no se puede crear por error con tres números diferentes si la regla de negocio exige un número único.

Esto no crea una realidad libre de errores. Las cantidades se pueden seguir contando mal y las entregas pueden llegar dañadas. Sin embargo, el software se encarga de que las desviaciones se registren de forma visible, se asignen y se puedan analizar posteriormente. Operativamente, esto tiene más valor que un inventario aparentemente limpio cuya procedencia nadie puede explicar.

No reconstruir cada proceso inmediatamente

El error común es empezar con algo demasiado grande. Quien quiera sustituir todos los procesos de una empresa al mismo tiempo espera mucho tiempo para obtener un resultado y concentra muchas preguntas abiertas en un único proyecto. Para las pequeñas y medianas empresas, un enfoque gradual suele ser más sensato.

El primer área debe cumplir dos criterios: genera un esfuerzo o unos costes por errores perceptibles y se deja delimitar con claridad. Esto puede ser el registro de mercancías entrantes, la creación de albaranes, la aceptación de pedidos o el control de los movimientos de almacén. Un cuello de botella concreto aporta mejores requisitos que la exigencia abstracta de una «solución digital global».

Excel puede seguir desempeñando un papel en ello. Para cálculos puntuales, análisis o pequeñas listas de planificación, suele ser más rápido y económico que una aplicación propia. Las exportaciones de datos para el control de gestión o la asesoría fiscal también siguen siendo útiles. Lo decisivo es que Excel deje de ser la fuente principal para los procesos críticos en el tiempo.

Además, una solución personalizada no tiene por qué replicar todas las funciones de un gran sistema ERP. Una empresa con dos almacenes y diez empleados posiblemente no necesite una lógica de múltiples mandantes internacional, pero sí requiere permisos limpios, registro móvil en la ubicación de almacenamiento y documentos fiables. Las suites estándar sobrecargadas suelen incluir funciones que nadie utiliza, mientras que el flujo de trabajo central sigue teniendo que adaptarse.

Observar los requisitos en el puesto de trabajo, no limitarse a consultarlos

La mejor lista de requisitos no surge únicamente en la sala de reuniones. Nace allí donde la mercancía se descarga, se prepara, se comprueba y se entrega. Una conversación con la dirección del almacén puede describir un proceso teórico. La observación de un turno muestra qué información falta, cuándo son necesarios los guantes o los escáneres y en qué puntos los empleados toman atajos deliberadamente.

Estos atajos no son automáticamente un mal comportamiento. A menudo apuntan a un problema del sistema. Si un empleado anota números en papel porque el ordenador está demasiado lejos, la solución no debería ser simplemente un campo obligatorio en el escritorio. Tal vez el proceso necesite una máscara de registro móvil, una impresión de etiquetas o un punto de transferencia más claro entre la entrada de mercancías y el almacenamiento.

Por lo tanto, en la fase de concepción se deben responder preguntas concretas: ¿Quién crea un pedido? ¿Quién puede corregir las cantidades? ¿Qué ocurre en caso de entrega parcial? ¿Cuándo se genera un albarán? ¿Qué datos deben ser visibles si la red del almacén no está disponible brevemente? ¿Y qué indicadores clave de rendimiento se utilizan realmente, en lugar de quedar bien solo en un panel de control?

Cuanto más claras estén estas decisiones antes del desarrollo, menos lógica especial surgirá más tarde. Un buen software personalizado no reproduce cada excepción histórica. Separa las reglas operativas sensatas de los hábitos que solo existen porque la herramienta anterior imponía limitaciones.

Pensar desde el principio en la técnica, los permisos y la explotación

Una aplicación profesional debe seguir siendo fácil de mantener en el día a día. Esto no solo afecta a la interfaz, a los modelos de datos claros, al aprovisionamiento documentado, a las copias de seguridad y a las responsabilidades, sino también a la tecnología. Las aplicaciones web modernas se pueden construir de manera sólida con PHP 8.4, JavaScript actual y MySQL 8. Lo decisivo no es el valor de tendencia de una pila tecnológica, sino si a largo plazo es comprensible, comprobable y operable.

Los roles y los permisos deben integrarse pronto en el concepto. No todos los usuarios deberían poder modificar los precios, los datos maestros o los asientos históricos. Para las funciones sensibles, resultan útiles las aprobaciones trazables, los registros y, si es necesario, los bloqueos de cuenta tras intentos de inicio de sesión fallidos. Estos detalles parecen puramente técnicos al principio, pero evitan responsabilidades confusas durante la explotación.

La migración de datos es igual de importante. Los archivos de Excel existentes suelen contener duplicados, unidades incoherentes o artículos que ya no se utilizan. Importar estos datos sin verificar traslada viejos problemas al nuevo sistema. Es preferible una limpieza controlada con reglas claras: qué datos se adoptan, cuáles se archivan y cuáles deben comprobarse técnicamente antes del inicio.

Introducción sin interrupción de las actividades

Una puesta en marcha no debe poner en peligro los envíos. Por eso, la introducción necesita un área piloto limitada, casos de prueba reales y empleados que conozcan el procedimiento. No basta con crear pedidos de ejemplo. El sistema debe ser capaz de gestionar entregas parciales, cantidades erróneas, cancelaciones, presión de tiempo y las excepciones que surgen en el día a día habitual.

Una fase paralela corta puede ser útil, pero debe tener un final claro. Si la tabla y la nueva aplicación se mantienen simultáneamente durante demasiado tiempo, se genera doble trabajo y de nuevo surge la pregunta de qué fuente es la válida. Es mejor una fecha de cambio definida, acompañada de interlocutores formados y un bucle de retroalimentación rápido para errores o detalles faltantes.

Tras el inicio, el valor de una solución personalizada no se demuestra en una interfaz especialmente compleja. Se demuestra cuando un pedido continúa sin consultas, el inventario sigue siendo explicable y una nueva compañera puede utilizar el proceso de forma segura tras una breve instrucción. Exactamente ahí es donde debe empezar la siguiente decisión: no en el siguiente archivo de Excel, sino en el paso de trabajo concreto que mañana volverá a costar tiempo.

Enlace permanente →

Digitalizar los procesos de almacén con software

Digitalizar los procesos de almacén con software

Un preparador de pedidos busca durante diez minutos un artículo que, según el archivo de Excel, debería estar en la estantería. Al mismo tiempo, un compañero registra la entrada de mercancías en un formulario de papel, mientras que en la oficina se modifica un pedido por teléfono. Este tipo de situaciones no son señal de un mal trabajo. Demuestran que la información ya no sigue de forma fiable a los movimientos físicos de las mercancías. Por lo tanto, quien quiera digitalizar los procesos de almacén con software no debe empezar por una lista de funciones lo más larga posible, sino precisamente por estas rupturas en el día a dia.

Para las pequeñas y medianas empresas, la cuestión rara vez es si un sistema empresarial internacional sería técnicamente potente. La pregunta es si realmente acorta el camino desde la recepción de mercancías hasta el envío, o si crea nuevas pantallas, autorizaciones y necesidades de formación. Una buena digitalización no sustituye todos los movimientos manuales. Se encarga de que cada movimiento necesario conduzca a la información, el registro y la acción de seguimiento correctos.

Cuándo tiene sentido digitalizar los procesos de almacén con software

Una hoja de cálculo no es fundamentalmente un problema. Para un inventario manejable, pocos empleados y movimientos poco frecuentes, puede ser razonable, económica y transparente. Un cambio solo vale la pena cuando el archivo se convierte en el centro de control oficioso: circulan varias versiones, los stocks se corrigen a posteriori o solo unas pocas personas entienden las fórmulas y los archivos.

Los desencadenantes típicos no son objetivos de crecimiento abstractos, sino fricciones operativas recurrentes. Los inventarios no suelen coincidir regularmente tras los recuentos. Las entradas de mercancías se quedan sin registrar hasta el final de la jornada. Los envíos salen sin el albarán completo. Los empleados se llaman entre sí para aclarar la ubicación de un artículo o el estado de un pedido. O una persona transfiere los mismos datos sucesivamente al correo electrónico, Excel, el portal de envíos y la contabilidad.

La digitalización en este contexto significa: el sistema refleja un estado claro. Un artículo ha llegado, ha sido comprobado, almacenado, reservado, preparado o enviado. Cada cambio de estado tiene un desencadenante, un momento determinado y, de manera ideal, una persona responsable. Esto no crea burocracia, sino que evita que las decisiones se basen en suposiciones.

El punto de partida correcto: movimientos en lugar de módulos de software

Muchas implantaciones empiezan con la pregunta sobre funciones como la conexión de escáneres, la gestión de lotes o los paneles de control. Esto es comprensible, pero a menudo conduce a un pliego de condiciones sobrecargado. Tiene más sentido realizar un análisis de los procesos a lo largo del movimiento real de la mercancía.

Tome un pedido real y sígalo desde la entrada hasta la entrega al proveedor de servicios de envío. ¿Dónde se genera la información? ¿Quién la comprueba? ¿Dónde se anota algo en papel, se transfiere más tarde o se transmite de forma verbal? Las excepciones son especialmente valiosas: entregas parciales, mercancía dañada, artículos de sustitución, stocks bloqueados y devoluciones. El proceso estándar suele parecer limpio en la pizarra. Las excepciones son las que determinan si la nueva aplicación será aceptada en el día a día.

Para un primer taller, a menudo bastan tres preguntas: ¿Qué información es la que más echan en falta los empleados? ¿Qué registro se realiza más a menudo con retraso o por duplicado? ¿Y qué errores cuestan realmente tiempo, dinero o la confianza de los clientes al mes? A partir de ahí se pueden deducir prioridades sin tener que cambiar toda la organización del almacén al mismo tiempo.

Un flujo pequeño y completo supera a un gran lanzamiento de sistema

En lugar de digitalizar todos los procesos de golpe, un área debe funcionar de principio a fin. Un primer alcance razonable puede cubrir, por ejemplo, la recepción de mercancías, el almacenamiento y la gestión de stocks. El aviso de expedición o el pedido se registran, la mercancía se comprueba, se asigna una ubicación en el almacén y el stock se registra de inmediato. Solo cuando este flujo funciona de forma estable se procede a la preparación de pedidos, las etiquetas de envío o la planificación de rutas.

Esto reduce el riesgo del proyecto. Los empleados no solo aprenden una nueva interfaz, sino un proceso claramente delimitado. Al mismo tiempo, se hace visible qué reglas faltan en la práctica. Por ejemplo, la cuestión de si la mercancía no comprobada ya puede ser reservable o si las faltas de stock deben generar inmediatamente un caso de aclaración.

Qué funciones del almacén muestran realmente resultados

La mejor aplicación de almacén no es la que tiene más opciones de menú. Hace que el siguiente paso de trabajo sea inequívoco y documenta el movimiento sin doble registro. En muchas empresas, son especialmente cuatro componentes los que aportan mejoras rápidamente medibles:

  • Una gestión centralizada del inventario con artículos, variantes, ubicaciones en el almacén, existencias mínimas y stocks bloqueados evita versiones de Excel en competencia.
  • Los registros móviles mediante escáneres manuales o teléfonos inteligentes conectan directamente el almacenamiento, el traslado interno y la extracción con el lugar real de la mercancía.
  • Las listas de pedidos y de preparación de pedidos muestran la prioridad, el estado y las faltas de stock, en lugar de distribuir los pedidos mediante llamadas a voces o pilas de papel.
  • Los albaranes, las etiquetas de envío y los registros de movimientos generados automáticamente reducen las transmisiones manuales y facilitan el seguimiento.

Si el escaneo de códigos de barras es necesario de inmediato depende del almacén. Con pocos artículos y estanterías fijas, una pantalla de introducción clara puede ser suficiente al principio. Sin embargo, con muchos artículos similares, ubicaciones cambiantes o un alto rendimiento, el escaneo suele dejar de ser una función de comodidad para convertirse en un freno de errores. La cobertura de red en el área también es decisiva. Una aplicación móvil que no tenga conexión en varios pasillos de estanterías no hace más que trasladar el problema a una cola de registros posteriores.

La automatización también necesita límites claros. Un sistema puede priorizar los pedidos de envío según la hora límite (cut-off) o preparar una solicitud de pedido en caso de stock mínimo. Sin embargo, no debe activar pedidos de forma silenciosa si hay que tener en cuenta los plazos de entrega, los límites de autorización o los pedidos de clientes especiales. Un buen software propone, marca las desviaciones y documenta las decisiones. No quita a los equipos el control sobre los casos excepcionales.

La calidad de los datos no es una tarea para más tarde

La digitalización rara vez fracasa por PHP, la base de datos o el hardware del escáner. A menudo fracasa porque los números de artículo no son unívocos, las unidades se entienden de forma diferente o las existencias históricas se adoptan sin comprobación. De lo contrario, dependiendo de la persona, un «cartón» se convierte en una pieza, una unidad de embalaje o un palé.

Por lo tanto, antes de la importación, los datos maestros deben depurarse: identificadores de artículos unívocos, denominaciones comprensibles, unidades definidas, ubicaciones de almacén trazables y reglas para los artículos activos o bloqueados. No es necesario transferir todos los antiguos conjuntos de datos al nuevo sistema. Llevarse duplicados obsoletos y ubicaciones de almacén que ya no se utilizan solo sirve para conservar la antigua incertidumbre en una interfaz más moderna.

Desde el punto de vista técnico, la aplicación necesita una base sólida. Una estructura clara de base de datos en MySQL 8 puede almacenar los movimientos de existencias como eventos individuales y trazables, en lugar de mantener únicamente un valor actual sobrescribible. De este (modo), se puede aclarar por qué difieren unas existencias: recepción de mercancías, extracción, traslado, corrección de inventario o anulación. Con tecnologías de fácil mantenimiento como PHP 8.4 y JavaScript moderno, una aplicación individual sigue siendo ampliable al mismo tiempo, sin convertirse en un gran proyecto por cada pequeño ajuste.

Integración solo donde elimina la duplicidad de trabajo

Un almacén rara vez trabaja de forma aislada. Los pedidos proceden de la tienda online, el ERP, el correo electrónico o el teléfono. Los datos de envío se envían a los proveedores de servicios, los documentos a la contabilidad y los indicadores clave a la dirección de la empresa. A pesar de ello, no es necesario conectar todos los sistemas externos desde el primer día.

Tienen prioridad las interfaces que sustituyen a la transmisión manual repetida o eliminan fuentes de errores. Si los pedidos se copian a mano todos los días desde una tienda online, una transferencia clara es valiosa. Si un proveedor de servicios de envío proporciona etiquetas y números de seguimiento, una conexión puede acelerar notablemente el proceso de empaquetado. En cambio, un archivo de exportación que se utiliza raras veces puede seguir siendo una exportación controlada al principio.

Lo importante son unas responsabilidades claras en caso de errores. ¿Qué ocurre cuando un pedido se crea en la tienda, pero no se transfiere a la aplicación de almacén? ¿Se registran las transferencias, se detectan los duplicados y se marcan de forma visible los procesos fallidos? Las interfaces solo son fiables cuando también ofrecen un procedimiento comprensible para los casos excepcionales.

Implementación en régimen de turnos: la aceptación se genera sobre el terreno

El software no se introduce mediante una presentación, sino entre la puerta de recepción de mercancías, la mesa de empaquetado y la estantería. Por ello, los empleados de almacén experimentados deben integrarse desde el principio. Conocen los atajos, los requisitos de seguridad y los puntos en los que un proceso teóricamente correcto fracasa bajo la presión del tiempo.

Un área piloto con mercancía real y pedidos reales suele ser más significativa que una larga fase de prueba con datos de ejemplo. Durante un tiempo limitado, puede ser útil un funcionamiento en paralelo seguro. Sin embargo, este no debe convertirse en un estado permanente, ya que el doble registro genera por sí mismo nuevos errores. Lo decisivo es un día de cambio claro, una persona de contacto responsable y una forma sencilla de reportar los problemas directamente.

La formación debe estar orientada al proceso: aceptar mercancías, registrar desviaciones, almacenar, preparar pedidos y completar el envío. Al principio, nadie necesita dominar todas las evaluaciones o funciones de administración. Los roles y los permisos ayudan a centrar la pantalla en la tarea correspondiente. Un preparador de pedidos necesita información diferente a la de la dirección del almacén, y una corrección de inventario debería poder autorizarse de forma trazable.

El éxito no se mide solo por el stock

Tras el inicio, vale la pena echar un vistazo a unos pocos indicadores clave que el equipo puede influenciar: el tiempo de tránsito desde la recepción de mercancías hasta la disponibilidad, el número de correcciones de inventario, los errores de picking, los tiempos de búsqueda, los pedidos enviados a tiempo y los casos de aclaración pendientes. Estos valores muestran más rápidamente que un proyecto de digitalización general si el proceso está mejorando.

softify.pro no desarrolla este tipo de sistemas como sustituto de los pasos de trabajo que funcionan, sino como un complemento preciso allí donde el papel, las hojas de cálculo y las llamadas a voces ya no son suficientes. A veces, la recomendación correcta es una pequeña aplicación para la recepción de mercancías y el envío en lugar de un sistema completo de gestión de almacenes. A veces, una hoja de cálculo para un análisis especial poco frecuente sigue siendo la solución más sensata.

Por lo tanto, el mejor paso siguiente no es la selección de productos, sino una mirada conjunta a un pedido concreto de la semana pasada. Si su recorrido por el almacén se vuelve claro, registrable y trazable en caso de desviaciones, se habrán sentado las bases para una digitalización que realmente ahorre tiempo en el día a día.

Enlace permanente →

Ponte en contacto

¿Tienes un proyecto en mente, un flujo de trabajo que todavía funciona con hojas de cálculo y buena voluntad, o un atraso de pruebas que COCO podría quitarle de encima a tu equipo? Cuéntanoslo.

Enviar mensaje