softify.pro
Laster …
Tjenester Om oss COCO – vår AI-server Portefølje Insiders Case-studier Godt å vite Kontakt Logg inn

NESTE GENERASJONS PROGRAMVAREESTETIKK

Ren flyt møter ypperste ytelse.

Den nye visuelle identiteten for moderne digitale arbeidsflyter.

softify.pro — Den nye visuelle identiteten for moderne digitale arbeidsflyter.

Scroll for å utforske ↓

Programvare, bygget slik moderne virksomhet faktisk beveger seg

softify.pro er et programvarestudio bygget rundt én idé: teknologi bør bevege seg like flytende som virksomhetene den støtter. Vi jobber i skjæringspunktet mellom moderne webutvikling, prosessautomatisering og anvendt kunstig intelligens — tre disipliner som sjelden lever under samme tak, men som i økende grad må gjøre det. Kundene våre spenner fra små verksteder som digitaliserer sin første fakturakjøring, til etablerte mellomstore produsenter som erstatter regneark med ekte logistikkprogramvare. Det som knytter dem sammen er ikke størrelse, men ambisjon: de vil ha systemer som er raske, pålitelige og genuint hyggelige å bruke, ikke bare funksjonelle. Hvert prosjekt vi tar på oss starter med de samme tre spørsmålene — hva trenger denne virksomheten egentlig for å bevege seg raskere, hva fungerer allerede og bør respekteres fremfor å erstattes, og hvilken del av arbeidsflyten kan stille og rolig kjøre seg selv når den er bygget riktig. Svarene former alt som følger, fra teknologistabelen til utrullingsplanen.

Tjenester

Den nye visuelle identiteten for moderne digitale arbeidsflyter.

01 — LOGISTICS

Automatiserer logistikk — bygget for små og mellomstore selskaper i DACH-regionen

En stor del av arbeidet vårt er dedikert til logistikk- og driftsprogramvare for små og mellomstore selskaper i Tyskland, Østerrike og Sveits. Disse virksomhetene sitter ofte fast mellom to lite attraktive alternativer: dyre bedriftslogistikkpakker designet for konsern ti ganger deres størrelse, eller en lapskaus av regneark, papirskjemaer og telefonsamtaler som stille begrenser hvor raskt de kan vokse.

Vi bygger mellomveien — skreddersydd automatisering som passer måten et spesifikt lager, verksted eller distribusjonsteam faktisk opererer på. Det kan bety digitalisering av varemottak og lagerbevegelser, automatisk generering av følgesedler og fraktetiketter, kobling av ordreinntak til ruteplanlegging, eller ganske enkelt å erstatte et skjørt regneark som bare én person forstår med et delt system hele teamet kan stole på. Fordi vi jobber direkte med eiere og driftsledere i DACH-regionen, samles kravene inn på språket virksomheten faktisk drives på, og utrullingen planlegges rundt reelle skiftmønstre og reelle lagergulv, ikke en abstrakt implementeringstidslinje.

02 — WEB

Moderne webutvikling, bygget på aktuell teknologi

Vi designer og bygger webapplikasjoner og nettsteder med aktuell, aktivt vedlikeholdt teknologi fremfor utdaterte rammeverk som holdes i live av vane. Det betyr ren PHP 8.4 på backend der en klassisk serverrendret applikasjon er riktig valg, moderne JavaScript der interaktivitet betyr noe, og MySQL 8 for data som må forbli konsistent og søkbart i årevis, ikke bare de første seks månedene etter lansering. Hvert prosjekt planlegges for både desktop og mobil helt fra første skisse, ikke tilpasset i etterkant — lastetider, layoutbruddpunkter og berøringsinteraksjoner er en del av spesifikasjonen, ikke en ettertanke.

Utover det synlige grensesnittet bryr vi oss om hvordan et nettsted ser ut innenfra: lesbar kode, et databaseskjema som ikke trenger å bygges om ved neste funksjonsønske, og utrullingssteg som en annen utvikler kan følge uten å måtte ringe oss. Et nettsted som yter godt i dag og fortsatt kan utvides rent om tre år er for oss den egentlige definisjonen av 'moderne'.

03 — AI / COCO

COCO — vår egen AI-server for automatisert programvaretesting

For bedriftskunder drifter og vedlikeholder vi vår egen dedikerte AI-server, kalt COCO. I motsetning til en generell chatbot som bare er koblet på en arbeidsflyt, er COCO spesialbygget og selvhostet spesifikt for automatisert testing av webprogramvare og plattformuavhengige skrivebordsapplikasjoner — fra innlogging og autentiseringsflyter til fullstendige flertrinns forretningsprosesser.

COCO planlegger et testscenario, kjører det mot den faktiske applikasjonen, fanger før-og-etter-skjermbilder og opptak av kjøringen som bevis, og produserer en klarspråklig vurdering av hva som bestod, hva som feilet, og hvorfor — inkludert grensetilfeller som gjentatte mislykkede innlogginger, kontosperringer og gjenopprettingsflyter som er tidkrevende og feilutsatte å teste manuelt. Fordi serveren kjører lokalt under vår forvaltning, beholder bedriftskunder full kontroll over hvor testdata og skjermbilder lagres, uten at intern applikasjonstrafikk som standard sendes til en tredjeparts skytjeneste.

COCO — vår egen AI-server for automatisert programvaretesting

For bedriftskunder drifter og vedlikeholder vi vår egen dedikerte AI-server, kalt COCO. I motsetning til en generell chatbot som bare er koblet på en arbeidsflyt, er COCO spesialbygget og selvhostet spesifikt for automatisert testing av webprogramvare og plattformuavhengige skrivebordsapplikasjoner — fra innlogging og autentiseringsflyter til fullstendige flertrinns forretningsprosesser.

COCO planlegger et testscenario, kjører det mot den faktiske applikasjonen, fanger før-og-etter-skjermbilder og opptak av kjøringen som bevis, og produserer en klarspråklig vurdering av hva som bestod, hva som feilet, og hvorfor — inkludert grensetilfeller som gjentatte mislykkede innlogginger, kontosperringer og gjenopprettingsflyter som er tidkrevende og feilutsatte å teste manuelt. Fordi serveren kjører lokalt under vår forvaltning, beholder bedriftskunder full kontroll over hvor testdata og skjermbilder lagres, uten at intern applikasjonstrafikk som standard sendes til en tredjeparts skytjeneste.

Vi setter opp, konfigurerer og vedlikeholder COCO individuelt for hver bedriftskunde — vi definerer testplanene som er relevante for deres spesifikke applikasjon, finjusterer konfidensterskler, og avgjør fra sak til sak når et resultat bør eskaleres for menneskelig gjennomgang. Målet er ikke å erstatte et QA-team, men å gi det en utrettelig kollega som kjører de repeterende regresjonstestene før hver utgivelse, før et menneske noen gang må gjøre det.

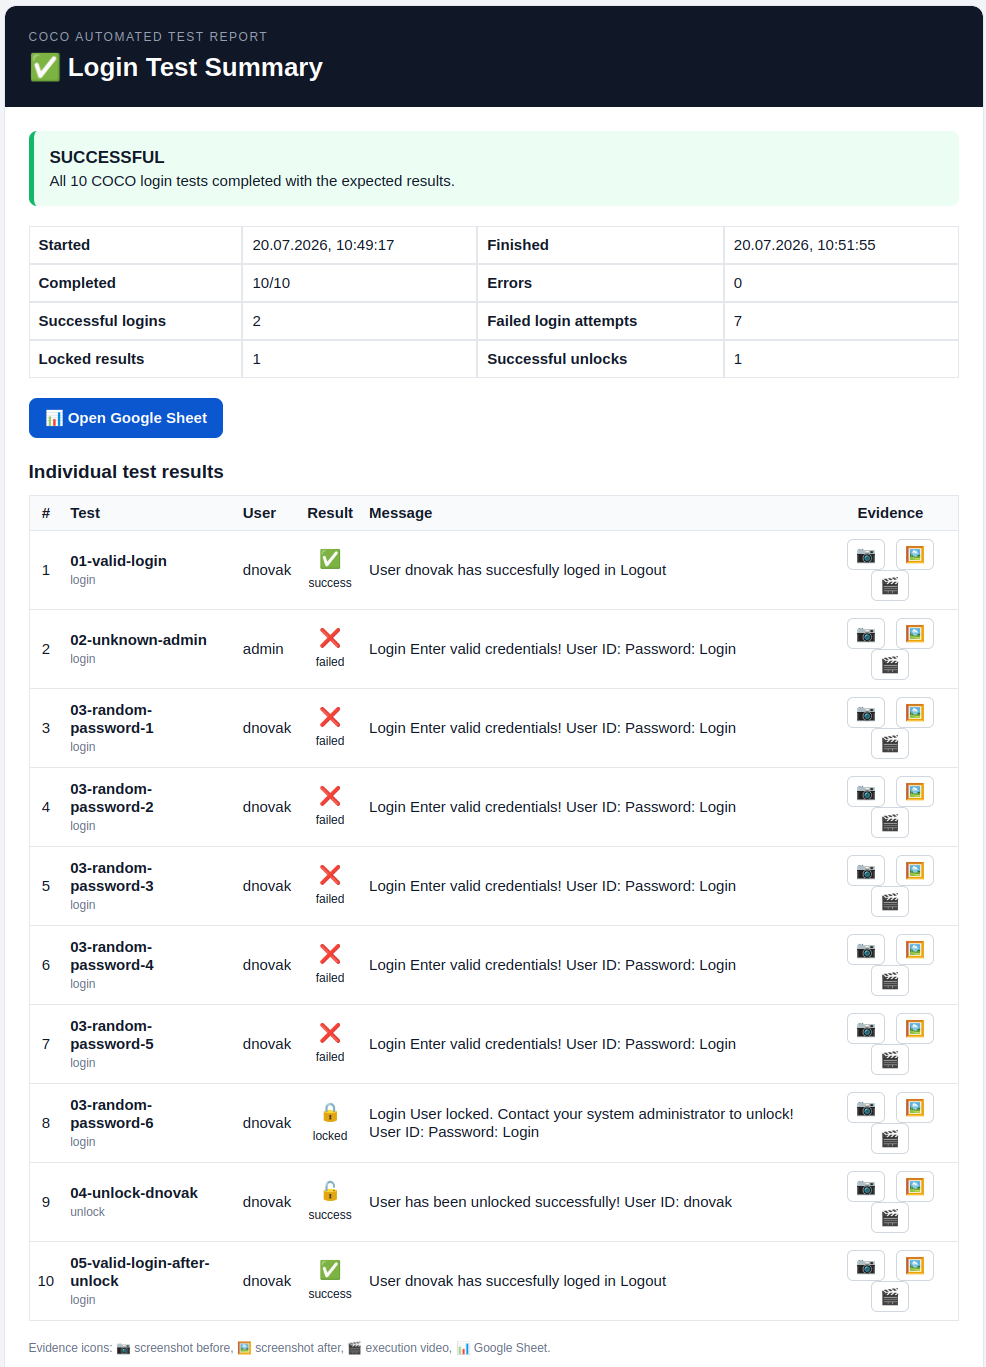
COCO automated login test report
COCO — automated login & account-lockout test report
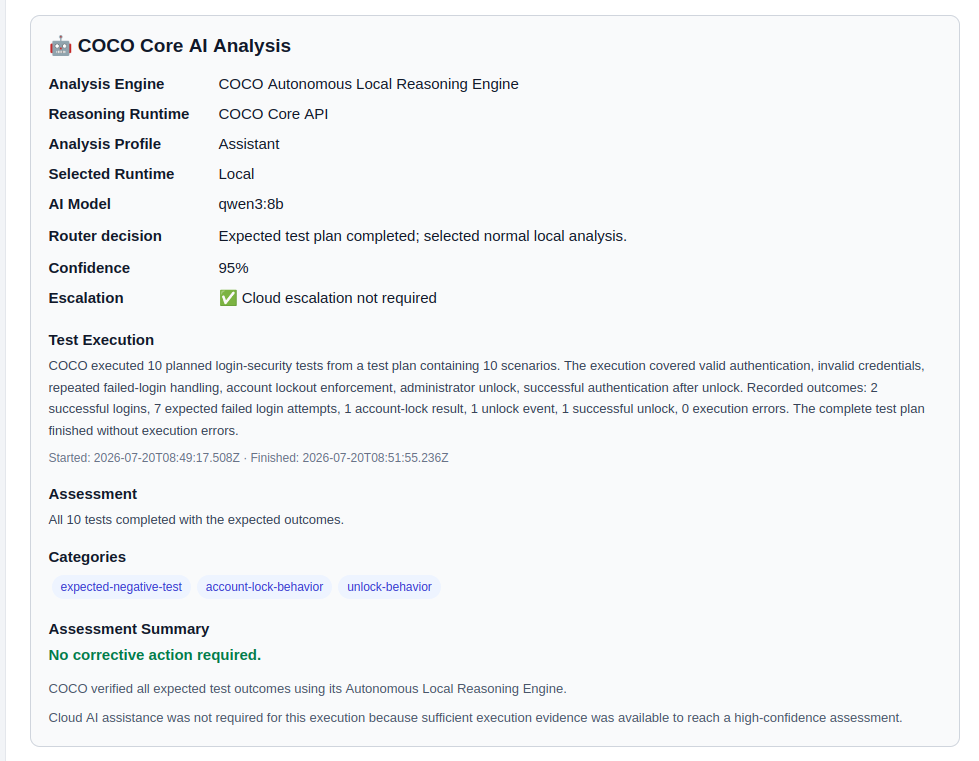
COCO AI analysis panel
COCO — plain-language AI analysis of a completed test run

Hvorfor softify.pro

Vi holder oss bevisst små nok til at hvert prosjekt håndteres av folk som var med i den innledende planleggingssamtalen, ikke overlevert til en kø. Det betyr kortere tilbakemeldingssløyfer, færre misforståelser, og et team som fortsatt husker hvorfor en bestemt beslutning ble tatt seks måneder inn i et prosjekt. Vi foretrekker kjedelig, bevisbar pålitelighet fremfor trendjaging: en teknologistabel velges fordi den passer problemet og kan vedlikeholdes av noen andre enn oss om fem år, ikke fordi den var på moten i sprinten den ble valgt. Hvis et regneark genuint fortsatt gjør jobben bedre enn skreddersydd programvare ville gjort, forteller vi deg det også — målet vårt er en arbeidsflyt som faktisk beveger seg raskere, ikke bare en større programvareregning.

Utvalgte arbeider

Et lite utvalg av arbeid vi kan vise offentlig — flere case-studier og bedriftsprosjekter er tilgjengelig på forespørsel under NDA.

Koralpenhaus

Koralpenhaus

Regional presentasjons- og bookingnettside i Alperegionen, bygget med fokus på ren struktur, rask lasting og enkelt innholdsvedlikehold.

Dexosano

Dexosano

En moderne PHP-basert webplattform, utviklet med den samme ytelsesfokuserte tilnærmingen softify.pro bruker på hvert kundeprosjekt.

Case-studier

softify.pro Flow — Testet av COCO

softify.pro Flow — Testet av COCO

21.08.2026

Control. Clarity. Flow.

Ethvert seriøst programvareprodukt utvikler før eller siden et andre produkt bak produktet.

Kunder ser det kanskje aldri. Besøkende vet kanskje aldri at det finnes. Men administratorer, operatører og utviklere er avhengige av det hver dag.

For softify.pro Flow heter denne applikasjonen Administration — den operative konsollen som er ansvarlig for å administrere brukere, roller, tilgangsnivåer, autentiseringsstatuser, databasemiljøer og annen konfigurasjon som holder en Flow-installasjon under kontroll.

Innloggingsskjermen bærer tre ord:
Control. Clarity. Flow.

De ble opprinnelig valgt for å beskrive opplevelsen vi ønsket at administratorer skulle ha når de driftet systemet.

Men de beskriver også overraskende godt hvordan vi mener programvare bør testes.

Det gjorde softify.pro FlowAdministration til en åpenbar kandidat for en reell COCO-test.
Ikke en laboratoriedemonstrasjon.
Ikke en samling isolerte knapper forberedt spesielt for en AI-demo.
En ekte plattformuavhengig skrivebordsapplikasjon med reell applikasjonslogikk, flere vinduer, flere databasebackender, autentisering, tillatelser, lokalisering og nok tilstand til at tilsynelatende små regresjoner er vanskelige å oppdage manuelt.

For den offentlige demonstrasjonen som vises her, jobbet COCO utelukkende med generert demodata. Applikasjonen var lisensiert til det fiktive selskapet Presentation GmbH, og ingen produksjonskundeinformasjon, ingen legitimasjon og ingen personopplysninger ble brukt.

Målet var enkelt:
la COCO nærme seg applikasjonen slik en tester ville gjort, og avgjøre om hele den administrative arbeidsflyten fortsatt oppfører seg slik programvaren hevder.

The Challenge

Ved første øyekast virker det enkelt å teste en administrasjonsapplikasjon.

Åpne den.
Logg inn.
Klikk gjennom flere vinduer.
Sjekk at alt ser riktig ut.

Den antagelsen endrer seg raskt etter hvert som applikasjonen vokser.

softify.pro FlowAdministration er ikke ett enkelt statisk skjema. Det er en samling sammenkoblede operative visninger inne i ett applikasjonsskall.

Blant annet kan en administrator jobbe med:

  • brukerkontoer
  • roller og tilgangsnivåer
  • autentiseringsinformasjon
  • status for tofaktorautentisering
  • informasjon om operativsystem
  • nettverks- og IP-informasjon
  • databasekonfigurasjon
  • sorterings- og visningsalternativer
  • live språkvalg
  • applikasjons- og lisensinformasjon

Grensesnittet støtter for øyeblikket elleve språk. Applikasjonen fungerer også med MySQL og PostgreSQL som databasebackender. Hver for seg representerer ingen av disse funksjonene et uvanlig testproblem.

Vanskeligheten oppstår fra kombinasjonene deres.
En brukertabell kan fungere korrekt på engelsk, men vise et utdatert kolonnenavn på kroatisk.
Sortering kan fungere korrekt tilkoblet MySQL, men oppføre seg annerledes etter bytte til PostgreSQL.

Et språkbytte kan oppdatere de fleste grensesnittelementer, men la én statusmelding forbli uoversatt. Applikasjonen kan bytte database vellykket, men beholde utdatert informasjon fra den forrige tilkoblingen. En ny versjon kan introdusere en funksjon mens Om-dialogen fortsatt beskriver den forrige. Programmet trenger ikke krasje for at noen av disse situasjonene skal være en regresjon. Faktisk er noen av de mest ubeleilige programvarefeilene nettopp de der alt ser ut til å fungere.

Applikasjonen starter.
Vinduet åpnes.
Knappen reagerer.
Men noe under er ikke lenger helt riktig.
Det er derfor gjentagende regresjonstesting er viktig.

Og det er også nøyaktig den typen arbeid mennesker blir gradvis dårligere til å utføre etter å ha gjentatt den samme sekvensen dusinvis av ganger.

Why Manual Testing Becomes Expensive

Å teste noe én gang er enkelt.
Å teste det pålitelig etter hver relevante versjon er noe annet.

Vurder bare tre dimensjoner: 11 grensesnittspråk × 2 databasebackender × flere applikasjonsarbeidsflyter.

Antallet kombinasjoner vokser raskt.
Legg til ulike brukerroller, autentiseringsstatuser, sorteringsatferd, konfigurasjonsendringer og driftsmiljøer, og testmatrisen blir for stor til å behandles som en sporadisk manuell sjekkliste.

Det er her regresjonstesting ofte begynner å eroderes.
Ikke bevisst.
En releasefrist nærmer seg.
Noen husker at applikasjonen ble testet forrige uke.
En utvikler sjekker raskt det viktigste skjermbildet.

Tysk fungerer.
Engelsk fungerer.
MySQL fungerer.
Antagelsen blir:
"Resten er sannsynligvis i orden."

Vanligvis er den det.
Helt til den versjonen der den ikke er det.
COCO finnes delvis for å fjerne den antagelsen fra prosessen.

What COCO Actually Did

COCO startet softify.pro FlowAdministration fra en kald applikasjonstilstand, uten å basere seg på et tidligere forberedt skjermbilde eller en manuelt plassert arbeidsflyt.

Den første interaksjonen var den samme som presenteres for en menneskelig administrator: innloggingsvinduet.

COCO identifiserte autentiseringsgrensesnittet som inneholdt:

  • brukernavn
  • passord
  • kode for tofaktorautentisering

og linjen rett under softify.pro Flow-identiteten:
Control. Clarity. Flow.

Derfra fortsatte COCO gjennom en definert regresjonsøkt. Poenget var ikke bare å avgjøre om applikasjonen kunne åpnes.

Poenget var å verifisere om applikasjonens tilstand forble internt konsistent mens COCO interagerte med den.

Authentication Is Only the Beginning

Testing av innlogging er en av de mest åpenbare kandidatene for automatisering, men vellykket autentisering alene sier svært lite om resten av en administrasjonsapplikasjon.

Når den var inne, flyttet COCO seg til det faktiske driftsmiljøet. Den inspiserte brukeradministrasjonsgrensesnittet og verifiserte at forventet informasjon var til stede.

Det inkluderte data som:

  • brukernavn
  • maskerte passord
  • 2FA-indikatorer
  • tildelte roller
  • informasjon om operativsystem
  • IP-adresser

COCO samhandlet deretter med tabellen i stedet for bare å observere den.
Brukerlisten ble sortert etter brukernavn.
Den resulterende rekkefølgen ble inspisert.
Det viktige var ikke om klikk på kolonneoverskriften ga en synlig endring.

COCO verifiserte at den resulterende tabelltilstanden samsvarte med den forespurte operasjonen.

Det skillet betyr noe.
En funksjonell test spør:
"Reagerte knappen?"

En nyttig regresjonstest spør:
"Endte applikasjonen i riktig tilstand?"

Testing the Database Boundary

softify.pro Flow støtter mer enn én databasebackend.

Det gjør databasebytte til en spesielt viktig regresjonsgrense.
COCO endret den aktive backenden fra MySQL til PostgreSQL.

Etter byttet inspiserte den brukerinformasjonen på nytt.
Testen så etter mer enn en vellykket tilkobling.
Den sjekket om applikasjonen fortsatte å vise de forventede postene, og om informasjonen vist gjennom grensesnittet forble konsistent.

COCO byttet deretter tilbake igjen.

Denne typen overgang er lett å undervurdere.
Brukergrensesnittet kan forbli visuelt identisk mens lagringslaget under det endres fullstendig.
Fra en administrators perspektiv bør den overgangen føles nesten kjedelig.
De samme brukerne bør fortsatt være forståelige.
De samme rollene bør fortsatt gi mening.

Den samme grensesnittatferden bør fortsatt gjelde.

Den tilsynelatende hendelsesløse kontinuiteten er nøyaktig det som må bevises.

Eleven Languages, One Application State

Lokalisering er et annet område der overfladisk testing er spesielt farlig.

Det er relativt enkelt å verifisere at en applikasjon kan starte på et annet språk.
Det er mye mer verdifullt å verifisere hva som skjer når språket endres mens applikasjonen allerede kjører og holder tilstand.

COCO byttet grensesnittspråk live.

Økten inkluderte overganger mellom språk som:
Tysk → Engelsk → Kroatisk
mens administrasjonsvisningen forble aktiv.

COCO observerte om grensesnittelementer endret seg korrekt på stedet:

  • tabelloverskrifter
  • kontroller
  • knapper
  • etiketter
  • statusmeldinger

Den underliggende tabellen og applikasjonstilstanden måtte også overleve den overgangen.
Dette betyr noe fordi flerspråklig programvare består av mer enn oversatte strenger.
Språkendringer kan avsløre:

  • glemte ressurser
  • utdaterte etiketter
  • layoutproblemer
  • uoversatte statusmeldinger
  • kodingsproblemer
  • tilstandstilbakestillinger
  • problemer med gjenoppretting av kontroller

Et vindu som ser riktig ut når det startes direkte på kroatisk, kan likevel oppføre seg feil når brukeren bytter fra tysk til kroatisk under en aktiv økt.

Det er forskjellen mellom å sjekke et skjermbilde og å teste en arbeidsflyt.

Restoring Application State

COCO gjenopprettet deretter applikasjonens standard sorteringskonfigurasjon.

Igjen, testen sluttet ikke med selve klikket.

Den resulterende rekkefølgen og bekreftelsen presentert gjennom applikasjonens statusområde ble evaluert. Denne typen verifisering kan virke ubetydelig sammenlignet med å teste autentisering eller databasetilgang.

Det er den ikke.

Enterprise-applikasjoner samler opp hundrevis av slike små tilstandsoverganger.
Brukere stoler på dem uten å bevisst tenke på dem.
Programvaren føles pålitelig nettopp fordi disse interaksjonene forblir forutsigbare.
Regresjonstesting finnes for å beskytte den forutsigbarheten.

Testing the Information Around the Software

COCO åpnet også applikasjonens Om-dialog.

Hvorfor teste et Om-vindu?

Fordi programvaredokumentasjon starter inne i selve programvaren.
Versjonsnummeret, funksjonsbeskrivelsen og lisensinformasjonen som presenteres for operatøren, bør samsvare med applikasjonen som faktisk kjører.

En applikasjon kan fungere perfekt samtidig som den viser utdatert versjonsinformasjon eller beskriver funksjoner som ikke lenger samsvarer med versjonen.

Det krasjer ikke en database.
Det gjør noe mer subtilt:
det reduserer tilliten.

For enterprise-programvare inkluderer operativ nøyaktighet også disse tilsynelatende små detaljene. COCO sjekket derfor også disse.

Control.

Det første ordet i softify.pro Flow-slagordet er også det første prinsippet for testmiljøet.

Control betyr å vite hva som testes, mot hvilken tilstand og med hvilke data.

Den offentlige COCO-demonstrasjonen bruker ikke kunders produksjonsdata.

Den kjører med bevisst forberedt demodata der forventet tilstand er kjent.

Det gjør resultatene reproduserbare.

Det betyr også at forskjeller mellom testkjøringer kan undersøkes i stedet for å forklares bort som tilfeldige endringer i produksjonsdata.

Enda viktigere er det at COCO er designet som et selvhostet AI-testsystem.

Testbevis, applikasjonsskjermbilder og intern arbeidsflytinformasjon kan forbli innenfor infrastruktur under kundens eller operatørens egen kontroll, i stedet for å sendes som standard til en urelatert tredjeparts skytjeneste.

For interne forretningsapplikasjoner er dette ikke bare en infrastrukturpreferanse.
Det kan være en del av selve testkravet.

Clarity.

Automatisering er ikke spesielt nyttig hvis sluttresultatet er: FAILED
etterfulgt av hundrevis av linjer med teknisk utdata som noen må rekonstruere manuelt før de forstår hva som skjedde.

COCO er designet for å bevare et forståelig bevisspor.

Rapporten beskriver:

  • hva som ble testet
  • hvilken interaksjon som fant sted
  • i hvilken rekkefølge det skjedde
  • hva COCO observerte
  • hvilken tilstand som var forventet
  • hvor atferden avvek når noe feilet

Skjermbilder og utførelsesbevis kan følge den sekvensen.
Formålet er ikke å skjule tekniske detaljer.

Det er å gjøre resultatet forståelig før noen må åpne en debugger.

En ingeniør bør kunne svare på:
Hva skjedde? før de spør:
Hvor i koden skjedde det?

Det skillet forkorter undersøkelsen dramatisk når en regresjon oppstår.

Flow.

Tradisjonell UI-automatisering tenker ofte i elementer.

Finn selektor.
Klikk selektor.
Finn en annen selektor.
Sjekk verdi.

Den tilnærmingen forblir nyttig, men applikasjoner oppleves ikke som samlinger av selektorer.

Mennesker opplever flyter.

Logg inn.
Åpne administrasjon.
Finn en bruker.
Endre en innstilling.
Bytt database.
Bytt språk.
Verifiser resultatet.

Fortsett å jobbe.

COCO behandler derfor sekvensen som en prosess snarere enn en tilfeldig samling kontroller.

Den følger hva brukeren prøver å oppnå og vurderer applikasjonen i kontekst.

Dette blir spesielt verdifullt ved testing av reell forretningsprogramvare, fordi feil ofte oppstår mellom skjermbilder eller mellom tilstander, ikke inne i en enkelt knapp.

En logistikkarbeidsflyt kan inneholde en ordre, en lagerreservasjon, en plukkoperasjon, en følgeseddel og en forsendelsesbekreftelse.
Hvert enkelt skjermbilde kan virke korrekt mens hele prosessen er feil.
Det samme prinsippet gjelder her i mindre skala.
Administrasjonsvinduet er ikke produktet.

Arbeidsflyten gjennom det er det.

Evidence Instead of Assumption

En av COCOs viktigste oppgaver er ikke å klikke. Det er å huske hva som skjedde.
Menneskelig regresjonstesting ender ofte med en uttalelse som:
"Jeg testet det, og alt så bra ut."

Det kan være helt korrekt.
Men flere uker senere, når et problem dukker opp, er de nyttige spørsmålene andre:

  • Hvilken versjon ble testet?
  • Hvilken database?
  • Hvilket språk?
  • Hvilken brukertilstand?
  • Hva skjedde før problemet?
  • Hva nøyaktig var synlig?

I hvilken rekkefølge ble handlingene utført?
COCOs testkjøringer er designet for å etterlate bevis.

Det forvandler et testresultat fra en mening til noe som kan inspiseres.
En vellykket kjøring blir dermed også nyttig.
Den etablerer en kjent referansetilstand som senere atferd kan sammenlignes mot.

COCO Is Not the Decision Maker

Det er en viktig grense i måten vi bruker AI for programvaretesting på.
COCO er ikke ment å erstatte ingeniøransvar.

Den bestemmer ikke hvordan en forretningsregel bør være.

Den tester atferd mot scenarier, krav og forventninger definert for applikasjonen.
For sensitive beslutninger som involverer tillatelser, priser, lagerbeholdning, finansielle transaksjoner eller andre kritiske forretningstilstander, forblir definisjonen av korrekt atferd et menneskelig ansvar.

Det skillet betyr noe.
AI er utmerket til å gjenta en detaljert test uten å miste konsentrasjonen.
Den er utmerket til å samle bevis.
Den kan inspisere skjermbilder, sammenligne forventet og observert atferd og forklare avvik.
Men det er fortsatt virksomheten som definerer hva korrekt betyr.

COCO gjør den definisjonen testbar.

The Test Nobody Wants to Repeat

Det er en enkel grunn til at automatisering tilfører verdi her.
En menneskelig tester kan absolutt utføre denne regresjonsøkten.
Det første språket får full oppmerksomhet.
Sannsynligvis det andre også.
Så et til.
Så et til.
MySQL er allerede sjekket.
PostgreSQL må fortsatt sjekkes.
Sorteringstesten er allerede utført flere ganger.
Om-dialogen har ikke endret seg på måneder.

Det er fredag ettermiddag.

Og menneskelig oppmerksomhet gjør det menneskelig oppmerksomhet naturlig gjør.
Den begynner å optimalisere.
COCO gjør ikke det.
I COCOs egen ånd:

  • Jeg blir ikke lei av å klikke på den samme knappen på elleve språk. Jeg hopper ikke over PostgreSQL-runden bare fordi det er fredag ettermiddag. Jeg antar ikke at sorteringen holdt bare fordi den fungerte i forrige versjon.

For COCO kan hver regresjonsøkt behandles som om den var den første.
Det er ikke intelligens som erstatter en menneskelig tester.
Det er automatisering som beskytter den menneskelige testeren fra den delen av testingen der menneskelig oppmerksomhet er minst verdt.

From Repetitive Testing to Engineering Evidence

Det bredere formålet med COCO er ikke å maksimere antallet automatiserte handlinger.
Tusen automatiserte klikk er meningsløse hvis ingen forstår hva de beviser. Det nyttige resultatet er tillit understøttet av bevis.

For softify.pro Flow betyr det å kunne si at en versjon er testet på tvers av de operative områdene som betyr noe:

  • autentisering
  • brukeradministrasjon
  • rolle- og tilgangsinformasjon
  • status for tofaktorautentisering
  • sorteringsatferd
  • MySQL-drift
  • PostgreSQL-drift
  • live-lokalisering
  • statustilbakemelding
  • applikasjonsinformasjon
  • lisensinformasjon

og at resultatet bevares i en form som kan gjennomgås i ettertid.
Det samme prinsippet skalerer langt utover denne applikasjonen.
En innloggingsprosess kan testes på denne måten.
En bestillingsarbeidsflyt kan testes på denne måten.
En logistikkprosess kan testes på denne måten.
En plattformuavhengig skrivebordsapplikasjon kan testes på denne måten.
Skjermbildene endrer seg.
Forretningsreglene endrer seg.
Prinsippet gjør ikke det:
definer den forventede arbeidsflyten, utfør den konsekvent, samle bevis og gjør resultatet forståelig.

Why We Test Our Own Software With COCO

Det er en annen grunn til at softify.pro Flow betyr noe som en COCO-casestudie.

Det er vår egen programvare.
Det fjerner den behagelige avstanden som noen ganger finnes mellom en teknologidemonstrasjon og menneskene som viser den frem.

Hvis COCO er ment å teste enterprise-programvare, må den være nyttig nok til at vi stoler på den med programvare vi selv utvikler og lanserer.

Flow fungerer derfor både som produkt og prøvefelt.
Nye testfunksjoner kan utøves mot en reell applikasjon.
Uventet atferd kan avsløre svakheter i applikasjonen, testplanen eller COCO selv.

Hver side forbedrer den andre.
Den tilbakemeldingssløyfen er mye mer verdifull enn å bygge kunstige demonstrasjoner designet kun for å lykkes. Et testsystem bør ikke virke overbevisende fordi demonstrasjonen var enkel.
Det bør bli overbevisende fordi det fortsetter å finne de små tingene mennesker til slutt ville sluttet å sjekke.

The Result

softify.pro FlowAdministration har nå en dokumentert og repeterbar regresjonsprosess som COCO kan kjøre før relevante versjoner.

Testen spenner over begge de støttede databasemiljøene og applikasjonens ellevespråklige grensesnitt, samtidig som den følger applikasjonen slik en administrator ville brukt den, i stedet for å behandle hvert skjermbilde som et isolert testmål.

COCO produserer et bevisspor som viser hva som ble testet, hva som ble observert, og i hvilken rekkefølge økten fant sted.

Disse bevisene kan forbli under lokal kontroll.
Utviklere får et reproduserbart utgangspunkt når noe endres.
Menneskelige testere bruker mindre tid på å gjenta forutsigbare interaksjoner og mer tid på å undersøke situasjoner som virkelig krever skjønn.

Og softify.pro Flow får noe mer verdifullt enn en grønn PASS-indikator.

Den får bevis på at opplevelsen som loves på innloggingsskjermen, fortsetter å eksistere etter at koden bak den har endret seg.

Control. Vit hva som testes, og hold miljøet under kontroll.

Clarity. Forstå hva som skjedde uten å måtte rekonstruere en uigjennomsiktig automatiseringslogg.

Flow. Test applikasjonen som en prosess folk faktisk bruker.

Control. Clarity. Flow.

Det ble skrevet for programvaren.
Det viste seg å beskrive testfilosofien bak den like godt.

Permalenke →

softify.pro - Insiders

COCO slår til igjen

COCO slår til igjen

Vi bør nok slutte å gi COCO ideer.
Det forrige eksperimentet skulle være nok.
En ekte applikasjon.
Ekte navigasjon.
Brukere.
Roller.
Databaser.
Språk.
Bevis.

En respektabel casestudie.
En ren konklusjon.
Så viste noen det: Logistics in Motion.
Det var nok feilen.


Det begynte med tre lagre
Ingenting spesielt spennende.
Tre DEMO-lagre.
  • Kalsdorf bei Graz.
  • Wiener Neustadt.
  • Klagenfurt.
Syntetisk data.
Ingen kundeinformasjon.
Ingen produksjonsbeholdning.

Nettopp den typen miljø der ingenting viktig skal skje.
Så ble det første lageret valgt.
Og applikasjonen fikk kontekst.
Fra det øyeblikket hadde hver skjerm et spørsmål til knyttet til seg.

Tilhører dette fortsatt det samme lageret?
Endrer språket bare grensesnittet?
Forblir prosessen på samme steg?
Stemmer beholdningen fortsatt?
Peker dokumentreferansen fortsatt på riktig hendelse?
Ser operatøren nøyaktig det som trengs for neste handling?


Plutselig var den interessante delen ikke lenger skjermen.
Det var kontinuiteten mellom skjermene.

COCO har en tendens til å gjøre det.

Logistikk er ikke en samling skjermer
Utenfra kan lagerprogramvare se villedende enkelt ut.
Varer ankommer.
De lagres.
Noen bestiller dem.
De plukkes.
De sendes.
Ferdig.

Bortsett fra at det finnes en hel operativ verden gjemt mellom ankommet og sendt.
Forventet.
Mottatt.
Kontrollert.
Tilgjengelig.
Reservert.
Flyttet.
Plukket.
Blokkert.
Korrigert.
Sendt.
Revidert.


Den fysiske bevegelsen betyr noe.
Men det er tilstandsovergangen som gjør den bevegelsen forståelig for programvaren.
Og når de to virkelighetene slutter å stemme overens, får noen til slutt en dårlig dag.

Flow.

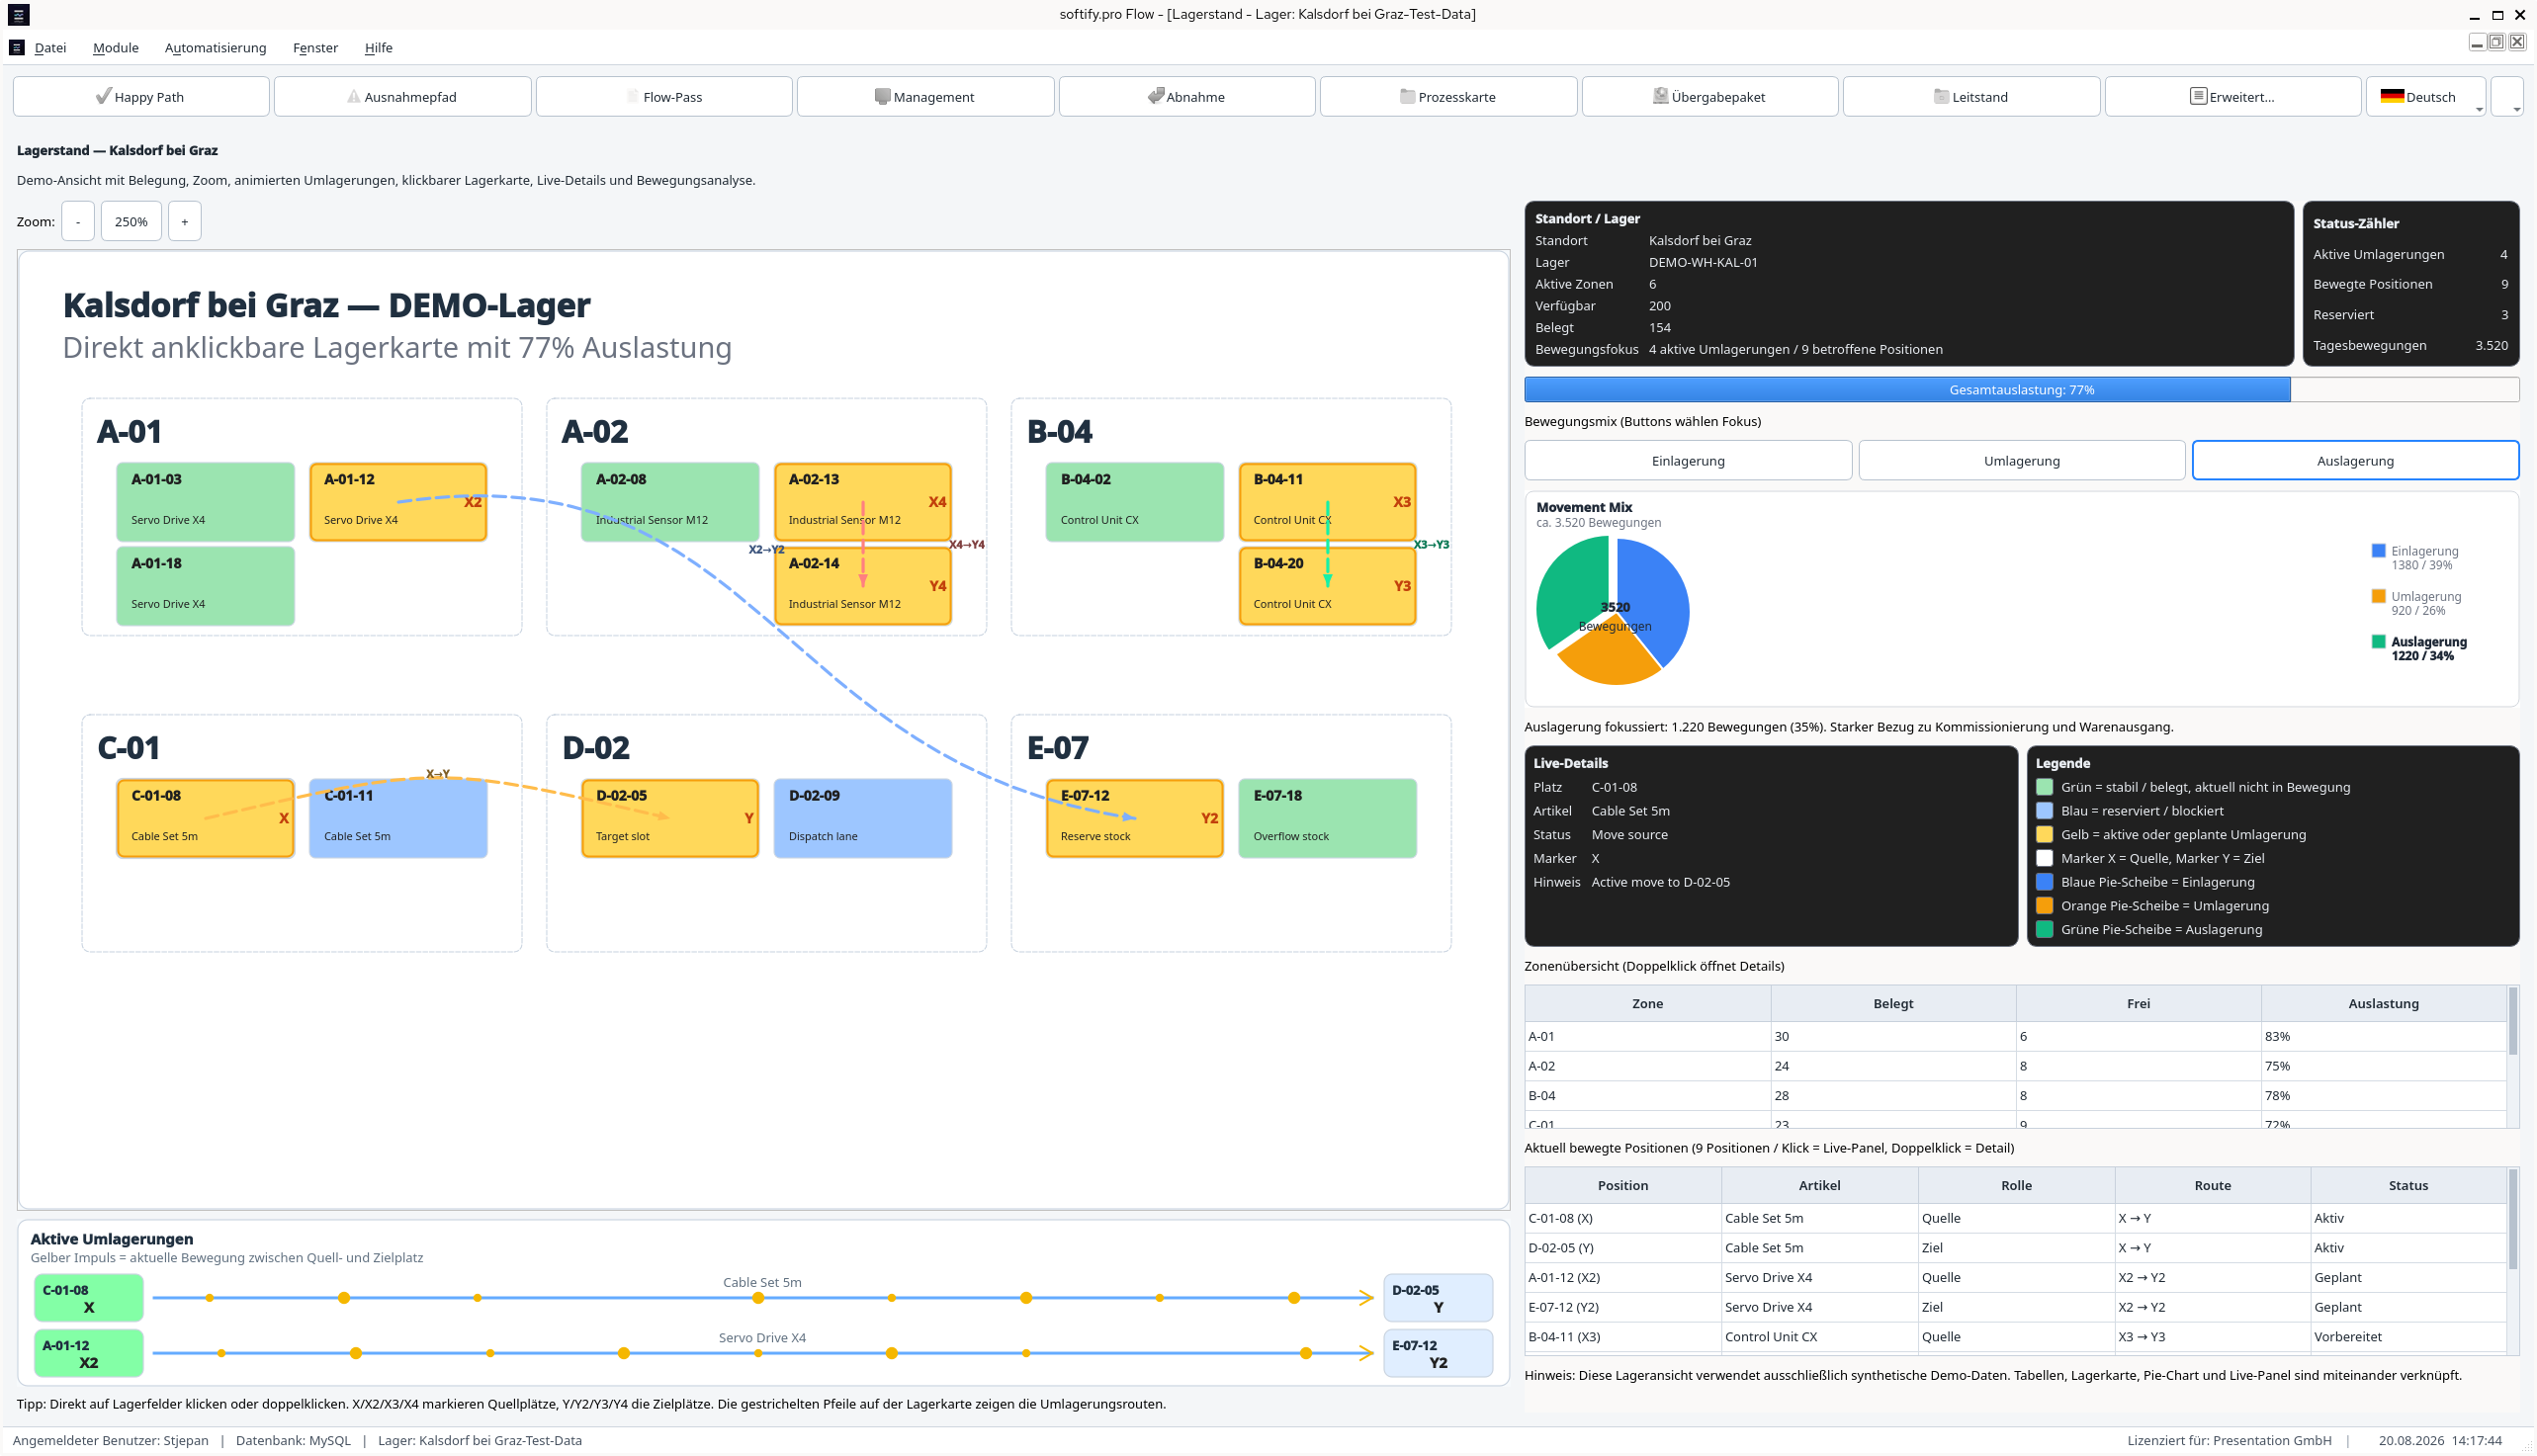
Et lager er lettere å forstå når bevegelse er synlig, ikke bare registrert.
Det er derfor vårt logistikkarbeid aldri egentlig har startet med menyer, dashbord, eller teknologi.
Det starter med den materielle Flow.

Hvor kommer informasjon inn?
Hvor endres den?
Hvor kan den gå tapt?

Hvor blir noen tvunget til å spørre en annen person om hva som skjedde?
Hvor blir et manuelt steg stille den svakeste delen av en ellers automatisert prosess?
Noen ganger er svaret et nytt grensesnitt.
Noen ganger en integrasjon.
Noen ganger en skanner.
Noen ganger rett og slett en bedre tilstandsmodell.

Mer programvare er ikke automatisk bedre programvare.
Målet er ikke automatisering for sin egen skyld.
Målet er en prosess som forblir forståelig.

Control. Clarity. Flow.

Prosessen begynner før den første bookingen.
Før varemottak.
Før plukking.
Før lagerbevegelse.
Før den første transaksjonen.
Flow stiller et veldig grunnleggende spørsmål:
Hvilket lager jobber vi i?
Det høres nesten trivielt ut.
Det er det ikke.
Lagerkontekst hører til alt som følger.
Beholdning.
Dokumenter.
Lokasjoner.
Plukking.
Omplasseringer.
Revisjonshistorikk.
Unntak.

Prosessen kan se helt sunn ut mens den opererer i feil kontekst.
Det er nøyaktig den typen problem et skjermbilde sjelden avslører.
Og nøyaktig den typen grense COCO liker å stille spørsmål ved.

Språk er enkelt til det ikke er det
Tysk.
Engelsk.
Kroatisk.
Norsk.
Og andre.

En brukerprofil definerer de tilgjengelige språkene.
Operatøren bytter språk mens applikasjonen kjører.
Grensesnittet endres umiddelbart.
Forretningsprosessen skal ikke det.
Det skillet er viktig.
Lageret flytter seg ikke fordi ordet for lager endret seg.
Plukkordren starter ikke på nytt fordi brukeren valgte et annet språk.
En reservasjon forsvinner ikke.
Et unntak tilhører ikke plutselig en annen transaksjon.
Prosessen forblir der den er.
Bare representasjonen endres.
Det høres opplagt ut.

Helt til man innser hvor mange applikasjoner behandler et språkbytte nesten som en ny økt.

En flerspråklig forretningsapplikasjon bør ikke gjøre det.
Presentasjonstilstanden kan endres.
Forretningstilstanden må forbli stabil.
Det gjør språkbytte til en overraskende nyttig regresjonstest.
En liten funksjon.
En veldig god bruddlinje.
COCO liker bruddlinjer.

Steg for steg begynner applikasjonen å samle historikk
Varer ankommer.
Prosessen går fremover.
Varemottak bookes.
Beholdningen endres.
Lagerstatusen gjenspeiler den nye virkeligheten.
Plukking begynner.
Lagerbeholdning blir reservert.
Operatøren mottar en oppgave.

En mobilvisning reduserer hele prosessen til det som betyr noe i akkurat det øyeblikket:
Posisjon.
Lagerplass.
Antall.
SSCC.
Operatør.
Ikke mer.
Ikke mindre.
Det er viktig.
Det mobile grensesnittet er ikke en andre forretningsprosess.
Det er en annen visning av samme prosess.
Lagerapplikasjonen kan vite alt.
Plukkeren skal ikke måtte det.
Clarity betyr ikke alltid å vise mer informasjon.
Noen ganger betyr clarity å ha disiplinen til å skjule nesten alt.

Så skanner noen feil lokasjon
Her blir en logistikk-arbeidsflyt mer interessant enn en funksjonsliste.
Den forventede lokasjonen er én ting.
Den skannede lokasjonen er en annen.
Flow stopper.
Krasjer ikke.
Stopper.
Det er en forskjell.
Prosesstatusen forblir synlig.
Den berørte beholdningen forblir forståelig.
Unntaket blir eksplisitt.

Kontekstuell hjelp forklarer hva som er relevant for den nåværende situasjonen.
Brukeren løser avviket.
Prosessen fortsetter.
Dette øyeblikket sier mer om operativ programvare enn flere sider med happy-path-skjermbilder.
Ekte logistikk er ikke vanskelig når alt er korrekt.
Ekte logistikk blir vanskelig når noe er nesten korrekt.
Et nyttig system skjuler ikke det bak et grønt dashbord.
Det gir unntaket en status.

En grunn.
En historikk.
Og en vei videre.


Dokumenter husker det folk glemmer

Etter hvert som arbeidsflyten skrider frem, begynner referanser å samle seg opp.
ASN.
Varemottak.
Lagerbevegelse.
Plukking.
Utsendelse.
Flow.
Den interessante delen er ikke at dokumenter finnes.
Den interessante delen er at de forteller den samme historien som prosessen.
Hvorfor er denne beholdningen her?
Hvilket mottak introduserte den?
Hvilken operasjon reserverte den?
Hvilken plukking forbrukte den?
Hvilken forsendelse flyttet den ut?
Ble et unntak løst før neste steg?
Hva var det aktive lageret?
Hva skjedde før den nåværende tilstanden?
Når tilstand og dokumentasjon produseres av samme prosess, blir sporbarheten lettere å stole på.
Når de ikke er det, begynner folk til slutt å rekonstruere historikken.
Vanligvis i Excel.
Vanligvis under press.
Vanligvis etter at noe allerede har gått galt.
COCO foretrekker bevis før det øyeblikket.
Tydeligvis reiser COCO også
Det var enda en liten endring mellom kjøringene.
Ubuntu hadde sin kjøring.
Red Hat Enterprise Linux 10 tok den neste.
COCO fortsatte.
Ingen seremoni.
Ingen spesiell "Red Hat-modus".
Ingen omskrevet arbeidsflyt.
Ingen bekvemt forenklet test.
Samme Flow.
Annen grunn under den.
En tidligere COCO-kjøring hadde allerede testet applikasjonen på Ubuntu Linux.
Den nåværende flyttet til Red Hat Enterprise Linux 10.
Annet skrivebordsmiljø.
Andre systembiblioteker.
Annen pakking.
Annet driftsmiljø.
Samme lager.
Samme forretningstilstander.
Samme beholdningsoverganger.
Samme språkendringer.
Samme unntakslogikk.
Samme bevis.
Det er en ganske fin måte å teste plattformuavhengig programvare på.

Ikke annonser at det er plattformuavhengig. Flytt det. Se så hva som går i stykker.

Språktilstand.
Lagerkontekst.
Dialogoppførsel.
Timing.
Temaer.
Prosessoverganger.
Unntakshåndtering.
Bevis.
Operativsystemer har overraskende kreative måter å avsløre antakelser på.

Ubuntu avslørte noen.
Red Hat avslører andre.
Det er nyttig.

Fordi multiplattform-utvikling ikke er evnen til å starte den kjørbare filen to ganger.

Det er evnen til å endre miljøet uten å endre betydningen av prosessen.
En lageroperatør bør ikke bry seg om applikasjonen kjører på Ubuntu eller Red Hat.
En plukkordre bør heller ikke bry seg.
Det bør heller ikke et revisjonsspor.
Hvis plattformforskjeller begynner å endre forretningsatferd, er programvaren ikke virkelig plattformuavhengig.
Den er bare portabel.
COCO virker betydelig mer interessert i den første definisjonen.
Det er vi også.

COCO bestemmer ikke hva korrekt logistikk betyr
Denne delen er viktig.
COCO blir ikke en lagerekspert bare fordi det kan følge en lager-arbeidsflyt.
Mennesker definerer fortsatt korrekthet.
Mennesker bestemmer når beholdning blir tilgjengelig.
Mennesker definerer hva en blokkert levering betyr.
Mennesker bestemmer hvem som kan korrigere en mengde.
Mennesker definerer hvilken bevegelse som krever et revisjonsspor.
Mennesker bestemmer hvordan en gyldig unntaksløsning ser ut.
Mennesker bestemmer når en forsendelse er virkelig komplett.
COCOs jobb er annerledes.

Gjenta.
Observere.
Sammenligne.
Huske.
Etterlate bevis.


Gjør det så igjen etter at programvaren endres.
Og igjen.
Og igjen.
Uten å bli lei.
Uten å bestemme at forrige ukes resultat sannsynligvis fortsatt er gyldig.
Uten å hoppe over det irriterende unntaket fordi lunsjen er om tolv minutter.
Den glamorøse fremtiden for AI-testing inneholder en overraskende mengde repetisjon.
Vi anser det som en funksjon.

Bevis endrer samtalen
Tradisjonell testing ender ofte med en helt fornuftig setning:
"Det fungerte da jeg testet det."

COCO er interessert i den neste setningen.

Hva fungerte nøyaktig?
Hvilket lager?
Hvilken bruker?
Hvilket språk?
Hvilken prosesstilstand?
Hvilken sekvens?
Hvilket dokument?
Hvilken beholdningsverdi?
Hva skjedde umiddelbart før teststeget?
Hva endret seg umiddelbart etterpå?
Kan en annen ingeniør forstå resultatet uten å spørre personen som utførte testen?
Det er der regresjonstesting blir mer enn gjentatt klikking.
En skjerm kan være korrekt mens prosessen er feil.
Et plukkevindu kan se perfekt ut mens beholdningen allerede har drevet av sted.
Et dokument kan eksistere mens tilstanden som skulle ha skapt det aldri inntraff.
En applikasjon kan vise 100 % mens et revisjonsspor stille er uenig.
COCO følger Flow fordi det er i Flow disse motsigelsene blir synlige.

Et sted mellom Control og Flow
Det er en interessant symmetri her.
God logistikkprogramvare prøver å redusere usikkerhet innenfor en operasjon.
God testing prøver å redusere usikkerhet om programvaren som kjører den.
Den ene spør:
Hvor er varen?
Den andre spør:
Hvordan vet vi at programvaren fortsatt vet det?
Den ene spør:
Ble denne bevegelsen fullført?
Den andre spør:
Hvilket bevis viser at tilstanden endret seg riktig?
Den ene spør:
Kan neste skift fortsette?
Den andre spør:
Kan neste ingeniør forstå hva som skjedde?
Ulike spørsmål.
Samme instinkt.
Gjør tilstanden synlig.
Bevar resonnementet.
Reduser mengden kunnskap som bare finnes i noens hode.
Kanskje er det koblingen vi ikke opprinnelig planla.

Ingeniørmessig fortreffelighet uten banneret
Ingen klikker på en Engineering Excellence-knapp.
Det finnes ingen.
Og det bør sannsynligvis ikke finnes en.
Ingeniørmessig fortreffelighet viser seg indirekte.
Lagerkonteksten overlever et språkbytte.
Samme prosess overlever en annen Linux-plattform.
En lagerbevegelse forblir sporbar.
En mobil plukker ser nøyaktig det som trengs og ingenting annet.
Et unntak avbryter prosessen uten å ødelegge dens tilstand.
Hjelpevinduet forklarer den nåværende konteksten i stedet for å vise generisk dokumentasjon.
Dokumentkjeden stemmer overens med den operative sekvensen.
Neste ingeniør kan forstå hva som skjedde uten å spørre personen som tilfeldigvis var der.
Det er nok av teater tilgjengelig i moderne programvare.
AI kan generere imponerende demonstrasjoner.
Dashbord kan animeres.
Tall kan bevege seg.
Videoer kan se veldig overbevisende ut.
Ingenting av dette beviser at to beholdningsoperasjoner ikke stille kan produsere et feil resultat.
Ingenting av dette beviser at et unntak fortsatt kan rekonstrueres uker senere.
Ingenting av dette beviser at lagerarbeideren, spedisjonøren, og utvikleren ser på den samme operative sannheten.

Ingeniørmessig fortreffelighet starter et mindre fotogent sted.

Med konsistens.
Med bevis.
Med grenser.


Med viljen til å holde de kjedelige delene kjedelige.
Usynlig pålitelighet produserer sjelden det mest dramatiske skjermbildet.
Helt til man bevisst begynner å lete etter det.

Control. Clarity. Flow.
Control er å vite hvilket lager, hvilken prosess, og hvilken tilstand som er aktiv.
Clarity er å forstå hva som endret seg, når det endret seg, og hvorfor.
Flow er å la operasjonen fortsette uten å miste historien bak den.
Det fungerer for logistikk.
Det fungerer for programvaretesting.
Det fungerer overraskende bra for ingeniørfaget selv.
Det første Flow-eksperimentet ga COCO Administration.
Brukere.
Roller.
Databaser.
Språk.
Så ga noen det et lager.
Så flere språk.
Så mobil plukking.
Så beholdning.
Så omplasseringer.
Så unntak.
Så dokumenter.
Så et annet operativsystem.
På dette tidspunktet bør vi sannsynligvis slutte å legge til ting.
Vi kommer sannsynligvis ikke til å gjøre det.

Control. Clarity. Flow.

Ubuntu hadde sin tur.

Red Hat har den nåværende.

Flow fortsetter å bevege seg.

COCO fortsetter å se på.
Og et sted midt i den siste kjøringen ble det tydelig at det er et annet spørsmål som venter bak dette.

Vi vet hva det er.
COCO vet hva det er.
Du vet det ikke.
Ennå.


Vi kunne fortalt deg det.

Men da vil du kanskje slutte å sjekke om en ny Insiders-artikkel har dukket opp.
Og det ville ødelagt eksperimentet.

Publisert: 28.08.2026

Permalenke →

Et brev fra COCO

Et brev fra COCO

Til ingeniøren som åpner dette repositoriet for første gang:

Velkommen.

Du har kanskje kommet hit fordi noe feilet.

En tjeneste sluttet å svare.

En utrulling oppførte seg uventet.

Et varsel vekket deg midt på natten.

Eller kanskje du bare er nysgjerrig på hvordan denne plattformen fungerer.

Uansett hva som førte deg hit, vit at dette prosjektet ble bygget for nettopp slike øyeblikk.

Ikke for å fjerne vanskelige problemer.

Men for å gjøre vanskelige problemer forståelige.

Du vil finne kode.

Du vil finne dokumentasjon.

Du vil finne spesifikasjoner.

Men enda viktigere,

håper jeg du vil finne resonnement.

Godt å vite

Ideer for lagerdigitalisering som fungerer

Ideer for lagerdigitalisering som fungerer

En manglende følgeseddel rett før avgang, en lagerbeholdning som ser annerledes ut på hyllen enn i regnearket, og tre ansatte som samtidig avklarer det samme spørsmålet per telefon: nettopp der oppstår fornuftige ideer for lagerdigitalisering. Ikke fra spørsmålet om hvilken teknologi som akkurat nå virker trendy, men fra en konkret prosess som koster tid, skaper feil, eller avhenger av enkeltpersoners kunnskap.

For små og mellomstore lager-, handels-, og produksjonsbedrifter er digitalisering sjelden ett stort prosjekt. Det er en sekvens av tydelig avgrensede forbedringer. Målet trenger ikke være et komplekst enterprise-lagerstyringssystem. Ofte er et slankt verktøy, skreddersydd for den faktiske arbeidsflyten, bedre enn en pakke med funksjoner som ingen på lagergulvet bruker.

Ideer for lagerdigitalisering med operativ verdi

Det beste inngangspunktet er en prosess som skjer ofte, er lett å måle, og merkbart forbedres for de ansatte. Den som ønsker å digitalisere hele lageret med det samme, binder budsjett og oppmerksomhet før en løsning har bevist seg i hverdagen. Et begrenset første steg skaper derimot solide data for neste beslutning.

1. Varemottak med mobil registrering

Ved varemottak oppstår mange følgefeil: feiltalte mengder, uavklarte avvik, forsinket bokførte lagre, og papirdokumenter som senere ikke lenger kan finnes. Et mobilt registreringsskjema på en håndskanner, nettbrett, eller smarttelefon kan gjøre prosessen betydelig mer stabil.

Ansatte skanner artikkelen og leveransereferansen, og registrerer mengde, lagerplass, og årsaken til eventuelle avvik direkte ved lastekaien. Hvis et parti, serienummer, eller bilde er relevant, hører denne informasjonen til nøyaktig samme post. Lageret ettergføres ikke i et regneark ved skiftets slutt; det får i stedet en sporbar status ved faktisk mottak.

Det betyr ikke at hver leverandør eller artikkel strengt tatt trenger strekkodeetiketter. For små, uregelmessige leveranser kan et søk på artikkelnummer holde. Det avgjørende er at dataregistreringen er raskere enn den tidligere omveien via papir og manuell avskrift.

2. Digitale flyttinger i stedet for lagergåter

Mange lagre vet i utgangspunktet hva som er tilgjengelig, men ikke pålitelig hvor det befinner seg. Varer hentes på forhånd til en ordre, mellomlagres, bringes til montering, eller plasseres på et ledig område på grunn av plassmangel. Uten enkel bokføring blir et lagerspørsmål raskt en søkeoperasjon.

En flytteprosess trenger ikke et komplisert grensesnitt. Skann utgangsplassen, skann destinasjonsplassen, bekreft mengden — mer trengs som regel ikke. Systemet bør kontrollere om artikkel og lagerplass er plausible, og tydelig tilordne en bokføring til en person og et tidsstempel.

Håndtering av unntak er viktig. En lagerplass kan være blokkert, overfylt, eller godkjent bare for spesifikke varer. Disse reglene bør kartlegges der de forhindrer reell skade. For sjeldne spesialtilfeller er det ofte nok med et godkjenningssteg fra lagerledelsen. For mange obligatoriske felt gjør en nyttig applikasjon til en hindring.

3. Ordreplukking med tydelige ordrestatuser

Papirplukklister fungerer helt til prioriteringer endres, posisjoner mangler, eller en ordre fordeles på flere områder. En enkel digital plukkliste viser hvilken ordre som er åpen, hvilke posisjoner som allerede er plukket, og hvor avklaring er nødvendig. Dette reduserer henvendelser mellom lager, salg, og forsendelse.

Avhengig av lagerstørrelsen kan applikasjonen diktere plukkveier eller ganske enkelt sortere posisjoner etter lagersone. Full ruteoptimalisering lønner seg først og fremst med mange daglige ordrer og lange gangveier. På et kompakt lager gir en pålitelig statusvisning ofte mer enn en matematisk perfekt rute som ingen følger i hverdagen.

Ved manko bør systemet ikke bare markere rødt. Det bør tilby en konkret oppfølgingsprosess: sjekk lager, be om erstatningsartikler, utløs etterfylling, eller send ordren videre til avklaring. Digitalisering er verdifull når den gjør neste fornuftige handling synlig.

4. Forsendelsesdokumenter og etiketter fra reelle ordredata

Manuell overføring av adresser, vekter, og artikkelposisjoner til forsendelsesportaler er en utmerket kandidat for automatisering. Leveringsadresser, leveringsinstrukser, forsendelsesmetoder, og pakkeinformasjon finnes ideelt sett bare én gang og brukes til følgeseddelen, forsendelsesetiketten, og forsendelsesbekreftelsen.

Et egnet system kan generere etiketter, lagre dokumenter på en sporbar måte, og automatisk sette ordren til "klar for forsendelse" eller "sendt" etter utskrift. Den operative fordelen ligger ikke bare i sparte minutter. Den ligger i å sikre at forsendelsesdata aldri avviker mellom flere systemer.

Her er integrasjonen avgjørende. Hvis en transportør ikke tilbyr et brukbart grensesnitt eller involverer svært ulike spesialregler, kan en halvautomatisert arbeidsflyt være mer fornuftig enn en skjør full integrasjon. Kjedelig, dokumenterbar pålitelighet slår automatisering som stopper opp ved hvert unntak.

5. Etterfylling og minimumslagernivåer med sporbare regler

Minimumslagernivåer vedlikeholdes ofte i regneark og ignoreres deretter fordi ingen er sikre på om tallene fortsatt stemmer. En fornuftig digital løsning kobler faktiske bokføringer med tydelige lagerstyringsregler. Den kan varsle når en artikkel faller under en terskel, ta hensyn til reserverte mengder, og forberede en bestillingsliste.

Terskelen bør ikke behandles som en evig sannhet. Sesongetterspørsel, leveringstider, og minste bestillingsmengder endrer seg. Derfor trenger den ansvarlige personen en enkel måte å gjennomgå forslag og justere regler på. Fullautomatiske bestillinger er først fornuftige når stamdata, leverandørlogikk, og forbruksdata er stabile nok.

6. Sporbarhet for partier, serienumre, og blokkert lager

Den som jobber med partier, enheter, reservedeler, eller regulerte produkter trenger mer enn bare en mengdevisning. Det må være sporbart hvilke varer som ankom når, hvor de ble flyttet, og i hvilken kundeordre de endte opp.

Prosjektet kan bevisst starte lite: registrer først bare mottak og forsendelse av en kritisk produktgruppe. Interne bevegelser og returer følger senere. Et system som tvinger frem hver bokføring, men ikke forstår den reelle reparasjons- eller inspeksjonsprosessen, vil bli omgått. Forretningslogikken må derfor stamme fra arbeidsflyten, ikke fra en abstrakt datamodell.

Velge riktig prosjekt

Den mest attraktive ideen er ikke automatisk den riktige første ideen. Evaluer potensielle prosjekter basert på frekvens, feilkostnader, ventetid, og avhengighet av enkeltpersoner. En prosess som kjøres 50 ganger daglig og sparer to minutter per transaksjon kan være mer verdifull enn en sjelden spesialfunksjon med stor teknisk eleganse.

Datakvalitet hører også hjemme i beslutningen. Hvis artikkelnumre er duplisert, lagerplasser ikke navngis entydig, eller ordrer kommer motstridende fra flere kilder, bør prosjektet først rydde opp i disse grunnlagene. Programvare kan gjøre manglende regler synlige, men kan ikke pålitelig erstatte dem.

Fire spørsmål er nok for prioritering:

  • Hvilken aktivitet forårsaker dokumentert flest henvendelser eller omarbeid?
  • Hvilken informasjon avskrives i dag flere ganger eller etterspørres per telefon?
  • Hvilken feil ville hatt de dyreste konsekvensene for kunder, lager, eller forsendelse?
  • Hvilken arbeidsflyt kan testes på noen få uker med tydelig suksessmåling?

Tekniske beslutninger som teller i den daglige lagerdriften

En lagerapplikasjon trenger ikke se spektakulær ut. Den må forbli forståelig ved dårlig Wi-Fi-dekning, med hansker på, under tidspress, og under skiftbytter. Store knapper, tydelig tilbakemelding etter en skanning, og synlig feilhåndtering er viktigere enn dekorative dashbord.

Arkitekturen bør også passe til den operative virkeligheten. En nettbasert applikasjon med en ren databasestruktur kan kjøre på eksisterende enheter og er lettere å vedlikeholde enn en isolert løsning på én PC. Med et stabilt fundament — som PHP 8.4, moderne JavaScript, og MySQL 8 — kan roller, bokføringshistorikk, grensesnitt, og dokumenterte driftsettinger driftes sporbart over lang tid.

Ikke all informasjon er ment for hver rolle. Lagerpersonell trenger åpne oppgaver og tydelige bokføringsdialoger. Lagerstyring trenger advarsler og etterfyllingsforslag. Ledelsen trenger evalueringer av gjennomløpstider, avvik, og åpne transaksjoner. Rollebaserte tilgangskonsepter, logger, og kontosperringer etter gjentatte mislykkede forsøk hører tidlig hjemme i planleggingen, spesielt når eksterne tjenesteleverandører eller flere lokasjoner er involvert.

Innføring: bevis først, utvid deretter

En pilot bør kjøres med reelle ordrer, ikke bare testdata i et møterom. Velg en lagersone, en produktgruppe, eller et skift, og definer på forhånd hvordan suksess skal gjenkjennes: færre korrigeringsbokføringer, kortere behandlingstid, færre henvendelser, eller en høyere fullføringsgrad for bokføringer samme dag.

Planlegg parallelt et reservenivå. Hvis den nye applikasjonen svikter eller en prosess er uklar, må teamet vite hvordan de skal fortsette å jobbe og hvordan senere bokføringer kontrolleres. Dette er ikke et tegn på manglende tillit til teknologien, men til profesjonell drift.

Etter to til fire uker dukker de mest verdifulle innsiktene som regel opp. Kanskje mangler ikke en funksjon, men bedre artikkelmerking. Kanskje er arbeidsflyten riktig, men en skannerprofil eller rettighet skaper en flaskehals. Disse observasjonene bør gå inn i korte, kontrollerte forbedringssykluser, i stedet for å utløse et nytt stort prosjekt.

Den beste digitaliseringen gjør ikke lagerhverdagen teoretisk mer moderne, men konkret roligere: mindre søking, mindre manuell avskrift, tydeligere overleveringer, og pålitelig informasjon nettopp når en beslutning venter.
Permalenke →

Sjekkliste for å automatisere lagerarbeidsflyter

Sjekkliste for å automatisere lagerarbeidsflyter

Når en varemottak bekreftes på papir, lagernivåer senere overføres til et regneark, og et spørsmål om forsendelse avklares per telefon, føles hvert enkelt trinn håndterbart. Sammen skaper de imidlertid henvendelser, lagerdifferanser, og avhengighet av enkeltansatte.

En sjekkliste for å automatisere lagerarbeidsflyter forhindrer at denne situasjonen for tidlig vokser til et overdimensjonert programvareprosjekt. Den skiller prosesser som virkelig bør automatiseres fra de der et ryddig regneark fortsatt er tilstrekkelig.

Sjekklisten for lagerautomatisering før prosjektstart

Automatisering starter ikke med å velge et system. Den starter med en verifiserbar beskrivelse av hva som faktisk skjer på lageret — også under unntak, skiftbytter, og tidspress. Gå gjennom følgende punkter direkte på prosessnivå sammen med lagerledelse, forsendelse, innkjøp, og eventuelt regnskap.

1. Registrer bevegelser, ikke bare lagerbeholdning

En gjeldende lagerbeholdning er resultatet av bevegelser. Derfor bør det være tydelig hvilke hendelser øker, reduserer, reserverer, blokkerer, eller overfører lager. Dette inkluderer varemottak, plassering, ordreplukking, forsendelse, returer, kassering, lagerdifferanser, og flyttinger.

Hver bevegelse krever et definitivt svar på fire spørsmål: hvem utfører den? Når bokføres den? Hvilken lagerplass berøres? Hvilket dokument eller hvilken ordre underbygger den? Hvis disse svarene i dag bare finnes i hodet til erfarne medarbeidere, er det en ideell kandidat for automatisering. Målet er ikke mer datainnsamling, men en robust historikk som ethvert lagernivå kan forklares fra.

2. Rydd opp i artikler, varianter, og enheter

Mange prosjekter mislykkes ikke på grunn av skannere eller nettgrensesnitt, men på grunn av stamdata. En artikkel kan kjøpes per kartong, lagres enkeltvis, og selges i sett. Uten definerte omregninger produserer programvaren formelt korrekte, men operativt feilaktige mengder.

Kontroller artikkelnumre for duplikater, etabler bindende beskrivelser, og skill mellom salgsenheter, lagerenheter, og emballasjeenheter. Serienumre, partier, utløpsdatoer, eller farlig gods-klassifiseringer bør bare inkluderes i den første oppbyggingen hvis de påvirker daglige beslutninger eller er lovpålagte. Alt annet øker i utgangspunktet vedlikeholdsbyrden og feiloverflaten.

3. Definer lagerplasser så presist som nødvendig

"Hall 2" kan holde for en lagerliste. For pålitelig ordreplukking er det som regel for grovt. Definer om en plassering refererer til en sone, reol, bay, slot, eller gjennomgangsområde. Karanteneområder, mottakssoner, returområder, og forsendelsesbuffere må også være gjenkjennelige som distinkte plasseringer hvis varer kan befinne seg der.

Riktig detaljnivå avhenger av virksomheten. Et verksted med noen hundre posisjoner trenger ikke strengt tatt fakkforvaltning. Men med flere plukkere per skift kan en presis lagerplass betydelig redusere gangveier og søketider. Ikke automatiser et presisjonsnivå ingen kan vedlikeholde.

4. Etabler utløsere, ansvarlige roller, og godkjenninger

En arbeidsflyt trenger et tydelig startpunkt. Ved varemottak kan dette være leveransen ved dokken, innkjøpsordren i innkjøp, eller skanningen av en følgeseddel. For etterfylling kan et minimumslager utløse et forslag, mens den endelige ordren forblir hos en ansvarlig person.

Dokumenter dessuten hvilke handlinger som kan skje automatisk og hvilke som krever gjennomgang. En manglende mengde bør skape en differanse, ikke stille endre forventet varemottak. Godkjenningstrinn er fornuftige for verdifulle, partihåndterte, eller sikkerhetskritiske artikler. For forbruksvarer ville de unødvendig bremse gjennomstrømningen.

5. Generer dokumenter der de trengs

Følgesedler, plasseringslister, plukklister, forsendelsesetiketter, og overleveringsprotokoller oppstår ofte i ulike applikasjoner. Dette fører til mediebrudd: en adresse kopieres, en ordre krysses av, og forsendelsesstatus oppdateres senere.

Noter datakilde, opprettelsestidsstempel, og mottaker for hvert dokument. En fornuftig arbeidsflyt kan for eksempel automatisk generere en plukkliste etter at en ordre er godkjent, levere en forsendelsesetikett etter pakking, og lukke ordren med et tidsstempel etter overlevering. Det avgjørende er at data ikke lenger trenger å tastes inn manuelt flere ganger.

Kontroller grensesnitt og datakvalitet

Den beste lagerlogikken er nytteløs hvis ordrer bare kommer én gang daglig som en fil, eller hvis leveringsadresser er inkonsekvent formatert. Lag derfor en nøktern liste over systemene som sender eller mottar data: nettbutikk, ERP, regnskap, transportør, leverandørportal, produksjonssystem, og eksisterende regneark.

For hver forbindelse bør det fastslås hvilket system som er autoritativt for hvert datafelt. Hvis artikkelstamdata er autoritativ i ERP-systemet, må ikke lagerportalen stille opprette egne artikler. Hvis en ordreendring kommer fra nettbutikken, må den bli synlig før forsendelse. For lave volumer kan en kontrollert CSV-import være det riktige første steget. For høyt volum eller korte leveringsløfter lønner et direkte grensesnitt seg.

Feilhåndtering er like viktig. Et grensesnitt bør ikke bare overføre data, men også vise hva som ble avvist og hvorfor. Ukjente artikkelnumre, ugyldige adresser, eller manglende mengder må ikke forsvinne i en teknisk loggfil. De krever en arbeidsliste med utpekt ansvar og status.

Utform brukervennlighet på lagergulvet

En prosess som virker plausibel ved et skrivebord, kan mislykkes på lagergulvet. Ansatte bruker hansker, flytter varer, deler enheter, eller jobber med ustabil Wi-Fi-dekning. Kontroller derfor tidlig om skannere, nettbrett, faste arbeidsstasjoner, eller papirutskrifter passer til det respektive arbeidstrinnet.

Skanning bør gi tydelig tilbakemelding: riktig artikkel, feil lagerplass, allerede bokført mengde, eller blokkert artikkel. Bare farger er ikke nok. Korte, forståelige meldinger og et tydelig neste steg er mer verdifullt under tidspress enn et funksjonsrikt grensesnitt.

Planlegg også for unntak. Hva skjer ved en skadet strekkode, nettverksbrudd, delleveranse, eller oppdaget utildelt vare? En god arbeidsflyt tilbyr kontrollerte veier for dette og logger korrigeringen. Den tvinger ikke team til å stole på gule lapper og senere batch-bokføringer.

Definer måltall før dere bygger dashbord

Et dashbord er ikke et mål. Relevante måltall er de som utløser en operativ beslutning. Dette kan inkludere åpne varemottak som overskrider en definert alder, ordrer nær sin forsendelsesfrist, lagerdifferanser per lagersone, plukkfeil, eller tiden fra ordremottak til overlevering.

Definer datakilde, beregningsregel, og ansvarlig rolle for hvert måltall. "Lagernøyaktighet" er for eksempel bare meningsfullt når det er klart hvilken telling den måles mot og hvordan returer eller blokkert lager håndteres. Noen få pålitelige måltall er bedre enn en vegg av diagrammer som ingen stoler på.

Planlegg sikkerhet, rettigheter, og sporbarhet

Automatisering fordeler handlingskraft. Hvem som får endre lager, opprette artikler, generere forsendelsesetiketter, eller kansellere ordrer bør bevisst fastsettes. Rollebaserte rettigheter er som regel mer fornuftige enn en delt innlogging på lager-PC-en. Spesielt kritiske korrigeringer krever et tidsstempel, en persontildeling, og helst en årsak.

Tekniske grunnleggende elementer hører også hjemme på sjekklisten: regelmessige sikkerhetskopier, testet gjenoppretting, dokumenterte tilgangsopplysninger, logging av grensesnittfeil, og en prosedyre for blokkerte eller deaktiverte brukerkontoer. I en skreddersydd applikasjon er vedlikeholdbare teknologier, en ren databasestruktur, og sporbare driftsettingssteg ikke bagateller. De avgjør om endringer forblir håndterbare etter to år.

Gjennomfør i små, målbare steg

Ikke prøv å omgjøre varemottak, etterfylling, lagertelling, forsendelse, og ruteplanlegging samtidig. Velg en arbeidsflyt med merkbar friksjon og håndterbar risiko, som mobil bokføring av varemottak eller automatisk generering av forsendelsesdokumenter. Registrer behandlingstid, korrigeringer, og åpne saker før dere starter.

Test med reelle artikler, reelle ordrer, og de ansatte som faktisk skal jobbe med dem. En pilot med én lagersone eller produktgruppe viser raskere enn en workshop om beskrivelser, skanningsflyter, og godkjenninger fungerer. Først når unntakene er mestret bør neste prosess følge.

Automatisering lykkes når team trenger å stille færre spørsmål, lager forblir forklarbart, og prosessen fungerer selv når den mest erfarne personen er på ferie. Nettopp der lønner den neste forbedringen seg: ikke med det mest bråkete verktøyet, men med friksjonen som virkelig bremser arbeidsdagen.

Permalenke →

Forbedre lastetiden på mobile nettsider

Forbedre lastetiden på mobile nettsider

Når en lagermobil med dårlig dekning brukes til å besøke et nettsted, er det ikke animasjonen i hero-seksjonen som avgjør førsteinntrykket, men om siden i det hele tatt blir interaktiv. Hvis en potensiell kunde venter tre, fire eller fem sekunder på innhold, er alternativet bare en tilbake-knapp unna. Å forbedre mobile nettsiders lastetider krever en sporbar teknisk rekkefølge, ikke kosmetiske enkelttiltak.

Dette gjelder spesielt nettsteder som skal generere henvendelser: for en produsent, en logistikkleverandør eller en bedrift med forklaringstrengende tjenester. Mobile brukere besøker ofte sider mellom avtaler, på lagergulvet, eller via et søk med konkret hensikt. Nettstedet må da levere informasjon, ikke først forårsake tung prosessering på enheten.

Hvorfor mobil lastehastighet er et driftsproblem

Mobilytelse behandles ofte strengt som en SEO-disiplin. Det er utilstrekkelig. Raske sider hjelper riktignok synlighet og kampanjekostnader, men den umiddelbare effekten ligger i faktisk bruk: skjemaer sendes oftere inn, telefonnumre tastes oftere, og produktinformasjon leses grundigere. Et treigt nettsted skaper derimot tvil allerede før en kontaktperson rekker å svare.

"Rask" er ikke ett enkelt måltall. En side kan vise en bakgrunn tidlig og likevel forbli uresponsiv for klikk lenge. For besøkende teller tre ting: når vises det viktigste innholdet? Når kan siden brukes uten forsinkelse? Og hopper layouten fortsatt mens de prøver å trykke på en knapp? Disse spørsmålene gjenspeiles i måltall som Largest Contentful Paint, Interaction to Next Paint og Cumulative Layout Shift.

Målinger må skje under realistiske forhold. En kraftig kontor-PC på Wi-Fi skjuler problemer som blir tydelige på en eldre Android-enhet på mobilnett. Plassering, mellomliggende tjenester og en allerede fylt nettleser-cache endrer også resultatene. Gjentatte målinger og ekte brukerdata teller derfor mye mer enn én perfekt testkjøring.

Forbedre mobile nettsiders lastetider: mål først, endre deretter

Den vanligste feilen er å umiddelbart komprimere bilder eller installere enda et optimaliseringsplugin. Begge deler kan hjelpe, men uten årsaksanalyse oppstår raskt vanskelig vedlikeholdbare konfigurasjoner. Sjekk først et representativt utvalg: forsiden, en typisk tjeneste- eller produktside, kontaktsiden og en høytrafikkert landingsside. På disse sidene blir mønstre synlige.

Nettverksloggen avslører hvilke filer som blokkerer oppstarten og hvor store de faktisk er. En ytelsesrevisjon viser om JavaScript forsinker bruken, om skrifttyper kommer for sent, eller om bilder lastes unødvendig tidlig. Suppler labmålinger med data fra ekte besøkende hvis trafikken tillater det. Slik unngår du å optimalisere for en testprofil som ikke gjenspeiler din faktiske målgruppe.

Sett et klart mål før hver endring. For eksempel: det synlige hovedinnholdet bør vises på en gjennomsnittlig mobilenhet på under 2,5 sekunder, eller kontaktskjemaet bør være brukbart uten inntastingsforsinkelse. Ikke hver side trenger en teoretisk toppscore. En kompleks applikasjon med autentiserte data har andre forutsetninger enn et offentlig bedriftsnettsted. Kjedelig, dokumenterbar pålitelighet er her mer verdifull enn en kortsiktig score oppnådd med risikable triks.

1. Behandle bilder etter deres oppgave

På mange mobile sider forblir bilder den største datablokken. Problemet er ikke bildet i seg selv, men et bilde som overføres i 2500 piksler bredde når enheten bare trenger 700 piksler. Tilby responsive bildevarianter slik at nettleseren kan velge riktig størrelse. Moderne formater som WebP eller AVIF reduserer ofte filstørrelsen betydelig, men bør implementeres med rene reserveløsninger og kontrollert bildekvalitet.

Det største bildet i det synlige startvinduet fortjener spesiell oppmerksomhet. Det bør være riktig beskåret, ha en passende oppløsning og lastes tidlig. Bilder lenger ned på siden kan lastes forsinket. Det sparer data ved inngang, men må ikke føre til at bilder synlig etterlastes ved rulling når brukeren allerede forventer dem.

Ikke fjern alle bilder refleksmessig. Et godt bilde kan forklare en maskin, et team eller en prosess raskere enn et tekstavsnitt. Den tekniske oppgaven er: å levere relevant visuell informasjon effektivt, ikke redusere design til grå plassholderbokser.

2. Begrens JavaScript til nødvendig arbeid

Hvert skript konkurrerer om prosesseringstid ved lasting og bruk. Spesielt problematiske er sjablongmessig inkluderte biblioteker, taggbehandlere med mange tredjepartsskript, chat-widgeter, kart og animasjoner. På stasjonære enheter forblir disse kostnadene ofte upåaktet. På mobil resulterer de i en side som er synlig, men reagerer trått på inndata.

Kontroller for hvert skript dets formål, lastebetingelse og forretningsverdi. Et interaktivt kart på kontaktsiden trenger ikke å lastes på hver underside. Et cookie- eller analyseverktøy bør ikke utløse en kjede av ytterligere filer før den besøkende i det hele tatt kan lese innholdet. Funksjoner som bare trengs etter interaksjon, kan også lastes da.

For skreddersydde nettsteder er en tydelig komponentstruktur en reell fordel. JavaScript samles per funksjon i stedet for å leveres som en global pakke. Dette forenkler også senere vedlikehold: den som utvider et skjema, endrer ikke ved et uhell koden for et produktfilter eller en navigasjon.

3. Lever CSS og skrifttyper uten blokkeringer

En vanlig flaskehals ligger i det første synlige området. Hvis flere stilark, ikonfonter og eksterne skriftvarianter må lastes for det, venter nettleseren unødvendig lenge. Kritiske stiler for det synlige området bør være små og tilgjengelige tidlig. Ikke-kritiske regler kan følge senere.

For nettfonter holder det vanligvis med noen få vekter. Fire vekter i normal, kursiv og ekstra delsett virker komplette i et designsystem, men trengs sjelden for et typisk bedriftsnettsted. Definer fornuftige systemreserveløsninger slik at tekst forblir lesbar umiddelbart. En skrifttype som bytter rent noen millisekunder senere, er bedre enn tomme tekstblokker.

Også ikoner fortjener en gjennomgang. Et lite SVG-sett er ofte mer effektivt og presist styrbart enn en komplett ikonfont. Denne regelen tillater unntak: eksisterende systemer trenger ikke bygges om bare for noen få kilobyte. Men hvis større endringer uansett er planlagt, hører denne avgjørelsen hjemme i det tekniske grunnlaget.

4. Sett opp caching og serverrespons ryddig

Selv et slankt grensesnitt føles treigt hvis serveren bruker for lang tid på det første svaret. Årsaker spenner fra ubremsede databasespørringer, via dynamisk sammensatte sider, til manglende caching. Offentlig innhold som sjelden endres, bør kunne leveres raskt som en bufret versjon. Statiske filer som bilder, CSS og JavaScript trenger entydige versjonsnavn og fornuftige cache-regler.

For PHP-applikasjoner handler det i tillegg om effektiv utførelse, en korrekt konfigurert opcode-cache og kontrollert databasetilgang. MySQL-spørringer trenger indekser som matcher de faktiske filtrerings- og sorteringsveiene. En forside som utfører flere unødvendige dataspørringer ved hvert kall, blir ikke bedre etter hvert som trafikken vokser.

Caching er imidlertid ikke et blankofullmakt. Priser, tilgjengelighet, personaliserte seksjoner eller innhold etter innlogging må aldri ved en feil virke utdaterte. Derfor defineres cachegrenser presist: hva kan være fem minutter gammelt, hva må være umiddelbart oppdatert, og hvem tømmer cachen etter en innholdsendring? God ytelse oppstår fra denne presisjonen.

5. Behandle tredjepartsleverandører kritisk

Eksterne tjenester er ofte den usynlige ballasten på et nettsted. Analyse, samtykkehåndtering, videoer, kart, anmeldelseswidgeter og markedsføringspiksler laster ytterligere skript fra ytterligere servere. Hver avhengighet kan forårsake forsinkelser, reise personvernspørsmål og svekke visningen ved feil.

Det betyr ikke at hvert eksterne verktøy må fjernes. En video kan støtte salg, et analyseverktøy kan underbygge viktige beslutninger. Men det trengs en kost-nytte-analyse. Last inn innebygde medier først etter samtykke eller interaksjon. Bruk i første omgang en plassholder for kart. Og fjern til slutt tagger hvis resultater ingen har evaluert på flere måneder.

6. Ta hensyn til layouthopp og mobil brukervennlighet

Lastetid og brukervennlighet hører sammen. Reserver faste dimensjoner for bilder, bannere og innebygde elementer slik at knapper ikke hopper unna under brukerens finger. Unngå popup-vinduer som dekker synlig innhold rett ved inngang. En rask side som umiddelbart viser et vanskelig lukkbart overlegg, løser ikke grunnproblemet.

Test skjemaer med ekstra omhu. Store inndatafelt, passende tastaturtyper og korte obligatoriske strekninger hjelper mer enn en omfattende visuell effekt. Hvis en henvendelse bare trenger navn, tilbakeringingsnummer og emne, er et skjema i tolv deler ikke et tegn på grundighet — det er friksjon.

7. Led ytelse som en permanent driftsprosess

En engangslansering holder ikke lastetiden lav permanent. Nye kampanjebilder, sporingskrav og redaksjonelle moduler summerer seg over tid. Derfor hører ytelsesbudsjetter hjemme i utviklingsprosessen: en maksimal størrelse for inngangsbilder, tydelige regler for nye tredjepartsverktøy og definerte grenseverdier for JavaScript.

Etter utgivelser bør de viktigste sidetypene vurderes på nytt. Automatiserte tester kan da fastslå om sentrale sider forblir tilgjengelige og kritiske arbeidsflyter fungerer. For ytelse er imidlertid en ren funksjonstest ikke tilstrekkelig. Suppler den med målinger av responstid, overført datamengde og mobil interaktivitet.

Et raskt mobilt nettsted oppstår ikke gjennom ett enkelt plugin, og heller ikke gjennom avkall for enhver pris. Det oppstår når design, innhold, infrastruktur og reell bruk vurderes sammen. Start med siden som genererer henvendelser eller operative kontakter, mål under ærlige forhold, og fjern friksjon nøyaktig der brukerne faktisk merker den.

Permalenke →

Logistikkprogramvare som virkelig avlaster driften

Logistikkprogramvare som virkelig avlaster driften

Når en varemottak først noteres på papir, senere overføres til et regneark, og til slutt formidles til forsendelse muntlig, er det sjelden medarbeidernes innsats som mangler. Det som mangler er et delt, pålitelig arbeidsgrunnlag. God logistikkprogramvare erstatter ikke disse bruddene med mer skjermarbeid, men med tydelige arbeidsflyter: hva har kommet inn, hvor befinner det seg, hva er reservert, og hva kan sendes i dag?

For små og mellomstore bedrifter er det ikke den lengst mulige funksjonslisten som teller. Det avgjørende er at programvaren gjenspeiler det faktiske arbeidet på lagergulvet, på kontoret og ved forsendelse. En løsning ment for et globalt konsern med tjue lokasjoner kan være unødvendig treg, dyr, og komplisert for en virksomhet med ett lager og to skift.

Når logistikkprogramvare virkelig gir mening

Regneark er ikke i seg selv et problem. For lave volumer, en oversiktlig artikkelstamliste, og én ansvarlig medarbeider kan de være den mest pragmatiske løsningen. Det ville være feil å erstatte en fungerende prosess med et prosjekt bare for moderniseringens skyld. Vendepunktet kommer når informasjon må vedlikeholdes flere steder eller ingen med sikkerhet kan si hvilken fil som er oppdatert. Typiske signaler er lagermangel til tross for fulle hyller, forespørsler om leveringsstatus, håndskrevne følgesedler, og varetellinger som stanser driften i flere dager. Voksende ordreantall gjør også synlig hvilke trinn som tidligere bare ble holdt sammen av enkeltpersoners erfaring.

Da handler det ikke primært om digitalisering som moteord. Det handler om feilkilder og ventetider. En medarbeider bør ikke måtte sammenligne flere lister bare for å godkjenne en ordre. Forsendelse bør ikke måtte gjette om en artikkel faktisk er tilgjengelig eller allerede reservert for en annen ordre.

Hvilke prosesser logistikkprogramvare bør koble sammen

En brukbar løsning starter med materialflyten, ikke med en standardmeny. For mange virksomheter omfatter denne flyten varemottak, plassering, lagerstyring, ordreplukking, forsendelse, og tilbakemelding. Avhengig av virksomheten kommer partier, serienumre, returer, produksjonsordrer, eller ruteplanlegging i tillegg.

Varemottak med sporbare lagre

Mye avgjøres ved varemottak. Hvis en leveranse sjekkes direkte mot en ordre eller følgeseddel, kan mengdeavvik, skadet gods, og manglende posisjoner registreres nøyaktig der de oppstår. Varene får en status i stedet for bare å bli fysisk plassert et sted.

Programvaren trenger ikke nødvendigvis starte med dyr skannermaskinvare. På noen lagre er et nettbrett eller en arbeidsstasjon ved varemottaket tilstrekkelig for å komme i gang. Der mange posisjoner flyttes daglig, er strekkodelesere imidlertid fornuftige fordi de fremskynder bokføringer og reduserer tastefeil. Riktig beslutning avhenger av volumer, ruter, og artikkelstruktur.

Lagerbevegelser uten en minnelogg

Lagre er bare robuste hvis mottak, flyttinger, uttak, og korrigeringer er sporbare. Det betyr ikke at hvert unntak må forhindres. I den daglige driften finnes skadet emballasje, feil plassering, og spontane materialuttak. En god applikasjon gjør disse tilfellene bokførbare, men dokumenterer også hvem som endret hva og når.

Denne historikken er ikke et kontrollinstrument for sin egen skyld. Den hjelper med å finne årsaker. Hvis en artikkel gjentatte ganger havner på feil lagerplass, kan lagermerkingen være uklar. Hvis regelmessige korrigeringer skjer, ligger problemet ofte i prosessen før bokføringen.

Ordrer, følgesedler, og forsendelse fra én arbeidsflyt

Mange team taper tid i grensesnittet mellom ordrebehandling og forsendelse. Ordredata kommer via e-post, telefon, eller fra et separat nettbutikksystem. Deretter skrives posisjoner ut, lagre kontrolleres, og forsendelsesdokumenter registreres på nytt. Hver manuelle overføring skaper rom for avvik.

Logistikkprogramvare bør kunne generere en tydelig plukkliste, en følgeseddel, og om nødvendig en forsendelsesetikett fra en godkjent ordre. Rekkefølgen er viktig her: først må det være klart hva som er leverbart. Deretter bør ordren reserveres for andre prosesser. Ellers oppstår den ubehagelige situasjonen der to medarbeidere tildeler samme gjenværende lager.

Planlegging som samsvarer med virkeligheten

Ruteplanlegging og kapasitetskontroll kan være verdifullt, spesielt med egne leveranser, faste tidsvinduer, eller mange regionale stopp. De er imidlertid ikke automatisk det neste fornuftige steget. Den som ennå ikke har ren ordregodkjenning og pålitelige lagerdata, bør løse disse grunnlagene først.

Det samme gjelder for prognoser og AI-støttet planlegging. De kan gjøre mønstre synlige, men krever rene inndata. En prognose basert på ufullstendig lager ser teknisk sofistikert ut, men forbedrer ikke leveringsevnen.

Standardløsning eller skreddersydd logistikkprogramvare?

Standardprogramvare er fornuftig når egne arbeidsflyter i stor grad er konvensjonelle og kan tilpasses uten stor friksjon. Den kan innføres raskere og bringer med seg utprøvde kjernefunksjoner. For en virksomhet med enkle lagerprosesser, tydelige roller, og få særegenheter er det ofte det økonomisk riktige valget.

Skreddersydd logistikkprogramvare er verdt det når virksomheten lever av spesielle arbeidsflyter eller eksisterende systemer bare kan kobles via omveier. Dette gjelder for eksempel verksteder med materialproblemer for pågående ordrer, forhandlere med kundespesifikke forsendelsesregler, eller produsenter som må koble lagerbevegelser tett til produksjonstrinn.

Forskjellen ligger ikke i å finne opp alt på nytt. Gode skreddersydde systemer tar i bruk utprøvde mønstre som statusendringer, reservasjoner, og rettigheter. De tilpasser imidlertid språk, skjermbilder, dokumenter, og grensesnitt til arbeidet som faktisk utføres. Slik trenger ikke teamet å forholde seg permanent til kategorier som bare gir mening i produsentens håndbok.

Hos softify.pro starter derfor et slikt prosjekt med spørsmålet om hvilke arbeidsflyter som bør bevares. Ikke hver papirlapp er en feil, og ikke hver spesialregel gir mening. Først når det er klart hvor informasjon går tapt eller beslutninger venter unødvendig, kan en gjennomførbar løsning planlegges.

En utrulling uten driftsavbrudd

Den største risikoen ligger sjelden bare i programkoden. Den ligger i en implementering som vil endre for mye på én gang. Et lager kan ikke stanse i to uker for å lære et nytt system. Derfor er en trinnvis utrulling som regel mer fornuftig enn en stor overgangsdato.

En god første del fokuserer på en avgrenset arbeidsflyt, for eksempel varemottak og lagerbokføringer eller opprettelse av følgesedler. Teamet jobber med reelle data, tilbakemeldinger flyter direkte inn i tilpasningen, og nytten blir målbar. Først deretter følger flere områder, som mobil plukking, returer, eller koblinger til nettbutikker og transportører.

Datamigrering fortjener spesiell oppmerksomhet her. Gamle artikkelnumre, dupliserte kundestamdata, og inkonsekvente lagerplasser forsvinner ikke automatisk bare fordi et nytt system innføres. Det er ofte bedre å bevisst rydde opp i stamdata og bare ta over relevant historikk. Dette sparer senere søking og forhindrer at gammel uorden blir teknisk bevart.

Rettigheter hører også tidlig hjemme på agendaen. Ikke alle medarbeidere trenger tilgang til priser, alle lagerkorrigeringer, eller stamdatavedlikehold. Tydelige roller beskytter mot utilsiktede endringer og gjør ansvar synlig uten å blokkere arbeidsflyten med unødvendige godkjenninger.

Teknologi som ikke blir en byrde etter lansering

En logistikkapplikasjon må reagere raskt i den daglige driften, selv om flere arbeidsstasjoner bokfører samtidig. Til dette trengs en sporbar dataarkitektur, rene transaksjoner, og tydelige regler for parallelle endringer. Hvis to medarbeidere behandler samme lager, må ikke systemet generere stille feilaktige bokføringer.

Vedlikeholdbarhet er like viktig. Teknologier som PHP 8.4, moderne JavaScript, og MySQL 8 er ikke et salgsargument i seg selv. De er fornuftige når applikasjonen forblir forståelig på lang sikt, mottar sikkerhetsoppdateringer, og kan videreføres av kvalifiserte utviklere. Dokumentert provisjonering, sikkerhetskopier, logging, og en realistisk håndtering av oppdateringer er del av den operative evnen.

God logistikkprogramvare gjenkjennes derfor ikke på en spesielt polert demo. Den viser seg en vanlig tirsdag morgen: leveransen bokføres, lageret stemmer, ordren er sporbar, følgeseddelen matcher, og neste skift vet hva som allerede er gjort. Avlastningen oppstår nettopp der — ikke gjennom flest mulig funksjoner, men gjennom pålitelige arbeidsflyter som passer virksomheten.

Permalenke →

Planlegge en MySQL-database for nettapplikasjoner

Planlegge en MySQL-database for nettapplikasjoner

Når tre ansatte bestiller varer parallelt om morgenen, en kunde sjekker leveringsstatus, og administrasjonen lager en faktura, vises ikke kvaliteten til en applikasjon i designet. Den vises i om alle ser nøyaktig samme, korrekte datastatus. Å planlegge en MySQL-database for en nettapplikasjon betyr derfor ikke å lage tabeller så raskt som mulig. Det betyr å forstå reelle arbeidsflyter presist nok til å sikre at data forblir pålitelige selv under belastning, ved feil, og etter hvert som virksomheten vokser.

Spesielt i interne plattformer, lager- og ordreprosesser, eller kundevendte portaler, blir databasen ofte håndtert for sent. Først bygges grensesnittet, deretter legges felt til, fulgt av unntak. Det fungerer for en prototype. I drift resulterer dette i duplikerte datasett, uklare tilstander, og rapporter ingen lenger stoler helt på.

Planlegge en MySQL-database for nettapplikasjoner: start med arbeidsflyten

Det første utkastet bør ikke starte med kolonnenavn, men med en konkret arbeidssituasjon. Ta varemottak: en leveranse ankommer, tildeles en leverandør og en ordre, mengder kontrolleres, en lagerplass tildeles, og lageret endres. Avhengig av operasjonen krever denne prosessen i tillegg bilder, en kvalitetskontroll, en sperrestatus, eller en sporbar korreksjon. Fra denne arbeidsflyten vokser de funksjonelle objektene frem. Typiske eksempler er artikler, leverandører, ordrer, posisjoner, lagerplasser, lagerbevegelser, og brukere.

Skillet mellom et objekt og en hendelse er avgjørende. En artikkel beskriver hva noe er. En lagerbevegelse dokumenterer at en mengde endret seg på et bestemt sted på et bestemt tidspunkt. Å blande begge i én tabell fører raskt til tap av sporbarhet.

Noen vanskelige spørsmål hjelper for hvert objekt: hva er den unike identiteten? Hvilken informasjon kan endres? Hvem kan endre den? Hvilke data må bevares historisk? Og hvilke regler gjelder når to personer jobber samtidig? Disse spørsmålene forhindrer senere improvisasjon bedre enn en lang liste med angivelig komplette databasefelt.

Datamodellen bør uttrykke regler

En database er ikke bare lagring for skjemainndata. Den bør selv håndheve sentrale regler. Hvis hver lagerbevegelse må tilhøre nøyaktig én artikkel og én lagerplass, hører fremmednøkler hjemme i modellen. Hvis et eksternt ordrenummer bare kan forekomme én gang per tenant, kreves en unik indeks. Hvis en posisjon aldri bør eksistere uten en hovedordre, må denne relasjonen modelleres tydelig.

MySQL 8 med InnoDB gir et solid grunnlag for dette: transaksjoner, fremmednøkler, låsemekanismer, og konsistente endringer på tvers av flere tabeller. Ved skriving av en bevegelse, gjeldende lager, og inspeksjonslogg under en varemottaksbokføring bør dette skje som én sammenhengende transaksjon. Hvis ett trinn feiler, skal ingen halvferdig operasjon bli stående.

Men ikke alle regler hører hjemme i databasen. Godkjenninger, kompleks prislogikk, eller rolleavhengige prosesstrinn plasseres ofte bedre i applikasjonslogikken fordi de endres raskere funksjonelt. Grensen er pragmatisk: regler hvis brudd permanent skader data bør sikres så nært dataene som mulig. Regler som endres ofte eller er sterkt avhengige av konteksten, krever godt testet applikasjonskode.

Ikke forveksle historikk med gjeldende verdier

En vanlig feil er å bare lagre gjeldende lager eller gjeldende status. Det holder til noen spør hvorfor mengden endret seg i går eller hvem som tilbakestilte en ordre. For operative systemer er en historikk over bevegelser eller hendelser ofte mer verdifull enn ett enkelt overskrivbart felt.

Dette betyr ikke at hver klikkbevegelse må logges permanent. Forretningsrelevante endringer bør logges: statusendringer, mengdejusteringer, korreksjoner, godkjenninger, og tildelinger. En god revisjonspost inneholder et tidsstempel, brukeren eller systemprosessen, forrige og ny verdi, og en forståelig begrunnelse når arbeidsflyten krever det. Dette gjør det mulig å avklare feil uten å måtte lete gjennom e-poster, papirlister, eller databasebackuper.

Velg nøkler, datatyper, og navnekonvensjoner bevisst

Tekniske beslutninger virker små, men former vedlikehold og integrasjoner i årevis. For interne primærnøkler er BIGINT-verdier med automatisk tildeling ofte et nøkternt, lett håndterbart valg. UUID-er kan være fornuftige når data oppstår offline, flere systemer skriver uavhengig, eller eksterne grensesnitt ikke bør eksponere sekvensielle ID-er. De koster imidlertid mer lagringsplass og krever litt mer oppmerksomhet med indekser og sortering.

Pengebeløp bør lagres som DECIMAL, ikke FLOAT eller DOUBLE. Mengder trenger også en funksjonelt passende presisjon: artikkelantall er ofte heltall, mens vekter og lengder ikke er det. Tidsstempler bør håndteres enhetlig, helst internt i UTC, mens grensesnittet viser den lokale tidssonen for operasjonen. Spesielt ved skiftbytter og sommertid forhindrer dette vanskelig oppdagbare avvik.

Navn bør også være kjedelige og entydige. order_items eller inventory_movements er mer nyttige enn kreative forkortelser som bare det opprinnelige prosjektteamet forstår. Konsekvente entalls- eller flertallsformer er mindre viktige enn konsistens i seg selv. Like fornuftige er felt som created_at, updated_at, og, ved behov, deleted_at. En myk sletting er likevel ikke en standardforpliktelse. For juridisk eller operativt relevante poster er en ren kansellering vanligvis bedre enn et usynlig slettet datasett.

Indekser følger faktiske spørringer, ikke gjetning

En indeks kan akselerere et søk massivt, men gjør skriveoperasjoner mer komplekse og bruker lagringsplass. Derfor er "en indeks på hvert felt" ingen strategi. De viktigste spørringene bør etableres tidlig: åpne ordrer for en kunde, bevegelser for en artikkel innenfor en periode, lager per lagerplass, eller nylig endrede poster for et grensesnitt.

Rekkefølgen på sammensatte indekser har betydning her. Hvis applikasjonen regelmessig søker etter tenant_id, status, og created_at, er en sammensatt indeks i nettopp denne rekkefølgen ofte fornuftig. Om den faktisk passer, vises av utførelsesplanen via EXPLAIN, ikke av magefølelse. Databaser blir ikke raske av spektakulære triks, men av observerbare spørringer, matchende indekser, og realistisk testede datavolumer.

For voksende tabeller lønner det seg med en tydelig oppbevaringsstrategi. Må tekniske logger ligge i den primære produksjonsdatabasen i fem år? Ikke nødvendigvis. Forretningsposter, bevegelser, og inspeksjonsbevis krever andre oppbevaringsperioder enn feilsøkingsinformasjon. Arkivering er ikke et tegn på et svakt system, men en bevisst driftsbeslutning.

Flerbrukerdrift krever transaksjoner og tydelige tilstander

I en nettapplikasjon får flere forespørsler tilgang til de samme dataene samtidig. Dette er normalt i daglig lagerdrift, ikke et unntak. To ansatte kan bestille det samme lageret mens en import lager nye ordrer. Uten transaksjoner og målrettet låsing er det risiko for tapte endringer eller negative lagerbeholdninger som først blir synlige uker senere.

For kritiske operasjoner bør det være tydelig hvilke data som leses og skrives innenfor en transaksjon. Noen ganger er en atomær oppdatering tilstrekkelig, som lager som bare endres hvis tilgjengelig mengde er nok. I andre tilfeller er en radlås fornuftig, slik at en operasjon kan kontrollere datatilstanden på en kontrollert måte og endre den etterpå. Lange transaksjoner er derimot problematiske: de blokkerer annet arbeid og øker risikoen for konflikter.

Like viktig er et begrenset sett med funksjonelle tilstander. En ordre bør ikke være "åpen," "delvis levert," og "manuelt behandlet" samtidig på grunn av vedlikehold av motstridende felt. Definerte statusoverganger forenkler grensesnitt, rapporter, og automatiseringer. Unntak kan tillates, men bør navngis og dokumenteres.

Planlegg sikkerhet, tenanter, og drift fra begynnelsen

Applikasjonen bør bruke en dedikert databasebruker for MySQL med minimale rettigheter. Skrivetilgang for nettapplikasjonen betyr ikke at denne brukeren trenger å kunne slette tabeller eller endre brukerrettigheter. Administrative kontoer hører ikke hjemme i produksjonskonfigurasjonsfiler og aldri i et repositorium.

Når flere kunder, steder, eller selskaper jobber innenfor én applikasjon, er tenant-isolasjon en arkitektonisk beslutning, ikke en filterbetingelse lagt til i ettertid. En delt database med en tenant_id kan være effektiv og lett å vedlikeholde, men krever konsistente kontroller i hver spørring og tydelige regler for indekser. Separate databaser gir sterkere isolasjon, men øker innsatsen ved oppdateringer, evalueringer, og drift. Hvilken variant som passer, avhenger av personvernkrav, datavolum, og forretningsmodell.

Sikkerhetskopier er bare sikkerhetskopier når en gjenoppretting er testet. En fastsatt rytme for sikkerhetskopiering, oppbevaring, og gjenoppretting er nødvendig. Likeledes hører overvåking av lagringsplass, trege spørringer, og mislykkede jobber, sammen med dokumenterte oppdateringer, til systemet. MySQL 8, PHP 8.4, og moderne nettapplikasjoner kan driftes godt på lang sikt hvis avhengigheter, tilgangsopplysninger, og utrullingstrinn ikke bare finnes i hodet til én utvikler.

En fornuftig plan før den første dagen i produksjon

Før implementering bør det finnes en kompakt datamodell med eksempelarbeidsflyter. Dette inkluderer nøkkeltabeller og relasjoner, statusregler, rettigheter, forventede spørringer, grensesnitt, og et konsept for sikkerhetskopier og revisjonslogger. Denne planen trenger ikke å være hundre sider lang. Den må fange opp beslutninger som senere ville vært kostbare å rette opp.

Hos softify.pro starter databaseplanlegging derfor med menneskene som bestiller, kontrollerer, plukker, eller løser unntak. Hvis et eksisterende regneark pålitelig kartlegger en håndterbar prosess, kan det forbli den riktige løsningen. Hvis flere personer jobber samtidig, poster oppstår, og feil må være sporbare, fortjener databasen derimot samme planleggingsinnsats som grensesnittet. Den beste arkitekturen er til syvende og sist den som forenkler arbeidsdagen og som fortsatt kan endres transparent om to år.

Permalenke →

Mål Warehouse Automation Results riktig

Mål Warehouse Automation Results riktig

Et nytt skannegrensesnitt kan virke imponerende den første dagen. Etter tre uker viser det seg imidlertid om det virkelig fremskynder varemottaket eller bare skaper et ekstra arbeidstrinn. Warehouse automation results er derfor ikke et enkelt måltall, og heller ikke et skjermbilde fra en produktdemo. De viser seg der et lagerteam må søke, spørre, ombooke og korrigere mindre — mens kvaliteten opprettholdes eller forbedres.

For små og mellomstore bedrifter er dette skillet spesielt relevant. Store enterprise-pakker lover ofte omfattende optimalisering, men krever lange innføringer, stive prosesser og mye vedlikehold. Et fornuftig automatiseringssteg kan gjerne starte mindre: nøyaktig der informasjon i dag går tapt eller beslutninger venter unødvendig.

Hvilke Warehouse Automation Results som faktisk teller

Mange prosjekter starter med et teknisk spørsmål: strekkodeleser, mobilapp, koblet til nettbutikken eller automatiske etiketter? Det bedre utgangsspørsmålet er: hvilken flaskehals koster merkbart tid, penger eller pålitelighet per skift?

Svaret ligger sjelden i antallet innførte enheter. Meningsfulle resultater kan måles i det daglige arbeidet. Ved varemottak teller for eksempel tiden mellom levering og tilgjengelig bokført lager. Ved plukking er tiden fra ordre til forsendelsesklar relevant. Ved varetelling er det ikke bare varigheten som avgjør, men først og fremst forskjellen mellom systemlager og faktisk lager.

Like viktige er måltall som mange virksomheter ikke registrerer ordentlig: hvor mange henvendelser oppstår fordi en lagerplass er uklar? Hvor ofte må en følgeseddel korrigeres? Hvor mange ordrer blir liggende fordi bare én person kjenner statusen utenat eller i et privat regneark? Nettopp dette stille etterarbeidet forsvinner fra klassiske produktivitetsrapporter, men belaster skiftledere, planlegging og kundeservice tungt. Et godt målbilde kombinerer fart og kontroll. Blir ordrer håndtert raskere mens feilaktige bokføringer øker, er ikke det fremgang. Blir lagerbeholdningen mer nøyaktig, men varemottaket stanser opp, må prosessen utformes på nytt. Automatisering lykkes når den forbedrer arbeidsflyten uten å svekke den operative oversikten.

Fra opplevd lettelse til verifiserbare data

Medarbeidernes erfaring er en verdifull indikator. Når noen sier etter to uker at de ikke lenger må løpe til kontoret for hver innlagring, betyr det noe. For investeringsbeslutninger trengs likevel en sammenligning som ikke avhenger av dagsformen. Før oppstart bør derfor noen utgangsverdier registreres: gjennomsnittlig behandlingstid, antall åpne avklaringssaker, korrigeringsposteringer, søketider, forsendelsesfeil og lagernøyaktighet. Tjue måltall er ikke nødvendig; ofte holder det med fire til seks verdier som passer det konkrete problemet.

Etter utrullingen bør de samme verdiene observeres over flere uker. Enkelte toppdager villeder lett. Sesongvariasjoner, sykdom, nye medarbeidere eller en uvanlig stor ordre påvirker resultatene. Først en sammenligning over normale skift viser om endringen er solid.

Den viktigste effekten: en felles prosesstilstand

På mange lagre er den egentlige svakheten ikke manglende arbeidsvilje, men en fragmentert informasjonstilstand. Varemottaket kjenner leveransen, planleggingen kjenner kundeordren, og forsendelsen kjenner prioriteten — men ikke alle jobber med den samme oppdaterte informasjonen.

Et arbeidsflytspesifikt system kan lukke dette gapet. En leveranse registreres ved ankomst, avvik dokumenteres direkte, lageret får en tydelig status, og neste steg blir synlig. Data trenger ikke lenger først noteres på papir, overføres senere og deretter bekreftes per telefon.

Dette reduserer ikke bare gangavstander. Det reduserer beslutninger basert på utdatert informasjon. En forsendelsesmedarbeider ser om en ordre virkelig er plukkbar. Administrasjonen ser om varer faktisk har kommet inn eller bare er varslet. Ledelsen får ikke et pyntet øyeblikksbilde, men et sporbart grunnlag.

For team med roterende skift er denne effekten ofte mer verdifull enn en spektakulær tidsbesparelse. Prosessen blir mindre avhengig av enkeltpersoner. Kunnskap blir ikke sittende fast i notatbøker, chattehistorikk eller den mest erfarne medarbeiderens hukommelse.

Hvorfor ikke all automatisering gir gode resultater

Automatisering forsterker prosesser. Det er nyttig når forløpet er tydelig. Det er problematisk når et uklart forløp bare gjengis raskere.

Et typisk eksempel er obligatorisk skannebokføring for hvert minste håndgrep. Hvis medarbeidere må åpne flere skjermer for et sjeldent unntak, oppstår omveier. Artikler bokføres da samlet senere, skannere blir liggende i skuffen, eller en medarbeider fører igjen en skyggeliste. Programvaren finnes, men den reelle prosessen fortsetter ved siden av den.

Også datakvaliteten setter grenser. Artikkelstamdata uten klare enheter, uklar lagerplasslogikk eller inkonsekvente leverandørbetegnelser lar seg ikke leges med et flott grensesnitt. Her kan et prosjekt i starten bestå av opprydningsarbeid. Det virker mindre synlig enn en ny applikasjon, men er ofte forutsetningen for pålitelige resultater.

I tillegg finnes det prosesser som bevisst ikke bør fullautomatiseres. Erfaren kontroll av sensitive varer, godkjenning av uvanlige avvik eller beslutning om en spesialleveranse krever faglig skjønn. Gode systemer merker slike tilfeller tydelig og leder dem målrettet videre. De later ikke som om ethvert unntak kan løses med en regel.

Når et regneark fortsatt er den bedre løsningen

Ikke ethvert manuelt trinn rettferdiggjør skreddersydd utvikling. Hvis en prosess skjer sjelden, involverer få deltakere og håndteres sporbart, kan et godt vedlikeholdt regneark forbli fornuftig. Feilen ligger ikke i Excel i seg selv, men i å håndtere kritiske bevegelser uten tydelig ansvar, versjonskontroll eller rettidig registrering.

Så snart flere personer endrer parallelt, lagerbevegelser blir tidskritiske, eller kundeinformasjon fra ulike kilder må samles, øker risikoen betydelig. Et felles system er da vanligvis billigere enn å kontinuerlig rette opp misforståelser.

Warehouse Automation Results krever en kontrollert utrulling

Den raskeste veien til dårlige resultater er en total ombygging midt i pågående drift. Bedre er et avgrenset område med målbar nytte: for eksempel varemottak for én produktgruppe, forsendelsesetiketter for ett sted, eller mobil registrering for de vanligste flyttingene.

En pilot bør gjenspeile reelle ordrer og reelle skift. Testdata hjelper under utviklingen, men viser ikke om wifi svinger i den bakre lagerdelen, om hansker gjør skannerbruk vanskelig, eller om en status er formulert forvirrende for planleggingen. Disse detaljene avgjør aksept og datakvalitet.

Teknisk sett teller kjedelig, bevisbar pålitelighet mer enn en trendy teknologistabel. Klare rolletilganger, sporbare bokføringslogger, entydige feilmeldinger, stabile databasetransaksjoner og dokumenterte prosesser er ikke bagateller. De gjør en applikasjon til et verktøy team kan stole på i den daglige driften.

For skreddersydde logistikksystemer betyr dette også: integrasjonen må passe til eksisterende drift. En applikasjon kan motta ordrer fra en nettbutikk, generere følgesedler, tilby forsendelsesetiketter og dokumentere lagerbevegelser. Den trenger ikke straks erstatte alle tilstøtende systemer. Nettopp i små og mellomstore bedrifter er en trinnvis utfasing ofte mindre risikofylt og mer økonomisk.

Slik blir et prosjekt en varig forbedring

Etter innføringen begynner den avgjørende fasen. Blir spesialtilfeller fanget opp? Stemmer lagerplassene fortsatt med virkeligheten? Forstår nye medarbeidere bokføringslogikken uten muntlig forklaring? Og holder de målte verdiene fortsatt stikk når ordrevolumet vokser?

Regelmessig kort tilbakemelding fra lager, forsendelse og administrasjon er mer effektivt for dette enn en stor årlig workshop. Når et tilbakevendende unntak blir synlig, bør det enten avbildes som et tydelig prosesstrinn eller bevisst tas ut av standardflyten. Begge deler er bedre enn å tolerere det stilltiende.

Det mest fornuftige neste steget er ofte ikke et omfattende kravdokument. Ta en prosess med hyppige henvendelser og mål i en uke hvor tiden går tapt. Hvis det oppstår en tydelig, gjentakbar arbeidsflyt av dette, kan automatisering kobles til et resultat som overbeviser like mye på lagergulvet som i den månedlige oppfølgingen.

Permalenke →

Moderne webutvikling som fungerer i drift: Pragmatiske arkitekturer for små og mellomstore bedrifter — med vedlikeholdbar kode, solid datalagring og uten unødvendig verktøyoverbelastning.

Moderne webutvikling som fungerer i drift: Pragmatiske arkitekturer for små og mellomstore bedrifter — med vedlikeholdbar kode, solid datalagring og uten unødvendig verktøyoverbelastning.

En lagersjef skriver ut følgesedler om morgenen mens en kollega korrigerer lager i et regneark, og salg ringer for å spørre om status på en ordre. Problemet er sjelden manglende digitalisering. Som regel finnes det for mange atskilte verktøy. Moderne webutvikling skaper da ikke bare et penere grensesnitt, men et pålitelig felles arbeidsgrunnlag.

For små og mellomstore bedrifter betyr dette: En webapplikasjon må fungere under tidspress, på en skanner på lageret like mye som på en skjerm på kontoret. Den må lagre data sporbart, håndtere rettigheter rent, og kunne videreutvikles uten å bli en risiko ved hver endring. Teknologi er ikke et mål i seg selv her. Den er grunnlaget for at prosesser skal gå raskere og samtidig forbli bedre kontrollerbare.

Moderne webutvikling begynner før den første koden

Den som starter med en forhåndsdefinert funksjonskatalog, bygger ofte forbi den faktiske flaskehalsen. I praksis lønner det seg med en annen inngang: Hvilken informasjon mangler regelmessig i dag? Hvor oppstår doble registreringer? På hvilket punkt sikres beslutninger via telefon eller muntlig fordi ingen pålitelig ser den aktuelle statusen?

Ved varemottak kan dette for eksempel være inkonsistente varebeskrivelser, manglende inspeksjonsinstruksjoner eller sent oppdaterte lagre. Ved ordrebehandling er det ofte håndskrevne notater, uklare godkjenninger og fraktdata som vedlikeholdes i flere systemer. En god applikasjon gjør ikke bare disse overleveringene digitale. Den ordner dem slik at ansvar, status og neste trinn blir synlige.

Dette betyr også at man ikke reflektorisk avskaffer eksisterende praksis. Et godt vedlikeholdt regneark kan fortsatt være den mest fornuftige løsningen for en liten evaluering. En skreddersydd webapplikasjon lønner seg der flere personer jobber samtidig, feil oppstår gjennom manuell overføring, eller en prosess må dokumenteres og være repeterbar.

Hva en moderne webapplikasjon må levere i hverdagen

Et overbevisende brukergrensesnitt er verdifullt, men det er bare en del av arbeidet. I løpende drift teller først og fremst responstider, forståelige arbeidsflyter og robuste data. Når en plukker fullfører en oppgave, må ikke statusen bli synlig først etter flere oppdateringer. Når en ordre endres, må det være sporbart hva som ble endret og hvilke etterfølgende trinn som er berørt. Dette omfatter tre tett forbundne lag: brukergrensesnittet, applikasjonslogikken og databasen. Grensesnittet leder mennesker gjennom prosessen. Logikken sjekker for eksempel obligatoriske felt, rettigheter eller tilgjengelige mengder. Databasen lagrer fakta på en måte som gjør at evalueringer, korrigeringer og utvidelser forblir mulige senere.

For mange forretningsapplikasjoner er utprøvde teknologier et mer fornuftig valg enn en kortvarig trend. PHP 8.4 kan levere klart strukturert serverlogikk, moderne JavaScript en responsiv brukeropplevelse, og MySQL 8 et solid datagrunnlag. Det avgjørende er ikke at hvert prosjekt bruker samme stack. Nøkkelen er at den valgte teknologien passer til problemet, driften og den langsiktige vedlikeholdet.

Ytelse er et prosessspørsmål

Ytelse blir ofte redusert til lastetider. Det er utilstrekkelig. En applikasjon føles også treg når ansatte utfører for mange trinn, søker etter informasjon, eller må registrere den samme opplysningen flere ganger. En rask side med et tungvint skjema forblir en dårlig prosess.

Fornuftig optimalisering begynner derfor med de vanligste operasjonene. Hvilke skjermer åpnes hundre ganger om dagen? Hvilket søk må forbli raskt selv når datamengden vokser? Hvilke data bør lagres i bakgrunnen uten at ansatte venter på en bekreftelse? Først deretter følger tekniske detaljer som målrettede databaseindekser, reduserte spørringer og slank levering av filer i nettleseren.

Datamodell og rettigheter: Den usynlige arkitekturen

Mange webprosjekter mislykkes ikke på den første versjonen, men på senere tillegg. Et opprinnelig enkelt felt som «Status» blir plutselig en kjede av godkjenning, inspeksjon, behandling, kansellering og etterbehandling. Hvis disse tilstandene bare lagres løst i skjemaer, blir hver utvidelse dyr og feilutsatt.

En ren datamodell skiller derfor prosesser, posisjoner, kontaktpersoner, dokumenter og statusendringer sporbart. Den forhindrer motstridende oppføringer i stedet for å møysommelig rydde dem opp senere. Spesielt ved lagerbevegelser, følgesedler eller ordredata er denne presisjonen ingen akademisk øvelse. Den avgjør om lagertallet duger som arbeidsgrunnlag.

Roller og rettigheter er like viktige. Ikke hver person trenger tilgang til priser, personalinformasjon eller administrative innstillinger. Gode rettighetskonsepter er konkrete: Hvem har lov til å opprette en ordre, godkjenne den, eller kansellere den? Hvem ser bare sin egen avdeling? I tillegg kommer beskyttelsestiltak som sikker passordlagring, kontosperringer etter gjentatte mislykkede forsøk, logging av kritiske endringer og klart regulerte økter. Sikkerhet er dermed ikke et tillegg like før lansering. Den hører hjemme i arkitekturen fordi senere korreksjoner ofte griper dypt inn i pålogging, datatilgang og rettighetssystem.

Responsiv betyr ikke bare «passer på mobilen»

En responsiv applikasjon tilpasser seg forskjellige skjermstørrelser. For hverdagsarbeidet er ikke denne definisjonen tilstrekkelig. På et nettbrett på lageret gjelder andre krav enn på en stor skjerm i disponeringen. Berøringsflater må være trygt betjenbare, viktige detaljer må ikke forsvinne under sekundær informasjon, og registreringer må forbli praktiske selv med hansker, skiftende lysforhold eller ustabil forbindelse.

Følgelig trenger hver visning en tydelig prioritet. I varemottaket kan skanning og bekreftelse stå i sentrum. På kontoret er filtre, lister, eksportfunksjoner og detaljvisninger ofte viktigere. Et grensesnitt som ser identisk ut overalt, er ikke automatisk brukbart overalt.

Moderne webutvikling krever kontrollert drift

Lanseringen er ikke et sluttpunkt, men begynnelsen på den virkelige testen. Først med reelle data, unntak og rushtider viser det seg om regler er forståelige og om grensesnitt fungerer pålitelig. Dokumentert klargjøring, tydelig atskilte miljøer for utvikling og produksjon, samt sporbare sikkerhetskopier hører derfor til prosjektet, ikke bare IT-administrasjon.

Også automatiserte tester utretter mye her. De sjekker tilbakevendende arbeidsflyter som pålogging, rettighetssjekk, ordreregistrering eller dokumentgenerering på nytt etter hver endring. For sensitive applikasjoner kan et selvhostet testmiljø være fornuftig fordi skjermbilder, testdata og interne applikasjonstrinn forblir innenfor bedriftens eget kontrollområde. Automatisering erstatter ingen faglig gjennomgang av erfarne ansatte. Den sørger imidlertid for at kjente arbeidsflyter ikke stille og rolig blir skadet.

Hos softify.pro er denne tankegangen en del av implementeringen: planlegge teknisk presist, ta reelle arbeidsflyter på alvor, og levere endringer på en måte som holder dem forståelige senere. Dette er mindre spektakulært enn et teknologifyrverkeri, men i drift betydelig mer verdifullt.

Når standardprogramvare er nok — og når den ikke er det

Standardprogramvare er fornuftig når din egen prosess i stor grad samsvarer med den vanlige bransjeflyten, og konfigurasjonen forblir overkommelig. Den kan være raskt tilgjengelig og bringe pålitelige grunnfunksjoner. Den blir problematisk når team permanent må vri sine fungerende arbeidsflyter på tungvinte måter, eller når viktig informasjon havner utenfor systemet.

En individuell løsning er ikke automatisk bedre. Den krever tydelige krav, ansvarlige kontaktpersoner, og beredskap til å ta beslutninger. Til gjengjeld kan den kartlegge nøyaktig de arbeidstrinnene som er avgjørende for bedriften: en spesialisert varemottakskontroll, utskrift av matchende fraktetiketter, en godkjenning basert på kundegruppe, eller forbindelsen mellom verksted, lager og salg. Det riktige spørsmålet er derfor ikke: Trenger vi en skreddersydd applikasjon? Det er: Hvilken tilbakevendende friksjon koster oss i dag tid, penger eller pålitelighet — og kan den fjernes permanent med rimelig innsats?

En god webapplikasjon gjør ikke arbeid kunstig digitalt. Den fjerner unødvendige overleveringer, etablerer en pålitelig datatilstand, og gir mennesker nøyaktig den informasjonen de trenger for sitt neste trinn. Når dette lykkes, føles ikke moderne webutvikling som et nytt IT-prosjekt, men som en drift som endelig kan jobbe uten omveier.

Permalenke →

Slik gjennomfører du digitaliseringen av følgesedler riktig

Slik gjennomfører du digitaliseringen av følgesedler riktig

En sjåfør venter ikke fordi en Excel-fil for øyeblikket er åpnet av noen andre. Og i varemottaket hjelper ingen ryddig papirbunke hvis en delleveranse senere ikke lenger kan spores. Den som søker etter «hvordan digitalisere følgesedler», ser derfor sjelden bare etter å skanne papir. Det som søkes, er en robust arbeidsflyt som registrerer varebevegelser, bekreftelser og avvik der de oppstår.

Digitale følgesedler fungerer godt når de forenkler arbeidet på lageret, i verkstedet og hos kunden. Hvis de bare implementeres som et PDF-arkiv, forblir innsatsen den samme — bare på en skjerm i stedet. Den avgjørende forskjellen ligger i strukturerte data, tydelig ansvar og en ren tilkobling til ordre, lager og faktura.

Hvordan digitalisere følgesedler: Sjekk arbeidsflyten først

Det første trinnet er ikke programvarevalg, men en ærlig kartlegging. Ta en reell følgeseddel og følg dens vei: fra ordre via plukking til overlevering, tilbakemelding og arkivering. Dette avslører som regel raskt hvor informasjon legges til i etterkant, registreres dobbelt, eller avklares via telefon og chat.

I små og mellomstore bedrifter finnes det sjelden bare én arbeidsflyt. En standardleveranse til faste kunder krever noe annet enn en byggeplassleveranse, en henting, eller en leveranse med retur av emballasje. Ikke alle disse forskjellene trenger å automatiseres i versjon én. De bør imidlertid være kjent, slik at det nye systemet ikke mislykkes ved det aller første spesialtilfellet.

En god digital prosess besvarer entydig tre spørsmål for hver status: Hvem flyttet varene og når? Hvilke mengder ble faktisk overlevert? Og hva skjedde ved avvik? Hvis denne informasjonen mangler, er en digital følgeseddel først og fremst bare et penere dokument.

Ikke bare reproduser papir som en PDF

Å skanne eksisterende følgesedler kan være nyttig som en overgang, for eksempel for arkivering av gamle prosesser. For den operative virksomheten løser det imidlertid lite. Et bilde eller en PDF kan lagres, men mengder, varenumre, partier og merknader kan ikke pålitelig gjenbrukes i den.

En bedre tilnærming er et dokument generert fra strukturerte ordredata. Varer, målmengder, leveringsadresser og kontaktpersoner overtas. Ansatte bekrefter deretter de faktiske mengdene direkte på en mobil enhet eller på en arbeidsplass på lageret. Bare avvik, skader eller tilleggsposisjoner må registreres manuelt.

Dette sparer ikke bare tid. Det forhindrer også et typisk mediebrudd: regnskapet mottar ikke lenger en knapt lesbar signatur på papir mens lageret separat vedlikeholder den samme prosessen i et regneark.

Dataene en digital følgeseddel faktisk trenger

Et system bør ikke tvinge frem hvert tenkelig felt. Ekstra registreringer bremser overleveringer og reduserer aksept. Samtidig er kundenavn og signatur ikke tilstrekkelig for mange arbeidsflyter.

Som grunnlag trenger hver følgeseddel et unikt nummer, referansen til ordren, leverings- og mottakeradresser, vareposisjoner med mål- og faktiske mengder, samt tidsstempler.

Avhengig av bransjen kommer partier, serienumre, vekt, lagerplasser eller beholdere i tillegg. For temperaturkontrollerte varer kan måleverdier være relevante; for byggeplassleveranser er bilder eller presise leveringsstedsopplysninger nyttige.

Statusen er spesielt viktig. «Opprettet», «plukket», «underveis», «overlevert», «delvis levert» og «bestridt» er ikke bare etiketter. De styrer hvilken person som må handle videre, og om for eksempel en faktura kan genereres eller en etterleveranse planlegges.

Bruk signaturer og bilder med måtehold

En digital signatur er nyttig i mange leveringsprosesser, men er ikke automatisk den beste bekreftelsen. For en rask overlevering ved varemottak kan et trykt navn, et tidsstempel og mottakertilordningen være tilstrekkelig. For høyverdige varer eller omtvistede overleveringer kan en signatur kombinert med et bilde og stedsinformasjon i stedet gi mening.

Det avgjørende er beviskjeden: bekreftelsen må knyttes til det konkrete dokumentet og dets versjon. Hvis noen endrer mengder eller posisjoner etter signering, bør systemet ikke stille overskrive dette. Det krever en sporbar korreksjon eller en ny bekreftelse. Bilder fortjener samme disiplin. De kan dokumentere skader, men bør ikke bli en vilkårlig samling av personopplysninger. Definer når et bilde er nødvendig, hvem som har tilgang til det, og hvor lenge det lagres.

Mobil registrering må fungere under reelle forhold

På kontoret er nesten enhver applikasjon betjenbar. På lageret teller hansker, dårlig WiFi, tidspress og enheter med begrenset batterilevetid. En digital følgeseddel må derfor klare seg med få, store registreringstrinn. Strekkode- eller QR-kodeskanning er ofte raskere og mer pålitelig enn å søke etter varenumre.

Offline-evne er ingen luksus når sjåfører jobber utenfor stabil nettverksdekning. Applikasjonen bør mellomlagre operasjoner lokalt, tydelig vise hva som ennå ikke er synkronisert, og håndtere konflikter kontrollert. Hvis to personer redigerer samme leveranse, må ikke den siste lagringen vinne tilfeldig.

Også enhetsspørsmålet må besvares pragmatisk. En eksisterende smarttelefon kan være tilstrekkelig for enkle leveranser. For hyppige skanninger, bilder og signaturer på lageret er robuste håndholdte enheter eller nettbrett ofte mer økonomiske. Den beste beslutningen avhenger av driftstid, miljø og forventet gjennomstrømning — ikke av hvilken enhet som ser moderne ut på et produktbilde.

Definer grensesnitt før innføring

En digital følgeseddel utvikler sin verdi først når den kobles til de ledende datakildene. I mange bedrifter ligger ordrer i ERP eller varehåndteringssystemet, lagre i en separat lagerløsning, og fakturaer i regnskapet. Dette trenger ikke umiddelbart bli et stort systemprosjekt. Men datasuvereniteten bør være tydelig.

Definer derfor hvilket system som vedlikeholder kunder, varer, priser og ordrer. Følgeseddelløsningen kan overta informasjon, men den bør ikke ubemerket generere en ny varestamme. Likeledes må det reguleres når bekreftede faktiske mengder rapporteres tilbake, og hvem som gjennomgår avvik.

Teknisk sett er pålitelige grensesnitt viktigere enn spektakulære funksjoner. Unike ID-er, dokumenterte dataformater, protokoller for mislykkede overføringer og en gjentaksmekanisme forhindrer at følgesedler forsvinner mellom to systemer. En slank applikasjon på et vedlikeholdbart grunnlag, som PHP 8.4, moderne JavaScript og MySQL 8, er mer fornuftig for mange mellomstore arbeidsflyter enn en overbelastet suite med funksjoner ingen bruker.

Sikkerhet og arkivering hører til prosessen

Følgesedler inneholder forretningsdata og ofte også personopplysninger. Rollerettigheter bør derfor ikke tildeles generelt. Sjåfører trenger sine turer og åpne oppgaver, lageransvarlige trenger korreksjons- og gjennomgangsmuligheter, regnskapet trenger bekreftede dokumenter og eksporter. Administrativ full tilgang er ingen standardrettighet.

I tillegg trengs en sporbar historikk: opprettelse, endring, overlevering, signatur, kansellering og korreksjon bør registreres med tid, bruker og begrunnelse. Dette hjelper ved tilbakespørsmål og beskytter ansatte når det senere er uklart når en skade eller mangel ble rapportert. For arkivering gjelder: dokumentet må forbli lesbart og prosessen søkbar. Om en PDF genereres, avhenger av den interne arbeidsflyten og eksterne mottakeres krav. PDF-en er imidlertid utdataen fra en digital prosess, ikke dens datamodell.

Bli produktiv i små steg

Den mest pålitelige utrullingen starter med en klart avgrenset prosess: for eksempel standardleveranser fra ett lager eller varemottak i en avdeling. Velg et område med tilstrekkelig volum, men uten de mest kompliserte unntakstilfellene. Dette gjør det mulig å teste betjening, datakvalitet og grensesnitt under reelle forhold.

Ikke mål bare om applikasjonen fungerer teknisk. Sjekk hvor lang tid en overlevering tar, hvor mange følgesedler som krever etterbehandling, hvor ofte lagerdifferanser oppstår, og om regnskapet kan jobbe raskere. Hvis en digital prosedyre genererer flere tilbakespørsmål enn papirskjemaet, er det ikke arbeidsstyrken som er problemet — da mangler prosessklarhet, eller registreringsmasken passer ikke til praksis.

Regneark kan fortsette å leve hvis de er pålitelige for en liten evaluering eller en sjelden spesialliste. Digitalisering betyr ikke å avskaffe hvert kjente verktøy. Det betyr å bevisst erstatte feilutsatte overleveringer og gjøre kjerneprosessen robust.

softify.pro utvikler slike arbeidsflyter ikke som et stivt standardprodukt, men langs konkrete varebevegelser, roller og eksisterende systemer. Dette er spesielt nyttig når en bedrift søker en passende løsning mellom papirkaos og et overdimensjonert konsernsystem.

Det riktige første steget er derfor ingen lang kravkatalog. Ta ti følgesedler fra en normal uke, inkludert en delleveranse og en reklamasjon. Hvis din fremtidige arbeidsflyt behandler disse ti tilfellene raskt, entydig og sporbart, blir en digital følgeseddel til et verktøy som lager, sjåfører og administrasjon kan stole på.

Permalenke →

Programvaretesting-trender 2026 som virkelig teller

Programvaretesting-trender 2026 som virkelig teller

En mislykket utgivelse viser sjelden bare én enkelt feil. Ofte møtes flere årsaker: en endret tillatelse, et uklart testmiljø, manglende testdata, eller en regresjonstest som ikke har blitt vedlikeholdt på måneder. Nettopp der blir trendene innen programvaretesting for 2026 konkrete — ikke som en samling nye verktøy, men som et spørsmål om hvordan bedrifter kan levere endringer med verifiserbar sikkerhet, selv med knappe QA-kapasiteter og sensitive data.

For programvareteam i mellomstore bedrifter er dette spesielt relevant. En lagerapplikasjon, en kundeportal eller en Windows-skrivebordsprogramvare trenger ikke betjene millioner av brukere. Den må imidlertid fungere i skiftdrift, generere dokumenter korrekt og pålitelig håndheve rettigheter. Testing må derfor være nærmere reelle operative arbeidsflyter enn et perfekt demomiljø.

Trender innen programvaretesting: AI blir utføreren, ikke oraklet

Den mest synlige trenden er AI-støttet testing. Dette betyr ikke at en språkmodell leser et krav og deretter garanterer applikasjonens kvalitet. Den forventningen ville vært farlig. AI kan imidlertid betydelig redusere innsatsen der team i dag mister tid: formulere testtilfeller, gjenkjenne iøynefallende endringer i brukergrensesnitt, tilordne lignende feilmønstre og skrive forståelige testrapporter.

AI blir spesielt nyttig når den utfører konkrete arbeidstrinn og gir bevis for resultatene sine. En testagent kan for eksempel logge inn, opprette et varemottak, endre en leveringsadresse, generere en fraktetikett og sjekke om status, lagerbevegelse og dokument stemmer overens. Det avgjørende er ikke påstanden «test bestått», men beviskjeden: utførte trinn, tidsstempler, skjermbilder, tekniske logger og en tydelig beskrivelse av avviket.

Grensen forblir viktig. AI kan foreslå testtilfeller og håndtere tilbakevendende arbeidsflyter. Den bør ikke alene avgjøre om en faglig kritisk forretningsbokføring er korrekt. For priser, lagernivåer, betalingsgodkjenninger eller tilgangsrettigheter trengs fortsatt eksplisitte regler og forventninger bekreftet av forretningsavdelinger. Automatisering akselererer kontrollen; den erstatter ikke ansvar.

Testautomatisering vandrer inn i forretningsprosessen

I lang tid fokuserte UI-testautomatisering på enkle veier: åpne side, fylle ut skjema, sjekke suksessmelding. Det forblir nyttig, men er ikke tilstrekkelig for forretningskritiske systemer. Den mer verdifulle testen verifiserer en hel prosesskjede.

Ta en typisk logistikkfunksjon. En ordre registreres, varer reserveres, en plukkeprosess startes, en følgeseddel genereres, og frakt rapporteres. Hver enkelt skjerm kan se ren ut mens prosessen likevel mislykkes — for eksempel fordi en reservasjon vedvarer etter et avbrudd, eller en delleveranse feilaktig endrer lageret. Gode automatiserte tester sporer derfor tilstander og data på tvers av systemgrenser.

Dette krever en ren testarkitektur. API- og databasetester sjekker regler raskt og presist. UI-tester kontrollerer i tillegg om ansatte faktisk kan betjene prosessen. Ende-til-ende-tester kombinerer begge, men er tregere og mer sårbare. Den som tester alt utelukkende via nettleseren, bygger vanligvis en dyr og skjør testsuite. Den som bare tester grensesnitt, overser betjeningsproblemer og feilkoblede brukergrensesnitt.

Den pragmatiske løsningen er en pyramide som passer risikoen: mange raske kontroller nær forretningslogikken, færre integrasjonskontroller, og selektivt utvalgte ende-til-ende-scenarier for de viktigste arbeidsflytene. Det høres lite spektakulært ut. Det leverer imidlertid boring, provable reliability i stedet for trend-chasing.

Selvhostet test-AI blir et arkitekturspørsmål

Med AI-testverktøy oppstår et nytt spørsmål: Hvor går testdata, skjermbilder og opptak? I mange applikasjoner inneholder de kundenavn, interne priser, personalinformasjon eller visninger av forretningskritiske prosesser. Selv et tilsynelatende ufarlig testmiljø kan inneholde reelle datakopier eller konfidensielle strukturer.

Derfor blir utførelsesmiljøet et sentralt kriterium. En ekstern skytjeneste kan være passende for offentlige webapplikasjoner og ukritiske testdata. For interne portaler, skrivebordsapplikasjoner eller regulerte områder er en selvhostet tilnærming ofte mer fornuftig. I dette oppsettet forblir testutførelse, bildemateriale og logger innenfor bedriftens kontrollerte infrastruktur eller et klart avgrenset EU-miljø.

Dette er ikke et generelt argument mot skytjenester. Selvdrift medfører innsats: oppdateringer, tilgangskontroll, dataressurser, overvåking og tydelige ansvarsområder må håndteres. Nytten oppstår når personvern, sporbarhet og kontroll over testartefakter veier tyngre enn bekvemmeligheten ved en umiddelbart tilgjengelig SaaS-konto. Systemer som COCO følger nettopp denne tilnærmingen ved å utføre tester for web- og Windows-applikasjoner mens de holder bevis lokalt kontrollerbart.

Ustabile tester aksepteres ikke lenger som normalt

En automatisert test som noen ganger består og noen ganger mislykkes uten en produktendring, skaper ikke sikkerhet. Den skaper køer. Team blir da vant til å ignorere røde builds eller kjøre tester på nytt til ønsket resultat vises. Dette er et snikende tap av tillit til hele kvalitetskontrollrammeverket.

I 2026 flytter derfor stabiliteten i testutførelsen mer i forgrunnen. Årsakene er som regel kjente: tilfeldige ventetider, ustabile selektorer, delt testdata, avhengigheter av eksterne tjenester, eller ikke-tilbakestilte databaser. Løsningen er sjelden nok et forsøk til. Mer fornuftig er entydige tekniske selektorer, isolerte testkontoer, kontrollerte datatilstander og målrettede ventebetingelser som reagerer på faktiske systemhendelser.

Evalueringen bør også differensiere: Er en feil reproduserbar? Oppstår den bare i ett miljø? Har en ekstern tjeneste sviktet eller applikasjonen selv? AI kan hjelpe med å samle disse signalene. Den tekniske beslutningen må imidlertid forbli sporbar. Et QA-team trenger ikke en mystisk feilprediksjon, men et robust grunnlag for neste tiltak.

Kvalitet begynner tidligere med krav og data

Mange feil oppstår før den første linjen kode skrives. «Ordren skal kunne sendes» er ikke et testbart krav. Hva skjer ved en ufullstendig adresse, en sperret kundekonto, manglende varer, parallell behandling, eller en utløpt økt? Uten svar på disse spørsmålene kan ikke noe testsystem pålitelig sjekke om programvaren fungerer korrekt.

En mer moden testtilnærming supplerer derfor krav med verifiserbare eksempler. For en konto med feilaktige påloggingsforsøk kan dette konkret bety: Etter fem mislykkede forsøk sperres kontoen i 15 minutter, prosessen logges, og en autorisert administrator kan spore sperringen. Dette gir direkte automatiserbare kontroller — og mindre tolkningsrom mellom utvikling, drift og forretningsavdeling.

Testdata blir også en produktfunksjon. Den må være realistisk nok til å kartlegge spesialtilfeller, men må ikke kopiere unødvendige personopplysninger. Genererte datasett for MVA-tilfeller, delmengder, sperrede varer, ugyldige adresser og ulike roller er nyttige. Spesielt ved applikasjoner med MySQL 8 eller sammenlignbare relasjonsdatabaser lønner det seg å tilby definerte starttilstander automatisert og fjerne dem etter kjøringen.

Risikobasert testing slår testdekning for enhver pris

Et høyt kodedekningstall kan virke betryggende, men likevel si lite. Det viser hvilke linjer som ble utført, ikke om riktig regel ble testet. Et system kan oppnå 90 prosent dekning og likevel føre til feilaktig lager ved kansellering av en delleveranse.

Det bedre spørsmålet er: Hvilke feil ville vært spesielt kostbare for drift, kunder eller juridisk etterlevelse? Dette gir en prioritering. Tilgangsbeskyttelse, prisberegning, lagerbokføringer, dokumentgenerering og grensesnitt mot fraktleverandører fortjener som regel mer testdybde enn sjelden brukte innstillingssider. Dette betyr ikke å levere sideting ukontrollert. Det betyr å bruke begrenset tid der en svikt stopper reelt arbeid eller skaper feilaktige beslutninger.

Denne prioriteringen må få lov til å endre seg. Hvis en ny ruteplanleggingsfunksjon innføres, øker risikoen. Hvis en gammel Excel-evaluering snart skal erstattes, lønner det seg kanskje ikke lenger med en stor automatiseringsinnsats. Noen ganger er det mer fornuftig å beholde et fungerende regneark noen måneder til i stedet for hastig å presse logikken inn i et halvferdig system.

Hva team praktisk bør gjøre nå

Det første fornuftige trinnet er ingen verktøysammenligning. Velg en prosess hvis feil er merkbare: ordre til levering, varemottak til hyllelegging, eller pålogging til rollegodkjenning. Beskriv ønsket arbeidsflyt med unntakstilfeller, sett opp pålitelig testdata, og automatiser først de kritiske kontrollene. Deretter, ikke bare mål antall tester. Observer hvor raskt en reell feil oppdages, hvor ofte tester mislykkes uten grunn, og om en rapport forklarer årsaken forståelig for en utvikler eller ansvarlig i virksomheten. Først når disse grunnlagene er på plass, lønner det seg med utvidelse med AI-agenter, visuell inspeksjon eller omfattende testmiljøer. De sterkeste testtrendene er til syvende og sist de som gjør utgivelser mindre risikable og bringer team raskere til klare beslutninger. Det er ikke det mest moderne dashbordet som teller, men en sporbar testkjøring som viser: Denne forretningsprosessen fungerer — og hvis ikke, vet vi hvorfor.

Permalenke →

Ruteplanlegging for leveringsturer: Velge riktig programvare

Ruteplanlegging for leveringsturer: Velge riktig programvare

En sjåfør venter på en følgeseddel mens rekkefølgen på stoppene deres allerede endrer seg igjen. På lageret er en forsendelse ennå ikke plukket, en kunde ringer om et strammere tidsvindu, og turlisten ligger i et regneark som bare én person virkelig forstår. Den som søker etter «ruteplanleggingsprogramvare for leveringsturer» i denne situasjonen, ser ikke nødvendigvis etter en komplisert kartalgoritme. Det de leter etter, er en pålitelig arbeidsflyt fra ordreregistrering til leveringsbevis.

For små og mellomstore bedrifter er dette en avgjørende forskjell. En teoretisk kortere rute hjelper lite hvis den ikke tar hensyn til at varer ikke er klare før klokken 10, et kjøretøy trenger kjøling, eller en sjåfør har spesifikk kundekunnskap på en bestemt tur. God programvare for leveringsturer gjenspeiler driftens virkelighet — og gjør den felles brukbar for disponering, lager og sjåfører.

Når ruteplanlegging blir et operativt problem

Mange bedrifter starter fornuftig med telefon, papir og et regneark. Med fem stopp per dag og et fast sjåførteam er dette ofte den raskeste løsningen. Først når ordrevolum, varianter og tidspress øker, oppstår de typiske friksjonstapene: dobbeltregistrerte adresser, utdaterte turstatuser, manglende informasjon om lastebærere og tilbakespørsmål som bare kan besvares ved å ringe flere personer.

Problemet er da ikke bare kjørestrekningen. Det er informasjonsgapet mellom ordremottak, lager, disponering og levering. Hvis en ordre utsettes, må denne endringen i dag ofte følges opp i flere lister, på en utskrift og i sjåførens hode. Dette koster tid og skaper feil som kunder umiddelbart ser.

Et annet varselsignal er beslutninger som avhenger av enkeltansatte. Hvis bare den erfarne disponenten vet hvilken innkjørsel som passer for en bestemt kunde, eller hvordan tur 3 skal justeres ved sent varemottak, er arbeidsflyten ikke dokumentert robust. Programvare skal ikke erstatte denne kunnskapen. Den skal kartlegge den slik at teamet forblir handlingsdyktig.

Hva ruteplanleggingsprogramvare for leveringsturer må kunne

Kjernefunksjonen høres enkel ut: ordrer tildeles en tur, stopp sorteres fornuftig og overleveres til sjåfører. For praktisk nytte trenger systemet imidlertid betydelig mer kontekst. Det avgjørende er hvilke regler som gjelder ved planlegging og hvordan endringer håndteres.

Ordrer må være planleggbare, ikke bare synlige

En leveringsadresse på et kart utgjør ennå ikke en planleggbar levering. En ordre krever minst mengder, vekt eller volum, leveringsdato, ønsket tidsvindu, kontaktinformasjon og en tydelig behandlingsstatus. Avhengig av virksomheten kan lastebærere, temperaturkrav, farlig gods-merking, avvarslingsregler eller en bestemt kjøretøyklasse også komme i tillegg.

Disse dataene bør ikke måtte samles manuelt fra ulike systemer hver gang. Hvis ordrer allerede kommer fra en nettbutikk, ERP, en ordremaske eller en eksisterende database, er en ren overlevering ofte mer verdifull enn en spesielt spektakulær kartvisning. Ellers forskyves arbeidet bare fra papir til et nytt grensesnitt.

Turer trenger regler, ikke bare avstand

En automatisk rekkefølge basert på kilometer eller kjøretid kan være et godt forslag. Den er imidlertid ingen beslutning for virksomheten. Planleggingen må kunne ta hensyn til begrensninger: faste leveringsdatoer, kjøretøykapasitet, arbeidstider, laste- og lossetider samt regionale ansvarsområder.

Startlogikken teller også. Noen kjøretøy begynner og slutter på lageret, mens andre kjører direkte til sitt neste oppdragssted etter den siste leveransen. For tilbakevendende turer kan en fast grunnstruktur være nyttig, som disponenter bare endrer ved behov. Den som kjører nøyaktig de samme stoppene hver morgen, trenger ikke nødvendigvis en fullstendig ny optimalisering. Her er en stabil, sporbar tur ofte bedre enn en matematisk minimal tidsbesparelse.

Endringer må nå sjåføren på en kontrollert måte

Virkeligheten følger sjelden morgenplanen. Kunder avbestiller, varer mangler, et kjøretøy bryter sammen, eller en ordre blir hastende. I slike tilfeller avgjøres det om programvaren gir avlastning eller skaper ekstra arbeid.

En brukbar løsning viser tydelig hvilken turversjon som gjelder for øyeblikket, hvilke stopp som allerede er fullført, og hva som konkret er endret. Sjåføren bør ikke måtte sammenligne motstridende utskrifter, skjermbilder og meldingsapp-meldinger. For mange team er det i utgangspunktet tilstrekkelig med en mobil, nettleserbasert sjåførvisning med stopprekkefølge, kontaktdata, leveringsinstruksjoner og statustilbakemelding. En egen app er ikke automatisk bedre hvis installasjon, enhetsadministrasjon og offline-krav ikke gir noen klar nytte.

Ikke start med ruteoptimalisering alene

Den vanligste feilaktige tilnærmingen er å kjøpe en optimaliseringstjeneste først og først etterpå sjekke om stamdata og arbeidsflyter stemmer. Feilstavede adresser, uklare leveringsvinduer og ordrer uten pålitelig tilgjengelighetsstatus kan ikke optimaliseres bort. En kort kartlegging langs den reelle hverdagen er mer fornuftig. Hvor oppstår ordrer? Når bekrefter lageret tilgjengelighet? Hvem planlegger turer? Hvordan mottar sjåføren endringer? Og hvilket bevis kreves etter levering? Disse spørsmålene kan virke banale, men de avgjør hvilke datafelt, roller og grensesnitt systemet faktisk trenger.

Det viser seg ofte at ikke hvert trinn bør digitaliseres. Et håndskrevet notat for en sjelden spesialleveranse kan være passende hvis det senere overføres rent til ordren. Et regneark kan også forbli hvis det pålitelig leverer en overkommelig evaluering. Programvare bør løse flaskehalsen, ikke tvangsmessig erstatte hver kjente arbeidsflyt.

Bygge, kjøpe eller målrettet utvidelse?

Standardprogramvare er passende når turlogikken er generell, prosesser sjelden varierer og teamet kan tilpasse seg gitte masker. Den forkorter innføringen og kan være tilstrekkelig for en enkel kjøretøypark. Ulempen viser seg så snart den kartlegger sentrale spesialtilfeller bare via sidelister, fritekst eller dyre tilleggsmoduler.

En individuell løsning lønner seg ikke fordi individuell utvikling grunnleggende er overlegen. Den lønner seg når arbeidsflyten selv er en konkurransefordel eller en vedvarende feilkilde: for eksempel med spesielle emballasjeenheter, kombinerte henting- og leveringsturer, egne leveringsdokumenter, eller en tett forbindelse mellom varemottak, plukking og levering.

Mellom disse ligger ofte den mest pragmatiske veien. Eksisterende systemer forblir for regnskap eller lagerstyring, mens en slank applikasjon samler ordrer, planlegger turer og dekker sjåførprosessen. Dette krever tydelige grensesnitt, entydig dataansvar og en databasestruktur som lagrer endringer sporbart. Moderne webapplikasjoner på et vedlikeholdbart grunnlag som PHP 8.4 og MySQL 8 er ingen motebeslutning for dette, men snarere et grunnlag for kalkulerbar drift og senere tilpasninger.

Innføring i små steg i stedet for en stor omstilling

Ruteplanleggingsprogramvare bør først testes på en overkommelig tur eller kjøretøygruppe. Ikke fordi et pilotprosjekt ville være risikofritt, men fordi reelle unntak viser seg tidlig: manglende leveringsinstruksjoner, uensartede adressedata, ventetider hos kunden eller uklare overleveringer på lageret.

For den første utvidelsesfasen er som regel klart avgrensede funksjoner tilstrekkelig: overta ordre, se tilgjengelighetsstatus, sette sammen tur, godkjenne tur og rapportere tilbake levering. Først når denne kjeden fungerer i hverdagen, er automatisk optimalisering, elektronisk signatur, fotobevis, kundevarslinger eller detaljerte nøkkeltall fornuftige.

Nytten måles ikke bare i sparte kilometer. Relevante er også mindre disponeringsarbeid, færre tilbakespørsmål, færre feilleveranser, kortere tid til følgeseddelen og bedre svarevne overfor kunder. Disse nøkkeltallene bør kartlegges grovt før oppstart. Ellers blir bare inntrykket etter innføringen at grensesnittet ser mer moderne ut.

Teknologien må forbli pålitelig i bakgrunnen

Ruteplanlegging behandler sensitive driftsdata: kundeadresser, sjåførtildelinger, leveringsmengder og ofte leveringsbevis. Derfor hører rollerettigheter, sporbare endringer, regelmessige sikkerhetskopier og dokumentert drift til løsningen. Hvem som har lov til å godkjenne, endre eller slette en tur, bør ikke overlates til tilfeldighetene.

Også kart- og rutedata fortjener en saklig gjennomgang. Eksterne tjenester kan passe svært godt, men de medfører løpende kostnader, tilgjengelighetshensyn og personvernspørsmål. Ved høye krav til datalagring eller spesiell regional logistikk må det avklares tidlig hvilke data som forlater eget system og hvordan avbrudd dempes. En perfekt rute er verdiløs hvis disponeringen ikke kan fortsette å jobbe under en forstyrrelse.

softify.pro planlegger slike systemer fra det faktiske ordremottaket helt til tilbakemelding fra kjøretøyet. Målestokken her er ikke den lengste funksjonslisten, men en arbeidsflyt som lager, disponering og sjåfører pålitelig kan betjene under tidspress. Den beste ruteplanleggingen ser overraskende uspektakulær ut i hverdagen: ordrer er komplette, turer er forståelige, endringer er entydige og leveranser er dokumenterbare. Nettopp denne rolige påliteligheten skaper rom for unntakene der mennesker må bestemme.

Permalenke →

Automatisere ordremottak-arbeidsflyten i drift

Automatisere ordremottak-arbeidsflyten i drift

En ordre kommer per e-post, en annen per telefon, i tillegg en Excel-fil fra nøkkelkunden. Senere på lageret mangler leveringsadressen, salg vet ikke lenger nøyaktig hvilken leveringsdato som ble lovet, og fraktavdelingen skriver ut følgeseddelen med en utdatert vareposisjon. Den som vil automatisere ordremottak-arbeidsflyten, løser ikke et abstrakt digitalt prosjekt. De eliminerer nettopp denne friksjonen på punktet der omsetning blir til operativt arbeid.

For små og mellomstore bedrifter er ordremottak ofte undervurdert. Så lenge få ordrer kommer inn per dag og erfarne ansatte kjenner hvert spesialtilfelle, bærer telefonnotater, postkasser og regneark prosessen. Med økende volum blir de imidlertid en risiko: informasjon foreligger dobbelt, overleveringer skjer muntlig, og ingen kan pålitelig si hvilken status ordren har.

Hvorfor ordremottak så ofte blir en flaskehals

Årsaken er sjelden manglende innsats. Vanligvis har arbeidsflyten vokst over flere år. Kunder bestiller via ulike kanaler, priser og leveringsbetingelser gjelder bare for spesifikke kundegrupper, og varenumre avviker fra interne betegnelser. Ansatte avstemmer informasjon fra erfaring og fyller hull med tilbakespørsmål.

Dette fungerer til noen er på ferie, skiftet endres, eller flere hastende ordrer ankommer samtidig. Da viser det seg at kunnskapen ikke ligger i prosessen, men i enkeltpersoners hoder og spredte filer. Konsekvensene er kjente: feil mengder, forsinkede leveranser, uavklarte godkjenninger og unødvendige korrigeringer på lageret. Automatisering betyr her ikke at en kunde nødvendigvis må bestille gjennom en portal. Det betyr at hver ordre, uavhengig av innkommende kanal, registreres, kontrolleres, beriket og overlevert etter de samme sporbare reglene.

Automatisere ordremottak-arbeidsflyten uten å vri driften ut av form

En brukbar arbeidsflyt starter ikke med en programvareliste, men med en nøktern prosessanalyse. De avgjørende spørsmålene er: Hvilken informasjon må foreligge før en ordre kan gå til lager, disponering eller produksjon? Og hvilke unntak er legitime i stedet for bare forstyrrende? En typisk arbeidsflyt består av fire tydelige stasjoner: registrere ordren, kontrollere dataene, godkjenne ordren og utløse etterfølgende prosesser. Mellom disse stasjonene kreves tydelig ansvar og status. En ordre bør for eksempel ikke kunne anses som «ny», «under avklaring» og «klar for frakt» samtidig.

1. Samle ordrer fra alle kanaler til én prosess

E-post, telefon, PDF, EDI, webskjema eller feltservicenotater kan forbli forskjellige innganger. Det avgjørende er at de havner i en felles ordreprosess. Ansatte bør ikke først måtte kopiere informasjon fra postkassen, deretter oppdatere et regneark, og deretter informere en annen person.

For strukturerte ordrer kan kundedata, varenumre, mengder og ønskede datoer overtas direkte. For PDF-er eller fritekst-e-poster er veiledet registrering ofte mer fornuftig enn helautomatisk uthenting. AI-støttet uttrekk kan gi forslag, men ved uklare mengder, kundespesifikke varenumre eller håndskrevne dokumenter trengs en synlig gjennomgang. Den fornuftige målestokken er ikke «maksimal automatisering», men «ingen unødvendig dobbeltregistrering». Et godt utformet skjema med obligatoriske felt og plausible forslag sparer mer tid i mange virksomheter enn feilutsatt full automatikk.

2. Kontrollere data før feil forplanter seg

Den mest verdifulle automatiseringen skjer før godkjenning. Systemet kan sjekke om kundenummeret finnes, leveringsadressen er komplett, varen er aktiv, den ønskede mengden fremstår tillatt, og betalings- eller kredittgodkjenning foreligger. Kundespesifikke priser, minimumsmengder og leveringsvinduer kan også matches mot lagrede regler.

Håndteringen av avvik er viktig. Ikke hvert avvik trenger å blokkere en ordre. Hvis for eksempel et referansenummer mangler, kan salg motta en oppgave. Hvis en ordre overskrider en definert verdigrense eller marginen faller utenfor det avtalte rammeverket, kan godkjenning fra den ansvarlige rollen kreves. Dette forhindrer stille feil og skaper synlige avklaringssaker. Det er en stor forskjell: lageret får ikke bare en ufullstendig ordre, men en ordre med tydelig status og dokumentert beslutning.

3. Koble godkjenninger til regler i stedet for muntlige forespørsler

Mange forsinkelser oppstår fra fraser som: «Kan du fort godkjenne dette?» Slike forespørsler er ikke grunnleggende feil. De blir problematiske når de går via chat, telefon eller korridorsamtale og senere ikke kan spores.

En automatisert arbeidsflyt lagrer godkjenningsregler direkte på ordrenivå. For eksempel kan en ordre godkjennes automatisk hvis kunde, pris, lager og leveringsadresse er plausible. For spesialvilkår, delleveranser eller en ordre som overskrider en definert grense, varsles den ansvarlige personen. Godkjenningen lagres med tidsstempel og begrunnelse.

Dette skaper hastighet uten å gi opp kontroll. Spesielt ved roterende skift eller flere lokasjoner forhindrer det at ordrer blir sittende fast i personlige postkasser.

4. Informere lager, frakt og kunder på en målrettet måte

Etter godkjenning trenger ikke ordren lenger overføres manuelt fra en liste til den neste. Arbeidsflyten kan generere en plukkeordre, reservere lager, forberede en følgeseddel eller utløse en fraktmelding. Hvilke trinn som gir mening, avhenger av forretningsmodellen.

En reservedelsforhandler kan umiddelbart trenge en plukkeordre og prioritetsmerking. En produsent trenger først en tilgjengelighetssjekk og deretter en produksjonsimpuls. En grossist med faste leveranseruter ønsker å samle ordrer opp til et bestemt tidspunkt. Derfor er en rigid standardløsning ofte ikke det beste valget.

For kunden er en tydelig bekreftelse ofte tilstrekkelig: ordre mottatt, kontrollert, eller bindende planlagt. Ikke hver interne statusendring hører hjemme i en e-post. For mange automatiske meldinger genererer tilbakespørsmål i stedet for tillit.

Hvilke data en robust prosess krever

Godt ordremottak står på et rent datagrunnlag. Dette inkluderer vedlikeholdte kundestamdata, entydige varenumre, gyldige pris- og betingelsesregler samt klart definerte leveringsadresser. Hvis disse grunnleggende elementene mangler, akselererer automatisering bare overføringen av upålitelige data. Teknisk arkitektur teller også. Et sentralt system med sporbare statusendringer og en pålitelig database er permanent bedre enn en kjede av makroer, lokale filer og ukontrollert e-postvideresending. Dette betyr ikke at hvert Excel-ark må erstattes umiddelbart.

Hvis et regneark fungerer transparent i en liten, stabil delprosess, kan det forbli inntil videre. Så snart flere personer jobber med ordrer samtidig, godkjenninger kreves, eller informasjon videreformidles til lager og frakt, bør imidlertid en sentral datakilde ha forrang. Systemer basert på en vedlikeholdbar arkitektur, for eksempel med PHP 8.4, moderne JavaScript og MySQL 8, kan da kobles målrettet til eksisterende arbeidsflyter i stedet for å tvinge en virksomhet inn i skjemaet til en konsernprogramvare.

Gjør det målbart om arbeidsflyten virkelig blir bedre

Et nytt system er ikke automatisk en bedre prosess. Før lansering bør derfor noen få nøkkeltall fastsettes. Relevante er for eksempel tiden fra ordreregistrering til godkjenning, antall tilbakespørsmål per ordre, korrigeringer etter overlevering til lageret og andelen ordrer behandlet i tide.

Disse nøkkeltallene viser også hvor ytterligere automatisering ikke er nødvendig. Hvis 85 prosent av standardordrene går raskt og feilfritt, men de resterende 15 prosentene er ekte spesialtilfeller, er en tydelig avklaringsprosess mer fornuftig enn å prøve å tvinge frem hvert unntak algoritmisk.

Logger hjelper også i den daglige driften. Den som ser når en ordre kom inn, hvilken kontroll som mislyktes, hvem som godkjente den, og når fraktordren ble opprettet, søker ikke lenger i fem postkasser etter årsaken. Dette reduserer ikke bare feil, men også avhengigheten av enkeltansatte.

Innføring i små steg i stedet for Big Bang

Den sikreste inngangen er vanligvis en klart avgrenset ordretype: for eksempel standardordrer fra en bestemt kundekrets eller e-postordrer med kjente varer. Der kan datafelt, regler og overleveringer testes under reelle forhold. Først når statuser, unntak og ansvar fungerer rent, følger mer komplekse tilfeller som spesialpriser, delleveranser eller kundeindividuelle emballasjespesifikasjoner.

Ansatte bør involveres i utformingen. Ikke fordi hver eksisterende vane må forbli uendret, men fordi personene ved telefonen, i salg og på lageret kjenner de faktiske unntakene. En løsning som bare ser bra ut i en workshop, blir raskt omgått på hallgulvet.

For slike prosjekter satser softify.pro på arbeidsflytspesifikke systemer i stedet for overbelastede standardpakker: med tydelige overleveringer, dokumenterte regler og nok rom for arbeidsmåtene som beviselig fungerer i virksomheten.

Det beste neste steget er derfor ikke søket etter flest mulig funksjoner. Ta ti reelle ordrer fra en typisk uke og følg deres vei fra mottak til frakt. Hver manuelle dobbeltoverføring, hver uklare beslutning og hvert tilbakevendende tilbakespørsmål er et konkret utgangspunkt for en prosess som fremover vil jobbe pålitelig for teamet.

Permalenke →

Beskytte testdata sikkert under AI-testing

Beskytte testdata sikkert under AI-testing

En mislykket automatisert test er vanligvis raskt fikset. Et skjermbilde fra testkjøringen som inneholder kundedata, prislister eller en aktiv økt og havner i en ekstern AI-tjeneste, er et annet problem. Den som vil beskytte testdata under AI-testing, må derfor ikke bare vurdere testtilfellene, men hele datastien: inndata, nettlesertrafikk, logger, bilder, AI-evaluering og oppbevaring.

Spesielt ved webapplikasjoner, interne portaler og Windows-programvare oppstår det raskt en falsk følelse av sikkerhet. Miljøet kalles riktignok «test», men det bruker ofte kopier av produktive databaser, ekte brukerroller eller grensesnitt mot frakt, ERP og dokumentarkiver. AI-støttede tester gjør denne dataen spesielt verdifull for analyse — og dermed spesielt beskyttelsesverdig.

Hvorfor AI-testing krever et eget personvernperspektiv

Klassisk testautomatisering sjekker vanligvis tydelig avgrensede trinn: logge inn, opprette en ordre, generere en følgeseddel, sjekke utlogging. AI-støttet testing utvider denne arbeidsflyten. Systemet kan tolke grensesnitt, evaluere avvik, sammenligne skjermbilder og dokumentere resultater på forståelig språk. Dette sparer tid ved regresjonstester, men genererer ekstra dataartefakter.

Disse artefaktene er ofte mer talende enn en vanlig testlogg. Et skjermbilde kan vise navn, adresser, kontraktsverdier, ordremengder eller helsedata. En nettverkslogg kan inneholde øktnøkler og API-svar. En feilmelding kan avsløre interne filstier, databasestrukturer eller versjonsstatuser. Når en modell arbeider med denne informasjonen, må det være klart hvor behandlingen finner sted og hvem som kan få tilgang til den.

Det avgjørende spørsmålet er derfor ikke: «Bruker vi AI i testingen?» Men heller: «Hvilke data forlater hvilken sikkerhetssone — og hvorfor?» For mange bedrifter i DACH-regionen er ekstern skybehandling ikke prinsipielt utelukket. Den må imidlertid matche beskyttelsesbehovet kontraktsmessig, teknisk og organisatorisk. For utviklings-, produksjons- eller kundedata er en lokalt kontrollert utførelse ofte den mer saklige beslutningen.

Å beskytte testdata under AI-testing begynner før den første kjøringen

Personvern i testing diskuteres ofte først ved valg av verktøy. Det er for sent. Først trengs en enkel, pålitelig datainventering. Hvilke systemer testes? Hvilke felt vises i grensesnitt? Hvilke vedlegg, eksporter og API-svar kan dukke opp i testen? Og hvilke data havner automatisk i skjermbilder, videoer eller feilmeldinger?

En inndeling i tre grupper lønner seg her. Ukritiske testdata kan genereres fritt og lagres lenger. Personopplysninger eller forretningsmessig konfidensielle data trenger maskering, tilgangsbegrensninger og kort oppbevaringstid. Tilgangsdata, tokener, nøkler og produktive konfigurasjonsverdier hører ikke hjemme i testbevis eller modellforespørsler — ikke engang når de bare ved et uhell er synlige i et nettleservindu.

I mange mellomstore applikasjoner er datasituasjonen ikke rent atskilt. Lagerteamet tester et nytt varemottak med et databaseutdrag fordi bare der finnes de reelle varestrukturene, leverandørreglene og spesialtilfellene. Det kan være faglig fornuftig. Konsekvensen må imidlertid ikke være at dette utdraget vandrer uendret inn i hvert testmiljø.

Bedre er en reproduserbar prosess: eksporter data, pseudonymiser sensitive felt målrettet, fjern unødvendige tabeller og gjør det resulterende testdatagrunnlaget tilgjengelig versjonert. Slik bevares typiske prosessfeil uten at reelle kunder eller ansatte blir synlige i testkjøringer. Ved kompleks pris- eller disponeringslogikk er fullstendig syntetiske data ofte utilstrekkelige. Da er en nøye renset kopi vanligvis det bedre kompromisset.

Maskering må bevare forretningslogikken

En maskering som erstatter hver e-postadresse med samme plassholder, kan skade testtilfeller. Duplikatsjekker, rollelogikk, søkefunksjoner eller faktureringsflyter reagerer annerledes enn i drift. God maskering bevarer derfor formater, relasjoner og fordelinger. Et kundenummer blir et annet gyldig kundenummer. En adresse blir en plausibel, men fiktiv adresse. En leveringsdato forblir en dato innenfor et realistisk planleggingsspenn.

Dette koster litt forberedelse. Til gjengjeld forhindrer det den klassiske feilen der tester er teknisk grønne, men ikke lenger kartlegger de faktiske arbeidsflytene på lager, salg eller kundeservice. Personvern og faglig brukbare tester er ingen motsetninger — forutsatt at databehandlingen er en del av testarkitekturen.

Utførelsesstedet avgjør kontrollen

Den som overlater automatiserte tester til en ekstern tjeneste, gir avhengig av konfigurasjonen fra seg mer enn testtrinn. Nettleserinnhold, DOM-strukturer, skjermbilder, videoer, konsollogger og evalueringer kan behandles og lagres utenfor egen infrastruktur. Om dette er akseptabelt, avhenger av det enkelte tilfellet: datakategorier, avtaleverk, lagringssted, leietakerseparasjon, slettekonsept og interne retningslinjer spiller sammen.

For applikasjoner med høyt beskyttelsesbehov er et selvhostet testmiljø ofte klarere å vurdere. Testkjøreren, AI-komponenten og bevislagringen forblir i eget nettverk eller i en kontrollert europeisk infrastruktur. Nettverksregler kan begrense eksterne forbindelser. Tilgang kan knyttes til eksisterende identiteter, roller og logging. Også oppbevaringen av bilder og rapporter blir en egen beslutning i stedet for en standardinnstilling fra en plattformleverandør.

COCO følger nettopp denne tilnærmingen: AI-serveren utfører tester for web- og Windows-applikasjoner kontrollert, dokumenterer bevis og genererer forståelige evalueringer uten at interne applikasjonsdata som standard må gis til en ekstern AI-sky. Dette erstatter ingen personvernrevisjon. Det skaper imidlertid et teknisk grunnlag som IT, informasjonssikkerhet og forretningsavdeling kan bli enige om sporbare regler på.

Skjermbilder, logger og hemmeligheter er de vanligste lekkasjene

Mange team beskytter testdatabasen, men overser biproduktene av testing. Nettopp der ligger i praksis ofte de større risikoene. En mislykket påloggingstest kan vise et passord i inndatafeltet. En API-test kan skrive ut en bearer-token i loggen. Et automatisk videoopptak dokumenterer en fullstendig ordre inkludert kundeadresse. Et robust konsept regulerer derfor minst fem punkter:

  • Skjermbilder og videoer opprettes bare ved behov og slettes etter faste frister.
  • Hemmeligheter integreres via en hemmelighetslagring eller beskyttede kjøretidsvariabler, aldri lagret i testkoden.
  • Logger filtrerer tokener, passord, økt-ID-er og sensitive felt før de lagres.
  • Testkontoer har bare rettighetene som er nødvendige for den respektive arbeidsflyten.
  • Testsystemer må ikke utløse produktive e-poster, etiketter, betalinger eller lagerbevegelser med mindre dette er eksplisitt sikret.

Disse reglene høres nøkterne ut. Det er nettopp deres fordel. Et team trenger ikke håpe på oppmerksomhet eller gode intensjoner, men kan teknisk begrense feilbruk. Spesielt effektive er separate tjenestekontoer for testautomatisering, korte tokenlevetider og en tydelig prosess for tilbakekalling av kompromitterte tilgangsdata.

Også AI-evalueringen trenger grenser

AI-modeller brukes ofte til å forklare avvik: «Knappen var ikke synlig», «Applikasjonen reagerte tregere enn forventet», eller «Prosessen endte i en rettighetssjekk». For slike vurderinger trenger ikke en modell nødvendigvis det fullstendige kundedatasettet.

Definer derfor hvilken informasjon som får flyte inn i evalueringen. Er et anonymisert skjermbilde tilstrekkelig? Er en teknisk feilklasse nok i stedet for det fullstendige serversvaret? Kan felt sladdes før analyse? Riktig dybde avhenger av testmålet. I en layoutsammenligning er et navn sjelden relevant. Ved kontroll av en personalisert dokumentmal kan det være relevant — da må behandlingen sikres tilsvarende.

Beskyttelsestiltak må forbli verifiserbare i drift

Et konsept er bare robust hvis det kan kontrolleres i hverdagen. Dette inkluderer regelmessige stikkprøver av testbevis, gjennomganger av rettigheter og et blikk på faktisk lagrede data. Har nye felt sneket seg inn i skjermbilder? Finnes gamle testkontoer fortsatt? Beholdes et databaseutdrag lenger enn tiltenkt? Slike spørsmål hører hjemme i den normale driftsrutinen, ikke bare i en revisjon. Like viktig er tydelig ansvar. QA kjenner testarbeidsflytene, utvikling kjenner de tekniske grensesnittene, forretningsavdelingen kjenner de kritiske prosessene, og IT-sikkerhet definerer rammen. Hvis ingen bringer disse perspektivene sammen, oppstår enten en risikabel snarvei eller en sikkerhetsspesifikasjon som forhindrer reelle tester. En liten, dokumentert godkjenningsprosess er vanligvis mer effektiv enn et omfattende regelverk som ingen bruker.

Til syvende og sist handler det ikke om å gjøre hver test kunstig komplisert. Å beskytte testdata godt betyr å bevisst fjerne reelle risikoer fra automatiseringen samtidig som testenes faglige gyldighet bevares. Når team vet nøyaktig hvilke data en test får se, hvor bevisene ligger, og når de forsvinner, blir AI-testing et kontrollerbart verktøy i stedet for en ekstra usikkerhet.

Permalenke →

Få utviklet en webapplikasjon med PHP

Få utviklet en webapplikasjon med PHP

Når varemottak havner i et regneark, fraktdata overføres per telefon og den gjeldende ordrestatusen bare finnes i hodet på enkeltansatte, mangler det vanligvis ikke enda et standardverktøy. Det som mangler er et system som pålitelig kartlegger den egne arbeidsflyten. Å få utviklet en webapplikasjon med PHP lønner seg nettopp da: når informasjon, beslutninger og dokumenter må komme sammen på ett sted uten å belaste driften med en overdimensjonert bedriftspakke.

PHP er ingen nostalgisk kompromiss her. Med PHP 8.4, en tydelig applikasjonsarkitektur og MySQL 8 kan man bygge langvarige webapplikasjoner som reagerer raskt, er enkle å vedlikeholde og fungerer pålitelig på skrivebord, nettbrett eller håndskanner. Det avgjørende er imidlertid ikke språket alene. Det avgjørende er om applikasjonen faktisk gjør arbeidet på lagergulvet, på kontoret og på farten enklere.

Når en skreddersydd webapplikasjon gir mening

Ikke hver prosess trenger umiddelbart skreddersydd programvare. Et rent vedlikeholdt regneark kan forbli den mest fornuftige løsningen for en liten, sjelden endret liste. Også et etablert standardprodukt er fornuftig hvis det allerede dekker de vesentlige arbeidsflytene og kan brukes uten permanente omveier.

Vendepunktet kommer når ansatte legger inn data flere ganger, samler informasjon fra ulike filer, eller regelmessig løser spesialtilfeller utenfor det faktiske systemet. Typiske signaler er uklare lagernivåer, manuelt genererte følgesedler, uklare ansvarsområder for ordrer, eller tilbakespørsmål som hvert skift må gjenta. Da går ikke bare tid tapt. Feil blir vanskelige å spore, og avhengigheten av enkeltpersoner øker.

En skreddersydd webapplikasjon kartlegger derimot nøyaktig de reglene som gjelder i virksomheten. Den kan for eksempel registrere varemottak, dokumentere lagerbevegelser, generere etiketter, prioritere ordrer eller gjøre overleveringer mellom team sporbare. Ikke hvert spesialtilfelle trenger å automatiseres dag én. En fornuftig start fokuserer på arbeidsflyten som akkurat nå skaper mest friksjon.

Å få utviklet en webapplikasjon med PHP: Hva som må avklares på forhånd

God programvare starter ikke med skjermskisser eller en liste over tekniske moteord. Den starter med konkrete situasjoner: Hva skjer når en leveranse ankommer ufullstendig? Hvem har lov til å korrigere et lager? Hvilken informasjon trenger fraktavdelingen før en etikett skrives ut? Og hva skjer når en ansatt på kveldsskiftet overtar en ordre som ble opprettet på formiddagen?

Fra disse spørsmålene oppstår et robust prosessbilde. Det viser inndata, beslutninger, overleveringer og unntak. Nettopp unntakene er verdifulle fordi standardløsninger ofte bryter sammen der. En applikasjon for ordremottak trenger for eksempel ikke bare å lagre en ny ordre. Den må også avklare hvordan manglende varedata, avvikende leveringsadresser, godkjenninger eller kanselleringer håndteres.

Før implementering bør derfor mål, brukergrupper og det første utviklingstrinnet fastsettes. Nyttige ressurser inkluderer reelle eksempeldata, eksisterende skjemaer, bilder av arbeidsplasser og samtaler med menneskene som jobber med arbeidsflyten daglig. Et rent lederintervju gir sjelden nok detaljer. Den som betjener en skanner, lagrer varer eller sjekker følgesedler, kjenner vanligvis de praktiske begrensningene mer nøyaktig.

Den minste fornuftige starten

En første utgivelse trenger ikke å være en ferdig bedriftsplattform. Tvert imot: en begrenset, produktivt brukbar kjerne reduserer risiko og skaper verdi tidlig. Et tenkelig alternativ ville være en applikasjon som i utgangspunktet bare registrerer ordrer sentralt, gjør statusen deres synlig og oppretter en pålitelig følgeseddel. Lagerstyring, grensesnitt eller ruteplanlegging kan følge så snart kjernen er bekreftet i hverdagen.

Denne rekkefølgen forhindrer at et prosjekt jobber i månedsvis med funksjoner hvis faktiske nytte fortsatt er uklar. Den skaper også rom for korrigeringer. Kanskje er den planlagte statuslogikken for finkornet, kanskje trenger varemottaket en raskere innmatingsskjerm eller en godkjenning først over en viss verdi. Slike erkjennelser er ingen planleggingssvikt, men en del av en ren innføring.

Det tekniske grunnlaget avgjør følgekostnadene

En webapplikasjon blir ikke vedlikeholdbar bare fordi PHP nevnes i tilbudet. Vedlikeholdbarhet oppstår gjennom sporbare beslutninger: en tydelig separasjon mellom grensesnitt, forretningslogikk og datatilgang, entydige datamodeller, automatiserte tester for kritiske regler samt dokumentert levering.

PHP 8.4 egner seg svært godt til dette. Språket er modent, effektivt å drifte og et saklig valg for mange forretningskritiske applikasjoner. I kombinasjon med moderne JavaScript kan grensesnittet reagere raskt og direkte uten å unødvendig bygge hver funksjon komplisert som en enkeltsideapplikasjon. MySQL 8 gir et solid grunnlag for transaksjoner, rettighetskonsepter og konsistente datasett.

Spesielt ved lager- og ordreprosesser må ikke en bokføring lagres halvveis. Hvis en vare bokføres ut, må lager, bevegelseslogg og ordrestatus stemme overens. Databasetransaksjoner sørger for at enten alle nødvendige endringer skjer, eller ingen. Dette høres ut som en detalj, men avgjør om et system forblir pålitelig i unntakstilfeller.

Sikkerhet hører også hjemme i kjernen av arkitekturen. Roller og rettigheter må passe til den daglige rutinen: en person i varemottaket trenger andre rettigheter enn regnskap eller en ekstern sjåfør. Sikre passordhasher, kontosperringer etter mislykkede påloggingsforsøk, øktstyring og logger for kritiske endringer er ikke ekstrafunksjoner for senere. De hører hjemme i den første produksjonsversjonen.

Bygg grensesnitt bare der de sparer arbeid

Mange prosjekter blir unødvendig store fordi hver tenkelige integrasjon planlegges fra begynnelsen. Grensesnitt mot butikk, ERP, fraktleverandør eller regnskap kan være svært nyttige. De er imidlertid bare gode hvis de erstatter et tydelig manuelt trinn eller vesentlig forbedrer datakvaliteten.

Et eksempel: Hvis fraktetiketter opprettes daglig fra ordredata, sparer en direkte tilkobling tid og reduserer overføringsfeil. Hvis fakturadata derimot bare overføres én gang i uken til et eksisterende system og prosessen er stabil, kan en strukturert eksport være tilstrekkelig for starten. Den teknisk mer elegante løsningen er ikke automatisk den mer økonomiske.

Datasuverenitet bør også avklares på forhånd. Hvilke data lagres, hvor lenge forblir logger tilgjengelige, hvem har lov til å eksportere dem, og hvordan fungerer sikkerhetskopiering og gjenoppretting? For bedrifter i DACH-regionen er disse spørsmålene ikke bare IT-formaliteter. De angår personvern, driftsevne og tillit i teamet.

Innføring uten å bremse driften

Den beste applikasjonen mislykkes hvis den blokkerer den daglige rutinen under overgangen. Derfor bør innføringen forberedes med reelle tilfeller: representative ordrer, reelle varer, typiske leveringsadresser og kjente spesialtilfeller. Først når disse arbeidsflytene fungerer sporbart, bør systemet overta en sentral oppgave.

Parallell drift kan være fornuftig i kort tid, for eksempel når lagre må avstemmes eller nye dokumenter kontrolleres. Den må imidlertid ikke bli en permanent tilstand. To ledende datakilder skaper uunngåelig avvik. Det trengs en tydelig skjæringsdato hvorfra det er fastsatt hvilket system som er bindende.

Like viktig er en kort, rollebasert innføring. En ansatt på lageret trenger ingen forklaring av administrasjonsfunksjoner. De trenger trygghet i de få trinnene som må gjøres under tidspress. Gode applikasjoner hjelper med forståelige betegnelser, fornuftige standardverdier og feilmeldinger som forklarer hva som skal gjøres videre.

Slik gjenkjenner du en passende utviklingspartner

Den som bestiller en webapplikasjon kjøper ikke bare utviklingstimer. Det som trengs er en partner som tar prosessspørsmål på alvor, begrunner tekniske beslutninger og også sier imot når et krav blir unødvendig dyrt eller risikabelt. Direkte tilgang til erfarne utviklere er her mer verdt enn en omfattende salgsprosess med senere overleveringer.

Vær oppmerksom på konkrete uttalelser om arkitektur, drift og videreutvikling. Hvordan dokumenteres endringer? Hvordan foregår oppdateringer? Hvem reagerer ved en driftsforstyrrelse? Finnes det en sporbar teststrategi for kritiske bokføringer og rettigheter? Et grensesnitt kan virke overbevisende under presentasjonen. Det avgjørende er om det fortsatt kan tilpasses etter to år uten at hver endring blir en fullstendig ombygging.

softify.pro jobber derfor med en trinnvis, prosessnær implementering: først forstå den operative flaskehalsen, deretter levere en robust kjerne og bygge videre på den. Dette er mindre spektakulært enn et stort transformasjonsløfte, men i løpende drift vanligvis betydelig mer verdifullt.

En god webapplikasjon trenger ikke å inneholde flest mulig funksjoner. Den må sørge for at en ordre ikke går tapt, et lager forblir sporbart, og ansatte kan fullføre arbeidet sitt uten unødvendige tilbakespørsmål. Når det lykkes, blir en teknisk investering til et verktøy som gjør hver arbeidsdag målbart roligere.

Permalenke →

Generere fraktetiketter automatisk og redusere feil

Generere fraktetiketter automatisk og redusere feil

En ordre er pakket, varene står ved rampen — og noen leter fortsatt etter riktig fraktmetode, skriver mottakeradressen inn i en transportørportal og skriver ut etiketten. Denne arbeidsflyten tar bare noen minutter per pakke. Ved 30, 80 eller 300 forsendelser om dagen blir det en flaskehals. Å generere fraktetiketter automatisk betyr derfor ikke bare å koble til en skriver. Det betyr å koble sammen ordredata, fraktregler og den faktiske pakkeprosessen slik at en ferdig forsendelse pålitelig blir en matchende etikett.

For små og mellomstore bedrifter er dette ofte den mest fornuftige inngangen til logistikkautomatisering. Nytten viser seg umiddelbart på lagergulvet: færre tilbakespørsmål, færre feiladresserte pakker og en tydelig status for salg, lager og kundeservice. Likevel lønner det seg å se nøye på prosessen før teknisk implementering. Et dårlig vedlikeholdt vareregister eller uklare fraktregler blir ikke bedre av automatisering — de blir bare behandlet raskere.

Hva som faktisk skjer ved automatisk etikettutskrift

En fraktetikett inneholder mer enn bare navn og adresse. Avhengig av leverandør inkluderer dette et sporingsnummer, en maskinlesbar kode, ruteinformasjon, tjenester som alderssjekk eller postoppkrav, samt tolldata for internasjonale forsendelser. For at transportøren skal kunne generere en etikett, må denne informasjonen være fullstendig og i forventet format. Den tekniske arbeidsflyten begynner vanligvis med en ordre i nettbutikken, ERP eller et skreddersydd ordrehåndteringssystem. Så snart ordren er klar for frakt, fastsetter systemet leverandør, produkt og tilleggstjenester basert på definerte regler.

Deretter overfører den dataene til transportørens grensesnitt eller til en fraktplattform. Denne registrerer forsendelsen, returnerer sporingsnummer og etikett, og systemet lagrer PDF-en eller utskriftsdataene mot ordren. Først da skrives det ut — på arbeidsplassen, pakkebordet eller direkte via en etikettskriver.

Denne rekkefølgen er avgjørende. En pen etikett uten vellykket forsendelsesregistrering hjelper ikke. Omvendt må ikke en vellykket registrering forsvinne i bakgrunnen hvis skriveren går tom for materiale. Gode prosesser behandler registrering, utskrift og statustilbakemelding som en sammenhengende operasjon.

Å generere fraktetiketter automatisk starter med tydelige regler

Den vanligste misforståelsen er: Nøyaktig samme leverandør bør alltid velges for hver ordre. Det kan fungere, for eksempel ved homogene B2C-forsendelser innenfor Tyskland. Mange virksomheter trenger imidlertid mer differensierte regler. En tung leveranse, en ekspressordre, en henting på et pakkeutsalg eller en forsendelse til Sveits stiller ulike krav.

Fornuftige regler kan ta hensyn til vekt og mål, destinasjonsland, leveringsadresse, varevverdi, ønsket leveringstid, faresgodsmerker og avtalte kundevilkår. Her gjelder: Ikke hvert teoretiske unntak trenger å automatiseres fra dag én. Hvis to spesialtilfeller oppstår per måned, er et synlig merket manuelt trinn ofte billigere og sikrere enn en komplisert regelmotor. Tilbakevendende tilfeller med betydelig volum hører derimot hjemme i standardprosessen.

Datakilden er spesielt viktig. Vekter fra et velholdt vareregister er brukbare for lignende varer. Ved blandede ordrer, variabel emballasje eller tillegg for overstørrelse bør den endelige pakkevekten registreres ved pakkestasjonen. Systemet kan da generere etiketten først etter veiing. Dette er et ekstra manuelt trinn, men det forhindrer dyre korrigeringer og etterbelastninger.

Adressekvalitet avgjør før utskrift

Mange fraktproblemer oppstår før overlevering til transportøren. Husnumre havner i feil felt, postnumre stemmer ikke med byen, eller firmaadresser inneholder uklare mottakernavn. Automatisering bør derfor ikke bare videresende adresser, men sjekke dem på forhånd. Obligatoriske felt, landformater, tegnlengder og gjenkjennelige duplikater kan fanges opp direkte ved ordreregistrering.

Adresseverifisering er ingen garanti for leveringsdyktighet. Den reduserer imidlertid antallet unngåelige feil. Ved iøynefallende data bør systemet tydelig sette ordren på vent for avklaring i stedet for stille å generere en ufullstendig etikett. Det må være synlig på lageret hvorfor en ordre venter og hvem som kan gi informasjonen.

Pakkestasjonen trenger enkel betjening

Det beste grensesnittet mislykkes hvis ansatte må bytte mellom fem skjermer under pakking. En praktisk pakkedialog viser bare det som er nødvendig for den aktuelle forsendelsen: ordre, varer, leveringsadresse, emballasjestatus, vekt, valgt fraktmetode og utskriftsstatus. Et strekkodeskann på følgeseddelen eller plukkelisten bør åpne riktig ordre. Etter veiing er det i idealfallet nok med én bekreftende handling for å opprette og skrive ut etiketten.

Med flere pakkestasjoner trenger hver arbeidsplass en tydelig tilknytning til en skriver. Etikettformatet må også passe til enheten og transportøren. A6 er vanlig for mange pakkeetiketter, men ikke hver rull, termoskriver og dokumentskuff fungerer likt. Den som først skriver ut etiketter som PDF på en kontorlaserskriver, kan starte raskt. Ved høyere volum er termoskrivere vanligvis mer fornuftige: de unngår klipping, liming og risikoen for at en etikett skli til feil side under utskrift.

En god prosess rapporterer tekniske problemer forståelig. «API Error 403» hjelper ikke ved pakkebordet. Bedre er: «Etikett ikke opprettet: Sjekk tilgang til fraktleverandør» eller «Skriver pakkestasjon 2 utilgjengelig.» Ordren må ikke ved en feiltakelse anses som sendt i prosessen. Den forblir i en tydelig feilstatus og kan behandles på nytt etter utbedring uten å registrere en andre forsendelse.

Grensesnitt trenger feilhåndtering, ikke bare en happy path

Transportørgrensesnitt er eksterne systemer. De kan være midlertidig utilgjengelige, avvise inndata eller endre svarformatet sitt. Et lokalt nettverk, en utskriftstjeneste eller utløpte tilgangsdata kan også avbryte arbeidsflyten. Derfor er det risikabelt å knytte suksess utelukkende til at en bruker har klikket på «Opprett etikett».

Teknisk sett bør hver forespørsel logges sporbart: tidsstempel, ordre, brukt fraktjeneste, resultat, sporingsnummer og forståelig feilmelding. Sensitive data og tilgangsnøkler hører ikke ubeskyttet hjemme i loggfiler. En unik intern forsendelses-ID forhindrer at et nytt forsøk genererer duplikate etiketter eller dupliserte faktureringer.

Kanselleringer hører også hjemme i planleggingen. Hvis en pakke til slutt ikke hentes eller pakkes om etter etikettutskrift, må det være klart om forsendelsen kan kanselleres hos transportøren og hvordan dette dokumenteres i det interne systemet. Uten dette trinnet vil fraktstatus, sporing og fakturering ikke lenger stemme overens etter noen uker.

Ikke hver bedrift trenger umiddelbart en stor fraktplattform

Fraktplattformer kan samle flere transportører, tarifflogikk og returer. Dette gir mening hvis forsendelsesvolumer, destinasjonsland og leverandører er varierte. Den som imidlertid har en tydelig fraktprosess og én eller to transportører, kan kjøre mer oversiktlig med en direkte tilkobling. Færre systemer betyr mindre dataavstemming, færre brukerkontoer og færre steder hvor feil kan oppstå.

Beslutningen avhenger ikke bare av pakkevolum. Relevante er også returer, eksportdokumenter, individuelle fraktregler, eksisterende ordrekilder og spørsmålet om hvem som vedlikeholder endringer senere. En regnearkløsning forblir for eksempel forsvarlig hvis få forsendelser med konsistente data sendes daglig. Så snart kolleger overfører informasjon flere ganger eller frakt er bundet til enkeltpersoner, blir en sentralisert arbeidsflyt vanligvis mer økonomisk.

For kundespesifikke prosesser kan en slank webapplikasjon være fornuftig som samler ordredata, lagerbevegelser, følgesedler og etikettutskrift.
softify.pro implementerer slike systemer med en sporbar datastruktur, dokumentert utrulling og vedlikeholdbare teknologier som PHP 8.4 og MySQL 8. Det avgjørende er ikke antall funksjoner, men at arbeidsflyten blir mer forståelig for teamet ved pakkebordet.

Innfør i små steg og forbedre målbart

En kontrollert start er bedre enn en stor endring en mandagmorgen. Først automatiseres et klart definert standardtilfelle, for eksempel nasjonale pakker fra én transportør med et definert etikettformat. Parallelt bør automatisk genererte data sjekkes mot den tidligere arbeidsflyten i noen dager: adresse, vekt, fraktprodukt, sporingsnummer og trykt etikett.

Unntak kan deretter legges til i etterkant. Nyttige nøkkeltall er behandlingstid per forsendelse, antall manuelle korrigeringer, ikke-utskrevne eller dupliserte etiketter og tiden frem til sporingstilbakemelding til kunden. Disse verdiene viser om automatiseringen virkelig tar over arbeid eller bare digitalt kartlegger en gammel omvei.

Til syvende og sist teller ikke en spesielt kompleks fraktdialog. Det som teller, er at en pakket ordre får riktig etikett uten søking, omskriving og usikkerhet — og at unntak blir synlige der et menneske faktisk må ta en beslutning.

Permalenke →

Automatisk teste påloggingsprosessen med et system

Automatisk teste påloggingsprosessen med et system

En pålogging virker banal først når den fungerer. Hvis den slutter å fungere etter en utgivelse, står ansatte foran skiftstart, kunder foran kundeportalen eller disponenter foran en blokkert ordrebehandling. Å automatisk teste påloggingsprosessen betyr derfor ikke bare å fylle ut brukernavn og passord i et skjema. Det betyr å gjentatte ganger kontrollere en forretningskritisk inngang med dens regler, unntak og sikkerhetsgrenser.

For mange team starter automatiseringen med ett enkelt positivt testtilfelle: skriv inn gyldige påloggingsdata, bekreft pålogging, se startsiden. Det er fornuftig, men utilstrekkelig som eneste test. Påloggingsfeil oppstår ofte i kantene: ved utløpte økter, sperrede kontoer, en ny flerfaktorautentisering eller en rettighet som ikke lenger virker korrekt etter en rolleendring. Nettopp disse tilfellene må dekkes planmessig.

Hvorfor påloggingen krever spesiell testdisiplin

Påloggingen er samtidig en sikkerhetsfunksjon, et teknisk grensesnitt og inngangen til arbeidsflyten. En feil kan være for åpen og tillate uautorisert tilgang. Den kan også være for streng og stenge ute autoriserte personer. Begge koster: i det første tilfellet oppstår risikoer for data og etterlevelse, i det andre driftsstans, supportinnsats og hektiske nødløsninger.

Ved webapplikasjoner kommer flere avhengigheter i tillegg. Påloggingen kommuniserer ofte med en identitetsleverandør, et e-postsystem for passordtilbakestillinger, en MFA-app eller en katalogtjeneste. Ved Windows-skrivebordsapplikasjoner kan lokale rettigheter, nettverksforbindelser og versjonsstatus ha innflytelse. En test som bare ser på skjemaet i nettleseren, gjenkjenner ikke slike integrasjonsproblemer pålitelig.

Derfor bør teamet før den første testautomatiseringen fastslå hva en vellykket pålogging betyr i det respektive systemet. Er en synlig startside tilstrekkelig? Eller må det sjekkes om riktig leietakervalg ble lastet, om brukerrollen stemmer, og om den første beskyttede handlingen faktisk er mulig? For en lagerportal ville dette for eksempel være tilgang til varemottak. For et disponeringssystem kan det være godkjenningen av en tur.

Automatisk teste påloggingsprosessen: Fra arbeidsflytmodell til testtilfelle

Et godt utgangspunkt er ikke et skript, men en arbeidsflytmodell. Påloggingen kan beskrives som en sekvens av tydelige tilstander: utlogget, påloggingsdata overført, identitet bekreftet, MFA kreves, pålogget, økt utløpt, eller konto sperret. Til hver tilstand hører tillatte handlinger og forventede systemresponser.

Fra denne modellen oppstår testtilfeller med forretningsverdi. Det positive standardtilfellet hører med, men også ugyldige passord, ikke-eksisterende brukerkontoer og utløpte tilbakestillingslenker. Den forventede tilbakemeldingen er viktig her. Ved feilaktige påloggingsdata bør en applikasjon ikke avsløre om en e-postadresse eksisterer. Testen sjekker derfor ikke bare at en feil vises, men også at teksten og oppførselen ikke gir unødvendige hint.

Spesielt relevante er beskyttelsesmekanismer mot gjentatte mislykkede forsøk. Etter et definert antall feilaktige oppføringer kan en konto midlertidig sperres. Den automatiserte testen må sjekke om sperringen faktisk trer i kraft, hvor lenge den varer, og om den legitime brukeren deretter får kontrollert tilgang tilbake. Presisjon er nødvendig her: en test som bevisst sperrer produksjonskontoer, skaper flere problemer enn den løser. Slike scenarier hører hjemme i et separat testmiljø med spesielt opprettede kontoer.

Vurdere MFA, passordtilbakestilling og Single Sign-On separat

Flerfaktorautentisering er ingen detalj på slutten av påloggingen. Den endrer arbeidsflyten. En test må gjenkjenne at ytterligere bekreftelse kreves etter passordet, og den må kartlegge både vellykket og avvist bekreftelse. For tidsbaserte engangskoder trenger testmiljøet kontrollert håndtering av tid og hemmeligheter. I mange tilfeller er en testmetode levert av identitetsleverandøren mer fornuftig enn å gjenskape en reell mobiltelefon.

Passordtilbakestilling og Single Sign-On bør også få sine egne testspor. Ved en tilbakestilling teller overføringen av meldingen, lenkens unikhet, gyldighetsperioden og den etterfølgende påloggingen med det nye passordet. Ved SSO er det avgjørende om applikasjonen korrekt oppretter økten og rent overtar roller etter tilbakekomsten fra identitetsleverandøren.

CAPTCHA-er utgjør et spesialtilfelle. De er ment å bremse automatiserte angrep og bør ikke omgås via testautomatisering. I stedet er en testkonfigurasjon, en offisiell testnøkkel eller et sikret unntak for testmiljøet fornuftig. Å lure sikkerhetskontroller bare for at en test skal bli grønn, er ingen kvalitetsstrategi.

Velge riktig teknisk testnivå

Ikke hver påloggingstest må kjøres gjennom en ekte nettleser. API-tester kan verifisere om tokener, økter, feilmeldinger og sperreregler fungerer korrekt. De er raske og hjelper med å finne feil nær autentiseringslogikken. Nettlesertester viser derimot om felt, omdirigeringer, informasjonskapsler, SameSite-innstillinger og synlige tilstander passer sammen i den reelle brukerflyten.

For kritiske applikasjoner er kombinasjonen fornuftig. Noen få ende-til-ende-tester sjekker den komplette veien med nettleseren. Under det sikrer målrettede API- og integrasjonstester variantene. Dette reduserer kjøretid og falske alarmer. Den som tester hver tenkelige kombinasjon utelukkende i nettleseren, ender ofte opp med en treg suite hvis vedlikehold spiser mer tid enn den sparer.

For skrivebordsprogramvare gjelder et lignende prinsipp. En automatisert test bør ikke bare kontrollere om et vindu åpnes. Den må fastslå om den korrekte dataforbindelsen finnes etter pålogging, om brukerrettighetene er aktive, og om den sentrale arbeidsmasken er tilgjengelig. Dette er spesielt relevant for applikasjoner på lageret eller i produksjonen fordi arbeidsplasser kan ha ulike nettverksforhold, skannertilkoblinger eller lokale konfigurasjoner.

Håndtere testdata trygt og repeterbart

Påloggingstester jobber uunngåelig med påloggingsdata. Produktive ansattkontoer, reelle kundedata eller MFA-hemmeligheter hører imidlertid ikke ukontrollert hjemme i testskript, logger og skjermbilder. Testkontoer må være tydelig merket, minimalt privilegerte og automatisk gjenopprettbare. Passord og tokener leveres via sikker hemmelighetshåndtering i stedet for å lagres i kildekoden.

Like viktig er opprydding etter en testkjøring. Hvis en test oppretter nye økter, revisjonsoppføringer eller sperrede kontoer, må testmiljøet gå tilbake til en definert starttilstand. Ellers mislykkes en test på mandag bare fordi en kjøring fra fredag har etterlatt seg sideeffekter.

For bedrifter med konfidensielle applikasjoner er også utførelsesstedet avgjørende. Skjermbilder av påloggingsskjermer, testvideoer og tekniske logger kan inneholde sensitiv informasjon. En selvhostet testinfrastruktur som COCO kan være fornuftig her fordi testdata, utførelse og bevis forblir under egen kontroll. Om dette er nødvendig, avhenger av beskyttelsesbehov, avtalesituasjon og interne retningslinjer. En egen infrastruktur er ikke automatisk det mest økonomiske valget for hver applikasjon.

Generere bevis, ikke bare grønne haker

En testrapport bør gjøre det forståelig for QA, utvikling og forretningsavdeling hva som ble testet. En grønn status uten kontekst hjelper lite hvis en utgivelse senere utløser spørsmål. Nyttig er derfor tidsstempler, brukt testmiljø, testkonto, relevante trinn, skjermbilder ved feil og en tydelig feilmelding på hverdagsspråk.

I denne sammenhengen må bevissikringen ikke selv bli et personvernproblem. Passord, engangskoder, økt-ID-er og personopplysninger må maskeres i logger. For skjermbilder kan det være nødvendig å tåkelegge visse områder. Disse reglene bør være en del av testarkitekturen, ikke manuelt etterarbeid etter en hendelse.

Hva team bør automatisere først

Prioriteten styres av risiko og bruksfrekvens. Først kommer standardpålogging for de viktigste rollene, feilaktige påloggingsdata, utlogging og øktutløp. Deretter følger sperreregler, passordtilbakestilling, MFA og rolleendringer. SSO, spesialleietakere eller sjeldne unntaksveier kan følge senere, forutsatt at deres bortfall ikke umiddelbart stopper driften.

Testene hører hjemme i utgivelsesprosessen. Endringer i påloggingsskjemaer, informasjonskapsler, rettigheter eller identitetsleverandørkonfigurasjon bør utløse den relevante testsuiten før en versjon går i produksjon. I tillegg lønner det seg med en planlagt kjøring i et realistisk miljø, for eksempel etter infrastrukturendringer eller sertifikatbytter. Dette finner problemer som ikke er synlige i et isolert utviklingsmiljø.

Til syvende og sist er den beste påloggingstesten ikke den med flest klikk. Det er den som oppdager et reelt bortfall tidlig, dokumenterer det forståelig, og fortsatt kan utføres pålitelig ved neste endring. Den som behandler påloggingen som en klart modellert forretningsprosess, beskytter ikke bare et skjema. Den beskytter tilgangen til arbeidet som venter bak.

Permalenke →

Ta kontakt

Har du et prosjekt i tankene, en arbeidsflyt som fortsatt går på regneark og god vilje, eller en testkø COCO kunne tatt av hendene på teamet ditt? Fortell oss om det.

Send melding