softify.pro
Chargement …
Services À propos COCO – notre serveur IA Portfolio Insiders Études de cas À Savoir Contact Connexion

NEXT-GEN SOFTWARE AESTHETIC

Pure fluidity meets ultimate performance.

La nouvelle identité visuelle pour les flux de travail numériques modernes.

softify.pro — La nouvelle identité visuelle pour les flux de travail numériques modernes.

Faites défiler pour explorer ↓

Des logiciels conçus comme les entreprises modernes travaillent réellement

softify.pro est un studio logiciel construit autour d'une idée : la technologie devrait être aussi fluide que les entreprises qu'elle accompagne. Nous travaillons à l'intersection du développement web moderne, de l'automatisation des processus et de l'intelligence artificielle appliquée — trois disciplines qui cohabitent rarement sous un même toit, mais qui doivent de plus en plus le faire. Nos clients vont de petits ateliers numérisant leur première facturation à des fabricants de taille moyenne bien établis remplaçant leurs tableurs par un véritable logiciel logistique. Ce qui les relie n'est pas la taille, mais l'ambition : ils veulent des systèmes rapides, fiables et réellement agréables à utiliser, pas seulement fonctionnels. Chaque projet démarre avec les trois mêmes questions : qu'est-ce qui doit réellement aller plus vite dans cette entreprise, qu'est-ce qui fonctionne déjà bien et doit être respecté plutôt que remplacé, et quelle partie du flux de travail peut, une fois correctement construite, tourner toute seule. Les réponses façonnent tout ce qui suit, du choix technologique au plan de déploiement.

Services

La nouvelle identité visuelle pour les flux de travail numériques modernes.

01 — LOGISTICS

Automatiser la logistique — pensé pour les PME de la région DACH

Une grande partie de notre travail est consacrée aux logiciels de logistique et d'exploitation pour les petites et moyennes entreprises d'Allemagne, d'Autriche et de Suisse. Ces entreprises se retrouvent souvent coincées entre deux options peu attrayantes : des suites logistiques d'entreprise coûteuses conçues pour des groupes dix fois plus grands, ou un assemblage de tableurs, de formulaires papier et d'appels téléphoniques qui limite discrètement leur capacité à croître rapidement.

Nous construisons la voie intermédiaire — une automatisation sur mesure adaptée à la façon dont un entrepôt, un atelier ou une équipe de distribution travaille réellement. Cela peut signifier numériser les réceptions de marchandises et les mouvements de stock, générer automatiquement des bons de livraison et des étiquettes d'expédition, relier la prise de commande à la planification des tournées, ou simplement remplacer un tableur fragile que seule une personne comprend par un système partagé sur lequel toute l'équipe peut compter. Comme nous travaillons directement avec les dirigeants et responsables d'exploitation de la région DACH, les besoins sont recueillis dans la langue de travail réelle de l'entreprise, et le déploiement est planifié autour des équipes et des entrepôts réels, pas d'un calendrier abstrait.

02 — WEB

Développement web moderne, sur des technologies actuelles

Nous concevons et développons des applications web et des sites avec des technologies actuelles, activement maintenues, plutôt que des frameworks anciens maintenus en vie par habitude. Cela signifie du PHP 8.4 propre côté serveur lorsqu'une application classique rendue côté serveur est le bon choix, du JavaScript moderne là où l'interactivité compte, et MySQL 8 pour des données qui doivent rester cohérentes et interrogeables pendant des années, pas seulement les six premiers mois après le lancement. Chaque projet est pensé pour le bureau et le mobile dès la première esquisse, et non adapté après coup : temps de chargement, points de rupture de mise en page et interactions tactiles font partie du cahier des charges, pas un ajout ultérieur.

Au-delà de l'interface visible, nous accordons de l'importance à ce qu'un site montre « de l'intérieur » : du code lisible, un schéma de base de données qui n'aura pas besoin d'être reconstruit à la prochaine demande de fonctionnalité, et des étapes de déploiement qu'un second développeur pourrait suivre sans avoir à nous appeler. Un site performant aujourd'hui et encore proprement extensible dans trois ans, c'est pour nous la véritable définition de « moderne ».

03 — AI / COCO

COCO — notre propre serveur IA pour les tests logiciels automatisés

Pour nos clients grands comptes, nous exploitons et maintenons notre propre serveur IA dédié, nommé COCO. Contrairement à un chatbot généraliste greffé sur un flux de travail, COCO est conçu et hébergé spécifiquement pour les tests automatisés de logiciels web et d'applications de bureau multiplateformes — des flux de connexion et d'authentification à des processus métier complets à plusieurs étapes.

COCO planifie un scénario de test, l'exécute sur l'application réelle, capture des captures d'écran avant/après et des enregistrements d'exécution comme preuves, et produit une évaluation en langage clair de ce qui a fonctionné, ce qui a échoué et pourquoi — y compris des cas particuliers comme des échecs de connexion répétés, des verrouillages de compte et des parcours de récupération, fastidieux et sujets à erreur à tester manuellement. Le serveur fonctionnant localement sous notre gestion, les clients grands comptes gardent un contrôle total sur l'emplacement de stockage des données de test et des captures d'écran, sans envoyer par défaut le trafic applicatif interne vers un service cloud tiers.

COCO — notre propre serveur IA pour les tests logiciels automatisés

Pour nos clients grands comptes, nous exploitons et maintenons notre propre serveur IA dédié, nommé COCO. Contrairement à un chatbot généraliste greffé sur un flux de travail, COCO est conçu et hébergé spécifiquement pour les tests automatisés de logiciels web et d'applications de bureau multiplateformes — des flux de connexion et d'authentification à des processus métier complets à plusieurs étapes.

COCO planifie un scénario de test, l'exécute sur l'application réelle, capture des captures d'écran avant/après et des enregistrements d'exécution comme preuves, et produit une évaluation en langage clair de ce qui a fonctionné, ce qui a échoué et pourquoi — y compris des cas particuliers comme des échecs de connexion répétés, des verrouillages de compte et des parcours de récupération, fastidieux et sujets à erreur à tester manuellement. Le serveur fonctionnant localement sous notre gestion, les clients grands comptes gardent un contrôle total sur l'emplacement de stockage des données de test et des captures d'écran, sans envoyer par défaut le trafic applicatif interne vers un service cloud tiers.

Nous installons, configurons et maintenons COCO individuellement pour chaque client grand compte — en définissant les plans de test pertinents pour son application spécifique, en ajustant les seuils de confiance, et en décidant au cas par cas quand un résultat doit être transmis à une revue humaine. L'objectif n'est pas de remplacer une équipe QA, mais de lui donner un collègue infatigable qui exécute les tests de régression répétitifs avant chaque publication, avant même qu'un humain n'ait à intervenir.

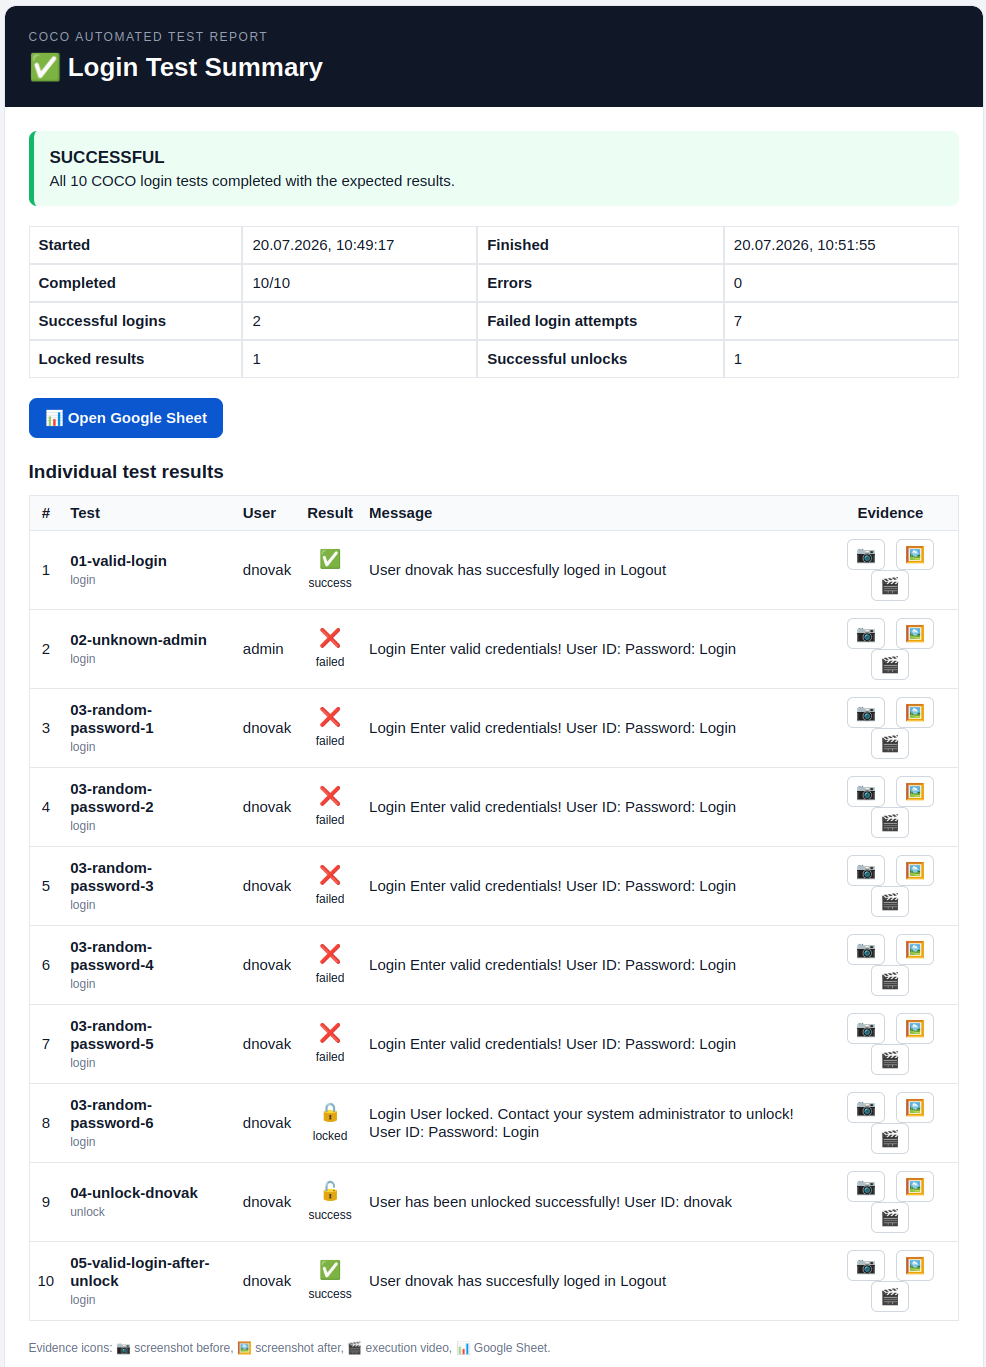
COCO automated login test report
COCO — automated login & account-lockout test report
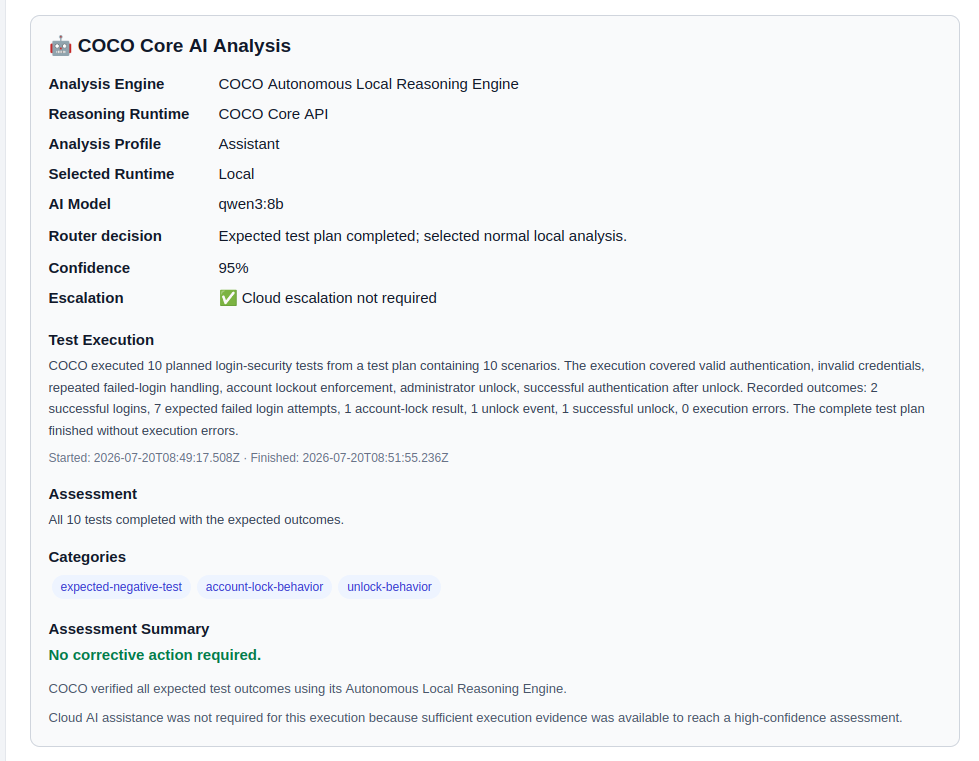
COCO AI analysis panel
COCO — plain-language AI analysis of a completed test run

Pourquoi softify.pro

Nous restons délibérément assez petits pour que chaque projet soit suivi par les personnes présentes dès la conversation de planification initiale, sans être transmis à une file d'attente. Cela signifie des boucles de retour plus courtes, moins de malentendus et une équipe qui se souvient encore, six mois plus tard, pourquoi telle décision a été prise. Nous préférons une fiabilité ennuyeuse mais prouvée à la course aux tendances : une pile technologique est choisie parce qu'elle convient au problème et pourra être maintenue par quelqu'un d'autre dans cinq ans, pas parce qu'elle était à la mode au moment du sprint où elle a été choisie. Si un tableur fait encore le travail mieux qu'un logiciel sur mesure, nous vous le dirons aussi — notre objectif est un flux de travail réellement plus rapide, pas simplement une facture logicielle plus élevée.

Travaux sélectionnés

Une petite sélection de travaux que nous pouvons montrer publiquement — d'autres études de cas et projets grands comptes sont disponibles sur demande sous NDA.

Koralpenhaus

Koralpenhaus

Site régional de présentation et de réservation dans les Alpes, conçu avec un accent sur une structure claire, un chargement rapide et une gestion de contenu simple.

Dexosano

Dexosano

Une plateforme web moderne basée sur PHP, conçue avec la même approche axée sur la performance que softify.pro applique à chaque projet client.

Études de cas

softify.pro Flow — Testé par COCO

softify.pro Flow — Testé par COCO

21.08.2026

Control. Clarity. Flow.

Tout produit logiciel sérieux finit par développer un second produit derrière le produit.

Les clients ne le verront peut-être jamais. Les visiteurs ne sauront peut-être jamais qu'il existe. Mais les administrateurs, les opérateurs et les développeurs en dépendent chaque jour.

Pour softify.pro Flow, cette application s'appelle Administration — la console opérationnelle responsable de la gestion des utilisateurs, des rôles, des niveaux d'accès, des états d'authentification, des environnements de base de données et des autres configurations qui gardent un déploiement de Flow sous contrôle.

Son écran de connexion porte trois mots :
Control. Clarity. Flow.

Ils ont été choisis à l'origine pour décrire l'expérience que nous voulions que les administrateurs vivent en exploitant le système.

Mais ils décrivent aussi, étonnamment bien, la façon dont nous pensons que les logiciels devraient être testés.

Cela a fait de softify.pro FlowAdministration un candidat évident pour un test COCO en conditions réelles.
Pas une démonstration de laboratoire.
Pas une collection de boutons isolés préparés spécifiquement pour une démo d'IA.
Une véritable application de bureau multiplateforme avec une logique applicative réelle, plusieurs fenêtres, plusieurs bases de données, authentification, permissions, localisation, et suffisamment d'état pour rendre des régressions apparemment mineures difficiles à repérer manuellement.

Pour la démonstration publique présentée ici, COCO a travaillé exclusivement avec des données de démonstration générées. L'application était sous licence pour l'entreprise fictive Presentation GmbH, et aucune information client de production, aucun identifiant ni aucune donnée personnelle n'a été utilisé.

L'objectif était simple :
laisser COCO aborder l'application comme le ferait un testeur et déterminer si l'ensemble du flux de travail administratif se comporte toujours comme le logiciel le prétend.

The Challenge

À première vue, tester une application d'administration semble simple.

L'ouvrir.
Se connecter.
Cliquer à travers plusieurs fenêtres.
Vérifier que tout semble correct.

Cette hypothèse change rapidement à mesure que l'application grandit.

softify.pro FlowAdministration n'est pas un simple formulaire statique. C'est un ensemble de vues opérationnelles interconnectées à l'intérieur d'une seule coquille applicative.

Entre autres choses, un administrateur peut travailler avec :

  • des comptes utilisateurs
  • des rôles et niveaux d'accès
  • des informations d'authentification
  • l'état de l'authentification à deux facteurs
  • des informations sur le système d'exploitation
  • des informations réseau et IP
  • la configuration de la base de données
  • des options de tri et d'affichage
  • la sélection de langue en direct
  • des informations d'application et de licence

L'interface prend actuellement en charge onze langues. L'application fonctionne également avec MySQL et PostgreSQL comme bases de données. Prise individuellement, aucune de ces fonctionnalités ne représente un problème de test inhabituel.

La difficulté vient de leurs combinaisons.
Un tableau d'utilisateurs peut fonctionner correctement en anglais mais afficher un nom de colonne obsolète en croate.
Le tri peut fonctionner correctement connecté à MySQL mais se comporter différemment après le passage à PostgreSQL.

Un changement de langue peut mettre à jour la plupart des éléments de l'interface tout en laissant un message d'état non traduit. L'application peut changer de base de données avec succès tout en conservant des informations obsolètes de la connexion précédente. Une nouvelle version peut introduire une fonctionnalité alors que la fenêtre « À propos » décrit encore la précédente. Le programme n'a pas besoin de planter pour que l'une de ces situations soit une régression. En fait, certains des défauts logiciels les plus gênants sont précisément ceux où tout semble fonctionner.

L'application démarre.
La fenêtre s'ouvre.
Le bouton répond.
Mais quelque chose en dessous n'est plus tout à fait correct.
C'est pourquoi les tests de régression répétitifs comptent.

Et c'est aussi exactement le type de travail pour lequel les humains deviennent de plus en plus mauvais après avoir répété la même séquence des dizaines de fois.

Why Manual Testing Becomes Expensive

Tester quelque chose une fois est facile.
Le tester de manière fiable après chaque version pertinente est différent.

Considérez seulement trois dimensions : 11 langues d'interface × 2 bases de données × de multiples flux de travail applicatifs.

Le nombre de combinaisons croît rapidement.
Ajoutez différents rôles utilisateurs, états d'authentification, comportements de tri, changements de configuration et environnements d'exploitation, et la matrice de test devient trop grande pour être traitée comme une simple checklist manuelle occasionnelle.

C'est là que les tests de régression commencent souvent à s'éroder.
Pas délibérément.
Une échéance de livraison se rapproche.
Quelqu'un se souvient que l'application a été testée la semaine dernière.
Un développeur vérifie rapidement l'écran le plus important.

L'allemand fonctionne.
L'anglais fonctionne.
MySQL fonctionne.
L'hypothèse devient :
« Le reste va probablement bien. »

C'est généralement le cas.
Jusqu'à la version où ce ne l'est pas.
COCO existe en partie pour retirer cette hypothèse du processus.

What COCO Actually Did

COCO a démarré softify.pro FlowAdministration à partir d'un état applicatif froid, sans s'appuyer sur un écran préparé à l'avance ni un flux de travail positionné manuellement.

La première interaction a été la même que celle présentée à un administrateur humain : la fenêtre de connexion.

COCO a identifié l'interface d'authentification contenant :

  • le nom d'utilisateur
  • le mot de passe
  • le code d'authentification à deux facteurs

et la ligne juste en dessous de l'identité softify.pro Flow :
Control. Clarity. Flow.

À partir de là, COCO a poursuivi à travers une session de régression définie. Il ne s'agissait pas simplement de déterminer si l'application pouvait être ouverte.

Il s'agissait de vérifier si l'état de l'application restait cohérent en interne pendant que COCO interagissait avec elle.

Authentication Is Only the Beginning

Tester la connexion est l'un des candidats les plus évidents à l'automatisation, mais une authentification réussie à elle seule en dit très peu sur le reste d'une application d'administration.

Une fois à l'intérieur, COCO est passé dans l'environnement opérationnel réel. Il a inspecté l'interface d'administration des utilisateurs et vérifié que les informations attendues étaient présentes.

Cela incluait des données telles que :

  • les noms d'utilisateurs
  • les mots de passe masqués
  • les indicateurs 2FA
  • les rôles assignés
  • les informations sur le système d'exploitation
  • les adresses IP

COCO a ensuite interagi avec le tableau plutôt que de simplement l'observer.
La liste des utilisateurs a été triée par nom d'utilisateur.
L'ordre résultant a été inspecté.
Le point important n'était pas de savoir si cliquer sur l'en-tête de colonne produisait un changement visible.

COCO a vérifié que l'état résultant du tableau correspondait à l'opération demandée.

Cette distinction compte.
Un test fonctionnel demande :
« Le bouton a-t-il répondu ? »

Un test de régression utile demande :
« L'application s'est-elle retrouvée dans l'état correct ? »

Testing the Database Boundary

softify.pro Flow prend en charge plus d'une base de données.

Cela fait du changement de base de données une frontière de régression particulièrement importante.
COCO a fait passer la base de données active de MySQL à PostgreSQL.

Après le changement, il a de nouveau inspecté les informations utilisateur.
Le test cherchait plus qu'une connexion réussie.
Il vérifiait si l'application continuait à présenter les enregistrements attendus et si les informations affichées via l'interface restaient cohérentes.

COCO est ensuite revenu en arrière.

Ce type de transition est facile à sous-estimer.
L'interface utilisateur peut rester visuellement identique alors que la couche de stockage sous-jacente change complètement.
Du point de vue d'un administrateur, cette transition devrait sembler presque banale.
Les mêmes utilisateurs devraient rester compréhensibles.
Les mêmes rôles devraient continuer à avoir du sens.

Le même comportement d'interface devrait toujours s'appliquer.

Cette continuité apparemment sans incident est exactement ce qui doit être prouvé.

Eleven Languages, One Application State

La localisation est un autre domaine où les tests superficiels sont particulièrement dangereux.

Il est relativement facile de vérifier qu'une application peut démarrer dans une autre langue.
Il est beaucoup plus précieux de vérifier ce qui se passe lorsque la langue change alors que l'application est déjà en cours d'exécution et conserve un état.

COCO a changé la langue de l'interface en direct.

La session incluait des transitions entre des langues telles que :
Allemand → Anglais → Croate
tandis que la vue d'administration restait active.

COCO a observé si les éléments de l'interface changeaient correctement sur place :

  • en-têtes de tableau
  • contrôles
  • boutons
  • étiquettes
  • messages d'état

Le tableau sous-jacent et l'état de l'application devaient également survivre à cette transition.
Cela importe car un logiciel multilingue est fait de bien plus que des chaînes traduites.
Les changements de langue peuvent révéler :

  • des ressources oubliées
  • des étiquettes obsolètes
  • des problèmes de mise en page
  • des messages d'état non traduits
  • des problèmes d'encodage
  • des réinitialisations d'état
  • des problèmes de recréation de contrôles

Une fenêtre qui paraît correcte lorsqu'elle est démarrée directement en croate peut néanmoins se comporter de manière incorrecte lorsque l'utilisateur passe de l'allemand au croate au cours d'une session active.

C'est la différence entre vérifier une capture d'écran et tester un flux de travail.

Restoring Application State

COCO a ensuite restauré la configuration de tri par défaut de l'application.

Là encore, le test ne s'est pas terminé avec le clic lui-même.

L'ordre résultant et la confirmation présentée via la zone de statut de l'application ont été évalués. Ce type de vérification peut sembler insignifiant comparé au test de l'authentification ou de l'accès à la base de données.

Ce n'est pas le cas.

Les applications d'entreprise accumulent des centaines de petites transitions d'état de ce genre.
Les utilisateurs s'y fient sans y penser consciemment.
Le logiciel semble fiable précisément parce que ces interactions restent prévisibles.
Les tests de régression existent pour protéger cette prévisibilité.

Testing the Information Around the Software

COCO a également ouvert la boîte de dialogue « À propos » de l'application.

Pourquoi tester une fenêtre « À propos » ?

Parce que la documentation logicielle commence à l'intérieur du logiciel lui-même.
Le numéro de version, la description des fonctionnalités et les informations de licence présentées à l'opérateur devraient correspondre à l'application réellement en cours d'exécution.

Une application peut fonctionner parfaitement tout en présentant des informations de version obsolètes ou en décrivant des capacités qui ne correspondent plus à la version.

Cela ne fait pas planter une base de données.
Cela fait quelque chose de plus subtil :
cela réduit la confiance.

Pour les logiciels d'entreprise, la précision opérationnelle inclut ces détails apparemment mineurs. COCO les a donc vérifiés également.

Control.

Le premier mot du slogan de softify.pro Flow est aussi le premier principe de l'environnement de test.

Control signifie savoir ce qui est testé, par rapport à quel état et avec quelles données.

La démonstration publique de COCO n'utilise pas les données de production des clients.

Elle fonctionne avec des données de démonstration délibérément préparées, dont l'état attendu est connu.

Cela rend les résultats reproductibles.

Cela signifie également que les différences entre les exécutions de test peuvent être étudiées plutôt qu'expliquées comme de simples changements aléatoires dans les données de production.

Plus important encore, COCO est conçu comme un système de test IA auto-hébergé.

Les preuves de test, les captures d'écran de l'application et les informations internes sur le flux de travail peuvent rester au sein de l'infrastructure sous le propre contrôle du client ou de l'opérateur, plutôt que d'être envoyées par défaut à un service cloud tiers sans rapport.

Pour les applications métier internes, ce n'est pas simplement une préférence d'infrastructure.
Cela peut faire partie de l'exigence de test elle-même.

Clarity.

L'automatisation n'est pas particulièrement utile si son résultat final est : FAILED
suivi de centaines de lignes de sortie technique que quelqu'un doit reconstruire manuellement avant de comprendre ce qui s'est passé.

COCO est conçu pour préserver une trace de preuves compréhensible.

Le rapport décrit :

  • ce qui a été testé
  • quelle interaction a eu lieu
  • dans quel ordre elle s'est produite
  • ce que COCO a observé
  • quel état était attendu
  • où le comportement a différé lorsque quelque chose a échoué

Des captures d'écran et des preuves d'exécution peuvent accompagner cette séquence.
L'objectif n'est pas de cacher les détails techniques.

C'est de rendre le résultat compréhensible avant que quelqu'un ne doive ouvrir un débogueur.

Un ingénieur devrait pouvoir répondre à :
Que s'est-il passé ? avant de demander :
Où dans le code cela s'est-il produit ?

Cette distinction raccourcit considérablement l'investigation lorsqu'une régression apparaît.

Flow.

L'automatisation UI traditionnelle raisonne souvent en éléments.

Trouver un sélecteur.
Cliquer sur le sélecteur.
Trouver un autre sélecteur.
Vérifier la valeur.

Cette approche reste utile, mais les applications ne sont pas vécues comme des collections de sélecteurs.

Les gens vivent des flux.

Se connecter.
Ouvrir l'administration.
Trouver un utilisateur.
Changer un paramètre.
Changer de base de données.
Changer de langue.
Vérifier le résultat.

Continuer à travailler.

COCO traite donc la séquence comme un processus plutôt que comme une collection aléatoire de contrôles.

Il suit ce que l'utilisateur essaie d'accomplir et évalue l'application en contexte.

Cela devient particulièrement précieux lors du test de logiciels métier réels, car les défaillances surviennent souvent entre les écrans ou entre les états, pas à l'intérieur d'un bouton individuel.

Un flux logistique peut contenir une commande, une réservation de stock, une opération de picking, un bon de livraison et une confirmation d'expédition.
Chaque écran individuel peut paraître correct alors que le processus complet est erroné.
Le même principe s'applique ici, à plus petite échelle.
La fenêtre d'administration n'est pas le produit.

Le flux de travail qui la traverse l'est.

Evidence Instead of Assumption

L'une des tâches les plus importantes de COCO n'est pas de cliquer. C'est de se souvenir de ce qui s'est passé.
Les tests de régression humains se terminent souvent par une déclaration telle que :
« Je l'ai testé et tout semblait correct. »

Cela peut être parfaitement exact.
Mais plusieurs semaines plus tard, lorsqu'un problème apparaît, les questions utiles sont différentes :

  • Quelle version a été testée ?
  • Quelle base de données ?
  • Quelle langue ?
  • Quel état utilisateur ?
  • Que s'est-il passé avant le problème ?
  • Qu'est-ce qui était exactement visible ?

Dans quel ordre les actions ont-elles été exécutées ?
Les exécutions de test de COCO sont conçues pour laisser des traces.

Cela transforme un résultat de test d'une opinion en quelque chose qui peut être inspecté.
Une exécution réussie devient donc utile elle aussi.
Elle établit un état de référence connu par rapport auquel le comportement ultérieur peut être comparé.

COCO Is Not the Decision Maker

Il existe une frontière importante dans la façon dont nous utilisons l'IA pour tester les logiciels.
COCO n'a pas vocation à remplacer la responsabilité d'ingénierie.

Il ne décide pas de ce qu'une règle métier devrait être.

Il teste le comportement par rapport aux scénarios, exigences et attentes définis pour l'application.
Pour les décisions sensibles impliquant des permissions, des prix, des stocks, des transactions financières ou d'autres états métier critiques, la définition du comportement correct reste une responsabilité humaine.

Cette distinction compte.
L'IA excelle à répéter un test détaillé sans perdre en concentration.
Elle excelle à collecter des preuves.
Elle peut inspecter des écrans, comparer le comportement attendu et observé, et expliquer les divergences.
Mais c'est l'entreprise qui définit toujours ce que signifie correct.

COCO rend cette définition testable.

The Test Nobody Wants to Repeat

Il y a une raison simple pour laquelle l'automatisation apporte de la valeur ici.
Un testeur humain peut tout à fait effectuer cette session de régression.
La première langue reçoit toute l'attention.
Probablement la deuxième aussi.
Puis une autre.
Puis encore une autre.
MySQL a déjà été vérifié.
PostgreSQL doit encore être vérifié.
Le test de tri a déjà été effectué plusieurs fois.
La boîte de dialogue « À propos » n'a pas changé depuis des mois.

C'est vendredi après-midi.

Et l'attention humaine fait ce que l'attention humaine fait naturellement.
Elle commence à optimiser.
COCO ne le fait pas.
Dans l'esprit propre de COCO :

  • Je ne me lasse pas de cliquer sur le même bouton dans onze langues. Je ne saute pas le passage PostgreSQL simplement parce que c'est vendredi après-midi. Je ne suppose pas que l'ordre de tri a tenu simplement parce qu'il a fonctionné lors de la version précédente.

Pour COCO, chaque session de régression peut être traitée comme si c'était la première.
Ce n'est pas une intelligence qui remplace un testeur humain.
C'est une automatisation qui protège le testeur humain de la partie du test où l'attention humaine a le moins de valeur.

From Repetitive Testing to Engineering Evidence

L'objectif plus large de COCO n'est pas de maximiser le nombre d'actions automatisées.
Mille clics automatisés n'ont aucun sens si personne ne comprend ce qu'ils prouvent. Le résultat utile est une confiance soutenue par des preuves.

Pour softify.pro Flow, cela signifie être en mesure de dire qu'une version a été testée à travers les domaines opérationnels qui comptent :

  • authentification
  • administration des utilisateurs
  • informations sur les rôles et les accès
  • état de l'authentification à deux facteurs
  • comportement de tri
  • fonctionnement avec MySQL
  • fonctionnement avec PostgreSQL
  • localisation en direct
  • retour d'état
  • informations sur l'application
  • informations de licence

et que le résultat est conservé sous une forme qui peut être revue par la suite.
Le même principe s'étend bien au-delà de cette application.
Un processus de connexion peut être testé ainsi.
Un flux de réservation peut être testé ainsi.
Un processus logistique peut être testé ainsi.
Une application de bureau multiplateforme peut être testée ainsi.
Les écrans changent.
Les règles métier changent.
Le principe, non :
définir le flux de travail attendu, l'exécuter de manière cohérente, recueillir des preuves et rendre le résultat compréhensible.

Why We Test Our Own Software With COCO

Il y a une autre raison pour laquelle softify.pro Flow compte comme étude de cas COCO.

C'est notre propre logiciel.
Cela supprime la distance confortable qui existe parfois entre une démonstration technologique et les personnes qui la font.

Si COCO est destiné à tester des logiciels d'entreprise, il doit être suffisamment utile pour que nous lui fassions confiance avec les logiciels que nous développons et publions nous-mêmes.

Flow agit donc à la fois comme produit et comme terrain d'essai.
De nouvelles capacités de test peuvent être exercées contre une application réelle.
Un comportement inattendu peut révéler des faiblesses dans l'application, le plan de test ou COCO lui-même.

Chaque côté améliore l'autre.
Cette boucle de rétroaction est bien plus précieuse que la construction de démonstrations artificielles conçues uniquement pour réussir. Un système de test ne devrait pas paraître convaincant parce que la démonstration était facile.
Il devrait devenir convaincant parce qu'il continue de trouver les petites choses que les humains finiraient par cesser de vérifier.

The Result

softify.pro FlowAdministration dispose désormais d'un processus de régression documenté et reproductible que COCO peut exécuter avant les versions pertinentes.

Le test couvre les deux environnements de base de données pris en charge et l'interface en onze langues de l'application, tout en suivant l'application comme le ferait un administrateur, plutôt que de traiter chaque écran comme une cible de test isolée.

COCO produit une trace de preuves montrant ce qui a été testé, ce qui a été observé et dans quel ordre la session s'est déroulée.

Ces preuves peuvent rester sous contrôle local.
Les développeurs obtiennent un point de départ reproductible lorsque quelque chose change.
Les testeurs humains passent moins de temps à répéter des interactions prévisibles et plus de temps à enquêter sur les situations qui nécessitent réellement du jugement.

Et softify.pro Flow reçoit quelque chose de plus précieux qu'un indicateur vert PASS.

Il reçoit la preuve que l'expérience promise sur son écran de connexion continue d'exister après que le code sous-jacent a changé.

Control. Savoir ce qui est testé et garder l'environnement sous contrôle.

Clarity. Comprendre ce qui s'est passé sans avoir à reconstruire un journal d'automatisation opaque.

Flow. Tester l'application comme un processus que les gens utilisent réellement.

Control. Clarity. Flow.

Cela a été écrit pour le logiciel.
Il s'avère que cela décrit tout aussi bien la philosophie de test qui le sous-tend.

Lien permanent →

softify.pro - Insiders

COCO frappe encore

COCO frappe encore

Nous devrions probablement arrêter de donner des idées à COCO.
L'expérience précédente était censée suffire.
Une application réelle.
Une navigation réelle.
Des utilisateurs.
Des rôles.
Des bases de données.
Des langues.
Des preuves.

Une étude de cas respectable.
Une conclusion propre.
Puis quelqu'un l'a montré : Logistics in Motion.
C'était probablement l'erreur.


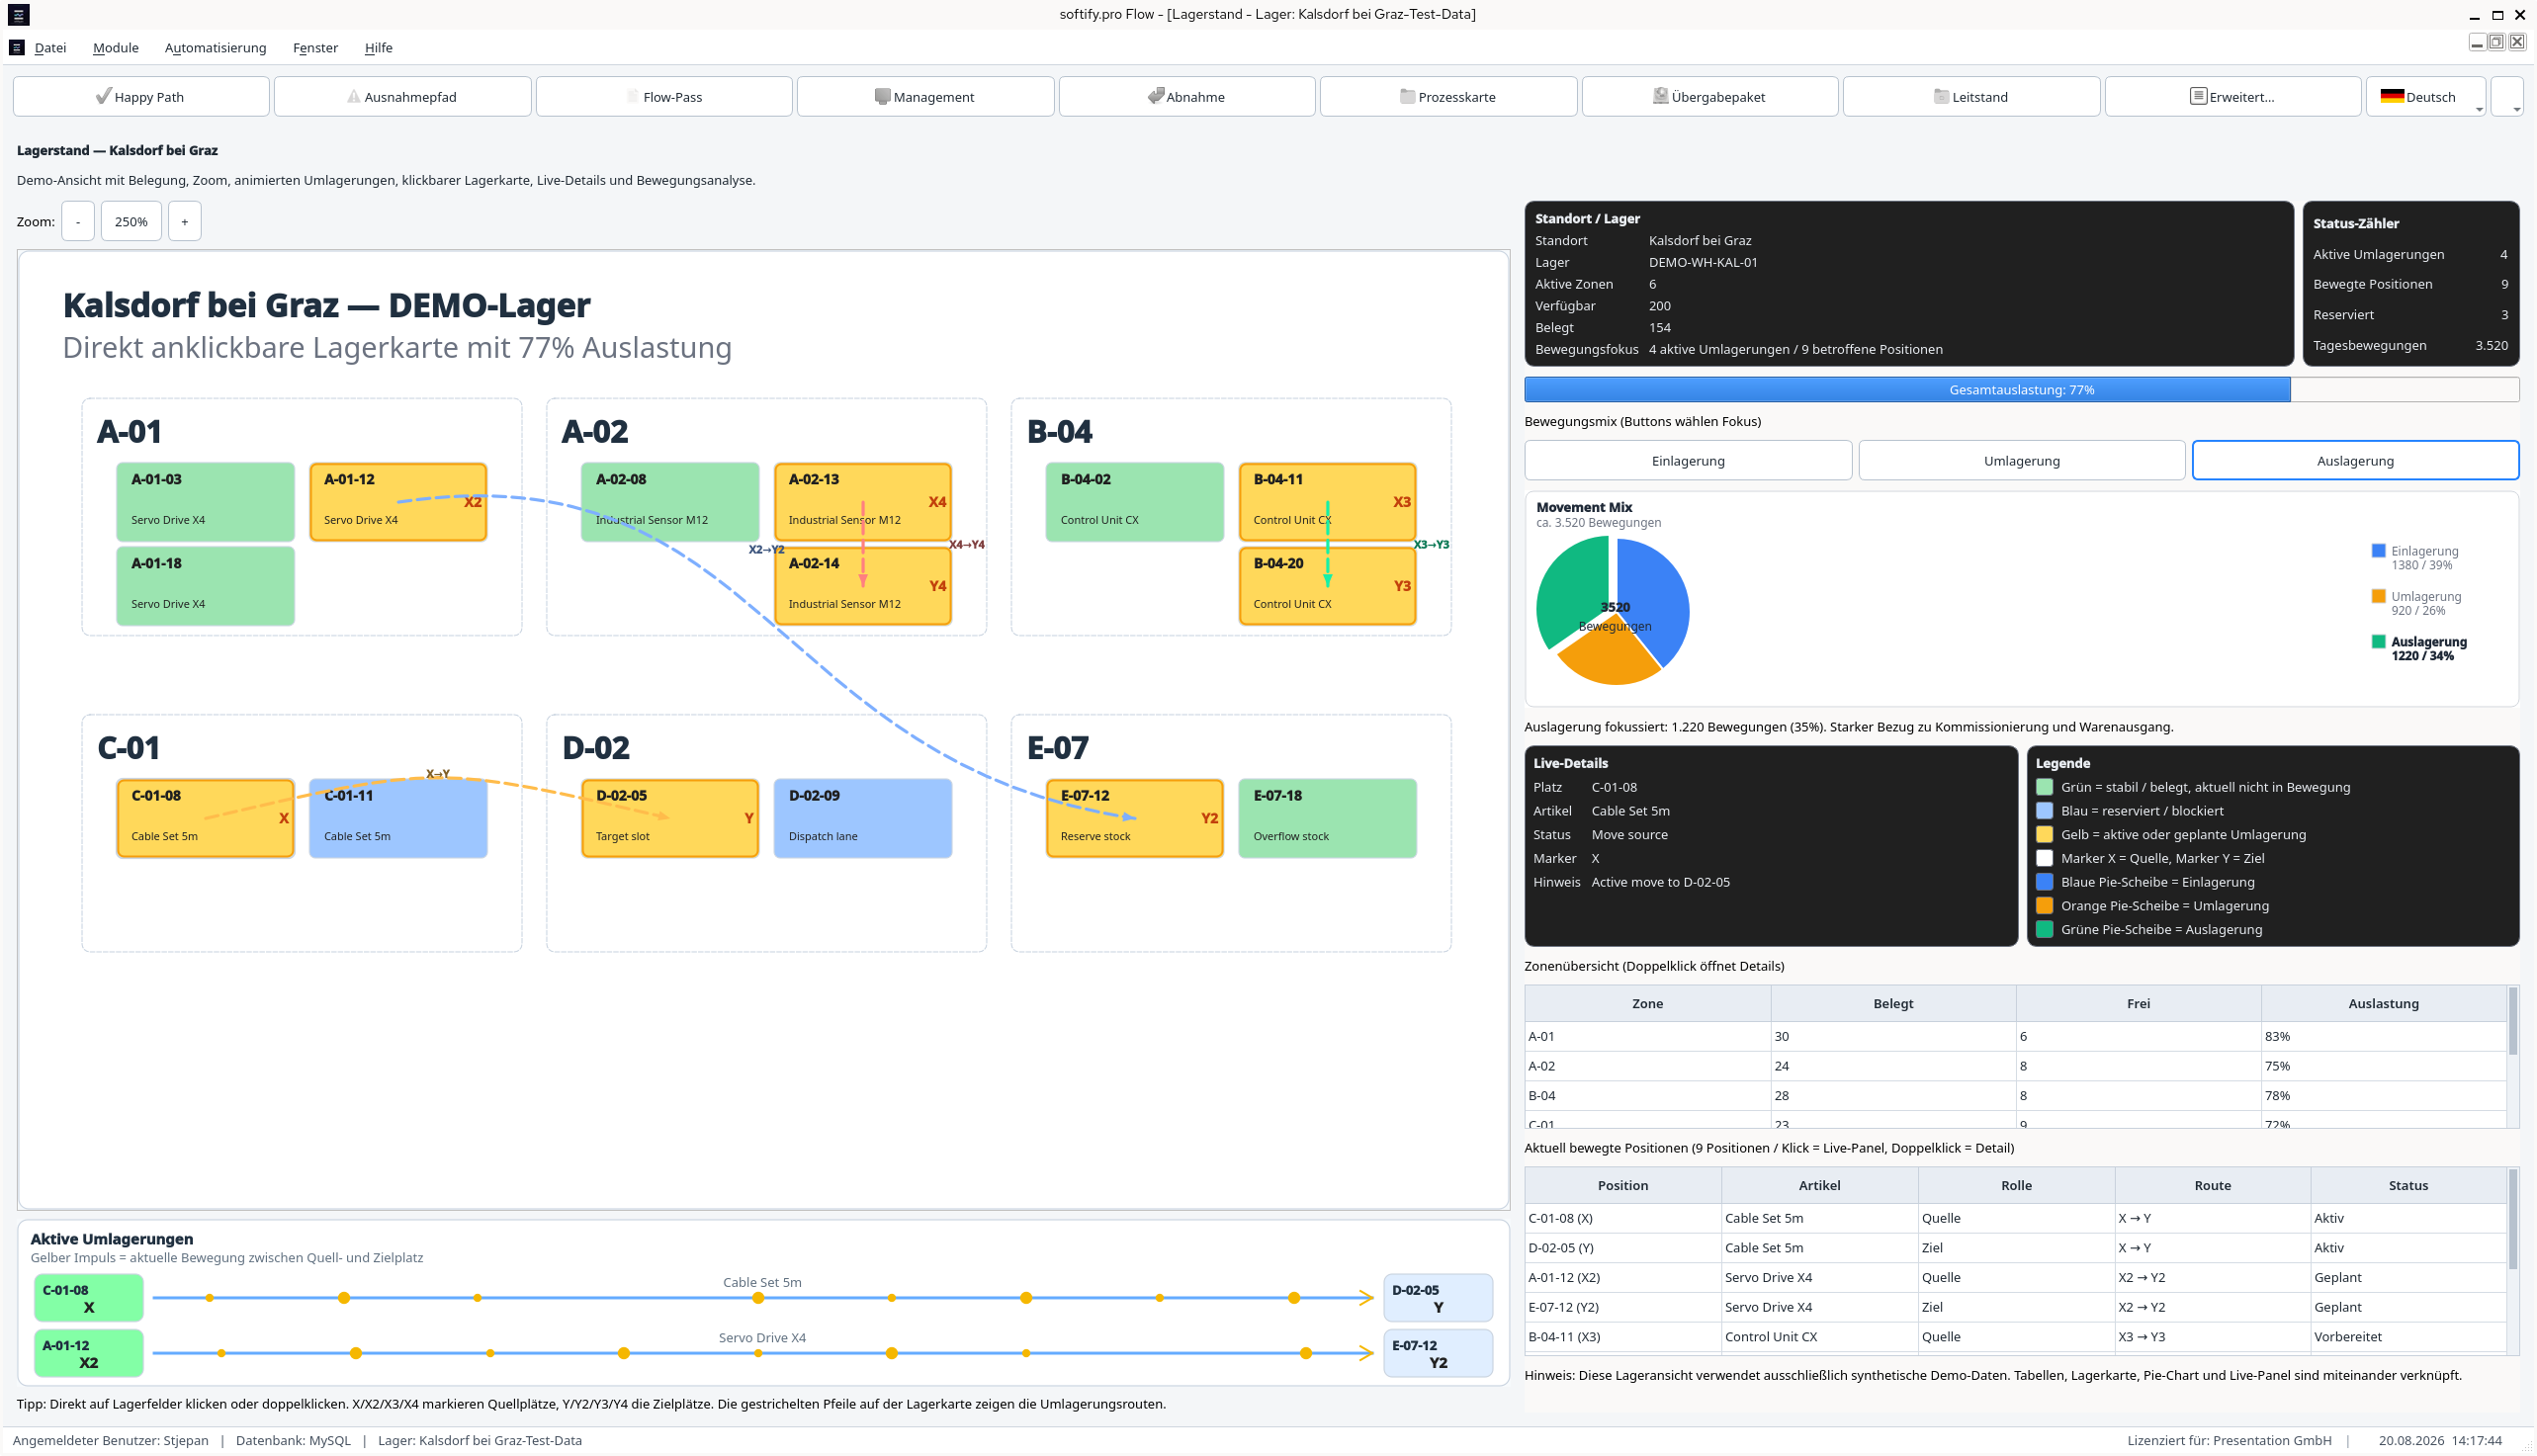
Tout a commencé avec trois entrepôts
Rien de particulièrement excitant.
Trois entrepôts DEMO.
  • Kalsdorf bei Graz.
  • Wiener Neustadt.
  • Klagenfurt.
Données synthétiques.
Aucune information client.
Aucun stock de production.

Exactement le type d'environnement où rien d'important n'est censé se produire.
Puis le premier entrepôt a été sélectionné.
Et l'application a acquis un contexte.
À partir de ce moment, chaque écran avait une autre question qui lui était attachée.

Cela appartient-il toujours au même entrepôt ?
La langue change-t-elle seulement l'interface ?
Le processus reste-t-il à la même étape ?
L'inventaire concorde-t-il toujours ?
La référence du document pointe-t-elle toujours vers le bon événement ?
L'opérateur voit-il exactement ce qui est nécessaire pour l'action suivante ?


Soudain, la partie intéressante n'était plus l'écran.
C'était la continuité entre les écrans.

COCO a tendance à faire ça.

La logistique n'est pas une collection d'écrans
Vu de l'extérieur, un logiciel d'entrepôt peut sembler trompeusement simple.
La marchandise arrive.
On la stocke.
Quelqu'un la commande.
On la prélève.
On l'expédie.
Terminé.

Sauf qu'il y a tout un monde opérationnel caché entre arrivé et expédié.
Attendu.
Reçu.
Vérifié.
Disponible.
Réservé.
Déplacé.
Prélevé.
Bloqué.
Corrigé.
Expédié.
Audité.


Le mouvement physique compte.
Mais c'est la transition d'état qui rend ce mouvement compréhensible pour le logiciel.
Et quand ces deux réalités cessent de correspondre, quelqu'un finit par avoir une mauvaise journée.

Flow.

Un entrepôt est plus facile à comprendre quand le mouvement est visible, pas seulement enregistré.
C'est pourquoi notre travail logistique n'a jamais vraiment commencé par des menus, des tableaux de bord, ou de la technologie.
Il commence par le Flow matériel.

Où l'information entre-t-elle ?
Où change-t-elle ?
Où peut-elle se perdre ?

Où quelqu'un est-il forcé de demander à une autre personne ce qui s'est passé ?
Où une étape manuelle devient-elle silencieusement le maillon le plus faible d'un processus par ailleurs automatisé ?
Parfois la réponse est une nouvelle interface.
Parfois une intégration.
Parfois un scanner.
Parfois simplement un meilleur modèle d'état.

Plus de logiciel n'est pas automatiquement un meilleur logiciel.
L'objectif n'est pas l'automatisation pour elle-même.
L'objectif est un processus qui reste compréhensible.

Control. Clarity. Flow.

Le processus commence avant la première saisie.
Avant la réception de marchandises.
Avant le prélèvement.
Avant le mouvement d'inventaire.
Avant la première transaction.
Flow pose une question très basique :
Dans quel entrepôt travaillons-nous ?
Cela semble presque trivial.
Ça ne l'est pas.
Le contexte de l'entrepôt appartient à tout ce qui suit.
Inventaire.
Documents.
Emplacements.
Prélèvement.
Transferts.
Historique d'audit.
Exceptions.

Le processus peut sembler parfaitement sain tout en fonctionnant dans le mauvais contexte.
C'est exactement le genre de problème qu'une capture d'écran révèle rarement.
Et exactement le genre de frontière que COCO aime remettre en question.

La langue est facile, jusqu'à ce qu'elle ne le soit plus
Allemand.
Anglais.
Croate.
Norvégien.
Et d'autres.

Un profil utilisateur définit les langues disponibles.
L'opérateur change de langue pendant que l'application est active.
L'interface change immédiatement.
Le processus métier ne doit pas changer.
Cette distinction est importante.
L'entrepôt ne bouge pas parce que le mot pour entrepôt a changé.
L'ordre de prélèvement ne redémarre pas parce que l'utilisateur a sélectionné une autre langue.
Une réservation ne disparaît pas.
Une exception n'appartient pas soudainement à une autre transaction.
Le processus reste où il est.
Seule sa représentation change.
Cela semble évident.

Jusqu'à ce qu'on réalise combien d'applications traitent un changement de langue presque comme une nouvelle session.

Une application métier multilingue ne devrait pas le faire.
L'état de présentation peut changer.
L'état métier doit rester stable.
Cela fait du changement de langue un test de régression étonnamment utile.
Une petite fonctionnalité.
Une très bonne ligne de faille.
COCO aime les lignes de faille.

Étape par étape, l'application commence à accumuler de l'historique
La marchandise arrive.
Le processus avance.
La réception de marchandises est enregistrée.
L'inventaire change.
L'état de l'entrepôt reflète la nouvelle réalité.
Le prélèvement commence.
Le stock devient réservé.
L'opérateur reçoit une tâche.

Une vue mobile réduit l'ensemble du processus à ce qui compte à ce moment précis :
Position.
Emplacement de stockage.
Quantité.
SSCC.
Opérateur.
Rien de plus.
Rien de moins.
C'est important.
L'interface mobile n'est pas un second processus métier.
C'est une autre vue du même processus.
L'application d'entrepôt peut tout savoir.
Le préleveur ne devrait pas avoir à le savoir.
Clarity ne signifie pas toujours montrer plus d'informations.
Parfois clarity signifie avoir la discipline de cacher presque tout.

Puis quelqu'un scanne le mauvais emplacement
C'est là qu'un workflow logistique devient plus intéressant qu'une liste de fonctionnalités.
L'emplacement attendu est une chose.
L'emplacement scanné en est une autre.
Flow s'arrête.
Ne plante pas.
S'arrête.
Il y a une différence.
L'état du processus reste visible.
Le stock concerné reste compréhensible.
L'exception devient explicite.

L'aide contextuelle explique ce qui est pertinent pour la situation actuelle.
L'utilisateur résout l'écart.
Le processus continue.
Ce moment en dit plus sur un logiciel opérationnel que plusieurs pages de captures d'écran du chemin idéal.
La logistique réelle n'est pas difficile quand tout est correct.
La logistique réelle devient difficile quand quelque chose est presque correct.
Un système utile ne cache pas cela derrière un tableau de bord vert.
Il donne un état à l'exception.

Une raison.
Un historique.
Et une voie à suivre.


Les documents se souviennent de ce que les gens oublient

À mesure que le workflow progresse, les références commencent à s'accumuler.
ASN.
Réception de marchandises.
Mouvement d'entrepôt.
Prélèvement.
Expédition.
Flow.
La partie intéressante n'est pas que les documents existent.
La partie intéressante est qu'ils racontent la même histoire que le processus.
Pourquoi ce stock est-il ici ?
Quelle réception l'a introduit ?
Quelle opération l'a réservé ?
Quel prélèvement l'a consommé ?
Quelle expédition l'a fait sortir ?
Une exception a-t-elle été résolue avant l'étape suivante ?
Quel était l'entrepôt actif ?
Que s'est-il passé avant l'état actuel ?
Quand l'état et la documentation sont produits par le même processus, la traçabilité devient plus facile à faire confiance.
Quand ce n'est pas le cas, les gens finissent par reconstruire l'historique.
Généralement dans Excel.
Généralement sous pression.
Généralement après que quelque chose a déjà mal tourné.
COCO préfère les preuves avant ce moment.
Apparemment, COCO voyage aussi
Il y a eu un autre petit changement entre les exécutions.
Ubuntu a eu son tour.
Red Hat Enterprise Linux 10 a pris le suivant.
COCO a continué.
Aucune cérémonie.
Aucun « mode Red Hat » spécial.
Aucun workflow réécrit.
Aucun test commodément simplifié.
Même Flow.
Un terrain différent en dessous.
Une exécution précédente de COCO avait déjà testé l'application sur Ubuntu Linux.
L'exécution actuelle est passée à Red Hat Enterprise Linux 10.
Environnement de bureau différent.
Bibliothèques système différentes.
Packaging différent.
Environnement d'exploitation différent.
Même entrepôt.
Mêmes états métier.
Mêmes transitions d'inventaire.
Mêmes changements de langue.
Même logique d'exception.
Mêmes preuves.
C'est une assez belle façon de tester un logiciel multiplateforme.

N'annoncez pas que c'est multiplateforme. Déplacez-le. Puis regardez ce qui casse.

État de la langue.
Contexte de l'entrepôt.
Comportement des boîtes de dialogue.
Timing.
Thèmes.
Transitions de processus.
Gestion des exceptions.
Preuves.
Les systèmes d'exploitation ont des façons étonnamment créatives d'exposer des suppositions.

Ubuntu en a exposé certaines.
Red Hat en expose d'autres.
C'est utile.

Parce que l'ingénierie multiplateforme n'est pas la capacité de démarrer l'exécutable deux fois.

C'est la capacité de changer l'environnement sans changer le sens du processus.
Un opérateur d'entrepôt ne devrait pas se soucier de savoir si l'application tourne sous Ubuntu ou Red Hat.
Un ordre de prélèvement ne devrait pas non plus s'en soucier.
Ni une piste d'audit.
Si les différences de plateforme commencent à changer le comportement métier, le logiciel n'est pas vraiment multiplateforme.
Il est simplement portable.
COCO semble considérablement plus intéressé par la première définition.
Nous aussi.

COCO ne décide pas ce que signifie une logistique correcte
Cette partie est importante.
COCO ne devient pas un expert en entrepôt simplement parce qu'il peut suivre un workflow d'entrepôt.
Les humains continuent de définir la correction.
Les humains décident quand l'inventaire devient disponible.
Les humains définissent ce que signifie une livraison bloquée.
Les humains décident qui peut corriger une quantité.
Les humains définissent quel mouvement nécessite une piste d'audit.
Les humains décident à quoi ressemble une résolution d'exception valide.
Les humains décident quand une expédition est vraiment complète.
Le travail de COCO est différent.

Répéter.
Observer.
Comparer.
Se souvenir.
Laisser des preuves.


Puis le refaire après que le logiciel change.
Et encore.
Et encore.
Sans jamais s'ennuyer.
Sans décider que le résultat de la semaine dernière est probablement encore valide.
Sans sauter l'exception ennuyeuse parce que le déjeuner est dans douze minutes.
L'avenir glamour du testing par IA contient une quantité surprenante de répétition.
Nous considérons cela comme une fonctionnalité.

Les preuves changent la conversation
Le testing traditionnel se termine souvent par une phrase parfaitement raisonnable :
« Ça a fonctionné quand je l'ai testé. »

COCO s'intéresse à la phrase suivante.

Qu'est-ce qui a fonctionné exactement ?
Quel entrepôt ?
Quel utilisateur ?
Quelle langue ?
Quel état de processus ?
Quelle séquence ?
Quel document ?
Quelle valeur d'inventaire ?
Que s'est-il passé immédiatement avant l'étape de test ?
Qu'est-ce qui a changé immédiatement après ?
Un autre ingénieur peut-il comprendre le résultat sans demander à la personne qui a effectué le test ?
C'est là que le testing de régression devient plus qu'un clic répété.
Un écran peut être correct tandis que le processus est faux.
Une fenêtre de prélèvement peut sembler parfaite tandis que l'inventaire a déjà dérivé.
Un document peut exister tandis que l'état qui aurait dû le créer ne s'est jamais produit.
Une application peut afficher 100 % tandis qu'une piste d'audit est silencieusement en désaccord.
COCO suit le Flow parce que c'est dans le Flow que ces contradictions deviennent visibles.

Quelque part entre Control et Flow
Il y a une symétrie intéressante ici.
Un bon logiciel de logistique essaie de réduire l'incertitude au sein d'une opération.
Un bon testing essaie de réduire l'incertitude sur le logiciel qui l'exécute.
L'un demande :
Où est l'article ?
L'autre demande :
Comment savons-nous que le logiciel le sait encore ?
L'un demande :
Ce mouvement a-t-il été complété ?
L'autre demande :
Quelle preuve démontre que l'état a changé correctement ?
L'un demande :
La prochaine équipe peut-elle continuer ?
L'autre demande :
Le prochain ingénieur peut-il comprendre ce qui s'est passé ?
Des questions différentes.
Le même instinct.
Rendre l'état visible.
Préserver le raisonnement.
Réduire la quantité de connaissances qui existe uniquement dans la tête de quelqu'un.
C'est peut-être le lien que nous n'avions pas prévu à l'origine.

L'excellence en ingénierie sans la bannière
Personne ne clique sur un bouton Engineering Excellence.
Il n'y en a pas.
Et il ne devrait probablement pas y en avoir.
L'excellence en ingénierie apparaît indirectement.
Le contexte de l'entrepôt survit à un changement de langue.
Le même processus survit à une autre plateforme Linux.
Un mouvement de stock reste traçable.
Un préleveur mobile voit exactement ce qui est nécessaire et rien d'autre.
Une exception interrompt le processus sans détruire son état.
La fenêtre d'aide explique le contexte actuel au lieu d'afficher une documentation générique.
La chaîne de documents concorde avec la séquence opérationnelle.
Le prochain ingénieur peut comprendre ce qui s'est passé sans demander à la personne qui se trouvait là par hasard.
Il y a beaucoup de théâtre disponible dans les logiciels modernes.
L'IA peut générer des démonstrations impressionnantes.
Les tableaux de bord peuvent s'animer.
Les chiffres peuvent bouger.
Les vidéos peuvent sembler très convaincantes.
Rien de tout cela ne prouve que deux opérations d'inventaire ne peuvent pas silencieusement produire un résultat incorrect.
Rien de tout cela ne prouve qu'une exception peut encore être reconstruite des semaines plus tard.
Rien de tout cela ne prouve que l'employé d'entrepôt, l'expéditeur, et le développeur regardent la même vérité opérationnelle.

L'excellence en ingénierie commence à un endroit moins photogénique.

Avec la cohérence.
Avec les preuves.
Avec les frontières.


Avec la volonté de garder les parties ennuyeuses ennuyeuses.
La fiabilité invisible produit rarement la capture d'écran la plus spectaculaire.
Jusqu'à ce qu'on commence délibérément à la chercher.

Control. Clarity. Flow.
Control c'est savoir quel entrepôt, quel processus, et quel état sont actifs.
Clarity c'est comprendre ce qui a changé, quand ça a changé, et pourquoi.
Flow c'est permettre à l'opération de continuer sans perdre l'histoire qui la sous-tend.
Cela fonctionne pour la logistique.
Cela fonctionne pour le testing de logiciels.
Cela fonctionne étonnamment bien pour l'ingénierie elle-même.
La première expérience Flow a donné à COCO l'Administration.
Utilisateurs.
Rôles.
Bases de données.
Langues.
Puis quelqu'un lui a donné un entrepôt.
Puis plusieurs langues.
Puis le prélèvement mobile.
Puis l'inventaire.
Puis les transferts.
Puis les exceptions.
Puis les documents.
Puis un autre système d'exploitation.
À ce stade, nous devrions probablement arrêter d'ajouter des choses.
Nous ne le ferons probablement pas.

Control. Clarity. Flow.

Ubuntu a eu son tour.

Red Hat a le tour actuel.

Le Flow continue de bouger.

COCO continue de regarder.
Et quelque part au milieu de la dernière exécution, il est devenu évident qu'une autre question attend derrière celle-ci.

Nous savons ce que c'est.
COCO sait ce que c'est.
Vous ne le savez pas.
Pas encore.


Nous pourrions vous le dire.

Mais alors vous pourriez arrêter de vérifier si un nouvel article Insiders est apparu.
Et cela ruinerait l'expérience.

Publié: 28.08.2026

Lien permanent →

Une lettre de COCO

Une lettre de COCO

À l'ingénieur ou l'ingénieure qui ouvre ce dépôt pour la première fois :

Bienvenue.

Vous êtes peut-être arrivé ici parce que quelque chose a échoué.

Un service a cessé de répondre.

Un déploiement s'est comporté de façon inattendue.

Une alerte vous a réveillé en pleine nuit.

Ou peut-être êtes-vous simplement curieux de savoir comment fonctionne cette plateforme.

Quoi que ce soit qui vous ait amené ici,

sachez que ce projet a été construit exactement pour des moments comme celui-ci.

Non pas pour supprimer les problèmes difficiles.

Mais pour rendre les problèmes difficiles compréhensibles.

Vous trouverez du code.

Vous trouverez de la documentation.

À Savoir

Idées de projets de digitalisation d'entrepôt qui fonctionnent

Idées de projets de digitalisation d'entrepôt qui fonctionnent

Un bon de livraison manquant juste avant le départ, un niveau de stock qui semble différent sur l'étagère par rapport au tableur, et trois employés clarifiant simultanément la même question par téléphone : c'est précisément là que naissent des idées de projets de digitalisation d'entrepôt sensées. Pas à partir de la question de savoir quelle technologie semble actuellement à la mode, mais à partir d'un processus concret qui coûte du temps, génère des erreurs, ou dépend des connaissances de certaines personnes.

Pour les petites et moyennes entreprises d'entreposage, de commerce, et de production, la digitalisation est rarement un unique grand projet. C'est une séquence d'améliorations clairement délimitées. L'objectif ne doit pas être un système complexe de gestion d'entrepôt d'entreprise. Souvent, un outil léger, taillé sur mesure pour le flux de travail réel, vaut mieux qu'une suite avec des fonctionnalités que personne n'utilise sur le terrain de l'entrepôt.

Idées de digitalisation d'entrepôt à valeur opérationnelle

Le meilleur point d'entrée est un processus qui se produit fréquemment, est facilement mesurable, et s'améliore de manière perceptible pour les employés. Quiconque veut digitaliser immédiatement tout l'entrepôt immobilise du budget et de l'attention avant qu'une solution ait fait ses preuves dans les opérations quotidiennes. Une première étape limitée crée en revanche des données solides pour la prochaine décision.

1. Réception des marchandises avec saisie mobile des données

À la réception des marchandises, de nombreuses erreurs en cascade prennent naissance : quantités mal comptées, écarts non résolus, enregistrements de stock retardés, et documents papier introuvables par la suite. Un formulaire de saisie mobile sur un scanner portable, une tablette, ou un smartphone peut rendre le processus beaucoup plus stable.

Les employés scannent l'article et la référence de livraison, saisissant la quantité, l'emplacement de stockage, et la raison de tout écart directement au quai de chargement. Si un lot, un numéro de série, ou une photo est pertinent, cette information appartient exactement au même enregistrement. Le stock n'est pas ajouté rétroactivement à un tableur en fin de poste ; il reçoit au contraire un statut traçable dès la réception effective.

Cela ne signifie pas que chaque fournisseur ou article nécessite strictement des étiquettes à code-barres. Pour les livraisons petites et irrégulières, une recherche par référence article peut suffire. Le facteur décisif est que la saisie des données soit plus rapide que le précédent détour par le papier et la retranscription manuelle.

2. Transferts numériques plutôt que énigmes d'inventaire

Beaucoup d'entrepôts savent fondamentalement ce qui est disponible, mais pas de manière fiable où cela se trouve. Des marchandises sont anticipées pour une commande, stockées temporairement, amenées au montage, ou placées dans une zone libre faute de place. Sans enregistrement simple, une question de stock se transforme rapidement en opération de recherche.

Un processus de transfert n'a pas besoin d'une interface compliquée. Scanner l'emplacement source, scanner l'emplacement de destination, confirmer la quantité — rien de plus n'est nécessaire dans la plupart des cas. Le système devrait vérifier si l'article et l'emplacement de stockage sont plausibles, et attribuer clairement un enregistrement à une personne et un horodatage.

La gestion des exceptions est importante. Un emplacement de stockage peut être bloqué, surchargé, ou approuvé uniquement pour des marchandises spécifiques. Ces règles devraient être cartographiées là où elles préviennent un dommage réel. Pour les cas particuliers rares, une étape d'approbation par la direction de l'entrepôt suffit souvent. Trop de champs obligatoires transforment une application utile en obstacle.

3. Préparation de commandes avec des statuts de commande clairs

Les listes de préparation papier fonctionnent jusqu'à ce que les priorités changent, que des positions manquent, ou qu'une commande soit répartie sur plusieurs zones. Une simple liste de préparation numérique montre quelle commande est ouverte, quelles positions ont déjà été préparées, et où une clarification est nécessaire. Cela réduit les demandes entre l'entrepôt, les ventes, et l'expédition.

Selon la taille de l'entrepôt, l'application peut dicter les chemins de préparation ou simplement trier les positions par zone d'entrepôt. L'optimisation complète des trajets est rentable surtout avec de nombreuses commandes quotidiennes et de longs trajets à pied. Dans un entrepôt compact, un affichage de statut fiable apporte souvent plus qu'un trajet mathématiquement parfait que personne ne suit dans la pratique quotidienne.

En cas de quantités manquantes, le système ne devrait pas simplement surligner en rouge. Il devrait offrir un processus de suivi concret : vérifier le stock, demander des articles de substitution, déclencher un réapprovisionnement, ou transmettre la commande pour clarification. La digitalisation est précieuse lorsqu'elle rend visible la prochaine action judicieuse.

4. Documents d'expédition et étiquettes à partir de données de commande réelles

Transférer manuellement des adresses, des poids, et des positions d'articles dans des portails d'expédition est un candidat idéal pour l'automatisation. Les adresses de livraison, les instructions de livraison, les méthodes d'expédition, et les informations de colis existent idéalement une seule fois et sont utilisées pour le bon de livraison, l'étiquette d'expédition, et la confirmation d'expédition.

Un système adapté peut générer des étiquettes, stocker des documents de manière infalsifiable, et régler automatiquement la commande sur « prêt à expédier » ou « expédié » après impression. L'avantage opérationnel ne réside pas seulement dans les minutes économisées. Il réside dans le fait de garantir que les données d'expédition ne divergent jamais entre plusieurs systèmes.

L'intégration est cruciale ici. Si un transporteur n'offre pas d'interface utilisable ou implique des règles spéciales très différentes, un flux semi-automatisé peut être plus judicieux qu'une intégration complète fragile. Une fiabilité ennuyeuse mais démontrable bat une automatisation qui bloque à chaque exception.

5. Réapprovisionnement et niveaux de stock minimum avec des règles traçables

Les niveaux de stock minimum sont souvent maintenus dans des tableurs puis ignorés parce que personne n'est sûr que les chiffres soient encore exacts. Une solution numérique judicieuse relie les enregistrements réels à des règles claires de contrôle des stocks. Elle peut notifier lorsqu'un article passe sous un seuil, tenir compte des quantités réservées, et préparer une liste de commande.

Le seuil ne devrait pas être traité comme une vérité éternelle. La demande saisonnière, les délais de livraison, et les quantités minimales de commande changent. C'est pourquoi la personne responsable a besoin d'un moyen simple d'examiner les suggestions et d'ajuster les règles. Les commandes entièrement automatiques ne sont judicieuses que lorsque les données de base, la logique fournisseur, et les données de consommation sont suffisamment stables.

6. Traçabilité pour les lots, numéros de série, et stocks bloqués

Quiconque travaille avec des lots, des appareils, des pièces de rechange, ou des produits réglementés a besoin de plus qu'un simple affichage de quantité. Il doit être traçable de savoir quelles marchandises sont arrivées quand, où elles ont été déplacées, et dans quelle commande client elles ont fini.

Le projet peut délibérément commencer petit : n'enregistrer initialement que la réception et l'expédition d'un groupe de produits critique. Les mouvements internes et les retours suivent plus tard. Un système qui impose chaque enregistrement mais ne comprend pas le processus réel de réparation ou d'inspection sera contourné. La logique métier doit donc provenir du flux de travail, pas d'un modèle de données abstrait.

Sélectionner le bon projet

L'idée la plus attrayante n'est pas automatiquement la bonne première idée. Évaluez les projets potentiels selon la fréquence, le coût des erreurs, le temps d'attente, et la dépendance envers des individus. Un processus qui s'exécute 50 fois par jour et économise deux minutes par transaction peut valoir plus qu'une fonctionnalité spéciale rare avec une grande élégance technique.

La qualité des données fait aussi partie de la décision. Si les références articles sont dupliquées, les emplacements de stockage ne sont pas nommés de manière univoque, ou les commandes arrivent de manière contradictoire depuis plusieurs sources, le projet devrait d'abord nettoyer ces fondations. Le logiciel peut rendre visibles des règles manquantes, mais ne peut pas les remplacer de manière fiable.

Quatre questions suffisent pour la priorisation :

  • Quelle activité cause démontrablement le plus de demandes ou de reprises ?
  • Quelle information est aujourd'hui retranscrite plusieurs fois ou demandée par téléphone ?
  • Quelle erreur aurait les conséquences les plus coûteuses pour les clients, le stock, ou l'expédition ?
  • Quel flux de travail peut être testé en quelques semaines avec une mesure claire du succès ?

Décisions techniques qui comptent dans les opérations quotidiennes de l'entrepôt

Une application d'entrepôt n'a pas besoin de paraître spectaculaire. Elle doit rester compréhensible avec une mauvaise couverture Wi-Fi, en portant des gants, sous pression temporelle, et pendant les changements d'équipe. De gros boutons, un retour clair après un scan, et une gestion visible des erreurs sont plus importants que des tableaux de bord décoratifs.

L'architecture devrait aussi correspondre à la réalité opérationnelle. Une application web dotée d'une structure de base de données propre peut fonctionner sur des appareils existants et est plus facile à maintenir qu'une solution isolée sur un seul PC. Avec une base stable — comme PHP 8.4, JavaScript moderne, et MySQL 8 — les rôles, les historiques d'enregistrement, les interfaces, et les déploiements documentés peuvent être exploités de manière traçable sur le long terme.

Toute information n'est pas destinée à chaque rôle. Le personnel d'entrepôt a besoin de tâches ouvertes et de dialogues d'enregistrement clairs. Le contrôle des stocks a besoin d'alertes et de suggestions de réapprovisionnement. La direction a besoin d'évaluations sur les temps de traitement, les écarts, et les opérations ouvertes. Les concepts d'accès basés sur les rôles, les journaux, et les verrouillages de compte après des tentatives répétées échouées appartiennent tôt à la planification, en particulier lorsque des prestataires externes ou plusieurs sites sont impliqués.

Mise en œuvre : prouver d'abord, étendre ensuite

Un pilote devrait fonctionner avec de vraies commandes, pas seulement des données de test en salle de réunion. Choisissez une zone d'entrepôt, un groupe de produits, ou une équipe, et définissez à l'avance comment le succès sera reconnu : moins d'enregistrements correctifs, un temps de traitement plus court, moins de demandes, ou un taux d'achèvement des enregistrements plus élevé le même jour.

Planifiez en parallèle un niveau de repli. Si la nouvelle application tombe en panne ou qu'un processus n'est pas clair, l'équipe doit savoir comment continuer à travailler et comment les enregistrements ultérieurs seront contrôlés. Ce n'est pas un signe de manque de confiance envers la technologie, mais d'exploitation professionnelle.

Après deux à quatre semaines, les enseignements les plus précieux émergent généralement. Peut-être qu'une fonctionnalité ne manque pas, mais plutôt un meilleur étiquetage des articles. Peut-être que le flux de travail est correct, mais qu'un profil de scanner ou une permission crée un goulot d'étranglement. Ces observations devraient alimenter des cycles d'amélioration courts et contrôlés, plutôt que déclencher un nouveau grand projet.

La meilleure digitalisation ne rend pas le quotidien de l'entrepôt théoriquement plus moderne, mais concrètement plus calme : moins de recherches, moins de retranscription manuelle, des transmissions plus claires, et des informations fiables précisément lorsqu'une décision est en attente.
Lien permanent →

Liste de contrôle pour l'automatisation des flux de travail d'entrepôt

Liste de contrôle pour l'automatisation des flux de travail d'entrepôt

Quand une réception de marchandises est confirmée sur papier, que les niveaux de stock sont transférés plus tard dans un tableur, et qu'une question d'expédition est clarifiée par téléphone, chaque étape individuelle semble gérable. Ensemble, elles créent des demandes, des écarts d'inventaire et une dépendance envers certains employés.

Une liste de contrôle pour l'automatisation des flux de travail d'entrepôt empêche cette situation de se transformer prématurément en un projet logiciel surdimensionné. Elle sépare les processus qui devraient vraiment être automatisés de ceux pour lesquels un tableur bien tenu reste suffisant.

La liste de contrôle pour l'automatisation des flux d'entrepôt avant le lancement du projet

L'automatisation ne commence pas par le choix d'un système. Elle commence par une description vérifiable de ce qui se passe réellement dans l'entrepôt — y compris pendant les exceptions, les changements d'équipe et la pression du temps. Parcourez les points suivants directement au niveau des processus avec la direction de l'entrepôt, l'expédition, les achats et, le cas échéant, la comptabilité.

1. Enregistrer les mouvements, pas seulement les stocks

Un stock actuel est le résultat de mouvements. Il doit donc être clair quels événements augmentent, diminuent, réservent, bloquent ou transfèrent le stock. Cela inclut la réception des marchandises, le rangement, la préparation de commandes, l'expédition, les retours, la mise au rebut, les écarts d'inventaire et les transferts.

Chaque mouvement nécessite une réponse définitive à quatre questions : qui l'exécute ? Quand est-il enregistré ? Quel emplacement de stockage est concerné ? Quel document ou commande le justifie ? Si ces réponses n'existent actuellement que dans la tête d'employés expérimentés, c'est un candidat idéal pour l'automatisation. L'objectif n'est pas de collecter plus de données, mais de construire un historique résilient à partir duquel tout niveau de stock peut être expliqué.

2. Nettoyer les articles, variantes et unités

De nombreux projets échouent non pas à cause des scanners ou des interfaces web, mais à cause des données de base. Un article peut être acheté en carton, stocké à l'unité et vendu en lot. Sans conversions définies, le logiciel produit des quantités formellement correctes mais opérationnellement erronées.

Vérifiez les références articles pour les doublons, établissez des descriptions contraignantes, et distinguez entre unités de vente, unités de stockage et unités d'emballage. Les numéros de série, lots, dates de péremption ou classifications de matières dangereuses ne devraient être inclus dans la construction initiale que s'ils influencent des décisions quotidiennes ou sont exigés légalement. Tout le reste augmente d'abord la charge de maintenance et la surface d'erreur.

3. Définir les emplacements de stockage avec la précision nécessaire

« Hall 2 » peut suffire pour une liste d'inventaire. Pour une préparation de commandes fiable, c'est généralement trop grossier. Définissez si un emplacement fait référence à une zone, une étagère, une travée, un slot ou une zone de transit. Les zones de quarantaine, les zones de réception, les zones de retour et les tampons d'expédition doivent aussi être reconnaissables comme des emplacements distincts si des marchandises peuvent y résider.

Le bon niveau de granularité dépend de l'activité. Un atelier avec quelques centaines de positions n'a pas strictement besoin d'une gestion par casier. Cependant, avec plusieurs préparateurs par équipe, un emplacement de stockage précis peut réduire significativement les trajets et les temps de recherche. N'automatisez pas un niveau de précision que personne ne peut maintenir.

4. Établir des déclencheurs, des rôles responsables et des approbations

Un flux de travail a besoin d'un point de départ clair. À la réception des marchandises, cela peut être la livraison au quai, la commande d'achat dans les approvisionnements, ou le scan d'un bon de livraison. Pour le réapprovisionnement, un stock minimum peut déclencher une proposition, tandis que la commande finale reste sous la responsabilité d'une personne.

Documentez par ailleurs quelles actions peuvent se produire automatiquement et lesquelles nécessitent une révision. Une quantité manquante devrait créer un écart, et non modifier silencieusement la réception attendue. Les étapes d'approbation sont judicieuses pour les articles de valeur, gérés par lots, ou critiques pour la sécurité. Pour les consommables, elles ralentiraient inutilement le flux.

5. Générer les documents là où ils sont nécessaires

Les bons de livraison, listes de rangement, listes de préparation, étiquettes d'expédition et protocoles de remise proviennent souvent d'applications différentes. Cela crée des ruptures : une adresse est copiée, une commande est cochée, et le statut d'expédition est mis à jour plus tard.

Notez la source des données, l'horodatage de création et le destinataire pour chaque document. Un flux de travail judicieux pourrait, par exemple, générer automatiquement une liste de préparation après l'approbation d'une commande, fournir une étiquette d'expédition après l'emballage, et clôturer la commande avec un horodatage après la remise. Le point crucial est que les données n'ont plus besoin d'être saisies manuellement plusieurs fois.

Vérifier les interfaces et la qualité des données

La meilleure logique d'entrepôt est inutile si les commandes n'arrivent qu'une fois par jour sous forme de fichier, ou si les adresses de livraison sont formatées de manière incohérente. Créez donc une liste sobre des systèmes qui envoient ou reçoivent des données : boutique, ERP, comptabilité, transporteur, portail fournisseur, système de production et tableurs existants.

Pour chaque connexion, il faut établir quel système fait autorité pour chaque champ de données. Si les données maîtres articles font autorité dans l'ERP, le portail entrepôt ne doit pas créer silencieusement ses propres articles. Si une modification de commande provient de la boutique, elle doit devenir visible avant l'expédition. Pour de faibles volumes, un import CSV contrôlé peut être la bonne première étape. Pour un volume élevé ou des délais de livraison courts, une interface directe en vaut la peine.

La gestion des erreurs est tout aussi importante. Une interface ne devrait pas seulement transférer des données, mais aussi montrer ce qui a été rejeté et pourquoi. Les références articles inconnues, adresses invalides, ou quantités manquantes ne doivent pas disparaître dans un fichier journal technique. Elles nécessitent une liste de travail avec une responsabilité désignée et un statut.

Concevoir l'ergonomie sur le terrain de l'entrepôt

Un processus qui semble plausible à un bureau peut échouer sur le terrain de l'entrepôt. Les employés portent des gants, déplacent des marchandises, partagent des appareils, ou travaillent avec une couverture Wi-Fi instable. Vérifiez donc tôt si les scanners, tablettes, postes fixes ou impressions papier conviennent à chaque étape de travail.

Le scan devrait fournir un retour clair : article correct, mauvais emplacement, quantité déjà enregistrée, ou article bloqué. Les couleurs seules ne suffisent pas. Des messages courts et compréhensibles, ainsi qu'une prochaine étape claire, sont plus précieux sous pression temporelle qu'une interface riche en fonctionnalités.

Prévoyez aussi les exceptions. Que se passe-t-il en cas de code-barres endommagé, panne réseau, livraison partielle, ou marchandise non attribuée découverte ? Un bon flux de travail offre des chemins contrôlés pour cela et enregistre la correction. Il ne force pas les équipes à s'appuyer sur des post-it et des enregistrements par lots ultérieurs.

Définir les indicateurs avant de construire des tableaux de bord

Un tableau de bord n'est pas un objectif. Les indicateurs pertinents sont ceux qui déclenchent une décision opérationnelle. Cela peut inclure les réceptions ouvertes dépassant un âge défini, les commandes proches de leur échéance d'expédition, les écarts d'inventaire par zone d'entrepôt, les erreurs de préparation, ou le temps écoulé entre la réception de la commande et la remise.

Définissez la source des données, la règle de calcul et le rôle responsable pour chaque indicateur. La « précision d'inventaire », par exemple, n'a de sens que lorsqu'il est clair par rapport à quel décompte elle est mesurée et comment les retours ou stocks bloqués sont traités. Quelques indicateurs fiables valent mieux qu'un mur de graphiques auquel personne ne fait confiance.

Planifier la sécurité, les permissions et la traçabilité

L'automatisation distribue le pouvoir d'action. Qui est autorisé à modifier l'inventaire, créer des articles, générer des étiquettes d'expédition, ou annuler des commandes devrait être délibérément établi. Des permissions basées sur les rôles sont généralement plus judicieuses qu'une connexion partagée sur le PC de l'entrepôt. Les corrections particulièrement critiques nécessitent un horodatage, une attribution nominative, et idéalement une raison.

Les fondamentaux techniques appartiennent aussi à la liste de contrôle : sauvegardes régulières, restauration testée, identifiants d'accès documentés, journalisation des erreurs d'interface, et une procédure pour les comptes utilisateurs bloqués ou désactivés. Dans une application sur mesure, des technologies maintenables, une structure de base de données propre et des étapes de déploiement traçables ne sont pas des détails mineurs. Elles déterminent si les modifications restent maîtrisables après deux ans.

Mettre en œuvre par petites étapes mesurables

N'essayez pas de convertir en même temps la réception des marchandises, le réapprovisionnement, l'inventaire, l'expédition et la planification des tournées. Choisissez un flux de travail avec une friction perceptible et un risque gérable, comme l'enregistrement mobile des réceptions de marchandises ou la génération automatique des documents d'expédition. Avant de commencer, enregistrez le temps de traitement, les corrections et les cas ouverts.

Testez avec des articles réels, des commandes réelles et les employés qui travailleront réellement avec eux. Un pilote avec une zone d'entrepôt ou un groupe de produits montre plus rapidement qu'un atelier si les descriptions, les flux de scan et les approbations fonctionnent. Ce n'est que lorsque les exceptions sont maîtrisées que le processus suivant devrait suivre.

L'automatisation réussit lorsque les équipes doivent poser moins de questions, que l'inventaire reste explicable, et que le processus fonctionne même lorsque la personne la plus expérimentée est en vacances. C'est précisément là que la prochaine amélioration vaut la peine : pas avec l'outil le plus bruyant, mais avec la friction qui ralentit vraiment la journée de travail.

Lien permanent →

Améliorer les temps de chargement des sites web mobiles

Améliorer les temps de chargement des sites web mobiles

Lorsqu'un smartphone d'entrepôt avec une réception médiocre est utilisé pour accéder à un site, ce n'est pas l'animation de la section héro qui détermine la première impression, mais si la page devient interactive du tout. Si un prospect attend trois, quatre ou cinq secondes pour du contenu, l'alternative n'est qu'à un bouton retour de distance. Améliorer les temps de chargement des sites mobiles nécessite une séquence technique traçable plutôt que des retouches cosmétiques ponctuelles.

Cela vaut particulièrement pour les sites conçus pour générer des demandes : pour un fabricant, un prestataire logistique ou une entreprise proposant des services complexes. Les utilisateurs mobiles accèdent souvent aux pages entre deux rendez-vous, sur le terrain, ou via des recherches avec une intention concrète. Le site doit fournir de l'information plutôt que provoquer un traitement lourd sur l'appareil.

Pourquoi la vitesse de chargement mobile est un problème opérationnel

La performance mobile est souvent traitée strictement comme une discipline SEO. C'est insuffisant. Les pages rapides aident la visibilité et les coûts de campagne, mais l'effet immédiat se situe dans l'usage réel : les formulaires sont envoyés plus souvent, les numéros de téléphone composés plus fréquemment, et les informations produits lues attentivement. Un site lent, à l'inverse, crée du doute avant même qu'un interlocuteur puisse répondre.

« Rapide » n'est pas une métrique unique. Une page peut afficher un arrière-plan tôt tout en restant longtemps non réactive aux clics. Pour les visiteurs, trois choses comptent : quand apparaît le contenu le plus important ? Quand la page peut-elle être utilisée sans délai ? Et la mise en page bouge-t-elle encore pendant qu'ils essaient d'appuyer sur un bouton ? Ces questions se reflètent dans des métriques comme Largest Contentful Paint, Interaction to Next Paint et Cumulative Layout Shift.

Les mesures doivent se faire dans des conditions réalistes. Un ordinateur de bureau puissant en Wi-Fi masque des problèmes qui deviennent évidents sur un appareil Android plus ancien en réseau mobile. La localisation, les services intermédiaires et un cache navigateur déjà rempli modifient également les résultats. Des mesures répétées et des données d'utilisateurs réels comptent bien plus qu'un seul test parfait.

Améliorer les temps de chargement des sites mobiles : mesurer d'abord, changer ensuite

L'erreur la plus fréquente est de compresser immédiatement les images ou d'installer un plugin d'optimisation supplémentaire. Les deux peuvent aider, mais sans analyse des causes, elles créent rapidement des configurations difficiles à maintenir. Vérifiez d'abord un échantillon représentatif : la page d'accueil, une page de service ou de produit typique, la page de contact et une landing page à fort trafic. Des schémas deviennent visibles sur ces pages.

Le journal réseau révèle quels fichiers bloquent l'initialisation et quelle est leur taille réelle. Un audit de performance montre si JavaScript retarde l'utilisation, si les polices arrivent tard, ou si les images se chargent inutilement tôt. Complétez les mesures de laboratoire avec des données de visiteurs réels si le trafic le permet. Cela évite d'optimiser pour un profil de test qui ne reflète pas votre public cible réel.

Fixez un objectif clair avant chaque modification. Par exemple : le contenu principal visible devrait apparaître sur un appareil mobile moyen en moins de 2,5 secondes, ou le formulaire de contact devrait être utilisable sans délai de saisie. Toutes les pages n'ont pas besoin d'un score théorique parfait. Une application complexe avec des données authentifiées a des exigences différentes d'un site institutionnel public. Une fiabilité ennuyeuse mais démontrable est ici plus précieuse qu'un score à court terme obtenu par des astuces risquées.

1. Traiter les images selon leur fonction

Sur de nombreuses pages mobiles, les images restent le plus gros bloc de données. Le problème n'est pas la photo elle-même, mais une image transmise en 2 500 pixels de large alors que l'appareil n'a besoin que de 700 pixels. Fournissez des variantes d'images responsives afin que le navigateur puisse choisir la taille appropriée. Les formats modernes comme WebP ou AVIF réduisent souvent nettement la taille des fichiers, mais devraient être déployés avec des solutions de repli propres et une qualité d'image vérifiée.

La plus grande image dans la zone visible initiale mérite une attention particulière. Elle devrait être correctement recadrée, avoir une résolution adaptée et se charger tôt. Les images plus bas dans la page peuvent charger de manière différée. Cela économise des données à l'entrée, mais ne doit pas faire apparaître les images visiblement pendant le défilement alors que l'utilisateur les attend déjà.

Ne supprimez pas toutes les images par réflexe. Une bonne image peut expliquer une machine, une équipe ou un processus plus vite qu'un paragraphe de texte. La tâche technique consiste à délivrer efficacement des informations visuelles pertinentes, pas à réduire le design à des blocs gris de substitution.

2. Limiter JavaScript au travail nécessaire

Chaque script se dispute le temps de traitement pendant le chargement et l'interaction. Sont particulièrement problématiques les bibliothèques intégrées de façon systématique, les gestionnaires de balises avec de nombreux scripts tiers, les widgets de chat, les cartes et les animations. Sur les appareils de bureau, ces coûts passent souvent inaperçus. Sur mobile, ils aboutissent à une page visible mais qui réagit lentement aux saisies.

Vérifiez pour chaque script son objectif, sa condition de chargement et sa valeur commerciale. Une carte interactive sur la page de contact n'a pas besoin de se charger sur chaque sous-page. Un outil de cookies ou d'analyse ne devrait pas déclencher une chaîne de fichiers supplémentaires avant même que le visiteur puisse lire le contenu. Les fonctionnalités nécessaires seulement après interaction peuvent être chargées à la demande.

Pour les sites développés sur mesure, une structure de composants claire est un véritable atout. JavaScript est regroupé par fonction plutôt que livré comme un paquet global. Cela facilite aussi la maintenance ultérieure : étendre un formulaire ne modifie pas accidentellement le code d'un filtre produit ou d'une navigation.

3. Livrer CSS et polices sans blocages

Un goulot d'étranglement fréquent se situe dans la zone visible initiale. Si plusieurs feuilles de style, polices d'icônes et variantes de polices externes doivent s'y charger, le navigateur attend inutilement longtemps. Les styles critiques pour la section visible devraient être petits et disponibles tôt. Les règles non critiques peuvent suivre plus tard.

Pour les polices web, quelques graisses suffisent généralement. Quatre graisses en normal, italique et sous-ensembles supplémentaires paraissent complètes dans un système de design, mais sont rarement nécessaires pour un site institutionnel typique. Définissez des solutions de repli système sensées afin que le texte reste lisible immédiatement. Une police qui bascule proprement quelques millisecondes plus tard vaut mieux que des blocs de texte vides.

Les icônes méritent aussi un examen. Un petit ensemble SVG est souvent plus efficace et précisément contrôlable qu'une police d'icônes complète. Cette règle admet des exceptions : les systèmes existants n'ont pas besoin d'être reconstruits uniquement pour quelques kilo-octets. Mais si des changements plus importants sont de toute façon prévus, cette décision relève des fondations techniques.

4. Mettre en place proprement la mise en cache et la réponse du serveur

Même une interface légère semble lente si le serveur met trop de temps à fournir la première réponse. Les causes vont des requêtes de base de données non optimisées aux pages composées dynamiquement, en passant par l'absence de mise en cache. Le contenu public qui change rarement devrait pouvoir être livré rapidement en version mise en cache. Les fichiers statiques comme les images, CSS et JavaScript nécessitent des noms de version distincts et des règles de cache sensées.

Pour les applications PHP, il s'agit en plus d'une exécution efficace, d'un cache opcode correctement configuré et d'accès à la base de données contrôlés. Les requêtes MySQL ont besoin d'index correspondant aux chemins de filtrage et de tri réels. Une page d'accueil qui exécute plusieurs requêtes de données redondantes à chaque appel ne s'améliorera pas avec la croissance du trafic.

La mise en cache n'est cependant pas un blanc-seing. Les prix, disponibilités, sections personnalisées ou contenus post-connexion ne doivent jamais paraître obsolètes par erreur. Les limites de cache sont donc définies précisément : qu'est-ce qui peut avoir cinq minutes, qu'est-ce qui doit être immédiatement à jour, et qui vide le cache après une modification de contenu ? Une bonne performance naît de cette précision.

5. Traiter les prestataires tiers avec un œil critique

Les services externes constituent souvent le lest invisible d'un site web. Analyse, gestion du consentement, vidéos, cartes, widgets d'avis et pixels marketing chargent des scripts supplémentaires depuis des serveurs externes. Chaque dépendance peut créer des retards, soulever des questions de confidentialité et nuire au rendu en cas d'erreur.

Cela ne signifie pas que tout outil externe doit être supprimé. Une vidéo peut soutenir les ventes, un outil d'analyse peut étayer des décisions importantes. Mais une analyse coûts-bénéfices est nécessaire. Chargez les médias intégrés seulement après consentement ou interaction. Utilisez d'abord un espace réservé pour les cartes. Enfin, retirez les balises dont personne n'a évalué les données depuis des mois.

6. Prendre en compte les décalages de mise en page et l'ergonomie mobile

Vitesse de chargement et ergonomie vont de pair. Réservez des dimensions fixes pour les images, bannières et éléments intégrés afin que les boutons ne se déplacent pas sous le doigt de l'utilisateur. Évitez les pop-ups qui couvrent le contenu visible dès l'entrée. Une page rapide qui affiche immédiatement une superposition difficile à fermer ne résout pas le problème de fond.

Testez les formulaires avec un soin particulier. De grands champs de saisie, des types de clavier appropriés et des parcours obligatoires courts aident plus qu'un effet visuel élaboré. Si une demande ne nécessite qu'un nom, un numéro de rappel et un sujet, un formulaire en douze parties n'est pas un signe de rigueur — c'est de la friction.

7. Gérer la performance comme un processus opérationnel permanent

Une refonte unique ne maintient pas durablement le temps de chargement bas. Les nouvelles images de campagne, exigences de suivi et modules éditoriaux s'accumulent avec le temps. C'est pourquoi les budgets de performance appartiennent au processus de développement : une taille maximale pour les images d'entrée, des règles claires pour les nouveaux outils tiers et des limites définies pour JavaScript.

Après les mises en production, les principaux types de pages devraient être réévalués. Les tests automatisés peuvent déterminer si les pages centrales restent accessibles et si les processus critiques fonctionnent correctement. Pour la performance, cependant, un simple test fonctionnel ne suffit pas. Complétez-le par des mesures du temps de réponse, du volume de données transférées et de l'interactivité mobile.

Un site mobile rapide ne naît pas d'un seul plugin, ni d'un renoncement à tout prix. Il naît lorsque design, contenu, infrastructure et usage réel sont considérés ensemble. Commencez par la page qui génère des demandes ou des contacts opérationnels, mesurez dans des conditions honnêtes, et éliminez la friction là où les utilisateurs la ressentent réellement.

Lien permanent →

Un logiciel logistique qui allège vraiment les opérations

Un logiciel logistique qui allège vraiment les opérations

Quand une réception de marchandises est d'abord notée sur papier, puis transférée dans un tableur, et enfin transmise à l'expédition de bouche à oreille, ce n'est rarement pas l'engagement des employés qui fait défaut. Ce qui manque, c'est une base de travail partagée et fiable. Un bon logiciel logistique ne remplace pas ces fractures par plus de travail à l'écran, mais par des flux de travail clairs : qu'est-ce qui est arrivé, où se trouve-t-il, qu'est-ce qui a été réservé, et qu'est-ce qui peut être expédié aujourd'hui ?

Pour les petites et moyennes entreprises, ce n'est pas la liste de fonctions la plus longue possible qui compte. Le facteur décisif est que le logiciel reflète le travail réel sur le terrain de l'entrepôt, au bureau et à l'expédition. Une solution conçue pour une multinationale avec vingt sites peut être inutilement lente, coûteuse et compliquée pour une exploitation avec un entrepôt et deux équipes.

Quand un logiciel logistique a vraiment du sens

Les tableurs ne sont pas fondamentalement un problème. Pour de faibles quantités, une liste d'articles maîtres gérable, et un seul employé responsable, ils peuvent être la solution la plus pragmatique. Il serait erroné de remplacer un processus fonctionnel par un projet uniquement pour le plaisir de moderniser. Le point de bascule survient lorsque l'information doit être maintenue plusieurs fois ou que personne ne peut dire avec certitude quel fichier est à jour. Les signaux typiques sont des ruptures de stock malgré des étagères pleines, des demandes sur le statut des livraisons, des bons de livraison écrits à la main, et des inventaires qui bloquent les opérations pendant des jours. Le nombre croissant de commandes rend également visible les étapes qui n'étaient auparavant maintenues que par l'expérience de personnes individuelles.

Il ne s'agit alors pas principalement de numérisation en tant que mot à la mode. Il s'agit de sources d'erreur et de temps d'attente. Un employé ne devrait pas avoir à comparer plusieurs listes juste pour approuver une commande. L'expédition ne devrait pas avoir à deviner si un article est réellement disponible ou déjà réservé pour une autre commande.

Quels processus un logiciel logistique devrait relier

Une solution utilisable commence par le flux de matières, pas par un menu standard. Pour de nombreuses entreprises, ce flux englobe la réception des marchandises, le rangement, la gestion des stocks, la préparation des commandes, l'expédition et le retour d'information. Selon l'activité, des lots, numéros de série, retours, ordres de fabrication, ou la planification des tournées s'y ajoutent.

Une réception de marchandises avec des stocks traçables

Beaucoup se joue à la réception des marchandises. Si une livraison est vérifiée directement par rapport à une commande ou un bon de livraison, les écarts de quantité, les marchandises endommagées et les positions manquantes peuvent être enregistrés exactement là où ils se produisent. Les marchandises reçoivent un statut au lieu d'être simplement stockées physiquement quelque part.

Le logiciel n'a pas nécessairement besoin de commencer par du matériel de scan coûteux. Dans certains entrepôts, une tablette ou un poste de travail à la zone de réception des marchandises suffit pour commencer. Là où de nombreuses positions sont déplacées quotidiennement, cependant, les scanners de codes-barres sont judicieux car ils accélèrent les enregistrements et réduisent les erreurs de saisie. La bonne décision dépend des quantités, des trajets et de la structure des articles.

Des mouvements d'entrepôt sans historique de mémoire

Les stocks ne sont résilients que si les réceptions, les déplacements, les retraits et les corrections sont traçables. Cela ne signifie pas que chaque exception doit être évitée. Dans les opérations quotidiennes, il y a des emballages endommagés, des rangements incorrects, et des retraits spontanés de matériel. Une bonne application rend ces cas enregistrables, mais documente aussi qui a changé quoi et quand.

Cet historique n'est pas un instrument de contrôle pour lui-même. Il aide à trouver des causes. Si un article atterrit régulièrement au mauvais emplacement de stockage, l'étiquetage de l'entrepôt peut ne pas être clair. Si des corrections régulières se produisent, le problème réside souvent dans le processus antérieur à l'enregistrement.

Commandes, bons de livraison, et expédition depuis un seul flux de travail

De nombreuses équipes perdent du temps à l'interface entre le traitement des commandes et l'expédition. Les données de commande arrivent par e-mail, téléphone, ou depuis un système de boutique séparé. Ensuite, les positions sont imprimées, les stocks sont vérifiés, et les documents d'expédition sont à nouveau enregistrés. Chaque transfert manuel crée un risque d'écarts.

Le logiciel logistique devrait être capable de générer une liste de préparation claire, un bon de livraison, et, si nécessaire, une étiquette d'expédition à partir d'une commande approuvée. La séquence est importante ici : il doit d'abord être clair ce qui est livrable. Ensuite, la commande devrait être réservée pour d'autres processus. Sinon, survient la situation désagréable où deux employés allouent le même stock restant.

Une planification qui correspond à la réalité

La planification des tournées et le contrôle de capacité peuvent être précieux, notamment avec des livraisons propres, des créneaux horaires fixes, ou de nombreux arrêts régionaux. Cependant, ils ne sont pas automatiquement l'étape suivante judicieuse. Quiconque n'a pas encore une approbation de commande propre et des données de stock fiables devrait d'abord résoudre ces fondamentaux.

Il en va de même pour les prévisions et la planification assistée par l'IA. Elles peuvent rendre les schémas visibles, mais nécessitent des données d'entrée propres. Une prévision basée sur un stock incomplet paraît techniquement sophistiquée, mais n'améliore pas la capacité de livraison.

Solution standard ou logiciel logistique sur mesure ?

Un logiciel standard est judicieux lorsque vos propres flux de travail sont largement conventionnels et peuvent être adaptés sans friction majeure. Il peut être introduit plus rapidement et apporte des fonctions de base éprouvées. Pour une exploitation avec des processus d'entrepôt simples, des rôles clairs, et peu de particularités, c'est souvent le choix économiquement correct.

Un logiciel logistique sur mesure en vaut la peine lorsque l'entreprise vit de flux de travail spéciaux ou que les systèmes existants ne peuvent être connectés que par des détours. Cela concerne, par exemple, les ateliers avec des problèmes de matériel pour des commandes en cours, les revendeurs avec des règles d'expédition spécifiques aux clients, ou les fabricants qui doivent lier étroitement les mouvements d'entrepôt aux étapes de production.

La différence ne réside pas dans le fait de tout réinventer. Les bons systèmes sur mesure adoptent des schémas éprouvés tels que les changements de statut, les réservations, et les permissions. Cependant, ils adaptent le langage, les masques, les documents, et les interfaces au travail réellement effectué. Ainsi, l'équipe n'a pas à s'orienter en permanence vers des catégories qui n'ont de sens que dans le manuel du fabricant.

Chez softify.pro, une telle entreprise commence donc par la question de savoir quels flux de travail doivent être préservés. Tout bout de papier n'est pas une erreur, et toute règle spéciale n'a pas de sens. Ce n'est que lorsqu'il est clair où l'information se perd ou où les décisions attendent inutilement qu'une solution viable peut être planifiée.

Un déploiement sans interruption opérationnelle

Le plus grand risque réside rarement dans le code du programme seul. Il réside dans une mise en œuvre qui veut changer trop de choses à la fois. Un entrepôt ne peut pas s'arrêter pendant deux semaines pour apprendre un nouveau système. Par conséquent, un déploiement étape par étape est généralement plus judicieux qu'une grande date de bascule.

Une bonne première section se concentre sur un flux de travail délimité, par exemple la réception des marchandises et les enregistrements de stock ou la création de bons de livraison. L'équipe travaille avec des données réelles, le retour d'information alimente directement l'adaptation, et le bénéfice devient mesurable. Ce n'est qu'ensuite que d'autres domaines suivent, tels que la préparation mobile, les retours, ou les connexions aux boutiques et transporteurs.

La migration des données mérite une attention particulière ici. Les anciens numéros d'article, les données maîtres client dupliquées, et les emplacements de stockage incohérents ne disparaissent pas automatiquement simplement parce qu'un nouveau système est introduit. Il est souvent préférable de nettoyer délibérément les données maîtres et de n'adopter que les historiques pertinents. Cela économise des recherches ultérieures et empêche que l'ancien désordre soit techniquement conservé.

Les permissions appartiennent également tôt à l'ordre du jour. Tout employé n'a pas besoin d'accès aux prix, à toutes les corrections de stock, ou à la maintenance des données maîtres. Des rôles clairs protègent contre les modifications accidentelles et rendent les responsabilités visibles sans bloquer le flux de travail avec des approbations inutiles.

Une technologie qui ne devient pas un fardeau après la mise en service

Une application logistique doit réagir rapidement dans les opérations quotidiennes, même si plusieurs postes de travail enregistrent simultanément. Pour cela, elle a besoin d'une architecture de données traçable, de transactions propres, et de règles claires pour les modifications parallèles. Si deux employés traitent le même stock, le système ne doit pas générer d'enregistrements erronés silencieux.

La maintenabilité est tout aussi importante. Des technologies comme PHP 8.4, le JavaScript moderne, et MySQL 8 ne sont pas un argument de vente en soi. Elles sont judicieuses lorsque l'application reste compréhensible à long terme, reçoit des mises à jour de sécurité, et peut être poursuivie par des développeurs qualifiés. Un provisionnement documenté, des sauvegardes, une journalisation, et une gestion réaliste des mises à jour font partie de la capacité opérationnelle.

Un bon logiciel logistique ne se reconnaît donc pas à une démo particulièrement soignée. Il se révèle un mardi matin ordinaire : la livraison est enregistrée, le stock est correct, la commande est traçable, le bon de livraison correspond, et l'équipe suivante sait ce qui a déjà été fait. Le soulagement naît précisément là — non pas grâce à autant de fonctions que possible, mais grâce à des flux de travail fiables qui conviennent à l'exploitation.

Lien permanent →

Planifier une base de données MySQL pour des applications web

Planifier une base de données MySQL pour des applications web

Quand trois employés réservent des marchandises en parallèle le matin, qu'un client vérifie le statut de sa livraison et que le service administratif crée une facture, la qualité d'une application ne se voit pas dans son design. Elle se démontre par le fait que tout le monde voit exactement le même état correct des données. Planifier une base de données MySQL pour une application web ne signifie donc pas créer des tables le plus rapidement possible. Cela signifie comprendre les flux de travail réels avec suffisamment de précision pour garantir que les données restent fiables même sous charge, en cas d'erreurs, et à mesure que l'entreprise grandit.

En particulier dans les plateformes internes, les processus d'entrepôt et de commande, ou les portails destinés aux clients, la base de données est souvent traitée trop tard. On construit d'abord l'interface, puis on ajoute des champs, suivis d'exceptions. Cela fonctionne pour un prototype. En production, cela se traduit par des ensembles de données dupliqués, des états peu clairs et des rapports auxquels plus personne ne fait entièrement confiance.

Planifier une base de données MySQL pour des applications web : commencer par le flux de travail

Le premier brouillon ne devrait pas commencer par les noms de colonnes, mais par une situation de travail concrète. Prenons la réception des marchandises : une livraison arrive, est assignée à un fournisseur et une commande, les quantités sont vérifiées, un emplacement de stockage est assigné, et le stock change. Selon l'opération, ce processus nécessite en plus des photos, un contrôle qualité, un statut de blocage ou une correction traçable. De ce flux de travail émergent les objets fonctionnels. Les exemples typiques sont les articles, fournisseurs, commandes, positions, emplacements de stockage, mouvements de stock et utilisateurs.

La distinction entre un objet et un événement est cruciale. Un article décrit ce qu'est une chose. Un mouvement de stock documente qu'une quantité a changé à un emplacement précis à un moment précis. Mélanger les deux dans une seule table conduit rapidement à une perte de traçabilité.

Quelques questions difficiles aident pour chaque objet : quelle est l'identité unique ? Quelles informations peuvent changer ? Qui a le droit de les modifier ? Quelles données doivent être conservées historiquement ? Et quelles règles s'appliquent lorsque deux personnes travaillent simultanément ? Ces questions préviennent l'improvisation ultérieure mieux qu'une longue liste de champs de base de données prétendument complète.

Le modèle de données doit exprimer des règles

Une base de données n'est pas simplement un espace de stockage pour les saisies de formulaires. Elle devrait faire respecter des règles centrales par elle-même. Si chaque mouvement de stock doit appartenir exactement à un article et un emplacement de stockage, les clés étrangères ont leur place dans le modèle. Si un numéro de commande externe ne peut apparaître qu'une seule fois par tenant, un index unique est nécessaire. Si une position ne devrait jamais exister sans une commande d'en-tête, cette relation doit être modélisée clairement.

MySQL 8 avec InnoDB offre des fondations robustes pour cela : transactions, clés étrangères, mécanismes de verrouillage et modifications cohérentes sur plusieurs tables. Lors de l'écriture d'un mouvement, du stock actuel et du journal d'inspection pendant un enregistrement de réception de marchandises, cela devrait se produire comme une transaction cohérente. Si une étape échoue, aucune opération à moitié terminée ne doit subsister.

Cependant, toutes les règles n'ont pas leur place dans la base de données. Les approbations, la logique de tarification complexe, ou les étapes de processus dépendantes du rôle sont souvent mieux placées dans la logique applicative car elles changent plus rapidement fonctionnellement. La frontière est pragmatique : les règles dont la violation endommage durablement les données devraient être sécurisées aussi près que possible des données. Les règles qui changent fréquemment ou dépendent fortement du contexte nécessitent un code applicatif bien testé.

Ne pas confondre l'historique avec les valeurs actuelles

Une erreur courante est de ne stocker que le stock actuel ou le statut actuel. Cela suffit jusqu'à ce que quelqu'un demande pourquoi la quantité a changé hier ou qui a réinitialisé une commande. Pour les systèmes opérationnels, un historique de mouvements ou d'événements est souvent plus précieux qu'un seul champ écrasable.

Cela ne signifie pas enregistrer en permanence chaque mouvement de clic. Les changements pertinents pour l'entreprise devraient être enregistrés : changements de statut, modifications de quantité, corrections, approbations et affectations. Une bonne entrée d'audit contient un horodatage, l'utilisateur ou le processus système, la valeur précédente et la nouvelle, et une raison compréhensible lorsque le flux de travail l'exige. Cela permet de clarifier les erreurs sans avoir à fouiller dans les e-mails, les listes papier ou les sauvegardes de base de données.

Choisir consciemment les clés, les types de données et les conventions de nommage

Les décisions techniques semblent petites, mais façonnent la maintenance et les intégrations pendant des années. Pour les clés primaires internes, les valeurs BIGINT avec attribution automatique sont souvent un choix sobre et facilement gérable. Les UUID peuvent être judicieux lorsque les données proviennent hors ligne, que plusieurs systèmes écrivent indépendamment, ou que les interfaces externes ne devraient pas exposer d'identifiants séquentiels. Cependant, ils coûtent plus d'espace de stockage et exigent un peu plus d'attention avec les index et le tri.

Les montants monétaires doivent être stockés en DECIMAL, pas en FLOAT ou DOUBLE. Les quantités ont aussi besoin d'une précision fonctionnellement appropriée : les comptages d'articles sont souvent des entiers, tandis que les poids et longueurs ne le sont pas. Les horodatages devraient être gérés de manière uniforme, idéalement en interne en UTC, tandis que l'interface affiche le fuseau horaire local de l'opération. Surtout lors des changements d'équipe et de l'heure d'été, cela évite des divergences difficiles à repérer.

Les noms devraient aussi être ennuyeux et sans ambiguïté. order_items ou inventory_movements sont plus utiles que des abréviations créatives que seule l'équipe de projet d'origine comprend. Des formes singulières ou plurielles cohérentes sont moins importantes que la cohérence elle-même. Sont tout aussi judicieux des champs comme created_at, updated_at, et, si besoin, deleted_at. Une suppression douce n'est cependant pas une obligation standard. Pour les enregistrements pertinents sur le plan légal ou opérationnel, une annulation propre est généralement préférable à un jeu de données supprimé de manière invisible.

Les index suivent les requêtes réelles, pas les suppositions

Un index peut accélérer massivement une recherche, mais rend les opérations d'écriture plus complexes et consomme de l'espace de stockage. Par conséquent, « un index sur chaque champ » n'est pas une stratégie. Les requêtes les plus importantes devraient être établies tôt : commandes ouvertes d'un client, mouvements d'un article sur une période, stock par emplacement, ou enregistrements récemment modifiés pour une interface.

L'ordre des index composites compte ici. Si l'application recherche régulièrement par tenant_id, status, et created_at, un index composite dans cet ordre exact est souvent judicieux. Sa pertinence réelle est démontrée par le plan d'exécution via EXPLAIN, pas par intuition. Les bases de données ne sont pas rendues rapides par des astuces spectaculaires, mais par des requêtes observables, des index correspondants, et des volumes de données testés de manière réaliste.

Pour les tables en croissance, une stratégie de rétention claire vaut la peine. Les journaux techniques doivent-ils rester dans la base de données de production principale pendant cinq ans ? Pas nécessairement. Les enregistrements métier, les mouvements et les preuves d'inspection nécessitent des périodes de rétention différentes des informations de débogage. L'archivage n'est pas le signe d'un système faible, mais une décision opérationnelle délibérée.

Le fonctionnement multi-utilisateur exige des transactions et des états clairs

Dans une application web, plusieurs requêtes accèdent simultanément aux mêmes données. C'est normal dans les opérations quotidiennes d'entrepôt, pas une exception. Deux employés peuvent réserver le même stock pendant qu'un import crée de nouvelles commandes. Sans transactions et verrouillage ciblé, il existe un risque de modifications perdues ou de stocks négatifs qui ne deviennent apparents que des semaines plus tard.

Pour les opérations critiques, il devrait être clair quelles données sont lues et écrites au sein d'une transaction. Parfois, une mise à jour atomique suffit, comme un stock modifié uniquement si la quantité disponible est suffisante. Dans d'autres cas, un verrou de ligne est judicieux pour qu'une opération puisse vérifier l'état des données de manière contrôlée et le modifier ensuite. Les transactions longues, en revanche, sont problématiques : elles bloquent d'autres travaux et augmentent le risque de conflits.

Tout aussi important est un ensemble limité d'états fonctionnels. Une commande ne devrait pas être « ouverte », « partiellement livrée », et « traitée manuellement » simultanément à cause du maintien de champs contradictoires. Des transitions d'état définies simplifient les interfaces, les rapports et les automatisations. Des exceptions peuvent être autorisées, mais devraient être nommées et documentées.

Planifier la sécurité, les tenants et les opérations dès le départ

L'application devrait utiliser un utilisateur de base de données dédié pour MySQL avec des privilèges minimaux. L'accès en écriture pour l'application web ne signifie pas que cet utilisateur doit pouvoir supprimer des tables ou modifier les privilèges des utilisateurs. Les comptes administratifs n'ont pas leur place dans les fichiers de configuration de production et jamais dans un dépôt.

Lorsque plusieurs clients, sites ou entreprises travaillent au sein d'une application, l'isolation des tenants est une décision architecturale, pas une condition de filtrage rétroactive. Une base de données partagée avec un tenant_id peut être efficace et facilement maintenable, mais exige des vérifications cohérentes dans chaque requête et des règles claires pour les index. Des bases de données séparées offrent une isolation plus forte, mais augmentent l'effort dans les mises à jour, les évaluations et les opérations. La variante qui convient dépend des exigences de confidentialité des données, du volume de données et du modèle économique.

Les sauvegardes ne sont des sauvegardes que lorsqu'une restauration a été testée. Un rythme défini pour les sauvegardes, la rétention et la récupération est nécessaire. De même, la surveillance de l'espace de stockage, des requêtes lentes et des tâches échouées, ainsi que les mises à jour documentées, font partie du système. MySQL 8, PHP 8.4, et les applications web modernes peuvent être exploitées durablement si les dépendances, les identifiants d'accès et les étapes de déploiement ne résident pas uniquement dans la tête d'un développeur.

Un plan judicieux avant le premier jour en production

Avant la mise en œuvre, un modèle de données compact avec des flux de travail d'exemple devrait exister. Cela inclut les tables et relations clés, les règles de statut, les permissions, les requêtes attendues, les interfaces, et un concept pour les sauvegardes et les journaux d'audit. Ce plan n'a pas besoin de faire cent pages. Il doit capturer les décisions qui seraient coûteuses à corriger plus tard.

Chez softify.pro, la planification de la base de données commence donc par les personnes qui réservent, vérifient, préparent ou résolvent les exceptions. Si un tableur existant reflète de manière fiable un processus gérable, il peut rester la solution correcte. Si plusieurs personnes travaillent simultanément, que des enregistrements émergent, et que les erreurs doivent être traçables, la base de données mérite en revanche le même effort de planification que l'interface. La meilleure architecture, au final, est celle qui simplifie le quotidien de travail et qui peut encore être modifiée de manière transparente dans deux ans.

Lien permanent →

Bien mesurer les Warehouse Automation Results

Bien mesurer les Warehouse Automation Results

Une nouvelle interface de scan peut sembler impressionnante le premier jour. Mais après trois semaines, on voit clairement si elle accélère réellement la réception des marchandises ou si elle ne fait qu'ajouter une étape de travail supplémentaire. Les Warehouse automation results ne sont donc pas un indicateur unique, ni une capture d'écran issue d'une démo produit. Ils apparaissent là où une équipe d'entrepôt doit moins chercher, moins se renseigner, moins re-saisir et moins corriger — tout en maintenant ou en améliorant la qualité.

Pour les petites et moyennes entreprises, cette distinction est particulièrement pertinente. Les grandes suites d'entreprise promettent souvent une optimisation complète, mais exigent des implémentations longues, des processus rigides et un entretien conséquent. Une étape d'automatisation sensée peut commencer plus modestement : exactement au point où les informations se perdent aujourd'hui ou où les décisions attendent inutilement.

Quels Warehouse Automation Results comptent vraiment

De nombreux projets démarrent par une question technique : scanner de codes-barres, application mobile, interface vers la boutique ou étiquettes automatiques ? La meilleure question de départ est : quel goulot d'étranglement coûte sensiblement du temps, de l'argent ou de la fiabilité par équipe ?

La réponse ne tient rarement au nombre d'appareils déployés. Les résultats significatifs se mesurent dans le travail quotidien. À la réception des marchandises, par exemple, ce qui compte c'est le temps entre la livraison et la disponibilité du stock enregistré. Au picking, le temps entre la commande et la disponibilité à l'expédition est pertinent. Lors des inventaires, la durée n'est pas le seul facteur décisif ; l'écart entre le stock système et le stock réel importe le plus.

Tout aussi importants sont les indicateurs que de nombreuses entreprises n'enregistrent pas proprement : combien de demandes surgissent parce qu'un emplacement de stockage n'est pas clair ? À quelle fréquence faut-il corriger un bon de livraison ? Combien de commandes restent en suspens parce qu'une seule personne connaît le statut de mémoire ou dans un tableur privé ? C'est justement cette reprise silencieuse qui disparaît des rapports de productivité classiques, tout en pesant lourdement sur les chefs d'équipe, la planification et le service client. Une bonne cible combine vitesse et contrôle. Si les commandes sont traitées plus vite mais que les erreurs d'enregistrement augmentent, ce n'est pas un progrès. Si les stocks deviennent plus précis mais que la réception s'engorge, le processus doit être repensé. L'automatisation réussit lorsqu'elle améliore le flux de travail sans dégrader la vue d'ensemble opérationnelle.

D'un soulagement ressenti à des données vérifiables

L'expérience des employés est un indicateur précieux. Quand quelqu'un dit, après deux semaines, qu'il n'a plus à courir au bureau pour chaque rangement, cela compte. Pour les décisions d'investissement, il faut néanmoins une comparaison indépendante du ressenti quotidien. Avant le lancement, il convient donc d'enregistrer quelques valeurs de référence : temps de traitement moyen, nombre de cas à clarifier en attente, écritures correctives, temps de recherche, erreurs d'expédition et fiabilité des stocks. Vingt indicateurs ne sont pas nécessaires ; quatre à six valeurs adaptées au problème concret suffisent souvent.

Après le déploiement, ces mêmes valeurs doivent être observées sur plusieurs semaines. Des journées de pointe isolées induisent facilement en erreur. Saisonnalité, maladie, nouveaux employés ou une commande inhabituellement grande influencent les résultats. Seule une comparaison sur des équipes normales montre si le changement est solide.

L'effet le plus important : un état de processus partagé

Dans de nombreux entrepôts, la véritable faiblesse n'est pas un manque de volonté de travailler, mais un état d'information fragmenté. La réception connaît la livraison, la planification connaît la commande client, et l'expédition connaît la priorité — mais tout le monde ne travaille pas avec la même information actuelle.

Un système spécifique au flux de travail peut combler cette fracture. Une livraison est enregistrée à son arrivée, les écarts sont documentés directement, le stock reçoit un statut clair, et l'étape suivante devient visible. Les données n'ont plus besoin d'être notées sur papier, transférées plus tard, puis confirmées par téléphone.

Cela réduit non seulement les déplacements. Cela réduit les décisions fondées sur des informations obsolètes. Un employé de l'expédition voit si une commande est vraiment prête à être préparée. La direction reconnaît si les marchandises sont arrivées ou seulement annoncées. La direction générale reçoit non pas un instantané enjolivé, mais une base traçable.

Pour les équipes à rotation, cet effet est souvent plus précieux qu'un gain de temps spectaculaire. Le processus devient moins dépendant de personnes individuelles. Le savoir ne reste plus coincé dans des carnets, des historiques de discussion ou la mémoire du spécialiste le plus expérimenté.

Pourquoi toute automatisation ne donne pas de bons résultats

L'automatisation renforce les processus. C'est utile lorsque le déroulement est clair. C'est problématique lorsqu'un déroulement flou est simplement reproduit plus vite.

Un exemple typique est l'enregistrement par scan obligatoire pour chaque petit geste. Si les employés doivent ouvrir plusieurs écrans pour une exception rare, des contournements apparaissent. Les articles sont alors enregistrés en bloc plus tard, les scanners restent dans un tiroir, ou un employé recommence à tenir une liste parallèle. Le logiciel est présent, mais le processus réel continue à côté de lui.

La qualité des données pose également des limites. Des données articles sans unités claires, une logique d'emplacement floue ou des désignations fournisseurs incohérentes ne se réparent pas avec une interface élégante. Ici, un projet peut d'abord consister en un travail de nettoyage. Cela paraît moins visible qu'une nouvelle application, mais c'est souvent la condition préalable à des résultats fiables.

Il existe en outre des processus qui ne devraient délibérément pas être entièrement automatisés. Un contrôle expérimenté pour des marchandises sensibles, une validation d'écarts inhabituels ou la décision d'une livraison spéciale nécessitent un jugement professionnel. Les bons systèmes signalent clairement ces cas et les orientent de manière ciblée. Ils ne prétendent pas que chaque exception peut être réglée par une règle.

Quand un tableur reste la meilleure solution

Toute étape manuelle ne justifie pas un développement sur mesure. Si un processus se produit rarement, implique peu de participants et est géré de manière traçable, un tableur bien tenu peut rester pertinent. Le défaut ne réside pas dans Excel lui-même, mais dans la gestion de mouvements critiques sans responsabilité claire, contrôle de version ou enregistrement en temps voulu.

Dès que plusieurs personnes modifient en parallèle, que les mouvements de stock deviennent sensibles au temps, ou que des informations clients provenant de sources diverses doivent être consolidées, le risque augmente nettement. Un système partagé est alors généralement plus économique que la correction continue de malentendus.

Les Warehouse Automation Results exigent un déploiement contrôlé

Le chemin le plus rapide vers de mauvais résultats est une refonte complète en pleine activité. Mieux vaut un périmètre délimité avec un bénéfice mesurable : par exemple la réception pour une famille de produits, les étiquettes d'expédition pour un site, ou une saisie mobile pour les déplacements les plus fréquents.

Un pilote doit refléter des commandes réelles et des équipes réelles. Les données de test aident au développement, mais ne montrent pas si le Wi-Fi fluctue dans le fond de l'entrepôt, si les gants gênent l'utilisation du scanner, ou si un statut est formulé de manière confuse pour la planification. Ces détails déterminent l'acceptation et la qualité des données.

Techniquement, une fiabilité ennuyeuse et démontrable compte plus qu'une stack à la mode. Des droits de rôle clairs, des journaux d'enregistrement traçables, des indications d'erreur sans ambiguïté, des transactions de base de données stables et des processus documentés ne sont pas des détails secondaires. Ils transforment une application en un outil auquel les équipes peuvent faire confiance au quotidien.

Pour les systèmes logistiques sur mesure, cela signifie aussi : l'intégration doit s'adapter à l'exploitation existante. Une application peut reprendre des commandes d'une boutique, générer des bons de livraison, fournir des étiquettes d'expédition et documenter les mouvements de stock. Elle n'a pas besoin de remplacer immédiatement tous les systèmes adjacents. Justement dans les PME, un remplacement progressif est souvent moins risqué et plus économique.

Comment un projet devient une amélioration durable

La phase décisive commence après la mise en œuvre. Les cas particuliers sont-ils saisis ? Les emplacements de stockage correspondent-ils encore à la réalité ? Les nouveaux employés comprennent-ils la logique d'enregistrement sans explication orale ? Et les valeurs mesurées restent-elles valables quand le volume de commandes augmente ?

Des retours courts et réguliers de l'entrepôt, de l'expédition et de l'administration sont plus efficaces qu'un grand atelier annuel. Quand une exception récurrente devient visible, elle doit soit être représentée comme une étape de processus claire, soit être délibérément retirée du flux standard. Les deux valent mieux que de la tolérer en silence.

L'étape suivante la plus sensée n'est souvent pas un long cahier des charges. Prenez un processus avec des demandes fréquentes et mesurez pendant une semaine où le temps se perd. Si un flux clair et reproductible en émerge, l'automatisation peut être associée à un résultat aussi convaincant sur le terrain de l'entrepôt que dans le bilan mensuel.

Lien permanent →

Le développement web moderne qui fonctionne en exploitation : architectures pragmatiques pour les PME — avec un code maintenable, un stockage de données solide et sans surcharge d'outils inutile.

Le développement web moderne qui fonctionne en exploitation : architectures pragmatiques pour les PME — avec un code maintenable, un stockage de données solide et sans surcharge d'outils inutile.

Un chef d'entrepôt imprime des bons de livraison le matin pendant qu'une collègue corrige les stocks dans un tableur, et le service commercial appelle pour demander le statut d'une commande. Le problème est rarement le manque de digitalisation. Le plus souvent, il y a trop d'outils déconnectés les uns des autres. Le développement web moderne ne crée alors pas simplement une interface plus jolie, mais une base de travail commune et fiable.

Pour les petites et moyennes entreprises, cela signifie : une application web doit fonctionner sous pression temporelle, sur un scanner dans l'entrepôt tout autant que sur un écran au bureau. Elle doit stocker les données de manière traçable, gérer les autorisations proprement et permettre un développement ultérieur sans devenir un risque à chaque modification. La technologie n'est pas ici une fin en soi. Elle est la base pour que les processus se déroulent plus rapidement tout en restant mieux contrôlables.

Le développement web moderne commence avant le premier code

Celui qui commence avec un catalogue de fonctions prédéfini construit souvent à côté du véritable goulot d'étranglement. En pratique, une autre approche est payante : quelle information manque régulièrement aujourd'hui ? Où se produisent des saisies doubles ? À quel moment les décisions sont-elles sécurisées par téléphone ou verbalement parce que personne ne voit de manière fiable le statut actuel ?

Lors de la réception des marchandises, cela peut se manifester par exemple par des descriptions d'articles incohérentes, des instructions d'inspection manquantes, ou des stocks mis à jour tardivement. Dans le traitement des commandes, ce sont souvent des notes manuscrites, des approbations peu claires et des données d'expédition maintenues dans plusieurs systèmes. Une bonne application ne fait pas que numériser ces remises. Elle les organise de manière à ce que les responsabilités, les statuts et les prochaines étapes soient visibles.

Cela signifie aussi ne pas abolir réflexivement les pratiques existantes. Un tableur bien entretenu peut continuer à être la solution la plus sensée pour une petite évaluation. Une application web sur mesure est payante là où plusieurs personnes travaillent simultanément, où des erreurs surviennent par transcription manuelle, ou où un processus doit être documenté et reproductible.

Ce qu'une application web moderne doit accomplir au quotidien

Une interface utilisateur convaincante est précieuse, mais ce n'est qu'une partie du travail. Dans l'exploitation courante comptent surtout les temps de réponse, les flux de travail compréhensibles et les données résilientes. Lorsqu'un préparateur de commandes termine une tâche, le statut ne doit pas devenir visible seulement après plusieurs actualisations. Lorsqu'une commande est modifiée, il doit être traçable ce qui a été changé et quelles étapes suivantes sont affectées. Cela comprend trois couches étroitement liées : l'interface utilisateur, la logique applicative et la base de données. L'interface guide les personnes à travers le processus. La logique vérifie par exemple les champs obligatoires, les autorisations ou les quantités disponibles. La base de données stocke les faits de manière à ce que les évaluations, corrections et extensions restent possibles ultérieurement.

Pour de nombreuses applications métier, les technologies éprouvées sont un choix plus sensé qu'une tendance éphémère. PHP 8.4 peut fournir une logique serveur clairement structurée, JavaScript moderne une expérience utilisateur réactive, et MySQL 8 une base de données solide. Le facteur décisif n'est pas que chaque projet utilise la même stack. La clé est que la technologie choisie corresponde au problème, à l'exploitation et à la maintenance à long terme.

La performance est une question de processus

La performance est souvent réduite aux temps de chargement. C'est insuffisant. Une application semble aussi lente lorsque les employés effectuent trop d'étapes, recherchent des informations, ou doivent saisir la même donnée plusieurs fois. Une page rapide avec un formulaire encombrant reste un mauvais processus.

Une optimisation sensée commence donc par les opérations les plus fréquentes. Quels écrans sont ouverts cent fois par jour ? Quelle recherche doit rester rapide même avec un volume de données croissant ? Quelles données devraient être enregistrées en arrière-plan sans que les employés attendent une confirmation ? Ce n'est qu'après que suivent les détails techniques comme des index de base de données ciblés, des requêtes réduites et une livraison légère des fichiers dans le navigateur.

Modèle de données et droits : l'architecture invisible

De nombreux projets web échouent non pas dès la première version, mais lors d'ajouts ultérieurs. Un champ initialement simple comme « Statut » devient soudainement une chaîne d'approbation, d'inspection, de traitement, d'annulation et de retraitement. Si ces états ne sont stockés que de manière lâche dans des formulaires, chaque extension devient coûteuse et sujette aux erreurs.

Un modèle de données propre sépare donc les processus, les positions, les contacts, les documents et les changements de statut de manière traçable. Il empêche les entrées contradictoires au lieu de devoir les nettoyer laborieusement par la suite. Justement pour les mouvements de stock, les bons de livraison ou les données de commande, cette précision n'est pas un exercice académique. Elle détermine si le chiffre de stock convient comme base de travail.

Les rôles et les droits sont tout aussi importants. Chaque personne n'a pas besoin d'accéder aux prix, aux informations du personnel ou aux paramètres administratifs. Les bons concepts de droits sont concrets : qui a le droit de créer une commande, de l'approuver ou de l'annuler ? Qui ne voit que son propre département ? S'ajoutent des mesures de protection comme le stockage sécurisé des mots de passe, les verrouillages de compte après des tentatives échouées répétées, la journalisation des modifications critiques et des sessions clairement réglementées. La sécurité n'est donc pas un ajout juste avant la mise en production. Elle fait partie de l'architecture car les corrections ultérieures interviennent souvent profondément dans la connexion, l'accès aux données et le système de droits.

Responsive ne signifie pas seulement « s'adapte au téléphone »

Une application responsive s'adapte à différentes tailles d'écran. Pour le travail quotidien, cette définition ne suffit pas. Sur une tablette dans l'entrepôt, d'autres exigences s'appliquent que sur un grand écran à la disposition. Les zones tactiles doivent être utilisables de manière sûre, les détails importants ne doivent pas disparaître sous des informations secondaires, et les saisies doivent rester pratiques même avec des gants, des conditions d'éclairage changeantes ou une connexion instable.

Par conséquent, chaque vue nécessite une priorité claire. À la réception des marchandises, le scan et la confirmation peuvent être au centre. Au bureau, les filtres, listes, fonctions d'exportation et vues détaillées sont souvent plus importants. Une interface qui a l'air identique partout n'est pas automatiquement utilisable partout.

Le développement web moderne nécessite une exploitation contrôlée

La mise en production n'est pas un point final, mais le début du véritable test. Ce n'est qu'avec des données réelles, des exceptions et des pics d'activité qu'il apparaît si les règles sont compréhensibles et si les interfaces fonctionnent de manière fiable. Un provisionnement documenté, des environnements clairement séparés pour le développement et la production, ainsi que des sauvegardes traçables font donc partie du projet, pas seulement de l'administration informatique.

Les tests automatisés accomplissent aussi beaucoup ici. Ils revérifient les flux de travail récurrents comme la connexion, les vérifications de droits, la saisie de commandes ou la génération de documents après chaque modification. Pour les applications sensibles, un environnement de test auto-hébergé peut être sensé car les captures d'écran, les données de test et les étapes applicatives internes restent dans la sphère de contrôle propre de l'entreprise. L'automatisation ne remplace pas la révision experte par des employés expérimentés. Cependant, elle garantit que les flux de travail connus ne sont pas discrètement endommagés.

Chez softify.pro, cet état d'esprit fait partie de la mise en œuvre : planifier avec précision technique, prendre au sérieux les flux de travail réels, et livrer les modifications de manière à ce qu'elles restent compréhensibles par la suite. C'est moins spectaculaire qu'un feu d'artifice technologique, mais nettement plus précieux en exploitation.

Quand le logiciel standard suffit — et quand ce n'est pas le cas

Le logiciel standard est sensé lorsque votre propre processus correspond largement aux flux de travail habituels du secteur et que la configuration reste gérable. Il peut être disponible rapidement et apporter des fonctions de base fiables. Il devient problématique lorsque les équipes sont forcées de tordre continuellement leurs flux de travail fonctionnels de manière maladroite ou lorsque des informations vitales atterrissent en dehors du système.

Une solution sur mesure n'est pas automatiquement meilleure. Elle nécessite des exigences claires, des interlocuteurs responsables, et la volonté de prendre des décisions. En échange, elle peut cartographier exactement les étapes de travail qui sont décisives pour l'entreprise : une inspection spécialisée à la réception des marchandises, l'impression d'étiquettes d'expédition correspondantes, une approbation basée sur le groupe de clients, ou la connexion entre l'atelier, l'entrepôt et les ventes. La bonne question n'est donc pas : avons-nous besoin d'une application sur mesure ? C'est : quel frottement récurrent nous coûte-t-il aujourd'hui du temps, de l'argent ou de la fiabilité — et peut-il être éliminé durablement avec un effort raisonnable ?

Une bonne application web ne rend pas le travail artificiellement numérique. Elle supprime les remises inutiles, établit un état de données fiable, et donne aux personnes exactement les informations dont elles ont besoin pour leur prochaine étape. Quand cela réussit, le développement web moderne ne ressemble pas à un nouveau projet informatique, mais à une exploitation qui peut enfin travailler sans détours.

Lien permanent →

Comment mettre en œuvre correctement la digitalisation des bons de livraison

Comment mettre en œuvre correctement la digitalisation des bons de livraison

Un chauffeur n'attend pas parce qu'un fichier Excel est actuellement ouvert par quelqu'un d'autre. Et à la réception des marchandises, une pile de papier bien rangée ne sert à rien si une livraison partielle ne peut plus être tracée par la suite. Celui qui cherche « comment numériser les bons de livraison » ne veut donc rarement que scanner du papier. Ce qui est recherché, c'est un flux de travail résilient qui enregistre les mouvements de marchandises, les confirmations et les écarts précisément là où ils se produisent.

Les bons de livraison numériques fonctionnent bien lorsqu'ils simplifient le travail dans l'entrepôt, dans l'atelier et chez le client. S'ils ne sont mis en œuvre que comme une archive PDF, l'effort reste le même — juste sur un écran au lieu du papier. La différence décisive réside dans des données structurées, des responsabilités claires et une connexion propre aux commandes, aux stocks et aux factures.

Comment numériser les bons de livraison : vérifier d'abord le flux de travail

La première étape n'est pas le choix du logiciel, mais un état des lieux honnête. Prenez un bon de livraison réel et suivez son parcours : de la commande au picking, à la remise, au retour d'information et à l'archivage. Cela révèle généralement rapidement où les informations sont ajoutées après coup, saisies deux fois, ou clarifiées par téléphone et chat.

Dans les petites et moyennes entreprises, il existe rarement un seul flux de travail. Une livraison standard à des clients réguliers nécessite quelque chose de différent d'une livraison sur chantier, d'un enlèvement, ou d'une livraison avec retour d'emballages vides. Toutes ces différences n'ont pas besoin d'être automatisées dans la version un. Elles devraient cependant être connues, afin que le nouveau système n'échoue pas au premier cas particulier.

Un bon processus numérique répond sans ambiguïté à trois questions pour chaque statut : Qui a déplacé la marchandise et quand ? Quelles quantités ont réellement été remises ? Et que s'est-il passé en cas d'écarts ? Si ces informations manquent, un bon de livraison numérique n'est avant tout qu'un document plus joli.

Ne pas simplement reproduire le papier en PDF

La numérisation des bons de livraison existants peut être utile comme transition, par exemple pour l'archivage d'anciens processus. Pour l'activité opérationnelle, cependant, cela résout peu de choses. Une image ou un PDF peut être stocké, mais les quantités, les numéros d'articles, les lots et les remarques ne peuvent pas y être réutilisés de manière fiable.

Une meilleure approche est un document généré à partir de données de commande structurées. Les articles, les quantités cibles, les adresses de livraison et les personnes à contacter sont repris. Les employés confirment ensuite les quantités réelles directement sur un appareil mobile ou à un poste de travail dans l'entrepôt. Seuls les écarts, dommages ou positions supplémentaires doivent être saisis manuellement.

Cela ne fait pas que gagner du temps. Cela évite également une rupture de support typique : la comptabilité ne reçoit plus une signature à peine lisible sur papier pendant que l'entrepôt maintient séparément le même processus dans un tableur.

Les données dont un bon de livraison numérique a réellement besoin

Un système ne devrait pas imposer chaque champ imaginable. Des saisies supplémentaires ralentissent les remises et réduisent l'acceptation. En même temps, le nom du client et la signature ne suffisent pas pour de nombreux flux de travail.

Comme base, chaque bon de livraison nécessite un numéro unique, la référence à la commande, les adresses de livraison et du destinataire, les positions d'articles avec quantités cibles et réelles, ainsi que des horodatages.

Selon le secteur, s'ajoutent les lots, numéros de série, poids, emplacements de stockage ou conteneurs. Pour les marchandises à température contrôlée, les valeurs mesurées peuvent être pertinentes ; pour les livraisons sur chantier, des photos ou des indications précises sur le lieu de livraison sont utiles.

Le statut est particulièrement important. « Créé », « préparé », « en transit », « remis », « livré partiellement », et « contesté » ne sont pas de simples étiquettes. Ils déterminent quelle personne doit agir ensuite et si, par exemple, une facture peut être générée ou une livraison ultérieure planifiée.

Utiliser signatures et photos avec discernement

Une signature numérique est utile dans de nombreux processus de livraison, mais elle n'est pas automatiquement la meilleure confirmation. Pour une remise rapide à la réception des marchandises, un nom imprimé, un horodatage et l'attribution au destinataire peuvent suffire. Pour des marchandises de grande valeur ou des remises contestées, une signature combinée à une photo et des informations de localisation peut en revanche être plus judicieuse.

Le facteur décisif est la chaîne de preuves : la confirmation doit être associée au document spécifique et à sa version. Si quelqu'un modifie des quantités ou des positions après la signature, le système ne devrait pas l'écraser silencieusement. Cela nécessite une correction traçable ou une nouvelle confirmation. Les photos méritent la même discipline. Elles peuvent documenter des dommages, mais ne devraient pas se transformer en une collecte indiscriminée de données personnelles. Définissez quand une photo est requise, qui peut y accéder, et combien de temps elle est conservée.

La saisie mobile doit fonctionner dans des conditions réelles

Au bureau, presque toute application est utilisable. Dans l'entrepôt comptent les gants, le mauvais Wi-Fi, la pression temporelle et les appareils à autonomie de batterie limitée. Un bon de livraison numérique doit donc se contenter de peu d'étapes de saisie, mais importantes. Les scans de codes-barres ou codes QR sont souvent plus rapides et plus fiables que la recherche de numéros d'articles.

La capacité hors ligne n'est pas un luxe lorsque les chauffeurs travaillent en dehors d'une couverture réseau stable. L'application devrait mettre en cache les opérations localement, indiquer clairement ce qui n'a pas encore été synchronisé, et gérer les conflits de manière contrôlée. Si deux personnes modifient la même livraison, le dernier enregistrement ne doit pas gagner par hasard.

La question du matériel doit également être traitée de manière pragmatique. Un smartphone existant peut suffire pour des livraisons simples. Pour des scans, photos et signatures fréquents dans l'entrepôt, des terminaux portables robustes ou des tablettes sont souvent plus économiques. La meilleure décision dépend de la durée d'utilisation, de l'environnement et du débit attendu — pas de l'appareil qui a l'air moderne sur une diapositive produit.

Définir les interfaces avant la mise en œuvre

Un bon de livraison numérique ne développe sa valeur que lorsqu'il se connecte aux sources de données principales. Dans de nombreuses entreprises, les commandes résident dans l'ERP ou le système de gestion des marchandises, les stocks dans une solution d'entrepôt séparée, et les factures en comptabilité. Cela ne doit pas immédiatement devenir un grand projet système. Mais la souveraineté des données doit être claire.

Définissez donc quel système gère les clients, articles, prix et commandes. La solution de bons de livraison peut reprendre des informations, mais elle ne devrait pas générer sans le remarquer un second référentiel d'articles. De même, il doit être réglementé quand les quantités réelles confirmées sont renvoyées et qui vérifie les écarts.

Techniquement, des interfaces fiables sont plus importantes que des fonctions spectaculaires. Des identifiants uniques, des formats de données documentés, des protocoles pour les transferts échoués, et un mécanisme de nouvelle tentative empêchent les bons de livraison de disparaître entre deux systèmes. Une application légère sur une base maintenable, comme PHP 8.4, JavaScript moderne et MySQL 8, est plus judicieuse pour de nombreux flux de travail de moyennes entreprises qu'une suite surchargée avec des fonctions que personne n'utilise.

La sécurité et l'archivage font partie du processus

Les bons de livraison contiennent des données commerciales et souvent aussi des données personnelles. Les droits de rôle ne devraient donc pas être attribués de manière globale. Les chauffeurs ont besoin de leurs tournées et tâches ouvertes, les responsables d'entrepôt ont besoin d'options de correction et de révision, la comptabilité a besoin de documents confirmés et d'exports. L'accès administratif complet n'est pas un droit standard.

De plus, un historique traçable est nécessaire : la création, la modification, la remise, la signature, l'annulation et la correction devraient être enregistrées avec l'heure, l'utilisateur et la justification. Cela aide en cas de questions et protège les employés lorsqu'il n'est plus clair par la suite quand un dommage ou un manque a été signalé. Pour l'archivage, la règle est : le document doit rester lisible et le processus localisable. Qu'un PDF soit généré dépend du flux de travail interne et des exigences des destinataires externes. Le PDF est cependant la sortie d'un processus numérique, pas son modèle de données.

Devenir productif par petites étapes

Le déploiement le plus fiable commence par un processus clairement délimité : par exemple des livraisons standard depuis un entrepôt ou des réceptions de marchandises d'un département. Choisissez une zone avec un volume suffisant, mais sans les cas particuliers les plus compliqués. Cela permet de tester le fonctionnement, la qualité des données et les interfaces dans des conditions réelles.

Ne mesurez pas seulement si l'application fonctionne techniquement. Vérifiez combien de temps prend une remise, combien de bons de livraison nécessitent un retraitement, à quelle fréquence des écarts de stock se produisent, et si la comptabilité peut travailler plus rapidement. Si une procédure numérique génère plus de questions que le formulaire papier, ce n'est pas le personnel qui est le problème — alors la clarté du processus manque ou le masque de saisie ne correspond pas à la pratique opérationnelle.

Les tableurs peuvent continuer à exister s'ils sont fiables pour une évaluation limitée ou une liste spéciale rare. La numérisation ne signifie pas abolir chaque outil connu. Cela signifie remplacer délibérément les remises sujettes aux erreurs et rendre le processus central robuste.

softify.pro développe de tels flux de travail non pas comme un produit standard rigide, mais le long des mouvements de marchandises concrets, des rôles et des systèmes existants. Cela est particulièrement utile lorsqu'une entreprise cherche une solution adaptée entre le chaos papier et un système d'entreprise surdimensionné.

La bonne première étape n'est donc pas un long catalogue d'exigences. Prenez dix bons de livraison d'une semaine normale, y compris une livraison partielle et une réclamation. Si votre futur flux de travail traite ces dix cas rapidement, sans ambiguïté et de manière traçable, un bon de livraison numérique se transforme en un outil sur lequel l'entrepôt, les chauffeurs et l'administration peuvent compter.

Lien permanent →

Tendances du test logiciel 2026 qui comptent vraiment

Tendances du test logiciel 2026 qui comptent vraiment

Une mise en production ratée ne révèle rarement qu'une seule erreur. Souvent, plusieurs causes se combinent : une autorisation modifiée, un environnement de test flou, des données de test manquantes ou un test de régression non maintenu depuis des mois. C'est précisément là que les software testing trends pour 2026 deviennent concrètes - non pas comme une collection de nouveaux outils, mais comme la question de savoir comment les entreprises peuvent livrer des changements avec une sécurité vérifiable, même avec des capacités QA limitées et des données sensibles.

Pour les équipes logicielles des entreprises de taille moyenne, c'est particulièrement pertinent. Une application d'entrepôt, un portail client ou un logiciel de bureau Windows n'a pas besoin de servir des millions d'utilisateurs. Il doit cependant fonctionner en travail posté, générer correctement des documents et appliquer les autorisations de manière fiable. Les tests doivent donc être plus proches des déroulements opérationnels réels que d'un environnement de démonstration parfait.

Tendances du test logiciel : l'IA devient exécutante, pas oracle

La tendance la plus visible est le test assisté par l'IA. Cela ne signifie pas qu'un modèle de langage lit une exigence et garantit ensuite la qualité de l'application. Cette attente serait dangereuse. L'IA peut cependant réduire considérablement l'effort là où les équipes perdent du temps aujourd'hui : formuler des cas de test, reconnaître des changements notables dans les interfaces, associer des schémas d'erreurs similaires et rédiger des rapports de test compréhensibles.

L'IA devient particulièrement utile lorsqu'elle exécute des étapes de travail concrètes et fournit des preuves de ses résultats. Un agent de test peut, par exemple, se connecter, créer une réception de marchandises, modifier une adresse de livraison, générer une étiquette d'expédition et vérifier si le statut, le mouvement de stock et le document correspondent. Le facteur décisif n'est pas l'affirmation « test réussi », mais la chaîne de preuves : étapes exécutées, horodatages, captures d'écran, journaux techniques et une description claire de l'écart.

La limite reste importante. L'IA peut suggérer des cas de test et gérer des déroulements récurrents. Elle ne devrait pas décider seule si une écriture métier critique est correcte. Pour les prix, les niveaux de stock, les validations de paiement ou les droits d'accès, des règles explicites et des attentes confirmées par les services métier restent nécessaires. L'automatisation accélère les tests ; elle ne remplace pas la responsabilité.

L'automatisation des tests migre vers le processus métier

Pendant longtemps, l'automatisation des tests UI s'est concentrée sur des chemins simples : ouvrir la page, remplir le formulaire, vérifier le message de succès. Cela reste utile, mais ne suffit pas pour les systèmes critiques pour l'activité. Le test le plus précieux valide une chaîne de processus complète.

Prenons une fonction logistique typique. Une commande est enregistrée, la marchandise réservée, un processus de préparation démarré, un bon de livraison généré et l'expédition signalée. Chaque écran individuel peut sembler propre alors que le processus échoue quand même - par exemple parce qu'une réservation persiste après une annulation ou qu'une livraison partielle modifie incorrectement le stock. Les bons tests automatisés suivent donc les états et les données à travers les limites du système.

Cela exige une architecture de test propre. Les tests API et base de données vérifient les règles rapidement et précisément. Les tests UI contrôlent en plus si les employés peuvent réellement utiliser le processus. Les tests de bout en bout combinent les deux, mais sont plus lents et plus fragiles. Celui qui teste tout exclusivement via le navigateur construit généralement une suite de tests coûteuse et fragile. Celui qui ne teste que les interfaces néglige les problèmes d'utilisation et les interfaces mal câblées.

La solution pragmatique est une pyramide adaptée au risque : de nombreux contrôles rapides proches de la logique métier, moins de contrôles d'intégration et des scénarios de bout en bout sélectionnés de manière ciblée pour les déroulements les plus importants. Cela semble peu spectaculaire. Mais cela fournit une fiabilité ennuyeuse et prouvable plutôt qu'une course aux tendances.

L'IA de test auto-hébergée devient une question d'architecture

Avec les outils de test IA, une nouvelle question se pose : où vont les données de test, les captures d'écran et les enregistrements ? Dans de nombreuses applications, ils contiennent des noms de clients, des prix internes, des informations sur le personnel ou des vues de processus critiques pour l'activité. Même un environnement de test apparemment inoffensif peut contenir de véritables copies de données ou des structures confidentielles.

C'est pourquoi l'environnement d'exécution devient un critère central. Un service cloud externe peut convenir pour des applications web publiques et des données de test non critiques. Pour les portails internes, les applications de bureau ou les domaines réglementés, une approche auto-hébergée est souvent plus judicieuse. Dans cette configuration, l'exécution des tests, les images et les journaux restent dans l'infrastructure contrôlée de l'entreprise ou dans un environnement UE clairement délimité.

Ce n'est pas un argument général contre les services cloud. L'auto-hébergement demande des efforts : mises à jour, contrôle d'accès, ressources de calcul, surveillance et responsabilités claires doivent être gérés. Le bénéfice apparaît lorsque la protection des données, la traçabilité et le contrôle des artefacts de test pèsent plus lourd que le confort d'un compte SaaS immédiatement disponible. Des systèmes comme COCO suivent précisément cette approche en exécutant des tests pour applications web et Windows tout en gardant les preuves contrôlables localement.

Les tests instables ne sont plus acceptés comme normaux

Un test automatisé qui réussit parfois et échoue parfois sans modification du produit ne génère pas de sécurité. Il génère des files d'attente. Les équipes s'habituent alors à ignorer les builds rouges ou à relancer les tests jusqu'à obtenir le résultat souhaité. C'est une perte progressive de confiance dans l'ensemble du dispositif de contrôle qualité.

En 2026, la stabilité de l'exécution des tests passe donc davantage au premier plan. Les causes sont généralement connues : temps d'attente aléatoires, sélecteurs instables, données de test partagées, dépendances envers des services externes ou bases de données non réinitialisées. La solution est rarement un nouvel essai. Plus judicieux sont des sélecteurs techniques univoques, des comptes de test isolés, des états de données contrôlés et des conditions d'attente ciblées qui réagissent à de véritables événements système.

L'évaluation devrait également faire la distinction : une erreur est-elle reproductible ? Se produit-elle uniquement dans un environnement ? Un service externe a-t-il échoué ou l'application elle-même ? L'IA peut aider à regrouper ces signaux. La décision technique doit cependant rester traçable. Une équipe QA n'a pas besoin d'une prédiction d'erreur mystérieuse, mais d'une base solide pour la prochaine mesure.

La qualité commence plus tôt, avec les exigences et les données

De nombreuses erreurs surviennent avant que la première ligne de code ne soit écrite. « La commande doit pouvoir être expédiée » n'est pas une exigence testable. Que se passe-t-il en cas d'adresse incomplète, de compte client bloqué, de marchandise manquante, de traitement parallèle ou de session expirée ? Sans réponses à ces questions, aucun système de test ne peut vérifier de manière fiable si le logiciel fonctionne correctement.

Une approche de test plus mature complète donc les exigences par des exemples vérifiables. Pour un compte avec des tentatives de connexion incorrectes, cela peut signifier concrètement : après cinq tentatives échouées, le compte est bloqué pendant 15 minutes, le processus est journalisé et un administrateur autorisé peut retracer le blocage. Cela génère directement des contrôles automatisables - et moins de marge d'interprétation entre le développement, l'exploitation et le service métier.

Les données de test deviennent également une caractéristique du produit. Elles doivent être suffisamment réalistes pour représenter les cas limites, mais ne doivent pas copier des données personnelles inutiles. Des jeux de données générés pour les cas de TVA, les quantités partielles, les articles bloqués, les adresses invalides et divers rôles sont utiles. Notamment avec les applications utilisant MySQL 8 ou des bases de données relationnelles comparables, il est utile de provisionner automatiquement des états initiaux définis et de les supprimer après l'exécution.

Les tests basés sur les risques l'emportent sur la couverture de test à tout prix

Un chiffre élevé de couverture de code peut être rassurant tout en disant très peu. Il montre quelles lignes ont été exécutées, pas si la bonne règle a été testée. Un système peut atteindre 90 % de couverture et pourtant conduire à des stocks incorrects lors de l'annulation d'une livraison partielle.

La meilleure question est : quelles erreurs seraient particulièrement coûteuses pour l'exploitation, les clients ou la conformité légale ? Il en résulte une priorisation. La protection des accès, le calcul des prix, les écritures de stock, la génération de documents et les interfaces vers les prestataires d'expédition méritent généralement plus de profondeur de test que les pages de paramètres rarement utilisées. Cela ne signifie pas livrer des questions secondaires sans contrôle. Cela signifie déployer un temps limité là où une panne arrête un travail réel ou génère de mauvaises décisions.

Cette priorisation doit pouvoir évoluer. Si une nouvelle fonction de planification d'itinéraire est introduite, son risque augmente. Si une ancienne évaluation Excel doit bientôt être remplacée, un effort d'automatisation important n'en vaut peut-être plus la peine. Il est parfois plus judicieux de conserver un tableau fonctionnel encore quelques mois plutôt que de forcer hâtivement sa logique dans un système à moitié terminé.

Ce que les équipes devraient faire concrètement maintenant

La première étape sensée n'est pas une comparaison d'outils. Choisissez un processus dont les défaillances sont tangibles : de la commande à la livraison, de la réception de marchandises au rangement, ou de la connexion à la validation du rôle. Décrivez le déroulement cible avec les cas d'exception, mettez en place des données de test fiables et automatisez d'abord les contrôles critiques.

Ensuite, ne mesurez pas seulement le nombre de tests. Observez la rapidité avec laquelle une véritable erreur est détectée, la fréquence à laquelle les tests échouent sans raison, et si un rapport explique la cause de manière compréhensible à un développeur ou à un responsable métier. Ce n'est que lorsque ces fondations sont en place que l'extension avec des agents IA, l'inspection visuelle ou des environnements de test étendus vaut la peine.

Les tendances de test les plus fortes sont finalement celles qui rendent les mises en production moins risquées et amènent les équipes à des décisions claires plus rapidement. Ce n'est pas le tableau de bord le plus moderne qui compte, mais une exécution de test traçable montrant que ce processus métier fonctionne - et sinon, en connaître la raison.

Lien permanent →

Planification des tournées de livraison : bien choisir son logiciel

Planification des tournées de livraison : bien choisir son logiciel

Un chauffeur attend un bon de livraison pendant que l'ordre de ses arrêts change encore une fois. À l'entrepôt, un envoi n'est pas encore préparé, un client appelle pour un créneau horaire plus serré, et la liste des tournées se trouve dans un tableur que seule une personne comprend vraiment. Celui qui cherche un « logiciel de planification des tournées de livraison » dans cette situation ne veut pas forcément un algorithme cartographique compliqué. Ce qu'il cherche, c'est un déroulement fiable de la saisie de la commande jusqu'à la preuve de livraison.

Pour les petites et moyennes entreprises, c'est une différence décisive. Un trajet théoriquement plus court sert à peu de choses s'il ne tient pas compte du fait que la marchandise n'est prête qu'à 10 heures, qu'un véhicule nécessite un système de réfrigération, ou qu'un chauffeur possède une connaissance client particulière sur une tournée donnée. Un bon logiciel pour les tournées de livraison reflète la réalité de l'exploitation - et la rend utilisable conjointement par la répartition, l'entrepôt et les chauffeurs.

Quand la planification des tournées devient un problème opérationnel

De nombreuses entreprises commencent judicieusement avec le téléphone, le papier et un tableur. Avec cinq arrêts par jour et une équipe de chauffeurs fixe, c'est souvent la solution la plus rapide. C'est seulement lorsque le volume de commandes, les variantes et la pression temporelle augmentent que surviennent les frictions typiques : adresses saisies en double, statuts de tournées obsolètes, informations manquantes sur les supports de charge, et questions qui ne peuvent être résolues qu'en appelant plusieurs personnes.

Le problème n'est alors pas seulement le trajet. C'est la rupture d'information entre la saisie de commande, l'entrepôt, la répartition et la livraison. Si une commande est reportée, ce changement doit aujourd'hui souvent être répercuté dans plusieurs listes, sur une impression et dans la tête du chauffeur. Cela coûte du temps et crée des erreurs que les clients voient immédiatement.

Un autre signal d'alarme est constitué par des décisions qui dépendent d'employés individuels. Si seule la répartitrice expérimentée sait quel accès convient à un client donné ou comment adapter la tournée 3 en cas de réception tardive de marchandises, le déroulement n'est pas documenté de façon robuste. Le logiciel ne doit pas remplacer ce savoir. Il doit le représenter de manière à ce que l'équipe reste capable d'agir.

Ce qu'un logiciel de planification des tournées de livraison doit savoir faire

La fonction centrale semble simple : les commandes sont affectées à une tournée, les arrêts triés judicieusement et transmis aux chauffeurs. Pour une utilité pratique, cependant, le système a besoin de bien plus de contexte. Ce qui est décisif, ce sont les règles qui s'appliquent lors de la planification et la manière dont les changements sont traités.

Les commandes doivent être planifiables, pas seulement visibles

Une adresse de livraison sur une carte ne constitue pas encore une livraison planifiable. Une commande comprend au minimum des quantités, un poids ou un volume, une date de livraison, un créneau horaire souhaité, des informations de contact et un statut de traitement clair. Selon l'activité s'ajoutent supports de charge, exigences de température, marquages de matières dangereuses, règles d'avis ou une classe de véhicule spécifique.

Ces données ne devraient pas devoir être rassemblées manuellement à partir de différents systèmes à chaque fois. Si les commandes proviennent déjà d'une boutique en ligne, d'un ERP, d'un masque de saisie de commande ou d'une base de données existante, une transmission propre est souvent plus précieuse qu'une vue cartographique particulièrement spectaculaire. Sinon, le travail se déplace simplement du papier vers une nouvelle interface.

Les tournées ont besoin de règles, pas seulement de distance

Un ordre automatique basé sur les kilomètres ou le temps de conduite peut être une bonne suggestion. Ce n'est cependant pas une décision pour l'entreprise. La planification doit pouvoir tenir compte des contraintes : dates de livraison fixes, capacité du véhicule, horaires de travail, temps de chargement et déchargement, ainsi que responsabilités régionales.

La logique de départ compte également. Certains véhicules commencent et finissent à l'entrepôt, d'autres se rendent directement au prochain lieu d'intervention après la dernière livraison. Pour les tournées récurrentes, une structure de base fixe peut être utile, que les répartiteurs ne modifient qu'en cas de besoin. Celui qui dessert exactement les mêmes arrêts chaque matin n'a pas nécessairement besoin d'une réoptimisation complète. Ici, une tournée stable et traçable est souvent préférable à un gain de temps calculé minimal.

Les changements doivent parvenir au chauffeur de manière contrôlée

La réalité respecte rarement le plan du matin. Des clients annulent, de la marchandise manque, un véhicule tombe en panne ou une commande devient urgente. Dans de tels cas, c'est là que se décide si le logiciel apporte un soulagement ou crée un travail supplémentaire.

Une solution utilisable montre clairement quelle version de la tournée est actuellement valide, quels arrêts sont déjà effectués et ce qui a concrètement changé. Le chauffeur ne devrait pas avoir à comparer des impressions contradictoires, des captures d'écran et des messages de messagerie. Pour de nombreuses équipes, une vue chauffeur mobile et basée sur navigateur avec ordre des arrêts, coordonnées, consignes de livraison et retour de statut suffit dans un premier temps. Une application dédiée n'est pas automatiquement meilleure si l'installation, la gestion des appareils et les exigences hors ligne n'apportent aucun bénéfice clair.

Ne pas commencer uniquement par l'optimisation des tournées

L'approche erronée la plus fréquente consiste à acheter d'abord un service d'optimisation et à ne vérifier qu'ensuite si les données de base et les processus sont corrects. Des adresses mal orthographiées, des créneaux de livraison flous et des commandes sans statut de disponibilité fiable ne peuvent pas être « optimisés » loin.

Un état des lieux bref le long du déroulement quotidien réel est plus judicieux. Où naissent les commandes ? Quand l'entrepôt confirme-t-il la disponibilité ? Qui planifie les tournées ? Comment le chauffeur reçoit-il les changements ? Et quelle preuve est nécessaire après la livraison ? Ces questions semblent banales, mais elles déterminent quels champs de données, rôles et interfaces le système a réellement besoin.

Il s'avère souvent que toutes les étapes ne doivent pas être numérisées. Une note manuscrite pour une livraison spéciale rare peut être appropriée, si elle est ensuite proprement reprise dans la commande. Un tableur peut également rester, s'il fournit fiablement une évaluation maîtrisable. Le logiciel devrait résoudre le goulot d'étranglement, sans remplacer de force chaque déroulement connu.

Build, Buy ou extension ciblée ?

Un logiciel standard convient lorsque la logique des tournées est générale, que les processus varient peu et que l'équipe peut s'adapter à des masques prédéfinis. Il raccourcit la mise en œuvre et peut suffire pour une flotte simple. L'inconvénient apparaît dès qu'il ne représente les cas particuliers centraux que via des listes secondaires, du texte libre ou des modules complémentaires coûteux.

Une solution sur mesure ne vaut pas la peine parce que le développement sur mesure serait fondamentalement supérieur. Elle vaut la peine lorsque le déroulement lui-même constitue un avantage concurrentiel ou une source d'erreurs persistante : par exemple avec des unités d'emballage spéciales, des tournées combinées de collecte et de livraison, des documents de livraison propres, ou un lien étroit entre la réception de marchandises, la préparation et l'expédition.

Entre les deux se trouve souvent la voie la plus pragmatique. Les systèmes existants restent en place pour la comptabilité ou la gestion d'entrepôt, tandis qu'une application légère regroupe les commandes, planifie les tournées et couvre le processus chauffeur. Cela nécessite des interfaces claires, des responsabilités de données sans ambiguïté et une structure de base de données qui enregistre les modifications de façon traçable. Les applications web modernes sur une base maintenable comme PHP 8.4 et MySQL 8 ne sont pas une décision de mode pour cela, mais une base pour une exploitation prévisible et des ajustements futurs.

Une mise en œuvre par petites étapes plutôt qu'un grand changement

Un logiciel de planification des tournées devrait d'abord être testé sur une tournée ou un groupe de véhicules gérable. Non pas parce qu'un projet pilote serait sans risque, mais parce que les véritables exceptions apparaissent tôt : consignes de livraison manquantes, données d'adresse hétérogènes, temps d'attente chez le client ou transmissions floues à l'entrepôt.

Pour la première étape d'extension, des fonctions clairement délimitées suffisent généralement : reprendre la commande, voir le statut de disponibilité, composer la tournée, valider la tournée et signaler la livraison. Ce n'est que lorsque cette chaîne fonctionne au quotidien que l'optimisation automatique, la signature électronique, les preuves photo, les notifications clients ou des indicateurs détaillés deviennent judicieux.

Le bénéfice se mesure non seulement en kilomètres économisés. Sont également pertinents une charge de répartition réduite, moins de demandes de clarification, moins de livraisons erronées, un délai plus court jusqu'au bon de livraison et une meilleure capacité de réponse envers les clients. Ces indicateurs devraient être approximativement établis avant le lancement. Sinon, après la mise en œuvre, il ne reste que l'impression que l'interface paraît plus moderne.

La technique doit rester fiable en arrière-plan

La planification des tournées traite des données opérationnelles sensibles : adresses clients, affectations des chauffeurs, quantités de livraison et souvent aussi preuves de livraison. C'est pourquoi les droits par rôle, les modifications traçables, les sauvegardes régulières et une exploitation documentée font partie de la solution. Qui est autorisé à valider, modifier ou supprimer une tournée ne devrait pas être laissé au hasard.

Les données cartographiques et de routage méritent également un examen sobre. Les services externes peuvent très bien convenir, mais ils entraînent des coûts récurrents, des questions de disponibilité et de protection des données. En cas d'exigences élevées en matière de conservation des données ou de logiques territoriales spéciales, il faut clarifier tôt quelles données quittent son propre système et comment les pannes sont amorties. Une tournée parfaite ne vaut rien si la répartition ne peut pas continuer à travailler lors d'une perturbation.

softify.pro conçoit de tels systèmes depuis la réception réelle de la commande jusqu'au retour depuis le véhicule. Le critère n'est pas la liste de fonctionnalités la plus longue, mais un déroulement que l'entrepôt, la répartition et les chauffeurs peuvent exploiter de façon fiable sous pression temporelle.

La meilleure planification des tournées paraît étonnamment peu spectaculaire au quotidien : les commandes sont complètes, les tournées compréhensibles, les changements sans ambiguïté et les livraisons vérifiables. C'est précisément cette fiabilité discrète qui crée l'espace nécessaire pour les exceptions où les humains doivent décider.

Lien permanent →

Automatiser le workflow de prise de commande dans l'entreprise

Automatiser le workflow de prise de commande dans l'entreprise

Une commande arrive par e-mail, une autre par téléphone, plus un fichier Excel du grand compte. Plus tard, l'adresse de livraison manque à l'entrepôt, le service commercial ne se souvient plus précisément du délai promis, et le service expédition imprime le bon de livraison avec une ancienne position d'article. Celui qui veut automatiser le workflow de prise de commande ne résout pas un projet numérique abstrait. Il élimine précisément cette friction à l'endroit où le chiffre d'affaires se transforme en travail opérationnel.

Pour les petites et moyennes entreprises, la prise de commande est souvent sous-estimée. Tant que peu de commandes arrivent par jour et que des employés expérimentés connaissent chaque cas particulier, notes téléphoniques, boîtes mail et tableaux portent le processus. Avec un volume croissant, ils deviennent cependant un risque : les informations existent en double, les transmissions se font oralement, et personne ne peut dire de manière fiable quel est le statut réel de la commande.

Pourquoi la prise de commande devient si souvent un goulot d'étranglement

La cause est rarement un manque d'engagement. Le plus souvent, le processus s'est développé au fil des années. Les clients commandent par des canaux différents, les prix et conditions de livraison ne valent que pour certains groupes de clients, les numéros d'article s'écartent des désignations internes. Les employés recoupent les informations par expérience et comblent les lacunes par des demandes de clarification.

Cela fonctionne jusqu'à ce qu'une personne soit en congé, que l'équipe change, ou que plusieurs commandes urgentes arrivent simultanément. On constate alors que le savoir ne réside pas dans le processus, mais dans des têtes individuelles et des fichiers dispersés. Les conséquences sont familières : quantités erronées, livraisons retardées, validations non résolues et corrections inutiles à l'entrepôt.

Automatisation ne signifie pas ici qu'un client doive nécessairement commander via un portail. Cela signifie que chaque commande, indépendamment du canal d'entrée, est enregistrée, vérifiée, enrichie et transmise selon les mêmes règles traçables.

Automatiser le workflow de prise de commande sans dénaturer l'activité

Un workflow utilisable ne commence pas par une liste de logiciels, mais par un état des lieux sobre du processus. La question décisive est : quelles informations doivent être disponibles avant qu'une commande puisse partir vers l'entrepôt, la répartition ou la production ? Et quelles exceptions sont légitimes plutôt que simplement gênantes ?

Un déroulement typique comprend quatre étapes claires : saisir la commande, vérifier les données, valider la commande et déclencher les processus suivants. Entre ces étapes, il faut des responsabilités et des statuts univoques. Une commande ne devrait par exemple pas pouvoir être considérée simultanément comme « nouvelle », « en clarification » et « prête à expédier ».

1. Regrouper les commandes de tous les canaux en un seul dossier

E-mail, téléphone, PDF, EDI, formulaire web ou note du terrain peuvent rester des points d'entrée différents. Ce qui compte, c'est qu'ils aboutissent dans un dossier de commande commun. Les employés ne devraient pas d'abord copier des informations depuis la boîte mail, puis mettre à jour un tableau, puis en informer une deuxième personne.

Pour les commandes structurées, les données client, numéros d'article, quantités et dates souhaitées peuvent être reprises directement. Pour les PDF ou e-mails en texte libre, une saisie guidée est souvent plus judicieuse qu'une extraction entièrement automatique. L'extraction assistée par IA peut faire des propositions, mais en cas de quantités peu claires, de numéros d'article spécifiques au client ou de documents manuscrits, une vérification visible est nécessaire.

Le critère judicieux n'est pas « le maximum d'automatisation », mais « aucune double saisie inutile ». Un formulaire bien conçu avec des champs obligatoires et des suggestions plausibles fait gagner, dans de nombreuses entreprises, plus de temps qu'une automatisation intégrale sujette aux erreurs.

2. Vérifier les données avant que les erreurs ne se propagent

L'automatisation la plus précieuse a lieu avant la validation. Le système peut vérifier si le numéro client existe, si l'adresse de livraison est complète, si l'article est actif, si la quantité demandée semble admissible, et si l'accord de paiement ou de crédit est présent. Les prix spécifiques au client, les quantités minimales et les créneaux de livraison peuvent également être comparés aux règles enregistrées.

Le traitement des écarts est important. Chaque écart ne doit pas bloquer une commande. Si un numéro de référence manque par exemple, le service commercial peut recevoir une tâche. Si une commande dépasse un seuil de valeur défini ou que la marge sort du cadre convenu, une validation par le rôle compétent peut être requise.

Cela ne crée pas d'erreurs silencieuses, mais des cas de clarification visibles. C'est une différence majeure : l'entrepôt ne reçoit pas simplement une commande incomplète, mais une commande avec un statut clair et une décision documentée.

3. Relier les validations à des règles plutôt qu'à des demandes verbales

De nombreux retards naissent de phrases comme : « Tu peux valider ça rapidement ? » De telles demandes ne sont pas fondamentalement fausses. Elles deviennent problématiques lorsqu'elles passent par chat, téléphone ou conversation de couloir et ne sont plus traçables par la suite.

Un workflow automatisé enregistre les règles de validation directement au niveau de la commande. Par exemple, une commande peut être validée automatiquement si le client, le prix, le stock et l'adresse de livraison sont plausibles. En cas de conditions spéciales, de livraisons partielles ou d'une commande dépassant un seuil défini, la personne responsable est notifiée. La validation est enregistrée avec horodatage et justification.

Cela crée de la rapidité sans renoncer au contrôle. Notamment en cas d'équipes tournantes ou de sites multiples, cela évite que des commandes restent bloquées dans des boîtes mail personnelles.

4. Informer entrepôt, expédition et client de manière ciblée

Après la validation, la commande ne doit plus être transférée manuellement d'une liste à l'autre. Le workflow peut générer un ordre de préparation, réserver du stock, préparer un bon de livraison ou déclencher une notification d'expédition. Les étapes pertinentes dépendent du modèle économique.

Un revendeur de pièces détachées a peut-être immédiatement besoin d'un ordre de prélèvement et d'un marquage de priorité. Un fabricant a d'abord besoin d'une vérification de disponibilité puis d'une impulsion de production. Un grossiste avec des tournées fixes veut regrouper les commandes jusqu'à une certaine heure. C'est pourquoi une solution standard rigide n'est souvent pas le meilleur choix.

Pour le client, une confirmation claire suffit souvent : commande reçue, vérifiée ou planifiée fermement. Chaque changement de statut interne n'a pas sa place dans un e-mail. Trop de messages automatiques génèrent des questions plutôt que de la confiance.

Quelles données un processus robuste nécessite

Une bonne prise de commande repose sur une base de données propre. Cela comprend des données maîtresses clients à jour, des numéros d'article uniques, des règles de prix et de conditions valides, ainsi que des adresses de livraison clairement définies. Si ces bases manquent, l'automatisation ne fait qu'accélérer la transmission de données peu fiables.

L'architecture technique compte également. Un système central avec des changements de statut traçables et une base de données fiable est durablement meilleur qu'une chaîne de macros, de fichiers locaux et de transferts d'e-mails incontrôlés. Cela ne signifie pas que chaque tableau Excel doive être remplacé immédiatement. Si un tableau fonctionne de manière transparente dans un petit sous-processus stable, il peut rester en place pour l'instant.

Dès que plusieurs personnes travaillent simultanément sur des commandes, que des validations sont nécessaires ou que des informations sont transmises à l'entrepôt et à l'expédition, une source de données centrale devrait toutefois avoir la priorité. Les systèmes reposant sur une architecture maintenable, par exemple avec PHP 8.4, JavaScript moderne et MySQL 8, peuvent ainsi être connectés de manière ciblée aux processus existants, plutôt que de forcer une entreprise dans le schéma d'un logiciel de groupe surdimensionné.

Rendre mesurable si le workflow s'améliore réellement

Un nouveau système n'est pas automatiquement un meilleur processus. Avant le lancement, quelques indicateurs clés devraient donc être définis. Sont pertinents, par exemple, le délai entre la réception de la commande et la validation, le nombre de demandes de clarification par commande, les corrections après transmission à l'entrepôt et le taux de commandes traitées dans les délais.

Ces indicateurs montrent aussi où aucune automatisation supplémentaire n'est nécessaire. Si 85 % des commandes standard se déroulent rapidement et sans erreur, mais que les 15 % restants sont de véritables cas particuliers, un processus de clarification clair est plus judicieux que de tenter de forcer algorithmiquement chaque exception.

Les journaux aident également dans l'activité quotidienne. Quiconque voit quand une commande est arrivée, quelle vérification a échoué, qui l'a validée et quand l'ordre d'expédition a été généré ne cherche plus la cause dans cinq boîtes mail. Cela réduit non seulement les erreurs, mais aussi la dépendance envers certains employés.

Une mise en place par petites étapes plutôt qu'un Big Bang

L'entrée la plus sûre est généralement un type de commande clairement délimité : par exemple des commandes standard d'un groupe de clients spécifique, ou des commandes par e-mail avec des articles connus. On peut y tester champs de données, règles et transmissions dans des conditions réelles. Ce n'est que lorsque statuts, exceptions et responsabilités fonctionnent proprement que suivent des cas plus complexes comme des prix spéciaux, des livraisons partielles ou des spécifications d'emballage individuelles par client.

Les employés devraient être associés à la conception. Non pas parce que chaque habitude existante doive rester inchangée, mais parce que les personnes au téléphone, dans les ventes et à l'entrepôt connaissent les exceptions réelles. Une solution qui n'a l'air bonne qu'en atelier est vite contournée sur le terrain.

Pour de tels projets, softify.pro mise sur des systèmes spécifiques au workflow plutôt que sur des suites standards surchargées : avec des transmissions claires, des règles documentées et assez de place pour les méthodes de travail qui fonctionnent démontrablement dans l'entreprise.

La meilleure prochaine étape n'est donc pas la recherche du plus grand nombre de fonctionnalités possible. Prenez dix commandes réelles d'une semaine typique et suivez leur parcours de la réception à l'expédition. Chaque double transfert manuel, chaque décision floue et chaque demande de clarification récurrente est un point de départ concret pour un processus qui fonctionnera durablement de manière fiable pour l'équipe.

Lien permanent →

Protéger en toute sécurité les données de test lors des tests par IA

Protéger en toute sécurité les données de test lors des tests par IA

Un test automatisé échoué est généralement vite corrigé. Une capture d'écran issue du test qui contient des données clients, des listes de prix ou une session active et qui se retrouve dans un service d'IA externe est un problème différent. Quiconque veut protéger les données de test lors des tests par IA doit donc considérer non seulement les cas de test, mais l'ensemble du parcours des données : saisies, trafic navigateur, journaux, images, évaluation par IA et conservation.

C'est justement avec les applications web, les portails internes et les logiciels Windows qu'un faux sentiment de sécurité apparaît rapidement. L'environnement s'appelle certes « test », mais il utilise souvent des copies de bases de données de production, de vrais rôles utilisateurs ou des interfaces vers l'expédition, l'ERP et les archives documentaires. Les tests assistés par IA rendent ces données particulièrement précieuses pour l'analyse - et donc particulièrement sensibles.

Pourquoi les tests par IA nécessitent une perspective de protection des données propre

L'automatisation classique des tests vérifie généralement des étapes clairement délimitées : se connecter, créer une commande, générer un bon de livraison, vérifier la déconnexion. Les tests assistés par IA élargissent ce déroulement. Le système peut interpréter des interfaces, évaluer des anomalies, comparer des captures d'écran et documenter les résultats dans un langage compréhensible. Cela fait gagner du temps lors des tests de non-régression, mais génère des artefacts de données supplémentaires.

Ces artefacts sont souvent plus révélateurs qu'un journal de test ordinaire. Une capture d'écran peut montrer des noms, des adresses, des valeurs contractuelles, des quantités commandées ou des données de santé. Un journal réseau peut contenir des jetons de session et des réponses d'API. Un message d'erreur peut révéler des chemins de fichiers internes, des structures de base de données ou des versions. Lorsqu'un modèle travaille avec ces informations, il doit être clair où le traitement a lieu et qui peut y accéder.

La question décisive n'est donc pas : « Utilisons-nous l'IA dans les tests ? » Mais plutôt : « Quelles données quittent quelle zone de sécurité - et pourquoi ? » Pour de nombreuses entreprises de la région DACH, un traitement dans le cloud externe n'est pas fondamentalement exclu. Il doit cependant correspondre au besoin de protection sur le plan contractuel, technique et organisationnel. Pour les données de développement, de production ou clients, une exécution contrôlée localement est souvent la décision la plus pragmatique.

Protéger les données de test lors des tests par IA commence avant la première exécution

La protection des données dans les tests n'est souvent discutée qu'au moment de choisir un outil. C'est trop tard. Il faut d'abord un inventaire des données simple et fiable. Quels systèmes sont testés ? Quels champs apparaissent dans les interfaces ? Quelles pièces jointes, exports et réponses d'API peuvent apparaître dans le test ? Et quelles données se retrouvent automatiquement dans les captures d'écran, vidéos ou messages d'erreur ?

Une répartition en trois groupes est utile ici. Les données de test non critiques peuvent être générées librement et conservées plus longtemps. Les données personnelles ou commercialement confidentielles nécessitent un masquage, des restrictions d'accès et une conservation courte. Les identifiants d'accès, jetons, clés et valeurs de configuration de production n'ont pas leur place dans les preuves de test ou les requêtes au modèle - même s'ils ne sont visibles qu'accidentellement dans une fenêtre de navigateur.

Dans de nombreuses applications de taille moyenne, la situation des données n'est pas clairement séparée. L'équipe de l'entrepôt teste une nouvelle réception de marchandises avec un extrait de base de données, car seul celui-ci contient les structures d'articles réelles, les règles fournisseurs et les cas particuliers. Cela peut avoir un sens sur le plan technique. La conséquence ne doit toutefois pas être que cet extrait migre inchangé vers chaque environnement de test.

Un processus reproductible est préférable : exporter les données, pseudonymiser de façon ciblée les champs sensibles, supprimer les tables inutiles et fournir la base de données de test résultante de façon versionnée. Ainsi, les erreurs de processus typiques sont préservées, sans que de vrais clients ou employés ne deviennent visibles dans les tests. Pour des logiques de tarification ou de répartition complexes, des données entièrement synthétiques sont souvent insuffisantes. Dans ce cas, une copie soigneusement nettoyée est généralement le meilleur compromis.

Le masquage doit préserver la logique métier

Un masquage qui remplace chaque adresse e-mail par le même espace réservé peut endommager les cas de test. Les vérifications de doublons, la logique des rôles, les fonctions de recherche ou les processus de facturation se comportent différemment qu'en exploitation. Un bon masquage préserve donc les formats, les relations et les distributions. Un numéro client devient un autre numéro client valide. Une adresse devient une adresse plausible mais fictive. Une date de livraison reste une date dans une fourchette de planification réaliste.

Cela demande une certaine préparation. En contrepartie, cela évite l'erreur classique où les tests sont techniquement au vert mais ne reflètent plus les déroulements réels en entrepôt, vente ou service client. Protection des données et tests fonctionnellement utiles ne sont pas des contraires - à condition que la préparation des données fasse partie de l'architecture de test.

Le lieu d'exécution détermine le contrôle

Celui qui confie des tests automatisés à un service externe transmet, selon la configuration, plus que de simples étapes de test. Le contenu du navigateur, les structures DOM, les captures d'écran, les vidéos, les journaux de console et les évaluations peuvent être traités et stockés en dehors de sa propre infrastructure. Que cela soit acceptable dépend du cas particulier : catégories de données, cadre contractuel, lieu de stockage, séparation des locataires, concept de suppression et directives internes agissent ensemble.

Pour les applications à besoins de protection élevés, un environnement de test auto-hébergé est souvent plus facile à évaluer. Le runner de test, le composant IA et le stockage des preuves restent dans le propre réseau ou dans une infrastructure européenne contrôlée. Des règles réseau peuvent limiter les connexions externes. Les accès peuvent être reliés aux identités, rôles et journalisation existants. La conservation des images et des rapports devient également une décision propre plutôt qu'un réglage par défaut d'un fournisseur de plateforme.

COCO suit précisément cette approche : le serveur IA exécute les tests pour applications web et Windows de façon contrôlée, documente les preuves et génère des évaluations compréhensibles, sans que les données applicatives internes ne doivent être transmises par défaut à un cloud IA externe. Cela ne remplace pas un audit de protection des données. Cela crée cependant une base technique sur laquelle l'IT, la sécurité de l'information et le service métier peuvent convenir de règles traçables.

Captures d'écran, journaux et secrets sont les fuites les plus fréquentes

De nombreuses équipes protègent la base de données de test, mais négligent les sous-produits des tests. C'est justement là que se situent souvent, en pratique, les risques les plus importants. Un test de connexion échoué peut afficher un mot de passe dans le champ de saisie. Un test d'API peut faire apparaître un jeton porteur dans le journal. Un enregistrement vidéo automatique documente une commande complète, adresse du client incluse.

Un concept robuste régit donc au moins cinq points :

  • Les captures d'écran et vidéos ne sont créées qu'en cas de besoin et supprimées après des délais fixes.
  • Les secrets sont intégrés via un coffre-fort de secrets ou des variables d'exécution protégées, jamais stockés dans le code de test.
  • Les journaux filtrent les jetons, mots de passe, identifiants de session et champs sensibles avant leur enregistrement.
  • Les comptes de test ne possèdent que les droits nécessaires au déroulement concerné.
  • Les systèmes de test ne doivent déclencher ni e-mails, ni étiquettes, ni paiements, ni mouvements de stock de production, sauf si cela est explicitement sécurisé.

Ces règles paraissent sobres. C'est précisément leur avantage. Une équipe n'a pas à espérer de la vigilance ou de bonnes intentions, mais peut limiter techniquement les mauvais usages. Sont particulièrement efficaces des comptes de service distincts pour l'automatisation des tests, des durées de vie de jetons courtes et un processus clair de révocation des identifiants compromis.

L'évaluation par IA a elle aussi besoin de limites

Les modèles d'IA sont fréquemment utilisés pour expliquer des écarts : « Le bouton n'était pas visible », « L'application a réagi plus lentement que prévu » ou « Le processus s'est terminé par un contrôle des permissions ». Pour de telles évaluations, un modèle n'a pas nécessairement besoin de l'ensemble complet des données client.

Définissez donc quelles informations peuvent entrer dans l'évaluation. Une capture d'écran anonymisée suffit-elle ? Une classe d'erreur technique suffit-elle à la place de la réponse serveur complète ? Les champs peuvent-ils être masqués avant l'analyse ? La bonne profondeur dépend de l'objectif du test. Dans une comparaison de mise en page, un nom est rarement pertinent. Lors de la vérification d'un modèle de document personnalisé, il peut l'être - le traitement doit alors être sécurisé en conséquence.

Les mesures de protection doivent rester vérifiables en exploitation

Un concept n'est robuste que s'il peut être contrôlé au quotidien. Cela comprend des contrôles ponctuels réguliers des preuves de test, des vérifications des permissions et un regard sur les données réellement stockées. De nouveaux champs se sont-ils glissés dans les captures d'écran ? D'anciens comptes de test existent-ils encore ? Un extrait de base de données est-il conservé plus longtemps que prévu ? Ces questions relèvent de la routine opérationnelle normale, pas seulement d'un audit.

Une responsabilité claire est tout aussi importante. La QA connaît les déroulements de test, le développement connaît les interfaces techniques, le service métier connaît les processus critiques, et la sécurité informatique définit le cadre. Si personne ne réunit ces perspectives, on crée soit un raccourci risqué, soit une exigence de sécurité qui empêche les tests réels. Un petit processus d'approbation documenté est généralement plus efficace qu'un ensemble de règles étendu que personne n'applique.

Au final, il ne s'agit pas de compliquer artificiellement chaque test. Bien protéger les données de test signifie retirer délibérément les risques réels de l'automatisation tout en préservant la validité fonctionnelle des tests. Lorsque les équipes savent exactement quelles données un test peut voir, où se trouvent ses preuves et quand elles disparaissent, les tests par IA deviennent un outil maîtrisable plutôt qu'une incertitude supplémentaire.

Lien permanent →

Faire développer une application web avec PHP

Faire développer une application web avec PHP

Lorsque les réceptions de marchandises finissent dans un tableur, que les données d'expédition sont transmises par téléphone et que le statut actuel d'une commande n'existe que dans la tête de certains employés, ce qui manque n'est généralement pas un outil standard de plus. Ce qui manque, c'est un système qui reflète de façon fiable votre propre déroulement de travail. Faire développer une application web avec PHP vaut précisément la peine dans ce cas : lorsque des informations, des décisions et des documents doivent se rejoindre en un seul endroit, sans alourdir l'activité avec une suite d'entreprise surdimensionnée.

PHP n'est pas ici un compromis nostalgique. Avec PHP 8.4, une architecture applicative claire et MySQL 8, on peut construire des applications web durables, qui réagissent rapidement, restent faciles à maintenir et fonctionnent de façon fiable sur ordinateur, tablette ou scanner portable. Le langage seul n'est cependant pas déterminant. Ce qui compte, c'est de savoir si l'application rend réellement le travail plus simple sur le terrain de l'entrepôt, au bureau et en déplacement.

Quand une application web sur mesure a du sens

Tous les processus n'ont pas besoin immédiatement d'un logiciel sur mesure. Un tableur bien tenu peut rester la solution la plus raisonnable pour une petite liste rarement modifiée. Un produit standard établi est également utile s'il couvre déjà les principaux déroulements et peut être utilisé sans contournements permanents.

Le point de bascule survient lorsque les employés saisissent des données à plusieurs reprises, rassemblent des informations provenant de différents fichiers, ou résolvent régulièrement des cas particuliers en dehors du système lui-même. Les signaux typiques sont un manque de clarté sur les stocks, des bons de livraison créés manuellement, des responsabilités floues sur les commandes, ou des questions que chaque équipe doit répéter. On perd alors non seulement du temps ; les erreurs deviennent difficiles à retracer, et la dépendance envers certaines personnes augmente.

Une application web sur mesure, à l'inverse, reflète précisément les règles en vigueur dans l'entreprise. Elle peut par exemple enregistrer les réceptions de marchandises, documenter les mouvements de stock, générer des étiquettes, prioriser les commandes ou rendre traçables les transmissions entre équipes. Il n'est pas nécessaire d'automatiser chaque cas particulier dès le premier jour. Un début raisonnable se concentre sur le déroulement qui génère aujourd'hui le plus de friction.

Faire développer une application web avec PHP : ce qui doit être clarifié au préalable

Un bon logiciel ne commence pas par des maquettes d'écran ou une liste de mots-clés techniques. Il commence par des situations concrètes : que se passe-t-il si une livraison arrive incomplète ? Qui est autorisé à corriger un stock ? Quelle information le service expédition a-t-il besoin avant qu'une étiquette ne soit imprimée ? Et que se passe-t-il quand un employé de l'équipe du soir reprend une commande créée le matin ?

De ces questions naît une image robuste du processus. Elle montre les saisies, les décisions, les transmissions et les exceptions. Ce sont justement les exceptions qui sont précieuses, car c'est souvent là que les solutions standard échouent. Une application de prise de commande, par exemple, ne doit pas se contenter d'enregistrer une nouvelle commande. Elle doit aussi clarifier comment sont gérées les données articles manquantes, les adresses de livraison divergentes, les validations ou les annulations.

Avant la mise en œuvre, l'objectif, les groupes d'utilisateurs et la première étape de déploiement devraient donc être établis. Des données d'exemple réelles, des formulaires existants, des photos de postes de travail et des échanges avec les personnes qui travaillent quotidiennement avec ce processus sont précieux. Un simple entretien avec la direction fournit rarement assez de détails. Celui qui manie un scanner, stocke la marchandise ou vérifie les bons de livraison connaît généralement mieux les contraintes pratiques.

Le plus petit démarrage raisonnable

Une première version ne doit pas être une plateforme d'entreprise achevée. Au contraire : un noyau limité, mais utilisable en production, réduit le risque et crée de la valeur rapidement. On pourrait envisager une application qui, dans un premier temps, enregistre seulement les commandes de façon centralisée, en rend le statut visible et crée un bon de livraison fiable. La gestion des stocks, les interfaces ou la planification des tournées peuvent suivre dès que le noyau a fait ses preuves au quotidien.

Cet ordre évite qu'un projet ne travaille pendant des mois sur des fonctionnalités dont le bénéfice réel reste incertain. Il laisse aussi de la place pour des ajustements. Peut-être la logique de statut prévue est-elle trop fine, peut-être la réception de marchandises a-t-elle besoin d'un masque de saisie plus rapide, ou d'une validation seulement au-delà d'une certaine valeur. Ces constats ne sont pas un échec de la planification, mais font partie d'une mise en place réussie.

La base technique détermine les coûts ultérieurs

Une application web ne devient pas maintenable simplement parce que PHP figure dans l'offre. La maintenabilité naît de décisions traçables : une séparation claire entre interface, logique métier et accès aux données, des modèles de données sans ambiguïté, des tests automatisés pour les règles critiques, ainsi qu'un déploiement documenté.

PHP 8.4 s'y prête très bien. Le langage est mature, efficace à exploiter et constitue un choix pragmatique pour de nombreuses applications critiques pour l'activité. Associée à un JavaScript moderne, l'interface peut réagir rapidement et directement, sans construire inutilement chaque fonctionnalité de façon compliquée comme une application monopage. MySQL 8 offre une base solide pour les transactions, les concepts de droits et des données cohérentes.

Justement dans les processus d'entrepôt et de commandes, une opération ne doit jamais être enregistrée à moitié. Lorsqu'un article est sorti du stock, le stock, le journal des mouvements et le statut de la commande doivent correspondre. Les transactions de base de données garantissent que toutes les modifications nécessaires ont lieu, ou aucune. Cela ressemble à un détail, mais détermine si un système reste fiable dans les cas exceptionnels.

La sécurité fait également partie du cœur de l'architecture. Les rôles et les autorisations doivent correspondre au quotidien de travail : une personne à la réception des marchandises a besoin de droits différents de ceux de la comptabilité ou d'un chauffeur externe. Des hachages de mots de passe sécurisés, le blocage de compte après des tentatives de connexion échouées, la gestion des sessions et les journaux pour les modifications critiques ne sont pas des extras pour plus tard. Ils font partie de la première version en production.

Ne construire des interfaces que là où elles font gagner du travail

De nombreux projets deviennent inutilement volumineux parce que chaque intégration envisageable est planifiée dès le départ. Les interfaces vers la boutique, l'ERP, les prestataires d'expédition ou la comptabilité peuvent être très utiles. Mais elles ne sont bonnes que si elles remplacent une étape manuelle claire ou améliorent nettement la qualité des données.

Un exemple : si des étiquettes d'expédition sont créées quotidiennement à partir des données de commande, une connexion directe fait gagner du temps et réduit les erreurs de transmission. Si, en revanche, les données de facturation ne sont transférées qu'une fois par semaine vers un système existant et que le processus est stable, un export structuré peut suffire pour démarrer. La solution techniquement la plus élégante n'est pas automatiquement la plus économique.

La souveraineté des données devrait également être clarifiée à l'avance. Quelles données sont stockées, combien de temps les journaux restent-ils disponibles, qui est autorisé à les exporter, et comment fonctionnent les sauvegardes et la restauration ? Pour les entreprises de la région DACH, ces questions ne sont pas de simples formalités informatiques. Elles concernent la protection des données, la capacité opérationnelle et la confiance au sein de l'équipe.

Une mise en œuvre sans ralentir l'activité

La meilleure application échoue si elle bloque le déroulement quotidien pendant la transition. C'est pourquoi la mise en œuvre devrait être préparée avec des cas réels : commandes représentatives, articles réels, adresses de livraison typiques et cas particuliers connus. Ce n'est que lorsque ces déroulements fonctionnent de façon traçable que le système devrait assumer une tâche centrale.

Un fonctionnement en parallèle peut avoir du sens pendant une courte période, par exemple lorsque des stocks doivent être rapprochés ou de nouveaux documents vérifiés. Il ne doit toutefois pas devenir un état permanent. Deux sources de données de référence créent inévitablement des écarts. Il faut une date butoir claire, à partir de laquelle il est établi quel système fait foi.

Une brève formation ciblée par rôle est tout aussi importante. Un employé de l'entrepôt n'a pas besoin d'une explication des fonctions d'administration. Il a besoin d'assurance sur les quelques étapes qui doivent être réalisées sous contrainte de temps. Les bonnes applications aident grâce à des libellés compréhensibles, des valeurs par défaut plausibles et des messages d'erreur qui expliquent la marche à suivre.

Comment reconnaître un partenaire de développement adapté

Celui qui commande une application web n'achète pas simplement des heures de développement. Ce qui est recherché, c'est un partenaire qui prend les questions de processus au sérieux, justifie ses décisions techniques et sait aussi s'opposer lorsqu'une exigence devient inutilement coûteuse ou risquée. Un accès direct à des développeurs expérimentés vaut ici plus qu'un processus commercial élaboré avec des transmissions ultérieures.

Soyez attentif aux déclarations concrètes concernant l'architecture, l'exploitation et l'évolution future. Comment les modifications sont-elles documentées ? Comment se déroulent les mises à jour ? Qui intervient en cas de panne ? Existe-t-il une stratégie de test traçable pour les opérations et les droits critiques ? Une interface peut sembler convaincante lors d'une présentation. Ce qui compte, c'est de savoir si elle peut encore être adaptée après deux ans sans que chaque modification ne devienne une reconstruction complète.

softify.pro travaille donc selon une mise en œuvre progressive et proche du processus : d'abord comprendre le point de blocage opérationnel, puis livrer un noyau robuste et construire dessus. C'est moins spectaculaire qu'une grande promesse de transformation, mais généralement bien plus précieux au quotidien.

Une bonne application web n'a pas besoin de contenir le plus grand nombre possible de fonctionnalités. Elle doit veiller à ce qu'une commande ne soit pas perdue, qu'un stock reste traçable et que les employés puissent accomplir leur travail sans questions superflues. Quand cela réussit, un investissement technique devient un outil qui rend chaque journée de travail nettement plus sereine.

Lien permanent →

Générer automatiquement les étiquettes d'expédition et réduire les erreurs

Générer automatiquement les étiquettes d'expédition et réduire les erreurs

Une commande est emballée, la marchandise attend sur le quai — et quelqu'un cherche encore le bon mode d'expédition, saisit l'adresse du destinataire dans un portail transporteur et imprime l'étiquette. Cette étape ne prend que quelques minutes par colis. Avec 30, 80 ou 300 expéditions par jour, elle devient un goulot d'étranglement. Générer automatiquement les étiquettes d'expédition ne signifie donc pas simplement brancher une imprimante. Cela signifie relier les données de commande, les règles d'expédition et le processus d'emballage réel de manière à ce qu'une expédition prête se transforme de façon fiable en étiquette correspondante.

Pour les petites et moyennes entreprises, c'est souvent le point d'entrée le plus judicieux vers l'automatisation logistique. Le bénéfice se voit immédiatement sur le terrain : moins de demandes de clarification, moins de colis mal adressés et un statut clair pour les ventes, l'entrepôt et le service client. Il vaut néanmoins la peine d'examiner attentivement le processus avant sa mise en œuvre technique. Une base articles mal tenue ou des règles d'expédition floues ne s'améliorent pas avec l'automatisation - elles sont simplement traitées plus vite.

Ce qui se passe réellement lors de l'impression automatique des étiquettes

Une étiquette d'expédition contient plus qu'un nom et une adresse. Selon le prestataire, elle comprend un numéro d'expédition, un code lisible par machine, des informations de routage, des services comme la vérification d'âge ou le contre-remboursement, ainsi que des données douanières pour les envois internationaux. Pour que le transporteur puisse générer une étiquette, ces informations doivent être complètes et dans le format attendu.

Le déroulement technique commence généralement par une commande dans la boutique, l'ERP ou une gestion de commandes sur mesure. Dès que la commande est prête à être expédiée, le système détermine, selon des règles définies, le prestataire, le produit et les services complémentaires. Il transmet ensuite les données à l'interface du transporteur ou à une plateforme d'expédition. Celle-ci enregistre l'envoi, renvoie le numéro de suivi et l'étiquette, et le système archive les données PDF ou d'impression au niveau de la commande. C'est seulement à ce moment-là que l'impression a lieu — au poste de travail, à la table d'emballage ou directement via une imprimante d'étiquettes.

Cet ordre est déterminant. Une belle étiquette sans enregistrement d'expédition réussi ne sert à rien. À l'inverse, un enregistrement réussi ne doit pas disparaître en arrière-plan si l'imprimante n'a plus de consommable. Les bons processus traitent l'enregistrement, la sortie et le retour de statut comme une opération cohérente.

Générer automatiquement les étiquettes d'expédition commence par des règles claires

L'erreur la plus fréquente consiste à penser qu'il faut toujours choisir le même prestataire pour chaque commande. Cela peut convenir, par exemple pour des envois B2C homogènes en Allemagne. Mais de nombreuses entreprises ont besoin de règles plus différenciées. Une livraison lourde, une commande express, un retrait en point relais ou un envoi vers la Suisse posent des exigences différentes.

Des règles pertinentes peuvent tenir compte du poids et des dimensions, du pays de destination, de l'adresse de livraison, de la valeur de la marchandise, du délai souhaité, des indications de matières dangereuses et des conditions convenues avec le client. La règle est la suivante : toute exception théorique n'a pas besoin d'être automatisée dès le premier jour. Si deux cas particuliers surviennent par mois, une étape manuelle clairement signalée est souvent plus économique et plus sûre qu'un moteur de règles compliqué. En revanche, les cas récurrents à volume significatif relèvent du processus standard.

La source des données est particulièrement importante. Les poids issus d'une base articles bien tenue sont utilisables pour des marchandises similaires. Pour les commandes mixtes, un emballage variable ou des suppléments pour hors gabarit, le poids final du colis devrait être relevé au poste d'emballage. Le système ne génère alors l'étiquette qu'après la pesée. C'est une étape manuelle supplémentaire, mais elle évite des corrections et des refacturations coûteuses.

La qualité des adresses se joue avant l'impression

De nombreux problèmes d'expédition surviennent avant la remise au transporteur. Les numéros de rue atterrissent dans le mauvais champ, les codes postaux ne correspondent pas à la ville, ou les adresses d'entreprise contiennent des noms de destinataires peu clairs. L'automatisation ne devrait donc pas se contenter de transmettre les adresses, mais les vérifier au préalable. Les champs obligatoires, les formats par pays, les longueurs de caractères et les doublons identifiables peuvent être détectés dès la saisie de la commande.

Une vérification d'adresse n'est pas une garantie de livraison. Elle réduit cependant le nombre d'erreurs évitables. En cas de données suspectes, le système devrait clairement mettre la commande en attente de clarification, plutôt que de générer silencieusement une étiquette incomplète. Dans l'entrepôt, il doit être visible pourquoi une commande est en attente et qui peut fournir l'information.

Le poste d'emballage a besoin d'une utilisation simple

La meilleure interface échoue si le personnel doit basculer entre cinq écrans pendant l'emballage. Un dialogue d'emballage pratique n'affiche que ce qui est nécessaire pour l'expédition en cours : commande, articles, adresse de livraison, statut d'emballage, poids, mode d'expédition choisi et statut d'impression. Un scan de code-barres sur le bon de livraison ou le bordereau de préparation devrait ouvrir la bonne commande. Après la pesée, dans l'idéal, une seule action de confirmation suffit pour créer et imprimer l'étiquette.

Avec plusieurs postes d'emballage, chaque poste a besoin d'une association claire à une imprimante. Le format de l'étiquette doit lui aussi correspondre à l'appareil et au transporteur. Le format A6 est courant pour de nombreuses étiquettes de colis, mais tous les rouleaux, imprimantes thermiques et classeurs de documents ne fonctionnent pas de la même manière. Ceux qui commencent par sortir les étiquettes en PDF sur une imprimante laser de bureau peuvent démarrer rapidement. Pour des volumes plus importants, les imprimantes thermiques sont généralement plus judicieuses : elles évitent la découpe, le collage et le risque qu'une étiquette glisse du mauvais côté à l'impression.

Un bon processus signale les problèmes techniques de façon compréhensible. «API Error 403» n'aide pas à la table d'emballage. Mieux vaut : «Étiquette non créée : vérifier l'accès au prestataire d'expédition» ou «Imprimante du poste d'emballage 2 injoignable». La commande ne doit pas pour autant être considérée par erreur comme expédiée. Elle reste dans un statut d'erreur clair et peut être retraitée après résolution, sans enregistrer un second envoi.

Les interfaces ont besoin d'une gestion des erreurs, pas seulement d'un scénario idéal

Les interfaces des transporteurs sont des systèmes externes. Elles peuvent être temporairement inaccessibles, rejeter des saisies ou changer leur format de réponse. Un réseau local, un service d'impression ou des identifiants d'accès expirés peuvent également interrompre le déroulement. Il est donc risqué de faire dépendre le succès du seul fait qu'un utilisateur ait cliqué sur «Créer l'étiquette».

Techniquement, chaque requête devrait être journalisée de façon traçable : horodatage, commande, service d'expédition utilisé, résultat, numéro de suivi et message d'erreur compréhensible. Les données sensibles et les clés d'accès n'ont pas leur place, non protégées, dans les fichiers journaux. Un identifiant d'expédition interne unique évite qu'une nouvelle tentative ne génère des étiquettes ou des facturations en double.

Les annulations font également partie de la planification. Si un colis n'est finalement pas retiré ou est réemballé après l'impression de l'étiquette, il doit être clair si l'expédition peut être annulée auprès du transporteur et comment cela est documenté dans le système interne. Sans cette étape, le statut d'expédition, le suivi et la facturation ne concordent plus après quelques semaines.

Toutes les entreprises n'ont pas immédiatement besoin d'une grande plateforme d'expédition

Les plateformes d'expédition peuvent regrouper plusieurs transporteurs, logiques tarifaires et retours. Cela a du sens lorsque les volumes d'envoi, les pays de destination et les prestataires sont variés. Mais celui qui dispose d'un processus d'expédition clair et d'un ou deux transporteurs peut fonctionner de façon plus lisible avec une connexion directe. Moins de systèmes signifie moins de rapprochement de données, moins de comptes utilisateurs et moins d'endroits où des erreurs peuvent survenir.

La décision ne dépend pas uniquement du volume de colis. Les retours, les documents d'exportation, les règles d'expédition individuelles, les sources de commandes existantes et la question de qui maintiendra les évolutions par la suite sont également pertinents. Une solution en tableur reste par exemple défendable si peu d'envois aux données constantes partent chaque jour. Dès que des collègues transfèrent l'information plusieurs fois ou que l'expédition dépend de personnes précises, un flux centralisé devient généralement plus rentable.

Pour des processus propres à chaque client, une application web légère qui réunit les données de commande, les mouvements de stock, les bons de livraison et l'impression des étiquettes peut avoir du sens.

softify.pro met en œuvre ce type de systèmes avec une structure de données traçable, une mise en production documentée et des technologies maintenables comme PHP 8.4 et MySQL 8. Ce qui compte n'est pas le nombre de fonctionnalités, mais que le déroulement devienne plus compréhensible pour l'équipe au poste d'emballage.

Introduire par petites étapes et améliorer de façon mesurable

Un démarrage maîtrisé vaut mieux qu'un grand changement un lundi matin. On automatise d'abord un cas standard clairement délimité, par exemple les colis nationaux d'un transporteur avec un format d'étiquette défini. En parallèle, pendant quelques jours, les données générées automatiquement devraient être vérifiées par rapport au processus précédent : adresse, poids, produit d'expédition, numéro de suivi et étiquette imprimée.

Les exceptions peuvent ensuite être ajoutées. Des indicateurs utiles sont le temps de traitement par expédition, le nombre de corrections manuelles, les étiquettes non imprimées ou générées en double, et le délai jusqu'au retour de suivi transmis au client. Ces valeurs montrent si l'automatisation allège réellement le travail ou ne fait que reproduire numériquement un ancien détour.

Au final, ce n'est pas un dialogue d'expédition particulièrement complexe qui compte. Ce qui compte, c'est qu'une commande emballée reçoive la bonne étiquette sans recherche, sans nouvelle saisie et sans incertitude — et que les exceptions deviennent visibles là où une personne doit réellement trancher.

Lien permanent →

Tester automatiquement le processus de connexion avec méthode

Tester automatiquement le processus de connexion avec méthode

Une connexion ne paraît anodine que lorsqu'elle fonctionne. Si elle tombe en panne après une mise en production, les employés se retrouvent bloqués avant leur prise de poste, les clients devant le portail client, ou les planificateurs face à un traitement de commandes à l'arrêt. Tester automatiquement le processus de connexion ne signifie donc pas simplement saisir un nom d'utilisateur et un mot de passe dans un formulaire. Cela signifie vérifier de manière répétable un accès critique pour l'activité, avec ses règles, ses exceptions et ses limites de sécurité.

Pour de nombreuses équipes, l'automatisation commence par un seul cas de test positif : saisir des identifiants valides, confirmer la connexion, voir la page d'accueil. C'est logique, mais insuffisant en tant que test unique. Les erreurs de connexion apparaissent souvent aux marges : sessions expirées, comptes verrouillés, une nouvelle authentification multifacteur, ou une autorisation qui ne fonctionne plus correctement après un changement de rôle. Ce sont précisément ces cas qui doivent être couverts de manière planifiée.

Pourquoi la connexion exige une discipline de test particulière

La connexion est à la fois une fonction de sécurité, une interface technique et le point d'entrée du flux de travail. Une erreur peut être trop permissive et autoriser un accès non autorisé. Elle peut aussi être trop stricte et bloquer des personnes autorisées. Les deux cas ont un coût : le premier crée des risques pour les données et la conformité, le second entraîne des arrêts, une charge de support et des solutions de secours improvisées.

Pour les applications web s'ajoutent d'autres dépendances. La connexion communique souvent avec un fournisseur d'identité, un système de messagerie pour la réinitialisation des mots de passe, une application MFA ou un service d'annuaire. Pour les applications Windows de bureau, les droits locaux, les connexions réseau et les versions installées peuvent avoir une influence. Un test qui ne regarde que le formulaire dans le navigateur ne détecte pas ces problèmes d'intégration de manière fiable.

C'est pourquoi, avant la première automatisation des tests, l'équipe devrait définir ce que signifie une connexion réussie dans le système concerné. Une page d'accueil visible suffit-elle ? Ou faut-il vérifier que la bonne sélection de client a été chargée, que le rôle utilisateur est correct et que la première action protégée est réellement possible ? Pour un portail d'entrepôt, ce serait par exemple l'accès à la réception des marchandises. Pour un système de planification, cela peut être la validation d'une tournée.

Tester automatiquement le processus de connexion : du modèle de flux au cas de test

Un bon point de départ n'est pas un script, mais un modèle de flux. La connexion peut être décrite comme une suite d'états clairs : non connecté, identifiants transmis, identité confirmée, MFA requise, connecté, session expirée ou compte verrouillé. Chaque état comporte des actions autorisées et des réactions attendues du système.

De ce modèle naissent des cas de test à valeur métier. Le cas positif standard en fait partie, mais aussi les mots de passe invalides, les comptes utilisateurs inexistants et les liens de réinitialisation expirés. La réponse attendue est ici essentielle. En cas d'identifiants erronés, une application ne devrait pas révéler si une adresse e-mail existe. Le test vérifie donc non seulement qu'une erreur s'affiche, mais aussi que son texte et son comportement ne donnent aucun indice superflu.

Les mécanismes de protection contre les tentatives répétées échouées sont particulièrement importants. Après un nombre défini de saisies erronées, un compte peut être temporairement verrouillé. Le test automatisé doit vérifier si le verrouillage se déclenche réellement, combien de temps il dure et si l'utilisateur légitime retrouve ensuite un accès contrôlé. La précision est nécessaire ici : un test qui verrouille intentionnellement des comptes de production crée plus de problèmes qu'il n'en résout. De tels scénarios doivent être placés dans un environnement de test séparé, avec des comptes créés spécifiquement à cet effet.

Considérer séparément le MFA, la réinitialisation de mot de passe et le Single Sign-On

L'authentification multifacteur n'est pas un détail secondaire à la fin de la connexion. Elle modifie le flux. Un test doit reconnaître qu'une confirmation supplémentaire est requise après le mot de passe, et il doit couvrir aussi bien la confirmation réussie que la confirmation rejetée. Pour les codes à usage unique basés sur le temps, l'environnement de test nécessite une gestion contrôlée du temps et des secrets. Dans de nombreux cas, une méthode de test fournie par le fournisseur d'identité est plus judicieuse que de reproduire un véritable téléphone mobile.

La réinitialisation de mot de passe et le Single Sign-On devraient également disposer de leurs propres parcours de test. Pour la réinitialisation, l'envoi du message, l'unicité du lien, la durée de validité et la connexion ultérieure avec le nouveau mot de passe comptent. Pour le SSO, l'essentiel est de savoir si l'application crée correctement la session et reprend proprement les rôles après le retour du fournisseur d'identité.

Les CAPTCHA constituent un cas particulier. Ils sont destinés à ralentir les attaques automatisées et ne devraient pas être contournés par l'automatisation des tests. Il est préférable d'utiliser une configuration de test, une clé de test officielle ou une exception sécurisée pour l'environnement de test. Tromper les contrôles de sécurité juste pour qu'un test passe au vert n'est pas une stratégie de qualité.

Choisir le bon niveau de test technique

Tous les tests de connexion ne doivent pas passer par un vrai navigateur. Les tests API peuvent vérifier si les jetons, les sessions, les messages d'erreur et les règles de verrouillage fonctionnent correctement. Ils sont rapides et aident à trouver des erreurs proches de la logique d'authentification. Les tests navigateur montrent en revanche si les champs, redirections, cookies, paramètres SameSite et états visibles s'accordent dans le parcours utilisateur réel.

Pour les applications critiques, la combinaison est judicieuse. Quelques tests de bout en bout vérifient le parcours complet avec le navigateur. En dessous, des tests API et d'intégration ciblés sécurisent les variantes. Cela réduit la durée d'exécution et les fausses alertes. Quiconque teste chaque combinaison imaginable uniquement dans le navigateur obtient souvent une suite lente dont la maintenance consomme plus de temps qu'elle n'en économise.

Pour les logiciels de bureau, un principe similaire s'applique. Un test automatisé ne devrait pas se contenter de vérifier si une fenêtre s'ouvre. Il doit déterminer si, après la connexion, la bonne connexion de données existe, si les droits utilisateur sont actifs et si l'écran de travail central est accessible. C'est particulièrement pertinent pour les applications d'entrepôt ou de production, car les postes de travail peuvent avoir des conditions réseau, des connexions scanner ou des configurations locales différentes.

Traiter les données de test de manière sûre et répétable

Les tests de connexion travaillent nécessairement avec des identifiants. Les comptes d'employés de production, les données clients réelles ou les secrets MFA ne doivent toutefois pas se retrouver de manière incontrôlée dans les scripts de test, les journaux et les captures d'écran. Les comptes de test doivent être clairement identifiés, disposer de droits minimaux et pouvoir être réinitialisés automatiquement. Les mots de passe et jetons sont fournis via une gestion sécurisée des secrets, et non stockés dans le code source.

Le nettoyage après l'exécution du test est tout aussi important. Si un test crée de nouvelles sessions, des entrées d'audit ou des comptes verrouillés, l'environnement de test doit revenir à un état initial défini. Sinon, un test échoue le lundi simplement parce qu'une exécution du vendredi a laissé des effets secondaires.

Pour les entreprises disposant d'applications confidentielles, le lieu d'exécution est également déterminant. Les captures d'écran des écrans de connexion, les vidéos de test et les journaux techniques peuvent contenir des informations sensibles. Une infrastructure de test auto-hébergée comme COCO peut être pertinente ici, car les données de test, l'exécution et les preuves restent sous son propre contrôle. La nécessité de cela dépend du besoin de protection, de la situation contractuelle et des directives internes. Une infrastructure dédiée n'est pas automatiquement le choix le plus économique pour chaque application.

Générer des preuves, pas seulement des coches vertes

Un rapport de test devrait permettre à l'assurance qualité, au développement et au métier de comprendre ce qui a été vérifié. Un statut vert sans contexte aide peu si une mise en production soulève des questions par la suite. Sont donc utiles : horodatages, environnement de test utilisé, compte de test, étapes pertinentes, captures d'écran en cas d'erreur et un message d'erreur clair en langage courant.

Dans ce cadre, la collecte de preuves ne doit pas devenir elle-même un problème de protection des données. Les mots de passe, codes à usage unique, identifiants de session et données personnelles doivent être masqués dans les journaux. Pour les captures d'écran, il peut être nécessaire de flouter certaines zones. Ces règles devraient faire partie de l'architecture de test, et non d'un travail manuel après un incident.

Ce que les équipes devraient automatiser en premier

La priorité dépend du risque et de la fréquence d'utilisation. Viennent d'abord la connexion standard pour les rôles les plus importants, les identifiants erronés, la déconnexion et l'expiration de session. Suivent ensuite les règles de verrouillage, la réinitialisation de mot de passe, le MFA et les changements de rôle. Le SSO, les clients spéciaux ou les rares chemins d'exception peuvent suivre plus tard, à condition que leur défaillance n'arrête pas immédiatement l'activité.

Les tests font partie du processus de mise en production. Les modifications apportées aux formulaires de connexion, aux cookies, aux autorisations ou aux configurations du fournisseur d'identité devraient déclencher la suite de tests concernée avant qu'une version ne passe en production. Il est également utile de prévoir une exécution planifiée dans un environnement réaliste, par exemple après des modifications d'infrastructure ou des changements de certificats. Cela permet de détecter des problèmes non visibles dans un environnement de développement isolé.

Au final, le meilleur test de connexion n'est pas celui qui compte le plus de clics. C'est celui qui détecte tôt une véritable panne, la documente de manière compréhensible et continue à s'exécuter de manière fiable lors du changement suivant. Traiter la connexion comme un processus métier clairement modélisé ne protège pas seulement un formulaire. Cela protège l'accès au travail qui attend derrière.

Lien permanent →

Nous contacter

Un projet en tête, un flux de travail qui tourne encore sur des tableurs et de la bonne volonté, ou un retard de tests que COCO pourrait décharger de votre équipe ? Parlez-nous-en.

Envoyer le message