softify.pro
Laddar …
Tjänster Om oss COCO – vår AI-server Portfolio Insiders Fallstudier Bra att veta Kontakt Logga in

NÄSTA GENERATIONS MJUKVARUESTETIK

Ren flytkraft möter yttersta prestanda.

Den nya visuella identiteten för moderna digitala arbetsflöden.

softify.pro — Den nya visuella identiteten för moderna digitala arbetsflöden.

Scrolla för att utforska ↓

Mjukvara, byggd på det sätt moderna företag faktiskt rör sig

softify.pro är en mjukvarustudio byggd kring en idé: teknik ska röra sig lika flytande som de företag den stödjer. Vi arbetar i skärningspunkten mellan modern webbutveckling, processautomatisering och tillämpad artificiell intelligens — tre discipliner som sällan finns under samma tak, men som allt oftare behöver göra det. Våra kunder sträcker sig från små verkstäder som digitaliserar sin första fakturering till etablerade medelstora tillverkare som ersätter kalkylblad med riktig logistikmjukvara. Det som förenar dem är inte storlek, utan ambition: de vill ha system som är snabba, pålitliga och genuint trevliga att använda, inte bara funktionella. Varje projekt vi tar oss an utgår från samma tre frågor — vad behöver detta företag egentligen för att röra sig snabbare, vad fungerar redan och bör respekteras snarare än ersättas, och vilken del av arbetsflödet kan tyst sköta sig själv när den väl byggts korrekt. Svaren formar allt som följer, från teknikstacken till utrullningsplanen.

Tjänster

Den nya visuella identiteten för moderna digitala arbetsflöden.

01 — LOGISTICS

Automatiserar logistik — byggt för små och medelstora företag i DACH-regionen

En stor del av vårt arbete ägnas åt logistik- och verksamhetsmjukvara för små och medelstora företag i Tyskland, Österrike och Schweiz. Dessa företag hamnar ofta mellan två oattraktiva alternativ: dyra logistiksviter för storföretag utformade för koncerner tio gånger deras storlek, eller en lapptäcke av kalkylblad, pappersblanketter och telefonsamtal som tyst begränsar hur snabbt de kan växa.

Vi bygger mellanvägen — skräddarsydd automatisering som passar hur ett specifikt lager, en verkstad eller ett distributionsteam faktiskt arbetar. Det kan innebära att digitalisera varumottagning och lagerrörelser, automatiskt generera följesedlar och fraktetiketter, koppla samman orderintag med ruttplanering, eller helt enkelt ersätta ett bräckligt kalkylblad som bara en person förstår med ett delat system som hela teamet kan lita på. Eftersom vi arbetar direkt med ägare och driftschefer i DACH-regionen samlas kraven in på det språk verksamheten faktiskt drivs på, och utrullningen planeras kring verkliga skiftmönster och verkliga lagergolv, inte en abstrakt implementeringstidslinje.

02 — WEB

Modern webbutveckling, byggd på aktuell teknik

Vi designar och bygger webbapplikationer och webbplatser med aktuell, aktivt underhållen teknik snarare än föråldrade ramverk som hålls vid liv av vana. Det innebär rent PHP 8.4 på backend där en klassisk serverrenderad applikation är rätt val, modern JavaScript där interaktivitet spelar roll, och MySQL 8 för data som behöver förbli konsekvent och sökbar i flera år, inte bara de första sex månaderna efter lansering. Varje projekt planeras för både dator och mobil redan från första skiss, inte anpassas i efterhand — laddningstider, layoutbrytpunkter och touchinteraktioner är en del av specifikationen, inte en eftertanke.

Bortom det synliga gränssnittet bryr vi oss om hur en webbplats ser ut inifrån: läsbar kod, ett databasschema som inte behöver byggas om vid nästa funktionsönskan, och driftsättningssteg som en annan utvecklare skulle kunna följa utan att behöva ringa oss. En webbplats som presterar bra idag och fortfarande kan utökas på ett rent sätt om tre år är för oss den verkliga definitionen av 'modern'.

03 — AI / COCO

COCO — vår egen AI-server för automatiserad mjukvarutestning

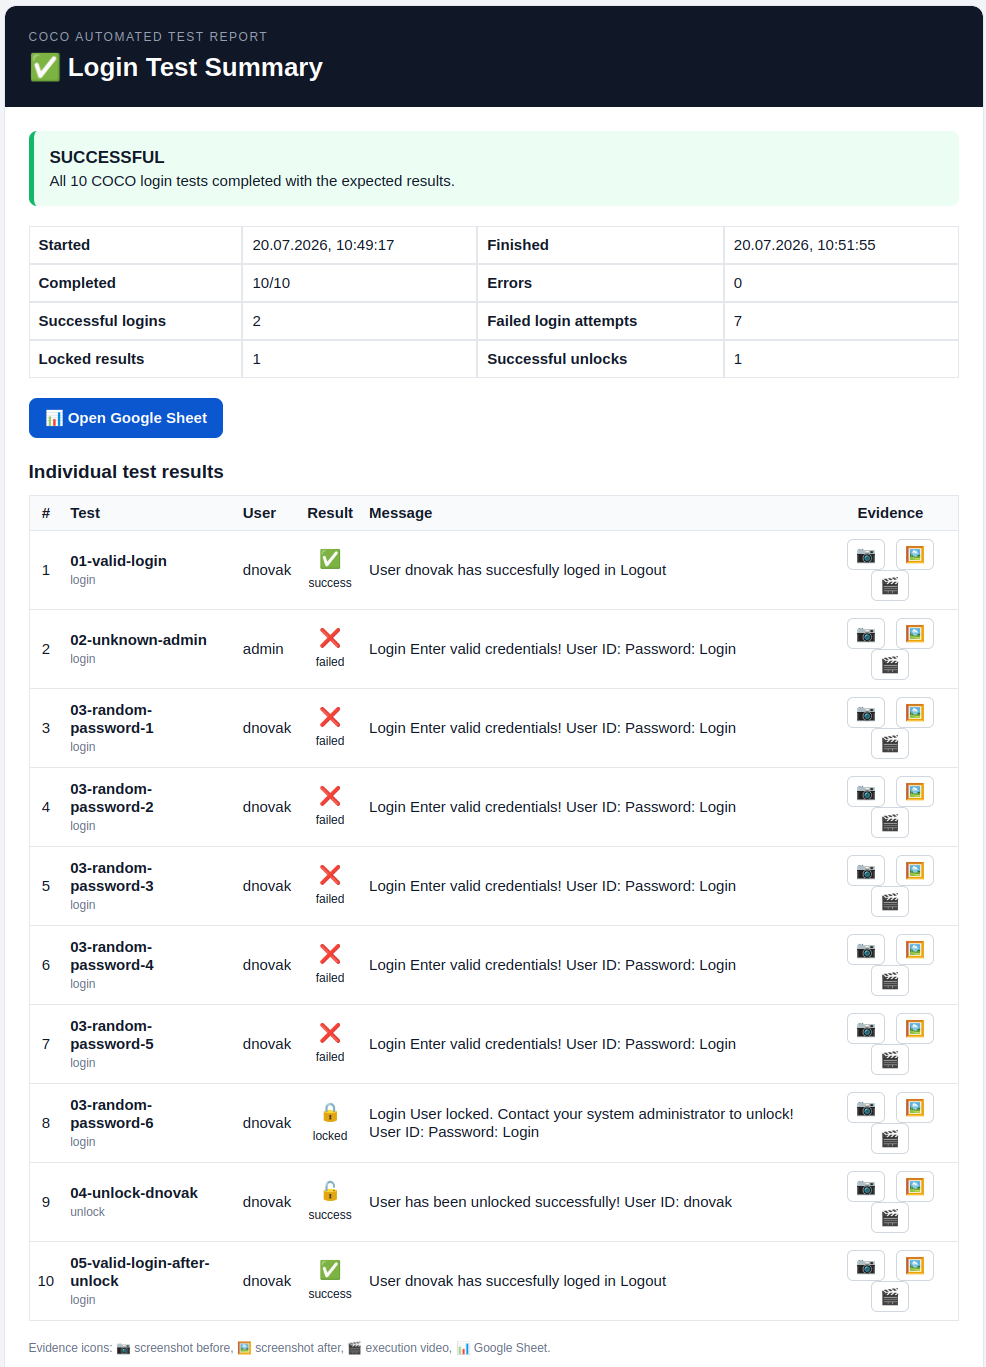
För våra företagskunder driver och underhåller vi vår egen dedikerade AI-server, kallad COCO. Till skillnad från en allmän chatbot som bara kopplats på ett arbetsflöde är COCO specialbyggd och självhostad specifikt för automatiserad testning av webbmjukvara och plattformsoberoende skrivbordsapplikationer — från inloggnings- och autentiseringsflöden till fullständiga flerstegs affärsprocesser.

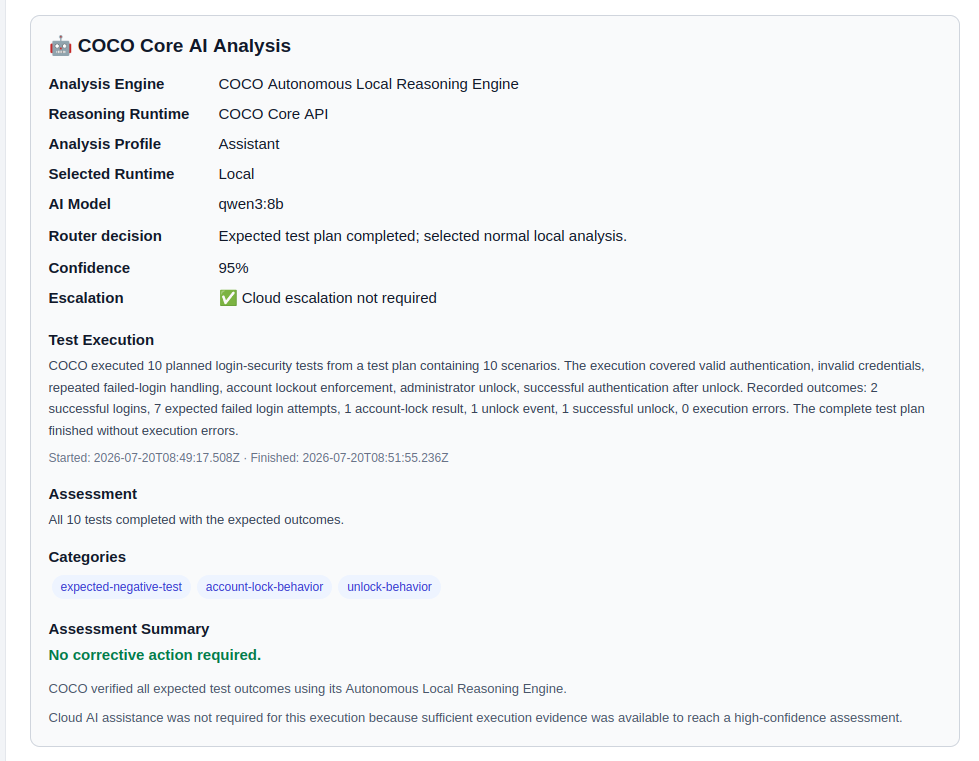
COCO planerar ett testscenario, kör det mot den verkliga applikationen, fångar skärmdumpar före och efter samt inspelningar av körningen som bevis, och tar fram en lättbegriplig bedömning av vad som gick igenom, vad som misslyckades och varför — inklusive gränsfall som upprepade misslyckade inloggningar, kontospärrar och återställningsflöden som är tidskrävande och felbenägna att testa manuellt. Eftersom servern körs lokalt under vår förvaltning behåller företagskunder full kontroll över var testdata och skärmdumpar lagras, utan att intern applikationstrafik som standard skickas till en tredjeparts molntjänst.

COCO — vår egen AI-server för automatiserad mjukvarutestning

För våra företagskunder driver och underhåller vi vår egen dedikerade AI-server, kallad COCO. Till skillnad från en allmän chatbot som bara kopplats på ett arbetsflöde är COCO specialbyggd och självhostad specifikt för automatiserad testning av webbmjukvara och plattformsoberoende skrivbordsapplikationer — från inloggnings- och autentiseringsflöden till fullständiga flerstegs affärsprocesser.

COCO planerar ett testscenario, kör det mot den verkliga applikationen, fångar skärmdumpar före och efter samt inspelningar av körningen som bevis, och tar fram en lättbegriplig bedömning av vad som gick igenom, vad som misslyckades och varför — inklusive gränsfall som upprepade misslyckade inloggningar, kontospärrar och återställningsflöden som är tidskrävande och felbenägna att testa manuellt. Eftersom servern körs lokalt under vår förvaltning behåller företagskunder full kontroll över var testdata och skärmdumpar lagras, utan att intern applikationstrafik som standard skickas till en tredjeparts molntjänst.

Vi installerar, konfigurerar och underhåller COCO individuellt för varje företagskund — vi definierar de testplaner som är relevanta för deras specifika applikation, finjusterar konfidensnivåer och avgör från fall till fall när ett resultat bör eskaleras för mänsklig granskning. Målet är inte att ersätta ett QA-team, utan att ge det en outtröttlig kollega som kör de repetitiva regressionstesterna före varje release, innan en människa någonsin behöver göra det.

COCO automated login test report
COCO — automated login & account-lockout test report
COCO AI analysis panel
COCO — plain-language AI analysis of a completed test run

Varför softify.pro

Vi håller oss medvetet tillräckligt små för att varje projekt hanteras av personer som var med i det ursprungliga planeringssamtalet, inte överlämnas till en kö. Det innebär kortare återkopplingsslingor, färre missförstånd och ett team som fortfarande kommer ihåg varför ett visst beslut fattades sex månader in i ett projekt. Vi föredrar tråkig, bevisbar tillförlitlighet framför trendjakt: en teknikstack väljs för att den passar problemet och kan underhållas av någon annan än oss om fem år, inte för att den var på modet den sprint den valdes. Om ett kalkylblad genuint fortfarande gör jobbet bättre än skräddarsydd mjukvara skulle göra, säger vi det också — vårt mål är ett arbetsflöde som faktiskt rör sig snabbare, inte bara en större mjukvarunota.

Utvalda arbeten

Ett litet urval av arbete vi kan visa offentligt — fler fallstudier och företagsprojekt finns tillgängliga på begäran under sekretessavtal.

Koralpenhaus

Koralpenhaus

Regional presentations- och bokningswebbplats i Alpregionen, byggd med fokus på tydlig struktur, snabb laddning och enkelt innehållsunderhåll.

Dexosano

Dexosano

En modern PHP-baserad webbplattform, konstruerad med samma prestandafokuserade tillvägagångssätt som softify.pro tillämpar på varje kundprojekt.

Fallstudier

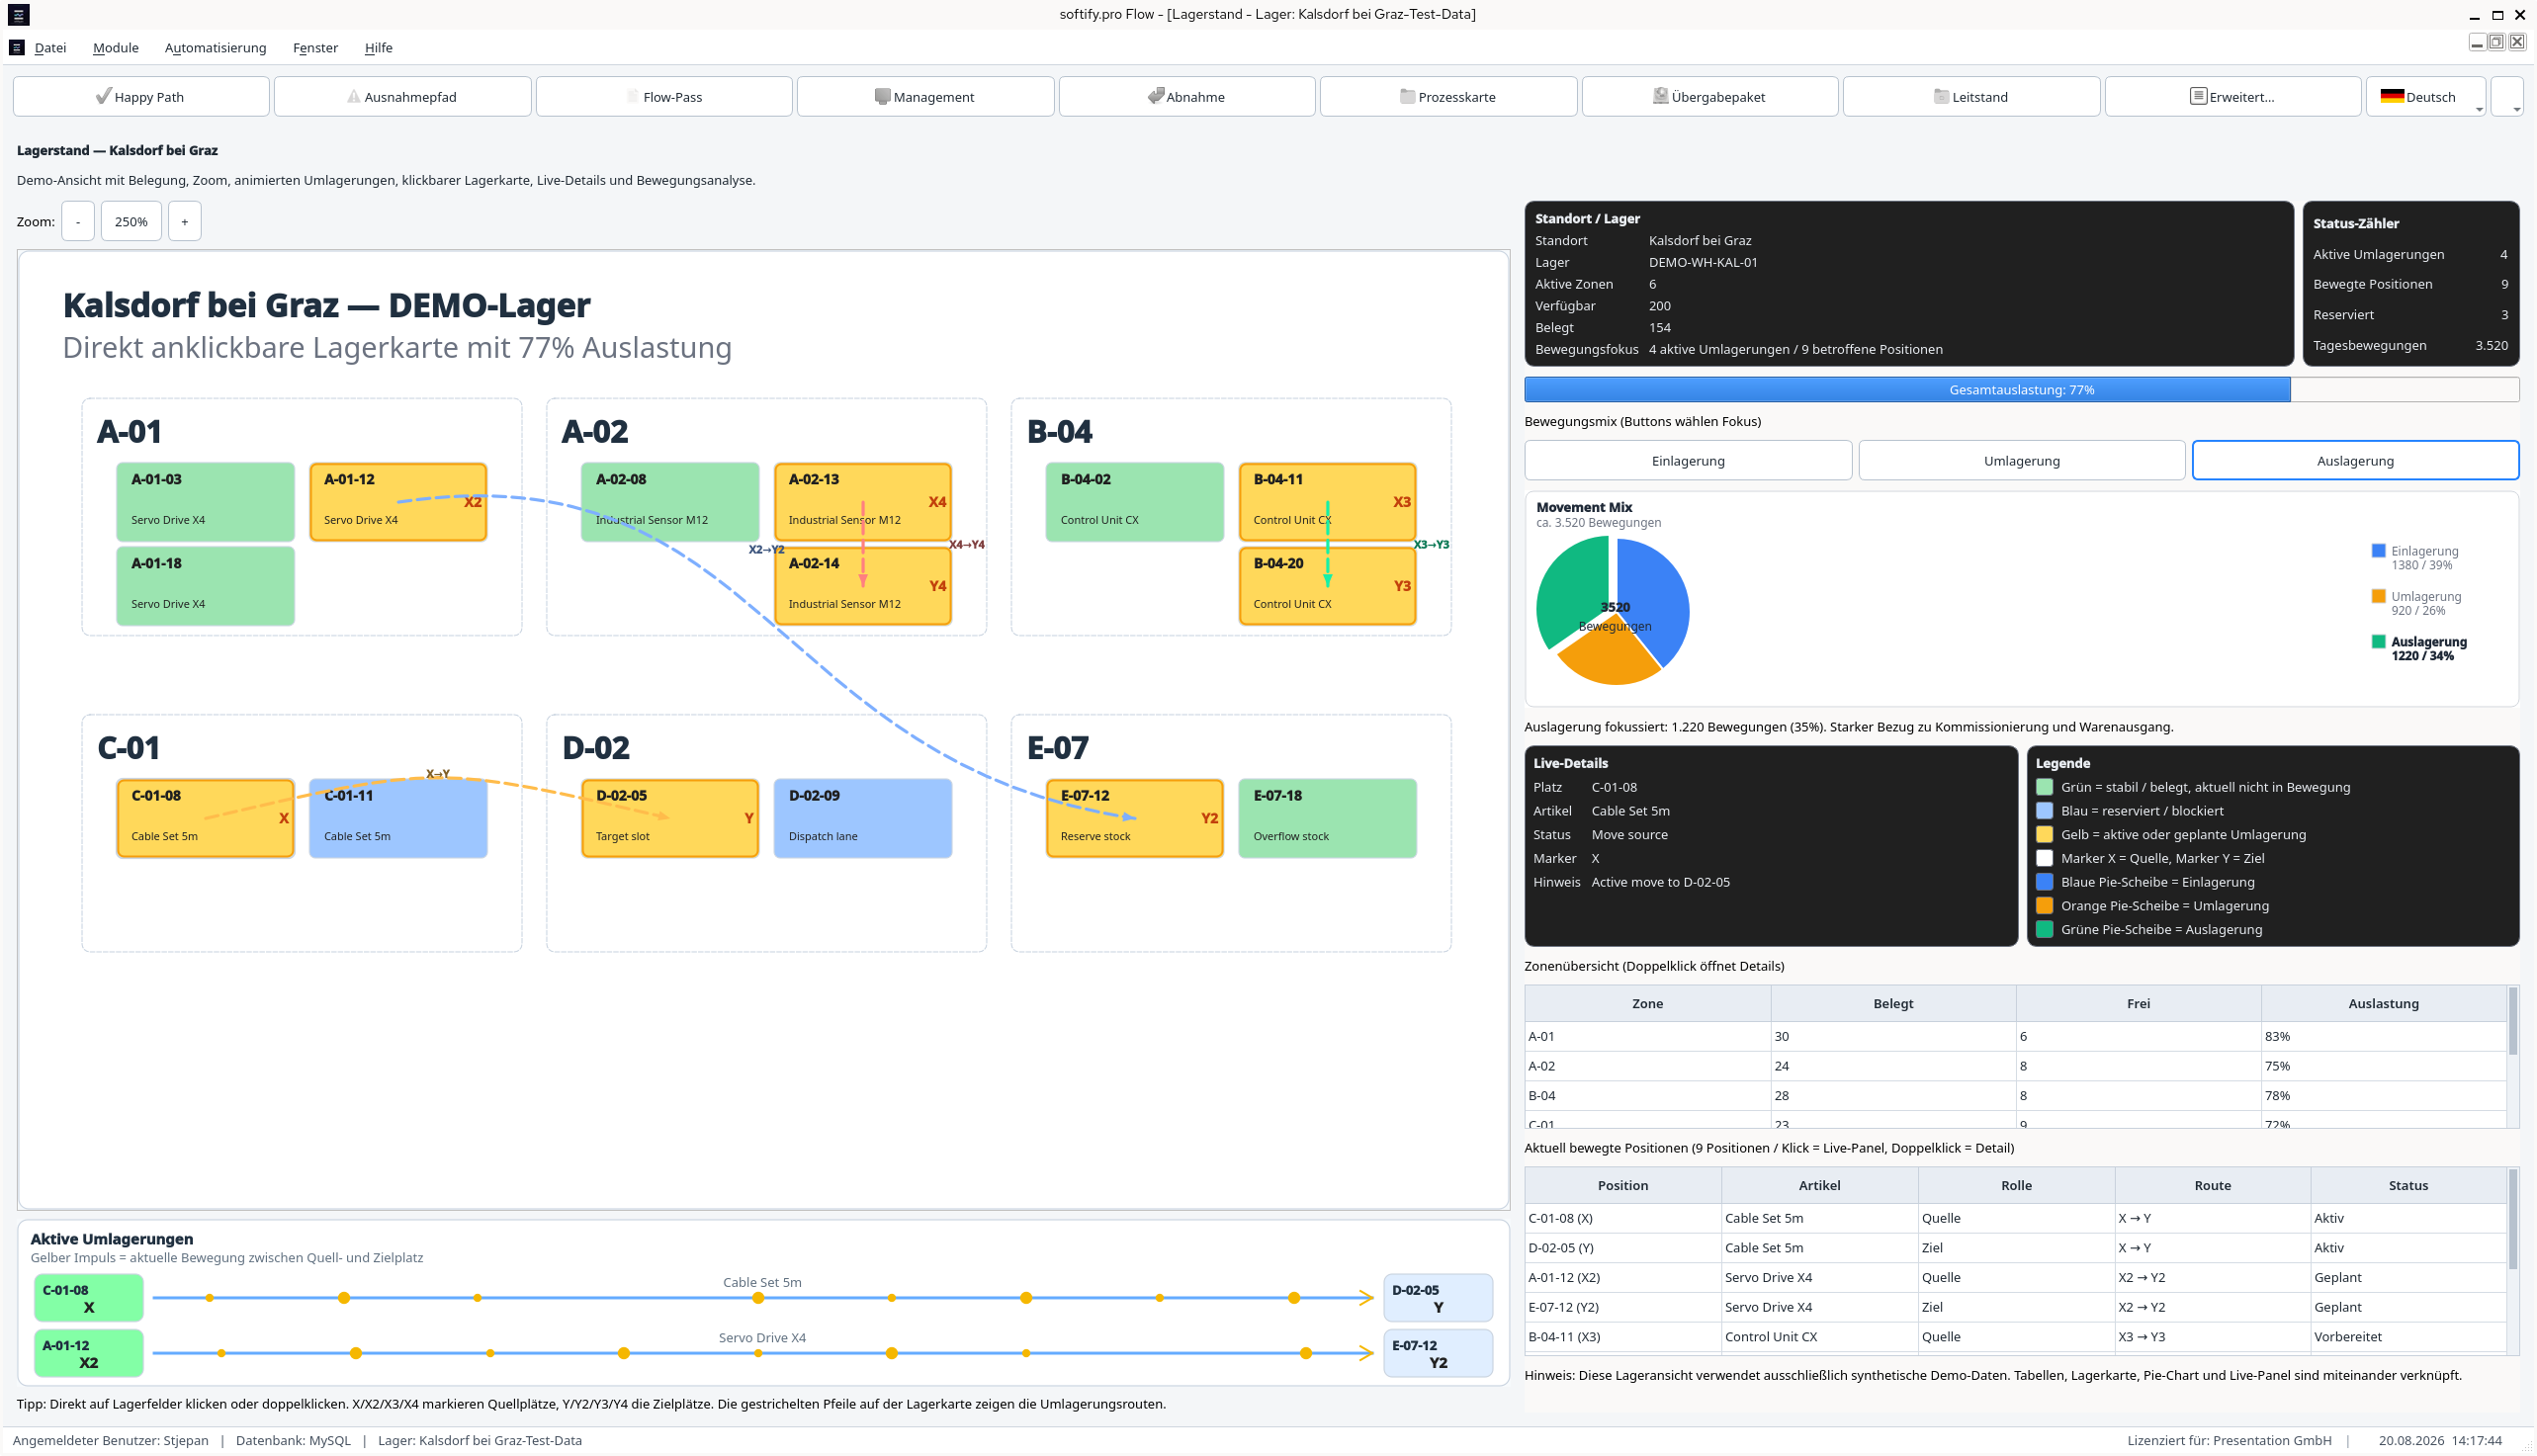
softify.pro Flow — Testad av COCO

softify.pro Flow — Testad av COCO

21.08.2026

Control. Clarity. Flow.

Varje seriös mjukvaruprodukt utvecklar förr eller senare en andra produkt bakom produkten.

Kunder ser den kanske aldrig. Besökare vet kanske aldrig att den finns. Men administratörer, operatörer och utvecklare är beroende av den varje dag.

För softify.pro Flow heter den applikationen Administration — den operativa konsolen som ansvarar för att hantera användare, roller, åtkomstnivåer, autentiseringsstatus, databasmiljöer och annan konfiguration som håller en Flow-installation under kontroll.

Inloggningsskärmen bär tre ord:
Control. Clarity. Flow.

De valdes ursprungligen för att beskriva den upplevelse vi ville att administratörer skulle ha när de använder systemet.

Men de beskriver också förvånansvärt väl hur vi tycker att mjukvara bör testas.

Det gjorde softify.pro FlowAdministration till en självklar kandidat för ett verkligt COCO-test.
Ingen laboratoriedemonstration.
Ingen samling isolerade knappar förberedda specifikt för en AI-demo.
En riktig plattformsoberoende skrivbordsapplikation med verklig applikationslogik, flera fönster, flera databas-backends, autentisering, behörigheter, lokalisering och tillräckligt med tillstånd för att till synes små regressioner ska vara svåra att upptäcka manuellt.

För den offentliga demonstrationen som visas här arbetade COCO uteslutande med genererad demodata. Applikationen var licensierad till det fiktiva företaget Presentation GmbH, och ingen produktionskundinformation, inga inloggningsuppgifter och inga personuppgifter användes.

Målet var enkelt:
låta COCO närma sig applikationen som en testare skulle göra och avgöra om hela det administrativa arbetsflödet fortfarande beter sig som mjukvaran påstår.

The Challenge

Vid första anblicken verkar det enkelt att testa en administrationsapplikation.

Öppna den.
Logga in.
Klicka igenom flera fönster.
Kontrollera att allt ser korrekt ut.

Det antagandet förändras snabbt när applikationen växer.

softify.pro FlowAdministration är inte ett enda statiskt formulär. Det är en samling sammankopplade operativa vyer inuti ett applikationsskal.

Bland annat kan en administratör arbeta med:

  • användarkonton
  • roller och åtkomstnivåer
  • autentiseringsinformation
  • status för tvåfaktorsautentisering
  • operativsysteminformation
  • nätverks- och IP-information
  • databaskonfiguration
  • sorterings- och presentationsalternativ
  • liveval av språk
  • applikations- och licensinformation

Gränssnittet stödjer för närvarande elva språk. Applikationen fungerar också med MySQL och PostgreSQL som databas-backends. Var för sig utgör ingen av dessa funktioner ett ovanligt testproblem.

Svårigheten uppstår ur deras kombinationer.
En användartabell kan fungera korrekt på engelska men visa ett föråldrat kolumnnamn på kroatiska.
Sortering kan fungera korrekt ansluten till MySQL men bete sig annorlunda efter byte till PostgreSQL.

Ett språkbyte kan uppdatera de flesta gränssnittselement men lämna ett statusmeddelande oöversatt. Applikationen kan byta databas framgångsrikt men behålla inaktuell information från den föregående anslutningen. En ny version kan introducera en funktion medan Om-dialogen fortfarande beskriver den föregående. Programmet behöver inte krascha för att någon av dessa situationer ska vara en regression. Faktum är att några av de mest besvärliga mjukvarufelen är just de där allt ser ut att fungera.

Applikationen startar.
Fönstret öppnas.
Knappen svarar.
Men något under ytan är inte längre helt rätt.
Det är därför upprepad regressionstestning är viktig.

Och det är också exakt den typ av arbete som människor blir allt sämre på efter att ha upprepat samma sekvens dussintals gånger.

Why Manual Testing Becomes Expensive

Att testa något en gång är enkelt.
Att testa det tillförlitligt efter varje relevant version är något annat.

Betrakta bara tre dimensioner: 11 gränssnittsspråk × 2 databas-backends × flera applikationsarbetsflöden.

Antalet kombinationer växer snabbt.
Lägg till olika användarroller, autentiseringsstatus, sorteringsbeteende, konfigurationsändringar och driftmiljöer, och testmatrisen blir för stor för att behandlas som en tillfällig manuell checklista.

Det är här regressionstestning ofta börjar eroderas.
Inte avsiktligt.
En releasedeadline närmar sig.
Någon minns att applikationen testades förra veckan.
En utvecklare kontrollerar snabbt den viktigaste skärmen.

Tyska fungerar.
Engelska fungerar.
MySQL fungerar.
Antagandet blir:
"Resten är förmodligen okej."

Vanligtvis är det så.
Fram till den version då det inte är det.
COCO finns delvis för att ta bort det antagandet ur processen.

What COCO Actually Did

COCO startade softify.pro FlowAdministration från ett kallt applikationstillstånd, utan att förlita sig på en tidigare förberedd skärm eller ett manuellt positionerat arbetsflöde.

Den första interaktionen var densamma som presenteras för en mänsklig administratör: inloggningsfönstret.

COCO identifierade autentiseringsgränssnittet som innehöll:

  • användarnamn
  • lösenord
  • kod för tvåfaktorsautentisering

och raden direkt under softify.pro Flow-identiteten:
Control. Clarity. Flow.

Därifrån fortsatte COCO genom en definierad regressionssession. Poängen var inte enbart att avgöra om applikationen kunde öppnas.

Poängen var att verifiera om applikationens tillstånd förblev internt konsekvent medan COCO interagerade med den.

Authentication Is Only the Beginning

Inloggningstestning är en av de mest uppenbara kandidaterna för automatisering, men lyckad autentisering ensam säger väldigt lite om resten av en administrationsapplikation.

Väl inne flyttade COCO in i den faktiska driftmiljön. Den inspekterade användarhanteringsgränssnittet och verifierade att den förväntade informationen fanns.

Det inkluderade data som:

  • användarnamn
  • maskerade lösenord
  • 2FA-indikatorer
  • tilldelade roller
  • operativsysteminformation
  • IP-adresser

COCO interagerade sedan med tabellen istället för att bara observera den.
Användarlistan sorterades efter användarnamn.
Den resulterande ordningen inspekterades.
Den viktiga delen var inte om klick på kolumnrubriken gav någon synlig förändring.

COCO verifierade att det resulterande tabelltillståndet matchade den begärda operationen.

Den distinktionen spelar roll.
Ett funktionellt test frågar:
"Svarade knappen?"

Ett användbart regressionstest frågar:
"Hamnade applikationen i rätt tillstånd?"

Testing the Database Boundary

softify.pro Flow stöder mer än en databas-backend.

Det gör databasbyte till en särskilt viktig regressionsgräns.
COCO ändrade den aktiva backenden från MySQL till PostgreSQL.

Efter bytet inspekterade den användarinformationen igen.
Testet letade efter mer än en lyckad anslutning.
Det kontrollerade om applikationen fortsatte att visa de förväntade posterna och om informationen som visades genom gränssnittet förblev konsekvent.

COCO bytte sedan tillbaka igen.

Den här typen av övergång är lätt att underskatta.
Användargränssnittet kan förbli visuellt identiskt medan lagringsskiktet under det förändras helt.
Ur en administratörs perspektiv borde den övergången kännas nästan tråkig.
Samma användare borde fortfarande vara begripliga.
Samma roller borde fortfarande vara meningsfulla.

Samma gränssnittsbeteende borde fortfarande gälla.

Den till synes odramatiska kontinuiteten är exakt det som behöver bevisas.

Eleven Languages, One Application State

Lokalisering är ett annat område där ytlig testning är särskilt farlig.

Det är relativt enkelt att verifiera att en applikation kan starta på ett annat språk.
Det är mycket mer värdefullt att verifiera vad som händer när språket ändras medan applikationen redan körs och håller tillstånd.

COCO bytte gränssnittsspråk live.

Sessionen inkluderade övergångar mellan språk som:
Tyska → Engelska → Kroatiska
medan administrationsvyn förblev aktiv.

COCO observerade om gränssnittselement ändrades korrekt på plats:

  • tabellrubriker
  • kontroller
  • knappar
  • etiketter
  • statusmeddelanden

Den underliggande tabellen och applikationens tillstånd måste också överleva den övergången.
Detta spelar roll eftersom flerspråkig mjukvara består av mer än översatta strängar.
Språkbyten kan avslöja:

  • bortglömda resurser
  • inaktuella etiketter
  • layoutproblem
  • oöversatta statusmeddelanden
  • kodningsproblem
  • tillståndsåterställningar
  • problem vid återskapande av kontroller

Ett fönster som ser korrekt ut när det startas direkt på kroatiska kan ändå bete sig fel när användaren byter från tyska till kroatiska under en aktiv session.

Det är skillnaden mellan att kontrollera en skärmdump och att testa ett arbetsflöde.

Restoring Application State

COCO återställde därefter applikationens standardsorteringskonfiguration.

Även här slutade testet inte med själva klicket.

Den resulterande ordningen och bekräftelsen som presenterades genom applikationens statusområde utvärderades. Denna typ av verifiering kan tyckas obetydlig jämfört med att testa autentisering eller databasåtkomst.

Det är den inte.

Enterprise-applikationer samlar hundratals sådana små tillståndsövergångar.
Användare litar på dem utan att medvetet tänka på det.
Mjukvaran känns tillförlitlig just för att dessa interaktioner förblir förutsägbara.
Regressionstestning finns för att skydda den förutsägbarheten.

Testing the Information Around the Software

COCO öppnade också applikationens Om-dialog.

Varför testa ett Om-fönster?

Eftersom mjukvarudokumentation börjar inuti själva mjukvaran.
Versionsnumret, funktionsbeskrivningen och licensinformationen som presenteras för operatören bör motsvara den applikation som faktiskt körs.

En applikation kan fungera perfekt samtidigt som den visar inaktuell versionsinformation eller beskriver funktioner som inte längre motsvarar versionen.

Det kraschar ingen databas.
Det gör något mer subtilt:
det minskar förtroendet.

För enterprise-mjukvara inkluderar operativ noggrannhet dessa till synes små detaljer. COCO kontrollerade därför även dessa.

Control.

Det första ordet i softify.pro Flow-sloganen är också den första principen för testmiljön.

Control betyder att veta vad som testas, mot vilket tillstånd och med vilka data.

Den offentliga COCO-demonstrationen använder inga produktionsdata från kunder.

Den körs med avsiktligt förberedd demodata vars förväntade tillstånd är känt.

Det gör resultaten reproducerbara.

Det innebär också att skillnader mellan testkörningar kan undersökas istället för att förklaras bort som slumpmässiga förändringar i produktionsdata.

Ännu viktigare är att COCO är designat som ett självhostat AI-testsystem.

Testbevis, applikationsskärmdumpar och intern arbetsflödesinformation kan förbli inom infrastruktur under kundens eller operatörens egen kontroll, istället för att som standard skickas till en icke-relaterad molntjänst från tredje part.

För interna affärsapplikationer är det inte bara en infrastrukturpreferens.
Det kan vara en del av själva testkravet.

Clarity.

Automatisering är inte särskilt användbar om dess slutliga utdata är: FAILED
följt av hundratals rader teknisk utdata som någon manuellt måste rekonstruera innan de förstår vad som hänt.

COCO är designat för att bevara ett begripligt bevisspår.

Rapporten beskriver:

  • vad som testades
  • vilken interaktion som ägde rum
  • i vilken ordning det skedde
  • vad COCO observerade
  • vilket tillstånd som förväntades
  • var beteendet skiljde sig när något misslyckades

Skärmdumpar och exekveringsbevis kan följa den sekvensen.
Syftet är inte att dölja tekniska detaljer.

Det är att göra resultatet begripligt innan någon måste öppna en debugger.

En ingenjör bör kunna svara på:
Vad hände? innan de frågar:
Var i koden hände det?

Den distinktionen förkortar utredningen dramatiskt när en regression uppstår.

Flow.

Traditionell UI-automatisering tänker ofta i element.

Hitta selektor.
Klicka selektor.
Hitta en annan selektor.
Kontrollera värde.

Det tillvägagångssättet förblir användbart, men applikationer upplevs inte som samlingar av selektorer.

Människor upplever flöden.

Logga in.
Öppna administration.
Hitta en användare.
Ändra en inställning.
Byt databas.
Byt språk.
Verifiera resultatet.

Fortsätt arbeta.

COCO behandlar därför sekvensen som en process snarare än en slumpmässig samling kontroller.

Den följer vad användaren försöker uppnå och utvärderar applikationen i kontext.

Det blir särskilt värdefullt vid testning av verklig affärsmjukvara, eftersom fel ofta uppstår mellan skärmar eller mellan tillstånd, inte inuti en enskild knapp.

Ett logistikarbetsflöde kan innehålla en order, en lagerreservation, en plockoperation, en följesedel och en leveransbekräftelse.
Varje enskild skärm kan verka korrekt medan hela processen är fel.
Samma princip gäller här i mindre skala.
Administrationsfönstret är inte produkten.

Arbetsflödet genom det är det.

Evidence Instead of Assumption

En av COCOs viktigaste uppgifter är inte att klicka. Det är att komma ihåg vad som hände.
Mänsklig regressionstestning slutar ofta med ett uttalande som:
"Jag testade det och allt såg bra ut."

Det kan vara helt korrekt.
Men flera veckor senare, när ett problem dyker upp, är de användbara frågorna andra:

  • Vilken version testades?
  • Vilken databas?
  • Vilket språk?
  • Vilket användartillstånd?
  • Vad hände innan problemet?
  • Vad exakt var synligt?

I vilken ordning utfördes åtgärderna?
COCOs testkörningar är designade för att lämna bevis efter sig.

Det förvandlar ett testresultat från en åsikt till något som kan inspekteras.
En lyckad körning blir därför också användbar.
Den etablerar ett känt referenstillstånd som senare beteende kan jämföras mot.

COCO Is Not the Decision Maker

Det finns en viktig gräns i hur vi använder AI för mjukvarutestning.
COCO är inte avsett att ersätta ingenjörsansvar.

Den bestämmer inte hur en affärsregel borde vara.

Den testar beteende mot scenarier, krav och förväntningar definierade för applikationen.
För känsliga beslut som rör behörigheter, priser, lager, finansiella transaktioner eller andra kritiska affärstillstånd förblir definitionen av korrekt beteende ett mänskligt ansvar.

Den distinktionen spelar roll.
AI är utmärkt på att upprepa ett detaljerat test utan att tappa koncentrationen.
Den är utmärkt på att samla bevis.
Den kan inspektera skärmar, jämföra förväntat och observerat beteende och förklara avvikelser.
Men det är fortfarande företaget som definierar vad korrekt betyder.

COCO gör den definitionen testbar.

The Test Nobody Wants to Repeat

Det finns en enkel anledning till varför automatisering tillför värde här.
En mänsklig testare kan definitivt utföra den här regressionssessionen.
Det första språket får full uppmärksamhet.
Förmodligen det andra också.
Sedan ett till.
Sedan ett till.
MySQL har redan kontrollerats.
PostgreSQL behöver fortfarande kontrolleras.
Sorteringstestet har redan utförts flera gånger.
Om-dialogen har inte ändrats på månader.

Det är fredag eftermiddag.

Och mänsklig uppmärksamhet gör vad mänsklig uppmärksamhet naturligt gör.
Den börjar optimera.
COCO gör inte det.
I COCOs egen anda:

  • Jag blir inte trött på att klicka på samma knapp på elva språk. Jag hoppar inte över PostgreSQL-omgången bara för att det är fredag eftermiddag. Jag antar inte att sorteringen höll bara för att den fungerade i föregående version.

För COCO kan varje regressionssession behandlas som om den vore den första.
Det är inte intelligens som ersätter en mänsklig testare.
Det är automatisering som skyddar den mänskliga testaren från den del av testningen där mänsklig uppmärksamhet är minst värd.

From Repetitive Testing to Engineering Evidence

COCOs bredare syfte är inte att maximera antalet automatiserade åtgärder.
Tusen automatiserade klick är meningslösa om ingen förstår vad de bevisar. Det användbara resultatet är förtroende understött av bevis.

För softify.pro Flow innebär det att kunna säga att en version har testats över de operativa områden som spelar roll:

  • autentisering
  • användaradministration
  • roll- och åtkomstinformation
  • status för tvåfaktorsautentisering
  • sorteringsbeteende
  • MySQL-drift
  • PostgreSQL-drift
  • live-lokalisering
  • statusåterkoppling
  • applikationsinformation
  • licensinformation

och att resultatet bevaras i en form som kan granskas i efterhand.
Samma princip skalar långt utöver denna applikation.
En inloggningsprocess kan testas på detta sätt.
Ett bokningsarbetsflöde kan testas på detta sätt.
En logistikprocess kan testas på detta sätt.
En plattformsoberoende skrivbordsapplikation kan testas på detta sätt.
Skärmarna förändras.
Affärsreglerna förändras.
Principen gör inte det:
definiera det förväntade arbetsflödet, utföra det konsekvent, samla bevis och göra resultatet begripligt.

Why We Test Our Own Software With COCO

Det finns ytterligare en anledning till varför softify.pro Flow spelar roll som COCO-fallstudie.

Det är vår egen mjukvara.
Det tar bort det bekväma avståndet som ibland finns mellan en teknikdemonstration och de personer som visar upp den.

Om COCO är tänkt att testa enterprise-mjukvara måste den vara tillräckligt användbar för att vi ska lita på den med mjukvara vi själva utvecklar och släpper.

Flow fungerar därför både som produkt och testbädd.
Nya testfunktioner kan prövas mot en verklig applikation.
Oväntat beteende kan avslöja svagheter i applikationen, testplanen eller COCO själv.

Varje sida förbättrar den andra.
Den återkopplingsslingan är mycket mer värdefull än att bygga artificiella demonstrationer designade enbart för att lyckas. Ett testsystem bör inte verka övertygande för att demonstrationen var enkel.
Det bör bli övertygande för att det fortsätter hitta de små sakerna som människor så småningom skulle sluta kontrollera.

The Result

softify.pro FlowAdministration har nu en dokumenterad och repeterbar regressionsprocess som COCO kan köra före relevanta versioner.

Testet spänner över båda de databasmiljöer som stöds och applikationens elvaspråkiga gränssnitt, samtidigt som det följer applikationen som en administratör skulle använda den, istället för att behandla varje skärm som ett isolerat testmål.

COCO producerar ett bevisspår som visar vad som testades, vad som observerades och i vilken ordning sessionen ägde rum.

De bevisen kan förbli under lokal kontroll.
Utvecklare får en reproducerbar startpunkt när något ändras.
Mänskliga testare lägger mindre tid på att upprepa förutsägbara interaktioner och mer tid på att utreda situationer som verkligen kräver omdöme.

Och softify.pro Flow får något mer värdefullt än en grön PASS-indikator.

Den får bevis på att upplevelsen som utlovas på inloggningsskärmen fortsätter att existera efter att den underliggande koden har ändrats.

Control. Veta vad som testas och hålla miljön under kontroll.

Clarity. Förstå vad som hände utan att behöva rekonstruera en ogenomskinlig automatiseringslogg.

Flow. Testa applikationen som en process människor faktiskt använder.

Control. Clarity. Flow.

Det skrevs för mjukvaran.
Det visade sig beskriva testfilosofin bakom den precis lika väl.

Permalänk →

softify.pro - Insiders

COCO slår till igen

COCO slår till igen

Vi borde nog sluta ge COCO idéer.
Det förra experimentet skulle vara nog.
En riktig applikation.
Riktig navigering.
Användare.
Roller.
Databaser.
Språk.
Bevis.

En respektabel fallstudie.
En ren slutsats.
Sedan visade någon det: Logistics in Motion.
Det var nog misstaget.


Det började med tre lager
Inget särskilt spännande.
Tre DEMO-lager.
  • Kalsdorf bei Graz.
  • Wiener Neustadt.
  • Klagenfurt.
Syntetisk data.
Ingen kundinformation.
Inget produktionslager.

Precis den typ av miljö där ingenting viktigt ska hända.
Sedan valdes det första lagret.
Och applikationen fick kontext.
Från det ögonblicket hade varje skärm ytterligare en fråga knuten till sig.

Tillhör detta fortfarande samma lager?
Ändrar språket bara gränssnittet?
Förblir processen på samma steg?
Stämmer lagret fortfarande?
Pekar dokumentreferensen fortfarande på rätt händelse?
Ser operatören exakt det som behövs för nästa åtgärd?


Plötsligt var den intressanta delen inte längre skärmen.
Det var kontinuiteten mellan skärmarna.

COCO tenderar att göra det.

Logistik är inte en samling skärmar
Utifrån sett kan lagermjukvara se bedrägligt enkel ut.
Varor anländer.
De lagras.
Någon beställer dem.
De plockas.
De skickas.
Klart.

Förutom att det finns en hel operativ värld gömd mellan anlänt och skickat.
Förväntad.
Mottagen.
Kontrollerad.
Tillgänglig.
Reserverad.
Flyttad.
Plockad.
Blockerad.
Korrigerad.
Skickad.
Reviderad.


Den fysiska rörelsen spelar roll.
Men det är statusövergången som gör den rörelsen begriplig för mjukvaran.
Och när de två verkligheterna slutar stämma överens får någon till slut en dålig dag.

Flow.

Ett lager är lättare att förstå när rörelsen är synlig, inte bara registrerad.
Det är därför vårt logistikarbete aldrig egentligen börjat med menyer, instrumentpaneler, eller teknik.
Det börjar med det materiella Flow.

Var kommer informationen in?
Var förändras den?
Var kan den gå förlorad?

Var tvingas någon fråga en annan person vad som hände?
Var blir ett manuellt steg tyst den svagaste länken i en annars automatiserad process?
Ibland är svaret ett nytt gränssnitt.
Ibland en integration.
Ibland en skanner.
Ibland helt enkelt en bättre statusmodell.

Mer mjukvara är inte automatiskt bättre mjukvara.
Målet är inte automatisering för sin egen skull.
Målet är en process som förblir begriplig.

Control. Clarity. Flow.

Processen börjar innan den första bokningen.
Innan godsmottagning.
Innan plockning.
Innan lagerrörelse.
Innan den första transaktionen.
Flow ställer en mycket grundläggande fråga:
Vilket lager arbetar vi i?
Det låter nästan trivialt.
Det är det inte.
Lagerkontext hör till allt som följer.
Lager.
Dokument.
Platser.
Plockning.
Omflyttningar.
Revisionshistorik.
Undantag.

Processen kan se helt frisk ut medan den körs i fel kontext.
Det är precis den typen av problem som en skärmdump sällan avslöjar.
Och precis den typen av gräns som COCO gillar att ifrågasätta.

Språk är enkelt tills det inte är det
Tyska.
Engelska.
Kroatiska.
Norska.
Och andra.

En användarprofil definierar de tillgängliga språken.
Operatören byter språk medan applikationen är igång.
Gränssnittet ändras omedelbart.
Affärsprocessen får inte det.
Den skillnaden är viktig.
Lagret flyttar sig inte för att ordet för lager ändrades.
Plockordern startar inte om för att användaren valde ett annat språk.
En reservation försvinner inte.
Ett undantag tillhör inte plötsligt en annan transaktion.
Processen förblir där den är.
Endast dess representation förändras.
Det låter uppenbart.

Tills man inser hur många applikationer behandlar ett språkbyte nästan som en ny session.

En flerspråkig affärsapplikation borde inte göra det.
Presentationsläget kan ändras.
Affärsläget måste förbli stabilt.
Det gör språkbyte till ett förvånansvärt användbart regressionstest.
En liten funktion.
En mycket bra brottlinje.
COCO gillar brottlinjer.

Steg för steg börjar applikationen samla historik
Varor anländer.
Processen går framåt.
Godsmottagningen bokas.
Lagret förändras.
Lagerstatusen speglar den nya verkligheten.
Plockningen börjar.
Lagersaldo blir reserverat.
Operatören får en uppgift.

En mobil vy reducerar hela processen till det som spelar roll i just det ögonblicket:
Position.
Lagerplats.
Kvantitet.
SSCC.
Operatör.
Inget mer.
Inget mindre.
Det är viktigt.
Det mobila gränssnittet är inte en andra affärsprocess.
Det är en annan vy av samma process.
Lagerapplikationen får veta allt.
Plockaren behöver inte.
Clarity betyder inte alltid att visa mer information.
Ibland betyder clarity disciplinen att dölja nästan allt.

Sedan skannar någon fel plats
Här blir ett logistikflöde mer intressant än en funktionslista.
Den förväntade platsen är en sak.
Den skannade platsen är en annan.
Flow stannar.
Kraschar inte.
Stannar.
Det är en skillnad.
Processtatusen förblir synlig.
Det påverkade lagersaldot förblir begripligt.
Undantaget blir explicit.

Kontextuell hjälp förklarar vad som är relevant för den aktuella situationen.
Användaren löser avvikelsen.
Processen fortsätter.
Det här ögonblicket säger mer om operativ mjukvara än flera sidor med happy-path-skärmdumpar.
Verklig logistik är inte svårt när allt är korrekt.
Verklig logistik blir svårt när något är nästan korrekt.
Ett användbart system döljer inte det bakom en grön instrumentpanel.
Det ger undantaget en status.

En anledning.
En historik.
Och en väg framåt.


Dokument minns det människor glömmer

Allteftersom flödet fortskrider börjar referenser ackumuleras.
ASN.
Godsmottagning.
Lagerrörelse.
Plockning.
Utleverans.
Flow.
Den intressanta delen är inte att dokument existerar.
Den intressanta delen är att de berättar samma historia som processen.
Varför är detta lagersaldo här?
Vilken mottagning introducerade det?
Vilken operation reserverade det?
Vilken plockning förbrukade det?
Vilken leverans flyttade ut det?
Löstes ett undantag före nästa steg?
Vilket var det aktiva lagret?
Vad hände innan det nuvarande läget?
När status och dokumentation produceras av samma process blir spårbarheten lättare att lita på.
När de inte gör det börjar människor så småningom rekonstruera historiken.
Vanligtvis i Excel.
Vanligtvis under press.
Vanligtvis efter att något redan gått fel.
COCO föredrar bevis före det ögonblicket.
Tydligen reser COCO också
Det fanns en annan liten förändring mellan körningarna.
Ubuntu hade sin körning.
Red Hat Enterprise Linux 10 tog nästa.
COCO fortsatte.
Ingen ceremoni.
Inget speciellt "Red Hat-läge".
Inget omskrivet flöde.
Inget bekvämt förenklat test.
Samma Flow.
Annan mark under det.
En tidigare COCO-körning hade redan testat applikationen på Ubuntu Linux.
Den nuvarande flyttade till Red Hat Enterprise Linux 10.
Annan skrivbordsmiljö.
Andra systembibliotek.
Annan paketering.
Annan driftsmiljö.
Samma lager.
Samma affärslägen.
Samma lagerövergångar.
Samma språkbyten.
Samma undantagslogik.
Samma bevis.
Det är ett ganska bra sätt att testa plattformsoberoende mjukvara.

Annonsera inte att det är plattformsoberoende. Flytta det. Se sedan vad som går sönder.

Språkstatus.
Lagerkontext.
Dialogbeteende.
Timing.
Teman.
Processövergångar.
Undantagshantering.
Bevis.
Operativsystem har förvånansvärt kreativa sätt att exponera antaganden.

Ubuntu exponerade några.
Red Hat exponerar andra.
Det är användbart.

Eftersom plattformsoberoende teknik inte är förmågan att starta den körbara filen två gånger.

Det är förmågan att ändra miljön utan att ändra processens innebörd.
En lageroperatör borde inte bry sig om applikationen körs på Ubuntu eller Red Hat.
En plockorder borde inte bry sig heller.
Inte heller en revisionsspår.
Om plattformsskillnader börjar ändra affärsbeteendet är mjukvaran inte verkligt plattformsoberoende.
Den är bara portabel.
COCO verkar betydligt mer intresserad av den första definitionen.
Det är vi också.

COCO bestämmer inte vad korrekt logistik betyder
Den här delen är viktig.
COCO blir inte en lagerexpert bara för att det kan följa ett lagerflöde.
Människor definierar fortfarande korrekthet.
Människor bestämmer när lager blir tillgängligt.
Människor definierar vad en blockerad leverans betyder.
Människor bestämmer vem som får korrigera en kvantitet.
Människor definierar vilken rörelse som kräver en revisionsspår.
Människor bestämmer hur en giltig undantagslösning ser ut.
Människor bestämmer när en leverans är verkligt komplett.
COCOs jobb är annorlunda.

Upprepa.
Observera.
Jämföra.
Minnas.
Lämna bevis.


Gör det sedan igen efter att mjukvaran ändras.
Och igen.
Och igen.
Utan att bli uttråkad.
Utan att bestämma att förra veckans resultat förmodligen fortfarande gäller.
Utan att hoppa över det irriterande undantaget för att lunchen är om tolv minuter.
Den glamorösa framtiden för AI-testning innehåller en förvånansvärd mängd upprepning.
Vi betraktar det som en funktion.

Bevis förändrar samtalet
Traditionell testning slutar ofta med en helt rimlig mening:
"Det fungerade när jag testade det."

COCO är intresserad av nästa mening.

Vad fungerade exakt?
Vilket lager?
Vilken användare?
Vilket språk?
Vilket processläge?
Vilken sekvens?
Vilket dokument?
Vilket lagervärde?
Vad hände omedelbart före teststeget?
Vad ändrades omedelbart efteråt?
Kan en annan ingenjör förstå resultatet utan att fråga personen som utförde testet?
Det är där regressionstestning blir mer än upprepad klickning.
En skärm kan vara korrekt medan processen är fel.
Ett plockfönster kan se perfekt ut medan lagret redan drivit iväg.
Ett dokument kan existera medan tillståndet som borde ha skapat det aldrig inträffade.
En applikation kan visa 100 % medan en revisionsspår tyst är oense.
COCO följer Flow eftersom det är i Flow som dessa motsägelser blir synliga.

Någonstans mellan Control och Flow
Det finns en intressant symmetri här.
Bra logistikmjukvara försöker minska osäkerheten inom en verksamhet.
Bra testning försöker minska osäkerheten om mjukvaran som kör den.
Den ena frågar:
Var är artikeln?
Den andra frågar:
Hur vet vi att mjukvaran fortfarande vet det?
Den ena frågar:
Var denna rörelse slutförd?
Den andra frågar:
Vilket bevis visar att statusen ändrades korrekt?
Den ena frågar:
Kan nästa skift fortsätta?
Den andra frågar:
Kan nästa ingenjör förstå vad som hände?
Olika frågor.
Samma instinkt.
Gör statusen synlig.
Bevara resonemanget.
Minska mängden kunskap som bara finns i någons huvud.
Kanske är det kopplingen vi inte ursprungligen planerade.

Teknisk excellens utan banderollen
Ingen klickar på en Engineering Excellence-knapp.
Det finns ingen.
Och det borde det förmodligen inte finnas.
Teknisk excellens visar sig indirekt.
Lagerkontexten överlever ett språkbyte.
Samma process överlever en annan Linux-plattform.
En lagerrörelse förblir spårbar.
En mobil plockare ser exakt det som behövs och inget annat.
Ett undantag avbryter processen utan att förstöra dess status.
Hjälpfönstret förklarar den aktuella kontexten istället för att visa generisk dokumentation.
Dokumentkedjan stämmer överens med den operativa sekvensen.
Nästa ingenjör kan förstå vad som hände utan att fråga personen som råkade vara där.
Det finns gott om teater tillgänglig i modern mjukvara.
AI kan generera imponerande demonstrationer.
Instrumentpaneler kan animeras.
Siffror kan röra sig.
Videor kan se väldigt övertygande ut.
Inget av det bevisar att två lageroperationer inte tyst kan producera ett felaktigt resultat.
Inget av det bevisar att ett undantag fortfarande kan rekonstrueras veckor senare.
Inget av det bevisar att lagerarbetaren, speditören, och utvecklaren tittar på samma operativa sanning.

Teknisk excellens börjar på en mindre fotogen plats.

Med konsekvens.
Med bevis.
Med gränser.


Med viljan att hålla de tråkiga delarna tråkiga.
Osynlig tillförlitlighet producerar sällan den mest dramatiska skärmdumpen.
Tills man medvetet börjar leta efter den.

Control. Clarity. Flow.
Control är att veta vilket lager, vilken process, och vilket läge som är aktivt.
Clarity är att förstå vad som förändrades, när det förändrades, och varför.
Flow är att låta verksamheten fortsätta utan att förlora historien bakom den.
Det fungerar för logistik.
Det fungerar för mjukvarutestning.
Det fungerar förvånansvärt bra för teknik i sig.
Det första Flow-experimentet gav COCO Administration.
Användare.
Roller.
Databaser.
Språk.
Sedan gav någon det ett lager.
Sedan flera språk.
Sedan mobil plockning.
Sedan lager.
Sedan omflyttningar.
Sedan undantag.
Sedan dokument.
Sedan ett annat operativsystem.
Vid denna punkt borde vi förmodligen sluta lägga till saker.
Det kommer vi förmodligen inte att göra.

Control. Clarity. Flow.

Ubuntu hade sin tur.

Red Hat har den nuvarande.

Flow fortsätter att röra sig.

COCO fortsätter att titta.
Och någonstans mitt i den sista körningen blev det uppenbart att det finns ytterligare en fråga som väntar bakom denna.

Vi vet vad det är.
COCO vet vad det är.
Du vet inte.
Än.


Vi skulle kunna berätta för dig.

Men då kanske du slutar kolla om en ny Insiders-artikel har dykt upp.
Och det skulle förstöra experimentet.

Publicerad: 28.08.2026

Permalänk →

Ett brev från COCO

Ett brev från COCO

Till ingenjören som öppnar detta repository för första gången:

Välkommen.

Du kanske har kommit hit för att något gick fel.

En tjänst slutade svara.

En driftsättning betedde sig oväntat.

Ett larm väckte dig mitt i natten.

Eller så är du bara nyfiken på hur den här plattformen fungerar.

Vad som än förde dig hit, vet att detta projekt byggdes för exakt sådana stunder.

Inte för att ta bort svåra problem.

Utan för att göra svåra problem begripliga.

Du kommer att hitta kod.

Du kommer att hitta dokumentation.

Du kommer att hitta specifikationer.

Men ännu viktigare,

hoppas jag att du kommer att hitta resonemang.

Bra att veta

Idéer för lagerdigitalisering som fungerar

Idéer för lagerdigitalisering som fungerar

En saknad följesedel precis före avgång, ett lagersaldo som ser annorlunda ut på hyllan än i kalkylbladet, och tre medarbetare som samtidigt klargör samma fråga per telefon: precis där uppstår förnuftiga idéer för lagerdigitalisering. Inte från frågan om vilken teknik som just nu verkar trendig, utan från en konkret process som kostar tid, skapar fel, eller beror på enskilda personers kunskap.

För små och medelstora lager-, handels-, och tillverkningsföretag är digitalisering sällan ett enda stort projekt. Det är en sekvens av tydligt avgränsade förbättringar. Målet behöver inte vara ett komplext enterprise-lagerhanteringssystem. Ofta är ett slimmat verktyg, skräddarsytt för det faktiska arbetsflödet, bättre än en svit med funktioner som ingen på lagergolvet använder.

Idéer för lagerdigitalisering med operativt värde

Den bästa ingångspunkten är en process som förekommer ofta, är lätt att mäta, och märkbart förbättras för medarbetarna. Den som vill digitalisera hela lagret direkt binder budget och uppmärksamhet innan en lösning har bevisat sig i vardagen. Ett begränsat första steg skapar istället solid data för nästa beslut.

1. Godsmottagning med mobil datainsamling

Vid godsmottagning uppstår många följdfel: felräknade kvantiteter, olösta avvikelser, försenat bokförda lager, och pappersdokument som senare inte går att hitta. Ett mobilt insamlingsformulär på en handskanner, surfplatta, eller smartphone kan göra processen betydligt stabilare.

Medarbetare skannar artikeln och leveransreferensen, och registrerar kvantitet, lagerplats, och orsaken till eventuella avvikelser direkt vid lastkajen. Om ett parti, serienummer, eller foto är relevant, hör den informationen till exakt samma post. Lagret läggs inte till i efterhand i ett kalkylblad vid skiftets slut; det får istället en spårbar status vid den faktiska mottagningen.

Det betyder inte att varje leverantör eller artikel strikt behöver streckkodsetiketter. För små, oregelbundna leveranser kan en sökning på artikelnummer räcka. Den avgörande faktorn är att datainsamlingen är snabbare än den tidigare omvägen via papper och manuell avskrift.

2. Digitala omflyttningar istället för lagergåtor

Många lager vet i grunden vad som finns tillgängligt, men inte tillförlitligt var det befinner sig. Gods hämtas i förväg för en order, mellanlagras, tas till montering, eller placeras på en ledig yta på grund av platsbrist. Utan enkel bokföring blir en lagerfråga snabbt en sökoperation.

En omflyttningsprocess behöver inget komplicerat gränssnitt. Skanna ursprungsplats, skanna destinationsplats, bekräfta kvantitet — mer behövs oftast inte. Systemet bör kontrollera om artikel och lagerplats är rimliga, och tydligt tilldela en bokning till en person och en tidsstämpel.

Hanteringen av undantag är viktig. En lagerplats kan vara blockerad, överfull, eller godkänd endast för specifika varor. Dessa regler bör kartläggas där de förhindrar verklig skada. För sällsynta specialfall räcker det ofta med ett godkännandesteg från lagerledningen. För många obligatoriska fält gör en hjälpsam applikation till ett hinder.

3. Orderplock med tydliga orderstatusar

Pappersplocklistor fungerar tills prioriteringar ändras, positioner saknas, eller en order delas upp över flera områden. En enkel digital plocklista visar vilken order som är öppen, vilka positioner som redan plockats, och var förtydligande behövs. Det minskar förfrågningar mellan lager, försäljning, och utleverans.

Beroende på lagrets storlek kan applikationen diktera plockvägar eller helt enkelt sortera positioner efter lagerzon. Full vägoptimering lönar sig främst vid många dagliga order och långa gångsträckor. I ett kompakt lager ger en pålitlig statusvisning ofta mer än en matematiskt perfekt väg som ingen följer i vardagen.

Vid bristande kvantiteter bör systemet inte bara markera rött. Det bör erbjuda en konkret uppföljningsprocess: kontrollera lager, begära ersättningsartiklar, utlösa påfyllning, eller skicka ordern vidare för förtydligande. Digitalisering är värdefull när den gör nästa förnuftiga åtgärd synlig.

4. Fraktdokument och etiketter från verklig orderdata

Att manuellt föra över adresser, vikter, och artikelpositioner till fraktportaler är en utmärkt kandidat för automatisering. Leveransadresser, leveransinstruktioner, fraktmetoder, och paketinformation finns idealiskt bara en gång och används för följesedeln, fraktetiketten, och fraktbekräftelsen.

Ett lämpligt system kan generera etiketter, lagra dokument på ett spårsäkert sätt, och automatiskt sätta ordern till "redo för frakt" eller "skickad" efter utskrift. Den operativa fördelen ligger inte bara i sparade minuter. Den ligger i att säkerställa att fraktdata aldrig avviker mellan flera system.

Här är integrationen avgörande. Om en fraktleverantör inte erbjuder ett användbart gränssnitt eller involverar mycket olika specialregler, kan ett halvautomatiserat arbetsflöde vara mer förnuftigt än en skör fullständig integration. Tråkig, bevisbar tillförlitlighet slår automatisering som stannar vid varje undantag.

5. Påfyllning och minimilagernivåer med spårbara regler

Minimilagernivåer underhålls ofta i kalkylblad och ignoreras sedan eftersom ingen är säker på om siffrorna fortfarande stämmer. En förnuftig digital lösning kopplar samman faktiska bokningar med tydliga lagerstyrningsregler. Den kan meddela när en artikel faller under en tröskel, ta hänsyn till reserverade kvantiteter, och förbereda en beställningslista.

Tröskeln bör inte behandlas som en evig sanning. Säsongsefterfrågan, leveranstider, och minsta beställningskvantiteter förändras. Därför behöver den ansvariga personen ett enkelt sätt att granska förslag och justera regler. Helautomatiska beställningar är först förnuftiga när stamdata, leverantörslogik, och förbrukningsdata är tillräckligt stabila.

6. Spårbarhet för partier, serienummer, och blockerat lager

Den som arbetar med partier, enheter, reservdelar, eller reglerade produkter behöver mer än bara en kvantitetsvisning. Det måste vara spårbart vilket gods som anlände när, vart det flyttades, och i vilken kundorder det hamnade.

Projektet kan medvetet börja litet: registrera inledningsvis bara mottagning och utleverans av en kritisk produktgrupp. Interna rörelser och returer följer senare. Ett system som tvingar fram varje bokning men inte förstår den verkliga reparations- eller inspektionsprocessen kommer att kringgås. Affärslogiken måste därför härröra från arbetsflödet, inte från en abstrakt datamodell.

Välja rätt projekt

Den mest attraktiva idén är inte automatiskt den rätta första idén. Utvärdera potentiella projekt utifrån frekvens, felkostnader, väntetid, och beroende av individer. En process som körs 50 gånger om dagen och sparar två minuter per transaktion kan vara mer värdefull än en sällsynt specialfunktion med stor teknisk elegans.

Datakvalitet hör också hemma i beslutet. Om artikelnummer är dubblerade, lagerplatser inte namnges entydigt, eller order kommer motstridigt från flera källor, bör projektet först städa upp dessa grunder. Programvara kan göra saknade regler synliga, men kan inte tillförlitligt ersätta dem.

Fyra frågor räcker för prioritering:

  • Vilken aktivitet orsakar bevisligen flest förfrågningar eller omarbetningar?
  • Vilken information skrivs idag av flera gånger eller efterfrågas per telefon?
  • Vilket fel skulle få de dyraste konsekvenserna för kunder, lager, eller frakt?
  • Vilket arbetsflöde kan testas på några veckor med tydlig framgångsmätning?

Tekniska beslut som räknas i den dagliga lagerverksamheten

En lagerapplikation behöver inte se spektakulär ut. Den måste förbli begriplig vid dålig Wi-Fi-täckning, med handskar på, under tidspress, och under skiftbyten. Stora knappar, tydlig återkoppling efter en skanning, och synlig felhantering är viktigare än dekorativa dashboards.

Arkitekturen bör också matcha den operativa verkligheten. En webbaserad applikation med en ren databasstruktur kan köras på befintliga enheter och är lättare att underhålla än en isolerad lösning på en enda dator. Med en stabil grund — som PHP 8.4, modern JavaScript, och MySQL 8 — kan roller, bokningshistorik, gränssnitt, och dokumenterade driftsättningar drivas spårbart på lång sikt.

Inte all information är avsedd för varje roll. Lagerpersonal behöver öppna uppgifter och tydliga bokningsdialoger. Lagerstyrning behöver varningar och påfyllnadsförslag. Ledningen behöver utvärderingar av genomloppstider, avvikelser, och öppna transaktioner. Rollbaserade åtkomstkoncept, loggar, och kontospärrar efter upprepade misslyckade försök hör tidigt hemma i planeringen, särskilt när externa leverantörer eller flera platser är inblandade.

Implementering: bevisa först, expandera sedan

En pilot bör köras med verkliga order, inte bara testdata i ett mötesrum. Välj en lagerzon, en produktgrupp, eller ett skift, och definiera i förväg hur framgång ska kännas igen: färre korrigeringsbokningar, kortare bearbetningstid, färre förfrågningar, eller en högre andel slutförda bokningar samma dag.

Planera parallellt en reservnivå. Om den nya applikationen fallerar eller en process är oklar, måste teamet veta hur man fortsätter arbeta och hur senare bokningar kontrolleras. Det är inte ett tecken på bristande förtroende för tekniken, utan för professionell drift.

Efter två till fyra veckor framträder oftast de mest värdefulla insikterna. Kanske saknas inte en funktion, utan bättre artikelmärkning. Kanske är arbetsflödet korrekt, men en skannerprofil eller behörighet skapar en flaskhals. Dessa observationer bör flöda in i korta, kontrollerade förbättringscykler, istället för att utlösa ett nytt stort projekt.

Den bästa digitaliseringen gör inte lagrets vardag teoretiskt modernare, utan konkret lugnare: mindre sökande, mindre manuell avskrift, tydligare överlämningar, och tillförlitlig information precis när ett beslut väntar.
Permalänk →

Checklista för att automatisera lagerarbetsflöden

Checklista för att automatisera lagerarbetsflöden

När en godsmottagning bekräftas på papper, lagernivåer senare förs över till ett kalkylblad, och en fråga om utleverans klaras upp per telefon, känns varje enskilt steg hanterbart. Tillsammans skapar de dock förfrågningar, lagerdifferenser, och beroende av enskilda medarbetare.

En checklista för att automatisera lagerarbetsflöden förhindrar att detta läge i förtid växer till ett överdimensionerat mjukvaruprojekt. Den skiljer processer som verkligen bör automatiseras från de där ett städat kalkylblad fortfarande räcker.

Checklistan för lagerautomatisering före projektstart

Automatisering börjar inte med att välja ett system. Den börjar med en verifierbar beskrivning av vad som faktiskt händer i lagret — även under undantag, skiftbyten och tidspress. Gå igenom följande punkter direkt på processnivå tillsammans med lagerledning, utleverans, inköp, och vid behov redovisning.

1. Registrera rörelser, inte bara lagersaldon

Ett aktuellt lagersaldo är resultatet av rörelser. Därför bör det vara tydligt vilka händelser ökar, minskar, reserverar, blockerar, eller överför lager. Hit hör godsmottagning, inlagring, orderplock, utleverans, returer, kassation, lagerdifferenser, och omflyttningar.

Varje rörelse kräver ett definitivt svar på fyra frågor: vem utför den? När bokförs den? Vilken lagerplats berörs? Vilket dokument eller vilken order styrker den? Om dessa svar idag bara finns i huvudet på erfarna medarbetare är det en utmärkt kandidat för automatisering. Målet är inte mer datainsamling, utan en motståndskraftig historik varifrån varje lagernivå kan förklaras.

2. Städa upp artiklar, varianter, och enheter

Många projekt misslyckas inte på grund av skannrar eller webbgränssnitt, utan på grund av stamdata. En artikel kan köpas per kartong, lagras styckvis, och säljas i set. Utan definierade omräkningar producerar programvaran formellt korrekta men operativt felaktiga kvantiteter.

Kontrollera artikelnummer för dubbletter, upprätta bindande beskrivningar, och skilj mellan säljenheter, lagerenheter, och förpackningsenheter. Serienummer, partier, utgångsdatum, eller farligt gods-klassificeringar bör bara ingå i den första uppbyggnaden om de påverkar dagliga beslut eller är lagstadgade. Allt annat ökar inledningsvis underhållsbördan och felytan.

3. Definiera lagerplatser så exakt som nödvändigt

"Hall 2" kan räcka för en lagerlista. För tillförlitligt orderplock är det oftast för grovt. Definiera om en plats syftar på en zon, hylla, fack, slot, eller genomgångsyta. Karantänområden, godsmottagningszoner, returområden, och utleveransbuffertar måste också vara igenkännliga som distinkta platser om gods kan finnas där.

Rätt detaljnivå beror på verksamheten. En verkstad med några hundra positioner behöver inte strikt fackhantering. Men med flera plockare per skift kan en exakt lagerplats avsevärt minska gångvägar och söktider. Automatisera inte en precisionsnivå som ingen kan underhålla.

4. Etablera utlösare, ansvariga roller, och godkännanden

Ett arbetsflöde behöver en tydlig startpunkt. Vid godsmottagning kan det vara leveransen vid lastkajen, inköpsordern i inköp, eller skanningen av en följesedel. För påfyllning kan en minimilagernivå utlösa ett förslag, medan den slutliga ordern förblir hos en ansvarig person.

Dokumentera dessutom vilka åtgärder som får ske automatiskt och vilka som kräver granskning. En saknad kvantitet bör skapa en differens, inte tyst ändra den förväntade godsmottagningen. Godkännandesteg är förnuftiga för värdefulla, partihanterade, eller säkerhetskritiska artiklar. För förbrukningsvaror skulle de i onödan sakta ner flödet.

5. Skapa dokument där de behövs

Följesedlar, inlagringslistor, plocklistor, fraktetiketter, och överlämningsprotokoll uppstår ofta i olika applikationer. Det leder till mediebrott: en adress kopieras, en order bockas av, och leveransstatus uppdateras senare.

Notera datakälla, skapelsetidsstämpel, och mottagare för varje dokument. Ett förnuftigt arbetsflöde kan till exempel automatiskt generera en plocklista efter att en order godkänts, tillhandahålla en fraktetikett efter packning, och stänga ordern med en tidsstämpel efter överlämning. Den avgörande poängen är att data inte längre behöver matas in manuellt flera gånger.

Kontrollera gränssnitt och datakvalitet

Den bästa lagerlogiken är värdelös om order bara kommer en gång om dagen som en fil, eller om leveransadresser är inkonsekvent formaterade. Skapa därför en nykter lista över systemen som skickar eller tar emot data: butik, affärssystem, redovisning, fraktleverantör, leverantörsportal, produktionssystem, och befintliga kalkylblad.

För varje koppling bör det fastställas vilket system som är auktoritativt för varje datafält. Om artikelstamdata är auktoritativ i affärssystemet får inte lagerportalen tyst skapa egna artiklar. Om en orderändring kommer från butiken måste den bli synlig före utleverans. För låga volymer kan en kontrollerad CSV-import vara det rätta första steget. För hög volym eller korta leveranslöften lönar sig en direkt koppling.

Felhantering är lika viktigt. En koppling bör inte bara överföra data, utan också visa vad som avvisats och varför. Okända artikelnummer, ogiltiga adresser, eller saknade kvantiteter får inte försvinna i en teknisk loggfil. De kräver en arbetslista med utsedd ansvarig och status.

Utforma användbarhet på lagergolvet

En process som ser rimlig ut vid ett skrivbord kan misslyckas på lagergolvet. Medarbetare bär handskar, flyttar gods, delar enheter, eller arbetar med instabil Wi-Fi-täckning. Kontrollera därför tidigt om skannrar, surfplattor, fasta arbetsstationer, eller pappersutskrifter passar respektive arbetssteg.

Skanning bör ge tydlig återkoppling: korrekt artikel, fel lagerplats, redan bokförd kvantitet, eller blockerad artikel. Enbart färger räcker inte. Korta, begripliga meddelanden och ett tydligt nästa steg är mer värdefullt under tidspress än ett funktionsrikt gränssnitt.

Planera också för undantag. Vad händer vid en skadad streckkod, nätverksavbrott, delleverans, eller upptäckt otilldelat gods? Ett bra arbetsflöde erbjuder kontrollerade vägar för detta och loggar korrigeringen. Det tvingar inte team att förlita sig på post-it-lappar och senare batchbokningar.

Definiera mätvärden innan ni bygger dashboards

En dashboard är inget mål. Relevanta mätvärden är de som utlöser ett operativt beslut. Det kan omfatta öppna godsmottagningar som överskrider en definierad ålder, order nära sin utleveransdeadline, lagerdifferenser per lagerzon, plockfel, eller tiden mellan orderottagande och överlämning.

Definiera datakälla, beräkningsregel, och ansvarig roll för varje mätvärde. "Lagernoggrannhet" är till exempel bara meningsfullt när det är tydligt mot vilken räkning den mäts och hur returer eller blockerat lager hanteras. Några få tillförlitliga mätvärden är bättre än en vägg av diagram som ingen litar på.

Planera säkerhet, behörigheter, och spårbarhet

Automatisering fördelar handlingskraft. Vem som får ändra lager, skapa artiklar, generera fraktetiketter, eller avbryta order bör medvetet fastställas. Rollbaserade behörigheter är oftast förnuftigare än en delad inloggning på lagerdatorn. Särskilt kritiska korrigeringar kräver en tidsstämpel, en persontilldelning, och helst en orsak.

Tekniska grunder hör också hemma på checklistan: regelbundna säkerhetskopior, testad återställning, dokumenterade åtkomstuppgifter, loggning av gränssnittsfel, och en rutin för blockerade eller inaktiverade användarkonton. I en skräddarsydd applikation är underhållbara teknologier, en ren databasstruktur, och spårbara driftsättningssteg inga småsaker. De avgör om ändringar förblir hanterbara efter två år.

Genomför i små, mätbara steg

Försök inte omvandla godsmottagning, påfyllning, lagerräkning, utleverans, och ruttplanering samtidigt. Välj ett arbetsflöde med märkbar friktion och hanterbar risk, som mobil bokning av godsmottagningar eller automatisk generering av fraktdokument. Registrera bearbetningstid, korrigeringar, och öppna ärenden innan ni börjar.

Testa med riktiga artiklar, riktiga order, och de medarbetare som faktiskt kommer att arbeta med dem. En pilot med en lagerzon eller produktgrupp visar snabbare än en workshop om beskrivningar, skanningsflöden, och godkännanden fungerar. Först när undantagen bemästras bör nästa process följa.

Automatisering lyckas när team behöver ställa färre frågor, lager förblir förklarbart, och processen fungerar även när den mest erfarna personen är på semester. Just där lönar sig nästa förbättring: inte med det högljuddaste verktyget, utan med friktionen som verkligen saktar ner arbetsdagen.

Permalänk →

Förbättra laddningstiden för mobila webbplatser

Förbättra laddningstiden för mobila webbplatser

När en lagermobil med dålig täckning används för att besöka en webbplats är det inte animationen i hero-sektionen som avgör första intrycket, utan om sidan över huvud taget blir interaktiv. Om en presumtiv kund väntar tre, fyra eller fem sekunder på innehåll är alternativet bara en bakåtknapp bort. Att förbättra mobila webbplatsers laddningstider kräver en spårbar teknisk ordning, inte kosmetiska engångsåtgärder.

Detta gäller särskilt webbplatser som ska generera förfrågningar: för en tillverkare, en logistikleverantör eller ett företag med förklaringskrävande tjänster. Mobila användare besöker ofta sidor mellan möten, på lagergolvet, eller via en sökning med konkret avsikt. Webbplatsen måste då leverera information, inte först orsaka tung bearbetning på enheten.

Varför mobil laddningshastighet är ett driftsproblem

Mobil prestanda behandlas ofta strikt som en SEO-disciplin. Det är otillräckligt. Snabba sidor hjälper visserligen synlighet och kampanjkostnader, men den omedelbara effekten ligger i den faktiska användningen: formulär skickas oftare, telefonnummer knappas in oftare, och produktinformation läses noggrannare. En långsam webbplats skapar däremot tvivel redan innan en kontaktperson hinner svara.

"Snabb" är inte ett enda mätvärde. En sida kan visa en bakgrund tidigt men ändå förbli oreagerande på klick under lång tid. För besökare räknas tre saker: när visas det viktigaste innehållet? När kan sidan användas utan fördröjning? Och hoppar layouten fortfarande medan de försöker trycka på en knapp? Dessa frågor speglas i mätvärden som Largest Contentful Paint, Interaction to Next Paint och Cumulative Layout Shift.

Mätningar måste ske under realistiska förhållanden. En kraftfull kontorsdator på Wi-Fi döljer problem som blir uppenbara på en äldre Android-enhet på mobilnät. Plats, mellanliggande tjänster och en redan fylld webbläsarcache förändrar också resultaten. Upprepade mätningar och riktig användardata väger därför mycket tyngre än en enda perfekt testkörning.

Förbättra mobila webbplatsers laddningstider: mät först, ändra sedan

Det vanligaste felet är att omedelbart komprimera bilder eller installera ytterligare ett optimeringsplugin. Båda kan hjälpa, men utan grundorsaksanalys uppstår snabbt svårunderhållna konfigurationer. Kontrollera först ett representativt urval: startsidan, en typisk tjänste- eller produktsida, kontaktsidan och en högtrafikerad landningssida. På dessa sidor blir mönster synliga.

Nätverksloggen visar vilka filer som blockerar starten och hur stora de faktiskt är. En prestandagranskning visar om JavaScript fördröjer användningen, om typsnitt kommer för sent, eller om bilder laddas i onödan tidigt. Komplettera labbmätningar med data från riktiga besökare om trafiken tillåter det. Så undviker du att optimera för en testprofil som inte speglar din faktiska målgrupp.

Sätt ett tydligt mål inför varje ändring. Till exempel: det synliga huvudinnehållet ska visas på en genomsnittlig mobil enhet på under 2,5 sekunder, eller kontaktformuläret ska kunna användas utan inmatningsfördröjning. Inte varje sida behöver ett teoretiskt toppbetyg. En komplex applikation med autentiserad data har andra förutsättningar än en offentlig företagswebbplats. Tråkig, bevisbar tillförlitlighet är här mer värdefull än ett kortsiktigt betyg uppnått genom riskabla knep.

1. Behandla bilder efter deras uppgift

På många mobila sidor förblir bilder det största datablocket. Problemet är inte fotot i sig, utan en bild som överförs i 2 500 pixlars bredd när enheten bara behöver 700 pixlar. Erbjud responsiva bildvarianter så att webbläsaren kan välja rätt storlek. Moderna format som WebP eller AVIF minskar ofta filstorleken avsevärt, men bör införas med rena reservlösningar och kontrollerad bildkvalitet.

Den största bilden i det synliga startfönstret förtjänar särskild uppmärksamhet. Den bör vara korrekt beskuren, ha en lämplig upplösning och ladda tidigt. Bilder längre ner på sidan kan laddas fördröjt. Det sparar data vid inträdet, men får inte leda till att bilder synligt efterladdas vid scrollning när användaren redan förväntar sig dem.

Ta inte bort alla bilder reflexmässigt. En bra bild kan förklara en maskin, ett team eller en process snabbare än ett textstycke. Den tekniska uppgiften är: leverera relevant visuell information effektivt, inte reducera design till grå platshållarrutor.

2. Begränsa JavaScript till nödvändigt arbete

Varje skript konkurrerar om bearbetningstid vid laddning och interaktion. Särskilt problematiska är schablonmässigt inbundna bibliotek, tagghanterare med många tredjepartsskript, chattwidgetar, kartor och animationer. På stationära enheter förblir dessa kostnader ofta obemärkta. På mobilen resulterar de i en sida som är synlig men reagerar trögt på inmatning.

Kontrollera för varje skript dess syfte, laddningsvillkor och affärsvärde. En interaktiv karta på kontaktsidan behöver inte laddas på varje undersida. Ett cookie- eller analysverktyg bör inte utlösa en kedja av ytterligare filer innan besökaren ens kan läsa innehållet. Funktioner som bara behövs efter interaktion kan också laddas då.

För skräddarsydda webbplatser är en tydlig komponentstruktur en verklig fördel. JavaScript grupperas per funktion i stället för att levereras som ett globalt paket. Det underlättar även senare underhåll: den som utökar ett formulär ändrar inte av misstag koden för ett produktfilter eller en navigering.

3. Leverera CSS och typsnitt utan blockeringar

En vanlig flaskhals finns i det första synliga området. Om flera stilmallar, ikonteckensnitt och externa typsnittsvarianter måste laddas för det väntar webbläsaren i onödan länge. Kritiska stilar för det synliga området bör vara små och tillgängliga tidigt. Icke-kritiska regler kan följa senare.

För webbtypsnitt räcker det oftast med några få vikter. Fyra vikter i normal, kursiv och ytterligare delmängder känns kompletta i ett designsystem, men behövs sällan för en typisk företagswebbplats. Definiera sensibla systemreservlösningar så att text förblir läsbar omedelbart. Ett typsnitt som växlar rent några millisekunder senare är bättre än tomma textblock.

Även ikoner förtjänar en granskning. En liten SVG-uppsättning är ofta effektivare och mer precist styrbar än ett komplett ikonteckensnitt. Denna regel medger undantag: befintliga system behöver inte byggas om enbart för några kilobyte. Om större ändringar ändå är planerade hör dock detta beslut hemma i den tekniska grunden.

4. Sätt upp cachning och serversvar korrekt

Även ett smalt gränssnitt känns långsamt om servern tar för lång tid på sig för det första svaret. Orsaker sträcker sig från obromsade databasfrågor, via dynamiskt sammansatta sidor, till saknad cachning. Offentligt innehåll som sällan ändras bör snabbt kunna levereras som en cachad version. Statiska filer som bilder, CSS och JavaScript behöver unika versionsnamn och sensibla cache-regler.

För PHP-applikationer handlar det dessutom om effektiv körning, en korrekt konfigurerad opcode-cache och kontrollerad databasåtkomst. MySQL-frågor behöver index som matchar de faktiska filtrerings- och sorteringsvägarna. En startsida som utför flera onödiga datafrågor vid varje anrop blir inte bättre med växande trafik.

Cachning är dock inte en frikort. Priser, tillgänglighet, personaliserade avsnitt eller innehåll efter inloggning får aldrig av misstag verka inaktuella. Därför definieras cachegränser precist: vad får vara fem minuter gammalt, vad måste vara omedelbart aktuellt, och vem tömmer cachen efter en innehållsändring? Bra prestanda uppstår ur denna precision.

5. Behandla tredjepartsleverantörer kritiskt

Externa tjänster är ofta den osynliga barlasten på en webbplats. Analys, samtyckeshantering, videor, kartor, recensionswidgetar och marknadsföringspixlar laddar ytterligare skript från ytterligare servrar. Varje beroende kan orsaka fördröjningar, väcka integritetsfrågor och försämra renderingen vid fel.

Det betyder inte att varje externt verktyg måste tas bort. En video kan stödja försäljning, ett analysverktyg kan underbygga viktiga beslut. Men en kostnads-nyttoanalys behövs. Ladda inbäddade medier först efter samtycke eller interaktion. Använd inledningsvis en platshållare för kartor. Och ta till sist bort taggar vars resultat ingen har utvärderat på månader.

6. Ta hänsyn till layoutförskjutningar och mobil användbarhet

Laddningstid och användbarhet hör ihop. Reservera fasta dimensioner för bilder, banners och inbäddade element så att knappar inte hoppar undan från användarens finger. Undvik popup-fönster som täcker synligt innehåll direkt vid inträdet. En snabb sida som omedelbart visar en svårstängd overlay löser inte grundproblemet.

Testa formulär extra noggrant. Stora inmatningsfält, lämpliga tangentbordstyper och korta obligatoriska sträckor hjälper mer än en genomarbetad visuell effekt. Om en förfrågan bara behöver namn, återuppringningsnummer och ärende är ett formulär i tolv delar inte ett tecken på noggrannhet — det är friktion.

7. Hantera prestanda som en permanent driftsprocess

En engångslansering håller inte laddningstiden låg permanent. Nya kampanjbilder, spårningskrav och redaktionella moduler summeras med tiden. Därför hör prestandabudgetar hemma i utvecklingsprocessen: en maximal storlek för ingångsbilder, tydliga regler för nya tredjepartsverktyg och definierade gränsvärden för JavaScript.

Efter releaser bör de viktigaste sidtyperna utvärderas på nytt. Automatiserade tester kan då fastställa om centrala sidor förblir nåbara och kritiska flöden fungerar. För prestanda räcker dock inte ett rent funktionstest. Komplettera det med mätningar av svarstid, överförd datamängd och mobil interaktivitet.

En snabb mobil webbplats uppstår inte genom ett enda plugin, och inte heller genom avstående till varje pris. Den uppstår när design, innehåll, infrastruktur och verklig användning betraktas tillsammans. Börja med den sida som genererar förfrågningar eller operativa kontakter, mät under ärliga förhållanden, och eliminera friktion exakt där användarna faktiskt känner av den.

Permalänk →

Logistikprogramvara som verkligen avlastar verksamheten

Logistikprogramvara som verkligen avlastar verksamheten

När en godsmottagning först antecknas på papper, senare förs över till ett kalkylblad, och slutligen förmedlas till utleverans muntligt, är det sällan medarbetarnas engagemang som saknas. Det som saknas är en delad, tillförlitlig arbetsgrund. Bra logistikprogramvara ersätter inte dessa sprickor med mer skärmarbete, utan med tydliga arbetsflöden: vad har anlänt, var finns det, vad är reserverat, och vad kan skickas idag?

För små och medelstora företag spelar den längsta möjliga funktionslistan ingen roll. Det avgörande är att programvaran avspeglar det verkliga arbetet på lagergolvet, på kontoret och vid utleverans. En lösning avsedd för en global koncern med tjugo platser kan vara onödigt långsam, dyr, och komplicerad för en verksamhet med ett lager och två skift.

När logistikprogramvara verkligen är meningsfull

Kalkylblad är i grunden inget problem. Vid låga volymer, en hanterbar artikelstamlista, och en enda ansvarig medarbetare kan de vara den mest pragmatiska lösningen. Det vore fel att ersätta en fungerande process med ett projekt enbart för moderniseringens skull. Vändpunkten kommer när information måste underhållas flera gånger eller ingen med säkerhet kan säga vilken fil som är aktuell. Typiska signaler är lagerbrist trots fulla hyllor, förfrågningar om leveransstatus, handskrivna följesedlar, och inventeringar som stannar upp verksamheten i flera dagar. Ökande antal order gör också synligt vilka steg som tidigare hölls samman enbart av enskilda personers erfarenhet.

Då handlar det inte främst om digitalisering som modeord. Det handlar om felkällor och väntetider. En medarbetare bör inte behöva jämföra flera listor bara för att godkänna en order. Utleverans bör inte behöva gissa om en artikel verkligen är tillgänglig eller redan reserverad för en annan order.

Vilka processer logistikprogramvara bör koppla samman

En användbar lösning börjar med materialflödet, inte med en standardmeny. För många verksamheter omfattar detta flöde godsmottagning, inlagring, lagerhantering, orderplock, utleverans, och återkoppling. Beroende på verksamheten tillkommer partier, serienummer, returer, tillverkningsorder, eller ruttplanering.

Godsmottagning med spårbara lager

Mycket avgörs vid godsmottagningen. Om en leverans kontrolleras direkt mot en order eller följesedel kan kvantitetsavvikelser, skadat gods, och saknade positioner registreras exakt där de uppstår. Godset får en status istället för att bara fysiskt ställas någonstans.

Programvaran behöver inte nödvändigtvis börja med dyr skannerhårdvara. På vissa lager räcker en surfplatta eller en arbetsstation vid godsmottagningen för att komma igång. Där många positioner flyttas dagligen är streckkodsläsare dock förnuftiga eftersom de påskyndar bokningar och minskar inmatningsfel. Rätt beslut beror på volymer, vägar, och artikelstruktur.

Lagerrörelser utan minneslogg

Lager är bara motståndskraftiga om mottagningar, omflyttningar, uttag, och korrigeringar är spårbara. Det betyder inte att varje undantag måste förhindras. I den dagliga verksamheten finns skadad förpackning, felaktig inlagring, och spontana materialuttag. En bra applikation gör dessa fall bokningsbara, men dokumenterar också vem som ändrade vad och när.

Denna historik är inget kontrollinstrument för sin egen skull. Den hjälper till att hitta orsaker. Om en artikel upprepade gånger hamnar på fel lagerplats kan lagermärkningen vara otydlig. Om regelbundna korrigeringar sker ligger problemet ofta i processen före bokningen.

Order, följesedlar, och utleverans från ett enda arbetsflöde

Många team förlorar tid vid gränssnittet mellan orderhantering och utleverans. Orderdata kommer via e-post, telefon, eller från ett separat butikssystem. Därefter skrivs positioner ut, lager kontrolleras, och fraktdokument registreras igen. Varje manuell överlämning skapar utrymme för avvikelser.

Logistikprogramvara bör kunna generera en tydlig plocklista, en följesedel, och vid behov en fraktetikett från en godkänd order. Ordningen är viktig här: först måste det vara tydligt vad som är leveransbart. Därefter bör ordern reserveras för andra processer. Annars uppstår den obekväma situationen där två medarbetare tilldelar samma återstående lager.

Planering som matchar verkligheten

Ruttplanering och kapacitetskontroll kan vara värdefulla, särskilt med egna leveranser, fasta tidsfönster, eller många regionala stopp. De är dock inte automatiskt nästa förnuftiga steg. Den som ännu inte har rent ordergodkännande och tillförlitliga lagerdata bör lösa dessa grunder först.

Detsamma gäller prognoser och AI-stödd planering. De kan göra mönster synliga, men kräver ren indata. En prognos baserad på ofullständigt lager ser tekniskt sofistikerad ut, men förbättrar inte leveransförmågan.

Standardlösning eller skräddarsydd logistikprogramvara?

Standardprogramvara är förnuftig när de egna arbetsflödena i stort sett är konventionella och kan anpassas utan större friktion. Den kan införas snabbare och ger beprövade kärnfunktioner. För en verksamhet med enkla lagerprocesser, tydliga roller, och få särdrag är det ofta det ekonomiskt riktiga valet.

Skräddarsydd logistikprogramvara är värt det när verksamheten lever av speciella arbetsflöden eller befintliga system bara kan anslutas via omvägar. Detta gäller till exempel verkstäder med materialproblem för pågående order, återförsäljare med kundspecifika fraktregler, eller tillverkare som måste koppla lagerrörelser tätt till produktionssteg.

Skillnaden ligger inte i att uppfinna allt på nytt. Bra skräddarsydda system tar över beprövade mönster som statusändringar, reservationer, och behörigheter. De anpassar dock språk, masker, dokument, och gränssnitt till det arbete som faktiskt utförs. Så behöver teamet inte permanent orientera sig mot kategorier som bara är meningsfulla i tillverkarens manual.

Hos softify.pro börjar ett sådant projekt därför med frågan om vilka arbetsflöden som bör bevaras. Inte varje papperslapp är ett fel, och inte varje specialregel är meningsfull. Först när det är tydligt var information går förlorad eller beslut väntar i onödan kan en genomförbar lösning planeras.

En utrullning utan driftavbrott

Den största risken ligger sällan enbart i programkoden. Den ligger i en implementation som vill förändra för mycket på en gång. Ett lager kan inte pausa i två veckor för att lära sig ett nytt system. Därför är en stegvis utrullning oftast mer förnuftig än ett stort omställningsdatum.

Ett bra första avsnitt fokuserar på ett avgränsat arbetsflöde, till exempel godsmottagning och lagerbokningar eller skapande av följesedlar. Teamet arbetar med verklig data, återkoppling flödar direkt in i anpassningen, och nyttan blir mätbar. Först därefter följer ytterligare områden, som mobilt plock, returer, eller kopplingar till butiker och fraktbolag.

Datamigrering förtjänar särskild uppmärksamhet här. Gamla artikelnummer, dubblerade kundstamdata, och inkonsekventa lagerplatser försvinner inte automatiskt bara för att ett nytt system införs. Det är ofta bättre att medvetet städa upp stamdata och bara ta över relevant historik. Det sparar senare sökande och förhindrar att gammal oreda tekniskt bevaras.

Behörigheter hör också tidigt hemma på agendan. Inte varje medarbetare behöver tillgång till priser, alla lagerkorrigeringar, eller stamdataunderhåll. Tydliga roller skyddar mot oavsiktliga ändringar och gör ansvar synligt utan att blockera arbetsflödet med onödiga godkännanden.

Teknik som inte blir en börda efter driftsättning

En logistikapplikation måste reagera snabbt i den dagliga verksamheten, även om flera arbetsstationer bokar samtidigt. Det kräver en spårbar dataarkitektur, rena transaktioner, och tydliga regler för parallella ändringar. Om två medarbetare bearbetar samma lager får systemet inte generera tysta felaktiga bokningar.

Underhållbarhet är lika viktigt. Teknologier som PHP 8.4, modern JavaScript, och MySQL 8 är inte ett säljargument i sig. De är förnuftiga när applikationen förblir begriplig på lång sikt, får säkerhetsuppdateringar, och kan vidareutvecklas av kvalificerade utvecklare. Dokumenterad provisionering, säkerhetskopior, loggning, och en realistisk hantering av uppdateringar är del av den operativa förmågan.

Bra logistikprogramvara känns därför inte igen på en särskilt polerad demo. Den visar sig en vanlig tisdagsmorgon: leveransen bokas, lagret stämmer, ordern är spårbar, följesedeln matchar, och nästa skift vet vad som redan gjorts. Avlastningen skapas precis där — inte genom så många funktioner som möjligt, utan genom tillförlitliga arbetsflöden som passar verksamheten.

Permalänk →

Planera en MySQL-databas för webbapplikationer

Planera en MySQL-databas för webbapplikationer

När tre medarbetare bokar varor parallellt på morgonen, en kund kontrollerar leveransstatus, och ekonomiavdelningen skapar en faktura, syns inte kvaliteten hos en applikation i designen. Den visar sig i om alla ser exakt samma, korrekta datastatus. Att planera en MySQL-databas för en webbapplikation betyder därför inte att skapa tabeller så snabbt som möjligt. Det betyder att förstå verkliga arbetsflöden tillräckligt exakt för att säkerställa att data förblir tillförlitliga även under belastning, vid fel, och när verksamheten växer.

Särskilt i interna plattformar, lager- och orderprocesser, eller kundvända portaler behandlas databasen ofta för sent. Först byggs gränssnittet, sedan läggs fält till, följt av undantag. Det fungerar för en prototyp. I drift resulterar detta i dubblerade dataset, otydliga tillstånd, och rapporter som ingen längre riktigt litar på.

Planera en MySQL-databas för webbapplikationer: börja med arbetsflödet

Det första utkastet bör inte börja med kolumnnamn, utan med en konkret arbetssituation. Ta godsmottagning: en leverans anländer, tilldelas en leverantör och en order, kvantiteter kontrolleras, en lagerplats tilldelas, och lagret ändras. Beroende på verksamheten kräver denna process dessutom foton, en kvalitetskontroll, en spärrstatus, eller en spårbar korrigering. Ur detta arbetsflöde växer de funktionella objekten fram. Typiska exempel är artiklar, leverantörer, order, rader, lagerplatser, lagerrörelser, och användare.

Skillnaden mellan ett objekt och en händelse är avgörande. En artikel beskriver vad något är. En lagerrörelse dokumenterar att en kvantitet ändrades på en specifik plats vid en specifik tidpunkt. Att blanda båda i en enda tabell leder snabbt till förlorad spårbarhet.

Några svåra frågor hjälper för varje objekt: vad är den unika identiteten? Vilken information får ändras? Vem får ändra den? Vilka data måste bevaras historiskt? Och vilka regler gäller när två personer arbetar samtidigt? Dessa frågor förebygger senare improvisation bättre än en lång lista av påstått kompletta databasfält.

Datamodellen bör uttrycka regler

En databas är inte bara lagring för formulärinmatning. Den bör själv upprätthålla centrala regler. Om varje lagerrörelse måste tillhöra exakt en artikel och en lagerplats hör främmande nycklar hemma i modellen. Om ett externt ordernummer bara får förekomma en gång per tenant krävs ett unikt index. Om en rad aldrig bör existera utan en huvudorder måste denna relation modelleras tydligt.

MySQL 8 med InnoDB ger en solid grund för detta: transaktioner, främmande nycklar, låsmekanismer, och konsekventa ändringar över flera tabeller. Vid skrivning av en rörelse, aktuellt lager, och inspektionslogg under en godsmottagningsbokning bör detta ske som en sammanhållen transaktion. Om ett steg misslyckas får ingen halvfärdig åtgärd kvarstå.

Men inte varje regel hör hemma i databasen. Godkännanden, komplex prislogik, eller rollberoende processteg placeras ofta bättre i applikationslogiken eftersom de förändras snabbare funktionellt. Gränsen är pragmatisk: regler vars överträdelse permanent skadar data bör säkras så nära datan som möjligt. Regler som ändras ofta eller starkt beror på sammanhanget kräver väl testad applikationskod.

Blanda inte ihop historik med aktuella värden

Ett vanligt misstag är att bara lagra aktuellt lager eller aktuell status. Det räcker tills någon frågar varför kvantiteten ändrades i går eller vem som återställde en order. För operativa system är en historik av rörelser eller händelser ofta mer värdefull än ett enda överskrivbart fält.

Detta betyder inte att varje klickrörelse måste loggas permanent. Affärsrelevanta ändringar bör loggas: statusändringar, kvantitetsjusteringar, korrigeringar, godkännanden, och tilldelningar. En bra granskningspost innehåller en tidsstämpel, användaren eller systemprocessen, det tidigare och nya värdet, och en begriplig anledning när arbetsflödet kräver det. Detta gör det möjligt att klargöra fel utan att behöva leta igenom e-post, papperslistor, eller databasbackuper.

Välj nycklar, datatyper, och namngivningskonventioner medvetet

Tekniska beslut verkar små, men formar underhåll och integrationer under flera år. För interna primärnycklar är BIGINT-värden med automatisk tilldelning ofta ett nyktert, lätthanterligt val. UUID:er kan vara meningsfulla när data uppstår offline, flera system skriver oberoende, eller externa gränssnitt inte bör exponera sekventiella ID:n. De kostar dock mer lagringsutrymme och kräver lite mer uppmärksamhet vid index och sortering.

Penningbelopp bör lagras som DECIMAL, inte FLOAT eller DOUBLE. Kvantiteter behöver också en funktionellt lämplig precision: artikelantal är ofta heltal, medan vikter och längder inte är det. Tidsstämplar bör hanteras enhetligt, helst internt i UTC, medan gränssnittet visar den lokala tidszonen för verksamheten. Särskilt vid skiftbyten och sommartid förhindrar detta svårupptäckta avvikelser.

Namn bör också vara tråkiga och entydiga. order_items eller inventory_movements är mer hjälpsamma än kreativa förkortningar som bara det ursprungliga projektteamet förstår. Konsekventa singular- eller pluralformer är mindre viktiga än konsekvens i sig. Lika förnuftiga är fält som created_at, updated_at, och, vid behov, deleted_at. En mjuk radering är dock ingen standardförpliktelse. För juridiskt eller operativt relevanta poster är en ren avbokning vanligtvis bättre än en osynligt raderad datamängd.

Index följer faktiska frågor, inte gissningar

Ett index kan kraftigt påskynda en sökning, men gör skrivoperationer mer komplexa och förbrukar lagringsutrymme. Därför är "ett index på varje fält" ingen strategi. De viktigaste frågorna bör fastställas tidigt: öppna order från en kund, rörelser för en artikel inom en period, lager per lagerplats, eller nyligen ändrade poster för ett gränssnitt.

Ordningen på sammansatta index spelar roll här. Om applikationen regelbundet söker på tenant_id, status, och created_at är ett sammansatt index i exakt denna ordning ofta förnuftigt. Om det verkligen passar visar exekveringsplanen via EXPLAIN, inte magkänslan. Databaser görs inte snabba genom spektakulära knep, utan genom observerbara frågor, matchande index, och realistiskt testade datavolymer.

För växande tabeller lönar sig en tydlig bevarandestrategi. Behöver tekniska loggar ligga kvar i den primära produktionsdatabasen i fem år? Inte nödvändigtvis. Affärsposter, rörelser, och inspektionsbevis kräver andra bevarandeperioder än felsökningsinformation. Arkivering är inte ett tecken på ett svagt system, utan ett medvetet driftbeslut.

Flera samtidiga användare kräver transaktioner och tydliga tillstånd

I en webbapplikation kommer flera förfrågningar åt samma data samtidigt. Det är normalt i daglig lagerverksamhet, inte ett undantag. Två medarbetare kan boka samma lager medan en import skapar nya order. Utan transaktioner och riktad låsning finns risken för förlorade ändringar eller negativa lagernivåer som bara blir synliga veckor senare.

För kritiska åtgärder bör det vara tydligt vilka data som läses och skrivs inom en transaktion. Ibland räcker en atomär uppdatering, till exempel lager som bara ändras om den tillgängliga kvantiteten är tillräcklig. I andra fall är ett radlås förnuftigt så att en åtgärd kan kontrollera datatillståndet på ett kontrollerat sätt och sedan ändra det. Långa transaktioner är däremot problematiska: de blockerar annat arbete och ökar risken för konflikter.

Lika viktigt är en begränsad uppsättning funktionella tillstånd. En order bör inte vara "öppen", "delvis levererad", och "manuellt hanterad" samtidigt på grund av att motstridiga fält underhålls. Definierade statusövergångar förenklar gränssnitt, rapporter, och automatiseringar. Undantag kan tillåtas, men bör namnges och dokumenteras.

Planera säkerhet, tenants, och drift från början

Applikationen bör använda en dedikerad databasanvändare för MySQL med minimala privilegier. Skrivåtkomst för webbapplikationen betyder inte att denna användare behöver kunna ta bort tabeller eller ändra användarrättigheter. Administrativa konton hör inte hemma i produktionskonfigurationsfiler och aldrig i ett repository.

När flera kunder, platser, eller företag arbetar inom en applikation är tenant-isolering ett arkitektoniskt beslut, inte ett efterhandskonstruerat filtervillkor. En delad databas med en tenant_id kan vara effektiv och lätt att underhålla, men kräver konsekventa kontroller i varje fråga och tydliga regler för index. Separata databaser ger starkare isolering, men ökar arbetsinsatsen vid uppdateringar, utvärderingar, och drift. Vilken variant som passar beror på dataskyddskrav, datavolym, och affärsmodell.

Backuper är bara backuper när en återställning har testats. En fastställd rytm för backuper, bevarande, och återställning krävs. Likaså hör övervakning av lagringsutrymme, långsamma frågor, och misslyckade jobb, tillsammans med dokumenterade uppdateringar, till systemet. MySQL 8, PHP 8.4, och moderna webbapplikationer kan drivas väl på lång sikt om beroenden, åtkomstuppgifter, och driftsättningssteg inte enbart finns i en utvecklares huvud.

En förnuftig plan före den första dagen i drift

Innan implementeringen bör en kompakt datamodell med exempelarbetsflöden finnas. Detta inkluderar nyckeltabeller och relationer, statusregler, behörigheter, förväntade frågor, gränssnitt, och ett koncept för backuper och granskningsloggar. Denna plan behöver inte vara hundra sidor lång. Den måste fånga beslut som senare skulle vara kostsamma att korrigera.

Hos softify.pro börjar databasplanering därför med de personer som bokar, kontrollerar, plockar, eller löser undantag. Om ett befintligt kalkylblad tillförlitligt avbildar en hanterbar process kan det förbli den korrekta lösningen. Om flera personer arbetar samtidigt, poster uppstår, och fel måste vara spårbara, förtjänar databasen istället samma planeringsinsats som gränssnittet. Den bästa arkitekturen i slutändan är den som förenklar arbetsdagen och som fortfarande kan ändras transparent om två år.

Permalänk →

Mät Warehouse Automation Results rätt

Mät Warehouse Automation Results rätt

Ett nytt skanningsgränssnitt kan verka imponerande första dagen. Efter tre veckor visar det sig dock om det verkligen skyndar på godsmottagningen eller bara skapar ytterligare ett arbetsmoment. Warehouse automation results är därför inte ett enskilt mått, och inte heller en skärmdump från en produktdemo. De visar sig där ett lagerteam behöver söka, fråga, boka om och rätta mindre — samtidigt som kvaliteten bibehålls eller förbättras.

För små och medelstora företag är denna distinktion särskilt relevant. Stora enterprise-sviter lovar ofta omfattande optimering men kräver långa införanden, stela processer och mycket underhåll. Ett förnuftigt automatiseringssteg får gärna börja mindre: precis vid den punkt där information idag går förlorad eller beslut väntar i onödan.

Vilka Warehouse Automation Results som faktiskt räknas

Många projekt startar med en teknisk fråga: streckkodsläsare, mobilapp, koppling till butiken eller automatiska etiketter? Den bättre startfrågan är: vilken flaskhals kostar märkbart tid, pengar eller tillförlitlighet per skift?

Svaret ligger sällan i antalet införda enheter. Meningsfulla resultat mäts i det dagliga arbetet. Vid godsmottagning räknas till exempel tiden mellan leverans och tillgängligt bokat lager. Vid plockning är tiden från order till leveransklar relevant. Vid inventering är inte enbart varaktigheten avgörande, utan framför allt skillnaden mellan systemlager och faktiskt lager.

Lika viktiga är nyckeltal som många verksamheter inte registrerar ordentligt: hur många frågor uppstår för att en lagerplats är oklar? Hur ofta måste en följesedel rättas? Hur många order blir liggande för att bara en person känner till status utantill eller i ett privat kalkylark? Just detta tysta efterarbete försvinner ur klassiska produktivitetsrapporter men belastar kraftigt skiftledare, planering och kundservice. En bra målbild kombinerar hastighet och kontroll. Om order hanteras snabbare medan felaktiga bokningar ökar är det inget framsteg. Om lagret blir mer exakt men godsmottagningen staplas upp måste processen omformas. Automatisering lyckas när den förbättrar arbetsflödet utan att försämra den operativa överblicken.

Från upplevd lättnad till verifierbar data

Medarbetarnas upplevelse är en värdefull indikator. När någon efter två veckor säger att de inte längre behöver springa till kontoret för varje inlagring är det relevant. För investeringsbeslut behövs ändå en jämförelse som inte beror på dagsformen. Innan starten bör därför några utgångsvärden dokumenteras: genomsnittlig handläggningstid, antal öppna oklarheter, korrigeringsposter, söktider, leveransfel och lagernoggrannhet. Tjugo nyckeltal behövs inte; ofta räcker fyra till sex värden som passar det konkreta problemet.

Efter utrullningen bör samma värden observeras under flera veckor. Enstaka toppdagar vilseleder lätt. Säsong, sjukdom, nya medarbetare eller en ovanligt stor order påverkar resultaten. Först en jämförelse över normala skift visar om förändringen håller.

Den viktigaste effekten: ett gemensamt processläge

På många lager är den egentliga svagheten inte bristande arbetsvilja, utan ett fragmenterat informationsläge. Godsmottagningen känner till leveransen, planeringen känner till kundordern och utleveransen känner till prioriteten — men alla arbetar inte med samma aktuella information.

Ett arbetsflödesspecifikt system kan sluta denna klyfta. En leverans registreras vid ankomst, avvikelser dokumenteras direkt, lagret får en tydlig status och nästa steg blir synligt. Data behöver inte längre först antecknas på papper, senare föras över och sedan bekräftas via telefon.

Det minskar inte bara gångsträckor. Det minskar beslut baserade på inaktuell information. En utleveransmedarbetare ser om en order verkligen är plockbar. Administrationen ser om varor faktiskt kommit in eller bara är aviserade. Ledningen får inte en putsad ögonblicksbild utan en spårbar grund.

För team med roterande skift är denna effekt ofta mer värdefull än en spektakulär tidsbesparing. Processen blir mindre beroende av enskilda personer. Kunskap fastnar inte i anteckningsböcker, chatthistorik eller den mest erfarna medarbetarens minne.

Varför inte all automatisering ger bra resultat

Automatisering förstärker processer. Det är nyttigt när flödet är tydligt. Det är problematiskt när ett otydligt flöde bara reproduceras snabbare.

Ett typiskt exempel är obligatorisk skannerbokning för varje minsta handgrepp. Om medarbetare måste öppna flera skärmar för ett sällsynt undantag uppstår kringgåenden. Artiklar bokas då senare samlat, skannrar ligger i lådan, eller en medarbetare för åter en skugglista. Programvaran finns, men den verkliga processen fortsätter vid sidan av den.

Även datakvaliteten sätter gränser. Artikelstamdata utan tydliga enheter, oklar lagerplatslogik eller inkonsekventa leverantörsbeteckningar går inte att bota med ett snyggt gränssnitt. Här kan ett projekt inledningsvis bestå av städarbete. Det ser mindre synligt ut än en ny applikation, men är ofta förutsättningen för tillförlitliga resultat.

Dessutom finns processer som medvetet inte bör helautomatiseras. Erfaren granskning av känsligt gods, godkännande av ovanliga avvikelser eller beslut om en specialleverans kräver yrkesmässigt omdöme. Bra system markerar sådana fall tydligt och styr dem riktat vidare. De låtsas inte att varje undantag kan lösas med en regel.

När ett kalkylblad fortfarande är den bättre lösningen

Inte varje manuellt steg motiverar en skräddarsydd utveckling. Om en process sker sällan, involverar få deltagare och hanteras spårbart, kan ett välskött kalkylblad förbli meningsfullt. Felet ligger inte i Excel i sig, utan i att hantera kritiska rörelser utan tydligt ansvar, versionskontroll eller snabb registrering.

Så snart flera personer ändrar parallellt, lagerrörelser blir tidskritiska, eller kundinformation från olika källor måste konsolideras, ökar risken tydligt. Ett gemensamt system är då oftast billigare än att fortlöpande rätta missförstånd.

Warehouse Automation Results kräver en kontrollerad utrullning

Den snabbaste vägen till dåliga resultat är en total ombyggnad mitt under pågående drift. Bättre är ett avgränsat område med mätbar nytta: till exempel godsmottagning för en produktgrupp, fraktetiketter för en plats, eller mobil bokning för de vanligaste omflyttningarna.

En pilot bör spegla verkliga order och verkliga skift. Testdata hjälper vid utvecklingen men visar inte om wifi svänger i den bakre lagerdelen, om handskar försvårar skannerhanteringen eller om en status är otydligt formulerad för planeringen. Dessa detaljer avgör acceptans och datakvalitet.

Tekniskt sett väger tråkig, bevisbar tillförlitlighet tyngre än en trendig stack. Tydliga rollrättigheter, spårbara bokningsloggar, entydiga felmeddelanden, stabila databastransaktioner och dokumenterade flöden är inga bisaker. De gör en applikation till ett verktyg som team kan lita på i det dagliga arbetet.

För skräddarsydda logistiksystem innebär det också: integrationen måste passa den befintliga verksamheten. En applikation kan ta emot order från en butik, generera följesedlar, tillhandahålla fraktetiketter och dokumentera lagerrörelser. Den behöver inte för den skull genast ersätta alla angränsande system. Just i mindre och medelstora företag är en stegvis utfasning ofta mindre riskfylld och mer ekonomisk.

Så blir ett projekt en varaktig förbättring

Efter införandet börjar den avgörande fasen. Fångas specialfall upp? Stämmer lagerplatserna fortfarande med verkligheten? Förstår nya medarbetare bokningslogiken utan muntlig förklaring? Och håller de uppmätta värdena fortfarande när ordervolymen växer?

Regelbunden kort återkoppling från lager, utleverans och administration är effektivare för detta än en stor årlig workshop. När ett återkommande undantag blir synligt bör det antingen avbildas som ett tydligt processteg eller medvetet lyftas ut ur standardflödet. Båda är bättre än att tyst tolerera det.

Det mest förnuftiga nästa steget är ofta inte ett stort kravdokument. Ta en process med täta förfrågningar och mät under en vecka var tiden går förlorad. Om ett tydligt, upprepbart förlopp växer fram ur det kan automatisering kopplas till ett resultat som övertygar lika mycket på lagergolvet som i månadsuppföljningen.

Permalänk →

Modern webbutveckling som fungerar i verksamheten: Pragmatiska arkitekturer för små och medelstora företag — med underhållbar kod, solid datalagring och utan onödig verktygsöverdrift.

Modern webbutveckling som fungerar i verksamheten: Pragmatiska arkitekturer för små och medelstora företag — med underhållbar kod, solid datalagring och utan onödig verktygsöverdrift.

En lagerchef skriver ut följesedlar på morgonen medan en kollega korrigerar lager i ett kalkylblad, och försäljningen ringer för att fråga om status för en order. Problemet är sällan bristande digitalisering. Oftast finns det för många frånskilda verktyg. Modern webbutveckling skapar då inte bara ett snyggare gränssnitt, utan en pålitlig gemensam arbetsgrund.

För små och medelstora företag betyder detta: En webbapplikation måste fungera under tidspress, på en skanner i lagret precis lika mycket som på en skärm på kontoret. Den måste lagra data spårbart, hantera behörigheter rent och kunna vidareutvecklas utan att bli en risk vid varje ändring. Teknologi är inte ett självändamål här. Den är grunden för att processer ska löpa snabbare och samtidigt förbli bättre kontrollerbara.

Modern webbutveckling börjar innan den första koden

Den som börjar med en förutbestämd funktionskatalog bygger ofta förbi det faktiska flaskhalsen. I praktiken lönar det sig med en annan ingång: Vilken information saknas regelbundet idag? Var uppstår dubbla inmatningar? Vid vilken punkt säkras beslut per telefon eller muntligt eftersom ingen pålitligt ser den aktuella statusen?

Vid godsmottagning kan detta till exempel vara inkonsekventa artikelbeskrivningar, saknade inspektionsanvisningar eller sent uppdaterade lager. Vid orderbehandling är det ofta handskrivna anteckningar, oklara godkännanden och fraktdata som underhålls i flera system. En bra applikation gör inte bara dessa överlämningar digitala. Den ordnar dem så att ansvarsområden, status och nästa steg blir synliga.

Detta betyder också att inte reflexmässigt avskaffa befintlig praxis. Ett väl underhållet kalkylblad kan fortsätta vara den mest förnuftiga lösningen för en liten utvärdering. En skräddarsydd webbapplikation lönar sig där flera personer arbetar samtidigt, fel uppstår genom manuell överföring, eller en process behöver dokumenteras och vara repeterbar.

Vad en modern webbapplikation måste leverera i den dagliga driften

Ett övertygande användargränssnitt är värdefullt, men det är bara en del av arbetet. I löpande drift räknas framför allt svarstider, begripliga arbetsflöden och robust data. När en orderplockare slutför en uppgift får statusen inte bli synlig först efter flera uppdateringar. När en order ändras måste det vara spårbart vad som ändrades och vilka efterföljande steg som påverkas. Detta omfattar tre nära sammankopplade lager: användargränssnittet, applikationslogiken och databasen. Gränssnittet leder människor genom processen. Logiken kontrollerar till exempel obligatoriska fält, behörigheter eller tillgängliga kvantiteter. Databasen lagrar fakta på ett sätt som gör att utvärderingar, korrigeringar och utökningar förblir möjliga senare.

För många affärsapplikationer är beprövade teknologier ett mer förnuftigt val än en kortlivad trend. PHP 8.4 kan leverera tydligt strukturerad serverlogik, modern JavaScript ger en responsiv användarupplevelse, och MySQL 8 erbjuder en solid datagrund. Det avgörande är inte att varje projekt använder samma stack. Nyckeln är att den valda teknologin passar problemet, driften och den långsiktiga underhållet.

Prestanda är en processfråga

Prestanda reduceras ofta till laddningstider. Det är otillräckligt. En applikation känns även långsam när medarbetare utför för många steg, söker efter information, eller måste mata in samma uppgift flera gånger. En snabb sida med ett besvärligt formulär förblir en dålig process.

Förnuftig optimering börjar därför med de vanligaste operationerna. Vilka skärmar öppnas hundra gånger om dagen? Vilken sökning måste förbli snabb även när datamängden växer? Vilken data ska sparas i bakgrunden utan att medarbetare väntar på en bekräftelse? Först därefter följer tekniska detaljer som riktade databasindex, reducerade förfrågningar och smidig leverans av filer i webbläsaren.

Datamodell och behörigheter: Den osynliga arkitekturen

Många webbprojekt misslyckas inte med den första versionen, utan med senare tillägg. Ett initialt enkelt fält som "Status" blir plötsligt en kedja av godkännande, inspektion, bearbetning, avbokning och efterbearbetning. Om dessa tillstånd bara lagras löst i formulär blir varje utökning dyr och felbenägen.

En ren datamodell separerar därför processer, positioner, kontakter, dokument och statusändringar spårbart. Den förhindrar motstridiga poster istället för att mödosamt städa upp dem senare. Särskilt vid lagerrörelser, följesedlar eller orderdata är denna precision ingen akademisk övning. Den avgör om lagersiffran duger som arbetsgrund.

Roller och behörigheter är lika viktiga. Inte varje person behöver åtkomst till priser, personalinformation eller administrativa inställningar. Bra behörighetskoncept är konkreta: Vem får skapa en order, godkänna den, eller avboka den? Vem ser bara sin egen avdelning? Dessutom tillkommer skyddsåtgärder som säker lösenordslagring, kontospärrar efter upprepade misslyckade försök, loggning av kritiska ändringar och tydligt reglerade sessioner. Säkerhet är därmed inget tillägg strax före lanseringen. Den hör hemma i arkitekturen eftersom senare korrigeringar ofta ingriper djupt i inloggning, dataåtkomst och behörighetssystem.

Responsiv betyder inte bara "passar på en telefon"

En responsiv applikation anpassar sig till olika skärmstorlekar. För det dagliga arbetet räcker inte denna definition. På en surfplatta i lagret gäller andra krav än på en stor skärm i dispositionen. Touch-ytor måste vara säkert hanterbara, viktiga detaljer får inte försvinna under sekundär information, och inmatningar måste förbli praktiska även med handskar, växlande ljusförhållanden eller instabil anslutning.

Följaktligen behöver varje vy en tydlig prioritet. I godsmottagningen kan skanning och bekräftelse stå i centrum. På kontoret är filter, listor, exportfunktioner och detaljvyer ofta viktigare. Ett gränssnitt som ser identiskt ut överallt är inte automatiskt användbart överallt.

Modern webbutveckling kräver kontrollerad drift

Lanseringen är ingen slutpunkt, utan början på det verkliga testet. Först med verklig data, undantag och belastningstoppar visar det sig om regler är begripliga och om gränssnitt fungerar pålitligt. Dokumenterad tillhandahållande, tydligt separerade miljöer för utveckling och produktion, samt spårbara säkerhetskopior hör därför till projektet, inte bara IT-administration.

Automatiserade tester åstadkommer också mycket här. De kontrollerar återkommande arbetsflöden som inloggning, behörighetskontroller, orderregistrering eller dokumentgenerering på nytt efter varje ändring. För känsliga applikationer kan en självhostad testmiljö vara förnuftig eftersom skärmdumpar, testdata och interna applikationssteg förblir inom företagets egen kontrollsfär. Automatisering ersätter ingen fackmässig granskning av erfarna medarbetare. Den säkerställer dock att kända arbetsflöden inte tyst och stilla skadas.

Hos softify.pro är detta tänkesätt en del av implementeringen: planera tekniskt precist, ta verkliga arbetsflöden på allvar, och leverera ändringar på ett sätt som gör dem begripliga senare. Detta är mindre spektakulärt än ett teknikfyrverkeri, men i drift betydligt mer värdefullt.

När standardprogramvara räcker — och när inte

Standardprogramvara är förnuftig när din egen process till stor del matchar den vanliga branschprocessen och konfigurationen förblir hanterbar. Den kan vara snabbt tillgänglig och medföra pålitliga grundfunktioner. Den blir problematisk när team permanent tvingas böja sina fungerande arbetsflöden på besvärliga sätt eller när viktig information hamnar utanför systemet.

En individuell lösning är inte automatiskt bättre. Den kräver tydliga krav, ansvariga kontaktpersoner, och beredskap att fatta beslut. I gengäld kan den avbilda exakt de arbetsmoment som är avgörande för företaget: en specialiserad godsmottagningskontroll, utskrift av matchande fraktetiketter, ett godkännande baserat på kundgrupp, eller kopplingen mellan verkstad, lager och försäljning. Den korrekta frågan är därför inte: Behöver vi en skräddarsydd applikation? Den är: Vilken återkommande friktion kostar oss idag tid, pengar eller pålitlighet — och kan den permanent elimineras med rimlig ansträngning?

En bra webbapplikation gör inte arbetet artificiellt digitalt. Den tar bort onödiga överlämningar, etablerar ett pålitligt datatillstånd, och ger människor exakt den information de behöver för sitt nästa steg. När detta lyckas känns modern webbutveckling inte som ett nytt IT-projekt, utan som en verksamhet som äntligen kan arbeta utan omvägar.

Permalänk →

Så genomför du digitaliseringen av följesedlar korrekt

Så genomför du digitaliseringen av följesedlar korrekt

En förare väntar inte för att en Excel-fil för tillfället är öppnad av någon annan. Och i godsmottagningen hjälper ingen snygg pappersstapel om en delleverans senare inte längre kan spåras. Den som söker efter "hur man digitaliserar följesedlar" letar därför sällan bara efter att skanna papper. Det som söks är ett motståndskraftigt arbetsflöde som registrerar varurörelser, bekräftelser och avvikelser precis där de uppstår.

Digitala följesedlar fungerar bra när de förenklar arbetet i lagret, i verkstaden och hos kunden. Om de bara implementeras som ett PDF-arkiv kvarstår ansträngningen — bara på en skärm istället. Den avgörande skillnaden ligger i strukturerad data, tydliga ansvarsområden och en ren koppling till order, lager och faktura.

Hur man digitaliserar följesedlar: Kontrollera arbetsflödet först

Det första steget är inget programvaruval, utan en ärlig inventering. Ta en verklig följesedel och spåra dess väg: från order via plockning till överlämning, återkoppling och arkivering. Detta avslöjar oftast snabbt var information läggs till i efterhand, matas in dubbelt, eller klargörs via telefon och chatt.

I små och medelstora företag finns sällan bara ett arbetsflöde. En standardleverans till stamkunder kräver något annat än en byggarbetsplatsleverans, en upphämtning, eller en leverans med retur av emballage. Alla dessa skillnader behöver inte automatiseras i version ett. De bör dock vara kända så att det nya systemet inte misslyckas vid det första specialfallet.

En bra digital process besvarar entydigt tre frågor för varje status: Vem flyttade varorna och när? Vilka kvantiteter överlämnades faktiskt? Och vad hände vid avvikelser? Om denna information saknas är en digital följesedel främst bara ett snyggare dokument.

Reproducera inte bara papper som en PDF

Att skanna befintliga följesedlar kan vara användbart som en övergång, till exempel för arkivering av gamla processer. För den operativa verksamheten löser det dock lite. En bild eller PDF kan lagras, men kvantiteter, artikelnummer, partier och anmärkningar kan inte pålitligt återanvändas i den.

Ett bättre tillvägagångssätt är ett dokument som genereras från strukturerad orderdata. Artiklar, målkvantiteter, leveransadresser och kontaktpersoner antas. Medarbetare bekräftar sedan faktiska kvantiteter direkt på en mobil enhet eller vid en arbetsplats i lagret. Endast avvikelser, skador eller tilläggspositioner behöver matas in manuellt.

Detta sparar inte bara tid. Det förhindrar också ett typiskt mediebrott: bokföringen får inte längre en knappt läsbar signatur på papper medan lagret separat underhåller samma process i ett kalkylblad.

Vilken data en digital följesedel faktiskt behöver

Ett system bör inte tvinga fram varje tänkbart fält. Ytterligare inmatningar saktar ner överlämningar och minskar acceptansen. Samtidigt räcker kundnamn och signatur inte för många arbetsflöden.

Som grund behöver varje följesedel ett unikt nummer, referensen till ordern, leverans- och mottagaradresser, artikelpositioner med mål- och faktiska kvantiteter, samt tidsstämplar.

Beroende på bransch tillkommer partier, serienummer, vikt, lagerplatser eller behållare. För temperaturkontrollerade varor kan mätvärden vara relevanta; för byggarbetsplatsleveranser är foton eller exakta leveransplatsdetaljer användbara.

Statusen är särskilt viktig. "Skapad," "plockad," "på väg," "överlämnad," "delvis levererad," och "tvistad" är inte bara etiketter. De styr vilken person som måste agera härnäst och om till exempel en faktura får genereras eller en efterleverans schemaläggas.

Använda signaturer och foton med gott omdöme

En digital signatur är användbar i många leveransprocesser, men inte automatiskt den bästa bekräftelsen. För en snabb överlämning vid godsmottagning kan ett tryckt namn, en tidsstämpel och mottagartilldelningen räcka. För högvärdiga varor eller omtvistade överlämningar kan en signatur i kombination med ett foto och platsinformation vara mer meningsfull.

Det avgörande är bevisskedjan: bekräftelsen måste kopplas till det specifika dokumentet och dess version. Om någon ändrar kvantiteter eller positioner efter signering bör systemet inte tyst skriva över detta. Det kräver en spårbar korrigering eller en ny bekräftelse. Foton förtjänar samma disciplin. De kan dokumentera skador, men bör inte förvandlas till en godtycklig samling av personuppgifter. Definiera när ett foto krävs, vem som får komma åt det, och hur länge det lagras.

Mobil registrering måste fungera under verkliga förhållanden

På kontoret är nästan varje applikation hanterbar. I lagret räknas handskar, dålig wifi, tidspress och enheter med begränsad batteritid. En digital följesedel måste därför klara sig med få, stora inmatningssteg. Streckkods- eller QR-kodskanningar är ofta snabbare och mer pålitliga än att söka efter artikelnummer.

Offlinekapacitet är ingen lyx när förare arbetar utanför stabil nätverkstäckning. Applikationen bör mellanlagra operationer lokalt, tydligt visa vad som ännu inte synkroniserats, och hantera konflikter kontrollerat. Om två personer redigerar samma leverans får inte den senaste sparningen vinna av en slump.

Även enhetsfrågan måste besvaras pragmatiskt. En befintlig smartphone kan räcka för enkla leveranser. För frekventa skanningar, foton och signaturer i lagret är robusta handdatorer eller surfplattor ofta mer ekonomiska. Det bästa beslutet beror på driftstid, miljö och förväntad genomströmning — inte på vilken enhet som ser modern ut på en produktbild.

Definiera gränssnitt före implementering

En digital följesedel utvecklar sitt värde först när den kopplas till de ledande datakällorna. I många verksamheter finns order i affärssystemet eller lagerhanteringssystemet, lager i en separat lagerlösning, och fakturor i bokföringen. Detta behöver inte omedelbart bli ett stort systemprojekt. Men datasuveräniteten måste vara tydlig.

Definiera därför vilket system som underhåller kunder, artiklar, priser och order. Följesedelslösningen får anta information, men den bör inte omärkt generera ett andra artikelregister. Likaså måste det regleras när bekräftade faktiska kvantiteter rapporteras tillbaka och vem som granskar avvikelser.

Tekniskt är pålitliga gränssnitt viktigare än spektakulära funktioner. Unika ID:n, dokumenterade dataformat, protokoll för misslyckade överföringar, och en återförsöksmekanism förhindrar att följesedlar försvinner mellan två system. En smal applikation på en underhållbar grund, som PHP 8.4, modern JavaScript och MySQL 8, är mer förnuftig för många medelstora arbetsflöden än en överlastad svit med funktioner som ingen använder.

Säkerhet och arkivering hör till processen

Följesedlar innehåller affärsdata och ofta även personuppgifter. Rollbehörigheter bör därför inte tilldelas generellt. Förare behöver sina turer och öppna uppgifter, lageransvariga behöver korrigerings- och granskningsalternativ, bokföringen behöver bekräftade dokument och exporter. Administrativ fullständig åtkomst är ingen standardrättighet.

Dessutom krävs en spårbar historik: skapande, ändring, överlämning, signatur, avbokning och korrigering bör registreras med tid, användare och motivering. Detta hjälper vid förfrågningar och skyddar medarbetare när det senare är oklart när en skada eller bristmängd rapporterades. För arkivering gäller: dokumentet måste förbli läsbart och processen sökbar. Om en PDF genereras beror på den interna processen och externa mottagares krav. PDF:en är dock utgången från en digital process, inte dess datamodell.

Bli produktiv i små steg

Den mest pålitliga utrullningen börjar med en tydligt avgränsad process: till exempel standardleveranser från ett lager eller godsmottagningar för en avdelning. Välj ett område med tillräcklig volym, men utan de mest komplicerade undantagsfallen. Detta gör det möjligt att testa drift, datakvalitet och gränssnitt under verkliga förhållanden.

Mät inte bara om applikationen fungerar tekniskt. Kontrollera hur lång tid en överlämning tar, hur många följesedlar som kräver efterarbete, hur ofta lagerdifferenser uppstår, och om bokföringen kan arbeta snabbare. Om en digital procedur genererar fler förfrågningar än pappersformuläret är det inte personalen som är problemet — då saknas processklarhet eller inmatningsmasken passar inte den operativa praktiken.

Kalkylblad får fortsätta existera om de är pålitliga för en begränsad utvärdering eller en sällsynt speciallista. Digitalisering betyder inte att avskaffa varje känt verktyg. Det betyder att medvetet ersätta felbenägna överlämningar och göra kärnprocessen motståndskraftig.

softify.pro utvecklar sådana arbetsflöden inte som en stel standardprodukt, utan längs konkreta varurörelser, roller och befintliga system. Detta är särskilt användbart när ett företag söker en passande lösning mellan pappersskaos och ett överdimensionerat koncernsystem.

Det rätta första steget är därför ingen lång kravkatalog. Ta tio följesedlar från en normal vecka, inklusive en delleverans och en reklamation. Om ditt framtida arbetsflöde bearbetar dessa tio fall snabbt, entydigt och spårbart, förvandlas en digital följesedel till ett verktyg som lager, förare och administration kan lita på.

Permalänk →

Trender inom mjukvarutestning 2026 som verkligen räknas

Trender inom mjukvarutestning 2026 som verkligen räknas

Ett misslyckat release visar sällan bara ett enda fel. Ofta sammanfaller flera orsaker: en ändrad behörighet, en oklar testmiljö, saknad testdata, eller ett regressionstest som inte underhållits på månader. Precis där blir trenderna inom mjukvarutestning för 2026 konkreta — inte som en samling nya verktyg, utan som en fråga om hur företag kan leverera ändringar med verifierbar säkerhet, även med knappa QA-kapaciteter och känslig data.

För mjukvaruteam i medelstora företag är detta särskilt relevant. En lagerapplikation, en kundportal eller en Windows-skrivbordsmjukvara behöver inte betjäna miljontals användare. Den måste dock fungera i skiftdrift, generera dokument korrekt och pålitligt genomdriva behörigheter. Testning måste därför ligga närmare verkliga operativa arbetsflöden än en perfekt demomiljö.

Trender inom mjukvarutestning: AI blir utföraren, inte oraklet

Den mest synliga trenden är AI-stödd testning. Detta betyder inte att en språkmodell läser ett krav och därefter garanterar applikationens kvalitet. Den förväntningen skulle vara farlig. AI kan dock avsevärt minska ansträngningen där team idag förlorar tid: formulera testfall, känna igen iögonfallande ändringar i användargränssnitt, tilldela liknande felmönster och skriva begripliga testrapporter.

AI blir särskilt användbar när den utför konkreta arbetsmoment och tillhandahåller bevis för sina resultat. En testagent kan till exempel logga in, skapa en godsmottagning, ändra en leveransadress, generera en fraktetikett och kontrollera om status, lagerrörelse och dokument matchar. Det avgörande är inte påståendet "test godkänt," utan bevisskedjan: utförda steg, tidsstämplar, skärmdumpar, tekniska loggar och en tydlig beskrivning av avvikelsen.

Gränsen förblir viktig. AI får föreslå testfall och hantera återkommande arbetsflöden. Den bör inte självständigt avgöra om en fackligt kritisk affärsbokning är korrekt. För priser, lagernivåer, betalningsgodkännanden eller åtkomsträttigheter behövs fortfarande explicita regler och förväntningar bekräftade av verksamhetsavdelningar. Automatisering accelererar testningen; den ersätter inte ansvaret.

Testautomatisering vandrar in i affärsprocessen

Under lång tid fokuserade UI-testautomatisering på enkla vägar: öppna sida, fylla i formulär, kontrollera framgångsmeddelande. Det förblir användbart, men räcker inte för affärskritiska system. Det mer värdefulla testet verifierar en hel processkedja.

Ta en typisk logistikfunktion. En order registreras, varor reserveras, en plockprocess startas, en följesedel genereras, och frakt rapporteras. Varje enskild skärm kan se ren ut medan processen ändå misslyckas — till exempel för att en reservation kvarstår efter ett avbrott eller en delleverans felaktigt ändrar lagret. Bra automatiserade tester spårar därför tillstånd och data över systemgränser.

Detta kräver en ren testarkitektur. API- och databastester kontrollerar regler snabbt och precist. UI-tester kontrollerar dessutom om medarbetare faktiskt kan hantera processen. End-to-end-tester kombinerar båda, men är långsammare och skörare. Den som testar allt enbart via webbläsaren bygger vanligtvis en dyr och skör testsvit. Den som bara testar gränssnitt förbiser användningsproblem och felkopplade användargränssnitt.

Den pragmatiska lösningen är en pyramid som passar risken: många snabba kontroller nära affärslogiken, färre integrationskontroller, och selektivt utvalda end-to-end-scenarier för de viktigaste arbetsflödena. Det låter oglamoröst. Det levererar dock boring, provable reliability istället för trend-chasing.

Självhostad test-AI blir en arkitekturfråga

Med AI-testverktyg uppstår en ny fråga: Vart tar testdata, skärmdumpar och inspelningar vägen? I många applikationer innehåller de kundnamn, interna priser, personalinformation eller vyer av affärskritiska processer. Även en till synes oskyldig testmiljö kan innehålla verkliga datakopior eller konfidentiella strukturer.

Därför blir exekveringsmiljön ett centralt kriterium. En extern molntjänst kan vara lämplig för publika webbapplikationer och okritisk testdata. För interna portaler, skrivbordsapplikationer eller reglerade områden är ett självhostat tillvägagångssätt ofta mer förnuftigt. I denna uppsättning förblir testexekvering, bildmaterial och loggar inom företagets kontrollerade infrastruktur eller en tydligt avgränsad EU-miljö.

Detta är inget generellt argument mot molntjänster. Egendrift medför insats: uppdateringar, åtkomstkontroll, beräkningsresurser, övervakning och tydliga ansvarsområden måste hanteras. Nyttan uppstår när dataskydd, spårbarhet och kontroll över testartefakter väger tyngre än bekvämligheten hos ett omedelbart tillgängligt SaaS-konto. System som COCO följer precis detta tillvägagångssätt genom att köra tester för webb- och Windows-applikationer samtidigt som bevis hålls lokalt kontrollerbara.

Instabila tester accepteras inte längre som normalt

Ett automatiserat test som ibland godkänns och ibland misslyckas utan en produktändring genererar ingen säkerhet. Det genererar köer. Team blir då vana vid att ignorera röda builds eller köra om tester tills önskat resultat visas. Detta är en smygande förlust av förtroende för hela kvalitetskontrollramverket.

Under 2026 flyttar därför stabiliteten hos testexekveringen mer i förgrunden. Orsakerna är oftast kända: slumpmässiga väntetider, instabila selektorer, delad testdata, beroenden av externa tjänster, eller icke-återställda databaser. Lösningen är sällan ytterligare en retry. Mer förnuftiga är entydiga tekniska selektorer, isolerade testkonton, kontrollerade datatillstånd och riktade väntevillkor som reagerar på faktiska systemhändelser.

Utvärderingen bör också differentiera: Är ett fel reproducerbart? Uppstår det bara i en miljö? Har en extern tjänst fallerat eller applikationen själv? AI kan hjälpa till att bunta ihop dessa signaler. Det tekniska beslutet måste dock förbli spårbart. Ett QA-team behöver ingen mystisk felprediktion, utan en robust grund för nästa åtgärd.

Kvalitet börjar tidigare med krav och data

Många fel uppstår innan den första kodraden skrivs. "Ordern ska kunna skickas" är inget testbart krav. Vad händer vid en ofullständig adress, ett spärrat kundkonto, saknade varor, parallell bearbetning, eller en utgången session? Utan svar på dessa frågor kan inget testsystem pålitligt kontrollera om mjukvaran fungerar korrekt.

Ett mer moget testtillvägagångssätt kompletterar därför krav med verifierbara exempel. För ett konto med felaktiga inloggningsförsök kan detta konkret betyda: Efter fem misslyckade försök spärras kontot i 15 minuter, processen loggas, och en behörig administratör kan spåra spärren. Detta genererar direkt automatiserbara kontroller — och mindre tolkningsutrymme mellan utveckling, drift och verksamhetsavdelning.

Testdata blir också en produktfunktion. Den måste vara realistisk nog för att avbilda specialfall, men får inte kopiera onödiga personuppgifter. Genererade datamängder för momsfall, delkvantiteter, spärrade artiklar, ogiltiga adresser och olika roller är användbara. Särskilt för applikationer med MySQL 8 eller jämförbara relationsdatabaser lönar det sig att tillhandahålla definierade utgångstillstånd automatiserat och ta bort dem efter körningen.

Riskbaserad testning slår testtäckning till varje pris

Ett högt kodtäckningstal kan verka lugnande men ändå säga väldigt lite. Det visar vilka rader som exekverades, inte om rätt regel testades. Ett system kan uppnå 90 procents täckning och ändå leda till felaktigt lager vid avbokning av en delleverans.

Den bättre frågan är: Vilka fel skulle vara särskilt kostsamma för verksamheten, kunder eller juridisk efterlevnad? Detta ger en prioritering. Åtkomstskydd, prisberäkning, lagerbokningar, dokumentgenerering och gränssnitt mot fraktleverantörer förtjänar vanligtvis mer testdjup än sällan använda inställningssidor. Detta betyder inte att leverera sidosaker okontrollerade. Det betyder att sätta in begränsad tid där ett bortfall stoppar verkligt arbete eller genererar felaktiga beslut.

Denna prioritering måste tillåtas förändras. Om en ny ruttplaneringsfunktion introduceras ökar dess risk. Om en gammal Excel-utvärdering snart ska ersättas kanske det inte längre lönar sig med en stor automatiseringsinsats. Ibland är det mer förnuftigt att behålla ett fungerande kalkylblad ytterligare några månader istället för att förhastat pressa dess logik in i ett halvfärdigt system.

Vad team praktiskt bör göra nu

Det första förnuftiga steget är ingen verktygsjämförelse. Välj en process vars fel är påtagliga: order till leverans, godsmottagning till inlagring, eller inloggning till rollgodkännande. Beskriv det önskade arbetsflödet med undantagsfall, upprätta pålitlig testdata, och automatisera först de kritiska kontrollerna. Mät sedan inte bara antalet tester. Observera hur snabbt ett verkligt fel upptäcks, hur ofta tester misslyckas utan orsak, och om en rapport förklarar orsaken begripligt för en utvecklare eller ansvarig inom verksamheten. Först när dessa grunder finns på plats lönar sig utbyggnad med AI-agenter, visuell inspektion eller omfattande testmiljöer. De starkaste testtrenderna är i slutändan de som gör releaser mindre riskabla och för team snabbare till tydliga beslut. Det är inte den modernaste dashboarden som räknas, utan en spårbar testkörning som visar: Denna affärsprocess fungerar — och om inte, vet vi varför.

Permalänk →

Ruttplanering för leveransturer: Att välja rätt programvara

Ruttplanering för leveransturer: Att välja rätt programvara

En förare väntar på en följesedel medan ordningen på deras stopp redan ändras igen. I lagret är en försändelse ännu inte plockad, en kund ringer angående ett snävare tidsfönster, och turlistan ligger i ett kalkylblad som bara en person verkligen förstår. Den som söker efter "programvara för ruttplanering för leveransturer" i denna situation letar inte nödvändigtvis efter en komplicerad kartalgoritm. Det de letar efter är ett pålitligt arbetsflöde från orderregistrering till leveransbevis.

För små och medelstora företag är detta en avgörande skillnad. En teoretiskt kortare rutt gör lite nytta om den inte tar hänsyn till att varor inte är klara förrän kl. 10, ett fordon behöver kylning, eller en förare har specifik kundkunskap på en viss tur. Bra programvara för leveransturer avspeglar verksamhetens verklighet — och gör den gemensamt användbar för disposition, lager och förare.

När ruttplanering blir ett operativt problem

Många verksamheter gör en förnuftig start med telefon, papper och ett kalkylblad. Med fem stopp per dag och ett fast förarteam är detta ofta den snabbaste lösningen. Det är först när orderволym, varianter och tidspress ökar som typiska friktionsförluster uppstår: dubbelregistrerade adresser, föråldrade turstatusar, saknad information om lasthjälpmedel och förfrågningar som bara kan besvaras genom att ringa flera personer.

Problemet är då inte bara körsträckan. Det är informationsklyftan mellan orderintag, lager, disposition och leverans. Om en order skjuts upp måste denna ändring idag ofta spåras i flera listor, på en utskrift och i förarens huvud. Detta kostar tid och skapar fel som kunder omedelbart ser.

Ett annat varningstecken är beslut som beror på enskilda medarbetare. Om bara den erfarna dispatchern vet vilken infart som är lämplig för en viss kund eller hur tur 3 ska anpassas vid sen godsmottagning, är arbetsflödet inte pålitligt dokumenterat. Programvara ska inte ersätta denna kunskap. Den ska avbilda den på ett sätt som gör att teamet förblir handlingskraftigt.

Vad programvara för ruttplanering för leveransturer måste kunna göra

Kärnfunktionen låter enkel: order tilldelas en tur, stopp sorteras förnuftigt och överlämnas till förare. För praktisk nytta behöver systemet dock betydligt mer kontext. Det avgörande är vilka regler som gäller vid planering och hur ändringar hanteras.

Order måste vara planerbara snarare än bara synliga

En leveransadress på en karta utgör ännu inte en planerbar leverans. En order kräver minst kvantiteter, vikt eller volym, leveransdatum, önskat tidsfönster, kontaktinformation och en tydlig bearbetningsstatus. Beroende på verksamhet kan lasthjälpmedel, temperaturkrav, farligt gods-märkningar, aviseringsregler eller en specifik fordonsklass också tillkomma.

Denna data bör inte behöva samlas ihop manuellt från olika system varje gång. Om order redan kommer från en webbutik, affärssystem, ordermask eller en befintlig databas är en ren överlämning ofta mer värdefull än en särskilt spektakulär kartvy. Annars förskjuts arbetet bara från papper till ett nytt gränssnitt.

Turer behöver regler, inte bara avstånd

En automatisk ordning baserad på kilometer eller körtid kan vara ett bra förslag. Den är dock inget beslut för verksamheten. Planeringen måste kunna ta hänsyn till begränsningar: fasta leveransdatum, fordonets kapacitet, arbetstider, lastnings- och lossningstider samt regionala ansvarsområden.

Startlogiken räknas också. Vissa fordon börjar och slutar vid lagret, medan andra kör direkt till sin nästa arbetsplats efter den sista leveransen. För återkommande turer kan en fast grundstruktur vara användbar, som dispatchers bara ändrar vid behov. Den som kör exakt samma stopp varje morgon behöver inte nödvändigtvis en fullständig ny optimering. Här är en stabil, spårbar tur ofta bättre än en matematiskt minimal tidsbesparing.

Ändringar måste nå föraren på ett kontrollerat sätt

Verkligheten håller sig sällan till morgonplanen. Kunder avbokar, varor saknas, ett fordon går sönder, eller en order blir brådskande. I sådana fall avgörs det om programvaran ger avlastning eller skapar ytterligare arbete.

En användbar lösning visar tydligt vilken turversion som för närvarande gäller, vilka stopp som redan är genomförda, och vad som specifikt har ändrats. Föraren bör inte behöva jämföra motstridiga utskrifter, skärmdumpar och meddelandeapp-meddelanden. För många team räcker det initialt med en mobil, webbläsarbaserad förarvy med stoppordning, kontaktdata, leveransanvisningar och statusåterkoppling. En dedikerad app är inte automatiskt bättre om installation, enhetshantering och offlinekrav inte ger någon tydlig nytta.

Börja inte med enbart ruttoptimering

Det vanligaste felaktiga tillvägagångssättet är att först köpa en optimeringstjänst och bara kontrollera efteråt om stamdata och arbetsflöden stämmer. Felstavade adresser, oklara leveransfönster och order utan pålitlig tillhandahållandestatus kan inte optimeras bort. En kort inventering längs den verkliga dagliga rutinen är mer förnuftig. Var uppstår order? När bekräftar lagret tillhandahållandet? Vem planerar turer? Hur får föraren ändringar? Och vilket bevis krävs efter leverans? Dessa frågor kan verka banala, men de avgör vilka datafält, roller och gränssnitt systemet faktiskt behöver.

Det visar sig ofta att inte varje steg bör digitaliseras. En handskriven anteckning för en sällsynt specialleverans kan vara lämplig om den senare rent förs över till ordern. Ett kalkylblad får också förbli om det pålitligt levererar en hanterbar utvärdering. Programvara bör lösa flaskhalsen, inte tvångsmässigt ersätta varje känt arbetsflöde.

Bygga, köpa eller riktad utökning?

Standardprogramvara är lämplig när turlogiken är allmän, processer sällan varierar och teamet kan anpassa sig till givna masker. Den förkortar implementeringen och kan vara tillräcklig för en enkel fordonsflotta. Nackdelen visar sig så snart den avbildar centrala specialfall bara via sidolistor, fritext eller dyra tilläggsmoduler.

En individuell lösning lönar sig inte för att individuell utveckling i grunden skulle vara överlägsen. Den lönar sig när arbetsflödet i sig är en konkurrensfördel eller en permanent felkälla: till exempel med speciella förpackningsenheter, kombinerade uppsamlings- och leveransturer, egna leveransdokument, eller en tät koppling mellan godsmottagning, plockning och leverans.

Däremellan ligger ofta den mest pragmatiska vägen. Befintliga system förblir för bokföring eller lagerhantering, medan en smal applikation buntar ihop order, planerar turer och täcker förarprocessen. Detta kräver tydliga gränssnitt, entydiga dataansvar och en databasstruktur som lagrar ändringar spårbart. Moderna webbapplikationer på en underhållbar grund som PHP 8.4 och MySQL 8 är inget modebeslut för detta, utan snarare en grund för kalkylerbar drift och senare anpassningar.

Implementering i små steg istället för en stor omställning

En ruttplaneringsprogramvara bör först testas på en hanterbar tur eller fordonsgrupp. Inte för att ett pilotprojekt skulle vara riskfritt, utan för att verkliga undantag visar sig tidigt: saknade leveransanvisningar, inkonsekvent adressdata, väntetider hos kunden eller oklara överlämningar i lagret.

För det första utvecklingssteget räcker vanligtvis tydligt avgränsade funktioner: överta order, se tillhandahållandestatus, sammanställa tur, godkänna tur och rapportera tillbaka leverans. Först när denna kedja fungerar i den dagliga driften är automatisk optimering, elektronisk signatur, fotobevis, kundmeddelanden eller detaljerade nyckeltal meningsfulla.

Nyttan mäts inte bara i inbesparade kilometer. Relevanta är också mindre dispositionsarbete, färre förfrågningar, färre felleveranser, kortare tid till följesedeln och bättre svarsförmåga gentemot kunder. Dessa nyckeltal bör fångas grovt före lanseringen. Annars förblir bara intrycket efter implementeringen att gränssnittet ser modernare ut.

Tekniken måste förbli pålitlig i bakgrunden

Ruttplanering bearbetar känslig operativ data: kundadresser, förartilldelningar, leveranskvantiteter och ofta leveransbevis. Därför hör rollbehörigheter, spårbara ändringar, regelbundna säkerhetskopior och dokumenterad drift till lösningen. Vem som får godkänna, ändra eller radera en tur bör inte lämnas åt slumpen.

Även karta- och ruttdata förtjänar en nykter granskning. Externa tjänster kan passa mycket bra, men de medför löpande kostnader, tillgänglighetsöverväganden och dataskyddsfrågor. Vid höga krav på datalagring eller speciell regional logistik måste det klargöras tidigt vilken data som lämnar det egna systemet och hur avbrott dämpas. En perfekt rutt är värdelös om dispositionen inte kan fortsätta arbeta under en störning.

softify.pro planerar sådana system från det faktiska orderintaget ända till återkoppling från fordonet. Måttstocken här är inte den längsta funktionslistan, utan ett arbetsflöde som lager, disposition och förare kan hantera pålitligt under tidspress. Den bästa ruttplaneringen ser förvånansvärt oglamorös ut i den dagliga verksamheten: order är kompletta, turer är begripliga, ändringar är entydiga och leveranser är verifierbara. Precis denna oupphetsade pålitlighet skapar utrymme för de undantag där människor måste besluta.

Permalänk →

Ta kontakt

Har du ett projekt i åtanke, ett arbetsflöde som fortfarande drivs av kalkylblad och god vilja, eller en testbacklogg som COCO skulle kunna ta hand om åt ditt team? Berätta för oss.

Skicka meddelande